こんにちは、Anagraftの伊藤です。
今回は、運用型広告の入札がどのような仕組みで決まっているのかを整理しました。運用型広告は、配信の状況に応じて、入札額や予算、配信の対象、表示する表現を調整しながら配信する広告です。検索連動型広告、ディスプレイ広告、動画広告、SNSの広告などで使われています。本コラムが主に扱うのは、広告を表示できる機会ごとにオークションが行われる配信です。そこでは、広告主の側は、その機会にいくらまで払ってよいかを見積もって入札します。主要な媒体や広告配信の事業者は、広告主の設定した目標に合わせて機会ごとの入札額を自動で決める機能(自動入札)を提供しています。広告の運用を見直す場面では、次のような問いが、広告運用の担当者だけでなく、事業の責任者や経営層にも届くことが多いように思います。
- 媒体の自動入札に任せておけば、入札は最適になるのか
- 目標の獲得単価(CPA。広告に割り振られたコンバージョン1件あたりの広告費。コンバージョンは、購入や申込など、広告主が目標として定めた利用者の行動を指します)を下げると、何が起きるのか
- 管理画面に出るコンバージョンの件数は、広告で増えた件数と同じなのか
- 1日の予算が昼までに無くなるのはなぜか、予算と目標のどちらを動かすべきか
- 同じ人に何回まで広告を見せるのか、どの表現を多く出すのかを、どう決めるのか
- 入札の仕組みを自社で持つべきか、媒体や外部の事業者に任せるべきか
本コラムでは、こうした問いに答えるための材料を、広告枠の取引とデータの基礎、反応の予測、入札と配信の設計、効果の測定と定着の4つのまとまりに分けて並べました。
この題材を選んだ理由は、運用型広告の入札が「目標の数字を設定すれば、あとは自動で最適になる仕組み」と受け取られることが多いように思うためです。そう受け取られると、獲得単価やクリック率といった管理画面の数字だけが議論されます。何をコンバージョンとするのか、その1件にどれだけの価値を見るのか、広告が無くても起きていたコンバージョンをどう除くのかは、決まらないまま進みがちです。
入札には、いくつかのつり合いがあります。入札額を上げれば落札できる機会は増えますが、表示の価値を超える額で買うことも増えます。入札額を下げれば落札できる機会が減り、価値のある機会を買い逃します。入札額を下げたときに1件あたりの支払額がどう変わるかは、オークションの方式によって違います(第3章)。予算を早い時間に使い切れば、その後に来る機会には参加できません。学習に使える記録にも偏りがあります。クリックやコンバージョンの結果が分かるのは落札して表示した機会だけで、落札できなかった機会で何が起きたはずかは分かりません。コンバージョンは表示やクリックから遅れて届き、直近の記録ほど結果が出そろっていません。こうした性質を踏まえずに目標の数字だけを動かしたときに出る損失を、本コラムでは6つの型に分けて整理し、各章で使います(序章で説明します)。
本コラムでは、公開されている一次情報を根拠にしました。手法の原論文や専門書、規格を定める団体の文書、法令と所管官庁の資料、業界団体や媒体、企業が公開している資料です。第2章から第12章では、架空の合成データ(配信の記録を乱数で作ったもの)に対して実際にPythonのコードを動かし、その出力とグラフを載せています。架空のデータで得た数値は、その条件での一例であり、実際の広告で期待できる成績の目安ではありません。大きな媒体のオークションや自動入札の内部の計算は、公開されていない部分が多くあります。本コラムでは、媒体の公式の説明と公開された論文で確かめられる範囲だけを書き、公開されていない仕組みを推測で補うことはしていません。自動入札が内部で行っている計算の考え方を、公開された理論と簡単な例題で理解できるようにすることを目指しました。
想定している読者は、広告の運用の見直しを任された方、あるいはそれを決める立場の方です。担当者としては、広告を出す事業会社でマーケティング、広告運用、事業企画、DX推進を担う方を念頭に置いています。広告会社や広告配信の事業者で企画や分析を担う方、配信の記録を分析するデータサイエンティストの方も想定しています。判断する立場としては、広告の予算と方針を決める事業の責任者や経営層の方を念頭に置いています。機械学習や広告配信の技術の専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その方法で何が分かり、入札と配信の判断にどうつながるか」「経営はどう判断するか」を意識して書きました。
本コラムは、広告を出す側が入札と配信を設計し、点検するための解説です。広告が表示される相手は「利用者」と呼び、利用者の側に生じる不利益(過剰な接触や、意図しない情報の利用)を、広告主の損失と並べて扱いました。媒体の広告審査をすり抜ける方法や、利用者の同意や識別子の制限を迂回して追跡を続ける方法、不正なクリックの作り方には触れていません。本コラムに出てくる企業や団体の取り組みは、その企業や団体が公開した資料を開いて確かめたものに限っています。媒体や製品の料金、手数料の額、広告費や市場の規模の金額、弊社の支援の条件には触れていません。公的な統計は、構成比や前年比で紹介しています。例題で入札額や支払額、予算、コンバージョンの価値を扱う箇所は、単位の無い「相対値」で書いています。法令の解釈や、自社に適用される規制の範囲については、法務やコンプライアンスの担当者、所管の官庁、専門家に確認していただく前提で書いています。
各章の題と、その章で答える問いは「全体の地図」の表にまとめています。本コラムで使う用語の定義も、同じ「全体の地図」の表にまとめています。

目次
- 序章 運用型広告の入札は何を見積もって何を決める仕組みか
- 全体の地図
- 第1章 運用型広告の仕組みと事業での位置づけ、広告枠の取引と費用の構造
- 第2章 広告配信のデータ、入札・表示・クリック・コンバージョンの記録と結果の定義
- 広告配信の記録の種類と、誰の手元に残るか
- 入札リクエストに含まれる情報、OpenRTB の公式文書で確かめた範囲
- 記録どうしを結びつける方法
- 結果の定義、何をコンバージョンとし、いつまでを数え、重複をどう除くか
- 架空の配信の記録を作る、入札リクエストから落札とクリックまで
- 各段の件数と率、計測期間と重複の除き方で変わるコンバージョン率と CPA
- 遅れて届くコンバージョンと、学習に使える範囲
- 結果が見えるのは落札した機会だけ、打ち切りの予告
- データの品質の問題と、集計の単位
- 標本の作り方と、入札の時点で手に入る情報だけを使うこと
- 経営の判断、コンバージョンの定義と計測期間を先に決める
- この章のまとめと次の章へ
- この章を深めたい方への参考書籍
- 第3章 オークションの仕組み、セカンドプライスとファーストプライスで変わる入札の考え方
- 第4章 クリック率の予測、ロジスティック回帰と特徴量の作り方
- 第5章 機械学習によるクリック率とコンバージョン率の予測、勾配ブースティングと遅れて届く結果
- 第6章 予測の評価と較正、対数損失と確率のずれが入札に与える影響
- 第7章 入札額の決め方、表示の価値にもとづく入札と目標の獲得単価
- 第8章 ファーストプライスでの入札、勝率曲線の推定と入札の引き下げ
- 第9章 予算のペース配分、1日の予算を使う速さの制御
- 第10章 配信の制御、フリークエンシーの上限とクリエイティブの出し分け
- 第11章 広告の効果の測り方、アトリビューションと増分の検証
- 第12章 配信の監視と品質、無効なトラフィック・掲載面の点検とモデルの見直し
- 第13章 導入の進め方と体制、自動入札の使い分け・内製と外部の分担
- 自社がどこまで決めるか、4つの段階と要るものの型
- どの段階を選ぶか、5つの観点で採点して最初の対象を決める
- 現状の把握と KPI の木、今の設定と成績を測ってから目標を分解する
- 自社が媒体に渡す情報、自動入札に任せても目標と価値は広告主が決める
- PoC の設計、配信での比較を組み、コンバージョンが出そろう期間を計画に入れる
- 効果の見立てと段階的な展開、金額ではなく率と件数の型で書く
- 役割と責任分担、入札の設定を決める人と成果を確かめる人を分ける
- 広告会社や外部の事業者との分担、外部に確かめることと報酬の決め方
- 最初の90日の計画と形骸化の型、点検の仕組みを先に作る
- 経営判断、成果の測り方と PoC の出口を先に決める
- この章を深めたい方への参考書籍
- 第14章 規制とガイドライン、識別子の制限と公開事例・最新動向
- 終章 運用型広告の入札を使い続けるために
- 本コラムで紹介した書籍一覧
- 第1章 運用型広告の仕組みと事業での位置づけ、広告枠の取引と費用の構造
- 第2章 広告配信のデータ、入札・表示・クリック・コンバージョンの記録と結果の定義
- 第3章 オークションの仕組み、セカンドプライスとファーストプライスで変わる入札の考え方
- 第4章 クリック率の予測、ロジスティック回帰と特徴量の作り方
- 第5章 機械学習によるクリック率とコンバージョン率の予測、勾配ブースティングと遅れて届く結果
- 第6章 予測の評価と較正、対数損失と確率のずれが入札に与える影響
- 第7章 入札額の決め方、表示の価値にもとづく入札と目標の獲得単価
- 第8章 ファーストプライスでの入札、勝率曲線の推定と入札の引き下げ
- 第9章 予算のペース配分、1日の予算を使う速さの制御
- 第10章 配信の制御、フリークエンシーの上限とクリエイティブの出し分け
- 第11章 広告の効果の測り方、アトリビューションと増分の検証
- 第12章 配信の監視と品質、無効なトラフィック・掲載面の点検とモデルの見直し
- 第13章 導入の進め方と体制、自動入札の使い分け・内製と外部の分担
- 第14章 規制とガイドライン、識別子の制限と公開事例・最新動向
- 参考情報
序章 運用型広告の入札は何を見積もって何を決める仕組みか
利用者がサイトやアプリの画面を開くと、広告を1回表示できる機会が生じます。本コラムではこれを表示の機会と呼びます。本コラムの主題である運用型広告は、配信の状況に応じて、入札額や予算、配信の対象、表現を調整しながら配信する広告です。本コラムが主に扱う配信では、表示の機会の1回ごとに、どの広告主の広告を表示するかがオークションで決まります。広告主の側は、機会ごとに入札額を決めて入札し、勝てば広告を表示する権利を得ます。実際の表示と支払いには配信と課金の条件が関わりますが、本コラムの例題では、落札した機会はすべて表示され、表示の時点で、オークションの方式に応じた額の支払いが生じるものとします。枠と期間を先に決めて買う予約型の広告と違い、買うかどうかと、いくらで買うかを、機会ごとに変えられる点が、こうした配信の特徴です。
機会ごとの入札額を人が決めることはできないので、入札は計算で決まります。計算の中心にあるのは、その機会に広告を表示したら何が起きるかの見積りです。本コラムでは、表示した場合にクリックされる確率の見積りを予測クリック率、クリックされた場合にコンバージョンに至る確率の見積りを予測コンバージョン率と呼びます。コンバージョンは、購入、申込、資料請求など、広告主が目標として定めた利用者の行動です。この2つの見積りに、コンバージョン1件が広告主にもたらす価値(広告費を引く前の粗利の見込み)を掛けたものが、1回の表示から得られると予測する価値(表示の価値)の基本の形になります。この見積りは、広告が無くても起きたコンバージョンの分を除いていません。その点は第7章と第11章で扱います。入札の仕組みは、表示の価値を見積もり、オークションの方式と予算の制約を踏まえて、その機会にいくらで入札するかを決める仕組みだと言えます。
実績の値と見積りの値は、言葉を分けて書きます。クリック率は表示のうちクリックされた割合、コンバージョン率はクリックのうちコンバージョンに至った割合で、どちらも実績の値です。予測クリック率と予測コンバージョン率は、まだ結果の出ていない機会についての見積りです。入札額は買い手が申し出る額、支払額は落札した買い手が実際に払う額で、この2つも方式によって一致する場合と一致しない場合があります(第3章)。例題に出てくる入札額、支払額、予算、価値は、すべて単位の無い相対値で書いています。入札額と支払額は、例題では表示1回あたりの額にそろえました。
運用型広告は、クリック率や獲得単価(CPA。広告に割り振られたコンバージョン1件あたりの広告費)といった管理画面の数字で語られることが多くあります。しかし、広告の価値を決めるのは、それらの数字そのものではなく、広告を出したことで事業の利益がどれだけ増えたかだと考えています。本コラムでは、広告を出したことで増えたコンバージョンの価値から広告費を引いた差を増分の利益と呼び、これを成果の指標とします。広告を出した場合と出さなかった場合の差を増分と呼びます。増分は0や負になることもあります。媒体の管理画面に出るコンバージョンの件数は、一般に、コンバージョンを、その前に接触した広告に規則(アトリビューション)で割り振った件数です。数え方の細部は媒体や設定によって違います。広告が無くても購入していた利用者のコンバージョンも、広告に接触していれば数えられます。増分は、広告を出さない群を残す実験などで見積もる値で、割り振った件数とは別のものです(第11章)。CPAが下がったことだけでは、成果が増えたとは判断できません。広告が無くても起きていたコンバージョンを安く数えているだけの場合があるためで、増分の価値と広告費の両方を確かめる必要があります。そのため本コラムでは、入札の取り組みを、確率を見積もる技術と、その見積りを使って入札額と予算の使い方を決め、増分で結果を測るところまでを含むものとして扱います。
入札を決める3つの見積り
入札額を決めるために見積もるものは、3つに分けて考えると整理しやすくなります。1つ目は、利用者の反応です。予測クリック率と予測コンバージョン率を、掲載面、端末、時間帯などの機会の属性と、過去の配信の記録から見積もります。クリックは表示のうちの一部でしか起きず、コンバージョンはさらに少ないので、少ない結果から確率を見積もる工夫が要ります。ロジスティック回帰と特徴量の作り方を第4章で、勾配ブースティングなどの機械学習の手法と、遅れて届くコンバージョンの扱いを第5章で扱います。表示の価値に一定の係数を掛けて入札額を決める場合、ほかの条件が同じなら、確率を高く見積もるほど入札額も高くなります。確率が実績より高く出ていれば、その分だけ高く入札することになります。順位が正しいことに加えて、確率の値そのものが実績の率と合っていることが費用に直接効きます。合っているかを確かめ、ずれていれば実績と対応するように調整します(較正。第6章)。
2つ目は、競合の動きです。落札できるかどうかには、自分と競合の入札額、最低落札価格などが関わります。支払額の決まり方は、オークションの方式によって違います。勝者が2番目に高い入札額にもとづいて払う方式(セカンドプライス・オークション)では、1つの枠の1回のオークションだけを考え、予算の制約が無い場合には、自分にとっての価値どおりに入札することが基本になります。ただし、本コラムの表示の価値は増分を除いていない予測なので、そのとおりに入札すれば増分の利益が最大になるとは限りません。勝者が自分の入札額をそのまま払う方式(ファーストプライス・オークション)では、価値どおりに入札すると利得(例題では、表示の価値から支払額を引いた差)が残りません。入札を下げると支払額は減りますが、落札できる割合も下がるので、両方を踏まえて利得の見込みが大きくなる額を選びます(第3章)。引き下げの幅を決めるには、入札額と勝率の関係(勝率曲線)を、過去の入札と落札の記録から見積もります。負けた機会について知らされる情報は取引の場によって違います。落札に必要だった額が知らされない場合、価格で負けた機会から分かるのは、その額が自分の入札額より高かったことだけなので、この見積りにも工夫が要ります(第8章)。
3つ目は、これから来る機会の量と質です。予算に限りがあるとき、目の前の機会を買うかどうかは、その後にどれだけ価値のある機会が来るかで変わります。予算が足りないときは、価値に対して支払額が低い機会から順に買うのが、同じ予算で得る価値を大きくする考え方になります(第7章)。1日の中で機会の数も競合の水準も変わるので、予算を使う速さを時間の中で制御します(ペース配分。第9章)。
媒体や広告配信の事業者が提供する自動入札の機能の内部の計算は、公開されていない部分が多く、本コラムはそれを推測するものではありません。この3つの見積りは、公開された論文や理論で、入札を決めるための要素として扱われてきたものです。本コラムでは、公開された理論と簡単な例題を通じて、自動入札に渡す目標や設定が何を意味するのかを、広告主の側で判断できるようにすることを目指しています。
広告主が決めること
見積りと入札の計算を自動入札に任せる場合でも、広告主の側にしか決められないことが4つあります。
- コンバージョンの定義:何をコンバージョンとするか、クリックや表示から何日以内のものを数えるか(計測期間)によって、コンバージョン率もCPAも変わります。自動入札は、広告主が設定した目標に合わせて入札を決める機能なので、コンバージョンの定義が事業の利益とずれていれば、ずれた定義に合わせて入札が決まります(第2章)。
- コンバージョンの価値と目標:1件のコンバージョンにどれだけの価値を見るのか、目標のCPAをいくつに置くのかは、粗利や、顧客がその後にもたらす利益の見込みから事業として決めます。目標のCPAを厳しくすると、CPAは下がっても、買える機会が減って利益の合計が減ることがあります(第7章)。
- 予算と配信の条件:予算の上限で配信が止まっているのか、目標が厳しくて買えていないのかで、打つ手は変わります(第9章)。同じ利用者に表示する回数の上限や、どの表現を多く出すかを決める指標も、広告主が決めます(第10章)。
- 成果の測り方:割り振られたコンバージョンの件数は管理の指標として使い、成果は増分の価値と広告費から測ります。増分をどの方法で見積もるかによって、媒体ごとの評価も予算の配分も変わります(第11章)。
この取り決めが無いまま自動入札の目標だけを動かすと、CPAは目標に収まっているのに売上が増えない、予算の消化は順調なのに新しい顧客が増えない、媒体ごとの管理画面のコンバージョンを足すと実際の件数を上回る、といったことが起きやすいと考えています。本コラムでは、予測と入札の手法の説明に加えて、効果の測定、配信の監視、導入の体制にも章を立てて扱います。広告の配信には、利用者の情報の取り扱いに関する法令、広告の表示に関する法令、ブラウザやOSによる識別子の制限が関わります。法令の条文と所管官庁の資料、各社の公式の発表で確認できた範囲を第14章で整理します。
決めないことで出る損失の型
運用型広告の入札を設計し、運用するときに起きうる損失は、金額ではなく型で整理すると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。6つは互いに重なることがあり、1つの出来事が複数の型に関わる場合もあります。
- 払いすぎ:見込んだ価値を超える額で広告枠を買います。または、同じ機会をもっと低い額で落札できたのに高く払います。予測した確率が実績より高く出ている場合や、取引の方式に合わない入札をしている場合に起きます。個々の表示でコンバージョンが起きなかったことだけを、払いすぎとは呼びません。
- 機会損失:価値のある表示の機会を買い逃します。入札額や目標が厳しすぎる場合に起きます。予算の使い残しや、早い時間に使い切ってその後の機会に参加できないことも、それによって利益を増やせる機会を逃した場合には機会損失になります。予算を使い切ること自体が目的ではありません。買わなかった機会で何が得られたはずかは記録に残らないので、この損失はつねに推定になります。
- 成果の数え違い:広告に割り振られたコンバージョンを、広告で増えた分と取り違え、予算の配分を誤ります。記録の重複や欠落、遅れによって、多く見積もる場合も少なく見積もる場合もあります。
- 信頼の毀損:同じ利用者への過剰な接触、不適切な内容のページへの掲載、不快に受け取られる表現、利用者の理解や期待に反する情報の利用によって、利用者の信頼やブランドを損ないます。
- 形骸化:自動入札の設定やレポートを点検する仕組みが働かないまま運用が続き、設定と実態のずれに気づけない、あるいは気づいても対応につながりません。
- 規制上の義務の不履行:利用者の情報の取り扱い、同意や通知、広告の表示など、自社の事業に適用される法令上の義務を果たせなくなります。
どの損失が自社で目立っているかを見れば、どこから着手するかの見当が付きます。払いすぎが疑われるなら、新しい手法を探す前に、買っている広告枠がどの方式で取引されているかと、予測した確率が実績と合っているかを確かめます(第3章・第6章・第8章)。機会損失が疑われるなら、手に入るレポートや記録で、予算の上限による制約と、入札額や目標による制約のそれぞれで、どれだけの機会に参加できていないかを確かめます(第7章・第9章)。成果の数え違いが疑われるなら、主要な媒体の1つで、広告を出さない群を残す実験ができるかを検討します(第11章)。信頼の毀損が気になるなら、利用者1人あたりの表示の回数の分布と、広告が掲載されたページの一覧を確かめます(第10章・第12章)。形骸化が起きているなら、コンバージョンの定義と目標を最後に見直した時期と、設定の変更の記録が残っているかを確かめます(第12章)。規制上の義務の不履行が気になるなら、配信と計測で利用者のどの情報を誰に送っているかを一覧にし、自社に適用される法令を法務の担当者と確かめます(第14章)。このように、目立っている損失の型によって最初の一歩は変わります。上に挙げた最初の一歩は、どれも新しい仕組みの導入より前にできることです。どの型から入っても、確かめていくと、次に述べるコンバージョンの定義、価値、成果の測り方に行き着きます。
入札の設計は、コンバージョンの定義と成果の測り方から始める
運用型広告の入札で最初に決めるべきことは、どの手法やどの機能を使うかではなく、何をコンバージョンとするのか、その1件にどれだけの価値を見るのか、そして成果を何で測るのかだと考えています。コンバージョンの定義が決まれば、予測のモデルや自動入札に学ばせる結果が決まります。コンバージョンの価値が決まれば、入札額と目標のCPAの根拠ができます。成果の測り方が決まれば、入札の方針や媒体の配分を変えたときに、良くなったのかどうかを判断する基準ができます。そのうえで、いまの設定の成績を測って比較の基準とし、その基準に勝てる方法だけを足していきます。比較の基準が決まれば、新しい仕組みに投資する理由を、数字で社内に説明できるようになります。
本コラムは、次の4つのまとまりで進みます。
- 広告枠の取引とデータの基礎:運用型広告の仕組みと費用の構造、配信の記録の性質とコンバージョンの定義、オークションの方式を整理します(第1章から第3章)。
- 反応の予測:クリック率とコンバージョン率の予測、評価と較正を、実行したコードとともに見ます(第4章から第6章)。
- 入札と配信の設計:入札額の決め方、ファーストプライスでの入札の引き下げ、予算のペース配分、表示の回数と表現の制御を扱います(第7章から第10章)。
- 効果の測定と定着:広告の効果の測り方、配信の監視と品質、導入の進め方と体制、規制とガイドライン、公開事例と最新の動向を扱います(第11章から第14章)。
経営判断に関わる方には、投資の進め方として、新しい入札の仕組みや外部の製品に予算を付ける前に、次の4つを確かめる順序をお勧めします。
- 何をコンバージョンとし、どの期間で数えるのかが、事業の利益とのつながりを踏まえて決まっているか
- コンバージョン1件の価値と、目標のCPAの根拠が、粗利などの事業の数字から説明できるか
- 配信の記録(費用、表示、クリック、コンバージョン)と、自社の売上の記録が、後から突き合わせて集計できる形で残っているか
- 主要な媒体について、広告で増えた分(増分)を測ったことがあるか、測る計画があるか
この順序であれば、投資の前提を社内に説明でき、成果が出なかったときにも原因を切り分けやすくなると考えています。反対に、入札の仕組みの導入を先に進め、定義と測り方を後回しにすると、入札は毎日動いていても、広告で利益が増えたのか、広告が無くても起きていたコンバージョンを数えているだけなのかを誰も答えられないおそれがあります。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、広告の入札と効果の測定を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章を、序章で示した4つのまとまりに分けて構成しています。章の題に出てくる専門の用語は、表の「その章で答える問い」の欄で平易に言い換え、それぞれの章の中で定義しています。
- 広告枠の取引とデータの基礎(第1章から第3章):運用型広告の仕組みと費用の構造、配信の記録の性質とコンバージョンの定義、オークションの方式
- 反応の予測(第4章から第6章):クリック率の予測、機械学習によるクリック率とコンバージョン率の予測、予測の評価と較正
- 入札と配信の設計(第7章から第10章):入札額の決め方、ファーストプライスでの入札の引き下げ、予算のペース配分、表示の回数と表現の制御
- 効果の測定と定着(第11章から第14章):広告の効果の測り方、配信の監視と品質、導入の進め方と体制、規制とガイドライン、公開事例と最新の動向
第2章から第12章には、架空の合成データ(乱数で作った配信の記録)で実際に動かしたPythonのコードと、その結果を載せています。例題では、落札した機会はすべて表示され、表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件として単純にしています。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | 運用型広告の仕組みと事業での位置づけ、広告枠の取引と費用の構造 | 広告を表示できる機会は、誰と誰の間でどう取引されているのか。入札を決める仕組みは普通の予測の問題と何が違うのか |
| 第2章 | 広告配信のデータ、入札・表示・クリック・コンバージョンの記録と結果の定義 | どの記録が誰の手元に残るのか。何をコンバージョンとし、どの期間で数えるのか |
| 第3章 | オークションの仕組み、セカンドプライスとファーストプライスで変わる入札の考え方 | 勝者が2番目の入札額にもとづいて払う方式(セカンドプライス)と、自分の入札額をそのまま払う方式(ファーストプライス)とで、入札の考え方はどう変わるのか |
| 第4章 | クリック率の予測、ロジスティック回帰と特徴量の作り方 | 表示した場合にクリックされる確率を、機会の属性からどう見積もるか。モデルの入力(特徴量)をどう作るか |
| 第5章 | 機械学習によるクリック率とコンバージョン率の予測、勾配ブースティングと遅れて届く結果 | 多数の決定木を順に足していく手法(勾配ブースティング)は何が違うのか。表示やクリックから遅れて届くコンバージョンを、学習でどう扱うか |
| 第6章 | 予測の評価と較正、対数損失と確率のずれが入札に与える影響 | 予測の良し悪しをどの指標で測るか。予測した確率が実績とずれていると、費用にどう響くか。ずれをどう直すか(較正) |
| 第7章 | 入札額の決め方、表示の価値にもとづく入札と目標の獲得単価 | 見積もった確率と価値から、入札額をどう決めるか。予算に限りがあるとき、目標の獲得単価(CPA)を動かすと何が起きるか |
| 第8章 | ファーストプライスでの入札、勝率曲線の推定と入札の引き下げ | 入札額と落札できる割合の関係(勝率曲線)を、過去の記録からどう見積もるか。支払額と落札できる割合の両方を踏まえて、入札をどこまで下げるか |
| 第9章 | 予算のペース配分、1日の予算を使う速さの制御 | 予算を1日の中でどの速さで使うか(ペース配分)。早く使い切ることと使い残すことを、どう避けるか |
| 第10章 | 配信の制御、フリークエンシーの上限とクリエイティブの出し分け | 同じ利用者に表示する回数(フリークエンシー)の上限をどう決めるか。複数の表現(クリエイティブ)のうちどれを多く出すかを、試しながらどう決めるか |
| 第11章 | 広告の効果の測り方、アトリビューションと増分の検証 | コンバージョンを広告に割り振った件数(アトリビューション)は、広告で増えた件数(増分)とどう違うのか。増分をどう測るか |
| 第12章 | 配信の監視と品質、無効なトラフィック・掲載面の点検とモデルの見直し | 配信が設定どおりに動き、成果につながっているかをどう見張るか。計測の上で正当な表示やクリックとして数えるべきでないもの(無効なトラフィック)と、掲載されるページをどう点検するか |
| 第13章 | 導入の進め方と体制、自動入札の使い分け・内製と外部の分担 | どこまでを媒体の自動入札に任せ、どこからを自社で決めるか。PoC(概念実証。実現できるかと効果を小さな規模で確かめる検証)をどう設計し、誰が何を担うか |
| 第14章 | 規制とガイドライン、識別子の制限と公開事例・最新動向 | 広告の配信と計測に関わる法令とガイドラインは何か。利用者を区別する符号(識別子)の制限はどう進んできたか。公開された事例と研究から何が読み取れるか |
本コラムで使う用語は、次の表の意味に固定しています。特定の章だけで使う用語は、その章の中で定義します。コードのある各章は、章ごとに別々に作った架空の合成データを使っているため、同じ名前の数値(クリック率、コンバージョン率、勝率、CPAなど)でも章によって値が違います。数える対象の集団や期間も章によって違うことがあり、各章の本文にその章の数え方を書いています。
| 用語 | 本コラムでの意味 |
|---|---|
| 運用型広告 | 配信の状況に応じて、入札額、予算、配信の対象、クリエイティブなどを継続的に調整しながら配信する広告。検索連動型広告、ディスプレイ広告、動画広告、SNSの広告などで使われる。本コラムでは主にオークションを使う配信を扱い、枠と期間を先に決めて買う予約型の広告と区別する |
| 利用者 | 広告が表示される相手。サイトやアプリを使っている人 |
| 広告主と媒体 | 広告主は広告を出す事業者。媒体は広告枠を持つサイトやアプリと、その運営者 |
| 表示の機会 | 広告を1回表示できる機会。利用者がページやアプリの画面を開いたときなどに生じる。表示の機会が生じたことを買い手の側に知らせ、入札を求める通知を入札リクエストと呼ぶ(第2章) |
| 表示 | 広告が1回配信されたこと。インプレッションとも呼ばれる。本コラムの例題の多くでは、落札した機会はすべて表示されたものとして単純にしている。利用者が実際に見られる状態だったかは別の指標で扱う(第12章) |
| 入札と入札額 | 入札は、表示の機会に対して買い手が出す価格の申し出。その額が入札額。本コラムの例題では表示1回あたりの額にそろえている。実務では、表示1,000回あたりやクリック1回あたりの額で入札する取引がある(第1章・第3章) |
| オークションと落札 | オークションは、1回の表示の機会について入札を比べ、勝者と支払額を決める手続き。落札は、オークションに勝って表示の権利を得ること |
| 支払額 | 落札した買い手が、その表示について払う額。オークションの方式によって、入札額と一致する場合と一致しない場合がある。本コラムの例題では、表示の時点で支払いが生じるものとし、手数料などは含めていない |
| ファーストプライス・オークション | 勝者が自分の入札額をそのまま払う方式 |
| セカンドプライス・オークション | 勝者が、自分以外の入札の最高額と最低落札価格の、大きいほうを払う方式(本コラムの例題での定義。端数や最小の上乗せ額は省いている)。複数の枠を順位で売る方式は第3章で別に扱う |
| 最低落札価格 | 売り手が定める、これ未満の入札では落札させないという下限 |
| 勝率 | 入札した機会のうち、落札した割合。同じ条件の機会で入札額を変えたときの、入札額と落札できる確率の関係を勝率曲線と呼ぶ(第8章) |
| 競合の最高入札額と落札のしきい値 | 競合の最高入札額は、自分以外の入札のうち最も高い額。落札のしきい値は、競合の最高入札額と最低落札価格の大きいほうで、落札できるかどうかを決める額。負けた機会について知らされる情報は取引の場によって違う。本コラムの例題では、落札のしきい値は知らされないものとし、価格で負けた機会から分かるのは、しきい値が自分の入札額より高かったことだけとする。このように値の範囲しか分からない状態を打ち切りと呼ぶ(第8章) |
| クリック率 | 表示のうち、クリックされた割合。実績の値。英語の略でCTRとも書く |
| 予測クリック率 | ある表示の機会で表示した場合に、クリックされる確率の見積り。実績の値であるクリック率と区別する |
| コンバージョン | 広告主が目標として定めた利用者の行動。購入、申込、資料請求、アプリの導入など。何をコンバージョンとするかは広告主が決める |
| コンバージョン率 | クリックのうち、計測期間のうちにコンバージョンに至った割合。実績の値。英語の略でCVRとも書く。その見積りは予測コンバージョン率と呼ぶ。本コラムの例題では、クリック1回につきコンバージョンは最大1件として扱う |
| 計測期間 | クリックや表示のあと、コンバージョンをその広告に結びつけて数える期間。媒体や設定によって違う。この期間の途中でコンバージョンが起きていなくても、期間のうちに起きないとは確定できない。レポートに含める日付の範囲(集計の期間)とは別のもの |
| アトリビューション | コンバージョンを、その前に接触した広告に割り振る規則。規則であって、広告がコンバージョンを起こしたことの証明ではない(第11章) |
| 増分 | 広告を出した場合と出さなかった場合の、コンバージョンまたはその価値の差。無作為に分けた群を比べる実験などで見積もる。0や負になることもある。広告を見た利用者と見なかった利用者の実績の差とは区別する(第11章) |
| コンバージョンの価値 | コンバージョン1件に対応する、広告費を引く前の粗利の見込み。例題では相対値で表す。売上を指すときは「売上」と書いて区別する |
| 表示の価値 | その機会に表示した場合に、その後のコンバージョンから得られると予測する、広告費を引く前の価値。本コラムの例題では、予測クリック率と予測コンバージョン率とコンバージョンの価値を掛けたものとする。広告が無くても起きたコンバージョンの分を除いていない見積りであり、増分にもとづく価値は「増分の表示の価値」と書いて区別する(第7章・第11章) |
| CPM・CPC・CPA・ROAS | CPMは表示1,000回あたりの広告費、CPCはクリック1回あたりの広告費、CPA(獲得単価)は広告に割り振られたコンバージョン1件あたりの広告費、ROASは広告費に対する、広告に割り振られた売上の比。いずれも実績の値で、利益や増分を表す指標ではない。設定する目標を指すときは「目標のCPA」のように書いて区別する |
| 成果(増分の利益) | 広告を出したことで増えたコンバージョンの価値から、広告費を引いた差。比較の相手は広告を出さない場合で、例題では広告費以外の費用の差を省いている。本コラムでは、これを広告の成果の指標とする。クリック率、CPA、ROAS、割り振られたコンバージョンの件数は、管理の指標として区別する(第11章・第13章) |
| 予算とペース配分 | 予算は、ある期間に使ってよい広告費の上限で、使い切る義務は無い。ペース配分は、予算を期間の中でどの速さで使うかを制御すること(第9章) |
| キャンペーン | 予算、期間、配信の対象、入札の方針をまとめた配信の単位 |
| クリエイティブ | 広告として表示する表現物。画像、文、動画など |
| フリークエンシー | 同じ利用者に、同じキャンペーンまたは同じクリエイティブが一定の期間に表示された回数。実際に数えられるのは、識別子で区別できた単位での回数である(第10章) |
| DSP・SSP・アドエクスチェンジ | DSPは、広告主の側に立って複数の取引の場から表示の機会を買い付ける仕組み。SSPは、媒体の側に立って表示の機会を複数の買い手に販売する仕組み。アドエクスチェンジは、買い手と売り手の入札を取り次ぐ取引の場(第1章) |
| リアルタイム入札 | 表示の機会が生じるたびに、その場でオークションを行う取引の方法。英語の略でRTBとも書く |
| 自動入札 | 媒体やDSPが、広告主の設定した目標(予算、目標のCPAなど)に合わせて、機会ごとの入札額を自動で決める機能 |
| 較正 | 予測した確率が同じくらいの機会を集めたとき、その実績の率が予測と対応するように、モデルの出す確率を調整すること。全体の平均が合っているだけでは足りない。合っているかを確かめる作業は「較正の確認」と呼び、対応している状態は「較正が取れている」と書く(第6章) |
| AUCと対数損失 | AUCは、ROC曲線の下の面積。モデルが、クリックのあった表示を無かった表示より上に並べられているかを表す順位づけの指標で、確率の正しさは表さない。対数損失は、予測した確率と実際の結果のずれを表す指標で、小さいほどよく、確率の正しさも反映する(第6章) |
| 情報の漏れ | ある機会の入札の時点では分からなかった情報をその機会の入力に使うことや、評価用のデータの情報が学習や入力の作成、モデルの選択に混ざることで、成績が実際より良く見えること。過去の機会の確定した結果を正解として学習することは、これに当たらない。個人情報が外に出る「漏えい」とは別の意味で使う |
| 無効なトラフィック | 計測の基準に照らして、正当な表示やクリックとして数えるべきでないもの。自動のプログラムによるものや、人の操作による不正なクリックなどを含み、不正を目的とするものに限らない。利用者の関心が低いことや、コンバージョンしなかったことだけでは無効としない(第12章) |
| 識別子 | アカウント、ブラウザ、端末などを区別するための符号。クッキーに保存した値や、端末の広告用の識別子など。識別子と人は1対1とは限らない(第14章) |
| 相対値 | 例題で入札額、支払額、予算、価値を表すときに使う、単位の無い仮の数。金額ではない。同じ例題の中では同じ尺度を使い、例題どうしで数値を直接比べない |
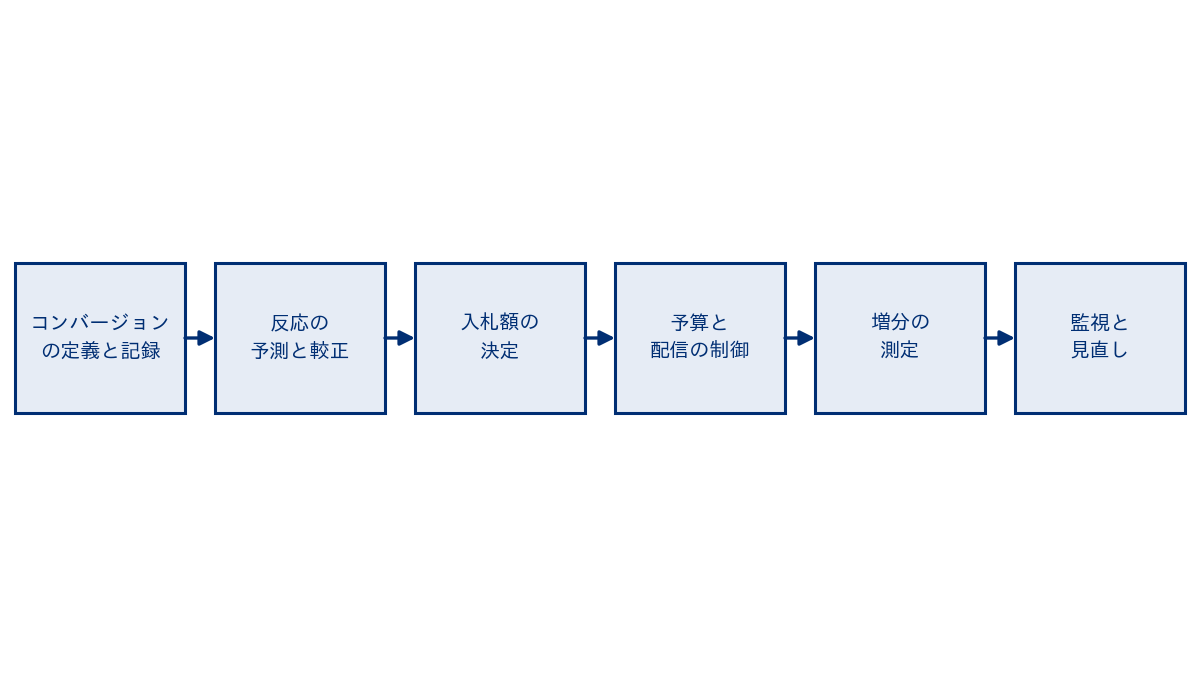
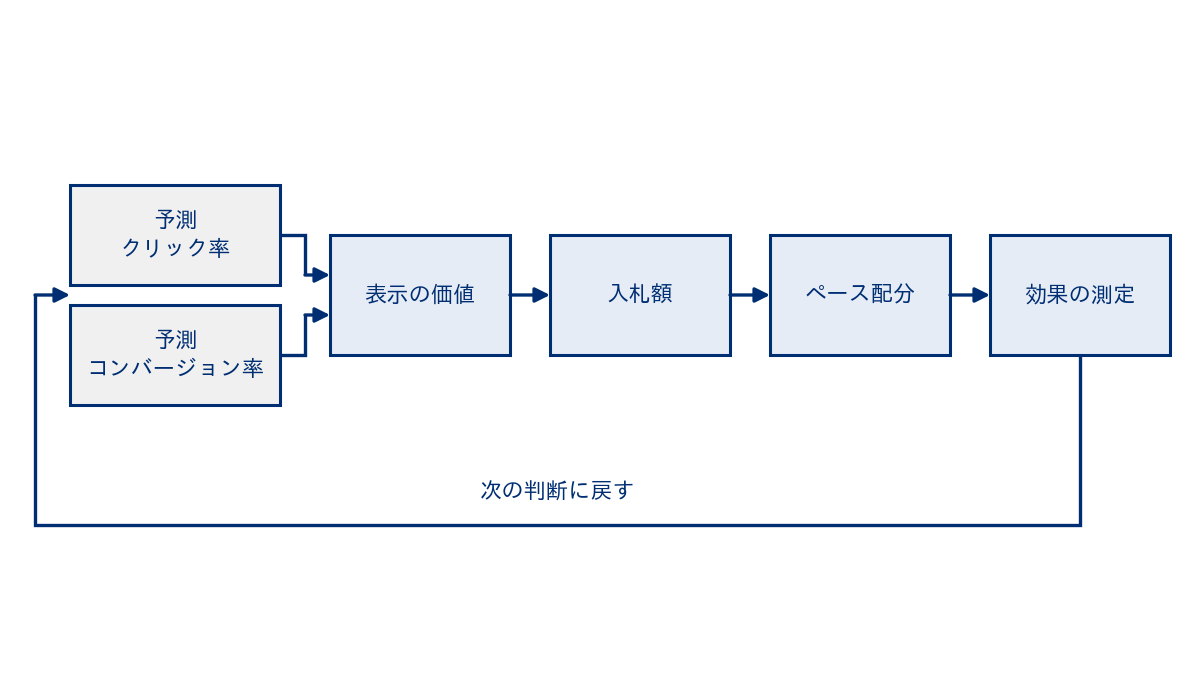
次の図は、入札を決める仕組みの主な流れを示したものです。1つ目の箱は第2章、2つ目は第4章から第6章、3つ目は第3章と第7章、第8章、4つ目は第9章と第10章、5つ目は第11章、6つ目は第12章に当たります。運用型広告の仕組み(第1章)、導入の進め方と体制(第13章)、規制と識別子の制限(第14章)は、6つの箱の全体に関わる事柄です。図には描いていませんが、5つ目の箱で測った増分は、1つ目の箱のコンバージョンの定義と価値を見直す材料になります。
第1章 運用型広告の仕組みと事業での位置づけ、広告枠の取引と費用の構造
この章では、運用型広告がどのような取引の仕組みで成り立ち、広告主の事業のどこに効くのかを整理します。第2章から第12章では、クリック率の予測、オークション、入札額の決め方、予算のペース配分、効果の測定、監視を、実行したコードと結果で説明し、第13章と第14章では導入の体制と規制を扱いますが、その前提として、誰が何を売り、誰が何を買い、広告費がどこへ流れ、どの数字が何を表しているのかを共有しておく必要があります。この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 広告が事業に効く経路と、運用型広告の位置づけ、国内の広告費の統計に表れた構成
- 広告の種類と、予約型の広告との違い
- 取引の当事者と、表示の機会が生じてから広告が表示されるまでの流れ
- 媒体が自社の枠を自社の仕組みで売る場合と、取引の場を通じて買う場合の違い
- 課金の方式と買い手が負うリスク、広告費のうち媒体に届く割合という論点
- 入札を決める仕組みの全体像と、本コラムの各章との対応、運用型広告の歴史
- 自動入札と広告主が決めること、普通の予測の問題と違う点、よくある誤解、経営の損失の型と経営判断
この章の主張は、何をコンバージョンとし、その価値をいくつと見て、どの指標で成果を測るのかを、入札の仕組みを選ぶ前に事業として決めておくことです。コンバージョンは、購入・申込・資料請求など、広告主が目標として定めた利用者の行動を指します。コンバージョンが起きたこと自体は、広告で利益が増えたことを意味しません。運用型広告の入札は、媒体や DSP の仕組みが自動で計算する部分が大きくなっています。しかし、その計算が目指す先(目標・予算・コンバージョンの定義・コンバージョンの価値・計測)を与えるのは広告主です。目指す先がずれていれば、ずれた目標のとおりに最適化が進みます。本コラムでは、成果を、広告を出したことで増えたコンバージョンの価値(広告費を引く前の粗利)から広告費を引いた差、つまり増分の利益と呼びます。クリック率(表示のうちクリックされた割合)・CPA(広告に割り振られたコンバージョン1件あたりの広告費)・ROAS(広告費に対する、広告に割り振られた売上の比)・管理画面に出るコンバージョンの件数は、この増分の利益を説明し、日々の運用を管理するための指標であり、単独では成果と呼びません。
広告が事業に効く経路と、運用型広告の位置づけ
広告が事業の売上や利益につながる経路は、一般に、利用者が商品やサービスを知る段階(認知)、比べて検討する段階(検討)、購入や申込をする段階(購入)に分けて説明されます。テレビや新聞の広告、動画の広告は認知の段階に、検索連動型広告や商品の比較の場面に出る広告は検討から購入の段階に効きやすい、という整理がよく使われます。ただし、この対応は目安であって、同じ種類の広告でも、配信の対象の設定(ターゲティング)やクリエイティブ(広告として表示する画像・文・動画などの表現物)によって効く段階は変わります。また、購入の段階に近い広告ほど管理画面のコンバージョンの件数が多く出やすい一方で、その中には広告が無くても購入した利用者の分が含まれます。この区別は本コラム全体の論点で、第11章で詳しく扱います。
本コラムでいう運用型広告は、配信の状況に応じて、入札・予算・配信の対象・クリエイティブなどを継続的に調整しながら配信する広告です。検索連動型広告、ディスプレイ広告、動画広告、SNS の広告を含みます。表示の機会ごとにすべての設定を変えるとは限らず、リアルタイム入札(後の節で説明します)を使うことも必須ではありません。本コラムでは、そのうち主にオークションを使う配信を扱います。これに対して、枠と期間を先に決めて買う広告を予約型の広告と呼びます。予約型の広告では、たとえば特定のサイトの特定の枠に、一定の期間、一定の回数の表示を出す契約を先に結びます。オークションを使う運用型広告の配信では、表示の機会が生じるたびに、その機会に広告を出すかどうかと、いくらで買うかが決まります。広告主の側から見ると、予約型は「先に買う量と条件を決める」取引、オークションを使う運用型は「機会ごとに買うかどうかを決め続ける」取引です。後者では、1回ごとの判断を自動で行う仕組みが欠かせず、その仕組みの中心にあるのが、本コラムで扱う予測とオークションと予算の制御です。
国内の広告費の統計で、運用型広告がどの程度の比重を占めているかを確かめておきます。電通が公表している「2025年 日本の広告費」によると、2025年の総広告費は前年比105.1%で、インターネット広告費は前年比110.8%、総広告費に占める構成比は50.2%でした。インターネット広告費は、インターネット広告媒体費・物販系ECプラットフォーム広告費・インターネット広告制作費の合計と定義されています。さらに、CARTA HOLDINGS、電通、電通デジタル、セプテーニの4社が2026年3月5日に公表した「2025年 日本の広告費 インターネット広告媒体費 詳細分析」では、運用型広告費がインターネット広告媒体費の88.7%を占め、前年比112.5%とされています。同じ資料では、運用型広告を、検索連動型広告と、デジタル・プラットフォーム(ツール)やアドネットワークを通じて入札方式で取引されるもの、と定義しています。この章で使う数字を次の表にまとめました。構成比の分母は、いずれもインターネット広告媒体費の全体です。
| 区分 | インターネット広告媒体費に占める構成比 | 前年比 |
|---|---|---|
| 運用型広告費(取引の方法による区分) | 88.7% | 112.5% |
| 運用型の検索連動型広告(広告の種類と取引の方法を掛け合わせた区分) | 38.7% | 資料の該当箇所に記載なし |
| ソーシャル広告(広告の種類ではなく、掲載される媒体の種類で分けた区分) | 39.5% | 118.7% |
表の区分は切り口が違い、互いに重なりうるので、単純に足し合わせることはできず、互いに独立した広告の種類の順位としても読めません。資料は、広告の種類と取引の方法を掛け合わせた区分の中で、運用型の検索連動型広告の構成比が最も高いと述べています。ソーシャル広告は、資料ではソーシャルメディアのサービス上で展開される広告と定義され、広告の種類による区分とは別の、媒体の種類による区分として示されています。そのため、その構成比は前者と同じ物差しの上の順位ではありません。
これらは推定の方法と定義が決まった統計であり、本コラムの「運用型広告」の定義と完全に同じ範囲を指すわけではありません。たとえば、同じ資料の運用型広告の定義は入札方式で取引されるものを中心にしており、SNS の広告の中にも予約型で買うものがあります。それでも、この定義での運用型広告費がインターネット広告媒体費の約9割を占めることから、国内のインターネット広告の媒体費の大半が、入札方式を中心とする取引で買われているという全体の姿は読み取れます。この数字は市場全体の推計であり、個々の広告主の広告費の構成を示すものではありません。自社の広告費に占める運用型広告の割合が高い場合には、入札の判断の誤りが広告費全体に大きく影響する可能性があります。
広告の種類と、予約型の広告との違い
運用型広告の中にも、主に掲載される場面と、入札の対象となる単位が違う種類があります。検索連動型広告では、利用者が入力した検索語句に応じて、広告を出すかどうかと順位が決まります。どの検索語句に広告を出す候補にするかは、広告主がキーワードとして設定します。ディスプレイ広告と動画広告では、サイトやアプリの画面の広告枠に対して、表示の機会ごとに入札が行われます。SNS の広告は、SNS のサービスの画面に出る広告で、媒体が自社の利用者の情報と配信の仕組みを使って配信します。アプリの導入や利用を促す広告は、アプリの導入やアプリの中での行動をコンバージョンとすることが多い種類で、掲載される場面は1つに限られません。小売の媒体の広告は、小売の事業者が自社のサイトやアプリの中の枠を、そこで商品を売る事業者などに販売するものです。前項の電通の統計には、物販系ECプラットフォーム上に店舗を持つ事業者が、そのプラットフォーム上に投下した広告費、と定義された「物販系ECプラットフォーム広告費」という区分がありますが、本コラムの小売の媒体の広告と定義が同じではありません。
次の表に、本コラムで扱う広告の種類と、入札の対象の単位、媒体の設定でコンバージョンとして数えられる行動の例、予約型との関係をまとめました。表の内容は一般的な整理で、個別の媒体によって仕組みや呼び方は違います。行動の例には、サイトの訪問や視聴のように事業の価値との結びつきが弱いものも含めています。それをコンバージョンとして数えるかどうかは、後の節で述べるとおり、広告主が事業の価値にもとづいて決めることです。
| 広告の種類 | 主な掲載場面の例 | 入札の対象の単位 | 媒体の設定で数えられる行動の例 | 予約型との関係 |
|---|---|---|---|---|
| 検索連動型広告 | 検索の結果の画面 | 検索された語句と、その検索の1回 | 購入・申込・資料請求 | 基本は入札で取引される |
| ディスプレイ広告 | サイトやアプリの画面の広告枠 | 広告枠の表示の機会の1回 | 購入・会員の登録・サイトの訪問 | 入札で買う場合と、枠を予約して買う場合がある |
| 動画広告 | 動画の前後や途中、画面の動画の枠 | 動画の広告枠の表示の機会の1回 | 視聴・サイトの訪問・購入 | 入札で買う場合と、予約して買う場合がある |
| SNS の広告 | SNS の投稿の並びの中など | 媒体の配信の仕組みが決める表示の機会 | 購入・アプリの導入・会員の登録 | 媒体の仕組みでの入札が中心で、予約して買う形を用意する媒体もある |
| アプリの導入・利用を促す広告 | アプリの画面の広告枠、アプリの配信の場の検索の結果、検索や動画の広告枠など | 表示の機会の1回 | アプリの導入・アプリの中での購入 | 入札で取引されることが多い |
| 小売の媒体の広告 | 小売の事業者のサイトやアプリの中の検索の結果や商品の一覧 | 小売の事業者の仕組みが決める表示の機会 | その小売の場での購入 | 入札の形が多いが、枠を販売する形もある |
表の「予約型との関係」の列が示すとおり、同じ広告枠が、入札で売られる場合と予約で売られる場合があります。予約型の広告では、表示の回数や期間があらかじめ約束されるので、広告主にとっては量が読みやすく、媒体にとっては収入が読みやすい取引になります。運用型では、表示の機会ごとに価値を見積もって買うかどうかを決めるので、価値の低い機会を買わずに済む一方で、買える量は競合の入札しだいで変わります。どちらを使うかは、認知のために一定の量の接触を確保したいのか、価値の高い機会を選んで買いたいのか、という目的で分かれます。
取引の当事者と、表示の機会が生じてから落札の通知が届くまで
運用型広告の取引には、多くの当事者が関わります。広告主は広告を出す事業者で、広告会社は広告主から広告の企画や運用を受託する事業者です。DSPは、広告主の側に立って、複数の取引の場から表示の機会を買い付ける仕組みです。SSPは、媒体の側に立って、表示の機会を複数の買い手に販売する仕組みです。アドエクスチェンジは、買い手と売り手の入札を取り次ぐ取引の場で、SSP がその役割を兼ねている場合もあります。媒体は広告枠を持つサイトやアプリとその運営者、計測の事業者は表示やクリックやコンバージョンを測る事業者です。そして、広告が表示される相手である利用者がいます。利用者は取引の当事者として契約を結ぶわけではありませんが、表示の機会は利用者がページやアプリの画面を開いたときに生じ、その利用者に関する情報が入札の判断に使われます。
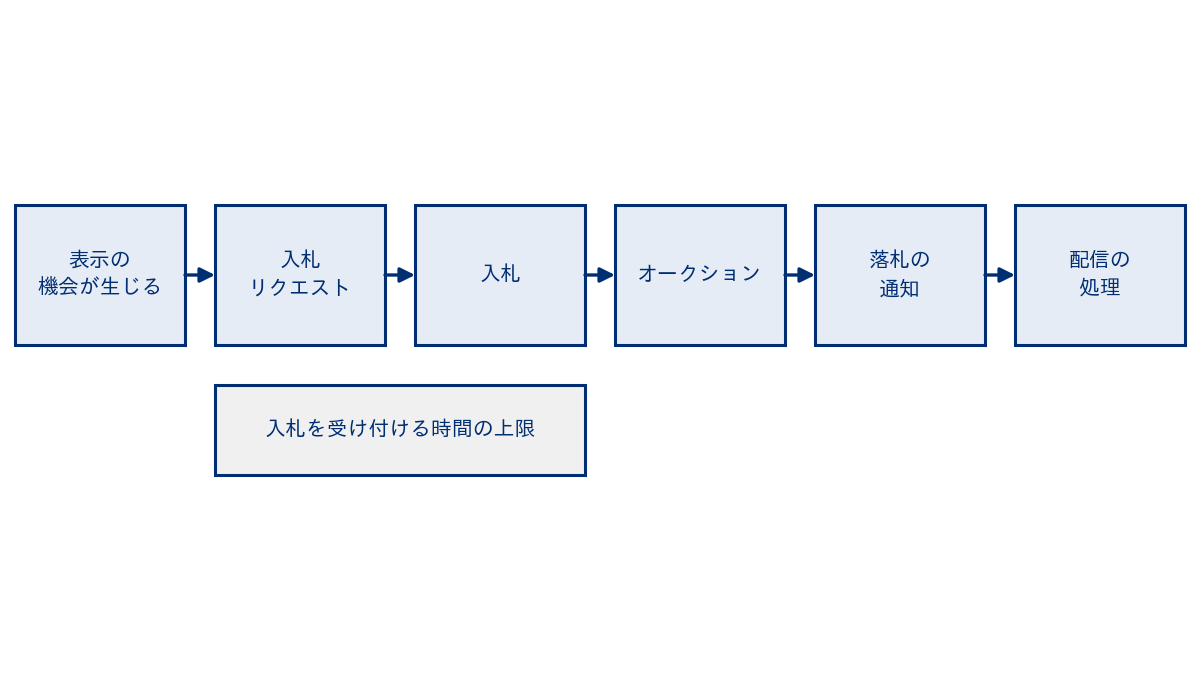
表示の機会が生じるたびに、その場でオークションを行う取引の方法をリアルタイム入札(RTB)と呼びます。売り手と買い手の間でやりとりする情報の形式として、IAB Tech Lab が OpenRTB という仕様を公開しています。OpenRTB 2.6 の仕様は、その目的を、買い手と売り手の間で通じる共通の言葉を作ることだと説明しています。仕様に書かれている流れを本コラムの言葉で言い換えると、次のようになります。
- 利用者がサイトやアプリの画面を開き、広告枠を表示する機会が生じる
- 媒体の側の仕組み(SSP やアドエクスチェンジ)が、その機会について入札リクエストを作り、複数の買い手(DSP など)に送る
- 各買い手は、その機会に広告を出すかどうかと入札額を決め、入札を返す
- 売り手の側が、定められたオークションの規則にしたがって入札を比べ、勝者を選ぶ
- 勝者には落札の通知が送られ、落札した広告の配信の処理が進む
ただし、落札したことは、広告が実際に表示されたことを意味しません。OpenRTB 2.6 の仕様は、落札の通知の本質的な役割は買い手にオークションに勝ったことを知らせることで、広告の配信・視認・課金を必ずしも意味しない、と説明しています。そのため、落札・表示・課金は区別して記録する必要があります。
この流れには時間の制約があります。OpenRTB 2.6 の入札リクエストには tmax という項目があり、仕様はこれを、通信の遅れを含めて、取引の場が入札を受け付ける最大の時間(ミリ秒)と説明しています。つまり、買い手は、入札リクエストを受け取ってから決められた短い時間のうちに、機会の価値を見積もって入札額を決め、返さなければなりません。仕様はこの上限を、タイムアウトを避けるためのものとして定めています。上限を過ぎた入札がどう扱われるかは取引の場の規則によるため、本コラムでは扱いません。第4章と第5章で扱うクリック率やコンバージョン率の予測のモデルを選ぶときに、成績だけでなく計算の速さが問われるのは、この制約があるためです。
同じ仕様には、オークションの方式を示す項目(at)もあり、1 がファーストプライス、2 がセカンドプライス・プラスと定められています。ファーストプライスは勝者が自分の入札額をそのまま払う方式、セカンドプライスは勝者が2番目に高い入札額(または最低落札価格)にもとづく額を払う方式で、詳しくは第3章で扱います。また、広告枠ごとに最低の入札額(bidfloor)を示す項目があり、仕様はこれを表示1,000回あたり(CPM)の価格で表すと定めています。これは第3章で扱う最低落札価格にあたります。仕様には、落札の通知とは別に、取引の場の方針にもとづいて課金の対象になったときに送る通知の項目もあります。負けた機会については、負けたことを知らせる通知や、落札に必要だった最低の額を知らせる項目が仕様にありますが、それを使うかどうか、落札価格を開示するかどうかは取引の場の方針によるとされています。負けた機会について知らされる情報が取引の場によって違うことは、第2章と第8章で扱います。
本コラムの例題では、単純化のため、入札額と支払額を表示1回あたりの相対値にそろえ、落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。これは実務の取引の説明ではなく、例題のための仮定です。実務の価格の表し方は取引によって違い、上で見たとおり OpenRTB の最低の入札額は表示1,000回あたりで表され、後の歴史の節で見る検索連動型広告はクリック1回あたりの入札から始まりました。数字を読むときは、何回あたりの額なのかを確かめる必要があります。
自社の枠を自社の仕組みで売る媒体と、取引の場を通じて買う場合
運用型広告の取引には、大きく分けて2つの形があります。1つは、検索や SNS の大きな媒体のように、媒体が自社の広告枠を、自社の広告の配信の仕組みで、広告主に直接売る形です。広告主はその媒体の広告の管理画面で、予算・入札の方針・配信の対象・クリエイティブを設定し、オークションも配信も計測の多くも、その媒体の仕組みの中で行われます。もう1つは、複数の媒体の広告枠を、SSP やアドエクスチェンジを通じて、DSP から買う形です。こちらでは、表示の機会ごとに入札リクエストが複数の買い手に送られ、OpenRTB のような共通の形式で入札がやりとりされます。
2つの形の違いを次の表に整理しました。どちらが良いという比較ではなく、広告主がどこまでの情報を手に入れ、どこまでの判断を自分で行えるかの違いとして読むためのものです。
| 観点 | 媒体が自社の枠を自社の仕組みで売る場合 | 複数の媒体の枠を取引の場で買う場合 |
|---|---|---|
| 買う相手 | その媒体 | SSP やアドエクスチェンジを通じて、複数の媒体 |
| 入札額を決める仕組み | 媒体の自動入札が中心で、広告主は目標と予算を設定する | DSP の入札の仕組み。広告主や広告会社が入札の方針を調整できる範囲が広い場合がある |
| オークションの方式 | 媒体の仕組みの中で決まる。公式ヘルプに書かれている範囲しか分からない | 取引の場ごとに決まり、入札リクエストで方式が示される場合がある |
| 広告主の手元に残る情報 | 媒体の管理画面のレポート(集計した数字)が中心 | DSP の記録として、機会ごとの入札や落札の記録が得られる場合がある |
| 利用者に関する情報 | 媒体が自社の利用者について持つ情報を、媒体の仕組みの中で使う | 入札リクエストで送られる情報と、広告主や DSP が持つ情報を使う。識別子の制限の影響を受ける(第14章) |
| 掲載面の把握 | その媒体の中に限られる | 掲載面が多岐にわたるため、点検が要る(第12章) |
| 費用の流れ | 広告主から媒体へ(広告会社を通す場合はその手数料を含む) | 広告主から DSP、取引の場、SSP を経て媒体へ。途中の手数料が重なる |
本コラムの第3章から第9章で扱うオークション・予測・入札額・入札の引き下げ・ペース配分の仕組みは、後者の、機会ごとに入札する取引で考えると見通しがよくなります。前者の大きな媒体で同じ考え方が使われているかどうかは、公開されている情報では確かめられません。本コラムでは、そうした媒体については公式ヘルプに書かれている範囲と公開された論文の範囲だけを扱います。広告主にとって大切なのは、自社の広告費のうちどれだけが、どちらの形で、どの方式で取引されているかを把握しておくことです。
課金の方式と、買い手が負うリスクの違い
広告主が何に対して支払うかを課金の方式と呼びます。主な方式は、表示に対して払う表示課金、クリックに対して払うクリック課金、コンバージョンに対して払う成果課金の3つです。成果課金は業界での呼び方で、ここでの成果はコンバージョンを指し、本コラムの成果(増分の利益)とは別のものです。表示課金の単価は表示1,000回あたりの広告費(CPM)で、クリック課金の単価はクリック1回あたりの広告費(CPC)で表します。成果課金では、コンバージョン1件ごとに払います。どの方式でも、オークションで入札しているのは結局は表示の機会であり、課金の方式が違うと、その機会がクリックやコンバージョンにつながらなかったときの損を、誰が負うかが変わります。
| 課金の方式 | 支払いの対象 | クリックやコンバージョンに至らない損を負う側 | 買い手に要る見積り | 注意点 |
|---|---|---|---|---|
| 表示課金(CPM) | 表示 | 買い手(広告主) | 予測クリック率・予測コンバージョン率・コンバージョンの価値のすべて | 利用者が見られる状態だったか(ビューアビリティ)にかかわらず払う場合や、無効なトラフィックなど、計測の上で正当な表示として数えるべきでないものの分も払う場合がある(第12章) |
| クリック課金(CPC) | クリック | クリックに至らない損は売り手(媒体)、クリックの後の損は買い手 | 予測コンバージョン率とコンバージョンの価値 | 媒体の側がクリック率の見積りをどう使うかは、公開された論文と公式ヘルプの範囲で第4章で扱う |
| 成果課金 | コンバージョン | コンバージョンに至らない損は売り手や仲介の事業者 | コンバージョンの価値 | 何をコンバージョンとして数えるかの定義と、広告が無くても起きたコンバージョンの扱いが争点になりやすい(第2章・第11章) |
表のとおり、表示課金では買い手が最も多くの見積りを自分で持つ必要があり、成果課金では見積りの負担の多くを売り手の側が持ちます。ただし、成果課金でリスクがすべて消えるわけではありません。成果課金で払うコンバージョンの中には、広告が無くても起きたものが含まれうるので、払った額に見合う増分があったかどうかは別に確かめる必要があります。また、売り手の側は、自分が負うリスクを、表示の機会の買い方や単価に織り込みます。課金の方式は、クリックやコンバージョンに至らなかった場合の費用を誰が負うかを変えますが、どの方式でも、支払いに見合う増分の利益が得られるとは限りません。
広告費のうち媒体に届く割合という論点
複数の媒体の枠を取引の場を通じて買う場合、広告主が払った広告費は、広告会社・DSP・アドエクスチェンジ・SSP などを経由して媒体に届き、それぞれの段で手数料が差し引かれます。このため、広告主が払った額のうち、媒体に届くのはどれだけかという論点があります。広告主にとっては、同じ広告費で買える表示の量と質に関わり、媒体にとっては収入に関わります。
この論点について、英国の競争・市場庁(CMA)は、2020年7月1日に公表したオンライン・プラットフォームとデジタル広告の市場調査の最終報告書で、事業者から集めた手数料のデータにもとづく推計を示しています。報告書は、新聞などの媒体の枠を DSP と SSP を通じて買う取引(オープン・ディスプレイ)全体で、仲介の事業者が広告主の購入額の少なくとも35%を得ていると推計しています(パラグラフ5.376)。同じ報告書は、英国の広告主の団体(ISBA)と PwC の調査が、媒体に届く割合を平均で51%と示したこと、その調査では広告費の約15%が、DSP の記録した落札額と SSP の記録した収入が一致しないために、どこへ流れたかを特定できなかったことも紹介しています。前者は競争・市場庁が事業者の手数料のデータから推計したオープン・ディスプレイ全体の値、後者は ISBA と PwC が DSP と SSP の記録を突き合わせた別の調査の値で、対象と方法が違うため、2つの数字を足したり引いたりはできません。これらは英国の、その時点の、その調査の方法での値であり、国内の取引や今の取引にそのまま当てはまる数字ではありません。
国内では、公正取引委員会が2021年2月17日に「デジタル・プラットフォーム事業者の取引慣行等に関する実態調査(デジタル広告分野)について(最終報告)」を公表しています。公表資料によると、この調査では広告主と広告代理店、広告仲介事業者、媒体の事業者に書面の調査を行い、関係者からの聞き取りも行っています。報告書本体の中身は第13章と第14章で、確かめた範囲で扱います。
広告主がこの論点から引き出すべきことは、特定の割合を目安として覚えることではありません。自社の広告費が、どの経路で、どの段の手数料を経て媒体に届いているのかを、取引先に開示を求めて把握することです。手数料の内訳が分からないままでは、表示の価値と支払額を比べても、その支払額のうちどれだけが表示そのものの対価なのかが分かりません。取引先に確かめることの一覧は第13章で表にします。
入札を決める仕組みの全体像と、本コラムの各章との対応
運用型広告の入札を、本コラムでは次の順に分解して扱います。まず、ある表示の機会で広告を表示したときに、クリックされる確率(予測クリック率)と、クリックの後にコンバージョンに至る確率(予測コンバージョン率)を見積もります。次に、それにコンバージョンの価値(コンバージョン1件に対応する、広告費を引く前の粗利の見込み)を掛けて、その機会に表示した場合に、その後のコンバージョンから得られると予測する、広告費を引く前の価値(表示の価値)を出します。本コラムの例題では、表示の価値を、予測クリック率 × 予測コンバージョン率 × コンバージョンの価値 とします。クリックを経ないコンバージョンは例題では扱いません。そして、表示の価値と、オークションの方式と、予算の制約から入札額を決め、予算を1日や1か月の中でどの速さで使うか(ペース配分)を制御します。最後に、配信の結果として、広告で増えたコンバージョンの価値(増分)を測り、次の判断に戻します。
この関係を数式で書くと、表示の価値は \( v = p_{\mathrm{click}} \times p_{\mathrm{cv}} \times V \) です。ここで \( p_{\mathrm{click}} \) は予測クリック率、\( p_{\mathrm{cv}} \) は予測コンバージョン率、\( V \) はコンバージョンの価値です。言葉で言い換えると、表示1回あたりに見込めるコンバージョンの件数に、1件あたりの価値を掛けたものです。たとえば、予測クリック率が0.02、予測コンバージョン率が0.05、コンバージョンの価値が相対値で100なら、表示の価値は相対値で0.1になります。この相対値は、コンバージョン1件の価値を100とおいたときの比べ方で、金額ではありません。なお、この式は、広告が無くても起きたはずのコンバージョンの分を除いていない単純な見積りです。表示の価値は「広告で増える価値」ではなく、増分にもとづく価値は「増分の表示の価値」と呼んで区別し、第7章と第11章で扱います。
| 段 | 見積もる、または決めるもの | 主に使う情報 | 扱う章 |
|---|---|---|---|
| 記録と結果の定義 | 何をコンバージョンとし、計測期間をどう置くか | 入札・表示・クリック・コンバージョンの記録 | 第2章 |
| 取引の方式 | オークションの方式と、それに合った入札の考え方 | 取引の場の規則 | 第3章 |
| 予測クリック率 | その機会で表示したときにクリックされる確率 | 掲載面・端末・時間帯などの機会の属性と、過去の実績 | 第4章・第5章 |
| 予測コンバージョン率 | クリックの後にコンバージョンに至る確率 | 学習には過去のクリックとコンバージョンの記録(遅れて届く)、入札の時点ではその時点で分かる機会の属性 | 第5章 |
| 予測の評価と較正 | 予測した確率が実績の率と合っているか | 学習に使っていない期間の記録 | 第6章 |
| 表示の価値と入札額 | 表示の価値と、予算の制約のもとでの入札額 | 予測・コンバージョンの価値・予算 | 第7章 |
| 入札の引き下げ | ファーストプライスで、入札額を下げたときの勝率の低下と、落札したときに残る価値の増加を比べて、どこまで下げるか | 過去の入札と落札の有無(勝率曲線) | 第8章 |
| ペース配分 | 予算を期間の中でどの速さで使うか | 現在までの費用の消化と、過去の記録から予測した残りの時間帯の機会の数 | 第9章 |
| 配信の制御 | 同じ利用者に何回見せるか、どの表現を見せるか | 利用者ごとの表示の回数、クリエイティブごとの反応 | 第10章 |
| 効果の測定 | 広告で増えたコンバージョンとその価値 | 配信しない群を残した実験など | 第11章 |
| 監視と品質 | 入力・予測・結果のずれと、無効なトラフィックや掲載面の問題 | 日ごとの配信の記録 | 第12章 |
表の上から下へ、見積りが次の段の入力になっています。予測クリック率が2倍にずれると表示の価値も2倍にずれます。表示の価値に一定の係数を掛けて入札する場合には、ほかの条件が同じなら、確率を高く見積もるほど入札額も高くなります。入札額がずれると、落札する機会の構成も支払額も変わり、予算の消化の速さも変わります。予測した確率のずれは、学習に使っていない期間の記録で点検できますが、それだけでは広告で増えた利益は分かりません。増分は実験などで別に確かめる必要があります。各段は独立した部品ではなく、前の段の誤りが後ろの段に持ち越される一続きの仕組みとして見る必要があります。
運用型広告の歴史、検索連動型広告からリアルタイム入札とファーストプライスへ
入札で広告を売る仕組みは、検索連動型広告から始まりました。Edelman、Ostrovsky、Schwarz の2007年の論文(検索連動型広告の一般化セカンドプライス・オークションの論文。American Economic Review 第97巻第1号)は、その経緯を次のように整理しています。それ以前のインターネット広告は、表示1,000回あたりの単価で、契約ごとに個別に交渉して売られていました。論文は、1997年に Overture(当時の社名は GoTo)が、広告主が検索の語句ごとに、クリック1回あたりに払ってよい額を入札する、新しい売り方を導入したと述べています。GoTo 自身が米国の証券取引委員会に提出した2001年の四半期報告書では、1997年に試験的な版の検索のサービスを始め、成果に応じて払うサービスを1998年2月に発表し、同年6月に正式に開始したと区別して書かれています。論文によると、この当初の方式では、勝者が自分の入札額を払っていました。その後、Google が2002年2月に、クリック課金の仕組みである AdWords Select を導入し、各順位の広告主が、1つ下の順位の広告主の入札にもとづく額を払う方式(一般化セカンドプライス)を採用した、と論文は述べています。一般化セカンドプライスの性質は第3章で扱います。
ディスプレイ広告の側では、表示の機会ごとにその場でオークションを行うリアルタイム入札が広がり、売り手と買い手が共通の形式で入札をやりとりする仕様として、IAB Tech Lab の OpenRTB が使われるようになりました。前項で見たとおり、現在公開されている OpenRTB 2.6 の仕様には、オークションの方式としてファーストプライスとセカンドプライス・プラスの両方が定められています。取引の方式については、Google が2019年9月5日の公式ブログで、Google Ad Manager を統一したファーストプライス・オークションに移すことを発表し、すべての Ad Manager の利用者への展開を翌週から始め、数週間で移行を終える見込みだと述べています。ディスプレイ広告の取引全体で、いつ、どの程度ファーストプライスに移ったかについては、本コラムでは公式の発表で確かめた範囲を超えて書きません。第3章で、方式の違いが入札の考え方をどう変えるかを扱います。
この歴史から読み取れるのは、オークションの方式は固定されたものではなく、時期と取引の場によって変わってきたということです。買い手が方式の変化を知らずに同じ入札の考え方を使い続けると、たとえばセカンドプライスを前提にした入札をファーストプライスの場で続けて、価値どおりの額を払い続けることになります。自社が買っている枠がどの方式で取引されているかを、定期的に確かめる意味はここにあります。
自動入札が広く使われていることと、それでも広告主が決めること
媒体や DSP には、広告主の設定した目標に合わせて、機会ごとの入札額を自動で決める機能(自動入札)があります。たとえば Google 広告のヘルプは、スマート自動入札を、Google の AI を使って、すべてのオークションでコンバージョン数またはコンバージョン値を最適化する入札の方法として説明し、オークションごとに、端末・地域・時間帯などの多くの要素を考慮するとしています。同じヘルプには、目標アクション単価・目標広告費用対効果・コンバージョン数の最大化・コンバージョン値の最大化という方針が挙げられています。ヘルプによると、前の2つは2026年6月に、より長い名称から現在の名称に改められ、入札の動作は変わっていないとされています。こうした機能の内部の計算は公開されていない部分が多く、本コラムでは推測で書きません。
自動入札が広く使われるようになっても、広告主が決めなければならないことは残ります。むしろ、機会ごとの判断を仕組みに任せるほど、仕組みに与える目標と入力の質が、結果を左右するようになります。序章で挙げた4つ(コンバージョンの定義、コンバージョンの価値と目標、予算と配信の条件、成果の測り方)を、設定の項目に分けて並べると次の表になります。最後の行の点検の仕組みは、4つを決めた後に、それが守られているかを確かめるために足したものです。表には、それを誤ったときに起きることもまとめました。
| 広告主が決めること | 序章の4つとの対応 | 中身 | 誤ったときに起きること | 扱う章 |
|---|---|---|---|---|
| コンバージョンの定義 | コンバージョンの定義 | 購入・申込・資料請求など、何を目標の行動として数えるか | 事業に価値の小さい行動を数えると、その行動を増やす方向に入札が動く | 第2章 |
| 計測期間 | コンバージョンの定義 | クリックや表示の後、何日までのコンバージョンを結びつけるか | 期間が長すぎると広告と関係の薄いコンバージョンまで数え、短すぎると遅れて届く分を落とす | 第2章・第5章 |
| コンバージョンの価値 | コンバージョンの価値と目標 | 1件に対応する、広告費を引く前の粗利の見込み | 価値を一律に置くと、価値の高いコンバージョンと低いものを同じ額で買う | 第7章 |
| 目標と予算 | 目標はコンバージョンの価値と目標、予算は予算と配信の条件 | 目標の CPA や ROAS、期間ごとの予算 | 目標が厳しすぎると買える機会が減り、緩すぎると払いすぎる。予算が少なすぎると買える機会が限られ、ペース配分が適切でない場合には早い時間に使い切ることがある | 第7章・第9章 |
| 成果の測り方 | 成果の測り方 | 増分をどう測り、どの頻度で確かめるか | 管理画面の件数だけで判断すると、広告が無くても起きたコンバージョンまで増分として数える | 第11章 |
| 点検の仕組み | 4つの外(4つが守られているかを確かめる仕組み) | 設定と実績のずれ、掲載面、計測の途切れを誰がいつ見るか | 設定と実態のずれに気づけない | 第12章・第13章 |
表の6つは、いずれも自動入札の仕組みの外にあり、媒体や DSP の仕組みが代わりに決めてくれるものではありません。コンバージョンの定義と価値は事業の会計と顧客の情報から決まり、成果の測り方は実験の設計の問題です。この6つが曖昧なまま自動入札を使うと、仕組みは与えられた定義のコンバージョンを、与えられた目標の範囲で増やそうとし、その結果が事業の利益と結びついているかどうかは誰も確かめていない、という状態になりえます。
普通の予測の問題と違う点
本コラムの第4章から第6章では、クリック率やコンバージョン率の予測を扱います。予測そのものは、機械学習の一般的な分類の問題として学べますが、運用型広告の入札の中で使う予測には、一般的な分類の練習問題では省かれがちな性質がいくつもあります。それぞれは広告に固有のものではありませんが、同時に重なって現れます。手法の選び方や評価の仕方が変わるのはこのためで、次の表にまとめました。
| 違う点 | 中身 | 起きうる問題 | 扱う章 |
|---|---|---|---|
| 結果が見えるのは落札した機会だけ | 落札できなかった機会では、表示もクリックも起きず、競合の入札額も分からないことがある | 落札した機会の記録だけで学習すると、全体とは構成の違う集団で学ぶことになる | 第2章・第8章 |
| コンバージョンは遅れて届く | クリックの後、数日たってからコンバージョンすることがある | 直近のクリックを「コンバージョンなし」と数えると、予測コンバージョン率が低く出る | 第2章・第5章 |
| 予測が入札を通じて費用に直結する | 例題では、予測した確率に比例する表示の価値をもとに入札額が決まる | 順位づけが正しくても、確率の水準がずれると払いすぎや買い逃しになる | 第6章・第7章 |
| 相手がいる | 同じ機会を競合の買い手も見積もって入札している | 競合が入札を変えると、勝率も支払額も変わり、過去の記録が古くなる | 第3章・第8章 |
| 予算の制約がある | 期間ごとに使える広告費に上限がある | 価値のある機会でも、予算が尽きた後には買えない | 第7章・第9章 |
| 結果の率が低い | クリック率は低い水準のことが多く、コンバージョンはさらに少ない | すべて「クリックなし」と答えても正解率が高くなり、正解率が成績の指標にならない | 第4章・第6章 |
これらの性質は互いに関係しています。たとえば、結果が見えるのは落札した機会だけなので、入札の方針を変えると、記録に残る機会の構成も変わります。その記録で次のモデルを学習すると、前の入札の方針の影響を受けたデータで学ぶことになります。また、予算の制約のもとでは、予測の誤りは個々の機会の損得だけでなく、予算の使い方全体を通じて別の機会の買い逃しにもつながります。予測のモデルを、ほかの部分から切り離した精度の競争として評価すると、こうした性質を見落とします。本コラムがモデルの成績を、対数損失(予測した確率と実際の結果のずれを測る指標)や較正の確認(予測した確率が実績の率と対応しているかを確かめる作業)で評価し、正解率を成績として扱わないのは、この理由によります。指標の詳細は第6章で扱います。
よくある誤解
運用型広告の判断の場面で出やすい誤解を3つ取り上げます。いずれも、指標の意味と、その指標が答えている問いを取り違えることから生じます。
1つ目は、自動入札に任せれば最適になる、という誤解です。自動入札は、与えられたコンバージョンの定義と目標と予算の範囲で、機会ごとの入札額を決める仕組みです。コンバージョンの定義が事業の価値とずれていれば、そのずれた定義のもとで最適に近づくだけです。また、コンバージョンを目的とする自動入札は、選んだ方針に応じて、計測されたコンバージョンの件数や値を重視します。計測されたコンバージョンには広告が無くても起きたものが含まれうるので、そうした利用者への表示を高く買うことがありえます。自動入札が役に立たないということではなく、何に対して最適なのかを決めるのは広告主である、ということです。
2つ目は、CPA が下がれば成果が上がっている、と受け取る誤解です。CPA は、広告費を、アトリビューション(コンバージョンを、その前に接触した広告に割り振る規則)で割り振ったコンバージョンの件数で割った値です。アトリビューションは規則であって、広告がコンバージョンを起こしたことの証明ではありません。目標の CPA を変えると、配信される機会の構成や量が変わり、CPA が下がる場合があります。しかし、割り振られたコンバージョンの中には広告が無くても起きたものが含まれうるので、CPA が下がったことだけでは、成果(増分の利益)が増えたとは判断できません。さらに、買える機会が減ってコンバージョンの総数が減れば、増分の利益の合計も減る場合があります。CPA は、増分の利益を説明する指標の1つとして、他の指標と並べて読む必要があります。
3つ目は、クリック率が高い広告が良い広告である、という誤解です。クリック率は表示のうちクリックされた割合で、クリックの後にコンバージョンに至るかどうか、そのコンバージョンにどれだけの価値があるかは含みません。クリックを誘いやすいが購入にはつながりにくい表現や、誤ってクリックされやすい置き方では、クリック率は高く出ても、事業の価値は小さいことがあります。誤操作を誘う置き方は、利用者の不快や信頼の毀損にもつながります。クリエイティブを何で評価するかは第10章で扱います。
経営の損失の型と、経営判断
運用型広告の入札の判断を誤ったときの損失を、本コラムでは次の6つの型で整理します。6つは互いに重なりうる説明上の整理で、金額ではなく型として、各章の経営判断の段落で使います。利用者の不利益(過剰な接触や意図しない情報の利用)は、信頼の毀損と規制上の義務の不履行の型に含めて、広告主の損失と並べて扱います。
| 損失の型 | 中身 | 運用型広告で起きる例 | 主に扱う章 |
|---|---|---|---|
| 払いすぎ | 見込んだ価値を超える額で広告枠を買う、または同じ機会をもっと低い額で落札できたのに高く払う | 表示の価値を過大に見積もり、実際の価値を超える額で落札する。ファーストプライスの場で入札を引き下げず、価値どおりの額を払う | 第3章・第6章・第8章 |
| 機会損失 | 価値のある表示の機会を買い逃す、予算を使い残す、早く使い切ってその後の機会を失う(いずれも、それによって利益を増やせる機会を逃した場合) | 目標の CPA が厳しすぎる。ペース配分が無く、昼までに予算が尽きる | 第7章・第9章 |
| 成果の数え違い | 広告が無くても起きたコンバージョンやその価値を、広告による増分として数え、予算の配分を誤る | 管理画面のコンバージョンの件数を、増分として扱う | 第11章 |
| 信頼の毀損 | 過剰な接触・不適切な掲載面・不快な表現、利用者の理解や期待に反する情報の利用で、利用者の信頼やブランドを損なう | 同じ利用者への表示の回数(フリークエンシー)に上限が無い。掲載面を点検しない | 第10章・第12章 |
| 形骸化 | 自動入札の設定やレポートを点検する仕組みが働かず、設定と実態のずれに気づけない、対応につながらない | コンバージョンの計測が途切れたことに気づかない。レポートが誰の判断にも使われない | 第12章・第13章 |
| 規制上の義務の不履行 | 自社に適用される、利用者の情報の取り扱い・同意や通知・広告の表示に関する義務を果たせない | 計測のための情報の送信について、必要な通知や公表を行っていない | 第14章 |
6つの型のうち、払いすぎと機会損失は、入札と予算の判断の精度の問題で、本コラムの第3章から第9章が主に扱います。成果の数え違いは、それらの判断の物差しそのものの問題で、物差しがずれていると、払いすぎと機会損失を測ることもできません。信頼の毀損と規制上の義務の不履行は、短期の管理画面の数字には表れにくく、表れたときには取り返しにくい損失です。形骸化は、残りの5つの型を見つけるための点検の仕組みが働いていない状態で、他の損失を長引かせます。
この章の経営判断は、何をコンバージョンとし、その価値をいくつと見て、どの指標で成果を測るのかを、入札の仕組みや自動入札の設定を選ぶ前に、事業として決めることです。コンバージョンの定義は、事業のどの行動が利益につながるのかという問いへの答えで、マーケティングの担当だけでなく、事業の責任者と財務の担当が関わって決める事柄です。コンバージョンの価値は、広告費を引く前の粗利の見込み(長期の取引になる商品なら、顧客の生涯にわたる粗利の見込み)から置き、予算と目標の CPA の根拠になります。成果の指標は、管理画面の CPA や ROAS を日々の管理に使いつつ、増分の利益を定期的に実験で確かめる、という二段の構えにすることが有効だと考えています。これらを決めずに入札の仕組みだけを高度にしても、成果の数え違いの上に払いすぎと機会損失を重ねることになりかねません。決めた内容は、予算の承認や KPI(管理のために定める重要な指標)の設定の場で、誰がどの頻度で見直すかとあわせて文書に残しておくと、担当者が替わっても判断の根拠をたどれます。
この章のまとめ
運用型広告は、配信の状況に応じて入札や予算などを調整しながら配信する広告で、国内の統計では、入札方式で取引されるものを中心とする定義での運用型広告費が、インターネット広告媒体費の約9割を占めています。表示の機会が生じてから広告が表示されるまでは、入札リクエスト・入札・オークション・落札の通知という流れが短い時間の制約の中で行われ、課金の方式と取引の形によって、広告主が負うリスクと手に入る情報が変わります。入札は、予測クリック率と予測コンバージョン率から表示の価値を見積もり、方式と予算に合わせて入札額を決める一続きの仕組みであり、その目指す先を決めるのは広告主です。第2章では、その仕組みの土台になる、入札・表示・クリック・コンバージョンの記録と、結果の定義を扱います。
この章を深めたい方への参考書籍
『アドテクノロジーの教科書 デジタルマーケティング実践指南』(広瀬信輔、翔泳社):書名のとおり、アドテクノロジーを主題にした入門の本で、2016年3月の刊行です。本章で扱った取引の当事者と仕組みを、より詳しく確かめるときの入口として挙げました。刊行の後に取引の方式や識別子の環境は変わっているので、本章の歴史の節とあわせ、刊行の時点の内容として読むのが安全です。
『いちばんやさしいはじめてのGoogle広告の教本 人気講師が教える運用型広告の基礎と実践』(杓谷匠・田中広樹・宮里茉莉奈、インプレス):書名と副題のとおり、1つの大きな媒体の広告を題材に、運用型広告の基礎と実践を扱う入門の本で、2024年の刊行です。本章の、広告主が決めることの節を、実際の媒体の広告に当てはめて考えるときの入口として挙げました。管理画面の操作や機能の名称は変わりうるので、刊行の時点の内容として読むのが安全です。
第2章 広告配信のデータ、入札・表示・クリック・コンバージョンの記録と結果の定義
第1章では、運用型広告の取引に関わる当事者と、表示の機会が生じてから広告が表示されるまでの流れ、入札を決める仕組みの全体像を整理しました。この章では、その流れの中でどんな記録が生まれ、それが誰の手元に残り、予測や入札の判断の材料としてどう使えるのかを扱います。予測のモデルも入札の方針も、ここで扱う記録の上に作られます。記録の意味を取り違えると、その上に積んだ数字がずれることがあります。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の配信の記録を使い、実行したコードと結果で確かめます。
- 記録の種類(入札リクエスト・入札・落札の通知・表示・クリック・コンバージョン・費用)と、それぞれが誰の手元に残るか
- 入札リクエストに含まれる情報の種類(業界の規格である OpenRTB の公式文書で確かめた範囲)
- 記録どうしを結びつける方法(クリックの識別子・タグ・サーバー間の連携)
- 結果の定義:何をコンバージョンとするか・計測期間・重複の除き方で、コンバージョン率も CPA も変わること
- 遅れて届くコンバージョンと、学習に使える範囲
- 結果が見えるのは落札した機会だけであること(打ち切りの予告)
- データの品質の問題、集計の単位、標本の作り方、利用者の情報の取り扱いの入口、経営の判断
この章の主張は1つです。コンバージョン(広告主が目標として定めた利用者の行動)の定義と計測期間(クリックや表示のあと、コンバージョンをその広告に結びつけて数える期間)は、モデルや自動入札の設定より前に、事業として決めておく必要があります。本コラムの架空データで同じクリックの記録を数え直したところ、計測期間を1日・3日・7日・14日と変え、重複した記録を含めるか除くかを変えるだけで、コンバージョン率はおよそ4.6%から11.1%まで、CPA は最も小さい値と最も大きい値で2.4倍ほどの開きになりました。広告の配信も、クリック率の予測も変えていません。なお、コンバージョンが起きたこと自体は、広告で利益が増えたことを意味するとは限りません(第11章)。この数字の幅は、定義が決まっていない状態で「CPA が下がった」「コンバージョン率が上がった」と議論することの危うさを示しています。
広告配信の記録の種類と、誰の手元に残るか
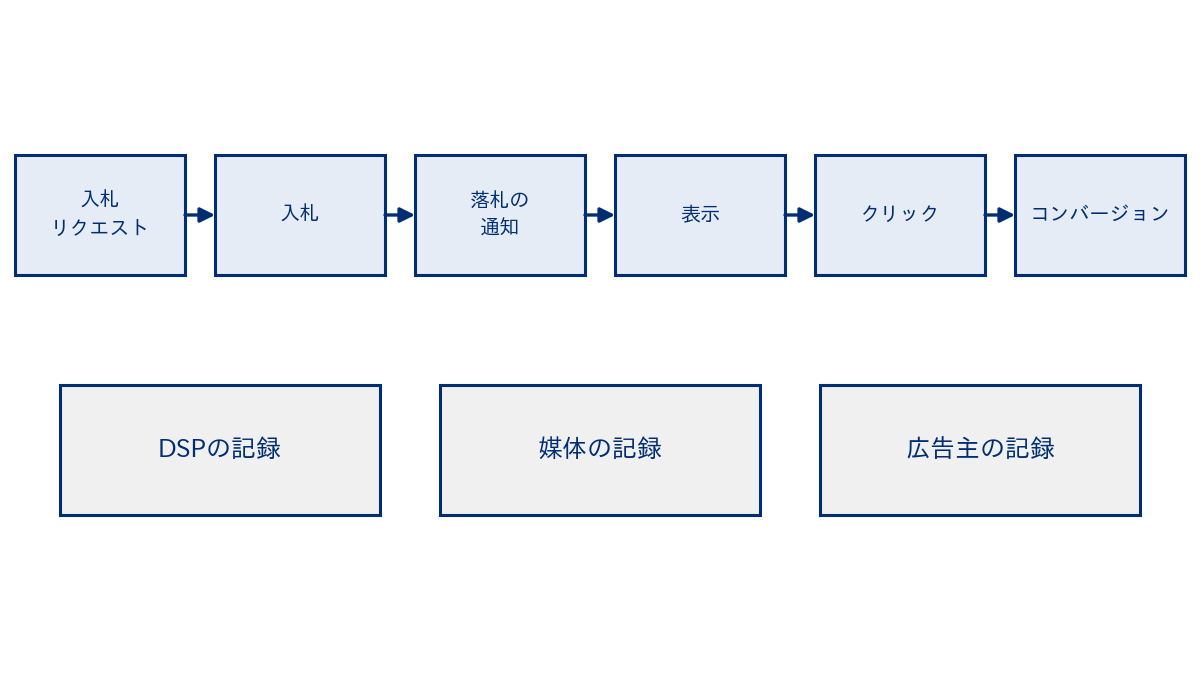
運用型広告では、1回の表示の機会について、いくつもの記録が順に生まれます。最初は、表示の機会が生じたことを買い手に知らせる入札リクエストです。買い手はそれを受けて入札するかどうか、いくらで入札するかを決めて応答します。売り手の側でオークションが行われると、勝った買い手に落札の通知が届き、広告の配信と表示に進みます。ただし、落札しても表示や課金に至らない場合があります(後で見る OpenRTB の仕様書にも、その旨の注記があります)。そのあと利用者がクリックすれば、クリックの記録が残ります。さらに利用者が広告主のサイトやアプリで購入や申込をすれば、コンバージョンの記録が残ります。落札した表示には支払額が付き、その合計が費用になります。
ここで大事なのは、これらの記録が1か所にそろうとは限らないことです。入札リクエストと入札の記録は、入札を行った DSP の手元に残ります。どの買い手がいくらで入札したかという全体の記録は、オークションを行う側(SSP やアドエクスチェンジ、あるいは自社の枠を自社で売る大きな媒体)の手元に残ります。クリックの記録は、広告を配信した側と、クリックの先のページを持つ広告主の両方に残りえます。コンバージョンの記録は、広告主のサイトやアプリで起きる出来事なので、広告主の手元にあり、タグなどを通じて媒体や計測の事業者に送られます。
| 記録 | 生じるとき | 主な中身 | 手元に残る主な当事者 |
|---|---|---|---|
| 入札リクエスト | 表示の機会が生じ、売り手が買い手に入札を求めたとき | 掲載面・広告枠・端末・利用者に関する情報・最低落札価格・応答の制限時間など | 売り手(SSP・アドエクスチェンジ)と、受け取った買い手(DSP) |
| 入札 | 買い手が入札リクエストに応答したとき | 入札額・表示する広告・通知の宛先など | 買い手(DSP)と売り手 |
| 落札の通知 | オークションで勝ったとき(負けたことを知らせる通知もある) | 勝ったこと・落札の価格(取引の場の方針によって知らされない場合がある) | 買い手(DSP) |
| 表示 | 広告が配信されたとき | 表示の時刻・広告・掲載面 | 配信した側・媒体・計測の事業者 |
| クリック | 利用者が広告をクリックしたとき | クリックの時刻・クリックの識別子・遷移先 | 配信した側・媒体・広告主(遷移先のページ) |
| コンバージョン | 利用者が、広告主が目標として定めた行動をしたとき | 行動の種類・時刻・価値・注文の番号など | 広告主(タグやサーバー間の連携で媒体・計測の事業者に送る) |
| 費用 | 落札した表示(課金の方式によってはクリック)ごと | 支払額とその合計 | 媒体・DSP・広告会社・広告主(請求の明細) |
広告主から見ると、手に入る記録の細かさには大きく2つの場合があります。1つは、媒体の管理画面のレポートしか手に入らない場合です。キャンペーンや日ごと、クリエイティブごとに集計した表示・クリック・コンバージョン・費用は見られても、表示の機会の1件ごとの記録は見られません。媒体によっては、この形のレポートだけが提供される場合があります。もう1つは、DSP を通じて買い付け、入札リクエストと入札、落札の結果を1件ごとに記録できる場合です。後者では、どの機会に入札して負けたのかまで分かるので、勝率や競合の水準を分析できます。前者では、それができません。どちらの場合にあたるかで、本コラムの後の章で扱う手法のうち使えるものが変わります。
入札リクエストに含まれる情報、OpenRTB の公式文書で確かめた範囲
入札リクエストの形式は、取引の場ごとに決めてよいものですが、多くの取引の場の間で共通の形式として使われている規格に、IAB Tech Lab が公開している OpenRTB があります。ここでは、IAB Tech Lab が GitHub で公開している OpenRTB 2.6 の仕様書を開いて確かめた範囲で、入札リクエストに含まれる情報の種類を整理します。仕様書には、互換性を壊さない改良(新しい項目の追加など)があればおよそ月に1回の頻度で更新すると書かれており、ここでの記述は2026年11月16日に開いた版(2026年4月1日の更新を最後とする版)によります。個々の取引の場が、仕様書にある項目のうちどれを実際に送るかは、取引の場ごとに違います。
入札リクエストの一番上の階層には、リクエストの識別子と、売りに出す表示の機会の一覧(Imp と呼ばれる要素。少なくとも1つ必要)があります。掲載面の情報は、ウェブサイトなら Site、アプリなら App の要素で送られます。端末の情報は Device の要素で、利用者に関する情報は User の要素で送られます。オークションの方式を表す項目 at もあり、1がファーストプライス、2がセカンドプライスにあたる方式(仕様書では Second Price Plus)と定められ、何も書かなければ2とみなされます。応答の制限時間を表す項目 tmax は、通信の遅れも含めて、入札を受け付ける最大の時間をミリ秒で表します。
| 要素 | 主な項目の例 | 入札の判断での使い道 | 注意すること |
|---|---|---|---|
| BidRequest(一番上の階層) | id・imp・at(オークションの方式)・tmax(制限時間)・bcat(受け付けない広告主の分類) | 方式に合わせた入札の考え方(第3章・第8章)・時間内に応答できるか | 方式の値は取引の場の独自の値を定義することもできる |
| Imp(表示の機会) | banner・video・native(広告の形式)・bidfloor(最低落札価格。表示1,000回あたり)・instl(インタースティシャル広告、つまり画面の切り替わりなどに挟まる広告か、全画面の広告か)・tagid | 広告枠の形式と大きさ・最低落札価格を下回る入札をしない | 最低落札価格の通貨は bidfloorcur で示される |
| Site・App(掲載面) | domain・cat(内容の分類)・page など | 掲載面ごとの反応の違い・掲載面の点検(第12章) | 1つのリクエストには Site・App などのうち1つだけが入る |
| Device(端末) | devicetype・os・ua・geo(位置)・lmt(追跡の制限の信号)・dnt | 端末の種類ごとの反応の違い | 追跡の制限の信号があるときの扱い(第14章) |
| User(利用者) | id・buyeruid・keywords など | 同じ利用者への表示の回数(第10章) | 識別子は取引の場の都合で入れ替わることがあると書かれている。生年と性別の項目は 2.6 で非推奨になった |
この表のうち、User の要素の識別子について、仕様書は取引の場が作るもので、入れ替えや、プライバシーの方針の対象になりうると説明しています。また、生年と性別の項目は OpenRTB 2.6 で非推奨(deprecated)と書かれています。本コラムの例題では、性別・年齢などの配慮の要る属性をモデルの入力に使いません。どの項目を使ってよいかは、規格に項目があるかどうかではなく、利用者への通知や同意、自社の方針で決まります。この点は第14章で扱います。
買い手の応答(入札)の側では、仕様書の Bid の要素に、入札額 price(表示1,000回あたりの額で表すが、取引は表示1回ごと)と、落札・課金・負けを知らせる3つの通知の宛先(nurl・burl・lurl)が定められています。要点は2つです。1つ目は、落札の通知と課金の通知が別に定められていて、仕様書は、落札したことが表示や課金を必ずしも意味しないと注記していることです。2つ目は、価格の情報が必ず知らされるとは限らないことです。落札の価格や、勝つのに必要だった最低の額を知らせる仕組み(置き換えの記号)は定められていますが、取引の場の方針によって、負けの通知や価格の開示が行われない場合があると書かれています。
つまり、買い手の手元に残る記録は、取引の場の方針によって中身が違います。落札した機会では支払額が分かっても、負けた機会では、自分より高い入札があったことしか分からない場合があります。逆に、負けた機会に勝つのに必要だった額を事後に知らせる仕組みも仕様書に定められており、それを使うかどうかは取引の場によります。この性質は、後の節で例題を使って確かめ、第8章で入札の引き下げを考えるときの前提になります。
記録どうしを結びつける方法
入札・表示・クリック・コンバージョンの記録は、別々の場所で、別々の時刻に生まれます。クリックごとのコンバージョンの予測や、広告への件数の割り振りに使うには、「このコンバージョンは、どのクリックの、どの表示から来たのか」を結びつける必要があります。一方、広告の増分を測る実験には、地域などの単位で配信を分けて結果を比べる方法のように、個々のクリックとの結びつけを必要としないものもあります(第11章)。結びつけ方には、大きく分けて次のような方法があります。
- クリックの識別子:クリックしたときに遷移先の URL に識別子を付け、広告主の側でそれを保存しておき、コンバージョンが起きたときにその識別子と一緒に媒体へ知らせる方法
- タグ:広告主のサイトに媒体や計測の事業者が提供するタグ(短いプログラム)を置き、利用者のブラウザから直接、出来事を送る方法
- サーバー間の連携:広告主のサーバーから媒体のサーバーへ、出来事のデータを送る方法。店舗での購入のように、サイトの外で起きたコンバージョンを結びつける用途にも使われる
- 注文の番号などによる照合:同じ出来事が複数の経路で届いたときに、同じ番号を持つ記録を1件にまとめる方法
媒体の公式ヘルプで確かめた範囲では、例えば Google 広告の自動タグ設定は、広告がクリックされたときに遷移先の URL へ GCLID というクリックの識別子を付け、コンバージョンの計測や、店舗での売上のようなオフラインのコンバージョンの取り込みに使う、と説明されています。Meta の Conversions API は、広告主のサーバーから Meta へ、ウェブサイト・アプリ・オフラインの出来事を送るサーバー間の接続で、設定を確かめるとブラウザのタグ(Meta Pixel)とサーバーから送った出来事の重複が除かれているかを確認できる、と説明されています。ここでは、こうした仕組みがあることの紹介にとどめます。管理画面の設定の手順は変わるので書きません。
結びつけには、クッキーや端末の広告用の識別子が関わることが多く、ブラウザやスマートフォンの基本ソフトによる識別子の制限、利用者の同意の状態によって、結びつけられる割合が変わります。個々の結びつけだけで集計すると、結びつけられなかったコンバージョンは、広告主の注文の記録には残っていても、その広告に割り振った件数からは漏れます。一方で、媒体のレポートには、直接は観測できないコンバージョンを推定して補った件数が含まれる場合があります。例えば Google 広告のヘルプは、クッキーの制限や利用者の同意の状態のために直接は計測できないコンバージョンを推定しており、コンバージョンの列には推定したものと測定したものの両方が含まれる、と説明しています。識別子の制限の経緯と、それに頼らない計測の方法は第14章で扱います。この章で押さえておきたいのは、記録の上のコンバージョンの件数は、結びつけの方法とその成功の割合(推定で補う場合は、その推定の方法)によって決まる数でもある、という点です。
結果の定義、何をコンバージョンとし、いつまでを数え、重複をどう除くか
予測のモデルを学習するには、「この表示(またはクリック)の結果は1か0か」というラベルが要ります。クリックは比較的はっきりした出来事ですが、コンバージョンは違います。何をコンバージョンとするか、クリックや表示のあといつまでの出来事を数えるか、同じ利用者の同じ出来事が2回記録されたときにどう数えるかを決めないと、ラベルが決まりません。そして、どう決めるかによって、コンバージョン率も CPA も変わります。
| 決めること | 選択肢の例 | 変わる数字 | 決め方の考え方 |
|---|---|---|---|
| コンバージョンの対象 | 購入・申込・資料請求・会員登録・アプリの導入・特定のページの閲覧 | 件数の水準・コンバージョンの価値・入札の向き | 事業の利益につながる行動を選ぶ。件数が多いからといって利益から遠い行動を選ばない |
| 計測期間 | クリックから1日・7日・30日など。表示のあとの期間を別に設けるか | 件数・コンバージョン率・CPA・結果が確定するまでの日数 | 商品の検討にかかる期間と、結果を早く確かめたい事情のつり合いで決める |
| 重複の除き方 | 注文の番号ごとに1件・利用者ごとに1日1件・すべて数える | 件数・コンバージョン率・CPA | 同じ購入を2回数えない。1人が複数回購入するのを数えたいかで決める |
| どの広告に割り振るか | 最後のクリック・複数の接触に配分する規則 | 媒体やキャンペーンごとの件数 | アトリビューションの規則は割り振りの規則であって、効果の証明ではない(第11章) |
| 取消・返品の扱い | 後から取り消す・取り消さない | 件数・コンバージョンの価値 | 利益の見積りに近づけるなら、確定した注文で数える |
このうち計測期間は、媒体や設定によって違います。計測期間が長いほど、クリックから時間がたって起きたコンバージョンまで数えるので件数は増えます。一方で、計測期間の途中でコンバージョンが起きていなくても、期間のうちに起きないとは確定できません(期間の中で起きたコンバージョンは、起きた時点で数えられます)。このため、直近のクリックほど「まだ結果が分からない」状態が続きます。計測期間は、レポートに含める日付の範囲(集計の期間)や、記録を締めるまでに結果を見届けた期間とは別のものです。重複の除き方も同じように件数を動かします。例えば、購入の完了のページが再読み込みされてタグが2回送られると、同じ注文が2件として記録されることがあります。注文の番号で重複を除けば1件になります。次の節から、これらの選び方で数字がどれだけ動くかを、架空のデータで確かめます。
架空の配信の記録を作る、入札リクエストから落札とクリックまで
ここからは、ある DSP を通じて買い付けている広告主が、表示の機会の1件ごとの記録を持っている場合を想定し、記録の性質をコードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの成績や率は、実際の配信での成績の目安にはなりません。示したいのは、同じ記録でも、結果の定義と数える時点によって数字がどう変わるか、そして記録に何が残らないか、という点です。
この例題では、21日間に届いた入札リクエスト40万件を、次の性質を持たせて乱数で作りました(乱数の種は20261116に固定しています)。コードは Python 3.14.3 で実行し、numpy 2.4.3・pandas 3.0.1・matplotlib 3.10.8・japanize-matplotlib 1.1.3 を使いました。額はすべて単位の無い相対値で、掲載面Aへの入札額を1とし、入札額と支払額を表示1回あたりの額にそろえました。CPM(表示1,000回あたりの広告費)だけは、その1,000倍の相対値になります。
- 表示の機会の属性:掲載面(A〜Eの5種類)・端末の種類(スマートフォン・パソコン・タブレット)・時間帯(夜に多い波)・日・広告枠の大きさ(小・中・大)
- 利用者の側の特徴にあたる項目:過去の訪問の回数(0〜5回)だけ。個人を特定する項目や、性別・年齢などの配慮の要る属性は入れていません
- クリックの確率:掲載面ごとに水準が違い(およそ1%から3%)、パソコンでやや低く、大きい広告枠と訪問の回数が多い場合に高い。掲載面Dをスマートフォンで見た場合にだけ高くなる組み合わせの関係も入れました
- 競合の最高入札額と落札のしきい値:競合の最高入札額は掲載面ごとに水準が違い、クリックの確率が高い機会ほど高くなる(他の買い手も価値の高い機会を高く買う、という想定)。最低落札価格は掲載面と広告枠の大きさで決めました。最低落札価格は競合の入札ではないので、落札できるかどうかを決める額は、競合の最高入札額と最低落札価格の大きいほうとし、これを落札のしきい値と呼びます。コードの変数
compは、この落札のしきい値にあたります - コンバージョン:クリックのうち一部が、遅れを伴ってコンバージョンに至る。遅れは、数時間のうちに起きるものと、平均4日ほどで起きるものの混合にしました
実務のディスプレイ広告の取引では、入札は表示1,000回あたりの価格で表されることが多く(前の節で見た OpenRTB の入札額も同じです)、検索連動型広告ではクリック1回あたりの入札と課金が一般的です。この例題の21日間は、記録を締めるまでの観測の期間で、後で比べる計測期間(1日〜14日)とは別のものです。
数え方の約束として、表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件として扱います(重複の記録は、この1件がタグの上で2回送られたものとして作りました)。落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。
最初のブロックは、入札リクエストの記録と、合成データだから分かる真の値(真のクリックの確率と落札のしきい値)を作ります。入札リクエストの列(日・時間帯・掲載面・端末・広告枠の大きさ・訪問の回数・最低落札価格)は入札の時点で分かる情報で、真のクリックの確率と落札のしきい値は、実際の記録には残らない値です(落札した機会では、支払額としてしきい値が分かります)。
# ---- 1. 入札リクエストの記録を作る(入札の時点で分かる項目だけ)
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261116)
N, DAYS = 400_000, 21
hour_w = np.array([2, 1, 1, 1, 1, 2, 3, 5, 7, 7, 6, 6, 8, 7, 6, 6, 6, 7, 8, 9, 10, 9, 6, 4], float)
req = pd.DataFrame({
    "day": rng.integers(0, DAYS, N),
    "hour": rng.choice(24, N, p=hour_w / hour_w.sum()),
    "site": rng.choice(list("ABCDE"), N, p=[0.30, 0.25, 0.20, 0.15, 0.10]),
    "device": rng.choice(["スマートフォン", "パソコン", "タブレット"], N, p=[0.6, 0.3, 0.1]),
    "size": rng.choice(["小", "中", "大"], N, p=[0.5, 0.35, 0.15]),
    "visits": np.minimum(rng.poisson(1.2, N), 5),
})
req["t"] = req["day"] + (req["hour"] + rng.random(N)) / 24
floor_by_site = {"A": 0.3, "B": 0.4, "C": 0.5, "D": 0.7, "E": 0.3}
req["floor"] = req["site"].map(floor_by_site) * req["size"].map({"小": 1.0, "中": 1.3, "大": 2.0})
print(req.head(3).to_string())
print("入札リクエストの件数:", len(req))

# ---- 2. 真のクリック確率と落札のしきい値(合成データだから分かる値)
base_ctr = {"A": 0.008, "B": 0.012, "C": 0.020, "D": 0.030, "E": 0.010}
logit = np.log(req["site"].map(base_ctr) / (1 - req["site"].map(base_ctr)))
logit += req["device"].map({"スマートフォン": 0.0, "パソコン": -0.2, "タブレット": 0.1})
logit += 0.6 * ((req["site"] == "D") & (req["device"] == "スマートフォン"))
logit += 0.3 * (req["size"] == "大") + 0.15 * req["visits"]
req["p_click"] = 1 / (1 + np.exp(-logit))
comp_level = {"A": 0.6, "B": 0.8, "C": 1.0, "D": 1.4, "E": 0.7}
log_comp = (np.log(req["site"].map(comp_level)) + 0.6 * (logit - logit.mean())
            + rng.normal(0, 0.5, N))
req["comp"] = np.maximum(np.exp(log_comp), req["floor"])  # 落札のしきい値(競合の最高入札額と最低落札価格の大きいほう)
2つめのブロックは、オークションとその後の出来事です。買い手(この例題の広告主)は、掲載面ごとに決めた一律の入札額で入札し、入札額が最低落札価格に届かない機会には入札しません。オークションはセカンドプライスとし、入札額が落札のしきい値以上であれば(同額を含めて)落札するものとしました。支払額は、自分以外の入札の最高額と最低落札価格の大きいほう(競合の入札が無ければ最低落札価格)、つまり落札のしきい値です。手数料・端数・最小の上乗せ額は省きました。表示された機会のうち、真の確率にしたがってクリックが起き、クリックのうち一部が遅れてコンバージョンに至ります。記録を締めた時点(21日目の終わり)までに起きたコンバージョンだけが記録に残り、そのうち1割は、購入の完了のページの再読み込みなどでタグが2回送られた重複の記録になる、という設定にしました。
# ---- 3. 入札・落札・表示・クリック(セカンドプライス。額は相対値)
bid_mult = {"A": 1.0, "B": 1.0, "C": 1.2, "D": 1.2, "E": 0.8}
req["bid_price"] = 1.0 * req["site"].map(bid_mult)          # 掲載面ごとの一律の入札
req["bid"] = req["bid_price"] >= req["floor"]
req["win"] = req["bid"] & (req["bid_price"] >= req["comp"])
req["pay"] = np.where(req["win"], req["comp"], 0.0)          # 落札した機会だけ支払額が分かる
req["click"] = req["win"] & (rng.random(N) < req["p_click"])
print("入札した件数:", int(req["bid"].sum()), " 落札(表示)した件数:", int(req["win"].sum()))
print("クリックの件数:", int(req["click"].sum()))

# ---- 4. コンバージョンを遅れつきで作り、記録の締めの時点で見えるものだけ残す
T_END = float(DAYS)                                          # 記録を締めた時点(21日目の終わり)
clk = req[req["click"]].copy().reset_index(drop=True)
p_cv = 0.08 * clk["site"].map({"A": 1.0, "B": 1.2, "C": 0.8, "D": 0.7, "E": 1.0}) * (1 + 0.1 * clk["visits"])
clk["cv_true"] = rng.random(len(clk)) < p_cv                 # いずれコンバージョンするか(真の値)
fast = rng.random(len(clk)) < 0.4
clk["delay"] = np.where(fast, rng.exponential(0.1, len(clk)), rng.exponential(4.0, len(clk)))
clk["cv_time"] = np.where(clk["cv_true"], clk["t"] + clk["delay"], np.inf)
cv = clk[clk["cv_time"] <= T_END][["t", "cv_time", "delay"]].copy()
cv["click_id"] = cv.index
dup = cv.sample(frac=0.1, random_state=1)                    # タグが2回送られた記録(再読み込みなど)
tag = pd.concat([cv, dup]).sort_values("cv_time")
print("クリックの件数:", len(clk), " 締めまでに届いたタグの件数:", len(tag),
      " 重複を除いた件数:", tag["click_id"].nunique())
実行すると、入札リクエスト400,000件のうち入札したのは391,138件、落札(表示)したのは258,339件、クリックは3,564件でした。記録を締めた時点までに届いたコンバージョンのタグは359件で、注文(ここではクリック)ごとに重複を除くと326件でした。重複を除くだけで、件数は1割ほど変わります。
各段の件数と率、計測期間と重複の除き方で変わるコンバージョン率と CPA
3つめのブロックでは、まず入札リクエストからコンバージョンまでの各段の件数と率(ファネル)を出し、次に計測期間と重複の除き方を変えたときのコンバージョン率と CPA を比べます。後半の比べ方では、記録を締めた時点で14日以上たっているクリック(0〜6日目のクリック)だけを使いました。こうすると、14日の計測期間でも結果が出そろった状態で比べられます。
# ---- 5. 各段の件数と率(ファネル)。コンバージョンは7日の計測期間・重複を除く
cv7 = tag[tag["delay"] <= 7]["click_id"].nunique()
n_req, n_bid, n_win, n_clk = len(req), int(req["bid"].sum()), int(req["win"].sum()), len(clk)
cost = req["pay"].sum()
funnel = pd.DataFrame({
    "段": ["入札リクエスト", "入札", "落札(表示)", "クリック", "コンバージョン"],
    "件数": [n_req, n_bid, n_win, n_clk, cv7],
    "前の段に対する率": [np.nan, n_bid / n_req, n_win / n_bid, n_clk / n_win, cv7 / n_clk],
})
print(funnel.round(4).to_string(index=False))
print("費用:", round(cost, 1), " CPM:", round(cost / n_win * 1000, 1),
      " CPC:", round(cost / n_clk, 2), " CPA:", round(cost / cv7, 1))

# ---- 6. 計測期間と重複の除き方で、コンバージョン率と CPA が変わる
early = clk["day"] <= 6                                      # 締めまで14日以上たったクリックだけを使う
cost_early = req.loc[req["day"] <= 6, "pay"].sum()
rows = []
for win_days in [1, 3, 7, 14]:
    hit = tag[(tag["delay"] <= win_days) & tag["click_id"].isin(clk.index[early])]
    for name, n in [("重複を含む", len(hit)), ("重複を除く", hit["click_id"].nunique())]:
        rows.append({"計測期間(日)": win_days, "数え方": name, "コンバージョン": n,
                     "コンバージョン率": n / early.sum(), "CPA(相対値)": cost_early / n})
print(pd.DataFrame(rows).round(4).to_string(index=False))
print("0〜6日目のクリック:", int(early.sum()), " 費用(相対値):", round(cost_early, 1))
ファネルの結果は次のとおりです。率は、それぞれ前の段の件数を分母にしています。入札の段の率は入札リクエストのうち入札した割合、落札の段の率は入札した機会のうち落札した割合(勝率)、クリックの段の率はクリック率、コンバージョンの段の率は、計測期間を7日とし重複を除いて数えたコンバージョン率です。
| 段 | 件数 | 前の段に対する率 |
|---|---|---|
| 入札リクエスト | 400,000 | (分母なし) |
| 入札 | 391,138 | 97.78% |
| 落札(表示) | 258,339 | 66.05% |
| クリック | 3,564 | 1.38% |
| コンバージョン(計測期間7日・重複を除く。21日分のクリックが分母) | 305 | 8.56% |
この期間の費用の合計は157,061.7(相対値)で、CPM は608.0、CPC は44.07、CPA は515.0でした。ただし、このファネルのコンバージョンの件数には注意が要ります。21日間のすべてのクリックを分母にしていますが、終わりのほうの日のクリックは、記録を締めた時点でまだ7日がたっておらず、これから届くコンバージョンが数えられていません。このため、ここでのコンバージョン率は低めに、CPA は高めに出ています。どれだけ低く出るかは、後の節で確かめます。
次は、0〜6日目のクリック1,167件(この期間の費用は52,474.3)について、計測期間と重複の除き方を変えた結果です。
| 計測期間 | 数え方 | コンバージョン | コンバージョン率 | CPA(相対値) |
|---|---|---|---|---|
| 1日 | 重複を含む | 63 | 5.40% | 832.9 |
| 1日 | 重複を除く | 54 | 4.63% | 971.7 |
| 3日 | 重複を含む | 92 | 7.88% | 570.4 |
| 3日 | 重複を除く | 80 | 6.86% | 655.9 |
| 7日 | 重複を含む | 119 | 10.20% | 441.0 |
| 7日 | 重複を除く | 104 | 8.91% | 504.6 |
| 14日 | 重複を含む | 130 | 11.14% | 403.6 |
| 14日 | 重複を除く | 115 | 9.85% | 456.3 |
同じクリック、同じ費用なのに、計測期間を1日から14日に延ばすと、重複を除いた数え方でコンバージョンは54件から115件へ2倍あまりに増え、CPA は971.7から456.3へ半分以下になりました。重複を含めて数えると、どの計測期間でも件数はさらに1割強から2割弱多くなり、CPA は低く出ます。最も小さい CPA(14日・重複を含む)と最も大きい CPA(1日・重複を除く)の開きは2.4倍ほどです。この例題では、遅れの分布と重複の割合を乱数の設定で決めているので、この幅そのものは実際の広告の目安になりません。示しているのは、定義が違う2つの CPA を比べても、広告の良し悪しは分からないということです。
この結果から、実務で気をつける点が3つ出てきます。1つ目は、媒体や計測の事業者ごとに計測期間や重複の除き方が違えば、管理画面の CPA を横に並べて比べられないことです。2つ目は、計測期間の設定を途中で変えると、広告の中身が同じでも CPA の推移に段差ができることです。3つ目は、目標の CPA を決めるときに、どの定義の CPA なのかを書いておかないと、目標そのものが意味を持たないことです。第7章で扱う目標の CPA にもとづく入札は、この定義の上に立っています。
遅れて届くコンバージョンと、学習に使える範囲
コンバージョンは、クリックのすぐあとに起きるとは限りません。商品を比べたり、家族と相談したりする間に日がたつことがあります。このため、記録を締めた時点では、直近のクリックほど、まだ起きていないコンバージョンが多く残っています。4つめのブロックでは、合成データだから分かる真の遅れの分布を集計し、記録を締めた時点で見えるコンバージョン率と、後から確定するコンバージョン率を、クリックした日のまとまりごとに比べます。あわせて、締めの時点で7日以上たっているクリック(0〜13日目)の記録だけから、クリックしてからの経過日数ごとに、7日の計測期間の分のうちどれだけが見えているかの割合を求めます。
# ---- 7. 遅れの分布と、直近の日のコンバージョンがまだ出そろっていないこと
d = clk.loc[clk["cv_true"], "delay"]                         # 真の遅れ(合成データだから全部分かる)
print("遅れが1日以内の割合:", round((d <= 1).mean(), 3), " 7日以内:", round((d <= 7).mean(), 3),
      " 14日以内:", round((d <= 14).mean(), 3), " 20日を超える件数:", int((d > 20).sum()))
seen = tag.drop_duplicates("click_id")
seen = seen[seen["delay"] <= 7]
clk["seen"] = clk.index.isin(seen["click_id"])
clk["final"] = clk["cv_true"] & (clk["delay"] <= 7)          # 計測期間が過ぎたあとに確定する値
clk["group"] = pd.cut(clk["day"], [-1, 13, 17, 20], labels=["0〜13日目", "14〜17日目", "18〜20日目"])
g = clk.groupby("group", observed=True)
print(pd.DataFrame({"クリック": g.size(), "締めの時点で見える率": g["seen"].mean(),
                    "後から確定する率": g["final"].mean()}).round(4).to_string())
mature = seen[seen["click_id"].isin(clk.index[clk["day"] <= 13])]   # 7日以上たったクリックの分
grid = np.arange(0, 7.25, 0.25)
share = [(mature["delay"] <= e).mean() for e in grid]       # 経過日数ごとに見えている割合
print("経過0.5日で見えている割合:", round(share[2], 3), " 経過3日:", round(share[12], 3))
遅れの集計の結果は次の表のとおりです。
| 見たもの | 分母 | 経過の日数 | 割合 |
|---|---|---|---|
| 真の遅れの分布(合成データだから分かる) | いずれ起きるコンバージョンの全体 | クリックから1日以内 | 46.9% |
| 真の遅れの分布(合成データだから分かる) | いずれ起きるコンバージョンの全体 | クリックから7日以内 | 88.3% |
| 真の遅れの分布(合成データだから分かる) | いずれ起きるコンバージョンの全体 | クリックから14日以内 | 98.4% |
| 0〜13日目のクリックの記録から求めた、見えている割合 | 7日の計測期間のうちに起きるコンバージョン | クリックから0.5日 | 47.2% |
| 0〜13日目のクリックの記録から求めた、見えている割合 | 7日の計測期間のうちに起きるコンバージョン | クリックから3日 | 76.1% |
真の遅れの分布では、いずれ起きるコンバージョンのうち、クリックから1日以内に起きたのは46.9%、7日以内は88.3%、14日以内は98.4%で、20日を超えたものはありませんでした。半分近くがすぐに起き、残りが日をかけて少しずつ届く形です。0〜13日目のクリックの記録から求めた割合では、7日の計測期間の分のうち、経過0.5日で見えているのは47.2%、経過3日で76.1%でした。46.9%と47.2%は近い数字ですが別の量です。前者はいずれ起きるコンバージョンの全体を分母にした1日以内の割合、後者は7日以内に起きるものを分母にした経過0.5日の割合です。
クリックした日のまとまりごとの比較は次のとおりです。「締めの時点で見える率」は21日目の終わりまでに届いたコンバージョン(7日以内・重複を除く)で数えた率、「後から確定する率」は、7日の計測期間が過ぎたあとに確定する率で、合成データだから分かる値です。
| クリックした日 | クリック | 締めの時点で見える率 | 後から確定する率 |
|---|---|---|---|
| 0〜13日目 | 2,399 | 9.09% | 9.09% |
| 14〜17日目 | 684 | 8.33% | 9.36% |
| 18〜20日目 | 481 | 6.24% | 10.60% |
0〜13日目のクリックでは、締めの時点で7日以上がたっているので、2つの率は一致します。14〜17日目では締めの時点の率がやや低く、18〜20日目では、締めの時点の率(6.24%)が、後から確定する率(10.60%)の6割ほどにとどまりました。この例題では、時期によってコンバージョンのしやすさを変えていません。それでも、直近の日だけを見るとコンバージョン率が下がったように見えます。直近の数日のコンバージョン率や CPA の悪化を見て入札を下げると、実際には変わっていない広告の入札を下げることになります。
この性質は、予測のモデルを学習するときにも問題になります。直近のクリックを「コンバージョンしなかった」として学習に入れると、まだ届いていないだけのものを負例として数えることになり、予測コンバージョン率が低く出ます。対処の考え方は2つあります。1つは、計測期間が過ぎて結果が出そろった期間のクリックだけで学習する方法です。計測期間が終わる前のクリックを、コンバージョンしなかったものと確定してしまう問題は避けられます(記録の欠落や結びつけの誤りまで解消するわけではありません)が、直近の変化が学習に入るのが遅れます。もう1つは、経過日数を考えに入れて、まだ結果が出そろっていないことを補正する方法です。どちらがよいかは条件によるので、第5章で実行して比べます。この章の段階で決めておきたいのは、記録を締めた日から何日前までのクリックを「結果が出そろった」とみなすか、という線です。その線は、計測期間と遅れの分布から決まります。
結果が見えるのは落札した機会だけ、打ち切りの予告
広告の記録には、普通の予測の問題には無い性質があります。クリックやコンバージョンの結果が見えるのは、落札して表示された機会だけで、落札できなかった機会や、入札しなかった機会では、その広告を表示した場合の反応を観測できません。5つめのブロックでは、入札リクエストの全体と落札した機会とで、掲載面の構成を比べ、合成データだから分かる真のクリックの確率の平均も比べます。
# ---- 8. 結果が見えるのは落札した機会だけ。全体と落札した機会とで構成が違う
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

comp_tab = pd.DataFrame({
    "入札リクエストに占める割合": req["site"].value_counts(normalize=True),
    "落札した機会に占める割合": req.loc[req["win"], "site"].value_counts(normalize=True),
    "掲載面ごとの勝率(入札した機会が分母)": req[req["bid"]].groupby("site")["win"].mean(),
}).sort_index()
print(comp_tab.round(3).to_string())
print("真のクリック確率の平均 全体:", round(req["p_click"].mean(), 4),
      " 落札した機会:", round(req.loc[req["win"], "p_click"].mean(), 4),
      " 落札できなかった機会:", round(req.loc[~req["win"], "p_click"].mean(), 4))
print("落札のしきい値の中央値 落札した機会(支払額から分かる):", round(req.loc[req["win"], "comp"].median(), 3),
      " 入札した機会の全体(合成データだから分かる):", round(req.loc[req["bid"], "comp"].median(), 3))
fig, ax = plt.subplots(figsize=(7, 4))
x = np.arange(len(comp_tab))
ax.bar(x - 0.2, comp_tab.iloc[:, 0], width=0.4, color="gray", label="入札リクエスト全体")
ax.bar(x + 0.2, comp_tab.iloc[:, 1], width=0.4, color="#002E73", label="落札した機会")
ax.set_xticks(x)
ax.set_xticklabels(["掲載面" + s for s in comp_tab.index])
ax.set_ylabel("構成比")
ax.legend(loc="upper right")
plt.savefig("../ch02_selection.png", dpi=120, bbox_inches="tight")
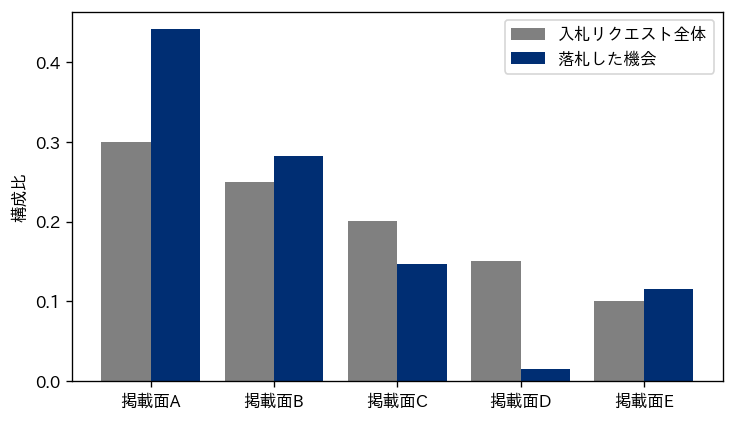
| 掲載面 | 入札リクエストに占める割合 | 落札した機会に占める割合 | 勝率(入札した機会が分母) |
|---|---|---|---|
| A | 30.0% | 44.1% | 95.0% |
| B | 24.9% | 28.2% | 73.1% |
| C | 20.0% | 14.7% | 47.2% |
| D | 15.0% | 1.5% | 7.5% |
| E | 10.0% | 11.6% | 74.4% |
入札リクエストの15.0%を占める掲載面Dは、競合の入札の水準が高いため勝率が7.5%にとどまり、落札した機会の中では1.5%しかありませんでした。逆に、競合の水準が低い掲載面Aは、全体の30.0%に対して落札した機会の44.1%を占めました。真のクリックの確率の平均は、入札リクエスト全体で2.07%、落札した機会で1.36%、落札できなかった機会(入札しなかった機会を含む)で3.37%でした。この例題では、クリックの確率が高い機会ほど競合も高く入札するように作ったので、落札できるのは、クリックされにくい機会に偏りました。
このことは2つの意味を持ちます。1つ目は、落札した機会の記録だけで計算したクリック率は、入札リクエストの全体に表示した場合のクリック率を表さないことです。この例題では、記録の上のクリック率(実績の値、1.38%)は、すべての機会にこの広告を表示した場合を想定した真のクリックの確率の平均(2.07%。合成データだから分かる値)より低く出ています。入札の方針を変えて、これまで負けていた機会を買い始めると、記録の上のクリック率も変わります。2つ目は、記録の少ない掲載面(この例題の掲載面D)では、予測のモデルが学ぶ材料がほとんど無いことです。掲載面Dはクリックの確率が最も高い掲載面ですが、落札した記録が少ないので、そのことをデータから知るのは難しくなります。
同じことは、落札のしきい値にも起きます。セカンドプライスで落札した機会では支払額としてしきい値が分かります。負けた機会について知らされる情報は取引の場によって違いますが、本コラムの例題では、負けた機会には落札のしきい値が知らされないものとします。その場合に分かるのは、落札のしきい値が自分の入札額より高かったことだけです。実際には、落札できない理由は価格だけとは限りません(応答の時間切れ、広告の審査、別の取引の優先など)が、この例題では価格だけで決まるものと単純化しています。このように、ある値以上(または以下)だったことしか分からない状態を打ち切りと呼びます。落札した機会の支払額だけでは、入札した機会の全体のしきい値の分布をそのまま推定できません。この例題では、落札した機会の支払額から分かる落札のしきい値の中央値は0.59で、入札した機会の全体(合成データだから分かる)の中央値0.774より低く出ました。ファーストプライスの取引では、落札しても次点の額が分からないことがあり、情報はさらに少なくなります。勝率曲線の推定でこれをどう扱うかは第8章で、オークションの方式の違いは第3章で扱います。
データの品質の問題と、集計の単位
記録の定義が決まっていても、記録そのものに問題があることがあります。広告の配信の記録で起きやすい問題には、次のようなものがあります。
- 重複した記録:通信の再送やページの再読み込みで、同じ表示・クリック・コンバージョンが2回記録される。例題で見たとおり、件数と率が変わる
- 時刻のずれとタイムゾーン:配信の仕組み・媒体・広告主のサーバーで時計やタイムゾーンが違うと、日ごとの集計の境目がずれ、クリックより前にコンバージョンが起きたような記録ができる
- 計測の欠落:タグの設置の漏れ、サイトの改修でタグが外れる、同意の状態や識別子の制限で結びつけられない、といった理由でコンバージョンが記録されない
- 自動のプログラムによる表示やクリック:計測の基準に照らして、正当な表示やクリックとして数えるべきでないもの(無効なトラフィック)が混ざると、表示・クリック・コンバージョンの件数や率がゆがむ。率が上がるか下がるかは、混ざる記録の種類(表示だけか、クリックも伴うか)によって違う
- 定義の途中の変更:コンバージョンの対象や計測期間を途中で変えると、変更の前後で数字がつながらない
これらは、配信が止まらずに動いていても気づきにくい問題です。日ごと・掲載面ごとに件数や率の推移を見て、急な変化がないかを点検する方法と、無効なトラフィックへの対応は、第12章で扱います。
もう1つの論点は、集計の単位です。媒体の管理画面のレポートしか手に入らない場合、手元にあるのは、キャンペーン・クリエイティブ・掲載面・時間帯などで集計した数字です。集計した数字でもできることはありますが、1件ごとの記録が無いとできないこともあります。
| やりたいこと | 集計した数字だけでできるか | 理由と補足 |
|---|---|---|
| キャンペーンやクリエイティブごとのクリック率・CPA の推移を見る | できる | 定義と計測期間がそろっていれば比べられる。直近の日は結果が出そろっていないことに注意する |
| 時間帯や掲載面ごとの反応の違いを見る | 集計の単位として出ていればできる | 出ていない切り口(例えば掲載面と端末の組み合わせ)は分からない |
| 表示の機会ごとのクリック率を予測するモデルを作る | 難しい | 機会ごとの属性と結果の対応が無い。第4章・第5章の手法は1件ごとの記録が前提になる |
| 勝率や競合の入札の水準を推定する | できない場合が多い | 入札して負けた機会の記録が無い。第8章の手法は入札と落札の結果の記録が前提になる |
| 同じ利用者への表示の回数ごとの反応を見る | 媒体の提供するレポートの範囲に限られる | 回数の分布が出ていても、回数ごとの反応の偏り(第10章)を自分で補正するのは難しい |
| 広告の増分を測る | 実験を組めばできる | 配信しない群を設けた実験の結果は集計でも読める。管理画面のコンバージョンの件数だけでは分からない(第11章) |
この表から分かるように、自社でモデルを持って入札を細かく決めるには、1件ごとの記録が手に入ることが前提になります。媒体の自動入札に任せる場合でも、広告主が決めて渡すもの(コンバージョンの定義・価値・計測の質)は残ります。どこまで自社で持つかの判断は第13章で扱います。
標本の作り方と、入札の時点で手に入る情報だけを使うこと
予測のモデルを学習するための標本を作るときに決めることは、主に3つあります。1つ目は、学習に使う期間です。古すぎる記録は、掲載面や競合、商品の状況が今と違うので役に立たないことがあり、新しすぎる記録は、前の節で見たとおり結果が出そろっていません。2つ目は、評価用のデータの切り方です。広告の記録では、学習用より後の日の記録で評価する(時間で切る)のが基本です。ランダムに切ると、同じ日の似た記録が学習用と評価用の両方に入り、成績が実際より良く見えることがあります。切り方による違いは第6章で扱います。3つ目は、負例の扱いです。クリックの無い表示はクリックのある表示よりはるかに多いので、学習を軽くするために、クリックの無い表示を一部だけ使う方法(負例の間引き)があります。間引くと予測した確率が高く出るので補正が要ります。詳しくは第5章で扱います。
そして、標本を作るときに最も気をつけたいのが、入札の時点で手に入る情報だけをモデルの入力に使うことです。入札の判断は、入札リクエストが届いてから制限時間のうちに行います。その時点では、その表示がクリックされるかどうかも、後から届くコンバージョンも、落札したあとに知らされる支払額も分かりません。ある機会の入札の時点では分からなかった情報をその機会の入力に使うと、評価のデータでは成績が良く見えても、実際の入札では同じ成績が出ません。これを情報の漏れと呼びます。評価用のデータの情報が、学習や入力の作成、モデルの選択に混ざることも情報の漏れです。なお、過去の機会の確定した結果を正解として学習することは、漏れではありません。
| 情報 | 入札の時点で分かるか | モデルの入力に使えるか |
|---|---|---|
| 掲載面・広告枠の大きさ・端末の種類・時間帯・曜日 | 分かる(入札リクエストに含まれる) | 使える。ただし取引の場が送る項目に限られる |
| 最低落札価格 | 分かる(送られる場合) | 使える |
| 過去の訪問の回数など、入札より前に記録した利用者の側の項目 | 入札より前の記録から計算すれば分かる | 使える。計算に使う記録の範囲を入札の時刻より前に限る。利用者への通知や同意の範囲で使う |
| その表示がクリックされたか | 分からない | 使えない(予測の対象そのもの) |
| その後のコンバージョン | 分からない | 使えない |
| その機会の支払額・落札のしきい値 | 分からない(落札した後に知らされるか、知らされない) | 使えない |
| 同じ日の、その機会より後の集計(その日のクリック率など) | 分からない | 使えない。日ごとの集計を特徴量にするときは前日までの値を使う |
表の最後の行は見落としやすい漏れです。例えば「掲載面ごとのその日のクリック率」を特徴量にすると、その日の後の時刻の結果まで含んだ値が入力に入ります。過去の実績の率を特徴量にする方法とその注意は第4章で扱いますが、計算に使う記録が入札の時刻より前のものだけになっているかを、標本を作る段階で確かめておく必要があります。この章の例題でも、入札の判断(入札するか・入札額)は、入札リクエストの列だけから決めています。
利用者の側の項目を使うときには、利用者の情報の取り扱いの規律も関わります。どの情報を、どの目的で、どの事業者に渡してよいかは、個人情報保護法や電気通信事業法の外部送信規律、業界の自主規制によって決まり、利用者への通知や同意の状態によっても変わります。これらは第14章で、条番号と施行日を確かめた範囲で扱います。この章の段階では、学習の標本に入れる項目を決めるときに、その項目を広告の配信と分析の目的で使ってよいかを、法務やプライバシーの担当と確かめる工程を置いておくのがよいと考えています。
経営の判断、コンバージョンの定義と計測期間を先に決める
この章で見たように、コンバージョンの件数・コンバージョン率・CPA は、何をコンバージョンとするか、計測期間をどう置くか、重複をどう除くか、いつの時点で数えるかによって動きます。本コラムの架空データでは、配信を何も変えずに定義だけを変えて、CPA に2.4倍ほどの開きが出ました。この数字そのものは実際の広告の目安になりませんが、定義が決まっていないまま数字を比べると判断を誤るという点は、実際の広告にも当てはまると考えています。
定義を誤ったときの損失は、序章で整理した型に当てはめると、次のように表れます。
- 成果の数え違い:重複・欠落・遅れで件数がずれる。重複は多く、欠落と遅れは少なく見積もる向きに働く。さらに、広告に割り振られたコンバージョンの件数を、広告で増えた件数(増分)と取り違える。複数の媒体の管理画面の件数は同じコンバージョンを重ねて数えていることがあるので、そのまま足さない
- コンバージョンの対象の選び方の誤り:利益につながらない行動をコンバージョンとすると、件数は増えても利益とは別の量を増やす方向に予算と入札を向けることになる
- 機会損失:直近の日のコンバージョンが出そろっていないことを悪化と取り違えて入札を下げると、価値のある表示の機会を買い逃す
- 形骸化:定義と計測期間が文書になっておらず、設定の変更が記録されていないと、数字の段差が広告の変化なのか定義の変化なのかを誰も判断できなくなる
- 規制上の義務の不履行:結びつけのために使う識別子や利用者の情報の取り扱いが、自社に適用される法令上の要件を満たさないと、義務の不履行につながるおそれがある(個別の判断は法務に確かめる。第14章)
経営の判断として決めておきたいのは、次の4点です。1つ目は、何をコンバージョンとするかを、事業の利益とのつながりで決めることです。2つ目は、計測期間と重複の除き方を、商品の検討の期間と結果を確かめたい速さのつり合いで決め、文書にしておくことです。3つ目は、媒体ごとに定義が違う場合に、管理画面の数字を横に並べて比べないことと、比べるなら自社の側で定義をそろえた集計を持つことです。4つ目は、これらの定義を、モデルを作る前、自動入札の目標を設定する前に決めることです。予測のモデルは、定義されたコンバージョンが起きる確率を見積もるものなので、定義が利益とずれていれば、見積もっている量そのものが利益とずれます。自動入札は、広告主が設定した目標に合わせて入札を調整する機能です。媒体の公式ヘルプで確かめた範囲では、例えば Google 広告のスマート自動入札は、コンバージョン数またはコンバージョン値を最適化する入札戦略と説明され、使うにはコンバージョンの計測を有効にする必要があると書かれています。定義がずれていれば、ずれた定義で数えたコンバージョンを目標として調整されることになります。
| 決めること | 決める人の例 | 確かめる頻度の例 | 確かめ方 |
|---|---|---|---|
| コンバージョンの対象と価値 | 経営・事業の担当・マーケティング | 商品や価格の体系が変わったとき | コンバージョンの価値が粗利の見積りと合っているか |
| 計測期間と重複の除き方 | マーケティング・データ分析 | 定義を決めたときと、媒体の仕様が変わったとき | 遅れの分布(何日で何割が届くか)を記録から測る |
| 結果が出そろったとみなす線 | データ分析・広告運用 | 学習やレポートのたび | 直近の日の数字に「未確定」の印を付ける |
| 記録の結びつけの成功の割合 | データ分析・エンジニア | 月ごと・サイトの改修のたび | 対象・期間・重複の除き方をそろえたうえで、送るべき出来事のうち媒体に届いた割合と、届いた出来事のうち広告への接触に結びつけられた割合を分けて見る(広告を経由しない注文や未確定の注文も差に入るので、注文の件数との単純な差だけでは測れない) |
| 使ってよい項目 | 法務・プライバシーの担当 | 新しい項目を使う前 | 利用目的・通知・同意の範囲と照らす(第14章) |
この章のまとめと次の章へ
広告配信の記録は、入札リクエストから入札・落札・表示・クリック・コンバージョン・費用まで順に生まれ、当事者ごとに手元に残るものが違います。コンバージョン率と CPA は、コンバージョンの対象・計測期間・重複の除き方・数える時点で動くので、これらをモデルや自動入札の設定より前に事業として決めておく必要があります。また、広告を表示した場合の反応が見えるのは落札した機会だけで、例題のように負けた機会に落札のしきい値が知らされない場合には、しきい値も打ち切られた形でしか分かりません。次の第3章では、落札と支払額を決めるオークションの方式を扱い、セカンドプライスとファーストプライスで入札の考え方がどう変わるかを確かめます。
この章を深めたい方への参考書籍
『[増補改訂]ビッグデータを支える技術 ラップトップ1台で学ぶデータ基盤のしくみ』(西田圭介、技術評論社):副題のとおり、データ基盤の仕組みを手元の環境で学ぶことを主題にした本です。入札・表示・クリック・コンバージョンのように別々の場所で生まれる記録を、1か所に集めて分析できる形にするときに、どんな仕組みが要るかを考える手がかりになると考えています。
『データ分析基盤構築入門 Fluentd、Elasticsearch、Kibanaによるログ収集と可視化』(鈴木健太、吉田健太郎、大谷純、道井俊介、技術評論社):副題のとおり、ログの収集と可視化を主題にした本です。配信の記録を集める仕組みを自社で持つかどうかを考えるときや、重複・時刻のずれといった記録の品質の問題を仕組みの側から考えるときの入口になると考えています。
第3章 オークションの仕組み、セカンドプライスとファーストプライスで変わる入札の考え方
第2章では、入札リクエスト・入札・落札・表示・クリック・コンバージョンの記録がどこに残り、結果の定義によってコンバージョン率や CPA がどう変わるかを確かめました。この章では、その記録の手前にある、1回の表示の機会の値段がどう決まるのかを扱います。運用型広告のうち、オークションを使う配信では、表示の機会ごとにオークションが行われ、勝者と支払額が決まります。同じ入札額でも、オークションの方式が違えば、落札したときに払う額も、得られる利得も変わります。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空のオークションを使い、実行したコードと結果で確かめます。
- 表示の機会の値段を、あらかじめ決めた価格ではなくオークションで決める理由
- 方式の比較(ファーストプライス・セカンドプライス・一般化セカンドプライス・VCG の考え方)
- セカンドプライスで、自分の価値どおりに入札するのが損にならない理由と、その前提
- ファーストプライスで入札を引き下げる理由と、引き下げの割合が競合の人数で変わること
- 収入同値定理の考え方、最低落札価格が売り手の収入と買い手の勝率・支払額に与える影響
- 検索連動型広告の一般化セカンドプライスと、品質を加味した順位づけ
- ディスプレイ広告の取引がファーストプライスへ移った経緯と、複数の取引の場が重なる構造
- 理論の前提が現実で崩れる点と、経営の判断
この章の主張は、入札額を決める前に、自分が買っている広告枠がどの方式のオークションで取引されているかを確かめ、入札の方針をその方式に合わせるべきだ、という点です。セカンドプライスでは、表示の価値どおりに入札するのが基本になります。ファーストプライスで同じ入札をすると、落札するたびに価値と同じ額を払うことになり、利得が残りません。ファーストプライスで利得が最大になる倍率は、本コラムの架空データでは、価値より下の値でした。
本章の例題は、乱数または説明用の固定値で作った架空のオークションです。実際の取引より単純で、例題の数字は実際の取引の成績の目安にはなりません。入札額・支払額・価値はすべて相対値(単位の無い仮の数)で、同じ例題の中では同じ尺度を使います。例題どうしで数値を直接比べることはしません。入札額と支払額は、一般化セカンドプライスの例(クリック1回あたり)を除いて、表示1回あたりの相対値にそろえ、落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。実務では落札が表示や支払いを保証するとは限らず、これは例題のための単純化です。また実務では、ディスプレイ広告の取引の入札は表示1,000回あたりの価格(CPM)で表されることが多く、検索連動型広告ではクリック1回あたりの入札と課金が一般的です。この章の例題の計算は、一般化セカンドプライスの例を除いて、表示1回あたりの相対値にそろえたもので、単位を変えた場合は確かめていません。
例題では、表示の価値から支払額を引いた差を「利得」と呼びます。表示の価値は、広告が無くても起きたコンバージョンの分を除いていない見積りなので、利得は増分の利益とは別のものです。本コラムで成果と呼ぶのは増分の利益だけで、利得・勝率・落札の件数は、それぞれの名前で書きます。
表示の機会ごとにオークションで値段を決める理由
表示の機会の価値は、機会ごとに違います。同じサイトの同じ広告枠でも、どのページか、どの端末か、どの時間帯か、その利用者が過去にどんなページを見たかによって、クリックやコンバージョンに至る見込みが変わるからです。第1章で見たように、オークションを使う運用型広告は、この機会ごとの違いに合わせて入札額を変えながら配信します。
価値は、買い手ごとにも違います。ある利用者に旅行の広告を見せる価値は、旅行の事業者には高く、事務用品の事業者には低いかもしれません。同じ旅行の事業者どうしでも、コンバージョンの価値(粗利)や、すでに顧客であるかどうかで、見込む価値は変わります。売り手(媒体)は、それぞれの買い手がどれだけの価値を見込んでいるかを知りません。
売り手が価格をあらかじめ決めて売る方法では、価格が高すぎれば売れ残り、低すぎれば高く買ってもよかった買い手に安く売ることになります。オークションは、買い手に入札させ、その入札を比べて勝者と支払額を決めることで、売り手が知らない買い手の価値を、価格に反映させる仕組みです。表示の機会は1日に膨大な数が生じ、1件ごとに人が交渉することはできません。そのため、機会が生じるたびに自動でオークションを行う仕組みが使われています。表示の機会が生じてから広告が表示されるまでの流れと、時間の制約は第1章で扱いました。
買い手の側から見ると、オークションで決めることは2つです。1つは、その機会にいくらの価値があるかの見積りで、これは第4章から第6章で扱う予測の問題です。見積りを入札額に変える考え方は第7章で扱います。もう1つは、その価値にもとづいて、いくらで入札するかです。この章で扱うのは後者で、答えはオークションの方式によって変わります。
オークションの方式の比較
本コラムで扱う方式を表にまとめます。ここでの「方式」は、勝者の決め方と支払額の決め方の組み合わせです。表の「価値どおりの入札」の列は、自分の見込む価値をそのまま入札額にしたときに何が起きるかを書いています。表に出てくる「均衡」は、だれも自分だけ入札の仕方を変えても得をしない状態のことです。「本章で確かめた根拠」の列は、その方式について本章で一次情報を開いて確かめた事柄で、方式が使われている場面の一覧ではありません。
| 方式 | 勝者の決め方 | 支払額の決め方 | 価値どおりの入札 | 本章で確かめた根拠 |
|---|---|---|---|---|
| ファーストプライス・オークション | 入札額が最も高い買い手 | 自分の入札額をそのまま払う | 落札しても利得が0になる。入札を価値より下げる必要がある | 2019年に Google Ad Manager が統一したファーストプライスのオークションへ移行すると公表した(後述) |
| セカンドプライス・オークション(1枠) | 入札額が最も高い買い手 | 自分以外の入札の最高額と最低落札価格の、大きいほう(落札のしきい値) | 損にならない戦略になる(前提つき。後述) | OpenRTB 2.6 の入札リクエストでは、オークションの種類の既定値が「Second Price Plus」という名称の値とされている(規格の文書は名称だけを定め、本章では中身の規則を確かめていない) |
| 一般化セカンドプライス(複数の枠) | 順位の基準(入札額に品質を加味したものなど)の高い順に枠を割り当てる | その順位を保つのに要る額(次の順位の買い手にもとづく) | 価値どおりの入札が均衡にならない場合がある | 検索連動型広告の順位づけの説明に使われる(Edelman、Ostrovsky、Schwarz の2007年の論文) |
| VCG の方式(Vickrey、Clarke、Groves の3人の名を冠した方式。考え方の入口) | 全体の価値の合計が最大になるように枠を割り当てる | 自分が参加したことで他の買い手が失った価値の合計 | 損にならない戦略になる(理論上) | 本章では考え方の紹介だけにとどめる |
1枠のオークションでは、ファーストプライスとセカンドプライスの違いは支払額の決め方だけです。勝者は同じ規則(入札額が最も高い買い手)で決まります。それでも、この違いが、買い手にとっての最適な入札額を大きく変えます。複数の枠を同時に売る検索連動型広告では、順位ごとに支払額が決まる一般化セカンドプライスが使われてきました。VCG は、セカンドプライスの考え方を複数の枠に一般化した理論上の方式で、Edelman、Ostrovsky、Schwarz の2007年の論文(インターネット広告の一般化セカンドプライスのオークションを分析した論文)は、一般化セカンドプライスが VCG に似ているものの、性質が大きく違うことを示しています。
実際の取引では、方式の名前だけで支払額が決まるわけではありません。最低落札価格の設定、手数料の差し引き、複数の取引の場をまたいだ比べ方などが重なります。この章では、まず方式ごとの基本の性質を確かめ、そのあとで現実の構造に戻ります。
セカンドプライスでは価値どおりの入札が損にならない
1枠のセカンドプライス・オークションでは、勝者は自分の入札額ではなく、自分以外の入札の最高額と最低落札価格の大きいほうを払います。落札できるかどうかを決めるこの額を、本コラムでは落札のしきい値と呼びます。最低落札価格は競合の入札ではないので、競合の最高入札額とは分けて考えます。手数料・端数・最小の上乗せ額は例題では省きます。この方式には、買い手が自分の価値をそのまま入札するのが損にならない、という性質があります。Vickrey の1961年の論文(投機を抑える競争入札の仕組みを論じた論文)は、最も高い入札者に、2番目に高い入札者の価格で落札させる封をした入札では、談合が無ければ、各入札者にとって自分にとっての価値いっぱいの額を入札するのが最適になることを述べています(同論文20ページ)。以下では、この性質を自分の言葉と計算で説明します。
ここでいう「価値」は、買い手自身にとっての本当の価値です。本コラムの例題の「表示の価値」は予測にもとづく見積りで、広告が無くても起きたコンバージョンの分を除いていません。そのため、表示の価値のとおりに入札しても、増分の利益が最大になるとは限りません。増分にもとづく考え方は第11章で扱います。
理由は次のとおりです。自分の価値を \( v \)、落札のしきい値を \( m \) とします。最低落札価格が無ければ、\( m \) は競合の最高入札額です。落札すれば、利得は \( v – m \)、つまり価値から支払額を引いた差です。ここで大事なのは、自分の入札額が、落札するかどうかには効いても、落札したときの支払額 \( m \) には効かないことです。
- 価値より高く入札した場合:\( m \) が価値と入札額の間にあるときだけ、結果が変わります。そのときは落札しますが、価値より高い \( m \) を払うので、利得は負になります。価値どおりなら落札せず、利得は0でした
- 価値より低く入札した場合:\( m \) が入札額と価値の間にあるときだけ、結果が変わります。そのときは落札できず、利得は0です。価値どおりなら落札して、正の利得 \( v – m \) を得られました
- それ以外の場合:価値どおりに入札したときと、結果も支払額も同じです
どちらにずらしても、得をする場面は無く、損をする場面だけが増えます。この性質は、他の買い手がどう入札するかに関係なく成り立ちます。ただし、成り立つ前提があります。1回かぎりのオークションであること、予算の制約が無いこと、自分の価値を自分で知っていること、そして支払額が、自分の入札額に依存しない落札のしきい値で決まることです。予算の制約がある場合の入札は第7章で扱います。くり返しや相手の学習の影響は、この章では前提が崩れる点の一覧(後の節の表)で触れるにとどめ、本コラムでは詳しく扱わず、数値でも確かめていません。
この性質を、架空のオークションで確かめます。自分と競合4者の表示の価値を対数正規分布(値が正で、右に長く裾を引く分布)から乱数で作り、最低落札価格は置かず、競合は価値どおりに入札するものとして、20万回のオークションをくり返しました。自分は価値に一定の倍率を掛けた額で入札し、倍率を0.5から1.5まで変えて、利得(価値から支払額を引いた差)の合計を比べます。価値の水準は、中央値が1になるように作りました。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

# 架空のセカンドプライス・オークション(1枠)を20万回くり返す
rng = np.random.default_rng(20261116)
n_auction = 200_000
n_rival = 4  # 自分以外の買い手の人数

# 自分の表示の価値と、競合の価値(相対値。対数正規分布)
my_value = rng.lognormal(mean=0.0, sigma=0.5, size=n_auction)
rival_value = rng.lognormal(mean=0.0, sigma=0.5, size=(n_auction, n_rival))
# 競合は自分の価値どおりに入札するものとする
rival_max = rival_value.max(axis=1)  # 競合の最高入札額

rows = []
for k in [0.5, 0.7, 0.8, 0.9, 1.0, 1.1, 1.2, 1.3, 1.5]:
    bid = my_value * k
    win = bid > rival_max
    pay = np.where(win, rival_max, 0.0)  # 支払額は落札のしきい値(最低落札価格は置かない)
    gain = np.where(win, my_value - rival_max, 0.0)
    loss_win = win & (rival_max > my_value)  # 落札したが支払額が価値を超えた
    rows.append({
        "入札の倍率": k,
        "勝率": win.mean(),
        "支払額の合計": pay.sum(),
        "利得の合計": gain.sum(),
        "赤字の落札の件数": int(loss_win.sum()),
    })
df = pd.DataFrame(rows)
pd.set_option("display.width", 120)
print(f"オークションの回数: {n_auction:,}  競合の人数: {n_rival}")
print(df.round(4).to_string(index=False))
実際のスクリプトでは、このあとに、各倍率の利得の合計から倍率1.0の利得の合計を引いて「価値どおりとの差」の列を足す計算と、グラフを描く数行が続きます(その部分は掲載を省きました)。実行した結果を表にまとめます。勝率の分母は、オークションの全回数(20万回)です。実行では9つの倍率を計算し、グラフには9点すべてを描きましたが、表では倍率0.7と1.3を省いて7行だけ載せています。
| 入札の倍率 | 勝率 | 利得の合計 | 価値どおりとの差 | 赤字の落札の件数 |
|---|---|---|---|---|
| 0.5 | 2.26% | 7,779.77 | -14,790.79 | 0 |
| 0.8 | 11.27% | 19,834.01 | -2,736.55 | 0 |
| 0.9 | 15.44% | 21,875.19 | -695.37 | 0 |
| 1.0(価値どおり) | 20.02% | 22,570.56 | 0.00 | 0 |
| 1.1 | 24.69% | 21,912.98 | -657.57 | 9,345 |
| 1.2 | 29.48% | 20,011.94 | -2,558.62 | 18,916 |
| 1.5 | 43.28% | 8,696.84 | -13,873.72 | 46,520 |
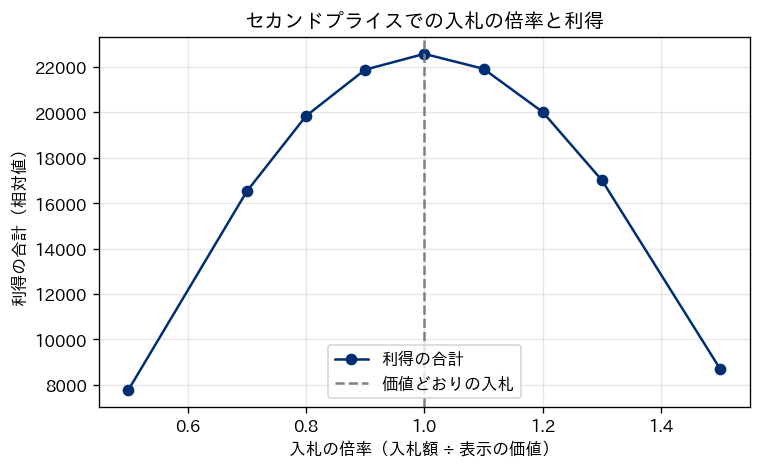
本コラムの架空データでは、利得の合計は倍率1.0(価値どおり)で最も大きくなりました。倍率を上げると勝率は上がりますが、支払額が価値を超える赤字の落札が増えます。倍率1.1では赤字の落札が9,345件あり、倍率1.5では46,520件に増えました。倍率を下げると赤字の落札は0件のままですが、利得が正になったはずの機会を逃し、利得の合計が減りました。価値どおりの入札の赤字の落札が0件なのは、支払額が競合の最高入札額で、それが自分の価値を下回るときにしか落札しないからです。
この結果から読み取れる実務上の意味は、勝率を上げること自体を目的にしてはいけない、という点です。勝率は倍率を上げるほど上がりましたが、利得は倍率1.0を境に減っていきました。落札した件数や勝率だけを見て入札を評価すると、払いすぎの入札が良く見えてしまいます。また、先に説明したとおり、この例題の利得は増分の利益ではありません。広告の成果を増分の利益で測る考え方は第11章で扱います。
ファーストプライスでは入札を価値より引き下げる
ファーストプライス・オークションでは、勝者は自分の入札額をそのまま払います。価値どおりに入札すると、落札したときの利得は価値から価値を引いた0です。利得を残すには、入札を価値より下げる必要があります。下げれば落札したときの利得は増えますが、落札できる確率(勝率)は下がります。利得の見込みは、落札したときの利得と勝率の掛け算で決まるので、この2つのつり合いが取れるところに、最も得な入札額があります。
どこまで下げるのがよいかは、競合がどう入札するかで決まります。単純な場合として、全員の価値が0から1の一様分布から独立に決まり、買い手は利得の見込みの平均で判断し(リスクに対して中立)、最低落札価格は置かない場合を考えます。Vickrey の1961年の論文は、この場合(同じ一様分布から価値が決まり、効用が金額について線形である場合)の唯一の均衡の入札が、買い手の総数を \( N \) として価値の \( \frac{N-1}{N} \) 倍であることを示しています(同論文16ページ)。ここでの均衡は、だれも自分だけ入札の仕方を変えても得をしない状態のことです。
この結果は短い計算で確かめられます。競合が全員、価値の \( c \) 倍で入札しているとき、自分が \( b \)(ただし \( b \le c \))を入札して落札する確率は、競合 \( N-1 \) 人の価値が全員 \( \frac{b}{c} \) 未満である確率 \( \left(\frac{b}{c}\right)^{N-1} \) です。利得の見込みは \( (v-b)\left(\frac{b}{c}\right)^{N-1} \) で、これを \( b \) で微分して0と置くと、\( b = \frac{N-1}{N} v \) が得られます。この答えは \( c \) によらないので、競合が \( \frac{N-1}{N} \) 倍で入札しているなら、自分も同じ倍率が最善です(買い手が2人なら価値の半分、10人なら9割)。
架空のオークションで確かめます。場合Aは、価値が0から1の一様分布で、競合が上の割合で入札する場合です。場合Bは、価値が対数正規分布で、競合が一律に価値の0.8倍で入札する場合で、理論の前提に当てはまらない例として置きました。どちらも20万回のオークションで、すべての機会に共通して掛ける入札の倍率を0.30から1.00まで0.01刻みで変え、その中で利得の合計が最大になる倍率を探しました。価値ごとに倍率を変える入札は探していません。また、各機会の競合の最高入札額を全機会について使えるのは、合成データの模擬だからです。実際の配信の記録からは、この額は分かりません。
# 架空のファーストプライス・オークション。入札額 = 価値 × 倍率(引き下げの割合 = 1 - 倍率)
rng = np.random.default_rng(20261116)
n_auction = 200_000
shades = np.round(np.arange(0.30, 1.001, 0.01), 2)

def best_multiplier(my_value, rival_bid_max):
    gains = []
    for s in shades:
        bid = my_value * s
        win = bid > rival_bid_max
        gains.append(np.where(win, my_value - bid, 0.0).sum())
    gains = np.array(gains)
    return shades[gains.argmax()], gains

# 場合A:価値は0〜1の一様分布、競合は理論上の均衡の入札(価値 × (n-1)/n)
rows = []
curves = {}
for n in [2, 3, 5, 10]:  # n はオークションに参加する買い手の総数(自分を含む)
    my_value = rng.uniform(0, 1, n_auction)
    rival_value = rng.uniform(0, 1, (n_auction, n - 1))
    rival_bid_max = (rival_value * (n - 1) / n).max(axis=1)
    s_best, gains = best_multiplier(my_value, rival_bid_max)
    curves[n] = gains / n_auction
    rows.append({"場合": "A 一様分布", "買い手の総数": n,
                 "利得が最大の倍率": s_best, "理論値(n-1)/n": round((n - 1) / n, 3),
                 "倍率1.0の利得": round(gains[-1] / n_auction, 4),
                 "最大の利得": round(gains.max() / n_auction, 4)})

# 場合B:価値は対数正規分布、競合は一律に価値の0.8倍で入札する(均衡ではない)
for n in [2, 3, 5, 10]:
    my_value = rng.lognormal(0.0, 0.5, n_auction)
    rival_value = rng.lognormal(0.0, 0.5, (n_auction, n - 1))
    rival_bid_max = (rival_value * 0.8).max(axis=1)
    s_best, gains = best_multiplier(my_value, rival_bid_max)
    rows.append({"場合": "B 対数正規分布", "買い手の総数": n,
                 "利得が最大の倍率": s_best, "理論値(n-1)/n": None,
                 "倍率1.0の利得": round(gains[-1] / n_auction, 4),
                 "最大の利得": round(gains.max() / n_auction, 4)})

pd.set_option("display.width", 140)
print("オークション1回あたりの利得(相対値)")
print(pd.DataFrame(rows).to_string(index=False))
このコードは、前のブロックの読み込み(import)を前提にしています。実行した結果は次のとおりです。利得はオークション1回あたりの値で、価値の単位(相対値)で表しています。
| 場合 | 買い手の総数 | 利得が最大の倍率 | 理論値 | 倍率1.0の利得 | 最大の利得 |
|---|---|---|---|---|---|
| A 一様分布 | 2 | 0.50 | 0.500 | 0.0 | 0.1667 |
| A 一様分布 | 3 | 0.67 | 0.667 | 0.0 | 0.0830 |
| A 一様分布 | 5 | 0.80 | 0.800 | 0.0 | 0.0334 |
| A 一様分布 | 10 | 0.90 | 0.900 | 0.0 | 0.0091 |
| B 対数正規分布 | 2 | 0.56 | (無し) | 0.0 | 0.2185 |
| B 対数正規分布 | 3 | 0.63 | (無し) | 0.0 | 0.1427 |
| B 対数正規分布 | 5 | 0.68 | (無し) | 0.0 | 0.0887 |
| B 対数正規分布 | 10 | 0.72 | (無し) | 0.0 | 0.0489 |
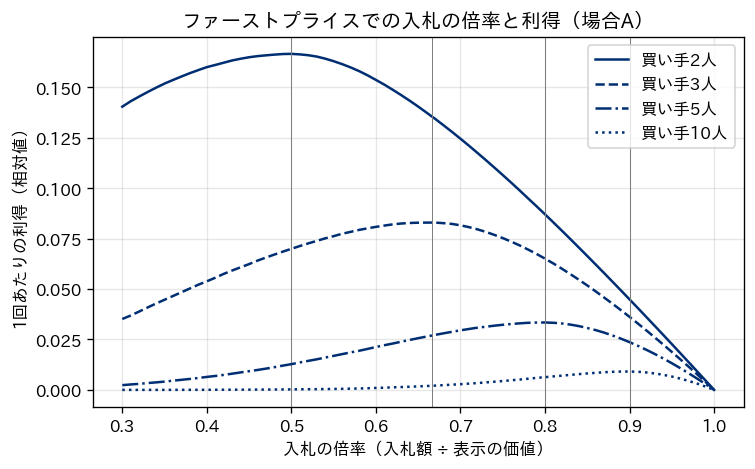
場合Aでは、利得が最大になる倍率は、買い手が2人で0.50、3人で0.67、5人で0.80、10人で0.90となり、0.01刻みの格子の上で理論値と一致しました。倍率1.0、つまり価値どおりの入札の利得は、どの場合も0でした。場合Bでも、探索した共通の倍率の中で利得が最大の倍率は、人数とともに0.56から0.72へ上がりましたが、値は場合Aの理論値とは違いました。価値の分布と競合の入札の仕方が変われば、利得が最大になる引き下げの割合も変わる、ということです。場合Bの値は共通の倍率の中での最善であり、価値ごとに入札を変える方法まで含めた最善ではありません。
この結果から、ファーストプライスでの入札について2つのことが読み取れます。1つ目は、本コラムの2つの設定(競合が価値に比例して入札する場合)では、競合が多いほど、引き下げの割合を小さくする(価値に近い額で入札する)ほうが得になったことです。この設定では、競合が多いと、大きく下げたときに落札できなくなる確率が高くなります。競合の入札の仕方が違う場合にも同じ向きになるかは、この例題では確かめていません。2つ目は、利得が最大になる引き下げの割合は、競合の入札額の分布が分からなければ決められないことです。現実の買い手は、競合の人数も価値の分布も知りません。手元に残るのは少なくとも自分の入札額と落札したかどうかの記録で、それ以外に何が知らされるか(落札に必要だった額など)は取引の場によって違います。そこから勝率曲線(入札額と勝率の関係)を推定し、引き下げの額を決める方法は、第8章で扱います。
収入同値定理と最低落札価格
ファーストプライスでは買い手が入札を下げ、セカンドプライスでは買い手が価値どおりに入札しますが、支払額は落札のしきい値になります。どちらが売り手にとって収入が多いのかについては、収入同値定理と呼ばれる結果が知られています。Myerson の1981年の論文(最適なオークションの設計を扱った論文)は、この定理を、売り手の期待収入が「それぞれの状況でだれが落札するか(割当の確率)」と「価値が最も低い場合に各買い手が得る期待利得」によって完全に決まる、という形で述べています(同論文65ページ)。言い換えると、均衡で同じ割当が実現し(たとえば、最も価値の高い買い手が必ず勝ち)、最も低い価値の買い手の期待利得も同じである方式どうしなら、売り手の期待収入は等しくなります。本章の例題は、買い手の価値が互いに独立に同じ分布から決まり、買い手がリスクに対して中立で(利得の見込みの平均だけで判断し、ばらつきを嫌いも好みもしない)、最低落札価格を置かない設定で、この条件に当てはまるように作りました。論文のモデルの前提の細部は、本コラムでは確かめた範囲に含めていません。
この考え方を、買い手が4人で価値が0から1の一様分布の架空のオークションで確かめました。セカンドプライスでは全員が価値どおりに入札し、ファーストプライスでは全員が価値の \( \frac{3}{4} \) 倍で入札するとして、20万回の平均の収入を比べています。さらに、セカンドプライスで最低落札価格を0から0.9まで動かしたときの変化を見ました。このとき、買い手は最低落札価格が変わっても入札を変えず、価値どおりに入札し続けるものとしています。
# 価値が0〜1の一様分布の買い手 n 人によるオークション(相対値)
rng = np.random.default_rng(20261116)
n_auction = 200_000
n = 4
values = rng.uniform(0, 1, (n_auction, n))
v_sorted = np.sort(values, axis=1)
v1, v2 = v_sorted[:, -1], v_sorted[:, -2]

# 1) 収入同値の確認:最低落札価格なし
rev_second = v2.mean()                      # セカンドプライス(価値どおりに入札)
rev_first = (v1 * (n - 1) / n).mean()       # ファーストプライス(均衡の入札)
print(f"買い手 {n} 人・最低落札価格なし")
print(f"  セカンドプライスの平均収入: {rev_second:.4f}")
print(f"  ファーストプライスの平均収入: {rev_first:.4f}")
print(f"  理論値 (n-1)/(n+1): {(n - 1) / (n + 1):.4f}")
print()

# 2) セカンドプライスで最低落札価格 r を動かす
rows = []
for r in np.round(np.arange(0.0, 0.91, 0.1), 1):
    sold = v1 >= r
    price = np.where(sold, np.maximum(v2, r), 0.0)
    rows.append({"最低落札価格": r,
                 "売れた割合": sold.mean(),
                 "落札時の平均支払額": price[sold].mean(),
                 "1回あたりの売り手の収入": price.mean(),
                 "1回あたりの買い手全体の利得": np.where(sold, v1 - price, 0.0).mean()})
df = pd.DataFrame(rows)
pd.set_option("display.width", 140)
print(df.round(4).to_string(index=False))
最低落札価格が無い場合の平均の収入は、セカンドプライスで0.5995、ファーストプライスで0.6000でした。一様分布で買い手が4人のときの2番目に高い価値の期待値は \( \frac{n-1}{n+1} \)、つまり0.6000で、どちらもこの値にほぼ一致しました。この条件では、方式を変えても売り手の収入はほとんど変わらず、変わったのは、だれがどう入札するかと、勝者の利得の分かれ方だけでした。
最低落札価格は、売り手が定める、これ未満の入札では落札させないという下限です。セカンドプライスに最低落札価格を設けると、最も高い入札が下限以上で2番目の入札が下限未満のとき、勝者は2番目の入札額ではなく下限の額を払います。最も高い入札も下限未満なら、その機会は売れません。実行した結果は次のとおりです。売れた割合の分母は、オークションの全回数です。「1回あたりの売り手の収入」と「1回あたりの買い手全体の利得」は、売れなかった回を0として全回数で平均した値です。買い手全体の利得は、その回に勝った買い手の利得(負けた買い手の利得は0)を足したもので、特定の買い手1者の平均ではありません。
| 最低落札価格 | 売れた割合 | 落札時の平均支払額 | 1回あたりの売り手の収入 | 1回あたりの買い手全体の利得 |
|---|---|---|---|---|
| 0.0 | 100.00% | 0.5995 | 0.5995 | 0.2006 |
| 0.3 | 99.15% | 0.6088 | 0.6036 | 0.1944 |
| 0.4 | 97.46% | 0.6247 | 0.6088 | 0.1832 |
| 0.5 | 93.81% | 0.6527 | 0.6123 | 0.1630 |
| 0.6 | 87.09% | 0.6948 | 0.6051 | 0.1330 |
| 0.7 | 75.96% | 0.7512 | 0.5707 | 0.0947 |
| 0.9 | 34.42% | 0.9051 | 0.3116 | 0.0164 |
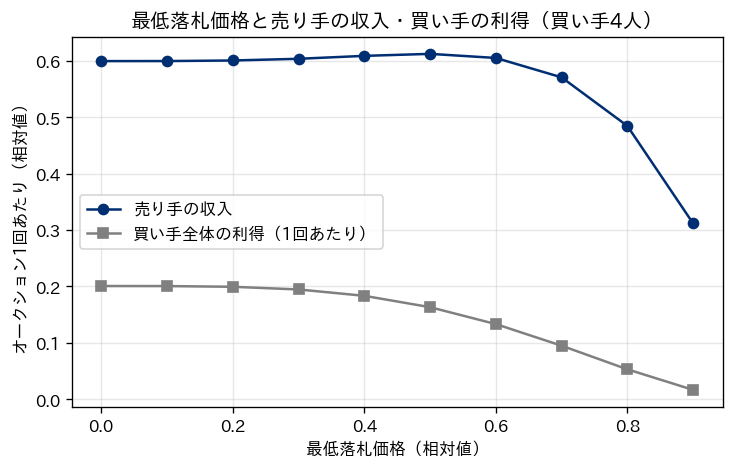
買い手が価値どおりに入札し続けるという前提の本コラムの架空データでは、売り手の収入は最低落札価格0.5で0.6123と最も大きく、最低落札価格が無い場合の0.5995より約2%多くなりました。最低落札価格を0.7以上に上げると、売れない機会が増え、収入はかえって下がりました。0.9では売れた割合が34.42%まで下がり、収入は0.3116でした。最低落札価格は0.1刻みでしか動かしていないので、収入が最大になる位置は0.5の近くという以上には言えません。
買い手の側から見ると、最低落札価格は、落札時の支払額を押し上げ、勝率を下げます。最低落札価格0.5では、落札時の平均支払額は0.6527で、最低落札価格が無い場合より約9%高く、1回あたりの買い手全体の利得は0.2006から0.1630へ下がりました。セカンドプライスの場では、競合が少ない機会ほど、支払額が2番目の入札額ではなく最低落札価格で決まる割合が高くなります。管理画面で支払額が上がったとき、それが競合の増加によるものか、最低落札価格の変更によるものかを区別できなければ、入札の方針を正しく直せません。入札リクエストには最低落札価格が含まれることがあり、OpenRTB 2.6 では広告枠ごとの最低の入札額(表示1,000回あたりの額)として定められています(第2章)。
収入同値定理の前提は、現実の広告の取引ではそのままは成り立ちません。買い手の価値は互いに関連しています(同じ利用者を高く見る買い手が多い)。買い手には予算があり、リスクへの態度もさまざまです。同じ枠の取引は1日に何度もくり返され、買い手も売り手も相手の入札から学習します。そのため、方式を変えると売り手の収入が変わることは、現実には十分にありえます。収入同値定理は、方式の違いがどこに効くのかを考えるための基準点として使うのが適切だと考えています。
検索連動型広告の一般化セカンドプライスと品質の加味
検索連動型広告では、1回の検索の結果のページに複数の広告の枠があり、枠の位置によって利用者の目に入りやすさが違いえます。複数の枠を同時に売るオークションとして説明されてきたのが、一般化セカンドプライスです。入札の高い順(または入札に品質を加味した基準の高い順)に枠を割り当て、各順位の広告は、その順位を保つのに要る額、つまり1つ下の順位の広告にもとづく額を払います。Edelman、Ostrovsky、Schwarz の2007年の論文と、Varian の2007年の論文(位置ごとのオークションを分析した論文)は、このオークションを理論の上で分析した論文です。前者の要旨は、一般化セカンドプライスでは価値どおりに入札することが均衡にならない場合があることを述べています。1枠のセカンドプライスの性質は、複数の枠になるとそのままは引き継がれない、ということです。
媒体の現在の仕組みについては、公式ヘルプに書かれている範囲だけを書きます。Google 広告のヘルプは、広告の掲載順位を決める「広告ランク」が、入札単価、広告とランディングページの品質、広告ランクの下限値、オークションにおける競争力、検索の文脈、広告アセットなどの見込みの効果をもとに、検索のたびに計算されると説明しています。実際のクリック単価については、広告ランクの下限値を満たし、1つ下の順位の競合の広告ランクを上回るのに必要な最低の額が請求される、と説明しています。同じヘルプは、各順位の価格が下位のすべての入札の影響を受けうることにも触れており、実際の請求額には競争の状況なども影響します。広告ランクの内部の計算の式は公開されていません。本コラムでは、その中身を推測しません。
品質を加味した順位づけが何を意味するかを、教科書的な単純な例で確かめます。2つの枠を4つの広告で争い、順位の基準を「入札額×品質の係数」とし、各広告は「1つ下の順位の基準÷自分の品質の係数」をクリック1回あたりに払うとしました。これは考え方を示すための単純化で、媒体の実際の計算ではありません。
# 教科書的な一般化セカンドプライスの例(2枠・4社。数はすべて相対値)
# 順位の基準 = 入札額 × 品質の係数。支払額は、自分の順位を保つのに要る最小のクリック単価
ads = pd.DataFrame({
    "広告": ["広告A", "広告B", "広告C", "広告D"],
    "入札額": [4.0, 3.0, 5.0, 2.0],
    "品質の係数": [0.6, 0.9, 0.3, 0.7],
})
ads["順位の基準"] = ads["入札額"] * ads["品質の係数"]
ads = ads.sort_values("順位の基準", ascending=False).reset_index(drop=True)
ads["順位"] = ads.index + 1
n_slot = 2
pay, rev = [], []
for i in range(len(ads)):
    if i < n_slot:
        nxt = ads.loc[i + 1, "順位の基準"]
        p = nxt / ads.loc[i, "品質の係数"]
        pay.append(round(p, 3))
        # 品質の係数をクリックされる確率と読んだときの、表示1回あたりの見込み収入
        rev.append(round(p * ads.loc[i, "品質の係数"], 3))
    else:
        pay.append(None)
        rev.append(None)
ads["クリック1回の支払額"] = pay
ads["表示1回あたりの見込み収入"] = rev
pd.set_option("display.width", 140)
print(ads.to_string(index=False))
| 順位 | 広告 | 入札額 | 品質の係数 | 順位の基準 | クリック1回の支払額 | 表示1回あたりの見込み収入 |
|---|---|---|---|---|---|---|
| 1 | 広告B | 3.0 | 0.9 | 2.7 | 2.667 | 2.4 |
| 2 | 広告A | 4.0 | 0.6 | 2.4 | 2.500 | 1.5 |
| 3 | 広告C | 5.0 | 0.3 | 1.5 | (枠外) | (枠外) |
| 4 | 広告D | 2.0 | 0.7 | 1.4 | (枠外) | (枠外) |
この例では、入札額が最も高い広告C(5.0)は、品質の係数が低いため3位となり、枠に入りませんでした。1位の広告Bは入札額3.0に対して2.667を払い、2位の広告Aは入札額4.0に対して2.500を払います。計算の上の読み方として、品質の係数をクリックされる確率の見積りと置くと、順位の基準「入札額(クリック1回あたり)×品質の係数」は、入札額を表示1回あたりに換算した順位づけの指標と読めます。ただし、売り手が実際に見込める表示1回あたりの収入は、入札額ではなく支払額に品質の係数を掛けたもので、この例では広告Bが2.4、広告Aが1.5となり、順位の基準の2.7、2.4とは一致しません。順位づけに使う入札額と、実際に払う額は別のものです。これは例題の式の読み方であり、実際の媒体がどういう理由でどんな式を使っているかを示すものではありません。予測クリック率が入札と課金の要になる点は、第4章で扱います。
買い手にとってこの構造が意味するのは、入札額を上げる以外にも、品質の評価が上がれば同じ順位をより低い支払額で得られる場合がある、ということです。ただし、品質がどう評価されるかの中身は媒体が公開している範囲でしか分からず、本コラムでは、品質の評価を上げる具体的な手順は扱いません。
ディスプレイ広告の取引がファーストプライスへ移った経緯と、取引の場が重なる構造
業界の技術規格である IAB Tech Lab の OpenRTB 2.6 では、入札リクエストのオークションの種類を表す項目の既定値が2(Second Price Plus)とされ、1がファーストプライスです。値の500以上は取引の場ごとに独自に定められます。規格の上でも、方式は取引の場ごとに違いうるものとして扱われています。
本コラムで確かめた範囲では、Google の公式ブログは2019年9月5日に、Google Ad Manager の全てのパートナーを対象に、統一したファーストプライスのオークションへ移行すると公表し、翌週から本格的に展開を始めて数週間で移行を終える見込みだと書いています。同じ記事は、数か月の試験でファーストプライスへの移行が媒体の収入の合計に中立から正の影響を与えたと報告し、買い手には各オークションの後に、落札に必要だった最低の入札額を知らせるとしています。業界全体でいつ、どの取引の場がどの方式に移ったかは、取引の場ごとに違い、本コラムでは一覧として確かめられていません。
移行の理由を、本コラムは確かめていません。ここでは、取引の場が重なる構造を説明します。ヘッダー入札(ヘッダー・ビディング)と呼ばれる仕組みでは、媒体のページの中のコードが、広告サーバーを呼ぶ前に複数の買い手の候補から入札を集め、その入札を広告サーバーでの選定に加えます。Prebid の公式文書は、最も一般的な構成では広告サーバーが最終の判断をし、ヘッダー入札はそれを置き換えるのではなく入札を送り込む形になると説明しています。こうした構造では、1回の表示の機会が複数の取引の場のオークションを経て決まるので、1枠のセカンドプライスの性質がそのまま成り立つとは言えません。
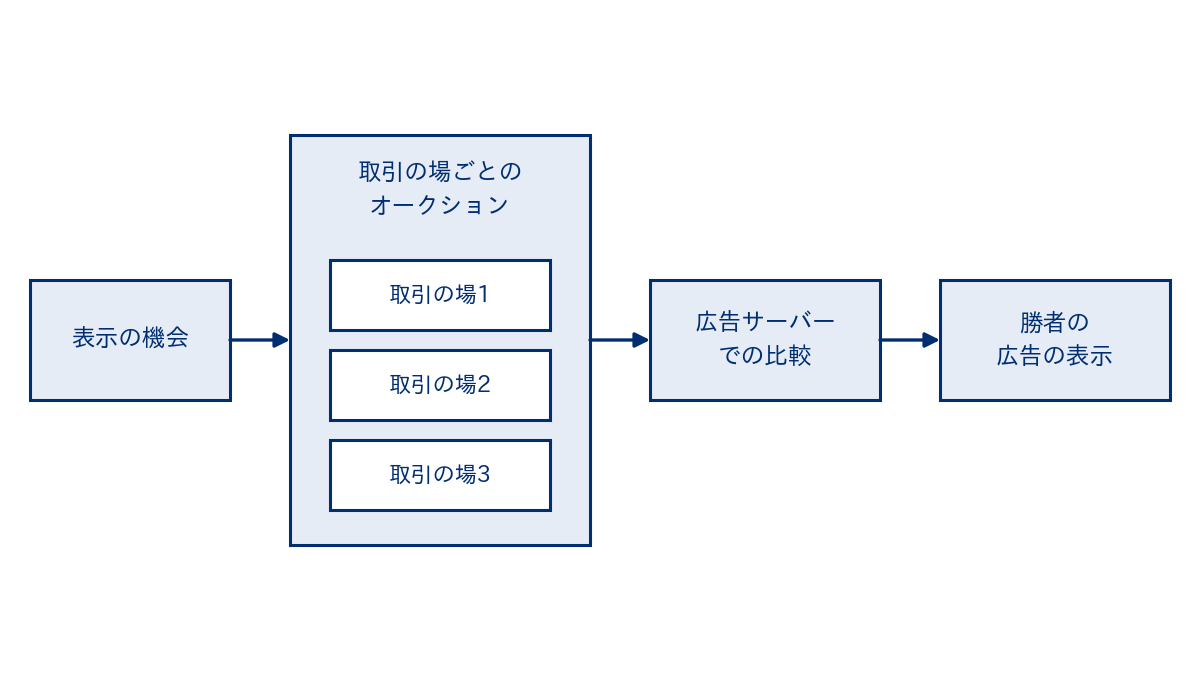
1つのファーストプライス・オークションの中では、手数料などを除く落札時の支払額は、そのオークションに実際に送った入札額です。複数の取引の場や手数料の差し引きが重なる経路で、買い手が設定した額と各オークションに届く額がどう対応するかは、経路ごとに違いうるもので、本コラムでは確かめていません。ファーストプライスでは、入札額を価値どおりにすると利得が残らないので、前の節で見たように、どこまで引き下げるかを買い手が決める必要が生じます。DSP や媒体が提供する入札の引き下げ(ビッド・シェーディング)の機能は、この問題に対応するものですが、その中身は第8章で扱います。
買い手にとって方式の違いが意味すること
ここまでの内容を、買い手が入札の方針を決めるときに使える形にまとめます。表の「同じ入札を続けた場合」の列は、方式が変わったことに気づかずに、以前と同じ入札額を出し続けたときに起きることです。
| 論点 | セカンドプライスの場 | ファーストプライスの場 | 同じ入札を続けた場合 |
|---|---|---|---|
| 入札額と価値の関係 | 価値どおりが基本(前提つき) | 価値より低くする | セカンドプライス向けの価値どおりの入札をファーストプライスで出すと、落札するたびに価値と同じ額を払い、利得が残らない |
| 支払額を決めるもの | 競合の最高入札額・最低落札価格 | 自分の入札額 | 支払額が上がった理由を、競合の変化と取り違える |
| 入札で必要な情報 | 自分の表示の価値の見積り | 価値の見積りに加えて、勝率曲線(競合の入札の分布) | 勝率曲線を持たずに引き下げると、下げすぎて機会を失うか、下げ足りずに払いすぎる |
| 勝率の読み方 | 入札が価値どおりなら、勝率は価値と競合の関係で決まる | 引き下げの割合しだいで勝率が変わる | 勝率が上がったことを良い変化と読み違える |
| 落札後に分かること | 支払額は競合の最高入札額か最低落札価格で決まるので、支払額が知らされれば競合の水準の手がかりになる | 次点の額は分からないことがある(取引の場が最低の落札額を知らせる場合もある) | 手元の記録で分かることと分からないことを取り違える(第8章) |
この表のうち、とくに確かめておきたいのは1行目です。方式を知らずに同じ入札を続けると、払いすぎ(見込んだ価値を超える額で買うこと、または同じ機会をもっと低い額で落札できたのに高く払うこと)が起きます。逆に、ファーストプライス向けに大きく引き下げた入札をセカンドプライスの場で出すと、本来は利得が正になる機会を逃します。それで利益を増やせる機会を逃した場合には、機会損失になります。どちらの損失も、管理画面の CPA や勝率だけを見ていると気づきにくいものです。
オークションの理論の前提が現実で崩れる点
この章で確かめた性質は、いずれも前提つきで成り立つものでした。現実の広告の取引では、その前提がさまざまな形で崩れます。崩れ方と、そのときに起きることを表にまとめます。
| 理論の前提 | 現実で崩れる点 | 入札への影響 | 扱う章 |
|---|---|---|---|
| 1回かぎりのオークション | 同じ買い手と売り手が、1日に何度も取引をくり返す | 相手の入札や最低落札価格が、自分の過去の入札に応じて変わりうる | (本コラムでは詳しく扱わない) |
| 予算の制約が無い | キャンペーンには期間ごとの予算がある | 価値どおりに入札すると、予算を早く使い切ることがある。入札を一定の割合で下げる考え方が要る | 第7章・第9章 |
| 自分の価値を自分で知っている | 価値は予測クリック率や予測コンバージョン率からの見積りで、誤差がある | 見積りが一律に高ければ、価値どおりのつもりで払いすぎる | 第4章〜第6章 |
| 相手の価値の分布が分かっている | 競合の人数も入札の分布も分からず、時間とともに変わる | ファーストプライスで最適な引き下げを事前に決められない | 第8章 |
| 支払額の規則が明確 | 複数の取引の場が重なり、手数料の差し引きもある | 自分の入札がどの規則で支払額に変わるのかが見えにくい | 第1章・第13章 |
| 価値は表示ごとに独立 | 同じ利用者への表示の回数が増えると、反応が変わることがある | 1回ごとの価値の見積りがずれる | 第10章 |
前提が崩れるからといって、理論が役に立たないわけではありません。「この前提が成り立てば、この入札が損にならない」という基準点があるので、どの前提が崩れたときに、どの方向へ入札を直せばよいかを考えられます。予算の制約があれば入札を下げる方向、ファーストプライスなら引き下げる方向、予測が一律に高ければ予測を直す方向です。基準点を持たないまま管理画面の数字だけを見ていると、どの方向に直せばよいかの判断がつきにくくなります。
情報の非対称にも触れておきます。各取引の場は、自分の場に届いた入札を見ることができます。媒体の広告サーバーにどこまでの入札が渡るかは構成によって違い、たとえば Prebid の公式文書は、既定ではすべての買い手の候補の入札を広告サーバーへ送り、設定によっては最も高い入札だけを送ることもできると説明しています。買い手は、自分の入札と落札したかどうか、場合によっては支払額や落札に必要だった最低の額しか知りません。集めた入札の情報が最低落札価格の設定などにどう使われているかは、取引の場ごとに違い、本コラムでは確かめていません。買い手にとって確かめられるのは、自分の手元にどんな情報が返ってくるかです。
経営の判断、取引の方式を確かめて入札の方針を合わせる
この章の内容を経営の判断に落とすと、自社が買っている広告枠がどの方式のオークションで取引されているかを確かめ、入札の方針をそれに合わせる、ということになります。自社が設定する上限の入札額は、方式によって意味が変わります。セカンドプライスの場の上限の入札額は「ここまでなら払ってよい」額の上限で、実際の支払額は競合の入札や最低落札価格で決まります。検索連動型広告について、Google 広告のヘルプも、ほとんどの場合、実際のクリック単価は上限クリック単価を下回ると説明しています。ファーストプライスの場で DSP や媒体の入札の引き下げの機能を使う場合、どこまで引き下げるかはその機能の側で決まり、その中身は提供する事業者が公開している範囲でしか分かりません。
この判断を誤ったときの損失は、第1章で整理した経営上の損失の6つの型のうち、主に次の3つに当たります。
- 払いすぎ:ファーストプライスの場で価値どおりの入札を続け、もっと低い額で落札できた機会に高く払う(引き下げの不足)。勝率や落札の件数が増えるので、良い変化に見えやすい
- 機会損失:セカンドプライスの場で大きく引き下げた入札を続け、利得が正になる機会を逃し、それによって増分の利益を得られたはずの機会も失う場合
- 形骸化:方式の変更や最低落札価格の変更が入札の方針に反映されず、設定と実態のずれに気づけない
確かめる相手は、自社で入札を運用しているなら DSP や取引の場の担当者、運用を外部に任せているなら広告会社です。確かめることを表にまとめます。
| 確かめること | なぜ確かめるか | 確かめた結果の使い方 |
|---|---|---|
| 買っている枠の取引の方式(ファーストプライスか、セカンドプライスか、混在か) | 入札額と支払額の関係が方式で変わるため | 入札の方針(価値どおりか、引き下げるか)を方式ごとに分ける |
| 入札の引き下げの機能が働いているか、どの程度引き下げられているか | ファーストプライスでは引き下げの程度が利得を決めるため | 第8章の勝率曲線の考え方で、引き下げの妥当性を点検する |
| 最低落札価格の有無と、変更されたかどうか | 支払額の変化の原因を区別するため | 支払額が上がったときに、競合の変化と最低落札価格の変化を分けて読む |
| 落札後にどんな情報が手に入るか(支払額・落札に必要だった最低の額など) | 使える推定の方法と、推定できる範囲・精度が変わるため | 第2章の記録の設計と、第8章の推定の方法を選ぶ |
| 手数料の差し引きと、入札額と媒体に届く額の関係 | 自社の入札額のうちどれだけが枠の購入に使われているかを知るため | 表示の価値と比べる額を正しく置く(第1章・第13章) |
この表の答えが得られない場合、それ自体が判断の材料になります。方式も、引き下げの程度も、落札後の情報も分からない取引では、自社の入札が払いすぎなのか機会損失なのかを点検できません。広告費が事業に占める重みが大きいほど、こうした情報を開示できる取引の経路を選ぶ価値は高くなると考えています。結果を予算と体制に落とすときは、入札の方針を決める人と、方式や最低落札価格の変更を点検する人を決め、点検の頻度を取り決めておくことが有効だと考えています。
この章では、オークションの方式によって最適な入札が変わることを、架空のオークションで確かめました。1枠のセカンドプライスでは、本コラムの架空データでも価値どおりの入札の利得が最も大きく、上げても下げても利得は減りました。ファーストプライスでは価値どおりの入札の利得は0で、利得が最大になる引き下げの割合は、競合の人数と入札の分布によって変わりました。最低落札価格は、売り手の収入を増やすことがある一方で、買い手の支払額を押し上げ、勝率を下げました。次の第4章からは、オークションに入札するときの前提となる表示の価値を見積もるために、予測クリック率の作り方を扱います。
この章を深めたい方への参考書籍
『オークション理論』(佐野隆司 著、栗野盛光 監修、共立出版):シリーズマーケットデザインの1冊で、2025年に刊行されたオークション理論の教科書です。目次の第1章では、さまざまなオークション・代表的なオークション・何をどうやって分析するのか・オークションのモデル化が扱われています。この章で実行結果と導出で示したセカンドプライスとファーストプライスの入札の違いや、収入同値定理の条件を、理論の側から確かめるのに向いています。
『マーケットデザイン入門 オークションとマッチングの経済学』(坂井豊貴 著、ミネルヴァ書房):書名のとおり、オークションとマッチングを中心に、制度の設計を経済学の立場から扱う入門書です。この章では1回の表示の機会を売る仕組みとしてオークションを見ましたが、売り手が方式や最低落札価格をどう選ぶか、という売り手の側の視点から取引の仕組みを捉え直すのに役立ちます。
第4章 クリック率の予測、ロジスティック回帰と特徴量の作り方
第3章では、オークションの方式によって、表示の価値と入札額の関係が変わることを確かめました。セカンドプライスでは価値どおりに入札するのが損にならない戦略になり、ファーストプライスでは価値より下げて入札する必要がありました。どちらの方式でも、出発点になるのは「この表示の機会に広告を出したら、どれだけの価値が見込めるか」という見積りです。この章では、その見積りの最初の部品である予測クリック率を、ロジスティック回帰と特徴量の工夫で作る方法を扱います。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の表示の記録を使い、実行したコードと結果で確かめます。
- 予測クリック率が入札と順位づけの要になる理由と、クリック率の予測が難しい理由
- ロジスティック回帰が広告のクリックの予測で長く使われてきた理由と、正則化
- 特徴量の作り方(カテゴリの one-hot・ハッシュ化・交差特徴・過去の実績の率)と、それぞれの注意
- 時間で切った評価用のデータでの、交差特徴の有無とハッシュの大きさによる成績の違い
- 過去の実績の率を特徴量にするときの、情報の漏れの防ぎ方と平滑化
- 新しいデータが届くたびにモデルを更新する逐次学習と、分布が途中で変わる場合の比較
- 新しい広告や掲載面、表示の位置による偏りの扱いと、経営の判断
この章の主張は2つあります。1つ目は、同じロジスティック回帰の中でも、どの項目をどう組み合わせて特徴量にするか・正則化をどれだけ効かせるか・入札の時点で手に入る情報だけを使うかで、成績が動く、という点です。本章の架空データでは、交差特徴の有無や情報の漏れの有無による差は対数損失で0.001前後かそれ以下と小さく、交差特徴の有無の差の向きは、正則化の設定や乱数の種で入れ替わることがありました。逐次学習の比較では、期間ごとの差は0.003〜0.005ほどでした。手法どうしの比較は第5章で扱います。2つ目は、広告や掲載面の顔ぶれは日々入れ替わるので、モデルは1回作って終わりではなく、どのデータでどの頻度で更新するかまでを含めて設計する必要がある、という点です。ただし、本章の数値はすべて架空の合成データでの結果で、差の大きさは読者の広告での差の目安にはなりません。
予測クリック率が入札と順位づけの要になる理由
本コラムの例題では、表示の価値(その機会に表示した場合に、その後のコンバージョンから得られると予測する、広告費を引く前の価値)を「予測クリック率 × 予測コンバージョン率 × コンバージョンの価値」と置いています(クリックを経ないコンバージョンは例題では扱いません)。これは、広告が無くても起きたコンバージョンの分を除いていない見積りです。この式の3つの部品のうち、予測クリック率は最初に掛かる数です。予測クリック率が実際より2倍高く出れば、他の部品が正しくても表示の価値は2倍に見積もられ、表示の価値に一定の係数を掛けて入札する場合、ほかの条件が同じなら、確率を高く見積もるほど入札額も高くなります。予測の誤りが、入札額を通じて払いすぎや機会損失につながりうるという点が、広告のクリックの予測を普通の分類の問題と分ける特徴です。確率のずれが費用に与える影響は第6章で詳しく扱います。
予測クリック率は、買い手の側の入札だけでなく、売り手の側の順位づけにも使われます。クリック課金の検索連動型広告では、クリックされなければ媒体の収入にならないので、入札額だけで順位を決めると、クリックされにくい広告が上に並び、収入も利用者の満足も下がりえます。Google 広告の公式ヘルプ「広告ランクについて」では、広告の掲載の可否と掲載の順位を決める広告ランクの要素として、入札単価と並んで、推定クリック率・広告の関連性・ランディングページの利便性などで評価される広告の品質が挙げられています。媒体の内部でこれらをどう組み合わせて計算しているかは公開されておらず、本コラムでは扱いません。ここで押さえておきたいのは、クリック率の見積りが、買い手と売り手の両方の判断に入っているという点です。
| 使う立場 | 予測クリック率の使い道 | ずれたときの影響 |
|---|---|---|
| 買い手(広告主・DSP) | 表示の価値を見積もり、入札額を決める | 高すぎれば払いすぎ、低すぎれば価値のある機会の買い逃し(機会損失) |
| 売り手(クリック課金の媒体) | 入札額と組み合わせて、広告の順位や掲載の可否を決める | クリックされにくい広告が上に並び、媒体の収入と利用者の満足が下がりうる |
| 広告主の運用担当 | クリエイティブや掲載面の良し悪しを比べる材料にする | 表示の位置や回数の偏りを広告の良し悪しと取り違える |
なお、クリック率は利用者の関心の目安の1つにすぎず、成果ではありません。クリックがコンバージョンにつながらなければ、クリック課金の場合には、クリック率の高い広告ほど費用だけがかさむこともあります。本コラムで成果と呼ぶのは増分の利益であり(第11章)、予測クリック率は、それを見積もるための部品の1つとして扱います。
クリック率の予測が難しい理由
クリック率の予測は、確率を出す二値の分類という意味では教科書どおりの問題ですが、広告の記録には予測を難しくする性質がいくつも重なっています。1つ目は、率そのものが低いことです。クリック率の水準は掲載面や広告の種類によって違い、本章の例題では2%前後に置いていますが、どの水準でも記録の大部分は「クリックなし」になります。このため、すべてを「クリックなし」と答えるだけで正解率は高くなり、正解率はモデルの成績の物差しとして役に立ちません。本章では、対数損失と AUC で成績を測ります。評価の単位は表示で、評価用のデータの表示1件ごとに、予測クリック率と実際のクリックの有無を突き合わせます。対数損失は、予測した確率と実際の結果のずれを表す指標で、小さいほど良く、確率の正しさも反映します。AUC は ROC 曲線の下の面積で、クリックされた表示とされなかった表示を1組選んだとき、クリックされたほうに高い予測を付けられる確率に相当します(予測が同じ値の組は0.5として数えます)。1.0なら完全に並べられており、0.5なら当てずっぽうと同じで、確率の水準の正しさは表しません(指標の詳細は第6章)。
2つ目は、項目の多くがカテゴリで、種類が非常に多いことです。掲載面・広告・クリエイティブ・広告枠の大きさ・端末の種類は、値の大小に意味の無いカテゴリです。時間帯は順序と1日の周期に意味がある項目ですが、夜だけ上がるような段差のある関係を表すために、本章の例題では時刻ごとのカテゴリとして扱います。掲載面・広告・クリエイティブはそれぞれ種類が多く、組み合わせを考えると特徴量の列の数はさらに増えます。3つ目は、新しい広告や新しい掲載面が次々に現れることです。昨日まで存在しなかったカテゴリは、学習用のデータに1件もありません。4つ目は、同じ広告でも、表示された位置や表示のされ方によってクリックのされやすさが変わることです。
| 難しさ | 何が起きるか | 本章での対処 |
|---|---|---|
| 率が低い | 正解率が役に立たない。件数の少ない区分では実績の率が大きくぶれる | 対数損失と AUC で測る。実績の率を使うときは平滑化する |
| カテゴリの種類が多い | one-hot の列の数が膨大になり、辞書の管理も重くなる | ハッシュ化で列の数を固定する |
| 組み合わせで効く | 項目を別々に入れた線形のモデルでは表せない関係がある | 交差特徴を足す(機械学習で自動に拾う方法は第5章) |
| 新しいカテゴリが現れる | 学習用のデータに無い値が届く | 上位の区分の情報で補う。逐次に更新する。探索は第10章 |
| 位置や表示のされ方で変わる | 位置の良さを広告の良さと取り違える | 位置の影響を分けて扱う考え方を後の節で紹介する(本章の例題では実行していない) |
ロジスティック回帰が長く使われてきた理由
ロジスティック回帰は、項目の重みつきの和 \( z \) を、0から1の間の確率に変換するモデルです。式で書くと \( p = 1 / (1 + e^{-z}) \) で、言葉で言えば「各特徴量が効く大きさを足し合わせた点数を、S字の曲線で確率に直す」ものです。回帰の一般論や係数の読み方は、弊社コラム「ビジネスの要因分析に効く回帰分析と統計モデリングについて」で扱っているので、ここでは広告のクリックの予測で好まれてきた理由に絞ります。
第1に、出力が0から1の確率の形で出て、対数損失を小さくするように学習するので、確率の水準が実績と合いやすい性質があります。ただし、正則化の強さや学習データの作り方(第5章で扱う負例の間引きなど)によって、水準はずれることがあります。前の節で見たとおり、広告の予測では順位だけでなく確率の水準が入札額に直結するので、この性質は扱いやすいものです。予測した確率が同じくらいの表示を集めたとき、その実績のクリック率が予測と対応するように調整することを較正と呼び、合っているかを確かめる作業を較正の確認と呼びます。全体の平均が合っているだけでは、較正が取れているとは言えません(第6章)。第2に、特徴量の列が数百万あっても、各表示で値が1になる列は数十個しかない(疎である)ので、学習も予測も速く、入札に許される短い時間の中で計算できます。第3に、新しい記録が届くたびに重みを少しずつ直す逐次の更新と相性が良く、記録の量が多くても全部を一度に読み込む必要がありません。McMahan らの2013年の論文(Google の広告のクリックの予測の実務を述べた論文。第19回 ACM SIGKDD 国際会議の予稿集に収録)は、大規模なクリックの予測に逐次学習の手法(FTRL-Proximal)を使った経験を報告しています。同じ論文は、記憶の節約・較正・予測の確からしさの見積りといった実務の工夫にも触れています。
一方で、ロジスティック回帰は、特徴量を足し算でしか組み合わせません。「動画の掲載面でスマートフォンのときだけクリックされやすい」といった組み合わせの関係は、人が交差特徴として明示的に作らない限り表せません。どの組み合わせを作るかは、業務の知識と、評価用のデータでの確認で決めることになります。この負担を減らすために決定木の集まり(勾配ブースティング)を使う方法は、第5章で扱います。因子分解機は、第5章で名前を紹介します。
正則化も欠かせません。列の数が多く、件数の少ないカテゴリが多いと、たまたまクリックが続いた掲載面の重みが大きくなりすぎ、学習用のデータには合っても後の日には外れる(過学習)ことが起きます。正則化は、重みの大きさに罰を科して、件数の少ないカテゴリの重みを0の近くに保つ仕組みです。scikit-learn のロジスティック回帰では、正則化の強さを C という値で指定し、C が小さいほど強く罰を科します。C は評価用のデータとは別に取り分けた検証用のデータで選びます。
特徴量の作り方の表
広告のクリックの予測では、記録の項目をどのような列に変えて渡すかで、同じモデルでも成績が変わります。代表的な作り方を表にまとめます。
| 作り方 | 中身 | 長所 | 注意 |
|---|---|---|---|
| カテゴリの one-hot | カテゴリの値ごとに列を1つ作り、その値のときだけ1にする | 分かりやすい。値ごとの重みが読める | 値の辞書を作って保守する必要がある。新しい値は辞書に無い |
| ハッシュ化 | 「項目名=値」という文字列をハッシュ関数で列の番号に変える | 辞書が要らず、列の数を先に固定できる。新しい値もそのまま扱える | 別の値が同じ列に入る衝突が起きる。列から元の値を逆にたどりにくい |
| 交差特徴 | 2つ以上の項目の値の組み合わせを1つのカテゴリにする | 組み合わせで効く関係を線形のモデルで表せる | 組み合わせの種類が増え、件数の少ない区分が増える。正則化と併せる |
| 過去の実績の率 | 掲載面や広告ごとの、過去のクリック率を数値の列にする | 少ない列で多くの情報を渡せる | その表示より前の記録だけで計算しないと情報の漏れになる。件数の少ない区分では率がぶれるので平滑化する |
| 数値の区分け | 過去の訪問の回数や時刻を区間に分けてカテゴリにする | 段差や頭打ちのある関係を表せる | 区間の切り方で結果が変わる |
この表で、利用者の側の特徴にあたる項目としては、過去の訪問の回数や直近の訪問からの日数のように、サイトの利用の状況を表すものを想定しています。本コラムの例題では、性別・年齢・国籍・信条・病歴・収入など、差別につながる、または配慮の要る属性をモデルの入力に使いません。どの情報を予測に使ってよいかは、利用者の同意や通知の義務とも関わります(第14章)。
ハッシュ化と衝突の意味
ハッシュ化(特徴量ハッシング)は、「掲載面=s012」「端末=1」のような文字列を、ハッシュ関数という決まった計算で、0から列の数マイナス1までの番号に変える方法です。辞書を持たないので、昨日まで存在しなかった掲載面の値が届いても、同じ計算で列の番号が決まり、そのまま学習と予測に使えます。Weinberger らの2009年の論文(大規模な多タスク学習のための特徴量ハッシングの論文。第26回 機械学習国際会議の予稿集に収録)は、この方法を理論と実験の両面から論じ、ハッシュで重なった部分空間どうしの干渉が小さいことを確率の不等式で示しています。
ハッシュ化の代償は衝突です。列の数を有限にする以上、別の値が同じ列に入ることがあり、そのとき衝突した値どうしは同じ列の係数を共有するので、それぞれの重みを独立に調整できません。列の数が少なすぎれば衝突が増えて成績が下がり、多すぎれば重みを保存する記憶が増えます。scikit-learn の FeatureHasher の公式ドキュメント(参照したのは1.9.1 の版。本章のコードの実行は1.9.0)は、内部で MurmurHash3 の符号つき32ビット版を使うことと、列の数を小さくすると衝突が起きやすいが、大きくすると線形のモデルの係数の次元が大きくなることを説明しています。既定の列の数は2の20乗です。また、既定では、特徴の名前のハッシュ値の符号に応じて値に正負の符号を付けます。ユーザーガイドによれば、これは無関係な特徴どうしの衝突が誤差を積み上げずに打ち消し合いやすくするためのものです。同じ列に衝突しても符号が逆なら、モデルへの寄与も逆向きになります。
どこまで衝突を許せるかは、データの種類の数と記憶の制約で決まるので、評価用のデータとは別に取り分けた検証用のデータで列の数を変えて確かめるのが確実です。次の節からの例題では、列の数による成績の変わり方を見るために、列の数を変えて成績を測ります。
架空の表示の記録を作る
ここからは、交差特徴・ハッシュの大きさ・過去の実績の率・逐次学習の効き方を、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの成績は、実際の配信での成績の目安にはなりません。示したいのは、同じ手法でも、特徴量の作り方・正則化・情報の漏れの有無・更新の仕方で結果がどう変わるかという点です。
この例題では、14日の間の表示200,000件を、次の性質を持たせて乱数で作りました(乱数の種は20261116に固定しています)。記録は表示の単位で、落札した機会はすべて表示されたものとし、表示1回につきクリックは最大1回として扱います。コードは Python 3.14.3 で実行し、scikit-learn 1.9.0 と、グラフの日本語の表示に japanize-matplotlib 1.1.3 を使いました。
- 表示の機会の属性:掲載面(400種類。人気に大きな偏りがあり、裾が長い)・掲載面の種類(A〜Dの4種類)・端末の種類(スマートフォン・PC・タブレット)・広告枠の大きさ(3種類)・時間帯(夜にクリックされやすい)
- 広告:40本(後で見る逐次学習の例題では、途中から10本が加わる)と、その種類(4種類)
- 利用者の側の特徴にあたる項目:過去の訪問の回数の区分(4段階)だけを入れ、個人を特定する項目や配慮の要る属性は入れない
- 組み合わせで効く関係:掲載面の種類Bでスマートフォンのときはクリックされやすく、掲載面の種類DでPCのときはされにくい。広告の種類と掲載面の種類の相性も入れる
- 時間の流れ:日(0〜13日目)を付け、学習と評価を日で切れるようにする
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

def make_log(n, n_days, seed, drift_day=None):
    rng = np.random.default_rng(seed)
    n_site, n_ad = 400, 50
    pop = 1.0 / np.arange(1, n_site + 1) ** 1.1          # 掲載面の人気は裾が長い
    site_type = rng.integers(0, 4, n_site)                # 掲載面の種類 A〜D
    site_eff = rng.normal(0, 0.5, n_site)
    ad_cat = rng.integers(0, 4, n_ad)
    ad_eff = rng.normal(0, 0.3, n_ad)
    ad_eff2 = ad_eff.copy()
    ad_eff2[:20] = rng.normal(0, 0.3, 20)                 # 途中から反応が変わる広告
    pair = rng.normal(0, 0.4, (4, 4))                     # 広告の種類 x 掲載面の種類
    d = pd.DataFrame({"day": rng.integers(0, n_days, n)})
    d["hour"] = rng.choice(24, n, p=np.r_[np.full(7, 1), np.full(17, 3)] / 58)
    d["site"] = rng.choice(n_site, n, p=pop / pop.sum())
    d["stype"] = site_type[d["site"]]
    d["device"] = rng.choice(3, n, p=[0.6, 0.3, 0.1])     # 0 スマートフォン 1 PC 2 タブレット
    d["size"] = rng.integers(0, 3, n)
    late = (d["day"] >= drift_day) if drift_day is not None else np.zeros(n, bool)
    n_ad_now = np.where(late, n_ad, 40)                   # 後半だけ新しい広告 40〜49 が出る
    d["ad"] = (rng.random(n) * n_ad_now).astype(int)
    d["visits"] = rng.choice(4, n, p=[0.4, 0.3, 0.2, 0.1])  # 過去の訪問の回数の区分
    eff_ad = np.where(late, ad_eff2[d["ad"]], ad_eff[d["ad"]])
    z = (-4.6 + site_eff[d["site"]] + eff_ad
         + 0.7 * ((d["stype"] == 1) & (d["device"] == 0))   # 組み合わせで効く関係
         - 0.5 * ((d["stype"] == 3) & (d["device"] == 1))
         + pair[ad_cat[d["ad"]], d["stype"]]
         + 0.15 * d["visits"] + 0.2 * (d["size"] == 2)
         + 0.25 * ((d["hour"] >= 19) & (d["hour"] <= 23)))
    d["click"] = (rng.random(n) < 1 / (1 + np.exp(-z))).astype(int)
    return d.sort_values("day", kind="stable").reset_index(drop=True)

log = make_log(200_000, 14, 20261116)
print("表示の件数", len(log), " クリック率", round(log["click"].mean(), 4))
print(log.groupby("device")["click"].mean().round(4).to_dict())
print(log.groupby("stype")["click"].mean().round(4).to_dict())
cnt = log["site"].value_counts()
print("掲載面の数", cnt.size, " 表示が100件未満の掲載面", int((cnt < 100).sum()))
実行すると、表示200,000件のクリック率は2.26%になりました。端末の種類ごとでは、スマートフォンが2.51%、PCが1.81%、タブレットが2.09%で、掲載面の種類ごとでは、Aが2.45%、Bが1.69%、Cが2.46%、Dが3.02%でした。掲載面の種類Bは平均では低いのに、スマートフォンとの組み合わせではクリックされやすく作ってあるので、種類ごとの平均だけを見ると関係が隠れます。掲載面400種類のうち172種類は、14日間の表示が100件に届きませんでした。人気のある少数の掲載面に表示が集まり、多くの掲載面は件数が少ないという形にしたのは、件数の少ない区分の扱いを確かめるためです。
項目そのままのモデルと、交差特徴を足したモデルを比べる
次に、各表示の項目を「項目名=値」の文字列にしてハッシュ化し、ロジスティック回帰で学習します。比べるのは、7つの項目をそのまま入れたモデルと、それに3つの交差特徴(掲載面×端末・掲載面の種類×端末・広告×掲載面の種類)を足したモデルです。学習には0〜10日目の157,119件を使い、評価には後の11〜13日目の42,881件を使いました。ランダムに切ると、同じ日の似た記録が学習と評価の両方に入り、後の日の成績を実際より良く見積もるおそれがあるので、時間で切っています。
from sklearn.feature_extraction import FeatureHasher
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import log_loss, roc_auc_score

BASE = ["hour", "site", "stype", "device", "size", "ad", "visits"]
CROSS = [("site", "device"), ("stype", "device"), ("ad", "stype")]

def to_tokens(df, cross):
    cols = {c: c + "=" + df[c].astype(str) for c in BASE}
    toks = [cols[c] for c in BASE]
    for a, b in cross:
        toks.append(a + "_x_" + b + "=" + df[a].astype(str) + "|" + df[b].astype(str))
    return [list(r) for r in zip(*toks)]

train, test = log[log["day"] <= 10], log[log["day"] >= 11]   # 時間で切る
print("学習", len(train), " 評価", len(test))

def fit_eval(cross, bits, C=0.3):
    h = FeatureHasher(n_features=2 ** bits, input_type="string")
    Xtr, Xte = h.transform(to_tokens(train, cross)), h.transform(to_tokens(test, cross))
    m = LogisticRegression(C=C, solver="liblinear", max_iter=200).fit(Xtr, train["click"])
    p = m.predict_proba(Xte)[:, 1]
    return log_loss(test["click"], p), roc_auc_score(test["click"], p), p.mean()

for name, cross in [("項目そのまま", []), ("交差特徴を追加", CROSS)]:
    ll, auc, pm = fit_eval(cross, 20)
    print(f"{name}: 対数損失 {ll:.5f}  AUC {auc:.4f}  予測の平均 {pm:.4f}")
print("評価期間のクリック率", round(test["click"].mean(), 4))
base = np.full(len(test), train["click"].mean())          # 学習期間の全体の率を毎回出すだけの予測
print(f"基準(学習期間の全体の率 {train['click'].mean():.4f} を毎回出す): 対数損失 {log_loss(test['click'], base):.5f}"
      f"  AUC {roc_auc_score(test['click'], base):.4f}")
正則化の強さを C = 0.3 に固定し、列の数を2の20乗にした結果を表にまとめます。対数損失の値の良し悪しを読むための基準として、何も学習せず、学習期間の全体のクリック率(0.0226)を毎回の予測として出すだけの場合の対数損失も並べました。
| モデル | 評価期間の対数損失 | 評価期間の AUC | 予測の平均 |
|---|---|---|---|
| 基準(学習期間の全体の率を毎回出す) | 0.10798 | 0.5000(全件が同じ予測) | 0.0226 |
| 項目そのまま | 0.10409 | 0.6635 | 0.0225 |
| 交差特徴を追加 | 0.10414 | 0.6669 | 0.0225 |
どちらのモデルも、基準の0.10798から対数損失を0.004ほど下げました。評価期間の実績のクリック率は0.0226で、どちらのモデルも予測の平均はほぼ合っていました。ただし、平均が合っていることは全体の確認にすぎず、予測の高い表示と低い表示のそれぞれで実績と対応しているか(較正の確認)は、本章では行っていません(第6章)。交差特徴を足すと AUC は0.6635から0.6669に上がりましたが、対数損失はわずかに悪くなりました(0.10409から0.10414)。組み合わせの関係を入れて作ったデータですが、C = 0.3 のままでは、交差特徴を足したモデルの対数損失は項目そのままのモデルより小さくなりませんでした。掲載面×端末の交差特徴は最大で1,200通り(400×3)の区分を作り、区分ごとの件数は少なくなります。そこで、件数の少ない区分の重みをどこまで抑えるかを決める正則化の強さを、選び直しました。
# 正則化の強さ C は、学習期間の中の後ろ3日(8〜10日目)で選ぶ。評価期間は使わない
fit_part, valid = train[train["day"] <= 7], train[train["day"] >= 8]
for name, cross in [("項目そのまま", []), ("交差特徴を追加", CROSS)]:
    h = FeatureHasher(n_features=2 ** 20, input_type="string")
    Xf, Xv = h.transform(to_tokens(fit_part, cross)), h.transform(to_tokens(valid, cross))
    scores = {}
    for C in [0.01, 0.03, 0.1, 0.3, 1.0]:
        m = LogisticRegression(C=C, solver="liblinear", max_iter=200).fit(Xf, fit_part["click"])
        scores[C] = log_loss(valid["click"], m.predict_proba(Xv)[:, 1])
    best = min(scores, key=scores.get)
    ll, auc, _ = fit_eval(cross, 20, C=best)
    print(name, {k: round(v, 5) for k, v in scores.items()})
    print(f"  選んだ C {best}  評価期間: 対数損失 {ll:.5f}  AUC {auc:.4f}")
C は、学習期間の中の前の0〜7日目で学習し、後ろの8〜10日目の対数損失が最も小さい値を選びました。評価期間(11〜13日目)は選ぶ作業に使っていません。結果は次のとおりです。
| モデル | 検証で選んだ C | 評価期間の対数損失 | 評価期間の AUC |
|---|---|---|---|
| 項目そのまま | 0.1 | 0.10402 | 0.6634 |
| 交差特徴を追加 | 0.1 | 0.10365 | 0.6721 |
検証用の期間では、どちらのモデルも C = 0.1 のときに対数損失が最も小さく(項目そのままは0.10483、交差特徴を追加は0.10445)、C = 0.1 で学習し直すと、交差特徴を足したモデルは対数損失・AUC の両方で項目そのままのモデルを上回りました。交差特徴は、正則化を合わせて調整したときに効いた、というのがこの例題での結果です。差が小さいので、掲載しないスクリプトで乱数の種を5通りに変えて、データを作り直して確かめました。C = 0.3 に固定した場合でも、5通りすべてで、交差特徴を足したモデルのほうが対数損失が小さく AUC が高くなりました。C = 0.3 で対数損失の上下が逆になったのは、主に使った種での結果だったことになります。確認の結果を表に示します(乱数の種は1〜5、データの作り方・学習と評価の切り方・列の数2の20乗・C = 0.3 は本文の例題と同じです)。
| 乱数の種 | 項目そのまま 対数損失 | 項目そのまま AUC | 交差特徴を追加 対数損失 | 交差特徴を追加 AUC |
|---|---|---|---|---|
| 1 | 0.08945 | 0.7082 | 0.08938 | 0.7095 |
| 2 | 0.08066 | 0.6716 | 0.08015 | 0.6863 |
| 3 | 0.08617 | 0.6234 | 0.08541 | 0.6463 |
| 4 | 0.07889 | 0.6868 | 0.07836 | 0.6962 |
| 5 | 0.10190 | 0.6876 | 0.10115 | 0.6985 |
この結果から言えるのは、交差特徴を足すかどうかは、正則化の強さと切り離して判断できないということです。交差特徴は区分を細かくするので、区分ごとの件数が減り、正則化が弱いと件数の少ない区分に引きずられます。どの組み合わせを作るかとあわせて、正則化の強さも検証用の期間で選び直す手順を、モデルを変えるたびに踏むのがよいと考えています。
ハッシュの大きさを変えたときの成績
続いて、ハッシュの列の数を2の6乗(64列)から2の20乗(約105万列)まで変えて、評価期間の対数損失と AUC を測りました。正則化の強さは C = 0.3 に固定しています。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

bits_list = [6, 8, 10, 12, 14, 16, 18, 20]
res = {"項目そのまま": [], "交差特徴を追加": []}
for bits in bits_list:
    for name, cross in [("項目そのまま", []), ("交差特徴を追加", CROSS)]:
        ll, auc, _ = fit_eval(cross, bits)
        res[name].append(ll)
        print(f"2の{bits}乗 {name}: 対数損失 {ll:.5f}  AUC {auc:.4f}")

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(bits_list, res["項目そのまま"], marker="o", color="#999999", label="項目そのまま")
ax.plot(bits_list, res["交差特徴を追加"], marker="o", color="#002E73", label="交差特徴を追加")
ax.set_xticks(bits_list, [f"2^{b}" for b in bits_list])
ax.set_xlabel("ハッシュの大きさ(特徴量の列の数)")
ax.set_ylabel("評価期間の対数損失(小さいほど良い)")
ax.legend(loc="upper right")
plt.savefig("../ch04_hash_size.png", dpi=120, bbox_inches="tight")
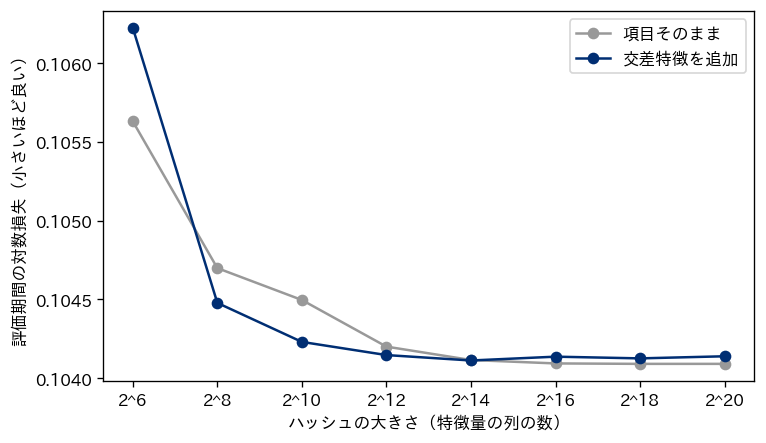
| 列の数 | 項目そのまま 対数損失 | 項目そのまま AUC | 交差特徴を追加 対数損失 | 交差特徴を追加 AUC |
|---|---|---|---|---|
| 2の6乗 | 0.10563 | 0.6295 | 0.10622 | 0.6091 |
| 2の8乗 | 0.10470 | 0.6494 | 0.10448 | 0.6537 |
| 2の10乗 | 0.10450 | 0.6542 | 0.10423 | 0.6618 |
| 2の12乗 | 0.10420 | 0.6608 | 0.10415 | 0.6661 |
| 2の14乗 | 0.10411 | 0.6630 | 0.10411 | 0.6669 |
| 2の16乗 | 0.10409 | 0.6634 | 0.10414 | 0.6668 |
| 2の20乗 | 0.10409 | 0.6635 | 0.10414 | 0.6669 |
(2の18乗の結果は、2の16乗・2の20乗とほぼ同じだったので表では省き、図には含めています。)列の数が64のときは衝突が多く、どちらのモデルも成績が下がりました。交差特徴を足したモデルは、64列では項目そのままのモデルより悪く(AUC 0.6091)、区分が多いほど衝突の害も大きいことが分かります。列の数を増やすと成績は良くなり、2の14乗(16,384列)あたりで頭打ちになりました。この例題の項目の値の種類は、交差特徴を含めても2,000通りに満たないので、それより十分に大きい列の数にすれば衝突の影響はほとんど消える、という結果です。実際の記録では、掲載面や広告の種類がずっと多く、交差特徴の組み合わせも増えるので、頭打ちになる列の数はこれより大きくなると考えられます。列の数は、検証用のデータで成績が頭打ちになる点と、重みを保存する記憶の制約を見比べて決め、評価用のデータは選んだあとの確認に使います。この表は評価期間(11〜13日目)で並べていますが、列の数による変わり方を見るためのもので、列の数を選ぶためのものではありません。
過去の実績の率を特徴量にするときの、情報の漏れと平滑化
掲載面や広告ごとの過去のクリック率は、少ない列で多くの情報を渡せる便利な特徴量です。一方で、作り方を誤ると成績が実際より良く見える原因になります。最もよくある誤りは、全期間の記録で掲載面ごとのクリック率を計算し、それを同じ期間の各表示の特徴量にすることです。その率には、予測しようとしている表示自身のクリックの有無が含まれているので、入札の時点で手に入らない情報が入力に入ります。これが情報の漏れで、評価用のデータの結果まで含めて率を計算すると、評価の成績も実際より良く見えます。入札の時点で手に入るのは、その表示より前の記録だけです。本章の例題では、各表示の率を「前日までの記録」だけで計算しました。評価期間の中でも、たとえば12日目の表示には11日目までの結果を使っています。本章の例題では、前日分のクリックの記録の取り込みが翌日の入札までに確定するものとしているので、これは漏れにはあたりません。実際の運用では、結果が起きた日時だけでなく、その記録が使えるようになった日時を基準に集計する必要があります。なお、各日の率の計算に使う全体の率は、前日までの記録が無い初日だけ、記録を見る前に決めた初期値(0.02)を使いました。
もう1つの問題は、件数の少ない区分の率がぶれることです。前日までに10回しか表示されていない掲載面で1回クリックされれば率は10%になり、1回もクリックされなければ0%になります。どちらも、その掲載面の本当のクリックのされやすさとはかけ離れているおそれがあります。そこで、件数の少ない区分の率を、全体の率に寄せる平滑化を行います。前日までの区分のクリックの件数を \( c \)、表示の件数を \( n \)、前日までの全体のクリック率を \( \bar{p} \) とすると、平滑化した率は \( (c + m\bar{p}) / (n + m) \) です。言葉で言えば、「全体の率で \( m \) 件ぶんの表示があったものとして足してから率を計算する」方法で、件数 \( n \) が \( m \) より十分に大きい区分は自分の実績の率に近く、件数の少ない区分は全体の率に近くなります。\( m \) を平滑化の強さと呼ぶことにします。この方法はベイズ推定の考え方(ベータ分布の事前分布を置いた推定)と対応しており、ベイズ推定の一般論は弊社コラム「ベイズ統計の考え方と使い方、MCMCから階層ベイズまで」で扱っています。
平滑化の効果を見るために、掲載面ごとの前日までの率をそのまま予測クリック率として使った場合の、評価期間(11〜13日目)の対数損失を、平滑化の強さごとに測りました。モデルを使わず、率だけで予測するという単純な比較です。評価期間で m を並べているのは平滑化の効き方を見るためで、m を選ぶためではありません。
def past_rate(df, key, prior_n, init=0.02):
    # init:初日は前日までの記録が無いので、記録を見る前に決めた初期値を使う
    # 各表示の「前日までの記録」だけで、区分ごとのクリック率を計算する
    g = df.groupby(["day", key])["click"].agg(["sum", "count"]).reset_index()
    g = g.sort_values([key, "day"])
    g[["cs", "cn"]] = g.groupby(key)[["sum", "count"]].cumsum().values
    g["cs"] -= g["sum"]
    g["cn"] -= g["count"]                                  # 当日の分を除く
    day_tot = df.groupby("day")["click"].agg(["sum", "count"]).cumsum().shift(1)
    g = g.merge(day_tot.rename(columns={"sum": "ts", "count": "tn"}), on="day")
    prior = (g["ts"] / g["tn"]).fillna(init)               # 前日までの全体の率
    g["rate"] = (g["cs"] + prior_n * prior) / (g["cn"] + prior_n).where(g["cn"] + prior_n > 0, 1)
    g.loc[(g["cn"] == 0) & (prior_n == 0), "rate"] = prior
    out = df.merge(g[["day", key, "rate", "cn"]], on=["day", key], how="left")
    return out["rate"].clip(1e-4, 0.5).values, out["cn"].values

y_te = test["click"].values
for prior_n in [0, 50, 200, 1000]:
    r, n_past = past_rate(log, "site", prior_n)
    r_te, n_te = r[log["day"] >= 11], n_past[log["day"] >= 11]
    few = n_te < 300
    print(f"平滑化の強さ {prior_n:>4}: 対数損失 全体 {log_loss(y_te, r_te):.5f}"
          f"  前日までの表示が300件未満の掲載面 {log_loss(y_te[few], r_te[few]):.5f}"
          f"  ({few.sum()}件)")
| 平滑化の強さ m | 評価期間全体の対数損失 | 前日までの表示が300件未満の掲載面(8,505件)の対数損失 |
|---|---|---|
| 0(平滑化なし) | 0.10771 | 0.12804 |
| 50 | 0.10577 | 0.11857 |
| 200 | 0.10544 | 0.11708 |
| 1000 | 0.10560 | 0.11692 |
前の節の基準(学習期間の全体の率を毎回出す)の対数損失は0.10798でした。平滑化をしない場合は、評価期間全体で0.10771と基準とほとんど変わらず、件数の少ない掲載面だけでは0.12804と、どの平滑化よりも悪くなりました。平滑化なしでは、前日までにクリックが0件の掲載面の率が0(計算では下限の0.0001に切り詰め)になり、そこでクリックが起きると対数損失が非常に大きくなるためです。評価期間全体では m = 200 が最も良く、件数の少ない掲載面だけでは m = 1000 がわずかに良い結果でした。強く寄せるほど件数の少ない区分は安定しますが、件数の多い区分の個性も薄まるので、全体ではどこかに最も良い強さがあります。m も、評価期間ではなく検証用の期間で選ぶ値です。
次に、情報の漏れがどう見えるかを確かめました。掲載面ごとの率を、その表示自身や後の日の結果まで含めて計算した場合(漏れあり)と、前日までの記録だけで計算した場合(漏れなし。どちらも平滑化の強さ m = 200)を作り、それぞれの率を1つだけの特徴量にしたロジスティック回帰を、学習期間(0〜10日目)で学習しました。漏れありの側は、学習期間の率は学習期間の全記録から、評価期間の率は評価期間の結果まで含めた全記録から計算しています。
# 漏れのある率:その表示自身や後の日の結果も含めて計算した掲載面ごとの率(平滑化の強さ 200)
def whole_rate(df, prior_n=200):
    s = df.groupby("site")["click"].agg(["sum", "count"])
    r = (s["sum"] + prior_n * df["click"].mean()) / (s["count"] + prior_n)
    return df["site"].map(r).values

def logit(p):
    return np.log(p / (1 - p)).reshape(-1, 1)

is_te = (log["day"] >= 11).values
y_tr = log.loc[~is_te, "click"].values
ok_rate, _ = past_rate(log, "site", 200)                    # 前日までの記録だけで計算した率
leak_tr = whole_rate(log[~is_te])                          # 学習期間の全記録(その表示自身を含む)
leak_te = whole_rate(log)[is_te]                           # 評価期間の結果まで含む
m_leak = LogisticRegression().fit(logit(leak_tr), y_tr)
m_ok = LogisticRegression().fit(logit(ok_rate[~is_te]), y_tr)
print(f"漏れのある率で学習・漏れのある率で評価: 対数損失 {log_loss(y_te, m_leak.predict_proba(logit(leak_te))[:, 1]):.5f}")
print(f"漏れのある率で学習・前日までの率で予測: 対数損失 {log_loss(y_te, m_leak.predict_proba(logit(ok_rate[is_te]))[:, 1]):.5f}")
print(f"前日までの率で学習・前日までの率で予測: 対数損失 {log_loss(y_te, m_ok.predict_proba(logit(ok_rate[is_te]))[:, 1]):.5f}")
| 学習に使った率 | 評価期間の予測に使った率 | 評価期間の対数損失 |
|---|---|---|
| 漏れあり | 漏れあり(評価の結果まで含む) | 0.10441 |
| 漏れあり | 前日までの率(入札の時点で使える率) | 0.10557 |
| 前日までの率 | 前日までの率 | 0.10545 |
漏れのある率で評価すると対数損失は0.10441で、前日までの率で学習・予測した場合(0.10545)より良く見えました。しかし、入札の時点では評価期間の結果は分からないので、配信で使えるのは前日までの率です。漏れのある率で学習したモデルに前日までの率を入れると0.10557になり、最初から前日までの率で学習した場合よりわずかに悪くなりました。この例題では、漏れのある評価は、配信の時点で得られる成績を0.001ほど良く見せていたことになります。差の大きさはデータによって変わり、この章ではこの1通りしか測っていません。
過去の実績の率を特徴量にするときの手順として、次の3つを挙げます。このうち、本章で比べたのは1つ目(漏れのある率との比較)と2つ目(平滑化の強さ)です。3つ目の計算の窓は動かしておらず、一般的な注意として挙げています。
- 各表示の率は、その表示より前の記録だけで計算する(全期間で計算した率を使わない)
- 件数の少ない区分の率は、上位の区分(全体・掲載面の種類など)の率に寄せる
- 計算の窓(何日前までを使うか)と平滑化の強さは、評価期間とは別の検証用の期間で選ぶ
なお、計測期間の終わっていないコンバージョンの率を特徴量にする場合は、直近の日の率が実際より低く出るという別の問題が加わります。遅れて届くコンバージョンの扱いは第5章で扱います。
逐次学習、新しいデータが届くたびに更新する
広告や掲載面の顔ぶれは日々入れ替わり、同じ広告でも時間がたつと反応が変わります。1回学習したモデルを使い続けると、学習した時点の関係と今の関係がずれていきます。この問題への対処の1つが逐次学習で、新しい記録が届くたびに、それまでの重みを出発点にして少しずつ更新します。前に触れた McMahan らの2013年の論文で使われた FTRL-Proximal も、この逐次学習の手法の1つです。本章の例題では、scikit-learn の SGDClassifier(確率的勾配降下法で学習する線形のモデル。損失を対数損失にするとロジスティック回帰と同じ形になる)の partial_fit を使い、日ごとに更新します。FTRL-Proximal は本章では実行していません。公式ドキュメントによれば、partial_fit は渡した記録で確率的勾配降下法を1周だけ行うもので、収束や学習率の調整は使う側が扱う前提になっています。
比べるために、前の例題とは別に、28日間の表示280,000件の架空の記録を作りました(乱数の種は20261117)。14日目から、40本の広告のうち20本の反応が変わり、新しい広告10本(広告40〜49)が出始めるように作っています。どちらの方法も、0〜6日目の記録で同じように学習を始め、7日目以降は、毎日その日の記録で評価してから、日ごとに更新する方は評価のあとにその日の記録で更新します。評価に使う日の記録で先に学習しないように、評価と更新の順番を固定しています。
from sklearn.linear_model import SGDClassifier

log2 = make_log(280_000, 28, 20261117, drift_day=14)
h = FeatureHasher(n_features=2 ** 18, input_type="string")
X2 = h.transform(to_tokens(log2, CROSS))
y2, day2 = log2["click"].values, log2["day"].values

online = SGDClassifier(loss="log_loss", alpha=1e-5, random_state=0)
first = day2 <= 6
for _ in range(3):
    online.partial_fit(X2[first], y2[first], classes=[0, 1])
import copy
static = copy.deepcopy(online)                             # 1回だけ学習して使い続ける

rows = []
p_s, p_o = np.full(len(y2), np.nan), np.full(len(y2), np.nan)
for d in range(7, 28):
    idx = day2 == d
    p_s[idx] = static.predict_proba(X2[idx])[:, 1]
    p_o[idx] = online.predict_proba(X2[idx])[:, 1]
    rows.append((d, log_loss(y2[idx], p_s[idx], labels=[0, 1]),
                 log_loss(y2[idx], p_o[idx], labels=[0, 1])))
    online.partial_fit(X2[idx], y2[idx])                   # 評価のあとで当日分を学習
r2 = pd.DataFrame(rows, columns=["day", "static", "online"])
for a, b in [(7, 13), (14, 20), (21, 27)]:
    i = (day2 >= a) & (day2 <= b)                          # 期間の全表示をまとめて計算する
    print(f"{a}〜{b}日目 対数損失 固定 {log_loss(y2[i], p_s[i]):.5f}  日ごとに更新 {log_loss(y2[i], p_o[i]):.5f}")

for a, b in [(0, 13), (14, 27)]:
    print(f"{a}〜{b}日目のクリック率", round(y2[(day2 >= a) & (day2 <= b)].mean(), 4))

gap = r2["static"] - r2["online"]                          # 正なら更新したほうが良い
fig, ax = plt.subplots(figsize=(7, 4))
ax.bar(r2["day"], gap, color=np.where(gap > 0, "#002E73", "#999999"))
ax.axhline(0, color="#333333", linewidth=0.8)
ax.axvline(13.5, color="#666666", linestyle=":")
ax.set_xlabel("日(14日目から広告の反応の一部が変わり、新しい広告が出る)")
ax.set_ylabel("対数損失の差(固定 - 日ごとに更新)")
ax.text(14.3, gap.min() * 0.85,"上向きの棒=日ごとに更新したほうが良い日", color="#002E73")
plt.savefig("../ch04_online.png", dpi=120, bbox_inches="tight")
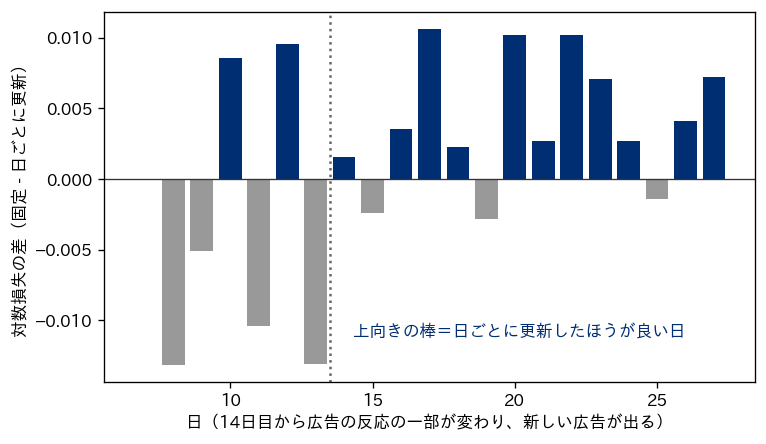
| 期間 | 1回だけ学習して使い続ける(期間の全表示の対数損失) | 日ごとに更新する(期間の全表示の対数損失) |
|---|---|---|
| 7〜13日目(変化の前) | 0.12977 | 0.13318 |
| 14〜20日目(変化の直後) | 0.11796 | 0.11471 |
| 21〜27日目 | 0.12262 | 0.11798 |
変化の前の7〜13日目では、日ごとに更新するモデルのほうが対数損失が大きく、1回だけ学習したモデルに負けました。図でも、14日目より前は棒が上下に振れています。なお、7日目は評価の時点でどちらのモデルもまだ同じ重みなので、差は0になり、図に棒がありません。変化の前に更新するほうが負けた理由は、確かめていません。14日目以降は、多くの日で日ごとに更新するモデルのほうが良く、14〜20日目では0.11796に対して0.11471、21〜27日目では0.12262に対して0.11798でした(表の値は、期間の中の全表示をまとめて計算した対数損失です)。1回だけ学習したモデルは、新しい広告10本について学習しておらず、反応が変わった20本についても古い重みのままです。これらが差に影響した可能性がありますが、更新する側は学習に使う記録の量も増えており、要因ごとの寄与は切り分けていません。なお、14日目以降は全体のクリック率も変わり(0〜13日目は2.44%、14〜27日目は2.23%)、対数損失の水準そのものは日によって上下するので、図では同じ日の2つのモデルの差を示しました。
乱数の種を3通りに変えて作り直した記録(掲載しないスクリプト)では、3通りとも、変化の前を含むすべての期間で日ごとに更新するモデルのほうが良い結果でした。変化の前の期間で更新するほうが負けたのは、主に使った種での結果で、常に起きることではありません。変化の後で更新するほうが良かったことは、4通りすべてで共通していました。確認に使った乱数の種は11〜13で、データの作り方・初めの学習・評価と更新の順番は本文の例題と同じです。
| 乱数の種 | 7〜13日目 固定 | 7〜13日目 更新 | 14〜20日目 固定 | 14〜20日目 更新 | 21〜27日目 固定 | 21〜27日目 更新 |
|---|---|---|---|---|---|---|
| 11 | 0.12119 | 0.11515 | 0.12282 | 0.11122 | 0.12672 | 0.11092 |
| 12 | 0.13810 | 0.12507 | 0.12656 | 0.10821 | 0.12788 | 0.10399 |
| 13 | 0.13004 | 0.10961 | 0.11849 | 0.09366 | 0.11958 | 0.09393 |
(表の値は、期間の全表示をまとめて計算した対数損失。固定は1回だけ学習して使い続けるモデル、更新は日ごとに更新するモデル。)比べたのは「更新しない」と「日ごとに更新する」の2つだけで、週ごとの更新や、直近の一定期間で学習し直す方法とは比べていません。実際の運用では、更新の頻度だけでなく、1回の更新でどれだけ重みを動かすか(学習率)や、古い記録をどれだけ残すかも合わせて調整します。更新したモデルが悪くなっていないかを確かめてから入れ替える仕組みや、更新を止める条件の設計は、本コラムでは詳しく扱いません(要点は、後の経営の判断の表の「入れ替えの条件」の行に挙げます)。
新しい広告・新しい掲載面と、表示の位置による偏り
逐次学習で更新しても、新しい広告や掲載面の最初の表示では、その値そのものについてはまだ何も学習していません。ハッシュ化したロジスティック回帰では、新しい値が既存の特徴と同じ列に衝突すれば、その列の学習済みの係数が使われます。衝突の無い未学習の列であれば寄与は0になり、予測は、掲載面の種類・端末・時間帯といった既に学習した他の特徴から作られます。この予測は、その区分の実績の平均や前の節の平滑化した率と一致するとは限りませんが、情報の少ない区分を共通の情報で補うという発想は平滑化と似ています。広告の種類のような粗い区分を入力に加える方法もあります(本章の例題の入力には入れていません)。粗い区分の項目を、細かい区分の項目と並べて特徴量に入れておくことが、新しい値への備えになります。
ただし、予測が平均的な水準から始まるだけでは、本当は反応の良い新しい広告が、予測が低いために入札で負け、表示の機会を得られず、実績も積み上がらない、という循環が起きえます。実績が無いものにあえて表示の機会を回して情報を集める考え方を探索と呼び、どれだけ探索に回すかは費用とのつり合いの問題になります。探索と活用の配分は第10章で扱います。
表示の位置による偏りも、記録からそのまま学習すると誤りの原因になります。検索結果の上の枠やページの目立つ位置に出た広告は、広告の中身にかかわらずクリックされやすくなります。記録上でクリック率が高い広告が、良い広告だからクリックされたのか、良い位置に出たからクリックされたのかは、位置を考えずに集計すると区別できません。位置を特徴量に入れて学習し、予測するときには位置の影響を分けて扱う(例えば、広告どうしを比べるときは同じ位置を仮定して予測する)という考え方があります。ただし、位置は多くの場合オークションの結果で決まるので、入札の時点では分かっていません。学習に位置を使う場合も、予測では位置をある値に固定するなどの扱いが要り、入札の時点で手に入る情報だけを使うという原則と食い違わないようにする必要があります。本章の例題のデータには位置の項目が無く、この扱いは実行していません。位置の影響の大きさを記録だけから正しく見積もれるかどうかは、どの位置にどの広告が出たかの決まり方に依存し、位置が予測の高さで決まっている場合には、位置の効果と広告の良さが混ざります。この点の一般論は、選択の偏りとして第11章で扱います。
研究の例として、Chapelle、Manavoglu、Rosales の2014年の論文(ディスプレイ広告の反応の予測を、単純で大規模に扱える形で述べた論文。ACM の知的システムと技術に関する論文誌の第5巻第4号)は、題名のとおり、ディスプレイ広告のクリックやコンバージョンといった反応の予測を、大規模なデータで扱う方法を論じた研究です。研究の数字は、その論文のデータとその条件での値で、読者の広告で期待できる成績ではありません。
経営の判断、予測の入力にするデータと更新の頻度を決める
この章の例題の範囲では、同じロジスティック回帰の中でも、特徴量の作り方・正則化・更新の仕方で成績が動きました。差は小さいものでしたが、情報の漏れのように評価の数字だけを良く見せるものもあり、関係が変わったあとは更新しないモデルとの差が開きました。経営の側で決めておくべきなのは、予測の入力にするデータを誰が持ち、どの頻度で更新し、更新したモデルを誰が確かめるかです。媒体の自動入札は、広告主の設定した目標に合わせて機会ごとの入札額を自動で決める機能で、その内部でどのような予測をしているかは、本コラムでは推測しません。その場合でも、何をコンバージョンとし、どう計測するか(第2章)は広告主が決めることなので、データの責任者を決めておく意味は変わりません。DSP や自社の仕組みで予測を持つ場合は、記録の取り込みから学習・評価・入れ替えまでの流れ全体に担当者が要ります。
この判断を誤ったときの損失は、本コラムの6つの型で整理できます。古いモデルを使い続けて予測が実態からずれれば、価値の低い表示を高く買う払いすぎと、価値の高い表示を買い逃す機会損失の両方が起きる場合があります。全期間で計算した実績の率のような情報の漏れを含む特徴量は、本章の例題では、評価の成績を配信の時点で得られる成績より良く見せました。評価の数字だけを見て判断すると、予算の配分を誤るおそれがあります。誰も評価の切り方や更新の状況を確かめていなければ、設定と実態のずれに気づけない形骸化に陥ります。利用者の情報を予測の入力に使う範囲を決めずに項目を増やせば、利用者の理解や期待に反する情報の利用として信頼の毀損や、規制上の義務の不履行につながるおそれがあります(第14章)。予測に使うコンバージョンの記録に重複や欠落があれば、広告に割り振られたコンバージョンの数が多くも少なくもずれ、それを広告で増えた分と取り違える成果の数え違いにもつながります。
| 決めること | 決める内容の例 | 関わる損失の型 |
|---|---|---|
| 入力にするデータの範囲 | 入札の時点で手に入る項目だけを使う。利用者の情報のうち使ってよい項目を、法務と合わせて決める | 形骸化・規制上の義務の不履行・信頼の毀損 |
| データの持ち主と責任者 | 配信の記録・コンバージョンの記録・自社の売上の記録を、誰が管理し、誰が結びつけるか。コンバージョンの記録の重複や欠落を誰が点検するか | 形骸化・成果の数え違い |
| 更新の頻度 | 日ごと・時間ごと・週ごとのどれで更新するか。新しい広告や掲載面が多い期間は頻度を上げるか | 払いすぎ・機会損失 |
| 評価の方法 | 時間で切った評価用のデータで、対数損失と AUC を基準の予測と並べて確かめる。予測の平均は全体の確認にすぎないので、予測が同じくらいの表示を集めて実績の率と比べる較正の確認(第6章)も行う。正解率は使わない | 形骸化(評価の数字を信じた配分の誤り) |
| 入れ替えの条件 | 更新したモデルが前のモデルより悪いときは入れ替えない。悪化に気づいたら誰が止めるか | 払いすぎ・形骸化 |
これらは、モデルの技術の話というより、データと仕事の流れの設計の話です。予算の規模が大きいほど、予測のずれが費用に与える影響も大きくなるので、更新と確認に担当と時間を割り当てることを、広告の予算の一部として考えるのがよいと考えています。
この章では、予測クリック率が入札額と媒体の順位づけの両方に入ることを見たうえで、本章の架空のデータで、次のことを1つずつ比べて確かめました。交差特徴は、正則化の強さを選び直したときに成績を上げましたが、差は小さく、その向きは正則化の強さや乱数の種で変わりえました。ハッシュの列の数が少なすぎると、衝突で成績が下がりました。平滑化は、件数の少ない掲載面の率を安定させました。漏れのある率は、評価の成績だけを良く見せました。これらを組み合わせたモデルの実験はしていません。また、関係が途中で変わるデータでは、日ごとに更新するモデルが1回だけ学習したモデルを上回りました。次の第5章では、組み合わせを自動で拾う勾配ブースティングでクリック率とコンバージョン率を予測する方法と、遅れて届くコンバージョンへの対応を説明します。
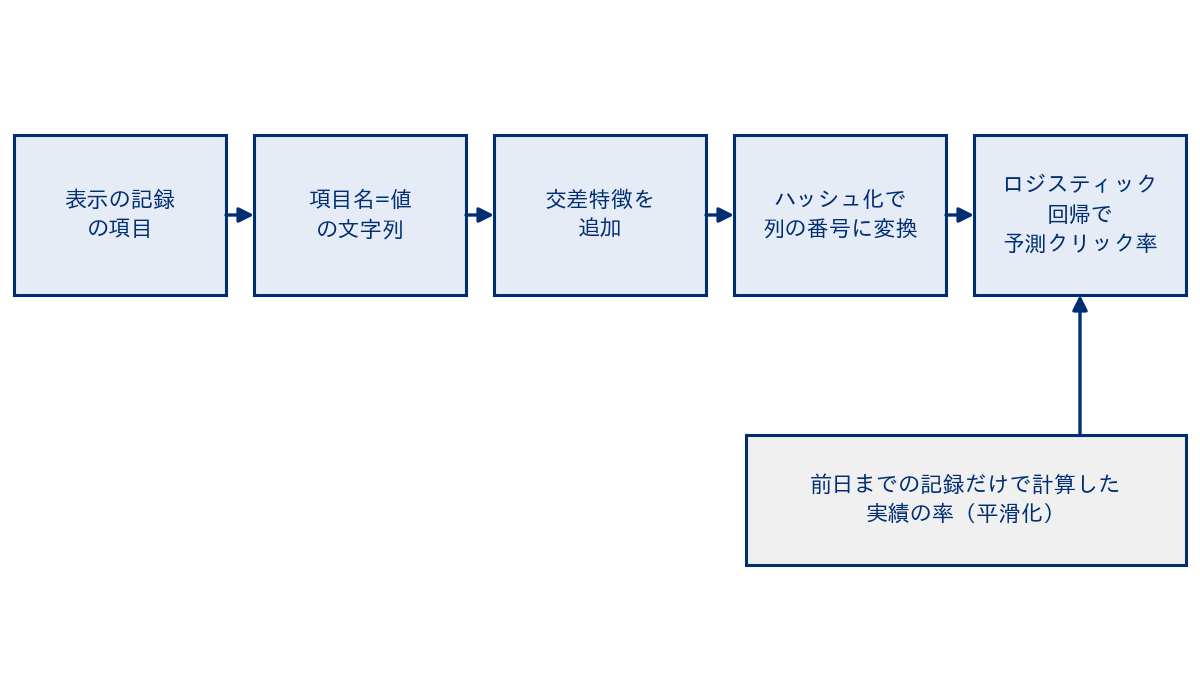
この章を深めたい方への参考書籍
『機械学習のための特徴量エンジニアリング:その原理とPythonによる実践』(Alice Zheng、Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン):カテゴリ変数の章で、One-Hot エンコーディングと、膨大なカテゴリ数の扱いとしての特徴量ハッシングとビンカウンティングを節に立てており、本章の特徴量の表と対応します。別の章には、ロジスティック回帰の正則化による調整の節もあります。
『ロジスティック回帰分析:SASを利用した統計解析の実際』新版(丹後俊郎、山岡和枝、高木晴良 著、朝倉書店):副題のとおり、統計解析のソフトウェアを使ったロジスティック回帰分析の実際を扱う本です。本章では予測の道具として使ったロジスティック回帰を、統計解析の立場から確かめたいときの土台になります。
第5章 機械学習によるクリック率とコンバージョン率の予測、勾配ブースティングと遅れて届く結果
第4章では、ロジスティック回帰で予測クリック率を作る方法と、カテゴリの項目をハッシュ化したり、項目どうしの組み合わせを交差特徴として足したりする特徴量の作り方を扱いました。ロジスティック回帰は、出力が確率の形で出る・学習が速い・逐次に更新できるという利点がある一方で、どの組み合わせが効くかを人が見つけて特徴量にしなければ、組み合わせの効果を拾えません。この章では、その組み合わせを自動で拾う手法として、決定木を多数つなげる勾配ブースティングを取り上げ、クリック率とコンバージョン率の予測に使うときの利点と負担を、実行したコードと結果で確かめます。
この章で扱うのは次の内容です。
- 勾配ブースティングを広告の反応の予測に使う動機と、学習・推論・更新の負担
- ロジスティック回帰・勾配ブースティング・因子分解機・深層学習のモデルの比較
- 架空の表示の記録での、ロジスティック回帰と勾配ブースティングの比較(時間で切った評価)
- 決定木の出力をロジスティック回帰の入力にする組み合わせ
- 負例の間引きと、間引いた分だけ高く出る予測の補正
- コンバージョン率の予測の難しさと、遅れて届くコンバージョンの扱い
- コンバージョンの価値が件ごとに違う場合、過学習の点検、更新の頻度、推論の時間の制約
- 経営の判断:成績の差と運用の負担の差を並べて選ぶ
先に、この章の結果の要点を書いておきます。本コラムの架空データでは、勾配ブースティングは全体の対数損失と AUC ではロジスティック回帰をわずかに上回るだけでしたが、項目の組み合わせで反応が変わる区分ごとに予測の平均と実績を比べると、ロジスティック回帰のずれが大きく、勾配ブースティングのずれは小さくなりました(乱数の種を10通りに変えると、勾配ブースティングでもずれが大きくなる回がありましたが、区分ごとの比の中央値で見ると、6つの区分すべてで勾配ブースティングのほうが1に近い値でした)。また、結果がまだ出そろっていない直近のクリックを「コンバージョンしなかった」として学習すると、予測コンバージョン率が低く出ました。どちらも、全体の指標を1つ見るだけでは見落としやすい点です。
勾配ブースティングを広告の反応の予測に使う動機と負担
決定木は、「掲載面がCか」「端末がスマートフォンか」のような条件で記録を順に分けていき、分けた先の区分ごとに予測の値を持つモデルです。1本の木は、条件を重ねることで項目の組み合わせを表せます。たとえば「掲載面がCで、かつ端末がスマートフォン」という区分を、木の枝の分かれ方そのもので表現できます。ただ、1本の木だけでは予測が粗く、学習に使った記録の偶然のばらつきにも合わせてしまいがちです。
勾配ブースティングは、小さな決定木を1本ずつ足していき、それまでの木の予測で外れていた部分を次の木で少しずつ直していく方法です。クリックの有無のような2値の結果では、予測の確率の対数オッズを木の出力の合計で表し、対数損失が小さくなる向きに次の木を作ります。木を足す数(木の本数)と、1本の木が直す量(学習率)、木の大きさ(葉の数)などを決めて使います。広告の反応の予測に使う動機は、項目の組み合わせの効果や、「直近の訪問から1日未満なら高い」のような段差のある関係を、人が特徴量として書き出さなくても木が拾えることにあります。
一方で、負担もあります。1つ目は学習の時間で、木を1本ずつ順に作るため、件数と木の本数が増えると時間が延びます。2つ目は更新のしかたで、第4章で扱ったロジスティック回帰の逐次学習のように、新しい記録が届くたびに少しずつ係数を直す使い方は、決定木を足していく方法では同じ形にはならず、木を足し続ける方法や学習し直す方法があります。実装によって違いはありますが、一般には一定の期間ごとに学習し直す運用がよく採られます。3つ目は推論の時間で、入札には応答の時間の制限があるため(第1章)、表示の機会1回ごとにすべての木をたどる計算が、その制限の中に収まるかを確かめる必要があります。4つ目は説明のしやすさで、係数を1つずつ読めるロジスティック回帰に比べ、どの項目がどう効いたかを読み取るには別の手法が要ります(説明の手法は弊社コラム「AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド」へ)。
機械学習の手法の一般的な性質(過学習・正則化・評価用のデータの分け方など)は、弊社コラム「機械学習の仕組みと使いどころ」で扱っています。この章では、広告の反応の予測に特有の点、すなわち反応の率が低いこと、記録の件数が多いこと、結果が遅れて届くこと、入札の時点で使える情報が限られることに絞って書きます。
手法の比較、ロジスティック回帰・勾配ブースティング・因子分解機・深層学習
クリック率やコンバージョン率の予測に使われる手法を、本コラムの観点で並べると次の表のようになります。因子分解機と深層学習のモデルは、本コラムでは実行しません。表の内容は、それぞれの手法の一般的な性質と、下に挙げた論文の書誌と要旨を確かめた範囲です。どの手法が優れているかは、データの量と性質、更新の頻度、推論にかけられる時間で変わるため、表は優劣ではなく、選ぶときに比べる項目を整理したものです。
| 手法 | 組み合わせの効果の扱い | 学習と更新 | 推論の重さ | 本コラムでの扱い |
|---|---|---|---|---|
| ロジスティック回帰 | 人が交差特徴として書き出した組み合わせだけを拾う | 学習が速く、逐次に更新しやすい | 軽い(係数の和) | 第4章と本章で実行 |
| 勾配ブースティング | 木の分かれ方で組み合わせや段差を自動で拾う | 木を順に作るので件数とともに時間が延びる。期間ごとに学習し直す運用がよく採られる | 木の本数と深さが増えるほど重くなる | 本章で実行(LightGBM) |
| 因子分解機(FM)とその発展 | 本コラムでは扱わない(論文の書誌のみ確認) | 本コラムでは扱わない | 本コラムでは扱わない | 名前の紹介のみ |
| 深層学習のモデル | 項目を低次元のベクトルに置き換え、組み合わせを学習で表す | 大量のデータと計算の環境が要る | 重くなりやすい | 紹介のみ |
因子分解機は、Rendle の2010年の論文(2010年の IEEE のデータマイニングの国際会議で発表)で示されたモデルの名前です。本コラムでは書誌を確かめた範囲で名前を紹介するにとどめ、中身の詳細には踏み込みません。深層学習のモデルの例としては、Cheng らの2016年の論文(推薦の深層学習の第1回ワークショップで発表)があります。この論文の要旨によれば、交差特徴を持つ線形のモデル(wide の部分)と、疎な項目を低次元のベクトルに置き換えるニューラルネットワーク(deep の部分)を同時に学習させ、Google Play というアプリの配布の場で配信して、オンラインの実験でアプリの導入が、どちらか片方だけのモデルより大きく増えたと報告しています。これはその場・その条件での報告で、広告の配信一般に同じ効果が出ることを示すものではありません。推薦の手法との関係は、弊社コラム「顧客に合った商品を届けるレコメンドの実践ガイド、協調フィルタリングから推薦の評価と運用まで」で扱っています。
本章で勾配ブースティングの実装に使ったのは LightGBM 4.6.0 です。scikit-learn 1.9.0 にも、同じ考え方の HistGradientBoostingClassifier があります。どちらを使っても、本章で述べる「時間で切って評価する」「区分ごとに予測と実績を比べる」「入札の時点で手に入らない情報を入力に入れない」という点は変わりません。
架空の表示の記録で、ロジスティック回帰と勾配ブースティングを比べる
ここからは、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの成績は、実際の配信での成績の目安にはなりません。示したいのは、同じ記録でも、モデルの形と評価のしかたで、見える結果がどう変わるかという点です。コードは Python 3.14.3 で実行しました。本章の例題では、落札した機会はすべて表示されたものとし、表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件として扱います。
この例題では、21日間の表示20万件を、次の性質を持たせて乱数で作りました(乱数の種は20261116に固定しています)。
- 表示の機会の属性:掲載面(AからJの10種類。件数の多い面と少ない面がある)・端末の種類(スマートフォン・PC・タブレット)・広告枠の種類(小・中・大・動画)・時刻・曜日
- 利用者の側の特徴にあたる項目:過去の訪問の回数・直近の訪問からの日数(個人を特定する項目や、差別につながる属性は入れていません)
- クリック率の水準:全体で2%弱。掲載面・広告枠の種類で違い、動画の枠や大きな枠で高い
- 段差のある関係:直近の訪問から1日未満で高く、30日を超えると低い
- 項目どうしの組み合わせ:掲載面CとFは、スマートフォンでは高く、PCでは低い。夜の21時から23時のスマートフォンでも高い
入力に使う項目は、すべて入札の時点で分かるもの(どの掲載面の、どの枠の、どの端末の、いつの機会か、利用者の過去の訪問の回数と直近の訪問からの日数)に限りました。その表示がクリックされたかどうかは、入札の時点では分からない結果なので、予測の対象としてだけ使います。学習用は0〜13日目、勾配ブースティングの木の本数を決める検証用は14〜16日目、成績を測る評価用は17〜20日目と、時間で切りました。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

# ---- 1. 架空の表示の記録を作る(21日分・20万件) ----
def make_impressions(seed, n=200_000):
    rng = np.random.default_rng(seed)
    sites = np.array(list("ABCDEFGHIJ"))
    site_p = np.array([.20, .16, .14, .12, .10, .09, .08, .06, .03, .02])
    site_eff = dict(zip(sites, [0.0, -0.3, 0.2, -0.5, 0.4, 0.1, -0.2, 0.3, 0.6, -0.6]))
    hp = np.r_[np.full(7, 1.0), np.full(14, 3.5), np.full(3, 3.0)]
    df = pd.DataFrame({
        "day": rng.integers(0, 21, n),
        "hour": rng.choice(24, n, p=hp / hp.sum()),
        "site": rng.choice(sites, n, p=site_p),
        "device": rng.choice(["スマートフォン", "PC", "タブレット"], n, p=[.6, .3, .1]),
        "slot": rng.choice(["小", "中", "大", "動画"], n, p=[.4, .3, .2, .1]),
        "visits": rng.poisson(rng.gamma(1.0, 3.0, n)),
        "days_since": rng.exponential(10.0, n),
    })
    df["weekday"] = df["day"] % 7
    z = (-4.6 + df["site"].map(site_eff)
         + df["device"].map({"スマートフォン": 0.1, "PC": 0.0, "タブレット": -0.2})
         + df["slot"].map({"小": -0.3, "中": 0.0, "大": 0.3, "動画": 0.5})
         + 0.15 * np.log1p(df["visits"])
         + np.select([df["days_since"] < 1, df["days_since"] < 7, df["days_since"] > 30], [0.5, 0.2, -0.3], 0.0)
         + 0.1 * (df["weekday"] >= 5))
    # 組み合わせで効く関係:掲載面C・Fはスマートフォンで高く、PCで低い
    cf = df["site"].isin(["C", "F"])
    z += 0.9 * (cf & (df["device"] == "スマートフォン")) - 0.6 * (cf & (df["device"] == "PC"))
    # 夜(21〜23時)のスマートフォンで高い
    z += 0.4 * ((df["hour"] >= 21) & (df["device"] == "スマートフォン"))
    df["click"] = rng.binomial(1, 1 / (1 + np.exp(-z)))
    return df

df = make_impressions(20261116)
cat_cols = ["site", "device", "slot", "hour", "weekday"]
num_cols = ["visits", "days_since"]
train = df[df["day"] <= 13]
valid = df[(df["day"] >= 14) & (df["day"] <= 16)]
test = df[df["day"] >= 17]
print("件数 学習", len(train), "検証", len(valid), "評価", len(test))
print("クリック率(実績) 学習 %.4f 評価 %.4f" % (train["click"].mean(), test["click"].mean()))
# 出力:
# 件数 学習 133451 検証 28531 評価 38018
# クリック率(実績) 学習 0.0188 評価 0.0195
学習用は133,451件、検証用は28,531件、評価用は38,018件で、実績のクリック率は学習用で1.88%、評価用で1.95%でした。次に、2つのモデルを学習させます。ロジスティック回帰には、カテゴリの項目を one-hot(種類ごとに0か1の列を作る方法)にし、訪問の回数と直近の訪問からの日数は対数をとって入れました。交差特徴は足していません。第4章で扱ったように交差特徴を人が書き出せばロジスティック回帰も組み合わせを拾えますが、ここでは「人が組み合わせを書き出さなかった場合」に2つのモデルがどう違うかを見るため、あえて項目をそのまま入れています。勾配ブースティングには同じ項目を、掲載面・端末の種類・広告枠の種類はカテゴリとして(候補の一覧は学習期間の記録だけから作りました)、時刻・曜日は整数として、訪問の回数と直近の訪問からの日数は数値として渡し、木の本数は検証用の日の対数損失が50本続けて下がらなくなったところで止める方法(早期終了)で決めました。
import time
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib
import lightgbm as lgb
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import OneHotEncoder
from sklearn.metrics import log_loss, roc_auc_score

# ---- 2. ロジスティック回帰(項目をそのまま入れる。交差特徴なし) ----
enc = OneHotEncoder(handle_unknown="ignore")
def lr_x(d):
    from scipy.sparse import hstack, csr_matrix
    nums = np.c_[np.log1p(d["visits"]), np.log1p(d["days_since"])]
    return hstack([enc.transform(d[cat_cols].astype(str)), csr_matrix(nums)]).tocsr()
enc.fit(train[cat_cols].astype(str))
t0 = time.perf_counter()
lr = LogisticRegression(C=1.0, max_iter=2000).fit(lr_x(train), train["click"])
t_lr = time.perf_counter() - t0
p_lr = lr.predict_proba(lr_x(test))[:, 1]

# ---- 3. 勾配ブースティング(LightGBM) ----
def gb_x(d):
    x = d[cat_cols + num_cols].copy()
    for c in ["site", "device", "slot"]:
        x[c] = pd.Categorical(x[c], categories=sorted(train[c].unique()))  # 候補は学習期間だけから決める
    return x
params = dict(objective="binary", learning_rate=0.05, num_leaves=31,
              min_data_in_leaf=200, verbose=-1, seed=1)
t0 = time.perf_counter()
gbm = lgb.train(params, lgb.Dataset(gb_x(train), train["click"]), num_boost_round=1000,
                valid_sets=[lgb.Dataset(gb_x(valid), valid["click"])],
                callbacks=[lgb.early_stopping(50, verbose=False)])
t_gb = time.perf_counter() - t0
p_gb = gbm.predict(gb_x(test), num_iteration=gbm.best_iteration)
print("勾配ブースティングの木の本数(検証の日で決定)", gbm.best_iteration)
# 出力: 勾配ブースティングの木の本数(検証の日で決定) 55
次のコードでは、決定木の出力をロジスティック回帰の入力にする組み合わせ(後の節で説明します)も作ってから、評価用の4日間で3つのモデルを比べ、さらに、組み合わせの関係を入れた区分ごとに、予測の平均と実績のクリック率を比べます。
# ---- 4. 木の葉の番号をロジスティック回帰の入力にする組み合わせ ----
leaf_enc = OneHotEncoder(handle_unknown="ignore")
leaf_tr = gbm.predict(gb_x(train), num_iteration=gbm.best_iteration, pred_leaf=True)
leaf_te = gbm.predict(gb_x(test), num_iteration=gbm.best_iteration, pred_leaf=True)
leaf_va = gbm.predict(gb_x(valid), num_iteration=gbm.best_iteration, pred_leaf=True)
leaf_enc.fit(leaf_tr)
best = (np.inf, None)
for c in [0.003, 0.01, 0.03, 0.1, 0.3]:  # 正則化の強さは検証の日で選ぶ
    m = LogisticRegression(C=c, max_iter=2000).fit(leaf_enc.transform(leaf_tr), train["click"])
    v = log_loss(valid["click"], m.predict_proba(leaf_enc.transform(leaf_va))[:, 1])
    print("木の葉+LR C=%.3f 検証の対数損失 %.5f" % (c, v))
    if v < best[0]:
        best = (v, m)
lr_leaf = best[1]
p_leaf = lr_leaf.predict_proba(leaf_enc.transform(leaf_te))[:, 1]

# ---- 5. 時間で切った評価用データ(17〜20日目)で比べる ----
rows = []
for name, p, t in [("ロジスティック回帰", p_lr, t_lr), ("勾配ブースティング", p_gb, t_gb),
                   ("木の葉+ロジスティック回帰", p_leaf, np.nan)]:
    rows.append([name, log_loss(test["click"], p), roc_auc_score(test["click"], p),
                 p.mean() / test["click"].mean(), t])
res = pd.DataFrame(rows, columns=["モデル", "対数損失", "AUC", "予測の平均/実績", "学習秒"])
print(res.round(4).to_string(index=False))
for name, f in [("ロジスティック回帰", lambda: lr.predict_proba(lr_x(test))),
                ("勾配ブースティング", lambda: gbm.predict(gb_x(test), num_iteration=gbm.best_iteration))]:
    t0 = time.perf_counter(); f(); dt = time.perf_counter() - t0
    print("%s 推論 %d件 %.3f秒" % (name, len(test), dt))

# ---- 6. 組み合わせの関係がある区分での予測の平均/実績 ----
seg = test.assign(p_lr=p_lr, p_gb=p_gb)
seg["区分"] = np.where(seg["site"].isin(["C", "F"]), "掲載面C・F", "その他の掲載面") + "×" + seg["device"]
g = seg.groupby("区分").agg(件数=("click", "size"), 実績=("click", "mean"),
                          LR=("p_lr", "mean"), GB=("p_gb", "mean"))
g["LR/実績"] = g["LR"] / g["実績"]; g["GB/実績"] = g["GB"] / g["実績"]
print(g.round(4).to_string())
評価用の4日間(17〜20日目)での結果は次の表のとおりです。
| モデル | 対数損失 | AUC | 予測の平均÷実績のクリック率 |
|---|---|---|---|
| ロジスティック回帰(交差特徴なし) | 0.0921 | 0.6786 | 1.0072 |
| 勾配ブースティング | 0.0918 | 0.6790 | 0.9937 |
| 木の葉+ロジスティック回帰 | 0.0920 | 0.6786 | 1.0173 |
学習の秒数は、同じコードを2回実行したところ、ロジスティック回帰が0.22秒と0.20秒、勾配ブースティングが0.63秒と0.50秒で、実行のたびに変わりました。どちらの回も勾配ブースティングのほうが長くかかりましたが、何倍かという比は回によって違うので、本章では秒数の比を結論には使いません。
評価の単位は表示1回です(クリック率の予測なので、表示ごとにクリックの有無と予測を比べます。後の節のコンバージョン率の予測では、クリック1回が単位になります)。対数損失(予測した確率と実際の結果のずれを表す指標。小さいほどよく、確率の正しさも反映しますが、対数損失が小さいことだけで、区分ごとに予測と実績が対応しているとは言えません)は、勾配ブースティングが0.0918、ロジスティック回帰が0.0921で、差は0.0003でした。AUC(ROC 曲線の下の面積。クリックのあった表示を、無かった表示より上に並べられているかを表す順位づけの指標で、確率の正しさは表しません)も0.6790と0.6786で、ほとんど同じです。評価用の期間の予測の平均を実績のクリック率で割った比は、どちらも1に近い値でした。全体の指標だけを見ると、2つのモデルの違いはわずかです。指標の詳しい読み方と、確率のずれの確かめ方は第6章で扱います。
差がこれだけ小さいと、1回の乱数の結果で「勾配ブースティングのほうが良い」とは言えません。そこで、乱数の種を20261116から20261125まで10通りに変えてデータを作り直し、同じ手順で比べました(このくり返しのコードは掲載していません)。対数損失で勾配ブースティングが小さかったのは10回中8回、AUC で勾配ブースティングが大きかったのは10回中7回でした。対数損失の差(ロジスティック回帰から勾配ブースティングを引いた値)は平均0.00030、最小-0.00021、最大0.00102で、AUC の差は平均0.00611、最小-0.00559、最大0.02018でした。本コラムの架空データでは、全体の指標では勾配ブースティングがやや良い回が多いものの、逆になる回もある、という程度の差です。
違いがはっきり出たのは、区分ごとの比べ方でした。組み合わせの関係を入れた掲載面CとFと、それ以外の掲載面を、端末の種類ごとに分けて、予測の平均を実績のクリック率で割った比を並べたのが次の表です。
| 区分 | 表示の件数 | 実績のクリック率 | ロジスティック回帰の予測の平均÷実績 | 勾配ブースティングの予測の平均÷実績 |
|---|---|---|---|---|
| その他の掲載面×PC | 8,820 | 1.33% | 0.73 | 1.00 |
| その他の掲載面×スマートフォン | 17,370 | 1.62% | 1.19 | 1.04 |
| その他の掲載面×タブレット | 2,862 | 1.33% | 0.58 | 0.87 |
| 掲載面C・F×PC | 2,609 | 1.15% | 1.90 | 0.92 |
| 掲載面C・F×スマートフォン | 5,433 | 4.90% | 0.87 | 0.97 |
| 掲載面C・F×タブレット | 924 | 0.97% | 1.79 | 1.23 |
交差特徴を入れていないロジスティック回帰は、「掲載面CとFは高め」「スマートフォンは高め」という効果を、それぞれ足し合わせる形でしか表せません。そのため、掲載面CとFのPCでは実績の1.90倍の予測を出し、その他の掲載面のPCでは0.73倍と低く出しました。勾配ブースティングでは、件数の少ない掲載面C・F×タブレット(924件)で1.23倍とずれが残ったものの、そのほかの区分では0.87〜1.04倍に収まりました。件数の少ない区分では、実績のクリック率そのものも偶然で大きく動くので(924件で実績の率が1%前後なら、クリックは10件前後です)、この区分の比はばらつきを含んで読む必要があります。
上の表は乱数の種1通り(20261116)の結果です。前に述べた10通りの種のくり返しで、区分ごとの比の範囲も確かめました(このくり返しのコードは掲載していません)。区分ごとの比の中央値は、ロジスティック回帰で0.72〜2.45、勾配ブースティングで0.92〜1.35で、6つの区分すべてで勾配ブースティングのほうが1に近い値でした。ただし勾配ブースティングでも、掲載面C・F×PCで最大1.95、掲載面C・F×タブレットで最小0.64と最大1.76、その他の掲載面×タブレットで最大1.59のように、種によっては大きくずれる回がありました。件数が数千件以下の区分では、勾配ブースティングでも予測の平均と実績が大きく離れることがある、というのが本コラムの架空データでの結果です。
| 区分 | ロジスティック回帰の予測の平均÷実績(10通りの最小・中央値・最大) | 勾配ブースティングの予測の平均÷実績(10通りの最小・中央値・最大) |
|---|---|---|
| その他の掲載面×PC | 0.63・0.72・1.06 | 0.88・1.00・1.32 |
| その他の掲載面×スマートフォン | 1.01・1.18・1.24 | 0.88・1.04・1.13 |
| その他の掲載面×タブレット | 0.58・0.79・1.20 | 0.87・1.10・1.59 |
| 掲載面C・F×PC | 1.88・2.45・3.32 | 0.92・1.35・1.95 |
| 掲載面C・F×スマートフォン | 0.73・0.83・0.91 | 0.83・0.92・1.05 |
| 掲載面C・F×タブレット | 1.19・1.66・2.18 | 0.64・1.15・1.76 |
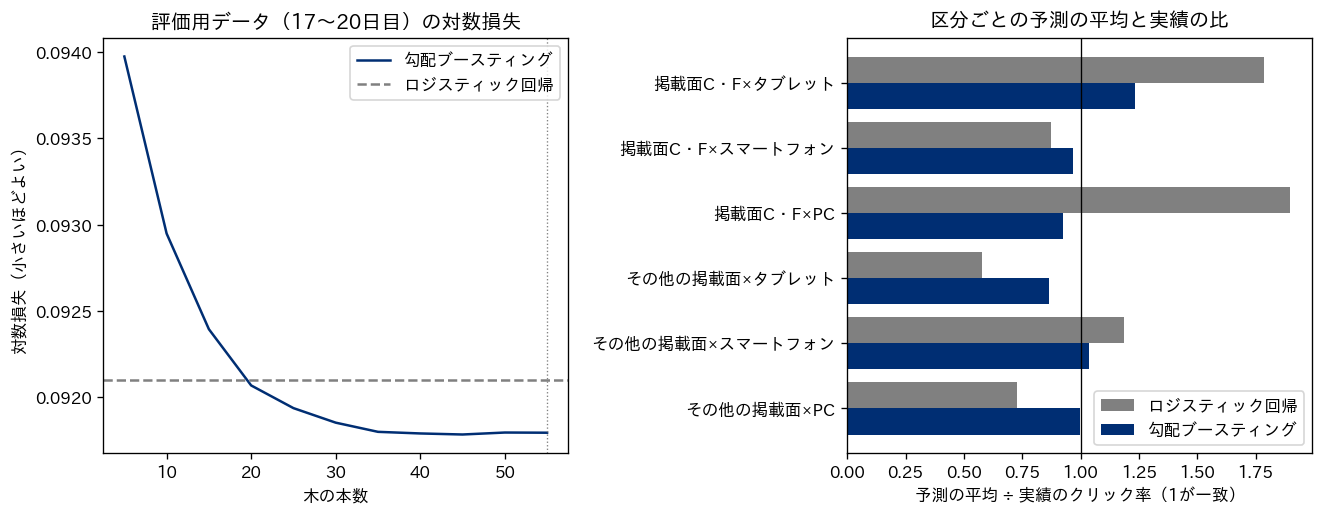
図の左は、勾配ブースティングの木の本数ごとに評価用データの対数損失を描いたものです。本数が少ないうちはロジスティック回帰より悪く、20本前後で同じ水準になり、40本前後からはほぼ横ばいでした。図の右は上の表を棒グラフにしたものです。
この結果が入札にとって意味するのは、全体の平均が合っていても、区分ごとに予測がずれていれば、入札額もその区分でずれるという点です。表示の価値に一定の係数を掛けて入札する場合(第7章)、ほかの条件が同じなら、確率を高く見積もるほど入札額も高くなります。表で求めたのは区分の中の予測の平均と実績の率の比で、個々の機会の予測が一律に同じ倍率でずれているわけではありませんが、上の例のロジスティック回帰をそのまま使うと、掲載面CとFのPCの機会では、区分全体として入札が高めになるおそれがあります。それが払いすぎ(見込んだ価値を超える額で買うこと)になるかどうかは、オークションの方式・落札のしきい値・その機会の価値によって決まり、本章のコードはそこまでは計算していません(方式ごとの違いは第3章、確率のずれが支払額と落札に与える影響は第6章で、実際に計算して確かめます)。逆に、その他の掲載面のタブレットの機会では区分全体として入札が低めになり、利益を増やせたはずの機会を落札できずに逃す場合には機会損失になります。全体の対数損失の差が0.0003しかなくても、このような区分ごとのずれは起きます。モデルを比べるときは、全体の指標に加えて、入札の判断に効く区分(掲載面・端末・広告枠の種類など)ごとに予測の平均と実績を並べることが大事だと考えています。ここで見た区分ごとの予測の平均と実績の比は簡易の見方で、区間を付けた較正の確認は第6章で詳しく扱います。較正は、予測した確率が同じくらいの機会を集めたとき、その実績の率が予測と対応するようにすることで、全体の平均が合っているだけでは、較正が取れているとは言いません。
なお、この比較は「交差特徴を人が書き出さなかったロジスティック回帰」との比較です。本章では、交差特徴を足したロジスティック回帰はこのデータで実行していません(交差特徴の効果は第4章の例題で扱っています)。効く組み合わせを人が把握して特徴量にできる場合と、把握できていない組み合わせが多い場合とでは、2つのモデルの差の出方が変わりうるので、比べるときは自社の記録で両方を試すのが確実です。
決定木の出力をロジスティック回帰の入力にする組み合わせ
勾配ブースティングとロジスティック回帰を組み合わせる方法として、広告のクリックの予測の実務を述べた論文に、He らの2014年の論文があります。Facebook の広告のクリックの予測について書かれたもので、2014年のデータマイニングの国際会議(KDD)に併設されたオンライン広告のデータマイニングのワークショップで発表されました。この論文では、学習した決定木の各本で、記録がどの葉に落ちたかを0か1の特徴量に置き換え、それをロジスティック回帰の入力にするモデルを示しています。要旨には、この組み合わせが、それぞれの手法を単独で使った場合を3%を超えて上回ったと書かれています。ただし本文の表1では、正規化エントロピー(指標は第6章で扱います)を決定木だけのモデルを100としたとき、ロジスティック回帰だけが99.43、組み合わせが96.58で、組み合わせの相対的な低下は、決定木だけと比べて3.42%、ロジスティック回帰だけと比べると約2.9%です。要旨の「3%を超えて」は、表1の値では決定木だけとの比較にあたります。これはその論文のデータ・その条件での結論で、ほかの広告の記録で同じ差が出ることを示すものではありません。
同じ論文の要旨には、最も大事なのは適切な特徴量を持つことで、利用者や広告の過去の情報をとらえた特徴量がほかの種類の特徴量を上回った、という趣旨も書かれています。また本文では、1日分のデータで学習したモデルを、その後の6日間で評価すると、学習からの日数がたつほど成績が下がり、週に1回の学習から毎日の学習に変えると正規化エントロピーがおよそ1%下がった、と報告しています。一方で要旨は、適切な特徴量とモデルを選んだあとでは、データの新しさの扱いなどほかの要素の効果は、価値の高い特徴量を足すことや最初に適切なモデルを選ぶことより小さい(ただし規模が大きいと小さな改善も重要)とも整理しています。特徴量とモデルの選択を先に固めたうえで、更新の頻度も点検の対象にする、という読み方が論文の整理に沿っています。
本コラムの架空データでも、この組み合わせを作ってみました。上のコードの4番目の部分で、勾配ブースティングの55本の木の葉の番号を one-hot にしてロジスティック回帰に入れ、正則化の強さ(C)を検証用の日の対数損失で選びました。検証用の対数損失は、試した中で最も正則化の強い C=0.003 で最も小さく(0.08873)、選んだ値が試した範囲の端だったので、もっと強い正則化のほうが良かった可能性があります。評価用の対数損失は0.0920、AUC は0.6786で、勾配ブースティング単独(0.0918、0.6790)を上回りませんでした。本コラムの架空データでは組み合わせる利点は出ませんでしたが、その理由は本章では切り分けていません。論文の結論と違う結果ですが、データの規模と性質がまったく違うので、どちらが正しいという話ではありません。組み合わせが効くかどうかは、自社の記録で時間で切って確かめるしかない、という点が実務の結論です。
なお、図を描く部分のコードは掲載を省きました。掲載したコードを上から順につなげて実行すると、掲載したコードに対応する表の数値を再現できます(学習と推論の秒数を除きます。乱数の種を10通りに変えたくり返しは、掲載していないコードで行いました)。
負例の間引きと、間引いた分だけ高く出る予測の補正
クリック率が1〜2%なら、記録の98%以上はクリックの無い表示(負例)です。媒体や DSP が扱う表示の件数は非常に多いので、すべての負例を学習に使うと、計算の時間と記憶の容量が大きくなります。そこで、クリックのあった表示(正例)はすべて残し、負例だけを一定の割合で無作為に残して学習する方法があります。これを負例の間引き(ネガティブ・ダウンサンプリング)と呼びます。第2章で予告した、学習に使う標本の作り方の1つです。
間引いたデータで学習すると、学習用のデータの中のクリック率は元より高くなるので、モデルの出す確率も、そのまま元の記録に当てはめると高く出ます。前の節の He らの2014年の論文には、この補正の式が書かれています。間引いたデータで学習したモデルの予測を \( p \)、負例を残した割合を \( w \) とすると、元の記録での確率 \( q \) は次の式で求めます。
\( q = \dfrac{p}{p + (1-p)/w} \)
言葉で言い換えると、間引きで負例を \( w \) 倍に減らしたので、予測の中の負例の重み \( 1-p \) を \( 1/w \) 倍に戻してから、確率に直す、という計算です。論文では、間引く前の平均のクリック率が0.1%のときに負例を0.01の割合で残すと、学習用のデータの中のクリック率はおよそ10%になる、という例を挙げ、配信で使う前にこの式で確率を戻す必要があると書いています。また、論文のデータでは、試した割合の中で負例を残す割合が0.025のときに最もよい成績だった、と報告しています。これもその論文のデータ・その条件での値です。
入札では、予測した確率がそのまま入札額の計算に入るので(第7章)、この補正を忘れると予測した確率が高く出て、表示の価値に一定の係数を掛けて入札する場合には、入札額も高く出ます。どれだけ高く出るかは、補正の式から分かるとおり、残す割合だけでなく予測の値そのものにもよります(式を変形すると、補正前の確率は補正後の確率の \( p + (1-p)/w \) 倍で、予測の値ごとに倍率が違います。後の表の負例を5%残した場合では、予測の平均どうしの比で約13倍でした)。間引きは学習を軽くするための工夫で、確率を元の記録の尺度に戻すところまでを1つの手順として扱う必要があります。
本コラムの架空データで、負例を残す割合を1(間引かない)、0.5、0.2、0.1、0.05と変えて、勾配ブースティングを学習させ、評価用の4日間で補正の前後の予測の平均と対数損失を比べました。木の本数は、前の節で決めた55本に固定しています。間引きは乱数で行うので、割合ごとに乱数を変えて5回くり返し、その平均を示します。
# ---- 負例の間引き:クリックの無い表示を割合 w だけ残して学習する ----
rows = []
for w in [1.0, 0.5, 0.2, 0.1, 0.05]:
    for rep in range(5):  # 間引きの乱数を変えて5回くり返す
        rng = np.random.default_rng(1000 + rep)
        keep = (train["click"] == 1) | (rng.random(len(train)) < w)
        sub = train[keep.to_numpy()]
        t0 = time.perf_counter()
        m = lgb.train(params, lgb.Dataset(gb_x(sub), sub["click"]), num_boost_round=55)
        sec = time.perf_counter() - t0
        p = m.predict(gb_x(test))
        q = p / (p + (1 - p) / w)  # 間引いた割合で確率を補正する
        rows.append([w, rep, len(sub), sub["click"].mean(), sec, p.mean(), q.mean(),
                     log_loss(test["click"], p), log_loss(test["click"], q),
                     roc_auc_score(test["click"], q)])
        if w == 1.0:
            break  # 間引かない場合は乱数を使わないので1回でよい
r = pd.DataFrame(rows, columns=["残す割合", "回", "学習の件数", "学習のクリック率", "学習秒",
                                "補正前の予測の平均", "補正後の予測の平均",
                                "補正前の対数損失", "補正後の対数損失", "AUC"])
print("評価用データ(17〜20日目)の実績のクリック率 %.4f" % test["click"].mean())
s = r.groupby("残す割合").agg({"学習の件数": "mean", "学習のクリック率": "mean", "学習秒": "mean",
                             "補正前の予測の平均": "mean", "補正後の予測の平均": "mean",
                             "補正前の対数損失": "mean", "補正後の対数損失": ["mean", "min", "max"],
                             "AUC": "mean"}).sort_index(ascending=False)
pd.set_option("display.width", 250)
print(s.round(4).to_string())
結果は次の表のとおりです(評価用の4日間の実績のクリック率は1.95%)。間引かない条件は乱数を使わないので1回だけ実行し、それ以外の割合は5回くり返しました。間引く条件の学習の件数・予測の平均・対数損失は5回の平均で、補正後の対数損失の括弧内は5回の最小と最大です。
| 負例を残す割合 | 学習の件数 | 学習用のデータの中のクリック率 | 補正前の予測の平均 | 補正後の予測の平均 | 補正前の対数損失 | 補正後の対数損失 |
|---|---|---|---|---|---|---|
| 1(間引かない) | 133,451 | 1.88% | 1.94% | 1.94% | 0.0918 | 0.0918 |
| 0.5 | 67,974 | 3.69% | 3.77% | 1.94% | 0.0974 | 0.0918(0.0918〜0.0918) |
| 0.2 | 28,687 | 8.75% | 8.63% | 1.93% | 0.1332 | 0.0917(0.0916〜0.0918) |
| 0.1 | 15,630 | 16.06% | 15.44% | 1.94% | 0.2019 | 0.0918(0.0916〜0.0920) |
| 0.05 | 9,072 | 27.66% | 25.78% | 1.95% | 0.3300 | 0.0918(0.0915〜0.0920) |
補正前の予測の平均は、負例を残す割合が小さいほど高くなり、0.05では25.78%と、実績の1.95%の10倍を超えました。補正前の対数損失も、0.0918から0.3300まで悪くなっています。補正の式を当てると、どの割合でも予測の平均は1.93〜1.95%に戻り、対数損失も0.0917〜0.0918で、間引かない場合とほぼ同じになりました。AUC は補正で順位が変わらないので、補正の前後で同じです(5回の平均で0.6785〜0.6810)。
学習の秒数(間引かない条件は1回、それ以外は5回の平均)は、同じコードを2回実行したところ、間引かない場合で0.30秒と0.29秒、負例を5%残す場合で0.10秒と0.11秒でした。どちらの回も残す割合を小さくすると短くなりましたが、件数が約15分の1になる5%の条件でも秒数は3分の1程度で、件数に比例しては減っていません。秒数は実行のたびに変わります。記録の件数が桁違いに多い実際の配信の記録では、時間の減り方はこの例題とは違いうるので、自社の環境で測る必要があります。
本コラムの架空データでは、負例を5%しか残さなくても、補正さえすれば評価用の対数損失はほとんど変わりませんでした。ただし、これは組み合わせの関係が単純な架空データでの結果です。件数の少ない掲載面や組み合わせでは、間引くことで負例の件数がさらに減り、その区分の予測が不安定になることがあります。間引きの割合を決めるときは、全体の対数損失だけでなく、第6章で扱う区分ごとの較正の確認を、間引かない場合と並べて行うのが安全だと考えています。
| 確かめること | なぜ要るか |
|---|---|
| 間引いた割合が、学習の記録と一緒に残っているか | 補正の式に割合 \( w \) が要る。割合が分からないと確率を戻せない |
| 補正を、配信に使う予測の出口で必ず当てているか | 当て忘れると予測した確率が高く出て、確率にもとづく入札額も高く出る。倍率は残す割合と予測の値による |
| 間引きを、時間で切った評価用データには当てていないか | 評価用のデータは元の記録のままで測らないと、実際の配信での成績にならない |
| 件数の少ない区分の予測が、間引かない場合と比べて不安定になっていないか | 全体の指標が同じでも、区分ごとのずれが大きくなることがある |
| 割合を変えたときに、学習の時間がどれだけ減ったか | 時間が減らないなら、間引く理由が弱い |
コンバージョン率の予測が難しい理由
入札の判断には、予測クリック率だけでなく、クリックのあとにコンバージョンに至る確率(予測コンバージョン率)も要ります。表示の価値を予測クリック率×予測コンバージョン率×コンバージョンの価値と見積もる場合(第7章)、予測コンバージョン率のずれは、予測クリック率のずれと同じ重さで入札額に効きます。ところが、コンバージョン率の予測には、クリック率の予測にない難しさが重なります。
- 件数がさらに少ない:本章の合成データではクリックは表示の2%弱で、コンバージョンはさらにそのうちの一部なので、学習に使える正例が少ない
- クリックした表示でしか観測できない:本コラムの定義では、コンバージョン率はクリックのうちコンバージョンに至った割合で、クリックされなかった表示については結果が無い。クリックした利用者は、表示された利用者全体と構成が違う
- 遅れて届く:クリックからコンバージョンまでに時間がかかる。届いたコンバージョンは起きた時点で数えられるが、計測期間の途中でコンバージョンが起きていなくても、期間のうちに起きないとは確定できない
- 定義が広告主ごとに違う:何をコンバージョンとするか、計測期間を何日にするか、重複をどう除くかで、率が変わる(第2章)
2つ目の点は、クリックした表示だけで学習したモデルを、表示の機会全体に当てはめて使うときの偏りの問題です。入札の時点では、まだクリックされるかどうか分からない機会に対して予測コンバージョン率を使うので、学習した集団と使う集団が違います。結論を先に書くと、予測クリック率と「クリックした場合の」予測コンバージョン率を分けて掛け合わせる限り、クリックした表示で学習する設計そのものは、本コラムの例題の表示の価値の式と整合します。残る問題は、クリックの件数の少ない掲載面や機会ではコンバージョン率のモデルが学習した例が少なく予測が不安定になることと、学習の材料がクリックした利用者に偏ることです。なお、表示の価値は予測にもとづく見積りで、広告が無くても起きたコンバージョンの分を除いていません。本章では、この中から3つ目の点、遅れて届くコンバージョンを取り上げます。
遅れて届くコンバージョン、未着を負例として学習すると予測が低く出る
利用者がクリックしてからコンバージョンするまでには、数分のこともあれば、数日から数週間かかることもあります。計測期間を30日とすると、期間の中で起きたコンバージョンは起きた時点で数えられますが、まだコンバージョンが起きていないクリックについては、期間のうちに起きないとは、クリックから30日がたつまで確定できません。モデルを学習し直す時点で、直近のクリックの多くは遅れて届くコンバージョンがまだ届いていない状態です。ここで「今の時点でコンバージョンしていないクリックは負例」として学習すると、本当はあとでコンバージョンするクリックも負例として数えるので、予測コンバージョン率が低く出ます。
遅れて届く反応を扱った研究として、Chapelle の2014年の論文(2014年のデータマイニングの国際会議 KDD で発表された、ディスプレイ広告での遅れて届く反応のモデルの論文)があります。本コラムでは書誌を確かめた範囲で紹介するにとどめ、論文の手法そのものは実行していません。下の例題の3つ目の方法は、本コラムで用意した簡単な重み付けで、論文の手法とは別のものです。
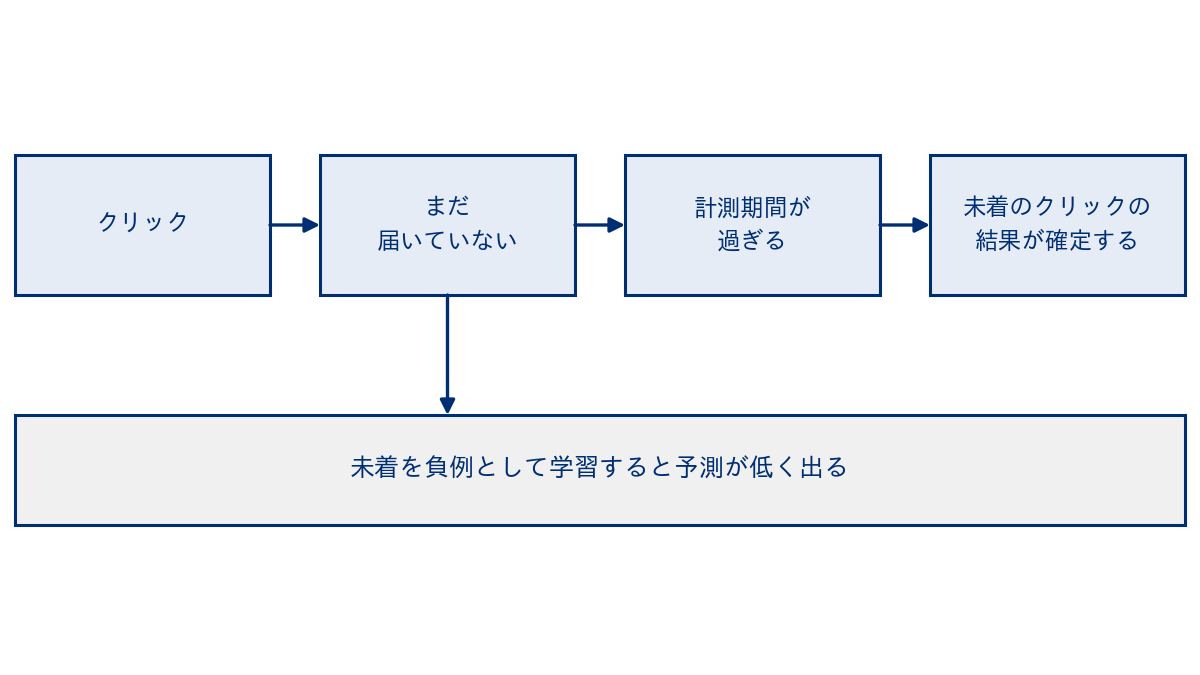
ここからは、コードで確かめます。前の節までとは別に、67日分のクリック20万件を架空に作りました。乱数の種は同じく20261116です。掲載面(AからFの6種類)・端末の種類・過去の訪問の回数でコンバージョンする確率が決まり、掲載面DのPCでは高くなる組み合わせの関係を入れました。コンバージョンするクリックには、クリックからの日数を平均5日の指数分布で付け、30日以内に届いたものだけを数えます(計測期間30日)。モデルを学習する時点は60日目の0時とし、それより前の0〜59日目のクリックを学習に、60〜66日目のクリックを評価に使います。評価用のクリックの結果は、合成データなので、計測期間が過ぎて確定したものが分かります。
さらに、確率が時間とともに変わる場合を見るために、確率の対数オッズに「クリックした日×傾き」を足し、傾きが0(時間で変わらない)の場合と0.005(67日でゆっくり上がる)の場合の2通りを作りました。どちらの場合も、モデルの入力は掲載面・端末の種類・過去の訪問の回数だけで、クリックした日は入れていません。
WINDOW = 30.0   # 計測期間:クリックから30日以内のコンバージョンだけを数える
TODAY = 60.0    # 学習する時点:60日目の0時。60日目以降のクリックは評価用

# ---- 架空のクリックとコンバージョン(67日分。遅れの分布つき) ----
def make_clicks(seed, trend, n=200_000):
    rng = np.random.default_rng(seed)
    clk = pd.DataFrame({
        "t": rng.uniform(0, 67, n),  # クリックの時刻(日)
        "site": rng.choice(list("ABCDEF"), n, p=[.3, .2, .2, .15, .1, .05]),
        "device": rng.choice(["スマートフォン", "PC", "タブレット"], n, p=[.6, .3, .1]),
        "visits": rng.poisson(rng.gamma(1.0, 3.0, n)),
    })
    z = (-3.3 + clk["site"].map(dict(zip("ABCDEF", [0, .3, -.2, .5, -.4, .2])))
         + clk["device"].map({"スマートフォン": -0.2, "PC": 0.2, "タブレット": 0.0})
         + 0.25 * np.log1p(clk["visits"])
         + 0.6 * ((clk["site"] == "D") & (clk["device"] == "PC"))  # 組み合わせで効く関係
         + trend * clk["t"])                                        # 時間とともに変わる
    will = rng.random(n) < 1 / (1 + np.exp(-z))
    delay = rng.exponential(5.0, n)                  # クリックからコンバージョンまでの日数
    clk["delay"] = np.where(will, delay, np.inf)     # 届いたコンバージョンの分だけ後から分かる
    clk["cv_final"] = (clk["delay"] <= WINDOW).astype(int)   # 計測期間が過ぎて確定する結果
    clk["elapsed"] = TODAY - clk["t"]                # 学習の時点までの経過日数
    clk["cv_seen"] = (clk["delay"] <= np.minimum(WINDOW, clk["elapsed"])).astype(int)
    return clk

cols = ["site", "device", "visits"]   # 入力はクリックの時点で分かる項目だけ
CATS = {"site": sorted("ABCDEF"), "device": sorted(["スマートフォン", "PC", "タブレット"])}
params = dict(objective="binary", learning_rate=0.05, num_leaves=15,
              min_data_in_leaf=200, verbose=-1, seed=1)
def X(d):
    x = d[cols].copy()
    for c in ["site", "device"]:
        x[c] = pd.Categorical(x[c], categories=CATS[c])  # 候補はデータを作る前に決めた一覧
    return x
def fit(d, y, w=None):
    return lgb.train(params, lgb.Dataset(X(d), y, weight=w), num_boost_round=150)
cv_seen は学習の時点で見えている結果、cv_final は計測期間が過ぎて確定する結果です。実際の記録では、学習の時点で手に入るのは cv_seen だけで、cv_final は合成データだから分かる「答え」です。この2つを使って、次の3つの学習の仕方を比べます。
- 直近まで全部を使い、学習の時点でまだコンバージョンしていないクリックを負例とする
- 計測期間(30日)が過ぎて結果が出そろったクリック(0〜29日目)だけを使う
- 直近まで全部を使い、まだコンバージョンしていないクリックに、経過日数に応じた重みを付ける
3つ目の重みは次のように作りました。まず、結果が出そろったクリックのうちコンバージョンしたものについて、クリックからコンバージョンまでの日数の分布を数え、「経過日数 \( e \) までに、いずれ数えられるコンバージョンのうち何割が届いているか」を表す割合 \( F(e) \) を求めます。そして、コンバージョンしたクリックの重みは1、まだコンバージョンしていないクリックの重みは \( F(e) \) とします。経過日数が短く、まだ届いていない可能性が高いクリックほど、負例として軽く数える、という考え方です。この重みで偏りがどこまで小さくなるかは本章では式で確かめておらず、この例題での結果は下の表のとおりです。比べるために、実際には手に入らない参考として、確定した結果 cv_final で学習した場合も並べます。
# ---- 3つの学習の仕方(と、実際には手に入らない参考) ----
def compare(clk):
    past = clk[clk["t"] < TODAY].copy()     # 学習の時点で手元にあるクリック
    test = clk[clk["t"] >= TODAY].copy()    # 次の1週間のクリック(確定した結果で評価)
    mature = past[past["elapsed"] >= WINDOW]
    # 遅れの分布 F:結果が出そろったクリックのコンバージョンまでの日数から作る
    d_obs = np.sort(mature.loc[mature["cv_seen"] == 1, "delay"].to_numpy())
    F = lambda e: np.searchsorted(d_obs, np.minimum(e, WINDOW), side="right") / len(d_obs)
    w3 = np.where(past["cv_seen"] == 1, 1.0, F(past["elapsed"].to_numpy()))
    models = [("(1)直近まで全部・未着は負例", past, past["cv_seen"], None),
              ("(2)出そろった期間だけ", mature, mature["cv_seen"], None),
              ("(3)経過日数で負例に重み", past, past["cv_seen"], w3),
              ("参考:確定した結果で学習", past, past["cv_final"], None)]
    rows = []
    for name, d, y, w in models:
        p = fit(d, y, w).predict(X(test))
        rows.append([name, len(d), p.mean(), p.mean() / test["cv_final"].mean(),
                     log_loss(test["cv_final"], p)])
    res = pd.DataFrame(rows, columns=["学習の仕方", "学習の件数", "予測の平均",
                                      "予測の平均/確定した率", "対数損失"])
    return past, test, res, F

for trend in [0.0, 0.005]:
    clk = make_clicks(20261116, trend)
    past, test, res, F = compare(clk)
    print("==== 時間の傾き trend =", trend, "====")
    print("学習の時点のクリック", len(past), "評価用のクリック", len(test),
          "評価用の確定したコンバージョン率 %.4f" % test["cv_final"].mean())
    print("遅れの分布 F", {e: round(float(F(np.array([e]))[0]), 3) for e in [1, 3, 7, 14, 30]})
    past["day"] = past["t"].astype(int)
    by_day = past.groupby("day").agg(seen=("cv_seen", "mean"), final=("cv_final", "mean"))
    print(by_day.iloc[[0, 29, 45, 52, 55, 57, 58, 59]].round(4).to_string())
    print(res.round(4).to_string(index=False))
学習の時点で手元にあるクリックは179,234件、評価用のクリックは20,766件でした。遅れの分布 \( F \) は、傾きが0の場合で、経過1日で0.206、3日で0.468、7日で0.760、14日で0.948でした。つまり、クリックから1週間の時点では、いずれ数えられるコンバージョンのうち4分の1近くがまだ届いていません。
傾きが0の場合に、クリックした日ごとに、学習の時点で見えているコンバージョン率と、後で確定する率を比べると、次のようになりました。
| クリックした日 | 学習の時点で見えている率 | 後で確定する率 |
|---|---|---|
| 0日目 | 5.19% | 5.19% |
| 29日目 | 5.34% | 5.34% |
| 45日目 | 5.10% | 5.30% |
| 52日目 | 4.34% | 5.45% |
| 55日目 | 2.95% | 5.05% |
| 57日目 | 2.12% | 5.12% |
| 58日目 | 1.21% | 4.80% |
| 59日目 | 0.60% | 5.56% |
計測期間の30日が過ぎた日(0〜29日目)では2つの率は一致しますが、直近の日ほど見えている率は下がり、学習の時点の前日(59日目)のクリックでは、後で5.56%になる率のうち0.60%しか見えていません。管理画面で直近の日のコンバージョン率が低く見えるとき、この遅れが理由の1つになりえます。遅れを確かめずに直近の日の率の低下を「配信の質が落ちた」と読むと、判断を誤るおそれがあります。
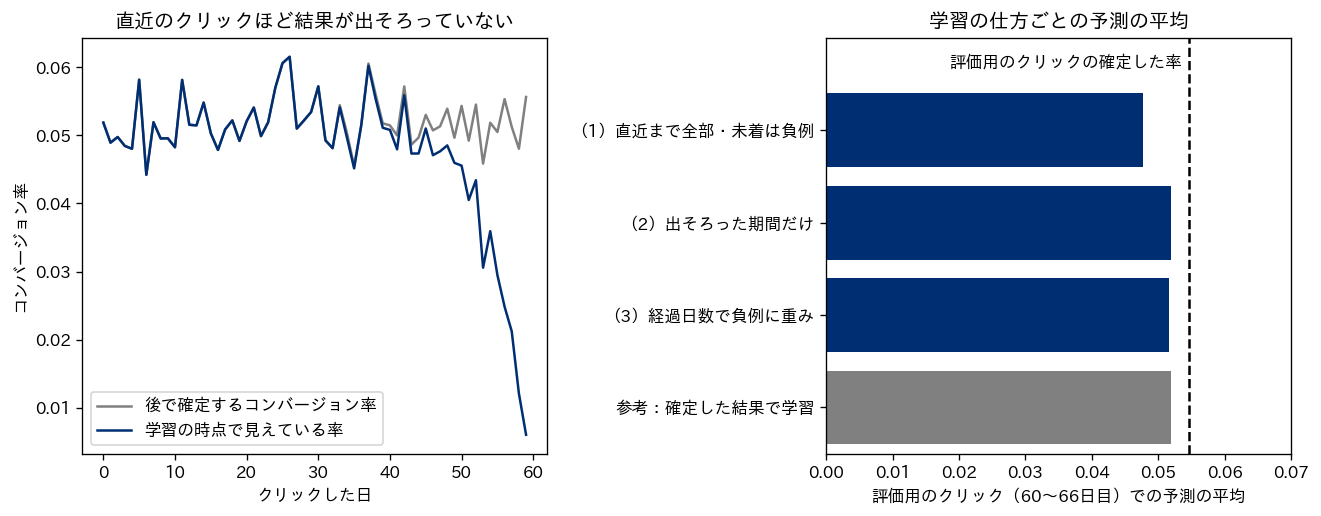
3つの学習の仕方で、評価用のクリック(60〜66日目)の予測の平均を、確定したコンバージョン率と比べた結果が次の表です。コンバージョン率の予測なので、評価の単位はクリック1回です。
| 学習の仕方 | 学習の件数 | 時間の傾き0:予測の平均 | 時間の傾き0:予測の平均÷確定した率 | 時間の傾き0.005:予測の平均 | 時間の傾き0.005:予測の平均÷確定した率 |
|---|---|---|---|---|---|
| (1)直近まで全部・未着は負例 | 179,234 | 4.77% | 0.87 | 5.41% | 0.74 |
| (2)出そろった期間だけ | 89,484 | 5.19% | 0.95 | 5.57% | 0.76 |
| (3)経過日数で負例に重み | 179,234 | 5.16% | 0.95 | 5.85% | 0.80 |
| 参考:確定した結果で学習(実際には手に入らない) | 179,234 | 5.19% | 0.95 | 5.96% | 0.81 |
評価用のクリックの確定したコンバージョン率は、傾き0の場合で5.46%、傾き0.005の場合で7.32%でした。傾き0の場合、確定した結果で学習した参考のモデルでも予測の平均は5.19%で、比は0.95です。評価用の1週間のクリックは20,766件で、確定した率5.46%の標準誤差を計算すると約0.16ポイントです。参考のモデルの予測の平均5.19%との差0.27ポイントは、標準誤差の1.71倍にあたります。このずれの原因は本章では切り分けていませんが、評価用の実績の率も件数が限られた中での値であることを踏まえ、ここでは同じ評価用のクリックに当てた参考のモデルの値を基準に比べます。その基準と比べると、(2)と(3)は参考とほぼ同じ(5.19%と5.16%)でしたが、(1)は4.77%で、参考より1割近く低く出ました。未着を負例として数えた分だけ、予測が低く出たことになります。
傾き0.005の場合は、どの方法も確定した率を下回りました。モデルにクリックした日を入れていないので、確率が上がり続けている状況では、過去の平均を学習したモデルは、確定した結果で学習した参考のモデルでも0.81にとどまります。その中で、出そろった期間(0〜29日目)だけを使う(2)は、古い期間だけで学習するので5.57%と、参考の5.96%より低く出ました。(3)は直近のクリックも重みを付けて使うので5.85%で、参考に近い値でした。(3)は直近のクリックの負例を軽く数えるので、その分、古い期間の重みが相対的に大きくなる方法でもあり、参考の値には届いていません。
この結果から、本コラムの架空データでは次のことが言えます。確率が時間で変わらないなら、出そろった期間だけで学習しても、経過日数で重みを付けても、未着を負例とする方法より偏りは小さくなりました。確率が時間で変わる場合には、出そろった期間だけで学習する方法は、直近の変化を取り込めない分だけ遅れます。どの方法でも、確率の変化そのものを追う仕組み(更新の頻度を上げる・較正をこまめにやり直す。第6章と第12章)が別に要ります。なお、この比較は乱数の種1通り(20261116)で確かめたものです。下の表の「向いていそうな場面の例」は、本章では試していない提案です。
| 学習の仕方 | 長所 | 短所 | 向いていそうな場面の例(本章では未検証) |
|---|---|---|---|
| 直近まで全部・未着は負例 | 手順が簡単で、記録をすべて使える | 直近の結果が出そろっていない分だけ予測が低く出る | コンバージョンの遅れが、学習の間隔に比べてごく短い場合 |
| 結果が出そろった期間だけ | 未着による偏りが無い | 計測期間の分だけ古い記録で学習することになり、直近の変化を取り込めない。使える件数も減る | 確率が時間であまり変わらず、計測期間が短い場合 |
| 経過日数で負例に重み | 直近の記録も使いながら、未着による偏りを小さくできる | 遅れの分布を推定する手間がかかり、遅れの分布そのものが変わるとずれる | 計測期間が長く、直近の変化も取り込みたい場合 |
遅れの分布は、商品や季節、キャンペーンの内容で変わりえます。区分によって遅れの長さが違えば、遅れの分布を全体で1つと置いた補正は、その区分では合いません。遅れの分布を区分ごとに推定するか、少なくとも区分ごとに、出そろった期間で予測と確定した結果を照らし合わせることが必要です。また、計測期間そのもの(30日にするか7日にするか)を変えると、何をコンバージョンと数えるかが変わり、率もモデルも変わります。計測期間を決めるのは事業の判断で、第2章で述べたとおり、モデルや自動入札の設定より前に決めておくべきことです。
コンバージョンの価値が件ごとに違う場合
ここまでは、コンバージョン1件の価値をどれも同じとみなしてきました。本コラムでは、コンバージョンの価値を、コンバージョン1件に対応する、広告費を引く前の粗利の見込みとしています(売上とは区別します)。実際には、購入の内容や商品の粗利率、申込の種類によって、1件から得られる粗利の見込みは件ごとに違います。表示の価値を予測クリック率×予測コンバージョン率×コンバージョンの価値と見積もるとき、価値の部分を一律の数で置くか、機会ごとに予測した価値で置くかで、入札額の配り方が変わります。
価値を機会ごとに予測する場合、予測の対象は「コンバージョンしたときの価値」で、コンバージョンしたクリックだけが学習の材料になります。件数はコンバージョン率の予測よりさらに少なく、価値の分布は少数の大きな値に引っぱられやすいので、平均の予測は不安定になりがちです。遅れて届くコンバージョンの問題も同じようにかかり、さらに返品や解約で価値が後から変わることもあります。価値の予測を入札に使う前に、少なくとも次の点を確かめるのがよいと考えています。
- 価値を粗利の見込みで置いているか(売上のまま使うなら、粗利との違いを区別して扱っているか)、返品や解約をどう引くかを、事業として決めてあるか
- 価値の予測を、時間で切った評価用データで、区分ごとの平均と実績で確かめたか
- 価値の予測が大きく外れたときに、入札額が上限なく大きくならない仕組み(上限の設定など)があるか
- 初回の購入の価値だけを見るのか、その後の継続的な購入まで含めて見るのか
最後の点の、顧客がその後にもたらす価値まで含める考え方(顧客の生涯価値)は、弊社コラム「顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで」で扱っています。コンバージョンの価値をどの水準に置くかは入札額の水準そのものを決めるので、第7章で改めて扱います。また、ここでいう価値は、広告が無くても起きたコンバージョンにも付く値で、広告による増分を表す値ではありません。増分の扱いは第11章で扱います。
過学習の点検、更新の頻度、推論の時間の制約
勾配ブースティングは表現の力が大きい分、学習用の記録の偶然のばらつきにも合わせてしまう(過学習)おそれがあります。本章の例題では、木の本数を検証用の日の対数損失で決め、葉の最小の件数(min_data_in_leaf=200)を大きめにとって、件数の少ない区分に細かく合わせすぎないようにしました。過学習の点検では、学習用・検証用・評価用を時間の順に切り、学習用での成績と評価用での成績の差を見ます。ランダムに切ると、同じ日の似た記録が学習用と評価用の両方に入り、成績が実際より良く見えることがあります(評価データの切り方は第6章で扱います)。
過学習とは別に、情報の漏れにも注意が要ります。特徴量の作り方の段階で、その表示より後に分かる情報(その日の集計の結果・あとで届いたコンバージョン・落札後に知らされる価格)が入ると、評価用のデータでの成績は良く見えても、入札の時点では同じ成績になりません。過去の実績の率を特徴量にする場合(第4章)は、その表示より前の記録だけで集計しているかを確かめます。本章の例題では、入力をすべて入札の時点で分かる項目に限りました。
更新の頻度については、前に見た He らの2014年の論文で、週に1回の学習から毎日の学習に変えると成績が良くなったという報告がありました。広告の記録では、新しい広告や掲載面が次々に現れ、季節や競合の入札も変わるので、モデルは時間とともに古くなります。ロジスティック回帰なら第4章で扱った逐次学習で少しずつ直せますが、勾配ブースティングでは、一定の期間ごとに学習し直すか、学習し直しの合間に予測の水準を合わせ直す運用がよく採られます。ただし、全体の平均を合わせ直しただけでは、区分ごとに較正が取れているとは言えません。どの頻度で学習し直すかは、学習にかかる時間と計算の費用、成績の落ち方の速さを並べて決めます。モデルの監視と見直しの段階は第12章で扱います。
推論の時間は、入札という用途に特有の制約です。第1章で扱ったとおり、リアルタイム入札では、入札リクエストを受けてから応答するまでの時間に制限があり、その中で予測・入札額の計算・応答の送信を済ませる必要があります。本章の例題では、評価用の38,018件をまとめて推論するのに、同じコードを2回実行したところ、ロジスティック回帰で0.033秒と0.051秒、55本の勾配ブースティングで0.056秒と0.048秒かかり、どちらが速いかも回によって入れ替わりました。これは1台のPCで小さなモデルをまとめて計算した場合の値で、実際の入札の仕組みでは、1件ずつ届く入札リクエストに応答する時間と、木の本数・深さ・特徴量の作成にかかる時間を合わせて測る必要があります。木の本数を増やすと、成績の改善が頭打ちになった後も推論の時間だけが延びます。本数は、本章の例題のように検証用のデータで改善が頭打ちになるところで選び、評価用のデータは選んだあとの確認にだけ使います。そうして選んだ本数で止めることは、時間の制約の面でも理にかなっています。
| 運用の項目 | ロジスティック回帰 | 勾配ブースティング | 確かめること |
|---|---|---|---|
| 学習し直しの頻度 | 逐次の更新ができる | 期間ごとに学習し直す運用がよく採られる | 学習にかかる時間が、決めた頻度に収まるか |
| 推論の時間 | 係数の和なので軽い | 木の本数と深さで延びる | 入札の応答の制限の中に、特徴量の作成も含めて収まるか |
| 組み合わせの効果 | 人が交差特徴を作る必要がある | 木が自動で拾う | 入札に効く区分ごとに予測と実績が合っているか |
| 説明 | 係数を読める | 別の説明の手法が要る | 予測が変わった理由を、社内で説明できるか |
| 過学習 | 正則化の強さで調整 | 木の本数・葉の数・葉の最小の件数で調整 | 時間で切った評価用データで、学習用との成績の差を見たか |
経営の判断、成績の差と運用の負担の差を並べて選ぶ
本章の結果は、モデルの選択を「全体の指標が良いほうを選ぶ」だけで決めないほうがよいことを示しています。本コラムの架空データでは、勾配ブースティングとロジスティック回帰の全体の対数損失の差は0.0003で、乱数の種を変えると逆転する回もありました。一方で、組み合わせの関係がある区分では、交差特徴の無いロジスティック回帰の予測は実績の0.58倍から1.90倍までずれていました。全体の指標の差が小さくても、入札に効く区分でのずれの差が大きいことがあります。逆に、交差特徴を工夫したロジスティック回帰で区分ごとのずれが十分に小さければ、更新の速さや推論の軽さを優先して線形のモデルを選ぶ判断もありえます。
判断を誤ったときの損失は、本コラムの6つの型で整理できます。区分ごとに高すぎる予測は、見込んだ価値を超える額で買う払いすぎにつながり(その起こり方はオークションの方式で違います)、低すぎる予測は、利益を増やせたはずの機会を買い逃す場合に機会損失になります。負例の間引きの補正を忘れたり、遅れて届くコンバージョンを未着のまま負例として学習したりすると、入札額の水準そのものがずれます。後者では予測コンバージョン率が低く出るので、入札が控えめになって機会損失が出やすくなります。また、学習し直しの頻度や推論の時間を誰も点検していないと、モデルが古くなっても気づけない形骸化につながります。どの型の損失も、予測クリック率や予測コンバージョン率がそれ自体として成果なのではなく、増分の利益(第11章)につながる入札の判断の材料である、という前提で見積もる必要があります。
媒体の自動入札を使っている場合、媒体の中の予測のモデルは広告主からは見えず、その中身は公開されていない部分が多いので、本コラムでは推測しません。それでも、自社がモデルを持つ意味がある範囲はあると考えています。1つは、媒体に渡すコンバージョンの定義・計測期間・価値の質を上げることで、本章で見た遅れの扱いや価値の予測は、媒体に渡す値を決める段階でも役に立ちます。もう1つは、DSP などで入札の方針を自社で調整できる場合に、自社だけが持つ情報(自社の顧客の購入の記録など、利用者の情報の取り扱いの規律に沿って使えるもの。規制は第14章)を予測に入れられることです。どの段階まで自社で持つかは、第13章で体制とあわせて扱います。
| 判断の項目 | 確かめること | 主に関わる損失の型 |
|---|---|---|
| モデルの比較の仕方 | 時間で切った評価用データで、全体の指標と区分ごとの予測と実績の比を両方並べたか。乱数やデータの期間を変えても差が安定しているか | 払いすぎ・機会損失 |
| 負例の間引き | 補正の式を配信に使う予測の出口で当てているか。間引いた割合を記録に残しているか | 払いすぎ |
| 遅れて届くコンバージョン | 計測期間と遅れの分布を把握し、未着を負例として数えていないか。直近の日の率の低下を、遅れと配信の変化に分けて読んでいるか | 機会損失・成果の数え違い |
| コンバージョンの価値 | 何を価値として数えるかを事業として決め、予測した価値を区分ごとに確かめたか | 払いすぎ・成果の数え違い |
| 更新と推論 | 学習し直しの頻度と、推論の時間を測って決め、点検する担当を置いたか | 形骸化 |
| 自社でモデルを持つ範囲 | 媒体の自動入札に渡す値の質を上げることと、自社のモデルを持つことの、どちらに手間をかけるかを決めたか | 形骸化・機会損失 |
経営として決めるべきことは、モデルの種類そのものよりも、成績の差と運用の負担の差を同じ表に並べて選ぶ手順です。具体的には、評価の指標と区分、時間での切り方、学習し直しの頻度、推論の時間の上限、点検の担当を先に決め、その条件のもとで候補のモデルを比べます。成績の差が、更新と運用にかかる人と計算の負担に見合わないなら、単純なモデルを選んで、浮いた手間をコンバージョンの定義や価値の見直し、増分の測定に回すほうが、事業の成果に近いと考えています。
この章では、勾配ブースティングが項目の組み合わせを自動で拾うこと、全体の指標の差が小さくても区分ごとの予測のずれには差が出ること、負例の間引きには確率の補正が要ること、遅れて届くコンバージョンを未着のまま負例とすると予測が低く出ることを、架空データで確かめました。どの話も、最後は「予測した確率が実績と合っているか」という確かめ方に行き着きます。次の第6章では、その確かめ方として、対数損失や正規化エントロピーなどの指標と確率の較正を扱い、確率のずれが入札の費用にどう効くかを確かめます。
この章を深めたい方への参考書籍
『Kaggleで勝つデータ分析の技術』(門脇大輔、阪田隆司、保坂桂佑、平松雄司 著、技術評論社):GBDT(勾配ブースティング木)の概要と主なライブラリ、パラメータの調整に加え、時系列データのバリデーション(評価用のデータの切り方)の手法と注意点を、章を立てて扱っています。本章で行った「時間で切って評価する」「検証用のデータで木の本数を決める」手順を、実装の水準で深めたい方に向きます。
『統計的学習の基礎 データマイニング・推論・予測』(Trevor Hastie、Robert Tibshirani、Jerome Friedman 著、杉山将、井手剛、神嶌敏弘、栗田多喜夫、前田英作 監訳、井尻善久 他訳、共立出版):機械学習の手法を統計の立場から体系的に扱う教科書の訳書(原著第2版の翻訳)です。本章で使ったロジスティック回帰や決定木の集まりの背景にある理論を、数式を使って深めたい方に向きます。
第6章 予測の評価と較正、対数損失と確率のずれが入札に与える影響
第4章ではロジスティック回帰と特徴量の作り方を、第5章では勾配ブースティングと遅れて届くコンバージョンの扱いを見てきました。どちらの章でも、モデルを比べるときに対数損失と AUC という指標を使い、詳しい説明はこの章に送っていました。この章では、予測クリック率をどの指標で評価し、予測した確率が実績の率と合っているかをどう確かめて直すか、そして確率のずれが入札を通じて費用と利得にどう効くかを扱います。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の表示の記録を使い、実行したコードと結果で確かめます。
- 広告の予測で、並べ方の良さ(順位)より確率の正しさが効く理由
- 指標の表(AUC・対数損失・正規化エントロピー・予測の平均と実績の比・区分ごとの較正の確認)と、正解率が役に立たない理由
- 順位は良いが確率がずれたモデルと、順位はやや劣るが確率のずれが小さいモデルの比較と、信頼性の図
- 較正の方法(プラットの方法・等調回帰・負例の間引きを戻す式)と、較正に使っていないデータでの確認
- 確率のずれを与えたときの、セカンドプライスのオークションでの落札の件数・支払額・利得の変化
- 掲載面ごとの較正と区間、評価データの切り方、指標の差のばらつき
- 媒体や外部の事業者の示す数字を読むときに聞くことと、経営の判断
この章の主張は、広告の予測では、モデルを選ぶ前に「どの指標で、どのデータの切り方で評価するか」を決め、予測した確率が実績と合っているかを、較正に使っていないデータで掲載面などの区分ごとに確かめ続けるべきだ、という点です。本コラムの架空データでは、予測クリック率に3通りのずれを与えて入札を計算しました。一律に1.5倍にした場合、一律に0.67倍にした場合、全体の平均を合わせたまま一部の掲載面だけを2倍にした場合です。3つとも、価値どおりに入札したつもりの利得は、ずれの無い場合より下がりました。
順位より確率の正しさが入札に効く理由
多くの分類の問題では、モデルの出す点数で対象を並べ、上から何件かを選べば用が足ります。審査で上位の申込を通す、点検の対象を上から選ぶ、といった使い方では、並べ方が正しければ点数の絶対値はあまり問題になりません。広告の入札は事情が違います。序章と第1章で見たとおり、本コラムの例題では、表示の価値を「予測クリック率 × 予測コンバージョン率 × コンバージョンの価値」と置き、入札額をこの価値にもとづいて決めます。表示の価値に一定の係数を掛けて入札する場合、ほかの条件が同じなら、確率を高く見積もるほど入札額も高くなります。この章の例題のように表示の価値そのものを入札額にする場合は、予測クリック率が実際の確率の2倍に出れば、入札額も2倍になります。
この関係があるため、並べ方がまったく同じ2つのモデルでも、確率の水準が違えば入札額が違い、落札する機会と支払額が変わります。順位だけを見る指標(AUC)では、この違いを捉えられません。予測した確率を全部2倍にしても並べ方は変わらないので、AUC は同じ値のままです。広告の予測を評価するときに、順位の指標だけでなく、確率の正しさを反映する指標と、予測の平均が実績と合っているかの確認を並べる必要があるのは、このためです。
確率のずれの影響は、入札の方式によっても違います。第3章で見たセカンドプライスでは、勝ったときに払うのは落札のしきい値(自分以外の入札の最高額と最低落札価格の大きいほう)なので、予測が高すぎると、価値より高い額を払う落札が増えます。ファーストプライスでは入札額そのものを払うので、予測が高すぎることは支払額に直接響きます(第8章)。どちらの方式でも、予測が低すぎると、価値のある機会を買い逃します。この章の後半のコードでは、セカンドプライスの場合について、ずれの向きと形ごとに、この影響を数字で確かめます。
評価の指標の表と、正解率が役に立たない理由
予測クリック率の評価に使う主な指標を表にまとめます。表の AUC は、ROC 曲線(予測のしきい値を動かしたときの、クリックのあった表示を拾えた割合と、クリックの無かった表示を誤って拾った割合の関係を描いた曲線)の下の面積のことです。予測が同じ値の組は半分と数えます。評価の単位は、クリック率の予測では表示、コンバージョン率の予測ではクリックです。この章で扱うのはクリック率の予測なので、単位は表示です。式は、評価に使う表示を \( i = 1, \dots, n \)、表示 \( i \) のクリックの有無を \( y_i \)(クリックありなら1、なしなら0)、予測クリック率を \( p_i \) と書いたものです。
| 指標 | 何を測るか | 言葉での言い換え | 確率の水準のずれに気づけるか |
|---|---|---|---|
| AUC | クリックのあった表示を、無かった表示より上に並べられているか | クリックのあった表示と無かった表示を1つずつ選んだとき、前者の予測のほうが高い割合。0.5 は無作為に並べた場合の基準と同じ値 | 気づけない(確率を一律に何倍にしても値は変わらない) |
| 対数損失 | 予測した確率と、実際の結果のずれ(並べ方の良さと確率の正しさの両方を反映する) | 実際に起きた結果に、モデルがどれだけ低い確率を付けていたかの平均。小さいほどよい | 気づける(水準がずれると大きくなる) |
| 正規化エントロピー | 対数損失を、学習の期間の平均のクリック率から計算したエントロピー(その率を一律に予測した場合の、学習の期間での対数損失)で割ったもの | 学習の期間の平均の率を言うだけの予測と比べた目安。小さいほどよい。評価の期間に率の水準が動くと、1 との比較だけでは評価の期間での優劣を判断できない | 気づける(ただし分母の取り方に注意。後述) |
| 予測の平均と実績の比 | 予測クリック率の合計と、実際のクリックの件数の比 | 見込んだクリックの件数が、実際の何倍か。1 に近いほどよい | 全体の水準のずれに気づける(区分ごとのずれは打ち消し合うことがある) |
| 区分ごとの較正の確認 | 掲載面・端末・キャンペーンなどの区分ごとの、予測の平均と実績の率 | 区分ごとに見込みと実績が合っているか | 気づける(件数の少ない区分はばらつきが大きい) |
| 正解率 | 0.5 などの境目で「クリックあり・なし」に分けたときに当たった割合 | 当たった割合 | ほとんど気づけない(下記) |
対数損失は、式で書くと \( -\frac{1}{n}\sum_i \{ y_i \log p_i + (1-y_i)\log(1-p_i) \} \) です。言葉で言い換えると、クリックがあった表示では予測クリック率の対数を、無かった表示では「クリックされない確率」の対数を取り、その平均の符号を反転させた値です。クリックが無かった表示に高い確率を付けていても、クリックがあった表示に低い確率を付けていても大きくなるので、確率の水準のずれも並べ方の誤りも反映します。両方が混ざった値なので、対数損失が小さいことだけで、確率が実績と対応している(後述の「較正が取れている」)とは言えません。
正規化エントロピーは、He らの2014年の論文(Facebook の広告のクリックの予測の実務を述べた論文。KDD の併設のワークショップで発表)が主な評価の指標として使ったものです。要旨は、平均の対数損失を、学習用のデータの平均のクリック率(背景のクリック率)を一律に予測した場合の値で割る、というものです。平均の率が0や1に近いと対数損失が小さく出やすいので、その影響をならすための割り算です。本章のコードでも、分母は学習の期間の平均のクリック率から計算しました(0.12201)。同じ論文は、予測の平均と実績の比も主な指標とし、1 に近いほどよいとしています。
正解率は、広告の予測の成績としてはほとんど役に立ちません。クリック率は多くの場合数% 以下なので、すべての表示について「クリックなし」と答えるだけで、正解率は9割台の後半になります。後のコードの評価の2日分では、すべて「クリックなし」と答えた場合の正解率は 0.9702 でした。予測クリック率が0.5以上の表示を「クリックあり」と答えると、確率が高めにずれたモデルAでは 0.9588 と、何も予測しない場合より下がり、確率のずれが小さいモデルBでは 0.9702 と、何も予測しない場合と同じでした。モデルBの予測には0.5以上の表示が1件も無く、すべて「クリックなし」と答えたのと同じになったためです。どちらの数字も、入札に使う確率の良し悪しを表していません。本コラムで予測モデルの「正解率」を成績として書かないのはこのためです。
架空の表示の記録で、2つのモデルを作る
ここからはコードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの成績は、実際の配信での成績の目安にはなりません。示したいのは、指標の選び方と較正の有無で、見え方と入札の結果がどう変わるかです。
14日間の表示の記録240,000件を、乱数の種を20261116に固定して作りました。日は0日目から13日目まで、0から数えています。コードは Python 3.14.3 で、scikit-learn 1.9.0 を使って実行しました。
表示の機会の属性として、掲載面(AからFの6種類)・端末の種類(スマートフォン・パソコン・タブレット)・広告枠の大きさ(小・中・大)・時刻を持たせました。利用者の側の特徴にあたる項目としては、過去の訪問の回数と直近の訪問からの日数を持たせました。個人を特定する項目や、差別につながる属性は入れていません。例題では、表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件として扱います。クリックの確率は次の規則で決めました。
- 掲載面によって水準が違う(全体のクリック率は 2.711%。掲載面ごとの実績はAの 5.58% からEの 0.85% まで)
- 端末・広告枠の大きさ・夜の時間帯(19時以降)・訪問の回数・直近の訪問からの日数が、それぞれ少しずつ効く
- 組み合わせで効く関係:掲載面Aをスマートフォンで見た場合はクリックされやすく、掲載面Dをパソコンで見た場合はされにくい
- 時間の流れ:0から数えて10日目から、掲載面Cの反応が上がる(掲載面の画面の変更などを想定した変化)
合成データなので、表示ごとの本当のクリックの確率が分かります。後半のオークションの計算では、この本当の確率を使って表示の価値を出します。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import time
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib
from scipy.special import expit
from scipy.stats import beta
from sklearn.linear_model import LogisticRegression
from sklearn.isotonic import IsotonicRegression
from sklearn.metrics import roc_auc_score, log_loss
from sklearn.preprocessing import OneHotEncoder
pd.set_option("display.width", 200)
t0 = time.time()

rng = np.random.default_rng(20261116)
n = 240_000
day = rng.integers(0, 14, n)
hw = np.r_[np.full(7, 0.3), np.full(12, 1.0), np.full(5, 1.6)]
hour = rng.choice(24, n, p=hw / hw.sum())
place = rng.choice(list("ABCDEF"), n, p=[0.25, 0.2, 0.18, 0.15, 0.12, 0.10])
device = rng.choice(["スマートフォン", "パソコン", "タブレット"], n, p=[0.6, 0.3, 0.1])
slot = rng.choice(["小", "中", "大"], n, p=[0.4, 0.4, 0.2])
visits = np.minimum(rng.poisson(1.5, n), 6)
recency = np.minimum(rng.exponential(10, n), 30).round()
base = pd.Series({"A": -3.4, "B": -3.8, "C": -4.3, "D": -4.5, "E": -4.9, "F": -4.0})
z = (base[place].to_numpy()
     + pd.Series({"スマートフォン": 0.0, "パソコン": 0.2, "タブレット": -0.1})[device].to_numpy()
     + pd.Series({"小": -0.2, "中": 0.0, "大": 0.3})[slot].to_numpy()
     + 0.12 * visits - 0.02 * recency + 0.15 * (hour >= 19))
z += 0.7 * ((place == "A") & (device == "スマートフォン"))   # 組み合わせで効く関係
z -= 0.6 * ((place == "D") & (device == "パソコン"))
z += 0.6 * ((place == "C") & (day >= 10))                     # 10日目から掲載面Cの反応が上がる
p_true = expit(z)
click = rng.binomial(1, p_true)
cvr = pd.Series({"A": 0.06, "B": 0.08, "C": 0.05, "D": 0.10, "E": 0.07, "F": 0.09})[place].to_numpy()
df = pd.DataFrame(dict(day=day, hour=hour, place=place, device=device, slot=slot,
                       visits=visits, recency=recency, p_true=p_true, cvr=cvr, click=click))
print("表示の件数", len(df), "クリック率", round(df.click.mean() * 100, 3), "%")
print((df.groupby("place").click.mean() * 100).round(2).to_string())
データは時間で3つに分けました。0〜9日目の171,529件を学習に、10・11日目の34,291件を較正に、12・13日目の34,180件を評価に使います。較正に使う日と評価に使う日を分けたのは、較正がうまくいったかどうかを、較正に使っていないデータで確かめるためです。
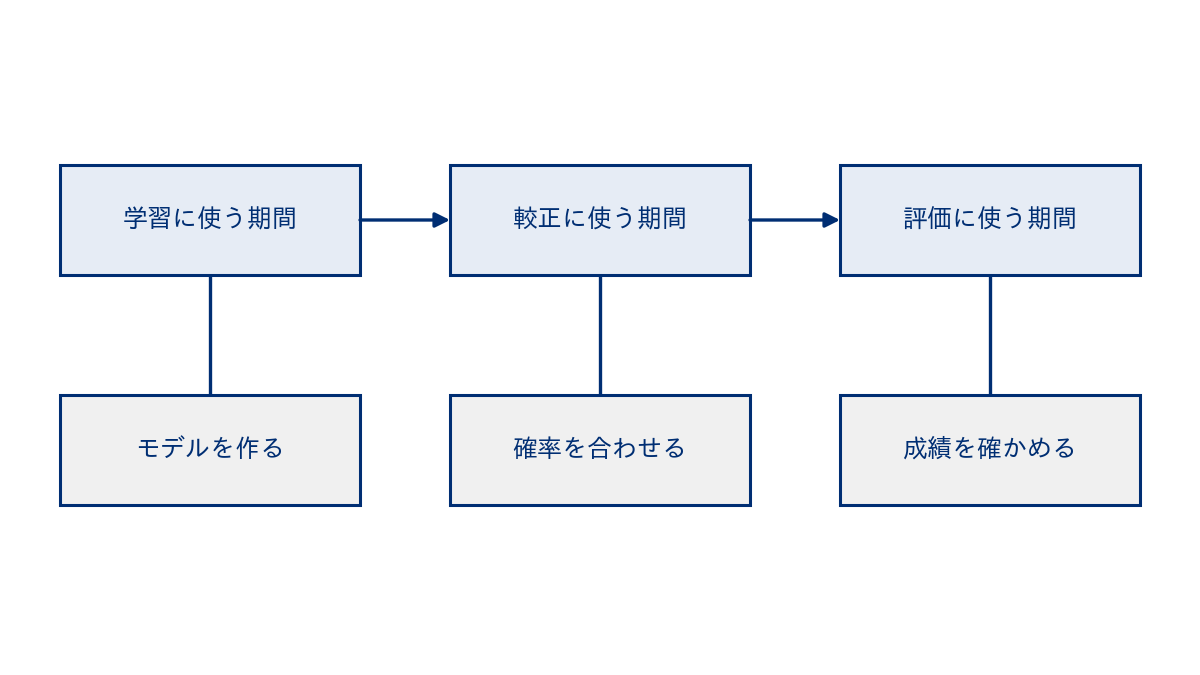
2つのモデルは、意図して性質を変えて作りました。モデルAは、掲載面と端末の組み合わせ(交差特徴。第4章)を入れたロジスティック回帰で、学習を軽くするために、クリックの無い表示を1割だけ使って学習しました(負例の間引き。第5章)。間引いたあとに確率を戻す補正はしていません。組み合わせの関係を拾えるので並べ方は良くなるはずですが、クリックの無い表示を減らしたぶん、確率は高く出るはずです。モデルBは、交差特徴を入れず、間引きもしないロジスティック回帰です。
feats = ["place", "device", "slot", "hour", "visits", "recency"]
tr, ca, te = df[df.day <= 9], df[df.day.isin([10, 11])], df[df.day >= 12]
print("学習", len(tr), "較正", len(ca), "評価", len(te))
enc = OneHotEncoder(handle_unknown="ignore").fit(tr[["place", "device", "slot"]])
def X_lin(d):
    oh = enc.transform(d[["place", "device", "slot"]]).toarray()
    return np.c_[oh, (d.hour >= 19), d.visits, d.recency]
lin = LogisticRegression(C=1.0, max_iter=2000).fit(X_lin(tr), tr.click)
enc2 = OneHotEncoder(handle_unknown="ignore").fit((tr.place + "_" + tr.device).to_frame())
def X_cross(d):                                             # 掲載面×端末の交差特徴を足す
    return np.c_[X_lin(d), enc2.transform((d.place + "_" + d.device).to_frame()).toarray()]
keep = (tr.click == 1) | (rng.random(len(tr)) < 0.1)        # クリックの無い表示を1割だけ使う
crs = LogisticRegression(C=1.0, max_iter=2000).fit(X_cross(tr[keep]), tr.click[keep])
pA_ca, pA_te = crs.predict_proba(X_cross(ca))[:, 1], crs.predict_proba(X_cross(te))[:, 1]
pB_ca, pB_te = lin.predict_proba(X_lin(ca))[:, 1], lin.predict_proba(X_lin(te))[:, 1]

bg = tr.click.mean()
H = -(bg * np.log(bg) + (1 - bg) * np.log(1 - bg))
def report(name, y, p):
    ll = log_loss(y, p)
    return dict(モデル=name, AUC=round(roc_auc_score(y, p), 4), 対数損失=round(ll, 5),
                正規化エントロピー=round(ll / H, 4), 予測の平均と実績の比=round(p.mean() / y.mean(), 3))
y = te.click.to_numpy()
rows = [report("モデルA(交差特徴あり・間引き・補正なし)", y, pA_te), report("モデルB(交差特徴なし)", y, pB_te)]
print(pd.DataFrame(rows).to_string(index=False))
print("学習の日の平均クリック率", round(bg * 100, 3), "%", "評価の日の実績", round(y.mean() * 100, 3), "%")
print("学習の日の平均を一律に予測したときの評価の日の対数損失", round(log_loss(y, np.full(len(y), bg)), 5),
      "正規化エントロピーの分母", round(H, 5))
print("すべてクリックなしと答えたときの正解率", round(1 - y.mean(), 4))
print("モデルAで0.5以上をクリックありと答えたときの正解率", round(((pA_te >= 0.5) == y).mean(), 4))
print("モデルBで0.5以上をクリックありと答えたときの正解率", round(((pB_te >= 0.5) == y).mean(), 4),
      "0.5以上の件数", int((pB_te >= 0.5).sum()))
noC = (te.place != "C").to_numpy()
print("掲載面Cを除いたモデルBの比", round(pB_te[noC].mean() / y[noC].mean(), 3))
評価の2日分での結果は次のとおりです。
| モデル | AUC | 対数損失 | 正規化エントロピー | 予測の平均と実績の比 |
|---|---|---|---|---|
| モデルA(交差特徴あり・間引き・補正なし) | 0.6905 | 0.26076 | 2.1372 | 6.531 |
| モデルB(交差特徴なし) | 0.6882 | 0.12767 | 1.0464 | 0.882 |
AUC はモデルAのほうがわずかに高く、並べ方はモデルAがやや良いという結果でした。一方で、対数損失はモデルAがモデルBの約2倍で、予測の平均と実績の比は 6.531 でした。モデルAは、実際の6.5倍のクリックを見込んでいたことになります。AUC だけを見てモデルAを選び、その予測クリック率をそのまま入札に使うと、入札額が6倍以上に膨らみます。AUC の差は 0.0023 と小さく、この差だけで並べ方の優劣を言い切ることもできません。
正規化エントロピーには注意が要ります。モデルBの値は 1.0464 と1を超えていて、論文の定義どおりに読むと「平均の率を言うだけより悪い」ように見えます。ところが、学習の日の平均のクリック率(2.64%)をすべての表示に予測した場合の、評価の日の対数損失は 0.13441 で、モデルBの 0.12767 より大きくなりました。モデルBは、学習の日の平均を言うだけより良いのです。食い違いの理由は、評価の日の実績のクリック率が 2.984% と、学習の日より高かったことにあります。掲載面Cの反応が10日目から上がったためです。分母(0.12201)は学習の日の平均の率から計算するので、評価の日に一律の予測をした場合の対数損失(0.13441)とは違う値です。そのため、評価の期間に率の水準が動くと、正規化エントロピーは1をまたいで動き、1との比較だけでは評価の期間での優劣を判断できません。期間をまたいで値を比べるときは、分母に使った率と、評価の期間の実績の率を並べて記録しておくのが安全だと考えています。
確率の較正の方法と、較正に使っていない日での較正の確認
本コラムでは、予測した確率が同じくらいの機会を集めたとき、その実績の率が予測と対応している状態を「較正が取れている」と呼びます。例えば予測クリック率がおよそ3%の表示を集めたら、実績のクリック率もおよそ3%になっている、という状態です。全体の予測の平均が実績の率と合っているだけでは、較正が取れているとは言いません。予測の高い帯で高すぎ、低い帯で低すぎるずれが打ち消し合っていることがあるからです。合っているかを確かめる作業は「較正の確認」と呼び、較正に使っていないデータで行います。
確率の較正は、較正が取れた状態に近づくように、モデルの出す確率を写し直すことです。モデルの並べ方を活かしたまま、確率の水準だけを直す後処理として使うことが多い方法です。学習で負例を間引いた場合は、その影響の補正も較正の一部として考えます。代表的な方法を表にまとめます。
| 方法 | やること | 要るデータ | 外れやすい場面 |
|---|---|---|---|
| プラットの方法 | モデルの出力を入力にした、1変数のロジスティック回帰を当てはめる(S字の曲線で写す) | 較正用のデータ(学習に使っていないもの)。件数が少なくても動く | ずれの形がS字の曲線で表せない場合 |
| 等調回帰 | 予測の順序を保ったまま、階段状の関数で実績の率に合わせる | 較正用のデータ。件数が多いほうがよい | 件数が少ないと階段が細かくなりすぎ、較正用のデータに合わせすぎる |
| 負例の間引きを戻す式 | 負例を残した確率(保持率)\( w \) を使い、\( q = p / \{p + (1-p)/w\} \) で確率を戻す | 負例の保持率だけ(データは要らない) | 間引き以外の原因(分布の変化など)によるずれは直らない |
| 区分ごとの補正 | 掲載面などの区分ごとに、予測の平均と実績の比で割り戻す | 区分ごとの較正用のデータ | 件数の少ない区分では比そのものがばらつく |
プラットの方法は、Platt の1999年の論文(サポートベクターマシンの出力を確率に変える方法の論文)で示された方法で、等調回帰による較正は、Zadrozny と Elkan の2002年の論文(分類器の点数を正確な確率の見積りに変える方法の論文。KDD 2002 で発表)で扱われた方法です。scikit-learn の公式ドキュメントによれば、等調回帰は単調でありさえすれば形を問わずに写せる代わりに、データが少ないと較正用のデータに合わせすぎやすい方法です。較正の関数は、モデルの学習に使ったデータとは別のデータで当てはめるのが望ましい、ともされています。負例の間引きを戻す式は、前述の He らの2014年の論文に書かれている式です。与信のモデルでの較正の考え方は、「貸し倒れのリスクを見積もる与信スコアリング、スコアカードの作り方から審査と途上与信の運用まで」という題の弊社コラムでも扱いました。
次のコードでは、モデルAに3つの方法を当てます。プラットの方法と等調回帰は較正用の2日分で当てはめ、評価の2日分で確かめます。間引きを戻す式は、負例を残した確率 0.1 を入れるだけです(クリックの無い表示の約9割を除き、約1割を残しました)。あわせて、信頼性の図を描きます。評価の表示を予測の小さい順に並べ、件数が等しくなるように10の帯に分け、帯ごとの予測の平均と実績のクリック率を点で並べた図です。
platt = LogisticRegression(C=1e6, max_iter=1000).fit(np.log(pA_ca / (1 - pA_ca)).reshape(-1, 1), ca.click)
pA_platt = platt.predict_proba(np.log(pA_te / (1 - pA_te)).reshape(-1, 1))[:, 1]
iso = IsotonicRegression(out_of_bounds="clip", y_min=1e-5, y_max=1 - 1e-5).fit(pA_ca, ca.click)
pA_iso = iso.predict(pA_te)
w = 0.1
pA_fix = pA_te / (pA_te + (1 - pA_te) / w)                   # 間引きの割合から戻す式
rows2 = [report("モデルA 補正なし", y, pA_te), report("モデルA 間引きの式で戻す", y, pA_fix),
         report("モデルA プラットの方法", y, pA_platt), report("モデルA 等調回帰", y, pA_iso),
         report("モデルB", y, pB_te)]
print(pd.DataFrame(rows2).to_string(index=False))
noC = (te.place != "C").to_numpy()
print("掲載面Cを除いた比", {k: round(p[noC].mean() / y[noC].mean(), 3)
      for k, p in [("間引きの式", pA_fix), ("プラット", pA_platt), ("等調回帰", pA_iso), ("モデルB", pB_te),
                   ("本当の確率", te.p_true.to_numpy())]})
print("本当の確率で計算した全体の比", round(te.p_true.mean() / y.mean(), 3))

def rel_curve(p, y, k=10):                       # 予測の小さい順に、件数が等しい10の帯に分ける
    q = pd.qcut(p, k, labels=False, duplicates="drop")
    g = pd.DataFrame(dict(q=q, p=p, y=y)).groupby("q").mean()
    return g.p.to_numpy(), g.y.to_numpy()
fig, ax = plt.subplots(1, 2, figsize=(11, 4.6))
lims = [0, 0]
for p, lab, mk, col in [(pA_te, "モデルA 補正なし", "o", "#002E73"), (pB_te, "モデルB", "s", "#888888")]:
    a, b = rel_curve(p, y); ax[0].plot(a, b, marker=mk, color=col, label=lab)
    lims[0] = max(lims[0], a.max(), b.max())
for p, lab, mk, col in [(pA_platt, "モデルA プラットの方法", "o", "#002E73"), (pA_iso, "モデルA 等調回帰", "^", "#000080"),
                        (pB_te, "モデルB", "s", "#888888")]:
    a, b = rel_curve(p, y); ax[1].plot(a, b, marker=mk, color=col, label=lab, alpha=0.9)
    lims[1] = max(lims[1], a.max(), b.max())
    print(lab, "最上位の帯 予測", round(a[-1], 4), "実績", round(b[-1], 4))
for k, lim in [(0, lims[0] * 1.08), (1, lims[1] * 1.08)]:      # 最上位の帯まで目盛りに収める
    ax[k].plot([0, lim], [0, lim], ls="--", color="#BBBBBB", label="予測と実績が一致する線")
    ax[k].set_xlim(0, lim); ax[k].set_ylim(0, lim)
    ax[k].set_xlabel("予測クリック率(10の帯ごとの平均)"); ax[k].set_ylabel("実績のクリック率")
    ax[k].legend(loc="upper left", fontsize=9)
ax[0].set_title("較正の前"); ax[1].set_title("較正の後(較正に使っていない評価の日)")
plt.tight_layout(); plt.savefig("../ch06_reliability.png", dpi=120, bbox_inches="tight"); plt.close()
| モデル | AUC | 対数損失 | 正規化エントロピー | 予測の平均と実績の比 |
|---|---|---|---|---|
| モデルA 補正なし | 0.6905 | 0.26076 | 2.1372 | 6.531 |
| モデルA 間引きの式で戻す | 0.6905 | 0.12748 | 1.0448 | 0.881 |
| モデルA プラットの方法 | 0.6905 | 0.12740 | 1.0442 | 0.927 |
| モデルA 等調回帰 | 0.6884 | 0.12753 | 1.0452 | 0.930 |
| モデルB | 0.6882 | 0.12767 | 1.0464 | 0.882 |
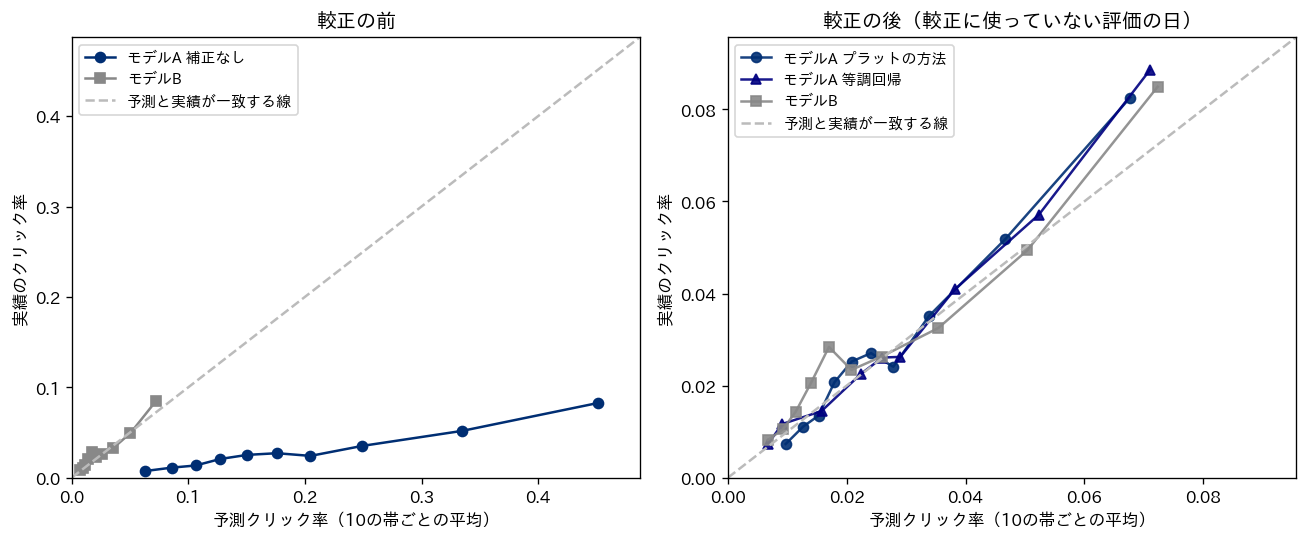
3つの方法のいずれでも、モデルAの対数損失は 0.26076 から 0.127 台まで下がり、モデルBの 0.12767 をわずかに下回りました。プラットの方法と間引きを戻す式は単調な変換なので、AUC は変わりません。等調回帰は階段状の関数で、近い予測を同じ値にまとめるため、この例では AUC が 0.6905 から 0.6884 にわずかに下がりました。同じ値にまとめることで AUC が変わりうる方法であり、この例では並べ方の良さが少し下がりました。
図の左側では、モデルAの点が一致する線から大きく右下にずれています。右側では、較正したモデルAの点もモデルBの点も、下位から中位の帯では線の近くに並びました。一方、最上位の帯では3つとも実績が予測を上回りました。プラットの方法では予測 6.77% に対して実績 8.26%、等調回帰では 7.11% に対して 8.86%、モデルBでは 7.24% に対して 8.49% です。予測の高い機会ほど入札額も高くなるので、この帯のずれは入札への影響が大きい部分です。10の帯に分けると1つの帯は約3,400件で、どこまでがばらつきかはこの図だけでは判断できません。なお、等調回帰の予測は同じ値が多いため、帯の境目が重なった分はまとめて描いています。
較正のあとでも、全体の予測の平均と実績の比は1になりませんでした。間引きを戻す式では 0.881、プラットの方法では 0.927、等調回帰では 0.930 です。ただし、合成データの本当のクリックの確率で同じ比を計算しても 0.944 でした。評価の2日分では、たまたま本当の確率から見込まれるより多くクリックが起きていたことになり、比が1から 0.05 程度離れることはばらつきの範囲で起こります。掲載面Cを除いて計算すると、比は間引きを戻す式で 0.968、プラットの方法で 0.999、等調回帰で 0.991、本当の確率で 0.960 でした。間引きを戻す式はデータを見ずに間引きの影響だけを戻すので、学習の期間(0〜9日目)の水準に戻るだけです。プラットの方法と等調回帰は較正用の10・11日目の実績に合わせるので、掲載面Cの反応が上がったあとの水準を一部取り込んだために、間引きを戻す式より比が1に近づいたと考えられます(較正用の日を変えて確かめることはしていません)。いずれにしても較正は、較正に使ったデータの時点の水準に合わせる作業なので、較正のあとに起きた変化は反映されません(この例題では、較正のあとに新たな変化は起こしていません)。この例題で確かめられるのは別の点で、全体に共通の写し方による較正では、較正の期間にすでに起きていた掲載面ごとのずれが残ることです。これを後の掲載面ごとの表で確かめます。
確率のずれが落札・支払額・利得に与える影響
次に、確率のずれが入札の結果にどう効くかを、セカンドプライスの架空のオークションで確かめます。評価の2日分の表示の機会34,180件のそれぞれに、本当の表示の価値と、競合の最高入札額を持たせます。本当の表示の価値は、合成データの本当のクリックの確率 × 掲載面ごとのコンバージョン率(5〜10%)× コンバージョンの価値としました。コンバージョンの価値は、コンバージョン1件に対応する、広告費を引く前の粗利の見込みで、例題では相対値で100と置きます。例題なので、クリックを経ないコンバージョンは扱いません。この表示の価値の式は、広告が無くても起きたコンバージョンを差し引いていない単純な見積りです(増分は第11章)。
入札額と支払額は、どちらも表示1回あたりの相対値で、表示の価値と同じ尺度です。落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。セカンドプライスの支払額は、例題では競合の最高入札額そのものとし、最低落札価格と手数料は省き、同額の場合は落札としました。競合の最高入札額は、価値の中央値を基準に掲載面ごとに水準を少し変え、対数の標準偏差を0.7とした対数正規分布から作りました。競合の水準の基準は価値の中央値と掲載面から決めましたが、同じ掲載面の中では、個々の表示の価値に応じて競合の額を変えていません。この単純な設定なので、以下の落札の件数や利得の大きさは、この設定に左右されます。
入札額は「入札の元にした予測クリック率 × コンバージョン率 × コンバージョンの価値」です。コンバージョン率には本当の値を使い、ずれはクリック率の予測だけに与えました。予測クリック率が本当の確率と一致していれば、価値どおりの入札になります。第3章で見たとおり、セカンドプライスでは価値どおりに入札するのが損にならない戦略です。ただし、そこでいう価値は買い手自身にとっての真の価値です。本コラムの表示の価値は増分を除いていない予測なので、実務でそのとおりに入札しても、増分の利益が最大になるとは限りません。この例題では、合成データの本当の表示の価値を真の価値とみなして、利得を計算します。
ここに、次の3つのずれを与えました。1つ目は、予測クリック率が一律に1.5倍に高い場合です。2つ目は、一律に0.67倍に低い場合です。3つ目は、掲載面Cだけ2倍に高くし、その他の掲載面を一律に下げて、評価の2日分の予測クリック率の全体の平均が本当の確率の平均と同じになるようにした場合です。3つ目では、掲載面C以外に掛けた倍率は 0.792 になりました。あわせて、前の節のモデルA(補正なし・等調回帰)とモデルBの予測で入札した場合も計算しました。表には、それぞれの予測クリック率の合計と実際のクリックの件数の比(予測と実績の比)も載せています。
V = 100.0                                         # コンバージョンの価値(相対値)
pt, cv = te.p_true.to_numpy(), te.cvr.to_numpy()  # コンバージョン率は本当の値を使う(ずれはクリック率だけ)
val = pt * cv * V                                 # 合成データなので本当の表示の価値が分かる
mloc = np.log(np.median(val)) + pd.Series({"A": 0.2, "B": 0.0, "C": -0.1, "D": 0.1, "E": -0.2, "F": 0.0})[te.place].to_numpy()
comp = np.exp(rng.normal(mloc, 0.7))              # 競合の最高入札額。基準は価値の中央値と掲載面で決め、個々の表示の価値には連動させない
isC = (te.place == "C").to_numpy()
k_other = (pt.sum() - 2 * pt[isC].sum()) / pt[~isC].sum()   # 予測クリック率の全体の平均を本当の平均に合わせる
cases = {"ずれなし": pt, "一律に1.5倍": 1.5 * pt, "一律に0.67倍": 0.67 * pt,
         "掲載面Cだけ2倍(平均は合わせる)": np.where(isC, 2 * pt, k_other * pt),
         "モデルA 補正なし": pA_te, "モデルA 等調回帰": pA_iso, "モデルB": pB_te}
rows4 = []
for name, ph in cases.items():
    bid = ph * cv * V                             # 入札額=予測クリック率×コンバージョン率×価値
    win = bid >= comp                             # 支払額は競合の最高入札額(最低落札価格・手数料は省く)
    rows4.append(dict(入札の元にした予測=name, 予測と実績の比=round(ph.sum() / y.sum(), 3),
                      入札の平均=round(bid.mean(), 4), 落札=int(win.sum()),
                      支払額の合計=round(comp[win].sum(), 1), 価値の合計=round(val[win].sum(), 1),
                      利得=round((val[win] - comp[win]).sum(), 1),
                      価値を超えて払った落札=int((win & (comp > val)).sum())))
r4 = pd.DataFrame(rows4)
print("掲載面C以外に掛けた倍率", round(k_other, 3))
print(r4.to_string(index=False))
| 入札の元にした予測 | 予測と実績の比 | 入札の平均 | 落札 | 支払額の合計 | 価値の合計 | 利得 | 価値を超えて払った落札 |
|---|---|---|---|---|---|---|---|
| ずれなし | 0.944 | 0.1876 | 16,470 | 2,075.6 | 4,032.5 | 1,957.0 | 0 |
| 一律に1.5倍 | 1.416 | 0.2813 | 22,482 | 3,304.0 | 5,040.6 | 1,736.6 | 6,012 |
| 一律に0.67倍 | 0.633 | 0.1257 | 10,642 | 1,127.0 | 2,877.7 | 1,750.7 | 0 |
| 掲載面Cだけ2倍(平均は合わせる) | 0.944 | 0.1778 | 15,824 | 1,964.4 | 3,748.1 | 1,783.8 | 2,099 |
| モデルA 補正なし | 6.531 | 1.3431 | 33,849 | 6,859.4 | 6,383.7 | -475.7 | 17,379 |
| モデルA 等調回帰 | 0.930 | 0.1901 | 17,134 | 2,187.8 | 4,072.2 | 1,884.4 | 1,804 |
| モデルB | 0.882 | 0.1784 | 15,294 | 1,960.6 | 3,822.0 | 1,861.3 | 1,225 |
表の額はすべて相対値です。利得は、落札した機会の「本当の表示の価値 – 支払額」の合計です。表示の価値は広告が無くても起きた分を除いていない見積りなので、利得は増分の利益とは別のものです。価値を超えて払った落札は、支払額が本当の表示の価値を上回った落札の件数です。ずれなしの予測と実績の比が1ではなく 0.944 なのは、前の節で見たとおり、評価の2日分ではたまたま本当の確率から見込まれるより多くクリックが起きていたためです。表の上の4行は意図して与えたずれ、下の3行はモデルの予測で入札した場合です。利得の列では、ずれなしの 1,957.0 が7つの中で最も大きくなりました。
ずれの無い場合の利得 1,957.0 に対して、一律に1.5倍では 1,736.6、一律に0.67倍では 1,750.7 に下がりました。セカンドプライスでは価値どおりの入札が損にならないので、本当の価値から入札をずらせば、この例題の設定では利得が下がる方向にしか動きません。下がり方の中身は向きによって違います。高すぎる場合は、落札が16,470件から22,482件に増え、価値の合計も増えましたが、そのうち6,012件で価値を超える額を払い、支払額の増え方が価値の増え方を上回りました。序章で挙げた損失の型でいえば、見込んだ価値を超える額で買う「払いすぎ」です。低すぎる場合は、価値を超えて払った落札は0件のままですが、落札が10,642件に減り、価値のある機会を買い逃しました。こちらは、利益を増やせる機会を逃す「機会損失」です。
3つ目の、掲載面Cだけが高いずれでは、予測と実績の比は 0.944 で、ずれの無い場合と同じでした。予測クリック率の全体の平均を本当の平均に合わせたためです。全体の予測と実績の比を見るだけなら、このずれは見つかりません。それでも利得は 1,783.8 に下がり、価値を超えて払った落札が2,099件ありました。掲載面Cの予測を高くした分は払いすぎに、その他の掲載面の予測を下げた分は買い逃しに働いたと考えられ、全体の比の上では打ち消し合って見えなくなっていました(掲載面別の内訳は出していません)。なお、入札の平均は 0.1778 で、ずれの無い場合の 0.1876 より低くなりました。掲載面ごとにコンバージョン率が違い、掲載面Cのコンバージョン率(5%)が低いためです。全体の平均が合っていても、区分ごとに較正の確認をする必要があるのはこのためです。
モデルの予測で入札した場合は、補正なしのモデルAでは入札の平均が 1.3431 と、ずれの無い場合の7倍ほどになりました。予測と実績の比の 6.531 とは分母が違います。6.531 は実際のクリックの件数に対する比で、本当の確率から見込まれるクリックの件数に対する比に直すと、約6.9(6.531 ÷ 0.944)です。そこからさらに入札の平均の比(約7.2)と少し違うのは、掲載面ごとにコンバージョン率が違い、入札額の重みが変わるためです。34,180件のうち33,849件を落札して、利得は -475.7 と負になりました。払った額が得た価値を上回ったということです。等調回帰で較正したモデルAの利得は 1,884.4、モデルBは 1,861.3 で、ずれの無い場合の 1,957.0 には届きませんでした。較正のあとの2つのモデルの利得の差は小さく、この1回の計算で、どちらが良いと言い切ることはできません。この表の計算は、本当の表示の価値が分かる合成データだからできるものです。実際の配信では、本当の価値は分からないので、同じ比較は配信での実験で行うことになります(後述)。
掲載面ごとの較正の確認と、件数の少ない区分のばらつき
全体の比が1に近くても区分ごとにずれていることがあるので、掲載面ごとに予測の平均と実績の率を比べます。件数の少ない区分では実績の率そのものがばらつくので、実績の率には95%の区間(二項分布にもとづく正確な区間)を添えます。合成データなので、本当のクリックの確率で計算した比も最後の列に並べ、ばらつきだけでどの程度1から離れるかの目安にします。区間推定の一般論は、弊社コラム「データから正しく結論を導く統計学のまとめ」で扱いました。
seg = pd.DataFrame(dict(place=te.place, y=y, pB=pB_te, pI=pA_iso, pt=pt))
rows3 = []
for k, g in seg.groupby("place"):
    c, m = int(g.y.sum()), len(g)
    lo = 0.0 if c == 0 else beta.ppf(0.025, c, m - c + 1)       # クリック0件なら下限は0
    hi = 1.0 if c == m else beta.ppf(0.975, c + 1, m - c)       # 全件クリックなら上限は1
    r = (lambda p: round(p / (c / m), 2)) if c > 0 else (lambda p: np.nan)  # 0件なら比は出さない
    rows3.append(dict(掲載面=k, 表示=m, クリック=c, 実績のクリック率=round(c / m * 100, 2),
                      区間の下限=round(lo * 100, 2), 区間の上限=round(hi * 100, 2),
                      モデルBの予測の平均=round(g.pB.mean() * 100, 2), モデルBの比=r(g.pB.mean()),
                      等調回帰後の比=r(g.pI.mean()), 本当の確率の比=r(g.pt.mean())))
print(pd.DataFrame(rows3).to_string(index=False))
| 掲載面 | 表示 | クリック | 実績のクリック率 | 区間の下限 | 区間の上限 | モデルBの予測の平均 | モデルBの比 | 等調回帰後の比 | 本当の確率の比 |
|---|---|---|---|---|---|---|---|---|---|
| A | 8,471 | 498 | 5.88% | 5.39% | 6.40% | 5.62% | 0.96 | 0.88 | 0.94 |
| B | 6,883 | 180 | 2.62% | 2.25% | 3.02% | 2.45% | 0.94 | 1.08 | 0.94 |
| C | 6,133 | 190 | 3.10% | 2.68% | 3.56% | 1.51% | 0.49 | 0.66 | 0.87 |
| D | 5,108 | 50 | 0.98% | 0.73% | 1.29% | 0.98% | 1.01 | 1.15 | 1.06 |
| E | 4,154 | 30 | 0.72% | 0.49% | 1.03% | 0.95% | 1.31 | 1.40 | 1.16 |
| F | 3,431 | 72 | 2.10% | 1.65% | 2.64% | 2.11% | 1.01 | 1.26 | 0.98 |
掲載面Cでは、モデルBの予測の平均が 1.51% で、実績の 3.10%(区間は 2.68〜3.56%)の半分ほどでした。比は 0.49 で、予測は区間の下限よりも大きく下にあり、この区間の前提のもとでは、偶然のばらつきだけでは説明しにくい差です。10日目からの反応の上昇を、0〜9日目で学習したモデルBが知らないためです。掲載面Cを除いて計算すると、モデルBの全体の比は 0.972 でした。全体の比 0.882 が1より低かった原因の多くは、この掲載面にあります。本当の確率で計算しても掲載面Cの比は 0.87 で、この2日分の掲載面Cではたまたまクリックが多めに起きていましたが、モデルBの 0.49 はそれよりずっと低い値です。等調回帰で較正したモデルAでも、掲載面Cの比は 0.66 でした。較正の関数は全体の予測の値から実績の率への写し方を1本だけ学ぶので、特定の掲載面だけのずれまで直る保証はなく、この例では掲載面Cのずれが残りました。
等調回帰後の比の列には、もう1つ読み取れることがあります。掲載面Fでは 1.26、Dでは 1.15、Aでは 0.88 と、モデルB(F 1.01、D 1.01、A 0.96)より1から離れた掲載面がありました。掲載面Eも 1.40 とモデルBの 1.31 より離れていますが、こちらはクリックが30件しかありません。掲載面Fの等調回帰後の予測の平均はおよそ 2.65% で、実績の率の区間の上限 2.64% とほぼ同じ位置です。全体の写し方を1本学ぶ較正は、予測の帯ごとの較正を整えることを狙ったもので、掲載面ごとの較正まで整う保証はありません。予測の帯ごとに較正が取れていても、掲載面ごとには取れていない区分が残ることがある、ということです。区分ごとに比で割り戻す補正(前の表の「区分ごとの補正」)は、この章では試していません。
掲載面Eについては、モデルBの比が 1.31 と1より高く出ましたが、クリックは30件しかなく、予測の平均 0.95% は実績の率の区間(0.49〜1.03%)の内側にありました。本当の確率で計算した比も 1.16 で、この件数では、比が1から離れていても、ばらつきの範囲と区別できません。区分ごとの較正の確認の表は、比だけでなく、件数と区間を並べて読む必要があります。比だけを並べて「掲載面Eは高すぎる」と判断して入札を下げると、ばらつきに反応して設定を動かすことになりかねません。区分を細かくするほど、この問題は大きくなります。
| 区分の例 | 確かめること | ずれが見つかったときの手当ての例 |
|---|---|---|
| 掲載面 | 掲載面ごとの予測の平均と実績の率、件数と区間 | 区間の外なら、その掲載面の補正・特徴量の見直し・再学習を検討する |
| 端末の種類 | 端末ごとの比 | 端末と掲載面の組み合わせ(交差特徴)を入れるかを検討する |
| キャンペーン・クリエイティブ | 新しいキャンペーンやクリエイティブの、配信の初期の比 | 実績の少ない間は上位の区分の率に寄せる(第4章) |
| 時間帯・曜日 | 時間帯ごとの比 | 時間帯を特徴量に入れているか、学習の期間が偏っていないかを確かめる |
| 予測の帯 | 予測の高い帯・低い帯ごとの比(信頼性の図) | 帯によってずれの向きが違えば、プラットの方法か等調回帰で較正する |
評価データの切り方と、指標の差のばらつき
評価に使うデータの切り方でも、成績の見え方は変わります。記録をランダムに切って一部を評価に使う方法は、機械学習の一般的な教材でよく使われます。しかし広告の予測は、過去の記録で学習したモデルを、これから来る表示の機会に使うものです。評価用のデータも、学習用より後の日で切るのが実際の使い方に近くなります。次のコードでは、モデルBと同じ作りのモデルを、全14日をランダムに8対2に切った場合と、0〜11日目で学習して12・13日目で評価した場合とで比べます。あわせて、2つのモデルの対数損失の差が、評価のデータのばらつきでどれだけ揺れるかを、ブートストラップで確かめます。ブートストラップは、評価のデータから重複を許して同じ件数を引き直し、差を計算し直すことをくり返す方法で、ここでは1,000回くり返しました。
msk = rng.random(len(df)) < 0.8
lin_r = LogisticRegression(C=1.0, max_iter=2000).fit(X_lin(df[msk]), df.click[msk])
tr12 = df[df.day <= 11]
lin_t = LogisticRegression(C=1.0, max_iter=2000).fit(X_lin(tr12), tr12.click)
ho = df[~msk]
p_r, p_t = lin_r.predict_proba(X_lin(ho))[:, 1], lin_t.predict_proba(X_lin(te))[:, 1]
for name, d, p in [("ランダムに切る(全14日の2割で評価)", ho, p_r), ("時間で切る(0〜11日目で学び12・13日目で評価)", te, p_t)]:
    c = (d.place == "C").to_numpy()
    print(name, "対数損失", round(log_loss(d.click, p), 5), "全体の比", round(p.mean() / d.click.mean(), 3),
          "掲載面Cの比", round(p[c].mean() / d.click[c].mean(), 3))
h12 = ho[ho.day >= 12]                            # 12・13日目のうち、どちらのモデルの学習にも使っていない行
c = (h12.place == "C").to_numpy()
for name, mdl in [("ランダムに切ったモデル", lin_r), ("時間で切ったモデル", lin_t)]:
    p = mdl.predict_proba(X_lin(h12))[:, 1]
    print(name, "を12・13日目の未学習の行", len(h12), "件に当てた場合 全体の比", round(p.mean() / h12.click.mean(), 3),
          "掲載面Cの比", round(p[c].mean() / h12.click[c].mean(), 3), "掲載面Cのクリック", int(h12.click[c].sum()))

def ll_vec(y, p):
    return -(y * np.log(p) + (1 - y) * np.log(1 - p))
dl = ll_vec(y, pB_te) - ll_vec(y, pA_iso)        # 正ならモデルA(等調回帰後)のほうが小さい
for name, idx in [("評価の2日分すべて", np.arange(len(y))), ("そのうち掲載面Eだけ", np.where(te.place == "E")[0])]:
    d = dl[idx]
    bs = np.array([d[rng.integers(0, len(d), len(d))].mean() for _ in range(1000)])
    print(name, "表示", len(d), "クリック", int(y[idx].sum()), "差の平均", round(d.mean(), 6),
          "95%区間", round(np.quantile(bs, 0.025), 6), round(np.quantile(bs, 0.975), 6))
print("実行時間", round(time.time() - t0, 1), "秒")
| 切り方 | 対数損失 | 全体の予測の平均と実績の比 | 掲載面Cの比 |
|---|---|---|---|
| ランダムに切る(全14日の2割で評価) | 0.11868 | 0.997 | 0.912 |
| 時間で切る(0〜11日目で学び12・13日目で評価) | 0.1273 | 0.89 | 0.559 |
ランダムに切った評価では、全体の比が 0.997 とほぼ1で、掲載面Cの比も 0.912 でした。時間で切った評価では、全体の比が 0.89、掲載面Cの比が 0.559 でした。ランダムに切ると、評価用のデータと同じ日の記録が学習にも入り、10日目以降の掲載面Cの変化も学習の中で平均されてしまいます。そのため、これから来る日に使ったときのずれが見えにくくなります。これを確かめるため、12・13日目の記録のうち、どちらのモデルの学習にも使っていない6,823件だけに、2つのモデルを当てました。ランダムに切って学習したモデルでは、全体の比が 0.898、掲載面Cの比が 0.619 で、ランダムに切った評価が示した 0.912 よりずっと低くなりました。時間で切って学習したモデルでは、同じ行で全体の比が 0.885、掲載面Cの比が 0.564 でした。ただし、この6,823件のうち掲載面Cのクリックは37件しかなく、比のばらつきは大きいと考えられます。なお、2つの切り方の対数損失は、評価に使った表示の構成とクリック率の水準が違うので、そのまま大小を比べることはできません。
ブートストラップの結果は次のとおりです。差は「モデルBの対数損失 – 等調回帰で較正したモデルAの対数損失」で、正ならモデルAのほうが小さいことを表します。評価の2日分すべて(表示34,180件・クリック1,020件)では、差の平均は 0.000146、95%の区間は -0.000333〜0.000647 でした。掲載面Eだけ(表示4,154件・クリック30件)では、差の平均は -0.000035、区間は -0.000844〜0.000885 でした。どちらも区間が0をまたいでいて、この評価のデータの大きさでは、2つのモデルの対数損失に差があるとは言えません。掲載面Eだけに絞ると、区間の幅はおよそ1.8倍に広がりました。この評価データの再標本化では、対数損失の差の区間が0をまたぎました。ブートストラップが示すのは、固定した評価の期間の中での表示の引き直しによるばらつきです。評価の期間を変えた場合や、学習をやり直した場合の変動は、この計算には入っていないので、別に確かめる必要があります。モデルを入れ替える判断をするときは、差の大きさと一緒に、このような区間を示すのがよいと考えています。
過去のデータでの評価の限界と、配信で確かめる必要
ここまでの評価は、すべて過去の記録の上で行いました。過去の記録での評価には、広告の予測に特有の限界があります。1つ目は、記録に残っているのが、過去に落札して表示された機会だけだという点です(第2章)。過去の入札が高い予測を付けた機会ほど落札されて記録に残るので、評価のデータは、全体の表示の機会とは構成が違います。2つ目は、入札の元にする予測を変えると、落札する機会の構成そのものが変わるという点です。新しいモデルが高い予測を付けて、新たに落札するようになる機会は、過去の記録にはほとんど無く、そこでの確率の正しさは過去の記録では確かめられません。
前の節のオークションの表は、本当の表示の価値と、落札しなかった機会の競合の最高入札額まで分かる合成データだから計算できたものです。負けた機会について知らされる情報は取引の場によって違いますが、落札のしきい値が知らされない場合に分かるのは、しきい値が自分の入札額より高かったことだけです(打ち切り。第8章)。また、実際の配信では本当の価値は分かりません。そのため、新しいモデルや較正の方法を入札に使ってよいかは、最終的には配信の中で、配信の一部を新しい方法に割り当てて比べる実験(A/Bテスト)で確かめる必要があります。実験の組み方と、成果を増分で測る方法は第11章で扱います。過去の記録での評価は、配信の実験に進める候補を絞るための段階として位置づけるのがよいと考えています。
| 段階 | 使うデータ | 分かること | 分からないこと |
|---|---|---|---|
| 過去の記録での評価(時間で切る) | 過去に落札した機会の記録 | 並べ方・確率の水準・区分ごとの較正の確認の結果 | 新たに落札する機会での確率の正しさ・費用と利得 |
| 較正に使っていない日での確認 | 較正用とは別の日の記録 | 較正が後の日でも保たれるか | 入札を変えたときの落札の構成の変化 |
| 配信での実験 | 配信の一部を新しい方法に割り当てた結果 | 費用・落札・コンバージョン・増分の差 | 実験の期間の外での持続(監視で確かめる。第12章) |
媒体や外部の事業者の示す数字を読むときに聞くこと
自社でモデルを持たず、媒体の自動入札や外部の事業者の仕組みを使う場合でも、予測の成績として数字が示されることがあります。そのときに数字だけを受け取ると、ここまでに見た問題(正解率のように役に立たない指標・ランダムに切った評価・全体の平均だけの較正・区間の無い比較)に気づけません。次の表は、示された数字を読むときに確かめることの一覧です。媒体の内部の仕組みは公開されていない部分が多く、すべてに答えが得られるとは限りませんが、答えが得られないこと自体も判断の材料になります。
| 聞くこと | なぜ聞くか |
|---|---|
| どのデータで評価したか(期間・掲載面・キャンペーンの範囲) | 自社の配信と構成が違うデータの数字は、自社に当てはまらないことがある |
| どの指標か(AUC・対数損失・予測の平均と実績の比など) | 正解率や AUC だけでは、入札に効く確率の正しさが分からない |
| 評価のデータをどう切ったか(ランダムか、時間か) | 配信の途中で反応の水準が変わる場合には、ランダムに切った評価は、これから来る日での成績より良く見えやすい(本コラムの架空データでも、そうなった) |
| 較正をどの単位で確かめているか(全体だけか、区分ごとか) | 全体の平均が合っていても、区分ごとのずれで払いすぎと買い逃しが起きる |
| 差に区間やくり返しの結果が添えてあるか | 件数の少ない比較では、小さな差はばらつきの範囲に収まることがある |
| 成果をどの指標で測ったか(割り振られたコンバージョンか、増分か) | 予測の成績の改善が、増分の利益の改善につながったかは別に確かめる必要がある(第11章) |
経営の判断、評価の指標と切り方をモデルを選ぶ前に決める
この章の内容を経営の判断に置き換えると、2つの決めごとになります。1つ目は、モデルを選ぶ前に、評価の指標とデータの切り方を決めておくことです。候補のモデルを見てから指標を選ぶと、都合のよい指標が選ばれやすくなります。本コラムの架空データでは、AUC の値だけを見ればモデルAがわずかに高く見えましたが、補正をしないままその確率で入札すると、利得は負になりました。指標は、並べ方の指標(AUC)・並べ方と確率の両方を反映する指標(対数損失)・水準の確認(予測の平均と実績の比、予測の帯ごとと区分ごと)を組にし、評価のデータは時間で切る、という形を先に決めておくのがよいと考えています。
2つ目は、確率のずれを誰がどの頻度で確かめるかを決めることです。本コラムの架空データでは、10日目から1つの掲載面の反応が変わっただけで、その掲載面の予測は実績の半分ほどになり、全体の写し方による較正では直りきりませんでした(区分ごとの補正はこの章では試していません)。この種のずれは、実行の記録の上では何の異常も出ないまま、払いすぎや機会損失として費用に表れます。自動で動く入札の設定やレポートを点検する仕組みが働かず、設定と実態のずれに気づけない状態は、損失の型でいう「形骸化」にあたります。予測の平均と実績の比を掲載面などの区分ごとに、件数と区間つきで定期的に確かめる手順と担当を決めておくことが、予算の使い方を守る仕組みになります。多くの掲載面をくり返し確かめると、偶然だけで区間の外に出る区分も出てきます。区間の外に出たときは、すぐに再学習へ進むのではなく、記録の欠落や重複などのデータの品質、ずれの大きさ、ずれが続いているかを確かめてから、較正のやり直しや再学習に進むのがよいと考えています。監視の具体的な設計は第12章で扱います。
| 決めること | 決めておく中身の例 | 決めないと起きやすい損失の型 |
|---|---|---|
| 評価の指標 | AUC・対数損失・予測の平均と実績の比を組にする。正解率は使わない | 払いすぎ(順位だけでモデルを選び、確率のずれを見逃す) |
| データの切り方 | 学習・較正・評価を時間で分ける | 払いすぎ・機会損失(評価が実際より良く見える) |
| 較正を確かめる単位と頻度 | 掲載面・端末・キャンペーンごとに、件数と区間つきで定期的に | 形骸化(全体の平均だけを見て区分のずれに気づかない) |
| モデルを入れ替える条件 | 差の区間、配信での実験の結果 | 形骸化(ばらつきに反応して設定を動かす) |
| 担当と権限 | ずれを見つけたときに較正のやり直し・再学習・入札の停止を決める人 | 形骸化(見つけても対応につながらない) |
この章では、広告の予測では順位より確率の正しさが入札額に直結すること、確率のずれは向きによって払いすぎにも機会損失にもなり、全体の平均が合っていても区分ごとのずれで利得が下がることを、架空データで確かめました。較正は後処理で確率の水準を直せますが、この例題では、全体に共通の写し方による較正では掲載面ごとのずれが残りました。また、較正はその時点の水準に合わせる作業なので、その後に起きる変化は反映されません。そのため、較正に使っていないデータで区分ごとに確かめ続ける必要があります。次の第7章では、こうして確かめた予測を使い、表示の価値から入札額をどう決めるか、目標の獲得単価や予算の制約があるときにどう入札するかを扱います。
この章を深めたい方への参考書籍
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):副題のとおり、評価の指標をデータサイエンスとビジネスの間をつなぐものとして扱う本です。この章で述べた、指標をモデルを選ぶ前に事業の目的から決めるという考え方を、広告に限らない形で整理するのに向いていると考えています。
『戦略的データサイエンス入門 ビジネスに活かすコンセプトとテクニック』(Foster Provost・Tom Fawcett 著、竹田正和 監訳、古畠敦ほか 訳、オライリー・ジャパン):データサイエンスの考え方を、ビジネスで使う側から解説した入門書の訳書です。モデルの出す点数を判断にどう使い、モデルの評価を事業の判断とどう結びつけるかを考える土台として、この章の内容と併せて読むことができると考えています。
第7章 入札額の決め方、表示の価値にもとづく入札と目標の獲得単価
第6章では、予測クリック率や予測コンバージョン率が順位として正しいだけでなく、確率として実績の率と合っていることが、入札額と費用に直接効くことを確かめました。この章では、その予測を入札額に変える段に進みます。予測した確率から1回の表示の価値を見積もり、オークションの方式と予算の制約を踏まえて、機会ごとにいくらで入札するかを決める考え方です。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の表示の機会を使い、実行したコードと結果で確かめます。
- 予測から入札額へ:表示の価値の式と、セカンドプライスで予算の制約が無いときの基本の入札
- 入札の方針の種類(一律・予測クリック率に比例・表示の価値に比例・目標の CPA・目標の ROAS・予算の制約つき)の表
- 予算が足りないときに、価値どおりの入札を一定の割合で引き下げる考え方と、ラグランジュ乗数による説明
- 同じ予算で3つの方針を比べた結果と、乗数を動かしたときの費用と得た価値の関係
- 平均の CPA と限界の CPA の違い、目標の CPA を厳しくしたときに起きること
- 複数のキャンペーンで予算を分ける考え方、媒体の自動入札の目標の種類と設定が意味すること
- 予測の誤差・増分を考えていないことによる限界と、経営の判断
この章で使う指標の略称を先に確かめておきます。CPA(獲得単価)は、広告費を広告に割り振られたコンバージョンの件数で割った値です。ROAS は、広告費に対する、広告に割り振られた売上(コンバージョン値)の比です。どちらも実績の値で、利益や増分を表す指標ではありません。本章では、ROAS の説明のコンバージョン値には売上を、入札の例題のコンバージョンの価値には粗利を使い、両者を同じ値として扱いません。設定する目標を指すときは「目標の CPA」「目標の ROAS」と書いて、実績の値と区別します。
この章の主張は2つあります。1つ目は、セカンドプライスの取引で予算の制約があるときには、見積もった表示の価値に1つの乗数を掛けて入札し、その乗数を予算に合わせて調整するという方針が、考え方の出発点になるという点です。これはあらゆる取引の場で最善になるという主張ではなく、本章で置いた前提のもとでの話であり、前提が崩れる場合も併せて書きます。2つ目は、目標の CPA は「下げるほど良い」数字ではなく、コンバージョンの価値から逆算して決めるべき数字だという点です。本コラムの架空データでは、目標の CPA をコンバージョンの価値と同じ値から半分以下へ厳しくすると、CPA は下がりましたが、利得の合計も減りました。本章で「利得」と呼ぶのは、表示の価値から支払額を引いた差です。表示の価値は、広告が無くても起きたコンバージョンの価値を除いていない見積りなので、利得は増分の利益とは別のもので、本章の例題の中で方針を比べるための値として使います。
予測から入札額へ、表示の価値という出発点
入札額を決める最初の手がかりは、その機会に表示した場合に、その後のコンバージョンから得られると予測する、広告費を引く前の価値です。本コラムではこれを表示の価値と呼び、例題では次の式で見積もります。
\( v = \hat{p}_{\mathrm{click}} \times \hat{p}_{\mathrm{conv}} \times V \)
言葉で書けば、表示の価値は「その表示がクリックされる確率の見積り(予測クリック率)」と「クリックされたときにコンバージョンに至る確率の見積り(予測コンバージョン率)」と「コンバージョン1件の価値」の積です。たとえば予測クリック率が 0.02、予測コンバージョン率が 0.05、コンバージョンの価値が 100 なら、表示の価値は 0.1 になります。コンバージョンの価値は、コンバージョン1件に対応する、広告費を引く前の粗利の見込みで、広告主が事業として決める値です。本章の例題では 100 という相対値(単位の無い数)で表します。例題では、クリックを経ないコンバージョン(表示だけを見て後から購入するような場合)は扱いません。
この式は、広告が無くても起きたはずのコンバージョンを区別していない単純な見積りです。広告を見なくても購入する利用者への表示にも、高い価値が付きます。広告で増えた分(増分)にもとづく価値は、本コラムでは「増分の表示の価値」と呼んで区別し、第11章で扱います。本章では入札の仕組みを説明するために、この単純な式を使います。
第3章で確かめたとおり、1回かぎりのセカンドプライス・オークションで、予算の制約が無く、自分の価値を知っているという前提のもとでは、価値どおりに入札するのが損にならない戦略です。勝ったときに払うのは落札のしきい値(競合の最高入札額と最低落札価格の大きいほう)で、自分の入札額では決まらないので、入札額を価値より上げても下げても、利得(価値から支払額を引いた差)は増えません。上げれば、価値より高い支払額で落札する機会が加わり、下げれば、利得が正になるはずの機会を逃します。したがって予算の制約が無ければ、入札額は表示の価値そのものになります。ただし、この理論で「価値」と呼んでいるのは、買い手自身にとっての真の価値です。本コラムの表示の価値は、広告が無くても起きたコンバージョンの分を除いていない予測なので、そのとおりに入札すれば増分の利益が最大になるとは限りません。現実の入札が難しくなるのは、この前提のどれかが外れるときで、本章では主に「予算の制約がある」場合と「価値が見積りである」場合を扱います。取引の方式がファーストプライスの場合の引き下げは第8章、1日の中で予算を使う速さの制御は第9章で扱います。
入札の方針の種類と、それぞれが前提にしていること
入札額の決め方には、いくつかの型があります。どれを使うかによって、機会ごとの違いをどこまで入札に反映するかが変わります。次の表は、本章で扱う方針を並べたものです。表の「機会ごとに見ているもの」の列は、その方針が入札額に反映する情報を指します。
| 入札の方針 | 入札額の決め方 | 機会ごとに見ているもの | 前提と弱点 |
|---|---|---|---|
| 一律の入札 | すべての機会に同じ額で入札する | 見ていない | 機会ごとの価値の違いを使わない。安く買える機会ばかりを落札しやすい |
| 予測クリック率に比例 | 予測クリック率に係数を掛ける | クリックの起きやすさ | クリックの後にコンバージョンに至りやすいかを見ていない |
| 表示の価値に比例 | 表示の価値に乗数を掛ける | クリックとコンバージョンの起きやすさと、その価値 | 予測が確率として合っていることが前提(第6章)。増分は見ていない |
| 目標の CPA にもとづく | 目標の CPA × 予測クリック率 × 予測コンバージョン率 | 表示の価値と同じ。コンバージョンの価値の代わりに目標の CPA を置く | 目標の CPA の根拠が価値から離れると、買える機会が減るか、価値を超えて買う |
| 目標の ROAS にもとづく | 広告費に対する、割り振られた売上の比の目標に合わせる | 件ごとに違うコンバージョンの価値 | コンバージョンの価値の計測が前提。売上は利益ではない |
| 予算の制約つき | 上のいずれかに、費用が予算の上限に収まる乗数を掛ける | 上の方針と同じ。加えて予算 | 期間を通じて機会の数と競合の水準が見込みどおりであることが前提(第9章) |
目標の CPA にもとづく入札は、表示の価値に比例する入札の特別な場合として読めます。入札額=目標の CPA × 予測クリック率 × 予測コンバージョン率 という関係は、表示の価値の式のコンバージョンの価値を、目標の CPA に置き換えたものです。目標の CPA をコンバージョンの価値と同じにすれば価値どおりの入札になり、目標の CPA を価値の半分にすれば、価値どおりの入札を半分に引き下げたのと同じになります。目標の獲得単価(目標の CPA)を下げると、すべての機会で入札額が同じ割合で下がり、落札できる機会が減ります。この関係は後のコードで確かめます。
目標の ROAS は、件ごとにコンバージョンの価値が違う場合(購入額が注文ごとに違う場合など)に使われる型です。ROAS は広告費に対する、広告に割り振られた売上の比なので、粗利の率が商品ごとに違うと、ROAS が同じでも利益は同じになりません。ROAS を目標に置く場合でも、その目標がどの利益の水準に当たるのかを、事業の側で換算しておく必要があります。
予算の制約があるときの入札、乗数の決め方
本章の予算は、その期間に使ってよい広告費の上限で、使い切る義務はありません。予算の制約があると、価値どおりの入札をそのまま続けることはできません。価値どおりに入札したときの費用が予算を超えるなら、どこかの機会を諦める必要があります。このとき、どの機会を諦めるかが問題です。直観的には、価値に対して支払額が高い機会から諦め、価値に対して支払額が低い機会を残すのがよいと考えられます。ただし、機会を1件ずつ「買う・買わない」で選ぶ問題では、支払額1あたりの価値が高い順に買うことが、いつも最適になるとは限りません。たとえば予算 10 で、支払額と価値の組が(6、12)・(5、9.5)・(5、9.5)の3件なら、比率の順では最初の1件しか買えませんが、後ろの2件を買うほうが価値の合計も利得も大きくなります。比率の順に、予算に収まらない機会が出るまで買った場合、最適な選び方との価値の差は、多くても機会1件分の価値に収まります。機会を一部だけ買えるとした場合の最適値は、比率の順に買った分に、収まらなかった最初の1件の一部を足したものになり、1件ずつ選ぶ場合の最適値はそれを超えないからです。機会の数が多く、1件の価値が合計に比べて十分小さい場合には、この差は相対的に小さくなり、比率の順に買う考え方が良い近似になります。
この考え方は、予算の制約つきの最適化問題として書けます。機会 \( i \) を買うかどうかを決め、買った機会の利得(表示の価値 \( v_i \) から支払額 \( c_i \) を引いた差)の合計を、支払額の合計が予算以下という条件のもとで最大にする問題です。制約のある問題を扱う定番の方法は、制約を破った分に罰を課して目的に組み込むことで、その罰の重さを表す数をラグランジュ乗数と呼びます。罰の重さを \( \mu \)(0以上)とすると、機会ごとに「\( v_i – c_i – \mu c_i \) が正なら買う」という判断に分かれ、整理すると次の形になります。
\( b_i = \dfrac{v_i}{1 + \mu} \)
言葉で書けば、「表示の価値を \( 1+\mu \) で割った額で入札し、それより安く買える機会だけを買う」という規則です。これはラグランジュ緩和から導いた判断の規則で、機会を一部だけ買える(購入の割合を連続的に扱える)と考える場合や、期待される費用で予算の制約を書く場合に最適になります。1件ずつ買う・買わないで選ぶ場合には、先の例のような端数の分だけ最適からずれることがあります。セカンドプライスでは、入札額が落札のしきい値を上回ると落札し、しきい値を支払うので、この入札額は「この額までなら払う」という線を引いたことになります。本章の例題では最低落札価格を置かず(手数料・端数も省く)、落札のしきい値は競合の最高入札額そのものとしています。予算に余裕があれば罰は要らず(\( \mu = 0 \))、価値どおりの入札に戻ります。予算が厳しいほど \( \mu \) は大きくなり、入札額は同じ割合で下がります。本章では \( 1/(1+\mu) \) を「乗数」と呼び、費用が予算を超えない範囲で上限に近づく乗数を探します。\( \mu \)(ラグランジュ乗数)と本章の乗数は別の数で、乗数は \( \mu \) が大きいほど小さくなります。制約に罰を課して目的に組み込む考え方(ラグランジュ緩和)を含む定式化の一般論は、弊社コラム『数理最適化の定式化パターン集』で扱っています。
この説明には前提があります。取引がセカンドプライスであること、自分の入札が競合の入札に影響しないこと、期間の中の機会の数と競合の水準をまとめて見たうえで乗数を1つに決めること、です。実際には機会は時間の順に届き、期間の初めには後で届く機会が分からないので、乗数は途中で調整する必要があります(第9章)。
前提が違えば、最適な入札の形も違います。本章が扱うのは価値に比例する入札ですが、研究では、別の前提から比例しない形が導かれています。
Zhang、Yuan、Wang の2014年の論文(リアルタイム入札の最適な入札の論文。KDD 2014 に掲載)は、予算の制約のもとで、予測した指標(クリック率など)から入札額への関数を求める問題を立てています。Zhang の2016年の博士論文の該当章で確かめた範囲では、落札の確率が入札額だけで決まる(勝率曲線)、費用を入札額で上から抑えて扱う(支払額を入札額で近似する)、という前提を置いています。さらに、実際の記録に合わせて選んだ具体的な形の勝率曲線を仮定すると、最適な入札は、指標に比例する直線ではなく、上に凸な曲線(指標が高くなるほど入札額の増え方が緩やかになる曲線)になると導かれています。指標の低い機会ほど、比例より相対的に高く入札する形です。勝率曲線が直線だと仮定すると、比例する入札が特別な場合として出てきます。
同じ博士論文は、比例する入札の先行研究として、Perlich らの2012年の論文(ターゲティング広告の入札の最適化と在庫の採点の論文。KDD 2012 に掲載)を挙げ、予測したクリック率に比例して入札する方式として紹介しています。博士論文の実験は、公開データセット(iPinYou のデータ)の9つのキャンペーンで、予算を記録上の費用の 1/64 から 1/2 にした条件で行われ、予算が厳しい条件ほど、上に凸な入札のクリックの件数の改善が大きかったと報告されています。これはそのデータ・その条件での値で、読者の広告で同じ差が出ることを示すものではありません。
本章のコードでは、競合の最高入札額が機会ごとの価値と結びついて違う合成データを使い、セカンドプライスで、乗数を掛けた比例の入札を扱います。支払額は入札額で近似せず、セカンドプライスの支払額(落札のしきい値)をそのまま使い、勝率も機会ごとに違います。この2点で博士論文の前提とは違い、どちらの形が良いかは、勝率曲線の形と、支払額をどう扱うか(取引の方式)に依存します。勝率曲線の推定は第8章で扱います。
架空の表示の機会を作る
ここからは、架空の合成データで確かめます。表示の機会を30万件、7日分作りました。機会ごとに、掲載面(A〜E の5種類)・端末の種類(スマートフォンと PC)・日・時刻・過去の訪問の回数を持たせ、真のクリック率とコンバージョン率を次の規則で決めています。クリック率は掲載面によって 0.8%〜2.5% 程度の水準があり、掲載面 D を PC で見た場合だけ 1.8 倍になる組み合わせの効果を入れました。コンバージョン率は、過去の訪問の回数が多いほど、PC のほうが、夜の時間帯(19時〜23時)のほうが高くなるようにしています。性別・年齢などの属性は使っていません。表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件として扱います。
予測クリック率と予測コンバージョン率は、モデルを学習させる代わりに、真の確率に乱数の誤差を掛けて作りました。誤差の倍率の期待値は1にしてあり、第6章で扱ったような一律の偏りや一部の掲載面だけの偏りは入れていません。ただし、倍率の期待値が1であることは、予測値で区分して集めたときに予測と実績が対応する(較正が取れている)ことまでは保証しません。予測の作り方は第4章・第5章で扱っているので、本章では「平均では合っているが、機会ごとには外れる予測」が手元にあるという設定から始めます。競合の最高入札額は、真の表示の価値に掲載面ごとの割高・割安の係数と乱数を掛けて作りました。価値の高い機会ほど競合も高く入札しますが、掲載面 D は割高、掲載面 C は割安という違いがあります。
合成データなので、落札しなかった機会を含め、すべての機会の真の確率と競合の最高入札額が分かっています。実際の配信の記録では、落札しなかった機会のクリックやコンバージョンは観測できず、競合の入札について事後に知らされる情報は取引の場によって違います(第2章・第8章)。この架空データは実際の配信の記録より単純で、ここでの成績は実際の広告の成績の目安にはなりません。
例題の単位と支払いの前提もそろえておきます。入札額・支払額・予算・コンバージョンの価値は、同じ尺度の相対値で、入札額と支払額は表示1回あたりの値です。落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。最低落札価格は置かず、落札のしきい値は競合の最高入札額そのものとし、手数料・端数も省きます。実務では、ディスプレイ広告の取引の入札は表示1,000回あたり(CPM)の価格で表されることが多く、検索連動型広告ではクリック1回あたりの入札と課金が一般的です。本章の表示の価値をクリック1回あたりに換算すると、予測コンバージョン率 × コンバージョンの価値 になり、表示1,000回あたりに換算すると、表示の価値の1,000倍になります。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261116)
n = 300_000
place = rng.choice(5, size=n, p=[0.30, 0.25, 0.20, 0.15, 0.10])  # 掲載面A〜E
device = rng.choice(2, size=n, p=[0.65, 0.35])                  # 0=スマートフォン 1=PC
day = rng.integers(0, 7, size=n)                                # 7日間
hour_w = 1 + 0.8 * np.sin((np.arange(24) - 6) / 24 * 2 * np.pi)
hour = rng.choice(24, size=n, p=hour_w / hour_w.sum())          # 時刻
visits = rng.poisson(1.2, size=n)                               # 過去の訪問の回数

base_ctr = np.array([0.012, 0.020, 0.008, 0.025, 0.015])
inter = np.where((place == 3) & (device == 1), 1.8, 1.0)        # 掲載面D×PCだけ高い
ctr = base_ctr[place] * inter * np.exp(rng.normal(-0.045, 0.3, n))
cvr = 0.04 * (1 + 0.5 * np.minimum(visits, 4)) * np.where(device == 1, 1.4, 1.0)
cvr = cvr * np.where((hour >= 19) & (hour <= 23), 1.3, 1.0)
V = 100.0                                                       # コンバージョンの価値(相対値)
v_true = ctr * cvr * V                                          # 真の表示の価値

# 予測は真の確率に誤差を掛けたもの(平均はずらさない)
pctr = ctr * np.exp(rng.normal(-0.25**2 / 2, 0.25, n))
pcvr = cvr * np.exp(rng.normal(-0.30**2 / 2, 0.30, n))
v_hat = pctr * pcvr * V                                         # 見積もった表示の価値

# 競合の最高入札額:価値の高い機会ほど高いが、掲載面で割高・割安がある
offset = np.log(np.array([0.6, 0.9, 0.5, 1.3, 0.8]))
comp = v_true * np.exp(offset[place] + rng.normal(0, 0.7, n))
print("機会の数", n, "機会ごとのクリック率の平均", round(ctr.mean(), 4),
      "機会ごとのコンバージョン率の平均", round(cvr.mean(), 4))
print("クリックで重み付けしたコンバージョン率", round((ctr * cvr).sum() / ctr.sum(), 4))
print("表示の価値の平均", round(v_true.mean(), 4),
      "競合の最高入札額の中央値", round(np.median(comp), 4))
# 出力:
# 機会の数 300000 機会ごとのクリック率の平均 0.0165 機会ごとのコンバージョン率の平均 0.0749
# クリックで重み付けしたコンバージョン率 0.0759
# 表示の価値の平均 0.1253 競合の最高入札額の中央値 0.0707
実行した結果、機会ごとの真のクリック率の平均は 1.65%、機会ごとの真のコンバージョン率の平均は 7.49% でした。コンバージョン率の 7.49% は機会ごとの値の単純な平均で、クリックが起きやすい機会ほど重く数えた値(クリック全体のうちコンバージョンに至る割合の期待値)は 7.59% です。表示の価値の平均は 0.1253、競合の最高入札額の中央値は 0.0707 です。
次に、入札額を与えるとセカンドプライスで落札と支払額を決め、結果を数える関数を作ります。合成データなので、クリックとコンバージョンは乱数で1回だけ起こす代わりに、落札した機会の真の確率を足し合わせた値(件数の期待値)で数えました。1回の乱数の偶然で方針の比較が左右されにくくするためです。そのため、本章のコンバージョンの件数は小数になります。予算は、価値どおりに入札したときの費用の30%としました。
def evaluate(bid):
    win = bid > comp                       # 落札(落札した機会はすべて表示されたとする)
    spend = comp[win].sum()                # セカンドプライス:競合の最高入札額を払う
    clicks = ctr[win].sum()                # 真の確率の和=件数の期待値
    conv = (ctr * cvr)[win].sum()
    value = conv * V
    return {"落札の件数": int(win.sum()), "費用": spend, "クリック": clicks,
            "コンバージョン": conv, "得た価値": value,
            "CPA": spend / conv if conv > 0 else np.nan, "利得": value - spend}

def scale_for_budget(score, budget):
    lo, hi = 1e-6, 1e6                     # 入札=係数×score の係数を二分法で探す
    for _ in range(100):
        mid = np.sqrt(lo * hi)
        if evaluate(mid * score)["費用"] > budget:
            hi = mid
        else:
            lo = mid
    return lo

full = evaluate(v_hat)                     # 予算の制約が無いときの価値どおりの入札
budget = 0.3 * full["費用"]
print("価値どおりの入札の費用", round(full["費用"], 1), "予算", round(budget, 1))
# 出力:
# 価値どおりの入札の費用 11836.3 予算 3550.9
関数 scale_for_budget は、入札額を「係数 × 方針ごとの点数」とし、費用が予算を超えない範囲で上限に近づく係数を二分法(範囲を半分ずつ狭めて探す方法)で探します。費用は係数を上げるほど増える(減らない)ので、二分法で探せます。ただし機会の数は有限で、費用は係数に対して階段状に変わるので、費用が予算とぴったり一致するとは限りません。また、この係数は、全期間の全機会の競合の最高入札額を使って事後的に決めています。実際の配信では、入札の時点で期間全体の競合の入札は分からないので、こうした係数は事前には決められません(期間の途中での調整は第9章で扱います)。予算の制約が無いときの価値どおりの入札の費用は 11836.3、予算はその30%の 3550.9 です(どちらも相対値)。
同じ予算で3つの方針を比べる
同じ予算のもとで、一律の入札・予測クリック率に比例する入札・表示の価値に比例する入札の3つを比べます。どの方針も、費用が予算を超えない範囲で上限に近づく係数を二分法で探してから入札させるので、費用はほぼ同じ額にそろいます(この比較では、表示の桁ではどれも 3,550.9 でした)。予算を使い切ること自体が目的なのではなく、同じ費用で比べるためにそろえています。比べるのは、同じ費用で何を買えたかです。続けて、表示の価値に比例する方針の乗数を 0.05 から 1.5 まで動かし、費用と得た価値の関係も見ます。
scores = {"一律の入札": np.ones(n), "予測クリック率に比例": pctr,
          "表示の価値に比例": v_hat}
rows, scale = {}, {}
for name, s in scores.items():
    c = scale_for_budget(s, budget)
    scale[name] = c
    rows[name] = evaluate(c * s)
rows["価値どおり(予算の制約なし)"] = full
tab = pd.DataFrame(rows).T
pd.set_option("display.width", 200)
print(tab.round(1))
print("表示の価値に比例する方針の乗数", round(scale["表示の価値に比例"], 3))

lams = np.round(np.arange(0.05, 1.51, 0.05), 2)
curve = pd.DataFrame([evaluate(l * v_hat) for l in lams], index=lams)
print(curve[["費用", "得た価値", "利得", "CPA"]].iloc[::3].round(1))
best = curve["利得"].idxmax()
print("利得が最大の乗数", best, "利得", round(curve.loc[best, "利得"], 1))
結果は次の表のとおりです。得た価値は、落札した機会のコンバージョンの件数の期待値にコンバージョンの価値 100 を掛けた値、利得は得た価値から費用を引いた差です。どちらも相対値です。得た価値と利得は、広告が無くても起きたコンバージョンの分を除いていない値で、増分の利益ではありません。
| 入札の方針 | 落札の件数 | 費用 | クリック | コンバージョン | 得た価値 | CPA | 利得 |
|---|---|---|---|---|---|---|---|
| 一律の入札 | 123,377 | 3,550.9 | 1,324.0 | 85.1 | 8,505.2 | 41.7 | 4,954.3 |
| 予測クリック率に比例 | 104,734 | 3,550.9 | 1,417.0 | 87.7 | 8,771.2 | 40.5 | 5,220.4 |
| 表示の価値に比例 | 89,400 | 3,550.9 | 1,198.3 | 90.2 | 9,018.6 | 39.4 | 5,467.7 |
| 価値どおり(予算の制約なし) | 181,190 | 11,836.3 | 2,650.3 | 200.2 | 20,019.7 | 59.1 | 8,183.4 |
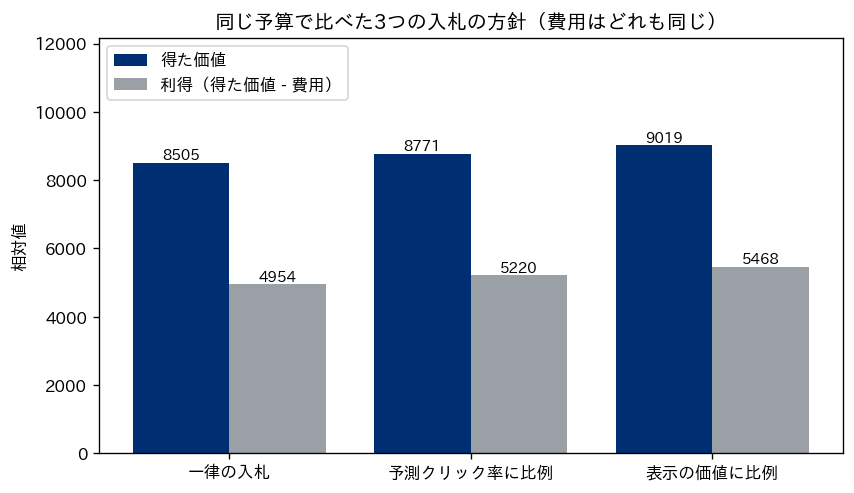
同じ予算で、得た価値と利得が最も大きかったのは表示の価値に比例する方針でした(得た価値 9,018.6、利得 5,467.7)。次が予測クリック率に比例する方針(8,771.2、5,220.4)、最も小さいのが一律の入札(8,505.2、4,954.3)です。表示の価値に比例する方針の乗数は 0.504 で、予算が価値どおりの費用の30%しかないため、価値どおりの入札をおよそ半分に引き下げたところで予算と釣り合いました。
この表で注目したいのは、クリックの件数の順位と、得た価値の順位が一致しないことです。クリックの件数が最も多かったのは予測クリック率に比例する方針(1,417.0)で、表示の価値に比例する方針(1,198.3)より多くのクリックを得ています。それでもコンバージョンの件数と得た価値では、表示の価値に比例する方針が上回りました。予測クリック率に比例する方針は、クリックされやすいがコンバージョンに至りにくい機会にも高く入札するからです。落札の件数では一律の入札が最も多く(123,377)、安く買える機会を数多く集めていますが、それらの機会の価値は低めでした。クリックの件数や落札の件数だけを見て方針を選ぶと、本コラムの架空データでは、得た価値の小さい方針を選ぶことになりました。
差の大きさは、1回の乱数の実行だけでは判断できません。そこで、乱数のシードを 20261116 から 20261125 までの10種類に変え、データの生成から比較までの同じ手順をくり返しました(掲載しない確認用のスクリプト。二分法のくり返しの回数を 100 回から 80 回に減らしている点だけが掲載したコードと違います)。10回すべてで、得た価値は表示の価値に比例する方針、予測クリック率に比例する方針、一律の入札の順になり、10回の平均はそれぞれ 9,048.4、8,796.6、8,528.7 でした。試した10種類のシードでは、同じ順位でした。ただし差の大きさは、合成データの作り方(コンバージョン率が機会ごとにどれだけ違うか、競合の入札が価値とどれだけ結びついているか)に依存し、別の作り方では差が縮むことも広がることもありえます。自社の広告での差は、自社の記録と配信での比較で確かめる必要があります。
乗数を動かした結果は次の図のとおりです。乗数を上げるほど費用も得た価値も増えますが、曲線はしだいに寝ていきます。同じ費用の増加に対して、得られる価値の増え方が小さくなっていくということです。
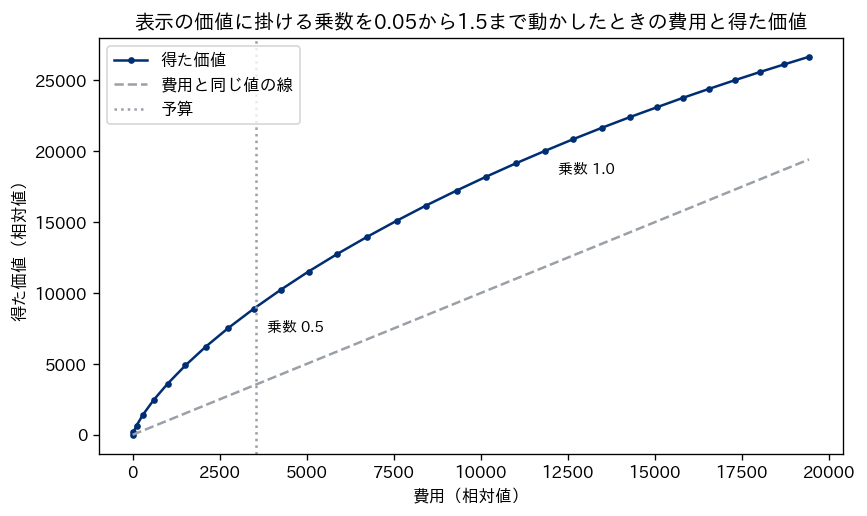
実行した結果の一部を表にします。乗数 0.5 では費用 3,487.7・得た価値 8,907.6 で、予算 3,550.9 にほぼ等しい費用です。乗数 0.95 では費用 11,002.2・得た価値 19,144.5、乗数 1.25 では費用 15,807.5・得た価値 23,770.9 でした。利得(得た価値 – 費用)は乗数 1.05 で最大の 8,199.0 になり、乗数 1.0 の 8,183.4 との差はわずかでした。価値どおり(乗数 1.0)が最も良いという先の説明とずれるので、確認用の計算で、誤差の無い真の表示の価値に乗数を掛けて入札した場合と比べました(乗数 0.90〜1.20 を 0.01 刻み)。真の価値で入札すると利得は乗数 1.0 で最大になり、見積もった価値で入札すると乗数 1.04 で最大になりました。乗数 1.0 からのずれは、入札に見積りを使ったときにだけ現れたことになります。ずれが上向きに出た理由は、この確認では調べていません。乗数 1.25 では 7,963.4、1.40 では 7,575.1 と、価値どおりより高く入札すると利得は減っていきます。価値どおりを超える入札は、価値より高い支払額で落札する機会を加えるので、得た価値は増えても利得は減る、という第3章の説明と同じ動きです。
| 乗数 | 費用 | 得た価値 | 利得 | CPA |
|---|---|---|---|---|
| 0.20 | 300.5 | 1,427.6 | 1,127.1 | 21.1 |
| 0.50 | 3,487.7 | 8,907.6 | 5,419.8 | 39.2 |
| 0.80 | 8,414.4 | 16,158.5 | 7,744.1 | 52.1 |
| 0.95 | 11,002.2 | 19,144.5 | 8,142.3 | 57.5 |
| 1.10 | 13,473.7 | 21,652.2 | 8,178.5 | 62.2 |
| 1.25 | 15,807.5 | 23,770.9 | 7,963.4 | 66.5 |
| 1.40 | 18,008.3 | 25,583.3 | 7,575.1 | 70.4 |
この表から、乗数を上げると CPA も上がることが分かります。乗数 0.2 の CPA は 21.1、乗数 1.0 の付近では 60 前後です。CPA だけを見れば乗数 0.2 が最も良く見えますが、そのときの利得は 1,127.1 で、乗数 1.05 の利得の約7分の1です。CPA が低いことは、買った機会の平均が割安だったことを示すだけで、得た価値や利得の大きさを示すものではありません。広告で増えた利益の大きさを示すものでもありません。
平均の CPA と限界の CPA、予算を増やしたときに起きること
図の曲線が寝ていくことは、CPA の言葉でも言い換えられます。予算を増やすと、乗数が上がり、それまで買わなかった「価値に対して割高な機会」まで買うようになります。追加で買った機会の CPA は、それまでに買っていた機会の CPA より高くなります。この追加分の CPA、つまり「予算を増やした分の費用 ÷ 増えたコンバージョンの件数」を、本章では限界の CPAと呼びます。管理画面に出る CPA は、期間全体の費用を件数で割った平均の CPA です。予算を価値どおりの費用の10%から100%まで動かし、両者を比べます。続けて、目標の CPA を変えたときの結果も出します。
mrows = []
prev = None
for frac in [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0]:
    b = frac * full["費用"]
    r = evaluate(scale_for_budget(v_hat, b) * v_hat)
    m = np.nan if prev is None else (r["費用"] - prev["費用"]) / (r["コンバージョン"] - prev["コンバージョン"])
    mrows.append({"予算の割合": frac, "費用": r["費用"], "コンバージョン": r["コンバージョン"],
                  "平均のCPA": r["CPA"], "限界のCPA": m, "利得": r["利得"]})
    prev = r
marg = pd.DataFrame(mrows)
print(marg.round(1).to_string(index=False))

trows = []
for t in [30, 50, 70, 100, 130, 160]:
    r = evaluate(t * pctr * pcvr)          # 入札=目標のCPA×予測クリック率×予測コンバージョン率
    trows.append({"目標のCPA": t, "落札の件数": r["落札の件数"], "コンバージョン": r["コンバージョン"],
                  "費用": r["費用"], "CPA": r["CPA"], "利得": r["利得"]})
print(pd.DataFrame(trows).round(1).to_string(index=False))
| 予算の割合 | 費用 | コンバージョン | 平均の CPA | 限界の CPA | 利得 |
|---|---|---|---|---|---|
| 0.1 | 1,183.6 | 40.7 | 29.1 | (基準) | 2,888.0 |
| 0.2 | 2,367.2 | 67.7 | 35.0 | 43.8 | 4,404.3 |
| 0.3 | 3,550.9 | 90.2 | 39.4 | 52.7 | 5,467.7 |
| 0.4 | 4,734.4 | 110.1 | 43.0 | 59.3 | 6,278.8 |
| 0.5 | 5,918.1 | 128.2 | 46.2 | 65.7 | 6,897.6 |
| 0.6 | 7,101.8 | 144.6 | 49.1 | 72.0 | 7,356.9 |
| 0.7 | 8,285.0 | 160.0 | 51.8 | 76.8 | 7,714.3 |
| 0.8 | 9,469.1 | 174.2 | 54.3 | 83.1 | 7,954.5 |
| 0.9 | 10,652.0 | 187.6 | 56.8 | 88.7 | 8,105.9 |
| 1.0 | 11,836.3 | 200.2 | 59.1 | 93.9 | 8,183.4 |
限界の CPA の列は、どの行も、予算の割合を 0.1 小さくした1つ上の行との差から計算した値です。たとえば 0.5 の行の 65.7 は、0.4 から 0.5 に増やした分の値です。表の0.2から1.0までのどの行でも、限界の CPA は同じ行の平均の CPA より高く、予算の割合を上げるにつれて、平均の CPA は 35.0 から 59.1 へ、限界の CPA は 43.8 から 93.9 へと、どちらも行ごとに大きくなっています。限界の CPA の 93.9 は、コンバージョンの価値 100 を下回ったままです。
予算を価値どおりの費用の30%にしたときの平均の CPA は 39.4 ですが、20%から30%に増やした分の限界の CPA は 52.7 でした。予算を100%にしたときの平均の CPA は 59.1、90%から100%に増やした分の限界の CPA は 93.9 で、コンバージョンの価値 100 に近づいています。限界の CPA がコンバージョンの価値を下回っている間は、予算を増やすと利得も増えます。表でも、利得は予算を増やすたびに増えていますが、増え方は小さくなっていきます(90%から100%の増加では 8,105.9 から 8,183.4)。
この違いは、予算の判断に直結します。平均の CPA が 59.1 で、コンバージョンの価値 100 を大きく下回っているからといって、「まだ予算を大幅に増やせる」とは限りません。最後に追加した予算の CPA は 93.9 で、価値とほぼ同じだからです。逆に、平均の CPA だけを見て予算を削ると、削られるのは限界の部分、つまり割高な機会から先なので、平均の CPA は下がって見えます。平均の CPA が下がったことを改善と読むと、利得が減っていることを見落とします。媒体をまたいで予算を配分するときも、比べるべきは各媒体の平均の CPA ではなく、追加の予算で増える価値です。媒体をまたぐ予算の配分の推定は、弊社コラム『広告の効果を測るマーケティング・ミックス・モデリング、効果の分解から広告予算の最適配分まで』で扱っています。
| 見方 | 平均の CPA | 限界の CPA |
|---|---|---|
| 定義 | 期間全体の費用 ÷ コンバージョンの件数 | 予算を増やした分の費用 ÷ 増えたコンバージョンの件数 |
| どこで見えるか | 管理画面のレポートにそのまま出る | 予算や目標を変えた前後の比較、実験、モデルで見積もる必要がある |
| 答える問い | 今の配信全体で、1件あたりいくら払ったか | 予算を少し増やす・減らすと、件数と価値がどれだけ変わるか |
| 読み違えやすい点 | 予算を削ると下がって見えるが、利得は減っていることがある | アトリビューションで割り振った件数で計算すると、増分の限界ではない |
| 判断に使う場面 | 過去の配信の振り返り | 予算の増減・媒体やキャンペーンの間の配分 |
なお、ここでのコンバージョンの件数は、合成データの真の確率から数えたものです。実際の広告で限界の CPA を見積もるとき、分母に管理画面のコンバージョンの件数(アトリビューションで割り振った件数)を使うと、広告が無くても起きたコンバージョンまで含まれます。増分にもとづく限界の費用は、第11章で扱う実験などで見積もる値です。
目標の CPA を厳しくすると何が起きるか
目標の CPA にもとづく入札(入札額=目標の CPA × 予測クリック率 × 予測コンバージョン率)で、目標の CPA を 30 から 160 まで変えた結果が次の表です。予算の制約は置かず、目標の CPA だけで入札額を決めています。
| 目標の CPA | 落札の件数 | コンバージョン | 費用 | CPA | 利得 |
|---|---|---|---|---|---|
| 30 | 38,426 | 36.1 | 1,009.0 | 27.9 | 2,603.9 |
| 50 | 88,399 | 89.1 | 3,487.7 | 39.2 | 5,419.8 |
| 70 | 132,261 | 139.6 | 6,732.8 | 48.2 | 7,228.0 |
| 100 | 181,190 | 200.2 | 11,836.3 | 59.1 | 8,183.4 |
| 130 | 214,105 | 244.0 | 16,547.9 | 67.8 | 7,849.7 |
| 160 | 237,027 | 276.2 | 20,724.2 | 75.0 | 6,892.4 |
目標の CPA を 100(コンバージョンの価値と同じ)から 50 に下げると、実際の CPA は 59.1 から 39.2 に下がりました。管理画面の上では改善に見えます。しかしコンバージョンの件数は 200.2 から 89.1 に、利得は 8,183.4 から 5,419.8 に減りました。目標の CPA を 30 まで下げると、CPA は 27.9 とさらに下がり、利得は 2,603.9 まで減ります。目標を厳しくするほど入札額が下がり、買える機会が減るからです。目標の CPA 50 の行は、先の表の乗数 0.5 の行と同じ数字になっています。目標の CPA を価値の半分にすることは、価値どおりの入札を半分に引き下げることと同じだからです。
反対に、目標の CPA を価値より高い 130 や 160 にすると、コンバージョンの件数は 244.0、276.2 と増えますが、利得は 7,849.7、6,892.4 と減りました。価値より高く払う機会を買うようになるためです。この表で比べた6つの設定の中では、利得が最も大きかったのは、目標の CPA をコンバージョンの価値と同じ 100 にした場合でした(先の節の確認では、見積もった価値に掛ける乗数を細かく動かすと、乗数 1.04 で利得が最大になりました。目標の CPA でいえば 104 に当たり、この表の刻みでは比べていません)。ここでは予算の制約を置いておらず、予算の制約がある場合は、先の節のように乗数が1より小さくなります。
実際の CPA は、どの目標でも目標の値より低くなっています(目標 100 のとき 59.1)。目標の CPA にもとづく入札は、機会ごとの入札額の上限を決めるもので、セカンドプライスでは実際の支払額は競合の最高入札額になるからです。この例題の規則では、目標の CPA は「期間全体の CPA をこの値にする」という意味ではありません。媒体の自動入札で「目標」と呼ばれる値がどの意味で使われているかは、次の節のように媒体の説明で確かめる必要があります。
複数のキャンペーンで予算を分ける、限界の価値をそろえる
予算を複数のキャンペーンに分ける場合も、考え方は同じです。予算1を追加したときに増える価値(限界の価値)が、どのキャンペーンでも等しくなるように分けるのが、合計の価値を大きくする条件です。あるキャンペーンの限界の価値が他より高ければ、そちらに予算を移せば合計が増えるからです。この条件は、予算を細かく動かせ、各キャンペーンの「費用と得た価値の曲線」が図のように滑らかで、しだいに寝ていく形をしている場合の話で、先の節の端数の注意はここにも当てはまります。乗数で言い換えると、すべてのキャンペーンに同じ乗数を掛けて入札することに当たります。表示の価値に比例する入札では、乗数は「この機会の価値に対して、いくらまでなら払うか」の比なので、乗数がそろっていれば、どのキャンペーンでも同じ割安さの機会まで買っていることになります。
これを確かめるため、表示の機会を2つのキャンペーン(キャンペーン01と02)に無作為に分け、キャンペーン02の機会は競合の最高入札額を 1.6 倍にして、競合が強い設定にしました。予算は先と同じ 3,550.9 です。予算を半分ずつ・01に7割・01に3割で分けて、それぞれの中で費用が割り当てた予算を超えない範囲で上限に近づく乗数を探す場合と、2つをまとめて共通の乗数で入札する場合を比べます。
camp = rng.integers(0, 2, size=n)          # キャンペーン01と02に機会を分ける
comp2 = np.where(camp == 1, comp * 1.6, comp)  # 02の機会は競合が強い
def evaluate_c(bid, mask):
    win = (bid > comp2) & mask
    spend = comp2[win].sum()
    value = (ctr * cvr)[win].sum() * V
    return spend, value

def lam_for(mask, b):
    lo, hi = 1e-6, 1e6
    for _ in range(100):
        mid = np.sqrt(lo * hi)
        lo, hi = (lo, mid) if evaluate_c(mid * v_hat, mask)[0] > b else (mid, hi)
    return lo

B2 = budget
for name, share in [("半分ずつ", 0.5), ("01に7割", 0.7), ("01に3割", 0.3)]:
    l0, l1 = lam_for(camp == 0, share * B2), lam_for(camp == 1, (1 - share) * B2)
    s0, v0 = evaluate_c(l0 * v_hat, camp == 0)
    s1, v1 = evaluate_c(l1 * v_hat, camp == 1)
    print(name, "乗数01", round(l0, 3), "乗数02", round(l1, 3),
          "費用", round(s0 + s1, 1), "得た価値", round(v0 + v1, 1), "利得", round(v0 + v1 - s0 - s1, 1))
lc = lam_for(np.ones(n, bool), B2)         # 共通の乗数で2つをまとめて入札
sc, vc = evaluate_c(lc * v_hat, np.ones(n, bool))
s0c, _ = evaluate_c(lc * v_hat, camp == 0)
print("共通の乗数", round(lc, 3), "費用", round(sc, 1), "得た価値", round(vc, 1),
      "利得", round(vc - sc, 1), "01の費用の割合", round(s0c / sc, 3))
# 出力:
# 半分ずつ 乗数01 0.504 乗数02 0.657 費用 3550.8 得た価値 7743.0 利得 4192.2
# 01に7割 乗数01 0.595 乗数02 0.531 費用 3550.8 得た価値 7916.0 利得 4365.2
# 01に3割 乗数01 0.402 乗数02 0.761 費用 3550.7 得た価値 7243.1 利得 3692.4
# 共通の乗数 0.569 費用 3550.9 得た価値 7897.5 利得 4346.7 01の費用の割合 0.643
予算を半分ずつに分けると、キャンペーン01の乗数は 0.504、02の乗数は 0.657 になり、乗数がそろいません。競合の強い02では、同じ予算で買える機会が少ないので、費用が上限に届くまで乗数が上がり、価値に対して割高な機会まで買っています。得た価値は 7,743.0 でした。共通の乗数(0.569)で入札すると得た価値は 7,897.5 に増え、そのとき費用の 64.3% がキャンペーン01に回っていました。予算を01に3割しか回さない分け方では、02の乗数が 0.761 まで上がり、得た価値は 7,243.1 と最も小さくなりました。
一方で、01に7割を回した分け方の得た価値(7,916.0)は、共通の乗数(7,897.5)をわずかに上回りました。この点も、シードを変えて10回確かめました。予算の分け方を 0.3 から 0.9 まで 0.05 刻みで探すと、見積もった表示の価値で入札した場合、10回すべてで01に7割を回す分け方が最も大きく、共通の乗数との差は平均で 0.19% でした。真の表示の価値(誤差の無い価値)で入札した場合は、10回すべてで共通の乗数の得た価値が、どの分け方の値以上になりました。本コラムの架空データでは、限界の価値をそろえる共通の乗数は、真の価値で入札できるなら、試した分け方の中では最も良い結果になり、見積りに誤差がある場合はわずかに及ばないことがある、という結果です。差が出る理由については、この確認では調べていません。
実務での示唆は、キャンペーンごとの予算を固定し、それぞれが上限まで使う前提で別々に入札させると、乗数(キャンペーンごとの割安さの線)がそろわず、合計の価値を取りこぼすことがある、という点です。予算をキャンペーンの間で共有する設定や、キャンペーンの間で予算を見直す定期の手順は、この取りこぼしを小さくする手段です。ただし、キャンペーンの間で予算を動かす判断には、各キャンペーンの限界の価値の見積りが要り、その見積りにも誤差があります。予算を共有させるかどうかは、この誤差の大きさと、キャンペーンごとに予算を守る事情(商品ごとの在庫や事業部ごとの予算など)を並べて決めることになります。
媒体の自動入札の目標と、設定が意味すること
多くの広告主は、入札額を自分で計算せず、媒体や DSP(広告主の側に立って、複数の取引の場から表示の機会を買い付ける仕組み)の自動入札を使っています。自動入札は、広告主が設定した目標(目標の CPA・目標の ROAS・予算など)に合わせて、機会ごとの入札額を自動で決める機能です。広告主が決めるのは、こうした目標と予算、コンバージョンの定義と価値です。ここでは、Google 広告の公式ヘルプに書かれている範囲を紹介します(2026年11月16日に確認)。媒体の内部で入札額がどう計算されているかは公開されておらず、本コラムでは推測しません。本章の例題の計算が自動入札の中で行われているという意味でもありません。
Google 広告ヘルプの「『目標アクション単価』入札戦略について」のページでは、広告主が1回のコンバージョンに使う平均の額として目標を指定し、オークションごとに、キャンペーンの過去のデータと、端末・地域・時間帯などのその時点の情報をもとに入札単価が設定されると説明されています。また、個々のコンバージョンの単価は目標を上回ることも下回ることもあり、全体として目標と同等になるように調整される、と書かれています。利用の前にコンバージョンの計測の設定が要ることも明記されています。本章の例題の目標の CPA が「機会ごとの入札額の上限を決める係数」だったのに対し、このヘルプの説明では、目標は期間全体の平均の単価を指す、という点が違います。同じ「目標の CPA」という言葉でも、仕組みによって意味が違うことがあります。
同じヘルプの「目標広告費用対効果」の説明では、目標は広告費に対して得たいコンバージョン値の平均の比で、目標の達成を目指しながらコンバージョン値が最大になるようにオークションごとに入札単価が調整されると説明されています。目標が高すぎると配信できる量が制限され、得られるコンバージョン値の合計が減ることがある、とも書かれています。これは、本章の目標の CPA の表で、目標を 100 から 50・30 へ厳しくすると利得が減った動きと同じ向きの注意です。また、利用の前にコンバージョン値の設定が要ること、キャンペーンの種類ごとに過去の一定期間のコンバージョンの件数の条件があることも書かれています。
ヘルプに書かれているのは、目標と、目標に合わせて入札を調整するという機能の説明までです。そのうえで、本章の例題の式に当てはめると、目標の CPA は、表示の価値の式でコンバージョンの価値が入る位置に置く数字として読めます。この読み方は例題の中のもので、自動入札が実際にその式で入札しているという意味ではありません。例題の中では、目標の CPA をコンバージョンの価値から逆算せずに厳しく置くと、件数と利得が減りながら CPA だけが下がりました。また、ヘルプには目標の ROAS を使う前提としてコンバージョン値の設定が要ると書かれているので、コンバージョンの定義や価値の設定が誤っていれば、目標と比べられる実績の ROAS も、その誤った値で計算されることになります。目標の値も、コンバージョンの定義と価値の設定も、広告主が根拠を持って決める必要があると考えています。
予測の誤差と、増分を考えていないことの限界
本章の比較は、予測が平均では合っているという設定で行いました。第6章で扱ったように、予測が一律に高い・一律に低い・一部の掲載面だけ高いといったずれがあると、表示の価値もそのまま同じ向きにずれます。一律のずれは、乗数を予算に合わせて調整するときにある程度吸収されます(予測が一律に2倍なら、費用が予算の上限に届く乗数が半分になる)。一方、一部の掲載面だけが高いずれは乗数では吸収されず、その掲載面に予算が偏ります。価値に比例する入札は予測を最も直接に使う方針なので、予測の較正の確認(第6章)が入札の前提になります。
もう1つの限界は、表示の価値の式が増分を考えていないことです。予測コンバージョン率が高い機会には、もともと購入する意向の強い利用者への表示が多く含まれます。こうした利用者は広告を見なくても購入したかもしれず、その場合、広告によって増えた価値は式の値より小さくなります。表示の価値に比例する入札は、こうした機会を高く買う方針なので、広告で増えた利益を基準にすると、本章の表ほどの差が出ない可能性があります。増分にもとづく入札の考え方は第11章で扱います。
経営の損失の型と、仕組みへの落とし込み
入札額の決め方を誤ったときの損失は、本コラムの6つの型のうち、払いすぎ・機会損失・成果の数え違い・形骸化の4つで主に整理できます。目標の CPA を価値より高く置く、あるいは価値の見積りが一部の機会で高すぎると、表示の価値を超える額で広告枠を買う払いすぎになります。目標の CPA を価値から離れて厳しく置くと、価値のある機会を買い逃す機会損失になり、本章の表では CPA が下がる一方で利得が減りました。キャンペーンごとの予算を固定して乗数がそろわない状態も、合計の価値の取りこぼしという点で機会損失の一種です。また、表示の価値の式は増分を考えていないので、割り振られたコンバージョンを価値として入札を続けると、成果の数え違いの上に予算の配分を重ねることになります。目標の CPA を設定したまま、その根拠や実績との関係を誰も見直さない状態は形骸化です。
これらを避けるには、入札の設定を仕組みに組み込むことが要ると考えています。次の表は、入札額の決め方に関わる判断と、その判断を誰が・何をもとに・どの頻度で見直すかをまとめたものです。
| 決めること | 根拠にするもの | 主に関わる役割 | 見直しの契機 |
|---|---|---|---|
| コンバージョンの価値 | 粗利、顧客の生涯価値、商品ごとの利益の率 | 経営・財務・事業の担当 | 価格や原価の改定、商品構成の変化 |
| 目標の CPA・目標の ROAS | コンバージョンの価値から逆算した上限と、増分の実験の結果 | マーケティング・広告運用・財務 | 四半期ごと、価値の見直しのとき |
| 予算と、その分け方 | 限界の CPA と、追加の費用あたりに増える価値の見積り | 経営・マーケティング | 予算の策定時、予算の上限で配信が止まっている割合が高いとき |
| 予測の較正の確認 | 区分ごとの予測と実績の比(第6章) | データ分析・広告運用 | 月ごと、媒体の仕様や掲載面の構成が変わったとき |
| 成果の測り方 | 増分の利益(第11章) | 経営・マーケティング・データ分析 | 実験の結果が出たとき |
経営の判断としては、コンバージョンの価値と目標の CPA の根拠を、事業として決めて見直すことが中心になります。コンバージョンの価値は粗利を基準にし、継続的な取引が見込める商材では顧客の生涯価値を加味して決めます。顧客の生涯価値の見積り方は、弊社コラム『顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで』で扱っています。目標の CPA は、その価値から逆算した上限として置き、「前期より下げる」こと自体を目標にしないことが大切です。KPI の報告では、平均の CPA と並べて、件数・利得・予算を増減したときの限界の CPA の見積りを示すと、CPA の低下が利得の減少を伴っていないかを確かめられます。
この章では、表示の価値に乗数を掛けて入札し、乗数を予算に合わせて調整するという考え方と、例題の式の中で目標の CPA がコンバージョンの価値の位置に入る数字であることを、セカンドプライスの架空データで確かめました。本コラムの架空データでは、同じ予算で表示の価値に比例する方針が最も多くの価値を得て、目標の CPA を価値と同じ 100 から 50・30 へ厳しくすると、CPA は下がったものの利得は減りました。次の第8章では、取引の方式がファーストプライスの場合に、勝率曲線を推定して入札をどこまで引き下げるかを扱います。
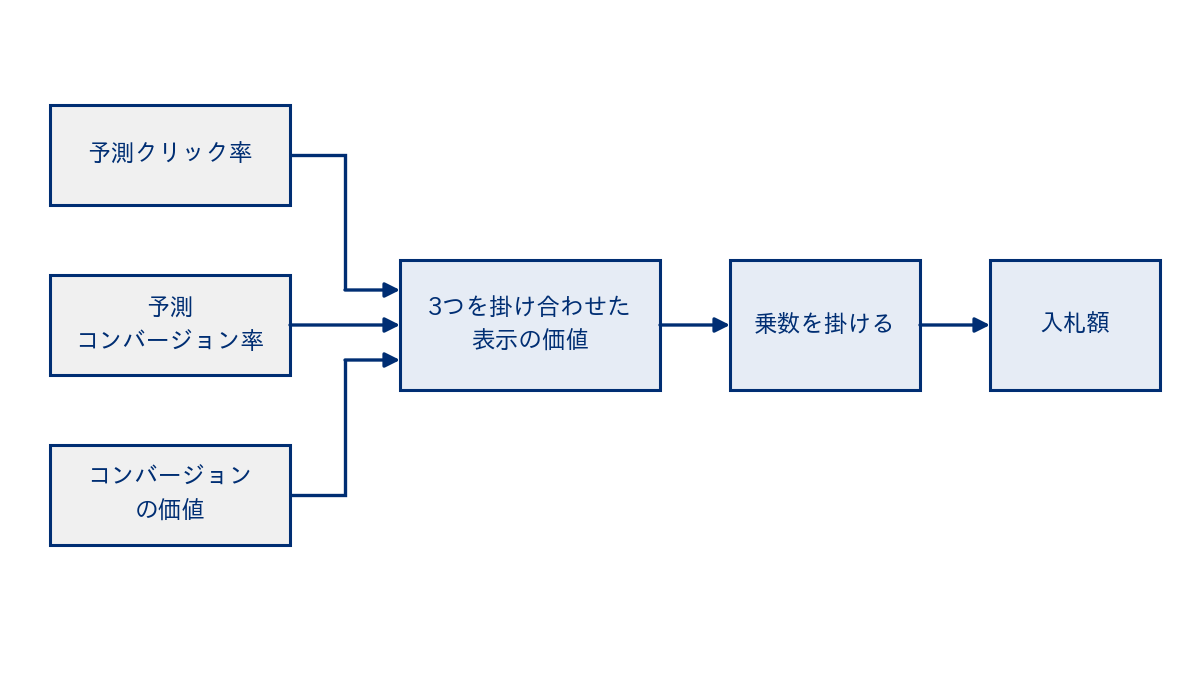
この章を深めたい方への参考書籍
『最適化手法入門』(寒野善博 著、駒木文保 編、講談社):線形計画の双対性や、制約のある非線形計画の最適性の条件を、データサイエンスの応用と併せて解説した入門書です。本章の予算の制約つきの入札で使ったラグランジュ乗数の考え方を、一般的な最適化の枠組みの中で確かめるのに向いています。
『数理計画入門 第3版 最適化の数理モデルとアルゴリズム』(福島雅夫、山下信雄 著、朝倉書店):線形最適化・ネットワーク最適化・非線形最適化・組合せ最適化を通して、最適化の数理モデルの立て方と解き方を扱う教科書です。予算を機会やキャンペーンに配分する問題を、定式化の型として整理し直すときの土台になります。
第8章 ファーストプライスでの入札、勝率曲線の推定と入札の引き下げ
第3章では、ファーストプライス・オークションでは勝者が自分の入札額をそのまま払うので、表示の価値どおりに入札すると利得が残らず、入札を引き下げる必要があることを確かめました。第7章では、表示の価値にもとづいて入札額を決める方法と、予算の制約があるときに入札を一律の割合で引き下げる考え方を扱いました。この章では、ファーストプライスの場で「どこまで引き下げるか」を、買い手が実際に手にできる記録から決める方法を扱います。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の表示の機会の記録を使い、実行したコードと結果で確かめます。
- 利得の見込みを「表示の価値と入札額の差」と「勝率」の積で表す考え方と、勝率曲線が要る理由
- 買い手の手元に残る情報と、落札できなかった機会で落札のしきい値が分からないこと(打ち切り)
- 勝率曲線の推定の方法の比較と、落札した機会の支払額だけを使う素朴な推定が偏ること
- 推定した勝率曲線から機会ごとの入札額を決め、価値どおりの入札・一律の引き下げと比べた結果
- 過去の入札額の範囲の外は推定できないことと、入札額をあえて散らして情報を集める考え方
- 区分ごとの曲線・競合の変化・予算の制約との組み合わせ、DSP や広告会社に確かめること
この章の主張は2つあります。1つ目は、ファーストプライスの場での引き下げの幅は、勝率曲線の推定で決まり、その推定には落札できなかった機会の記録まで含めて使う必要がある、という点です。本コラムの架空データでは、落札した機会の支払額だけで作った曲線は勝率を大きく低く見積もり、その曲線にもとづく入札は、落札の有無を使った推定にもとづく入札より払いすぎになりました。2つ目は、過去に同じような額でしか入札していなければ、その範囲の外の勝率はデータだけでは確かめられないので、一部の機会で入札額を散らす費用を、情報を得るための費用として計画に入れるべきだ、という点です。
ファーストプライスでは「勝てる範囲でどこまで下げるか」が利得を決める
ファーストプライス・オークションでは、落札した買い手が自分の入札額をそのまま払います。表示の価値が1.0の機会に1.0で入札して勝てば、支払額も1.0で、表示の価値から支払額を引いた差(本コラムの例題でいう利得)は0です。ここでの表示の価値は、その機会に表示した場合にその後のコンバージョンから得られると予測する、広告費を引く前の価値で、広告が無くても起きたコンバージョンの分を除いていない見積りです。そのため利得は、序章で成果と定めた増分の利益とは別のものです。利得を残すには価値より低く入札する必要がありますが、低くするほど競合に負ける機会が増えます。下げれば1回あたりの利得は増え、勝てる回数は減るので、その間のどこかに利得の見込みが最も大きくなる入札額があります。入札額を価値より下げることを、本コラムでは入札の引き下げ(ビッド・シェーディング)と呼びます。
ある機会に入札額 \( b \) で入札したときの利得の見込みは、次のように書けます。
\( \text{利得の見込み} = (v – b) \times W(b) \)
ここで \( v \) はその機会の表示の価値(第7章で見積もった値)、\( W(b) \) は入札額 \( b \) で入札したときに落札できる確率です。言葉で言えば、「勝ったときに残る差」に「勝てる確率」を掛けたものが、その入札額を選んだときに平均して残る利得です。入札額と勝率の関係 \( W(b) \) を、本コラムでは勝率曲線と呼びます。価格の面で落札できるかどうかを決めるのは、自分以外の入札のうち最も高い額(競合の最高入札額)と、売り手の定める最低落札価格の、大きいほうです。本コラムではこの額を落札のしきい値と呼びます。最低落札価格は競合の入札ではないので、競合の最高入札額には含めません。しきい値が \( b \) 以下なら勝つので、勝率曲線は「落札のしきい値が \( b \) 以下である確率」と同じものです。本章の例題では最低落札価格を置かないので、しきい値は競合の最高入札額に一致します。なお本章では、入札額がしきい値と等しい場合も落札として扱います。勝率の分母は「入札した機会」です。
この式から分かるのは、引き下げの幅を決めるのに必要な情報は、表示の価値と勝率曲線の2つだということです。表示の価値の見積りは第4章から第7章で扱いました。本章はもう1つの勝率曲線を扱います。勝率曲線が手元に無ければ、引き下げの幅は勘で決めるしかありません。推定した曲線の形がずれると、選ばれる入札額もずれます。入札額が高すぎる方向にずれれば、同じ機会をもっと低い額で落札できたのに高く払うことになり、低すぎる方向にずれれば、利得が見込める機会を買い逃します。序章で挙げた損失の型でいえば、前者が払いすぎ(引き下げの不足)、後者が機会損失にあたります。どちらの向きにずれるかは、勝率を高く見るか低く見るかだけでは決まらず、曲線の形(入札額を上げたときの勝率の伸び方)によります。例えば、どの入札額でも勝率を一律に半分と見積もっても、利得の見込みが全体に半分になるだけで、最大になる入札額は変わりません。
勝率曲線が分かっていれば、利得の見込みが最大になる入札額は、数式の上では次の条件を満たす \( b \) として求まります。
\( W(b) = (v – b) \times W'(b) \)
\( W'(b) \) は、入札額を少し上げたときに勝率がどれだけ上がるかを表します。入札額を少しだけ上げると、2つのことが起きます。1つ目に、もともと勝てていた機会では、上げた分だけ多く払うので、利得の見込みが「勝率×上げ幅」だけ減ります。式の左辺はこの減り方にあたります。2つ目に、上げたことで新たに勝てるようになる機会が生じ、そこでは「価値と入札額の差」の利得が得られます。右辺はこの増え方にあたります。この2つがつり合うところが、最もよい入札額の候補です。ただしこの式は、勝率曲線が滑らかで、最もよい入札額が候補の範囲の内側にある場合に成り立つ条件で、これを満たす入札額が複数あることや、範囲の端で利得の見込みが最大になることもあります。段差のある曲線にはこの式をそのまま使えません。そのため、候補の範囲の端も含めて利得の見込みを比べる必要があります。実務では、この式を解析的に解くより、入札額の候補を細かく並べて利得の見込みが最大のものを選ぶ(格子で探す)ほうが扱いやすく、本章のコードもその方法を使いました。
買い手の手元に残る情報と打ち切り
勝率曲線を推定するには、過去の入札の記録を使います。問題は、買い手の手元に残る情報が限られていることです。リアルタイム入札の取引の規格である IAB Tech Lab の OpenRTB 2.6(OpenRTB 2.6 の公式の仕様)では、入札リクエストにオークションの方式を示す項目があり、1がファーストプライス、2がセカンドプライスにあたると定められています。落札したときには取引の場が買い手の指定した通知先を呼び出し(落札の通知)、その通知の中で清算された価格を伝えるための置き換えの記号が用意されています。規格では、落札の通知は広告が表示されたことや課金の対象になったことを必ずしも意味しないとされ、課金の対象になったときの通知は別に用意されています。落札は表示や支払いを保証しません。落札できなかったことを伝える通知も規格にありますが、取引の場がこれに対応していない場合や、価格の情報を外して送る場合があることも、規格の中に書かれています。
OpenRTB 2.6 には、オークションで勝つのに必要だった最低の額(最低落札に要した額)を伝える置き換えの記号も定義されています。規格の注記では、この記号は任意で、取引の場によって扱いが違い、取引の場が値を出さないと決めた場合やプライバシーの制御で価格の共有が制限される場合には空になるとされています。また、例えば Google のAuthorized Buyers の OpenRTB の案内には、ファーストプライスのオークションでは、入札の結果の通知に、勝つのに必要だった最低の入札額を入れると書かれています。つまり、負けた機会について知らされる情報は取引の場によって違い、落札に必要だった額を事後に知らせる仕組みを持つ取引の場もあります。本コラムの例題では、最も情報が少ない場合として、落札のしきい値は知らされないものとします。買い手の手元に残るのは「入札額」と「落札したか否か」だけで、ファーストプライスなので支払額は自分の入札額と同じです。
その場合に、価格で負けたと分かる機会について分かるのは「落札のしきい値が自分の入札額より高かった」という下限だけで、しきい値がいくらだったのかは分かりません。第2章で説明したとおり、これを打ち切りと呼びます。さらに例題の条件では、落札した機会でも、自分が払った額は自分の入札額なので、しきい値がいくらだったか(どこまで下げても勝てたか)は分かりません。分かるのは「しきい値が自分の入札額以下だった」という上限だけです。つまり、落札した機会も落札できなかった機会も、しきい値そのものではなく、「自分の入札額より上か下か」だけが記録に残ります。統計の言葉では、このように「ある値より上か下か」だけが分かるデータは、生存時間分析の分野で扱われる打ち切りのあるデータの一種です(打ち切りデータの一般論は弊社コラム「顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで」の生存時間分析の説明が参考になります)。
ただし、実務では落札できない理由は価格だけではありません。OpenRTB 2.6 は、落札できなかった理由を伝える符号を用意しています。その符号の一覧は別の規格の OpenRTB 3.0 に載っており(OpenRTB 3.0 の仕様)、そこには、より高い入札に負けた・最低落札価格を下回った、という価格の理由のほかに、表示の機会の期限切れ、取引の場による広告の不承認、売り手の側の広告主やカテゴリの除外による広告の除外、あらかじめ条件を決めた取引の入札に負けた、といった理由が並んでいます。こうした機会を「価格で負けた」と読むと、しきい値を実際より高く見積もることになります。どの理由がどこまで通知されるかは取引の場によります。本章の例題では、入札はすべて有効に受け付けられ、落札できるかどうかは価格だけで決まると単純化しています。勝率の分母は、例題でも「入札した機会」です。
| 取引の条件 | 落札した機会で分かること | 落札できなかった機会で分かること | 勝率曲線の推定への影響 |
|---|---|---|---|
| ファーストプライスで、結果の通知に価格の情報が無い | 自分の入札額(=支払額)で勝ったこと | 価格だけで負けた場合、落札のしきい値が自分の入札額より高かったこと | 入札額と落札の有無だけで推定する。本章の例題はこの条件 |
| ファーストプライスで、勝つのに必要だった最低の額が通知される | 勝つのに必要だった最低の額(通知される場合) | 勝者に並ぶのに必要だった額(通知される場合) | しきい値にあたる値が直接分かる機会が増え、推定が楽になる。通知されない機会が残るかは取引の場による |
| セカンドプライスで、清算された価格が通知される | 次点の入札額または最低落札価格にもとづく支払額 | 価格だけで負けた場合、落札のしきい値が自分の入札額より高かったこと | 落札した機会ではしきい値にあたる額が分かり、落札できなかった機会は打ち切りになる。この場合の推定は後述の研究が扱っている |
表の中の取引の条件は、規格に用意された仕組みから整理したもので、ある取引の場がどの条件にあたるかは、その取引の場の公式文書か、取引を仲介する DSP に確かめる事項です。
勝率曲線の推定の方法
入札額と落札の有無の記録から勝率曲線を作る方法は、大きく次の3つに分けられます。1つ目は、入札額を帯に分け、帯ごとに落札した割合を数える方法です。分布の形を仮定せずに済みますが、帯の数だけ件数が要り、入札したことの無い額の帯については何も分かりません。2つ目は、落札したか否かを結果とし、入札額の対数を入力にしたロジスティック回帰(結果が起きる確率を、入力の重みつきの和から S 字の曲線で求める方法。第4章)で勝率を予測する方法です。区分(掲載面や時間帯)を入力に足せば、区分ごとの曲線を少ない件数で作れます。3つ目は、しきい値の分布の形を仮定する方法です。例えば、正の値だけをとり、高い側に裾の長い対数正規分布を仮定します。使う記録は「勝った機会ではしきい値が入札額以下、負けた機会では入札額より上」という打ち切りの情報です。そのうえで、観測された勝ち負けが最も起こりやすくなるように分布の中心やばらつき(母数)を選びます。この選び方を最尤推定と呼びます。分布の形を仮定することで、少ない件数でも安定した推定ができる場合がありますが、仮定が実際と合っていなければ偏ります。
1つ目の帯ごとの割合には、読み方の注意があります。帯ごとの落札の割合は、「その帯の額で入札した機会のうち、落札した割合」です。入札した機会の中身が帯ごとに違うと、この割合は「同じ機会で入札額を変えたときに勝率がどう変わるか」をそのまま表しません。例えば、価値の高い機会ほど高く入札していて、その機会では競合の水準も高いとすると、高い帯には競合の強い機会が集まり、高い帯の落札の割合は、入札額を上げたときの勝率より低く出ます。この違いは、後のコードで例題のデータを使って確かめます。
これらとは別に、落札した機会の支払額を集めて、その分布をしきい値の分布とみなしたくなることがあります。落札した機会の支払額は、手元に残りやすい集計だからです。本章ではこれを「素朴な推定」と呼び、検証の対象に置きます。ファーストプライスでは落札した機会の支払額は自分の入札額なので、この方法は「自分が勝ったときの入札額の分布」を「しきい値の分布」と取り違えることになります。勝ったときの入札額は、同じ機会のしきい値以上の額です。さらに、落札した機会だけが選ばれているので、その分布と、負けた機会を含むすべての機会のしきい値の分布との大小は、一般には決まりません。この取り違えと選ばれ方の偏りが、例題の勝率曲線にどう表れるかを、後のコードで確かめます。
| 方法 | 使う記録 | 置く仮定 | 強み | 外れやすいところ |
|---|---|---|---|---|
| 素朴な推定(落札した機会の支払額の分布) | 落札した機会の支払額だけ | 支払額がしきい値の標本とみなせる | 集計だけで作れる | ファーストプライスでは支払額が自分の入札額なので、しきい値と取り違えている。落札できなかった機会を捨てているので、選ばれ方の偏りもある |
| 入札額の帯ごとの落札の割合 | 入札額と落札の有無 | 帯の中では勝率がほぼ一定。帯どうしで入札した機会の中身が同じ | 分布の形を仮定しない | 帯ごとに件数が要る。入札したことの無い額の帯は分からない。帯ごとに機会の中身が違うと、入札額を変えたときの勝率を表さない |
| 入札額の対数を入力にしたロジスティック回帰 | 入札額と落札の有無(区分を足せる) | 勝率が入札額の対数に対して S 字の形で変わる | 区分を足しても件数が少なくて済む。既存の道具で作れる | 曲線の形の仮定が外れると、端のほうでずれる |
| 打ち切りを考えた最尤推定 | 入札額と落札の有無 | しきい値が特定の分布(例:対数正規分布)に従う | 分布の形が合っていれば、少ない件数でも安定した推定ができる場合があり、しきい値の分布そのものが得られる | 分布の形が実際と違うと偏る |
研究では、Cui、Zhang、Li、Mao の2011年の論文(ディスプレイ広告の取引の場での、入札の状況の予測の論文。KDD 2011)が、配信の対象の属性の組み合わせごとに入札の分布を予測し、対数正規分布の混合でキャンペーン単位の分布にまとめる仕組みを提案しています(Cui らの論文の書誌)。Wu、Yeh、Chen の2015年の論文(打ち切りのあるデータでの落札価格の予測の論文。KDD 2015)は、DSP の立場から、落札できなかった入札の記録も使って落札価格を予測する方法を研究しています(Wu らの論文の書誌)。これらはそれぞれの論文のデータと条件での結果で、読者の広告で同じ精度が得られることを示すものではありません。また、Wu らの論文は落札したときに落札価格が見える場面を扱っており、本章の例題(落札しても次点の額が分からない条件)とは前提が違います。
架空の表示の機会の記録を作る
ここからは、勝率曲線の推定と入札の引き下げを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの成績は、実際の配信での成績の目安にはなりません。示したいのは、同じ記録から作った勝率曲線でも、推定の方法によって入札額と利得がどう変わるかという点です。
この例題では、28日の間に生じた表示の機会196,000件を、次の性質を持たせて乱数で作りました(乱数の種は20261116に固定しています)。コードは Python 3.14.3 で実行し、numpy 2.4.3・pandas 3.0.1・scipy 1.16.3・scikit-learn 1.9.0・matplotlib 3.10.8 を使い、グラフの日本語の表示には japanize-matplotlib 1.1.3 を使いました。額はすべて単位の無い相対値で、掲載面A・昼の競合の最高入札額の中央値がおよそ1になる尺度で表しています。
- 表示の機会の属性:掲載面(A・B・Cの3種類。件数の比は5対3対2)・時刻(0〜23時)・日(0〜27日目)
- 表示の価値:掲載面ごとに水準の違う対数正規分布から作る。第7章の方法で見積もった値で、見積りに誤りは無いものとする
- 競合の最高入札額:対数正規分布で、掲載面によって水準が違い(Bが高くCが低い)、夜(18〜23時)はどの掲載面でも高くなる。ばらつきの大きさは全区分で同じ
- 過去の入札:表示の価値に、乱数で決めた割合(中心はおよそ0.78倍)を掛けた額で入札していた
- 取引の方式:ファーストプライス。最低落札価格は置かないので、落札のしきい値は競合の最高入札額と同じ。入札額がそれ以上なら落札し、支払額は自分の入札額
- 入札の受け付け:入札はすべて有効に受け付けられ、落札できるかどうかは価格だけで決まる
入札額と支払額は表示1回あたりの相対値で、表示の価値と同じ尺度です。本章の例題では、落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。実務では、ディスプレイ広告の取引の入札は、表示1,000回あたり(CPM)の価格で表されることが多く、例題の数値とは単位が違います。区分は「掲載面×昼か夜か」の6つです。前の21日(0〜20日目)を推定に使う期間、後の7日(21〜27日目)を評価に使う期間とし、推定には前の期間の記録だけを使います。そして、推定に使うのは、買い手の手元に残る「区分・入札額・落札の有無」の3つの列だけにしました。合成データなので、各機会の競合の最高入札額(真の値)も分かっていますが、これは推定には使わず、推定した曲線や入札の方法の答え合わせにだけ使います。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
from scipy.stats import norm
from scipy.optimize import minimize
from sklearn.linear_model import LogisticRegression
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

SEED = 20261116
rng = np.random.default_rng(SEED)

# ブロック1:架空の表示の機会(28日分)。額はすべて相対値
n = 196_000
day = rng.integers(0, 28, n)
hour = rng.integers(0, 24, n)
place = rng.choice(["A", "B", "C"], n, p=[0.5, 0.3, 0.2])
evening = ((hour >= 18) & (hour <= 23)).astype(int)
mu_v = pd.Series({"A": 0.2, "B": 0.4, "C": 0.0})[place].to_numpy()
mu_c = pd.Series({"A": 0.0, "B": 0.3, "C": -0.3})[place].to_numpy()
value = np.exp(rng.normal(mu_v, 0.6))            # 表示の価値(第7章で見積もった値とする)
sigma_true = 0.45
comp = np.exp(rng.normal(mu_c + 0.25 * evening, sigma_true))  # 競合の最高入札額(真の値)
cell = np.char.add(place.astype(str), np.where(evening == 1, "夜", "昼"))
df = pd.DataFrame({"day": day, "hour": hour, "place": place, "evening": evening,
                   "cell": cell, "value": value, "comp": comp})
print("機会の件数", len(df), " 区分の数", df["cell"].nunique())
print(df.groupby("cell")["comp"].median().round(3).to_string())

# ブロック2:過去の入札(価値に乱数の割合を掛けて散らしていた)と、買い手の手元に残る記録
df["bid_hist"] = df["value"] * np.exp(rng.normal(-0.25, 0.30, n))
df["win_hist"] = (df["bid_hist"] >= df["comp"]).astype(int)   # ファーストプライス
train = df[df["day"] <= 20].copy()   # 推定に使う期間
test = df[df["day"] >= 21].copy()    # 評価に使う期間
log = train[["cell", "bid_hist", "win_hist"]]   # 買い手が見られるのはこの3列だけ
print("推定用", len(train), "件  評価用", len(test), "件")
print("推定用の期間の勝率 %.3f" % log["win_hist"].mean())
won = log[log["win_hist"] == 1]
print("落札した機会", len(won), "件(支払額=自分の入札額)")
実行すると、区分ごとの競合の最高入札額の中央値は、A昼が1.001、A夜が1.290、B昼が1.351、B夜が1.731、C昼が0.743、C夜が0.952でした(答え合わせ用の真の値です)。推定に使う期間は147,000件、評価に使う期間は49,000件です。過去の入札のもとでの推定期間の勝率(入札した機会のうち落札した割合)は0.440で、落札した機会は64,714件でした。
4つの方法で勝率曲線を作り、真の曲線と比べる
次に、前の21日の記録から、4つの方法で区分ごとの勝率曲線を作ります。素朴な推定は、区分ごとに落札した機会の支払額を並べ、「ある額以下の支払額の割合」をその額での勝率とみなします。帯ごとの割合は、区分ごとに入札額を件数の等しい10の帯に分けて落札の割合を数え、帯の中央の入札額どうしを線でつなぎます(入札額が上がると勝率が下がる形にならないよう、累積の最大値で整えました)。ロジスティック回帰は、区分を表す6つの列と入札額の対数を入力にします。打ち切りの最尤推定は、しきい値が対数正規分布に従い、その中心は区分ごとに違い、ばらつきは全区分で共通だと仮定します。使う記録は、勝った機会の「しきい値が入札額以下だった」と、負けた機会の「入札額より上だった」という情報です。この勝ち負けが最も起こりやすくなる中心とばらつきを求めます。
# ブロック3:勝率曲線の4つの推定(使うのは入札額と落札の有無だけ)
cells = sorted(log["cell"].unique())

def naive_curve(c, b):
    # 素朴な推定:落札した機会の支払額を「競合の最高入札額の標本」とみなす
    pay = np.sort(won.loc[won["cell"] == c, "bid_hist"].to_numpy())
    return np.searchsorted(pay, b, side="right") / len(pay)

edges = {}
for c in cells:
    s = log[log["cell"] == c]
    q = np.quantile(s["bid_hist"], np.linspace(0, 1, 11))
    k = np.clip(np.searchsorted(q, s["bid_hist"], side="right") - 1, 0, 9)
    rate = s.groupby(k)["win_hist"].mean().reindex(range(10)).to_numpy()
    mid = s.groupby(k)["bid_hist"].median().reindex(range(10)).to_numpy()
    edges[c] = (mid, np.maximum.accumulate(rate))

def binned_curve(c, b):
    # 入札額の帯ごとの落札の割合を線でつなぐ(帯の外は端の値のまま)
    mid, rate = edges[c]
    return np.interp(b, mid, rate)
def design(cell_arr, b):
    X = pd.get_dummies(pd.Series(cell_arr), dtype=float).reindex(columns=cells, fill_value=0.0)
    X["logb"] = np.log(b)
    return X.to_numpy()

lr = LogisticRegression(C=100.0, max_iter=2000, fit_intercept=False)
lr.fit(design(log["cell"].to_numpy(), log["bid_hist"].to_numpy()), log["win_hist"])
def logit_curve(c, b):
    return lr.predict_proba(design(np.full(len(b), c), b))[:, 1]

idx = pd.Series(range(len(cells)), index=cells)[log["cell"]].to_numpy()
lb, y = np.log(log["bid_hist"].to_numpy()), log["win_hist"].to_numpy()
def nll(p):
    # 打ち切りを考えた最尤推定:勝ち=競合の額は入札額以下、負け=入札額より上
    z = (lb - p[idx]) / np.exp(p[-1])
    return -(y * norm.logcdf(z) + (1 - y) * norm.logsf(z)).sum()
res = minimize(nll, np.zeros(len(cells) + 1), method="L-BFGS-B")
mu_hat, sig_hat = res.x[:-1], np.exp(res.x[-1])
def mle_curve(c, b):
    return norm.cdf((np.log(b) - mu_hat[cells.index(c)]) / sig_hat)

def true_curve(c, b):   # 答え合わせ専用(合成データなので分かる)
    m = {"A": 0.0, "B": 0.3, "C": -0.3}[c[0]] + (0.25 if c[1] == "夜" else 0.0)
    return norm.cdf((np.log(b) - m) / sigma_true)

print("最尤推定の sigma %.3f(真の値 %.2f)" % (sig_hat, sigma_true))
print("ロジスティック回帰の log(入札額) の係数 %.3f" % lr.coef_[0][-1])
最尤推定で求めたばらつきの大きさは0.450で、データを作ったときの値0.45とほぼ一致しました。ロジスティック回帰の入札額の対数の係数は3.874でした。ただし、この例題ではしきい値(競合の最高入札額)を実際に対数正規分布で作っているので、最尤推定は仮定した分布の形が正しい、最も有利な条件に置かれています。実際の配信の記録では、しきい値の分布の形は分からず、仮定が外れれば最尤推定も偏ります。この点は結果を読むときの前提として押さえておく必要があります。
作った曲線を、2つの物差しで比べました。1つ目は答え合わせで、入札額0.3から3.0までの55点で、推定した勝率と真の勝率の差の絶対値を平均し、さらに6つの区分で平均したものです。2つ目は、評価に使う期間(後の7日)で、過去と同じ方針の入札額に対する落札の有無を、推定した勝率がどれだけ言い当てたかを対数損失(第6章)で測ったものです。こちらは実際の配信でも計算できる物差しです。
# ブロック4:真の曲線との差(答え合わせ)と、評価用の期間の落札の当てはまり
methods = {"素朴な推定": naive_curve, "帯ごとの割合": binned_curve,
           "ロジスティック回帰": logit_curve, "打ち切りの最尤推定": mle_curve}
grid = np.linspace(0.3, 3.0, 55)
rows = []
for name, f in methods.items():
    mae = np.mean([np.abs(f(c, grid) - true_curve(c, grid)).mean() for c in cells])
    p = np.concatenate([f(c, test.loc[test["cell"] == c, "bid_hist"].to_numpy()) for c in cells])
    yy = np.concatenate([test.loc[test["cell"] == c, "win_hist"].to_numpy() for c in cells])
    p = np.clip(p, 1e-4, 1 - 1e-4)
    ll = -np.mean(yy * np.log(p) + (1 - yy) * np.log(1 - p))
    rows.append([name, round(mae, 3), round(ll, 4), round(p.mean(), 3), round(yy.mean(), 3)])
print(pd.DataFrame(rows, columns=["方法", "真の曲線との平均の差", "評価期間の対数損失",
                                  "予測した勝率の平均", "実際の勝率"]).to_string(index=False))

fig, ax = plt.subplots(figsize=(7, 4.5))
bb = np.linspace(0.2, 3.0, 200)
ax.plot(bb, true_curve("A昼", bb), color="#000000", lw=2.5, label="真の勝率曲線(答え合わせ用)")
ax.plot(bb, naive_curve("A昼", bb), color="#999999", lw=2, ls="--", label="素朴な推定(落札した機会の支払額だけ)")
ax.plot(bb, binned_curve("A昼", bb), color="#7f9cc9", lw=1.5, label="帯ごとの落札の割合")
ax.plot(bb, logit_curve("A昼", bb), color="#002E73", lw=2, ls=":", label="ロジスティック回帰")
ax.plot(bb, mle_curve("A昼", bb), color="#000080", lw=1.2, ls="-.", label="打ち切りを考えた最尤推定")
ax.set_xlabel("入札額(相対値)"); ax.set_ylabel("勝率")
ax.set_title("掲載面A・昼の勝率曲線")
ax.legend(loc="lower right", fontsize=8.5)
plt.savefig("../ch08_win_curve_estimates.png", dpi=120, bbox_inches="tight"); plt.close()
| 方法 | 真の曲線との平均の差 | 評価期間の対数損失 | 予測した勝率の平均 | 実際の勝率 |
|---|---|---|---|---|
| 素朴な推定 | 0.161 | 0.5045 | 0.275 | 0.436 |
| 帯ごとの割合 | 0.011 | 0.3879 | 0.437 | 0.436 |
| ロジスティック回帰 | 0.007 | 0.3874 | 0.439 | 0.436 |
| 打ち切りの最尤推定 | 0.001 | 0.3868 | 0.439 | 0.436 |
素朴な推定は、真の曲線との平均の差が0.161と、他の3つの方法(0.001〜0.011)より大きく外れました。評価期間の実際の勝率が0.436だったのに対し、素朴な推定が予測した勝率の平均は0.275で、勝率を大きく低く見積もっています。落札した機会の支払額は、同じ機会のしきい値以上の額で、しかも落札した機会だけが選ばれています。この例題では、その分布がすべての機会のしきい値の分布より高い側に寄り、勝率を低く見積もる結果になりました。落札の有無を使った3つの方法は、どれも真の曲線に近く、予測した勝率の平均も実際の勝率とほぼ一致しました。3つの中の順位は、真の曲線との差でも対数損失でも、最尤推定・ロジスティック回帰・帯ごとの割合の順でしたが、対数損失の差は0.001程度と小さく、この差だけで方法の優劣は決められません。
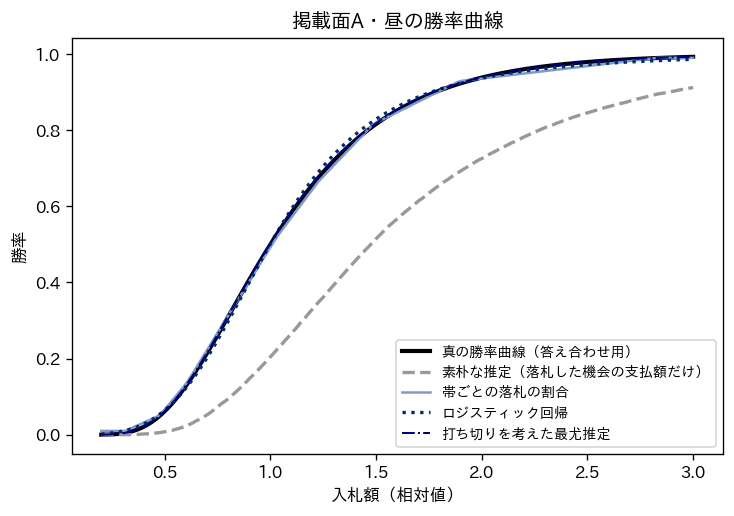
図は掲載面A・昼の区分の曲線です。帯ごとの割合・ロジスティック回帰・最尤推定の3本は真の曲線とほぼ重なり、素朴な推定だけが右(高い入札額の側)にずれています。例えば入札額1.0のとき、真の勝率はおよそ0.5ですが、素朴な推定はおよそ0.2と読めます。
ここで、帯ごとの割合の読み方の注意を、例題のデータで確かめます。上の帯ごとの割合は区分ごとに数えたものでした。区分を分けずに、推定に使う期間の全体を入札額で10の帯に分けて落札の割合を数え、答え合わせとして「推定に使う期間のすべての機会に、その帯の中央の額で入札した場合の勝率」(真の競合の最高入札額から計算)と比べました。
# ブロック4b:区分を分けずに帯ごとの割合を数えると、何を表すか
q = np.quantile(log["bid_hist"], np.linspace(0, 1, 11))
k = np.clip(np.searchsorted(q, log["bid_hist"], side="right") - 1, 0, 9)
comp_tr = train["comp"].to_numpy()          # 答え合わせ専用
rows = []
for j in range(10):
    s = log[k == j]
    b_mid = s["bid_hist"].median()
    rows.append([j + 1, round(b_mid, 3), round(s["win_hist"].mean(), 3),
                 round((comp_tr <= b_mid).mean(), 3),          # 全機会にこの額で入札した場合
                 round((s["cell"].str[0] == "B").mean(), 3)])
print(pd.DataFrame(rows, columns=["帯", "帯の中央の入札額", "帯の落札の割合",
                                  "全機会にこの額で入札した場合の勝率(答え合わせ)",
                                  "帯の中の掲載面Bの割合"]).to_string(index=False))
| 帯 | 帯の中央の入札額 | 帯の落札の割合 | すべての機会にこの額で入札した場合の勝率(答え合わせ) | 帯の中の掲載面Bの割合 |
|---|---|---|---|---|
| 1 | 0.314 | 0.013 | 0.007 | 0.167 |
| 2 | 0.478 | 0.060 | 0.051 | 0.215 |
| 3 | 0.611 | 0.136 | 0.126 | 0.241 |
| 4 | 0.744 | 0.236 | 0.223 | 0.267 |
| 5 | 0.889 | 0.345 | 0.340 | 0.282 |
| 6 | 1.057 | 0.464 | 0.471 | 0.307 |
| 7 | 1.264 | 0.598 | 0.608 | 0.332 |
| 8 | 1.537 | 0.727 | 0.745 | 0.354 |
| 9 | 1.970 | 0.857 | 0.875 | 0.383 |
| 10 | 2.974 | 0.966 | 0.975 | 0.449 |
この例題では、表示の価値が高い掲載面Bは競合の水準も高く、過去の入札は価値に乱数の割合を掛けた額だったので、高い帯ほど掲載面Bの機会が多く入っています(最も低い帯で0.167、最も高い帯で0.449)。その結果、区分を分けずに数えた帯の落札の割合は、低い帯では「すべての機会にその額で入札した場合の勝率」より高く(帯1で0.013に対して0.007)、高い帯では低く(帯9で0.857に対して0.875)なりました。この例題の差は最大で0.02程度ですが、入札額を上げたときの勝率の伸びを、帯ごとの割合は小さめに見せています。差の大きさは、入札額と機会の中身がどれだけ結びついているかで変わります。本章の例題では、区分の中では競合の額が表示の価値と無関係に作られているので、区分ごとに数えた帯の割合は、その区分で入札額を変えたときの勝率と読み替えてよい条件になっています。
実際の配信では、この条件が成り立つかは分からないので、区分を分けて数えるか、機会の属性を入力に入れたモデルで推定することになります。ただし、そのためには、同じ属性の機会の中では過去の入札額としきい値が結びついていないことが必要で、属性を足してもこの条件が満たされるとは限りません。
この注意は帯ごとの割合だけでなく、ロジスティック回帰と最尤推定にも当てはまります。
推定した勝率曲線で入札額を決め、真の結果で比べる
次に、推定した勝率曲線を使って、評価に使う期間(後の7日、49,000件)の機会ごとに入札額を決めます。各機会について、入札額の候補を「表示の価値の0.02倍から1.0倍まで」の50通り並べ、推定した曲線で利得の見込み(表示の価値と入札額の差×勝率)が最大になる候補を選びました。比べる相手は、表示の価値どおりの入札、一律に価値の0.8倍で入札、一律に価値の0.6倍で入札の3つです。勝ち負けは、評価期間の各機会の真の競合の最高入札額で決め、落札の件数・勝率(分母は評価期間に入札した49,000件)・支払額の合計・落札した機会の表示の価値の合計・利得(表示の価値の合計から支払額の合計を引いた差)を数えました。ここでの表示の価値は第7章の方法による予測の見積りで、実際に生じた利益ではありません。真の曲線にもとづいて決めた入札も、答え合わせのために並べています。この例題には予算の制約を入れていません。
# ブロック5:評価用の期間で、機会ごとに(価値 - 入札額)×勝率 が最大になる入札額を格子で探す
frac = np.linspace(0.02, 1.0, 50)          # 入札額=価値×割合 の割合の候補
def best_bid(f):
    out = np.empty(len(test))
    for c in cells:
        m = (test["cell"] == c).to_numpy()
        v = test["value"].to_numpy()[m]
        B = v[:, None] * frac[None, :]
        W = f(c, B.ravel()).reshape(B.shape)
        out[m] = B[np.arange(len(v)), np.argmax((v[:, None] - B) * W, axis=1)]
    return out

def score(name, bid):
    v, cp = test["value"].to_numpy(), test["comp"].to_numpy()
    w = bid >= cp                                   # 真の競合の額で勝ち負けを決める
    return [name, int(w.sum()), round(w.mean(), 3), round(bid[w].sum(), 1),
            round(v[w].sum(), 1), round((v[w] - bid[w]).sum(), 1),
            round(np.median(bid / v), 3)]                  # 入札額の価値に対する比の中央値

v = test["value"].to_numpy()
rows = [score("価値どおりの入札", v), score("一律に価値の0.8倍", 0.8 * v),
        score("一律に価値の0.6倍", 0.6 * v)]
for name, f in methods.items():
    rows.append(score("推定にもとづく(" + name + ")", best_bid(f)))
rows.append(score("真の曲線にもとづく(答え合わせ用)", best_bid(true_curve)))
tab = pd.DataFrame(rows, columns=["入札の方法", "落札の件数", "勝率", "支払額の合計",
                                  "落札した機会の表示の価値の合計", "利得",
                                  "入札額÷価値の中央値"])
print("評価用の機会", len(test), "件(勝率の分母)")
print(tab.to_string(index=False))
| 入札の方法 | 落札の件数 | 勝率 | 支払額の合計 | 落札した機会の表示の価値の合計 | 利得 | 入札額の価値に対する比の中央値 |
|---|---|---|---|---|---|---|
| 価値どおりの入札 | 27,552 | 0.562 | 53,836.5 | 53,836.5 | 0.0 | 1.00 |
| 一律に価値の0.8倍 | 21,754 | 0.444 | 36,830.5 | 46,038.1 | 9,207.6 | 0.80 |
| 一律に価値の0.6倍 | 14,753 | 0.301 | 21,022.0 | 35,036.6 | 14,014.6 | 0.60 |
| 推定にもとづく(素朴な推定) | 19,847 | 0.405 | 26,043.0 | 41,270.6 | 15,227.6 | 0.78 |
| 推定にもとづく(帯ごとの割合) | 16,542 | 0.338 | 19,302.5 | 35,354.3 | 16,051.8 | 0.68 |
| 推定にもとづく(ロジスティック回帰) | 16,942 | 0.346 | 19,792.0 | 35,888.1 | 16,096.1 | 0.72 |
| 推定にもとづく(打ち切りの最尤推定) | 16,798 | 0.343 | 19,524.0 | 35,653.5 | 16,129.6 | 0.72 |
| 真の曲線にもとづく(答え合わせ用) | 16,799 | 0.343 | 19,528.6 | 35,663.0 | 16,134.4 | 0.72 |
価値どおりの入札は、落札の件数が27,552件と最も多い一方で、ファーストプライスなので支払額の合計と表示の価値の合計が一致し、利得は0.0でした。第3章で確かめたことが、この例題でもそのまま表れています。一律に価値の0.8倍、0.6倍と下げると、落札の件数は減り、利得は9,207.6、14,014.6と増えました。勝率曲線の推定にもとづく入札は、素朴な推定を使った場合が15,227.6、落札の有無を使った3つの方法が16,051.8〜16,129.6で、真の曲線を使った場合の16,134.4に近い値でした。
素朴な推定にもとづく入札は、入札額の価値に対する比の中央値が0.78で、落札の有無を使った方法(0.68〜0.72)や真の曲線にもとづく入札(0.72)より高くなりました。この例題で素朴な推定が描いた曲線の形のもとでは、高い入札額が選ばれたということです。その結果、落札の件数は19,847件と、落札の有無を使った方法(16,542〜16,942件)より多くなり、支払額の合計も26,043.0と多くなりました。落札した機会の表示の価値の合計は増えていますが、増えた分以上に払っているので、利得は落札の有無を使った方法より小さくなりました。これは序章で挙げた損失の型でいう払いすぎにあたります。一方、落札の件数が最も多かった価値どおりの入札の利得が0.0だったことから分かるように、落札の件数や勝率の高さは、それだけでは入札の良し悪しを表しません。
落札の有無を使った3つの方法の利得の差は、真の曲線にもとづく入札の利得に対して1%未満でした。1回の乱数の結果で順位を言い切らないよう、乱数の種を変えて同じ計算を8回繰り返しました(確認用のスクリプトは掲載していません。種は101・202・303・404・505・606・707・808の8つで、掲載したコードの種の値だけを置き換えて実行しました)。8回すべてで、素朴な推定にもとづく入札の利得は、真の曲線にもとづく入札の利得の0.939倍から0.945倍、一律に価値の0.6倍の入札は0.864倍から0.878倍、0.8倍の入札は0.564倍から0.573倍でした。落札の有無を使った3つの方法は0.995倍から1.001倍の範囲に入り、種によっては真の曲線にもとづく入札をわずかに上回ることもありました。利得の見込みが最大になる入札は平均の上で最もよい入札ですが、限られた件数の実際の結果では順位が入れ替わることがあるためです。したがって、この例題で言えるのは「落札の有無を使った推定にもとづく入札は、一律の引き下げと素朴な推定にもとづく入札を上回った」ことまでで、3つの方法の間の順位は決められません。
なお、この比較は「表示の価値の見積りが正しい」という条件のもとでのものです。表示の価値の見積りがずれていれば、勝率曲線が正しくても入札額はずれます(確率のずれが入札に与える影響は第6章)。また、この例題の利得は、第7章と同じく、表示の価値を広告による増分と区別しない単純な見積りの上での値で、広告によって増えた利益そのものではありません(第11章)。
過去の入札額の範囲の外はデータで確かめられない
前の節の例題では、過去の入札額が表示の価値に乱数の割合を掛けた額で、広い範囲に散らばっていました。実際の運用では、一定の額で入札し続けていたり、毎回ほぼ同じ割合で引き下げていたりして、過去の入札額が狭い範囲に集まっていることがあると考えられます。その場合、入札したことの無い額での勝率は、データだけでは確かめられず、モデルの仮定に頼ることになります。ロジスティック回帰や最尤推定は範囲の外でも勝率の値を返しますが、計算できることと、データの裏付けがあることは別です。いつも高く入札していれば低い額での勝率は確かめられず、いつも低く入札していれば高い額での勝率は確かめられません。分布の形を仮定する方法でも、入札額が1つしか無ければ、曲線の傾き(入札額を変えたときに勝率がどれだけ変わるか)は求まりません。
これを確かめるため、推定に使う期間の過去の入札を、次のように作り直しました。基本は「どの機会にも同じ額1.2で入札していた」とし、そのうち一定の割合の機会だけ、入札額を0.3から3.0の範囲で(対数の上で一様に)散らします。散らす割合を0%・2%・10%・30%と変え、それぞれの記録からロジスティック回帰で勝率曲線を作り、前の節と同じ方法で評価期間の入札額を決めました。
# ブロック6:過去の入札がいつも同じ額だった場合と、一部の機会で入札額を散らした場合
rng2 = np.random.default_rng(SEED + 1)
rows = []
for share in [0.0, 0.02, 0.10, 0.30]:
    b = np.full(len(train), 1.2)                    # いつも同じ額で入札していた
    ex = rng2.random(len(train)) < share            # 散らす機会
    b[ex] = np.exp(rng2.uniform(np.log(0.3), np.log(3.0), ex.sum()))
    w = (b >= train["comp"].to_numpy()).astype(int)
    hist_gain = ((train["value"].to_numpy() - b) * w).sum()
    m = LogisticRegression(C=100.0, max_iter=2000, fit_intercept=False)
    m.fit(design(train["cell"].to_numpy(), b), w)
    f = lambda c, bb, m=m: m.predict_proba(design(np.full(len(bb), c), bb))[:, 1]
    low = np.linspace(0.3, 0.9, 25)
    err_low = np.mean([np.abs(f(c, low) - true_curve(c, low)).mean() for c in cells])
    err_all = np.mean([np.abs(f(c, grid) - true_curve(c, grid)).mean() for c in cells])
    r = score("散らす割合 %d%%" % round(share * 100), best_bid(f))
    rows.append([r[0], round(m.coef_[0][-1], 2), round(err_low, 3), round(err_all, 3),
                 round(hist_gain, 1), r[1], r[5], r[6]])
print(pd.DataFrame(rows, columns=["過去の入札", "log(入札額)の係数", "低い額での差",
                                  "全体での差", "推定期間の利得", "評価期間の落札の件数",
                                  "評価期間の利得", "入札額÷価値の中央値"]).to_string(index=False))
| 過去の入札 | 入札額の対数の係数 | 低い額での差 | 全体での差 | 推定期間の利得 | 評価期間の落札の件数 | 評価期間の利得 | 入札額の価値に対する比の中央値 |
|---|---|---|---|---|---|---|---|
| 散らす割合 0% | 0.19 | 0.378 | 0.282 | 20,023.8 | 35 | 213.3 | 0.08 |
| 散らす割合 2% | 4.11 | 0.019 | 0.016 | 19,247.7 | 17,393 | 16,033.0 | 0.74 |
| 散らす割合 10% | 3.87 | 0.010 | 0.010 | 16,055.1 | 17,009 | 16,095.0 | 0.72 |
| 散らす割合 30% | 3.82 | 0.008 | 0.008 | 8,585.6 | 16,896 | 16,099.4 | 0.72 |
表の「低い額での差」は入札額0.3から0.9の範囲、「全体での差」は0.3から3.0の範囲での、推定した勝率と真の勝率の差の絶対値の平均(6つの区分の平均)です。散らす割合が0%、つまりいつも同じ額で入札していた場合、入札額が1つしか無いので、入札額の対数の係数はデータからは決まりません。この設定(ロジスティック回帰の正則化の強さなど)では係数は0.19という小さな値になり、勝率曲線はほとんど平らになりました。係数の値は設定によって変わり、0.19という値自体に意味はありません。ほとんど平らな曲線では「入札額を下げても勝率はあまり変わらない」ことになるので、選ばれた入札額は、価値に対する比の中央値で0.08と極端に低くなりました(候補の最小は0.02倍)。その結果、評価期間の落札は35件、利得は213.3にとどまりました。データから決まらない傾きについて、モデルが根拠の無い答えを返してしまう例で、序章で挙げた損失の型でいえば大きな機会損失にあたります。
2%の機会で入札額を散らすだけで、係数は4.11になり、全体での差は0.016まで縮み、評価期間の利得は16,033.0になりました。10%で16,095.0、30%で16,099.4と、散らす割合を増やしても評価期間の利得はわずかしか増えませんでした。一方、散らすことには費用があります。推定に使う期間の利得は、散らす割合0%で20,023.8、2%で19,247.7、10%で16,055.1、30%で8,585.6と、散らす割合が大きいほど減りました(散らした機会では、表示の価値と関係なく入札額を決めているためです。推定期間の利得は21日分、評価期間の利得は7日分の値で、互いに比べるものではありません)。この例題の条件では、少ない割合の散らしで曲線の推定に足りる情報が集まり、それ以上に散らすと費用のほうが大きくなりました。ただし、どれだけの割合が適切かは、機会の件数・区分の数・競合の変わる速さによって変わるので、この例題の数字をそのまま使うことはできません。
散らし方にも工夫の余地があります。表示の価値と無関係に散らすのではなく、推定した最適な入札額のまわりで少しだけ上下に動かせば、費用を抑えながら、判断に効く範囲の勝率を確かめられます。探索と活用のつり合いをどうとるかという問題は、第10章のバンディットの考え方とつながります(バンディットの一般論は弊社コラム「価格を決める数理モデル、需要曲線の推定からダイナミックプライシングまで」へ送ります)。
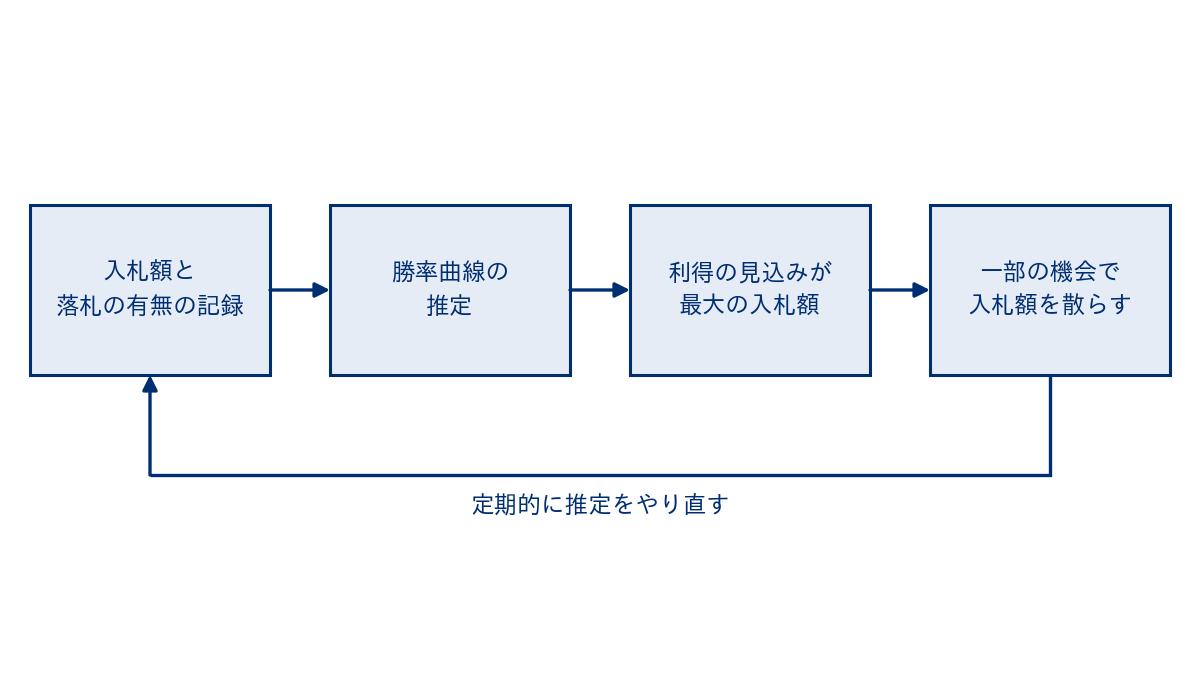
区分ごとの曲線と件数、競合の変化
本章の例題では、掲載面と昼夜で競合の水準が違うので、区分ごとに曲線を作りました。実際の配信でも、掲載面・広告枠の大きさ・端末・時間帯・曜日などで競合の水準は違うと考えられます。区分を細かくするほど、その区分に合った曲線を作れますが、区分あたりの件数は減り、推定のばらつきが大きくなります。帯ごとの割合の方法は、区分の数×帯の数だけの件数が要るので、区分を細かくすると最初に件数が足りなくなります。ロジスティック回帰や分布を仮定する方法は、「区分ごとに中心は違うが、傾き(ばらつき)は共通」のように一部の母数を区分の間で共有できるので、同じ件数でより細かい区分を扱えます。件数の少ない区分の推定を全体の推定に寄せる平滑化の考え方は、第4章で扱った実績の率の平滑化と同じです。
もう1つの問題は、勝率曲線が時間とともに変わることです。勝率曲線は、他の買い手の入札と、売り手の定める最低落札価格で決まります。他の買い手が予算を増やしたり、入札の方針を変えたり、新しい買い手が加わったりすれば、同じ入札額での勝率は変わります。季節や曜日、大きな販売の時期にも競合の水準は動くと考えられます。また、他の買い手も同じように勝率曲線を推定して引き下げていれば、自社の入札の変化が相手の入札を変え、それがまた自社の曲線を変えるという相互の影響も起こりえます(オークションの理論の前提がくり返しや相手の学習で崩れる点は、第3章で触れたとおりで、本コラムでは詳しく扱いません)。そのため、勝率曲線は一度作って終わりではなく、直近の記録で定期的に推定をやり直し、評価期間の対数損失や「予測した勝率の平均と実際の勝率の比」で、曲線が古くなっていないかを確かめ続ける必要があります。この比は、本章の例題でも実際の配信でも計算できる指標で、配信の監視の指標の1つにできます(監視は第12章)。ただし、全体の平均が合っているだけでは、曲線の形が合っているとは言えません。予測した勝率が同じくらいの入札を集めて実際の勝率と比べる、較正の確認(第6章)も合わせて行う必要があります。
| 区分の切り方 | 得られるもの | 件数の目安の考え方 | 気をつけること |
|---|---|---|---|
| 区分を分けない(全体で1本) | 件数が最も多く、推定が安定する | 全体の件数で足りる | 掲載面や時間帯で競合の水準が違うと、高い区分では負け、低い区分では払いすぎる |
| 掲載面・時間帯などの少数の区分 | 主な違いを取り込める | 区分ごとに、入札額の範囲全体に落札と非落札が十分にあること | 区分の間で傾きを共有するなど、母数を減らす工夫が要る |
| 細かい区分(掲載面×広告枠×端末×時間帯など) | 区分に合った曲線 | 区分ごとの件数が急に減る | 件数の少ない区分は推定がばらつく。全体の推定に寄せる平滑化を使う |
| 入札リクエストの項目を入力にしたモデル | 機会ごとの勝率の予測 | 項目の数に応じて件数が要る | 入札の時点で手に入る項目だけを使う。落札後に分かる情報を入れない |
DSP の機能と最低落札価格、予算との組み合わせ
多くの広告主は、自社で勝率曲線を推定するのではなく、DSP や媒体の自動入札を通じて入札しています。その場合、引き下げの幅は DSP や媒体の仕組みが決めていることになります。本章で見たように、引き下げの幅の良し悪しは勝率曲線の推定の質と、推定に使える情報(落札できなかった機会の扱い・取引の場から通知される情報)で決まりますが、個別の DSP の引き下げの仕組みの中身は、公開されている範囲が限られます。本コラムでは個別の製品の引き下げの機能を確かめておらず、内部の計算を推測して書くことはしません。広告主にできるのは、後の節の表のような問いで、引き下げが行われているか、その結果どうなっているかを確かめることです。
セカンドプライスの場でも、最低落札価格の扱いには注意が要ります。1枠のセカンドプライスでは、価値どおりの入札が基本になることを第3章と第7章で確かめました。ここでの価値は買い手自身にとっての真の価値で、本コラムの表示の価値は増分を除いていない予測なので、そのとおりに入札すれば増分の利益が最大になるとは限りません。また、売り手が最低落札価格を買い手ごとや機会ごとに動かしている場合、支払額は最低落札価格に引き上げられることがあります。さらに、取引の場によっては、方式の表示がセカンドプライスでも、実際の支払額の決まり方が単純な次点の額ではないことがありえます。OpenRTB 2.6 のオークションの方式の項目でも、2は「Second Price Plus」と呼ばれ、取引の場ごとの独自の方式を500以上の値で定義できるとされています。自社が買っている場の方式と、支払額の決まり方は、取引の場や DSP の公式文書で確かめる必要があります。
予算の制約がある場合は、第7章の乗数の考え方と組み合わせます。第7章では、予算が足りないときは、価値どおりの入札を一定の割合で引き下げる(表示の価値に1より小さい乗数を掛ける)考え方を扱いました。ファーストプライスの場では、まず乗数を掛けた価値を「その機会に払ってよい上限」とみなし、その上限に対して本章の方法で勝率曲線にもとづく引き下げを行う、という2段の組み立てが考えられます。予算が制約として効く場合は、見込みの支出が予算に収まるように乗数を調整し、引き下げは勝率曲線で決めます。予算の制約が効かない場合は、予算を使い切る必要はありません。予算を期間の中でどの速さで使うかの制御は、第9章で扱います。
経営の判断、自社の入札がどれだけ引き下げられているかを確かめる
ファーストプライスの場での入札で経営が押さえるべきことは、自社の入札が、どの方式の場で、どれだけ引き下げられているかを把握することです。引き下げが無ければ、ファーストプライスの場では払いすぎになります。引き下げが強すぎれば、価値のある機会を買い逃す機会損失になります。本章の例題で見たように、価値どおりの入札は落札の件数と勝率が最も高くても利得は0で、落札の件数や勝率だけを報告の指標にしていると、払いすぎに気づけません。これは序章で挙げた損失の型でいう形骸化(レポートの指標が実態のずれを映さない)の一例でもあります。報告の指標には、落札の件数と勝率に加えて、表示の価値に対する支払額の比(どれだけ引き下げて買えているか)と、勝率曲線の推定が古くなっていないかを並べることが有効だと考えています。
DSP や広告会社に任せている場合は、次の表の問いで確かめることを勧めます。答えが得られない項目があれば、それ自体が「引き下げの良し悪しを自社では確かめられない」ことを意味するので、契約や報告の取り決めを見直す材料になります。
| 確かめること | なぜ要るか | 確かめる相手 |
|---|---|---|
| 買っている場ごとの取引の方式(ファーストプライスか、セカンドプライスか、独自の方式か) | 方式によって、入札額と支払額の関係が違う | DSP・広告会社・取引の場の公式文書 |
| 入札の引き下げが行われているか、どの場で行われているか | ファーストプライスで引き下げが無ければ払いすぎになる | DSP・広告会社 |
| 引き下げの前の入札額と、引き下げた後の入札額・支払額の比の推移 | 引き下げの強さが分かる。強すぎれば機会損失、弱すぎれば払いすぎ | DSP のレポート |
| 落札できなかった機会の記録と、勝つのに必要だった額の通知の有無 | 勝率曲線の推定に使える情報の量が分かる | DSP・取引の場 |
| 勝率曲線(またはそれにあたるもの)をどの頻度で推定し直しているか | 競合の変化に追いついているかが分かる | DSP・広告会社 |
| 入札額を散らして情報を集めているか、その割合と費用 | 過去の入札額の範囲の外は推定できない | DSP・広告会社 |
| 最低落札価格がどう決まり、支払額にどう効いているか | セカンドプライスの場でも支払額が引き上げられることがある | 取引の場・DSP |
この章では、ファーストプライスの場での引き下げの幅が勝率曲線の推定で決まること、その推定には落札できなかった機会まで含めた「入札額と落札の有無」の記録が要り、落札した機会の支払額だけを使う素朴な推定は勝率を低く見積もって払いすぎにつながることを、架空データで確かめました。また、過去の入札額の範囲の外は推定できないので、一部の機会で入札額を散らす費用を計画に入れる必要があることも見ました。次の第9章では、予算を1日の中でどの速さで使うかというペース配分を扱います。
この章を深めたい方への参考書籍
『ミクロ経済学の力』(神取道宏、日本評論社):ミクロ経済学の教科書です。入札する側が、競合の出方を見込んで払う額を決めるという本章の問題を、価格と市場の理論の側から捉え直すときの土台になります。
『生存時間解析 SASによる生物統計 第2版』(大橋靖雄・浜田知久馬・魚住龍史 著、東京大学出版会):打ち切りのあるデータの扱い方を、生存時間分析の基本の考え方から解説する本です。落札できなかった機会では「落札のしきい値が入札額より上」としか分からないという本章の打ち切りの問題を、統計の手法として扱う考え方を学ぶのに役立ちます。
第9章 予算のペース配分、1日の予算を使う速さの制御
第8章では、ファーストプライスの場で、勝率曲線を推定して入札額をどこまで引き下げるかを扱いました。第7章では、予算の制約があるときは、表示の価値にもとづく入札額に一定の乗数を掛けて引き下げるという考え方を確かめました。ただし第7章の計算は、1日の表示の機会をすべて先に並べて、予算に見合う乗数を後から探すものでした。実際の配信では、表示の機会は時間の順に1件ずつ届き、その日の後の時間帯にどれだけの機会が来るかは、その時点では分かりません。
この章では、予算を1日の中でどの速さで使うかを制御するペース配分(ペーシング)を扱います。扱う内容は次のとおりです。中ほどでは、他の章とは独立に作った架空の1日の表示の機会を使い、実行したコードと結果で確かめます。
- 予算の制約があるのに制御しないと何が起きるか
- ペース配分の目的と、方法の3つの型(入札に参加する割合を下げる・入札額に乗数を掛ける・時間帯ごとに予算を割り当てる)
- 制御なし・間引き・乗数の3つの方法を、同じ予算で比べた結果と、乱数の種を変えた繰り返しでの確認
- 目標の消化の線の作り方と、制御の強さの調整
- 月の予算と日の予算、複数のキャンペーンが同じ機会を取り合う場合、媒体の予算の設定が意味すること
- ペース配分の指標の表と、経営の判断
この章の主張は2つあります。1つ目は、予算の制約があるときは、予算を使い切ったかどうかだけでなく、いつ使ったか、どの機会に使ったかを点検すべきだ、という点です。本コラムの架空データでは、制御をせずに価値どおりに入札すると、累積の費用が予算の99.9%に達した時刻は20回の繰り返しの平均で15時台で、価値の高い機会が多い夜の時間帯をほとんど買えませんでした。消化の割合が同じ1.000の方法どうしでも、得た価値は一致しませんでした。2つ目は、制御の方法と、制御が追いかける目標の消化の線の作り方で、得られる価値が変わるという点です。本コラムの架空データでは、初期値を過去の日から決めた乗数による制御が、参加の割合を下げる間引きより、20回すべてで多くの価値を得ました。また、目標の消化の線を、過去の日の機会の数から作るか、価値の見込みから作るかで、結果が変わりました。どちらも、この架空データの条件での結果であり、一般にそうなるという主張ではありません。
予算の制約があるのに制御しないと何が起きるか
予算は、ある期間に使ってよい広告費の上限です。上限であって、使い切る義務があるわけではありません。媒体の管理画面の「1日の予算」の設定は、媒体によっては厳密な上限とは違う意味を持つことがあり、その点は後の節で公式ヘルプの範囲で扱います。ここでは、本コラムの意味での1日の予算を考えます。予算の制約がなければ、第3章と第7章で見たとおり、セカンドプライスの場では価値どおりに入札するのが基本になります。ここでの価値は、買い手自身にとっての真の価値です。本コラムの表示の価値は、広告がなくても起きたコンバージョンの価値を差し引いていない予測なので、そのとおりに入札すれば増分の利益が最大になるとは限りません。本章の例題では、この点を措いて、表示の価値どおりの入札を基準にします。しかし、価値どおりに入札したときの1日の費用が予算を上回る場合、何も制御しなければ、費用は機会が届いた順に積み上がり、予算に達した時点でその日の入札は止まります。
このとき起きる問題は2つあります。1つ目は、予算が尽きた後の時間帯の機会をすべて買えなくなることです。早い時間の機会が、後の時間の機会より価値が高いとは限りません。利用者の行動や競合の入札は時間帯によって変わるので、例えば夜の時間帯のほうがコンバージョン率が高い商品では、昼までに予算を使い切ると、価値の高い機会を買えなくなります。2つ目は、予算が尽きる前の時間帯に、価値に対して割高な機会まで買ってしまうことです。予算が足りないときは、第7章で見たとおり、価値に対して支払額が低い機会から順に買うのがよいという考え方がありますが、制御しない場合は、届いた順に、価値が支払額を上回る機会をすべて買います。
予算が尽きた後の時間帯に、価値が支払額を上回る機会が来ていて、それを買っていれば同じ予算でより多くの価値を得られた場合、この2つは序章で整理した損失の型の機会損失にあたります。後の時間帯に価値のある機会が来ていなければ、早く使い切ったことは損失になりません。管理画面では「予算をすべて消化した」と見えるので、どちらの場合かを見分けにくい点に注意が要ります。予算を使い切ったことは、予算を有効に使ったことを意味しません。
ペース配分の目的と方法の3つの型
ペース配分の目的は、同じ予算で得る価値を大きくすることです。本来の目的は、広告で増えた利益、つまり増分の利益を大きくすることですが(第11章)、本章の例題では、広告がなくても起きたコンバージョンの価値を差し引いていない表示の価値の合計で代わりに測ります。この目的のために、ペース配分は次の3つの点を扱います。1つ目は、予算の使い残しです。価値が支払額を上回る機会を買えたのに予算を残した場合、その使い残しは機会損失になります。買う価値のある機会が無くて残ったのであれば、損失ではありません。予算を使い切ること自体は目的ではありません。2つ目は、早い時間の使い切りです。その後の時間帯に価値のある機会が来ていれば、それを逃した分が機会損失になります。3つ目は、配信の停止です。ある時間帯に配信が止まると、その時間帯にしか広告を見ない利用者に届かなくなります。止まったことが損失かどうかは、止まっていた間に来た機会の価値によります。均等に使うことが、いつも望ましいわけでもありません。
方法は、大きく3つの型に分けて考えると整理しやすくなります。1つ目は、入札リクエストのうち一部にだけ入札する間引き(スロットリング)です。入札額は変えず、参加する割合だけを変えます。2つ目は、入札額に乗数を掛けて下げる方法です。乗数を下げると、価値に対して競合の入札が高い機会から順に落札しにくくなります。3つ目は、時間帯ごとに予算を割り当て、その時間帯の予算が尽きたら次の時間帯まで止める方法です。後の節で比べる「制御なし・間引き・乗数」は、このうち1つ目と2つ目の型にあたり、3つ目の型は本コラムでは実行していません。
| 方法 | 動かすもの | 長所 | 短所 |
|---|---|---|---|
| 間引き | 入札に参加する割合 | 入札額の計算を変えずに使える。参加の割合が費用にほぼ比例するので、消化の速さを読みやすい | 買う機会を価値と無関係に減らすので、価値に対して割安な機会も同じ割合で捨てる |
| 乗数 | 入札額に掛ける乗数 | 価値に対して割高な機会から先に買わなくなる(第7章の考え方と一致する) | 乗数と費用の関係が競合の入札の分布で変わり、効き方を読みにくい。ファーストプライスの場では第8章の引き下げと重なる |
| 時間帯ごとの予算の割り当て | 時間帯ごとの予算の上限 | 配信を1日の中で散らせる。運用の担当者に説明しやすい | 割り当てを誤ると、価値の高い時間帯に予算が足りず、低い時間帯に使い残す |
研究では、これらの型がそれぞれ扱われてきました。Agarwal らの2014年の論文は、LinkedIn の対象を絞った広告の予算のペース配分を扱った論文です(本コラムでは書誌だけを確かめ、この内容は題名から読み取れる範囲です)。Xu らの2015年の論文は、DSP のキャンペーンで、予算を時間の中で滑らかに使いながらキャンペーンの成績を高めるペース配分の方法を提案しています。あわせて、実際の DSP での実装と、配信中のキャンペーンでの実験、オフラインの模擬の結果を報告しています。Zhang らの2016年の論文は、リアルタイム入札で入札額を動的に調整して、落札の割合やクリック1回あたりの費用のような指標を目標に保つフィードバック制御の仕組みを提案し、実データでの検証と商用の取引の場での試験を報告しています。Balseiro と Gur の2019年の論文は、予算のあるくり返しのオークションでの学習を、後悔(後から振り返ったときの最善との差)の最小化と均衡の観点から扱った論文です(本コラムでは書誌だけを確かめ、この内容は題名から読み取れる範囲です)。いずれも、それぞれの論文のデータと前提での結果であり、どの媒体や DSP がどの方法を使っているかを示すものではありません。本コラムでは、論文の書誌と、要旨または題名に書かれている範囲だけを確かめています。
ペース配分を考える前提として、表示の機会の数は1日の中で大きく変わります。利用者がサイトやアプリを開く時間帯に機会が増え、深夜には減ります。機会の価値(コンバージョン率など)と、競合の入札の水準も時間帯で変わります。どの時間帯にどれだけの機会が来るかは、制御を始める時点では分からないので、過去の日の記録から予測して使います。予測の一般論は、弊社コラム『ビジネスデータの予測に効く時系列分析、基礎から実務まで』で扱っています。
ここで大事なのは、制御に使う予測を、その時点までに分かっている情報だけで作ることです。例えば、その日の夜に機会がどれだけ来たかを使って、その日の朝の入札を決めることはできません。本章の例題では、目標の消化の線と乗数の初期値を、評価する日より前の14日分の記録だけから作りました。その日の中の制御は、その時点までに使った費用だけを見て行います。
架空の1日の表示の機会を作る
ここからは、制御の方法によって、予算の使われ方と得られる価値がどう変わるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの成績は、実際の配信での成績の目安にはなりません。示したいのは、同じ予算でも、制御の方法と目標の消化の線の作り方で、予算の使われ方がどう変わるかという点です。
この例題では、15日分の表示の機会を、次の性質を持たせて乱数で作りました(乱数の種は20261116に固定しています)。0日目から13日目を過去の日、14日目を制御を評価する当日とします。1日は15分ごとの96の区間に分けました。コードは Python 3.14.3 で実行し、グラフの日本語の表示には japanize-matplotlib 1.1.3 を使いました。
- 機会の数の波:深夜に少なく、朝8時ごろ・昼12時半ごろ・夜21時ごろに山がある。日ごとに機会の多さが揺れる
- 表示の機会の属性:掲載面(掲載面A・B・C)と端末(PCかスマートフォンか)。予測クリック率は掲載面で0.8%から3%まで違い、PCではスマートフォンの0.8倍とした
- 予測コンバージョン率:基準は6%で、19時から24時は1.6倍。さらに、夜の時間帯にPCで表示した場合だけ1.5倍になる組み合わせの関係を入れた
- 表示の価値:予測クリック率 × 予測コンバージョン率 × コンバージョンの価値。コンバージョンの価値は100(相対値)とした
- 競合の最高入札額:対数正規分布。夜の時間帯は1.5倍、掲載面で水準が違い、日ごとに競合の強さが揺れる
- オークション:セカンドプライス。最低落札価格は設けず、落札すると競合の最高入札額を払う(手数料・端数は省く)
本章の額は、すべてコンバージョン1件の価値を100とした相対値で、金額ではありません。例題では、入札額と支払額は表示1回あたりの相対値で、落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件とし、クリックを経ないコンバージョンは扱いません。表示の価値の式は、広告が無くても起きたコンバージョンを差し引いていない単純な見積りで、増分の考え方は第11章で扱います。また、予測クリック率と予測コンバージョン率は、合成に使った真の確率と同じとしました。予測がずれた場合の影響は第6章で扱っています。コンバージョンの有無は、表示した場合に起きるかどうかを機会ごとに乱数で1回だけ決めておき、どの方法で落札しても同じ結果になるようにしました。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

SEED = int(sys.argv[1]) if len(sys.argv) > 1 else 20261116
rng = np.random.default_rng(SEED)
N_DAYS, SLOTS = 15, 96            # 15日分(0〜13日目が過去、14日目が当日)、15分ごとの96区間
VALUE_CV = 100.0                  # コンバージョン1件の価値(相対値)
h = (np.arange(SLOTS) + 0.5) / 4  # 区間の中央の時刻(時)
rate = 2 * (150 + 700 * np.exp(-((h - 8) / 1.5) ** 2) + 500 * np.exp(-((h - 12.5) / 1.0) ** 2)
        + 900 * np.exp(-((h - 21) / 2.0) ** 2))      # 区間あたりの機会の数の平均
evening = ((h >= 19) & (h < 24)).astype(float)

def make_day(day):
    vol = rng.lognormal(0, 0.15)                    # その日の機会の多さの揺れ
    comp = rng.lognormal(0, 0.10)                   # その日の競合の強さの揺れ
    n = rng.poisson(rate * vol)
    slot = np.repeat(np.arange(SLOTS), n)
    m = len(slot)
    site = rng.choice(3, size=m, p=[0.5, 0.3, 0.2])     # 掲載面A・B・C
    pc = rng.random(m) < 0.35                           # 端末がPCか
    ctr = np.array([0.008, 0.015, 0.03])[site] * np.where(pc, 0.8, 1.0)
    cvr = 0.06 * (1 + 0.6 * evening[slot]) * np.where(pc & (evening[slot] > 0), 1.5, 1.0)
    v = ctr * cvr * VALUE_CV                            # 表示の価値(予測は真の確率と同じとする)
    med = 0.045 * comp * (1 + 0.5 * evening[slot]) * np.array([0.8, 1.0, 1.6])[site]
    mbid = med * rng.lognormal(0, 0.7, size=m)          # 競合の最高入札額
    conv = (rng.random(m) < ctr) & (rng.random(m) < cvr)  # 表示した場合のコンバージョンの有無
    return pd.DataFrame({"day": day, "slot": slot, "v": v, "m": mbid, "conv": conv})

df = pd.concat([make_day(d) for d in range(N_DAYS)], ignore_index=True)
past, today = df[df.day < 14], df[df.day == 14].reset_index(drop=True)
print("機会の数:1日あたり平均", round(len(past) / 14), "件、当日", len(today), "件")
print("当日の平均の表示の価値", round(today.v.mean(), 4), "平均の競合の最高入札額", round(today.m.mean(), 4))
実行すると、過去の14日の機会の数は1日あたり平均78,045件、当日は75,705件でした。当日の表示の価値の平均は0.1072、競合の最高入札額の平均は0.068でした。
次に、予算と、制御に使う目標の消化の線を、過去の日の記録だけから作ります。この例題では、過去の14日は予算の制約なしに価値どおりに入札し、落札した機会の支払額を記録していたものとします。落札できなかった機会の競合の入札額は記録に残らないので、コードでも、価値どおりの入札で落札した機会だけを過去の記録として使いました。予算は、過去の日の1日の費用の平均の4割としました。つまり、この例題では、価値どおりに入札すると予算が足りない状況を作っています。
あわせて、第7章と同じく、予算を超えない範囲でできるだけ多く使う一定の乗数(1以下)を、二分法で探す関数を用意しました。機会の数が有限なので、予算とちょうど一致する乗数があるとは限りません。この乗数は、その日の機会をすべて見終わってからでないと求められないので、当日の制御には使えません。過去の日については、乗数が1以下の入札で落札できる機会は、価値どおりの入札で落札できた機会に含まれるので、上の記録の範囲で計算できます。その平均を、当日の乗数の初期値に使います。当日について求めた乗数は、合成データだから計算できる比較の参考としてだけ使います。
def spend_by_mult(d, lam):
    win = lam * d.v.values > d.m.values                 # セカンドプライス:勝てば競合の最高入札額を払う
    return d.m.values[win].sum(), d.v.values[win].sum()

def best_mult(d, budget):                               # 予算を超えない範囲でできるだけ多く使う一定の乗数(1以下)を二分法で探す
    lo, hi = 0.0, 1.0
    if spend_by_mult(d, 1.0)[0] <= budget:
        return 1.0
    for _ in range(40):
        mid = (lo + hi) / 2
        lo, hi = (mid, hi) if spend_by_mult(d, mid)[0] <= budget else (lo, mid)
    return lo

# 過去の14日は予算の制約なしに価値どおりに入札し、落札した機会の支払額を記録していたものとする
obs = past[past.v > past.m]                             # 記録が残るのは価値どおりの入札で落札した機会だけ
past_full = np.array([spend_by_mult(obs[obs.day == d], 1.0)[0] for d in range(14)])
BUDGET = round(0.4 * past_full.mean(), 1)               # 予算:過去の日に制約なしで使った額の平均の4割
past_lam = np.array([best_mult(obs[obs.day == d], BUDGET) for d in range(14)])  # 乗数が1以下なら記録の範囲で計算できる
cnt = past.groupby("slot").size().reindex(range(SLOTS), fill_value=0).values / 14
val = past.groupby("slot").v.sum().reindex(range(SLOTS), fill_value=0).values / 14
lines = {"均等": np.full(SLOTS, 1 / SLOTS), "機会の数に比例": cnt / cnt.sum(), "価値の見込みに比例": val / val.sum()}
print("予算", BUDGET, "(過去の日の制約なしの消化の平均", round(past_full.mean(), 1), ")")
print("過去の日で予算を超えない範囲でできるだけ使う一定の乗数の平均", round(past_lam.mean(), 3), "範囲", round(past_lam.min(), 3), "〜", round(past_lam.max(), 3))
実行すると、予算は1,239.9(過去の日の制約なしの費用の平均3,099.8)でした。過去の14日のそれぞれで、予算を超えない範囲でできるだけ多く使う一定の乗数は、平均0.501、範囲は0.429から0.585でした。日によって乗数が1.4倍ほど違うことは、前の日の乗数をそのまま使っても、当日の予算に見合うとは限らないことを示しています。
目標の消化の線は、各区間の終わりまでに予算のどれだけを使っているべきかを表す線です。ここでは3つの作り方を用意しました。「均等」は96の区間に同じ額を割り当てます。「機会の数に比例」は、過去の14日の区間ごとの機会の数の平均に比例して割り当てます。「価値の見込みに比例」は、過去の14日の区間ごとの表示の価値の合計の平均に比例して割り当てます。比べる方法の節では「機会の数に比例」を使い、線の作り方の違いは後の節で比べます。
制御なし・間引き・乗数を同じ予算で比べる
3つの方法を、15分ごとの区間を順に進める形で書きます。どの方法でも、区間の中では機会を届いた順に1件ずつ処理し、入札額を、その時点の残りの予算以下に抑えます。セカンドプライスでは支払額が入札額を超えないので、この処理で費用が予算を超えることはありません。残りの予算が小さくなると、ほとんどの機会で落札できなくなります。区間が終わるごとに、その時点までの累積の費用を目標の消化の線と比べ、その差(予算に対する割合)を次の区間の制御に使います。
- 制御なし:価値どおりに入札する(入札額は残りの予算以下)
- 間引き:入札額は価値どおりのまま、入札に参加する割合を調整する。目標より遅れていれば割合を上げ、進んでいれば下げる。初期値は、予算を過去の日の制約なしの費用の平均で割った値(0.4)とした
- 乗数:入札額に乗数を掛ける。目標より遅れていれば乗数を上げ、進んでいれば下げる。初期値を1とした場合と、過去の日について求めた一定の乗数の平均(0.501)とした場合の2つを試した
調整の規則は、どちらの方法も同じ形にしました。目標の線との差を予算で割った値を \( e \) として、次の区間の乗数(または参加の割合)を \( \exp(k e) \) 倍します。言葉で言い換えると、目標より予算の1%ぶん遅れていれば、\( k = 10 \) のとき、乗数をおよそ1.1倍にするという規則です。\( k \) は制御の強さで、この節では10としました。乗数は0.05から1の範囲、参加の割合は0.01から1の範囲に収めています。乗数の上限を1にしたのは、1を超えると表示の価値より高く入札することになり、支払額が価値を上回る機会まで落札するからです。消化の線に追いつくために価値を超える入札をすることは、払いすぎにあたります。
def run(d, method, line, k=10.0, lam0=1.0, p0=1.0, seed=1):
    r = np.random.default_rng(seed)
    target = BUDGET * np.cumsum(line)                   # 目標の消化の線(各区間の終わりまでに使う額)
    lam, p, spent = lam0, p0, 0.0
    won = np.zeros(len(d), bool)
    lams, cum = [], []
    v_all, m_all = d.v.values.tolist(), d.m.values.tolist()
    for s in range(SLOTS):
        idx = np.flatnonzero(d.slot.values == s)
        join = (r.random(len(idx)) < p) if method == "間引き" else np.ones(len(idx), bool)
        mult = lam if method == "乗数" else 1.0
        for i, j in zip(idx.tolist(), join.tolist()):   # 機会を1件ずつ、届いた順に処理する
            bid = min(mult * v_all[i], BUDGET - spent)   # 入札額は残りの予算以下にする
            if j & (bid > m_all[i]):
                won[i] = True
                spent += m_all[i]
        err = (target[s] - spent) / BUDGET              # 目標の線より遅れていれば正
        if method == "乗数":
            lam = float(np.clip(lam * np.exp(k * err), 0.05, 1.0))  # 価値を超える入札はしない
        if method == "間引き":
            p = float(np.clip(p * np.exp(k * err), 0.01, 1.0))
        lams.append(lam if method == "乗数" else p)
        cum.append(spent)
    return won, np.array(lams), np.array(cum)
結果を集計する関数では、消化の割合(費用 ÷ 予算)、得た価値(落札した機会の表示の価値の合計)、コンバージョンの見込み(得た価値をコンバージョンの価値の100で割った値)、実際に起きたコンバージョンの件数、CPA(費用 ÷ コンバージョンの件数。件数が0なら算出不可とする)、利得、予算の99.9%に達した時刻(累積の費用が予算の99.9%以上になった最初の15分区間の終わりの時刻)、勝てた機会のうち落札しなかった割合を計算します。利得は、表示の価値から支払額を引いた差の合計です。表示の価値は広告がなくても起きたコンバージョンの価値を差し引いていない見積りなので、利得は増分の利益とは別のものです。最後の指標は、価値どおりに入札すれば落札できた機会のうち、制御や予算の制約のために落札しなかった割合です。後から分かる一定の乗数で入札した場合でもこの割合は0になりません。予算に見合う範囲で、価値に対して割高な機会を意図して買わない分を含むので、この割合が高いこと自体は損失を意味しません。
def summarize(d, won, cum, name):
    spend = d.m.values[won].sum()
    conv = int(d.conv.values[won].sum())
    winnable = d.v.values > d.m.values                  # 価値どおりに入札すれば勝てた機会
    out = np.flatnonzero(cum >= BUDGET * 0.999)          # 累積の費用が予算の99.9%以上になった最初の区間
    stop_h = (out[0] + 1) / 4 if len(out) else "達せず"
    return {"方法": name, "消化の割合": round(spend / BUDGET, 3),
            "得た価値": round(d.v.values[won].sum(), 1), "CVの見込み": round(d.v.values[won].sum() / VALUE_CV, 1), "CV": conv,
            "CPA": round(spend / conv, 2) if conv > 0 else "算出不可", "利得": round(d.v.values[won].sum() - spend, 1),
            "99.9%に達した時刻": stop_h, "勝てた機会のうち落札しなかった割合": round(1 - won[winnable].mean(), 3)}

line = lines["機会の数に比例"]
res = {}
res["制御なし"] = run(today, "制御なし", line)
res["間引き"] = run(today, "間引き", line, p0=BUDGET / past_full.mean())
res["乗数(初期値1)"] = run(today, "乗数", line, lam0=1.0)
res["乗数(初期値は過去の日から)"] = run(today, "乗数", line, lam0=past_lam.mean())
lam_star = best_mult(today, BUDGET)
won_star = lam_star * today.v.values > today.m.values
cum_star = np.cumsum(np.bincount(today.slot.values, weights=today.m.values * won_star, minlength=SLOTS))
rows = [summarize(today, w, c, n) for n, (w, l, c) in res.items()]
rows.append(summarize(today, won_star, cum_star, "参考:当日の一定の乗数(後から分かる値)"))
pd.set_option("display.width", 200)
print(pd.DataFrame(rows).to_string(index=False))
print("当日の後から分かる一定の乗数", round(lam_star, 3))
実行した結果は次の表のとおりです。最後の行は、当日の機会をすべて見終わってから求めた一定の乗数(0.493)で入札した場合で、実際の制御では得られない、比較の目安です。
| 方法 | 消化の割合 | 得た価値 | コンバージョンの見込み | コンバージョンの件数 | CPA | 利得 | 予算の99.9%に達した時刻 | 勝てた機会のうち落札しなかった割合 |
|---|---|---|---|---|---|---|---|---|
| 制御なし | 1.000 | 2,638.7 | 26.4 | 25 | 49.60 | 1,398.8 | 15時45分 | 0.484 |
| 間引き | 1.000 | 2,751.6 | 27.5 | 27 | 45.92 | 1,511.7 | 23時30分 | 0.561 |
| 乗数(初期値1) | 0.986 | 3,578.6 | 35.8 | 30 | 40.77 | 2,355.5 | 達せず | 0.472 |
| 乗数(初期値は過去の日から) | 0.984 | 4,011.1 | 40.1 | 32 | 38.14 | 2,790.5 | 達せず | 0.430 |
| 参考:当日の一定の乗数(後から分かる値) | 1.000 | 4,247.4 | 42.5 | 31 | 40.00 | 3,007.5 | 24時00分 | 0.446 |
制御なしでは、15時45分に終わる区間で累積の費用が予算の99.9%に達し、図のとおり、それ以降の費用はほとんど増えていません。得た価値は2,638.7で、後から分かる一定の乗数で入札した場合(4,247.4)の6割ほどでした。間引きは、予算を23時30分まで持たせましたが、得た価値は2,751.6で、制御なしとの差は小さいものでした。間引きは、価値と無関係に参加する機会を減らすので、価値に対して割安な機会も同じ割合で捨てます。勝てた機会のうち落札しなかった割合が0.561と、5つの中で最も大きいのはそのためです。乗数による制御は、初期値を過去の日から決めた場合に得た価値が4,011.1で、後から分かる一定の乗数で入札した場合の94%ほどでした。初期値を1とした場合は3,578.6で、初期値を過去の日から決めた場合より少なくなりました。参考の行の24時00分は、後から分かる一定の乗数で入札すると、最後の区間で累積の費用が予算の99.9%に達したことを表します。
コンバージョンの件数の列には注意が要ります。乗数(初期値は過去の日から)の件数は32で、後から分かる一定の乗数の31より多くなっていますが、得た価値(コンバージョンの見込み)は後者のほうが大きくなっています。1日に数十件のコンバージョンは、乱数によるばらつきが大きく、1日の件数や CPA だけで方法の良し悪しを判断すると誤ることがあります。本章で方法を比べるときは、得た価値(見込み)を主に見て、件数は参考として示しています。なお、利得は表示の価値の式にもとづく値で、増分の利益ではありません。
次の図は、時刻ごとの累積の費用を、予算に対する割合で描いたものです。凡例は図の左上に置きました。太い灰色の線が、機会の数に比例して作った目標の消化の線です。制御なしの線は、朝の機会の山で急に立ち上がり、15時台に1に達して平らになります。間引きと乗数の線は、目標の線の近くを通って、夜の時間帯に残りの予算を使っています。
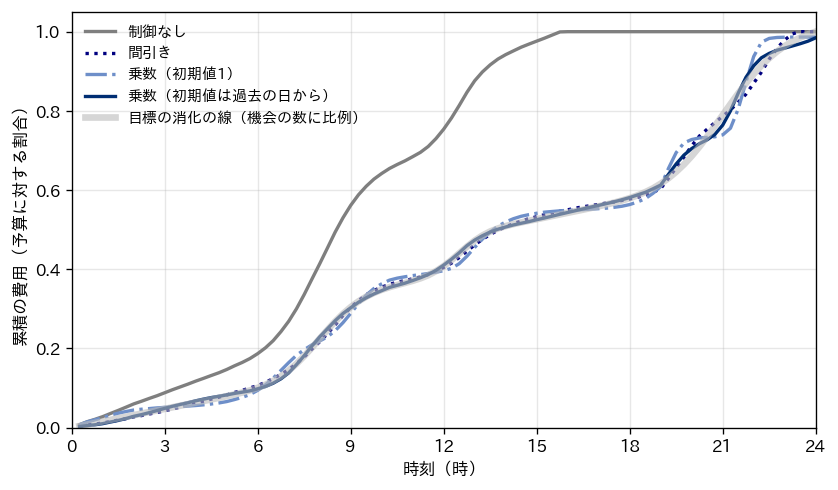
1回の乱数の結果だけでは、方法の差が偶然によるものかどうか分かりません。そこで、掲載していない別のスクリプトで、乱数の種を1から20に変えて、同じ手順を20回繰り返しました。手順は、掲載したコードの乱数の種だけを差し替えて上から実行し、各回の集計の結果を方法ごとに平均したものです。乱数の種を変えると、過去の日と当日の機会、予算、目標の消化の線もすべて作り直されます。得た価値は、その回の当日の後から分かる一定の乗数で得られた価値に対する比で示しました。標準偏差は20回の値の標本標準偏差(20ではなく19で割る)です。
| 方法 | 価値の比の平均 | 価値の比の標準偏差 | 価値の比の最小 | 消化の割合の平均 | 予算の99.9%に達した回数(最後の15分区間で達した回を含む) |
|---|---|---|---|---|---|
| 制御なし | 0.618 | 0.042 | 0.534 | 1.000 | 20 |
| 間引き | 0.642 | 0.041 | 0.557 | 1.000 | 20 |
| 乗数(初期値1) | 0.853 | 0.048 | 0.743 | 0.979 | 2 |
| 乗数(初期値は過去の日から) | 0.934 | 0.020 | 0.891 | 0.983 | 0 |
20回の繰り返しでも、順序は1回目の結果と同じでした。乗数(初期値は過去の日から)は、制御なしと間引きのどちらよりも、20回すべてで多くの価値を得ました。間引きは制御なしより20回すべてで多くの価値を得ましたが、平均の差は0.024と小さいものでした。乗数の初期値を過去の日から決めた場合は、初期値を1とした場合より、20回のうち19回で多くの価値を得ました。制御なしで予算の99.9%に達した時刻は、20回の平均で15.41時(15時25分ごろ)、最も早い回で10時45分、最も遅い回で19時45分でした。
この結果から言えるのは、この架空データの条件、つまり夜の時間帯に価値の高い機会が多く、予算が制約なしの費用の4割しかない条件では、制御しないことの損が大きく、乗数による制御が間引きより有利だった、ということです。夜の価値が高いという条件を外した場合の実行は、本コラムではしていません。
目標の消化の線の作り方による違い
制御は、目標の消化の線に費用を合わせようとするので、線の作り方が結果を左右します。同じ乗数の制御(初期値は過去の日から、\( k = 10 \))で、3つの線を比べました。下のコードは、前の節の累積の費用の図を描く部分と、線の比較の部分です。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib
x = np.arange(1, SLOTS + 1) / 4
fig, ax = plt.subplots(figsize=(8, 4.5))
styles = {"制御なし": ("#7F7F7F", "-"), "間引き": ("#000080", ":"), "乗数(初期値1)": ("#6E8FC9", "-."),
          "乗数(初期値は過去の日から)": ("#002E73", "-")}
for n, (w, l, c) in res.items():
    ax.plot(x, c / BUDGET, color=styles[n][0], ls=styles[n][1], lw=2, label=n)
ax.plot(x, np.cumsum(line), color="#BBBBBB", lw=4, alpha=0.6, label="目標の消化の線(機会の数に比例)")
ax.set_xlabel("時刻(時)"); ax.set_ylabel("累積の費用(予算に対する割合)")
ax.set_xticks(range(0, 25, 3)); ax.set_xlim(0, 24); ax.set_ylim(0, 1.05)
ax.legend(loc="upper left", fontsize=9, frameon=False)
ax.grid(alpha=0.3)
plt.savefig("../ch09_cumulative_spend.png", dpi=120, bbox_inches="tight")
plt.close()

rows = []
for ln, shape in lines.items():
    w, l, c = run(today, "乗数", shape, lam0=past_lam.mean())
    r_ = summarize(today, w, c, "乗数・" + ln)
    r_["12時までの消化"] = round(c[47] / BUDGET, 3)
    rows.append(r_)
print(pd.DataFrame(rows).to_string(index=False))
| 目標の消化の線 | 消化の割合 | 得た価値 | コンバージョンの件数 | CPA | 12時までの消化 | 20回の価値の比の平均 |
|---|---|---|---|---|---|---|
| 均等 | 0.957 | 2,898.0 | 25 | 47.45 | 0.468 | 0.684 |
| 機会の数に比例 | 0.984 | 4,011.1 | 32 | 38.14 | 0.411 | 0.934 |
| 価値の見込みに比例 | 0.995 | 4,225.7 | 30 | 41.13 | 0.309 | 0.990 |
表の「20回の価値の比の平均」以外の列は、乱数の種20261116の当日の結果です。均等の線は、得た価値が2,898.0で、制御なし(2,638.7)より多いものの、機会の数に比例する線(4,011.1)を大きく下回りました。20回の繰り返しの平均は0.684で、制御なしの0.618を20回すべてで上回りましたが、機会の数に比例する線の0.934との差は大きいままでした。別に確かめたところ、均等の線では、機会の少ない0時から6時に、乗数が上限の1まで上がり、6時までに予算の0.173を使っていました。機会の数に比例する線では、この割合は0.098でした。均等の線は、機会の少ない深夜にも1日の96分の1ずつ使わせようとするので、この例題では、制御が乗数を上げ、価値に対して割高な機会まで買っていました。価値の高い19時以降に使った予算は0.207にとどまりました(機会の数に比例する線では0.372、価値の見込みに比例する線では0.529)。
価値の見込みに比例する線は、機会の数に比例する線より、20回すべてで多くの価値を得て、価値の比の平均は0.990でした。この例題では、価値の高い機会が夜に集まるように作ってあるので、過去の日の価値の合計の形に合わせた線は、夜に多くの予算を残します。ただし、価値の見込みに比例する線では、20回のうち18回で、累積の費用が1日の終わり近くで予算の99.9%に達していました(消化の割合の平均は0.999)。価値が高いと予測した時間帯へ予算を配分する線は、その時間帯の機会の数や価値を見誤ると、使い残しや予算の不足が生じます。
線の作り方の要点をまとめると、次の表のようになります。
| 線の作り方 | 必要なデータ | 向いている場面 | 外れるところ |
|---|---|---|---|
| 均等 | 不要 | 機会の数が1日の中でほぼ一定の場合 | 機会の少ない時間帯に無理に使わせ、割高な機会を買う(本コラムの架空データで見られた) |
| 機会の数に比例 | 過去の日の時間帯ごとの機会の数 | 機会の価値が時間帯であまり変わらない場合 | 価値の高い時間帯に予算を十分に残せない |
| 価値の見込みに比例 | 過去の日の時間帯ごとの価値の見込み(予測クリック率などが要る) | 価値の高い時間帯が過去の日でも安定している場合 | 価値が高いと予測した時間帯の機会の数や価値を見誤ると、使い残しや予算の不足が生じる。価値の予測の誤差がそのまま線に入る |
機会の数や価値の見込みに比例する線は、過去の日の記録から作る予測です。曜日や季節、キャンペーンの変更で時間帯の形が変われば、線は外れます。過去の何日分を使うか、曜日を分けるかは、予測の当たり方を過去の日で確かめて決めるのがよいと考えています。
制御の強さの調整
次に、制御の強さ \( k \) を変えたときに、乗数がどう動くかを確かめました。初期値を1とした乗数の制御で、\( k \) を2・10・60の3通りにしました。
fig, ax = plt.subplots(figsize=(8, 4.5))
rows = []
for k, col, ls in [(2, "#9E9E9E", "--"), (10, "#002E73", "-"), (60, "#6E8FC9", ":")]:
    w, l, c = run(today, "乗数", line, k=k, lam0=1.0)
    ax.plot(x, l, color=col, ls=ls, lw=2, label=f"制御の強さ k={k}")
    r_ = summarize(today, w, c, f"k={k}")
    r_["乗数の区間ごとの変化の平均"] = round(np.mean(np.abs(np.diff(np.log(l)))), 3)
    rows.append(r_)
ax.axhline(lam_star, color="#BBBBBB", lw=3, label="当日の一定の乗数(後から分かる値)")
ax.set_xlabel("時刻(時)"); ax.set_ylabel("乗数"); ax.set_xticks(range(0, 25, 3)); ax.set_xlim(0, 24)
ax.set_ylim(0, 1.35); ax.legend(loc="upper left", ncol=2, fontsize=9, frameon=False); ax.grid(alpha=0.3)
plt.savefig("../ch09_gain_multiplier.png", dpi=120, bbox_inches="tight")
plt.close()
print(pd.DataFrame(rows).to_string(index=False))
次の図は、時刻ごとの乗数を描いたものです。凡例は図の左上に置きました。太い灰色の横線は、当日の後から分かる一定の乗数(0.493)です。
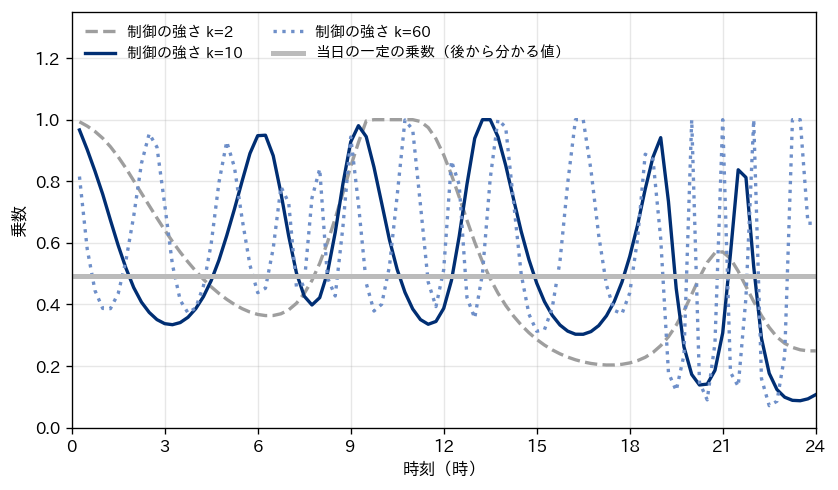
| 制御の強さ | 消化の割合 | 得た価値 | 予算の99.9%に達した時刻 | 乗数の区間ごとの変化の平均 | 20回の価値の比の平均 | 20回の価値の比の標準偏差 | 20回で予算の99.9%に達した回数(最後の15分区間で達した回を含む) |
|---|---|---|---|---|---|---|---|
| k=2 | 1.000 | 3,839.8 | 22時45分 | 0.058 | 0.902 | 0.045 | 11 |
| k=10 | 0.986 | 3,578.6 | 達せず | 0.153 | 0.853 | 0.048 | 2 |
| k=60 | 1.000 | 3,480.3 | 23時45分 | 0.377 | 0.857 | 0.063 | 8 |
乗数の区間ごとの変化の平均は、区間ごとの乗数の対数の変化の絶対値の平均で、乗数がどれだけ振れたかを表します。\( k = 60 \) の制御は、目標の線とのわずかな差に強く反応して、乗数が区間ごとに大きく振れ、19時以降は0.071から上限の1まで動きました。この日の得た価値は3つの中で最も少なく、20回の平均は0.857で \( k = 10 \) の0.853とほぼ並び(\( k = 10 \) が上回ったのは20回のうち8回)、標準偏差は0.063と3つの中で最も大きくなりました。乗数が振れると、同じ程度の価値の機会を、ある区間では高く買い、別の区間では買わないことになり、第7章で見た「1日を通して同じ乗数で入札する」状態から離れます。
\( k = 10 \) の制御も、図のとおり乗数が上下をくり返しました。別に確かめたところ、0時から19時の乗数はおよそ0.30から上限の1の間で上下し、19時以降は最小0.087まで下がりました。図からは、目標の線より遅れると乗数が上がり、進むと下がる、という動きが周期的に続いているように見えます。この周期的な動きが生じる仕組みの分析は、本コラムではしていません。
\( k = 2 \) の制御は、乗数がゆっくり動き、得た価値は20回の平均で0.902と、3つの中で最も大きくなりました。\( k = 10 \) が \( k = 2 \) より多くの価値を得たのは20回のうち3回、\( k = 60 \) が \( k = 2 \) より多くの価値を得たのは20回のうち4回でした。一方で、\( k = 2 \) は20回のうち11回で、1日のうちに累積の費用が予算の99.9%に達しました(最後の15分区間で達した回を含みます)。別に確かめたところ、20回の平均で、12時の時点の累積の費用は、\( k = 2 \) では目標の線より予算の0.034ぶん先行し、\( k = 10 \) では0.013ぶん遅れていました。初期値の1から乗数が下がるのが遅い分、昼までの費用が目標より先行していたことは確かめられましたが、それが早い使い切りにどうつながったかまでは切り分けていません。ここでの結果は、反応が鈍いと使い残す、という単純な見込みとは違い、この例題では使い残しより早めの使い切りとして現れました。
制御の強さは、強すぎると乗数が振れます。弱い場合(k=2)は、この例題では、乗数の動きがゆっくりで、昼までの費用が目標の線より先行し、20回のうち11回で予算の99.9%に達しました。ただし得た価値は3つの中で最も大きく、使い残しより早めの使い切りが多く出ました(消化の割合の最小は0.938で、使い残した回もありました)。どの値が良いかは、機会の数の揺れ、競合の入札の揺れ、初期値の当たり方で変わり、本コラムの架空データで得た値を他の配信にそのまま使うことはできません。実務では、過去の日の記録で模擬して候補を絞ったうえで、配信で確かめることになります。制御の規則そのものを、目標との差の大きさだけでなく、差の変化も見る形に変えるといった工夫は、制御工学で扱われる内容で、Zhang らの2016年の論文もリアルタイム入札のフィードバック制御を扱っています。本コラムでは、本章の単純な規則以外の制御は実行していません。
第7章では、予算の制約があるとき、表示の価値に一定の乗数を掛けて入札すると、同じ費用で得られる価値の合計が大きくなるという考え方を見ました。本章の結果も、この考え方と整合しています。当日の機会をすべて知っていれば、1日を通して同じ乗数(この例題では0.493)で入札するのが目安になり、この日(乱数の種20261116)の比較の表では、その乗数の価値を超える方法はありませんでした(20回の比で1を超えた回があったかは確かめていません)。
ただし、その乗数は、その日の機会の数と競合の入札が分かって初めて求められます。過去の14日では、予算を超えない範囲でできるだけ多く使う乗数が0.429から0.585まで動いていました。ペース配分の制御は、事前には分からないこの乗数を、その日の途中の費用の進み方から推し量りながら近づける仕組みだと考えることができます。本章の例題では、初期値を過去の日から決めた乗数の制御が、初期値を1とした制御より多くの価値を得ました。別に、初期値だけを0.3から1.0まで変えて20回ずつ実行したところ、価値の比の平均は、初期値0.3で0.924、0.4で0.930、0.5で0.933、0.6で0.936とほぼ並び、0.8では0.908、1.0では0.853でした。20回の当日の後から分かる乗数と、過去の日の乗数の平均との差は、平均0.043、最大0.095でした。この例題では、初期値を当日の乗数より大きくとった0.8と1.0で価値が少なくなりましたが、初期値がなぜ効くのかの仕組みまでは切り分けていません。
ファーストプライスの場では、入札額の引き下げ(第8章)と、予算のための乗数が重なります。この場合は、第8章の勝率曲線にもとづく最適な入札額を求める計算の中で、表示の価値の代わりに、乗数を掛けた価値を使うという組み合わせ方が考えられます。本コラムでは、ファーストプライスでのペース配分の実行はしていません。
月の予算と日の予算、複数のキャンペーン
予算は1日ごとに決めるとは限りません。月の予算を決めて、それを日ごとに割り振る場合は、1日の中の制御と同じ問題が、日の単位でも起きます。曜日によって機会の数や価値が違えば、月の予算を日数で均等に割るより、曜日の波に合わせて割り振るほうが、価値の高い日に予算を回せる可能性があります。月末に予算が余りそうなときに残りの日に詰め込むと、本章の均等の線と同じく、割高な機会を買うことになりかねません。反対に、月の前半に使いすぎると、月末の機会を失います。月の中の進み方を、日の単位の目標の線と比べて点検することは、1日の中の制御と同じ考え方で行えます。
媒体によっては、予算の設定の意味が、1日の上限という言葉から想像するものと違うことがあります。例えば Google 広告のヘルプ「超過配信と 1 日の平均予算について」と「費用の上限について」(いずれも2026年11月16日に参照)では、ほとんどのキャンペーンについて、ある日の費用が1日の平均予算の最大2倍になることがあり、1か月の上限は1日の平均予算に30.4を掛けた額である、と説明されています。同じヘルプでは、月の途中で1日の平均予算を変えた場合は残りの月の上限の計算が変わること、コンバージョンに対して支払う形のキャンペーンには1日の上限が無いこと、配信にかかった費用が上限を超えることはあっても、上限を超えた分は請求されないことも説明されています。つまり上限が対象にしているのは請求額です。このような仕組みの媒体では、ある1日の費用を見て予算の超過と判断せず、キャンペーンの種類と期間中の予算の変更の有無を確かめたうえで、月の単位の請求額で確かめる必要があります。仕組みは媒体ごとに違い、変わることもあるので、使っている媒体の公式ヘルプで確かめることが前提です。媒体の内部でペース配分がどのように計算されているかは、公式ヘルプに書かれている範囲を超えては分かりません。
同じ広告主の複数のキャンペーンが、同じ表示の機会に入札する場合もあります。それぞれのキャンペーンが自分の予算だけを見て制御すると、同じ機会を自社の中で取り合い、片方の制御が乗数を上げると、もう片方の勝率が下がる、という相互の影響が生じえます。セカンドプライスの場で自社の2つのキャンペーンが互いの次点になれば、自社の入札どうしで支払額を押し上げることにもなります。キャンペーンをまたいで乗数をそろえる、あるいは同じ機会には1つのキャンペーンだけが入札するように整理する、といった設計が考えられます。媒体の中でこの取り合いがどう扱われるかは媒体の仕組みによるので、本コラムでは扱いません。
媒体をまたいで予算を配分する問題は、本章の扱う範囲より上の単位の判断です。広告の効果の分解と、媒体をまたぐ予算の配分は、弊社コラム『広告の効果を測るマーケティング・ミックス・モデリング、効果の分解から広告予算の最適配分まで』で扱っています。
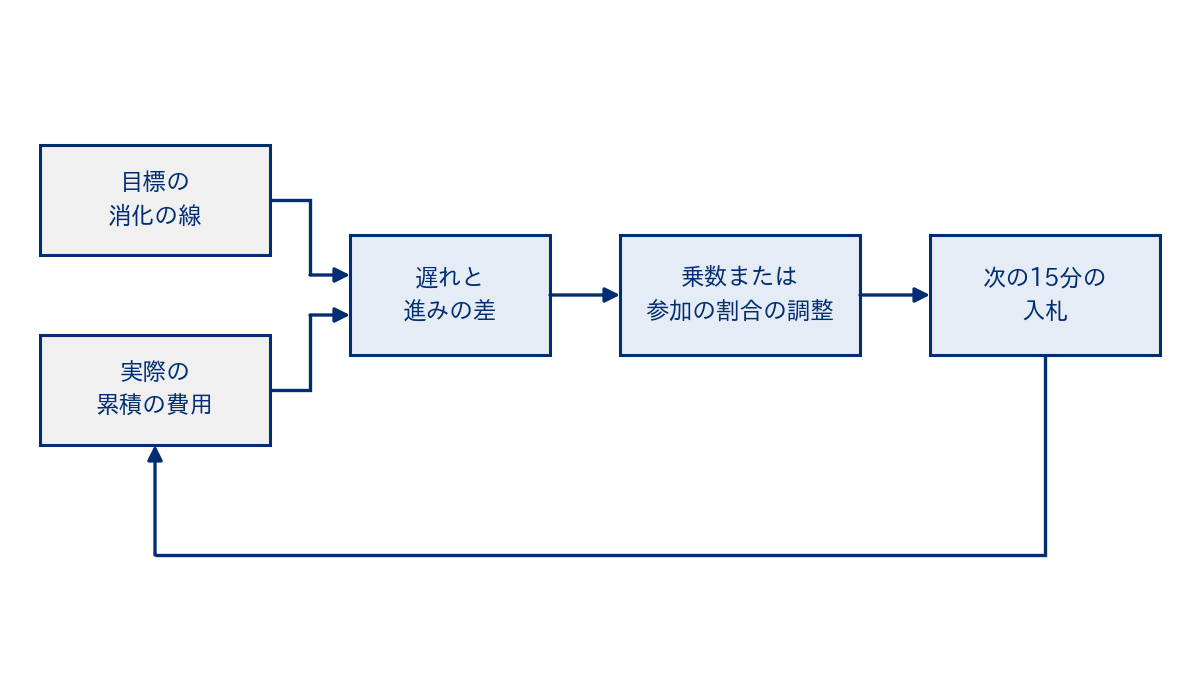
ペース配分の指標と点検
ペース配分が働いているかは、消化の割合だけでは分かりません。本章の例題では、制御なしも間引きも消化の割合は1.000でしたが、得た価値は一致しませんでした(2,638.7と2,751.6)。点検には、次のような指標を組み合わせるのがよいと考えています。
| 指標 | 計算の仕方 | 何が分かるか | 注意 |
|---|---|---|---|
| 消化の割合 | 期間の費用 ÷ 予算 | 使い残し・使いすぎ | 1に近くても、価値の高い機会に使ったとは限らない |
| 時間帯ごとの費用の構成 | 時間帯ごとの費用 ÷ 期間の費用 | どの時間帯に予算を使ったか | 時間帯ごとのコンバージョン率や価値の見込みと並べて見る |
| 予算が尽きた時刻と、予算が尽きたあとの時間の割合 | 予算の上限で入札しなかった時間 ÷ 期間の時間 | 予算の制約で配信が止まっている度合い | 媒体のレポートで取れる形は媒体によって違う |
| 価値どおりなら落札できたが落札しなかった割合 | 価値どおりに入札すれば落札できた機会のうち、制御や予算の上限のために落札しなかった割合 | 予算に対して、価値が支払額を上回る機会がどれだけ多いか | 割高な機会を意図して買わない分を含むので、高いこと自体は損失ではない。入札しなかった機会では推定になる。媒体の管理画面に近い指標があるかは媒体による |
| 乗数(または参加の割合)の推移 | 区間ごとの値と、その振れ | 制御が安定しているか | 媒体の自動入札では見えないことが多い |
このうち、価値どおりなら落札できたが落札しなかった割合は、本章の例題では「勝てた機会のうち落札しなかった割合」として計算しました。合成データなので、入札しなかった機会でも落札できたかどうかが分かりますが、実際の配信では、入札しなかった機会の競合の入札額は分かりません。第8章の勝率曲線のような推定を使って見積もることになり、見積りの誤差を含みます。
点検の仕組みが無いと、自動入札の予算の設定と実態のずれに気づけません。これは序章の損失の型でいえば形骸化にあたります。例えば、毎日昼過ぎに予算が尽きていても、消化の割合が1であるという報告だけが続けば、夜の機会を失い続けていることは見えません。
経営の判断:予算で止まっている割合を確かめ、予算と目標のどちらを動かすかを決める
経営の側から見たペース配分の論点は、予算が尽きたあとの時間がどれだけあり、その時間帯に価値が支払額を上回る機会が来ていたかを確かめ、そのうえで予算と目標のどちらを動かすかを決めることです。止まっていた時間が長くても、その間に買う価値のある機会が来ていなければ損失ではありません。価値のある機会を逃していた場合、取れる手は大きく2つあります。1つは予算を増やすことです。ただし、第7章で見たとおり、予算を増やしたときに追加で得られる価値は、だんだん小さくなっていきます。追加の予算は、乗数を上げてより割高な機会を買うことに使われるからです。もう1つは、予算を据え置いたまま、目標の CPA を厳しくするなどして乗数を下げ、割高な機会を買わないようにすることです。この場合、個々の機会では落札しにくくなりますが、配信できる時間が延びるため、1日全体の落札の件数は増える場合も減る場合もあります。
どちらを選ぶかは、追加の予算で得られる価値が、その予算に見合うかどうかで決まります。その判断には、表示の価値の見込みだけでなく、広告によって増えたコンバージョンの価値から広告費を引いた、増分の利益の見積りが要ります(第11章)。追加の予算については、追加で増えるコンバージョンの価値と、追加の費用を比べることになります。表示の価値の式にもとづく利得は、広告が無くても起きたコンバージョンも含むので、追加の予算の効果を大きく見せる可能性があります。予算を増やして払いすぎになっていないか、予算を抑えて機会損失になっていないかの両方を、同じ尺度で比べられるようにしておくことが、予算を決める前提になると考えています。
体制の面では、次の3つを決めておくのがよいと考えています。1つ目は、予算が尽きた時刻と、予算が尽きたあとの時間の割合、その時間帯の機会の価値の見込みを、誰がどの頻度で確かめるかです。2つ目は、日の予算と月の予算のどちらを管理の単位にするかで、媒体の予算の設定の意味(1日の予算を超えて配信されることがあるかなど)を、公式ヘルプで確かめておくことも含みます。3つ目は、予算を動かす判断と、目標の CPA を動かす判断を、誰が持つかです。予算は財務やマーケティングの責任者が、目標の CPA は広告の運用の担当者が決めている場合、両者がそれぞれ動かすと、ペース配分の制御が追いかける目標そのものが揺れます。
| 確かめること | 確かめる相手 | 答えが曖昧なときに起きうる損失の型 |
|---|---|---|
| 予算が尽きた時刻と、予算が尽きたあとの時間の割合を、レポートで取れるか | 媒体・DSP・広告会社 | 機会損失・形骸化 |
| 使っている媒体で、1日の予算を超えて配信されることがあるか、月の上限はどう決まるか | 媒体の公式ヘルプ | 払いすぎ(の誤認)・形骸化 |
| ペース配分の方法(参加の割合を下げるのか、入札額を下げるのか)が分かるか | DSP・広告会社 | 払いすぎ・機会損失 |
| 同じ機会に自社の複数のキャンペーンが入札していないか | DSP・広告会社 | 払いすぎ |
| 予算と目標の CPA を、誰がどの根拠で動かすか | 社内(財務・マーケティング・広告の運用) | 形骸化・成果の数え違い |
この章では、予算の制約があるときに、予算を1日の中でどの速さで使うかを制御するペース配分を扱いました。本コラムの架空データでは、制御しないと累積の費用は平均で15時台に予算の99.9%に達し、乗数による制御と、価値の見込みにもとづく目標の消化の線を組み合わせると、後から分かる一定の乗数で入札した場合に近い価値を得られました。一方で、均等の線のように線の作り方が合っていないと、同じ乗数の制御でも、得た価値は機会の数に比例する線より大きく下がりました(制御なしよりは高い値でした)。第10章では、入札額と予算に並んで、広告で増える利益を左右する配信の中身、つまり同じ利用者に何回見せるか(フリークエンシーの上限)と、どの表現を見せるか(クリエイティブの出し分け)を扱います。
この章を深めたい方への参考書籍
『はじめての制御工学 改訂第2版』(佐藤和也・平元和彦・平田研二、講談社):目標との差を見て操作を変えるフィードバック制御の基本を、初学者向けに説明した教科書です。本章で見た、制御を強くすると乗数が大きく振れ(k=60)、弱くすると乗数の動きが遅れて昼までの費用が目標より先行した(k=2)といった動きを、制御工学の言葉で理解する助けになります。
『オンライン機械学習』(海野裕也・岡野原大輔・得居誠也・徳永拓之、講談社):データが1件ずつ届く状況で、届くたびにモデルを更新していく学習の方法と、その性能の解析を扱った本です。本章で紹介した Balseiro と Gur の2019年の論文のように、予算のあるくり返しのオークションでの学習は、比べる相手となる方策に対する取り逃しの累積を小さくする考え方(後悔の最小化)から扱われることがあり、データが届くたびに更新していく学習の考え方を知る入口になります。
第10章 配信の制御、フリークエンシーの上限とクリエイティブの出し分け
第9章では、1日の予算を期間の中でどの速さで使うかを制御する方法を扱いました。入札額と予算の使い方が決まっても、配信の中身はまだ決まっていません。同じ利用者に何回まで見せるか、複数のクリエイティブのうちどれを多く出すかによって、同じ予算で得られるクリックやコンバージョンの数は変わります。この章では、この2つの制御を扱います。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の合成データを使い、実行したコードと結果で確かめます。
- 同じ利用者への表示の回数と反応の関係、回数ごとのクリック率を素朴に集計したときの偏り
- フリークエンシーの上限を変えたときの、同じ予算での表示・届いた利用者の数・クリックとコンバージョンの期待値
- クリエイティブの出し分けを、A/Bテストで決める方法とバンディットで配分を動かす方法の比較
- 何を報酬にするか(クリック・コンバージョン・価値)で選ばれる表現が変わること
- 新しいクリエイティブの扱い、表現の疲れ、配信の対象の設定、利用者の側から見た過剰な接触
- 制御の指標の表と、経営の判断
この章の主張は2つあります。1つ目は、回数ごとのクリック率を記録から素朴に集計すると、利用者の構成の違いが混ざり、回数を重ねたときの反応の下がり方を実際より大きく見積もることがある、という点です。上限を考えるときは、同じ利用者の集団の中で比べた下がり方を併せて見たうえで、上限ごとのクリックやコンバージョンの見込みと、予算の使い残しの大きさを並べて決める必要があります。予算を使い切ること自体は目的ではありません。本コラムの架空データでは、上限2回が、クリック・コンバージョンの期待値と届いた利用者の数のすべてで上限3回以上を上回り、予算の約1割を使い残しました。2つ目は、クリエイティブの出し分けでは、配分の方法よりも先に、何を報酬にするかを事業として決める必要がある、という点です。本コラムの架空データでは、クリックを報酬にするとクリック率の最も高い表現が選ばれ、その表現は、コンバージョンの件数でも価値の合計でも4本のうち最も少ない表現でした。
回数と反応、広告の疲れと届かない損失
同じ利用者に同じ広告を何回も表示すると、回数を重ねるにつれて反応が下がる傾向があると考えられており、これを広告の疲れと呼ぶことがあります。一方で、表示が1回だけでは、利用者がその広告に気づかないまま終わることもあります。どの回数で反応がどれだけ下がるかは、商品・表現・掲載面・期間によって違い、一般に何回が良いという数字を置くことはできません。本コラムでは、回数と反応の関係を一般論として断定せず、自社の記録でどう確かめるか、その確かめ方のどこで判断を誤りやすいかを扱います。
回数を制御するための代表的な仕組みがフリークエンシーの上限です。同じ利用者に、同じキャンペーン(または同じクリエイティブ)を一定の期間に表示する回数に上限を設けます。例えば Google 広告の公式ヘルプでは、ディスプレイ広告のキャンペーンでは1日・1週間・1か月の単位で表示の回数の上限を設定でき、キャンペーン・広告グループ・広告の単位で設定できることが説明されています。同じヘルプには、動画広告のキャンペーンではキャンペーンの単位だけで設定することと、ディスプレイ広告では既定でサードパーティ・クッキー(利用者が見ているサイトとは別のサイトとのやり取りで扱われるクッキー。詳しくは第14章)を使い、使えない場合はファーストパーティのクッキーで表示の回数を推定することも書かれています(Google 広告ヘルプ「フリークエンシー キャップ」)。記載は2026年11月16日に同ヘルプで確かめた内容です。ここから分かるのは、回数を数えるには利用者(またはブラウザや端末)を区別する識別子が要り、識別子が使えない環境では回数を正確に数えられないということです。さらに、識別子と人は1対1とは限りません。1人が複数の端末を使う場合、1台の端末を複数の人が使う場合、識別子が消去された場合があるので、フリークエンシーとその上限は「識別できた単位での回数」であり、人ごとの回数の上限を保証するものではありません。識別子の制限の経緯は第14章で扱います。
回数の制御を誤ったときの損失は、2つの方向に出ます。回数が多すぎると、反応の下がった表示に予算を使う払いすぎになり、利用者の側では同じ広告を繰り返し見せられる過剰な接触という不利益になります(信頼の毀損)。回数を絞りすぎると、すでに接触した利用者への追加の表示が制限され、その追加の接触によって利益を増やせたはずの表示を逃す機会損失になりえます。予算の使い残しが機会損失になるのは、その予算で利益を増やせる機会を逃した場合に限られ、使い残したこと自体が損失なのではありません。上限は、この2つの方向の損失のつり合いで決める値です。
架空の利用者ごとの表示の記録を作る
ここからは、回数と反応の関係を記録から読むときに何が起きるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの成績は、実際の配信での成績の目安にはなりません。本章の例題では、表示の機会はすべて落札でき、落札した機会はすべて表示されたものとして単純化しました。また、表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件として扱います。例題の利用者は、識別できた単位がそのまま1人に対応するものとしています。
例題では、架空の利用者3万人について、14日間の表示の機会を、次の性質を持たせて乱数で作りました(乱数の種は20261116に固定しています)。このうち、1回以上の機会が生じたのは28,492人です。コードは Python 3.14.3 で実行し、グラフの日本語の表示には japanize-matplotlib 1.1.3 を使いました。この章のコードは3つのスクリプトに分かれており、前半の回数の例題、クリエイティブの比較、報酬の比較を、それぞれ別に実行しています。
- 閲覧の多さの個人差:1日あたりの表示の機会の数の平均は利用者ごとに違い、少ない利用者が多く、ごく一部がとても多い(対数正規分布)
- もともとの反応のしやすさの個人差:利用者ごとに違い、さらに、よく閲覧する利用者ほど1回あたりはクリックしにくい
- 掲載面の違い:掲載面A・B・Cでクリックのされやすさが違う
- 真の規則:同じ利用者への表示が1回増えるごとに、クリックの確率がロジットの尺度で0.10ずつ下がる(確率そのものが0.10ずつ下がるという意味ではなく、1回ごとにおよそ1割弱ずつ小さくなる程度の下がり方です)
こうして作った表示の機会は252,640件で、1回目の表示のクリック率は2%弱、回数を重ねると1%を下回る水準です。利用者の属性として、性別・年齢などの配慮の要る属性や、個人を特定する項目は入れていません。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261116)

# 1) 架空の利用者(14日間)。閲覧の多さと、もともとの反応のしやすさに個人差を入れる
n_users = 30000
days = 14
lam = np.exp(rng.normal(np.log(0.4), 0.9, n_users))      # 1日あたりの表示の機会の数の平均
base = -4.2 + rng.normal(0, 0.5, n_users) - 0.35 * np.log(lam / 0.4)  # よく閲覧する利用者ほど1回あたりは反応しにくい
n_opp = rng.poisson(lam * days)

uid = np.repeat(np.arange(n_users), n_opp)
t = rng.uniform(0, days, uid.size)                      # 機会の時刻(日)
place = rng.choice(3, uid.size, p=[0.5, 0.3, 0.2])      # 掲載面A・B・C
place_off = np.array([0.0, 0.4, -0.3])[place]
decay = 0.10                                            # 1回表示が増えるごとの低下(真の規則)

def click_prob(u, pl_off, k):
    return 1 / (1 + np.exp(-(base[u] + pl_off - decay * (k - 1))))

df = pd.DataFrame({"uid": uid, "t": t, "place_off": place_off}).sort_values(["t"]).reset_index(drop=True)
print("利用者の数:", n_users, " 表示の機会の数:", len(df))
回数ごとのクリック率を素朴に集計すると偏る
まず、上限を設けずにすべての機会に表示した記録で、各表示が「その利用者にとって何回目の表示か」を数え、回数ごとのクリック率を集計しました。これが、配信の記録から回数と反応の関係を読むときに最初に作りがちな集計です。比べる相手として、合成データなので分かる真の規則を、3万人全員に同じ回数ずつ表示したと仮定して当てはめた値を計算しました。さらに、15回以上表示された利用者だけに絞り、同じ利用者の集団の中で回数ごとのクリック率を集計した値も並べました。
# 2) 上限なしで全機会に表示した記録で、回数ごとのクリック率を素朴に集計する
df["k"] = df.groupby("uid").cumcount() + 1
p = click_prob(df["uid"].to_numpy(), df["place_off"].to_numpy(), df["k"].to_numpy())
df["click"] = rng.random(len(df)) < p
n_imp = df.groupby("uid").size()
df["n_user"] = df["uid"].map(n_imp)

rows = []
for k in range(1, 16):
    d = df[df["k"] == k]
    allu = np.arange(n_users)
    true_all = sum(w * click_prob(allu, o, k).mean() for w, o in zip([0.5, 0.3, 0.2], [0.0, 0.4, -0.3]))
    coh = df[(df["k"] == k) & (df["n_user"] >= 15)]
    rows.append([k, len(d), d["click"].mean() * 100, coh["click"].mean() * 100, true_all * 100])
tab = pd.DataFrame(rows, columns=["回数", "表示", "素朴な集計(%)", "15回以上の利用者だけ(%)", "全員に当てた真の規則(%)"])
print(tab.round(3).to_string(index=False))
print("15回以上表示された利用者の数:", int((n_imp >= 15).sum()))
r_naive = tab.iloc[9, 2] / tab.iloc[0, 2]
r_coh = tab.iloc[9, 3] / tab.iloc[0, 3]
r_true = tab.iloc[9, 4] / tab.iloc[0, 4]
print(f"10回目/1回目の比  素朴な集計 {r_naive:.3f}  15回以上の利用者だけ {r_coh:.3f}  真の規則 {r_true:.3f}")
実行した結果のうち、主な回数を抜き出したのが次の表です。表示の列は、その回数目にあたる表示の件数です。
| 回数 | 表示 | 素朴な集計のクリック率 | 15回以上表示された利用者だけのクリック率 | 真の規則を全員に当てた値 |
|---|---|---|---|---|
| 1回目 | 28,492 | 1.846% | 1.243% | 1.899% |
| 2回目 | 25,915 | 1.544% | 0.964% | 1.723% |
| 3回目 | 22,945 | 1.547% | 1.157% | 1.563% |
| 5回目 | 17,468 | 1.191% | 0.964% | 1.285% |
| 9回目 | 9,985 | 0.511% | 0.407% | 0.867% |
| 10回目 | 8,728 | 0.470% | 0.557% | 0.785% |
| 11回目 | 7,647 | 0.432% | 0.300% | 0.711% |
| 15回目 | 4,666 | 0.364% | 0.364% | 0.478% |
| 10回目と1回目の比 | 比には件数なし | 0.254 | 0.448 | 0.413 |
素朴な集計では、10回目のクリック率は1回目の0.254倍まで下がりました。真の規則を全員に当てた値では0.413倍です。素朴な集計は、回数を重ねたときの反応の下がり方を、真の規則より大きく見せています。理由は、回数ごとに集計に入る利用者の構成が違うことです。1人の利用者に1回目の表示は1回しかないので、回数ごとの表示の件数は、その回数に達した利用者の数と同じです。1回目の表示には、表示の機会のあった利用者の全員(28,492人)が入りますが、10回目の表示に入るのは、14日間に10回以上表示の機会のあった、よく閲覧する利用者(8,728人)だけです。この例題では、よく閲覧する利用者ほど1回あたりはクリックしにくいように作ったので、回数の多い列ほど、もともと反応しにくい利用者の比重が増えます。素朴な集計の低下には、広告の疲れの分と、利用者の構成が変わった分とが混ざっています。
15回以上表示された利用者4,666人だけに絞ると、1回目から15回目まで同じ利用者の集団で比べることになり、構成の違いが除かれます。この1回の実行では、この集計の10回目と1回目の比は0.448でした。ただし、絞った集団は4,666人と少なく、10回目のクリックは数十件しかないので、点ごとの揺れが大きくなります。表でも、同じ列の9回目は0.407%、11回目は0.300%で、10回目の0.557%はたまたま上に出ています。表に載せていない回数でも、コードの出力では同じ列が5回目0.964%・6回目0.664%・7回目0.836%と、隣り合う回数どうしで上下しています。
そこで、同じ作り方のまま乱数の種だけを変えて30回繰り返し、10回目と1回目の比を求めました(掲載しない確認用のコードで行いました)。素朴な集計の比は平均0.289(標準偏差0.028、最小0.239・最大0.347)、15回以上表示された利用者だけの比は平均0.412(標準偏差0.092、最小0.254・最大0.643)でした。真の規則の比は0.413です。素朴な集計の比が、15回以上の利用者だけの比より小さかったのは30回のうち28回でした。この例題で読めるのは、素朴な集計は下がり方を一貫して大きく見せ、同じ利用者の集団で比べる集計は、平均では真の規則に近いものの、1回ごとの値は大きく揺れる、ということです。また、絞った集団はもともと反応しにくい利用者に偏っているので、クリック率の水準そのものは全体より低く(1回目で1.243%)なります。この集計で読めるのは下がり方の比であって、全体の利用者の水準ではありません。
素朴な集計のまま下がり方を読むと、回数を重ねたときの反応の低下を実際より強いと見て、上限を低く置く向きの判断に傾きうると考えています。ただし、本章の例題では、偏った見積りから上限を選んだ場合の結果までは計算していません。
実際の記録では、閲覧の多さとクリックのしやすさの関係が、この例題と逆向きのこともありえます。その場合、素朴な集計は下がり方を小さく見せます。どちらの向きに偏るかは記録だけからは決められないので、回数と反応の関係を上限の根拠にするときは、同じ利用者の集団の中で比べる集計を併せて見ることが、少なくとも必要だと考えています。ただし、同じ集団にそろえる集計も記述的な点検であり、回数を重ねたこと自体による反応の低下(疲れの効果)を確定するものではありません。実際の配信では、回数ごとに時刻や掲載面の構成が違うことが残ります。また、クリックや購入のあとに配信を止める設定がある場合には、「15回以上表示された」という、配信の結果で決まる条件で利用者を選ぶこと自体が偏りを生みえます。さらに確かに知りたい場合は、利用者を無作為に分けて上限を変えた配信を比べる実験が要ります。実験の組み方は第11章で扱います。
フリークエンシーの上限を変えたときに、同じ予算で何が変わるか
次に、同じ記録の表示の機会を時刻の順に並べ、上限を1回から20回、および上限なしまで変えて配信したときの結果を比べました。予算は表示60,000回分で、表示1回の費用を1とした相対値で置いています(費用は機会によらず一定と単純化しました)。上限に達した利用者の機会は見送り、予算が尽きたらその時点で配信を止めます。クリックとコンバージョンは、乱数の揺れを除くために、真の確率を足し合わせた期待値で数えました。クリックのうちコンバージョンに至る割合は、どの表示でも4%としています。
# 3) フリークエンシーの上限を変え、同じ予算(表示1回の費用を1とした相対値)で配信する
budget = 60000
cvr = 0.04
for_cap = [1, 2, 3, 5, 8, 12, 20, None]
import math
uid_s = df["uid"].tolist()
off_s = df["place_off"].tolist()
t_s = df["t"].tolist()
base_l = base.tolist()
rows = []
for cap in for_cap:
    cap_n = 10**9 if cap is None else cap
    cnt = [0] * n_users
    spent = 0
    exp_click = 0.0
    end_day = None
    skipped = 0                                         # 上限を理由に見送った機会の数
    for i in range(len(uid_s)):
        u = uid_s[i]
        if cnt[u] >= cap_n:
            skipped += 1
            continue
        cnt[u] += 1
        spent += 1
        exp_click += 1 / (1 + math.exp(-(base_l[u] + off_s[i] - decay * (cnt[u] - 1))))
        if spent >= budget:
            end_day = t_s[i]                            # 予算を使い切った表示の時刻
            break
    reach = sum(1 for c in cnt if c > 0)
    rows.append(["なし" if cap is None else cap, spent, spent / budget * 100, reach,
                 spent / reach, exp_click, exp_click * cvr, skipped,
                 "-" if end_day is None else f"{end_day:.1f}"])
res = pd.DataFrame(rows, columns=["上限", "表示", "予算の消化(%)", "届いた利用者", "平均の回数",
                                  "クリックの期待値", "コンバージョンの期待値", "上限で見送った機会", "予算が尽きた日"])
print(res.round(2).to_string(index=False))
| 上限 | 表示 | 予算の消化 | 届いた利用者 | 平均の回数 | クリックの期待値 | コンバージョンの期待値 | 上限で見送った機会 | 予算が尽きた日 |
|---|---|---|---|---|---|---|---|---|
| 1回 | 28,492 | 47.49% | 28,492 | 1.00 | 525.22 | 21.01 | 224,148 | 尽きない |
| 2回 | 54,407 | 90.68% | 28,492 | 1.91 | 941.01 | 37.64 | 198,233 | 尽きない |
| 3回 | 60,000 | 100.00% | 25,329 | 2.37 | 929.70 | 37.19 | 54,503 | 6.3日目 |
| 5回 | 60,000 | 100.00% | 22,495 | 2.67 | 834.50 | 33.38 | 14,104 | 4.1日目 |
| 8回 | 60,000 | 100.00% | 21,491 | 2.79 | 787.26 | 31.49 | 4,560 | 3.6日目 |
| 12回 | 60,000 | 100.00% | 21,099 | 2.84 | 765.49 | 30.62 | 1,626 | 3.4日目 |
| 20回 | 60,000 | 100.00% | 20,950 | 2.86 | 754.23 | 30.17 | 380 | 3.3日目 |
| なし | 60,000 | 100.00% | 20,886 | 2.87 | 749.98 | 30.00 | 0 | 3.3日目 |
この例題でクリックの期待値が最も多かったのは上限2回で、941.01でした。コンバージョンの期待値(37.64)と届いた利用者の数(28,492人)も、上限3回以上のどれよりも多くなっています。それでいて表示は54,407回で、予算の90.68%しか使っていません。つまり、この例題では、上限2回は上限3回より少ない費用で、より多くのクリックとコンバージョンの期待値を得ました。上限を3回以上にすると予算は使い切りますが、クリックの期待値は上限3回の929.70から、上限なしの749.98まで、上限を緩めるほど減りました。上限なしでは、上限3回の場合より届いた利用者が少なく(20,886人)、平均の回数が多く(2.87回)なり、予算は3.3日目に尽きました。上限を3回以上にした場合は、どれも期間の途中で予算が尽き、その後に表示の機会のあった利用者には表示できていません。上限1回と上限2回で届いた利用者が最も多い(28,492人)のは、このためです。
上限を1回にすると、表示の機会のあった28,492人全員に1回ずつ表示しても予算の47.49%しか使えず、クリックの期待値は525.22で、上限2回より少なくなりました。上限2回と比べると、上限1回は届いた利用者の数は同じで、2回目の表示で得られたはずのクリックを得ていません。2回目の表示で利益を増やせたのであれば、これは機会損失です。この例題はクリックとコンバージョンの期待値までしか計算していないので、利益を増やせたかどうかは言えません。
上限2回で使い残した予算(約1割)が機会損失になるかどうかは、その予算を使って利益を増やせる別の機会があるかで決まります。例えば、他のキャンペーンや媒体に回して利益を増やせるなら、使い残しを放置することは機会損失になります。別の使い道が無い場合、この例題の範囲では、残りを使い切るために上限を3回以上に緩めても、クリックとコンバージョンの期待値はかえって減りました。予算を使い切ること自体を目的にして上限を緩めると、反応の下がった表示に費用を払うことになりえます。上限は、反応の下がり方から見た上限ごとの見込みと、予算の使い残しの大きさとその使い道を並べて決めるもので、予算を使い切れるかどうかだけでは決まりません。
この表には、読むときの限定条件が3つあります。1つ目に、ここでのコンバージョンは表示のあとに起きたものを数えた件数で、広告が無くても起きたコンバージョンを含みます。広告による増分は第11章で扱います。2つ目に、予算が尽きた日が3〜6日目と早いのは、この例題が第9章のペース配分をかけずに配信しているためです。実際には、上限とペース配分を組み合わせて使います。3つ目に、どの上限が良いかは、真の規則の下がり方(ここでは0.10)と、利用者ごとの機会の数の分布で変わります。この例題で期待値が最も多かった「2回」や、予算を使い切った境界の「3回」という数字には、一般的な意味はありません。
表の「上限で見送った機会」は、上限に達した利用者に表示の機会が来たために見送った件数です(上限1回・2回は14日間の全体、上限3回以上は予算が尽きるまでの件数)。上限に達した利用者がいても、その後に表示の機会が来なければ、上限が見送らせた配信はありません。上限が配信をどれだけ止めているかは、上限に達した利用者の割合ではなく、この見送った件数で見ます。
クリエイティブの出し分け、試しながら決める
次の論点は、複数のクリエイティブのうちどれを多く出すかです。どの表現の反応が良いかは、出してみるまで分かりません。分からないので試す(探索)必要があり、試した結果から良さそうな表現を多く出す(活用)こともしたい、という2つの要求がぶつかります。これは探索と活用のつり合いと呼ばれる問題で、推薦や価格の設定でも同じ構造が現れます(弊社コラム『顧客に合った商品を届けるレコメンドの実践ガイド、協調フィルタリングから推薦の評価と運用まで』、『価格を決める数理モデル、需要曲線の推定からダイナミックプライシングまで』)。
よく使われる方法は2つあります。1つは A/Bテストで、一定の期間は表現を無作為に配分して反応を比べ、その結果で表現を選びます。実務の A/Bテストでは、必要な標本の大きさを先に決め、差が統計的に確かめられた場合だけ切り替える運用もあります。本章の例題では、無作為に配分して比べたあと、観測したクリック率が最も高い1本に固定する単純な方法を使い、統計的に差を確かめてから切り替える運用は扱いません。もう1つはバンディットと呼ばれる方法の一群で、結果が届くたびに配分を少しずつ動かし、良さそうな表現に多く配分しながら、他の表現も確率的に試し続けます。その代表的な方法の1つがトンプソン・サンプリングです。各表現のクリック率について「今の記録から見て、真の値がどのあたりにありそうか」という分布(事後分布)を持ち、表示のたびにその分布から値を1つずつ引いて、最も大きい値が出た表現を出します。記録の少ない表現は分布の幅が広いので、ときどき大きな値が出て試され、記録が増えると分布が狭まって、良い表現に配分が集まります。考え方の起源は Thompson の1933年の論文(2つの未知の確率のどちらが大きいかを、2つの標本の結果から見積もる論文。Biometrika 誌25巻)にさかのぼります。Chapelle と Li の2011年の論文(NIPS 2011)は、模擬のデータと実データでトンプソン・サンプリングを他の方法と比べて評価し、競争力があったと報告しています(NeurIPS の論文ページ)。この結論は、その論文のデータと条件での結果です。
| 観点 | A/Bテストの後に1本に絞る | バンディット(トンプソン・サンプリングなど) |
|---|---|---|
| 目的 | どの表現が良いかを、比べて判定する | 試している間も含めて、得られる反応の合計を大きくする |
| 配分 | 期間中は均等。期間後は1本に固定 | 結果が届くたびに、良さそうな表現へ寄せていく |
| 試すことの費用 | 期間中は劣った表現にも同じだけ配分する | 劣った表現への配分が早く減る |
| 誤って選ぶ危険 | 期間の終わりに1本を選ぶので、差が小さいと誤った表現に固定されることがある | 固定しないので、後から記録が増えれば配分を直せる |
| 結果の説明のしやすさ | 差と区間で説明しやすい(検定の一般論は弊社コラム『データから正しく結論を導く統計学のまとめ』) | 配分が偏るので、表現ごとの差の推定は粗くなる |
| 向いている場面の例 | 表現の違いから学んだことを次の制作に使いたい場合 | 出せる期間が短く、試す間の機会損失を小さくしたい場合 |
A/Bテストとトンプソン・サンプリングを、シードを変えて比べる
2つの方法の違いを、架空のクリエイティブ5本で確かめました。真のクリック率は1.00%・1.10%・1.20%・1.25%・1.40%で、最良はクリエイティブ5です。表示の総数は20万回とし、結果は2,000表示ごとにまとめて反映する(それまでの配分は前回の記録で決める)ことにしました。実際の配信でも、クリックの記録が配分に反映されるまでには時間がかかるためです。比べたのは、20万回を均等に配分し続ける場合、最初の4万回を均等に出す A/Bテストの後に、観測したクリック率が最も高い1本に絞る場合、トンプソン・サンプリング(事前分布は一様なベータ分布)の場合の3つです。1回の乱数の結果で比べると差を見誤るので、乱数の種を20261116から1つずつ変えて100回繰り返し、平均とばらつきで示します。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np

ctr = np.array([0.0100, 0.0110, 0.0120, 0.0125, 0.0140])   # クリエイティブ1〜5の真のクリック率
K = len(ctr)
best = int(np.argmax(ctr))
T, batch = 200000, 2000           # 表示の総数と、結果をまとめて反映する単位
n_batch = T // batch
test_len = 40000                  # A/Bテストの期間(表示の数)
R = 100                           # シードを変えた繰り返しの回数

def run(policy, seed):
    rng = np.random.default_rng(seed)
    imp = np.zeros(K)
    clk = np.zeros(K)
    chosen_ab = None
    regret, share = [], []
    for b in range(n_batch):
        if policy == "均等":
            arms = rng.integers(0, K, batch)
        elif policy == "A/Bテストの後に1本":
            if b * batch < test_len:
                arms = rng.integers(0, K, batch)
            else:
                if chosen_ab is None:
                    chosen_ab = int(np.argmax(clk / imp))
                arms = np.full(batch, chosen_ab)
        else:  # トンプソン・サンプリング(ベータ分布、事前分布は一様)
            draws = rng.beta(1 + clk, 1 + imp - clk, size=(batch, K))
            arms = np.argmax(draws, axis=1)
        n = np.bincount(arms, minlength=K)
        c = rng.binomial(n, ctr)
        imp += n
        clk += c
        regret.append((n * (ctr[best] - ctr)).sum())
        share.append(n[best] / batch)
    return clk.sum(), np.cumsum(regret), np.array(share), imp[best] / T, chosen_ab
policies = ["均等", "A/Bテストの後に1本", "トンプソン・サンプリング"]
out = {}
for pol in policies:
    res = [run(pol, 20261116 + s) for s in range(R)]
    out[pol] = res
    clicks = np.array([r[0] for r in res])
    reg = np.array([r[1][-1] for r in res])
    sh = np.array([r[3] for r in res])
    print(f"{pol}: クリック 平均 {clicks.mean():.1f} 標準偏差 {clicks.std(ddof=1):.1f} | "
          f"失ったクリックの期待値 平均 {reg.mean():.1f} 標準偏差 {reg.std(ddof=1):.1f} 最小 {reg.min():.1f} 最大 {reg.max():.1f} | "
          f"最良の1本への配分 平均 {sh.mean()*100:.1f}% 標準偏差 {sh.std(ddof=1)*100:.1f}%")
    if pol == "A/Bテストの後に1本":
        ch = np.array([r[4] for r in res])
        for k in range(K):
            print(f"  A/Bテストでクリエイティブ{k+1}を選んだ回数: {(ch == k).sum()} / {R}")
    if pol == "トンプソン・サンプリング":
        last = np.array([r[2][-10:].mean() for r in res])
        print(f"  最後の10回の反映(2万表示)での最良への配分 平均 {last.mean()*100:.1f}% 最小 {last.min()*100:.1f}%")
print("最良の1本だけを出し続けた場合のクリックの期待値:", T * ctr[best])
# グラフの描画(失ったクリックの推移と、最良の1本への配分の推移)は省略
「失ったクリックの期待値」は、各表示で、最良の1本を出していれば得られたクリック率と実際に出した表現のクリック率の差を足し上げたもので、最良の表現が分からない状態で配分したことによるクリックの期待値の損失です。試している期間の損失と、誤った表現に固定した期間の損失の両方を含みます。100回の繰り返しの結果は次のとおりです。最良の1本だけを最初から出し続けた場合(実際には、どれが最良かは分からないので取れない選択です)のクリックの期待値は2,800でした。
| 方法 | クリックの件数(平均と標準偏差) | 失ったクリックの期待値(平均と標準偏差) | 失ったクリックの期待値の最小と最大 | 最良の1本に配分した割合(平均と標準偏差) |
|---|---|---|---|---|
| 均等に配分し続ける | 2,387.3(49.3) | 419.9(0.6) | 418.5〜421.2 | 20.0%(0.1%) |
| A/Bテストの後に1本に絞る | 2,646.1(134.6) | 159.2(126.1) | 83.2〜404.3 | 62.4%(35.7%) |
| トンプソン・サンプリング | 2,678.8(66.5) | 116.3(52.8) | 40.2〜333.3 | 72.6%(14.5%) |
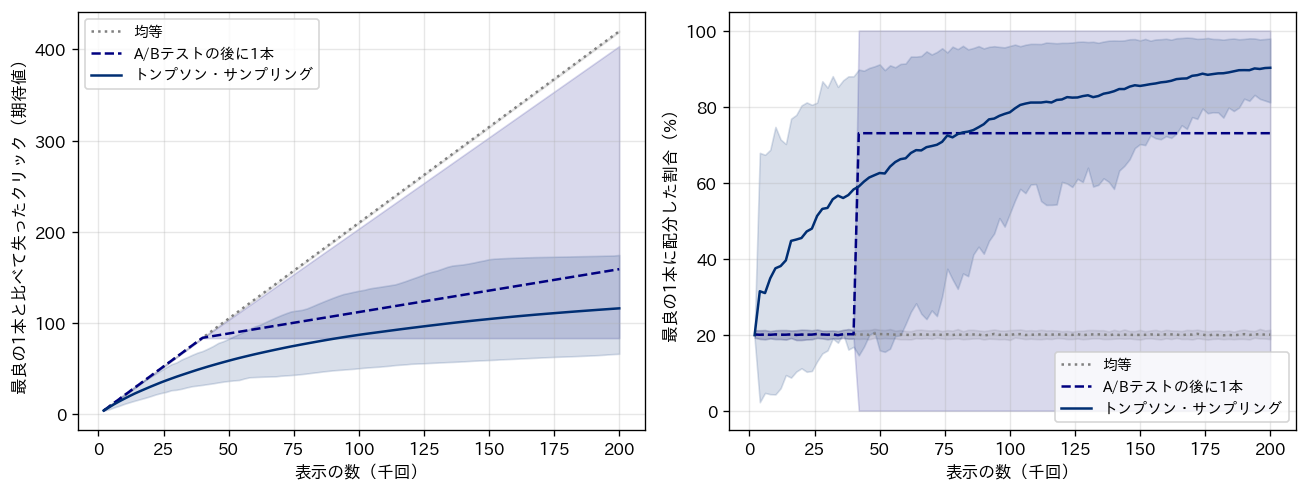
図の線は100回の平均で、薄い帯は100回のうち10%点から90%点の範囲です。帯は方法ごとに線と同じ色で塗っていますが、重なっている部分があります。A/Bテストの後に1本に絞る方法の帯は、左の図では上端がおよそ400まで、右の図では0%から100%まで広がっています。
この例題では、失ったクリックの期待値の平均は、トンプソン・サンプリングが116.3で最も少なく、A/Bテストの後に1本に絞る方法が159.2、均等に配分し続ける方法が419.9でした。違いが大きく出たのはばらつきです。A/Bテストの後に1本に絞る方法では、100回のうち73回は最良のクリエイティブ5を選びましたが、13回はクリエイティブ3を、14回はクリエイティブ4を選び、その回は残りの16万回を劣った表現に固定しました。そのため失ったクリックの期待値は最小83.2から最大404.3まで広がり、標準偏差は126.1でした。真のクリック率の差が1.25%と1.40%のように小さいと、4万回の表示(1本あたり8,000回)では、どれが最良かを取り違えることがかなりの割合で起きます。
トンプソン・サンプリングでも、配分が最良の1本に集まる速さは回によって違いました。最後の2万表示で最良の1本に配分した割合は、100回の平均で89.6%でしたが、最も低い回は17.6%で、その回はまだ他の表現に多く配分していました。差の小さい表現どうしを見分けるには、どの方法でも多くの表示が要ります。バンディットは、その間の配分を劣った表現から早く減らす方法であって、少ない表示で正しく見分けられる方法ではありません。この比較は、表現のクリック率が期間中に変わらず、結果が2,000表示ごとに遅れなく届くという、単純な条件での結果です。
何を報酬にするかで、選ばれる表現が変わる
バンディットは、与えられた報酬を大きくするように配分を動かします。報酬をクリックにすれば、クリックの多い表現に配分が集まります。しかし、序章から繰り返し述べているとおり、クリック率の高さはそのまま成果ではありません。クリックは多いがコンバージョンに至りにくい表現や、コンバージョンは多いが1件あたりの価値が低い表現もありえます。
これを確かめるために、架空のクリエイティブA〜Dを作りました。Bはクリック率が2.0%と最も高いがコンバージョン率が2.5%と低い表現、Cはコンバージョンの件数が最も多い表現、Dはクリック率は1.0%と最も低いが、コンバージョン1件の価値(相対値)が1.6と高い表現です。価値の違いは、例えば表現によって申し込まれる商品の構成が違う場合を想定しています。報酬をクリック・コンバージョン・価値の3通りに変えて、それぞれトンプソン・サンプリングで100万表示を配分し(1万表示ごとに反映)、シードを変えて50回繰り返しました。単純にするため、コンバージョンは遅れなく観測でき、1件の価値は表現ごとに分かっているものとしました。遅れて届くコンバージョンの扱いは第5章で扱っています。4本の設定は次の表のとおりです。表示あたりの値は、クリック率とコンバージョン率と1件の価値を掛けたもので、表示1万回あたりに直しています。コンバージョンや価値を報酬にするときにコードが見積もるのは、表示1回からコンバージョンに至る確率で、これはクリック率とクリック後のコンバージョン率の積にあたります。
| クリエイティブ | クリック率 | コンバージョン率 | コンバージョン1件の価値(相対値) | 表示1万回あたりのコンバージョン | 表示1万回あたりの価値 |
|---|---|---|---|---|---|
| A | 1.2% | 5.0% | 1.0 | 6.00 | 6.000 |
| B | 2.0% | 2.5% | 1.0 | 5.00 | 5.000 |
| C | 1.4% | 6.0% | 0.8 | 8.40 | 6.720 |
| D | 1.0% | 6.0% | 1.6 | 6.00 | 9.600 |
クリック率はBが、表示1万回あたりのコンバージョンはCが、表示1万回あたりの価値はDが最も高く、Bは表示1万回あたりのコンバージョンでも価値でも4本のうち最も低い表現です。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np

# クリエイティブA〜D:クリック率・コンバージョン率・コンバージョン1件の価値(相対値)
name = np.array(["A", "B", "C", "D"])
ctr = np.array([0.012, 0.020, 0.014, 0.010])
cvr = np.array([0.050, 0.025, 0.060, 0.060])
val = np.array([1.0, 1.0, 0.8, 1.6])
T, batch, R = 1000000, 10000, 50
n_batch = T // batch

def run(reward, seed):
    rng = np.random.default_rng(seed)
    imp = np.zeros(4); clk = np.zeros(4); cv = np.zeros(4)
    tail = np.zeros(4)
    for b in range(n_batch):
        if reward == "クリック":
            d = rng.beta(1 + clk, 1 + imp - clk, size=(batch, 4))
        else:
            d = rng.beta(1 + cv, 1 + imp - cv, size=(batch, 4))   # 表示1回からコンバージョンに至る確率
            if reward == "価値":
                d = d * val                                       # 1件の価値は既知とする
        n = np.bincount(np.argmax(d, axis=1), minlength=4)
        c = rng.binomial(n, ctr)
        v = rng.binomial(c, cvr)
        imp += n; clk += c; cv += v
        if b >= n_batch * 0.8:
            tail += n
    return clk.sum(), cv.sum(), (cv * val).sum(), tail / tail.sum()

for reward in ["クリック", "コンバージョン", "価値"]:
    res = [run(reward, 20261116 + s) for s in range(R)]
    c = np.array([r[0] for r in res]); v = np.array([r[1] for r in res]); w = np.array([r[2] for r in res])
    sh = np.array([r[3] for r in res])
    print(reward, c.mean(), c.std(ddof=1), v.mean(), v.std(ddof=1), w.mean(), w.std(ddof=1), sh.mean(0))
掲載したコードは、実行に使ったスクリプトから表現ごとの率の表示と出力の整形を省いたもので、計算の手順と乱数の使い方は同じです。結果は次のとおりです(50回の平均。かっこ内は標準偏差)。表の「最後の2割の配分」は、100万表示のうち最後の20万表示で、各表現に配分した割合の平均です。
| 報酬 | クリックの件数 | コンバージョンの件数 | 価値の合計(相対値) | 最後の2割の配分 |
|---|---|---|---|---|
| クリック | 19,909(153) | 493.8(23.9) | 494.1(23.8) | B 99.9% |
| コンバージョン | 13,864(243) | 796.5(36.1) | 675.7(33.5) | C 94.0%・A 2.8%・D 2.1%・B 1.0% |
| 価値 | 10,765(615) | 614.5(40.0) | 906.0(63.4) | D 95.7%・C 2.4%・A 1.2%・B 0.7% |
報酬をクリックにすると、50回すべてで配分がBに集まり、クリックの件数は3通りのうち最も多い19,909でした。しかし、Bは表示あたりのコンバージョンが4本のうち最も少ない表現で、コンバージョンの件数は493.8、価値の合計は494.1と、3通りのうちどちらも最も少なくなりました。報酬をコンバージョンにすると配分は50回すべてでCに集まり、コンバージョンの件数は796.5で最も多くなりました。報酬を価値にすると、50回のうち49回で最後の2割にDを最も多く出し、価値の合計は906.0で最も大きくなりました。そのとき、クリックの件数は10,765で3通りのうち最も少なくなっています。
3つの報酬のどれを選んでも、その報酬の上では最も良い結果になり、他の報酬の上では劣る結果になりました。配分の方法が正しく働くほど、選んだ報酬に忠実に配分が寄ります。したがって、表現を評価する指標を何にするかは、配分の方法を選ぶより先に決めておく必要があります。3つのうち事業の利益に最も近いのは価値ですが、価値やコンバージョンを報酬にすると、件数がクリックよりずっと少ないので、配分が定まるまでに多くの表示が要ると考えられます。この例題では、価値を報酬にした場合のクリックの件数の標準偏差が615と、3通りのうち最も大きくなりました。ただし、この値はクリックの総数のばらつきで、配分が定まる速さを直接示すものではありません。さらに、ここでのコンバージョンの件数と、その件数に1件の価値を掛けた合計は、配信後の観測にもとづく量であり、広告による増分ではありません。表現の違いが増分にどう効くかは、第11章の実験の考え方で確かめる必要があります。
新しいクリエイティブ・表現の疲れ・配信の対象の設定
実際の配信では、表現の候補は途中で増えます。新しいクリエイティブを足すと、その表現にはまだ記録がありません。トンプソン・サンプリングでは、記録の無い表現の分布は幅が広いので自然に試されますが、既存の表現に多くの記録がある場合、新しい表現が十分に試される前に配分が減ることもあります。新しい表現に一定の表示を先に割り当てる、似た表現の実績を事前分布の目安にする、といった扱いが考えられます。どちらも、新しい表現をどれだけ試すかという費用を、先に決めておく考え方です。新しい広告に実績が無い場合の扱いは、予測の側からは第4章でも触れています。
表現の疲れは、同じ利用者に繰り返し見せたときの反応の低下(この章の前半)とは別に、同じ表現を長く出し続けると、全体の反応が時間とともに下がっていく現象を指して使われることがあります。表現の反応が時間とともに変わる場合、前節の例題のような「反応は変わらない」という前提は崩れます。古い記録の重みを小さくする、一定の期間ごとに記録を区切って見直す、といった調整が要ります。差し替えの判断は、表現ごとのクリック率やコンバージョン率の推移を見ながら、利用者の構成の変化(季節や配信の対象の変更)と表現そのものの疲れとを分けて考えます。前半の回数の集計と同じく、集計に入る利用者の構成が変わっていないかを確かめることが先です。
配信の対象の設定(ターゲティング)を絞ると、反応しやすい利用者に表示が集まり、クリック率やコンバージョン率の見た目は上がることがあります。しかし、絞った分だけ表示の機会が減り、対象の外にいた、利益を増やせたはずの機会を逃す(機会損失)、あるいは同じ利用者に表示が重なってフリークエンシーが上がる(過剰な接触)ことにつながります。さらに、反応しやすい利用者は、広告が無くてもコンバージョンする利用者であることも多く、率の見た目の改善が増分の改善とは限りません(成果の数え違い)。絞り方を変えたときは、率だけでなく、届いた利用者の数・平均の回数・予算の消化も並べて見ることが必要です。
利用者の側から見た過剰な接触と不快な表現
回数と表現の制御は、広告主の効率の問題であると同時に、利用者の体験の問題です。同じ広告を短い期間に何度も見せられること、画面の操作を妨げる表示、音の出る自動再生などは、利用者の不快につながり、広告のブロックや媒体からの離脱を招くこともあります。業界の取り組みの例として、Coalition for Better Ads は、15万人を超える消費者への調査をもとに、受け入れられにくい広告の体験を定めた基準(Better Ads Standards)を公表しています。そこでは、パソコンのウェブ向けにポップアップの広告・音の出る自動再生の動画広告・大きな追従型の広告など6種類、スマートフォンのウェブ向けにポップアップの広告・広告の占める割合が30%を超えるページ・点滅するアニメーションの広告など10種類が挙げられています(2026年11月16日に基準のページで確認。Coalition for Better Ads の基準のページ)。
この基準は表示の形式についてのもので、フリークエンシーの上限の回数を定めたものではありません。ただ、反応の数字に表れない利用者の不利益があることを、表現と回数の設計の前提に置くうえで参考になります。過剰な接触によるブランドへの印象の悪化は、管理画面の指標では見えにくい損失として懸念されます(信頼の毀損)。識別子を使って回数を数えることや、利用者の情報を配信に使うことに関わる法令とガイドラインは、第14章で扱います。
制御の指標と、点検の仕方
回数と表現の制御を点検するために、少なくとも次の指標を並べて見ることを考えています。どの指標も単独では成果を表しません。表の右の列は、その指標が動いたときに疑うべきことです。
| 指標 | 何を表すか | 見るときの注意 |
|---|---|---|
| 平均のフリークエンシー | 届いた利用者1人あたりの表示の回数 | 平均は少数の利用者への集中を隠す。回数の分布と併せて見る |
| 回数の分布 | 1回・2〜3回・4回以上などの帯ごとの利用者の数と表示の割合 | 上限に達した利用者の割合だけでは、上限が配信を止めたとは言えない。上限を理由に見送った機会の件数と割合を併せて見る |
| 届いた利用者の数 | 期間中に1回以上表示した利用者の数(リーチ) | 識別子が使えない環境では推定値になる |
| 回数ごとの反応 | 何回目の表示かごとのクリック率・コンバージョン率 | 素朴な集計は利用者の構成の違いを含む。同じ利用者の集団の中で比べる集計を併せて見る(これも記述的な点検で、疲れの効果を確定するものではない) |
| 予算の消化 | 予算のうち使った割合と、予算が尽きた時刻 | 上限を厳しくすると使い残しが出ることがある。使い残した予算に、利益を増やせる別の使い道があるかと併せて見る。ペース配分(第9章)も併せて見る |
| クリエイティブごとの配分 | 各表現に配分した表示の割合とその推移 | 配分が1本に固まった時期と、固まった表現を記録する |
| クリエイティブごとの反応 | 表現ごとのクリック率・コンバージョン率・価値 | 報酬にしていない指標も並べる。報酬に選んだ指標だけが良くなっていないかを見る |
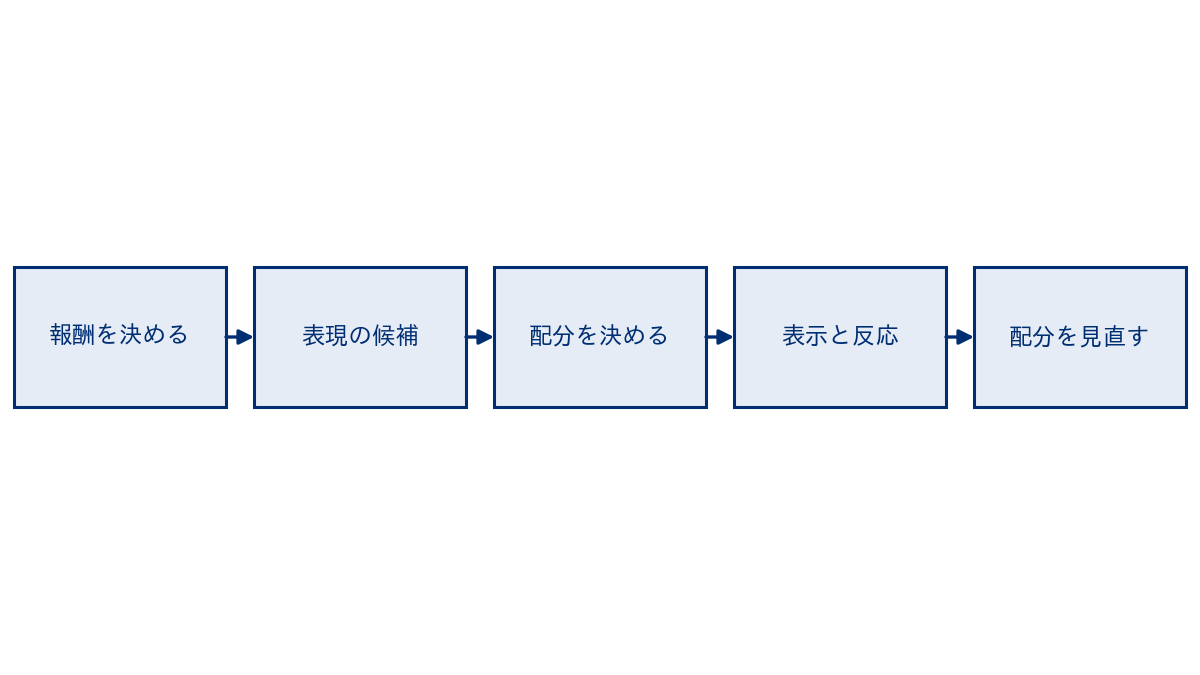
点検の仕組みが働かない状態の典型は、上限やバンディットの設定を最初に決めたまま、配分と反応の推移を誰も見ていない状態です(形骸化)。上限が厳しすぎて、反応が見込める表示まで逃していても、管理画面ではクリック率が高く見えるため、問題として扱われないことがあります。逆に、上限なしで配信して少数の利用者に表示が集中していても、平均のフリークエンシーだけを見ていると気づけません。指標は、点検する担当と頻度を決めて初めて働きます。
経営の判断、接触の回数の上限と報酬を事業として決める
この章の内容を経営の判断に落とすと、決めることは2つです。1つは、同じ利用者への接触の回数の上限です。これは広告運用の担当者が設定する数字ですが、反応の下がり方だけでなく、使い残した予算に別の使い道があるか、利用者に過剰な接触をさせていないか、という事業とブランドの判断を含みます。もう1つは、クリエイティブを評価する指標、つまりバンディットやA/Bテストで何を報酬にするかです。この章の例題で見たとおり、クリックを報酬にすれば、コンバージョンや価値で劣る表現が選ばれることがあります。
| 決めること | 決める根拠 | 判断を誤ったときの損失の型 | 見直す時期の例 |
|---|---|---|---|
| 接触の回数の上限と、その期間の単位 | 同じ利用者の集団で見た反応の下がり方、予算の消化、利用者の体験 | 払いすぎ・機会損失・信頼の毀損 | 新しいキャンペーンの開始時、予算の使い残しや配信の集中が出たとき |
| クリエイティブを評価する報酬 | コンバージョンの価値の定義(第7章)と、件数の多さ | 成果の数え違い・払いすぎ | コンバージョンの定義や価値を変えたとき |
| 試す費用の上限 | 出せる期間と、表現の差の大きさの見込み | 機会損失 | 新しい表現を足すとき |
| 表現と配信の対象の基準 | 業界団体の基準や自社のブランドの方針 | 信頼の毀損・規制上の義務の不履行 | 定期的に、および利用者からの苦情があったとき |
| 点検の担当と頻度 | 制御の指標の表 | 形骸化 | 体制や委託先を変えたとき |
報酬の選び方は、コンバージョンの件数が少ない事業ほど難しくなります。価値を報酬にすべきだと分かっていても、件数が少なければ配分が定まりません。その場合、クリックを報酬にしつつ、コンバージョン率や価値で大きく劣る表現を候補から外す、一定の期間ごとにコンバージョンの実績で表現を見直す、といった折衷が考えられます。どの折衷を選ぶにしても、何を報酬にしているかを明示し、報酬にしていない指標を併せて報告する仕組みを持つことが、報酬にした指標の改善を事業の成果と取り違えないための最低限の手当てだと考えています。
この章では、同じ利用者への表示の回数とクリエイティブの出し分けという、入札額とは別の配信の制御を扱いました。回数ごとの反応の素朴な集計は利用者の構成の違いで偏ることがあり、上限は予算を使い切れるかどうかではなく、上限ごとの反応の見込みと、使い残した予算の大きさとその使い道を並べて決めること、出し分けでは配分の方法より先に報酬を決める必要があることを、架空データで確かめました。ここまでの章で見てきたクリックや配信後のコンバージョンの件数だけでは、広告による増分は分かりません。コンバージョンには、広告が無くても起きた分が含まれる可能性があります。次の第11章では、広告によって増えた分をどう測るかを扱います。
この章を深めたい方への参考書籍
『バンディット問題の理論とアルゴリズム』(本多淳也、中村篤祥 著、講談社):講談社の機械学習プロフェッショナルシリーズの1冊として2016年に刊行された、探索と活用の問題を扱う日本語の教科書です。この章で使ったトンプソン・サンプリングを含む方策が、どのような前提で、どの程度の損失で済むと示されているかを確かめるときに参考になります。
『Bandit Algorithms』(Tor Lattimore、Csaba Szepesvári 著、Cambridge University Press):2020年に刊行された、バンディットの理論を体系的にまとめた英語の本です。結果が遅れて届く場合や、反応が時間とともに変わる場合など、この章の例題で単純化した条件を外したときの扱いを調べるときの手がかりになります。
第11章 広告の効果の測り方、アトリビューションと増分の検証
第10章では、同じ利用者に何回見せるかと、どの表現を見せるかを、配信の中で制御する方法を扱いました。そこまでの章は、予測・入札・予算・配信の制御のどれも、「その広告から得られる価値」(表示の価値)を見積もる前提で組み立ててきました。この見積りは、広告が無くても起きたコンバージョンを除いていません。この章では、広告で実際に増えた分を後から測る方法を扱います。本コラムで成果と呼ぶのは増分の利益、つまり広告を出したことで増えたコンバージョンの価値(粗利)から広告費を引いた差です。この章は、その定義が何を意味し、どう測るのかを示す章でもあります。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の利用者の記録を使い、実行したコードと結果で確かめます。
- 管理画面のコンバージョンの数が「広告に割り振られた件数」であり、「広告で増えた件数」ではないこと
- アトリビューションの規則の種類と、規則が変わると媒体ごとの件数が変わること
- 選択の偏り:配信の仕組みが、もともとコンバージョンしやすい利用者に表示を寄せること
- 架空の利用者で、割り振った件数・見た利用者と見なかった利用者の差・実験の差を、真の増分と比べた結果
- 無作為化の実験の作り方(配信しない群・代わりの広告・表示されるはずだった利用者の記録・地域で分ける実験)
- 実験に要る規模と検出力、観察データと実験を比べた研究
- 増分にもとづく入札の考え方と、架空データでの比較
- 効果の測定に使う指標の表、実験ができないときの次善の方法、経営の判断
この章の主張は2つあります。1つ目は、管理画面に出るコンバージョンの件数や、そこから計算した CPA と ROAS は、規則にもとづいて割り振った結果であって、広告で増えたコンバージョンの大きさではない、という点です。2つ目は、広告で増えたコンバージョン、つまり増分を見積もるには、広告を出さない比較の相手を無作為に作る実験が、選択の偏りを抑えられる有力な方法であり、広告による上乗せが小さく結果のばらつきが大きい場合には、その実験に大きな規模が要る、という点です。観察データによる推定もありますが、追加の仮定が要ります。本コラムの架空データ(配信・クリック・上乗せの設定)では、最後のクリックで割り振った件数は真の増分のおよそ7倍、見た利用者と見なかった利用者の差から計算した値はおよそ8倍になりました。
管理画面のコンバージョンは「割り振られた件数」である
媒体や計測の事業者の管理画面には、キャンペーンごとのコンバージョンの件数が出ます。この件数は、利用者がコンバージョンに至る前に接触した広告に、そのコンバージョンを結びつけて数えたものです。ここでのコンバージョンは、広告主が目標として定めた利用者の行動(購入・申込など)で、コンバージョンが起きたこと自体は、広告で利益が増えたことを意味しません。この結びつけの規則をアトリビューションと呼びます。第2章で見たとおり、何をコンバージョンとするか、クリックや表示のあと何日までを数えるか(計測期間)、重複をどう除くかで件数は変わります。アトリビューションは、さらにその上で「どの広告に何件を割り振るか」を決める規則です。
ここで大事なのは、アトリビューションは規則であって、広告がコンバージョンを起こしたことの証明ではない、という点です。ある利用者が広告をクリックしてから購入したとしても、その利用者が広告が無くても購入していたのであれば、その購入は広告によって増えたものではありません。例えば、自社の商品名で検索した利用者が、検索結果の広告をクリックして購入した場合を考えます。この利用者は、広告が無ければ、そのすぐ下に出る自然検索の結果から同じサイトに来ていた可能性があります。アトリビューションの規則は、この購入を広告に割り振ります。
これに対して増分は、広告を出した場合と出さなかった場合の、コンバージョン(またはその価値)の差です。インクリメンタリティとも呼ばれます。同じ利用者について、広告を出した場合と出さなかった場合の両方を観測することはできないので、増分は直接には数えられず、実験などで見積もる値になります。広告が無くても同じ行動をとる利用者ばかりに表示した場合には、増分は0に近くなります。増分は0や負になることもあります。本コラムでは、管理画面に出る件数を「割り振られたコンバージョン」、実験などで見積もった差を「増分のコンバージョン」と呼び分けます。
| 比べる点 | 割り振られたコンバージョン | 増分のコンバージョン |
|---|---|---|
| 何を表すか | 規則にもとづいて、その広告に結びつけた件数 | 広告を出したことで増えた件数 |
| どう得るか | 媒体や計測の事業者の記録を、アトリビューションの規則で集計する | 広告を出さない比較の相手を作る実験などで見積もる |
| いつ分かるか | 毎日の集計で分かる(計測期間の途中でコンバージョンが起きていなくても、期間のうちに起きないとは確定できないので、後から件数が増えることがある) | 実験の期間が終わり、結果が出そろってから分かる |
| 規則や設定で変わるか | 計測期間・アトリビューションの規則・重複の除き方で変わる | アトリビューションの規則には依存しない。ただし、コンバージョンの定義・観測の期間・対象の利用者・比較の条件を変えると、測る増分そのものが変わる。標本の大きさで見積りの精度が変わる |
| 広告が無くても起きたコンバージョン | 含まれる | 含まれない(差を取るので打ち消される) |
| 答えられる問い | どの広告に接触した利用者が、コンバージョンに至ったか | この広告を止めたら、コンバージョンは何件減るか |
表の最後の行が、2つの違いを最もよく表しています。広告を続けるか止めるかを決めるときに知りたいのは、「この広告を止めたら何件減るか」、つまり増分です。予算を少し増やすか減らすかを決めるには、それに加えて、支出の水準を変えた場合の追加の増分も確かめる必要があります。割り振られた件数は、どちらの問いにも答えるようには作られていません。CPA(広告費÷広告に割り振られたコンバージョンの件数)と ROAS(広告に割り振られた売上÷広告費)も、どちらもアトリビューションで割り振った件数や売上を使う指標なので、同じ限界を持ちます。
アトリビューションの規則と、規則で変わる件数
利用者は、コンバージョンに至るまでに複数の広告に接触することがあります。例えば、ある日に動画の広告を見て、翌日に SNS の広告をクリックし、数日後に検索連動型広告をクリックして購入した、という場合です。この購入を、どの広告に何件ずつ割り振るかを決めるのがアトリビューションの規則です。代表的な規則を表にまとめます。
| 規則 | 割り振り方 | 件数が多く出やすい広告 | 注意すること |
|---|---|---|---|
| 最後のクリック | コンバージョンの直前にクリックされた広告に1件をすべて割り振る | 購入の直前に使われる広告(自社名の検索など) | 購入の意思が固まった後の接触に件数が集まる |
| 最初のクリック | 最初にクリックされた広告に1件をすべて割り振る | 最初の接点になりやすい広告 | その後の接触の役割が見えない |
| 均等 | 経路上の広告に均等に分ける | 接触の回数が多い広告 | 接触の重みの違いを考えない |
| 時間で減らす | コンバージョンに近い接触ほど多く割り振る | 購入の直前の広告 | 減らし方の速さは決めの問題 |
| データにもとづく配分 | 過去の経路のデータから、接触ごとの貢献を計算して割り振る | 計算の方法による | 計算の中身は提供する事業者の方法による。割り振りであることは変わらない |
規則が違えば、同じ記録から計算した媒体ごとの件数が変わります。最後のクリックの規則では、購入の直前に使われやすい広告に件数が集まり、最初のクリックの規則では、最初の接点になりやすい広告に件数が集まります。どの規則も、全体の件数をどう分けるかを決めているだけで、全体の件数のうち広告が無くても起きた分を取り除くものではありません。規則を変えて媒体ごとの CPA が良く見えるようになったことだけでは、増分の利益が増えたとは判断できません。
媒体の提供する規則の種類は変わることがあります。例えば、Google 広告のヘルプのアトリビューション モデルの説明(2026年11月に確認)では、現在選べるモデルはデータドリブンとラストクリックで、ファースト クリック・線形・減衰・接点ベースのモデルはサポートが終了し、それらを使っていたコンバージョン アクションはデータドリブンに切り替わった、と書かれています。データにもとづく配分の計算の中身は、媒体の公式ヘルプに書かれている範囲を超えて推測しないことにします。本章で押さえたいのは、どの規則も割り振りの規則である、という点です。
媒体ごとに別々の管理画面で件数を見る場合には、もう1つの問題があります。それぞれの媒体が、自分の広告に接触した利用者のコンバージョンを自分の規則で数えるので、同じ1件の購入が複数の媒体の管理画面で数えられることがあります。媒体ごとの件数を足し合わせると、実際のコンバージョンの件数を超えることがあるのはこのためです。媒体をまたいで、どの媒体の広告が売上にどれだけ効いたかを分けて見積もる方法(マーケティング・ミックス・モデリング)は、弊社コラム『広告の効果を測るマーケティング・ミックス・モデリング、効果の分解から広告予算の最適配分まで』で扱っています。
選択の偏り、配信の仕組みはコンバージョンしやすい利用者に表示を寄せる
割り振られた件数や素朴な比較が増分とずれる理由の1つが、選択の偏りです。第4章から第7章で見たとおり、入札のモデルは、予測コンバージョン率の高い表示の機会ほど表示の価値を高く見積もり、高く入札します。予測コンバージョン率が高いのは、例えば最近何度もサイトを訪れている利用者や、商品を比較している最中の利用者への表示です。こうした利用者は、広告が無くてもコンバージョンする確率がもともと高いことが多いと考えられます。
その結果、広告を見た利用者の集団は、見なかった利用者の集団と比べて、もともとコンバージョンしやすい利用者に偏ります。この2つの集団で、コンバージョンした利用者の割合を比べると、差には広告の効果だけでなく、集団の違いが混ざります。どちらがどれだけ大きいかは配信と広告によって違い、本章の例題では集団の違いが差の大部分を占めました。広告を見たか見なかったかは、無作為に決まったのではなく、配信の仕組みが利用者の性質にもとづいて選んだ結果だからです。年齢や性別のような属性で集団をそろえても、配信の仕組みが使っている情報(閲覧の履歴など)をすべてそろえることは難しく、偏りが残ります。
この偏りは、入札のモデルの性能が良いほど強くなる場合がある点に注意が要ります。予測にもとづいて入札する配信で、予測が正確になるほど、もともとコンバージョンする利用者に配信が集中する場合には、割り振られる件数も、見た利用者と見なかった利用者の差も大きくなりえます。一方で、その利用者たちへの広告による上乗せが小さければ、増分は増えません。予測の改善がいつもこの集中を強めるとは限りませんが、予測の性能を上げることと、増分の利益を上げることは、同じではありません。選択の偏りと効果検証の一般論は、弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』で扱っています。
架空の利用者で、割り振った件数と増分を比べる
ここからは、割り振った件数と増分の違いを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の配信の記録よりずっと単純です。合成データでの結果は、実際の広告での結果の目安にはなりません。示したいのは、配信の偏りがあるときに、それぞれの見積り方がどう外れるかという点です。合成データなので、利用者ごとの「広告が無くてもコンバージョンする確率」(以下、もとの確率)と「広告による上乗せ」が分かり、真の増分を計算できます。
この例題では、利用者100万人を、次の性質を持たせて乱数で作りました(乱数の種は20261116に固定しています)。コードは Python 3.14.3 で実行し、グラフの日本語の表示には japanize-matplotlib 1.1.3 を使いました。1人の利用者は、キャンペーンの期間に表示されるかされないかのどちらかとし、表示の回数は扱いません。コンバージョンは1人につき最大1件とします。
- 利用者の側の項目:過去30日の訪問の回数・直近の訪問からの日数・端末の種類(パソコンかスマートフォンか)。個人を特定する項目や、配慮の要る属性は入れていません
- もとの確率:訪問の回数が多く、直近に訪れた利用者ほど高い。パソコンでは訪問の回数がより強く効く(項目どうしの組み合わせ)
- 広告による上乗せ:訪問の少ない利用者ほど大きく、訪問の多い利用者では小さい(最大で0.4ポイント)
- 配信しない群:利用者の20%を無作為に選び、広告を表示しない
- 配信の偏り:配信の仕組みが表示を選ぶ確率は、もとの確率が高いほど高い。配信しない群でも「配信の仕組みが選んだはずだったか」を記録しておく
- クリック:表示された利用者のうち、コンバージョンする利用者は50%、しない利用者は2%の確率で広告をクリックする(購入の直前に広告をクリックしてサイトに来る行動を単純化したもの)
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261116)
N = 1_000_000
d = pd.DataFrame({
    "visits": rng.poisson(2.0, N),                 # 過去30日の訪問の回数
    "recency": rng.integers(1, 31, N),             # 直近の訪問からの日数
    "pc": (rng.random(N) < 0.3).astype(int),       # 端末の種類(1=パソコン、0=スマートフォン)
})
logit0 = (-5.0 + 0.45 * d.visits - 0.04 * d.recency + 0.3 * d.pc
          + 0.15 * d.visits * d.pc)                # 訪問の回数と端末の組み合わせが効く
d["p0"] = 1 / (1 + np.exp(-logit0))                # 広告が無くてもコンバージョンする確率(もとの確率)
d["tau"] = 0.004 * np.exp(-0.3 * d.visits)         # 広告による上乗せ(訪問の少ない利用者ほど大きい)
d["holdout"] = rng.random(N) < 0.2                 # 無作為に選んだ配信しない群(20%)
d["would"] = rng.random(N) < np.clip(0.1 + 6 * d.p0, 0, 0.95)  # 配信の仕組みが表示を選ぶか(もとの確率が高いほど選ばれやすい)
d["exposed"] = d.would & ~d.holdout               # 配信しない群には表示しない
d["conv"] = rng.random(N) < np.where(d.exposed, d.p0 + d.tau, d.p0)
d["click"] = d.exposed & (rng.random(N) < np.where(d.conv, 0.5, 0.02))  # コンバージョンする利用者は広告をクリックして来やすい
print(f"利用者 {N:,}人 / 表示した利用者 {d.exposed.sum():,}人 / 期間内にコンバージョンした利用者の割合 {d.conv.mean():.4f}")
print(f"もとの確率の平均  表示した利用者 {d.p0[d.exposed].mean():.4f}  表示しなかった利用者(配信する群) {d.p0[~d.exposed & ~d.holdout].mean():.4f}")
実行すると、利用者100万人のうち表示された利用者は153,374人で、期間内にコンバージョンした利用者の割合は全体で0.0157でした。本章の例題と実験の比較では、コンバージョン率と呼ばずに、利用者の数を分母にした「コンバージョンした利用者の割合」を使います(本コラムの定義のコンバージョン率は、クリックを分母にします)。もとの確率の平均は、表示された利用者で0.0269、配信する群で表示されなかった利用者で0.0129でした。配信の仕組みが、もとの確率が2倍ほど高い利用者に表示を寄せていることが分かります。
次に、表示された利用者で増えたコンバージョンの件数として示される4つの値を、真の増分と比べます。4つのうち2つ(割り振りと、偏りうる素朴な比較)は増分の見積りではなく、残りの2つが実験による増分の見積りです。3つ目と4つ目の無作為化の実験は、利用者を配信する群と配信しない群に無作為に割り付け、同じ定義と期間で、割り付けた群どうしを比べる方法で、実際に広告が表示された利用者だけを取り出して比べる方法(2つ目)とは区別します。
- 最後のクリックで割り振った件数:この例題では他の広告が無いので、表示されてクリックしたうえでコンバージョンした件数になります(増分の見積りではありません)
- 見た利用者と見なかった利用者の率の差:配信する群の中で、表示された利用者と表示されなかった利用者の、コンバージョンした利用者の割合の差に、表示された人数を掛けた値です(増分の見積りではありません)
- 実験で群の全体の差を割り戻した値:配信する群と配信しない群の全体どうしの、コンバージョンした利用者の割合の差を、配信する群で表示された割合で割り戻します。配信する群には表示されなかった利用者も含まれて差が薄まっているので、表示された割合で割ると、表示された利用者1人あたりの差に戻せます(表示されなかった利用者には広告の影響が無い、という前提です)
- 実験で表示されるはずだった利用者どうしの差:両方の群で「配信の仕組みが表示を選んだはずだった利用者」だけを取り出して比べます。表示を選んだはずだったかどうかは、群への割り付けとは関係なく決まり、両方の群で同じ基準で記録しているので、この比較も割り付けた群どうしの比較になり、偏りが入りません
# 4つの見積りを、表示した利用者に生じた真の増分(上乗せの合計)と比べる
n_exp = d.exposed.sum()
true_inc = d.tau[d.exposed].sum()
last_click = (d.exposed & d.conv & d.click).sum()            # (1) 最後のクリックで割り振った件数
treat = d[~d.holdout]
naive = (treat.conv[treat.exposed].mean() - treat.conv[~treat.exposed].mean()) * n_exp  # (2) 見た人と見なかった人の差
ctrl = d[d.holdout]
itt = treat.conv.mean() - ctrl.conv.mean()                    # (3) 群の全体どうしの差を、表示した割合で割り戻す
exp_rate = treat.exposed.mean()
se_itt = np.sqrt(treat.conv.var() / len(treat) + ctrl.conv.var() / len(ctrl))
ghost_t = treat.conv[treat.would]                             # (4) 配信しない群でも「表示されるはずだった」利用者を記録して比べる
ghost_c = ctrl.conv[ctrl.would]
ghost = ghost_t.mean() - ghost_c.mean()
se_g = np.sqrt(ghost_t.var() / len(ghost_t) + ghost_c.var() / len(ghost_c))
rows = [
    ("最後のクリックで割り振った件数", last_click, np.nan),
    ("見た利用者と見なかった利用者の率の差", naive, np.nan),
    ("実験:群の全体の差を割り戻す", itt / exp_rate * n_exp, 1.96 * se_itt / exp_rate * n_exp),
    ("実験:表示されるはずだった利用者どうしの差", ghost * n_exp, 1.96 * se_g * n_exp),
    ("真の増分(合成データなので分かる)", true_inc, np.nan),
]
res = pd.DataFrame(rows, columns=["方法", "増えた件数として示された値", "95%区間の半幅"])
res["真の増分に対する倍率"] = res["増えた件数として示された値"] / true_inc
print(res.round(2).to_string(index=False))
実行した結果は次のとおりです。真の増分は、表示された利用者についての上乗せの合計(期待値)です。
| 方法 | 増えた件数として示された値 | 95%区間の半幅 | 真の増分に対する倍率 |
|---|---|---|---|
| 最後のクリックで割り振った件数 | 2,207.00 | (区間は計算していない) | 6.95 |
| 見た利用者と見なかった利用者の率の差 | 2,492.34 | (区間は計算していない) | 7.85 |
| 実験:群の全体の差を割り戻す | 41.08 | 486.70 | 0.13 |
| 実験:表示されるはずだった利用者どうしの差 | 460.62 | 275.50 | 1.45 |
| 真の増分(合成データなので分かる) | 317.37 | (真の値なので区間は無い) | 1.00 |
最後のクリックで割り振った件数は2,207件で、真の増分317.37件の6.95倍でした。見た利用者と見なかった利用者の率の差から計算した値は2,492.34件で、7.85倍でした。どちらも、表示された利用者の多くが広告が無くてもコンバージョンしていたことを、広告で増えたコンバージョンとして数えています。2つ目の方法は、表示されたかどうかを比べているので一見すると効果の推定のように見えますが、配信の偏りのために、もとの確率の違いを広告の効果と取り違えています。なお、最後のクリックの倍率は、コンバージョンする利用者の50%が広告をクリックするという例題の仮定に強く依存し、仮定を変えれば変わります。クリックする割合を十分小さく置けば、割り振った件数が増分より小さくなることもあり、割り振りと増分の大小関係は一般には保証されません。ここで示したのは、本章の例題の配信・クリック・上乗せの設定では過大に出た、という結果です。
実験の2つの見積りは、真の増分に近い場合も遠い場合もありました。群の全体の差を割り戻す方法は41.08件で、95%区間の半幅は486.70件でした。表示されるはずだった利用者どうしの差は460.62件で、半幅は275.50件でした。どちらも区間の中に真の増分を含んでいますが、区間の幅が増分そのものより大きく、1回の実験の結果だけでは増分の大きさを細かく言えません。表示されるはずだった利用者だけを比べる方法の区間が狭いのは、表示されることの無い利用者(広告の影響を受けず、結果のばらつきだけを加える利用者)を比較から外しているためです。
1回の乱数の結果で判断しないために、乱数の種を20通りに変えて同じ計算をくり返しました(乱数の種は20261116から20261135までの20通りで、このくり返しのコードは掲載していません。標準偏差は20個の値の標本標準偏差です)。真の増分に対する倍率の平均は、最後のクリックで6.95(最小6.71、最大7.30)、見た利用者と見なかった利用者の率の差で7.75(最小7.26、最大8.09)でした。実験の2つの方法の平均は、群の全体の差を割り戻す方法で0.84(標準偏差0.79、最小-1.24、最大2.18)、表示されるはずだった利用者どうしの差で1.01(標準偏差0.61、最小-0.27、最大2.21)でした。本コラムの架空データでは、割り振りと素朴な比較は毎回ほぼ同じ大きさだけ過大に出て、実験の見積りは平均では真の増分の近くにありながら、1回ごとのばらつきが大きい、という結果になりました。偏りの無い方法を選んでも、標本が足りなければ答えは粗いままです。この点は後の「実験に要る規模」の節で扱います。
fig, ax = plt.subplots(figsize=(8, 4))
y = np.arange(len(res))[::-1]
colors = ["#9e9e9e", "#9e9e9e", "#002E73", "#002E73", "#000080"]
ax.barh(y, res["増えた件数として示された値"], color=colors)
ci = res["95%区間の半幅"].notna().to_numpy()               # 区間は実験の2つにだけ引く
ax.errorbar(res["増えた件数として示された値"][ci], y[ci], xerr=res["95%区間の半幅"][ci], fmt="none", ecolor="black", capsize=4)
ax.axvline(true_inc, color="#000080", linestyle="--", linewidth=1, label="真の増分")
ax.set_yticks(y)
ax.set_yticklabels(res["方法"])
ax.set_xlabel("表示した利用者で増えたコンバージョンの件数として示された値")
ax.legend(loc="lower right")
plt.savefig("../ch11_attribution_vs_incremental.png", dpi=120, bbox_inches="tight")
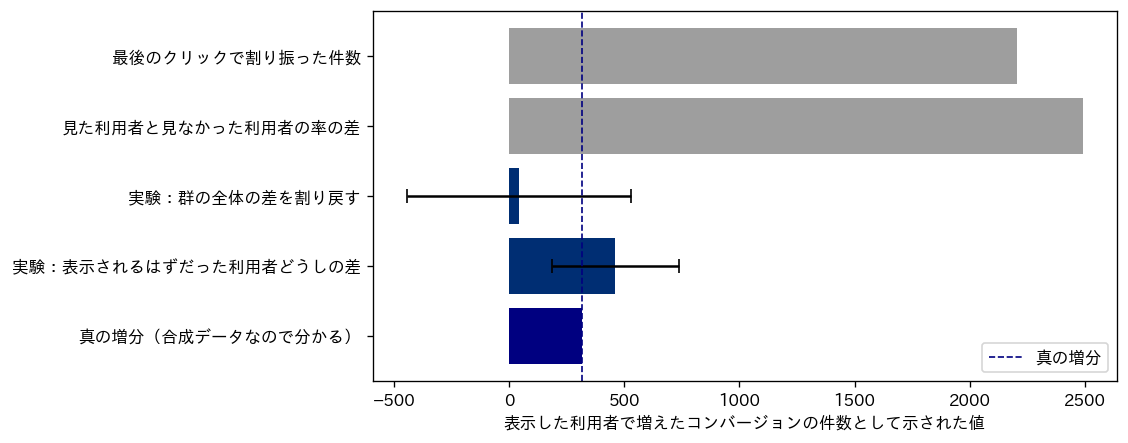
図の灰色の2本が割り振りと素朴な比較、紺色の2本が実験の見積り(紺色の2本の横線は95%区間)、最も下の棒と破線が真の増分です。灰色の棒には区間を付けていません。仮に区間を付けても、区間は標本のばらつきだけを表し、偏りの大きさは区間に入らないので、真の値とのずれは小さくなりません。管理画面の件数が毎日安定して出ることは、その件数が増分に近いことを意味しません。
無作為化の実験の作り方
選択の偏りを抑える有力な方法は、広告を見せるかどうかを無作為に決めることです。無作為に分けた2つの群は、もとの確率の分布が平均的にはそろうので、群の間の、コンバージョンした利用者の割合の差を、広告を割り当てたことの効果とみなせます(表示された利用者への効果に直すには、前の例題のように割り戻します)。広告の効果の測定では、配信の対象になる利用者の一部を無作為に選び、その群には広告を出さないようにします。この配信しない群をホールドアウトと呼びます。実験の作り方には、配信しない群をどう扱うかで、いくつかの型があります。
| 型 | 配信しない群の扱い | 比べるもの | 長所 | 注意すること |
|---|---|---|---|---|
| 配信しない群との比較 | 広告を出さない | 群の全体どうしの、コンバージョンした利用者の割合 | 仕組みが単純で、偏りが入りにくい | 実際に表示されない利用者も含めて比べるので、ばらつきが大きく、大きな標本が要る |
| 代わりの広告を出す | 関係の無い広告(公共広告など)を代わりに出す | 自社の広告を見た利用者と、代わりの広告を見た利用者 | 実際に表示された利用者どうしを比べられる | 代わりの広告の表示に費用がかかる。配信の仕組みが広告ごとに表示の相手を選ぶ場合は、2つの群の利用者がそろわなくなりうる |
| 表示されるはずだった利用者を記録する | 広告を出さず、配信の仕組みが表示を選んだはずだった利用者を記録する | 表示された利用者と、表示されるはずだった利用者 | 代わりの広告の費用がかからず、比較の対象を絞れる | 配信の仕組みの側で記録の機能が要る。広告主の側だけでは作りにくいことが多い |
| 地域で分ける実験 | 地域を無作為に2つに分け、片方の地域では広告を出さない | 地域ごとの売上やコンバージョン | 利用者を識別しなくてよい。店舗の売上なども含められる | 地域の数が限られるので精度が上がりにくい。地域の間の移動や波及が入る |
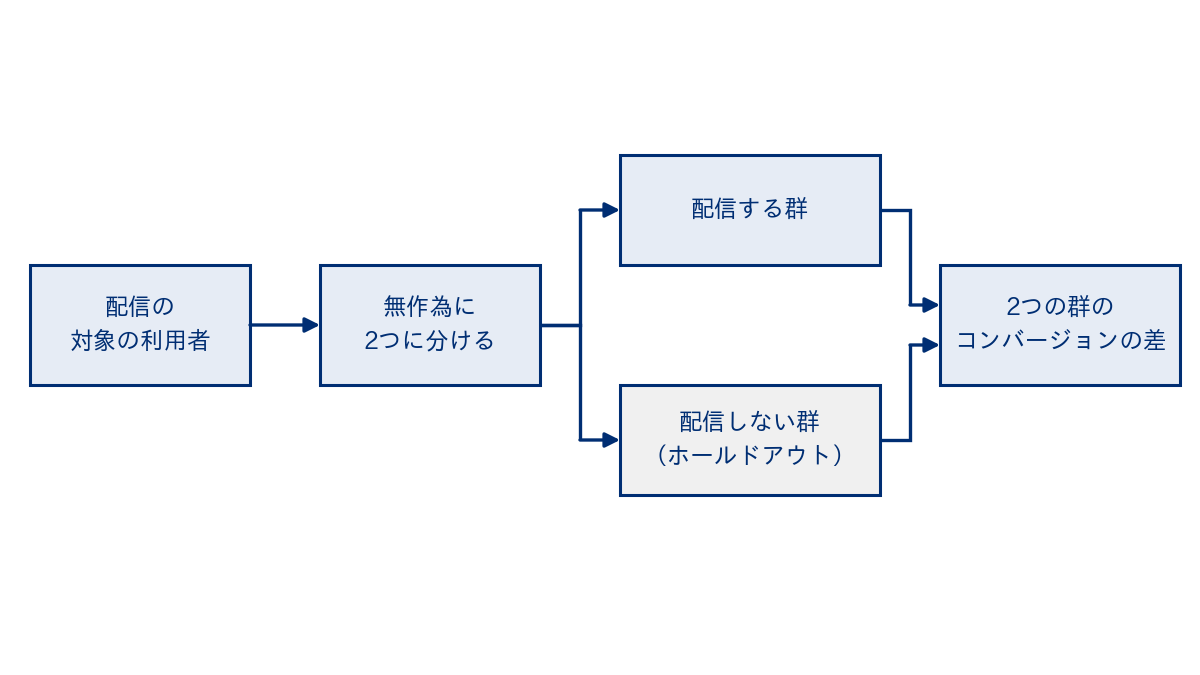
3つ目の型は、本章の例題の4つ目の方法にあたります。Johnson、Lewis、Nubbemeyer の2017年の論文(Journal of Marketing Research の第54巻第6号に掲載)は、題名のとおり「ゴースト広告」と呼ぶ方法で、ネット広告の効果の測定の経済性を改善することを扱った論文です。方法の細部と結果は、論文で確かめてください。本章の例題が示すのは、表示されるはずだった利用者に比較を絞ると、同じ人数でも区間が狭くなる、という架空データでの結果までです。
4つ目の型の地域で分ける実験については、Vaver と Koehler の2011年の Google の論文(地域を使った実験による広告の効果の測定の論文)が、重ならない地域を無作為に対照と処置に分け、処置の地域で地域を指定した広告を配信する方法を説明しています。地域で分ける方法は、識別子の制限で利用者ごとの記録が取りにくい場合や、店舗での購入のように利用者ごとに広告と結びつけられないコンバージョンを含めたい場合に、候補になります。一方で、地域の数は利用者の数よりずっと少ないので、偶然の差が大きく出やすく、地域の選び方と期間の設計が結果の精度を左右します。
どの型でも、実験を始める前に決めておくことがあります。何をコンバージョンとし、どの期間で数えるか(第2章)、配信しない群の割合、実験の期間、結果を判断する基準です。とくに、結果を見てから期間を延ばしたり、都合の良い区分だけを取り出したりすると、偶然の差を効果と取り違えやすくなります。実験の設計と判断の基準を事前に記録しておくことが、結果を信頼できるものにします。
実験に要る規模、広告の効果は小さく結果のばらつきは大きい
例題で見たとおり、偏りの無い実験でも、1回の結果のばらつきは大きくなります。これは、広告による上乗せが、利用者1人あたりで見ると小さく、コンバージョンするかしないかという結果のばらつきに比べて埋もれやすいからです。Lewis と Rao の2015年の論文(The Quarterly Journal of Economics 第130巻第4号)は、米国の小売や証券の会社の大規模なフィールド実験25件をもとに、広告の効果の測定が難しいことを示した論文です。要旨には、利用者ごとの売上のばらつきが大きいため、有益な結果を得るための実験の規模が非常に大きくなりうることが書かれています。これは、その実験群・その条件での結論です。
実験の規模の見当をつけるために、検出力を計算します。検出力は、本当に効果があるときに、検定でその効果を「偶然とは言いにくい」と判定できる割合です。ここでは、配信しない群で期間内にコンバージョンした利用者の割合(分母は利用者の数)を2%と置き、広告による上乗せがもとの率の1%・3%・5%・10%(例えば5%なら、2%が2.1%になる)の4つの場合を考えました。それぞれについて、1群あたりの利用者の数ごとの検出力を、2つの群の率の差を「偶然の差とは言いにくい」と判定する基準を5%とした検定(差がどちらの向きでも判定する両側の検定)の近似式で計算しました。式の値が合っているかを、乱数で作った実験2,000回でも確かめています。検定と標本の大きさの一般論は、弊社コラム『データから正しく結論を導く統計学のまとめ』で扱っています。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib
import numpy as np
from scipy.stats import norm

base = 0.02                                   # 配信しない群で期間内にコンバージョンした利用者の割合(分母は利用者の数)
lifts = [0.01, 0.03, 0.05, 0.10]              # 広告による上乗せ(もとの率に対する割合)
ns = np.logspace(4, 7, 31).astype(int)        # 1群あたりの利用者の数(1万人〜1,000万人)
z = norm.ppf(0.975)                           # 両側5%の検定

def power(n, lift):
    p1 = base * (1 + lift)
    se = np.sqrt(base * (1 - base) / n + p1 * (1 - p1) / n)
    return norm.cdf((p1 - base) / se - z) + norm.cdf(-(p1 - base) / se - z)

for lift in lifts:
    pw = power(ns, lift)
    need = ns[np.argmax(pw >= 0.8)] if (pw >= 0.8).any() else None
    print(f"上乗せ {lift:.0%}:検出力80%に要る1群の人数の目安 {need:,}人" if need else f"上乗せ {lift:.0%}:1,000万人でも検出力80%に届かない({pw[-1]:.2f})")

rng = np.random.default_rng(20261116)         # 式の値を、乱数で作った実験2,000回で確かめる
n, lift = 200_000, 0.05
c = rng.binomial(n, base, 2000) / n
t = rng.binomial(n, base * (1 + lift), 2000) / n
se = np.sqrt(c * (1 - c) / n + t * (1 - t) / n)
print(f"1群{n:,}人・上乗せ{lift:.0%}:式の検出力 {power(n, lift):.3f} / 乱数の実験で差を検出できた割合 {(np.abs(t - c) / se > z).mean():.3f}")
実行した結果、検出力が80%に届く1群あたりの人数の目安は、上乗せ10%で100,000人、5%で316,227人、3%で1,000,000人、1%で7,943,282人でした。この人数は、1万人から1,000万人までを約1.26倍の刻みで調べた格子の上で、初めて80%以上になった値です。1群200,000人・上乗せ5%の場合、式の検出力は0.607で、乱数で作った2,000回の実験で差を検出できた(偶然の差とは言いにくいと判定された)割合は0.615でした。式と乱数の結果がほぼ一致することを確かめています。
fig, ax = plt.subplots(figsize=(7, 4))
for lift, col in zip(lifts, ["#c0c0c0", "#808080", "#002E73", "#000080"]):
    ax.plot(ns, power(ns, lift), color=col, label=f"上乗せ {lift:.0%}")
ax.axhline(0.8, color="gray", linestyle=":", linewidth=1)
ax.set_xscale("log")
ax.set_xlabel("1群あたりの利用者の数")
ax.set_ylabel("効果を検出できる割合(検出力)")
ax.legend(loc="upper left")
plt.savefig("../ch11_power.png", dpi=120, bbox_inches="tight")
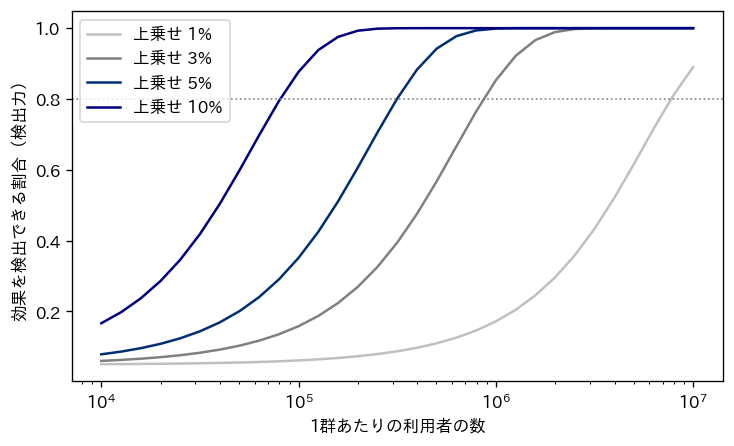
図の点線が検出力80%の線です。上乗せが半分になると、要る人数は近似式の上ではおよそ4倍になります(上の人数は格子の上の値なので、ちょうど4倍にはなっていません)。差の大きさが半分になると、同じ精度で見分けるには標準誤差(見積りのばらつきの大きさ)を半分にする必要があり、標準誤差は人数の平方根に反比例するためです。ここでの数字は、コンバージョンした利用者の割合が2%という仮定の上の計算です。実際に要る規模は、自社のコンバージョンした利用者の割合・上乗せの見込み・配信しない群の割合・表示されない利用者の多さで変わるので、実験の前に自社の数字で計算し直す必要があります。
経営の判断としては、ここから2つのことが言えます。1つ目は、小さなキャンペーンや短い期間で実験をしても、増分の大きさを決められないことが多いという点です。差を検出できなかったことは、効果が無いことを意味しません。その規模では見分けられなかった、という意味です。2つ目は、広告で利益が増える場合には、配信しない群の利用者に広告を出さない分だけ機会損失になるので、それを測定の費用として予算に組み込む必要がある、という点です。配信しない群の割合を小さくするとこの費用は減りますが、配信しない群の人数が減って精度が落ちます。測定の費用と見積りの精度の兼ね合いを、実験の前に数字で検討しておきます。
観察データと実験を比べた研究
実験ではなく、配信の記録などの観察データから増分を推定する方法もあります。広告を見た利用者と見なかった利用者を、閲覧の履歴や属性でそろえて比べる方法(マッチング)や、回帰で偏りを調整する方法です。こうした方法が実験の結果をどれだけ再現できるかを、大規模な実験と並べて調べた研究があります。
Gordon、Zettelmeyer、Bhargava、Chapsky の2019年の論文(Marketing Science 第38巻第2号)は、2015年に Facebook で無作為化の実験として行われた米国の広告キャンペーン15件のデータを使い、実験の結果と、複数の観察データの方法の結果を比べた論文です。要旨には、観察データの方法は、利用者の属性や行動の多くの項目で条件をそろえても、無作為化の実験と同じ効果を出せないことが多かった、と書かれています。これは、その15件のキャンペーン・その時点のデータと方法での結論で、すべての広告に当てはまると言える結果ではありません。
Blake、Nosko、Tadelis の2015年の論文(Econometrica 第83巻第1号)は、eBay での検索連動型広告の大規模なフィールド実験の論文です。NBER の要旨によれば、実験で測った効果は実験によらない推定よりずっと小さく、ブランド名を含まないキーワードの広告では、広告費の多くが、頻繁に利用していて購買行動が広告に左右されない利用者に向いていて、広告費を考慮した平均の収益(リターン)はマイナスでした。購入そのものへの効果がマイナスだったという意味ではありません。これもその会社・その時期の検索連動型広告での結論です。本章の例題で、訪問の少ない利用者ほど上乗せが大きいと置いたのは、こうした構造が起こりうることを示すための仮定であり、どの広告でも成り立つという主張ではありません。
2つの研究から読み取れるのは、観察データの方法が使えないということではなく、自社の広告で観察データの方法が実験とどれだけ一致するかは、実験と並べてみないと分からない、ということです。一度実験を行い、観察データの方法と比べておけば、実験のできない期間の判断材料として、その方法をどこまで信頼してよいかの見当がつきます。
増分にもとづく入札の考え方
第7章では、表示の価値を「予測クリック率×予測コンバージョン率×コンバージョンの価値」と置き、それに比例して入札する方法を扱いました。この式は、クリックを経由するコンバージョンの価値の期待値を見積もるもので、広告が無くても起きたコンバージョンを差し引いていません。成果を増分の利益で測るのであれば、入札で見積もるべきは、表示した場合と表示しなかった場合のコンバージョンの確率の差、つまり広告による上乗せです。この差に比例して入札すると、何が変わるかをコードで確かめます。
この例題も、他の例題とは独立に作った架空の合成データです。事前の期間と評価の期間に、それぞれ表示の機会30万件を作り、機会ごとに、もとの確率・広告による上乗せ・競合の最高入札額を持たせました。もとの確率と上乗せの作り方は前の例題と同じ形で、上乗せは訪問の少ない利用者ほど大きくしています。オークションはセカンドプライスとし、最低落札価格は無いものとして、落札したら競合の最高入札額を払います。手数料などは省きます。入札額と支払額は表示1回あたりの相対値とし、落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。コンバージョンの価値(広告費を引く前の粗利の見込み)は100、予算は2,000で、入札額・支払額と同じ尺度の単位の無い相対値です。この例題では、落札した機会で起きるコンバージョンは、広告が無くても起きた分も含めてすべて広告に割り振られるものとします(前の例題の最後のクリックの割り振りとは集計の仕方が違います)。
入札額は、各機会の価値の見積りに、すべての機会で共通の係数(乗数)を掛けた額とします。乗数が大きいほど多くの機会を落札して支払額が増えます。そこで、事前の期間のデータで、支払額の合計が予算を超えない範囲で最も大きい乗数を、範囲を半分ずつ絞り込む方法(二分法)で探し、評価の期間ではその乗数を固定して、機会が届いた順に入札し、予算が尽きたらそこで止めました。合成データなので競合の最高入札額は全機会について分かりますが、乗数を決めるのに評価の期間の価格は使っていません。それでも、事前の期間について全機会の価格を知っている前提は実際の買い手には無いので、これは模擬の中での比較で、そのまま運用できる制御ではありません(日々の制御は第9章で扱います)。つまり、3つの入札を、予算をほぼ使い切る条件で比べています。予算は使ってよい上限であり、使い切る義務はありません。価値の見積りは次の3つです。2つ目と3つ目の「上乗せ×コンバージョンの価値」は、広告で増えるコンバージョンの価値を見積もったもので、本コラムでは増分の表示の価値と呼び、広告が無くても起きた分を除いていない表示の価値と区別します。
- 表示の価値に比例:コンバージョンの価値×(もとの確率+上乗せ)に比例して入札する。表示した場合に起きるコンバージョンの価値の期待値を、正しく見積もれている場合にあたる。第7章の表示の価値はクリックを経由する形(予測クリック率×予測コンバージョン率×コンバージョンの価値)で書いていますが、この例題ではクリックを分けず、表示した場合にコンバージョンが起きる確率をまとめて置いています
- 上乗せに比例(真の値):増分の表示の価値(コンバージョンの価値×上乗せ)に比例して入札する。上乗せを正しく見積もれている理想の場合
- 上乗せに比例(誤差あり):上乗せの見積りに、自然対数が平均0・標準偏差0.5の正規分布に従う誤差の倍率を掛けた場合
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261116)
M, V, BUDGET = 300_000, 100.0, 2000.0          # 1期間の表示の機会の数・コンバージョンの価値・予算(いずれも相対値)

def make(m):                                    # 表示の機会を作る(事前の期間と評価の期間で別々に作る)
    visits = rng.poisson(2.0, m)                # 過去30日の訪問の回数
    recency = rng.integers(1, 31, m)            # 直近の訪問からの日数
    pc = (rng.random(m) < 0.3).astype(int)      # 端末の種類(1=パソコン)
    p0 = 1 / (1 + np.exp(-(-5.0 + 0.45 * visits - 0.04 * recency + 0.3 * pc + 0.15 * visits * pc)))
    tau = 0.004 * np.exp(-0.3 * visits)         # 広告による上乗せ
    comp = rng.lognormal(np.log(0.3), 0.6, m)   # 競合の最高入札額(セカンドプライスの支払額。最低落札価格は無し)
    noise = rng.lognormal(0, 0.5, m)            # 上乗せの見積りの誤差の倍率(自然対数が平均0・標準偏差0.5)
    return {"p0": p0, "tau": tau, "comp": comp, "noise": noise}

def scores(s):                                  # 入札の元になる価値の見積り
    return {"表示の価値に比例": V * (s["p0"] + s["tau"]),
            "上乗せに比例(真の値)": V * s["tau"],
            "上乗せに比例(誤差あり)": V * s["tau"] * s["noise"]}

pre, ev = make(M), make(M)

def fit_m(score, comp):                         # 事前の期間で、支払額の合計が予算を超えない最大の乗数を二分法で探す
    lo, hi = 0.0, 1000.0
    for _ in range(60):
        m = (lo + hi) / 2
        lo, hi = (m, hi) if comp[m * score > comp].sum() <= BUDGET else (lo, m)
    return lo
def evaluate(score, s, m):                      # 評価の期間では乗数を固定し、届いた順に入札して予算が尽きたら止める
    win = m * score > s["comp"]
    win = win & (np.cumsum(np.where(win, s["comp"], 0.0)) <= BUDGET)
    spend = s["comp"][win].sum()
    attr = (s["p0"][win] + s["tau"][win]).sum() # 落札した機会で起きるコンバージョン(すべて広告に割り振られるとする。期待値)
    inc = s["tau"][win].sum()                   # そのうち広告で増えた件数(真の増分の期待値)
    return [m, win.sum(), spend, attr, spend / attr, inc, spend / inc, V * inc - spend]

rows = {}
for name, sc_pre in scores(pre).items():
    rows[name] = evaluate(scores(ev)[name], ev, fit_m(sc_pre, pre["comp"]))
cols = ["乗数", "落札の件数", "支払額の合計", "割り振られるコンバージョン", "CPA", "増分のコンバージョン", "増分あたりの費用", "増分の利益"]
print(pd.DataFrame(rows, index=cols).T.round(2).to_string())
結果は次のとおりです。コンバージョンの件数は、乱数でコンバージョンを起こす代わりに、確率を足し合わせた期待値で示しています。増分の利益は、コンバージョンの価値×増分のコンバージョン – 支払額の合計です。ここでの増分の利益は、比較の相手を広告を出さない場合とし、そのときとの利益の差のうち、増えたコンバージョンの価値と広告費だけを数えたものです。広告費以外の費用の差(運用の手間や、計測の費用など)は省いています。増分は0や負になることもあり、増分の利益は、増分が小さければ広告費の分だけ負になります。
| 入札 | 乗数 | 落札の件数 | 支払額の合計 | 割り振られるコンバージョン | CPA | 増分のコンバージョン | 増分あたりの費用 | 増分の利益 |
|---|---|---|---|---|---|---|---|---|
| 表示の価値に比例 | 0.04 | 11,215 | 1,999.93 | 883.14 | 2.26 | 12.44 | 160.73 | -755.62 |
| 上乗せに比例(真の値) | 0.45 | 17,981 | 1,999.97 | 182.26 | 10.97 | 58.77 | 34.03 | 3,876.73 |
| 上乗せに比例(誤差あり) | 0.32 | 14,427 | 1,983.68 | 154.69 | 12.82 | 45.35 | 43.75 | 2,550.92 |
表示の価値に比例する入札は、割り振られるコンバージョンが883.14件で、CPA は2.26でした。管理画面で見る数字としては3つの中で最も良く見えます。しかし、増分のコンバージョンは12.44件にとどまり、増分の利益は-755.62でした。もとの確率が高く、上乗せの小さい利用者への表示を高く買ったためです。上乗せに比例する入札(真の値)は、CPA が10.97と悪く見える一方で、増分のコンバージョンは58.77件、増分の利益は3,876.73でした。上乗せの見積りに誤差を入れた場合も、増分の利益は2,550.92で、表示の価値に比例する入札を上回りました。乗数の値は、価値の見積りの尺度が入札ごとに違うので、入札どうしで比べる意味はありません。なお、-755.62 は、予算をほぼ使い切る条件で比べた結果です。広告を出さなければ増分の利益は0なので、この入札では、予算を使わないほうが増分の利益は大きかったことになります。
この結果は、本コラムの架空データで、上乗せが訪問の少ない利用者ほど大きいと置いたうえでのものです。対照として、上乗せをもとの確率に比例させた(もとの確率の0.1倍とした)データでも同じ計算をしました(このコードは掲載していません)。その場合、2つの見積りは機会の並び順が同じになるので、表示の価値に比例する入札と上乗せに比例する入札(真の値)は同じ機会を落札し、増分の利益はどちらも6,707.34で差がなくなりました。上乗せの見積りに誤差がある入札は5,651.09で、表示の価値に比例する入札を下回りました。上乗せに比例する入札の利点は、上乗せがもとの確率と違う形で利用者ごとに異なり、しかも上乗せを十分に正しく見積もれる場合に限られます。実際には上乗せを機会ごとに見積もるのは難しく、無作為に配信しない群を含む実験のデータは、その見積りの有力な材料になります。この例題が示すのは、CPA が良く見える入札と増分の利益が大きい入札は一致するとは限らないこと、そして何を最大にするかで入札の向きが変わることまでです。
媒体の効果検証の機能と、識別子の制限のもとでの計測
大きな媒体の中には、自社の広告について、無作為に分けた比較の群を使って増分を測る機能を提供しているものがあります。例えば、Google 広告のヘルプのコンバージョン リフト測定の説明(2026年11月に確認)では、広告を見た群と見なかった群に分けた対照実験で、コンバージョンの増分を測る仕組みが説明されています。比較の群を利用者にもとづいて作る方法と、地域にもとづいて作る方法の2種類があり、増分のコンバージョンや増分あたりの単価などの指標が示されること、すべてのアカウントで使えるわけではないことも書かれています。どの媒体でも、機能の条件と結果の読み方は公式ヘルプで確かめ、ヘルプに書かれていない内部の計算は推測しないことにします。
媒体の提供する実験は、その媒体の広告の増分を測るものです。複数の媒体を並行して使っている場合、ある媒体の実験の結果を合計しても、媒体の間の重なりは分かりません。媒体をまたいだ効果の分解は、前に挙げた弊社コラムのマーケティング・ミックス・モデリングが扱う範囲です。
利用者を識別する符号(識別子)の制限が進むと、広告の接触とコンバージョンを利用者ごとに結びつけにくくなります。観測できない分を何らかの方法で見積もって件数に含める場合でも、その件数が割り振りの件数であることに変わりはありません。識別子の制限と、それに関わる規制の経緯は第14章で扱います。識別子に頼りにくい環境では、利用者ごとの結びつけを必要としない地域で分ける実験の役割が大きくなると考えています。
効果の測定に使う指標の表と、それぞれが答える問い
ここまでの内容を、指標ごとに整理します。どの指標も使い道がありますが、答えられる問いが違います。成果と呼んでよいのは増分の利益で、それ以外の指標は、増分の利益を説明する部品か、日々の運用の目安として使います。
| 指標 | 計算の仕方 | 答える問い | 答えられない問い |
|---|---|---|---|
| 割り振られたコンバージョン | アトリビューションの規則で広告に結びつけた件数 | どの広告に接触した利用者がコンバージョンしたか | 広告を止めたら何件減るか |
| CPA | 広告費÷割り振られたコンバージョン | 割り振りの上で1件あたりいくら使ったか | 増えた1件あたりいくら使ったか |
| ROAS | 広告に割り振られた売上÷広告費 | 割り振りの上で広告費の何倍の売上が結びついたか | 広告で増えた利益はいくらか |
| 増分のコンバージョン | 実験などで見積もった、広告を出した場合と出さなかった場合の差 | 広告で何件増えたか | その増加が費用に見合うか(価値と費用を合わせて見る必要がある) |
| 増分あたりの費用 | 広告費÷増分のコンバージョン(増分が0なら定義できず、負の場合や区間が0をまたぐ場合は単価として読めない) | 増えた1件を得るのにいくら使ったか | コンバージョンの価値が件ごとに違う場合の利益 |
| 増分の利益 | 増分のコンバージョンの価値(粗利)- 広告費 | 広告で事業の利益がいくら増えたか | 今後も同じだけ増えるか(条件が変われば変わる) |
増分の指標は、実験の期間ごとにしか得られず、見積りには区間が付きます。日々の運用では、割り振られたコンバージョンや CPA を目安として使いながら、定期的な実験で、同じ対象・同じ期間について「見積もった増分の件数÷割り振られた件数」という比を確かめ、その比で目安を読み替える使い方が考えられます。この比は、個々のコンバージョンが増分だったかを見分けるものではなく、負になることも1を超えることもあります。また、広告の種類・配信の対象・時期で変わりうるので、一度測った比を使い続けることはできません。
実験ができないときの次善の方法と限界
配信しない群を作れない媒体や、実験に要る規模に届かない広告もあります。その場合の次善の方法と限界を表にまとめます。どの方法も、無作為化の実験と比べて、偏りが残りうるという前提で使います。
| 方法 | やること | 使える場面 | 限界 |
|---|---|---|---|
| 配信の停止と再開の前後比較 | 一定の期間だけ広告を止め、前後のコンバージョンを比べる | 配信しない群を作れないが、期間を区切って止められる場合 | 季節・販促・競合の動きなど、同じ時期の他の変化と区別しにくい |
| 地域の時系列の比較 | 広告を変えた地域と変えなかった地域の推移を比べる | 地域を指定して配信できる場合 | 地域を無作為に選べないと、地域の違いが残る |
| 観察データでの調整 | 見た利用者と見なかった利用者を、項目でそろえて比べる | 利用者ごとの記録がある場合 | 配信の仕組みが使った情報をすべてそろえられず、偏りが残りうる(前節の研究) |
| マーケティング・ミックス・モデル | 週ごとの広告費と売上の推移から、媒体ごとの効果を推定する | 媒体をまたいで、長い期間のデータがある場合 | 広告費の動きが少ないと推定が不安定。実験の結果で確かめることが望ましい |
次善の方法を使うときに大事なのは、結果を「増分」と呼ぶ前に、どの偏りが残りうるかを書き添えることです。また、どこかの時点で一度でも実験を行えれば、次善の方法の結果と並べて、その方法の外れ方の見当をつけられます。実験は毎回の判断に使うものというより、他の方法の目盛りを合わせる基準として使うことも考えられます。
経営の判断、増分を定期的に測る予算と期間を確保する
この章で見た誤りは、経営の上では主に成果の数え違いにつながります。広告が無くても起きたコンバージョンを広告で増えたコンバージョンとして数えると、もとの確率の高い利用者に強く入札する広告や媒体ほど割り振られる件数が多く見え、予算がそちらに寄ります。本コラムの架空データでは、CPA が最も良く見えた入札で、増分の利益がマイナスになりました。これは、広告が無くても起きた分を含む見積りで入札したことによる、成果の数え違いの型です。逆に、広告による上乗せの大きい利用者への配信を、CPA が悪く見えるという理由で減らせば、利益を増やせる機会を逃すので、機会損失になります。さらに、管理画面の件数だけを見る体制では、規則や計測の設定が変わっても気づきにくく、点検が形骸化します。
利用者の側から見ると、広告が無くても購入する利用者に同じ広告を何度も表示することは、広告主にとっての払いすぎであると同時に、利用者にとっての過剰な接触にもなりえます。増分にもとづいて配信を考えることは、利用者に不要な表示を減らす方向にも働きうると考えています。
これを予算・体制・KPI の仕組みに落とすには、次のことを決めておくことが有効だと考えています。
- 少なくとも主要な媒体について、増分を測る実験を、年に何回・どの期間で行うかを決め、配信しない群に出さない分の機会損失(広告で利益が増える場合)を含めた実験の予算を確保する
- 実験の前に、コンバージョンの定義・計測期間・配信しない群の割合・判断の基準を記録する。要る規模を、自社のコンバージョンした利用者の割合と上乗せの見込みで計算しておく
- 社内の報告では、割り振られたコンバージョンと増分のコンバージョンを別の行に書き、CPA や ROAS を成果と呼ばない
- 実験の結果から「見積もった増分の件数÷割り振られた件数」の比を記録し、日々の目安を読み替える。その比を定期的に測り直す
- 媒体や広告会社に、効果検証の機能の有無と条件、実験への協力の可否を確かめる
代わりの広告に費用がかかる場合や、同じ予算を少ない人数に配信する場合には、実験の期間の CPA が悪く見えることがあります。そうした費用を、予算の配分を誤らないための測定の費用として、事前に経営の承認を得ておくことが、実験を続けるための条件になると考えています。
この章のまとめ
管理画面のコンバージョンの件数と、そこから計算した CPA と ROAS は、アトリビューションの規則で割り振った結果であり、広告で増えた件数ではありません。配信の仕組みがもともとコンバージョンしやすい利用者に表示を寄せる場合、割り振った件数や、見た利用者と見なかった利用者の差は、増分と大きくずれることがあります。本コラムの架空データでは、真の増分に対して、最後のクリックの割り振りはおよそ7倍、見た利用者と見なかった利用者の差はおよそ8倍でした。配信しない群を無作為に作る実験は、選択の偏りを抑えて増分を見積もる有力な方法で、上乗せが小さい場合には大きな規模が要ります。次の第12章では、こうして測る成果の手前で、配信そのものが正しく動いているかを日々点検する方法を扱います。
この章を深めたい方への参考書籍
『効果検証入門』(安井翔太 著、ホクソエム 監修、技術評論社):副題のとおり、正しい比較のための因果推論と計量経済学の基礎を扱った本です。本章で見た「見た利用者と見なかった利用者の差が効果を過大に見せる」構造を、より一般的な形で学べます。
『A/Bテスト実践ガイド』(Ron Kohavi、Diane Tang、Ya Xu 著、大杉直也 訳、ドワンゴ):副題は「真のデータドリブンへ至る信用できる実験とは」で、オンラインでの無作為化の実験(A/Bテスト)を、信頼できる形で行うための実践を扱った本です。本章で扱った配信しない群の実験を、社内で続けて行う仕組みを考えるときの参考になります。
第12章 配信の監視と品質、無効なトラフィック・掲載面の点検とモデルの見直し
第11章では、管理画面に出るコンバージョンの件数は広告に割り振られた件数であって広告で増えた件数ではないこと、増分を知るには配信しない群を残した実験が要ることを確かめました。測り方が決まっても、測る対象の配信そのものが崩れていれば、その数字は判断の材料になりません。この章では、配信が始まったあとの監視と品質の点検を扱います。監視は入力・予測・結果の3つの層に分けて考えます。品質の点検では、正当な表示やクリックとして数えるべきでないもの、見られる状態に無かった表示、不適切な掲載面を取り上げ、最後に予測のモデルが古くなったときの直し方を扱います。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の配信の記録を使い、実行したコードと結果で確かめます。
- 監視の3つの層(入力・予測・結果)と、それぞれで見る指標
- コンバージョンが遅れて届くことを前提にした、判定の日までに分かる情報だけでの点検
- 予測の平均と実績の比の推移、構成の変化の指標、管理図の考え方による外れの検知
- 無効なトラフィック・ビューアビリティ・ブランドセーフティ・売り手の確認の仕組み
- モデルが古くなる理由と、較正のやり直し・再学習・特徴量の見直しという見直しの段階
- 自動入札を使っている場合の点検、記録、警報の設計、経営の判断
この章の主張は2つあります。1つ目は、コンバージョンは遅れて届くので、監視は先に分かる指標(表示の機会の数・勝率・支払額・クリック率・予測と実績の比)を中心に組み、コンバージョンの指標は結果が出そろう日数をそろえて比べるべきだ、という点です。2つ目は、予測と実績がずれたとき、原因を確かめずにモデルを直すと、かえって払いすぎを招くことがある、という点です。本コラムの架空データでは、ある掲載面に正当なクリックとして数えるべきでないクリックが上乗せされると、配信中のモデルは実績より大幅に低く予測しているように見えました。この記録のまま再学習したところ、その掲載面の予測クリック率の平均は0.0173から0.0301に上がり、落札した表示の支払額の合計は、その表示の真の価値の合計の1.19倍になりました。疑わしい期間を除いて再学習した場合は0.88倍でした。
動いていることと、成果が出ていることは別
自動入札やペース配分の仕組みは、設定さえ済めば毎日止まらずに動きます。予算は消化され、表示もクリックも記録されます。しかし、仕組みが動いていることは、成果が出ていることを意味しません。予測のモデルが前提にした利用者の行動や掲載面の構成が変われば、予測は外れたまま入札額を決め続けます。正当なクリックとして数えるべきでないクリックが混じれば、クリック率は上がって見えます。その分のコンバージョンが付かない場合もあれば、MRC の指針が挙げるように、コンバージョンや帰属の記録まで偽装される場合もあります。コンバージョンの計測のタグが外れれば、自動入札の調整に使われるコンバージョンのデータが欠け、設定した目標に合わせた調整が実態とずれるおそれがあります(媒体の公式ヘルプに書かれている対処は後の節で扱います)。いずれの場合も、配信の仕組みそのものがエラーを出すとは限りません。
こうした崩れは、自動で動く部分が大きいほど気づきにくくなります。自動入札では、人が日々の入札額を確かめる場面が減るため、点検を仕組みとして持たないと、異変に気づく機会が少なくなると考えています。そのため、自動入札を使うほど、監視を仕組みとして持つ必要があると考えています。本章の監視は、配信の仕組みが正しく動いているかを見るシステムの監視とは別に、配信が事業の意図どおりの結果を出しているかを見るものです。
監視の対象は、次の3つの層に分けると整理しやすくなります。入力の層は、表示の機会がどれだけ、どんな構成で届いているかです。予測の層は、モデルの出す予測クリック率や予測コンバージョン率が、実績の率と合っているかです。結果の層は、費用・コンバージョン・CPA・予算の消化のような、最終的に事業が見る数字です。結果の層だけを見ていると、異変に気づいたときには数日分の予算を使ったあとになりやすく、原因が入力か予測かも分かりません。
| 層 | 見る指標の例 | 分かるまでの時間 | 崩れたときに起きやすい損失の型 |
|---|---|---|---|
| 入力 | 入札リクエストの数・掲載面や端末の構成比・最低落札価格の水準・勝率・支払額 | 当日 | 機会損失・払いすぎ |
| 予測 | 予測クリック率の合計と実績のクリックの件数の比・区分ごとの比・予測の分布 | 当日(クリック)、数日後(コンバージョン) | 払いすぎ・機会損失 |
| 結果 | 費用・クリック率・成熟したコンバージョン率・CPA・予算の消化の割合・配信が止まっていた時間 | クリックは当日、コンバージョンは結果が出そろう日数が過ぎてから | 成果の数え違い・形骸化 |
| 品質 | 無効なトラフィックとして除外された割合・ビューアビリティ・除外した掲載面への配信の有無 | 計測の事業者の報告の頻度による | 払いすぎ・信頼の毀損 |
表の4行目の品質は、3つの層のどれにも入る横断的な点検として別に置きました。最後の列は、序章で定めた6つの損失の型(払いすぎ・機会損失・成果の数え違い・信頼の毀損・形骸化・規制上の義務の不履行)のうち、その層が崩れたときに主に問題になるものです。たとえば入力の層で表示の機会の構成が変わると、それまでの入札の方針では価値のある機会を買い逃す機会損失と、価値の低い機会に高く払う払いすぎの両方が起こりえます。結果の層の崩れは、成果の数え違いとして予算の配分を誤らせ、点検の仕組みが働かなければ形骸化につながります。
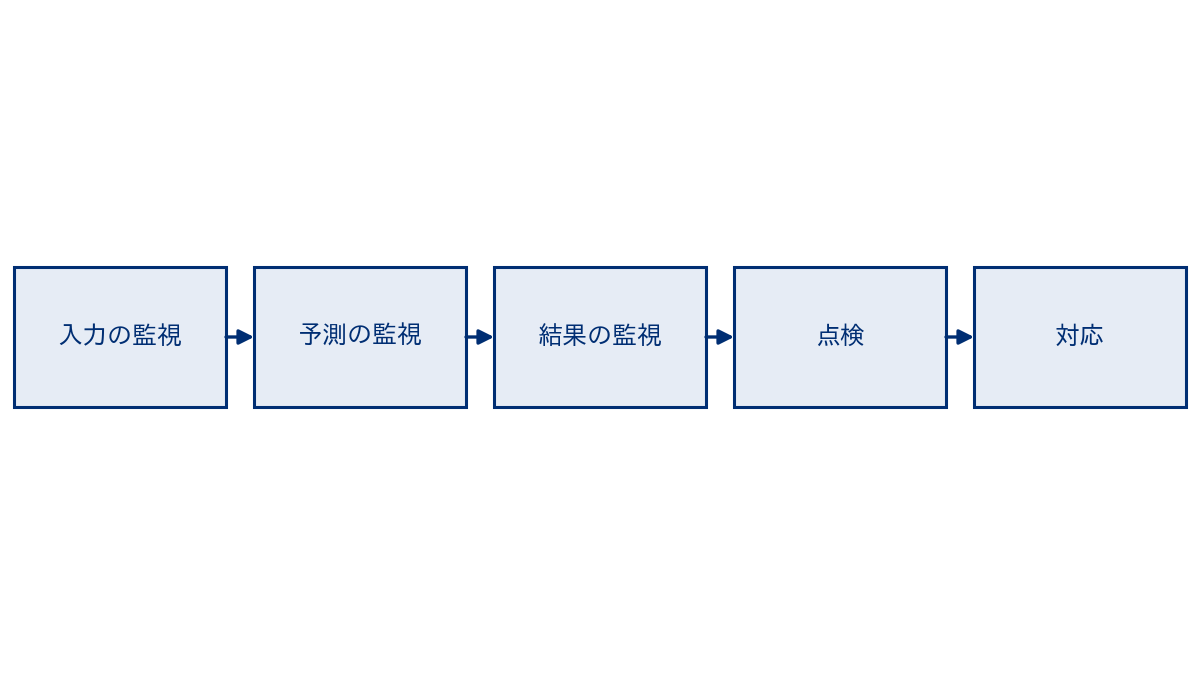
先に分かる指標で見る、遅れて届くコンバージョンと判定の日
監視を組むときの最大の制約は、コンバージョンが遅れて届くことです(第2章・第5章)。クリックした日にコンバージョンする利用者もいれば、数日後にする利用者もいます。ある日の終わりに直近のクリックのコンバージョン率を計算すると、まだ届いていないコンバージョンの分だけ低く出ます。この低さを異変と取り違えると、何も起きていないのに入札を下げることになります。逆に、本当にコンバージョンが付かなくなっていても、それが確かめられるのは、比べる期間の結果がある程度出そろってからです。
ここで、計測期間と、点検のために結果をそろえる日数は別のものです。計測期間は、クリックや表示のあと、コンバージョンをその広告に結びつけて数える期間で、計測期間の中で起きたコンバージョンは起きた時点で数えられます。ただし、計測期間の途中でコンバージョンが起きていなくても、期間のうちに起きないとは確定できません。本章の例題では計測期間を区切らず、クリックから何日後のコンバージョンもそのクリックに結びつけて数えるものとし、点検のときだけ、クリックから3日以内に届いたものに限って数えています。
そこで、監視の指標を2種類に分けます。1つ目は、当日のうちに分かる指標です。表示の機会の数、勝率、支払額、クリック率、予測と実績の比(クリックについて)がこれにあたります。2つ目は、日数が過ぎないと分からない指標で、コンバージョン率や CPA がこれにあたります。2つ目の指標は、比べる期間どうしで結果が出そろうまでの日数をそろえてから比べます。本章では、クリックから一定の日数(例題では3日)が過ぎたクリックだけを対象に、その日数のうちに届いたコンバージョンで率を計算したものを「成熟したコンバージョン率」と呼びます。
ここから、架空の合成データで確かめます。表示の機会の属性(掲載面・端末・時間帯)と、利用者の側の特徴にあたる項目(過去の訪問の回数)を持つ28日分の入札の記録を作り、セカンドプライスのオークションで落札した機会でだけクリックとコンバージョンが分かるようにしました。落札した機会はすべて表示され、表示の時点で支払いが生じるものとします。入札額は予測にもとづく表示の価値(予測クリック率 × コンバージョン率0.10 × コンバージョンの価値1.0)とし、支払額は競合の最高入札額です(最低落札価格は置いていません)。額はすべて表示1回あたりの相対値で、この例題の中では同じ尺度で比べられますが、他の章の例題の数値とは直接比べられません。表示1回につきクリックは最大1回、クリック1回につきコンバージョンは最大1件として扱います。この記録は実際の配信の記録より単純で、この合成データでの数値は実際の配信での目安にはなりません。
この記録には、途中の日から3つの変化を入れました。1つ目は、15日目から掲載面Eで、正当なクリックが無かった落札した表示に、3%の確率で、自動のプログラムなどによる、正当なクリックとして数えるべきでないクリックを上乗せする変化です。この例題では、上乗せされたクリックにコンバージョンは付かないと仮定します。2つ目は、18日目から入札リクエストに占める掲載面Fの割合が増える、構成の変化です。3つ目は、21日目からスマートフォンでだけ真のクリック率が下がる変化で、表示のされ方が変わった場合を想定しています。配信中のモデルは、変化の前の真のクリック率に小さな誤差を加えた値を予測クリック率として出し、28日間更新しないものとしました。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

# ブロック1:架空の配信の記録を作る(28日・入札した表示の機会)
rng = np.random.default_rng(20261116)
n_days, n_per_day = 28, 16000
n = n_days * n_per_day
day = np.repeat(np.arange(1, n_days + 1), n_per_day)
hour = rng.integers(0, 24, n)
places = np.array(list("ABCDEF"))
p_base = np.array([0.24, 0.22, 0.20, 0.17, 0.15, 0.02])   # 掲載面Fは当初ほとんど無い
p_late = np.array([0.19, 0.17, 0.16, 0.14, 0.12, 0.22])   # 18日目から掲載面Fが増える
place = np.where(day < 18,
                 rng.choice(6, n, p=p_base),
                 rng.choice(6, n, p=p_late))
device = rng.choice(2, n, p=[0.35, 0.65])                  # 0=PC、1=スマートフォン
visits = rng.poisson(1.5, n)
# 真のクリック率(ロジット)。掲載面×端末の組み合わせが効く
b_place = np.array([-4.0, -4.3, -4.6, -4.2, -4.4, -5.0])
logit = (b_place[place] + 0.25 * device + 0.12 * np.minimum(visits, 5)
         + 0.5 * ((place == 2) & (device == 1)))
p_click_base = 1 / (1 + np.exp(-logit))
# 配信中のモデルの予測クリック率=変化の前の真の値に小さな誤差
pred_ctr = p_click_base * np.exp(rng.normal(0, 0.05, n))
# 21日目から、スマートフォンでだけ真のクリック率が下がる(表示のされ方の変化)
p_click = p_click_base * np.where((day >= 21) & (device == 1), 0.65, 1.0)
# 入札とオークション(セカンドプライス・最低落札価格なし。額は表示1回あたりの相対値)
cv_rate, cv_value = 0.10, 1.0                   # コンバージョン率とコンバージョンの価値
value = pred_ctr * cv_rate * cv_value           # 入札額=予測にもとづく表示の価値
comp = rng.lognormal(np.log(0.0016), 0.5, n)    # 競合の最高入札額(同じ尺度)
won = value > comp
cost = np.where(won, comp, 0.0)                 # 支払額=競合の最高入札額
# 落札した機会でだけ、クリックとコンバージョンが分かる
click = won & (rng.random(n) < p_click)
# 15日目から、掲載面Eで正当なクリックとして数えるべきでないクリックが上乗せされる
junk = won & (place == 4) & (day >= 15) & (rng.random(n) < 0.03) & ~click
conv = click & (rng.random(n) < cv_rate)
delay = rng.geometric(0.4, n) - 1              # クリックからコンバージョンまでの日数
df = pd.DataFrame(dict(day=day, hour=hour, place=places[place], device=device,
                       visits=visits, pred=pred_ctr, p_true=p_click, comp=comp, won=won, cost=cost,
                       click=click | junk, conv=conv, conv_day=day + delay))
imp = df[df.won].copy()
print("入札した機会", n, "落札(表示)", len(imp), "勝率", round(imp.shape[0] / n, 3))
print("クリック", int(imp.click.sum()), "クリック率", round(imp.click.mean(), 4),
      "コンバージョン", int(imp.conv.sum()))
実行した結果、入札した機会は448,000件、落札した表示は274,776件で、入札した機会を分母とする勝率は61.3%でした。クリックは6,279件(上乗せされたクリックを含む)、クリック率は2.29%、28日間のクリックに結びつくコンバージョンは、28日目より後に届くものも含めて567件です。
次に、判定の日の終わりに、その日までに分かっている情報だけで掲載面ごとの率を出します。クリック率は判定の日を含む直近3日の表示から計算し、成熟したコンバージョン率は、判定の日の3日前までのクリック(さらにその前の7日分)を対象に、クリックから3日以内に届いたコンバージョンで計算しました。判定の日より後に届くコンバージョンは使いません。
# ブロック2:判定の日までに分かっていることだけで、掲載面ごとの率を出す
def as_of(imp, judge_day, window=3, mature=3):
    # 判定の日の直前 window 日のクリック率と、mature 日が過ぎたクリックの
    # mature 日以内のコンバージョン率(成熟度をそろえる)
    rec = imp[(imp.day > judge_day - window) & (imp.day <= judge_day)]
    ctr = rec.groupby("place").click.mean()
    cl = imp[(imp.click) & (imp.day <= judge_day - mature)
             & (imp.day > judge_day - mature - 7)]
    ok = cl.conv & (cl.conv_day <= cl.day + mature)
    cvr = ok.groupby(cl.place).mean()
    return pd.DataFrame({"クリック率": ctr.round(4), "成熟したCVR": cvr.round(3)})

for jd in [14, 17, 20, 24]:
    print(f"--- 判定の日 {jd} 日目の終わり")
    print(as_of(imp, jd).to_string())
掲載面Eの結果を判定の日ごとに並べると、次の表のとおりです。比較のため、掲載面A〜Dの値の範囲も並べました。
| 判定の日 | 掲載面Eのクリック率 | 掲載面Eの成熟したコンバージョン率 | 掲載面A〜Dのクリック率 | 掲載面A〜Dの成熟したコンバージョン率 |
|---|---|---|---|---|
| 14日目の終わり | 1.78% | 9.0% | 1.77〜2.76% | 8.7〜11.2% |
| 17日目の終わり | 4.95% | 7.3% | 2.16〜2.86% | 7.4〜9.2% |
| 20日目の終わり | 4.96% | 3.9% | 2.23〜2.89% | 7.3〜9.0% |
| 24日目の終わり | 4.19% | 2.0% | 1.48〜1.90% | 7.9〜9.3% |
上乗せが始まってから3日目にあたる17日目の終わりには、掲載面Eのクリック率は4.95%と、他の掲載面の2倍前後に上がっていました。一方、成熟したコンバージョン率は7.3%で、他の掲載面の範囲とほぼ重なっています。17日目の終わりに成熟したコンバージョン率の対象になるのは14日目までのクリックで、上乗せが始まった後のクリックはまだ1件も入っていないためです。成熟したコンバージョン率が他の掲載面より明らかに低くなったのは20日目の終わり(3.9%)で、24日目の終わりには2.0%まで下がりました。
この結果が示すのは、クリックだけが増えてコンバージョンが付かないという異変は、コンバージョンの指標では数日遅れてしか見えず、先に動くのはクリック率だということです。「クリック率が急に上がったのはよい知らせ」と受け取らず、クリック率が過去の水準から大きく外れたこと自体を点検のきっかけにする必要があります。なお、24日目の終わりに掲載面A〜Dのクリック率が下がっているのは、21日目からのスマートフォンの変化によるもので、掲載面Eの上乗せとは別の原因です。1つの表の中に、原因の違う2つの変化が同時に出ることがある点にも注意が要ります。
予測の平均と実績の比を日ごとに追う
予測の層で最も基本になる指標は、ある区分の表示について、予測クリック率の合計を実績のクリックの件数で割った比です(第6章)。比が1に近ければ、その区分の予測は平均として実績と合っています。1より大きければ予測が高すぎ、1より小さければ低すぎます。ただし、比は平均の一致を見るだけで、較正が取れていること、つまり予測した確率が同じくらいの機会を集めたときにその実績の率が予測と対応していることの確認にはなりません。較正が取れているかを確かめる作業(較正の確認)は第6章で扱いました。本章で区分ごとに比を見るのは、全体の比が1に近くても区分ごとにはずれていることがあるためです。この例題のように、表示の価値(予測クリック率 × コンバージョン率 × コンバージョンの価値)をそのまま入札額にし、コンバージョン率と価値を固定している場合、比が1.5であれば、その区分の入札額は真の表示の価値の1.5倍前後になっていると読めます(入札の決め方は第7章)。クリックは当日に分かるので、この比は当日のうちに計算できます。クリックが0件の日は比を出さず、欠測として扱います(この例題では欠測の日はありませんでした)。
# ブロック3:予測の平均と実績の比(予測クリック率の合計÷クリックの件数)を日ごとに見る
def ratio(g):
    # クリックが0件の日は比を出さず、欠測として扱う
    return g.pred.sum() / g.click.sum() if g.click.sum() > 0 else np.nan
seg = {"PC(掲載面E以外)": (imp.place != "E") & (imp.device == 0),
       "スマートフォン(掲載面E以外)": (imp.place != "E") & (imp.device == 1),
       "掲載面E": imp.place == "E"}
rt = pd.DataFrame({k: imp[m].groupby("day").apply(ratio) for k, m in seg.items()})
print("--- 予測と実績の比(日ごと)", "欠測の日数", int(rt.isna().sum().sum()))
print(rt.round(2).iloc[[0, 6, 13, 14, 17, 19, 20, 23, 27]].to_string())
print("PC(掲載面E以外)の日ごとの比の範囲", round(rt.iloc[:, 0].min(), 2), round(rt.iloc[:, 0].max(), 2))
for k in rt.columns:
    print(k, "1〜14日の平均", round(rt[k].iloc[:14].mean(), 2),
          "21〜28日の平均", round(rt[k].iloc[20:].mean(), 2))
fig, ax = plt.subplots(figsize=(8, 4))
styles = [("#002E73", "-"), ("#000080", "--"), ("gray", ":")]
for (k, (c, ls)) in zip(rt.columns, styles):
    ax.plot(rt.index, rt[k], color=c, ls=ls, marker="o", ms=3, label=k)
ax.axhline(1.0, color="gray", lw=0.8)
ax.set_xlabel("日"); ax.set_ylabel("予測の合計 ÷ 実績のクリック数")
ax.legend(loc="lower left", frameon=False)
plt.savefig("../ch12_pred_actual_ratio.png", dpi=120, bbox_inches="tight")
plt.close()
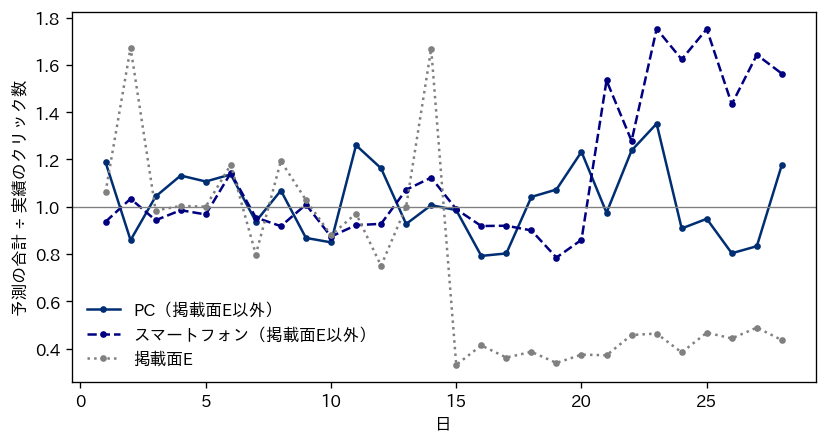
実行した結果、掲載面E以外のPCの比は、1〜14日の平均が1.04、21〜28日の平均が1.03で、期間を通じて1の前後にありました。掲載面E以外のスマートフォンの比は、1〜14日の平均が0.99でしたが、21日目に1.53へ上がり、21〜28日の平均は1.57でした。真のクリック率を0.65倍にした変化に対して、予測を変えていないので、比はおよそ1÷0.65にあたる水準まで上がったことになります。掲載面Eの比は、1〜14日の平均が1.08で、15日目に0.33へ下がり、21〜28日の平均は0.44でした。
図から読み取れることが2つあります。1つ目は、日ごとの比は区分が細かいほど大きく揺れることです。真のクリック率を変えていないPCでも、28日の間に日によって0.79から1.35までの値が出ています。1日の値だけで判断すると、何もない日に異変を見つけたことになりやすいので、数日の平均や、次の節で扱う件数に応じた幅と合わせて見る必要があります。2つ目は、比が下がったことと上がったことでは、取るべき対応がまったく違うことです。スマートフォンの比の上昇は、モデルの予測が実態より高くなったことを示しています。この例題のように他の条件を固定すると、予測の過大評価は入札額を押し上げます。セカンドプライスの例題では支払額は競合の最高入札額なので、入札額が過大でも個々の支払いが価値を超えるとは限りませんが、価値を超える額で落札する機会が増え、払いすぎを招くおそれがあります。こちらは較正のやり直しや再学習の対象です(後の節)。
掲載面Eの比の低下は、見かけの上では「モデルが実績より低く予測している」状態です。しかし、増えたクリックは正当なクリックとして数えるべきでないもので、この例題ではコンバージョンを生みません。ここで比を1に戻すように掲載面Eの予測を引き上げると、入札額も上がり、価値の無いクリックをさらに高く買うことになります。予測と実績がずれたときは、まず原因を確かめ、ずれの原因がクリックそのものの質にある場合はモデルを直す前に配信と記録の側で対処します。具体的には、その掲載面を配信の対象から外すか入札を止めて調べ、疑わしい期間の記録を再学習のデータから除きます。
このことを、同じ記録で確かめます。21日目の朝に、8〜20日の表示の記録でロジスティック回帰のモデルを再学習する場合を考え、上乗せを含む記録のまま学習したモデルと、掲載面Eの15日目以降の記録を疑わしい期間として除いて学習したモデルを作りました。それぞれのモデルで、21〜28日の掲載面Eの入札した機会に、予測にもとづく表示の価値で入札し直し、落札した表示の支払額の合計と、その表示の真の価値(上乗せを除いた真のクリック率から計算した表示の価値)の合計を比べます。合成データなので、真の価値が分かります。
# ブロック4:掲載面Eの上乗せを含む記録で再学習すると、入札はどう動くか
from sklearn.linear_model import LogisticRegression
def feats(d):
    pl = d.place.to_numpy()
    cols = [pl == p for p in "BCDEF"] + [d.device.to_numpy(), np.minimum(d.visits, 5)]
    cols += [(pl == p) & (d.device.to_numpy() == 1) for p in "ABCDEF"]
    return np.column_stack(cols).astype(float)
tr = imp[(imp.day >= 8) & (imp.day <= 20)]            # 21日目の朝に再学習する
keep = ~((tr.place == "E") & (tr.day >= 15))           # 疑わしい期間を除いた記録
models = {"上乗せを含めて再学習": LogisticRegression(max_iter=1000).fit(feats(tr), tr.click),
          "疑わしい期間を除いて再学習": LogisticRegression(max_iter=1000).fit(
              feats(tr[keep]), tr.click[keep])}
opp = df[(df.place == "E") & (df.day >= 21)]          # 21〜28日の掲載面Eの入札した機会
true_v = opp.p_true * cv_rate * cv_value               # 表示の価値の真の値
bids = {"配信中のモデル": opp.pred.to_numpy() * cv_rate * cv_value}
for k, m in models.items():
    bids[k] = m.predict_proba(feats(opp))[:, 1] * cv_rate * cv_value
print("--- 掲載面Eの21〜28日(入札した機会", len(opp), "件)")
for k, b in bids.items():
    w = b > opp.comp.to_numpy()
    print(f"{k}: 予測クリック率の平均 {b.mean() / cv_rate / cv_value:.4f}"
          f" 落札 {w.sum()} 件 支払額の合計 {opp.comp[w].sum():.3f}"
          f" 落札した表示の真の価値の合計 {true_v[w].sum():.3f}"
          f" 支払額÷真の価値 {opp.comp[w].sum() / true_v[w].sum():.2f}")
print("真のクリック率の平均(上乗せを除く)", round(opp.p_true.mean(), 4))
| モデル | 予測クリック率の平均 | 落札した表示 | 支払額の合計 | 落札した表示の真の価値の合計 | 支払額 ÷ 真の価値 |
|---|---|---|---|---|---|
| 配信中のモデル(更新しない) | 0.0173 | 8,468件 | 10.135 | 11.189 | 0.91 |
| 上乗せを含めて再学習 | 0.0301 | 13,401件 | 20.747 | 17.496 | 1.19 |
| 疑わしい期間を除いて再学習 | 0.0171 | 8,304件 | 9.834 | 11.113 | 0.88 |
21〜28日の掲載面Eの入札した機会は15,408件で、その真のクリック率の平均は0.0130でした。上乗せを含めて再学習すると、予測クリック率の平均は0.0301と、真の値の2倍を超えました。入札額が上がった結果、落札した表示は8,468件から13,401件に増え、支払額の合計は2倍余りになり、落札した表示の真の価値の合計を上回りました(支払額 ÷ 真の価値が1.19)。これは、見込んだ価値を超える額で買う払いすぎにあたります。疑わしい期間を除いて再学習した場合は、予測クリック率の平均は0.0171で、配信中のモデルとほぼ同じ水準に留まりました。なお、配信中のモデルは28日間更新しておらず、21日目からのスマートフォンの真のクリック率の低下は予測に含まれていません。0.0173と0.0130の差の内訳は、この例題では分けて確かめていません。ここでの真の価値は、合成データの生成条件から求めたコンバージョンの価値の期待値で、広告を出さなかった場合との差(増分)ではありません。この結果は本コラムの架空データでのもので、上乗せの割合や、学習に使う期間に疑わしい記録が占める割合が違えば、予測の上がり方も変わります。
構成の変化を測る、掲載面の構成比の PSI
入力の層では、表示の機会の構成がどれだけ変わったかを1つの数で表す指標がよく使われます。その1つが PSI(Population Stability Index)で、基準の期間の構成比 \( b_i \) と、比べる期間の構成比 \( c_i \) から、\( \mathrm{PSI} = \sum_i (c_i – b_i) \ln(c_i / b_i) \) で計算します。言葉で言えば、区分ごとの構成比の差に、構成比の比の対数を掛けて足し合わせたもので、構成がまったく変わらなければ0になり、変わるほど大きくなります。与信の分野でも使われる指標で、与信での使い方は『貸し倒れのリスクを見積もる与信スコアリング、スコアカードの作り方から審査と途上与信の運用まで』という弊社コラムで扱っています。この指標を最初に示した文献は、本コラムでは確かめられなかったため、ここでは計算の定義だけを使います。コードでは、構成比が0の区分で対数が計算できなくなるのを避けるため、構成比に小さな値(0.0001)を足しています。
# ブロック5:入札リクエストの構成の変化(掲載面の構成比の PSI)
def psi(base, cur, eps=1e-4):
    b = base.value_counts(normalize=True).reindex(places, fill_value=0) + eps
    c = cur.value_counts(normalize=True).reindex(places, fill_value=0) + eps
    return float(((c - b) * np.log(c / b)).sum())
base_req = df[df.day <= 14].place
base_imp = imp[imp.day <= 14].place
print("--- 掲載面の構成比の PSI(基準は1〜14日)")
for d in [15, 17, 18, 21, 28]:
    print(d, "日目 入札リクエスト", round(psi(base_req, df[df.day == d].place), 3),
          "表示", round(psi(base_imp, imp[imp.day == d].place), 3))
print("1〜14日の表示の構成比", (base_imp.value_counts(normalize=True).round(3)).to_dict())
late = df[df.day >= 18]
print("18〜28日の掲載面ごとの勝率(入札した機会が分母)",
      late.groupby("place").won.mean().round(3).to_dict())
print("18〜28日の表示の構成比",
      (imp[imp.day >= 18].place.value_counts(normalize=True).round(3)).to_dict())
| 日 | 入札リクエストの PSI | 表示の PSI |
|---|---|---|
| 15日目 | 0.001 | 0.001 |
| 17日目 | 0.000 | 0.001 |
| 18日目 | 0.522 | 0.147 |
| 21日目 | 0.540 | 0.154 |
| 28日目 | 0.539 | 0.154 |
基準を1〜14日の記録で固定し、15日目以降の各日をその日までの記録だけで計算した結果、15〜17日の PSI は入札リクエスト・表示ともに0.001以下でしたが、掲載面Fが増えた18日目には入札リクエストで0.522、表示で0.147に上がりました。表示の PSI が入札リクエストより小さいのは、掲載面Fは予測クリック率が低く、入札額が低いので、増えた入札リクエストの多くを落札しなかったためです。18〜28日の掲載面Fの勝率(入札した機会が分母)は15.8%で、他の掲載面の54.9〜80.0%より低くなっていました。表示に占める掲載面Fの割合は、1〜14日の0.5%から、18〜28日の6.3%に増えました。15日目の掲載面Eの異変は、構成比を変えない変化なので、PSI には表れていません。
この結果から、PSI の使い方について2つのことが言えます。1つ目は、PSI が大きく動いたことは、それだけではモデルの誤りを意味しないことです。この合成データでは、掲載面Fについても予測は真の値に合うように作ってあり、構成が変わった18日目以降も、PCの予測と実績の比は1の前後のままでした。構成の変化は、予測が外れていないかを確かめるきっかけであって、再学習の合図そのものではありません。2つ目は、PSI が動かなくても異変は起きうることです。掲載面Eの上乗せのように、構成を変えずに中身が変わる変化は、構成の指標では捉えられません。
PSI について、いくつ以上なら対応するという目安の値が紹介されることがありますが、その値は区分の数や件数、比べる期間の長さで変わります。本コラムでは、目安の値を機械的な基準としては扱いません。自社の過去の記録で、変化の無い期間どうしの PSI がどの程度の範囲に収まるかを確かめ、その範囲から外れたことを点検のきっかけにする使い方が安全だと考えています。
外れた日を拾う、管理図の考え方と警報の鳴りすぎ
掲載面ごとのクリック率のように、日ごとに表示の件数が違う率を監視するときは、件数に応じた揺れの幅を考える必要があります。表示が少ない日は、何も起きていなくても率が大きく揺れます。ここでは、品質管理で使われる管理図の考え方を借りて、基準の期間の率 \( p_0 \) と、その日の表示の件数 \( n \) から、揺れの幅の目安となる標準偏差 \( \sqrt{p_0(1-p_0)/n} \) を計算し、その日の率が基準から標準偏差の何倍外れたかを見ます。この幅は、表示ごとのクリックが互いに独立で、クリックの確率が安定しているとみなす近似です。同じ利用者への繰り返しの表示などで依存が強い場合や、基準の期間のクリックが少ない場合は、外れる確率をそのまま警報の確率として読めません。基準は1〜7日の記録だけから作り、8日目以降の各日を、その日までに分かっている表示とクリックだけで判定しました。不正の検知の一般論は、弊社コラム『取引の不正を見つける不正検知の実践ガイド、ルールと機械学習の使い分けから調査と運用まで』で扱っています。
# ブロック6:掲載面ごとの日次クリック率を管理図の考え方で点検する
# 基準は1〜7日。8日目以降の各日を、その日の表示の数から決まる幅と比べる
daily = imp.groupby(["place", "day"]).agg(n=("click", "size"), k=("click", "sum"))
daily["ctr"] = daily.k / daily.n
p0 = (imp[imp.day <= 7].groupby("place").click.mean())
print("基準(1〜7日)の掲載面ごとの表示とクリックの数",
      imp[imp.day <= 7].groupby("place").click.agg(["size", "sum"]).to_dict("index"))
daily["p0"] = p0.reindex(daily.index.get_level_values(0)).values
daily["sd"] = np.sqrt(daily.p0 * (1 - daily.p0) / daily.n)
daily["z"] = (daily.ctr - daily.p0) / daily.sd
ev = daily[daily.index.get_level_values(1) >= 8]
for L in [2, 3]:
    flag = ev[ev.z.abs() > L]
    early = flag[flag.index.get_level_values(1) <= 20]
    fa = early[early.index.get_level_values(0) != "E"]
    print(f"--- 幅 {L} 標準偏差:8〜20日に掲載面E以外で外れた日数 {len(fa)}"
          f"(点検した日数 {5 * 13})", fa.index.tolist(),
          "その日の表示の数", fa.n.tolist())
    e_days = flag.loc["E"].index.tolist() if "E" in flag.index.get_level_values(0) else []
    print("掲載面Eで外れた日", e_days)
    late = flag[(flag.index.get_level_values(1) >= 21)
                & (flag.index.get_level_values(0) != "E")]
    print("21〜28日に掲載面E以外で外れた日数", len(late), "うち下に外れた",
          int((late.z < 0).sum()))
fig, axes = plt.subplots(1, 2, figsize=(10, 3.8), sharey=True)
for ax, pl in zip(axes, ["A", "E"]):
    g = daily.loc[pl]
    ax.plot(g.index, g.ctr, color="#002E73", marker="o", ms=3, label="日次のクリック率")
    ax.plot(g.index, g.p0 + 3 * g.sd, color="gray", ls="--", label="基準 ± 3標準偏差")
    ax.plot(g.index, g.p0 - 3 * g.sd, color="gray", ls="--")
    ax.axvline(7.5, color="gray", lw=0.6)
    ax.set_title(f"掲載面{pl}"); ax.set_xlabel("日")
axes[0].set_ylabel("クリック率")
axes[0].legend(loc="upper left", frameon=False)
plt.savefig("../ch12_control_chart.png", dpi=120, bbox_inches="tight")
plt.close()
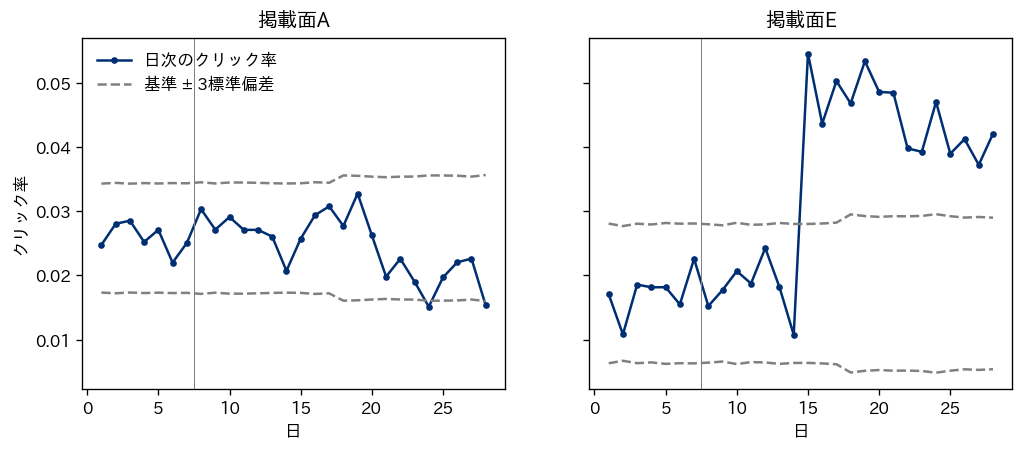
| 外れとみなす幅 | 8〜20日に掲載面E以外で外れた日数(点検した65組の掲載面と日のうち) | 掲載面Eで外れた日 | 21〜28日に掲載面E以外で外れた日数 |
|---|---|---|---|
| 標準偏差の2倍 | 3日 | 15〜28日の全日 | 13日(すべて下に外れた) |
| 標準偏差の3倍 | 0日 | 15〜28日の全日 | 3日(すべて下に外れた) |
実行した結果、掲載面Eは、幅を標準偏差の2倍にしても3倍にしても、上乗せが始まった15日目から28日目まで毎日外れと判定されました。上乗せの大きさがクリック率の水準より大きいので、初日から見つかったことになります。一方、クリック率を変える変化を入れていない8〜20日の掲載面E以外(5つの掲載面×13日=65組)では、幅を2倍にすると3日が外れと判定され、3倍にすると0日でした。2倍で外れた3日の内訳は、掲載面Aの19日目と、掲載面Fの19日目・20日目です。掲載面Fは、基準の1〜7日の表示が336件でクリックが3件しかなく、基準の率そのものが不安定でした。また、19日目・20日目は、18日目から掲載面Fの入札リクエストが増えたあとの日にあたります。図の縦の細線は、基準の期間(1〜7日)の終わりを示しています。21〜28日に掲載面E以外で外れた日(2倍で13日、3倍で3日)は、すべて下に外れたもので、スマートフォンのクリック率の低下という本物の変化を反映しています。
幅の取り方は、見逃しと鳴りすぎの入れ替わりです。幅を狭くすれば小さな変化にも早く気づけますが、何も起きていない日にも警報が鳴ります。この例題で幅を2倍にした場合、5つの掲載面の合計で、13日間に3回、点検してもクリック率の異変が見つからない警報が鳴ったことになります。掲載面の数や指標の数が増えれば、何も起きていない日の警報の件数もそれに比例して増えます。警報が鳴りすぎると、担当者は警報を見なくなり、本当の異変のときにも対応されなくなります。これは形骸化の典型的な型です。
鳴りすぎを抑えるには、いくつかの工夫が考えられます。1つは、幅を広げる代わりに、2日続けて外れたときだけ鳴らすように条件を重ねることです。もう1つは、件数の少ない区分は日ごとではなく数日分をまとめて判定し、掲載面Fのように基準の件数が少ない区分では基準の期間を伸ばすことです。さらに、警報を、すぐに配信を止めるべきもの(費用が急に増えた、コンバージョンの計測が止まった)と、翌営業日に点検すればよいもの(ある掲載面のクリック率がやや外れた)に分けておくことも有効だと考えています。どの工夫を選ぶにしても、何も起きていない期間の記録で鳴る回数を先に数えておくと、警報の設計を数字で議論できます。
無効なトラフィックと、広告主にできること
計測の基準に照らして、正当な表示やクリックとして数えるべきでないものを、本コラムでは無効なトラフィックと呼びます。自動のプログラムによるもの、人の操作による不正なクリック、誤操作を誘うものなどを含み、不正を目的とするものに限りません。一方で、利用者の関心が低いことや、コンバージョンしなかったことだけでは、無効とはしません。掲載面Eの例題の上乗せは、自動のプログラムなどによる、正当なクリックとして数えるべきでないクリックを想定したものです。広告の計測の基準づくりと認定のための監査に関わる米国の団体である Media Rating Council(MRC)は、無効なトラフィックの検知と除外の指針(2015年10月に初版、2020年6月に更新した版を確認)で、無効なトラフィックを2つの区分に分けています。1つは一般的な無効なトラフィック(GIVT)で、無効な通信の発生元として確認されたデータセンターからの通信(データセンターを経由するだけの正当な利用者の通信は含まない)や、既知のクローラーのように、一覧表や標準的な項目の点検といった定型の方法で除外できるものです。もう1つは巧妙な無効なトラフィック(SIVT)で、見つけるのに高度な分析や複数の情報の突き合わせ、人による調査が要るものです。MRC は2024年4月にこの指針の暫定の更新を示す文書も公表しています。
本コラムでは、無効なトラフィックの作り方や、検知の仕組みを避ける方法は扱いません。広告主の立場でできることは、検知の仕組みそのものを自分で作ることよりも、検知の結果を確かめ、配信と契約に反映することにあると考えています。次の表は、広告主が取りうる対応を整理したものです。
| 対応 | 内容 | 確かめること |
|---|---|---|
| 計測の事業者の利用 | 第三者の計測の事業者の報告で、無効なトラフィックとして除外された割合を見る | その事業者がどの区分(一般的なもの・巧妙なもの)まで検知の対象にしているか、どの第三者の認定や認証を受けているか |
| 自社の記録での点検 | 本章の例のように、クリック率は高いのにコンバージョンが付かない掲載面を、成熟したコンバージョン率で確かめる | 比べる期間の結果が出そろう日数をそろえているか |
| 掲載面の除外 | 疑わしい掲載面を配信の対象から外す | 外したことを記録し、外した理由と日付を残しているか |
| 返金の取り決めの確認 | 無効なトラフィックと判定された表示やクリックの費用の扱いを、媒体・DSP・広告会社との取り決めで確かめる | 誰の判定を基準にするか、いつまでに申し出るか |
| 学習の記録からの除外 | 疑わしい期間・掲載面の記録を、自社のモデルの学習に使わない。媒体の自動入札については、媒体が提供する機能の対象条件を確かめ、媒体や DSP に対応を相談する | 除外した範囲を記録しているか |
表の最後の行は、前の節で見た「ずれを直そうとして払いすぎる」ことを防ぐための対応です。無効なトラフィックは、その日の費用を無駄にするだけでなく、記録に残ることで、翌日以降のモデルや自動入札の判断を歪めます。媒体の自動入札にも、コンバージョンの計測に問題があった期間のデータを入札の学習から除く機能を用意しているものがあります(後の節)。ただし、その機能はコンバージョンの計測の障害を対象とするものとして説明されており、疑わしい掲載面のクリックの記録を除くための機能としては説明されていません。自社のモデルの学習からの除外と、媒体の自動入札への対応は分けて考えます。
見られる状態だったか、どこに出たか、誰から買ったか
表示として記録されても、利用者が実際に見られる状態だったとは限りません。ページの下の方に配信されて一度も画面に入らなかった広告も、表示として数えられることがあります。広告が見られる状態にあったかどうかを表す指標をビューアビリティと呼びます。MRC の見られる状態の表示の計測の指針(2015年8月の第2版)では、ディスプレイ広告は、広告のピクセルの50%以上が、ブラウザの見えている範囲に、連続して1秒以上入っていた場合に、見られる状態の表示として数えるとしています。動画広告は、同じピクセルの条件を満たしたうえで、連続して2秒以上再生された場合としています。これは一般的なディスプレイ広告の条件で、同じ指針は、242,500ピクセル以上の大きな広告についてはピクセルの30%以上が連続して1秒以上という別の条件を示しています。モバイルについては、別に2016年6月の指針があります。
ビューアビリティは、表示が見られる状態にあったかどうかを表すだけで、利用者が広告に注意を向けたことや、広告が効いたことを示すものではありません。それでも、見られる状態の割合が極端に低い掲載面を表示課金で買う場合、その低さが価格に反映されていなければ、見込んだ価値を超える額で買う払いすぎになりえます。予測のモデルにとっても、クリックが起こりえない表示を多く含む記録になります。掲載面ごとのビューアビリティを、クリック率やコンバージョン率と並べて見ておくと、どの掲載面の数字を信頼してよいかの手がかりになります。
どこに出たかの点検がブランドセーフティです。広告が、違法な内容や、広告主のブランドにふさわしくない内容のページに掲載されることを避ける取り組みを指します。不適切な掲載面への配信は、費用の無駄だけでなく、広告主がその内容を支援しているように受け取られるおそれがあり、利用者の信頼を損なうことにつながりえます。国内では、日本アドバタイザーズ協会・日本広告業協会・日本インタラクティブ広告協会が中心となって、デジタル広告品質認証機構(JICDAQ)が2021年3月に設立され、同年4月に事業を始めています。JICDAQ は、アドフラウド(広告詐欺)やブランドの毀損のリスクといった掲載品質の課題への対応を掲げ、デジタル広告の掲載に関わる事業者を認証して公開しています。取引先を選ぶときに、認証の有無とその範囲を確かめる材料になります。認証の区分の詳しい内容は、本コラムでは公式の文書で確かめきれていないため、JICDAQ の公式の情報で確かめてください。
誰から買ったかを確かめる仕組みもあります。IAB Tech Lab が定める ads.txt は、媒体が、自社の広告枠を売ることを認めた事業者を公開するファイルで、最新の版は2022年8月の1.1です。アプリ向けには app-ads.txt があります。sellers.json は、広告枠を直接売る事業者や仲介する事業者を、買い手が確かめられるようにするファイルで、OpenRTB の SupplyChain オブジェクト(入札リクエストに、その機会を売った・転売した事業者を順に並べたもの)と組み合わせて、取引の経路にいる事業者を照合するために使われます。買い手の側では、媒体の ads.txt に載っていない売り手からの入札リクエストを買わないように設定できるかを、DSP に確かめることが出発点になります。売り手を確かめないと、媒体が認めていない事業者から転売された枠や、経路の分からない枠を買うことになり、表示の機会の中身が見込みと違えば、見込んだ価値を超える額で買う払いすぎにつながります。
| 点検の対象 | 問い | 使う仕組み・資料 | 主に防ぐ損失の型 |
|---|---|---|---|
| 無効なトラフィック | 計測の基準に照らして、正当な表示やクリックとして数えてよいか | MRC の指針にもとづく計測の事業者の報告・自社の成熟したコンバージョン率 | 払いすぎ・成果の数え違い |
| ビューアビリティ | その表示は見られる状態にあったか | MRC の見られる状態の表示の指針にもとづく計測 | 払いすぎ(見られる状態の割合の低さが価格に反映されていない場合) |
| ブランドセーフティ | その掲載面は自社の広告を出してよい内容か | 掲載面の報告・除外の一覧・JICDAQ の認証を受けた事業者の利用 | 信頼の毀損 |
| 売り手の確認 | その広告枠は、媒体が認めた事業者から買っているか | ads.txt・app-ads.txt・sellers.json・SupplyChain オブジェクト | 払いすぎ(認められていない転売や、経路の分からない枠を見込みより高く買う場合) |
モデルが古くなる理由と、見直しの段階
予測のモデルは、学習に使った期間の利用者の行動・掲載面・競合・商品の状態を前提にしています。前提が変われば、モデルは何もしなくても古くなります。古くなる理由として、季節や曜日の波、取り扱う商品や価格の変更、競合の入札の変化、新しい掲載面の追加や既存の掲載面の表示のされ方の変更、識別子の使える範囲の変化(第14章)などが挙げられます。モデルの監視と再学習の一般論は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。
予測と実績がずれたとき、いきなり作り直すのではなく、軽い対応から順に検討すると考えやすくなります。表の「較正のやり直し」は、モデルの中身は変えずに、出力する確率を直近の実績の率と対応するように変換し直すことを指します。次の表は、見直しの段階を整理したものです。
| 段階 | 内容 | 向いている変化 | 要るデータと手間 |
|---|---|---|---|
| 0. 原因の確認 | ずれが記録の質(無効なトラフィック・計測の欠落)によるものかを先に確かめる | すべて | 計測の事業者の報告・タグの稼働の記録 |
| 1. 較正のやり直し | モデルの出力を対数オッズ(確率 \( p \) を \( p/(1-p) \) にして対数をとった値)にしたものを入力に、直近の実績に合わせる変換だけを学び直す | 全体の水準が一律に動いた変化 | 直近の少ないデータで済む。手間が小さい |
| 2. 再学習 | 同じ特徴量で、直近を含むデータでモデルの係数を学び直す | 区分によって向きや大きさが違う変化 | 区分ごとに十分な件数が要る。検証の手間がかかる |
| 3. 特徴量の見直し | 新しい項目や組み合わせを加える、使えなくなった項目を外す | 今の特徴量では表せない変化 | 開発と検証の手間が最も大きい |
段階1と段階2のどちらで足りるかを、別に作った架空の表示の記録で確かめます。28日分の表示を作り、14日目までで学習したモデルを、15日目からの変化のあとも使い続ける場合を考えます。変化は2つの型を用意しました。1つ目は、すべての表示で真のクリック率が0.65倍になる「一律に下がる」型です。2つ目は、スマートフォンでは0.70倍、PCでは1.5倍と、端末によって逆向きに動く型です。この型では、実際に生成したクリックの率で見ると、全体のクリック率の変化(1〜14日の2.07%から15〜28日の1.86%)は、端末ごとの変化(PC は1.64%から2.46%、スマートフォンは2.31%から1.53%)より小さくなります。18日目の朝に判定するものとし、15〜17日の3日分の記録を使って、①そのまま使う、②全体の較正をやり直す、③直近3日で再学習する、④1〜17日で再学習する(直近の3日に5倍の重み)、の4つを18〜28日の記録で比べました。
# ブロック7:較正のやり直しで済む変化と、再学習が要る変化
from sklearn.metrics import log_loss

def make_log(kind, rng, n_days=28, n_per_day=10000):
    m = n_days * n_per_day
    d = np.repeat(np.arange(1, n_days + 1), n_per_day)
    pl = rng.integers(0, 5, m); dv = rng.choice(2, m, p=[0.35, 0.65])
    vs = np.minimum(rng.poisson(1.5, m), 5)
    lg = (np.array([-4.0, -4.3, -4.6, -4.2, -4.4])[pl] + 0.25 * dv + 0.12 * vs
          + 0.5 * ((pl == 2) & (dv == 1)))
    p = 1 / (1 + np.exp(-lg))
    after = d >= 15
    if kind == "一律に下がる":
        p = p * np.where(after, 0.65, 1.0)
    else:  # 端末によって逆向きに動く
        p = p * np.where(after & (dv == 1), 0.70, 1.0) * np.where(after & (dv == 0), 1.5, 1.0)
    y = rng.random(m) < p
    X = np.column_stack([pl == j for j in range(1, 5)] + [dv, vs]
                        + [(pl == j) & (dv == 1) for j in range(5)]).astype(float)
    return d, dv, X, y

def ratios(pred, y, dv):
    out = {"全体": pred.sum() / y.sum()}
    for v, name in [(0, "PC"), (1, "スマートフォン")]:
        out[name] = pred[dv == v].sum() / y[dv == v].sum()
    return out
for kind in ["一律に下がる", "端末によって逆向きに動く"]:
    d, dv, X, y = make_log(kind, np.random.default_rng(20261116))
    tr, rc, te = d <= 14, (d >= 15) & (d <= 17), d >= 18   # 18日目の朝に判定する
    print(f"{kind}:全体のクリック率 1〜14日 {y[tr].mean():.4f} 15〜28日 {y[d >= 15].mean():.4f}"
          f" PC {y[tr & (dv == 0)].mean():.4f}→{y[(d >= 15) & (dv == 0)].mean():.4f}"
          f" スマートフォン {y[tr & (dv == 1)].mean():.4f}→{y[(d >= 15) & (dv == 1)].mean():.4f}")
    base = LogisticRegression(C=1.0, max_iter=1000).fit(X[tr], y[tr])
    z = base.decision_function(X)
    cal = LogisticRegression(C=1e6).fit(z[rc].reshape(-1, 1), y[rc])
    re3 = LogisticRegression(C=1.0, max_iter=1000).fit(X[rc], y[rc])
    w = np.where(d <= 14, 1.0, 5.0)
    re17 = LogisticRegression(C=1.0, max_iter=1000).fit(X[d <= 17], y[d <= 17],
                                                         sample_weight=w[d <= 17])
    preds = {"そのまま使う": base.predict_proba(X[te])[:, 1],
             "全体の較正をやり直す": cal.predict_proba(z[te].reshape(-1, 1))[:, 1],
             "直近3日で再学習": re3.predict_proba(X[te])[:, 1],
             "1〜17日で再学習(直近に重み)": re17.predict_proba(X[te])[:, 1]}
    print(f"--- 変化の型:{kind}(評価は18〜28日、表示 {te.sum()} 件、"
          f"クリック {int(y[te].sum())} 件)")
    for k, p in preds.items():
        r = ratios(p, y[te], dv[te])
        print(f"{k}: 対数損失 {log_loss(y[te], p):.5f} 比 全体 {r['全体']:.2f}"
              f" PC {r['PC']:.2f} スマートフォン {r['スマートフォン']:.2f}")
| 変化の型 | 方法 | 対数損失 | 比(全体) | 比(PC) | 比(スマートフォン) |
|---|---|---|---|---|---|
| 一律に下がる | そのまま使う | 0.06994 | 1.62 | 1.60 | 1.63 |
| 一律に下がる | 全体の較正をやり直す | 0.06816 | 1.04 | 1.01 | 1.05 |
| 一律に下がる | 直近3日で再学習 | 0.06830 | 1.02 | 1.15 | 0.98 |
| 一律に下がる | 1〜17日で再学習(直近に重み) | 0.06870 | 1.31 | 1.36 | 1.29 |
| 端末によって逆向きに動く | そのまま使う | 0.09232 | 1.13 | 0.68 | 1.50 |
| 端末によって逆向きに動く | 全体の較正をやり直す | 0.09166 | 1.04 | 0.80 | 1.25 |
| 端末によって逆向きに動く | 直近3日で再学習 | 0.09094 | 1.04 | 1.10 | 1.00 |
| 端末によって逆向きに動く | 1〜17日で再学習(直近に重み) | 0.09110 | 1.08 | 0.90 | 1.23 |
表の「比」は、予測クリック率の合計を実績のクリックの件数で割った値です。評価の18〜28日の表示は、どちらの型も110,000件で、クリックは「一律に下がる」型で1,410件、「端末によって逆向きに動く」型で2,021件でした。
一律に下がる型では、そのまま使うと比は全体で1.62と、予測が実績の1.6倍前後になりました。全体の較正をやり直すと、比は全体で1.04、PCで1.01、スマートフォンで1.05に戻り、対数損失も4つの中で最も小さくなりました(0.06816)。直近3日での再学習も全体の比は1.02に戻りましたが、PCの比は1.15で、対数損失は較正のやり直しよりわずかに大きくなりました(0.06830)。この差の理由は、この例題では確かめていません。1〜17日で再学習した場合は、変化の前の記録が多く残るので、比は1.31までしか戻りませんでした。
端末によって逆向きに動く型では、そのまま使った場合の全体の比は1.13で、全体だけを見ると大きな異変には見えません。しかし、端末ごとに分けると、PCは0.68、スマートフォンは1.50で、予測は逆向きに大きくずれていました。全体の較正をやり直すと、全体の比は1.04になりましたが、PCは0.80、スマートフォンは1.25と、端末ごとのずれは残りました。この例題では、全体に共通する較正だけでは端末ごとのずれが残りました。直近3日での再学習では、PCが1.10、スマートフォンが1.00となり、対数損失も4つの中で最も小さくなりました(0.09094)。
差の小さい比較なので、掲載していないスクリプトで乱数のシードを1〜10に変えて繰り返しました(①〜③の3つを比較)。一律に下がる型では、10回のうち9回で全体の較正のやり直しの対数損失が最も小さく、残りの1回は直近3日の再学習と小数第5位まで同じ値(0.07009)でした。端末によって逆向きに動く型では、10回すべてで直近3日の再学習が最も小さく、全体の較正のやり直しのあとのスマートフォンの比は1.14〜1.29に残りました。この架空データの条件では、全体の水準が一律に動いた変化には較正のやり直しで足り、区分によって向きの違う変化には再学習が要る、という結果でした。ただし、この結論は、変化の後の3日間に区分ごとに十分な件数がある条件でのものです。件数が少なければ、直近だけでの再学習は揺れが大きくなります。
この例題から、監視の設計について言えることがあります。全体の比だけを見ていると、端末によって逆向きに動く型の変化を見逃します。予測と実績の比は、少なくとも入札額に大きく効く区分(掲載面・端末・キャンペーンなど)ごとに見る必要があります。また、見直しの段階を選ぶ前に、区分ごとの比を見て、ずれが一律か区分によって違うかを確かめると、どの段階で足りるかの見当がつきます。
自動入札を使っている場合の点検
媒体の自動入札を使っている場合、予測のモデルや入札の計算は媒体の側にあり、広告主は中身を見られません。それでも、広告主の側で点検できることは多くあります。1つ目は、設定した目標と実績のずれです。目標の CPA や目標の ROAS に対して、成熟した期間で見た実績がどれだけ離れているかを、キャンペーンごとに定期的に見ます。2つ目は、コンバージョンの計測そのものです。タグの外れやデータの取り込みの失敗でコンバージョンが記録されなくなると、自動入札の調整に使われるコンバージョンのデータが欠けます。計測の件数を、自社の売上や申込の記録と日ごとに突き合わせておくと、計測の欠落に早く気づけます。
媒体の公式ヘルプには、点検の手がかりになる情報が書かれています。要点を2つ挙げます。1つ目は、設定の変更のあと、成績が落ち着くまで待つ期間と、成績を評価する期間を分けて考えることです。たとえば Google 広告のヘルプは、スマート自動入札の「学習中」の状態と、変更後の成績の評価の目安を別の項目として説明しています。2つ目は、コンバージョンの計測に障害があった期間を自動入札の学習から除く「データの除外」という機能です。同じヘルプでは、除外の日付はクリックの日付に適用されるため、障害の発生日だけでなく、コンバージョンに至るまでの日数を考えて、影響を受けた可能性のあるクリックの日を含めるよう案内されています。どちらも詳細や条件は公式ヘルプで確かめる必要があり、自動入札の内部の計算がどうなっているかは公開されていません。
こうした機能を使うかどうかにかかわらず、設定を変えた日と、変えた理由を記録しておくことが点検の前提になります。自動入札の成績は設定の変更のあと一定の期間揺れることがあるので、変更の履歴が無いと、成績の変化が設定によるものか、市場の変化によるものかを区別できません。
| 記録するもの | 内容 | 使う場面 |
|---|---|---|
| 設定の変更の履歴 | 目標・予算・配信の対象・入札の方針・コンバージョンの定義を、いつ、誰が、なぜ変えたか | 成績の変化の原因を切り分ける |
| 入札の方針 | どの価値の見積りで、どの目標にもとづいて入札しているか | 担当者が替わっても方針を引き継ぐ |
| 計測の障害 | タグの外れ・取り込みの失敗・サイトの停止の期間 | 学習のデータから除く範囲を決める |
| 除外した掲載面 | 除外した掲載面・日付・理由(無効なトラフィック・ブランドセーフティなど) | 除外の見直し・取引先との協議 |
| 実験の結果 | 増分の実験(第11章)の期間・設計・結果 | 目標の CPA や予算の見直し |
| モデルの見直し | 較正のやり直し・再学習を行った日と、その前後の区分ごとの比 | 見直しの効果の確認と、次の見直しの判断 |
警報の設計と、経営の判断
ここまでの点検を毎日の業務として回すには、どの指標を、どの頻度で、誰が見て、外れたときに誰が何をするかを決めておく必要があります。とくに重要なのは、異常のときに配信を止める権限を、誰が持つかを先に決めておくことです。費用が急に増えた、コンバージョンの計測が止まった、不適切な掲載面への配信が見つかった、といった場合には、数時間の遅れが払いすぎや信頼の毀損につながります。止める判断のたびに上の承認を待つ仕組みでは、その時間を取り戻せません。
| 警報の種類 | 例 | 見る頻度の例 | 対応の例 |
|---|---|---|---|
| すぐに止める | 費用が予算の計画を大きく超えて増えた・コンバージョンの計測が止まった・除外したはずの掲載面に配信された | 1時間〜数時間ごと | 担当者がその場で配信を止め、事後に報告する |
| 当日中に点検 | 掲載面のクリック率が幅の外に出た・区分の予測と実績の比が大きく動いた | 毎日 | 原因を確かめ、必要なら掲載面の除外や入札の見直しを提案する |
| 週ごとに見直し | 構成の指標の変化・成熟したコンバージョン率の低下・目標と実績のずれ | 毎週 | 較正のやり直しや再学習の要否を判断する |
| 月ごとに報告 | 無効なトラフィックの割合・ビューアビリティ・警報の件数と誤報の割合 | 毎月 | 取引先の見直し・監視の設計の見直し |
経営の立場から決めるべきことは、3つに整理できます。1つ目は監視の指標で、結果の層の数字だけでなく、先に分かる入力と予測の層の指標を、経営への報告に含めるかどうかです。2つ目は点検の頻度で、表の例のように、警報の重さに応じて見る頻度を分けます。3つ目は止める権限で、どの条件で、誰が、上の承認を待たずに配信を止めてよいかを、文書にしておきます。監視の仕組みがあっても、警報が鳴ったあとに誰も動けなければ、形骸化の型に陥ります。逆に、止める権限が現場にあれば、止めたことによる短い機会損失と引き換えに、大きな払いすぎを避けられます。どちらの損失を重く見るかは事業によって違うので、条件を決めるときに、止めた場合と止めなかった場合の損失の型を並べて議論するのがよいと考えています。
もう1つ、監視の仕組みそのものも点検の対象です。警報の件数のうち、点検しても何も見つからなかったものの割合を毎月数えておくと、警報の幅や条件が適切かを判断できます。何も見つからない警報が大半を占めるなら幅を見直し、逆に警報が長く鳴っていないなら、計測が止まっていないかを確かめます。警報が鳴らないことは、何も起きていないことと同じではありません。
この章のまとめ
配信の仕組みが止まらずに動いていても、成果が出ているとは限りません。本章では、監視を入力・予測・結果の3つの層に分け、遅れて届くコンバージョンより先に分かる指標で異変を拾い、コンバージョンの指標は結果が出そろう日数をそろえて比べることを、架空の合成データで確かめました。同じデータで、正当なクリックとして数えるべきでないクリックを含む記録のまま再学習すると、予測クリック率が上がって支払額の合計が落札した表示の真の価値の合計を上回り、疑わしい期間を除けば下回ったこと(この例題の合計値での比較)も確かめました。予測と実績のずれは原因を確かめてから直し、全体の水準のずれには較正のやり直しを、区分によって向きの違うずれには再学習を検討します。あわせて、無効なトラフィック・ビューアビリティ・ブランドセーフティ・売り手の確認の仕組みを整理しました。次の第13章では、ここまでの章で扱った予測・入札・ペース配分・効果の測定・監視を、自社の体制の中でどこまで自分で持ち、どこを外部に任せるかという導入の進め方を扱います。
この章を深めたい方への参考書籍
『機械学習システムデザイン:実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習のシステムを本番で動かし続けるための設計を扱う本で、データ分布のシフトと監視、実環境での継続学習とテストに章を割いています。本章で扱った、予測と実績のずれを監視し、較正のやり直しや再学習で対応する考え方を、広告に限らない一般的な形で学べます。
『異常検知と変化検知』(井手剛・杉山将 著、講談社):機械学習プロフェッショナルシリーズの1冊で、ホテリングの T2 法から、部分空間法や密度比推定による変化検知までを扱います。本章では管理図の考え方による単純な外れの検知だけを使いましたが、多くの指標をまとめて監視したいときや、分布の変化を検知したいときの手法を体系的に学べます。
第13章 導入の進め方と体制、自動入札の使い分け・内製と外部の分担
第12章では、配信が止まらずに動いていても成果が出ているとは限らないこと、コンバージョンが遅れて届くので先に分かる指標で監視することを扱いました。あわせて、無効なトラフィックや掲載面の点検、モデルを見直す段階、異常のときに配信を止める権限の決め方も扱いました。第1章から第12章は、運用型広告の入札を「どの表示の機会を、どのデータとどの方法で評価し、いくらで入札して、予算をどう使い、その成果をどう測り、どう監視するか」という順に説明してきました。この章では、それを自社のどの広告から、どの順番で、誰の責任で入れていくかを扱います。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 自社がどこまで自分で決めるかの4つの段階と、それぞれに要るデータ・人・費用の型、どの段階を選ぶかの採点表
- 今の設定と成績を測る現状の把握と、増分の利益を頂点にした KPI の分解
- 自社が媒体に渡す情報(コンバージョンの定義・価値・目標)と、自動入札に任せても広告主が決めること(媒体の公式ヘルプで確かめたのは、自動入札が最適化の対象にするものと、導入の前に計測が要ることまで)
- 本格的な導入の前に限られた範囲で試す段階の設計と、効果の見立て方(金額ではなく、率と件数の型で書く)、段階的な展開
- 役割と責任分担、広告会社や外部の事業者との分担と、外部に確かめること
- 人材とデータの基盤、最初の90日の計画、形骸化の型、経営判断
この章の主張は、PoCの出口と、成果の測り方を、始める前に決めておくことです。PoC は Proof of Concept の略で、本格的な導入の前に、限られた範囲で、使えるかどうかと効果を確かめる小さな検証を指します。出口とは、何が確かめられたら次の段階へ進み、何が確かめられなければやめるか、という決まりのことです。運用型広告の入札の見直しは、管理画面の CPA が下がった、ROAS が上がった、という数字が出たところで「成果が出た」と判断されやすいように思います。しかし、序章と第11章で述べたとおり、本コラムで成果と呼ぶのは増分の利益、つまり広告を出したことで増えたコンバージョンの価値(粗利)から広告費を引いた差です。比べる相手は広告を出さなかった場合で、広告費以外の費用の差は省いています。増分は0や負になることもあります。CPA や ROAS は、アトリビューションで割り振った件数や売上にもとづく実績の値で、広告が無くても起きたコンバージョンを含みます。目標の CPA を低く設定すると、第7章で扱ったとおり、買える機会が減って配信量が減る場合があります。そのとき実績の CPA が下がるとは限らず、下がったとしても、それだけでは成果が増えたとは判断できません。増分の利益の合計が減る場合もあります。この章で中心に扱うのは2つです。1つは、増分の利益を頂点に置いた測り方を、PoC の計画に最初から組み込むことです。もう1つは、コンバージョンが出そろうまでの期間と、増分を測る実験に要る期間を、計画に入れておくことです。
自社がどこまで決めるか、4つの段階と要るものの型
運用型広告の入札で、広告主が自分で決める範囲には幅があります。本コラムでは、その幅を次の4つの段階に分けて考えます。段階の分け方は本コラムが考えた整理で、業界の規格や公的な指針で定められたものではありません。
- 段階1 媒体の自動入札に任せる:媒体の管理画面で予算と入札の方針(コンバージョン数の最大化など)を選び、入札額の決定を媒体に任せる。広告主が決めるのは、予算・コンバージョンの定義・配信の対象の大枠
- 段階2 目標と価値と計測を自社で設計して媒体に渡す:入札額の決定は媒体の自動入札に任せたまま、何をコンバージョンとするか、その価値をいくつと見るか、目標の CPA や ROAS の根拠、購入後の情報(成約や返品)を自社で設計し、媒体に渡す
- 段階3 DSP で入札の方針を調整する:複数の取引の場から表示の機会を買い付ける DSP を使い、掲載面の選び方・入札の上限・フリークエンシーの上限・ペース配分の設定などを、自社または委託先が調整する
- 段階4 自社でモデルと入札の仕組みを持つ:入札リクエストを受けて、予測クリック率・予測コンバージョン率・表示の価値・入札額・ペース配分を自社の仕組みで計算し、入札する
段階が上がるほど、第4章から第9章で扱った予測・較正・入札・引き下げ・ペース配分を、自社が持つ範囲が広がります。一方で、どの段階にも共通して広告主が決めなければならないことがあります。何をコンバージョンとするか(第2章)、コンバージョンの価値をいくつと見るか(第7章)、成果を何で測るか(第11章)の3つです。この3つは、段階1を選んでも媒体に任せることはできません。媒体の公式ヘルプでは、自動入札は、広告主が設定した目標に合わせて入札を調整する機能として説明されています。目標の置き方が事業の利益とずれていれば、その目標に合わせて入札を調整しても、事業の利益につながるとは限りません。本コラムでは、段階1から段階2へ進むことを、多くの広告主にとって最初に検討する価値のある一歩だと考えています。段階2は、入札の仕組みを自社で持たずに、自動入札に渡す目標と価値を事業の利益に近づける段階だからです。
各段階に要るデータ・人・費用の型を次の表にまとめました。費用は金額ではなく、何に費用がかかるかの型で書いています。
| 段階 | 自社が決めること | 媒体や外部に任せること | 要るデータ | 要る人 | 費用の型 |
|---|---|---|---|---|---|
| 段階1 媒体の自動入札に任せる | 予算・コンバージョンの定義・配信の対象の大枠・入札の方針の種類。どの段階でも共通して、コンバージョンの価値と成果の測り方も広告主が決める | 機会ごとの入札額・予測・ペース配分 | 媒体の計測タグで取れるコンバージョン | 管理画面を扱える担当者 | 広告費・運用の人件費または委託の費用 |
| 段階2 目標と価値と計測を自社で設計して渡す | 段階1に加えて、自社の粗利や成約の情報との連携を深めた価値の設計・目標の根拠・購入後の情報の連携・増分を測る実験の計画 | 機会ごとの入札額・予測・ペース配分 | 自社の売上や成約の記録と、広告のクリックを結びつける記録(第2章) | 段階1に加えて、事業の担当者・データ分析の担当者・連携の仕組みを作るエンジニア | 段階1に加えて、記録を結びつける仕組みの構築と保守・実験で配信を止める群の機会費用 |
| 段階3 DSP で入札の方針を調整する | 段階2に加えて、掲載面の選び方・入札の上限・フリークエンシーの上限・ペース配分の設定・取引の方式の確認 | 機会ごとの予測と入札額の計算(DSP の機能の範囲) | 段階2に加えて、掲載面ごと・取引の方式ごとの記録(第2章・第8章) | 段階2に加えて、DSP を扱える担当者または委託先・監視の担当者(第12章) | 段階2に加えて、DSP の利用の費用・計測の事業者の費用 |
| 段階4 自社でモデルと入札の仕組みを持つ | 予測・較正・入札額・引き下げ・ペース配分・監視のすべて | 取引の場への接続(媒体の側で広告枠を売る SSP や、入札を取り次ぐアドエクスチェンジ。第1章) | 機会ごとの入札リクエスト・入札・落札・表示・クリック・コンバージョンの記録(第2章) | 段階3に加えて、モデルを作るデータ分析の担当者・入札の時間の制約の中で動く仕組みを作り運用するエンジニア | 段階3に加えて、入札の仕組みの開発と運用の費用・計算の基盤の費用・取引の場への接続の費用 |
表の「要るデータ」の列は、段階を上げるときに最も重くなりやすい列だと考えています。段階2に進むには、自社の売上や成約の記録と、広告のクリックを結びつける仕組みが要ります。段階4に進むには、第2章で扱った機会ごとの記録を、入札の時点で手に入る情報だけで扱える形で持つ必要があり、第1章で扱ったとおり、入札リクエストには応答までの時間の制約があるので、計算の仕組みにも制約がかかります。段階4は、予測と入札の仕組みを自社で持つことで、媒体に渡せない形の情報や、媒体の機能の範囲では選べない計算の方法を、入札に使える余地がある段階です。ただし、それが成果につながるかは、自社の記録と実験で確かめるまで分かりません。自社の情報のうち、成約や返品のように媒体に渡せるものは、段階2でも入札に生かせる場合があります。段階を上げること自体を目的にせず、自社の広告の重みと、自社が持つデータに見合う段階を選ぶことが大事です。
どの段階を選ぶか、5つの観点で採点して最初の対象を決める
多くの広告主は、複数の媒体・複数のキャンペーンに広告を出しています。すべてのキャンペーンで一度に段階を上げようとすると、記録の整備・実験・監視の負担が重なり、どれも中途半端に終わりやすくなります。反対に、社内で関心の高いキャンペーンから手を付けて、コンバージョンの件数が少なく比較ができないことに後から気づく、ということも起こりえます。最初の対象は、取り組む価値があることと、成果を確かめやすいことの両方で選ぶ必要があります。
本コラムでは、候補の媒体やキャンペーンと、目指す段階の組み合わせを、次の5つの観点で採点する方法を考えます。
- 広告費が事業に占める重み:その広告への支出が、事業の費用や獲得の経路の中でどの程度の重さを占めるか。重いほど、入札の改善が事業の利益に効く
- コンバージョンの件数:直近の集計の期間(たとえば週ごと)に、比較に足りるだけのコンバージョンが出ているか。件数が少ないと、予測のモデルの学習も、実験で差を確かめることも難しい(第5章・第11章)
- 自社だけが持つデータの有無:成約・返品・継続の利用・粗利のように、媒体の計測タグでは取れず、自社だけが持つ情報があり、それを広告のクリックと結びつけられるか(第2章・第7章)
- 取引の方式:その広告枠が、媒体が自社の仕組みで売る枠(検索連動型広告や大きな SNS の広告のように、媒体自身の管理画面で買う枠)か、複数の取引の場で買う枠か、ファーストプライスかセカンドプライスか、自社の側で入札の方針を調整できる余地があるか(第3章・第8章)
- 体制:記録の整備・実験・監視・設定の変更を担える人が社内にいるか、委託先とどこまで分担できるか
5つのうち、広告費が事業に占める重みは「取り組む価値」を、コンバージョンの件数と自社だけが持つデータの有無は「確かめやすさ」と「上の段階に進む意味」を表します。取引の方式は、段階3や段階4を選ぶ意味があるかを決める観点です。媒体が自社の仕組みで売る枠では、入札を調整できる範囲が媒体の提供する機能に限られることが多いので、段階3や段階4に進む余地は小さく、段階2が中心になりやすいと考えています。体制は、どの段階を選んでも必要になる観点です。採点の目安を次の表にまとめました。点数の付け方は本コラムが考えた例です。各観点を1点から3点で付け、合計点だけで決めるのではなく、「コンバージョンの件数」と「体制」のどちらかに1点が付く組み合わせは、最初の PoC の対象から外し、計測や体制の整備を先に進める、という使い方を想定しています。
| 観点 | 3点 | 2点 | 1点 | 確かめ方(主に情報を持つ人) |
|---|---|---|---|---|
| 広告費が事業に占める重み | 広告が主な獲得の経路で、支出が事業の費用の中で大きな割合を占める | 獲得の経路の1つで、支出は中程度 | 支出が小さく、改善しても事業の利益への影響が小さい | 広告費の推移と、獲得の経路ごとの件数(経営・財務・マーケティング) |
| コンバージョンの件数 | 直近の集計の期間に、キャンペーンごとの比較や実験に足りる件数が継続して出ている | 件数はあるが、複数のキャンペーンや期間を合わせないと足りない | 件数が非常に少ないか、コンバージョンの定義が決まっていない | キャンペーンごとの週次のコンバージョンの件数と計測期間の設定(広告運用・データ分析) |
| 自社だけが持つデータの有無 | 成約・返品・粗利などの記録が、広告のクリックと結びつく形で残っている | 記録はあるが、クリックとの結びつけが手作業か、一部だけ | 自社の記録と広告の記録を結びつける手段が無い | 売上や顧客の管理のシステムの項目と、計測の仕組みの一覧(データ分析・情報システム) |
| 取引の方式 | 複数の取引の場で買う枠で、方式と引き下げの有無を確かめられ、自社の側で入札の方針を調整できる | 一部の設定は調整できるが、方式や手数料の内訳が分からない部分がある | 媒体が自社の仕組みで売る枠だけで、入札を調整できる範囲が媒体の機能に限られる | 取引の方式・入札の引き下げ・手数料の内訳の開示(広告運用・広告会社・DSP の事業者) |
| 体制 | 記録の整備・実験・監視・設定の変更を担える人が社内にいて、委託先との分担も決まっている | 担える人はいるが兼務で、分担が文書になっていない | 担える人がおらず、委託先の報告をそのまま受け取っている | 担当者と委託先の役割の一覧(マーケティング・経営) |
表の「取引の方式」で1点が付くことは、悪いことではありません。媒体が自社の仕組みで売る枠が中心の広告主では、段階3や段階4を選ぶ意味が小さく、段階2で目標と価値と計測を磨くことに力を割くほうが合理的な場合が多いと考えています。反対に、3点が付く組み合わせでは、第8章で扱った入札の引き下げがどれだけ行われているか、手数料の内訳がどう開示されているかを確かめることが、段階を上げる前の作業になります。採点は、マーケティング・広告運用・事業の担当・データ分析・財務が同じ表を見ながら行うのがよいと考えています。データ分析の担当者や委託先だけで採点すると、「確かめやすさ」の観点は付いても、広告費の重みや体制の観点が実態とずれることがあります。
現状の把握と KPI の木、今の設定と成績を測ってから目標を分解する
最初の対象が決まったら、入札の仕組みを変える前に、今の設定と成績を測ります。運用型広告では、管理画面に CPA・ROAS・コンバージョンの件数が毎日表示されるので、現状は分かっているように見えます。しかし、その数字が、どのコンバージョンの定義で、どの計測期間で、どのアトリビューションの規則で数えたものか、予算の上限で配信が止まっていた時間がどれだけあったか、広告が無くても起きたコンバージョンがどれだけ含まれているかは、管理画面の数字だけでは分かりません。媒体ごとに定義や計測期間が違えば、媒体の間で CPA を並べて比べることもできません(第2章)。現状の把握で確かめる項目を、次のチェックリストにまとめました。
- コンバージョンの定義:何をコンバージョンとして数えているか。資料請求と成約、仮の登録と本登録のように、価値の違うものを同じ1件として数えていないか(第2章)
- 計測期間とアトリビューションの規則:媒体ごと、キャンペーンごとに、クリックや表示から何日までを数え、どの規則で割り振っているか(第2章・第11章)
- 重複の除き方:同じ購入を複数の媒体がそれぞれ自分のコンバージョンとして数えていないか。媒体ごとの件数は重なりうるのでそのまま足さず、自社の売上の記録の件数と比べたことがあるか
- 入札の方針と目標:どの入札の方針を使い、目標の CPA や ROAS をいくつに置き、その値の根拠(粗利・顧客の生涯価値)が文書になっているか(第7章)
- 予算の制約で止まっている割合:1日のうち、予算を使い切って配信が止まっていた時間の割合や、予算の制約で失った機会の割合(第9章)
- 取引の方式と引き下げ:買っている枠がどの方式で取引され、入札額がどれだけ引き下げられているか(第3章・第8章)
- 増分を測ったことがあるか:配信しない群を残した実験などで、広告による増分を測ったことがあるか。測っていない場合、管理画面の件数のうちどれだけが増分かは分からない(第11章)
- 監視と記録:設定の変更の履歴、実験の結果、異常のときの対応の記録が残っているか(第12章)
この中で、最後から2つ目の「増分を測ったことがあるか」は、測っていない広告主も少なくないと考えています。第11章で扱ったとおり、増分の実験には配信を止める群が要り、その群の分だけ短期の機会を手放すことになるので、後回しにされやすいからです。測っていない場合、管理画面の CPA が良いキャンペーンほど、もともとコンバージョンしやすい利用者への配信に偏っているだけかもしれない、という可能性を排除できません。現状の把握の結果として「増分は測っていない」と記録すること自体に意味があります。それが、PoC で何を比べるかを決める出発点になるからです。
今の成績が分かったら、何をどこまで改善するのかを決めます。本コラムでは、そのための道具としてKPI の木を使います。KPI の木は、事業の最終の目標を表す指標を頂点に置き、それを分解できる中間の指標へ、さらに日々の運用や設定が直接動かせる指標へと枝分かれさせて書いたものです。本章では、木を表の形で示します。
頂点に置くのは増分の利益です。増分の利益は、規模をそろえた2つの群(広告を出す群と出さない群)のコンバージョンの価値(粗利)の総額の差から、実際の広告費を引いたものです。広告によって購入される商品の構成が変われば、件数の差が小さくても価値の差は生じうるので、価値の総額で比べるのが基本です。1件あたりの価値が群の間で同じとみなせる場合に限って、増分の利益は、増分のコンバージョンの件数と1件あたりの価値の積から、広告費を引いた差として分解できます。
広告費は、表示の単位で支払いが生じる場合には、表示の件数と表示1回あたりの支払額の積として、さらに分解できます(クリックの単位で課金される場合は、クリックの件数とクリック1回あたりの支払額の積になります)。
本コラムでは、増分の推定は無作為化した実験を基本とします(観察データから推定する方法もありますが、その結果は置いた前提に左右されます。第11章)。実験は毎日は行えないので、日々の運用では、実験で見積もった増分の件数と、同じ対象・同じ期間・同じ規模で数えたアトリビューションの件数の比(本章では「増分とアトリビューションの比」と呼びます)を、割り振った件数に掛けて、目安として扱うことになります。この比は、割り振った件数の内訳を表す割合ではありません。増分とアトリビューションは別の規則で数えた量なので、比は1を超えることも、0や負になることもあり、割り振った件数が0の場合は使えません。比は、実験を行った媒体・期間・条件での値なので、条件が変われば測り直します。
| 階層 | 指標の例 | 指標の種類 | 主に持つ人 | いつ分かるか | 注意すること |
|---|---|---|---|---|---|
| 頂点 | 増分の利益(増分のコンバージョンの価値から広告費を引いた差。相対値) | 成果の指標 | 経営(目指す水準を決める)・マーケティングの責任者(木を設計し承認する) | 増分の実験の結果が出た後。計測期間がたち、実験の期間が終わってから | 実験を行った媒体・期間・条件での値であることを書く。季節や販促の影響と切り分けて読む |
| 増分の枝 | 増分のコンバージョンの件数と価値、増分とアトリビューションの比(内訳を表す割合ではない) | 成果の指標を分解したもの | データ分析・マーケティング | 実験の後 | 割り振った件数だけを追うと、広告が無くても起きたコンバージョンを成果として数える |
| 価値の枝 | コンバージョン1件あたりの価値(粗利)、成約や返品を反映した価値 | 管理の指標 | 事業の担当・財務 | 成約や返品が確定した後 | 売上ではなく粗利で置く。価値の置き方は自動入札に渡す値にもなる(第7章) |
| 費用の枝 | 広告費、表示の件数、表示1回あたりの支払額、勝率(分母を明記) | 管理の指標 | 広告運用 | 日次 | 支払額が下がっても、価値の高い機会を買い逃していれば機会損失になる(第7章・第8章) |
| 反応の枝 | クリック率、コンバージョン率、予測と実績の比(第6章) | 管理の指標 | 広告運用・データ分析 | クリック率は日次、コンバージョン率は計測期間がたった後 | クリック率だけを上げると、コンバージョンの価値の低いクリックが増える場合がある(第10章) |
| 予算の枝 | 予算の消化の割合、予算の制約で配信が止まっていた時間の割合(第9章) | 管理の指標 | 広告運用・マーケティング | 日次 | 消化の割合が高いことは成果を表さない。止まっている時間が長いなら予算と目標のどちらを動かすかを決める |
| 実績の指標(割り振った数字) | アトリビューションで割り振ったコンバージョンの件数、CPA、ROAS | 管理の指標(単独では成果と呼ばない) | 広告運用 | 日次から計測期間の後まで | 定義・計測期間・規則を明記する。媒体ごとの数字は重複を含みうる |
| ガードレールの指標(分解の外に置き、並べて測る) | フリークエンシーの分布、不適切な掲載面への表示の件数、無効なトラフィックの割合(第10章・第12章)、利用者からの苦情の件数 | 管理の指標 | マーケティング・法務やコンプライアンス・広告運用 | 週次から月次。PoC と展開の各段階で、他の指標と同時に測る | 頂点が改善しても、事前に決めた範囲を超えて悪化したら合格にしない |
表の「いつ分かるか」の列は、運用型広告の KPI の木で最も大事な列だと考えています。表示の件数・支払額・クリック率は日次で分かりますが、コンバージョン率は計測期間がたつまで確定せず(第2章・第5章)、増分の利益は実験の期間が終わるまで分かりません。この時間の差があるので、管理画面に早く表示される暫定の CPA(遅れて届くコンバージョンがまだ分母に入っていない値)やクリック率の改善だけで、入札の見直しの成否を判断してしまうことが起きやすくなります。KPI の木を作るときは、遅れて分かる指標の代わりに、どの先に分かる指標(第12章で扱った機会の数・勝率・支払額・予測と実績の比)で途中の状態を見るかを、表の中に書いておきます。表の「ガードレールの指標」は、入札や配信の変更が、別の場所に損失を生んでいないかを見張るための指標です。増分の利益が改善していても、同じ利用者への接触の回数が増えていれば、信頼の毀損という型の損失が隠れている可能性があります。これとは別に、利用者の情報の取り扱いや広告の表示に関する義務を満たしていること(第14章)は、悪化の幅を管理する指標とは分け、合格の前提として扱います。義務の未履行には許容の幅を置きません。
自社が媒体に渡す情報、自動入札に任せても目標と価値は広告主が決める
段階1や段階2を選ぶ広告主にとって、広告主の側で決められる手段の1つが、媒体に渡す情報です。入札戦略の選び方・予算・配信の対象も手段ですが、ここでは渡す情報を扱います。媒体の自動入札がどのように入札額を計算しているかの中身は、公式ヘルプに書かれている範囲を超えては分かりません。本コラムでも、その中身を推測しません。ここでは、媒体の公式ヘルプに書かれていることを例に、広告主の側で決められることを整理します。
Google 広告のヘルプの「スマート自動入札について」は、スマート自動入札を、機械学習を使ってオークションごとにコンバージョン数またはコンバージョン値を最適化する入札戦略として説明しています。同じページは、入札戦略の種類として、「目標アクション単価」「目標広告費用対効果」「コンバージョン数の最大化」「コンバージョン値の最大化」を挙げ、入札のときに端末・地域・時間帯・検索語句などの情報を使うこと、導入の前にコンバージョンの計測を有効にする必要があることを書いています。同じページには、掲載結果を正確に評価するために、一定の期間に一定の件数のコンバージョンを得ていることが推奨されるという目安も書かれています(2026年11月に確かめた内容。目安の値は変わることがあるので、使うときは最新のヘルプで確かめます)。
このヘルプの説明では、スマート自動入札が最適化の対象にするのは、コンバージョン数またはコンバージョン値です。何をコンバージョンとして数え、値としていくつを渡すかは、広告主が決めます。どの行動を入札の最適化の対象にするかは、媒体の設定で分かれる場合があるので、公式ヘルプで確かめます。価値の低い行動(仮の登録など)を、コンバージョン数を増やす入札の最適化の対象に含めれば、その行動も目標の件数の中に入ります。値として売上を渡せば、商品ごとの粗利の差は、渡した値には反映されません。自社だけが持つ粗利の差を渡す値に反映しなければ、その値は粗利を直接表しません。第7章の例題の考え方では、目標の CPA にもとづく入札額は「目標の CPA × 予測クリック率 × 予測コンバージョン率」で表されました。これは例題の考え方で、媒体の自動入札が同じ計算をしているとは言えません。ただ、ヘルプは、目標アクション単価や目標広告費用対効果などの入札戦略を挙げ、スマート自動入札をコンバージョン数またはコンバージョン値を最適化する入札戦略として説明しています。目標の値が配信の結果に関わる設定であることは、ここから読み取れます。自動入札に任せる段階でも、何をコンバージョンとし、その価値をいくつと見るかは、広告主が決めて渡すものです。
購入や成約がウェブの外で起きる事業では、その結果を媒体に戻す仕組みが要ります。Google 広告のヘルプの「オフライン コンバージョンのインポートについて」は、広告のクリックの後にウェブの外で起きたコンバージョン(店舗での購入や電話での申込など)を、クリックごとに付く識別子と結びつけて取り込む機能を説明しています。同じページには、API を使った取り込みについて、2026年6月15日以降の扱いが変わる(Data Manager API という別の API への移行)という記載もあります。対象や既存の利用の扱いは公式の告知で確かめる必要があり、こうした仕組みは仕様が変わることがあります。仕組みの詳細は媒体ごとに違い、利用者の情報を媒体に送ることになる場合は、第14章で扱う個人情報保護法や電気通信事業法の規律との関係を、法務やコンプライアンスが先に確かめる必要があります。
媒体に渡す情報を設計するときに決めておきたい項目を、次の表にまとめました。
| 渡す情報 | 決めること | 決めずに渡すと起きること | 主に決める人 | 関連する章 |
|---|---|---|---|---|
| コンバージョンの定義 | 何を1件と数えるか、価値の違う行動を分けるか、重複をどう除くか | 価値の低い行動を入札の最適化の対象に含めると、価値の高い行動と同じ1件として扱われる | マーケティング・事業の担当 | 第2章 |
| コンバージョンの価値 | 売上か粗利か、成約や返品を反映するか、件ごとに違う価値をどう置くか | 売上を値として渡すと、商品ごとの粗利の差が渡した値に反映されない | 事業の担当・財務 | 第7章 |
| 目標の CPA や ROAS | 値と、その根拠(粗利・顧客の生涯価値・増分とアトリビューションの比) | 目標の根拠が無く、厳しくしすぎて機会を失うか、緩すぎて払いすぎる | マーケティングの責任者・財務 | 第7章 |
| 購入後の情報の連携 | ウェブの外の成約や返品を戻すか、どの識別子で結びつけるか、どの頻度で戻すか | 成約に至らないコンバージョンと至るコンバージョンを区別できない | データ分析・エンジニア・法務やコンプライアンス | 第2章・第14章 |
| 計測期間と規則 | 計測期間の長さ、アトリビューションの規則 | 媒体ごとに違う数え方の数字を並べて比べる | データ分析・広告運用 | 第2章・第11章 |
| 予算と期間 | 1日と月の予算、配信の期間、予算の上限で止まることを許すか | 予算の制約で配信が止まり、その後の機会を失う | マーケティングの責任者 | 第9章 |
表の各行は、段階1を選んだ広告主でも決めることのできる項目です。自動入札がどのような予測と計算で入札額を決めているかを、広告主が確かめることはできません。広告主が確かめられるのは、自分が渡した情報が事業の利益に沿っているかと、結果として増分の利益がどうだったかです。
PoC の設計、配信での比較を組み、コンバージョンが出そろう期間を計画に入れる
最初の対象と KPI の木が決まったら、PoC を設計します。本コラムでいう運用型広告の入札の PoC は、すべてのキャンペーンに広げる前に、限られた期間と範囲で「この媒体のこのキャンペーンについて、この変更(コンバージョンの価値の渡し方・目標の置き方・入札の方針・自社のモデル)が、今の設定より、決めた KPI を改善するか」を確かめる段階です。PoC で確かめるのは「AI の入札が使えるか」という漠然とした問いではありません。始める前に、何を確かめ、どの結果なら次へ進み、どの結果ならやめるかを、文書にして関係者で合意しておく必要があります。
運用型広告の PoC には、次の3つの特徴があります。1つ目は、過去の記録での評価に強い限界があることです。第6章で扱ったとおり、過去の記録には落札した機会の結果しか残っておらず、入札を変えると落札する機会の構成そのものが変わります。過去の記録で新しい予測のモデルの対数損失が良くなっても、それで入札したときに増分の利益が増えるかは、配信してみるまで分かりません。2つ目は、配信での比較が組みやすいことです。表示の機会や利用者を無作為に2つに分け、今の設定と新しい設定を同じ期間に並べて動かす A/Bテストは、媒体の機能や DSP の設定で組める場合があります(第11章)。3つ目は、結果が出るまでに2種類の待ち時間があることです。1つはコンバージョンが計測期間の内に出そろうまでの時間(第2章・第5章)、もう1つは、増分の差を偶然のばらつきと区別できるだけの件数がたまるまでの時間(第11章)です。
この3つの特徴から、運用型広告の PoC は、過去の記録での評価で見込みの無い案を落とし、配信での比較で効果を確かめる、という2段で組むのが基本になると考えています。配信での比較では、比べる2つの群の予算をそろえることに注意が要ります。第7章で扱ったように追加の予算で買える機会の価値が下がっていく場合には、予算の多い群ほど平均の CPA が悪く見えることがあり、設定の違いではなく予算の違いが結果に出ます。もう1つの注意は、2つの群が同じ表示の機会をめぐって競り合うかどうかです。媒体の実験の機能が、同じ広告主の2つの群をどう扱うかは、公式ヘルプで確かめます。媒体や取引の仕組みによっては、2つの群が同じ表示の機会に別々に入札し、互いの支払額に影響しうるからです。扱いが分からない場合は、利用者や地域で群を分けるなど、競り合いの起きにくい分け方を検討します。
PoC の設計で最初に決めておきたい項目を、次の表にまとめました。どの項目も、本コラムの各章で扱った論点を、PoC の計画書の欄に置き換えたものです。
| 決める項目 | 中身 | 決めずに始めると起きること | 関連する章 |
|---|---|---|---|
| 対象 | 対象の媒体・キャンペーン・配信の対象、試す変更の中身(価値の渡し方・目標・入札の方針・自社のモデル) | 途中で対象や変更が増え、何が効いたのか分からなくなる | 第1章・第2章 |
| コンバージョンの定義と計測期間 | 何を1件と数えるか、計測期間、重複の除き方、コンバージョンの価値の置き方 | 群ごと、報告ごとに数え方が違い、数字を比べられない | 第2章・第7章 |
| 比べる相手 | 今の設定。同じ期間・同じ予算・同じ定義で並べる | 前の月との比較になり、季節や競合の変化と区別できない | 第11章 |
| 群の分け方 | 利用者・表示の機会・地域のどれで分けるか、群の大きさ、同じオークションでの競り合いの扱い | 群の間で利用者が重なり、または互いに支払額を押し上げ、差が歪む | 第11章 |
| 過去の記録での評価 | 時間で切った評価、対数損失と較正の確認、落札した機会しか結果が無いことの限界の明記 | 過去の記録での成績だけで判断し、配信で再現しない | 第4章・第5章・第6章 |
| 期間 | 配信の期間、学習の期間を除く扱い、計測期間がたって結果が出そろうまでの待ち時間、検出したい差の大きさと、それを確かめるのに必要な件数の見積り(第11章の検出力の考え方) | コンバージョンが出そろう前に判断し、遅れて届く分だけ結果がずれる | 第2章・第5章・第11章 |
| 合格の条件 | 増分の利益(増分の粗利から実際の広告費を引いた値)の差を事前に決めた幅で。区間で判定する方法と、結論が出ない場合の扱い。予算の上限をそろえた比較で、実際の広告費も記録する。ガードレールの指標の悪化の上限 | 「CPA が下がった」という数字は出ても、次へ進むかを判断できない | 第7章・第11章 |
| 監視と止める条件 | PoC の期間中に見る先に分かる指標、異常のときに群を止める条件と判断する人 | 新しい設定が払いすぎていても、期間の終わりまで気づかない | 第12章 |
| 出口 | 合格したら何をするか(対象の拡大・段階の移行)、不合格なら何をするか(設定の見直し・対象の変更・中止) | 結果が出ても次の判断ができず、PoC を延長し続ける | 本章 |
| 判断する人 | 合格の条件の値を誰が決めるか、出口を誰が承認するか | 結果の解釈がマーケティング・広告運用・財務で分かれ、結論が出ない | 本章 |
この表で最も大事なのは、「合格の条件」と「出口」の2つです。合格の条件は、「CPA が下がる」「ROAS が上がる」のような実績の値ではなく、「増分の粗利から実際の広告費を引いた値(増分の利益)が、今の設定より事前に決めた幅以上に大きい」という形で書くのが本来の形です。予算の上限をそろえても、実際に使われた広告費は群によって違いうるので、広告費は実績で引きます。増分のコンバージョンの件数で代用できるのは、1件あたりの価値と実際の広告費が群の間で同じとみなせる場合に限られます。
何を推定する PoC なのかも、計画書に書き分けます。広告を出さない場合と比べた増分の水準を測るなら配信しない群が要ります。新旧の設定の差を測るなら、利用者や地域を無作為に割り付け、群ごとの購入・粗利・広告費をすべて観測できれば、配信しない群を設けずに差を推定できる設計もあります。
どちらの場合も件数が要るので、PoC の規模では差を確かめられない場合があります。その場合は、割り振ったコンバージョンの件数と価値で比べ、その差がどこまで増分に当たるかは確かめられていない、と合格の判断の文書に書いておきます。合格の条件の値そのものは、対象の広告費の重みと、事業にとって意味のある改善の大きさで決まるので、本コラムでは具体的な値を示しません。第11章で扱ったとおり、広告の効果は小さくばらつきが大きいので、少ない件数で小さな差を確かめようとすると、差が偶然のばらつきの内に収まってしまい、どちらとも判断できない結果になります。合格の条件を決めるときは、事業にとって意味のある改善の幅と、その差を PoC の件数でどこまで確かめられるかを分けて考え、確かめられないと分かったら、期間や対象を始める前に見直します。
出口は、合格した場合と不合格だった場合の両方を書きます。合格した場合の出口は、対象のキャンペーンの拡大か、次の段階への移行です。不合格だった場合の出口は、結果の中身によって分かれます。過去の記録での評価で今の設定に勝てなかったなら予測の入力やデータの見直しへ、過去の記録では勝ったのに配信での比較で差が出なかったなら、過去の記録の限界(落札した機会しか結果が無いこと)が効いた可能性を調べる方向へ、配信での比較で割り振った件数は増えたのに増分が増えなかったなら、コンバージョンの定義と価値の置き方の見直しへ、という具合です。「不合格なら期間を延ばしてもう少し試す」は、出口として書かないほうがよいと考えています。延長を出口にすると、何が足りなかったのかを分析しないまま期間だけが延び、PoC が終わらなくなります。ただし、計測期間がたって結果が出そろう時点での確定の判断は、延長ではなく、最初から計画に書いておく判断の時期として扱います。
運用型広告の PoC が本格的な展開に進まずに止まる型として、次の3つが起きやすいと考えています。1つ目は、管理画面の CPA の比較だけで報告書を作り、増分がどうだったかが分からないまま終わる型です。2つ目は、比べる2つの群の予算や期間がそろっておらず、差が設定の違いによるのか予算の違いによるのか分からない型です。3つ目は、PoC を委託先に任せ、委託先の報告をそのまま受け取ったものの、自社の売上の記録と照らして確かめる人がいないまま判断を迫られる型です。どれも、始める前の設計で手を打てるものです。
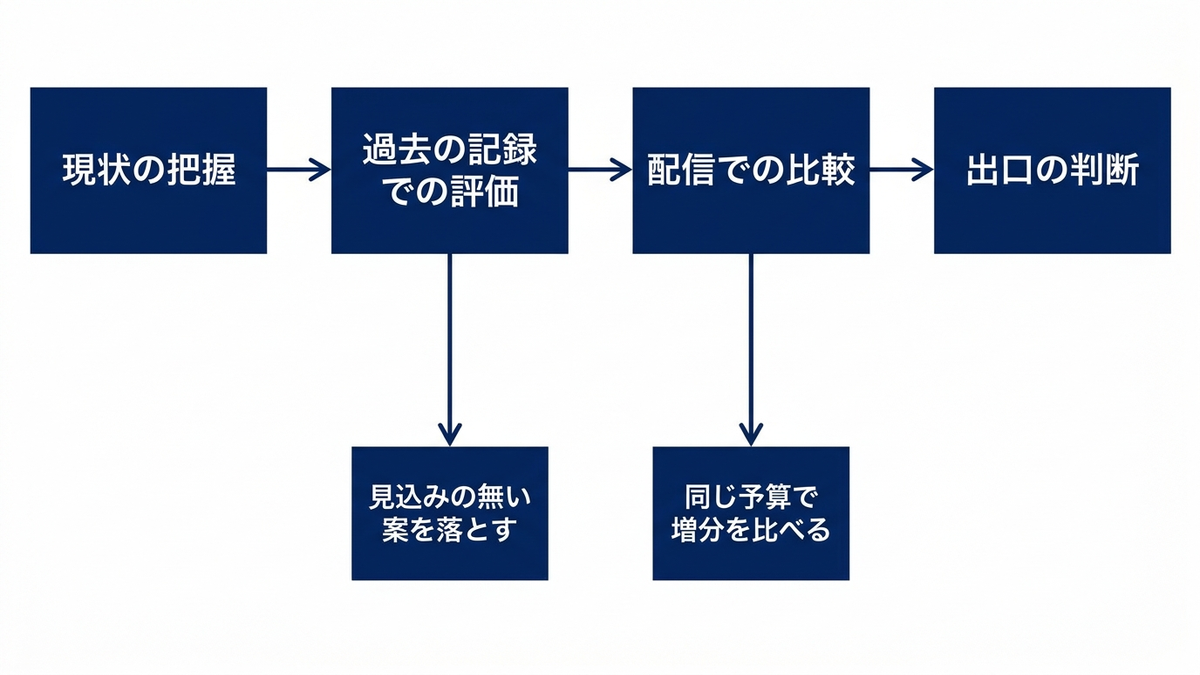
効果の見立てと段階的な展開、金額ではなく率と件数の型で書く
PoC の計画を通すにも、展開の予算を得るにも、効果の見立てが求められます。このとき、効果をいきなり金額で書こうとすると、根拠の薄い前提を掛け合わせた数字が一人歩きしやすくなります。本コラムでは、効果の見立てを金額ではなく、率と件数の型で書くことを勧めます。KPI の木の頂点の増分の利益も、計画の段階では、比べる案に共通する基準の価値(たとえばコンバージョン1件の価値)を1とした相対値で、増分の価値から広告費を引く形のまま置けば足ります。金額への換算は、各社のマーケティングの責任者と財務が、自社の粗利と広告費の記録で行えばよいと考えています。
見立ての骨格は、KPI の木の末端から上へ積み上げる形で書けます。たとえば、対象のキャンペーンの表示の件数・クリック率・コンバージョン率・割り振ったコンバージョンの件数を出発点にして、コンバージョンの価値の渡し方を変えたときに、価値の高いコンバージョンの割合がどの程度の幅で動けば、価値の合計がどれだけ動くかを、幅を持たせて計算しておきます。増分とアトリビューションの比が分かっていない場合は、その比を複数の値に置いた場合を並べ、前提によって結論が変わるかを確かめます。改善の幅は PoC の前には分からないので、見立ての段階では「この程度の改善があれば、頂点がこれだけ動く」という形で置きます。こうしておくと、PoC の合格の条件を「事業にとって意味のある最小の改善」として決める根拠にもなります。見立ての数字を書くときに避けたいのは、公開の事例や研究の数字、媒体や委託先の資料にある数字を、そのまま自社の効果として書くことです。第14章で扱う公開された研究の数字と同様に、公開の事例や媒体・委託先の資料の数字は、その会社の、その広告の、その条件での値で、自社の広告で同じ値が出る根拠にはなりません。
見立ての対象は、序章で整理した6つの損失の型に沿って考えると、漏れが少なくなります。6つの型は互いに重なりうる説明上の整理で、1つの変更が複数の型に効くこともありますが、型ごとに数えるものを決めておくと、改善した型だけを報告して悪化した型を見落とすことを防げます。
| 損失の型 | 数えるもの(率・件数) | 導入の前の数字の取り方 | 導入の後に比べるもの |
|---|---|---|---|
| 払いすぎ | 表示の価値の見積りに対する支払額の比、入札の引き下げの有無、予測と実績の比(第6章・第8章) | 現状の把握で集めた、取引の方式ごとの支払額と予測と実績の比 | 同じ予算・同じ期間で比べた支払額と、得られたコンバージョンの価値 |
| 機会損失 | 予算の制約で配信が止まっていた時間の割合、予算の使い残しの割合、目標が厳しすぎて入札しなかった機会の割合(第7章・第9章)。いずれも、それによって利益を増やせる機会を逃していた場合に機会損失になる | 媒体のレポートの予算の消化と配信の状況。入札しなかった理由まで分かる指標は取得できる場合に限り、推定した値なら算定の方法を書く。取得できない指標は不明として扱う | 同じ指標。止まっていた時間が減った分、増分が増えたか |
| 成果の数え違い | 増分とアトリビューションの比、媒体ごとの件数の合計と自社の売上の記録の件数の差(第11章) | 増分の実験の結果。無ければ「測っていない」と記録する | 同じ実験の方法で測った増分とアトリビューションの比 |
| 信頼の毀損 | フリークエンシーの分布、不適切な掲載面への表示の件数、苦情の件数(第10章・第12章) | 配信の記録と計測の事業者のレポート、問い合わせの記録 | 同じ指標。入札の変更で接触の回数や掲載面が偏っていないか |
| 形骸化 | 設定と目標を最後に見直してからの期間、監視の結果が設定の見直しにつながった件数 | 設定の変更の履歴(第12章)。履歴が無ければ記録するところから始める | 決めた間隔で見直しが行われ、判断の記録が残っているか |
| 規制上の義務の不履行 | 外部送信や同意に関する表示・通知の対応の状況、購入後の情報の連携が利用目的の範囲に収まっているかの確認の記録(第14章) | 法務やコンプライアンスの確認の記録 | 同じ確認。情報の連携を増やしたことで、通知や公表の対応が抜けていないか |
PoC に合格しても、すぐにすべての媒体とキャンペーンを新しい設定に切り替えることは避けるべきだと考えています。PoC は、限られた期間・媒体・キャンペーンで行ったもので、季節の変わり目・大きな販促・競合の入札の変化のもとでの動きまでは含んでいません。本コラムでは、変更を、影響の小さい範囲から大きい範囲へ、段階を分けて広げることを勧めます。展開の段階を次の表にまとめました。段階の区切り方は本コラムが考えた例で、事業の規模や広告の構成によって変わります。
| 展開の段階 | 範囲 | 主に確かめること | 次へ進む条件 | 主に判断する人 |
|---|---|---|---|---|
| 今の設定の整理 | 変更しない。定義・計測期間・目標・予算の制約を文書にし、記録の不足を埋める | 現状の把握のチェックリストの各項目 | 比べる相手の成績が、同じ定義と期間で出ている | マーケティング・広告運用 |
| PoC | 1つの媒体の一部のキャンペーンで、今の設定と並べる | 合格の条件、ガードレールの指標 | 合格の条件を満たし、計測期間がたった後の確定の判断が済んだ | マーケティングの責任者 |
| 同じ媒体の中での拡大 | 同じ媒体の他のキャンペーンに広げる。一部を今の設定のまま残す | 先に分かる指標(支払額・勝率・予測と実績の比)、割り振った件数と価値 | 広げた範囲で、PoC と同じ向きの結果が続いている | マーケティングの責任者 |
| 媒体をまたぐ拡大と段階の移行 | 他の媒体へ広げる。必要なら段階2から段階3、段階3から段階4へ移る | 媒体ごとの増分とアトリビューションの比、記録と連携の仕組みの安定 | (最終の段階。監視と定期的な増分の実験を続ける) | 経営・マーケティングの責任者 |
表の「同じ媒体の中での拡大」で、一部を今の設定のまま残すのは、比べる相手を保つためです。すべてを切り替えた後では、季節や競合の変化と、設定の変更の効果を区別できなくなります。第11章で扱った配信しない群(ホールドアウト)も、展開の後も小さく残し続けることで、増分とアトリビューションの比を定期的に測り直す手段になります。範囲を戻す判断を誰がどの指標で行うかを、段階を進める前に決めておくことも大事です。範囲を戻す手順が決まっていないと、悪化に気づいても止められません。
役割と責任分担、入札の設定を決める人と成果を確かめる人を分ける
運用型広告の入札の見直しに関わる人は、管理画面を操作する人よりずっと多くなります。コンバージョンの定義は事業の担当が、価値は財務が、目標と予算はマーケティングの責任者が、記録の連携はデータ分析とエンジニアが、利用者の情報の扱いは法務やコンプライアンスが、それぞれ最もよく知っているからです。本コラムでは、関わる役割を次の11に分けて考えます。役割の名前は一般的なものにしてあり、組織によっては1人が複数の役割を兼ねます。
- 経営:広告への投資の方針と全体の予算、成果を増分の利益で測るという方針を決める
- マーケティングの責任者:担当する事業の広告の目的と KPI の木、目標と予算、PoC の出口、展開の段階の移行を承認する
- 広告運用:媒体や DSP の設定、日々の配信の点検、設定の変更の記録を担う
- 事業の担当:コンバージョンの定義と、成約・返品・継続の利用などの事業の結果の情報を持つ
- データ分析:現状の成績の測定、増分の実験の設計と分析、予測のモデル(段階4の場合)、効果の報告を担う
- エンジニア:計測と記録の連携の仕組み、購入後の情報を媒体に戻す仕組み、段階4では入札の仕組みを作る
- 法務やコンプライアンス:利用者の情報の取り扱い、外部送信に関する通知や公表、広告の表示に関する義務を確かめる(第14章)
- 財務:コンバージョンの価値の根拠となる粗利、広告費の予算と実績、外部への支払いの内訳を確かめる
- 広告会社:運用の代行、媒体の買い付け、レポートの作成など、委託された範囲を担う
- 媒体:広告枠と自動入札の機能、実験の機能、レポートを提供する
- 計測の事業者:無効なトラフィック・ビューアビリティ・掲載面の計測を提供する(第12章)
この11の役割で、主な作業ごとの責任分担を表にしたのが次の表です。この4つの区分の考え方は RACI と呼ばれ、フレームワークとしての一般的な使い方は弊社コラム『経営とAIの打ち手を導く戦略フレームワーク大全179選』で扱っています。ここでは運用型広告の入札の導入に当てはめた表を示します。表の割り振りは本コラムが考えた例で、組織の大きさや委託の範囲によって変わります。表の記号の意味は次のとおりです。
- R:実行する(作業を担う)
- A:最終的に責任を持つ(承認する)。各行に1つだけ置く
- C:相談を受ける(意見を出す)
- I:結果を知らされる
表が横に広くなるので、列名は次の略称で書いてあります。経営は「経営」、マーケティングの責任者は「マ責」、広告運用は「運用」、事業の担当は「事業」、データ分析は「分析」、エンジニアは「技術」、法務やコンプライアンスは「法務」、財務は「財務」、広告会社は「広告会社」、媒体は「媒体」、計測の事業者は「計測」です。空欄は、その作業に通常は関わらないことを表します。
| 作業 | 経営 | マ責 | 運用 | 事業 | 分析 | 技術 | 法務 | 財務 | 広告会社 | 媒体 | 計測 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 成果を増分の利益で測る方針の決定 | A | R | I | C | C | C | I | ||||
| 段階の選択と最初の対象の採点 | I | A | R | C | R | C | C | C | C | ||
| コンバージョンの定義と計測期間 | A | C | R | R | C | C | C | I | |||
| コンバージョンの価値と目標の根拠 | I | A | C | R | R | R | C | ||||
| 購入後の情報の連携の仕組み | A | C | C | R | R | C | C | C | |||
| 媒体や DSP の設定と日々の点検 | A | R | C | R | C | ||||||
| PoC の計画と合格の条件 | I | A | R | C | R | C | C | C | C | ||
| 増分の実験の設計と分析 | I | A | C | C | R | C | I | C | C | ||
| 監視と異常のときに配信を止める判断 | A | R | I | C | C | C | R | C | C | ||
| 掲載面と無効なトラフィックの点検 | A | R | C | C | R | C | R | ||||
| 利用者の情報の取り扱いと表示の義務の確認 | I | C | R | C | C | R | A | C | |||
| 外部への支払いの内訳と契約の確認 | I | A | C | R | R | C | |||||
| 出口と展開の段階の移行の承認 | C | A | R | C | R | C | C | C | I |
表で意識したのは、入札の設定を決めて動かす人と、その成果を確かめる人を分けることです。表の「媒体や DSP の設定と日々の点検」は広告運用と広告会社が R ですが、「増分の実験の設計と分析」の R はデータ分析に置きました。設定を担う人の手元にある数字は、主に割り振った件数や CPA です。その人が設定の結果を自分の手元の数字だけで報告すると、誰の意図によるものでなくても、報告が割り振った件数の見え方に寄りうると考え、成果を確かめる役割を別の人に置く設計にしました。そのうえで、増分の実験の結果を、設定を担う人と同じ表で見ることで、第12章で扱った形骸化の型の損失を減らせると考えています。小さな組織で両方を1人が担う場合は、増分の実験の結果を、マーケティングの責任者と財務が定期的に確かめる場を設けることで代えます。
表の「コンバージョンの価値と目標の根拠」で、財務を R に置いたのは、価値の根拠となる粗利の数字を持つのが財務だからです。広告の担当者だけで目標の CPA を決めると、過去の CPA の実績から目標を決める、という循環になりやすく、その値が事業の利益とどう結びつくかが確かめられないまま使われます。表の「利用者の情報の取り扱いと表示の義務の確認」は、計測のタグや記録の連携の仕組みを実際に点検する広告運用とエンジニアを R に、確かめた結果を承認する法務やコンプライアンスを A に置きました。購入後の情報の連携や計測の仕組みの変更は、第14章で扱う規律との関係を確かめてから行うものなので、マーケティングの責任者が承認する行の前提になる確認として扱います。
広告会社や外部の事業者との分担、外部に確かめることと報酬の決め方
運用型広告では、媒体の設定や買い付けを広告会社に委託する広告主もあります。外部との分担の型は、大きく3つに分けて考えられます。1つ目は、運用を外部に任せる型で、目標と予算を渡し、設定と日々の点検とレポートを委託します。2つ目は、一部を内製する型で、コンバージョンの定義・価値・増分の実験・成果の確認を自社が持ち、設定と日々の点検を委託します。3つ目は、全部を内製する型で、設定から成果の確認まで自社で行い、外部は媒体と計測の事業者だけになります。どの型が良いかは、広告費の重み・社内の人材・広告の種類によって変わり、本コラムで一般に優劣を決めることはしません。ただし、どの型を選んでも、増分の利益で成果を測るという方針と、コンバージョンの定義と価値は、自社が持つべきものだと考えています。この2つを外部に任せると、成果の基準そのものが外部の手元にある状態になるからです。
外部の事業者との取引の透明性については、公正取引委員会が令和3年(2021年)2月17日に公表した「デジタル・プラットフォーム事業者の取引慣行等に関する実態調査(デジタル広告分野)について(最終報告)」が、事業者向けのアンケート(広告主・広告代理店、広告仲介事業者、媒体社の3つの区分)と、事業者や有識者への聴取調査の結果を整理しています。この報告書は、デジタル・プラットフォーム事業者との取引を対象にした調査で、広告主と広告会社の間の取引を直接の対象にしたものではない点に注意が要ります。報告書の概要(25枚の資料)によると、広告主・広告代理店向けのアンケートは790社に送られ、105社が回答しています(回収率は約13.3%)。同じ概要の13ページには、サプライチェーンの透明性に問題・課題があるという回答が、広告主・広告代理店で45%弱から50%強だったことが示されています(概要では幅で示されています)。同じページには、聴取調査での指摘として、広告主が払う広告費のうち各段階の事業者がどの程度の手数料を取り、媒体社にどの程度が残るのかが分からない、という趣旨の声も並んでいます。14ページには、ビューアビリティ(広告が見られる状態にあったか。第12章)の水準に問題・課題があるという回答が広告主・広告代理店で50%強から55%だったことが示されています。同じページには、アドフラウド(不正を目的とした表示やクリック。第12章で扱った無効なトラフィックに含まれるもの)の対策に不満があるという回答が、40%強から60%弱だったことも示されています。いずれも2021年に公表された、その回答者のその時点の回答の割合です。現在の取引の状況や、個々の事業者の取引に当てはまることを示すものではなく、広告主と広告会社の間の取引にそのまま当てはまるとも限りません。この調査から確認できるのは、取引の透明性やビューアビリティ、アドフラウドの対策に問題・課題を感じる回答が、当時一定の割合であったことまでです。
外部の事業者に委託する場合に、契約の前と定期的に確かめておきたい項目を、次の表にまとめました。どの項目も、本コラムの各章で扱った論点を、委託先への確認に置き換えたものです。
| 確かめること | 聞く中身 | 確かめないと起きうること | 関連する章 |
|---|---|---|---|
| コンバージョンの定義 | 報告の件数がどの定義・計測期間・アトリビューションの規則で数えたものか、媒体の間の重複をどう扱っているか | 報告の件数と自社の売上の記録の件数が合わず、成果の数え違いに気づけない | 第2章・第11章 |
| 入札の方針 | どの入札の方針と目標を使い、いつ、なぜ変えたか。変更の履歴を受け取れるか | 設定の変更と成績の変化の関係が分からない | 第7章・第12章 |
| 取引の方式と引き下げ | 買っている枠の取引の方式、入札の引き下げの機能を使っているか、その設定 | ファーストプライスの場で価値どおりの入札を続け、払いすぎる | 第3章・第8章 |
| 手数料の内訳の開示 | 広告費のうち、媒体への支払いと、委託先や仲介の事業者の手数料に当たる部分の内訳を、どの粒度で開示できるか | 広告費のうち表示の買い付けに使われた割合が分からず、支払額の評価ができない | 第1章 |
| 掲載面の報告 | どの掲載面に表示されたかの一覧を受け取れるか、除外の設定をどう管理しているか | 不適切な掲載面への表示に気づけず、信頼の毀損につながる | 第12章 |
| 無効なトラフィックへの対応 | 計測の事業者を使っているか、無効と判定された表示やクリックの扱い、返金の取り決め | 計測の基準に照らして正当と言えない表示やクリックに、費用を払い続ける | 第12章 |
| データの帰属 | 管理画面のアカウント、配信の記録、学習に使われた記録が誰に帰属し、委託の終了の後に自社が受け取れるか | 委託先を変えたときに過去の記録と設定の履歴を失い、比べる相手を作れない | 第2章 |
| 実験への協力 | 配信しない群を残す実験、同じ予算で並べる比較に協力できるか、その手順 | 増分を測れないまま、割り振った件数だけで評価が続く | 第11章 |
表の「データの帰属」は、見落とされやすい項目だと考えています。管理画面のアカウントが委託先の名義になっていると、委託を終えたときに、過去の配信の記録や設定の変更の履歴を引き継げないことがあります。過去の記録が無ければ、新しい委託先や内製の体制で現状の把握をやり直すことになり、比べる相手を作るまでの期間がかかります。契約の段階で、アカウントの名義と、記録の受け渡しの範囲を確かめておくことが、将来の選択肢を残すことにつながります。
報酬の決め方も、運用の向きに影響しうる要素です。一般論として、委託の報酬の決め方には、広告費に比例させる方法、作業の量や期間で決める方法、特定の指標の値にもとづいて決める方法などがあります(本コラムでは、具体的な率や条件は書きません)。広告費に比例する報酬では、広告費を増やすことが委託先の報酬を増やす方向に働く、という構造があります。これは、個々の委託先が広告費を不必要に増やすことを意味するものではありませんが、広告主の側から見ると、予算を増やす提案を受けたときに、第7章で扱った限界の CPA(追加の予算で得られる追加のコンバージョンの費用)と増分の実験の結果で、提案を確かめる手段を持っておくことが大事になります。指標にもとづく報酬(支払いの基準にする指標を契約で決める方法)を選ぶ場合は、どの指標を基準にするかが報酬の向きを決めます。割り振ったコンバージョンの件数を基準にすると、広告が無くても起きたコンバージョンを多く数える方向に働く可能性があります。報酬の基準を増分にもとづく指標に近づけるには、増分の実験を定期的に行う仕組みが前提になります。どの決め方にも長所と短所があり、本コラムで一般にどれが良いかを決めることはしません。報酬の基準にする指標と、自社が成果(増分の利益)を測る方法が整合しているかを、契約の前に確かめておくことを勧めます。
人材の面では、運用型広告の入札の見直しには、広告の業務の知識とデータ分析の両方が要ります。媒体の設定・取引の方式・計測の仕組みを知っている人と、実験の設計・較正の確認・増分の推定ができる人が、同じ表を見て話せることが大事です。両方を1人で持つ人材は多くないので、本コラムでは、両方の知識を1人に求めるより、広告運用の担当者とデータ分析の担当者が同じ KPI の木と同じ PoC の計画書を使う仕組みを作るほうが現実的だと考えています。データの基盤の面では、目的によって要る記録が違うので、分けて考えます。成約や返品をコンバージョンごとに媒体に戻すには、広告のクリックの識別子のような照合の情報と、自社の注文や成約の記録を結びつける仕組みが要ります。コンバージョンの価値を粗利で置くには、注文と商品の情報から粗利を求める仕組みが要ります。増分の実験の結果を自社の売上で確かめるには、群ごと(利用者の群や地域)の売上と粗利を集計できる記録が要り、地域で分ける実験のように、個々のクリックと購入を結びつけなくても行える設計もあります(第11章)。つなぐ仕組みを作るときは、利用者の情報をどの範囲で扱うか、利用目的の範囲に収まるかを、法務やコンプライアンスと先に確かめます(第14章)。
最初の90日の計画と形骸化の型、点検の仕組みを先に作る
ここまでの内容を、最初の90日の計画に落とすと、次の表のようになります。13週を5つの期間に分けました。期間の長さは本コラムが考えた例で、対象のコンバージョンの件数や計測期間の長さによって変わります。計測期間が長い商品では、第13週の時点で配信での比較の結果が出そろわないことがあるので、その場合は、第13週を途中の判断とし、確定の判断の時期を計画に書いておきます。
| 週 | 主な作業 | 主に担う人 | この期間に作るもの |
|---|---|---|---|
| 第1〜2週 | 成果を増分の利益で測る方針の合意、候補の媒体とキャンペーンの採点、最初の対象と目指す段階の決定 | マーケティングの責任者・広告運用・データ分析・財務 | 採点表と最初の対象、目指す段階の決定の記録 |
| 第3〜4週 | 現状の把握(コンバージョンの定義・計測期間・目標と根拠・予算の制約で止まっている割合・取引の方式・増分の測定の有無)、委託先への確認 | 広告運用・データ分析・広告会社 | 現状の把握のチェックリストの結果、委託先への確認の回答 |
| 第5〜6週 | KPI の木の作成、コンバージョンの定義と価値の見直し、購入後の情報の連携の要否と法務やコンプライアンスの確認、PoC の計画書の作成 | マーケティングの責任者・事業の担当・データ分析・法務やコンプライアンス | KPI の木、PoC の計画書(合格の条件・出口・止める条件・判断する人) |
| 第7〜11週 | 配信での比較の実施(同じ予算・同じ期間)、先に分かる指標による監視、ガードレールの指標の測定 | 広告運用・データ分析・広告会社 | 週次の監視の記録、設定の変更の履歴 |
| 第12〜13週 | 計測期間がたった分の結果の集計、合格の条件との照合、出口の判断(または途中の判断と確定の時期の決定) | データ分析・マーケティングの責任者・財務 | PoC の結果の報告(増分または割り振った件数のどちらで比べたかを明記)、出口の判断の記録 |
表の第3〜4週の現状の把握と、第5〜6週の PoC の計画書は、配信での比較より前に置きました。設定を変える前に、何と比べるかと、何をもって合格とするかを決めておくためです。第7週から配信を始めるのは遅いと感じられるかもしれませんが、比べる相手と合格の条件が決まっていない比較は、結果が出ても判断に使えません。
導入した入札の仕組みや設定が、時間とともに点検されなくなり、設定と実態のずれに気づけなくなることを、本コラムでは形骸化と呼んでいます。運用型広告では、媒体の自動入札が日々入札額を変え続けるので、人が設定を変えなくても配信は続きます。その分、形骸化に気づきにくい面があります。起きやすい型を次の表にまとめました。
| 形骸化の型 | 起きていること | 気づくための指標 | 手当て |
|---|---|---|---|
| 目標の据え置き | 目標の CPA や ROAS を決めたときの根拠(粗利・商品の構成)が変わったのに、値が据え置かれている | 目標を最後に見直した日、粗利の推移 | 目標の見直しの間隔を決め、財務と一緒に根拠を確かめる |
| 定義の劣化 | 計測の仕組みの変更やサイトの改修で、コンバージョンの計測が途切れた、または数え方が変わったことに気づいていない | 媒体の件数と自社の売上の記録の件数の比の推移 | 比の推移を週次で監視し、外れたら計測を点検する(第12章) |
| 増分の未測定 | 一度も増分を測っていない、または最後に測ってから条件が大きく変わった | 最後に増分の実験を行った日と、その後の変化 | 増分の実験の予算と期間を年間の計画に入れる(第11章) |
| 報告の固定 | 委託先のレポートが割り振った件数と CPA だけで、毎月同じ形で届き、判断につながっていない | レポートの後に設定や予算の判断が行われた件数 | レポートの形を KPI の木に合わせ、判断の記録を残す |
| 予算の天井 | 予算の上限で配信が止まっている状態が続いているのに、予算と目標のどちらも動かしていない | 予算の制約で配信が止まっていた時間の割合(第9章) | 止まっている割合を月次で確かめ、予算と目標のどちらを動かすかを決める |
| 監視の放置 | 警報が鳴りすぎて見られなくなった、または警報が誰にも届いていない | 警報の件数と、対応した件数 | 警報の基準と宛先を見直し、止める権限を持つ人を決める(第12章) |
形骸化の型の多くは、設定を変える人がいないことではなく、設定を見直すきっかけが仕組みになっていないことから起きます。見直しの間隔・確かめる指標・判断する人を、PoC の計画書と同じ文書に書き、展開の後も続けることが手当ての中心になります。
経営判断、成果の測り方と PoC の出口を先に決める
この章で扱った判断を誤ったときの経営上の損失は、序章で整理した6つの型に沿って整理できます。成果を管理画面の CPA や割り振った件数で測ったまま入札を見直すと、広告が無くても起きたコンバージョンを成果として数え、その数字にもとづいて予算を配分するので、成果の数え違いの型の損失が生じます。目標の CPA を根拠なく低く設定すれば、価値のある機会を買い逃し、機会損失の型の損失が生じえます。実績の CPA が下がったことだけでは、成果が増えたとは判断できません。取引の方式を確かめずに委託を続ければ、払いすぎの型の損失が見えないままになりえます。設定と成果を確かめる人を分けずに運用すれば、形骸化の型の損失が、利用者の情報の扱いを確かめずに記録の連携を増やせば、規制上の義務の不履行の型の損失が生じえます。
経営として最初に決めるべきことは、2つあると考えています。1つは、成果を増分の利益で測るという方針と、そのための増分の実験の予算と期間を確保することです。増分の実験は、配信しない群の分だけ短期の機会を手放すので、広告の担当者の判断だけでは後回しにされやすく、経営の方針として決める必要があります。もう1つは、PoC を始める前に、合格の条件と出口と判断する人を決めることです。この2つが決まっていれば、どの段階を選んでも、どの委託の型を選んでも、結果を同じ基準で判断できます。反対に、この2つが決まっていなければ、段階を上げても委託先を変えても、管理画面の数字が良くなったかどうかという判断から抜け出せません。予算・体制・KPI の仕組みに落とすときは、KPI の木の頂点と、増分の実験の予算を年間の計画に入れることを勧めます。目標の CPA や ROAS は KPI の木の中の管理の指標として扱い、その根拠を財務と一緒に定期的に見直します。
この章では、自社がどこまで決めるかの4つの段階と、どの段階を選ぶかの採点、増分の利益を頂点にした KPI の木、自動入札に渡す情報の質、配信での比較を組む PoC の設計、効果の見立てと段階的な展開、役割と外部との分担、最初の90日の計画と形骸化の型を扱いました。どの段階を選んでも、コンバージョンの定義と価値と成果の測り方は広告主が決めるものであり、それを PoC の計画に最初から組み込むことが導入の要になります。次の第14章では、本章で詳しい説明を先に譲った、利用者の情報の取り扱いと表示の義務、識別子の制限と公開事例・最新動向を扱います。
Anagraftでは、広告の入札と効果の測定を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『マーケティングとは「組織革命」である。 個人も会社も劇的に成長する森岡メソッド』(森岡毅、日経BP社):書名のとおり、マーケティングを組織の問題として扱う本です。本章で扱った、設定を担う人と成果を確かめる人の分担や、KPI の木を関係者で共有する仕組みを、マーケティングの組織の側から考えるときの材料として挙げました。
『会社を変える分析の力』(河本薫、講談社):書名のとおり、企業の中のデータ分析を主題にした本です。本章の、広告運用とデータ分析が同じ計画書を使う体制や、PoC の結果を判断につなげる仕組みを考えるときの材料として挙げました。
第14章 規制とガイドライン、識別子の制限と公開事例・最新動向
第13章では、自社がどこまで入札の判断を持つかの段階、KPI の木、PoC の出口、広告会社や外部の事業者との分担を扱いました。第1章から第13章は、広告を出す側が入札と配信を自社の判断で設計し、点検し続けるための話でした。ただ、その設計には自社だけでは決められない前提があります。利用者の情報をどう取り扱い、何を通知し、どこで同意を得るか。広告であることをどう示すか。広告の取引の場を運営する大きな事業者にどんな義務がかかっているか。そして、ブラウザやスマートフォンの側で識別子の使い方がどう変わってきたか、です。この章では、それらを一次情報で確かめた範囲で整理し、あわせて公開された取り組みと研究で使われる公開データセット、最近の動向をまとめます。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 個人情報保護法の個人関連情報の第三者提供の規律と利用目的、令和8年の改正の位置づけ
- 電気通信事業法の外部送信規律
- 景品表示法の不当な表示の禁止と、広告であることを隠す表示の告示
- 特定デジタルプラットフォームの透明性及び公正性の向上に関する法律(以下、透明化法)のデジタル広告の分野と、公正取引委員会の報告書
- EU の規制の入口
- ブラウザとスマートフォンでの識別子の制限の経緯と、それを踏まえた配信と計測の方法
- 公開された取り組み、公開データセット、最近の動向、規制への対応が形だけになる場面と経営判断
法令の条番号と施行日は、2026年11月16日に e-Gov 法令検索(法令の本文を配信する公式の仕組みを含む)で確かめました。所管の官庁の公表資料・企業の公式の発表も、同じ日に開いて確かめた範囲で書いています。法令とガイドラインはこの後も改正されることがあるので、実際の対応の前には最新の版を確かめてください。本コラムは法律の助言ではありません。ここに挙げる義務は、それぞれの法令の対象になる事業者に課されるもので、自社の事業にどの規定が適用されるか、自社のサイトやアプリ、広告の使い方が法令のどの定義に当たるかは、所管の官庁の資料と専門家の判断で確かめる必要があります。
この章の主張は、利用者の情報の取り扱いと表示の義務を、入札と計測を設計した後から合わせるのではなく、設計の前提に置くことです。序章で、損失の型の1つとして「規制上の義務の不履行」を挙げました。第2章で扱った記録どうしの結びつけ、第10章のフリークエンシーの上限、第11章の効果の測定は、どれも利用者やブラウザを区別する識別子に頼る部分があります。識別子をどう扱えるかが変われば、配信の制御も計測も変わります。その意味で、この章の内容は第2・5・10・11章などの多くの章に関わります。
どの規定がどの場面に主に関わるかの目安を次の表にまとめました。表は本コラムが整理した目安で、実際に対象になるかは、それぞれの法令の定義と所管の官庁の資料で確かめる必要があります。
| 法令や枠組み | 主に関わる事業者 | 入札と配信の設計との主な接点 |
|---|---|---|
| 個人情報保護法 | 個人情報を取り扱う事業者(業種を問わない) | 利用目的の特定と通知、個人関連情報を提供先で個人データとして取得させる場合の確認 |
| 電気通信事業法の外部送信規律 | 同法の定める電気通信役務を提供する事業者のうち、総務省令で定める役務を提供する者 | サイトやアプリに広告や計測のタグを置き、利用者の端末から外部へ情報を送らせる場合の通知・公表など |
| 景品表示法 | 商品や役務を供給する事業者(広告主) | 広告の表示の内容、広告であることを隠す表示の禁止 |
| 透明化法 | 指定を受けた大規模なデジタルプラットフォームの提供者 | 指定を受けた事業者に義務を課す法律(義務の条文ごとの中身は本コラムでは確かめていない) |
| EU のeプライバシー指令・デジタルサービス法・デジタル市場法など | EU の域内の利用者に向けて広告や役務を提供する事業者などに関わりうる(対象の範囲は規則ごとに確かめる) | 端末への情報の保存とアクセスの同意、広告の透明性、プロファイリングにもとづく広告の制限 |
| ブラウザとスマートフォンの仕組み(法令ではない) | ウェブとアプリで広告を配信・計測するすべての事業者 | サードパーティ・クッキーや端末の広告用の識別子が使えない場面での配信の制御と計測 |
個人情報保護法、個人関連情報と利用目的
利用者の情報を扱うときに業種を問わず関わるのが、個人情報の保護に関する法律(平成15年法律第57号。以下、個人情報保護法)です。2026年11月16日に e-Gov 法令検索で確かめた現在の条文は、2026年11月2日施行の版でした。運用型広告の設計に関わる主な規定を、条文で確かめた範囲で次の表にまとめます。条文の文言は長いので、要旨を本コラムの言葉で書いています。
| 規定 | 条番号 | 内容の要旨 | 入札と配信の設計との関係 |
|---|---|---|---|
| 個人関連情報の定義 | 第2条第7項 | 生存する個人に関する情報であって、個人情報・仮名加工情報・匿名加工情報のいずれにも当たらないもの | クッキーなどの識別子にひもづく閲覧の履歴のような情報が、自社の手元でどの区分に当たるかを整理する出発点になる(当てはめは所管官庁の資料と専門家で確かめる) |
| 利用目的の特定 | 第17条 | 個人情報を取り扱うときは、利用目的をできる限り特定する。変更は、変更前の目的と関連性を有すると合理的に認められる範囲を超えてはならない | 広告の配信や効果の測定、モデルの学習に使うことが、取得したときの利用目的に含まれているかを確かめる |
| 取得に際しての利用目的の通知等 | 第21条第1項・第2項 | 個人情報を取得したときは、あらかじめ利用目的を公表している場合を除き、速やかに本人に通知するか公表する(第1項)。契約書などの書面(電磁的記録を含む)に書かれた本人の個人情報を本人から直接取得する場合は、原則として、あらかじめ本人に利用目的を明示する(第2項) | プライバシーポリシーなどの公表の文面や、会員登録などの入力の画面での明示と、実際のデータの使い方を対応させておく |
| 個人関連情報の第三者提供の制限等 | 第31条 | 提供先が個人関連情報を個人データとして取得することが想定されるときは、本人の同意が得られていることなどを、あらかじめ確認しないで提供してはならない(外国にある第三者への提供では、参考となる情報の提供の確認も加わる) | 広告の配信や計測の事業者に識別子にひもづく情報を渡し、相手の側で会員の情報などと結びつけられる場合に関わりうる。海外の事業者へ渡す場合に当たりうるときは、法務の担当者や専門家に確かめる |
第31条の個人関連情報の規律は、提供する側の手元では誰の情報か分からなくても、提供先で個人データとして取得されることが想定されるときに、本人の同意などの確認を求めるものです。第2章で触れた、広告の事業者と広告主の記録を結びつける仕組みは、この「提供先で結びつけられる」場面に近いところがあります。どの連携が第31条の対象になるか、確認をどの事業者がどう行うかは、条文だけでは決まらず、個人情報保護委員会のガイドラインなどで確かめる事項です。本コラムでは、ガイドラインの該当箇所の文言までは確かめていないので、内容は書きません。
個人情報保護法は改正の途中にあります。e-Gov 法令検索の改正履歴では、令和8年法律第56号(個人情報の保護に関する法律等の一部を改正する法律)は2026年7月17日に公布され、2026年11月16日時点で未施行と表示されています。個人情報保護委員会が掲載している改正法の本文の附則第1条は、原則として公布の日から起算して2年を超えない範囲内において政令で定める日から施行し、一部の規定は公布の日から起算して6月を経過した日などから施行すると定めています。原則の施行日を定める政令は、本コラムでは確かめていません。
個人情報保護委員会の改正法のページは、法律が2026年7月10日に成立し、7月17日に公布されたことと、政令・規則・ガイドラインなどの検討を続けることを掲載しています。検討の資料の見出しには、適正なデータの利活用の推進とリスクに応じた規律、不適正な利用などの防止と規律の遵守の実効性の確保、16歳未満の者の個人情報等の取扱いに関する項目が並んでいました。本コラムでは改正の条文の中身を確かめていないので、改正後の規定を前提にした書き方はしません。広告の配信や計測に関わる改正があるかは、施行の前に委員会の公表資料で確かめる必要があります。
電気通信事業法の外部送信規律
サイトやアプリに広告や計測のタグを置くと、利用者の端末から広告や計測の事業者へ、利用者に関する情報が送られることがあります。この送信について通知などを求めるのが、電気通信事業法(昭和59年法律第86号)の第27条の12の規定で、総務省はこれを外部送信規律と呼んでいます。総務省の外部送信規律のページによると、2022年6月の改正で設けられ、2023年6月16日に施行されました。2026年11月16日に e-Gov 法令検索で確かめた現在の条文は、2026年5月27日施行の版で、ほかに未施行の改正(令和7年法律第46号の一部と令和5年法律第53号)が表示されていました。その施行の日の定めと、第27条の12に関わるかは、本コラムでは確かめていません。
条文の要旨を短くまとめると次のとおりです。対象は、電気通信事業者などのうち、総務省令で定める役務を提供する者です。これらの者が、利用者の端末に記録された利用者の情報を外部へ送らせる仕組み(タグなど)を働かせるときは、あらかじめ、送られる情報の内容や送信先などを、利用者に知らせるか、利用者が容易に知り得る状態に置く必要があります。ただし、次の情報は除かれます。
- 画面を適正に表示するために必要な情報など、役務の利用に必要なものとして総務省令で定める情報(第1号)
- その事業者が自らの役務の提供の際に送った識別符号で、その事業者自身の設備に送られるもの(第2号)
- 送信先に送られることに利用者が同意している情報(第3号)
- 利用者の求めに応じて送信や利用を停止する措置を講じ、その措置と求めの受け付け方などを利用者が容易に知り得る状態に置いている場合で、利用者がその措置を求めていない情報(第4号)
総務省のページは、対象になる役務として、メッセージの交換のサービス、SNS、検索のサービス、ニュースの配信などの情報の配信のサービスを挙げ、企業などが自らのホームページを運営する場合の一部の例を、電気通信事業に当たらないので対象にならないとしています。通知や公表の方法についても、日本語で、小さな文字で隠さず、利用者が容易に見られる場所に示すことなどを挙げていました。自社のサイトやアプリが対象になる役務に当たるかは、総務省令と総務省のガイドラインの定めで決まるので、所管の総務省の資料と専門家の判断で確かめる事項です。
広告主の側から見ると、この規律の対象になるかどうかにかかわらず、自社のサイトやアプリにどの事業者のタグが置かれ、どの情報がどこへ送られているかの一覧を持っておくことが、第2章の記録の設計と、この章の義務の確認の両方の出発点になると考えています。タグを追加する担当と、サイトやアプリの担当、法務の担当が分かれている場合には、一覧が更新されないことがあります。
景品表示法、不当な表示と広告であることを隠す表示
入札と配信の仕組みとは別に、表示される広告の中身には、不当景品類及び不当表示防止法(昭和37年法律第134号。以下、景品表示法)が関わります。2026年11月16日に e-Gov 法令検索で確かめた現在の条文は、2026年5月21日施行の版でした。第5条は、事業者が自己の供給する商品や役務の取引について、次の表示をしてはならないと定めています。
- 品質・規格その他の内容について、実際のものや競争する事業者のものより著しく優良であると一般消費者に示す表示で、不当に顧客を誘引し、一般消費者の自主的かつ合理的な選択を阻害するおそれがあると認められるもの(第1号)
- 価格その他の取引条件について、著しく有利であると一般消費者に誤認される表示で、同じおそれがあると認められるもの(第2号)
- そのほか、取引に関する事項について一般消費者に誤認されるおそれがある表示で、同じおそれがあると認めて内閣総理大臣が指定するもの(第3号)
第3号の指定は告示によって行うとされています(第6条第2項)。消費者庁のステルスマーケティングのページは、2023年10月1日からステルスマーケティング(広告であるのに広告であることを隠す表示)が景品表示法の違反になると掲載し、公表資料として「一般消費者が事業者の表示であることを判別することが困難である表示」とその運用基準を挙げています。ページの説明では、規制の対象は一般消費者が広告であると判別できない広告で、事業者がインフルエンサーなどに依頼・指示した表示も含まれます。SNS の投稿やレビューの投稿だけでなく、テレビ・新聞・ラジオ・雑誌などの表示も対象になり、規制の対象になるのは商品や役務を供給する事業者(広告主)で、依頼を受けた第三者は対象外とされています。告示の本文によると、これは景品表示法第5条第3号にもとづく令和5年内閣府告示第19号(2023年3月28日)で、2023年10月1日から施行されています。運用基準は、2023年3月28日の消費者庁長官決定です。
入札の数理との関係では、第10章で扱ったクリエイティブの出し分けが関わります。クリック率やコンバージョン率を報酬にしてクリエイティブを選ぶ仕組みは、表現の中身を判断しません。誇張した表現のほうがクリック率が高い場合に、その表現への配分を自動で増やす、ということが起こりえます。報酬の設計とは別に、配信に回すクリエイティブを表示の規制とブランドの方針の両方で事前に確かめる手順を置くことが、仕組みの外側で要ると考えています。表現が第5条のどの号に当たるかは、表示の内容と取引の実態によって変わるので、消費者庁の資料と専門家の判断で確かめる事項です。
透明化法のデジタル広告の分野と、公正取引委員会の報告書
広告の取引の場を運営する側の義務もあります。特定デジタルプラットフォームの透明性及び公正性の向上に関する法律(令和2年法律第38号)は、一定の規模以上のデジタルプラットフォームの提供者を指定し、取引の条件の開示などの義務を課す法律です。対象になる事業の区分と規模は政令(令和3年政令第17号)で定められており、e-Gov 法令検索の改正履歴では、この政令は2021年2月1日に施行され、2022年7月8日に公布された改正(2022年8月1日施行)を経て、2025年12月18日施行の版が現在のものと表示されています。
2026年11月16日に e-Gov 法令検索で確かめた政令の現在の条文には、広告に関わる区分が2つあります。1つは、利用者に情報の検索や投稿による交流の場を提供し、その場で事業者の商品などの情報を広告として表示する事業で、広告を表示する事業者を主として競りによって決めるもの。もう1つは、事業者が自らの広告表示枠に他の事業者の広告素材を表示する役務を提供する事業で、どの提供者の役務を使うかを主として競りによって決めるものです。規模の基準は国内の売上の額で定められていますが、本コラムでは額は書きません。どの事業者が指定を受けているかは、経済産業省のページを本コラムの取得の手段で開けなかったため、確かめていません。
この法律と同じ分野を扱う調査として、公正取引委員会は2021年2月17日に「デジタル・プラットフォーム事業者の取引慣行等に関する実態調査(デジタル広告分野)について(最終報告)」を公表しました。公表のページによると、調査は広告主・広告代理店、広告仲介の事業者、媒体を対象にした事業者向けのアンケート(2020年2月から3月)、消費者向けのアンケート、89名からの聴取などで行われ、指摘された問題について独占禁止法と競争政策の上の考え方を示すことを目的としています。今後の取り組みとして、独占禁止法の執行に加え、透明化法などによる規律、データの移転や開放、個人情報の保護を含めた多面的な対応を検討するとしています。報告書の本体の個別の論点(取引の条件の開示や広告の効果の検証に関わる記述など)は、本コラムでは確かめていません。
広告主の立場では、この法律の義務は直接には取引の場を運営する側にかかります。指定を受けた事業者に課される義務の条文ごとの中身は、本コラムでは確かめていません。取引の場の側から取引の条件などの開示がある場合には、その情報は広告主が自社の設定を見直すときの材料になりえます。第13章で挙げた、外部に確かめることの表と合わせて、取引の場の側から届く情報を誰が読み、自社の設定にどう反映するかを決めておくことが要ると考えています。
EU の規制、端末への保存の同意・広告の透明性・プロファイリングにもとづく広告の制限
EU の規制は、EU の域内の利用者に向けて広告や役務を提供する場合などに関わりえます。対象の範囲は規則ごとに定められているので、規則ごとに確かめる必要があります。また、広告の配信を規制の中でどう位置づけるかを条文で書いている例として、日本の事業者にとっても設計の参考になります。2026年11月16日に EUR-Lex で条文を確かめた範囲を、次の表にまとめました。表の義務は、それぞれの条文が定める主体(オンライン・プラットフォームの提供者やゲートキーパー)に課されるもので、すべての広告主に一律にかかるものではありません。規模による適用の除外の有無など、対象になる提供者の範囲は、本コラムでは確かめていません。
| 規制 | 条番号 | 内容の要旨 | 適用の日 |
|---|---|---|---|
| eプライバシー指令(指令2002/58。2009年の改正を反映した統合版) | 第5条第3項 | 利用者の端末に情報を保存したり、保存された情報にアクセスしたりすることは、目的についての明確で包括的な情報を受けたうえで利用者が同意している場合に限って認めるよう、加盟国に求める。通信の送信だけを目的とする技術的な保存と、利用者が明示的に求めたサービスの提供に厳密に必要な場合は除く | 指令であり、加盟国の国内法を通じて働く(各国の法令は本コラムでは確かめていない) |
| デジタルサービス法(規則2022/2065) | 第26条第1項・第3項 | オンライン・プラットフォームの提供者は、プラットフォームで広告を表示するときは、広告であること、誰のための広告か、誰が費用を払ったか(異なる場合)、誰に表示するかを決めた主なパラメータと、変えられる場合はその変更の方法を、利用者が表示のたびに分かるようにする。一般データ保護規則第9条第1項の特別な種類の個人データを使うプロファイリングにもとづく広告を表示してはならない | 2024年2月17日(第93条。一部の規定は2022年11月16日から) |
| デジタルサービス法 | 第28条第2項 | オンライン・プラットフォームの提供者は、利用者が未成年者であることを合理的な確実さで認識している場合、その利用者の個人データを使うプロファイリングにもとづく広告を表示してはならない | 同上 |
| デジタル市場法(規則2022/1925) | 第5条第2項 | ゲートキーパー(指定を受けた大規模な事業者)は、オンライン広告のサービスの提供のために、自社の中核のサービスを使う第三者のサービスの利用者の個人データを処理したり、サービスをまたいで個人データを組み合わせたりしてはならない。利用者に具体的な選択を示し、同意を得た場合を除く | 本コラムでは適用の日の条文は確かめていない |
| デジタル市場法 | 第5条第9項・第10項、第6条第8項 | 広告主と媒体の求めに応じて、広告ごとの価格や手数料、媒体への支払いなどの情報を日ごとに無償で提供する(相手方の同意が要る項目がある)。広告主と媒体、その許可を受けた第三者に、効果の測定の道具と、独立した検証に要るデータへの無償のアクセスを提供する | 同上 |
| 政治広告の透明性と配信の対象の設定に関する規則(規則2024/900) | 第30条第2項(適用の日) | 前文は、政治広告であることや出稿者の透明性の表示と、特別な種類の個人データを使うプロファイリングによる配信の対象の設定の禁止などを説明している(本文の条文は本コラムでは確かめていない。入口として位置づけだけを扱う) | 2025年10月10日(定義などの一部の規定は発効の日から) |
表のうち、第3章で触れた、支払額から手数料が差し引かれて媒体に届く仕組みに関わるのが、デジタル市場法の第5条第9項・第10項と第6条第8項です。広告ごとの価格や手数料、媒体への支払いの情報を広告主が求めて受け取れる仕組みは、第1章で触れた「広告主が払った額のうち媒体に届く割合」という論点と、第13章の外部に確かめることの表に対応します。また、デジタルサービス法の第26条第1項(d)が求める「誰に表示するかを決めた主なパラメータ」の表示は、第10章の配信の対象の設定を、利用者の側から見えるものにする規定です。一般データ保護規則そのものの条文の中身は、本章では扱いません(デジタルサービス法の第26条第3項は、その第9条第1項の特別な種類の個人データを参照しています)。
米国の州のプライバシー法と連邦取引委員会の動きは、本コラムでは一次情報を開いて確かめていないので扱いません。米国で広告を配信する場合は、対象の州の法令と連邦取引委員会の公表資料をその時点で確かめる必要があります。
識別子の制限の経緯、ブラウザとスマートフォンで何が変わったか
法令とは別に、ブラウザとスマートフォンの仕組みの側でも、識別子の使い方が変わってきました。サードパーティ・クッキーは、利用者が見ているサイトとは別のサイト(ドメイン)とのやり取りで扱われるクッキーです。サイトの区別はブラウザの技術的な基準によるもので、運営する事業者が同じか別かだけでは決まりません。識別子は人と1対1とは限りません(1人が複数の端末を使う、1台の端末を複数の人が使う、識別子が消去される、などの場合があります)。フリークエンシーとその上限も、識別できた単位での回数であり、人ごとの回数の上限を保証するものではありません。第10章のフリークエンシーの上限を複数のサイトにまたがって数えることや、第11章の表示とコンバージョンの結びつけは、こうした識別子に頼る部分があります。公式の発表で日付を確かめた範囲を、次の表にまとめます。表は発表の時点の内容で、その後の変更があるものは後の行に書いています。
| 発表の日 | 発表した主体と文書 | 内容の要旨 |
|---|---|---|
| 2019年6月4日 | Mozilla の公式ブログ(Firefox の強化型トラッキング防止の既定の有効化) | 新規の利用者の標準の設定で強化型トラッキング防止を既定で有効にし、Disconnect のリストに載った既知のサードパーティのトラッキング・クッキーを遮断する。既存の利用者には数か月かけて順次広げる |
| 2020年1月14日 | Chromium の公式ブログ(サードパーティ・クッキーを不要にする道筋) | Chrome でサードパーティ・クッキーを不要にしていく方針を示した記事(題名と投稿日だけを確かめた。本文の時期の目標は確かめていない) |
| 2020年3月24日 | WebKit の公式ブログ(サードパーティ・クッキーの完全な遮断) | iOS と iPadOS の13.4、macOS の Safari 13.1 で、サイトをまたぐ資源のクッキーを例外なく既定で遮断する |
| 2024年7月22日 | Privacy Sandbox の公式ブログ(Google の Privacy Sandbox 担当の副社長の名義) | サードパーティ・クッキーを廃止する代わりに、利用者が閲覧の全体に適用される選択を、情報を得たうえで行い、いつでも変えられる新しい体験を Chrome に導入する方針を示した。英国の競争・市場庁や情報コミッショナー事務局などの規制当局と協議を続けるとした |
| 2025年4月22日 | 同じ公式ブログ(同じ名義) | 現在の方式を維持し、サードパーティ・クッキーについての新しい独立した選択の画面は導入しないとした。利用者は Chrome のプライバシーとセキュリティの設定で引き続き選択できる。シークレットモードではサードパーティ・クッキーが既定で遮断されていると記載している |
| 2025年10月17日 | 同じ公式ブログ(同じ名義) | 期待される価値と採用の低さを考慮した結果として、Attribution Reporting API・Protected Audience・Topics などの Privacy Sandbox の技術を、Chrome の非推奨の手続きに沿って段階的に終える(retire)とした。CHIPS・FedCM・Private State Tokens は残し、広告の効果の計測については W3C などの場で相互運用できる標準の議論を続けるとした |
Chrome については、2020年1月の記事の本文は確かめていませんが、2024年7月以降の発表は、表のとおり、利用者の選択を軸にする方針(2024年7月)、新しい選択の画面を導入しない方針(2025年4月)と移り、2025年10月には Privacy Sandbox の多くの技術を段階的に終えることが発表されました。本コラムで確かめたのはこれらの発表の内容までで、2026年11月の時点で Chrome の既定の設定がどうなっているか、段階的に終えるとされた技術がどこまで終わっているかは確かめていません。2024年7月の発表は協議の相手として英国の競争・市場庁に触れていますが、同庁の側の公表資料は、本コラムでは開いて確かめていません。ブラウザの仕様は、配信や計測を設計する時点で、各社の公式の文書で確かめ直す必要があります。
スマートフォンのアプリでは、Apple の App Tracking Transparency の仕組みがあります。Apple の開発者向けのページ(利用者のプライバシーとデータの利用)によると、iOS 14.5・iPadOS 14.5・tvOS 14.5 以降では、アプリが利用者を追跡したり、端末の広告用の識別子にアクセスしたりするには、AppTrackingTransparency のフレームワークで許可を得る必要があり、許可が無い場合の広告用の識別子の値はすべてゼロになります。同じページでの追跡は、自社のアプリで集めた利用者や端末のデータを、他社のアプリやサイトなどで集めたデータと結びつけ、配信の対象の設定や広告の効果の計測に使うこと、データブローカーと共有することと説明されています。また同じページは、許可されなかった場合に別の識別子で追跡することや、端末の情報から個体を識別することを認めないとしています。
計測の側では、Apple は AdAttributionKit という仕組みを公開しています。開発者向けの文書によると、利用者のプライバシーを保ちながら、広告への反応として割り振られた(アトリビューション。Apple の文書の訳では「割り当て」)アプリの導入や再度の利用を計測するための枠組みです。Apple の広告のアトリビューションのページでは、クリックや表示にもとづく導入の割り振りは iOS 17.4・iPadOS 17.4 以降、再度の利用の情報は iOS 18・iPadOS 18 以降とされています。割り振られた件数は、第11章でいう増分の利益を直接示すものではありません。Apple が署名して広告の事業者に届ける通知(ポストバック)には利用者や端末に固有のデータは含まれず、一部の値は Apple の定めるプライバシーのしきい値を満たす場合にだけ含まれるとされています。従来の SKAdNetwork との相互運用についての文書も別に用意されていますが、本コラムではその中身は確かめていません。
これらの変化は、各章の例題が単純化のために前提にしてきた「機会ごとの記録が識別子の単位で結びつく」状態が、場面によっては成り立たないことを意味します。識別子で結びつけられる場合でも、先に書いたとおり、識別子の単位は人の単位と同じとは限りません。計測の通知が集計した形で、遅れて届く場合には、第5章の遅れて届くコンバージョンの扱いと、第11章の増分の検証の設計が変わります。
識別子の制限を踏まえた配信と計測の方法
識別子の制限に対して考えられる方向として、次の4つを挙げます。サードパーティ・クッキーに頼らないことと、識別子をまったく使わないことは別で、会員の ID などの識別子を使う方法もあります。表には方法ごとの識別子への依存も書きました。ここでは方法の種類だけを整理し、個々の製品の比較はしません。表の「確かめた範囲」の列は、本章で公式の文書を開いて確かめた例です。同意や識別子の制限を迂回して追跡を続ける方法は、本コラムでは扱いません。上で見たとおり、Apple の開発者向けのページは、許可されなかった場合に別の識別子で追跡することを認めないとしています。
| 方法の種類 | 考え方と識別子への依存 | 入札と計測への影響 | 確かめた範囲 |
|---|---|---|---|
| 自社で得たデータの活用 | 利用者との直接の関係(会員の登録・購買の記録など)で、利用目的を示して得たデータを使う。会員の ID などの自社の識別子を使うことが多い | 第2章の結果の定義や、第7章のコンバージョンの価値を見積もる材料になる。改善するかどうかは、データの欠けや評価の結果で確かめる。提供する場合は、個人データの第三者提供(第27条など)か、個人関連情報の提供(第31条など)かを、情報の区分と提供の形に応じて確かめる | 個人情報保護法の条文 |
| 文脈にもとづく配信 | 利用者ではなく、掲載面の内容や表示の機会の属性で配信の対象を決める。利用者の識別子への依存は小さい | 掲載面や表示の機会の項目から作る特徴量で予測する。第12章の掲載面の点検とも関わる | 本章では個別の公式文書は確かめていない |
| 集計した形での計測 | 利用者の単位ではなく、集計した値やしきい値つきの通知で、広告に割り振られた反応を数える。利用者ごとの識別子を計測の結果に含めない | コンバージョンの粒度が変わりうる。割り振られた件数は増分ではない。第11章の地域で分ける実験など、集計の単位で設計する検証が重要になる | Apple の AdAttributionKit の文書 |
| データを持ち寄って照合する環境 | 広告主と媒体などが、互いの生のデータを渡さずに、決められた集計だけを取り出す環境で照合する。照合には会員の ID などの識別子を使う場合がある | 第11章の効果の測定に使える場合がある。提供か委託かなど、個人情報保護法の扱いを事前に確かめる | 本章では個別の公式文書は確かめていない |
表の4つは互いに排他的ではなく、組み合わせることもできます。どの方法でも、利用者の情報を扱う以上、適用される義務が無くなるとは限りません。外部送信規律や個人情報保護法の対象になるかは、この章の前半の節のとおり、方法ごとに確かめる必要があります。
業界の自主規制と公開された研究、公開データセット
国内の業界団体では、一般社団法人日本インタラクティブ広告協会(JIAA)が、公式のページにプライバシーポリシーガイドラインや、電気通信事業法における外部送信規律についてのガイダンスなどを掲載しています。一般社団法人デジタル広告品質認証機構(JICDAQ)は、公式のページで、業務を適切に行っている広告関連事業者を認証して公開しているとしています。ガイドラインの版と改定日、認証の基準の中身は、本コラムでは確かめていません。自社や取引先がこれらの指針や認証にどう対応しているかは、各団体の公式のページで最新の版を確かめてください。
研究の側では、入札の判断を公開の論文で示した取り組みがあります。arXiv で書誌を確かめた範囲で次の表に挙げます。内容は、それぞれのページに書かれていることだけで、取り組みどうしを比べたり、評価したりする意図はありません。また、論文は公表の時点のもので、今もその形で運用されているとは限りません。
| 文献と公表時期 | 対象 | 手法 | ページに書かれた結果と限定条件 |
|---|---|---|---|
| Cai、Ren、Zhang、Malialis、Wang、Yu、Guo の2017年の論文(ディスプレイ広告のリアルタイム入札を強化学習で行う論文。WSDM 2017) | キャンペーンの期間を通した入札 | キャンペーンの入札を逐次の意思決定の問題として、状態をオークションの情報とキャンペーンの残りの予算などの値、行動を入札額とするマルコフ決定過程で表し、状態の価値をニューラルネットワークで近似する | 要旨のページには使ったデータと数値の結果は書かれていない |
| Wu らの2018年の論文(予算の制約つきの入札をモデルを仮定しない強化学習で行う論文。CIKM 2018) | 固定の予算のもとで、落札した表示の価値の合計を最大にする入札 | マルコフ決定過程として定式化し、資源の制約がある問題では目先の報酬が誤った方向を示すとして、報酬の関数を新たに設計し、深層のニューラルネットワークで学習する | 要旨は大規模な実データで有効性を示したとしているが、データの名前と数値の結果は要旨には書かれていない |
| Zhang、Yuan、Wang、Shen の2014年の論文(iPinYou のデータでのリアルタイム入札のベンチマークの論文) | リアルタイム入札の研究のための公開データ | iPinYou が2013年の入札のアルゴリズムの競技で使ったデータを公開したことと、その上でのベンチマークを述べる | 要旨は、データにオークション・入札・表示・クリック・最終的なコンバージョンの記録が含まれるとしている。件数などは要旨のページには書かれていない |
公開データセットのうち、Criteo AI Lab が公開している Criteo 1TB Click Logs のデータは、公式のページで、利用条件がクリエイティブ・コモンズの表示・非営利・継承の4.0国際ライセンスであると確かめました。非営利(NonCommercial)の条件が付いているので、商用の利用の可否はライセンスの条文で確かめる必要があります。Criteo AI Lab のダウンロードのページには、24日分の記録で、先頭の列がクリックの有無を示すラベル、整数の特徴量が13個、カテゴリの特徴量が26個(32ビットにハッシュ化)と記載されています。件数は、本コラムが開いたページでは確かめていません。iPinYou のデータは上の表の論文で内容の種類を確かめた範囲で、配布の場所と利用条件は確かめていません。ほかにも研究で使われる公開データはありますが、本コラムでは確かめていません。
研究の数字の読み方として、本コラムの各章で書いてきたことを繰り返します。公開データセットでの成績は、そのデータ・その期間・その評価の方法での値で、読者の広告で期待できる成績ではありません。入札の研究では、公開データの記録が落札した機会に偏る場合や、競合の入札が記録の時点のものである場合には、別の入札の方針を試したときの結果を正確には再現できないことがあります(第6章と第8章で扱った打ち切りと、記録の偏りの問題)。どの公開データがそれに当たるかは、本コラムでは確かめていません。
最近の動向、生成 AI と大規模言語モデル
最近の動向として、生成 AI によるクリエイティブの制作、入札の自動化の拡大、小売の媒体の広がりがよく話題になります。ただし、これらの広がりの程度を示す一次情報は、本コラムでは確かめていないので、規模や普及の度合いは書きません。媒体が提供する生成 AI の機能や自動化の機能を使う場合は、その媒体の公式のヘルプで、何が自動で決まり、広告主が何を設定・確認できるかを確かめる必要があります。
研究の側では、大規模言語モデルが作る文章と広告のオークションを組み合わせる研究があります。Duetting、Mirrokni、Paes Leme、Xu、Zuo の2023年の論文(大規模言語モデルのためのメカニズム・デザインの論文。arXiv での最新の改訂は2024年7月で、WWW 2024 の最優秀論文と記載)は、広告のクリエイティブの生成などを例に、入札を文章の生成に組み込む仕組みを提案し、その入札のルールの性質を理論的に検討した研究です。第3章で扱ったセカンドプライスの考え方を、生成される文章の場面に当てはめる研究です。実際の媒体でどう使われているかは、論文の範囲では分かりません。
生成 AI で作ったクリエイティブに景品表示法の規制がどうかかるかは、表示の内容と取引の実態によって決まり、消費者庁の資料と専門家で確かめる事項です。生成 AI で作ったことを理由に、表示の確認を省かないことが要ると考えています。制作の量に確認の体制が追いつかない場合には、第10章の出し分けの仕組みが誇張した表現を選んでも見落とすおそれがあります。生成と配信を自動化するほど、配信の前に人が確かめる関門をどこに置くかを先に決めることが要ると考えています。
規制への対応が形だけになる場面と、経営の判断
規制とガイドラインへの対応は、文書を整えても、実態が伴わない状態になることがあります。序章の損失の型でいう「規制上の義務の不履行」と「形骸化」が重なる場面を、本コラムの整理として次の表にまとめました。
| 形だけになる型 | 起きていること | 点検の問い |
|---|---|---|
| タグの一覧が無い | サイトやアプリに置かれた広告や計測のタグと送信先を、誰も一覧で把握していない | どのタグが、どの情報を、どこへ送っているかを示せるか。追加と削除の手順と記録があるか |
| 公表の文面と実態のずれ | プライバシーポリシーや外部送信の公表の文面が、実際のタグや連携と合っていない | 最後に文面と実態を突き合わせたのはいつか。タグの追加のたびに文面を見直す手順があるか |
| 利用者の選択が処理に届いていない | 同意や停止の求めを受ける画面はあるが、利用者の選択が、同意を必要とする処理や停止を求められた送信に反映されているかを確かめていない | 同意を必要とする処理について、拒否や撤回が実際に反映されていることを確かめたか |
| 提供先での結びつけを確かめていない | 識別子にひもづく情報を渡した相手の側で、会員の情報などと結びつけられているかを把握していない | 個人関連情報の規律(第31条)に当たる連携の有無を、法務と確かめたか |
| クリエイティブの確認が自動化に追いつかない | 生成と出し分けが自動で回り、表示の規制の確認が配信の後になっている | 配信の前に人が確かめる関門がどこにあるか。誰が止める権限を持つか |
| 識別子の環境の変化に気づかない | ブラウザやスマートフォンの仕様の変更で計測できる範囲が変わったのに、レポートの数字の意味を見直していない | 公式の発表を誰が追い、計測と入札の設定への影響を誰が判断するか |
経営の判断として、本コラムの考えは、利用者の情報の取り扱いと表示の義務を、配信と計測の設計の前提にすることです。具体的には、タグと送信先の一覧、利用目的と公表の文面、同意の記録の扱い、クリエイティブの事前の確認の手順を、広告の運用の担当・サイトやアプリの担当・法務の担当のどこが持つかを決め、第12章の監視と同じ頻度で点検する仕組みに組み込むことです。これを怠ったときの損失は、規制上の義務の不履行にとどまりません。同意を必要とする処理で拒否や撤回が反映されていなければ、利用者の信頼を損ない(信頼の毀損)、計測の範囲が変わったことに気づかなければ、管理画面の数字の意味を取り違えて予算の配分を誤ります(成果の数え違い)。識別子の環境は今後も変わりうるので、特定の識別子に頼る計測や配信の制御の比重と、変わったときに切り替える方法を、平時から把握しておくことが、入札の仕組み全体を守ることにつながると考えています。
規制とガイドライン、識別子の環境は、入札の数理の外側にある前提ですが、第2章の記録の結びつけから第11章の効果の測定まで、多くの章の設計に関わります。本章では、国内の個人情報保護法・電気通信事業法の外部送信規律・景品表示法・透明化法、EU の規制、ブラウザとスマートフォンの識別子の制限の経緯を、一次情報で確かめた範囲で整理しました。終章では、ここまでの14章を通して、運用型広告の入札を使い続けるために何を決め、何を点検し続けるかをまとめます。
この章を深めたい方への参考書籍
『外部送信規律スピード対応マニュアル』(山下大介 著、日経BP):書名のとおり電気通信事業法の外部送信規律を扱う本で、副題は「Web/アプリ運営者必見」です(2023年7月刊)。本章で扱った外部送信規律の節の内容を、サイトやアプリの運営者の立場から確かめるときの手がかりになると考えています。刊行の後の改正や総務省の資料の更新は、公式の資料で補う必要があります。
『おそろしいビッグデータ』(山本龍彦 著、朝日新聞出版):副題は「超類型化AI社会のリスク」で、ビッグデータと AI による人の類型化のリスクを扱う新書です(朝日新書、2017年11月刊)。本章で扱った、プロファイリングにもとづく広告の制限や、利用者の側から見た情報の利用の問題を考えるときの手がかりになると考えています。2017年の刊行で、その後の法改正やブラウザの仕様の変化は反映されていないので、制度の現状は本章で示した一次情報と合わせて読むことを想定しています。
終章 運用型広告の入札を使い続けるために
本コラムでは、運用型広告の入札を、表示の機会ごとの価値を見積もり、オークションの方式と予算の制約を踏まえて入札額を決め、広告で増えた利益で結果を測る仕組みとして整理しました。最後に、4つのまとまりで確かめたことを振り返り、仕組みを使い続けるために決めておく事柄をまとめます。
4つのまとまりで確かめたこと
1つ目のまとまり(第1章から第3章)では、取引とデータの性質を確かめました。表示の機会は、媒体、取引の場、買い付けの仕組みを通って広告主に届き、その1回ごとにオークションが行われます。広告主の手元に残る記録は、落札して表示した機会の結果に偏っており、コンバージョンは遅れて届きます。何をコンバージョンとし、どの期間で数えるかによって、同じ配信でも率や単価の数字は変わります。オークションの方式がセカンドプライスかファーストプライスかによって、価値どおりに入札してよいのか、引き下げが要るのかも変わります。
2つ目のまとまり(第4章から第6章)では、利用者の反応の見積りを扱いました。予測クリック率と予測コンバージョン率は、表示の価値を見積もる材料です。順位づけの指標が良いモデルでも、確率の値が実績より高く出ていれば、表示の価値を高く見積もることになり、払いすぎを招くおそれがあります。影響の大きさは、オークションの方式や予算の制約によって変わります。全体の平均が合っていても、一部の掲載面だけで高く出ていれば、その掲載面で同じことが起こりえます。予測は、対数損失のように確率の正しさを反映する指標と、区分ごとの予測と実績の比で確かめ、ずれていれば較正します。直近の記録ではコンバージョンがまだ届いていないことを踏まえて、学習に使う範囲を決めます。
3つ目のまとまり(第7章から第10章)では、見積りを入札と配信の判断に変える方法を扱いました。予算に限りがあるときは、価値に対して支払額が低い機会から買うという考え方が基本になり、目標のCPAや予算を動かすと、買える機会の範囲が変わります。平均のCPAが目標に収まっていても、配信を買い足したときの、追加のコンバージョン1件あたりの費用(限界のCPA)は、それより高くなっていることがあります。ファーストプライスの場では、勝率曲線を見積もって入札を引き下げます。予算は、1日の中の機会の波を踏まえて使う速さを制御します。同じ利用者への表示の回数と、表現の出し分けも、何を指標にして決めるかで結果が変わります。
4つ目のまとまり(第11章から第14章)では、結果の測り方と、仕組みを組織に定着させる方法を扱いました。管理画面に出るコンバージョンの件数は、規則で広告に割り振った件数であり、広告で増えた件数ではありません。第11章の例題のように、広告が無くてもコンバージョンする確率の高い利用者へ配信が偏る場合、割り振った件数だけを見ていると、広告の効果を大きく見積もることがあります。増分は、広告を出さない群を残す実験などで測ります。配信は自動で動き続けるので、コンバージョンが出そろう前に分かる指標(クリック率の予測と実績の比など)での監視と、掲載されるページや無効なトラフィックの点検を、運用の中に組み込みます。導入にあたっては、媒体の自動入札にどこまで任せ、どこからを自社で決めるかの段階を選び、成果の指標から管理の指標への分解(KPIの木)と、PoCの合格の条件と出口を先に決めます。利用者の情報の取り扱いと広告の表示に関する法令、識別子の制限は、配信と計測の設計の前提になります。
使い続けるために決めておくこと
入札の仕組みは、入れたときの設定のまま動かし続けると、少しずつ実態とずれていきます。商品や価格が変われば、コンバージョン1件の価値が変わります。競合の入札が変われば、勝率曲線が変わります。季節や掲載面の構成が変われば、予測と実績の関係が変わります。識別子の環境が変われば、計測できるコンバージョンの範囲が変わります。本コラムの各章で経営判断として挙げた事柄を、見直しの対象ときっかけという形でまとめると、次の表のようになります。定期的な点検の間隔は、広告費が事業に占める重みと、コンバージョンの件数に応じて決めるものです。
| 決めておくこと | 見直しのきっかけ | 主に扱った章 |
|---|---|---|
| コンバージョンの定義と計測期間 | 商品や申込の流れを変えたとき、計測の方法が変わったとき | 第2章 |
| 配信の記録と自社の売上の記録の突き合わせ | 計測の方法や売上の記録の持ち方を変えたとき、定期的な点検のとき | 第2章・第13章 |
| コンバージョンの価値と目標のCPAの根拠 | 粗利や価格を変えたとき、顧客がその後にもたらす利益の見込みを更新したとき | 第7章 |
| 取引の方式と入札の引き下げの確認 | 買い付けの経路や媒体を変えたとき、定期的な点検のとき | 第3章・第8章 |
| 予測と実績の比の確認、較正のやり直し | 定期的な点検のとき、比が決めた範囲を外れたとき(コンバージョン率は、計測期間が十分にたった記録で確かめる) | 第6章・第12章 |
| 予算の上限で配信が止まっている割合 | 予算や目標を変える前 | 第9章 |
| 表示の回数の上限と、表現を評価する指標 | 新しい表現を足すとき、反応が下がってきたとき | 第10章 |
| 増分を測る実験 | 主要な媒体ごとに定期的に。配信の対象や入札の方針を大きく変えたとき | 第11章 |
| 掲載されるページと無効なトラフィックの点検 | 定期的な点検のとき、クリックだけが増えてコンバージョンが伴わないとき | 第12章 |
| 役割と、配信を止める権限 | 体制や外部の委託先を変えたとき | 第13章 |
| 法令と識別子の制限への対応 | 法令の改正や施行、ブラウザやOSの方針の変更があったとき | 第14章 |
表の各行について、誰が、どの数字を見て、どの範囲を外れたら何をするのかを文書にしておくと、担当者が替わっても仕組みが続きやすくなります。とくに、コンバージョンの価値と成果の測り方は、広告運用の担当者だけでは決められません。事業の責任者、財務、広告運用、データ分析の担当者が同じ定義を使っていることを、定期的に確かめることが有効だと考えています。
自動入札と人の役割
媒体の自動入札は、機会ごとの見積りと入札の計算を、人には扱えない件数と速さで行います。自動入札の内部の計算は公開されていない部分が多く、本コラムの例題と同じ計算が行われているかは確かめられません。確かめられるのは、自動入札が、広告主の渡した定義と目標に合わせて入札を決める機能だということです。コンバージョンの定義が利益とずれていれば、ずれた方向に進みます。目標が増分ではなく割り振られた件数で与えられていれば、広告が無くても起きていたコンバージョンを安く数える方向に進むことがあります。
自動入札を使う場合、人の役割は、入札額を1件ずつ決めることではなく、何を目標として渡し、結果を何で確かめるかを決めることになると考えています。本コラムで扱った予測、オークション、予算の制約、増分の考え方は、その判断のための共通の言葉になると考えています。自社でモデルや入札の仕組みを持つかどうかにかかわらず、渡している目標が事業の利益とつながっているか、結果を増分で確かめているかを、広告主の側で説明できる状態を目指すことをお勧めします。
最初の一歩としては、序章に挙げた4つの確認(コンバージョンの定義、価値と目標の根拠、配信と売上の記録の突き合わせ、増分の測定)のうち、自社でまだ答えられないものを1つ選び、そこから着手するのが現実的だと考えています。4つの確認がそろえば、増分の利益とその見積りの幅を共通の基準にして、手法や機能を比べる土台が整います。
Anagraftでは、広告の入札と効果の測定を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 運用型広告の仕組みと事業での位置づけ、広告枠の取引と費用の構造
『アドテクノロジーの教科書 デジタルマーケティング実践指南』(広瀬信輔、翔泳社):書名のとおり、アドテクノロジーを主題にした入門の本で、2016年3月の刊行です。本章で扱った取引の当事者と仕組みを、より詳しく確かめるときの入口として挙げました。刊行の後に取引の方式や識別子の環境は変わっているので、本章の歴史の節とあわせ、刊行の時点の内容として読むのが安全です。
『いちばんやさしいはじめてのGoogle広告の教本 人気講師が教える運用型広告の基礎と実践』(杓谷匠・田中広樹・宮里茉莉奈、インプレス):書名と副題のとおり、1つの大きな媒体の広告を題材に、運用型広告の基礎と実践を扱う入門の本で、2024年の刊行です。本章の、広告主が決めることの節を、実際の媒体の広告に当てはめて考えるときの入口として挙げました。管理画面の操作や機能の名称は変わりうるので、刊行の時点の内容として読むのが安全です。
第2章 広告配信のデータ、入札・表示・クリック・コンバージョンの記録と結果の定義
『[増補改訂]ビッグデータを支える技術 ラップトップ1台で学ぶデータ基盤のしくみ』(西田圭介、技術評論社):副題のとおり、データ基盤の仕組みを手元の環境で学ぶことを主題にした本です。入札・表示・クリック・コンバージョンのように別々の場所で生まれる記録を、1か所に集めて分析できる形にするときに、どんな仕組みが要るかを考える手がかりになると考えています。
『データ分析基盤構築入門 Fluentd、Elasticsearch、Kibanaによるログ収集と可視化』(鈴木健太、吉田健太郎、大谷純、道井俊介、技術評論社):副題のとおり、ログの収集と可視化を主題にした本です。配信の記録を集める仕組みを自社で持つかどうかを考えるときや、重複・時刻のずれといった記録の品質の問題を仕組みの側から考えるときの入口になると考えています。
第3章 オークションの仕組み、セカンドプライスとファーストプライスで変わる入札の考え方
『オークション理論』(佐野隆司 著、栗野盛光 監修、共立出版):シリーズマーケットデザインの1冊で、2025年に刊行されたオークション理論の教科書です。目次の第1章では、さまざまなオークション・代表的なオークション・何をどうやって分析するのか・オークションのモデル化が扱われています。この章で実行結果と導出で示したセカンドプライスとファーストプライスの入札の違いや、収入同値定理の条件を、理論の側から確かめるのに向いています。
『マーケットデザイン入門 オークションとマッチングの経済学』(坂井豊貴 著、ミネルヴァ書房):書名のとおり、オークションとマッチングを中心に、制度の設計を経済学の立場から扱う入門書です。この章では1回の表示の機会を売る仕組みとしてオークションを見ましたが、売り手が方式や最低落札価格をどう選ぶか、という売り手の側の視点から取引の仕組みを捉え直すのに役立ちます。
第4章 クリック率の予測、ロジスティック回帰と特徴量の作り方
『機械学習のための特徴量エンジニアリング:その原理とPythonによる実践』(Alice Zheng、Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン):カテゴリ変数の章で、One-Hot エンコーディングと、膨大なカテゴリ数の扱いとしての特徴量ハッシングとビンカウンティングを節に立てており、本章の特徴量の表と対応します。別の章には、ロジスティック回帰の正則化による調整の節もあります。
『ロジスティック回帰分析:SASを利用した統計解析の実際』新版(丹後俊郎、山岡和枝、高木晴良 著、朝倉書店):副題のとおり、統計解析のソフトウェアを使ったロジスティック回帰分析の実際を扱う本です。本章では予測の道具として使ったロジスティック回帰を、統計解析の立場から確かめたいときの土台になります。
第5章 機械学習によるクリック率とコンバージョン率の予測、勾配ブースティングと遅れて届く結果
『Kaggleで勝つデータ分析の技術』(門脇大輔、阪田隆司、保坂桂佑、平松雄司 著、技術評論社):GBDT(勾配ブースティング木)の概要と主なライブラリ、パラメータの調整に加え、時系列データのバリデーション(評価用のデータの切り方)の手法と注意点を、章を立てて扱っています。本章で行った「時間で切って評価する」「検証用のデータで木の本数を決める」手順を、実装の水準で深めたい方に向きます。
『統計的学習の基礎 データマイニング・推論・予測』(Trevor Hastie、Robert Tibshirani、Jerome Friedman 著、杉山将、井手剛、神嶌敏弘、栗田多喜夫、前田英作 監訳、井尻善久 他訳、共立出版):機械学習の手法を統計の立場から体系的に扱う教科書の訳書(原著第2版の翻訳)です。本章で使ったロジスティック回帰や決定木の集まりの背景にある理論を、数式を使って深めたい方に向きます。
第6章 予測の評価と較正、対数損失と確率のずれが入札に与える影響
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):副題のとおり、評価の指標をデータサイエンスとビジネスの間をつなぐものとして扱う本です。この章で述べた、指標をモデルを選ぶ前に事業の目的から決めるという考え方を、広告に限らない形で整理するのに向いていると考えています。
『戦略的データサイエンス入門 ビジネスに活かすコンセプトとテクニック』(Foster Provost・Tom Fawcett 著、竹田正和 監訳、古畠敦ほか 訳、オライリー・ジャパン):データサイエンスの考え方を、ビジネスで使う側から解説した入門書の訳書です。モデルの出す点数を判断にどう使い、モデルの評価を事業の判断とどう結びつけるかを考える土台として、この章の内容と併せて読むことができると考えています。
第7章 入札額の決め方、表示の価値にもとづく入札と目標の獲得単価
『最適化手法入門』(寒野善博 著、駒木文保 編、講談社):線形計画の双対性や、制約のある非線形計画の最適性の条件を、データサイエンスの応用と併せて解説した入門書です。本章の予算の制約つきの入札で使ったラグランジュ乗数の考え方を、一般的な最適化の枠組みの中で確かめるのに向いています。
『数理計画入門 第3版 最適化の数理モデルとアルゴリズム』(福島雅夫、山下信雄 著、朝倉書店):線形最適化・ネットワーク最適化・非線形最適化・組合せ最適化を通して、最適化の数理モデルの立て方と解き方を扱う教科書です。予算を機会やキャンペーンに配分する問題を、定式化の型として整理し直すときの土台になります。
第8章 ファーストプライスでの入札、勝率曲線の推定と入札の引き下げ
『ミクロ経済学の力』(神取道宏、日本評論社):ミクロ経済学の教科書です。入札する側が、競合の出方を見込んで払う額を決めるという本章の問題を、価格と市場の理論の側から捉え直すときの土台になります。
『生存時間解析 SASによる生物統計 第2版』(大橋靖雄・浜田知久馬・魚住龍史 著、東京大学出版会):打ち切りのあるデータの扱い方を、生存時間分析の基本の考え方から解説する本です。落札できなかった機会では「落札のしきい値が入札額より上」としか分からないという本章の打ち切りの問題を、統計の手法として扱う考え方を学ぶのに役立ちます。
第9章 予算のペース配分、1日の予算を使う速さの制御
『はじめての制御工学 改訂第2版』(佐藤和也・平元和彦・平田研二、講談社):目標との差を見て操作を変えるフィードバック制御の基本を、初学者向けに説明した教科書です。本章で見た、制御を強くすると乗数が大きく振れ(k=60)、弱くすると乗数の動きが遅れて昼までの費用が目標より先行した(k=2)といった動きを、制御工学の言葉で理解する助けになります。
『オンライン機械学習』(海野裕也・岡野原大輔・得居誠也・徳永拓之、講談社):データが1件ずつ届く状況で、届くたびにモデルを更新していく学習の方法と、その性能の解析を扱った本です。本章で紹介した Balseiro と Gur の2019年の論文のように、予算のあるくり返しのオークションでの学習は、比べる相手となる方策に対する取り逃しの累積を小さくする考え方(後悔の最小化)から扱われることがあり、データが届くたびに更新していく学習の考え方を知る入口になります。
第10章 配信の制御、フリークエンシーの上限とクリエイティブの出し分け
『バンディット問題の理論とアルゴリズム』(本多淳也、中村篤祥 著、講談社):講談社の機械学習プロフェッショナルシリーズの1冊として2016年に刊行された、探索と活用の問題を扱う日本語の教科書です。この章で使ったトンプソン・サンプリングを含む方策が、どのような前提で、どの程度の損失で済むと示されているかを確かめるときに参考になります。
『Bandit Algorithms』(Tor Lattimore、Csaba Szepesvári 著、Cambridge University Press):2020年に刊行された、バンディットの理論を体系的にまとめた英語の本です。結果が遅れて届く場合や、反応が時間とともに変わる場合など、この章の例題で単純化した条件を外したときの扱いを調べるときの手がかりになります。
第11章 広告の効果の測り方、アトリビューションと増分の検証
『効果検証入門』(安井翔太 著、ホクソエム 監修、技術評論社):副題のとおり、正しい比較のための因果推論と計量経済学の基礎を扱った本です。本章で見た「見た利用者と見なかった利用者の差が効果を過大に見せる」構造を、より一般的な形で学べます。
『A/Bテスト実践ガイド』(Ron Kohavi、Diane Tang、Ya Xu 著、大杉直也 訳、ドワンゴ):副題は「真のデータドリブンへ至る信用できる実験とは」で、オンラインでの無作為化の実験(A/Bテスト)を、信頼できる形で行うための実践を扱った本です。本章で扱った配信しない群の実験を、社内で続けて行う仕組みを考えるときの参考になります。
第12章 配信の監視と品質、無効なトラフィック・掲載面の点検とモデルの見直し
『機械学習システムデザイン:実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習のシステムを本番で動かし続けるための設計を扱う本で、データ分布のシフトと監視、実環境での継続学習とテストに章を割いています。本章で扱った、予測と実績のずれを監視し、較正のやり直しや再学習で対応する考え方を、広告に限らない一般的な形で学べます。
『異常検知と変化検知』(井手剛・杉山将 著、講談社):機械学習プロフェッショナルシリーズの1冊で、ホテリングの T2 法から、部分空間法や密度比推定による変化検知までを扱います。本章では管理図の考え方による単純な外れの検知だけを使いましたが、多くの指標をまとめて監視したいときや、分布の変化を検知したいときの手法を体系的に学べます。
第13章 導入の進め方と体制、自動入札の使い分け・内製と外部の分担
『マーケティングとは「組織革命」である。 個人も会社も劇的に成長する森岡メソッド』(森岡毅、日経BP社):書名のとおり、マーケティングを組織の問題として扱う本です。本章で扱った、設定を担う人と成果を確かめる人の分担や、KPI の木を関係者で共有する仕組みを、マーケティングの組織の側から考えるときの材料として挙げました。
『会社を変える分析の力』(河本薫、講談社):書名のとおり、企業の中のデータ分析を主題にした本です。本章の、広告運用とデータ分析が同じ計画書を使う体制や、PoC の結果を判断につなげる仕組みを考えるときの材料として挙げました。
第14章 規制とガイドライン、識別子の制限と公開事例・最新動向
『外部送信規律スピード対応マニュアル』(山下大介 著、日経BP):書名のとおり電気通信事業法の外部送信規律を扱う本で、副題は「Web/アプリ運営者必見」です(2023年7月刊)。本章で扱った外部送信規律の節の内容を、サイトやアプリの運営者の立場から確かめるときの手がかりになると考えています。刊行の後の改正や総務省の資料の更新は、公式の資料で補う必要があります。
『おそろしいビッグデータ』(山本龍彦 著、朝日新聞出版):副題は「超類型化AI社会のリスク」で、ビッグデータと AI による人の類型化のリスクを扱う新書です(朝日新書、2017年11月刊)。本章で扱った、プロファイリングにもとづく広告の制限や、利用者の側から見た情報の利用の問題を考えるときの手がかりになると考えています。2017年の刊行で、その後の法改正やブラウザの仕様の変化は反映されていないので、制度の現状は本章で示した一次情報と合わせて読むことを想定しています。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 電通「2025年 日本の広告費」で総広告費は前年比105.1%、インターネット広告費は前年比110.8%、構成比50.2%
https://www.dentsu.co.jp/knowledge/ad_cost/2025/ - インターネット広告費は、インターネット広告媒体費・物販系ECプラットフォーム広告費・インターネット広告制作費の合計
https://www.dentsu.co.jp/knowledge/ad_cost/2025/media3.html - 4社が2026年3月5日に公表した詳細分析で、運用型広告費はインターネット広告媒体費の88.7%、前年比112.5%
https://kyodonewsprwire.jp/release/202603034899 - 物販系ECプラットフォーム広告費は、物販系ECプラットフォーム上に店舗を持つ事業者がそのプラットフォーム上に投下した広告費
https://www.dentsu.co.jp/knowledge/ad_cost/2025/about.html - OpenRTB 2.6 の bidfloor は表示1,000回あたりの価格で表す、tmax はタイムアウトを避けるための上限
https://github.com/InteractiveAdvertisingBureau/openrtb2.x/blob/main/2.6.md - それ以前のインターネット広告は、表示1,000回あたりの単価で、契約ごとに個別に交渉して売られていた
https://www.nber.org/system/files/working_papers/w11765/w11765.pdf - Google 広告のスマート自動入札の方針のうち目標アクション単価と目標広告費用対効果は2026年6月に長い名称から改められ、入札の動作は変わっていない
https://support.google.com/google-ads/answer/7065882?hl=ja - 英国の競争・市場庁の最終報告書は2020年7月1日公表、仲介の事業者はオープン・ディスプレイで広告主の購入額の少なくとも35%を得ていると推計
https://www.gov.uk/cma-cases/online-platforms-and-digital-advertising-market-study - ISBA と PwC の調査では媒体に届く割合が平均51%、約15%は落札額と収入が一致せず特定できなかった
https://assets.publishing.service.gov.uk/media/5fa557668fa8f5788db46efc/Final_report_Digital_ALT_TEXT.pdf - 公正取引委員会が2021年2月17日にデジタル広告分野の実態調査の最終報告を公表、広告主と広告代理店・広告仲介事業者・媒体の事業者に書面の調査を行い聞き取りも実施
https://www.jftc.go.jp/houdou/pressrelease/2021/feb/210217.html - Edelman、Ostrovsky、Schwarz の2007年の論文の書誌
https://www.aeaweb.org/articles?id=10.1257/aer.97.1.242 - GoTo は1997年に試験的な版の検索のサービスを始め、成果に応じて払うサービスを1998年2月に発表し、同年6月に正式に開始した
https://www.sec.gov/Archives/edgar/data/1060439/000095014801501395/v74643e10-q.htm - Google が2019年9月5日の公式ブログで Google Ad Manager の統一したファーストプライス・オークションへの移行を発表、翌週から展開し数週間で移行の見込み
https://blog.google/products/admanager/rolling-out-first-price-auctions-google-ad-manager-partners/ - 参考書籍『アドテクノロジーの教科書 デジタルマーケティング実践指南』(広瀬信輔、翔泳社)
https://ndlsearch.ndl.go.jp/books/R100000002-I027138984 - 参考書籍『いちばんやさしいはじめてのGoogle広告の教本 人気講師が教える運用型広告の基礎と実践』(杓谷匠・田中広樹・宮里茉莉奈、インプレス)
https://ndlsearch.ndl.go.jp/books/R100000002-I033642116
第2章
- OpenRTB 2.6 の仕様書は IAB Tech Lab が GitHub で公開しており、互換性を壊さない改良があればおよそ月に1回更新される
https://github.com/InteractiveAdvertisingBureau/openrtb2.x/blob/main/2.6.md - Google 広告の自動タグ設定はクリック時に遷移先の URL に GCLID を付け、コンバージョンの計測やオフラインのコンバージョンの取り込みに使う
https://support.google.com/google-ads/answer/3095550?hl=ja - Meta の Conversions API は広告主のサーバーから Meta へ出来事を送るサーバー間の接続で、設定を確かめると Pixel とサーバーの出来事の重複が除かれているかを確認できる
https://developers.facebook.com/docs/marketing-api/conversions-api/ - Google 広告のスマート自動入札はコンバージョン数またはコンバージョン値を最適化する入札戦略で、使うにはコンバージョンの計測を有効にする必要がある
https://support.google.com/google-ads/answer/7065882?hl=ja - OpenRTB 2.6 の仕様書は2026年4月1日の更新を最後とする版を確認した
https://github.com/InteractiveAdvertisingBureau/openrtb2.x/commit/403cbba542de3a5d9cfcccd0a34e74b01b79a9f1 - Google 広告はクッキーの制限や同意の状態で直接は計測できないコンバージョンを推定し、コンバージョンの列には推定と測定の両方が含まれる
https://support.google.com/google-ads/answer/10081327?hl=ja - 参考書籍『[増補改訂]ビッグデータを支える技術 ラップトップ1台で学ぶデータ基盤のしくみ』西田圭介、技術評論社
https://gihyo.jp/book/2021/978-4-297-11952-2 - 参考書籍『データ分析基盤構築入門 Fluentd、Elasticsearch、Kibanaによるログ収集と可視化』鈴木健太、吉田健太郎、大谷純、道井俊介、技術評論社
https://gihyo.jp/book/2017/978-4-7741-9218-5
第3章
- Vickrey の1961年の論文(投機を抑える競争入札の仕組みを論じた論文)
https://doi.org/10.1111/j.1540-6261.1961.tb02789.x - Vickrey の論文の20ページは、最も高い入札者に2番目に高い入札者の価格で落札させる封をした入札では、談合が無ければ、価値いっぱいの額を入札するのが最適だと述べている
https://cramton.umd.edu/market-design-papers/vickrey-counterspeculation-auctions-and-competitive-sealed-tenders.pdf - Myerson の1981年の論文(最適なオークションの設計を扱った論文)
https://doi.org/10.1287/moor.6.1.58 - Myerson の論文の65ページは、売り手の期待収入が割当の確率と、価値が最も低い場合の各買い手の期待利得によって完全に決まることを、収入同値定理の系として述べている
https://ranger.uta.edu/~weems/NOTES6319/PAPERSTWO/myerson.pdf - Prebid は既定ではすべての買い手の候補の入札を広告サーバーへ送り、設定によっては最も高い入札だけを送ることもできる
https://docs.prebid.org/dev-docs/publisher-api-reference/setConfig.html - Edelman、Ostrovsky、Schwarz の2007年の論文は、一般化セカンドプライスが VCG に似ているが性質が大きく違い、価値どおりの入札が均衡にならないことを述べている
https://www.aeaweb.org/articles?id=10.1257/aer.97.1.242 - OpenRTB 2.6 の「Second Price Plus」は名称だけが定められ、本章では中身の規則を確かめていない
https://github.com/InteractiveAdvertisingBureau/openrtb2.x/blob/main/2.6.md - 実務では、ディスプレイ広告の取引の入札は表示1,000回あたりの価格で表されることが多く、検索連動型広告ではクリック1回あたりの入札と課金が一般的
https://support.google.com/google-ads/answer/6297?hl=ja - Varian の2007年の論文(位置ごとのオークションを分析した論文)
https://doi.org/10.1016/j.ijindorg.2006.10.002 - Google 広告のヘルプでは、広告ランクは入札単価・広告とランディングページの品質・広告ランクの下限値・オークションにおける競争力・検索の文脈・広告アセットなどの見込みの効果をもとに、検索のたびに計算される
https://support.google.com/google-ads/answer/1722122?hl=ja - Google の公式ブログは2019年9月5日に、Google Ad Manager の全てのパートナーを対象に統一したファーストプライスのオークションへ移行すると公表し、翌週から展開を始めて数週間で終える見込みとした
https://blog.google/products/admanager/rolling-out-first-price-auctions-google-ad-manager-partners/ - ヘッダー入札は広告サーバーを呼ぶ前に複数の買い手の候補から入札を集め、最も一般的な構成では広告サーバーが最終の判断をする
https://docs.prebid.org/overview/intro-to-header-bidding.html - 参考書籍『オークション理論』佐野隆司 著、栗野盛光 監修、共立出版、2025年
https://ndlsearch.ndl.go.jp/books/R100000002-I034137439 - 参考書籍『マーケットデザイン入門 オークションとマッチングの経済学』坂井豊貴 著、ミネルヴァ書房、2010年
https://ndlsearch.ndl.go.jp/books/R100000002-I000011029768
第4章
- Google 広告の公式ヘルプ「広告ランクについて」では、広告ランクの要素として入札単価と、推定クリック率・広告の関連性・ランディングページの利便性などで評価される広告の品質が挙げられている
https://support.google.com/google-ads/answer/1722122?hl=ja - McMahan らの2013年の論文(Google の広告のクリックの予測の実務を述べた論文)は、FTRL-Proximal による逐次学習と、記憶の節約・較正・予測の確からしさの見積りの工夫を報告している
https://doi.org/10.1145/2487575.2488200 - McMahan らの2013年の論文(Google の広告のクリックの予測の実務を述べた論文)は、FTRL-Proximal による逐次学習と、記憶の節約・較正・予測の確からしさの見積りの工夫を報告している
https://research.google/pubs/ad-click-prediction-a-view-from-the-trenches/ - Weinberger らの2009年の論文(大規模な多タスク学習のための特徴量ハッシングの論文)は、ハッシュで重なった部分空間どうしの干渉が小さいことを確率の不等式で示している
https://doi.org/10.1145/1553374.1553516 - Weinberger らの2009年の論文(大規模な多タスク学習のための特徴量ハッシングの論文)は、ハッシュで重なった部分空間どうしの干渉が小さいことを確率の不等式で示している
https://arxiv.org/abs/0902.2206 - Chapelle、Manavoglu、Rosales の2014年の論文は、ディスプレイ広告の反応の予測を大規模なデータで扱う方法を論じた研究で、ACM の知的システムと技術に関する論文誌の第5巻第4号に掲載された
https://doi.org/10.1145/2532128 - scikit-learn の FeatureHasher は MurmurHash3 の符号つき32ビット版を使い、列の数が少ないと衝突が起きやすく、多いと係数の次元が大きくなる
https://scikit-learn.org/stable/modules/generated/sklearn.feature_extraction.FeatureHasher.html - SGDClassifier は損失を log_loss にするとロジスティック回帰になる
https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.SGDClassifier.html - FeatureHasher は既定で、特徴の名前のハッシュ値の符号に応じて値に正負の符号を付け、無関係な特徴どうしの衝突が打ち消し合いやすくなる
https://scikit-learn.org/stable/modules/feature_extraction.html - 参考書籍『機械学習のための特徴量エンジニアリング:その原理とPythonによる実践』(Alice Zheng、Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン、2019年)
https://www.oreilly.co.jp/books/9784873118680/
第5章
- He らの2014年の論文、Facebook の広告のクリックの予測の実務を述べた論文
https://doi.org/10.1145/2648584.2648589 - He らの2014年の論文の要旨、決定木とロジスティック回帰の組み合わせがそれぞれ単独を3%を超えて上回った
https://quinonero.net/Publications/predicting-clicks-facebook.pdf - Chapelle の2014年の論文、ディスプレイ広告での遅れて届く反応のモデル
https://doi.org/10.1145/2623330.2623634 - Rendle の2010年の論文、因子分解機
https://doi.org/10.1109/ICDM.2010.127 - Cheng らの2016年の論文、推薦の深層学習の第1回ワークショップ
https://doi.org/10.1145/2988450.2988454 - Cheng らの2016年の論文の要旨、交差特徴を持つ線形のモデルと疎な項目を低次元のベクトルにするニューラルネットワークを同時に学習し、Google Play で配信してアプリの導入が片方だけのモデルより大きく増えた
https://arxiv.org/abs/1606.07792 - 参考書籍『Kaggleで勝つデータ分析の技術』(門脇大輔、阪田隆司、保坂桂佑、平松雄司 著、技術評論社、2019年)
https://gihyo.jp/book/2019/978-4-297-10843-4
第6章
- He らの2014年の論文(Facebook の広告のクリックの予測の実務を述べた論文
https://doi.org/10.1145/2648584.2648589 - 正規化エントロピーは、平均の対数損失を背景のクリック率を一律に予測した場合の平均の対数損失で割った値で、背景のクリック率は学習用のデータの平均のクリック率
https://quinonero.net/Publications/predicting-clicks-facebook.pdf - Platt の1999年の論文(サポートベクターマシンの出力を確率に変える方法の論文)でプラットの方法が示された
https://scikit-learn.org/stable/modules/calibration.html - Zadrozny と Elkan の2002年の論文(分類器の点数を正確な確率の見積りに変える方法の論文
https://doi.org/10.1145/775047.775151
第7章
- Zhang、Yuan、Wang の2014年の論文(リアルタイム入札の最適な入札の論文)、KDD 2014 に掲載
https://doi.org/10.1145/2623330.2623633 - Zhang の2016年の博士論文の該当章で、予算の制約のもとで予測した指標から入札額への関数を求める問題を立て、勝率曲線が入札額だけで決まる・費用を入札額で上から抑えるという前提で、最適な入札は上に凸な曲線になると導いている
https://discovery.ucl.ac.uk/1496878/1/weinan-zhang-phd-2016.pdf - Perlich らの2012年の論文(ターゲティング広告の入札の最適化と在庫の採点の論文)、KDD 2012 に掲載
https://doi.org/10.1145/2339530.2339655 - Google 広告ヘルプの「目標アクション単価」入札戦略についてのページの説明:平均の額として目標を指定、オークションごとに過去のデータと端末・地域・時間帯などの情報で入札単価を設定、個々の単価は目標を上下し全体として目標と同等に調整、コンバージョンの計測の設定が必要
https://support.google.com/google-ads/answer/6268632?hl=ja - Google 広告ヘルプの目標広告費用対効果の説明:広告費に対するコンバージョン値の平均の比を目標とし、コンバージョン値が最大になるよう調整、目標が高すぎると配信量が制限され合計が減ることがある、コンバージョン値の設定が必要
https://support.google.com/google-ads/answer/6268637?hl=ja - 参考書籍『最適化手法入門』寒野善博 著、駒木文保 編、講談社、2019年、データサイエンス入門シリーズ
https://ndlsearch.ndl.go.jp/books/R100000002-I029903864 - 参考書籍『数理計画入門 第3版 最適化の数理モデルとアルゴリズム』福島雅夫、山下信雄 著、朝倉書店、2024年
https://ndlsearch.ndl.go.jp/books/R100000002-I033686165
第8章
- OpenRTB 2.6 の入札リクエストにはオークションの方式を示す項目があり、1がファーストプライス、2がセカンドプライスにあたる
https://raw.githubusercontent.com/InteractiveAdvertisingBureau/openrtb2.x/main/2.6.md - Google の Authorized Buyers の OpenRTB の案内には、ファーストプライスのオークションでは、入札の結果の通知に勝つのに必要だった最低の入札額を入れると書かれている
https://developers.google.com/authorized-buyers/rtb/openrtb-guide - Cui、Zhang、Li、Mao の2011年の論文(取引の場での入札の状況の予測
https://doi.org/10.1145/2020408.2020454 - Cui、Zhang、Li、Mao の2011年の論文(取引の場での入札の状況の予測
https://api.openalex.org/works/doi:10.1145/2020408.2020454 - Wu、Yeh、Chen の2015年の論文(打ち切りのあるデータでの落札価格の予測
https://doi.org/10.1145/2783258.2783276 - Wu、Yeh、Chen の2015年の論文(打ち切りのあるデータでの落札価格の予測
https://api.openalex.org/works/doi:10.1145/2783258.2783276 - 落札できなかった理由の符号の一覧には、より高い入札に負けた・最低落札価格を下回った・表示の機会の期限切れ・取引の場による広告の不承認・広告主やカテゴリの除外・条件を決めた取引の入札に負けた、が含まれる
https://raw.githubusercontent.com/InteractiveAdvertisingBureau/openrtb/main/OpenRTB%20v3.0%20FINAL.md - OpenRTB 2.6 の公式の仕様へのリンク
https://github.com/InteractiveAdvertisingBureau/openrtb2.x/blob/main/2.6.md
第9章
- Agarwal らの2014年の論文は、LinkedIn の対象を絞った広告の予算のペース配分を扱った論文
https://doi.org/10.1145/2623330.2623366 - Xu らの2015年の論文は、DSP のキャンペーンで予算を時間の中で滑らかに使いながら成果の指標を高めるペース配分の方法を提案し、実際の DSP での実装、配信中のキャンペーンでの実験、オフラインの模擬の結果を報告
https://arxiv.org/abs/1506.05851 - Zhang らの2016年の論文は、リアルタイム入札で入札額を動的に調整して落札の割合やクリック1回あたりの費用のような指標を目標に保つフィードバック制御の仕組みを提案し、実データでの検証と商用の取引の場での試験を報告
https://doi.org/10.1145/2835776.2835843 - Balseiro と Gur の2019年の論文は、予算のあるくり返しのオークションでの学習を、後悔の最小化と均衡の観点から扱った論文
https://doi.org/10.1287/mnsc.2018.3174 - Google 広告のヘルプでは、ほとんどのキャンペーンについて、ある日の費用が1日の平均予算の最大2倍になることがあり、1か月の上限は1日の平均予算に30.4を掛けた額と説明されている
https://support.google.com/google-ads/answer/2375423?hl=ja - 月の途中で1日の平均予算を変えると残りの月の上限の計算が変わること、コンバージョンに対して支払う形のキャンペーンには1日の上限が無いこと、配信にかかった費用が上限を超えても上限を超えた分は請求されないこと
https://support.google.com/google-ads/answer/10486637?hl=ja - 参考書籍『はじめての制御工学 改訂第2版』佐藤和也・平元和彦・平田研二著、講談社、2018年11月
https://ndlsearch.ndl.go.jp/books/R100000002-I029323589 - 参考書籍『オンライン機械学習』海野裕也・岡野原大輔・得居誠也・徳永拓之著、講談社(機械学習プロフェッショナルシリーズ)、2015年4月
https://www.kspub.co.jp/book/detail/1529038.html
第10章
- Google 広告のフリークエンシー キャップは、ディスプレイ広告では1日・1週間・1か月の単位で、キャンペーン・広告グループ・広告の単位で設定でき、動画広告ではキャンペーンの単位だけで設定する
https://support.google.com/google-ads/answer/117579?hl=ja - Thompson の1933年の論文(2つの未知の確率のどちらが大きいかを2つの標本の結果から見積もる論文)、Biometrika 誌25巻
https://academic.oup.com/biomet/article/25/3-4/285/200862 - Chapelle と Li の2011年の論文(NIPS 2011、トンプソン・サンプリングを実験で評価した論文)は、模擬のデータと実データの実験で十分に競争力があり、実装が簡単なので比較の基準に入れるべきだと述べている
https://papers.nips.cc/paper_files/paper/2011/hash/e53a0a2978c28872a4505bdb51db06dc-Abstract.html - Coalition for Better Ads は15万人を超える消費者への調査をもとに Better Ads Standards を公表し、パソコンのウェブ向けに6種類、スマートフォンのウェブ向けに10種類の広告の体験を挙げている
https://www.betterads.org/standards/ - 参考書籍『Bandit Algorithms』(Tor Lattimore、Csaba Szepesvári 著、Cambridge University Press、2020年)
https://www.cambridge.org/core/books/bandit-algorithms/8E39FD004E6CE036680F90DD0C6F09FC
第11章
- Google 広告のヘルプのアトリビューション モデルの説明で、現在選べるモデルはデータドリブンとラストクリックで、ファースト クリック・線形・減衰・接点ベースはサポート終了
https://support.google.com/google-ads/answer/6259715?hl=ja - Google 広告のヘルプのコンバージョン リフト測定の説明で、見た群と見なかった群の対照実験で増分を測る
https://support.google.com/google-ads/answer/12003020?hl=ja - Johnson、Lewis、Nubbemeyer の2017年の論文、ゴースト広告と呼ぶ方法でネット広告の効果の測定の経済性を改善する論文
https://doi.org/10.1509/jmr.15.0297 - Lewis と Rao の2015年の論文、米国の小売や証券の会社の大規模なフィールド実験25件をもとに、広告の効果の測定が難しいことを示した
https://doi.org/10.1093/qje/qjv023 - Gordon、Zettelmeyer、Bhargava、Chapsky の2019年の論文、2015年に Facebook で無作為化の実験として行われた米国の広告キャンペーン15件で、観察データの方法は実験と同じ効果を出せないことが多かった
https://doi.org/10.1287/mksc.2018.1135 - Gordon、Zettelmeyer、Bhargava、Chapsky の2019年の論文、2015年に Facebook で無作為化の実験として行われた米国の広告キャンペーン15件で、観察データの方法は実験と同じ効果を出せないことが多かった
https://www.kellogg.northwestern.edu/faculty/gordon_b/files/fb_comparison.pdf - Blake、Nosko、Tadelis の2015年の論文、eBay での検索連動型広告の大規模なフィールド実験
https://doi.org/10.3982/ECTA12423 - Blake、Nosko、Tadelis の2015年の論文、eBay での検索連動型広告の大規模なフィールド実験
https://www.nber.org/papers/w20171 - Vaver と Koehler の2011年の Google の論文、重ならない地域を無作為に対照と処置に分け、処置の地域で地域を指定した広告を配信する方法
https://research.google/pubs/measuring-ad-effectiveness-using-geo-experiments/ - 書籍 効果検証入門(安井翔太 著、ホクソエム 監修、技術評論社)
https://ndlsearch.ndl.go.jp/api/opensearch?title=効果検証入門&cnt=3 - 書籍 A/Bテスト実践ガイド(Ron Kohavi、Diane Tang、Ya Xu 著、大杉直也 訳、ドワンゴ)
https://ndlsearch.ndl.go.jp/api/opensearch?title=A/Bテスト実践ガイド&cnt=3
第12章
- Media Rating Council の無効なトラフィックの検知と除外の指針は2015年10月に初版、2020年6月に更新
https://mediaratingcouncil.org/standards-and-guidelines - Media Rating Council の無効なトラフィックの検知と除外の指針は2015年10月に初版、2020年6月に更新
https://mediaratingcouncil.org/sites/default/files/Standards/IVT%20Addendum%20Update%20062520.pdf - ビューアビリティの定義(ディスプレイはピクセルの50%以上が連続1秒以上、動画は同じ条件で連続2秒以上の再生)、2015年8月の第2版
https://mediaratingcouncil.org/sites/default/files/Standards/081815%20Viewable%20Ad%20Impression%20Guideline_v2.0_Final.pdf - JICDAQ は広告3団体が中心となり2021年3月に設立、同年4月に事業開始
https://www.jicdaq.or.jp/about.html - JICDAQ は広告3団体が中心となり2021年3月に設立、同年4月に事業開始
https://www.jicdaq.or.jp/ - ads.txt は媒体が自社の枠を売ることを認めた事業者を公開するファイル、最新は2022年8月の1.1、アプリ向けに app-ads.txt
https://iabtechlab.com/ads-txt/ - sellers.json は売り手と仲介する事業者を買い手が確かめるためのもので、SupplyChain オブジェクトと組み合わせて照合する
https://iabtechlab.com/sellers-json/ - Google 広告のヘルプは、スマート自動入札の「学習中」の状態と、変更後の成績の評価の目安を別の項目として説明している
https://support.google.com/google-ads/answer/13020501?hl=ja - コンバージョンの計測に障害があった期間を自動入札の学習から除く「データの除外」という機能があり、コンバージョンの計測の障害を対象とする機能として説明されている
https://support.google.com/google-ads/answer/10370710?hl=ja - データの除外の日付はクリックの日付に適用され、障害の発生日だけでなくコンバージョンに至るまでの日数を考えて、影響を受けた可能性のあるクリックの日を含める
https://support.google.com/google-ads/answer/10276486?hl=ja - 参考書籍 機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス
https://www.oreilly.co.jp/books/9784814400409/ - 参考書籍 機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス
https://ndlsearch.ndl.go.jp/books/R100000002-I033001073 - 参考書籍 異常検知と変化検知 井手剛・杉山将 著 講談社
https://www.kspub.co.jp/book/detail/1529083.html - 参考書籍 異常検知と変化検知 井手剛・杉山将 著 講談社
https://ndlsearch.ndl.go.jp/books/R100000002-I026619229
第13章
- Google 広告のヘルプ「スマート自動入札について」は、機械学習でオークションごとにコンバージョン数またはコンバージョン値を最適化する入札戦略と説明している
https://support.google.com/google-ads/answer/7065882?hl=ja - Google 広告のヘルプ「オフライン コンバージョンのインポートについて」は、クリックの後にウェブの外で起きた成果を、クリックごとの識別子と結びつけて取り込む機能を説明している
https://support.google.com/google-ads/answer/2998031?hl=ja - 公正取引委員会が令和3年2月17日にデジタル広告分野の取引実態に関する実態調査の最終報告を公表した
https://www.jftc.go.jp/houdou/pressrelease/2021/feb/210217.html - 広告主・広告代理店向けのアンケートは790社に送付し105社が回答(回収率約13.3%)
https://www.jftc.go.jp/houdou/pressrelease/2021/feb/digital/210217_gaiyou2.pdf - 『マーケティングとは「組織革命」である
https://ndlsearch.ndl.go.jp/books/R100000002-I028982171 - 『会社を変える分析の力』河本薫、講談社
https://ndlsearch.ndl.go.jp/books/R100000002-I024658384
第14章
- 個人情報保護法の現在の条文は2026年11月2日施行の版
https://laws.e-gov.go.jp/law/415AC0000000057 - 改正法は2026年7月10日成立・7月17日公布、政令・規則・ガイドラインの検討を続ける、検討資料の見出し
https://www.ppc.go.jp/personalinfo/legal/r8kaiseihogohou/ - 改正法の附則第1条は、原則として公布の日から起算して2年を超えない範囲内において政令で定める日から施行し、一部の規定は公布の日から起算して6月を経過した日などから施行する
https://www.ppc.go.jp/files/pdf/260717_houritsu.pdf - 電気通信事業法第27条の12の外部送信規律の条文の要旨と除外の4つの号
https://laws.e-gov.go.jp/law/359AC0000000086 - 外部送信規律は2022年6月の改正で設けられ2023年6月16日施行、対象の役務の例、通知や公表の方法、ホームページの運営の一部の例は対象外
https://www.soumu.go.jp/main_sosiki/joho_tsusin/d_syohi/gaibusoushin_kiritsu.html - 景品表示法の現在の条文は2026年5月21日施行の版、第5条の3つの号、第6条第2項の告示
https://laws.e-gov.go.jp/law/337AC0000000134 - ステルスマーケティングは2023年10月1日から景品表示法の違反、公表資料の名称と運用基準、規制の対象は一般消費者が広告と判別できない広告で依頼や指示をした表示を含むこと、SNS やレビューの投稿に加えテレビ・新聞・ラジオ・雑誌の表示も対象
https://www.caa.go.jp/policies/policy/representation/fair_labeling/stealth_marketing/ - 告示は景品表示法第5条第3号にもとづく令和5年内閣府告示第19号(2023年3月28日)で、2023年10月1日から施行
https://www.caa.go.jp/policies/policy/representation/fair_labeling/public_notice/assets/representation_cms216_230328_07.pdf - 運用基準は2023年3月28日の消費者庁長官決定
https://www.caa.go.jp/policies/policy/representation/fair_labeling/guideline/assets/representation_cms216_230328_03.pdf - 透明化法は令和2年法律第38号
https://laws.e-gov.go.jp/law/502AC0000000038 - 政令の広告に関わる2つの区分と、主として競りで決めるという要件
https://laws.e-gov.go.jp/law/503CO0000000017 - 公正取引委員会のデジタル広告分野の最終報告は2021年2月17日公表、調査の方法と今後の取り組み
https://www.jftc.go.jp/houdou/pressrelease/2021/feb/210217.html - eプライバシー指令第5条第3項の端末への保存とアクセスの同意と例外
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:02002L0058-20091219 - デジタルサービス法第26条第1項・第3項、第28条第2項
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32022R2065 - デジタル市場法第5条第2項・第9項・第10項、第6条第8項
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32022R1925 - 政治広告の透明性と配信の対象の設定に関する規則2024/900は2025年10月10日から適用、定義などの一部は発効の日から
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32024R0900 - Firefox の強化型トラッキング防止の既定の有効化は2019年6月4日、新規の利用者の標準の設定で有効、Disconnect のリスト、既存の利用者には数か月かけて順次
https://blog.mozilla.org/en/products/firefox/firefox-now-available-with-enhanced-tracking-protection-by-default/ - Chromium の公式ブログの2020年1月14日の記事(サードパーティ・クッキーを不要にする道筋)
https://blog.chromium.org/2020/01/building-more-private-web-path-towards.html - Safari のサードパーティ・クッキーの完全な既定の遮断は2020年3月24日の記事、iOS と iPadOS の13.4、macOS の Safari 13.1
https://webkit.org/blog/10218/full-third-party-cookie-blocking-and-more/ - 2024年7月22日の Privacy Sandbox の方針の変更(利用者の選択)、Privacy Sandbox 担当の副社長の名義、英国の競争・市場庁や情報コミッショナー事務局などの規制当局と協議を続けるとした
https://privacysandbox.google.com/blog/privacy-sandbox-update - 2025年4月22日の新しい選択の画面を導入しない決定、利用者は Chrome のプライバシーとセキュリティの設定で引き続き選択できること、シークレットモードの既定の遮断
https://privacysandbox.google.com/blog/privacy-sandbox-next-steps - 2025年10月17日の Privacy Sandbox の技術を段階的に終える発表と残す技術、理由として期待される価値と採用の低さを挙げたこと
https://privacysandbox.google.com/blog/update-on-plans-for-privacy-sandbox-technologies - App Tracking Transparency の許可の必要(iOS 14.5・iPadOS 14.5・tvOS 14.5 以降)、追跡の定義、許可が無いときの識別子、別の識別子での追跡と端末の情報による識別の禁止
https://developer.apple.com/app-store/user-privacy-and-data-use/ - AdAttributionKit の概要、iOS 17.4 以降、Apple が署名するポストバックに利用者や端末に固有のデータを含まない、しきい値
https://developer.apple.com/tutorials/data/documentation/adattributionkit.json - AdAttributionKit のクリックや表示にもとづく導入の割り当ては iOS 17.4・iPadOS 17.4 以降、再度の利用の情報は iOS 18・iPadOS 18 以降
https://developer.apple.com/app-store/ad-attribution/ - 一般社団法人日本インタラクティブ広告協会(JIAA)が、プライバシーポリシーガイドラインと、電気通信事業法における外部送信規律についてのガイダンスなどを掲載
https://www.jiaa.org/ - 一般社団法人デジタル広告品質認証機構(JICDAQ)が、業務を適切に行っている広告関連事業者を認証・公開しているとしている
https://www.jicdaq.or.jp/ - Cai、Ren、Zhang、Malialis、Wang、Yu、Guo の2017年のリアルタイム入札を強化学習で行う論文、WSDM 2017、手法の要旨
https://arxiv.org/abs/1701.02490 - Wu らの2018年の予算の制約つきの入札の論文、CIKM 2018、手法の要旨
https://arxiv.org/abs/1802.08365 - Zhang、Yuan、Wang、Shen の2014年の iPinYou のデータの論文と、データに含まれる記録の種類
https://arxiv.org/abs/1407.7073 - Criteo 1TB Click Logs の利用条件はクリエイティブ・コモンズの表示・非営利・継承4.0
https://ailab.criteo.com/criteo-1tb-click-logs-dataset/ - Criteo 1TB は24日分、先頭の列がクリックの有無のラベル、整数の特徴量13個、カテゴリの特徴量26個(32ビットにハッシュ化)
https://ailab.criteo.com/download-criteo-1tb-click-logs-dataset/ - Duetting、Mirrokni、Paes Leme、Xu、Zuo の2023年の大規模言語モデルのためのメカニズム・デザインの論文、最新の改訂は2024年7月、WWW 2024 の最優秀論文の記載
https://arxiv.org/abs/2310.10826 - 参考書籍 外部送信規律スピード対応マニュアル、山下大介 著、日経BP、2023年
https://ndlsearch.ndl.go.jp/books/R100000002-I032940500 - 参考書籍 おそろしいビッグデータ、山本龍彦 著、朝日新聞出版、朝日新書、2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I028608020