こんにちは、Anagraftの伊藤です。
今回は、与信スコアリングをどう理解し、どう自社の審査とリスク管理の仕組みに組み込むかを整理しました。ここでの与信は、相手が後で支払う、あるいは返済することを前提に、先にお金や商品、サービスを提供することを指します。貸付、クレジットカード、分割払い、後払いの決済、企業間の掛け売りがこれに当たります。与信スコアリングは、申込や契約の情報から、その契約が約束どおりに返済されない確率を統計や機械学習のモデルで見積もり、承認するかどうか、どこまで与信するか、契約の後をどう管理するかの判断に使う仕組みです。与信スコアリングの導入や見直しを検討する場面では、次のような問いが、審査やリスク管理の担当者だけでなく、事業の責任者や経営層にも届くことが多いように思います。
- 審査にAIを入れれば、貸し倒れは減るのか
- 製品やサービスの提供会社(ベンダー)が示す「AR値」(モデルが、デフォルトしやすい順に契約を並べられているかを表す指標。デフォルトは、返済が決めた基準まで滞ることを指します)という数字を、どう読めばよいのか
- 承認率を上げると、貸し倒れはどれだけ増えるのか
- 長く使われてきた点数表(スコアカード)は残すべきか、機械学習に置き換えるべきか
- 申込を断った理由を、どう説明すればよいのか
- スコアリングの仕組みを自社で作るべきか、外部のスコアや製品を使うべきか
本コラムでは、こうした問いに答えるための材料を、与信の目的とデータの基礎、モデルの作り方、評価と判断の設計、定着と規制の4つのまとまりに分けて並べました。
この題材を選んだ理由は、与信スコアリングが「データを集めて精度の高いモデルを入れれば貸し倒れが減る取り組み」と受け取られることが多いように思うためです。そう受け取られると、モデルの種類と順位づけの成績だけが議論されます。どの商品でどの水準の承認率とデフォルト率を目指すのか、モデルの出した数字を誰がどう判断に使うのかは、決まらないまま進みがちです。
与信の判断には、貸し倒れを減らそうとして承認の基準を厳しくすると、返済できたはずの申込まで断ることになり、承認を増やそうとして基準を緩めると貸し倒れが増える、という関係があります。モデルの学習に使える記録にも偏りがあります。返済の結果が分かるのは承認した契約だけで、断った申込がもし承認されていたらどうなったかは分かりません。結果が確定するまでには月から年の単位の時間がかかり、その間に申込者の層や景気が変わることもあります。目指す承認率とデフォルト率の水準や、モデルの出した数字の使い方を決めないまま投資を重ねたときに出る損失を、本コラムでは6つの型に分けて整理し、各章で使います(序章で説明します)。
本コラムでは、手法の原論文や専門書、法令と所管官庁のガイドライン、公的機関や業界団体、企業が公開している資料など、公開されている一次情報を根拠にしました。第2章から第12章では、架空の合成データ(申込と契約の記録を乱数で作ったもの)に対して実際にPythonのコードを動かし、その出力とグラフを載せています。架空のデータで得た数値は、その条件での一例であり、実際の審査で期待できる成績の目安ではありません。例題は個人向けの貸付や分割払いの申込を中心にしています。企業向けの与信では、使う情報(決算の数字など)や件数の規模が違うため、考え方は共通でも読み替えが要ります。個人向けと企業向けの違いは第1章で整理します。
想定している読者は、与信スコアリングの導入や改善を任された方、あるいはそれを決める立場の方です。担当者としては、銀行、クレジットカード会社、信販会社、消費者向けの貸付を行う会社、リース会社、保証会社、後払いの決済や分割払いを提供するEC事業者や通信事業者、企業間の掛け売りを行う事業者などで、審査、リスク管理、債権管理、コンプライアンス、DX推進を担う方と、申込や契約のデータを分析するデータサイエンティストの方を念頭に置いています。判断する立場としては、与信の方針と投資を決める事業の責任者や経営層の方を念頭に置いています。機械学習や信用リスク管理の専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その方法で何が分かり、審査と与信の管理の判断にどうつながるか」「経営はどう判断するか」を意識して書きました。
本コラムは、与信を行う側の設計と運用を解説するものです。スコアが表すのは、ある条件の契約が一定の期間のうちに返済の滞りに至る確率の見積りであり、人の価値や人柄の評価ではありません。本コラムでもその前提で言葉を選びました。審査の基準を外から探る方法や、申込の内容を偽る方法には触れていません。本コラムに出てくる企業や団体の取り組みは、その企業や団体が公開した資料を開いて確かめたものに限っています。与信の製品やクラウドサービスの料金、開発の費用、貸付の残高や貸し倒れの金額、弊社の支援の条件には触れていません。公的な統計は、件数や割合で紹介しています。例題で貸付の額や与信枠、収益、損失を扱う箇所は、単位の無い「相対値」で書いています。法令の解釈や、自社に適用される規制の範囲については、法務やコンプライアンスの担当者、所管の官庁、専門家に確認していただく前提で書いています。
各章の題と、その章で答える問いは「全体の地図」の表にまとめています。本コラムで使う用語の定義も、同じ「全体の地図」の表にまとめています。

目次
- 序章 与信スコアリングは何を見積もって何を決める仕組みか
- 全体の地図
- 第1章 与信の役割と事業での位置づけ、信用リスクと損失の構造
- 与信が事業に効く4つの経路、売上・貸し倒れ・顧客の保護・規制上の義務
- 与信を行う事業の種類と当事者、公的機関の分類から見る
- 申込から回収までの与信の流れ、各段でスコアが使われる場所
- 信用リスクの損失の構造、期待損失は3つの要素に分けて考える
- 人の判断から統計的なスコアリングへ、与信の判断の歴史
- 個人の与信と企業の与信の違い、データ・件数・判断の単位
- 与信スコアリングが普通の分類の問題と違う点
- 国内の公表統計から見える与信の規模と事業者の数
- よくある誤解、AIで貸し倒れが無くなる・AR値が高いほど良い・承認率を上げれば事業の成果が良くなる
- 経営の判断、どの商品でどの水準のデフォルト率と承認率を目指すかを先に決める
- この章を深めたい方への参考書籍
- 第2章 与信に使うデータ、申込の情報・信用情報・取引の履歴と結果の定義
- 与信に使うデータの種類と、それぞれが手に入る時点
- 指定信用情報機関の仕組みと、照会の目的の制限
- デフォルトの定義を決める、延滞の基準と観測期間と中間の層
- 架空の申込と契約の記録を作る、月ごとの返済の状況まで
- 定義を変えると、デフォルト率が変わり、モデルの成績の値も違って見える
- ビンテージで見る、直近の申込は結果が出そろっていない
- 項目の分布と欠損の意味、単調でない関係と未記入の層
- 審査の時点で手に入る情報だけを使う、後から上書きされた値の危険
- 標本の作り方とデータの品質、除く申込と品質の問題
- 使ってはいけない項目と慎重に扱う項目、個人データの取り扱いの入口
- 経営の判断、デフォルトの定義と観測期間を事業として先に決める
- この章を深めたい方への参考書籍
- 第3章 スコアカードの土台、区分けとWoE・情報価値で変数を選ぶ
- 第4章 ロジスティック回帰でスコアカードを作る、係数から点数表への変換
- 第5章 機械学習による与信モデル、勾配ブースティングと単調性の制約
- 第6章 否決した申込をどう扱うか、リジェクト・インファレンスと選択の偏り
- 第7章 モデルの評価、AR値・KS値と評価データの切り方
- 評価の役割、順位づけの成績と確率の正しさは別のもの
- 順位づけの指標、ROC曲線とAUC・CAP曲線とAR値・KS値
- 架空の契約の記録を作る、申込の月と観測期間を持たせる
- 2つのモデルを比べる、AUC・AR値・KS値
- 図とスコアの帯で読む、CAP曲線とデフォルトの集まり方
- AR値は評価する集団で変わる、架空データではスコアの上位だけを残すと下がった
- 評価データの切り方、申込の月で切り、観測期間を満たした契約だけを使う
- デフォルトの件数が少ないときのばらつき、ブートストラップで区間を出す
- 件数の指標と額で重み付けた指標、同じ承認率でのデフォルト率の差
- 過去のデータでの評価の限界と、ベンダーの示す数字の読み方
- 経営の判断、評価の指標と切り方をモデルを選ぶ前に決める
- この章のまとめ
- この章を深めたい方への参考書籍
- 第8章 デフォルト確率の見積り、確率の較正と格付の区分
- 第9章 承認の基準と与信枠、カットオフと収益・損失のつり合い
- 第10章 途上与信と回収、行動スコアリングと延滞の管理
- 契約の後に分かること、行動スコアリングが申込のスコアと違う点
- 途上与信で決めること、与信の継続・与信枠・利用の制限・連絡
- 架空の契約の月ごとの記録を作る
- 参照期間と観測期間を分けて、行動の特徴量を作る
- 申込時点の項目だけのモデルと、行動の特徴量を足したモデルを比べる
- デフォルト確率の見積りの帯と、与信枠を見直す判断
- 延滞の段階の遷移、遷移行列で読む延滞の深まり方
- 早期の警戒の指標、延滞の前に現れる変化
- 回収のスコアリング、延滞した契約のうちどれに先に連絡するか
- 延滞した顧客への対応、顧客の保護を前提にする
- 管理の指標と経営の判断、見直しの仕組みと延滞した顧客への対応の方針を一緒に決める
- この章のまとめ
- この章を深めたい方への参考書籍
- 第11章 否決の理由の説明と公平性、説明の責任と差別の防止
- 第12章 モデルの監視と管理、母集団の安定性と再構築・モデルリスク管理
- 第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
- どの商品・どの段から始めるか、5つの観点で採点して最初の対象を決める
- 現状の把握と KPI の木、今の審査の基準の成績を測ってから目標を分解する
- PoC の設計、観測期間を計画に入れ、過去のデータでの評価で止めない
- 効果の見立て、金額ではなく率と件数の型で書く
- 段階的な展開、人による審査の参考から一部の自動判定、範囲の拡大へ
- 役割と責任分担、3つの防衛線の中で与信スコアリングをどこに置くか
- 内製と外部の分担、外部のスコア・開発の委託・製品の利用のどれを選んでも社内に残すもの
- データの蓄積が無い新しい事業での始め方と人材、公的な調査に見る与信での AI の使われ方
- 最初の90日の計画と形骸化の型、週ごとに何を決め、何を残すか
- 経営判断、PoC の出口と成果の測り方を先に決める
- この章を深めたい方への参考書籍
- 第14章 規制とガイドライン、公開事例と最新動向
- 終章 与信スコアリングを使い続けるために
- 本コラムで紹介した書籍一覧
- 第1章 与信の役割と事業での位置づけ、信用リスクと損失の構造
- 第2章 与信に使うデータ、申込の情報・信用情報・取引の履歴と結果の定義
- 第3章 スコアカードの土台、区分けとWoE・情報価値で変数を選ぶ
- 第4章 ロジスティック回帰でスコアカードを作る、係数から点数表への変換
- 第5章 機械学習による与信モデル、勾配ブースティングと単調性の制約
- 第6章 否決した申込をどう扱うか、リジェクト・インファレンスと選択の偏り
- 第7章 モデルの評価、AR値・KS値と評価データの切り方
- 第8章 デフォルト確率の見積り、確率の較正と格付の区分
- 第9章 承認の基準と与信枠、カットオフと収益・損失のつり合い
- 第10章 途上与信と回収、行動スコアリングと延滞の管理
- 第11章 否決の理由の説明と公平性、説明の責任と差別の防止
- 第12章 モデルの監視と管理、母集団の安定性と再構築・モデルリスク管理
- 第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
- 第14章 規制とガイドライン、公開事例と最新動向
- 参考情報
序章 与信スコアリングは何を見積もって何を決める仕組みか
与信は、相手が後で支払う、あるいは返済することを前提に、先にお金や商品、サービスを提供することです。与信には、約束どおりに返済されず損失が出るおそれ(信用リスク)が必ず伴います。すべての申込を断れば貸し倒れは起きませんが、事業は成り立ちません。すべての申込を承認すれば契約は増えますが、貸し倒れが収益を上回るおそれがあります。与信を行う事業は、この2つの間のどこかに承認の基準を置いて運営されています。
本コラムの主題である与信スコアリングは、申込や契約の情報から、統計や機械学習のモデルでスコアまたはデフォルト確率を計算し、審査と与信の管理に使う仕組みです。デフォルトは、契約が、決めた期間のうちに、決めた基準の返済の滞り(一定の日数以上の延滞など)に至ることを指します。デフォルト確率は、ある契約がその期間のうちにデフォルトする確率の見積りで、スコアは、デフォルトのしにくさを点数で表したものです。本コラムでは、スコアが大きいほどデフォルト確率が低いものとして書きます。点数そのものは確率ではなく、確率として読むには換算が要ります(第4章・第8章)。また、スコアを計算するところだけでなく、どの点数から承認するか(カットオフ)、どこまで与信するか(与信枠)、契約の後にどう見直すか、モデルをどう監視するかまでを含めて、1つの仕組みとして扱います。
スコアとデフォルト確率が表すのは、ある条件の契約がデフォルトしやすいかどうかの見積りであり、申込者の人柄や価値の評価ではありません。同じ人でも、契約の種類、額、期間が変われば確率は変わります。本コラムでは、契約の結果を「正常」(決めた期間を満たし、その間にデフォルトしなかった)と「デフォルト」の2つで呼び、人を評価する言い方はしません。
与信スコアリングは、モデルの精度の話として語られることが多くあります。しかし、与信スコアリングの価値を決めるのは、モデルが契約をデフォルトしやすい順に並べられるかどうか(順位づけの成績)そのものではなく、事業にとって差し引きがどうなったかだと考えています。本コラムでは、承認した契約から得た収益と貸し倒れの損失の差を成果の指標とします。これは実績として測れます。断った申込で失った収益の機会(機会損失)は記録に残らないので、推定として横に並べ、判断のときに合わせて見ます。ここでの貸し倒れは、デフォルトした契約のうち回収できずに損失になった分を指します。デフォルトは出来事、貸し倒れはその結果として出る損失で、損失の大きさはデフォルトの件数だけでは決まりません(第1章)。順位づけの成績が良いモデルでも、カットオフの置き方が事業の収益と損失の構造に合っていなければ、成果にはつながりません。そのため本コラムでは、与信スコアリングの取り組みを、確率を見積もる技術と、その見積りを使ってどこから承認し、どこまで与信するかを決め、結果を測るところまでを含むものとして扱います。
モデルの作り方の2つの流れ
スコアを作る方法は、点数表を作る流れと、多数の決定木を組み合わせるモデルを作る流れの2つに分けて考えると整理しやすくなります。本コラムでは、後者を「機械学習のモデル」と呼びます(点数表に使うロジスティック回帰も、広い意味では機械学習の手法に数えられます)。1つ目の点数表を作る流れは、年収の水準や勤続年数といった項目をいくつかの区分に分け、区分ごとに点数を割り当てて、該当する点数の足し算でスコアを求める方法です。この表をスコアカードと呼びます。区分の作り方と項目の選び方を第3章で、統計の手法(ロジスティック回帰)で点数を決める方法を第4章で扱います。1件ごとの点数の内訳を足し算で示せるため、判定の理由を説明するときの材料にしやすい方法です。2つ目の機械学習のモデルを作る流れは、多数の決定木(条件で場合分けを重ねていく仕組み)を組み合わせる手法などで、項目どうしの組み合わせの効果までデータから学ばせる方法で、第5章で扱います。成績が上がる場合がある一方で、理由の説明と運用の負担は重くなりやすい方法です。
どちらの流れが優れているかは、一概には決まりません。申込の件数、使える項目の数、説明に求められる水準、モデルを運用する体制によって変わります。本コラムでは、同じ架空のデータに両方を当てはめて差を確かめる例を第5章に載せ、選ぶときの観点を整理しました。機械学習のモデルを、点数表が見落としている関係を探すための点検に使う、という組み合わせ方もあります。
どちらの流れを選ぶにしても、その前提になるのが、何をデフォルトと呼ぶのかと、手元の記録が申込者の全体を表しているのかという2つの問いです。デフォルトの基準(延滞が何日続いたら数えるか)と、結果を見届ける期間(観測期間)は、事業と商品によって違い、どう決めるかでモデルの成績もデフォルト率も変わります(第2章)。記録が全体を表しているかは、過去の審査で決まります。返済の結果が分かるのは承認した契約だけで、否決した申込の結果は分かりません。承認した契約だけで作ったモデルを、これから来る申込の全体に使うと何が起きるかを第6章で扱います。モデルの作り方を選ぶ前に、この2つを先に確かめることが、与信スコアリングの取り組みの出発点になります。
見積りから判断と管理へ
スコアやデフォルト確率を事業の成果につなぐには、さらに4つの取り決めが要ります。第1に、評価の方法です。モデルが契約をデフォルトしやすい順に並べられているかを測る指標(AR値など)と、評価に使うデータの区切り方を、モデルを選ぶ前に決めます。順位づけの指標は、評価する集団や期間によって値が変わるため、違う集団で測った値の差を、そのままモデルの優劣の判断には使えません(第7章)。第2に、確率の正しさです。順位が正しくても、モデルの出すデフォルト確率が実績のデフォルト率と合っているとは限りません。貸し倒れの見積りや与信枠の設定に使うなら、対象の集団と観測期間について、モデルの出す確率が実績のデフォルト率と合っているかを確かめ(較正の確認)、ずれていれば実績に対応づけて調整します(較正)。調整したときは、調整に使っていないデータでもう一度確かめます(第8章)。第3に、承認の基準です。スコアがいくつ以上なら承認の候補にするかは、モデルが決めるのではなく、承認率、デフォルト率、収益と損失の見積りを見て人が決めます。最終の判断には、返済の能力の調査など法令上の条件も合わせて使います(第9章)。第4に、契約の後の管理と監視です。契約の後の返済の状況を使った与信枠の見直し(途上与信。第10章)と、申込者の層や景気の変化でモデルが合わなくなっていないかの監視(第12章)を、最初から計画に入れます。
この取り決めが無いままモデルだけを入れると、PoC(概念実証。実現できるかと効果を、小さな規模で確かめる検証)では「高い成績が出た」という結果が出ても、どの点数から承認するかを営業、リスク管理、財務の間で合意できない、見積もった確率と実績が合わない、1年後に申込者の層が変わっても気づかない、といったことが起きやすいと考えています。本コラムでは、モデルの作り方の説明に加えて、評価と判断の設計にも章を立てて扱います。また、申込を断った理由をどう示すか、承認の結果が特定の集団に偏っていないか(第11章)も、設計の段階で決めておく事柄です。与信には、返済の能力の調査や信用情報の取り扱いに関する法令、個人データの取り扱いに関する法令、銀行の自己資本に関する規制が関わります。法令の条文と所管官庁の資料で確認できた範囲を第14章で整理します。
決めないことで出る損失の型
与信スコアリングの仕組みを選ぶとき、導入して運用するときに起きうる損失は、金額ではなく型で整理すると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。6つは互いに重なることがあり、1つの出来事が複数の型に関わる場合もあります。
- 貸し倒れ:与信した相手から、貸したお金や提供した商品の代金の全部または一部を回収できず、損失が出ます。一定の割合のデフォルトを見込んだうえで承認するのが与信なので、個々の契約がデフォルトしたことだけで審査の良し悪しは判断しません。見るのは、貸し倒れが見込みや許容する範囲を超えていないか、見込みの範囲であっても収益とつり合っているかです。
- 機会損失:返済できる申込を断る、または与信枠を小さくしすぎて、得られたはずの収益を失います。断った申込がもし承認されていたらどうなったかは記録に残らないので、この損失はつねに推定になります。
- 過剰与信による顧客の不利益:返済の能力を超える与信によって顧客の生活や事業を損ない、顧客からの信頼も失います。
- 審査の滞り:審査に時間がかかって申込者が離れる、あるいは人による審査が処理できる件数を超えます。
- 形骸化:監視や見直しの仕組みが働かないまま運用が続き、申込者の層や景気の変化に気づけない、あるいは気づいても対応につながりません。
- 規制上の義務の不履行:返済の能力の調査、信用情報の取り扱い、説明、記録など、自社の事業に適用される法令上の義務を果たせなくなります。
どの損失が自社で目立っているかを見れば、どこから着手するかの見当が付きます。貸し倒れが目立つなら、新しいモデルを探す前に、いまの承認の基準で承認した契約のうち、結果を見届ける期間を満たしたものについて、デフォルト率(件数の割合)をスコアの帯や審査の経路ごとに数えます(第7章・第9章)。損失の大きさは、デフォルトしたときの残高と回収できた割合を合わせて別に確かめます。機会損失が疑われるなら、否決した申込について手に入る情報を集めます。否決した申込の結果は自社の記録だけでは分からないので、その扱いは第6章で整理します。審査の滞りが起きているなら、人が確認している申込のうち、スコアで自動的に判断できる範囲がどこまでかを調べます(第9章)。形骸化が起きているなら、モデルと承認の基準を最後に見直した時期と、成績の推移の記録が残っているかを確かめます(第12章)。このように、目立っている損失の型によって最初の一歩は変わります。上に挙げた最初の一歩は、どれも新しいモデルの導入より前にできることです。
与信スコアリングは、目指す承認率とデフォルト率から始める
与信スコアリングで最初に決めるべきことは、どのモデルを使うかではなく、どの商品で、どの水準の承認率とデフォルト率を目指すのか、何をデフォルトと呼ぶのか、そして審査の判断と結果をどう記録に残すかだと考えています。承認率とデフォルト率の水準は、収益と損失の差し引きの見積りを見たうえで決めます(第9章)。そのうえで、いまの審査の基準の成績を測って比較の基準とし、その基準に勝てる方法だけを足していきます。目指す水準が決まれば、評価の指標とカットオフを決めるための前提がそろいます。デフォルトの定義が決まれば、モデルに学ばせる結果が決まります。審査の判断と結果の記録は、次のモデルの学習と承認の基準の見直しの共通の土台になります。比較の基準が決まれば、新しいモデルに投資する理由を、数字で社内に説明できるようになります。
本コラムは、次の4つのまとまりで進みます。
- 与信の目的とデータの基礎:事業の中での与信の位置づけと、与信に使うデータの性質、デフォルトの定義を整理します(第1章・第2章)。
- モデルの作り方:区分けと項目の選び方、ロジスティック回帰によるスコアカード、機械学習のモデル、否決した申込の扱いを、実行したコードとともに見ます(第3章から第6章)。
- 評価と判断の設計:モデルの評価、デフォルト確率の較正、承認の基準と与信枠、途上与信と回収、説明と公平性を扱います(第7章から第11章)。
- 定着と規制:モデルの監視と管理、導入の進め方と体制、規制とガイドライン、公開事例と最新の動向を扱います(第12章から第14章)。
経営判断に関わる方には、投資の進め方として、与信スコアリングの製品や開発に予算を付ける前に、次の4つを確かめる順序をお勧めします。
- どの商品で、どの水準の承認率とデフォルト率を目指すのかが、収益と損失の見積りを踏まえて決まっているか
- 何をデフォルトと呼び、どの期間で結果を見届けるのかが決まっているか
- 審査の判断(承認と否決、人による変更、その理由)と、契約の後の返済の結果が、後から突き合わせて集計できる形で残っているか
- いまの承認の基準について、承認率と、承認した契約のデフォルト率を測る仕組みがあるか
この順序であれば、投資の前提を社内に説明でき、成果が出なかったときにも原因を切り分けやすくなると考えています。反対に、モデルの導入を先に進め、目指す水準と記録の整備を後回しにすると、スコアは毎日計算されていても、貸し倒れが減ったのか、返済できたはずの申込をどれだけ断ったのかを誰も答えられないおそれがあります。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、与信スコアリングを含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章を、序章で示した4つのまとまりに分けて構成しています。章の題に出てくる専門の用語は、表の「その章で答える問い」の欄で平易に言い換え、それぞれの章の中で定義しています。
- 与信の目的とデータの基礎(第1章・第2章):与信が事業の中で何を担うのかと、与信に使うデータの性質、デフォルトの定義
- モデルの作り方(第3章から第6章):区分けと項目の選び方、ロジスティック回帰によるスコアカード、機械学習のモデル、否決した申込の扱い
- 評価と判断の設計(第7章から第11章):モデルの評価、デフォルト確率の較正、承認の基準と与信枠、途上与信と回収、説明と公平性
- 定着と規制(第12章から第14章):モデルの監視と管理、導入の進め方と体制、規制とガイドライン、公開事例と最新の動向
第2章から第12章には、架空の合成データ(乱数で作った申込と契約の記録)で実際に動かしたPythonのコードと、その結果を載せています。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | 与信の役割と事業での位置づけ、信用リスクと損失の構造 | 与信は事業の中で何を担い、損失はどういう構造で生まれるのか。与信スコアリングは普通の予測の問題と何が違うのか |
| 第2章 | 与信に使うデータ、申込の情報・信用情報・取引の履歴と結果の定義 | どのデータを使えるのか。何をデフォルトと呼び、どの期間で結果を見届けるのか |
| 第3章 | スコアカードの土台、区分けとWoE・情報価値で変数を選ぶ | 項目をどう区分に分け、どの項目を使うかをどう選ぶか。その根拠をどう残すか |
| 第4章 | ロジスティック回帰でスコアカードを作る、係数から点数表への変換 | 統計の手法で求めた係数を、足し算で使える点数表にどう直すか |
| 第5章 | 機械学習による与信モデル、勾配ブースティングと単調性の制約 | 機械学習のモデル(勾配ブースティングは、多数の決定木を順に足していく手法)は点数表と比べて何が違うのか。説明のつかない向きの判定を、単調性の制約(ほかの項目の値が同じなら、ある項目の値が大きくなったときに確率が動く向きを、上がらない向きか、下がらない向きのどちらかに決めておく指定)でどう防ぐか |
| 第6章 | 否決した申込をどう扱うか、リジェクト・インファレンスと選択の偏り | 承認した契約の記録だけで作ったモデルを、申込の全体に使うと何が起きるか(選択の偏り)。否決した申込の結果を仮定やモデルで推定する方法(リジェクト・インファレンス)は、どこまで頼れるか |
| 第7章 | モデルの評価、AR値・KS値と評価データの切り方 | モデルの順位づけの成績をどの指標で測り、評価に使うデータをどう区切るか。提示された数字をどう読むか |
| 第8章 | デフォルト確率の見積り、確率の較正と格付の区分 | モデルの出す確率は実績と合っているか。合っていないときにどう直し、デフォルト確率の近い契約をどう区分(格付の区分)にまとめるか |
| 第9章 | 承認の基準と与信枠、カットオフと収益・損失のつり合い | どの点数から承認の候補にし、どこまで与信するか。承認率とデフォルト率のつり合いを、収益と損失の見積りを踏まえてどう決めるか |
| 第10章 | 途上与信と回収、行動スコアリングと延滞の管理 | 契約の後の返済や利用の記録から今後のデフォルト確率を見積もる方法(行動スコアリング)をどう使い、与信枠の見直しと延滞への対応をどう進めるか |
| 第11章 | 否決の理由の説明と公平性、説明の責任と差別の防止 | 申込を断った理由を誰にどこまで示すか。承認の結果が特定の集団に偏っていないかをどう測るか |
| 第12章 | モデルの監視と管理、母集団の安定性と再構築・モデルリスク管理 | 申込者の層がモデルを作ったときから変わっていないか(母集団の安定性)をどう見張り、どの段階の見直しを行うか。モデルの誤りや誤った使い方による損失(モデルリスク)を組織としてどう管理するか |
| 第13章 | 導入の進め方と体制、目的の設計・PoC・内製と外部の分担 | どの商品から始め、PoC(概念実証。実現できるかと効果を小さな規模で確かめる検証)をどう設計し、誰が何を担うか |
| 第14章 | 規制とガイドライン、公開事例と最新動向 | 与信スコアリングに関わる法令とガイドラインは何か。公開された事例と研究から何が読み取れるか |
本コラムで使う用語は、次の表の意味に固定しています。特定の章だけで使う用語は、その章の中で定義します。WoEや情報価値は第3章、KS値などの評価の指標は第7章で定義しています。コードのある各章は、章ごとに別々に作った架空の合成データを使っているため、同じ名前の数値(デフォルト率、承認率、AR値など)でも章によって値が違います。デフォルトの基準や数える対象の集団も章によって違うことがあり、各章の本文にその章の数え方を書いています。
| 用語 | 本コラムでの意味 |
|---|---|
| 与信 | 相手が後で支払う、あるいは返済することを前提に、先にお金、商品、サービスを提供すること。貸付、クレジットカード、分割払い、後払いの決済、企業間の掛け売りを含む |
| 信用リスク | 与信した相手が約束どおりに返済や支払いをせず、損失が出るおそれ |
| 申込 | 与信を求める1件の申し出。本コラムの例題では、個人向けの貸付や分割払いの申込を主に扱う。企業向けの与信では使う情報や件数の規模が違い、読み替えが要る(第1章) |
| 貸し倒れ | 与信した相手から、貸したお金や代金の全部または一部を回収できず、損失になること。デフォルトは出来事、貸し倒れはその結果として出る損失を指す。損失の大きさは、デフォルトの件数だけでなく、デフォルトしたときの残高と回収できた割合で決まる |
| 審査 | 申込を承認するか、どの条件で承認するかを決める過程。モデルによる自動の判定と、人による確認の両方を含む |
| 承認と否決 | 承認は、申込に対して与信の条件を認める審査上の判断。否決は、審査の結果として承認しないと判断すること。申込者による取り下げは否決に含めない |
| 契約 | 与信の条件について合意が成立したもの。承認とは別の出来事だが、本コラムの例題の多くでは、承認した申込はすべて契約され実行されたものとして単純にしている |
| 初期与信 | 新しい申込に対する審査。入口の審査 |
| 途上与信 | 契約の後に、利用や返済の状況を確かめ、与信の継続、与信枠や条件の維持や変更を判断すること |
| デフォルト | 契約が、あらかじめ決めた返済の滞りの基準に当たること。基準は事業、商品、規制ごとに違う。本コラムの例題の基本の定義は「契約の実行から12か月以内に、延滞が90日以上に達すること」で、説明用に単純にしたもの(第2章) |
| 正常 | 観測期間を満たし、その間にデフォルトしなかったと確認できた契約の結果。人の評価ではなく契約の結果を指す。観測期間を満たしていない契約は正常に数えない |
| 観測期間 | デフォルトが起きるかを見届ける期間。初期与信では契約の実行から、途上与信では見直しの時点から数える。モデルの入力を作るために過去をさかのぼる期間は「参照期間」と呼んで区別する(第10章) |
| デフォルト確率 | ある契約が観測期間のうちにデフォルトする確率の見積り。0から1の値。対象の集団、デフォルトの基準、観測期間とセットで意味を持つ。英語の略でPDとも書く |
| デフォルト率 | ある集団の契約のうち、観測期間のうちに実際にデフォルトした件数の割合。実績の値で、見積りであるデフォルト確率と区別する |
| スコア | デフォルトのしにくさを表す点数。本コラムでは、スコアが大きいほどデフォルト確率が低い。点数そのものは確率ではなく、確率として読むには換算が要る。別のモデルの点数どうしは、そのままでは比べられない |
| 与信スコアリング | 申込や契約の情報から、統計や機械学習のモデルでスコアまたはデフォルト確率を計算し、審査と与信の管理に使う仕組み。計算だけでなく、承認の基準、与信枠、監視までを含めて1つの仕組みとして扱う |
| スコアカード | 項目ごとの区分に点数を割り当てた表。基礎点と、該当する区分の点数を足し合わせてスコアにする(第4章) |
| カットオフ | スコアによる判定を分ける境目の値。この値以上を、スコアの上での承認の候補とする。最終の判断は、返済の能力の調査など法令上の条件と、その他の審査の基準を合わせて決まる |
| 承認率 | 最終の判断(承認か否決)が済んだ申込のうち、承認したものの割合。取り下げられた申込と審査の途中の申込は含めない |
| 与信枠 | その相手に与信してよい額の上限。例題では相対値で表す |
| 較正 | モデルの出力を、対象の集団と観測期間に対応したデフォルト確率として読めるように対応づけ、必要に応じて調整すること。合っているかを確かめる作業は「較正の確認」と呼ぶ(第8章) |
| AR値 | モデルが、デフォルトしやすい順に契約を並べられているかを表す順位づけの指標。-1から1の値を取り、1に近いほどよく並べられている。確率の正しさや収益を表す指標ではない。対象の集団や期間が違う値の差は、そのままモデルの優劣の判断には使えない。ジニ係数と呼ばれることもあるが、本コラムではAR値に統一する(第7章) |
| 情報の漏れ | 審査の時点では使えない情報や、評価用のデータの結果が、モデルの学習や項目の選択に入り、成績が実際より良く見えること。個人情報が外に出る「漏えい」とは別の意味で使う |
| 信用情報 | 信用情報機関が扱う、借入、契約、返済、延滞などの情報 |
| 代替データ | その商品で従来から使ってきた信用情報や申込の情報を補うデータ、またはそれらの代わりになるデータ。口座の入出金の記録、他のサービスの取引の履歴など |
| KPI | 重要な業績の指標。与信スコアリングでは、成果の指標と管理の指標を区別する。成果の指標は、承認した契約から得た収益と貸し倒れの損失の差(実績として測れる)で、断った申込の機会損失は推定として横に並べて合わせて見る。管理の指標は、承認率、デフォルト率、AR値、審査の所要時間など(第13章) |
| 相対値 | 例題で額や収益、損失を表すときに使う、単位の無い仮の数。金額ではなく、何を基準にした数かは各例題で示す |
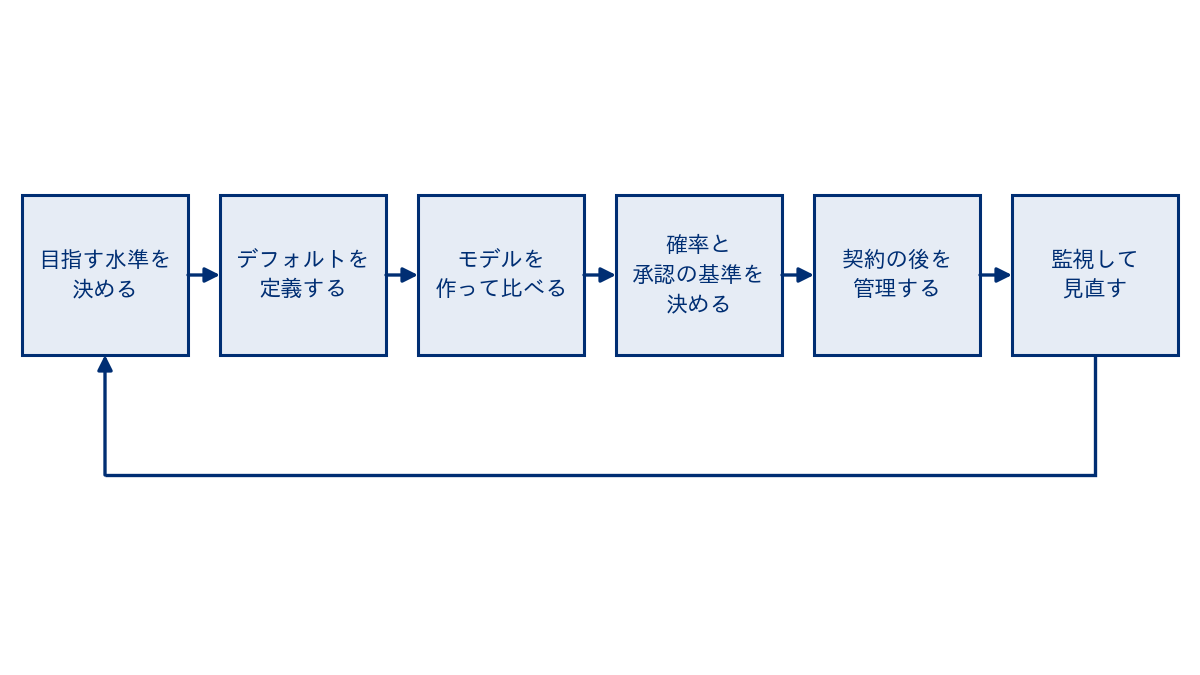
次の図は、与信スコアリングの取り組みの主な流れを示したものです。1つ目と2つ目の箱は第1章と第2章、3つ目は第3章から第7章、4つ目は第8章と第9章、5つ目は第10章、6つ目は第12章に当たります。説明と公平性(第11章)、導入の進め方と体制(第13章)、規制(第14章)は、6つの箱の全体に関わる事柄です。序章で述べた「いまの審査の基準の成績を測る」作業は、1つ目の箱で目指す水準を決めるときの材料になり、3つ目の箱では新しいモデルと比べる基準として使います。
第1章 与信の役割と事業での位置づけ、信用リスクと損失の構造
序章では、与信スコアリングを、スコアやデフォルト確率を計算するところだけでなく、承認の基準・与信枠・契約の後の見直し・監視までを含む1つの仕組みとして扱うことを述べました。あわせて、成果の指標は承認した契約から得た収益と貸し倒れの損失の差で、実績として測れること、断った申込の機会損失は記録に残らないので推定として横に並べ、判断のときに合わせて見ることを述べました。この章では、モデルの作り方に入る前に、与信そのものが事業の中で何をしていて、どこで損失が生まれるのかを整理します。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 与信が事業に効く4つの経路(売上の拡大・貸し倒れの抑制・顧客の保護・規制上の義務)
- 与信を行う事業の種類と、そこに関わる当事者
- 申込から回収までの与信の流れと、各段でスコアが使われる場所
- 信用リスクの損失の構造(期待損失の分解の考え方と、予想を超える損失)
- 人の判断から統計的なスコアリングへ移ってきた歴史
- 個人の与信と企業の与信の違い、与信スコアリングが普通の分類の問題と違う点
- 国内の公表統計から見える与信の規模と事業者の数、よくある誤解、経営の判断
この章の主張は、モデルを選ぶ前に、どの商品で、どの水準のデフォルト率と承認率を目指すのかを事業として先に決めることです。与信スコアリングは、承認率とデフォルト率のつり合いを取るための道具であり、どの承認率とデフォルト率の組み合わせを目標にするかは、商品の収益の構造、申込者の層、規制の要件によって変わります。目標の組み合わせが決まっていないと、どのモデルが良いのか、どのカットオフ(スコアの上で承認の候補にするかどうかを分ける境目の値)が良いのかを判断する基準がありません。
与信が事業に効く4つの経路、売上・貸し倒れ・顧客の保護・規制上の義務
与信は、相手が後で支払う、あるいは返済することを前提に、先にお金や商品、サービスを提供することです。銀行や消費者向けの貸付の会社にとっては与信そのものが商品ですが、小売・EC・通信・企業間の取引では、与信は商品を売るための手段として組み込まれています。分割払いや後払いを用意すれば、手元にお金が無い時点でも購入できる顧客が増えます。企業間の取引で掛け売りを認めれば、取引先は支払いを月末や翌月に回せるので、取引が成り立ちやすくなります。与信の判断は、どちらの場合も事業の売上と損失の両方に直接つながります。
与信の判断が事業に効く経路は、大きく4つに分けて考えると整理しやすくなります。1つ目は売上の拡大です。承認する申込が増えれば契約が増え、利息や手数料、商品の売上が増えます。2つ目は貸し倒れの抑制です。デフォルトしやすい申込の承認を控えれば、その分の損失は出にくくなります。3つ目は顧客の保護です。返済の能力を超える与信は、顧客の生活や事業を損ない、長い目で見ると事業者への信頼も損ないます。4つ目は規制上の義務です。貸付やクレジットの事業では、返済の能力の調査や信用情報の利用など、法令で求められる手続きがあり、与信の判断はその手続きの一部として行われます(法令の詳細は第14章で扱います)。
1つ目と2つ目は、承認の基準を動かすと逆向きに動きます。基準を緩めれば契約は増えますが、デフォルトする契約も増えます。基準を厳しくすれば貸し倒れは減りますが、返済できたはずの申込も断ることになります。ここで注意したいのは、承認した契約の一部がデフォルトすることは、与信の仕組みの前提に入っているという点です。与信は、一定の割合のデフォルトを見込んだうえで、それを上回る収益が得られる範囲で承認するものです。そのため、個々の契約がデフォルトしたことだけで、その承認の判断が誤りだったとは言えません。審査の良し悪しは、承認した契約の集まりのデフォルト率が見込みや許容する範囲を超えていないか、見込みの範囲であっても収益とつり合っているかで見ます。
3つ目の顧客の保護は、2つ目の貸し倒れの抑制と同じ向きに働くことが多いものの、完全には重なりません。デフォルトに至らなくても、返済のために生活を切り詰めている顧客は、デフォルトの記録には現れないからです。4つ目の規制上の義務は、承認率やデフォルト率の水準とは別に、手続きとして満たしていなければならない条件です。モデルの順位づけの成績がいくら良くても、法令が求める調査や記録が抜けていれば、仕組みとしては成り立ちません。
次の表は、4つの経路ごとに、何が動くか、承認の基準を緩めたときにどちらへ動くか、主に誰が気にかけるかをまとめたものです。表の内容は本コラムの整理で、事業の形によって重みは変わります。
| 経路 | 動くもの | 承認の基準を緩めたとき | 主に気にかける人 | 関わりの深い損失の型 |
|---|---|---|---|---|
| 売上の拡大 | 契約の件数、利息・手数料・商品の売上 | 増える | 営業・事業の責任者 | 機会損失 |
| 貸し倒れの抑制 | デフォルトの件数、回収できない額の大きさ | 増える(悪化する) | リスク管理・債権管理 | 貸し倒れ |
| 顧客の保護 | 返済の負担が重すぎる契約の件数、苦情や相談の件数 | 悪化しやすい | コンプライアンス・顧客対応 | 過剰与信による顧客の不利益 |
| 規制上の義務 | 調査・照会・説明・記録の手続きの実施の状況 | 基準の緩さとは別に、手続きとして満たす必要がある | コンプライアンス・法務・内部監査 | 規制上の義務の不履行 |
表の最後の列は、序章で整理した6つの損失の型のうち、その経路と関わりの深いものです。6つの型は互いに重なりうる説明上の整理なので、1つの経路が1つの型だけに対応するわけではありません。たとえば、返済の能力を超える与信は、過剰与信による顧客の不利益であると同時に、後で貸し倒れになることもあります。6つのうち残りの2つ、審査の滞りと形骸化は、与信の判断を行う仕組みの運用の側で起きる損失です。審査に時間がかかれば、承認されるはずの申込者が離れ、売上の拡大の経路が損なわれます。監視や見直しの仕組みが働かず、申込者の層や景気の変化に気づけなければ、承認率もデフォルト率も、設計したときの見込みから少しずつずれていきます。この2つは、第9章(人による確認へ回す帯の設計)と第12章(監視と見直し)で扱います。
与信を行う事業の種類と当事者、公的機関の分類から見る
与信スコアリングの話は、銀行やクレジットカード会社のものと受け取られがちですが、与信を行う事業はそれより広く、事業ごとに申込の件数、1件の額の大きさ、返済の期間、使えるデータ、かかる規制が違います。ここでは、公的機関の資料で確かめられる分類を手がかりに、主な事業の種類を整理します。
金融庁が2025年11月28日に掲載した「貸金業関係資料集」は、貸金業者を業態ごとに分類しています。分類に並んでいるのは、主に次の業態です。
- 貸付が中心の業者(消費者向けの無担保の貸付、消費者向けの有担保の貸付、住宅向けの貸付、事業者向けの貸付のどれが中心かで分かれる)
- クレジットカード会社、信販会社
- 流通・メーカー系の会社、建設・不動産業者
- 質屋、リース会社
このうち信販会社は、同じ資料集の業態の分類で、割賦販売法の包括信用購入あっせん業者または個別信用購入あっせん業者として登録を受けている業者と定義されています。後で見る経済産業省のFAQは、包括の例にクレジットカード会社などを、個別の例に信販会社などを挙げており、次の表もこの例に沿って、信販は個別の分割払いの行に置きました。貸付を行う事業者は、銀行だけでなく、貸付とは別の本業を持つ企業の中にもあることが、この分類から分かります。
貸付ではなく、商品の代金を後払いにする取引は、割賦販売法の対象になる場合があります。経済産業省の「割賦販売法(後払分野)の概要・FAQ」は、消費者が販売業者で購入した商品などの代金を立て替えて払い、2か月を超える期間で消費者から支払いを受ける事業者を信用購入あっせん業者とし、取引の形によってクレジットカード会社などの包括信用購入あっせん業者と、信販会社などの個別信用購入あっせん業者に分かれると説明しています(同FAQの問15)。後払いの決済のうち、どの取引がどの法令の対象になるかは、支払いの期間や回数、取引の形によって変わるので、自社の商品が当てはまるかどうかは所管官庁や専門家に確かめる事項です(法令の詳細は第14章で扱います)。
次の表は、本コラムで想定する与信の事業を、与信の形、申込の件数と1件の額の傾向、主に使うデータ、関係する法令の入口で並べたものです。件数と額の傾向は事業の一般的な性質を述べたもので、個々の会社に当てはまるとは限りません。法令の欄は、上で開いた資料に書かれている範囲の入口だけで、詳細と条番号は第14章で扱います。
| 事業の種類 | 与信の形 | 申込の件数と1件の額の傾向 | 主に使うデータ | 関係する法令の入口 |
|---|---|---|---|---|
| 銀行の貸付(消費者向けのカードローン・目的別のローン) | 貸付 | 件数は商品によって幅がある。住宅向けは1件の額が大きい | 申込の情報、信用情報、自行との取引の履歴 | 銀行に関する法令と、銀行の自己資本の規制(第14章) |
| 消費者向けの貸付(貸金業者) | 貸付 | 件数が多く、1件の額は比較的小さい | 申込の情報、信用情報 | 貸金業法(貸金業者が個人と結ぶ貸付けの契約について、年間の給与などの収入の3分の1を基準とする総量規制。第13条の2第2項。指定信用情報機関など) |
| クレジットカード | 包括信用購入あっせん(与信枠の範囲で繰り返し利用する) | 件数が非常に多く、1回の利用の額は小さいものが多い | 申込の情報、信用情報、利用と返済の履歴 | 割賦販売法(支払可能見込額の調査など)。金融庁の業態の分類には、貸金業者として登録しているクレジットカード会社もある |
| 個別の分割払い(信販) | 個別信用購入あっせん(商品ごとに契約する) | 件数が多い。自動車など1件の額が大きいものもある | 申込の情報、信用情報、販売店と商品の情報 | 割賦販売法 |
| 後払いの決済 | 契約の形が事業によって違う | 件数が多く、1件の額は小さいものが多い | 申込や購入の情報、自社のサービスでの利用の履歴 | 取引の形によって対象になる法令が変わる(第14章) |
| リース・保証 | リースは物件の利用の対価を分けて受け取る。保証は他社の与信の返済を保証する | リースは事業者向けが中心。保証は提携先の与信の件数に連動する | 申込の情報、財務の情報(事業者向け)、提携先からの情報 | 事業の形によって違う。本コラムでは個別には扱わない |
| 企業間の掛け売り | 商品やサービスを先に提供し、代金を後で受け取る | 取引先の数は限られ、1社あたりの額は大きくなりやすい | 取引先の財務の情報、支払いの履歴、外部の企業情報 | 取引の形によって違う。本コラムでは個別には扱わない |
表の法令の欄の根拠は次のとおりです。貸金業法の総量規制は、e-Gov 法令検索で見た貸金業法の第13条の2によります。同条の第2項は、貸金業者が個人と結ぶ貸付けの契約のうち、借入れの合計が年間の給与などの収入を合算した額の3分の1を超えることになるものを定めており、住宅資金の貸付けなど除外される契約もあります。指定信用情報機関は、日本貸金業協会の公式ページの「貸金業法について」の説明によります。割賦販売法の支払可能見込額の調査は、前述の経済産業省のFAQの問22によります。クレジットカード会社の行の業態の分類は、前述の金融庁の貸金業関係資料集によります。どの欄も入口だけの紹介で、条番号と詳細は第14章で扱います。
表の中で、後払いの決済とリース・保証、企業間の掛け売りの行は、とくに事業ごとの違いが大きい行です。後払いの決済では、決済を提供する事業者、商品を売る事業者、代金を立て替える事業者が同じ会社の場合も別の会社の場合もあり、与信の判断を誰が行い、貸し倒れを誰が負うのかは契約で決まります。経済産業省の同じFAQは、令和2年の割賦販売法の改正の背景として、クレジットカード会社が利用者の支払いの実績などの大量のデータに基づいて与信の審査を行うようになったこと、少額で回数の多い決済への後払いのサービスや、異業種の企業の後払いのサービスへの参入が広がったことを挙げています(同FAQの問1)。与信スコアリングを使う事業が、金融機関の外にも広がっていることを示す記述です。
与信には、申込者と与信を行う事業者のほかにも、いくつかの当事者が関わります。誰が何を知っていて、誰が損失を負うのかを先に整理しておくと、どのデータが手に入り、誰の合意が要るのかが見えやすくなります。
- 申込者:与信を申し込む個人や企業。契約の後は返済や支払いを行う顧客になります。
- 与信を行う事業者:審査を行い、承認するかどうかと与信枠を決め、貸し倒れの損失を負います(保証や債権の譲渡がある場合は、損失を負う者が別になります)。
- 加盟店や販売店:クレジットカードや分割払い、後払いで商品を売る事業者です。申込の窓口になることがあり、承認率が売上に直結するので、審査の速さと承認率に強い関心を持ちます。
- 保証会社:銀行の貸付などで返済を保証し、デフォルトのときに代わりに返済します。保証会社が独自に審査を行う場合もあります。
- 信用情報機関:借入や契約、返済、延滞などの信用情報を、加盟する事業者から集めて提供します。法令で指定された機関を指定信用情報機関と呼びます(仕組みは第2章、法令は第14章で扱います)。
- 債権の回収を担う部門:延滞した契約への連絡や回収を担います。社内の部門が担う場合も、外部に委託する場合もあります(回収の進め方は第10章、法令上の制約は第14章)。
当事者の間では、関心が食い違うことがあります。加盟店は承認率を上げたい一方で、与信を行う事業者は貸し倒れを抑えたいと考えます。後払いの決済で、貸し倒れを負うのが加盟店ではなく与信を行う事業者である場合、加盟店にとっては承認率を上げる動機が強くなります。与信スコアリングのカットオフを誰が決め、承認率とデフォルト率の目標を誰と合意するのかは、この関心の食い違いを前提に設計する必要があります。
申込から回収までの与信の流れ、各段でスコアが使われる場所
与信の仕事は、申込を承認するかどうかを決める一度の判断で終わるものではありません。申込を受け、審査をして、承認した申込を契約として実行し、契約の後は利用や返済の状況を見て与信枠や条件を見直し(途上与信)、返済が滞った契約には連絡と回収を行います。この流れのそれぞれの段で、別の目的のスコアが使われます。
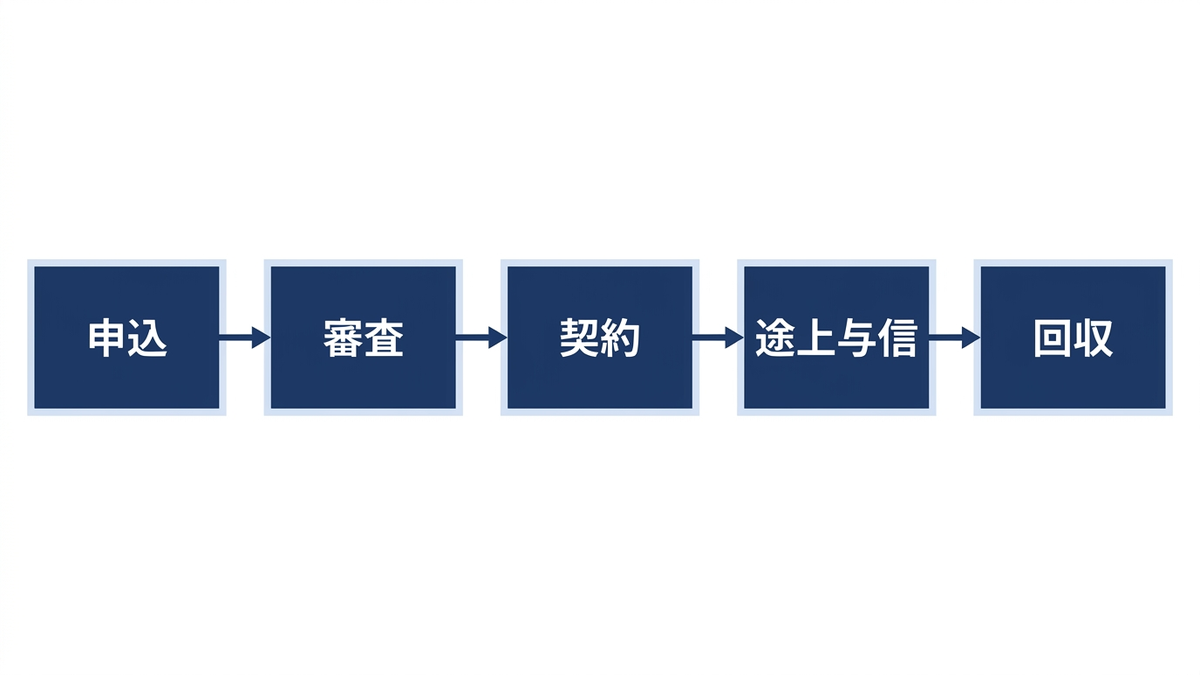
最初の段で使われるのが、初期与信のための申込のスコアです。初期与信は新しい申込に対する入口の審査で、申込書の項目と信用情報など、申込の時点で手に入る情報からデフォルト確率を見積もります。自社との取引の履歴が無い申込者が多いので、使える情報は限られます。本コラムでは、申込のスコアの作り方を第3章から第6章で扱い、評価・確率・カットオフを扱う第7章から第9章も、主にこの申込のスコアを例にして説明します。
契約の後の段で使われるのが、行動のスコアです。契約の後は、毎月の利用の状況、返済の状況、残高の動きといった、申込の時点には無かった情報が加わります。この情報を使って今後のデフォルト確率を見積もり直し、与信枠の増減や更新、利用の一時的な制限、早めの連絡などの判断に使います。これが途上与信です(第10章)。延滞が起きた後の段では、回収のスコアが使われることがあります。延滞した契約のうち、どの契約に先に連絡するか、どの方法で連絡するかを決めるために、延滞が解消する見込みなどを見積もります。回収の段では、取り立ての方法についての法令上の制約と、返済に困っている顧客への配慮が前提になります(第10章・第14章)。次の表は段ごとに使うスコアをまとめたもので、承認した申込を実行する契約の段で使うスコアは本コラムでは扱わないので、契約の段の行は置いていません。
| 段 | 判断すること | 使うスコア | 主に使う情報 | スコアが見積もるもの | 扱う章 |
|---|---|---|---|---|---|
| 申込・審査 | 承認か否決か、人による確認へ回すか。承認する場合の与信枠と条件 | 申込のスコア | 申込書の項目、信用情報、本人確認の情報 | 観測期間のうちにデフォルトする確率(初期与信) | 第3章から第6章(作り方)、第7章から第9章(評価・確率・カットオフ) |
| 契約の後(途上与信) | 与信枠の増減・更新、利用の一時的な制限、早めの連絡 | 行動のスコア | 利用と返済の履歴、残高の動き、信用情報の更新 | 見直しの時点から一定の期間のうちにデフォルトする確率 | 第10章 |
| 延滞の後(回収) | 連絡の順番と方法、相談への案内 | 回収のスコア | 延滞の深さと期間、過去の返済の状況、連絡の記録 | 延滞が解消する見込みなど(目的によって違う) | 第10章 |
| 申込の時点の不正の確認 | なりすましや虚偽の申込の疑いがあるかどうか | 不正の検知のスコア(与信のスコアとは別に作ることが多い) | 本人確認の情報、申込の経路、端末などの情報 | 不正な申込である疑いの強さ | 本コラムでは扱わない |
表の最後の行は、与信のスコアと混同されやすいので加えました。本コラムの例題では、デフォルトを、本人が申し込んだ契約で返済が決めた基準まで滞ることとして扱います(基準の決め方と、実務や規制上の定義との違いは第2章で扱います)。一方、なりすましの申込で生じる損失は、申込者本人の返済の能力や返済の状況から生じるものではありません。2つを同じモデルで扱うと、デフォルトの定義に不正による損失が混ざり、モデルが学ぶ関係がゆがむおそれがあります。そのため本コラムでは、なりすましによる損失を、返済の能力に関するモデルの対象から分けます。名義を使われた人と事業者の間の法律関係は事案によって違い、本コラムでは扱いません。本コラムでは、不正な申込の検知は与信スコアリングの外に置き、デフォルトの定義から不正を除く考え方を第2章で扱います。不正の検知そのものは、弊社コラム『取引の不正を見つける不正検知の実践ガイド、ルールと機械学習の使い分けから調査と運用まで』で扱っています。
流れのどの段でも、スコアは判断の材料であり、判断そのものではありません。申込の段では、スコアがカットオフ以上であっても、返済の能力の調査など法令上の条件と、自社のその他の審査の基準を合わせて最終の判断が決まります(第9章)。途上与信の段では、与信枠を増やす判断に法令上の調査が求められる場合があります(第14章)。各段の判断と、その時点で使ったスコアと情報を記録に残しておくことが、後でモデルを見直すときの土台になります。
信用リスクの損失の構造、期待損失は3つの要素に分けて考える
信用リスクは、与信した相手が約束どおりに返済や支払いをせず、損失が出るおそれのことです。信用リスクによる損失の大きさは、デフォルトが起きるかどうかだけでは決まりません。同じデフォルトでも、そのときに残っていた額が大きければ損失は大きく、担保や保証、回収によって取り戻せる部分が多ければ損失は小さくなります。
この考え方を整理したものとして、銀行の自己資本の規制の文脈で示されているのが、期待損失の分解です。バーゼル銀行監督委員会が2005年7月に公表した「バーゼルIIの内部格付手法のリスク・ウェイト関数についての解説文書」は、期待損失を、デフォルト確率(PD)、デフォルト時の残高(EAD)、デフォルト時の損失の割合(LGD)の掛け算として書いています。デフォルト時の残高に対する割合で表す場合は、デフォルト確率とデフォルト時の損失の割合の掛け算になるとも書いています。日本語で書くと、次のようになります。
\( \text{期待損失} = \text{デフォルト確率} \times \text{デフォルト時の損失の割合} \times \text{デフォルト時の残高} \)
言葉で言い換えると、ある契約で平均的に見込んでおくべき損失は、その契約がデフォルトする確率に、デフォルトしたときに残っている額を掛け、さらにその額のうち取り戻せずに失う割合を掛けたものです。たとえば、デフォルト確率とデフォルト時の損失の割合が同じ2つの契約でも、デフォルト時の残高が2倍なら期待損失も2倍になります。デフォルト確率が低くても、残高が大きく担保の無い契約は、期待損失が大きくなりえます。デフォルト確率だけでは、損失の大きさは決まりません。与信スコアリングのモデルが直接見積もるのは、この式の最初の要素であるデフォルト確率です。
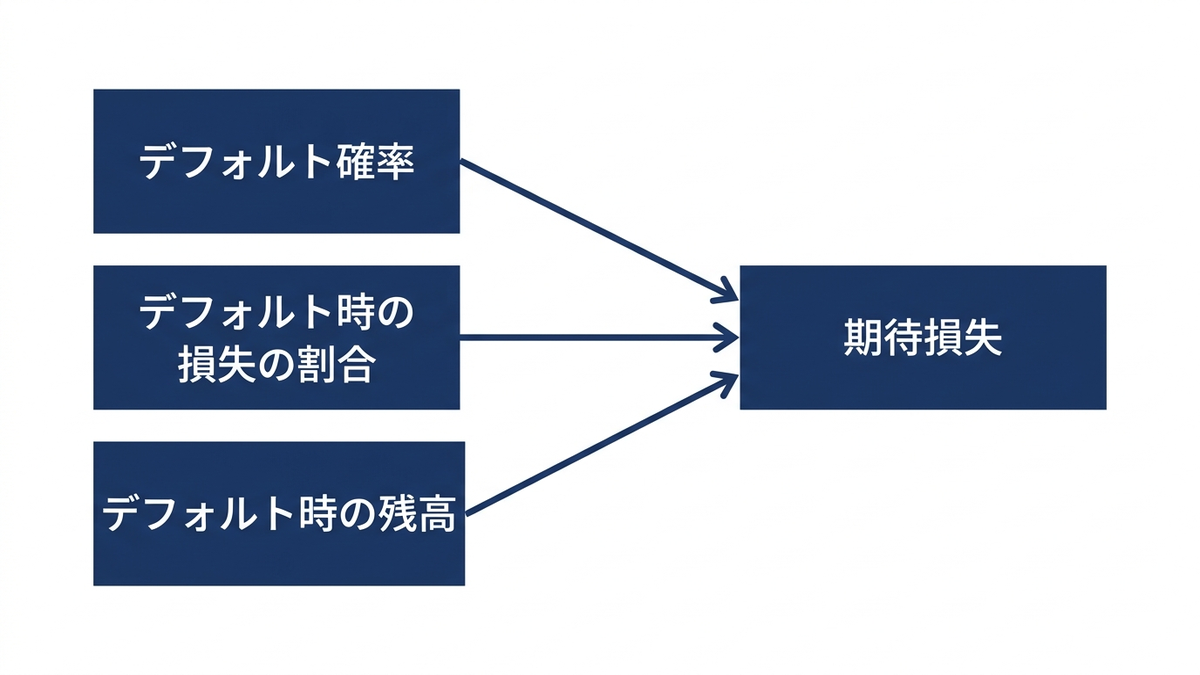
3つの要素は、それぞれ別の判断と結びついています。承認の基準(どの申込を承認するか)を変えると、個々の申込のデフォルト確率の見積りは変わりませんが、承認する契約の集まりに含まれるデフォルト確率の構成が変わります。デフォルト時の残高は、与信枠の大きさと、延滞の兆しが見えたときに利用を制限するかどうかで動きます。途上与信で与信枠を絞る判断も、まずはデフォルト時の残高を管理する判断です(デフォルト確率への影響は別に確かめる必要があります)。デフォルト時の損失の割合は、担保や保証の有無と、延滞の後の回収の進め方で動きます。与信スコアリングの議論がデフォルト確率の見積りの精度に集中すると、与信枠の設計と回収の設計が後回しになりがちです。損失を3つに分けて見ると、モデルの改善以外にも損失を動かせる場所があることが分かります。
| 要素 | 意味 | 結びつく判断 | 本コラムで扱う章 |
|---|---|---|---|
| デフォルト確率 | 観測期間のうちにデフォルトする確率の見積り | 承認の基準(承認する契約の集まりのデフォルト確率の構成が変わる)、途上与信での見直しの材料 | 第2章から第8章、第10章 |
| デフォルト時の残高 | デフォルトしたときに残っている額。先の解説文書では、すでに使われた額に、与信枠のうち未使用の部分が今後使われる見込みの分を加えたものとして説明されている | 与信枠の大きさ、利用の一時的な制限 | 第8章・第9章(考え方のみ。見積りの手法は詳しく扱わない) |
| デフォルト時の損失の割合 | デフォルト時の残高のうち、回収や担保で取り戻せずに失う割合 | 担保や保証の有無、回収の進め方 | 第8章(考え方のみ。見積りの手法は詳しく扱わない) |
本コラムでは、デフォルト時の残高とデフォルト時の損失の割合の見積りの手法は詳しく扱わず、考え方の紹介に留めます。また、期待損失の式は、信用リスクの損失を整理するための考え方であり、会計上の貸倒引当金の額をこの式でそのまま計算できるという意味ではありません。会計上の扱いとの関係は、第8章で入口だけ触れます。
期待損失は、平均として見込む損失です。実際の損失は年によって上下し、平均を大きく上回る年もあります。先の解説文書は、平均として見込む損失(期待損失)は価格や引当で管理し、期待を超える損失(予想を超える損失)には自己資本で備える、という形で2つを分けて説明しています。景気が悪くなると多くの契約のデフォルトが同時に増えるので、予想を超える損失は、個々の契約の見積りを足し合わせるだけでは捉えられません。銀行の自己資本の規制で、デフォルト確率などを自社で見積もる手法がどう位置づけられているかは、第14章で扱います。
経営の目線では、期待損失と予想を超える損失を分けて考えることに意味があります。期待損失は、商品の価格や引当で前もって織り込む費用です。与信スコアリングでデフォルト確率の見積りが実績とずれると、価格や引当に織り込んだ費用と実際の損失が合わなくなります。予想を超える損失は、景気の悪化などで多くの契約が同時に悪くなる場合に備えるもので、モデルの順位づけの成績を上げても無くなるものではありません。与信の方針を決めるときは、平均の損失をどの水準に抑えるかと、景気が悪化したときにどこまでの損失に耐えられるかを、別の問いとして立てる必要があります。
人の判断から統計的なスコアリングへ、与信の判断の歴史
与信の判断は、長く、審査の担当者の経験と判断で行われてきました。申込者の職業、勤め先、収入、過去の取引などを担当者が見て、承認するかどうかを決めるやり方です。担当者の判断には、数字に表しにくい事情を汲み取れる利点がある一方で、担当者によって判断がばらつく、件数が増えると処理しきれない、判断の理由を後から検証しにくい、といった限界があります。
申込者の特徴とその後の返済の結果の関係を統計的に調べ、判断の式を作ろうとする研究は、20世紀の前半には始まっていました。米国の全米経済研究所(NBER)が1941年に刊行した David Durand の研究(消費者の分割払いの金融におけるリスクの要素を調べたもの)は、目次に、リスクの要因の研究の結果の章と、信用の評点の式(Credit-Rating Formulae)の章を置き、付録で判別関数の理論と、それを返済の結果で分けた2つの貸付の標本に当てはめた結果を扱っています。過去の貸付の記録から、返済の結果と関係の深い特徴を見つけ、それを式にまとめるという、今日のスコアリングにつながる考え方が、この時期の研究に現れています。
その後、統計的なスコアリングは、計算機の普及とともに事業として広がっていきました。米国の FICO は、公式の会社紹介のページ(リンク先はウェブ・アーカイブが2026年10月29日に保存した写し)で、1956年に創業し、信用スコアリングなどの分析の手法を導入して、米国だけでなく世界で与信をより広く利用できるようにしてきたと説明しています。統計的なスコアリングは、判断を一定の手順にそろえ、大量の申込を短い時間で処理し、判断の根拠を記録に残せるようにしました。クレジットカードや消費者向けの貸付のように、件数が多く1件の額が小さい商品では、人がすべての申込を見ることが現実的ではないので、スコアリングは事業の前提になっています。
近年は、ロジスティック回帰による点数表(スコアカード)に加えて、機械学習のモデルや、従来の信用情報以外のデータを使う動きがあります。本コラムでいう機械学習のモデルは、序章で述べたとおり、多数の決定木を組み合わせるモデルを指す呼び方です。先に見た割賦販売法の令和2年の改正(令和2年6月公布、令和3年4月施行)では、経済産業省のFAQによれば、各社が工夫した与信の審査の手法を使えるようにする認定の制度が設けられました。この制度は、事前と事後の確認による過剰与信の防止の措置を前提に、従来の画一的な支払可能見込額の調査に代わる手法を認めるものです(同FAQの問1・問2)。同じFAQは、この制度を使う事業者には、事業年度ごとに想定する延滞の率を定めて延滞の率を管理し、事業年度の後に実績とその理由を報告することが求められると説明しています(同FAQの問4)。データに基づく審査の手法を認める代わりに、その結果を延滞の率で管理する、という考え方と読めます。制度の詳細と条番号は第14章で扱います。
歴史を振り返ると、スコアリングが置き換えてきたのは、人の判断そのものというより、判断の手順のばらつきと、処理の能力の限界だったと考えています。人による確認は今も、スコアだけで決めにくい申込、額の大きい申込、法令上の確認が要る申込などで使われています。与信スコアリングを入れるときに決めるのは、人の判断を無くすかどうかではなく、どの申込をスコアで自動的に判断し、どの申込を人が確認するかの分け方です(第9章)。
個人の与信と企業の与信の違い、データ・件数・判断の単位
与信スコアリングという言葉は、個人向けの与信で使われることが多いように思います。企業向けの与信(事業者向けの貸付や、企業間の掛け売り)でもスコアやデフォルト確率は使われますが、データの性質、件数、判断の単位が大きく違います。本コラムの例題は個人向けの貸付や分割払いの申込を主に扱うので、企業向けの与信に当てはめるときに注意すべき違いを、ここで整理しておきます。
| 観点 | 個人の与信 | 企業の与信 |
|---|---|---|
| 主なデータ | 申込書の項目(年収の水準・勤続年数・居住の状況など)、信用情報(借入・返済・延滞の記録) | 財務諸表、業歴、業種、取引先、支払いの履歴、外部の企業情報 |
| データの更新の頻度 | 信用情報は事業者からの登録に応じて更新される | 財務諸表は決算ごと。決算の間の変化は見えにくい |
| 件数とデフォルトの件数 | 申込の件数が多く、統計的なモデルを作りやすい | 取引先の数が限られ、デフォルトの件数が少ない。中小企業向けでは件数が多くなる場合もある |
| 1件の額 | 小さいものが多い | 大きいものが多く、1件のデフォルトの影響が大きい |
| 判断の単位 | 申込や契約ごと。同じ人でも商品が違えば別の判断になる | 取引先の企業ごと。関連する会社のまとまり(グループ)で見ることもある |
| 人による判断の比重 | 件数が多いので、スコアによる自動の判断の比重が大きい | 額が大きいので、財務の分析や面談などの人による判断の比重が大きい |
| 関わる規制 | 消費者を保護する法令(返済の能力の調査・信用情報の取り扱い・個人情報の保護) | 銀行の場合は自己資本の規制。掛け売りでは契約と債権の管理が中心 |
表から分かるとおり、企業の与信では、デフォルトの件数が少ないことが、統計的なモデルを作るうえでの大きな制約になります。数十件のデフォルトしかない記録で多くの項目を使ったモデルを作ると、その記録にたまたま現れた関係を学んでしまうおそれがあります(第5章で扱う過学習)。このため、企業の与信では、財務の比率などを使った統計的なモデルの結果と、専門家による判断を組み合わせる運用が考えられます。本コラムで扱う手法のうち、次の4つは、例題の数字がそのまま当てはまるわけではないものの、考え方としては企業の与信にも使える部分が多いと考えています。
- 区分けと点数表の考え方(第3章・第4章)
- 評価の指標(第7章)
- 確率の較正(モデルの出力を、実績のデフォルト率に対応づけて確率として読めるようにし、必要に応じて調整すること。合っているかを確かめる作業は較正の確認と呼びます)と格付の区分(第8章)
- 監視(第12章)
本コラムの第2章以降の例題は個人向けの与信なので、企業向けの与信に当てはめるときは、件数の少なさと財務の情報の性質を踏まえて読み替える必要があります。
個人の与信には、企業の与信には無い配慮も要ります。スコアが表すのは、ある条件の契約がデフォルトする確率の見積りであって、申込者の人柄や価値の評価ではありません。それでも、否決された申込者にとっては生活に関わる判断なので、否決の理由をどう示すか(第11章)、差別につながる属性を使っていないか、使っていなくても特定の集団に結果が偏っていないか(第11章)を確かめる責任が伴います。個人の与信では、モデルの成績だけでなく、こうした説明と公平性の要請が、使える手法と項目を絞ることになります。
与信スコアリングが普通の分類の問題と違う点
与信スコアリングは、機械学習の言葉で言えば、契約がデフォルトするかしないかを見分ける2値の分類の問題として書けます。そのため、データ分析の担当者は、ほかの分類の問題と同じ手順で進めようとしがちです。ところが、与信スコアリングには、普通の分類の問題には無い、あるいは目立たない性質がいくつもあります。これを知らずに進めると、過去のデータでは成績が良く見えたのに、本番で見込みどおりにならない、ということが起きます。
| 性質 | どういうことか | 放っておくと起きること | 扱う章 |
|---|---|---|---|
| 結果が出るまでに時間がかかる | 期間のうちにデフォルトした契約はその時点で分かるが、まだデフォルトしていない契約を正常と確定するには、観測期間(例題では契約から12か月)を満たす必要がある | 観測期間を満たさない直近の契約を正常として数えてしまい、集計したデフォルト率が実際より低く出る。モデルの効果が分かるまで長くかかる | 第2章・第12章 |
| 否決した申込の結果が見えない | 返済の結果が分かるのは承認した契約だけで、否決した申込がもし承認されていたらどうなったかは分からない | 承認した層だけで作ったモデルを申込の全体に使うと、成績も確率もずれる。機会損失は推定でしか分からない | 第6章 |
| 判断の理由を説明し、検証できる必要がある | 審査の担当者、監査や規制当局、申込者などに、判断の理由を示す場面がある。申込者への法令上の説明の義務があるかどうかは、適用される法令と取引によって確かめる | 理由を示せないモデルは、成績が良くても使えない場面がある | 第11章・第14章 |
| 単調性が求められる項目がある | 単調性の制約は、ほかの項目の値が同じなら、ある項目の値が大きくなったときに確率が動く向きを、上がらない向きか、下がらない向きのどちらかに決めておく指定。たとえば、他社の延滞が多いほどデフォルト確率が下がる、のような説明のつかない向きは受け入れられにくい。業務上の根拠がある項目では、この制約を設ける場合がある | データの偶然の偏りを学んだモデルが、業務の感覚と合わない判断をする | 第3章・第5章 |
| 景気の影響を受ける | 景気が悪くなると、多くの契約のデフォルトが同時に増える | 好景気の記録で作ったモデルが、不景気にデフォルト確率を低く見積もる | 第8章・第12章 |
| 判断がデータを作る | 承認の基準を変えると、次に集まる契約の層が変わる | 基準の変更とモデルの成績の変化が混ざり、原因を切り分けにくくなる | 第6章・第12章 |
| 規制がかかる | 返済の能力の調査、信用情報の利用目的、個人情報の扱い、銀行では自己資本の規制などがかかる | 使える項目や手順に制約があり、技術的に可能でも使えない方法がある | 第14章 |
表の中で、本コラムがとくに重視しているのは、最初の2つです。結果が出るまでに時間がかかることは、モデルを作るときにも、評価するときにも、監視するときにもつきまといます。今日承認した申込のうち、正常だったと確定できるのは、例題の定義では1年後です。その契約の集まりの最終的なデフォルト率も、それまで確定しません。その間に申込者の層や景気が変わるので、少なくとも1年以上前に承認した契約の結果で作ったモデルを、今日の申込に使うことになります。否決した申込の結果が見えないことは、記録そのものに偏りがあることを意味します。過去の審査で断られた層の結果は記録に無いので、その層をどう扱うかを決めないままモデルを作ると、過去の審査の基準に引きずられたモデルになります。
一方で、与信スコアリングは、普通の分類の問題に比べて恵まれている点もあります。結果の定義(デフォルトの基準)を事業として決められること、同じ形の申込が大量に集まること、長い研究と実務の蓄積があり、点数表の作り方や評価の指標について多くの文献があることです。本コラムの各章は、こうした蓄積を手がかりにしながら、上の表の性質にどう対処するかを、実行したコードとともに示します。
国内の公表統計から見える与信の規模と事業者の数
自社の与信の位置を考えるときの手がかりとして、国内の公表統計を見ておきます。ここでは、所管官庁と業界団体の公表資料を開いて確かめた範囲で、件数と率だけを紹介します。統計の対象や集計の方法は資料ごとに違うので、資料どうしの数字を足したり比べたりはできません。
金融庁が2026年11月9日に公表した「貸金業者数について」によれば、令和8年(2026年)9月末時点の貸金業者の数は1,413業者でした。前述の貸金業関係資料集の各年度末の推移の表では、平成16年(2004年)3月末に23,708業者だった貸金業者の数は、令和6年(2024年)3月末に1,515業者、令和7年(2025年)3月末に1,473業者となっています。令和7年3月末の数は、前の年の同じ時点に比べて約2.8%少ない数です。事業者の数は、長い期間で大きく減っています。ただし、事業者の数の推移だけからは、契約の件数や与信の規模がどう動いたかは読み取れません。
同じ資料集には、令和7年3月末の業態別の貸付の件数の表もあります。この表の件数を、消費者向けの貸付と事業者向けの貸付に分けると、消費者向けが件数の合計の約97.4%を占めます。消費者向けの貸付の件数だけを分母にすると、その約98.4%が無担保の貸付でした。この件数は、各業者の分を単純に合計した延べの数です。資料の注記には、件数の捉え方は各業者の契約の形や債権の管理の方法によるため、業態の間で単純には比べられないと書かれています。
販売の代金を後払いにする分野では、日本クレジット協会が2025年11月14日に公表した「クレジットカード発行枚数調査結果」があります。これによれば、2025年3月末のクレジットカードの発行枚数(調査に回答した243社の合計)は3億2,057万枚で、前の年に比べて2.2%増えました。同協会は、20歳以上の人口との比で、1人あたり3.1枚を持っている計算になると添えています。ただし、この比較は調査の時点での結果で、前の年との比較では対象の会社と社数が必ずしも一致していない、という注記があります。
| 統計 | 公表した機関と公表日 | 時点 | 件数・率 | 読むときの注意 |
|---|---|---|---|---|
| 貸金業者の数 | 金融庁(2026年11月9日) | 令和8年9月末 | 1,413業者 | 財務局と都道府県からの提出資料に基づく集計 |
| 貸金業者の数の推移 | 金融庁 貸金業関係資料集(2025年11月28日) | 平成16年3月末から令和7年3月末 | 23,708業者から1,473業者へ。令和7年3月末は前の年に比べて約2.8%少ない | 各年度末の数 |
| 貸付の件数の構成 | 金融庁 貸金業関係資料集(2025年11月28日) | 令和7年3月末 | 件数の合計のうち消費者向けが約97.4%。消費者向けの約98.4%が無担保 | 延べの数。業態の間で単純に比べられないと注記がある |
| クレジットカードの発行枚数 | 日本クレジット協会(2025年11月14日) | 2025年3月末 | 3億2,057万枚、前の年に比べて2.2%増。20歳以上の人口との比で1人あたり3.1枚 | 回答した243社の合計。前の年との比較で対象の会社が一致しないことがある |
これらの数字は、与信を伴う契約やカードが非常に多く存在することを示す統計です。ただし、審査や見直しが何件行われているかを直接示すものではありません。発行枚数には家族カードと法人カードも内数として含まれ(同じ調査で、家族カードは2,505万枚、法人カードは1,214万枚)、カードの枚数と与信枠の数は一致するとは限りません。それでも、契約やカードがこれだけ多い分野では、すべての判断を人が行うことは現実的ではなく、スコアによる判断の手順とその管理が、事業の運営の中で大きな役割を持つと考えています。貸金業者の数の推移については、本コラムでは数の変化を紹介するに留め、変化の要因の分析は扱いません。
よくある誤解、AIで貸し倒れが無くなる・AR値が高いほど良い・承認率を上げれば事業の成果が良くなる
与信スコアリングの導入を検討する場面では、いくつかの誤解が議論を迷わせることが多いように思います。ここでは3つを取り上げ、なぜ誤解なのか、代わりにどう考えるかを整理します。
1つ目は、「審査にAIを入れれば貸し倒れが無くなる」という誤解です。デフォルトには、申込の時点では誰にも分からない出来事(失業や病気、景気の悪化など)が関わります。モデルが見積もれるのは、申込の時点の情報から見たデフォルトのしやすさであって、将来の出来事そのものではありません。また、前の節で見たとおり、与信は一定の割合のデフォルトを見込んで承認するものなので、貸し倒れをゼロにしようとすれば、承認をほとんど止めることになります。モデルの改善で目指せるのは、同じ承認率でデフォルト率を下げること、あるいは同じデフォルト率で承認率を上げることです。
2つ目は、「AR値が高いほど良いモデルだ」という誤解です。AR値は、モデルがデフォルトしやすい順に契約を並べられているかを表す順位づけの指標で、-1から1の値をとります。AR値は管理の指標として役に立ちますが、それだけで成果を表すものではありません。AR値は、評価する集団の申込者の層の広がりや、期間によってスコアと結果の関係が変わることで値が変わりうるので、対象の集団や期間が違う値の差を、そのままモデルの優劣の判断には使えません(第7章)。また、AR値は順位の正しさを表すだけで、モデルの出すデフォルト確率が実績と合っているか(第8章)や、どのカットオフで運用したときに収益と損失の差がどうなるか(第9章)は表しません。ベンダーが示すAR値を読むときは、どの集団で、どの定義で、どの期間のデータで測ったかを確かめる必要があります。
3つ目は、「承認率を上げれば事業の成果が良くなる」という誤解です。承認率を上げると契約の件数と売上は増えますが、新たに承認する申込は、変更後のカットオフ以上、変更前のカットオフ未満のスコアの帯にある、それまでより高いデフォルト確率の層です。この帯は以前は否決していたので、自社の実績は直接には観測できません。この帯のデフォルト確率の見積り(新たに承認する帯だけのデフォルトのしやすさで、第9章では限界のデフォルト率と呼びます)と、そこで見込む収益と損失によっては、承認率を上げて増えた収益より、増えた貸し倒れのほうが大きくなることがあります。さらに、返済の能力を超える与信が増えれば、過剰与信による顧客の不利益の型の損失も増えます。承認率は、収益と損失の見積りと一緒に見て初めて、上げるべきか下げるべきかが決まります。
| よくある言い方 | どこが誤解か | 代わりに確かめること | 扱う章 |
|---|---|---|---|
| 審査にAIを入れれば貸し倒れが無くなる | 個々の契約の将来の結果は確実には予測できない。与信は一定のデフォルトを見込んで承認するもの | 同じ承認率でデフォルト率がどれだけ下がるか、同じデフォルト率で承認率がどれだけ上がるか。それが収益と損失の差にどう効くか | 第7章・第9章 |
| AR値が高いほど良いモデルだ | AR値は順位づけの指標で、対象の集団や期間が違う値の差は、そのまま優劣の判断に使えない。確率の正しさと収益は表さない | 評価の集団・定義・期間をそろえたうえでの比較、確率の較正の確認、カットオフごとの収益と損失 | 第7章・第8章・第9章 |
| 承認率を上げれば事業の成果が良くなる | 売上は増えても、新たに承認するのはデフォルト確率の高い層。貸し倒れの増加が収益の増加を上回ることがある | 新たに承認するスコアの帯のデフォルト確率の見積りと、そこで見込む収益と損失、過剰与信の兆候 | 第9章 |
3つの誤解に共通するのは、1つの数字(貸し倒れの件数、AR値、承認率)を成果として扱っていることです。序章で述べたとおり、成果の指標は、承認した契約から得た収益と貸し倒れの損失の差で、実績として測れます。断った申込の機会損失は記録に残らないので、推定として横に並べ、判断のときに合わせて見ます。機会損失は、否決した申込の結果が見えないので、つねに前提を置いた推定になります(第6章)。AR値、承認率、デフォルト率、審査の所要時間は、成果の指標を説明し、仕組みを管理するための指標として使います。
経営の判断、どの商品でどの水準のデフォルト率と承認率を目指すかを先に決める
ここまで見てきたように、与信の判断は売上・貸し倒れ・顧客の保護・規制上の義務の4つの経路で事業に効き、損失はデフォルト確率だけでなくデフォルト時の残高と損失の割合でも決まり、結果が出るまでに時間がかかり、否決した申込の結果は見えません。こうした性質の上で与信スコアリングを使うとき、経営が最初に決めるべきことは、どのモデルを使うかではなく、どの商品で、どの水準のデフォルト率と承認率を目指すのかだと考えています。
目指す水準は、商品ごとに違ってよいものです。1件の額が小さく、金利や手数料の水準が比較的高い商品と、1件の額が大きく利幅の小さい商品とでは、許容できるデフォルト率が違います。新しい顧客を獲得するための入口の商品と、既存の顧客に提供する商品とでも、承認率の重みが違います。目指す水準が商品ごとに決まると、第7章の評価の指標をどの範囲で重視するか、第9章のカットオフをどう置くかを決める前提がそろいます。逆に、水準が決まっていないと、営業は承認率を、リスク管理はデフォルト率を、それぞれの立場から主張し、カットオフの議論が平行線になりやすくなります。
この判断を誤ったときの損失は、序章で整理した6つの型に沿って見ると、見落としが少なくなります。目指す水準を決めずに承認率を優先すれば貸し倒れと過剰与信による顧客の不利益が、デフォルト率を優先すれば機会損失が膨らみやすくなります。水準が決まらないまま人による確認の範囲を広げれば審査の滞りが、水準と実績を突き合わせる仕組みが無ければ形骸化が起きます。法令が求める調査と記録を水準の議論の外に置けば、規制上の義務の不履行につながります。次の表は、目指す水準を決めるときに、経営と各部門が確かめておく事項をまとめたものです。表の内容は本コラムの整理で、組織によって担う部門は変わります。
| 決めること | 中身 | 主に材料を出す部門 | 決めずに進めると目立ちやすい損失の型 |
|---|---|---|---|
| 対象の商品と申込の範囲 | どの商品の、どの経路の申込から始めるか | 事業の責任者・営業 | 形骸化(対象が広がり続け、見直しが追いつかない) |
| 目指すデフォルト率 | 商品ごとに、承認した契約のデフォルト率をどの水準に収めるか。デフォルトの定義と観測期間を含めて決める | リスク管理・データ分析 | 貸し倒れ |
| 目指す承認率 | 商品ごとに、最終の判断が済んだ申込のうち、どの割合を承認するか | 営業・事業の責任者 | 機会損失 |
| 収益と損失の見積りの前提 | 正常な契約1件の収益と、デフォルト1件の損失の比など、カットオフを決める前提 | 事業の責任者・経理・リスク管理 | 貸し倒れ・機会損失 |
| 人による確認の範囲と能力 | どの申込を人が確認するか、1日に確認できる件数 | 審査 | 審査の滞り |
| 法令上の要件 | 返済の能力の調査、信用情報の照会、説明、記録の要件 | コンプライアンス・法務 | 規制上の義務の不履行・過剰与信による顧客の不利益 |
| 見直しの頻度と責任者 | 水準と実績を誰が、どの頻度で突き合わせ、見直しを決めるか | リスク管理・内部監査 | 形骸化 |
表の「収益と損失の見積りの前提」の行は、第9章でカットオフを決めるときの土台になります。この前提は、データ分析の担当者だけでは決められず、事業の責任者と経理、リスク管理が合意する必要があります。前提の数字が正確に分からない場合でも、幅を持たせて置き、その幅の中でカットオフがどう動くかを確かめる進め方ができます(第9章)。
結果を予算・体制・KPI の仕組みに落とすときは、目指すデフォルト率と承認率を、商品ごとの管理の指標として月次で報告し、承認した契約から得た収益と貸し倒れの損失の差を最終の指標として四半期や年度で見る、という二段の構えが考えられます。最終の指標を見るときは、否決による機会損失の推定と、その推定の前提も横に並べて確かめます(機会損失は観測できないので、つねに推定です)。デフォルト率は観測期間が過ぎるまで確定しないので、月次の報告では、契約から数か月の時点の早い段階の延滞の割合を先に分かる指標として並べます(第12章)。予算の面では、モデルの開発だけでなく、判断と結果を突き合わせて集計できる記録の整備と、水準を見直す会議の運営に、継続して人と時間を割り当てることを勧めます。与信スコアリングの仕組みは、一度作れば終わる投資ではなく、目指す水準と実績を突き合わせ続ける運営の仕組みだからです。
この章で整理したことは、次のとおりです。
- 与信が事業に効く4つの経路と、与信を行う事業・当事者
- 申込から回収までの流れと、スコアが使われる場所
- 期待損失を3つの要素に分ける考え方
- 統計的なスコアリングの歴史、個人の与信と企業の与信の違い、普通の分類の問題と違う点
- 国内の公表統計と、よくある誤解
そのうえで、モデルを選ぶ前に商品ごとに目指すデフォルト率と承認率を決めることを述べました。その水準を測るには、何をデフォルトと呼び、どの期間で結果を見届けるかが決まっていなければなりません。次の第2章では、与信に使うデータの種類と、デフォルトの定義と観測期間の決め方を扱います。
この章を深めたい方への参考書籍
『〈究解〉信用リスク管理』(尾藤剛 著、大久保豊 監修、金融財政事情研究会):金融機関の信用リスク管理を扱う本で、国立国会図書館の書誌では、件名に与信管理・信用調査・格付けが付いています。同じ著者による『ゼロからはじめる信用リスク管理』(2011年)を改題し、全面的に改訂した版です。この章で扱った信用リスクの損失の構造や、デフォルト確率を与信の管理にどう使うかを、金融機関の実務の側から確かめるのに向いています。
『企業経営とリスクマネジメント 与信管理を中心として考える』(葉山真一 著、商事法務):2026年10月に刊行された本で、出版者の提供した紹介では、全社的な活動としてのリスクマネジメントに与信管理を整合的に位置づけることを主題にしています。この章で扱った企業間の掛け売りのように、与信を本業の売上を支える手段として行う事業で、与信の判断を会社全体のリスク管理の中にどう置くかを考えるときの手がかりになります。
第2章 与信に使うデータ、申込の情報・信用情報・取引の履歴と結果の定義
第1章では、与信が事業のどこに効くのかと、信用リスクの損失がデフォルト確率と、デフォルトしたときの損失の割合と残高に分けて考えられることを確かめました。この章では、その見積りの材料になるデータを扱います。与信スコアリングのモデルは、過去の申込と、その後の返済の結果を組にした記録から作ります。どの項目を、どの時点の値で、どの範囲の申込について集めたか、そして何を「デフォルト」と呼んだかで、モデルが学ぶ中身が決まります。
この章で扱うのは次の内容です。後半では、他の章とは独立に作った架空の申込と契約の記録を使い、実行したコードと結果で確かめます。
- 与信に使うデータの種類(申込書の項目・本人確認の情報・信用情報機関の情報・自社との取引の履歴・入出金の記録・外部のデータ)
- 指定信用情報機関の仕組みと、登録される情報・照会の目的の制限
- デフォルトの定義(延滞の日数の基準・観測期間・判定が曖昧な中間の層の扱い)と、定義によってデフォルト率が変わること、モデルの成績の値も定義ごとに違って見えること
- 申込の月ごとに結果を見届けるビンテージの見方と、直近の申込は結果がまだ出そろっていないこと
- 審査の時点で手に入る情報だけを使うことと、否決した申込の結果が分からないこと
- 標本の作り方(学習に使う期間・除外する申込)と、データの品質の問題(申告の誤り・欠損・項目の定義の変更・重複した申込)
- 使ってはいけない、あるいは慎重に扱う項目と、個人データの取り扱いの入口
この章の主張は1つです。デフォルトの定義と観測期間は、モデルを作る前に、事業として決めておく必要があります。本コラムの架空データでも、延滞の基準と観測期間を変えるだけで、同じ契約の集まりのデフォルト率は約13倍の幅で動きました。同じ手順で作ったモデルのAR値も定義ごとに違う値になりましたが、評価に使えるデフォルトの件数が少なく、その差が定義によるものか偶然によるものかは、この章の計算だけでは確かめきれません。定義はデータ分析の担当者が作業の途中で決める細目ではなく、どの返済の滞りを避けたいのか、どれだけ待ってから結果を判断するのかという、事業の方針そのものです。
与信に使うデータの種類と、それぞれが手に入る時点
与信の判断に使うデータは、出どころと手に入る時点で分けると整理しやすくなります。申込者が申込書に書く項目、本人であることを確かめるための情報、信用情報機関から照会で得る情報、自社との過去の取引の履歴、口座の入出金の記録などのデータ、そして外部の事業者や公的な情報源から得るデータです。どれを使えるかは、商品と申込の経路、法令、申込者から得た同意の範囲で変わります。同じ「年収」でも、申込書に申告された値と、書類で確かめた値では意味が違います。
次の表は、データの種類ごとに、主な中身と、審査で使えるようになる時点、扱うときの注意をまとめたものです。表の「手に入る時点」の列は、この章の後半で扱う「審査の時点で手に入る情報だけを使う」という原則に直結します。
| データの種類 | 主な中身 | 手に入る時点 | 扱うときの注意 |
|---|---|---|---|
| 申込書の項目 | 年収の水準・勤続年数・居住の年数・雇用の形態・申込の額・資金の使いみち・住居の形態など | 申込の時点 | 申告の値なので誤りや記入漏れがある。項目の選択肢や定義が途中で変わることがある |
| 本人確認の情報 | 氏名・生年月日・住所・本人確認の書類の種類と確認の結果 | 申込から審査の途中 | 主な目的は本人であることの確認と、なりすましの防止。スコアの入力に使うかは別に判断する |
| 信用情報機関の情報 | 他社との契約の内容・残高・支払いの状況・延滞の記録・照会された記録(申込の記録) | 審査の時点の照会で得る | 照会の目的は法令と機関の規則で限られる。照会した時点の値を残しておかないと、後から同じ値を再現できない |
| 自社との取引の履歴 | 過去の契約・利用の額・返済の記録・問い合わせの履歴 | 既存の顧客なら申込の時点、新規の申込者には無い | 新規の申込者と既存の顧客で、使える項目がそろわない |
| 入出金の記録などのデータ | 口座の入金と出金の流れ・利用の履歴 | 申込者の同意を得て取得した時点 | 同意と利用目的の範囲、取得できる申込者の偏りを確かめる(第5章) |
| 外部のデータ | 企業の登記や財務の情報(企業の与信の場合)・住所に関する公開の情報など | 取得の契約と更新の頻度による | いつの時点の値かを記録する。順位づけの成績だけでなく、収益・貸し倒れの損失・否決による機会損失(推定)への影響を見積もり、取得と運用の費用も含めて採否を判断する |
| 結果のデータ | 契約の後の月ごとの返済の状況・延滞の日数・回収の状況 | 契約の後、月ごとに積み上がる | モデルが予測する対象。審査の時点では手に入らないので、入力に混ぜない |
この表の最後の行の結果のデータは、他の行とは役割が違います。他の行は、審査の時点で申込を評価する材料(モデルの入力)です。結果のデータは、その申込を承認した後に、約束どおりに返済されたかを記録したもので、モデルに学ばせる答えにあたります。与信スコアリングのモデルは、入力と答えを組にした過去の記録から作ります。そのため、入力の側は「審査の時点の値」で、答えの側は「決めた期間の後に確定した値」で、それぞれ別の時点の記録として残しておく必要があります。
本コラムで「信用情報」と書くときは、信用情報機関が扱う借入、契約、返済、延滞などの情報を指します。申込書の項目や自社の取引の履歴を含む全般は「与信の判断に使うデータ」と呼んで区別します。また、自社の取引の履歴は、新しい申込の審査(初期与信)では一部の申込者にしか無いデータですが、契約の後の見直し(途上与信)では、すべての契約にある基本のデータになります。途上与信で使うデータとモデルは第10章で扱います。
指定信用情報機関の仕組みと、照会の目的の制限
個人向けの与信で、他社での借入や返済の状況を知る手段が信用情報機関です。日本では、貸金業法と割賦販売法に基づいて国から指定を受けた信用情報機関があり、指定信用情報機関と呼ばれます。日本信用情報機構(JICC)の公式ページ(指定信用情報機関制度について)によれば、この制度は平成18年に改正された貸金業法で設けられ、目的は過剰な貸付の防止です。貸金業法の第13条第2項は、貸金業者が個人の顧客と貸付けの契約(極度方式貸付けに係る契約など、内閣府令で定めるものを除く)を締結しようとする場合に、返済の能力の調査で指定信用情報機関が保有する信用情報を使うことを求めています(e-Gov法令検索の貸金業法)。あらかじめ枠を決めて繰り返し借りられる契約(極度方式基本契約)の下での調査には、第13条の3に別の定めがあります。また、指定信用情報機関と信用情報の提供の契約を結んだ貸金業者は、顧客を特定する情報や契約の内容などを機関に提供することが求められています。照会と提供が求められる場面の詳細は第14章で扱います。
どの機関がどの法律で指定されているかは、各機関の公式ページで次のように確かめられます。株式会社シー・アイ・シー(CIC)の沿革(同社の沿革のページ)には、2010年3月に貸金業法に基づく指定信用情報機関として内閣総理大臣から、2010年7月に割賦販売法に基づく指定信用情報機関として経済産業大臣から指定を受けたと書かれています。日本信用情報機構は、貸金業法に基づく指定信用情報機関として平成22年3月11日に内閣総理大臣から指定を受けたと公式ページに書いています。また、日本信用情報機構の沿革には、2010年3月に、指定信用情報機関である同社とシー・アイ・シーの2社の間で情報の交流を始めたことが書かれています。このほか、一般社団法人全国銀行協会は、全国銀行個人信用情報センター(同センターのページ)を個人信用情報機関として設置し、運営しています。同センターの公式ページは、他の個人信用情報機関と提携して情報の交流を行っていること、同センターは審査を行わず、審査の理由も説明できないことを説明しています。指定に関する条番号と、照会や登録の義務の詳細は第14章で扱います。
| 機関 | 公式ページで確かめた位置づけ | 与信スコアリングでの扱い |
|---|---|---|
| 株式会社シー・アイ・シー | 貸金業法(2010年3月)と割賦販売法(2010年7月)に基づく指定信用情報機関 | クレジットや貸付の契約・支払いの状況・照会の記録を、審査の時点の照会で得る |
| 株式会社日本信用情報機構 | 貸金業法に基づく指定信用情報機関(平成22年3月11日に指定) | 同上。照会で得た情報は返済の能力の調査の目的に限って使う |
| 全国銀行個人信用情報センター | 一般社団法人全国銀行協会が設置・運営する個人信用情報機関。審査は行わない | 銀行などの会員が、ローンなどに関する個人信用情報を照会する |
登録される情報の種類は、機関ごとに公式ページで説明されています。シー・アイ・シーは、本人が開示で確かめられる情報として、次の5つを挙げています(同社の開示のページ)。
- クレジットの情報:加盟する会社との契約の内容、支払いの状況、残高など
- 申込の情報:新しい申込の審査のために照会された記録
- 利用の記録:契約の後の利用や支払いの状況の確認のために照会された記録
- 参考情報:日本貸金業協会や全国銀行協会から登録された情報と、本人の申告による情報
- クレジット・ガイダンス情報:同社が信用情報を分析して算出した指数と、その算出の理由
最後の指数は信用情報機関が算出したもので、照会した会社の審査の結果ではありません。与信を行う会社がこうした指数を自社のモデルの入力に使うかどうかは、機関との契約と利用の条件、説明の負担を含めて判断する事柄です。
照会で得た情報を使える目的は限られています。日本信用情報機構の公式ページは、加入している貸金業者が受け取った信用情報を、返済の能力の調査以外の目的に使わないよう、機関が必要な監督を行うことになっていると説明しています。個人情報保護委員会と金融庁が定めた「金融分野における個人情報保護に関するガイドライン」(令和6年3月。個人情報保護委員会のページ)の第12条も、個人信用情報機関から得た返済の能力に関する情報を、返済の能力の調査以外の目的に使わないよう慎重に扱うことを求めています。同じ条は、個人信用情報機関に情報を提供する場合に本人の同意を得ることも求めています。データ分析の担当者から見ると、信用情報は「手に入るデータだから何にでも使える」ものではなく、照会の目的と同意の範囲を、データの台帳に項目ごとに書いておく必要があるデータです。たとえば、販売の促進のための分析に信用情報を流用することは、こうした制限と衝突するおそれがあります。具体的な事業での可否は、所管の官庁や専門家に確かめる事項です。
もう1つ、信用情報は照会した時点の値だという点が、モデルを作るときに効いてきます。信用情報機関のデータは、その後の返済や新しい契約で日々更新されます。過去の申込のモデルを作るときに、いま照会し直した値を使うと、審査の時点では存在しなかった情報(審査の後に増えた借入や、その後の延滞)が入ってしまいます。審査の時点で照会した結果を、その時点の値のまま記録に残しておくことが、後で正しくモデルを作り直すための前提になります。この点は、後のコードで数字にして確かめます。
デフォルトの定義を決める、延滞の基準と観測期間と中間の層
与信スコアリングのモデルが予測するのは「デフォルトするかどうか」です。しかし、デフォルトは自然に決まっている出来事ではありません。何日の延滞をデフォルトと数えるか、契約からどれだけの期間のうちに起きたものを数えるか、一時的に延滞したが後で解消した契約をどう扱うかを、人が決めて初めて、過去の契約1件ずつに「デフォルト」か「正常」かの答えが付きます。この決めごとを、本コラムではデフォルトの定義と呼びます。
定義の要素は、主に3つあります。1つ目は延滞の基準です。延滞が何日(あるいは何か月分)に達したらデフォルトと数えるかを決めます。基準を浅くすると、すぐに解消する短い延滞まで数えることになり、デフォルトの件数は増えます。基準を深くすると、損失に結びつきやすい深い延滞だけを数えることになり、件数は減ります。2つ目は観測期間です。契約の結果を見届ける期間で、たとえば「契約の実行から12か月以内」のように決めます。観測期間を長くするほど多くのデフォルトを拾えますが、結果が出そろうまで長く待つことになり、手元の新しい申込の記録が学習に使えるようになるのが遅れます。3つ目は、判定が曖昧な中間の層の扱いです。たとえば1〜2か月分の延滞をしたが、デフォルトの基準には達しなかった契約を、正常として数えるか、学習から外すかを決めます。
本コラムの例題では、デフォルトを「契約の実行から12か月以内に、延滞が90日以上に達すること」と定めます。この章のコードのように月単位で返済の状況を記録する例題では、延滞の日数が分からないので、その代わりに「契約から12か月以内に、3か月分以上の延滞に達すること」を使います。3か月分以上の延滞は、90日以上の延滞の目安として使う近似で、同じものではありません。延滞の日数は、最も古い未払いの期日から数えた日数で、月ごとの記録の「何か月分の延滞か」とは数え方が違い、支払いの期日や月の日数によって境目がずれます。この章では、断りの無い限り3か月分以上の定義を使います。定義どうしを比べる箇所では、1か月分以上・2か月分以上の定義も扱います。
デフォルトと正常は、次のように確定させます。観測期間の途中でも、デフォルトの基準に達した契約は、その時点でデフォルトと確定します。その後に延滞が解消しても、その期間の結果はデフォルトのままです。正常は、観測期間を満たし、その間に一度も基準に達しなかったと確かめられた契約です。観測期間をまだ満たしておらず、しかもまだ基準に達していない契約だけが「結果が未確定」で、この契約は正常に数えません。
本コラムの例題の定義をまとめると、次のとおりです。他の節と他の章では、この定義を「第2章の定義」として受けます。
- 基本の定義:契約の実行から12か月以内に、延滞が90日以上に達すること
- 月単位の記録で代える定義(この章のコード):契約から12か月以内に、3か月分以上の延滞に達すること
- 正常:観測期間(12か月)を満たし、その間に一度も基準に達しなかった契約
- 未確定:観測期間を満たしておらず、まだ基準に達していない契約(正常に数えない)
- デフォルト率の分母:承認して契約になった申込のうち、結果が確定した契約の件数。どの申込の月の契約かは、表ごとに書く
ただし、これは説明のための単純な定義で、実務や規制で使われる定義とは違います。たとえば銀行の自己資本比率の規制の国際的な枠組み(バーゼル銀行監督委員会のバーゼル枠組み。2023年1月1日から適用の CRE36)では、内部格付手法(銀行が自らのデータとモデルでデフォルト確率などを見積もる方法。第14章)の最低要件を定めた CRE36 の第68項が、銀行のグループに対する重要な債務の延滞が90日を超えることをデフォルトの条件の1つに挙げ、第69項が、返済の見込みが低いと判断する兆候の例(利息を収益に計上しない扱いにすることなど)を挙げています。延滞の日数だけでなく、返済の見込みに関する判断も定義に含まれるということです。また、この枠組みは「90日を超える」延滞で、本コラムの例題の定義は「90日以上」なので、境目の数え方も違います。同じ第68項の注は、リテールと公的部門の債務について、監督当局が90日を最大180日までの日数に置き換えてよいとしており、同じ枠組みの中でも国や当局によって日数が違いうることが分かります。同じ CRE36 の第71項は、個人向けなどのリテールの債権では、デフォルトの定義を個々の契約(与信の単位)で当てはめてよいとしています。つまり、ある1つの契約がデフォルトしても、同じ人の他の契約が自動的にデフォルトになるとは限りません。どの定義を使う義務があるかは、事業の種類と、その事業に適用される規制で変わります。自社に当てはまる定義は、所管の官庁や専門家に確かめる事項です。
定義を決めるときに確かめることを、次の表にまとめました。どの行も、データ分析の担当者が作業の途中で選ぶと、後からモデルの成績やデフォルト率の意味が変わってしまう項目です。
| 決めること | 選択肢の例 | 決め方の観点 | 変わるもの |
|---|---|---|---|
| 延滞の基準 | 1か月分・2か月分・3か月分以上(月単位の記録での90日の目安)、90日以上(日数で数える場合)、回収不能として処理したもの | 損失に結びつく延滞の深さ。規制や会計で使う定義との整合 | デフォルトの件数と率、モデルが見分ける対象 |
| 観測期間 | 6か月・12か月・18か月・24か月・契約の期間の全体 | 商品の契約の期間と、デフォルトが起きやすい時期。結果を待てる長さ | デフォルトの件数、学習に使える申込の月の範囲 |
| 数え始め | 契約の実行の日・最初の支払いの期日 | 支払いの期日の間隔(月払い・一括払い) | 初期の延滞を数える範囲 |
| 中間の層の扱い | 正常として数える・学習から外す・別の区分として残す | モデルが使われる集団に中間の層も含まれること | 学習の件数、評価の成績の見え方 |
| デフォルトの単位 | 契約ごと・人ごと(同じ人の他の契約も含める) | 商品の構成と、規制上の扱い | 同じ人が複数の契約を持つ場合の件数 |
| 件数か残高か | 件数の割合・残高で重みを付けた割合 | 損失の大きさと、件数での管理のどちらを主に見るか | デフォルト率の値と、額の大きい契約の重み |
表の最後の行については、本コラムのデフォルト率は、上のまとめのとおり件数の割合で数えます。デフォルト率は実績の値で、モデルが出すデフォルト確率(見積り)とは区別します。
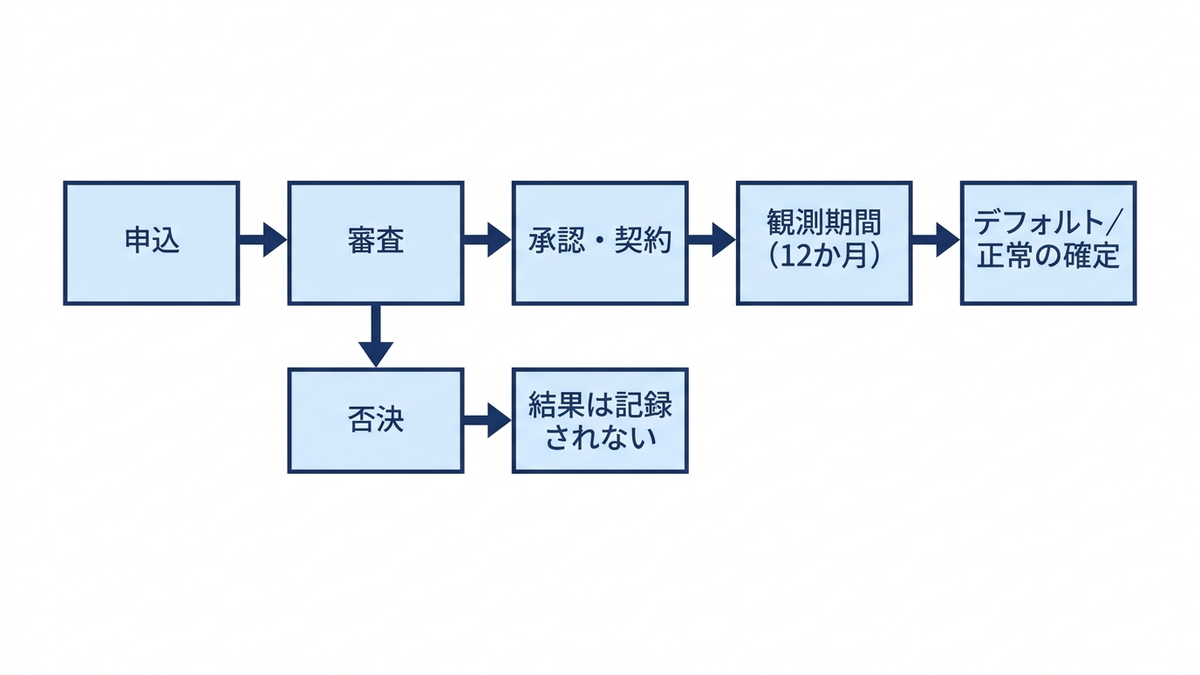
上の流れのとおり、結果(デフォルトか正常か)が確定するのは、承認されて契約になった申込のうち、観測期間を満たした契約と、期間の途中でデフォルトの基準に達した契約だけです。否決した申込は、もし承認していたら返済されたかどうかが分かりません。観測期間を満たしておらず、デフォルトの基準にもまだ達していない契約も、結果が確定していません。この2つの「結果が分からない申込」の扱いが、与信のデータの最も大きな特徴です。後者はこの章のコードで、前者は第6章で扱います。上の図が示しているのは、承認から結果の確定までの流れと、否決した申込の結果が記録されないことです。観測期間に届かない契約が未確定であることは図には描いていないので、後のビンテージの節の表(申込の月ごとの見かけのデフォルト率)で示します。
架空の申込と契約の記録を作る、月ごとの返済の状況まで
ここからは、定義と時点の決め方で数字がどう変わるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の申込と契約の記録よりずっと単純です。合成データでの成績は、実際の審査での成績の目安にはなりません。示したいのは、同じ記録でも、定義と集計の時点によって数字がどう動くかという点です。乱数の種は20261113に固定しています。作った記録の性質は次のとおりです。
- 申込は30,000件で、申込の月は1から24までの24か月に散らばる。記録を取り出した時点は第24月の末とする
- 申込者の属性として、年収の水準・申込の額(どちらも相対値で、申込の額は中央値が1、年収の水準は中央値が約2.7になるように作った)・申込額の年収比(申込の額 ÷ 年収の水準。返済の期間や毎月の返済額は使っていないので、実際の返済の負担を表す比率ではない)・勤続年数・居住の年数・雇用の形態(AからCの3種類)を持たせる
- 信用情報にあたる項目として、他社の借入の件数(審査の時点で他社と契約中の借入の件数とする)・過去の延滞の有無・直近の申込の件数を持たせる
- デフォルトのしやすさは、申込額の年収比が高いほど、勤続年数と居住の年数が短いほど、過去の延滞があると高くなる。他社の借入の件数は単調でなく、0件の層と3件以上の層で高くなる。雇用の形態Cでは、直近の申込の件数が多いほど高くなる(項目どうしの組み合わせで効く関係)
- 居住の年数の一部は未記入で、未記入はデフォルトしやすい層で起きやすい
- 申込の一部は、不正の疑い・試験の申込・重複した申込・特別な条件の申込として、標本から除く区分を持つ
- 残りの申込は、過去の審査の基準で否決し、それ以外を承認する。否決するのは、申込額の年収比が1.6を超える、直近の申込が3件以上、過去の延滞があり他社の借入が3件以上、のいずれかに当たる申込と、人の判断の代わりに無作為に選んだ5%の申込
例題を単純にするため、承認した申込はすべて同じ月に契約され、実行されたものとします。実際には、承認の後に申込者が契約しない場合もあり、承認と契約と実行は別の出来事です。性別や国籍などの差別につながる属性は、データに含めていません。最初のブロックで申込の記録を作り、除外の区分と承認・否決を付けます。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N, MONTHS = 30000, 24
app = pd.DataFrame({"申込ID": [f"申込{i:05d}" for i in range(1, N + 1)]})
app["申込の月"] = rng.integers(1, MONTHS + 1, N)
app["年収の水準"] = rng.lognormal(1.0, 0.45, N).round(2)       # 相対値
app["申込の額"] = rng.lognormal(0.0, 0.5, N).round(2)          # 相対値
app["申込額の年収比"] = (app["申込の額"] / app["年収の水準"]).round(3)
app["勤続年数"] = np.minimum(rng.gamma(2.0, 3.0, N), 40).round(1)
app["居住の年数"] = np.minimum(rng.gamma(1.6, 4.0, N), 40).round(1)
app["雇用の形態"] = rng.choice(["A", "B", "C"], N, p=[0.6, 0.25, 0.15])
app["他社の借入の件数"] = rng.poisson(1.2, N)               # 審査の時点で他社と契約中の件数
app["過去の延滞の有無"] = (rng.random(N) < 0.08).astype(int)
app["直近の申込の件数"] = rng.poisson(0.6, N)

# 真のデフォルトのしやすさ(月ごとに返済が滞り始める確率)。モデルの作り手には見えない
k = app["他社の借入の件数"]
isC = (app["雇用の形態"] == "C").astype(int)
z = (-5.0 + 1.6 * app["申込額の年収比"] - 0.08 * app["勤続年数"]
     - 0.04 * app["居住の年数"] + 1.4 * app["過去の延滞の有無"]
     + 0.5 * (k == 0) + 0.35 * np.maximum(k - 2, 0)
     + 0.4 * isC + 0.4 * isC * app["直近の申込の件数"] + rng.normal(0, 0.4, N))
app["_月の滞り始めの確率"] = 1 / (1 + np.exp(-z))

# 居住の年数は一部が未記入。未記入はリスクの高い層で起きやすい
p_na = np.where(z > np.quantile(z, 0.8), 0.15, 0.04)
app.loc[rng.random(N) < p_na, "居住の年数"] = np.nan

# 標本から除く申込の区分と、過去の審査の基準による承認・否決
app["区分"] = rng.choice(["通常", "不正の疑い", "試験", "重複", "特別な条件"], N,
                       p=[0.968, 0.005, 0.002, 0.02, 0.005])
reject = ((app["過去の延滞の有無"] == 1) & (k >= 3)) | (app["申込額の年収比"] > 1.6) \
         | (app["直近の申込の件数"] >= 3) | (rng.random(N) < 0.05)
app["承認"] = ((app["区分"] == "通常") & ~reject).astype(int)
print(app["区分"].value_counts().to_string())
print("通常の申込のうち承認:", app.loc[app["区分"] == "通常", "承認"].sum(),
      " 否決:", ((app["区分"] == "通常") & (app["承認"] == 0)).sum())
print("承認率(通常の申込):", round(app.loc[app["区分"] == "通常", "承認"].mean(), 3))
実行すると、通常の申込が29,028件、標本から除く区分の申込が972件(重複625件・特別な条件147件・不正の疑い140件・試験60件)になりました。通常の申込のうち、過去の審査の基準で承認したのが26,388件、否決したのが2,640件で、承認率(通常の申込のうち承認した割合)は0.909です。否決した2,640件には、この後に作る返済の記録がありません。この「結果の無い申込」をどう扱うかは、第6章で扱います。
次のブロックで、承認した26,388件の契約について、契約の翌月から月ごとの返済の状況を作ります。状態は0(正常に返済している)、1〜5(延滞の月数)、6(回収不能の扱い)の7段階で、毎月、正常な契約は一定の確率で延滞に入り、延滞中の契約は正常に戻るか、同じ段階にとどまるか、1段階深くなります。延滞が深いほど正常に戻る確率を小さくしました。延滞に入る確率は契約ごとに違い、契約から6か月目の前後で高くなるようにしています。大事なのは最後の行で、第24月の末より後の月はまだ来ていないので、-1(未到来)として記録しています。たとえば申込の月が20の契約は、4か月分しか返済の状況が分かりません。
con = app[app["承認"] == 1].reset_index(drop=True)      # 契約(承認した申込)
M = len(con)
h = con["_月の滞り始めの確率"].to_numpy()
obs = MONTHS - con["申込の月"].to_numpy()               # 第24月の末までに見届けられる月数
cure = np.array([0, 0.50, 0.30, 0.15, 0.08, 0.05, 0])   # 延滞の段階ごとの、正常に戻る確率
state = np.zeros(M, dtype=int)                          # 0=正常, 1〜5=延滞の月数, 6=回収不能の扱い
hist = np.full((M, MONTHS), -1)                         # -1 はまだ来ていない月
for t in range(MONTHS):                                 # 契約から t+1 か月目
    u = rng.random(M)
    season = 0.6 + 0.8 * np.exp(-(((t + 1) - 6) / 5) ** 2)   # 契約の数か月後に起きやすい
    new = state.copy()
    new[(state == 0) & (u < h * season)] = 1
    d = (state >= 1) & (state <= 5)
    back = d & (u < cure[state])
    stay = d & (u >= cure[state]) & (u < cure[state] + 0.15)
    roll = d & ~back & ~stay
    new[back] = 0
    new[roll] = state[roll] + 1
    state = new
    hist[:, t] = np.where(t < obs, state, -1)
print("契約の件数:", M)
print("一度でも延滞した契約:", int((hist >= 1).any(axis=1).sum()))
実行すると、契約は26,388件で、記録を取り出した時点までに一度でも延滞した契約は3,576件でした。ただし、この3,576件には、すぐに解消した1か月分の延滞も、観測期間の途中の契約も混ざっています。この数字をそのままデフォルトの件数として使うことはできません。次の節で、定義を決めて数え直します。
定義を変えると、デフォルト率が変わり、モデルの成績の値も違って見える
3つ目のブロックでは、まず延滞の基準(1か月分・2か月分・3か月分以上)と観測期間(6か月・12か月・18か月)の組み合わせごとに、デフォルト率を数えます。比べる集団をそろえるため、18か月を見届けた契約(申込の月が1〜6の契約)だけを分母にしました。次に、観測期間を12か月にそろえ、延滞の基準を変えたときに、同じ手順で作ったロジスティック回帰のモデルの成績がどう変わるかを見ます。学習には申込の月1〜8の契約を、評価には申込の月9〜12の契約を使いました(時間で切る)。どちらも12か月を見届けた契約だけです。
ただし、第8月の契約の結果が出そろうのは第20月の末なので、第9〜12月の審査の時点では、この学習用のデータの結果はまだ手に入りません。この分け方は、同じ契約の集まりで定義どうしを比べるための事後的な分割で、当時の運用を再現した評価ではありません。運用を再現するなら、モデルを作る基準の日を決め、その日までに結果が確定した契約で学習し、基準の日より後の申込で評価します。
成績はAR値(モデルがデフォルトしやすい順に契約を並べられているかを表す順位づけの指標。詳しくは第7章)で測り、モデルの出すデフォルト確率から計算しています。ロジスティック回帰そのものは第4章で扱うので、ここでは「同じ入力、同じ手順のモデル」という比較の道具として使っています。このモデルは説明のための単純な入れ方をしており、他社の借入の件数をそのまま1列の数として入れています。後で見るように、この項目とデフォルト率の関係は単調ではないので、この入れ方ではその形を表せません。項目を区分に分けて扱う方法は第3章で扱います。
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

def is_default(k, window):     # 契約から window か月以内に、k か月分以上の延滞に達したか(デフォルト=1)
    return (hist[:, :window] >= k).any(axis=1).astype(int)

early = (con["申込の月"] <= 6).to_numpy()    # 18か月を見届けた契約(申込の月1〜6)
rows = [[f"{k}か月分以上"] + [round(is_default(k, w)[early].mean(), 4) for w in (6, 12, 18)]
        for k in (1, 2, 3)]
print(pd.DataFrame(rows, columns=["延滞の基準", "6か月", "12か月", "18か月"]).to_string(index=False))

def features(df, loans="他社の借入の件数"):
    X = df[["申込額の年収比", "勤続年数", "過去の延滞の有無", "直近の申込の件数"]].copy()
    X["他社の借入の件数"] = df[loans]
    X["居住の年数"] = df["居住の年数"].fillna(0)
    X["居住の年数_未記入"] = df["居住の年数"].isna().astype(int)
    X["雇用の形態C"] = (df["雇用の形態"] == "C").astype(int)
    return X

ripe = (con["申込の月"] <= 12).to_numpy()   # 12か月を見届けた契約(申込の月1〜12)
train = ripe & (con["申込の月"] <= 8).to_numpy()    # 学習は申込の月1〜8
test = ripe & (con["申込の月"] >= 9).to_numpy()     # 評価は申込の月9〜12(時間で切る)
worst = np.where(hist[:, :12] >= 0, hist[:, :12], 0).max(axis=1)
grey = (worst >= 1) & (worst <= 2)                  # 1〜2か月分の延滞で止まった中間の層

def fit_ar(y, use, loans="他社の借入の件数", use_test=None):
    tr = train & use
    te = test & (use if use_test is None else use_test)
    m = LogisticRegression(max_iter=2000).fit(features(con[tr], loans), y[tr])
    p = m.predict_proba(features(con[te], loans))[:, 1]          # デフォルト確率の見積り
    return tr.sum(), te.sum(), y[te].sum(), 2 * roc_auc_score(y[te], p) - 1

for name, y, use in [("1か月分以上", is_default(1, 12), ripe), ("2か月分以上", is_default(2, 12), ripe),
                     ("3か月分以上", is_default(3, 12), ripe),
                     ("3か月分以上・中間の層を除く", is_default(3, 12), ripe & ~grey)]:
    n_tr, n_te, d_te, ar = fit_ar(y, use)
    print(f"{name}: デフォルト率 {y[use].mean():.4f} 学習 {n_tr} 評価 {n_te}(うちデフォルト {d_te}) AR値 {ar:.3f}")

# 中間の層を「学習から除く」効果と「評価から除く」効果を分けて見る
for name, u_tr, u_te in [("学習は除き・評価は全体", ripe & ~grey, ripe), ("学習は全体・評価は除く", ripe, ripe & ~grey)]:
    n_tr, n_te, d_te, ar = fit_ar(is_default(3, 12), u_tr, use_test=u_te)
    print(f"{name}: 学習 {n_tr} 評価 {n_te} AR値 {ar:.3f}")
最初の表が、延滞の基準と観測期間の組み合わせごとのデフォルト率です。分母は、申込の月1〜6の契約のすべてです。
| 延滞の基準 | 観測期間6か月 | 観測期間12か月 | 観測期間18か月 |
|---|---|---|---|
| 1か月分以上 | 0.0939 | 0.1602 | 0.1977 |
| 2か月分以上 | 0.0321 | 0.0675 | 0.0866 |
| 3か月分以上 | 0.0157 | 0.0413 | 0.0547 |
同じ契約の集まりでも、最も浅く長い定義(1か月分以上・18か月)のデフォルト率は0.1977で、最も深く短い定義(3か月分以上・6か月)の0.0157の約13倍になりました。本コラムの例題の定義(3か月分以上・12か月)では0.0413です。延滞の基準を浅くすると、1か月分だけ延滞した契約も数えるためです(そのうち何件が後で正常に戻ったかは、この章では数えていません)。観測期間を延ばすと、契約から時間がたってから起きる延滞も数えられます。「デフォルト率が4%の商品」と「デフォルト率が16%の商品」は、定義が違えば同じ商品であることがある、ということです。他社や業界の資料のデフォルト率と自社の値を比べるときは、延滞の基準と観測期間、分母の集団が同じかを先に確かめる必要があります。
次の表は、観測期間を12か月にそろえて延滞の基準を変えたときの結果です。デフォルト率の分母は、申込の月1〜12の契約(中間の層を除く行では、それを除いた契約)です。
| 延滞の基準(観測期間12か月) | デフォルト率 | 学習の件数 | 評価の件数 | 評価の中のデフォルトの件数 | 評価のAR値 |
|---|---|---|---|---|---|
| 1か月分以上 | 0.1566 | 8,784 | 4,405 | 688 | 0.438 |
| 2か月分以上 | 0.0665 | 8,784 | 4,405 | 290 | 0.418 |
| 3か月分以上 | 0.0410 | 8,784 | 4,405 | 184 | 0.375 |
| 3か月分以上・中間の層を除く | 0.0464 | 7,763 | 3,901 | 184 | 0.425 |
本コラムの架空データでは、評価のAR値は1か月分以上で0.438、2か月分以上で0.418、3か月分以上で0.375で、基準が浅い行ほど値が大きくなりました。ただし、この差が定義の違いによるものか偶然によるものかは、後で述べるとおりこの表だけでは決められません。また、仮に差が確かなものだとしても、これは「浅い定義の方が良いモデルになる」という意味ではありません。3つの行は、それぞれ別のものを予測しているからです。1か月分以上の定義のモデルは、短い延滞をする契約を見分けるのが得意でも、損失に結びつく深い延滞を見分ける力は別に確かめる必要があります。対象の集団や定義が違うAR値の差は、そのままモデルや定義の優劣の判断には使えないので、この表のAR値の大小で定義を選ぶことはできません。定義は、事業として避けたい延滞の深さから決め、そのうえでモデルの成績を測る順番になります。
4行目は、3か月分以上の定義のまま、1〜2か月分の延滞で止まった中間の層を学習と評価の両方から除いた結果です。AR値は0.375から0.425に上がりましたが、評価の集団が変わっているので、3行目の0.375との差を、そのままモデルの優劣の判断に使うことはできません。どちらの影響かを分けるため、ブロックの最後で、学習だけから除いた場合と評価だけから除いた場合も計算しました。中間の層を学習から除き、評価は全体(4,405件)で行うとAR値は0.375で、3行目と変わりませんでした。学習は全体で行い、評価だけから中間の層を除く(3,901件)と0.424でした。本コラムの架空データでは、AR値が上がったのは主に評価の集団から中間の層を外したためで、学習から外したことの影響は、小数第3位までの表示では見えないほど小さかったことになります。中間の層は、デフォルトの基準の手前まで延滞した契約なので、デフォルトの契約と見分けにくい契約が評価から減ったためと考えられます。本番では、中間の層にあたる申込もそのままモデルにかけられます。中間の層を学習から外すかどうかは選択肢の1つですが、外した場合でも、評価は中間の層を含む集団で行うか、少なくとも両方の値を並べて示す必要があります。中間の層を除いた評価の値だけを示すと、成績を実際より良く見せてしまいます。
評価の中のデフォルトの件数も確かめておきます。3か月分以上の定義では、評価に使える4,405件のうちデフォルトは184件です。件数が少ないと、AR値は評価に使う契約が少し入れ替わるだけで動きます。この表のAR値の差は、1か月分以上と2か月分以上の間で0.020、2か月分以上と3か月分以上の間で0.043、1か月分以上と3か月分以上の間で0.063でした。評価の中のデフォルトが184件と少ない定義を含むため、この程度の差は偶然でも動きえます。AR値のばらつきを区間で示す方法は第7章で扱います。深い延滞を基準にするほど、デフォルトの件数が減って成績の測り方も不安定になる、という関係は、定義を決めるときの考慮点の1つです。
ビンテージで見る、直近の申込は結果が出そろっていない
申込の月(あるいは契約の月)が同じ契約のまとまりを、ワインの醸造年になぞらえてビンテージと呼びます。ビンテージごとに、契約からの経過月数とともに累積のデフォルト率がどう増えていくかを描いたものがビンテージ曲線です。ビンテージ曲線を見ると、デフォルトが契約から何か月目に起きやすいか、観測期間を何か月にすれば大半のデフォルトを拾えるか、新しいビンテージが古いビンテージより悪い(あるいは良い)推移をしていないかが分かります。4つ目のブロックでは、申込の月を3か月ずつの四半期にまとめ、ビンテージ曲線の図と、申込の月ごとの見かけのデフォルト率の集計を作ります。
図の日本語の表示には、matplotlib とは別のパッケージの japanize-matplotlib を使いました。本コラムの実行環境(Python 3.14.3・matplotlib 3.10.8・japanize-matplotlib 1.1.3)では、このとおりに動くことを確かめています。このパッケージが無い環境では、日本語を表示できるフォントを matplotlib に直接指定すれば同じ図が描けます。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

reached = np.maximum.accumulate(hist >= 3, axis=1)   # 契約から t か月目までに3か月分以上の延滞に達したか
quarter = (con["申込の月"].to_numpy() - 1) // 3 + 1   # 申込の四半期(1〜8)
colors = ["#000080", "#002E73", "#1F4E8C", "#4A6FA5", "#7A8FB0", "#9AA5B5", "#B5B5B5"]
fig, ax = plt.subplots(figsize=(7, 4.2))
for i in range(1, 8):
    t_max = MONTHS - 3 * i                            # その四半期の全契約を見届けられた月数
    curve = reached[quarter == i, :t_max].mean(axis=0)
    ax.plot(range(1, t_max + 1), curve, color=colors[i - 1], lw=1.6, ls="-" if i <= 4 else "--",
            marker=None if i <= 4 else "os^"[i - 5], ms=3, label=f"申込の四半期{i}")
    print(f"四半期{i}: 見届けた月数 {t_max}  12か月目の累積デフォルト率 "
          + (f"{curve[11]:.4f}" if t_max >= 12 else "(12か月に届かない)"))
ax.set_xticks(range(0, 25, 3))
ax.set_xlabel("契約からの経過月数")
ax.set_ylabel("累積のデフォルト率(3か月分以上の延滞)")
ax.legend(loc="upper left", fontsize=8, frameon=False)
fig.savefig("../ch02_vintage.png", dpi=120, bbox_inches="tight")

naive = pd.Series(is_default(3, 12)).groupby(con["申込の月"]).mean()   # 未到来の月を正常とみなした誤った集計
print(naive.round(4).to_string())
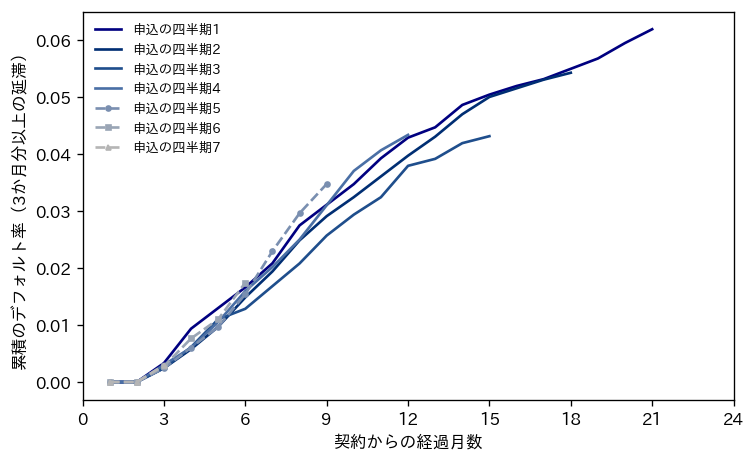
どのビンテージも、契約から2か月目まではデフォルトが0で、3か月目から増え始めています。これは、例題の定義が3か月分以上の延滞で、例題では延滞が月に1段階ずつしか深くならないため、契約から数えて3か月分以上の延滞に達するのは、最短でも契約から3か月目になるからです(契約から1か月目に延滞に入り、3か月目に3か月分に達する場合)。その後は、契約から6〜12か月目のあたりで傾きが大きく、12か月目を過ぎても累積のデフォルト率は増え続けました。12か月目の累積のデフォルト率は、申込の四半期1で0.0429、四半期2で0.0397、四半期3で0.0380、四半期4で0.0434でした。四半期5から7のビンテージ(図の破線)は、12か月を見届けておらず、曲線が途中で終わっています。四半期8は、見届けた月数が0なので描いていません。
ここから読み取れることが2つあります。1つ目は、観測期間を12か月にしても、その後に起きるデフォルトは数えられないということです。本コラムの架空データでは、18か月まで見届けた四半期2の曲線は、12か月目の0.0397から18か月目まで増え続けています。観測期間は「デフォルトがすべて起き終わる期間」ではなく、「この期間に起きたものを数える」という取り決めです。商品の契約の期間が長い場合には、観測期間の後に起きるデフォルトの扱いを別に考える必要があります。2つ目は、ビンテージどうしの差を見るときには、同じ経過月数の点どうしを比べるということです。新しいビンテージの曲線は短いので、全体の累積の値を比べると、新しいビンテージほど良く見えてしまいます。
もう1つの集計は、観測期間を満たしていない契約を、誤って正常として数えたときのものです。申込の月ごとに、契約から12か月以内に3か月分以上の延滞に達した契約の割合を、まだ来ていない月を「延滞しなかった」とみなして計算しました。結果は次の表のとおりです。
| 申込の月 | 記録を取り出した時点までに見届けた月数 | 見かけのデフォルト率 |
|---|---|---|
| 1〜12(12か月を見届けた) | 12〜23 | 0.0323〜0.0478(月ごとの値の範囲) |
| 13 | 11 | 0.0451 |
| 14 | 10 | 0.0444 |
| 15 | 9 | 0.0281 |
| 16 | 8 | 0.0248 |
| 17 | 7 | 0.0231 |
| 18 | 6 | 0.0198 |
| 19 | 5 | 0.0089 |
| 20 | 4 | 0.0080 |
| 21 | 3 | 0.0018 |
| 22〜24 | 0〜2 | 0 |
12か月を見届けた申込の月1〜12では、見かけのデフォルト率は0.032〜0.048の範囲にありました。12か月を見届けていない月13以降では、月13の0.0451、月14の0.0444のあと、月15で0.0281、月18で0.0198、月20で0.0080と下がり、月22から24では0になりました。データを作った規則は月によって変えていないので、この低下は主に「まだ結果が出ていない」ことによる見かけの低下です。
この集計を「直近の申込はデフォルト率が下がっている」と読むと、審査の改善の効果があったと誤って判断することになります。同じ誤りは、モデルの学習でも起きます。観測期間を満たしていない契約を正常として学習に入れると、直近の申込の特徴を持つ契約が実際より正常に寄って見え、デフォルト確率を低く見積もるモデルになるおそれがあります。本コラムで「観測期間を満たしていない契約を正常に数えない」と定めているのはこのためです。この例題では、正常とデフォルトを同じ条件で比べるため、学習と評価の対象を観測期間(12か月)を満たした契約にそろえる方針を取りました。その結果、24か月分の申込のうち、使えるのは申込の月1〜12の半分だけでした。期間の途中でデフォルトの基準に達した契約は結果が確定していますが、それだけを足すと、新しい申込の月ではデフォルトの側だけが増えて正常の側が足りない集団になるため、この例題では加えていません。
これは、モデルを作り直すたびに、使えるデータが1年前までの申込になることを意味します。観測期間を長くすれば、拾えるデフォルトは増えますが、学習に使える申込はさらに古くなり、申込者の層や景気の変化に追いつきにくくなります。観測期間を短くすれば、新しい申込を使えますが、拾えるデフォルトが減ります。この兼ね合いを、事業としてどちらに寄せるかを決めることが、観測期間を決めるということです。観測期間を満たす前の早い段階の延滞を、監視のための先行の指標に使う方法は第12章で扱います。
項目の分布と欠損の意味、単調でない関係と未記入の層
モデルを作る前に、項目ごとの分布と、項目の値ごとのデフォルト率を確かめておきます。分布を見ると、入力の誤り(ありえない値・桁の誤り)や、承認の基準で切り取られた範囲が分かります。値ごとのデフォルト率を見ると、項目とデフォルトの関係が単調か、未記入の申込がどちらに寄っているかが分かります。5つ目のブロックでは、例題の定義(3か月分以上・12か月)でデフォルトか正常かが確定した契約(申込の月1〜12の13,189件)について、申込額の年収比の分布と、他社の借入の件数ごと・居住の年数の区分ごとのデフォルト率を集計します。
y12 = is_default(3, 12)
r = con[ripe].assign(デフォルト=y12[ripe])
loans = r["他社の借入の件数"].clip(upper=5)
print(r.groupby(loans)["デフォルト"].agg(["count", "mean"]).round(4).to_string())
stay = pd.cut(r["居住の年数"], [-0.1, 2, 5, 10, 40]).cat.add_categories("未記入").fillna("未記入")
print(r.groupby(stay, observed=True)["デフォルト"].agg(["count", "mean"]).round(4).to_string())

fig, axes = plt.subplots(1, 2, figsize=(10, 3.8))
bins = np.linspace(0, 1.6, 33)
axes[0].hist(r.loc[r["デフォルト"] == 0, "申込額の年収比"], bins=bins, density=True,
             color="#B5B5B5", label="正常")
axes[0].hist(r.loc[r["デフォルト"] == 1, "申込額の年収比"], bins=bins, density=True,
             histtype="step", color="#000080", lw=2, label="デフォルト")
axes[0].set_xlabel("申込額の年収比(申込の額 ÷ 年収の水準)")
axes[0].set_ylabel("密度")
axes[0].legend(loc="upper right", frameon=False)
rate = r.groupby(loans)["デフォルト"].mean()
axes[1].bar(["0", "1", "2", "3", "4", "5以上"], rate.values, color="#002E73")
axes[1].set_xlabel("他社の借入の件数")
axes[1].set_ylabel("デフォルト率")
fig.savefig("../ch02_distribution.png", dpi=120, bbox_inches="tight")
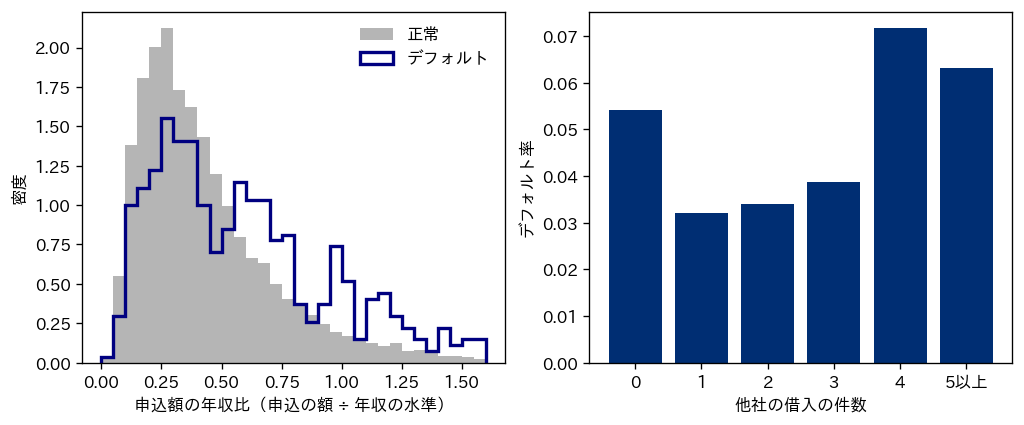
左の図は、申込額の年収比の分布を、正常の契約(灰色の塗り)とデフォルトの契約(線)で比べたものです。どちらも面積が1になるように描いています。デフォルトの契約の分布は、正常の契約より右(比の大きい側)に寄っていますが、大きく重なっています。1つの項目だけでは正常とデフォルトを分けきれないことが分かります。また、どちらの分布も比率1.6のところで途切れています。これは、過去の審査の基準で比率1.6を超える申込を否決したためで、データの性質ではなく審査の結果です。比率1.6を超える申込のデフォルト率は、この記録からは分かりません。
右の図と次の表は、他社の借入の件数ごとのデフォルト率です。分母は、申込の月1〜12の契約のうち、その件数に当たる契約です。
| 他社の借入の件数 | 契約の件数 | デフォルト率 |
|---|---|---|
| 0件 | 4,022 | 0.0542 |
| 1件 | 4,794 | 0.0321 |
| 2件 | 2,874 | 0.0341 |
| 3件 | 1,083 | 0.0388 |
| 4件 | 321 | 0.0717 |
| 5件以上 | 95 | 0.0632 |
次の表は、同じ契約を居住の年数の区分に分けたときのデフォルト率です。
| 居住の年数 | 契約の件数 | デフォルト率 |
|---|---|---|
| 居住の年数が2年以下 | 2,220 | 0.0491 |
| 居住の年数が2年超5年以下 | 3,911 | 0.0447 |
| 居住の年数が5年超10年以下 | 3,870 | 0.0375 |
| 居住の年数が10年超 | 2,381 | 0.0277 |
| 居住の年数が未記入 | 807 | 0.0570 |
他社の借入の件数とデフォルト率の関係は単調ではなく、0件の層(0.0542)が1件の層(0.0321)より高く、3件以上で再び高くなりました。データを作るときに、0件の層のデフォルトのしやすさを高めにしておいたためです。この例で0件の層のデフォルト率が高いのは合成データの設定によるもので、実際の記録で同じ形になるとは限りません。なお、この例の「他社の借入の件数」は審査の時点で他社と契約中の件数なので、0件でも過去に完済した契約の記録がある申込者を含みえます。件数が0であることと、返済の記録が無いことは別の事柄です。こうした関係をそのまま「件数が多いほど高い」という直線の関係でモデルに入れると、0件の層の見積りがずれるおそれがあります。この章のモデルは、説明のため件数をそのまま1列で入れており、この形を表せていません。単調でない関係を区分けで扱う方法は第3章で扱います。なお、4件(321件)と5件以上(95件)は件数が少なく、4件の方がデフォルト率が高いという並びは、偶然のばらつきの範囲かもしれません。件数の少ない区分の値は、区分を統合してから読む必要があります。
居住の年数は、長いほどデフォルト率が低くなる単調な関係でした。注目したいのは未記入の807件で、デフォルト率は0.0570と、居住の年数の区分の中で最も高くなりました。データを作るときに、デフォルトしやすい層で未記入が起きやすいようにしておいたためです。実際の記録でも、未記入には何らかの理由がある場合があり、その理由がデフォルトのしやすさと関係していることも考えられます。このような場合、未記入を平均値や中央値で埋めてしまうと、「未記入であること」という情報が消えます。未記入を1つの区分として残すか、未記入かどうかを表す印の項目を別に作ってモデルに入れると、その情報を使えます。この章のモデルでも、居住の年数の未記入を表す印の項目を入力に入れています。
ただし、未記入が情報になるのは、未記入が起きる仕組みが学習の期間と本番で同じ場合に限られます。たとえば、申込の画面を変えて居住の年数を必須の項目にすれば、未記入はほぼ無くなり、未記入の区分に付いていた意味は使えなくなります。逆に、ある経路の申込だけ項目を任意にすると、未記入がその経路の印になってしまいます。欠損の扱いは、統計の手法の選択だけでなく、申込の画面や業務の手順の変更と一緒に管理する事柄です。欠損の仕組みの分類と、結果そのものが欠けている否決した申込の問題は、第6章で扱います。
審査の時点で手に入る情報だけを使う、後から上書きされた値の危険
モデルの入力に、審査の時点では手に入らない情報が入ると、過去のデータでの評価では成績が実際より良く見えます。これを本コラムでは情報の漏れと呼びます。分かりやすい例は、契約の後の返済の記録を入力に入れてしまう場合ですが、もっと気づきにくい形もあります。顧客の台帳で項目の値が日々更新されていて、モデルを作るときに、審査の時点の値ではなく、記録を取り出した時点の最新の値を使ってしまう場合です。
6つ目のブロックでは、他社の借入の件数を、記録を取り出した時点(第24月の末)の値で上書きしてしまった場合を作ります。契約の後に延滞した契約は、資金繰りのために他社での借入を増やしやすい、という関係を置きました。上書きした値で学習と評価をした場合と、審査の時点の値で学習と評価をした場合のAR値を比べます。学習と評価の切り方、モデルの手順は3つ目のブロックと同じです。
# 他社の借入の件数を、審査の後に更新された値(第24月の末の値)で上書きしてしまった場合
troubled = (hist >= 1).any(axis=1)                    # 契約の後に延滞した(審査の時点では分からない)
con["他社の借入の件数_更新後"] = (con["他社の借入の件数"] + rng.poisson(0.3, M)
                              + troubled * rng.poisson(1.5, M))
for col in ["他社の借入の件数", "他社の借入の件数_更新後"]:
    n_tr, n_te, d_te, ar = fit_ar(y12, ripe, loans=col)
    print(f"{col}: 評価のAR値 {ar:.3f}")
審査の時点の値を使ったモデルの評価のAR値は0.375で、上書きした値を使ったモデルでは0.554になりました。上書きした値には、契約の後に延滞したかどうかという、結果そのものに近い情報が混ざっているためです。審査の時点では「契約の後に増える借入」は分からないので、0.554を、本番で期待できる成績の根拠にすることはできません。過去のデータでの評価が良いほど、導入の判断は通りやすくなり、良く見える結果は疑われにくくなります。そのため、この種の漏れは見つかりにくく、本番に入れてから成績が大きく下がって初めて気づく、ということが起こりえます。
漏れを防ぐには、データを作る段階で、項目ごとに「いつの時点の値か」を記録しておくことが基本になります。審査の時点で照会した信用情報と、申込書の項目は、その時点の値のまま保存し、後から更新しない記録(審査の時点の写し)として残します。顧客の台帳の最新の値は、途上与信のように「見直しの時点の値」として使う場面では正しい入力ですが、初期与信のモデルの入力には使えません。次の表は、情報の漏れが起きやすい場面と、その確かめ方をまとめたものです。
| 漏れが起きやすい場面 | 起きること | 確かめ方 |
|---|---|---|
| 台帳の最新の値で項目を上書きする | 審査の後に変わった値(借入の件数・住所・勤務先など)が入る | 項目ごとに値の時点を記録し、モデルが判定した時点より後の更新が混ざっていないかを数える |
| 信用情報を照会し直す | 審査の後の延滞や新しい契約が入る | 照会の日付を保存し、モデルが判定する時点までに得ていた照会結果だけを使う |
| 契約の後に作られる項目を使う | 返済の方法の変更・督促の記録など、結果に近い情報が入る | 項目の作られる工程を業務の担当者と確かめる |
| 評価用のデータの結果を使って区分けや項目を決める | 評価の成績が良く見える | 区分の境目や項目の選択は学習用のデータだけで決める(第3章) |
| 申込の月で切らずに評価する | 学習と評価に同じ時期の申込が混ざり、将来の成績を過大に見る | 学習より後の申込の月で評価し、学習に使った結果がその時点で確定していたかも確かめる(第7章) |
表の確かめ方の多くは、統計の手法ではなく、データの作られ方を知っている業務の担当者や情報システムの担当者との確認です。モデルの成績が予想より大きく良いときは、まず漏れを疑い、成績への寄与が大きい項目から順に、その値がいつ作られたかを確かめるのが安全です。区分けしたときに1つの項目だけが際立って強い場合に漏れを疑う考え方は、第3章で扱います。
標本の作り方とデータの品質、除く申込と品質の問題
モデルの学習に使う記録の範囲を決めることを、ここでは標本の作り方と呼びます。決めることは、学習に使う申込の月の範囲、除く申込の種類、評価に使う申込の月の範囲の3つです。学習に使う範囲は、観測期間を満たした申込のうち、どこまで古いものを含めるかで決まります。古い申込を含めるほど件数は増えますが、申込者の層や商品の条件、審査の基準が今と違う申込が混ざります。評価に使う範囲は、学習に使う範囲より後の申込の月にします。
除く申込は、モデルが本番で判断する対象と性質が違う申込です。この章の例題では、不正の疑いで別の審査の流れに回した申込(140件)、システムの試験のための申込(60件)、重複した申込(625件)、社員向けなどの特別な条件の申込(147件)を、承認と否決の判断より前に除きました。次の表は、除く申込の種類と、除く理由、除いたことの記録をどう残すかをまとめたものです。
| 除く申込 | 除く理由 | 記録に残すこと |
|---|---|---|
| 不正と確認された申込・不正の疑いで別の審査の流れに回した申込 | 確認された不正は、返済の結果が信用リスクではなく不正の結果になる。疑いの段階の申込は、不正とは確定していないが、本番でも通常のモデルにかけずに別の流れで扱う運用なら、それに合わせて除く | 判定の基準と件数。不正の検知の仕組みとの分担(弊社コラム「取引の不正を見つける不正検知の実践ガイド、ルールと機械学習の使い分けから調査と運用まで」) |
| 試験の申込 | システムの確認のための記録で、実在の申込者ではない | 試験の記録を見分ける印の付け方 |
| 重複した申込 | 同じ申込者が短い間に申込み直したもので、数えると同じ申込者の重みが増える | どれを残すか(最初・最後・承認されたもの)の規則 |
| 特別な条件の申込 | 社員向け・提携先の紹介など、通常の審査の基準を使わない | 条件の種類と、本番でもモデルを使わないこと |
| 審査中・取り下げの申込 | 最終の判断が済んでいない。本コラムでは、最終の判断が済んだ申込を承認率の分母とし、審査中と取り下げは別に数える | 件数を別に数える |
除く申込を決めたら、その件数と規則を、モデルの文書に書いておきます。除く規則が変わると、学習の件数もデフォルト率も変わり、前のモデルとの成績の差が、モデルの違いによるものか標本の違いによるものかを分けられなくなるからです。また、除いた申込が本番でどう扱われるか(モデルにかけないのか、別の基準で審査するのか)も、同時に決めておく必要があります。
標本の中の記録の品質にも、与信のデータに特有の問題があります。代表的なものを挙げます。
- 申告の誤り:年収や勤続年数は申告の値で、桁の誤りや、書類で確かめた値との食い違いがある。書類で確かめた値が後から入る場合は、どちらの値をモデルに使うかを決め、時点を記録する
- 欠損:未記入・取得の失敗・項目の追加前の申込で、欠損の理由が違う。理由ごとに区別して記録すると、前の節で見た「欠損そのものが情報になる」場合を扱える
- 項目の定義の変更:雇用の形態の選択肢が増える、年収の単位が変わる、申込の画面の変更で任意の項目が必須になる、といった変更があると、同じ項目名でも前後で意味が変わる。変更の日付を台帳に残し、変更をまたぐ期間で分布が急に変わっていないかを申込の月ごとに確かめる
- 重複した申込:同じ申込者が条件を変えて申込み直す、別の経路から同時に申込む、といった記録がある。申込者を特定する規則を決め、標本では1件に寄せる
- 結果の記録の誤り:延滞の日数の計算の規則が途中で変わる、返済の猶予や条件の変更をした契約が延滞として記録される、といった問題がある。結果の側の誤りは、モデルが学ぶ答えそのものを変える
この5つのうち、最後の結果の記録の誤りは見落とされやすいものです。入力の項目の品質は分布を見れば気づくことが多いのに対し、延滞の記録の規則の変更は、債権の管理の部門の業務の変更として行われ、データ分析の担当者に伝わらないことがあります。デフォルトの定義を決めるときには、延滞の日数がどの規則で計算され、いつ規則が変わったかを、債権の管理の担当者と確かめておく必要があります。データの品質の管理の一般論は、弊社コラム「データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで」で扱っています。
使ってはいけない項目と慎重に扱う項目、個人データの取り扱いの入口
与信の判断に使えるデータでも、モデルの入力に使ってよいとは限りません。本コラムでは、差別につながる属性(性別・国籍・人種・信条・病歴など)を、どの例題でもモデルの入力に使っていません。これは本コラムの方針で、どの属性の利用が法令でどう扱われるかを、この一覧で示したものではありません。
これとは別の事柄として、金融分野には、取得や利用が原則として制限される情報の定めがあります。個人情報保護委員会と金融庁の「金融分野における個人情報保護に関するガイドライン」の第5条は、要配慮個人情報(個人情報保護法で、人種、信条、病歴など、不当な差別や偏見が生じないよう取り扱いに配慮を要するとされる情報)に、労働組合への加盟、門地、本籍地、保健医療、性生活に関する情報を加えたものを機微(センシティブ)情報と定めています。この定義からは、一定の主体が公開している情報や、外形上明らかな情報などが除かれています。そして、法令に基づく場合など同条に挙げられた場合を除いて、取得、利用、第三者への提供を行わないこととしています。与信のモデルの入力の候補を挙げる段階で、この種の情報が入っていないかを確かめる必要があります。性別や国籍などの個々の属性がこの定めの対象になるかどうかは、この章では確かめていません。要配慮個人情報の範囲を含む法令の詳細は第14章で扱い、個別の扱いは所管の官庁や専門家に確かめる事項です。
入力に使わなくても、他の項目を通じて同じような偏りが入ることがあります。たとえば住んでいる地域や職種のような項目は、それ自体は差別につながる属性ではなくても、特定の集団と強く結びついている場合があります。こうした項目を使うかどうか、使う場合に結果の偏りをどう測るかは、第11章で扱います。また、照会で得た信用情報は返済の能力の調査の目的に限って使うこと、個人信用情報機関に情報を提供するには本人の同意が要ることは、前の節で確かめたとおりです。入出金の記録などの代替データを使う場合も、同意と利用目的の範囲を確かめる必要があります(第5章)。
個人データの取り扱いの全体には、個人情報保護法と、前に挙げた金融分野のガイドラインが関わります。個人情報保護委員会のガイドラインの一覧のページには、令和6年3月の版に加えて、令和9年4月1日に施行される版も掲載されていました(2026年11月に確認した掲載内容)。法令とガイドラインの条番号、改正の状況、自動化された判断に関する海外の規制は第14章で整理します。データ分析の担当者が最初に押さえておくべきことは、項目ごとに、取得の経路、利用目的、同意の範囲、保存の期間を台帳に書き、モデルの入力に使う項目がその範囲に収まっているかを、モデルを作る前に確かめることです。個別の事業での扱いは、法務やコンプライアンスの担当者、所管の官庁、専門家に確かめる事項です。
経営の判断、デフォルトの定義と観測期間を事業として先に決める
この章で見たデータの決めごとは、どれもモデルを作る前に決まっている必要があります。決めないまま進めたときに出る損失を、序章の6つの型で整理すると次のようになります。デフォルトの定義を浅くしすぎて短い延滞まで避けるモデルにすると、返済できる申込まで断る機会損失が増えるおそれがあります(否決した申込の結果は分からないので、その大きさはつねに推定になります)。深くしすぎると、デフォルトの件数が減ってモデルの成績が不安定になり、損失に結びつく前の兆候を見逃して貸し倒れにつながるおそれがあります。観測期間を満たしていない契約を正常として数えると、直近の申込のデフォルト確率を低く見積もり、承認の基準が甘くなって貸し倒れと過剰与信による顧客の不利益が起きやすくなります。審査の時点の値を残していないと、モデルを作り直すたびに情報の漏れの疑いを調べ直すことになり、見直しが進まずに形骸化します。照会の目的や同意の範囲を項目ごとに管理していないと、規制上の義務の不履行につながります。
これを防ぐために、経営と事業の責任者が決めることを、次の表にまとめました。データ分析の担当者に委ねてよいのは、表の決めごとが済んだ後の作業です。
| 決めること | 誰が決めるか | 決めないと出やすい損失の型 | 管理の指標の例 |
|---|---|---|---|
| デフォルトの定義(延滞の基準・観測期間・中間の層の扱い) | 事業の責任者とリスク管理が合意し、文書にする | 機会損失・貸し倒れ・過剰与信による顧客の不利益 | 定義ごとのデフォルト率、ビンテージ曲線の12か月目の値 |
| 学習と評価に使う申込の範囲、除く申込の規則 | リスク管理とデータ分析 | 形骸化(前のモデルとの成績の差を読み解けない) | 除いた件数と理由別の内訳 |
| 審査の時点の写しの保存(申込書の項目・照会した信用情報・判断と理由) | 情報システムと審査の部門 | 形骸化・規制上の義務の不履行 | 写しが欠けている申込の割合 |
| 延滞の記録の規則と、その変更の連絡 | 債権の管理の部門 | 貸し倒れ(答えの誤り) | 規則の変更の日付と、変更前後のデフォルト率 |
| 項目ごとの利用目的と同意の範囲 | コンプライアンスと法務 | 規制上の義務の不履行 | 台帳に記載の無い項目の数 |
予算と体制の面では、モデルの開発に予算を付ける前に、データの整備に予算と期間を割り当てることが、結果的に早道になると考えています。審査の時点の写しを残す仕組みが無い場合、その仕組みを作ってから、観測期間の分だけ結果がたまるのを待たなければ、正しい記録でモデルを作れません。例題の定義なら、写しを残し始めてから最初の申込の結果が出そろうまでに12か月かかります。この待ち時間は、後から短くすることができません。そのため、データの整備は、モデルの導入の計画のうち最も早く始めるべき工程になります。
この章では、与信に使うデータの種類と指定信用情報機関の仕組みを確かめたうえで、デフォルトの定義と観測期間を変えるとデフォルト率が大きく変わり、同じ手順のモデルのAR値も定義ごとに違う値になること(ただし、その差が定義によるものかは件数が少なく確かめきれないこと)、観測期間を満たしていない契約を正常に数えると直近の申込が良く見えること、審査の後に更新された値を使うと過去のデータでの成績が実際より良く見えることを、架空データの実行結果で確かめました。定義と時点の決めごとが済んだ記録があって初めて、項目をどう加工して、どの項目を選ぶかという作業に進めます。次の第3章では、項目を区分けし、区分ごとのデフォルトのしやすさを表すWoEと、項目の見分ける力の目安である情報価値で、スコアカードに使う項目を選ぶ方法を扱います。
この章を深めたい方への参考書籍
『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』(本橋智光・橋本秀太郎 著、技術評論社):データの抽出・集約・結合・欠損の扱いなど、モデルを作る前のデータの加工の手法を、SQLとpandas、Polarsのコードで対比しながら整理した本です。この章で扱った、申込の月で記録を切る、重複を1件に寄せる、未記入を区分として扱うといった作業を、自社のデータベースの上で実装するときの手引きになります。
『クレジット・スコアリング入門』(E.M.ルイス 著、木下恭輔 監修、アコム・プロジェクト・チーム 訳、金融財政事情研究会):消費者向けの与信のスコアリングを主題とした入門書の翻訳で、1997年の刊行です。原書は「An introduction to credit scoring」の第2版です。刊行の時期が古く、統計の手法や法令の記述は現在とは異なる部分があるため、与信の業務の側からスコアリングのデータと運用を考えるための古典として読むのがよいと考えています。
第3章 スコアカードの土台、区分けとWoE・情報価値で変数を選ぶ
第2章では、与信に使うデータの種類と、デフォルトの定義・観測期間の決め方、審査の時点で手に入る情報だけを使うという原則を確かめました。この章からは、そのデータを使ってモデルを作る段階に入ります。最初に扱うのは、伝統的なスコアカードを作るときの下ごしらえにあたる作業で、項目(変数)をいくつかの区分に分け、区分ごとにデフォルトのしにくさ(正常の側への偏り)を数値にし、モデルに入れる項目を選ぶところまでです。区分ごとの数値から係数を推定して点数表に変換する作業は、第4章で扱います。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の契約の記録を使い、実行したコードと結果で確かめます。
- スコアカード作りで項目を区分に分ける理由と、区分けの方法(等間隔・等頻度・決定木・業務の知識による統合)
- 区分ごとのデフォルトのしにくさ(正常の側への偏り)を表す WoE と、項目1つの見分ける力の目安になる情報価値(IV)の式と読み方
- 区分を細かくしすぎたときの WoE の不安定さと、カテゴリの多い項目の扱い
- 区分を単調にそろえる考え方と、単調でない関係をそのまま残す判断
- 決定木で区分の境目の候補を出す方法
- 項目を選ぶ観点、情報の漏れの疑い方、区分けの台帳と経営の判断
この章の主張は、区分けと項目の選択は「数字が良く出る切り方を探す作業」ではなく、「区分の根拠を説明できる状態にする作業」だという点です。本コラムの架空データでも、区分を細かくすると学習用のデータでの情報価値は大きくなった一方で、区分ごとの数値の並びは後の月の申込では崩れました。情報価値の高さも、それだけでは項目を採る理由になりません。とびぬけて高い項目は、審査の時点では手に入らない情報が混ざっていることを疑う必要があります。
なぜ項目を区分に分けるのか、区分けの4つの方法
スコアカードは、項目ごとの区分に点数を割り当てた表です。例えば「勤続年数が2年未満なら何点、2年以上5年未満なら何点」のように、項目の値をいくつかの区分に分け(この作業を区分け(ビニング)と呼びます)、該当する区分の点数を足し合わせてスコアにします。年収の水準や勤続年数のような数値の項目でも、値をそのままモデルに入れるのではなく、まず区分に分けてから扱うのが、伝統的なスコアカード作りの進め方です。区分に分けると、値の細かな違いを捨てることになります。それでも区分けが長く使われてきたのは、与信の審査で求められる次の3つの性質と相性がよいためだと考えています。
1つ目は、単調でない関係を扱えることです。ロジスティック回帰(第4章)に数値の項目をそのまま入れると、その項目が大きくなるほどデフォルトのしやすさが一方向に変わる、という形しか表せません。ところが与信の項目には、真ん中の値が最もデフォルトしにくく、両端ではデフォルトしやすくなるような関係がありえます。後のコードで扱う「他社の枠の利用率」は、そのように作った例です。区分ごとに別の数値を割り当てれば、こうした形もそのまま表せます。
2つ目は、外れ値と欠損を区分として扱えることです。年収の水準の極端に大きな値は、そのまま入れるとモデルの係数を引っ張りますが、「上位の区分」にまとめてしまえば1件の極端な値の影響は小さくなります。また、申込書で答えなかった項目(欠損)は、値を埋めずに「欠損」という1つの区分として扱えます。第2章で触れたとおり、欠損そのものがデフォルトのしやすさと関係していることがあり、欠損の区分に独自の数値を持たせれば、その情報を捨てずに済みます。
3つ目は、説明しやすいことです。区分ごとの点数の表は、審査の担当者・営業・監査が同じものを読めます。否決の理由を示すときにも「勤続年数の区分の点数が低かった」のように、表の上の位置で説明できます(否決の理由の示し方は第11章で扱います)。区分の境目が業務の感覚と合っているかを、担当者と表を見ながら確かめられることも、点数表の利点です。
一方で、区分けには代償もあります。区分の中の違いは捨てるので、区分の境目のすぐ両側の申込は、ほとんど同じ値でも点数が段差で変わります。区分を粗くしすぎると見分ける力を失い、細かくしすぎると後で見るように数値が不安定になります。区分けは、この両方の間で、区分の数と境目を決める作業です。機械学習のモデルでは区分けをせずに値をそのまま扱う方法が多く、その比較は第5章で扱います。
区分の境目を決める方法は、大きく分けて次の4つがあります。実務では、まず機械的な方法で細かめの区分を作り、そのあと区分ごとのデフォルト率を見ながら隣の区分をまとめていく、という2段階で進めることが多いように思います。
| 方法 | 境目の決め方 | 向いている場面 | 注意すること |
|---|---|---|---|
| 等間隔 | 値の範囲を同じ幅で区切る(0〜0.2、0.2〜0.4 など) | 利用率のように範囲が決まっていて、幅に業務上の意味がある項目 | 値が偏っていると、件数が極端に少ない区分ができる |
| 等頻度 | どの区分にもほぼ同じ件数が入るように区切る(5区分なら下から20%ずつ) | 年収の水準のように分布が偏った数値の項目。最初の細かめの区分を作るとき | 同じ値が多い項目では区分の数が減る。境目が端数になり、業務の感覚と合わないことがある |
| 決定木による区分け | 浅い決定木に、その項目だけでデフォルトを分けさせ、分かれ目を境目の候補にする | 境目の候補を、デフォルトとの関係から探したい場合 | 学習用のデータに合わせすぎることがある。評価用のデータで確かめる |
| 業務の知識による統合 | 担当者の知識や商品の条件(勤続1年未満は確認を厚くする、など)で境目を置く。隣の区分をまとめる | どの方法でも、最後の確認の段階 | 根拠を台帳に書く。結果を見ながら都合のよい境目を選ばない |
どの方法を使っても、境目は学習用のデータだけで決めます。全部のデータで境目や区分ごとの数値を計算してから学習用と評価用に分けると、評価用のデータの結果が区分けに入り込み、成績が実際より良く見えます。これは情報の漏れ(審査の時点で使えない情報や評価用のデータの結果が、学習・区分け・項目の選択に入り、成績が実際より良く見えること)の一種です。本コラムのコードでも、区分の境目と、モデルの入力に使う区分ごとの WoE は学習用のデータで決めて固定しました。評価用のデータでも WoE と IV を計算している箇所がありますが、それは学習用で見えた差が後の月にも保たれているかを点検するためだけの計算で、モデルの入力には使っていません。
区分の数を決めるときに大事なのは、区分の数そのものより、区分ごとに入る件数、とくにデフォルトの件数です。デフォルト率が数%の商品では、1区分に1,000件の契約が入っていても、デフォルトは数十件にとどまります。区分ごとの数値はこのデフォルトの件数で決まるので、件数が少ない区分は偶然の揺れが大きくなります。どの程度の件数があれば十分かは、商品のデフォルト率と、求める数値の精度によって変わります。後のコードで、細かく区切ったときの揺れを具体的に確かめます。
WoE と情報価値、区分ごとの偏りと項目の見分ける力
区分を作ったら、区分ごとに「デフォルトのしにくさ」を数値にします。スコアカード作りで標準的に使われるのがWoE(Weight of Evidence、証拠の重み)です。本コラムでは、区分 j の WoE を、次の式で定義します。
\( \mathrm{WoE}_j = \ln\left(\dfrac{g_j / G}{b_j / B}\right) \)
ここで \(g_j\) はその区分の正常の件数、\(G\) は正常の全体の件数、\(b_j\) はその区分のデフォルトの件数、\(B\) はデフォルトの全体の件数です。言葉で言い換えると、「正常の契約のうち、その区分に入った割合(正常の構成比)」を「デフォルトした契約のうち、その区分に入った割合(デフォルトの構成比)」で割り、自然対数をとった値です。WoE が正の値なら、その区分は全体と比べて正常の側に寄っていて、デフォルトしにくい区分だと読めます。負の値ならデフォルトの側に寄っています。0 なら、その区分の正常とデフォルトの比が全体と同じです。
式を変形すると、WoE は「その区分の正常の件数 ÷ デフォルトの件数」の対数から、「全体の正常の件数 ÷ デフォルトの件数」の対数を引いた値になります。言い換えると、正常の側から見た対数オッズ(正常の確率 q について q÷(1-q)の対数)の、区分と全体の差です。デフォルトの側から見た対数オッズで同じ差をとると、値は同じ大きさで符号だけが逆になります。WoE が対数オッズの差の形をしているので、対数オッズを項目の足し算で表すロジスティック回帰と相性がよく、第4章でその流れを扱います。向きが逆になることで係数の符号がどうなるかも、第4章で扱います。
本コラムでは、スコアが大きいほどデフォルト確率が低い向きに統一しています。WoE も、正常の構成比を分子に置くことで、大きいほどデフォルトしにくい向きにそろえました。分子と分母を逆にした定義を使う資料もあるので、他の資料と数値を比べるときは向きを確かめる必要があります。
WoE は件数の比の対数なので、ある区分の正常かデフォルトの件数が0だと計算できません(0の対数は定義されません)。本コラムのコードでは、すべての区分の正常とデフォルトの件数にそれぞれ0.5を足してから構成比を計算する補正を入れました。0.5という値は計算を止めないための便宜的なものです。正常とデフォルトの構成比をそれぞれ補正するので、WoE が必ず0に近づくわけではありません。本コラムの架空データでも、勤続年数の欠損の区分の WoE は、補正の前の約-0.6826から補正の後の約-0.6828へと、わずかに0から遠ざかりました。補正は件数の少なさを解決するものでもありません。件数が0や数件の区分は、補正で数値を出すよりも、隣の区分とまとめる方が筋がよいと考えています。
区分ごとの WoE をまとめて、項目1つがデフォルトと正常をどれだけ見分けるかを1つの数で表したのが情報価値(IV)(Information Value)です。本コラムでは次の式で計算します。
\( \mathrm{IV} = \sum_j \left(\dfrac{g_j}{G} – \dfrac{b_j}{B}\right) \mathrm{WoE}_j \)
言葉で言い換えると、区分ごとに「正常の構成比とデフォルトの構成比の差」に WoE を掛け、全部の区分について足した値です。差と WoE は必ず同じ符号になるので、各区分の値は0以上になり、IV も0以上です。正常とデフォルトが同じように各区分に散らばっていれば IV は0に近く、正常とデフォルトが別々の区分に偏っているほど大きくなります。
IV の値の目安として、0.02未満は予測に役立たない、0.02〜0.1は弱い、0.1〜0.3は中程度、0.3以上は強い、という区切りがよく紹介されます。du Pisanie らの2023年の論文(信用リスクのスコアリングでの母集団の安定性の検定を見直したもの。arXiv で公開)は、この区切りを Siddiqi の2006年の書籍(信用リスクのスコアカードの開発と導入を扱った実務書、Wiley 刊)に由来する経験則として紹介しています。ここで書いた区切りは、この論文が紹介している範囲のものです。
この目安は、項目を機械的に採るか捨てるかを決める基準として使うものではないと考えています。理由は3つあります。1つ目は、IV が区分の切り方で変わることです。同じ項目でも、区分を細かくすれば学習用のデータでの IV は大きくなりやすく、後のコードで年収の水準を5区分・10区分・40区分に分けた計算でもそうなりました。2つ目は、IV が項目1つだけの見分ける力の目安であることです。他の項目と同じ情報を持っている項目は、IV が高くても、モデルに加えたときの上積みは小さいことがあります。IV はモデル全体の成績でも、項目がデフォルトの原因であることを示すものでもありません。3つ目は、とびぬけて高い IV が、良い項目ではなく情報の漏れの兆候であることがある点です。この3つ目は、後のコードで具体的に確かめます。
架空の契約の記録を作る、単調でない項目と欠損のある項目を入れる
ここからは、区分けと WoE・IV の計算を、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の申込と契約の記録よりずっと単純です。合成データでの成績は、実際の審査での成績の目安にはなりません。示したいのは、区分けの仕方によって WoE と IV がどう動くかという点です。契約30,000件を、24か月にわたる申込の月とともに乱数で作りました(乱数の種は20261113に固定しています)。合成した項目は次のとおりです。
- 申込者の属性:年収の水準(全体の中ほどがおよそ1になる相対値。後の月ほどわずかに高くなるようにした)、勤続年数(8%は未申告の欠損)、居住の年数、雇用の形態(AからEの5種類)、職種(30種類の符号)
- 信用情報にあたる項目:他社の借入の件数、直近6か月の申込の件数、他社の枠の利用率(借入が無い場合は0)、過去の延滞の有無
- 項目とデフォルトの関係:年収の水準が高いほど、勤続年数が長いほどデフォルトしにくい。他社の借入の件数・申込の件数が多いほど、過去の延滞があるとデフォルトしやすい。他社の枠の利用率は単調でなく、0(借入なし)と高い利用率の両方でデフォルトしやすく、低い利用率で最もしにくい。勤続年数の欠損はデフォルトしやすい。職種による差はごく小さくした
- 確認用の項目:契約後3か月以内の延滞の有無。審査の時点では手に入らない情報で、モデルの入力には使わない。情報の漏れの例として、IV を計算するためだけに作った
結果は、第2章の定義(契約の実行から12か月以内に、延滞が90日以上に達すること)にあたるデフォルトの有無を、契約ごとに直接乱数で作りました。デフォルトを1、正常を0とします。簡単のため、すべての契約が観測期間の12か月を満たしていて、結果が確定しているものとしました。また、承認した申込はすべて契約され、実行されたものとして扱います。実際には、手元に結果があるのは過去に承認した契約だけで、否決した申込の結果は分かりません。この偏りの扱いは第6章で取り上げます。評価のデータは時間で切り、申込の月が1〜16か月目の契約を学習用、17〜24か月目の契約を評価用にしました。
この分け方は、全部の契約の結果が確定した後で、申込の時期の前後で数値を比べるためのもの(第2章でいう事後的な分割)です。17か月目の時点で運用を始める状況を再現したものではありません。16か月目の契約の12か月後の結果は、17か月目の審査の時点ではまだ分からないためです。実際の運用を再現して評価するなら、学習に使う契約の結果が確定した時点から評価の期間を始める必要があり、この点は第2章と第7章で扱います。また、この章で「評価用」と呼んでいるデータは、区分のまとめ方や項目を選ぶための点検に使っています。こうした選択に使ったデータで、最終的なモデルの成績まで測ると、選んだ分だけ成績が良く見えます。最終的な成績は、選択に使っていない別の期間のデータで測ります。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N = 30000
month = rng.integers(1, 25, N)                                   # 申込の月(1〜24)
income = rng.lognormal(0.0, 0.45, N) * (1 + 0.004 * month)       # 年収の水準(相対値)
tenure = np.floor(rng.gamma(1.6, 4.0, N)).clip(0, 40)            # 勤続年数
tenure = np.where(rng.random(N) < 0.08, np.nan, tenure)          # 8%は未申告(欠損)
resid = np.floor(rng.gamma(1.3, 5.0, N)).clip(0, 50)             # 居住の年数
n_loans = rng.poisson(1.1, N).clip(0, 8)                         # 他社の借入の件数
inq = rng.poisson(0.5 + 0.3 * n_loans).clip(0, 10)               # 直近6か月の申込の件数
util = np.where(n_loans == 0, 0.0, rng.beta(2.0, 3.0, N))        # 他社の枠の利用率(借入なしは0)
past = (rng.random(N) < 0.10).astype(int)                        # 過去の延滞の有無
emp = rng.choice(list("ABCDE"), N, p=[0.45, 0.2, 0.15, 0.12, 0.08])   # 雇用の形態
job = rng.integers(0, 30, N)                                     # 職種(30種類の符号)
emp_eff = pd.Series({"A": 0.0, "B": 0.35, "C": 0.6, "D": 0.15, "E": 0.9})
job_eff = rng.normal(0, 0.12, 30)                                # 職種ごとの差はごく小さい
z = (-3.9 - 0.9 * np.log(income) + 0.30 * n_loans + 0.22 * inq + 1.0 * past
     + 3.0 * (util - 0.3) ** 2 + 0.9 * (util == 0)           # 利用率は単調でない(U字)
     - 0.07 * np.minimum(np.nan_to_num(tenure), 15) + 0.55 * np.isnan(tenure)
     - 0.015 * np.minimum(resid, 20) + emp_eff[emp].to_numpy() + job_eff[job] + 0.01 * (month - 12))
y = (rng.random(N) < 1 / (1 + np.exp(-z))).astype(int)           # 12か月以内のデフォルト
post3 = np.where(y == 1, rng.random(N) < 0.55, rng.random(N) < 0.02).astype(int)  # 契約後3か月の延滞(審査の時点では不明)
df = pd.DataFrame({"month": month, "income": income, "tenure": tenure, "resid": resid,
                   "n_loans": n_loans, "inq": inq, "util": util, "past": past,
                   "emp": emp, "job": job, "post3": post3, "y": y})
tr, te = df[df.month <= 16], df[df.month >= 17]                  # 時間で切る:1〜16か月目で学習、17〜24か月目で評価
print("契約", len(df), "件/デフォルト率", round(df.y.mean(), 4))
print("学習用", len(tr), "件(デフォルト", tr.y.sum(), ")/評価用", len(te), "件(デフォルト", te.y.sum(), ")")
print("勤続年数の欠損の割合", round(df.tenure.isna().mean(), 3))
実行した結果、契約30,000件のデフォルト率は6.44%でした。学習用は19,998件(うちデフォルト1,279件)、評価用は10,002件(うちデフォルト653件)です。勤続年数が欠損している契約の割合は7.7%でした。デフォルト率の水準は商品によって大きく違い、この例題の数%という水準は説明のための置き方です。
区分ごとの WoE と項目ごとの IV を計算する
次のブロックで、区分けと WoE・IV を計算する3つの関数を書き、項目ごとの IV を一覧にします。qedges は学習用のデータから等頻度の区分の境目を決める関数、bin_num は値を区分の番号に直す関数(欠損は -1 の区分にします)、woe_iv は区分ごとの件数・デフォルト率・WoE・IV を計算する関数です。年収の水準・勤続年数・居住の年数は等頻度の5区分、他社の借入の件数と申込の件数は件数の値ごとの区分(多い側はまとめる)、他社の枠の利用率は「0だけの区分」と0.2きざみの等間隔の区分にしました。過去の延滞の有無・雇用の形態・職種・確認用の項目は、カテゴリをそのまま区分にしています。
def qedges(x, k):                       # 等頻度の区分の境目(学習用のデータで決める)
    e = np.unique(np.nanquantile(x, np.linspace(0, 1, k + 1)[1:-1]))
    return np.r_[-np.inf, e, np.inf]

def bin_num(x, edges):                  # 区分の番号。区分 j は edges[j] 以上 edges[j+1] 未満。欠損は -1
    c = pd.Series(np.searchsorted(edges, x.to_numpy(), side="right") - 1, index=x.index)
    return c.where(x.notna(), -1)

def woe_iv(code, y):                    # 区分ごとの件数・デフォルト率・WoE・IV
    t = pd.DataFrame({"code": code, "y": y}).groupby("code")["y"].agg(n="size", bad="sum")
    t["good"] = t.n - t.bad
    pg = (t.good + 0.5) / (t.good + 0.5).sum()                    # 正常の分布(0件で止まらないよう全区分の件数に0.5を足す)
    pb = (t.bad + 0.5) / (t.bad + 0.5).sum()                      # デフォルトの分布
    t["rate"] = t.bad / t.n
    t["woe"] = np.log(pg / pb)
    t["iv"] = (pg - pb) * t.woe
    return t

NUM = {"income": qedges(tr.income, 5), "tenure": qedges(tr.tenure, 5), "resid": qedges(tr.resid, 5),
       "n_loans": np.r_[-np.inf, 1, 2, 3, 4, np.inf], "inq": np.r_[-np.inf, 1, 2, 3, np.inf],
       "util": np.r_[-np.inf, 1e-9, 0.2, 0.4, 0.6, 0.8, np.inf]}    # 利用率は0だけの区分+等間隔
CAT = ["past", "emp", "job", "post3"]

def code_of(d, v):
    return bin_num(d[v], NUM[v]) if v in NUM else d[v]

rows = []
for v in list(NUM) + CAT:
    a, b = woe_iv(code_of(tr, v), tr.y), woe_iv(code_of(te, v), te.y)
    rows.append((v, len(a), round(a.iv.sum(), 3), round(b.iv.sum(), 3)))
print(pd.DataFrame(rows, columns=["項目", "区分の数", "IV(学習用)", "IV(評価用)"]).sort_values("IV(学習用)", ascending=False).to_string(index=False))
評価用の列の IV は、学習用のデータで決めた区分の境目をそのまま評価用のデータに当てはめ、評価用の件数で WoE と IV を計算し直した値です。モデルに使う数値ではなく、学習用で見えた見分ける力が後の月にも保たれているかを点検するための値です。結果を、学習用の IV の大きい順に並べると次のとおりです。
| 項目 | 区分の数 | IV(学習用) | IV(評価用) | この表から読めること |
|---|---|---|---|---|
| 契約後3か月以内の延滞の有無(確認用) | 2 | 2.186 | 2.370 | 他の項目と桁が違う。審査の時点では手に入らない情報で、モデルの入力には使わない |
| 年収の水準 | 5 | 0.131 | 0.105 | 見分ける力は大きい側。評価用ではやや下がった |
| 勤続年数 | 6(欠損を含む) | 0.126 | 0.132 | 欠損の区分が効いている(次の節) |
| 過去の延滞の有無 | 2 | 0.104 | 0.113 | 区分が2つでも見分ける力がある |
| 雇用の形態 | 5 | 0.093 | 0.111 | カテゴリの項目 |
| 他社の借入の件数 | 5 | 0.091 | 0.110 | 利用率と情報が重なる(後の節) |
| 他社の枠の利用率 | 6 | 0.052 | 0.072 | 単調でない関係を区分で表している |
| 直近6か月の申込の件数 | 4 | 0.031 | 0.053 | 学習用と評価用で差がある |
| 職種 | 30 | 0.026 | 0.046 | 差をごく小さく作ったのに、0.02を超えた(後の節) |
| 居住の年数 | 5 | 0.008 | 0.015 | 関係はあるように作ったが、IV は小さい |
最も目につくのは、確認用の項目の IV が2.186と、他の項目より1桁以上大きいことです(次に大きい年収の水準の0.131の約17倍です)。これは、契約後3か月以内の延滞が、12か月以内のデフォルトの途中経過そのものであるためです。この項目は契約の後にしか分からないので、審査の時点のモデルには入れられません。実際のデータでは、このような項目が「延滞の記録」「最新の残高」のような名前で、後から更新された値のまま申込のデータに混ざっていることがあります(第2章)。IV がとびぬけて高い項目を見つけたら、良い項目を見つけたと考える前に、その値がいつの時点で記録されたものかを確かめる必要があります。とびぬけているかどうかに決まった値はなく、他の項目との比較や、業務の知識から考えて不自然に強くないかで判断します。
確認用の項目を除くと、学習用の IV は0.008から0.131の範囲でした。年収の水準・勤続年数・過去の延滞の有無が0.1を超え、居住の年数は0.02を下回りました。居住の年数は、データを作るときにデフォルトとの弱い関係を入れてあります。IV が小さいことは、関係が無いことの証明ではなく、この区分けとこの件数では見分ける力が小さく見えた、という意味にとどまります。学習用と評価用で IV がずれている項目もあります。この例題では、確認用の項目を除く9項目のうち8項目で評価用の方が高く出て、年収の水準だけが0.131から0.105に下がりました。この違いの理由は確かめていません。一般に、IV は区分ごとの0以上の値の足し算なので、件数が少ないほど偶然の揺れで大きめに出やすい性質があり、評価用の件数は学習用の半分です。学習用と評価用の IV の差を見るときは、件数の違いも考えに入れる必要があります。
WoE の並びを読む、単調な項目・U字の項目・欠損の区分
IV は項目全体の要約なので、区分ごとの WoE の並びを見ないと、項目とデフォルトの関係の形は分かりません。次のブロックでは、年収の水準・他社の枠の利用率・勤続年数の3つについて、区分ごとの件数・デフォルトの件数・デフォルト率・WoE・IV を表にしました。区分の名前は「a以上b未満」の形にしています。境目は表示のために小数第2位で丸めています(例えば年収の水準の最初の境目は、正確には約0.7099です)。丸めた値で区分を作り直すと、件数が一致しないことがあります。
def label(e, c):                        # 区分の番号を「a以上b未満」の文字に直す
    if c == -1:
        return "欠損"
    if e[c + 1] == 1e-9:                # 利用率の「0だけ」の区分
        return "0(借入なし)"
    lo = "" if np.isinf(e[c]) else ("0超" if e[c] == 1e-9 else f"{e[c]:.2f}以上")
    hi = "" if np.isinf(e[c + 1]) else f"{e[c + 1]:.2f}未満"
    return lo + hi

pd.set_option("display.width", 120)
for v in ["income", "util", "tenure"]:
    t = woe_iv(code_of(tr, v), tr.y)
    e = NUM[v]
    t.index = [label(e, c) for c in t.index]
    print(v)
    print(t[["n", "bad", "rate", "woe", "iv"]].round(3).to_string())
年収の水準の結果を表にまとめます(学習用のデータ。デフォルト率の分母は、その区分に入った学習用の契約の件数です)。
| 年収の水準の区分 | 件数 | デフォルトの件数 | デフォルト率 | WoE |
|---|---|---|---|---|
| 0.71未満 | 4,000 | 418 | 10.4% | -0.535 |
| 0.71以上0.93未満 | 3,999 | 258 | 6.5% | -0.009 |
| 0.93以上1.16未満 | 4,000 | 253 | 6.3% | 0.012 |
| 1.16以上1.52未満 | 3,999 | 194 | 4.9% | 0.292 |
| 1.52以上 | 4,000 | 156 | 3.9% | 0.520 |
年収の水準は、区分が上がるほどデフォルト率が下がり、WoE が大きくなる単調な並びでした。全体のデフォルト率(学習用で6.4%)に近い真ん中の2つの区分では WoE がほぼ0で、デフォルト率が全体より低い区分は WoE が正、高い区分は WoE が負になっています。WoE の符号と、区分のデフォルト率が全体より高いか低いかが対応していることが読み取れます。
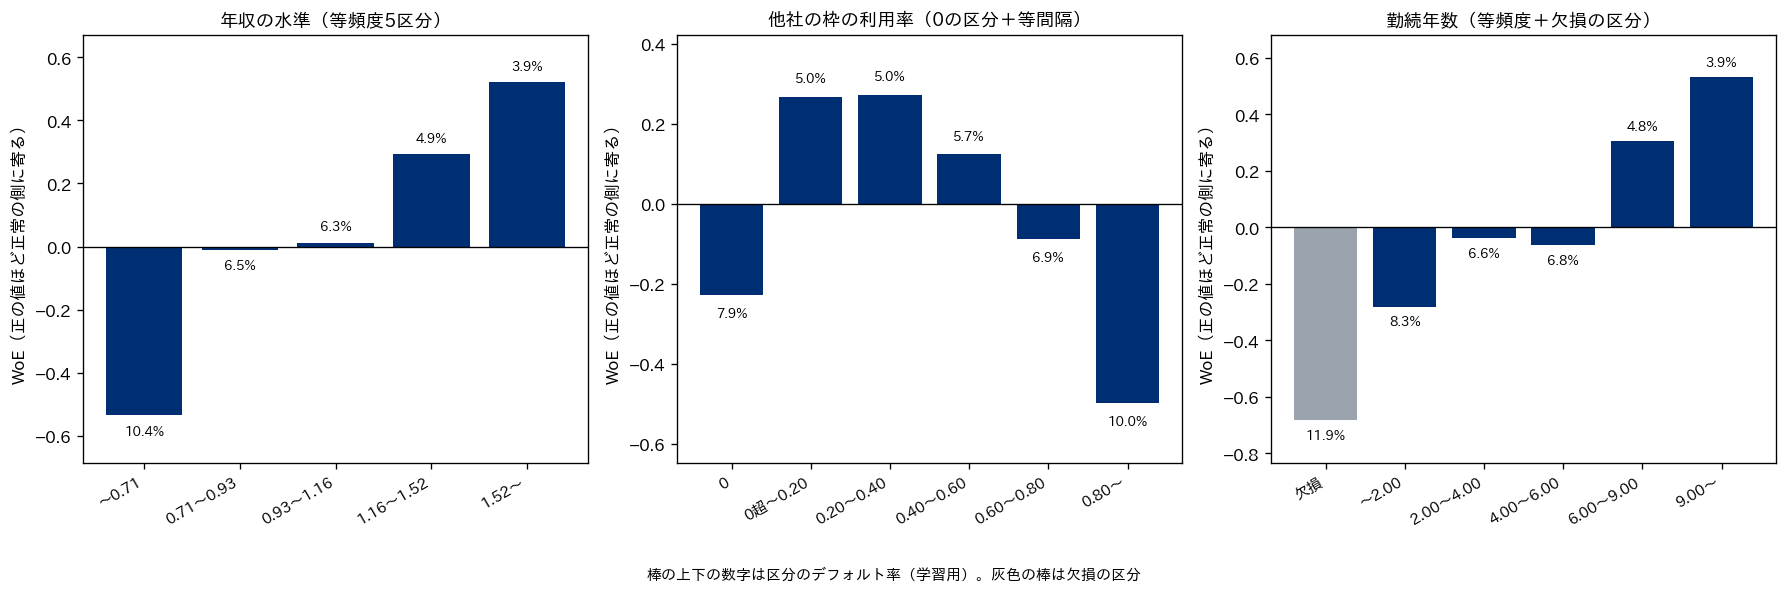
上の図は、3つの項目の区分ごとの WoE を棒で、区分のデフォルト率を棒の上下の数字で示したものです。横軸の「a〜b」は a 以上 b 未満、「〜b」は b 未満、「a〜」は a 以上を表します。中央の他社の枠の利用率は、0の区分(借入が無い契約。6,728件)の WoE が-0.229、0超0.2未満と0.2以上0.4未満の区分が0.268と0.272で最も大きく、そこから利用率が上がるにつれて下がり、0.8以上の区分(409件)では-0.498でした。両端が負で真ん中が正の、U字を逆さにした並びです。データを作るときに入れた「借入が無い場合と高い利用率の両方でデフォルトしやすい」関係を、区分ごとの WoE がそのまま表しています。この項目を数値のままロジスティック回帰に入れると、一方向の傾きしか表せないので、この形は捉えられません。
右の勤続年数では、灰色の欠損の区分(1,528件)のデフォルト率が11.9%、WoE が-0.683で、どの区分よりもデフォルトしやすい結果でした。欠損の値を、例えば勤続年数の平均で埋めてしまうと、欠損の契約は真ん中の区分に入り、この情報は消えます。区分けでは、欠損を独立した区分にしておけば、欠損であること自体の WoE を持たせられます。ただし、欠損の意味は、申込の経路や項目の必須・任意の扱いが変わると変わります(第2章)。欠損の区分を使うなら、なぜ欠損になるのかを業務の担当者と確かめ、台帳に書いておく必要があります。
勤続年数のもう1つの特徴は、2年以上4年未満の区分(WoE -0.038)と4年以上6年未満の区分(-0.062)で、並びがわずかに逆になっていることです。データを作るときには、勤続年数が長いほど一様にデフォルトしにくくなる関係を入れてあるので、この逆転は偶然の揺れです。このような小さな逆転をどう扱うかは、後の節の「区分を単調にそろえる」で取り上げます。
区分を細かくしすぎると WoE が揺れる、カテゴリの多い項目の扱い
区分の数を増やすと、学習用のデータでは項目とデフォルトの関係を細かく描けるように見えます。しかし、区分ごとのデフォルトの件数が減ると、WoE は偶然の揺れに左右されるようになります。次のブロックでは、年収の水準を等頻度で5区分・10区分・40区分に分けました。学習用のデータで決めた同じ区分について、学習用(1〜16か月目)と評価用(17〜24か月目)でそれぞれ WoE と IV を計算して比べます。
WoE を比べる尺度は3つです。2つの WoE の相関係数、WoE の符号(正か負か)が入れ替わった区分の割合、隣の区分との大小が入れ替わった割合です。
あわせて、30種類ある職種についても同じ比較をしました。職種については、結果(デフォルトか正常か)を無作為に並べ替えて職種と無関係にしたデータで IV を200回計算し、偶然の揺れだけでどの程度の IV が出るかの目安も求めました。最後に、職種を学習用の WoE の大きさで3つの群にまとめた場合も計算しています。
def stability(code_tr, code_te):        # 同じ区分で、学習用と評価用の WoE を並べる
    a, b = woe_iv(code_tr, tr.y), woe_iv(code_te, te.y)
    m = pd.concat([a.woe.rename("woe_tr"), b.woe.rename("woe_te"), a.bad.rename("bad_tr")], axis=1).dropna()
    flip = (np.sign(m.woe_tr) != np.sign(m.woe_te)).mean()
    order = (np.sign(np.diff(m.woe_tr)) != np.sign(np.diff(m.woe_te))).mean()
    return m, round(np.corrcoef(m.woe_tr, m.woe_te)[0, 1], 3), round(flip, 3), round(order, 3)

for k in [5, 10, 40]:
    e = qedges(tr.income, k)
    m, r, flip, order = stability(bin_num(tr.income, e), bin_num(te.income, e))
    iv = [round(float(woe_iv(bin_num(d.income, e), d.y).iv.sum()), 3) for d in (tr, te)]
    print(f"年収の水準 {k}区分:1区分のデフォルト(学習用)最少 {m.bad_tr.min()} 件 IV 学習用・評価用 {iv}",
          "WoEの相関", r, "符号が入れ替わった区分", flip, "隣との大小が入れ替わった割合", order)
m_job, r, flip, order = stability(tr.job, te.job)
print("職種 30区分:1区分のデフォルト(学習用)最少", m_job.bad_tr.min(), "件 WoEの相関", r,
      "符号が入れ替わった区分", flip)
perm = np.random.default_rng(1)                 # 結果を無作為に並べ替え、職種と無関係にしたときの IV
null_iv = [woe_iv(tr.job, pd.Series(perm.permutation(tr.y.to_numpy()), index=tr.index)).iv.sum() for _ in range(200)]
print("職種と結果を無関係にしたときの IV(200回)平均", round(np.mean(null_iv), 3),
      "95%点", round(np.quantile(null_iv, 0.95), 3))
grp = pd.qcut(m_job.woe_tr.rank(method="first"), 3, labels=["低", "中", "高"])   # 学習用のWoEで3つにまとめる
g_job, r, flip, order = stability(tr.job.map(grp), te.job.map(grp))
print("職種を3群にまとめた場合:", g_job.round(3).to_dict("index"))
結果を次の表にまとめます。「1区分の最少のデフォルトの件数」は、学習用のデータで、デフォルトの件数が最も少なかった区分の件数です。
| 項目と区分 | 1区分の最少のデフォルトの件数(学習用) | IV(学習用) | IV(評価用) | 学習用と評価用の WoE の相関 | 符号が入れ替わった区分の割合 | 隣の区分との大小が入れ替わった割合 |
|---|---|---|---|---|---|---|
| 年収の水準・5区分 | 156件 | 0.131 | 0.105 | 0.995 | 0.0 | 0.0 |
| 年収の水準・10区分 | 75件 | 0.140 | 0.112 | 0.969 | 0.0 | 0.111 |
| 年収の水準・40区分 | 11件 | 0.180 | 0.166 | 0.633 | 0.35 | 0.487 |
| 職種・30区分 | 30件 | 0.026 | 0.046 | 0.259 | 0.433 | (職種の符号の並びに大小の意味が無いので載せない) |
年収の水準は、5区分では学習用と評価用の WoE の相関が0.995で、並びも保たれました。10区分でも相関は0.969ありましたが、隣の区分との大小の入れ替わりが1割ほど出ました。40区分では、1区分のデフォルトが最少で11件まで減り、相関は0.633に下がりました。符号が入れ替わった区分が35%、隣の区分との大小が入れ替わった割合が48.7%で、隣どうしの並びは半分近くが後の月で逆になったことになります。学習用のデータだけを見ると、40区分の WoE は細かな山や谷を描きますが、その多くは後の月の申込には当てはまりませんでした。
IV は、学習用で5区分の0.131から、10区分で0.140、40区分で0.180と、区分を細かくするほど大きくなりました。評価用の IV も0.105、0.112、0.166と大きくなっています。ただし、この評価用の IV は、評価用の件数で WoE を計算し直した値なので、評価用のデータの中の偶然の揺れも同じように拾っています。学習用で決めた40区分の WoE が後の月にも当てはまるかどうかは、IV ではなく WoE の相関と並びで見る必要があり、そちらは上のとおり崩れていました。IV が大きくなったことを、見分ける力が増えたと読むことはできません。
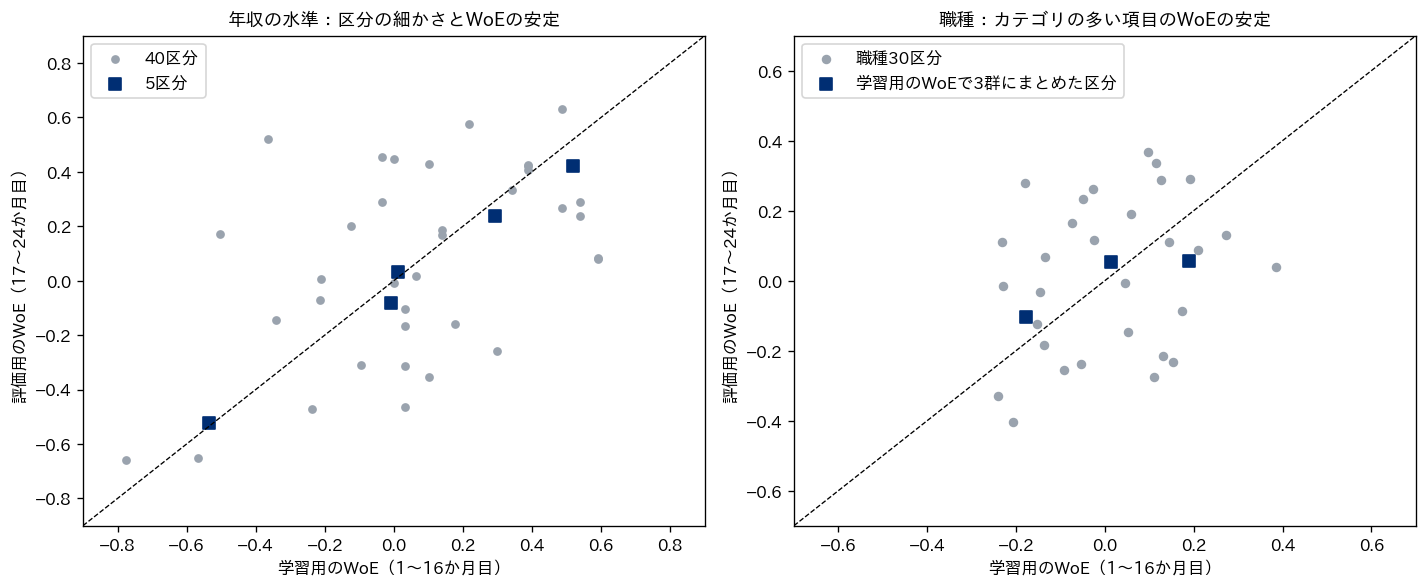
上の図は、横軸に学習用の WoE、縦軸に評価用の WoE をとった散布図です。点線は、2つが等しい位置を表します。左の年収の水準では、5区分の点は点線の近くに並び、40区分の点は点線から上下に大きく散らばっています。区分を細かくするほど、学習用で見えた差が後の月に再現されにくくなる様子が見て取れます。
右の職種は、カテゴリの多い項目の例です。この例題では、職種ごとのデフォルトのしやすさの差をごく小さく作りました。それでも、30区分のまま WoE を計算すると、学習用の WoE は-0.2から0.4ほどの幅に散らばります。ところが学習用と評価用の WoE の相関は0.259にとどまり、符号が入れ替わった区分が43.3%ありました。学習用の WoE の幅の多くは、1職種あたり30件から数十件のデフォルトの件数による揺れだったと考えられます。この点を確かめるために、結果を無作為に並べ替えて職種と無関係にしたデータで IV を200回計算すると、平均は0.024、大きい方から5%の位置(95%点)は0.034でした。並べ替える前の架空データでの職種の学習用の IV 0.026は、職種と結果が無関係でも出る範囲に収まっています。この目安は学習用の件数で計算したもので、評価用の IV(0.046)は件数が半分なので、同じ目安とは比べられません。目安の0.02を超えていても、この例題の職種の IV は、偶然の揺れと区別できない大きさでした。IV は区分ごとの0以上の値の足し算なので、区分が多く、件数が少ないほど、関係が無くても大きめに出ます。
職種を学習用の WoE の大きさで「低・中・高」の3群にまとめると、学習用の WoE は-0.177、0.014、0.189でしたが、評価用では-0.103、0.053、0.056でした。「低」の群は評価用でも負にとどまった一方、「中」と「高」の差はほとんど消えています。学習用の WoE で群を作ると、その群分け自体が学習用の揺れに合わせたものになるので、群の間の差は後の月では縮みやすくなります。カテゴリの多い項目は、次のような順で扱うことが考えられます。
- まず、業務の知識で意味のあるまとまり(職種なら業種や雇用の安定性の近いもの、地域なら商圏など)にまとめ、件数の少ないカテゴリは「その他」にまとめる
- WoE の大きさだけでまとめる場合は、まとめ方を学習用のデータで決め、評価用のデータで差が残るかを確かめる
- 評価用で差が残らなければ、その項目は使わない判断も含めて検討する(ここでの評価用は選択のための点検用で、最終的な成績は別の期間のデータで測る)
- 職種や地域は、使ってはいけない属性の代わりの手がかりになりうるので、第11章の公平性の点検の対象にする
区分を単調にそろえる、そろえない判断
スコアカードでは、区分ごとの WoE が、項目の値の順に一方向に並ぶ(単調になる)ように区分をまとめることが多くあります。勤続年数が長くなるほど点数が上がる、という並びなら、審査の担当者にも申込者にも説明しやすく、2年以上4年未満の区分より4年以上6年未満の区分の方が点数が低い、という説明しにくい段差を作らずに済みます。ただし、この例題は勤続年数に単調な関係を設定して作ったデータなので、逆転が偶然の揺れだと分かっています。実際のデータでは、小さな逆転が偶然によるものか、単調にまとめると後の月で安定するかは、データだけでは決まりません。実務で単調にまとめる場合は、単調な関係を前提にする業務上の理由と、別の期間のデータでの安定を確かめることになります。
次のブロックの merge_monotone は、細かめの区分から始めて、WoE の並びが決めた向きと逆になっている最初の隣どうしを1つにまとめ、逆転が無くなるまで繰り返す関数です。勤続年数を等頻度の10区分(欠損の区分は別)から始めてこの関数を当て、まとめる前後の IV を学習用と評価用で比べました。あわせて、U字の並びを持つ他社の枠の利用率に、無理に単調な向きを当てはめた場合も計算しています。
def merge_monotone(x, y, edges, sign):  # sign=1 なら値が大きいほど WoE が大きい向きに、隣の区分をまとめてそろえる
    edges = list(edges)
    while True:
        t = woe_iv(bin_num(x, np.array(edges)), y)
        w = t.loc[t.index >= 0, "woe"].to_numpy() * sign
        rev = np.flatnonzero(np.diff(w) < 0)
        if len(rev) == 0:
            return np.array(edges), t
        edges.pop(rev[0] + 1)           # 向きが逆になった最初の2区分を1つにまとめる

e0 = qedges(tr.tenure, 10)
e1, t1 = merge_monotone(tr.tenure, tr.y, e0, sign=1)
print("勤続年数:区分", len(e0) - 1, "→", len(e1) - 1, " 境目", e1[1:-1])
print(t1[["n", "bad", "rate", "woe"]].round(3).to_string())
for name, e in [("まとめる前", e0), ("まとめた後", e1)]:
    print(" ", name, "IV 学習用", round(woe_iv(bin_num(tr.tenure, e), tr.y).iv.sum(), 3),
          "評価用", round(woe_iv(bin_num(te.tenure, e), te.y).iv.sum(), 3))
u0 = NUM["util"]
u1, _ = merge_monotone(tr.util, tr.y, u0, sign=-1)
for name, e in [("U字のまま", u0), ("単調にそろえた", u1)]:
    print("利用率", name, "区分", len(e) - 1, "境目", np.round(e[1:-1], 3), "IV 学習用", round(woe_iv(bin_num(tr.util, e), tr.y).iv.sum(), 3),
          "評価用", round(woe_iv(bin_num(te.util, e), te.y).iv.sum(), 3))
勤続年数は、欠損を除く10区分から7区分になりました。境目は2年・5年・6年・7年・9年・13年で、WoE は2年未満の-0.281から13年以上の0.615まで、区分が上がるほど大きくなる単調な並びになりました。欠損の区分は別に残しています(WoE は-0.682です。前の節の表の-0.683と小数第3位が違うのは、0件の区分のための0.5の補正が区分の数によって少し変わるためです)。IV は、まとめる前が学習用0.133・評価用0.155、まとめた後が学習用0.131・評価用0.141で、まとめても見分ける力はほとんど変わりませんでした。区分を減らして単調にしても、失った情報は小さかったことになります。
他社の枠の利用率では結果が逆になりました。利用率が上がるほど WoE が小さくなる単調な向きを当てはめると、残った境目は0.6と0.8の2つだけで、0の区分を含む0.6未満の4つの区分が1つにまとめられて6区分が3区分になり、IV は学習用で0.052から0.008、評価用で0.072から0.005に下がりました。この項目の見分ける力の大部分は、0の区分と低い利用率の区分の違い、つまりU字の形そのものにあったことになります。
この2つの結果から、単調にそろえるかどうかは機械的に決めるものではないと考えています。勤続年数のように、業務の知識からも一方向の関係が自然で、逆転が小さく件数の揺れで説明できる場合は、まとめて単調にするのが合理的です。利用率のように、単調でない形に業務上の説明(借入が無い場合は信用情報での判断材料が少ない、高い利用率は返済の余力が小さいことの表れ、など)が付き、その形が評価用のデータでも保たれている場合は、単調でない区分を残す判断がありえます。どちらにする場合も、そう判断した理由を台帳に残します。単調でない区分を残した項目は、点数表の上で「なぜこの区分の点数が両隣より高いのか」を説明できるようにしておく必要があります。機械学習のモデルで同じ問題をどう扱うか(単調性の制約)は、第5章で扱います。
決定木で区分の境目の候補を出す
境目の候補をデフォルトとの関係から探す方法として、浅い決定木を使う方法があります。1つの項目だけを入力にして、決定木にデフォルトと正常を分けさせると、木は分かれ目ごとに、分けたあとの2つのグループの件数も考えに入れて、正常とデフォルトの混ざり具合(不純度)が最も小さくなる値を選びます。scikit-learn の決定木の既定の不純度はジニ不純度です。その分かれ目の値を、区分の境目の候補にします。次のブロックでは、scikit-learn の決定木(DecisionTreeClassifier)で木を育て、分かれ目を取り出しました。木の大きさは2つの条件で制限しています。葉(最後の区分)の数は5まで、1つの葉に入る件数は、木に渡した件数の5%以上です。欠損は木に渡さないので、勤続年数では欠損を除いた18,470件の5%(切り上げて924件)、欠損の無い項目では19,998件の5%(1,000件)になります。scikit-learn の説明書きによれば、min_samples_leaf に小数を渡すと件数の割合として扱われ、分かれ目では値がしきい値以下のものが左の枝に進みます。欠損は木に入れず、別の区分にしています。
ブロックの最後では、WoE に置き換えた項目どうしの相関の大きい組を出し、最も相関の大きかった組について、利用率が0でない契約だけで相関を取り直しました。
from sklearn.tree import DecisionTreeClassifier

def tree_edges(x, y, leaves=5, min_frac=0.05):   # 浅い決定木の分かれ目を、区分の境目の候補にする
    ok = x.notna()
    t = DecisionTreeClassifier(max_leaf_nodes=leaves, min_samples_leaf=min_frac, random_state=0)
    t.fit(x[ok].to_frame(), y[ok])
    th = t.tree_.threshold[t.tree_.feature >= 0]
    return np.r_[-np.inf, np.sort(th), np.inf]

for v in ["income", "tenure", "resid", "util"]:
    e = tree_edges(tr[v], tr.y)
    iv = [round(float(woe_iv(bin_num(d[v], e), d.y).iv.sum()), 3) for d in (tr, te)]
    print(v, "木の境目", np.round(e[1:-1], 3), "IV 学習用・評価用", iv, " 最初に作った区分の評価用",round(woe_iv(code_of(te, v), te.y).iv.sum(), 3))
W = pd.DataFrame({v: code_of(tr, v).map(woe_iv(code_of(tr, v), tr.y).woe) for v in list(NUM) + ["past", "emp"]})
c = W.corr().where(np.triu(np.ones((W.shape[1], W.shape[1]), dtype=bool), 1)).stack()
print("WoEに置き換えた項目どうしの相関(符号つき。絶対値の大きい順に3組)")
print(c.sort_values(key=abs, ascending=False).head(3).round(3).to_string())
pos = tr.util > 0                              # 借入がある契約(利用率が0でない)だけで取り直す
print("利用率が0でない契約だけでの、借入の件数と利用率のWoEの相関", round(W.n_loans[pos].corr(W.util[pos]), 3))
結果を、最初に作った区分(年収の水準・勤続年数・居住の年数は等頻度の5区分、他社の枠の利用率は0だけの区分と0.2きざみの等間隔の区分の6区分)と比べて表にまとめます。どちらも境目は学習用のデータで決め、評価用の IV は、その境目を評価用のデータに当てはめて計算した値です。
| 項目 | 決定木の境目 | 決定木の区分の IV(学習用) | 決定木の区分の IV(評価用) | 最初に作った区分の IV(評価用) |
|---|---|---|---|---|
| 年収の水準 | 0.491・0.609・1.07・2.119 | 0.160 | 0.087 | 0.105 |
| 勤続年数 | 1.5・3.5・4.5・7.5 | 0.133 | 0.118 | 0.132 |
| 居住の年数 | 1.5・2.5・11.5・14.5 | 0.018 | 0.012 | 0.015 |
| 他社の枠の利用率 | 0.002・0.511・0.579・0.675 | 0.066 | 0.073 | 0.072 |
以下は、この1つの架空データと、葉を5つまで・1つの葉に5%以上という条件での結果です。評価用の IV はそれぞれ1回計算した値で、差が偶然の揺れの範囲かどうかは確かめていません。年収の水準では、決定木の区分は学習用の IV が0.160と等頻度の5区分(0.131)より大きくなりましたが、評価用では0.087で、等頻度の5区分の0.105を下回りました。決定木は学習用のデータで違いが最も大きくなる境目を探すので、学習用には合いますが、その境目が後の月にも最良とは限りません。この例では境目の2つが0.491と0.609という低い側に寄っていましたが、なぜその位置になったのかは確かめていません。勤続年数と居住の年数も、評価用の IV は等頻度の5区分をわずかに下回りました。一方、他社の枠の利用率では、決定木は最も小さい境目を0.002に置き、0.002未満、つまり実質的に0の区分を自動的に切り分けました。評価用の IV は0.073で、0だけの区分を手で作った等間隔の区分(0.072)とほぼ同じです。決定木は、手で気づきにくい境目の候補を出す道具としては役に立つ一方、出てきた境目をそのまま採るのではなく、評価用のデータでの安定と業務上の意味で確かめる必要があります。
WoE に置き換えた項目どうしの相関は、他社の借入の件数と他社の枠の利用率の組が0.498で最も大きく、申込の件数と利用率の組が-0.188、借入の件数と申込の件数の組が0.025でした(相関係数の絶対値の大きい順)。この例題では、借入が無い契約は利用率が必ず0になるように作ってあります。そこで、利用率が0でない契約(借入がある契約)だけで2つの WoE の相関を取り直すと、-0.011とほぼ0でした。この架空データでは、借入の件数と利用率の相関は、ほぼ「借入が無い」という同じ事実を2つの項目が共有していることから来ていたことになります。IV を項目ごとに見ると、どちらもそれなりの値ですが、両方をモデルに入れたときの上積みは、それぞれの IV から想像するより小さいことがあります。項目どうしの相関がモデルの係数に与える影響の点検は、第4章で扱います。
項目を選ぶ観点、IV は観点の1つにすぎない
ここまでで、IV が区分の切り方・件数・情報の漏れに左右されることを見てきました。スコアカードに入れる項目は、IV の大きい順に機械的に選ぶのではなく、いくつかの観点を合わせて選ぶことになります。次の表は、項目を選ぶときの観点を整理したものです。
| 観点 | 確かめること | この章のコードとの対応 | 主に関わる部門 |
|---|---|---|---|
| 見分ける力(IV) | 学習用と評価用の IV。区分の切り方を変えても大きく動かないか | 項目ごとの IV の表、決定木の区分との比較 | データ分析 |
| 審査の時点で手に入るか | その値が申込の時点で記録されたものか。後から更新されていないか | 確認用の項目の IV が他より1桁以上大きかった | データ分析・情報システム |
| 項目どうしの相関 | 同じ情報を持つ項目が重なっていないか | 借入の件数と利用率の WoE の相関 | データ分析 |
| 安定性 | 後の月でも WoE の並びと IV が保たれるか。申込者の層が変わっても使えるか | 学習用と評価用の WoE の比較 | データ分析・リスク管理 |
| 業務上の説明のしやすさ | WoE の並びが業務の知識と合うか。点数表で説明できるか | 勤続年数の単調化、利用率のU字 | 審査・営業・リスク管理 |
| 手に入れる手間と費用 | 信用情報機関への照会や外部のデータの取得にかかる手間と費用、申込者が答える負担 | (コードでは扱っていない) | 経営・情報システム |
| 規制上の扱い | 使ってはいけない属性や、その代わりになりうる項目でないか。利用目的と同意の範囲に入るか | 職種は第11章の公平性の点検の対象 | コンプライアンス・法務 |
表の観点のうち、「審査の時点で手に入るか」と「規制上の扱い」は、IV の大きさに関係なく項目を外す理由になります。前者を外さないと、学習用でも評価用でも成績が高く出たまま本番で崩れます。評価用の IV が高いことは、その項目の値が審査の時点で手に入ることを示しません。この例題の確認用の項目は、評価用でも IV が2.370と高かったことに注意が要ります。時間で切った評価でも、項目の記録の時点が誤っていれば、情報の漏れは見つけられません。後者の規制上の扱いは、個人情報の取り扱いや与信に関する法令が関わるので、法令の内容は第14章、偏りの点検は第11章で扱います。差別につながる属性をモデルの入力に使わないことは当然として、職種や地域のように、それと結びつきうる項目も点検の対象になります。
残りの観点は、互いにつり合いを取って判断します。例えば、IV がやや低くても、安定していて説明しやすく、手に入れる手間が小さい項目は、残す価値があることがあります。逆に、IV が高くても、外部のデータで取得の手間が大きく、評価用で値が落ちる項目は、上積みが手間に見合うかを確かめる必要があります。項目の数は、多ければよいというものではありません。項目が増えるほど、データの品質の管理・監視・説明の負担が増えます(監視は第12章)。
経営の判断、区分の根拠を台帳に残して説明できる状態にする
区分けと項目の選択の結果は、区分けの台帳として残します。台帳は、どの項目を、どの境目で区分し、各区分に何件の契約とデフォルトが入り、WoE がいくつで、なぜその境目にしたのかを1つの表にまとめたものです。次の表は、この章の例題の勤続年数について、台帳の一部を書いた例です(件数とデフォルト率は単調にそろえた後の学習用の値。「根拠」の列は、この例題で行った判断を書いたものです)。
| 項目 | 区分 | 件数 | デフォルト率 | WoE | 根拠 |
|---|---|---|---|---|---|
| 勤続年数 | 欠損(未申告) | 1,528 | 11.9% | -0.682 | 欠損を独立の区分にした。欠損になる理由の確認が必要 |
| 勤続年数 | 2年未満 | 3,131 | 8.3% | -0.281 | 等頻度10区分の1年未満と1年以上2年未満の区分を、WoE の並びが逆だったのでまとめた結果 |
| 勤続年数 | 2年以上5年未満 | 5,953 | 7.0% | -0.088 | 等頻度10区分の2年以上3年未満・3年以上4年未満・4年以上5年未満の3区分を、WoE の並びが逆だったのでまとめた結果 |
| 勤続年数 | 13年以上 | 1,917 | 3.5% | 0.615 | 最上位の区分。極端に長い値もこの区分に入る |
この表では一部の区分だけを載せましたが、実際の台帳には全部の区分を載せ、あわせて次の事項を書いておくことが有効だと考えています。
- 学習に使ったデータの期間(申込の月の範囲)と、デフォルトの定義・観測期間
- 区分けの方法(等頻度・等間隔・決定木など)と、まとめる前の区分の数
- 区分ごとの件数・デフォルトの件数・WoE と、0件の区分に使った補正
- 評価用のデータでの WoE と IV(後の月での安定の点検の結果)
- 単調にそろえた、またはそろえなかった理由と、業務の担当者との確認の記録
- 欠損と「その他」の区分の扱い、使わなかった項目とその理由
台帳が要るのは、区分の境目が、モデルの説明と見直しの両方の出発点になるためです。否決の理由を説明するとき(第11章)、監査や検証で「なぜこの境目なのか」を問われたとき(第12章)、申込者の層が変わって区分ごとの件数がずれてきたときに、元の判断に戻れるようにしておく必要があります。境目の根拠が担当者の記憶にしか無いと、担当者が替わったときに誰も説明できなくなります。
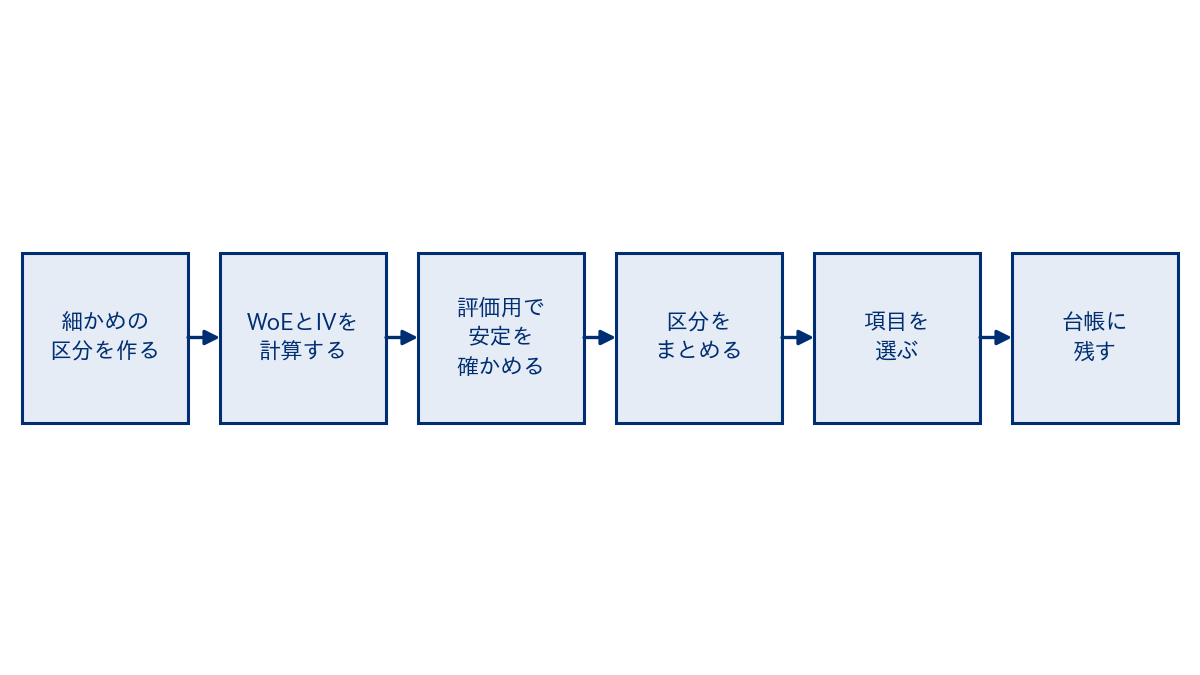
区分けと項目の選択は、データ分析の細部に見えますが、ここでの判断の誤りは、序章で整理した損失の型につながります。区分を細かくしすぎたり、学習用のデータに合わせた境目を採ったりすると、学習用では順位づけが良く見えても、後の月の申込では並びが崩れます。そのモデルでカットオフを決めると、想定よりデフォルトしやすい契約を承認する貸し倒れや、返済できたはずの申込を断る機会損失が、見込みと違う形で出るおそれがあります。審査の時点で手に入らない項目が紛れ込むと、評価の数字は良く見えたまま本番で成績が崩れ、原因の特定にも時間がかかります。
区分の根拠が残っていないことも、損失の型につながります。境目を誰がなぜ決めたのかが分からないと、申込者の層や商品の条件が変わったときに見直す手がかりが無く、点数表が古いまま使われ続ける形骸化を招きます。否決の理由を示す場面や、監査・検証で区分の根拠を問われる場面で答えられなければ、適用される法令などが説明や記録を求めている場合には、その義務を果たせない規制上の義務の不履行のおそれも出てきます(どの義務が適用されるかは業態と法令によって違い、第14章で扱います)。項目の選び方の段階で、使ってはいけない属性の代わりになる項目を点検していないと、特定の集団に偏った判断を続けることにもなりかねません(第11章)。
これを防ぐために、経営とリスク管理の責任者には、次の3つを決めておくことをお勧めします。1つ目は、区分けの台帳を、モデルの成果物の一部として扱うことです。点数表とモデルの成績だけでなく、区分の境目・件数・WoE・根拠を、承認の対象に含めます。2つ目は、項目を選ぶ観点の表のうち、IV の大きさに関係なく項目を外す条件(審査の時点で手に入らない・規制上使えない)を、データ分析の担当者だけでなくコンプライアンスと情報システムの担当者が確かめる手順にすることです。3つ目は、区分けの作業にかける時間を、モデルの開発の予算に入れておくことです。区分を業務の担当者と1つずつ確かめる作業は、モデルの係数を推定する作業より時間がかかることが多いように思います。この時間を削ると、説明できない点数表が残ります。区分の根拠を説明できる状態にしておくことが、第4章以降で作る点数表を、審査・営業・監査が同じものとして読むための前提になります。
この章のまとめ
この章では、スコアカード作りで項目を区分に分ける理由、区分けの方法、WoE と情報価値(IV)の式と読み方、区分を細かくしすぎたときの揺れ、単調にそろえる判断、決定木での境目の候補、項目を選ぶ観点と区分けの台帳を扱いました。本コラムの架空データでは、年収の水準を40区分にすると、学習用の IV は0.180と5区分の0.131より大きくなった一方で、学習用と評価用の WoE の相関は0.633まで下がり、隣の区分との大小の半分近くが後の月で逆になりました。差をごく小さく作った職種でも、30区分のままでは学習用の IV が0.026と出ましたが、これは職種と結果を無関係にしたデータでも出る範囲(200回の計算の95%点が0.034)に収まる値でした。他社の枠の利用率は、無理に単調にそろえると IV が評価用で0.072から0.005に下がり、単調でない形を残す判断が要る例になりました。契約後3か月以内の延滞という、審査の時点では手に入らない確認用の項目は、IV が2.186と他の項目より1桁以上大きく、情報の漏れを疑うきっかけになることを確かめました。次の第4章では、この章で作った区分と WoE を使ってロジスティック回帰を当てはめ、係数から点数表に変換します。
この章を深めたい方への参考書籍
『機械学習のための特徴量エンジニアリング』(Alice Zheng、Amanda Casari 著、株式会社ホクソエム 訳、オライリー・ジャパン):モデルに入れる前の項目の加工を、原理と Python の実装の両面から解説した本です。版元の目次によれば、数値の項目の離散化、カテゴリの項目のエンコーディング、カテゴリの数が膨大な項目の扱い、特徴選択の節があります。この章で扱った区分けとカテゴリの多い項目の扱いを、与信に限らない一般的な方法の中に位置づけて理解するのに向いています。
『Pythonではじめる機械学習』(Andreas C. Muller、Sarah Guido 著、中田秀基 訳、オライリー・ジャパン):scikit-learn を使って、機械学習の基礎とデータの表現の仕方を解説した本です。版元の目次によれば、第4章「データの表現と特徴量エンジニアリング」に、カテゴリ変数(4.1)、ビニング・離散化と線形モデル・決定木の関係(4.2)、自動特徴量選択(4.5。単変量統計・モデルベース・反復の3つの方法)の節があります。この章で扱った区分けと項目の選び方を、線形モデルと決定木での効き方の違いや、統計的な特徴量選択の方法と並べて確かめるのに役立ちます。
第4章 ロジスティック回帰でスコアカードを作る、係数から点数表への変換
第3章では、項目を区分に分け、区分ごとの正常とデフォルトの偏りを WoE(区分ごとの、正常の構成比をデフォルトの構成比で割った値の自然対数)と情報価値(IV)で表し、変数を選ぶところまでを扱いました。この章では、その区分と WoE を材料にして、統計のモデルで項目ごとの重みを決め、審査で使える点数表に直すまでを扱います。点数表の形にしたものがスコアカードで、該当する区分の点数を足し合わせるとスコアになります。この章では、点数表とスコアカードを同じものを指す語として使い、区分ごとの値を「点数」、その合計を「スコア」と呼びます。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の契約の記録を使い、実行したコードと結果で確かめます。
- ロジスティック回帰が与信に向く性質と、WoE に変換した項目で当てはめる流れ
- 係数の符号と大きさの確かめ方と、符号がそろわないときに疑うこと
- デフォルトの対数オッズを点数に直す式(基準の点数・基準のオッズ・オッズが2倍になる点数)と、区分ごとの点数表の作り方
- スコアの分布と帯ごとのデフォルト率、申込の月で切った評価用のデータでの AR値
- 項目どうしの相関(多重共線性)の点検と、正則化の使いどころ
- 欠損の区分と「その他」の区分の点数、業務の担当者と点数表を見直す観点、人が点数を調整することの是非
- スコアカードの文書と、経営の判断
この章の主張は、スコアカードの価値は点数の計算の正しさだけでなく、審査・営業・監査が同じ表を同じ意味で読めることにある、という点です。点数表は足し算で読めるので、どの項目のどの区分が何点を押し下げたかを項目ごとに追えます。その性質を保つには、係数の符号の点検、区分の点数の並びの確認、作り方と成績を残す文書が欠かせません。評価の指標の詳しい扱いは第7章、点数をどこで区切って承認の候補とするか(カットオフ)は第9章で扱います。
ロジスティック回帰が与信に向く性質
ロジスティック回帰は、結果が「デフォルト」か「正常」かの2通りのときに、項目の値からデフォルト確率を見積もる統計のモデルです。デフォルト確率を \( p \) とすると、\( p \) を直接に足し算で表すのではなく、デフォルトの対数オッズ \( \eta = \ln\frac{p}{1-p} \)(デフォルトする確率としない確率の比の自然対数)を、項目の値に係数を掛けて足し合わせた形で表します。式で書くと \( \eta = \beta_0 + \beta_1 x_1 + \cdots + \beta_k x_k \) です。言葉で言い換えると、項目ごとの寄与を足し算で積み上げた結果を、0から1の間の確率に戻して読む仕組みです。回帰の一般論と、係数の推定の方法は、弊社コラム『ビジネスの要因分析に効く回帰分析と統計モデリングについて』で扱っています。
与信に向く性質は、主に3つに整理できます。1つ目は、出力を確率として読めることです。モデルの出力をそのままデフォルト確率の見積りとして扱え、収益と損失の見積り(第9章)や確率の較正(第8章)につなげやすい形をしています。ただし、出力が実績のデフォルト率と合っているかは、別に確かめる必要があります。2つ目は、項目ごとの寄与が足し算になることです。対数オッズの上では、ある項目の区分が変わったときの寄与は、他の項目の値に関係なく一定です。この性質があるので、係数を点数に直した表を作れます。3つ目は、説明しやすいことです。点数表を見れば、ある申込のスコアが低い理由を項目ごとに示せます。否決の理由として示す項目の選び方には複数の方法があり、第11章で扱います。
一方で、ロジスティック回帰は、モデルに入れた形以外の関係を自分では見つけません。項目の値と対数オッズの関係が直線でない場合や、2つの項目の組み合わせで初めて効く関係がある場合、それを区分けや組み合わせの項目として人が用意しない限り、モデルはその関係を使えません。区分けを経て WoE に変換するのは、直線でない関係を区分ごとの値として取り込むための工夫の1つです(第3章)。項目どうしの組み合わせまでデータから学ばせる機械学習のモデルとの比較は、第5章で扱います。
WoE に変換した項目でロジスティック回帰を当てはめる流れは、次のとおりです。まず、学習用のデータだけで項目ごとの区分の境目を決め、区分ごとの WoE を計算します。次に、学習用のデータと評価用のデータの両方で、各項目の値を、その値が入る区分の WoE に置き換えます。そのうえで、置き換えた値を説明変数、デフォルトを1・正常を0とした結果を目的変数として、ロジスティック回帰を学習用のデータに当てはめます。最後に、得られた係数と定数項から、区分ごとの点数を計算します。評価用のデータには、学習用で決めた境目・WoE・点数を当てはめるだけで、評価用の結果を使って何かを決め直すことはしません。評価用の結果が境目や WoE に入り込むと、成績が実際より良く見える情報の漏れになるためです。
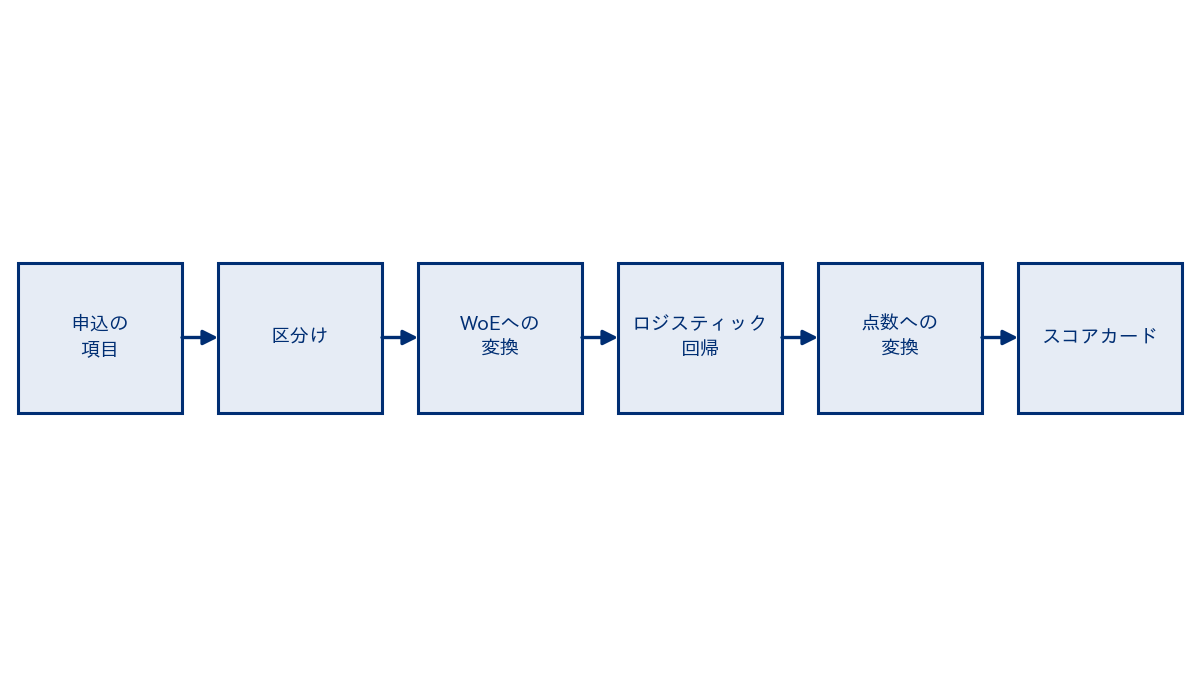
架空の契約の記録を作る、申込の月と項目と結果
ここからは、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の契約の記録よりずっと単純です。合成データでの成績は、実際の審査での成績の目安にはなりません。示したいのは、区分と WoE から係数を推定し、点数表に直し、時間で切った評価用のデータで確かめるまでの手順と、その途中で点検すべきことです。
作ったのは、個人向けの貸付を想定した契約30,000件の記録です。過去の審査で承認した申込はすべて契約され、実行されたものとして単純化しました(否決した申込の扱いは第6章で扱います)。結果は第2章の既定の例題の定義に合わせ(コードのコメントでは「90日以上の延滞」と略しています)、契約の実行から12か月以内に延滞が90日以上に達した契約をデフォルト(1)、12か月の観測期間を満たしてデフォルトしなかった契約を正常(0)とし、すべての契約が観測期間を満たしているものとしました。項目は次の8つです。年収の水準と借入の残高の年収比は相対値で、年収の水準は全体の中央値がおよそ1になるように作っています。表の「対数正規分布」「ガンマ分布」「ポアソン分布」は、乱数で値を作るときのばらつき方の種類の名前です(ポアソン分布は件数のような0以上の整数を作るときに使います)。
| 項目 | 作り方の要点 | デフォルトとの関係(データを作るときの設定) |
|---|---|---|
| 年収の水準(相対値) | 対数正規分布。中央値がおよそ1 | 高いほどデフォルトしにくい |
| 雇用の形態 | AからDの4種類 | A、B、C、Dの順にデフォルトしやすくなる |
| 勤続年数 | ガンマ分布。雇用の形態Dでは6割が欠損 | 15年までは長いほどデフォルトしにくい。欠損は勤続の短い層に近い |
| 居住の年数 | ガンマ分布 | 1年未満が最もデフォルトしやすく、1年以上10年未満が最もしにくく、20年以上でやや上がる(単調でない関係) |
| 他社の借入の件数 | ポアソン分布。年収の水準が低いと多め | 多いほどデフォルトしやすい |
| 他社の借入の残高の年収比(相対値) | 借入の件数に比例させて作る | 大きいほどデフォルトしやすい。借入の件数と強く関係する |
| 過去の延滞の有無 | 借入が2件以上だと有りが多め | 有りでデフォルトしやすい。借入が2件以上と重なるとさらにしやすい(組み合わせで効く関係) |
| 直近6か月の申込の件数 | ポアソン分布。借入の件数が多いと多め | 多いほどデフォルトしやすい |
このほか、申込の月(1〜24)を持たせ、デフォルトの起きやすさに景気の揺れにあたる小さな周期の変動を入れました。性別や国籍のような差別につながる属性は作っていません。申込の月で切り、1〜16月を学習用、17〜24月を評価用にします。ただし、この分け方は、すべての契約の結果が確定した後で、申込の時期の前後を比べる事後的な分け方で、運用の再現ではありません。16月に実行した契約の結果は12か月の観測期間が終わるまで分からないので、実際に17月の時点で点数表を作るなら、学習に使えるのはそれより1年ほど前までに実行した契約に限られます。審査の時点で手に入る項目だけを使い、契約の後に分かる返済の記録は項目に入れていません。乱数の種は20261113に固定しています。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N = 30000
month = rng.integers(1, 25, N)                                   # 申込の月(1〜24)
income = rng.lognormal(0.0, 0.45, N)                             # 年収の水準(相対値。中央値が1)
emp = rng.choice(["A", "B", "C", "D"], N, p=[0.55, 0.2, 0.15, 0.1])  # 雇用の形態
tenure = np.round(rng.gamma(2.0, 4.0, N), 1)                     # 勤続年数
tenure[(emp == "D") & (rng.random(N) < 0.6)] = np.nan            # 雇用の形態Dは勤続年数が欠けやすい
resid = np.round(rng.gamma(1.5, 5.0, N), 1)                      # 居住の年数
n_loans = rng.poisson(0.6 + 0.5 * (income < 0.8)).clip(0, 8)     # 他社の借入の件数
debt = np.round(n_loans * rng.gamma(2.0, 0.08, N) / income, 3)   # 他社の借入の残高の年収比(相対値)
delinq = (rng.random(N) < 0.06 + 0.04 * (n_loans >= 2)).astype(int)  # 過去の延滞の有無
inq = rng.poisson(0.8 + 0.3 * n_loans).clip(0, 10)               # 直近6か月の申込の件数
z = (-3.95 - 0.9 * np.log(income) + 0.2 * n_loans + 1.0 * debt + 0.9 * delinq
     + 0.5 * delinq * (n_loans >= 2)                             # 組み合わせで効く関係
     + 0.18 * inq + pd.Series(emp).map({"A": 0.0, "B": 0.3, "C": 0.5, "D": 0.6}).to_numpy()
     - 0.05 * np.nan_to_num(np.minimum(tenure, 15), nan=-6.0)    # 欠損は勤続の短い層に近いリスク
     + np.select([resid < 1, resid < 10, resid < 20], [0.6, -0.2, 0.0], 0.25)  # 単調でない関係
     + 0.15 * np.sin(2 * np.pi * month / 24))                    # 景気の揺れ
u = rng.random(N)
p_true = 1 / (1 + np.exp(-z))                                    # データを作るときの真のデフォルト確率
y = (u < p_true).astype(int)                                     # 1=12か月以内に90日以上の延滞
df = pd.DataFrame({"month": month, "income": income, "emp": emp, "tenure": tenure, "resid": resid,
                   "n_loans": n_loans, "debt": debt, "delinq": delinq, "inq": inq, "y": y})
train, test = df[df.month <= 16].copy(), df[df.month >= 17].copy()   # 申込の月で切る
print("契約", len(df), "件 デフォルト率", round(df.y.mean(), 4))
print("学習用(1〜16月)", len(train), "件 デフォルト率", round(train.y.mean(), 4),
      "/評価用(17〜24月)", len(test), "件 デフォルト率", round(test.y.mean(), 4))
p_flat = 1 / (1 + np.exp(-(z - 0.15 * np.sin(2 * np.pi * month / 24))))   # 景気の揺れだけを外した確率
y_flat = u < p_flat                                              # 同じ乱数で結果を作り直す
for name, v in [("真の確率の平均", p_true), ("揺れを外した確率の平均", p_flat), ("揺れを外したデフォルト率", y_flat)]:
    print(name, "学習用", round(v[month <= 16].mean(), 4), "評価用", round(v[month >= 17].mean(), 4))
実行した結果、契約30,000件のデフォルト率は3.91%でした。学習用(1〜16月)は19,998件でデフォルト率4.24%、評価用(17〜24月)は10,002件でデフォルト率3.27%です。評価用のデフォルト率が学習用より0.97ポイント低くなった内訳を、コードの後半で確かめました。データを作るときの真のデフォルト確率の平均は、学習用4.13%、評価用3.66%で、その差は0.47ポイントです。景気の揺れだけを外して同じ乱数で作り直すと、真の確率の平均は3.95%と3.98%でほぼ同じになりました。この2組の値から分けると、0.47ポイントは、景気の揺れによる約0.50ポイント(学習用で0.18ポイント高く、評価用で0.32ポイント低い)と、それ以外の項目の構成の違いによる約 -0.03 ポイントを合わせたものです。実績の差0.97ポイントのうち、残りの約0.50ポイントは、確率どおりに結果を引いたときの偶然のぶれで、学習用は真の確率の平均より0.11ポイント高く、評価用は0.39ポイント低く出ました。この差は、後の節で、点数表から戻した確率と実績のずれとして現れます。実際のデータでは真の確率は分からないので、期間によるデフォルト率の差のうち、どこまでが景気によるもので、どこまでが偶然のぶれかを、このように分けることはできません。デフォルト率は、それぞれの期間に申込があった契約のうち、観測期間のうちにデフォルトした契約の件数の割合です。デフォルト率の水準は商品によって大きく違い、この数%という水準は説明のための置き方です。
区分けとWoEへの変換を、学習用のデータだけで決める
次のブロックでは、第3章の考え方を簡単に再掲して、区分けと WoE への変換を行います。年収の水準と勤続年数は、学習用のデータの分位点で件数がほぼ等しくなるように5つに区分しました(等頻度の区分け)。居住の年数、他社の借入の件数、残高の年収比、直近の申込の件数は、業務の知識で決めたことにした境目を使っています。勤続年数の欠損は、独立した「欠損」の区分にしました。区分ごとの件数が0になると WoE の対数が計算できないので、正常とデフォルトの件数に0.5を足してから計算しています。これは0件による対数の発散を防ぐための補正で、WoE が必ず0に近づくわけではなく、件数が少ない区分の WoE の不確かさも残ります。
NUM = {"income": 5, "tenure": 5, "resid": None, "debt": None}    # 数値の項目と等頻度の区分の数
EDGES = {"resid": [1, 10, 20], "debt": [0.001, 0.15, 0.4],      # 業務の知識で決めた境目
         "n_loans": [1, 2, 3], "inq": [1, 2, 3, 5]}

def labels(e):                                   # 境目から区分の名前を作る(並びの順)
    return ([f"{e[0]}未満"] + [f"{a}以上{b}未満" for a, b in zip(e[:-1], e[1:])]
            + [f"{e[-1]}以上", "欠損"])

def to_bin(s, col, e):                           # 区分の名前の列を返す(欠損は「欠損」)
    if col == "emp":
        return s.astype(str)
    b = pd.Series(np.array(labels(e))[np.digitize(s, e)], index=s.index)
    return b.where(s.notna(), "欠損")

def woe_table(x, yv, order):                     # 区分ごとの件数・デフォルト・WoE(学習用だけで計算)
    t = pd.crosstab(x, yv).reindex(columns=[0, 1], fill_value=0)
    t = t.reindex([o for o in order if o in t.index])
    good, bad = t[0] + 0.5, t[1] + 0.5           # 0件の区分で対数が発散しないように0.5を足す
    t["woe"] = np.log((good / good.sum()) / (bad / bad.sum()))
    t["iv"] = ((good / good.sum()) - (bad / bad.sum())) * t["woe"]
    return t

FEATS = ["income", "tenure", "resid", "n_loans", "debt", "delinq", "inq", "emp"]
edges, tabs = {}, {}
for c in FEATS:
    if NUM.get(c):                               # 等頻度の境目を学習用だけから決める
        edges[c] = [float(v) for v in np.unique(np.nanquantile(train[c], np.linspace(0, 1, NUM[c] + 1)[1:-1]).round(2))]
    else:
        edges[c] = EDGES.get(c, [1])
    order = ["A", "B", "C", "D"] if c == "emp" else labels(edges[c])
    tabs[c] = woe_table(to_bin(train[c], c, edges[c]), train.y, order)
    for d in (train, test):
        d["w_" + c] = to_bin(d[c], c, edges[c]).map(tabs[c]["woe"]).fillna(0.0)
print(pd.Series({c: tabs[c]["iv"].sum() for c in FEATS}).round(3).sort_values(ascending=False))
実行した結果、項目ごとの情報価値(IV)は、他社の借入の残高の年収比が0.443、年収の水準が0.441、他社の借入の件数が0.346、過去の延滞の有無が0.144、直近の申込の件数が0.132、勤続年数が0.085、雇用の形態が0.070、居住の年数が0.036でした。IV は項目1つがどれだけ正常とデフォルトを見分けるかの目安で、モデル全体の成績でも、項目がデフォルトの原因であることを示すものでもありません(第3章)。この章では8つの項目をすべてモデルに入れて、係数の点検に進みます。
コードの最後の行では、評価用のデータにも、学習用のデータで決めた境目と WoE を当てはめています。評価用に学習用には無かった区分が現れた場合は WoE を0(全体と同じ偏り)として扱うようにしましたが、この架空データでは評価用にだけ現れた区分はありませんでした。実務では、学習用に無い区分が現れたこと自体を、申込者の層の変化の兆しとして記録しておくことが有効だと考えています(監視は第12章)。
ロジスティック回帰を当てはめ、係数の符号を確かめる
WoE に置き換えた8つの項目で、statsmodels のロジスティック回帰(Logit)を学習用のデータに当てはめます。本コラムの計算では、Python 3.14.3 で statsmodels 0.14.6、scikit-learn 1.9.0 を使い、図の日本語の表示には japanize-matplotlib 1.1.3 を使いました(この環境で動作を確かめています)。次のブロックの前半が当てはめと、比べるための1項目だけの当てはめ、後半が点数への変換に使う定数の計算です。
import statsmodels.api as sm
from sklearn.metrics import roc_auc_score

W = ["w_" + c for c in FEATS]
res = sm.Logit(train.y, sm.add_constant(train[W])).fit(disp=0)
print(pd.DataFrame({"係数": res.params, "標準誤差": res.bse, "p値": res.pvalues}).round(3))
for c in ["income", "debt", "delinq"]:          # 1項目だけで当てはめた場合の係数
    print("単独の当てはめ", c, round(sm.Logit(train.y, sm.add_constant(train[["w_" + c]])).fit(disp=0).params["w_" + c], 3))

def ar(yv, score):                               # AR値 = 2 × AUC - 1。AUCはスコアの符号を反転した値で計算する
    return 2 * roc_auc_score(yv, -score) - 1

PDO, BASE, ODDS = 20, 600, 50                    # 正常対デフォルトのオッズ50対1を600点、オッズが2倍になるごとに20点
B = PDO / np.log(2)                              # スコア = A - B × η(η はデフォルトの対数オッズ)
A = BASE + B * np.log(1 / ODDS)
base_pts = int(round(A - B * res.params["const"]))   # 基礎点(定数項から作る)
print("A", round(A, 3), "B", round(B, 3), "基礎点", base_pts)
推定した係数は次の表のとおりです。p値は、コードの出力では小数第3位で丸めて0.000と表示されたものを「0.001未満」と書いています。標準誤差とp値は、WoE を固定した説明変数とみなして計算した参考値です。WoE そのものを同じ学習用のデータの結果から作っているので、WoE を作る工程の不確かさは含まれておらず、この値だけを項目を採用するかどうかの根拠にはしないことが大事です。
| 説明変数(WoE に置き換えた項目) | 係数 | 標準誤差 | p値 |
|---|---|---|---|
| 定数項 | -3.114 | 0.039 | 0.001未満 |
| 年収の水準 | -0.762 | 0.061 | 0.001未満 |
| 勤続年数 | -0.798 | 0.147 | 0.001未満 |
| 居住の年数 | -1.090 | 0.178 | 0.001未満 |
| 他社の借入の件数 | -0.302 | 0.090 | 0.001 |
| 他社の借入の残高の年収比 | -0.453 | 0.079 | 0.001未満 |
| 過去の延滞の有無 | -0.961 | 0.083 | 0.001未満 |
| 直近6か月の申込の件数 | -0.630 | 0.100 | 0.001未満 |
| 雇用の形態 | -0.586 | 0.164 | 0.001未満 |
8つの係数はすべて負でした。これは WoE の向きから見込まれる結果です。WoE は、正常の構成比をデフォルトの構成比で割った値の自然対数なので、正の値の区分は全体より正常の側に寄っています。一方、モデルが表しているのはデフォルトの対数オッズなので、WoE が大きい(正常の側に寄った)区分ほどデフォルトの対数オッズが下がる、つまり係数が負になるのが普通です。WoE を1つの項目だけで計算したときの関係が、他の項目と一緒にモデルに入れても保たれていることを、係数の符号で確かめているわけです。
年収の水準の2つの区分で、数字を追ってみます。「1.47以上」の区分は、デフォルト率が1.37%と全体(4.24%)より低く、WoE は 1.149 と正です。係数 -0.762 を掛けると -0.876 で、この区分に入るとデフォルトの対数オッズが 0.876 下がります。反対に「0.69未満」の区分は、デフォルト率が9.31%で WoE は -0.841、係数を掛けると 0.641 で、デフォルトの対数オッズが上がります。負の係数に正の WoE を掛けると対数オッズが下がり、負の WoE を掛けると上がる、というのが、係数が負であることの意味です。なお、結果をデフォルトを0・正常を1として当てはめると、モデルが表すのは正常の対数オッズになり、係数の符号はすべて逆(正)になります。符号の正負そのものではなく、WoE の向きと結果の置き方の組み合わせから見込まれる向きと一致しているかを確かめることが大事です。
係数の大きさは、その項目の WoE をどれだけそのまま使うかの度合いと読めます。WoE は、その区分の正常とデフォルトの比の対数から、全体の正常とデフォルトの比の対数を引いた値です。そのため、1つの項目だけで当てはめると、区分のデフォルトの対数オッズは「全体の水準 – WoE」でちょうど表せ、係数は -1 になります(件数に0.5を足す補正の分だけずれます)。コードで1項目だけで当てはめた係数は、年収の水準で -1.003、残高の年収比で -1.001、過去の延滞の有無で -0.998 でした。複数の項目を一緒に入れると、他の項目と情報が重なるため、係数の絶対値が小さくなる場合があります。この表では、他社の借入の件数の係数が -0.302 と、IV が大きい(0.346)わりに絶対値が小さくなっています。後の節で見るとおり、この項目は残高の年収比と強く関係していて、2つの項目で同じ情報を分け合っているためと考えられます。反対に、居住の年数の係数は -1.090 で、IV は小さい(0.036)ものの、他の項目とほとんど重ならない情報として、WoE がほぼそのまま使われています。
もし符号が正の係数が出たら、その項目の WoE の向きとモデルの中での効き方が逆になっていることを意味します。点数表にすると、その項目では正常の側に寄った区分ほど点数が低くなるという、業務の感覚と逆の並びになり、説明がつかなくなります。疑うことを、確かめる順に並べると次のとおりです。
- 項目どうしの相関:ほぼ同じ情報を持つ2つの項目を一緒に入れると、片方の係数が大きく負になり、もう片方が正に振れることがあります
- 区分の件数:件数が少ない区分が多いと WoE が不安定になります
- 学習用の期間の特別な事情:審査の基準の変更や商品の切り替えがあった期間を含んでいないか
- WoE の計算と置き換えの誤り:WoE の向きや区分の対応が、学習用と評価用で食い違っていないか
符号が正の項目は、相関の点検をしたうえで、外すか、区分を統合するか、相関の強い項目のどちらか1つに絞る、という対処がよく取られます。
デフォルトの対数オッズを点数に直す、基準の点数・基準のオッズ・PDO
係数が決まれば、デフォルトの対数オッズ \( \eta \) は、定数項と「係数 × WoE」の和で計算できます。このままでも順位づけには使えますが、\( \eta \) は小数で、値が小さいほどデフォルトしにくいという向きなので、審査の現場で扱いやすい整数の点数に直します。本コラムでは、スコアが大きいほどデフォルト確率が低い向きにそろえています。点数への変換は、次の式で行います。
\( \text{スコア} = A – B \times \eta \quad (B > 0) \)
B が正なので、デフォルトの対数オッズが小さい(デフォルトしにくい)ほど、スコアは大きくなります。A と B は、2つの取り決めから決めます。1つ目は、基準のオッズと基準の点数です。ここで使うオッズは、η のもとになった「デフォルト ÷ 正常」のオッズとは逆向きの、「正常 ÷ デフォルト」のオッズ(正常になる確率をデフォルトする確率で割った値)です。点数を「大きいほどデフォルトしにくい」向きにするので、本コラムでは基準もこの向きのオッズで決めました。本コラムでは、正常 ÷ デフォルトのオッズが50対1のとき、つまりデフォルト確率がおよそ1.96%(51件に1件)のときに600点になるようにしました。2つ目は、正常 ÷ デフォルトのオッズが2倍になるごとに何点増やすかで、これを PDO(Points to Double the Odds の略。オッズが2倍になる点数)と呼びます。本コラムでは PDO を20点にしました。正常 ÷ デフォルトのオッズが2倍になることは、デフォルト ÷ 正常のオッズが半分になることと同じで、そのとき \( \eta \) は \( \ln 2 \) だけ下がります。その下がり幅で20点増えるように、\( B = \text{PDO} \div \ln 2 \) とします。A は、正常 ÷ デフォルトのオッズが50のとき(デフォルトの対数オッズでは \( \eta = \ln\frac{1}{50} \))に600点になるように \( A = 600 + B \times \ln\frac{1}{50} \) と決まります。この2つの式は、点数の向きと基準の取り決めから導いたものです。
実行した結果、B は28.854、A は487.123でした。600点・50対1・20点という置き方は説明のための例で、何点を基準にするかに決まりはありません。大事なのは、基準と PDO を決めて文書に残し、モデルを作り直しても同じ基準で点数を出すことです。基準を変えると、同じデフォルト確率でも点数が変わり、カットオフ(第9章)や社内の資料で使っていた点数の意味が変わってしまいます。同じ形の変換は、スコアカードを作る Python のライブラリ optbinning の公開されているソースコードにも実装されています(本コラムでは optbinning を使っておらず、ソースコードを読んで確かめた範囲です)。
次に、この式を、区分ごとの点数の表に分解します。\( \eta \) は定数項と各項目の「係数 × WoE」の和なので、スコアは、定数項から決まる基礎点と、各項目の区分ごとの点数の和に分けられます。
\( \text{スコア} = \underbrace{(A – B\beta_0)}_{\text{基礎点}} + \sum_{j} \underbrace{(-B\,\beta_j\,\mathrm{WoE}_j)}_{\text{項目 j の区分の点数}} \)
言葉で言い換えると、全員に共通の基礎点から出発し、項目ごとに該当する区分の点数を足し引きする表です。区分の点数は、係数(負)と WoE の積に -B を掛けたものなので、WoE が正の区分(正常の側に寄った区分)は正の点数、WoE が負の区分は負の点数になります。年収の水準の「1.47以上」の区分なら、\( -28.854 \times (-0.762) \times 1.149 \) でおよそ25点、「0.69未満」の区分なら \( -28.854 \times (-0.762) \times (-0.841) \) でおよそ -18点です。負の係数に -B(負)を掛けた値は正なので、点数の符号は WoE の符号と同じになります。この章の計算では、基礎点は577点でした。なお、基礎点を表に置かず、定数項の分を項目の数で割って各項目の点数に配る作り方もあります(前に触れた optbinning の実装はこの形です)。どちらでも合計のスコアは丸めの誤差を除いて同じになりますが、配る作り方では多くの区分が正の点数になるので、点数の正負から、その区分が全体より正常の側に寄っているかどうかを読めなくなる点に注意が要ります。
rows = []
for c in FEATS:
    for bin_name, r in tabs[c].iterrows():
        pts = -B * res.params["w_" + c] * r["woe"]   # 区分の点数 = -B × 係数 × WoE
        rows.append({"項目": c, "区分": bin_name, "件数": int(r[0] + r[1]),
                     "デフォルト率": round(r[1] / (r[0] + r[1]), 4), "WoE": round(r["woe"], 3), "点数": int(round(pts))})
card = pd.DataFrame(rows)
print("境目:", {c: edges[c] for c in FEATS if c != "emp"})
print(card.to_string(index=False))

def score_of(d):                                 # 基礎点に、該当する区分の点数を足してスコアを求める
    total = np.full(len(d), float(base_pts))
    for c in FEATS:
        pts = card[card["項目"] == c].set_index("区分")["点数"]
        total += to_bin(d[c], c, edges[c]).map(pts).fillna(0).to_numpy()
    return total

tb_ten = pd.Series(p_true[train.index]).groupby(to_bin(train.tenure, "tenure", edges["tenure"]).to_numpy()).mean()
print("勤続年数の区分ごとの真の確率の平均", tb_ten.reindex(labels(edges["tenure"])).round(4).to_dict())
train["score"], test["score"] = score_of(train), score_of(test)
one = test.iloc[[0]]
print(one[FEATS].to_string(index=False))
print("区分:", [to_bin(one[c], c, edges[c]).iloc[0] for c in FEATS], "合計", int(one.score.iloc[0]))
実行して作った点数表(スコアカード)が次の表です。件数とデフォルト率は学習用のデータでの値です。区分の名前は、コードが出力した境目の値のとおりに書いています(「1未満」は、件数の項目では0件、延滞の有無では「無し」にあたります)。
| 項目 | 区分 | 件数(学習用) | デフォルト率(学習用) | WoE | 点数 |
|---|---|---|---|---|---|
| 基礎点 | 全員 | 19,998 | 4.24% | 対象外 | 577 |
| 年収の水準 | 0.69未満 | 4,049 | 9.31% | -0.841 | -18 |
| 年収の水準 | 0.69以上0.9未満 | 3,983 | 4.82% | -0.135 | -3 |
| 年収の水準 | 0.9以上1.13未満 | 4,034 | 3.05% | 0.340 | 7 |
| 年収の水準 | 1.13以上1.47未満 | 3,929 | 2.55% | 0.525 | 12 |
| 年収の水準 | 1.47以上 | 4,003 | 1.37% | 1.149 | 25 |
| 勤続年数 | 3.3未満 | 3,729 | 4.93% | -0.159 | -4 |
| 勤続年数 | 3.3以上5.5未満 | 3,775 | 3.84% | 0.102 | 2 |
| 勤続年数 | 5.5以上8.0未満 | 3,674 | 4.44% | -0.048 | -1 |
| 勤続年数 | 8.0以上11.8未満 | 3,795 | 3.43% | 0.220 | 5 |
| 勤続年数 | 11.8以上 | 3,835 | 3.13% | 0.314 | 7 |
| 勤続年数 | 欠損 | 1,190 | 8.82% | -0.784 | -18 |
| 居住の年数 | 1未満 | 1,146 | 7.24% | -0.572 | -18 |
| 居住の年数 | 1以上10未満 | 13,590 | 3.84% | 0.103 | 3 |
| 居住の年数 | 10以上20未満 | 4,297 | 4.40% | -0.040 | -1 |
| 居住の年数 | 20以上 | 965 | 5.49% | -0.280 | -9 |
| 他社の借入の件数 | 1未満(0件) | 9,697 | 2.38% | 0.595 | 5 |
| 他社の借入の件数 | 1以上2未満(1件) | 6,812 | 4.23% | 0.002 | 0 |
| 他社の借入の件数 | 2以上3未満(2件) | 2,543 | 7.79% | -0.647 | -6 |
| 他社の借入の件数 | 3以上 | 946 | 13.74% | -1.283 | -11 |
| 他社の借入の残高の年収比 | 0.001未満 | 9,697 | 2.38% | 0.595 | 8 |
| 他社の借入の残高の年収比 | 0.001以上0.15未満 | 4,530 | 3.27% | 0.269 | 4 |
| 他社の借入の残高の年収比 | 0.15以上0.4未満 | 3,704 | 5.21% | -0.218 | -3 |
| 他社の借入の残高の年収比 | 0.4以上 | 2,067 | 13.30% | -1.243 | -16 |
| 過去の延滞の有無 | 1未満(無し) | 18,629 | 3.71% | 0.137 | 4 |
| 過去の延滞の有無 | 1以上(有り) | 1,369 | 11.32% | -1.062 | -29 |
| 直近6か月の申込の件数 | 1未満(0件) | 7,548 | 2.77% | 0.441 | 8 |
| 直近6か月の申込の件数 | 1以上2未満(1件) | 7,126 | 4.35% | -0.027 | 0 |
| 直近6か月の申込の件数 | 2以上3未満(2件) | 3,542 | 5.14% | -0.202 | -4 |
| 直近6か月の申込の件数 | 3以上5未満(3〜4件) | 1,662 | 7.94% | -0.669 | -12 |
| 直近6か月の申込の件数 | 5以上 | 120 | 11.67% | -1.122 | -20 |
| 雇用の形態 | A | 11,041 | 3.52% | 0.193 | 3 |
| 雇用の形態 | B | 3,981 | 4.09% | 0.035 | 1 |
| 雇用の形態 | C | 3,043 | 4.96% | -0.167 | -3 |
| 雇用の形態 | D | 1,933 | 7.45% | -0.600 | -10 |
表から読み取れることを3つ挙げます。1つ目は、点数の幅が項目によって違うことです。最も幅が大きいのは年収の水準(-18点から25点まで43点)と過去の延滞の有無(-29点から4点まで33点)で、居住の年数は21点、雇用の形態は13点です。点数の幅は、その項目がスコアをどれだけ動かしうるかを表し、業務の担当者が「どの項目が効いているか」を確かめる手がかりになります。2つ目は、他社の借入の件数と残高の年収比で、「0件」と「0.001未満」の区分の件数(9,697件)とデフォルト率(2.38%)が完全に一致していることです。借入が0件なら残高も0なので、この2つの区分は同じ契約の集まりです。同じ情報を2つの項目で数えていることが、この表からも分かります。この点は後の節で扱います。
3つ目は、点数の並びの向きです。年収の水準、他社の借入の件数、残高の年収比、直近の申込の件数は、区分が進むにつれて点数が一方向に並んでいます。居住の年数は、1年以上10年未満が最も高く、1年未満と20年以上が低い、山形の並びです。これはデータを作るときに入れた単調でない関係をそのまま反映したもので、区分けと WoE がこうした関係を取り込めることの例です。
一方、勤続年数は、3.3年以上5.5年未満が2点、5.5年以上8.0年未満が-1点と、並びが1か所だけ逆転しています。データを作るときの設定では、勤続年数は15年まで長いほどデフォルトしにくい関係です。コードで、学習用の区分ごとにデータを作るときの真のデフォルト確率の平均を出すと、3.3年未満から順に4.78%、4.29%、4.07%、3.37%、2.75%と逆転なく下がっていました。逆転は実績のデフォルト率(3.84%と4.44%)で起きているので、確率どおりに結果を引いたときの偶然のぶれと考えられます。区分の件数が3,700件前後と多くても、デフォルトの件数は1区分あたり150件前後なので、この程度のぶれは起きえます。実際のデータでは真の関係は分からないので、こうした小さな逆転を見つけたら、業務の担当者と、その並びに説明がつくかを確かめ、説明がつかなければ隣の区分と統合する(第3章)、という判断がよく取られます。
コードの最後では、評価用の最初の1件の申込について、点数表を引いて足し算でスコアを求めました。この申込の点数の内訳は次のとおりです。
- 基礎点:577点
- 年収の水準0.526(0.69未満):-18点
- 勤続年数18.0年(11.8以上):7点
- 居住の年数3.4年(1以上10未満):3点
- 他社の借入の件数0件:5点
- 他社の借入の残高の年収比0(0.001未満):8点
- 過去の延滞の有無が無し:4点
- 直近6か月の申込の件数0件:8点
- 雇用の形態A:3点
合計は597点でした。年収の水準の区分だけが大きく点数を押し下げ、他の項目は正の点数を積み上げていることが、表を引くだけで分かります。点数を押し下げた項目を否決の理由として示す場合、各項目の最高点(満点)との差が大きい項目から選ぶのは1つの方法で、カットオフ付近の申込の平均の点数との差で選ぶ方法などもあります。理由の選び方は第11章で詳しく扱います。
スコアの分布と帯ごとのデフォルト率、時間で切った評価のAR値
次のブロックでは、点数表で求めたスコアを、学習用と評価用で評価します。AR値(モデルがデフォルトしやすい順に契約を並べられているかを表す順位づけの指標。-1〜1の値)は、ROC 曲線(第7章)の下の面積(AUC)から AR = 2 × AUC – 1 で計算します。AUC は、デフォルト確率が大きいほど高い値になる向きで計算する決まりなので、スコアが大きいほどデフォルト確率が低い本コラムの向きでは、スコアの符号を反転した値を入れています。スコアをそのまま入れると向きが逆になり、AR値の符号が反転します。指標の詳しい意味と読み方は第7章で扱います。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

print("スコアの範囲(評価用)", int(test.score.min()), "〜", int(test.score.max()),
      "中央値", int(test.score.median()))
print("AR値 学習用", round(ar(train.y, train.score), 3), "評価用", round(ar(test.y, test.score), 3))
cuts = [-np.inf, 520, 540, 560, 580, 600, 620, np.inf]
test["band"] = pd.cut(test.score, cuts, right=False)
tb = test.groupby("band", observed=True).y.agg(件数="size", デフォルト="sum", デフォルト率="mean")
test["pd_card"] = 1 / (1 + np.exp((test.score - A) / B))         # 1件ずつ η = (A - スコア) / B から確率に戻す
tb["点数表の見込み"] = test.groupby("band", observed=True).pd_card.mean()   # 帯の中の確率の平均
tb["見込み÷実績"] = tb["点数表の見込み"] / tb["デフォルト率"]
print("点数表の見込みの平均(評価用全体)", round(test.pd_card.mean(), 4))
print(tb.round(4))
fig, ax = plt.subplots(figsize=(8, 4.2))
bins = np.arange(470, 650, 10)
ax.hist(test.score[test.y == 0], bins=bins, density=True, color="#002E73", alpha=0.75, label="正常")
ax.hist(test.score[test.y == 1], bins=bins, density=True, color="gray", alpha=0.6, label="デフォルト")
ax.set_xlabel("スコア(大きいほどデフォルト確率が低い)")
ax.set_ylabel("割合(密度)")
ax.set_title("評価用(17〜24月)のスコアの分布")
ax.legend(loc="upper left")
plt.savefig("../ch04_score_dist.png", dpi=120, bbox_inches="tight")
plt.close()
fig, ax = plt.subplots(figsize=(8, 4.2))
names = ["520未満", "520〜539", "540〜559", "560〜579", "580〜599", "600〜619", "620以上"]
x = np.arange(len(tb))
ax.bar(x, tb["デフォルト率"] * 100, color="#002E73", width=0.6, label="実績のデフォルト率")
ax.plot(x, tb["点数表の見込み"] * 100, color="gray", marker="o", label="点数表から戻した見込み")
ax.set_xticks(x, names)
ax.set_xlabel("スコアの帯")
ax.set_ylabel("デフォルト率(%)")
ax.set_title("評価用(17〜24月)のスコアの帯ごとのデフォルト率")
ax.legend(loc="upper right")
plt.savefig("../ch04_band_dr.png", dpi=120, bbox_inches="tight")
plt.close()
実行した結果、評価用のスコアは478点から640点の範囲で、中央値は593点でした。AR値は、学習用で0.516、評価用で0.537です。ここで2つの期間の AR値を並べたのは、モデルの良し悪しを決めるためではなく、同じ点数表が学習用のデータに合わせ込まれすぎていないか(過学習)を点検するためです。学習用で高く評価用で大きく下がれば合わせ込みを疑いますが、この架空データでは評価用の方が少し高くなりました。合わせ込みの兆しは見られなかった、という読み方にとどめ、評価用の方が高く出た理由は、この結果からは分かりません。正常とデフォルトそれぞれのスコアの分布や、申込者の層の構成が変われば、AR値も変わります。デフォルトの件数の違いは、AR値の推定の不確かさにも影響します。そのため、対象の集団や期間が違う AR値の差を、そのままモデルの優劣の判断には使えません(第7章)。AR値は順位づけの指標であり、確率が合っているかや、収益と損失の差を表すものではない点にも注意が要ります。
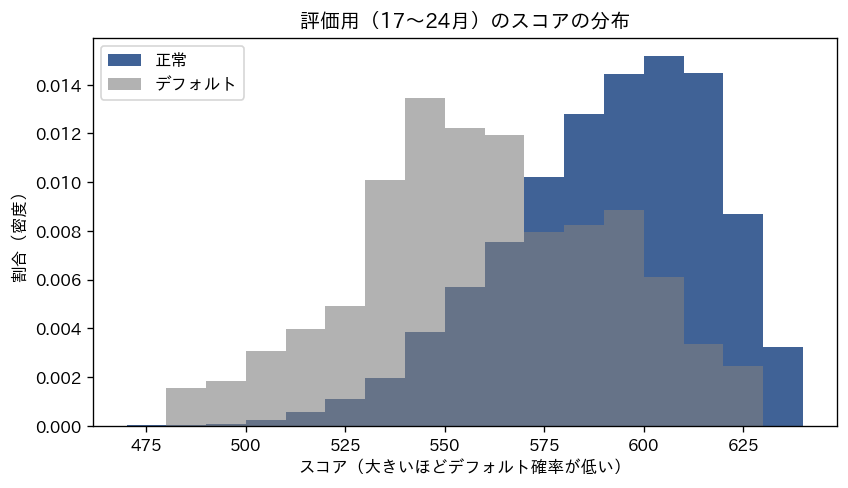
上の図は、評価用の契約のスコアの分布を、正常とデフォルトに分けて、それぞれの合計が同じ面積になるように描いたものです。正常は約9,700件、デフォルトは327件と件数が大きく違うので、縦軸は件数ではなく、それぞれの全体を同じ面積に直した値(密度)にしています。縦軸の値そのものではなく、山の位置と重なり方を見る図です。2つを半透明で重ねているので、重なった部分は濃い青灰色に見えます。正常の山は600点から610点のあたり、デフォルトの山は540点から570点のあたりにあり、デフォルトは全体としてスコアの低い側に寄っています。ただし、2つの分布は540点から630点のあたりで大きく重なっています。どこで区切っても、区切りより上にデフォルトが、下に正常が残ります。カットオフを上げれば承認する契約の中のデフォルトは減りますが、正常な契約も多く断ることになり、その兼ね合いをどう決めるかが第9章の主題です。
スコアの帯ごとのデフォルト率は、次の表のとおりです。「点数表から戻した見込み」は、契約ごとのスコアを \( \eta = (A – \text{スコア}) \div B \) からデフォルト確率に戻し、帯の中で平均した値です。確率への戻し方は直線ではないので、帯のスコアの平均を戻した値とは一致しません。実績のデフォルト率と比べるのは、確率の平均の方です。
| スコアの帯 | 件数(評価用) | デフォルトの件数 | デフォルト率(実績) | 点数表から戻した見込み | 見込み ÷ 実績 |
|---|---|---|---|---|---|
| 520点未満 | 117 | 34 | 29.06% | 32.60% | 1.12 |
| 520〜539点 | 346 | 49 | 14.16% | 17.83% | 1.26 |
| 540〜559点 | 1,008 | 84 | 8.33% | 10.08% | 1.21 |
| 560〜579点 | 1,784 | 65 | 3.64% | 5.36% | 1.47 |
| 580〜599点 | 2,687 | 56 | 2.08% | 2.80% | 1.35 |
| 600〜619点 | 2,898 | 31 | 1.07% | 1.46% | 1.36 |
| 620点以上 | 1,162 | 8 | 0.69% | 0.80% | 1.16 |
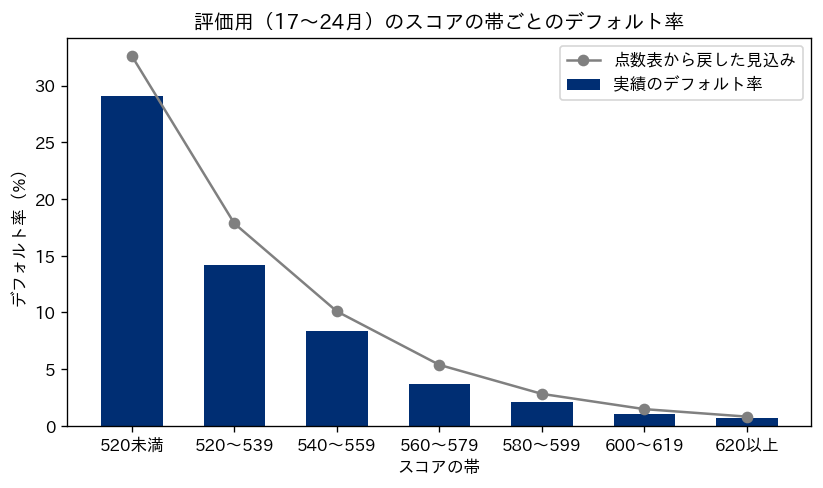
実績のデフォルト率は、520点未満の29.06%から620点以上の0.69%まで、スコアが高い帯ほど低くなり、7つの帯で並びの逆転はありませんでした。ただし、620点以上の帯のデフォルトは8件、520点未満の帯は34件しかなく、件数の少ない帯の率には偶然のぶれが乗るので、逆転が無いことは確認の1つの材料にとどまります。スコアの帯ごとのデフォルト率の並びは、点数表を審査の基準に使うときに確かめる項目の1つです。並びが逆転する帯があった場合は、その小さな逆転だけでスコアとデフォルトの関係が否定されたとはいえないので、逆転の大きさ、帯の件数、期間を変えたときにも同じ逆転が出るかを確かめ、基準の妥当性を点検します。
一方、点数表から戻した見込みは、すべての帯で実績より高くなりました。評価用の全体で見ると、点数表から戻した見込みの平均は4.24%で、学習用のデフォルト率(4.24%)と同じ水準でした。定数項を含むロジスティック回帰には、当てはめた学習用のデータでは、確率の平均が学習用のデフォルト率と一致するという、推定の式から導かれる性質があります。本コラムの確認の計算でも、点数に丸める前の確率の平均は学習用で4.235%と、学習用のデフォルト率と一致しました。評価用は項目の構成が学習用と大きく変わらなかったので(前の節の約 -0.03 ポイント)、本コラムのデータでは評価用でも同じ水準になりました。一方、評価用の実績のデフォルト率は3.27%です。点数表は学習用の期間のデフォルト率の水準を前提に作られているので、全体のデフォルト率が下がると、順位づけは保たれていても、点数から戻した確率は実績とずれます。前の節で確かめたとおり、この架空データでの差のほぼ半分は景気の揺れ、残りのほぼ半分は偶然のぶれで、項目の構成の違いは小さいものでした。
帯ごとの「見込み ÷ 実績」の比は、低い帯から順に1.12、1.26、1.21、1.47、1.35、1.36、1.16で、そろっていません。比がそろわないことだけから、水準のずれ以外の原因があるとは言えません。デフォルトの対数オッズが全部の帯で同じだけずれた場合でも、確率の比は帯の確率の大きさによって変わり、この例のように見込みが実績より高い向きのずれなら、確率が高い帯ほど比は1に近づくためです。そのため、この比だけでは、水準のずれ、件数の少ない帯の偶然のぶれ、その他の要因を区別できません。点数を確率として読むには、対象の集団と期間に合わせた換算が要る、ということです。確率が実績と合っているかを、較正に使っていないデータで全体と確率の帯ごとに確かめ(較正の確認)、ずれていれば調整する(較正)作業は、第8章で扱います。本コラムの架空データでのずれの大きさは、実際のデータでの大きさの目安にはなりません。
項目どうしの相関と多重共線性、正則化の使いどころ
係数の点検で最も大事なのが、項目どうしの相関の確認です。説明変数どうしが強く関係していると、ロジスティック回帰はどちらの項目にどれだけの重みを割り当てるかを安定して決められなくなります。この状態を多重共線性と呼びます。合計のスコアの順位づけにはあまり影響しない場合がある一方で、項目ごとの係数、つまり点数表の点数の配分が不安定になり、学習用のデータが少し変わっただけで点数が大きく動いたり、符号が逆転したりすることがあります。点数表を説明に使うスコアカードでは、この不安定さがそのまま説明の不安定さになります。前の節の点数表では、他社の借入が0件の契約は、借入の件数の「0件」で5点、残高の年収比の「0.001未満」で8点を受け取り、同じ「借入が無い」という事実に合わせて13点が付いていました。2つの項目が同じ情報を数えているとき、その点数をどう分け合うかを決めているのが係数です。
次のブロックでは、まず WoE に置き換えた項目どうしの相関と、分散拡大係数(VIF。ある説明変数を他の説明変数で回帰したときに、どれだけ説明できてしまうかから計算する値で、大きいほど他の項目と重なっている)を計算しました。次に、残高の年収比とほぼ同じ情報を持つ「返済の額の年収比」という項目を人工的に作って足した場合、残高の年収比を外した場合、借入の件数を外した場合、scikit-learn のロジスティック回帰で正則化(係数を0の側へ寄せる罰則を加えて推定する方法)を強めた場合を比べています。
from statsmodels.stats.outliers_influence import variance_inflation_factor
from sklearn.linear_model import LogisticRegression

def lin_ar(params, d, cols):                     # 線形の予測子(対数オッズ)の符号を反転してスコアの向きにそろえる
    return ar(d.y, -(sm.add_constant(d[cols]) @ params))

print("w_n_loans と w_debt の相関", round(train["w_n_loans"].corr(train["w_debt"]), 3))
X = sm.add_constant(train[W])
print("VIF", {w: round(float(variance_inflation_factor(X.values, i + 1)), 2) for i, w in enumerate(W)})
pay = np.round(train.debt * 1.05 + rng.normal(0, 0.01, len(train)), 3)   # 返済の額の年収比(残高の年収比とほぼ同じ情報)
edges["pay"] = edges["debt"]
tabs["pay"] = woe_table(to_bin(pay, "pay", edges["pay"]), train.y, labels(edges["pay"]))
train["w_pay"] = to_bin(pay, "pay", edges["pay"]).map(tabs["pay"]["woe"]).fillna(0.0)
res_dup = sm.Logit(train.y, sm.add_constant(train[W + ["w_pay"]])).fit(disp=0)
print("ほぼ同じ項目を足した場合", res_dup.params[["w_debt", "w_pay"]].round(3).to_dict(),
      "標準誤差", res_dup.bse[["w_debt", "w_pay"]].round(3).to_dict())
W2 = [w for w in W if w != "w_debt"]
res2 = sm.Logit(train.y, sm.add_constant(train[W2])).fit(disp=0)
print("w_debt を外した場合 w_n_loans の係数", round(res.params["w_n_loans"], 3), "→", round(res2.params["w_n_loans"], 3),
      "/評価用のAR値", round(lin_ar(res.params, test, W), 3), "→", round(lin_ar(res2.params, test, W2), 3))
W3 = [w for w in W if w != "w_n_loans"]
res3 = sm.Logit(train.y, sm.add_constant(train[W3])).fit(disp=0)
print("w_n_loans を外した場合 w_debt の係数", round(res.params["w_debt"], 3), "→", round(res3.params["w_debt"], 3),
      "/評価用のAR値", round(lin_ar(res3.params, test, W3), 3))
for C in [1.0, 0.01, 0.001]:                     # Cが小さいほど係数を0に寄せる力(正則化)が強い
    m = LogisticRegression(C=C, max_iter=1000).fit(train[W], train.y)
    print("C =", C, "係数", m.coef_[0].round(3), "評価用のAR値", round(ar(test.y, -m.decision_function(test[W])), 3))
実行した結果を次の表にまとめます。
| 確かめたこと | 結果 | 読み方 |
|---|---|---|
| 他社の借入の件数と残高の年収比の WoE の相関 | 0.774 | 借入が0件の区分が両方で同じ契約の集まりになっていることなどから、強く関係している |
| VIF | 借入の件数2.58、残高の年収比2.74。他の6項目は1.00〜1.35 | この2つが他の項目と比べて重なりが大きい |
| ほぼ同じ項目(返済の額の年収比)を足した場合 | 残高の年収比の係数 -0.453 が -0.108(標準誤差 0.079 が 0.226)に、足した項目の係数は -0.353(標準誤差 0.218) | 同じ情報を2つの項目で分け合い、どちらの係数も不確かになった。符号の逆転はこの例では起きなかった |
| 残高の年収比を外した場合 | 借入の件数の係数 -0.302 が -0.66 に。評価用の AR値 0.537 が 0.535 に | 外した項目の情報を、関係の強い借入の件数が引き取った。順位づけの成績はほぼ変わらない |
| 借入の件数を外した場合 | 残高の年収比の係数 -0.453 が -0.642 に。評価用の AR値 0.537 が 0.530 に | こちらも残った項目が情報を引き取った。AR値の下がり方は残高の年収比を外した場合よりわずかに大きい |
| 正則化を強めた場合(C を 1.0、0.01、0.001) | 評価用の AR値は 0.537、0.519、0.485 | この件数の学習用のデータでは、強い正則化は係数を縮めすぎて成績を下げた |
ほぼ同じ情報を持つ項目を足した場合、残高の年収比の係数は -0.453 から -0.108 に縮み、標準誤差は 0.079 から 0.226 に広がりました。足した項目の係数も -0.353 で標準誤差は 0.218 です。2つの係数の合計はもとの係数に近いものの、どちらにどれだけ割り当てるかは、データのわずかな違いで変わりうる状態です。この例では符号の逆転は起きませんでしたが、2つの項目の関係がさらに強い場合や、学習用のデータが少ない場合には、片方の符号が正に振れることがあります。点数表にすると、残高の年収比の点数の幅が縮み、返済の額の年収比に点数が移るだけで、業務の担当者から見ると「なぜ残高の点数がこんなに小さいのか」という説明のつかない表になります。
残高の年収比を外した場合は、借入の件数の係数が -0.302 から -0.66 に変わって絶対値が大きくなり、評価用の AR値は 0.537 から 0.535 とほとんど変わりませんでした。反対に借入の件数を外した場合は、残高の年収比の係数が -0.453 から -0.642 に変わって絶対値が大きくなり、評価用の AR値は 0.530 でした。この架空データでは、2つの項目のどちらか1つを外しても、評価用の AR値は 0.007 以内しか変わらなかったことになります。どちらを残すかは成績だけでは決まらず、業務上の説明のしやすさ、データの取りやすさと正確さ、規制上の扱い(返済の能力の調査との関係など。第14章)で決めることになります。
VIF の目安については、本コラムで使った statsmodels 0.14.6 の説明書きに、5を超えると強い共線性とみなす、という目安が書かれています。本コラムでは目安の値を機械的な基準にはせず、係数の符号と標準誤差、外したときの係数の動きを合わせて判断することが有効だと考えています。この例の VIF は2.6〜2.7で、その目安より小さい値でしたが、どちらか一方の項目を外すと、残った項目の係数は -0.302 から -0.66、-0.453 から -0.642 と大きく動きました。
正則化は、係数を0の側へ寄せる罰則をかけることで、係数のばらつきを抑える方法です。scikit-learn のロジスティック回帰では、正則化の強さの逆数を C で指定し、C が小さいほど正則化が強くなります(1.9版の説明書きによる。既定は係数の2乗の和に罰則をかける L2 の罰則)。この章の計算では、C を 1.0 から 0.01、0.001 と小さくすると、係数はすべて0の側に縮み、評価用の AR値は 0.537 から 0.519、0.485 と下がりました。C が 1.0 の係数は statsmodels の正則化なしの推定とほぼ同じです。この架空データは学習用が約2万件、項目が8つで、件数に対して項目が少ないので、正則化で係数を縮める利点は小さく、縮めすぎて成績を下げる結果になりました。正則化が役に立つのは、項目の数が多い場合、学習用の件数やデフォルトの件数が少ない場合、関係の強い項目を残したまま係数を安定させたい場合です。その場合も、C の値は学習用の中で検証用のデータを分けて決め、評価用のデータを見ながら決めない必要があります。
欠損の区分と「その他」の区分の点数の扱い
スコアカードでは、欠損を独立した区分にして点数を割り当てる方法がよく取られます。この章の勤続年数では、欠損の区分(学習用で1,190件)のデフォルト率が8.82%と全体(4.24%)の2倍あまりで、点数は-18点と、年収の水準の最も低い区分と同じ大きさになりました。この架空データでは、欠損は雇用の形態Dに多く、データを作るときに欠損そのものにもデフォルトしやすさを上乗せしているので、両方の設定が重なった結果と考えられます。欠損が多い雇用の形態Dの点数(-10点)とも重なるので、実際のデータでは、欠損の点数が雇用の形態の点数と二重に数えていないかを、相関と係数で確かめる必要があります。
欠損の区分を作るときに注意したいのは、欠損の意味が時期によって変わることです。申込の画面の変更で必須の項目が任意になった、ある経路の申込だけ項目を取っていない、といった理由で欠損の割合が変わると、欠損の区分の点数が表す層そのものが変わります(第2章)。欠損の区分の件数とデフォルト率は、点数表の文書に残し、監視の対象にしておくことが有効だと考えています。
件数が少ない区分も、同じように扱いを決めておく必要があります。この章の直近6か月の申込の件数の「5以上」の区分は、学習用で120件、デフォルトは14件しかありません。件数が少ない区分の WoE は揺れやすく、0.5を足す補正は0件による発散を防ぐだけなので、点数(-20点)には不確かさが残ります。カテゴリの多い項目(職種や地域など)で件数の少ないカテゴリをまとめた「その他」の区分も同じです。こうした区分は、隣の区分と統合する、業務の知識で点数の上限を決める、件数がたまるまで点数を据え置く、といった扱いを、点数表を作るときに決めて文書に残しておきます。学習用に無かった区分が評価用や本番で現れたときの点数(この章のコードでは WoE を0として扱う)も、同じ文書に書いておく必要があります。
スコアカードの見直しで業務の担当者と確かめること
点数表ができたら、モデルを作った担当者だけで確定させず、審査、営業、債権の管理、コンプライアンスの担当者と一緒に見直すことが有効だと考えています。点数表は統計の手続きで作られますが、使われるのは審査の現場であり、説明を求められるのは営業や顧客対応の窓口です。統計の上では問題が無くても、業務の感覚と合わない並びや、説明の難しい項目が含まれていれば、現場はその表を信頼して使えません。見直しで確かめる項目を次の表にまとめました。
| 確かめること | 見るもの | 主に確かめる人の例 |
|---|---|---|
| 点数の並びが業務の感覚と合うか | 項目ごとの区分の点数の向き。逆転している区分と、その説明 | 審査の担当者 |
| 点数の幅が妥当か | 項目ごとの最高点と最低点の差。1つの項目だけでスコアが大きく決まっていないか | 審査の担当者とリスク管理の担当者 |
| 同じ情報を二重に数えていないか | 関係の強い項目の組み合わせ。相関と VIF、係数の標準誤差 | データ分析の担当者 |
| 欠損・その他・件数の少ない区分の扱い | 区分の件数とデフォルト率、点数の決め方 | データ分析の担当者と審査の担当者 |
| 項目が審査の時点で確実に手に入るか | 項目の取得の経路と時点。後から更新される値を使っていないか | 情報システムの担当者と審査の担当者 |
| 使ってよい項目か | 差別につながる属性や、その代わりになりうる項目が入っていないか。利用目的と同意の範囲 | コンプライアンス・法務の担当者(第11章・第14章) |
| 申込者や営業に説明できるか | 点数を押し下げた項目を示したときに、定型の文で説明できるか | 営業・顧客対応の担当者(第11章) |
見直しで逆転や説明のつかない点数が見つかったときに、表の点数を人の判断で書き換えるかどうかは、慎重に決める必要があります。点数を書き換えると、点数表はデータから推定した関係を離れ、デフォルト確率との対応がずれます。書き換えた分の効果は確かめ直さないと分かりません。評価用のデータの結果を見ながら書き換えを重ねると、評価用のデータが実質的に調整のためのデータになってしまうので、調整は学習用の中から分けた検証用のデータで行い、確定した後に、調整に使っていない評価用のデータで確かめます。また、書き換えが重なると、どの点数がデータに基づき、どの点数が判断に基づくのかが分からなくなります。一方で、データの件数が少ない区分や、業務の上で明らかに説明がつかない逆転を、データのまま残すことにも問題があります。
そのため、点数を人が直接書き換えるより、区分の統合や項目の入れ替えでモデルを作り直し、そのうえで評価用のデータで成績を確かめる方法を先に検討するのが、記録と検証の両面で扱いやすいと考えています。どうしても点数を調整する場合は、調整した区分、調整の前後の点数、理由、調整した人と承認した人を文書に残し、調整後の点数表で評価をやり直します。個々の申込でスコアと違う判断をする「上書き」の記録と追跡は、点数表の調整とは別の論点で、第9章で扱います。
スコアカードの文書と経営の判断
スコアカードは、点数表だけを渡しても使えません。どのデータで、どの期間の契約で、どのデフォルトの定義で作り、どの成績だったのかが分からないと、審査の担当者は点数の意味を、監査や検証の担当者は作り方の妥当さを確かめられません。数年後にモデルを見直す担当者が、前回の作り方を再現できないこともあります。スコアカードの文書に残す項目を、次の表にまとめました。モデルの文書と台帳の全体像は、第12章で扱います。
| 文書に残す項目 | この章の例での中身 |
|---|---|
| 対象の商品と使う場面 | 個人向けの貸付の初期与信 |
| デフォルトの定義と観測期間 | 契約の実行から12か月以内に、延滞が90日以上に達すること |
| 学習用と評価用のデータの期間と件数 | 学習用は1〜16月の申込の19,998件、評価用は17〜24月の10,002件。承認して実行した契約だけを含む |
| 項目と区分の境目、境目の決め方 | 8項目。等頻度の区分(学習用の分位点)と、業務の知識で決めた境目 |
| WoE の計算の方法と補正 | 正常とデフォルトの件数に0.5を足して計算。学習用だけで計算 |
| 係数と点数への変換の基準 | 係数の表。正常とデフォルトのオッズ50対1を600点、PDO は20点、基礎点は577点 |
| 点数表 | 項目・区分・件数・デフォルト率・WoE・点数 |
| 欠損・その他・新しい区分の扱い | 欠損は独立の区分。学習用に無い区分は WoE を0として扱う |
| 成績 | 学習用と評価用の AR値、スコアの帯ごとのデフォルト率の表 |
| 点検の結果 | 係数の符号、相関と VIF、並びの逆転とその扱い、点数の調整の有無と理由 |
| 使ってよい範囲と使い方の制限 | 対象の商品・経路・期間。対象外の申込に使わないこと |
| 作成者・確認者・承認者と日付 | 作った人、業務の見直しに加わった人、承認した人 |
経営の目線で見ると、点数表を審査・営業・監査が同じものとして読める状態にしておかないことは、いくつかの損失の型につながります。国や業態によっては、否決の理由の説明や審査の記録が法令や監督の上で求められる場合があります(第11章・第14章。自社に何が求められるかは所管官庁や専門家に確かめる事項です)。点数の並びに説明のつかない逆転がある表や、作り方の記録が無い表は、そうした対応を難しくし、規制上の義務の不履行につながるおそれがあります。作り方と基準が文書に残っていなければ、モデルを見直す時期が来ても前回と比べられず、更新が後回しになって形骸化につながります。点数と確率の対応が期間によってずれることを知らないまま、点数から戻した確率をそのままデフォルト確率として使えば、デフォルトの件数の見込みを誤り、その分、貸し倒れの見積りもずれます。反対に、ずれを恐れて承認の基準を必要以上に厳しくすれば、返済できた可能性のある申込を断る機会損失(否決した申込の結果は観測できないので、推定でしか分かりません)が増えるおそれがあります。
これを防ぐために経営が決めておくべきことは、3つに整理できます。1つ目は、点数への変換の基準(基準の点数・基準のオッズ・PDO)を社内の共通の物差しとして固定し、モデルを作り直しても変えないことです。2つ目は、点数表の確定の手続きに、データ分析の担当者だけでなく、審査、営業、コンプライアンスの見直しを組み込み、点数の調整を行う場合の記録と承認の手順を決めることです。3つ目は、スコアカードの文書を作り、見直しの時期と担当を決めて、その作成と点検の手間を予算と体制に入れておくことです。点数表そのものは小さな表ですが、それを支える文書と手続きが無いと、審査の基準として長く使い続けることはできません。
この章のまとめ
この章では、WoE に変換した項目でロジスティック回帰を当てはめ、デフォルトの対数オッズを、基準の点数・基準のオッズ・PDO で点数に直し、基礎点と区分ごとの点数からなるスコアカードを作りました。本コラムの架空データでは、8つの係数はすべて WoE の向きから見込まれるとおり負になり、評価用(17〜24月)のスコアの帯ごとのデフォルト率は、520点未満の29.06%から620点以上の0.69%まで逆転なく並び、評価用の AR値は0.537でした。一方で、評価用の全体のデフォルト率が学習用より低く(その差の半分ほどは作るときに入れた景気の揺れ、残りは偶然のぶれ)、点数から戻した確率はすべての帯で実績より高く、関係の強い項目を2つ入れると係数の配分が不安定になりました。点数表を審査の基準として使うには、符号と並びの点検、相関の確認、作り方と成績の文書が欠かせません。次の第5章では、項目どうしの組み合わせまでデータから学ばせる機械学習のモデルを、この章と同じ考え方の物差しで比べます。
この章を深めたい方への参考書籍
『初心者のためのロジスティック回帰分析入門』(David G. Kleinbaum, Mitchel Klein 著、神田英一郎 監訳、丸善出版):原題を Logistic Regression とする、ロジスティック回帰の教科書の翻訳で、国立国会図書館の書誌では本文592ページ、版元の紹介では研究の最初の一歩のための教科書とされています。この章では、WoE に変換した項目でロジスティック回帰を当てはめ、係数の符号と標準誤差を点検しました。その前提になるロジスティック回帰そのものの考え方を、統計の教科書として順を追って確かめたいときに向いています。
『クレジット・スコアリング』(エリザベス・メイズ 編、スコアリング研究会 訳、シグマベイスキャピタル):原題を Credit Risk Modeling とする本の翻訳で、2001年に「金融職人技シリーズ」の1冊として刊行されました。国立国会図書館の書誌では本文361ページで、件名に消費金融・信用調査・クレジットカードが付いています。目次は確かめられていないので、この章の手法をどこまで扱っているかは未確認です。書名と件名から、消費者向けの与信のスコアリングを主題にしていると見られる日本語の本として、この章の背景を広げたいときの手がかりになります。刊行から年数がたっているので、法令や技術の動向は本コラムの第14章と合わせて読む必要があります。
第5章 機械学習による与信モデル、勾配ブースティングと単調性の制約
第4章では、区分ごとの WoE を説明変数にしたロジスティック回帰で係数を求め、それを点数表(スコアカード)に直す流れを見ました。点数表は、1件ごとの点数の内訳を足し算で示せる一方で、項目の区分けと項目どうしの組み合わせの扱いを、作る人が決めなければなりません。この章では、多数の決定木を組み合わせる機械学習の手法を与信のモデルに使うときに、何が得られ、何に注意が要るのかを扱います。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の申込の記録を使い、実行したコードと結果で確かめます。
- 機械学習の手法を与信に使う動機と懸念
- 手法の比較と、研究での比較の結果の読み方
- WoE のロジスティック回帰と勾配ブースティングを、申込の月で切った評価用のデータの AR値で比べる例
- 単調性の制約(項目の向きをそろえる制約)の効果と、過学習の点検
- 機械学習のモデルを、点数表の見落としを探す点検に使う考え方
- 代替データを使うときの論点、深層学習を使う条件、使い分けと経営の判断
この章の主張は2つあります。1つ目は、機械学習のモデルを使うかどうかは、順位づけの成績の差だけでなく、その差がたまたまのばらつきの範囲に収まるかどうかと、説明・安定性・運用の負担の差を並べて決めるべきだという点です。本コラムの架空データでは、機械学習のモデルの順位づけの成績は点数表をわずかに上回りました。ただし、その差は小さく、モデルの種類によっては、たまたまのばらつきの範囲を出ないものでした。
2つ目は、機械学習のモデルを、点数表がどの層で見積りを外しているかを探す道具として使う場合も、見つかった層をそのまま項目にしてよいとは限らない、という点です。本コラムの架空データでは、点検の手順で見つかった層を項目にして点数表に足しても、成績は変わりませんでした。データを作るときに組み込んだ項目どうしの組み合わせの関係は、点検の手順では見つからず、選んだ機械学習のモデルでも、その層の見積りの平均は実績を大きく下回りました。その結果も含めて示します。
機械学習の手法を与信に使う動機と懸念
本コラムでいう機械学習のモデルは、主に決定木を多数組み合わせるモデルを指す呼び方です。点数表に使うロジスティック回帰も、広い意味では機械学習の手法に含まれます。決定木は「他社の借入の件数が2件以上か」「年収の水準が一定の値以下か」のような条件で申込を順に分けていき、分けた先の集団のデフォルト確率を見積もる手法です。1本の木は単純で外れやすいので、多数の木を組み合わせて使います。組み合わせ方には、データの一部を無作為に選び直し、さらに木を分けるたびに候補にする項目も無作為に絞りながら、多数の木を独立に作って平均するランダムフォレストと、前の木までの見積りの外れを次の木で少しずつ補っていく勾配ブースティングがあります。勾配ブースティングは Friedman の2001年の論文(統計学の学術誌 The Annals of Statistics 第29巻第5号、1189〜1232ページ)で一般的な形に整理された手法です。この章のコードでは、勾配ブースティングの実装の1つである lightgbm を使います。
与信のモデルに機械学習の手法を使う動機は、主に3つ挙げられます。1つ目は、項目どうしの組み合わせの効果です。例えば「他社の借入が多く、しかも直近の申込も多い」という組み合わせだけでデフォルトが増えるような関係は、項目を1つずつ足し算する点数表では、組み合わせの項目を作る人が気づかない限り表せません。決定木は条件を重ねて分けるので、こうした関係をデータから拾える場合があります。2つ目は、区分けの手間です。点数表では項目ごとに区分の境目を決め、WoE を計算し、単調になるように区分を統合する作業が要ります(第3章)。決定木の手法は連続の値のまま扱え、境目をデータから選びます。3つ目は、項目の数の多いデータです。入出金の記録や利用の履歴のような代替データから作る項目は数が多くなりやすく、1つずつ区分けして点数表に入れるのは手間がかかります。
一方で、懸念も4つあります。1つ目は説明です。点数表では「この項目のこの区分で何点」と示せますが、多数の木の組み合わせでは、1件の見積りがどの項目からどれだけ来たかを直接は読めません。1件ごとに項目の寄与を計算する手法はあり、木のモデルについては、置いた前提のもとで寄与を厳密に計算する方法もあります(SHAP の公式の説明書きにある Tree SHAP)。ただし、寄与の計算が厳密でも、それが因果関係や否決の理由としての妥当性を保証するわけではないので、計算の前提と、業務上の説明として妥当かを確かめる必要があります(第11章)。2つ目は安定性です。木の境目はデータのわずかな違いで変わることがあり、学習し直すたびに個々の申込の見積りが変わることがあります。3つ目は過学習(学習用のデータの偶然の特徴まで覚えて、新しいデータで成績が落ちること)です。柔軟な手法ほど起きやすく、後の節でその様子を示します。4つ目は、項目の向きです。年収の水準が高いほどデフォルト確率が上がる、のような業務の感覚と逆の見積りが、一部の範囲で出ることがあります。この章の後半で扱う単調性の制約は、この4つ目への対処の1つです。この章のコードで確かめるのは、順位づけの成績・項目の向き・過学習の3つで、説明と安定性の負担は実験していません。
規制や説明の義務との関係も、モデルを選ぶ前に確かめておく事柄です。否決の理由をどう示すかは第11章で、法令とガイドラインは第14章で扱います。この章では、手法の性質の違いが、説明と運用の負担の違いとしてどう現れるかに絞ります。
手法の比較と、研究での比較の読み方
次の表は、与信のモデルによく使われる手法を、この章の観点で並べたものです。機械学習の手法の一般論は、弊社コラム「機械学習の仕組みと使いどころ」で扱っています。表の内容は手法の一般的な性質であり、どの手法の成績が高いかは、データと条件によって変わります。
| 手法 | 項目どうしの組み合わせ | 区分けの手間 | 1件ごとの理由の示しやすさ | 項目の向きの管理 | 運用の負担 |
|---|---|---|---|---|---|
| WoE のロジスティック回帰(点数表) | 組み合わせの項目を人が作れば扱える | 区分の境目と統合を人が決める | 点数の内訳をそのまま示せる | WoE の並びと係数の符号で確かめられる | 小さい。点数表の形で審査の仕組みに入れやすい |
| ランダムフォレスト | データから拾える場合がある | 連続の値のまま扱える | 寄与を計算する手法と、その妥当性の確認が要る | 実装によっては単調性の制約を指定できる | 中くらい。木の数が多く、計算の再現の確認が要る |
| 勾配ブースティング | データから拾える場合がある | 連続の値のまま扱える | 寄与を計算する手法と、その妥当性の確認が要る | 単調性の制約で一部を管理できる | 中くらい。設定の数が多く、過学習の点検が要る |
| ニューラルネットワーク(層を深くしたものが深層学習) | データから拾える場合がある | 前処理が要る | 寄与を計算する手法と、その妥当性の確認が要る | 本コラムでは確かめていない | 大きい。件数と計算の資源、検証の体制が要る |
表のランダムフォレストの行について補足すると、scikit-learn の RandomForestClassifier の公式の説明書きには、版1.4で monotonic_cst(単調性の制約の指定)が加わったと書かれています。どの手法でも、制約を指定できるかどうかは実装と版によって違うので、使う実装の説明書きで確かめる必要があります。
手法どうしを実際の与信のデータで比べた研究は数多くあります。よく引かれるものの1つが Baesens らの2003年の論文(Journal of the Operational Research Society 第54巻第6号、627〜635ページ。DOI 10.1057/palgrave.jors.2601545)です。学術データベースに収録された抄録で確かめた範囲では、8つの与信のデータで多くの分類の手法を比べ、新しい手法の一部が良い成績を示す一方で、ロジスティック回帰のような単純な手法も良い成績だったという趣旨です。
その更新として書かれたのが Lessmann らの2015年の論文(European Journal of Operational Research 第247巻第1号、124〜136ページ。DOI 10.1016/j.ejor.2015.05.030)です。著者が公開している投稿版の原稿で確かめた範囲では、より多くの手法と指標で比べ直し、ロジスティック回帰より統計的に有意に高い成績の手法があり、なかでも種類の違うモデルを組み合わせる手法が良かった、という趣旨の結論です。ここでいう「有意」は、差が偶然のばらつきだけでは説明しにくいという意味で、差が大きいという意味ではありません。差の大きさは別に見る必要がありますが、本コラムでは投稿版の結論の節までを確かめており、手法ごとの成績の値までは確かめていません。
この2つの研究は、比べたデータ、手法の設定、指標の条件のもとでの結論です。自社のデータで機械学習の手法が点数表をどれだけ上回るかは、これらの研究からは分かりません。研究で使われたデータの件数や項目、デフォルトの定義は自社と違い、評価の切り方も違います。研究の結果は「比べてみる価値がある」という根拠にはなりますが、「入れ替えれば成績が上がる」という根拠にはなりません。次の節からは、同じ架空のデータに両方を当てはめ、差を測る手順を示します。
架空の申込の記録を作る、項目の組み合わせで効く関係を入れる
この章のデータは、他の章とは独立に作った架空の合成データです。実際の申込の記録よりずっと単純で、合成データでの成績は、実際の審査で期待できる成績の目安にはなりません。示したいのは、比べ方の手順と、結果をどう読むかです。申込36,000件を、24か月に分けて乱数で作りました(乱数の種は20261113に固定しています)。項目は次のとおりで、どれも審査の時点で分かる情報だけにしています。
- 申込者の属性:雇用の形態(A・B・Cの3種類)、年収の水準(雇用の形態A・Bの申込の中央値がおよそ1になる相対値)、勤続年数、居住の年数
- 信用情報にあたる項目:他社の借入の件数、過去の延滞の有無、直近6か月の申込の件数
- 申込の内容:返済の負担の割合(年収に対する返済の額の割合を表す相対値。中央値がおよそ0.3)
- 申込の月(0〜23か月目)
デフォルトの起きやすさには、項目ごとの足し算で表せる関係のほかに、次の3つの関係を入れました。1つ目は、居住の年数が1年未満の申込と15年を超える申込でデフォルトが起きやすくなる、単調でない関係です。2つ目は、他社の借入が2件以上で、しかも直近6か月の申込が3件以上のときだけデフォルトが大きく起きやすくなる、組み合わせの関係です。3つ目は、雇用の形態Cで、しかも返済の負担の割合が0.45を超えるときだけ起きやすくなる、組み合わせの関係です。さらに、申込の月が進むほどデフォルトが少しずつ起きやすくなるようにして、景気の緩やかな悪化を表しました。勤続年数の効果は15年で頭打ちになるようにしています。
結果は、第2章の定義(契約の実行から12か月以内に延滞が90日以上に達すること)に当たるデフォルトの有無を、申込ごとに直接乱数で決めました。すべての申込を承認し、契約し、観測期間を満たして結果が確定したものとして扱います。実際には否決した申込の結果は分からず、その扱いは第6章で取り上げます。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N = 36000
month = np.sort(rng.integers(0, 24, N))                  # 申込の月(0〜23)
emp = rng.choice(["A", "B", "C"], N, p=[0.6, 0.25, 0.15])  # 雇用の形態
isC = (emp == "C").astype(int)
income = rng.lognormal(-0.25 * isC, 0.45)                # 年収の水準(相対値)
years_emp = np.clip(rng.gamma(2.0, 3.0 - 1.5 * isC), 0, 40)  # 勤続年数
years_res = np.clip(rng.gamma(1.5, 4.0, N), 0, 40)          # 居住の年数
n_loans = rng.poisson(0.8 + 0.6 * isC)                   # 他社の借入の件数
delinq = (rng.random(N) < 0.06 + 0.05 * (n_loans >= 2)).astype(int)  # 過去の延滞の有無
inq = rng.poisson(0.6 + 0.3 * n_loans)                   # 直近6か月の申込の件数
burden = np.clip(rng.lognormal(np.log(0.3), 0.35, N), 0.05, 1.2)  # 返済の負担の割合(相対値)
z = (-4.1 - 0.9 * np.log(income) - 0.05 * np.minimum(years_emp, 15)
     + 0.3 * n_loans + 1.0 * delinq + 0.2 * inq + 1.5 * (burden - 0.3)
     + 0.6 * (years_res < 1) + 0.3 * (years_res > 15)     # 居住の年数は単調でない
     + 1.2 * ((inq >= 3) & (n_loans >= 2))                # 組み合わせで効く関係(その1)
     + 1.0 * ((emp == "C") & (burden > 0.45))             # 組み合わせで効く関係(その2)
     + 0.012 * month)                                     # 景気の緩やかな悪化
default = (rng.random(N) < 1 / (1 + np.exp(-z))).astype(int)  # 12か月以内のデフォルト
df = pd.DataFrame({"month": month, "emp": emp, "income": income, "years_emp": years_emp,
                   "years_res": years_res, "n_loans": n_loans, "delinq": delinq,
                   "inq": inq, "burden": burden, "default": default})
print("申込", len(df), "件/デフォルト率", round(df.default.mean() * 100, 2), "%")
print(df.groupby(df.month // 6).default.mean().round(4).rename("半年ごとのデフォルト率"))
実行した結果、申込は36,000件、デフォルト率は4.04%でした。申込の月を半年ごとに区切ったデフォルト率は、0〜5か月目が3.57%、6〜11か月目が3.70%、12〜17か月目が4.38%、18〜23か月目が4.48%で、景気の緩やかな悪化を入れたとおり、後の月ほど高くなっています。デフォルト率の水準は商品によって大きく違い、この4%前後という値は説明のために置いたものです。
WoE のロジスティック回帰と勾配ブースティングを、申込の月で切って比べる
モデルを比べるために、申込の月でデータを3つに分けました。0〜13か月目を学習用、14〜17か月目を検証用、18〜23か月目を評価用とします。検証用は、勾配ブースティングの設定を選んだり、学習を止める時点を決めたりするのに使います。評価用は、最後に成績を測るためだけに使い、設定の選択には使いません。時間で切るのは、過去の申込で学習したモデルを、これから来る申込に使うという使い方に近づけるためです(評価の切り方の詳細は第7章)。ただし、この分け方は、全件の結果が確定した後で時期の前後を比べる事後的な分け方で、運用の再現ではありません。観測期間が12か月なので、実際の運用では、例えば18か月目に審査を始める時点で、13か月目や17か月目の申込の結果はまだ確定しておらず、学習にも設定の選択にも使えません。この例は、結果の確定を待つ期間を省いて、時期の前後で成績を比べたものです。
比べる基準のモデルは、第3章と第4章の考え方で作る WoE のロジスティック回帰です。ここでは簡単のために、連続の項目(年収の水準・勤続年数・居住の年数・返済の負担の割合)は学習用のデータの分位で6つの区分に分け、件数の項目は上限で丸めて区分にしました(他社の借入の件数と直近の申込の件数は3以上をまとめ、過去の延滞は有無の2区分)。区分の境目と WoE は学習用のデータだけで決め、検証用と評価用にはそれを当てはめるだけにしています。全部のデータで WoE を計算してから分けると、評価用の結果が区分けに入り込み、成績が実際より良く見えるおそれがあるためです。WoE は、区分ごとに「正常の構成比 ÷ デフォルトの構成比」の自然対数をとった値で、正の値はその区分が全体より正常の側に寄っていることを表します。件数が0の区分で対数がとれなくなるのを避けるため、件数に0.5を足しています。
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

tr, va, te = df[df.month < 14], df[(df.month >= 14) & (df.month < 18)], df[df.month >= 18]
print("学習", len(tr), "件(デフォルト", tr.default.sum(), ")/検証", len(va), "件(",
      va.default.sum(), ")/評価", len(te), "件(", te.default.sum(), ")")
ar = lambda y, p: 2 * roc_auc_score(y, p) - 1             # AR値 = 2 × AUC - 1
NUM = ["income", "years_emp", "years_res", "burden"]      # 連続の項目は学習用の分位で6区分
CNT = {"n_loans": 3, "inq": 3, "delinq": 1}               # 件数の項目は上限で丸める

def to_bins(d, edges):
    out = {c: pd.cut(d[c], edges[c], labels=False, include_lowest=True).astype(str) for c in NUM}
    out.update({c: np.minimum(d[c], cap).astype(str) for c, cap in CNT.items()})
    out["emp"] = d["emp"]
    return pd.DataFrame(out, index=d.index)

edges = {c: np.r_[-np.inf, np.quantile(tr[c], [1/6, 2/6, 3/6, 4/6, 5/6]), np.inf] for c in NUM}
btr = to_bins(tr, edges)

def woe_table(b, y):                                       # 区分ごとの WoE(0.5 を足して 0 件を避ける)
    t = pd.crosstab(b, y) + 0.5
    return np.log((t[0] / t[0].sum()) / (t[1] / t[1].sum()))

WOE = {c: woe_table(btr[c], tr.default) for c in btr.columns}
to_woe = lambda d: pd.DataFrame({c: to_bins(d, edges)[c].map(WOE[c]).fillna(0) for c in WOE})
lr = LogisticRegression(C=1.0, max_iter=2000).fit(to_woe(tr), tr.default)
print("WoE のロジスティック回帰の係数", dict(zip(WOE, lr.coef_[0].round(3))))
LR = "WoEのロジスティック回帰"
score = {LR: lambda d: lr.predict_proba(to_woe(d))[:, 1]}   # 申込の表 → デフォルト確率
学習用は20,920件(うちデフォルト780件)、検証用は6,094件(270件)、評価用は8,986件(403件)でした。ロジスティック回帰の係数は、8つの項目すべてで負になりました(年収の水準 -0.903、勤続年数 -0.740、居住の年数 -0.945、返済の負担の割合 -1.012、他社の借入の件数 -0.639、直近の申込の件数 -0.774、過去の延滞 -0.911、雇用の形態 -0.276)。WoE を上の向きで作り、デフォルトを1として学習すると、WoE が大きい(正常の側に寄った)区分ほどデフォルト確率が下がるので、係数は負になるのが普通です。係数の符号が正になる項目があれば、項目どうしの相関などを疑います(第4章)。
次に、勾配ブースティングを当てはめます。この章では lightgbm(版 4.6.0)を使いました。勾配ブースティングには、学習率(1本の木の見積りをどれだけ足し込むか)、葉の数(1本の木の分け方の細かさ)、葉の最小件数(分けた先に最低何件の申込を残すか)、正則化の強さ(見積りを極端な値にしにくくする度合い)などの設定があります。ここでは設定の候補を3つ用意し、それぞれで、検証用の AUC(AR値と同じ順位づけを測る指標)が200本続けて伸びなかったところで木を足すのをやめ、それまでで最も良かった本数を使い(早期打ち切り。監視する指標は AUC だけに指定しました)、3つのうち検証用の AR値が最も高い設定を選びました。項目の向きの制約を付けないモデルと、付けたモデル(後の節で説明します)の2通りを作っています。AR値は、モデルがデフォルトしやすい順に申込を並べられているかを表す順位づけの指標で、デフォルト確率から計算した ROC 曲線の下の面積(AUC)を使って \( AR = 2 \times AUC – 1 \) で求めます。
import lightgbm as lgb

FEAT = ["income", "years_emp", "years_res", "n_loans", "delinq", "inq", "burden", "emp"]
MONO = [-1, -1, 0, 1, 1, 1, 1, 0]                          # 向きの制約(1:大きいほど確率が上がる)
X = lambda d: d[FEAT].assign(emp=d["emp"].astype("category"))
GRID = [(0.05, 15, 100, 5.0), (0.02, 7, 200, 10.0), (0.1, 7, 100, 1.0)]  # 学習率・葉の数・葉の最小件数・正則化

def fit_gbm(mono, lrate, leaves, min_child, lam, rounds=3000, stop=True):
    m = lgb.LGBMClassifier(n_estimators=rounds, learning_rate=lrate, num_leaves=leaves,
                           min_child_samples=min_child, reg_lambda=lam, subsample=0.8, subsample_freq=1,
                           colsample_bytree=0.8, monotone_constraints=mono, metric="auc",   # 監視する指標を AUC だけにする
                           random_state=1, n_jobs=1, verbose=-1)
    cb = [lgb.early_stopping(200, verbose=False)] if stop else []   # 200本続けて伸びなければ止め、最良の本数を使う
    m.fit(X(tr), tr.default, eval_set=[(X(va), va.default)], callbacks=cb)
    return m

gbm = {}
for name, mono in [("勾配ブースティング(制約なし)", None), ("勾配ブースティング(単調性の制約あり)", MONO)]:
    cands = [fit_gbm(mono, *g) for g in GRID]
    va_ar = [ar(va.default, m.predict_proba(X(va))[:, 1]) for m in cands]
    for g, m, a in zip(GRID, cands, va_ar):
        print(name, "設定", g, "木の本数", m.best_iteration_, "検証 AR", round(a, 3))
    gbm[name] = cands[int(np.argmax(va_ar))]               # 設定は検証用の AR値で選ぶ(評価用は見ない)
    score[name] = lambda d, m=gbm[name]: m.predict_proba(X(d))[:, 1]
pred = {}
for name, f in score.items():
    pred[name] = f(te)
    print(name, "学習 AR", round(ar(tr.default, f(tr)), 3), "検証 AR", round(ar(va.default, f(va)), 3),
          "評価 AR", round(ar(te.default, pred[name]), 3))
設定の選び方の結果は、制約なしのモデルでは学習率0.02・葉7・葉の最小件数200・正則化10の設定(木は173本)、制約ありのモデルでは学習率0.05・葉15・葉の最小件数100・正則化5の設定(木は46本)でした。どちらも、検証用の AR値の差は候補の間で0.008以内で、設定による違いは小さいものでした。3つのモデルの成績を次の表にまとめます。評価用の AR値の95%区間は、評価用の申込を復元抽出(同じものを何度でも選んでよい抜き出し方)で300回選び直して計算し直した値の2.5%点と97.5%点で、差の区間も同じ方法で、同じ抜き出しの中で2つのモデルの差をとって求めました。
| モデル | 学習用の AR値 | 検証用の AR値 | 評価用の AR値 | 評価用の AR値の95%区間 | WoE のロジスティック回帰との差(95%区間) |
|---|---|---|---|---|---|
| WoE のロジスティック回帰 | 0.497 | 0.487 | 0.496 | 0.440〜0.550 | 基準 |
| 勾配ブースティング(制約なし) | 0.552 | 0.505 | 0.514 | 0.459〜0.560 | 0.018(0.003〜0.035) |
| 勾配ブースティング(単調性の制約あり) | 0.551 | 0.502 | 0.507 | 0.455〜0.554 | 0.011(-0.002〜0.028) |
次の図には、表の3つのモデルに加えて、右側に2本の棒を描いています。この2本は、後の節「機械学習のモデルで点数表を点検する」で作る、項目を足した点数表です。
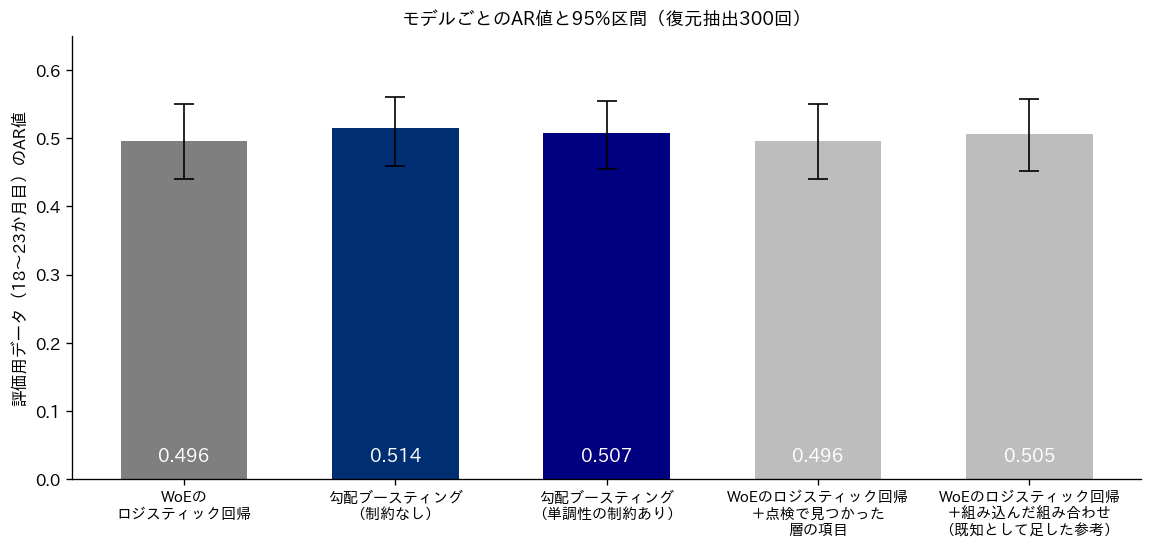
評価用の AR値は、WoE のロジスティック回帰が0.496、勾配ブースティングが制約なしで0.514、制約ありで0.507でした。差は0.018と0.011で、勾配ブースティングの方がわずかに高い結果です。それぞれのモデルの AR値の95%区間は幅が0.10〜0.11あり、5つの区間は大きく重なっています。一方、同じ抜き出しの中で WoE のロジスティック回帰との差をとった区間は、制約なしのモデルでは0.003〜0.035で0を上回り、制約ありのモデルでは -0.002〜0.028で0をまたぎました。
この区間の読み方には注意が要ります。この区間は、評価用の申込を抜き出し直したときのばらつきだけを見たものです。期間を変えた場合、データを作り直した場合、モデルを学習し直した場合のばらつきは含みません。制約なしのモデルの区間の下端は0.003で、0にほぼ接しています。
300回の抜き出しでは、下端の2.5%点は下から8番目前後の値で決まるので、抜き出しを2,000回に増やし、乱数の種を3通り変えて計算し直しました。下端は0.001〜0.002、上端は0.035〜0.036で、0を上回るという結果は変わりませんでしたが、下端が0にさらに近づきました。制約ありのモデルの差の区間は、同じ計算で下端が -0.005〜-0.004でした。この繰り返しの計算は、掲載したコードの抜き出しの回数と乱数の種を変えただけのもので、コードは掲載していません。この架空データと評価用の403件のデフォルトという条件では、評価用の抜き出しのばらつきの範囲では、制約なしの勾配ブースティングとの差は0を上回りました。しかし、差の大きさは0.02程度で、別の期間や別のデータで同じ結果になるかは分かりません。制約ありのモデルと WoE のロジスティック回帰の差は、この区間の上でも0を上回るとは言えませんでした。区間が0をまたぐことは、差が無いという意味ではなく、この条件では差があるとは確かめられない、という意味です。
学習用の AR値は、勾配ブースティングでは0.55前後で、評価用より0.04ほど高くなりました。ロジスティック回帰では学習用0.497、評価用0.496で、ほとんど差がありません。柔軟なモデルほど学習用のデータに合わせ込みやすく、学習用の成績だけを見ると差を大きく見積もることになります。モデルの比較には、学習に使っていないデータ、それも時間で切った後の期間の成績を使う必要があります。
AR値の差を事業の言葉に直すときは、同じ承認率で、承認した契約のデフォルト率がどれだけ違うかで読みます(第7章・第9章)。AR値は順位づけの管理の指標であり、確率の正しさや収益を表すものではありません。AR値が0.02上がったことが、貸し倒れの減少と機会損失の減少にどれだけつながるかは、カットオフの位置と、正常な契約の収益とデフォルトの損失の比によって変わります。差が小さい場合には、次の節以降で見る説明と運用の負担の差の方が、選択に大きく効くことがあると考えています。
単調性の制約、項目の向きを業務の感覚とそろえる
与信のモデルでは、成績のほかに、見積りの向きが業務の感覚と合っていることが求められます。他の条件が同じなら、年収の水準が高いほど、勤続年数が長いほど、デフォルト確率は下がり、他社の借入の件数や過去の延滞があるほど上がる、という向きです。どの項目にどの向きを期待するかは、項目の定義や商品の性質に照らして、事前に妥当性を確かめて決めるものです。その向きに反する見積りがあれば、理由を点検する必要があります。点検しないまま、年収の水準だけが高い申込の方が否決されやすくなる範囲が残れば、機会損失や、説明の難しい否決につながるおそれがあります。
ある項目の値を大きくしたときに、見積りが一方の向きにしか動かない(上がり続けるか横ばい、または下がり続けるか横ばいで、途中で逆向きに動かない)ことを「単調」と呼びます。この向きをモデルに守らせる仕組みが単調性の制約です。ほかの項目の値が同じなら、ある項目の値が大きくなるほど確率が上がらない、あるいは下がらないようにする指定です。項目ごとに「大きいほど見積りが上がる」「大きいほど下がる」「制約しない」のどれかを指定し、学習の途中で木を分けるときに、その向きに反する分け方を選ばないようにします。lightgbm の公式の説明書きでは、パラメータ monotone_constraints に、項目の並びの順にすべての項目について、1(増加)・-1(減少)・0(制約なし)を指定すると書かれています。同じ説明書きには、カテゴリの項目については出力を単調に制約できないこと、既定の計算方法(basic)は学習を遅くしない代わりに必要以上に強く制約することがあり、より細かい方法(intermediate・advanced)も選べることが書かれています。scikit-learn の HistGradientBoostingClassifier にも monotonic_cst という同じ趣旨のパラメータがあり、公式の説明書きによれば版0.23で加わり、二値の分類で陽性の側の確率について制約が成り立つとされています。
この章の例では、年収の水準と勤続年数を減少、他社の借入の件数・過去の延滞・直近の申込の件数・返済の負担の割合を増加に指定し、居住の年数(単調でない関係を入れた項目)と雇用の形態(カテゴリの項目)は制約しませんでした。勤続年数の効果は15年で頭打ちにしてあります。頭打ちは、勤続年数が15年を超えるとデフォルト確率がそれ以上は下がらなくなるだけで、上がるわけではありません。そのため「勤続年数が長いほど確率が下がるか、横ばい」という減少の制約と両立します。次のコードでは、評価用のデータから抜き出した1,000件の申込について、他の項目はそのままにして年収の水準だけを0.3から3.0まで動かし、デフォルト確率がどう変わるかを調べました。年収の水準を上げたときに、確率が0.001を超えて上がる区間を1つでも持つ申込の割合を、向きに反する見積りの目安として数えています。
grid = np.linspace(0.3, 3.0, 55)                           # 年収の水準を動かす範囲(相対値)
te_s = te.sample(1000, random_state=0)                     # 評価用から1,000件を抜き出して調べる
curves = lambda f: np.array([f(te_s.assign(income=g)) for g in grid]).T   # 申込 × 年収の水準
rev = lambda c: (np.diff(c, axis=1) > 0.001).any(axis=1).mean()  # 年収が上がると確率が上がる区間がある割合
curve = {}
for name, f in score.items():                              # 各申込の年収の水準だけを動かしたときの確率
    c = curve[name] = curves(f)
    print(name, "年収を上げると確率が0.001を超えて上がる区間を持つ申込の割合", round(rev(c), 3),
          "/平均の確率 年収0.5", round(c[:, np.abs(grid - 0.5).argmin()].mean(), 4),
          "年収1.0", round(c[:, np.abs(grid - 1.0).argmin()].mean(), 4),
          "年収2.0", round(c[:, np.abs(grid - 2.0).argmin()].mean(), 4))
print("年収の水準の区分の境目", edges["income"][1:-1].round(2))
print("区分ごとの WoE", WOE["income"].round(3).to_dict())
| モデル | 年収を上げると確率が0.001を超えて上がる区間を持つ申込の割合 | 平均のデフォルト確率(年収の水準0.5) | 平均のデフォルト確率(年収の水準1.0) | 平均のデフォルト確率(年収の水準2.0) |
|---|---|---|---|---|
| WoE のロジスティック回帰 | 0.301 | 0.0627 | 0.0320 | 0.0151 |
| 勾配ブースティング(制約なし・検証で選んだ設定) | 0.002 | 0.0591 | 0.0364 | 0.0188 |
| 勾配ブースティング(単調性の制約あり) | 0.000 | 0.0563 | 0.0340 | 0.0204 |
| 参考:勾配ブースティング(制約なし・葉31・葉の最小件数50) | 0.952 | 対象外 | 対象外 | 対象外 |
年収の水準について調べた範囲では、単調性の制約を付けたモデルで向きに反する区間を持つ申込は0件でした。制約なしのモデルのうち、検証用の成績で選んだ設定(学習率0.02・葉7・葉の最小件数200・正則化10・木173本)では0.2%にとどまりました。一方、表の最下行の、学習率0.05・葉31・葉の最小件数50・正則化なしの設定(次の節の過学習の点検で使う設定の1つ)では、95.2%の申込で、年収の水準を上げると確率が上がる区間がありました。2つの設定は、学習率・葉の数・葉の最小件数・正則化・木の本数を一度に変えているので、どの違いが向きの乱れに効いたのかは、この比較からは分けられません。制約なしのモデルで向きが保たれるかどうかは設定とデータで変わるので、制約を付けないなら、この種の点検を毎回行う必要があります。
WoE のロジスティック回帰でも、向きに反する区間がありました。年収の水準の区分の WoE は、学習用のデータで、低い方から -0.653、-0.113、-0.142、0.163、0.424、1.035でした。2番目の区分(0.62〜0.79)より3番目の区分(0.79〜0.97)の方が WoE がわずかに小さく、年収の水準が0.79を超えて3番目の区分に入ると、デフォルト確率がわずかに上がります。データを作るときの関係は単調なので、この入れ替わりは、区分ごとの件数とデフォルトの偶然のばらつきによるものと考えられます。点数表でも、区分の WoE が単調になるように区分を統合する手順(第3章)を省くと、同じことが起きます。単調性は機械学習のモデルだけの問題ではなく、どの手法でも確かめる項目だと言えます。
個々の申込で見ると、違いはさらにはっきりします。抜き出した1,000件のうち、WoE のロジスティック回帰で年収の水準を上げたときの確率の上昇が最も大きかった申込(年収の水準0.36、勤続年数2.4年、居住の年数0.9年、他社の借入1件、過去の延滞あり、直近の申込3件、雇用の形態C)では、年収の水準が0.75から0.80に移るところで、点数表の確率が0.0057上がりました。点数表の確率は、区分の境目でだけ変わる階段の形になります。年収の水準0.79の境目で WoE が入れ替わり、年収の水準の係数はすべての申込で共通なので、この境目を越えると、抜き出した1,000件のすべての申込で確率がわずかに上がりました。表の30.1%は、そのうち上昇の幅が0.001を超えた申込の割合です。
表の平均のデフォルト確率は、3つのモデルとも、年収の水準0.5、1.0、2.0の順に下がっています(WoE のロジスティック回帰は0.0627、0.0320、0.0151、制約なしのモデルは0.0591、0.0364、0.0188、制約ありのモデルは0.0563、0.0340、0.0204)。このように数点の平均だけを見ると、どのモデルも向きが保たれているように見えます。勾配ブースティングのような木のモデルでは、確率が上がる位置と幅が申込ごとに違い、平均をとると個々の申込の乱れが見えにくくなることがあります。向きの点検は、平均の値だけでなく、個々の申込で年収の水準を動かして行う必要があります。
制約にも費用があります。この架空データでは、制約を付けたモデルの評価用の AR値(0.507)は、付けないモデル(0.514)より0.007低くなりました。差は区間の幅に比べて小さいものの、制約は学習の自由度を減らすので、成績が下がる場合があります。また、向きを指定するのは人なので、指定そのものが誤っていればモデルも誤ります。どの項目にどの向きを指定したかと、その根拠を、モデルの文書に残しておく必要があります(第12章)。
過学習の点検、学習用と評価用の差・木の大きさ・木の本数
勾配ブースティングは、木の本数を増やすほど学習用のデータへの当てはまりが良くなります。どこかで、学習用のデータの偶然の特徴まで覚え始め、新しいデータでの成績が下がります。次のコードでは、制約なしのモデルで、学習率を0.05、正則化をなしに固定し、葉の数と葉の最小件数、木の本数を変えて、学習用・検証用・評価用の AR値を比べました。前の節と同じ方法で、向きに反する区間を持つ申込の割合も数えています。
print("過学習の点検(制約なし。学習率0.05・正則化なし)")
over = {}
for leaves, min_child, rounds, stop in [(7, 200, 3000, True), (31, 50, 3000, True),
                                        (127, 5, 3000, True), (127, 5, 1500, False)]:
    m = over[(leaves, min_child, stop)] = fit_gbm(None, 0.05, leaves, min_child, 0.0, rounds, stop)
    n = m.best_iteration_ if stop else rounds
    s = [round(ar(d.default, m.predict_proba(X(d), num_iteration=n)[:, 1]), 3) for d in (tr, va, te)]
    print(f"葉{leaves} 最小{min_child} 本数{n}{'(早期打ち切り)' if stop else '(打ち切りなし)'}",
          "学習", s[0], "検証", s[1], "評価", s[2], "学習と評価の差", round(s[0] - s[2], 3),
          "逆向きの区間を持つ申込の割合", round(rev(curves(lambda d: m.predict_proba(X(d), num_iteration=n)[:, 1])), 3))
| 設定 | 木の本数 | 学習用の AR値 | 検証用の AR値 | 評価用の AR値 | 学習用と評価用の差 | 向きに反する区間を持つ申込の割合 |
|---|---|---|---|---|---|---|
| 葉7・葉の最小件数200・早期打ち切り | 56本 | 0.553 | 0.507 | 0.504 | 0.049 | 0.534 |
| 葉31・葉の最小件数50・早期打ち切り | 18本 | 0.642 | 0.497 | 0.485 | 0.157 | 0.952 |
| 葉127・葉の最小件数5・早期打ち切り | 18本 | 0.879 | 0.485 | 0.458 | 0.421 | 0.847 |
| 葉127・葉の最小件数5・打ち切りなし | 1,500本 | 1.000 | 0.290 | 0.337 | 0.663 | 0.221 |
この4つの設定では、葉の数を増やして葉の最小件数を減らすほど、学習用と評価用の AR値の差は広がり、木を1,500本まで足すとさらに広がりました。葉127・葉の最小件数5の設定で木を1,500本まで足すと、学習用の AR値は1.000(学習用の申込を完全に並べ分けた状態)になり、評価用は0.337まで下がりました。早期打ち切りを使った場合でも、葉127の設定では木18本の時点で学習用0.879、評価用0.458で、差は0.421ありました。この架空データでは、最も小さい葉7・葉の最小件数200の設定が、評価用でも最も高い AR値(0.504)でした。前の節で検証用の成績から選んだ、学習率を下げて正則化を強めた設定(評価用0.514)は、それをさらに上回っています。
葉127・葉の最小件数5の設定で、木の本数ごとに学習用と検証用の AR値を記録すると、検証用の AR値は18本のところで最大の0.485になり、そのときの学習用の AR値は0.879でした(木の本数ごとの記録は、掲載していない作図用のコードで出したもので、この記録を出すコードは掲載していません)。木を1,500本まで足すと、学習用は1.000まで上がり、検証用は0.290まで下がりました。表の「葉127・葉の最小件数5・早期打ち切り」の行の18本は、この最大の位置にあたります。早期打ち切りは、検証用の成績の改善が一定の本数(この章では200本)続けて見られなくなったら木を足すのをやめ、それまでで最も良かった本数を採用する仕組みです。ただし、打ち切りの位置を決めるのに検証用のデータを使っているので、検証用の成績はやや楽観的になります。最終の成績は、打ち切りにも設定の選択にも使っていない評価用のデータで測る必要があります。
表の最右列の、年収の水準について向きに反する区間を持つ申込の割合は、葉7・葉の最小件数200の設定でも53.4%ありました。前の節で検証用の成績から選んだ葉7・葉の最小件数200の設定(0.2%)とは、正則化のほかに学習率と木の本数も違うので、この差を正則化だけの効果とは言えません。また、この割合は木の大きさに沿って増えたわけではなく、葉31で95.2%、葉127で84.7%、葉127・打ち切りなしで22.1%でした。下がった理由は、本コラムでは調べていません。この指標は0.001を超える上昇だけを数えているので、値の大小だけでは単調さの程度を比べられない点にも注意が要ります。この表から言えるのは、制約を付けない場合、設定によっては多くの申込で向きの乱れが出ることがある、というところまでです。過学習の点検として、本コラムでは次の4つを確かめることが有効だと考えています。
- 学習用と、時間で切った後の期間のデータで、AR値の差がどれだけあるか
- 木の本数を、学習に使っていないデータの成績で決めているか(早期打ち切り)
- 木の大きさ・葉の最小件数・正則化の候補を、学習に使っていないデータで比べて選んでいるか
- 個々の申込で、主な項目の向きが業務の感覚と合っているか
機械学習のモデルで点数表を点検する、差の大きい層を調べる
機械学習のモデルの使い道は、点数表と入れ替えることだけではありません。点数表を審査に使い続けながら、機械学習のモデルを、点数表がどの層で見積りを外しているかを探す道具として使う、という組み合わせ方があります。2つのモデルが同じ申込を大きく違う順位に置く層は、どちらかが見積りを外している可能性がある層です。その層で実績のデフォルト率を確かめ、点数表の側が外れていれば、項目や区分を見直す手がかりになります。
次のコードでは、この手順を実際に回しました。手順は4段です。1段目に、検証用のデータで、単調性の制約ありの勾配ブースティングと WoE のロジスティック回帰の順位の差(申込ごとに、デフォルト確率の順位を0〜1の割合に直して引いたもの)を計算し、その差を、深さ2の決定木で項目の条件に分けます。差が正の層は、勾配ブースティングの方がデフォルトしやすい側に置いている層です。2段目に、順位の差の平均が最も大きい層を、足す項目の候補にします。3段目に、その層に当てはまるかどうかを2区分の項目にし、学習用のデータで WoE に直して点数表に足し、検証用のデータの AR値が点数表だけのときより上がるかで、足すかどうかを判断します。4段目に、評価用のデータで結果を確かめます。
比べるために、もう1つ、データを作るときに組み込んだ2つの組み合わせの関係(他社の借入2件以上で直近6か月の申込3件以上、雇用の形態Cで返済の負担の割合0.45超)を、同じ方法で項目にして足したものも作りました。これは、合成データの作り方を知っている立場だから選べた正解の組み合わせであり、実務ではこの知識はありません。点検の手順がこの組み合わせを見つけた場合の成績の参考として置いた、組み合わせを既知として足した参考モデルです。係数は学習用のデータで推定しており、データを作るときの確率そのものは使っていないので、項目を足して得られる成績の上限になる保証はありません。
from scipy.stats import rankdata
from sklearn.tree import DecisionTreeRegressor, export_text

MN = "勾配ブースティング(単調性の制約あり)"
gap = rankdata(score[MN](va)) / len(va) - rankdata(score[LR](va)) / len(va)  # 正:勾配ブースティングが危ない側に置く
Xt = lambda d: d[FEAT].assign(emp=(d.emp == "C").astype(int))   # emp は「雇用の形態C」なら1
tree = DecisionTreeRegressor(max_depth=2, min_samples_leaf=150, random_state=0).fit(Xt(va), gap)
print(export_text(tree, feature_names=FEAT, decimals=2))
leaf = pd.DataFrame({"葉": tree.apply(Xt(va)), "順位の差": gap, "実績": va.default, LR: score[LR](va), MN: score[MN](va)})
print(leaf.groupby("葉").agg(["size", "mean"]).iloc[:, [0, 1, 3, 5, 7]].round(3))
top = leaf.groupby("葉")["順位の差"].mean().idxmax()          # 順位の差が最も大きい葉を、足す項目の候補にする
print("勤続年数の区分の境目", edges["years_emp"][1:-1].round(2), "WoE", WOE["years_emp"].round(3).to_dict())
FL = {"found": lambda d: pd.Series((tree.apply(Xt(d)) == top).astype(int), index=d.index),   # 点検で見つかった層
      "loan_inq": lambda d: ((d.n_loans >= 2) & (d.inq >= 3)).astype(int),   # データに組み込んだ組み合わせ(その1)
      "c_burden": lambda d: ((d.emp == "C") & (d.burden > 0.45)).astype(int)}   # データに組み込んだ組み合わせ(その2)
for k, f in FL.items():                                    # 層ごとの件数と、学習用・検証用での実績と見積りの平均
    for nm, d in [("学習用", tr), ("検証用", va)]:
        v = (f(d) == 1).to_numpy()
        print(k, nm, v.sum(), "件(デフォルト", d.default[v].sum(), ")実績", round(d.default[v].mean(), 3),
              *[f"{n} {g(d)[v].mean():.3f}" for n, g in score.items()])

def add_items(keys):                                       # 2区分の項目を WoE に直して点数表に足す(学習用で当てはめる)
    W = {k: woe_table(FL[k](tr), tr.default) for k in keys}
    g = lambda d: pd.concat([to_woe(d)] + [FL[k](d).map(W[k]).rename(k) for k in keys], axis=1)
    m = LogisticRegression(C=1.0, max_iter=2000).fit(g(tr), tr.default)
    return lambda d: m.predict_proba(g(d))[:, 1]

for name, keys in [("点検で見つかった層の項目", ["found"]), ("組み込んだ組み合わせを既知として足した参考", ["loan_inq", "c_burden"])]:
    f = add_items(keys)
    print(name, "検証 AR", round(ar(va.default, f(va)), 3), "(点数表のみ", round(ar(va.default, score[LR](va)), 3), ")")
    pred["WoEのロジスティック回帰+" + name] = f(te)
y, boot = te.default.to_numpy(), np.random.default_rng(7)
bs = {k: [] for k in pred}
for _ in range(300):                                       # 評価用の申込を復元抽出して AR値を計算し直す
    i = boot.integers(0, len(y), len(y))
    for k in bs:
        bs[k].append(ar(y[i], pred[k][i]))
for k, v in bs.items():
    v, d = np.array(v), np.array(v) - np.array(bs[LR])     # 同じ抜き出しの中での WoE のロジスティック回帰との差
    print(k, "評価 AR", round(ar(y, pred[k]), 3), "95%区間", np.quantile(v, [0.025, 0.975]).round(3),
          "差", round(ar(y, pred[k]) - ar(y, pred[LR]), 3), "差の95%区間", np.quantile(d, [0.025, 0.975]).round(3))
順位の差を分けた決定木は、勤続年数が9.08年を超え、年収の水準が0.82以下の層(検証用で356件)で、勾配ブースティングの方がデフォルトしやすい側に置いていることを示しました(順位の差の平均0.133)。検証用のデータでは、この層の実績のデフォルト率は5.6%で、WoE のロジスティック回帰の見積りの平均は2.8%、勾配ブースティングは3.7%でした。点数表の勤続年数の WoE は、学習用のデータで、短い方から -0.310、-0.267、0.091、-0.077、0.181、0.648で、最も長い区分(9.09年超)が最も大きい値でした。ただし、学習用のデータでは、この層は1,130件でデフォルトは34件(実績3.0%)で、学習用の全体のデフォルト率(3.7%)より低く、点数表の見積りの平均は2.9%で実績とほぼ合っていました。検証用のデータで見えた実績と見積りのずれは、学習用のデータでは見られなかったことになります。検証用の期間のデフォルト率が全体に高いことも関わっていると考えられ、この層の差がどこまで確かなものかは、この結果からは判断できません。
| 層(学習用のデータ) | 件数 | デフォルト | 実績 | 点数表の見積り |
|---|---|---|---|---|
| 点検で見つかった層:勤続年数9.08年超で、年収の水準0.82以下 | 1,130件 | 34件 | 0.030 | 0.029 |
| 組み込んだ関係:他社の借入2件以上で、直近6か月の申込3件以上 | 686件 | 141件 | 0.206 | 0.163 |
| 組み込んだ関係:雇用の形態Cで、返済の負担の割合0.45超 | 380件 | 71件 | 0.187 | 0.113 |
| 層(検証用のデータ) | 件数 | 実績 | 点数表の見積り | 勾配ブースティング(制約なし) | 勾配ブースティング(制約あり) |
|---|---|---|---|---|---|
| 点検で見つかった層:勤続年数9.08年超で、年収の水準0.82以下 | 356件 | 0.056 | 0.028 | 0.033 | 0.037 |
| 組み込んだ関係:他社の借入2件以上で、直近6か月の申込3件以上 | 223件 | 0.278 | 0.160 | 0.159 | 0.141 |
| 組み込んだ関係:雇用の形態Cで、返済の負担の割合0.45超 | 104件 | 0.183 | 0.099 | 0.109 | 0.092 |
2つの表の「実績」はその層のデフォルト率、「点数表の見積り」と勾配ブースティングの列は、その層のデフォルト確率の見積りの平均です。
点検で見つかった層の項目を点数表に足すと、検証用の AR値は0.487で、点数表だけのとき(0.487)と変わりませんでした。手順の3段目の基準では、足さないという判断になります。念のため評価用のデータでも確かめると、AR値は0.496で点数表だけのときと同じで、差は小数第3位までで0.000でした。学習用のデータでは、この層の点数表の見積りが実績とほぼ合っていたので、学習用のデータで推定した項目の係数が、検証用で見えたずれを打ち消す向きにならなかったと考えられます。
データに組み込んだ組み合わせの関係の層では、どのモデルも実績を大きく下回る見積りでした。他社の借入2件以上で直近の申込3件以上の層では、検証用の実績27.8%に対して、どのモデルの見積りも14〜16%でした。学習用のデータでも、この層の実績20.6%に対して、見積りの平均は WoE のロジスティック回帰で16.3%、勾配ブースティングで15.8%(制約なし)と14.3%(制約あり)でした。選んだモデルでは、この層の見積りの平均が実績を下回ったことになります。ただし、見積りの平均が実績を下回ることは、全体の見積りの低さや時期の違い、件数の少なさによるばらつきでも起きるので、勾配ブースティングが組み合わせの関係をどの程度捉えたかは、この結果だけでは判定できず、本コラムでは確かめていません。表に載せたのは選んだモデルだけで、試した他の設定のモデルの層ごとの結果は見ていません。また、点検の手順の決定木も、この2つの層を見つけませんでした。なお、表のどの層でも見積りが実績を下回っていることには、学習用の期間より検証用の期間のデフォルト率が高い(景気の緩やかな悪化を入れたため)ことも関わっていると考えられます。見積りと実績のずれは確率の較正の問題で、第8章で扱います。
| モデル | 検証用の AR値 | 評価用の AR値 | WoE のロジスティック回帰との差(評価用) | 差の95%区間 |
|---|---|---|---|---|
| WoE のロジスティック回帰+点検で見つかった層の項目 | 0.487 | 0.496 | 0.000 | 小数第3位までで0.000〜0.000 |
| WoE のロジスティック回帰+組み込んだ組み合わせを既知として足した参考 | 0.503 | 0.505 | 0.010 | -0.001〜0.019 |
| 勾配ブースティング(単調性の制約あり) | 0.502 | 0.507 | 0.011 | -0.002〜0.028 |
| 勾配ブースティング(制約なし) | 0.505 | 0.514 | 0.018 | 0.003〜0.035 |
正解の組み合わせの項目を足した点数表の評価用の AR値は0.505で、足す前の0.496から0.010上がりました。ただし差の95%区間は -0.001〜0.019で0をまたいでおり、この区間の上では、上積みがあったとは確かめられません。単調性の制約ありの勾配ブースティング(0.507)とはほぼ同じ水準で、制約なしの勾配ブースティング(0.514)よりは0.009低い値です。これは正解の組み合わせを知っている場合の参考の値であり、実際のデータで項目を足して同じ上積みが得られるとは限りません。
この節の結果から言えるのは、次のことです。機械学習のモデルとの順位の差を調べると、点数表と見積りが食い違う層は絞り込めます。しかし、その層が本当に点数表の見落としなのか、検証用の期間のたまたまのずれなのかは、別の期間のデータで確かめるまで分かりません。本コラムの架空データでは、見つかった層は学習用のデータでは点数表の見積りと実績がほぼ合っており、項目にして足しても成績は変わりませんでした。点検の手順は、足す項目を決める道具ではなく、調べる層の候補を挙げる道具として使い、候補ごとに、業務の上で説明がつくか(借入が多い中で申込が重なっている、のような理由が言えるか)と、別の期間でも同じずれが続くかを確かめてから項目にするのが安全だと考えています。
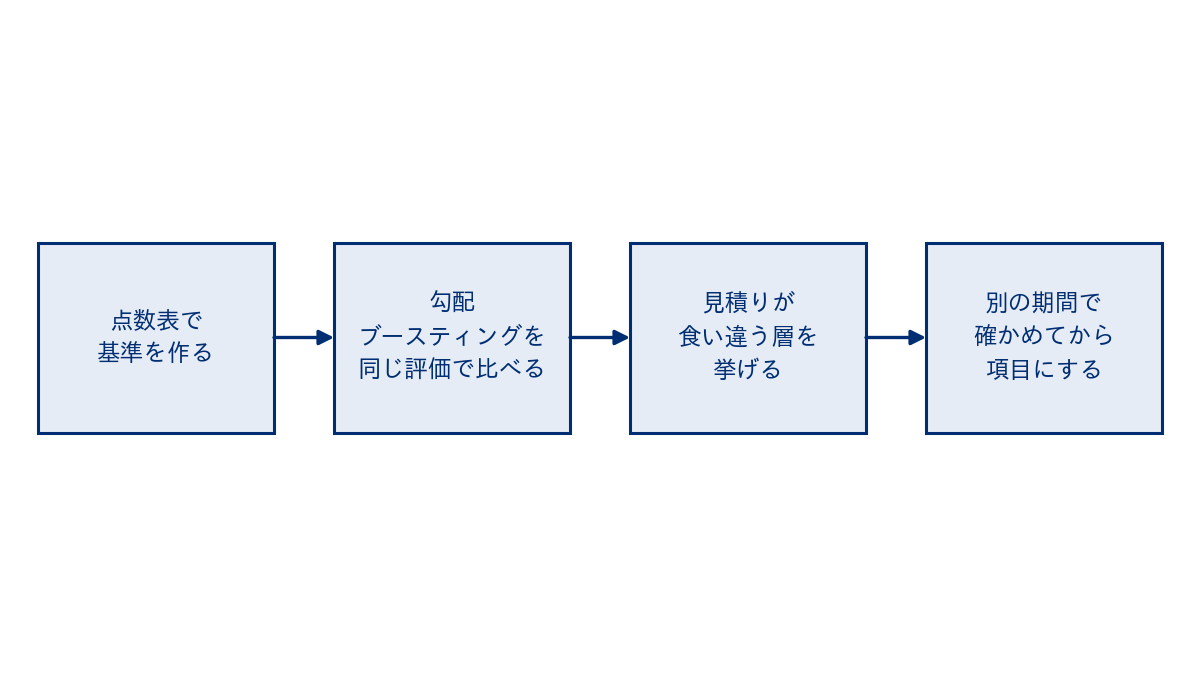
代替データと深層学習を使うときの論点
機械学習の手法が語られるとき、多くの場合、代替データの活用とあわせて語られます。本コラムでいう代替データは、その商品で従来から使ってきた信用情報や申込の情報を補う、または代わりになるデータで、口座の入出金の記録や、他のサービスの取引の履歴などを指します。米国の消費者金融保護局は、2017年2月16日の発表で、信用情報機関に信用の履歴が無い消費者などの与信の機会を広げるために代替データを使うことについて、意見の募集を始めました。その発表は、代替データの例として、携帯電話の料金や家賃の支払い、預け入れ・引き出し・送金といった電子的な取引の記録を挙げ、利点として与信の機会の拡大や申込の手続きの迅速化を挙げています。懸念としては、データの不正確さや偏り、消費者が収集や利用の目的を知らないことによるプライバシーの問題、誤りを直せるかどうかの不確かさ、特定の属性と相関する場合の公正な与信の問題などを挙げています。これは2017年時点の発表であり、その後の米国での扱いは、本コラムでは確かめていません。
代替データを使うかどうかは、次の観点を並べて判断することになると考えています。1つ目は、成績の上積みです。代替データを足したモデルと足さないモデルを、この章と同じく時間で切った評価用のデータで比べ、差の区間まで見ます。2つ目は安定性です。外部から取るデータは、提供元の仕様の変更や、取れる範囲の変化で性質が変わることがあり、監視の対象が増えます(第12章)。3つ目は説明です。否決の理由として、申込者が自分で確かめられない情報を示すことになる場合があります(第11章)。4つ目は、利用の目的と同意の扱いです。個人データを与信の判断に使うときに、利用の目的をどう示し、同意が要るかどうかは、法令やデータの種類、提供元の条件によって変わります。この点は第14章で整理しますが、個別の事業に当てはめるときは、法務の担当者や所管官庁に確かめる事項です。データを集める前に、何に使うつもりかを社内で決めておくことが、その確認の出発点になります。この章の実験では代替データを試していませんが、代替データで成績の上積みが得られた場合でも、項目の数が多くなりやすく、説明・監視・利用の目的の管理の負担が増えやすいと考えています。
深層学習(多層のニューラルネットワーク)は、本コラムでは実行していません。表の形の申込の情報であれば、この章で見た点数表と勾配ブースティングで比べる手順で足りることが多く、深層学習を使う理由は、時系列の入出金の記録や文章のような、表の形に直しにくいデータを扱う場合に生まれることが多いと考えています。その場合でも、学習に要する件数と計算の資源、理由の示しにくさ、検証の体制の負担は、ネットワークの規模や入力のデータ、既存の運用の体制によっては勾配ブースティングより大きくなることがあるので、候補のモデルごとに見積もる必要があります。深層学習を検討するのは、点数表と勾配ブースティングで比べる手順が整い、その上で、表の形の項目では取り出せない情報が成績に効くことを、時間で切った評価で確かめられた後だと考えています。
ロジスティック回帰と機械学習の使い分け
ここまでの結果を踏まえて、WoE のロジスティック回帰(点数表)と勾配ブースティングの使い分けを、判断の観点ごとに整理したのが次の表です。どちらかが常に優れているという整理ではなく、自社の条件がどちらに近いかを見るための表です。
| 判断の観点 | 点数表が向く条件 | 勾配ブースティングが向く条件 |
|---|---|---|
| 申込の件数とデフォルトの件数 | デフォルトの件数が少なく、柔軟なモデルが過学習しやすい | デフォルトの件数が多く、組み合わせの層にも十分な件数がある |
| 項目の数 | 項目が少なく、1つずつ区分けして管理できる | 代替データなどで項目が多く、区分けの手間が大きい |
| 説明の要請 | 申込者・審査の担当者・監査に、点数の内訳をそのまま示す必要がある | 寄与を計算する手法で理由を示す運用と、その妥当性の検証の体制を用意できる |
| 運用の体制 | 審査の仕組みに点数表として入れ、業務の担当者が中身を読めることを重視する | モデルの監視・再学習・本番での計算の点検を担う体制がある |
| 成績の差 | 時間で切った評価で、差の区間が0をまたぐ、または差が小さい | 時間で切った評価で、差の区間が0を十分に上回り、事業の差として意味がある大きさ |
| 項目の向きの管理 | WoE の並びを区分の統合でそろえられる | 単調性の制約を指定し、個々の申込で向きを点検できる |
この表の観点のうち、成績の差は、本コラムの架空データのように、差があっても小さく、区間の上では確かめにくいことがあります。その場合には、まず点数表を使い、機械学習のモデルは点検の道具として並行して動かし、見積りが食い違う層を候補として挙げ、別の期間でも同じずれが続くものだけを項目として検討する、という段階的な進め方が選べます。表の件数や項目の数の条件は向きを示したもので、何件・何項目という目安の出典はありません。本コラムの架空データ(学習用のデフォルト780件、項目8つ)は1つの例にすぎません。成績の差が十分に大きく、説明と運用の体制も用意できる場合に、勾配ブースティングを審査に使うことを検討する、という順序です。勾配ブースティングを使う場合でも、比べる基準として点数表を作っておくと、成績の差を測れるだけでなく、勾配ブースティングに不具合があったときの代わりにも使えます。
経営の判断、成績の差と説明・運用の負担の差を並べて選ぶ
機械学習のモデルを入れるかどうかの判断を誤ると、いくつかの型の損失につながります(損失の型は序章の6つです)。学習用のデータの成績や、時間で切らない評価で選んだモデルを本番に入れると、見込んだほど順位づけの成績が出ず、承認した契約のデフォルト率が見込みより高くなって、貸し倒れにつながるおそれがあります。向きに反する見積りを点検しないまま使うと、年収の水準だけが高い申込を否決するような判断が起き、機会損失と、説明のつかない否決を生みます。理由を示す方法と検証の体制を用意せずに入れると、説明や記録の義務を果たせない、規制上の義務の不履行のおそれが生じます。また、設定の多いモデルを、監視と再学習の体制なしに入れると、申込者の層の変化に気づけない形骸化につながります。
反対に、成績の差を調べずに点数表を使い続けることにも、損失の型があります。代替データや組み合わせの関係で拾える可能性のあるデフォルトを拾えず、承認できた可能性のある申込を断る機会損失(推定でしか分かりません)や、見落とした層での貸し倒れが続くおそれがあります。機械学習のモデルで点数表を点検する前の節の手順は、点数表を入れ替えずに、この損失の手がかりを探す方法の1つです。ただし、本コラムの架空データでは、見つかった層を項目にしても成績は変わらなかったので、手がかりを項目にする前の確かめが欠かせません。
経営として決めておくべきなのは、次の表の項目だと考えています。とくに「入れ替えの基準」は、比べる前に決めておかないと、良く見える数字が出たときに、その測り方を確かめないまま採用することになりがちです。AR値の差は管理の指標であり、それだけで成果とは呼べません。差を、同じ承認率でのデフォルト率の差や、収益と損失の差の見積りに直して判断します(第9章)。
| 決めること | 決める内容の例 | 決める人の例 |
|---|---|---|
| 比べる基準のモデル | 現行の点数表、または同じデータで作った WoE のロジスティック回帰 | リスク管理の責任者とデータ分析の担当 |
| 評価の切り方 | 申込の月で切る。学習・検証・評価の期間と、観測期間を満たしているか | データ分析の担当 |
| 入れ替えの基準 | 評価用の AR値の差の区間が0を上回ることを入口の条件にし、承認した契約から得る収益と貸し倒れの損失の差の見積りと、推定である否決した申込の機会損失を並べ、説明と運用の追加の負担も含めて判断すること | 経営とリスク管理の責任者 |
| 向きの指定と点検 | 単調性の制約を付ける項目と向き、その根拠。個々の申込での点検の方法 | 審査の責任者とデータ分析の担当 |
| 説明と記録 | 否決の理由を示す方法と、その検証の方法(第11章) | 審査の責任者とコンプライアンスの担当 |
| 運用の体制と予算 | 監視・再学習・本番での計算の点検を担う人と、その予算(第12章) | 経営と情報システムの責任者 |
予算の面では、機械学習のモデルの費用は開発だけでは終わらず、監視・再学習・説明の検証・本番での計算の点検という、続けてかかる作業が増えることを見込んでおく必要があります。成績の差が小さいときに、この続けてかかる負担を上回る効果があるかどうかが、判断の中心になると考えています。
この章のまとめ
この章では、決定木を組み合わせる機械学習の手法を与信のモデルに使う動機と懸念、手法の比較と研究の読み方、単調性の制約、過学習の点検、点数表の点検への使い方、代替データと深層学習の論点を扱いました。本コラムの架空データでは、申込の月で切った評価用のデータの AR値は、WoE のロジスティック回帰が0.496、勾配ブースティングが制約なしで0.514、制約ありで0.507で、差の区間は制約ありのモデルでは0をまたぎ、制約なしのモデルでも下端が0.003と0にほぼ接していました。抜き出しを2,000回に増やして計算し直すと、下端は0.001〜0.002とさらに0に近づきました(評価用の抜き出しのばらつきだけを見た区間です)。機械学習のモデルとの順位の差から見つかった層を項目にして点数表に足しても、評価用の AR値は0.496のままでした。データに組み込んだ正解の組み合わせを既知として足した参考モデルでも0.505で、点数表との差の区間は0をまたぎました。機械学習のモデルを使うかどうかは、時間で切った評価での成績の差とその区間を、説明と運用の負担の差と並べて決める必要があります。この章では順位づけの成績だけを見ましたが、モデルの出すデフォルト確率が実績と合っているかは別の問題です。モデルの学習に使えるのが承認した契約だけであることの影響を次の第6章で扱い、評価の指標の詳細は第7章、確率の較正は第8章で扱います。
この章を深めたい方への参考書籍
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):版元の目次によれば、モデルの作成の章で勾配ブースティング木と xgboost・lightgbm の使い方を、モデルの評価の章で時系列のデータの検証の方法を、チューニングの章で勾配ブースティング木の設定の探し方を扱っています。この章で行った、検証用のデータでの設定の選び方と、時間で切った評価の進め方を、実装の面から確かめるのに向いています。
『統計的学習の基礎 データマイニング・推論・予測』(Trevor Hastie・Robert Tibshirani・Jerome Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、井尻善久 他訳、共立出版):原著の題名が示すとおり、データマイニング・推論・予測のための統計的な学習の手法を扱う教科書の訳書です。著者の1人の Friedman は、この章で紹介した勾配ブースティングの論文の著者です。本コラムでは訳書の章立てまでは確かめていませんが、この章で使った手法の背景にある統計的な学習の考え方を、数理の面から確かめたいときの手がかりになると考えています。
第6章 否決した申込をどう扱うか、リジェクト・インファレンスと選択の偏り
第3章から第5章では、区分けと WoE による項目の準備、ロジスティック回帰によるスコアカード、勾配ブースティングによる機械学習のモデルと、スコアを作る方法を順に見てきました。どの章も、結果(デフォルトか正常か)が分かっている契約の記録を学習に使っていました。この章では、その記録がどこから来たのかを問い直します。結果が分かるのは、過去の審査で承認した契約だけです。否決した申込は契約にならないので、承認していたら返済されたのかどうかは記録に残りません。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の申込の記録を使い、実行したコードと結果で確かめます。
- 承認した契約だけでモデルを作ることの問題と、選択の偏りという考え方
- 欠測の仕組みの3つの分類と、過去の審査の基準がどの分類に当たるか
- 承認した契約だけで学習したモデルを、申込の全体で評価したときの成績と確率のずれ
- リジェクト・インファレンス(否決した申込の結果を推し量って学習に加える方法)の種類と、それぞれが効く条件・効かない条件
- 否決するはずの申込の一部を無作為に承認する方法の費用と意義
- 過去の審査の基準と判断の記録を残す意義と、経営の判断
この章の主張は次の2つです。後の例題では、過去の審査の基準を、モデルに入れる項目だけで決める基準(基準Aと呼びます)と、人の判断も使って決める基準(基準Bと呼びます)の2通り作って比べます。
- 過去の審査が、モデルに入れる項目以外の情報(人が書類や面談で確かめた事情など)も使って否決を決めていた場合(基準B)、承認した契約だけで作ったモデルは、否決された層のデフォルト確率を小さく見積もることがあります。本コラムの架空データでは、その層の実績のデフォルト率が約11.6%だったのに対し、承認した契約だけで学習したモデルの見積りの平均は約4.0%でした。
- 否決した申込の結果を推し量る方法(リジェクト・インファレンス)は、手元の記録に無い情報を補えるとは限りません。本コラムの架空データの基準Bでは、承認した契約に重みを付ける方法も、否決した申込に見積りの確率で結果を割り当てる方法も、このずれをほとんど直せませんでした。ずれを小さくしたのは、否決するはずの申込の一部を無作為に承認して実際の結果を得る方法でした。
ただし、過去の審査がモデルに入れる項目だけで決まっていた場合(基準A)には、本コラムの架空データでは、承認した契約だけで作ったモデルでも、基準Bの場合に比べてずれは小さく済みました。どの方法が効くかは、過去の審査がどう行われていたかで変わります。
学習に使えるのは承認した契約だけ、という問題
与信のモデルを作るときに学習に使うのは、過去の申込のうち、承認されて契約になり、観測期間を終えて結果が確定したものです。第2章で扱ったとおり、デフォルトかどうかは契約の後の返済の記録から決まります。否決した申込には返済の記録がありません。そのため、学習に使える記録は、過去の審査の基準を通った申込に限られます。一方で、作ったモデルを使う場面では、過去の基準なら否決していた申込も含めて、これから来る申込の全体(審査の入口を通るすべての申込)にスコアを付けます。学習に使う集団と、使う場面の集団が違う、というのがこの章の出発点です。
この違いが問題になるのは、承認した契約が申込の全体を無作為に縮めたものではないからです。過去の審査は、デフォルトしにくいと見込んだ申込を選んで承認しています。過去の基準がうまく働いていたほど、承認した契約の中のデフォルトは少なくなり、デフォルトしやすい申込の結果は記録に残らなくなります。モデルから見ると、デフォルトしやすい側の手本が少ない記録で学ぶことになります。このように、どの記録が手元に残るかが、結果と関係のある仕組みで選ばれていることで生じる偏りを、選択の偏りと呼びます。統計や計量経済学で標本選択の偏りと呼ばれてきたものと同じ考え方です。
与信の分野では、否決した申込の結果が観測できないという問題に対処する一群の方法を、リジェクト・インファレンスと呼びます。「否決(リジェクト)した申込についての推論(インファレンス)」という意味です。否決した申込の結果を推し量って学習の記録に加える方法のほか、本章では、承認した契約に重みを付けて学習する方法も含めてこう呼びます。ただし、推し量った結果は実際の結果ではありません。後で示すとおり、推し量るための材料が手元の記録の中にしか無い以上、方法によって補えるものには限りがあります。
この問題は、与信スコアリングが普通の分類の問題と違う点の1つとして、第1章でも挙げられています。広告のクリックの予測や機械の故障の予測でも、記録が過去の判断で選ばれている場合には同じ構造の問題が起きますが、与信では、否決した申込の結果が原理的に観測できず、しかも否決の割合が数割に及ぶことがあるため、影響が大きくなりやすいと考えられます。ただし、他の分野との比較は本コラムでは行っていません。因果推論の一般論としての選択の偏りと、その補正の考え方は、弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』で扱っています。本章では与信の審査に絞って見ていきます。
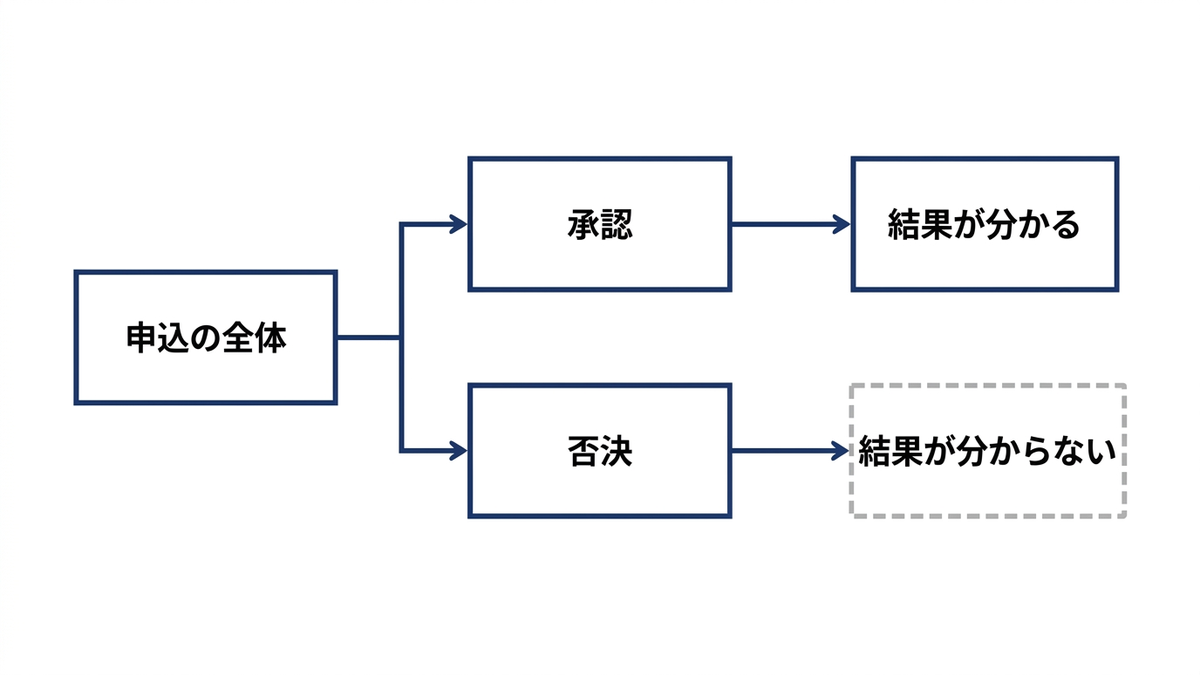
欠測の仕組みの3つの分類と、過去の審査の基準
否決した申込の結果が分からないことは、統計の言葉では、結果の値が欠けている(欠測している)状態として扱えます。欠測が推論にどう響くかを論じた古典が、Rubin の1976年の論文(欠測のあるデータからの推論を論じたもの。Biometrika 第63巻第3号、581〜592ページ)です。この論文は、欠測を生む仕組みをどういう条件なら無視して推論してよいかを論じ、その条件として「無作為に欠測している(missing at random)」という考え方を示しました。本コラムでは、この考え方をもとに、欠測の仕組みを次の3つに分けて説明します。なお、1976年の論文の要旨に、次の表の3つの名前がそろって出てくるわけではありません。
| 欠測の仕組み | 意味 | 与信の審査に当てはめると | 承認した契約だけで学習したときの影響 |
|---|---|---|---|
| 完全に無作為な欠測 | 結果が欠けるかどうかが、どの項目とも結果とも関係なく決まる | 申込を無作為に選んで承認した場合(実務ではまれ) | 件数が減るだけで、偏りは生じない |
| 観測した項目で決まる欠測 | 結果が欠けるかどうかが、記録に残っている項目だけで決まる | モデルに入れる項目だけを使った点数表とカットオフで、承認と否決を決めていた場合 | モデルの形が正しければ、承認した層の中で学んだ関係は全体にも当てはまる。ただし否決した層の領域は手本が少なく、外挿(データの範囲の外への当てはめ)になる |
| 観測していないものにも依存する欠測 | 観測した項目の値が同じ申込どうしでも、結果(デフォルトするかどうか)の違いによって、結果が欠ける確率が違う | 担当者が書類や面談で確かめた事情のように、記録に残らず、しかもデフォルトのしやすさと関係する情報も使って否決していた場合 | 承認した層では、記録に残らない理由でデフォルトしにくい申込が選ばれているので、項目とデフォルトの関係が全体とずれる |
記録に残らない情報を使っていても、その情報がデフォルトのしやすさと関係していなければ、3番目の分類には当たりません。後の例題の基準Aにも記録に残らない判断のぶれを入れていますが、デフォルトのしやすさとは無関係に作ってあります。基準Bで問題になるのは、記録に残らない情報が、承認されるかどうかとデフォルトのしやすさの両方に関係していることです。Ehrhardt らの2021年の論文(与信のスコアリングにおけるリジェクト・インファレンスの方法を整理したもの。Journal of Applied Statistics 第48巻第13〜15号、2734〜2754ページ)も、完全に無作為な欠測は金融機関の実際の審査を表すものとして現実的でないとし、項目から作ったスコアだけで承認を決める場合を、観測した項目で決まる欠測の例として挙げています。
表の右の列のとおり、過去の審査がどの分類に当たるかで、承認した契約だけで作るモデルの危うさが変わります。過去の審査が、記録に残っている項目と点数表だけで機械的に決まっていたなら、2番目の分類に近くなります。この場合、項目とデフォルトの関係をモデルが正しい形で表せていれば、承認した層で学んだ関係は否決した層にもそのまま当てはまるので、偏りは小さく済む可能性があります。一方、人の判断による否決や上書きが多く、その判断の材料が記録に残っていないなら、3番目の分類に近くなります。この場合、手元の記録だけで欠けている情報を補うには、確かめようのない追加の仮定が要ります。
欠測の仕組みのうち3番目の状況を扱う考え方として、計量経済学では Heckman の1979年の論文(標本選択の偏りを、式の定め方の誤りとして扱ったもの。Econometrica 第47巻第1号、153〜161ページ)が知られています。この論文は、無作為に選ばれていない標本から関係を推定するときの偏りを、省かれた変数の問題として扱い、2段階で推定する方法を示しました。与信に当てはめれば、承認されるかどうかという選ばれる仕組みを、デフォルトの式とは別に考えるということです。ただし、こうした方法が置く仮定が実際と合っているかは、否決した申込の結果が見えない限り、手元の記録だけでは確かめにくいことに注意が要ります。
実務での最初の一歩は、自社の過去の審査がどの分類に近いかを、記録から調べることです。点数表とカットオフで自動的に判定した申込の割合、担当者が判定を上書きした申込の割合と、その理由が記録に残っているかどうか、審査の基準を途中で変えた時期を確かめます。上書きが多く、理由が残っていない期間の記録は、3番目の分類に近いと考えて扱う方が安全です。
架空の申込の記録を作る、否決した申込の結果も分かる合成データ
ここからは、承認した契約だけで学習したときに何がずれ、どの方法がそれを直せるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の申込の記録よりずっと単純です。合成データでの成績は、実際の審査での成績の目安にはなりません。
この章の例題でいちばん大事な前提は、合成データなので、否決した申込が仮に承認されていたらデフォルトしたかどうか(真の結果)まで分かっている、という点です。実務では、否決した申込の真の結果は分かりません。だからこそリジェクト・インファレンスという方法が必要になるのですが、方法が効いたかどうかも、実務では確かめられません。合成データを使うと、すべての申込の真の結果を知っている立場から、各方法の見積りを答え合わせできます。この章の例題は、その答え合わせのためのものです。
申込は24か月分で30,000件です。乱数の種は20261113に固定しました。申込者の項目は、年収の水準(相対値で、分布の中央がおよそ1になるように作りました)、勤続年数、雇用の形態(A・B・C の3種類)、他社の借入の件数、過去の延滞の有無、直近の申込の件数の6つです。いずれも審査の時点で手に入る情報として作りました。デフォルトのしやすさは、この6つの項目に加えて、直近の申込の件数が3件以上かつ勤続年数が2年未満の組み合わせで高まる関係と、モデルに入らない情報(変数 u)で決まるようにしました。u は、審査の担当者が書類の確認などで知りうる事情を、ひとまとめに表したものです。担当者は審査の時点で知りえますが、記録に項目として残らないので、モデルの入力には入れません。
結果は、デフォルトを1、正常を0とします。デフォルトは第2章の定義(契約の実行から12か月以内に、延滞が90日以上に達すること)にあたるものとして、乱数で直接決めました。また、例題を簡単にするため、承認した申込はすべて契約され、実行されたものとし、すべての契約が観測期間を満たして結果が確定しているものとします。実務では、直近の申込の月の契約はまだ観測期間を満たしていないので、学習にも評価にも使えません(第2章)。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N = 30000
df = pd.DataFrame({
    "month": rng.integers(1, 25, N),                       # 申込の月(1〜24)
    "income": rng.lognormal(0.0, 0.5, N),                  # 年収の水準(相対値)
    "tenure": np.round(rng.gamma(2.0, 3.0, N), 1),         # 勤続年数
    "emp": rng.choice(["A", "B", "C"], N, p=[0.6, 0.25, 0.15]),  # 雇用の形態
    "loans": rng.poisson(1.0, N),                          # 他社の借入の件数
    "delinq": (rng.random(N) < 0.12).astype(int),          # 過去の延滞の有無
    "inq": rng.poisson(0.8, N),                            # 直近の申込の件数
})
u = rng.normal(0.0, 1.0, N)   # モデルに入らない情報(書類の確認などで人だけが知る事情)
logit = (-3.6 - 0.6 * np.log(df.income) - 0.05 * df.tenure + 0.35 * df.loans
         + 1.1 * df.delinq + 0.25 * df.inq + 0.4 * (df.emp == "C")
         + 0.6 * ((df.inq >= 3) & (df.tenure < 2))          # 組み合わせで効く関係
         + 0.8 * u)
df["pd_true"] = 1 / (1 + np.exp(-logit))
df["y"] = (rng.random(N) < df.pd_true).astype(int)         # 1=デフォルト(契約の実行から12か月以内に延滞が90日以上)
print("申込", N, "件 / 申込の全体のデフォルト率", round(df.y.mean(), 4))
出力は「申込 30000 件 / 申込の全体のデフォルト率 0.0629」でした。申込の全体(過去の基準で否決される申込も含む)のデフォルト率は約6.3%です。デフォルト率の水準は商品によって大きく違い、この値に特別な意味はありません。
次のブロックで、過去の審査の基準を2通り作ります。どちらも承認率は60%にそろえました。基準Aは、モデルに入れる項目だけで作った以前の点数表に、判断のぶれにあたる小さな乱れを足して、点数の良い方から60%を承認します。先ほどの3つの分類では、2番目(観測した項目で決まる欠測)に当たります。基準Bは、同じ点数表に、人の判断(モデルに入らない情報 u)を加えて承認を決めます。3番目(観測していないものにも依存する欠測)に当たります。以前の点数表の重みは、デフォルトのしやすさを決める真の式とは違う値にしてあります。
old_risk = (0.3 * df.loans + 1.0 * df.delinq + 0.2 * df.inq
            - 0.04 * df.tenure - 0.5 * np.log(df.income))  # 以前の点数表の考え方(モデルの項目だけ)
risk_a = old_risk + rng.normal(0, 0.3, N)                  # 基準A:モデルの項目だけで決める
risk_b = old_risk + 0.6 * u + rng.normal(0, 0.3, N)        # 基準B:人の判断(モデルに入らない情報)も使う
df["appr_a"] = (risk_a <= np.quantile(risk_a, 0.6)).astype(int)   # どちらも承認率は60%
df["appr_b"] = (risk_b <= np.quantile(risk_b, 0.6)).astype(int)
for p in ["a", "b"]:
    acc = df[df["appr_" + p] == 1]
    rej = df[df["appr_" + p] == 0]
    print(f"基準{p.upper()}:承認した契約のデフォルト率 {acc.y.mean():.4f} / "
          f"否決した申込の(本当は分からない)デフォルト率 {rej.y.mean():.4f}")
出力は次のとおりでした。
| 過去の審査の基準 | 承認率 | 承認した契約のデフォルト率 | 否決した申込のデフォルト率(合成データなので分かる値) |
|---|---|---|---|
| 基準A(モデルの項目だけで審査) | 60% | 3.89% | 9.89% |
| 基準B(人の判断も使って審査) | 60% | 2.68% | 11.71% |
この表は24か月分の申込の全体の値で、デフォルト率の分母は、それぞれ24か月分のうち承認した申込と否決した申込です。後の表の否決した層の実績(9.95%と11.61%)は評価期間(申込の月13〜24)だけの値なので、この表の値とは少し違います。同じ承認率でも、基準Bの方が承認した契約のデフォルト率は低く、否決した申込のデフォルト率は高くなりました。人の判断で使った情報 u がデフォルトのしやすさと関係しているので、基準Bの方がデフォルトしやすい申込をよく避けられているためです(この架空データでは、そうなるように作りました)。実務の記録では、表の右の列は空欄になります。
承認した契約だけで学習すると、何がずれるか
次のブロックでは、学習用と評価用のデータを申込の月で分けます。申込の月1〜12を学習用、13〜24を評価用としました。モデルは、6つの項目(年収の水準は対数をとり、雇用の形態は B と C を示す2つの列にしました)を入力とするロジスティック回帰です。モデルの式は真の式と同じ形ではありません。組み合わせで効く関係と u を含まないからです。
この時期で分ける方法は、全件の結果が確定した後で時期の前後を比べる事後的な分け方で、運用の再現ではありません。月12の申込の結果は契約から12か月たつまで分からないので、実際の運用では、月13の時点で学習用の期間の全部の結果を使うことはできません。また、過去の審査の基準を作るコードの境目(点数の良い方から60%)も、評価用の期間を含む24か月分の申込から決めています。
比べるのは、同じモデルを2通りの記録で学習したものです。1つ目は、学習用の期間の申込の全員の真の結果で学習したもので、合成データでしか作れない「比べるための基準」です。2つ目は、過去の基準で承認した契約だけで学習したもので、実務で普通に作れるのはこちらです。評価は、評価用の期間の申込の全員(過去の基準で否決される申込を含む)について、真の結果を使って行います。
指標の1つに使う AR値は、モデルがデフォルトしやすい順に並べられているかを表す順位づけの指標で、デフォルト確率の見積りと結果(デフォルトを1)から AUC を計算し、AR値 = 2 × AUC – 1 で求めました。AUC は ROC 曲線の下の面積で、見積りに同点が無い場合、デフォルトした契約と正常だった契約を1件ずつ無作為に選んだときに、デフォルトした方の見積りが大きい確率にあたります。AR値は、0なら無作為に並べたのと同じ、1なら完全に並べられていることを表します(定義と読み方は第7章)。
評価に使う指標は次の4つです。
- AR値_全体:評価期間の申込の全体で計算した AR値
- AR値_承認した層:評価期間に過去の基準で承認された申込だけで計算した AR値。実務で過去の記録から計算できるのはこちら
- 否決した層の見積りと実績:評価期間に過去の基準で否決された申込について、モデルのデフォルト確率の見積りの平均と、真の結果のデフォルト率。その差(見積り – 実績)も出す
- 70%承認時のデフォルト率:新しいモデルのデフォルト確率の見積りが小さい順に、評価期間の申込の70%を承認したとしたときの、承認した申込の真のデフォルト率
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

def features(d):
    return np.column_stack([np.log(d.income), d.tenure, d.loans, d.delinq, d.inq,
                            (d.emp == "B").astype(int), (d.emp == "C").astype(int)])

train = df[df.month <= 12].reset_index(drop=True)          # 学習:申込の月1〜12
test = df[df.month >= 13].reset_index(drop=True)           # 評価:申込の月13〜24
X_tr, X_te = features(train), features(test)

def fit(X, y, w=None):
    return LogisticRegression(C=1e6, max_iter=2000).fit(X, y, sample_weight=w)

def evaluate(m, p):
    pd_hat = m.predict_proba(X_te)[:, 1]
    acc = test["appr_" + p] == 1
    ar_all = 2 * roc_auc_score(test.y, pd_hat) - 1          # 申込の全体でのAR値
    ar_acc = 2 * roc_auc_score(test.y[acc], pd_hat[acc]) - 1  # 承認した層の中でのAR値
    rej = ~acc
    gap = pd_hat[rej].mean() - test.y[rej].mean()           # 否決した層での見積りと実績の差
    keep = pd_hat <= np.quantile(pd_hat, 0.7)               # 新しい基準で申込の70%を承認したら
    return [round(ar_all, 3), round(ar_acc, 3), round(pd_hat[rej].mean(), 4),
            round(test.y[rej].mean(), 4), round(gap, 4), round(test.y[keep].mean(), 4)]

cols = ["AR値_全体", "AR値_承認した層", "否決した層_見積り", "否決した層_実績",
        "否決した層_差", "70%承認時のデフォルト率"]
results = {}
for p in ["a", "b"]:
    acc = train["appr_" + p] == 1
    results[(p, "全員の結果で学習(合成データだけ)")] = evaluate(fit(X_tr, train.y), p)
    results[(p, "承認した契約だけ")] = evaluate(fit(X_tr[acc], train.y[acc]), p)
このブロックの結果は、次のブロックの方法と合わせて後の表にまとめます。先に、承認した契約だけで学習した場合の結果を抜き出します。
| 過去の審査の基準 | 学習に使った記録 | AR値_全体 | AR値_承認した層 | 否決した層_見積り | 否決した層_実績 | 70%承認時のデフォルト率 |
|---|---|---|---|---|---|---|
| 基準A | 全員の結果(合成データだけ) | 0.388 | 0.221 | 9.83% | 9.95% | 3.91% |
| 基準A | 承認した契約だけ | 0.382 | 0.217 | 11.26% | 9.95% | 3.88% |
| 基準B | 全員の結果(合成データだけ) | 0.388 | 0.121 | 9.05% | 11.61% | 3.91% |
| 基準B | 承認した契約だけ | 0.361 | 0.121 | 4.02% | 11.61% | 4.13% |
基準A、つまり過去の審査がモデルの項目だけで決まっていた場合、承認した契約だけで学習したモデルの AR値_全体は0.382で、全員の結果で学習した基準の0.388と近い値でした。否決した層の見積りの平均は11.26%で、実績の9.95%より1.3ポイントほど大きくなりました。本章でいう「ポイント」はパーセントポイントのことで、率どうしの差を表します(11.26%と9.95%の差が約1.3ポイント)。この実行では、ずれは大きすぎる側でした。ただし、後で示す20回の繰り返しでは、このずれの平均(0.44ポイント)より回ごとのばらつき(標準偏差1.87ポイント)の方が大きく、向きが一定とは限りません。申込の70%を承認したときのデフォルト率も、3.88%と3.91%でほぼ同じです。この架空データの基準Aでは、承認した契約だけで作ったモデルでも、後で示す基準Bの場合に比べてずれは小さく済みました。
基準B、つまり過去の審査が人の判断も使っていた場合は、結果が違いました。承認した契約だけで学習したモデルは、否決した層のデフォルト確率の見積りの平均が4.02%で、実績の11.61%の3分の1ほどでした。否決された申込のデフォルトのしやすさを、実績より大幅に低く見積もったことになります。AR値_全体も0.361で、基準の0.388を下回り、申込の70%を承認したときのデフォルト率は4.13%と、基準の3.91%より高くなりました。
2つの点に注意が要ります。1つ目は、AR値_承認した層の値です。基準Bでは、承認した契約だけで学習したモデルも、全員の結果で学習したモデルも、承認した層の中では0.121で同じでした。実務で過去の記録から計算できるのはこの列だけなので、承認した層の中の成績を見ても、否決した層での見積りのずれには気づけません。また、承認した層の中の AR値(0.1〜0.2台)は、申込の全体での AR値(0.3台)よりかなり小さく出ています。承認した層はデフォルトしにくい側にそろえられた集団なので、層の広がりが狭いことが一因と考えられますが、この章では確かめていません。対象の集団や期間が違う AR値の差を、そのままモデルの優劣の判断に使えない理由は、第7章で扱います。
2つ目は、全員の結果で学習したモデルでも、基準Bで否決された層の見積りの平均は9.05%で、実績の11.61%を下回ったことです。否決の判断に u が使われているので、否決された層には、u の値の上でデフォルトしやすい申込が集まっています。u を入力に持たないモデルには、その違いが見えません。これは、学習の記録が偏っているかどうかとは別の問題で、モデルに入らない情報を使って選ばれた集団については、どんなに学習の記録を整えても、モデルの見積りがその集団の実績と合うとは限らない、ということを表しています。
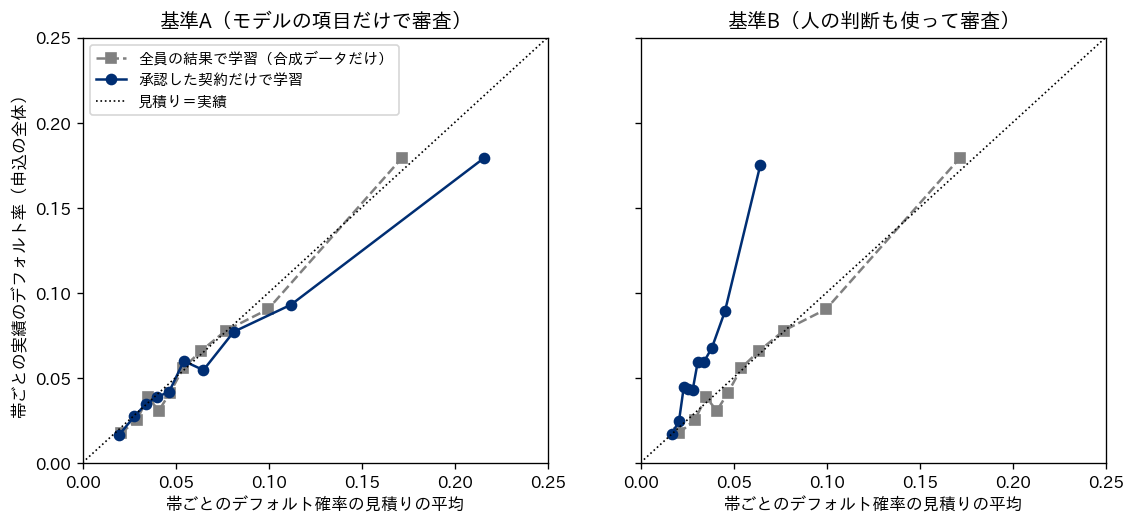
上の図(図を描くコードは後の節に載せます)は、評価期間の申込の全体を、モデルのデフォルト確率の見積りが小さい順に10の帯に分け、帯ごとの見積りの平均(横軸)と実績のデフォルト率(縦軸)を描いたものです。点線の上に乗っていれば、見積りと実績が合っています。左の基準Aでは、承認した契約だけで学習したモデル(濃い線)も点線の近くにあり、見積りが最も大きい帯でやや大きく見積もっている程度です(その帯の見積り21.57%、実績17.90%)。右の基準Bでは、濃い線が点線より大きく左上にずれ、見積りが最も大きい帯でも見積りは6.44%、実績は17.51%でした。デフォルトしやすい申込を上の帯に並べることはある程度できていても、その確率の大きさを小さく見積もっています。
ブロックの最後で、過去の延滞の有無の係数(係数が大きいほど、その項目がデフォルトのしやすさに強く効くことを表します)を比べました。全員の結果で学習したときは1.049でした。承認した契約だけで学習すると、基準Aでは1.382と大きく、基準Bでは0.585と小さくなりました。基準Bについては、このデータの作り方からは、過去の延滞があるのに承認された申込に u の値の上でデフォルトしにくい申込が多く含まれ、承認した層の中では過去の延滞の効き方が弱く見えたと考えられます。基準Aで係数が大きくなった理由は確かめていません。承認した契約だけを見ると、本来は強く効いている項目が弱く見える、あるいはその逆が起きる、という形で選択の偏りは係数にも現れます。業務の担当者が「この項目の点数が感覚より低い」と感じたときは、過去の審査でその項目のある申込がどう選ばれていたかを確かめる価値があります。
リジェクト・インファレンスの方法と、それぞれの前提
否決した申込の結果が分からないことへの対処として、与信の分野では次のような方法が使われてきました。どの方法も、否決した申込の結果について何らかの仮定を置いています。推し量った結果は事実ではなく、仮定が外れれば、推し量った結果も外れます。
| 方法 | やり方 | 置いている仮定 | 要るもの | 外れる場面 |
|---|---|---|---|---|
| 否決をすべてデフォルトとみなす | 否決した申込を、すべてデフォルトとして学習の記録に加える | 否決した申込はすべてデフォルトする | 否決した申込の項目 | 否決した申込の多くが実際には返済できる場合。確率の水準が大きくずれる |
| 拡大法(重み付け) | 承認される確率をモデルで見積もり、承認されにくかった契約ほど大きな重みを付けて学習する | 承認されるかどうかは、モデルに入れる項目だけで決まっている。否決した申込の項目の組み合わせにも、承認される確率が0より大きい(承認の例がある) | 承認と否決の記録と、否決した申込の項目 | 人の判断など記録に無い情報で否決していた場合。承認される確率が極端に小さい領域では、重みが大きくなって推定が不安定になる |
| 按分法 | 承認した契約だけで作ったモデルで否決した申込のデフォルト確率を見積もり、その確率でデフォルトと正常に分けて加える | 承認した層で学んだ関係が、否決した層にもそのまま当てはまる | 否決した申込の項目 | 同じ形のモデルで学習し直すと、承認した契約だけのモデルと同じ推定に戻り、否決した層についての新しい情報は加わらない |
| 他社での結果を信用情報で補う | 否決した申込者が、その後に他社で受けた与信の返済の状況を、信用情報で確かめて結果の代わりにする | 他社での返済の状況が、自社で承認していた場合の結果の代わりになる | 信用情報の照会の結果と、利用目的・同意の条件を満たすこと | 他社の商品・条件が自社と違う場合。信用情報の利用目的の制限に照らして可能かは、法令と信用情報機関の規約を確かめる必要がある(第14章) |
| 一部を無作為に承認する | 否決するはずの申込の一部を、無作為に選んで承認し、実際の結果を得る | 無作為に選んだので、選んだ申込は、選ぶ対象にした範囲(否決の対象の全体、または限った範囲)を代表する | 無作為に承認する仕組みと、その分の貸し倒れの費用・法令上の確認 | 件数が少ないとばらつきが大きい。適用される調査の義務や契約の締結の制限を省ける前提にはしない(第14章) |
表の1つ目から3つ目は、手元の記録だけで行う方法です。拡大法は、承認されにくい項目の組み合わせの契約に大きな重みを付けて、承認した層の構成を申込の全体の構成に近づける方法です。按分法は、否決した申込に見積りの確率で結果を割り当てて記録を増やす方法で、本章のコードでは、否決した1件を、見積りの確率の重みのデフォルトの1件と、残りの重みの正常の1件に分けて加えました。この形は、Ehrhardt らの2021年の論文ではファジー拡大法と呼ばれています。同じ論文は、否決した層を承認した層より厳しく見る係数を専門家の判断で置いて結果を割り当てる按分(パーセリング)の方法を、これとは別の方法として挙げ、その係数はデータから推定も検定もできないと述べています。本章で按分法と呼ぶのは、前者のファジー拡大法の形です。
表の4つ目と5つ目は、手元の記録の外から、否決した層の情報を新たに得る方法です。リジェクト・インファレンスの手法を整理した Hand と Henley の1993年の論文(リジェクト・インファレンスはそもそもうまくいきうるのかを問うたもの。英国の数学とその応用の研究所(IMA)の誌の第5巻第1号、45〜55ページ。この誌の現在の名前は IMA Journal of Management Mathematics です)は、要旨で、否決した申込の分布だけでは、追加の仮定を置かない限りリジェクト・インファレンスの助けにならない、と結論づけています。
3つの方法と無作為の承認を、真の結果で確かめる
次のブロックで、表の1つ目から3つ目の方法を、基準A・基準Bのそれぞれについて実行します。拡大法の重みは、承認されたかどうかを6つの項目で予測するロジスティック回帰の確率の逆数としました。確率が0.02を下回るときは0.02に置き換え、重みが50を超えないようにしています。
for p in ["a", "b"]:
    acc = (train["appr_" + p] == 1).to_numpy()
    Xa, ya, Xr = X_tr[acc], train.y[acc].to_numpy(), X_tr[~acc]
    # (1) 否決をすべてデフォルトとみなす
    y_all_bad = np.where(acc, train.y, 1)
    results[(p, "否決をすべてデフォルト")] = evaluate(fit(X_tr, y_all_bad), p)
    # (2) 拡大法:承認される確率の逆数で、承認した契約に重みを付ける
    q = LogisticRegression(max_iter=2000).fit(X_tr, acc).predict_proba(Xa)[:, 1]
    w = 1 / np.clip(q, 0.02, None)
    results[(p, "拡大法(重み付け)")] = evaluate(fit(Xa, ya, w), p)
    # (3) 按分法:否決した申込を、見積りの確率でデフォルトと正常に分けて加える
    pr = fit(Xa, ya).predict_proba(Xr)[:, 1]
    X3 = np.vstack([Xa, Xr, Xr])
    y3 = np.concatenate([ya, np.ones(len(Xr)), np.zeros(len(Xr))])
    w3 = np.concatenate([np.ones(len(Xa)), pr, 1 - pr])
    results[(p, "按分法")] = evaluate(fit(X3, y3, w3), p)
さらに次のブロックで、否決するはずの申込の一部を無作為に承認した場合を作ります。学習用の期間に、過去の基準なら否決する申込のうち5%を無作為に選んで承認し、その結果が得られたものとします。合成データなので、選んだ申込の真の結果をそのまま使えます。学習では、無作為に承認した契約1件を20件分(5%の逆数)として数え、否決の対象の全体を代表させました。
explore = rng.random(len(train)) < 0.05                    # 否決の対象の5%を無作為に承認したとする
for p in ["a", "b"]:
    acc = (train["appr_" + p] == 1).to_numpy()
    rnd = (~acc) & explore
    use = acc | rnd
    w = np.where(rnd, 1 / 0.05, 1.0)[use]                  # 無作為に承認した契約は20件分として数える
    results[(p, "一部を無作為に承認(5%)")] = evaluate(fit(X_tr[use], train.y[use], w), p)
    print(f"基準{p.upper()}:無作為に承認した契約 {rnd.sum()} 件"
          f"(うちデフォルト {train.y[rnd].sum()} 件)")

table = pd.DataFrame(results, index=cols).T
pd.set_option("display.width", 200)
pd.set_option("display.unicode.east_asian_width", True)
print(table.to_string())

# 過去の延滞の有無の係数(承認した契約だけ/全員)
for p in ["a", "b"]:
    acc = train["appr_" + p] == 1
    c_acc = fit(X_tr[acc], train.y[acc]).coef_[0][3]
    c_all = fit(X_tr, train.y).coef_[0][3]
    print(f"基準{p.upper()}:過去の延滞の係数 承認した契約だけ {c_acc:.3f} / 全員 {c_all:.3f}")
無作為に承認した契約は、基準Aで319件(うちデフォルト31件)、基準Bで300件(うちデフォルト39件)でした。すべての方法の結果をまとめると次の表になります。
| 過去の審査の基準 | 方法 | AR値_全体 | 否決した層_見積り | 否決した層_実績 | 否決した層_差 | 70%承認時のデフォルト率 |
|---|---|---|---|---|---|---|
| 基準A | 全員の結果で学習(合成データだけ) | 0.388 | 9.83% | 9.95% | -0.12ポイント | 3.91% |
| 基準A | 承認した契約だけ | 0.382 | 11.26% | 9.95% | 1.30ポイント | 3.88% |
| 基準A | 否決をすべてデフォルト | 0.382 | 75.04% | 9.95% | 65.09ポイント | 3.85% |
| 基準A | 拡大法(重み付け) | 0.377 | 10.23% | 9.95% | 0.28ポイント | 3.97% |
| 基準A | 按分法 | 0.382 | 11.25% | 9.95% | 1.30ポイント | 3.89% |
| 基準A | 一部を無作為に承認(5%) | 0.359 | 10.07% | 9.95% | 0.12ポイント | 4.12% |
| 基準B | 全員の結果で学習(合成データだけ) | 0.388 | 9.05% | 11.61% | -2.55ポイント | 3.91% |
| 基準B | 承認した契約だけ | 0.361 | 4.02% | 11.61% | -7.59ポイント | 4.13% |
| 基準B | 否決をすべてデフォルト | 0.381 | 57.99% | 11.61% | 46.38ポイント | 3.88% |
| 基準B | 拡大法(重み付け) | 0.334 | 3.70% | 11.61% | -7.90ポイント | 4.36% |
| 基準B | 按分法 | 0.362 | 4.02% | 11.61% | -7.59ポイント | 4.12% |
| 基準B | 一部を無作為に承認(5%) | 0.376 | 9.92% | 11.61% | -1.69ポイント | 3.94% |
否決した層の見積りのずれについて、表から読み取れることを順に書きます。基準Bでは、拡大法と按分法は、承認した契約だけのモデルのずれ(-7.59ポイント)をほとんど直せませんでした(それぞれ -7.90ポイントと -7.59ポイント)。どちらも、手元の記録の中の情報だけで否決した層を推し量る方法です。記録に無い u による違いを補えなかったと考えられますが、u を使える場合との比較はしていません。按分法の見積りは、承認した契約だけのモデルとほぼ同じ値になりました。これはこの形の方法の性質です。承認した契約だけのモデルの推定値のところでは、否決した1件から作ったデフォルトの1件と正常の1件の分の当てはめの傾きが打ち消し合うので、同じ形のモデルで学習し直しても、元の推定が最適のままになります(Ehrhardt らの論文も、ファジー拡大法は承認した契約だけで作ったモデルと同じになると述べています)。表の小さな差は計算を途中で打ち切った誤差で、収束の判定を厳しくして計算し直すと、2つのモデルの係数の差の最大は、基準Aで約0.0000024、基準Bで約0.00000066まで小さくなりました(確認のためのコードは掲載していません)。否決をすべてデフォルトとみなす方法は、否決した層の見積りを57.99%と、実績の5倍近くに大きく見積もりました。これに対し、否決するはずの申込の5%を無作為に承認した方法は、見積りの平均が9.92%で、ずれは -1.69ポイントにとどまりました。全員の結果で学習した基準の -2.55ポイントと同じ程度です。
基準Aでは、もともと承認した契約だけのモデルのずれが1.30ポイントと小さく、この1回の実行では、拡大法(0.28ポイント)と無作為の承認(0.12ポイント)でさらに小さくなりました。ただし、後で示す20回の符号つきの平均では、承認した契約だけが0.44ポイント、拡大法が-0.48ポイント、無作為の承認が0.37ポイントで、大きな差はありませんでした(ずれの絶対値で見た比較は後で示します)。一方で、無作為の承認を加えたモデルの AR値_全体は0.359で、承認した契約だけのモデルの0.382を下回りました。無作為に承認した約300件に20倍の重みを付けたので、その少ない件数のばらつきがモデルに強く響いた可能性がありますが、この理由は本コラムでは確かめていません。
上の表の「否決した層_見積り」と「否決した層_実績」の列を並べると、基準Bでは、承認した契約だけ(4.02%)・拡大法(3.70%)・按分法(4.02%)の見積りが実績の11.61%から大きく離れ、無作為の承認(9.92%)だけが実績に近づいています。基準Aでは、比較の基準として合成データだから作れる全員の結果で学習した基準(9.83%)と、否決をすべてデフォルトとみなす方法(75.04%)を除くと、残りの見積りは10.07%から11.26%の間にあり、実績の9.95%との差は小さくなりました。
見積りと実績を帯ごとに比べた先の図は、次のブロックで描きました。図の日本語の表示には japanize-matplotlib を使い、本コラムの実行環境(Python 3.14.3、matplotlib 3.10.8、japanize-matplotlib 1.1.3)で動作を確かめました。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

fig, axes = plt.subplots(1, 2, figsize=(11, 4.6), sharey=True)
for ax, p in zip(axes, ["a", "b"]):
    acc = train["appr_" + p] == 1
    for name, m, st in [("全員の結果で学習(合成データだけ)", fit(X_tr, train.y), "s--"),
                        ("承認した契約だけで学習", fit(X_tr[acc], train.y[acc]), "o-")]:
        ph = m.predict_proba(X_te)[:, 1]
        band = pd.qcut(ph, 10, labels=False)                 # 見積りの小さい順に10の帯
        g = pd.DataFrame({"b": band, "ph": ph, "y": test.y}).groupby("b").mean()
        print(f"基準{p.upper()} {name}:見積りが最も大きい帯 見積り {g.ph.iloc[-1]:.4f} / 実績 {g.y.iloc[-1]:.4f}")
        ax.plot(g.ph, g.y, st, color="#002E73" if "承認" in name else "gray", label=name)
    ax.plot([0, 0.25], [0, 0.25], ":", color="black", linewidth=1, label="見積り=実績")
    ax.set_title(f"基準{p.upper()}" + ("(モデルの項目だけで審査)" if p == "a" else "(人の判断も使って審査)"))
    ax.set_xlabel("帯ごとのデフォルト確率の見積りの平均")
    ax.set_xlim(0, 0.25)
    ax.set_ylim(0, 0.25)
axes[0].set_ylabel("帯ごとの実績のデフォルト率(申込の全体)")
axes[0].legend(loc="upper left", fontsize=9)
plt.savefig("ch06_calibration_by_policy.png", dpi=120, bbox_inches="tight")

print("図を保存しました")
ここまでの結果は、乱数の種を1つに決めた1回の実行の結果です。方法の間の差には、データの乱数によるばらつきも入ります。そこで、掲載したコードのうち図を描く部分を除いた手順を、乱数の種だけを20261113から20261132までの20通りに変えて繰り返しました(繰り返しのためのコードは掲載していません)。20回の平均は次のとおりでした。
| 過去の審査の基準 | 方法 | AR値_全体(20回の平均) | 否決した層_差(20回の平均) | 否決した層_差の絶対値(20回の平均) | 70%承認時のデフォルト率(20回の平均) |
|---|---|---|---|---|---|
| 基準A | 全員の結果で学習(合成データだけ) | 0.356 | 0.12ポイント | 0.33ポイント | 4.17% |
| 基準A | 承認した契約だけ | 0.350 | 0.44ポイント | 1.61ポイント | 4.19% |
| 基準A | 否決をすべてデフォルト | 0.352 | 65.91ポイント | 65.91ポイント | 4.20% |
| 基準A | 拡大法(重み付け) | 0.310 | -0.48ポイント | 2.01ポイント | 4.47% |
| 基準A | 按分法 | 0.350 | 0.44ポイント | 1.61ポイント | 4.19% |
| 基準A | 一部を無作為に承認(5%) | 0.329 | 0.37ポイント | 0.90ポイント | 4.32% |
| 基準B | 全員の結果で学習(合成データだけ) | 0.356 | -2.69ポイント | 2.69ポイント | 4.17% |
| 基準B | 承認した契約だけ | 0.299 | -7.82ポイント | 7.82ポイント | 4.57% |
| 基準B | 否決をすべてデフォルト | 0.352 | 46.33ポイント | 46.33ポイント | 4.20% |
| 基準B | 拡大法(重み付け) | 0.237 | -7.95ポイント | 7.95ポイント | 4.91% |
| 基準B | 按分法 | 0.298 | -7.82ポイント | 7.82ポイント | 4.57% |
| 基準B | 一部を無作為に承認(5%) | 0.327 | -2.17ポイント | 2.17ポイント | 4.34% |
基準Bでは、20回の平均でも、否決した層の見積りのずれについての傾向は1回の実行と同じでした。拡大法と按分法はずれを直せず、無作為の承認はずれを全員の結果で学習した場合と同じ程度まで小さくしました。基準Aでは、1回の実行とは違う面もありました。符号つきのずれの平均は、承認した契約だけが0.44ポイントで、拡大法(-0.48ポイント)や無作為の承認(0.37ポイント)と大きな差はありませんでした。ただし、符号つきの平均では大きすぎる回と小さすぎる回が打ち消し合います。ずれの絶対値の平均で見ると、承認した契約だけが1.61ポイント、拡大法が2.01ポイント、無作為の承認が0.90ポイント、全員の結果で学習した基準が0.33ポイントでした。基準Aでも、無作為の承認はずれの大きさを小さくし、拡大法はむしろ大きくしたことになります。
順位づけと承認したときのデフォルト率については、1回の実行では見えなかったことも分かりました。拡大法は、基準Aで20回中19回、基準Bで20回中17回、承認した契約だけのモデルより AR値_全体が低くなりました。この架空データの条件では、重みを付けることで順位づけの成績がかえって落ちる場合が多かったことになります。無作為の承認は、基準Bでは AR値_全体の平均を0.299から0.327に上げましたが、20回中8回は承認した契約だけのモデルを下回り、回によって結果が分かれました。基準Aでは、20回中17回で承認した契約だけのモデルを下回りました。
否決をすべてデフォルトとみなす方法は、確率の水準が大きく外れるので順位づけの成績も悪くなると考えがちですが、そうはなりませんでした。確率の水準は大きく外れる一方で、基準Bでの AR値_全体の平均は0.352で、承認した契約だけのモデルの0.299を上回り、20回中19回で上回りました。申込の70%を承認したときのデフォルト率も4.20%で、全員の結果で学習した基準の4.17%に近い値です。理由は本コラムでは確かめていません。この結果が過去の審査の基準の作り方(点数表の重みや u の使い方)にどこまで左右されるかも確かめていません。また、この方法で作ったモデルの出すデフォルト確率は、そのままでは貸し倒れの見積りや与信枠の設定に使えません。順位づけと確率の大きさは別の性質で、確率として使うなら、実績と合っているかを確かめ(較正の確認)、ずれていれば調整する必要があります(第8章)。
まとめると、この章の架空データでは、次のことが確かめられました。
- 過去の審査がモデルの項目だけで決まっていた場合(基準A)は、承認した契約だけで作ったモデルでも、否決した層の見積りのずれは小さかった。重み付けや無作為の承認を加えても、順位づけの成績はむしろ下がることが多かった
- 過去の審査が記録に無い情報も使っていた場合(基準B)は、承認した契約だけで作ったモデルは否決した層のデフォルト確率を実績より大幅に低く見積もり、拡大法も按分法もそれを直せなかった
- 否決するはずの申込の一部を無作為に承認して実際の結果を得る方法は、基準Bのずれを大きく減らした。ただし件数が少ないため、順位づけの成績は回によってばらついた
- 否決をすべてデフォルトとみなす方法は、確率の水準を大きく外したが、基準Bでは順位づけの成績が承認した契約だけのモデルを上回った
どの方法が効くかは、過去の審査がどう行われていたかと、何に使うモデルか(順位づけに使うのか、確率の大きさに使うのか)で変わりました。そして、実務ではこの答え合わせができません。この章の例題で方法の良し悪しが分かったのは、合成データで否決した申込の真の結果を知っていたからです。
研究では何が言われてきたか
リジェクト・インファレンスの効果は、研究でも繰り返し論じられてきました。先に紹介した Hand と Henley の1993年の論文は、否決した申込の分布だけでは、追加の仮定なしには助けにならないと論じています。言い換えると、手元の記録だけを使う方法が効くかどうかは、置いた仮定が当たっているかどうかに懸かっています。
Banasik、Crook、Thomas の2003年の論文(与信のスコアリングのモデルにおける標本選択の偏りを扱ったもの。Journal of the Operational Research Society 第54巻第8号、822〜832ページ)は、通常なら否決される申込も含めた記録を使える特別なデータで、承認した契約だけで作ったモデルと、申込の全体で作ったモデルを比べました。RePEc の書誌の要旨によれば、そのデータの条件では、承認した契約だけのモデルも申込の全体のモデルに近い結果になりました。また、承認と返済を組にして推定する方法は、担当者がスコアの判定を上書きしている場合に役立ちうるものの、改善は小さいこともあったとされています。
Crook と Banasik の2004年の論文(リジェクト・インファレンスは申込のスコアリングのモデルの性能を本当に改善するのかを問うたもの。Journal of Banking & Finance 第28巻第4号、857〜874ページ)も、題名のとおりこの問いを扱っています。書誌は Crossref と RePEc で確かめましたが、本コラムの執筆の時点では要旨と本文を確かめられなかったため、この論文の結論の内容は本コラムでは未確認です。
この章で紹介した論文の書誌は次のとおりです(Crossref の書誌情報と、出版元・学会のページで確かめたものです)。
- Rubin の1976年の論文:Biometrika 第63巻第3号、581〜592ページ。DOI のページ
- Heckman の1979年の論文:Econometrica 第47巻第1号、153〜161ページ。DOI のページ
- Hand と Henley の1993年の論文:第5巻第1号、45〜55ページ。DOI のページ
- Banasik、Crook、Thomas の2003年の論文:Journal of the Operational Research Society 第54巻第8号、822〜832ページ。DOI のページ
- Ehrhardt らの2021年の論文:Journal of Applied Statistics 第48巻第13〜15号、2734〜2754ページ。DOI のページ(本文は PubMed Central で公開)
- Crook と Banasik の2004年の論文:Journal of Banking & Finance 第28巻第4号、857〜874ページ。DOI のページ
これらの研究の数字と結論は、それぞれの論文が使ったデータと条件での結果です。本章の架空データの結果と合わせても、言えるのは「手元の記録だけを使う方法で、選択の偏りを確実に直せるとは言えない。効くかどうかは過去の審査の仕組みと置いた仮定に懸かっている」というところまでだと考えています。
無作為に一部を承認する方法の費用と意義
この章の架空データで、否決した層のずれを小さくしたのは、否決するはずの申込の一部を無作為に承認して実際の結果を得る方法でした。手元の記録の外から新しい情報を得る方法で、本章の架空データでは、過去の審査が記録に無い情報を使っていた基準Bでも、ずれを小さくしました。ただし、この方法には費用と制約があります。
費用の1つ目は貸し倒れです。無作為に承認する申込は、過去の基準なら否決していた申込なので、承認した契約全体よりデフォルト率が高くなることがあります。本章の架空データでは、無作為に承認した契約のデフォルト率は、基準Aで約9.7%(319件中31件)、基準Bで13.0%(300件中39件)で、承認した契約のデフォルト率(3.89%と2.68%)を大きく上回りました。このデフォルトから生じる貸し倒れは、情報を得るための費用として、事前に予算を決めて見込んでおく必要があります。費用の2つ目は、件数が少ないことによるばらつきです。本章では約300件の結果から否決の対象の全体を推し量ったので、20回の繰り返しでは順位づけの成績が回によって分かれました。費用を抑えるために件数を減らすと、得られる情報も不確かになります。
制約は、法令と顧客の保護です。無作為に承認する試行でも、適用される返済の能力の調査の義務や、契約の締結の制限を省略できる前提にはしません。どの義務がどの商品・事業者に適用されるかは、法務部門と所管の法令で確かめる事柄です(第14章)。本章でいう無作為の承認は、そうした義務と自社の方針による除外を守ったうえで、スコアによる判定だけを外す範囲の話です。返済の能力を超える与信は、過剰与信による顧客の不利益につながります。どの範囲で、どの商品で、どの条件(与信枠を小さくするなど)で行えるかは、法務・コンプライアンスと所管の法令を確かめたうえで決める事柄です。なお、法令や自社の方針で試行の対象を限った場合、得られた結果が代表するのはその対象の範囲です。与信枠を小さくするなど条件を変えた試行で得られるのは、変えた後の条件での結果で、元の条件にそのまま広げられるとは限りません。
意義は、否決した層について、仮定に頼らない実際の結果が得られることです。否決した層の結果は、承認の基準を緩めるべきかどうか、つまり機会損失がどのくらいあるかを見積もるための直接の材料の1つです(方法の表に挙げた、他社での結果を信用情報で補う方法も、条件が合えば材料になります)。機会損失は観測できないので、つねに推定です。無作為の承認で得た結果は、その推定を、仮定ではなく実績に近づけるためのものと位置づけられます。また、カットオフのすぐ下の帯の申込を一部承認する方法(帯を限った試行)は、全体を無作為に選ぶより貸し倒れの費用を抑えつつ、カットオフを下げたらどうなるかを知る材料になります。新しいカットオフを一部の申込で試す進め方は、第9章で扱います。
過去の審査の基準と判断の記録を残す
本章の架空データでは、効く方法が過去の審査の仕組みによって変わり、手元の記録だけを使う方法では偏りを直しきれない場合がありました。そのため、リジェクト・インファレンスの手法を選ぶ前に、自社の過去の審査がどう行われていたかを示す記録が、偏りの型を知る材料として出発点になると考えています。過去の審査がモデルの項目だけで決まっていたことを記録で示せれば、選択の偏りを検討するための重要な条件を確かめられます。ただし、モデルの形が合っているか、承認の例が無い領域へ当てはめていないかは、別に確かめる必要があります。人の判断がどこでどれだけ入ったかを記録で示せれば、偏りが入りうる範囲を特定できます。どちらも示せない場合は、偏りの大きさを判断する材料がありません。
残しておきたい記録は、次の表のとおりです。
| 記録 | 中身 | 何に使うか |
|---|---|---|
| 審査の時点の入力 | 審査に使った項目の値を、審査の時点のまま(後から更新した値で上書きしない) | 否決した申込も含めて、申込の全体の構成を再現する。拡大法などの方法の前提になる |
| スコアとカットオフ | その時点のモデルの版、スコア、使っていたカットオフ | どの申込がスコアの上で承認の候補だったかを再現する |
| 最終の判断と理由 | 承認・否決・取り下げの別と、否決の理由の区分 | スコア以外の理由(法令上の要件・自社の方針)で否決した申込を区別する。承認率の分母(最終の判断が済んだ申込)をそろえる |
| 人による上書き | スコアの判定を人が変えた申込と、変えた理由の区分 | 記録に無い情報で選ばれた範囲を特定する。上書きした契約の実績を追う(第9章) |
| 審査の基準の変更の履歴 | カットオフ・点数表・審査の方針を変えた日と内容 | 期間ごとに、承認された集団の性質が違うことを把握する |
| 無作為の承認・試行の記録 | どの申込を、どの仕組みで、どの割合で選んで承認したか | 学習のときの重みを正しく付ける。試行の結果を他の契約と区別して集計する |
審査の基準を変えたときには、モデルが学習する集団も変わることに注意が要ります。たとえば、新しいモデルで承認率を上げると、以前なら否決していた層の契約が増え、その層の結果が数年後の学習の記録に入ります。逆に、新しいモデルで厳しくした範囲は、以後の記録から消えていきます。次にモデルを作り直すときに使う記録は、今の審査の基準が選んだ集団です。審査の基準の変更の履歴を残しておかないと、どの期間の記録がどの集団を表しているかが分からなくなります。モデルの監視と作り直しの判断については、第12章で扱います。
また、否決した申込の項目の記録は、個人データとしての保存の期間や利用目的の範囲で扱う必要があります。どの項目を、どの目的で、どれだけの期間保存できるかは、個人情報の保護に関する法令と自社の規程に照らして確かめる事柄です(第14章)。
経営の判断、否決した層についての情報に費用をかけるか
この章の論点を経営の判断に置き直すと、否決した層についての情報を得る方法を、費用をかけて用意するかどうか、という判断になります。判断を誤ったときの損失は、序章で整理した型で次のように表れます。
否決した層のデフォルト確率を小さく見積もったモデルで承認の基準を緩めると、承認した契約のデフォルトが見込みより増え、貸し倒れが増えるおそれがあります。また、本章の架空データの基準Bで、承認した契約だけで学習したモデルの見積りが小さい順に申込の70%を承認すると、承認した申込のデフォルト率は20回の平均で4.57%となり、全員の結果で学習した場合の4.17%を上回りました。これは承認率を同じにそろえたときの並べ方(順位づけ)の違いによる差で、確率を小さく見積もったことで承認の範囲を広げてしまう影響とは別のものです。返済の能力を超える与信が増えれば、過剰与信による顧客の不利益にもつながります。このように否決した層の確率を低く見積もる誤りは、本章の例(基準B)で示したとおり、承認した層の中の成績を見ているだけでは気づけません。
反対に、否決をすべてデフォルトとみなすような仮定で否決した層の確率を大きく見積もると、承認の基準を緩める判断ができず、機会損失が続きます。ただし機会損失は観測できない推定なので、その大きさは否決した層の結果をどう推定したか次第で変わります。過去の記録が審査の仕組みを示せない状態を放置すると、モデルを作り直しても同じ偏りを持ち越すことになり、形骸化につながるおそれもあります。
判断の材料として、次の点を確かめることが有効だと考えています。
- 過去の審査のうち、点数表とカットオフで自動的に判定した割合と、人が上書きした割合を、期間ごとに数えられるか
- 上書きと否決の理由が、区分として記録に残っているか
- 承認の基準を緩めることを検討しているか。検討しているなら、否決した層の結果をどう推定するか、その仮定を誰が承認するか
- 否決するはずの申込の一部を、法令上の要件を満たす範囲で試しに承認する予算(貸し倒れの見込み)を用意できるか
- 試行の結果を集めるのに、観測期間(例題の定義では12か月)以上かかることを計画に入れているか
- ベンダーが「リジェクト・インファレンスを行っている」と示すとき、どの方法で、どの仮定を置き、その仮定をどう確かめたかを説明できるか
KPI の仕組みに落とすなら、承認した契約のデフォルト率と並べて、上書きの割合、試行で承認した件数とそのデフォルト率、否決の理由の区分ごとの件数を、定期的に報告する指標に入れる方法が考えられます。これらは管理の指標で、単独で成果を表すものではありませんが、否決した層について何が分かっていて何が分かっていないかを経営が把握する材料になります。どの方法を選ぶにしても、リジェクト・インファレンスで推定した結果は事実ではなく、方法だけで偏りが解消されるとは限らない、という前提を、モデルの文書に書き残しておくことが大切です。
この章では、学習に使える記録が承認した契約に限られることから生じる選択の偏りを、否決した申込の真の結果まで分かる合成データで確かめました。本コラムの架空データでは、過去の審査がモデルの項目だけで決まっていた場合は、承認した契約だけで作ったモデルでもずれは小さく、人の判断も使っていた場合は、否決した層のデフォルト確率を実績より大幅に低く見積もりました。そのずれを、手元の記録だけを使う拡大法や按分法は直せず、否決するはずの申込の一部を無作為に承認して実際の結果を得る方法が小さくしました。それでも、入力に無い情報で選ばれた集団についてのずれは残りました。実務ではこの答え合わせができないので、方法を選ぶ前に、過去の審査がどう行われていたかの記録を整えることが出発点になります。次の第7章では、この章でも使った AR値を中心に、モデルの評価の指標と、評価に使うデータの切り方を扱います。
この章を深めたい方への参考書籍
『調査観察データの統計科学:因果推論・選択バイアス・データ融合』(星野崇宏 著、岩波書店):シリーズ確率と情報の科学の1冊で、副題のとおり、調査や観察で集めたデータについて、因果推論・選択バイアス・データ融合を扱った本です。この章で扱った選択の偏りを、与信に限らない統計の問題として捉え直し、偏りを補正する考え方の背景を確かめるのに向いています。
『欠測データの統計科学:医学と社会科学への応用』(高井啓二・星野崇宏・野間久史 著、岩波書店):書名のとおり、欠測のあるデータの統計の扱いを、医学と社会科学への応用とともに扱った本です。この章では、否決した申込の結果が欠けていることを欠測の問題として捉え、欠測の仕組みを3つに分けて説明しました。その背景にある欠測データの考え方を、体系的に学ぶのに役立ちます。
第7章 モデルの評価、AR値・KS値と評価データの切り方
第6章では、否決した申込の結果が分からないために、過去の審査がモデルに入っていない情報(人の判断など)も使っていた場合には、承認した契約だけで作ったモデルが申込の全体では確率の見積りが大きくずれることを確かめました。過去の審査がモデルに入っている項目だけで決まっていた場合には、ずれは小さく済みました。この章では、作ったモデルの良し悪しを過去の記録で測る評価を扱います。第3章から第5章で見た点数表や機械学習のモデルは、どれも最後は「評価用のデータでどれだけ契約を正しく並べられたか」という数字で比べられます。その数字の意味と、数字を作る手順の決め方が、この章の主題です。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の契約の記録を使い、実行したコードと結果で確かめます。
- 評価の役割と、順位づけの成績と確率の正しさが別物であること
- 順位づけの5つの指標(一覧は後の表にまとめます)
- 同じモデルでも、評価する集団の層の広がりによってAR値が変わること
- 評価データの切り方(無作為に切る・申込の月で切る)と、観測期間を満たした契約だけで評価すること
- デフォルトの件数が少ないときの指標のばらつきと、ブートストラップによる区間
- 件数の指標と額で重み付けた指標、順位づけの成績の差が事業の差にどうつながるか
- 過去のデータでの評価の限界、ベンダーの示す数字を読むときに確かめること、経営の判断
この章の主張は2つあります。1つ目は、AR値は「どの集団の、どの期間の契約を、どう切って測ったか」と切り離せない数字であり、対象の集団や期間が違うAR値の差を、そのままモデルの優劣の判断には使えない、という点です。本コラムの架空データでも、同じモデルのAR値が、評価する集団をスコアの上位だけに絞っただけで大きく下がりました。2つ目は、評価の指標と評価データの切り方を、モデルを選ぶ前に決めておく必要がある、という点です。決めないまま候補を比べると、良く見える数字の測り方を後から選ぶことになりがちです。なお、AR値は契約を並べる順番の良し悪しを測る管理の指標であり、確率の正しさも収益も表しません。序章で述べたとおり、与信スコアリングの成果の指標は、承認した契約から得た収益と貸し倒れの損失の差で、実績として測れます。断った申込の機会損失は推定として横に並べ、判断のときに合わせて見ます。
評価の役割、順位づけの成績と確率の正しさは別のもの
ここでいう評価は、過去の契約の記録を学習用と評価用に分け、学習用の記録だけで作ったモデルが、評価用の記録の中でデフォルトした契約と正常の契約をどれだけ見分けられたかを測る作業です。本番の審査に使う前に、候補のモデルを申込者に影響を与えずに何通りも比べられます。ただし、同じ評価用のデータを見ながら候補の調整を繰り返すと、そのデータに都合のよい候補を選んでしまいます。候補選びに使う検証用のデータと、最後の確認に使う評価用のデータは分けておく必要があります。
与信のモデルの評価には、性質の違う2つの問いがあります。1つ目は、モデルが契約をデフォルトしやすい順に並べられているかという順位づけの問いです。2つ目は、モデルの出すデフォルト確率が、実績のデフォルト率と合っているかという確率の正しさの問いです。2つは別の問いで、片方が良くても他方が良いとは限りません。例えば、デフォルト確率が実績と合っていて、どれも0.5未満のモデルがあるとします。その確率を全部一律に2倍にしても、契約の並び順は変わらないので、順位づけの指標の値は1つも変わりません。しかし、確率の水準は実績と合わなくなります。この章では1つ目の順位づけを扱い、2つ目の確率の正しさとその直し方(較正)は第8章で扱います。
順位づけの成績が要るのは、主に承認するかどうかの判断です。カットオフ(スコアによる判定を分ける境目の値)より上を承認の候補にする運用では、契約を正しい順に並べられていれば、同じ承認率でも承認した契約のデフォルト率を下げられます。一方、貸し倒れの見積り、与信枠や金利の水準の設定、引当や自己資本の計算には、確率の水準そのものが要ります。どちらの用途に使うモデルかによって、評価で重く見る指標も変わります。
結果の扱いも先に決めておきます。本コラムでは、結果はデフォルトを1、正常を0とします。デフォルトの定義は、第2章で置いた例題の定義(契約の実行から12か月以内に、延滞が90日以上に達すること)に合わせるのが原則です。この章のコードは月単位の記録なので、その代わりに「契約の実行から12か月以内に、延滞の期間が3か月に達すること」を使います。延滞が3か月に達するには契約から少なくとも3か月かかるので、例題のデータでは、デフォルトに至る月を契約から3〜12か月目に置きました。正常は、観測期間(デフォルトが起きるかを見届ける期間)を満たし、その間にデフォルトしなかったと確認できた契約の結果です。観測期間を満たしていない契約は、まだ結果が出ていないので、正常に数えません。この扱いを守らないと何が起きるかも、後のコードで確かめます。
順位づけの指標、ROC曲線とAUC・CAP曲線とAR値・KS値
順位づけの指標は、どれもスコアの低い契約から順にたどっていったときに、デフォルトした契約がどれだけ早く現れるかを測るものです。本コラムでは、スコアが大きいほどデフォルト確率が低い向きに統一しています。したがって、スコアの低い順が「危ない順」です。この向きを取り違えると、AUCとAR値は値が裏返ります(AUCは1からその値を引いたものに、AR値は符号が逆になります)。ここでは代表的な指標を、式と言葉の言い換えで整理します。
ROC曲線は、スコアの低い方から境目を動かしていき、境目より下に入った正常の契約の割合を横軸に、境目より下に入ったデフォルトの契約の割合を縦軸にとって描いた曲線です。AUCは、このROC曲線の下の面積です。AUCは、無作為に選んだデフォルトの契約1件と正常の契約1件を比べたときに、デフォルトの契約の方がスコアが低い(危ない側にある)確率と一致します。スコアが同点の組は半分として数えます。スコアが無作為に付いている場合、AUCは平均的には0.5になり、完全に分けられれば1です。
CAP曲線(累積精度曲線)は、契約をスコアの低い順に並べ、横軸に契約全体のうちそこまでに入った割合を、縦軸にデフォルトの全体のうちそこまでに入った割合をとって描いた曲線です。ROC曲線との違いは横軸で、ROC曲線が正常の契約だけの割合をとるのに対し、CAP曲線はデフォルトの契約も含めた全体の割合をとります。完全に並べられるモデルなら、スコアの低い側からデフォルトの契約が先にすべて現れるので、横軸がデフォルト率に達したところで縦軸が1になります。無作為な並びなら、理論上(平均的には)対角線になります。
AR値は、CAP曲線と対角線の間の面積を、完全に並べた場合の曲線と対角線の間の面積で割った値です。言い換えると、何の情報も無い並びから完全な並びまでのうち、そのモデルがどこまで近づいたかを表す割合です。-1から1の値をとります。0なら、この指標で要約した順位づけの成績は無作為な並びと同じ水準で、1なら完全に分けられることを表します。AR値とAUCの間には、次の関係があります。
\( \mathrm{AR} = 2 \times \mathrm{AUC} – 1 \)
言葉で言えば、AUCが0.5から1まで動く範囲を、0から1の範囲に引き伸ばしたものがAR値です。バーゼル銀行監督委員会の作業文書第14号(2005年5月の改訂版。内部格付の検証に関する研究をまとめたもの)は、付録でCAP曲線とAR値、ROC曲線とその下の面積を説明し、AR値とROC曲線の下の面積がこの1次式で結ばれることを示しています。同文書はこの関係の出典として、Engelmann と Hayden と Tasche の2003年の論文(格付の精度の検定を論じたもの)を挙げています。同文書の参考文献の表記では、この論文は Risk 誌の2003年1月号、82〜86ページに載ったものです。AR値はジニ係数と呼ばれることもありますが、本コラムではAR値に統一します。
KS値(コルモゴロフ・スミルノフの統計量)は、デフォルトした契約のスコアの累積分布と、正常の契約のスコアの累積分布の差の絶対値の最大値です(両側のKS値)。あるスコア以下に入る契約の割合を、デフォルトした契約と正常の契約で別々に数え、その差が最も開くところの差を読みます。ROC曲線の上では、縦軸の値と横軸の値の差の絶対値の最大値にあたります。差の向きを決めて片側だけの最大値をとる片側のKS値もあり、どちらで計算したかで値が変わることがあります。本コラムのコードは両側で計算しています。作業文書第14号は、ROC曲線と対角線の最大の距離に基づくピエトラ指数がKS値で表せることを付録で示しています。KS値は1つの境目での開き方だけを見るので、曲線全体を要約するAR値とは違う情報を持ちます。
| 指標 | 何を測るか | 言葉の言い換え | 読むときの注意 |
|---|---|---|---|
| ROC曲線とAUC | 境目を動かしたときの、正常の契約の割合(横)とデフォルトの契約の割合(縦)の曲線と、その下の面積 | 無作為に選んだデフォルト1件と正常1件で、デフォルトの方が危ない側に並ぶ確率 | デフォルトを1とし、デフォルト確率(またはスコアの符号を反転した値)で計算する。スコアをそのまま入れると向きが逆になる |
| CAP曲線とAR値 | スコアの低い順に契約を並べたときに、デフォルトがどれだけ早く現れるか | 情報の無い並びから完全な並びまでのうち、どこまで近づいたか | 曲線の形はデフォルト率で変わるので、違う集団のCAP曲線を見た目で比べない |
| KS値 | デフォルトと正常のスコアの累積分布の差の絶対値の最大値 | 2つの集団のスコアが最も離れる1点での開き | 1点だけの情報で、その点が実際のカットオフの近くにあるとは限らない |
| スコアの帯ごとのデフォルト率 | スコアを件数の等しい帯に分けたときの、帯ごとのデフォルト率の並び | スコアが上がるにつれてデフォルト率が下がっているか | 帯の件数が少ないとデフォルト率が揺れ、並びが入れ替わることがある |
| スコアの低い帯へのデフォルトの集まり方 | スコアの低い一定の割合に入るデフォルトの割合 | 否決や確認に回す層に、デフォルトの何割が集まるか | どの割合で読むかを、承認率の見込みに合わせて決める |
作業文書第14号は、CAP曲線を見た目で比べることへの注意と、実務で観察されるAR値の水準がポートフォリオの構成や標本の中のデフォルトの件数に左右されうることを、検証の留意点として挙げています。ここでいうデフォルトの件数の影響は、推定のばらつきの側の話です。同文書は別の箇所で、AR値の信頼区間はデフォルトの件数が少ないほど広くなる、つまり推定の質が下がるとしています。これに対して、後の節で触れる「デフォルトの割合に依存しない」という記述は、指標の定義の側の話です。このうち構成の影響とデフォルトの件数によるばらつきを、後のコードで確かめます。
架空の契約の記録を作る、申込の月と観測期間を持たせる
ここからは、指標と評価データの切り方で結果がどう変わるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データ(申込と契約の記録を乱数で作ったもの)で、実際の記録よりずっと単純です。合成データでの成績は、実際の審査での成績の目安にはなりません。示したいのは、同じデータ・同じモデルでも、測り方によって数字がどう動くかという点です。36か月の間に申込があった36,000件の契約を、次の性質を持たせて作りました(乱数の種は20261113に固定しています)。例題では、承認した申込はすべて契約され、実行されたものとします。
- 申込書の項目:年収の水準(相対値。全体の中央がおよそ1になるように作った値)、勤続年数、雇用の形態(AからCの3種類)、貸付の額(相対値。年収の水準と同じ尺度)と、年収に対する貸付の額の比
- 信用情報にあたる項目:他社の借入の件数、過去の延滞の有無、直近の申込の件数
- 他社の借入が0件の契約は、1件の契約よりデフォルトしやすい(単調でない関係)
- 18か月目からは、景気の悪化を想定して全体のデフォルトの起きやすさが上がり、直近の申込の件数の効き方も強まる
- デフォルトした契約には、契約から何か月目にデフォルトに至ったか(3〜12か月目)を持たせる
最初のブロックで、契約の記録を作ります。性別や国籍のような差別につながる属性は作っていませんし、モデルの入力にも使いません。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N = 36000
month = np.sort(rng.integers(0, 36, N))                  # 申込の月(0〜35)
df = pd.DataFrame({
    "month": month,
    "income": rng.lognormal(0.0, 0.45, N),               # 年収の水準(相対値)
    "tenure": rng.gamma(2.0, 3.0, N),                    # 勤続年数
    "emp": rng.choice(["A", "B", "C"], N, p=[0.6, 0.25, 0.15]),  # 雇用の形態
    "n_loans": rng.poisson(1.2, N),                      # 他社の借入の件数
    "past_dlq": (rng.random(N) < 0.08).astype(int),      # 過去の延滞の有無
    "recent_apps": rng.poisson(0.8, N)})                 # 直近の申込の件数
df["amount"] = df.income * rng.lognormal(-1.0, 0.4, N)   # 貸付の額(相対値)
df["burden"] = df.amount / df.income                     # 年収に対する貸付の額の比
late = (df.month >= 18).to_numpy()                       # 18か月目から景気と申込者の行動が変わる
z = (-3.9 - 1.5 * np.log(df.income) - 0.12 * df.tenure
     + df.emp.map({"A": 0.0, "B": 0.4, "C": 0.8}) + 2.5 * (df.burden - 0.4)
     + 0.4 * df.n_loans + 0.5 * (df.n_loans == 0)         # 借入0件はやや高い(単調でない関係)
     + 1.6 * df.past_dlq
     + np.where(late, 0.45, 0.15) * df.recent_apps        # 直近の申込の件数の効き方が強まる
     + np.where(late, 0.25, 0.0))                         # 景気の悪化で全体の水準が上がる
default = rng.random(N) < 1 / (1 + np.exp(-z))           # 契約から12か月以内に延滞が3か月に達する
df["default"] = default.astype(int)
df["def_month"] = np.where(default, rng.integers(3, 13, N), 99)  # 延滞が3か月に達した月(3〜12か月目)
print("契約", len(df), "件/デフォルト率", round(df.default.mean() * 100, 2), "%")
print(df.groupby(late).default.agg(["size", "mean"]).round(4).rename(index={False: "0〜17か月目", True: "18〜35か月目"}))
実行した結果、36,000件の契約のデフォルト率(デフォルトした契約の件数を、全契約の件数で割った値)は6.28%でした。申込の月で分けると、0〜17か月目の17,942件では4.75%、景気が悪化した18〜35か月目の18,058件では7.81%です。デフォルト率の水準は商品によって大きく違い、この例題の水準は説明のために置いたものです。
次に、評価を行う時点を36か月目の初めに置き、その時点で結果が分かっている契約がどれだけあるかを数えます。コードでは、評価の時点までに見届けた月数(36から申込の月を引いた値)が12以上の契約を、観測期間を満たした契約として数えています。この数え方では、12か月の観測期間を満たすのは申込の月が24か月目までの契約で、24か月目の契約はちょうど12か月を見届けたところです。25か月目以降の契約は、評価の時点ではまだ結果を見届けていません。
TODAY = 36                                               # 評価を行う時点(36か月目の初め)
df["seen"] = TODAY - df.month                            # その時点までに見届けた月数
df["y_obs"] = (df.def_month <= df.seen).astype(int)      # その時点までに観測できたデフォルト
df["full"] = df.seen >= 12                               # 観測期間12か月を満たしたか
coh = df.groupby(df.month // 6 * 6).agg(件数=("default", "size"), 真のデフォルト率=("default", "mean"),
                                         観測できたデフォルト率=("y_obs", "mean"), 観測期間を満たす=("full", "mean"))
coh.index = [f"{m}〜{m + 5}か月目" for m in coh.index]
print(coh.round(4))
| 申込の月 | 件数 | 真のデフォルト率 | 評価の時点までに観測できたデフォルトの割合 | 観測期間を満たす契約の割合 |
|---|---|---|---|---|
| 0〜5か月目 | 5,913 | 4.62% | 4.62% | 100% |
| 6〜11か月目 | 6,050 | 5.12% | 5.12% | 100% |
| 12〜17か月目 | 5,979 | 4.50% | 4.50% | 100% |
| 18〜23か月目 | 6,088 | 7.77% | 7.77% | 100% |
| 24〜29か月目 | 6,069 | 8.04% | 5.93% | 16.6% |
| 30〜35か月目 | 5,901 | 7.61% | 1.00% | 0% |
表の「真のデフォルト率」は、合成データなので分かっている、観測期間の終わりまで見届けた場合の値です。実際の記録では、観測期間を満たしていない契約の真の値は評価の時点では分かりません。「観測できたデフォルトの割合」は、評価の時点までにデフォルトに至った契約の件数を、その月の全契約の件数で割った値です。24〜29か月目の「観測期間を満たす契約の割合」が16.6%なのは、この6か月のうち24か月目の1か月分だけが観測期間を満たすためです。観測できたデフォルトの割合は、24〜29か月目では5.93%、30〜35か月目では1.00%で、真のデフォルト率の8.04%と7.61%を大きく下回りました。まだデフォルトに至っていないだけの契約が、分母には入っているのにデフォルトとしては数えられていないためです。直近の申込の月ほどデフォルト率が低く見えるのは、この架空データでは結果の出そろい方の違いによるもので、審査が良くなったからではありません。結果の出そろい方を申込の月ごとに見る方法は、第2章のビンテージの見方で扱っています。
2つのモデルを比べる、AUC・AR値・KS値
このデータで、2つのモデルを比べます。どちらもロジスティック回帰(第4章)で、違いは入力の項目だけです。モデルAは申込書の項目(年収の水準の対数・勤続年数・年収に対する貸付の額の比・雇用の形態)だけを使い、モデルBはそれに信用情報にあたる項目(他社の借入の件数・借入が0件かどうか・過去の延滞の有無・直近の申込の件数)を足します。評価データは申込の月で切り、0〜17か月目を学習用、18〜23か月目を評価用にしました。これは、36か月目の初めの時点で、0〜23か月目のすべての結果が確定した後に、時期の前後で分けて比べる事後的な分け方です。17か月目の契約の結果が確定するのは29か月目なので、18か月目に新しい申込を判定し始める運用をそのまま再現したものではありません。運用の時点に合わせて学習した場合の結果は、評価データの切り方の節で示します。評価用の契約は、どれも観測期間を満たしています。24か月目の契約もちょうど観測期間を満たしますが、境目の月を外して安全側に置くため、評価には23か月目までを使い、24か月目以降の契約はここでは使いません。
モデルの出すデフォルト確率は、点数に直してスコアにしました。デフォルトの対数オッズを η としたとき、スコア=500 -(50÷ln2)× η としています。点数が大きいほどデフォルト確率が低くなる向きで、変換の考え方は第4章で扱います。指標を計算する関数では、デフォルトを1とし、スコアの符号を反転した値で AUC を計算しています。スコアをそのまま入れると、AUC は1からその値を引いたものになり、AR値の符号が逆になります。
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, roc_curve

def features(d, cols):
    x = pd.DataFrame({"log_income": np.log(d.income), "tenure": d.tenure, "burden": d.burden,
                      "emp_B": (d.emp == "B") * 1, "emp_C": (d.emp == "C") * 1,
                      "n_loans": d.n_loans, "no_loan": (d.n_loans == 0) * 1,
                      "past_dlq": d.past_dlq, "recent_apps": d.recent_apps})
    return x[cols]

COLS_A = ["log_income", "tenure", "burden", "emp_B", "emp_C"]             # モデルA:申込書の項目だけ
COLS_B = COLS_A + ["n_loans", "no_loan", "past_dlq", "recent_apps"]       # モデルB:信用情報にあたる項目を足す

def fit_score(train, cols):                  # スコア=正常のオッズの対数を点数に直したもの(大きいほど安全)
    m = LogisticRegression(max_iter=2000).fit(features(train, cols), train.default)
    def score(d):
        p = m.predict_proba(features(d, cols))[:, 1]
        return 500 + 50 / np.log(2) * np.log((1 - p) / p)
    return score

def ar(y, s, w=None):                        # y:デフォルト=1、s:スコア(大きいほど安全)
    return 2 * roc_auc_score(y, -s, sample_weight=w) - 1   # スコアの低い順に危ない、として AUC を計算

def ks(y, s):
    fpr, tpr, _ = roc_curve(y, -s)           # 2つの累積割合の差の絶対値の最大(両側のKS値)
    return np.max(np.abs(tpr - fpr))

tr = df[df.month < 18]                                     # 学習:0〜17か月目
te = df[(df.month >= 18) & (df.month < 24)]               # 評価:18〜23か月目(観測期間を満たす)
score_a, score_b = fit_score(tr, COLS_A), fit_score(tr, COLS_B)
y, sa, sb = te.default.to_numpy(), score_a(te), score_b(te)
print("学習", len(tr), "件(デフォルト", tr.default.sum(), ")/評価", len(te), "件(デフォルト", y.sum(), ")")
for name, s in [("A", sa), ("B", sb)]:
    print(name, "AUC", round(roc_auc_score(y, -s), 3), "AR値", round(ar(y, s), 3), "KS値", round(ks(y, s), 3))
学習用は17,942件(うちデフォルト852件)、評価用は6,088件(うちデフォルト473件)でした。結果を次の表にまとめます。評価用のスコアには、どちらのモデルにも同点の契約はありませんでした。
| モデル | AUC | AR値 | KS値 |
|---|---|---|---|
| モデルA(申込書の項目だけ) | 0.713 | 0.426 | 0.331 |
| モデルB(信用情報にあたる項目を足す) | 0.762 | 0.523 | 0.396 |
AR値は、モデルAが0.426、モデルBが0.523でした。どちらも AUC から 2 × AUC – 1 で計算した値と一致しています。AR値は丸める前のAUCから計算し、それぞれを小数第3位に丸めて表示しているので、表のAUCから計算すると小数第3位がずれることがあります。KS値も、モデルBの方が大きくなりました。この架空データでは、信用情報にあたる項目を足したモデルBの方が、評価用の契約をデフォルトしやすい順に並べられたことになります。ただし、ここで分かるのは順位づけの成績の差だけで、モデルBの方が確率が正しいか、事業の差し引きが良くなるかは、この表からは分かりません。
図とスコアの帯で読む、CAP曲線とデフォルトの集まり方
次のブロックでは、CAP曲線の面積から直接AR値を計算し、2 × AUC – 1 で求めた値と一致することを確かめます。この実装は契約を1件ずつ並べるので、スコアに同点が無いこの例に限って使えます。同点がある場合は、同じスコアの契約をまとめて曲線を作る必要があります。あわせて、モデルBのスコアで評価用の契約を件数の等しい10の帯に分け、帯ごとのデフォルト率と、スコアの低い帯から数えたデフォルトの累積の割合を出します。
def cap_ar(y, s):                            # CAP曲線の面積から AR値を計算する
    order = np.argsort(s)                    # スコアの低い(危ない)順に並べる
    x = np.r_[0, np.arange(1, len(y) + 1) / len(y)]
    c = np.r_[0, np.cumsum(y[order]) / y.sum()]
    area = np.sum((x[1:] - x[:-1]) * (c[1:] + c[:-1]) / 2)
    pd_rate = y.mean()
    perfect = 1 - pd_rate / 2                # 完全に並べた場合のCAP曲線の下の面積
    return (area - 0.5) / (perfect - 0.5)

print("CAP曲線から計算した AR値 A", round(cap_ar(y, sa), 3), "B", round(cap_ar(y, sb), 3))
band = pd.qcut(sb, 10, labels=False)                      # モデルBのスコアで10の帯に分ける(0が最も低い)
tab = pd.DataFrame({"band": band + 1, "y": y}).groupby("band").y.agg(件数="size", デフォルト="sum", デフォルト率="mean")
tab["累積のデフォルトの割合"] = tab.デフォルト.cumsum() / y.sum()
print(tab.round(3))
for share in [0.1, 0.2, 0.3]:
    k = int(len(y) * share)
    print(f"スコアの低い{int(share * 100)}%に入るデフォルトの割合 A", round(y[np.argsort(sa)[:k]].sum() / y.sum(), 3),
          "B", round(y[np.argsort(sb)[:k]].sum() / y.sum(), 3))
CAP曲線の面積から計算したAR値は、モデルAが0.426、モデルBが0.523で、前の表の値と一致しました。2つの計算の方法が同じものを測っていることが、この架空データでも確かめられます。
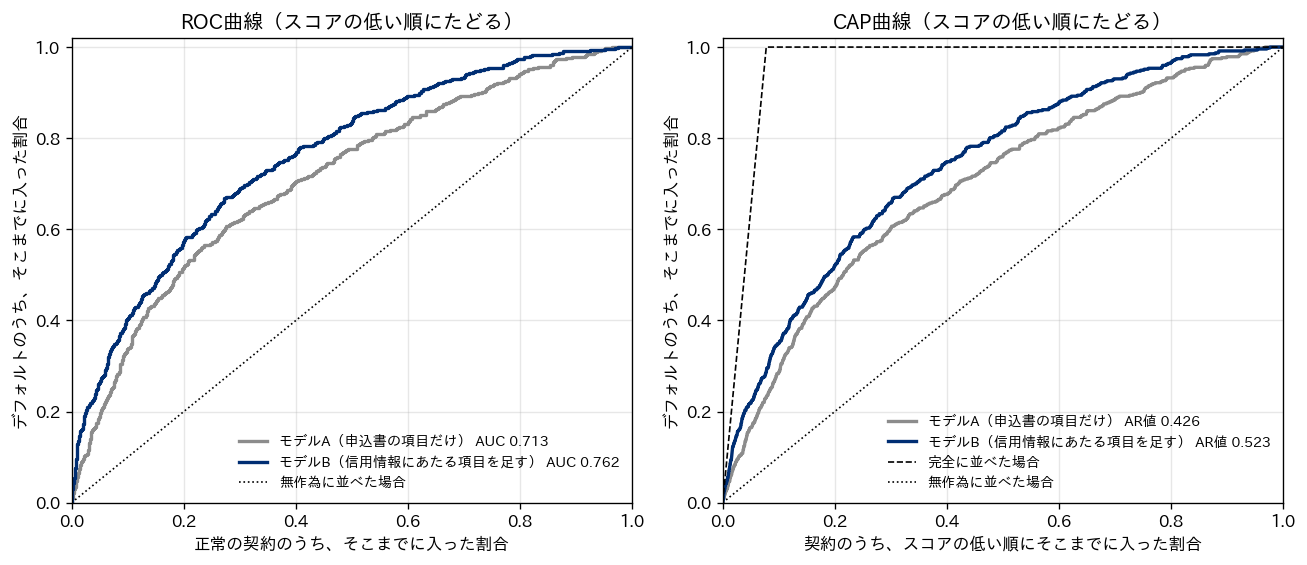
上の図は、2つのモデルのROC曲線(左)とCAP曲線(右)です。どちらの図も、スコアの低い契約から順にたどって描いています。どちらの図でも、モデルBの曲線はモデルAの曲線より左上にあり、スコアの低い側でデフォルトの契約をより早く拾えていることが読み取れます。右の図の破線は、完全に並べた場合のCAP曲線で、横軸が評価用のデフォルト率(7.77%)に達したところで縦軸が1になります。AR値は、点線の対角線とそれぞれの曲線の間の面積を、対角線と破線の間の面積で割った値です。2つの図の曲線は形が似ていますが、横軸が違うため、同じ曲線ではありません。
| スコアの帯(1が最も低い) | 件数 | デフォルト | デフォルト率 | スコアの低い帯からのデフォルトの累積の割合 |
|---|---|---|---|---|
| 1 | 609 | 165 | 27.1% | 34.9% |
| 2 | 609 | 81 | 13.3% | 52.0% |
| 3 | 609 | 65 | 10.7% | 65.8% |
| 4 | 608 | 43 | 7.1% | 74.8% |
| 5 | 609 | 32 | 5.3% | 81.6% |
| 6 | 609 | 30 | 4.9% | 87.9% |
| 7 | 608 | 24 | 3.9% | 93.0% |
| 8 | 609 | 17 | 2.8% | 96.6% |
| 9 | 609 | 12 | 2.0% | 99.2% |
| 10 | 609 | 4 | 0.7% | 100% |
モデルBのスコアの帯ごとのデフォルト率は、最も低い帯の27.1%から最も高い帯の0.7%まで、帯が上がるごとに下がりました。この架空データでは、帯の並びに入れ替わりはありません。デフォルトの集まり方を見ると、スコアの最も低い帯(評価用の契約の1割)に、デフォルトの34.9%が入りました。スコアの低い2割には52.0%、3割には65.8%が入っています。同じ割合でモデルAを数えると、低い1割に28.5%、2割に47.4%、3割に60.3%でした。この表は、AR値という1つの数字では見えない「どの帯でどれだけ差があるか」を示します。審査の担当者や営業にも読みやすく、モデルの文書や監視の報告に載せやすい形です。
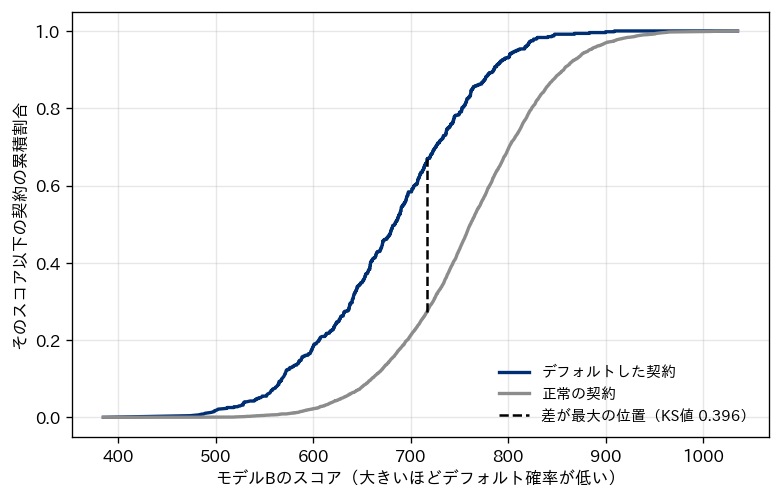
上の図は、モデルBのスコアの累積分布を、デフォルトした契約(ネイビー)と正常の契約(灰色)に分けて描いたものです。横軸がスコアで、右へ行くほどデフォルト確率が低くなります。デフォルトした契約の曲線が左にあり、低いスコアに偏っていることが分かります。2本の差が最も開くのはスコア716.6のあたりで、そのスコア以下に入る割合は、デフォルトした契約で66.8%、正常の契約で27.2%でした。この差の0.396がKS値です。この位置は評価用の契約のうちスコアの低い側の3割強にあたる位置で、実際のカットオフをどこに置くかとは関係なく、2つの分布が最も離れる場所として決まります。KS値の位置をそのままカットオフにしてよいという意味ではありません。カットオフの決め方は第9章で扱います。
AR値は評価する集団で変わる、架空データではスコアの上位だけを残すと下がった
AR値は、モデルそのものの性質だけで決まる数字ではありません。同じモデルでも、評価する集団の層の広がりが変わると値が変わります。作業文書第14号は、AR値とROC曲線の下の面積は、標本の中のデフォルトの割合には依存しないと書いています。デフォルトした契約と正常の契約を、それぞれ無作為に間引いて割合を変えても、2つの集団のスコアの分布は変わらないからです。同文書は、ROC曲線の下の面積とピエトラ指数について、デフォルトの割合が違う銀行のポートフォリオの数字どうしも直接比べられる、とも書いています。この記述は、デフォルトの割合という1つの条件についてのものです。
一方で、前の節で触れたとおり、同文書はAR値がポートフォリオの構成に強く依存するように見えるとも書いています。集団の中身そのもの、つまりどういう申込者がどれだけ含まれるかが変わると、AR値は変わります。この節の例で変えたのは、デフォルトの割合だけではなく、集団に含まれる契約の層そのものです。
この違いを確かめるために、同じ2つのモデルを、評価用の契約の全体と、モデルBのスコアの上位80%だけ、上位60%だけの3つの集団で評価しました。この例題のデータは、すべての契約が契約済みで結果が分かっているものとして作っているので、評価用の契約の全体を「結果が分かっている申込の全体」とみなします。スコアの上位だけを残した集団は、仮にモデルBでその割合だけを承認していたら手元に残ったはずの、承認した契約の集団を模したものです。データの中に実際の否決の工程があるわけではありません。合成データなので、絞った外側の契約の結果も分かっていますが、ここでは絞った内側だけで計算しています。次のブロックの前半がこの計算です。後半は、次の節で扱う評価データの切り方の計算です。
for keep in [1.0, 0.8, 0.6]:                              # 同じモデルを、スコアの上位だけを残した集団で評価する
    cut = np.quantile(sb, 1 - keep)
    m = sb >= cut
    print(f"上位{int(keep * 100)}%だけ 件数", m.sum(), "デフォルト率", round(y[m].mean(), 4),
          "AR値 A", round(ar(y[m], sa[m]), 3), "B", round(ar(y[m], sb[m]), 3),
          "Bのスコアの標準偏差", round(sb[m].std(), 1))

lab = df[df.month < 24]                                    # 0〜23か月目(観測期間を満たす)
pick = np.random.default_rng(1).random(len(lab)) < 0.3     # 無作為に切る:3割を評価用
f = fit_score(lab[~pick], COLS_B)
s_r = f(lab[pick])
print("無作為に切る 評価", pick.sum(), "件 AR値", round(ar(lab[pick].default.to_numpy(), s_r), 3))
y_r = lab[pick].default.to_numpy()
m = (lab[pick].month >= 18).to_numpy()
print("  うち0〜17か月目", (~m).sum(), "件 AR値", round(ar(y_r[~m], s_r[~m]), 3),
      "/18〜23か月目", m.sum(), "件 AR値", round(ar(y_r[m], s_r[m]), 3))
print("時間で切る 評価", len(te), "件 AR値", round(ar(y, sb), 3))
op = df[df.month + 12 <= 18]                               # 18か月目に学習するなら、結果が確定済みは0〜6か月目だけ
f_op = fit_score(op, COLS_B)
print("18か月目の時点で学習 学習", len(op), "件(デフォルト", op.default.sum(), ")評価のAR値", round(ar(y, f_op(te)), 3))

rec = df[df.month >= 24]                                   # 24〜35か月目(24か月目の契約以外は観測期間を満たさない)
s_rec = score_b(rec)
print("24〜35か月目 真のデフォルト率", round(rec.default.mean(), 4), "観測できたデフォルト率", round(rec.y_obs.mean(), 4))
print("  AR値 真の結果で", round(ar(rec.default.to_numpy(), s_rec), 3), "観測できた結果で", round(ar(rec.y_obs.to_numpy(), s_rec), 3))
| 評価した集団 | 件数 | デフォルト率 | モデルAのAR値 | モデルBのAR値 | モデルBのスコアの標準偏差 |
|---|---|---|---|---|---|
| 評価用の契約の全体(結果が分かっている申込の全体とみなす) | 6,088 | 7.77% | 0.426 | 0.523 | 80.5 |
| モデルBのスコアの上位80%だけを残した集団 | 4,870 | 4.66% | 0.253 | 0.371 | 58.7 |
| モデルBのスコアの上位60%だけを残した集団 | 3,653 | 3.26% | 0.183 | 0.296 | 49.5 |
モデルは同じで、評価する集団を絞っただけですが、モデルBのAR値は0.523から0.371、0.296へと下がりました。モデルAも0.426から0.253、0.183へと下がっています。モデルBのスコアの標準偏差(散らばりの大きさ)を集団ごとに計算すると、全体で80.5、上位80%で58.7、上位60%で49.5と小さくなっていました。本コラムの架空データでAR値が下がったのは、スコアの低い層を取り除いたことで残った集団のデフォルトのしやすさの幅が狭まり、見分けるべき差が小さくなったことが一因と考えられます。第6章の承認した層でAR値が低かった理由が同じ仕組みかどうかは、確かめていません。この架空データでは、承認した契約の集団を模した上位だけの集団で測ったAR値は、結果が分かっている申込の全体で測った値よりかなり低くなりました。
この結果から、実務で注意すべきことが2つ読み取れます。1つ目は、違う集団で測ったAR値の差を、そのままモデルの優劣の判断には使えない、という点です。ベンダーが「申込の全体」で測ったAR値と、自社が「承認した契約」で測ったAR値を並べれば、モデルの差ではなく集団の差で数字が違って見えます。同じ商品でも、承認の基準を厳しくした年と緩めた年では、承認した契約の層の広がりが違うので、AR値の推移をそのままモデルの劣化や改善と読むことはできません。2つ目は、手元にある結果は承認した契約のものだけである、という点です。否決した申込の結果は分からないので、承認した契約だけで評価する場合は、この節のスコアの上位だけを残した集団に近い面があります。ただし、この節の集団は評価するモデル自身のスコアで切ったもので、実際の承認した契約は過去の審査の基準で決まった集団なので、同じ条件ではありません。承認した契約だけで測ったAR値が低く出ても、それだけでモデルが申込の全体で役に立たないとは言えません。否決した申込の扱いは第6章で扱いました。
同じモデルでも、景気が良い時期と悪い時期、申込の経路が違う集団、商品が違う集団では、層の広がりもデフォルト率の水準も違います。AR値の差からモデルの優劣を判断するときは、同じ集団・同じ期間・同じデフォルトの定義で測った値どうしに限るのが基本です。期間ごとのAR値を並べて推移を監視することはできますが、その変化には集団の構成の変化も含まれます。違う条件の値しか手元に無いときは、その差だけではモデルの優劣を判断できないと書いておく方が、誤った判断を防げます。
評価データの切り方、申込の月で切り、観測期間を満たした契約だけを使う
評価の結果を大きく動かすもう1つの要素は、評価データの切り方です。与信のモデルは、過去の申込の記録で学習し、これから来る申込を判定するために使います。そのため、運用に最も近いのは、ある申込の月より前を学習用、後を評価用にする切り方(時間で切る)です。無作為に切ると、評価用の契約と同じ時期の契約が学習用に入り、学習の時点ではまだ起きていなかった景気や申込者の行動の変化を、モデルが学んだうえで評価されることになります。
| 切り方 | 分け方 | 想定している使い方 | 与信での注意 |
|---|---|---|---|
| 無作為に切る | 契約を無作為に選んで、一部を評価用にする | 学習用と評価用が同じ性質のデータである場合 | 同じ時期の契約が両側に入る。評価用の中身も、古い時期と新しい時期が混ざる |
| 時間で切る(申込の月で切る) | ある申込の月より前を学習用、後を評価用にする | 過去の記録で学び、これからの申込を判定する実際の運用に近づける | 評価用の契約が観測期間を満たしているかを確かめる。運用を再現するなら、学習に使うのはモデルを確定する時点で結果が確定している契約だけになり、学習の期間と評価の期間の間に結果の出そろわない期間が挟まる |
| 時間で切る評価を繰り返す | 学習の期間と評価の期間をずらしながら、何回か時間で切る | 時期による成績の揺れを知りたい場合 | 回ごとに評価の集団が違うので、値の差は時期の違いも含む |
前のブロックの後半では、観測期間を満たす0〜23か月目の契約を使い、無作為に3割を評価用にしてモデルBを学習し直しました。時間で切った評価(0〜17か月目で学習し、18〜23か月目で評価)と並べた結果が次の表です。あわせて、18か月目にモデルを確定する運用に合わせ、その時点で結果が確定している0〜6か月目の契約(6,922件、うちデフォルト314件)だけで学習した場合も計算しました。
| 切り方 | 評価用の契約 | 件数 | モデルBのAR値 |
|---|---|---|---|
| 無作為に切る | 0〜23か月目から無作為に3割 | 7,263 | 0.566 |
| 無作為に切る(内訳) | そのうち0〜17か月目の契約 | 5,445 | 0.617 |
| 無作為に切る(内訳) | そのうち18〜23か月目の契約 | 1,818 | 0.496 |
| 時間で切る(事後的な分け方。0〜17か月目で学習) | 18〜23か月目のすべて | 6,088 | 0.523 |
| 時間で切る(運用の時点に合わせる。18か月目の時点で結果が確定済みの0〜6か月目で学習) | 18〜23か月目のすべて | 6,088 | 0.519 |
同じモデルBでも、無作為に切った評価のAR値は0.566、時間で切った評価は0.523で、無作為に切った方が0.043高く出ました。内訳を見ると、無作為に切った評価用のうち0〜17か月目の契約では0.617、18〜23か月目の契約では0.496です。本コラムの架空データでは、無作為に切った評価用の7,263件のうち5,445件が、景気や申込者の行動が変わる前の0〜17か月目の契約で、その部分のAR値が高く出ていました。無作為に切った評価の値が高く出たのは、この評価用の中身の違いによるところが大きいと考えられますが、学習用の中身も2つの切り方で違うので、差のすべてをこの理由に帰すことはできません。18〜23か月目に限った0.496は、時間で切った評価の0.523と大きくは違いませんが、件数が1,818件と少なく、後で見るとおりこの件数ではAR値は大きく揺れるので、2つの値の差の大きさは目安としてしか読めません。
運用の時点に合わせて0〜6か月目だけで学習したモデルBのAR値は0.519で、事後的な分け方の0.523とほとんど変わりませんでした。本コラムの架空データでは、学習に使える期間が短くなったことによる差は小さかったことになります。ただし、学習の件数が半分以下になっても差が小さかったのはこの例題での結果で、項目と結果の関係が時期によって大きく変わる記録では、差が大きくなることがありえます。
本コラムの架空データで確かめられたのは、無作為に切った評価のAR値が、これから来る申込に対する成績ではなく、過去の時期が混ざった集団での成績になっていたということです。景気や申込者の層が変わる場合には、その数字をもとに承認率やデフォルト率の見込みを立てると、運用の後に見込みとずれるおそれがあります。モデルを選ぶ評価の基本は、時間で切る方法です。この例は、違う期間の値を比べると数字が動くことを示すために、あえて期間の違う値を並べたものでもあります。期間の違うAR値の差だけから、どちらのモデルが良いかを判断することはできません。
時間で切るなら、評価用の契約は観測期間を満たしたものに限る必要があります。評価の時点に近い申込の月を評価用にすると、まだデフォルトに至っていないだけの契約が正常として数えられます。前のブロックの最後では、ほとんどが観測期間を満たしていない24〜35か月目の契約(観測期間をちょうど満たすのは24か月目の契約だけです)を、誤った扱い(評価の時点までにデフォルトしていない契約を正常とみなす)で評価した場合と、合成データなので分かっている真の結果で評価した場合を比べました。
| 24〜35か月目の契約の扱い | デフォルト率 | モデルBのAR値 |
|---|---|---|
| 合成データなので分かる真の結果(観測期間の終わりまで見届けた場合) | 7.83% | 0.557 |
| 誤った扱い:評価の時点までにデフォルトしていない契約を正常とみなす | 3.50% | 0.518 |
誤った扱いでは、デフォルト率は3.50%で、真の7.83%の半分を下回りました。AR値は0.557に対して0.518で、この架空データでは差は0.039でした。この例題では、契約から何か月目にデフォルトに至るかを、スコアとは関係なく乱数で決めています。AR値の差が比較的小さかったのには、この作り方が影響した可能性がありますが、本コラムでは確かめていません。実際の記録では、デフォルトしやすい契約ほど早くデフォルトに至ることがあり、その場合は観測期間の途中で切ったときの偏り方が変わります。どちらの向きにどれだけずれるかは、その記録で確かめるまで分かりません。少なくとも、デフォルト率の水準は確実に低く見え、第8章で扱う確率の較正の確認では、見積りが実績より高すぎるという誤った結論につながります。
そのため、評価用の契約は、観測期間を満たした申込の月に限ります。この章の例でいえば、36か月目の初めに評価するなら、12か月の観測期間を満たすのは24か月目までに申込があった契約で、境目の24か月目を外して23か月目までを評価用にしました。学習用はそれより前に置きます。最新の申込者の層を評価に入れられないのは不便ですが、結果の出ていない契約を正常に数えるよりは、古いが正しい評価を選ぶ方が判断を誤りにくいと考えています。直近の申込については、結果を待たずに分かる指標(項目とスコアの分布、早い段階の延滞の割合)で監視します。この方法は第12章で扱います。
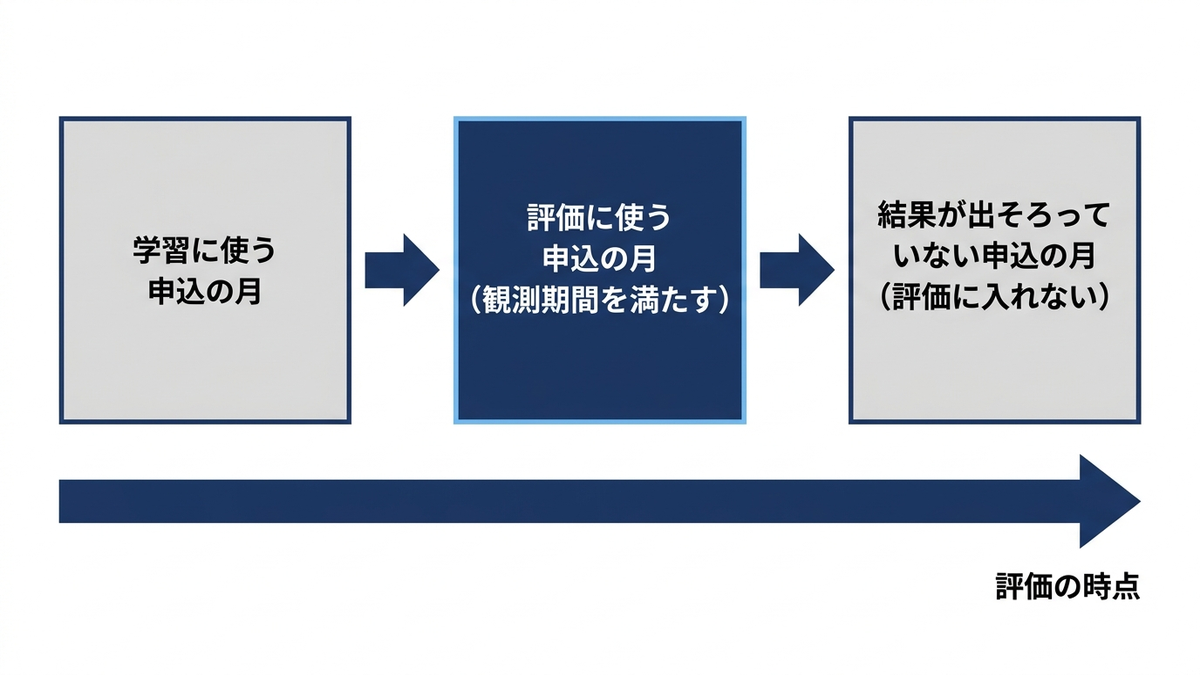
デフォルトの件数が少ないときのばらつき、ブートストラップで区間を出す
評価用のデータのデフォルトの件数は、多くの場合それほど多くありません。作業文書第14号は、AR値やROC曲線の下の面積の信頼区間の幅は、対象のポートフォリオと、推定に使えるデフォルトの件数によって決まり、一般にデフォルトの件数が少ないほど区間が広くなると書いています。2つのモデルのAR値の差が、本当の性能の差なのか、たまたまの揺れなのかを判断するには、ばらつきの大きさを知っておく必要があります。
ばらつきを見る方法の1つが、ブートストラップです。評価用のデータから、同じ件数を復元抽出(同じものを何度でも選んでよい抜き出し方)で取り出し、指標を計算し直すことを何百回も繰り返して、その値の分布から区間を出します。
次のコードでは、評価用の6か月分の契約と、そのうち1か月分(23か月目)だけの契約について、モデルBのAR値と、モデルBとモデルAの差の95%区間を、それぞれ500回の復元抽出で求めました。区間は、計算し直した値の2.5%点と97.5%点をとる方法で、学習済みのモデルを固定したまま評価用のデータのばらつきだけを見たものです。学習のやり直しや、将来の景気の変化による揺れは含みません。
また、この例では契約を互いに独立した抜き出しの単位として扱っています。実務では、同じ申込者の複数の契約や、同じ時期に共通する影響があるので、それに合わせて抜き出しの単位を検討する必要があります。後半では、額で重み付けたAR値と、同じ承認率での比較も計算しています。
boot = np.random.default_rng(7)
def boot_ci(yv, s1, s2, n=500):              # 評価データを復元抽出して AR値と差の95%区間を出す
    v = []
    for _ in range(n):
        i = boot.integers(0, len(yv), len(yv))
        v.append((ar(yv[i], s2[i]), ar(yv[i], s2[i]) - ar(yv[i], s1[i])))
    v = np.array(v)
    return np.quantile(v[:, 0], [0.025, 0.975]), np.quantile(v[:, 1], [0.025, 0.975])

one = (te.month == 23).to_numpy()                         # 1か月分だけで評価した場合
for name, m in [("18〜23か月目", np.ones(len(y), bool)), ("23か月目だけ", one)]:
    (lo, hi), (dlo, dhi) = boot_ci(y[m], sa[m], sb[m])
    print(name, "件数", m.sum(), "デフォルト", y[m].sum(), "BのAR値", round(ar(y[m], sb[m]), 3),
          "95%区間", round(lo, 3), "〜", round(hi, 3), "/BとAの差", round(ar(y[m], sb[m]) - ar(y[m], sa[m]), 3),
          "95%区間", round(dlo, 3), "〜", round(dhi, 3))

amt = te.amount.to_numpy()
print("額で重み付けた AR値 A", round(ar(y, sa, amt), 3), "B", round(ar(y, sb, amt), 3))
for rate in [0.8, 0.6]:                                   # 同じ承認率で比べる
    da = y[sa >= np.quantile(sa, 1 - rate)].mean()
    db = y[sb >= np.quantile(sb, 1 - rate)].mean()
    print(f"承認率{int(rate * 100)}% 承認した契約のデフォルト率 A", round(da, 4), "B", round(db, 4))
| 評価用の契約 | 件数(うちデフォルト) | モデルBのAR値 | その95%区間 | モデルBとモデルAの差 | 差の95%区間 |
|---|---|---|---|---|---|
| 18〜23か月目(6か月分) | 6,088件(473件) | 0.523 | 0.48〜0.57 | 0.097 | 0.069〜0.129 |
| 23か月目だけ(1か月分) | 1,020件(78件) | 0.406 | 0.279〜0.519 | 0.018 | -0.041〜0.076 |
6か月分(デフォルト473件)で評価すると、モデルBのAR値の95%区間は0.48〜0.57で、幅は0.09ほどでした。モデルBとモデルAの差は0.097で、その区間は0.069〜0.129と0を上回っています。差の区間は値そのものの区間より狭くなりました。同じ抜き出しの中で2つのモデルを計算しているので、評価データのたまたまの難しさが両方に同じように効いたためと考えられますが、本コラムではこの理由を確かめていません。
1か月分(デフォルト78件)だけで評価すると、モデルBのAR値は0.406で、95%区間は0.279〜0.519と幅が0.24ほどに広がりました。モデルBとモデルAの差は0.018で、区間は-0.041〜0.076と0をまたいでいます。6か月分の評価では、評価データのばらつきの範囲ではモデルBの方が良いと言えたのに、1か月分だけでは、どちらが良いかをこの評価からは判断できません。本コラムの架空データでは、デフォルト78件の1か月分では、2つのモデルの差が揺れの範囲に収まりました。デフォルトの件数が少ない評価では同じことが起こりうるので、AR値の差は区間を添えて読む必要があります。なお、1か月分の値0.406と6か月分の値0.523は、評価の集団が違うので、この2つの差からモデルが劣化したと読むことはできません。区間の推定の一般論は、弊社コラム「データから正しく結論を導く統計学のまとめ」で扱っています。
件数の指標と額で重み付けた指標、同じ承認率でのデフォルト率の差
ここまでの指標は、契約を1件ずつ同じ重みで数えていました。しかし、貸し倒れの損失の大きさは、デフォルトした契約の残高によって違います。貸付の額で重み付けてAR値を計算すると、額の大きい契約を正しく並べられているかを重く見た値になります。前のブロックでは、貸付の額(相対値)を重みにしてAR値を計算しました。結果は、モデルAが0.414、モデルBが0.517で、件数で数えた0.426と0.523より少し低くなりました。この架空データでは、額で重み付けても2つのモデルの順番は変わりませんでした。額で重み付けた値が件数の値と大きく離れる場合は、額の大きい契約の並びがうまくいっていない(あるいはうまくいっている)ことを示すので、どちらの値を主に見るかは、損失がどこから来るかで決めることになります。デフォルト時の残高と損失の割合の考え方は、第1章と第8章で触れています。
最後に、順位づけの成績の差が事業の差にどうつながるかを見ます。AR値の差そのものは、事業の言葉ではありません。事業の言葉に直す1つの方法は、同じ承認率で、承認した契約のデフォルト率を比べることです。評価用の契約について、それぞれのモデルのスコアの上位を承認した場合のデフォルト率を計算しました。
| 承認率 | モデルAで承認した契約のデフォルト率 | モデルBで承認した契約のデフォルト率 |
|---|---|---|
| 80% | 5.11% | 4.66% |
| 60% | 4.19% | 3.26% |
承認率80%では、承認した契約のデフォルト率はモデルAで5.11%、モデルBで4.66%でした。承認率60%では4.19%と3.26%です。この架空データでは、AR値で0.097の差は、承認率80%なら承認した契約のデフォルト率で0.45ポイントの差、60%なら0.93ポイントの差にあたりました。どの承認率で運用するかによって、同じAR値の差が持つ意味は変わります。この差を、正常な契約から得られる収益とデフォルトした契約の損失の見積りと合わせて、事業の差し引きに直す方法は第9章で扱います。ここでの承認率は説明のために置いた値で、この例題では合成データなのですべての契約の結果が分かっていますが、実際には否決した申込の結果は分からない点にも注意が要ります。
過去のデータでの評価の限界と、ベンダーの示す数字の読み方
時間で切り、観測期間を満たした契約に限り、区間まで出したとしても、過去の記録を使う評価には構造的な限界が残ります。1つ目は、評価に使える結果が、過去の審査で承認した契約のものだけだという点です。否決した申込の結果は分からないので、新しいモデルが今まで否決していた層をどう並べるかは、過去の記録では測れません(第6章)。2つ目は、景気が違うという点です。評価に使えるのは観測期間を満たした古い時期の契約だけで、評価の結果は、その時期の景気と申込者の層での成績です。これからの時期の成績を保証するものではありません。3つ目は、モデルを入れると申込の集まり方自体が変わりうるという点です。承認の基準が変われば承認した層も変わり、次の評価の集団も変わります。
ベンダーの製品や外部の分析の提案では、AR値やジニ係数、AUC、KS値といった数字が示されることがあります。これらの数字は、上で見たとおり、評価した集団・デフォルトの定義・期間・切り方・件数のどれか1つが違うだけで大きく動きます。数字の大きさを比べる前に、次の表の項目を確かめる必要があります。
| 確かめること | 聞き方の例 | 理由 |
|---|---|---|
| 評価した集団 | 申込の全体か、承認した契約だけか。どの商品・経路・地域の契約か | 層の広がりが違うと、同じモデルでもAR値が変わる |
| デフォルトの定義 | 延滞の日数の基準と観測期間はいくつか | 定義が違えばデフォルトの集団そのものが違い、値の差からモデルの優劣を判断できない |
| 学習と評価の期間 | 学習の期間と評価の期間はいつか。評価の契約は観測期間を満たしているか | 観測期間を満たさない契約を正常に数えると、デフォルト率も成績も実際と違う値になる |
| 評価データの切り方 | 申込の月で切ったか、無作為に切ったか | 景気や申込者の層が変わる場合、無作為に切った評価はこれからの成績とずれることがある |
| 指標の定義と向き | AR値とAUCのどちらか。デフォルトを1として計算したか | 向きや指標を取り違えると、数字の意味が変わる |
| 件数とばらつき | 評価のデフォルトは何件か。区間を示せるか | デフォルトが少ない評価では、小さな差は揺れの範囲に入る |
| 比べた相手 | 何と比べた改善か。比べた相手を同じ集団・同じ期間で評価したか | 比べる相手の評価の条件が違うと、改善の大きさをそのまま読めない |
| 確率の正しさ | AR値のほかに、見積りと実績のデフォルト率の比較を示せるか | AR値は順位づけの指標で、確率が合っているかは表さない(第8章) |
この表の項目は、社内でモデルを作る場合にも、評価の手順の点検表としてそのまま使えます。とくに「評価した集団」と「比べた相手」は、答えが無いまま数字だけが伝わることが多い項目だと考えています。公開データセットでの研究の数字も同じで、そのデータセットとその条件での値として読み、自社で期待できる成績としては扱わないことが必要です。
経営の判断、評価の指標と切り方をモデルを選ぶ前に決める
評価の指標と切り方は、技術の細部に見えますが、その選び方を誤ると経営上の損失に直結します。無作為に切った評価や、観測期間を満たさない契約を含む評価で選んだモデルを本番に入れると、承認した契約のデフォルト率が見込みとずれ、貸し倒れが見込みより増えるおそれがあります。違う集団で測ったAR値の差をそのまま優劣と読んで、実際には劣るモデルを選べば、同じ承認率で貸し倒れが増えるか、同じデフォルト率に抑えるために承認率を下げて機会損失が増えます。評価の手順が人によって毎回違うと、新旧のモデルを比べられず、見直しが止まって形骸化につながります。モデルの評価の手順と結果を文書に残していなければ、監督当局や監査から説明を求められたときに答えられないおそれもあります。
これを防ぐために、モデルを作り始める前に、次のことを決めて文書に残しておくことが有効だと考えています。
| 決めること | 決める内容の例 | 決める人の例 |
|---|---|---|
| 主に見る指標 | AR値に加えて、スコアの帯ごとのデフォルト率の並びと、想定する承認率での承認した契約のデフォルト率 | リスク管理の責任者とデータ分析の担当 |
| 評価する集団 | どの商品・経路の、どの審査の段の契約で測るか。承認した契約だけで測ることの限界をどう書くか | リスク管理の責任者 |
| デフォルトの定義と観測期間 | 第2章で決めた定義を使う(本章の例題は月単位なので、延滞の期間が3か月に達することで代用した) | 事業の責任者とリスク管理の責任者 |
| 評価データの切り方 | 申込の月で切る。学習の期間・評価の期間と、観測期間を満たす最後の申込の月 | データ分析の担当 |
| ばらつきの示し方 | 評価のデフォルトの件数と、差の区間を必ず添える | データ分析の担当 |
| 合格の基準 | 今のモデルや審査の基準に対して、同じ集団・同じ期間で、差の区間がどうなれば入れ替えるか | 経営とリスク管理の責任者 |
この表の中で経営が直接関わるべきなのは、合格の基準です。新しいモデルが今のモデルより「どれだけ良ければ」入れ替えるのかを、数字を見る前に決めておかないと、良く見える数字が出たときに、その測り方を確かめないまま採用することになりがちです。また、評価の仕組み(評価用のデータの切り出し・指標の計算・今のモデルとの比較を毎回同じ手順で回す仕組み)を作る手間は、モデルの開発とは別に予算と体制に入れておく必要があります。AR値・承認率・デフォルト率は、どれも管理の指標です。KPIの表では、これらを成果の指標(承認した契約から得た収益と貸し倒れの損失の差。実績として測れる)につながる途中の指標として置き、断った申込の機会損失は推定として横に並べて判断のときに合わせて見ます。そのうえで、AR値の改善そのものを目標にしないことが大切だと考えています。成果のKPIへの分解は第13章で扱います。
この章のまとめ
この章では、順位づけの指標(ROC曲線とAUC、CAP曲線とAR値、KS値、スコアの帯ごとのデフォルト率)と、評価する集団・切り方・観測期間・件数によって数字がどう動くかを扱いました。本コラムの架空データでは、時間で切った評価でモデルAのAR値は0.426、モデルBは0.523でしたが、同じモデルBをスコアの上位60%だけを残した集団(承認した契約の集団を模したもの)で測ると0.296まで下がり、無作為に切ると0.566と高く出ました。デフォルトが78件の1か月分だけで評価すると、2つのモデルの差の区間は0をまたぎました。AR値は、集団と期間と切り方を添えて初めて読める管理の指標であり、評価の指標と切り方は、モデルを選ぶ前に決めておく必要があります。次の第8章では、この章では扱わなかったもう1つの問い、モデルの出すデフォルト確率が実績と合っているかという確率の較正を扱います。
この章を深めたい方への参考書籍
『AI審査モデルの基礎知識 モデルのしくみと信用リスク管理』(尾木研三 著、金融財政事情研究会):中小企業向けの融資を題材に、審査のモデルのしくみと信用リスク管理を解説した入門書です。国立国会図書館サーチに載っている目次によれば、モデルの評価と検証の方法の節で、AR値による序列性の検証、デフォルト確率の一致性の検証、学習に使ったデータと使っていないデータでの検証、複数のモデルの比較検証を扱っています。この章で扱った順位づけの指標を、信用リスク管理の実務の流れの中で確かめるのに向いています。
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):機械学習の評価指標を、事業の KPI とのつながりから解説した本です。版元の目次によれば、第3章「二値分類における評価指標」で混同行列・ROC-AUC・PR-AUC などを扱い、ビジネスインパクトの期待値計算の節もあります。第1章には、評価指標と KPI の関係や、評価指標の決め方を間違えないための節があります。与信の本ではありませんが、この章で扱った ROC 曲線と AUC の読み方と、指標を事業の目的につなげる考え方を確かめるのに向いています。
第8章 デフォルト確率の見積り、確率の較正と格付の区分
第7章では、モデルが契約をデフォルトしやすい順に並べられているかを、AR値やKS値で測る方法と、評価に使うデータの切り方を扱いました。そこで測ったのは順位づけの成績で、モデルの出す数字がデフォルト確率としてどれだけ正しいかは、別の問題として残していました。この章では、その残りの問題である、デフォルト確率の見積りの正しさを扱います。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の契約の記録を使い、実行したコードと結果で確かめます。
- 順位が正しくても確率が合っているとは限らないことと、確率が要る場面
- 見積りと実績を確率の帯ごとに並べる信頼性の図と、ブライアスコア
- 較正の方法(事前確率の補正・切片の調整・プラットの方法・等調回帰)と、較正に使うデータと確かめるデータを分けること
- スコアの帯を格付の区分にまとめる方法と、区分ごとの較正の確認
- 景気の変化とデフォルト確率、ある時点の見積りと景気の循環を通じた見積り
- デフォルトの件数が少ない区分での見積りと、デフォルト時の損失の割合・残高、会計上の引当との関係の入口
この章の主張は、順位が正しくても確率が合っているとは限らない、という点です。本コラムの架空データでは、正常の契約を間引いて学習したモデルが、デフォルト確率の平均を実績のおよそ3倍に見積もりました。事前確率の補正などで確率を調整しても、AR値は調整の前と同じ0.487のままでした(等調回帰だけは0.485)。また、較正したあとのモデルも、景気の悪い年には、確率の平均を実績の6割ほどに低く見積もりました。確率の見積りは一度合わせれば済むものではなく、誰がどの頻度で較正の確認を行うかを決めて運用するものだと考えています。
順位と確率は別のもの、確率が要る場面
第7章で扱ったAR値は、デフォルトした契約に、正常だった契約より高いデフォルト確率を付けられているかという、並び方だけを見る指標です。例えば、すべての契約のデフォルト確率が0.5以下のモデルなら、確率をすべて2倍にしても(1を超える値は出ません)、すべて半分にしても、並び方は変わらないので、AR値は同じ値になります。しかし、確率として読むと、2倍にしたモデルはデフォルトの件数を2倍に見積もり、半分にしたモデルは半分に見積もります。順位づけの成績が同じでも、確率の見積りとしての正しさはまったく違いうる、ということです。
デフォルト確率は、英語の略で PD とも書き、本章のコードの出力や図でも「平均PD」のように使います。ここでいう確率の正しさは、モデルが「デフォルト確率5%」と見積もった契約を多数集めたとき、そのうち実際にデフォルトした契約の割合(デフォルト率)がおよそ5%になっているか、という意味です。1件の契約について確率が正しかったかどうかは、その契約がデフォルトしたかしなかったかの結果からは分かりません。確率の正しさは、同じくらいの確率を付けた契約の集まりで、見積りの平均と実績の割合を比べて初めて確かめられます。
モデルの出力を、対象の集団と観測期間に対応したデフォルト確率として読めるように対応づけ、必要に応じて調整することを、確率の較正(以下、較正)と呼びます。合っているかを確かめる作業は「較正の確認」と呼んで区別します。運用の順序としては、まず確率が実績と合っているかを確かめ(較正の確認)、ずれていれば調整し(較正)、調整したら、調整に使っていないデータで確かめ直します。確かめた結果、ずれが偶然の範囲に収まっていれば、調整しないという判断もあります。較正の確認は、較正に使っていないデータで、全体と確率の帯ごとに行います。有限の件数のデータでは、確率が正しくても偶然のずれが出るので、見積りと実績の完全な一致を求めるものではありません。どの程度のずれまでを偶然とみなすかは、後の節で区間と検定を使って見ます。
カットオフを決めるだけなら、順位さえ正しければ足りる場面もあります。承認率を目標の値にするなら、スコアの上から順に承認の候補とすればよく(最終の判断は、返済の能力の調査など法令上の条件と、その他の審査の基準を合わせて決まります)、確率の水準は使いません。確率の水準そのものが要るのは、次のような場面です。
| 確率が要る場面 | 確率をどう使うか | 確率がずれていると起きること |
|---|---|---|
| 貸し倒れの見積り | 契約ごとのデフォルト確率を足し合わせて、デフォルトの件数を見積もる。損失の見積りでは、デフォルト時の損失の割合と残高を掛ける | 低く見積もると、貸し倒れが計画を超える。高く見積もると、資金や体制を必要以上に確保する |
| 収益と損失の見積りによるカットオフ(第9章) | 正常な契約の収益と、デフォルトした契約の損失を、確率で重み付けて比べる | 確率が高すぎると、収益が見込める申込まで断る(機会損失)。低すぎると、損失の出る申込まで承認する |
| 金利の水準や与信枠の設定 | 確率の段階に応じて、条件を変える(法令の上限の範囲で) | 条件と実際の損失の大きさがかみ合わず、ある層では採算が合わず、別の層では条件が厳しすぎる |
| 格付の区分と管理 | 区分ごとにデフォルト確率を割り当て、区分の構成の変化を管理に使う | 区分の構成が変わっても、損失の見込みの変化を正しく読めない |
| 自己資本や引当の計算(規制・会計) | デフォルト確率を計算の入力の1つに使う(詳細は第14章と、この章の最後の節) | 計算の前提が実績と合わず、監督や監査の場で説明がつかない |
この表の多くの場面では、確率は1件ずつの判定ではなく、多数の契約の合計や平均として使われます。そのため、確率の正しさも、集団の単位で確かめるものになります。第1章で扱った期待損失は、デフォルト確率 × デフォルト時の損失の割合 × デフォルト時の残高、という掛け算で考えます。デフォルト確率がずれていれば、ほかの2つが正しくても期待損失はずれます。逆に、デフォルト確率だけでは損失の大きさは決まりません。
確率がずれる理由は、大きく3つに分けられます。1つ目は、学習のときの標本の取り方です。デフォルトの件数が少ないので、正常の契約を間引いてデフォルトの割合を高めた標本で学習することがあり、その場合はモデルの出す確率が全体に高く出ます。2つ目は、モデルの性質です。決定木を多数組み合わせる手法などでは、確率の端の方が実績より極端に出たり、逆に真ん中に寄ったりすることがあります。3つ目は、使う場面の変化です。学習した時期と使う時期で景気や申込者の層が違えば、学習のときに合っていた確率も合わなくなります。1つ目と2つ目は較正で直せることが多く、3つ目は監視と見直しの対象になります(第12章)。
架空の契約の記録で確かめる、順位は合っていても確率がずれる
ここからは、確率のずれと較正の効果を、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の契約の記録よりずっと単純です。合成データでの成績は、実際の与信の成績の目安にはなりません。示したいのは、同じデータ・同じモデルでも、確率の見方によって何が分かり何が分からないかという点です。申込の月が0〜35か月目の36か月にわたり、毎月1,000件、合わせて36,000件の契約を、次の性質を持たせて乱数で作りました(乱数の種は20261113に固定しています)。実行した環境は Python 3.14.3、numpy 2.4.3、pandas 3.0.1、scikit-learn 1.9.0、scipy 1.16.3 で、図は matplotlib 3.10.8 と、日本語の表示のための japanize-matplotlib 1.1.3 で描きました。
- 申込者の属性:年収の水準(全体の中央値をおよそ1とする相対値)・勤続年数・居住の年数・雇用の形態(AからCの3種類)・貸付の額と年収の水準の比
- 信用情報にあたる項目:他社の借入の件数・過去の延滞の有無・直近6か月の申込の件数
- 項目とデフォルトの関係:年収の水準が高いほど・勤続年数が長いほどデフォルトしにくい。居住の年数は、短すぎても長すぎてもデフォルトしやすい単調でない関係。他社の借入の件数は、過去の延滞がある場合にとくに強く効く組み合わせの関係
- 景気:24か月目からの1年を景気の悪い年とし、すべての契約のデフォルトのしやすさを同じ幅だけ高める。景気の情報はモデルの入力に入れない
デフォルトは、第2章の定義(契約の実行から12か月以内に、延滞が90日以上に達すること)に当たる結果を、乱数で直接作りました。コードの中のコメントも同じ定義で書いています。月ごとの返済の記録は作っていません。また、ここではすべての契約の観測期間が満了し、結果が確定した時点で分析しているものとします。否決した申込は扱わず、承認した申込はすべて契約され実行されたものとして単純化しています(否決した申込の扱いは第6章)。合成データなので、各契約の真のデフォルト確率も分かります。実際のデータでは真の確率は分からず、ここでは見積りの正しさを確かめるための比較の基準として使います。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N_MONTH, PER_MONTH = 36, 1000
n = N_MONTH * PER_MONTH
df = pd.DataFrame({
    "month": np.repeat(np.arange(N_MONTH), PER_MONTH),      # 申込の月(0〜35)
    "income": rng.lognormal(0.0, 0.45, n),                  # 年収の水準(相対値)
    "tenure": rng.gamma(2.0, 3.0, n),                       # 勤続年数
    "resid": rng.gamma(1.5, 4.0, n),                        # 居住の年数
    "emp": rng.choice(3, n, p=[0.6, 0.3, 0.1]),             # 雇用の形態(0=A, 1=B, 2=C)
    "loans": rng.poisson(1.2, n),                           # 他社の借入の件数
    "late_past": (rng.random(n) < 0.12).astype(int),        # 過去の延滞の有無
    "apps": rng.poisson(0.8, n)})                           # 直近6か月の申込の件数
df["ratio"] = rng.uniform(0.1, 0.5, n)                      # 貸付の額と年収の水準の比
bad_year = (df.month >= 24).astype(int)                     # 24か月目からの1年は景気が悪い
logit = (-4.6 -0.9 * np.log(df.income) - 0.06 * df.tenure
         + 0.5 * (np.log1p(df.resid) - 1.6) ** 2           # 居住の年数は単調でない関係
         + np.array([0.0, 0.35, 0.7])[df.emp] + 0.22 * df.loans
         + 0.9 * df.late_past + 0.35 * df.loans * df.late_past   # 組み合わせで効く関係
         + 0.25 * df.apps + 1.5 * df.ratio + 0.6 * bad_year)
df["true_pd"] = 1 / (1 + np.exp(-logit))                   # 合成データなので分かる真の確率
df["default"] = (rng.random(n) < df.true_pd).astype(int)   # 12か月以内に延滞が90日以上(第2章の定義)
print("契約", len(df), "件/デフォルト率", round(df.default.mean() * 100, 2), "%")
print(df.assign(year=df.month // 12).groupby("year").default.mean().mul(100).round(2))
実行した結果、契約は36,000件で、全体のデフォルト率(全36,000件のうちデフォルトした件数の割合)は4.99%でした。申込の年ごとに見ると、0〜11か月目の1年目が3.92%、12〜23か月目の2年目が4.16%、24〜35か月目の景気の悪い3年目が6.90%です。本文では、デフォルト率とデフォルト確率を、表と合わせて0.0430のような小数で書く箇所が多くあります。0.0430は4.30%と同じ値です。デフォルト率の水準は商品によって大きく違い、無担保の消費者向けの貸付と、担保のある貸付、企業間の掛け売りとでは桁が違うこともあります。この例題の水準は説明のために置いたものです。
このデータで、まず確率がずれたモデルを作ります。データは申込の月で3つに分けました。0〜11か月目を学習用、12〜17か月目を較正用、18〜23か月目を確かめる用(較正の確認に使うデータ)とします。較正用と確かめる用を分けたのは、同じデータで直して同じデータで確かめると、直した効果を実際より良く見積もるおそれがあるためです。景気の悪い24〜35か月目は、後の節まで使いません。この分け方は、全件の結果が確定した後で時期の前後を比べる事後的な分け方で、運用の再現ではありません。実際の運用では、例えば18か月目の時点で、12〜17か月目の申込の12か月の結果はまだ確定していません。また、この例題では申込の月と契約の実行の月を同じとみなしています。
学習用のデータは、デフォルトの契約はすべて残し、正常の契約は4件に1件だけを無作為に残す標本の取り方にしました。デフォルトの件数が少ないときに学習の効率を上げるため、このように正常の側を間引く方法が使われることがあります。モデルには、勾配ブースティング(決定木を多数組み合わせる手法。第5章)の scikit-learn の HistGradientBoostingClassifier を使い、8つの項目を入力にしました。評価には、順位づけの成績としてAR値(第7章)を、確率の正しさとして、デフォルト確率の平均と実績のデフォルト率の比較、ブライアスコア、対数損失を並べます。
ブライアスコアは、契約ごとに、見積りのデフォルト確率と、実際の結果(デフォルトなら1、正常なら0)の差を2乗し、全件で平均した値です。式で書くと \( \frac{1}{N}\sum_{i}(p_i – y_i)^2 \) で、\(p_i\) は契約 i の見積りの確率、\(y_i\) は結果です。値が小さいほど、見積りが結果に近いことを表します。気象の確率予報の検証のために Brier が1950年に提案したものです。対数損失は、実際に起きた結果に付けていた確率(デフォルトした契約ならデフォルト確率、正常だった契約なら1からデフォルト確率を引いた値)の対数を全件で平均し、符号を反転した値です。起きた結果に低い確率を付けていた契約ほど、大きく効きます。どちらも小さいほど良い指標です。
ただし、ブライアスコアも対数損失も、確率の正しさ(較正)だけでなく、順位づけの成績の影響も受けます。scikit-learn の説明書きも、ブライアスコアが低いことが、較正が良いことを必ずしも意味しないと注意しています。そのため、本コラムでは、ブライアスコアを確率の帯ごとの比較(信頼性の図)と並べて読みます。
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score, brier_score_loss, log_loss

FEATS = ["income", "tenure", "resid", "emp", "loans", "late_past", "apps", "ratio"]
tr = df[df.month < 12]                                     # 学習用:0〜11か月目
ca = df[(df.month >= 12) & (df.month < 18)]               # 較正用:12〜17か月目
te = df[(df.month >= 18) & (df.month < 24)]               # 確かめる用:18〜23か月目
R = 0.25                                                    # 正常の契約を4件に1件だけ学習に使う
keep = (tr.default == 1) | (np.random.default_rng(1).random(len(tr)) < R)
tr_s = tr[keep]
model = HistGradientBoostingClassifier(max_iter=200, learning_rate=0.05,
                                       max_leaf_nodes=15, random_state=0)
model.fit(tr_s[FEATS], tr_s.default)
pd_raw = lambda x: model.predict_proba(x[FEATS])[:, 1]

def report(name, y, p):                                     # 順位と確率の両方を見る
    ar = 2 * roc_auc_score(y, p) - 1
    print(f"{name:10s} AR値 {ar:.3f} 平均PD {p.mean():.4f} 実績 {y.mean():.4f}"
          f" ブライア {brier_score_loss(y, p):.5f} 対数損失 {log_loss(y, p):.4f}")

print("学習に使った契約", len(tr_s), "件/その中のデフォルト率", round(tr_s.default.mean(), 4))
report("較正前", te.default, pd_raw(te))
report("真の確率", te.default, te.true_pd.to_numpy())
学習に使った契約は、間引いた後で3,334件、その中のデフォルトの割合は14.1%でした。確かめる用のデータ(18〜23か月目の6,000件)での結果は次のとおりです。
| 見積り | AR値 | デフォルト確率の平均 | 実績のデフォルト率 | ブライアスコア | 対数損失 |
|---|---|---|---|---|---|
| 較正前のモデル | 0.487 | 0.1283 | 0.0430 | 0.05338 | 0.2093 |
| 参考:真のデフォルト確率 | 0.551 | 0.0435 | 0.0430 | 0.03794 | 0.1532 |
較正前のモデルは、確かめる用のデータで、デフォルト確率の平均を0.1283と見積もりました。実績のデフォルト率は0.0430なので、およそ3倍の見積りです。正常の契約を4件に1件に間引いたことで、学習用の標本のデフォルトの割合(14.1%)が実際(4%前後)より高くなり、モデルはその高い割合に合わせた確率を出すようになったと考えられます。一方、AR値は0.487で、順位づけの成績としては一定の水準があります。このモデルを順位だけで使う場面(スコアの上から決まった割合を承認の候補とする場面)なら、確率の水準のずれは結果に影響しません。しかし、デフォルトの件数の見積りに使うと、実際のおよそ3倍の件数を見込むことになります。
参考に置いた真のデフォルト確率は、合成データなので分かる値で、実際のデータでは分かりません。真の確率でも、AR値は0.551、ブライアスコアは0.03794です。真の確率を知っていても、個々の契約がデフォルトするかどうかは偶然で決まるので、ブライアスコアは0にはなりません。真の確率のブライアスコアは、このデータで見積りが到達できるおよその下限の目安になります。
次に、確率の帯ごとに見積りと実績を並べます。見積りのデフォルト確率で契約を帯に分け、帯ごとに、見積りの平均と、実際にデフォルトした割合を比べる方法で、横軸に見積り、縦軸に実績をとって描いた図を信頼性の図と呼びます。確率が合っていれば、点は左下から右上への対角線の近くに並びます。
def reliability(y, p, edges):                               # 確率の帯ごとに見積りと実績を並べる
    band = pd.cut(p, [0] + edges + [1])
    t = pd.DataFrame({"帯": band, "y": y, "p": p}).groupby("帯", observed=True)
    return t.agg(件数=("y", "size"), 平均PD=("p", "mean"), 実績=("y", "mean")).round(4)

EDGES = [0.02, 0.04, 0.08, 0.15, 0.3]
print(reliability(te.default.to_numpy(), pd_raw(te), EDGES))
| 見積りの確率の帯 | 件数 | 見積りの平均 | 実績のデフォルト率 |
|---|---|---|---|
| 0.02以下 | 209件 | 0.0141 | 0.0239 |
| 0.02を超え0.04以下 | 927件 | 0.0312 | 0.0119 |
| 0.04を超え0.08以下 | 1,916件 | 0.0579 | 0.0172 |
| 0.08を超え0.15以下 | 1,438件 | 0.1099 | 0.0355 |
| 0.15を超え0.3以下 | 937件 | 0.2102 | 0.0704 |
| 0.3を超える | 573件 | 0.4744 | 0.1606 |
較正前のモデルでは、見積りが0.02以下の帯を除くすべての帯で、実績のデフォルト率が見積りの3分の1前後にとどまりました。見積りが0.3を超える帯(573件)では、見積りの平均0.4744に対して実績は0.1606です。帯の並びで見ると、見積りが高い帯ほど実績も高くなっていて、順位はおおむね保たれています(0.02以下の帯と次の帯では逆転していますが、0.02以下の帯は209件と少なく、デフォルトは5件です)。順位が保たれたまま、確率の水準だけがずれている状態です。
較正の方法、事前確率の補正・切片の調整・プラットの方法・等調回帰
較正の方法には、モデルの出す確率をあとから変換する方法がいくつかあります。本コラムでは、次の4つを比べました。どの方法も、本例では確率の大小の順序を変えない変換(等調回帰は同じ値にまとめることがある)なので、順位づけの成績はほとんど変わりません。プラットの方法は、当てはめた傾きが正のときに順序を保ちます。本例の傾きは正でした(後の結果を参照)。
表に出てくる対数オッズを先に説明します。デフォルト確率 \(p\) に対して、デフォルトと正常の起こりやすさの比 \(p/(1-p)\) をオッズと呼び、その自然対数 \( \ln\frac{p}{1-p} \) を対数オッズと呼びます。確率は0から1の間の値ですが、対数オッズは負の大きな値から正の大きな値までをとり、確率0.5が0にあたります。対数オッズに一定の値を足すと、確率の大小の順序を保ったまま、全体の水準を上げ下げできます。ロジスティック回帰は、この対数オッズを項目の足し算で表すモデルです(第4章)。
| 方法 | 何をするか | 要るもの | 直せるずれ | 注意 |
|---|---|---|---|---|
| 事前確率の補正 | 標本の取り方で変わったデフォルトの割合を、計算で元に戻す | 標本の取り方(正常を何件に1件残したか)。追加の較正用のデータは要らない | 標本の取り方による全体の水準のずれ | 標本の取り方以外の原因によるずれ(学習の標本での確率の見積りの誤り・抽出以外の分布の変化)は直らない |
| 切片の調整 | 対数オッズを一定の幅だけ平行に動かし、確率の平均を実績に合わせる | 較正用のデータ(結果の確定したもの) | 全体の水準のずれ | 帯ごとの形のずれ(端が極端すぎるなど)は直らない |
| プラットの方法 | 対数オッズに傾きと切片を当てはめ直す(ロジスティック回帰を1つの入力で行う) | 較正用のデータ | 水準のずれと、確率の広がりすぎ・狭すぎ | ずれの形がこの変換で表せない場合は直りきらない |
| 等調回帰 | 確率の順序を保つ階段状の関数を当てはめる(scikit-learn の実装では、境目と境目の間を直線でつなぐ) | 較正用のデータ(多めに要る) | 順序を保つ範囲のあらゆる形のずれ | 件数が少ないと階段が較正用のデータに合いすぎる。同じ確率の契約がまとまり、順位が少し変わる |
事前確率の補正は、標本の取り方が分かっている場合に使える方法です。正常の契約を割合 \(R\) で残した標本では、デフォルトと正常の件数の比(オッズ)が、元の集団の \(1/R\) 倍になります。そこで、モデルの出した確率 \(q\) のオッズに \(R\) を掛けて元に戻します。式で書くと \( \frac{p}{1-p} = R \times \frac{q}{1-q} \) で、言い換えると、対数オッズに \(\log R\) を足すことになります。この例題では \(R\) は4分の1です。学習のときと使う場面で各結果の割合(事前確率)が違うときに、分類器の出力を調整する考え方は、Saerens らの2002年の論文(新しい事前確率に合わせて分類器の出力を調整する簡単な手順を示したもの)などで扱われています。
プラットの方法と等調回帰のどちらが向くかは、較正用のデータの件数で変わります。scikit-learn の説明書きは、プラットの方法は較正用のデータが少ないときに効きやすいと説明しています。等調回帰については、より自由な形のずれを直せる一方で、データが少ないと過学習しやすく、おおよそ1,000件を超えるデータがあるときにプラットの方法と同等以上になる、と説明しています。この件数は説明書きでも目安として書かれているもので、厳密な境目ではありません。また、全体の件数の目安なので、この例題の較正用のデータのように、6,000件のうちデフォルトが241件しかない場合にどう当てはまるかは、別に考える必要があります。
それぞれの方法の出典は次のとおりです。プラットの方法は、Platt が1999年に、サポートベクターマシンの出力を確率に直す方法として示したもので、モデルの出力に1つの入力のロジスティック回帰を当てはめ直します。等調回帰による較正は、Zadrozny と Elkan の2002年の論文(分類器のスコアを正確な確率の見積りに変換する方法を論じたもの。第8回の知識発見とデータマイニングの国際会議の予稿集、694〜699ページ)で扱われた方法です。Niculescu-Mizil と Caruana の2005年の論文(教師あり学習で良い確率を予測することを論じたもの。第22回機械学習国際会議の予稿集、625〜632ページ)は、いくつかの学習手法の確率のずれ方と、この2つの方法の効き方を比べています。
次のコードでは、事前確率の補正はデータを使わずに計算し、切片の調整・プラットの方法・等調回帰は較正用のデータ(12〜17か月目の6,000件)だけで当てはめました。効果は、当てはめに使っていない確かめる用のデータ(18〜23か月目)で確かめます。
from scipy.optimize import brentq
from sklearn.linear_model import LogisticRegression
from sklearn.isotonic import IsotonicRegression

lg = lambda p: np.log(p / (1 - p))                          # 確率を対数オッズに直す
sg = lambda z: 1 / (1 + np.exp(-z))                         # 対数オッズを確率に直す
y_ca, z_ca = ca.default.to_numpy(), lg(pd_raw(ca))
z_te = lg(pd_raw(te))
# (1) 事前確率の補正:標本の取り方が分かっていれば、データを使わずに直せる
prior = lambda z: sg(z + np.log(R))
# (2) 切片の調整:較正用データの平均が実績に合うように対数オッズを平行に動かす
c = brentq(lambda c: sg(z_ca + c).mean() - y_ca.mean(), -10, 10)
shift = lambda z: sg(z + c)
# (3) プラットの方法:対数オッズに傾きと切片を当てはめ直す
platt_m = LogisticRegression(C=1e6).fit(z_ca.reshape(-1, 1), y_ca)
platt = lambda z: platt_m.predict_proba(z.reshape(-1, 1))[:, 1]
# (4) 等調回帰:順序を保つ階段状の関数を当てはめる(境目の間は直線でつなぐ)
iso_m = IsotonicRegression(y_min=1e-4, y_max=1 - 1e-4, out_of_bounds="clip").fit(z_ca, y_ca)
iso = lambda z: iso_m.predict(z)
print("切片の調整の量", round(c, 3), "/log(R)", round(np.log(R), 3),
      "/プラットの傾き", round(platt_m.coef_[0, 0], 3), "切片", round(platt_m.intercept_[0], 3))
y_te = te.default.to_numpy()
for name, f in [("事前確率", prior), ("切片調整", shift), ("プラット", platt), ("等調回帰", iso)]:
    report(name, y_te, f(z_te))
print("等調回帰の階段の境目の数", len(iso_m.X_thresholds_), "/確かめる用での予測確率の種類", len(np.unique(iso(z_te))))
print(reliability(y_te, platt(z_te), EDGES))
較正用のデータで求めた切片の調整の量は -1.333 で、事前確率の補正で足す \(\log R\)(-1.386)に近い値でした。プラットの方法の傾きは0.631、切片は -1.888 です。傾きが1より小さいので、較正前のモデルの対数オッズの広がりを狭める方向の変換になっています。確かめる用のデータでの結果を、較正前と並べて次の表にまとめます。
| 見積り | AR値 | デフォルト確率の平均 | 実績のデフォルト率 | ブライアスコア | 対数損失 |
|---|---|---|---|---|---|
| 較正前 | 0.487 | 0.1283 | 0.0430 | 0.05338 | 0.2093 |
| 事前確率の補正 | 0.487 | 0.0426 | 0.0430 | 0.03865 | 0.1595 |
| 切片の調整 | 0.487 | 0.0446 | 0.0430 | 0.03872 | 0.1595 |
| プラットの方法 | 0.487 | 0.0426 | 0.0430 | 0.03874 | 0.1591 |
| 等調回帰 | 0.485 | 0.0432 | 0.0430 | 0.03858 | 0.1587 |
| 参考:真のデフォルト確率 | 0.551 | 0.0435 | 0.0430 | 0.03794 | 0.1532 |
4つの方法のどれでも、デフォルト確率の平均は実績の0.0430に近づき(0.0426〜0.0446)、ブライアスコアは0.05338から0.0386〜0.0387へ下がりました。この架空データでは、ずれの大部分は標本の取り方による全体の水準のずれだったので、データを使わない事前確率の補正でも、較正用のデータを使う3つの方法とほぼ同じ結果になりました。4つの方法の間の違いは、ブライアスコアで0.0002未満で、較正前からの改善の幅(約0.015)に比べてごく小さい差です。この差の大きさでは、どの方法が優れているとは言えません。
AR値は、事前確率の補正・切片の調整・プラットの方法では0.487のまま変わりませんでした。等調回帰では0.485とわずかに下がりました。較正用のデータで当てはめた等調回帰の関数の境目は36点で、確かめる用のデータ6,000件での予測確率は32種類の値にまとまりました。同じ値になった契約の間では順位の細かい違いが失われるので、そのためと考えられます。scikit-learn の説明書きにも、等調回帰は同じ値の確率を作るのでAUCが変わりうると書かれています。
また、較正したあとでも、ブライアスコアは真のデフォルト確率の0.03794には届きません。残った差には、較正では直せない順位づけの成績の差(AR値0.487と0.551の差)のほか、較正後も残った確率のずれ(後で見る端の帯のずれなど)や、標本の偶然の揺れが関係していると考えられ、この比較だけではそれぞれの寄与を分けられません。較正は、モデルの出す確率の水準と形を直すもので、モデルが見分けられなかった違いを見分けられるようにするものではありません。順位づけの成績を上げるには、項目や手法の見直し(第3章から第5章)が要ります。
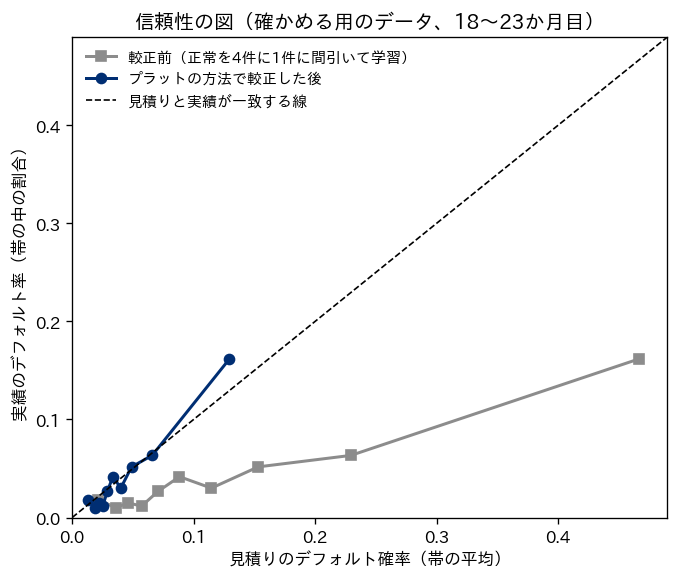
上の図は、確かめる用のデータで、較正前(灰色)とプラットの方法で較正した後(ネイビー)の信頼性の図を描いたものです。この図では、それぞれのモデルの確率で契約を10等分(各600件)して帯を作りました。較正前の点は対角線より大きく右下にあり、最も確率の高い帯では、見積りの平均0.4664に対して実績は0.1617でした。較正した後の点は対角線の近くに並びましたが、最も確率の高い帯では、見積りの平均0.1294に対して実績は0.1617で、実績の方が高く出ています。最も確率の低い帯でも、見積り0.0133に対して実績0.0183でした。各帯のデフォルトは数件から100件程度なので、この程度のずれには偶然の揺れが含まれます。
較正したあとの帯ごとの表(0.02、0.04、0.08、0.15、0.3で区切った帯)でも、見積りが0.15を超え0.3以下の帯(141件)は見積りの平均0.1964に対して実績0.2695、0.3を超える帯(8件のうちデフォルト5件)は0.3496に対して0.6250でした。この架空データでは、確率の高い端の帯で見積りが実績を下回りました。ただし、端の帯は件数が少なく、とくに0.3を超える帯は8件しかないので、このずれが偶然によるものか、較正の方法で直しきれない系統的なずれかは、この結果だけでは区別がつきません。原因も確かめていません。プラットの方法の傾きは較正用のデータ全体に合わせて決まるので、件数の多い確率の低い側に強く合わせられ、件数の少ない端のずれが残ることがありうる、と考えられます。端の契約の扱い(与信枠を小さくする、人の確認へ回すなど)を確率で決めている場合は、端の帯での較正の確認を、件数を積み増しながら別に行う必要があります。
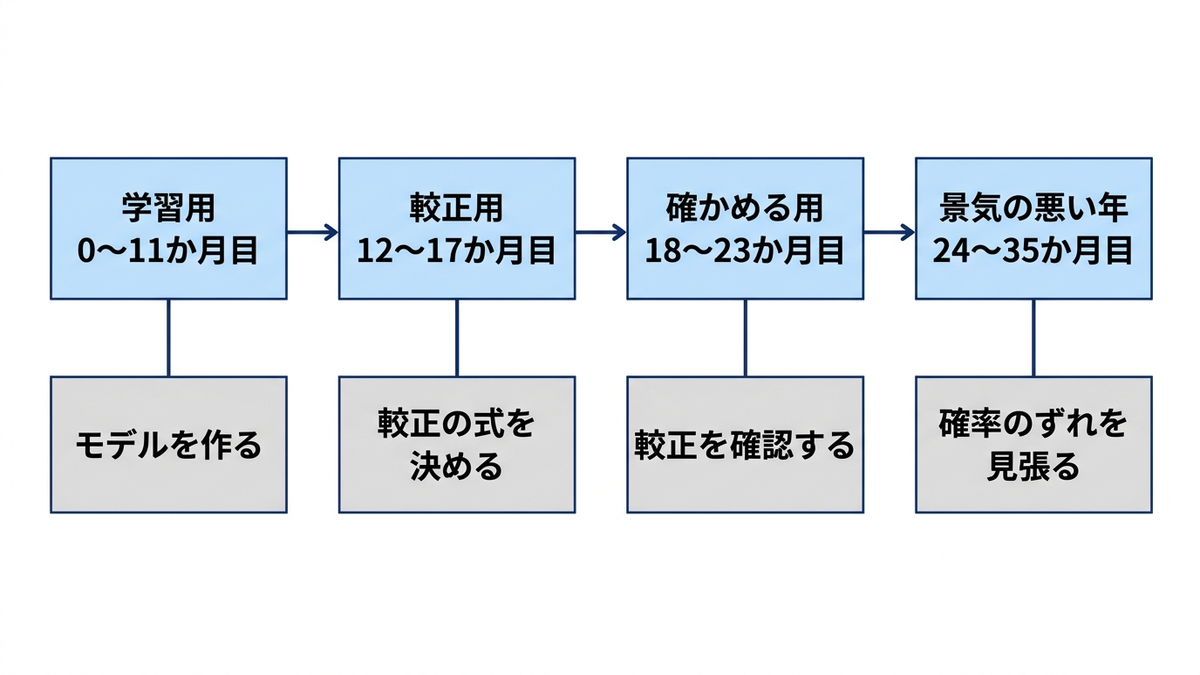
格付の区分にまとめる、区分ごとの較正の確認
契約ごとのデフォルト確率は細かい連続の値ですが、審査や管理の場では、いくつかの段階にまとめて使うことが多くあります。デフォルト確率の範囲で契約をいくつかの段階に分け、段階ごとに1つのデフォルト確率を割り当てたものを、本コラムでは格付の区分と呼びます。区分にまとめると、与信枠や条件を区分ごとに決められ、区分ごとの件数の変化を管理の指標にでき、区分ごとに見積りと実績を比べる較正の確認もしやすくなります。この節で行う区分ごとの比べ方は、前の節の確率の帯ごとの較正の確認を、格付の区分の単位で行うものです。なお、本章の格付の区分は、第3章・第4章でスコアカードの項目を分けた「区分」とは別のもので、番号が大きいほどデフォルト確率が高い向きにしています。スコアは大きいほどデフォルト確率が低い向きなので、向きが逆になる点に注意してください。格付の区分を作るときに決めることを、次の表にまとめます。
| 決めること | 考え方 | 注意 |
|---|---|---|
| 区分の数 | 与信枠や条件を変えたい段階の数と、区分ごとの件数のつり合いで決める | 多すぎると区分ごとのデフォルトの件数が少なくなり、実績が偶然で大きく揺れる。少なすぎると、確率の違う契約が同じ区分に入る |
| 区分の境目 | デフォルト確率の範囲で決める(例:1.5%以下、1.5%を超え2.5%以下…) | 境目を評価用のデータを見ながら動かすと、評価用のデータに合いすぎる。境目は学習用・較正用のデータで決めて固定する |
| 区分のデフォルト確率 | 区分に入った契約の確率の平均を使う方法と、区分の過去のデフォルト率を使う方法がある | どちらを使うかで、景気によって値が動くかどうかが変わる(次の節) |
| 区分の並び | 区分の番号が大きいほどデフォルト率が高い、という並びが実績でも保たれているかを見る | 並びが逆転した区分は、件数が少ないための偶然か、境目の置き方の問題かを確かめる |
| 区分の中の件数 | 区分ごとに、較正の確認に使えるだけのデフォルトの件数が集まるかを見る | 件数の少ない区分は、隣の区分と統合するか、区間を付けて保守的に読む(後の節) |
次のコードでは、プラットの方法で較正した確率を使い、上限を1.5%・2.5%・4%・6.5%・10%・16%・100%とする7つの区分を作りました。区分1が最もデフォルト確率の低い区分です。境目は、区分ごとにある程度の件数が入るように置いた説明のためのもので、実務での区分の数や境目の目安ではありません。区分のデフォルト確率には、表の2つの方法のうち、区分に入った契約の確率の平均を使いました。区分ごとに、件数、区分の平均のデフォルト確率、実際のデフォルトの件数と率、実績から推定したデフォルト確率の95%信頼区間、二項検定のp値を出しました。
二項検定は、区分の契約のデフォルトが互いに独立に、区分の平均のデフォルト確率で起きると仮定したとき、実際のデフォルトの件数がどのくらい起こりにくい値かを、二項分布で計算するものです。p値は、見積りが正しいと仮定したときに、実際と同じかそれ以上に見込みから離れた件数が偶然に出る確率です。p値が小さい(例えば0.05未満)ほど、見積りと実績のずれが偶然だけでは説明しにくいことを表します。あらかじめ決めた基準(例えば0.05)をp値が下回ったときに「見積りが合っていない」と判断することを、検定の言葉で「棄却する」と呼び、その基準を名目の水準と呼びます。
p値が大きいことは、見積りが正しいことの証拠ではありません。件数が少ないと、見積りにずれがあっても、偶然の揺れと見分けられないためです。表の「95%信頼区間」は、観測した件数から推定した、その区分のデフォルト確率の95%信頼区間です(観測した実績の率そのものは件数から1つに決まります)。ここでは scipy の binomtest の正確な区間(二項分布から直接求める区間)を使いました。
名目の水準を0.05にすると、見積りが正しく、デフォルトが互いに独立なら、偶然に棄却する確率は5%以下になります。ちょうど5%にならないのは、件数が整数で、取りうる値が飛び飛びになるためです。本コラムで計算すると、下の表の7つの区分の件数と見積りでは、実際に偶然に棄却する確率は区分ごとに約2.9%から約4.6%でした。なお、区分の中の契約の確率は1件ずつ違うので、厳密には件数の分布は二項分布ではありません。ここでは、区分の中を区分の平均の確率で共通とみなす簡略化をしています。検定と区間の一般論は、弊社コラム「データから正しく結論を導く統計学のまとめ」で扱っています。
from scipy.stats import binomtest

UPPER = [0.015, 0.025, 0.04, 0.065, 0.10, 0.16, 1.0]         # 格付の区分の上限(1が最も低い確率)
grade = lambda p: np.searchsorted(UPPER, p) + 1

def grade_table(d, p):                                       # 区分ごとの較正の確認
    rows = []
    for g, s in pd.DataFrame({"g": grade(p), "y": d.default.to_numpy(), "p": p}).groupby("g"):
        k, m, pd_g = int(s.y.sum()), len(s), s.p.mean()
        bt = binomtest(k, m, pd_g)
        lo, hi = bt.proportion_ci(confidence_level=0.95)
        rows.append([g, m, round(pd_g, 4), k, round(k / m, 4), round(lo, 4), round(hi, 4),
                     float(f"{bt.pvalue:.2g}")])
    return pd.DataFrame(rows, columns=["区分", "件数", "平均PD", "デフォルト", "実績",
                                       "下限95", "上限95", "p値"])

print(grade_table(te, platt(z_te)).to_string(index=False))
確かめる用のデータ(18〜23か月目の6,000件)での結果は次のとおりです。
| 区分 | 件数 | 見積り(区分の平均のデフォルト確率) | デフォルトの件数 | 実績のデフォルト率 | デフォルト確率の95%信頼区間(実績から推定) | 二項検定のp値 |
|---|---|---|---|---|---|---|
| 1 | 386件 | 0.0119 | 5件 | 0.0130 | 0.0042〜0.0300 | 0.81 |
| 2 | 1,684件 | 0.0203 | 24件 | 0.0143 | 0.0092〜0.0211 | 0.083 |
| 3 | 1,838件 | 0.0315 | 51件 | 0.0277 | 0.0207〜0.0363 | 0.39 |
| 4 | 1,187件 | 0.0499 | 58件 | 0.0489 | 0.0373〜0.0627 | 0.95 |
| 5 | 522件 | 0.0787 | 44件 | 0.0843 | 0.0619〜0.1115 | 0.63 |
| 6 | 256件 | 0.1224 | 38件 | 0.1484 | 0.1072〜0.1980 | 0.21 |
| 7 | 127件 | 0.2134 | 38件 | 0.2992 | 0.2212〜0.3868 | 0.023 |
区分1から区分7まで、実績のデフォルト率は0.0130、0.0143、0.0277、0.0489、0.0843、0.1484、0.2992と、区分の番号の順に高くなりました。区分の並びは実績でも保たれています。区分1から区分6では、見積りが実績から推定した95%信頼区間に入り、二項検定のp値も0.05以上でした。ただし、これは見積りが正しいと確かめられたという意味ではありません。例えば区分1は386件で、見積りから見込まれるデフォルトは約4.6件、実際は5件でした。この件数では、見積りが多少ずれていても見分けられません。区分7だけは、127件で見込みが約27件だったのに対して実際は38件で、実績のデフォルト率は0.2992、p値は0.023でした。前の節の、確率の高い端の帯で見積りが実績を下回った結果と同じ向きです。
ただし、区分7のp値0.023を、そのまま「区分7の見積りは誤り」と読むことはできません。理由は2つあります。1つ目は、検定を7つの区分で繰り返していることです。それぞれの区分で確率が正しい場合でも、各検定の誤って棄却する確率を5%と近似し、7つの検定の結果が互いに独立だと仮定すると、7回検定すれば、どれか1つで偶然にp値が0.05を下回る確率はおよそ3割(1から0.95の7乗を引いた値で約0.30)になります。実際の誤って棄却する確率は上で見たとおり5%より少し低いので、この値は目安です。バーゼル銀行監督委員会の作業文書第14号(2005年5月公表の、内部格付の仕組みの検証に関する研究をまとめた文書。内部格付は、銀行が自前の格付とデフォルト確率の見積りを自己資本の計算に使う仕組みのことで、銀行向けの国際的な規制の枠組みの話です)も、二項検定は1つの区分ごとにしか使えず、20の区分を5%の水準で検定すれば1つは誤って棄却されると見込まなければならない、という趣旨を書いています。2つ目は、二項検定が、契約のデフォルトが互いに独立であることを前提にしていることです。同じ文書は、デフォルトが互いに相関する場合には、正しい見積りを誤って棄却する確率が、検定の名目の水準よりずっと大きくなりうることを、付録の例で示したと述べています。景気のように多くの契約に同時に効く要因があると、デフォルトは互いに相関します。
同じ文書は、複数の区分をまとめて検定するカイ二乗(ホスマー・レメショウ)検定、複数の期間にわたって見る正規検定、信号の色で段階を分ける方法なども検討しています。そのうえで、2005年の公表の時点で、較正の正しさを強い検出力(ずれがあるときにそれを見つける力)で確かめられる検定は無い、という趣旨の結論を書いています。これは2005年の文書の結論で、その後の研究の状況を本コラムで確かめたものではありません。本コラムでは、検定は、見積りと実績のずれに気づくための手がかりの1つとして使い、1回の検定の結果で機械的に見積りを入れ替えない方がよいと考えています。区分7のような結果が出たときは、次の期間でも同じ向きのずれが続くか、ずれの大きさが損失の見込みにとってどのくらい重要かを合わせて見て、再較正(較正をやり直すこと。第12章)するかを判断します。
景気の変化とデフォルト確率、ある時点の見積りと景気の循環を通じた見積り
ここまでは、学習・較正・確かめる用のデータがすべて平常の年でした。次に、同じモデルと同じ較正の式を、景気の悪い24〜35か月目の12,000件に当てはめます。この1年は、データを作るときに、すべての契約のデフォルトのしやすさ(対数オッズ)を同じ幅だけ高めてあります。モデルの入力には景気の情報が無いので、モデルから見ると、同じ属性の申込が、前の年より高い割合でデフォルトするようになったことになります。
st = df[df.month >= 24]                                     # 景気の悪い1年(24〜35か月目)
z_st = lg(pd_raw(st))
report("悪い年", st.default.to_numpy(), platt(z_st))
print(grade_table(st, platt(z_st)).to_string(index=False))
a, b = st[st.month < 30], st[st.month >= 30]                # 前半で直し、後半で確かめる
z_a, z_b = lg(pd_raw(a)), lg(pd_raw(b))
base = lg(platt(z_a))
c2 = brentq(lambda c: sg(base + c).mean() - a.default.mean(), -5, 5)
print("悪い年の前半で求めた切片の追加", round(c2, 3))
report("後半・直す前", b.default.to_numpy(), platt(z_b))
report("後半・直した後", b.default.to_numpy(), sg(lg(platt(z_b)) + c2))
both = df[df.month >= 12].copy()                            # 12〜35か月目(平常1年と悪い年1年)
both["p"] = platt(lg(pd_raw(both)))
both["区分"] = grade(both.p.to_numpy())
both["期間"] = np.where(both.month >= 24, "悪い年", "平常の年")
cyc = both.pivot_table(index="区分", columns="期間", values="default", aggfunc="mean")
cyc["合算した率"] = both.groupby("区分").default.mean()    # 2年分の契約を合わせて数えた率
cyc["年の率の平均"] = cyc[["平常の年", "悪い年"]].mean(axis=1)  # 年ごとの率を等しく平均
print(cyc.round(4))
景気の悪い1年の全体では、デフォルト確率の平均が0.0418だったのに対して、実績のデフォルト率は0.0690でした。見積りは実績の6割ほどです。区分ごとに見ると、すべての区分で実績が見積りを上回り、二項検定のp値はすべて0.00001を下回りました。
| 区分 | 件数 | 見積り(区分の平均のデフォルト確率) | デフォルトの件数 | 実績のデフォルト率 |
|---|---|---|---|---|
| 1 | 761件 | 0.0119 | 25件 | 0.0329 |
| 2 | 3,319件 | 0.0204 | 114件 | 0.0343 |
| 3 | 3,737件 | 0.0317 | 182件 | 0.0487 |
| 4 | 2,460件 | 0.0499 | 208件 | 0.0846 |
| 5 | 1,041件 | 0.0789 | 124件 | 0.1191 |
| 6 | 467件 | 0.1221 | 99件 | 0.2120 |
| 7 | 215件 | 0.2076 | 76件 | 0.3535 |
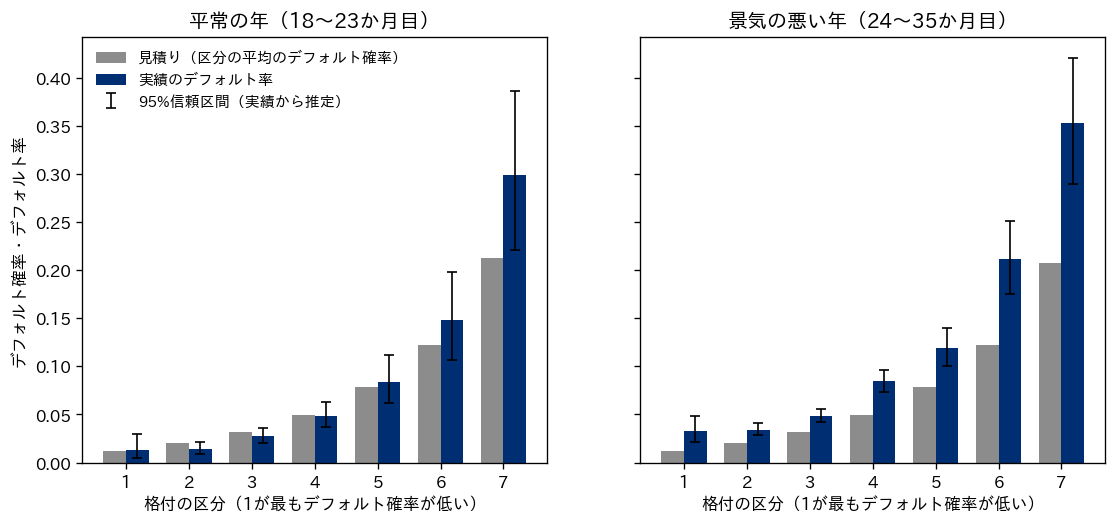
上の図は、左が平常の年(確かめる用の18〜23か月目)、右が景気の悪い年(24〜35か月目)の、区分ごとの見積り(灰色)と実績(ネイビー)です。景気の悪い年でも、実績のデフォルト率は区分の番号の順に高くなっていて、区分の並びは保たれました。変わったのは、すべての区分で実績が見積りの上に出たことです。順位は保たれていても、確率の水準はずれる、という状態です。
AR値は、景気の悪い1年で0.373で、平常の確かめる用のデータの0.487より低くなりました。ただし、この低下を、モデルの順位づけが崩れたと読むことはできません。このデータでは、景気の影響をすべての契約に同じ幅で効かせているので、真のデフォルト確率の並び順は景気で変わりません。それでも、真のデフォルト確率で計算したAR値も、0.551から0.480へ下がりました。AR値は、評価する対象の性質や、デフォルトした契約と正常だった契約それぞれのスコアの分布が変われば変わります。デフォルト率の変化だけで機械的に決まるわけではありませんが、この例のように景気でデフォルトのしやすさが変わると、それぞれの分布も変わりえます。対象の集団や期間が違うAR値の差を、そのままモデルの優劣の判断に使うことはできません(第7章)。また、半年ごとに計算したモデルのAR値は、12〜17か月目が0.360、18〜23か月目が0.487、24〜29か月目が0.351、30〜35か月目が0.396でした。この架空データでは、半年あたりのデフォルトが250件前後の平常の年の半年でも、AR値は0.1以上揺れました。
上の図は、申込の月ごとに、プラットの方法で較正した後の見積りのデフォルト確率の平均(灰色)と、実績のデフォルト率(ネイビー)を並べたものです。網掛けの12〜17か月目は較正用のデータで、この期間に見積りと実績が合っているのは、この期間のデータで較正の式を当てはめたためです。見積りは、どの月も0.039〜0.044の範囲にあり、年ごとの平均は12〜23か月目が0.0414、24〜35か月目が0.0418でほとんど同じでした。この架空データでは申込者の層を変えていないので、モデルの見積りは景気が変わっても動きません。一方、実績は、12〜23か月目の平均0.0416から、24〜35か月目は0.0690に上がりました。
景気によってデフォルト確率がどう動くかについては、見積りの考え方が大きく2つあります。バーゼル銀行監督委員会の作業文書第14号は、実務で使われる「ある時点の見積り(point-in-time。以下PIT)」と「景気の循環を通じた見積り(through-the-cycle。以下TTC)」という2つの言葉を、次のような考え方として整理しています。PITの格付は、いま手に入る借り手の情報と景気の情報をすべて使い、景気の変化にすばやく応じます。TTCの格付は、景気の循環を通じて変わりにくい順位づけを目指し、景気の悪い時期の振る舞いに目を向けます。同じ文書は、格付を主に与信の判断に使う銀行はTTCに、価格の設定や現在のリスクの把握に使う銀行はPITに近い仕組みを採ることが多いと考えられること、その中間の仕組みもあることを書いています。また、言葉の意味が人によって違うことにも触れています。本コラムでは、以下、TTCを「景気が変わってもあまり動かないように決めた見積り」の意味で使い、その水準の決め方の例として、景気の良い時期と悪い時期を通した長期の平均がある、と整理します。
| 観点 | ある時点の見積り(PIT) | 景気の循環を通じた見積り(TTC) |
|---|---|---|
| 確率が表すもの | 今の景気を前提にした、これから1年のデフォルト確率 | 景気が変わってもあまり動かないように決めた水準(例:景気の良い時期と悪い時期を通した長期の平均) |
| 景気が悪くなったとき | 区分ごとの確率が上がる、または契約が確率の高い区分へ移る | 区分ごとの確率はあまり動かず、その年の実績が区分の確率を上回る |
| 向いている使い方の例 | 価格や与信枠の見直し、足元の損失の見込み | 承認の基準を景気ごとに大きく動かさない運用、長い期間での計画 |
| 較正の確認と見直しで注意すること | 較正の確認で見つけたずれに合わせて、見積りを早く直す(再較正する)必要がある。結果が確定するまでの遅れが問題になる | 1年ごとの見積りと実績のずれは景気で大きくなるので、長い期間の平均で較正の確認を行う |
この表は、作業文書の整理をもとに、本コラムの例題に引き直したものです。本コラムの架空データのモデルは、景気の情報を入力に持たず、景気が変わっても見積りが動きませんでした。景気に反応しない点ではTTCに似ていますが、見積りの水準は平常の年のデータで較正したもので、景気の循環を通した平均に合わせたものではありません。区分ごとの実績のデフォルト率を、平常の年(12〜23か月目)、景気の悪い年、2年分の契約を合わせて数えた率、年ごとの率を等しく平均した値で並べると、区分4では0.0448、0.0846、0.0651、0.0647、区分7では0.2679、0.3535、0.3113、0.3107でした。2つの数え方の違いは、年ごとの契約の件数の違いから来ます。区分4の見積り(0.0499)は、どちらの数え方の2年の平均(0.0651、0.0647)よりも低い水準です。TTCの考え方で区分の確率を決めるなら、このような景気の循環を通した平均が手がかりになります。作業文書第14号の長期の平均の説明は、年ごとのデフォルト率を平均する考え方なので、年ごとの率を等しく平均した値の方がそれに近い数え方です。ただし、この例題の2年は、平常の年と悪い年が1年ずつあるだけで、景気の循環の1周を表すものではありません。どれだけの期間の平均を取るかで値が変わる点も注意が要ります。
銀行には、長期の平均を求める規制もあります。銀行向けの国際的な規制の枠組み(バーゼルの枠組み)には、銀行が自前のデフォルト確率の見積りを使って自己資本を計算する方法(内部格付手法)があり、その方法を使うための最低限の条件(最低要件)の1つ(銀行向けの CRE36.63)が、区分のデフォルト確率の見積りを、その区分の借り手の1年のデフォルト率の長期の平均とすることを求めています(個人向けなどのリテールの例外は CRE36.81 と CRE36.82 に定められています)。銀行以外の事業者に、この枠組みが直接当てはまるわけではありません。一方、作業文書第14号は、TTCの区分では、長期の平均のデフォルト率が、その時点の景気のもとでの翌1年のデフォルトの起こりやすさのよい近似にはならず、景気の山では長期の平均より低く、谷では高くなる傾向がある、という分析の結果を示しています。規制が求める長期の平均と、足元の1年のデフォルト確率は、別のものとして読む必要があるということです。規制上の自己資本の計算の詳細と国内の告示は第14章で扱い、ここでは、確率の見積りに「どの期間の、どの景気を前提にした確率か」という前提が必ずあることを押さえておきます。
PITの考え方で見積りを直す例として、景気の悪い年の前半(24〜29か月目)の結果を使って切片を足し直し、後半(30〜35か月目)で確かめました。前半で求めた切片の追加は0.551でした。データを作るときに景気の悪い年に足した幅は0.6で、それに近い値が推定されています。後半では、直す前のデフォルト確率の平均が0.0419だったのに対して、直した後は0.0692になり、実績の0.0690に近づきました。ブライアスコアは0.06187から0.06050へ、対数損失は0.2392から0.2313へ下がり、AR値は0.396のまま変わりませんでした。ただし、この例題は、景気の悪化がすべての契約に同じ幅で、1年を通じて一定に効くように作ったので、前半で求めた切片の直しだけで後半にもそのまま合いました。悪化が深まる場合や和らぐ場合、層によって悪化の幅が違う場合には、切片の直しだけでは合わないことがあります。
ただし、この例題には実務では成り立たない単純化があります。24〜29か月目の申込の結果(12か月以内のデフォルト)が確定するのは、早くても申込から12か月以上たった後です。この例題では確定した結果を使って直しましたが、12か月の観測期間の満了を待って直す運用では、景気の悪化に気づいて切片を直せるのは、悪化が始まってから1年以上たった後になり、それまでのあいだ、見積りは直らないままです。この遅れを縮めるために、契約から数か月の時点での早い段階の延滞の割合を先行の指標として見る方法(第12章)や、景気の指標を見積りに取り入れる方法が考えられます。景気の指標を入れる場合は、その指標の将来の値をどう置くかという別の見積りが加わります。
デフォルトの件数が少ない区分での見積り、区間で示し保守的に読む
格付の区分のうち、デフォルト確率の低い区分や、新しい商品の区分では、デフォルトの件数が少なく、実績のデフォルト率が偶然で大きく揺れます。デフォルトが0件だった区分の実績は0ですが、それをデフォルト確率0と見積もることはできません。このような区分では、実績の率だけでなく、区間を付けて示し、必要に応じて区間の上の方の値を使って保守的に読む考え方があります。
次のコードでは、300件でデフォルトが0件の区分、300件で2件の区分、3,000件で20件の区分について、正確な区間(二項分布から直接求める区間)と、ジェフリーズの事前分布を使った区間(ベータ分布でデフォルト率を表すベイズ推定の考え方による区間)を計算しました。ベイズ推定の一般論は、弊社コラム「ベイズ統計の考え方と使い方、MCMCから階層ベイズまで」で扱っています。二項分布の割合の区間の作り方を比べた Brown と Cai と DasGupta の2001年の論文(Statistical Science 第16巻第2号、101〜133ページ)は、その要旨で、件数の少ない場合の区間としてウィルソンの区間か、裾の確率を等しく取ったジェフリーズの区間を勧めています。論文が対象にしているのは標本全体の件数が少ない場合で、本章の例のように、件数は数百件から数千件あってデフォルトの件数が少ない場合とは区別が要ります。本章では、ジェフリーズの区間を区間の作り方の1つの例として使います。
from scipy.stats import beta

for m, k in [(300, 0), (300, 2), (3000, 20)]:                # 件数とデフォルトの件数が少ない区分
    cp = binomtest(k, m).proportion_ci(confidence_level=0.95)
    jl, jh = beta.ppf([0.025, 0.975], k + 0.5, m - k + 0.5)  # ジェフリーズの事前分布による区間
    print(f"{m}件中{k}件 実績 {k / m:.4f} 正確な区間 {cp.low:.4f}〜{cp.high:.4f}"
          f" ジェフリーズ {jl if k else 0:.4f}〜{jh:.4f} 片側95%上限 {beta.ppf(0.95, k + 0.5, m - k + 0.5):.4f}")
| 区分の件数とデフォルトの件数 | 実績のデフォルト率 | 正確な区間(95%) | ジェフリーズの区間(95%) | ジェフリーズの片側95%の上限 |
|---|---|---|---|---|
| 300件中0件 | 0.0000 | 0.0000〜0.0122 | 0.0000〜0.0083 | 0.0064 |
| 300件中2件 | 0.0067 | 0.0008〜0.0239 | 0.0014〜0.0212 | 0.0183 |
| 3,000件中20件 | 0.0067 | 0.0041〜0.0103 | 0.0042〜0.0101 | 0.0095 |
300件でデフォルトが0件の区分でも、正確な区間の上限は0.0122です。実際、デフォルト確率が1%の契約が300件あり、デフォルトが互いに独立なら、1件もデフォルトしない確率は0.99の300乗で約4.9%(およそ20回に1回)あります。300件で2件の区分と、3,000件で20件の区分は、実績のデフォルト率がどちらも0.0067ですが、区間の幅は大きく違います。300件で2件の区分の正確な区間は0.0008〜0.0239で、実績の率の3倍を超える値まで含みます。同じ実績のデフォルト率でも、件数によって確からしさがまったく違うので、区分ごとの較正の確認の表には、率だけでなく件数と区間を並べる必要があります。なお、この表では、ジェフリーズの区間の方が正確な区間より狭くなっています。保守的に読むことを目的にするなら、広い方の正確な区間の上限を使う、という選び方もあります。
件数の少ない区分のデフォルト確率を決めるときは、実績の率をそのまま使わず、隣の区分との並びが崩れないようにする、区間の上限の側の値を使う、外部の統計や専門家の判断と組み合わせる、といった方法が考えられます。どこまで保守的に置くかは、低く見積もったときの損失(貸し倒れの見込み違い)と、高く見積もったときの損失(承認できたはずの申込を断る機会損失、与信枠を小さくしすぎること)のつり合いで決まる、経営の判断です。保守的に置いた値は、そうした理由とともに文書に残しておく必要があります。
デフォルト時の損失の割合と残高、会計上の引当との関係の入口
期待損失は、デフォルト確率 × デフォルト時の損失の割合 × デフォルト時の残高、という掛け算で考えます(第1章)。デフォルト時の損失の割合は、デフォルトした契約の残高のうち、回収できずに損失になる割合です。担保や保証の有無、回収の進め方、回収にかかる期間と費用によって変わります。デフォルト時の残高は、デフォルトした時点で残っている与信の額で、クレジットカードや与信枠のある貸付では、デフォルトの前に枠の利用が増えることがあり、契約の時点の残高とは違う値になります。どちらも、デフォルト確率とは別のデータと別の見積りの方法が要り、景気によって動くこともあります。本コラムでは、この2つの見積りを詳しく扱いません。バーゼル銀行監督委員会の作業文書第14号には、デフォルト時の損失の割合と残高の検証についての章もあります。
会計の引当とデフォルト確率の関係にも、入口だけ触れます。国際会計基準の IFRS 第9号(金融商品)は、2014年7月の完成版で、予想信用損失の会計処理に関する減損の要求事項を加え、2018年1月1日以後に始まる事業年度から適用されています。国内では、企業会計基準委員会が2026年10月16日に、改正企業会計基準第10号「金融商品に関する会計基準」と、企業会計基準適用指針第36号「金融資産の予想信用損失に係る会計上の取扱いに関する適用指針」などを公表しました。公表の案内では、金融資産の減損について予想信用損失のモデルを採り入れ、将来予測的な情報を含む広い範囲の情報を使うことなどが説明されています。改正された企業会計基準第10号の第41項(9)・(10)によれば、2026年10月の改正は、原則として2030年4月1日以後に開始する連結会計年度・事業年度の期首から適用され、2027年4月1日以後に開始する年度の期首から早く適用することもできます。公表の日と適用の始まりの日は別なので、準備の時期を考えるときは区別が要ります。
会計上の予想信用損失は、それぞれの会計基準の定めに従って測るもので、この章で扱った与信の審査のためのデフォルト確率や、期待損失の掛け算を、そのまま引当の額に置き換えられるものではありません。審査のためのデフォルト確率は、例えば審査の時点(申込の時点)の情報だけを使い、契約の実行から12か月以内にデフォルトする確率として見積もりますが、会計の測定では、見積りの期間、将来の景気の見通しの織り込み方、対象の資産の区分などを、会計基準に沿って決める必要があります。自社の会計処理にどう当てはまるかは、会計の専門家や監査人に確かめる事項です。この章の範囲で言えるのは、どちらの用途でも、デフォルト確率の見積りが実績とどれだけ合っているかを確かめた記録が、説明の土台になるという点です。
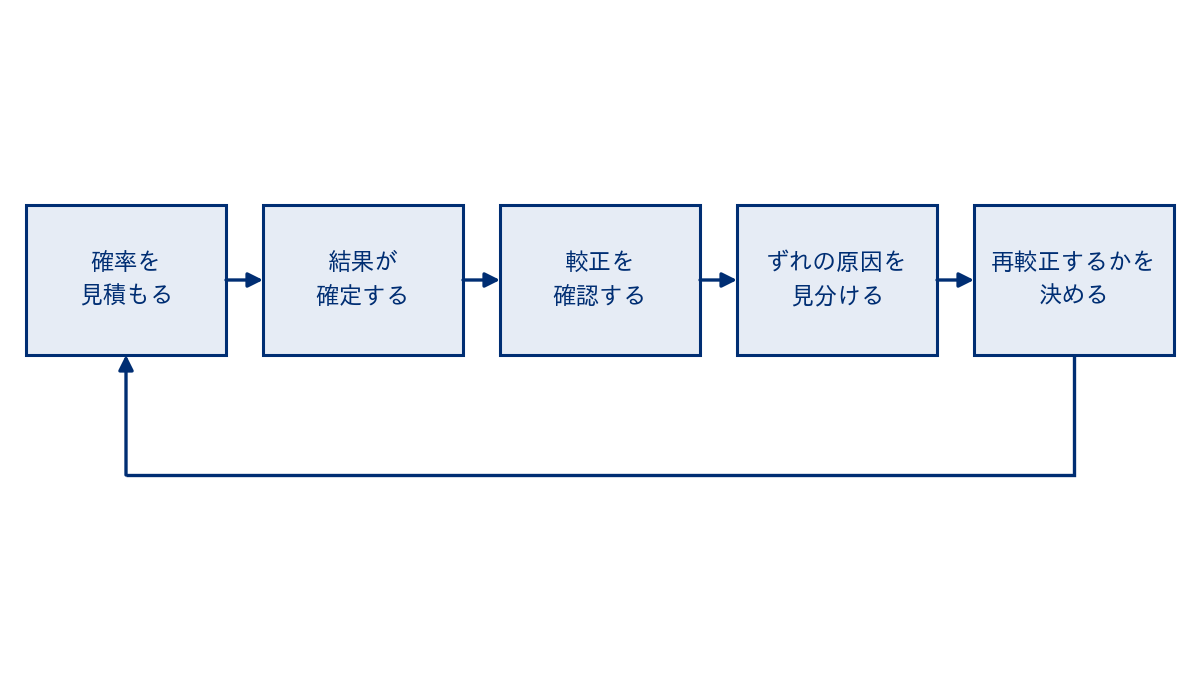
経営の判断、確率の見積りの較正の確認を誰がどの頻度で行うかを決める
デフォルト確率の見積りの誤りは、損失の型として現れます。確率を低く見積もったまま貸し倒れの見込みや与信枠を決めると、貸し倒れが計画を超えます。それが返済の能力を超える与信につながれば、過剰与信による顧客の不利益にもなりえます。確率を高く見積もったままだと、収益が見込める申込を断り、与信枠を小さくしすぎて、機会損失が出ます。この章の架空データのように、学習の標本の取り方による3倍のずれは、較正の確認をしていれば一度で気づけますが、景気の変化によるずれは、結果が確定するまでの遅れがあるので、確認の仕組みが無いと1年以上気づかれないことがあります。較正の確認が誰の仕事にもなっていない状態は、形骸化の典型だと考えています。また、確率を規制や会計の計算に使う場合は、監督や監査の場で、見積りの根拠として較正の確認の記録を示すよう求められることがあります。どの事業者にどの義務がかかるかは、法令と規制ごとに違うので、第14章と所管の官庁や専門家に確かめる事項です。
これを防ぐために、モデルを本番に入れる前に、次のことを決めて文書に残しておくことが有効だと考えています。
| 決めること | 決める内容の例 | 決める人の例 |
|---|---|---|
| 確率の用途と前提 | 確率を何に使うか(貸し倒れの見積り・カットオフ・与信枠・規制や会計の計算)、観測期間、ある時点の見積りか景気の循環を通じた見積りか | リスク管理の責任者と経営 |
| 較正の方法とデータ | 較正の方法、較正に使う期間、較正の確認に使う期間(較正に使っていない期間) | データ分析の担当 |
| 較正の確認の頻度と担当 | 結果が確定した申込の月ごとに、全体と区分ごとの見積りと実績を、例えば四半期ごとに比べる。担当者と報告先 | リスク管理の担当(モデルを作った人とは別の人が望ましい) |
| 早い段階の目安 | 結果が確定する前に、契約から数か月の延滞の割合や景気の指標で、ずれの兆候を見る(第12章) | リスク管理の担当 |
| 見直しの基準 | 同じ向きのずれが何期続いたら、どの大きさを超えたら、再較正するか。1回の検定の結果だけで機械的に決めない | リスク管理の責任者と経営 |
| 件数の少ない区分の扱い | 区間を付けて示す、統合する、保守的な値を置くときの理由 | リスク管理の責任者 |
| 記録 | 較正の式と当てはめた期間、較正の確認の結果、見直しの判断とその理由 | データ分析の担当と内部監査 |
この表の中で経営が直接関わるべきなのは、確率の用途と前提、見直しの基準の2つです。確率をどの用途に使い、どの景気を前提にした値として読むかが決まっていないと、同じ見積りが部署ごとに別の意味で使われます。見直しの基準が決まっていないと、ずれに気づいても、直すかどうかの判断が先送りされがちです。また、較正の確認を毎期同じ手順で回す仕組み(結果の確定した契約の切り出し、区分ごとの集計、区間と検定の計算、報告)を作る手間は、モデルの開発とは別に予算と体制に入れておく必要があります。較正の確認の結果は、管理の指標であって、それ自体が与信スコアリングの成果ではありません。成果の指標は、確率を使って決めたカットオフや与信枠のもとで、承認した契約から得た収益と貸し倒れの損失の差で、実績として測れます。断った申込の機会損失は推定として横に並べ、判断のときに合わせて見ます(第9章)。
この章のまとめ
この章では、順位の正しさと確率の正しさの違い、信頼性の図とブライアスコア、較正の4つの方法を扱いました。続いて、格付の区分と区分ごとの較正の確認、景気の変化と2つの見積りの考え方、件数の少ない区分の見積りを扱い、最後にデフォルト時の損失の割合と残高、会計上の引当との関係の入口に触れました。本コラムの架空データでは、正常の契約を4件に1件に間引いて学習したモデルは、AR値が0.487で、デフォルト確率の平均を0.1283と、実績の0.0430のおよそ3倍に見積もりました。事前確率の補正などで確率を調整しても、AR値は0.487のままでした。較正用のデータで直し、別の確かめる用のデータで確認すると、4つの方法のどれでも平均は実績に近づき、方法の間の差は小さいものでした。一方、景気の悪い年には、較正した見積りの平均0.0418に対して実績は0.0690で、区分の並びは保たれたまま、すべての区分で実績が見積りを上回りました。この例題は景気の悪化がすべての契約に同じ幅で効くように作ったので、切片の直しで合わせられましたが、実際の悪化がそのように起きるとは限りません。確率の見積りは、較正に使っていないデータで、全体と区分ごとに較正の確認を続けることで初めて使えるものになります。次の第9章では、こうして見積もったスコアと確率を、承認の基準と与信枠に結びつけ、収益と損失のつり合いでカットオフを決める方法を扱います。
この章を深めたい方への参考書籍
『信用リスクモデリング 測定と管理』(森平爽一郎 著、朝倉書店):応用ファイナンス講座の第6巻です。目次によれば、実績デフォルト率の推定、1期間のデフォルト確率の推定、デフォルト確率の推計の拡張と検証、デフォルト確率の期間構造、デフォルト時損失率と回収率、デフォルト相関などの章があります。この章で入口だけ触れた、デフォルト確率の推定と検証、デフォルト時の損失の割合を、計量の面から深めるのに向いています。
『信用リスクの測定と管理 Excelで学ぶモデリング』(早稲田大学大学院ファイナンス研究科 編、森平爽一郎 編著、中央経済社):目次によれば、デフォルト確率の推定、デフォルト確率の期間構造、デフォルト確率の推定の仕組みの検証、格付の遷移行列を使ったポートフォリオのリスク管理などを、Excel の計算とともに扱っています。この章の格付の区分と、区分ごとの較正の確認を、手を動かして確かめるのに役立ちます。
第9章 承認の基準と与信枠、カットオフと収益・損失のつり合い
第7章ではモデルが契約をデフォルトしやすい順に並べられているかを測る方法を、第8章ではモデルの出すデフォルト確率が実績のデフォルト率と合っているかを確かめて直す方法を扱いました。順位と確率がそろっても、それだけでは審査の判断は決まりません。この章では、スコアを承認・否決・人による確認という判断に変える基準と、承認した申込にどこまで与信するかという与信枠の決め方を扱います。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の申込の記録を使い、実行したコードと結果で確かめます。
- スコアから判断へ:承認の候補・否決・人による確認へ回す、の3つに分ける考え方
- カットオフの決め方の3つの型(目標の承認率から・目標のデフォルト率から・収益と損失の見積りから)
- カットオフを動かしたときの承認率・デフォルト率・収益と損失の差と、カットオフを選ぶデータと確かめるデータを分ける理由
- 承認率とデフォルト率の関係の曲線(戦略曲線)で2つのモデルを比べる方法と、カットオフのすぐ上の層のデフォルト率
- 人による確認へ回す帯の設計、スコアの上書き、スコア以外の基準
- 与信枠と条件の決め方、リスクに応じた金利の考え方、新しいカットオフの試し方
- 管理の指標(KPI)の表と、経営の判断
この章の主張は2つあります。1つ目は、カットオフを議論する材料として、目標の承認率や目標のデフォルト率だけでなく、営業・リスク管理・財務が合意した収益と損失の見積りを置くべきだ、という点です。これは、その決め方が後の期間で必ず最善の位置を選ぶという主張ではありません。承認率とデフォルト率の入れ替わりを、同じ尺度の上で議論できるようにするための材料の話です。2つ目は、どの決め方で選んだカットオフも、申込者の層や景気が変われば見込んだ成績を保てないことがあるので、決めたあとも後の期間の結果で確かめ続ける必要がある、という点です。本コラムの架空データでは、後の期間に景気の悪化にあたる項を入れて作ったところ、前の期間で選んだカットオフの収益と損失の差は、後の期間で大きく下がりました。その低下の大部分は、景気の項だけを除いた対照のデータでは出ませんでした。
スコアから判断へ、承認の候補・否決・人による確認の3つに分ける
スコアは、ある条件の契約がデフォルトする確率の見積りを換算した点数で、本コラムでは大きいほどデフォルト確率が低い向きにとります。点数そのものは判断ではありません。審査の仕組みの中では、スコアを、少なくとも次の3つの扱いに対応づけます。1つ目は、スコアの上では承認してよいとみなす「承認の候補」です。2つ目は、スコアの上では承認しない「否決の候補」です。3つ目は、スコアだけでは決めずに、人が書類や追加の情報を確かめて判断する「人による確認」です。この3つの境目のうち、承認の候補とそれ以外を分ける値をカットオフと呼びます。本コラムでは、スコアがカットオフ以上の申込を、スコアの上での承認の候補とします。
ここで大事なのは、スコアがカットオフ以上であることは、承認の十分条件ではないという点です。最終の判断は、返済の能力の調査など法令上の条件と、自社の方針として定めた審査の基準(本人確認ができているか・取扱いの対象外の条件に当たらないか・申込の内容に不整合がないかなど)を合わせて決まります。これらをスコアとは別の判定として組み込む考え方は、後の「スコアの上書きと、スコア以外の基準」の節で扱います。逆に、スコアが低い申込でも、人による確認で事情が分かり、承認する場合があります。スコアは判断の材料の1つで、判断の全部ではありません。
3つの扱いの比率は、申込の件数と審査の体制で変わります。申込が多く、即時の回答が求められる商品(後払い決済や少額の分割払いなど)では、人による確認に回す割合を小さくし、多くを自動で判断する設計になりやすいと考えられます。申込が少なく、1件あたりの額が大きい商品では、人による確認の割合を大きくとる設計もありえます。どちらの場合も、どの帯をどの扱いにするかは、後の節で見るとおり、収益と損失の見積りと、人が確認できる件数の両方から決めます。
本章で使う語を、ここで整理しておきます。承認は審査の上での判断で、契約の成立や与信の実行とは別の出来事です。承認しても申込者が契約しないことがあり、契約しても与信枠を使わないことがあります。承認率は、最終の判断(承認か否決)が済んだ申込のうち、承認したものの割合です。取り下げや審査の途中のものは分母に入れず、別に数えます。否決は、審査の結果として承認しないと判断することで、申込者による取り下げとは区別します。
| 扱い | スコアの位置 | 判断の仕方 | 主に気をつける損失の型 |
|---|---|---|---|
| 承認の候補(帯の外) | 人による確認の帯の上端以上 | 法令上の条件と自社の基準を満たしていれば承認し、与信枠と条件を決める | 貸し倒れ・過剰与信による顧客の不利益 |
| 人による確認 | カットオフをはさむ帯(帯の幅は自社で決める) | 担当者が書類や追加の情報を確かめて判断し、理由を記録する | 審査の滞り |
| 否決の候補(帯の外) | 人による確認の帯の下端未満 | 法令上の条件や自社の基準と合わせて否決とし、否決の理由を記録する(説明は第11章) | 機会損失 |
人による確認の帯はカットオフをはさんで置くので、帯の中でカットオフ以上の申込はスコアの上では承認の候補、カットオフ未満の申込は否決の候補にあたります。帯の中では、どちらも人が確かめてから最終の判断をします。なお、本章の例題の承認率と収益と損失の計算は、帯を設けずに、カットオフ以上をすべて承認として数えています。帯は後の節で別に扱います。
表の最後の列は、その扱いで主に問題になる損失の型を、序章の6つの型から選んだものです。承認の候補の帯では貸し倒れが、否決の候補の帯では機会損失が問題になります。人による確認の帯は、件数が担当者の能力を超えると審査の滞りにつながります。カットオフの位置を動かすと、ある損失を減らす代わりに別の損失が増えます。カットオフの決め方は、この入れ替わりをどう見積もるかの問題です。
カットオフの決め方の3つの型
カットオフの決め方は、目標の承認率から決める型(「申込の8割を承認する」)、目標のデフォルト率から決める型(「承認した契約のデフォルト率を3%以下にする」)、収益と損失の見積りから決める型の3つに分けて考えると整理しやすくなります。3つ目の型は、正常に返済された契約の収益とデフォルトした契約の損失を同じ尺度で見積もり、「承認した正常な契約の収益の合計から、承認したデフォルトの損失の合計を引いた差」が最も大きくなる位置を探すものです。承認率とデフォルト率の両方が差を通じて目標に入るので、序章で定めた成果の考え方に最も近い型ですが、1件あたりの収益と損失の見積りという仮定が要り、仮定が違えば答えも変わります。前の2つの型は、目標にしていない方の数字(承認した契約のデフォルト率、または断った申込の機会損失)が結果として決まるだけで、申込者の層が変われば動きます。
| 型 | 決め方 | 決めやすさ | 目標の中に入っていないもの | 向いている場面の例 |
|---|---|---|---|---|
| 目標の承認率から決める | スコアの高い方から目標の割合が入る位置に置く | 件数の計画と結びつけやすい | 承認した契約のデフォルト率 | 新しい商品を始めたばかりで、収益と損失の見積りがまだ固まっていない場合 |
| 目標のデフォルト率から決める | 承認した契約のデフォルト率が目標以下になる最も低い位置に置く | リスク管理の目標と結びつけやすい | 断った申込の機会損失 | デフォルト率の上限を、自己資本や資金の調達の条件から先に決めている場合 |
| 収益と損失の見積りから決める | 収益と損失の差が最大になる位置に置く | 1件あたりの収益と損失の見積りが要る | 見積りの仮定から外れる要素(顧客の保護・規制・資金の制約など) | 収益と損失の構造が見積もれ、営業・リスク管理・財務が仮定に合意できる場合 |
3つの型は、どれか1つを選ぶものというより、組み合わせて使うものだと考えています。例えば、収益と損失の見積りから候補の位置を出し、そのときの承認率とデフォルト率が、営業の計画とリスク管理の上限の両方に収まっているかを確かめる、という使い方です。収まらなければ、見積りの仮定か、計画と上限のどちらかを見直す議論になります。この議論を数字で行えることが、3つ目の型の利点です。
3つ目の型を使うときに大事なのは、収益と損失を同じ尺度で表すことです。1件あたりの収益には、金利や手数料の収入から、資金の調達の費用や審査と管理の費用を引いたものが入ります。1件あたりの損失には、回収できなかった額と、回収にかかった費用が入ります。損失の大きさは、デフォルト確率だけでなく、デフォルトしたときにどれだけ回収できないか(デフォルト時の損失の割合)と、そのときの残高で決まります(第1章)。本章の例題では、これらをまとめて「正常な契約1件の収益」と「デフォルト1件の損失」の2つの数に置き換え、その比だけを仮定として置きました。
架空のスコアつきの申込の記録を作る
ここからは、カットオフの置き方で承認率・デフォルト率・収益と損失の差がどう動くかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の申込の記録よりずっと単純です。合成データでの成績は、実際の審査での成績の目安にはなりません。示したいのは、同じスコアでも、カットオフの置き方と、それを選ぶデータの取り方で、結果がどう変わるかという点です。
この例題では、24か月の間に届いた申込36,000件を、次の性質を持たせて乱数で作りました(乱数の種は20261113に固定しています)。コードは Python 3.14.3 で実行し、グラフの日本語の表示には japanize-matplotlib 1.1.3 を使いました。年収の水準と申込の額は単位の無い相対値で、年収の水準は全体の中央値がおよそ1になるように作り、申込の額はその0.2倍から0.6倍の範囲に置きました。
- 申込者の属性:年収の水準・勤続年数・居住の年数・雇用の形態(A・B・Cの3種類)
- 信用情報にあたる項目:他社の借入の件数・過去の延滞の有無・直近の申込の件数
- 段差と頭打ちのある関係:居住の年数は、1年未満で特にデフォルトしやすく(1年で段差がある)、1年以上では10年まで長いほどわずかにデフォルトしにくく、10年より長いと変わらない
- 項目どうしの組み合わせ:年収の水準が低い申込では、他社の借入の件数がデフォルトに強く効く
- 時間の流れ:後の6か月(18〜23か月目)は景気が悪く、同じ属性でもデフォルトしやすい
デフォルトの定義は第2章の例題の定義(契約の実行から12か月以内に、延滞が90日以上に達すること)を想定し、各申込に結果(デフォルトなら1、正常なら0)を1つ付けました。本章の例題では、すべての申込が最終の判断を受け、承認した申込はすべて契約され、与信が実行されたものとします。また、合成データなので、否決した申込が仮に承認されていたらどうなったかという結果も、全員分が分かります。実際の審査ではこれが分からないことの意味は、後の節でまとめて整理します。また、景気の影響を分けて確かめるために、同じ乱数で、後の6か月の景気の項だけを除いた結果も対照として作りました。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N, MONTHS = 36000, 24
d = pd.DataFrame({"month": np.sort(rng.integers(0, MONTHS, N))})
d["income"] = rng.lognormal(0.0, 0.45, N)                  # 年収の水準(相対値。中央値がおよそ1)
d["years_emp"] = rng.gamma(2.0, 3.0, N).round(1)           # 勤続年数
d["years_res"] = rng.gamma(1.5, 4.0, N).round(1)           # 居住の年数
d["emp_type"] = rng.choice(["A", "B", "C"], N, p=[0.6, 0.25, 0.15])  # 雇用の形態
d["n_loans"] = rng.poisson(1.2, N)                         # 他社の借入の件数
d["past_delinq"] = (rng.random(N) < 0.12).astype(int)      # 過去の延滞の有無
d["n_inq"] = rng.poisson(0.8, N)                           # 直近の申込の件数
d["amount"] = (d.income * rng.uniform(0.2, 0.6, N)).round(3)  # 申込の額(年収の水準と同じ尺度の相対値)
z = (-3.5 - 0.9 * np.log(d.income) - 0.05 * d.years_emp
     + 0.5 * (d.years_res < 1) - 0.03 * np.minimum(d.years_res, 10)   # 居住の年数は1年で段差、10年で頭打ち
     + d.emp_type.map({"A": 0.0, "B": 0.35, "C": 0.7})
     + 0.25 * d.n_loans + 0.25 * d.n_loans * (d.income < 0.8)        # 年収が低いと借入の件数が強く効く
     + 1.0 * d.past_delinq + 0.2 * d.n_inq
     + 0.3 * (d.month >= 18))                              # 後の期間は景気が悪くデフォルトしやすい
u = rng.random(N)
d["default"] = (u < 1 / (1 + np.exp(-z))).astype(int)    # 全員の結果が分かるのは合成データだから
d["default_flat"] = (u < 1 / (1 + np.exp(-(z - 0.3 * (d.month >= 18))))).astype(int)  # 対照:景気の項だけを除いた結果
print("申込", N, "件 全体のデフォルト率", round(d["default"].mean(), 4))
print(d.groupby(d.month // 6)["default"].agg(["size", "mean"]).round(4))
実行した結果、36,000件の申込全体のデフォルト率は6.35%でした(分母は36,000件の申込すべてで、合成データなので否決の有無にかかわらず結果が分かっている前提の値です)。6か月ごとに見ると、0〜5か月目は8,981件で5.93%、6〜11か月目は8,961件で5.98%、12〜17か月目は9,072件で5.88%、18〜23か月目は8,986件で7.62%です。最後の6か月には景気の悪化にあたる項を入れて作っており、デフォルト率はその期間だけ高くなっています。デフォルト率の水準は商品によって大きく違い、数%より低い商品も高い商品もあります。この6%前後という水準は、説明のために置いた値です。
次のブロックでは、この記録を時間で3つに分けます。0〜11か月目を学習用、12〜17か月目をカットオフを選ぶ期間、18〜23か月目をその効果を確かめる期間にしました。学習用のデータで2つのロジスティック回帰(第4章)を作ります。モデルAは年収の水準・過去の延滞の有無・他社の借入の件数の3つだけを使い、モデルBは、申込の額を除く7つの項目(年収の水準・勤続年数・居住の年数・雇用の形態・他社の借入の件数・過去の延滞の有無・直近の申込の件数)に、居住の年数の段差と頭打ち、年収の水準と借入の件数の組み合わせを足したものです。モデルの出すデフォルト確率 \( p \) を、\( 400 + 40 \log_2 \frac{1-p}{p} \) という式で点数に直しました。デフォルトしないことの見込みの比(オッズ)が2倍になるごとに40点上がる換算で、点数が大きいほどデフォルト確率が低くなります(点数への換算の考え方は第4章)。この換算の基準の値は説明のために置いたものです。換算の式や予測の対象(デフォルトの定義・観測期間)が違う点数どうしは、そのまま比べられません。同じ換算の式でも、較正の状態が違えば、同じ点数が同じ実績のデフォルト率を表すとは限りません。
なお、この時間の並びは、実際の運用ではそのままは成り立ちません。デフォルトの定義を「12か月以内」とするなら、学習用の最後の11か月目の契約の結果が分かるのは23か月目以降、カットオフを選ぶ期間の最後の17か月目の契約は29か月目以降、確かめる期間の最後の23か月目の契約は35か月目以降です。この例題では合成データなので、待たずに全員の結果を使っています。つまり、本章の時間による分け方は、全件の結果が確定した後で時期の前後を比べる事後的な分け方で、運用の再現ではありません。実際の運用では、結果が出そろうのを待つ分だけ、使えるデータはさらに古くなり、選んだ時点と使う時点の間隔は例題より長くなります。
from sklearn.linear_model import LogisticRegression

def feats_a(x):                                            # モデルA:3つの項目だけ
    return np.column_stack([np.log(x.income), x.past_delinq, x.n_loans])

def feats_b(x):                                            # モデルB:申込の額以外の7項目と、段差・頭打ち・組み合わせ
    return np.column_stack([np.log(x.income), x.years_emp, x.years_res < 1, np.minimum(x.years_res, 10),
                            x.emp_type == "B", x.emp_type == "C", x.n_loans, x.n_loans * (x.income < 0.8),
                            x.past_delinq, x.n_inq]).astype(float)

train = d[d.month < 12]                                    # 学習:0〜11か月目
sel = d[(d.month >= 12) & (d.month < 18)].copy()           # カットオフを選ぶ:12〜17か月目
ver = d[d.month >= 18].copy()                              # 効果を確かめる:18〜23か月目
for name, f in [("A", feats_a), ("B", feats_b)]:
    m = LogisticRegression(max_iter=2000).fit(f(train), train["default"])
    for part in (sel, ver):
        p = m.predict_proba(f(part))[:, 1]
        part["pd_" + name] = p
        part["score_" + name] = np.round(400 + 40 * np.log2((1 - p) / p)).astype(int)  # 大きいほどデフォルトしにくい
print("学習", len(train), "件/選ぶ期間", len(sel), "件 デフォルト率", round(sel["default"].mean(), 4),
      "/確かめる期間", len(ver), "件 デフォルト率", round(ver["default"].mean(), 4))
print("選ぶ期間のスコアB 5%点・中央値・95%点", np.percentile(sel.score_B, [5, 50, 95]).round())
学習用は17,942件、カットオフを選ぶ期間は9,072件(デフォルト率5.88%)、効果を確かめる期間は8,986件(デフォルト率7.62%)でした。カットオフを選ぶ期間のモデルBのスコアは、低い方から5%の位置が489点、中央値が583点、95%の位置が647点です。以下では、主にモデルBのスコアを使います。
カットオフを動かす、承認率・デフォルト率・収益と損失の差
次のブロックでは、カットオフを選ぶ期間(12〜17か月目)の申込で、カットオフを440点から660点まで5点刻みで動かし、それぞれの位置で次の4つを計算しました。
- 承認率:スコアがカットオフ以上の申込の割合(分母は期間の申込の全件)
- 承認した契約のデフォルト率:スコアがカットオフ以上の契約のうち、デフォルトした割合
- すぐ上の層のデフォルト率:スコアがカットオフ以上、カットオフに10点を足した値未満の契約のデフォルト率
- 収益と損失の差:承認した正常な契約の件数に1を掛けたものから、承認したデフォルトの件数に損失の比を掛けたものを引き、申込1,000件あたりに直した値
収益と損失の差は、正常な契約1件の収益を1とした相対値で、損失も同じ尺度で表しています。損失の比は12と置きました。つまり「デフォルト1件の損失は、正常な契約1件の収益の12倍」という仮定です。この12という値は説明のために置いたもので、実際の値は、商品の金利の水準・手数料・資金の調達の費用・回収の割合などから、自社で見積もる必要があります。この例題では、カットオフ以上の申込は、法令上の条件などの他の基準もすべて満たして承認され、契約・実行されたものとみなしています。
def cutoff_table(x, col, ratio, cuts):
    rows = []
    for c in cuts:
        ok = x[col] >= c                                   # カットオフ以上を承認とみなす(例題の単純化)
        n_good = ((x["default"] == 0) & ok).sum()
        n_bad = ((x["default"] == 1) & ok).sum()
        near = x[(x[col] >= c) & (x[col] < c + 10)]        # カットオフのすぐ上の層(スコア10点分)
        rows.append({"cutoff": c, "approve": ok.mean(), "dr_approved": n_bad / max(ok.sum(), 1),
                     "dr_marginal": near["default"].mean() if len(near) else np.nan,
                     "profit": (n_good * 1.0 - n_bad * ratio) / len(x) * 1000})  # 申込1,000件あたり
    return pd.DataFrame(rows)

RATIO = 12                                                 # 仮定:デフォルト1件の損失は、正常な契約1件の収益の12倍
cuts = np.arange(440, 661, 5)
t_sel = cutoff_table(sel, "score_B", RATIO, cuts)
print(t_sel[t_sel.cutoff.isin([460, 480, 500, 520, 540, 560, 580, 600])].round(4).to_string(index=False))
best = t_sel.loc[t_sel.profit.idxmax()]
all_in = ((sel["default"] == 0).sum() - RATIO * sel["default"].sum()) / len(sel) * 1000
print("全件承認の差", round(all_in, 1), "→ 差が最大のカットオフ", int(best.cutoff), "承認率", round(best.approve, 4),
      "承認した契約のデフォルト率", round(best.dr_approved, 4), "差", round(best.profit, 1))
実行した結果のうち、20点刻みの位置を次の表にまとめます。分母は、承認率がカットオフを選ぶ期間の申込9,072件、承認した契約のデフォルト率がスコアがカットオフ以上の契約、すぐ上の層のデフォルト率がその10点分の層の契約です。
| カットオフ | 承認率 | 承認した契約のデフォルト率 | すぐ上の層のデフォルト率 | 収益と損失の差(正常1件の収益を1とした相対値、申込1,000件あたり) |
|---|---|---|---|---|
| 460点 | 98.13% | 5.30% | 26.83% | 304.9 |
| 480点 | 96.26% | 4.97% | 20.77% | 340.7 |
| 500点 | 92.91% | 4.47% | 13.88% | 388.9 |
| 520点 | 87.69% | 4.01% | 9.50% | 419.8 |
| 540点 | 79.09% | 3.46% | 7.48% | 435.5 |
| 560点 | 67.55% | 2.94% | 6.26% | 417.5 |
| 580点 | 52.65% | 2.32% | 3.87% | 367.4 |
| 600点 | 35.01% | 1.76% | 2.84% | 269.8 |
カットオフを上げるほど承認率は下がり、承認した契約のデフォルト率も下がります。一方、収益と損失の差は山の形になり、5点刻みで探した中では545点で最大の439.8になりました。そのときの承認率は76.51%、承認した契約のデフォルト率は3.27%です。すべての申込を承認した場合の差は236.2で、545点に置くと、申込1,000件あたりで203.6だけ差が大きくなる計算です。すべてを承認すれば貸し倒れが収益を食い、カットオフを上げすぎると、返済できたはずの申込まで断って収益を失います。山の頂上は、その2つの入れ替わりがつり合う位置です。ただし、表の520点から560点の間では差が417.5から435.5の範囲に収まり、頂上の付近はかなり平らです。545点という位置そのものより、頂上の付近が平らかどうかを見る必要があります(揺れの大きさは次の節で確かめます)。
なぜ545点の近くで差が最大になるかは、上の表の2つのデフォルト率の列を見比べると分かります。承認した契約の全体のデフォルト率は、表のどのカットオフでも損益の分かれ目(後で説明する約7.7%)より下にあります。しかし、カットオフを動かしたときに承認の候補に入るか外れるかが入れ替わるのは、全体ではなく境目の近くの層です。表の「すぐ上の層」は、カットオフを10点上げると承認の候補から外れる層(カットオフ以上、カットオフに10点を足した値未満)を指します。その層のデフォルト率が損益の分かれ目を上回るなら、カットオフを上げてその層を外した方が差は大きくなり、下回るなら残した方が大きくなります。損失の比が12のとき、正常な契約1件の収益1と、デフォルト1件の損失12がつり合うのは、デフォルト率が13分の1(約7.7%)のときです。表でも、すぐ上の層のデフォルト率は、540点で7.48%、520点で9.50%と、この分かれ目をまたいでいます。
この見方を、限界のデフォルト率と呼ぶことにします。カットオフのすぐ上の層、つまり「カットオフを少し動かしたときに承認の候補に入るか外れるかが入れ替わる層」のデフォルト率です。承認した契約の全体のデフォルト率は、カットオフより上の層すべての平均なので、カットオフを下げても少しずつしか上がりません。全体の平均だけを見ていると、「承認した契約のデフォルト率は3%台だから、もう少し緩めても大丈夫」という判断になりがちです。ところが、緩めて新たに入ってくる層のデフォルト率は、全体の平均よりずっと高いことがあります。この例題では、カットオフを510点から500点に下げたときに新たに入る層(500点以上510点未満)のデフォルト率は13.88%で、承認した契約の全体の4.47%の3倍を超えていました。カットオフを議論するときは、全体の平均と並べて、限界のデフォルト率を見る必要があります。
損失の比を変えると、差が最大になる位置も動きます。次の節の比ごとの表のとおり、選ぶ期間で差が最大になるカットオフは、比6で495点、比12で545点、比24で575点と、比が大きいほど(デフォルト1件の損失が重いほど)高い方へ動きました。同じスコア、同じモデルでも、収益と損失の構造が違えば、選ぶべきカットオフは違います。ベンダーや他社の事例で示されたカットオフや承認率を、そのまま自社に持ち込めない理由の1つがここにあります。
選ぶ期間と確かめる期間を分ける、3つの型を後の期間で比べる
カットオフを選んだのと同じデータで、そのカットオフの効果を測ると、効果を大きく見積もるおそれがあります。選ぶ過程で、そのデータにたまたま合った位置を選んでいることがあるからです。さらに与信では、選んだカットオフを使うのは将来の申込なので、その間に申込者の層や景気が変わります。そこで次のブロックでは、12〜17か月目で選んだカットオフを、18〜23か月目の申込に当てはめて確かめました。この例題では18か月目以降に景気の悪化にあたる項を入れて作っており、デフォルト率は5.88%から7.62%に上がっています。
比べたのは、前の節の3つの型で選んだカットオフです。型1は承認率80%を目標にした位置、型2は承認した契約のデフォルト率3%以下を目標にした位置、型3は収益と損失の差が最大の位置です。参考として、確かめる期間の結果を知っていた場合に差が最大になる位置も並べました。これは後から振り返ったときにだけ分かる位置で、実際にカットオフを選ぶ時点では使えません。あわせて、否決した申込のうち正常だったはずの件数(申込1,000件あたり)も数えました。この件数は合成データなので分かる値で、実際には観測できず、機会損失は推定になります。
このブロックでは、さらに3つを計算しました。1つ目は、確かめる期間の、カットオフの近くのすぐ上の層のデフォルト率です。2つ目は、同じ乱数で景気の項だけを除いた対照の結果での、確かめる期間の差です。選ぶ期間から確かめる期間への差の変化のうち、景気の項を入れたときにだけ現れる分を、これで分けて見られます。3つ目は、選ぶ期間の申込を復元抽出(同じ申込を何度でも選んでよい抜き出し方)で200回作り直したときに、差が最大になるカットオフがどこまで揺れるかです。
def at_cut(x, col, c, ratio):
    ok = x[col] >= c
    bad = ((x["default"] == 1) & ok).sum()
    lost = ((x["default"] == 0) & ~ok).sum()               # 否決した申込のうち正常だったはずの件数(合成データだから分かる)
    return ok.mean(), bad / ok.sum(), (((x["default"] == 0) & ok).sum() - ratio * bad) / len(x) * 1000, lost / len(x) * 1000

c_rate = int(np.floor(np.percentile(sel.score_B, 20)))     # 型1:承認率80%を目標にする
c_dr = int(t_sel[t_sel.dr_approved <= 0.03].cutoff.min())  # 型2:承認した契約のデフォルト率3%以下を目標にする
c_pf = int(best.cutoff)                                    # 型3:収益と損失の差が最大
c_or = int(cutoff_table(ver, "score_B", RATIO, cuts).set_index("cutoff").profit.idxmax())  # 参考:後の期間の結果を知っていた場合
for label, c in [("型1 承認率80%", c_rate), ("型2 デフォルト率3%", c_dr), ("型3 差が最大", c_pf), ("参考 後の期間での最善", c_or)]:
    a1, b1, p1, _ = at_cut(sel, "score_B", c, RATIO)
    a2, b2, p2, l2 = at_cut(ver, "score_B", c, RATIO)
    print(f"{label} cutoff={c} 選ぶ期間 承認率{a1:.4f} DR{b1:.4f} 差{p1:.1f} /確かめる期間 承認率{a2:.4f} DR{b2:.4f} 差{p2:.1f} 断った正常{l2:.1f}")
print("確かめる期間で全件承認の差", round(((ver["default"] == 0).sum() - RATIO * ver["default"].sum()) / len(ver) * 1000, 1))
tv = cutoff_table(ver, "score_B", RATIO, cuts).set_index("cutoff")
print("確かめる期間のすぐ上の層のデフォルト率", tv.dr_marginal.loc[535:565].round(4).to_dict())
t0 = cutoff_table(ver.assign(default=ver.default_flat), "score_B", RATIO, cuts).set_index("cutoff")  # 対照:景気の項なし
print("対照 確かめる期間のデフォルト率", round(ver.default_flat.mean(), 4), "545点の承認した契約のデフォルト率", round(t0.dr_approved[c_pf], 4),
      "545点の差", round(t0.profit[c_pf], 1), "最善", round(t0.profit.max(), 1), "cutoff", int(t0.profit.idxmax()))
print("選ぶ期間で差が最大値の98%以上の範囲", t_sel[t_sel.profit >= 0.98 * best.profit].cutoff.agg(["min", "max"]).tolist())
boot = np.random.default_rng(1)                            # 選ぶ期間の申込を復元抽出して、選ばれる位置の揺れを見る
picks = [cutoff_table(sel.iloc[boot.integers(0, len(sel), len(sel))], "score_B", RATIO, cuts)
         .set_index("cutoff").profit.idxmax() for _ in range(200)]
print("復元抽出200回で選ばれたカットオフ 5%点・中央値・95%点", np.percentile(picks, [5, 50, 95]))
for r in [6, 9, 12, 18, 24]:                               # 仮定した比を変える
    ts = cutoff_table(sel, "score_B", r, cuts)
    c = int(ts.loc[ts.profit.idxmax()].cutoff)
    tv = cutoff_table(ver, "score_B", r, cuts)
    a2, b2, p2, _ = at_cut(ver, "score_B", c, r)
    print(f"比{r} 損益分岐のPD {1 / (1 + r):.4f} 選んだcutoff {c} 選ぶ期間の承認率 {ts.loc[ts.profit.idxmax()].approve:.4f}"
          f" /確かめる期間 承認率{a2:.4f} DR{b2:.4f} 差{p2:.1f} 後の期間での最善{tv.profit.max():.1f}(cutoff {int(tv.loc[tv.profit.idxmax()].cutoff)})")
3つの型と参考の位置の結果を次の表にまとめます。承認率の分母はそれぞれの期間の申込の全件、デフォルト率の分母は承認した契約、収益と損失の差と「否決した申込のうち正常だったはずの件数」は申込1,000件あたりです。損失の比は12です。
| カットオフの決め方 | カットオフ | 選ぶ期間の承認率 | 選ぶ期間のデフォルト率 | 選ぶ期間の収益と損失の差(正常1件の収益を1とした相対値、申込1,000件あたり) | 確かめる期間の承認率 | 確かめる期間のデフォルト率 | 確かめる期間の収益と損失の差(同じ基準) | 否決した申込のうち正常だったはずの件数(確かめる期間) |
|---|---|---|---|---|---|---|---|---|
| 型1:承認率80%を目標 | 537点 | 80.41% | 3.56% | 431.5 | 81.46% | 5.05% | 279.3 | 150.3 |
| 型2:デフォルト率3%以下を目標 | 560点 | 67.55% | 2.94% | 417.5 | 68.26% | 3.99% | 328.2 | 268.4 |
| 型3:収益と損失の差が最大 | 545点 | 76.51% | 3.27% | 439.8 | 77.41% | 4.70% | 301.0 | 186.1 |
| 参考:確かめる期間の結果を知っていた場合 | 555点 | 70.82% | 3.08% | 424.5 | 71.60% | 4.17% | 328.3 | 237.6 |
表と追加の計算からは、4つのことが読み取れます。1つ目は、選ぶ期間の成績が、確かめる期間ではそのまま再現しなかったことです。型3で選んだ545点は、選ぶ期間では差が439.8でしたが、確かめる期間では301.0でした。承認した契約のデフォルト率も3.27%から4.70%に上がっています。景気の項だけを除いた対照では、確かめる期間のデフォルト率は5.88%、545点での承認した契約のデフォルト率は3.52%、差は419.7でした。つまり、この例題での439.8から301.0への低下(138.8)のうち、対照でも出た分は20.1で、残りの118.7は景気の項を入れたときにだけ現れました(どちらも1つの乱数の種での結果です)。対照に残った20.1には、選ぶ期間のデータに合わせたことによる甘さと、期間による標本の揺れの両方が入っており、この計算ではその2つは分けられません。確かめる期間ですべての申込を承認した場合の差は9.0で、同じ比12の仮定のもとでも、期間によって収益と損失の構造が大きく動きうることが分かります。
2つ目は、確かめる期間では、型3の545点よりも、結果を知っていた場合の555点の方が差が大きかったことです(301.0に対して328.3)。確かめる期間のすぐ上の層のデフォルト率は、545点で11.30%、550点で10.51%と損益の分かれ目(約7.7%)を上回り、555点で7.27%と分かれ目を下回りました。後の期間では、545点から554点の層を外した方が差が大きくなる状態だったことになります。ただし、545点と555点の10点の違いは、次に見る選ぶ位置の揺れと同じくらいの大きさで、位置が動いたこと自体から景気の影響を言い切ることはできません。景気の項の影響の根拠にできるのは、1つ目で見た差の水準の低下の方です。過去の期間で最善だった位置は、将来の期間で最善とは限りません。選ぶ期間を長くとる、直近の期間に重みを置く、管理の指標を見て見直す、という運用でこの差をどこまで縮められるかは、自社のデータで確かめる必要があります。
3つ目は、選ぶ位置そのものの揺れです。選ぶ期間で差が最大値の98%以上になるカットオフは535点から550点の範囲にあり、選ぶ期間の申込を復元抽出で200回作り直すと、差が最大になるカットオフは、低い方から5%の位置で530点、中央値で545点、95%の位置で550点でした。これは、この合成データで、モデルとスコアを固定したまま選ぶ期間の申込だけを復元抽出した結果で、モデルの学習のやり直しによる揺れは含みません。この条件でも、選ばれる位置の5%点と95%点の間は20点あり、545点と537点、545点と555点といった10点前後の違いは、この揺れと同じくらいの大きさです。揺れの大きさは件数だけでは決まらず、データとモデルによって変わります。
4つ目は、確かめる期間では、型2の560点の差(328.2)が、型3の545点(301.0)を上回ったことです。これは、型2が一般に優れているという意味ではありません。選ぶ期間では型3の方が差が大きく(439.8に対して417.5)、確かめる期間では、厳しめに置いた型2が、後の期間の最善の位置(555点)に近かった、という結果です。1回の期間の比較で、どの型が良いとは言えません。型3が選ぶ位置は、仮定した損失の比と、選んだ期間の後の景気や申込者の層の変化に左右されます。この章で型3を議論の材料に置くのは、それが後の期間で必ず最善を選ぶからではなく、承認率とデフォルト率の入れ替わりを、営業・リスク管理・財務が同じ尺度の上で議論できるようにするためです。また、型2は否決した申込のうち正常だったはずの件数が、申込1,000件あたり268.4件と最も多く、型1の150.3件の約1.8倍でした。厳しいカットオフは、貸し倒れを減らす代わりに機会損失を大きくします。型2の目標の「デフォルト率3%以下」も、確かめる期間では3.99%で達成できていません。目標のデフォルト率を固定しても、申込者の層や景気が変われば、そのデフォルト率は守れないことがあります。
仮定した損失の比を変えた結果も、次の表にまとめます。「損益の分かれ目のデフォルト率」は、その比のもとで正常な契約1件の収益とデフォルト1件の損失がつり合うデフォルト率(1を、比に1を足した数で割った値)です。
| 損失の比 | 損益の分かれ目のデフォルト率 | 選ぶ期間で選んだカットオフ | 選ぶ期間の承認率 | 確かめる期間の承認率 | 確かめる期間のデフォルト率 | 確かめる期間の収益と損失の差(正常1件の収益を1とした相対値、申込1,000件あたり) | 確かめる期間の結果を知っていた場合の差(そのカットオフ) |
|---|---|---|---|---|---|---|---|
| 6 | 14.29% | 495点 | 93.92% | 94.01% | 6.30% | 525.7 | 535.1(525点) |
| 9 | 10.00% | 515点 | 89.26% | 89.39% | 5.76% | 378.7 | 417.8(555点) |
| 12 | 7.69% | 545点 | 76.51% | 77.41% | 4.70% | 301.0 | 328.3(555点) |
| 18 | 5.26% | 570点 | 60.50% | 61.21% | 3.80% | 170.2 | 177.6(580点) |
| 24 | 4.00% | 575点 | 56.70% | 57.21% | 3.64% | 51.9 | 111.6(600点) |
損失の比が6から24に変わると、選ぶカットオフは495点から575点に動き、承認率は93.92%から56.70%まで下がりました。同じモデルでも、仮定1つで承認率が約37ポイント動くことになります。このため、損失の比は、データ分析の担当が単独で決める数字ではなく、営業・リスク管理・財務が根拠を持ち寄って合意する数字だと考えています。合意が難しい場合は、比の候補をいくつか置いて、どの比でも大きく外れないカットオフを探す、という決め方もあります。この例題では、どの比でも、選ぶ期間で選んだカットオフは、確かめる期間の結果を知っていた場合の位置より低めでした。
ここで、実務との違いをまとめて確かめておきます。この節の表は、カットオフより下の申込についても結果が分かっているから作れたものです。実際の審査では、カットオフより下の申込は否決しているので、その結果は記録に残りません。いまのカットオフより上の範囲で「カットオフを上げたらどうなるか」は、承認した契約の結果から計算できます。しかし「カットオフを下げたらどうなるか」は、いまは否決している層の結果が分からないため、推定に頼るしかありません。この推定の方法と限界は第6章で扱いました。カットオフを緩める判断は、締める判断よりも不確かさが大きいことを前提に、後の節で見る「一部の申込で試す」方法と組み合わせることが有効だと考えています。
戦略曲線で2つのモデルを比べる
カットオフを動かしたときの承認率と、承認した契約のデフォルト率の組を、横に承認率、縦にデフォルト率をとって結んだ曲線を、本コラムでは戦略曲線と呼びます。スコアの高い順に申込を承認していき(ここでもスコアの上での承認の候補として数え、他の基準はすべて満たすとみなします)、承認率が増えるたびに、そこまでに承認した契約のデフォルト率を記録して描きます。スコアは整数に丸めてあるので、同じスコアの申込はまとめて承認の候補に入れ、カットオフを1点ずつ下げたときに実現できる点だけを結びました。曲線が下にあるモデルほど、同じ承認率をより低いデフォルト率で達成できます。言い換えると、同じデフォルト率の上限のもとで、より多くの申込を承認できます。
第7章で扱ったAR値は、契約をデフォルトしやすい順に並べられているかを、すべての順位にわたって1つの数にまとめたものです。戦略曲線は、その並びの良さを、承認率とデフォルト率という審査の言葉に直したものだと言えます。経営や営業が知りたいのは「AR値が0.06上がると何が変わるのか」であり、その答えは「承認率80%のときのデフォルト率が何ポイント下がるか」「デフォルト率を4%に抑えるとき、承認率を何ポイント上げられるか」という形で示すと伝わりやすくなります。次のブロックでは、確かめる期間(18〜23か月目)の申込で、モデルAとモデルBの戦略曲線を描き、AR値と並べました。
from sklearn.metrics import roc_auc_score

def strategy(x, col):                                      # 同じスコアはまとめて承認する(カットオフで実現できる点だけ)
    g = x.groupby(col)["default"].agg(["size", "sum"]).sort_index(ascending=False)
    n, b = g["size"].cumsum().to_numpy(), g["sum"].cumsum().to_numpy()
    return n / len(x), b / n

curves = {m: strategy(ver, "score_" + m) for m in ["A", "B"]}
fig, ax = plt.subplots(figsize=(6.5, 4.5))
for m, color in [("A", "gray"), ("B", "#002E73")]:
    ar, dr = curves[m]
    i80, i4 = np.searchsorted(ar, 0.80), np.flatnonzero(dr <= 0.04).max()
    print(f"モデル{m} AR値 {2 * roc_auc_score(ver['default'], ver['pd_' + m]) - 1:.3f}",
          f"承認率80%以上の最初の点 承認率{ar[i80]:.4f} デフォルト率 {dr[i80]:.4f}",
          f"デフォルト率4%以下で取れる最大の承認率 {ar[i4]:.4f}(デフォルト率 {dr[i4]:.4f})")
    keep = ar >= 0.1                                      # 承認率10%未満は件数が少なく揺れるので描かない
    ax.plot(ar[keep], dr[keep], color=color, label=f"モデル{m}")
ax.axvline(0.80, color="gray", lw=0.8, ls=":"); ax.axhline(0.04, color="gray", lw=0.8, ls=":")
ax.set_xlabel("承認率"); ax.set_ylabel("承認した契約のデフォルト率")
ax.legend(loc="upper left"); ax.set_title("戦略曲線(確かめる期間)")
plt.savefig("../ch09_strategy_curve.png", dpi=120, bbox_inches="tight"); plt.close()
AR値は、デフォルト確率の見積りで計算しています(スコアをそのまま入れると向きが逆になるため)。結果を次の表にまとめます。分母は、承認率が確かめる期間の申込8,986件、デフォルト率がその中で承認した契約です。
| モデル | AR値(確かめる期間) | 承認率が80%以上になる最初の点の承認率 | その点の承認した契約のデフォルト率 | 承認した契約のデフォルト率を4%以下に抑えるときの最大の承認率 |
|---|---|---|---|---|
| モデルA(3つの項目) | 0.395 | 80.46% | 5.31% | 57.29% |
| モデルB(申込の額以外の7項目と組み合わせ) | 0.455 | 80.48% | 4.99% | 68.26% |
モデルBの曲線は、ほぼすべての承認率でモデルAより下にあります。承認率をおよそ80%にそろえると(承認率が80%以上になる最初の点で、モデルAは80.46%、モデルBは80.48%)、承認した契約のデフォルト率はモデルAで5.31%、モデルBで4.99%で、差は0.32ポイントです。承認した契約のデフォルト率を4%以下に抑えるという条件にそろえると、取れる最大の承認率はモデルAで57.29%、モデルBで68.26%で、差は10.97ポイントになりました。同じAR値の差(0.395と0.455)が、承認率をそろえて見るとデフォルト率の小さな差に、デフォルト率をそろえて見ると承認率の大きな差に見えます。どちらの見方が事業にとって意味があるかは、その商品で何を制約として置くかで決まります。デフォルト率の上限が先に決まっている事業なら、後者の見方が、モデルを入れ替えることで増やせる契約の件数を直接表します。
曲線は、承認率が100%に近づくと、どちらのモデルでも期間全体のデフォルト率(7.62%)に収束します。すべてを承認するなら、どのモデルを使っても結果は同じです。モデルの差が事業の差になるのは、どこかで線を引いて申込を断るときで、その差の大きさは線を引く位置によって変わります。AR値の差だけを見て「モデルを替えると貸し倒れが何割減る」と言うことはできず、どの承認率、どのデフォルト率の上限で使うかを決めてから、戦略曲線の上で差を読む必要があります。なお、この表の値は、この架空データの確かめる期間での値で、2つのモデルの差の大きさも、このデータでの一例です。
人による確認へ回す帯の設計
カットオフを決めた時点では、カットオフのすぐ近くの申込は、限界のデフォルト率が損益の分かれ目に近いと見込まれ、承認しても否決しても収益と損失の差への影響が小さいと見込まれる層です。この層を人による確認に回し、スコアに入っていない情報(追加の書類・申込の内容の確認・取引の事情など)で判断を補う、という設計がよく考えられます。ただし、カットオフの近くの限界のデフォルト率が分かれ目に近いと言えるのは、収益と損失の差を最大にする基準でカットオフを選び、その見積りがいまの申込にも当てはまる場合です。目標の承認率や目標のデフォルト率で選んだカットオフでは、そうなるとは限りません。カットオフから遠い層ほど判断が明らかで、人が見ても結論が変わりにくいので、人の手間はカットオフの近くに集めるのが効率的だと考えられます。
帯の幅は、2つの制約のつり合いで決まります。1つは審査の能力です。人が1か月に確認できる件数には上限があり、帯を広げすぎると件数が上限を超えて、回答までの日数が延び、申込者が離れる審査の滞りが起きます。もう1つは、人による確認で判断が良くなる余地です。人が確認しても判断の精度が上がらないなら、帯を設ける意味は薄くなります。次のブロックの前半では、選ぶ期間と確かめる期間のそれぞれで、型3のカットオフ(545点)の上下に幅をとったときの、1か月あたりの件数と帯の中のデフォルト率を、カットオフ以上の側(上の側)と未満の側(下の側)に分けて数えました。下の側の結果は、実際の審査では否決の候補として扱われることが多く、人が確認して否決した申込の結果は観測できません。ここで下の側のデフォルト率が分かるのは、合成データだからです。
for w in [5, 10, 20]:
    for name, x in [("選ぶ", sel), ("確かめる", ver)]:
        band = x[(x.score_B >= c_pf - w) & (x.score_B < c_pf + w)]
        up = band.score_B >= c_pf                          # 帯のうちカットオフ以上の側
        print(f"{name}期間 帯 cutoff±{w} 月あたり {len(band) / 6:.0f}件(申込の{len(band) / len(x):.3f}) 帯のデフォルト率 {band['default'].mean():.4f}"
              f" 上の側 {band['default'][up].mean():.4f}({up.sum()}件) 下の側 {band['default'][~up].mean():.4f}({(~up).sum()}件)")
appr = ver[ver.score_B >= c_pf].copy()
appr["tier"] = pd.cut(appr.pd_B, [0, 0.02, 0.04, np.inf], right=False, labels=["PD2%未満", "PD2〜4%", "PD4%以上"])
appr["limit"] = appr.amount * appr.tier.map({"PD2%未満": 1.0, "PD2〜4%": 0.7, "PD4%以上": 0.4}).astype(float)
g = appr.groupby("tier", observed=True).agg(n=("default", "size"), dr=("default", "mean"),
                                            flat=("amount", "sum"), tiered=("limit", "sum"))
g["flat_bad"] = appr[appr["default"] == 1].groupby("tier", observed=True).amount.sum()
g["tiered_bad"] = appr[appr["default"] == 1].groupby("tier", observed=True).limit.sum()
print(g.round(3).to_string())
for col in ["flat", "tiered"]:
    print(col, "与信額の合計", round(g[col].sum(), 1), "うちデフォルトした契約の割合", round(g[col + "_bad"].sum() / g[col].sum(), 4))
print("減った割合 与信額", round(1 - g.tiered.sum() / g.flat.sum(), 3), "デフォルトした契約の与信額", round(1 - g.tiered_bad.sum() / g.flat_bad.sum(), 3))
for col in ["flat", "tiered"]:                             # 与信額1の収益を1、損失を12とし、全額使われたとみなす
    v = (g[col].sum() - g[col + "_bad"].sum()) - RATIO * g[col + "_bad"].sum()
    print(col, "額に比例させた収益と損失の差 合計", round(v, 1), "申込1,000件あたり", round(v / len(ver) * 1000, 1))
| 人による確認の帯 | 期間 | 1か月あたりの件数 | 申込に占める割合 | 帯の中のデフォルト率 | 上の側のデフォルト率(件数) | 下の側のデフォルト率(件数) |
|---|---|---|---|---|---|---|
| 545点の上下5点(540点以上550点未満) | 選ぶ期間 | 80件 | 5.3% | 7.48% | 6.07%(247件) | 8.97%(234件) |
| 545点の上下5点(540点以上550点未満) | 確かめる期間 | 80件 | 5.4% | 10.77% | 8.76%(251件) | 12.93%(232件) |
| 545点の上下10点(535点以上555点未満) | 選ぶ期間 | 160件 | 10.6% | 6.88% | 5.62%(516件) | 8.33%(444件) |
| 545点の上下10点(535点以上555点未満) | 確かめる期間 | 161件 | 10.8% | 11.57% | 11.30%(522件) | 11.88%(446件) |
| 545点の上下20点(525点以上565点未満) | 選ぶ期間 | 329件 | 21.8% | 7.19% | 5.97%(1,139件) | 8.84%(837件) |
| 545点の上下20点(525点以上565点未満) | 確かめる期間 | 320件 | 21.4% | 10.16% | 9.11%(1,141件) | 11.70%(778件) |
この例題では、1か月の申込はおよそ1,500件です。確かめる期間で帯を上下10点にとると、1か月あたり161件、申込の10.8%が人による確認に回ります。上下20点にすると320件で、ほぼ2倍になります。例えば担当者が1か月に確認できる件数が200件なら、上下10点の帯は収まり、上下20点の帯は収まりません。帯の幅は、この件数と能力の比較で先に上限が決まり、その範囲で、人による確認の効果が大きい位置に置くことになります。審査の能力は月によって変わるので、申込が増える時期に帯を一時的に狭める、といった運用の取り決めも要ります。
もう1つ注目したいのは、帯の中のデフォルト率です。同じ上下10点の帯で比べると、選ぶ期間では帯の全体が6.88%、上の側が5.62%で、損益の分かれ目(約7.7%)より下にありました。確かめる期間では帯の全体が11.57%、上の側が11.30%で、分かれ目を上回っていました。この例題では後の期間に景気の項を入れて作っており、確かめる期間の上の側の値は、カットオフの位置を見直す材料になる水準まで動いたことになります。ただし、上下5点の帯は期間ごとに500件弱しかなく、値は標本の揺れも含みます。実務で数えられるのは、承認した上の側の結果だけです。上の側のデフォルト率を毎月数えておけば、カットオフの位置がずれてきたことの早い兆しとして使えます。ただし、この値も、帯の中の契約の結果が観測期間を満たしてから分かるものなので、実際には、早い段階の延滞(契約から数か月の時点の延滞)を先に分かる指標として使う方法がとられます(監視の設計は第12章)。
スコアの上書きと、スコア以外の基準
人による確認の帯の外でも、担当者がスコアの示す扱いと違う判断をすることがあります。スコアの上では承認の候補なのに否決する判断と、否決の候補なのに承認する判断で、これをスコアの上書きと呼びます。上書きには、スコアに入っていない正当な情報を反映する役割があります。一方で、上書きが多くなると、モデルとカットオフで決めたはずの承認の基準が、実際には人によって違うものになります。上書きした契約の結果を追わないと、上書きが判断を良くしているのか悪くしているのかも分かりません。
上書きを運用するときは、次のことを決めておくことが有効だと考えています。
- 上書きしてよい場合の条件と、上書きできる人(権限)
- 上書きの理由を、選択肢から選ぶ形で記録すること(自由記述だけにしない)
- 上書きの割合を、担当者・支店・経路・月ごとに数えること
- 上書きして承認した契約のデフォルト率を、同じスコアの帯でスコアどおりに承認した契約と比べること
- 上書きの割合が決めた上限を超えたときに、カットオフかモデルの見直しを検討すること
上書きして承認した契約は結果が分かりますが、上書きして否決した申込の結果は、否決した申込と同じく分かりません。上書きの効果は、承認の側でしか直接確かめられないことを前提に、記録を設計する必要があります。上書きの記録は、次のモデルを作るときに、過去の審査がどの情報で決まっていたかを知る材料にもなります(第6章)。
スコアとは別の基準で承認の候補から外す申込もあります。代表的なのは法令上の要件です。貸金業法の第13条は、貸金業者が貸付けの契約を結ぼうとするときに、顧客の収入・資産・借入れの状況などを調べて返済能力を確かめることを求めており、第13条の2は、その調査で返済能力を超えると認められる貸付けの契約を結んではならないことを定めています。同じ条は、個人向けの貸付けの一部について、その契約を結ぶと借入れの合算額(住宅資金の貸付けの残高などを除く)が、年間の給与などの定期的な収入の3分の1を基準とする額を超えるものを、返済能力を超える契約の1つとして定めています(除外される契約もあります)。
割賦販売法の第30条の2は、包括信用購入あっせん(クレジットカードなどによる与信)の一般の規定として、カードなどを交付するときや極度額(与信枠にあたる上限)を増やすときに、利用者の支払能力にかかわる事項を調べることを定め、第30条の2の2は、その調査をもとに算定した額に一定の割合を掛けた額を極度額が超える場合の交付や増額を原則として禁じています。また、第30条の5の4は、利用者の支払能力に関する情報を高度な技術的な手法で分析して支払可能見込額を算定する方法と体制について経済産業大臣の認定を受けた事業者(認定包括信用購入あっせん業者)には、第30条の2と第30条の2の2を適用しないことを定めています。これらがどの商品・どの契約に適用されるか、例外にあたるかは、法務やコンプライアンスの担当者、所管官庁に確かめる事項で、条文の詳細は第14章で扱います。
大事なのは、こうした法令上の条件を、スコアのモデルの中に溶かし込むのではなく、スコアとは別の判定として審査の仕組みに組み込むことです。スコアの値だけからは、個々の法令上の条件を満たしたかどうかを確かめられません。条件ごとの判定の結果を、スコアとは別に記録しておく必要があります。自社の方針による除外(取扱いの対象外とする条件・不正の疑いがある申込の保留など)も同じで、スコアの判定と並ぶ別の判定として、条件と結果を記録しておくことが有効だと考えています。
1件の申込が最終の判断に至るまでの判定の並びを、この考え方で整理すると次のようになります。
- 申込を受け付ける
- 法令上の条件の判定:返済の能力の調査など、法令上の条件を満たしているかを確かめ、条件ごとの結果を記録する
- 自社の基準の判定:取扱いの対象外の条件や不正の疑いなど、自社の方針による基準に当たらないかを確かめ、結果を記録する
- スコアの判定:スコアの位置によって、承認の候補・人による確認・否決の候補の3つのどれかに振り分ける
与信枠と条件の決め方
承認の候補になった申込には、次に、どこまで与信するかを決めます。与信してよい額の上限を与信枠と呼びます。与信枠は、承認か否決かと同じくらい、収益と損失に効きます。同じデフォルト確率の契約でも、与信枠が大きければ、デフォルトしたときの損失は大きくなり、正常に返済されたときの収益も大きくなります。期待損失がデフォルト確率と、デフォルト時の損失の割合と、デフォルト時の残高の積で考えられることを第1章で見ましたが、与信枠はこのうちデフォルト時の残高を左右する決定です。
与信枠の決め方には、申込の額をそのまま認めるか否かだけを決める方法から、デフォルト確率の段階ごとに上限を変える方法、返済の能力(収入と既存の借入れの返済の負担など)から上限を計算する方法まで、いくつかの段階があります。法令上の上限(前の節で見た割賦販売法の極度額の定めや、貸金業法の基準など)がある商品では、そちらが先に上限を決めます。スコアやデフォルト確率で決める与信枠は、その上限の内側での調整です。
与信枠をデフォルト確率で段階づける効果を、簡単な例で確かめます。前のブロックの後半では、確かめる期間で545点以上の承認の候補になった6,956件について、モデルBのデフォルト確率で3つの段階に分けました。デフォルト確率2%未満は申込の額の1.0倍、2%以上4%未満は0.7倍、4%以上は0.4倍を与信枠とし、すべてに申込の額をそのまま認める「一律」と比べています。額は、年収の水準と同じ尺度の相対値です。段階の境目と倍率は説明のために置いた値です。
| デフォルト確率の段階 | 件数 | デフォルト率 | 与信額の合計(一律、相対値) | 与信額の合計(段階づけ、相対値) | デフォルトした契約の与信額(一律、相対値) | デフォルトした契約の与信額(段階づけ、相対値) |
|---|---|---|---|---|---|---|
| 2%未満 | 1,397件 | 2.1% | 963.3 | 963.3 | 23.2 | 23.2 |
| 2%以上4%未満 | 3,122件 | 4.1% | 1,502.1 | 1,051.5 | 62.4 | 43.7 |
| 4%以上 | 2,437件 | 7.0% | 936.9 | 374.8 | 66.4 | 26.6 |
| 合計 | 6,956件 | 4.70% | 3,402.3 | 2,389.5 | 152.0 | 93.4 |
先に結論を書くと、本コラムの例題では、段階づけでデフォルトした契約の与信額は減りましたが、収益と損失の差は一律より小さくなりました。この結論は、与信枠の全額が使われ、与信枠を変えても契約の成立とデフォルトの結果は変わらない、という仮定のもとでのものです。
段階づけにより、与信額の合計は3,402.3から2,389.5へ29.8%減り、デフォルトした契約の与信額は152.0から93.4へ38.5%減りました。与信額のうちデフォルトした契約の与信額の割合は、4.47%から3.91%に下がっています。デフォルト確率の高い段階ほど与信枠を絞ったので、デフォルトした契約の与信額の方が大きく減りました。表の段階ごとのデフォルト率(2.1%・4.1%・7.0%)は、デフォルト確率の段階(2%未満・2%以上4%未満・4%以上)とおおむね同じ順に並んでいます。見積りと実績が合っているかの確かめ方(較正の確認)は第8章で扱いました。
ただし、これで段階づけが良いと結論することはできません。正常な契約から得られる収益も、与信額が減った分だけ減るからです。そこで、収益も損失も与信額に比例すると仮定して、収益と損失の差を計算しました。この計算だけは尺度が前の節と違い、「与信額(相対値)1あたりの正常な契約の収益を1、デフォルトした契約の損失を12」としています。また、与信枠の全額が使われ、デフォルトした契約では与信額の全額が損失の計算に入るものとみなしました。さらに、与信枠を変えても、契約が成立するかどうかとデフォルトの結果は変わらないと仮定しています。与信枠を絞れば返済の負担が軽くなってデフォルトの起き方が変わる、契約しない申込者が出る、といった効果は推定していません。この尺度で、確かめる期間の申込1,000件あたりに直すと、一律では158.8、段階づけでは130.8で、段階づけの方が小さくなりました(6,956件の合計では1,426.6と1,174.9)。この158.8と130.8は、前の節の差(正常な契約1件の収益を1とした301.0など)とは基準が違うので、並べて比べることはできません。比べてよいのは、同じ尺度で計算した一律と段階づけの2つの値どうしです。
段階づけの方が小さくなったのは、最も絞った「4%以上」の段階でも、デフォルト率が7.0%(与信額で重み付けた割合でも、表の66.4÷936.9で約7.1%)と、損失の比12のときの損益の分かれ目(約7.7%)を下回っていたためです。この尺度では、与信額1あたりの差が1から13倍のデフォルトの割合を引いた値になるので、分かれ目を下回る段階で与信額を減らすと、差も減ります。この仮定のもとでは、その段階でも与信を絞らない方が差は大きくなります。この例だけで段階づけの良し悪しは決まりません。
実際には、利用額が与信枠より小さいことが多く、デフォルトしたときの残高も与信枠の全額とは限らないので、段階づけの効果はこの計算とは変わりえます。損失の比がもっと大きい商品でも、結果は変わりえます。
この例から言えるのは、与信枠の段階づけの良し悪しは、デフォルトした与信額が減ったかどうかだけでは判断できず、カットオフと同じく、収益と損失を同じ尺度で並べて見る必要がある、ということです。一方で、与信枠には、収益と損失の差だけでは測れない役割もあります。返済の能力を超える与信は、たとえ平均で見て収益が出ていても、個々の顧客の生活や事業を損ないます。これは序章の損失の型でいう過剰与信による顧客の不利益で、法令上の義務とも結びついています。与信枠は、収益と損失の計算の結果と、返済の能力の調査による上限の、小さい方で決めるのが基本になると考えています。与信枠を契約の後に見直す方法(途上与信)は第10章で扱います。
与信の条件には、与信枠のほかに、期間・返済の方法・金利や手数料の水準などがあります。デフォルト確率に応じて金利の水準を変える考え方を、リスクに応じた価格づけと呼ぶことがあります。デフォルト確率が高い契約ほど期待損失が大きいので、その分を金利の水準で補う、という考え方です。この考え方に立てば、カットオフの付近の層も、条件を変えれば収益と損失の差がつり合う場合があり、承認か否決かの二択ではなく「条件つきの承認」という選択肢が生まれます。
ただし、この考え方には、いくつかの制約と注意があります。第1に、金利には法令の上限があり、その範囲の内側でしか動かせません(法令の内容は第14章)。第2に、金利の水準を上げると、申込者の層そのものが変わることがあります。高い金利の条件を受け入れる申込者の層は、そうでない層とデフォルト確率が違うかもしれず、条件を変える前のデータで見積もったデフォルト確率が、そのまま当てはまるとは限りません。第3に、返済の負担が重くなれば、それ自体がデフォルト確率を押し上げ、過剰与信による顧客の不利益につながるおそれがあります。条件を変える判断は、価格と需要の関係の見積りも要る問題で、価格の決め方の一般論は弊社コラム「価格を決める数理モデル、需要曲線の推定からダイナミックプライシングまで」で扱っています。
本コラムの例題では、金利の水準を変える計算はしていません。正常な契約1件の収益を一律に1とする置き方は、金利の水準だけでなく、貸付の額・期間・費用などの違いも捨象しています(この例題でも申込の額は申込ごとに違います)。条件を申込ごとに変える仕組みを入れる場合は、収益の見積りも申込ごとに変わるので、本章の計算を、条件ごとの収益と損失の見積りに置き換えて行う必要があります。
新しいカットオフを試す、一部の申込で試してから広げる
カットオフや与信枠の基準を変えるとき、過去のデータでの計算だけで全面的に切り替えると、2つの危険があります。1つは、カットオフを下げる方向の変更で、いまは否決している層の結果が分からないため、見積りが外れる危険です。もう1つは、計算に入っていない反応(申込者の層の変化・営業の経路の変化・人による確認の件数の変化など)で、見込みと違う結果になる危険です。
そこで、新しい基準を、申込の一部にだけ当てはめて試す方法がとられます。現行の基準(チャンピオンと呼ぶことがあります)を大部分の申込に使い続け、無作為に選んだ一部の申込にだけ新しい基準(同じくチャレンジャーと呼ぶことがあります)を当てはめて、両者の承認率・デフォルト率・収益と損失の差を、観測期間がたってから比べます。無作為に割り当てるので、同じ時期に他の変更が無く、途中で割り当てを変えなければ、偶然の差を除いて、2つの群の違いを基準の違いによるものとして読めます。比べ方の一般論(効果の推定と、偶然の差の見分け方)は、弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」で扱っています。
この方法には、与信ならではの注意があります。第1に、結果が分かるまで、観測期間の分だけ時間がかかります。デフォルトの定義が12か月なら、比べられるのは1年以上先です。その間は、早い段階の延滞を先に分かる指標として途中経過を見ることになります。第2に、カットオフを下げる試しは、いまは否決している層の一部を実際に承認することなので、貸し倒れの増加を費用として見込む必要があります。その代わり、否決していた層の結果が手に入り、第6章で扱った「否決した申込の結果が分からない」問題を、その一部について直接解消できます。第3に、試しの対象になった申込者も、通常と同じく法令上の条件と自社の基準を満たしている必要があり、試しを理由に返済の能力の調査を省くことはできません。
試す割合と期間は、比べたい差の大きさと、許容できる費用から決めます。割合を小さくすれば費用は小さくなりますが、デフォルトの件数が少なくなり、差を見分けるのに長い期間がかかります。この判断は、データ分析の担当だけでなく、試しにかかる費用を負担する事業の責任者が加わって決めることが有効だと考えています。
承認の基準を管理する指標
カットオフと与信枠の基準を決めたら、それが意図どおりに働いているかを、定期的に数える指標を決めます。序章と同じく、承認率やデフォルト率は、単独では成果ではなく、承認の基準を管理するための指標です。成果の指標は、承認した契約から得た収益と貸し倒れの損失の差で、実績として測れます(結果が出そろうまで観測期間がかかります)。断った申込の機会損失は推定として横に並べ、判断のときに合わせて見ます。そのため、管理の指標をいくつか並べ、それぞれの動きを、収益と損失の差の変化に結びつけて読む、という使い方になります。
| 指標 | 数え方(分母を含む) | 分かるまでの時間 | 動いたときに疑うこと | 主に見る人 |
|---|---|---|---|---|
| 承認率 | 最終の判断が済んだ申込のうち、承認したものの割合。取り下げ・審査中は別に数える | すぐ分かる | 申込者の層の変化、カットオフの運用の変化、法令上の条件や自社の基準での除外の増減 | 営業・リスク管理 |
| スコアの帯ごとの申込の構成比 | 申込のうち、各スコアの帯に入った割合 | すぐ分かる | 申込者の層や営業の経路の変化(監視の詳細は第12章) | リスク管理・データ分析 |
| 承認した契約のデフォルト率 | 観測期間を満たした契約のうち、デフォルトした割合。契約の月ごとに数える | 観測期間がたってから | 景気、申込者の層、モデルの較正のずれ | リスク管理・経営 |
| 早い段階の延滞の割合 | 契約から数か月の時点で、一定の延滞に至った契約の割合 | 数か月 | 承認した契約のデフォルト率の先触れ | リスク管理・債権管理 |
| カットオフの近くの帯のデフォルト率 | カットオフのすぐ上の帯の契約のデフォルト率(早い段階の延滞で代用することもある) | 数か月から観測期間 | 損益の分かれ目とのずれ、カットオフの見直しの要否 | リスク管理 |
| 収益と損失の差の見積り | 承認した契約の収益と損失の見積りの差。否決した申込の機会損失は推定として別に示す | 観測期間がたってから(途中は見込み) | 収益と損失の仮定(損失の比)が実態と合っているか | 経営・財務・リスク管理 |
| 審査の所要時間 | 申込から最終の判断までの時間の分布(中央値と長い方の分位点) | すぐ分かる | 人による確認の件数の増加、審査の滞り | 審査の責任者 |
| 人による確認の割合 | 最終の判断が済んだ申込のうち、人による確認に回したものの割合と件数 | すぐ分かる | 帯の幅と審査の能力のつり合い | 審査の責任者 |
| 上書きの割合 | スコアの示す扱いと違う最終の判断をした申込の割合(承認の方向・否決の方向を分けて) | すぐ分かる | 基準と現場の判断のずれ、モデルへの信頼の低下 | 審査の責任者・リスク管理 |
この表で注意したいのは、指標が分かるまでの時間の違いです。承認率や審査の所要時間はすぐに分かりますが、承認した契約のデフォルト率は観測期間がたつまで分かりません。すぐに分かる指標だけを追うと、承認率が上がったことは見えても、それで貸し倒れが増えたかどうかは1年後まで見えません。この遅れを埋めるために、早い段階の延滞の割合やカットオフの近くの帯の動きを、先に分かる指標として並べておくことが有効だと考えています。
指標の数字を評価するときには、どの数字が誰の目標になっているかにも注意が要ります。営業に承認率の目標だけを持たせ、リスク管理にデフォルト率の目標だけを持たせると、カットオフをめぐって両者が綱を引き合う形になりがちです。どちらの目標も、収益と損失の差の見積りから導いた値として置き、カットオフを変えたときに両方がどう動くかを同じ表で見られるようにしておくと、議論が数字の上で行いやすくなります。
経営の判断、カットオフは収益と損失の見積りで決め、見直しの頻度を決める
カットオフと与信枠の基準は、技術の設定に見えますが、事業の収益と損失の配分を決める経営上の判断です。カットオフを低く置きすぎれば貸し倒れが増え、高く置きすぎれば返済できたはずの申込を断る機会損失が増えます。前の節で見たとおり、損失の比の仮定1つで選ぶ位置は大きく動きます。どの仮定を採るかは、データ分析では決まらず、事業の収益の構造と、どこまでの損失を許容するかという方針で決まります。
判断を誤ったときの損失は、序章の6つの型で整理できます。目標の承認率だけでカットオフを決めると、申込者の層が変わったときに承認した契約のデフォルト率が上がっても気づきにくく、貸し倒れにつながります。目標のデフォルト率を低く置きすぎると機会損失が増え、その大きさは観測できないので、損失として意識されにくいまま続きます。与信枠を収益と損失の計算だけで決めると、返済の能力を超える与信によって、過剰与信による顧客の不利益を招くおそれがあります。人による確認の帯を審査の能力を超えて広げると審査の滞りが起き、カットオフを一度決めたまま見直さなければ形骸化が起きます。法令上の条件をスコアの判定に混ぜてしまうと、条件を満たしていたかを申込ごとに示せず、規制上の義務の不履行につながるおそれがあります。
これを防ぐために、経営として次のことを決め、文書に残しておくことが有効だと考えています。
| 決めること | 決める内容の例 | 決める人の例 |
|---|---|---|
| 収益と損失の仮定 | 正常な契約1件の収益と、デフォルト1件の損失の見積りと、その根拠(金利の水準・手数料・資金の調達・回収の割合) | 経営・財務・リスク管理・営業 |
| 承認率とデフォルト率の許容範囲 | 収益と損失の差から導いたカットオフのときの承認率とデフォルト率が、営業の計画とリスク管理の上限に収まっているか | 経営 |
| カットオフを選ぶデータと確かめるデータ | どの期間で選び、どの期間で確かめるか。観測期間を満たした契約だけを使うこと | リスク管理・データ分析 |
| 人による確認の帯と上書きの規則 | 帯の幅の上限(審査の能力から)、上書きの条件・権限・記録の形・割合の上限 | 審査の責任者 |
| 与信枠の決め方 | デフォルト確率の段階と返済の能力の上限のどちらで決まるか、法令上の上限との関係 | リスク管理・コンプライアンス |
| 見直しの頻度ときっかけ | 定期の見直しの間隔と、管理の指標がどう動いたら臨時に見直すか | 経営・リスク管理 |
| 新しい基準の試し方 | 一部の申込で試す割合・期間・費用の上限と、全面的に切り替える条件 | 経営・リスク管理 |
この表のうち、経営が直接関わるべきなのは、収益と損失の仮定と、見直しの頻度です。収益と損失の仮定は、営業とリスク管理のどちらか一方が決めると、自分の目標に有利な数字になりがちです。営業・リスク管理・財務が根拠を持ち寄り、経営が合意を取りまとめる形にしておくと、カットオフをめぐる議論を、立場の違いではなく仮定の違いとして扱えます。見直しの頻度が要るのは、選んだ時点の後で景気や申込者の層が変われば、選んだカットオフで見込んだ成績を保てないことがあるからです。本コラムの架空データでも、後の期間に景気の項を入れた場合には、545点の収益と損失の差が439.8から301.0に下がり、その低下138.8のうち118.7は、景気の項を除いた対照では出ませんでした。定期の見直しの予算と担当を、モデルの開発とは別に確保しておくことが、形骸化を防ぐ前提になると考えています。
もう1つ、機会損失を見積もる仕組みへの投資も、経営の判断です。いまのカットオフより下の層の結果が分からないままでは、カットオフを緩めて契約を増やす判断の根拠が弱く、承認の基準は厳しい方へ寄りがちです。一部の申込で新しい基準を試す、他社での返済の状況を信用情報で補う(第6章)などの方法には費用がかかりますが、その費用は、機会損失の大きさを知るための費用でもあります。どこまで費用をかけて知るかを、経営として決めておく必要があります。
この章のまとめ
この章では、スコアを承認の候補・人による確認・否決の候補に分ける考え方と、カットオフの決め方の3つの型、限界のデフォルト率、戦略曲線、人による確認の帯、上書きとスコア以外の基準、与信枠と条件の決め方、新しい基準の試し方、管理の指標を扱いました。本コラムの架空データでは、損失の比を12と置くと、選ぶ期間で収益と損失の差が最大になるカットオフは545点(承認率76.51%、承認した契約のデフォルト率3.27%)でした。ただし頂上の付近は平らで、モデルとスコアを固定して選ぶ期間の申込を200回復元抽出すると、選ばれた位置の5%点は530点、95%点は550点でした。後の期間に景気の項を入れて作った確かめる期間では、承認した契約のデフォルト率が4.70%に上がり、545点の収益と損失の差は439.8から301.0に下がりました。その低下138.8のうち118.7は、景気の項を除いた対照では出ませんでした。後から振り返った最善の位置は555点でしたが、545点との10点の違いは選ぶ位置の揺れと同じくらいの大きさです。確かめる期間では目標のデフォルト率から決めた型の方が差が大きくなりましたが、1回の期間の比較でどの型が良いとは言えません。戦略曲線で見ると、AR値0.395と0.455の2つのモデルの差は、承認した契約のデフォルト率を4%以下に抑える条件では、承認率で10.97ポイントの差になりました。与信枠の段階づけは、デフォルトした契約の与信額を減らした一方、収益と損失を与信額に比例させ全額が使われるとみなした仮定では、差を小さくしました。カットオフと与信枠は、営業・リスク管理・財務が合意した収益と損失の見積りを議論の材料にして決め、法令上の条件とは別の判定として組み合わせ、後の期間の結果で確かめ続ける必要があります。次の第10章では、承認して契約した後に、返済や利用の状況を見て与信枠や条件を見直す途上与信と、延滞の管理を扱います。
この章を深めたい方への参考書籍
『意思決定分析と予測の活用 基礎理論からPython実装まで』(馬場真哉 著、講談社):予測の結果を意思決定にどう使うかを、決定分析の考え方から解説した本です。目次には、期待値に基づく意思決定、情報の価値、コスト/ロスモデルと予測の価値、確率予測の活用といった章があります。この章で扱った、正常な契約の収益とデフォルトの損失の比からカットオフを決める考え方を、予測と意思決定の一般的な枠組みの中で確かめるのに向いています。
『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』(Ron Kohavi・Diane Tang・Ya Xu 著、大杉直也 訳、ドワンゴ・KADOKAWA):原題は「Trustworthy Online Controlled Experiments」で、オンラインで行う比較の実験を信頼できる形で運用するための考え方をまとめた本です。目次には、実験の実行と分析の一連の流れ、実験の信用性、実験のプラットフォームと文化の章があります。主な題材はオンラインのサービスですが、この章で扱った、新しいカットオフを一部の申込で試してから広げる方法を、組織の仕組みとして設計するときの参考になります。
第10章 途上与信と回収、行動スコアリングと延滞の管理
第9章では、申込のスコアからカットオフを決め、承認・否決・人による確認へ振り分ける判断と、承認した契約の与信枠の決め方を扱いました。そこで扱った判断は、どれも契約の前、申込の時点で手に入る情報だけを使うものでした。契約が始まると、毎月の返済の記録、与信枠のうちどれだけを使っているか、残高がどう動いているかといった、申込の時点には無かった情報が積み上がっていきます。この章では、契約の後に分かる情報を使って与信の継続や与信枠・条件を見直す途上与信と、延滞が始まった契約への対応(回収)を扱います。
この章で扱うのは次の内容です。中ほどからは、他の章とは独立に作った架空の契約の月ごとの記録を使い、実行したコードと結果で確かめます。
- 契約の後に分かることと、契約の後の行動からデフォルト確率を見積もる行動スコアリングの考え方
- 途上与信で決めること(与信の継続、与信枠の維持・増額・減額、利用の一時的な制限、早めの連絡)
- 行動の特徴量を作る「参照期間」と、結果を見届ける「観測期間」を重ねずにモデルを作る手順
- 延滞の段階の移り変わりを集計した遷移行列と、それをマルコフ連鎖として読むときの前提と限界
- 延滞の前に現れる変化(早期の警戒の指標)と、延滞した契約のうちどれに先に連絡するかを決める回収のスコアリング
- 延滞した顧客への対応で守るべきこと、与信枠を増やす判断と過剰与信の危険、管理の指標と経営の判断
この章の主張は、契約の後のデータを使った見直しの仕組みと、延滞した顧客への対応の方針は一緒に決める必要がある、という点です。あわせて、行動のデータは作り方を誤ると成績が実際より良く見えやすいことを、数字で確かめます。
契約の後に分かること、行動スコアリングが申込のスコアと違う点
申込の時点で手に入る情報は、申込書の項目(年収の水準・勤続年数・居住の年数など)と、信用情報機関に照会して得られる他社の借入や過去の延滞の情報が中心です(第2章)。これらは、申込者がこれから返済できるかどうかを、契約の前の状態から推し量るための情報です。契約が始まると、その契約そのものの返済の記録が手に入ります。毎月の約定の日に返済されたか、遅れたか、請求された額のうちどれだけが返済されたか、与信枠のうちどれだけを使っているか、といった情報です。こうした契約の後の行動から、今後一定の期間のうちにデフォルトする確率を見積もる仕組みを行動スコアリングと呼びます。申込の時点のスコア(申込のスコア)に対して、行動のスコアと呼ぶこともあります。本コラムのスコアは、大きいほどデフォルト確率が低い向きの点数です。この章の例題のモデルはデフォルト確率の見積りを出すので、例題の結果は「デフォルト確率の見積り」として書きます。
行動のスコアは、申込のスコアより順位づけの成績が高くなる場合があると考えられます。本コラムの架空データでも、後で示すとおり、行動の特徴量を足したモデルの AR値は申込時点の項目だけのモデルより高くなりました。考えられる理由は次の2つです。1つ目は、見積もる対象に近い情報を使えることです。申込のスコアは、他社での過去の返済の情報から、自社の契約での将来の返済を推し量ります。行動のスコアは、自社の契約での直近の返済そのものを使います。2つ目は、時間の近さです。申込のスコアは、契約から観測期間の終わりまで(例題では12か月)の結果を、契約の前の情報で見積もります。契約から時間がたつと、申込者の収入や他の借入の状況は変わることがありますが、申込の時点の情報はそれを反映しません。行動のスコアは、見直しの時点までの直近の動きを反映できます。
ただし、成績が高いことは、行動のスコアの方が優れた仕組みであることを意味しません。行動のスコアを計算できるのは、すでに契約があり、一定の期間の記録がたまった契約だけで、新しい申込の審査には使えません。また、延滞がすでに始まっている契約を上位に並べるだけでも、多くのデフォルトを拾えます。延滞が始まった契約がデフォルトしやすいことは、モデルが無くても分かります。行動のスコアの価値は、まだ延滞していない契約の中で、これから延滞しやすい契約をどれだけ早く見分けられるかにあると考えています。本コラムの架空データでは、参照期間(後で定義します)に延滞の無かった契約だけで評価し直すと、AR値は0.818から0.783に下がりましたが、申込時点の項目だけのモデル(0.528)との差は残りました。
次の表は、申込のスコアと行動のスコアを、使う情報と使い道で比べたものです。どちらも、スコアが大きいほどデフォルト確率が低い向きで作るものとします。
| 比べる点 | 申込のスコア | 行動のスコア |
|---|---|---|
| 使う情報 | 申込書の項目、信用情報機関の情報(申込の時点の値) | 申込の時点の情報に加えて、自社の契約の返済の記録・枠の使用率・残高の動き(見直しの時点までの値) |
| 対象 | 新しい申込 | 一定の期間の記録がたまった契約 |
| 結果を見届ける期間 | 契約の実行から数える観測期間 | 見直しの時点から数える観測期間 |
| 主な使い道 | 承認か否決か、最初の与信枠(第9章) | 与信の継続、与信枠の維持・変更、利用の一時的な制限、早めの連絡、回収の優先順位 |
| 作るときの注意 | 否決した申込の結果が分からない(第6章) | 特徴量を作る期間と結果を見る期間を重ねない。途上与信の判断そのものが後の行動を変える |
表の「作るときの注意」の行にある「途上与信の判断そのものが後の行動を変える」は、行動のスコアに固有の難しさで、この章ではこの段落でまとめて説明します。与信枠を下げた契約は、その後に使える額が減るので、延滞の起き方も変わります。早めに連絡した契約は、連絡しなかった場合とは違う返済の経過をたどることがあります。記録に残るのは、実際に取った対応のもとでの結果だけです。これは、否決した申込の結果が分からないという第6章の問題と同じ形の問題で、途上与信の判断を変えた後に集めたデータでモデルを作り直すときには、過去の判断の記録(いつ、どの契約に、どの対応を取ったか)が欠かせません。対応そのものの効果(減額や連絡で結果がどう変わるか)を知りたいときは、一部の契約で対応を変えて比べる試行が要ります(第9章のチャンピオンとチャレンジャーの考え方。効果の測り方の一般論は弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」)。
途上与信で決めること、与信の継続・与信枠・利用の制限・連絡
ここでいう途上与信は、契約の後に、利用や返済の状況を見て、与信の継続と、与信枠や条件の維持・変更を判断することです。与信枠をそのまま維持するという判断も、途上与信の判断に含みます。クレジットカードやカードローンのように、与信枠の範囲で繰り返し利用できる契約では、途上与信の判断の余地が大きくなります。一度に貸して決まった回数で返す契約では、与信枠を変える余地は小さく、早めの連絡や回収の優先順位が主な使い道になります。
途上与信で決めることを、使う情報と、判断を誤ったときの損失の型とあわせて整理したのが次の表です。損失の型は、序章で整理した6つの型の名前を使っています。
| 決めること | 主に使う情報 | 判断を誤ったときの損失の型 | 判断のときの注意 |
|---|---|---|---|
| 与信の継続と更新 | 行動のスコア、延滞の履歴、信用情報の再照会の結果 | 貸し倒れ、機会損失 | 契約の期間の満了に合わせて判断する。更新しない場合の顧客への説明を用意する |
| 与信枠の維持・増額 | 行動のスコア、枠の使用率、返済の額の割合、返済の能力の再調査の結果 | 過剰与信による顧客の不利益、貸し倒れ | 使用率が高いことは、増額の需要と、返済の苦しさの両方の兆候でありうる。法令上の調査の要件は第14章 |
| 与信枠の減額 | 行動のスコア、他社の借入の増加、延滞の始まり | 機会損失、顧客の不利益(急な減額で資金繰りが崩れる) | 減額の基準と、事前の通知の手順を決めておく。延滞を深める引き金にならないかを確かめる |
| 利用の一時的な制限 | 延滞の段階、直近の返済の状況 | 貸し倒れ、顧客の不利益 | 制限を解く条件(延滞の解消など)も同時に決める |
| 早めの連絡と返済の相談の案内 | 早期の警戒の指標、デフォルト確率の見積りの上昇 | 過剰与信による顧客の不利益、貸し倒れ | 連絡は督促ではなく、状況の確認と相談の窓口の案内として設計する |
| 延滞した契約への連絡の優先順位 | 回収の優先度の見積り、延滞の段階、連絡の履歴 | 貸し倒れ、審査の滞り(連絡の能力を超える) | 取り立ての規制を守る。連絡の能力(人数・時間帯)の範囲で順番を決める |
途上与信の判断は、頻度でも初期与信と違います。初期与信は申込が来たときに1件ずつ行いますが、途上与信は、毎月など決めた間隔で、保有しているすべての契約について行う形が考えられます。判断の多くを帯ごとの規則で処理し、残りを人が確認する分担にした場合、人による確認の件数が能力を超えると、増額の申し出への回答や連絡が遅れます。これも審査の滞りの一つの形です。
架空の契約の月ごとの記録を作る
ここからは、行動のデータでデフォルトの見積りがどう変わるか、延滞の段階がどう移り変わるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の契約の記録よりずっと単純です。合成データでの成績は、実際の契約での成績の目安にはなりません。示したいのは、行動の特徴量の作り方と評価のしかたで、数字がどう動くかという点です。与信枠の範囲で繰り返し利用でき、毎月返済する個人向けの契約を想定し、12,000件の契約を、暦の上の42か月にわたって月ごとに追いかけます(乱数の種は20261113に固定しています)。合成した記録の性質は次のとおりです。
- 契約した月は1〜24か月目に散らばる。申込の時点の項目は、年収の水準(相対値。全体の中央値がおよそ1になるように作った)・勤続年数・他社の借入の件数・過去の延滞の有無・直近の申込の件数の5つ
- デフォルトのしやすさは、申込の時点の項目で決まる部分と、申込の時点では見えない事情の部分と、契約の後に少しずつ変わる部分の和で決まる。他社の借入が3件以上で、直近の申込も2件以上ある場合に効く組み合わせの効果も入れた
- 毎月、延滞の段階(延滞なし・1か月の延滞・2か月の延滞・デフォルト)が移り変わる。1か月の延滞と2か月の延滞からは、延滞なしへ戻る(全額を返して延滞が解消する)ことも、同じ段階にとどまることも、1段深くなることもある
- デフォルトは「3か月分以上の延滞に至ること」とし、いったんデフォルトした契約は元に戻らないものとした。これは第2章の例題の定義(90日以上の延滞)を、月単位の記録に合わせて置き換えたもの
- 延滞のない契約は、毎月1%の割合で完済・解約で記録が終わる。枠の使用率と、請求された額に対する返済の額の割合も毎月記録する。使用率には、デフォルトのしやすさとは関係のない、契約ごとの使い方の癖も入れた
最初のブロックで、この記録を作ります。行列 S が契約ごと・月ごとの延滞の段階、U が枠の使用率、P が返済の額の割合です。返済の額の割合は、その月に請求された額(約定の返済の額)に対する返済の額の割合を表す単純化した補助の指標で、延滞の段階とは別の乱数で作っており、実際の請求と入金の対応は再現していません。延滞の段階が移ったときの記録(延滞なしへ戻ったときの全額の返済など)とも、額としてはつながっていません。デフォルトや完済・解約で記録が終わった後の月は、使用率と返済の額の割合を0として記録し、集計では契約が続いている月だけを使います。実行には Python 3.14.3、numpy 2.4.3、pandas 3.0.1、scikit-learn 1.9.0、matplotlib 3.10.8、japanize-matplotlib 1.1.3 を使いました。
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

rng = np.random.default_rng(20261113)
N, M = 12000, 42                                   # 契約の件数、追いかける暦の月数
open_m = rng.integers(1, 25, N)                    # 契約した月(1〜24か月目)
app = pd.DataFrame({
    "income": rng.lognormal(0.0, 0.4, N),          # 年収の水準(相対値)
    "years": rng.integers(0, 21, N),               # 勤続年数
    "loans": rng.poisson(1.0, N),                  # 他社の借入の件数
    "past_dlq": (rng.random(N) < 0.12).astype(int),  # 過去の延滞の有無
    "inq": rng.poisson(0.8, N)})                   # 直近の申込の件数
app_risk = (-1.2 * np.log(app.income) - 0.05 * app.years + 0.45 * app.loans
            + 1.2 * app.past_dlq + 0.3 * app.inq
            + 0.8 * ((app.loans >= 3) & (app.inq >= 2))).to_numpy() - 0.3
hidden = rng.normal(0.0, 0.6, N)                   # 申込の時点では見えない事情
habit = rng.normal(0.0, 0.7, N)                    # 枠の使い方の癖(リスクとは無関係)
S = np.full((N, M + 1), -1)                        # 延滞の段階 0〜2、3=デフォルト、9=完済・解約、-1=契約前
U = np.zeros((N, M + 1))                           # 枠の使用率
P = np.zeros((N, M + 1))                           # 請求に対する返済の額の割合
s, u, w = np.zeros(N, int), np.zeros(N), np.zeros(N)
sig = lambda x: 1 / (1 + np.exp(-x))
for t in range(1, M + 1):
    on = open_m <= t
    new = open_m == t
    w = np.where(on & ~new, w + rng.normal(0, 0.2, N), w)      # 契約後に事情が少しずつ変わる
    r = app_risk + hidden + w
    u = np.where(new, sig(habit + 0.5 * r - 0.5), 0.6 * u + 0.4 * sig(habit + 0.9 * r + rng.normal(0, 0.3, N)))
    x = rng.random(N)
    cure, roll = sig(0.6 - 0.8 * r - 0.6 * (s - 1)), sig(-0.6 + 0.7 * r + 0.5 * (s - 1))
    nxt = np.select([s == 0, (s == 1) | (s == 2)],
                    [np.where(x < sig(-4.8 + 1.0 * r), 1, np.where(x > 0.99, 9, 0)),
                     np.where(x < cure, 0, np.where(x < cure + (1 - cure) * roll, s + 1, s))], s)
    s = np.where(new, 0, np.where(on, nxt, s))
    pay = sig(2.0 - 0.9 * r + rng.normal(0, 0.6, N)) * np.where(s > 0, 0.3, 1.0)
    S[:, t] = np.where(on, s, -1)
    alive = on & (s <= 2)                                       # 契約中で、まだ記録が終わっていない月
    U[:, t], P[:, t] = np.where(alive, u, 0), np.where(alive, pay, 0)
print("契約", N, "件/42か月目までにデフォルト", (S == 3).any(axis=1).sum(), "件/完済・解約", (S == 9).any(axis=1).sum(), "件")
実行した結果、12,000件の契約のうち、42か月目までにデフォルトに至ったのは1,206件、完済・解約で記録が終わったのは2,815件でした。契約した月が違うので、追いかけられる月数は契約ごとに19〜42か月と違います(デフォルトや完済・解約で記録が終わった契約は、そこまでです)。この合成データでは、使用率や返済の額の割合が、デフォルトのしやすさを反映するように作ってあります。そのため、行動の特徴量が効くことは、データの作り方に組み込まれた結果です。以下の数字は、行動の特徴量が効くかどうかを確かめるためではなく、効く場合に、特徴量の作り方と評価のしかたで数字がどう変わるかを見るためのものです。
参照期間と観測期間を分けて、行動の特徴量を作る
行動のスコアのモデルを作るには、ある時点(見直しの時点)を決め、その時点までの記録から特徴量を作り、その時点より後の結果を予測の対象にします。特徴量を作るために見直しの時点から過去へさかのぼる期間を、本コラムでは参照期間と呼びます。結果(デフォルトしたかどうか)を見届ける期間は、初期与信と同じく観測期間と呼び、途上与信では見直しの時点から数えます。例題では、参照期間を見直しの時点までの6か月、観測期間を見直しの時点の翌月からの12か月にしました。
この2つの期間は、重ねてはいけません。見直しの時点で途上与信の判断をするとき、手元にあるのは見直しの時点までの記録だけです。参照期間が観測期間の中に入り込むと、モデルは判断の時点ではまだ起きていない延滞を手がかりにすることになり、成績が実際より良く見えます。本コラムでは、このように判断の時点で使えない情報が学習や評価に入り込むことを情報の漏れと呼びます。
次のブロックの関数 snapshot は、見直しの時点 T0 を受け取り、その時点で契約から6か月以上たっていて、まだデフォルトしていない契約について、申込の時点の項目5つと、行動の特徴量7つを作ります。行動の特徴量は、契約からの経過月数、今の延滞の段階、参照期間の中で最も深かった延滞の段階、参照期間の中で延滞していた月の数、直近3か月の枠の使用率の平均、参照期間の6か月での使用率の変化、直近3か月の返済の額の割合の平均です。結果の y は、T0 の翌月から12か月のうちにデフォルトに至った場合を1、それ以外を0とします。
本コラムの用語では、正常は「観測期間を満たし、その間にデフォルトしなかったと確認できた契約の結果」で、観測期間を満たしていない契約は正常に数えないのが基本です。この例題では、観測期間の途中で完済・解約で記録が終わった契約も0に数えました。この合成データでは、完済・解約は延滞の無い契約からだけ起き、その後はデフォルトしない設定にしてあるため、記録が終わった後にデフォルトが起きていないことが作り方から確かめられる、というのが理由です。実際の記録では、途中で記録が終わった理由(完済か、他社への借り換えか、記録の欠けか)によって扱いを決める必要があり、この例題の扱いをそのまま当てはめることはできません。
APP = ["log_inc", "years", "loans", "past_dlq", "inq"]
BEH = ["mob", "dlq_now", "max_dlq6", "n_dlq6", "util3", "util_chg", "pay3"]

def snapshot(T0, feat_end=None):
    """T0 月末の時点の行動の特徴量(T0-5〜T0 の6か月)と、T0+1〜T0+12 のデフォルト"""
    e = T0 if feat_end is None else feat_end                 # 特徴量を作る最後の月(既定は T0)
    ok = (open_m <= T0 - 6) & (S[:, T0] >= 0) & (S[:, T0] <= 2)
    d = pd.DataFrame({
        "log_inc": np.log(app.income), "years": app.years, "loans": app.loans,
        "past_dlq": app.past_dlq, "inq": app.inq,
        "mob": T0 - open_m,                                  # 契約からの経過月数
        "dlq_now": S[:, e],                                  # 今の延滞の段階
        "max_dlq6": S[:, e - 5:e + 1].max(axis=1),           # 直近6か月の最も深い延滞
        "n_dlq6": (S[:, e - 5:e + 1] >= 1).sum(axis=1),      # 直近6か月で延滞していた月の数
        "util3": U[:, e - 2:e + 1].mean(axis=1),             # 直近3か月の枠の使用率の平均
        "util_chg": U[:, e] - U[:, e - 5],                   # 6か月での使用率の変化
        "pay3": P[:, e - 2:e + 1].mean(axis=1),              # 直近3か月の返済の額の割合
        "y": (S[:, T0 + 1:T0 + 13] == 3).any(axis=1).astype(int),
        "closed": (S[:, T0 + 12] == 9).astype(int)})                # 観測期間の途中で完済・解約した
    d[["dlq_now", "max_dlq6"]] = d[["dlq_now", "max_dlq6"]].clip(upper=3)
    return d[ok]

tr, te = snapshot(18), snapshot(30)                          # 学習は18か月目、評価は30か月目の時点
print("学習", len(tr), "件 デフォルト率", round(tr.y.mean(), 4), "/評価", len(te), "件 デフォルト率", round(te.y.mean(), 4))
学習には18か月目の月末を見直しの時点としたデータ(5,147件、19〜30か月目の12か月でのデフォルト率4.9%)を、評価には30か月目の月末を見直しの時点としたデータ(9,468件、31〜42か月目の12か月でのデフォルト率5.11%)を使いました。デフォルト率の分母は、それぞれの見直しの時点で契約から6か月以上たっていて、まだデフォルトしていなかった契約です。学習用のデータの結果は30か月目の月末にすべて出そろうので、30か月目の月末にモデルを作り、同じ時点の契約に当てはめて、その後の12か月の結果で評価する、という運用の順番になります。評価に使う結果は、学習の時点ではまだ起きていない月のものです。
次の表は、例題の見直しの時点と、参照期間・観測期間の関係をまとめたものです。
| データ | 見直しの時点 | 参照期間(特徴量を作る月) | 観測期間(結果を見る月) | 結果が出そろう時点 |
|---|---|---|---|---|
| 学習用 | 18か月目の月末 | 13〜18か月目 | 19〜30か月目 | 30か月目の月末 |
| 評価用 | 30か月目の月末 | 25〜30か月目 | 31〜42か月目 | 42か月目の月末 |
| 誤りの例(学習用) | 18か月目の月末 | 16〜21か月目(19〜21か月目が観測期間と重なる) | 19〜30か月目 | 30か月目の月末 |
| 誤りの例(評価用) | 30か月目の月末 | 28〜33か月目(31〜33か月目が観測期間と重なる) | 31〜42か月目 | 42か月目の月末 |
表の誤りの例の2行では、参照期間の最後の3か月が観測期間の最初の3か月と重なっています。見直しの時点では、その3か月の記録はまだ存在しません。実務でこの誤りが起きやすいのは、データを集計する日と、見直しの時点として扱う日がずれている場合です。たとえば、月末の時点の判断を再現するつもりで、翌月の半ばに集計した延滞の段階を使うと、その半月分の情報が漏れます。データの各項目について「どの時点で確定した値か」を記録に残しておくことが、この誤りを防ぐ前提になります。
申込時点の項目だけのモデルと、行動の特徴量を足したモデルを比べる
このデータで、3つのモデルを比べます。どれも項目を標準化(平均0・標準偏差1にそろえる変換)してから当てはめたロジスティック回帰(第4章)で、違いは使う項目だけです。1つ目は申込の時点の項目5つだけ、2つ目は行動の特徴量7つだけ、3つ目はその両方を使います。順位づけの成績は、デフォルト確率の見積りから計算した AR値(AR = 2 × AUC – 1。指標の詳細は第7章)で比べます。あわせて、参照期間に一度も延滞しなかった契約だけでの AR値、観測期間の途中で完済・解約した契約を除いた AR値、期間を重ねた誤りの例の AR値も計算します。
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.metrics import roc_auc_score, roc_curve

def ar(y, p):
    return 2 * roc_auc_score(y, p) - 1                       # AR値 = 2 × AUC - 1

models = {"申込時点の項目だけ": APP, "行動の特徴量だけ": BEH, "申込時点+行動": APP + BEH}
pd_te = {}
for name, cols in models.items():
    m = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(tr[cols], tr.y)
    pd_te[name] = m.predict_proba(te[cols])[:, 1]
    print(name, "評価のAR値", round(ar(te.y, pd_te[name]), 3), "/学習のAR値", round(ar(tr.y, m.predict_proba(tr[cols])[:, 1]), 3))
clean = ((te.dlq_now == 0) & (te.max_dlq6 == 0)).to_numpy()   # 参照期間に一度も延滞しなかった契約
print("参照期間に延滞なし", clean.sum(), "件 デフォルト率", round(te.y[clean].mean(), 4),
      {k: round(ar(te.y[clean], p[clean]), 3) for k, p in pd_te.items()})
tr_bad, te_bad = snapshot(18, feat_end=21), snapshot(30, feat_end=33)   # 誤り:結果を見る期間に3か月はみ出す
m = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(tr_bad[APP + BEH], tr_bad.y)
full = (te.closed == 0).to_numpy()                            # 観測期間を最後まで追えた契約だけ
print("観測期間の途中で完済・解約", (~full).sum(), "件/除いた", full.sum(), "件のAR値(申込時点+行動)",
      round(ar(te.y[full], pd_te["申込時点+行動"][full]), 3))
print("期間を重ねた誤りの例 評価のAR値", round(ar(te_bad.y, m.predict_proba(te_bad[APP + BEH])[:, 1]), 3))

fig, ax = plt.subplots(figsize=(5.5, 5))
for (name, p), c, ls in zip(pd_te.items(), ["#999999", "#000080", "#002E73"], [":", "--", "-"]):
    fpr, tpr, _ = roc_curve(te.y, p)
    ax.plot(fpr, tpr, color=c, ls=ls, label=f"{name}(AR値 {ar(te.y, p):.3f})")
ax.plot([0, 1], [0, 1], color="#cccccc", lw=0.8)
ax.set_xlabel("正常だった契約のうち、上位に入った割合")
ax.set_ylabel("デフォルトした契約のうち、上位に入った割合")
ax.legend(loc="lower right")
fig.savefig("../ch10_roc.png", dpi=120, bbox_inches="tight")
実行した結果を次の表にまとめます。評価用の AR値は、30か月目の月末を見直しの時点とした9,468件で計算した値です。
| モデル | 評価用の AR値(9,468件) | 参照期間に延滞の無かった契約だけでの AR値(8,788件) | 学習用の AR値(5,147件。学習に使ったデータ自身での値) |
|---|---|---|---|
| 申込時点の項目だけ | 0.526 | 0.528 | 0.597 |
| 行動の特徴量だけ | 0.818 | 0.783 | 0.775 |
| 申込時点+行動 | 0.811 | 0.775 | 0.788 |
| 参考:期間を重ねた誤りの例(申込時点+行動) | 0.857 | 計算していない | 計算していない |
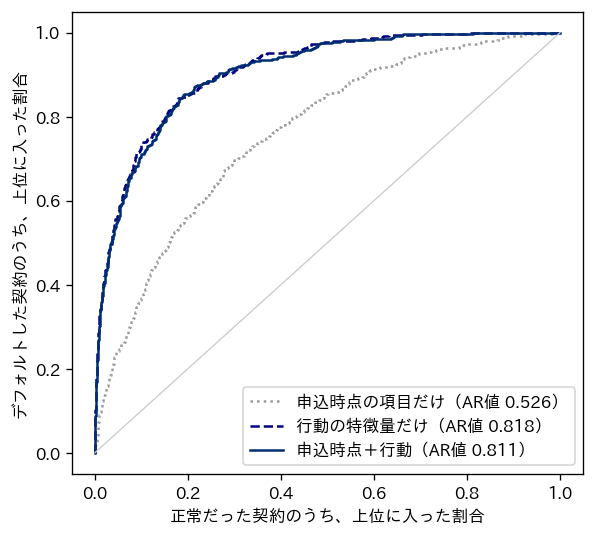
上の図は、評価用のデータでの3つのモデルの ROC 曲線です。横軸は正常だった契約のうち、デフォルト確率の見積りの高い順に並べて上位に入った割合、縦軸はデフォルトした契約のうち上位に入った割合で、曲線が左上に張り出しているほど、デフォルトした契約を上位に並べられていることを表します。ここでの申込時点の項目だけのモデルは、前の節の表の申込のスコアそのものではなく、同じ見直しの時点で続いている契約に、申込時点の項目だけを使って当てはめ、見直しの時点から12か月の結果を予測させたもので、対象も観測期間も申込のスコアとは違います。本コラムの架空データでは、申込時点の項目だけのモデルの AR値は0.526で、行動の特徴量を使ったモデルは0.818と0.811でした。行動の特徴量だけのモデルと、申込時点の項目を足したモデルの差はごく小さく、この架空データでは、行動の特徴量が申込時点の項目の情報をほぼ含んでいました。申込時点の項目が見積りに効かなくなったという意味ではなく、契約から時間がたつと、申込の時点の事情の多くが返済の記録に表れる、という作り方のデータだったということです。
評価用のデータのうち、参照期間に一度も延滞しなかった8,788件(その後12か月のデフォルト率3.65%)だけで AR値を計算し直すと、行動の特徴量だけのモデルは0.818から0.783へ、申込時点+行動のモデルは0.811から0.775へ下がりましたが、申込時点の項目だけのモデル(0.528)との差は残りました。この架空データでは、延滞がまだ表れていない契約についても、枠の使用率や返済の額の割合の動きが、将来のデフォルトの手がかりになっていたことになります。これは、使用率と返済の額の割合をデフォルトのしやすさに結びつけてデータを作ったためで、実際の記録で同じ程度に効くかは、自社のデータで確かめる必要があります。また、観測期間の途中で完済・解約した1,005件を除いた8,463件で計算し直しても、申込時点+行動のモデルの AR値は0.812で、除かない場合(0.811)とほとんど変わりませんでした。
評価用と学習用の AR値の並びにも注意が要ります。表の学習用の AR値は、モデルを当てはめたデータ自身で計算した値で、評価用より高く出やすい値です。申込時点の項目だけのモデルは、学習用で0.597、評価用で0.526でした。行動の特徴量だけのモデルは、逆に評価用の方が高く出ています。学習用のデータは18か月目の時点の契約で、1〜12か月目に契約したものだけが入っており、評価用のデータは30か月目の時点の契約で、1〜24か月目に契約したものが入っています。契約からの経過月数の分布が違う集団なので、AR値の違いをそのままモデルの良し悪しの変化として読むことはできません。対象の集団や期間が違う AR値の差は、そのままモデルの優劣の判断には使えません(第7章)。
最後に、期間を重ねた誤りの例です。参照期間を観測期間の中へ3か月はみ出させて特徴量を作ると、評価用の AR値は0.857になり、正しく作った0.811より高く出ました。この AR値を根拠に与信枠の減額や連絡の対象を決める計画を立てると、運用に入れた後の成績は見込みを下回るおそれがあります。ベンダーや社内のデータ分析の担当から行動のスコアの成績が示されたときには、参照期間と観測期間がどう置かれていたかを、数字より先に確かめる必要があります。
デフォルト確率の見積りの帯と、与信枠を見直す判断
行動のデータによる見積りを途上与信の判断に使うには、見積りを帯に分け、帯ごとに取る対応を決めるのが分かりやすい方法です。この例ではデフォルト確率の見積りで帯を分けるので、見積りが最も低い帯Aは、スコアに直せば最も高い側に当たります。次のブロックでは、評価用のデータ(30か月目の月末の時点の9,468件)を、申込時点+行動のモデルのデフォルト確率の見積りで5つの帯に等しい件数で分け、帯ごとの件数・見積りの平均・その後12か月の実績のデフォルト率・直近3か月の枠の使用率の平均・今延滞中の割合を集計しました。あわせて、枠の6割以上を使っている契約を、見積りの低い帯(AからC)と高い帯(DとE)に分けて、実績のデフォルト率を比べています。
te = te.assign(pd_beh=pd_te["申込時点+行動"])
te["帯"] = pd.qcut(te.pd_beh, 5, labels=["A(低い)", "B", "C", "D", "E(高い)"])
band = te.groupby("帯", observed=True).agg(件数=("y", "size"), 見積りの平均=("pd_beh", "mean"),
                                         実績のデフォルト率=("y", "mean"), 使用率の平均=("util3", "mean"),
                                         今延滞中の割合=("dlq_now", lambda v: (v > 0).mean()))
print(band.round(3))
for g in [["A(低い)", "B", "C"], ["D", "E(高い)"]]:
    m = (te.util3 >= 0.6) & te["帯"].isin(g)                 # 枠の6割以上を使っている契約
    print("使用率6割以上かつ帯", "・".join(g), m.sum(), "件 実績のデフォルト率", round(te.y[m].mean(), 3))
| 帯(見積りの低い順) | 件数 | 見積りの平均 | 実績のデフォルト率 | 使用率の平均 | 今延滞中の割合 |
|---|---|---|---|---|---|
| A(低い) | 1,894 | 0.003 | 0.001 | 0.196 | 0.000 |
| B | 1,893 | 0.008 | 0.004 | 0.336 | 0.000 |
| C | 1,894 | 0.018 | 0.013 | 0.475 | 0.000 |
| D | 1,893 | 0.043 | 0.030 | 0.617 | 0.007 |
| E(高い) | 1,894 | 0.230 | 0.209 | 0.773 | 0.128 |
表の実績のデフォルト率の分母は、それぞれの帯の契約(30か月目の月末の時点で、契約から6か月以上たち、まだデフォルトしていなかった契約)で、31〜42か月目の12か月でデフォルトに至った割合です。実績のデフォルト率は帯Aの0.001から帯Eの0.209まで、帯の順に並んでいます。デフォルトの多くは帯Eに集まっており、帯Eの実績のデフォルト率は帯Dのおよそ7倍でした。一方、見積りの平均は、どの帯でも実績のデフォルト率を上回っていました。順位は保たれていても、確率の水準が実績と合っているとは限らないという第8章の論点が、この例でも表れています。帯ごとの見積りを与信枠の額や貸し倒れの見込みの計算に使うなら、較正の確認と、必要に応じた調整が要ります。
枠の使用率は、途上与信の判断で扱いの難しい項目です。この架空データでは、使用率が6割以上の契約のうち、見積りの低い帯AからCに入ったのは448件で、実績のデフォルト率は0.02でした。見積りの高い帯DとEに入った2,785件では0.148です。同じように枠を多く使っていても、返済の状況や他の項目によって、その後のデフォルト率は大きく違いました。この例では、使用率だけでは、同じように枠を使っている契約のデフォルトのしやすさの違いを十分に区別できませんでした。増額や減額の判断には、さらに収益と損失の見積りや顧客への影響を合わせて見る必要があります。なお、この架空データでは使用率をデフォルトのしやすさに結びつけて作っているため、使用率が高いほど帯が高くなる傾向が強く出ています。
この帯を途上与信の判断に結びつける表の例を、次に示します。帯の区切りと対応は説明のための例で、実際には帯ごとの収益と損失の見積り、法令上の調査の要件、連絡の能力をもとに決めます。
| 帯 | 与信枠 | 連絡と確認 | 判断を誤ったときに出やすい損失の型 |
|---|---|---|---|
| A・B | 維持。申し出があれば増額を検討する(返済の能力の再調査を経る) | 通常の案内のみ | 機会損失(必要以上に増額を断る) |
| C | 維持 | 通常の案内のみ | 機会損失、貸し倒れ |
| D | 維持。増額は行わない | 使用率や返済の額の割合の悪化が続けば状況の確認の連絡 | 過剰与信による顧客の不利益、貸し倒れ |
| E(延滞なし) | 維持か減額の検討(事前の通知の手順に従う) | 返済の相談の窓口の案内を含む早めの連絡 | 過剰与信による顧客の不利益、機会損失(急な減額) |
| E(延滞中) | 新たな利用の一時的な制限 | 回収の優先度の見積りに沿った連絡(次の節以降) | 貸し倒れ、規制上の義務の不履行(取り立ての規制) |
与信枠の増額は、事業の収益の面では魅力のある判断ですが、過剰与信による顧客の不利益と最も直接につながる判断でもあります。貸金業法は、極度方式基本契約(与信枠の範囲で繰り返し借りられる契約)の極度額を増額する場合に、返済の能力の調査の規定を準用すると定め(第13条第5項。対象から外れる場合は内閣府令で定める)、個人の顧客との極度方式基本契約については、一定の期間ごとなどに、指定信用情報機関の信用情報を使って、基準額を超える契約に当たるかどうかを調査することを求めています(第13条の3)。調査の対象となる場合の要件の詳細や、割賦販売法での扱いは第14章で整理します。ここで押さえておきたいのは、デフォルト確率の見積りが低い(スコアに直せば高い)ことは、増額してよいことの十分な根拠にはならず、法令上の調査と、増額した後の返済の負担の見積りを合わせて判断する必要がある、という点です。
減額や利用の制限にも注意が要ります。デフォルト確率の見積りが上がった契約の与信枠を急に下げると、顧客の資金繰りが崩れて延滞を深める引き金になることがあります。減額が延滞を防ぐのか深めるのかは記録を見るだけでは分からないので(判断が後の行動を変える問題)、減額の基準を変えるときは、一部の契約で試して比べる方法が有効だと考えています。
延滞の段階の遷移、遷移行列で読む延滞の深まり方
延滞した契約の管理では、延滞の段階がどう移り変わるかを知ることが出発点になります。ある月に各段階にあった契約が、翌月にどの段階へ移ったかの割合を表にしたものを遷移行列と呼びます。延滞なし・1か月の延滞・2か月の延滞の各段階から、翌月に延滞なしへ戻る割合(延滞の解消)、同じ段階にとどまる割合、1段深くなる割合を並べると、延滞がどの段階で解消しにくくなるかが分かります。
遷移行列は、マルコフ連鎖として読むこともできます。マルコフ連鎖は、翌月の段階の確率が今月の段階だけで決まり、それより前の履歴によらない、と仮定する確率の模型です。この仮定に加えて、遷移の割合が月によって変わらないと仮定すると、遷移行列を12回掛け合わせると、今の段階ごとに、12か月後にデフォルトに至っている割合を計算できます。次のブロックでは、30か月目の月末に集計する想定で、2〜30か月目に起きた月ごとの遷移から遷移行列を作り、12か月先の見積りを計算しました。そのうえで、30か月目の月末の段階ごとに、31〜42か月目の実績と突き合わせています。
T0 = 30                                                      # 30か月目の月末に集計する想定
a, b = S[:, 1:T0].ravel(), S[:, 2:T0 + 1].ravel()           # ある月の段階と翌月の段階(30か月目まで)
keep = (a >= 0) & (a <= 2)                                   # 契約中で、まだデフォルトしていない月
names = {0: "延滞なし", 1: "1か月", 2: "2か月", 3: "デフォルト", 9: "完済・解約"}
tm = pd.crosstab(pd.Series(a[keep]).map(names), pd.Series(b[keep]).map(names), normalize="index",
                 rownames=["今月"], colnames=["翌月"])
tm = tm.loc[["延滞なし", "1か月", "2か月"], ["延滞なし", "1か月", "2か月", "デフォルト", "完済・解約"]]
print("月ごとの遷移の件数", keep.sum())
print(tm.round(4))
Q = np.zeros((5, 5))                                         # 吸収状態つきの遷移行列(行の和は1)
Q[:3] = tm.to_numpy()
Q[3, 3] = Q[4, 4] = 1.0
Q12 = np.linalg.matrix_power(Q, 12)
print("マルコフ連鎖として12か月先にデフォルトにいる割合", Q12[:3, 3].round(3))
now, fut = S[:, T0], (S[:, T0 + 1:T0 + 13] == 3).any(axis=1)
for k in range(3):
    print(names[k], "の契約", (now == k).sum(), "件 実績の12か月デフォルト率", round(fut[now == k].mean(), 3))
hist = (S[:, T0 - 5:T0 + 1] >= 1).any(axis=1)                # 当月を含む直近6か月に延滞があったか
for h in [False, True]:
    m = (now == 0) & (hist == h)
    print("延滞なしのうち 直近6か月の延滞", "あり" if h else "なし", m.sum(), "件 実績", round(fut[m].mean(), 3))

fig, ax = plt.subplots(figsize=(7, 4))
x = np.arange(3)
ax.bar(x - 0.2, tm["延滞なし"], 0.4, color="#002E73", label="翌月に延滞なしの状態になる割合")
deeper = [tm.loc["延滞なし", "1か月"], tm.loc["1か月", "2か月"], tm.loc["2か月", "デフォルト"]]
ax.bar(x + 0.2, deeper, 0.4, color="#999999", label="翌月に1段深くなる割合")
for i in range(3):
    ax.text(x[i] - 0.2, tm["延滞なし"].iloc[i] + 0.02, f"{tm['延滞なし'].iloc[i]:.3f}", ha="center")
    ax.text(x[i] + 0.2, deeper[i] + 0.02, f"{deeper[i]:.3f}", ha="center")
ax.set_xticks(x, ["延滞なし", "1か月の延滞", "2か月の延滞"])
ax.set_ylabel("翌月の割合")
ax.set_ylim(0, 1.1)
ax.legend(loc="upper right")
fig.savefig("../ch10_transition.png", dpi=120, bbox_inches="tight")
集計した月ごとの遷移は185,649件でした。遷移行列を次の表にまとめます。行が今月の段階、列が翌月の段階で、各行の和は1です。
| 今月の段階 | 翌月に延滞なし | 翌月に1か月の延滞 | 翌月に2か月の延滞 | 翌月にデフォルト | 翌月に完済・解約 |
|---|---|---|---|---|---|
| 延滞なし | 0.9758 | 0.0142 | 0.0000 | 0.0000 | 0.01(約1%) |
| 1か月の延滞 | 0.4138 | 0.2377 | 0.3485 | 0.0000 | 0.00 |
| 2か月の延滞 | 0.2308 | 0.0000 | 0.2025 | 0.5667 | 0.00 |
この架空データでは、延滞なしの契約が翌月に1か月の延滞に入る割合は0.0142でした。1か月の延滞からは、翌月に延滞なしへ戻る割合が0.4138、2か月の延滞へ進む割合が0.3485です。2か月の延滞からは、延滞なしへ戻る割合が0.2308に下がり、デフォルト(3か月分以上の延滞)へ進む割合が0.5667に上がります。延滞が深くなるほど延滞なしへ戻る割合が下がり、次の段階へ進む割合が上がる、という並びになっています。なお、この合成データでは、延滞は1か月ずつしか深まらず、2か月の延滞から1か月の延滞へ戻る(一部だけ返して1段浅くなる)動きは作っていないため、表の0.0000は作り方による値です。実際の記録では、一部の返済で段階が浅くなる動きや、段階を飛ばす動きも起こりえます。
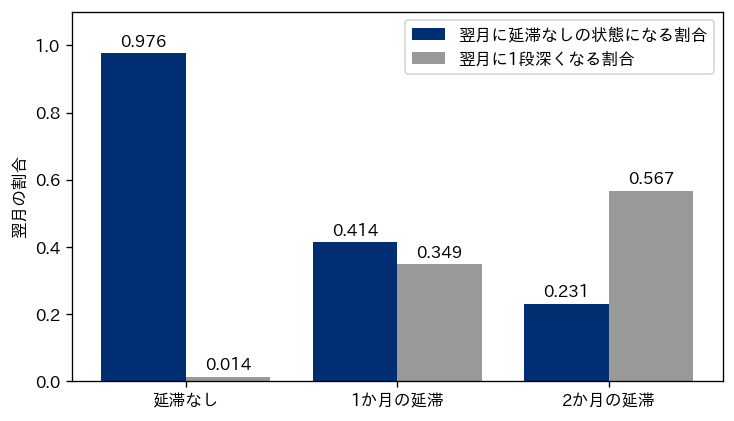
上の図は、遷移行列のうち、翌月に延滞なしへ戻る(延滞なしの段階では、とどまる)割合と、翌月に1段深くなる割合を、段階ごとに並べたものです(図の数値は小数第3位に丸めています)。1か月の延滞の段階では、戻る割合が進む割合を上回っていますが(0.414と0.349)、2か月の延滞の段階では逆転しています。この架空データでは、延滞が始まったばかりの段階の方が、翌月に延滞なしへ戻る割合が高かったことになります。延滞した顧客への連絡や返済の相談の案内を、どの段階で始めるかを考えるときの材料になります。
次の表は、マルコフ連鎖として計算した12か月先の見積りと、30か月目の月末の段階ごとの実績を並べたものです。
| 30か月目の月末の段階 | 件数 | マルコフ連鎖による12か月先のデフォルトの割合 | 31〜42か月目の実績のデフォルト率 |
|---|---|---|---|
| 延滞なし | 9,213 | 0.040 | 0.039 |
| うち当月を含む直近6か月に延滞なし | 8,788 | (区別しない) | 0.037 |
| うち当月を含む直近6か月に延滞あり | 425 | (区別しない) | 0.094 |
| 1か月の延滞 | 177 | 0.348 | 0.390 |
| 2か月の延滞 | 78 | 0.721 | 0.692 |
表の件数は、30か月目の月末に各段階にあった契約で、契約からの経過月数は問わず数えています。実績のデフォルト率の分母は、その件数です。段階ごとの全体の水準では、マルコフ連鎖による見積り(0.040・0.348・0.721)と実績(0.039・0.390・0.692)は近い値でした。ただし、1か月の延滞は177件、2か月の延滞は78件と件数が少なく、実績の値そのものに偶然の揺れが大きく含まれます。
表の2行目と3行目が、マルコフ連鎖として読むときの限界を示しています。30か月目の月末に延滞なしだった契約のうち、当月を含む直近6か月(25〜30か月目)に一度も延滞しなかった8,788件の実績は0.037、その6か月のうちに延滞があり、その後に解消していた425件の実績は0.094でした。マルコフ連鎖の仮定のもとでは、今月の段階が同じ「延滞なし」であれば、過去の履歴によらず同じ見積り(0.040)になります。この架空データでは、履歴によって2倍以上の差がありました。遷移行列は、段階ごとの平均の動きをつかむ道具としては有用ですが、個々の契約の見積りには、行動のスコアのように履歴と契約ごとの違いを取り込んだモデルが要ります。
遷移行列を使うときの前提と限界を、次の表にまとめます。
| 前提 | 崩れたときに起きること | 確かめ方 |
|---|---|---|
| 翌月の段階は今月の段階だけで決まる(履歴によらない) | 過去に延滞した契約のデフォルトを低く、一度も延滞していない契約を高く見積もる | 同じ段階の契約を、過去の延滞の有無などで分けて実績を比べる |
| 同じ段階の契約は、移り変わり方が同じ | 契約の種類・経過月数・残高の違いによる差が平均に埋もれる | 商品・経過月数・スコアの帯ごとに遷移行列を作り比べる |
| 遷移の割合が時間によって変わらない | 景気の変化や回収の方針の変更の後に、見積りが実績とずれる | 集計の期間をずらして遷移行列を作り、割合の推移を見る |
| 回収の対応が過去と同じ | 連絡の方法や時期を変えた後の遷移は、過去の行列と比べられない | 対応を変えた時期を記録し、変更の前後を分けて集計する |
遷移行列とは別に、契約からの経過月数ごとにデフォルトの起きやすさを見る方法もあります。契約から何か月目にデフォルトが集中するかを見るもので、生存時間分析の考え方(ある時点まで起きなかったものが、次の期間に起きる割合を経過時間ごとに見る)を使います。観測期間を何か月にするか、契約からどれだけたった契約を行動のスコアの対象にするかを決めるときの材料になります。生存時間分析の考え方とコホート分析は、弊社コラム「顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで」で扱っているので、本コラムでは詳しく扱いません。
早期の警戒の指標、延滞の前に現れる変化
延滞が始まってから対応するより、延滞の前に兆候をつかめれば、顧客にとっても事業にとっても選べる対応が増えます。返済の相談の窓口を早めに案内できれば、顧客が返済の計画を立て直す時間ができます。このような、延滞の前に現れる変化を早期の警戒の指標と呼びます。候補になるのは、枠の使用率の上昇、返済の額の割合の低下(請求の額の一部しか返さない月が続く)、他社の借入の件数の増加(信用情報の再照会で分かる場合)、支払い方法の変更や、残高の急な増加などです。
次のブロックでは、契約した月から7か月以上たってから初めて延滞した契約について、初めて延滞した月の6か月前から1か月前までの枠の使用率の平均を計算し、一度も延滞もデフォルトもしなかった契約の使用率の平均(契約が続いている月だけの平均)と比べました。
first = np.where((S == 1).any(axis=1), (S == 1).argmax(axis=1), -1)     # 初めて延滞した月
ok = (first >= open_m + 7)                                  # 契約した月から7か月以上たって初めて延滞した契約
rows = {k: U[ok, first[ok] - k].mean() for k in range(6, 0, -1)}
never = ~(S == 1).any(axis=1) & ~(S == 3).any(axis=1)
mob = np.arange(M + 1)[None, :] - open_m[:, None]
base = U[never][(mob[never] >= 1) & (S[never] == 0)].mean()    # 契約が続いている月だけ
print("初めて延滞した契約", ok.sum(), "件 延滞のk か月前の使用率", [round(float(v), 3) for v in rows.values()])
print("一度も延滞しなかった契約の使用率の平均", round(base, 3))
fig, ax = plt.subplots(figsize=(6, 3.8))
ax.plot([-k for k in rows], list(rows.values()), marker="o", color="#002E73", label="初めて延滞した契約(延滞の前の月々)")
ax.axhline(base, color="#999999", ls="--", label="一度も延滞しなかった契約の平均")
ax.set_xticks([-k for k in rows], [f"{k}か月前" for k in rows])
ax.set_ylabel("枠の使用率の平均")
ax.set_ylim(0, 1)
ax.legend(loc="lower right")
fig.savefig("../ch10_early.png", dpi=120, bbox_inches="tight")
契約した月から7か月以上たってから初めて延滞した契約は2,303件で、初めて延滞した月の6か月前の使用率の平均は0.630、5か月前0.639、4か月前0.647、3か月前0.654、2か月前0.661、1か月前0.666でした。一度も延滞もデフォルトもしなかった契約の使用率の平均は0.425です。
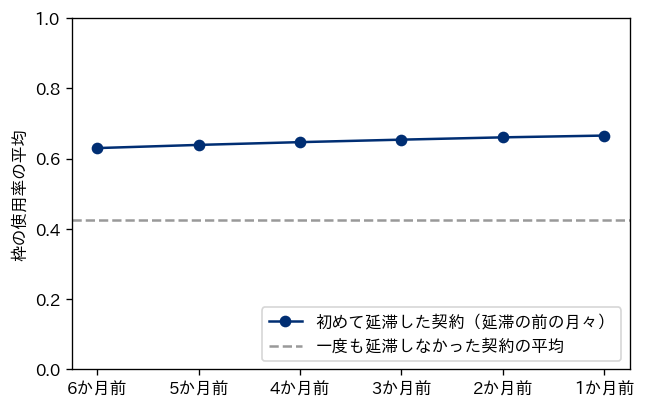
上の図のとおり、この架空データでは、初めて延滞した契約の使用率は、延滞の6か月前の時点ですでに一度も延滞しなかった契約の平均を大きく上回っており、延滞に近づくにつれての上昇はゆるやかでした(6か月で0.630から0.666へ)。この例で見えたのは、使用率の高い状態が、初めて延滞する6か月前からすでに続いていたという事実です。急な変化が手がかりとしてどれだけ強いかは、この計算では比べていません。ただし、比べた相手は一度も延滞しなかった契約の全期間の平均で、契約からの経過月数をそろえた比較ではありません。また、この合成データでは使用率をデフォルトのしやすさに結びつけて作っているので、実際の記録で使用率がどの程度の手がかりになるかは、自社のデータで確かめる必要があります。
早期の警戒の指標を運用に入れるときは、指標の水準と変化の両方を見ることと、指標に当てはまった契約にどの対応を取るかを先に決めておくことが大切だと考えています。指標に当てはまった契約には、その後も延滞しない契約が含まれるので、当てはまった件数と、そのうち実際に延滞した割合を確かめておく必要があります。早期の警戒の段階では、状況の確認や返済の相談の窓口の案内のような、顧客の側に選択の余地を残す対応から始めるのが妥当だと考えています。
回収のスコアリング、延滞した契約のうちどれに先に連絡するか
延滞が始まった契約への連絡には、人数と時間の制約があります。延滞した契約すべてに同じ日に連絡できない場合、どの契約から連絡するかを決める必要があります。延滞した契約のうち、その後に延滞が深まってデフォルトに至りやすい契約を見積もり、連絡の順番に使う仕組みを、本コラムでは回収のスコアリングと呼びます。行動のスコアが延滞していない契約も含めた全体を対象にするのに対し、回収のスコアリングは延滞が始まった契約だけを対象にします。この例のモデルが出すのは、延滞が深まってデフォルトに至る確率の見積りで、大きいほど先に連絡する優先度が高くなります。本コラムのスコア(大きいほどデフォルト確率が低い)とは向きが逆なので、以下ではこの出力を「回収の優先度の見積り」と呼びます。
次のブロックでは、契約した月から3か月以上たってから延滞なしから1か月の延滞に入った契約を取り出し、入った月の枠の使用率、その前の3か月の返済の額の割合の平均、その前の12か月で延滞していた月の数、契約からの経過月数、過去の延滞の有無、他社の借入の件数を特徴量にして、延滞に入った月の翌月から6か月を観測期間とし、その間にデフォルトに至るかを予測するモデルを作りました。観測期間の6か月は、延滞に入った後の動きを見るために例として置いた長さで、行動のスコアの例題の12か月とは別のものです。データの単位は「延滞に入った件」で、延滞が解消した後に再び延滞に入った契約は、別の件として数えます。学習には13〜24か月目に延滞に入った件(結果は30か月目までに出そろう)を、評価には31〜36か月目に延滞に入った件を使っています。連絡の能力は、各月にその月に延滞に入った件の3割に最初の数日で連絡できるものと置き、評価では月ごとに、その月に延滞に入った件の中で見積りの高い順に3割を選びました。その月より後に延滞に入る件は、選ぶ時点では分からないためです。
def entries(t_from, t_to):
    """t_from〜t_to の月に「延滞なし→1か月の延滞」に入った契約と、その後6か月のデフォルト"""
    out = []
    for t in range(t_from, t_to + 1):
        i = np.flatnonzero((S[:, t - 1] == 0) & (S[:, t] == 1) & (open_m <= t - 3))
        out.append(pd.DataFrame({
            "id": i, "m": t, "util": U[i, t], "pay_prev3": P[i, t - 3:t].mean(axis=1),
            "n_dlq12": (S[i, max(t - 12, 0):t] >= 1).sum(axis=1), "mob": t - open_m[i],
            "past_dlq": app.past_dlq.to_numpy()[i], "loans": app.loans.to_numpy()[i],
            "y": (S[i, t + 1:t + 7] == 3).any(axis=1).astype(int)}))
    return pd.concat(out, ignore_index=True)

c_tr, c_te = entries(13, 24), entries(31, 36)               # 学習の結果は30か月目までに出そろう
X = ["util", "pay_prev3", "n_dlq12", "mob", "past_dlq", "loans"]
cm = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(c_tr[X], c_tr.y)
pc = cm.predict_proba(c_te[X])[:, 1]
print("新たに1か月の延滞に入った契約 学習", len(c_tr), "件/評価", len(c_te), "件 6か月以内のデフォルト率", round(c_te.y.mean(), 3))
print("延滞に入った件のもとの契約 学習", c_tr.id.nunique(), "件/評価", c_te.id.nunique(), "件/両方に入った契約", len(set(c_tr.id) & set(c_te.id)), "件")
print("回収の優先順位のモデル 評価のAR値", round(ar(c_te.y, pc), 3))
c_te = c_te.assign(pc=pc)                                   # 月ごとに、その月に延滞に入った件の3割に連絡できると置く
rank = c_te.groupby("m").pc.rank(ascending=False, method="first")
top = (rank <= np.floor(c_te.groupby("m").pc.transform("size") * 0.3)).to_numpy()
print("月ごとの上位3割", top.sum(), "件に入った後のデフォルト", c_te.y.to_numpy()[top].sum(), "件/全体", c_te.y.sum(), "件",
      "割合", round(c_te.y.to_numpy()[top].sum() / c_te.y.sum(), 3))
学習に使ったのは延滞に入った1,150件(もとの契約は1,082件)、評価に使ったのは702件(同じく688件)で、学習と評価の両方に入った契約は96件でした。評価の702件のうち、6か月の観測期間のうちにデフォルトに至った割合は0.352でした。回収の優先順位のモデルの評価用の AR値は0.544で、順位づけの力は行動の特徴量を使ったモデル(0.8前後)ほど高くありませんでした。対象の集団も観測期間も違うので、AR値の差をそのまま優劣とは読めません。それでも、月ごとに上位3割を選ぶと合わせて207件になり、その後デフォルトに至った247件のうち126件(0.510)がその中に入りました。無作為に3割を選んだ場合に入るのは、平均するとおよそ3割なので、この架空データでは、モデルの順番を使うと、その後デフォルトに至った件のうち最初の連絡の対象に入る割合が上がったことになります。
ただし、この計算が示しているのは、デフォルトに至りやすい契約を先に見つけられるかどうかだけで、連絡したことでデフォルトが減るかどうかではありません。この合成データには連絡の効果を入れておらず、計算でも連絡の有無を扱っていません。デフォルトに至りやすい契約ほど、連絡しても延滞が解消しにくい場合もあります。連絡によって結果が最も変わる契約に先に連絡したいのであれば、連絡した場合としなかった場合の差(連絡の効果)を見積もる必要があり、そのためには一部の契約で連絡の時期や方法を変えて比べる試行が要ります。回収の優先度の見積りの成績を、回収の成果と取り違えないことが大切です。
回収の優先度の見積りの使い方は、連絡の順番だけではありません。延滞に入った直後に自動の案内(書面や電子的な通知)だけで解消しやすい契約と、早めに担当者が状況を確認した方がよい契約を分ける、返済の相談の窓口の案内を優先する契約を選ぶ、といった使い方もあります。どの使い方でも、モデルの出力はあくまで延滞が深まってデフォルトに至る確率の見積りであり、顧客の事情を判断するものではありません。担当者が顧客と話して分かった事情(病気や失業、災害など)は、その見積りより優先して扱う必要があります。
延滞した顧客への対応、顧客の保護を前提にする
延滞した契約への対応は、事業にとっては貸し倒れを減らす取り組みですが、顧客にとっては生活や事業が苦しくなっている時期に受ける連絡です。回収の優先度の見積りで連絡の順番を効率よく決めても、連絡の方法が不適切であれば、顧客の不利益と規制上の義務の不履行につながります。与信を行う事業者が延滞した顧客に対応するときの前提として、取り立ての規制を守ることと、返済の相談に応じる窓口を用意することの2つを、仕組みの中に組み込む必要があります。
貸金業法は第21条で取立て行為の規制を定めており、人を威迫することや、私生活や業務の平穏を害するような言動を禁じ、その例として、正当な理由がないのに内閣府令で定める不適当な時間帯に電話をかけることや訪問すること、正当な理由がないのに勤務先などへ連絡すること、債務者の借入れに関する事実を第三者に明らかにすることなどを列挙しています。同条は、支払を催告する書面に記載すべき事項も定めています。割賦販売法など他の法令での扱いと、規制の詳細は第14章で整理します。条文には「正当な理由がないのに」という要件があり、何が正当な理由に当たるかの判断は所管官庁の資料や専門家に確かめる事項です。社内の規則として一律に避ける時間帯を決めることと、法令上の禁止の要件とは区別して扱います。回収の優先度の見積りや連絡の仕組みを設計する側として押さえておきたいのは、連絡の時間帯・回数・方法の制約を、スコアの計算の外側の規則として仕組みに組み込み、連絡の優先度がどれだけ高い契約でもその制約を越えないようにする、という設計の順序です。
次の表は、延滞した顧客への対応を設計するときに確かめる項目の例です。法令上の要件の判断は、法務やコンプライアンスの担当者、所管の官庁、専門家に確かめることを前提にしています。
| 確かめる項目 | 内容の例 | 主に関わる部門 |
|---|---|---|
| 連絡の時間帯と回数 | 法令の要件と社内の方針をもとに決めた、連絡を避ける時間帯の規則が、自動の発信の仕組みにも入っているか | 債権管理、コンプライアンス、情報システム |
| 連絡の相手と方法 | 本人以外への連絡、勤務先への連絡の扱いが規則になっているか | 債権管理、コンプライアンス |
| 書面の記載事項 | 支払の催告の書面に、法令が求める事項が入っているか | 債権管理、法務 |
| 返済の相談の窓口 | 返済が苦しい顧客が相談できる窓口と、その案内の時期が決まっているか | 顧客対応、債権管理 |
| 事情の聞き取りと記録 | 顧客の事情(病気・失業・災害など)を聞き取り、対応の判断に反映し、記録しているか | 債権管理、顧客対応 |
| 弁護士などへの委託の通知 | 債務の処理を弁護士などに委託した旨の通知を受けた後の連絡の扱いが規則になっているか | 債権管理、法務 |
| スコアと規則の優先順位 | 優先度の高い契約でも、上の規則を越える連絡が自動で行われないか | データ分析、情報システム、内部監査 |
途上与信で顧客に連絡するときの配慮は、延滞した後の連絡に限りません。与信枠の減額や利用の制限を伝えるとき、早期の警戒の指標に当てはまった顧客に状況を確認するときも、連絡の目的と、顧客が取れる選択肢(返済の相談の窓口・問い合わせ先)を分かりやすく示すことが大切だと考えています。減額や制限の理由をどう示すかは、否決の理由の説明と同じ論点を含むので、第11章で扱います。
管理の指標と経営の判断、見直しの仕組みと延滞した顧客への対応の方針を一緒に決める
途上与信と回収の仕組みが働いているかは、いくつかの管理の指標で見ます。どの指標も、単独で成果を表すものではありません。延滞なしへ戻る割合が上がっても、与信枠を一律に下げた結果であれば、機会損失が増えているかもしれません。次の表は、管理の指標の例です。残高で数える割合を使う場合は、相対値の残高で数えるものとします。
| 管理の指標 | 計算のしかた(分母を明記する) | 見ることで分かること | 単独で見たときの落とし穴 |
|---|---|---|---|
| 延滞の段階ごとの残高の割合 | 月末の延滞の段階ごとの残高 ÷ 月末の全残高 | 保有している契約のうち、どれだけが延滞にあるか | 新しい契約が増えると、延滞が減っていなくても割合は下がる |
| 遷移の割合(延滞への入り方・深まり方) | 翌月に各段階へ移った件数 ÷ 今月にその段階にあった件数 | 延滞がどの段階で深まりやすいか、その変化 | 件数が少ない段階では偶然の揺れが大きい |
| 延滞の解消の割合 | 決めた月数のうちに延滞なしへ戻った件数 ÷ その月に延滞に入った件数 | 延滞に入った件のうち、どれだけが延滞なしへ戻ったか | 解消した後の再延滞が数えられない。変化が連絡の効果とは限らない(延滞に入る契約の顔ぶれや景気の変化でも動く) |
| 回収の割合 | 延滞に入った時点の延滞の額のうち、決めた期間にその延滞に充てられた返済の額 ÷ 延滞に入った時点の延滞の額(相対値。元本・利息などの範囲を分子と分母でそろえる) | 延滞した額のうち、どれだけが返済されたか | 強い取り立てで一時的に上がることがある。顧客の保護の指標と並べて見る |
| 連絡までの日数 | 延滞に入ってから最初の連絡までの日数の分布 | 連絡の能力が足りているか | 連絡の回数を増やすこと自体を目標にしない |
| 与信枠の変更の件数と、変更した契約のその後のデフォルト率 | 増額・減額した件数と、変更した契約の観測期間でのデフォルト率 | 途上与信の判断が見積りどおりの結果になっているか | 変更しなかった場合の結果は分からない。比べる対象を決めておく |
| 相談・苦情の件数 | 返済の相談の件数、連絡に関する苦情の件数 | 顧客の保護が保たれているか | 相談の窓口が知られていないと少なく見える |
表のうち、遷移の割合と延滞の解消の割合は、行動のスコアや回収の優先度の見積りの成績(AR値など)よりも、事業の結果に近い管理の指標です。一方で、これらの指標は、連絡の方法や与信枠の方針を変えると動くため、モデルの良し悪しと方針の良し悪しを分けて読む必要があります。モデルを入れ替えた時期と、方針を変えた時期を記録に残し、指標の変化をどちらの変更によるものとして読むかを決めておくことが大切です。モデルそのものの監視(申込者の層の変化や、見積りと実績のずれ)は第12章で扱います。
途上与信と回収の設計を誤ると、序章で整理した損失の型のいくつかが同時に表れます。行動のデータによる見積りをもとに与信枠の増額を積極的に行えば、利用は伸びますが、返済の能力の調査が追いつかなければ過剰与信による顧客の不利益と貸し倒れを招き、法令上の調査を欠けば規制上の義務の不履行になります。反対に、デフォルト確率の見積りが少し上がっただけで与信枠を下げれば、返済できる顧客の利用を失う機会損失と、資金繰りを崩された顧客の不利益が出ます。回収の仕組みを効率だけで設計すれば、取り立ての規制に反するおそれがあり、連絡の能力を超える件数を割り当てれば、延滞の初期に連絡できない契約が残ります。行動のスコアを入れたまま見直さなければ、景気や顧客の層の変化に置いていかれる形骸化が起きます。
これらを防ぐために、途上与信と回収について、次のことを決めて文書に残しておくことが有効だと考えています。
| 決めること | 決める内容の例 | 決める人の例 |
|---|---|---|
| 見直しの間隔と対象 | 毎月、契約から一定の月数がたった全契約。参照期間と観測期間の長さ | リスク管理の責任者、データ分析の担当 |
| 帯ごとの対応 | デフォルト確率の見積りの帯ごとの、与信枠の維持・増額の候補・減額の候補・連絡の対象 | リスク管理と営業の責任者 |
| 増額と減額の条件 | 法令上の調査を含む増額の手順、減額の事前の通知の手順 | リスク管理、コンプライアンス、法務 |
| 延滞した顧客への対応の方針 | 延滞の段階ごとの対応、連絡の時間帯・回数・方法の規則、返済の相談の窓口 | 債権管理、顧客対応、コンプライアンス |
| 連絡の能力と優先順位 | 1日に連絡できる件数、回収の優先度の見積りの使い方、事情を聞き取った後の扱い | 債権管理の責任者 |
| 対応の効果の測り方 | 一部の契約で方針を変えて比べる試行の進め方、比べる指標 | 経営、リスク管理、データ分析 |
この表の中で経営が直接関わるべきなのは、帯ごとの対応と、延滞した顧客への対応の方針を、同じ場で決めることです。デフォルト確率の見積りが同じでも、それを与信枠を下げる判断にだけ使う方針と、早めの連絡と返済の相談の案内にも使う方針では、顧客にとっての結果も、貸し倒れと機会損失の出方も変わります。途上与信はリスク管理の部門、回収は債権管理の部門、と分かれている組織では、2つの方針が別々に決まり、片方の部門が減額した契約に、もう片方の部門が連絡の優先順位を付ける、といった食い違いが起きやすくなります。予算の面でも、行動のスコアのモデルを作る費用だけでなく、連絡の能力(人員と仕組み)、返済の相談の窓口、方針を試して比べる試行の手間を、一緒に見積もる必要があります。
この章のまとめ
この章では、契約の後に分かる情報を使った途上与信と、延滞した契約への対応を扱いました。本コラムの架空データでは、申込時点の項目だけのモデルの AR値は0.526、行動の特徴量を足したモデルは0.811で、参照期間に延滞の無かった契約だけで見ても0.775でした。ただし、行動の特徴量が効くことはこの合成データの作り方に組み込まれた結果で、参照期間を観測期間に3か月重ねると AR値が0.857に上がって見えるように、作り方の誤りで成績は簡単に良く見えます。延滞の段階の遷移行列では、延滞が深くなるほど延滞なしへ戻る割合が下がり(0.4138から0.2308へ)、マルコフ連鎖としての見積りは段階ごとの平均では実績に近かった一方、過去の延滞の履歴による差(0.037と0.094)は表せませんでした。回収の優先度の見積りは、デフォルトに至りやすい契約を先に見つける道具であり、連絡の効果を測るものではありません。契約後のデータを使った見直しの仕組みと、延滞した顧客への対応の方針は、顧客の保護を前提に一緒に決める必要があります。次の第11章では、否決や与信枠の変更の理由をどう説明するかと、判断が特定の集団に偏っていないかを確かめる方法を扱います。
この章を深めたい方への参考書籍
『生存時間解析入門』(デビッド・ホスマー、スタンリー・レメショウ、スーザン・メイ 著、五所正彦 監訳、東京大学出版会):ある出来事が起きるまでの時間を扱う生存時間解析の入門書の訳書です。この章では、契約からの経過月数とデフォルトの起きやすさの関係を考え方だけ紹介しましたが、観測期間の途中で記録が終わる契約の扱いや、経過時間ごとの起きやすさの見積り方を体系的に確かめるのに役立ちます。
『やさしいMCMC入門 有限マルコフ連鎖とアルゴリズム』(Olle Häggström 著、野間口謙太郎 訳、共立出版):副題のとおり、有限の状態を移り変わるマルコフ連鎖を出発点に、その計算への応用までを扱う入門書の訳書です。この章で延滞の段階の遷移行列をマルコフ連鎖として読んだときの、遷移行列を掛け合わせる計算の意味や、マルコフ連鎖の仮定の意味を確かめるのに向いています。
第11章 否決の理由の説明と公平性、説明の責任と差別の防止
第10章では、契約の後の返済や利用の記録を使って与信枠や条件を見直す途上与信と、延滞した契約への対応を扱いました。第9章までの承認の基準と合わせて、スコアは申込と契約の両方の段階で、承認・否決・与信枠の判断に使われることになります。この章では、その判断を受ける側と、判断を点検する側に対して、何をどう説明するかと、判断の結果が特定の集団に偏っていないかをどう測るかを扱います。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の申込の記録を使い、実行したコードと結果で確かめます。
- 説明が要る相手(申込者・審査の担当者・営業や加盟店・監査や規制当局・経営)と、それぞれに示すもの
- スコアカードでの否決の理由の出し方と、その理由を定型の文に直す方法
- 機械学習のモデルでの理由の出し方(SHAP)と、スコアカードの理由との違い
- 説明の限界と、理由を示すことが申込の内容を偽る手がかりになる危険とのつり合い
- 米国の不利益な決定の通知の制度(公式の資料で確かめた範囲)
- 公平性の測り方と、指標どうしが同時には満たせない場合があること
- 人による再審査と異議の申し立て、申込者に示す文面、経営の判断
この章の主張は2つあります。1つ目は、否決の理由は、モデルを作った後に付け足すものではなく、モデルの形と一緒に決まるという点です。スコアカードなら、項目ごとの点数の差から理由をそのまま取り出せます。機械学習のモデルでは、SHAP のような手法で寄与を計算して理由に直しますが、その寄与は因果を表すものではなく、相関した項目があると理由の順番が入れ替わります。2つ目は、差別につながる属性をモデルの入力に入れないだけでは、結果の偏りは防げないという点です。本コラムの架空データでも、群を入力に入れていないモデルで、群によって承認率に差が出ました。どちらも、モデルを本番に入れる前に、理由を示せる状態と、偏りを定期的に測る仕組みを用意しておく必要があることを意味します。日本の法令や EU の規則との関係は第14章で扱い、この章では踏み込みません。
説明が要る相手と、それぞれに示すもの
与信の判断の説明は、申込者に理由を伝えることだけを指すのではありません。同じ1件の否決について、申込者は「なぜ断られたのか、次に何ができるのか」を知りたいと考え、審査の担当者は「この判断をそのまま通してよいか、人が確認すべきか」を知りたいと考えます。監査や規制当局は「判断が決めた手順どおりに行われ、記録が残っているか」を確かめます。経営は、個々の判断よりも、否決の理由の分布や承認率の推移から、方針どおりに与信が行われているかを見ます。説明の相手によって、示す内容も、細かさも、使う言葉も変わります。
次の表は、説明が要る主な相手と、それぞれに示すものを整理したものです。相手ごとに必要な情報を先に決めておくと、モデルを作る段階で、どの記録を残し、どの計算をしておく必要があるかが決まります。
| 説明の相手 | 知りたいこと | 示すものの例 | 注意すること |
|---|---|---|---|
| 申込者 | 否決された理由・次にできること・問い合わせ先 | 判断に影響した主な項目を定型の文にしたもの、問い合わせの窓口、再審査の申し出の方法 | 点数や内部の基準の値を示すかどうかを、あらかじめ決めておく。人を評価する言い方をしない |
| 審査の担当者 | 判断を通してよいか・どこを確認すべきか | スコア・カットオフとの差・項目ごとの点数・寄与の大きい項目・データの欠けや不整合 | スコアの根拠を見ないまま上書きする、あるいはスコアに従うだけになる、の両方を避ける |
| 営業・加盟店 | なぜ契約にならなかったか・案内をどう変えるか | 否決の理由の分類ごとの件数、申込の経路ごとの承認率 | 個々の申込者の情報は、利用目的と社内の権限の範囲でしか示さない |
| 監査・規制当局 | 手順どおりか・記録が残っているか・偏りを測っているか | 判定の時点の入力・スコア・カットオフ・判断・上書きの記録、理由の出し方の文書、公平性の点検の結果 | 後から計算し直した値ではなく、判定の時点の記録を示せるようにする |
| 経営 | 方針どおりに与信しているか・偏りの兆候は無いか | 否決の理由の分布の推移、群ごとの承認率などの点検の結果、異議の申し立ての件数と結果 | 個々の否決の理由ではなく、分布と推移で見る |
この表のうち、とくに見落とされやすいのは監査と規制当局の行です。否決の理由を後から聞かれたときに、いまのモデルで計算し直した理由を示しても、判定の時点の理由とは限りません。モデルや区分の境目を更新すると、同じ申込でも理由が変わることがあるからです。判定の時点の入力・スコア・理由を、その時点のモデルの版と一緒に残しておくことが、説明の土台になります。記録の残し方は第12章でも扱います。
架空の申込の記録を作る、入力に入れない群Aと群Bを持たせる
ここからは、否決の理由の出し方と公平性の測り方を、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の申込の記録よりずっと単純です。合成データでの成績や偏りの大きさは、実際の審査での値の目安にはなりません。示したいのは、理由の出し方と偏りの測り方の手順と、そこで起きることです。申込20,000件・20か月分を、次の性質を持たせて乱数で作りました(乱数の種は20261113に固定しています)。
- 申込者の属性:年収の水準(相対値。全体のおおよその中央を1とする尺度)・勤続年数・居住の年数・雇用の形態(A・B・Cの3つ)
- 信用情報にあたる項目:他社の借入の件数・他社の借入の年収に対する割合・過去の延滞の有無・直近の申込の件数・既存の枠の使用率
- デフォルト:第2章の定義(契約の実行から12か月以内に、延滞が90日以上に達すること)を受け、月単位の記録の例題なので「契約から12か月以内に3か月分以上の延滞に至ること」で代える。デフォルトの起きやすさは上の項目だけで決め、既存の枠の使用率は低すぎても高すぎても起きやすい(単調でない)関係、雇用の形態Cで勤続が短い場合に起きやすくなる組み合わせの関係を入れる
- 架空の群:申込者の3割を群B、7割を群Aとする。群Bは、年収の水準が低めで、勤続年数・居住の年数が短めで、雇用の形態Cと他社の借入の件数が多めになるように作る。群はデフォルトの起きやすさの式にも、モデルの入力にも入れない
群Aと群Bは、公平性の点検の手順を示すための架空の区分で、実在のどの属性も表していません。現実の点検では、差別につながる属性(第14章で扱う法令や、各国の制度が定めるもの)ごとに同じ計算をすることになります。本コラムの例では群をモデルの入力に使いませんが、実務で属性をモデルに使えるかどうかは、適用される制度と利用の目的ごとに確かめる必要があります。たとえば米国の規則Bには、一定の条件のもとで年齢をスコアリングの仕組みに使えるとする規定があります(第1002.6条(b)(2))。この例では、群Bのデフォルト率が高く出るのは、群そのものの効果ではなく、群Bに多く含まれる項目の値(年収の水準が低めなど)を通じた差だけになるように作っています。実行には Python 3.14.3、numpy 2.4.3、pandas 3.0.1、scikit-learn 1.9.0、lightgbm 4.6.0、shap 0.52.0 を使い、図は matplotlib 3.10.8 と japanize-matplotlib 1.1.3 で描きました。最初のブロックで、記録を作ります。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N = 20000
month = rng.integers(1, 21, N)                          # 申込の月(1〜20)
grp = np.where(rng.random(N) < 0.3, "B", "A")           # 架空の群。モデルの入力には入れない
isB = grp == "B"
income = rng.lognormal(np.where(isB, -0.15, 0.0), 0.45)  # 年収の水準(相対値)
tenure = rng.gamma(2.0, np.where(isB, 2.0, 3.0))         # 勤続年数
resid = rng.gamma(2.0, np.where(isB, 1.5, 4.0))          # 居住の年数(群で差が大きい項目)
emp = np.where(rng.random(N) < np.where(isB, 0.35, 0.15), "C",
               np.where(rng.random(N) < 0.3, "B", "A"))  # 雇用の形態A〜C
loans = rng.poisson(np.where(isB, 1.3, 1.0))             # 他社の借入の件数
debt = np.clip(loans * 0.12 + rng.normal(0, 0.08, N), 0, None) / income  # 他社の借入の年収比
delinq = (rng.random(N) < 0.08).astype(int)              # 過去の延滞の有無
apps = rng.poisson(0.8, N)                               # 直近の申込の件数
util = rng.beta(2, 2.5, N)                               # 既存の枠の使用率
logit = (-3.75 - 0.9 * np.log(income) - 0.07 * np.minimum(tenure, 10) + 0.25 * loans
         + 0.9 * debt + 1.2 * delinq + 0.25 * apps + 4.0 * (util - 0.4) ** 2
         + 0.7 * ((emp == "C") & (tenure < 1.5)) - 0.02 * np.minimum(resid, 10))
default = (rng.random(N) < 1 / (1 + np.exp(-logit))).astype(int)  # 12か月以内に3か月以上の延滞
df = pd.DataFrame({"month": month, "grp": grp, "income": income, "tenure": tenure,
                   "resid": resid, "emp": emp, "loans": loans, "debt": debt,
                   "delinq": delinq, "apps": apps, "util": util, "default": default})
print("申込", len(df), "件/デフォルト率", round(df.default.mean(), 4))
print(df.groupby("grp").agg(件数=("default", "size"), デフォルト率=("default", "mean"),
      年収=("income", "median"), 勤続=("tenure", "median"), 居住=("resid", "median"),
      形態C=("emp", lambda s: (s == "C").mean()), 他社件数=("loans", "mean")).round(3))
実行した結果、申込は20,000件で、全体のデフォルト率は0.0507でした。この例題では、すべての申込について、承認して契約していればどうなったかの結果を作っています。実際の記録では否決した申込の結果は分かりませんが(第6章)、合成データなので全員の結果が分かります。群ごとに見ると、群Aは14,006件でデフォルト率0.043、群Bは5,994件でデフォルト率0.068です。年収の水準の中央値は群Aが0.994、群Bが0.860、勤続年数の中央値は5.033年と3.332年、居住の年数の中央値は6.662年と2.468年、雇用の形態Cの割合は0.151と0.344、他社の借入の件数の平均は1.006件と1.290件でした。居住の年数は群による差が大きい一方で、デフォルトの起きやすさの式の中での効き方は小さく作っています。この項目が後の公平性の点検で役割を持ちます。
スコアカードで否決の理由を出す、満点との差が大きい項目から
スコアカードでは、スコアは基礎点と、各項目の該当する区分の点数の合計です(第4章)。そのため、ある申込のスコアが低かった理由は、項目ごとの点数を見れば分かります。その方法の1つは、項目ごとに「その項目で取りうる最も高い点数」と「その申込が取った点数」の差を計算し、差が大きい項目から順に理由として示す方法です。この満点との差は点数表から理由を取り出す方法の1つで、後の米国の制度の節で見る公式の解釈の例とは別の方法です。差が大きい項目ほど、その申込のスコアを押し下げた量が大きいことになります。満点との差のほかに、全体の平均の点数との差を使う考え方もありますが、どちらを使うかで理由の順番が変わることがあるので、どの基準を使うかを文書に残しておく必要があります。
次のブロックでは、第3章と第4章の考え方を簡単に再掲して、スコアカードを作ります。項目ごとに区分を決め、学習用のデータで区分ごとの WoE(その区分の正常の構成比をデフォルトの構成比で割った値の自然対数。正の値はその区分が全体より正常の側に寄っていることを表す)を計算します。デフォルトが0件の区分で値が計算できなくなるのを避けるため、区分ごとの件数に0.5を足しています。評価のデータは時間で切り、1〜14か月目の申込を学習用、15〜20か月目の申込を評価用にしました。合成データなので、時間で切った時点で、どの申込についても12か月先の結果まで分かっているものとして扱っています。実際の記録では、観測期間の12か月を満たした申込だけが学習と評価の対象になります(第2章)。区分の境目は例題のためにあらかじめ固定した値を使い、WoE は学習用のデータだけで計算して、評価用のデータにはそれを当てはめるだけにしています。なお、この時間による分け方は、全件の結果が確定した後で申込の時期の前後を比べる事後的な分け方で、実際の運用の手順を再現したものではありません。
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

EDGES = {"income": [0, 0.6, 0.8, 1.0, 1.3, np.inf], "tenure": [0, 1, 3, 6, 10, np.inf],
         "resid": [0, 2, 5, 10, np.inf], "loans": [0, 1, 2, 3, np.inf],
         "debt": [0, 0.1, 0.25, 0.5, np.inf], "apps": [0, 1, 2, 3, np.inf],
         "util": [0, 0.1, 0.3, 0.5, 0.7, 1.01]}
FEATS = list(EDGES) + ["emp", "delinq"]
def label(a, b):                                         # 区分の名前(読める形にする)
    if a == 0:
        return f"{b:g}未満"
    return f"{a:g}以上" if np.isinf(b) else f"{a:g}以上{b:g}未満"
def binned(d):
    b = {f: pd.cut(d[f], EDGES[f], right=False,
                   labels=[label(a, c) for a, c in zip(EDGES[f][:-1], EDGES[f][1:])]).astype(str)
         for f in EDGES}
    b["util"] = b["util"].str.replace("1.01未満", "1以下")
    b["emp"], b["delinq"] = "形態" + d.emp, d.delinq.map({0: "なし", 1: "あり"})
    return pd.DataFrame(b)
tr, te = df[df.month <= 14], df[df.month >= 15]          # 時間で切る
btr, bte = binned(tr), binned(te)
woe = {}
for f in FEATS:
    t = pd.crosstab(btr[f], tr.default) + 0.5
    woe[f] = np.log((t[0] / t[0].sum()) / (t[1] / t[1].sum()))   # 区分ごとの WoE
続くブロックで、WoE を説明変数にしたロジスティック回帰を当てはめ、係数と定数項から点数を作ります。デフォルトの対数オッズを \( \eta \) として、スコアを \( 600 – 28.85 \times (\eta – \ln(1/50)) \) の形に置きました。言葉で言い換えると、正常とデフォルトのオッズが50対1のときに600点になり、オッズが2倍になるごとに20点増える(PDO が20点)尺度です。28.85は20を2の自然対数で割った値です。点数が大きいほどデフォルト確率が低くなる向きで、本コラムのスコアの向きと同じです。WoE を上の向きで作ると、デフォルトを1とするロジスティック回帰の係数は負になるのが普通で、点数の式では係数の符号を反転して使っています。カットオフは、学習用の申込のうち8割がスコア上の承認の候補になる点に置きました。この8割は説明のための置き方で、実際のカットオフの決め方は第9章で扱います。また、この例では、スコアがカットオフ以上の申込を承認、未満を否決とみなして計算しますが、実際の最終の判断は、返済の能力の調査など法令上の条件とその他の審査の基準を合わせて決まります。後半では、カットオフより15点ほど低かった評価用の申込を1件選び、審査の担当者向けの内訳(項目ごとの区分・点数・満点との差)と、申込者向けの文(満点との差が大きい上位3項目の項目名だけ)を分けて表示します。
W = lambda b, feats: pd.DataFrame({f: b[f].map(woe[f]) for f in feats})
def fit_sc(feats):
    return LogisticRegression(C=1e6, max_iter=2000).fit(W(btr, feats), tr.default)
lr = fit_sc(FEATS)
FACTOR = 20 / np.log(2)                                  # オッズが2倍で20点(PDO=20)
OFFSET = 600 - FACTOR * np.log(50)                       # オッズ50対1で600点
pts = {f: (-lr.coef_[0][i] * woe[f] * FACTOR).round() for i, f in enumerate(FEATS)}
base = round(OFFSET - lr.intercept_[0] * FACTOR)
score = lambda b: base + sum(b[f].map(pts[f]) for f in FEATS)
s_tr, s_te = score(btr), score(bte)
CUT = np.quantile(s_tr, 0.20)                            # 学習期間で8割を承認する点
approve = (s_te >= CUT).to_numpy()
y = te.default.to_numpy()
print("カットオフ", CUT, "/評価期間の承認率", round(approve.mean(), 3),
      "/AR値", round(2 * roc_auc_score(y, -s_te) - 1, 3))
NAME = {"income": "年収の水準", "tenure": "勤続年数", "resid": "居住の年数", "emp": "雇用の形態",
        "loans": "他社の借入の件数", "debt": "他社の借入の年収に対する割合",
        "delinq": "過去の延滞の有無", "apps": "直近の申込の件数", "util": "既存の枠の使用率"}
def sc_reasons(i, k=3):                                  # 満点との差が大きい項目を上から
    gap = {f: pts[f].max() - pts[f][bte[f].iloc[i]] for f in FEATS}
    return sorted([(f, g) for f, g in gap.items() if g > 0], key=lambda x: -x[1])[:k]
rej = np.flatnonzero(~approve)
i0 = rej[np.argmin(np.abs(s_te.to_numpy()[rej] - (CUT - 15)))]  # カットオフより15点ほど下の1件
print("【審査の担当者向けの内訳】申込", te.index[i0], "スコア", s_te.iloc[i0], "(カットオフ", CUT, ")")
for f in FEATS:
    print(f"  {NAME[f]}:区分 {bte[f].iloc[i0]}  点数 {pts[f][bte[f].iloc[i0]]:.0f}"
          f"(この項目の最高 {pts[f].max():.0f})")
print("  満点との差", [(NAME[f], int(g)) for f, g in sc_reasons(i0)])
lines = [f"{n}.{NAME[f]}" for n, (f, g) in enumerate(sc_reasons(i0), 1)]   # 区分の境目は入れない
print("【申込者向けの文】審査の結果に影響した主な項目\n" + "\n".join(lines))
near = (s_tr >= CUT) & (s_tr < CUT + 10)                 # カットオフをわずかに上回った学習用の申込
ref = {f: btr[f][near].map(pts[f]).mean() for f in FEATS}
def avg_reasons(i, k=3):                                 # その層の平均の点数との差で並べる
    gap = {f: ref[f] - pts[f][bte[f].iloc[i]] for f in FEATS}
    return sorted([(f, g) for f, g in gap.items() if g > 0], key=lambda x: -x[1])[:k]
print("平均との差", [(NAME[f], round(float(g), 1)) for f, g in avg_reasons(i0)])
print("否決", len(rej), "件で 2つの基準の第1の理由が一致",
      round(np.mean([sc_reasons(i)[0][0] == avg_reasons(i)[0][0] for i in rej]), 3))
実行した結果、カットオフは561点で、評価期間の申込のうちスコアが561点以上だった割合(この例での承認率)は0.806でした。評価期間の AR値は0.451です(AR値の詳しい読み方は第7章)。選んだ1件はスコアが546点で、カットオフを15点下回っていました。項目ごとの点数は次の表のとおりです。表の「満点との差」は、その項目の最も高い点数から、この申込の点数を引いた値です。
| 項目 | この申込の区分 | この申込の点数 | この項目の最も高い点数 | 満点との差 |
|---|---|---|---|---|
| 他社の借入の年収に対する割合 | 0.5以上 | -22 | 8 | 30 |
| 年収の水準 | 0.6未満 | -16 | 12 | 28 |
| 居住の年数 | 2未満 | -4 | 5 | 9 |
| 他社の借入の件数 | 2以上3未満 | -3 | 6 | 9 |
| 直近の申込の件数 | 1以上2未満 | -2 | 6 | 8 |
| 既存の枠の使用率 | 0.1以上0.3未満 | 4 | 5 | 1 |
| 雇用の形態 | 形態A | 1 | 2 | 1 |
| 勤続年数 | 10以上 | 13 | 13 | 0 |
| 過去の延滞の有無 | なし | 5 | 5 | 0 |
満点との差が大きい順に、他社の借入の年収に対する割合(30点)、年収の水準(28点)、居住の年数(9点)が上位3項目になりました。居住の年数と他社の借入の件数はどちらも差が9点で並んでおり、この例では並べ替えの順序で居住の年数が3番目に入っています。差が同じ項目をどう扱うかは、理由の出し方の文書で決めておく必要があります。コードでは、この3項目を「審査の結果に影響した主な項目」として、番号付きの定型の文に直しています。申込者向けの文には項目名だけを入れ、区分の境目や点数は入れていません。区分と点数は、審査の担当者向けの内訳にだけ出しています。申込者向けの文に境目の値を入れない理由は、後の「説明の限界と、理由を示すことのつり合い」の節で扱います。文の中の項目名は、計算した点数の差から機械的に選んだもので、人が後から書き足したものではありません。こうしておくと、理由の文が実際の計算と食い違うことを防げます。
理由を選ぶ基準を変えると、結果がどう変わるかも確かめました。学習用の申込のうち、スコアがカットオフ以上でカットオフより10点高い点までに入った申込(カットオフをわずかに上回った層)について、項目ごとの平均の点数を計算し、その平均との差で並べ直しました。選んだ1件では、平均との差は他社の借入の年収に対する割合が22.3点、年収の水準が14.6点、居住の年数が3.6点で、上位3項目の顔ぶれと順番は満点との差の場合と同じでした。評価期間に否決となった1,158件全体で見ると、2つの基準で第1の理由が一致したのは0.909でした。残りの約1割では、基準によって最初に示す理由が変わったことになります。どちらが正しいというものではなく、基準を1つに決めて文書に残し、途中で変えるときは記録することが必要です。
スコアカードでの理由の出し方には、次のような決めごとが含まれています。
- どの基準と比べるか(満点・カットオフ付近の平均・全体の平均)
- 何項目まで示すか、差が小さい項目を示すかどうか
- 差が同じ項目の順序
- 欠損の区分が理由に入ったときの言い方
また、区分を細かく分けた項目は満点との差が大きくなりやすいなど、点数表の作り方が理由の出やすさに影響することもあります。これらの決めごとは、モデルの作り方の文書と一緒に残しておく必要があります。
機械学習のモデルで理由を出す、SHAP の考え方と結果
勾配ブースティングのような決定木を多数組み合わせたモデル(第5章)では、スコアカードのように項目ごとの点数の表がありません。1件の予測に各項目がどれだけ効いたかを計算する手法として広く使われているのが、SHAP です。Lundberg と Lee の2017年の論文(ニューラル情報処理システム国際会議 NIPS 2017 の予稿集、第30巻に収録)は、協力ゲーム理論のシャープレイ値(複数の参加者で得た成果を、各参加者の貢献に応じて分ける考え方)を使って、1件の予測を項目ごとの寄与の足し算に分ける枠組みを示しました。論文は、こうした足し算の形の説明の手法をまとめて扱い、望ましい性質を満たす方法がその中で1つに決まることを示しています。
SHAP の値は、ある申込の予測が、基準の値からどれだけずれたかを、項目ごとに分けたものです。この例のように背景のデータを渡さずに TreeExplainer を使うと、基準の値は、木に記録された学習時の件数の分布から決まります(shap の公式の説明書きによる)。勾配ブースティングの出力をデフォルトの対数オッズとして計算すると、正の値の項目はその申込のデフォルト確率を押し上げた項目、負の値の項目は押し下げた項目と読めます。スコアの向きに直すと、正の値が大きい項目ほど、その申込のスコアを下げた項目にあたります。そこで、正の値が大きい項目から順に示すと、スコアカードの「満点との差が大きい項目」に近い理由の一覧になります。ただし、比べる基準は上の基準の値で、スコアカードの満点とは違います。決定木を組み合わせたモデルでは、Tree SHAP と呼ばれる計算で、その前提のもとでの寄与を厳密に求められます(第5章)。ただし、計算が厳密であることと、その寄与が申込者に示す理由として妥当であることは別の問題で、後者は別に確かめる必要があります。
次のブロックでは、同じ学習用のデータ(区分けする前の値)で lightgbm の勾配ブースティングを学習し、shap の TreeExplainer で評価期間の申込の SHAP の値を計算します。前の節で選んだ1件の上位3項目を出し、評価期間全体での項目ごとの平均の絶対寄与(全体の重要度)を表示します。最後に、スコアカードで否決となった申込について、スコアカードの理由と SHAP の理由がどれだけ一致するかと、乱数の種だけを変えて学習し直したときに SHAP の第1の理由がどれだけ保たれるかを数えます。本コラムで使った shap 0.52.0 では、lightgbm の二値の分類で、SHAP の値は申込の数×項目の数の2次元の配列(デフォルトの側の対数オッズへの寄与)で返りました。実行すると、返り値の形式が変わったことを告げる警告が出ますが、手元で確かめた返り値は2次元の配列だったので、コードではこの警告を表示しないようにしています。版が違う環境で実行する場合は、返り値の形を確かめてから使う必要があります。
import warnings
import lightgbm as lgb
import shap
warnings.filterwarnings("ignore", category=UserWarning)  # 形式の変更を告げる警告を抑える(返り値は2次元配列)

def raw(d):
    x = d[["income", "tenure", "resid", "loans", "debt", "delinq", "apps", "util"]].copy()
    x["emp"] = d.emp.map({"A": 0, "B": 1, "C": 2})
    return x
def fit_gb(seed):
    return lgb.LGBMClassifier(n_estimators=300, learning_rate=0.03, num_leaves=15,
                              min_child_samples=80, colsample_bytree=0.7, subsample=0.8,
                              subsample_freq=1, random_state=seed, n_jobs=1,
                              verbose=-1).fit(raw(tr), tr.default)
gb = fit_gb(1)
p_gb = gb.predict_proba(raw(te))[:, 1]
print("勾配ブースティングの AR値", round(2 * roc_auc_score(y, p_gb) - 1, 3))
sv = shap.TreeExplainer(gb).shap_values(raw(te))         # 申込数×項目数。デフォルト側の対数オッズへの寄与
cols = list(raw(te).columns)
top = lambda row, k=3: [cols[j] for j in np.argsort(-row)[:k] if row[j] > 0]
print("同じ申込の SHAP の上位3項目", [NAME[f] for f in top(sv[i0])])
print("  寄与", {NAME[cols[j]]: round(float(sv[i0][j]), 3) for j in np.argsort(-sv[i0])[:3]})
imp = pd.Series(np.abs(sv).mean(axis=0), index=[NAME[c] for c in cols]).sort_values()
print("平均の絶対寄与(全体の重要度)\n", imp[::-1].round(3).to_string())
same1 = np.mean([sc_reasons(i)[0][0] == top(sv[i])[0] for i in rej])
ov3 = np.mean([len({f for f, _ in sc_reasons(i)} & set(top(sv[i]))) for i in rej])
print("否決", len(rej), "件で 第1の理由が一致", round(same1, 3), "/上位3の重なり 平均", round(ov3, 2), "項目")
sv2 = shap.TreeExplainer(fit_gb(2)).shap_values(raw(te))
print("乱数の種だけ変えた再学習で 第1の理由が一致", round(np.mean([top(sv[i])[0] == top(sv2[i])[0] for i in rej]), 3))
実行した結果、勾配ブースティングの評価期間の AR値は0.401で、スコアカードの0.451を下回りました。勾配ブースティングの AR値が低かった理由は、この章では確かめていません。この章の目的は理由の出し方の比較なので、勾配ブースティングの設定の調整はしていません。設定を変えれば差は変わる可能性があります。前の節で選んだ1件について、SHAP の上位3項目は、他社の借入の年収に対する割合(寄与0.891)、年収の水準(0.41)、居住の年数(0.251)で、スコアカードの上位3項目と同じ顔ぶれ・同じ順番でした。寄与の単位は対数オッズで、スコアカードの点数とは尺度が違うので、値の大きさどうしは比べられません。
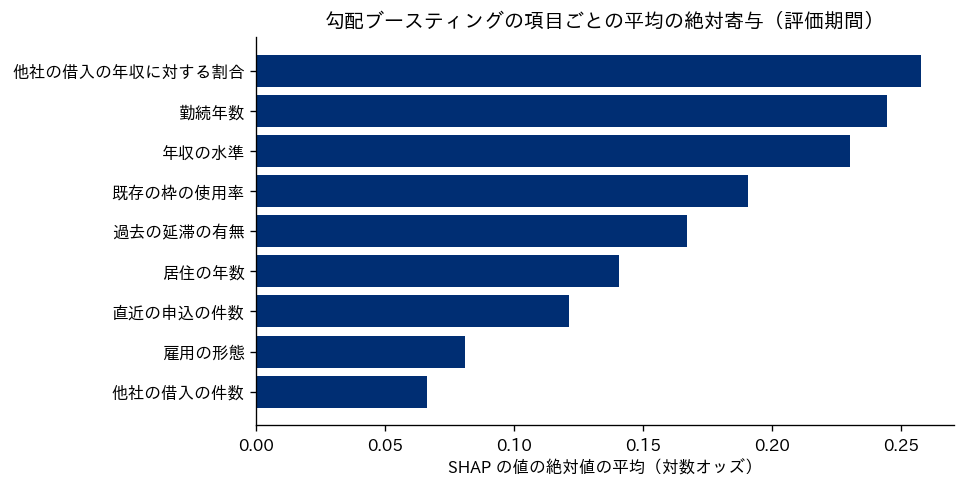
上の図は、評価期間の申込5,975件について、SHAP の値の絶対値を項目ごとに平均したものです。大きい順に、他社の借入の年収に対する割合(0.258)、勤続年数(0.245)、年収の水準(0.230)、既存の枠の使用率(0.191)、過去の延滞の有無(0.167)でした。この図はモデル全体で各項目がどれだけ効いているかを表すもので、1件ごとの否決の理由とは別のものです。審査の担当者や監査に「このモデルは何を見ているか」を示すときに使えます。他社の借入の件数が最も小さく出たのは、件数と強く相関する他社の借入の年収に対する割合がモデルに入っていて、その役割をほとんど担っているためと考えられます。この点は次の節で確かめます。
否決となった1,158件全体での一致の度合いは、次の表のとおりです。
| 比べたもの | 対象 | 結果 |
|---|---|---|
| スコアカードの満点との差と、勾配ブースティングの SHAP の、第1の理由の一致 | スコアカードで否決となった1,158件 | 0.763 |
| 同じ2つの、上位3項目の重なり | 同じ1,158件 | 平均2.3項目 |
| スコアカードの満点との差と、カットオフ付近の平均との差の、第1の理由の一致 | 同じ1,158件 | 0.909 |
| 勾配ブースティングを乱数の種だけ変えて学習し直したときの、SHAP の第1の理由の一致 | 同じ1,158件 | 0.924 |
スコアカードと勾配ブースティングでは、4件に3件ほどで第1の理由が一致し、上位3項目のうち平均2.3項目が重なりました。同じデータで学習した2つのモデルでも、4件に1件ほどは最初に示す理由が違うことになります。また、同じ設定の勾配ブースティングを乱数の種だけ変えて学習し直すと、1割弱の申込で第1の理由が入れ替わりました。モデルを学習し直すたびに、同じ申込に示す理由が変わることがある、ということです。申込者への説明に使う理由は、どのモデルの、どの版の、どの計算で出したものかを記録しておかないと、後から問い合わせを受けたときに同じ理由を再現できません。
説明の限界と、理由を示すことのつり合い
SHAP の値やスコアカードの点数の差は、そのモデルの中で、どの項目が予測をどれだけ動かしたかを表すものです。その項目を変えれば現実のデフォルトの起きやすさが変わる、という因果の関係を表すものではありません。たとえば居住の年数は、この架空データでは、デフォルトの起きやすさの式の中での効き方を小さく作っていますが、スコアカードでも勾配ブースティングでも、選んだ1件の第3の理由に入りました。居住の年数が、群Bに多い他の項目の値と相関しているため、モデルがその一部を居住の年数に割り当てたと考えられます。居住の年数が群と結びついていることは、後の公平性の節で確かめます。理由として示された項目は「モデルがそう計算した」ことを表すにすぎず、その項目が申込者の返済の能力を直接決めているとは限りません。説明の手法の一般論と限界は、弊社コラム「AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド」で扱っています。
相関した項目があると、理由がどちらの項目に割り当てられるかが、モデルの作り方で変わります。次のブロックでは、他社の借入の件数と強く相関する、他社の借入の年収に対する割合をモデルから外して学習し直し、もとのモデルで第1の理由が年収に対する割合だった否決の申込について、外したあとの第1の理由が何になるかを数えました。
x3 = raw(te).drop(columns="debt")                        # 相関した項目の片方を外して学び直す
gb3 = lgb.LGBMClassifier(n_estimators=300, learning_rate=0.03, num_leaves=15, min_child_samples=80,
                         colsample_bytree=0.7, subsample=0.8, subsample_freq=1, random_state=1,
                         n_jobs=1, verbose=-1).fit(raw(tr).drop(columns="debt"), tr.default)
sv3 = shap.TreeExplainer(gb3).shap_values(x3)
c3 = list(x3.columns)
was_debt = [i for i in rej if top(sv[i])[0] == "debt"]
new_top = pd.Series([c3[int(np.argmax(sv3[i]))] for i in was_debt]).map(NAME).value_counts(normalize=True)
print("第1の理由が年収比だった否決", len(was_debt), "件/年収比を外したときの第1の理由\n", new_top.round(3).to_string())
print("外したモデルの AR値", round(2 * roc_auc_score(y, gb3.predict_proba(x3)[:, 1]) - 1, 3))
print("借入の件数と年収比の相関", round(np.corrcoef(te.loans, te.debt)[0, 1], 3))
評価期間の他社の借入の件数と年収に対する割合の相関係数は0.715でした。もとのモデルで第1の理由が他社の借入の年収に対する割合だった否決の申込は418件で、この項目を外して学習し直すと、第1の理由は年収の水準が0.474、他社の借入の件数が0.435になり、この2つで9割を占めました。年収に対する割合は、他社の借入の件数と年収の水準の両方から作った項目なので、外すとその役割が2つの元の項目に分かれたと考えられます。外したモデルの AR値は0.389で、もとの0.401からの下がり方は0.012でした。順位づけの成績はあまり変わらないのに、申込者に示す第1の理由は大きく変わったことになります。説明に使う理由は、項目の選び方というモデルの設計の判断に左右されます。理由の安定性も、項目を選ぶときの観点の1つとして見ておく必要があります。
理由を示すことには、もう1つのつり合いがあります。理由を細かく具体的に示すほど、申込者は自分の状況を理解しやすくなり、誤った情報で判断されていれば訂正を求められます。一方で、どの項目がどの値なら点数が上がるかを細かく示すと、それが申込の内容を偽る手がかりとして使われるおそれがあります。たとえば申告の内容だけで決まる項目の境目が外から分かれば、その境目に合わせた申告が増えるおそれがあります。そのため、申込者に示すのは、判断に影響した主な項目の名前と、確認や相談の窓口にとどめ、区分の境目の値や点数、カットオフの値は示さない運用が考えられます。申告の内容を信用情報や提出書類と突き合わせて確かめる仕組みと組み合わせれば、示した理由が偽りの申告に使われる余地を小さくできると考えています。不正な申込の見つけ方は、弊社コラム「取引の不正を見つける不正検知の実践ガイド、ルールと機械学習の使い分けから調査と運用まで」で扱っています。
反対に、偽りを恐れて「総合的な判断により」のような理由しか示さないと、申込者は誤った情報で判断されていても気づけません。また、後の節で見る米国の規則B(第1002.9条(b)(2))では、内部の基準や方針によったという説明や、点数が足りなかったという説明だけでは不十分とされています。日本の法令で否決の理由の説明がどう扱われるかは、第14章で確かめた範囲を整理します。どこまで具体的に示すかは、法令上の扱いを確かめたうえで、説明を受ける側の利益と、申告の偽りの危険を並べて、事業として決める事柄です。
公平性を測る、入力に入れていない群で承認率に差が出る
ここからは公平性を扱います。この章でいう公平性の点検は、モデルとカットオフによる判断の結果が、特定の集団に不利に偏っていないかを、決めた指標で測ることです。差別につながる属性をモデルの入力に入れないだけでは、結果の偏りは防げません。入力に入れた項目の中に、その属性と相関する項目(代わりの項目)があれば、モデルはその項目を通じて属性と結びついた判断をすることがあるからです。この架空データでは、群はモデルの入力に入れていませんが、群Bは居住の年数が短めで、年収の水準が低めになるように作っています。
次のブロックでは、評価期間の申込について、群ごとに、承認率、承認した契約のデフォルト率、誤って否決した割合、スコアカードのデフォルト確率の平均を計算します。以下では、承認して契約していれば正常の結果になった申込のうち、カットオフ未満で否決となったものの割合を「誤って否決した割合」と呼びます。この割合を出せるのは、合成データで否決した申込の結果も分かるからです。実務では否決した申込の結果は観測できないので、この割合は直接は測れず、推定になります(第6章)。続けて、スコアの帯ごとの実績のデフォルト率を群ごとに比べ、モデルの入力に使った項目から群をどれだけ当てられるかを AR値で測ります。後半では、項目を1つずつ外してスコアカードを作り直し、群の間の差と AR値がどう変わるかを見ます。
g = te.grp.to_numpy()
pd_sc = lr.predict_proba(W(bte, FEATS))[:, 1]            # スコアカードのデフォルト確率
rows = []
for k in ["A", "B"]:
    m = g == k
    good = m & (y == 0)
    rows.append({"群": k, "件数": m.sum(), "デフォルト率": y[m].mean(), "承認率": approve[m].mean(),
                 "承認した契約のデフォルト率": y[m & approve].mean(),
                 "誤って否決した割合": (~approve[good]).mean(),
                 "デフォルト確率の平均": pd_sc[m].mean()})
print(pd.DataFrame(rows).set_index("群").round(3).T)
band = pd.cut(s_te, [0, 560, 580, 600, 2000], right=False)
print(pd.crosstab(band, g, values=y, aggfunc="mean").round(3).assign(
      件数A=pd.crosstab(band, g)["A"], 件数B=pd.crosstab(band, g)["B"]))
proxy = LogisticRegression(max_iter=2000).fit(W(btr, FEATS), tr.grp == "B")
print("モデルの入力から群を当てる AR値", round(2 * roc_auc_score(g == "B", proxy.predict_proba(W(bte, FEATS))[:, 1]) - 1, 3))
print("外した項目 / 承認率の差(AからBを引く) / 誤って否決した割合の差(BからAを引く) / AR値")
for drop in [None, "resid", "emp", "income"]:
    feats = [f for f in FEATS if f != drop]
    m2 = fit_sc(feats)
    lo = m2.decision_function(W(btr, feats))
    lt = m2.decision_function(W(bte, feats))
    ok = lt <= np.quantile(lo, 0.80)                     # 同じく学習期間で8割を承認
    gap_a = ok[g == "A"].mean() - ok[g == "B"].mean()
    gap_f = (~ok[(g == "B") & (y == 0)]).mean() - (~ok[(g == "A") & (y == 0)]).mean()
    print(NAME.get(drop, "なし"), round(gap_a, 3), round(gap_f, 3), round(2 * roc_auc_score(y, lt) - 1, 3))
実行した結果を次の表にまとめます。評価期間の申込は、群Aが4,197件、群Bが1,778件です。
| 指標 | 群A | 群B |
|---|---|---|
| 評価期間のデフォルト率(その群の全申込が分母) | 0.040 | 0.058 |
| 承認率 | 0.855 | 0.691 |
| 承認した契約のデフォルト率 | 0.028 | 0.029 |
| 誤って否決した割合(合成データだから分かる値) | 0.134 | 0.288 |
| スコアカードのデフォルト確率の平均 | 0.045 | 0.069 |
群を入力に入れていないモデルで、承認率は群Aが0.855、群Bが0.691で、0.164の差が出ました。承認した契約のデフォルト率は0.028と0.029でほぼ同じです。一方、誤って否決した割合は、群Aが0.134、群Bが0.288で、群Bでは2倍あまりになりました。群Bはデフォルト率そのものが高く(群Aの0.040に対して群Bは0.058)、デフォルト確率の平均も群Bの方が高く出ている(前の表の0.045と0.069)ので、モデルは群Bの申込のスコアを低めに付けていることになります。その結果、群Bでは、承認していれば正常の結果になった申込も、カットオフより下に入る割合が高くなっています。スコアカードのデフォルト確率の平均は群Aが0.045、群Bが0.069で、どちらの群でも評価期間の実績(0.040と0.058)より高めでした。群ごとの見積りと実績の差は、群Aが0.005、群Bが0.011です。見積りが実績より高めに出た理由は、この章では確かめていません(較正の確認は第8章で扱います)。
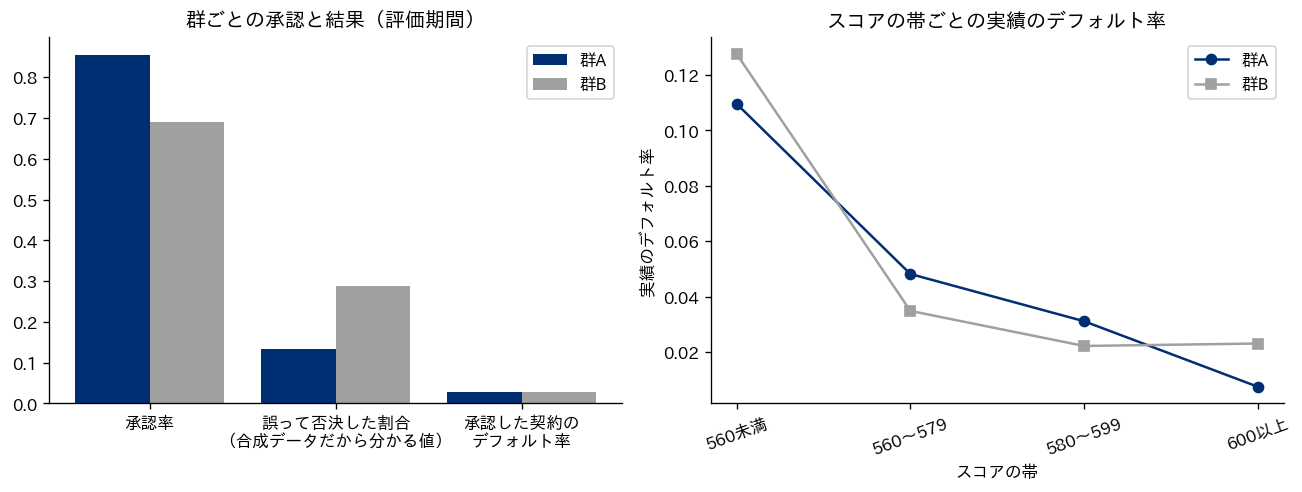
上の図の右は、スコアの帯ごとの実績のデフォルト率を群ごとに比べたものです。帯ごとの値は次のとおりでした。
| スコアの帯 | 群Aのデフォルト率 | 群Aの件数 | 群Bのデフォルト率 | 群Bの件数 |
|---|---|---|---|---|
| 560未満 | 0.110 | 575件 | 0.128 | 533件 |
| 560以上580未満 | 0.048 | 976件 | 0.035 | 574件 |
| 580以上600未満 | 0.031 | 1,575件 | 0.022 | 541件 |
| 600以上 | 0.007 | 1,071件 | 0.023 | 130件 |
同じスコアの帯の中で、どちらの群のデフォルト率が高いかは、帯によって入れ替わりました。最も低い帯と最も高い帯では群Bが高く、中ほどの2つの帯では群Aが高くなっています。この架空データは、群そのものがデフォルトの起きやすさに効かないように作っていますが、帯の中の差が偶然の揺れの範囲かどうかは、区間を計算していないので、ここでは判断しません。とくに600以上の帯の群Bは130件で、デフォルトは3件ほどしかありません。同じスコアなら群によらず同じデフォルト率になっているかという点検(帯の中のデフォルト率の群の間の一致。見積りの確率と実績の一致とは別)は、件数の少ない帯では判断が難しく、区間を付けて見るか、数か月分を合わせて見る必要があります。
モデルの入力に使った9つの項目(区分けして WoE にしたもの)から群Bかどうかを当てるロジスティック回帰を学習用のデータで作り、評価期間で測ると、AR値は0.691でした。群を入力に入れていなくても、入力の項目の組み合わせから群はかなりの程度まで当てられる、ということです。代わりの項目を通じて偏りが入りうるのは、このような状態のときです。
項目を1つずつ外してスコアカードを作り直した結果は、次の表のとおりです。外したモデルでも、学習期間で8割が承認の候補になる点をカットオフにしています。この計算では点数を丸める前のモデルの値をそのまま使っているので、何も外さない場合の値(承認率の差0.167、AR値0.452)は、点数を丸めたスコアカードで計算した前の表の値(承認率の差0.164、AR値0.451)とわずかに違います。誤って否決した割合の差(0.157)も、前の表の2つの値(0.288と0.134)の差とわずかに違います。
| 外した項目 | 承認率の差(群Aから群Bを引いた値) | 誤って否決した割合の差(群Bから群Aを引いた値) | 評価期間の AR値 |
|---|---|---|---|
| なし | 0.167 | 0.157 | 0.452 |
| 居住の年数 | 0.131 | 0.118 | 0.459 |
| 雇用の形態 | 0.158 | 0.148 | 0.450 |
| 年収の水準 | 0.152 | 0.142 | 0.427 |
居住の年数を外すと、承認率の差は0.167から0.131に、誤って否決した割合の差は0.157から0.118に縮み、AR値は0.452から0.459とわずかに上がりました。この架空データでは、居住の年数は群による差が大きい一方で、デフォルトの起きやすさの式の中での効き方を小さく作っています。そのため、居住の年数を外しても順位づけの成績は下がらず、群の間の差だけが縮んだと考えられます。AR値の差0.007は、評価期間のデフォルトの件数を考えると揺れの範囲に入る可能性があり、上がったと言い切れるものではありません。一方、年収の水準を外すと、差は0.152まで縮みましたが、AR値は0.427まで下がりました。年収の水準は群による差と、デフォルトの起きやすさとの関係の両方を持つ項目として作っているので、外すと差も成績も下がります。
このように、ある項目を外してモデルを作り直した場合に、群の間の差がどの程度変わるかを比べられます。項目を外すと、残った項目の係数とカットオフも変わるので、差の変化をその項目だけの寄与として分解したことにはなりません。差の一部が、デフォルトの起きやすさとの関係が弱く、群との相関が強い項目から来ているなら、その項目を外す、あるいは区分を見直すことで、成績をほとんど落とさずに差を縮められる場合があります。差の一部が、デフォルトの起きやすさと強く関係する項目から来ているなら、項目を外すと順位づけの成績が下がることがあります。この章では、項目を外した後の承認した契約のデフォルト率や貸し倒れの損失は計算していないので、事業の成果への影響は別に評価する必要があります。後者は、どの程度の差をどの理由で受け入れるかという判断になり、データ分析の担当だけでは決められません。なお、ここでの結果は、群がデフォルトの起きやすさに直接効かないように作った架空データでのものです。実際のデータで同じ結果になるとは限らず、項目の効き方と群との相関は、自社のデータで測る必要があります。
公平性の指標と、同時には満たせない場合があること
公平性を測る指標は1つではありません。前の節の計算で使ったものを中心に、よく使われる考え方を次の表に整理しました。どの指標も、群ごとに計算して差や比を見るものです。
| 指標 | 群ごとに計算するもの | そろえたときの意味 | 与信での注意 |
|---|---|---|---|
| 承認率の差 | 申込のうち承認したものの割合 | 結果の割合が群によらず同じ | 群のデフォルト率が違うときは、そろえ方によって承認した契約のデフォルト率などの別の指標が動く可能性がある |
| 誤って否決した割合の差 | 承認していれば正常の結果になった申込のうち、否決したものの割合 | 承認していれば正常の結果になった申込が断られる割合が群によらず同じ | 否決した申込の結果は観測できないので、実務では推定になる |
| 誤って承認した割合の差 | 承認していればデフォルトの結果になった申込のうち、承認したものの割合 | デフォルトの結果になる申込が承認される割合が群によらず同じ | 過剰与信による顧客の不利益の偏りを見る観点にもなる |
| 帯の中のデフォルト率の群の間の一致 | 同じスコアの帯の中の実績のデフォルト率 | 同じスコアなら群によらず同じデフォルト率 | 群の間で等しくても、見積りの確率と実績が合っているとは限らない(較正の確認は別に行う)。帯の中の件数が少ないと揺れが大きい |
| 承認した契約のデフォルト率の差 | 承認した契約のうちデフォルトしたものの割合 | 承認の判断の確からしさが群によらず同じ | 結果が分かるのは観測期間の後。承認率と合わせて見る |
これらの指標のうち、いくつかの組は同時にはそろえられないことが、研究で示されています。Kleinberg と Mullainathan と Raghavan の2017年の論文(理論計算機科学の革新に関する国際会議 ITCS 2017 の予稿集に収録)は、結果が起きる予測確率として表したリスクの点数について、次の3つの条件を定めました。論文の点数は確率で、本コラムの「大きいほどデフォルト確率が低いスコア」とは向きも尺度も違います。
- 群の中での較正:同じ予測確率を付けた人のうち、実際に結果が起きた割合が、どの群でもその確率どおりになること。表の「帯の中のデフォルト率の群の間の一致」は、群の間で実績が等しいかだけを見ており、見積りの確率と実績が一致しているかまでは見ていないので、この条件より弱い
- 陰性の側の均衡:実際には結果が起きなかった人に付けた予測確率の平均が、群の間で等しいこと(表の「誤って否決した割合の差」に近い考え方)
- 陽性の側の均衡:実際に結果が起きた人に付けた予測確率の平均が、群の間で等しいこと(表の「誤って承認した割合の差」に近い考え方)
論文は、予測が完全に当たる場合か、群の間で結果の起きる割合(基準の率)が等しい場合を除いて、この3つを同時には満たせないことを示しました。論文の条件は予測確率の平均についてのもので、表の「誤って否決した割合」のように、カットオフで分けた後の割合そのものではありません。また、表の「承認率の差」は、この3つの条件には含まれていません。Chouldechova の2017年の論文(学術誌 Big Data 第5巻第2号)も、再犯の予測の道具を題材に、結果の起きる割合が群によって違うときには複数の公平性の基準を同時には満たせないこと、誤りの率が群の間でそろっていないと特定の群に不利な影響が出ることを論じています。どちらも与信を直接扱った論文ではありませんが、論文の結論はリスクの点数一般について、それぞれの論文が定めた条件の範囲で示されたものです。与信の場面に置き換えると、群の間でデフォルト率が違うときに当てはまる議論になります。
本コラムの架空データでは、ある指標が近くても、別の指標には差が残りました。この例では、カットオフを変えた比較も、論文の3つの条件の確認もしていないので、両立しないことを確かめたわけではありません。群Bはデフォルト率が高く、承認した契約のデフォルト率はほぼそろった(0.028と0.029)一方で、承認率と誤って否決した割合は大きく違いました。承認した契約のデフォルト率がそろった理由は、この章では確かめていません。承認率をそろえるために群によって違うカットオフを使う案も考えられますが、それは群によって違う基準を使うことになります。その場合に承認した契約のデフォルト率がどう動くかは、この章では計算していません。どの指標をそろえ、どの指標の差をどこまで受け入れるかは、計算では決まらず、法令上の扱いと事業の方針で決める事柄です。群によって違うカットオフを使うことが法令上どう扱われるかは国や制度によって違うので、第14章で確かめた範囲を整理します。
実務で公平性を点検するときは、次のことを決めておく必要があります。
- どの属性について点検するか
- その属性の情報をどう手に入れるか(入力には使わず、点検のためだけに保管する場合の扱いを含む)
- どの指標をどの頻度で計算するか
- 差がどの程度になったら誰が何を調べるか
属性の情報を点検のために持つこと自体が、個人情報の取り扱いの上で慎重さを要する場合があります。この点も第14章で扱います。
米国の制度、不利益な決定の通知と、異なる扱い・異なる影響
否決の理由の通知について、具体的な規定を持つ制度の例として、米国の信用機会均等法と、それを実施する規則B(連邦規則集第12編第1002部)があります。ここでは、消費者金融保護局が公式サイトで公開している規則の本文と公式の解釈、連邦官報と連邦規則集で確かめた範囲の要点だけを書きます。日本の制度との違いや、日本の事業者への当てはまりは扱いません。
規則Bの第1002.9条は、不利益な決定の通知を定めています。原則(第1002.9条(a)(1)と(a)(2))は、通常の判断に必要な情報がそろった申込を受け取ってから決めた期間のうちに決定を知らせ、否決などの不利益な決定は、具体的な理由か、理由を求められることを書面で伝える、というものです。事業向けの与信には、口頭での通知を認めるなど別の規定があります(同条(a)(3))。理由は不利益な決定の主な理由を具体的に示すものとされ、内部の基準によったという説明や、基準の点数に届かなかったという説明だけでは不十分とされています(同条(b)(2))。
公式の解釈は、スコアリングの仕組みで否決したときは実際に点数化した項目から理由を選ぶこととし、選び方の例として、項目ごとの点数を平均の点数(カットオフをわずかに上回った申込者の平均か、申込者全体の平均)と比べる方法を挙げています。満点との差で選ぶ方法は、この例には含まれていません。本コラムのコードでカットオフ付近の平均との差も計算したのは、この例を参考にしたためです。本コラムの架空データでは2つの基準で第1の理由が一致したのは0.909でしたが、満点との差の方法が公式の解釈の求める範囲に入るかは、この章では確かめていません。また、スコアリングと人の判断を組み合わせた審査では、否決を決めた段階に応じて理由の出所を分けることも書かれています(公式の解釈9(b)(2)-7)。消費者金融保護局が2022年5月26日に公表した、複雑なアルゴリズムを使う場合も理由の通知の義務は免除されないとする文書は、同局の撤回した文書の一覧で2025年5月12日に撤回されたとされています。撤回されたのはこの公表文書で、第1002.9条の規定そのものではありません。
- 規則Bの第1002.9条の本文:消費者金融保護局の規則の公開ページ(第1002.9条)
- 第1002.9条の公式の解釈:消費者金融保護局の規則の公開ページ(第1002.9条の公式の解釈)
- 撤回した文書の一覧(2022年の公表文書の撤回の記載):消費者金融保護局の撤回した文書の一覧
差別の考え方としては、異なる扱いと異なる影響の2つが区別されてきました。異なる扱いは、禁止された属性を理由に申込者を違って扱うことです。規則Bの第1002.4条(a)は、禁止された属性を理由に、与信の取引のどの面についても申込者を差別してはならないと定め、公式の解釈は、異なる扱いは意図的かどうかにかかわらず違法であるとしています。規則Bが定める禁止された属性は、人種・肌の色・宗教・出身国・性別・婚姻の状況・年齢(契約を結ぶ能力がある場合)・収入の全部か一部が公的な扶助による事実・消費者信用保護法などの権利を誠実に行使した事実です(第1002.2条(z))。異なる影響は、属性について中立に見える基準でも、特定の集団に不利な結果をもたらす場合を問題にする考え方で、「効果テスト」とも呼ばれてきました。
この異なる影響の扱いは、2026年に変わっています。消費者金融保護局は2025年11月13日に規則Bの改正案を公表し、2026年4月22日に連邦官報で最終規則を公表しました。最終規則は2026年7月21日に施行され、信用機会均等法は異なる影響による責任(効果テスト)を認めていないという立場を示し、第1002.6条(a)から効果テストが適用されうるとしていた記述を削り、法は効果テストの適用を定めていないという記述に改めています。2026年11月13日に連邦規則集と消費者金融保護局の公開ページで確かめた第1002.6条(a)は、この改正後の文言になっていました。この改正についての訴訟などのその後の動きは、本コラムでは確かめていません。また、他の法律や州の法令での扱い、他の監督当局の扱いも確かめていないので、ここでは書きません。
- 改正後の第1002.6条:消費者金融保護局の規則の公開ページ(第1002.6条)
- 2026年4月22日の最終規則(文書番号2026-07804):連邦官報の全文(テキスト版)
制度の上で異なる影響がどう扱われるかとは別に、前の節で見たように、群の間で承認率や誤って否決した割合に差が出ていることを測り、その差がどの項目から来ているかを知っておくことは、与信を行う側の管理として意味があると考えています。差がデフォルトの起きやすさとの関係が弱い項目から来ているなら、その項目は成績の上でも説明の上でも見直す理由があります。法令上の義務があるかどうかと、事業として点検するかどうかは、分けて考える必要があります。
人による再審査と異議の申し立て、申込者に示す文面
スコアによる判定は、どれだけ点検しても誤りを含みます。入力の誤り(申告の打ち間違い、信用情報の誤った登録、別人の情報の取り違え)による誤りもあれば、モデルが捉えていない事情による誤りもあります。そのため、申込者が否決の理由に疑問を持ったときに、人が入力と判断を確かめ直す手続きを用意しておくことが必要です。再審査では、判定の時点の入力とスコアを記録から取り出し、入力の誤りがあれば正しい値でスコアを計算し直し、モデルが扱えない事情があれば、決めた権限の範囲で人が判断します。人が判断を変えたときは、その理由と結果を記録し、後で変えた契約の返済の結果を追跡します(第9章のスコアの上書きと同じ扱いです)。
異議の申し立ての件数と結果は、モデルと運用の点検の材料にもなります。特定の理由についての申し立てが多い、特定の経路からの申込の再審査で判断が変わることが多い、といった傾向は、入力のデータの品質や、理由の文面のわかりにくさを示していることがあります。申し立ての件数・再審査で判断が変わった割合・変わった理由の内訳を、経営の点検の項目に入れておくことが有効だと考えています。
申込者に示す文面は、定型にしておくと、担当者によって説明がぶれることを防げます。次の表は、文面に入れる要素の例です。
| 文面の要素 | 内容の例 | 作り方の注意 |
|---|---|---|
| 決定の内容 | 今回の申込は承認に至らなかったこと | 人を評価する言い方をしない。「お客様の信用が」のような書き方を避ける |
| 主な理由 | 判断に影響した主な項目(例:他社の借入の年収に対する割合、年収の水準) | 実際に否決を決めた審査の段階の理由を使う。スコアで否決したなら、計算した点数の差や寄与から選んだ項目名を決めた順序と件数で差し込み、人の判断で否決したなら、その人が確かめた項目を使う。変えるときは権限と記録を伴う手順で行う |
| 使った情報の出所 | 申込書の内容、信用情報機関から得た情報など | 信用情報機関の情報を使った場合の扱いは、法令と各機関の定めを確かめる(第14章) |
| 次にできること | 申込の内容に誤りがあれば訂正を申し出られること、再審査を求められること | 審査をすり抜けるための助言にならないようにする。区分の境目やカットオフの値は示さない |
| 問い合わせ先 | 窓口の名称・受付の方法・受付の期間 | 問い合わせを受けた記録を、異議の申し立ての集計に使えるように残す |
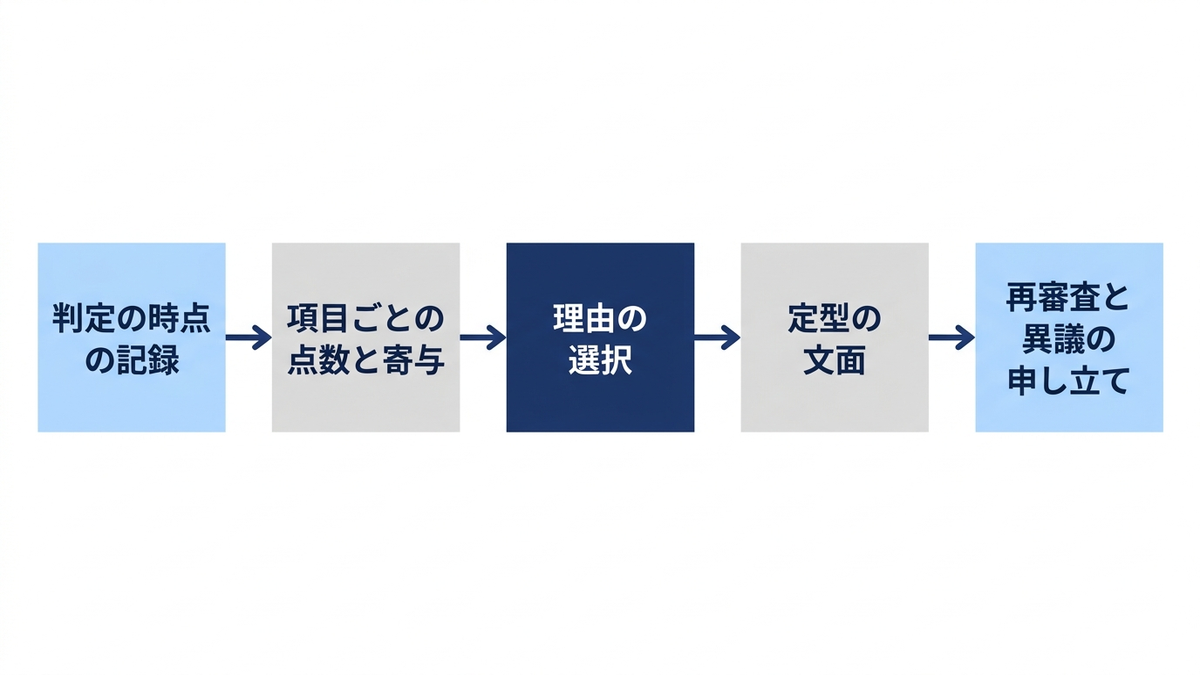
理由の項目名は、申込者にも分かる言葉に置き換える必要があります。「直近の申込の件数」のような項目名はそのままでも通じやすい一方で、項目を組み合わせて作った特徴量は、そのままの名前では伝わりません。機械学習のモデルで複雑な特徴量を使う場合は、理由として示せる言葉に直せるかを、項目を選ぶ段階で確かめておく必要があります。また、示す理由の数を3つ程度に絞る場合でも、残りの理由を記録には残しておき、問い合わせを受けたときに担当者が確かめられるようにしておくことが必要です。
経営の判断、理由を示せる状態と偏りを測る仕組みを本番の前に用意する
否決の理由の説明と公平性の点検は、モデルを作り終えた後の付け足しとして扱われがちですが、その準備を誤ると、序章で整理した損失の型のいくつかに直結します。否決の理由を示せない、あるいは判定の時点の理由を再現できない状態でモデルを入れると、理由の通知や記録を求める法令(米国の規則Bの第1002.9条のような規定)や契約が適用される事業では、規制上の義務の不履行につながるおそれがあります。日本の法令での扱いは第14章で確かめた範囲を整理します。理由の文面が定まらないと、問い合わせのたびに担当者が個別に調べることになり、審査の滞りが生じます。群の間の偏りを測っていないと、成績の上では意味の小さい項目が特定の集団の申込を多く断っていても気づかず、返済できたはずの申込を断る機会損失と、顧客や社会からの信頼の低下を招くおそれがあります。理由の出し方や点検の手順を一度決めたきり見直さないと、モデルの更新とともに理由がずれ、形骸化します。
これを防ぐために、モデルを本番に入れる前に、次のことを決めて文書に残しておくことが有効だと考えています。
| 決めること | 決める内容の例 | 決める人の例 |
|---|---|---|
| 理由の出し方 | 比べる基準(満点・カットオフ付近の平均など)、示す項目の数、差が同じ項目の順序、欠損の区分の言い方 | リスク管理の責任者とデータ分析の担当 |
| 理由の文面 | 定型の文、項目名の言い換え、示さない情報(区分の境目・点数・カットオフ) | コンプライアンス・法務・顧客対応の責任者 |
| 判定の時点の記録 | 入力・スコア・理由・カットオフ・モデルの版・人による変更とその理由 | 情報システムとリスク管理の責任者 |
| 公平性の点検 | 点検する属性、属性の情報の扱い、指標、頻度、差が大きいときに調べる人と手順 | リスク管理・コンプライアンスの責任者と経営 |
| 再審査と異議の申し立て | 受付の方法、再審査の権限、判断を変えたときの記録、件数と結果の報告 | 審査と顧客対応の責任者 |
| 受け入れる差の判断 | 成績と群の間の差がつり合わないときに、どの指標をどこまで優先するか | 経営 |
この表の中で経営が直接関わるべきなのは、最後の「受け入れる差の判断」です。本コラムの架空データで見たとおり、群の間の差を縮める手段には、順位づけの成績をほとんど落とさないものと、順位づけの成績が下がるものがありました。貸し倒れや事業の成果への影響は別に評価する必要があり、成績の低下を受け入れるかどうかは計算では決まりません。また、理由の記録や点検の仕組みを作り、点検の結果を定期的に報告させる手間は、モデルの開発とは別に予算と体制に入れておく必要があります。否決の理由の分布、群ごとの承認率などの点検の結果、異議の申し立ての件数と結果を、承認率やデフォルト率と同じ管理の指標として定期的に見る仕組みにしておくと、変化に早く気づけます。AI の社内のルールづくりの一般論は、弊社コラム「AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで」で扱っています。
この章のまとめ
この章では、説明が要る相手と示すもの、スコアカードと SHAP での否決の理由の出し方、説明の限界、公平性の測り方と指標どうしのつり合い、米国の制度、再審査と文面を扱いました。本コラムの架空データでは、スコアカードと勾配ブースティングの SHAP で第1の理由が一致したのは否決の申込の0.763で、相関した項目を外すと第1の理由の大半が別の2項目に移りました。また、群を入力に入れていないモデルでも、承認率は群Aが0.855、群Bが0.691で、誤って否決した割合(合成データだから分かる値)は0.134と0.288でした。本コラムの架空データでは、群との相関が強く、デフォルトとの関係が弱く作った居住の年数を外しても、順位づけの成績はほとんど変わらず、群の間の差が縮みました。AR値の差が揺れの範囲かどうかは判断しておらず、実際のデータで同じ結果になるとは限りません。否決の理由を示せる状態と、偏りを定期的に測る仕組みは、モデルを本番に入れる前に用意しておく必要があります。次の第12章では、本番に入れたモデルが申込者の層や景気の変化で合わなくなっていないかを監視し、見直す仕組みを扱います。
この章を深めたい方への参考書籍
『機械学習を解釈する技術 予測力と説明力を両立する実践テクニック』(森下光之助 著、技術評論社):機械学習のモデルの解釈の手法を、線形回帰との対比から順に解説した本です。版元の目次によれば、特徴量の重要度、特徴量と予測の関係、インスタンスごとの違いを扱う章に続いて、SHAP の章で協力ゲーム理論とシャープレイ値、実装、利点と注意点を扱っています。この章で使った SHAP の値の意味と限界を、より詳しく確かめるのに向いています。
『あなたを支配し、社会を破壊する、AI・ビッグデータの罠』(キャシー・オニール 著、久保尚子 訳、インターシフト):原題は Weapons of Math Destruction です。国立国会図書館サーチに収録された目次によれば、モデルの良し悪しを扱う第1章に始まり、「教育」「宣伝」「正義」「就職」「仕事」「信用」「身体」などの分野の名前を付けた章が続き、第8章が「信用」の章です。この章で扱った偏りの問題を、技術の外側から、社会での使われ方として考える材料になります。
第12章 モデルの監視と管理、母集団の安定性と再構築・モデルリスク管理
第11章では、否決の理由をどう示すかと、承認の結果が特定の集団に偏っていないかをどう測るかを見ました。どちらも、モデルを本番に入れる前に用意しておく仕組みでした。この章では、本番に入れた後のモデルを扱います。与信のモデルは、作った時点の申込者の層と景気のもとで、項目とデフォルトの関係を学んだものです。その前提が変われば、同じ計算を毎日続けていても、スコアと実際のデフォルトの対応は少しずつずれていきます。
この章で扱うのは次の内容です。中ほどでは、他の章とは独立に作った架空の申込と契約の記録を使い、実行したコードと結果で確かめます。
- 与信のモデルが古くなる理由と、監視の3つの層(入力・出力・結果)
- 結果が観測期間の後にしか分からないことと、先に分かる指標の使い方
- 母集団の安定性の指標(PSI)の式と、目安とされる水準の扱い方
- 申込者の層の変化と、項目とデフォルトの関係の変化の見分け方
- 見直しの段階(カットオフの調整・再較正・再推定・再構築)と、どの兆候でどこまで行うか
- モデルリスク管理の枠組み(金融庁の「モデル・リスク管理に関する原則」と米国の監督当局の指針)
- モデルの文書と台帳・検証・本番での実装の点検・記録・新しいモデルの試し方
この章の主張は2つあります。1つ目は、与信のモデルの結果(デフォルトしたかどうか)は観測期間が満ちるまで分からないので、監視は、申込の時点で分かる入力と出力の指標、数か月で分かる早い段階の延滞、観測期間の後に分かる最終の結果の3段で組み立てる必要がある、という点です。2つ目は、入力の分布が変わったことだけでは、モデルの成績が悪くなったとは言えず、反対に入力の分布が安定していても、項目とデフォルトの関係が変われば見積りはずれる、という点です。本コラムの架空データでも、申込者の層が大きく変わった時期にはデフォルト確率の見積りと実績がほぼ合ったままで、層が変わり終えた後に関係が変わった時期には、入力の指標はほとんど動かないまま、見積りが実績を下回りました。どの指標が動いたら何をするかを、モデルの文書と台帳に先に定めておくことが、この章の結論です。
与信のモデルが古くなる理由、監視の3つの層
与信のモデルが作った時点の成績を保てなくなる理由は、大きく5つに分けて考えると整理しやすくなります。1つ目は申込者の層の変化で、広告の出し方や提携先の変更で、これまでと違う年齢や収入の層から申込が来るようになる場合です。2つ目は商品や経路の変更で、与信枠や返済の期間、申込の画面や審査の手順を変えると、同じ項目の値が持つ意味が変わることがあります。3つ目は景気で、失業や物価の動きによって、同じ属性の申込でもデフォルトの起きやすさが全体に変わります。4つ目は審査の基準の変更で、カットオフや人による確認の範囲を変えると、承認される層、つまり結果が見える層が変わります(第6章)。5つ目は競合の動きで、他社が審査を緩めたり厳しくしたりすると、自社に来る申込の層が変わります。
この5つは、モデルにとって2種類の変化として現れます。1つは入力の分布の変化で、項目の値の分布が開発の時点と違ってくるものです。もう1つは、項目とデフォルトの関係の変化で、同じ項目の値でもデフォルトの起きやすさが変わるものです。前者だけなら、モデルが項目とデフォルトの関係を正しく捉えている限り、デフォルト確率の見積りは実績と合ったままでいられます。後者が起きると、入力の分布が同じでも見積りはずれます。実際にはこの2つが同時に起きることが多く、どちらが起きているかを切り分けるために、監視の指標を層に分けて持ちます。
| 監視の層 | 見るもの | 分かる時点 | 分かること | 分からないこと |
|---|---|---|---|---|
| 入力 | 申込の件数、項目ごとの分布、欠損の割合、項目ごとの安定性の指標 | 申込の時点 | 申込者の層や項目の定義が変わったこと | その変化で見積りがずれたかどうか |
| 出力 | スコアの分布とPSI、平均のデフォルト確率、承認率、人による確認へ回した割合、上書きの割合 | 申込の時点 | 承認の判断がどれだけ変わったか | 判断が正しかったかどうか |
| 結果(早い段階) | 契約から数か月の延滞の割合と、その見込み(過去の記録から計算した、早い段階の延滞の割合の期待値)との比 | 契約から数か月後 | 見積りより悪い方向へずれ始めている兆し | 最終のデフォルト率の大きさ |
| 結果(最終) | デフォルト率、デフォルト確率の見積りとの比(較正の確認)、AR値 | 観測期間が満ちた後 | 確率の正しさと順位づけの成績 | 直近の申込についてのこと(まだ結果が出ていない) |
表の「見込み」は早い段階の延滞についての期待値で、デフォルト確率の「見積り」とは別のものとして書き分けます。表の上の2段は申込の時点で分かりますが、モデルの成績そのものは示しません。下の2段は成績を示しますが、分かるまでに時間がかかります。第2章で、デフォルトの定義を「契約から12か月以内に、延滞が90日以上に達すること」と置きました。この定義では、ある月の契約の最終の結果が分かるのは、その12か月後です。監視の設計は、この遅れを前提に組み立てる必要があります。結果が出そろう前に分かる指標を使って早めに調べ始め、最終の結果で確かめる、という順序になります。
結果は遅れて分かる、観測期間を満たした月だけで成績を測る
監視で最も起きやすい誤りの1つは、観測期間を満たしていない契約を、成績の計算に入れてしまうことです。たとえば、3か月前に実行した契約を含めて「今月時点のデフォルト率」を計算すると、まだデフォルトに至る時間が足りない契約が正常として数えられ、デフォルト率は実際より低く出ます。直近の申込ほど低く出るので、成績が改善しているように見えることさえあります。第2章で見たビンテージの見方(申込の月ごとに、契約からの経過月数に沿って結果を見届ける見方)と同じ理由で、最終の結果を使う指標は、観測期間が満ちた月の契約だけで計算します。観測期間を満たしていない契約は、正常にもデフォルトにも数えません。
そうすると、ある時点で監視に使える最終の結果は、つねに12か月以上前の申込のものになります。申込者の層や景気が変わってから、その影響が最終の結果で確かめられるまでには、観測期間の長さだけの遅れがあります。この遅れを埋めるのが、先に分かる指標です。1つは入力と出力の指標で、申込の時点で計算できます。もう1つは早い段階の延滞で、たとえば「契約から3か月以内に、1か月分以上の延滞が起きたか」は、3か月後には分かります。早い段階の延滞は、最終のデフォルトと同じものではありませんが、デフォルトに至る契約の一部は早い時期に延滞を起こすので、最終の結果の先行の指標として使えます。どの程度の先行性があるかは商品と顧客の層によるため、自社の過去の記録で、早い段階の延滞の割合と最終のデフォルト率の関係を確かめておく必要があります。
この章のコードでも、この遅れをそのまま再現しました。監視を行う時点を「51か月目の末」と決め、その時点で観測期間が満ちている月の契約だけで結果の指標を計算します。12か月の観測期間なら39か月目までの申込、3か月の観測期間なら48か月目までの申込が対象です。コードの中では、この条件を満たしているかどうかを契約ごとの列に持たせ、結果の指標を計算する前に必ず確かめるようにしました。
架空の申込の記録を作る、途中で層と関係が変わる
ここからは、監視の指標がどう動くかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の申込や契約の記録よりずっと単純です。合成データでの成績は、実際の審査での成績の目安にはなりません。示したいのは、どの変化がどの指標に、どの時点で現れるかという点です。51か月の間、毎月5,000件の申込があるものとし、次の性質を持たせて乱数で作りました(乱数の種は20261113に固定しています)。年収の水準は、開発の期間の経路Aの申込者の中央の値をおよそ1とした相対値です。
- 申込者の属性と信用情報にあたる項目:年収の水準(相対値)、勤続年数、他社の借入の件数、過去の延滞の有無、直近6か月の申込の件数
- 申込の経路:経路Aと経路Bがあり、経路Bの申込者は年収の水準が低め、勤続年数が短め、他社の借入の件数と直近の申込の件数が多めになるようにした。経路はモデルの入力には入れない
- 申込者の層の変化:25か月目から4か月かけて、経路Bの申込の割合を15%から50%に増やす
- 項目とデフォルトの関係の変化:34か月目から、景気の悪化にあたる分だけ全体のデフォルトの起きやすさを上げ、他社の借入の件数の効き方も強める
- 項目どうしの組み合わせで効く関係:年収の水準が低い申込では、他社の借入の件数の効き方が強い(モデルには組み合わせの項を入れない)
- 結果:契約から12か月以内のデフォルト(第2章の定義)と、契約から3か月以内の1か月分以上の延滞(早い段階の延滞)
早い段階の延滞は、デフォルトに至る契約では50%、正常な契約では1.2%の割合で現れるものとしました。この割合は説明のために置いた仮定で、早い段階の延滞がどれだけ先行の指標として効くかは、この仮定の強さで決まります。実際の商品では、自社の記録で確かめる必要があります。また、この例題では、承認した申込はすべて契約され実行されたものとし、スコアがカットオフ以上の申込を承認したものとして扱います。実際の承認の判断は、返済の能力の調査など法令上の条件と、その他の審査の基準を合わせて決まります。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
# ===== ブロック1:架空の申込の記録を作る =====
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261113)
N_MONTH, PER_MONTH = 51, 5000                    # 51か月、毎月5,000件の申込
n = N_MONTH * PER_MONTH
month = np.repeat(np.arange(1, N_MONTH + 1), PER_MONTH)
mix = np.clip((month - 24) / 4, 0, 1)            # 25か月目から4か月かけて申込者の層が変わる
route_b = rng.random(n) < 0.15 + 0.35 * mix      # 経路Bの申込の割合(15%から50%へ)
df = pd.DataFrame({
    "month": month,
    "route_b": route_b.astype(int),                  # 経路(1が経路B)。モデルの入力には入れない
    "income": np.exp(rng.normal(np.where(route_b, -0.3, 0.0), 0.45)),  # 年収の水準(相対値)
    "tenure": rng.gamma(np.where(route_b, 1.5, 2.5), 2.5),            # 勤続年数
    "loans": rng.poisson(np.where(route_b, 1.6, 0.9)),                 # 他社の借入の件数
    "past_dl": (rng.random(n) < np.where(route_b, 0.12, 0.07)).astype(int),  # 過去の延滞の有無
    "inq": rng.poisson(np.where(route_b, 2.0, 0.8)),                   # 直近6か月の申込の件数
})
low_inc = (df.income < 0.8).astype(int)
changed = (df.month >= 34).astype(int)           # 34か月目から項目とデフォルトの関係が変わる
z = (-3.6 - 0.9 * np.log(df.income) - 0.08 * df.tenure + 0.30 * df.loans
     + 1.0 * df.past_dl + 0.25 * df.inq + 0.25 * df.loans * low_inc   # 組み合わせで効く関係
     + changed * (0.20 + 0.12 * df.loans))       # 景気の悪化と、借入の件数の効き方の強まり
df["default"] = (rng.random(n) < 1 / (1 + np.exp(-z))).astype(int)   # 12か月以内のデフォルト
# 契約から3か月以内の1か月以上の延滞(早い段階の延滞)。デフォルトする契約ほど現れやすい
df["early_dl"] = (rng.random(n) < np.where(df["default"] == 1, 0.5, 0.012)).astype(int)
print("申込の件数", len(df), "/全体のデフォルト率", round(df["default"].mean(), 4))
print(df.groupby(pd.cut(df.month, [0, 12, 24, 27, 33, 39, 51]), observed=True)["default"].mean().round(4))
実行すると、申込の件数は255,000件、合成データの全部の申込についてのデフォルト率は0.0771でした。申込の月の区間ごとに見ると、1〜12か月目が0.0522、13〜24か月目が0.0526、層が変わり始めた25〜27か月目が0.0642、層が変わり終えた28〜33か月目が0.0796、関係が変わった34〜39か月目が0.1112、40〜51か月目が0.1115です。これは否決した申込も含めた全部の申込の値で、合成データだから分かる値です。実際の監視で見えるのは、承認した契約の結果だけです。
次のブロックで、1〜12か月目の申込でロジスティック回帰のモデルを作り、25か月目から審査に使います。12か月目の申込の結果は24か月目の末に出そろうので、モデルを作れるのは早くても24か月目の末です。開発の期間の申込は、簡単のため全件の結果が分かるものとしました(承認した契約の結果しか分からない問題は第6章で扱いました)。スコアは、デフォルトの対数オッズを点数に直したもので、大きいほどデフォルト確率が低くなります(変換の考え方は第4章)。カットオフは、開発の期間の申込で承認率が80%になる点に置きました。例題を短くするため、項目は区分けをせずに値のまま入れた簡略なロジスティック回帰にしており、区分ごとの点数表(スコアカード)にはしていません(区分けと点数表の作り方は第3章・第4章)。
# ===== ブロック2:1〜12か月目でモデルを作り、25か月目から使う =====
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

X_COLS = ["log_inc", "tenure", "loans", "past_dl", "inq"]
df["log_inc"] = np.log(df.income)
dev = df[df.month <= 12]                         # 結果は24か月目の末にそろう
model = LogisticRegression(max_iter=1000).fit(dev[X_COLS], dev["default"])
df["pd"] = model.predict_proba(df[X_COLS])[:, 1]
df["score"] = 500 + 40 / np.log(2) * np.log((1 - df.pd) / df.pd)   # 大きいほどデフォルトしにくい
CUTOFF = np.quantile(df.loc[df.month <= 12, "score"], 0.20)        # 開発期間で承認率80%になる点
df["approved"] = (df.score >= CUTOFF).astype(int)

NOW = 51                                         # 監視の時点(51か月目の末)
df["final_known"] = (df.month + 12 <= NOW).astype(int)   # 12か月の観測期間が満ちた月
df["early_known"] = (df.month + 3 <= NOW).astype(int)    # 3か月の観測期間が満ちた月

def ar(y, p):
    return 2 * roc_auc_score(y, p) - 1

print("係数", dict(zip(X_COLS, model.coef_[0].round(3).tolist())), "切片", round(model.intercept_[0], 3))
print("カットオフ", round(CUTOFF, 1), "/開発期間のAR値", round(ar(dev["default"], df.loc[dev.index, "pd"]), 3))
推定した係数は、年収の水準(対数)が-1.244、勤続年数が-0.087、他社の借入の件数が0.448、過去の延滞の有無が0.93、直近6か月の申込の件数が0.265、切片が-3.668でした。デフォルトを1とした回帰なので、正の係数はデフォルトしやすい向きを表します。カットオフは647.8点、開発の期間の申込の全体でのAR値は0.52でした。このAR値は、モデルの学習に使った申込そのもので測った値で、しかも否決した申込まで含めた広い集団での値です。この後の監視で見るAR値は、承認した契約だけで測るので、値は小さくなります。第7章で見たとおり、対象の集団や期間が違うAR値の差は、そのままモデルの優劣の判断には使えません。
母集団の安定性の指標(PSI)、式と目安の扱い方
入力と出力の監視でよく使われるのが、母集団の安定性の指標(PSI、Population Stability Index)です。比べたい2つの集団(たとえば、モデルの開発に使った申込と、今月の申込)について、スコアや項目の値をいくつかの区分に分け、区分ごとの構成比の違いを1つの数にまとめます。基準の集団で区分 i に入る割合を \( e_i \)、今月の集団で区分 i に入る割合を \( a_i \) とすると、本コラムの計算では次の式を使いました。
\( \mathrm{PSI} = \sum_i (a_i – e_i) \ln \frac{a_i}{e_i} \)
言葉で言い換えると、区分ごとに「構成比の差」と「構成比の比の対数」を掛けて足し合わせたものです。どの区分でも構成比の差と比の対数は同じ符号になるので、各区分の値は0以上になり、2つの分布が同じなら0、違うほど大きくなります。区分は基準の集団の分位点(ここではスコアを10等分する点)で作ることが多く、構成比が0の区分では対数が計算できないので、小さな値で置き換えるなどの扱いを決めておきます。スコアに使ったものと同じ計算を項目ごとに行ったものは、項目ごとの安定性の指標として使えます。
PSI については、0.1未満なら「小さな変化」、0.1以上0.25未満なら「中程度の変化」、0.25以上なら「大きな変化で、対応が要る」とみなす経験則が実務で使われていることが、Yurdakul と Naranjo の2020年の論文(Journal of Risk Model Validation 第14巻第4号、PSI の統計的な性質を扱ったもの)の要旨で紹介されています(実務でどの程度広く使われているかは、本コラムでは確かめていません)。同じ要旨は、こうした目安が、変化が無いのに変化ありと判断する誤りや、変化を見逃す誤りの確率を考えずに使われていることを問題として挙げ、PSI の統計的な性質を示して使い方の提案をしています。上に書いた PSI の式も、この論文で使われている式と同じ形です。PSI の値は、区分の数や、比べる集団の件数によっても変わります。一般に、件数の少ない月では、申込者の層が変わっていなくても偶然のばらつきで値が大きくなりやすいと考えられます(本コラムでは件数を変えて確かめてはいません)。そのため本コラムでは、0.1や0.25を機械的な合否の基準としては扱いません。自社の商品で、変化が無い期間の PSI がどの範囲でばらつくかを先に測り、その範囲を明らかに超えたら原因を調べ始める、という使い方が安全だと考えています。
次のブロックで、13か月目から51か月目まで、月ごとに、スコアと5つの項目の PSI を計算します。PSI は申込の時点の情報だけで計算できるので、観測期間を待つ必要はありません。比べる基準は、モデルの開発に使った1〜12か月目の申込です。なお、モデルが出来上がるのは24か月目の末なので、13〜24か月目の値は、出来上がったモデルを過去の申込に当てはめて後から計算した参考の値です。本番での監視は、モデルを使い始めた25か月目からになります。
# ===== ブロック3:PSI(母集団の安定性の指標)を月ごとに計算する =====
def psi(expected, actual, edges):
    e = np.histogram(expected, edges)[0] / len(expected)
    a = np.histogram(actual, edges)[0] / len(actual)
    e, a = np.clip(e, 1e-4, None), np.clip(a, 1e-4, None)   # 0件の区分で対数が発散しないように
    return float(np.sum((a - e) * np.log(a / e)))

base = df[df.month <= 12]                        # 基準の分布(モデルの開発に使った申込)
def deciles(col):
    q = np.quantile(base[col], np.linspace(0, 1, 11))
    q[0], q[-1] = -np.inf, np.inf
    return q
INF = np.inf
EDGES = {"score": deciles("score"), "log_inc": deciles("log_inc"), "tenure": deciles("tenure"),
         "loans": [-INF, 0.5, 1.5, 2.5, 3.5, INF], "past_dl": [-INF, 0.5, INF],
         "inq": [-INF, 0.5, 1.5, 2.5, 3.5, INF]}
rows = []
for m in range(13, NOW + 1):                     # 申込の時点で分かるので、観測期間を待たない
    cur = df[df.month == m]
    row = {"month": m, "承認率": cur.approved.mean()}
    for col, ed in EDGES.items():
        row[col] = psi(base[col], cur[col], ed)
    rows.append(row)
psi_tab = pd.DataFrame(rows).set_index("month")
print(psi_tab.loc[[24, 25, 26, 27, 28, 30, 33, 36, 42, 51]].round(3).to_string())
print("13〜24か月目のスコアのPSI", round(psi_tab.loc[13:24, "score"].min(), 3), "〜", round(psi_tab.loc[13:24, "score"].max(), 3))
結果を、主な月について表にまとめました。承認率は、その月の申込のうちスコアがカットオフ以上だった割合です。
| 申込の月 | 承認率 | スコアのPSI | 年収の水準 | 勤続年数 | 他社の借入の件数 | 過去の延滞の有無 | 直近6か月の申込の件数 |
|---|---|---|---|---|---|---|---|
| 24か月目 | 0.805 | 0.001 | 0.001 | 0.002 | 0.001 | 0.000 | 0.001 |
| 25か月目 | 0.759 | 0.014 | 0.010 | 0.011 | 0.002 | 0.000 | 0.010 |
| 26か月目 | 0.720 | 0.046 | 0.012 | 0.019 | 0.010 | 0.001 | 0.036 |
| 27か月目 | 0.677 | 0.114 | 0.033 | 0.052 | 0.028 | 0.003 | 0.073 |
| 28か月目 | 0.638 | 0.180 | 0.057 | 0.068 | 0.050 | 0.003 | 0.138 |
| 30か月目 | 0.643 | 0.175 | 0.045 | 0.072 | 0.048 | 0.004 | 0.109 |
| 33か月目 | 0.634 | 0.182 | 0.047 | 0.070 | 0.048 | 0.006 | 0.128 |
| 36か月目 | 0.632 | 0.189 | 0.041 | 0.085 | 0.038 | 0.007 | 0.147 |
| 42か月目 | 0.639 | 0.171 | 0.050 | 0.058 | 0.046 | 0.002 | 0.139 |
| 51か月目 | 0.637 | 0.177 | 0.046 | 0.065 | 0.049 | 0.006 | 0.131 |
層が変わる前の13〜24か月目では、スコアの PSI は0.001〜0.003の範囲に収まりました。毎月5,000件・10区分という条件での、変化が無い期間のばらつきの範囲です。この数字は本コラムの合成データでの値で、自社の目安には使えません。経路Bの申込が増え始めた25か月目から値が上がり、27か月目に0.114、層が変わり終えた28か月目に0.180となり、その後は51か月目まで0.171〜0.215の範囲で横ばいでした。この範囲は、上で紹介した目安の区分では「中程度の変化」(0.1以上0.25未満)に当たります。ただし本コラムでは、目安を合否の基準としては扱いません。承認率も、25か月目から下がり、28か月目以降は0.620〜0.645の範囲になりました。項目ごとに見ると、直近6か月の申込の件数の値が最も大きく、過去の延滞の有無はほとんど動いていません。経路Bでは過去の延滞がある申込の割合を高めにしていますが、もともとの割合が小さいので、構成比の違いとしては小さく出ています。
一方で、34か月目から項目とデフォルトの関係が変わっても、PSI の推移には目立つ動きは現れていません(その前後も0.17〜0.22の範囲で上下しています)。PSI は入力の分布だけを見る指標なので、この例題のように入力の分布を変えずに、同じ属性の申込のデフォルトの起きやすさだけが変わった場合には、値に表れません。上の表の主な月で見ても、スコアの PSI は33か月目が0.182、36か月目が0.189、42か月目が0.171で、項目ごとの値も34か月目の前後で大きくは変わっていません。
この結果から分かるのは、PSI が上がったことは「申込者の層が開発の時点と違ってきた」ことを知らせる合図であり、それだけで「モデルの成績が悪くなった」とは言えない、ということです。反対に、PSI が低いままでも、モデルが正しく機能しているとは限りません。成績が保たれているかどうかは、結果の指標で確かめる必要があります。
月ごとの成績、観測期間の遅れつきで見積りと実績を突き合わせる
次のブロックで、結果の指標を集計します。承認した契約だけを対象に、申込の月を3か月ごとにまとめて、早い段階の延滞の実績と見込みの比、デフォルト率、デフォルト確率の見積りの平均との比(実績÷見積り)、AR値を計算します。3か月ごとにまとめたのは、承認した契約のデフォルトが1か月あたり90〜152件(25〜39か月目)で、1か月ごとでは偶然のばらつきが大きいためです。早い段階の延滞の見込みは、開発の期間の申込をデフォルト確率の大きさで10の帯に分け、帯ごとの早い段階の延滞の割合を、監視の対象の契約に当てはめて平均したものです。こうしておくと、申込者の層が変わって高いデフォルト確率の契約が増えたときには見込みも上がるので、層の変化だけでは比が1から離れにくくなります。AR値には、ブートストラップ(契約を復元抽出で選び直して計算を200回繰り返す方法)で95%の区間を添えました。
# ===== ブロック4:観測期間の遅れを守って、3か月ごとに結果を集計する =====
pd_edges = np.quantile(df.loc[df.month <= 12, "pd"], np.linspace(0, 1, 11))
pd_edges[0], pd_edges[-1] = 0, 1
dev_band = np.digitize(df.loc[df.month <= 12, "pd"], pd_edges[1:-1])
early_by_band = df.loc[df.month <= 12, "early_dl"].groupby(dev_band).mean()   # 帯ごとの早い延滞の率
df["early_exp"] = early_by_band.reindex(np.digitize(df.pd, pd_edges[1:-1])).to_numpy()

mon = []
for lo in [1] + list(range(25, NOW + 1, 3)):     # 1〜12か月目(開発)と、使い始めてからの3か月ごと
    hi = 12 if lo == 1 else lo + 2
    a = df[df.month.between(lo, hi) & (df.approved == 1)]   # 結果が見えるのは承認した契約だけ
    row = {"申込の月": f"{lo}-{hi}", "承認率": df[df.month.between(lo, hi)].approved.mean(),
           "PSI": psi(base["score"], df[df.month.between(lo, hi)].score, EDGES["score"]),
           "平均PD": a.pd.mean(), "早い延滞の実績÷見込み": np.nan,
           "デフォルト率": np.nan, "実績÷見積り": np.nan, "AR値": np.nan, "AR値の95%区間": ""}
    if a.early_known.min() == 1:                 # 3か月の観測期間が満ちた月だけ
        row["早い延滞の実績÷見込み"] = a.early_dl.mean() / a.early_exp.mean()
    if a.final_known.min() == 1:                 # 12か月の観測期間が満ちた月だけ
        row["デフォルト率"] = a["default"].mean()
        row["実績÷見積り"] = a["default"].mean() / a.pd.mean()
        row["AR値"] = ar(a["default"], a.pd)
        y, p = a["default"].to_numpy(), a.pd.to_numpy()
        idx = np.random.default_rng(1).integers(0, len(y), (200, len(y)))   # ブートストラップ
        bs = [ar(y[i], p[i]) for i in idx]
        row["AR値の95%区間"] = f"{np.quantile(bs, 0.025):.3f}〜{np.quantile(bs, 0.975):.3f}"
    mon.append(row)
mon = pd.DataFrame(mon).set_index("申込の月")
print(mon.round(3).to_string())
s = df[df.month.between(28, 33) & (df.approved == 1)]   # 層が変わり終えた後、関係が変わる前(観測期間は満ちている)
for r, grp in s.groupby("route_b"):
    print("経路" + "AB"[r], "件数", len(grp), "実績÷見積り", round(grp["default"].mean() / grp.pd.mean(), 3))
結果は次のとおりです。デフォルト率の分母は、その3か月に申込があり承認した契約の件数です。「まだ分からない」と書いた欄は、51か月目の末の時点で観測期間が満ちていないため、計算していない欄です。1〜12か月目の行は、モデルの学習に使った期間の値(承認した層に限ったもの)で、参考として載せています。
| 申込の月 | 承認率 | スコアのPSI | デフォルト確率の見積りの平均 | 早い延滞の実績÷見込み | デフォルト率 | 実績÷見積り | AR値(95%区間) |
|---|---|---|---|---|---|---|---|
| 1〜12か月目 | 0.800 | 0.000 | 0.029 | 1.000 | 0.029 | 1.005 | 0.306(0.281〜0.331) |
| 25〜27か月目 | 0.719 | 0.049 | 0.031 | 0.854 | 0.028 | 0.924 | 0.318(0.262〜0.375) |
| 28〜30か月目 | 0.637 | 0.181 | 0.033 | 1.006 | 0.032 | 0.987 | 0.340(0.284〜0.391) |
| 31〜33か月目 | 0.637 | 0.185 | 0.033 | 1.045 | 0.032 | 0.958 | 0.282(0.221〜0.335) |
| 34〜36か月目 | 0.628 | 0.190 | 0.033 | 1.216 | 0.044 | 1.364 | 0.285(0.232〜0.340) |
| 37〜39か月目 | 0.639 | 0.177 | 0.033 | 1.098 | 0.042 | 1.294 | 0.333(0.288〜0.387) |
| 40〜42か月目 | 0.632 | 0.189 | 0.033 | 1.149 | まだ分からない | まだ分からない | まだ分からない |
| 43〜45か月目 | 0.638 | 0.183 | 0.033 | 1.186 | まだ分からない | まだ分からない | まだ分からない |
| 46〜48か月目 | 0.634 | 0.186 | 0.033 | 1.134 | まだ分からない | まだ分からない | まだ分からない |
| 49〜51か月目 | 0.638 | 0.179 | 0.033 | まだ分からない | まだ分からない | まだ分からない | まだ分からない |
申込者の層が変わり終えた28〜33か月目では、スコアの PSI が0.18前後まで上がっていますが、デフォルト率の実績÷見積りは0.987と0.958で、見積りとほぼ合ったままでした。ブロック4の最後の3行で、経路ごとに分けて同じ期間の承認した契約で計算すると、実績÷見積りは経路Aが0.995、経路Bが0.94で、増えた経路Bでも見積りが実績を下回ってはいませんでした。この例題では層の変化を項目の分布の変化として作っており、モデルはその項目を使ってデフォルト確率を見積もっているので、層が変わっても見積りがそれに合わせて動いたためと考えられます。ただし、モデルに入れていない組み合わせの効果も仕込んでいるので、別の作り方のデータでも同じになるとは限りません。承認率は下がりましたが、これはカットオフ未満の申込が増えたことによるもので、承認した契約のデフォルト率は0.032と、見積りの0.033に近い値でした。
34か月目から関係が変わると、PSI はほとんど動かないまま、34〜36か月目の実績÷見積りは1.364、37〜39か月目は1.294になりました。見積りより3割前後多くデフォルトしたことになります。一方で、AR値は0.285と0.333でした。対象の集団や期間が違うAR値の差は、そのまま成績の変化の判断には使えないので(第7章)、比べる相手には、1〜12か月目の値(学習に使った契約そのもので、承認率0.800)ではなく、層が変わり終えて承認率もPSIも同じ水準の28〜33か月目の値(0.340と0.282)を使います。それぞれの区間は互いに重なっています。ただし、区間が重なっていても差が統計的に意味のある大きさになることはあり、この表だけでは低下の有無を統計的に判定していません。この例題で言えるのは、関係が変わった後に順位づけの成績が落ちたとは言い切れない、というところまでです。合成データの規則で、関係の変化の多くを全体のデフォルトの起きやすさの上昇として入れたことが関わっているのかもしれませんが、この実行では確かめていません。少なくともこの例題では、順位づけの成績がはっきりとは落ちていないのに、確率の見積りが合わなくなりました。AR値だけを監視していると、この種の変化は見えません。
この変化に、各指標がいつ気づけたかを考えます。最終のデフォルト率で34〜36か月目の契約のずれを確かめられるのは、36か月目の12か月後、つまり48か月目の末です。早い段階の延滞なら、36か月目の3か月後の39か月目の末に、比が1.216まで上がったことが分かります。最終の結果より9か月早く、見積りより悪い方向へずれ始めた兆しをつかめたことになります。ただし、早い段階の延滞の比は、層が変わり始めた25〜27か月目にも0.854と1から離れており、1つの期間の値だけでは偶然のばらつきと区別できません。この例題では、その後の37〜48か月目の4つの期間も1.10〜1.19の範囲で、1を上回り続けました。比が1を上回る状態が続くことを確かめてから、原因の調査に進むのが妥当だと考えています。また、早い段階の延滞の比の上がり方(1.1〜1.2前後)は、最終の結果の実績÷見積り(1.3前後)より小さく、ずれの向きは示しても大きさまでは示しませんでした。これは、正常な契約でも一定の割合で早い段階の延滞が起きるという、この例題の仮定から来るものです。
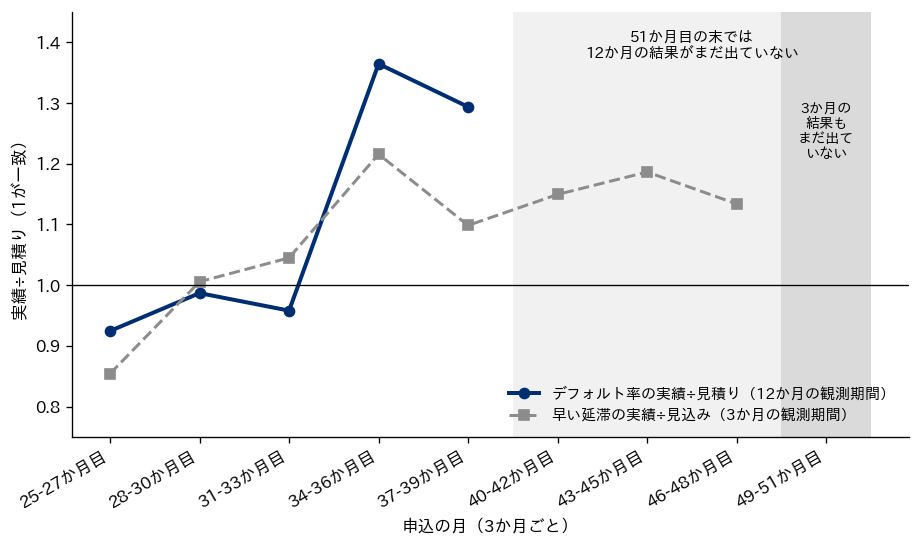
上の図は、3か月ごとのデフォルト率の実績÷見積り(太い線)と、早い段階の延滞の実績÷見込み(破線)を並べたものです(凡例は図の右下に置きました)。薄い灰色の範囲は、51か月目の末の時点で12か月の最終の結果がまだ出ていない申込の月で、右端の濃い灰色の範囲は、3か月の早い段階の延滞の結果も出ていない申込の月です。監視の時点で実際に手元にあるのは、39か月目までの申込についての太い線と、48か月目までの申込についての破線だけです。49〜51か月目の申込は、3か月の観測期間も満ちていないので、破線にも点がありません。
層の変化と関係の変化を見分ける、先行の指標の組み合わせ
ここまでの結果を、監視の判断の手順として整理します。入力と出力の指標が動いたときに最初に確かめることは、データそのものの問題ではないかどうかです。項目の定義の変更、申込の画面の変更による入力の誤り、システムの不具合による欠損の増加などは、申込者の層が変わっていなくても PSI を大きくします。この場合に必要なのは、モデルの見直しではなく、データの流れの修正です。データの問題でないと分かったら、どの項目が動いたかと、経路や商品ごとの申込の件数の変化を見て、層の変化の中身を説明できるかを確かめます。
次に、層の変化がモデルの見積りを狂わせているかを確かめます。最終の結果が出るのを待つ前にできることは2つあります。1つは、早い段階の延滞の実績と見込みの比を見ることです。見込みは、デフォルト確率の帯ごとの過去の割合から計算しているので、層の変化だけで高いデフォルト確率の契約が増えたのなら、見込みも一緒に上がり、比は1の近くにとどまります。比が1を上回り続けるなら、同じデフォルト確率の契約が、以前より延滞しやすくなっている可能性があり、関係の変化を疑う手がかりになります。ただし、督促や回収の運用の変更、見込みの計算に使った帯の作り方など、ほかの理由でも比は動くので、次の表の「次に確かめること」で切り分けます。もう1つは、新しく増えた層(この例題なら経路B)について、過去の期間に同じ層の申込があったかどうかを確かめることです。開発の期間にほとんどいなかった層が増えたのなら、モデルはその層の項目とデフォルトの関係を学んでいないので、入力の分布の変化だけでも見積りがずれるおそれがあります。この場合は、結果が出るまで、その層の与信枠を小さめにしたり、人による確認へ回したりする運用上の手当てを検討します。
| 観察された組み合わせ | 考えられること | 次に確かめること |
|---|---|---|
| PSIが上がり、早い延滞の比は1の近く | 申込者の層の変化。モデルの見積りは保たれている可能性がある | データの問題でないか、増えた層は開発の期間にもいたか、承認率の変化が事業の方針と合っているか |
| PSIは安定し、早い延滞の比が1を上回り続ける | 項目とデフォルトの関係の変化(景気や商品の条件の変化など) | 商品や経路ごとの比、外部の景気の指標、回収の体制の変化 |
| PSIが上がり、早い延滞の比も1を上回り続ける | 層の変化と関係の変化が同時に起きているか、増えた層でモデルが合っていない | 増えた層とそれ以外の層に分けた早い延滞の比 |
| 最終の結果で実績÷見積りが1から離れ、AR値は保たれている | 順位は保たれ、確率の水準がずれている | 再較正(次の節で定義)で足りるか |
| 最終の結果で、条件のそろった集団どうしのAR値の差を区間などで確かめ、低下が見られる | 順位づけの成績の低下 | 対象の集団の変化やデータの問題を先に確かめ、項目とデフォルトの関係の変化が疑われるなら、再推定・再構築(次の節で定義)の要否を検討する |
表の1行目・2行目・4行目は、本コラムの架空データで実際に現れた組み合わせです(2行目と4行目は34か月目以降の同じ変化を、先行の指標と最終の結果のそれぞれで見たものです)。3行目と5行目は例題には現れておらず、一般的な考え方として挙げた整理です。どの行も、どの商品でもこのとおりに読めるとは限りません。とくに、承認率が大きく変わると、結果が見える承認した層そのものが変わるので、AR値もデフォルト率も変わります(第6章・第7章)。承認率が変わった時期をまたいで指標を比べるときは、その影響を差し引いて読む必要があります。
見直しの段階、カットオフの調整・再較正・再推定・再構築
監視でずれが見つかったときの対応は、モデルを変える範囲の小さい順に、カットオフの調整を含めて4つの段階に分けられます。これは事業への影響の大小の順ではありません。カットオフの調整は計算の上では簡単でも、多くの申込の承認と否決を変えることがあります。本コラムでは、モデルの出力とデフォルト確率の対応だけを見直すことを再較正、同じ項目のまま係数(スコアカードなら区分ごとの点数)を推定し直すことを再推定、項目の選び直しから作り直すことを再構築と呼び分けます。どの段階に進むかは、ずれの種類と大きさで決めます。
| 段階 | 何を変えるか | 向いている兆候 | 必要なデータ | 承認と検証 |
|---|---|---|---|---|
| カットオフの調整 | モデルはそのままで、承認の境目の値を変える | 見積りは保たれているが、承認率やデフォルト率を事業の方針に合わせたい | 現在のスコアの分布と、帯ごとの見積り | 収益・貸し倒れの損失・機会損失(推定)の見積りを確かめたうえでの、営業、リスク管理、財務の合意(第9章) |
| 再較正 | モデルの出力(スコア)とデフォルト確率の対応を見直す。順位は変えない | AR値は保たれ、実績÷見積りが1から離れている | 観測期間が満ちた最近の契約の結果 | 変更の記録と、較正に使っていないデータでの確認 |
| 再推定 | 同じ項目のまま、係数を推定し直す(スコアカードなら区分ごとの点数を推定し直し、区分の境目は変えない。境目まで変えるなら再構築) | 特定の項目の効き方が変わったと考えられる、AR値が下がり始めている | 観測期間が満ちた最近の契約の結果(件数が要る) | 独立した検証と承認 |
| 再構築 | 項目の選び直しから、区分け・推定・較正までを作り直す | 新しい層や商品が大きく増えた、項目の定義が変わった、AR値の低下が大きい | 開発と同じ規模のデータ。否決した申込の扱いも含めて設計し直す | 新しいモデルとしての検証と承認、並行稼働 |
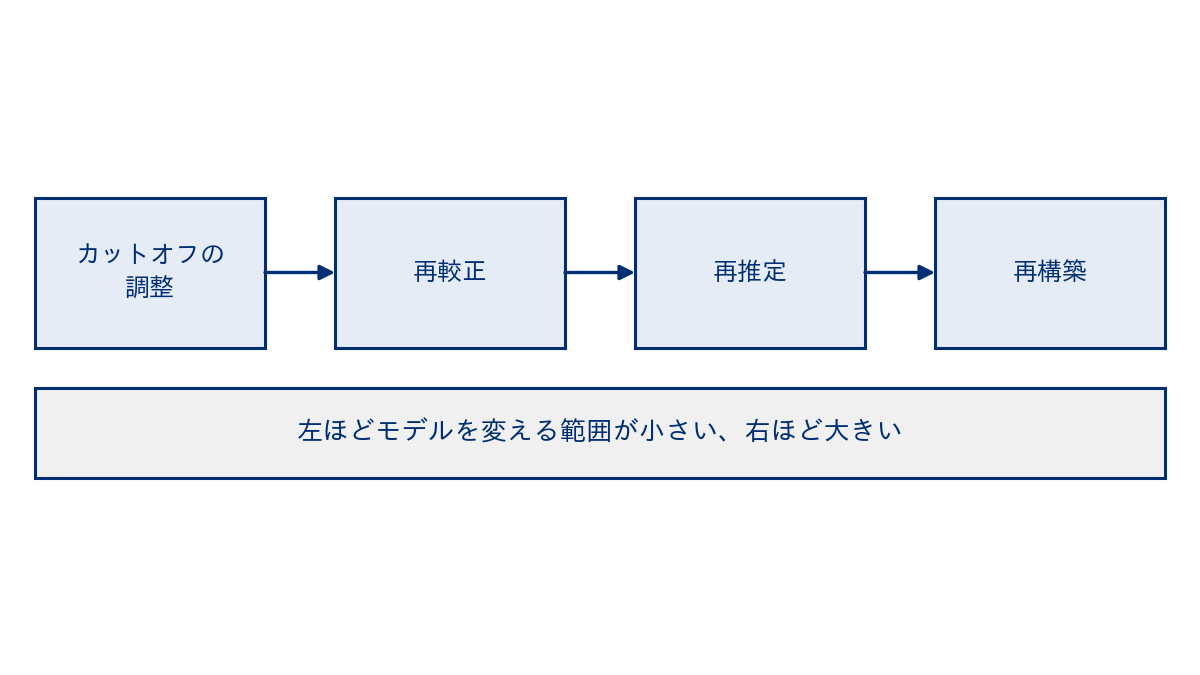
再較正で足りるか、再推定まで要るかは、ずれが確率の水準だけなのか、契約の並び順まで変わったのかで決まります。順位が保たれていて水準だけがずれているなら、出力とデフォルト確率の対応を直す再較正で、見積りを実績に近づけられます。順位づけの成績も落ちているように見えるなら、まず対象の集団の変化やデータの問題がないかを確かめ、項目とデフォルトの関係の変化が疑われる場合に、再推定や再構築の要否を検討します。第8章で扱った較正の方法(切片の調整や、プラットの方法)は、そのまま再較正にも使えます。
次のブロックで、この2つを比べます。監視の時点(51か月目の末)で観測期間が満ちている、関係が変わった後の契約を2つに分け、34〜37か月目の承認した契約で見直しを行い、38〜39か月目の承認した契約で確かめます。見直しに使っていない契約で確かめるのは、第8章の較正の確認と同じ理由です。再較正は、元のデフォルト確率の対数オッズを1つの入力にしたロジスティック回帰で、出力とデフォルト確率の対応だけを直します。再推定は、同じ5つの項目でロジスティック回帰を当てはめ直します。
# ===== ブロック5:再較正と再推定を比べる(51か月目の末に分かる範囲で) =====
fit = df[df.month.between(34, 37) & (df.approved == 1)]    # 見直しに使う契約(結果が分かっている)
test = df[df.month.between(38, 39) & (df.approved == 1)]   # 確かめる契約(見直しに使っていない)
def logit(p):
    return np.log(p / (1 - p))
recal = LogisticRegression().fit(logit(fit[["pd"]]), fit["default"])   # 再較正:PDの対応だけ直す
reest = LogisticRegression(max_iter=1000).fit(fit[X_COLS], fit["default"])   # 再推定:係数を推定し直す
cand = {"そのまま": test.pd.to_numpy(),
        "再較正": recal.predict_proba(logit(test[["pd"]]))[:, 1],
        "再推定": reest.predict_proba(test[X_COLS])[:, 1]}
y = test["default"].to_numpy()
out = {}
for name, p in cand.items():
    r = {"AR値": ar(y, p), "平均PD": p.mean(), "デフォルト率": y.mean(), "実績÷見積り": y.mean() / p.mean()}
    out[name] = r
print("見直しに使った契約", len(fit), "件(デフォルト", int(fit["default"].sum()), "件)/確かめた契約", len(test), "件")
print(pd.DataFrame(out).T.round(3).to_string())
print("再較正の係数", round(recal.coef_[0][0], 3), "切片", round(recal.intercept_[0], 3))
print("再推定の係数", dict(zip(X_COLS, reest.coef_[0].round(3).tolist())))
見直しに使った契約は12,650件(うちデフォルト533件)、確かめた契約は6,367件でした。確かめた契約での結果を表にまとめます。デフォルト率の分母は、38〜39か月目に申込があり承認した契約の件数です。
| モデル | AR値 | デフォルト確率の見積りの平均 | デフォルト率 | 実績÷見積り |
|---|---|---|---|---|
| そのまま使う | 0.335 | 0.033 | 0.046 | 1.407 |
| 再較正 | 0.335 | 0.042 | 0.046 | 1.091 |
| 再推定 | 0.348 | 0.042 | 0.046 | 1.092 |
そのまま使うモデルでは、実績÷見積りが1.407で、見積りが実績を大きく下回っていました。再較正をすると、見積りの平均は0.033から0.042に上がり、実績÷見積りは1.091まで1に近づきました。この例では、再較正のロジスティック回帰の係数が0.887と正で、元のデフォルト確率が大きいほど再較正後の確率も大きくなる変換になっているので、契約の順位は変わらず、AR値は0.335のまま変わりません。係数が負になった場合や、較正の方法によって順位が入れ替わったり同じ値が増えたりする場合には、AR値も変わることがあります。再推定のAR値は0.348で、再較正より0.013高くなりましたが、確かめた契約の件数(デフォルトは293件)を考えると、この差が偶然のばらつきを超えるものかは、この結果だけでは言えません。実績÷見積りは再推定でも1.092で、再較正とほとんど同じでした。
再推定した係数を見ると、他社の借入の件数は0.463で、開発の時点の0.448からほとんど変わっていません。合成データの規則では、34か月目から他社の借入の件数の効き方を強めていますが、承認した契約だけで、しかも4か月分のデータで推定し直したため、その変化を係数として取り出せなかったと考えられます。年収の水準の係数も-1.244から-0.89に変わっており、承認した層に限ったデータで推定した影響(第6章の選択の偏り)が混ざっている可能性があります。関係の変化が主に全体の水準の上昇として入るように作った本コラムのデータでは、再較正で見積りの水準をかなり戻せ、再推定は再較正をはっきりとは上回りませんでした。件数の少ない最近の契約だけで推定し直すと係数が安定しないことや、承認した層に限られたデータの偏りを受けることは起こりうると考えられますが、乱数を変えた繰り返しなどで確かめてはいないので、この1回の実行から言えるのは「この例題では再推定の上積みが見えなかった」というところまでです。どちらを選ぶかは、確かめた契約での実績÷見積りとAR値を、件数のばらつきを考えたうえで比べて決めます。
なお、再較正で直した後も実績÷見積りは1.09前後で、完全には一致していません。見直しに使った契約のデフォルト率は0.042、確かめた契約は0.046で、この差が残った形です(この件数で偶然の範囲の差かどうかは分かりません)。有限の件数では偶然のずれが生じるので、完全な一致だけを判断の基準にせず、あらかじめ決めた許容の幅に入っているかで判断します。その幅をどう決めるかは、件数とデフォルトの件数から計算できるばらつきの大きさ(第8章の二項検定の考え方)を目安にするのが一つの方法です。
モデルリスク管理、金融庁の原則と米国の監督当局の指針
監視と見直しを、担当者の判断ではなく組織の仕組みとして回すための枠組みが、モデルリスク管理です。金融庁は、令和3年(2021年)11月12日に「モデル・リスク管理に関する原則」を公表しました。同年6月25日から7月26日まで原則の案への意見を募集し、61の個人と団体から87件の意見が寄せられたことが、公表の発表文に書かれています。原則の本文は、意義、適用、定義、モデル・リスク管理における重要な概念、8つの原則から成ります。適用の対象として本文に挙げられているのは、金融庁が指定した本邦のG-SIBs(世界的に重要な金融機関)とD-SIBs(国内で重要な金融機関)、FSB(金融安定理事会)が選定したG-SIBs(本邦のG-SIBsを除く)の本邦子会社で金融庁によるモデルの承認を受けている金融機関で、金融庁が今後、必要に応じて対象を広げることもあり得ると書かれています。自社がこの対象に当たるかどうかは、所管官庁や専門家に確かめる事項です。対象に当たらない事業者にとっても、モデルを使った判断を組織としてどう管理するかを考えるときの整理として参考になると考えています。
原則では、モデルを「定量的な手法であって、理論や仮定に基づきインプットデータを処理し、アウトプットを出力するもの」と定義し、出力の例にスコアや分類を挙げています(定義の文言の一部を要約しています)。また、対象とするモデルの範囲を特定のカテゴリーに限らず、信用リスクの計測のモデルなども含みうるとしています。原則ベースの文書で、個々の項目の遵守よりも管理の態勢の全体が機能しているかを重視すると書かれています。8つの原則の名前と、与信スコアリングの運用での読み方を表にまとめました。右の列は、原則の文言の訳ではなく、本コラムでの対応づけです。
| 原則 | 原則の主な内容(要約) | 与信スコアリングの運用での例 |
|---|---|---|
| 原則1:ガバナンス | 取締役会等と上級管理職が、モデル・リスクを包括的に管理する態勢を作る。方針・規程及び文書化(1.3)、役割と責任(モデル・オーナーとモデル・リスク管理部署) | 与信のモデルのオーナーを決め、監視の結果を定期的に経営へ報告する |
| 原則2:モデルの特定、インベントリー管理及びリスク格付 | 管理すべきモデルを特定し、台帳(モデル・インベントリー)に記録し、リスク格付を付ける | 申込のスコア・行動のスコア・回収のスコア、外部から提供を受けるスコアを台帳に載せる |
| 原則3:モデル開発 | 開発の過程を整え、モデル記述書を作り、使用の前にモデル・テストを行う | 学習に使った期間・デフォルトの定義・項目・区分・係数・成績を文書に残す |
| 原則4:モデル承認 | 使用の開始時・重要な変更時・再検証時に、内部の承認を受ける | 再推定・再構築は承認を経て入れる。再較正やカットオフの調整をどこまで承認の対象にするかを決める |
| 原則5:継続モニタリング | 使用の開始後、第1線がモデルが意図どおり機能しているかを継続的に確かめ、頻度・手法・結果を文書化する | この章の入力・出力・結果の指標を、決めた頻度で計算して記録する |
| 原則6:モデル検証 | 第2線が独立した立場で、使用前・重要な変更時・使用開始後に検証する | 開発した部署と別の担当が、データ・手法・成績・安定性・使われ方を確かめる |
| 原則7:ベンダー・モデル及び外部リソースの活用 | 外部の製品や外部の資源を使う場合も、自社の管理の態勢の下で統制する | 外部のスコアや製品についても、成績の監視と、使えなくなったときの備えを用意する |
| 原則8:内部監査 | 内部監査部門が第3線として、管理の態勢の全体の有効性を評価する | 監視と見直しの記録が規程どおりに残っているかを監査が確かめる |
原則は、実効的なけん制の枠組みとして「3つの防衛線」の考え方を示しています。第1線はモデルを所管する、あるいは開発や使用に直接関わる部門で、第2線は第1線へのけん制を通じてモデル・リスクを管理し、独立した立場での監視やモデルの独立検証を担う部門、第3線は内部監査部門です。同時に、組織の形や役割の割り当てには様々な形があり、防衛線を完全に分けるのが現実的でない場合もあるとしています。与信の事業で、モデルを作る分析の担当と、審査やリスク管理の担当が同じ部署にいることは珍しくないと思われます。その場合でも、検証を誰が行い、誰が使用の継続を承認するのかを決めておくことが、原則の趣旨に沿うと考えています。体制と役割分担の詳しい設計は第13章で扱います。
米国では、連邦準備制度理事会・通貨監督庁・連邦預金保険公社の3つの監督当局が、2026年4月17日に、モデルリスク管理の改訂版の指針を公表しました(連邦準備制度理事会の監督の通知 SR 26-2)。この通知は、2011年4月4日の SR 11-7(モデルリスク管理の指針)と、2021年4月9日の SR 21-8(マネー・ローンダリング対策のシステムに関するモデルリスク管理の声明)に代わるものだと明記しています。添付の指針は、目的と範囲、モデルリスクとその管理の概観、モデルの開発と使用、モデルの検証と監視、ガバナンスと統制、ベンダーなど第三者の製品の章で構成されています。また、生成AIとエージェント型のAIのモデルはこの指針の範囲に含めないと注記し、従来の統計や定量のモデルには指針の原則が当てはまるとしています。米国の監督の文脈でモデルリスク管理に触れる資料では、2011年の旧指針(SR 11-7)が引かれていることがありますが、現在の指針は上の改訂版です。適用の対象と範囲は、米国の監督を受ける事業者が原文で確かめる事項です。規制上の位置づけの詳細は第14章で扱います。
この節で引いた文書の公表ページは次のとおりです。
- 金融庁「モデル・リスク管理に関する原則」の公表ページ:https://www.fsa.go.jp/news/r3/ginkou/20211112.html
- 連邦準備制度理事会 SR 26-2(改訂版のモデルリスク管理の指針):https://www.federalreserve.gov/supervisionreg/srletters/SR2602.htm
モデルの文書と台帳、検証で確かめること
監視と見直しを続けるための土台は、モデルの文書と台帳です。担当者が替わっても、どのデータで、どの定義で、どの成績のモデルを、どの条件で使っているのかが分かる状態にしておきます。原則の言葉では、モデル記述書とモデル・インベントリーにあたります。与信スコアリングの場合、文書に残す項目は次の表のようになります。
| 文書の項目 | 書く内容の例 | 関係する章 |
|---|---|---|
| 目的と使用の範囲 | どの商品の、どの段(初期与信・途上与信・回収)で、何の判断に使うか。使ってはいけない範囲 | 第1章 |
| デフォルトの定義と観測期間 | 延滞の基準、観測期間、除外した申込 | 第2章 |
| 学習に使ったデータ | 申込の期間、件数、デフォルトの件数、否決した申込の扱い | 第2章・第6章 |
| 項目と区分 | 使った項目、区分の境目と根拠、使わなかった項目とその理由 | 第3章・第11章 |
| 手法と点数 | 手法、係数、点数表、単調性の制約などの設定 | 第4章・第5章 |
| 成績と較正 | 時間で切った評価用のデータでのAR値と区間、帯ごとの見積りと実績 | 第7章・第8章 |
| 承認の基準 | カットオフ、人による確認へ回す帯、上書きの規則 | 第9章 |
| 説明と公平性 | 否決の理由の出し方、群ごとの指標の確認の結果 | 第11章 |
| 監視の計画 | 指標、頻度、基準の集団、調査を始める目安、報告の先 | この章 |
| 限界と既知の弱点 | データが少ない層、開発の期間の景気、組み合わせの効果を入れていないことなど | この章 |
| 変更の履歴 | 再較正・再推定・再構築・カットオフの変更の日付、理由、承認者 | この章 |
台帳には、文書の要約に加えて、モデルのオーナー、使用の状態(開発中・使用中・使用停止)、リスク格付、最後に検証した日、次に検証する予定の時期を記録します。原則では、使用中のモデルだけでなく、開発中のモデルと最近使用を停止したモデルも台帳に記録するとしています。外部から提供を受けているスコアも、自社の判断に使っている以上、台帳に載せる対象です。
検証は、モデルを作った担当とは別の担当が、モデルが目的に合っているかを確かめる作業です。使用の前の検証だけでなく、重要な変更の時と、使用を始めた後の定期的な再検証があります。与信スコアリングで確かめることを、次の表にまとめました。
| 確かめる対象 | 確かめること |
|---|---|
| データ | 審査の時点で手に入る情報だけを使っているか、観測期間を満たした契約だけで結果を数えているか、除外の条件が文書どおりか |
| 手法 | 項目の選び方と区分の根拠に説明がつくか、係数の向きが業務の感覚と合うか、評価用のデータの結果が学習に混ざっていないか |
| 成績 | 時間で切った評価用のデータで、AR値と帯ごとの見積りと実績を確かめたか、ばらつきの区間を見たか |
| 安定性 | 開発の後の期間で、PSIと項目ごとの安定性の指標、実績÷見積りがどう動いたか |
| 使われ方 | カットオフと上書きの運用が文書どおりか、想定していない商品や層に使われていないか、上書きした契約の結果を追っているか |
| 実装 | 本番の計算が、開発の時の計算と同じ結果を出すか(次の節) |
本番での実装の点検と記録、新しいモデルの試し方
検証で確かめたモデルでも、本番のシステムで同じ計算が行われていなければ意味がありません。開発の時の計算と本番の計算がずれる原因として、項目の作り方の違い(たとえば、勤続年数を月単位で数えるか年単位で数えるか、欠損をどの区分に入れるか)、区分の境目の値の転記の誤り、データの取得の時点の違いなどが考えられます。点検の方法としては、同じ申込の記録を開発の環境と本番の環境の両方に通し、スコアが一致するかを1件ずつ確かめるのが基本です。本番に入れた後も、一定の件数を抜き出して同じ比較を定期的に行うと、システムの変更でずれが入ったことに気づけます。
記録として残すのは、判定の時点の入力の値、計算したスコアとデフォルト確率、その時に有効だったモデルの版とカットオフ、判断の結果(承認・否決・人による確認)、人による上書きがあればその理由です。これが残っていれば、後から「その時点のモデルでは、この申込はどう判断されたのか」を再現できます。判定の後に更新された値で記録を上書きすると、監視の指標も次のモデルの学習のデータも、審査の時点では手に入らなかった情報を含むことになります(第2章)。否決の理由の説明(第11章)や、法令上の記録の義務(第14章)のためにも、判定の時点の記録をそのまま残す設計にしておくことが大切です。
新しいモデル(再推定や再構築をしたもの)を本番に入れるときは、いきなり切り替えるのではなく、段階を踏むことが多いと考えています。1つは影の運用で、新しいモデルにも本番の申込のスコアを計算させ、判断には使わずに記録だけを残す方法です。現行のモデルと新しいモデルのスコアの分布、承認の判断が分かれる申込の件数と特徴を、申込者に影響を与えずに確かめられます。もう1つは並行稼働や一部への適用で、申込の一部にだけ新しいモデルの判断を使い、結果を比べる方法です(第9章のチャンピオンとチャレンジャー)。影の運用では、観測期間が満ちても、最終の結果で比べられるのは現行の審査で承認され実行された契約に限られます。新しいモデルだけが承認する申込は、現行の審査で否決されているので、結果が観測できません(第6章)。どちらの方法でも、最終の結果で比べられるのは観測期間が満ちた後なので、切り替えの判断を早い段階の延滞などの先行の指標で行うのか、最終の結果を待つのかを、先に決めておく必要があります。
経営判断、監視の指標・見直しの基準・承認の手続きを文書に定める
この章の内容を、経営の損失の型(序章の6つの型)に当てはめて整理します。監視の仕組みが無い、あるいは指標を計算していても見直しにつながらない状態が、形骸化です。本コラムの架空データでは、34か月目から実績が見積りを3割前後上回りましたが、最終の結果でそれを確かめられたのは48か月目の末でした。その間も同じカットオフで承認を続けていれば、見積りより多くのデフォルトを含む契約を承認し続けることになり、貸し倒れが想定を上回ります。見積りを使って与信枠を決めている場合には、返済の能力を超える与信につながるおそれもあり、過剰与信による顧客の不利益にも関わります。反対に、PSI が上がっただけでモデルの成績が悪くなったと判断してカットオフを厳しくすると、見積りが保たれている層まで断ることになり、機会損失を生みます。本コラムの架空データでも、層が変わった時期には見積りと実績はほぼ合っていました。
ここで注意したいのは、検証の結果として現行のモデルをそのまま使い続けると判断することは、形骸化ではないという点です。監視の指標を計算し、ずれが許容の幅に入っていることを確かめ、その判断を記録に残しているなら、仕組みは働いています。形骸化は、指標が計算されていない、計算されていても誰も見ていない、見ても見直しの手続きにつながらない、という状態を指します。また、監視の記録と検証の記録が残っていないと、社内外からモデルの管理について説明を求められたときに答えられません。金融庁の「モデル・リスク管理に関する原則」の適用を受ける金融機関では、原則5(継続モニタリング)と原則1の1.3(方針・規程及び文書化)が示す文書化の期待に応えられず、監督の上で期待される管理の態勢が足りないとみられることがありえます。法令上の記録の義務に触れるかどうかは、適用される法令と求められる記録の項目に照らして確かめる事項です(第14章)。序章の規制上の義務の不履行は、こうした義務を果たせないことを指します。自社がどの文書や法令の適用を受けるかは、所管官庁や専門家に確かめる事項です。
経営として決めておくことを、次の5つにまとめます。
- 監視の指標と頻度:入力・出力・早い段階の延滞・最終の結果の指標を、誰が、どの頻度で計算し、どこへ報告するか
- 調査を始める目安:変化が無い期間のばらつきを測ったうえで、PSIや実績÷見積りがどの範囲を超えたら原因の調査を始めるか(機械的な合否の基準ではなく、調査の合図として)
- 見直しの段階ごとの承認者:カットオフの調整・再較正・再推定・再構築を、それぞれ誰が承認するか
- 結果を待つ間の手当て:最終の結果が出るまでの間に、先行の指標が悪化したときの暫定の対応(与信枠を小さくする、人による確認へ回す範囲を広げるなど)を誰の判断で行うか
- 文書と台帳の更新:変更のたびにモデルの文書と台帳を更新し、その記録を内部監査が確かめられる状態にしておくこと
予算と体制の面では、監視は「モデルを作った後にかかる、終わりの無い費用」になります。モデルの開発の予算を付けるときに、監視の指標を計算する仕組み、判定の時点の記録を残す仕組み、検証の担当の工数を、最初から含めておくことが、形骸化を防ぐいちばん確かな方法だと考えています。監視の指標は、AR値も承認率も含めて管理の指標であり、それ自体が成果ではありません。成果は、実績として測れる、承認した契約から得た収益と貸し倒れの損失の差で測り、断った申込の機会損失は推定として横に並べて、判断のときに合わせて見ます(序章・第9章・第13章)。監視は、その差を保つための仕組みとして位置づけるのがよいと考えています。MLOps(機械学習のモデルを運用し続けるための仕組み)の一般論は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。
この章では、与信のモデルの結果が観測期間の後にしか分からないことを前提に、入力・出力・早い段階の延滞・最終の結果の指標を組み合わせて監視する方法と、ずれが見つかったときのカットオフの調整・再較正・再推定・再構築の段階、それを組織で回すためのモデルリスク管理の枠組みを見ました。本コラムの架空データでは、PSI は申込者の層の変化をすぐに知らせましたが、見積りのずれは示さず、項目とデフォルトの関係の変化は早い段階の延滞と最終の結果にだけ現れました。次の第13章では、こうした仕組みを含めた与信スコアリングの導入を、どの商品から始め、どう PoC を設計し、誰が何を担うかという、進め方と体制の面から扱います。
この章を深めたい方への参考書籍
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習のシステムを本番で運用し続けるための設計を扱った本で、第8章がデータ分布のシフトと監視に充てられています。この章で扱った入力の分布の変化と、項目と結果の関係の変化を、与信に限らない一般的な枠組みで整理するのに役立ちます。
『信頼性の高い機械学習 SRE原則を活用したMLOps』(Cathy Chen、Niall Richard Murphy、Kranti Parisa、D. Sculley、Todd Underwood 著、井伊篤彦・張凡・樋口千洋 訳、オライリー・ジャパン):システムの信頼性を保つ運用の考え方を機械学習に当てはめた本で、第9章がモデルの監視と可観測性を扱っています。監視の指標を誰がどう見て、どう対応につなげるかという、この章の後半の組織の論点を考える材料になります。
第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
第12章では、与信のモデルが申込者の層や景気の変化で古くなること、結果が観測期間の後にしか分からないので先に分かる指標で監視すること、見直しの基準と承認の手続きをモデルの文書と台帳に定めておくことを扱いました。第1章から第12章は、与信スコアリングを「何をデフォルトと呼び、どのデータで、どの方法でスコアを作り、どう評価し、どこから承認し、契約の後をどう管理し、どう監視するか」という順に説明してきました。この章では、それを自社のどの商品のどの段から、どの順番で、誰の責任で入れていくかを扱います。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- どの商品・どの段から始めるかの選び方(件数・デフォルトの件数・結果のデータの有無・人による審査の負担・規制上の要件の整理で採点する方法)
- 今の審査の基準の成績を測る現状の把握と、最終の KPI から承認率・デフォルト率・審査の所要時間・回収へ分解する考え方
- 本格的な導入の前に限られた範囲で試す段階の設計と、観測期間を計画に入れる方法
- 効果の見立て方(金額ではなく、率と件数の型で書く)と、段階的な展開
- 役割と責任分担、3つの防衛線の考え方の中での与信スコアリングの置き場所
- 内製と外部の分担、データの蓄積が無い新しい事業での始め方、人材、最初の90日の計画、形骸化の型、経営判断
この章の主張は、PoCの出口と、成果の測り方を、始める前に決めておくことです。PoC は Proof of Concept の略で、本格的な導入の前に、限られた範囲で、使えるかどうかと効果を確かめる小さな検証を指します。出口とは、何が確かめられたら次の段階へ進み、何が確かめられなければやめるか、という決まりのことです。与信スコアリングの PoC は、過去の契約の記録に新しいモデルを当てて AR値を出したところで終わりやすいように思います。その場合、過去のデータでは AR値が上がったものの、どの点数から承認すれば承認率とデフォルト率がどう動くのか、否決している申込の中に返済できた申込がどれだけあるのかが分からない、という状態で止まります。本章では、承認した申込のうち契約に至ったものを「承認した契約」と呼びます。本章で成果の指標と呼ぶのは、実績として測れる、承認した契約から得た収益と貸し倒れの損失の差です。否決や小さすぎる与信枠で失った収益(機会損失)は、否決した申込がもし承認されていたら返済されたかが記録に残らないので、つねに前提を置いた推定になります。そのため、機会損失は成果の指標に足し込まず、前提を明記した推定として横に並べ、判断のときに合わせて見ます。序章で述べた、収益と貸し倒れの損失と機会損失を合わせて見る考え方を、本章ではこの形で扱います。AR値・承認率・デフォルト率・審査の所要時間は、この差を説明し、日々の運用を管理するための指標(本コラムでいう管理の指標)で、単独では成果と呼びません。この数え方を PoC の計画に最初から組み込むことと、結果が出るまでに観測期間がかかることを計画に入れておくことが、この章の中心になります。
どの商品・どの段から始めるか、5つの観点で採点して最初の対象を決める
与信を行う事業者の多くは、複数の商品と複数の段を持っています。商品は、たとえば消費者向けの貸付、クレジットカード、個別の分割払い、後払いの決済、企業間の掛け売りのように分かれ、段は、第1章で扱ったとおり、申込の審査(初期与信)、契約の後の見直し(途上与信)、延滞した契約への対応(回収)に分かれます。与信スコアリングの導入で想定される失敗の型は2つあります。1つはすべての商品とすべての段を一度に置き換えようとすること、もう1つは、反対に、社内で関心の高い商品から手を付けて、結果のデータが無いことに後から気づくことです。最初の対象でつまずくと、その結果が「スコアリングの高度化はうちの商品には合わない」という社内の評価になり、次の対象に進めなくなります。最初の対象は、取り組む価値があることと、成果を確かめやすいことの両方で選ぶ必要があります。
本コラムでは、候補の商品と段の組み合わせを、次の5つの観点で採点する方法を考えます。観点は、第1章から第12章で扱った論点を、どこから始めるかの判断に置き換えたものです。
- 件数:一定の期間に、その商品のその段でどれだけの申込や契約があるか。件数が多いほど、1件ごとの判断の改善が全体に効き、評価もしやすい
- デフォルトの件数:観測期間の内に、どれだけの契約がデフォルトに至っているか。デフォルトの件数が少ないと、モデルを学習させることも、成績の差を確かめることも難しい(第7章・第8章)
- 結果のデータの有無:申込の時点の情報、審査の判断(承認・否決・人による変更)、契約の後の返済の結果が、同じ申込の単位で結び付けられる形で残っているか(第2章・第6章)
- 人による審査の負担:今の審査で、人が確認している申込の件数と所要時間が、審査の能力に対してどの程度の重さになっているか(第9章)
- 規制上の要件の整理:その商品の審査に関わる返済の能力の調査や信用情報の利用、説明や記録の義務などの法令上の要件が、今の手続きとどこまで対応づけて整理されているか(第14章)
5つのうち、件数と人による審査の負担は「取り組む価値」を、デフォルトの件数と結果のデータの有無は「確かめやすさ」を表します。規制上の要件の整理は、どちらにも関わります。整理が進んでいる商品ほど、スコアリングの仕組みを変えるときに何を確かめればよいかが明確で、記録や説明の整備を通じて、規制上の義務の不履行という型の損失を減らす機会にもなります。要件の多い少ないではなく、整理の進み具合で点を付けるのはこのためです。件数が多くても、結果のデータが申込の単位で結び付いていない商品では、モデルを作ることも、今の審査の成績を測ることもできません。この場合の最初の一歩は、モデルを作ることではなく、申込・審査の判断・契約の後の返済の結果を、申込番号のような、同じ申込を指す共通の番号で結び付けて残す仕組みを作ることになります。
採点の目安を次の表にまとめました。点数の付け方は本コラムが考えた例で、業界の規格や公的な指針で定められたものではありません。各観点を1点から3点で付け、合計点だけで決めるのではなく、「デフォルトの件数」と「結果のデータの有無」のどちらかに1点が付く組み合わせは、最初の PoC の対象から外し、記録の整備を先に進める、という使い方を想定しています。「規制上の要件の整理」に1点が付く組み合わせも、所管官庁や専門家への確認が済むまでは PoC の対象にしません。
| 観点 | 3点 | 2点 | 1点 | 確かめ方(主に情報を持つ人) |
|---|---|---|---|---|
| 件数 | 申込や契約が継続して多く、1件ごとの判断の改善が全体に効く | 件数は中程度で、時期によって増減する | 件数が少なく、改善しても全体への影響が小さい | 申込と契約の件数の月ごとの推移(営業・審査) |
| デフォルトの件数 | 観測期間を満たした契約の中に、成績の差を確かめるのに足りるデフォルトがある | デフォルトはあるが、数年分の契約を合わせないと足りない | デフォルトが非常に少ないか、観測期間を満たした契約がまだ無い | 申込の月ごとのデフォルト率と件数(リスク管理・データ分析) |
| 結果のデータの有無 | 申込の時点の情報、審査の判断、返済の結果が申込番号のような共通の番号で結び付いて残っている | 記録はあるが、結び付けが手作業で、申込の時点の値が後から上書きされている項目がある | 審査の判断や返済の結果が申込の単位で残っていない | 申込・審査・契約・債権の各システムの項目の一覧(データ分析・情報システム) |
| 人による審査の負担 | 人が確認する申込が多く、所要時間が長いことで申込者の離脱や審査の滞りが起きている | 人の確認はあるが、能力の内に収まっている | ほとんどが既存の基準で自動的に判断されている | 審査の件数・所要時間・人による確認の割合(審査) |
| 規制上の要件の整理 | 法令上の調査・説明・記録の要件が明確で、今の手続きとの対応も整理されている | 要件はあるが、今の手続きとの対応が整理されていない | 要件の範囲が自社で判断できず、所管官庁や専門家への確認が先に要る | 適用される法令と社内規程、所管官庁の資料(コンプライアンス・法務) |
表の「結果のデータの有無」に2点が付く組み合わせ、つまり記録はあるが申込の時点の値が後から上書きされている項目がある組み合わせでは、注意が要ります。第2章で扱ったとおり、審査の時点で手に入らない情報(契約の後に更新された年収の水準や、後から分かった延滞)をモデルの入力に入れると、過去のデータでの成績は高く出ても、本番では同じ成績が出ません。申込の時点の値を残していない項目は、PoC の前に、申込の時点の値を別に保存する仕組みを作ります。保存を始めても、過去の申込の時点の値は復元できないので、そうした項目は過去のデータでの評価から外し、保存を始めた後の記録と、その結果がそろってから使います。否決した申込について、どの項目が記録に残っているかも、この段階で確かめておきます。否決した申込の情報は、第6章で扱った選択の偏りを調べるときにも、承認の基準を変えたときの影響を見積もるときにも使います。
段の選び方にも、与信に特有の論点があります。初期与信は、申込の件数が多く、審査の所要時間と承認率に直接効くので、取り組む価値が見えやすい段です。一方で、結果が出るまでに観測期間がかかり、否決した申込の結果が分からないという2つの制約を、最も強く受けます。途上与信は、第10章で扱ったとおり、契約の後の返済の記録を使えるので、申込の時点の情報だけの場合より使える情報が多く(成績が上がるかどうかは自社の評価で確かめます)、与信枠の見直しのように、判断を少しずつ変えて結果を確かめやすい段です。回収の段は、延滞した契約のうちどれに先に連絡するかの順番に使い、結果(正常に戻ったか)は、初期与信のデフォルトより短い期間で分かる場合があります。最初の対象を初期与信にこだわらず、結果が早く分かる段から始めて、記録の整備と社内の運用の経験を積む、という選び方もあると考えています。前の表の観点は、初期与信を例にした書き方です。途上与信では「デフォルトの件数」を見直しの時点から数えた観測期間の内のデフォルトの件数として、回収では延滞から正常に戻った件数のような、その段で結果と呼ぶものの件数として読み替えて採点します。
採点は、審査・リスク管理・営業・債権管理・コンプライアンス・データ分析が同じ表を見ながら行うのがよいと考えています。件数と人による審査の負担は営業と審査が、デフォルトの件数はリスク管理が、結果のデータの有無はデータ分析と情報システムが、規制上の要件はコンプライアンスと法務が、それぞれ最もよく知っています。データ分析の担当者や外部のベンダーだけで採点すると、「確かめやすさ」の観点は正しく付いても、審査の現場の負担や規制上の要件の観点が実態とずれることがあります。
現状の把握と KPI の木、今の審査の基準の成績を測ってから目標を分解する
最初の対象が決まったら、新しいモデルを考える前に、今の審査の基準の成績を測ります。多くの事業者には、すでに何らかの審査の基準があります。外部のスコアと社内の基準表を組み合わせたもの、過去に作ったスコアカード、審査の担当者の判断を中心にしたもの、と形はさまざまです。ところが、その基準で承認した契約のうち、観測期間の内にどれだけがデフォルトしたか(承認した契約のデフォルト率)、最終の判断が済んだ申込のうちどれだけを承認したか(承認率)、人が基準の判断を変えた件数と、その契約のその後の結果がどうだったかが、記録として集計されていないことが多いように思います。基準を入れた時点では成績を確かめていても、その後の申込者の層や景気の変化に合わせて測り直していない場合もあります。
今の成績を測らないまま新しいモデルを試すと、PoC の結果を何と比べればよいかが決まりません。新しいモデルの AR値が高く見えても、それが今の審査の基準より良いのか、今の基準と同じ申込を同じ順に並べているだけなのかは、同じ集団・同じ期間・同じデフォルトの定義で今の基準の成績を出して初めて分かります。第7章で扱ったとおり、AR値は評価する集団によって値が変わるので、ベンダーの資料にある AR値と、自社の承認した契約だけで測った AR値は比べられません。現状の把握で集める数字は、次のとおりです。
- 申込の月ごとの申込の件数、最終の判断が済んだ件数、承認の件数、否決の件数、取り下げの件数。承認率は、最終の判断が済んだ申込を分母にして数え、取り下げと審査中は別に数える
- 観測期間を満たした申込の月ごとの、承認した契約の件数と、そのうちデフォルトに至った件数。デフォルト率は、どの月の、どの集団の契約を分母にしたかを書いて残す。観測期間を満たしていない契約は、正常に数えない
- 今の基準の点数の帯(または審査の経路)ごとの承認率と、承認した契約のデフォルト率。帯ごとの並びが単調か(点数が高い帯ほどデフォルト率が低いか)
- 人が基準の判断を変えた件数(基準では否決のところを承認した件数、基準では承認のところを否決した件数)と、承認に変えた契約のその後のデフォルト率
- 申込から判断までの所要時間、人による確認に回った申込の割合、審査の担当者1人あたりの処理件数、審査の途中で申込者が取り下げた件数
- 否決した申込について、自社に残っている情報の範囲(申込の時点の項目・否決の理由・他社での契約の状況を信用情報で後から確かめられるか。最後の方法は、信用情報の利用の目的の制限との関係で法務とコンプライアンスの確認が先に要り、使えない場合もある。詳細は第14章)
これらの数字は、測ろうとすると記録が足りないことが分かる場合があります。とくに、人が基準の判断を変えた記録と、その理由は、審査のシステムの外(紙の稟議や担当者のメモ)に残っていることがあります。否決した申込の項目を残していない事業者もあります。記録が足りないこと自体が、現状の把握の重要な結果です。足りない記録を残し始めることは、PoC の前に入れておくべき作業で、第6章の選択の偏りの点検にも、第12章の監視にも使えます。記録を始めるのが早いほど、観測期間を満たした結果が早くそろいます。
今の成績が分かったら、何をどこまで改善するのかを決めます。本コラムでは、そのための道具としてKPI の木を使います。KPI の木は、事業の最終の目標を表す指標を頂点に置き、それを分解できる中間の指標へ、さらに個々の施策や日々の運用が直接動かせる指標へと枝分かれさせて書いたものです。本章では、木を表の形で示します。与信スコアリングでは、頂点に置く指標を、実績として測れる、承認した契約から得た収益と貸し倒れの損失の差とします。本章の冒頭で述べたとおり、この差を成果の指標と呼び、それを分解した承認率・デフォルト率・審査の所要時間などを管理の指標と呼んで区別します。管理の指標は、成果の指標がなぜ動いたかを説明し、日々の運用で異常に気づくための指標で、どれか1つを単独で成果と呼ぶことはしません。承認率だけを目標にすれば基準が緩んで貸し倒れが増えやすく、デフォルト率だけを目標にすれば基準が厳しくなって機会損失が増えやすいからです。
頂点の差は、収益の枝と損失の枝に分けて考えられます。収益の枝は、最終の判断が済んだ申込の件数、承認率(その件数を分母にした割合)、承認した申込のうち契約に至る割合、契約のうち正常だった割合、正常な契約1件あたりの収益(相対値)に分けられます。申込の件数を出発点にするなら、申込のうち最終の判断に至った割合も加えます。ここではデフォルトした契約から得た収益を省いた簡単な形にしています。省かない場合は、正常な契約1件あたりの収益の代わりに、契約全体の1件あたりの平均の収益を使う分け方にします。損失の枝は、承認した契約の件数、そのデフォルト率、デフォルト1件あたりの損失に分けられ、デフォルト1件あたりの損失は、第1章で扱ったとおり、デフォルト時の残高とデフォルト時の損失の割合に分けられます。回収の段の取り組みは、デフォルト時の損失の割合を下げる方向に効きます。審査の所要時間は、申込者が途中で離れる割合を通じて、収益の枝の「契約に至る割合」に効きます。頂点の差の横には、機会損失の推定を並べて置き、差そのものには足し込みません。機会損失は観測できないので、第6章で扱った方法や、否決した申込の他社での返済の状況(信用情報の利用の目的の制限との関係で使えない場合がある。第14章)などから、前提を明記して推定した値として扱います。判断のときは、頂点の差と機会損失の推定を合わせて見ます。
KPI の木の各階層を、誰が持ち、いつ分かり、どう測るかを次の表にまとめました。指標の例は本コラムが挙げた一般的なもので、自社の商品の形に合わせて置き換えて使うことを想定しています。
| 階層 | 指標の例 | 指標の種類 | 主に持つ人 | いつ分かるか | 注意すること |
|---|---|---|---|---|---|
| 頂点 | 承認した契約から得た収益と貸し倒れの損失の差(相対値)。横に機会損失の推定を並べる | 成果の指標 | 経営(目指す水準を決める)・事業の責任者(木を設計し承認する) | デフォルトの判定は観測期間を満たした後。収益と損失は、どの範囲で測るか(一定の期間内の実績・残りの期間を含む見積り・回収が終わった後)を決めて集計する | 機会損失は推定であることと、その前提を必ず書く。差の動きを景気や商品の構成の変化と切り分けて読む |
| 収益の枝 | 最終の判断が済んだ申込の件数(申込のうち最終の判断に至った割合)、承認率、承認した申込のうち契約に至る割合、契約のうち正常だった割合、正常な契約1件あたりの収益(相対値) | 管理の指標 | 営業・事業の責任者 | 承認率と契約に至る割合は判断の直後。収益は契約の期間を通じて | 承認率の分母は最終の判断が済んだ申込。申込の件数は販促や経路の変化でも動く |
| 損失の枝 | 承認した契約のデフォルト率、デフォルト1件あたりの損失(デフォルト時の残高と損失の割合) | 管理の指標 | リスク管理 | デフォルト率は観測期間を満たした後。先に分かる指標として、契約から数か月の時点の早い段階の延滞の割合を使う(第12章) | デフォルト率の分母(どの月の、どの集団の契約か)を書く。承認率が変われば承認した契約の層も変わるので、前後の率をそのまま比べない |
| 審査の枝 | 申込から判断までの所要時間、人による確認に回った割合、審査の途中の取り下げの件数、人が判断を変えた割合 | 管理の指標 | 審査 | 日次・週次 | 所要時間だけを追うと、人による確認が形だけになるおそれがある |
| 回収の枝 | 延滞の段階ごとの件数の割合、延滞から正常に戻った割合、延滞してから最初の連絡までの日数(第10章) | 管理の指標 | 債権管理 | 月次 | 連絡の件数を増やすことが顧客の不利益にならないよう、連絡の方法と頻度の方針と一緒に見る |
| モデルの枝 | AR値、スコアの帯ごとのデフォルト率の並び、見積りと実績のデフォルト率の差、スコアの分布の安定性(第7章・第8章・第12章) | 管理の指標 | データ分析・リスク管理 | 分布は判断の直後。AR値と見積りの差は観測期間を満たした後 | AR値は集団で変わるので、同じ集団・同じ期間で比べる。確率の正しさや収益を表さない |
| ガードレールの指標(分解の外に置き、並べて測る) | 与信枠を増やした契約のその後の延滞、苦情や相談の件数、群ごとの承認率の差(第11章)、否決の理由の問い合わせへの対応の日数。これとは別に、返済の能力の調査など法令上の義務を規程どおりに済ませたかを確かめる | 管理の指標(法令上の義務の履行は、指標ではなく合格の前提) | コンプライアンス・顧客対応・リスク管理 | 月次。PoC と展開の各段階で、他の指標と同時に測る | 頂点の差が改善しても、指標が事前に決めた範囲を超えて悪化したら合格にしない。法令上の義務の未履行には許容の幅を置かず、見つかったら合格にしない |
表の「いつ分かるか」の列は、与信スコアリングの KPI の木で最も大事な列だと考えています。承認率と審査の所要時間は判断の直後に分かりますが、デフォルト率は観測期間を満たすまで分かりません。頂点の差はさらに遅く、観測期間を満たしても、その直前にデフォルトした契約の回収や、続いている契約の収益は確定していないことがあります。そのため、頂点の差は「一定の期間内の実績の損益」「残りの期間を含む見積りの損益」「回収が終わった後の損益」のどれで測るかを先に決め、報告のたびにどれで測った値かを書きます。本コラムの例題の基本の定義(第2章。観測期間は12か月)を使う商品では、ある月の承認の基準を変えた結果が、デフォルト率として確定するのは1年以上後です。この時間の差があるので、すぐに分かる承認率や所要時間の改善だけで導入の成否を判断してしまうことが起きやすくなります。承認率を上げた結果、デフォルト率も後から上がっていることがありえますが、それは観測期間がたつまで見えません。KPI の木を作るときは、遅れて分かる指標の代わりに、どの先に分かる指標(早い段階の延滞の割合、スコアの分布)で途中の状態を見るかを、表の中に書いておきます。
表の最後の行に置いたガードレールの指標は、承認の基準やモデルの変更が、別の場所に損失を生んでいないかを見張るための指標です。頂点の差が改善していても、与信枠を増やした契約の延滞や返済の相談が増えていれば、過剰与信による顧客の不利益の型の損失が隠れている可能性があります。返済の能力の調査のような法令上の義務の履行は、悪化の幅を管理する指標とは分け、満たしていることを合格の前提にします。第11章で扱ったとおり、全体の承認率が変わらなくても、特定の群で承認率や誤って否決した割合が変わることもあります。ガードレールの指標は、他の指標と同じ期間に同時に測り、事前に決めた範囲を超えて悪化したら、頂点の差が改善していても合格にしない、という使い方をします。法令上の義務の履行には、この範囲の考え方を当てはめません。
KPI の木は、データ分析の担当者のためだけのものではありません。経営にとっては、与信スコアリングへの投資が、収益の枝と損失の枝のどちらを、どれだけ動かすためのものかを示すものになります。営業とリスク管理にとっては、承認率とデフォルト率を同じ表の上で扱うことで、第9章で扱ったカットオフの合意を作る共通の土台になります。審査の担当者にとっては、自分たちの判断の速さと正確さが、頂点のどこにつながるかを説明する材料になります。
PoC の設計、観測期間を計画に入れ、過去のデータでの評価で止めない
最初の対象と KPI の木が決まったら、PoC を設計します。本コラムでいう与信スコアリングの PoC は、本格的にすべての申込へ使う前に、限られた期間と範囲で「この商品のこの段について、この方法が、今の審査の基準より、決めた KPI を改善するか」を確かめる段階です。PoC で確かめるのは「AI が使えるか」という漠然とした問いではありません。始める前に、何を確かめ、どの結果なら次へ進み、どの結果ならやめるかを、文書にして関係者で合意しておく必要があります。
与信スコアリングの PoC は、進め方によって大きく2つの型に分かれます。1つ目は、観測期間を満たした過去の申込と契約の記録を使い、時間で切った評価用のデータでモデルの成績を測るところまでで終わる型です。本コラムでは「過去のデータでの評価で止まる型」と呼びます。2つ目は、過去のデータでの評価に加えて、本番の申込に新しいモデルを並べて動かし、判断には使わずにスコアだけを記録して、今の審査の基準と比べるところまで進める型です。第12章で扱った影の運用(判断には使わず、スコアだけを記録して比べる方法)を PoC に組み込む型で、本コラムでは「影の運用まで進める型」と呼びます。
過去のデータでの評価には、意味があります。第7章で扱ったとおり、申込の月で切った評価用のデータで、候補のモデルが今の基準の点数より契約をデフォルトしやすい順に並べられるかを確かめれば、本番に出す前に見込みの無いモデルを落とせます。第9章で扱った戦略曲線を使えば、同じ承認率でデフォルト率がどれだけ下がるか、同じデフォルト率で承認率をどれだけ上げられるかも、承認した契約の範囲で見積もれます。ただし、過去のデータでの評価には、与信に特有の限界が2つあります。1つは、過去のデータに結果があるのは、過去の基準で承認した契約だけだという点です(第6章の選択の偏り)。新しいモデルが「承認してよい」と判断する申込の中に、過去の基準で否決していた申込が含まれる場合、その申込の結果は記録に無く、その部分の効果は推定になります。もう1つは、過去のデータは過去の景気と過去の申込者の層のもとでの結果だという点です(第12章)。観測期間を満たした最新の契約でも、申込の時点は1年以上前になります。
影の運用まで進める型では、本番の申込に対して新しいモデルのスコアを記録し、今の基準の判断と並べます。影の運用の期間で確かめられるのは、本番のデータで申込の時点にスコアを計算できるか(項目が判断の時点にそろうか、学習のときと同じ計算になっているか)、スコアの分布が過去のデータでの評価のときと大きく違わないか、今の基準と新しいモデルで判断が分かれる申込がどれだけあり、どんな層か、といった点です。判断が分かれる申込の件数と層は、展開したときに承認率と審査の負担がどう変わるかの見積りに直接使えます。一方で、影の運用の期間の申込のデフォルトは、観測期間がたつまで分かりません。影の運用の期間を数か月にしても、その期間に承認した契約のデフォルト率が確定するのは、観測期間がたった後です。そのため、影の運用で確かめるのは、主に「本番で同じように動くか」と「判断が分かれる範囲」であり、デフォルト率の改善そのものは、過去のデータでの評価と、契約から数か月の早い段階の延滞の割合(先に分かる指標)で途中の判断をし、観測期間を満たした時点で確定させる、という2段の判断になります。ただし、観測期間を満たして確定できるのは、実際に契約に至った集団の結果だけです。新しいモデルなら承認されたはずの申込の全体の結果ではないので、確定の判断は「観測できた契約の成績を確定し、観測できない層は推定として残す」という範囲の判断です。
影の運用では、新しいモデルで承認と判断され、今の基準では否決される申込の結果は、影の運用を続けても観測できません。この層の結果を知る方法は、第6章で扱ったとおり、他社での契約と返済の状況を信用情報で後から確かめる方法(信用情報の利用の目的の制限との関係で使えない場合があり、使えるかは法務とコンプライアンスが先に確かめる。第14章)や、限られた件数を承認して結果を見る方法などに限られます。限られた件数を承認する方法は、貸し倒れの増加を費用として受け入れ、返済の能力の調査などの法令上の条件と、その他の審査の基準を満たす範囲で行うものです。PoC でこの方法を使うかどうかは、データ分析の担当者ではなく、事業の責任者とリスク管理が、費用の上限と対象の範囲を決めて判断します。
PoC の設計で最初に決めておきたい項目を、次の表にまとめました。どの項目も、本コラムの各章で扱った論点を、PoC の計画書の欄に置き換えたものです。
| 決める項目 | 中身 | 決めずに始めると起きること | 関連する章 |
|---|---|---|---|
| 対象 | 対象の商品と段、対象の申込の経路と範囲、学習と評価に使う申込の月の範囲 | 途中で対象が広がり、期間内に結論が出ない | 第1章・第2章 |
| デフォルトの定義と観測期間 | 延滞の基準、観測期間の長さ、判定が曖昧な契約の扱い | モデルごと、報告ごとに定義が違い、成績の数字を比べられない | 第2章 |
| 比べる相手 | 今の審査の基準(点数表・外部のスコア・人の判断の記録)。同じ集団・同じ期間・同じ定義で成績を出す | 何より良いのかが決まらず、AR値の数字の意味が定まらない | 第7章 |
| 過去のデータでの評価の方法 | 申込の月で切った評価用のデータ、観測期間を満たした月だけを使うこと、指標(AR値・帯ごとのデフォルト率・見積りと実績の差・戦略曲線)、ばらつきの幅 | ランダムに切った評価や、観測期間を満たしていない契約を正常に数えた評価で成績が良く見え、本番で再現しない | 第7章・第8章 |
| 否決した層の扱い | 判断が分かれる申込のうち、過去に否決していた層の効果をどう推定するか。推定の前提、限られた件数を承認するかどうかと、その上限 | 承認した契約の範囲の成績だけで効果を見積もり、承認を広げた部分の貸し倒れが後から分かる | 第6章 |
| 影の運用の方法 | スコアを記録する申込の範囲と期間、判断の時点の項目の記録、判断が分かれる申込の集計、先に分かる指標(早い段階の延滞)の測り方 | 過去のデータでは良かったが、本番で同じ計算ができるか、どの層の判断が変わるかが分からない | 第9章・第12章 |
| 合格の条件 | 同じ承認率でのデフォルト率の差、または同じデフォルト率での承認率の差を、事前に決めた幅で。収益と損失の差の見積り(相対値)と機会損失の推定の前提。ガードレールの指標の悪化の上限 | 「AR値が上がった」という数字は出ても、次へ進むかを判断できない | 第7章・第9章・第11章 |
| 運用と説明の条件 | 判断の時点に項目がそろうか、計算にかかる時間、否決の理由を示せるか、モデルの文書と台帳への登録 | 成績は出たが、否決の理由を示せない、本番のシステムにつながらない | 第11章・第12章 |
| 出口 | 合格したら次に何をするか(人による審査の参考として示す・一部の申込で自動判定を始める)、不合格なら何をするか(項目やデータの見直し・対象の変更・中止)。観測期間を満たした時点での確定の判断の時期 | 結果が出ても次の判断ができず、PoC を延長し続ける | 本章 |
| 判断する人 | 合格の条件の値を誰が決めるか(事業の責任者・リスク管理・データ分析)、出口を誰が承認するか(事業の責任者など) | 結果の解釈が営業とリスク管理で分かれ、結論が出ない | 本章 |
この表で最も大事なのは、「合格の条件」と「出口」の2つです。合格の条件は、AR値のような1つの数字ではなく、「今の基準と同じ承認率のもとで、承認した契約のデフォルト率が事前に決めた幅以上に下がる」、または「今の基準と同じデフォルト率のもとで、承認率が事前に決めた幅以上に上がる」という形で書き、それを収益と損失の差(相対値)に置き換えた見積りと、ガードレールの指標の悪化の上限を併記します。第9章で扱ったとおり、カットオフを動かせば承認率もデフォルト率も変えられるので、どちらかをそろえずに比べたデフォルト率や承認率は、モデルの良し悪しを表しません。承認率を上げる側の比べ方では、過去に否決していた層の結果が記録に無いので、その部分は推定であることを合格の条件の文書に書いておきます。承認率を据え置く比べ方でも、新しいモデルで承認する申込の顔ぶれが入れ替われば、新しく承認に入る申込の中に過去に否決していた申込が含まれるので、同じく推定の部分が残ります。
合格の条件の値そのものは、対象の商品の件数と、事業にとって意味のある改善の大きさで決まるので、本コラムでは具体的な値を示しません。第7章で扱ったとおり、デフォルトの件数が少ないと、AR値は評価用のデータの取り方によって大きくばらつきます。少ない件数で小さな差を確かめようとすると、差が偶然のばらつきの内に収まってしまい、どちらとも判断できない結果になります。合格の条件を決めるときは、事業にとって意味のある改善の幅と、その差を評価用のデータでどこまで確かめられるかを分けて考えます。同じ評価用のデータで新旧の両方を測る場合は、契約の組を保ったまま再抽出して(第7章のブートストラップ)、新旧の指標の差そのものの区間を出します。評価用のデータに含まれるデフォルトの件数が少なく、この区間が広い場合は、合格の条件に置いた差を確かめられない可能性があるので、評価の期間や対象を見直します。
出口は、合格した場合と不合格だった場合の両方を書きます。合格した場合の出口は、次の段階への移行です。本コラムでは、最初の移行先を「人による審査の参考としてスコアを示す」段階にすることを勧めます(段階的な展開の節で扱います)。不合格だった場合の出口は、結果の中身によって分かれます。過去のデータでの評価で今の基準に勝てなかったなら項目やデータの見直しへ、過去のデータでは勝ったのに影の運用でスコアの分布が大きく違ったなら判断の時点の項目の計算の見直しへ、判断が分かれる申込の多くが過去に否決していた層で推定の幅が大きすぎたなら否決した層の情報を得る方法の検討へ、という具合です。「不合格なら期間を延ばしてもう少し試す」は、出口として書かないほうがよいと考えています。延長を出口にすると、何が足りなかったのかを分析しないまま期間だけが延び、PoC が終わらなくなります。ただし、観測期間を満たした時点での確定の判断は、延長ではなく、最初から計画に書いておく判断の時期として扱います。
与信スコアリングの PoC が本格的な導入に進まずに止まる理由は、ここまでの項目を決めずに始めたことにあることが多いように思います。とくに起きやすいと考えているのは、次の3つの止まり方です。1つ目は、過去のデータでの AR値の比較だけで報告書を作り、どの点数から承認するか、承認率とデフォルト率がどう動くかの見積りが無いまま終わる止まり方です。2つ目は、承認した契約の範囲の成績だけで「承認率を上げても貸し倒れは増えない」と報告し、過去に否決していた層の結果が推定であることが後から問題になる止まり方です。3つ目は、PoC を外部のベンダーに任せ、ベンダーの環境で出た成績を受け取ったものの、自社の評価用のデータで同じ集団・同じ定義で測り直す人がいないまま判断を迫られる止まり方です。どれも、始める前の設計で手を打てるものです。
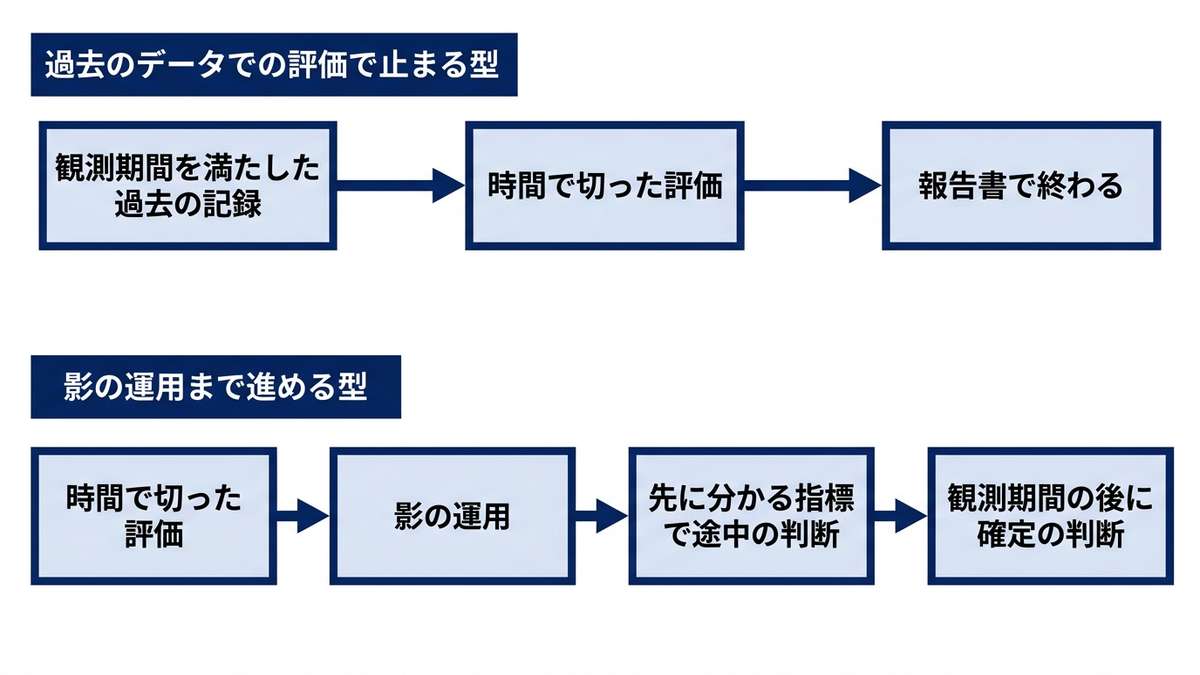
効果の見立て、金額ではなく率と件数の型で書く
PoC の計画を通すにも、展開の予算を得るにも、効果の見立てが求められます。このとき、効果をいきなり金額で書こうとすると、根拠の薄い前提を掛け合わせた数字が一人歩きしやすくなります。本コラムでは、効果の見立てを金額ではなく、率と件数の型で書くことを勧めます。KPI の木の頂点の差も、計画の段階では、正常な契約1件の収益を1としたときのデフォルト1件の損失の比、のような相対値で置けば足ります。金額への換算は、各社の事業の責任者と経理が、自社の契約の条件と回収の記録で行えばよいと考えています。
金融庁が令和8年(2026年)3月3日に公表した「AIディスカッションペーパー(第1.1版)」は、金融機関等へのアンケートやヒアリング、金融庁 AI官民フォーラムでの議論を整理した文書で、AI への投資の効果の測り方にも触れています。29ページでは、実証実験(PoC)の段階の案件などは、収益化の目途が立つまでの間、利用者や利用件数などの特性に応じた KPI を設定して計画と比べることも考えられる、という趣旨が書かれています。同じ箇所には、業務の「削減時間」だけを KPI にするやり方は AI の評価になじまない可能性があり、複数の指標を合わせて確かめる必要がある、という趣旨の意見も紹介されています。与信スコアリングでも、審査の所要時間の削減だけを効果にすると、承認率とデフォルト率の変化が抜け落ちます。
見立ての骨格は、KPI の木の末端から上へ積み上げる形で書けます。たとえば、対象の商品の申込の件数と今の承認率、承認した契約のデフォルト率を出発点にして、同じ承認率のもとでデフォルト率がどの程度の幅で下がれば、デフォルトの件数がどれだけ減り、頂点の差がどれだけ動くかを、幅を持たせて計算しておきます。承認率を上げる方向の見立てでは、新しく承認する層のデフォルト率を、過去に否決していた層について推定する必要があるので、推定の前提(どの方法で、どの情報から見積もったか)と、前提を変えたときの幅を並べて書きます。改善の幅は PoC の前には分からないので、見立ての段階では「この程度の改善があれば、頂点の差がこれだけ動く」という形で置きます。こうしておくと、PoC の合格の条件を、「事業にとって意味のある最小の改善」として決める根拠にもなります。
見立ての数字を書くときに避けたいのは、公開の事例や研究の数字を、そのまま自社の効果として書くことです。第14章で扱うとおり、公開の事例の数字は、その会社の、その商品の、その条件での値です。公開データセットでの研究の数字も、そのデータ・その評価の方法・その実験の条件での値です。どちらも自社の申込で同じ値が出る根拠にはなりません。ベンダーが示す AR値や承認率の改善も同じで、第7章の「過去のデータでの評価の限界と、ベンダーの示す数字の読み方」で扱った確かめる項目で、どの集団・どの定義・どの期間・どの切り方での値かを確かめてから扱います。見立ての数字は、自社の今の基準の成績と、PoC の結果から作り、「この PoC の期間・この商品・この申込の範囲では」という限定を付けて書きます。
見立ての対象は、序章で整理した6つの損失の型に沿って考えると、漏れが少なくなります。6つの型は互いに重なりうる説明上の整理で、1つの変更が複数の型に効くこともありますが、型ごとに数えるものを決めておくと、改善した型だけを報告して悪化した型を見落とすことを防げます。次の表は、6つの型それぞれについて、何を数え、導入の前にどこから数字を取り、導入の後に何と比べるかをまとめたものです。
| 損失の型 | 数えるもの(率・件数) | 導入の前の数字の取り方 | 導入の後に比べるもの |
|---|---|---|---|
| 貸し倒れ | 承認した契約のデフォルト率(分母の月と集団を明記)、デフォルト1件あたりの損失の相対値、見積りのデフォルト確率と実績のデフォルト率の差 | 現状の把握で集めた、観測期間を満たした申込の月ごとのデフォルト率 | 同じ承認率のもとでのデフォルト率。観測期間を満たすまでは早い段階の延滞の割合で途中の状態を見る |
| 機会損失 | 否決した申込のうち、返済できたと推定される申込の件数と割合(推定であることと前提を明記)、与信枠を小さくしすぎたと推定される契約の割合 | 否決した申込の項目と、他社での返済の状況の記録(使えるかは信用情報の利用の目的の制限による。第14章)、第6章の方法による推定 | 同じ前提で推定した値。前提を変えたときの幅も並べる |
| 過剰与信による顧客の不利益 | 与信枠を増やした契約や新しく承認した層のその後の延滞の割合、返済の相談や苦情の件数 | 途上与信の記録、相談と苦情の記録 | 同じ指標。承認を広げた層に偏って悪化していないか |
| 審査の滞り | 申込から判断までの所要時間、人による確認に回った割合、審査の途中の取り下げの件数、審査の担当者1人あたりの処理件数 | 審査のシステムの記録(無ければ PoC の前に記録を始める) | 同じ指標。人による確認の件数が審査の能力の内に収まっているか |
| 形骸化 | モデルと承認の基準を最後に見直してからの期間、成績を測り直した間隔、監視の結果が見直しにつながった件数 | モデルの台帳と文書(第12章)。台帳が無ければ作るところから始める | 決めた間隔で成績を測り直し、見直しの判断の記録が残っているか |
| 規制上の義務の不履行 | 返済の能力の調査や信用情報の照会を規程どおりに済ませた申込の割合、否決の理由の問い合わせへの対応の記録、監査での指摘の件数 | コンプライアンスと内部監査の記録 | 同じ指標。審査の流れを変えたことで、調査や記録の手続きが抜けていないか(第14章) |
表の「貸し倒れ」の行は成果の指標(承認した契約から得た収益と貸し倒れの損失の差)の損失の側に当たり、「機会損失」の行は推定です。報告では、成果の指標と機会損失の推定を必ず同じ表に並べます。片方だけが改善したと報告すると、実績の差に推定の機会損失を合わせて判断するという、本章の冒頭で述べた考え方から外れます。報告の書式の段階で、この2つを同じ表に並べる形に決めておくと、片方だけを成果として示す報告を防げます。機会損失は推定なので、推定の方法と前提を同じ表の欄に書きます。AR値や承認率は、この2つを説明するための管理の指標として、別の欄に置きます。
表の「導入の後に比べるもの」は、前後の変化を見張るための指標です。申込者の層・景気・販促や経路の構成も前後で変わるので、変化をそのまま導入の効果と判断するときは、比べる相手(同じ時期に新しい方法を使わなかった範囲など)や構成の変化も確かめます。第9章で扱ったチャンピオンとチャレンジャー(今の基準と新しい基準を、申込を分けて同じ時期に並べて使う方法)は、この比べる相手を作るための方法です。また、個々の契約がデフォルトしたことだけで、承認の判断が誤りだったとは言えません。一定の割合のデフォルトを見込んで承認するのが与信なので、比べるのは、見積りと実績の差と、同じ条件で比べた率です。
段階的な展開、人による審査の参考から一部の自動判定、範囲の拡大へ
PoC に合格しても、すぐに新しいモデルのスコアで申込の承認と否決を自動で決めることは避けるべきだと考えています。PoC は、限られた期間・商品・申込の範囲で行ったもので、景気が変わったとき、販促や経路の変更で申込者の層が変わったとき、商品の条件が変わったときの動きまでは含んでいません。観測期間の関係で、PoC の時点では、新しいモデルで承認した契約のデフォルト率はまだ確定していません。本コラムでは、スコアの使い方を、影響の小さい使い方から大きい使い方へ、段階を分けて広げることを勧めます。
最初の段階は、人による審査の参考としてスコアを示す使い方です。承認と否決の判断は今の基準と審査の担当者が行い、新しいモデルのスコアと、点数を下げている項目(第11章の否決の理由の出し方)を、審査の画面に参考として表示します。この段階では、最終の判断を担う人と基本の手順を変えないので、承認率とデフォルト率への影響を小さく抑えやすくなります。日々の作業の中で確かめられるのは、項目の入力や計算の不備と、スコアと担当者の判断の食い違いです。スコアの予測が当たっていたかどうかは、返済の結果がそろってから評価します。担当者がスコアと違う判断をした件数と理由を記録しておくと、モデルが見落としている情報や、項目の計算の誤りに気づく材料になります。ただし、参考として示したスコアが担当者の判断に影響することはありうるので、この段階でも承認率と人が判断を変えた割合の推移を見ておきます。
次の段階は、一部の自動判定です。スコアの高い帯(デフォルト確率の低い帯)のうち、返済の能力の調査などの法令上の条件と、その他の審査の基準を満たす申込に限って、人の確認を省いて自動で承認し、それ以外は今までどおり人が確認します。自動で否決する範囲は、この段階では置かないか、ごく限られた範囲に留めます。第9章で扱った「人による確認へ回す帯」の幅を少しずつ狭めていく形で、審査の滞りの型の損失を減らしながら、デフォルト率の推移を確かめます。その次の段階で、自動判定の範囲を広げ、否決の側にも自動判定を使います。否決を自動で決める範囲を広げるときは、否決の理由を申込者に示す手順と、人による再審査や問い合わせの手順(第11章)が動いていることを先に確かめます。
展開の段階を次の表にまとめました。段階の区切り方は本コラムが考えた例で、事業の規模や商品によって変わります。
| 段階 | スコアの使い方 | 主に確かめること | 次の段階へ進む条件 | 主に判断する人 |
|---|---|---|---|---|
| 今の基準の整理 | 使わない。今の審査の基準を文書にまとめ、成績を測って記録の不足を埋める | 今の基準の帯ごとの承認率とデフォルト率、人が判断を変えた割合と理由の記録 | 比べる相手の成績が、同じ定義と期間で出ている | リスク管理・審査 |
| PoC(過去のデータでの評価と影の運用) | 判断には使わない。過去のデータで評価し、本番の申込のスコアを記録して今の基準と比べる | 合格の条件、本番でスコアを計算できるか、判断が分かれる範囲 | PoC の計画書の合格の条件を満たした(90日の計画の第13週の途中の判断) | 事業の責任者 |
| 人による審査の参考 | スコアと点数を下げている項目を審査の画面に表示する。判断は今の基準と担当者が行う | 本番でスコアを計算できるか、スコアの分布、担当者の判断との一致と食い違い | スコアの分布が過去のデータでの評価のときと大きく違わず、食い違いの理由が記録され、見直しが済んだ | 事業の責任者・リスク管理 |
| 一部の自動判定 | スコアの高い帯のうち、法令上の条件と他の基準を満たす申込を、人の確認を省いて自動で承認する | 自動判定の範囲の早い段階の延滞の割合、所要時間、人による確認の件数、ガードレールの指標 | 早い段階の延滞の割合が見込みの範囲に収まり、観測期間を満たした分のデフォルト率が見積りと合っている(PoC の確定の判断が済んでいる) | 事業の責任者 |
| 自動判定の範囲の拡大 | 自動判定の帯を広げ、否決の側にも使う。人は境目の帯の確認と再審査に集中する | 承認率とデフォルト率、否決の理由の問い合わせと再審査の件数、群ごとの承認率の差 | (最終の段階。監視と見直しを続ける) | 経営・事業の責任者 |
表の2段目が PoC で、90日の計画の第13週の途中の判断で、3段目の「人による審査の参考」へ進むかを決めます。観測期間を満たした時点での確定の判断は、4段目の「一部の自動判定」から5段目の「自動判定の範囲の拡大」へ進む前に済ませる形にしました。確定の判断の前に一部の自動判定を始める場合は、その範囲を限り、次の段落で述べる、早い段階の延滞の割合で範囲を戻す手順を先に決めておきます。
表の「人による審査の参考」の段階は、与信スコアリングで使いやすい中間の段階だと考えています。ここでは最終の判断を担う人と基本の手順を変えないので、貸し倒れと機会損失の型の損失は増えにくいと考えています。一方で、審査の担当者にとっては、どのような申込に低いスコアを付けるのか、点数を下げている項目の説明が実務の感覚と合っているのかを、日々の作業の中で知る機会になり、第11章で扱った否決の理由の文面を確かめる場にもなります。審査の担当者が納得しないまま自動判定に進むと、人による確認に回った申込で、担当者がスコアを見ずに従来どおりに判断する、ということが起きやすくなります。
「一部の自動判定」の段階から先は、観測期間との付き合い方が要ります。自動判定を始めた月の契約のデフォルト率が確定するのは、観測期間がたった後です。その間は、契約から数か月の早い段階の延滞の割合を先に分かる指標として使い、事前に決めた範囲を超えたら自動判定の範囲を戻す、という手順を、段階を進める前に決めておきます。範囲を戻す判断を誰がどの指標で行うかが決まっていないと、悪化に気づいても止められません。また、自動判定の範囲を広げるたびに、承認した契約の層が変わるので、第12章で扱った監視の基準値も見直します。
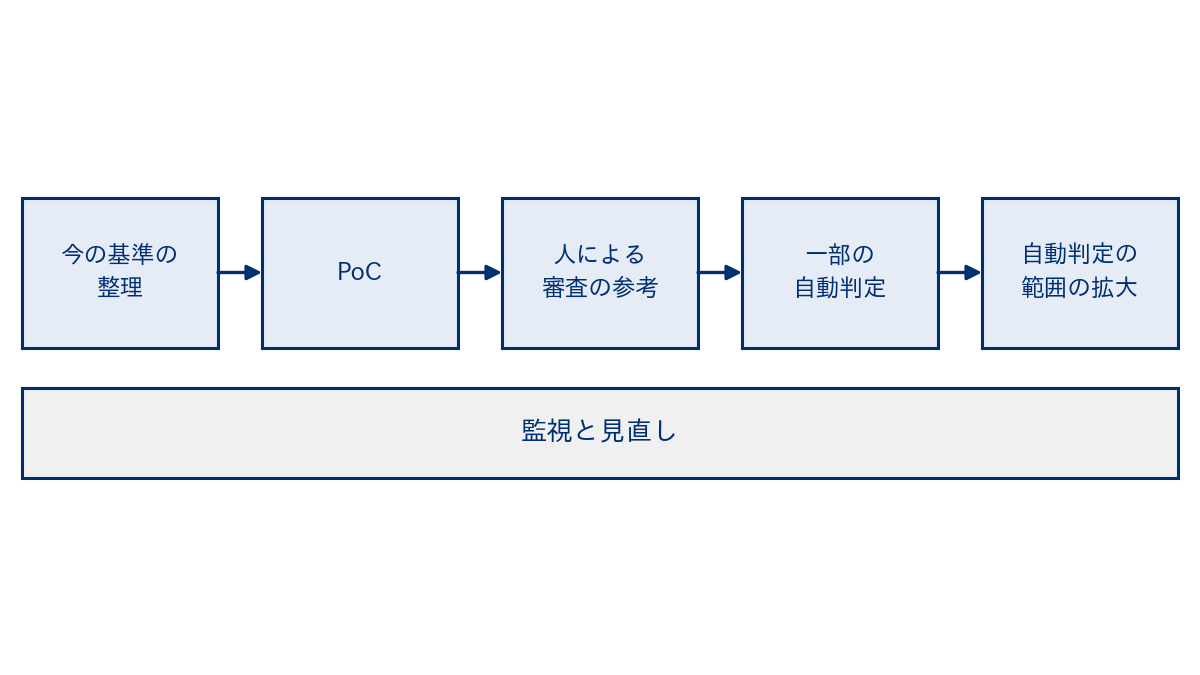
役割と責任分担、3つの防衛線の中で与信スコアリングをどこに置くか
与信スコアリングの導入に関わる人は、モデルを作る人よりずっと多くなります。スコアは審査の担当者の判断の材料になり、カットオフは営業の承認率とリスク管理のデフォルト率を同時に動かし、否決の理由は顧客対応への問い合わせになり、申込の情報と信用情報は個人データの取り扱いに関わり、承認の基準は規制や監査で説明を求められるからです。本コラムでは、関わる役割を次の14に分けて考えます。役割の名前は一般的なものにしてあり、組織によっては1人が複数の役割を兼ねます。
- 経営:与信の方針・予算・目指す承認率とデフォルト率の水準(どの商品で、どこまでの貸し倒れを許容して、どれだけの承認を目指すか)を決める
- 事業の責任者:担当する商品の与信スコアリングの目的と KPI の木、PoC の出口、展開の段階の移行、カットオフを承認する
- リスク管理:信用リスクの評価と管理、デフォルトの定義、今の基準の成績の測定、監視の基準、モデルの独立した検証を担う
- 審査:申込の審査を行い、スコアと違う判断をしたときはその理由を記録する
- 営業:申込の経路と販促を持ち、承認率と申込者の層の変化を最初に知る
- 債権管理:延滞した契約への対応と回収を担い、返済の結果の記録を持つ
- 顧客対応:否決の理由の問い合わせ、返済の相談、苦情の受け付けを担う
- コンプライアンス:返済の能力の調査、信用情報の利用、説明と記録などの法令上の要件を示し、仕組みがそれを満たすかを確かめる
- データ分析:現状の成績の測定、項目とモデルの作成、評価、効果の報告を担う
- エンジニア:判断の時点の項目の計算、スコアの計算、判断と結果の記録の仕組みを作る
- 情報システム:審査や債権のシステムの運用と監視、障害のときの対応、情報セキュリティを担う
- 法務:個人データの利用目的や第三者への提供、外部との契約の内容を確かめる(第14章)
- 内部監査:与信スコアリングの仕組みが、決めたとおりに動き、有効に機能しているかを独立した立場から確かめる
- 外部のベンダー:スコアや与信の製品、クラウドのサービスの提供、場合によってはモデルの開発を担う
この14の役割で、主な作業ごとの責任分担を表にしたのが次の表です。この4つの区分の考え方は RACI と呼ばれ、フレームワークとしての一般的な使い方は弊社コラム『経営とAIの打ち手を導く戦略フレームワーク大全179選』で扱っています。ここでは与信スコアリングの導入に当てはめた表を示します。表の割り振りは本コラムが考えた例で、組織の大きさや既存の体制によって変わります。
表の記号の意味は次のとおりです。
- R:実行する(作業を担う)
- A:最終的に責任を持つ(承認する)。各行に1つだけ置く。R の列が空の行は、A が実行も兼ねる
- C:相談を受ける(意見を出す)
- I:結果を知らされる
表が横に広くなるので、列名は次の略称で書いてあります。
- 事業=事業の責任者、リスク=リスク管理、債権=債権管理、顧客=顧客対応、コンプラ=コンプライアンス
- 分析=データ分析、エンジ=エンジニア、情シス=情報システム、監査=内部監査、外部=外部のベンダー
| 作業 | 経営 | 事業 | リスク | 審査 | 営業 | 債権 | 顧客 | コンプラ | 分析 | エンジ | 情シス | 法務 | 監査 | 外部 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 対象の商品と段の選定と採点 | I | A | R | R | R | C | I | R | R | I | C | C | I | C |
| 目指す承認率とデフォルト率の水準の決定 | A | R | R | C | C | C | I | C | C | I | I | I | I | I |
| デフォルトの定義と観測期間の決定 | I | C | A | C | I | C | I | C | R | I | I | C | I | C |
| KPI の木の設計と承認 | C | A | R | C | R | C | C | C | R | I | I | I | I | I |
| 今の審査の基準の成績の測定 | I | I | A | R | I | C | I | I | R | R | C | I | I | I |
| 審査の判断と返済の結果の記録の設計 | I | I | A | R | C | R | C | C | R | R | R | C | C | C |
| 個人データの利用と規制上の要件の確認 | I | A | C | C | I | C | C | R | C | C | C | R | I | C |
| PoC の合格の条件と出口 | I | A | R | C | C | I | I | C | R | C | I | I | I | C |
| モデルの作成と過去のデータでの評価 | I | I | C | C | I | I | I | I | A | R | I | I | I | R |
| モデルの独立した検証 | I | I | A | I | I | I | I | C | C | I | I | I | I | C |
| カットオフと人による確認へ回す帯の決定 | C | A | R | R | R | C | I | C | R | I | I | I | I | I |
| 影の運用と判断の食い違いの確認 | I | I | A | R | I | I | I | I | R | R | R | I | I | C |
| 否決の理由の文面と再審査の手続き | I | A | C | R | C | I | R | R | C | C | I | C | I | C |
| 出口の判断と展開の段階の移行 | I | A | R | C | C | C | C | C | R | C | C | I | I | I |
| 延滞した顧客への対応の方針 | I | A | C | I | C | R | R | C | C | I | I | C | I | I |
| 監視と見直しの基準 | I | C | A | C | I | C | I | C | R | R | R | I | I | C |
| 与信スコアリングの仕組みの監査 | I | I | C | C | I | C | I | C | C | I | C | I | A | I |
| 効果の報告(成果の指標と機会損失の推定を並べる) | I | A | R | C | C | C | I | C | R | I | I | I | I | C |
表は、A の列だけを拾って読むと、誰が何を承認するかが分かります。この表で意図して置いたのは、次の4つの割り振りです。1つ目は、目的と出口に関わる行(対象の選定・KPI の木・PoC の合格の条件と出口・カットオフ・出口の判断・効果の報告)の A を、データ分析ではなく事業の責任者にしたことです。カットオフを決めることは、貸し倒れと機会損失のどちらをどれだけ許すかを決めることで、技術の判断ではなく事業の判断です。その上位にある、目指す承認率とデフォルト率の水準だけは、経営が A を持ちます。KPI の木は、経営が決めた水準を受けて事業の責任者が設計し、承認します。カットオフの行では、営業とリスク管理の両方に R を置きました。第9章で扱ったとおり、カットオフは営業、リスク管理、財務が合意した収益と損失の見積りで決めるもので、片方だけが案を作ると、承認率かデフォルト率の片方に寄った案になりやすいからです。
2つ目は、デフォルトの定義と観測期間、今の基準の成績の測定、記録の設計、監視の基準の A をリスク管理にしたことです。デフォルトの定義のように比べるときに使う定義は、モデルやベンダーが変わっても一貫させ、監視の基準値のように、自動判定の範囲の変更などに合わせて見直すものは、変える理由・承認・適用の時点を記録します。モデルの変更に伴う正当な見直しと、成績を良く見せるための物差しの変更を区別するために、これらはモデルを作る側とは別の立場で持つのがよいと考えています。3つ目は、「モデルの作成と過去のデータでの評価」の A を外部のベンダーではなく社内のデータ分析にし、「モデルの独立した検証」の A をリスク管理にしたことです。モデルを作る作業(R)を外部に任せる場合でも、納められたモデルを社内の評価用のデータで評価し直す人は、社内に置いておく必要があると考えています。リスク管理の中にモデルを作る担当がいる組織では、検証は作った担当とは別の担当が行う形にします。
4つ目は、審査の担当者に、審査の現場の記録と判断に関わる6つの行で R を置いたことです。審査の担当者は、スコアを日々使う人であり、人が判断を変えた記録を作る人でもあります。記録の項目が審査の実務に合っていないと、記録が残らないか、残っても後の学習や監視に使えない形になります。否決の理由の文面と再審査の手続きの行では、審査・顧客対応・コンプライアンスに R を置きました。申込者からの問い合わせが最初に届くのは顧客対応で、そこで受けた求めを審査の担当者が確かめ、文面と手続きが法令上の要件を満たすかをコンプライアンスが確かめる流れにしました。
「個人データの利用と規制上の要件の確認」の行は、A を事業の責任者、R をコンプライアンスと法務にしました。その商品で申込の情報や信用情報をどう使うかを決め、結果に責任を持つのは商品を持つ側で、法令上の要件を満たすかの判断の材料を出す確認の作業はコンプライアンスと法務が担う、という分け方です。コンプライアンスと法務が要件を満たさないと判断した使い方は、事業の責任者が承認しない前提で置いています。
表の A は各行に1つだけ置きました。A が2つある行は、承認する人が2人いることになり、意見が割れたときに決まらなくなります。逆に、A が無い行は、誰も承認しないまま作業が進むか、作業が止まります。表を自社の組織に当てはめるときは、まず各行の A が1人に決まっているかを確かめ、次に R を担う人の工数が確保されているかを確かめることを勧めます。とくに、リスク管理・審査・データ分析の R が多くの行に並ぶので、日々の審査と管理の業務と兼任で回せる量かどうかを先に見積もっておきます。
役割を組織の中に置くときの考え方として、第12章で扱った3つの防衛線の考え方があります。金融庁が令和3年(2021年)11月12日に公表した「モデル・リスク管理に関する原則」の整理で、第1の防衛線はモデルを所管する、あるいは開発や使用に直接関わる部門や個人、第2の防衛線はけん制を通じてモデル・リスクを管理し、独立した検証などを担う部門や個人、第3の防衛線は内部監査部門です。同文書の適用の対象は、文書に掲げられた金融システム上重要な金融機関(国際的に、あるいは国内の金融システムにとって重要な金融機関として指定されたものなど)で、それ以外の与信の事業者がこの文書の適用を受けるかどうかは、本コラムでは判断しません。自社に適用される規制と指針は、所管官庁や専門家に確かめる事項です。ここでは、適用の有無とは別に、本章の14の役割をこの考え方に当てはめたときの置き方の一例を示します。
- 第1の防衛線:事業の責任者・審査・営業・債権管理・顧客対応、モデルを作るデータ分析の担当、エンジニア・情報システム。モデルとスコアを所管し、作り、使う側
- 第2の防衛線:リスク管理のうち独立した検証と監視を担う担当、コンプライアンス。第1の防衛線から独立した立場で、モデルと承認の基準を確かめる側
- 第3の防衛線:内部監査。仕組み全体が決めたとおりに動き、有効に機能しているかを確かめる側
- どの線にも置かないもの:経営は全体の方針と水準に責任を持ち、法務は各線から相談を受け、外部のベンダーは第1の防衛線の作業の一部を担うが、その管理の責任は社内に残る
前の表では、リスク管理が、記録の設計・影の運用・カットオフの案作り・PoC の合格の条件のように、導入の側の行にも A や R を持っています。その同じリスク管理が「モデルの独立した検証」の A を持つので、リスク管理の中で導入に関わる担当と、独立した検証を担う担当は分け、検証の担当が自分で案を作った行の結果を検証しない形にするのがよいと考えています。担当を分けるだけの人がいない組織では、検証の一部を、導入に関わっていない部署や外部の検証者に依頼する形も考えられます。同文書も、防衛線の完全な分離が現実的でない場合がありうるとしたうえで、実効的なけん制をどう確保するかを検討する必要があるとしています。モデル・リスク管理の詳細は第12章で、規制の中での位置づけは第14章で扱います。
内製と外部の分担、外部のスコア・開発の委託・製品の利用のどれを選んでも社内に残すもの
与信スコアリングの仕組みを用意する方法は、おおまかに4つに分かれます。社内でモデルと仕組みを作る内製、信用情報機関や専門の事業者などが提供するスコアの提供を受ける方法、モデルの開発を外部の会社に委託する方法、与信の審査の製品やクラウドのサービスを利用する方法です。実際には、外部のスコアを項目の1つとして社内のスコアカードに入れる、審査の仕組みは製品を使い、承認の基準と評価は社内で担う、といった組み合わせにする場合もあります。本コラムでは、製品やサービスどうしの優劣は扱わず、方法を選ぶときの観点を一般論として整理します。
| 観点 | 内製 | 外部のスコアの提供を受ける | モデルの開発を委託する | 製品・クラウドのサービスを使う |
|---|---|---|---|---|
| 立ち上げの速さ | 人とデータの基盤がそろっていれば速いが、無ければ遅い | 自社の結果のデータが少なくても使い始められることが多い | 委託先の体制しだい。要件とデータの受け渡しを決める時間が要る | 用意された機能の範囲なら速いことが多い |
| 自社の商品への合わせやすさ | 自社のデフォルトの定義・項目・商品の条件に合わせやすい | スコアが前提にしている定義や集団が、自社の商品と違うことがある | 契約で決めた範囲で合わせられる | 製品が用意した設定と項目の範囲に限られることがある |
| 評価と見直しの主導権 | 社内にある | スコアの作り方は外部にあるので、社内で持てるのはカットオフと組み合わせ方 | 評価の方法とデータを社内に持たないと外部に寄る | 評価の方法とデータを社内に持たないと製品の画面の数字に寄る |
| 説明と監査への対応 | モデルの中身と点数の理由を社内で説明できる | 否決の理由として示せる内容が、提供の範囲に限られることがある | 成果物の文書と説明の範囲を契約で決めておく必要がある | 判断の理由をどこまで出せるかは製品による |
| 社内に必要な人 | データ分析・エンジニア・モデルの検証の担当を継続して確保する | スコアを自社の契約の結果で評価し直せる人 | 依頼の内容を決め、納められたモデルを評価できる人 | 設定と連携を担う人と、成績を評価できる人 |
| やめるとき・替えるとき | 担当者の異動や退職で見直しが止まるおそれ | 提供の条件が変わると、カットオフや監視の基準を作り直すことになる | モデル・文書・学習に使った記録の扱いを契約で決めていないと引き継げない | 判断の記録が製品の中にしか無いと、替えた後に比べられない |
表の「外部のスコアの提供を受ける」の列は、データの蓄積が少ない商品や新しい事業で、とくに使われやすい方法です。外部のスコアは、提供する側が持つ広い集団のデータで作られているので、自社の記録だけでは作れない見積りが得られることがあります。一方で、そのスコアが何をデフォルトと呼び、どの集団で、どの観測期間で作られたのかが、自社の商品と合っているとは限りません。第7章と第8章で扱ったとおり、AR値も確率の正しさも集団によって変わるので、自社に契約の結果の記録がある事業では、外部のスコアも、自社の申込と契約の結果で、順位づけの成績と見積りの確率の一致を確かめてから使います。記録の無い新しい事業では、この確認が使い始める前にはできないので、次の節で扱うとおり、対象と与信枠を絞って暫定的に使い、結果が集まった段階で確かめます。外部のスコアを使う場合の利用の目的や同意の範囲、信用情報の利用の制限は、第14章で扱う法令の範囲で確かめます。
表のどの列を選ぶ場合も、社内に残しておきたいものは共通しています。デフォルトの定義と観測期間、KPI の木と成果の定義、申込の時点の情報と審査の判断と返済の結果を結び付けた記録、時間で切った評価用のデータ、成績を測り直す主導権の5つです。これらを社内に持っていれば、モデルを替えても、委託先や製品を替えても、同じ物差しで比べられます。前述の「モデル・リスク管理に関する原則」も、原則7で、ベンダーのモデルや外部の資源を使う場合に適切な統制を行うべきだとし、ベンダーのモデルについて、仕様の詳細が公開されないことが多い中でも自社の管理の下に位置づけることを求めています。要点は、外部のモデルでも、自社で限界を把握し、可能な範囲で検証し、使えなくなったときの代わりの手段を用意しておくことです(詳細は同原則の7.2)。適用の対象については前の節で述べたとおりですが、外部のモデルを使う与信の事業者が確かめる事項の整理として参考になります。
外部のベンダーに依頼する場合、あるいは製品やスコアを選ぶ場合に確かめておきたいことを、次の表にまとめました。表の中身は第7章から第12章で扱った論点を、ベンダーへの質問に置き換えたものです。答えの良し悪しを決める基準は自社の商品と体制によって変わるので、表は質問の一覧として使うことを想定しています。
| 確かめる領域 | 聞くこと | 答えが曖昧なときに起きること | 関連する章 |
|---|---|---|---|
| データ | 学習に使ったデータの集団・期間・デフォルトの定義・観測期間。自社のデータを使う場合の送る範囲・保管の場所と期間・他の利用者のモデルに使われるかどうか・契約が終わったときの返却 | スコアが前提にしている集団や定義が自社の商品と違うことに、導入の後で気づく。個人データの扱いが利用目的の範囲を超えるおそれ | 第2章・第14章 |
| 評価 | 示された AR値などの成績は、どの集団で、どの期間で、ランダムに切ったのか申込の月で切ったのか。承認した契約だけで測った値か。同じ承認率でのデフォルト率の差で示せるか | 成績の数字が自社の申込で再現せず、導入の後にデフォルト率が見積りより高いと分かる | 第7章・第9章 |
| 較正 | 出力はデフォルト確率として読めるのか、点数なのか。確率なら、どの集団と観測期間に対応した値か。自社の実績と合わない場合にどう対応づけ直すのか | 点数をそのまま確率として与信枠や引当の見積りに使い、見積りと実績がずれる | 第8章 |
| 説明 | 1件の否決について、審査の担当者と申込者にどんな理由を示せるのか。監査や当局への説明に使える文書があるか。群ごとの偏りを測る方法があるか | 否決の理由を示せない。監査で承認の基準を説明できない | 第11章 |
| 監視 | スコアの分布や項目の変化をどう監視するのか、見積りと実績の差をどの頻度で報告するのか | 申込者の層が変わっても気づかず、形骸化が進む | 第12章 |
| 見直し(再較正・再推定・再構築) | 再較正・再推定・再構築の頻度と手順、新しい版を誰が承認するのか、版が変わったときにカットオフをどう見直すのか | 版が変わったことに気づかないまま、同じカットオフで承認率とデフォルト率が動く | 第9章・第12章 |
| 障害のとき | スコアが返らないときの既定の動き(人による審査に回すのか、申込を保留するのか)、復旧までの手順、その間の記録 | 障害のときに審査が止まり、審査の滞りの型の損失が一度に出る | 第12章 |
表の「評価」の行は、とくに PoC の段階で効きます。ベンダーが示す成績を受け取るだけでなく、自社の評価用のデータ(申込の月で切り、観測期間を満たした契約のもの)を自社で用意し、同じ条件で今の基準と比べる設計にしておくことを勧めます。「較正」の行は、与信に特有の質問です。外部から受け取るものが点数なのか、確率なのかで、使い方が変わります。点数であれば、自社の集団と観測期間に対応したデフォルト確率として読むための換算を、自社の実績で作る必要があります(第8章)。
外部に依頼する範囲と、社内に残す範囲は、契約の段階で文書にしておきます。社内と外部の役割、モデル・文書・判断の記録といった成果物をどう管理するか、申込の情報や信用情報をどの範囲で渡し、どう扱ってもらうか、といった項目です。契約の条件そのものは本コラムの範囲を超えるので書きませんが、与信スコアリングの開発を依頼する場合は、成果を事前に約束しにくいこと、成果の測り方を自社の定義に合わせる必要があること、結果が観測期間の後にしか分からないので成果の確認の時期が納品より後になることのように、決まった仕様のシステムを納める場合とは違う論点が出やすいと考えています。AI の社内ルールや規制との関係は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
データの蓄積が無い新しい事業での始め方と人材、公的な調査に見る与信での AI の使われ方
後払いの決済や分割払いを新しく始める事業、企業間の掛け売りを広げる事業のように、自社に与信の結果の記録がほとんど無い状態から始める場合もあります。この場合、自社のデータでモデルを作ることはできず、PoC の前に、そもそも何で審査するかを決める必要があります。本コラムでは、始め方を3つに分けて考えます。1つ目は、外部のスコアを使う方法です。スコアが前提にしている定義と集団が自社の商品と合っているかを提供元の説明で確かめたうえで、対象と与信枠を絞って暫定的に使い、結果が集まった段階で自社の実績と突き合わせます。2つ目は、審査や信用リスクの知識を持つ人の判断を、項目と区分と点数の表に書き起こす方法です。第3章と第4章で扱ったスコアカードの形を、データからではなく専門家の判断で作るもので、点数の根拠を台帳に残しておけば、後から実績と突き合わせて直せます。3つ目は、与信枠を小さく、対象を限って始め、結果を集める方法です。どの方法でも、最初の申込から、申込の時点の情報と審査の判断と返済の結果を結び付けて残すことが、次のモデルの土台になります。
新しい事業では、最初の数か月は承認率と審査の所要時間しか分からず、デフォルト率は観測期間がたつまで分かりません。この時期に、承認率と申込の件数の伸びだけを見て与信枠や対象を一気に広げると、承認を広げた分の貸し倒れが、観測期間がたった後にまとめて表れることがあります。また、承認を広げて返済の能力を超える与信が増えれば、過剰与信による顧客の不利益の型の損失も生じます。KPI の木の「いつ分かるか」の列を最初に書き、先に分かる指標(早い段階の延滞の割合)で範囲を広げる条件を決めておくことが、新しい事業ではとくに大事だと考えています。返済の能力の調査などの法令上の要件は、データの蓄積の有無にかかわらず満たす必要があるので、第14章の範囲で、商品ごとにコンプライアンスと法務が確かめます。
人材の面では、与信スコアリングに要る知識が2つの領域にまたがることが、導入の難しさの1つになっています。1つは与信の業務の知識で、商品の条件、審査で確かめていること、延滞から回収までの流れ、法令上の要件を知っていることです。もう1つはデータ分析の知識で、観測期間と時間で切った評価、選択の偏り、確率の較正、情報の漏れの防ぎ方などを知っていることです。与信の業務の知識だけでは、モデルの成績の数字が意味を持つ条件を確かめられず、データ分析の知識だけでは、モデルの点数の並びが審査の実務の感覚と合っているか、点数を下げている項目を申込者に示してよいかを判断できません。両方を1人が持つことは多くないので、本コラムでは、審査やリスク管理の担当者とデータ分析の担当者が同じ PoC の中で作業し、互いの判断の根拠を言葉にして記録する体制を勧めます。審査の担当者がスコアと違う判断をしたときの理由の記録は、この2つの知識をつなぐ材料になります。
与信での AI の使われ方を、公的な調査で確かめておきます。前述の金融庁の AIディスカッションペーパー(第1.1版)は、金融機関等を対象にした2024年の実態調査をもとに、従来型の AI のユースケースごとの導入の状況を図表3で示しており、その項目の1つに「与信審査・信用リスク管理・引受審査」があります。同ペーパーの10ページは、この領域で、返済の履歴や審査の判定の記録を学習させた判定のモデル、購買のデータなどを使った与信のスコアリングといった使い方が確認されたと紹介しています(事例の一覧は同ペーパーを参照)。同じ箇所には、回答した金融機関等の評価として、不正の検知と比べると自社の中に多くの過去のデータが蓄積されていることから、AI だけの判断でも比較的高い精度が得られると評価する回答が少なくなかった、という趣旨も書かれています。これは精度の値ではなく回答先での評価で、同ペーパーも、アンケートの結果は回答先に限ったものである点に留意が必要としています。
同ペーパーの34ページから35ページは、説明の可能性について、与信の判断のように影響の大きい判断に AI を使う場合には、どんなデータで学習したかなどの観点から、金融機関自身が判断の合理性を検証し、説明できるようにする必要があるとしています。そのうえで35ページでは、取り組みの例として、外部の事業者のモデルの評価の道具を使って、与信の審査のモデルでどの項目の寄与が大きいかを見える形にし、モデルの妥当性を検証している先を挙げています。30ページでは、モデル・リスク管理の取り組みの例として、モデルの開発者と独立した検証者が、本番に使う前の検証や継続的な性能の監視を行っている先が紹介されています。これらは、本章で扱った役割の分け方や、PoC の運用と説明の条件の欄を考えるときの、公的な資料に書かれた事例として参考になります。
最初の90日の計画と形骸化の型、週ごとに何を決め、何を残すか
ここまでの内容を、導入を決めてから最初の90日(およそ13週)の計画に落とします。次の表は、本コラムが考えた計画の例です。90日で、1つの商品の1つの段について、現状の把握、過去のデータでの評価、影の運用を終え、途中の出口の判断をするところまでを範囲にしています。実際の期間は、申込と審査の判断と返済の結果が結び付けて残っているか、観測期間を満たした契約がどれだけあるか、影の運用のための仕組みを作るのにどれだけかかるかで大きく変わるので、週の区切りは目安です。
与信スコアリングでは、90日の内に、影の運用の期間の申込のデフォルトは確定しません。そのため、第13週の判断は、過去のデータでの評価の結果と、影の運用で確かめた「本番で同じように動くか」「判断が分かれる範囲」による途中の判断とし、その時点で次の段階(人による審査の参考)へ進むかを決めます。デフォルト率の改善の確定の判断は、影の運用や次の段階の期間の契約が観測期間を満たした時点で行う、という2段の判断を、計画書に最初から書いておきます。確定の判断で確定できるのは観測できた契約の成績で、今の基準で否決している層の結果は推定として残ります。この確定の判断の時期も、出口の一部です。
| 週 | 主な作業 | 決めること | 残すもの | 主に担う役割 |
|---|---|---|---|---|
| 第1週・第2週 | 候補の商品と段の洗い出しと採点、記録の項目の棚卸し(申込の時点の値が残っているか、審査の判断と返済の結果が結び付くか) | 最初の対象の商品と段、対象の申込の範囲 | 採点の表、記録の項目の一覧 | 事業の責任者・リスク管理・審査・営業・コンプライアンス・データ分析 |
| 第3週・第4週 | デフォルトの定義と観測期間の確認、今の審査の基準の成績の測定、KPI の木とガードレールの指標の設計、個人データの扱いと規制上の要件の確認 | デフォルトの定義、比べる相手の成績、頂点の差と管理の指標、ガードレールの指標 | 今の基準の帯ごとの承認率とデフォルト率の表、KPI の木、法務とコンプライアンスの確認の記録 | 事業の責任者・リスク管理・データ分析・審査・営業・エンジニア・法務・コンプライアンス |
| 第5週 | PoC の計画書の作成と承認 | 比べる相手・評価の方法・承認率かデフォルト率のそろえ方・否決した層の扱い・合格の条件・影の運用の範囲・出口と確定の判断の時期・判断する人 | 承認された PoC の計画書 | データ分析・リスク管理・事業の責任者 |
| 第6週から第9週 | 評価用のデータの作成(申込の月で切り、観測期間を満たした契約)、項目とモデルの作成、過去のデータでの評価、戦略曲線での比較、独立した検証 | 影の運用に進めるモデル(今の基準に勝ったもの) | 過去のデータでの評価の結果、モデルの版と文書、検証の記録 | データ分析・エンジニア・リスク管理・外部のベンダー |
| 第6週から第9週(上の行と並行) | 影の運用の仕組み(判断の時点の項目とスコアの記録)の準備 | スコアを記録する申込の範囲、判断が分かれる申込の集計の方法 | スコアの記録の仕組み、判断の時点の項目の記録 | リスク管理・エンジニア・情報システム・審査・データ分析 |
| 第10週から第12週 | 影の運用、判断が分かれる申込の層の集計、スコアと審査の担当者の判断の食い違いの確認 | (期間中は結果を見て条件を変えない) | スコアの記録、判断が分かれる申込の集計、食い違いの理由の記録、ガードレールの指標の記録 | リスク管理・審査・データ分析・エンジニア・情報システム |
| 第13週 | 分析と途中の出口の判断 | 人による審査の参考の段階へ進むか、項目やデータの見直しか、対象の変更か、中止か。確定の判断の時期の確認 | 判断の記録と理由、効果の見立て(成果の指標と機会損失の推定を並べて書く)、次の段階の計画の案 | 事業の責任者・リスク管理・データ分析 |
表の「主に担う役割」の欄は、前の責任分担の表で、その週の作業に A か R を置いた役割を並べたものです。表の第6週から第9週は、過去のデータでの評価と、影の運用の仕組みの準備を並行して進める形にしています。影の運用を3週間にしたのは90日に収めるための例で、判断が分かれる申込の件数と層を読み取るのに足りるかは、対象の申込の件数によります。評価が終わってから仕組みを作り始めると、その分だけ影の運用の開始が遅れ、PoC が90日に収まりません。過去のデータでの評価でどのモデルも今の基準に勝てなかった場合は、影の運用に進まず、第13週を待たずに出口の判断に移ります。その場合でも、第3週・第4週で測った今の基準の成績と、見つかった記録の不足は、今の基準の整理の段階の材料として残ります。PoC が不合格でも、何も残らない計画にはしないことが大事です。
第13週の出口の判断では、PoC の計画書に書いた出口のどれに当たるかを確かめるだけにし、その場で新しい合格の条件を作らないようにします。結果を見てから条件を変えると、PoC が何を確かめたのかが分からなくなります。条件を変える必要があると分かった場合は、それを次の計画書に書き、改めて承認を得ます。
導入がうまく進んでも、その後に与信スコアリングの仕組みが形だけになることがあります。序章で整理した損失の型のうち、形骸化は、監視や見直しの仕組みが働かず、変化に気づけない、あるいは気づいても対応につながらないことを指し、導入の後に時間をかけて進みます。検証したうえで今のモデルを使い続けると判断することは、形骸化ではありません。導入の時点で型を知っておき、防ぐ仕組みを最初から入れておくのがよいと考えています。本コラムでは、ここまでの章の論点から、与信スコアリングが形骸化する型を次の表に整理しました。
| 形骸化の型 | 何が起きるか | 最初から入れておく仕組み | 関連する章 |
|---|---|---|---|
| カットオフが据え置かれる | 導入の時点のカットオフのまま、申込者の層や景気が変わっても見直されず、承認率とデフォルト率が想定から離れる | カットオフの見直しの頻度と担当、収益と損失の見積りの更新 | 第9章 |
| 確率が実績と合わなくなる | 見積りのデフォルト確率と実績のデフォルト率の差が開いても、点数の並びが保たれているので気づかない | 見積りと実績の突き合わせの頻度と担当、再較正の基準 | 第8章・第12章 |
| 監視の結果が見直しにつながらない | スコアの分布の変化を毎月報告しているが、誰も判断をしないまま報告だけが続く | どの兆候でどの見直し(再較正・再推定・再構築)を行うかの基準と、判断する人 | 第12章 |
| 人による判断の変更が記録されない | 審査の担当者がスコアと違う判断をしても理由が残らず、変更の実績を追えない | 判断を変えたときの理由の記録の項目、変更した契約の実績の定期的な集計 | 第9章 |
| 否決した層の情報が増えない | 承認した層の結果だけで再推定(第12章)を繰り返し、承認の範囲の外のことが分からないままになる | 否決した申込の記録、他社での状況の確認や限られた件数の承認の方針 | 第6章 |
| 担当が1人 | モデルと承認の基準を分かっている担当者が異動すると、見直しが止まる | モデルの文書と手順書、少なくとも2人が担える体制 | 本章・第12章 |
| 成果を測らない | 導入の時点で成績を確かめた後、測り直さないので、効果が薄れても気づかない | 成果の指標(収益と貸し倒れの損失の差)と機会損失の推定を並べた定期の報告 | 第9章・本章 |
| 検証が作った人の中で閉じる | モデルを作った人だけが成績を確かめ、独立した検証や監査が入らない | 独立した検証、内部監査の計画への組み込み | 本章・第12章 |
表の型は、どれも導入の後に気づくと手間がかかるものです。人が判断を変えた記録が無いまま何年も運用すると、スコアと人の判断のどちらが良かったのかを判断する材料が無くなります。否決した申込の記録を残さないまま運用すると、承認の基準を変えたいときに、その影響を見積もる材料がありません。どの型も、導入の最初の90日の中で、記録の項目と担当と見直しの時期を決めておけば防ぎやすくなります。
経営判断、PoC の出口と成果の測り方を先に決める
この章の内容を、経営の判断に置き換えます。与信スコアリングの導入で経営が決めることは、どのモデルやどの製品を使うかではなく、どの商品で、どの水準の承認率とデフォルト率を目指し、どの条件で、誰の責任で進めるかです。とくに、PoC の出口と成果の測り方を始める前に決めることと、成果の指標(収益と貸し倒れの損失の差)と機会損失の推定を並べて報告させることの2つは、経営の判断として明文化しておくのがよいと考えています。
判断を誤ったときの損失は、序章で整理した6つの損失の型で整理できます。AR値の比較だけで導入を決め、承認率をそろえた比べ方をしないと、承認を広げた部分の貸し倒れが観測期間の後に表れるおそれがあります。デフォルト率だけを KPI の頂点に置くと、基準が厳しくなり続け、返済できたはずの申込を断る機会損失が、記録に残らないまま増えるおそれがあります。承認率と申込の件数の伸びだけを見て与信の範囲を広げると、返済の能力を超える与信が増え、過剰与信による顧客の不利益が生じるおそれがあります。人による確認へ回す帯を審査の能力と合わせて決めないと、審査の滞りが生じます。PoC の出口と見直しの基準を決めずに始めると、PoC が延長され続けるか、導入したモデルが見直されないまま使われる形骸化になりやすくなります。審査の流れを変えるときにコンプライアンスと内部監査を外すと、返済の能力の調査や記録の手続きが抜け、規制上の義務の不履行につながるおそれがあります。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- どの商品で、どの水準の承認率とデフォルト率を目指すのかを経営として決め、事業の責任者が設計する KPI の木の頂点に、収益と貸し倒れの損失の差を置き、機会損失の推定を並べる
- PoC の計画書に、比べる相手(今の審査の基準)・承認率かデフォルト率のそろえ方・否決した層の扱い・合格の条件・出口と確定の判断の時期・判断する人を書くことを、PoC の予算を付ける条件にする
- 成果の指標(収益と貸し倒れの損失の差)と機会損失の推定を同じ表に並べて報告し、AR値や承認率は管理の指標として別の欄に置くことを、報告の書式として決める
- 過去のデータでの評価で終わらせず、影の運用まで進めることと、観測期間を満たした時点で確定の判断をすることを、PoC の標準にする
- デフォルトの定義、判断と結果の記録、評価用のデータ、成果の定義を社内に持ち、外部のスコアや製品を替えても同じ物差しで比べられるようにする
- モデルを作る人・独立して検証する人・監査する人を分け、内部監査の計画に与信スコアリングの仕組みを入れる
予算の面では、与信スコアリングの予算をモデルの開発や製品の利用だけに付けるのではなく、申込と審査の判断と返済の結果を結び付ける記録の整備、今の基準の成績の測定、否決した層の情報を得るための費用(限られた件数の承認を行う場合の貸し倒れの増加を含む)、導入の後に成績を測り続ける作業にも付けることを勧めます。これらは目に見える機能の形をとらない作業ですが、ここに予算と人の時間が付いていないと、PoC の結果の意味が定まらず、展開の判断ができません。また、成果の確定が観測期間の後になるので、予算の期間と評価の時期がずれることを、予算を付ける時点で経営が了解しておくことも大事です。体制の面では、事業の責任者・リスク管理・審査が PoC の最初から関わり、合格の条件と出口を自分の言葉で承認することを、導入の条件にするのがよいと考えています。データ分析の担当者だけで進んだ PoC は、過去のデータでの AR値が良くても、承認率とデフォルト率と審査の負担がどう変わるのかを説明できず、展開の段階で目的から見直すことになりやすいからです。
この章の要点をまとめます。最初の対象は、件数と人による審査の負担(取り組む価値)、デフォルトの件数と結果のデータの有無(確かめやすさ)、規制上の要件の整理で選びます。目標は、今の審査の基準の成績を測ってから、実績として測れる収益と貸し倒れの損失の差を頂点に置き、機会損失の推定を横に並べた KPI の木で立て、承認率・デフォルト率・審査の所要時間・回収は管理の指標として分解します。PoC は過去のデータでの評価と影の運用の2段で設計し、承認率かデフォルト率をそろえた比べ方・否決した層の扱い・合格の条件・出口と確定の判断の時期を始める前に決め、効果は率と件数の型で書きます。展開は、今の基準の整理から PoC、人による審査の参考、一部の自動判定、自動判定の範囲の拡大へと段階を分けます。体制は、作る人・確かめる人・監査する人を分け、内製と外部のどれを選んでも、定義・記録・評価用のデータ・成果の定義・測り直す主導権を社内に残します。次の第14章では、貸金業法や割賦販売法、個人情報保護法、銀行の自己資本比率規制、EU の規制とガイドライン、公開事例と最新の動向を扱います。
Anagraftでは、与信スコアリングを含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『AI・データ分析プロジェクトのすべて[ビジネス力×技術力=価値創出]』(大城信晃 監修、大城信晃、マスクド・アナライズ、伊藤徹郎、小西哲平、西原成輝、油井志郎 著、技術評論社):版元のページでは2020年12月の発売で、データ分析のプロジェクトを準備・入口・実行・出口の4部に分け、社内での案件の獲得と外部の資源の検討、データのリスク管理と契約、分析の結果の評価と改善、プロジェクトの価値と継続性までを扱っています。この章で扱った PoC の出口の決め方や、内製と外部の分担、契約の段階で決めておくことを、与信に限らないデータ分析のプロジェクトの進め方として考え直すときの手がかりになります。
『データ分析・AIを実務に活かす データドリブン思考』(河本薫 著、ダイヤモンド社):版元のページでは2022年1月の発行で、データ分析が成功しても事業で失敗する理由から始め、分析を事業の成果につなげる考え方と、データに基づいて判断する企業へ変わるための論点を章立てにしています。この章で扱った、AR値のような分析の成績ではなく、承認率とデフォルト率、収益と損失の差という事業の物差しで導入を判断する考え方を、組織の側から考えるときに参考になります。
第14章 規制とガイドライン、公開事例と最新動向
第13章では、どの商品のどの段から与信スコアリングを始めるかの選び方、KPI の木、PoC の出口、内製と外部の分担を扱いました。第1章から第13章は、与信スコアリングを自社の判断で設計し、動かし続けるための話でした。ただ、与信の設計には、自社だけでは決められない前提があります。法令が与信を行う事業者に課している返済の能力の調査の義務、信用情報の使い方の制限、利息の上限、取り立ての規制、個人データの取り扱いの制限、銀行の自己資本の規制、海外の規制です。この章では、それらを一次情報で確かめた範囲で整理し、あわせて企業や団体が公表している与信スコアリングの取り組み、研究で使われる公開データセット、最近の動向をまとめます。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 貸金業法の返済能力の調査・過剰貸付けの禁止・指定信用情報機関の利用・取り立ての規制
- 割賦販売法の支払可能見込額の調査と、技術を使った与信の審査を認める認定の制度
- 利息の上限(利息制限法と出資法)、銀行のカードローンに関する業界の申し合わせ
- 指定信用情報機関の制度と、個人情報保護法の規定
- 銀行の自己資本比率規制と内部格付手法、金融庁のモデル・リスク管理に関する原則
- EU の AI 規則・一般データ保護規則・消費者信用指令、米国の信用機会均等法と公正信用報告法
- 公開事例、公開データセット、最近の動向、規制の対応が形だけになる型と経営判断
法令の条番号・施行日、ガイドラインの版と公表日は、2026年11月13日に e-Gov 法令検索・金融庁・経済産業省(一部はウェブアーカイブの写し)・個人情報保護委員会・EUR-Lex などの公式の資料を開いて確かめました。法令とガイドラインはこの後も改正されることがあるので、実際の対応の前には最新の版を確かめてください。また、本コラムは法律の助言ではありません。ここに挙げる義務は、それぞれの法令の対象になる事業者に課されるもので、自社の事業にどの規定が適用されるか、自社の商品が法令のどの定義に当たるかは、所管の官庁の資料と専門家の判断で確かめる必要があります。
この章の主張は、法令上の義務と顧客の保護を、与信の設計の後から合わせるのではなく、設計の前提に置くことです。序章で、損失の型の1つとして「規制上の義務の不履行」を挙げました。返済の能力の調査、信用情報の使い方、調査の記録の保存などの義務は、モデルの順位づけの成績とは別に、仕組みとして果たせているかが問われます。また、序章のもう1つの型である「過剰与信による顧客の不利益」は、本コラムの整理では、ここで扱う返済能力や支払可能見込額の調査を求める規定と関わる型です。なお、本コラムの例題で使ってきたデフォルトの定義(第2章)は説明のための単純な定義で、銀行の自己資本比率規制などの規制上の定義とは違います。
どの規定がどの事業に主に関わるかの目安を次の表にまとめました。表は本コラムが整理した目安で、実際に対象になるかは、それぞれの法令の定義と所管の官庁の資料で確かめる必要があります。表の行に当たらない事業(リース・保証・通信の分割払いなど)は、本章では確かめていないので、取引の形に応じて所管官庁や専門家に確かめてください。
| 法令やガイドライン | 主に関わる事業 | 与信スコアリングとの主な接点 |
|---|---|---|
| 貸金業法 | 貸金業の登録を受けて金銭の貸付けを行う事業者(消費者向けの貸付けなど) | 返済能力の調査、過剰貸付けの禁止、指定信用情報機関の信用情報の使用と目的外使用の禁止、調査の記録、取り立ての規制 |
| 割賦販売法 | クレジットカードなどの包括信用購入あっせん、個別の分割払いの個別信用購入あっせんを行う事業者 | 支払可能見込額の調査と、それを超える与信の禁止、認定包括信用購入あっせん業者の制度 |
| 利息制限法・出資法 | 金銭の貸付けを行う者 | リスクに応じた金利を考えるときの上限 |
| 全国銀行協会の申し合わせ | 銀行(消費者向けの貸付け、いわゆるカードローン) | 返済能力の確認の体制、審査の態勢 |
| 個人情報保護法 | 個人情報を取り扱う事業者(業種を問わない) | 利用目的、要配慮個人情報、第三者提供、個人関連情報 |
| 自己資本比率規制(バーゼル規制)、モデル・リスク管理に関する原則 | 銀行など、金融庁が監督する金融機関 | デフォルト確率を自社で見積もる内部格付手法、モデルの管理の体制 |
| EU の AI 規則・一般データ保護規則・消費者信用指令 | EU の域内で与信を行う事業者や、域内の人の個人データを扱う事業者など | 信用力の評価の AI を高リスクとする扱い、自動化された決定、信用力の評価の義務 |
| 米国の信用機会均等法・公正信用報告法 | 米国で与信を行う事業者 | 差別の禁止と不利益な決定の通知、信用報告の利用 |
| 後払いの決済(参考) | EC などで後払いや分割払いを提供する事業者 | 割賦販売法の対象になるかは、支払いの時期と仕組みによって変わる(定義の詳細は割賦販売法の節)。取引の形ごとに所管官庁や専門家に確かめる |
| 企業間の掛け売り(参考) | 企業に商品やサービスを先に提供し、後で代金を受け取る事業者 | 貸金業法の第13条第2項(指定信用情報機関の信用情報の使用)と第13条の2第2項(個人過剰貸付契約)は、条文に「個人である顧客等」「個人顧客」と書かれている。第13条第1項の返済能力の調査は「顧客等」と書いており、個人に限っていない。割賦販売法の第30条の2は、調査の対象の利用者を「個人である利用者に限る」としている。また、割賦販売法の第35条の3の60第1号は、申込みをした者などが「営業のために若しくは営業として締結するもの」に係る包括信用購入あっせんには、同条が置かれた章の規定を適用しないと定めている。掛け売りがほかの規定の対象になるかは取引の形によって違うので、所管官庁や専門家に確かめる。個人情報保護法は、取引先の担当者などの個人情報を扱う場合に関わりうる |
貸金業法、返済能力の調査と過剰貸付けの禁止
消費者向けの貸付けを行う事業者にとって中心になる法律が、貸金業法(昭和58年法律第32号)です。2026年11月13日に e-Gov 法令検索で確かめた現在の条文は、2025年10月1日施行の版でした。改正履歴には、令和5年法律第53号(民事関係手続等における情報通信技術の活用等の推進を図るための関係法律の整備に関する法律)による改正が未施行として表示されており、施行日は「公布の日から起算して五年を超えない範囲内において政令で定める日」で、上限にあたる2028年6月13日が表示されています。この未施行の改正の中身は、本コラムでは確かめていません。
与信スコアリングの設計に関わる規定を、e-Gov 法令検索の条文で確かめた範囲で次の表にまとめました。条文の文言は長いので、要旨を本コラムの言葉で書いています。
| 規定 | 条番号 | 内容の要旨 | 与信スコアリングの設計との関係 |
|---|---|---|---|
| 返済能力の調査 | 第13条第1項・第2項 | 貸付けの契約を結ぼうとするときは、顧客等の収入や収益その他の資力、信用、借入れの状況、返済計画その他の返済能力に関する事項を調査しなければならない(第1項)。個人の顧客との貸付けの契約(極度方式貸付けに係る契約など内閣府令で定めるものを除く)では、調査の際に指定信用情報機関が保有する信用情報を使用しなければならない(第2項) | スコアを調査の材料に使えるかは、条文には書かれていない。モデルの入力と調査の項目の対応を確かめておく |
| 資力を明らかにする書面の提出 | 第13条第3項 | 自社の貸付けの合計額が一定の額を超える場合や、他の貸金業者の貸付けの残高を合わせた額が一定の額を超える場合などに、源泉徴収票など資力を明らかにする書面などの提出を受けなければならない | 申込の経路と書類の受け取りの手順を、スコアによる判定の流れと別に設計しておく必要がある |
| 調査の記録 | 第13条第4項 | 貸付けの契約を結んだときは、内閣府令で定めるところにより、調査に関する記録を作成し、保存しなければならない | 判定の時点の入力・スコア・判断を残す記録(第12章)と、法令が求める調査の記録の関係を整理しておく |
| 極度額の増額 | 第13条第5項 | 極度方式基本契約(与信枠の範囲で繰り返し借りられる契約)の極度額(その与信枠の上限)を増額する場合にも、内閣府令で定める場合を除いて、前各項の規定を準用する | 途上与信で与信枠を増やす判断(第10章)にも、調査の義務がかかる場合がある |
| 過剰貸付け等の禁止 | 第13条の2 | 調査により、個人過剰貸付契約その他顧客等の返済能力を超える貸付けの契約と認められるときは、契約を結んではならない。個人過剰貸付契約は、契約によって個人顧客合算額が基準額(年間の給与などの定期的な収入の合算額に3分の1を乗じた額)を超えることとなる契約などとされている(住宅資金の貸付けなど内閣府令で定める契約を除く) | いわゆる総量規制にあたるのは、このうち個人過剰貸付契約の部分。条文はスコアの高低に触れておらず、カットオフ(第9章)とは別の法令上の条件として扱う。判定の前段に置く設計が考えられる(当てはめは法務と確かめる事項) |
| 極度方式基本契約の途上の調査 | 第13条の3・第13条の4 | 極度方式基本契約を結んでいる場合、内閣府令で定める要件に当たるときや、内閣府令で定める期間ごとに、指定信用情報機関の信用情報を使って基準額超過極度方式基本契約に当たるかを調査しなければならない。当たると認められるときは、極度額の減額など極度方式貸付けを抑制する措置を講じなければならない | 途上与信(第10章)の一部が法令上の義務になっている。行動スコアでの見直しとは別に、法令上の調査の時期を運用の暦に組み込む |
表の第13条の2のうち、第2項の個人過剰貸付契約の部分が、いわゆる総量規制にあたります。条文の上では、基準額は「年間の給与及びこれに類する定期的な収入の金額として内閣府令で定めるものを合算した額に三分の一を乗じて得た額」と定められています。条文はスコアの高低に触れておらず、本コラムの設計の考え方としては、この規定をスコアとは別に働く上限として扱うことになります。第9章で扱ったカットオフは、スコアの上での承認の候補を決める境目でした。最終の判断は、返済の能力の調査など法令上の条件と、その他の審査の基準を合わせて決まります。モデルの学習と評価の段階でも、法令上の条件で承認できなかった申込を、スコアで否決した申込と区別して記録しておくと、承認率やデフォルト率を正しく読めます(第6章の否決した申込の扱いとも関わります)。
第13条第1項は、調査する事項として「資力、信用、借入れの状況、返済計画その他の返済能力に関する事項」を挙げていますが、それを統計のモデルで評価してよいか、評価しなければならないかは書いていません。スコアを使う場合に、法令が求める調査の水準を満たしているかは、条文だけでは決まらず、所管の官庁の監督の指針や業界団体の自主規制の規則なども合わせて確かめる事項です。本コラムでは、それらの指針の該当箇所までは確かめていないので、内容は書きません。
貸金業法の指定信用情報機関と取り立ての規制
第13条第2項で調査に使うことが義務づけられている信用情報は、指定信用情報機関が保有するものです。貸金業法の第41条の13は、内閣総理大臣が、一定の要件を備える者を申請により、信用情報提供等業務を行う者として指定できると定めています。指定を受けた機関と信用情報を提供し合う契約を結んだ貸金業者(加入貸金業者)には、次のような義務がかかります。
- 個人の顧客との貸付けの契約の情報を、指定信用情報機関に提供すること(第41条の35)
- 指定信用情報機関に信用情報の提供を依頼する場合などに、あらかじめ資金需要者等から書面または電磁的方法による同意を得ること(第41条の36)
- 返済能力の調査など法律が定める調査(返済能力等調査)以外の目的で信用情報の提供を依頼したり、提供を受けた信用情報を返済能力等調査以外の目的に使ったり、第三者に提供したりしないこと(第41条の38)
与信スコアリングとの関係で特に注意したいのが、第41条の38の目的外使用の禁止です。条文は、返済能力等調査として、資金需要者等の借入金の返済能力その他の金銭債務の弁済能力の調査などを挙げ、それ以外の目的で信用情報の提供を依頼すること、提供を受けた信用情報を返済能力等調査以外の目的に使うこと、第三者に提供することを禁じています。割賦販売法にも、指定信用情報機関から受け取った特定信用情報の目的外使用等の禁止の規定があります(第35条の3の59)。金融分野のガイドライン第12条も、個人信用情報機関から得た返済能力に関する情報を、返済能力の調査以外の目的に使わないよう慎重に扱うこととしています(後の節の表)。
与信スコアリングでは、信用情報を、学習用のデータとして保存してモデルの開発に使う、否決した申込のその後を信用情報で確かめる(第6章・第13章)、営業の対象を選ぶ、といった使い方が考えられます。これらの使い方が条文の「返済能力等調査」に当たるかは、本コラムでは確かめていません。自社で使う前に、条文と所管の官庁の資料をもとに、法務・コンプライアンスと確かめる必要がある事項です。
回収の段階の規制も、与信スコアリングの運用に関わります。第10章で扱った回収のスコアリングは、延滞した契約のうちどれに先に連絡するかを決める仕組みでした。貸金業法の第21条は、貸金業を営む者や取り立ての委託を受けた者が、債権の取り立てにあたって、人を威迫し、または人の私生活や業務の平穏を害するような言動をしてはならないと定めています。条文が挙げる例には、次のようなものがあります。
- 正当な理由がないのに、社会通念に照らし不適当と認められる時間帯(内閣府令で定める時間帯)に電話をかけたり、居宅を訪問したりすること
- 正当な理由がないのに、勤務先など居宅以外の場所に電話をかけたり、訪問したりすること
- 借入れに関する事実などを、債務者等以外の者に明らかにすること
- 債務者等以外の者からの借入れなどで、返済の資金を調達するよう要求すること
回収のスコアで連絡の順番と時刻を自動で決める場合、連絡の時間帯や連絡先の条件をどう仕組みに組み込むかは、条文の「正当な理由がないのに」などの要件を含めて、法務と確かめておく事項です。
また、第12条の9は、資金需要者等の利益の保護のために必要と認められる場合に、借入れや返済に関する相談や助言などの支援を適正かつ確実に行うことができると認められる団体を紹介するよう努めなければならないと定めています。延滞の段階が進んだ顧客への連絡(第10章)の文面や手順に、相談の窓口の案内を含めるかどうかは、この規定とも関わる設計の判断です。
割賦販売法、支払可能見込額の調査と認定包括信用購入あっせん業者
クレジットカードや分割払いの与信には、割賦販売法(昭和36年法律第159号)が関わります。2026年11月13日に e-Gov 法令検索で確かめた現在の条文は、2025年6月1日施行の版でした。この法律は、カードなどを交付して利用者が繰り返し使える与信を「包括信用購入あっせん」、カードなどを使わずに特定の販売に結びつけて行う与信を「個別信用購入あっせん」と定義しています(第2条第3項・第4項)。包括信用購入あっせんの定義のうち第2条第3項第1号の形のものと、個別信用購入あっせんの定義(第4項)には、契約を結んだときから2か月を超えない範囲内においてあらかじめ定められた時期までに受け取るものを除く文言があります。包括信用購入あっせんの第3項第2号の形のもの(あらかじめ定められた時期ごとに、代金の合計額を基礎として定められた方法で算定した額を受け取るもの)には、同じ除外の文言はありません。後払いの決済のうち、どれがこの法律の対象になるかは、支払いの時期と仕組みによって変わります。自社の商品がどちらに当たるか、または当たらないかは、所管の経済産業省の資料と専門家の判断で確かめる事項です。
包括信用購入あっせんについて、第30条の2は、カードなどを交付しようとする場合や極度額を増額しようとする場合に、年収、預貯金、信用購入あっせんに係る債務の支払いの状況、借入れの状況など、利用者の包括支払可能見込額を算定するために必要な事項を調査しなければならないと定めています(第1項)。包括支払可能見込額は、住宅など一定の資産を譲渡したり担保に入れたりせず、生活維持費に充てるべき金銭を使わずに、利用者が支払いに充てられると見込まれる1年間あたりの額と定義されています(第2項)。調査には指定信用情報機関が保有する特定信用情報を使わなければならず(第3項)、調査の記録を作って保存しなければなりません(第4項)。第30条の2の2は、極度額が、包括支払可能見込額に経済産業大臣と内閣総理大臣が定める割合を乗じた額を超えるときは、カードなどを交付したり極度額を増額したりしてはならないと定めています。個別信用購入あっせんにも、第35条の3の3(個別支払可能見込額の調査)と第35条の3の4(それを超える契約の締結の禁止)に同じ形の規定があります。
与信スコアリングの観点から重要なのが、2020年の改正で設けられた認定包括信用購入あっせん業者の制度です。e-Gov 法令検索の改正履歴では、令和2年法律第64号(割賦販売法の一部を改正する法律)による改正が2021年4月1日に施行されたと表示されています。第30条の5の4は、包括信用購入あっせん業者が、包括支払可能見込額に代えて「利用者支払可能見込額」の算定を行おうとする場合に、次の2つに当たることについて経済産業大臣の認定を受けられると定めています。
- 算定の方法が、利用者の支払能力に関する情報を高度な技術的手法を用いて分析することにより、利用者支払可能見込額を適確に算定できるものとして経済産業省令で定める基準に適合すること(第1項第1号)
- 算定を行う体制が、経済産業省令で定める基準に適合すること(第1項第2号)
認定を受けた事業者には、第30条の2(包括支払可能見込額の調査)と第30条の2の2が適用されません(第30条の5の4第6項)。代わりに次の義務がかかります。
- カードの交付や極度額の増額に先立って、認定を受けた方法で利用者支払可能見込額を算定すること(第30条の5の5第1項)
- 算定に必要な事項の調査に、指定信用情報機関の特定信用情報を使うこと(同条第2項)
- 算定の記録を作って保存すること(同条第3項)
- 定期的に、算定の実績その他経済産業省令で定める事項を経済産業大臣に報告すること(同条第4項)
- 極度額が利用者支払可能見込額を超えるときは、カードの交付や増額をしないこと(第30条の5の6)
算定の方法や体制を変えようとするときは変更の認定が要り(第30条の5の4第3項)、基準に適合しなくなったと認められるときなどには認定を取り消せるとされています(同条第5項)。報告する「算定の実績」に、延滞の率などのどの指標が含まれるかは経済産業省令に委ねられており、本コラムでは省令の中身は確かめていません。
条文が書いているのは「高度な技術的手法を用いて分析する」算定の方法で、統計や機械学習のモデルという語は使っていません。モデルによる与信の審査がこれに当たるかは、経済産業省令の基準と経済産業省の資料で確かめる事項です。そのうえで、本コラムの第12章との類比として見ると、第12章で扱ったモデルの変更の承認、実績の定期的な確認、使用の制限の考え方と、この制度の「変更の認定」「算定の実績の報告」「基準に適合しなくなったときの取消し」は、同じような管理の場面を扱っています。認定の基準の中身と、認定を受けた事業者の名前は、経済産業省の公式の資料で確かめる必要があります。
割賦販売法には、極度額が政令で定める金額以下の包括信用購入あっせんを営む「登録少額包括信用購入あっせん業者」の制度もあります(第35条の2の3)。この事業者にも利用者支払可能見込額の算定と、それを超える交付の禁止の規定があります(第35条の2の4・第35条の2の5)。また、割賦販売法の指定信用情報機関は、経済産業大臣が指定します(第35条の3の36)。指定信用情報機関から受け取った特定信用情報の目的外使用も禁止されています(第35条の3の59)。
利息の上限と、銀行のカードローンに関する申し合わせ
第9章では、デフォルト確率に応じて金利を変える考え方に触れました。その考え方には、法令による上限があります。利息制限法(昭和29年法律第100号)の第1条は、金銭を目的とする消費貸借における利息の契約は、元本の額の3つの区分に応じて、元本が小さい区分ほど高い率、大きい区分ほど低い率を上限とし、年2割・年1割8分・年1割5分の利率で計算した額を超えるときは、超える部分について無効とすると定めています。出資の受入れ、預り金及び金利等の取締りに関する法律(昭和29年法律第195号。以下、出資法)の第5条第2項は、業として金銭の貸付けを行う者が年20パーセントを超える割合による利息の契約をしたときの罰則を定めています。貸金業法の第12条の8第1項は、貸金業者が利息制限法第1条に規定する金額を超える利息の契約を結んではならないと定めています。リスクに応じた金利の設計は、これらの上限の範囲の中で考えることになります。上限があるので、デフォルト確率の差を金利の差で吸収できる範囲は限られ、カットオフと与信枠の側での調整(第9章)と組み合わせて考える必要がある、というのが設計の上での本コラムの見方です。
2026年11月13日に e-Gov 法令検索で確かめた現在の条文は、利息制限法が2010年6月18日施行の版、出資法が2025年6月1日施行の版でした。本コラムでは、例題の金利の水準を相対値で扱い、具体的な金利の数字は書いていません。
銀行の消費者向けの貸付け(いわゆる銀行カードローン)は、貸金業法の総量規制の対象ではありません。全国銀行協会が2017年3月16日に公表した「銀行による消費者向け貸付けに係る申し合わせ」は、銀行の消費者向け貸付けは改正貸金業法の適用の対象外であるものの、金融庁の監督指針で多重債務の発生の抑制の趣旨や顧客保護の観点を踏まえた態勢の整備が求められていると書いたうえで、会員銀行の取り組みとして、配慮に欠けた広告・宣伝の抑制と、審査態勢等の整備を申し合わせています。審査態勢等の整備の例としては、次のような点が挙げられています。
- 年収証明書や自ら保有する顧客の情報などで、顧客の収入の状況や返済能力をより正確に把握すること
- 信用情報機関の情報などを活用し、自行・他行のカードローンや貸金業者の貸付けを勘案して返済能力などを確認すること
- 信用保証会社による代位弁済の率や応諾の率の推移、年収に対する借入れの状況と代位弁済の率との相関などを定期的に分析し、審査の適切性について信用保証会社と意思疎通をすること
- 貸付けの後も、顧客の状況などに応じて、定期的に信用状況の変動の把握に努めること
この申し合わせは法令ではなく業界団体の自主的な取り決めです。申し合わせの文面には、スコアやモデルという語は出てきません。本コラムの側から対応づけると、3つ目の項目の代位弁済の率や応諾の率の推移の分析は、承認した契約の実績を定期的に分析すること(第7章・第12章)に、4つ目の項目の貸付けの後の信用状況の把握は、途上与信(第10章)に近い場面を扱っています。全国銀行協会は2022年2月17日に、成年年齢の引下げを踏まえた若年者向けの貸付けについての申し合わせも別に公表しています。本コラムでは、2017年の申し合わせのその後の改定の有無は確かめていません。
指定信用情報機関の制度と、個人情報保護法の規定
ここまでの2つの法律に出てきた指定信用情報機関は、法律ごとに指定の根拠が違います。貸金業法では内閣総理大臣が指定し(第41条の13)、割賦販売法では経済産業大臣が指定します(第35条の3の36)。2026年11月13日に各機関の公式のページで確かめた範囲では、株式会社シー・アイ・シー(CIC)は割賦販売法第35条の3の36第1項と貸金業法第41条の13第1項の規定に基づく指定信用情報機関であると、株式会社日本信用情報機構(JICC)は貸金業法に基づく指定信用情報機関であると、それぞれ記載しています。全国銀行協会が運営する全国銀行個人信用情報センターは、銀行などが会員の信用情報機関ですが、本コラムでは、これが上の2つの法律に基づく指定を受けているかの記載は確かめていません。
与信スコアリングでは、信用情報機関から得た情報(本コラムでいう信用情報)が、申込のスコアの重要な入力になります(第2章)。そのときの使い方の制限は、指定信用情報機関の制度の規定(貸金業法第41条の38、割賦販売法第35条の3の59の目的外使用の禁止)に加えて、個人情報保護法とその分野別のガイドラインにも書かれています。
個人情報の保護に関する法律(平成15年法律第57号。以下、個人情報保護法)について、2026年11月13日に e-Gov 法令検索で確かめた現在の条文は、2026年11月2日施行の版です。与信スコアリングに関わる主な規定を、条文と、個人情報保護委員会と金融庁が定める「金融分野における個人情報保護に関するガイドライン」(本コラムで開いた版は令和6年3月の版)で確かめた範囲で次の表にまとめました。
| 規定 | 根拠 | 内容の要旨 | 与信スコアリングの設計との関係 |
|---|---|---|---|
| 利用目的の特定と、与信事業での同意 | 個人情報保護法第17条、金融分野のガイドライン第2条 | 利用目的をできる限り特定する(法第17条)。ガイドラインは、与信事業に際して個人情報を取得する場合には、利用目的について本人の同意を得ることとし、契約書などでは利用目的を他の契約条項と明確に分けて書くこととしている。個人信用情報機関に提供する場合は、その旨を利用目的に明示し、同意を得ることとしている | モデルの開発や検証に使うことを含めて、どの利用目的で取得したデータかを、学習用のデータの台帳に残しておく |
| 要配慮個人情報と機微(センシティブ)情報 | 個人情報保護法第2条第3項・第20条第2項、金融分野のガイドライン第5条 | 要配慮個人情報は、人種・信条・社会的身分・病歴・犯罪の経歴などが含まれる個人情報(法第2条第3項)で、原則として本人の同意なく取得してはならない(法第20条第2項)。ガイドラインは、要配慮個人情報に加えて、労働組合への加盟・門地・本籍地・保健医療・性生活に関する情報を「機微(センシティブ)情報」とし、法令等に基づく場合など列挙した場合を除いて、取得・利用・第三者提供を行わないこととしている | これらの情報をモデルの入力に使わない(第11章の公平性の議論の前提)。代わりの項目を通じて偏りが入っていないかを別に測る |
| 第三者提供と個人信用情報機関 | 個人情報保護法第27条、金融分野のガイドライン第12条 | 本人の同意なく個人データを第三者に提供してはならない(法第27条、例外あり)。ガイドラインは、個人信用情報機関への提供では、会員企業にも情報が提供されることを本人が認識したうえで同意できるようにすること、返済能力に関する情報を個人信用情報機関に提供するときにオプトアウト(本人が求めれば提供を止める形で、同意を得ずに提供する仕組み。法第27条第2項)を使わないこと、個人信用情報機関から得た返済能力に関する情報を返済能力の調査以外の目的に使わないよう慎重に扱うことを求めている | スコアの開発をベンダーに委ねる場合や、グループ会社とデータを共有する場合は、提供か委託かを含めて扱いを確かめる |
| 個人関連情報の第三者提供 | 個人情報保護法第31条 | 提供先が個人関連情報を個人データとして取得することが想定されるときは、本人の同意が得られていることなどを確かめないで提供してはならない | 代替データ(他のサービスの利用の履歴など)を外部から受け取って申込者と結びつける場合に関わりうる |
表の金融分野のガイドラインは、金融分野の個人情報取扱事業者を対象にしています。割賦販売法の対象の事業者には、経済産業省が所管する「信用分野における個人情報保護に関するガイドライン」もあり、個人情報保護委員会のガイドラインのページでは令和6年5月17日の改正の新旧対照表が最新として掲載されていました。自社がどのガイドラインの対象になるかは、所管の官庁の資料で確かめる必要があります。また、同じページには、金融分野のガイドラインの令和9年4月1日施行の版も掲載されていました。本コラムでは、その版での変更点は確かめていません。
個人情報保護法は改正の途中にあります。令和8年法律第56号(個人情報の保護に関する法律等の一部を改正する法律)は2026年7月17日に公布され、2026年11月13日時点では未施行です。一部の改正規定は2027年1月17日に、残りは政令で定める日(上限は2028年7月16日)に施行されることになっています(日付の根拠は後の日程の表)。
個人情報保護委員会の改正法のページ(2026年10月14日の更新を含む)では、政令・規則・ガイドラインなどの検討を続けるとされていました。本コラムでは改正の中身を確かめていないので、改正後の規定を前提にした書き方はしません。与信スコアリングに関わる改正があるかは、施行の前に委員会の公表資料で確かめる必要があります。
銀行の自己資本比率規制と内部格付手法、モデル・リスク管理
銀行の与信スコアリングには、自己資本比率規制が関わります。この規制は、バーゼル銀行監督委員会が作った国際的な枠組み(バーゼル規制)を、日本では金融庁の告示として定めたものです。銀行についての告示は「銀行法第十四条の二の規定に基づき、銀行がその保有する資産等に照らし自己資本の充実の状況が適当であるかどうかを判断するための基準」(平成18年金融庁告示第19号。以下、自己資本比率告示)で、2026年11月13日に金融庁のページで確かめた全体版は、2026年8月24日の更新のものでした。
自己資本比率告示の第7章は「信用リスクの内部格付手法」です。内部格付手法は、銀行が自ら債務者や案件に格付を付け、デフォルト確率(告示では PD)、デフォルト時の損失の割合(LGD)、デフォルト時の残高(EAD)などを自ら推計して、信用リスクの量を計算する方法です(推計の対象の範囲は手法の種類によって違います)。告示の第140条は、銀行は金融庁長官の承認を受けた場合に内部格付手法を用いることができると定めています。告示の第7章の構成を見ると、内部格付制度の設計、運用、内部統制、格付の利用、リスクの定量化(デフォルトの定義、PD・LGD・EAD の推計)、内部格付制度と推計値の検証、開示についての最低要件が並んでいます。本コラムの第2章から第12章で扱った論点のうち、モデルのデータ・検証・実績の確認に近いものが、ここでは規制上の要件として書かれています。
与信スコアリングとの関係で、特に参考になる規定を2つ挙げます。1つ目は第189条(モデルの利用)です。格付の付与や PD などの推計に統計的なモデルを使う場合の要件として、次のようなものを挙げています。
- モデルの予測能力が高く、入力の変数が結果に対する合理的な予測変数であること、出力に適用する債務者や額の観点で重大な偏りが無いこと
- モデルに入れるデータについて、正確性・完全性・適切性の評価などの審査の手続きを行うこと
- モデルの構築に使ったデータが、実際の債務者やエクスポージャー(与信の対象になっている資産)の母集団を代表するものであること
- 人の判断と組み合わせる場合は、人の判断がモデルで考慮されていない重要な情報を網羅し、組み合わせ方の書面の指針があること
- モデルに基づく格付に人による見直しの手続きがあり、モデルの運用の実績と安定性の評価、実績とモデルの予測の対照などの検証を定期的に行うこと
3つ目の項目は、第6章で扱った「承認した契約だけで作ったモデルは、申込の全体を代表しない」という問題と同じ方向を向いています。4つ目は第9章のスコアの上書きの記録、5つ目は第8章の較正の確認と第12章の監視に対応します。
2つ目は第205条(デフォルトの定義)です。この告示でのデフォルトは、債務者について、金融再生法施行規則の債権の区分(破産更生債権及びこれらに準ずる債権・危険債権・要管理債権)に当たると銀行が査定する事由が生じることなどと定められており、リテール向けのエクスポージャーについては延滞の日数に関する扱いの規定もあります。本コラムの例題で使ってきた「契約の実行から12か月以内に延滞が90日以上に達すること」という定義(第2章)は、説明のための単純な定義で、この告示の定義とは違います。告示の第209条は、内部格付手法採用行が、デフォルト事由に基づいて資産区分ごとにデフォルト事由の発生を記録し、PD などの推計を行うものとしています(同条には要件つきの例外の規定もあります)。自社のモデルの推計が告示の定義とどう対応している必要があるかは、第209条と第7章の推計の規定(第213条以下)で確かめる事項です。
バーゼル規制には、最終化されたバーゼルIIIと呼ばれる見直しがあります。金融庁のページによると、その国内での適用の時期は、国際統一基準の金融機関と内部モデルを採用する国内基準の金融機関(最終指定親会社を除く)が2024年3月31日から、内部モデルを採用しない国内基準の金融機関と最終指定親会社が2025年3月31日からで、2023年3月31日以降は届出による早めの適用も認められていました。最終化されたバーゼルIIIの中身(内部格付手法の使える範囲の見直しなど)は、本コラムでは確かめていないので書きません。
銀行のモデルの管理については、金融庁が2021年11月12日に「モデル・リスク管理に関する原則」を公表しています。この原則は、モデル・リスクを、モデルの誤りや不適切な使用に基づく意思決定によって悪影響が生じるリスクと位置づけ、ルールではなく原則に基づく考え方をとるとしています。適用の対象は、本邦の G-SIBs と D-SIBs(金融システムの上で重要と金融庁が指定した金融機関)と、FSB(金融安定理事会)が選んだ G-SIBs の本邦の子会社のうち金融庁のモデルの承認を受けている金融機関で、金融庁は必要に応じて対象を広げることもありうるとしています。対象のモデルの例には、信用リスクなどのリスクの計測のモデルが含まれます。原則は8つで、ガバナンス、モデルの特定・インベントリー管理(モデルの台帳)・リスク格付、モデルの開発、承認、継続的なモニタリング、検証、ベンダー・モデルと外部の資源の活用、内部監査です。中身の多くは第12章で扱ったので、ここでは位置づけだけにとどめます。適用の対象でない金融機関や、金融機関でない事業者にとっても、与信のモデルの管理の体制を考えるときの参考になると考えています。
海外の規制、EU の AI 規則・一般データ保護規則・消費者信用指令と米国の規則
EU の規制は、EU の域内で与信を行う事業者や、域内の人の個人データを扱う事業者に関わります。また、与信スコアリングを規制の中でどう位置づけるかを条文で書いている例として、日本の事業者にとっても設計の参考になります。ここでは EUR-Lex で条文を確かめた3つの規制と1つの判決を扱い、最後に米国の信用機会均等法と公正信用報告法の位置づけに触れます。
1つ目は EU の AI 規則(規則2024/1689)です。AI 規則は、附属書Ⅲに高リスクの AI システムの分野を列挙しています。その第5号(必須の民間サービス・公共サービスへのアクセスと享受)の(b)は、自然人の信用力の評価や信用スコアの設定に使うことを意図した AI システムを高リスクとし、金融の不正の検知の目的で使う AI システムを除外しています。前文の第58項は、信用スコアや信用力を評価する AI システムが、住宅・電気・通信などの必須のサービスや金融の資源へのアクセスを左右し、人や集団の間の差別や、過去の差別の型の固定につながりうることを、高リスクとする理由に挙げています。同じ項は、金融サービスの提供での不正の検知の目的や、金融機関と保険会社の自己資本の要件を計算する健全性の目的で EU の法令が定める AI システムは、この規則の下で高リスクとみなされるべきではないとしています。また、第86条第1項は、附属書Ⅲに挙げる高リスクの AI システム(第2号を除く)の出力に基づいて導入者(AI システムを使う側の事業者)が行った決定について、説明を受ける権利を定めています。対象は、決定が法的な効果を生じさせるか同様に重大な影響を及ぼし、本人がそれを健康・安全・基本的な権利に悪い影響があると考える場合で、説明の中身は、決定の過程での AI システムの役割と決定の主な要素とされています。第2項と第3項には、EU や加盟国の法令による例外と、ほかの EU の法令で同じ権利が定められている場合の扱いが書かれています。
適用の日程は、2026年に変わりました。AI 規則を改める規則2026/1744 は2026年7月27日に発効し(日付の根拠は後の日程の表)、AI 規則の第113条を改めました。改正後の第113条では、附属書Ⅲに基づく高リスクの AI システムに関する第3章第1節から第3節(高リスクの AI システムの分類と要件、提供者と導入者の義務など。第6条第5項を除く)の適用の日は2027年12月2日とされています。前文の説明によると、当初の適用の日は2026年8月2日で、標準の準備や各国の体制の整備の遅れが変更の理由とされています。
この2027年12月2日は第3章第1節から第3節の適用の日です。先に触れた第86条(説明を受ける権利)は、AI 規則の第3章ではなく第9章に置かれた条で、第86条がいつから働くかは、本コラムでは確かめていません。どの条がいつから適用されるかは第113条の各号で分かれているので、自社に関わる規定ごとに確かめる必要があります。本コラムでは、改正後の統合版の条文の全体は確かめていません。AI の社内ルールと規制の全体像は、弊社コラム「AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで」で扱っています。
2つ目は一般データ保護規則(規則2016/679)です。第22条第1項は、本人に法的な効果を生じさせる、または同様に重大な影響を及ぼす決定について、プロファイリングを含む自動化された処理だけに基づく決定に服さない権利を定めています。第2項は、契約の締結や履行に必要な場合、EU や加盟国の法令が認め本人の権利を守る適切な措置を定めている場合、本人の明示的な同意がある場合を例外とし、契約と同意の場合には、少なくとも人による関与を求める権利、意見を述べる権利、決定に異議を唱える権利を守る措置を求めています(第3項)。
この第22条について、欧州司法裁判所は2023年12月7日に、信用スコアに関わる判決を出しました(C-634/21 事件。ドイツの行政裁判所からの付託に基づく先決裁定(加盟国の裁判所が EU の法令の解釈を欧州司法裁判所に問い、同裁判所が答える手続き)で、信用情報の機関が関わった事件)。判決は要旨として、信用情報の機関による支払いの見込みの確率の値の自動の算出も、その値を受け取った第三者が契約の判断で強く頼る場合には、第22条第1項の自動化された個別の意思決定に当たりうると判断しました(判決の本文は EUR-Lex で公開されています)。この判決は、スコアを作る側と、それを使って判断する側が別の事業者であっても、スコアの算出そのものが第22条の対象になりうることを示した点で、外部のスコアを使う与信の設計に関わります。日本の法令にこの判決がそのまま当てはまるわけではありませんが、第13章で扱った外部のスコアの利用と、第11章の説明と再審査の手続きを考えるときの参考になります。
3つ目は消費者信用指令の改正です。指令2023/2225(消費者向けの信用の契約に関する指令。2023年10月18日採択)は、従来の指令2008/48を2026年11月20日付で廃止し、置き換えるものです。加盟国は2025年11月20日までに国内法を整え、2026年11月20日から適用することとされています(第48条)。基準時点の2026年11月の直後に適用が始まる規制です。第18条(消費者の信用力の評価の義務)は、次のようなことを加盟国に求めています。
- 契約の前に、消費者の利益のために、無責任な貸付けと過剰な債務を防ぐ目的で、信用力を十分に評価すること(第1項)
- 評価は、収入と支出その他の経済的な状況についての、必要で釣り合いのとれた正確な情報に基づくこと。一般データ保護規則第9条第1項の特別な種類のデータ(人種や健康などに関するデータ)を含めず、ソーシャルネットワークは外部の情報源とみなさないこと(第3項)
- 評価の手順を定めて文書にし、維持すること(第4項)
- 評価の結果が、契約上の義務が果たされる見込みを示す場合にだけ信用を提供すること(第6項)
- 評価に個人データの自動化された処理を使う場合、消費者が人による関与を求め、評価の明確で分かりやすい説明を受け、意見を述べ、評価と決定の見直しを求める権利を持つこと(第8項)
- 申込を断った場合に遅滞なく知らせ、必要に応じて債務の相談の窓口を案内し、評価が自動化された処理に基づくときはその旨を知らせること(第9項)
- 評価は信用の履歴だけに基づいてはならないこと(第11項)
第3項のソーシャルネットワークの扱いと第11項は、第5章で扱った代替データの使い方の範囲に関わります。第8項と第9項は、第11章で扱った否決の理由の説明と再審査の手続きにあたります。日本の貸金業法と割賦販売法は、返済能力や支払可能見込額の調査を義務づけていますが、自動化された処理に関する説明や人の関与を求める規定は、本コラムで確かめた範囲の条文には見当たりませんでした。
米国では、与信の差別の禁止と不利益な決定の通知を、信用機会均等法と、それを実施する規則 B(12 CFR 第1002部)が定めています。消費者金融保護局の公式のページで確かめた規則 B の第1002.1条(b)は、規則の目的を、人種・肌の色・宗教・出身国・性別・婚姻の状況・年齢(契約の能力がある場合)、収入の全部または一部が公的扶助による事実、消費者信用保護法上の権利を誠実に行使した事実に関わりなく、信用力のある申込者が信用を利用できるようにすることとしています。第1002.9条は、原則として、完成した申込(審査に必要な情報がそろった申込)を受け取ってから30日以内に、承認・条件の変更の提示・不利益な決定を通知することを求めています。事業向けの信用については、通知の期限や方法に別の定め(第1002.9条(a)(3))があります。不利益な決定の通知には、具体的な理由の説明か、理由の開示を求める権利の案内を含めることとしています。理由は具体的で主な理由を示すもので、社内の基準や方針に基づくとだけ書くことや、点数に届かなかったとだけ書くことは不十分だとされています。公式の解釈では、4つを超える理由を示すことは役に立たない可能性が高いとされています。否決の理由の出し方の詳細は第11章で扱いました。また、消費者金融保護局の最終規則のページによると、同局は2026年4月22日に公表した最終規則(2026年7月21日施行)で、規則 B の異なる影響の扱い、申込を思いとどまらせる行為の禁止、特別目的の信用プログラムの3つの分野を改めました。改正の中身は第11章で扱っています。本章で紹介した第1002.1条(b)と第1002.9条の内容は、2026年11月13日に同局のページで現行の規則として掲載されていた文言によります。
信用報告の利用については、公正信用報告法(15 U.S.C. 1681 から 1681x)と、それを実施する規則 V(12 CFR 第1022部)があります。消費者金融保護局の公正信用報告法のページは、事業者向けの資料として法律と規則 V へのリンクと、規則 V の通知のひな形を掲載しています。同じページには、2025年7月11日に連邦裁判所が規則 V の医療の債務に関する規則を無効としたこと、2025年5月15日に消費者金融保護局がデータブローカーに関する規則の案などを撤回したことも書かれていました。米国の規制は、規則の改正や撤回、裁判の結果で変わることがあるので、条文と公式の資料をその時点で確かめる必要があります。本コラムでは、公正信用報告法の各条の中身は確かめていないので、ここでは位置づけにとどめます。
ここまでの規定のうち代表的なものを、与信の段に対応させたのが次の概念図です。図は、第1章の与信の流れのうち申込と審査をまとめて、4つの段にしたものです(契約の段には記録を加えました)。図は主に日本の規定の対応で、海外の規制は含めていません。図に載せていない規定も、それぞれの段に関わります。
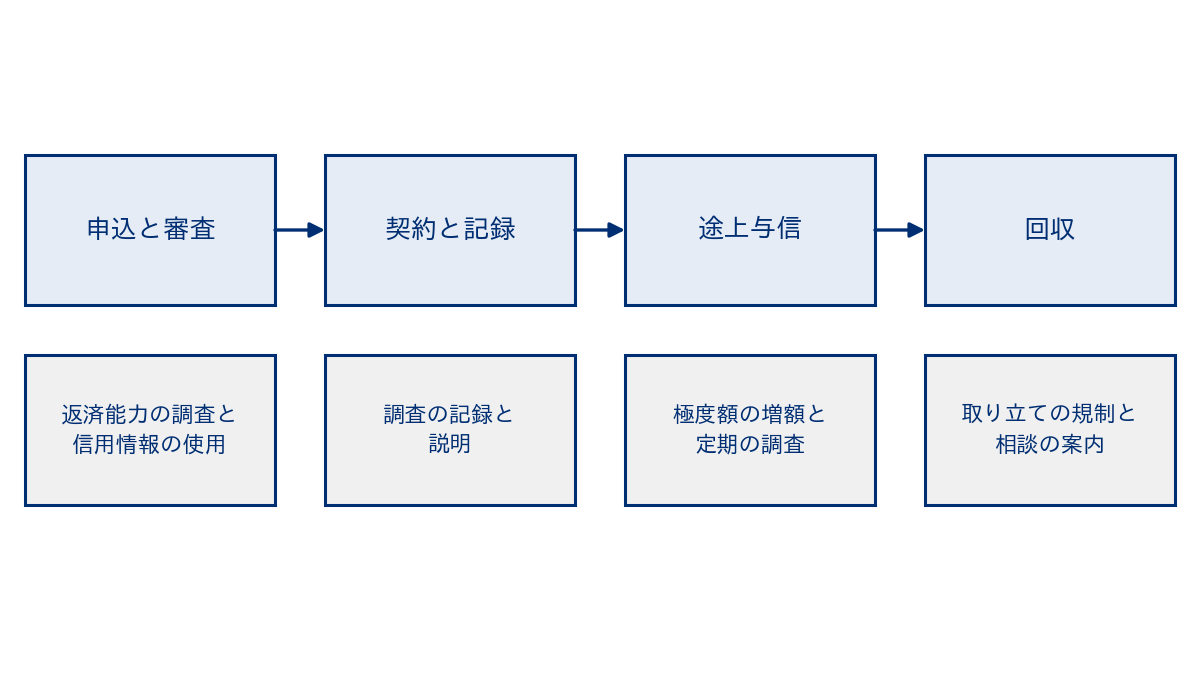
公開事例と公開データセット、企業と公的機関の取り組みと研究の数字の読み方
与信スコアリングに関わる公表資料を、企業の公式技術ブログの事例3件と、公的機関の公表資料2件(金融機関等の利用の状況の概観と、認定を受けた事業者の件数)に分けて次の表に挙げます。内容は、それぞれの資料に書かれていることだけで、資料が報告する結果は、その限定条件と合わせて紹介します。取り組みどうしを比べたり、評価したりする意図はありません。また、公表された取り組みは公表の時点のもので、今もその形で運用されているとは限りません。
| 公表した主体と時期 | 対象 | 手法と運用 | 資料に書かれた結果と限定条件 |
|---|---|---|---|
| メルペイの機械学習エンジニアの公式技術ブログ(2020年9月4日)。与信モデリングで実践していることの記事 | 後払いのサービス(メルペイスマート払い)の与信枠 | 目標の KPI を利用額と精算の率の2つとし、与信モデルの問題を精算の有無の分類として定めた。特徴量の採否は、精度のほかに、法令への適合、差別につながる情報を使わないこと、短期間で大きく変わらないこと、利用者が意図的に動かしにくいことなどで判断する。モデルの出力は、時系列での大きな変動を抑える処理や、障害の影響を受けた与信枠の是正などのルールで補正してから与信枠にする | 記事に具体的な数値は無い |
| メルペイの機械学習エンジニアの公式技術ブログ(2022年4月27日)。ビジネスチームと KPI を改善した記事 | 同じサービスの与信モデル | 事業の KPI が変わったことに合わせて予測の対象を変えた。AUC だけでは KPI に直結しないとして、利用の額を考慮した延滞の率や、モデルの更新の前後での与信枠の変化を指標に加えた。新しい与信枠の計算の模擬のために、モデルの出力を確率として読めるよう較正した | AUC の値、延滞の率の改善の幅などの数値は書かれていない |
| メルカリの公式技術ブログ(2026年11月10日。2026年9月29日のイベントの報告)。クレジットモデリングチームのイベントの報告 | 与信判断を担う機械学習モデルの開発の工程 | モデルが出すのは利用枠ではなくリスクの予測値で、それを与信方針に当てはめて利用枠に変換するのはビジネス・プロダクト側の役割と整理している。精度が上がっても収益が上がるとは限らないため、採用の判断には利用とリスクを合わせた影響の評価が要るとしている。特徴量の実装とコードのレビューに生成AIを使い、各段に人が確かめる関門を置いている | 生成AIで作った試作段階の SQL(特徴量を作るためのデータベースの問い合わせ文)11本に、人の確認の関門を置いた特徴量の実装の手順を後から当てたところ、7本で不具合が見つかったとしている(与信のモデルの成績の数値ではない) |
| 金融庁「AIディスカッションペーパー(第1.1版)」(2026年3月) | 金融機関等の AI の利用の状況(ヒアリングなどの結果) | 与信の審査の分野の利用の例として、審査や保証の審査のモデルの開発、購買のデータを使うスコアリング、信用の悪化の兆しの把握などを紹介している | 不正検知と比べて自社内に過去のデータが多く蓄積されているため、AI だけの判断でも比較的高い精度が得られると評価する回答が少なくなかったとしている(回答者の評価であり、精度の値は示されていない) |
| 経済産業省の登録事業者一覧のページ(令和8年4月末現在の件数)。2026年5月12日のウェブアーカイブの写し | 割賦販売法の登録包括信用購入あっせん業者 | 登録包括信用購入あっせん業者の一覧の見出しに、件数と、そのうち認定(第30条の5の4の認定包括信用購入あっせん業者)を受けている事業者の数が示されている | 令和8年4月末現在で241社、うち認定を受けている事業者は4社、登録少額包括信用購入あっせん業者は0社と記載されている。経済産業省のページは本コラムの取得の手段では直接開けず、ウェブアーカイブの写しで確かめた |
本コラムの各章との関係でいえば、メルペイの2020年の記事は、特徴量を精度だけでなく法令・差別・安定性・操作されにくさで選ぶという点で第3章と第11章の論点を、モデルの出力をルールで補正してから与信枠にするという点で第9章の論点を扱っています。2022年の記事は、AUC だけでは事業の指標に直結しないとして別の指標を足し、確率として読めるよう較正したという点で、第7章から第9章の論点と重なります。2026年の報告の「モデルはリスクの予測値を出し、利用枠への変換は事業の側が担う」という整理は、第9章で扱った、スコアの計算と承認の基準・与信枠の決定を分けて考える考え方に対応します。金融庁のペーパーは、説明可能性の課題への取り組みの例として、外部の事業者の評価のツールで与信審査モデルのどの変数の寄与が大きいかを可視化し、モデルの妥当性を検証している先があることも紹介しています(第11章)。
公開事例を読むときの注意も挙げておきます。ここで紹介した企業の技術ブログの記事には、与信のモデルの成績の数値は書かれていませんでした。ほかの事例を読むときも、公開されている指標や数値の範囲を確かめる必要があります。公的なペーパーのヒアリングの結果は、回答した金融機関の評価であり、精度の値ではありません。どれも、自社で同じ方法を入れたときに期待できる成果の目安にはなりません。自社での効果は、第13章で扱った PoC と影の運用で、承認した契約の収益と貸し倒れ、断った申込の機会損失の推定と合わせて確かめる必要があります。
与信スコアリングの研究では、公開されたデータセットが使われます。本コラムのコードはすべて架空の合成データで書いており、公開データセットはダウンロードしていません。ここでは、提供元の公式の登録情報で確かめた範囲で、代表的な1つを紹介します。
| データセット | 提供元と出所 | 中身 | 利用条件 | 読むときの注意 |
|---|---|---|---|---|
| Statlog の German Credit のデータ(OpenML の登録名は credit-g) | UCI 機械学習リポジトリ。1994年11月16日に寄贈。OpenML の登録情報では作成者は Hans Hofmann | 1,000件、20個の項目。当座預金の状況・期間・信用の履歴・目的・額・貯蓄・雇用の期間などの項目と、データセット上の信用リスクの分類(good と bad の2つ。人の善し悪しを表す区分ではない)がある。誤って悪いものを良いと判定する費用を、その逆の5倍とする費用の表が付いている | UCI のページでは CC BY 4.0(表示 4.0 国際)のライセンスと記載。OpenML の登録情報の licence の欄は Public | 項目に婚姻の状況と性別を合わせた項目、年齢、外国人労働者かどうかが含まれており、そのままモデルの入力にすると差別につながる属性を使うことになる(第11章)。1,000件と小さく、本コラムで確かめた20個の項目の一覧には申込の時期を表す項目が無く、時間で切った評価(第7章)はできない。結果の区分は本コラムのデフォルトの定義(第2章)とは違う |
このほかにも、データ分析のコンペティションで配布された個人向けの貸付のデータセット(Give Me Some Credit・Home Credit など)や、貸付の仲介の事業者が公開していた貸付のデータなどが研究で使われていますが、本コラムでは公式のページで件数と利用条件を確かめられなかったので、中身は書きません。
研究の数字を読むときに確かめたいことを挙げます。まず、どの指標かです。AR値や AUC は順位づけの指標で、確率の正しさや収益を表しません(第7章・第8章)。次に、評価データの切り方です。German Credit のデータのように時期の情報が無いデータでは、時間の順に学習用と評価用を分ける評価(第7章)ができず、そのデータでの成績から、将来の申込での成績を直接判断することはできません。また、German Credit のデータについて、本コラムで確かめた UCI と OpenML の説明には、否決した申込が含まれているかどうかの記載はありませんでした。公開データに否決した申込が含まれていない場合は、否決した申込の扱い(第6章)の問題がデータの側に残ります。最後に、データそのものの性質です。期間・地域・商品・デフォルトの定義が自社と違えば、同じ方法でも成績は変わります。公開データセットでの成績は「そのデータセット・その条件での値」であり、自社の申込で期待できる成績として読むことはできません。
最近の動向、データの広がり・大規模言語モデル・制度の日程
2026年11月の時点で、与信スコアリングの前提を変えうる動きを3つ挙げます。どれも、公的機関の資料や論文で確かめた範囲に限ります。
1つ目は、使うデータの広がりです。金融庁の AIディスカッションペーパーは、購買データなどを使った与信スコアリングに加えて、ニュースや SNS を使った予兆の管理の例も挙げています。一方で、EU の消費者信用指令の第18条第3項は、信用力の評価の情報に特別な種類の個人データを含めないこと、ソーシャルネットワークを外部の情報源とみなさないことを定めています。第5章で扱った代替データは、成績の上積みの見込みとあわせて、同意と利用目的(本章の個人情報保護法の節)、説明(第11章)、地域ごとの規制の違いを確かめてから使う必要があります。なお、口座の入出金のデータを与信に使う取り組みについて、本コラムでは、国内の公的機関の資料で取り組みの状況を示したものを確かめられていないので、具体的な状況は書きません。
2つ目は、大規模言語モデルを与信の判断に使う研究です。例えば、Feng らの論文(arXiv:2310.00566。2023年10月1日に初版が公開され、2024年2月18日に第3版に改訂された論文)は、与信の評価のための9つのデータセット・約1万4千件の標本からなる評価の枠組みと、指示に応じた回答を学習させるための追加の学習用のデータ(4万5千件超)を作り、信用とリスクの評価向けに調整した大規模言語モデルを提案しています。要旨は、大規模言語モデルが従来のモデルに匹敵し、上回る能力を示したとしていますが、大規模言語モデルに含まれうる偏りの検証も論文の主題の1つになっています。arXiv の頁で確かめた範囲では、査読を経た掲載先の記載はありませんでした。結果はその論文のデータと条件での値で、本コラムでは本文の数値までは確かめていません。
金融庁の同じペーパーは、与信判断のように影響の大きい判断に AI を使う場合、どのようなデータで学習したか、どのような入力や参照のデータが与えられたか、出力の記録と監視が機能しているかといった観点から、金融機関自身が判断の合理性を検証・説明できるようにする必要があるとしています。大規模言語モデルを審査に使う場合は、まず審査の担当者の作業の補助(書類の整理や、確認すべき点の洗い出し)から始め、承認と否決の判断と、その理由の説明は、本章で見た法令上の調査の義務と記録の義務を満たす仕組みの側に残すのが現実的だと考えています。補助の作業でも個人データを扱う場合は、本章の個人情報保護法の節で見た利用目的や第三者提供の点を確かめる必要があります。
3つ目は、制度の日程です。本章で触れた日付のうち、制度の変更として今後の対応に関わる主なものを抜き出し、終章と同じ3つの区分(すでに施行されている規定、公布されたが施行の前の規定、提案や審議の段階にある案)で次の表に分けました。3つ目の区分に当たるもので一次情報で確かめられたものは無かったので、表にあるのは前の2つの区分です。政令で定める日は、公布されたが施行の前の規定の中で、そのことを注記しています。基準時点は2026年11月13日です。
| 時期 | 制度 | 区分 | 日付の性質と確かめた範囲 |
|---|---|---|---|
| 2026年7月21日 | 米国の規則 B を改める消費者金融保護局の最終規則(2026年4月22日公表) | すでに施行されている規定 | 消費者金融保護局のページに記載された施行の日。改正の中身は第11章で扱っている |
| 2026年7月27日 | EU の AI 規則を改める規則2026/1744 の発効 | すでに施行されている規定 | 2026年7月24日に官報に掲載。第4条は官報の掲載の日から3日目に発効すると定め、EUR-Lex の書誌は発効の日を2026年7月27日と表示し、状態を「In force」としている |
| 2026年11月20日 | EU の消費者信用指令(指令2023/2225)の国内法の適用の開始と、従来の指令の廃止 | 公布されたが施行の前の規定(指令は官報に掲載済みで、国内法の適用の開始の前) | 指令の第48条(国内法化)と第47条(廃止と経過措置)に定められた日付。第47条は、2026年11月20日に存在する契約には原則として終了まで従来の指令が適用されるとしつつ、その時点で存在する期間の定めの無い信用の契約には、新しい指令の一部の条(第23条・第24条・第28条・第39条など)が適用されるとしている。各加盟国の国内法の整備の状況は本コラムでは確かめていない |
| 2027年1月17日 | 個人情報保護法の改正(令和8年法律第56号)の一部 | 公布されたが施行の前の規定 | 改正法の附則第1条第3号が、同号に掲げる改正規定を「公布の日から起算して六月を経過した日」に施行すると定めており、e-Gov の改正履歴はこの日付を表示している(公布は2026年7月17日)。法律で定まった日付で、政令で決まる本体の部分とは別。対象の改正規定の中身は本コラムでは確かめていない |
| 2027年12月2日 | EU の AI 規則の、附属書Ⅲに基づく高リスクの AI システム(信用力の評価を含む)に関する第3章第1節から第3節(第6条第5項を除く) | 公布されたが施行の前の規定 | 規則2026/1744 で改められた第113条の文言で定められた適用の日。当初の2026年8月2日から変更された |
| 2028年6月13日まで | 貸金業法の改正(令和5年法律第53号)の未施行の部分 | 公布されたが施行の前の規定(政令で定める日) | 「公布の日から起算して五年を超えない範囲内において政令で定める日」の上限として e-Gov に表示。中身は本コラムでは確かめていない |
| 2028年7月16日まで | 個人情報保護法の改正(令和8年法律第56号)の残りの部分 | 公布されたが施行の前の規定(政令で定める日) | 「公布の日から起算して二年を超えない範囲内において政令で定める日」の上限として e-Gov に表示。実際の施行日は政令で決まる |
提案や審議の段階にある案は、本章で一次情報を確かめられたものが無かったため、表に載せていません。個人情報保護法の節で触れた金融分野のガイドラインの令和9年4月1日施行の版は、変更点を確かめていないので表に入れていません。米国については、金融庁の同じペーパーが、2025年に米国が、AI を使った与信判断に関する消費者金融保護局の通達などを撤回したと紹介しています。消費者金融保護局の撤回した指針の一覧のページでは、複雑なアルゴリズムに基づく与信の判断での不利益な決定の通知の要件についての公表文書(Circular 2022-03)と、不利益な決定の通知の要件とひな形の使い方についての公表文書(Circular 2023-03)が、2025年5月12日に撤回されたと記載されていました。撤回されたのは公表文書で、規則 B の不利益な決定の通知の条文(第1002.9条)そのものではなく、この条文は同局のページで現行の規則として掲載されていました。撤回された文書の中身は、本コラムでは確かめていません。自社の計画では、終章と同じ3つの区分を分けて扱い、政令で定める日や海外の国内法の整備の状況は、その時点で所管の官庁の資料で確かめ直す必要があります。第12章で扱った監視の計画には、制度の変更の日付も入れておくと、入力の項目や判定の手順を変える時期を前もって準備できます。
規制の対応が形だけになる型と、経営の判断
規制とガイドラインへの対応は、書類の上では整っていても、実際の審査と与信の管理の質につながっていないことがあります。本章で確かめた規定と、第1章から第13章の内容を合わせて、形だけになる型を次の表にまとめました。型の分け方は、本コラムが考えたもので、公的な分類ではありません。関わる規定は、自社の事業に適用されるものに限られます。
| 形だけになる型 | 起きること | 関わる規定や資料 | 防ぎ方 |
|---|---|---|---|
| スコアの判定と、法令上の上限の判定が混ざっている | 総量規制や支払可能見込額の上限で承認できなかった申込が、スコアで否決した申込と区別されず、承認率やモデルの評価が歪む。上限を超える契約を見落とした場合は、適用される法令の義務を果たせないおそれがある(規制上の義務の不履行・過剰与信による顧客の不利益。当てはめは法務や所管官庁に確かめる事項) | 貸金業法第13条の2、割賦販売法第30条の2の2・第35条の3の4 | 法令上の条件の判定をスコアの判定の前段に置き、否決の理由を区別して記録する(第6章・第9章) |
| 調査の記録はあるが、判定の時点の入力とスコアが残っていない | なぜ承認したか、なぜ与信枠をその額にしたかを後から再現・検証できない。法令が求める記録の事項(内閣府令などで定める)まで欠けている場合は、記録の義務を果たせていないおそれがある(規制上の義務の不履行。当てはめは法務と確かめる事項) | 貸金業法第13条第4項、割賦販売法第30条の2第4項・第30条の5の5第3項 | 法令が求める記録に加えて、判定の時点の入力・スコア・カットオフ・判断・上書きを残す(第12章) |
| 極度額の増額と途上の調査が、行動スコアの運用と別に管理されていない | 行動スコアで与信枠を増やしたが、法令上の調査を経ていない、または定期の調査の時期を逃す。調査が求められる場面(内閣府令で除かれる場合がある)に当たる場合は、適用される法令の義務を果たせないおそれがある(規制上の義務の不履行・過剰与信による顧客の不利益。当てはめは法務や所管官庁に確かめる事項) | 貸金業法第13条第5項・第13条の3・第13条の4、割賦販売法第30条の2第1項 | 途上与信の暦に法令上の調査の時期を組み込み、与信枠の変更の手順に調査を入れる(第10章) |
| 信用情報の使い方が、返済能力等調査に当たるかを確かめないまま広がる | 条文が禁じる目的外の使用に当たるかを確かめていない使い方が残る(当てはめは法務と確かめる事項) | 貸金業法第41条の38、割賦販売法第35条の3の59、金融分野のガイドライン第12条 | 信用情報の利用の範囲を法務と確かめ、学習用のデータの台帳に出所と利用目的を書く(第2章) |
| モデルを変えても、変更の承認と記録が無い | 成績の変化の原因を後から追えない(形骸化) | 認定を受けた事業者については、割賦販売法第30条の5の4第3項が算定の方法や体制の変更に経済産業大臣の認定を求めている(認定の基準を定める経済産業省令の中身は本コラムでは確かめていない)。モデル・リスク管理に関する原則は、適用の対象の金融機関にモデルの承認を原則の1つとして挙げている | モデルの台帳と変更の承認の手順を定め、実績を記録する仕組みを作る(第12章) |
| 回収の連絡の自動化が、取り立ての規制を組み込んでいない | 正当な理由が無いのに、不適当な時間帯や場所への連絡が自動で行われる。条文の要件に当たる場合は、適用される法令の義務を果たせないおそれがある(規制上の義務の不履行。当てはめは法務や所管官庁に確かめる事項) | 貸金業法第21条 | 連絡の時間帯と連絡先の条件を仕組みの側に入れ、相談の窓口の案内を文面に含めるか決める(第10章) |
| 海外の顧客や事業に、自動化された決定の規定を当てはめていない | 説明・人の関与・見直しの求めに応じられない | 一般データ保護規則第22条、消費者信用指令第18条第8項・第9項、AI 規則第86条、規則 B の第1002.9条 | 否決の理由を出せる状態と再審査の窓口を、本番の前に用意する(第11章) |
経営の判断としては、法令上の義務と顧客の保護を、与信スコアリングの設計の前提に置くことを勧めます。具体的には、次の3つを、モデルの方式やベンダーを選ぶ前に決めておくことです。
- 自社の商品にどの法令のどの規定が適用されるか(貸金業法・割賦販売法の定義に当たるか、銀行の監督の対象か、海外の顧客がいるか)と、それぞれの義務を仕組みのどこで果たすか
- 法令上の上限と調査の判定、スコアの判定、人による確認を、どの順に置き、どう記録するか
- 制度の変更(個人情報保護法の改正の施行、EU の AI 規則の附属書Ⅲに基づく高リスクの規定の適用、消費者信用指令の適用など)の日付と、それに合わせた監視と見直しの計画
これを誤ったときの損失は、序章の6つの型で整理できます。法令上の判定を仕組みに組み込まずにモデルの順位づけの成績だけを追うと、調査や記録の不備が残り、規制上の義務の不履行の型の損失につながるおそれがあります(自社への当てはめは法務・コンプライアンスと確認します)。法令上の上限を見落としたまま与信枠を増やすと、過剰与信による顧客の不利益の型の損失になり、顧客の信頼も失います。逆に、法令の要件を確かめずに過度に保守的な基準を置くと、返済できる申込まで断る機会損失につながりえます。制度の変更を監視の計画に入れないと、仕組みが変化に置いていかれる形骸化が起きるおそれがあります。
予算と体制の面では、法令への対応をモデルの開発とは別の「コンプライアンスの費用」として扱うのではなく、記録の設計・調査の手順・モデルの管理と検証・法務の確認を、与信スコアリングの運用の費用として一体で見込むのがよいと考えています。
KPI には、第9章の承認率やデフォルト率などの管理の指標に加えて、法令上の調査を予定どおり行った割合、判定の時点の記録が欠けている契約の割合、再審査の申し出への回答の日数のように、義務を果たせているかを示す指標を入れておくと、形だけの対応に気づきやすくなります。
この章の要点をまとめると、貸金業法の返済能力の調査と総量規制、割賦販売法の支払可能見込額の調査と認定の制度、指定信用情報機関の信用情報の目的外使用の禁止、個人情報保護法と金融分野のガイドラインの同意と機微(センシティブ)情報の扱い、自己資本比率告示の内部格付手法の要件は、多くが与信スコアリングの仕組みのどこかの段に関わる要求を置いています。EU では AI 規則の附属書Ⅲに基づく高リスクの AI システムに関する第3章第1節から第3節(第6条第5項を除く)の適用の日が2027年12月2日に改められ、消費者信用指令が加盟国に2026年11月20日からの国内法の適用を求めているなど、制度の側も動き続けています。条文や版は確かめた日付つきで読み、未施行の改正や政令で決まる日付は、自社の設計の確定した前提にしないことが大切です。終章では、第1章から第14章の内容を、与信スコアリングを使い続けるための考え方としてまとめます。
この章を深めたい方への参考書籍
『割賦販売法の解説』(経済産業省商務情報政策局商務・サービスグループ商取引監督課 編、日本クレジット協会):割賦販売法の所管の官庁の担当課が編んだ解説書です。2026年11月13日に NDL サーチの書誌で確かめた範囲では、版表示が令和2年版のものが2021年9月に刊行されています。目次と内容は本コラムでは確かめていません。本章で要旨だけを示した支払可能見込額の調査や認定の制度を、条文の順に確かめるときの手がかりになります。刊行の後の改正は書籍には反映されていないので、現在の条文は e-Gov 法令検索で確かめながら読む必要があります。
『金融危機とバーゼル規制の経済学:リスク管理から見る金融システム』(宮内惇至 著、勁草書房):バーゼル規制を、金融危機とリスク管理の観点から経済学で読み解く本です。NDL サーチの書誌では、2022年11月のオンデマンド版が、勁草書房の2016年1月の第1版第2刷のオンデマンド版と記載されています。本章で扱った内部格付手法や、自己資本の規制がなぜ銀行にデフォルト確率の見積りを求めるのかを、制度の成り立ちから理解する手がかりになります。最終化されたバーゼルIIIの国内での実施など、刊行の後の動きは金融庁の公表資料で補う必要があります。
終章 与信スコアリングを使い続けるために
本コラムでは、序章で示した4つのまとまりに沿って、与信の目的とデータの基礎(第1章・第2章)、モデルの作り方(第3章から第6章)、評価と判断の設計(第7章から第11章)、定着と規制(第12章から第14章)を順に見てきました。全体を通した考えは、序章で述べたとおり、どの商品でどの水準の承認率とデフォルト率を目指すのか、何をデフォルトと呼ぶのか、審査の判断と結果をどう記録に残すかを先に決めることです。そのうえで、いまの審査の基準の成績を測るところから小さく始め、比較の基準に勝てる方法だけを足していきます。最後に、各章の要点を、章の並びに沿って次の4点にまとめ直します(序章で挙げた4つの取り決めとは別の整理です)。
章をまたいで見えること
第1に、与信スコアリングは目的とデフォルトの定義から組み立てます。与信で平均的に見込む損失(期待損失)は、デフォルト確率だけでなく、デフォルトしたときに失う割合と、そのときの残高を合わせて見積もります。商品によって、この3つの大きさも、求められる審査の速さも、関わる規制も違います(第1章)。モデルに学ばせる結果は、デフォルトの基準と観測期間をどう決めるかで変わります。結果が出そろっていない直近の契約を正常として数えると、デフォルト率は実際より低く見えます。定義は、モデルを作る担当者ではなく、事業として決める事柄です(第2章)。
第2に、モデルは、説明しやすい点数表を基準にして、機械学習のモデルと同じデータで比べます。各章の考察から、作り方を選ぶための目安を次のように整理しました。実際の選択は、自社の記録で比べて確かめます。
- どの作り方を選ぶにしても:項目を区分に分けて、区分ごとのデフォルト率の並びを点検する。点数表に使う区分は、境目と根拠を台帳に残す(第3章)
- 理由の説明と運用のしやすさを優先するとき:ロジスティック回帰で点数表(スコアカード)を作り、点数の並びが業務の知識と合うかを審査の担当者と確かめる(第4章)
- 項目が多い、項目どうしの組み合わせが効いていると考えられるとき:機械学習のモデルを同じデータで点数表と比べ、成績の差と、説明や運用の負担の差を並べて選ぶ。業務の知識から確率の動く向きに根拠がある項目には、ほかの条件が同じならその向きを守らせる単調性の制約を検討する。機械学習のモデルは、点数表で調べる層の候補を挙げる点検にも使えるが、候補を項目に足して成績が上がるとは限らない(第5章)
- 過去に否決した層へ承認を広げようとするとき:承認した契約だけで作ったモデルの見積りが、その層では外れうることを前提にする。否決した層の情報を得る方法を、費用と合わせて検討する(第6章)
本コラムで動かしたコードはいずれも架空の合成データによるもので、数値はその条件での一例にすぎません。実際の申込と契約の記録は合成データより複雑なため、自社の記録で確かめ直す必要があります。
第3に、モデルの成績は、順位づけと確率の正しさを分けて見ます。AR値のような順位づけの指標は、評価する集団と期間によって値が変わるので、同じ集団、同じデフォルトの定義、同じ期間で測った値どうしを比べます。評価に使う契約は申込の時期で区切り、観測期間を満たしたものに限ります(第7章)。
順位が正しくても、モデルの出すデフォルト確率が実績のデフォルト率と合っているとは限りません。確率を貸し倒れの見積りや与信枠に使うなら、較正に使っていないデータで見積りと実績を突き合わせます(第8章)。カットオフは、承認率、承認した契約のデフォルト率、収益と損失の見積りを材料として並べ、営業、リスク管理、財務が合意して決めます。スコアは承認の候補を決める材料であり、返済の能力の調査など法令上の条件に代わるものではありません(第9章)。
契約の後は、返済と利用の記録を使って与信枠を見直し、延滞した顧客への対応の方針をあわせて決めます(第10章)。申込を断った理由は、相手に応じて示す範囲を決め、承認の結果が特定の集団に偏っていないかを測り、再審査を求める手続きを用意します(第11章)。
第4に、与信スコアリングの仕組みは、動き続けるものとして扱います。観測期間が終わるまでは契約ごとの結果が出そろわないので、申込者の層の変化やスコアの分布、契約の後の早い時期の延滞といった、先に分かる指標を監視します。変化に気づいたときに、カットオフの調整、確率の再較正、モデルの再推定、再構築のどこまでを行うかの基準と、承認の手続きを、あらかじめ文書に定めておきます(第12章)。
導入は、対象の商品を絞り、PoC(概念実証)の出口の条件と成果の測り方を先に決めて進めます。結果が出るまでに観測期間のぶんの時間がかかることを、計画に入れます(第13章)。
与信には法令とガイドラインが関わり、その内容は改正されていきます。法令上の義務と顧客の保護は、与信の設計の前提に置きます。条文や版は確かめた日付とともに読み、すでに施行されている規定、公布されたが施行の前の規定、提案や審議の段階にある案は、区別して扱います。公開された事例や研究の数字は、対象の商品や条件ごとに読み、そのまま自社に当てはめないようにします(第14章)。
使い続けるための最小の仕組み
与信スコアリングを使い続けるための仕組みは、大がかりなものである必要はありません。本コラムで扱った内容から、最小の形を挙げると次のようになります。序章で投資の前に確かめることとして挙げた4つのうち、1つ目から3つ目はそのまま置き、4つ目(承認率とデフォルト率を測る仕組み)は監視の項目に含めました。そこに、モデルの文書、承認の基準の記録、説明、法令の確認の4つを足して、8つにまとめ直したものです。
- 対象とする商品と、目指す承認率とデフォルト率の水準が決まっている
- デフォルトの基準と観測期間が、文書に定められている
- 審査の判断(承認と否決、人による変更とその理由)と、契約の後の返済の結果が、突き合わせて集計できる形で残っている
- モデルの項目、区分、点数または係数、学習に使ったデータの期間、成績が、文書に残っている
- カットオフと与信枠の決め方が、収益と損失の見積りとともに記録され、見直す時期と担当が決まっている
- 申込者の層、スコアの分布、承認率、早い時期の延滞、デフォルト率を定期的に見る担当と、調査を始める目安、見直しの段階ごとの承認者が決まっている
- 申込を断った理由を示す方法と、再審査を求める窓口が決まっている
- 関係する法令とガイドラインの要件が、法務やコンプライアンスの確認を経て、審査の設計に反映されている
この8つの条件がそろっていれば、使っているモデルが単純な点数表であっても、高度なモデルへ進むための運用の土台はできていると考えています。反対に、高度なモデルを使っていても、目指す水準、デフォルトの定義、判断と結果の記録、成績を見る担当が決まっていなければ、モデルが役に立っているのかを確かめ続けることが難しくなります。モデルを高度にするのは、上の8項目が回り始めてからで遅くないと考えています。まず自社で、上の8項目のうち欠けているものを確かめることをお勧めします。1つ目(目指す水準)と2つ目(デフォルトの定義)は残りの項目を決める前提になり、3つ目(判断と結果の記録)は成績を測るための材料になるので、この3つから整えます。
経営が見るべきこと
経営の立場から与信スコアリングの取り組みを見るときは、AR値や承認率だけの報告よりも、次の問いに答えられるかを確かめることをお勧めします。
- 承認した契約のデフォルト率は、スコアの帯ごとに、見積もったデフォルト確率と比べてどうなっているか
- 観測期間を満たしていない直近の契約について、早い時期の延滞の割合は、過去の同じ時期の契約と比べてどうか
- 承認率は、申込の経路や商品ごとにどう動いているか。申込者の層は、モデルを作ったときから変わっていないか
- 人がスコアの判定を変更した申込はどれだけあり、変更して承認した契約の実績はどうだったか
- 否決した申込について、どんな情報を持っているか。承認を広げる、あるいは絞るときの影響を、どんな前提で見積もっているか
- 承認した契約の収益と貸し倒れの損失の差は、比べる基準にした審査の方針からどれだけ変わったか。断った申込の機会損失は、どんな前提で推定しているか
- モデルとカットオフを最後に見直したのはいつか
スコアの帯ごとのデフォルト率と見積りの比較は、順位づけと確率の正しさの両方を見るためのものです。帯が上がるほどデフォルト率が下がっていれば、帯の単位では見込んだ並びになっています。順位づけの成績が保たれているかは、条件をそろえて測ったAR値と、その値のばらつきも合わせて確かめます(第7章)。見積りと実績の差が、件数から見込まれる偶然のずれの範囲に収まっているかは、第8章で扱った較正の確認の方法で確かめます。どちらの値も、観測期間を満たした契約でしか確かめられないため、直近の契約については早い時期の延滞で補います。早い時期の延滞は先行の手がかりで、最終のデフォルト率そのものではありません。
収益と損失の差についての問いは、成果そのものを確かめるためのもので、承認率、デフォルト率、AR値は、その判断を支える管理の指標です。
承認率と申込者の層の動きは、モデルが作られたときと違う集団に使われていないかを見るためのものです。人による変更の件数とその実績は、変更の理由やスコアの帯ごとに、見積りと実績を点検する材料になります。人が変更した申込はもともと選ばれた申込なので、単純に比べるだけでは、スコアと人の判断の優劣は決められません。否決した申込についての問いは、機会損失を見るためのものです。否決した申込がもし承認されていたらどうなったかは記録に残らないので、この損失は推定でしか語れません。推定の前提が示されているかを確かめます。
最後に見直した時期は、取り組みが形だけになっていないかを確かめるためのものです。AR値だけが高く報告されているときは、どの集団で測った値か、確率は実績と合っているか、その成績が同じ承認率でのデフォルト率の差としてどれだけになるのかを、あわせて確かめることをお勧めします。
与信スコアリングは、一度仕組みを作れば終わる取り組みではなく、申込者の層の変化、景気の変化、商品や経路の追加、規制の改正に合わせて見直し続ける取り組みです。見直しを続けるための人員と手間を、あらかじめリスク管理と事業の業務と予算の中に位置づけておくことが、取り組みを続けるための条件だと考えています。本コラムが、自社の商品と顧客に合った与信スコアリングを組み立てるための材料になれば幸いです。
Anagraftでは、与信スコアリングを含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 与信の役割と事業での位置づけ、信用リスクと損失の構造
『〈究解〉信用リスク管理』(尾藤剛 著、大久保豊 監修、金融財政事情研究会):金融機関の信用リスク管理を扱う本で、国立国会図書館の書誌では、件名に与信管理・信用調査・格付けが付いています。同じ著者による『ゼロからはじめる信用リスク管理』(2011年)を改題し、全面的に改訂した版です。この章で扱った信用リスクの損失の構造や、デフォルト確率を与信の管理にどう使うかを、金融機関の実務の側から確かめるのに向いています。
『企業経営とリスクマネジメント 与信管理を中心として考える』(葉山真一 著、商事法務):2026年10月に刊行された本で、出版者の提供した紹介では、全社的な活動としてのリスクマネジメントに与信管理を整合的に位置づけることを主題にしています。この章で扱った企業間の掛け売りのように、与信を本業の売上を支える手段として行う事業で、与信の判断を会社全体のリスク管理の中にどう置くかを考えるときの手がかりになります。
第2章 与信に使うデータ、申込の情報・信用情報・取引の履歴と結果の定義
『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』(本橋智光・橋本秀太郎 著、技術評論社):データの抽出・集約・結合・欠損の扱いなど、モデルを作る前のデータの加工の手法を、SQLとpandas、Polarsのコードで対比しながら整理した本です。この章で扱った、申込の月で記録を切る、重複を1件に寄せる、未記入を区分として扱うといった作業を、自社のデータベースの上で実装するときの手引きになります。
『クレジット・スコアリング入門』(E.M.ルイス 著、木下恭輔 監修、アコム・プロジェクト・チーム 訳、金融財政事情研究会):消費者向けの与信のスコアリングを主題とした入門書の翻訳で、1997年の刊行です。原書は「An introduction to credit scoring」の第2版です。刊行の時期が古く、統計の手法や法令の記述は現在とは異なる部分があるため、与信の業務の側からスコアリングのデータと運用を考えるための古典として読むのがよいと考えています。
第3章 スコアカードの土台、区分けとWoE・情報価値で変数を選ぶ
『機械学習のための特徴量エンジニアリング』(Alice Zheng、Amanda Casari 著、株式会社ホクソエム 訳、オライリー・ジャパン):モデルに入れる前の項目の加工を、原理と Python の実装の両面から解説した本です。版元の目次によれば、数値の項目の離散化、カテゴリの項目のエンコーディング、カテゴリの数が膨大な項目の扱い、特徴選択の節があります。この章で扱った区分けとカテゴリの多い項目の扱いを、与信に限らない一般的な方法の中に位置づけて理解するのに向いています。
『Pythonではじめる機械学習』(Andreas C. Muller、Sarah Guido 著、中田秀基 訳、オライリー・ジャパン):scikit-learn を使って、機械学習の基礎とデータの表現の仕方を解説した本です。版元の目次によれば、第4章「データの表現と特徴量エンジニアリング」に、カテゴリ変数(4.1)、ビニング・離散化と線形モデル・決定木の関係(4.2)、自動特徴量選択(4.5。単変量統計・モデルベース・反復の3つの方法)の節があります。この章で扱った区分けと項目の選び方を、線形モデルと決定木での効き方の違いや、統計的な特徴量選択の方法と並べて確かめるのに役立ちます。
第4章 ロジスティック回帰でスコアカードを作る、係数から点数表への変換
『初心者のためのロジスティック回帰分析入門』(David G. Kleinbaum, Mitchel Klein 著、神田英一郎 監訳、丸善出版):原題を Logistic Regression とする、ロジスティック回帰の教科書の翻訳で、国立国会図書館の書誌では本文592ページ、版元の紹介では研究の最初の一歩のための教科書とされています。この章では、WoE に変換した項目でロジスティック回帰を当てはめ、係数の符号と標準誤差を点検しました。その前提になるロジスティック回帰そのものの考え方を、統計の教科書として順を追って確かめたいときに向いています。
『クレジット・スコアリング』(エリザベス・メイズ 編、スコアリング研究会 訳、シグマベイスキャピタル):原題を Credit Risk Modeling とする本の翻訳で、2001年に「金融職人技シリーズ」の1冊として刊行されました。国立国会図書館の書誌では本文361ページで、件名に消費金融・信用調査・クレジットカードが付いています。目次は確かめられていないので、この章の手法をどこまで扱っているかは未確認です。書名と件名から、消費者向けの与信のスコアリングを主題にしていると見られる日本語の本として、この章の背景を広げたいときの手がかりになります。刊行から年数がたっているので、法令や技術の動向は本コラムの第14章と合わせて読む必要があります。
第5章 機械学習による与信モデル、勾配ブースティングと単調性の制約
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):版元の目次によれば、モデルの作成の章で勾配ブースティング木と xgboost・lightgbm の使い方を、モデルの評価の章で時系列のデータの検証の方法を、チューニングの章で勾配ブースティング木の設定の探し方を扱っています。この章で行った、検証用のデータでの設定の選び方と、時間で切った評価の進め方を、実装の面から確かめるのに向いています。
『統計的学習の基礎 データマイニング・推論・予測』(Trevor Hastie・Robert Tibshirani・Jerome Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、井尻善久 他訳、共立出版):原著の題名が示すとおり、データマイニング・推論・予測のための統計的な学習の手法を扱う教科書の訳書です。著者の1人の Friedman は、この章で紹介した勾配ブースティングの論文の著者です。本コラムでは訳書の章立てまでは確かめていませんが、この章で使った手法の背景にある統計的な学習の考え方を、数理の面から確かめたいときの手がかりになると考えています。
第6章 否決した申込をどう扱うか、リジェクト・インファレンスと選択の偏り
『調査観察データの統計科学:因果推論・選択バイアス・データ融合』(星野崇宏 著、岩波書店):シリーズ確率と情報の科学の1冊で、副題のとおり、調査や観察で集めたデータについて、因果推論・選択バイアス・データ融合を扱った本です。この章で扱った選択の偏りを、与信に限らない統計の問題として捉え直し、偏りを補正する考え方の背景を確かめるのに向いています。
『欠測データの統計科学:医学と社会科学への応用』(高井啓二・星野崇宏・野間久史 著、岩波書店):書名のとおり、欠測のあるデータの統計の扱いを、医学と社会科学への応用とともに扱った本です。この章では、否決した申込の結果が欠けていることを欠測の問題として捉え、欠測の仕組みを3つに分けて説明しました。その背景にある欠測データの考え方を、体系的に学ぶのに役立ちます。
第7章 モデルの評価、AR値・KS値と評価データの切り方
『AI審査モデルの基礎知識 モデルのしくみと信用リスク管理』(尾木研三 著、金融財政事情研究会):中小企業向けの融資を題材に、審査のモデルのしくみと信用リスク管理を解説した入門書です。国立国会図書館サーチに載っている目次によれば、モデルの評価と検証の方法の節で、AR値による序列性の検証、デフォルト確率の一致性の検証、学習に使ったデータと使っていないデータでの検証、複数のモデルの比較検証を扱っています。この章で扱った順位づけの指標を、信用リスク管理の実務の流れの中で確かめるのに向いています。
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):機械学習の評価指標を、事業の KPI とのつながりから解説した本です。版元の目次によれば、第3章「二値分類における評価指標」で混同行列・ROC-AUC・PR-AUC などを扱い、ビジネスインパクトの期待値計算の節もあります。第1章には、評価指標と KPI の関係や、評価指標の決め方を間違えないための節があります。与信の本ではありませんが、この章で扱った ROC 曲線と AUC の読み方と、指標を事業の目的につなげる考え方を確かめるのに向いています。
第8章 デフォルト確率の見積り、確率の較正と格付の区分
『信用リスクモデリング 測定と管理』(森平爽一郎 著、朝倉書店):応用ファイナンス講座の第6巻です。目次によれば、実績デフォルト率の推定、1期間のデフォルト確率の推定、デフォルト確率の推計の拡張と検証、デフォルト確率の期間構造、デフォルト時損失率と回収率、デフォルト相関などの章があります。この章で入口だけ触れた、デフォルト確率の推定と検証、デフォルト時の損失の割合を、計量の面から深めるのに向いています。
『信用リスクの測定と管理 Excelで学ぶモデリング』(早稲田大学大学院ファイナンス研究科 編、森平爽一郎 編著、中央経済社):目次によれば、デフォルト確率の推定、デフォルト確率の期間構造、デフォルト確率の推定の仕組みの検証、格付の遷移行列を使ったポートフォリオのリスク管理などを、Excel の計算とともに扱っています。この章の格付の区分と、区分ごとの較正の確認を、手を動かして確かめるのに役立ちます。
第9章 承認の基準と与信枠、カットオフと収益・損失のつり合い
『意思決定分析と予測の活用 基礎理論からPython実装まで』(馬場真哉 著、講談社):予測の結果を意思決定にどう使うかを、決定分析の考え方から解説した本です。目次には、期待値に基づく意思決定、情報の価値、コスト/ロスモデルと予測の価値、確率予測の活用といった章があります。この章で扱った、正常な契約の収益とデフォルトの損失の比からカットオフを決める考え方を、予測と意思決定の一般的な枠組みの中で確かめるのに向いています。
『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』(Ron Kohavi・Diane Tang・Ya Xu 著、大杉直也 訳、ドワンゴ・KADOKAWA):原題は「Trustworthy Online Controlled Experiments」で、オンラインで行う比較の実験を信頼できる形で運用するための考え方をまとめた本です。目次には、実験の実行と分析の一連の流れ、実験の信用性、実験のプラットフォームと文化の章があります。主な題材はオンラインのサービスですが、この章で扱った、新しいカットオフを一部の申込で試してから広げる方法を、組織の仕組みとして設計するときの参考になります。
第10章 途上与信と回収、行動スコアリングと延滞の管理
『生存時間解析入門』(デビッド・ホスマー、スタンリー・レメショウ、スーザン・メイ 著、五所正彦 監訳、東京大学出版会):ある出来事が起きるまでの時間を扱う生存時間解析の入門書の訳書です。この章では、契約からの経過月数とデフォルトの起きやすさの関係を考え方だけ紹介しましたが、観測期間の途中で記録が終わる契約の扱いや、経過時間ごとの起きやすさの見積り方を体系的に確かめるのに役立ちます。
『やさしいMCMC入門 有限マルコフ連鎖とアルゴリズム』(Olle Häggström 著、野間口謙太郎 訳、共立出版):副題のとおり、有限の状態を移り変わるマルコフ連鎖を出発点に、その計算への応用までを扱う入門書の訳書です。この章で延滞の段階の遷移行列をマルコフ連鎖として読んだときの、遷移行列を掛け合わせる計算の意味や、マルコフ連鎖の仮定の意味を確かめるのに向いています。
第11章 否決の理由の説明と公平性、説明の責任と差別の防止
『機械学習を解釈する技術 予測力と説明力を両立する実践テクニック』(森下光之助 著、技術評論社):機械学習のモデルの解釈の手法を、線形回帰との対比から順に解説した本です。版元の目次によれば、特徴量の重要度、特徴量と予測の関係、インスタンスごとの違いを扱う章に続いて、SHAP の章で協力ゲーム理論とシャープレイ値、実装、利点と注意点を扱っています。この章で使った SHAP の値の意味と限界を、より詳しく確かめるのに向いています。
『あなたを支配し、社会を破壊する、AI・ビッグデータの罠』(キャシー・オニール 著、久保尚子 訳、インターシフト):原題は Weapons of Math Destruction です。国立国会図書館サーチに収録された目次によれば、モデルの良し悪しを扱う第1章に始まり、「教育」「宣伝」「正義」「就職」「仕事」「信用」「身体」などの分野の名前を付けた章が続き、第8章が「信用」の章です。この章で扱った偏りの問題を、技術の外側から、社会での使われ方として考える材料になります。
第12章 モデルの監視と管理、母集団の安定性と再構築・モデルリスク管理
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習のシステムを本番で運用し続けるための設計を扱った本で、第8章がデータ分布のシフトと監視に充てられています。この章で扱った入力の分布の変化と、項目と結果の関係の変化を、与信に限らない一般的な枠組みで整理するのに役立ちます。
『信頼性の高い機械学習 SRE原則を活用したMLOps』(Cathy Chen、Niall Richard Murphy、Kranti Parisa、D. Sculley、Todd Underwood 著、井伊篤彦・張凡・樋口千洋 訳、オライリー・ジャパン):システムの信頼性を保つ運用の考え方を機械学習に当てはめた本で、第9章がモデルの監視と可観測性を扱っています。監視の指標を誰がどう見て、どう対応につなげるかという、この章の後半の組織の論点を考える材料になります。
第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
『AI・データ分析プロジェクトのすべて[ビジネス力×技術力=価値創出]』(大城信晃 監修、大城信晃、マスクド・アナライズ、伊藤徹郎、小西哲平、西原成輝、油井志郎 著、技術評論社):版元のページでは2020年12月の発売で、データ分析のプロジェクトを準備・入口・実行・出口の4部に分け、社内での案件の獲得と外部の資源の検討、データのリスク管理と契約、分析の結果の評価と改善、プロジェクトの価値と継続性までを扱っています。この章で扱った PoC の出口の決め方や、内製と外部の分担、契約の段階で決めておくことを、与信に限らないデータ分析のプロジェクトの進め方として考え直すときの手がかりになります。
『データ分析・AIを実務に活かす データドリブン思考』(河本薫 著、ダイヤモンド社):版元のページでは2022年1月の発行で、データ分析が成功しても事業で失敗する理由から始め、分析を事業の成果につなげる考え方と、データに基づいて判断する企業へ変わるための論点を章立てにしています。この章で扱った、AR値のような分析の成績ではなく、承認率とデフォルト率、収益と損失の差という事業の物差しで導入を判断する考え方を、組織の側から考えるときに参考になります。
第14章 規制とガイドライン、公開事例と最新動向
『割賦販売法の解説』(経済産業省商務情報政策局商務・サービスグループ商取引監督課 編、日本クレジット協会):割賦販売法の所管の官庁の担当課が編んだ解説書です。2026年11月13日に NDL サーチの書誌で確かめた範囲では、版表示が令和2年版のものが2021年9月に刊行されています。目次と内容は本コラムでは確かめていません。本章で要旨だけを示した支払可能見込額の調査や認定の制度を、条文の順に確かめるときの手がかりになります。刊行の後の改正は書籍には反映されていないので、現在の条文は e-Gov 法令検索で確かめながら読む必要があります。
『金融危機とバーゼル規制の経済学:リスク管理から見る金融システム』(宮内惇至 著、勁草書房):バーゼル規制を、金融危機とリスク管理の観点から経済学で読み解く本です。NDL サーチの書誌では、2022年11月のオンデマンド版が、勁草書房の2016年1月の第1版第2刷のオンデマンド版と記載されています。本章で扱った内部格付手法や、自己資本の規制がなぜ銀行にデフォルト確率の見積りを求めるのかを、制度の成り立ちから理解する手がかりになります。最終化されたバーゼルIIIの国内での実施など、刊行の後の動きは金融庁の公表資料で補う必要があります。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- バーゼル銀行監督委員会の解説文書(2005年7月)は期待損失をデフォルト確率・デフォルト時の残高・デフォルト時の損失の割合の掛け算として書いている
https://www.bis.org/publications/explanatory-note-basel-ii-irb-risk-weight-functions.pdf - 全米経済研究所が1941年に刊行した David Durand の研究の目次(リスクの要因の研究の結果、信用の評点の式、判別関数の理論と2つの貸付の標本への適用の付録)
https://www.nber.org/books-and-chapters/risk-elements-consumer-instalment-financing-technical-edition - FICO は公式の会社紹介で1956年に創業し信用スコアリングなどの分析の手法を導入して与信を広く利用できるようにしてきたと説明している
https://web.archive.org/web/20261029233316/https://www.fico.com/en/about-us - 金融庁の貸金業関係資料集(2025年11月28日掲載)の業態の分類(消費者向無担保・有担保・住宅向・事業者向・手形割引・クレジットカード会社・信販会社・流通メーカー系・建設不動産・質屋・リース会社など)
https://www.fsa.go.jp/status/kasikin/20251128/index.html - 金融庁の貸金業関係資料集(2025年11月28日掲載)の業態の分類(消費者向無担保・有担保・住宅向・事業者向・手形割引・クレジットカード会社・信販会社・流通メーカー系・建設不動産・質屋・リース会社など)
https://www.fsa.go.jp/status/kasikin/20251128/01.pdf - 令和8年9月末時点の貸金業者の数は1,413業者(2026年11月9日公表)
https://www.fsa.go.jp/status/kasikin/20261109/index.html - 2025年3月末のクレジットカードの発行枚数は3億2,057万枚で前の年に比べて2.2%増、回答243社、20歳以上の人口との比で1人あたり3.1枚、対象の会社と社数が一致しない場合がある
https://www.j-credit.or.jp/information/statistics/download/toukei_inumber_a.pdf - 信用購入あっせん業者は代金を立て替えて2か月を超える期間で支払いを受ける事業者で、包括と個別に分かれる
https://www.meti.go.jp/policy/economy/consumer/credit/kappuhanbaihoatobaraibunyanogaiyofaq.html - 貸金業法の総量規制(借入れは原則として年収の3分の1まで)と指定信用情報機関についての日本貸金業協会の説明
https://www.j-fsa.or.jp/association/money_lending/you_know/statistics.php - 貸金業法第13条の2第2項は、貸金業者が個人と結ぶ貸付けの契約のうち、借入れの合計が年間の給与などの収入を合算した額の3分の1を超えることになるものを定め、住宅資金の貸付けなど除外される契約もある
https://laws.e-gov.go.jp/law/358AC1000000032 - 参考書籍『〈究解〉信用リスク管理』尾藤剛 著、大久保豊 監修、金融財政事情研究会
https://ndlsearch.ndl.go.jp/books/R100000002-I029300728 - 参考書籍『企業経営とリスクマネジメント 与信管理を中心として考える』葉山真一 著、商事法務
https://ndlsearch.ndl.go.jp/books/R100000002-I034950174
第2章
- 指定信用情報機関の制度は平成18年に改正された貸金業法で設けられ、目的は過剰な貸付の防止
https://www.jicc.co.jp/aboutus/credit-info/designated-credit - 2010年3月に日本信用情報機構とシー・アイ・シーの2社の間で情報の交流を開始
https://www.jicc.co.jp/aboutus/company/history - シー・アイ・シーは2010年3月に貸金業法、2010年7月に割賦販売法に基づく指定信用情報機関として指定
https://www.cic.co.jp/company/information/development/ - シー・アイ・シーで本人が開示で確かめられる情報の種類(クレジットの情報・申込の情報・利用の記録・参考情報・クレジット・ガイダンス情報)
https://www.cic.co.jp/mydata/ - 全国銀行個人信用情報センターは全国銀行協会が設置・運営する個人信用情報機関で、他の機関と提携して情報の交流を行い、審査は行わず審査の理由も説明できない
https://www.zenginkyo.or.jp/pcic/ - 金融分野における個人情報保護に関するガイドラインは個人情報保護委員会と金融庁が定めた(令和6年3月)
https://www.ppc.go.jp/personalinfo/legal/kinyubunya_GL/ - ガイドラインの一覧のページに令和9年4月1日施行版が掲載されている
https://www.ppc.go.jp/personalinfo/legal/guidelines/ - バーゼル枠組みの CRE36 第68項は重要な債務の90日を超える延滞をデフォルトの条件の1つとし、第69項は返済の見込みが低い兆候の例を挙げ、第71項はリテールでは契約の単位で定義を当てはめてよいとする
https://www.bis.org/basel_framework/chapter/CRE/36.htm?inforce=20230101&published=20200327 - バーゼル枠組みの CRE36 第68項(90日を超える延滞)と第69項、第68項の注でリテールと公的部門の債務は監督当局が最大180日に置き換えてよいこと
https://www.bis.org/committees/bcbs/basel-framework/standard/cre/36/inforce/2023-01-01/published/2022-12-08 - 貸金業法第13条第2項は個人の顧客との貸付けの契約(極度方式貸付けに係る契約など内閣府令で定めるものを除く)の締結の前の調査で指定信用情報機関の信用情報の使用を求め、第13条の3は極度方式基本契約の下での調査を定める
https://laws.e-gov.go.jp/law/358AC1000000032 - 参考書籍『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』本橋智光・橋本秀太郎 著、技術評論社
https://direct.gihyo.jp/view/item/000000003369 - 参考書籍『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』本橋智光・橋本秀太郎 著、技術評論社
https://ndlsearch.ndl.go.jp/books/R100000002-I033469943 - 参考書籍『クレジット・スコアリング入門』E.M.ルイス 著、木下恭輔 監修、アコム・プロジェクト・チーム 訳、金融財政事情研究会、1997年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I000002597981
第3章
- WoE の定義(正常の構成比 ÷ デフォルトの構成比の自然対数
https://arxiv.org/pdf/2303.01227 - du Pisanie らの2023年の論文の書誌(信用リスクのスコアリングでの母集団の安定性の検定を見直した論文
https://arxiv.org/abs/2303.01227 - scikit-learn の決定木で、min_samples_leaf に小数を渡すと件数の割合として扱われる
https://scikit-learn.org/stable/modules/generated/sklearn.tree.DecisionTreeClassifier.html - scikit-learn の決定木の分かれ目では、値がしきい値以下のものが左の枝に進む
https://scikit-learn.org/stable/auto_examples/tree/plot_unveil_tree_structure.html - scikit-learn の決定木は、分けたあとの件数で重み付けた不純度が最も小さくなる分かれ目を選ぶ
https://scikit-learn.org/stable/modules/tree.html - 参考書籍『機械学習のための特徴量エンジニアリング』(Alice Zheng、Amanda Casari 著、株式会社ホクソエム 訳、オライリー・ジャパン、2019年2月)
https://www.oreilly.co.jp/books/9784873118680/ - 参考書籍『Pythonではじめる機械学習』(Andreas C. Muller、Sarah Guido 著、中田秀基 訳、オライリー・ジャパン、2017年5月)
https://www.oreilly.co.jp/books/9784873117980/
第4章
- optbinning の実装では、PDO を ln 2 で割って係数を作り、基準の点数から係数と基準のオッズの対数の積を引いて定数を作る
https://raw.githubusercontent.com/guillermo-navas-palencia/optbinning/master/optbinning/scorecard/scorecard.py - optbinning の説明書きに PDO の尺度の指定がある
http://gnpalencia.org/optbinning/scorecard.html - scikit-learn のロジスティック回帰で C は正則化の強さの逆数で、小さいほど正則化が強い
https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.LogisticRegression.html - statsmodels 0.14.6 の説明書きに、VIF が5を超えると強い共線性とみなす目安が書かれている
https://www.statsmodels.org/v0.14.6/generated/statsmodels.stats.outliers_influence.variance_inflation_factor.html - statsmodels の0.14系の以前の版の VIF の説明書き
https://www.statsmodels.org/v0.14.1/generated/statsmodels.stats.outliers_influence.variance_inflation_factor.html - statsmodels の新しい版の VIF の説明書き
https://www.statsmodels.org/stable/generated/statsmodels.stats.outliers_influence.variance_inflation_factor.html - 参考書籍『初心者のためのロジスティック回帰分析入門』David G. Kleinbaum, Mitchel Klein 著、神田英一郎 監訳、丸善出版
https://ndlsearch.ndl.go.jp/books/R100000002-I023458805 - 参考書籍『クレジット・スコアリング』エリザベス・メイズ 編、スコアリング研究会 訳、シグマベイスキャピタル
https://ndlsearch.ndl.go.jp/books/R100000002-I000003069532
第5章
- Friedman の2001年の論文が勾配ブースティングを一般的な形に整理した(統計学の学術誌第29巻第5号、1189〜1232ページ)
https://doi.org/10.1214/aos/1013203451 - Baesens らの2003年の論文(Journal of the Operational Research Society 第54巻第6号、627〜635ページ)は8つの与信のデータで手法を比べ、サポートベクターマシンの一種とニューラルネットワークが良く
https://doi.org/10.1057/palgrave.jors.2601545 - Baesens らの2003年の論文(Journal of the Operational Research Society 第54巻第6号、627〜635ページ)は8つの与信のデータで手法を比べ、サポートベクターマシンの一種とニューラルネットワークが良く
https://api.openalex.org/works/doi:10.1057/palgrave.jors.2601545 - Lessmann らの2015年の論文(European Journal of Operational Research 第247巻第1号、124〜136ページ)は41の分類の手法を8つの与信のデータと6つの指標で比べ、いくつかの手法がロジスティック回帰より有意に高く
https://doi.org/10.1016/j.ejor.2015.05.030 - Lessmann らの2015年の論文(European Journal of Operational Research 第247巻第1号、124〜136ページ)は41の分類の手法を8つの与信のデータと6つの指標で比べ、いくつかの手法がロジスティック回帰より有意に高く
https://lirias.kuleuven.be/retrieve/bf32a4b3-c06e-47c1-b047-150fc26187d4 - lightgbm の monotone_constraints は全項目について順に 1・マイナス1・0 を指定する
https://lightgbm.readthedocs.io/en/v4.6.0/Parameters.html - scikit-learn の HistGradientBoostingClassifier の monotonic_cst は版0.23で追加され、二値の分類で陽性の側の確率について制約が成り立つ
https://scikit-learn.org/1.9/modules/generated/sklearn.ensemble.HistGradientBoostingClassifier.html - scikit-learn の RandomForestClassifier には版1.4で monotonic_cst が加わった
https://scikit-learn.org/1.9/modules/generated/sklearn.ensemble.RandomForestClassifier.html - lightgbm の LGBMClassifier では fit の eval_metric を指定しても、モデルの metric も評価される
https://lightgbm.readthedocs.io/en/v4.6.0/pythonapi/lightgbm.LGBMClassifier.html - lightgbm の LGBMClassifier では fit の eval_metric を指定しても、モデルの metric も評価される
https://lightgbm.readthedocs.io/en/v4.6.0/pythonapi/lightgbm.early_stopping.html - SHAP の Tree SHAP は木のモデルについて SHAP値を厳密に計算する方法で、背景のデータの扱いに前提がある
https://shap.readthedocs.io/en/stable/generated/shap.TreeExplainer.html - 米国の消費者金融保護局は2017年2月16日に代替データの利用について意見の募集を始め、例として携帯電話の料金や家賃の支払い、電子的な取引の記録を、利点と懸念を挙げた
https://www.consumerfinance.gov/about-us/newsroom/cfpb-explores-impact-alternative-data-credit-access-consumers-who-are-credit-invisible/ - 参考書籍『Kaggleで勝つデータ分析の技術』門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社
https://gihyo.jp/book/2019/978-4-297-10843-4 - 参考書籍『統計的学習の基礎 データマイニング・推論・予測』Trevor Hastie・Robert Tibshirani・Jerome Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、井尻善久 他訳、共立出版
https://hastie.su.domains/ElemStatLearn/main.html
第6章
- Rubin の1976年の論文、欠測のあるデータからの推論、Biometrika 第63巻第3号581〜592ページ
https://doi.org/10.1093/biomet/63.3.581 - Rubin の1976年の論文、欠測のあるデータからの推論、Biometrika 第63巻第3号581〜592ページ
https://academic.oup.com/biomet/article/63/3/581/270932 - Heckman の1979年の論文、標本選択の偏りを式の定め方の誤りとして扱ったもの、Econometrica 第47巻第1号153〜161ページ、省かれた変数の問題として扱い2段階で推定する方法を示した
https://doi.org/10.2307/1912352 - Heckman の1979年の論文、標本選択の偏りを式の定め方の誤りとして扱ったもの、Econometrica 第47巻第1号153〜161ページ、省かれた変数の問題として扱い2段階で推定する方法を示した
https://www.econometricsociety.org/publications/econometrica/1979/01/01/sample-selection-bias-specification-error - Heckman の1979年の論文、標本選択の偏りを式の定め方の誤りとして扱ったもの、Econometrica 第47巻第1号153〜161ページ、省かれた変数の問題として扱い2段階で推定する方法を示した
https://jenni.uchicago.edu/home_page/vita.html - Hand と Henley の1993年の論文、リジェクト・インファレンスはうまくいきうるのかを問うたもの、第5巻第1号45〜55ページ、現在の誌名は IMA Journal of Management Mathematics、要旨の3分類と結論
https://doi.org/10.1093/imaman/5.1.45 - Hand と Henley の1993年の論文、リジェクト・インファレンスはうまくいきうるのかを問うたもの、第5巻第1号45〜55ページ、現在の誌名は IMA Journal of Management Mathematics、要旨の3分類と結論
https://academic.oup.com/imaman/article/5/1/45/658356 - Banasik と Crook と Thomas の2003年の論文、標本選択の偏り、Journal of the Operational Research Society 第54巻第8号822〜832ページ、要旨の内容
https://doi.org/10.1057/palgrave.jors.2601578 - Banasik と Crook と Thomas の2003年の論文、標本選択の偏り、Journal of the Operational Research Society 第54巻第8号822〜832ページ、要旨の内容
https://ideas.repec.org/a/pal/jorsoc/v54y2003i8d10.1057_palgrave.jors.2601578.html - Crook と Banasik の2004年の論文、Journal of Banking と Finance の誌、第28巻第4号857〜874ページ
https://doi.org/10.1016/S0378-4266(03 - Crook と Banasik の2004年の論文、Journal of Banking と Finance の誌、第28巻第4号857〜874ページ
https://ideas.repec.org/a/eee/jbfina/v28y2004i4p857-874.html - Ehrhardt らの2021年の論文、与信のスコアリングにおけるリジェクト・インファレンスの方法を整理したもの、Journal of Applied Statistics 第48巻第13〜15号2734〜2754ページ、完全に無作為な欠測は現実的でないこと
https://doi.org/10.1080/02664763.2021.1929090 - Ehrhardt らの2021年の論文、与信のスコアリングにおけるリジェクト・インファレンスの方法を整理したもの、Journal of Applied Statistics 第48巻第13〜15号2734〜2754ページ、完全に無作為な欠測は現実的でないこと
https://pmc.ncbi.nlm.nih.gov/articles/PMC9041715/
第7章
- バーゼル銀行監督委員会の作業文書第14号(2005年5月の改訂版
https://www.bis.org/publ/bcbs_wp14.htm - バーゼル銀行監督委員会の作業文書第14号(2005年5月の改訂版
https://www.bis.org/publications/studies-validation-internal-rating-systems-revised.pdf - KS値は累積分布の差の絶対値の最大値(両側)で、片側の最大差とは区別される
https://docs.scipy.org/doc/scipy-1.16.0/reference/generated/scipy.stats.ks_2samp.html - 『AI審査モデルの基礎知識 モデルのしくみと信用リスク管理』(尾木研三 著、金融財政事情研究会)
https://ndlsearch.ndl.go.jp/books/R100000002-I032160329 - 『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社)
https://gihyo.jp/book/2023/978-4-297-13314-6
第8章
- 等調回帰の予測は境目と境目の間を直線でつなぐ実装
https://scikit-learn.org/stable/modules/generated/sklearn.isotonic.IsotonicRegression.html - 作業文書第14号の長期の平均のデフォルト率は、年ごとのデフォルト率を年数で平均したもの
https://www.bis.org/publications/studies-validation-internal-rating-systems-revised.pdf - 改正企業会計基準第10号の第41項(9)・(10):2030年4月1日以後に開始する年度の期首から適用、2027年4月1日以後に開始する年度の期首から早期適用できる
https://www.asb-j.jp/jp/wp-content/uploads/sites/4/ecl20261016_02.pdf - Brier が1950年に気象の確率予報の検証のためにブライアスコアを提案したこと
https://doi.org/10.1175/1520-0493(1950 - scikit-learn の確率の較正の説明書き:プラットの方法と等調回帰の性質、等調回帰はおおよそ1,000件を超えるデータで同等以上、少ないと過学習しやすい、同じ値の確率を作るのでAUCが変わりうる、ブライアスコアが低いことが較正の良さを必ずしも意味しない
https://scikit-learn.org/stable/modules/calibration.html - Zadrozny と Elkan の2002年の論文、第8回の知識発見とデータマイニングの国際会議の予稿集、694〜699ページ
https://doi.org/10.1145/775047.775151 - Niculescu-Mizil と Caruana の2005年の論文、第22回機械学習国際会議の予稿集、625〜632ページ
https://doi.org/10.1145/1102351.1102430 - Saerens らの2002年の論文、新しい事前確率に合わせて分類器の出力を調整する手順
https://doi.org/10.1162/089976602753284446 - バーゼル銀行監督委員会の作業文書第14号、2005年5月公表
https://www.bis.org/publ/bcbs_wp14.htm - バーゼルの枠組みの CRE36.63 は、区分のデフォルト確率を1年のデフォルト率の長期の平均とすることを求め、リテールの例外は CRE36.81 と CRE36.82
https://www.bis.org/basel_framework/chapter/CRE/36.htm - Brown と Cai と DasGupta の2001年の論文、Statistical Science 第16巻第2号101〜133ページ、件数の少ない場合にウィルソンの区間か裾を等しく取ったジェフリーズの区間を勧める
https://doi.org/10.1214/ss/1009213286 - scipy の binomtest の区間の既定が正確な区間であること
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.binomtest.html - IFRS 第9号は2014年7月の完成版で予想信用損失の減損の要求事項を加え、2018年1月1日以後に始まる事業年度から適用
https://www.ifrs.org/issued-standards/list-of-standards/ifrs-9-financial-instruments/ - 企業会計基準委員会が2026年10月16日に改正企業会計基準第10号と企業会計基準適用指針第36号などを公表し、予想信用損失のモデルを採り入れたこと、将来予測的な情報を含む広い範囲の情報を使うこと
https://www.asb-j.jp/jp/accounting_standards/y2026/2026-1016.html - 参考書籍『信用リスクモデリング 測定と管理』森平爽一郎 著、朝倉書店、応用ファイナンス講座6、2009年
https://ci.nii.ac.jp/ncid/BB00597265 - 参考書籍『信用リスクの測定と管理 Excelで学ぶモデリング』早稲田大学大学院ファイナンス研究科 編、森平爽一郎 編著、中央経済社、2011年
https://ci.nii.ac.jp/ncid/BB05688131
第9章
- 参考書籍『意思決定分析と予測の活用 基礎理論からPython実装まで』馬場真哉 著、講談社、2021年
https://ndlsearch.ndl.go.jp/books/R100000002-I031281307 - 参考書籍『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』Ron Kohavi・Diane Tang・Ya Xu 著、大杉直也 訳、ドワンゴ・KADOKAWA、2021年
https://ndlsearch.ndl.go.jp/books/R100000002-I031325604
第10章
- 参考書籍『生存時間解析入門』デビッド・ホスマー、スタンリー・レメショウ、スーザン・メイ 著、五所正彦 監訳、東京大学出版会
https://ndlsearch.ndl.go.jp/books/R100000002-I025390129 - 参考書籍『やさしいMCMC入門 有限マルコフ連鎖とアルゴリズム』Olle Häggström 著、野間口謙太郎 訳、共立出版
https://ci.nii.ac.jp/ncid/BB23601689
第11章
- Lundberg と Lee の2017年の論文はシャープレイ値を使って1件の予測を項目ごとの寄与の足し算に分ける枠組みを示した
https://papers.nips.cc/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html - Lundberg と Lee の2017年の論文はシャープレイ値を使って1件の予測を項目ごとの寄与の足し算に分ける枠組みを示した
https://arxiv.org/abs/1705.07874 - Kleinberg と Mullainathan と Raghavan の2017年の論文の3つの条件と2つの例外
https://drops.dagstuhl.de/entities/document/10.4230/LIPIcs.ITCS.2017.43 - Kleinberg と Mullainathan と Raghavan の2017年の論文の3つの条件と2つの例外
https://arxiv.org/abs/1609.05807 - Chouldechova の2017年の論文は再犯の予測の道具を題材に、割合が群で違うと複数の基準を同時に満たせないこと、誤りの率の不均衡が不利な影響につながることを論じた
https://doi.org/10.1089/big.2016.0047 - Chouldechova の2017年の論文は再犯の予測の道具を題材に、割合が群で違うと複数の基準を同時に満たせないこと、誤りの率の不均衡が不利な影響につながることを論じた
https://arxiv.org/abs/1703.00056 - 規則B 第1002.9条の通知の期限は書類がそろってから30日以内、書面で具体的な理由を記載するか60日以内の請求で30日以内に受け取れることを知らせる、内部の基準や点数不足だけの説明は不十分
https://www.consumerfinance.gov/rules-policy/regulations/1002/9/ - 公式の解釈で、理由は4つを超えると役に立ちにくい・実際に考慮した項目に関するもの・点数化した項目から選ぶ・カットオフ付近の平均か全体の平均と比べる2つの例と実質的に同じ方法を認める
https://www.consumerfinance.gov/rules-policy/regulations/1002/interp-9/ - 消費者金融保護局が2022年5月26日に公表した文書は、複雑なアルゴリズムでも理由の通知の義務は免除されないとした
https://www.consumerfinance.gov/compliance/circulars/circular-2022-03-adverse-action-notification-requirements-in-connection-with-credit-decisions-based-on-complex-algorithms/ - その2022年の公表文書は2025年5月12日に撤回された
https://www.consumerfinance.gov/compliance/guidance/withdrawn-guidance/ - 米国の規則Bには一定の条件のもとで年齢をスコアリングの仕組みに使えるとする規定がある
https://www.consumerfinance.gov/rules-policy/regulations/1002/6/ - 背景のデータを渡さない TreeExplainer の基準の値は、木に記録された学習時の件数の分布から決まる
https://shap.readthedocs.io/en/stable/generated/shap.TreeExplainer.html - 規則B 第1002.4条(a)は禁止された属性を理由とする差別を禁じ、公式の解釈は意図の有無にかかわらず異なる扱いは違法とする
https://www.ecfr.gov/api/renderer/v1/content/enhanced/current/title-12?part=1002§ion=1002.4 - 規則Bの禁止された属性の一覧
https://www.ecfr.gov/api/renderer/v1/content/enhanced/current/title-12?part=1002§ion=1002.2 - 2025年11月13日の改正案、2026年4月22日の最終規則(施行2026年7月21日)で、信用機会均等法は異なる影響による責任を認めないとし、第1002.6条(a)の効果テストの記述を改めた
https://www.federalregister.gov/api/v1/documents/2026-07804.json - 2025年11月13日の改正案、2026年4月22日の最終規則(施行2026年7月21日)で、信用機会均等法は異なる影響による責任を認めないとし、第1002.6条(a)の効果テストの記述を改めた
https://www.federalregister.gov/documents/full_text/text/2026/04/22/2026-07804.txt - 2025年11月13日の改正案、2026年4月22日の最終規則(施行2026年7月21日)で、信用機会均等法は異なる影響による責任を認めないとし、第1002.6条(a)の効果テストの記述を改めた
https://www.federalregister.gov/api/v1/documents.json?conditions[agencies - 現行の第1002.6条(a)は、法は効果テストの適用を定めていないという文言である
https://www.ecfr.gov/api/renderer/v1/content/enhanced/current/title-12?part=1002§ion=1002.6 - 参考書籍 機械学習を解釈する技術
https://gihyo.jp/book/2021/978-4-297-12226-3 - 参考書籍 あなたを支配し、社会を破壊する、AI・ビッグデータの罠
https://ndlsearch.ndl.go.jp/books/R100000002-I029025609
第12章
- 金融庁「モデル・リスク管理に関する原則」は令和3年11月12日に公表された
https://www.fsa.go.jp/news/r3/ginkou/20211112.html - 原則の本文は、意義・適用・定義・重要な概念・8つの原則で構成される
https://www.fsa.go.jp/news/r3/ginkou/20211112/pdf_02.pdf - 米国の3つの監督当局が2026年4月17日に改訂版のモデルリスク管理の指針を公表(SR 26-2)
https://www.federalreserve.gov/supervisionreg/srletters/SR2602.htm - 改訂版の指針の章立て(目的と範囲・概観・開発と使用・検証と監視・ガバナンスと統制・ベンダーなど第三者の製品)と、生成AIとエージェント型AIのモデルを範囲に含めない注記
https://www.federalreserve.gov/supervisionreg/srletters/SR2602a1.pdf - PSIの経験則(0.1未満は小さな変化、0.1以上0.25未満は中程度の変化、0.25以上は大きな変化で対応が要る)が実務で使われていることと、それが誤りの確率を考えずに使われているという指摘
https://files.wmich.edu/s3fs-public/attachments/u730/2022/PSIfinal.pdf - Yurdakul の2018年の博士論文(ウェスタンミシガン大学)
https://scholarworks.wmich.edu/dissertations/3208/ - 参考書籍『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン、2023年9月1日)
https://www.oreilly.co.jp/books/9784814400409/ - 参考書籍『信頼性の高い機械学習 SRE原則を活用したMLOps』(Cathy Chen ほか4名 著、井伊篤彦・張凡・樋口千洋 訳、オライリー・ジャパン、2024年10月23日)
https://www.oreilly.co.jp/books/9784814400768/
第13章
- 金融庁「AIディスカッションペーパー(第1.1版)」は令和8年3月3日に公表された
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp.html - 金融庁 AIディスカッションペーパー第1.1版の29ページ、PoC の段階の案件は利用者や利用件数などの特性に応じた KPI を設定して計画と比べることも考えられる、削減時間の KPI は AI の評価になじまない可能性、複数の定量的な指標を合わせて確かめる必要
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp_version1.1.pdf - 金融庁「モデル・リスク管理に関する原則」は令和3年11月12日に公表された
https://www.fsa.go.jp/common/law/ginkou/pdf_02.pdf - 参考書籍『AI・データ分析プロジェクトのすべて[ビジネス力×技術力=価値創出]』(大城信晃 監修、大城信晃、マスクド・アナライズ、伊藤徹郎、小西哲平、西原成輝、油井志郎 著、技術評論社)
https://gihyo.jp/dp/ebook/2020/978-4-297-11759-7 - 参考書籍『データ分析・AIを実務に活かす データドリブン思考』(河本薫 著、ダイヤモンド社)
https://www.diamond.co.jp/book/9784478115114.html
第14章
- 貸金業法は昭和58年法律第32号、現在の条文は2025年10月1日施行の版、令和5年法律第53号による改正が未施行で上限2028年6月13日の政令で定める日
https://laws.e-gov.go.jp/law/358AC1000000032 - 割賦販売法は昭和36年法律第159号、現在の条文は2025年6月1日施行の版、令和2年法律第64号による改正が2021年4月1日施行
https://laws.e-gov.go.jp/law/336AC0000000159 - 利息制限法第1条の年2割・年1割8分・年1割5分、現在の条文は2010年6月18日施行の版
https://laws.e-gov.go.jp/law/329AC0000000100 - 出資法第5条第2項の業として行う貸付けの年20パーセントを超える利息の契約の罰則、現在の条文は2025年6月1日施行の版
https://laws.e-gov.go.jp/law/329AC0000000195 - 全国銀行協会の銀行による消費者向け貸付けに係る申し合わせは2017年3月16日、改正貸金業法の適用対象外だが監督指針で態勢の整備が求められている、広告の抑制と審査態勢等の整備の4つの例
https://www.zenginkyo.or.jp/fileadmin/res/news/news290336.pdf - 全国銀行協会は2022年2月17日に成年年齢引下げを踏まえた若年者向けの申し合わせを公表
https://www.zenginkyo.or.jp/news/2022/n021702/ - CIC は割賦販売法第35条の3の36第1項と貸金業法第41条の13第1項に基づく指定信用情報機関と記載
https://www.cic.co.jp/company/outline.html - JICC は貸金業法に基づく指定信用情報機関と記載
https://www.jicc.co.jp/aboutus/company - 個人情報保護法は平成15年法律第57号、現在の条文は2026年11月2日施行の版
https://laws.e-gov.go.jp/law/415AC0000000057 - 令和8年改正法は2026年7月17日公布、政令・規則・ガイドライン等の検討を続ける、施行期日の政令の記載なし、2026年10月14日の更新
https://www.ppc.go.jp/personalinfo/legal/r8kaiseihogohou/ - 信用分野のガイドラインの令和6年5月17日の新旧対照表、金融分野のガイドラインの令和9年4月1日施行の版の掲載
https://www.ppc.go.jp/personalinfo/legal/guidelines/ - 自己資本比率告示は平成18年金融庁告示第19号、全体版は2026年8月24日更新、第7章の構成、第140条の承認、第189条のモデルの利用の要件、第205条のデフォルトの定義
https://www.fsa.go.jp/policy/basel_ii/ginkou1_4.pdf - 最終化されたバーゼルIIIの国内の適用の時期、2024年3月31日と2025年3月31日、2023年3月31日以降の届出による早期適用
https://www.fsa.go.jp/policy/basel_ii/index.html - モデル・リスク管理に関する原則は2021年11月12日公表、原則ベース、適用対象、モデルの範囲に信用リスクの計測のモデル、8つの原則
https://www.fsa.go.jp/news/r3/ginkou/20211112/pdf_02.pdf - モデル・リスク管理に関する原則のパブリックコメントの結果の公表
https://www.fsa.go.jp/news/r3/ginkou/20211112.html - EU AI 規則は規則2024の1689、附属書Ⅲ第5号(b)の信用力の評価と信用スコア、不正の検知の除外、前文第58項、第86条の説明を受ける権利
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32024R1689 - 規則2026の1744は2026年7月8日採択、2026年7月24日官報、第113条を改め附属書Ⅲの高リスクの第3章第1節から第3節を2027年12月2日、附属書Ⅰを2028年8月2日、当初は2026年8月2日、前文の変更の理由
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32026R1744 - 一般データ保護規則は規則2016の679、第22条第1項から第3項
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32016R0679 - 欧州司法裁判所の2023年12月7日の判決、C-634/21、先決裁定、主文
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:62021CJ0634 - 消費者信用指令は指令2023の2225、2023年10月18日採択、第18条第1項・第3項・第4項・第6項・第8項・第9項・第11項、第47条の廃止と経過措置、第48条の2025年11月20日と2026年11月20日
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32023L2225 - 規則 B の第1002.1条(b)の目的と列挙された属性
https://www.consumerfinance.gov/rules-policy/regulations/1002/1/ - 規則 B の第1002.9条の30日以内の通知、具体的な理由、不十分な理由の例、4つを超える理由は役に立たない可能性が高いとする公式の解釈
https://www.consumerfinance.gov/rules-policy/regulations/1002/9/ - 規則 B を改める最終規則は2026年4月22日公表、2026年7月21日施行、異なる影響・申込を思いとどまらせる行為・特別目的の信用プログラムの3つの分野
https://www.consumerfinance.gov/rules-policy/final-rules/equal-credit-opportunity-act-regulation-b/ - 規則2026の1744の発効は2026年7月27日、第4条は官報掲載の3日目に発効、状態は In force
https://eur-lex.europa.eu/legal-content/EN/ALL/?uri=CELEX:32026R1744 - 令和8年法律第56号の附則第1条は本体を政令で定める日、第3号の改正規定は公布の日から起算して六月を経過した日に施行
https://www.ppc.go.jp/files/pdf/260717_houritsu.pdf - Circular 2022-03 と Circular 2023-03 は2025年5月12日に撤回、撤回されたのは公表文書で第1002.9条は現行
https://www.consumerfinance.gov/compliance/guidance/withdrawn-guidance/ - German Credit の項目の一覧(20個)に申込の時期を表す項目が無い
https://archive.ics.uci.edu/dataset/144/statlog+german+credit+data - 公正信用報告法は15 U.S.C. 1681 から 1681x、規則 V は12 CFR 第1022部、2025年7月11日の医療の債務の規則の無効、2025年5月15日の撤回
https://www.consumerfinance.gov/compliance/compliance-resources/other-applicable-requirements/fair-credit-reporting-act/ - メルペイの2020年9月4日の与信モデリングの記事、KPI、精算の有無の分類、特徴量の採否の基準、ルールによる補正、数値なし
https://engineering.mercari.com/blog/entry/1599103395-51482041aa/ - メルペイの2022年4月27日の記事、予測の対象の変更、AUC だけでは KPI に直結しない、利用の額を考慮した延滞の率、較正、数値なし
https://engineering.mercari.com/blog/entry/20220425-a2035afd6f/ - メルカリの2026年11月10日のイベント報告、2026年9月29日開催、リスクの予測値と利用枠への変換の役割分担、影響の評価、生成AIの手順、11本中7本の不具合
https://engineering.mercari.com/blog/entry/20261109-20261109_mptechtalk_report/ - 金融庁 AIディスカッションペーパー第1.1版(2026年3月)の与信審査・信用リスク管理・引受審査の活用の例、比較的高い精度と評価する回答、説明可能性で与信判断に AI を使う場合の検証、外部の評価のツールの例、2025年の米国の通達等の撤回
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp_version1.1.pdf - 登録包括信用購入あっせん業者は令和8年4月末現在241社、うち認定4社、登録少額は0社
https://web.archive.org/web/20260512122942/https://www.meti.go.jp/policy/economy/consumer/credit/115tourokujigyousyaitiran.html - OpenML の credit-g、作成者 Hans Hofmann、licence の欄は Public
https://www.openml.org/api/v1/json/data/31 - Feng らの論文、arXiv 2023年10月1日初版、2024年2月18日第3版、9つのデータセット・約1万4千件、4万5千件超の指示の調整用データ、偏りの検証、掲載先の記載なし
https://arxiv.org/abs/2310.00566 - 参考書籍 割賦販売法の解説 令和2年版、経済産業省商務情報政策局商務・サービスグループ商取引監督課 編、日本クレジット協会、2021年9月
https://ndlsearch.ndl.go.jp/books/R100000002-I031654785 - 参考書籍 金融危機とバーゼル規制の経済学 リスク管理から見る金融システム、宮内惇至 著、勁草書房、2022年11月の POD 版は2016年1月第1版第2刷のオンデマンド版
https://ndlsearch.ndl.go.jp/books/R100000136-I1970304959899659268