こんにちは、Anagraftの伊藤です。
今回は、不正検知をどう理解し、どう自社のリスク管理と業務の仕組みに組み込むかを整理しました。ここでの不正検知は、決済、送金、申込、請求、注文、ログインといった取引の中から、不正の疑いが強いものを見つけ、止める、追加で確認する、調査に回すための仕組みを指します。クレジットカードの不正利用、アカウントの乗っ取り、不正送金、保険金の不正請求、ECの不正注文など、対象になる不正は業種ごとに違いますが、検知の仕組みが抱える課題には共通する部分が多くあります。不正検知の導入や見直しを検討する場面では、次のような問いが、不正対策の担当者だけでなく、事業の責任者や経営層にも届くことが多いように思います。
- 不正検知にAIを入れれば、被害は減るのか
- 製品やサービスの提供会社(ベンダー)が示す「検知率」(不正のうち見つけられた割合。本コラムでは再現率と呼びます)という数字を、どう読めばよいのか
- 誤って止めてしまった正当な取引の損失を、どう見ればよいのか
- いま使っているルールは残すべきか、機械学習に置き換えるべきか
- 検知の仕組みを自社で作るべきか、製品を入れるべきか
本コラムでは、こうした問いに答えるための材料を、不正検知の目的とデータの基礎、検知の方式、評価と運用の設計、定着と規制の4つのまとまりに分けて並べました。
この題材を選んだ理由は、不正検知が「データを集めて精度の高いモデルを入れれば不正が減る取り組み」と受け取られて、モデルの種類と検知率の数字だけが議論され、どの不正をどの水準まで減らしたいのか、アラートを誰がどう調べるのかが決まらないまま進むことが多いように思うためです。
不正検知には、見逃しを減らそうとすると誤検知が増え、誤検知を減らそうとすると見逃しが増える、という関係があります。不正を多く見つけるようにしきい値を下げれば、正当な取引を止める回数が増え、顧客の信頼と売上の機会を失います。アラートが調査の担当者の処理できる件数を超えれば、見られないまま流れるアラートが出ます。不正の手口は変わっていくので、導入したときの成績は時間とともに下がることがあります。こうした点を決めないまま投資を重ねたときに出る損失を、本コラムでは6つの型に分けて整理し、各章で使います(序章で説明します)。
本コラムでは、検知の手法の原論文、法令と所管官庁のガイドライン、公的機関や業界団体、企業が公開している資料など、公開されている一次情報を根拠にしました。第2章から第12章では、架空の合成データ(取引の記録を乱数で作ったもの)に対して実際にPythonのコードを動かし、その出力とグラフを載せています。架空のデータで得た数値は、その条件での一例であり、実際の取引で期待できる成績の目安ではありません。
想定している読者は、不正検知の導入や改善を任された方、あるいはそれを決める立場の方です。担当者としては、金融機関、カード会社、決済事業者、保険会社、EC事業者、通信事業者などで、不正対策、リスク管理、コンプライアンス、DX推進を担う方と、取引のデータを分析するデータサイエンティストの方を念頭に置いています。判断する立場としては、不正対策への投資を決める事業の責任者や経営層の方を念頭に置いています。機械学習の専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その方法で何が分かり、検知と調査の判断にどうつながるか」「経営はどう判断するか」を意識して書きました。
本コラムは、不正から守る側の設計と運用を解説するものです。不正の手口については、公的機関や業界団体が注意喚起として公表している類型の水準に留め、検知の仕組みを避ける方法には触れていません。本コラムに出てくる企業や団体の取り組みは、その企業や団体が公開した資料を開いて確かめたものに限っています。不正検知の製品やクラウドサービスの料金、開発の費用、不正の被害額、弊社の支援の条件には触れていません。公的な被害の統計は、件数や割合で紹介しています。例題で取引の額や損失を扱う箇所は、単位の無い「相対値」で書いています。法令の解釈や、自社に適用される規制の範囲については、法務やコンプライアンスの担当者、所管の官庁、専門家に確認していただく前提で書いています。
各章の題と、その章で答える問いは「全体の地図」の表にまとめています。本コラムで使う用語の定義も、同じ「全体の地図」の表にまとめています。

目次
- 序章 不正検知は何を見つけて何を決める仕組みか
- 全体の地図
- 第1章 不正検知の役割と事業での位置づけ、不正の種類と損失の構造
- 第2章 不正検知に使うデータ、取引の記録とラベルの遅れ・不均衡の扱い
- 第3章 ルールによる検知、しきい値と速度のルールでベースラインを作る
- 第4章 教師あり学習による検知、不均衡なデータで不正の確率を見積もる
- 教師あり学習で不正のスコアを作る流れ、ラベルのある過去から次の取引を採点する
- 手法の比較、ロジスティック回帰・決定木・ランダムフォレスト・勾配ブースティング
- 架空の取引の記録を作り、時間で切る
- ロジスティック回帰と勾配ブースティングを、ルールと同じ物差しで比べる
- 不均衡への対処、クラスの重み付け・少数側を増やす方法・多数側を減らす方法
- 不均衡への対処は、上位の適合率よりもスコアの値の水準を大きく変えた
- 確率の較正、削減の割合を使う補正・等調回帰・プラットの方法
- 過学習とデータの分け方による漏れ、評価の分け方で成績が良く見える
- 深層学習を使う条件
- 経営の判断、スコアを確率として使うなら較正を確かめる
- この章を深めたい方への参考書籍
- 第5章 特徴量の設計、取引の履歴から集計と速度の特徴を作る
- 特徴量が成績を決める理由、1件の取引だけでは普段と違うかが分からない
- 特徴量の型、取引そのものから相手側の集計まで
- 架空の取引の記録を作る、顧客ごとの普段の行動と、短い時間にまとまる不正
- 時間窓の集計と普段との差を作る、その取引自身を含めない
- 特徴量の型を足すごとの成績、平均適合率は 0.203 から 0.773 へ
- リーク(情報の漏れ)、誤った作り方は評価で成績を良く見せる
- 種類の多い項目の扱い、加盟店や端末を数に置き換えるときの漏れの防ぎ方
- 判定の時点で計算できるか、リアルタイムの判定が特徴量に課す制約
- 特徴量の重要度の読み方と限界、寄与は原因ではない
- 特徴量の台帳と経営の判断、特徴量の定義を資産として管理する
- この章を深めたい方への参考書籍
- 第6章 教師なしの異常検知、ラベルの無い不正を外れ方から探す
- 第7章 つながりで見る不正、口座・端末・住所のネットワーク分析
- 第8章 検知の評価、適合率・再現率・PR曲線と評価データの切り方
- 評価の役割、検知の方法を選ぶ前に物差しを決める
- 混同行列と指標、適合率・再現率・偽陽性率・ROC曲線・PR曲線
- 不均衡なデータで、正解率とROC曲線のAUCに注意が要る理由
- 架空の取引の記録を作る、手口が途中で変わり、ラベルが遅れて届く
- 2つのモデルを比べる、ROC曲線のAUCだけでは上位のアラートの質が読み取れない
- 評価データの切り方、無作為に切る・時間で切る・顧客で切る
- ラベルの遅れと、被害の大きさ・発生の単位で見る評価
- 不正の件数が少ないときの指標のばらつき、ブートストラップで区間を出す
- オフラインの評価の限界と、ベンダーの示す数字の読み方
- 経営の判断、評価の指標と切り方をモデルを選ぶ前に決める
- この章のまとめ
- この章を深めたい方への参考書籍
- 第9章 しきい値と調査の運用、アラートの量と調査能力のつり合い
- 第10章 手口の変化への追従、概念ドリフトの監視と再学習
- 不正検知のモデルが古くなる理由、手口・顧客・商品・検知そのもの
- 変化の種類、入力の分布・不正の割合・関係そのもの
- 架空データで確かめる、途中の月から不正の特徴が変わる取引の記録
- 学習し直す頻度と期間を比べる、固定・毎月の再学習・直近の期間だけ
- ラベルの遅れと再学習、確定したラベルだけで学習する
- ラベルを待たない監視、分布のずれの指標とアラートの割合
- 新しい手口はラベルにも残りにくい、無作為の点検で偏りを補う
- ルールで先に対応してモデルに取り込む流れと、敵対的な変化への守る側の対処
- 再学習の手順と承認、作り直したモデルを入れ替えるまで
- 経営判断、再学習と監視を運用の費用として最初から見込む
- この章を深めたい方への参考書籍
- 第11章 検知の理由の説明と公平性、誤検知が顧客に与える影響
- 説明が要る相手と、相手ごとに示すもの
- 理由コード、アラートの理由を定型の文で示す、ルールの理由とモデルの理由の違い
- 架空の取引の記録を作り、勾配ブースティングで不正のスコアを出す
- SHAP で1件のアラートの理由を取り出し、定型の文に直す
- 全体の重要度を2つの方法で比べる
- 説明の限界、寄与は因果ではなく、理由は作り直しで入れ替わる
- 顧客にどこまで理由を示すか、説明の責任と検知を避ける手がかりのつり合い
- 誤検知が顧客に与える影響
- 公平性、群ごとの偽陽性率を測り、偏りの出どころと代わりの変数を探す
- 異議の申し立てと救済の手続き、人による確認の位置づけ
- 経営判断、誤検知の偏りを測り、救済の手続きを先に用意する
- この章を深めたい方への参考書籍
- 第12章 システムの構成と運用、リアルタイムの判定・監視・障害時の扱い
- 第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
- どの不正から始めるか、5つの観点で採点して最初の対象を決める
- 現状の把握と KPI の木、今のルールの成績を測ってから目標を分解する
- PoC の設計、過去のデータでの評価で止めず影の運用まで進める
- 効果の見立て、金額ではなく率と件数の型で書く
- 段階的な展開、ルールの整理からスコアによる順位づけ、自動の措置へ
- 役割と責任分担、三つの防衛線の中で不正検知をどこに置くか
- 内製と外部委託・製品の利用、何を外に任せ、何を社内に残すか
- 業界での情報の共有と人材、1社では集まらない知識をどう補うか
- 最初の90日の計画と形骸化の型、週ごとに何を決め、何を残すか
- 経営判断、PoC の出口と成果の測り方を先に決める
- この章を深めたい方への参考書籍
- 第14章 規制とガイドライン、公開事例と最新動向
- マネー・ローンダリング対策の法令、取引時確認・記録・疑わしい取引の届出
- 金融庁のガイドライン、リスクベースのアプローチと取引モニタリングの位置づけ
- FATF の相互審査と為替取引分析業、国際的な評価と分析の共同化
- クレジットカードの不正利用の防止、割賦販売法とセキュリティガイドライン
- 不正送金と口座の不正利用、金融庁の要請と金融機関の間の情報共有
- 不正検知のための個人データの利用、利用目的と第三者提供の制限
- EU の規制、強力な顧客認証と取引リスク分析・自動化された決定・AI規則
- 公開事例と公開データセット、企業と公的機関の取り組みと研究の数字の読み方
- 最近の動向、生成AIによるなりすまし・本人確認の見直し・調査の支援
- 規制の対応が形だけになる型と、経営の判断
- この章を深めたい方への参考書籍
- 終章 不正検知を使い続けるために
- 本コラムで紹介した書籍一覧
- 第1章 不正検知の役割と事業での位置づけ、不正の種類と損失の構造
- 第2章 不正検知に使うデータ、取引の記録とラベルの遅れ・不均衡の扱い
- 第3章 ルールによる検知、しきい値と速度のルールでベースラインを作る
- 第4章 教師あり学習による検知、不均衡なデータで不正の確率を見積もる
- 第5章 特徴量の設計、取引の履歴から集計と速度の特徴を作る
- 第6章 教師なしの異常検知、ラベルの無い不正を外れ方から探す
- 第7章 つながりで見る不正、口座・端末・住所のネットワーク分析
- 第8章 検知の評価、適合率・再現率・PR曲線と評価データの切り方
- 第9章 しきい値と調査の運用、アラートの量と調査能力のつり合い
- 第10章 手口の変化への追従、概念ドリフトの監視と再学習
- 第11章 検知の理由の説明と公平性、誤検知が顧客に与える影響
- 第12章 システムの構成と運用、リアルタイムの判定・監視・障害時の扱い
- 第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
- 第14章 規制とガイドライン、公開事例と最新動向
- 参考情報
序章 不正検知は何を見つけて何を決める仕組みか
取引の不正への備えには、大きく分けて3つの段があります。1つ目は防止で、本人確認や認証を強くして、不正な取引がそもそも起きにくいようにします。2つ目は検知で、起きている取引の中から不正の疑いが強いものを見つけます。3つ目は対応で、見つけた取引を止め、顧客に確認し、被害を回復し、必要な届出をします。防止を強くすると不正は起きにくくなりますが、正当な顧客の手間も増えるため、すべての取引に最も重い確認を課すことはできません。そこで、多くの取引は手間をかけずに通し、疑いのあるものだけを選んで確認する役割を、検知が担います。
本コラムの主題である不正検知は、取引や申込の中から不正の疑いが強いものを見つけ、止める、追加で確認する、調査に回すための仕組みです。本コラムでは、見つけるところだけでなく、見つけた後に何をするか(措置)と、人が確認する作業(調査)までを含めて、1つの仕組みとして扱います。検知の仕組みが「不正の疑いあり」として出す通知をアラートと呼びます。アラートは不正の確定ではなく、調査や確認の入口です。
不正検知は、機械学習のモデルの精度の話として語られることが多くあります。しかし、不正検知の価値を決めるのは、モデルの精度そのものではなく、見つけて防いだ不正と、誤って止めた正当な取引の両方を数えたうえで、事業にとって差し引きがどうなったかだと考えています。両方を件数で数えても、1件あたりの事業への影響は同じではありません。比べるには、防げた不正による損失と、正当な取引を止めたことで生じた損失を、同じ尺度の数に直す必要があります。その方法は第8章と第9章で扱います。仮の例として、ほとんどの取引をアラートにすれば不正の大半は見つかりますが、正当な取引も大量にアラートの対象になります。アラートを一律に保留や拒否にする運用では正当な取引が大量に止まり、人が確認する運用では調査の担当者が確認しきれません。反対に、確実なものだけをアラートにすれば誤って止める取引は減りますが、不正の多くを通してしまいます。そのため本コラムでは、不正検知の取り組みを、疑いの強さを見積もる技術と、どこから先をアラートにするか、アラートを誰がどう扱うかを決め、その結果を測るところまでを含むものとして扱います。
検知の方式の3つのグループ
検知の方式は、人が決めた条件による検知、過去の不正から学ぶ検知、普段からの外れ方とつながりを見る検知の3つに分けて考えると整理しやすくなります。1つ目の人が決めた条件による検知は、「短い時間に一定の回数を超える取引」のようなルールで疑いを判定する方法で、第3章で扱います。理由を説明しやすく、すぐに直せるため、他の方式と比べるときの基準(ベースライン)にもなります。2つ目の過去の不正から学ぶ検知は、不正だったと分かっている取引と正当だった取引の記録から、不正の疑いの強さ(スコア)を見積もるモデルを作る方法です。教師あり学習(正解の分かっている記録から判定のしかたを学ぶ方法。第4章)と、その成績を左右する特徴量(取引の記録から作る、判定の手がかりになる数)の設計(第5章)がこれに当たります。3つ目の普段からの外れ方とつながりを見る検知は、不正かどうかの記録(ラベル)に頼らず、普段の取引から大きく外れたものを探す方法(第6章)と、複数の口座や端末のつながりから、1件ずつでは見えない不正を探す方法(第7章)です。第1章では、この3つ目を教師なしの異常検知とネットワーク分析に分け、4つの方式として比べます。
3つのグループは、外れ方が違います。ルールは、決めた条件に当てはまらない手口を見つけられず、条件に当てはまる正当な取引も不正の疑いありと判定します。過去の不正から学ぶ検知は、過去に無かった新しい手口には弱く、学習に使う記録が偏っていれば、その偏りを引き継ぎます。普段からの外れ方を見る検知は、珍しいだけで正当な取引を多く拾います。すべての取引に最も新しい方式を使う必要はなく、対象の不正、手元にある記録の量と質、調査に使える人手に応じて、どの方式を使うか、どう組み合わせるかを選びます。既知の手口と規制上の要件はルールで押さえ、ルールに当たらなかった取引も含めた全体に、モデルのスコアで疑いの強さの順位を付ける、という組み合わせも選べます(第3章・第12章)。
どの方式を選ぶにしても、その前提になるのが、どの不正をどの水準まで減らしたいのかと、手元の記録が不正の実態を表しているのかという2つの問いです。減らしたい不正は、事業によって違います。件数は少なくても1件の被害が大きい不正と、1件は小さくても件数が多い不正とでは、求める検知の速さも措置も変わります(不正の種類は第1章、対象の選び方は第13章で扱います)。記録が実態を表しているかは、ラベルの作られ方で決まります。不正かどうかは、本人の申告や調査の完了を待って確定するため、直近の取引ほどラベルが欠けています。止めた取引や調査しなかった取引には、本当に不正だったかが分からないまま残るものがあります(第2章)。方式を選ぶ前に、この2つを先に確かめることが、不正検知の取り組みの出発点になります。
検知から措置と調査へ
スコアを事業の成果につなぐには、さらに3つの取り決めが要ります。第1に、評価の方法です。不正は正当な取引に比べて極端に少ないため、すべての取引を正当と答えるだけで正解率は高くなります。正解率ではなく、アラートのうち本当に不正だった割合(適合率)と、不正のうちアラートにできた割合(再現率)の組で成績を見ます。評価に使う取引は時間で区切り、学習に使った期間より後の取引で確かめます(第8章)。第2に、しきい値と調査の能力です。スコアがいくつ以上ならアラートにするかは、モデルが決めるのではなく、調査の担当者が1日に確認できる件数と、見逃しと誤検知のそれぞれの損失を見て人が決めます(第9章)。第3に、変化への追従です。不正の手口と顧客の行動は変わっていくので、成績の変化を監視し、モデルとルールを見直す手順を決めておきます(第10章)。
この3つの取り決めが無いままモデルだけを入れると、PoC(概念実証。実現できるかと効果を、小さな規模で確かめる検証)では「高い精度が出た」という結果が出ても、アラートが調査の能力を超えて処理しきれない、誤って止めた顧客からの苦情が増える、半年後に成績が下がっても気づかない、といったことが起きやすいと考えています。本コラムでは、検知の方式の説明に加えて、評価と運用にも章を立てて扱います。また、アラートの理由を調査の担当者や顧客にどう示すか、誤検知が特定の顧客に偏っていないか(第11章)、判定の仕組みが止まったときに取引を通すのか止めるのか(第12章)も、設計の段階で決めておく事柄です。不正検知には、マネー・ローンダリング対策やクレジットカードの不正利用の防止に関する法令とガイドライン、個人データの取り扱いに関する法令が関わります。法令の条文と所管官庁の資料で確認できた範囲を第14章で整理します。
決めないことで出る損失の型
検知の方式を選ぶとき、検知の仕組みを導入して運用するときに起きうる損失は、金額ではなく型で整理すると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。
- 見逃しによる被害:不正な取引をアラートにできずに通してしまい、顧客や自社が被害を受けます。
- 誤検知による機会損失:正当な取引を止め、売上や手数料の機会を失います。
- 調査の過負荷:アラートが調査の能力を超え、見られないまま流れるアラートが出ます。
- 顧客の離反:正当な顧客が取引を止められて信頼を失い、利用をやめます。
- 形骸化:ルールやモデルが更新されないまま運用が続き、手口の変化に置いていかれます。
- 規制上の義務の不履行:確認、届出、記録などの法令上の義務を果たせなくなります。
どの損失が自社で目立っているかを見れば、どこから着手するかの見当が付きます。調査の過負荷が起きているなら、新しいモデルを探す前に、ルールごとのアラートの件数と適合率を数えます。そのうえで、拾っている不正の被害の大きさ、他のルールとの重なり、規制上の確認を担っているかも見て、見直すルールの候補を選びます(第3章・第9章)。誤検知による機会損失や顧客の離反が疑われるなら、止めた取引のうち、顧客からの申し出や調査によって後から正当と分かったものを数えます(第9章・第11章)。止めた取引のすべてについて正当だったかどうかが分かるわけではない点は、第2章で扱います。形骸化が起きているなら、ルールとモデルを最後に見直した時期と、成績の推移の記録が残っているかを確かめます(第10章)。このように、目立っている損失の型によって最初の一歩は変わり、その多くは新しいモデルの導入ではありません。すべての取引を一度に高度なモデルの判定に切り替える必要はない、というのが本コラムの考えです。
不正検知は、減らしたい不正と調査の能力から始める
不正検知で最初に決めるべきことは、どのモデルを使うかではなく、どの不正をどの水準まで減らしたいのか、アラートを誰が1日に何件まで調べられるのか、そして調査の結果をどう記録に残すかだと考えています。そのうえで、いまあるルールの成績を測るところから小さく始め、比較の基準に勝てる方式だけを足していきます。減らしたい不正が決まれば、評価の指標が決まります。調査の能力が決まれば、アラートにできる件数の上限が決まります。調査の結果の記録は、次のモデルの学習とルールの見直しの共通の土台になります。比較の基準が決まれば、複雑なモデルに投資する理由を、数字で社内に説明できるようになります。
本コラムは、次の4つの流れで進みます。
- 不正検知の目的とデータの基礎:事業の中での不正検知の位置づけと、検知に使うデータの性質を整理します(第1章・第2章)。
- 検知の方式:ルール、教師あり学習、特徴量の設計、教師なしの異常検知、ネットワーク分析を、実行したコードとともに見ます(第3章から第7章)。
- 評価と運用の設計:検知の評価、しきい値と調査の運用、手口の変化への追従、説明と公平性を扱います(第8章から第11章)。
- 定着と規制:システムの構成と運用、導入の進め方と体制、規制とガイドライン、公開事例と最新の動向を扱います(第12章から第14章)。
経営判断に関わる方には、投資の進め方として、不正検知の製品や開発に予算を付ける前に、次の4つを確かめる順序をお勧めします。
- どの不正を、どの水準まで減らしたいのかが決まっているか
- アラートごとの調査の結果が、後から集計できる形で残っているか
- 後から届く本人の申告なども取り込んで(ラベルの遅れ。第2章)、いまのルールの適合率と再現率を測る仕組みがあるか
- 調査の担当者が1日に確認できる件数と、アラートの件数のつり合いを見ているか
この順序であれば、投資の前提を社内に説明でき、成果が出なかったときにも原因を切り分けやすくなると考えています。反対に、モデルの導入を先に進め、減らしたい不正と調査の体制を後回しにすると、アラートの件数は積み上がっても、被害が減ったのか、正当な顧客をどれだけ止めたのかを誰も答えられないおそれがあります。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、不正検知を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章を、序章で示した4つのまとまりに分けて構成しています。
- 不正検知の目的とデータの基礎(第1章・第2章):不正検知が事業の何を守るのかと、検知に使うデータの性質
- 検知の方式(第3章から第7章):比較の基準になるルールから、過去の不正から学ぶ方法、普段からの外れ方とつながりを見る方法まで
- 評価と運用の設計(第8章から第11章):検知の成績の測り方、しきい値と調査の運用、手口の変化への追従、説明と公平性
- 定着と規制(第12章から第14章):システムの構成と運用、導入の進め方と体制、規制とガイドライン、公開事例と最新の動向
第2章から第12章には、架空の合成データ(乱数で作った取引の記録)で実際に動かしたPythonのコードと、その結果を載せています。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | 不正検知の役割と事業での位置づけ、不正の種類と損失の構造 | 不正検知は事業の何を守るための仕組みで、普通の予測の問題とは何が違うのか。どの不正を、どの水準まで減らすことを目指すのか |
| 第2章 | 不正検知に使うデータ、取引の記録とラベルの遅れ・不均衡の扱い | 不正かどうかの記録はどう作られ、どこが欠けているのか。どの記録を残すべきか |
| 第3章 | ルールによる検知、しきい値と速度のルールでベースラインを作る | 人が決めた条件でどこまで見つけられるか。ルールをどう管理し、比較の基準をどう作るか |
| 第4章 | 教師あり学習による検知、不均衡なデータで不正の確率を見積もる | 過去の不正から疑いの強さをどう見積もるか。不正が極端に少ないデータをどう扱い、スコアを確率として読めるようにするか |
| 第5章 | 特徴量の設計、取引の履歴から集計と速度の特徴を作る | 取引の履歴から、普段との違いをどう数にするか。成績を実際より良く見せる情報の漏れをどう防ぐか |
| 第6章 | 教師なしの異常検知、ラベルの無い不正を外れ方から探す | 不正の記録が無いとき、新しい手口が出たときに、何を手がかりに探すか。異常と不正はどう違うか |
| 第7章 | つながりで見る不正、口座・端末・住所のネットワーク分析 | 1件ずつ見ても分からない組織的な不正を、つながりからどう見つけるか |
| 第8章 | 検知の評価、適合率・再現率・PR曲線と評価データの切り方 | 検知の成績をどの指標で測り、評価に使う取引をどう区切るか。提示された数字をどう読むか |
| 第9章 | しきい値と調査の運用、アラートの量と調査能力のつり合い | どこから先をアラートにし、誰がどの順に調べるか。調査の能力とアラートの件数をどうつり合わせるか |
| 第10章 | 手口の変化への追従、概念ドリフトの監視と再学習 | 手口や顧客の行動が変わったことにどう気づき、モデルとルールをどう更新し続けるか |
| 第11章 | 検知の理由の説明と公平性、誤検知が顧客に与える影響 | アラートの理由を誰にどこまで示すか。誤検知が特定の顧客に偏っていないかをどう測るか |
| 第12章 | システムの構成と運用、リアルタイムの判定・監視・障害時の扱い | 判定の仕組みをどう組み立て、何を監視し、止まったときにどう扱うか |
| 第13章 | 導入の進め方と体制、目的の設計・PoC・内製と外部の分担 | どの不正から始め、PoC(概念実証。実現できるかと効果を小さな規模で確かめる検証)をどう設計し、誰が何を担うか |
| 第14章 | 規制とガイドライン、公開事例と最新動向 | 不正検知に関わる法令とガイドラインは何か。公開された事例と研究から何が読み取れるか |
本コラムで使う用語は、次の表の意味に固定しています。特定の章だけで使う用語は、その章の中で定義します。PR曲線や平均適合率などの評価の指標の定義は第8章にまとめています。コードのある各章は、章ごとに別々に作った架空の合成データを使っているため、同じ名前の数値(不正の割合、適合率、再現率など)でも章によって値が違います。指標の数え方(取引の単位か顧客の単位か、どの期間で数えるかなど)も章によって違うことがあり、各章の本文にその章の数え方を書いています。
| 用語 | 本コラムでの意味 |
|---|---|
| 不正 | 他人をだまして、または権限を偽って、不当に利益を得る行為。本コラムでは主に、取引の場面で起きる不正を扱う |
| 不正検知 | 取引や申込の中から不正の疑いが強いものを見つけ、止める、追加で確認する、調査に回すための仕組み。見つけた後の措置と調査までを含めて1つの仕組みとして扱う |
| 取引 | 検知の対象になる1件の出来事。カードの決済、口座からの送金、ログイン、会員登録、保険金の請求、注文など |
| スコア | 不正の疑いの強さを表す数。本コラムでは0から1の値とし、大きいほど疑いが強い。0から1の値でも、そのまま不正の確率とは限らない。実際の不正の割合と対応しているかを評価用のデータで確かめ、必要に応じて較正(スコアが実際の割合に合うように補正すること)をする(第4章) |
| しきい値 | スコアがこの値以上ならアラートにする、という境目の値 |
| アラート | 検知の仕組みが「不正の疑いあり」と判定して出す通知。不正の確定ではない |
| 措置 | アラートに対して取る行動。本コラムでは、承認(そのまま通す)、保留(取引をいったんとどめて、追加の認証や確認を求める。本人による追加の認証で進める場合と、担当者の確認を待つ場合の両方を含む)、拒否(止める)、事後の調査(通したうえで後から調べる)の4つに分ける |
| 調査 | アラートを人が確認し、不正かどうかを判断する作業。1日に確認できる件数(調査の能力)には上限がある |
| 誤検知 | 正当な取引を、不正の疑いありと判定すること。偽陽性とも呼ぶ |
| 見逃し | 実際には不正だった取引を、不正の疑いありと判定できず、アラートにできなかったこと。偽陰性とも呼ぶ。アラートにしたうえで承認して被害が出た場合は、措置の結果として別に扱う |
| 適合率 | アラートのうち、実際に不正だったものの割合 |
| 再現率 | 実際の不正のうち、アラートにできたものの割合。「検知率」と呼ばれることがあるが、本コラムでは再現率に統一する |
| ラベル | その取引が不正だったかどうかの記録。本人の申告や調査の完了を待つため、確定までに遅れがある。止めた取引や調査しなかった取引は、真のラベルが分からないことがある |
| 不均衡データ | 不正の件数が、正当な取引に比べて極端に少ないデータ |
| ルール | 人が決めた条件で不正の疑いを判定する方法。「短い時間に一定の回数を超える取引」など |
| ベースライン | 比較の基準となる単純な検知。本コラムでは主に、ルールだけによる検知を指す。自社では、いま運用しているルールがこれに当たる(第3章では、例題用の単純なルールを作って基準にする) |
| 概念ドリフト | 時間がたつにつれて、取引の特徴と、不正かどうかとの関係が変わること。手口の変化や顧客の行動の変化によって起きる。取引の特徴の分布だけが変わる場合との区別は第10章で扱う |
| KPI | 重要な業績の指標。不正検知では、見逃した不正と誤って止めた取引の両方を含む最終の指標と、それを分解した検知の指標、調査の指標の組を指す |
| 相対値 | 例題で取引の額や損失を表すときに使う、単位の無い仮の数。金額ではなく、何を基準にした数かは各例題で示す |
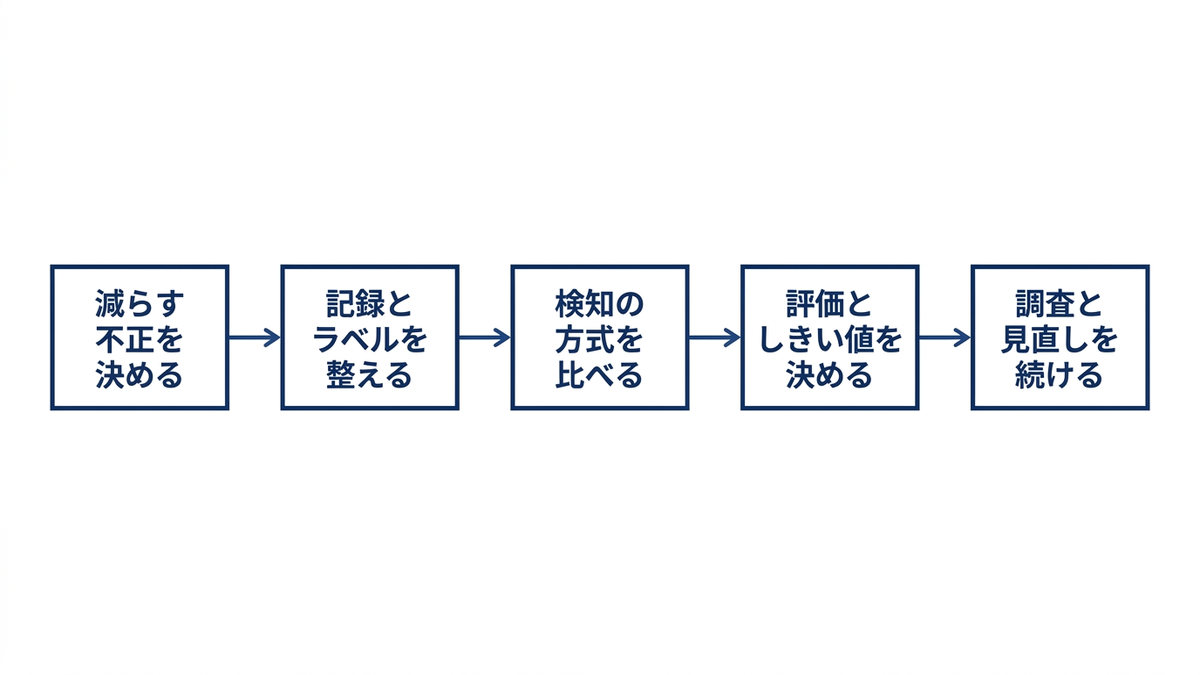
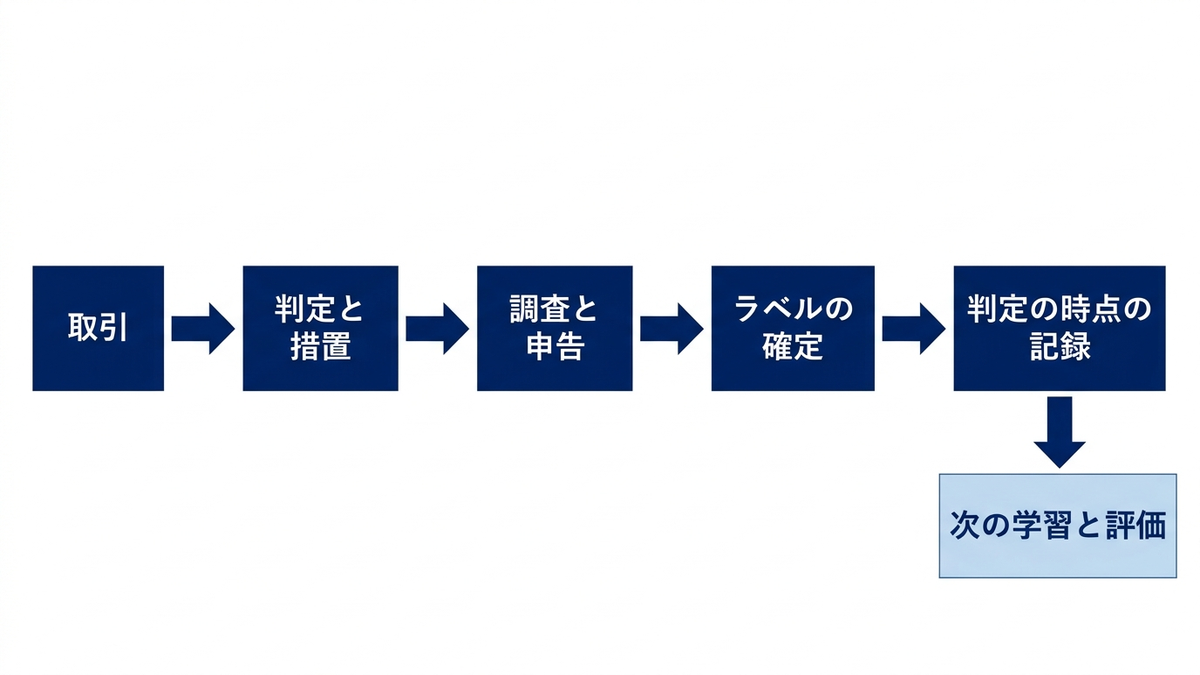
次の図は、本コラムの章の並びに沿って、不正検知の取り組みの流れを示したものです。序章で述べた「いまあるルールの成績を測る」作業は、3つ目の「検知の方式を比べる」の最初に行います。
第1章 不正検知の役割と事業での位置づけ、不正の種類と損失の構造
この章では、不正検知が事業のどこに効くのか、どんな不正があり、その損失を誰が負うのかを整理します。第2章から第12章で扱うデータ・ルール・機械学習・評価・運用の話は、すべて「どの不正を、どの水準まで減らすのか」という問いに答えるための道具です。その問いを立てる前提として、この章では不正の種類・当事者・損失の構造・検知の方式の全体像を1か所にまとめます。
この章はコードを載せず、表と概念図で説明します。
この章の主張は、検知の方式を選ぶ前に、どの不正を、どの水準まで減らすのかを先に決めることです。同じ判定の方式のまましきい値を動かす場合には、見逃しを減らそうとすれば誤検知が増え、誤検知を減らそうとすれば見逃しが増えます(特徴量やモデルを改善して両方を減らせる場合もあります)。不正検知は、このつり合いの上で運用する仕組みです。どの不正を優先するのか、どこまでの誤検知なら許せるのかが決まっていないと、方式の良し悪しも、ベンダーの示す数字の意味も判断できません。
不正検知が事業に効く4つの経路
本コラムでは、不正検知を「取引や申込の中から不正の疑いが強いものを見つけ、止める・追加で確認する・調査に回すための仕組み」と定義しています。見つけるだけでなく、その後の措置と調査までを含めて1つの仕組みとして扱うのが、本コラムの立場です。この仕組みが事業に効く経路は、大きく4つに分けられると考えています。
1つ目は被害の防止です。不正な取引を通してしまえば、その分の損失が事業者か顧客のどこかに生じます。誰が負うかは取引の種類と契約で変わりますが(後の節で扱います)、事業者が直接負う場合も、補償や返金の手続きを通じて間接に負う場合もあります。2つ目は顧客の保護です。アカウントの乗っ取り(盗まれた ID とパスワードなどで、正規の会員のアカウントに不正にログインされること)や不正送金では、被害を受けるのは事業者ではなく顧客本人であることが多く、検知の目的は事業者の損失を減らすことではなく、顧客の資産と生活を守ることになります。
3つ目は規制上の義務です。金融機関やクレジットカードを扱う事業者などには、法令で取引時の確認・疑わしい取引の届出・不正利用の防止のための措置などが求められています。この場合、不正検知は被害の大小にかかわらず、義務を果たすための仕組みとして必要になります。法令の条番号と内容は第14章でまとめて扱います。4つ目はブランドの信頼です。不正が多発するサービスは、顧客から「安心して使えない」と見られます。一方で、正当な取引を頻繁に止めるサービスも「使いにくい」と見られます。信頼は、見逃しの少なさと誤検知の少なさの両方で作られます。
この4つの経路は、同じ仕組みに対して別々の物差しを当てます。被害の防止だけを見れば、疑わしい取引をすべて止めるのが最善に見えますが、そうすると正当な顧客を止め、信頼を損ないます。規制上の義務だけを見れば、届出の件数が多いほど安全に見えますが、調査の能力を超えたアラートは形だけの確認につながります。不正検知の設計は、この4つの経路のつり合いをどこに置くかを決める作業だと考えています。
取引の場面で起きる不正の種類と、公表資料で確かめられる範囲
「不正検知」とひとくちに言っても、対象になる不正は業種と取引の場面によって大きく違います。カード会社が見る不正と、銀行が見る不正と、EC の事業者が見る不正と、保険会社が見る不正は、使えるデータも、損失を負う人も、取れる措置も異なります。本コラムでは、不正を「他人をだまして、または権限を偽って、不当に利益を得る行為」と定義し、主に取引の場面で起きるものを扱います。マネー・ローンダリング(犯罪で得た収益の出所を隠す行為)はこの定義にそのまま収まるものではありませんが、取引の記録から疑わしい資金の動きを見つけるという点で手法が重なるので、関連する領域として表に含めます。
次の表は、本コラムで扱う不正の種類を、関連する公的機関・業界団体の公表資料と並べてまとめたものです。手口の説明は、注意喚起として公表されている水準(何が起きるか・どこで気づけるか)に留め、実行の方法には触れません。保険金の不正請求とポイントやクーポンの不正取得の2つの行は、類型の一覧が資料に無く、「何が起きるか」の列は本コラムによる一般的な説明です。「主に気づける場面」の列は、検知の仕組みをどこに置くかを考えるための目安として本コラムが整理したものです。
| 不正の種類 | 何が起きるか | 主に損失を受ける人 | 主に気づける場面 | 関連する公表資料 |
|---|---|---|---|---|
| クレジットカードの不正利用 | 盗まれたカード情報や偽造カードで、本人になりすまして決済される。日本クレジット協会の集計は「偽造カード」「番号盗用」「その他」に分けている | カード会社・加盟店(契約と国際ブランドの規則による)。本人は請求の取り消しを求めることになる | 決済の承認の前後(カード会社に利用の可否を照会する時点。オーソリゼーションと呼ばれる)、決済の後の請求の確認 | 日本クレジット協会の不正利用被害の集計、クレジットカード・セキュリティガイドライン |
| アカウントの乗っ取り | 盗まれた ID とパスワードなどで、正規の会員のアカウントに不正にログインされ、登録されたカードやポイントを使われる | 会員本人・事業者 | ログインの時点、登録の情報の変更の時点(決済の前) | クレジットカード・セキュリティガイドライン(不正ログイン対策の節) |
| 不正なアカウントや口座の開設、名義の貸し借り | 盗まれた属性の情報で会員登録される。預貯金口座が他人に譲り渡され、詐欺の被害金の受け皿や資金の移動に使われる | 口座を開いた金融機関・詐欺の被害者 | 申込・口座開設の時点、開設後の入出金の動き | クレジットカード・セキュリティガイドライン(不正アカウント作成)、国家公安委員会の犯罪収益移転危険度調査書 |
| 不正送金 | フィッシングなどで盗まれたインターネットバンキングの認証の情報で、本人の口座から送金される | 口座の名義人(個人・法人)、補償の範囲で金融機関 | ログインの時点、送金先の登録の時点、送金の時点 | 警察庁のサイバー空間をめぐる脅威の情勢 |
| マネー・ローンダリング(関連する領域) | 犯罪で得た収益の出所や真の所有者を分からなくするために、口座や決済の手段を経由して資金を移す | 社会全体(事業者は規制上の義務の不履行の危険を負う) | 取引のモニタリング(入出金の流れ・口座どうしのつながり) | 国家公安委員会の犯罪収益移転危険度調査書 |
| 保険金の不正請求 | 事故や損害を偽ったり、損害を実際より大きく見せたりして保険金を請求する | 保険会社と、保険料を通じて契約者全体 | 請求の受付・査定の時点 | 日本損害保険協会の保険金不正請求への対応のページ(業界の取り組みを公表。類型の一覧は資料に無く、左の説明は一般的なもの) |
| EC の不正注文と転売 | 不正に入手したカード情報などで商品を購入し、指定の住所に配送させて転売する | 加盟店・カード会社 | 決済の時点、配送先の指定から商品の受け渡しまで(決済の後) | クレジットカード・セキュリティガイドライン(線の考え方) |
| ポイントやクーポンの不正取得 | 不正に取得したアカウントなどを使って、ポイントや特典を本来の条件を外れて得る | ポイントを発行する事業者 | 会員登録・特典の付与の時点 | 警察庁の令和8年上半期のサイバー空間をめぐる脅威の情勢(注記でポイントの不正取得に使うアカウントの不正な取得に触れている。類型の一覧は資料に無く、左の説明は一般的なもの) |
| 社内の不正・会計の不正 | 従業員が会社の資産を不正に流用する。財務諸表に意図的に事実と異なる数字を載せる | 会社・株主・取引先 | 経費の精算・支払・仕訳の点検、内部監査 | 日本公認会計士協会の監査基準報告書240(財務諸表監査における不正) |
表から読み取れるのは、同じ「不正」でも、気づける場面が取引の流れの中のどこにあるかが種類ごとに違うことです。クレジット取引セキュリティ対策協議会のクレジットカード・セキュリティガイドライン(6.1版、2026年3月)は、EC 加盟店での不正利用が「カード決済前」「カード決済時」「カード決済後」の取引の流れの中で行われるとし、その流れを「線」として捉えて、各時点で対策を講じる考え方を示しています(ガイドラインでは「線の考え方」と呼んでいます)。たとえば、アカウントの乗っ取りや不正なアカウントの作成は決済の前に起き、なりすましの決済は決済の時点で起き、不正に購入された商品の配送と転売は決済の後に起きます。不正検知を1か所の判定だけで考えず、取引の流れの複数の時点で何を見るかを考える必要がある、というのが本コラムの立場でもあります。
アカウントの乗っ取りでは、ログインに使われる ID とパスワードは正規の会員のものなので、取引の記録の上では本人の取引と見分けがつきにくくなります。見分ける手がかりには、普段と違う端末・接続の環境・時間帯、ログインの直後の登録情報の変更などがあります。このため、1件の取引の中身に加えて、その顧客の普段の行動との違いを見る仕組み(第5章の特徴量)や、端末や連絡先のつながりを見る方法(第7章)を組み合わせることが考えられます。
不正の種類を比べるときには、件数と1件あたりの被害の大きさの組み合わせも見ておく必要があります。件数は少なくても1件の被害が大きい不正(たとえば1回で大きな額が動く送金のような型)と、1件の被害は小さくても件数が多い不正(たとえば少額の不正注文や特典の不正取得のような型)とでは、求める検知の速さも措置も変わります。前者では、1件を通すだけで大きな被害になるので、取引の承認の前に止める判定や、追加の確認を求める措置の価値が高く、調査に時間をかけることも正当化されやすくなります。後者では、1件ずつ人が調べると調査の能力をすぐに超えるので、自動の措置やルールでまとめて扱い、人の調査は傾向の把握とルールの見直しに使うことが多くなると考えています。どちらの型の不正から手を付けるかは、第13章で扱う対象の選び方につながります。
社内の不正と会計の不正は、本コラムの主な対象である取引の不正とは性質が違います。日本公認会計士協会の監査基準報告書240は、財務諸表の監査で考慮する不正を、不正な財務報告(いわゆる粉飾)と資産の流用の2つに分けています。取引の不正の検知では、外部の第三者が顧客になりすます場合が多いと考えられるのに対し、社内の不正では、権限を持つ内部の人が正規の手続きの中で行うので、検知に使うデータも、調査の進め方も、報告の経路も異なります。本コラムでは、社内の不正の点検で使われる考え方として、第6章で桁の分布(ベンフォードの法則)を扱います。
国内の被害の統計から見える傾向、件数・前年比・構成比で読む
不正の被害の大きさを示す公的な統計は、いくつかの団体と官庁から公表されています。本コラムでは、被害の統計を金額ではなく、件数・前年比・構成比・発生率で紹介します。以下は、2026年11月の時点で開いて確かめた資料の範囲です。
1つ目は、日本クレジット協会のクレジットカード不正利用被害の集計です。この集計の構成比と発生率は、件数ではなく被害額に基づく割合です。2026年9月7日に公表された2026年第2四半期(4月から6月)の集計では、被害額の内訳の構成比は、番号盗用が92.9%、偽造カードが1.3%、その他の不正利用が5.8%でした。被害額は前期(2026年1月から3月)より5.2%減り、不正利用発生率(クレジットカードのショッピングの利用額に占める被害額の割合)は0.029%で、前期より0.004ポイント下がりました。同協会は、2026年の調査分から調査の方法を変えたので、2026年以降の集計値を使うときにはその点に注意するよう求めています。
年単位で見ると、同協会の集計では、番号盗用の構成比は2014年に58.8%だったものが、2020年に88.4%、2025年に93.1%になっています。偽造カードの構成比は2014年の17.0%から2025年の1.4%に下がっています。クレジットカード・セキュリティガイドライン(6.1版)は、対面取引ではIC取引の定着により偽造カードによる不正利用被害の減少傾向が続いていること、非対面取引での不正利用被害はほぼ EC 加盟店で発生していることを記しています。年間の不正利用発生率は、2023年の0.051%から2024年に0.047%、2025年に0.038%と下がり、2025年の被害額は2024年より約8%減りました。ただし、発生率が下がっても、番号盗用の構成比が9割を超える状態は続いています。
2つ目は、警察庁の「令和7年におけるサイバー空間をめぐる脅威の情勢等について」(2026年3月)で、令和7年(通年)の値を示しています。令和7年(2025年)のインターネットバンキングに係る不正送金事犯の発生件数は4,747件で、手口の約9割がフィッシングでした。同じ資料が引用する令和6年(2024年)の被害件数は4,369件なので、件数は前年から約9%増えています。フィッシング対策協議会によるフィッシングの報告件数は、令和7年に245万4,297件で、警察庁は「右肩上がりの増加が続いている」としています。
令和8年上半期については、同庁の「令和8年上半期におけるサイバー空間をめぐる脅威の情勢等について」(2026年9月)があります。上半期の値は通年の値と期間が違うので、両者を並べても増減は分かりません。この資料は、令和8年上半期の不正送金事犯の発生件数を253件と記しています。前年同期の発生件数は資料に示されておらず、通年の4,747件と集計の条件が同じかどうかも、本コラムでは確かめていません。フィッシングの報告件数は、同じ資料の図表(出典はフィッシング対策協議会)で上半期どうしを比べると、令和7年上半期の約119.6万件に対して令和8年上半期は約73.1万件と、前年同期より約39%少なくなっています。これはフィッシングの報告件数の比較で、不正送金の件数の増減を示すものではありません。同じ資料は、企業への電話をきっかけに遠隔操作のソフトを入れさせる新しい手口による被害が2026年5月に急増したことにも触れています。
3つ目は、国家公安委員会の犯罪収益移転危険度調査書(2025年11月)です。この調査書は、令和6年(2024年)に警察庁へ通知された疑わしい取引の届出が年間約85万件だったこと、過去3年間の合計では預金取扱金融機関が扱う商品・サービスがマネー・ローンダリングに悪用された取引の約6割を占めることを記しています。また、預貯金通帳などの譲渡などによる犯罪収益移転防止法違反の検挙件数は、令和4年の2,951件、令和5年の3,230件、令和6年の4,321件と増えています。調査書は、譲り渡された口座の数は検挙件数を大きく上回るとみられることにも触れています。
| 統計 | 公表元と資料 | 本コラムで紹介した値 | 読むときの注意 |
|---|---|---|---|
| クレジットカード不正利用の内訳と発生率 | 日本クレジット協会、2026年第2四半期の集計(2026年9月7日公表)と年間の集計 | 被害額に基づく番号盗用の構成比92.9%(2026年4月から6月)、93.1%(2025年)。被害額に基づく発生率0.029%(2026年4月から6月)、0.038%(2025年) | 主要なカード発行会社を対象にした集計で、海外で発行されたカードの分は含まない。2026年から調査の方法が変わった。対面と非対面の内訳は無い |
| インターネットバンキングに係る不正送金 | 警察庁、令和7年のサイバー空間をめぐる脅威の情勢(2026年3月)、令和8年上半期の同資料(2026年9月) | 発生件数4,747件(2025年)、4,369件(2024年)、253件(2026年上半期)。手口の約9割がフィッシング(2025年) | 警察が把握した件数で、警察が把握していない被害は含まれない。2026年上半期の値は、前年同期の件数が資料に無く、通年の値と集計の条件が同じかは確かめていない |
| フィッシングの報告件数 | フィッシング対策協議会の集計(警察庁の上の資料が引用) | 245万4,297件(2025年)。約119.6万件(2025年上半期)、約73.1万件(2026年上半期) | 報告された件数で、被害の件数ではない。上半期どうしで比べる |
| 疑わしい取引の届出と口座の譲渡 | 国家公安委員会、犯罪収益移転危険度調査書(2025年11月) | 届出の通知件数は約85万件(2024年)。預貯金通帳などの譲渡などの検挙件数は2,951件、3,230件、4,321件(2022年から2024年) | 届出の件数は不正の件数ではない。検挙件数は実際に譲り渡された口座の数より少ないとみられる |
統計を読むときに気をつけたいのは、これらの数字がいずれも、把握された被害・報告・届出などに基づくことです。単位も、件数のものと、被害額に基づく割合のものとで異なります。不正は、本人が気づかなかったり、集計する側が把握できなかったりすると統計に入りません。疑わしい取引の届出の件数は、不正の件数ではなく、事業者が「疑わしい」と判断した件数です。届出の件数が増えたことは、不正が増えたことも、事業者の検知が広くなったことも意味しえます。この性質は、自社の不正のラベル(その取引が不正だったかどうかの記録)にもそのまま当てはまります。自社で把握している不正の件数は、多くの場合、実際に起きた不正の件数より少なくなります。逆に、正当な取引が誤って不正と記録されることもあるので、把握した件数が実際より多くなる場合もあります。ラベルの作られ方と、こうしたラベルの誤りや偏りは第2章で扱います。また、これらの公表値は、集計の対象も定義も自社の記録とは異なるので、自社の件数や発生率と並べて優劣を言う根拠にはなりません。
当事者と、不正の損失を誰が負うか、カードの紛争の扱いを Visa の手引きで見る
不正の損失を誰が負うかは、取引の種類・契約・業界の規則で変わります。検知の仕組みを設計する側が「誰の損失を減らすための仕組みなのか」を取り違えると、優先順位を誤ります。ここでは、クレジットカードの取引を例に、当事者の役割を国内のガイドラインの用語で整理し、損失の流れを Visa の加盟店向けの手引きの範囲で説明します。他の国際ブランドの規則や、国内のカード会社ごとの扱いは、本コラムでは確かめていません。
クレジットカード・セキュリティガイドラインの用語集では、カードを発行する会社をイシュアー、加盟店と契約して加盟店の売上を扱う会社をアクワイアラーと呼び、それぞれを割賦販売法の第35条の16第1項に定めるクレジットカード番号等取扱業者などに対応させています。インターネットの取引で EC 加盟店に決済の仕組みを提供し、カード情報を処理する事業者は PSP(決済代行業者)と呼ばれています。ガイドラインは、カード会社がオーソリゼーション(承認の照会)の情報などで不正利用を検知する仕組みを「オーソリモニタリング」と呼び、「不正検知システム」とも呼ばれることを注記しています。
| 当事者 | 役割 | 不正検知との関わり |
|---|---|---|
| 顧客(カード会員・口座の名義人・会員) | 取引を行う本人。被害に気づいて申し出る | 本人の申し出が、不正のラベルの主な出所になる。正当な取引がアラートになり、保留や拒否の措置を受けると不便を受ける |
| 加盟店(EC の事業者・店舗) | 商品やサービスを売り、カードでの支払いを受ける | 決済の前と後(ログイン・会員登録・配送)の対策を担う。不正利用の取引の売上が取り消されることがある |
| カード会社(イシュアー) | カードを発行し、カード会員の利用を承認する | 承認の照会の時点でのモニタリング、追加の本人認証の判定を担う |
| カード会社(アクワイアラー) | 加盟店と契約し、加盟店の売上を扱う | 加盟店の管理、イシュアーからの取り消しの要求の受け渡しを担う |
| 決済代行業者(PSP) | EC 加盟店に決済の仕組みを提供し、カード情報を処理する | 加盟店への不正利用対策の提供、不正の発生状況の情報提供を担うことがある |
| 銀行(口座を扱う金融機関) | 口座の開設、送金、インターネットバンキングを提供する | 口座開設の時点の確認、送金の時点のモニタリング、疑わしい取引の届出を担う |
| 調査担当(社内の不正対策の部門) | アラートを確認し、不正かどうかを判断して措置を決める | 調査の結果がラベルになり、ルールとモデルの見直しに戻る。調査の能力に上限がある |
クレジットカードの取引で、損失の負担を決める仕組みとして知られているのがチャージバック(カード会員の申し出などを受けて、取引の売上を加盟店の側へ差し戻す手続き)です。以下は Visa の手引きに書かれている範囲の説明です。Visa の加盟店向けの紛争対応の手引き(Visa Dispute Management Guide for Merchants、2026年10月版)によれば、カード会員が取引に疑問を持ってイシュアーに申し出ると、イシュアーが申し出を審査し、条件を満たせば取引が決済網を通じてアクワイアラーへ差し戻されます。加盟店は、アクワイアラーを通じて取引の正当性を示す資料を出せる場合があります。同じ手引きは、紛争の理由を不正・承認・処理の誤り・消費者の紛争の4つの区分に分けており、不正の区分を、カード会員が取引を承認していない、または取引に関わっていないと申し出る場合としています。どの区分で、どの条件のときに加盟店が損失を負担するかは、各国際ブランドの規則と加盟店の契約で決まり、手引き自身も規則と契約が優先すると明記しています。
この仕組みから、不正検知にとって大事な性質が2つ出てきます。1つは、不正の損失が取引の時点ではなく、後から確定することです。カード会員が明細を見て申し出て、イシュアーが審査し、アクワイアラーと加盟店に届くまでには時間がかかります。この遅れが、第2章で扱う「ラベルの遅れ」の主な原因の1つです。もう1つは、同じ不正でも、取引の処理のされ方によって損失を負担する人が変わりうることです。Visa の手引きも、不正の紛争の扱いが取引の処理のされ方や認証の有無に左右されうると説明しています。具体的な条件は適用される規則と契約によって異なるので、本コラムでは扱いません。どこで本人認証を行うかは、検知の設計だけでなく、損失の負担の配分にも関わりうると考えています。
銀行の不正送金では、被害を受けるのは口座の名義人で、補償の扱いは金融機関の規定と、個人か法人かによって異なります。補償の具体的な条件は本コラムでは扱いません。保険金の不正請求では、不正に支払われた保険金は保険会社の損失になり、長い目で見ると保険料を通じて契約者全体に及びます。マネー・ローンダリングでは、直接の損失を受ける当事者がはっきりしないことが多い一方で、事業者には取引時の確認や疑わしい取引の届出などの規制上の義務があります(第14章)。このように、不正の種類ごとに「誰の損失を減らすのか」が違うので、検知の目的と成果の測り方も種類ごとに決める必要があります。
不正が起きる条件と、防止・検知・対応の3つの段の中での不正検知の位置
不正がなぜ起きるのかを説明する考え方として広く知られているのが、不正のトライアングルです。米国の公認不正検査士協会(ACFE)の解説によれば、この考え方は犯罪学者の Donald Cressey が、横領をした人たちを対象に行った研究に基づいています。Cressey の研究は、1953年に初版が出た著書『Other People’s Money』にまとめられています。ACFE の解説では、3つの要素を、人に打ち明けられない金銭上の必要(プレッシャー)、不正をする機会があると認識していること、自分の行為を正当化すること、と説明し、3つがそろうと不正が起きやすいとしています。
日本の監査の実務にも、同じ考え方が入っています。日本公認会計士協会の監査基準報告書240「財務諸表監査における不正」(最終改正2024年9月26日)は、適用指針のA1項で、不正は不正を実行する「動機・プレッシャー」「機会」、不正行為に対する「姿勢・正当化」を伴って生じると説明しています。なお、同協会は、国際監査基準の改訂に対応するための同報告書の改正の公開草案を2026年8月10日に公表しています。同協会の監査基準報告書の一覧(2026年10月19日現在)では、240の最新版は2024年9月26日改正のものでした。それより後に改正が確定したかどうかは、本コラムでは確かめていません。
不正のトライアングルは、もともと組織の内部の人による横領の研究から生まれた考え方で、第三者が顧客になりすます取引の不正にそのまま当てはまるわけではありません。それでも、不正検知の設計を考えるときに、3つの要素のうち「機会」が、事業者が直接手を入れられる部分だという整理は役に立つと考えています。動機や正当化は相手の側の事情で、事業者が変えることは難しい一方で、本人確認・認証・限度額・取引のモニタリングは、不正をする機会を狭める手段です。不正検知は、機会を狭める仕組みの1つとして位置づけられます。
不正のトライアングルは不正が起きる条件を説明する考え方で、対策の後に相手がどう動くかまでは説明しません。ただ、一般的な見方として、ある経路の対策が強くなると、手口が別の経路に移ることがあると言われています。前の節で見た偽造カードと番号盗用の構成比の変化は、ガイドラインが記す IC 取引の定着の時期と重なっていますが、構成比は一方が下がれば他方が上がる性質を持つので、構成比の変化だけでは手口が移ったことを示すとは限りません。本コラムでは件数の推移までは確かめていません。手口の変化への追従は第10章で扱います。
不正への備えは、本コラムでは防止・検知・対応の3つの段に分けて考えます。防止は、不正が起きる機会そのものを減らすことです。本人確認・多要素認証・カード情報を持たない仕組み・限度額の設定などがここに入ります。検知は、防止をすり抜けて起きようとしている不正、または起きてしまった不正を、取引の記録から見つけることです。対応は、見つけた不正に措置を取り、調査し、被害を回復し、仕組みを見直すことです。
本コラムの不正検知は、この3つの段のうち検知を中心にしつつ、対応の一部(措置と調査)までを含めて1つの仕組みとして扱います。理由は、検知の判定だけを切り出すと成果が測れないからです。アラートを出しても、誰も調べなければ不正は止まりませんし、調べた結果がラベルとして戻ってこなければ、ルールもモデルも良くなりません。逆に、リスクの判定は防止の段とも重なります。クレジットカード・セキュリティガイドラインの用語集が説明する EMV 3-D セキュアでは、イシュアーがリスクを判定し、低い場合はパスワードなどの入力なしに認証を終え、中程度の場合は追加の認証を求め、高い場合は認証を拒否します。これは、リスクに応じて本人認証の処理を変える例です。認証を終えることは取引の承認と同じではなく、取引を承認するかどうかの判断は別に行われます。本コラムの措置の区分では、追加の認証を求めることは保留に含まれ、担当者の確認を待つ保留と区別するときは「追加の認証を求める保留」と書き分けます。
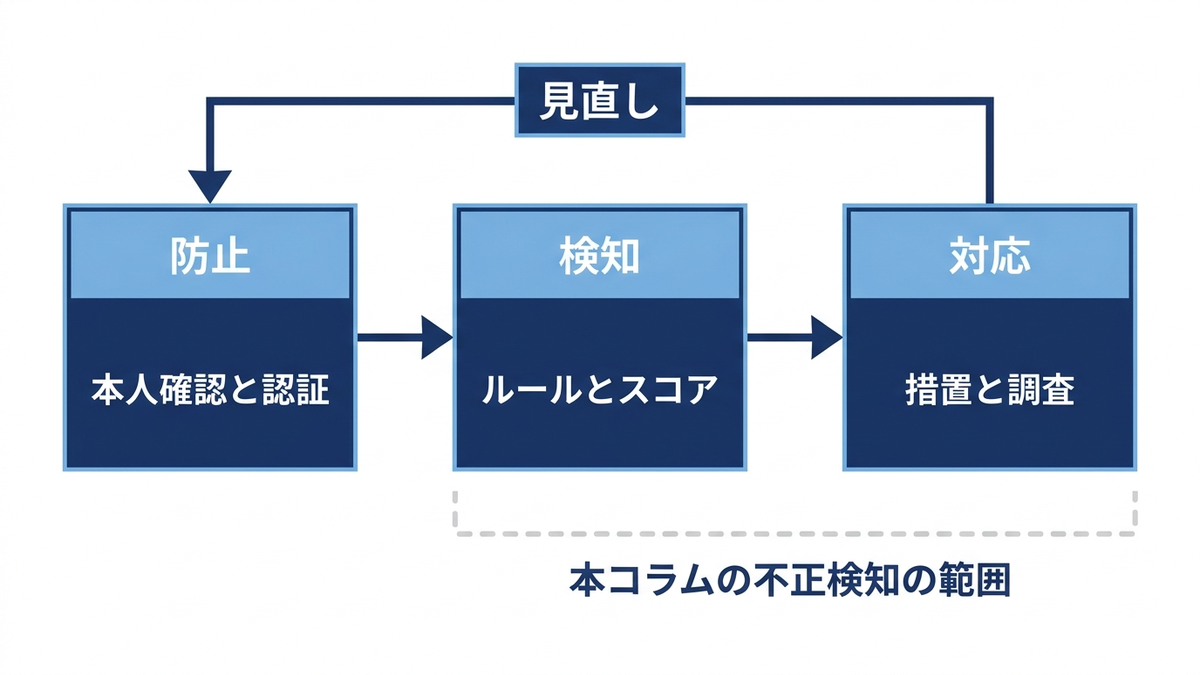
3つの段の考え方から、不正検知の位置について2つのことが言えます。1つは、防止の策が見つけやすい不正を先に除く場合、検知の段に届く不正は減り、残った不正が相対的に見つけにくくなることがある点です。防止を強めた後に検知の成績が下がって見えることがありますが、それは検知が悪くなったのではなく、見つけやすい不正が防止の段で止まった結果である場合があります。もう1つは、検知の段で見つけた不正の情報を、防止の段に戻す経路が要ることです。新しい手口が見つかったら、本人確認や認証の条件を見直す、限度額を変える、といった防止の段の手当てにつなげます。この戻しの経路が無いと、検知の段が同じ手口を毎日見つけ続けることになります。
検知の方式の全体像、ルール・教師あり学習・異常検知・ネットワーク分析
検知の段で使う方式は、本コラムでは大きく4つに分けて扱います。人が決めた条件で判定するルール、過去の不正のラベルから学ぶ教師あり学習、ラベルを使わずに普段と違う取引を探す教師なしの異常検知、口座・端末・住所などのつながりを見るネットワーク分析です。序章では検知の方式を3つのグループに分けましたが、この章では、序章の3つ目(普段からの外れ方とつながりを見る検知)を教師なしの異常検知とネットワーク分析の2つに分け、4つの方式として比べます。実際の仕組みでは、これらを組み合わせて使うことが多いと考えています。詳細は第3章から第7章で扱い、ここでは選ぶときの観点を比較の表にまとめます。
| 方式 | 何が分かるか | 必要なデータ | 得意なこと | 外れやすいところ | 扱う章 |
|---|---|---|---|---|---|
| ルール | 人が決めた条件に当てはまる取引 | 取引の記録と、条件を決めるための業務の知識 | 既知の手口・規制上の要件への対応、理由の説明、すぐ直せること | ルールが増え続けて矛盾する、誤検知が多くなりやすい、手口が変わると効かない | 第3章 |
| 教師あり学習 | 過去の不正に似ている度合い(スコア) | 取引の記録と、不正かどうかのラベル(確定までに遅れがある) | 多くの特徴の組み合わせで順位を付けること | ラベルの無い新しい手口、ラベルの選択の偏り(止めた取引や調査しなかった取引には、真のラベルが分からないまま残るものがあること)、スコアを確率として読むときの歪み | 第4章・第5章 |
| 教師なしの異常検知 | 全体や本人の普段から外れている度合い | 取引の記録(ラベルは無くてもよい) | ラベルの無い不正、過去に無かった型の候補を挙げること | 珍しいが正当な取引を拾う、成績をラベル無しでは測れない | 第6章 |
| ネットワーク分析 | 口座・端末・住所などを共有するつながりと、既知の不正との関連 | 名寄せ(同じ人・同じ端末の記録をひとまとめにすること)をした顧客・端末・連絡先・送金先の記録。既知の不正との関連を見る場合は、そのラベル | 組織的な不正、名義を変えた繰り返し、資金の移動の連鎖 | 名寄せの誤り、家族や事業所などの正当な共有を疑う、計算に時間がかかる | 第7章 |
表のどの方式も、単独で「不正を見つける」わけではありません。どの方式も、取引に疑いの強さの順位を付けるか、条件に当てはまるかどうかを判定するだけで、それを措置と調査につなげるのは運用の側です。また、方式の良し悪しは、扱う不正の種類と、手元にあるデータで変わります。ラベルが十分にたまっていない新しいサービスでは、教師あり学習を最初から使うのは難しく、ルールや異常検知から始める方法が考えられます。組織的な不正が問題になっている場合は、1件ずつの取引をいくら細かく見ても限界があり、つながりのデータが要ります。本コラムでは、ルールだけの検知を後の章の比較の基準(ベースライン)にし、機械学習を足したときに何が変わるかを示します。自社では、いま運用しているルールがこの基準に当たります。第3章では、例題用の単純なルールを作って基準にします。
不正検知が普通の分類問題と違う点
不正検知は、機械学習の言葉で言えば「不正か正当か」を当てる分類問題です。ただ、教科書の例題で扱うような単純化した分類問題の前提と比べると、いくつもの点で条件が厳しくなります。表の各項目は不正検知だけに起きるものではありませんが、不正検知ではこれらが重なります。読者がベンダーの説明やデータ分析の担当者の報告を読むときに、どの点に注意すればよいかを次の表にまとめました。
| 違い | この章で比べる、単純化した分類問題の前提 | 不正検知で起きること | どこで外れるか | 扱う章 |
|---|---|---|---|---|
| 不均衡 | 分類する群の件数がある程度そろっている | 不正の件数が正当な取引に比べて極端に少ない(不均衡データ) | 「全部正当」と答えても正解率が高くなり、正解率が成績の物差しにならない | 第2章・第4章・第8章 |
| ラベルの遅れ | 正解のラベルがすぐ手に入る | 本人の申告・チャージバック・調査の完了を待つので、確定までに日から月の単位でかかる | 直近のデータほどラベルが欠け、不正が少なく見える。評価の期間を誤る | 第2章・第8章・第10章 |
| 選択の偏り | すべての事例に正解のラベルがある | 止めた取引・調査しなかった取引には、真のラベルが分からないまま残るものがある(後日の申告で分かる場合もある) | 今の検知の仕組みが見たものだけで学ぶので、見ていない不正を学べない | 第2章・第10章 |
| 相手が適応する | データの性質が時間がたっても変わらない | 手口が変わり、検知そのものに合わせて行動が変わる | 過去のデータでの成績が、本番ではしだいに下がる | 第10章 |
| 誤りの代償が非対称 | 誤りの種類による損失の差を考えないことが多い | 見逃し1件と誤検知1件の損失が大きく違い、取引ごとにも違う | 誤りの件数だけで比べると、損失の大きい誤りを見落とす | 第8章・第9章 |
| 調査の能力の上限 | 判定の結果をそのまま使う | アラートを人が確認するので、1日に確認できる件数に上限がある | アラートが多すぎると、見られないまま流れるか、確認が形だけになる | 第9章 |
| リアルタイム | 判定にかかる時間を問わない | 決済や送金の承認の前に、短い時間で判定しなければならないことがある | 判定の時点で使えない情報を使ったモデルは、本番で動かない | 第5章・第12章 |
| 規制と説明 | 判定の理由を問われない | 規制上の義務、顧客への説明、監査への対応がある | 理由を示せない判定は、運用と監査で使いにくい | 第11章・第14章 |
表の項目は互いにつながっています。たとえば、ラベルの遅れと選択の偏りがあるので、不正の件数はもともと少ないうえに、学習に使えるラベルはさらに少なく偏っています。相手が適応するので、ラベルがたまるのを待っている間に手口が変わることもあります。調査の能力に上限があるので、どれだけ良いモデルを作っても、運用で扱えるアラートの件数に合わせて使い方を決めなければなりません。不正検知の難しさは、個々の項目よりも、これらが同時に起きることにあると考えています。
よくある3つの誤解
不正検知の導入を検討する場面で、判断を誤らせやすい考え方が3つあります。いずれも、ここまでの節で扱った性質から説明できます。
1つ目は、「AIを入れれば不正が無くなる」という考え方です。教師あり学習のモデルは、不正と正当のラベルと取引の特徴の関係を学び、教師なしの異常検知は、データの中での外れ方を評価します。どちらもスコアを付けるだけで、スコアだけでは不正を確定できず、不正を無くすわけでもありません。スコアが高い取引を誰がどう調べ、どう止めるかという運用が無ければ、スコアは使われません。また、相手は対策に合わせて手口を変えるので、ある時点で効いていたモデルも、手を入れなければ古くなります。不正をゼロにすることを目標にすると、正当な取引を大量に止めることになりかねません。目標は「無くす」ではなく、「どの不正を、どの水準まで、どれだけの誤検知と調査の負担で減らすか」で立てる必要があります。
2つ目は、「検知率が高いほど良い」という考え方です。ここでいう検知率は、本コラムでいう再現率(実際の不正のうちアラートにできたものの割合)です。再現率は、アラートにする対象を広げれば上げられる場合があります。極端に言えば、すべての取引をアラートにすれば再現率は100%になりますが、正当な取引もすべて調査の対象になります。さらに、アラートをすべて保留や拒否にする運用なら、正当な取引もすべて止まります。再現率は、アラートのうち実際に不正だったものの割合(適合率)、アラートの件数、誤検知の件数、誤って止めた正当な取引の件数と一緒に見なければ意味を持ちません。ベンダーが示す「検知率」は、どの条件で、どれだけのアラートを出したときの値かを確かめる必要があります。評価の指標は第8章で扱います。
3つ目は、「正解率が高ければ良い」という考え方です。不正の件数が全体のごく一部しかない不均衡なデータでは、すべての取引を「正当」と答えるだけで、正解率は不正でない取引の割合と同じだけの高い値になります。この場合、不正は1件も見つかっていません。正解率は、不均衡なデータでは成績の物差しになりません。この性質は第2章で架空のデータを使って確かめます。
3つの誤解に共通しているのは、不正検知の成果を1つの数字で表そうとしていることです。本コラムでは、成果と呼んでよいのは、見つけて防いだ不正と、誤って止めた正当な取引の両方を数えたうえでの差だと考えています。アラートの件数や再現率だけを成果として報告すると、誤検知の増加という損失が見えなくなります。差を取るには、防いだ不正の被害と、誤って止めた取引の損失を同じ尺度にそろえる必要があります。その尺度のそろえ方(誤検知1件と見逃し1件の損失の比の置き方)は第9章で扱います。
経営の損失の型と、どの不正をどの水準まで減らすのかを先に決める
不正検知の判断を誤ったときに経営が受ける損失を、本コラムでは次の6つの型に分けて扱います。損失は金額ではなく型で書き、各章でどの型に関わるかを示します。
| 損失の型 | 何が起きるか | 起きやすい原因 | 見張る指標の例 |
|---|---|---|---|
| 見逃しによる被害 | 不正な取引をアラートにできず、通してしまう | しきい値が高すぎる、手口の変化に追いついていない、気づける場面に検知を置いていない | 後から判明した不正の件数と、その被害の大きさ(自社の損失の測り方に合わせた数。本コラムの例題では相対値) |
| 誤検知による機会損失 | 正当な取引を止め、売上や手数料の機会を失う | しきい値が低すぎる、ルールが増えすぎて重なっている | 保留や拒否にした取引のうち正当だったと確かめられたものの割合(止めた取引には正当かどうか分からないまま残るものがある。第2章・第9章)、追加の認証で離脱した割合 |
| 調査の過負荷 | アラートが調査の能力を超え、見られないまま流れる | アラートの件数を調査の人員と一緒に決めていない | 調査の滞留の件数、アラートから確認までの時間 |
| 顧客の離反 | 正当な顧客が止められて信頼を失い、利用をやめる | 誤検知が特定の顧客に繰り返される、止めた後の連絡や救済が遅い | 誤って止めた顧客のその後の利用の継続、問い合わせ・苦情の件数 |
| 形骸化 | ルールやモデルが更新されず、手口の変化に置いていかれる | 見直しの担当と時期が決まっていない、調査の結果が戻ってこない | 最後に見直した日、ルールごとの適合率の推移 |
| 規制上の義務の不履行 | 確認・届出・記録などの義務を果たせない | 検知と届出の手順がつながっていない、判定の記録が残っていない | 届出の判断までの日数、判定の記録の欠け |
この6つの型は、互いに引っ張り合います。同じ判定の方式のまま、見逃しによる被害を減らそうとしてしきい値を下げれば、誤検知と調査の過負荷が増え、アラートを保留や拒否につなげる運用では誤検知による機会損失も増えます。誤って止めた取引が特定の顧客に集まれば顧客の離反につながります。誤検知を減らそうとしてしきい値を上げれば、見逃しによる被害が増え、規制上の義務の面でも説明が難しくなることがあります。法令上の義務を満たすことを前提にしたうえで、被害・顧客の負担・調査の能力のどこに目標を置くかは、技術の問題ではなく経営の判断です。
このため、本コラムでは、検知の方式を選ぶ前に「どの不正を、どの水準まで減らすのか」を先に決めることを勧めます。具体的には、次の6つを文書にして、関係する部門と合意しておくことが有効だと考えています。
- 対象にする不正の種類と、その不正で損失を負うのは誰か(事業者・顧客・加盟店・社会)
- 減らしたい水準を何で表すか(後から判明した不正の件数・被害の大きさの相対値・不正利用の発生率など)と、それをいつまでにどこまで下げるか
- 許せる誤検知の水準
- 追加の認証を求めることによる顧客の負担の水準
- 誤って止めた顧客への救済の手続き
- アラートを調べる人員と、1日に確認できる件数の上限(調査の能力を検知の一部として予算に入れる)
3つ目の誤検知の水準は、正当な取引のうちアラートになったものの割合や、正当な取引のうち保留や拒否にしたものの割合のように、分母を正当な取引の全体にして決めます。4つ目は、保留のうち追加の認証を求める保留について、顧客にかかる手間を別に見るためのものです。追加の認証を求める取引には不正な取引も正当な取引も含まれるので、その割合は誤検知の水準とは別に決めます。
この6つが決まっていれば、ベンダーの示す数字も、データ分析の担当者が作るモデルも、「その目標に対してどうか」で判断できます。決まっていなければ、再現率の高さやアラートの件数といった、比べやすいが成果を表さない数字で選ぶことになりがちです。目標の数字は最初から正確である必要はありません。まず今のルールの成績と調査の実態を測り(第3章・第13章)、その結果を見て見直していく前提で、仮の目標を置くことから始めるのが現実的だと考えています。
予算と体制の面では、不正検知を「システムの導入」として予算を組むのではなく、検知・調査・見直しを続ける運用の費用として組むことが大事です。調査の人員は、アラートの件数を決めるしきい値と一緒に決める必要があります(第9章)。ルールとモデルの見直しは、手口が変わる限り終わらないので、担当と時期を最初から決めておきます(第10章)。KPI は、見逃しによる被害と誤って止めた正当な取引の2つを最終の指標に置き、検知の指標(適合率・再現率)と調査の指標(滞留・所要時間)をその下に並べる形が、損失の型と対応しやすいと考えています。KPI の木の作り方は第13章で扱います。
この章では、不正検知が4つの経路(被害の防止・顧客の保護・規制上の義務・ブランドの信頼)で事業に効くことを確かめました。不正の種類ごとに、気づける場面と損失を負う人は違います。公表されている統計は、いずれも把握された被害・報告・届出などに基づき、件数のものと被害額に基づく割合のものがあります。不正のトライアングルの考え方からは、不正検知が不正の機会を狭める仕組みの1つだと位置づけられます。また、不正検知では、不均衡・ラベルの遅れと選択の偏り・相手の適応・誤りの代償の非対称・調査の能力の上限が同時に起きることを整理しました。検知の方式を選ぶ前に、どの不正を、どの水準まで、どれだけの誤検知と調査の負担で減らすのかを先に決めることが、この章の結論です。
第2章では、そのための材料になるデータを扱います。取引の記録・顧客の属性・端末の情報・調査の結果などの種類と、ラベルがどう作られ、なぜ遅れて偏るのかを、架空のデータを使って確かめます。
この章を深めたい方への参考書籍
『COSO不正リスク管理ガイド』第2版(八田進二・橋本尚 監訳、堺咲子・城内将人・真柳元 訳、日本内部監査協会):COSO と ACFE が2023年に公表した不正リスク管理の手引きの第2版の訳書で、日本語版は2026年3月に発行されました。目次は、不正リスクのガバナンス、不正リスク評価、不正統制活動、不正調査と是正措置、不正リスク管理モニタリング活動の5つの章で構成されています。COSO の発表では、第2版でデータ分析に関する記述が広げられたとされています。不正への備えを、検知の仕組みだけでなく、組織の統制と見直しの仕組みとして捉えるときの土台になります。
『企業不正の調査実務 徴候の検知から調査技術、事後処理まで』第2版(KPMG Forensic & Risk Advisory 編、中央経済社):書名のとおり、不正の徴候の検知から調査の技術、事後の処理までを扱う実務書で、2025年12月に第2版が出ています。主な対象は社内の不正ですが、アラートの後の調査と、その結果を再発の防止につなげる流れを考えるときの参考になります。
この2冊は、どちらも組織の統制と不正の調査の側から書かれた本です。カードや送金などの取引の不正をデータで見つける方法については、第3章以降の各章で紹介する書籍が近い内容を扱っています。
第2章 不正検知に使うデータ、取引の記録とラベルの遅れ・不均衡の扱い
第1章では、不正検知が事業のどこに効くのか、不正にどのような種類があり、損失を誰が負うのかを整理しました。また、不正検知が普通の分類の問題と違う点として、不正の件数が極端に少ないこと、不正かどうかの記録が遅れて届くこと、相手が手口を変えてくることを挙げました。この章では、そのうちデータに関わる性質を取り上げ、不正検知に使うデータの種類と、そのデータを学習や評価に使うときに気をつけることを扱います。
この章で扱うのは次の内容です。後半は、架空の取引の記録(顧客5,000人・90日分)を使い、実行したコードと結果で確かめます。
- 不正検知に使うデータの種類(取引の記録・顧客の属性・端末と接続の情報・認証の記録・過去のアラートと調査の結果・外部の情報)
- 不正かどうかの記録(ラベル)がどこから来るか、確定までにどれだけかかるか
- 止めた取引・調査しなかった取引のラベルが分からないことから生じる偏りと、ラベルの誤り
- 不正の件数が極端に少ないデータで、正解率が意味を持たない理由
- データの品質の問題と、判定の時点の値を残す記録の設計
- 個人データの取り扱いの入口と、経営の判断
この章の主張は、不正検知のデータでは、ラベルが遅れて届き、しかも偏っている、という点です。ラベルの遅れを無視して直近までの記録で学習や評価をすると、不正が実際より少なく見えます。止めた取引は実行後の結果を観測できず、追加の確認をしなければ不正だったかどうかが分からないまま残るものがあるので、手元のラベルには、すでに止めている型の不正ほど少なく入ります。こうした性質は後からデータを分析しても取り戻しにくいので、調査の結果をラベルとして残す仕組みを、検知の仕組みと同時に作っておくことが必要だと考えています。
不正検知に使うデータの種類、取引の記録から外部の情報まで
不正検知に使うデータの中心は、取引の記録です。1件の取引について、いつ(日時)、いくら(額)、誰から誰へ(顧客と相手。カードの決済なら加盟店、送金なら受取口座)、どの経路で(店頭・インターネット・アプリ・電話など)行われたかが記録されます。取引の記録だけでも、1件ずつの額や時刻は分かります。ただし、その額や時刻がその顧客にとって普段どおりなのかどうかは、1件の記録からは分かりません。普段との違いを見るには、同じ顧客の過去の取引を集めて比べる必要があり、これが第5章で扱う特徴量の設計の出発点になります。
取引の記録に加えて、顧客の属性(登録してからの期間・登録の住所や連絡先・契約の種類など)、端末と接続の情報(取引に使われた端末の識別子・その端末が初めて使われたかどうか・接続元の地域など)、認証の記録(どの認証の方法を通ったか、失敗が何回あったか、登録の情報がいつ変更されたか)が使われます。第1章で扱ったアカウントの乗っ取りのように、本人以外が本人の権限で操作する型の不正では、取引の額や相手よりも、端末が新しい・認証に何度も失敗している・連絡先が直前に変更された、といった記録の方が手がかりになることがあります。
もう1つ、見落とされやすいのが、過去のアラートと調査の結果です。どの取引にアラートが出て、誰がいつ確認し、不正と判断したのか正当と判断したのか、どの措置を取ったのかという記録は、そのまま次の学習のラベルになり、ルールの見直しの材料になります。最後に、外部の情報として、業界の団体や他の事業者と共有される情報(不正に使われたことが分かった口座や端末の情報など)や、住所・電話番号の確認の結果などが使われることがあります。外部の情報を共有する仕組みと、それに関わる法令上の扱いは、第14章で扱います。
データの種類を次の表にまとめました。「判定の時点で使えるか」の列は、取引を承認するかどうかを決める瞬間に、そのデータが手元にあるかどうかを表します。後から届くデータは、事後の調査には使えても、取引を止める判定には使えません。
| データの種類 | 主な項目の例 | 分かること | 判定の時点で使えるか | 注意点 |
|---|---|---|---|---|
| 取引の記録 | 日時・額・相手(加盟店や受取口座)・経路・加盟店の種類 | 1件ずつの額と時刻。集計すれば顧客の普段の行動 | 使える(その取引までの分) | 1件だけでは普段どおりかが分からない。時刻の基準を揃える |
| 顧客の属性 | 登録してからの期間・契約の種類・登録の住所や連絡先 | 新しい顧客かどうか、登録の情報と取引の情報の食い違い | 使える | 後から更新された値で上書きすると、判定の時点の値が分からなくなる |
| 端末と接続の情報 | 端末の識別子・初めて使う端末かどうか・接続元の地域 | 本人がいつも使う環境と違うかどうか | 使える(取得している経路だけ) | 正当な機種変更や旅行でも変わる。経路によっては取得できない |
| 認証の記録 | 認証の方法・失敗の回数・登録の情報の変更の時刻 | 本人の権限が他人に使われている疑い | 使える | 認証の仕様の変更で値の意味が変わる |
| 過去のアラートと調査の結果 | アラートの有無・調査の判断・措置・判断の理由 | どの取引が不正と確かめられたか(ラベル) | 過去の分だけ使える | 調査した取引にしか結果が無い。判断の基準が人で揺れる |
| 外部の情報 | 共有された不正の口座や端末の情報・住所や電話番号の確認の結果 | 他社で起きた不正とのつながり | 仕組みによる | 利用の条件と法令上の扱いを確かめる(第14章) |
ラベルの作られ方と遅れ、本人の申告・チャージバック・調査の結果・届出
教師あり学習で不正のスコアを作るにも、検知の成績を測るにも、取引ごとに「不正だったかどうか」の記録が要ります。本コラムではこれをラベルと呼びます。不正検知のラベルは、取引が起きた瞬間には付いていません。ラベルは、取引の後に、いくつかの経路を通って少しずつ届きます。
代表的な経路は次の4つです。
- 本人の申告:利用の明細や通知を見た顧客が「この取引に覚えがない」と連絡してくるもの
- チャージバック:カードの取引で、会員の申し出を受けて請求を取り消す手続き(次の段落で説明します)
- 調査の結果:アラートを調査担当が確認して、不正と判断したもの
- 届出:マネー・ローンダリングの疑いのように、事業者が疑わしい取引として当局に届け出たもの。届出は疑いを届け出るもので、不正の確定ではありません。ラベルとして使う場合は、確定したラベルとは区別して扱う必要があります。届出の義務と手続きは第14章で扱います
チャージバックについて、日本クレジット協会のウェブサイトで公開されている吉元利行氏の論文(クレジットカード利用者の保護の現状とその限界)の説明では、チャージバックは国際ブランドが定める手続きで、会員の申し出を受けて、会員側のカード会社が、加盟店側のカード会社を経由して届いた販売店からの請求を取り消す制度とされています。同じ論文は、チャージバックを使える理由が国際ブランドの定めで限られていることも指摘しており、理由の例には事務的な誤りに関するものも挙げられています。チャージバックは不正な利用だけを理由とするものではないので、チャージバックの有無だけで不正のラベルとせず、理由の区分や調査の結果を確かめて使う必要があります。チャージバックの記録は、会員の申し出から手続きが進んだ後で届きます。
この4つの経路は、届くまでの時間が大きく違うと考えられます。以下の時間の傾向は、経路の仕組みから考えた本コラムの整理で、日数を裏づける統計は確認していません。本人の申告は、顧客が明細や通知を見たときに届くので、通知の仕組みがあれば取引から数日で届くことがあります。一方で、毎月の明細でしか気づかない顧客や、明細をあまり見ない顧客の申告は、それより遅れます。チャージバックは会員の申し出から手続きを経て記録されるので、申し出そのものより後になります。調査の結果は、調査担当がアラートを確認した時点で決まりますが、アラートが出なかった取引には調査の結果がありません。こうして、ある取引が不正だったかどうかが確定するまでに、日の単位から月の単位の時間がかかることがあります。本コラムでは、この時間の差をラベルの遅れと呼びます。
ラベルの遅れは、学習と評価の両方に影響します。ある日にデータを締めて学習をすると、直近の取引のうち、まだ申告やチャージバックが届いていない不正は、記録の上では「正当」のまま残ります。直近の期間ほど、不正が実際より少なく見えるわけです。この性質を知らずに直近までの記録を使うと、モデルは直近の不正を正当な取引として学び、評価では、確定していない不正をアラートにできなくても見逃しとして数えられないなど、成績がゆがみます。この章の後半で、架空の取引の記録を使ってこの性質を数字で示します。
ラベルの経路ごとの性質を次の表にまとめました。表の「届くまでの時間」は一般的な傾向を書いたもので、実際の日数は、通知の仕組み・手続きの規約・調査の体制によって事業者ごとに違います。自社のラベルの遅れは、取引の日とラベルが確定した日の両方を記録しておけば測れます。ただし、直近の取引のうち確定したものだけを集計すると、早く確定したものに偏ります。十分に時間がたった時期の取引を追い続け、まだ確定していない件数も一緒に記録しておくことが必要です。
| ラベルの経路 | 誰が決めるか | 届くまでの時間 | 拾えない不正 | 記録に残すこと |
|---|---|---|---|---|
| 本人の申告 | 顧客 | 通知があれば早い。明細でしか気づかない顧客は遅い | 顧客が気づかない不正、申告しない顧客の不正 | 申告の日・対象の取引・申告の内容 |
| チャージバック | カード会社と加盟店の手続き | 会員の申し出から手続きを経た後なので、申し出そのものより後になる | カードの取引以外の不正。手続きに至らなかった不正 | 申し出の日・理由の区分・手続きの結果 |
| 調査の結果 | 調査担当 | アラートを確認した時点 | アラートが出なかった取引、調査しきれなかったアラート | 確認の日・判断・判断の理由・確認した人 |
| 届出(疑いの届出で、不正の確定ではない) | 事業者(届出の判断をする部署) | 疑いを持ってから社内の判断を経た時点 | 疑いを持たれなかった取引 | 届出の日・対象の取引。確定したラベルとは別の項目として残す(扱いは第14章) |
止めた取引のラベルは分からない、選択の偏りとラベルの誤り
ラベルの遅れに加えて、不正検知のラベルにはもう1つ、構造的な偏りがあります。検知の仕組みがすでに動いていると、疑いが強い取引は拒否されるか、保留になって追加の確認を求められます。拒否した取引は実行されないので、実行後の被害や、本人の申告・チャージバックといった結果は観測できません。顧客への確認や調査で不正な試みだったと分かる場合もありますが、追加の確認をしなければ、不正だったかどうかが分からないまま残るものがあります。調査しなかったアラートや、アラートにならずに通した取引の大半も、申告が届かない限り「正当」のまま記録に残ります。
その結果、手元にラベルがそろっている取引は、全部の取引の中から、過去の検知の仕組みが選んだ一部になります。本コラムでは、過去の判定の仕組みや調査の方針によって、ラベルの付く取引が偏って選ばれることを選択の偏りと呼びます。選択の偏りがあると、すでにルールで止めている型の不正は、学習のデータの中で少なく見えます。そのデータで学習したモデルは、その型の不正を「あまり起きない」と学ぶことがあり、古いルールを外して新しいモデルに置き換えた途端に、その型の不正をアラートにできず、通してしまうおそれがあります。この章の後半で、この偏りも架空のデータで確かめます。
選択の偏りへの対処は、データを分析する段階だけでは難しく、運用の設計で補う必要があります。よく挙げられる考え方は、判定のときにスコアとルールの結果と措置をすべて記録しておくこと、拒否した取引についても、後の調査や顧客への確認で分かった結果を残すこと、そしてアラートにならなかった取引からも一部を無作為に選んで調査し、偏りの無いラベルを少しずつ集めることです。ただし、アラートにならなかった取引から無作為に選んだラベルは、その範囲の取引を代表するもので、調査したアラートのラベルとそのまま混ぜても、全部の取引を代表するとは限りません。どの範囲から、どの割合で選んだのかを記録しておくことが前提になります。無作為の点検をどう運用するかは、第10章で扱います。
ラベルには誤りも入ります。1つは、不正なのに不正と記録されない誤りです。顧客が少額の不正に気づかない場合や、申告の手間を避けて黙っている場合、その取引は正当のまま残ります。もう1つは、正当なのに不正と記録される誤りです。家族が本人の了解のもとで使った取引を本人が覚えておらず申告した場合や、調査担当の判断の誤りが例になります。調査の判断の基準が人によって揺れると、同じような取引に別のラベルが付きます。ラベルの誤りは、第8章で扱う評価の数字の信頼性に直接響くので、調査の判断の基準を文書にしておくこと、判断の理由を記録に残すことが、ラベルの品質を保つための前提になります。
ここまでの3つの性質(遅れ・選択の偏り・誤り)は、どれも「データを分析する人」ではなく「取引を処理し調査する仕組み」の側で生まれます。分析の担当が後から気づいても、記録に残っていない情報は取り戻せません。ラベルの設計は、検知の仕組みを作るときに、調査の業務の設計と一緒に決めておくことが必要です。
架空の取引の記録を作る、顧客ごとの普段の行動と不正に多い特徴
ここからは、ここまでに述べた性質を、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の取引の記録よりずっと単純です。合成データでの数字は、実際の事業での成績や不正の割合の目安にはなりません。データの作り方を変えれば数字も変わるので、本コラムでは、コードの結果を、性質の向きを確かめる例として示します。データは、顧客5,000人・90日分の取引を、次の性質を持たせて乱数で作りました。
- 顧客ごとの普段の行動:取引の額の水準、よく使う時間帯、1日あたりの取引の回数、よく使う加盟店の種類(A〜Hの8種類)を、顧客ごとに変える
- 正当な取引:顧客の普段の額の水準のまわりでばらつき、よく使う時間帯のまわりで起き、7割はよく使う加盟店の種類で起き、残りの3割は8種類から無作為に選ぶ(その中にもよく使う種類が入るので、よく使う種類での取引は7割よりやや多くなる)。2%は新しい端末から行われる
- 不正な取引:顧客の中から370人を選び、その人の取引として、ある日の短い時間(最初の不正から2時間以内)に1〜6件の不正をまとめて起こす。額は普段より大きめで、時刻は深夜から明け方が多く、加盟店の種類は普段と無関係、8割が新しい端末から行われる
- 時間の流れ:取引ごとに0日目から89日目までの日付と時刻を持たせる
取引の額は単位の無い相対値で、金額ではありません。最初のブロックでは、顧客ごとの普段の行動を作り、それにしたがって正当な取引を作ります。乱数のシードを固定しているので、同じ版のライブラリなら、同じ結果が出ます。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

rng = np.random.default_rng(20261112)
N_CUST, DAYS = 5000, 90
cats = np.array(list("ABCDEFGH"))          # 加盟店の種類A〜H

# 顧客ごとの普段の行動
level = rng.lognormal(3.0, 0.6, N_CUST)    # 額の水準(相対値)
home_hour = np.clip(rng.normal(14, 3, N_CUST), 7, 22)   # よく使う時間帯
freq = rng.gamma(2.0, 0.4, N_CUST)         # 1日あたりの取引の回数
fav = rng.integers(0, 8, N_CUST)           # よく使う加盟店の種類

# 正当な取引
n = rng.poisson(freq * DAYS)
cid = np.repeat(np.arange(N_CUST), n)
m = len(cid)
legit = pd.DataFrame({
    "cid": cid,
    "day": rng.integers(0, DAYS, m),
    "hour": np.mod(rng.normal(home_hour[cid], 2.5), 24),
    "amount": level[cid] * rng.lognormal(0, 0.5, m),
    "cat": cats[np.where(rng.random(m) < 0.7, fav[cid], rng.integers(0, 8, m))],
    "new_device": rng.random(m) < 0.02,
    "is_fraud": 0})
print(f"正当な取引 {m:,} 件")
実行すると、正当な取引は362,362件になりました(実行環境の注:図の日本語の表示には japanize-matplotlib を使っています。本コラムの実行環境では 1.1.3、Python 3.14.3 で動作を確認しました。この部品を読み込めない環境では、導入済みの日本語フォントを Matplotlib で直接指定すると、同じ図を描けます)。次のブロックで不正な取引を作り、正当な取引とつなげて時刻の順に並べます。
# 不正な取引:被害に遭う顧客を選び、短時間に続けて起きる(日付をまたぐ場合もある)
victims = rng.choice(N_CUST, 370, replace=False)
k = rng.integers(1, 7, len(victims))       # 1人あたりの不正の件数(1〜6件)
vid = np.repeat(victims, k)
f = len(vid)
start_day = np.repeat(rng.integers(0, DAYS - 1, len(victims)), k)
start_hour = np.repeat(np.mod(rng.normal(2, 4, len(victims)), 24), k)
t_f = start_day + (start_hour + rng.uniform(0, 2, f)) / 24   # 最初の不正から2時間以内
fraud = pd.DataFrame({
    "cid": vid,
    "day": np.floor(t_f).astype(int),
    "hour": (t_f - np.floor(t_f)) * 24,
    "amount": level[vid] * rng.lognormal(1.0, 0.7, f),
    "cat": cats[rng.integers(0, 8, f)],
    "new_device": rng.random(f) < 0.8,
    "is_fraud": 1})

tx = pd.concat([legit, fraud], ignore_index=True)
tx["t"] = tx["day"] + tx["hour"] / 24      # 0日目の0時からの経過日数
tx = tx.sort_values("t", ignore_index=True)
print(f"取引 {len(tx):,} 件 / 不正 {tx.is_fraud.sum():,} 件 / 不正の割合 {tx.is_fraud.mean():.3%}")
print(f"不正に遭った顧客 {len(victims)} 人(全顧客の {len(victims) / N_CUST:.1%})")
実行した結果は次のとおりです。
| 項目 | 値 |
|---|---|
| 取引の件数 | 363,622件 |
| 不正な取引の件数 | 1,260件 |
| 不正の割合 | 0.347% |
| 不正に遭った顧客 | 370人(全顧客の7.4%) |
取引の件数で見ると、不正は全体の0.347%、およそ290件に1件です。一方で、顧客の単位で見ると、90日のあいだに7.4%の顧客が少なくとも1件の不正に遭っています。同じデータでも、取引の単位で数えるか顧客の単位で数えるかで、不正の割合の見え方は大きく変わります。不正の割合を報告するときや、ベンダーの資料の数字を読むときは、何を単位に数えた割合なのかを先に確かめる必要があります。単位の違いが評価に与える影響は、第8章で扱います。
正当な取引と不正な取引の分布、全部を正当と答えても正解率は99%を超える
次のブロックでは、正当な取引と不正な取引で、額・時刻・端末の分布がどう違うかを調べます。額は、顧客によって普段の水準が大きく違うので、そのままでは比べにくくなります。ここでは、各顧客の正当な取引の額の中央値で割った「本人の普段の額との比」を使いました。なお、この比は説明のために期間全体の中央値で計算しています。検知に使う特徴量としては、判定の時点より後の取引を含めてはいけないので、作り方が違います(第5章)。後半では、すべての取引を正当と答えた場合と、新しい端末からの取引だけをアラートにした場合の成績を比べます。
# 本人の普段の額との比(説明のための集計。期間全体の中央値を使う)
med = tx[tx.is_fraud == 0].groupby("cid")["amount"].median()
tx["ratio"] = tx["amount"] / tx["cid"].map(med)
tx["night"] = tx["hour"] < 6
for lab, g in tx.groupby("is_fraud"):
    print(f"is_fraud={lab}: 額の比の中央値 {g.ratio.median():.2f} / "
          f"0〜6時 {g.night.mean():.1%} / 新しい端末 {g.new_device.mean():.1%}")
for col in ["night", "new_device"]:
    s = tx[tx[col]]
    print(f"{col} が真の取引 {len(s):,} 件のうち不正 {s.is_fraud.sum():,} 件({s.is_fraud.mean():.1%})")

fig, ax = plt.subplots(1, 2, figsize=(11, 4))
for lab, name, c in [(0, "正当", "#999999"), (1, "不正", "#002E73")]:
    g = tx[tx.is_fraud == lab]
    ax[0].hist(np.log10(g.ratio), bins=60, range=(-1.5, 2), density=True,
               histtype="step", lw=2, color=c, label=name)
    ax[1].hist(g.hour, bins=24, range=(0, 24), density=True,
               histtype="step", lw=2, color=c, label=name)
ax[0].set_xlabel("本人の普段の額との比(常用対数。0が普段どおり、1が10倍)")
ax[1].set_xlabel("取引の時刻(時)")
ax[0].legend(loc="upper right")
ax[1].set_ylim(0, 0.15)
ax[1].legend(loc="upper center")
for a in ax:
    a.set_ylabel("密度(正当・不正それぞれで面積1)")
fig.savefig("../ch02_distribution.png", dpi=120, bbox_inches="tight")

y = tx["is_fraud"].to_numpy()
pred = np.zeros_like(y)                    # すべて「正当」と答える
print(f"全部正当:正解率 {(pred == y).mean():.4%} / 再現率 {pred[y == 1].mean():.1%} / アラート {pred.sum()} 件")

alert = tx["new_device"].to_numpy().astype(int)   # 新しい端末ならアラート
tp = int(((alert == 1) & (y == 1)).sum())
print(f"新しい端末:正解率 {(alert == y).mean():.4%} / 適合率 {tp / alert.sum():.1%} / "
      f"再現率 {tp / y.sum():.1%} / アラート {alert.sum():,} 件")
実行した結果を次の表にまとめました。
| 項目 | 正当な取引 | 不正な取引 |
|---|---|---|
| 本人の普段の額との比(中央値) | 1.00 | 2.70 |
| 0時から6時までの取引の割合 | 2.4% | 56.3% |
| 新しい端末からの取引の割合 | 2.0% | 80.2% |
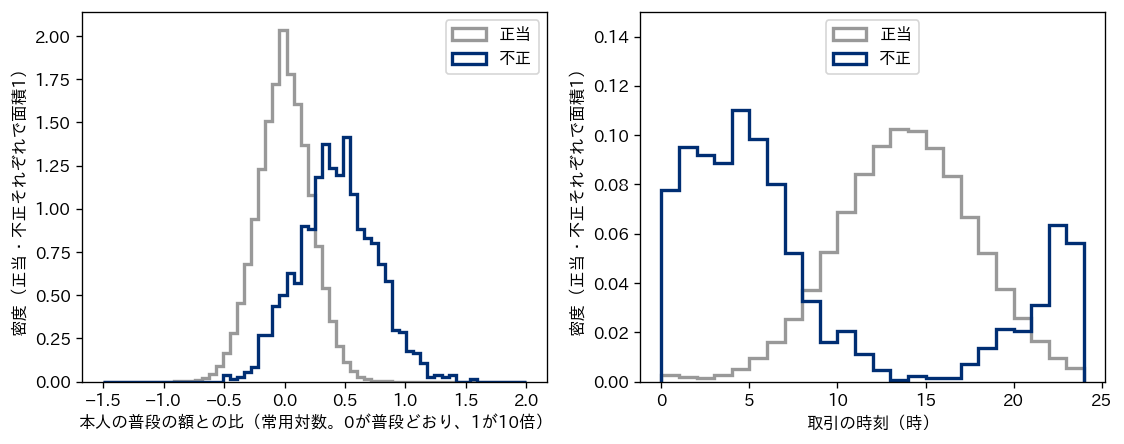
図の左は本人の普段の額との比の分布(常用対数の目盛り)で、右は取引の時刻の分布です。どちらも、正当な取引と不正な取引をそれぞれ面積が1になるように描いているので、件数の差は見えなくなっています。この架空データでは、不正な取引は普段より大きい額、深夜から明け方の時刻に寄っています。額の分布は、正当と不正で山の位置は違いますが、裾が大きく重なっています。不正な取引の中にも普段どおりの額のものがあり、正当な取引の中にも普段の数倍の額のものがあります。時刻の分布は、面積をそろえた図の上では重なりが小さく見えます。不正は0時から8時ごろに加えて、21時から24時にも山があります。これは、不正の始まりの時刻を2時を中心にばらつかせて作り、0時より前にはみ出した分を、24時から数えた夜の時刻(例えば2時間はみ出せば22時)に折り返して扱ったためです。
件数の差を戻すと、時刻の図で重なりが小さく見えても、深夜の取引の大半は正当だと分かります。0時から6時までの取引は9,313件あり、そのうち不正は709件(7.6%)でした。新しい端末からの取引は8,241件あり、そのうち不正は1,011件(12.3%)でした。不正な取引の8割が新しい端末からなのに、新しい端末からの取引の9割近くは正当です。この例では、「不正に多い特徴」を持つ取引の大半が正当でした。正当な取引にも一定の割合で現れる特徴の場合、正当な取引の件数が圧倒的に多いので、その特徴を持つ取引の中では正当な取引の方が多くなりやすくなります(正当な取引にほとんど現れない特徴であれば、この限りではありません)。本コラムでは、このように不正の件数が極端に少ないデータを不均衡データと呼びます。正当な取引にも現れる特徴を1つ見つけても、それだけでアラートにすれば誤検知が多くなり、そのまま止めれば正当な顧客を大勢止めることになる、というのが、不均衡データでの検知の難しさです。
ブロックの後半の結果は次のとおりです。
| 判定の方法 | 正解率 | 適合率 | 再現率 | アラートの件数 |
|---|---|---|---|---|
| すべて「正当」と答える | 99.6535% | 計算できない(アラートが0件) | 0.0% | 0件 |
| 新しい端末からの取引をアラートにする | 97.9432% | 12.3% | 80.2% | 8,241件 |
この表の再現率の分母は、合成データの真の不正(1,260件)です。ラベルの遅れを加える前の、すべての不正が分かっている状態で計算しています。すべての取引を「正当」と答える判定は、不正を1件も見つけないのに、正解率(全取引のうち判定が当たった割合)が99.6535%になります。不正が全体の0.347%しかないので、全部を正当と答えれば残りの99.653%はすべて当たるからです。一方、新しい端末からの取引をアラートにする判定は、不正の80.2%をアラートにできていますが、正解率は97.9432%と、何もしない判定より低くなります。正当な取引を7,000件以上アラートにしているからです。
この結果は、不均衡データでは正解率が検知の良し悪しを表さないことを示しています。「正解率99%」という数字は、不正の割合が1%未満のデータでは、何も見つけない判定でも出せる数字です。本コラムでは、正解率を検知の成績として使いません。検知の成績は、アラートのうち実際に不正だった割合(適合率)と、実際の不正のうちアラートにできた割合(再現率)の両方で見ます。ただし、この2つも単独では成果になりません。上の例の新しい端末のルールは再現率が80.2%と高く見えますが、適合率は12.3%で、アラートの9割近くが正当な取引です。そのアラートをすべて拒否すれば、正当な顧客の取引を7,000件以上止めることになり、すべて調査に回せば、調査の能力を大きく超えるかもしれません。検知の成果を、防いだ不正と誤って止めた正当な取引の両方で測る方法は第8章と第9章で、指標の詳しい定義は第8章で扱います。
ラベルの遅れをコードで見る、学習に使えるラベルは直近ほど欠ける
次に、ラベルの遅れを架空データに加えます。不正な取引ごとに、ラベルが届く経路を「本人の申告」「チャージバック」「調査の結果」「申告されない」の4つから、40%・40%・10%・10%の割合で割り当てました。経路ごとに、取引からラベルが確定するまでの日数を、本人の申告は短く、調査の結果は中くらい、チャージバックは長くなるように乱数で決めています。「申告されない」に割り当てた不正は、いつまでたってもラベルが付きません。この割合と日数は、説明のために置いた架空の値で、実際の経路の割合や日数を表すものではありません。
# ラベルが確定するまでの日数:届く経路によって遅れが違う
fr = tx.index[tx.is_fraud == 1]
route = rng.choice(["本人の申告", "チャージバック", "調査の結果", "申告されない"],
                   size=len(fr), p=[0.40, 0.40, 0.10, 0.10])
delay = np.select(
    [route == "本人の申告", route == "チャージバック", route == "調査の結果"],
    [rng.gamma(1.5, 2.0, len(fr)), rng.gamma(4.0, 9.0, len(fr)), rng.gamma(3.0, 5.0, len(fr))],
    np.inf)                                # 申告されない不正は永久に確定しない
tx["route"] = "(正当)"
tx["delay"] = np.nan
tx.loc[fr, "route"] = route
tx.loc[fr, "delay"] = delay
d = tx.loc[fr]
summ = d[np.isfinite(d.delay)].groupby("route")["delay"].quantile([0.5, 0.9]).unstack()
summ.columns = ["中央値(日)", "9割が確定する日数"]
summ["件数"] = d.groupby("route").size()
print(summ.round(1).to_string())
print(f"申告されない不正 {(d.route == '申告されない').sum()} 件")
経路ごとの確定までの日数は、次のとおりになりました。表は、確定までの日数の中央値が短い順に並べています。
| ラベルの経路 | 件数 | 確定までの日数の中央値 | 9割が確定するまでの日数(確定した分のうち) |
|---|---|---|---|
| 本人の申告 | 529件 | 2.2日 | 6.0日 |
| 調査の結果 | 111件 | 13.6日 | 28.8日 |
| チャージバック | 494件 | 34.5日 | 60.7日 |
| 申告されない | 126件 | 確定しない | 確定しない |
次のブロックでは、データを締めた時点を、0日目の0時から90日後(89日目の終わり)とし、その時点でラベルが確定している不正を週ごとに数えます。あわせて、学習に使う期間を、締めた時点から何日か手前で切った場合に、期間の中の不正のうち何割のラベルが確定しているかを調べます。最後に、確定までの日数の分布と、週ごとの不正の割合を図にしています(本コラムでは図の掲載を省き、結果を表で示します)。
# データを締めた時点(0日目の0時から90日後=89日目の終わり)で確定しているラベル
CUT = DAYS
tx["known"] = (tx["is_fraud"] == 1) & (tx["t"] + tx["delay"] <= CUT)
tx["week"] = (tx["day"] // 7).astype(int)
wk = tx.groupby("week").agg(取引=("is_fraud", "size"), 不正=("is_fraud", "sum"),
                            確定=("known", "sum"))
wk["真の割合"] = wk["不正"] / wk["取引"]
wk["見かけの割合"] = wk["確定"] / wk["取引"]
wk["確定率"] = wk["確定"] / wk["不正"]
print(wk.round(4).to_string())

for gap in [0, 14, 30, 60]:               # 締めの時点から何日手前で学習の期間を切るか
    s = tx[tx["t"] <= CUT - gap]
    print(f"手前 {gap:2d} 日で切る:不正 {s.is_fraud.sum():4d} 件のうち確定 {s.known.sum():4d} 件"
          f"({s.known.sum() / s.is_fraud.sum():.1%})/ 残る取引 {len(s):,} 件")

fig, ax = plt.subplots(1, 2, figsize=(11, 4))
fin = d[np.isfinite(d.delay)]
for r, c in [("本人の申告", "#999999"), ("調査の結果", "#000080"), ("チャージバック", "#002E73")]:
    ax[0].hist(fin[fin.route == r].delay, bins=40, range=(0, 120), histtype="step",
               lw=2, color=c, ls="--" if r == "調査の結果" else "-", label=r)
ax[0].set_xlabel("取引からラベルの確定までの日数")
ax[0].set_ylabel("件数")
ax[0].legend(loc="upper right")
ax[1].plot(wk.index + 1, wk["真の割合"] * 100, "o-", color="#999999", label="真の不正の割合")
ax[1].plot(wk.index + 1, wk["見かけの割合"] * 100, "s-", color="#002E73", label="締めた時点(89日目の終わり)に確定している割合")
ax[1].set_xlabel("取引の週(1が最初の週、13が最後の6日間)")
ax[1].set_ylabel("取引に占める割合(%)")
ax[1].set_ylim(0, None)
ax[1].legend(loc="lower left")
fig.savefig("../ch02_label_delay.png", dpi=120, bbox_inches="tight")
経路ごとの確定までの日数は、前の表のとおり、本人の申告は9割が6.0日までに確定するのに対して、チャージバックは中央値でも34.5日かかります。週ごとの取引に占める真の不正の割合と、締めた時点(89日目の終わり)で確定している割合、確定率を次の表にまとめました。
| 取引の週 | 不正の件数 | そのうち確定 | 真の不正の割合 | 確定している割合 | 確定率 |
|---|---|---|---|---|---|
| 1週目 | 96件 | 87件 | 0.34% | 0.30% | 90.6% |
| 2週目 | 136件 | 119件 | 0.48% | 0.42% | 87.5% |
| 3週目 | 80件 | 72件 | 0.28% | 0.25% | 90.0% |
| 4週目 | 83件 | 74件 | 0.29% | 0.26% | 89.2% |
| 5週目 | 123件 | 104件 | 0.44% | 0.37% | 84.6% |
| 6週目 | 104件 | 81件 | 0.37% | 0.29% | 77.9% |
| 7週目 | 61件 | 48件 | 0.22% | 0.17% | 78.7% |
| 8週目 | 91件 | 62件 | 0.32% | 0.22% | 68.1% |
| 9週目 | 84件 | 57件 | 0.30% | 0.20% | 67.9% |
| 10週目 | 81件 | 54件 | 0.29% | 0.19% | 66.7% |
| 11週目 | 99件 | 50件 | 0.35% | 0.18% | 50.5% |
| 12週目 | 126件 | 60件 | 0.45% | 0.21% | 47.6% |
| 13週目(最後の6日間) | 96件 | 25件 | 0.40% | 0.10% | 26.0% |
結論を先に書くと、確定率(その週の不正のうちラベルが確定している割合)は、最初の週で約9割、中盤の8週目から10週目で7割弱、直近の週ほど低く、最後の6日間では26.0%でした。
週ごとに見ると、最初の週は真の割合が0.34%、確定している割合が0.30%で、件数でいえば不正96件のうち87件(90.6%)のラベルが確定していました(表と本文の割合は小数第2位までに丸めているので、割合どうしの比は90.6%と少しずれます)。最初の週のように十分に時間がたった週では、確定率の上限は、いつまでも確定しない申告されない不正(全体の1割)で決まります。一方、6週目のあたりから確定率は8割を下回り、8週目から10週目は7割を下回りました。別に集計したところ、8週目から10週目でラベルが確定していない不正は週ごとに29件・27件・27件で、そのうちチャージバックの経路が22件・20件・18件と大半を占めていました。直近の週でなくても、確定までに数十日かかる経路のラベルは、まだ届いていないことがあるわけです。さらに直近に近づくと、11週目の確定率は50.5%、12週目は47.6%、最後の6日間(13週目)は26.0%でした。最後の6日間の真の不正の割合は0.40%ですが、記録の上では0.10%にしか見えません。
このまま直近までの記録で学習すると、モデルは最後の6日間の不正の7割以上を「正当な取引」として学びます。評価に使えば、確定していない不正を正当として扱うことになり、見逃しや誤検知の数が誤って数えられます。例えば、アラートにできなかった未確定の不正は「正当な取引を正しく通した」と数えられ、アラートにした未確定の不正は誤検知と数えられて適合率が低く出ます。評価が良く見えるか悪く見えるかは、指標と、どの不正のラベルが欠けているかによって変わり、どちらにしても評価はゆがみます。学習の期間の切り方を変えた結果を次の表にまとめました。
| 学習の期間の終わり | 期間の中の取引 | 期間の中の真の不正 | そのうちラベルが確定している不正 | 確定している割合 |
|---|---|---|---|---|
| 締めた時点まで使う | 363,622件 | 1,260件 | 893件 | 70.9% |
| 締めた時点の14日前で切る | 307,298件 | 1,025件 | 800件 | 78.0% |
| 締めた時点の30日前で切る | 242,747件 | 805件 | 671件 | 83.4% |
| 締めた時点の60日前で切る | 121,682件 | 413件 | 366件 | 88.6% |
学習の期間を手前で切るほど、期間の中の不正のうちラベルが確定している割合は上がり、締めた時点の60日前で切ると88.6%になりました。確定しない1割を除けば、ほぼ確定しきった状態です。その代わり、使える取引は363,622件から121,682件へ減り、学習に使えるデータは古くなります。ラベルの遅れの分だけ手前で切ることは、ラベルの正しさと、データの量と新しさを交換することだといえます。どこで切るかは、自社のラベルの遅れの分布(本コラムの例でいえば、どの経路が何日で何割確定するか)を測ってから決めることが必要です。新しい手口にどれだけ早く追従したいかとの兼ね合いは、第10章で扱います。評価の期間をどう切るかは、第8章で扱います。
ここで使った数字は、すべて架空の設定から出たものです。ただし、確定していない不正を正当として扱えば、その期間の真の不正を少なく数えることになる、という点は、架空の設定に限りません。ラベルが届く仕組みが時期によって変わらなければ、観測できた期間の短い直近の取引ほど、確定していない不正が多く残りやすくなります。遅れの大きさは事業者ごとに違うので、自社の記録で、取引の日とラベルの確定の日の差を測っておくことが、学習と評価の期間を決める出発点になります。
選択の偏りをコードで見る、止めた取引は学習のデータから消える
最後に、選択の偏りを確かめます。この架空データで、取引の当時に「本人の普段の額の4倍を超え、かつ新しい端末からの取引は拒否する」というルールが動いていたと仮定します。この「4倍」は、実際の運用で使う値ではなく、合成データに合わせた説明用の値です。拒否した取引は実行されないので、後から申告もチャージバックも届かず、記録の上ではラベルが分かりません。学習に使えるのは、通した取引だけです。説明を簡単にするため、ここでもルールの判定には期間全体の中央値で計算した額の比を使っています。また、この節ではラベルの遅れと申告されない不正の影響をいったん除き、拒否による選び方の影響だけを比べます。そのため、次の表の件数は、締めた時点で確定しているラベルの件数ではなく、合成データの真の不正の件数です。
# 選択の偏り:当時のルールで拒否した取引は、その後の結果が分からない
rejected = (tx["ratio"] > 4) & tx["new_device"]
print(f"拒否した取引 {rejected.sum():,} 件(うち真の不正 {tx[rejected].is_fraud.sum()} 件。"
      f"記録上のラベルは不明)")
known_set = tx[~rejected]                  # 学習に使えるのは通した取引だけ
for name, s in [("全取引の不正", tx[tx.is_fraud == 1]),
                ("通した取引の不正", known_set[known_set.is_fraud == 1])]:
    print(f"{name} {len(s):,} 件:新しい端末 {s.new_device.mean():.1%} / "
          f"額の比の中央値 {s.ratio.median():.2f}")
実行した結果は次のとおりです。
| 対象 | 不正の件数 | 新しい端末からの割合 | 本人の普段の額との比(中央値) |
|---|---|---|---|
| 全取引の不正(真の姿) | 1,260件 | 80.2% | 2.70 |
| 通した取引に含まれる真の不正(ラベルが付きうる範囲) | 983件 | 74.7% | 2.21 |
当時のルールで拒否した取引は294件で、そのうち277件は実際には不正でした。拒否した取引は、この例では記録の上でラベルが分からないとしているので、ラベルが付きうる不正は、ラベルの遅れを考える前の段階で、すでに1,260件から983件に減ります。実際に学習に使える件数は、ここからさらにラベルの遅れと申告されない不正の分だけ減ります。減ったのは、ちょうどルールが止めていた型、つまり額が大きく新しい端末からの不正です。その結果、通した取引に含まれる不正では、新しい端末からの割合が80.2%から74.7%に、額の比の中央値が2.70から2.21に下がりました。通した取引に含まれる真の不正だけを見ると、不正は実際よりも「普段に近い額で、新しい端末からは少ない」ように見えます。
このデータで学習したモデルは、額が大きく新しい端末からの不正の危険を、実際より小さく見積もるおそれがあります。そのモデルを入れて古いルールを外すと、それまでルールが止めていた型の不正が通るようになるかもしれません。こうした事態を避けるには、拒否した取引をラベルの分からない取引として記録に残し、学習や評価からただ落とさないこと、古いルールを外すときは影の運用(判定には使わずスコアだけを記録して比べる方法。第12章)で新旧の判定の違いを確かめること、無作為の点検で偏りの無いラベルを集めること(第10章)が考えられます。ただし、影の運用で分かるのは判定の違いで、古いルールが拒否した取引のラベルが増えるわけではありません。拒否した取引の一部について顧客への確認や調査を行い、結果を残すことと組み合わせる必要があります。どの対処も、判定の時点の措置と、その後に分かった結果の両方が記録に残っていることが前提です。
データの品質の問題と記録の設計、判定の時点の値をその時点のまま残す
ここまでの架空データは、欠けも誤りも無い、きれいな記録でした。実際の取引の記録には、検知の成績を左右する品質の問題がいくつも入ります。不正検知で起きやすい問題は、次のようなものです。
- 重複:同じ取引が、再送や連携の都合で2回記録される。速度のルールや直近の回数の集計が、実際より多く数える
- 時刻のずれ:システムごとに時刻の基準(日本時間か協定世界時か)や、記録する時点(取引の発生か、承認か、売上の確定か)が違う。並べ順や「直近1時間」の集計が狂う
- 欠損:経路によって端末の情報が取れない、古い時期には認証の記録が無い、といった欠け。欠けていること自体が経路を表してしまい、意図しない手がかりになることがある
- 試験用の取引:システムの試験や加盟店の接続確認のための取引が本番の記録に混ざる。不正に似た特徴(同じ端末から短時間に何度も、など)を持つことがある
- 仕様の変更:項目の意味や値の区分が途中で変わる。加盟店の種類の付け直し、認証の方法の追加、端末の識別子の取り方の変更などで、同じ項目名のまま値の意味が変わる
これらは、どれも記録の作られ方の問題です。重複は取引の識別子で、時刻のずれは時刻の基準と記録の時点を項目ごとに定義しておくことで、試験用の取引は試験であることを示す印を付けておくことで、後から取り除けます。仕様の変更は、変更の日と内容を記録に残しておけば、変更の前後でデータを分けて扱えます。逆に、こうした情報が残っていないと、分析の担当はデータの奇妙な動きに気づいても、それが手口の変化なのか記録の仕様の変化なのかを見分けられません。第10章で扱う概念ドリフトの監視でも、仕様の変更の記録が無いと、誤った警報が出ることがあります。
記録の設計で最も大切なのは、判定の時点で使えた情報を、その時点の値のまま残すことだと考えています。顧客の登録の住所や連絡先、端末の登録の状態、顧客の区分などは、後から更新されます。更新のたびに古い値を新しい値で上書きする作りになっていると、過去の取引について「判定の時点で、その顧客の連絡先は何日前に変更されていたか」が分からなくなります。そのデータで学習すると、判定の時点では知りえなかった、後から更新された値を使うことになり、学習や評価の成績は実際より良く見えます。これは第5章で扱うリーク(情報の漏れ)の一種で、データベースの作りの段階で入り込むので、後から見つけるのが難しい誤りです。
具体的には、属性の値が変わるたびに、いつからいつまでその値だったかに加えて、その値をシステムが受け取って登録した時刻も持たせて履歴として残すか(過去にさかのぼる訂正や、遅れて届く更新があると、値の有効な期間だけでは判定の時点で知っていた値を再現できないため)、判定のたびに、判定に使った入力の値・スコア・ルールの結果・措置をそのまま書き残すかのどちらか(あるいは両方)が必要です。後者の記録は、第12章で扱う監査の記録にもなります。ラベルも同じで、「いつ、どの経路で、誰が、不正と判断したか」を、取引の記録とは別の履歴として残しておくと、後から「ある日付の時点で確定していたラベル」を正確に再現できます。この章の後半で、締めた時点で確定しているラベルを数えたのは、まさにこの再現をした計算です。
記録の設計で確かめることを、次の表にまとめました。自社の記録がどこまで満たしているかを点検する表として使えます。
| 点検の項目 | 確かめること | 満たしていないと起きること |
|---|---|---|
| 取引の識別子 | 再送や連携をまたいで、同じ取引を同じ識別子で特定できるか | 重複を取り除けず、回数や合計の集計が多く出る |
| 時刻の定義 | 時刻の基準と、記録する時点(発生・承認・確定)が項目ごとに決まっているか | 並べ順と時間窓の集計が狂う。ラベルの遅れを測れない |
| 判定の時点の値 | 判定に使った入力・スコア・ルールの結果・措置を、その時点の値で残しているか | 後から更新された値で学習し、成績が良く見える。判定の理由を説明できない |
| 属性の履歴 | 住所・連絡先・端末の登録などの変更を、いつからいつまでの値として残しているか | 判定の時点の状態を再現できない |
| ラベルの履歴 | ラベルの経路・確定の日・判断した人・理由を残しているか | ある日付の時点で確定していたラベルを再現できない。ラベルの誤りを追えない |
| 措置の記録 | 承認・保留・拒否・事後の調査のどれを取ったか、拒否した取引のその後を残しているか | 選択の偏りを測れない。止めた取引が学習から消える |
| 試験用の印 | 試験や接続確認の取引に印があるか | 試験の取引を不正や正当として学習してしまう |
| 仕様の変更の記録 | 項目の意味や区分を変えた日と内容を残しているか | 記録の変化を手口の変化と取り違える |
個人データの取り扱いの入口と、経営の判断
不正検知に使うデータの多くは、顧客の個人データです。取引の記録・端末の情報・接続元の地域・認証の記録は、特定の個人と結びつけて保存され、その人の行動を細かく表します。どのデータを、どの目的で、どれだけの期間保存して使うのか、他の事業者と共有してよいのかは、個人情報の保護に関する法令や、業界のガイドラインに従って決める必要があります。不正検知のために個人データを使うことや、他の事業者と不正の情報を共有することの法令上の扱いは、条番号と出典を付けて第14章で扱います。この章では、データの設計の段階で次の点を決めておく必要がある、という入口だけを示します。
1つ目は、利用の目的を決めて記録しておくことです。不正の防止のために集めるデータと、販売の促進のために集めるデータは、同じ記録の中にあっても、使える範囲が違うことがあります。2つ目は、保存の期間です。ラベルの遅れを考えると、ラベルが確定するまでの期間より短く記録を消すと学習に使えませんが、必要以上に長く保存することは別の危険を生みます。3つ目は、閲覧できる人の範囲です。不正検知の記録には、どの取引がなぜ止められたかという情報が入り、顧客の個人データであると同時に、検知の仕組みの中身を表す情報でもあります。閲覧できる人を限ることは、個人データの保護と、検知の仕組みの詳細を外に出さないことの両方に役立ちます。
経営の判断として最も大切なのは、調査の結果をラベルとして残す仕組みを、検知の仕組みと同時に最初から作ることだと考えています。ラベルの遅れ・選択の偏り・ラベルの誤りは、どれも後からデータを分析して取り戻すことが難しく、記録が残っていなければ、どれだけ優れた手法を使っても補えません。調査の結果を残す仕組みが無いまま検知の仕組みだけを入れると、序章で示した6つの損失の型のうち、次のような損失につながります。
- 見逃しによる被害:直近の不正や、止めていた型の不正が学習のデータから抜け落ちたモデルが、その型の不正をアラートにできない
- 誤検知による機会損失:判定の時点の値が残っておらず、後から更新された値で学習したモデルが、本番では成績を出せずに正当な取引を止める
- 調査の過負荷:調査の判断が残らないので、同じ型の誤検知が何度も調査に回り続ける
- 形骸化:ラベルが集まらず、ルールやモデルを更新する根拠が得られないまま、古い仕組みが使われ続ける
- 規制上の義務の不履行:判定の時点の記録が無いと、事業に適用される確認・記録の保存などの義務について、履行したことを後から示せなくなるおそれがある(どの義務が適用されるかは第14章)
予算と体制に落とすと、調査の担当がアラートを確認したときに、判断と理由と措置を決まった形で入力する業務の手順と、それを受け取って取引の記録と結びつける仕組み(ケース管理の仕組み。第12章)を、検知のモデルの開発と同じ段階で予算に入れることになります。KPI としては、アラートのうち調査の判断が記録された割合、ラベルが確定するまでの日数の分布、拒否した取引のうちその後の結果が分かった割合を、データの基盤の状態を表す指標として持つことが考えられます。これらは検知の成果そのものではありませんが、第8章と第9章で扱う成果の測り方が成り立つための前提になります。
この章では、不正検知に使うデータの種類と、ラベルが遅れて届き、止めた取引のラベルが分からず、誤りも含むという性質を、架空の取引の記録で確かめました。本コラムの架空データでは、すべてを正当と答えるだけで正解率が99.6535%になり、データを締めた時点の直前の6日間では不正の26.0%しかラベルが確定していませんでした。判定の時点の値と調査の結果を残す記録の設計が、以降の章で扱う手法と評価の前提になります。第3章では、このような記録の上で最初に作る検知の仕組みとして、ルールによる検知を扱います。
この章を深めたい方への参考書籍
『改訂新版 エンジニアのためのデータ分析基盤入門 基本編』(斎藤友樹、技術評論社):データ分析基盤の整備・運用・活用を扱う本で、データの品質の管理を、問題を防ぐ・見つける・直すという観点で整理しています。この章で扱った重複・時刻のずれ・仕様の変更のような品質の問題を、分析の段階ではなく記録を作り蓄える側の仕組みとしてどう扱うかを考えるときの土台になります。2026年4月には同じ著者による実践編も発売されています。
『Human-in-the-Loop機械学習 人間参加型AIのための能動学習とアノテーション』(Robert(Munro)Monarch 著、上田隼也、角野為耶、伊藤寛祥 訳、共立出版):人がデータにラベルを付ける工程(アノテーション)と、どのデータに人の判断を割り当てるかを選ぶ能動学習を扱う本です。不正検知では、調査担当の確認の結果は、顧客の申告などと並んでラベルを作る情報源の1つです。どの取引を人が確認するかの選び方がラベルの偏りを生むこと、人の判断の揺れがラベルの誤りになることを、ラベルを作る工程の設計として考える手がかりになります。
第3章 ルールによる検知、しきい値と速度のルールでベースラインを作る
第2章では、不正検知に使うデータの種類と、ラベルが遅れて届くこと、止めた取引や調査しなかった取引にはラベルが分からないまま残るものがあること、不正の件数が正当な取引に比べて極端に少ないことを扱いました。この章では、そのデータを使って最初に作る検知の方式として、人が決めた条件で不正の疑いを判定するルールを扱います。
この章で扱うのは次の内容です。後半は、架空の取引の記録(顧客3,000人・60日)を使い、実行したコードと結果で確かめます。
- ルールの種類(しきい値のルール・速度のルール・不一致のルール・リスト・組み合わせのルール)と、それぞれで分かること
- ルールの長所(説明できる・すぐ直せる・規制や監査に示しやすい)と短所(増え続ける・矛盾する・誤検知が多い・手口が変わると効かない)
- 4本のルールを pandas で実装し、ルールごとと組み合わせの適合率・再現率・アラートの件数を比べる方法
- しきい値を動かしたときの適合率と再現率の変化
- 浅い決定木を使い、ルールの候補をデータから作る方法
- ルールの台帳と管理の項目、ルールと機械学習の役割分担、ルールだけの検知をベースラインとして残すこと
この章の主張は2つあります。1つ目は、ルールは説明でき、すぐ直せるという強みを持つ一方で、管理の仕組みが無いと本数が増え続け、誤検知の多いルールが残り続けるので、台帳と廃止の基準を最初から持つ必要がある、という点です。2つ目は、ルールだけで組んだ検知の成績を、評価の期間と数え方を決めたうえで記録し、後の章で扱う機械学習の方式と比べる基準(ベースライン)にする、という点です。ルールの成績を測っていないまま機械学習を入れると、機械学習で何が良くなったのかを誰も示せなくなります。
ルールによる検知とは、人が決めた条件で疑いを判定する方法
本コラムでいうルールは、「短時間に一定の回数を超える取引」のように、人が決めた条件で不正の疑いを判定する方法です。条件に当てはまった取引をアラートにし、保留・拒否・事後の調査といった措置につなげます。こうした条件の集まりで判定する方式を、ルールベースの検知と呼びます。ルールベースの検知は、機械学習の利用が広がる前から、カードの決済や送金の監視で使われてきた方式で、機械学習のモデルを入れている組織でも、ルールを併用していることが多いように思います。
ルールの中身は、大きく5つの型に分けて考えると整理しやすくなります。1つ目は、1件の取引の値がある水準を超えたらアラートにするしきい値のルールです。2つ目は、一定の時間の中での回数や合計を数える速度のルール(ベロシティチェック)で、同じカードや同じ口座で短時間に取引が続くことを捉えます。3つ目は、登録されている情報と取引の情報の食い違いを見る不一致のルールです。4つ目は、過去に不正が確定した相手や端末を載せた拒否リストと、確認済みの相手を載せた許可リストです。5つ目は、これらを「かつ」で重ねる組み合わせのルールです。
| ルールの型 | 条件の例 | 分かること | 外れやすい場面 | 必要なデータ |
|---|---|---|---|---|
| しきい値のルール | 1件の取引の額が一定の値以上 | 1件だけで目立つ取引 | 顧客ごとに普段の水準が違うと、普段から大きな取引をする顧客の正当な取引ばかりが当たる | 取引の記録 |
| 速度のルール | 同じ顧客の直近1時間の取引が一定の回数以上、24時間の合計が一定の値以上 | 短い時間に取引が集中すること | まとめ買い・定期の支払いの集中など、正当な連続も当たる。回数や合計が設定した条件に届かない不正は捉えられない | 同じ顧客・同じカードの過去の取引を時刻つきで引けること |
| 不一致のルール | 登録の住所の国と接続元の国が違う、登録と違う端末から操作した | 本人以外が操作している疑い | 旅行・出張・機種変更などの正当な食い違い | 顧客の登録の情報、端末・接続の情報 |
| リスト | 拒否リストに載った端末・受取口座との取引を止める。許可リストの相手は確認を省く | 過去に確定した不正と同じ相手 | 初めて現れる相手には効かない。リストの更新が止まると古い情報で判定する | 過去の調査の結果、業界で共有される情報(第14章) |
| 組み合わせのルール | 新しい端末かつ額が一定の値以上、夜間かつ普段と違う加盟店の種類 | 単独では弱い兆候が重なること | 条件を重ねるほど当たる件数が減り、見逃しが増える | 上の各ルールのデータ |
表の「外れやすい場面」の列が示すとおり、どの型のルールにも、正当な取引が条件に当てはまる場面があります。不正に多い特徴は、正当な取引にも一定の割合で現れるからです。ルールを書くときは、「不正ならこうなる」という条件を考えるだけでなく、「その条件に当てはまる正当な取引がどれだけあるか」を同じデータで数える必要があります。後半のコードでは、この2つを同時に数えます。
なお、本コラムでは、ルールの条件を、型を説明するための一般的な例に留めます。実際に運用しているルールの具体的なしきい値は、検知を避ける手がかりになるので、社外に出さないのが原則です(第10章・第12章)。この章の後半に出てくる条件の値(額の8以上、1時間に3回以上など)は、実際の運用で使う値ではなく、合成データに合わせた説明用の値で、実在のルールとは関係しません。実運用の水準の目安にもなりません。
ルールの長所と短所、説明できてすぐ直せるが、増え続ける
ルールの最大の長所は、判定の理由をそのまま言葉で示せることです。「直近1時間に4回目の取引で、新しい端末からだったため保留にした」という説明は、調査担当にも、顧客対応の担当にも、監査の担当にも通じます。2つ目の長所は、すぐに直せることです。新しい手口の注意喚起が出たとき、ルールなら条件を1本足して当日から判定に加えられます。新しい手口の特徴を教師あり学習のモデルに直接学ばせるには、その手口のラベルが要ります。既存のモデルが、共通する特徴から新しい手口の一部を拾える場合もありますが、どこまで拾えるかは確かめてみないと分かりません(第10章)。3つ目の長所は、規制や監査に示しやすいことです。ルールの台帳を持っていれば、取引のモニタリングの方法を説明するよう求められたとき、条件と変更の記録を示せます(規制の詳細は第14章)。
一方で、ルールには運用の中で表に出てくる短所があります。新しい手口が出るたびにルールを足し、古いルールを消さないので、本数が増え続けます。本数が増えると、あるルールが止めた取引を別のルールの例外が通すといった矛盾が起き、どのルールが成績に効いているのかも分からなくなります。また、ルールは1つの条件で白黒を付けるので、条件の境目の近くにある取引を区別できず、誤検知が多くなりやすい方式です。さらに、条件が固定されているので、手口が変わると効かなくなります。この最後の点は、序章で挙げた損失の型のうちの形骸化そのものです。
| 観点 | ルールの長所 | ルールの短所 |
|---|---|---|
| 説明 | 判定の理由を条件の言葉で示せる | 多数のルールが重なると、どれが効いたかを説明しにくくなる |
| 変更の速さ | 条件を足す・直すだけで当日から判定に反映できる | 足すのが簡単なので、検証せずに足したルールが残りやすい |
| データの要件 | ラベルが少なくても、注意喚起や調査の知見から書ける | 書いた人の知っている手口しか捉えられない |
| 成績 | 既知の手口で条件がはっきりしていれば、適合率の高いルールを作れる | 弱い兆候の組み合わせや順位づけが苦手で、誤検知が多くなりやすい |
| 規制・監査 | 条件と変更の記録をそのまま示せる | 台帳が無いと、なぜそのルールがあるのかを誰も示せなくなる |
| 時間の経過 | 手口の注意喚起に合わせてすぐ追加できる | 見直さないと手口の変化に置いていかれる(形骸化) |
表の短所の多くは、ルールという方式そのものの欠点というより、管理の仕組みが無いことから生まれます。足す手続きはあっても、成績を測る手続きと消す手続きが無い、という状態です。この章の後半で扱うルールの台帳と廃止の基準は、この短所を抑えるための仕組みです。
架空の取引の記録を作る、普段の行動と不正に多い特徴
ここからは、ルールを実装して成績を比べます。この章のデータは、他の章とは独立に作った架空の合成データです。実際の取引の記録よりずっと単純で、この合成データでの成績は、実際の取引での成績の目安にはなりません。数字は、ルールの比べ方と読み方を示すためのものです。
顧客3,000人の60日分の取引を、次の性質を持たせて乱数で作りました。取引の額は単位の無い相対値で、金額ではありません。
- 顧客ごとの普段の行動:額の水準・よく取引する時間帯・1日あたりの取引の回数・よく使う加盟店の種類(AからHの8種類)を顧客ごとに変える
- 正当な取引にも、不正に多い特徴が一定の割合で現れる:夜間の取引(普段の時間帯のばらつきに加え、3%の確率で時刻を夜間に置き換える。結果として正当な取引の約3.7%が夜間になった)・まれな大きな買い物(2%)・新しい端末(2%)・普段と違う加盟店の種類(2割の確率で種類を無作為に選び直す。選び直しで普段の種類に当たることもあるので、結果として正当な取引の約17%が普段と違う種類になった)・短時間のまとめ買い
- 不正な取引は1件から5件のまとまりで起きる:まとまりの中の取引は短い間隔で続き、額は顧客の普段の水準より大きく、夜間が多く、新しい端末が多く、加盟店の種類は普段と関係なく選ばれる
- 時間の流れ:取引に日付と時刻を持たせ、前半40日と後半20日に分ける
# === block1: 架空の取引の記録を作る ===
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261112)
N_CUST, N_DAYS, CATS = 3000, 60, list("ABCDEFGH")
cust = pd.DataFrame({
    "customer": [f"顧客{i:04d}" for i in range(N_CUST)],
    "level": rng.lognormal(0.0, 0.7, N_CUST),         # 普段の額の水準(相対値)
    "usual_hour": rng.normal(15, 3, N_CUST).clip(8, 22),
    "rate": rng.lognormal(-0.3, 0.6, N_CUST),         # 1日あたりの取引の回数
    "usual_cat": rng.choice(CATS, N_CUST),            # よく使う加盟店の種類
})

rows = []
for c in cust.itertuples():
    n = rng.poisson(c.rate * N_DAYS)
    day = rng.integers(0, N_DAYS, n)
    hour = rng.normal(c.usual_hour, 3, n)
    night = rng.random(n) < 0.03                      # 正当でも夜間の取引はある
    hour = np.where(night, rng.uniform(0, 5, n), hour).clip(0, 23.99)
    amt = c.level * rng.lognormal(0, 0.6, n)
    amt = np.where(rng.random(n) < 0.02, amt * 5, amt)  # まれな大きな買い物
    cat = np.where(rng.random(n) < 0.8, c.usual_cat, rng.choice(CATS, n))
    newdev = rng.random(n) < 0.02                     # 機種変更などの新しい端末
    for d, h, a, k, nd in zip(day, hour, amt, cat, newdev):
        rows.append((c.customer, d * 24 + h, a, k, nd, 0))
    # 正当な短時間の連続(まとめ買いなど)
    for d in np.flatnonzero(rng.random(N_DAYS) < 0.01):
        t0 = d * 24 + rng.normal(c.usual_hour, 2)
        for j in range(3):
            rows.append((c.customer, t0 + j * 0.15, c.level * rng.lognormal(0, 0.5),
                         c.usual_cat, False, 0))
print("正当な取引:", len(rows))
最初のブロックで正当な取引を作り、次のブロックで不正な取引のまとまりを230個混ぜます。そのうえで、ルールに使う項目を作ります。直近1時間の取引の回数(cnt_1h)は、同じ顧客の取引を時刻の順に並べ、その取引の時刻から1時間前までに起きた取引を数えたものです。その取引自身を含み、その取引より後の取引は数えません。判定の時点で手に入る情報だけで作ることは、ルールでも機械学習でも同じく守るべき条件です(第5章)。
# === block2: 不正な取引を混ぜ、ルールに使う項目を作る ===
for e in range(230):                                  # 不正のまとまり(1件〜5件)
    c = cust.iloc[rng.integers(N_CUST)]
    night = rng.random() < 0.5
    h0 = rng.uniform(0, 5) if night else rng.uniform(8, 23)
    t0 = rng.integers(0, N_DAYS) * 24 + h0
    newdev = rng.random() < 0.7
    for j in range(rng.integers(1, 6)):
        rows.append((c.customer, t0 + j * rng.uniform(0.05, 0.3),
                     c.level * rng.lognormal(1.0, 0.7), rng.choice(CATS), newdev, 1))

df = pd.DataFrame(rows, columns=["customer", "t", "amount", "cat", "new_device", "fraud"])
df = df.merge(cust[["customer", "usual_cat"]], on="customer")
df = df.sort_values(["customer", "t"]).reset_index(drop=True)
df["day"] = (df["t"] // 24).astype(int)
df["hour"] = df["t"] % 24
df["ts"] = pd.Timestamp("2026-01-01") + pd.to_timedelta(df["t"], unit="h")
# 同じ顧客の直近1時間の取引の回数(その取引を含む。過去だけを見る)
df["cnt_1h"] = (df.set_index("ts").groupby("customer")["amount"]
                  .rolling("1h").count().to_numpy())
df["night"] = df["hour"] < 5
df["unusual_cat"] = df["cat"] != df["usual_cat"]
print("取引の件数:", len(df), " 不正:", df["fraud"].sum(),
      f" 不正の割合: {df['fraud'].mean():.3%}")
print(df.groupby("fraud")[["amount", "cnt_1h", "night", "unusual_cat", "new_device"]]
        .mean().round(3))
実行した結果、取引は165,202件、そのうち不正は733件で、不正の割合は0.444%になりました。不正と正当な取引で、ルールに使う項目の平均を比べると、次の表のとおりです。真偽の項目の平均は、その特徴を持つ取引の割合を表します。
| 項目 | 正当な取引 | 不正な取引 |
|---|---|---|
| 額の平均(相対値) | 1.671 | 3.951 |
| 直近1時間の取引の回数の平均 | 1.150 | 2.398 |
| 夜間(0時から5時)の割合 | 0.037 | 0.547 |
| 普段と違う加盟店の種類の割合 | 0.168 | 0.887 |
| 新しい端末の割合 | 0.020 | 0.704 |
平均で見ると、どの項目も不正な取引の方がはっきり大きく、ルールで簡単に分けられそうに見えます。ただ、正当な取引は不正の約220倍あるので、正当な取引の3.7%が夜間というだけで、夜間の取引の件数は正当な取引の方が多くなります。平均の差が大きいことと、その条件でアラートにしたときに不正が多く含まれることは、別の話です。次の節で、ルールごとに実際に数えます。
4本のルールを実装し、適合率・再現率・アラートの件数を比べる
ルールは、次の4本を書きました。どれも、前の表の5つの型のうちの1つか2つにあたる、ごく一般的な形です。
- R1 額のしきい値:額が8以上の取引(しきい値のルール)
- R2 速度:同じ顧客の直近1時間の取引が3回以上(速度のルール)
- R3 夜間かつ普段と違う種類:0時から5時の取引で、加盟店の種類が顧客のよく使う種類と違う(組み合わせのルール)
- R4 新しい端末かつ額3以上:新しい端末からの取引で、額が3以上(不一致の兆候と額の組み合わせ)
さらに、4本を束ねる方法として、「いずれか1本以上に該当したらアラート」と「2本以上に同時に該当したらアラート」の2つを比べます。データは前半40日(109,930件、うち不正481件)と後半20日(55,272件、うち不正252件)に分け、成績は後半の20日で数えます。
R1からR4の条件の値は、合成データの生成条件を踏まえて本コラムが先に設定したもので、前半のデータから選んだものではありません。前半のデータは、次の節のしきい値の動かし方の説明と、決定木の学習に使います。実際の運用では、条件を決めるときに見たデータと成績を数えるデータを分けておくことが必要で、この章もその形に合わせて成績を後半で数えています。
数えるのは、アラートの件数・そのうちの不正の件数・適合率(アラートのうち不正だった割合)・再現率(不正のうちアラートにできた割合)の4つです。この章の合成データでは、どの取引が不正かがすべて分かっているものとして、後半の不正252件全部を分母にして再現率を数えます。実際の記録では、ラベルの遅れや選択の偏りのために分からないままの不正があり、再現率の分母はその時点で分かっている不正になります(第2章)。
# === block3: 4本のルールと組み合わせを、後半の期間で評価する ===
train = df[df["day"] < 40].copy()                    # 前半40日:ルールの設計・木の学習
test = df[df["day"] >= 40].copy()                    # 後半20日:評価

def rule_flags(d):
    return pd.DataFrame({
        "R1 額のしきい値(8以上)": d["amount"] >= 8,
        "R2 速度(1時間に3回以上)": d["cnt_1h"] >= 3,
        "R3 夜間かつ普段と違う種類": d["night"] & d["unusual_cat"],
        "R4 新しい端末かつ額3以上": d["new_device"] & (d["amount"] >= 3),
    })

def evaluate(alert, y):
    tp = int((alert & (y == 1)).sum())
    n = int(alert.sum())
    prec = tp / n if n > 0 else float("nan")
    return n, tp, prec, tp / int((y == 1).sum())

flags = rule_flags(test)
flags["いずれか1本以上"] = flags.iloc[:, :4].any(axis=1)
flags["2本以上が同時に該当"] = flags.iloc[:, :4].sum(axis=1) >= 2
res = pd.DataFrame([evaluate(flags[k], test["fraud"]) for k in flags],
                   index=flags.columns, columns=["アラート", "うち不正", "適合率", "再現率"])
print("前半の取引:", len(train), " 不正:", train["fraud"].sum())
print("後半の取引:", len(test), " 不正:", test["fraud"].sum())
print(res.round(3).to_string())
f4 = flags.iloc[:, :4].astype(int)
f4.columns = ["R1", "R2", "R3", "R4"]
print("2本のルールに同時に当たった件数(対角はそのルールのアラート)")
print(f4.T @ f4)
実行した結果を次の表にまとめました。
| ルール | アラート | うち不正 | 適合率 | 再現率 |
|---|---|---|---|---|
| R1 額のしきい値(8以上) | 1,019 | 31 | 0.030 | 0.123 |
| R2 速度(1時間に3回以上) | 1,303 | 108 | 0.083 | 0.429 |
| R3 夜間かつ普段と違う種類 | 505 | 126 | 0.250 | 0.500 |
| R4 新しい端末かつ額3以上 | 209 | 93 | 0.445 | 0.369 |
| いずれか1本以上 | 2,843 | 208 | 0.073 | 0.825 |
| 2本以上が同時に該当 | 161 | 120 | 0.745 | 0.476 |
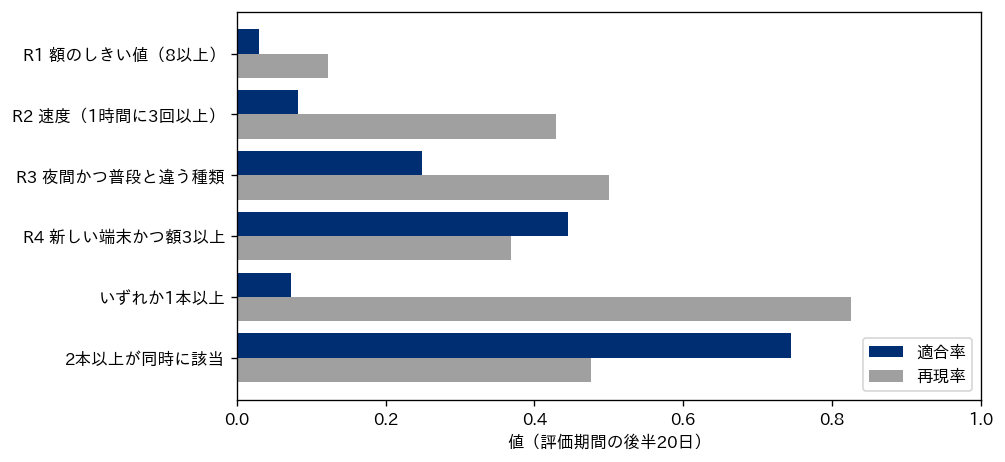
本コラムの架空データでは、R1 額のしきい値の成績が最も低く、アラート1,019件のうち不正は31件、適合率は0.030でした。アラートの約97%が正当な取引だったことになります。この合成データでは、顧客ごとに普段の額の水準を変え、正当な取引にもまれに大きな買い物を混ぜているので、全員に同じしきい値を当てると、普段から大きな取引をする顧客の取引や、正当な大きな買い物も当たります。どちらがどれだけ効いているかは、この章では切り分けていません。顧客の普段の水準との比で見直した結果は次の節に載せ、比を含む特徴量の作り方は第5章で扱います。
本コラムの架空データでは、単独のルールで適合率が最も高かったのは R4 新しい端末かつ額3以上(0.445)で、再現率が最も高かったのは R3 夜間かつ普段と違う種類(0.500)でした。この合成データでは、単独の兆候を1つだけ見るルール(R1・R2)より、兆候を2つ重ねたルール(R3・R4)の方が、適合率が高く出ています。不正の側に兆候が強く入るように合成しているので、これは作り方の結果でもあります。束ね方による違いも大きく、「いずれか1本以上」は再現率0.825まで上がった代わりに、アラートが2,843件、適合率が0.073まで下がりました。「2本以上が同時に該当」はアラートが161件まで減り、適合率は0.745になりましたが、再現率は0.476です。
この結果から読み取れるのは、ルールの成績を1つの数字で語れないということです。再現率だけを見れば「いずれか1本以上」が最も良く、適合率だけを見れば「2本以上が同時に該当」が最も良く見えます。どちらを選ぶかは、アラートを何件まで調査できるか、誤検知をどこまで許せるか(誤検知のうち保留や拒否にしたものは、正当な取引を誤って止めることになります)で決まり、データだけでは決まりません。アラートを措置にどうつなげるか、しきい値を調査の能力とどう合わせるかは第9章で扱います。この章では、どのルールについても、アラートの件数・適合率・再現率の3つを並べて記録しておくことを基本の形にします。
もう1つ注意が要るのは、この4本のルールは、合成データの生成条件を踏まえて本コラムが設定したものだという点です。不正に多い特徴を自分で決めて合成しているので、どの条件が効くかを最初から知っています。実際のルールの担当者は、手口の全体像を知らないまま、注意喚起や調査の結果からルールを書くことになります。このデータで「2本以上が同時に該当」の適合率が高く出たことを、実際のルールでも同じ水準が出る根拠にはできません。
しきい値を動かすと、適合率と再現率はどう変わるか
ルールのしきい値は、決め方しだいで成績が大きく変わります。ここでは、R1 額のしきい値と R2 速度の回数を動かし、前半40日のデータで適合率と再現率を数えました。しきい値の候補を選ぶのは、成績を数える後半のデータではなく、前半のデータで行います。後半のデータを見ながらしきい値を選ぶと、後半の成績がその選び方の分だけ良く見えるからです。同じブロックで、前の節のルールごとの比較の図も描き、最後に、額を顧客の普段の水準との比に直したルールも数えています。
# === block4: ルールごとの比較を図にし、しきい値を動かす(前半の期間) ===
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

fig, ax = plt.subplots(figsize=(8, 4.2))
x = np.arange(len(res))
ax.barh(x - 0.2, res["適合率"], 0.4, color="#002E73", label="適合率")
ax.barh(x + 0.2, res["再現率"], 0.4, color="#A0A0A0", label="再現率")
ax.set_yticks(x, res.index)
ax.invert_yaxis()
ax.set_xlim(0, 1)
ax.set_xlabel("値(評価期間の後半20日)")
ax.legend(loc="lower right")
plt.savefig("../ch03_rule_compare.png", dpi=120, bbox_inches="tight")
plt.close()

sweep = []
for th in [2, 3, 4, 5, 6, 8, 10, 12, 15, 20]:
    n, tp, p, r = evaluate(train["amount"] >= th, train["fraud"])
    sweep.append((th, n, p, r))
sweep = pd.DataFrame(sweep, columns=["額のしきい値", "アラート", "適合率", "再現率"])
print(sweep.round(3).to_string(index=False))
for k in [2, 3, 4, 5]:
    n, tp, p, r = evaluate(train["cnt_1h"] >= k, train["fraud"])
    print(f"1時間に{k}回以上: アラート {n}  適合率 {p:.3f}  再現率 {r:.3f}")
# 普段の水準との比で見直す(合成に使った水準。実際は過去の取引から見積もる)
ratio = train["amount"] / train["customer"].map(cust.set_index("customer")["level"])
for k in [3, 5, 8]:
    n, tp, p, r = evaluate(ratio >= k, train["fraud"])
    print(f"普段の水準の{k}倍以上: アラート {n}  適合率 {p:.3f}  再現率 {r:.3f}")

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(sweep["額のしきい値"], sweep["適合率"], "o-", color="#002E73", label="適合率")
ax.plot(sweep["額のしきい値"], sweep["再現率"], "s--", color="#808080", label="再現率")
ax.set_xlabel("額のしきい値(相対値。この値以上をアラートにする)")
ax.set_ylabel("値(前半40日)")
ax.set_ylim(0, 1)
ax.legend(loc="upper right")
plt.savefig("../ch03_threshold.png", dpi=120, bbox_inches="tight")
plt.close()
額のしきい値を動かした結果は次の表のとおりです。
| 額のしきい値 | アラート | 適合率 | 再現率 |
|---|---|---|---|
| 2 | 26,594 | 0.011 | 0.613 |
| 3 | 14,369 | 0.014 | 0.410 |
| 4 | 8,663 | 0.017 | 0.299 |
| 5 | 5,591 | 0.019 | 0.225 |
| 6 | 3,887 | 0.022 | 0.181 |
| 8 | 2,088 | 0.026 | 0.112 |
| 10 | 1,249 | 0.035 | 0.091 |
| 12 | 815 | 0.028 | 0.048 |
| 15 | 473 | 0.027 | 0.027 |
| 20 | 222 | 0.032 | 0.015 |
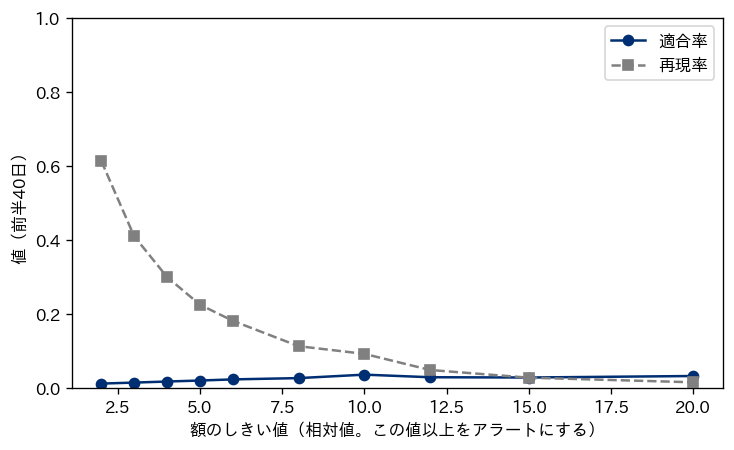
しきい値を上げるほど、アラートの件数と再現率は下がります。一般に、しきい値を上げると適合率は上がることが期待されますが、本コラムの架空データの額のルールでは、しきい値を2から20まで動かしても適合率は0.011から0.035のあいだに留まりました。図でも、適合率の線はほぼ平らなまま、再現率の線だけが右へ行くほど下がっています(図の線は表の10点を結んだもので、点のあいだの値は計算していません)。しきい値15と20ではアラートが数百件と少なく、適合率の小さな上下には件数の少なさによる揺れも含まれていると考えられます。
顧客の普段の額の水準との比で見直すと、前半40日で、普段の水準の3倍以上をアラートにするとアラート5,444件・適合率0.040・再現率0.451、5倍以上で1,542件・0.060・0.191、8倍以上で570件・0.054・0.064でした。全員に同じ値を当てるよりは適合率が少し高くなりましたが、0.06前後に留まっています。ここで使った普段の水準は合成に使った値そのもので、実際の記録では過去の取引から見積もる必要があり、見積もりの誤差の分だけ成績は下がりうると考えられます。この合成データでは、額という1つの項目だけでは、比に直しても不正と正当な取引を十分には分けられませんでした。しきい値をいくら調整しても、条件そのものが不正と正当な取引を分けていなければ、アラートの件数が増えるか減るかを選んでいるだけになります。
速度のルールでは、様子が違いました。前半40日で、直近1時間の回数を2回以上にするとアラート14,059件・適合率0.023・再現率0.686、3回以上で2,708件・0.075・0.424、4回以上で413件・0.259・0.222、5回以上で50件・0.580・0.060でした。この速度のルールでは、回数を上げるほど適合率ははっきり上がり、再現率は下がりました。同じデータでしきい値を厳しくすると、再現率が上がることはありませんが、適合率が必ず上がるとは限りません。額のルールでしきい値を10から12に上げたときは、適合率と再現率の両方が下がっています。これはルールにも機械学習のスコアにも当てはまることで、しきい値ごとに実際に数えて確かめる必要があります。どこで切るかは第9章で扱う調査の能力と損失の見積りで決めます。どちらのルールでも、しきい値を1つの値に決めた理由(どの期間のデータで、どの成績を見て選んだか)を台帳に残しておくことが、後で見直すときの手がかりになります。
決定木でルールの候補をデータから作る
ルールの条件は、人が考えるだけでなく、データから候補を作ることもできます。そのための道具としてよく使われるのが決定木です。決定木は、データを「額が4.17以下か」のような1つの条件で2つに分け、分けた先でまた条件で分ける、という操作を繰り返して、木の形の判定を作る方法です。根から1つの葉までの条件をつなげると、「AかつBかつC」という組み合わせのルールとして読めます。scikit-learn の決定木は、公式の説明によると、CART と呼ばれる方法を最適化したものを使っています。
ここでは、前半40日のデータで深さ3までの浅い決定木を学習しました。深さを3に抑えたのは、1本のルールの条件を3つまでにして、人が読んで意味を確かめられるようにするためです。葉1つあたりの件数は30件以上としました。不正が少ないので、何もしないと木は「全部正当」に近い分け方を選びやすくなります。そこで、件数の少ない不正の側の1件を、件数の少なさに応じて重く数える設定(class_weight="balanced")を付けました。木の葉ごとに、前半のデータでの件数と不正の割合を数え、不正の割合が2割以上の葉をアラートにするルールを作ります。そのルールを後半の20日に当てて成績を数えます。
# === block5: 浅い決定木でルールの候補を作り、葉をルールとして読む ===
from sklearn.tree import DecisionTreeClassifier

cols = ["amount", "cnt_1h", "night", "unusual_cat", "new_device"]
tree = DecisionTreeClassifier(max_depth=3, min_samples_leaf=30,
                              class_weight="balanced", random_state=0)
tree.fit(train[cols].astype(float), train["fraud"])
t = tree.tree_

def leaf_paths(node=0, conds=()):
    if t.children_left[node] == -1:                   # 葉に着いた
        return {node: " かつ ".join(conds)}
    name, th = cols[t.feature[node]], t.threshold[node]
    out = leaf_paths(t.children_left[node], conds + (f"{name} <= {th:.2f}",))
    out.update(leaf_paths(t.children_right[node], conds + (f"{name} > {th:.2f}",)))
    return out

paths = leaf_paths()
train["leaf"] = tree.apply(train[cols].astype(float))
test["leaf"] = tree.apply(test[cols].astype(float))
leaf = train.groupby("leaf")["fraud"].agg(件数="size", 不正="sum", 不正の割合="mean")
leaf["条件"] = [paths[i] for i in leaf.index]
print(leaf.sort_values("不正の割合", ascending=False).round(3).to_string())

chosen = leaf.index[leaf["不正の割合"] >= 0.2]       # 前半で不正の割合が2割以上の葉
print("木が使わなかった夜間で、選んだ葉をさらに分けると(前半)")
print(train[train["leaf"].isin(chosen)].groupby(["leaf", "night"])["fraud"]
      .agg(件数="size", 不正="sum", 不正の割合="mean").round(3))
n, tp, p, r = evaluate(test["leaf"].isin(chosen), test["fraud"])
print(f"木から作ったルール(後半): アラート {n}  うち不正 {tp}  適合率 {p:.3f}  再現率 {r:.3f}")
前半40日で、葉ごとの件数と不正の割合は次のようになりました。条件の列の unusual_cat > 0.50 は「普段と違う加盟店の種類である」、new_device > 0.50 は「新しい端末である」、cnt_1h > 1.50 は「直近1時間の取引が2回以上」を表します(真偽の項目を0と1の数として扱っているので、0.50 が境目になります)。額の境目の値(0.84・4.17)は表示のために小数第2位で丸めたもので、表の値をそのまま書き写すと、木の実際の判定とわずかに食い違う場合があります。木の判定を再現するときは、学習済みの木か、丸める前の値を使います。
| 葉の条件(言い換え) | 件数 | 不正 | 不正の割合 |
|---|---|---|---|
| 普段と違う種類かつ新しい端末かつ直近1時間に2回以上 | 252 | 208 | 0.825 |
| 普段と違う種類かつ新しい端末かつ直近1時間に1回 | 429 | 88 | 0.205 |
| 普段と違う種類かつ新しい端末でないかつ直近1時間に2回以上 | 1,975 | 91 | 0.046 |
| 普段の種類かつ新しい端末かつ額0.84より大きい | 1,108 | 36 | 0.032 |
| 普段の種類かつ新しい端末かつ額0.84以下 | 728 | 2 | 0.003 |
| 普段と違う種類かつ新しい端末でないかつ直近1時間に1回 | 16,201 | 42 | 0.003 |
| 普段の種類かつ新しい端末でないかつ額4.17より大きい | 6,387 | 8 | 0.001 |
| 普段の種類かつ新しい端末でないかつ額4.17以下 | 82,850 | 6 | 0.000 |
不正の割合が2割以上の葉は、上の2つでした。どちらも「普段と違う加盟店の種類で、新しい端末からの取引」という条件を共有していて、直近1時間の回数で2つに分かれています。この2つの葉をアラートにするルールを後半の20日に当てると、アラート313件・うち不正165件・適合率0.527・再現率0.655になりました。人が書いた「2本以上が同時に該当」(適合率0.745・再現率0.476)と比べると、適合率は低く、再現率は高い位置にあります。どちらが良いとは言えず、アラートの件数と調査の能力のつり合いで選ぶ話になるのは、前の節と同じです。
この木は、夜間かどうか(night)を一度も使いませんでした。ただし、夜間が不正を見分けるのに役立たない、ということではありません。選んだ2つの葉を、前半のデータで夜間かどうかでさらに分けて数えると、2つ目の葉(直近1時間に1回)では、夜間でない370件の取引のうち不正の割合が0.100だったのに対し、夜間の59件の取引では0.864でした。1つ目の葉でも、夜間でない128件の取引では0.656、夜間の124件の取引では1.000でした。木の深さを3に制限したので、木は先に普段と違う種類・新しい端末・直近1時間の回数で分け、夜間で分ける段まで届かなかった、という形です。木が使わなかった項目を「要らない項目」と読むと誤ります。浅い木から作ったルールは読みやすい代わりに、使える条件の数を制限している分だけ、データにある手がかりを取りこぼすことがあります。木の候補を人が読むときは、木が使わなかった項目でも、この例のように葉の中で分けて数えてみるのがよいと考えています。
決定木から作った条件は、そのまま本番のルールにするのではなく、ルールの候補として扱うのがよいと考えています。理由は3つあります。1つ目は、木の分け方が学習に使ったデータに強く依存し、期間を少しずらすだけで別の分岐が選ばれることがある点です。2つ目は、木が選んだ境目の値(このデータでは額の0.84や4.17)に、業務上の意味があるとは限らない点です。3つ目は、木が見つけた組み合わせが、正当な顧客の特定の集団(例えば、機種を変えたばかりで、普段と違う店で買い物をした顧客)を巻き込んでいないかを、人が確かめる必要がある点です。候補を調査担当や不正対策の担当が読み、意味の通る条件だけを台帳に載せる、という使い方を想定しています。
ルールだけの検知をベースラインにする
この章で作ったルールの成績のような、ルールだけで組んだ検知の成績は、機械学習の方式と比べる基準になります。本コラムでは章ごとに別の合成データを使うので、後の章では、その章のデータの上でルールを数え直して比べる基準にし、この章の数値を別の章の数値と直接は比べません。本コラムでは、この基準をベースラインと呼びます。ベースラインは、新しい方式を入れたときに「何と比べて、どれだけ良くなったか」を示すための比べる相手で、評価の期間・数え方・データの切り方を揃えて記録しておかないと、比べる意味を持ちません。最後のブロックでは、後半20日について、3つの束ね方の成績を1日あたりのアラートの件数・見逃しの件数・誤検知の件数と合わせて出します。
# === block6: ベースラインとして残す成績(後半20日・1日あたりのアラート) ===
base = {
    "いずれか1本以上": flags["いずれか1本以上"],
    "2本以上が同時に該当": flags["2本以上が同時に該当"],
    "木から作ったルール": test["leaf"].isin(chosen),
}
days = test["day"].nunique()
for name, alert in base.items():
    n, tp, p, r = evaluate(alert, test["fraud"])
    missed = int(test["fraud"].sum()) - tp
    print(f"{name}: 1日あたりのアラート {n / days:.1f}  適合率 {p:.3f}  "
          f"再現率 {r:.3f}  見逃し {missed}  誤検知 {n - tp}")
実行した結果は次の表のとおりです。見逃しは後半の不正252件のうちアラートにできなかった件数、誤検知はアラートのうち正当な取引だった件数です。
| ベースラインの候補 | 1日あたりのアラート | 適合率 | 再現率 | 見逃し | 誤検知 |
|---|---|---|---|---|---|
| いずれか1本以上 | 142.2 | 0.073 | 0.825 | 44 | 2,635 |
| 2本以上が同時に該当 | 8.1 | 0.745 | 0.476 | 132 | 41 |
| 木から作ったルール | 15.7 | 0.527 | 0.655 | 87 | 148 |
見逃しと誤検知を並べると、3つの束ね方の違いが損失の型で読めるようになります。「いずれか1本以上」は見逃しが44件と最も少ない代わりに、誤検知が2,635件あり、1日あたり142.2件のアラートが出ます。調査の能力が1日に数十件しかない組織なら、この束ね方を選ぶと調査の過負荷が起き、アラートの多くが見られないまま流れます。「2本以上が同時に該当」は1日8.1件と調査の負担は小さいものの、後半の不正252件のうち132件をアラートにできませんでした。ここで数えているのはアラートにしたかどうかで、取引を止めたかどうかや、防げた被害の大きさではありません。どの束ね方を選ぶかは、見逃しによる被害、誤って止める正当な取引、調査の能力を合わせて判断することになります(第9章)。
ベースラインとして残すときは、この表のように、成績の数字と一緒に、どの期間のデータで、どの単位(取引の単位か、顧客の単位か)で数えたかを書いておきます。本コラムのこの章の数え方は取引の単位で、不正のまとまりのうち1件でも止めれば被害が止まる、という効き方は数えていません。取引の単位とカードや顧客の単位の評価の違い、評価のばらつきの見方は、第8章で扱います。第4章では、同じ考え方で作ったルールを、機械学習のスコアと比べます。
ルールの管理、台帳・担当・見直しの時期・廃止の基準
ルールの短所の多くは、管理の仕組みが無いことから生まれる、と前に書きました。管理の中心になるのは、ルールを1本ずつ記録する台帳です。台帳には、そのルールが何を捉えるために、いつ、誰の判断で入り、今どれだけの成績を出しているかを残します。台帳があれば、ルールを足すときに似たルールが既に無いかを確かめられ、成績の落ちたルールを見つけられ、監査や規制当局に取引のモニタリングの方法を説明するときの材料にもなります。台帳に載っていないルールは本番の判定に入れない、という決まりにしておくと、検証されないまま足されるルールを防げます。
台帳に持たせたい項目を次の表にまとめました。項目の選び方は本コラムが考えた例で、業界の規格や公的な指針で定められたものではありません。
| 項目 | 書く内容 | この項目が無いと起きること |
|---|---|---|
| ルールの番号と名前 | 一意の番号と、条件を短く言い表した名前 | 調査の記録や顧客対応の記録から、どのルールが当たったのかを辿れない |
| 目的 | どの不正の型(第1章)を捉えるためか。規制上の要件に基づくものか | 目的の分からないルールを、誰も消せなくなる |
| 条件と措置 | 条件の正確な定義(どの期間の何を数えるか)と、当たったときの措置(保留・拒否・事後の調査) | 実装と台帳の条件がずれ、説明と実際の判定が食い違う |
| 担当 | ルールの成績に責任を持つ人、変更を承認する人 | 成績が落ちても誰も気づかない。変更が承認なしに入る |
| 根拠 | 導入のきっかけ(注意喚起・調査の結果・決定木の候補など)と、しきい値を決めたときのデータの期間と成績 | しきい値を見直すとき、何を基準に決めたのかが分からない |
| 成績 | 直近の期間のアラートの件数・適合率・再現率(その時点で分かっている不正を分母にした値)・他のルールとの重なり | 誤検知ばかりのルールが残り、調査の能力を食い続ける |
| 見直しの時期 | 次に成績を確かめる日と、見直しの間隔 | 足した日のまま、手口の変化に置いていかれる |
| 廃止の基準 | どの状態になったら廃止の検討を始めるか(例えば、一定の期間、当たった取引に不正が確認されていない、他のルールとの重なりが大きい、など)と、廃止を決める前に確かめること(ラベルが確定していない取引、発生の少ない不正、そのルールだけが捉えている不正) | ルールが減らず、本数と矛盾が増え続ける |
| 変更の記録 | いつ、誰が、何を、なぜ変えたか。変更の前後の成績 | 成績の変化が、手口の変化なのかルールの変更なのか区別できない |
表の中で、運用の中で最も抜けやすいのが廃止の基準だと考えています。ルールを足す理由は分かりやすく、「この手口を止めるため」と説明できますが、消す理由は「最近は当たっていない」くらいしか言えず、消した後にその手口が戻ってきたら責任を問われる、という心配から、消す判断が先送りされがちです。だからこそ、足すときに消す条件を決めておきます。廃止の基準は、廃止を決める条件ではなく、見直しを始める条件として置くのがよいと考えています。基準に当たったルールは、すぐに消すのではなく、判定には使わずに当たった取引を記録する状態にしばらく置き、そのルールだけが当たった取引の中に後から不正と分かったものが無いか、実際の束ね方で消す前後の見逃しと誤検知、措置がどう変わるかを確かめてから消す、という段階を挟む方法も考えられます。
成績の欄には、適合率は書けても、再現率は書けないことがあります。適合率は、アラートを全件調査しているか、無作為に選んだ一部を調査している場合には、その結果から数えられます(調査の能力が足りず、選んで調査している場合は、調査した範囲の値で、アラート全体の値とは区別します)。一方で、再現率を数えるには、ルールが当たらなかった取引の中の不正の件数が要るからです。そこには、本人の申告やチャージバックで後から分かった不正しか現れず、ラベルの遅れもあります(第2章)。台帳の再現率は「その時点で分かっている不正のうち」という限定付きの値として扱い、確定するまで時間がたった期間で数え直すのがよいと考えています。ルールに当たらなかった取引の一部を無作為に調査して選択の偏り(第2章)を補う考え方は、第10章で扱います。
もう1つ、ルールどうしの重なりを数えておくことも大切です。別々に書いたルールが、実は同じ取引を捉えていることがあるからです。この章のコードでは、後半20日について、2本のルールに同時に当たった件数を数えました(3つ目のブロック)。結果は次の表のとおりで、対角のマスはそのルール単独のアラートの件数です。
| ルール | R1 | R2 | R3 | R4 |
|---|---|---|---|---|
| R1 額のしきい値 | 1,019 | 25 | 22 | 42 |
| R2 速度 | 25 | 1,303 | 57 | 39 |
| R3 夜間かつ普段と違う種類 | 22 | 57 | 505 | 41 |
| R4 新しい端末かつ額3以上 | 42 | 39 | 41 | 209 |
本コラムの架空データでは、どの2本の組み合わせでも、同時に当たった件数はそれぞれのアラートの件数よりずっと少なく、たとえば R3 と R4 の両方に当たったのは41件で、R4 のアラート209件の約2割でした。このデータの4本は、ほぼ別々の取引を捉えていたことになります。実際の運用では、似た目的のルールを何本も足していくうちに、この表の対角の外の数が対角に近づくこともありえます。重なりの大きいルールは見直しの候補になります。ただし、アラートの重なりが大きくても、重ならない少数の取引に、そのルールだけが捉えている不正が集まっていることがあります。「いずれか1本以上」で束ねているなら、消したときに下がる再現率は、そのルールだけが捉えた不正の件数で決まるので、重なりの件数と合わせて、そのルールだけが当たった不正の件数を数えて判断します。重なりを見るには、取引ごとにどのルールが当たったかを全部記録しておく必要があり、最初に当たった1本だけを記録する作りにすると、後から数えられなくなります。
ルールと機械学習の役割分担、既知の手口と規制はルール、組み合わせと順位づけは機械学習
この章で見たとおり、人が書くルールは条件がはっきりした既知の手口を捉えるのが得意で、多数の弱い兆候の組み合わせを人の手で管理したり、細かく順位づけしたりするのは得意ではありません。第4章で扱う機械学習は、多数の項目の組み合わせから不正の疑いの強さをスコアにするのが得意な一方で、複雑なモデルほど判定の理由をそのまま言葉にしにくくなります。また、新しい手口の特徴を教師あり学習で直接学ばせるには、その手口のラベルが要ります。この2つは置き換えの関係ではなく、得意な場面が違う道具として組み合わせるのがよいと考えています。
| 役割 | ルールが向く | 機械学習が向く |
|---|---|---|
| 規制上の要件 | 法令や業界のガイドラインで確認が求められる条件、拒否リストとの照合(第14章) | 法令で明確に定められた確認の条件そのものはルールで判定し、規制対応の業務の中のリスクの評価や、調査の優先順位づけに使う |
| 既知の手口 | 注意喚起が出た手口のうち、条件が明確なもの。ラベルが集まる前の当座の対応 | ラベルが集まった後に、その手口の微妙な変形まで拾う |
| 弱い兆候の組み合わせ | 条件の数に上限は無いが、人の手で管理できるのは少数の条件の組み合わせ | 多数の項目の組み合わせ(第4章・第5章) |
| 順位づけ | 1本のルールの出力は当たったかどうかの2値。当たった本数や重みの合計で並べることはできる | スコアで並べ、調査の能力に合わせて上から見る(第9章) |
| 説明 | 条件をそのまま理由として示せる | 浅い決定木なら分岐をそのまま示せる。複雑なモデルでは理由を示す別の手法が要る(第11章) |
| 障害のとき | モデルが使えないときの最低限の判定(第12章) | モデルの判定が返らない前提の設計が要る |
組み合わせ方として多いのは、ルールとモデルのスコアを並べて使う形です。規制上の要件と拒否リストのルールはモデルの結果にかかわらず先に判定し、それ以外の取引はモデルのスコアで並べ、明らかな既知の手口のルールはスコアに上乗せするか、モデルの特徴量として渡す、といった形です。どの組み合わせ方を取るにしても、ルールとモデルのどちらがアラートを出したかを記録しておかないと、後でどちらの成績が落ちたのかを分けられません。
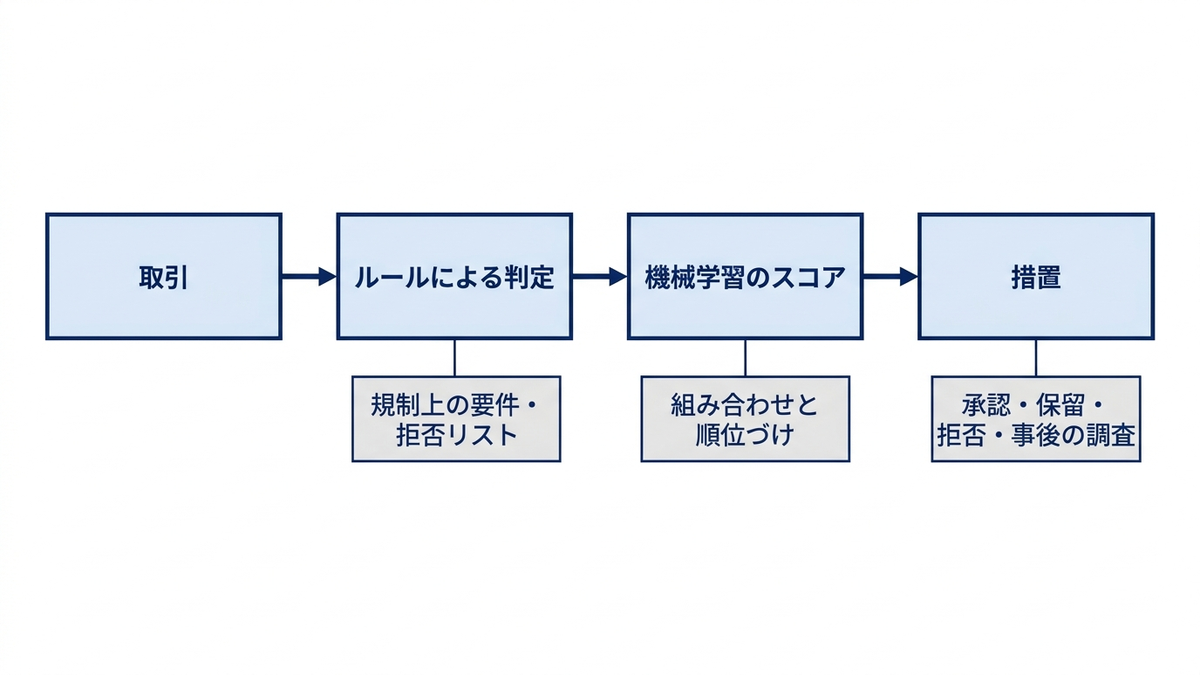
経営判断、ルールの台帳を持ち、廃止の基準を決める
ルールについての経営の判断は、ルールを何本持つかではなく、ルールを管理する仕組みを持つかどうかです。ルールの本数が増え続けている状態は、一見すると対策が積み重なっているように見えますが、序章で挙げた損失の型で見ると、4つの損失が同時に進んでいることがあります。誤検知の多いルールが残り、そのアラートで保留や拒否にした正当な取引から生じる機会損失と顧客の離反、アラートが増え続けることによる調査の過負荷、そして、どのルールが効いているか分からないまま見直されないことによる形骸化です。この章の架空データでも、4本のルールを「いずれか1本以上」で束ねただけで、1日あたりのアラートが142.2件になり、その9割以上が誤検知でした。
これを仕組みに落とすには、次の3つを決めておくのがよいと考えています。
- 台帳に載っていないルールは本番の判定に入れない、という決まりと、台帳の管理の担当
- ルールを足すときに、目的・しきい値の根拠・見直しの時期・廃止の基準を同時に書くこと
- 定期的な見直しの場で、ルールごとのアラートの件数・適合率・重なりを確かめ、廃止の基準を満たしたものを止めること
KPI の面では、ルールの本数そのものを目標にしないことが大切です。「今期は新しいルールを何本追加した」は活動の量であって成果ではありません。ルールの成果は、ルール全体で防いだ不正と、ルール全体で誤って止めた正当な取引の両方で見ます(第8章・第9章)。また、ルールだけで組んだ検知の成績を、この章のベースラインの表の形で記録しておくことは、機械学習への投資を判断するための前提になります。機械学習を入れるかどうかは、このベースラインと比べて、同じ調査の能力のもとで見逃しと誤検知がどれだけ変わるかで判断できるからです。ベースラインが無い状態で機械学習のベンダーの成績を受け取ると、比べる相手が無く、その数字が自社にとって良いのかどうかを判断できません。
この章では、ルールの5つの型と長所・短所を整理し、架空の取引の記録で4本のルールを実装して、ルールごとと束ね方ごとの適合率・再現率・アラートの件数を比べました。本コラムの架空データでは、全員に同じ値を当てる額のしきい値は、試した10個のしきい値のどれでも適合率が低いままで、兆候を2つ重ねたルールや決定木から作った組み合わせの方が適合率が高く出ました。ルールの成績はアラートの件数・適合率・再現率を並べて記録し、台帳と廃止の基準で管理し、ルールだけの検知の成績をベースラインとして残すことが、この章の結論です。第4章では、教師あり学習で不正のスコアを作り、この章の考え方を簡単にしたルールと比べます。
この章を深めたい方への参考書籍
『データマイニングの基礎』(元田浩・津本周作・山口高平・沼尾正行 共著、オーム社):情報処理学会が編集する教科書の1冊で、データから規則を見つけ出すデータマイニングの手法を体系的に扱っています。この章で使った決定木のように、データから人が読める規則を作る方法の考え方を、基礎から確かめるのに向いています。
『集合知プログラミング』(Toby Segaran 著、當山仁健・鴨澤眞夫 訳、オライリー・ジャパン):データから推薦・分類・最適化などを行う手法を、コードを書きながら説明する本で、第7章が決定木によるモデリングにあてられています。決定木の分け方の仕組みと、木を規則として読む考え方を、手を動かして確かめたい方に向いています。掲載のコードは刊行当時の環境で書かれています。
第4章 教師あり学習による検知、不均衡なデータで不正の確率を見積もる
第3章では、人が決めた条件で不正の疑いを判定するルールを作り、その成績を後の章の比較の基準(ベースライン)にしました。ルールは理由を説明でき、すぐに直せる一方で、条件の組み合わせが増えると管理しきれなくなります。この章では、第3章の考え方を簡単にしたルール(アラートにするかどうかの2択で判定するもの)を比べる相手に置きながら、過去の取引の記録と、その取引が不正だったかどうかのラベルから、不正の疑いの強さを表すスコアを機械に学ばせる方法を扱います。
この章で扱うのは次の内容です。後半は、架空の取引の記録(顧客3,000人・120日)を使い、実行したコードと結果で確かめます。
- 教師あり学習で不正のスコアを作る流れと、各段階で決めること
- ロジスティック回帰・決定木・ランダムフォレスト・勾配ブースティングの違いと使いどころ
- 時間で切った学習用と評価用のデータで、2つのモデルとルールを比べる方法
- 不均衡データへの対処(クラスの重み付け・少数側を増やす方法・多数側を減らす方法)と、それがスコアの値に与える影響
- スコアを確率として読めるようにする較正(削減の割合を使う補正・等調回帰・プラットの方法)
- 過学習とデータの分け方による漏れ、深層学習を使う条件、経営の判断
この章の主張は、不均衡への対処が、上位の取引の適合率よりも、スコアの値の水準を大きく変えうるという点です。本コラムの架空データでは、クラスの重み付け・少数側の合成・多数側の削減のどれを使っても、上位0.5%をアラートにしたときの適合率はほとんど変わりませんでした。一方で、評価の期間の実際の不正の割合が0.0039だったのに対し、クラスの重み付けをしたモデルのスコアの平均は0.2410で、60倍を超えていました。スコアを「不正である確率」として予算の見積りや措置の判断に使うなら、学習のしかたを確かめ、較正をしてから使う必要があります。
教師あり学習で不正のスコアを作る流れ、ラベルのある過去から次の取引を採点する
教師あり学習は、答えの分かっている過去の例から、入力と答えの関係を学ぶ方法です。不正検知では、入力は1件の取引の特徴(取引の額が普段と比べてどれだけ大きいか、普段と違う時間帯か、初めて使う端末か、直前に何回取引があったか、など)で、答えはラベル(その取引が不正だったかどうか)です。学習したモデルは、新しい取引の特徴を受け取り、0から1のスコアを返します。本コラムでは、スコアは大きいほど不正の疑いが強いことを表します。0から1の値でも、そのまま不正の確率とは限らないので、実際の不正の割合と対応しているかを評価用のデータで確かめ、必要に応じて較正します(全体の地図の用語表の定義)。
流れは、おおまかに次の5つの段階に分かれます。1つ目は、学習に使う取引とラベルを集めることです。第2章で扱ったとおり、ラベルは本人の申告・チャージバック・調査の結果などから作られ、確定までに日から月の単位の遅れがあります。止めた取引や調査しなかった取引は真のラベルが分からないことがあり、学習のデータはその偏りを含みます。2つ目は、取引の特徴を数に直すことです。これを特徴量と呼び、作り方は第5章で扱います。この章のコードでは、特徴量はすでに作られているものとして進めます。
3つ目は、学習用と評価用にデータを分けることです。不正検知では、過去の期間で学習し、それより後の期間で評価する、時間で切る分け方を基本にします。モデルが実際に使われるのは、学習したときより後に来る取引だからです。4つ目は、モデルを学習させ、評価用のデータでスコアの並び順と値の両方を確かめることです。5つ目は、スコアをしきい値と照らして措置(承認・保留・拒否・事後の調査)に結びつけることで、これは第9章で扱います。この章は主に3つ目と4つ目を扱います。
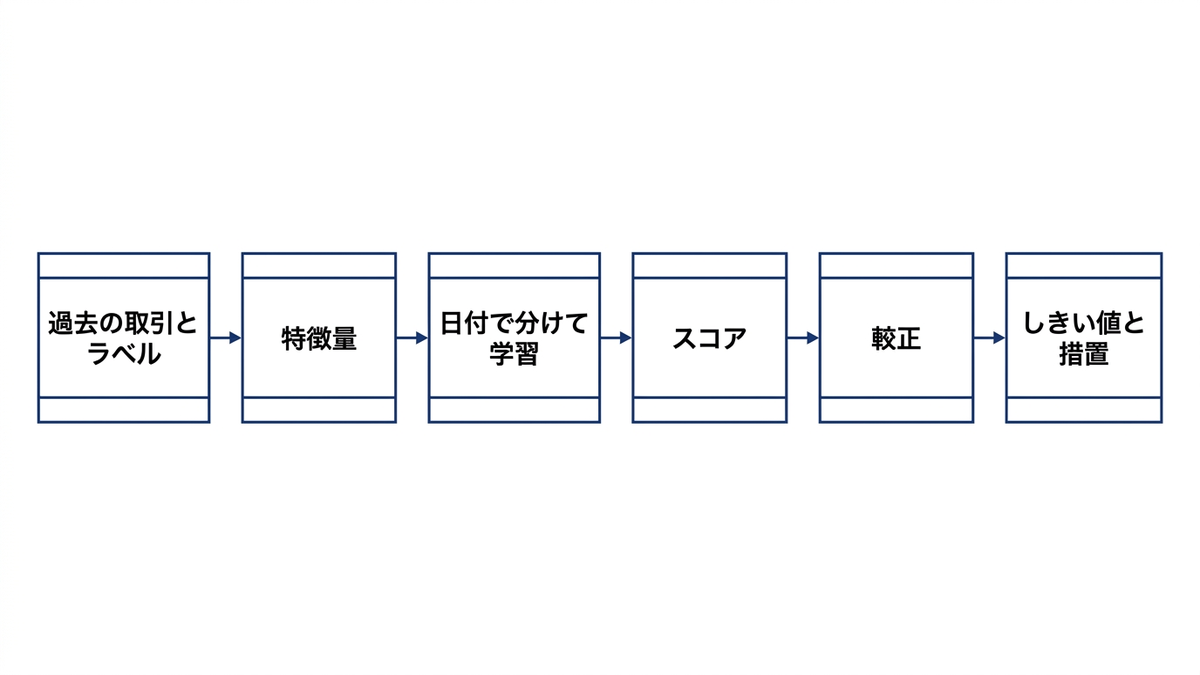
ルールとの違いは、組み合わせを機械が探す点にあります。ルールでは「初めての端末で、かつ額が普段の3倍を超える」のように、人が条件の組み合わせを1つずつ書きます。教師あり学習では、どの特徴がどの程度、どの組み合わせで不正と結びつくかを、過去の記録から自動で重み付けします。その代わり、既知の不正と特徴が大きく異なる新しい型の不正は、教師あり学習だけでは捉えにくくなります。新しい手口への備えは、教師なしの異常検知(第6章)と、手口の変化の監視(第10章)で扱います。
手法の比較、ロジスティック回帰・決定木・ランダムフォレスト・勾配ブースティング
取引の記録のような表の形のデータで不正のスコアを作るとき、よく使われるのは次の4つの手法です。機械学習の手法の一般論は弊社コラム『機械学習の仕組みと使いどころ』で扱っているので、ここでは不正検知で使うときの違いに絞ります。
ロジスティック回帰は、特徴量に重みを掛けて足し合わせ、その合計を0から1の値に変換するモデルです。重みを見れば、どの特徴が疑いを強める方向に効いているかが分かり、説明しやすい手法です。ただし、そのままでは特徴量どうしの組み合わせ(「種類2の加盟店なら額が大きくても普通だが、他の種類では疑わしい」のような関係)を表せません。組み合わせを使うには、人が組み合わせの特徴量を作って足す必要があります。決定木は、特徴量の条件で取引を次々に分けていくモデルで、分岐をそのままルールとして読めます。第3章では、浅い決定木をルールの候補を作る道具として使いました。1本の木は、学習データの細かな揺れに引きずられやすい弱点があります。
ランダムフォレストは、Breiman の2001年の論文で示された手法で、データと特徴量の一部を無作為に選んで作った多数の決定木の結果を平均します。1本の木より安定し、組み合わせも表せます。勾配ブースティングは、Friedman の2001年の論文で体系化された手法で、前の木が外した部分を次の木が補うように、浅い木を順番に足していきます。表の形のデータでは、木の手法が深層学習より良い成績だったという比較もあります(この章の後半の、深層学習を使う条件の節で扱います)。
勾配ブースティングには、LightGBM・XGBoost・scikit-learn の HistGradientBoostingClassifier などの実装があります。本コラムのコードでは、scikit-learn 1.9.0 の HistGradientBoostingClassifier を使いました。この実装は、scikit-learn の公式ドキュメントで、特徴量の値をあらかじめ区間に分けて計算を速める方式であり、LightGBM に着想を得たものと説明されています。
| 手法 | 何が分かるか | 組み合わせの扱い | どこで外れるか | 不正検知での使いどころ |
|---|---|---|---|---|
| ロジスティック回帰 | 特徴ごとの重み(疑いを強める向きと強さ) | 人が組み合わせの特徴量を作らないと表せない | 特徴と不正の関係が曲がっている場合、組み合わせが効く場合 | 最初のモデル、説明の要求が強い場面、比べる基準 |
| 決定木 | 分岐の条件(そのままルールとして読める) | 分岐の重なりで表せる | 学習データの揺れに引きずられ、木が深いと過学習する | ルールの候補づくり(第3章)、調査担当への説明 |
| ランダムフォレスト | 特徴量の重要度(全体の傾向) | 多数の木で表せる | スコアをそのまま確率として読めるとは限らない(較正を確かめる)。木が多いと判定に時間がかかる | 安定したスコアが欲しい場面、勾配ブースティングとの比較 |
| 勾配ブースティング | 特徴量の重要度、1件ごとの寄与(第11章の手法を使う) | 木を足していく過程で表せる | 設定(木の数・学習率・葉の大きさ)しだいで成績が変わり、少ない不正の件数では過学習しやすい | 表の形の取引の記録で、組み合わせの効く不正を順位づけする場面 |
表の「どこで外れるか」の列は、いずれも一般的な傾向で、データによって変わります。特に、どの手法が最も成績が良いかは、データの性質と特徴量の作り方しだいです。本コラムでは、表の形のデータの最初の候補として、説明しやすいロジスティック回帰と、組み合わせを自動で扱える勾配ブースティングの2つを並べて比べる進め方が有効だと考えています。両者の差が小さければ説明しやすい方を選び、差が大きければ、その差がどの組み合わせから来ているかを調べてから選ぶ、という判断になります。
架空の取引の記録を作り、時間で切る
ここからは、架空の合成データでコードを動かします。この記録は、顧客ごとの普段の行動(取引の額の水準・よく使う時間帯・1日あたりの回数・よく使う加盟店の種類)と、不正に多い特徴を乱数で再現したもので、実際の記録より大幅に単純です。合成データでの成績は、実際の取引での成績の目安にはなりません。取引の額は相対値(単位なしの数)で、金額ではありません。
不正は取引全体の0.4%前後になるように作り、そのうち7割は「普段と違う額・深夜・新しい端末・直前の連続・加盟店の種類4」のいずれかの特徴を持ちやすく、残りの3割は普段の取引と区別のつかない特徴を持つようにしました。こうした特徴は正当な取引にも一定の割合で現れます。さらに、加盟店の種類2は正当な取引でも額が大きくなりやすく、種類5は正当な取引でも短時間に続きやすいようにしました。「額が大きい」「直前に取引が続いている」という特徴が、加盟店の種類によって意味を変える、組み合わせの効く関係を入れるためです。特徴量は次の11個です(加盟店の種類は6つの列に分けて数えています)。
- 額と顧客の普段の水準の比の対数
- 普段の時間帯とのずれ(時間)
- 深夜(0時から5時)かどうか
- 新しい端末かどうか
- 直前1時間の取引の数
- 加盟店の種類(6種類を、0と1の6つの列に分けたもの)
本コラムの合成データでは、ラベルは取引と同時に確定しているものとして作りました。実際の記録にあるラベルの遅れ(第2章)は入れていない単純化です。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

# 架空の合成データ。顧客3,000人・120日。取引の額は相対値(単位なし)
rng = np.random.default_rng(20261112)
n_cust, n_days = 3000, 120
level = rng.lognormal(0.0, 0.6, n_cust)        # 顧客ごとの普段の額の水準
rate = rng.gamma(2.0, 0.5, n_cust)             # 1日あたりの取引の回数
usual_hour = rng.normal(14, 3, n_cust)         # よく使う時間帯
fav = rng.integers(0, 6, n_cust)               # よく使う加盟店の種類
cust = np.repeat(np.arange(n_cust), rng.poisson(rate * n_days))
n = len(cust)
day = rng.integers(0, n_days, n)
fraud = rng.random(n) < 0.004
odd = fraud & (rng.random(n) < 0.7)            # 不正の7割は普段と違う特徴を持つ
merch = np.where(rng.random(n) < 0.6, fav[cust], rng.integers(0, 6, n))
merch = np.where(odd & (rng.random(n) < 0.4), 4, merch)
# 種類2は正当でも額が大きくなりやすく、種類5は正当でも短時間に続きやすい
amount = level[cust] * rng.lognormal(0.0, 0.6, n) * np.where(odd, rng.lognormal(1.0, 0.7, n),
         np.where(merch == 2, rng.lognormal(1.0, 0.5, n), 1.0))
hour = np.where(odd & (rng.random(n) < 0.5), rng.uniform(0, 5, n),
                rng.normal(usual_hour[cust], 3, n)) % 24
new_dev = rng.random(n) < np.where(odd, 0.45, 0.03)
n_1h = rng.poisson(np.where(odd, 1.2, np.where(merch == 5, 1.0, 0.2)))  # 直前1時間の取引の数
df = pd.DataFrame({"customer": cust, "day": day, "fraud": fraud.astype(int),
                   "log_ratio": np.log(amount / level[cust]),
                   "hour_gap": np.abs((hour - usual_hour[cust] + 12) % 24 - 12),
                   "night": (hour < 5).astype(int), "new_device": new_dev.astype(int),
                   "n_1h": n_1h, "merch": merch})
df = pd.concat([df, pd.get_dummies(df["merch"], prefix="m", dtype=int)], axis=1)
print("取引の件数:", len(df), " 不正の件数:", df["fraud"].sum(),
      " 不正の割合:", round(df["fraud"].mean() * 100, 3), "%")
# 学習は0〜74日目、較正は75〜89日目、評価は90〜119日目(時間で切る)
tr, ca, te = df[df.day < 75], df[(df.day >= 75) & (df.day < 90)], df[df.day >= 90]
for name, part in [("学習", tr), ("較正", ca), ("評価", te)]:
    print(name, "の件数:", len(part), " 不正:", part["fraud"].sum())
実行すると、取引は360,619件、そのうち不正は1,444件(0.4%)になりました。学習の期間(0〜74日目)は225,589件で不正が920件、較正の期間(75〜89日目)は45,028件で不正が172件、評価の期間(90〜119日目)は90,002件で不正が352件です。評価の期間の不正は352件しかないので、評価の数字には偶然の揺れが大きく含まれます。少ない件数での指標のばらつきの測り方は第8章で扱います。
3つに分けたのは、較正のためです。後で扱う較正では、学習に使っていない期間のデータで、スコアと実際の不正の割合の対応を調べます。学習の期間のデータで較正すると、モデルが覚えたデータに合わせることになり、較正の効果を正しく測れません。評価の期間は、学習にも較正にも設定の調整にも使わず、方式を比べるときにだけ見るデータとして取っておきます。
ロジスティック回帰と勾配ブースティングを、ルールと同じ物差しで比べる
次に、学習の期間のデータでロジスティック回帰と勾配ブースティングを学習し、評価の期間でルールと比べます。ルールは、第3章の考え方を簡単にした2本の組み合わせで、「新しい端末で、額が普段の3倍を超える」か「深夜で、直前1時間に2件以上の取引がある」のどちらかに当てはまればアラートにします。この「3倍」「2件以上」は、実際の運用で使う値ではなく、この合成データに合わせて置いた説明用の値です。モデルの側は、スコアの高い順に並べて上位0.5%をアラートにします。比べる指標は、平均適合率と、上位0.5%での適合率・再現率です。
平均適合率は、スコアの高い順に1件ずつアラートを増やしていったときの適合率と再現率の関係(PR曲線、適合率と再現率の曲線)を1つの数にまとめた値で、0から1をとります。scikit-learn の公式ドキュメントの定義では、しきい値ごとの適合率を、そこで再現率が増えた分を重みとして平均したもので、PR曲線の点を直線で結んで面積を求めた値とは異なります。並び順の全体の良さを1つの数で表したもので、不正を1件も見分けられない並びでは不正の割合(ここでは0.0039)に近づきます。上位0.5%での適合率・再現率は、実際の運用でアラートにする件数を決めたときの成績です。指標の定義と使い分けの詳細は第8章で扱います。勾配ブースティングの設定(学習率0.1・木の数150・葉の数15まで・葉ごとに最低100件)は、本コラムで一度決めたものを全モデルで共通に使い、評価の期間を見て調整することはしていません。
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import average_precision_score

feats = ["log_ratio", "hour_gap", "night", "new_device", "n_1h"] + [f"m_{i}" for i in range(6)]
hp = dict(learning_rate=0.1, max_iter=150, max_leaf_nodes=15, min_samples_leaf=100,
          early_stopping=False, random_state=0)
y_tr, y_te = tr["fraud"].to_numpy(), te["fraud"].to_numpy()
lr = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)).fit(tr[feats], y_tr)
gb = HistGradientBoostingClassifier(**hp).fit(tr[feats], y_tr)
s_lr, s_gb = lr.predict_proba(te[feats])[:, 1], gb.predict_proba(te[feats])[:, 1]

def top_k(score, y, k):
    idx = np.argsort(-score, kind="stable")[:k]   # 同点は記録の並び順で選ぶ
    hit = y[idx].sum()
    return hit / k, hit / y.sum()

k = int(np.ceil(len(te) * 0.005))              # 上位0.5%をアラートにする
rule = ((te["new_device"] == 1) & (te["log_ratio"] > np.log(3))) | \
       ((te["night"] == 1) & (te["n_1h"] >= 2))
r_hit = y_te[rule.to_numpy()].sum()
print("アラートの件数(上位0.5%):", k)
print(f"ルール        件数 {rule.sum():5d}  適合率 {r_hit / rule.sum():.3f}  再現率 {r_hit / y_te.sum():.3f}")
for name, s in [("ロジスティック回帰", s_lr), ("勾配ブースティング", s_gb)]:
    p, r = top_k(s, y_te, k)
    p2, r2 = top_k(s, y_te, int(rule.sum()))
    print(f"{name}  平均適合率 {average_precision_score(y_te, s):.3f}  上位0.5% 適合率 {p:.3f} 再現率 {r:.3f}"
          f"  ルールと同じ件数 適合率 {p2:.3f} 再現率 {r2:.3f}")
実行した結果を表にまとめます。上位0.5%は451件です。ルールのアラートは484件だったので、モデルの側もルールと同じ484件をアラートにした場合の成績を並べました。
| 方式 | アラートの件数 | 適合率 | 再現率 | 平均適合率 |
|---|---|---|---|---|
| ルール(2本の組み合わせ) | 484 | 0.174 | 0.239 | (並び順を持たないので計算しない) |
| ロジスティック回帰(上位0.5%) | 451 | 0.319 | 0.409 | 0.367 |
| 勾配ブースティング(上位0.5%) | 451 | 0.322 | 0.412 | 0.315 |
| ロジスティック回帰(ルールと同じ件数) | 484 | 0.300 | 0.412 | 0.367 |
| 勾配ブースティング(ルールと同じ件数) | 484 | 0.300 | 0.412 | 0.315 |
同じ484件をアラートにしたとき、ルールが捕まえた不正は評価の期間の不正352件の23.9%だったのに対し、2つのモデルはどちらも41.2%を捕まえ、適合率も0.174から0.300に上がりました。同じ484件を調査の対象にした場合に、その中に含められた不正の取引がおよそ1.7倍になったことになります。調査にかかる時間や難しさ、実際に防げた不正、誤って止めた正当な取引は、この比較では測っていません。ルールを2本だけで組んだ単純なルールとの比較なので、手入れの行き届いたルールの台帳と比べた場合の差は、この数字より小さくなりえます。
2つのモデルの差は小さく、上位0.5%での適合率はロジスティック回帰が0.319、勾配ブースティングが0.322でした。平均適合率では、むしろロジスティック回帰のほうが高く出ています。加盟店の種類によって額の意味が変わる組み合わせを入れたデータでしたが、本コラムの架空データでは、その組み合わせがあっても、上位の並びに2つのモデルの大きな差は出ませんでした。下の図は、評価の期間のPR曲線です。
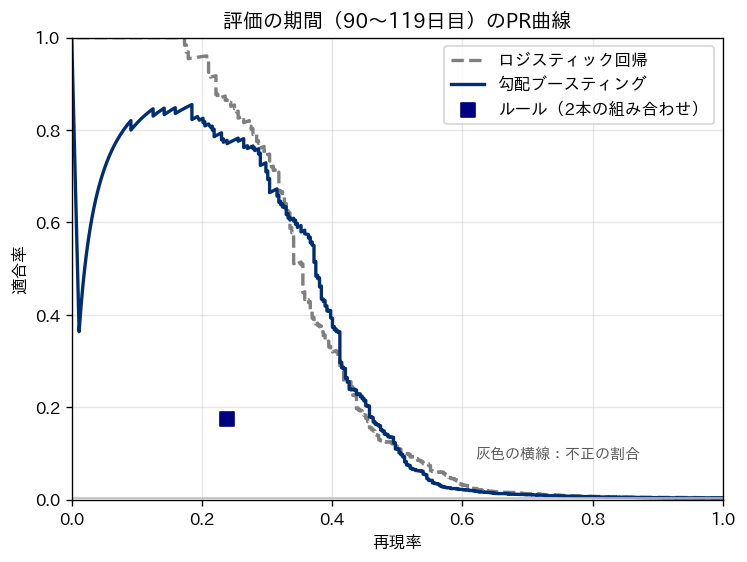
図の再現率が低い側(0.3より左)では、ロジスティック回帰の適合率が1.0付近から下がっていくのに対し、勾配ブースティングは0.8前後で、ロジスティック回帰より低く出ています。勾配ブースティングの曲線の左端には、適合率が0.37ほどまで一時的に下がる谷もあります。別に集計したところ、勾配ブースティングのスコアの上位10件のうち不正は4件で、最も高いスコアの数件に正当な取引が含まれていました。評価の期間の不正は352件しかないので、数件のラベルの違いで曲線の左端の形が大きく変わります。平均適合率は曲線全体の形を反映する(再現率が増えた分を重みとして適合率を平均する)ので、この左端の差が数字に響いていると考えられます。一方、再現率0.3から0.5付近では2本の曲線はほぼ重なっており、運用で使う上位0.5%(再現率0.4前後)もこの範囲に入ります。
この結果から読み取れることは3つあります。1つ目は、本コラムの架空データでは、単純なルールに比べてどちらのモデルも同じアラートの件数で多くの不正を捕まえた、ということです。2つ目は、勾配ブースティングがいつもロジスティック回帰より良いとは限らないことです。組み合わせの効く関係を入れたこのデータで勾配ブースティングが上回らなかった理由は、本コラムでは確かめていません。3つ目は、平均適合率と上位K件の成績が、モデルの順位について別のことを言う場合があることです。どちらの指標でモデルを選ぶかは、実際にアラートにできる件数(調査の能力)で決まり、その決め方は第8章と第9章で扱います。
なお、勾配ブースティングの成績は設定に左右されます。scikit-learn の HistGradientBoostingClassifier は、公式ドキュメントによると、既定の設定では学習のデータが10,000件を超えると一部を検証用に取り分けて学習を早めに打ち切る仕組み(早期終了)が働きます。不正が少ないデータでは、取り分けた検証用のデータに入る不正がさらに少なくなり、打ち切りの判断が不安定になることがあります。本コラムのコードでは、この仕組みを止めて設定を固定しました。設定を変えれば、2つのモデルの差の向きも変わりうるので、モデルの比較は、設定の決め方まで含めて記録しておく必要があります。
不均衡への対処、クラスの重み付け・少数側を増やす方法・多数側を減らす方法
不正は取引全体の0.4%前後しかありません。このような不均衡データでそのまま学習すると、モデルは「ほとんどの取引は正当」という事実に引っ張られ、不正の側の特徴を学ぶ材料が少なくなります。そこで、学習のときに不正の側を重く扱う工夫がよく使われます。代表的なものは次の3つです。
1つ目はクラスの重み付けで、学習のときに不正の1件を、正当な取引の何件分にも数えるように重みを付けます。scikit-learn では class_weight="balanced" と指定すると、公式ドキュメントの説明では、各クラスの件数に反比例する重み(取引の件数を、クラスの数とそのクラスの件数の積で割った値)が付きます。データを捨てたり作ったりしないので、手軽に試せます。2つ目は少数側を増やす方法で、不正の取引を複製したり、似た取引を合成したりして件数を増やします。合成の代表は、Chawla らの2002年の論文(Journal of Artificial Intelligence Research 第16巻)で示された SMOTE で、少数側の取引と、その近くにある少数側の取引との間に、新しい取引を人工的に作ります。3つ目は多数側を減らす方法で、正当な取引の一部だけを無作為に残して学習します。学習のデータが小さくなるので計算が速くなる一方、捨てた取引の情報は使えません。
| 方法 | やること | 長所 | 注意点 | スコアの値への影響 |
|---|---|---|---|---|
| クラスの重み付け | 不正の1件に大きな重みを付けて学習する | データを捨てず、作らない。指定が簡単 | 重みの大きさで成績が変わる | 不正の側に大きくずれる(確率として読めない) |
| 少数側を増やす(複製・SMOTE など) | 不正の取引を複製する、近くの不正の取引の間に人工の取引を作る | 不正の側の学習の材料が増える | 人工の取引は実在しない。0か1の列(端末が新しいか等)にも中間の値が入る。評価のデータに合成した取引を混ぜてはいけない | 不正の側にずれる |
| 多数側を減らす | 正当な取引の一部だけを無作為に残す | 学習が速い。残した割合が分かっていれば、スコアを式で補正できる | 捨てた正当な取引の情報を使えない | 不正の側にずれる(残した割合で補正できる) |
SMOTE は2つの取引の間の点を作るので、取引の記録に多い0か1の列やカテゴリの列の扱いに注意が要ります。浮動小数点の列で渡すと、「新しい端末かどうか」のような0か1の列にも中間の値が入ります。本コラムで別に確かめた計算では、合成した10,313件のうち、新しい端末の列の13.8%が0でも1でもない値になりました。一方、本コラムの掲載コードのように整数の列のまま渡すと、imbalanced-learn 0.14.2 では合成後の列が元の整数の型で返され、値は整数になりました。その場合も、加盟店の種類を6つの列に分けた部分では、合成した取引の11.1%で6列がすべて0(どの種類にも当たらない取引)になりました。どちらの渡し方でも、合成した取引には実在しない形のものが混ざります。imbalanced-learn の公式ドキュメントでは、連続の値とカテゴリが混ざったデータには SMOTENC という派生の方法が案内されています。また、どの方法を使う場合も、増やしたり減らしたりするのは学習のデータだけで、評価のデータは元の不均衡のまま残します。評価のデータまで均すと、実際の運用で出る適合率よりはるかに高い適合率が出ます。
不均衡への対処は、上位の適合率よりもスコアの値の水準を大きく変えた
3つの方法を、何もしない場合と比べます。どれも同じ設定の勾配ブースティングで、学習のしかただけを変えました。多数側を減らす方法では、正当な取引の5%だけを残しました。少数側を増やす方法では、imbalanced-learn 0.14.2 の SMOTE で、不正の件数が正当な取引の件数の5%になるまで合成しました。この部分を動かすには imbalanced-learn が要ります。比べるのは、並び順の成績(平均適合率・上位0.5%での適合率)と、スコアの値(評価の期間のスコアの平均・上位0.5%のスコアの平均)、そして両方をまとめて測るブライアスコアです。ブライアスコアは、スコアと実際の答え(不正なら1、正当なら0)の差の2乗の平均で、小さいほど良い値です。
from sklearn.metrics import brier_score_loss
from imblearn.over_sampling import SMOTE

beta = 0.05                                    # 正当な取引の5%だけを残す
keep = (y_tr == 1) | (rng.random(len(y_tr)) < beta)
X_sm, y_sm = SMOTE(sampling_strategy=0.05, random_state=0).fit_resample(tr[feats], y_tr)
models = {
    "重み付けなし": HistGradientBoostingClassifier(**hp).fit(tr[feats], y_tr),
    "クラスの重み付け": HistGradientBoostingClassifier(**hp, class_weight="balanced").fit(tr[feats], y_tr),
    "少数側の合成": HistGradientBoostingClassifier(**hp).fit(X_sm, y_sm),
    "多数側の削減": HistGradientBoostingClassifier(**hp).fit(tr[feats][keep], y_tr[keep]),
}
print("学習の件数 元:", len(y_tr), " 合成後:", len(y_sm), " 削減後:", int(keep.sum()))
print("評価の期間の実際の不正の割合:", round(y_te.mean(), 4))
for name, m in models.items():
    s = m.predict_proba(te[feats])[:, 1]
    p, r = top_k(s, y_te, k)
    print(f"{name:8s} 平均適合率 {average_precision_score(y_te, s):.3f}  上位0.5% 適合率 {p:.3f}"
          f"  スコアの平均 {s.mean():.4f}  上位0.5%のスコアの平均 {np.sort(s)[-k:].mean():.3f}"
          f"  ブライアスコア {brier_score_loss(y_te, s):.5f}")
学習のデータは、元の225,589件が、合成のあとは235,902件、削減のあとは11,967件になりました。評価の期間の実際の不正の割合は0.0039です。結果は次のとおりです。
| 学習のしかた | 平均適合率 | 上位0.5%での適合率 | スコアの平均 | 上位0.5%のスコアの平均 | ブライアスコア |
|---|---|---|---|---|---|
| 重み付けなし | 0.315 | 0.322 | 0.0041 | 0.405 | 0.00300 |
| クラスの重み付け | 0.376 | 0.326 | 0.2410 | 0.963 | 0.07872 |
| 少数側の合成(SMOTE) | 0.366 | 0.324 | 0.0286 | 0.728 | 0.00522 |
| 多数側の削減 | 0.376 | 0.322 | 0.0454 | 0.814 | 0.00913 |
並び順の成績から見ます。上位0.5%での適合率は、4つとも0.322から0.326の間に収まりました。451件のアラートのうち不正だった件数に直すと、145件から147件の違いで、この評価だけでは区別できない差です。平均適合率は、何もしない場合が0.315で、残りの3つが0.366から0.376と高く出ました。上位の件数を変えて適合率を別に集計したところ、スコアの上位10件の適合率は、何もしない場合が0.400、残りの3つはいずれも1.000でした。上位100件では0.790と0.810から0.890、上位451件では4つとも0.322から0.326です。本コラムの架空データでは、平均適合率の差には、スコアの最上位の並びの違いが大きく効いていると考えられます(確かめたのは5つの件数での適合率です)。この差は、運用の上位0.5%の成績にはほとんど表れていません。
一方、スコアの値は大きく変わりました。評価の期間の実際の不正の割合は0.0039で、何もしないモデルのスコアの平均は0.0041と、ほぼ一致しています。クラスの重み付けをしたモデルではスコアの平均が0.2410になり、実際の割合の60倍を超えました。上位0.5%のスコアの平均は0.963で、スコアを確率として読めば「ほぼ確実に不正」と読めてしまいますが、実際にその中で不正だったのは3割ほどです。多数側を減らしたモデルでも、スコアの平均は0.0454と実際の割合の10倍を超え、少数側を合成したモデルでも0.0286と7倍を超えました。ブライアスコアは、何もしないモデルが0.00300と最も小さく、重み付けをしたモデルが0.07872と最も大きくなりました。
この結果は、不均衡への対処が何をしているかを示しています。どの方法も、学習のときに、不正が実際より多いデータをモデルに見せています。そのデータで学んだモデルは、不正の割合を実際より高く見積もり、スコアの値の水準が全体に持ち上がります。正当な取引を特徴によらず無作為に減らす場合については、Dal Pozzolo らの2015年の論文が、減らしたことによるスコアの偏りはスコアの大小の順序には影響しないと述べています。重み付けや合成にはそうした保証は無く、本コラムの架空データでも、平均適合率は0.315から0.366〜0.376に変わりました。本コラムの架空データで言えるのは、運用で使う上位451件の適合率の変化は小さく、スコアの値の水準は大きく変わった、ということです。
このことは、実務では次の場面で問題になります。スコアが一定の値(例えば0.5)を超えたら止める、という判定を組んでいる場合、重み付けをしたモデルに入れ替えた途端に、止める取引の件数が跳ね上がります。しきい値は、モデルを入れ替えるたびに、検証用のデータで件数と成績を確かめて決め直す必要があります。スコアを「不正である確率」として、見逃しの被害の見積りや、損失の期待値が最小になるしきい値の計算(第9章)に使う場合、見積りの全体が何倍にもずれます。ベンダーの製品のスコアや、社内で作ったモデルのスコアを受け取るときは、そのスコアがどの学習のしかたで作られ、確率として較正されているかを確かめる必要があります。
確率の較正、削減の割合を使う補正・等調回帰・プラットの方法
スコアを実際の不正の割合に合わせ直す作業を確率の較正と呼びます。較正ができているスコアでは、「スコアが0.1前後の取引を集めると、その中の約1割が実際に不正である」という対応が成り立ちます。較正は並び順を(ほぼ)変えずに値だけを直す作業なので、前の節で見た「順位は良いが値がずれている」モデルを、確率として使える形に戻せます。ここでは3つの方法を扱います。
1つ目は、多数側を減らして学習した場合に限って使える、式による補正です。不正の取引はすべて残し、正当な取引を特徴によらず一定の確率 \(\beta\) で残して学習したモデルのスコアを \(p_s\) とすると、元の割合のもとでのスコア \(p\) は \(p = \frac{\beta p_s}{\beta p_s – p_s + 1}\) で求められます。言葉で言い換えると、捨てた正当な取引の分だけ、正当な側の重みを戻して計算し直す式です。この式は、Dal Pozzolo らの2015年の論文(IEEE Symposium Series on Computational Intelligence で発表。多数側を減らした学習でのスコアの較正を扱ったもの)で、ベイズの定理から導かれた式(論文の式(4))として示されています。残した割合さえ分かっていれば、追加のデータなしで使えるのが利点です。一方で、モデルがその縮小したデータの上で正しく較正されていることが前提で、重み付けや合成には使えません。
2つ目は等調回帰(アイソトニック回帰)で、学習に使っていない期間のデータで、スコアの順序を保ったまま、スコアを実際の不正の割合に合わせる階段状の対応を作ります。Zadrozny と Elkan の2002年の論文(KDD 2002)などで、分類器のスコアを確率に直す方法として扱われています。形の制約が「スコアが大きいほど割合も大きい」だけなので、単調な対応で表せる歪みであれば柔軟に合わせられます(スコアが大きくなる途中で実際の割合が下がるような関係には合わせられません)。ただし、scikit-learn の公式ドキュメントでは、データが少ないと過学習しやすく、十分なデータ(目安として1,000件程度を超える)があるときにシグモイドの方法と同等以上になると説明されています。また、階段状に直すので、異なるスコアが同じ値にまとめられ、並び順の一部が失われます。
3つ目はプラットの方法(シグモイドによる較正)で、Platt の1999年の論文で示された方法です。元のスコアを入力に、ロジスティック回帰を当てはめて確率に直します。本コラムのコードでは、元のスコアをそのまま入れるのではなく、スコアの対数オッズ(\(\log\frac{p}{1-p}\)、確率を負の無限大から正の無限大の範囲に引き伸ばした値)を入力にしました。scikit-learn の公式ドキュメントでは、シグモイドの方法は、元のスコアの歪みが S 字の形で直せることを仮定しており、その仮定は一般には成り立つとは限らず、不均衡の強い問題では仮定が崩れやすいことにも触れています。
from sklearn.isotonic import IsotonicRegression

m_us = models["多数側の削減"]
s_ca, s_te = m_us.predict_proba(ca[feats])[:, 1], m_us.predict_proba(te[feats])[:, 1]
y_ca = ca["fraud"].to_numpy()
# 削減の割合 beta を使った補正(Dal Pozzolo らの2015年の論文の式)
fix = lambda p: beta * p / (beta * p - p + 1)
# 等調回帰:較正の期間で、スコアの順序を保ったまま実際の割合に合わせる
iso = IsotonicRegression(out_of_bounds="clip").fit(s_ca, y_ca)
# プラットの方法:スコアの対数オッズを入力に、ロジスティック回帰を当てはめる
logit = lambda p: np.log(np.clip(p, 1e-6, 1 - 1e-6) / (1 - np.clip(p, 1e-6, 1 - 1e-6)))
platt = LogisticRegression().fit(logit(s_ca).reshape(-1, 1), y_ca)
cal = {"較正なし": s_te, "削減の割合で補正": fix(s_te), "等調回帰": iso.predict(s_te),
       "プラットの方法": platt.predict_proba(logit(s_te).reshape(-1, 1))[:, 1]}
for name, s in cal.items():
    top = np.argsort(-s, kind="stable")[:k]       # 同点は記録の並び順で選ぶ
    print(f"{name:10s} スコアの平均 {s.mean():.4f}  上位0.5%のスコアの平均 {s[top].mean():.3f}"
          f"  上位0.5%の実際の不正の割合 {y_te[top].mean():.3f}  ブライアスコア {brier_score_loss(y_te, s):.5f}"
          f"  平均適合率 {average_precision_score(y_te, s):.3f}")
3つの方法は、どれも多数側を減らして学習したモデルのスコアに当てはめました。等調回帰とプラットの方法は、較正の期間(75〜89日目、45,028件で不正172件)で対応を作り、評価の期間で確かめています。
| 較正の方法 | スコアの平均 | 上位0.5%のスコアの平均 | 上位0.5%の実際の不正の割合 | ブライアスコア | 平均適合率 |
|---|---|---|---|---|---|
| 較正なし | 0.0454 | 0.814 | 0.322 | 0.00913 | 0.376 |
| 削減の割合で補正 | 0.0040 | 0.298 | 0.322 | 0.00288 | 0.376 |
| 等調回帰 | 0.0039 | 0.301 | 0.326 | 0.00287 | 0.354 |
| プラットの方法 | 0.0039 | 0.279 | 0.322 | 0.00290 | 0.376 |
較正の前は、上位0.5%のスコアの平均が0.814だったのに対し、その中で実際に不正だった割合は0.322でした。スコアを確率として読むと、2.5倍ほど高く見積もっていたことになります。3つの方法はいずれも、評価の期間のスコアの平均を実際の割合(0.0039)にほぼ合わせ、上位0.5%のスコアの平均も0.279から0.301と、実際の割合0.322に近づきました。ブライアスコアは0.00913から0.0029前後に下がり、何もしないで学習したモデル(0.00300)と同じ水準になりました。
並び順への影響も見ておきます。削減の割合での補正とプラットの方法は、スコアの順序を変えない変換なので、平均適合率は0.376のまま変わりませんでした。等調回帰は、平均適合率が0.354に下がりました。上位0.5%での適合率は0.326でしたが、後で述べるとおり同じスコアの取引が多いため、この値は上位451件にどの取引を入れるかで変わります。同点の取引の選び方によって、本コラムで確かめた範囲では0.319から0.326まで動きました(ここでは記録の並び順で選んでいます)。別に集計したところ、評価の期間のスコアの異なる値の数は、較正の前の46,055から、等調回帰のあとは57に減っていました。上位451件の中の異なる値は26しかなく、451番目の値と同じ値を持つ取引は283件ありました。階段状に直す過程で、もとは区別されていたスコアが同じ値にまとめられており、平均適合率の低下はこの同点によると考えられます。下の図は、評価の期間の取引をスコアの順に分けた群ごとに、スコアの平均と実際の不正の割合を比べた信頼性の図です。
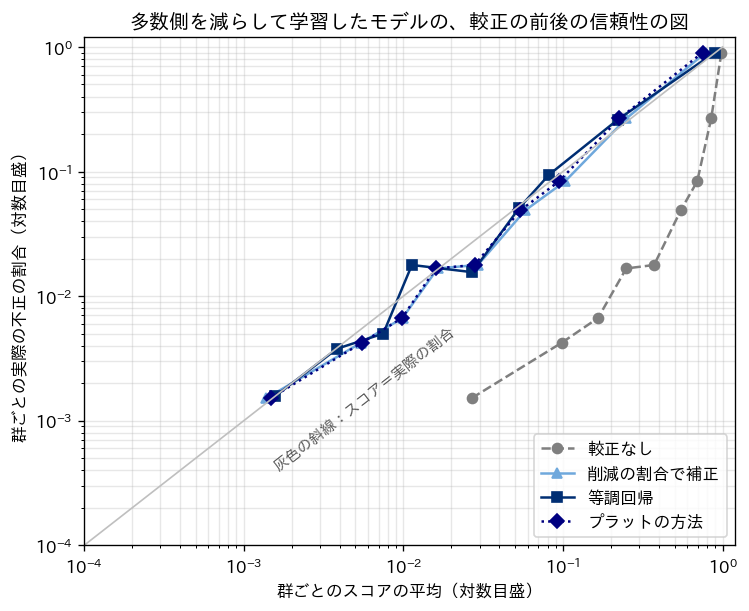
点が灰色の斜線の上にあれば、スコアと実際の割合が一致しています。不正は上位に集中するので、群の分け方は、スコアの低い90%を1つの群にまとめ、残りの上位10%を8つの群に細かく分けました(全体で9つの群)。両方の軸は対数目盛です。較正なしの点は、最上位の群を除いて斜線より右下にあり、群ごとに集計すると、スコアの平均は実際の割合の3倍から25倍ほどでした。最上位の群(スコアの上位0.1%)だけは、較正なしでもほぼ斜線の上(1.09倍)にあります。3つの較正の方法の点は、どの群でも斜線の近くに並びました(群ごとの比は0.6倍から1.7倍ほどの範囲でした)。群の中の不正の件数が少ないので、点の位置には揺れがあり、斜線からの細かなずれをそのまま較正の誤差と読むことはできません。
実務で較正を入れるときに決めておくことは、次のとおりです。
- 較正に使うデータの期間(学習に使っていない期間で、ラベルが確定している期間)
- 較正の方法(多数側を減らした学習なら式による補正、それ以外は等調回帰かプラットの方法。scikit-learn の公式ドキュメントでは、シグモイドの方法はデータが少ない場合に最も効果的とされる一方、不均衡の強い問題では仮定が崩れやすいとも書かれている。本コラムのデータでは、どちらが安定するかは確かめていない)
- 較正の確かめ方(信頼性の図と、群ごとのスコアの平均と実際の割合の表を、評価の期間で作る)
- 較正をし直す時期(モデルを学習し直したとき、不正の割合が変わったとき。不正の割合の変化は第10章で扱う)
較正が保たれる前提は、較正に使った期間と運用する期間とで、同じスコアに対応する実際の不正の割合が変わらないことです。手口の流行や季節で、スコアと実際の割合の対応が変われば、較正したスコアも実際の割合からずれていきます。較正は一度で終わる作業ではなく、監視の項目に入れておく必要があります。
過学習とデータの分け方による漏れ、評価の分け方で成績が良く見える
教師あり学習には、学習のデータに合わせすぎて、新しいデータで成績が落ちる過学習の問題があります。不正検知では、不正の件数が少ないことがこの問題を強めます。本コラムの架空データでも、学習の期間の不正は920件しかありません。木の数が多く、葉が細かい勾配ブースティングは、920件の不正の1件1件に合わせた条件を作ることができ、それは新しい取引には当てはまりません。本コラムのコードで、葉ごとの最低の件数を100件にしたのは、この過学習を抑えるためです。
過学習と並んで注意が要るのが、学習用と評価用のデータの分け方による漏れです。既存の顧客の将来の取引を採点する運用では、その顧客の過去の取引で学習すること自体は自然です。問題になるのは、無作為に分けたことで、運用では手に入らない情報が学習の側に入る場合です。例えば、同じカードや同じ口座で短い期間に不正が続けて起きている場合、無作為に分けると、同じ一連の不正の一部で学習し、残りで評価することになり、成績が実際より良く見えます。また、手口が時間とともに変わる場合、無作為に分けると「未来の手口」で学習したモデルを過去の取引で評価することになります。
本コラムのコードで、学習・較正・評価を日付で切ったのはこのためです。モデルを実際に使う状況(過去の記録で学び、まだ見ていない将来の取引を採点する)を、評価でもそのまま再現します。無作為に分けた評価と、時間で分けた評価で、成績がどれだけ変わるかをコードで比べる例は、第8章で扱います。第5章で扱うリーク(情報の漏れ)は、判定の時点では手に入らないはずの情報が特徴量を通して学習や評価に入り込むことを指し、ここで扱ったデータの分け方による漏れとは別のものです。
もう1つ、ラベルの遅れにも注意が要ります。第2章で扱ったとおり、不正のラベルは確定までに時間がかかります。評価の期間の直近の取引は、まだ不正と分かっていないものを含むので、そのまま評価すると、見逃しが少なく見えたり、正当とされていた取引が後から不正と分かって成績が変わったりします。学習と評価には、ラベルが確定するだけの時間がたった期間を使い、評価の期間の終わりを、ラベルの遅れの分だけ手前に置く必要があります。
深層学習を使う条件
深層学習(多層のニューラルネットワーク)は、画像や文章で大きな成果を上げてきた手法で、不正検知でも研究が進んでいます。ただし、本コラムが扱っているような、1件の取引を特徴量で表した表の形のデータについては、Grinsztajn らの2022年の論文が、45の表の形のデータセットを使った比較で、1万件程度の中規模のデータでは、XGBoost やランダムフォレストのような木の手法が深層学習より良い成績だったと報告しています。これはその論文のデータセットと条件での結果ですが、表の形のデータでは木の手法を先に試す理由の1つになります。深層学習が選択肢になるのは、主に次のような条件があるときだと考えています。
- 取引の並び(顧客の取引の時系列)をそのまま入力にしたい場合。集計の特徴量に直す前の順序の情報を使える
- 文章(申込の自由記述・問い合わせの内容)や画像(本人確認の書類)など、表にしにくい情報を組み合わせる場合
- 口座や端末のつながり(第7章のネットワーク)を、グラフのまま学習に使う場合
- 大量のラベルつきのデータと、学習や推論の計算の環境、モデルを保守できる人材がそろっている場合
一方で、深層学習のモデルは、理由の説明(第11章)が難しく、設定の数が多くて成績が設定に左右されやすく、判定の応答の時間(第12章)の制約にも注意が要ります。不正のラベルが少ない場合には、表の形のデータで木の手法より良い成績が出るとは限りません。本コラムでは、深層学習のコードは実行しません。深層学習の実装の一般論は弊社コラム『Python実務で必ず使うディープラーニングレシピ100選』で扱っています。最初の段階では、ロジスティック回帰と勾配ブースティングでどこまで成績が出るかを確かめ、それで足りない理由が特定できてから深層学習を検討する順番が有効だと考えています。
経営の判断、スコアを確率として使うなら較正を確かめる
この章の内容を経営の判断に落とすと、最も大きな点は、スコアの使い方を先に決めることです。スコアを調査の順番を決めるための並びとしてだけ使うなら、較正の有無は大きな問題になりません。上位から順に調査の能力の分だけ見ればよいからです。スコアを確率として使う場面、つまり「不正の確率が0.3の取引を通したときの被害の見込み」を計算する場面では、較正の有無が判断の結果を直接変えます。本コラムの架空データでは、重み付けをしたモデルのスコアは、上位0.5%で平均0.963と出ましたが、実際の不正の割合は0.326でした。このスコアを確率と読むと、その集団の中の不正の件数の見積りは3倍近く膨らみます(不正1件あたりの損失を一律と置けば、被害の見積りも同じ倍率で膨らみます)。一方、一定のスコアを超えたら止める判定は、スコアが較正されていなくても、検証用のデータで件数と損失を確かめてしきい値を選べば組めます。その場合に欠かせないのは、モデルを入れ替えるたびにしきい値を確かめ直すことです。
較正を確かめないまま運用すると、損失の型のうち少なくとも3つにつながります。1つ目は誤検知による機会損失で、値が膨らんだスコアに固定のしきい値を当てて保留や拒否を決める運用では、正当な取引を必要以上に止めます。2つ目は調査の過負荷で、モデルを入れ替えたときにスコアの水準が変わり、アラートの件数が調査の能力を超えます。3つ目は顧客の離反で、止められた正当な顧客が増えれば、利用をやめる顧客も増えます。逆に、較正されたスコアであれば、見逃し1件と誤検知1件の損失の比から、しきい値を損失の期待値で決めることができます(第9章)。
モデルを社内で作る場合も、ベンダーの製品を使う場合も、次の点を確かめておくことが有効だと考えています。
| 確かめること | なぜ必要か | 確かめる相手 |
|---|---|---|
| スコアは確率として較正されているか | 確率として読めないスコアで被害を見積もると、見積りが何倍にもずれる | データ分析の担当、ベンダー |
| 学習で不均衡への対処(重み付け・合成・削減)をしたか、した場合に補正したか | 対処のしかたでスコアの水準が大きく変わる | データ分析の担当、ベンダー |
| 学習・較正・評価の期間は日付で分けたか | 無作為に分けた評価は成績を良く見せる | データ分析の担当、ベンダー |
| 評価の期間はラベルが確定した期間か | 確定していないラベルで評価すると見逃しが少なく見える | データ分析の担当、調査の担当 |
| 成績は、上位何件(何%)でアラートにした場合の適合率と再現率か | 平均適合率と運用の件数での成績は、モデルの順位について別のことを言う場合がある | データ分析の担当、ベンダー |
| モデルを入れ替えたとき、スコアの水準としきい値をどう合わせるか | 入れ替えでアラートの件数が跳ね上がると、調査が追いつかなくなる | 不正対策の責任者、調査の担当 |
| 較正をし直す時期と、較正のずれの監視の方法 | 不正の割合が変わると、較正したスコアもずれていく | データ分析の担当、システムの担当 |
予算と体制の面では、モデルを作る費用だけでなく、較正の期間のデータを取り分けておくことと、較正のずれを監視し続けることを、最初から運用の作業に入れておく必要があります。較正の期間を取り分けるには、ラベルが確定した期間が学習の分とは別に必要で、ラベルの遅れが長い不正ほど、その分だけ新しいデータを使えなくなります。このつり合いは、ラベルの遅れを短くする仕組み(調査の結果をすぐにラベルとして残す仕組み。第2章)への投資の判断にもつながります。
この章では、教師あり学習で不正のスコアを作り、本コラムの架空データで、ロジスティック回帰と勾配ブースティングが単純なルールより同じアラートの件数で多くの不正を捕まえたこと、不均衡への対処が並び順よりもスコアの値を大きくずらしたこと、較正でその値を実際の不正の割合に合わせ直せたことを確かめました。成績を左右するのは、モデルの種類よりも、入力に使う特徴量の作り方であることが多いと考えています。第5章では、取引の履歴から集計と速度の特徴量を作る方法と、そこで起きやすい情報の漏れを扱います。
この章を深めたい方への参考書籍
『Pythonではじめる機械学習:scikit-learnで学ぶ特徴量エンジニアリングと機械学習の基礎』(Andreas C.Müller, Sarah Guido 著、中田秀基 訳、オライリー・ジャパン):この章で使った scikit-learn で、線形モデル・決定木・決定木のアンサンブル法などを動かしながら、教師あり学習の考え方と過学習を学べます。クラス分類器の不確実性の推定(予測した確率の読み方)や、評価の基準とスコアの章もあり、この章のコードを自分のデータに置き換えるときの土台になります。
『統計的学習の基礎:データマイニング・推論・予測』(Trevor Hastie, Robert Tibshirani, Jerome Friedman 著、杉山将, 井手剛, 神嶌敏弘, 栗田多喜夫, 前田英作 監訳、井尻善久 他訳、共立出版):教師あり学習の手法を、数理の側から体系的に説明した教科書です。この章で引いた勾配ブースティングの論文の著者である Friedman が著者の1人で、この章で扱った手法がなぜそう動くのかを、式に立ち返って理解したいときに向いています。
第5章 特徴量の設計、取引の履歴から集計と速度の特徴を作る
第4章では、教師あり学習で不正のスコアを作る流れと、不均衡なデータへの対処がスコアの順位よりもスコアの値(確率としての読み)を大きく動かすこと、スコアを確率として使うなら較正を確かめることを扱いました。そこでは、学習に使う入力の項目(取引の額や時間帯など)が先に与えられている前提で話を進めました。この章では、その入力の項目、すなわち特徴量をどう作るかを扱います。特徴量とは、取引の記録や顧客の履歴から計算して、モデルやルールに渡す数の1つ1つのことです。
この章で扱うのは次の内容です。後半は、架空の取引の記録(顧客3,000人・90日)を使い、実行したコードと結果で確かめます。
- 特徴量が検知の成績を決める理由(1件の取引だけでは、その顧客にとって普段と違うかが分からない)
- 特徴量の型(取引そのもの・顧客の普段との差・集計・速度・初めての相手や端末・相手側の集計・時刻や曜日)
- pandas の時間窓の集計で、顧客ごとの直近の回数や合計を作る方法と、特徴量の型を足すごとの成績の変化
- 情報の漏れの典型と、誤った作り方が評価で成績を良く見せる仕組み
- 加盟店や端末のように種類の多い項目の扱いと、そこでの漏れの防ぎ方
- 判定の時点で計算できるかという制約、特徴量の重要度の読み方と限界
- 特徴量の台帳と、経営の判断
この章の主張は2つあります。1つ目は、不正検知の成績は、同じ手法のままでも、取引の履歴から作る特徴量しだいで大きく変わることがある、という点です。本コラムの架空データでは、取引そのものの項目だけで学習したモデルと、履歴から作った特徴量を足したモデルとで、平均適合率が3倍以上違いました。2つ目は、特徴量の作り方を誤って、判定の時点では手に入らない情報(その取引より後の取引や、まだ確定していないラベル)を混ぜると、評価では成績が良く見え、本番に出したときに崩れることがある、という点です。本コラムの架空データでも、手元の評価では正しい作り方より高く出た成績が、本番で入る値では正しい作り方を下回りました。この誤りは評価の数字を見ているだけでは気づけないので、特徴量の定義の段階で防ぐ必要があります。
なお、この章の架空データは他の章とは別に作ったもので、同じ平均適合率という指標でも、第4章など他の章の値とは比べられません。
特徴量が成績を決める理由、1件の取引だけでは普段と違うかが分からない
取引の記録に最初から入っている項目は、日時・額・加盟店や送金先・端末・経路といった、その1件についての事実です。ところが、不正かどうかの手がかりの多くは、その1件の中ではなく、その顧客の過去の取引との比較の中にあります。ある額の決済は、普段から同じくらいの額を使う顧客にとっては珍しくありませんが、普段は小さな額しか使わない顧客にとっては大きく外れた取引です。深夜の取引も、夜に働く顧客にとっては普段どおりで、昼にしか取引しない顧客にとっては異例です。1件の取引の項目だけを見るモデルは、この2つを区別できません。
第1章で整理した不正の類型のうち、第三者がカードの情報やアカウントを不正に使う型では、取引をしているのが本人ではないので、本人の普段の行動との食い違いが手がかりになりえます。第4章で使った勾配ブースティングのような手法は、与えられた項目の組み合わせを細かく学べますが、与えられていない情報、たとえば「この顧客の過去30日の額の中央値」を自分で作ることはしません。顧客ごとの履歴を集計して、普段との差を数にするのは、特徴量を作る側の仕事です。手法を高度なものに替えるより先に、この仕事の出来が成績を大きく左右する場合が多いと考えています。
特徴量を作る仕事には、もう1つの面があります。判定のたびに、その時点で使える情報だけで計算した値を用意する必要がある、ということです。値はその場で計算しても、取引ごとに更新して保管しておいた値を引いてきてもかまいません。取引の承認の前に判定するなら、顧客の直近24時間の取引の回数は、その取引が届いた瞬間までの記録で計算しなければなりません。学習のときに便利だからといって、その日の終わりに一括で計算した値や、後から修正された値を使うと、学習と本番で同じ名前の特徴量が別の値になります。この食い違いが、この章の後半で扱う情報の漏れの入口になります。
特徴量の型、取引そのものから相手側の集計まで
取引の不正検知で使われる特徴量は、何を材料にして、何と比べるかで、いくつかの型に分けられます。本コラムでは次の7つの型に整理します。なかでも、顧客ごとに過去の一定の時間の取引を数えたり足したりした集計の特徴量と、その時間を短く取って取引の勢いを見る速度の特徴量は、第3章の速度のルールと同じ考え方を、モデルの入力として使う形です。
| 特徴量の型 | 例 | 何が分かるか | どこで外れるか |
|---|---|---|---|
| 取引そのもの | 額・時刻・加盟店の種類・経路(店頭か通信販売か) | その1件の性質 | 顧客ごとの違いが分からない。額が大きい顧客の正当な取引を疑いやすい |
| 顧客の普段との差 | 過去の額の中央値との比・よく取引する時間帯からのずれ | その顧客にとって珍しい取引か | 履歴の少ない新しい顧客では計算できないか、値が不安定になる |
| 集計 | 直近1時間・24時間・7日の回数と合計 | 短い期間に取引が集まっていないか | まとめ買いや月末の支払いのように、正当でも集まる時期がある |
| 速度 | 前の取引からの経過時間・短い時間あたりの回数 | 取引の勢いが急に上がっていないか | 窓の長さの選び方で効き方が変わる |
| 初めての相手や端末 | 初めての加盟店の種類か・初めての端末か・初めての送金先か | 普段の関係の外で起きた取引か | 機種の変更や引っ越しのように、正当な「初めて」もある |
| 相手側の集計 | 加盟店や受取口座の過去の不正の割合・取引の件数 | 不正が集まりやすい相手か | ラベルの遅れを無視すると漏れになる。件数が少ない相手では割合が不安定 |
| 時刻や曜日 | 時間帯・曜日・祝日か | 全体の時間の傾向 | 顧客ごとの違いが分からない。夜に働く顧客の深夜の取引のように、時刻だけでは普段どおりかを判断できないので、顧客の普段との差と組み合わせて使う |
型によって、作るのに必要な記録の範囲が違います。取引そのものと時刻や曜日の特徴量はその1件の記録だけで作れますが、普段との差や集計には顧客の過去の記録が要り、相手側の集計には他の顧客の取引と、確定したラベルが要ります。どの型を作るかは、成績への効き方と、判定の時点でその計算が間に合うかの両方で決まります。後者は後の節と第12章で扱います。なお、顧客どうしが端末や連絡先を共有しているかのような、つながりから作る特徴量は第7章で扱います。
表の「どこで外れるか」の列にあるとおり、どの型にも、正当な取引で同じ値が出る場面があります。初めての端末からの取引は、普段との違いを見る手がかりになりえますが、機種を替えた顧客の新しい端末での最初の取引も「初めての端末」になります。1つの特徴量だけで判定すると誤検知が増えるのはこのためで、複数の型を組み合わせ、モデルにその組み合わせ方を学ばせることに意味があります。
架空の取引の記録を作る、顧客ごとの普段の行動と、短い時間にまとまる不正
ここからは、特徴量の型を足すと成績がどう変わるか、誤った作り方をすると評価がどうゆがむかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の取引の記録よりずっと単純です。合成データでの成績は、実際の取引での成績の目安にはなりません。また、このデータは不正に多い特徴(普段と違う額や時間帯・新しい端末・短い時間の連続)を入れて作っているので、そうした特徴を数にした特徴量が効くこと自体は、作り方からある程度決まっている結果です。ここで確かめたいのは、型ごとの効き方の違いと、漏れが評価をどうゆがめるかの仕組みです。
顧客3,000人・加盟店400・90日分の取引を、次の性質を持たせて乱数で作りました。取引の額は相対値(単位なしの数)です。
- 顧客ごとの普段の行動:額の水準・よく取引する時間帯・1日あたりの取引の回数・よく使う加盟店の種類(12種類から重複を許して3回選ぶので、同じ種類が重なる顧客もいる)を顧客ごとに持たせる
- 正当な取引:85% はよく使う種類の加盟店で、残りの15% は全12種類から無作為に選ぶ(よく使う種類が選ばれることもある)。時刻は普段の時間帯の近くになる。正当な取引でも1% は新しい端末から行われる
- 不正な取引:150回の「出来事」として作り、1回の出来事で1件から5件の取引が4時間以内にまとまって起きる。7割は新しい端末からにする。加盟店は、取引ごとに50% の確率で不正が集まりやすい30の加盟店から選び、残りは全400の加盟店から選ぶ(全体では約54% がその30の加盟店になる)。額は本人の普段の水準より大きい側に寄せる。出来事の始まりの時刻は、50% の確率で0時から5時の間、残りは0時から20時の間から選ぶ(全体では約63% が0時から5時の間に始まる)
- ラベルの遅れ:取引からラベルが確定するまでの日数を、平均14日の分布から取引ごとに持たせる
コードの冒頭で計算に使う並列の数を1本に固定しているのは、本コラムの実行環境で実行時間が安定したためで、結果の数値には関係しません。
import sys, io, os
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
os.environ["OMP_NUM_THREADS"] = "1"   # 計算を1本で動かし、実行時間を安定させる
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261112)
N_CUST, N_DAYS, N_MERCH, N_CAT = 3000, 90, 400, 12
# 顧客ごとの普段の行動
level = rng.lognormal(1.0, 0.6, N_CUST)       # 取引の額の水準(相対値)
home_hour = rng.normal(14, 3, N_CUST) % 24     # よく取引する時間帯
freq = rng.gamma(2.0, 0.2, N_CUST)             # 1日あたりの平均の取引回数
fav = rng.integers(0, N_CAT, (N_CUST, 3))      # よく使う加盟店の種類(3つ)
merch_cat = rng.integers(0, N_CAT, N_MERCH)    # 加盟店ごとの種類
by_cat = [np.flatnonzero(merch_cat == c) for c in range(N_CAT)]

def pick_merchant(cat):
    m = np.empty(len(cat), dtype=int)
    for c in range(N_CAT):
        idx = np.flatnonzero(cat == c)
        m[idx] = rng.choice(by_cat[c], len(idx))
    return m

# 正当な取引
n = rng.poisson(freq * N_DAYS)
cust = np.repeat(np.arange(N_CUST), n)
day = rng.integers(0, N_DAYS, len(cust))
hour = np.clip(rng.normal(home_hour[cust], 2.5), 0, 23.99)
use_fav = rng.random(len(cust)) < 0.85
cat = np.where(use_fav, fav[cust, rng.integers(0, 3, len(cust))],
               rng.integers(0, N_CAT, len(cust)))
legit = pd.DataFrame({
    "cust": cust, "t": day + hour / 24, "cat": cat,
    "merch": pick_merchant(cat),
    "amount": level[cust] * rng.lognormal(0, 0.5, len(cust)),
    "dev": cust * 100 + (rng.random(len(cust)) < 0.3),
    "fraud": 0})
new_dev = rng.random(len(legit)) < 0.01        # 正当でも新しい端末はある
legit.loc[new_dev, "dev"] += rng.integers(2, 100, new_dev.sum())
# 不正な取引:短い時間にまとまって起きる「出来事」として作る
risky = rng.choice(N_MERCH, 30, replace=False)  # 不正が集まりやすい加盟店
rows = []
for _ in range(150):
    c = rng.integers(0, N_CUST)
    k = rng.integers(1, 6)                      # 1回の出来事の取引数
    start_day = rng.integers(5, N_DAYS)
    start_h = rng.uniform(0, 5) if rng.random() < 0.5 else rng.uniform(0, 20)
    hrs = start_h + np.sort(rng.uniform(0, 4, k))
    new_device = rng.random() < 0.7
    for h in hrs:
        if rng.random() < 0.5:
            m = rng.choice(risky)
        else:
            m = rng.integers(0, N_MERCH)
        rows.append({"cust": c, "t": start_day + h / 24, "cat": merch_cat[m],
                     "merch": m,
                     "amount": level[c] * rng.lognormal(0.8, 0.7),
                     "dev": c * 100 + (50 if new_device else 0),
                     "fraud": 1})
df = pd.concat([legit, pd.DataFrame(rows)], ignore_index=True)
# ラベルが確定するまでの日数(不正だけに意味がある)
df["confirm_t"] = df["t"] + rng.gamma(2.0, 7.0, len(df))
df["ts"] = pd.Timestamp("2026-01-01") + pd.to_timedelta(df["t"], unit="D")
df = df.sort_values(["cust", "ts"]).reset_index(drop=True)
print("取引の件数", len(df), " 不正の件数", int(df["fraud"].sum()),
      " 不正の割合 %.3f%%" % (100 * df["fraud"].mean()))
実行すると、取引は108,424件、そのうち不正は468件で、不正の割合は 0.432% になりました。第2章で扱った不均衡データ(不正の件数が正当な取引に比べて極端に少ないデータ)になるように、不正の出来事の回数を150回に抑えています。不正な取引を1回の出来事として作っているのは、速度の特徴量が何を捉えるのかを示すための単純化で、実際の不正がいつもこの形で起きるという意味ではありません。手口の細部は再現していませんし、検知の仕組みを説明するうえで再現する必要もありません。
時間窓の集計と普段との差を作る、その取引自身を含めない
次に、顧客ごとの履歴から特徴量を作ります。集計と速度の特徴量には、pandas の時間窓の集計(rolling)を使います。時刻を索引にして顧客ごとにまとめ、rolling("24h") のように窓の長さを時間で指定すると、各取引の時点から過去24時間に入る取引だけを数えたり足したりできます。pandas の公式ドキュメント(参照したのは 3.1.1 版のページ)によると、closed の引数を指定しない場合の既定は右端を含む窓です。この既定では、窓の最後の点、つまりその取引自身が計算に入ります。closed="left" を指定すると、左端を含み右端を含まない窓になります。この場合は、その取引自身を除いた「それまでの」集計になります。本コラムのコードは pandas 3.0.1 で実行しました。
その取引自身を集計に含めるかどうかは、小さな違いに見えますが、意味が変わります。自身を含めた「直近24時間の回数」は、1件目の取引でも1になり、その取引の額が含まれた合計になります。判定の時点で使うこと自体はできますが、「その取引を除いた過去の勢い」と「その取引を含めた勢い」のどちらとして定義したのかを、学習と本番で揃える必要があります。本コラムでは、過去の勢いとして定義し、自身を含めない形に統一しました。普段との差の特徴量も同じで、過去の額の中央値は、1件前までの取引から計算します(shift(1) で1件ずらしてから累積の中央値を取ります)。
よく取引する時間帯も、過去の時刻の中央値で代表させ、ずれは24時間を一周とみなして近い側で測りました。ただし、時刻をふつうの中央値で代表させる方法は、日付の境目をまたぐ習慣を表せません。過去の時刻が23時と1時の顧客では中央値が12時になり、深夜に取引する習慣が見えなくなります。この合成データでは、顧客のよく取引する時間帯を平均14時・標準偏差3時間の分布から取っているので、この弱点が出る顧客は少ないと考えられます。深夜をまたぐ習慣を持つ顧客が多いデータでは、時刻を円の上の角度として平均するなど、別の求め方が必要です。
相手側の集計として、加盟店ごとの過去の不正の割合も作ります。ここで注意が要るのは、ラベルの遅れです。第2章で扱ったとおり、取引が不正だったかどうかは、本人の申告やチャージバック、調査の完了を待って、日から月の単位で遅れて確定します。判定の時点で使えるのは、その時点までに確定していたラベルだけです。次のコードの後半では、各取引の時点で、同じ加盟店の不正のうち確定日がその時点より前のものだけを数え、その時点までの取引の件数で割っています。取引の件数が少ない加盟店では割合が大きく揺れるので、全体の不正の割合(0.4% 前後)に向けて値を寄せる処理(擬似的な件数を足す平滑化)を入れました。
# 顧客ごとの履歴の特徴量。closed="left" でその取引自身を含めない
g = df.set_index("ts").groupby("cust")["amount"]
df["cnt_1h"] = g.rolling("1h", closed="left").count().fillna(0).values
df["cnt_24h"] = g.rolling("24h", closed="left").count().fillna(0).values
df["sum_24h"] = g.rolling("24h", closed="left").sum().fillna(0).values
df["cnt_7d"] = g.rolling("7D", closed="left").count().fillna(0).values
# 普段との差:過去の中央値との比、よく使う時間帯からのずれ
df["hour"] = (df["t"] % 1) * 24
past_med = df.groupby("cust")["amount"].transform(
    lambda s: s.shift(1).expanding().median())
df["amt_ratio"] = df["amount"] / past_med
past_hour = df.groupby("cust")["hour"].transform(
    lambda s: s.shift(1).expanding().median())
d = (df["hour"] - past_hour).abs()
df["hour_gap"] = np.minimum(d, 24 - d)
# 初めての加盟店の種類・初めての端末か(1件目は「初めて」になる)
df["new_cat"] = (df.groupby(["cust", "cat"]).cumcount() == 0).astype(int)
df["new_dev"] = (df.groupby(["cust", "dev"]).cumcount() == 0).astype(int)
df["dow"] = df["ts"].dt.dayofweek
print(df[["cnt_24h", "amt_ratio", "hour_gap", "new_cat", "new_dev"]]
      .groupby(df["fraud"]).mean().round(2))


# 加盟店の不正の割合:判定の時点までに「確定していた」ラベルだけで数える
def merchant_rate(df, known_t, prior=0.004, a=50):
    out = np.zeros(len(df))
    t_all, f_all = df["t"].values, df["fraud"].values
    for m, idx in df.groupby("merch").indices.items():
        t = t_all[idx]
        conf = np.sort(known_t[idx][f_all[idx] == 1])
        k = np.searchsorted(conf, t, side="left")    # 確定済みの不正の数
        n_before = np.searchsorted(np.sort(t), t, side="left")  # それまでの取引数
        out[idx] = (k + a * prior) / (n_before + a)    # 件数が少ない加盟店は全体の割合に寄せる
    return out

df["merch_rate"] = merchant_rate(df, df["confirm_t"].values)
print(df.groupby("fraud")["merch_rate"].mean().round(4))
不正と正当な取引で特徴量の平均を比べると、次のようになりました。直近24時間の回数(その取引を除く)は、正当な取引で0.59回、不正な取引で1.77回でした。過去の中央値との額の比は、正当で1.15、不正で2.55でした。よく取引する時間帯からのずれは、正当で2.12時間、不正で5.89時間でした。初めての加盟店の種類である割合は、正当で0.16、不正で0.60、初めての端末である割合は、正当で0.06、不正で0.24でした。どの特徴量も不正の側で大きくなっていますが、正当な取引にも同じ値が一定の割合で現れています。正当な取引の「初めての端末」の割合には、顧客ごとの最初の取引(どの端末も最初は「初めて」になる)と、合成のときに入れた1% の新しい端末の両方が含まれます。正当な取引の「初めての種類」の割合も同じで、顧客ごとに各種類の最初の取引と、合成のときに15% の取引の種類を全種類から無作為に選んだことの両方が含まれます。
加盟店の不正の割合の平均は、正当な取引で0.0031、不正な取引で0.0096でした。不正が集まりやすい加盟店で起きた不正が、過去に確定した不正の多い加盟店として値に表れています。
特徴量の型を足すごとの成績、平均適合率は 0.203 から 0.773 へ
特徴量の型を1つずつ足しながら、同じ手法(scikit-learn の HistGradientBoostingClassifier。勾配ブースティングの一種で、公式ドキュメントによれば欠損値を前処理なしで扱えるので、履歴の無い1件目の取引の欠損をそのまま渡しています)で学習し、評価の成績を比べます。加盟店の種類は番号のまま数として渡しているので、番号の大小に意味が無いのに大小関係として扱われます。この例では簡単さを優先しましたが、実際にはカテゴリとして扱う設定を使う選択肢があります。学習用は最初の60日、評価用は後の30日で、時間で切っています。評価の指標は、第8章で詳しく扱う平均適合率(PR曲線を1つの数に要約した値で、不正の取引をどれだけ上位に集められたかを表す。大きいほど良い。scikit-learn の公式ドキュメントによれば、しきい値ごとの適合率を再現率の増え幅で重み付けた平均で、PR曲線の下の面積を台形で近似した値とは異なる)と、評価期間の取引の上位0.5% をアラートにしたときの適合率と再現率です。なお、この例では説明を簡単にするため、学習用の60日のラベルをすべて確定したものとして扱っています。実際には、学習の時点でまだ確定していないラベルがあるので、ラベルの遅れの分だけ学習の期間を手前で切る必要があります(第2章・第8章)。
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import average_precision_score

train, test = df[df["t"] < 60], df[df["t"] >= 60]   # 時間で切る

def fit(cols):
    model = HistGradientBoostingClassifier(max_iter=200, learning_rate=0.05,
                                           early_stopping=False, random_state=0)
    return model.fit(train[cols], train["fraud"])

def score(model, X):
    s = model.predict_proba(X)[:, 1]
    y = test["fraud"].values
    k = int(len(X) * 0.005)                          # 上位0.5%をアラートにする
    hit = y[np.argsort(-s)[:k]].sum()
    return average_precision_score(y, s), hit / k, hit / y.sum()

steps = [
    ("取引そのもの", ["amount", "hour", "dow", "cat"]),
    ("+普段との差", ["amt_ratio", "hour_gap"]),
    ("+集計・速度", ["cnt_1h", "cnt_24h", "sum_24h", "cnt_7d"]),
    ("+初めての種類・端末", ["new_cat", "new_dev"]),
    ("+加盟店の不正の割合", ["merch_rate"]),
]
cols, results = [], []
for name, add in steps:
    cols = cols + add
    model = fit(cols)
    ap, prec, rec = score(model, test[cols])
    results.append((name, ap))
    print("%-14s 特徴量%2d個  平均適合率 %.3f  上位0.5%%の適合率 %.3f  再現率 %.3f"
          % (name, len(cols), ap, prec, rec))
print("評価用の不正の件数", int(test["fraud"].sum()), " 取引の件数", len(test))
# 足す順序を変えた場合(集計・速度を先、普段との差を後にする)
alt = steps[0][1]
for name, add in [("+集計・速度", steps[2][1]), ("+普段との差", steps[1][1])]:
    alt = alt + add
    print("順序を変えた場合 %-10s 特徴量%2d個  平均適合率 %.3f"
          % (name, len(alt), score(fit(alt), test[alt])[0]))
実行した結果を次の表にまとめました。評価期間の取引は36,409件、そのうち不正は166件で、上位0.5% のアラートは182件です。件数はすべて取引の単位で数えています(不正の出来事の数ではありません)。上位0.5% は評価期間の取引全体のスコアの上位で、スコアが同じ値の取引の並べ方は指定しておらず、同点がどれだけあるかは確かめていません。
| 使った特徴量の型 | 特徴量の数 | 平均適合率 | 上位0.5%の適合率 | 上位0.5%の再現率 |
|---|---|---|---|---|
| 取引そのもの(額・時刻・曜日・加盟店の種類) | 4 | 0.203 | 0.247 | 0.271 |
| +普段との差(額の比・時間帯のずれ) | 6 | 0.477 | 0.462 | 0.506 |
| +集計・速度(直近1時間・24時間・7日の回数と24時間の合計) | 10 | 0.662 | 0.582 | 0.639 |
| +初めての種類・端末 | 12 | 0.744 | 0.659 | 0.723 |
| +加盟店の不正の割合(確定済みのラベルだけ) | 13 | 0.773 | 0.654 | 0.717 |
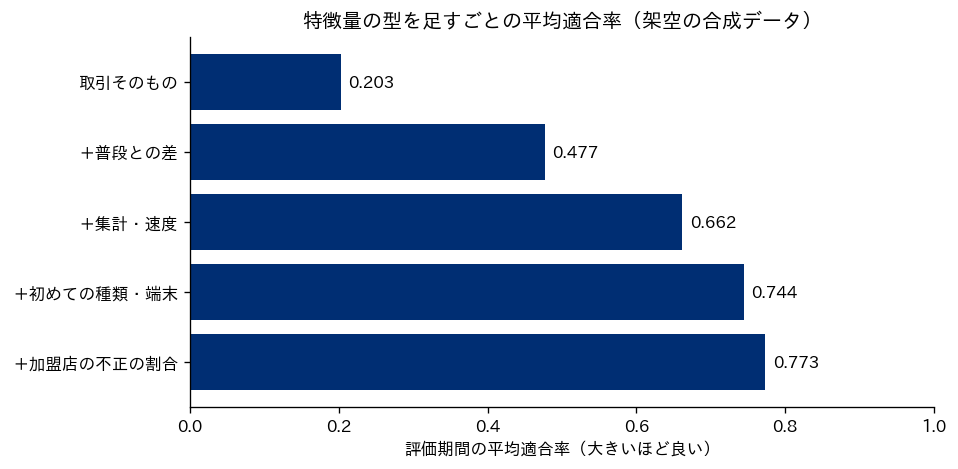
取引そのものの4つの特徴量だけでは、平均適合率は0.203でした。顧客の普段との差を足すと0.477に、集計と速度を足すと0.662に、初めての加盟店の種類と端末を足すと0.744に上がりました。どの段階でも手法と設定は同じで、変えたのは入力の特徴量だけです。この足し方の順では、最も大きく上がったのは普段との差を足した段階(0.203から0.477)でした。
ただし、各段階の上がり幅は、型を足す順序で変わります。同じコードの最後で、集計・速度を先に、普段との差を後に足す順も試しました。この順では、取引そのものに集計・速度を足すと0.421に、続けて普段との差を足すと0.662になりました。普段との差の上がり幅は、先に足すと0.274、後に足すと0.241で、集計・速度の上がり幅は、先に足すと0.218、後に足すと0.185でした。どちらの型も、他の型が先に入っていると上がり幅が小さくなっています。似た情報の一部を先に入った型がすでに持っているためと考えられます。表の上がり幅は、この足し方の順での値で、型ごとの寄与の大きさそのものではありません。
最後の加盟店の不正の割合を足した段階では、平均適合率は0.744から0.773に上がった一方で、上位0.5% の適合率は0.659から0.654に、再現率は0.723から0.717に、わずかに下がりました。182件のアラートに入った不正の件数で言えば、120件から119件への1件の差です。平均適合率はスコアの順位の全体を見る指標で、上位0.5% の適合率と再現率は、決まった件数で区切った1点だけを見る指標なので、このように向きが食い違うことがあります。評価期間の不正は166件と少なく、差は1件にとどまるので、この評価だけでは上位0.5% での優劣を判断できません。少ない件数での指標のばらつきは第8章で扱います。特徴量を足すかどうかは、1つの指標の小さな上下だけで決めず、実際に運用するしきい値の近くでの成績と、計算の手間を合わせて判断するのがよいと考えています。
ここで、上位0.5% の適合率0.654という値だけを取り出して、検知の成果として読まないことも確かめておきます。序章と第1章で整理したとおり、成果と呼べるのは、見つけて防いだ不正と、誤って止めた正当な取引の両方を数えたうえでの差です。この表の値は、同じデータ・同じ評価の手順の中で特徴量の型を比べるためのもので、運用での成果の見積もりではありません。
リーク(情報の漏れ)、誤った作り方は評価で成績を良く見せる
特徴量の設計で最も注意が要るのが、リーク(情報の漏れ)です。本コラムでは、判定の時点では手に入らないはずの情報が、特徴量を通して学習や評価に入り込むことをリークと呼びます。リークのある特徴量は、学習のときにも評価のときにも同じ誤った作り方で計算されるので、評価の数字は良く出ます。ところが本番では、判定の時点で手に入る情報でしか計算できないので、同じ名前の特徴量に別の値が入り、モデルは学習のときに頼りにしていた手がかりを失います。評価で良く見えて本番で崩れる、という形になるのはこのためです。
不正検知で起きやすいリークは、大きく2つの型に分けられます。次の表では、それと似た問題として、学習と本番で計算の仕方が食い違う場合も並べました。こちらは判定の時点で使える情報だけを使っているのでリークではありませんが、評価では見えない成績の低下につながる点が共通しています。
| 問題の型 | 誤った作り方の例 | なぜ起きやすいか | 正しい作り方 |
|---|---|---|---|
| 学習と本番の計算の不一致(リークではない):その取引自身の扱いが食い違う | 学習用では直近24時間の回数や合計に判定する取引自身を含め、本番では含めない(またはその逆) | 集計の関数の既定の動きが、窓の右端を含む形になっていることがある | 自身を含めるかどうかを定義で決め、学習と本番で同じ計算にする |
| リーク:未来の取引を含める | その日の顧客の取引回数を、その日の終わりまでの取引で数える。顧客の額の中央値を全期間で計算する | 日ごと・顧客ごとの一括の集計のほうが書きやすく、計算も速い | その取引の時刻より前の記録だけで計算する |
| リーク:未確定のラベルを使う | 加盟店の不正の割合を、全期間の確定したラベルで計算する(判定の時点では確定していなかった不正まで数える) | 学習の時点では、過去の取引のラベルが全部そろって見える | 判定の時点までに確定していたラベルだけで数える |
表の1行目は、前の節で触れたとおり、その取引自身を含めること自体が誤りなのではありません。その取引の額や件数は判定の時点で使えます。含めるかどうかの定義が学習と本番で食い違うと、同じ名前の特徴量に別の値が入る、という点が問題です。2行目と3行目のリークは、判定の時点では手に入らない情報そのものを使ってしまう誤りです。3行目は、不正検知に特有の注意点です。第2章で扱ったとおり、ラベルは遅れて確定します。学習用のデータを作る時点では、数か月前の取引のラベルはほぼそろっていますが、その取引が判定された瞬間には、同じ加盟店で数日前に起きた不正はまだ申告されていなかったかもしれません。全期間のラベルで計算した「加盟店の不正の割合」は、判定の時点の担当者が知りえなかった情報を含みます。さらに、その取引自身のラベルまで割合に含めてしまうと、特徴量が答えそのものを一部含むことになります。
次のコードでは、表の2行目と3行目のリークを確かめます。1行目の計算の不一致はコードでは確かめていません。3つの特徴量を誤った作り方に差し替えて学習し、2通りに評価します。差し替えるのは、直近24時間の回数をその日の終わりまでの回数に、額の比を全期間の中央値との比に(どちらも2行目の型)、加盟店の不正の割合を、全期間の不正の件数を全期間の取引の件数で割った割合に(3行目の型。その取引自身と未来の取引のラベルも含む)する3つです。全期間の割合にも、正しい作り方と同じ平滑化をかけています。1つ目は、評価用のデータでも同じ誤った作り方で計算した値を使う評価で、作った本人が手元で見る評価に当たります。2つ目は、同じモデルに、判定の時点で同じ定義のまま計算した値(その日の取引回数ならその取引までの回数、額の中央値ならその取引までの中央値、加盟店の不正の割合なら確定済みのラベルだけの値)を入れる評価で、本番で実際に起きることに当たります。
# 誤った作り方:その日の後の取引・全期間の値・全期間のラベルを使ってしまう
df["day"] = df["t"].astype(int)
df["cnt_day_leak"] = df.groupby(["cust", "day"])["amount"].transform("size")
df["ratio_leak"] = df["amount"] / df.groupby("cust")["amount"].transform("median")
gm = df.groupby("merch")["fraud"]                    # 全期間の不正の件数と取引の件数
df["rate_leak"] = (gm.transform("sum") + 50 * 0.004) / (gm.transform("size") + 50)
# 同じ定義を判定の時点で計算した値(本番で実際に入ってくる値)
df["cnt_day_now"] = df.groupby(["cust", "day"]).cumcount() + 1
df["ratio_now"] = df["amount"] / df.groupby("cust")["amount"].transform(
    lambda s: s.expanding().median())
train, test = df[df["t"] < 60], df[df["t"] >= 60]

swap = {"cnt_24h": "cnt_day_leak", "amt_ratio": "ratio_leak", "merch_rate": "rate_leak"}
now = {"cnt_24h": "cnt_day_now", "amt_ratio": "ratio_now", "merch_rate": "merch_rate"}
leak = [swap.get(c, c) for c in cols]
m_leak = fit(leak)
ap_leak = score(m_leak, test[leak])[0]
now_X = test[[now.get(c, c) for c in cols]].copy()
now_X.columns = leak                                  # 同じ列に本番の値を入れる
ap_prod = score(m_leak, now_X)[0]
ap_good = results[-1][1]
print("正しい作り方             平均適合率 %.3f" % ap_good)
print("漏れのある作り方(評価) 平均適合率 %.3f" % ap_leak)
print("漏れのある作り方(本番) 平均適合率 %.3f" % ap_prod)
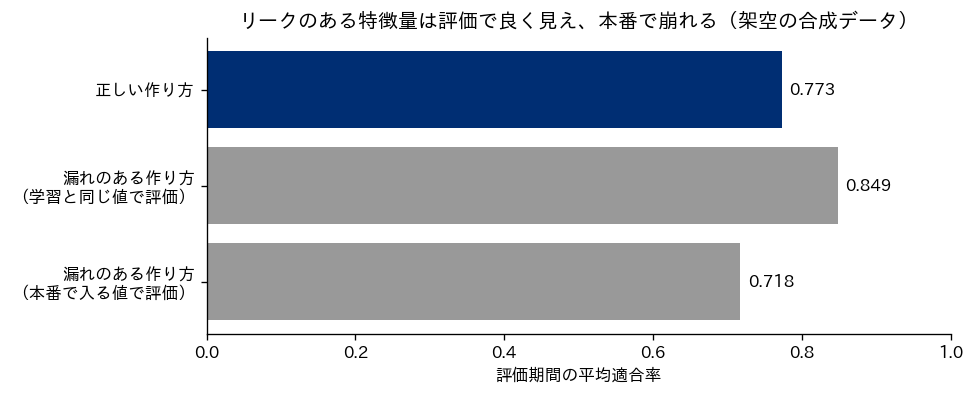
実行した結果、正しい作り方の平均適合率は0.773でした(前の節の13個の特徴量の値と同じものです)。漏れのある作り方は、学習と同じ誤った値で評価すると0.849で、正しい作り方より高く出ました。ところが、同じモデルに本番で入る値を渡すと0.718に下がり、正しい作り方を下回りました。ここで渡した本番の値は、漏れのある定義をそのまま判定の時点で計算した値(その日のその取引までの回数、その取引を含めた累積の中央値との比など)で、正しい作り方の列(その取引を除いた直近24時間の回数、1件前までの中央値との比など)とは定義そのものが違います。そのため、0.773と0.718の差は、漏れだけの効果ではなく、定義の違う列で学習したことの影響も含みます。この例で確かめられるのは、漏れのある定義で学習したモデルは、評価と本番で値の意味が変わると成績が崩れる、ということです。手元の評価では漏れのある作り方のほうが良く見えるので、評価の数字だけで特徴量を選ぶと、漏れのある作り方を採用してしまいます。そして本番に出すと、この例のように評価のときより成績が落ちることがあります。本コラムの架空データでは、手元の評価と本番の差は平均適合率で0.131でした。差の大きさはデータと漏れの程度によって変わり、この値が一般的な目安になるわけではありません。
リークを見つける手がかりとして、次の点を確かめることが有効だと考えています。
- 特徴量を1つ足しただけで、評価の成績が他の改善と比べて不自然に大きく上がっていないか
- 特徴量の重要度の上位に、ラベルや調査の結果と直接つながる項目(調査の状態・チャージバックの有無・後から付いた区分など)が入っていないか
- 各特徴量について「この値は、判定の瞬間に、どのシステムのどの記録から計算できるか」を説明できるか
- 本番に出す前に、判定には使わずスコアだけを記録する運用(影の運用。第12章)で、本番で計算した特徴量の値と学習用の値を比べたか
最後の点は、とくに重要です。学習用のデータの特徴量と、本番で計算した特徴量を、同じ取引について突き合わせると、定義の食い違いは値の違いとして直接見えます。評価の数字は、漏れがあっても無くても「それらしい値」になるので、漏れの有無を評価の数字から推し量ることはできません。
ここまでの内容を、判定の時点を境にまとめると次のようになります。
- 特徴量に使ってよい情報:判定より前の取引と、判定の時点までに確定していたラベル。この2つから、判定の時点の特徴量を作る
- 特徴量に使ってはいけない情報:判定より後の取引と、判定の時点ではまだ確定していないラベル
種類の多い項目の扱い、加盟店や端末を数に置き換えるときの漏れの防ぎ方
加盟店・端末・受取口座・郵便番号のように、取りうる値の種類がとても多い項目は、そのままではモデルに渡しにくい項目です。加盟店が数万あるとき、加盟店ごとに「その加盟店かどうか」の列を作ると列の数が膨れ上がり、取引の少ない加盟店の列はほとんど学習に使われません。新しく加わった加盟店については、その加盟店に固有の傾向を学習できないので、学習のときに無かった値をどう扱うか(たとえばすべての列を0にする)を決めておく必要があります。そこで、種類の多い項目は、何らかの数に置き換えて渡すのが普通です。置き換え方には主に次のものがあります。
| 置き換え方 | 中身 | 長所 | 漏れと注意点 |
|---|---|---|---|
| 頻度での置き換え | その加盟店のそれまでの取引の件数や、件数の順位 | ラベルを使わないので、ラベルの漏れが起きない | 全期間の件数で数えると未来の取引が入る。判定の時点までの件数にする |
| 過去の不正の割合での置き換え | その加盟店の、それまでに確定した不正の件数の割合 | 不正が集まりやすい相手を直接表せる | 未確定のラベルや、その取引自身のラベルを含めると漏れになる。件数の少ない加盟店では値が揺れるので、全体の割合に寄せる |
| 上位の区分での置き換え | 加盟店の種類・地域など、粗い区分に置き換える | 種類が少なくなり、新しい加盟店にも値が付く | 区分の中の違いが消える。区分の付け方を後から変えると、過去の値と意味が変わる |
| 初めてかどうかでの置き換え | その顧客にとって初めての加盟店・端末か | 顧客の普段との差を表せる。ラベルを使わない | どこまでさかのぼって「初めて」とするかで値が変わる。記録の保存期間と揃える |
過去の不正の割合での置き換えは、カテゴリごとの答えの平均で置き換える方法の一種で、ターゲットエンコーディングとも呼ばれます。scikit-learn の公式ドキュメント(参照したのは 1.9.1 版のページ)は、この方法を実装した TargetEncoder について、学習用のデータを既定で5つに分け、それぞれの分割を残りの分割から学んだ値で置き換える交差の手順で、学習用の値に答えの情報が漏れるのを防ぐと説明しています。この手順が働くのは学習用のデータに fit_transform を使った場合で、fit の後に transform を呼ぶと同じ結果にならないことも、同じドキュメントに書かれています。同じドキュメントは、出現回数の少ないカテゴリほど全体の平均に引き寄せる平滑化の式も示しています。不正検知では、それに加えて、時間の向きとラベルの遅れを守る必要があります。ある取引の値は、その取引より前に確定したラベルだけで計算し、学習用でも評価用でも本番でも同じ計算にします。この章のコードで、確定日の配列を渡して数え、件数の少ない加盟店を全体の割合に寄せたのは、この2つを満たすためです。
寄せ方の強さ(コードの擬似的な件数 50)は、本コラムで決めた値で、決まった正解はありません。強くしすぎると、不正が集まりやすい加盟店も全体の割合に近い値になって手がかりが弱くなり、弱くしすぎると、取引が数件しかない加盟店で1件の不正が大きな割合になって誤検知を増やします。取引の件数の分布を見て、学習の期間の中に時間で切った検証の期間を設け、そこで成績を確かめながら決めることになります。最後の評価に使う期間(この章では後の30日)を調整に使うと、その期間の成績が実際より良く見えます。寄せる先の全体の割合(コードの 0.004)も、評価の期間を含む全データから求めた値ではなく、本コラムで先に決めた仮の値です。
また、この特徴量の分母には、まだラベルが確定していない取引も入っています。そのため、値が表すのは「それまでの全取引のうち、その時点で不正と確定していたものの割合」で、最終的な不正の割合とは違い、確定の遅さにも左右されます。
さらに、加盟店の不正の割合のような特徴量は、検知で止めた取引のラベルが分からないまま残るものがある(第2章の選択の偏り)影響も受けます。止めた取引が多い加盟店ほど確定した不正が少なく数えられることがあるので、措置の記録と一緒に解釈する必要があります。
判定の時点で計算できるか、リアルタイムの判定が特徴量に課す制約
特徴量の候補を考えるときは、成績への効き方と同じくらい、判定の時点でその値を計算できるかを確かめる必要があります。取引の承認の前に判定する場合、判定に使える時間はシステムの設計で決まった短い時間に限られ、その間に特徴量を計算するか、計算済みの値を引いてくる必要があります。直近24時間の回数のような集計は、取引が届くたびに顧客ごとの値を更新して保管しておけば引くだけで済みますが、過去90日の中央値のように計算の重い特徴量は、中央値そのものを足し合わせて更新することはできないので、前日までの取引の額の記録(または中央値を計算し直せる集計の状態)を保管しておき、当日の取引を加え、90日より古い取引を除いて計算し直すといった分担が必要になります。こうした保管と分担の仕組みは第12章で扱います。
ここで起きやすいのが、学習のときと判定のときで、同じ名前の特徴量の計算の仕方が少しずつ違ってしまうことです。学習用のデータは過去の記録から一括で作るので、たとえば「前日までの一括の集計」と「当日のリアルタイムの集計」の境目を意識せずに、すべてを1つの窓で計算しがちです。本番では、一括の集計の更新が数時間遅れることがあり、その間の取引は集計に入っていません。学習と本番の値のずれは、リークと同じく、評価では見えない成績の低下につながります。特徴量ごとに「判定の時点で、どの時刻までの記録が反映されているか」を決め、学習用のデータもその定義で作ることが、この問題の基本の対処です。
時刻そのものの扱いにも注意が要ります。取引の記録の時刻が、取引が起きた時刻なのか、システムに届いた時刻なのか、記録された時刻なのかで、集計の窓に入る取引が変わります。複数のシステムから集めた記録では、時刻の基準(時間帯の扱い)がそろっていないこともあります。同じ時刻の取引が複数あるとき、どちらを先とみなすかでも、「それまでの」集計の値は変わります。こうしたデータの品質の問題は第2章で扱いましたが、特徴量の定義では、どの時刻を基準に、どの順で並べて集計するかまで書き残しておく必要があります。
特徴量の重要度の読み方と限界、寄与は原因ではない
特徴量を作ったあとは、どの特徴量がモデルの判定に効いているかを確かめたくなります。ここでは、scikit-learn の並べ替えによる重要度(permutation importance)を使います。公式ドキュメント(参照したのは 1.9.1 版のページ。本コラムのコードは scikit-learn 1.9.0 で実行)によると、この方法は、ある特徴量の値を無作為に並べ替えて特徴量と答えの関係を壊し、成績がどれだけ下がるかで重要度を測るものです。評価用のデータで計算すると、未知のデータでの成績にその特徴量がどれだけ寄与しているかが分かります。同じドキュメントは、決定木の分割から計算する重要度には、取りうる値の種類が多い特徴量を高く出す偏りがあることも説明しています。
from sklearn.inspection import permutation_importance

# model は特徴量の型を足していくループの最後(13個)で学習したもの
pi = permutation_importance(model, test[cols], test["fraud"],
                            scoring="average_precision", n_repeats=3,
                            random_state=0)
imp = pd.DataFrame({"平均": pi.importances_mean, "標準偏差": pi.importances_std},
                   index=cols).sort_values("平均", ascending=False)
print(imp.round(3).to_string())
評価期間の平均適合率の下がり幅で測った重要度は、大きい順に、よく取引する時間帯からのずれ(0.222)、直近24時間の合計(0.160)、過去の中央値との額の比(0.141)、時刻(0.131)、直近1時間の回数(0.094)でした。続いて、初めての加盟店の種類(0.057)、加盟店の不正の割合(0.049)、初めての端末(0.041)、直近7日の回数(0.025)、額(0.022)、直近24時間の回数(0.010)、加盟店の種類(0.002)、曜日(-0.004)の順でした。並べ替えは3回だけ繰り返したので、値には揺れがあります。3回の結果のばらつきを表す標準偏差は、時間帯のずれで0.035、額の比で0.022と大きく、0.131の時刻と0.141の額の比の差(0.010)は、額の比の標準偏差(0.022)より小さく、この2つの順位に意味を持たせることはできません。
この結果の読み方には、2つの注意が要ります。1つ目は、似た情報を持つ特徴量どうしで重要度が分け合われることです。直近24時間の回数の重要度は0.010と小さく出ましたが、これは回数が効いていないという意味ではありません。直近24時間の合計や直近1時間の回数は、回数とよく似た情報を持っています。回数だけを並べ替えても、モデルは他の特徴量から同じ情報を得られるので、成績があまり下がらなかったと考えられます。本コラムでは、回数を外して学習し直す確認はしていません。公式ドキュメントは、2つの特徴量が強く相関している場合、一方を並べ替えてもモデルが他方から同じ情報を得られるので、両方の重要度が小さく出ることがあると注意し、相関する特徴量をまとめて1つずつ残す方法を紹介しています。重要度の小さい特徴量を「要らない」と判断する前に、似た特徴量との関係を確かめる必要があります。
2つ目は、重要度はモデルが何に頼っているかを示すもので、不正の原因を示すものではない、ということです。この合成データでは、不正の出来事の約63% が0時から5時の間に始まるように作りました。時間帯のずれと時刻そのものの重要度が上位に出たのは、この作り方によるものと考えられますが、深夜の不正を入れずに作り直す確認はしていません。特徴量の型の表では、時刻は顧客の普段との差と組み合わせて使う型としましたが、この合成データのように不正が特定の時間帯に寄っている場合には、時刻そのものも効くことがあります。実際のデータで同じ結果になるとは限りません。いずれの場合も、重要度が大きいことは「時間帯がずれた取引は不正だ」という因果の主張にはなりません。また、重要度の上位にラベルと直接つながる特徴量が入っていたら、前の節のリークを疑う手がかりになります。1件ずつのアラートについて理由を示す方法(理由コードや SHAP)と、説明の限界は第11章で扱います。説明の手法の一般論は、弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』で扱っています。
特徴量の台帳と経営の判断、特徴量の定義を資産として管理する
特徴量は、作った本人の頭の中やコードの中にだけあると、時間がたつほど扱いにくくなります。「直近24時間の回数」という同じ名前でも、その取引自身を含むのか、拒否した取引も数えるのか、どの時刻を基準にするのかは、コードを読まないと分かりません。担当者が替わったときや、本番のシステムで計算し直すとき、監査で判定の根拠を説明するときに、その定義が分からなくなります。本コラムでは、特徴量ごとに次の項目を台帳に残すことを勧めます。
| 台帳の項目 | 書く内容 | 書いておかないと起きること |
|---|---|---|
| 名前と定義 | 計算の式を言葉で。対象の取引(承認・拒否・保留を含めるか)、窓の長さ、その取引自身を含めるか | 学習と本番、担当者どうしで同じ名前の別の値が使われる |
| 計算の時点 | 判定の時点でどの時刻までの記録が反映されるか。一括の計算か、取引ごとの更新か | 学習と本番の値のずれに気づけない。リークが入り込む |
| 元のデータ | どのシステムのどの記録から作るか。時刻の基準 | 元の記録の仕様が変わったときに、影響を受ける特徴量が分からない |
| ラベルの使い方 | ラベルを使うか。使うなら、判定の時点までに確定したものだけか | 未確定のラベルによる漏れを見落とす |
| 担当と見直しの時期 | 定義を決めた人、変更を承認する人、次に見直す時期 | 使われなくなった特徴量が残り続け、計算の手間と障害の原因が増える |
| 変更の記録 | いつ、何を、なぜ変えたか。変更の前後で値を比べた結果 | 過去のモデルの判定を、当時の定義で説明できない |
台帳は、第3章で扱ったルールの台帳と同じ考え方で、ルールの条件に使う項目と、モデルの特徴量を同じ台帳で管理すると、両方で定義をそろえやすくなります。たとえば、速度のルールの「1時間の回数」と、モデルの特徴量の「直近1時間の回数」の定義が違っていると、ルールとモデルのアラートを突き合わせたときに説明がつかなくなります。複数のモデルで同じ特徴量を使い回す場合、特徴量を計算して保管し、学習と判定の両方から同じ値を引けるようにする仕組み(第12章で扱う特徴量の保管の仕組み)を使うこともありますが、仕組みがあっても、定義を言葉で残す台帳の役割は変わりません。
この章の内容を、経営の判断に置き換えます。特徴量は、モデルを替えても使い続けられる資産です。手法を勾配ブースティングから別の手法に替えても、直近24時間の回数や普段との差のような特徴量の定義と、それを判定の時点で計算する仕組みは、そのまま次のモデルに引き継げます。本コラムの架空データでは、同じ手法のまま特徴量だけで平均適合率が0.203から0.773まで変わりました。実際のデータで同じ大きさの差が出るとは限りませんが、手法の選定より特徴量の整備のほうが成績に効く場面があることは、予算と体制を考えるうえで押さえておく価値があると考えています。
特徴量の判断を誤ったときの損失は、本コラムの損失の型に沿って整理できます。
- リークを見逃して本番に出すと、評価で見込んだ成績が出ず、見逃しによる被害が見込みより増えるおそれがある。評価の数字を根拠に調査の人員を減らしていれば、調査の過負荷にもつながる
- 普段との差を表す特徴量が無いと、額が大きいだけの正当な取引をアラートにしやすくなる。そうした取引を保留や拒否にまで進めれば、誤検知による機会損失と顧客の離反が増えるおそれがある
- 特徴量の定義が台帳に無いと、担当者が替わったときに誰も直せなくなり、手口の変化に合わせた見直しが止まって形骸化する
- 判定の根拠になった特徴量の定義と値を残していないと、監査や当局への説明で、当時の判定を再現できない。記録の義務がある業務では規制上の義務の不履行につながりうる(規制の詳細は第14章)
こうした損失を避けるには、特徴量の台帳の整備と、学習と本番で同じ値を計算する仕組みを、モデルの開発とは別の項目として予算と担当に組み込むのがよいと考えています。KPI としては、台帳に定義が書かれた特徴量の割合、本番の値と学習用の値を突き合わせた結果(ずれた特徴量の数)、見直しの時期を過ぎた特徴量の数のように、特徴量の管理の状態を表す数を置くことができます。これらは検知の成果そのものではありませんが、成果を支える土台が保たれているかを見る指標になります。検知の成果の測り方は第8章と第9章で扱います。
この章では、不正検知の特徴量を7つの型に整理し、本コラムの架空データで、同じ手法のまま特徴量の型を足すと平均適合率が0.203から0.773まで上がることを確かめました。また、未来の取引や、判定の時点では未確定のラベルを特徴量に混ぜると、手元の評価では成績が良く見え(0.849)、本番で入る値では正しい作り方より低くなる(0.718)ことを示しました。特徴量は、判定の時点で計算できる定義で作り、その定義を台帳に残して管理することが、成績と説明の両方の土台になります。第6章では、ラベルが無い、または新しい手口でラベルが足りない場面で、取引の外れ方から不正を探す教師なしの異常検知を扱います。
この章を深めたい方への参考書籍
『機械学習のための特徴量エンジニアリング』(Alice Zheng, Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン):数値データ・カテゴリ変数などの特徴量の作り方を、原理とPythonの実装の両面から説明した本です。種類の多いカテゴリ変数について説明する節があり、この章の加盟店や端末を数に置き換える考え方の背景を確かめられます。
『Kaggleで勝つデータ分析の技術』(門脇大輔, 阪田隆司, 保坂桂佑, 平松雄司 著、技術評論社):分析コンペの手法を題材に、特徴量の作成、集約して統計量をとる方法、時系列データの扱い、リーク、時系列データのバリデーションを章や節を立てて説明した本です。この章の時間窓の集計や、過去の不正の割合による置き換えと漏れの防ぎ方を、より一般的な形で学べます。
第6章 教師なしの異常検知、ラベルの無い不正を外れ方から探す
第5章では、1件の取引だけでは普段と違うかどうかが分からないため、顧客ごとの普段との差や直近の回数といった特徴量を作ることが成績を決めること、そしてその集計に未来の情報を混ぜると成績が実態より良く見えることを扱いました。第4章と第5章の方法は、どれも「過去に不正と確定した取引」というラベルから学ぶ、教師あり学習の考え方に立っています。この章では、ラベルを使わずに、普段の取引からの外れ方だけで疑わしい取引を探す、教師なしの異常検知を扱います。
この章で扱うのは次の内容です。後半は、架空の取引の記録を使い、実行したコードと結果で確かめます。
- 教師なしの異常検知が要る場面(ラベルが無い・新しい手口・ラベルの遅れを待てない)
- 「異常」と「不正」は同じではないこと
- 統計的な外れ値・Isolation Forest・局所外れ値因子・1クラスSVM(SVM はサポートベクターマシンの略)・自己符号化器の考え方と、それぞれが苦手な場面
- 既知の型の不正と、学習の期間に無かった新しい型の不正を、教師ありと教師なしでどれだけ拾えるかの比較
- 全体の中での外れ値と、本人の普段の中での外れ値の違い
- 教師なしのスコアを、教師ありの特徴量や調査の優先順位に組み込む方法
- 会計や経費の点検で使われる桁の法則(ベンフォードの法則)と、その誤用
- ラベルが無いときの評価の難しさと、経営の判断
この章の主張は、教師なしの異常検知は「珍しい取引」を見つける道具であって「不正」を見つける道具ではない、という点です。珍しいが正当な取引は、不正より多くなる場合があります。そのため、教師なしのスコアは、単独で取引を止める判定には使わず、調査の入口や、教師ありのモデルが見ていない範囲を補う枠として位置づけるのが妥当だと考えています。
教師なしの異常検知が要る場面、ラベルが無い・新しい手口・遅れを待てない
教師あり学習は、過去に不正と確定した取引と、正当だった取引の違いを学びます。この方法が働くには、学ぶのに足りる数のラベルがあり、そのラベルが評価や運用の時点の不正を代表している必要があります。第2章で見たとおり、不正のラベルは本人の申告やチャージバック、調査の完了を待って確定するため、確定までに日から月の単位の遅れがあります。また、止めた取引や調査しなかった取引には、真のラベルが分からないまま残るものがあります。教師なしの異常検知は、こうした条件が満たされない場面で検討の対象になります。
1つ目の場面は、ラベルがほとんど無い場合です。新しく始めた事業や決済の経路、新しく対象にした取引の種類(例えば、これまで見ていなかった会員登録やポイントの交換)では、不正と確定した記録がまだ数件しかないことがあります。この段階で教師あり学習のモデルを作っても、学べる例が少なすぎて、たまたま記録された数件の特徴をなぞるだけになりやすいと考えられます。教師なしの異常検知は、正当な取引が大部分を占め、不正が記録の項目の上で普段と違って見える、という前提で動くので、ラベルが揃う前から使い始められます。
2つ目は、新しい手口です。教師あり学習のモデルは、過去のラベルにある不正の型には強い一方で、学習の期間に無かった型の不正については、それを見分ける手がかりを学んでいません。新しい型の不正が、たまたま既知の型と似た特徴を持っていれば拾える場合がありますが、学習に無い型での検知の力は保証されません。教師なしの異常検知は「普段と違う」ことだけを見るので、新しい型の不正が普段の取引と違う特徴を持っていれば、ラベルが無くても上位に挙がる可能性があります。手口の変化への追従そのものは第10章で扱いますが、この章では、その入口としての役割を確かめます。
3つ目は、ラベルの遅れを待てない場合です。チャージバックが届くまでの間にも、同じ型の不正は続くことがあります。教師あり学習のモデルを学習し直すには、新しい型の不正のラベルが一定の数だけ確定するのを待たなければなりません。その間、教師なしの異常検知で上位に挙がった取引を調査担当が見て、新しい型を早く見つけ、ルールで先に対応する、という使い方が考えられます。ルールで先に対応し、後からモデルに取り込む流れは第10章で扱います。
反対に、教師なしの異常検知が向かない場面もあります。記録の項目の上で不正が普段の取引と見分けられない場合は、外れ方を見ても見つかりません。また、ラベルが十分にあり、手口が安定している対象では、教師あり学習のほうが少ない誤検知で多くの不正を拾えることが多いと考えられます。教師なしの異常検知は、教師あり学習の代わりではなく、教師あり学習が見えていない範囲を補う道具として検討するのが妥当です。
「異常」と「不正」は同じではない、珍しいが正当な取引の多さ
本コラムでいう異常(外れ値)とは、データの大部分が従う型から外れた観測のことです。この意味には、不正かどうかという意味は含まれていません。外れているかどうかはデータの分布だけで決まり、不正かどうかは、他人をだます、権限を偽るといった行為の中身で決まります。この2つは重なる部分がありますが、同じものではありません。
取引の記録には、珍しいが正当な取引が大量に含まれます。年に一度の大きな買い物、旅行先での普段と違う時間帯や地域での利用、新しい端末への機種変更、引っ越しによる住所の変更、季節の行事に合わせた普段と違う種類の店での利用などです。これらは、その顧客の普段から見れば明らかに外れていますが、不正ではありません。不正の割合が小さい取引の記録(本コラムでは 0.1〜1% 程度を想定し、この章の合成データでは 0.391%)では、外れている取引の中でも、正当なものが不正より多くなることが普通に起こりえます。
逆に、外れ方を見る方法では拾いにくい不正の型もあります。普段の取引と見分ける手がかりが記録の項目に現れない不正は、外れ方をいくら細かく見ても上位には挙がりません。また、密度を基準にする手法では、同じ型の不正が学習データに多く含まれると、その型の点数が上がりにくくなることがあります。この点は、後半のコードで局所外れ値因子の結果として現れます。教師なしの検知をルールや教師あり学習、第7章のつながりの分析と併用する必要があるのは、このためです。
このため、教師なしの異常検知のスコアは「不正の疑いの強さ」ではなく「普段からの外れ方の強さ」として読む必要があります。本コラムの用語の定義では、スコアを不正の疑いの強さを表す 0〜1 の値としていますが、この章の教師なしの手法が出す点数は、それとは別の「外れ方の強さ」です。点数の範囲は手法ごとに違い、0〜1 の確率としては読めません。スコアが高い取引は、調査担当が見る価値がある候補ではありますが、そのまま拒否の判定に使うと、珍しいが正当な取引を止めることになります。これは、序章で示した6つの損失の型のうち、誤検知による機会損失と顧客の離反に直結します。旅行先で使えなかったカードや、大きな買い物を止められた顧客は、そのカードや決済の手段を使わなくなることがあります。
手法の比較、統計的な外れ値から自己符号化器まで
教師なしの異常検知の手法は多くありますが、取引の記録に使われる代表的なものは次の5つに整理できます。どの手法も「普段の取引がどんな形をしているか」をデータから捉え、そこからの外れ方をスコアにする点は共通しています。違うのは、普段の形の捉え方と、どんな外れ方に敏感かです。
| 手法 | 普段の形の捉え方 | 得意な外れ方 | 苦手な場面 | 原典 |
|---|---|---|---|---|
| 統計的な外れ値(標準化した距離・四分位) | 平均と標準偏差、または四分位の範囲で、項目ごとの普通の幅を決める | 1つの項目が極端に大きい・小さい | 分布が偏っている項目(額など)、項目の組み合わせでだけ外れる取引 | 特定の原典なし(統計の基本) |
| Isolation Forest | 無作為に項目と分割の値を選んで木を作り、少ない分割で切り離される観測を外れとみなす | どの項目の組み合わせでも、周りから離れている観測 | 外れ方が少数の項目に集中していない場合の解釈、標本の取り方への依存 | Liu・Ting・Zhou の2008年の論文(第8回 IEEE データマイニング国際会議) |
| 局所外れ値因子 | 近い k 件の観測の密度と、その観測自身の密度を比べる | 密な集団のすぐ外側にいる観測、密度の違う集団が混ざったデータ | 同じ型の外れが多数集まって密な集団を作った場合、計算量 | Breunig・Kriegel・Ng・Sander の2000年の論文(ACM SIGMOD 2000) |
| 1クラスSVM | 普段の観測の大部分を囲む境界を学ぶ | 境界の外に出た観測 | 学習データに外れが混ざっている場合、設定の値(nu)への敏感さ、件数が多いときの計算量 | Schölkopf らの2001年の論文(Neural Computation 誌 第13巻第7号) |
| 自己符号化器 | 入力をいったん少ない次元に縮め、元に戻すニューラルネットワークを、普段の観測で学ぶ | 元に戻したときの誤差が大きい観測(普段の観測の組み合わせ方から外れたもの) | 学習の設定が多い、誤差が大きい理由の説明、学習データに外れが多い場合 | 次元を縮める使い方は Hinton・Salakhutdinov の2006年の論文(Science 誌 第313巻) |
統計的な外れ値は、最も単純で、説明もしやすい方法です。額を平均と標準偏差(ばらつきの大きさを表す値)で標準化し、平均から標準偏差の何倍離れているかで外れを判定する、あるいは四分位範囲(値を小さい順に並べて4等分したときの、真ん中の半分が入る幅)を使って上下の境界を設ける、といった方法です。米国国立標準技術研究所(NIST)の統計の手引きの箱ひげ図の説明では、下側の四分位点から四分位範囲の1.5倍だけ下、上側の四分位点から1.5倍だけ上に内側の境界を置き、その外側の点を個別に描きます。ただし、取引の額のように右に長く裾を引く分布では、平均と標準偏差が大きな値に引っ張られます。また、1つずつの項目では普通の範囲に収まっていても、組み合わせると珍しい取引(普段の額だが、普段使わない時間帯に、普段使わない種類の店で、新しい端末から行われた取引)は見つけられません。この組み合わせの外れを捉えるのが、残りの4つの手法です。
Isolation Forestは、Liu らが2008年の IEEE データマイニング国際会議で発表した方法です。scikit-learn の説明では、無作為に1つの項目を選び、その項目の最小値と最大値の間で無作為に分割の値を選ぶ、という分割を繰り返して観測を「切り離し」ます。外れている観測は少ない分割で切り離されるので、木の根からの道のりが短くなります。多くの木で道のりが短い観測ほど、外れのスコアが高くなります。距離や密度を計算しないので、件数が多いデータでも比較的速く動きます。scikit-learn の実装では、1本の木を作るのに使う標本の数が既定で最大256件に抑えられています。
局所外れ値因子(Local Outlier Factor、LOF)は、Breunig らが2000年の ACM SIGMOD で発表した方法です。scikit-learn の説明では、観測の近くにある k 件の観測から局所的な密度を求め、近くの観測の密度の平均と、その観測自身の密度の比をスコアにします。普段の観測は周りと同じくらいの密度にあり、外れた観測は周りより密度が低い、という考え方です。全体で見ると普通の値でも、その近くの集団から見ると離れている観測を拾える点が特徴です。一方で、同じ型の外れが多数集まると、その外れどうしが互いに近くなり、密度が高く見えるため、外れとみなされにくくなります。
1クラスSVM は、Schölkopf らが2001年に Neural Computation 誌で示した、高い次元の分布の大部分を含む領域を推定する方法に基づきます。普段の観測を囲む境界を学び、その外に出た観測を外れとします。scikit-learn の説明では、1クラスSVM は学習データに混ざった外れに敏感で、外れが混ざったデータでは設定の値 nu(scikit-learn の説明では、学習データのうち境界の外に出る割合の上限を決める値)の調整が要るとされています。取引の記録には、ラベルの無い不正が混ざっている可能性が高いので、この性質には注意が要ります。また、件数の2乗以上で計算量が増えるため、数十万件の取引にそのまま使うのは難しく、scikit-learn には件数に比例する計算量で近似する別の実装も用意されています。
自己符号化器(オートエンコーダ)は、入力を少ない次元に縮める部分と、そこから元の入力を復元する部分からなるニューラルネットワークです。Hinton と Salakhutdinov の2006年の論文は、この形のネットワークでデータの次元を縮める方法を示しました。異常検知では、普段の取引だけ(あるいは大部分が普段の取引であるデータ)で学習させ、復元したときの誤差が大きい取引を外れとみなします。項目が多く、項目どうしの関係が複雑なデータでは候補になりますが、学習の設定が多く、誤差が大きい理由を調査担当に説明するのが難しい面があります。本コラムでは自己符号化器は実行していません。深層学習の実装の一般論は、弊社コラム「Python実務で必ず使うディープラーニングレシピ100選」で扱っています。
手法を使うときの注意点が2つあります。1つは、距離や密度を使う手法(局所外れ値因子・1クラスSVM など)では、項目の尺度をそろえることが重要な点です。額のように桁が大きい項目と、0か1の項目を並べたまま距離を計算すると、桁の大きい項目だけで外れ方が決まってしまいます。Isolation Forest は項目ごとにその範囲の中で分割するので、尺度をそろえることは必須ではありません。後半のコードでは、前処理を共通にするため、どの手法にも標準化した項目を渡しました。もう1つは、どの項目を入れるかで「普段」の意味が変わることです。額だけを入れれば額の外れを、時間帯と店の種類を入れれば行動の外れを見ることになります。教師なしの手法は、入れた項目の範囲でしか外れを見られないので、第5章で扱った特徴量の設計が、教師なしの検知でも成績を左右します。
架空の取引の記録で比べる、既知の型と新しい型の不正
ここからは、架空の合成データで、教師ありと教師なしの手法がどの型の不正を拾えるかを確かめます。本コラムで使うデータは乱数で作った架空の取引の記録で、実際の記録よりずっと単純です。合成データでの成績は、実際の取引での成績の目安にはなりません。ここで示すのは、手法ごとの拾い方の違いが、どういう条件で現れるかの例です。
正当な取引は、顧客1,500人の120日分として作りました。顧客ごとに、普段の額の水準(相対値)・よく使う時間帯・1日あたりの平均の回数・よく使う加盟店の種類を決め、そのまわりにばらつく取引を作ります。そのうえで、珍しいが正当な取引を意図的に混ぜました。普段と違う時間帯の利用(全体の3%)、普段の3〜12倍の大きな買い物(1%)、新しい端末からの利用(3%)、短い時間に続けて買う取引(2%)です。
# ===== ブロック1:架空の取引の記録(正当な取引)を作る =====
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261112)
N_CUST, N_DAYS = 1500, 120
cust = pd.DataFrame({
    "cust": np.arange(N_CUST),
    "level": rng.lognormal(0.0, 0.8, N_CUST),        # 普段の額の水準(相対値)
    "hour0": rng.normal(14, 3, N_CUST).clip(8, 21),  # よく使う時間帯
    "rate": rng.gamma(2.0, 0.6, N_CUST),             # 1日あたりの平均回数
    "cat0": rng.integers(0, 8, N_CUST),              # よく使う加盟店の種類
})
parts = []
for c in cust.itertuples():
    n = rng.poisson(c.rate * N_DAYS)
    day = rng.integers(0, N_DAYS, n)
    hour = rng.normal(c.hour0, 2.5, n).clip(0, 23.99)
    hour = np.where(rng.random(n) < 0.03, rng.uniform(0, 24, n), hour)  # 普段と違う時間帯(正当)
    amt = c.level * rng.lognormal(0.0, 0.5, n)
    big = rng.random(n) < 0.01                       # まれな大きな買い物(正当)
    amt = np.where(big, amt * rng.uniform(3, 12, n), amt)
    cat = np.where(rng.random(n) < 0.8, c.cat0, rng.integers(0, 8, n))
    parts.append(pd.DataFrame({"cust": c.cust, "t": day * 24 + hour,  # t は通しの時刻(時間)
        "amt": amt, "cat": cat, "newdev": rng.random(n) < 0.03, "kind": "正当"}))
tx = pd.concat(parts, ignore_index=True)
rep = tx[rng.random(len(tx)) < 0.02].copy()          # 短時間に続けて買う(正当)
rep["t"] = rep["t"] + rng.uniform(0.05, 0.8, len(rep))
rep["amt"] = rep["amt"] * rng.lognormal(0.0, 0.3, len(rep))
tx = pd.concat([tx, rep], ignore_index=True)
print("正当な取引の件数:", len(tx))
不正は2つの型を混ぜました。既知の型は120日の全期間に起き、1回の出来事で短い時間に2〜5件の取引が続き、半分ほどが新しい端末からで、額は普段の1〜3.5倍です。新しい型は、最初の90日(後で述べる基準の期間と学習の期間)には一度も起きず、評価に使う最後の30日にだけ起きます。1回の出来事は1〜2件で、新しい端末は使わず、額は普段の2.5〜8倍、時間帯は普段から大きくずれています。どちらの型も、加盟店の種類は無作為に選ぶので、普段と違う種類の店になりやすい作りです。手口の記述は、検知の側から見た特徴の違いを作るための架空の設定であり、実際の手口を表したものではありません。
特徴量は、第5章の考え方に沿って5つにしました。本人の普段の額との比(対数)、本人の普段の時間帯からのずれ、直前1時間の本人の取引の回数、新しい端末かどうか、普段と違う種類の店かどうか、です。120日は、普段の値を作る基準の期間(最初の30日)、モデルの学習の期間(次の60日)、評価の期間(最後の30日)の3つに分けました。本人の普段の値(額の中央値・時間帯の平均・最も多い店の種類)は基準の期間の取引だけから計算し、学習と評価に使う取引が自分自身や後日の取引から作った値を使わないようにしています。基準の期間に取引の無い顧客の取引(31件)は、基準の期間の全体の値で補いました。時刻は日をまたいでも続く通しの時刻で扱い、時間帯の平均とずれは、23時と1時の差を2時間と数えるように、24時で一回りする時刻として計算しました。直前1時間の回数は、その取引自身と同じ時刻の取引を含めず、それより前の取引だけを数えています。
# ===== ブロック2:既知の型と新しい型の不正を混ぜ、特徴量を作る =====
def add_fraud(n_event, day_from, kind, size_lo, size_hi, ratio_lo, ratio_hi, p_newdev, shift):
    out = []
    for _ in range(n_event):
        c = cust.iloc[rng.integers(0, N_CUST)]
        k = rng.integers(size_lo, size_hi + 1)       # 1回の出来事で起きる取引の件数
        t0 = rng.integers(day_from, N_DAYS) * 24 + (c.hour0 + shift + rng.normal(0, 3)) % 24
        out.append(pd.DataFrame({"cust": int(c.cust), "t": t0 + np.sort(rng.uniform(0, 0.8, k)),
            "amt": c.level * rng.uniform(ratio_lo, ratio_hi, k),
            "cat": rng.integers(0, 8, k), "newdev": rng.random() < p_newdev, "kind": kind}))
    return pd.concat(out)

fa = add_fraud(220, 0, "既知の型", 2, 5, 1.0, 3.5, 0.6, 0)  # 全期間に起きる
fb = add_fraud(70, 90, "新しい型", 1, 2, 2.5, 8.0, 0.0, 7)  # 評価の期間にだけ起きる
tx = pd.concat([tx, fa, fb], ignore_index=True)
tx = tx[tx["t"] < N_DAYS * 24].sort_values(["cust", "t"], ignore_index=True)
tx["day"], tx["hour"] = (tx["t"] // 24).astype(int), tx["t"] % 24  # 日をまたいでも正しく分ける
tx["fraud"] = (tx["kind"] != "正当").astype(int)
bp = tx["day"] < 30                                   # 基準の期間(普段の値を作る)
tr = (tx["day"] >= 30) & (tx["day"] < 90)             # 学習の期間
ev = tx["day"] >= 90                                  # 評価の期間
tx["sin"], tx["cos"] = np.sin(tx["hour"] / 24 * 2 * np.pi), np.cos(tx["hour"] / 24 * 2 * np.pi)
base = tx[bp].groupby("cust").agg(med=("amt", "median"), s=("sin", "mean"), c=("cos", "mean"),
                                  cat_top=("cat", lambda x: x.mode().iloc[0]))
base["hmean"] = (np.arctan2(base["s"], base["c"]) / (2 * np.pi) * 24) % 24  # 時刻の平均(24時で循環)
tx = tx.join(base[["med", "hmean", "cat_top"]], on="cust")
print("基準の期間に取引が無い顧客の取引:", tx["med"].isna().sum(), "件(基準の期間の全体の値で補う)")
tx = tx.fillna({"med": tx.loc[bp, "amt"].median(), "hmean": 14.0, "cat_top": -1})
tx["ratio"] = np.log(tx["amt"] / tx["med"])           # 本人の普段の額との比(対数)
d = (tx["hour"] - tx["hmean"]).abs()
tx["hour_dev"] = np.minimum(d, 24 - d)                # 本人の普段の時間帯からのずれ(循環)
key = tx["cust"].to_numpy() * 10000.0 + tx["t"].to_numpy()
tx["n_1h"] = np.searchsorted(key, key, side="left") - np.searchsorted(key, key - 1.0, side="left")
tx["newcat"] = (tx["cat"] != tx["cat_top"]).astype(int)  # n_1h は直前1時間の本人の回数(同時刻は除く)
tx["lamt"] = np.log(tx["amt"])                        # 額そのもの(対数)
print(tx.groupby("kind").size().to_string())
print("不正の割合: %.3f%%" % (100 * tx["fraud"].mean()))
print("基準の期間 %d件、学習の期間 %d件、評価の期間 %d件" % (bp.sum(), tr.sum(), ev.sum()))
実行すると、正当な取引は221,704件、既知の型の不正は762件、新しい型の不正は108件で、不正の割合は 0.391% でした。基準の期間の取引は55,425件、学習の期間は111,313件、評価の期間は55,836件です。型ごとの特徴量の平均は次のとおりです。
| 取引の種類 | 件数 | 普段の額との比(対数) | 普段の時間帯からのずれ(時間) | 直前1時間の回数 | 新しい端末の割合 | 普段と違う種類の店の割合 |
|---|---|---|---|---|---|---|
| 正当 | 221,704 | 0.015 | 2.127 | 0.217 | 0.030 | 0.174 |
| 既知の型の不正 | 762 | 0.712 | 2.319 | 1.562 | 0.547 | 0.904 |
| 新しい型の不正 | 108 | 1.608 | 7.763 | 0.380 | 0.000 | 0.917 |
既知の型は直前1時間の回数と新しい端末の割合が高く、新しい型は額の比と時間帯のずれが大きい、という違いがあります。一方で、どちらの型も普段と違う種類の店の割合が9割あまりあり、正当な取引(17.4%)との差が大きくなっています。この差は、加盟店の種類を無作為に選ぶという合成の作り方から来ているもので、教師なしの手法の結果に強く効きます。結果を読むときは、この作り方を前提にする必要があります。
教師ありと教師なしの比較、既知の型と新しい型の再現率
比べたのは3つの方法です。教師ありは、scikit-learn の HistGradientBoostingClassifier(勾配ブースティングの実装)を、学習の期間のラベルで学習させました。学習の期間には新しい型の不正が無いので、このモデルは既知の型だけを学んでいます。学習の回数は300回に固定しました。教師なしは、Isolation Forest と局所外れ値因子で、どちらもラベルを使わず、学習の期間の特徴量だけで普段の形を捉えます。局所外れ値因子は計算量が大きいため、学習の期間から無作為に選んだ2万件で学習させ、新しい観測に点数を付ける設定(novelty=True)で評価の期間の取引に点数を付けました。scikit-learn の説明では、この設定では学習に使った観測ではなく新しい観測にだけ点数を付けて使うこととされています。
どの方法も、評価の期間の取引を点数の高い順に並べ、上位1%(558件)をアラートにしました。アラートの件数をそろえたのは、調査の能力が決まっている前提で、同じ件数を調べたときにどれだけ拾えるかを比べるためです。評価の期間に含まれる不正は、既知の型が179件、新しい型が108件です。これは最後の30日分をまとめて点数の順に並べた事後の比較で、日ごとの調査の上限・アラートが届く順番・待ち時間は扱っていません。1件あたりの調査にかかる時間が方法によって違えば、件数をそろえても必要な人員は同じになりません。使っている scikit-learn は 1.9.0 です。
# ===== ブロック3:教師ありと教師なしで評価の期間の上位1%を比べる =====
from sklearn.ensemble import IsolationForest, HistGradientBoostingClassifier
from sklearn.neighbors import LocalOutlierFactor
from sklearn.preprocessing import StandardScaler

HGB = dict(max_iter=300, learning_rate=0.05, early_stopping=False, random_state=0)
F = ["ratio", "hour_dev", "n_1h", "newdev", "newcat"]
Xtr, Xte = tx.loc[tr, F].astype(float), tx.loc[ev, F].astype(float)
te = tx[ev].copy()
print(tx.groupby("kind")[F].mean().round(3).to_string())
sc = StandardScaler().fit(Xtr)
iso = IsolationForest(n_estimators=200, random_state=0).fit(sc.transform(Xtr))
te["s_iso"] = -iso.score_samples(sc.transform(Xte))  # 大きいほど外れている
samp = rng.choice(len(Xtr), 20000, replace=False)
lof = LocalOutlierFactor(n_neighbors=50, novelty=True).fit(sc.transform(Xtr)[samp])
te["s_lof"] = -lof.score_samples(sc.transform(Xte))
ok = tx.loc[tr, "fraud"].to_numpy()[samp] == 0       # 確認用:不正を除いて学習した場合
lof0 = LocalOutlierFactor(n_neighbors=50, novelty=True).fit(sc.transform(Xtr)[samp][ok])
te["s_lof0"] = -lof0.score_samples(sc.transform(Xte))
gb = HistGradientBoostingClassifier(**HGB).fit(Xtr, tx.loc[tr, "fraud"])
te["s_sup"] = gb.predict_proba(Xte)[:, 1]            # 既知の型のラベルだけで学習

K = int(len(te) * 0.01)                               # アラートにする件数(上位1%)
nA, nB = (te["kind"] == "既知の型").sum(), (te["kind"] == "新しい型").sum()
def report(name, top):
    cA, cB = (top["kind"] == "既知の型").sum(), (top["kind"] == "新しい型").sum()
    rA, rB = cA / nA, cB / nB
    print("%-16s 適合率 %.3f  再現率 既知の型 %.3f  新しい型 %.3f  (不正 %d件=既知の型 %d件+新しい型 %d件)"
          % (name, top["fraud"].mean(), rA, rB, cA + cB, cA, cB))
    return rA, rB

print("評価の期間の取引 %d件、アラート %d件、既知の型 %d件、新しい型 %d件" % (len(te), K, nA, nB))
res = {}
for n, c in [("教師あり", "s_sup"), ("Isolation Forest", "s_iso"), ("局所外れ値因子", "s_lof")]:
    res[n] = report(n, te.nlargest(K, c))
report("(確認)不正を除いた局所外れ値因子", te.nlargest(K, "s_lof0"))
結果を読む前に、比べ方の条件を確かめておきます。新しい型は学習の期間に1件も無く、教師ありのモデルには見る機会が無かった型です。また、新しい型は、額と時間帯の外れ方が大きくなるように意図して作りました。合成データなので評価の期間の全ての取引の正解が分かっていますが、実際の取引では、調査しなかった取引の正解は分からないまま残るものがあります(第2章の選択の偏り)。結果は次のとおりです。適合率はアラート558件のうち不正だった割合、再現率は型ごとに、評価の期間のその型の不正のうちアラートに入った割合です。確認用の行は図には含めていません。
| 方法 | 適合率 | 再現率(既知の型) | 再現率(新しい型) | アラートに入った不正の件数(既知の型+新しい型) |
|---|---|---|---|---|
| 教師あり(既知の型のラベルで学習) | 0.247 | 0.665 | 0.176 | 138(119+19) |
| Isolation Forest | 0.332 | 0.592 | 0.731 | 185(106+79) |
| 局所外れ値因子 | 0.195 | 0.073 | 0.889 | 109(13+96) |
| (確認用)不正を除いて学習した局所外れ値因子 | 0.228 | 0.173 | 0.889 | 127(31+96) |
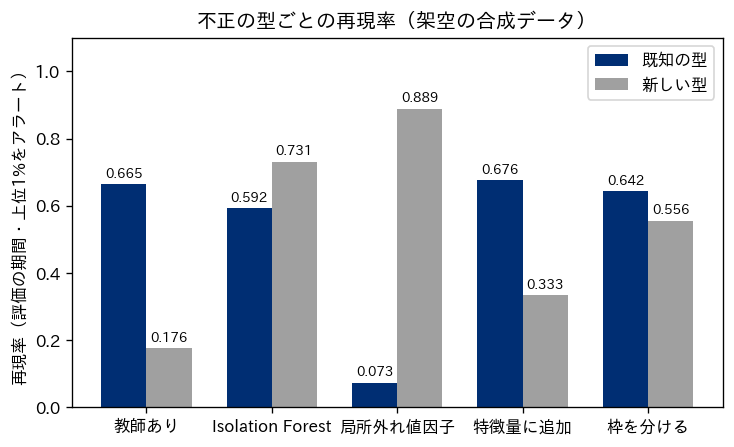
教師ありのモデルは、既知の型の再現率が 0.665 で3つの中で最も高い一方、新しい型の再現率は 0.176 で、108件のうち19件しか拾えませんでした。学習の期間に一度も現れなかった型の不正は、教師ありのモデルにとって「学んでいない型」であり、そうした型での検知の力は保証されません。学習に無かった型なので、拾いにくいのは想定される動きです。
Isolation Forest は、既知の型の再現率が 0.592、新しい型が 0.731 でした。適合率は 0.332 で、教師ありの 0.247 より高くなっています。ただし、アラートに入った不正の件数を型ごとに見ると、既知の型は教師ありが119件、Isolation Forest が106件で、教師ありのほうが多く拾っています。不正の件数の差(138件と185件)は、新しい型で Isolation Forest が60件多く(19件と79件)、既知の型で13件少なかった結果です。
この比較で教師なしが適合率で上回ったのは、教師ありが学習の期間に一度も見ていない型が評価の期間に混ざっている、という条件のもとでの結果です。Isolation Forest が新しい型をここまで拾えたことが、新しい型の外れ方を大きく作ったこの合成データの作り方にどこまで依存しているかは、切り分けていません。外れ方がはっきりしない不正が多い実際の記録で、同じ順番の結果になるとは限りません。この結果から言えるのは、教師なしの手法が、ラベルの無い新しい型の不正も、外れ方があれば拾える場合がある、という点までです。
局所外れ値因子は、新しい型の再現率が 0.889 と最も高い一方で、既知の型は 0.073 しか拾えませんでした。既知の型の不正は全期間を通じて起きていて、学習に使った2万件の中にも含まれています。局所外れ値因子は周りとの密度の比で点数を付けるので、同じ型の取引が学習データの中に集まっていると、その近くの密度が高くなり、点数が上がりにくくなることが原因の1つと考えられます。学習に使う2万件から不正を除いて学習し直すと、既知の型の再現率は 0.073 から 0.173 に上がりましたが、新しい型の 0.889 には遠く及びません。残りの差の理由は切り分けていません。新しい型は、108件のうち96件がアラートに入りました。
この章のデータでは、繰り返し起きる既知の型を局所外れ値因子はほとんど拾えず、学習から不正を除いても再現率は 0.173 に留まりました。一方で、新しく少数だけ現れた型は、局所外れ値因子が3つの方法の中で最も多く拾いました。ただし、この合成データの2つの型は、新しさや繰り返しの多さだけでなく、額・時間帯・連続の件数・新しい端末の割合も同時に違うように作っています。どの条件がこの差を生んだのかは切り分けていないので、この結果を「密度に基づく手法は新しい型に強い」という一般論として読むことはできません。手法を選ぶときは、見つけたい不正の型に対してその手法がどう振る舞うかを、自社の記録と調査の結果で確かめる必要があります。繰り返し起きる型はラベルが溜まれば教師あり学習で扱えるので、教師なしの手法には、教師ありが見えていない範囲を補う役を担わせる、という分担が考えられます。
全体での外れ値と本人の中での外れ値、何と比べて外れているか
外れ方を測るときには、何と比べて外れているのかを決める必要があります。同じ額の取引でも、普段から大きな額を使う顧客にとっては普通で、普段は小さな額しか使わない顧客にとっては大きく外れています。全ての取引をまとめた分布の中で外れているかを見るのが「全体での外れ値」、その顧客自身の普段の取引の中で外れているかを見るのが「本人の中での外れ値」です。前者は額の大きい取引を、後者は普段と違う取引を拾います。
この違いを確かめるため、評価の期間の取引について、額そのもの(全体での外れ値)と、本人の普段の額との比(本人の中での外れ値)のそれぞれで上位1%をアラートにしました。あわせて、Isolation Forest の上位1%に入った正当な取引が、どんな取引だったかを数えました。
# ===== ブロック4:全体での外れ値と、本人の中での外れ値 =====
for name, col in [("額そのもの", "lamt"), ("本人の普段との比", "ratio")]:
    top = te.nlargest(K, col)
    big_cust = (top["med"] > base["med"].quantile(0.9)).mean()  # 顧客単位の上位10%
    print("%-10s 適合率 %.3f  不正を拾った件数 %d  普段の額が上位10%%の顧客の取引の割合 %.2f"
          % (name, top["fraud"].mean(), top["fraud"].sum(), big_cust))
top = te.nlargest(K, "s_iso")
lg = top[top["fraud"] == 0]                           # 外れているが正当な取引
print("Isolation Forest の上位1%%のうち正当な取引 %d件(重なりあり)" % len(lg))
print("  普段の額の1.5倍超 %d件、新しい端末 %d件、直前1時間に1回以上 %d件、普段の時間帯から4時間以上 %d件、普段と違う種類 %d件"
      % ((lg["ratio"] > np.log(1.5)).sum(), lg["newdev"].sum(), (lg["n_1h"] >= 1).sum(),
         (lg["hour_dev"] >= 4).sum(), lg["newcat"].sum()))
額そのもので選んだ558件では、適合率は 0.052 で、不正を拾ったのは29件でした。この558件のうち68%は、普段の額(基準の期間の中央値)が、基準の期間に取引のある顧客の中で上位10%に入る顧客の取引でした。額の大きい取引を選ぶと、もともと大きな額を使う顧客の取引に偏ります。本人の普段の額との比で選ぶと、適合率は 0.122、不正は68件となり、普段の額が上位10%の顧客の取引の割合は7%まで下がりました。本コラムの架空データでは、同じ「額」という1つの項目でも、本人の普段と比べるだけで、拾える不正の件数がおよそ2.3倍(29件と68件、適合率で 0.052 と 0.122)になりました。
ただし、1つの項目だけで選んだ場合の適合率は、5つの特徴量を組み合わせた Isolation Forest の 0.332 には及びません。この合成データでは、不正の外れ方を額だけでなく、時間帯・回数・端末・店の種類にも分けて作っているためです。本人の中での外れ値は、教師なしの手法に入れる特徴量として使うのが基本になります。第5章で扱った「顧客の普段との差」の特徴量は、教師あり学習だけでなく、教師なしの検知でも中心になります。
Isolation Forest の上位1%に入った558件のうち、正当な取引は373件でした。その内訳(1件が複数に当てはまることがあります)は、普段と違う種類の店が240件、新しい端末が199件、直前1時間に1回以上の取引があったものが197件、普段の時間帯から4時間以上ずれたものが160件、普段の額の1.5倍を超えたものが120件でした。合成のときに意図的に混ぜた、珍しいが正当な取引が、そのまま上位に挙がっていることが分かります。実際の取引でも、旅行・機種変更・大きな買い物といった正当な理由で外れる取引は、教師なしの検知の上位に入ってきます。調査担当がこれらを効率よく除けるように、顧客から事前に届けられた情報(旅行の予定など)や、過去に正当と確認された外れ方を記録しておく仕組みが要ると考えています。
教師なしのスコアの使い方、教師ありの特徴量と調査の枠
教師なしのスコアを実際の検知に組み込む方法は、大きく次の2つです。
- 特徴量に加える:教師なしのスコアを、教師あり学習の特徴量の1つとして加える
- 調査の枠を分ける:教師ありのモデルで上位に挙がった取引とは別に、教師ありのモデルでは選ばれなかった取引の中から、教師なしのスコアが高いものを一定の件数だけ調査に回す
この2つを、同じアラートの件数(558件)で比べました。調査の枠を分ける方法では、558件のうち8割(446件)を教師ありの上位に充てました。残りの2割(112件)は、教師ありで選ばれなかった取引の中の Isolation Forest の上位に充てました。
# ===== ブロック5:教師なしのスコアを組み合わせる =====
Xtr2 = np.column_stack([Xtr, -iso.score_samples(sc.transform(Xtr))])
gb2 = HistGradientBoostingClassifier(**HGB).fit(Xtr2, tx.loc[tr, "fraud"])
te["s_sup2"] = gb2.predict_proba(np.column_stack([Xte, te["s_iso"]]))[:, 1]
res["特徴量に追加"] = report("特徴量に追加", te.nlargest(K, "s_sup2"))
# 調査の枠の8割を教師あり、残り2割を教師ありで選ばれなかった中の教師なし上位に充てる
k1 = int(K * 0.8)
pick = te.nlargest(k1, "s_sup").index
rest = te.drop(pick).nlargest(K - k1, "s_iso").index
res["枠を分ける"] = report("枠を分ける", te.loc[pick.union(rest)])
print("教師なしの枠 %d件のうち不正 %d件(既知の型 %d件、新しい型 %d件)" % (len(rest),
      te.loc[rest, "fraud"].sum(), (te.loc[rest, "kind"] == "既知の型").sum(), (te.loc[rest, "kind"] == "新しい型").sum()))
| 方法 | 適合率 | 再現率(既知の型) | 再現率(新しい型) | アラートに入った不正の件数(既知の型+新しい型) |
|---|---|---|---|---|
| 教師ありだけ | 0.247 | 0.665 | 0.176 | 138(119+19) |
| Isolation Forest のスコアを教師ありの特徴量に追加 | 0.281 | 0.676 | 0.333 | 157(121+36) |
| 調査の枠を分ける(教師あり8割・教師なし2割) | 0.314 | 0.642 | 0.556 | 175(115+60) |
| (参考)Isolation Forest だけ | 0.332 | 0.592 | 0.731 | 185(106+79) |
特徴量に加える方法では、既知の型の再現率が 0.665 から 0.676、新しい型の再現率が 0.176 から 0.333 に上がりました。新しい型も一部は拾えるようになりましたが、調査の枠を分ける方法の 0.556 には届きませんでした。教師あり学習は、ラベルのある不正を見分けるのに役立つ範囲で教師なしのスコアを使うので、学習の期間に無い型の点数を上げることを、ラベルから直接には学べません。また、この実装では、学習側の教師なしのスコアは、Isolation Forest が学習に使った取引そのものについて計算した値で、評価側は学習に使っていない取引の値です。この違いが、この方法の成績にどう影響したかは切り分けていません。この合成データの1つの例から、特徴量に加える方法が新しい型にどれだけ効くかを一般化することはできません。
調査の枠を分ける方法では、既知の型の再現率は 0.642 で教師ありだけ(0.665)より少し下がり、新しい型の再現率は 0.556、適合率は 0.314 になりました。既知の型が下がったのは、教師ありの上位に充てる件数が558件から446件に減ったためで、教師ありの枠に入った既知の型は119件から112件になり、教師なしの枠で拾った3件と合わせて115件でした。教師なしの枠に充てた112件のうち不正は47件で、その内訳は既知の型が3件、新しい型が44件でした。教師ありのモデルが見ていない範囲を、教師なしのスコアで別に見に行くことで、この合成データでは新しい型の不正の5割あまりを調査に乗せられたことになります。教師なしの枠の適合率は、112件中47件でおよそ 0.42 でした。この値は合成データの作り方に強く依存しており、実際の取引で同じ水準になるとは限りません。
ここで、表の最後の行と比べておきます。この合成データでは、Isolation Forest だけで558件を選んだほうが(適合率 0.332、新しい型の再現率 0.731)、調査の枠を分ける方法(0.314、0.556)より、適合率でも新しい型の再現率でも上回りました。それでも本コラムが、教師なしだけに任せる形ではなく、調査の枠を分ける形を勧めるのには、次の3つの理由があります。
- 既知の型と新しい型で、差の向きが逆です。新しい型では Isolation Forest だけのほうが19件多く(79件と60件)、既知の型では枠を分けたほうが9件多く(115件と106件)拾っています。既知の型の再現率は、枠を分ける方法が 0.642、Isolation Forest だけが 0.592 です。調査の枠の全部を教師なしに任せると、ラベルから学べる既知の型の手がかりを使わないことになります
- どちらの成績も、新しい型の外れ方を大きく作ったこの合成データでの値で、実際の取引での水準は示していません。Isolation Forest だけの適合率の高さも、枠を分けた方法で新しい型の5割あまりを拾えたことも、同じ限定のもとでの結果です
- 教師なしのスコアは外れ方の強さであって不正の疑いではないので、調査の枠の全部を、まして止める判定を、そのスコアだけに任せることは、この章の位置づけ(調査の入口)と合いません
なお、新しい型のラベルが溜まった後に教師ありを学習し直した場合の成績は、この章のデータでは確かめていません。
調査の枠を分ける方法は、調査の運用の設計としても扱いやすい形です。教師なしの枠で見つかった不正は、新しい型の兆しとしてルールの担当とモデルの担当に共有し、ルールで先に対応したうえで、ラベルが溜まった段階で教師あり学習に取り込む、という流れを作れます。教師なしの枠の大きさ(ここでは2割)は、調査の能力と、新しい型の不正への備えをどれだけ重く見るかで決める経営の判断になります。調査の能力としきい値の決め方の詳細は第9章で、新しい手口をルールで先に受け止める流れは第10章で扱います。
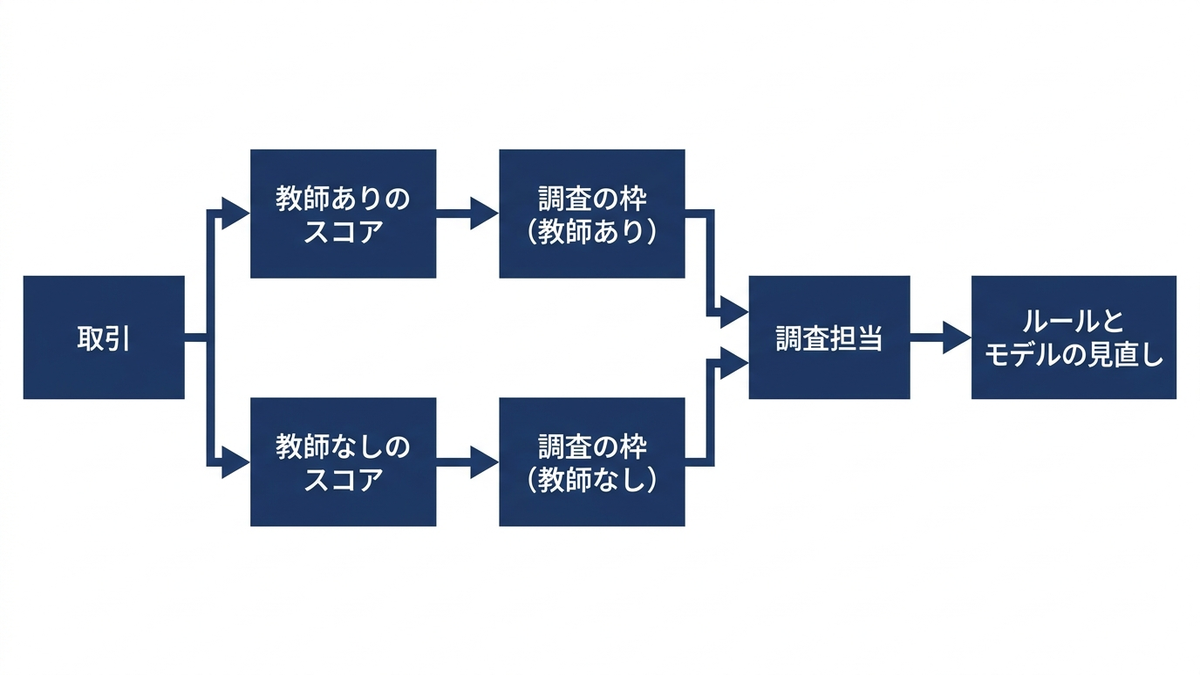
桁の法則(ベンフォードの法則)、会計や経費の点検での使われ方と誤用
教師なしの点検の中でも、会計・経費・請求の数値の点検で使われてきた考え方に、桁の法則(ベンフォードの法則)があります。何桁にもまたがる自然な数値の集まりでは、先頭の桁が1である数が最も多く、9である数が最も少ない、という経験則です。先頭の桁が \(d\) である割合は \(P(d)=\log_{10}(1+1/d)\) で表され、言葉で言い換えると、先頭が1の数はおよそ30.1%、2はおよそ17.6%、9はおよそ4.6%になります。この偏りは、1881年に Newcomb が American Journal of Mathematics 誌の報告で指摘しており、のちに Benford の名で広く知られるようになりました。
不正の点検への応用では、Nigrini の仕事がよく知られています。Nigrini は1996年に米国の課税の学会誌(Journal of the American Taxation Association 第18巻第1号)で、納税の申告の点検にこの法則を応用する論文を発表しました。2012年に Wiley から出た Nigrini の著書は、版元の紹介によれば、ベンフォードの法則を使った監査と不正の点検の方法と、その応用例を扱っています。人が作った数値や書き換えた数値は、先頭の桁が期待される分布から外れることがある、というのが点検に使う理由です。
次のコードでは、架空の数値を3種類作り、先頭の桁の分布を法則と比べました。1つ目は何桁にもまたがる額(対数正規分布)、2つ目は幅の狭い額(平均500・標準偏差60の正規分布)、3つ目は100から999までの一様な数(人が均等に作った数の代わりとして使う)です。額はいずれも単位の無い相対値です。法則との差は、9つの桁の割合の差の絶対値の平均(平均絶対偏差)で表しました。
# ===== ブロック6:先頭の桁の分布(ベンフォードの法則)=====
r2 = np.random.default_rng(20261112)
benford = np.log10(1 + 1 / np.arange(1, 10))
sets = {
    "桁にまたがる額": r2.lognormal(3.0, 1.5, 5000),       # 何桁にもまたがる
    "幅の狭い額": r2.normal(500, 60, 5000),               # 1桁の範囲に集中
    "一様に作った数": r2.uniform(100, 999, 5000),          # 人が均等に作った数の代わり
}
def first_digit(x):
    x = np.abs(x[x > 0])
    return (x / 10 ** np.floor(np.log10(x))).astype(int)
print("桁  法則の割合  " + "  ".join(sets))
obs = {k: np.bincount(first_digit(v), minlength=10)[1:10] / len(v) for k, v in sets.items()}
for d in range(9):
    print("%d   %.3f      " % (d + 1, benford[d]) + "  ".join("%.3f" % obs[k][d] for k in sets))
for k in sets:
    mad = np.abs(obs[k] - benford).mean()            # 平均絶対偏差
    print("%s の平均絶対偏差 %.4f" % (k, mad))
| 先頭の桁 | 法則の割合 | 桁にまたがる額 | 幅の狭い額 | 一様に作った数 |
|---|---|---|---|---|
| 1 | 0.301 | 0.300 | 0.000 | 0.115 |
| 2 | 0.176 | 0.173 | 0.000 | 0.101 |
| 3 | 0.125 | 0.126 | 0.048 | 0.114 |
| 4 | 0.097 | 0.096 | 0.456 | 0.113 |
| 5 | 0.079 | 0.084 | 0.450 | 0.106 |
| 6 | 0.067 | 0.063 | 0.045 | 0.121 |
| 7 | 0.058 | 0.061 | 0.001 | 0.117 |
| 8 | 0.051 | 0.049 | 0.000 | 0.104 |
| 9 | 0.046 | 0.049 | 0.000 | 0.110 |
| 平均絶対偏差 | 0.0025 | 0.1621 | 0.0606 |
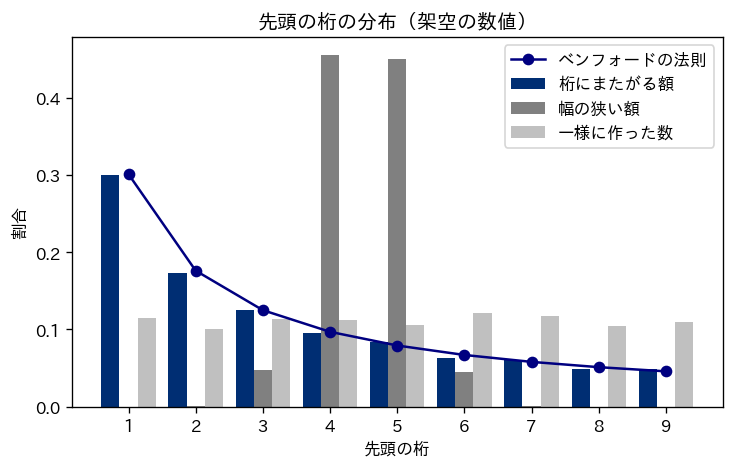
何桁にもまたがる額は、法則の割合とほぼ一致し、平均絶対偏差は 0.0025 でした。一様に作った数は、どの桁もおよそ1割ずつになり、平均絶対偏差は 0.0606 です。注意したいのは、幅の狭い額です。この額はすべて正当な値として作ったものですが、先頭の桁は4と5に集中し、平均絶対偏差は 0.1621 と、一様に作った数よりも大きく法則から外れました。この例のように、数値の範囲の制約や数値の作られ方によっては、不正が無くても法則から大きく外れます。
この結果から、桁の法則を点検に使う前に確かめるべきことが分かります。1つは、対象の数値にこの分布を期待できる根拠があるかです。何桁にもまたがっていることだけでは法則が成り立つとは限らず、範囲の狭い数値や、上限・下限の決まった数値(決まった範囲の手数料や、上限のある精算の額)は、正当な値でも法則から外れることがあります。桁の数だけで使えるかどうかを決めず、過去の正当な数値で分布を確かめてから使うのが安全です。もう1つは、数値が人に割り当てられた番号ではないことです。伝票の番号や商品の番号は、先頭の桁に意味がありません。さらに、法則からの外れは、集まり全体についての兆しであり、どの1件が不正かは教えてくれません。外れが見つかったら、その集まり(特定の取引先、特定の担当者、特定の期間)を絞り込み、個別の伝票を調べる入口として使います。桁の法則は、取引ごとのリアルタイムの判定ではなく、会計・経費・請求の事後の点検の道具として位置づけるのが妥当です。
教師なしの検知の評価、ラベルが無いと成績が測れない
教師なしの異常検知の最大の難しさは、成績を測りにくいことです。ラベルが無い場面で使うための手法なので、そもそも「上位に挙がった取引のうち何件が不正だったか」を計算するためのラベルが手元に無いことが多くなります。この章の比較でも、適合率と再現率を計算できたのは、合成データなので全ての取引の正解を知っていたからです。実際の取引では、教師なしの検知の成績は、調査の結果を通してしか分かりません。
ラベルが少ない場面での評価の方法は、次の表のように整理できます。どの方法にも偏りがあるので、1つだけで判断せず、組み合わせて使うことが必要です。
| 評価の方法 | 何が分かるか | 偏り・限界 |
|---|---|---|
| 上位の取引を調査担当が確認する | 上位 K 件の適合率(アラートのうち不正だった割合) | 上位に挙がらなかった取引の中の不正(見逃し)は分からない。調べた取引だけがラベルになるため、どの枠から来た取引かを分けて記録する必要がある。調査担当の判断にもばらつきがある |
| 過去に確定した不正が上位に入るかを確かめる | 既知の型の不正に対する再現率の目安 | 新しい型をどれだけ拾えるかは分からない。過去の不正は検知された不正に偏っている |
| 無作為に選んだ取引を調査する | 全体の不正の割合と、上位に挙がらなかった取引の中の不正の目安 | 不正の割合が小さいと、必要な調査の件数が多くなる |
| 遅れて届くラベル(本人の申告・チャージバック)と突き合わせる | 時間がたってから、見逃しを含めた成績 | 確定までの遅れがある。申告されない不正は残る |
| 上位の取引の外れ方の理由を分類する | 正当な理由で外れている取引の型(旅行・機種変更など)と、その割合 | 不正かどうかの判定そのものにはならない |
このうち最も現実的なのは、上位の取引を調査し、その結果を記録として残していく方法です。教師なしの枠で調べた取引の結果は、そのまま教師あり学習のラベルになります。新しい型の不正が見つかればラベルとして溜まり、正当だった取引はその外れ方の型として記録されます。教師なしの検知を入れることは、ラベルの無い範囲に調査の目を向け、ラベルを作り始める仕組みを入れることでもあります。第2章で扱ったとおり、止めた取引や調査しなかった取引には真のラベルが分からないまま残るものがあるので、教師なしの枠で調べた取引は、どの枠から来たものかを記録に残しておく必要があります。枠ごとに分けて記録しないと、後から成績を計算するときに、選ばれ方の違う取引が混ざってしまいます。評価の指標と評価データの切り方の詳細は、第8章で扱います。
もう1つ注意したいのは、教師なしの手法の設定(Isolation Forest の木の数や標本の数、局所外れ値因子の近くの件数 k)を、評価の結果を見ながら選ぶ場合です。ラベルの少ないデータで設定を何度も選び直すと、たまたまそのラベルに合う設定を選ぶことになりやすく、新しい期間では成績が下がることがあります。設定を選ぶのに使った期間と、成績を確かめる期間は分けておく必要があります。
経営の判断、教師なしの検知を調査の入口として位置づける
教師なしの異常検知について経営が決めるべきことは、その出力を何に使うかです。本コラムの考えは、教師なしのスコアは調査の入口として使い、単独で取引を止める判定には使わない、というものです。この章の架空データでも、Isolation Forest の上位1%に入った558件のうち373件は正当な取引でした。教師なしのスコアだけで拒否すれば、このような珍しいが正当な取引を止めることになり、誤検知による機会損失と顧客の離反を生みます。教師なしのスコアを使った措置は、拒否ではなく、事後の調査か、保留(追加の認証や確認を求める)に留めるのが妥当だと考えています。ただし、保留にも正当な取引を遅らせ、途中でやめさせる負担があるので、保留を含め、正当な取引への影響を確かめたうえで措置を決める必要があります。
教師なしの検知を位置づけるときの判断は、次の表のように整理できます。
| 使い方 | 向いている条件 | 措置の上限 | 避けたい損失の型 |
|---|---|---|---|
| 調査の枠の一部に充てる | 教師ありのモデルがあり、新しい型への備えを持ちたい | 事後の調査 | 見逃しによる被害、形骸化 |
| 教師ありの特徴量に加える | 既知の型の見分けを補いたい | 教師ありのモデルの措置に従う | 見逃しによる被害 |
| ラベルが溜まるまでの検知の中心にする | 新しい事業や経路で、ラベルがほとんど無い | 保留・事後の調査 | 見逃しによる被害、調査の過負荷 |
| 会計・経費・請求の事後の点検(桁の法則など) | 数値が何桁にもまたがり、集まりごとに点検できる | 事後の調査 | 見逃しによる被害(社内の不正を含む) |
| 単独で拒否の判定に使う | 本コラムでは勧めない | 誤検知による機会損失、顧客の離反 |
予算と体制の面では、教師なしの検知は、モデルを作る費用だけでなく、上位の取引を調べる調査の体制にも継続的な費用がかかる仕組みです。教師なしの枠を作るなら、その枠を見る調査の人員を最初から確保する必要があります。枠だけ作って人員を付けなければ、アラートは見られないまま流れ、調査の過負荷という損失の型になります。逆に、枠の大きさを決めておけば、教師なしの検知が増やす調査の量は、その枠の範囲に収まります。
KPI としては、教師なしの枠の件数・適合率・そこで見つかった新しい型の数・その型がルールやモデルに取り込まれるまでの日数を、教師ありの枠とは分けて見ることが考えられます。教師なしの枠を、教師ありの枠と同じ適合率の基準だけで比べ、低い時期に「成績が悪い」と枠を削ると、新しい型への備えがなくなります。教師ありでは見つからなかった型をどれだけ早く見つけたかは、この枠の働きを見る活動の指標として追います。成果そのものは、他の枠と同じく、その後の措置で防いだ不正と、誤って止めた正当な取引の両方を数えて評価します。
この章では、教師なしの異常検知が、ラベルの無い新しい型の不正を外れ方から拾える場合がある一方で、珍しいが正当な取引も多く拾うことを、架空データで確かめました。本コラムの架空データでは、教師ありのモデルは学習に無かった新しい型を2割弱しか拾えず、Isolation Forest はそれだけで新しい型の約7割を拾いました。ただし、これは新しい型の外れ方を大きく作った合成データでの結果です。本コラムでは、既知の型を拾う力のある教師ありを主にし、調査の枠の一部を教師なしに充てる形を勧めます。この例では枠の2割を充てることで、既知の型の再現率の下がりを小さく抑えながら(0.665 から 0.642)、新しい型の5割あまりを調査に乗せられました。教師なしのスコアは「普段からの外れ方」であって「不正の疑い」ではないので、調査の入口として使うのが妥当です。次の第7章では、1件ずつの取引の外れ方では見えない不正を、口座・端末・住所のつながりから見るネットワーク分析を扱います。
この章を深めたい方への参考書籍
『入門 機械学習による異常検知 Rによる実践ガイド』(井手剛 著、コロナ社):正規分布に従うデータ・従わないデータからの異常検知、性能評価の方法、不要な次元を含むデータ、時系列データの異常検知を、R のコードとともに順に扱った入門書です。この章で扱った統計的な外れ値の考え方を、分布の仮定から手を動かしながら確かめるのに向いています。性能評価の章は、ラベルが少ない場面での評価を考えるときの参考になります。
『異常検知と変化検知』(井手剛・杉山将 著、講談社):機械学習プロフェッショナルシリーズの1冊で、ホテリングの T2 法、近傍法、混合分布、サポートベクトルデータ記述法、密度比推定などによる異常検知と変化検知を、数式で体系的に整理しています。この章の手法の比較の背景にある考え方を、もう一段深く理解したい読者に向いています。手口の変化に関わる変化検知も含むため、第10章の内容とのつながりもあります。
第7章 つながりで見る不正、口座・端末・住所のネットワーク分析
第6章では、ラベルの無い不正を、取引の外れ方から探す教師なしの異常検知を扱いました。第3章から第6章までの方法は、どれも1件の取引や1人の顧客を単位にして、その取引が普段と違うか、過去の不正に似ているかを見るものでした。この章では単位を変え、口座・端末・住所・電話番号のあいだの「つながり」から不正を探すネットワーク分析を扱います。
この章で扱うのは次の内容です。後半は、架空の申込の記録(会員約2万人・180日)を使い、実行したコードと結果で確かめます。
- 1件ずつ見ても分からない不正の型と、つながりで見ると何が分かるか
- 何を点にし、何を線にするか(顧客・口座・端末・住所・電話番号・受取口座)
- 連結成分・共有の数・中心性・コミュニティ検出の使いどころ
- つながりの特徴量を教師あり学習に足したときの成績の変化と、判定の時点の管理
- 多くの人が使う端末や回線が作る巨大な成分と、名寄せの難しさ
- 送金のネットワークと、グラフニューラルネットワークの考え方
- 家族や事業所による正当な共有を誤って疑う危険と、調査での使い方
この章の主張は、1件ずつの特徴量では見えない不正の一部が、端末や連絡先の共有を通したつながりとして見えるようになり、その効き目は「同じものを指している記録を同じ点にまとめる」名寄せのデータの質に大きく左右されると考えられる、という点です(本コラムのコードで確かめたのは、共用の識別子の扱いと判定の時点の管理までで、名寄せの誤りを入れた実験はしていません)。もう1つの主張は、つながりは疑いを広げる道具でもあるので、共有しているという事実だけで止める判定に使わず、調査担当がつながりを確かめる材料として渡すのがよい、ということです。
1件ずつ見ても分からない不正、集団・名義の繰り返し・資金の移動の連鎖
第3章のルールや第4章の教師あり学習は、取引1件ごと、あるいは顧客1人ごとに、その記録が不正らしいかを判定します。第5章の特徴量も、多くは「この顧客の普段と比べてどうか」という、1人の顧客の中での比較でした。この見方は、他人のカードを使った決済や、乗っ取ったアカウントでの普段と違う操作のように、1人の顧客の記録の中に変化が現れる不正には向いています。一方で、1件ずつ見ると普通に見えるのに、複数の記録を並べると不自然さが現れる不正があります。
1つ目は、同じ集団が複数の名義で申込や取引を行う型です。1件ごとの申込の内容(年齢・職業・利用枠の希望など)は正当な申込と区別がつかなくても、複数の申込が同じ端末から送られている、同じ電話番号を連絡先にしている、といった共有が見つかることがあります。2つ目は、名義を変えた繰り返しです。一度止められた者が、別の名義で同じ端末や同じ受取口座を使って申込み直す場合、名義は新しくても、端末や受取口座は過去の記録とつながっています。3つ目は、資金の移動の連鎖です。不正に得た資金が複数の口座を経由して移される場合、1つの口座の入出金だけを見ても、その口座が連鎖の途中にあることは分かりにくく、口座どうしの送金をたどって初めて形が見えます。資金の移動の型については、この章の後半で公的機関の公表資料の範囲で触れます。
3つに共通するのは、手がかりが1件の記録の中ではなく、記録と記録の「あいだ」にあることです。この「あいだ」を扱うのがネットワーク分析です。ネットワーク分析では、顧客や端末を点(ノード)、点と点の関係を線(エッジ)として表し、点がどうつながっているかを調べます。数学ではこの点と線の集まりをグラフと呼びます(棒グラフや折れ線グラフのグラフとは別の意味です)。不正検知では、つながりそのものを調査担当が見る材料にする使い方と、つながりから計算した数(共有している人数・つながっている集まりの大きさなど)を第4章の教師あり学習の特徴量に足す使い方の、2つが中心になります。
反対に、ネットワーク分析が役に立たない不正もあります。単独で行われ、端末も連絡先も他の誰とも共有しない不正は、つながりの上では普通の顧客と同じに見えます。この章の後半の架空データでも、共有を持たない単独の不正には、つながりの特徴量がほとんど効かないことを確かめます。この型は、第3章から第6章の1件ずつの方法と、調査の結果を学習に戻す流れで補う必要があります。ネットワーク分析は第3章から第6章の方法を置き換えるものではなく、1件ずつの判定では見えない部分を補う方法として位置づけるのがよいと考えています。
何を点と線にするかと、つながりから取り出す数(連結成分・共有の数・中心性・コミュニティ検出)
ネットワーク分析で最初に決めるのは、何を点にし、何を線にするかです。この決め方で、見えるつながりが変わります。不正検知でよく使われるのは、顧客(会員・名義)や口座を1種類目の点にし、端末・住所・電話番号・メールアドレス・受取口座のような「識別子」を2種類目の点にする形です。線は、顧客がその識別子を使ったときに、顧客と識別子のあいだに引きます。2種類の点のあいだにだけ線が引かれるこの形を、2部グラフと呼びます。例えば、会員Aと会員Bが同じ端末から申し込んでいれば、会員A、端末、会員Bの順に線でつながり、AとBは端末を介して「2歩」の距離にあることになります。
もう1つの形は、顧客どうし、口座どうしを直接線で結ぶものです。送金の記録なら、送金元の口座から送金先の口座へ、向きのある線を引きます。共有の関係から作る場合も、「同じ端末を使った会員どうし」を直接結ぶことができます。ただし、1つの端末を多くの会員が使っていると、その会員どうしをすべて結ぶ線の数が人数の2乗に近い速さで増えます。識別子を点として残す2部グラフの形なら、線の数は異なる「会員と識別子の組」の数で済み(同じ会員が同じ端末を何度使っても線は1本です)、どの識別子でつながったのかも後から読めるので、調査の材料としても扱いやすくなります。この章のコードも2部グラフの形にしました。
点と線の候補を次の表にまとめます。どれを使えるかは、自社の記録に何が残っているか(第2章)と、その情報を不正検知に使うことが利用目的の範囲に入っているか(第14章)で決まります。
| 点にするもの | 線を引く条件 | 見えやすい不正の型 | 正当な共有の例 | 注意点 |
|---|---|---|---|---|
| 端末(端末の識別子) | 同じ端末から申込・ログイン・取引をした | 1つの端末から複数の名義で申し込む集団、止められた後の別名義での申込み直し | 家族の共用の端末、店頭や事業所の共用の端末 | 端末の識別子の取り方で、同じ端末が別物に見えたり、別の端末が同じに見えたりする |
| 電話番号 | 同じ番号を連絡先として登録した | 連絡先をまとめて管理する集団 | 事業所の代表番号、家族の固定電話 | 番号は解約の後に別の人へ割り当てられることがあり、古い共有が別人どうしをつなぐ |
| 住所 | 同じ住所を登録した | 同じ住所に多くの名義が集まる申込 | 世帯、集合住宅、社員寮、事業所 | 表記の揺れ(番地の書き方・建物名の有無)で同じ住所が別物に見える |
| メールアドレス | 同じアドレス、または同じ規則で作られたアドレスを登録した | 多数の会員登録を行う集団 | 家族で1つのアドレスを使う | 規則の似たアドレスを結ぶと、無関係な人まで結びやすい |
| 受取口座・送金先 | 同じ口座へ出金・送金した | 複数の名義で得た資金を1つの口座に集める型 | 家族への仕送り、取引先への支払い | 自社の外の口座は、名義を確かめられないことが多い |
| 口座どうし(送金) | 送金元から送金先へ向きのある線を引く | 資金が複数の口座を経由して移る型 | 給与の振込、事業の支払い | 自社が扱った送金の相手先は分かっても、他社の口座に移った後の資金の動きは自社の記録だけでは追えない |
線にはもう1つ、いつ引かれたかという情報があります。会員Aが1月に使った端末を、会員Bが6月に使ったとき、この2人を同じようにつなぐかどうかは、目的によって変わります。端末の使い回しを探すなら半年の間隔でもつなぐ意味がありますが、中古の端末の譲渡のように、時間を置いた共有は正当な場合も多くなります。線に日付を持たせておき、「直近90日の共有だけでつなぐ」のように分析のたびに選べるようにしておくと、後から見直しやすくなります。この日付は、後で説明する判定の時点の管理にも必要です。
点と線を作ったら、そのつながりから数を取り出します。最も基本になるのは連結成分です。連結成分は、線をたどって互いに行き来できる点の集まりのことで、どの集まりにも属さない点は、それだけで大きさ1の連結成分になります。同じ端末や電話番号で直接・間接につながっている会員は、同じ連結成分に入ります。連結成分は計算が速く、結果の意味も「線をたどって行き来できる範囲」と説明しやすいので、つながりの分析の最初の一歩に向いています。
連結成分の次によく使うのが、共有の数です。共有の数は、ある会員が使った端末を他に何人が使っているか、登録した電話番号を他に何人が登録しているか、という数で、識別子の種類ごとに分けて数えます。種類ごとに分けるのは、住所の共有は世帯では当たり前に起きる一方、電話番号の共有は世帯では起きにくい、というように、種類によって正当な共有の起きやすさが違うためです。さらに、連結成分の中に、すでに不正と確定した会員が何人いるか(既知の不正と同じ成分に入っているか)も、よく使われる数です。
中心性は、つながりの中でその点がどれだけ「要の位置」にあるかを表す数の総称です。線の数そのもの(次数)、他の点どうしを結ぶ最短の経路の上にどれだけ乗っているか(媒介中心性)などがあります。送金のネットワークで、多くの口座から資金を受けて別の多くの口座へ流す口座は、媒介中心性が高くなりやすく、連鎖の要の候補として調べる価値があります。コミュニティ検出は、つながりの密な点の集まりを見つける方法です。連結成分は線が1本でもあれば1つの集まりにしてしまうので、大きな成分の中に、密につながった小さな集まりが複数含まれていることがあります。コミュニティ検出は、その大きな成分を、内側のつながりが密で外側とのつながりが疎な集まりに分けます。
連結成分・共有の数・既知の不正と同じ成分にいるか・中心性・コミュニティ検出の5つの使いどころを、次の表にまとめます。
| つながりから取り出す数 | 何が分かるか | 計算の重さ | 苦手な場面 | 検知と調査での使い方 |
|---|---|---|---|---|
| 連結成分の大きさ | 線をたどって行き来できる会員の人数 | 軽い。点と線の数に比例する程度 | 多くの人が使う識別子が1つあるだけで、無関係な人が1つの巨大な成分にまとまる | 特徴量。調査で「同じ成分の会員」を一覧にする |
| 共有の数(識別子の種類別) | 同じ端末・電話番号・住所を使う他の会員の人数 | 軽い | 世帯や事業所の正当な共有でも大きくなる | 特徴量。種類ごとに分けて使う |
| 既知の不正と同じ成分にいるか | 確定した不正とつながっているか | 軽い。ただし判定の時点で確定していたラベルだけを数える必要がある | ラベルの遅れの間は効かない。正当な会員が不正な会員と住所を共有しているだけでも1以上になる | 特徴量。調査の優先順位 |
| 中心性(次数・媒介中心性など) | つながりの中で要の位置にある点 | 媒介中心性は重い。大きなネットワークでは近似を使う | 正当な取引の集まる口座(給与の支払いの元など)も高くなる | 送金のネットワークで調べる口座の候補を出す |
| コミュニティ検出 | 大きな成分の中の、密につながった集まり | 中程度。手法と設定で結果が変わる | 乱数や設定で分け方が変わり、説明が難しい | 巨大な成分を調査できる大きさに分ける |
コミュニティ検出の手法の例として、ネットワークの分け方の良さを表す数(モジュラリティ。集まりの内側の線が、偶然に期待されるより多いほど大きくなる値)を大きくするように点をまとめていく Blondel らの2008年の論文の方法(ルーヴァン法と呼ばれます)があり、本コラムのコードで使った networkx にも、この方法を実装した関数があります。ただし、コミュニティ検出の結果は乱数のシードや設定で変わることがあり、「なぜこの会員とこの会員が同じ集まりなのか」を調査担当や顧客に説明するのは、連結成分より難しくなります。本コラムでは、説明しやすい連結成分と共有の数を先に使い、巨大な成分を分けたいときにコミュニティ検出を足す順番がよいと考えています。
架空の申込の記録で、連結成分と共用の識別子の影響を調べる
ここからは、つながりの分析を架空のデータで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の申込の記録よりずっと単純です。合成データでの成績は、実際の記録での成績の目安にはなりません。申込の記録は、会員1人につき1件の申込で、180日のうちのどこかの日に申し込み、端末・電話番号・住所の3つの識別子を登録する、という形にしました。識別子の名前は「D00012」「P00034」のような記号で、実在の端末や番号とは関係ありません。次の性質を持たせています。
- 正当な会員2万人。うち約8,000人は2〜5人の世帯に分かれて住所を共有し、世帯の3割は端末も共有する
- 正当な会員の一部(約600人)は3〜8人の事業所に分かれ、代表の電話番号と住所を共有する
- 3台の共用の端末を、それぞれ無作為に選んだ80人の正当な会員が使う(店頭や事業所の共用の端末を想定)
- 不正な集団が20組。1組3〜10人で、最大90日にわたって申込が続く。組ごとに共有する端末と電話番号の候補を各1〜2個用意し、各会員は端末を8割、電話番号を6割の確率でその候補から選び、残りは自分だけの識別子を使う。住所は3割が組で共有する住所、残りは自分だけの住所で、さらに組の会員の1割は正当な会員の住所と同じ住所を登録する
- 単独の不正が45人。どの集団にも属さず、原則として自分だけの識別子を使う(ただし1割は共用の端末を使う)
- 1件の申込そのものの特徴量は3つだけ(利用の希望の額の相対値・深夜の申込か・登録の地域と接続の地域の食い違い)。不正に多い特徴だが正当な申込にも現れ、区別する力は弱くしてある
- 不正のラベルは、申込から10〜45日後に確定する
正当な会員の中に、世帯・事業所・共用の端末という3種類の正当な共有を入れたのは、実際の記録でも、共有の多くは正当な理由によるものだと考えられるからです。共有があれば不正、という単純な規則が成り立たないデータにしておかないと、つながりの効き目を過大に見せてしまいます。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261112)
rows = []
def add(day, dev, phone, addr, fraud, kind):
    rows.append(dict(day=int(min(day, 179)), dev=dev, phone=phone,
                     addr=addr, fraud=fraud, kind=kind))

N = 20000                                   # 正当な会員
legit_dev = [f"D{i:05d}" for i in range(N)]
legit_addr = [f"A{i:05d}" for i in range(N)]
legit_phone = [f"P{i:05d}" for i in range(N)]
order = rng.permutation(N)
pos = 0
while pos < 8000:                           # 世帯:住所を共有し、3割は端末も共有
    size = int(rng.integers(2, 6))
    members = order[pos:pos + size]
    share_dev = rng.random() < 0.3
    for m in members[1:]:
        legit_addr[m] = legit_addr[members[0]]
        if share_dev:
            legit_dev[m] = legit_dev[members[0]]
    pos += size
while pos < 8600:                           # 事業所:代表の電話番号と住所を共有
    size = int(rng.integers(3, 9))
    members = order[pos:pos + size]
    for m in members[1:]:
        legit_phone[m] = legit_phone[members[0]]
        legit_addr[m] = legit_addr[members[0]]
    pos += size
for k in range(3):                          # 多くの人が使う共用の端末
    for m in rng.choice(N, 80, replace=False):
        legit_dev[m] = f"D_PUB{k}"
for i in range(N):
    add(rng.integers(0, 180), legit_dev[i], legit_phone[i], legit_addr[i], 0, "正当")
続いて、不正な集団と単独の不正を加え、1件の申込の特徴量とラベルの確定日を付けます。
for r in range(20):                         # 端末や連絡先を共有する少数の集団
    size, start = int(rng.integers(3, 11)), int(rng.integers(0, 120))
    devs = [f"DR{r}_{j}" for j in range(int(rng.integers(1, 3)))]
    phones = [f"PR{r}_{j}" for j in range(int(rng.integers(1, 3)))]
    for j in range(size):
        dev = rng.choice(devs) if rng.random() < 0.8 else f"DR{r}_x{j}"
        phone = rng.choice(phones) if rng.random() < 0.6 else f"PR{r}_x{j}"
        addr = f"AR{r}" if rng.random() < 0.3 else f"AR{r}_x{j}"
        if rng.random() < 0.1:              # 正当な会員と同じ住所が使われる
            addr = legit_addr[int(rng.integers(0, N))]
        add(start + rng.integers(0, 90), dev, phone, addr, 1, "集団")
for j in range(45):              # 単独の不正(原則は自分だけの識別子、1割は共用の端末)
    dev = f"D_PUB{j % 3}" if rng.random() < 0.1 else f"DS{j}"
    add(rng.integers(0, 180), dev, f"PS{j}", f"AS{j}", 1, "単独")

df = (pd.DataFrame(rows).sample(frac=1, random_state=0)        # 同じ日の中の順番は無作為
      .sort_values("day", kind="stable").reset_index(drop=True))
df["uid"] = [f"U{i:05d}" for i in range(len(df))]
n = len(df)
df["amount"] = rng.lognormal(0.0 + 0.5 * df["fraud"], 0.6, n)    # 相対値
df["night"] = (rng.random(n) < np.where(df["fraud"] == 1, 0.25, 0.08)).astype(int)
df["mismatch"] = (rng.random(n) < np.where(df["fraud"] == 1, 0.15, 0.04)).astype(int)
df["confirm_day"] = df["day"] + rng.integers(10, 46, n)          # ラベルが確定する日
print("申込の件数", n, "不正", int(df["fraud"].sum()),
      "不正の割合 %.2f%%" % (100 * df["fraud"].mean()))
print(df["kind"].value_counts().to_string())
実行した結果、申込は20,169件、うち不正は169件(0.84%)でした。内訳は、集団の不正が124件、単独の不正が45件です。単独の不正を入れたのは、つながりの分析では拾えない不正があることを確かめ、他の方式で補う必要を示すためです。
次に、会員と識別子を点、登録を線にした2部グラフを networkx(本コラムの実行環境では 3.6.1)で作り、連結成分を取ります。ここで、共用の識別子を外す前と後を比べます。外す基準は、20人より多くの会員が使っている識別子としました。この20人は、この合成データの共用の端末(1台80人)と世帯・事業所(最大8人)のあいだに置いた説明用の値で、実際の運用で使う値ではありません。実際の基準は自社の記録の分布から決めるもので、ルールやしきい値の詳細と同じく、外に出さない情報として扱うのがよいと考えています(第10章)。
import networkx as nx

G = nx.Graph()
for r in df.itertuples():
    for col in ("dev", "phone", "addr"):
        G.add_edge(r.uid, f"{col}:{getattr(r, col)}")

def components_of_accounts(graph):
    out = {}
    for k, comp in enumerate(nx.connected_components(graph)):
        for node in comp:
            if node.startswith("U"):
                out[node] = k
    return out

HUB = 20         # 共用とみなして外す人数。合成データに合わせた説明用の値
hubs = [v for v in G if (not v.startswith("U")) & (G.degree(v) > HUB)]
for label, graph in (("外す前", G), ("外した後", G.subgraph(set(G) - set(hubs)))):
    comp = pd.Series(components_of_accounts(graph))
    size = comp.map(comp.value_counts())
    print(f"共用の識別子を{label}:成分の数 {comp.nunique()}  最大の成分 {size.max()}人")
print("外した識別子", sorted(hubs))
comp = pd.Series(components_of_accounts(G.subgraph(set(G) - set(hubs))))
df["comp_size_final"] = df["uid"].map(comp.map(comp.value_counts()))
bins = pd.cut(df["comp_size_final"], [0, 1, 3, 9, 1000],
              labels=["1人", "2〜3人", "4〜9人", "10人以上"])
print(df.groupby(bins, observed=False)["fraud"].agg(["size", "sum", "mean"]).round(4))
print(df.groupby("kind")["comp_size_final"].apply(lambda s: (s >= 2).mean()).round(3))
結果を次の表にまとめます。
| 集計 | 共用の識別子を外す前 | 共用の識別子を外した後 |
|---|---|---|
| 連結成分の数(会員を含むもの) | 13,623 | 13,859 |
| 最大の連結成分の会員数 | 205人 | 21人 |
| 外した識別子 | なし | 共用の端末3台 |
共用の端末3台を残したままだと、その端末を使った会員と、その会員の世帯や事業所の会員が1つにつながり、205人の巨大な成分ができました。3台を外すと最大の成分は21人まで小さくなりました。このデータでは共用の端末を3台と分かって入れているので、外す基準を決めるのは簡単でしたが、実際の記録では、どの識別子が共用なのかは分かっていません。この点は後の節で扱います。
共用の識別子を外した後の連結成分の大きさごとに、不正の割合を数えると次のとおりでした。
| 連結成分の大きさ | 会員の数 | うち不正 | 不正の割合 |
|---|---|---|---|
| 1人 | 11,440 | 49 | 0.43% |
| 2〜3人 | 2,951 | 18 | 0.61% |
| 4〜9人 | 5,695 | 56 | 0.98% |
| 10人以上 | 83 | 46 | 55.42% |
このデータでは、成分が大きいほど不正の割合が高くなり、10人以上の成分では会員の半分以上が不正でした。一方で、4〜9人の成分には正当な会員が5千人以上いて、不正の割合は1%に届きません。世帯や事業所も4〜9人の成分を作るためです。成分の大きさは手がかりになりますが、それだけで不正と正当を分けることはできません。また、2人以上の成分に入っていた会員の割合は、集団の不正で96.8%、正当な会員で43.0%、単独の不正で0%でした。単独の不正は、つながりの上では1人きりの正当な会員と同じに見えます。
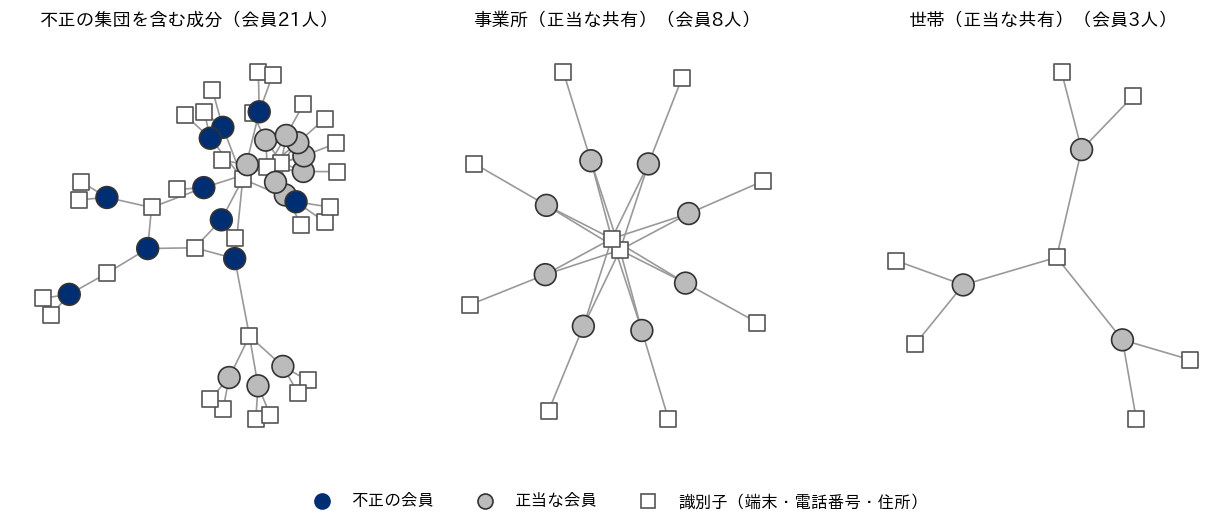
上の図は、このデータから3つの連結成分を取り出して描いたものです。丸が会員(濃い色が不正、灰色が正当)、四角が識別子です。左の成分は会員21人のうち10人が不正で、残りの11人は正当な会員でした。正当な会員がこの成分に入ったのは、集団の会員2人が、正当な会員と同じ住所を登録していたためです(1つの住所は正当な会員8人と、もう1つの住所は正当な会員3人と共有されていました)。連結成分は、線を1本たどれば同じ集まりに入れるので、不正な集団の近くにいる正当な会員も、同じ成分にまとめてしまいます。中央の事業所の成分と右の世帯の成分は、どちらも正当な共有だけでできています。事業所の成分は、代表の電話番号と住所に8人がつながる形です。この図では左の成分と形が違って見えますが、1台の端末を複数の名義で使い回す集団も、1つの識別子に多くの会員がつながる形になりうるので、形だけで正当か不正かを決めることはできないと考えています。
判定の時点で使えた情報だけでつながりの特徴量を作り、成績の変化を見る
前の節の集計は、180日の最後の時点のつながりを使ったものでした。しかし、実際の判定は申込の時点で行います。その時点では、まだ申し込んでいない会員の端末や電話番号は記録に無く、まだ確定していない不正のラベルも使えません。第5章で扱ったリーク(情報の漏れ)は、つながりの特徴量でも起きます。とくに「既知の不正と同じ成分にいるか」は、ラベルの遅れを無視して、判定の時点で確定していなかったラベルまで数えると、成績が良く見える誤りになります。
そこで、申込を起きた順に1件ずつ足しながらつながりを作り、各申込について、その申込までの記録だけで次の5つの特徴量を作りました。同じ日の申込どうしも、先に来た申込は後から来た申込を数えません(同じ日の中の順番は無作為に決めました)。
- 端末の共有の数:同じ端末を、その申込より前に使った他の会員の人数
- 電話番号の共有の数:同じ電話番号を、その申込より前に登録した他の会員の人数
- 住所の共有の数:同じ住所を、その申込より前に登録した他の会員の人数
- 成分の大きさ:その時点のつながりで、共用の識別子を通らずにたどれる会員の人数(本人を含む)
- 既知の不正の数:同じ成分の中で、申込の日より前にラベルが確定していた不正の会員の人数
共用の識別子も、その時点までに基準の人数を超えたものだけを外します。最後の時点では共用と分かる端末も、使い始めの頃はまだ利用者が少なく、外す対象になりません。共用の扱いが定まらないこうした期間や、外した識別子のつながりは、この方法では見えにくくなるので、1件ずつの特徴量(第4章から第6章)と無作為の点検(第10章)で補う前提で使います。コードの最後の確認用の集計(特徴量には使いません)は、既知の不正が0人だった集団の会員が、まだラベルの確定していない不正とつながっていたのか、どの不正ともつながっていなかったのかを数えるものです。
def accounts_reachable(graph, start, hubs):
    seen, stack = {start}, [start]            # 共用の識別子は通らずにたどる
    while stack:
        for v in graph[stack.pop()]:
            if (v not in seen) & (v not in hubs):
                seen.add(v)
                stack.append(v)
    return [v for v in seen if v.startswith("U")]

conf = dict(zip(df.loc[df["fraud"] == 1, "uid"], df.loc[df["fraud"] == 1, "confirm_day"]))
G, hubs, feat = nx.Graph(), set(), []
for r in df.itertuples():                     # 申込の順に1件ずつ足し、それまでの記録だけで作る
    for col in ("dev", "phone", "addr"):
        node = f"{col}:{getattr(r, col)}"
        G.add_edge(r.uid, node)
        if G.degree(node) > HUB:
            hubs.add(node)
    members = accounts_reachable(G, r.uid, hubs)
    feat.append(dict(
        uid=r.uid,
        share_dev=G.degree(f"dev:{r.dev}") - 1,
        share_phone=G.degree(f"phone:{r.phone}") - 1,
        share_addr=G.degree(f"addr:{r.addr}") - 1,
        comp_size=len(members),
        known_fraud=sum(conf.get(m, 999) < r.day for m in members),
        check_fraud=sum((m in conf) & (m != r.uid) for m in members)))  # 確認用
df = df.merge(pd.DataFrame(feat), on="uid")
print(df.groupby("kind")[["share_dev", "share_phone", "share_addr",
                          "comp_size", "known_fraud"]].mean().round(3))
print("既知の不正と同じ成分にいた割合(成分に確定済みの不正が1人以上)")
print(df.groupby("kind")["known_fraud"].apply(lambda s: (s >= 1).mean()).round(3))
print("正当な会員で1以上になった人数",
      int(((df["kind"] == "正当") & (df["known_fraud"] >= 1)).sum()))
g = df[(df["kind"] == "集団") & (df["known_fraud"] == 0)]   # 確認用:特徴量には使わない
print("集団で既知の不正0人", len(g), "うち未確定の不正とつながっていた",
      int((g["check_fraud"] >= 1).sum()), "どの不正ともつながっていなかった",
      int((g["check_fraud"] == 0).sum()))
種類ごとの平均は次のとおりでした。
| 会員の種類 | 端末の共有の数 | 電話番号の共有の数 | 住所の共有の数 | 成分の大きさ | 既知の不正の数 | 既知の不正が1人以上の割合 |
|---|---|---|---|---|---|---|
| 正当 | 0.652 | 0.080 | 0.650 | 1.698 | 0.003 | 0.1% |
| 集団の不正 | 1.573 | 1.040 | 0.524 | 4.548 | 1.194 | 41.9% |
| 単独の不正 | 0.533 | 0.000 | 0.000 | 1.667 | 0.000 | 0% |
本コラムの架空データでは、集団の不正は、端末と電話番号の共有の数が正当な会員より大きく、住所の共有の数はむしろ小さくなりました。このデータでは、正当な会員の住所の共有は世帯でよく起きる一方、集団の会員は住所を組の中で共有する割合を低く作ってあります。識別子の種類を分けて数えると、この違いをモデルが使えます。既知の不正が1人以上いる成分に入っていたのは、集団の不正の41.9%でした。既知の不正が0人だった集団の会員72人を確認用の集計で分けると、37人はまだラベルの確定していない不正とつながっていて、35人はその時点でどの不正ともつながっていませんでした。後者の内訳は数えていませんが、このデータの作り方からは、組の最初の申込や、組で共有しない端末と電話番号で申し込んだ会員が当てはまりうると考えられます。
正当な会員でも16人が、既知の不正が1人以上いる成分に入りました。この16人は、このデータでは不正とは関係の無い会員ですが、「既知の不正とつながっている」という特徴量だけを見ると、疑いの強い会員に見えます。単独の不正は、最後の時点の集計(前の節)では全員が1人きりの成分でしたが、判定の時点の成分の大きさの平均は1.667でした。共用の端末がまだ基準の人数を超えていない時期には、その端末を使った他の会員とつながるためです。判定の時点のつながりと最後の時点のつながりは、このように違います。
この5つの特徴量を使って、1件の申込の特徴量だけのモデルと、つながりの特徴量を足したモデルを比べます。モデルは scikit-learn(本コラムの実行環境では 1.9.0)の勾配ブースティング(HistGradientBoostingClassifier)で、121日目に学習して121〜180日目の申込を判定する想定にしました。
学習のラベルも時点を守ります。このデータではラベルの確定に最長45日かかるので、121日目より前に確定したラベルだけで学習できるのは、1〜75日目の申込です(この期間のラベルは121日目までにすべて確定しています)。76〜120日目の申込は、ラベルが出そろっていないので学習には使わず、つながりを作る記録としてだけ使います。第2章で扱ったラベルの遅れの分だけ手前で切る考え方です。期間の使い分けは次のとおりです。
- 1〜75日目:学習に使う(ラベルは121日目までにすべて確定)
- 76〜120日目:学習には使わず、つながりの記録としてだけ使う
- 121〜180日目:評価に使う
評価は、ラベルが十分に確定した後に過去を振り返って行う想定で、評価期間の申込の最終的なラベルを使いました。合成データなので全件の真のラベルが分かりますが、実際の記録では、止めた申込や調査しなかった申込には、ラベルが分からないまま残るものがあります(第2章の選択の偏り)。
評価の指標は、平均適合率(スコアの高い順に並べ、再現率が増えた分を重みにして各位置の適合率を平均した値。PR曲線の点を直線で結んで面積を求める方法とは計算が異なります。第8章で扱います)と、評価期間の申込の上位1%(67件)をアラートにしたときの適合率と再現率です。上位1%は、評価期間全体のスコアを後から並べて選んだ比較のための指標で、申込のたびに上位1%を選べる運用を再現したものではありません。本番のしきい値や日々の調査の能力に合わせたアラートの量は、第9章で扱います。比較のために、最後の時点の成分とすべてのラベルで「既知の不正の数」を作った、時点を守らない誤った作り方も並べました。
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import average_precision_score

# 比較のための誤った作り方:180日の最後の時点の成分と、すべてのラベルを使う
comp_id = df["uid"].map(comp)
df["known_fraud_leak"] = df.groupby(comp_id)["fraud"].transform("sum") - df["fraud"]

base = ["amount", "night", "mismatch"]
sets = {"1件の特徴量だけ": base,
        "+共有の数・成分の大きさ": base + ["share_dev", "share_phone",
                                     "share_addr", "comp_size"],
        "+既知の不正と同じ成分": base + ["share_dev", "share_phone", "share_addr",
                                   "comp_size", "known_fraud"],
        "(誤り)最後の時点の成分を使う": base + ["share_dev", "share_phone",
                                       "share_addr", "comp_size", "known_fraud_leak"]}
# 121日目に学習する想定。ラベルの確定は最長45日かかるので、1〜75日目(day が 0〜74)だけで学習する
train, test = df[df["day"] < 75].copy(), df[df["day"] >= 120]
train["label"] = ((train["fraud"] == 1) & (train["confirm_day"] < 120)).astype(int)
K = int(len(test) * 0.01)
print("学習", len(train), "件(不正", int(train["fraud"].sum()), "うち確定済み",
      int(train["label"].sum()), ")", "評価", len(test), "件(不正",
      int(test["fraud"].sum()), ")", "上位K =", K)
results = {}
for name, cols in sets.items():
    model = HistGradientBoostingClassifier(max_iter=200, learning_rate=0.05,
                                           min_samples_leaf=10, early_stopping=False,
                                           random_state=0)
    model.fit(train[cols], train["label"])
    s = model.predict_proba(test[cols])[:, 1]
    top = test.assign(s=s).nlargest(K, "s")
    ap = average_precision_score(test["fraud"], s)
    rec = {k: top.loc[top["kind"] == k].shape[0] / max((test["kind"] == k).sum(), 1)
           for k in ("集団", "単独")}
    results[name] = ap
    print(f"{name: <16} 平均適合率 {ap:.3f}  上位K件の適合率 {top['fraud'].mean():.3f}"
          f"  再現率 {top['fraud'].sum() / test['fraud'].sum():.3f}"
          f"(集団 {rec['集団']:.3f} 単独 {rec['単独']:.3f})")
実行した結果は次のとおりです。学習用は8,475件(うち不正60件。60件とも121日目より前に確定)、評価用は6,725件(うち不正47件。集団の不正31件・単独の不正16件)でした。表の再現率の分母は、評価期間の合成データの真の不正(47件、集団31件、単独16件)です。
| 特徴量の組 | 平均適合率 | 上位67件の適合率 | 再現率 | 集団の不正の再現率 | 単独の不正の再現率 |
|---|---|---|---|---|---|
| 1件の特徴量だけ | 0.023 | 0.045 | 0.064 | 0.065 | 0.062 |
| +共有の数・成分の大きさ | 0.431 | 0.313 | 0.447 | 0.581 | 0.188 |
| +既知の不正と同じ成分 | 0.530 | 0.358 | 0.511 | 0.742 | 0.062 |
| (誤り)最後の時点の成分を使う | 0.566 | 0.373 | 0.532 | 0.806 | 0 |
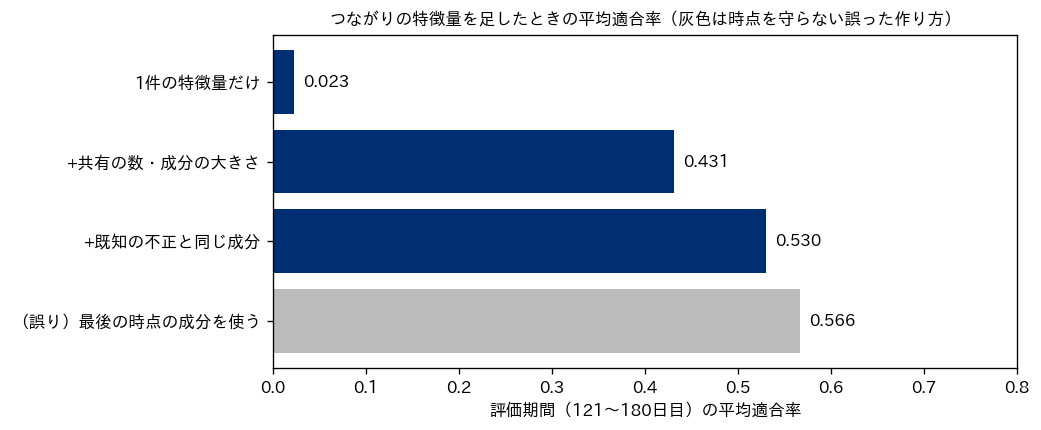
本コラムの架空データでは、共有の数と成分の大きさを足すと、平均適合率は0.023から0.431に上がり、既知の不正の数を足すと0.530になりました。これは乱数の種1つのデータでの値です。後で示すとおり、種を変えると、正しい作り方の平均適合率は0.184から0.547まで動きました。他の種での足す前の値は測っていないので、上がり幅が他の種でも同程度かは確かめていません。上位67件の中に入った不正は、1件の特徴量だけでは3件でしたが、つながりの特徴量をすべて足すと24件になりました。ただし、伸びたのは主に集団の不正の再現率(0.065から0.742、31件のうち2件から23件)です。単独の不正の再現率は、正しい作り方の3つの行で0.062から0.188の間で動きましたが、16件のうち1件から3件の違いで、つながりの特徴量で単独の不正が拾えるようになったとは言えません。つながりの特徴量は、つながりを持つ不正には効き、つながりを持たない不正にはほとんど効かない、というデータの作り方から想定される結果です。この方法では拾えない不正があるので、守る側は、第4章から第6章の1件ずつの方法と、無作為に一部を調査する点検(第10章)を併せて使い、つながりだけに頼らない構成にする必要があります。全体の再現率だけを見ていると、この偏りは見えません。評価のときは、不正の型ごとに再現率を分けて見ることが必要です。
1件の特徴量だけの成績がとても低いのは、このデータでそう作ったからです。実際の記録では、1件の特徴量(第5章の集計の特徴量を含む)がもっと強い場合が多いと考えられ、つながりの特徴量を足したときの上がり幅は、このデータよりずっと小さくなることもあります。この結果から言えるのは「つながりの特徴量でここまで上がる」ではなく、「集団の不正が一定の割合を占め、端末や連絡先の共有が記録に残っている場合には、つながりが1件の特徴量では取れない情報を足せる」ということです。評価用の不正は47件しかないので、指標の値にはかなりのばらつきがあります(指標のばらつきの見方は第8章で扱います)。
時点を守らない誤った作り方では、平均適合率は0.566で、正しい作り方の0.530より高く出ました。最後の時点の成分には、評価の時点ではまだ申し込んでいなかった同じ組の会員と、まだ確定していなかったラベルが含まれています。ただし、この1組のデータでの差は0.036で、評価用の不正も47件しかなく、この1回の評価だけでは差の安定性は判断できません。そこで、本文のコード(図の部分を除く)を、データを作る乱数の種だけ変えて、ほかに5通り実行しました。結果は次のとおりです。
| データの乱数の種 | 評価用の不正の件数 | 正しい作り方の平均適合率 | 誤った作り方の平均適合率 | 差 |
|---|---|---|---|---|
| 20261112(本文のデータ) | 47 | 0.530 | 0.566 | +0.036 |
| 1 | 46 | 0.184 | 0.553 | +0.370 |
| 2 | 64 | 0.226 | 0.507 | +0.280 |
| 3 | 70 | 0.508 | 0.508 | +0.000 |
| 4 | 58 | 0.547 | 0.682 | +0.135 |
| 5 | 62 | 0.192 | 0.653 | +0.461 |
6通りとも、誤った作り方の平均適合率は正しい作り方と同じか、それより高くなりました。差は0から0.461まで大きく開き、本文のデータの差(0.036)は6通りの中では小さい方でした。正しい作り方の平均適合率そのものも、0.184から0.547まで、データの作り直しだけで大きく変わっています。同じ規則で作ったデータでもこれだけ動くので、1組のデータの1回の評価で、つながりの特徴量の効き目や漏れの大きさを読むことはできません(評価のばらつきの見方は第8章で扱います)。この表から言えるのは、このデータの作り方では、時点を守らない作り方は成績を同じか高めに見せた、ということまでです。漏れが成績を良く見せる例は、第5章でも扱っています。そもそも本番では、その時点に存在しない情報は特徴量として計算できないので、誤った作り方で評価した成績は本番では再現しません。
送金のネットワークと資金の移動の連鎖、公的機関が示す類型の範囲で
ここまでは、申込の記録で識別子の共有を扱いました。銀行や資金移動のサービスでは、もう1つ、口座から口座への送金のネットワークがあります。送金のネットワークでは、口座を点にし、送金元から送金先へ向きのある線を引きます。線には送金の日時と額(の相対値)を持たせます。共有のネットワークが「誰と誰が同じものを使っているか」を表すのに対して、送金のネットワークは「資金がどこからどこへ流れたか」を表します。
国家公安委員会・警察庁の犯罪収益移転危険度調査書の概要版(令和7年11月)は、マネー・ローンダリング事犯で架空の名義や他人の名義の口座が主要な犯罪のインフラになっていると述べ、譲渡された口座の悪用や、名義人を介して資金を別の口座へ移す悪用を報告しています。同じ概要版によると、預貯金通帳等の譲渡等の検挙件数は、令和4年の2,951件、令和5年の3,230件から、令和6年は4,321件に増えています。また、決済代行や収納代行を自称する業者の複数の法人名義の口座を経由して、最終的に外国の口座へ資金が移される例があることも記されています。概要版が述べているのは、こうした手口があることと件数の推移までです。そのうえで本コラムでは、どれも1つの口座の入出金だけを見ても全体の形が分かりにくく、口座どうしのつながりをたどることで見えてくる型だと考えています。
送金のネットワークの分析でよく見るのは、短い期間に多くの口座から資金を受けて、すぐに別の口座へ出す口座(受けてすぐ流す口座)、資金が何段かの口座を経由して戻ってくる輪の形、少数の口座に資金が集まる形などです。ただし、どの形にも正当な取引で同じ形になる例があります。給与の振込を行う口座は多数の口座へ送金し、集金の代行を行う事業者の口座は多数の口座から資金を受けます。形だけで不正と決めることはできず、その口座の名義や事業の内容、口座の開設からの日数といった、つながり以外の情報と合わせて判断する必要があります。
送金のネットワークの分析には、自社の外が見えないという大きな制約もあります。自社の口座から他社の口座へ送金されると、その先の流れは自社の記録には残りません。資金が他社の口座を1つ経由するだけで、連鎖は自社の記録の上では切れてしまいます。この制約を補うために、金融機関どうしの情報の共有の取り組みがありますが、その制度と法令上の扱いは第14章で扱います。マネー・ローンダリング対策の規制上の義務(取引の確認・疑わしい取引の届出)も第14章で扱い、この章では分析の方法に留めます。
グラフニューラルネットワークの考え方と、研究の数字の読み方
連結成分や共有の数は、人が決めた計算でつながりを数に直すものでした。これに対して、つながりの形から有用な数の作り方そのものを学習させる方法がグラフニューラルネットワークです。基本の考え方は、各点が持つ特徴量(会員なら1件の申込の特徴量)を、線でつながった隣の点の特徴量と混ぜ合わせる操作を何回か繰り返し、隣や隣の隣の情報を取り込んだ数を作って、それで点を分類する、というものです。人が「共有の数」「既知の不正の数」と決めなくても、つながった先の会員の特徴量のどんな組み合わせが不正に効くかを、学習で見つけさせることができます。
よく引かれる方法の1つに、Kipf と Welling の論文(arXiv で2016年9月に初版、ICLR 2017 の会議論文)が示したグラフ畳み込みネットワークがあります。この論文は、少数の点にしかラベルが無いネットワークで、隣の点の情報を使って残りの点を分類する方法を、計算を簡単にした形で示しました。不正検知への応用の例としては、Weber らの2019年の論文(KDD 2019 の金融の異常検知のワークショップで発表)があります。この論文は、暗号資産ビットコインの取引を点、資金の流れを線にした Elliptic のデータセットを公開し、ロジスティック回帰・ランダムフォレスト・多層のニューラルネットワーク・グラフ畳み込みネットワークを比べています。論文によると、このデータは203,769件の取引と234,355本の線からなり、不正とラベルの付いた取引は2%(4,545件)、正当とラベルの付いた取引は21%(42,019件)で、残りはラベルがありません。このラベルは、取引を始めた主体が違法と合法のどちらの区分に属するかに基づいて付けられたもので、個々の取引について調査や裁判で不正が確定した記録と同じものではありません。時間は49の時点に分かれ、論文では前の34時点で学習し、後の15時点で評価しています。
この論文の結果で目を引くのは、2つの点です。1つ目は、その条件の比較では、グラフ畳み込みネットワークよりもランダムフォレストの成績が良く、著者たちが木のモデルとグラフの方法の組み合わせを今後の課題に挙げていることです。2つ目は、データの期間の途中(43番目の時点)で闇市場の閉鎖があり、その後はどの方法も成績が大きく落ちたと報告していることです。毎時点で学習し直したランダムフォレストでも、閉鎖の後の新しい不正をうまく捉えられなかったと書かれています。どちらも、そのデータセット・その特徴量・その評価の条件での結果であり、グラフニューラルネットワークが一般に劣る、あるいは優れる、という意味ではありません。ただ、「新しい方法を入れれば成績が上がる」とは限らないことと、手口や環境の変化(第10章)には、どの方法も弱いことを示す例として読めます。
本コラムでは、グラフニューラルネットワークは実行していません。実務で検討する場合には、次の条件がそろっているかを先に確かめるのがよいと考えています。1つ目は、連結成分や共有の数のような簡単な特徴量を足した勾配ブースティングを、比較の基準として先に作ってあることです。2つ目は、ネットワークが大きく変わり続ける中で、学習用の各記録でも本番の判定でも、それぞれの判定の時点までに使えたつながりだけを使う仕組みを作れることです。3つ目は、判定の理由を調査担当や顧客に説明する方法を用意できることです(説明は第11章で扱います)。深層学習の実装の一般論は、弊社コラム「Python実務で必ず使うディープラーニングレシピ100選」で扱っています。
実務上の難しさ、名寄せ・巨大な成分・計算量・時点の管理
架空データでは、端末や住所の識別子は最初から正確に付いていました。実際の記録で最も手間がかかるのは、この識別子を作ることです。同じ人、同じ端末、同じ住所を指している記録を、同じ1つの点にまとめる作業を名寄せと呼びます。住所なら表記の揺れ(丁目と番地の書き方・全角と半角・建物名の有無)を揃える必要があり、氏名なら同姓同名の別人と、表記を変えた同一人物を見分ける必要があります。端末の識別子は、取り方によって、同じ端末が設定の変更で別の識別子になったり、多くの端末が同じ識別子に見えたりします。名寄せが緩すぎると無関係な人がつながり、厳しすぎると本来つながるべき記録がつながりません。
2つ目は、巨大な成分です。架空データで共用の端末3台を外さなかったときに205人の成分ができたように、多くの人が使う識別子があると、無関係な会員が1つの成分にまとまります。実際の記録では、店頭の端末、事業所や学校の回線、通信事業者が多くの利用者で共有する接続、集合住宅の住所、配送の受取の拠点など、共用になりうる識別子が多くあります。この章のコードでは、合成データに合わせた説明用の人数で外す単純な基準を使いましたが、外す基準を低くしすぎると、不正な集団が使う識別子まで外してしまいます。外した識別子の一覧を残し、定期的に中身を確かめること、外した識別子を使う申込は無作為に一部を調査に回して確かめること(第10章)で、外したことによる見落としを補う運用が必要です。
3つ目は計算量です。連結成分や共有の数は点と線の数にほぼ比例する計算で済みますが、媒介中心性のように重い計算は、大きなネットワークではそのままでは使えません。この章のコードでも、申込を起きた順に1件ずつつながりに足し、その申込の成分を本人からたどって求める形にしました。申込のたびに全体の連結成分を作り直すと、記録が増えるほど時間がかかります。4つ目は、すでに見た時点の管理です。つながりは時間とともに増え、識別子が共用かどうかも時間とともに変わり、ラベルも遅れて確定します。判定の時点で何がつながっていたかを再現できるように、線に日付を持たせ、ラベルの確定日を残しておく必要があります。
4つの難しさと対処を、次の表にまとめます。
| 難しさ | 起きること | 対処の例 | 放置したときの損失の型 |
|---|---|---|---|
| 名寄せ | 同じものが別の点になる、別のものが同じ点になる | 住所・氏名の正規化の規則を決めて台帳にする。名寄せの規則を変えたら、つながりを作り直して影響を確かめる | 見逃しによる被害(つながりが切れる)・誤検知による機会損失(無関係な人がつながる) |
| 巨大な成分 | 共用の識別子で無関係な会員が1つにまとまる | 共用の識別子を一覧にして外す。外した一覧を定期的に確かめる。巨大な成分はコミュニティ検出で分ける | 調査の過負荷・顧客の離反 |
| 計算量 | ネットワークが大きくなると計算が判定に間に合わない | 判定のときは本人の周りだけをたどる。重い指標は一括の処理で計算しておく(第12章) | 見逃しによる被害(判定に使えない) |
| 時点の管理 | 判定の時点に無かったつながりやラベルで学習・評価してしまう | 線と識別子に日付を持たせる。ラベルの確定日を残す。判定の時点の値をそのまま記録する | 形骸化(評価の成績が本番で再現しない) |
正当な共有を誤って疑う危険と、調査担当への渡し方
つながりの分析には、疑いを広げてしまう性質があります。架空データの図の成分では、集団の会員2人が正当な会員と同じ住所を登録していただけで、正当な会員11人が不正な集団と同じ成分に入りました。判定の時点の特徴量でも、16人の正当な会員が「既知の不正とつながっている」と数えられました。実際の記録では、家族、同じ事業所の同僚、同じ集合住宅の住人、中古で端末を買った人、解約された電話番号を後から割り当てられた人などが、不正な会員と識別子を共有することがあります。この人たちは、自分では知らないうちに疑いの強い会員として扱われる可能性があります。
この危険があるので、つながりは止める判定の唯一の根拠にしないのがよいと考えています。つながりの特徴量はスコアの一部として使い、スコアが高い申込は、止めるのではなく追加の確認や調査に回すのがよいと考えています。また、特定の地域の集合住宅や、特定の属性の人が多く住む地域で住所の共有が多くなると、つながりの特徴量を通じて、その地域の顧客に誤検知が偏ることがあります。誤検知の偏りの測り方と、止められた顧客が正当だと示すための救済の手続きは、第11章で扱います。
つながりは、調査担当にとっては強い手がかりになります。1件のアラートを調べるときに、その会員と識別子を共有している会員の一覧、その中ですでに不正と確定した会員、共有の始まった日付が見えれば、調査担当は「この会員は家族と住所を共有しているだけか」「数日のうちに同じ端末から複数の名義で申込が続いているか」といった、確認すべき関係を把握しやすくなります。架空データの図のように、点と線で描いたつながりの図を、アラートと一緒に渡す使い方です。調査担当に渡す情報の例を、次の表にまとめます。
| 渡す情報 | 中身 | 調査での使い方 | 注意点 |
|---|---|---|---|
| つながりの図 | アラートの会員から2〜3歩以内の会員と識別子を、点と線で描いたもの | 共有の構造を確かめ、世帯・事業所などの情報と照らし合わせる | 歩数を広げすぎると、無関係な会員まで図に入る |
| 共有している識別子の一覧 | 端末・電話番号・住所ごとの共有の人数と、共有が始まった日付 | 短い期間に共有が増えたかを確かめる | 共用として外した識別子は、外したことが分かるように示す |
| 同じ成分の確定した不正 | 成分の中で、調査で不正と確定した会員と、その確定日 | 過去の調査の結論を引き継ぐ | 確定した不正と識別子を共有しているだけの正当な会員がいることを前提に読む |
| 同じ成分の過去の調査の結果 | 正当と確認された会員と、その理由(世帯・事業所など) | 同じ成分を何度も調べ直さない | 正当と確認した後に新しい会員が加わっていないかを確かめる |
| 調査の結論の記録欄 | 集団と判断したか、正当な共有と判断したか、その根拠 | 次のラベルと、共用の識別子の一覧の見直しに戻す | 結論を記録しないと、同じ成分の判断が調査担当ごとにばらつく |
表の最後の行の記録は、次の学習のラベルになるだけでなく、共用の識別子の一覧や名寄せの規則を見直す材料にもなります。調査の記録に残す項目の全体と、調査の能力に合わせたアラートの量の決め方は、第9章で扱います。
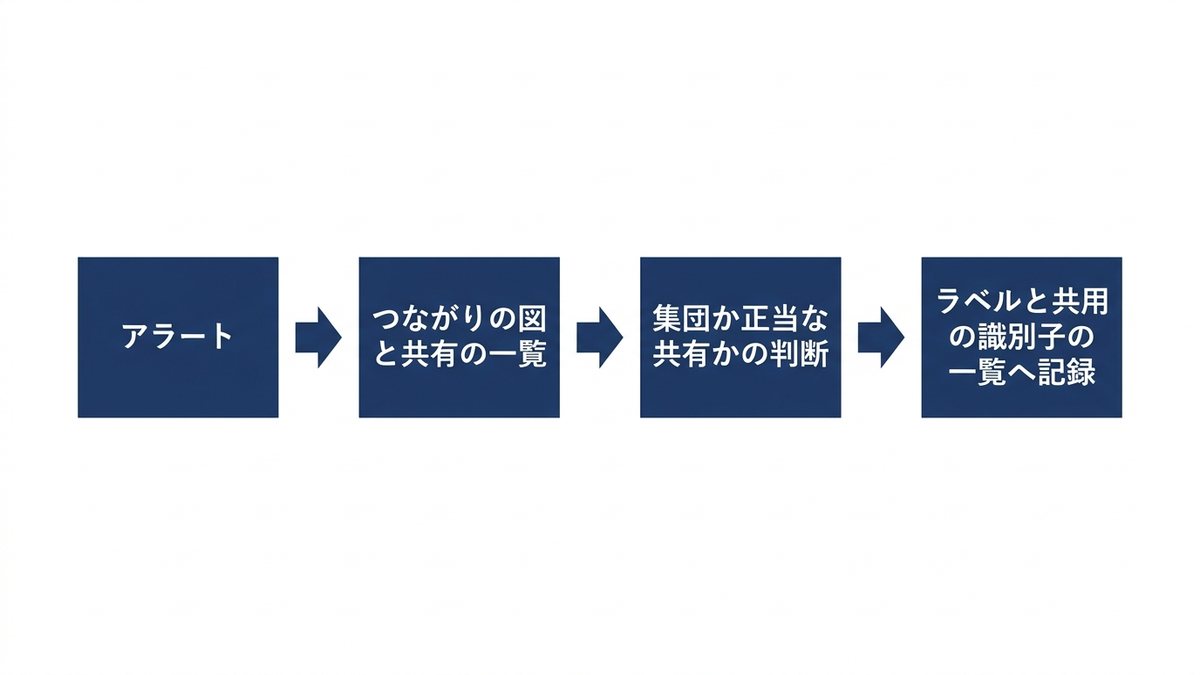
経営の判断、名寄せとつながりのデータに投資する
この章の分析で、経営が判断すべきことは、モデルの手法の選択よりも、つながりを作るためのデータへの投資です。この章の架空データは、端末・電話番号・住所の識別子が最初から正確に付いていて、共用の識別子が分かり、ラベルの確定日が残っている前提で作りました。その前提が崩れたときの成績は、本コラムでは実験していません。ただ、つながりの特徴量は識別子が同じかどうかだけから作るので、考え方としては、名寄せの誤りがそのまま特徴量の誤りになると考えています。実際の記録では、この前提を満たすために、名寄せの規則づくり、端末の識別子を取る仕組み、住所の正規化、識別子と日付の保管といった、地味で時間のかかる作業が要ります。これらは特定のモデルのためではなく、ルール・教師あり学習・調査のすべてに効く資産です。
判断を誤ったときの損失は、序章で示した6つの損失の型で整理できます。名寄せの誤りを放置すると、つながりが切れて集団の不正をアラートにできない(見逃しによる被害)か、無関係な人をつなげて正当な申込をアラートにする(誤検知)おそれがあります。誤検知のアラートで申込を保留や拒否にすれば、誤検知による機会損失と顧客の離反につながります。共用の識別子を放置したまま、成分への所属だけで一律にアラートを出す設計にすると、巨大な成分の会員がまとめてアラートになり、調査の件数が膨らむおそれがあります(調査の過負荷)。時点を守らずに評価した成績を信じて導入すると、本番で成績が再現せず、つながりの分析そのものが使われなくなります(形骸化)。マネー・ローンダリング対策で事業者がどんな確認や届出を求められているかは、第14章で法令とガイドラインの範囲で扱います。この章では、つながりの分析がその義務にどう関わるかを断定しません。
予算と体制に落とすときは、次の点を決めておくのがよいと考えています。
- 名寄せの規則と共用の識別子の一覧を、担当を決めた台帳として管理する(第3章のルールの台帳、第5章の特徴量の台帳と同じ扱い)
- つながりの特徴量の効果は、全体の再現率ではなく、集団の不正と単独の不正に分けて測る
- つながりは追加の確認や調査に回す材料として使い、止める判定の唯一の根拠にしない
- 調査担当がつながりの図と共有の一覧を見られる画面を、検知の仕組みの一部として予算に入れる
- 正当な共有で疑われた顧客の数を、誤検知の KPI の1つとして数える
KPI としては、つながりの特徴量を足す前と後で、集団の不正の再現率、上位K件の適合率、正当な共有で調査に回った件数の3つを並べて見るのが分かりやすいと考えています。成果として数えるのは、防いだ集団の不正と、つながりを理由に誤って止めた正当な申込の両方を数えた差です(成果の測り方は第8章と第9章で扱います)。
この章では、口座・端末・住所・電話番号のつながりから不正を探すネットワーク分析を扱いました。本コラムの架空データ(乱数の種1つ)では、共有の数・成分の大きさ・既知の不正の数を足すと、集団の不正の再現率は大きく上がった一方、単独の不正には効かず、正当な共有で疑われる会員も出ました。確かめたのは共用の識別子の扱いと時点の管理までですが、つながりの効き目は名寄せと時点の管理に大きく左右されると考えられ、つながりは止める根拠ではなく調査の材料として使うのがよい、というのがこの章の結論です。次の第8章では、ここまでの章で使ってきた平均適合率や上位K件の適合率を含め、検知の評価の指標と、評価データの切り方を扱います。
この章を深めたい方への参考書籍
『Pythonで学ぶネットワーク分析 ColaboratoryとNetworkXを使った実践入門』(村田剛志 著、オーム社):本章のコードと同じ NetworkX を使う、ネットワーク分析の入門書です。版元の目次によると、連結成分を含む基礎の用語、さまざまな中心性、コミュニティの抽出を章や節として扱っています。連結成分や中心性を自社の記録で試す前の準備に向いています。
『ネットワーク分析 第2版』(鈴木努 著、共立出版):シリーズ「Rで学ぶデータサイエンス」の第8巻で、統計の言語 R を使ってネットワーク分析を扱った本です。この章では Python の networkx を使いましたが、つながりの指標を別の道具と別の説明で確かめたいときの参考になります。
『グラフニューラルネットワーク』(佐藤竜馬 著、講談社):機械学習プロフェッショナルシリーズの1冊で、題名のとおりグラフニューラルネットワークを主題にした専門書です。この章で考え方だけを紹介したグラフニューラルネットワークを、実務で検討するかどうかを判断する前に、何ができて何が難しいのかを知る材料になります。
第8章 検知の評価、適合率・再現率・PR曲線と評価データの切り方
第3章から第7章では、ルール、教師あり学習、特徴量の設計、教師なしの異常検知、ネットワーク分析と、不正の疑いを見つける方法を順に見てきました。各章では成績を適合率や再現率、平均適合率で示してきましたが、その測り方の決まりごとは簡単に触れるだけにしていました。この章では、検知の方法の良し悪しを過去の記録で測る評価を、指標と評価データの切り方の両面から扱います。
この章で扱うのは次の内容です。後半は、他の章とは独立に作った架空の取引の記録を使い、実行したコードと結果で確かめます。
- 評価の役割と、評価で分かること・分からないこと
- 混同行列と、適合率・再現率・偽陽性率・F値・ROC曲線(受信者動作特性曲線)とAUC・PR曲線と平均適合率・上位K件の適合率と再現率
- 不均衡なデータで、正解率とROC曲線のAUCに注意が要る理由
- 評価データの切り方(無作為に切る・時間で切る・顧客で切る)と、ラベルの遅れを考えた評価の期間
- 被害の大きさで重み付けた指標と、カードや顧客の単位での評価
- 不正の件数が少ないときの指標のばらつきと、オフラインの評価の限界
- ベンダーの示す数字の読み方と、経営の判断
この章の主張は2つあります。1つ目は、不正の割合が小さいデータでは、正解率では方法の差がほとんど見えず、ROC曲線のAUCも全部のしきい値にわたる並び方の要約なので、調査に回す上位のアラートの質はそれだけでは分からない、という点です。本コラムの架空データでも、上位K件で何件の不正を拾えるかは、PR曲線と上位K件の適合率で初めて読み取れました。2つ目は、時間による依存や手口の変化がある場合、評価データを時間で切らない評価や、学習の時点ではまだ確定していなかったラベルで学習した評価は、将来の性能を過大に見積もることがある、という点です。本コラムの架空データでも、そのとおりの結果になりました。どちらも、モデルを選ぶ前に評価の指標と切り方を決めておかないと、良く見える数字を選んでしまう危険があることを意味します。しきい値を決めてアラートの量を調査の能力に合わせる運用は、第9章で扱います。
評価の役割、検知の方法を選ぶ前に物差しを決める
ここでいう評価は、過去の取引の記録を学習用と評価用に分け、学習用の記録だけで作った検知の方法が、評価用の記録の中の不正をどれだけ見つけ、正当な取引をどれだけ誤って疑ったかを測る作業です。本番の取引に使う前に、ルールの組み合わせやモデルの候補を、顧客に迷惑をかけずに何通りも比べられます。ただし、同じ評価用のデータを見ながら候補の調整を繰り返すと、そのデータに都合のよい候補を選んでしまいます。候補選びに使う検証用のデータと、最後の確認に使う評価用のデータは分けておく必要があります。本番に入れる前の候補の絞り込みでは、この方法が基本になります。過去の記録だけで行うので、オフラインの評価とも呼びます。
評価が答えるのは、主に次の3つの問いです。1つ目は、候補の方法のうちどれが良いかという順位の問いです。2つ目は、選んだ方法を使うと、アラートのうち何割が実際に不正で、不正のうち何割をアラートにできるかという水準の問いです。3つ目は、その水準が時間とともに保たれるかという安定の問いです。1つ目だけなら指標の大小を比べれば済みますが、2つ目と3つ目は、評価のしかたが実際の運用の条件に近くないと答えられません。
序章と全体の地図では、不正検知の成果を「見つけて防いだ不正と、誤って止めた正当な取引の両方を数えたうえでの差」と定めました。評価の指標は、この成果を直接測るものではありません。適合率は誤検知の側を、再現率は見逃しの側を、それぞれ片方ずつ見る数字です。どちらか一方だけを見ると、方法の良し悪しを取り違えます。全部の取引をアラートにすれば再現率は1になりますが、適合率は不正の割合まで下がります。逆にアラートを上位のごく一部に絞ると適合率が上がる場合がありますが、見逃しが増えるおそれがあります。評価では、必ず両方を、同じアラートの量で並べて見る必要があります。
評価の結果は、検知の方法の選び方だけでなく、調査の体制や予算の見積りにも使われます。上位K件の適合率が低ければ、調査担当は正当な取引の確認に多くの時間を使うことになり、調査の過負荷につながります。再現率が低ければ、見逃しによる被害が残ります。どの指標を、どの切り方で、どの期間で測るかを、モデルを作る前に決めて書き残しておくことが、評価の最初の仕事です。決めずに始めると、候補を作ったあとで、その候補が良く見える指標を選ぶことになりがちです。
混同行列と指標、適合率・再現率・偽陽性率・ROC曲線・PR曲線
ここでいうアラートは「不正の疑いありと判定した」ことで、取引を止めたこととは限りません(措置は承認・保留・拒否・事後の調査の4つです)。アラートにするかどうかの判定と、その取引が実際に不正だったかどうかの組み合わせは、4通りあります。不正をアラートにしたもの(真陽性、TP)、正当な取引をアラートにしたもの(偽陽性、FP。誤検知)、不正をアラートにしなかったもの(偽陰性、FN。見逃し)、正当な取引をアラートにしなかったもの(真陰性、TN)です。この4つの件数を2行2列に並べた表を混同行列と呼びます。しきい値を1つに決めた判定の指標(正解率・適合率・再現率・偽陽性率・F値)は、この4つの件数から計算します。ROC曲線やPR曲線と、それを要約した値は、しきい値を動かしながら評価します。
| アラートにした | アラートにしなかった | |
|---|---|---|
| 実際に不正 | 真陽性(TP):アラートにできた不正 | 偽陰性(FN):見逃し |
| 実際に正当 | 偽陽性(FP):誤検知 | 真陰性(TN):アラートにならなかった正当な取引 |
次の表は、本コラムで使う指標を、式と言葉の言い換えで整理したものです。不正検知では、真陰性(TN)の件数が他の3つに比べて桁違いに多いことに注意してください。そのため正解率は、少数の不正に対する判定を改善しても全体の値が変わりにくくなります。偽陽性率は、わずかな率の差が多数の誤検知に相当することがあります。
| 指標 | 式 | 言葉の言い換え | 不正検知での注意 |
|---|---|---|---|
| 正解率 | \( \frac{TP+TN}{\text{全件}} \) | 判定が当たった取引の割合 | TN が大半を占めるので、全部を正当と判定しても1に近い |
| 適合率 | \( \frac{TP}{TP+FP} \) | アラートのうち、実際に不正だった割合 | 調査担当の手間の効率に直結する。アラートの量とセットで見る |
| 再現率 | \( \frac{TP}{TP+FN} \) | 実際の不正のうち、アラートにできた割合。「検知率」と呼ばれることがある | アラートを増やすと上がりやすい(上限は1)。適合率とセットで見る |
| 偽陽性率 | \( \frac{FP}{FP+TN} \) | 正当な取引のうち、誤ってアラートにした割合 | 分母の TN が大きいので、小さな値でも誤検知の件数は多いことがある |
| F値 | 適合率と再現率の調和平均(2つの数の逆数の平均の逆数) | 2つを1つの数にまとめたもの。小さい方の値に引きずられる | 2つの重みを等しいとみなす前提が入る。誤検知と見逃しの損失の比は反映しない |
| ROC曲線とAUC | しきい値を動かしたときの偽陽性率(横)と再現率(縦)の曲線と、その下の面積 | スコアに同点が無い場合、無作為に選んだ不正1件と正当1件で、不正の方のスコアが高い確率と一致する | 偽陽性率の分母は正当な取引の全件なので、偽陽性率の小さな違いが、誤検知の件数では大きな違いになる |
| PR曲線と平均適合率 | しきい値を動かしたときの再現率(横)と適合率(縦)の曲線と、再現率が増えた分で適合率を重み付けて平均した値 | アラートを上から順に増やしたときの、適合率の平均的な高さ | 不正の割合で基準の値が変わる。不正の割合が違うデータどうしで値を比べない |
| 上位K件の適合率・再現率 | スコアの上位K件をアラートにしたときの適合率・再現率 | 調査できる件数がK件のとき、その中に何件の不正が入るか、不正の何割を拾えるか | K を調査の能力に合わせて決める。K を変えると値も変わる |
PR曲線(適合率と再現率の曲線)は、スコアのしきい値を高い方から下げていき、アラートが増えるたびに再現率と適合率を計算して、横に再現率、縦に適合率をとって描いた曲線です。左上から右下へ下がっていく形になることが多く、曲線全体が上にある方法ほど、同じ再現率をより少ない誤検知で達成できます。何もしない基準の高さ(スコアを無作為に付けたときの適合率)は、評価データの不正の割合そのものです。不正の割合が0.4%のデータなら、基準の高さは0.004です。
平均適合率は、PR曲線の上の適合率を、再現率が増えた分で重み付けて平均した値です。本コラムで使った scikit-learn の average_precision_score は、しきい値ごとの適合率を、そのしきい値で再現率が増えた分の幅で重み付けて足し合わせます。式で書くと \( \mathrm{AP}=\sum_n (R_n-R_{n-1})P_n \) で、\(P_n\) と \(R_n\) は n 番目のしきい値での適合率と再現率です。言い換えると、不正を1件ずつ拾うたびに、その時点の適合率を記録し、それを平均したものに近い値です。scikit-learn の説明書きによれば、この実装は点の間を直線でつなぐ補間をしておらず、台形の公式で面積を出す方法とは異なります。点を直線で結んだPR曲線の下の面積とは計算が違い、値も少し違うことがあるので、比べるときは計算の方法を揃える必要があります。
再現率@K(以下、上位K件の再現率)は、スコアの上位K件をアラートにしたとき、実際の不正のうち何割がその中に入ったかを表します。同じ条件の適合率@K(以下、上位K件の適合率)と組にして使います。後のコードでは、Kを評価期間の取引の0.5%にあたる件数に置き、表では「上位212件」「上位0.5%」のように具体的な件数や割合で書いています。調査の能力が1日に一定の件数と決まっている現場では、しきい値で区切るより、上位K件で区切った方が運用の実態に近くなります。PR曲線ではアラートの量による適合率と再現率の変化を確かめ、平均適合率ではそれを1つの数に要約します。要約なので、平均適合率が高くても、すべてのアラートの量で上回っているとは限りません。これに対して、上位K件の指標は「実際に使うアラートの量で良いか」を見る指標です。評価では、どちらか一方ではなく、両方を並べて見る必要があります。
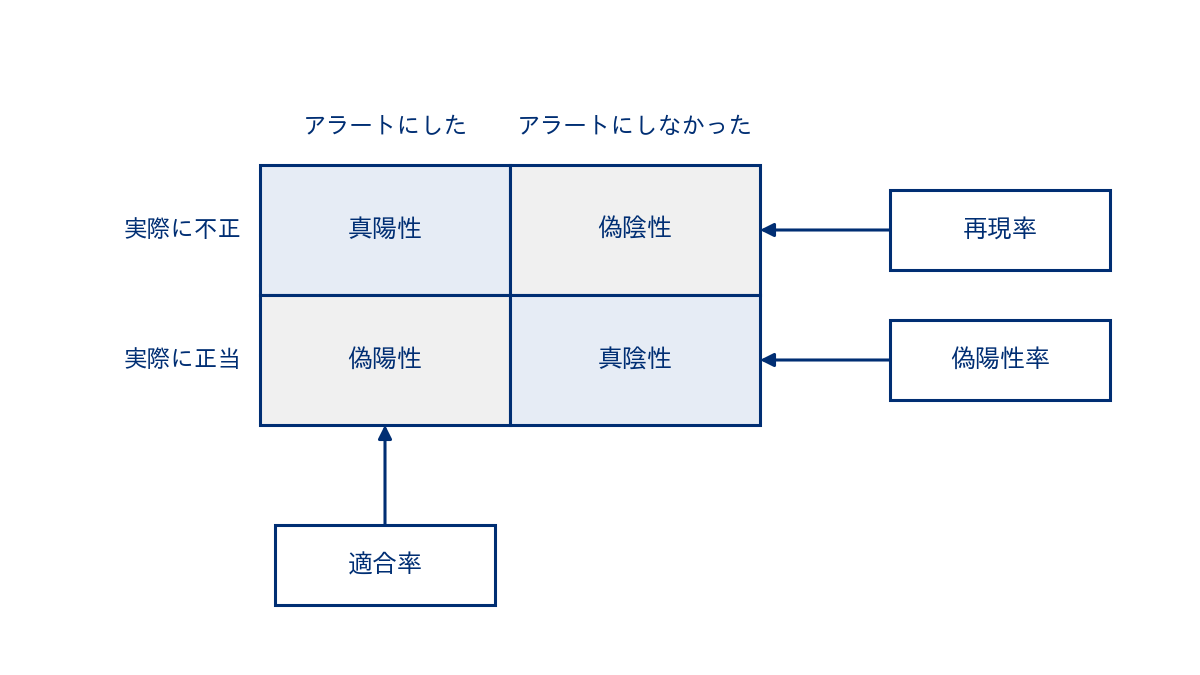
上の図では、適合率は左の列(アラートにした取引)から、再現率は上の行(実際に不正だった取引)から、偽陽性率は下の行(実際に正当だった取引)から計算することを、矢印で示しています。マスの塗り分けは、判定が当たったマス(真陽性・真陰性)と外れたマス(偽陰性・偽陽性)を区別したものです。
不均衡なデータで、正解率とROC曲線のAUCに注意が要る理由
不正検知の評価で最初に避けるべき数字は正解率です。不正の割合が0.4%のデータでは、すべての取引を正当と判定するだけで正解率は99.6%になります。この判定は不正を1件も見つけていませんが、正解率だけを見ると高い成績に見えます。第1章のよくある誤解でも触れたとおり、正解率は不均衡なデータでは方法の良し悪しをほとんど区別できません。本コラムで正解率を成績として書かないのは、このためです。
正解率ほど極端ではありませんが、ROC曲線(受信者動作特性曲線)とその下の面積(AUC)にも、不正検知で注意が要る性質があります。ROC曲線の横軸の偽陽性率は、正当な取引のうち誤ってアラートにした割合で、分母は正当な取引の全件です。正当な取引が数万件あれば、誤検知が数百件増えても偽陽性率は1%ほどしか動きません。ところが調査担当から見ると、数百件の誤検知は数百件の余分な確認作業です。ROC曲線では、この「偽陽性率としては小さいが、件数としては大きい」違いが、横軸の0に近い狭い範囲の違いとして表れます。また、AUC は全部のしきい値にわたる並び方を1つの数にまとめた値なので、調査に回すことのない低いスコアの範囲の並び方も、上位の並び方と同じように含みます。
この点は研究でも論じられてきました。Davis と Goadrich の2006年の論文(PR曲線とROC曲線の関係を論じたもの)は、偏りの大きいデータではPR曲線の方が性能の違いをよく表すこと、ROC曲線の下の面積が大きい方法がPR曲線でも優れるとは限らないことを論じています。
Saito と Rehmsmeier の2015年の論文は、題名のとおり、不均衡なデータで二値の分類器を評価するときに、ROC曲線よりPR曲線の方が多くの情報を与えると論じたものです。実務に引き直すと、不正の割合が小さいときは、ROC曲線のAUCだけでなく、PR曲線でアラートのうち実際に不正だった割合を確かめる、ということになります。どちらの論文も、ROC曲線が誤りだと言っているわけではありません。Fawcett の2006年の解説論文(Pattern Recognition Letters 第27巻第8号)は、ROC曲線の魅力の1つとしてクラスの偏りに左右されにくいことを挙げ、AUC は「無作為に選んだ陽性1件のスコアが、無作為に選んだ陰性1件より高い確率」と同じであると書いています(スコアに同点が無い場合の読み方です。本コラムのモデルBのスコアには、評価期間で同点はありませんでした)。不正検知で問題になるのは、実際に効いてくるのがスコアの上位のごく一部の並び方だという点です。
不正検知の運用では、調査できるのは全取引のうちごく一部です。そのため、評価で知りたいのは「上位の数百件にどれだけ不正が入っているか」で、AUC の値からはその件数は直接読み取れません。次に示すコードでは、この違いを数字で確かめます。なお、論文の結論は、それぞれの論文が扱ったデータと条件での議論であり、どのデータでもROC曲線のAUCとPR曲線で結論が分かれるという意味ではありません。
論文の書誌は次のとおりです(いずれも出版社や学会の公式の書誌情報で確かめたものです)。
- Davis と Goadrich の2006年の論文:第23回機械学習国際会議(ICML 2006)の予稿集、233〜240ページ。DOI 10.1145/1143844.1143874
- Saito と Rehmsmeier の2015年の論文:PLOS ONE 第10巻第3号、論文番号 e0118432、2015年3月4日公開。DOI 10.1371/journal.pone.0118432
- Fawcett の2006年の論文(ROC分析の入門の解説):Pattern Recognition Letters 第27巻第8号、861〜874ページ。DOI 10.1016/j.patrec.2005.10.010
架空の取引の記録を作る、手口が途中で変わり、ラベルが遅れて届く
ここからは、指標と評価データの切り方で結果がどう変わるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の取引の記録よりずっと単純です。合成データでの成績は、実際の取引での成績の目安にはなりません。示したいのは、同じデータ・同じモデルでも、測り方によって数字がどう動くかという点です。顧客3,000人の120日分の取引を、次の性質を持たせて乱数で作りました(乱数の種は20261112に固定しています)。
- 顧客ごとの普段の行動:取引の額の水準(相対値)・よく使う時間帯・よく使う加盟店の種類(AからHの8種類)の割合・取引の頻度を顧客ごとに変える
- 正当な取引の中にも、普段と違う額・時間帯の取引や、新しい端末からの取引(3%)が一定の割合で現れる
- 不正は「発生」の単位で起き、1回の発生で同じ顧客の取引が平均0.4時間おきに数件続く
- 不正な取引は、普段より大きい額・夜間・新しい端末・特定の加盟店の種類が多い。ただし75日目から手口が少し変わり、額が普段に近づき、新しい端末と夜間の割合が下がり、多く使われる加盟店の種類も変わる
- 不正のラベルは、発生から確定まで日数がかかる(3日に、平均20日のガンマ分布の日数を足したもの)
最初のブロックで、正当な取引を作ります。顧客ごとの取引の件数は、1日あたり平均0.5件前後を中心にばらつかせました。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261112)
N_CUST, DAYS = 3000, 120
level = rng.lognormal(0.0, 0.8, N_CUST)            # 顧客ごとの普段の額の水準(相対値)
center = rng.normal(15, 3.5, N_CUST) % 24           # 顧客ごとのよく使う時間帯の中心(時)
pref = rng.dirichlet(np.full(8, 0.5), N_CUST)       # よく使う加盟店の種類(A〜Hの8種類)の割合

def pick_type(c):                                   # 顧客の好みの割合に従って加盟店の種類を選ぶ
    u = rng.random(len(c))[:, None]
    return (u > pref[c].cumsum(axis=1)).sum(axis=1).clip(0, 7)

n_tx = rng.poisson(rng.lognormal(np.log(0.5), 0.5, N_CUST) * DAYS)
c = np.repeat(np.arange(N_CUST), n_tx)
legit = pd.DataFrame({
    "cust": c,
    "t": rng.integers(0, DAYS, len(c)) + (rng.normal(center[c], 2.5) % 24) / 24,
    "amt": level[c] * rng.lognormal(0.0, 0.5, len(c)),
    "mtype": pick_type(c),
    "new_dev": (rng.random(len(c)) < 0.03).astype(int),
    "event": -1})
print("正当な取引", len(legit), "件")
次のブロックで不正な取引を作り、正当な取引と合わせて、ラベルが確定する日と、モデルに入れる5つの特徴量を計算します。特徴量は、普段の額の水準との比(対数)、普段の時間帯からのずれ(時間)、新しい端末かどうか、その取引より前の直近1時間の同じ顧客の取引の回数、普段ほとんど使わない加盟店の種類かどうか、の5つです。直近1時間の回数は、第3章で扱った速度のルールと同じ考え方の特徴量です。
N_EV = 260                                          # 不正の発生(1件の発生で数件の不正な取引が続く)
ev_c = rng.integers(0, N_CUST, N_EV)
late = rng.integers(0, DAYS, N_EV) >= 75           # 発生の日(75日目から手口が少し変わる)
ev_day = np.where(late, rng.integers(75, DAYS, N_EV), rng.integers(0, 75, N_EV))
night = rng.random(N_EV) < np.where(late, 0.2, 0.65)
hour = np.where(night, rng.uniform(0, 5, N_EV), rng.normal(center[ev_c], 3) % 24)
k = 1 + rng.poisson(np.where(late, 3.0, 2.0))       # 1回の発生で続く件数
fc, fe, fl = np.repeat(ev_c, k), np.repeat(np.arange(N_EV), k), np.repeat(late, k)
gap = rng.exponential(0.4 / 24, len(fc))            # 続く取引の間隔(平均0.4時間)
ft = np.repeat(ev_day + hour / 24, k) + pd.Series(gap).groupby(fe).cumsum().to_numpy() - gap
fraud = pd.DataFrame({
    "cust": fc, "t": ft,
    "amt": level[fc] * rng.lognormal(np.where(fl, 0.4, 1.1), 0.6),   # 後の手口は額が普段に近い
    "mtype": np.where(rng.random(len(fc)) < 0.5, np.where(fl, 2, 6), pick_type(fc)),  # 前はG、後はC
    "new_dev": (rng.random(len(fc)) < np.where(fl, 0.35, 0.7)).astype(int),
    "event": fe})
df = pd.concat([legit, fraud], ignore_index=True).sort_values(["cust", "t"], ignore_index=True)
df["fraud"] = (df.event >= 0).astype(int)
delay = 3 + rng.gamma(2.0, 10.0, N_EV)              # 不正の確定までの日数(申告・チャージバック・調査)
df["label_day"] = np.where(df.fraud == 1, df.t + delay[df.event.clip(0)], np.inf)
print("取引", len(df), "件/不正", df.fraud.sum(), "件/不正の割合", round(df.fraud.mean() * 100, 3), "%")
print("ラベル確定までの日数 中央値", round(np.median(delay), 1), "日/90%点", round(np.quantile(delay, 0.9), 1), "日")
key = df.cust.to_numpy() * 1000.0 + df.t.to_numpy()     # 顧客ごとに時刻を並べるためのキー
df["cnt_1h"] = np.arange(len(df)) - np.searchsorted(key, key - 1 / 24)   # その取引より前の直近1時間の回数
df["amt_ratio"] = np.log(df.amt / level[df.cust])        # 普段の額の水準との比(対数)
h = (df.t % 1) * 24
d = np.abs(h - center[df.cust])
df["hour_gap"] = np.minimum(d, 24 - d)                   # 普段の時間帯からのずれ(時間)
df["rare_type"] = (pref[df.cust, df.mtype] < 0.05).astype(int)  # 普段ほとんど使わない加盟店の種類か
print(df.groupby("fraud")[["amt_ratio", "hour_gap", "new_dev", "cnt_1h", "rare_type"]].mean().round(3).T)
実行した結果、正当な取引は204,385件、不正な取引は906件で、取引全体は205,291件、不正の割合は0.441%でした。ラベルが確定するまでの日数は、不正の発生(260回)を単位に集計すると、中央値が18.8日、90%点(短い方から並べて9割の位置)が42.0日です。特徴量の平均を比べると、普段の額の水準との比(対数)は正当な取引で0.000、不正な取引で0.800、普段の時間帯からのずれは1.997時間と5.454時間、新しい端末の割合は0.031と0.533、直近1時間の回数は0.080回と1.173回、普段ほとんど使わない加盟店の種類の割合は0.055と0.253でした。なお、簡単化のため、顧客ごとの普段の額の水準・よく使う時間帯・よく使う加盟店の種類の割合は、過去の取引から推定せず、データを作るときの設定値を判定の時点で分かっているものとして使っています。どの特徴量も不正の方が大きい値をとりますが、正当な取引にも同じ値を持つものが多く含まれていて、1つの特徴量だけでは分けきれないように作っています。
2つのモデルを比べる、ROC曲線のAUCだけでは上位のアラートの質が読み取れない
このデータで、2つのモデルを比べます。どちらもロジスティック回帰(第4章)で、違いは特徴量だけです。モデルAは、額・時間帯・新しい端末・普段使わない加盟店の種類の4つを使い、モデルBはそれに直近1時間の回数を足した5つを使います。評価データは時間で切り、0〜69日目を学習用、70〜94日目を評価用にしました。学習は70日目に行う想定にして、70日目までにラベルが確定した不正を1とし、それ以外の取引(まだ確定していない不正を含む)は暫定的に0として学習しました。評価には、合成データなので分かっている真のラベルを使っています(実際のデータでは真のラベルは分からず、この扱いの影響は後の節で確かめます)。95日目以降は評価に使っていません。上位K件のKは、評価期間の取引の0.5%にあたる212件としました。この0.5%は説明のための置き方で、実際には1日の調査の能力から決めます(第9章)。
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, average_precision_score

FEAT_A = ["amt_ratio", "hour_gap", "new_dev", "rare_type"]      # モデルA:速度の特徴なし
FEAT_B = FEAT_A + ["cnt_1h"]                                    # モデルB:直近1時間の回数を足す
TODAY = 120                                                     # 評価を行う日(データの最後の日)
df["y_obs"] = (df.label_day <= TODAY).astype(int)               # 120日目までに確定したラベル
df["y_at70"] = (df.label_day <= 70).astype(int)                 # 学習を行う70日目までに確定したラベル

def top_k(y, s, k):                     # スコアの上位k件をアラートにしたときの適合率と再現率
    hit = y[np.argsort(-s)[:k]].sum()
    return hit / k, hit / y.sum()

def fit(tr, feats, label):              # label:学習に使うラベルの列の名前
    m = LogisticRegression(max_iter=1000).fit(tr[feats], tr[label])
    return lambda x: m.predict_proba(x[feats])[:, 1]

tr, te = df[df.t < 70], df[(df.t >= 70) & (df.t < 95)]          # 時間で切る
y = te.fraud.to_numpy()
K = int(len(te) * 0.005)                                        # 評価期間の取引の上位0.5%
print("学習", len(tr), "件(不正", tr.fraud.sum(), "件のうち70日目までに確定", tr.y_at70.sum(), "件)")
print("評価", len(te), "件(不正", y.sum(), ")/K =", K)
print("評価期間の不正のうち", TODAY, "日目までにラベルが確定した割合", round(te.y_obs.sum() / y.sum(), 3))
print("全部を正当と答えたときの正解率", round(1 - y.mean(), 4))
scores, models = {}, {}
for name, feats in [("A", FEAT_A), ("B", FEAT_B)]:
    models[name] = fit(tr, feats, "y_at70")                     # 70日目に学習する想定
    s = scores[name] = models[name](te)
    p, r = top_k(y, s, K)
    print(name, "ROC-AUC", round(roc_auc_score(y, s), 3), "平均適合率", round(average_precision_score(y, s), 3),
          "上位K件の適合率", round(p, 3), "再現率", round(r, 3))
学習用は120,086件で、その中の不正483件のうち70日目までにラベルが確定していたのは302件でした。残りの181件は、学習の時点ではまだ正当な取引として扱われています。評価用は42,547件(うち不正187件)で、評価期間の取引をすべて正当と答えた場合の正解率は0.9956です。2つのモデルの結果を次の表にまとめます。表の再現率の分母は、評価期間の真の不正187件です。
| モデル | ROC曲線のAUC | 平均適合率 | 上位212件の適合率 | 上位212件の再現率 |
|---|---|---|---|---|
| モデルA(速度の特徴なし) | 0.868 | 0.353 | 0.340 | 0.385 |
| モデルB(直近1時間の回数を足す) | 0.927 | 0.482 | 0.429 | 0.487 |
| 参考:全部を正当と答える | 対象外 | 対象外 | 対象外 | 対象外 |
ROC曲線のAUCは0.868と0.927で、どちらも0.9前後の値です。曲線の上側の残りの面積(1からAUCを引いた値)で見ると0.132と0.073です。ここまでは、ROC曲線のAUCでもモデルBが良いことは分かります。一方、AUC の値からは、調査担当が上位212件を確認したときに何件の不正に当たるかは分かりません。上位212件の適合率は0.340と0.429で、当たる不正はモデルAでは72件、モデルBでは91件です。同じ212件の確認の手間で、拾える不正はモデルBの方が19件多くなります。平均適合率は0.353と0.482でした。なお、表の「全部を正当と答える」はアラートが0件なので、上位212件の指標の対象外です(アラートが0件なら再現率は0です)。
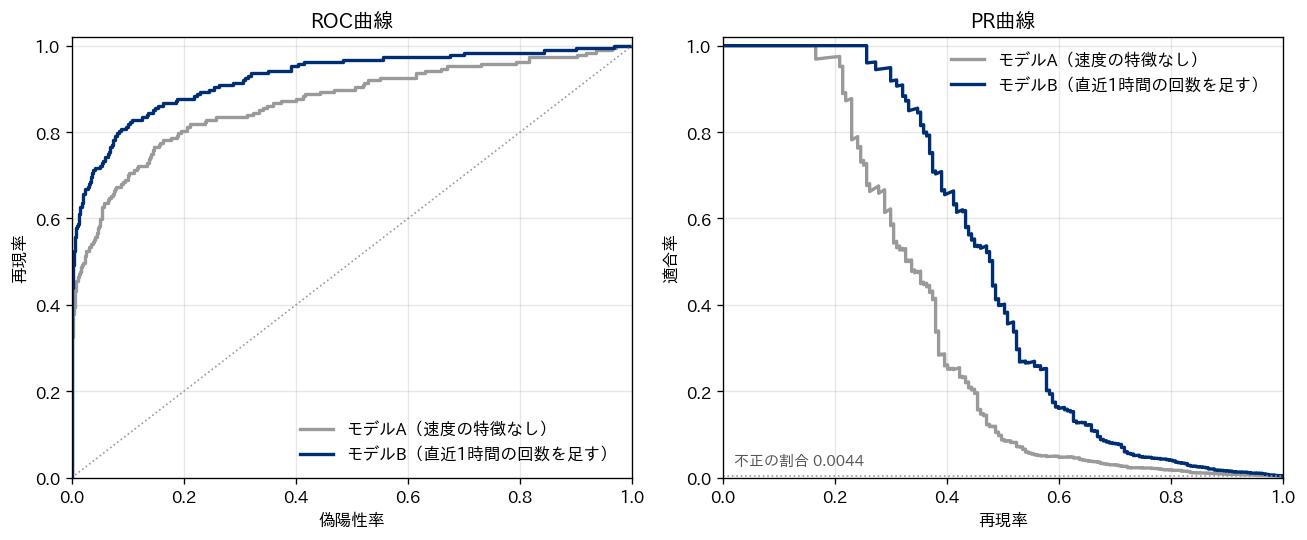
上の図は、2つのモデルのROC曲線(左)とPR曲線(右)です。ROC曲線でも、モデルBは偽陽性率の広い範囲でモデルAより上にあります。本コラムの計算では、偽陽性率0.05での再現率はモデルAが0.594、モデルBが0.722、偽陽性率0.2では0.802と0.877でした。ただし、評価期間の正当な取引は約4万2千件あるので、偽陽性率0.05は約2,100件、0.2は約8,500件の誤検知にあたり、上位212件を調べる運用からは遠い範囲です。PR曲線では、再現率0.4に届く位置で取れる最も高い適合率が、モデルAで0.261、モデルBで0.664でした。調査の量に近い範囲での違いは、PR曲線の方が直接読めます。右の図の下端の点線は、評価期間の不正の割合(0.0044)で、スコアを無作為に付けた場合の適合率の高さです。PR曲線の値は、この基準の高さと比べて読みます。
この結果は、本コラムの架空データと、この2つのモデルでの値です。ROC曲線のAUCで方法の順位が分からないという意味ではありません。ROC曲線のAUCは全部のしきい値にわたる並び方の要約であり、不正の割合が小さく、比べたいのがスコアの上位の並び方であるという条件では、それだけでは「上位K件で何件拾えるか」が分からない、という例です。モデルを比べるときは、ROC曲線のAUCに加えて、平均適合率と、実際の調査の能力に合わせたKでの上位K件の適合率と再現率を並べて見る必要があります。
評価データの切り方、無作為に切る・時間で切る・顧客で切る
評価の結果を大きく動かすもう1つの要素は、評価データの切り方です。過去の記録を学習用と評価用に分ける方法には、主に次の3つがあります。
| 切り方 | 分け方 | 想定している使い方 | 不正検知での注意 |
|---|---|---|---|
| 無作為に切る | 取引を無作為に選んで、一部を評価用にする | 学習用と評価用が同じ性質のデータである場合 | 同じ時期・同じ顧客・同じ発生の取引が両側に入り、未来の手口を学習に使ってしまう |
| 時間で切る | ある日より前を学習用、後を評価用にする | 過去の記録で学び、これからの取引を判定する実際の運用 | 評価期間のラベルが確定しているかを確かめる。評価期間が短いと不正の件数が少ない |
| 顧客で切る | 顧客を分け、一部の顧客の取引をすべて評価用にする | 学習に使っていない顧客に対する性能を知りたい場合 | 時期の違いは残るので、時間で切る方法と組み合わせることが多い |
不正検知のモデルは、過去の記録で学習し、これから起きる取引を判定するために使います。そのため、運用に最も近いのは時間で切る方法です。無作為に切ると、評価用の取引と同じ日・同じ週の取引が学習用に入ります。手口が途中で変わる場合、新しい手口の例が学習用に入るので、モデルは「まだ知らないはずの手口」を学んだうえで評価されることになります。また、1回の発生で数件の不正な取引が続く場合、同じ発生の取引が学習用と評価用に分かれて入り、その発生に特有の特徴をモデルが覚えてしまうことがあります。
次のコードでは、0〜94日目の取引を使い、3つの切り方でモデルBを学習し直して評価しました。切り方の違いだけを比べるために、ここでは学習にも評価にも、合成データなので分かっている真のラベルを使っています。無作為に切る方法と顧客で切る方法は、それぞれ取引と顧客の3割を評価用にしています。時間で切る方法は、前の節と同じく0〜69日目を学習用、70〜94日目を評価用にしました。
lab = df[df.t < 95]                                     # 0〜94日目の取引(真のラベルで学習・評価)
in_late = (lab.t >= 70).to_numpy()                      # 時間で切ったときの評価期間
pick = np.random.default_rng(1).random(len(lab)) < 0.3  # 無作為に切る:取引の3割を評価用
cust_pick = np.random.default_rng(1).random(N_CUST) < 0.3
by_cust = cust_pick[lab.cust]                           # 顧客で切る:顧客の3割の取引を評価用
splits = {"無作為に切る": pick, "顧客で切る": by_cust, "時間で切る": in_late}
split_ap = {}
for name, is_te in splits.items():
    f = fit(lab[~is_te], FEAT_B, "fraud")              # 切り方の違いだけを比べるため真のラベルを使う
    yt, st = lab[is_te].fraud.to_numpy(), f(lab[is_te])
    split_ap[name] = average_precision_score(yt, st)
    p, r = top_k(yt, st, int(len(yt) * 0.005))
    print(name, "評価", len(yt), "件(不正", yt.sum(), ")ROC-AUC", round(roc_auc_score(yt, st), 3),
          "平均適合率", round(split_ap[name], 3), "上位0.5%の適合率", round(p, 3), "再現率", round(r, 3))
    if name == "無作為に切る":                          # 評価用のうち70〜94日目だけに絞って比べる
        m = in_late[is_te]
        print("  うち70〜94日目の取引だけ 不正", yt[m].sum(), "件 平均適合率", round(average_precision_score(yt[m], st[m]), 3))
実行した結果を次の表にまとめます。この表の時間で切る評価の値(平均適合率0.534)は真のラベルで学習した値で、前の節のモデルBの0.482(70日目までに確定したラベルで学習)とは、学習に使ったラベルだけが違います。再現率の分母は、それぞれの評価用の不正(表の括弧内の件数)です。
| 切り方 | 評価用の件数(うち不正) | ROC曲線のAUC | 平均適合率 | 上位0.5%の適合率 | 上位0.5%の再現率 |
|---|---|---|---|---|---|
| 無作為に切る | 48,770件(200件) | 0.988 | 0.786 | 0.621 | 0.755 |
| 顧客で切る | 49,732件(206件) | 0.975 | 0.795 | 0.645 | 0.777 |
| 時間で切る | 42,547件(187件) | 0.939 | 0.534 | 0.472 | 0.535 |
同じモデルBでも、無作為に切ると平均適合率は0.786、時間で切ると0.534でした。無作為に切った評価は、実際の運用に近い時間で切った評価より、平均適合率で0.252高く出たことになります。この差の理由として考えられるのは2つです。1つ目は、評価用の取引の中身の違いです。無作為に切った評価用の取引は0〜94日目にまたがっており、75日目より前の手口の不正が多く含まれます。2つ目は、学習用の中身の違いです。無作為に切ると、75日目以降の新しい手口の例が学習用に入ります。なお、学習用の件数も、無作為に切った場合(0〜94日目の取引の約7割)と時間で切った場合(0〜69日目)で揃っていません。
評価する取引の期間を揃えて比べるために、無作為に切った評価用の取引のうち、70〜94日目のものだけで平均適合率を計算し直しました。結果は0.603で、時間で切った評価の0.534を上回りました。期間を揃えても差が残ったことは、2つ目の理由(新しい手口の例が学習用に入ること)と矛盾しませんが、学習用の件数の違いも残っているので、差のすべてをその理由に帰すことはできません。また、この比較の評価用の不正は53件しかなく、次の節で見るとおり、この件数では平均適合率は大きくばらつきます。0.603と0.534の差の大きさそのものは、目安として読む必要があります。
顧客で切った評価は0.795で、無作為に切った評価とほぼ同じでした。本コラムの架空データは、不正の起き方を特定の顧客に結びつけて作っておらず、モデルも個々の顧客を覚えられない単純なロジスティック回帰なので、同じ顧客の取引が両側に入ることによる差は出にくい条件だと考えられます。顧客ごとの累積の値のような特徴量を使う場合や、個々の顧客を覚えやすい柔軟なモデルを使う場合、同じ顧客が繰り返し被害にあう場合には、顧客で切るかどうかで結果が変わることがあります。この影響の大きさは、自社のデータで、無作為に切った評価と顧客で切った評価の両方を計算して確かめる必要があります。
3つの切り方のうち、モデルを選ぶ評価の基本にするのは時間で切る方法です。時間による依存や手口の変化がある場合、無作為に切った評価は、運用に入れたあとの性能を過大に見積もることがあります。その数字をもとに調査の体制や効果の見込みを立てると、運用時の適合率や再現率が見込みとずれ、見逃しによる被害や調査の過負荷が見込みより大きくなるおそれがあります。時間で切った評価を、学習の期間と評価の期間をずらしながら何回か繰り返すと、時期による成績の揺れも分かります。
また、時間で切るなら、学習に使うラベルも学習の時点で確定していたものに限る必要があります。この表の時間で切る評価(真のラベルで学習)の平均適合率は0.534で、前の節の、70日目までに確定したラベルだけで学習したモデルBの0.482より高くなりました。2つの計算の違いは学習に使ったラベルだけなので、この差は、学習の時点で未確定だった不正を学習に使えるかどうかの差です。後から確定したラベルで学習すると、運用の時点では使えない情報を使うことになり、この架空データではそれが成績を高く見せる方向に働きました。
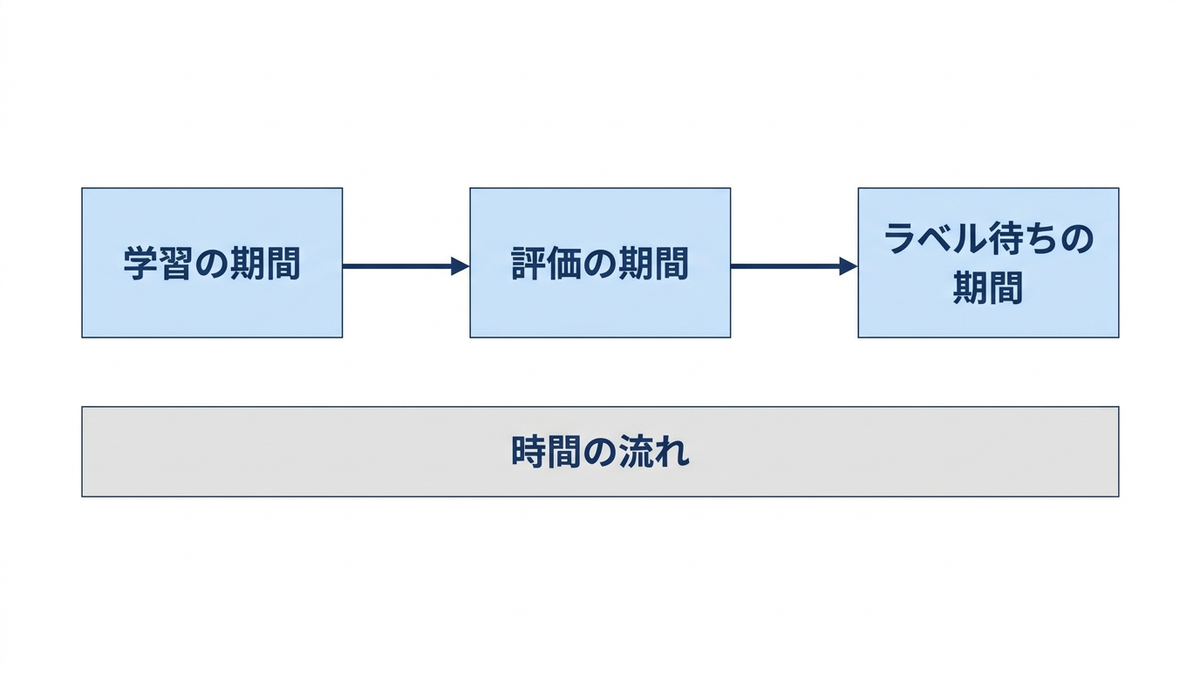
ラベルの遅れと、被害の大きさ・発生の単位で見る評価
第2章で扱ったとおり、不正のラベルは、本人の申告やチャージバック、調査の完了を待って確定するため、取引の日から日数がたってから届きます。評価の日に確定していない不正は、記録の上では正当な取引に見えます。評価の期間を直近に置くと、確定していない不正が正当として数えられ、適合率も再現率も実際とは違う値になります。評価の期間は、ラベルが確定するだけの日数がたった期間に置く必要があります。
次のコードの前半では、データの最後の日(120日目)に評価を行う想定で、評価の期間を70〜94日目に置いた場合と、直近の95〜119日目に置いた場合を比べました。それぞれ、120日目までに確定したラベルだけで計算した上位0.5%の適合率と、合成データなので分かっている真のラベルで計算した値を並べています。後半では、被害の大きさで重み付けた再現率と、不正の発生の単位での評価を計算しました。
f_b = models["B"]
for lo, hi in [(70, 95), (95, 120)]:                     # ラベルの遅れ:評価期間をどこに置くか
    w = df[(df.t >= lo) & (df.t < hi)]
    s, k = f_b(w), int(len(w) * 0.005)
    print(f"{lo}〜{hi - 1}日目 不正{w.fraud.sum()}件のうち確定{w.y_obs.sum()}件",
          "上位0.5%の適合率 確定済みのラベルで", round(top_k(w.y_obs.to_numpy(), s, k)[0], 3),
          "真のラベルで", round(top_k(w.fraud.to_numpy(), s, k)[0], 3))
alert = scores["B"] >= np.sort(scores["B"])[-K]           # 評価期間の上位K件をアラートにする
fr = te.fraud.to_numpy() == 1
amt = te.amt.to_numpy()
print("件数の再現率", round(alert[fr].mean(), 3), "/額で重み付けた再現率", round(amt[fr & alert].sum() / amt[fr].sum(), 3))
ev = pd.DataFrame({"event": te.event[fr].to_numpy(), "alert": alert[fr]})
ev["cnt_1h"] = te.cnt_1h[fr].to_numpy()
first = ev.groupby("event").alert.first()                 # 発生ごとの1件目でアラートにできたか
c1 = ev.groupby("event").cnt_1h.first()
print("発生の1件目の直近1時間の回数 平均", round(c1.mean(), 3), "/0回の割合", round((c1 == 0).mean(), 3),
      "/2件目以降の平均", round(ev.cnt_1h[ev.event.duplicated()].mean(), 3))
miss_before = ev.groupby("event").alert.apply(lambda a: np.argmax(a.to_numpy()) if a.any() else len(a))
print("不正の発生", len(first), "件 1件目でアラート", round(first.mean(), 3),
      "/どこかでアラート", round(ev.groupby("event").alert.any().mean(), 3),
      "/最初のアラートより前の不正な取引 平均", round(miss_before.mean(), 2), "件")
| 評価の期間 | 不正の件数 | 120日目までに確定した件数 | 上位0.5%の適合率(確定済みのラベルで) | 上位0.5%の適合率(真のラベルで) |
|---|---|---|---|---|
| 70〜94日目 | 187件 | 154件 | 0.373 | 0.429 |
| 95〜119日目 | 236件 | 84件 | 0.141 | 0.432 |
直近の95〜119日目では、不正236件のうち120日目までに確定したのは84件で、確定済みのラベルで計算した適合率は0.141でした。真のラベルで計算すると0.432で、確定済みのラベルだけで計算した値は真の値の3分の1ほどです。2つの計算でスコアは同じで、違うのはラベルだけなので、この差は、アラートにした取引のうち、まだ確定していない不正が正当として数えられた分です。70〜94日目に置いた場合も、確定は187件のうち154件(82.4%)で、確定済みのラベルで計算した適合率0.373は、真の値0.429より低く出ました。この架空データでは、ラベルが確定するまでの日数の90%点が42.0日なのに対し、94日目から120日目までは26日しかなく、70〜94日目でも確定は8割あまりにとどまりました。
実務では、自社のラベルが確定するまでの日数の分布を調べ、例えばその90%点より長い日数がたった期間を評価に使うことが考えられます。この例でいえば、120日目に評価するなら、78日目より前(120日から42日を引いた日より前)の取引を評価期間にすることになります。この例の評価期間(70〜94日目)は、78日目以降の取引を含むので、この条件を満たしていません。90%点を超えて待っても未確定の不正は残りうるので、待つ日数を変えたときに評価の値が安定しているかも確かめておくことが有効だと考えています。
ラベルの遅れは、評価の期間を古くするだけでなく、方法を比べるときの公平さにも影響します。新しいモデルの評価だけを直近の期間で行い、既存のルールの評価を古い期間で行うと、確定の割合の違いだけで成績が変わります。比べる方法は、同じ期間・同じ時点で確定したラベルで評価する必要があります。また、止めた取引や調査しなかった取引には真のラベルが分からないまま残るものがあるという選択の偏り(第2章)は、ラベルが確定するのを待っても解消しません。この点は、この節の最後とオフラインの評価の限界の節で触れます。
次に、被害の大きさで重み付けた指標です。件数の再現率は、不正を1件ずつ同じ重みで数えます。しかし、被害の大きさは取引の額によって違います。額の相対値で重み付けた再現率(アラートにできた不正な取引の額の合計を、すべての不正な取引の額の合計で割った値)を計算すると、件数の再現率が0.487だったのに対して、額で重み付けた再現率は0.649でした。額で重み付けた方が高く出たので、この架空データでは、額の大きい不正ほどアラートに入りやすかったことになります。逆に、額の小さい不正を多く見逃しているモデルは、件数の再現率では低く、額で重み付けた再現率では高く見えることがあります。どちらを主に見るかは、その不正の損失がどこから来るか(被害の額か、件数に比例する対応の手間か)で決めることになります。
最後に、評価の単位です。ここまでの指標は、取引を1件ずつ数えていました。しかし、1回の発生で数件の不正な取引が続く場合、事業にとって大事なのは「その発生の何件目でアラートにできたか」です。評価期間に入った不正の発生52件について調べると、発生の1件目の取引でアラートにできたのは28.8%、発生のどこかの取引でアラートにできたのは71.2%で、最初のアラートより前にあった不正な取引は平均1.58件でした(最後までアラートにならなかった発生は、その発生の不正な取引の件数をすべて数えています)。この架空データでは、評価期間の始まり(70日目)と終わり(95日目)をまたぐ発生は無かったので、評価期間の中の1件目は発生の1件目と同じです。ここで数えたのはアラートにできたかどうかで、その取引を止められたかどうかではありません。件数の再現率0.487と、発生のどこかで捉えた割合0.712は、同じモデルの同じアラートを別の単位で数えた値です。
1件目でアラートにできた割合が低い理由を確かめるために、モデルBが使っている直近1時間の回数を、発生の1件目と2件目以降で比べました。発生の1件目では平均0.019回で、98.1%が0回でした。2件目以降では平均1.504回です。この架空データでは、直近1時間の回数は発生の1件目ではほとんど手がかりにならず、2件目以降で効く特徴量になっています。カードや顧客の単位で評価すると、モデルの役割が「1件目でアラートにする」なのか「2件目以降で早くアラートにして被害の拡大を抑える」なのかを区別できます。取引の単位の指標だけを見ていると、この違いは見えません。なお、一連の不正を止める措置が成功すれば、その後の取引は起きなくなることがあります。2件目以降の取引の記録は、1件目で措置が取られなかった場合のものだという点に注意が要ります。
不正の件数が少ないときの指標のばらつき、ブートストラップで区間を出す
評価期間の不正の件数は、多くの場合それほど多くありません。本コラムの架空データでは、評価期間の4万件あまりの取引に対して、不正は187件でした。不正が数百件程度だと、評価に使う期間を少しずらしただけで、平均適合率が大きく動くことがあります。2つの方法の差が、本当の性能の差なのか、たまたまの揺れなのかを判断するには、指標のばらつきの大きさを知っておく必要があります。
ばらつきを見る方法の1つが、ブートストラップです。評価用のデータから、同じ件数を復元抽出(同じものを何度でも選んでよい抜き出し方)で取り出し、指標を計算し直すことを何百回も繰り返して、その値の分布から区間を出します。不正検知では、何を単位に抜き出すかが重要です。1回の発生の取引が数件続くように、同じ顧客の取引どうしは似た結果になりやすいので、取引を単位に抜き出すと、ばらつきを小さく見積もることがあります。次のコードでは、取引を単位にする方法と、顧客を単位にする方法の両方で、モデルBの平均適合率と、モデルBとモデルAの差の95%区間を、それぞれ300回の復元抽出で求めました。区間は、復元抽出で計算し直した値の2.5%点と97.5%点をとるパーセンタイル法で、学習済みのモデルを固定したまま評価用のデータのばらつきだけを見たものです。学習のやり直しや将来の手口の変化による揺れは含みません。
boot = np.random.default_rng(7)
sa, sb = scores["A"], scores["B"]
cust_te = te.cust.to_numpy()
ids = np.unique(cust_te)
pos = {c: np.flatnonzero(cust_te == c) for c in ids}       # 顧客ごとの取引の位置
nf = te[te.fraud == 1].groupby("cust").size()
print("評価期間に不正があった顧客", len(nf), "人/1人あたりの不正な取引 平均", round(nf.mean(), 2), "件 最大", nf.max(), "件")
res = {"取引で": [], "顧客で": []}
for _ in range(300):
    i = boot.integers(0, len(y), len(y))                     # 取引を単位に復元抽出
    res["取引で"].append((average_precision_score(y[i], sb[i]),
                         average_precision_score(y[i], sb[i]) - average_precision_score(y[i], sa[i])))
    j = np.concatenate([pos[c] for c in boot.choice(ids, len(ids))])   # 顧客を単位に復元抽出
    res["顧客で"].append((average_precision_score(y[j], sb[j]),
                         average_precision_score(y[j], sb[j]) - average_precision_score(y[j], sa[j])))
for name, v in res.items():
    v = np.array(v)
    lo, hi = np.quantile(v[:, 0], [0.025, 0.975])
    dlo, dhi = np.quantile(v[:, 1], [0.025, 0.975])
    print(name, "Bの平均適合率 95%区間", round(lo, 3), "〜", round(hi, 3),
          "/BとAの差 95%区間", round(dlo, 3), "〜", round(dhi, 3))
| 復元抽出の単位 | モデルBの平均適合率の95%区間 | モデルBとモデルAの差の95%区間 |
|---|---|---|
| 取引 | 0.405〜0.554 | 0.094〜0.162 |
| 顧客 | 0.366〜0.580 | 0.099〜0.166 |
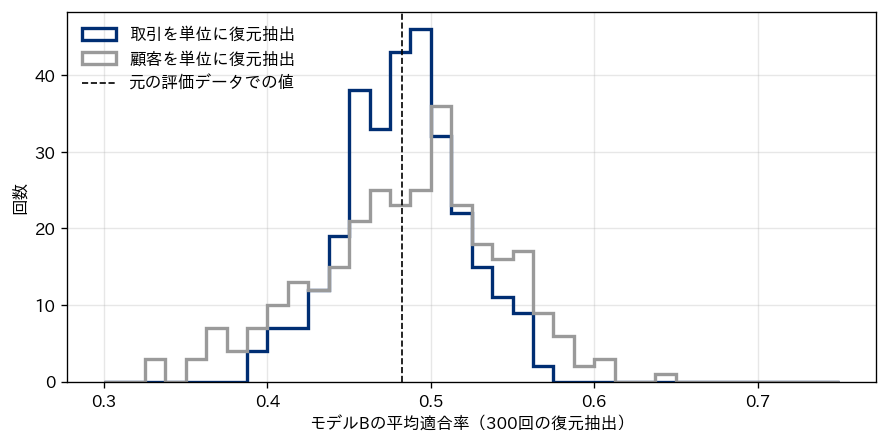
元の評価データでのモデルBの平均適合率は0.482でしたが、取引を単位にした95%区間は0.405〜0.554、顧客を単位にした95%区間は0.366〜0.580でした。評価期間に不正があった顧客は51人で、1人あたりの不正な取引は平均3.67件(最大7件)です。顧客を単位にすると、こうした同じ顧客の不正な取引がまとまって選ばれたり、まとめて外れたりするので、区間が広くなったと考えられます。評価期間に187件の不正があっても、平均適合率の95%区間の幅は、取引を単位にすると約0.15、顧客を単位にすると約0.21あることになります。前の節で示した、無作為に切って期間を揃えた評価と時間で切った評価の差(0.603と0.534の差)は、評価の不正が53件の比較であり、この程度の揺れに埋もれる可能性があります。
一方、モデルBとモデルAの差の95%区間は、どちらの単位でも0.09から0.17の間にあり、0を上回りました。本コラムの計算では、差の区間の幅(約0.07)は、モデルBの値そのものの区間の幅(約0.15から0.21)より狭くなりました。同じ抜き出しの中で2つのモデルを計算しているので、評価データのたまたまの難しさが両方に同じように効き、差を取ると打ち消し合う部分があると考えられます。モデルを比べるときは、それぞれの指標の区間を別々に見るより、同じ抜き出しの中で差を計算し、その差の区間を見る方が判断に使いやすくなります。なお、300回という回数は、区間の端の値をおおまかに知るための回数です。区間の推定と検定の一般論は、弊社コラム「データから正しく結論を導く統計学のまとめ」で扱っています。
ベンダーや社内の分析担当から「新しいモデルで平均適合率が0.02上がった」という報告を受けた場合は、評価の不正が何件あり、その差の区間がどうなっているかを確かめる必要があります。不正の件数が少ない評価では、小さな差は揺れの範囲にとどまることが多いと考えています。
オフラインの評価の限界と、ベンダーの示す数字の読み方
時間で切り、ラベルの遅れを考え、区間まで出したとしても、過去の記録を使う評価には構造的な限界が残ります。1つ目は、過去の記録が過去の検知の影響を受けていることです。過去のルールで止めた取引は、その先の取引が起きていないことがありますし、止めた取引が本当に不正だったかも分からないまま残ることがあります(第2章の選択の偏り)。過去のルールが得意な型の不正は、記録の中で早く止められて件数が少なく見え、ルールが苦手な型の不正は、記録に多く残ります。新しいモデルの評価は、この偏った記録の上で行うことになります。
2つ目は、相手が適応することです。検知の仕組みが変わると、不正を行う側の行動も変わることがあります。過去の記録での評価は、相手が過去と同じように行動するという前提の上に成り立っていて、新しい仕組みを入れたあとの行動の変化は測れません。手口の変化への追従は第10章で扱います。3つ目は、措置の効果が測れないことです。過去の記録での評価が答えるのは「アラートにできたか」であり、アラートのあとに追加の認証で不正を止められたか、正当な顧客が追加の認証の手間で離れていかなかったかは分かりません。本番の取引で新しい方法を確かめる方法のうち、影の運用(判定には使わずスコアだけ記録して比べる方法。第12章)では、判定の傾向や処理の時間は確かめられますが、措置を実際には適用しないので、措置の効果は分かりません。措置の効果は、一部の取引にだけ新しい方法を実際に使うチャンピオンとチャレンジャー(第12章)のように、措置を適用して比べる方法で確かめることになります。
選択の偏りを補う方法としては、止めなかった取引のうち一部を無作為に選んで調査し、真のラベルを付けておく方法があります。これにより、止めなかった取引の中では、調査の対象の選び方による偏りを減らせます。ただし、止めた取引は抽出の対象に入らないので、止めた取引や措置のあとの行動に関する偏りは残ります。調査の能力の一部をこの無作為の点検に割り当てるかどうかは、評価の質と調査の手間のつり合いの判断です(第10章でも扱います)。
ベンダーの製品や外部の分析の提案では、「検知率」や「誤検知の削減」といった数字が示されることがあります。これらの数字は、上で見たとおり、指標・切り方・評価の期間・単位・不正の割合のどれか1つが違うだけで大きく動きます。数字の大きさを比べる前に、次の表の項目を確かめる必要があります。
| 確かめること | 聞き方の例 | 理由 |
|---|---|---|
| 指標の定義 | 「検知率」は再現率か。適合率は同じアラートの量で示されているか | 再現率だけ、適合率だけの数字は、アラートの量を変えると大きく動き、片方だけでは良し悪しが分からない |
| アラートの量 | その再現率は、全取引の何%をアラートにしたときの値か | 自社の調査の能力に合ったアラートの量での値でなければ、運用に使えない |
| 評価データの切り方 | 時間で切ったか。学習の期間と評価の期間はいつか | 時間による依存や手口の変化がある場合、無作為に切った評価は将来の性能を過大に見積もることがある |
| ラベルの確定 | 評価の期間のラベルは確定しているか。確定までの日数をどう扱ったか | 未確定の不正が正当として数えられると、成績が実際と違う値になる |
| 評価の単位 | 取引の単位か、カードや顧客、発生の単位か | 同じアラートでも、単位によって再現率が大きく違う |
| 不正の割合とデータの出所 | 評価データの不正の割合はいくつか。自社のデータか、他社や公開のデータか | 平均適合率や適合率は不正の割合で基準が変わる。他のデータでの値は自社の値の目安にならない |
| 件数とばらつき | 評価の不正は何件か。差の区間を示せるか | 不正が少ない評価では、小さな差は揺れの範囲に入る |
| 比べた相手 | 何と比べた改善か。比べた相手を同じ期間・同じラベルで評価したか | 比べる相手の評価の条件が違うと、改善の大きさは意味を持たない |
この表の項目は、社内でモデルを作る場合にも、評価の手順の点検表としてそのまま使えます。とくに「アラートの量」と「比べた相手」は、答えが無いまま数字だけが伝わることが多い項目だと考えています。公開データセットでの研究の数字も同じで、そのデータセットとその条件での値として読み、自社で期待できる成績としては扱わないことが必要です。
経営の判断、評価の指標と切り方をモデルを選ぶ前に決める
評価の指標と切り方は、技術の細部に見えますが、その選び方を誤ると経営上の損失に直結します。無作為に切った評価や、ラベルの確定を待たない評価で選んだモデルを本番に入れると、運用時の再現率が見込みとずれ、見逃しによる被害が残るおそれがあります。ROC曲線のAUCだけで選ぶと、上位のアラートの適合率が低いモデルを選ぶことがあり、調査の過負荷や、アラートをもとに正当な取引を保留・拒否した場合の誤検知による機会損失・顧客の離反を招くことがあります。評価の手順が人によって毎回違うと、新旧のモデルを比べられず、モデルの更新が止まって形骸化につながります。
これを防ぐために、モデルを作り始める前に、次のことを決めて文書に残しておくことが有効だと考えています。
| 決めること | 決める内容の例 | 決める人の例 |
|---|---|---|
| 主に見る指標 | 調査の能力に合わせたKでの上位K件の適合率と再現率。補助として平均適合率 | 不正対策の責任者とデータ分析の担当 |
| K(アラートの量) | 1日の調査の能力から決めた件数(しきい値と調査の能力の関係は第9章) | 調査の責任者 |
| 評価データの切り方 | 時間で切る。学習の期間・評価の期間・ラベル待ちの期間の長さ | データ分析の担当 |
| 評価の単位 | 取引の単位に加えて、カード・顧客・発生の単位で何を見るか | 不正対策の責任者 |
| 被害の重み | 件数で数えるか、額の相対値で重み付けるか、その両方か | リスク管理の責任者 |
| 合格の基準 | 既存のルール(ベースライン、第3章)に対して、差の区間がどうなれば入れ替えるか | 経営とリスク管理の責任者 |
この表の中で経営が直接関わるべきなのは、合格の基準です。新しいモデルが既存のルールより「どれだけ良ければ」入れ替えるのかを、数字を見る前に決めておかないと、良く見える数字が出たときに、その数字の測り方を確かめないまま採用することになりがちです。また、評価の仕組み(評価用のデータの切り出し・指標の計算・既存のルールとの比較を毎回同じ手順で回す仕組み)を作る手間は、モデルの開発とは別に予算に入れておく必要があります。この仕組みが無いと、モデルを替えるたびに評価をやり直すことになり、改善したのかどうかが分からなくなります。
もう1つの判断は、評価の指標と事業の成果のつながりを意識しておくことです。上位K件の適合率と再現率は、調査担当の手間と見逃しの割合を表す数字であり、それだけでは事業の成果になりません。序章で定めたとおり、成果は、見つけて防いだ不正と、誤って止めた正当な取引の両方を数えたうえでの差です。評価の指標で選んだモデルを、どのしきい値で、どの措置(承認・保留・拒否・事後の調査)に結びつけ、その結果として被害と誤って止めた取引がどう変わったかを測るところまでが、検知の成果の測り方になります。しきい値と措置の決め方は第9章で、成果の KPI への分解は第13章で扱います。
この章のまとめ
この章では、混同行列と指標、不均衡なデータで正解率とROC曲線のAUCに注意が要る理由、評価データの切り方、ラベルの遅れ、被害の大きさと発生の単位で見る評価、指標のばらつきを扱いました。本コラムの架空データでは、2つのモデルのROC曲線のAUCは0.868と0.927でしたが、その値からは上位212件で拾える不正の件数は分からず、上位212件で当たる不正はモデルAで72件、モデルBで91件でした。また、同じモデルでも、無作為に切った評価は平均適合率0.786、時間で切った評価は0.534で、この架空データでは無作為に切ると成績が高く出ました。学習に後から確定したラベルを使った場合も、成績が高く出ました(0.482に対して0.534)。評価の指標と切り方は、モデルを選ぶ前に、調査の能力とラベルの確定の日数をもとに決めておく必要があります。次の第9章では、評価で選んだスコアを、しきい値と措置に結びつけ、アラートの量を調査の能力とつり合わせる運用を扱います。
この章を深めたい方への参考書籍
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):機械学習の評価指標を、事業の KPI とのつながりから解説した本です。版元の目次によれば、二値分類の章で混同行列・正解率・適合率・再現率・F値・ROC曲線のAUC・PR曲線の下の面積などを扱い、ビジネスインパクトの期待値計算やコスト考慮型学習の節もあります。この章で扱った指標の選び方を、事業の目的から逆算して考えるのに向いています。
『ブートストラップ入門』(汪金芳・桜井裕仁 著、共立出版):シリーズ「Rで学ぶデータサイエンス」の第4巻として刊行された、ブートストラップの入門書です。この章では、評価の指標のばらつきを復元抽出で見積もる方法を簡単に使いましたが、その考え方と、区間の作り方の違いや注意点を体系的に確かめるのに役立ちます。
第9章 しきい値と調査の運用、アラートの量と調査能力のつり合い
第8章では、適合率・再現率・PR曲線を使って検知の良し悪しを測る方法と、評価データを時間で切る理由を確かめました。そこで扱ったのは、スコアの順位の付け方がどれだけ良いかという、モデルそのものの評価でした。ところが、スコアは数を出すだけで、取引を止めることも調査担当に回すこともしません。スコアを措置に変えるには、どこで線を引き、線を越えた取引を誰がどの順で見るかを決める必要があります。この章では、その線であるしきい値の決め方と、アラートを受け取る調査の運用を扱います。
この章で扱うのは次の内容です。後半は、架空のスコアつきの取引(60日・1日5,000件)を使い、実行したコードと結果で確かめます。
- スコアから4つの措置(承認・保留・拒否・事後の調査)への変え方
- しきい値の決め方の3つの型(調査の能力から決める・適合率の下限から決める・損失の見積もりから決める)
- しきい値を動かしたときのアラートの件数・適合率・再現率・見逃した額の変化
- 誤検知と見逃しの損失の比で決めるコスト考慮型の判定と、取引の額に応じてしきい値を変える考え方
- 段階的な措置と、追加の認証の位置づけ
- 調査の待ち行列と、アラートの優先順位づけ
- アラート疲れ、調査の記録、運用の KPI と経営の判断
この章の主張は、しきい値はモデルの性能だけでは決まらず、調査の能力と一緒に決めるものだ、という点です。本コラムの架空データでは、調査の能力にちょうど合うように選んだしきい値でも、日ごとのアラートの件数のばらつきのため、60日のうち23日で能力を超えました。また、調査の待ち行列の計算では、アラートの到着が調査の能力の1.05倍以上になると、調べられないアラートが列にたまり、期限を過ぎたものが見られずに流れ始めました。しきい値を下げて再現率を上げても、調査の能力・優先順位の付け方・自動の措置を併せて見直さなければ、再現率の改善が被害の防止につながらない場合があります。
スコアから措置へ、4つの措置と判定の分担
本コラムでは、アラートに対して取る行動を措置と呼び、承認・保留・拒否・事後の調査の4つに分けています(全体の地図の用語の定義)。承認は、取引をそのまま通すことです。保留は、取引をいったん止めて、顧客に追加の認証や確認を求めることです。拒否は、取引を止めることです。事後の調査は、取引はいったん通したうえで、後から調査担当が記録を確かめることです。どの措置を取れるかは、取引の種類と判定のタイミングで変わります。カードの決済のように承認の前に判定できる取引では4つすべてを選べますが、すでに完了した取引を後から一括で調べる場合には、事後の調査しか選べません。判定のタイミングとシステムの構成は第12章で扱います。
4つの措置は、顧客と事業に与える影響がそれぞれ違います。拒否は、取引の実行の前に拒否できれば、不正であればその取引による被害を防げますが、正当な取引であれば売上の機会を失い、顧客の信頼を損ないます。保留は、拒否より顧客への影響が小さい一方で、手続きの手間のために正当な取引の一部が中止されることがあります。事後の調査は、取引の時点では顧客を待たせませんが、後日の確認や連絡が顧客の負担になる場合があり、調査が終わるまでに被害が確定してしまうこともあり、調査担当の時間も使います。承認は、何の負担もかけない代わりに、不正であれば被害が出ます。しきい値を決めるとは、スコアの範囲ごとに、この4つのどれを割り当てるかを決めることだと言い換えられます。
ここで、言葉の使い分けを確かめておきます。アラートは「不正の疑いあり」と判定したことであり、取引を止めたこととは限りません。本コラムでは、正当な取引をアラートにすることを誤検知、正当な取引を保留や拒否にすることを誤って止めた取引と呼び分けます。また、見逃しは、不正な取引をアラートにできなかったことに限ります。アラートにしたうえで承認したり、保留の後に認証を通ってしまったりして被害が出た場合は、見逃しではなく、措置の結果として別に数えます。
| 措置 | 不正だった場合 | 正当だった場合 | 使う資源 | 向いているスコアの範囲 |
|---|---|---|---|---|
| 承認 | 被害が出る(アラートにならずに承認した場合は見逃し) | 負担なし | なし | 低い |
| 保留(追加の認証や確認) | 認証で止まれば被害を防ぐ。止まらなければ被害が出る | 手続きの負担。一部の取引は中止される | 認証の仕組み・顧客対応の窓口 | 中間 |
| 拒否 | 実行の前に拒否できれば、その取引の被害を防ぐ | 誤って止めた取引になり、機会を失う。顧客の離反につながりうる | 問い合わせへの対応 | 高い |
| 事後の調査 | 調査が間に合えば被害を抑える。間に合わなければ被害が確定する | 取引の時点では負担なし。後日の確認や連絡が負担になる場合がある | 調査担当の時間 | 中間から高い。止められない取引の全範囲 |
この表の「使う資源」の列が、この章の中心になります。拒否と保留は、判定した瞬間に機械が措置を実行できます。一方で、事後の調査と、保留の後の顧客対応には、人の時間が要ります。人の時間には上限があり、本コラムではこれを調査の能力(1日に確認できる件数)と呼んでいます。モデルがどれほど多くの疑わしい取引を拾っても、人が見られる件数を超えた分は、確認されないまま残ります。
判定の分担として、ルールとモデルの役割も決めておく必要があります。第3章で扱ったとおり、規制上の要件や既知の手口に対応するルールは、スコアに関係なく保留や拒否に回すことがあります。たとえば拒否リストに載った相手への送金は、モデルのスコアが低くても止めます。本コラムでは、ルールで措置が決まる取引を先に除き、残りの取引についてスコアとしきい値で措置を決める、という順を想定して説明します。ルールとモデルの判定が食い違ったときに、どちらを優先するかは、事前に文書で決めておくことが必要です。
しきい値の決め方の3つの型、能力から・適合率から・損失から
しきい値の決め方には、大きく分けて3つの型があります。どれか1つが正しいというものではなく、それぞれ何を固定して何を結果として受け入れるかが違います。
1つ目は、調査の能力から決める型です。1日に調べられる件数が決まっているなら、アラートの件数がその件数に収まるところまでしきい値を上げます。調査担当が10人いて1人1日20件を確認できるなら、1日のアラートを200件程度に収めるしきい値を選ぶ、という決め方です。人の時間という制約を最初に置くので、アラートが見られずに流れることを防ぎやすい一方で、そのしきい値でどれだけの不正を見逃しているかは結果として受け入れることになります。見逃しが大きすぎるなら、しきい値ではなく調査の能力のほうを見直す、という判断につなげます。
2つ目は、適合率の下限から決める型です。「アラートのうち少なくとも1割は不正であってほしい」のように、アラートの質の下限を決め、その下限を満たす範囲で最も低いしきい値を選びます。適合率が低すぎると、調査担当は空振りの確認ばかりを繰り返すことになり、後で扱うアラート疲れを招きます。拒否の措置であれば、適合率の下限は「止めた取引のうち正当な取引が何割までなら許せるか」という、顧客への影響の上限として読めます。ただし、適合率は不正の割合が変わると動くので、下限を満たすしきい値も時期によって変わります。
3つ目は、損失の見積もりから決める型です。誤検知1件で失うものと、見逃し1件で失うものを、それぞれ見積もり、損失の合計が最も小さくなるしきい値を選びます。この型は、検知の判断を事業の損失の言葉で説明できる点が利点です。一方で、誤検知1件の損失(売上の機会・顧客対応の手間・顧客の離反のおそれ)は見積もりにくく、見積もりの置き方しだいで結果のしきい値が大きく動きます。本コラムでは損失を金額ではなく相対値で扱い、後のコードで、誤検知1件の損失の置き方を変えると最適なしきい値がどれだけ動くかを示します。
| 型 | 先に固定するもの | 結果として受け入れるもの | 必要な情報 | 外れやすい場面 |
|---|---|---|---|---|
| 調査の能力から決める | 1日のアラートの件数 | 再現率・見逃した被害 | 調査担当の人数と1件あたりの所要時間 | アラートの件数が日によってばらつくとき。不正が急に増えたとき |
| 適合率の下限から決める | アラートの質(適合率) | アラートの件数・再現率 | しきい値ごとの適合率の見積もり(ラベルが要る) | 不正の割合が変わったとき。ラベルの遅れで適合率が後から変わるとき |
| 損失の見積もりから決める | 誤検知1件と見逃し1件の損失の比 | アラートの件数・適合率・再現率 | 実際の不正の割合と対応しているかを確かめたスコアと、損失の見積もり | 損失の見積もりが不確かなとき。最適なしきい値が調査の能力を超えるとき |
実務では、3つの型を組み合わせて使うことが多いように思います。損失の見積もりから望ましいしきい値の目安を出し、それが調査の能力に収まるかを確かめ、収まらなければ能力を増やすか、しきい値を上げて見逃しを受け入れるかを決める、という順です。いずれの型でも、決めたしきい値は固定ではありません。不正の割合や手口が変われば、同じしきい値でもアラートの件数と適合率が変わります。手口の変化への追従は第10章で扱います。
架空のスコアつきの取引で、しきい値を動かす
ここからは、しきい値を動かしたときに何が変わるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の取引の記録よりずっと単純です。60日分・1日5,000件、合計300,000件の取引に、額(相対値)とスコアと不正かどうかの印を乱数で付けました。不正の確率は、取引ごとの潜在的な不正らしさと、額の大きさから決めています。額が大きい取引ほど、不正の確率がやや高くなるようにしました。
この章では、スコアそのものを不正の確率として作っています。つまり、検知のモデルが出すスコアが、第4章で扱った確率の較正を済ませた状態で、スコアの値をそのまま不正の確率として読める、と仮定したデータです。実際のモデルのスコアは、0から1の値であっても、そのまま不正の確率として使えるとは限りません。損失の見積もりから決める型を使う前には、評価用のデータでスコアと実際の不正の割合が対応しているかを確かめ、必要に応じて較正します。合成データでの成績は、実際の成績の目安にはなりません。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

rng = np.random.default_rng(20261112)
n_days, n_per_day = 60, 5000          # 60日・1日5,000件の取引
n = n_days * n_per_day
df = pd.DataFrame({"day": np.repeat(np.arange(n_days), n_per_day)})
# 取引の額は相対値(単位なし)。大半は小さく、一部が大きい
df["amount"] = np.round(rng.lognormal(mean=3.0, sigma=1.0, size=n), 1)
# 不正らしさの潜在的な強さ u と、額の大きさから、不正の確率を決める
u = rng.normal(size=n)
logit = -6.3 + 1.5 * u + 0.4 * (np.log(df["amount"]) - 3.0)
df["score"] = 1 / (1 + np.exp(-logit))   # 較正済みのスコアとみなす
df["fraud"] = rng.random(n) < df["score"]
print("取引の件数:", n, " 不正の件数:", int(df["fraud"].sum()),
      " 不正の割合:", round(df["fraud"].mean() * 100, 3), "%")
print("1日あたりの不正の件数:", round(df["fraud"].sum() / n_days, 1))
print("不正の額の合計(相対値):", round(df.loc[df["fraud"], "amount"].sum()))

# しきい値を動かして、アラートの件数・適合率・再現率・見逃した額を表にする
fraud_total = df.loc[df["fraud"], "amount"].sum()
rows = []
for t in [0.005, 0.01, 0.02, 0.03, 0.05, 0.1, 0.2, 0.3, 0.5]:
    alert = df["score"] >= t
    tp = (alert & df["fraud"]).sum()
    missed = df.loc[~alert & df["fraud"], "amount"].sum()
    rows.append({"しきい値": t,
                 "1日のアラート": round(alert.sum() / n_days, 1),
                 "適合率": round(tp / max(alert.sum(), 1), 3),
                 "再現率": round(tp / df["fraud"].sum(), 3),
                 "見逃した額": round(missed),
                 "見逃した額の割合": round(missed / fraud_total, 3)})
sweep = pd.DataFrame(rows)
print(sweep.to_string(index=False))
実行すると、300,000件のうち不正は1,828件(不正の割合 0.609%)で、1日あたり30.5件の不正が起きるデータになりました。不正の額の合計は相対値で93,867です。しきい値を動かしたときの結果は次の表のとおりです。「1日のアラート」は60日の平均、「見逃した額の割合」は、不正の額の合計のうちアラートにならずに通った額の割合です。コードは見逃した額そのもの(相対値)も出力しますが、表では割合だけを載せました。再現率は、合成データの真の不正1,828件を分母にした値です。なお、この章に出てくるしきい値や損失の数は、合成データに合わせた説明用の値で、実際の運用で使う値ではありません。
| しきい値 | 1日のアラート | 適合率 | 再現率 | 見逃した額の割合 |
|---|---|---|---|---|
| 0.005 | 1,298.8 | 0.019 | 0.795 | 0.140 |
| 0.01 | 682.3 | 0.030 | 0.664 | 0.252 |
| 0.02 | 301.3 | 0.048 | 0.479 | 0.422 |
| 0.03 | 170.6 | 0.066 | 0.370 | 0.542 |
| 0.05 | 76.5 | 0.104 | 0.261 | 0.650 |
| 0.1 | 20.9 | 0.180 | 0.123 | 0.824 |
| 0.2 | 3.7 | 0.321 | 0.039 | 0.939 |
| 0.3 | 1.3 | 0.380 | 0.016 | 0.973 |
| 0.5 | 0.2 | 0.333 | 0.002 | 0.998 |
表から読めることは3つあります。1つ目は、しきい値を下げると、アラートの件数が再現率よりずっと速く増えることです。しきい値を 0.05 から 0.01 に下げると、再現率は 0.261 から 0.664 へ約2.5倍になりますが、1日のアラートは76.5件から682.3件へ約9倍になります。不正は全体のわずか 0.6% なので、しきい値を下げて新しく拾う取引の大半は正当な取引だからです。2つ目は、適合率がどのしきい値でも低いことです。この架空データでは、しきい値を 0.3 まで上げても適合率は 0.380 にとどまり、アラートの6割以上は正当な取引でした。不均衡なデータでは、スコアの順位がある程度正しくても、アラートの多くが誤検知になることは珍しくありません。3つ目は、見逃した額の割合が再現率と同じ動きをしないことです。しきい値 0.05 では再現率が 0.261 なので件数で見れば74%を見逃していますが、見逃した額の割合は 0.650 です。この架空データでは額の大きい取引ほど不正の確率を高くしているので、アラートになる取引には額の大きい不正が多く含まれます。
次に、1日の調査の能力を60件と置き、1日のアラートの平均が60件以下になる最も低いしきい値を求めました。
# 1日の調査の能力に合わせたしきい値を求める
capacity = 60
ts = np.linspace(0.001, 0.6, 600)
daily_mean = np.array([(df["score"] >= t).sum() / n_days for t in ts])
t_cap = ts[np.argmax(daily_mean <= capacity)]
alert = df["score"] >= t_cap
per_day = alert.groupby(df["day"]).sum()
tp = (alert & df["fraud"]).sum()
print("調査の能力", capacity, "件/日に合わせたしきい値:", round(t_cap, 3))
print("  1日のアラートの平均:", round(per_day.mean(), 1),
      " 最小:", per_day.min(), " 最大:", per_day.max())
print("  能力を超えた日:", int((per_day > capacity).sum()), "/", n_days, "日")
print("  適合率:", round(tp / alert.sum(), 3),
      " 再現率:", round(tp / df["fraud"].sum(), 3))

fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
axes[0].plot(ts, daily_mean, color="#002E73")
axes[0].axhline(capacity, color="gray", linestyle="--", label="調査の能力(60件/日)")
axes[0].set_xscale("log")
axes[0].set_yscale("log")
axes[0].set_xlabel("しきい値(対数目盛)")
axes[0].set_ylabel("1日のアラートの件数(対数目盛)")
axes[0].legend(loc="upper right")
prec = [((df["score"] >= t) & df["fraud"]).sum() / max((df["score"] >= t).sum(), 1) for t in ts]
rec = [((df["score"] >= t) & df["fraud"]).sum() / df["fraud"].sum() for t in ts]
axes[1].plot(ts, prec, color="#002E73", label="適合率")
axes[1].plot(ts, rec, color="gray", label="再現率")
axes[1].axvline(t_cap, color="#000080", linestyle=":", label="能力に合わせたしきい値")
axes[1].set_xscale("log")
axes[1].set_xlabel("しきい値(対数目盛)")
axes[1].set_ylim(0, 1)
axes[1].legend(loc="center left")
plt.tight_layout()
plt.savefig("ch09_threshold.png", dpi=120, bbox_inches="tight")
plt.close()
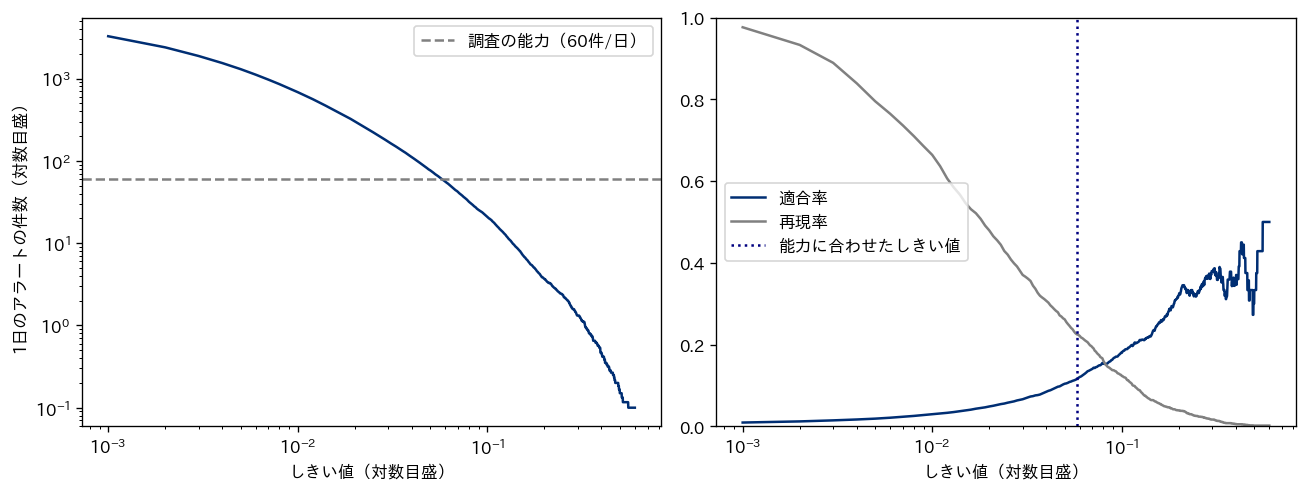
求めたしきい値は 0.058 で、このときの1日のアラートの平均は59.1件、適合率は 0.116、再現率は 0.225 でした。左の図は、しきい値(横軸)と1日のアラートの件数(縦軸)を、どちらも対数目盛で描いたものです。破線の調査の能力と曲線が交わるところが、能力に合わせたしきい値です。右の図は、同じしきい値の範囲での適合率と再現率で、点線が求めたしきい値の位置です。この例では、しきい値を上げると再現率が下がり、適合率がおおむね上がるという、大まかなつり合いの関係が見られます。ただし、適合率は単調には動きません。表でも、しきい値を 0.3 から 0.5 に上げると、適合率は 0.380 から 0.333 へ、再現率は 0.016 から 0.002 へと、両方が下がっています。右端で適合率の線がぎざぎざになっているのは、高いしきい値ではアラートが1日1件に満たず、数件の当たり外れで値が大きく動くためです。
注意したいのは、平均で能力に合わせても、日ごとには合わないことです。このしきい値での1日のアラートは、最も少ない日で38件、最も多い日で77件でした。60日のうち23日は、アラートが調査の能力の60件を超えています。取引の件数と不正の起き方には日ごとの揺らぎがあるので、平均に合わせて能力を用意すると、4割近い日は人手が足りず、残りの日は人手が余ることになります。本コラムの架空データでは1日の取引の件数を一定にしましたが、実際には曜日・月末・大型の販売の時期などで取引の件数そのものが動くので、アラートの件数の揺らぎはさらに大きくなると考えられます。
この揺らぎへの対処には、いくつかの選択肢があります。1つは、能力に余裕を持たせて、多い日に合わせて人員を用意することです。もう1つは、能力を超えた日は翌日に持ち越すことを前提に、持ち越しの上限と期限を決めることです。さらに、能力を超えたアラートをスコアや額で並べ替えて、優先度の低いものを事後の点検に回すことも考えられます。どれを選ぶにしても、「平均のアラートの件数」だけでなく、「アラートの件数が能力を超える日の割合」を運用の指標として持つことが必要です。持ち越しが積み上がると何が起きるかは、後の待ち行列の節で確かめます。
コスト考慮型の判定、誤検知と見逃しの損失の比でしきい値を決める
3つ目の型である損失の見積もりから決める方法を、本コラムではコスト考慮型の判定と呼びます。考え方は、1件ごとに「アラートにした場合に見込まれる損失」と「通した場合に見込まれる損失」を比べ、小さいほうを選ぶというものです。この考え方を整理した文献に、Elkan の2001年の論文(第17回人工知能国際合同会議、IJCAI 2001 の論文集の973〜977ページ)があります。この論文は、誤りの種類ごとに損失が違う場合に、各クラスの確率と誤りごとの損失から、期待される損失が小さいほうを選ぶ考え方を整理しています。
この節では、話を簡単にするため、アラートにした取引はすべて止める(拒否する)と仮定します。この仮定のもとでは、誤検知はそのまま誤って止めた取引になり、見逃しはそのまま通した不正になります。保留や事後の調査を組み合わせる場合は、次の節で扱います。
不正検知に当てはめると、次のようになります。スコア \(p\) が実際の不正の割合と対応していて、取引が不正である確率として読めるとします。この取引を通したときの損失の期待値は、不正なら額 \(a\) の被害が出るので \(p \times a\) です。アラートにして止めたときの損失の期待値は、正当な取引だった場合に誤検知の損失 \(c\) がかかるので \((1-p) \times c\) です。前者が後者より大きければ止める、という判定を式で整理すると、\(p \ge c / (c + a)\) のときにアラートにする、という形になります。言葉で言えば、「誤検知1件の損失と取引の額の比で、しきい値が決まる」ということです。額 \(a\) が大きい取引ほど右辺が小さくなるので、しきい値は低くなり、少しの疑いでも止めるべきだという結論になります。
ここで \(c\) は、正当な取引を止めたときに失うもの(売上や手数料の機会・問い合わせへの対応の手間・顧客の離反のおそれ)を、額と同じ相対値の単位で表した数です。下のコードでは \(c = 5\) と置きました。比較のため、能力に合わせた一律のしきい値(前節の 0.058)、損失の合計が最も小さくなる一律のしきい値、額に応じたしきい値の3つを、同じ仮定(アラートはすべて拒否)で並べています。損失の合計は「見逃した不正の額」と「誤検知の件数 × \(c\)」の和で、調査担当の人件費などは含めていません。
# コスト考慮型の判定:誤検知1件の損失 c_fp と、見逃した取引の額で損失を数える
def total_loss(alert, c_fp):
    fp = (alert & ~df["fraud"]).sum()
    missed = df.loc[~alert & df["fraud"], "amount"].sum()
    return missed + c_fp * fp, missed, fp

c_fp = 5.0
losses = np.array([total_loss(df["score"] >= t, c_fp)[0] for t in ts])
t_best = ts[np.argmin(losses)]
res = []
for name, alert in [("能力に合わせた一律のしきい値", df["score"] >= t_cap),
                    ("損失が最小の一律のしきい値", df["score"] >= t_best),
                    ("額に応じたしきい値", df["score"] >= c_fp / (c_fp + df["amount"]))]:
    loss, missed, fp = total_loss(alert, c_fp)
    tp = (alert & df["fraud"]).sum()
    res.append({"判定の方法": name, "1日のアラート": round(alert.sum() / n_days, 1),
                "再現率": round(tp / df["fraud"].sum(), 3),
                "見逃した額": round(missed), "誤検知": int(fp), "損失の合計": round(loss)})
print("c_fp =", c_fp, " 損失が最小の一律のしきい値:", round(t_best, 3))
print(pd.DataFrame(res).to_string(index=False))

# 前半30日でしきい値を選び、後半30日に固定して当てはめて確かめる
first, later = df["day"] < 30, df["day"] >= 30
def loss_on(mask, alert):
    missed = df.loc[mask & ~alert & df["fraud"], "amount"].sum()
    return round(missed + c_fp * (mask & alert & ~df["fraud"]).sum())
t_first = ts[np.argmin([loss_on(first, df["score"] >= t) for t in ts])]
later_losses = [loss_on(later, df["score"] >= t) for t in ts]
print("前半30日で選んだしきい値:", round(t_first, 3),
      " その後半30日の損失:", loss_on(later, df["score"] >= t_first))
print("後半30日で事後に最小のしきい値:", round(ts[np.argmin(later_losses)], 3),
      " その損失:", min(later_losses))
print("額に応じたしきい値の後半30日の損失:",
      loss_on(later, df["score"] >= c_fp / (c_fp + df["amount"])))
| 判定の方法 | 1日のアラート | 再現率 | 見逃した額 | 誤検知 | 損失の合計 |
|---|---|---|---|---|---|
| 能力に合わせた一律のしきい値(0.058) | 59.1 | 0.225 | 65,447 | 3,135 | 81,122 |
| 損失が最小の一律のしきい値(0.071) | 40.5 | 0.190 | 68,793 | 2,081 | 79,198 |
| 額に応じたしきい値 | 41.5 | 0.138 | 60,639 | 2,235 | 71,814 |
見逃した額と損失の合計は単位のない相対値、誤検知は件数で、どちらも60日分の合計です。この架空データでは、探索した一律のしきい値の候補(0.001 から 0.6 までの600通り)の中で損失の合計が最も小さくなるのは 0.071 で、能力に合わせた 0.058 より少し高いしきい値でした。ただし、この 0.071 は、同じ60日分の正解のラベルでしきい値を選び、同じデータで成績を出した事後の比較です。将来の取引に当てはめたときの成績ではありません。額に応じたしきい値は、1日のアラートの件数がほぼ同じ(41.5件)なのに、損失の合計を 71,814 まで下げました。注目したいのは、額に応じたしきい値の再現率が 0.138 と、3つの中で最も低いことです。件数で数えれば不正を最も多く見逃していますが、額の大きい不正を優先して止めるので、見逃した額は最も小さくなっています。この結果は、評価の指標を件数の再現率だけにすると、損失の観点で良い判定を悪いと判断しかねないことを示しています。第8章で扱った、額の相対値で重み付けた再現率を併せて見る理由がここにあります。
事後の比較であることの影響を確かめるため、上のコードの後半では、前半の30日だけでしきい値を選び、そのしきい値を後半の30日に固定して当てはめました。前半で選んだしきい値は 0.067 で、後半の30日での損失の合計は 41,535 でした。後半の30日の正解を使って事後に選んだ場合のしきい値は 0.079、損失の合計は 40,942 で、前半で選んだしきい値との差は1.5%ほどでした。これは1回の分け方・1つの乱数の種での結果です。また、ここではラベルの遅れは考えず、前半30日の真のラベルをそのまま使っています。実際には第8章のとおり、ラベルの確定を待ってからしきい値を選ぶ必要があります。この合成データは、期間の途中で不正の起き方を変えていません。実際には手口が変わるので、過去の期間で選んだしきい値と後の期間で最適なしきい値との差は広がりうると考えられます(第10章)。しきい値の選択と成績の確認は、時間で分けた別の期間で行うのが原則です。なお、額に応じたしきい値は正解のラベルを使って選ぶ値を持たないので、後半の30日でも同じ式で当てはめられ、損失の合計は 37,935 でした。
次のコードでは、一律のしきい値を動かしたときの損失の内訳を図にし、誤検知1件の損失 \(c\) の置き方を変えたときに、損失が最小になる一律のしきい値がどう動くかを調べました。
# 誤検知1件の損失 c_fp の置き方を変える
for c in [1.0, 5.0, 20.0, 50.0]:
    ls = np.array([total_loss(df["score"] >= t, c)[0] for t in ts])
    tb = ts[np.argmin(ls)]
    print("c_fp =", c, " 損失が最小のしきい値:", round(tb, 3), " 1日のアラート:",
          round((df["score"] >= tb).sum() / n_days, 1))

missed_part = [total_loss(df["score"] >= t, c_fp)[1] for t in ts]
fp_part = [c_fp * total_loss(df["score"] >= t, c_fp)[2] for t in ts]
plt.figure(figsize=(7, 4.2))
plt.plot(ts, losses, color="#002E73", label="損失の合計")
plt.plot(ts, missed_part, color="gray", linestyle="--", label="見逃した額")
plt.plot(ts, fp_part, color="gray", linestyle=":", label="誤検知の損失(5×件数)")
plt.axvline(t_best, color="#000080", linewidth=0.8)
plt.xscale("log")
plt.ylim(0, 300000)
plt.ticklabel_format(axis="y", style="plain")
plt.xlabel("しきい値(対数目盛)")
plt.ylabel("損失(相対値)")
plt.legend(loc="upper right")
plt.savefig("ch09_cost.png", dpi=120, bbox_inches="tight")
plt.close()
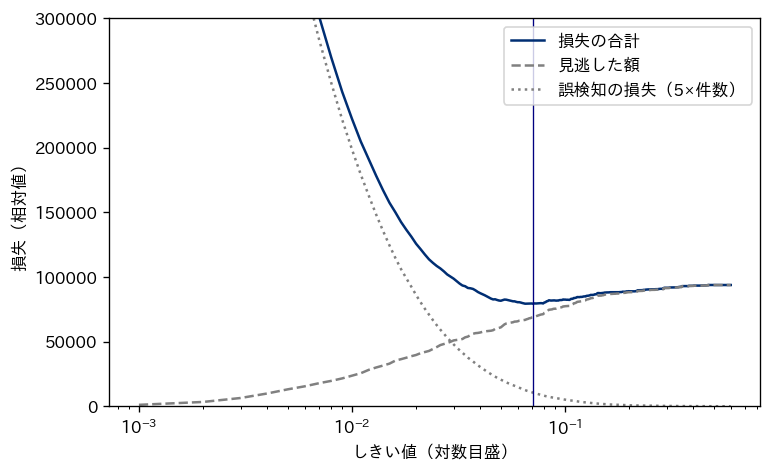
図は、一律のしきい値を動かしたときの損失の内訳です。しきい値を下げると誤検知の損失(点線)が急に増え、上げると見逃した額(破線)が増えます。2つを足した損失の合計(実線)は、縦線で示した 0.071 の付近で底になりますが、底の付近は平らで、0.05 から 0.1 の範囲では損失の合計があまり変わりません。損失の曲線の底が平らな場合には、しきい値を損失の最小点に厳密に合わせることより、調査の能力や顧客への影響など、損失の式に入っていない事情でしきい値を選ぶ余地があります。
誤検知1件の損失 \(c\) の置き方を変えると、損失が最小になる一律のしきい値は大きく動きました。\(c = 1\) では 0.02(1日のアラート301.3件)、\(c = 5\) では 0.071(同40.5件)、\(c = 20\) では 0.21(同3.3件)、\(c = 50\) では 0.29(同1.5件)です。\(c\) を1から5へ5倍にすると1日のアラートは約7分の1に、5から20へ4倍にすると約12分の1になり、1から50まで動かすと約200分の1になりました。\(c\) の見積もりが数倍ずれるだけで、アラートの件数は桁が変わるほど動くということです。誤検知の損失は、売上の機会のように数えやすいものだけでなく、顧客の離反のように数えにくいものを含むので、1つの値に決め打ちすると判定が見積もりの誤差に大きく振り回されます。\(c\) をいくつかの値で計算して、しきい値がどの範囲に入るかを示し、その範囲の中で調査の能力に合う値を選ぶ、という使い方が現実的だと考えています。
額に応じたしきい値を本番で使うには、2つの条件があります。1つは、スコアが実際の不正の割合と対応しているかを、評価用のデータで確かめてあることです。式の \(p\) を確率として使っているので、実際の割合と対応していないスコアをそのまま入れると、額の大きい取引で止めすぎたり、止めなさすぎたりします。もう1つは、措置ごとの損失を事前に合意しておくことです。誤検知の損失を誰がどう見積もったかが記録に残っていないと、しきい値が変わったときに説明ができません。また、このコードでは調査担当の時間を損失に含めていないので、損失が最小のしきい値が調査の能力に収まる保証はありません。本コラムの架空データでは、\(c = 1\) と置くと最適なしきい値でのアラートが1日301.3件になり、60件の能力の5倍を超えました。損失の見積もりから決める型を使う場合でも、能力の制約を最後に必ず確かめる必要があります。
段階的な措置、低いスコアは通し、中間は追加の認証、高いスコアは止める
ここまでは、スコアがしきい値を超えたらアラートにする、という1本の線で考えてきました。実際の運用では、2本以上の線を引いて、スコアの範囲ごとに違う措置を割り当てることがよくあります。低いスコアは承認し、中間のスコアは保留にして追加の認証を求め、高いスコアは拒否する、という段階的な措置です。追加の認証は、本人であれば手間はかかっても通過でき、不正であれば止まりやすい手続きとして置かれます。人の調査を使わずに中間の範囲を処理できる点が、段階的な措置の大きな利点です。
下のコードでは、追加の認証についての2つの数を仮定しました。保留にした不正のうち、追加の認証で止まる割合を 0.7、保留にした正当な取引のうち、手間を嫌って取引が中止される割合を 0.05 としています。どちらも説明のために置いた架空の値で、実際の値は認証の方式・顧客の層・取引の種類によって大きく変わります。この2つの値は、自社の追加の認証の実績から測る必要があります。
# 段階的な措置:低いスコアは承認、中間は保留(追加の認証)、高いスコアは拒否
stop_rate, drop_rate = 0.7, 0.05     # 仮定:追加の認証で止まる不正の割合・保留した正当な取引が中止される割合
def tiered(t_hold, t_reject):
    hold = (df["score"] >= t_hold) & (df["score"] < t_reject)
    reject = df["score"] >= t_reject
    f, a = df["fraud"], df["amount"]
    passed = a[f & ~hold & ~reject].sum() + (1 - stop_rate) * a[f & hold].sum()
    return {"保留": int(hold.sum()), "拒否": int(reject.sum()),
            "拒否した正当な取引": int((reject & ~f).sum()),
            "保留で離脱する正当な取引": round(float(drop_rate * (hold & ~f).sum()), 1),
            "通った不正の額の割合": round(float(passed / fraud_total), 3)}
for name, th, tr in [("一律に拒否 0.05以上", 0.05, 0.05),
                     ("保留 0.02以上・拒否 0.2以上", 0.02, 0.2),
                     ("保留 0.01以上・拒否 0.2以上", 0.01, 0.2)]:
    print(name, tiered(th, tr))
| 措置の組み合わせ | 保留の件数 | 拒否の件数 | 拒否した正当な取引 | 保留で離脱する正当な取引 | 通った不正の額の割合 |
|---|---|---|---|---|---|
| 一律に拒否(0.05以上) | 0 | 4,591 | 4,113 | 0 | 0.650 |
| 保留 0.02以上・拒否 0.2以上 | 17,856 | 221 | 150 | 852.6 | 0.577 |
| 保留 0.01以上・拒否 0.2以上 | 40,715 | 221 | 150 | 1,978.6 | 0.458 |
件数は60日分の合計で、「保留で離脱する正当な取引」は保留にした正当な取引の件数に 0.05 を掛けた期待値です。数えているのは取引の件数で、同じ顧客が何度か保留になることもあるので、顧客の人数とは一致しません。「通った不正の額の割合」には、承認した不正に加えて、保留にした不正のうち追加の認証を通ってしまった分(保留にした不正の額の 0.3倍)を含めています。0.05 以上を一律に拒否する方法では、正当な取引を4,113件止めました。段階的な措置(0.02 以上を保留、0.2 以上を拒否)では、拒否した正当な取引は150件に減り、通った不正の額の割合も 0.650 から 0.577 へ下がりました。その代わりに、17,856件の取引で顧客に追加の認証を求め、そのうち正当な取引の852.6件分で顧客が取引をやめると見込まれます。保留の範囲を 0.01 まで広げると、通った不正の額の割合は 0.458 まで下がりますが、保留は40,715件、離脱の見込みは1,978.6件分に増えます。
この結果から分かるのは、段階的な措置は誤検知を減らすのではなく、誤検知の形を変える、ということです。拒否という重い措置を、追加の認証という軽い措置に置き換え、その代わりに件数を増やしています。どちらが良いかは、正当な取引を1件拒否する損失と、追加の認証で1件の取引が離脱する損失を、どう比べるかで決まります。また、離脱の割合 0.05 という仮定が 0.2 であれば、段階的な措置の離脱の見込みは4倍になります。追加の認証の離脱の割合と、認証で止まる不正の割合は、段階的な措置の設計を左右するので、導入の前に測り、導入の後も監視し続ける必要があります。
追加の認証の位置づけについて、本コラムの立場を補足しておきます。追加の認証は、本人確認の仕組みの一部であり、認証の方式や、どの取引に追加の認証を求めるかは、事業者が自由に決められるとは限らず、法令や業界のガイドラインの要件が関わる場合があります。規制の詳細は第14章で扱います。また、追加の認証で止まる不正の割合は、手口の変化によって下がることがあります。認証を通過した後に不正と分かった取引の件数を、手口の変化の兆しとして監視しておくことが必要です。監視と再学習は第10章で扱います。
調査の待ち行列、アラートの到着が能力を超えると何が起きるか
保留の後の確認や事後の調査に回したアラートは、調査担当の前に列を作ります。この列を待ち行列と呼びます。1日の到着の件数は日によって揺らぐので、平均の到着が調査の能力より少なくても、多い日の分が翌日に持ち越されて滞留が生じます。平均の到着が能力に近いほど、この滞留は大きくなります。到着が能力を上回る状態が続くと、期限で外す仕組みが無ければ列は伸び続けます。不正検知の調査では、アラートに期限があることが多いという事情が加わります。保留にした取引は一定の時間が過ぎると顧客に結果を返さなければならず、事後の調査も、時間がたつほど被害の回復が難しくなります。期限を過ぎたアラートは、確認されないまま列から外れます。本コラムでは、これを「見られずに流れる」と呼びます。期限を過ぎたアラートをどう扱うか(事後の調査に回すのか、保留のまま顧客に確認を求めるのか、承認として処理するのか)は、守る側の設計の弱点になりやすいところなので、運用を始める前に措置ごとに決め、文書にしておく必要があります。
下のコードでは、1日の調査の能力を60件とし、1日に到着するアラートの件数を、平均が能力の 0.7倍から 1.3倍になるようにポアソン分布(一定の平均のまわりで件数が揺らぐ到着を表す分布)で発生させました。アラートは古い順に処理し、到着した日から3日たった日には、その日の処理の前に、まだ処理されていないものを期限切れとして列から外す(流れる)としています。365日分を計算し、1日の終わりに残っている件数(滞留件数)の平均、流れたアラートの割合、処理したアラートの平均の待ち日数を出しました。待ち行列の一般論とシミュレーションの考え方は、弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」で扱っています。
# 調査の待ち行列:到着が能力を超えると、期限(3日)を過ぎたアラートが見られずに流れる
def simulate(arrival, capacity=60, limit=3, days=365, seed=1):
    r = np.random.default_rng(seed)
    queue, expired, done, wait_sum, backlog = [], 0, 0, 0, []
    for d in range(days):
        queue += [d] * r.poisson(arrival)
        kept = [x for x in queue if d - x < limit]
        expired += len(queue) - len(kept)
        queue = kept
        for x in queue[:capacity]:      # 古い順に処理する
            wait_sum += d - x
        done += min(capacity, len(queue))
        queue = queue[capacity:]
        backlog.append(len(queue))
    return np.mean(backlog), expired / (expired + done + len(queue)), wait_sum / max(done, 1)

ratios = np.round(np.arange(0.7, 1.31, 0.05), 2)
qres = [simulate(60 * rho) for rho in ratios]
qdf = pd.DataFrame(qres, columns=["平均の滞留件数", "流れた割合", "平均の待ち日数"], index=ratios)
qdf.index.name = "到着/能力"
print(qdf.round(3).to_string())

fig, ax1 = plt.subplots(figsize=(7, 4.2))
ax1.plot(ratios, qdf["平均の滞留件数"], color="#002E73", marker="o", label="平均の滞留件数(左目盛)")
ax1.set_xlabel("到着の件数 ÷ 調査の能力")
ax1.set_ylabel("1日の終わりの滞留件数")
ax2 = ax1.twinx()
ax2.plot(ratios, qdf["流れた割合"] * 100, color="gray", marker="s", label="見られずに流れた割合(右目盛)")
ax2.set_ylabel("見られずに流れた割合(%)")
h1, l1 = ax1.get_legend_handles_labels()
h2, l2 = ax2.get_legend_handles_labels()
ax1.legend(h1 + h2, l1 + l2, loc="upper left")
plt.savefig("ch09_queue.png", dpi=120, bbox_inches="tight")
plt.close()
| 到着の件数 ÷ 調査の能力 | 平均の滞留件数 | 見られずに流れた割合 | 平均の待ち日数 |
|---|---|---|---|
| 0.70 | 0.044 | 0.000 | 0.001 |
| 0.75 | 0.077 | 0.000 | 0.002 |
| 0.80 | 0.208 | 0.000 | 0.004 |
| 0.85 | 0.523 | 0.000 | 0.010 |
| 0.90 | 1.301 | 0.000 | 0.024 |
| 0.95 | 4.605 | 0.000 | 0.081 |
| 1.00 | 27.668 | 0.000 | 0.462 |
| 1.05 | 115.195 | 0.039 | 1.790 |
| 1.10 | 130.627 | 0.080 | 1.905 |
| 1.15 | 141.901 | 0.120 | 1.945 |
| 1.20 | 152.025 | 0.157 | 1.959 |
| 1.25 | 162.126 | 0.192 | 1.972 |
| 1.30 | 170.660 | 0.221 | 1.976 |
表には、計算した13通りをすべて載せています。コードの最後の部分は滞留件数と流れた割合を図に描いて保存しますが、本コラムでは図の掲載は省き、同じ内容を表で示しました。到着が能力の 0.9倍までは、滞留件数の平均は多くても約1.3件で、アラートはほぼその日のうちに処理されました。0.95倍で4.6件、ちょうど1倍で27.7件と、能力に近づくにつれて滞留が急に増えます。1倍を超えると様子が変わり、1.05倍では滞留件数の平均が115.2件、平均の待ち日数は1.79日になり、流れたアラートが 3.9% 出始めました。1.3倍では、流れた割合が 22.1% に達しています。能力を超えた分は、期限のために列の中で積み上がり続けることはなく、ほぼそのまま流れていく形になりました。
この結果から、運用上の教訓が3つ引き出せます。1つ目は、到着と能力の比が1に近い運用は危ういということです。比が 0.95 から 1.05 に動くだけで、滞留件数は25倍になり、待ち日数は1日を超えました。平均で能力ぎりぎりにしきい値を合わせると、少しの揺らぎで調査が回らなくなります。前節の、平均で能力に合わせても23日は能力を超えたという結果と合わせると、能力には余裕を持たせる必要があると言えます。2つ目は、古い順に処理する運用でも、能力を超えた分は期限切れという形で失われるということです。到着が能力を超え続けると、列の先頭から毎日60件ずつ処理しても列は短くならず、アラートは到着してから処理の順番が回ってくるまで期限の近くまで待たされます(表の平均の待ち日数は、比が1.05以上で1.79日から1.98日でした)。順番が回る前に期限の3日に達したアラートは、確認されないまま列から外れます。古い順の処理は待ち時間の公平さを保ちますが、能力の不足そのものは解消しないので、期限切れの扱いと、次の節で扱う優先順位づけを併せて決める必要があります。3つ目は、流れたアラートは調べていないので、不正かどうかが分からないまま残るものがあることです。後日の申告やチャージバックで分かる場合もありますが、分からないまま残った分はラベルが付かず、後の学習と評価に偏りを残します(第2章の選択の偏り)。また、流れた中の不正は、アラートにはしているので本コラムの定義では見逃しに数えられず、見逃しの件数だけを見ていると気づけません。流れたアラートの件数は、見逃しとは別の指標として数える必要があります。
このシミュレーションは、到着の件数だけが揺らぎ、1件の調査にかかる時間が一定という単純な仮定で作っています。実際には、調査の難しさによって1件の所要時間が大きく違い、調査担当の休暇や繁忙期もあります。自社の運用で同じ計算をするときは、アラートの到着の記録と調査の所要時間の記録から、分布を推定して使うことが必要です。
優先順位づけ、スコアだけでなく被害の大きさと時間の制約で並べる
到着が能力を超えたときに、どのアラートから調べるかで、調査の対象に入る不正が変わります。古い順に処理する方法は、待ち時間の公平さを優先しますが、被害の大きさを考えません。スコアの高い順に処理する方法は、不正の可能性が高いものから見るので適合率が上がります。さらに、スコア(不正の確率)と額を掛けた値、つまり調べずに通したときに出る損失の期待値の大きい順に処理する方法もあります。下のコードでは、しきい値 0.02 で出したアラート(1日301.3件)を、調査の能力60件で処理する場合を考え、毎日60件をどの順で選ぶかの3通りを比べました。到着順は、その日の取引の記録の並びの先頭から60件を選ぶものです。この比較は、その日のアラートがすべてそろってから1日分をまとめて並べ替える、日ごとの一括処理を想定しています。到着した時点ではまだ分からない、後から来るアラートの情報を使っているので、1件ずつ判定する運用とは条件が違います。また、選ばれなかったアラートは翌日に持ち越さず、その日のうちに対象から外しているので、前の節の待ち行列の計算とも条件が違います。
# 能力を超えたアラートの中から、どれを先に調べるか:到着順・スコア順・期待損失順
t_low = 0.02
cand = df[df["score"] >= t_low].copy()
cand["expected"] = cand["score"] * cand["amount"]   # 調べずに通したときの損失の期待値
print("しきい値", t_low, "のアラート:", round(len(cand) / n_days, 1), "件/日、能力は", capacity, "件/日")
for name, key in [("到着順", None), ("スコア順", "score"), ("期待損失順", "expected")]:
    picked = []
    for d, g in cand.groupby("day"):
        g = g if key is None else g.sort_values(key, ascending=False)
        picked.append(g.head(capacity))
    p = pd.concat(picked)
    print(name, " 調べた不正:", int(p["fraud"].sum()),
          " 調べた不正の額の割合:", round(p.loc[p["fraud"], "amount"].sum() / fraud_total, 3),
          " 適合率:", round(p["fraud"].mean(), 3))
| 並べ方 | 調べた不正の件数 | 調べた不正の額の割合 | 適合率 |
|---|---|---|---|
| 到着順 | 183 | 0.105 | 0.051 |
| スコア順 | 419 | 0.305 | 0.116 |
| 期待損失順 | 307 | 0.389 | 0.085 |
60日間で調べた不正の件数は、到着順で183件、スコア順で419件、期待損失順で307件でした。調査の対象に含まれる不正の件数は、スコア順が最も多くなりました。一方で、調べた不正の額が不正の額の合計に占める割合では、期待損失順が 0.389 と最も高く、スコア順の 0.305 を上回りました。到着順は、件数でも額でも最も成績が低く、適合率は 0.051 で、しきい値 0.02 のアラート全体の適合率(0.048)とほぼ同じです。このデータでは1日の中の取引の並びを乱数で作っているので、到着順で選ぶことは、アラートの中から無作為に選ぶのとほとんど変わらない結果になりました。実際の到着順は時刻の順なので、時間帯によって不正の割合が違えば、結果も変わります。
どの並べ方を選ぶかは、何を重く見るかで決まります。この架空データでは、調査の対象に含まれる不正な取引の件数ではスコア順が、その相対額の合計では期待損失順が多くなりました。ここで数えたのは調査の対象に入った不正であり、調査の後に実際に防げた被害や、誤って止めた正当な取引は計算していません。並べ方を変えた成果を測るには、第13章で扱う成果の定義に沿って、その両方を数える必要があります。ただし、期待損失順には守る側の設計としての弱点があります。額の小さいアラートが後回しになり続けるので、1件ごとの額は小さくても件数の多い被害の把握が遅れるおそれがあります。この弱点への対処として、取引1件の期待損失だけで並べるのではなく、同じ顧客や同じ相手のアラートをまとめた単位でも件数と額の合計を見て、優先順位に反映させることが考えられます。また、スコアの高い順にだけ調べると、スコアの低いアラートは調べられずに終わり、そこに含まれる新しい手口がラベルとして記録されません。
実務では、並べ方に時間の制約も加えます。保留にした取引の回答の期限が迫っているもの、顧客から問い合わせが来ているもの、被害の拡大が続いているもの(同じ顧客や同じ相手での連続した取引)は、スコアや額にかかわらず先に見る必要があります。並べ方の規則は、スコア・額・期限の3つを組み合わせた点数として定め、規則そのものを文書にして変更の記録を残すことが必要です。さらに、調べられなかったアラートの中から一定の割合を無作為に選んで調べると、優先順位の付け方が見落としている不正を見つける手がかりになります。無作為の点検でラベルの偏りを補う考え方は第10章で扱います。
アラート疲れと、調査の結果をラベルとルールの見直しに戻す流れ
誤検知の多いアラートを長く確認し続けると、調査担当は「どうせまた正当な取引だろう」と考えるようになり、確認が形だけになっていきます。この状態をアラート疲れと呼びます。本コラムの架空データでは、能力に合わせたしきい値での適合率は 0.116 で、アラートの9割近くが正当な取引でした。適合率が低い状態が続くと、調査担当が1件ごとに確認する手順を省くようになり、本物の不正を正当と判断してしまう危険が高まります。アラート疲れは、数字の上ではアラートを処理しているように見えるので、処理件数だけを監視していると気づけません。
アラート疲れを防ぐ手立てとして、次のようなものが考えられます。
- 適合率の下限を決め、下回ったらしきい値・ルール・モデルを見直す
- 正当と判断したアラートの一部を、別の担当が抜き取りで確かめ直す
- 同じ理由で繰り返し出る誤検知(決まった顧客の決まった取引など)を、ルールの見直しや許可リストの対象として扱う
- アラートの理由(どの特徴やルールが効いたか)を調査担当に示し、確認の手がかりにする(理由の示し方は第11章)
- 調査担当1人あたりの1日の件数に上限を設け、交代や休憩を運用に組み込む
調査は、アラートを処理するだけの作業ではありません。調査の結果は、その取引が不正だったかどうかのラベルとして記録され、次の学習とルールの見直しに使われます。この流れが途切れると、モデルは古いラベルのまま学習し続け、ルールは誤検知の多いものが残り続けます。第2章で扱ったとおり、調査の結果はラベルの重要な出所の1つで、ラベルの遅れを短くする手段でもあります。調査の結果を、後から学習と評価に使える形で残すことが、検知の仕組みを使い続けるための前提になります。
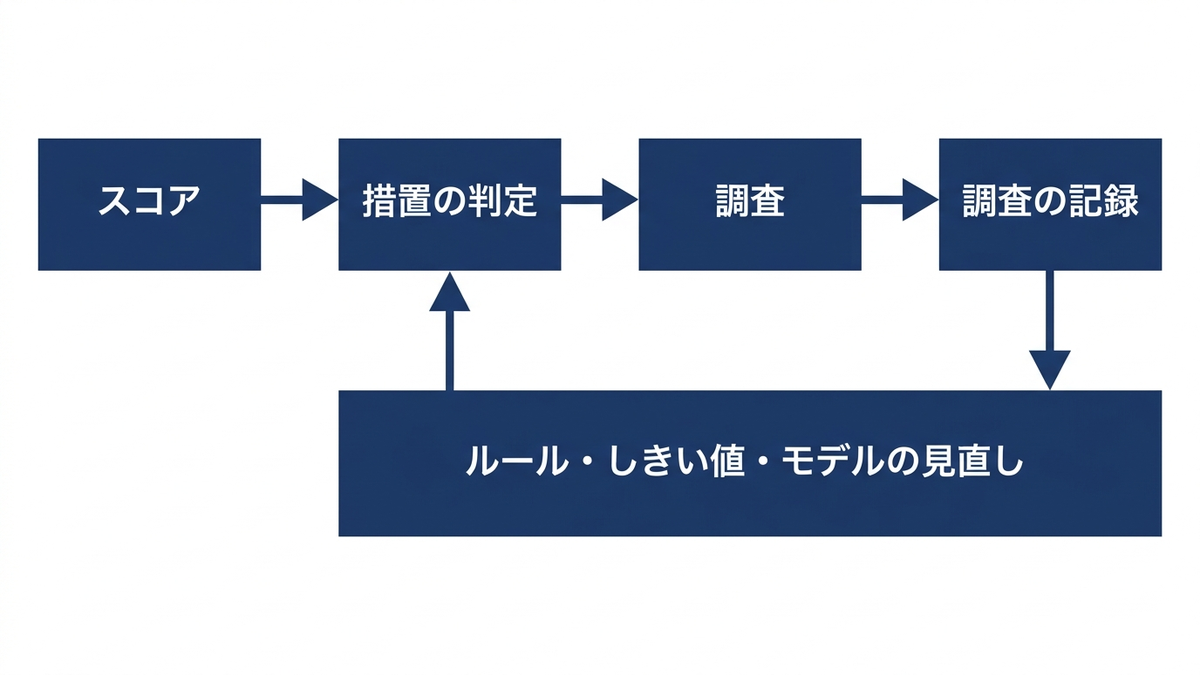
調査の記録に残す項目を、次の表にまとめました。どの項目も、後から「なぜその措置を取ったか」「その判断は正しかったか」を確かめるために要るものです。
| 項目 | 内容 | 何に使うか |
|---|---|---|
| アラートの識別子と取引の識別子 | どの取引のどのアラートか | 取引の記録・ラベルとの突き合わせ |
| 判定の時点の情報 | スコア・効いたルール・モデルの版・しきい値の版 | 判定の再現。しきい値やモデルの変更の効果の比較 |
| 措置 | 承認・保留・拒否・事後の調査のどれか。追加の認証の結果 | 措置ごとの成績の集計 |
| 調査の経過 | 担当者・着手と完了の日時・確認した情報・顧客への連絡 | 所要時間・滞留の測定。監査への説明 |
| 調査の結論 | 不正・正当・判断できない、の区別と、その根拠 | ラベル。適合率の測定 |
| 不正の型 | 第1章の不正の種類の区分 | 手口の変化の監視。ルールの見直し |
| 後から分かった事実 | チャージバック・本人の申告など、調査の後に届いた情報 | ラベルの訂正。調査の結論の正しさの点検 |
| 誤検知の理由 | 正当だった場合に、なぜアラートになったと考えられるか | ルールの廃止・許可リスト・特徴量の見直し |
表の中で見落とされやすいのは、「判断できない」という結論と「後から分かった事実」です。調査しても不正かどうか決めきれない取引は少なくありません。これを正当として記録すると、本物の不正が正当のラベルで学習に入ります。また、調査で正当と判断した取引に、後からチャージバックが届くこともあります。調査の結論と、後から届いた事実を分けて記録しておけば、ラベルを訂正でき、調査の判断の正しさも点検できます。記録の設計(判定の時点の値を、その時点のまま残す)の考え方は第2章で、記録と監査の仕組みは第12章で扱います。
運用の KPI と経営の判断、しきい値と調査の人員を一緒に決める
しきい値と調査の運用の状態を測る KPI を、次の表にまとめました。1つの指標だけを良くしようとすると他の指標が悪くなる組み合わせが多いので、組で見ることが必要です。
| KPI | 定義 | 組で見る指標 | 悪化したときに疑うこと |
|---|---|---|---|
| アラートの件数 | 1日あたりの件数と、能力を超えた日の割合 | 調査の能力・滞留 | 不正の増加。取引の件数の変化。データの異常 |
| 調査済みアラートの適合率 | 調査の結論が出たアラートのうち不正だった割合。未調査のアラートと「判断できない」としたアラートの割合を併せて示す。調べる対象を選んでいる場合は、アラート全体の適合率とは一致しない | 再現率・アラートの件数 | 手口の変化。誤検知の多いルール。アラート疲れの前兆 |
| 調査の所要時間 | 1件あたりの着手から完了までの時間 | 適合率・調査の結論の内訳 | 難しいアラートの増加。手順の不備。人員の不足 |
| 滞留 | 1日の終わりに残っている件数と、期限を過ぎて流れた件数 | アラートの件数・調査の能力 | 到着と能力の比が1に近い、または超えている |
| 顧客への連絡までの時間 | 保留・拒否から顧客に結果を伝えるまでの時間 | 誤って止めた取引の割合 | 保留の範囲が広すぎる。顧客対応の人員の不足 |
| 誤って止めた取引の割合 | 拒否・保留にした取引のうち、正当だったものの割合 | 見逃した額の割合(1から、額の相対値で重み付けた再現率を引いた値) | しきい値が低すぎる。特定の顧客の層に誤検知が偏っている(第11章) |
この表には、成果そのものを表す指標が入っていないことに注意が必要です。本コラムの方針では、不正検知の成果と呼んでよいのは、見つけて防いだ不正と、誤って止めた正当な取引の両方を数えたうえでの差です。表の KPI は、その成果を出すための運用が回っているかを見る指標であり、アラートの件数が増えた、適合率が上がった、というだけでは成果とは言えません。成果の測り方と KPI の木への分解は、第13章で扱います。
経営の判断として最も重要なのは、しきい値を調査の能力と一緒に決め、調査の人員を検知の仕組みの一部として予算化することだと考えています。しきい値を下げれば再現率は上がりますが、本コラムの架空データでは、しきい値を 0.05 から 0.01 に下げると再現率が約2.5倍になる一方で、アラートは約9倍になりました。調査の能力・優先順位の付け方・自動の措置を見直さずにしきい値だけを下げると、到着が能力を超えます。待ち行列の計算は到着が能力の1.3倍までの範囲で行い、その範囲でも、能力を超えた分は期限切れで流れ、1.3倍では2割余りのアラートが流れました。到着がさらに大きくなれば、流れる割合はさらに増えると考えられます。その結果、数字の上では再現率が上がっても、調べた不正がそれに見合って増えるとは限らず、序章で挙げた損失の型のうち調査の過負荷が現れます。さらに、誤検知の多い確認を続ければアラート疲れから形骸化に進み、見逃しによる被害が増えます。逆に、しきい値を上げすぎれば見逃しによる被害が増え、誤検知を減らすつもりで保留を増やせば、追加の認証による顧客の離反が増えます。
したがって、検知の予算は「モデルやシステムの費用」と「調査と顧客対応の人員」を分けずに組むことが必要です。しきい値を変える判断には、必ず「その変更でアラートが何件増減し、調査の能力に収まるか」という確認を付けます。能力に収まらない変更をするなら、人員を増やすのか、優先順位の付け方を変えるのか、保留や事後の点検に回すのかを、同時に決めます。誤検知1件の損失のように見積もりにくい数は、いくつかの値で計算してしきい値の幅を示し、その幅の中で選んだ理由を記録に残します。こうした決め方の記録が、しきい値の変更を監査や経営に説明するときの根拠になります。
この章では、スコアから措置への変え方、しきい値の3つの決め方、コスト考慮型の判定と段階的な措置、調査の待ち行列と優先順位づけ、アラート疲れと調査の記録を扱いました。要点は、しきい値はモデルの性能だけでなく調査の能力と損失の見積もりで決まり、到着が能力を超えれば調べられないアラートが流れていく、ということです。ここまでは、手口や顧客の行動が変わらないことを前提にしてきました。次の第10章では、時間がたつにつれて不正の特徴が変わり、モデルやしきい値が古くなっていく問題と、その監視と再学習を扱います。
この章を深めたい方への参考書籍
『意思決定分析と予測の活用 基礎理論からPython実装まで』(馬場真哉 著、講談社):予測の結果をもとに、損失や利得を考えてどの行動を選ぶかを決める意思決定分析を、基礎の理論から Python の実装まで扱った本です。この章のコスト考慮型の判定のように、スコアと損失の見積もりから措置を選ぶ考え方を、不正検知に限らない一般的な枠組みとして学べます。
『待ち行列理論の基礎と応用』(川島幸之助 監修、塩田茂雄・河西憲一・豊泉洋・会田雅樹 著、共立出版):到着と処理の能力の関係から、待ち時間や滞留の長さを求める待ち行列の理論の教科書です。この章の調査の待ち行列のシミュレーションで見た、到着が能力に近づくと滞留が急に増える現象を、理論の側から理解する助けになります。
『ザ・ゴール 企業の究極の目的とは何か』(エリヤフ・ゴールドラット 著、三本木亮 訳、ダイヤモンド社):工場の生産を題材に、全体の成果は最も能力の小さい工程(制約)で決まるという考え方を説明した本です。人による調査を経て措置を決める運用では、調査の工程が処理の能力の制約になり、滞留によって不正を止める機会を失うことがあります。しきい値やモデルだけでなく、調査の能力と措置の設計を併せて見直すというこの章の主張を、業務の設計の観点から考える手がかりになります。
第10章 手口の変化への追従、概念ドリフトの監視と再学習
第9章では、スコアから措置への分け方と、しきい値を調査の能力と一緒に決めることを扱いました。そこで決めたしきい値や調査の段取りは、検知の仕組みが作られた時点の取引の姿を前提にしています。この章では、その前提が時間とともに崩れていくことと、崩れたことに気づき、作り直すための監視と再学習を扱います。
この章で扱うのは次の内容です。後半は、途中の月から不正の特徴が変わるように作った架空の取引の記録を使い、実行したコードと結果で確かめます。
- 不正検知のモデルが古くなる4つの理由
- 変化の種類(入力の分布の変化・不正の割合の変化・関係そのものの変化)と、それぞれで何が起きるか
- 最初の期間だけで学習したモデルと、毎月学習し直す方式・直近の期間だけで学習する方式の比較
- ラベルが遅れて届くときの再学習の考え方
- ラベルを待たない監視(スコアや特徴量の分布のずれ、アラートの割合)と、その限界
- アラートだけを調べていると、新しい手口がラベルの記録に残りにくいことと、無作為の点検で補う考え方
- ルールで先に対応し、後からモデルに取り込む流れと、敵対的な変化(相手が検知を避けるように行動を変えること)への守る側の対処
- 再学習の手順と承認、経営判断
この章の主張は、不正検知のモデルは運用中の手口や顧客の行動の変化によって成績が下がることがあるので、ラベルを待たない監視と定期的な再学習を、最初から運用の一部として見込んでおくべきだ、という点です。本コラムの架空データでは、最初の3か月だけで学習して固定したモデルの成績(平均適合率)は、5月の 0.938 から12月の 0.146 まで下がりました。
もう1つ、全取引の分布を見張るだけでは、こうした変化に気づけない場合があることも示します。この架空データで変化と重なって大きく動いたのは、分布のずれの指標ではなく、基準の期間で決めたしきい値を超える取引の割合でした。ただし、その動きの原因を手口の入れ替わりだけに切り分けたわけではありません。
不正検知のモデルが古くなる理由、手口・顧客・商品・検知そのもの
機械学習のモデルは、学習に使った期間の取引に見られた「不正と正当な取引の違い」を覚えたものです。その違いが学習のあとも同じなら、モデルは同じように働きます。不正検知では、その違いが時間とともに変わる理由がいくつもあります。主な理由は次の4つです。
- 手口の変化:不正を働く側が、新しい経路・新しい商品・新しいだまし方へ移る(不正の類型は第1章、公的機関の注意喚起は第14章)
- 顧客の行動の変化:オンラインでの利用が増える、時間帯が変わる、季節の行事で額が変わるなど、正当な取引の姿そのものが動く
- 商品や経路の変更:新しい決済の手段、新しいアプリ、本人確認の方法の変更、加盟店の追加などで、記録される項目や値の意味が変わる
- 検知そのものへの適応:止められた手口は使われなくなり、止められにくい形へ移る。検知を入れたこと自体が、次の不正の姿を変える
4つ目の理由は、不正検知で目立つ性質です。不正検知では、検知の仕組みが効くほど、その仕組みに引っかかる形の不正は減り、引っかからない形の不正の割合が増えていきます。このため、作った時点で成績の良いモデルでも、時間がたつと「過去によく効いた手口」にだけ強いモデルになっていく、ということが起きうると考えられます。この点は、この章の実験では確かめていません。
もう1つ、古くなったことが見えにくいという問題があります。見逃した不正は、その場ではアラートにならないので、本人の申告やチャージバック(カードの利用者の申し出による売上の取り消し。仕組みは第1章)で後から分かるまで記録に現れません。第2章で扱ったラベルの遅れがあるため、モデルの成績が落ちていることは、落ち始めてから数週間から数か月たってようやく数字で確かめられることがあります。その間、アラートの件数が減っていれば、現場では「不正が減った」と読まれてしまうこともあります。この章の後半のコードでも、まさにこの形の変化が起きます。
変化の種類、入力の分布・不正の割合・関係そのもの
時間とともに起きる変化は、何が変わったかで分けると、対処を考えやすくなります。データの流れの中で予測の対象と入力の関係が変わる問題は、機械学習の研究では概念ドリフト(concept drift)と呼ばれ、多くの研究があります。Gama らの2014年の概説(ACM Computing Surveys 第46巻第4号、概念ドリフトへの適応の方法の整理)は、こうした研究をまとめた文献の1つです。本コラムでは、全体の地図の用語表のとおり、時間がたつにつれて、取引の特徴と、不正かどうかとの関係が変わることを概念ドリフトと呼びます。概念ドリフトは、手口の変化や顧客の行動の変化によって起きます。この章では、取引の特徴の分布が動く場合を「入力の分布の変化」、不正の割合が変わる場合を「不正の割合の変化」として、概念ドリフトと分けて整理します。同じ顧客の行動の変化でも、特徴の分布だけが動くなら入力の分布の変化、不正との関係まで動くなら概念ドリフト、という分け方です。ただし、3つは互いに排他的とは限りません。正当な取引の側だけで特徴の分布が変わったり、不正の割合が変わったりすると、同じ特徴を持つ取引が不正である見込みも、一般には変わります。次の表は、何が主に変わるかで分けた目安です。
| 変化の種類 | 何が変わるか | 不正検知での例 | ラベル無しで気づけるか | 主な対処 |
|---|---|---|---|---|
| 入力の分布の変化 | 特徴量の分布(取引の姿)が主に変わる | オンラインの利用の割合が増える、新しい決済の手段が増える | 気づける(特徴量の分布を測る) | 影響を確かめる。成績が落ちていなければ作り直しは急がない |
| 不正の割合の変化 | 不正が全体に占める割合が主に変わる | ある時期に同じ型の不正がまとまって増える | 一部だけ(アラートの件数の増減に出る) | しきい値と調査の人員の見直し(第9章)。スコアを確率として使うなら較正の見直し(第4章) |
| 関係そのものの変化(概念ドリフト) | 同じ特徴の取引が、不正である見込みが変わる | 以前は不正に多かった特徴が出なくなり、正当な取引に近い特徴の不正が増える | 気づきにくい(不正が少数なら全体の分布はほとんど動かないことがある) | 再学習・ルールの追加・特徴量の追加 |
変化の速さでも分けられます。ある日を境に急に変わる場合、少しずつ置き換わる場合、以前の状態に戻る場合(季節や行事で繰り返す場合)などです。急な変化は、新しい商品の開始やシステムの変更のように、社内の出来事と結びついていることが多く、変更の記録と照らし合わせれば原因を特定しやすい変化です。少しずつ置き換わる変化は、どの月にも「前の月とあまり変わらない」ように見えるため、気づくのが遅れます。この章のコードでは、新しい型の不正が数か月かけて増えていく、少しずつの変化を作りました。
表の右から2列目が、この章の後半の論点です。入力の分布の変化は、ラベルが無くても特徴量の分布を比べれば気づけます。ところが、不正検知で最も困る関係そのものの変化は、不正の件数が全体の 0.5% 程度しかない場合には、全取引の分布にほとんど現れないことがあります。ラベルを待たない監視は必要ですが、それだけで概念ドリフトを捉えられるとは限らない、という点を、後のコードの結果で確かめます。
架空データで確かめる、途中の月から不正の特徴が変わる取引の記録
ここからは、架空の合成データを使います。顧客1,200人の12か月分(1か月を30日とした360日分)の取引の記録を、乱数で合成しました。記録は実際の取引の記録よりずっと単純で、ここで得られる成績は、実際の取引での成績の目安にはなりません。変化に対する方式の違いの「出方」を見るための例です。データはこの章のために独立に作ったもので、他の章のデータや数字は使っていません。
各取引には、本人の普段の額との比(amount_ratio。額は相対値で、単位はありません)、普段の時間帯とのずれ(hour_gap。時間)、新しい端末かどうか、直近1時間の取引の回数(cnt_1h)、初めての加盟店の種類かどうか、オンラインかどうか(online)の6つの特徴量を持たせました。第5章で扱った集計の特徴量を、すでに計算済みの形で持たせた、と考えてください。正当な取引でも、オンラインの割合は月を追うごとに少しずつ増えるようにしています(顧客の行動の変化)。不正の側のオンラインの割合は固定しているので、この変化は特徴の分布を動かすだけでなく、オンラインの取引が不正である見込みにも影響します。まず、正当な取引を作る部分です。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261112)
N_CUST, N_MONTH = 1200, 12
cust_rate = rng.gamma(4.0, 5.0, N_CUST)   # 顧客ごとの月あたりの取引の回数(平均20回)
cust_online = rng.beta(2, 3, N_CUST)       # 顧客ごとのオンライン利用のしやすさ

def b_share(m):
    # 新しい型(型B)が不正に占める割合。0始まりの5か月目から増える
    return float(np.clip((m - 4) * 0.2, 0, 0.9))

def make_legit(m):
    n = rng.poisson(cust_rate)
    cid = np.repeat(np.arange(N_CUST), n)
    k = len(cid)
    d = pd.DataFrame({
        "month": m, "day": m * 30 + rng.integers(0, 30, k), "cust": cid,
        "amount_ratio": rng.lognormal(0.0, 0.5, k),          # 本人の普段の額との比
        "hour_gap": np.abs(rng.normal(0, 2.0, k)).clip(0, 12),  # 普段の時間帯とのずれ
        "new_device": (rng.random(k) < 0.03).astype(int),
        "cnt_1h": rng.poisson(0.3, k),                         # 直近1時間の回数
        "new_merchant": (rng.random(k) < 0.08).astype(int),   # 初めての加盟店の種類
        "online": (rng.random(k) < np.clip(cust_online[cid] + 0.02 * m, 0, 1)).astype(int),
        "fraud": 0, "ftype": "-"})
    return d
次に、不正な取引を混ぜます。不正の割合はどの月も 0.5% 前後です。不正には2つの型を用意しました。前半から見られる型Aは、普段より大きい額・普段と違う時間帯・新しい端末が多い、という特徴を持ちます。途中から現れる型Bは、額も時間帯も普段に近く、新しい端末も少ない代わりに、直近1時間の回数が型Aより多く、ほぼすべてオンラインで起きる、という特徴を持ちます。不正に占める型Bの割合は、5月を0として毎月 0.2 ずつ増え(6月 0.2、7月 0.4、8月 0.6、9月 0.8)、10月以降は 0.9 で止まるようにしました。実際に記録に型Bが現れるのは6月からです。ここで作った型は、変化の出方を見るために特徴の数値を決めただけのもので、実在の手口を写したものではありません。
def add_fraud(d, m):
    k = len(d)
    idx = rng.choice(k, rng.binomial(k, 0.005), replace=False)
    is_b = rng.random(len(idx)) < b_share(m)
    a, b = idx[~is_b], idx[is_b]
    d.loc[a, "amount_ratio"] = rng.lognormal(1.3, 0.6, len(a))
    d.loc[a, "hour_gap"] = rng.uniform(4, 12, len(a))
    d.loc[a, "new_device"] = (rng.random(len(a)) < 0.6).astype(int)
    d.loc[a, "cnt_1h"] = rng.poisson(1.0, len(a))
    d.loc[a, "new_merchant"] = (rng.random(len(a)) < 0.4).astype(int)
    d.loc[a, "online"] = (rng.random(len(a)) < 0.7).astype(int)
    d.loc[b, "amount_ratio"] = rng.lognormal(0.1, 0.4, len(b))
    d.loc[b, "new_device"] = (rng.random(len(b)) < 0.1).astype(int)
    d.loc[b, "cnt_1h"] = rng.poisson(2.5, len(b))
    d.loc[b, "new_merchant"] = (rng.random(len(b)) < 0.5).astype(int)
    d.loc[b, "online"] = (rng.random(len(b)) < 0.95).astype(int)
    d.loc[idx, "fraud"] = 1
    d.loc[a, "ftype"], d.loc[b, "ftype"] = "A", "B"
    return d

data = pd.concat([add_fraud(make_legit(m), m) for m in range(N_MONTH)], ignore_index=True)
s = data.groupby("month").agg(取引=("fraud", "size"), 不正=("fraud", "sum"),
                              型B=("ftype", lambda x: (x == "B").sum()))
s["不正の割合%"] = (100 * s["不正"] / s["取引"]).round(2)
print(s.to_string())
print("全体の取引", len(data), "不正", int(data.fraud.sum()))
実行した結果を月ごとにまとめると、次の表のとおりです。全体で 295,845 件の取引のうち、不正は 1,418 件でした。
| 月 | 取引の件数 | 不正の件数 | うち型B | 不正の割合(%) |
|---|---|---|---|---|
| 1月 | 25,014 | 127 | 0 | 0.51 |
| 2月 | 24,621 | 131 | 0 | 0.53 |
| 3月 | 24,711 | 131 | 0 | 0.53 |
| 4月 | 24,708 | 120 | 0 | 0.49 |
| 5月 | 24,671 | 103 | 0 | 0.42 |
| 6月 | 24,602 | 112 | 19 | 0.46 |
| 7月 | 24,764 | 125 | 38 | 0.50 |
| 8月 | 24,463 | 98 | 55 | 0.40 |
| 9月 | 24,601 | 107 | 81 | 0.43 |
| 10月 | 24,447 | 119 | 103 | 0.49 |
| 11月 | 24,609 | 121 | 100 | 0.49 |
| 12月 | 24,634 | 124 | 110 | 0.50 |
6月には型Bは不正の 17%(112件中19件) でしたが、12月には 89%(124件中110件) に増えています。不正の割合そのものは 0.40〜0.53% の範囲で、大きくは動いていません。つまり、この架空データで起きているのは、主に不正の中身の入れ替わり(関係そのものの変化)と、正当な取引でのオンラインの増加(主に入力の分布の変化で、不正との関係にも影響するもの)の2つです。
学習し直す頻度と期間を比べる、固定・毎月の再学習・直近の期間だけ
モデルの作り方は3通りを比べました。1つ目は、1〜3月の記録だけで学習し、その後は作り直さない「固定」です。2つ目は、毎月、その時点で使えるすべての期間の記録で学習し直す「毎月学習し直す」です。3つ目は、毎月、使える期間のうち直近3か月分だけで学習し直す「直近3か月だけ」です。機械学習の手法は、3通りとも scikit-learn の HistGradientBoostingClassifier(勾配ブースティングの一種。第4章)にそろえました。
ここで大事なのが、ラベルの遅れの扱いです。本コラムの例では、取引のラベルが確定するまでに1か月かかると置きました。ある月の判定に使うモデルは、その前の月の取引のラベルをまだ持っていません。そのため、評価する月を m とすると、学習に使えるのは m の2か月前までの記録です。この条件を、学習のたびに守らせています。最初の評価は5月で、5月に使えるのは1〜3月の記録だけなので、5月の3つのモデルは同じものになります。評価には、平均適合率(第8章。ここでは scikit-learn の average_precision_score の値で、しきい値ごとの適合率を再現率の増分で重み付けて足したもの)と、スコアの上位 0.5% をアラートにしたときの再現率(以下、再現率@0.5%)を使いました。
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import average_precision_score

FEATS = ["amount_ratio", "hour_gap", "new_device", "cnt_1h", "new_merchant", "online"]

def fit(months):
    t = data[data.month.isin(list(months))]
    clf = HistGradientBoostingClassifier(max_iter=100, learning_rate=0.1, random_state=0)
    return clf.fit(t[FEATS], t.fraud)

def evaluate(clf, m, rate=0.005):
    t = data[data.month == m]
    sc = clf.predict_proba(t[FEATS])[:, 1]
    y = t.fraud.to_numpy()
    top = np.argsort(-sc)[: int(np.ceil(len(sc) * rate))]   # 上位0.5%をアラートにする
    return average_precision_score(y, sc), y[top].sum() / y.sum()

DELAY = 1   # ラベルの確定に1か月かかる。評価する月mの学習に使えるのは m-2 月まで
static = fit(range(0, 3))
rows = []
for m in range(4, N_MONTH):
    last = m - 1 - DELAY
    models = {"固定": static, "毎月学習し直す": fit(range(0, last + 1)),
              "直近3か月だけ": fit(range(last - 2, last + 1))}
    for name, clf in models.items():
        ap, rc = evaluate(clf, m)
        rows.append({"月": m + 1, "方式": name, "平均適合率": ap, "再現率@0.5%": rc})
res = pd.DataFrame(rows)
print(res.pivot(index="月", columns="方式", values="平均適合率").round(3).to_string())
print(res.pivot(index="月", columns="方式", values="再現率@0.5%").round(3).to_string())
print(res.groupby("方式")[["平均適合率", "再現率@0.5%"]].mean().round(3).to_string())
月ごとの平均適合率は次のとおりでした。
| 評価した月 | 固定 | 毎月学習し直す | 直近3か月だけ |
|---|---|---|---|
| 5月 | 0.938 | 0.938 | 0.938 |
| 6月 | 0.802 | 0.704 | 0.759 |
| 7月 | 0.644 | 0.566 | 0.534 |
| 8月 | 0.416 | 0.454 | 0.365 |
| 9月 | 0.275 | 0.375 | 0.196 |
| 10月 | 0.178 | 0.333 | 0.252 |
| 11月 | 0.214 | 0.387 | 0.428 |
| 12月 | 0.146 | 0.491 | 0.465 |
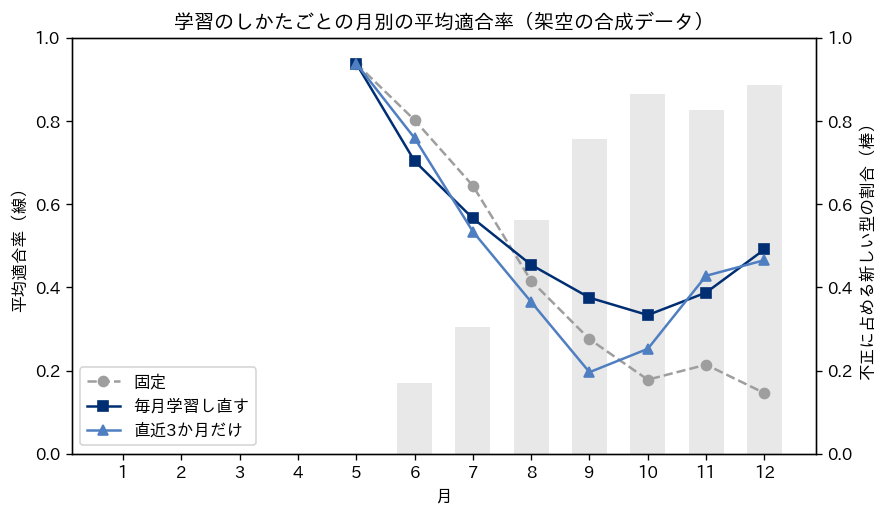
図の線は平均適合率、棒は不正に占める型Bの割合です(評価は5月からなので、1〜4月は線がありません。グラフを描くコードは省略しました)。固定のモデルは、型Bが増えるにつれて成績が下がり、平均適合率は5月の 0.938 から12月の 0.146 まで下がりました。再現率@0.5% も、5月の 0.913 から12月の 0.121 まで下がっています。12月の固定のモデルは、上位 0.5% をアラートにしても、不正のおよそ1割しか捉えていないことになります。毎月学習し直したモデルも8〜10月には成績が落ちましたが、型Bの記録が学習に入るにつれて持ち直し、12月の平均適合率は 0.491、再現率@0.5% は 0.492 でした。8か月の平均では、次のとおりです。
| 方式 | 平均適合率(8か月の平均) | 再現率@0.5%(8か月の平均) |
|---|---|---|
| 固定 | 0.452 | 0.433 |
| 毎月学習し直す | 0.531 | 0.577 |
| 直近3か月だけ | 0.492 | 0.544 |
この結果から読めることは3つあります。1つ目は、学習し直さないモデルは、手口が入れ替わると成績が大きく下がることです。2つ目は、学習し直しても、変化の直後には追いつけないことです。8〜10月の毎月の再学習の成績は5月の水準に戻りませんでした。ラベルの遅れは追従を遅らせる一因ですが、それだけでは説明できません。後で示すとおり、遅れが0か月でも8〜10月の平均適合率は 0.478・0.335・0.318 で、正当な取引と特徴の重なる型Bそのものの見分けにくさも成績に影響しています。3つ目は、変化の途中の6・7月には、固定のモデルの方が成績の良い月もあったことです。月ごとの不正は100件前後しかなく、1か月の成績には大きなばらつきが入ります。1か月の数字だけで方式を入れ替える判断はせず、数か月の推移で見る必要があります(少ない件数での指標のばらつきは第8章)。
「直近3か月だけ」で学習する方式は、古い手口を早く忘れ、新しい手口に早く合わせることを狙ったものです。本コラムの架空データでは、8か月の平均で毎月の再学習(すべての期間)をわずかに下回り、9月には3つの中で最も低い 0.196 になりました。これは乱数の種を1つに決めた1回の実行の結果で、種を変えると順位が入れ替わる月もありえます。学習に使える不正の件数が減ることが一因の可能性がありますが、この章では不正の件数を変えた実験をしておらず、確かめていません。一方で、型Aが減っていく後半には毎月の再学習とほぼ同じ水準でした。どちらが良いかは、手口の入れ替わりの速さと、1か月あたりの不正の件数で変わります。学習の期間の長さは、決め打ちせず、過去の記録で何通りか試して決める設定の1つとして扱うのが妥当だと考えています。古い期間を捨てずに、新しい期間ほど重く扱う(重み付ける)方法もあります。
ラベルの遅れと再学習、確定したラベルだけで学習する
再学習で最初に決めるのは、どの時点までの記録を学習に使うかです。ラベルの確定には遅れがあるので(第2章)、直近の取引ほど、不正だったかどうかがまだ分かっていません。確定していない取引を「正当」として学習に入れると、直近の不正を正当として覚えさせることになります。そのため、学習に使う期間は、ラベルが十分に確定した時点で手前に切るのが基本です。前のコードで、評価する月の2か月前までしか使わなかったのはこのためです。
手前で切れば、学習に入る記録は遅れの分だけ古くなります。遅れが長いほど、新しい手口への追従は遅れます。本コラムの架空データで、遅れを0か月(前の月のラベルまで使える)・1か月・2か月と変えて、毎月学習し直したときの平均適合率を比べたのが次のコードです。
rows = []
for m in range(4, N_MONTH):
    for delay in [0, 2]:                       # 遅れ1か月は前の比較の「毎月学習し直す」
        ap_d, rc_d = evaluate(fit(range(0, m - delay)), m)
        rows.append({"月": m + 1, "遅れ(か月)": delay, "平均適合率": ap_d})
one = res[res["方式"] == "毎月学習し直す"].assign(**{"遅れ(か月)": 1})
dl = pd.concat([pd.DataFrame(rows), one[["月", "遅れ(か月)", "平均適合率"]]])
dl = dl.pivot(index="月", columns="遅れ(か月)", values="平均適合率")
print(dl.round(3).to_string())
print("平均", dl.mean().round(3).to_dict())
| 評価した月 | 遅れ0か月 | 遅れ1か月 | 遅れ2か月 |
|---|---|---|---|
| 5月 | 0.770 | 0.938 | 0.637 |
| 6月 | 0.653 | 0.704 | 0.802 |
| 7月 | 0.669 | 0.566 | 0.554 |
| 8月 | 0.478 | 0.454 | 0.341 |
| 9月 | 0.335 | 0.375 | 0.392 |
| 10月 | 0.318 | 0.333 | 0.321 |
| 11月 | 0.474 | 0.387 | 0.362 |
| 12月 | 0.405 | 0.491 | 0.384 |
| 8か月の平均 | 0.513 | 0.531 | 0.474 |
8か月の平均は、遅れ0か月で 0.513、1か月で 0.531、2か月で 0.474 でした。遅れ2か月は他の2つより低くなりましたが、遅れ0か月と1か月の差は月ごとのばらつきに埋もれ、遅れ0か月の方が低い月もありました。本コラムの架空データでは、遅れが短いほど成績が良い、というきれいな順序は出ていません。ラベルの遅れは追従を遅らせる要因の1つですが、その影響の大きさは、手口の入れ替わりの速さと不正の件数しだいだ、というのがこの結果の読み方です。
実務では、ラベルは1種類ではありません。調査担当がアラートを確認した結果は数日で確定し、本人の申告やチャージバックは数週間から数か月かけて届くことがあります。Dal Pozzolo らの2018年の論文(IEEE のニューラルネットワークと学習システムの論文誌、第29巻第8号)は、クレジットカードの不正検知を、不均衡・概念ドリフト・ラベルが確定するまでの遅れが同時にある問題として定式化し直し、それらをまとめて扱う学習の方法を提案しています。調査の結果として早く届くラベルと、遅れて届くラベルとでは、どの取引についてのラベルなのか(アラートになった取引か、ならなかった取引か)が違います。アラートの調査から得る早いラベルは、アラートになった取引に偏り、遅いラベルは見逃した不正も含みます。2種類を同じものとして混ぜずに、出どころの違いを記録に残しておくことが、再学習の前提になると考えています。
ラベルを待たない監視、分布のずれの指標とアラートの割合
ラベルの確定を待っていると、成績の低下に気づくのは数か月後になります。そこで、ラベルが無くても計算できる指標で、変化の兆しを見張ります。よく使われるのが、基準の期間と比べて、スコアや特徴量の分布がどれだけずれたかを測る指標です。その1つが、信用スコアのモデルの監視で使われてきた PSI(Population Stability Index、母集団の安定性の指標)です。Yurdakul の2018年の博士論文(ウェスタンミシガン大学、PSI の統計的な性質)は、PSI を、信用スコアのモデルを作ったときの母集団から、使っている時点の母集団がずれていないかを確かめる指標として扱っています。
本コラムのコードでは、基準の期間の値を、同じ数の取引が入るように区切りました(詳しい区切り方は掲載したコードのとおりです。0と1だけの特徴量は2つの区間になります)。各区間に入る割合を、基準の期間(\( e_i \))と比べる期間(\( a_i \))でそれぞれ数え、次の式で合計しています。
\( \mathrm{PSI} = \sum_i (a_i – e_i) \ln (a_i / e_i) \)
言葉で言い換えると、区間ごとに「割合の差」と「割合の比の対数」を掛けて足し合わせたもので、分布が同じなら0、ずれるほど大きくなります。Yurdakul の論文によれば、PSI が 0.10 未満なら変化は小さく、0.10〜0.25 なら対応が要る大きな変化、という目安が使われていますが、論文はこの区切りが、誤って警報を出す確率や変化を見逃す確率を考えずに使われていると指摘しています。この論文の要旨は、0.25 を超える場合の扱いに触れていません。0.1 と 0.25 の区切りは目安であって、決まりではありません。区切りの意味は件数や区間の数でも変わるので、自社の過去の記録で平常時のばらつきを見てから決めるのが安全だと考えています。
次のコードでは、1〜3月を基準として、固定のモデルのスコアと3つの特徴量の PSI を、5月から月ごとに計算し、あわせて「基準の期間の上位 0.5% に当たるスコアを超えた取引の割合」(以下、アラートの割合)を数えました。方式を比べた節の評価では、毎月、その月のスコアの上位 0.5% をアラートにしたので、アラートは常に 0.5% でした。この節と次の節では、しきい値を基準の期間の値に固定しているので、アラートの割合は月によって変わります。5月から始めたのは、1〜3月のラベルで学習した固定のモデルを、ラベルの遅れ(1か月)を守って使えるのが5月からだからです。
def psi(ref, cur, eps=1e-4):
    edges = np.unique(np.quantile(ref, np.linspace(0, 1, 11))[1:-1])
    e = np.bincount(np.searchsorted(edges, ref), minlength=len(edges) + 1) / len(ref)
    a = np.bincount(np.searchsorted(edges, cur), minlength=len(edges) + 1) / len(cur)
    e, a = np.clip(e, eps, None), np.clip(a, eps, None)   # 0件の区間を小さな値で置き換える
    e, a = e / e.sum(), a / a.sum()                         # 置き換えた後に合計を1へ戻す
    return float(np.sum((a - e) * np.log(a / e)))

data["score"] = static.predict_proba(data[FEATS])[:, 1]
ref = data[data.month < 3]
cut = np.quantile(ref.score, 0.995)          # 基準の期間で上位0.5%に当たるスコア
rows = []
for m in range(4, N_MONTH):                 # 1〜3月のラベルが揃うのは5月から
    cur = data[data.month == m]
    row = {"月": m + 1}
    for col in ["score", "amount_ratio", "cnt_1h", "online"]:
        row["PSI_" + col] = psi(ref[col].to_numpy(), cur[col].to_numpy())
    row["アラートの割合%"] = 100 * (cur.score >= cut).mean()
    rows.append(row)
mon = pd.DataFrame(rows).set_index("月")
print(mon.round(4).to_string())
| 月 | スコアの PSI | 額の比の PSI | 直近1時間の回数の PSI | オンラインの PSI | アラートの割合(%) |
|---|---|---|---|---|---|
| 5月 | 0.0000 | 0.0008 | 0.0005 | 0.0119 | 0.4256 |
| 6月 | 0.0002 | 0.0003 | 0.0001 | 0.0232 | 0.3577 |
| 7月 | 0.0001 | 0.0005 | 0.0000 | 0.0411 | 0.3554 |
| 8月 | 0.0003 | 0.0006 | 0.0001 | 0.0558 | 0.1840 |
| 9月 | 0.0001 | 0.0008 | 0.0002 | 0.0863 | 0.1341 |
| 10月 | 0.0004 | 0.0004 | 0.0005 | 0.0961 | 0.1145 |
| 11月 | 0.0004 | 0.0002 | 0.0006 | 0.1301 | 0.1260 |
| 12月 | 0.0001 | 0.0006 | 0.0003 | 0.1602 | 0.0852 |
結果は、この章で最も重要な点を示しています。固定のモデルの成績が大きく下がった9〜12月にも、スコアの PSI は 0.0004 以下で、ほぼ0のままでした。額の比や直近1時間の回数の PSI も同じです。不正は全体の 0.5% 程度しかないので、この区切り方の PSI では、不正の中身が入れ替わっても大きな値になりませんでした。一方で、正当な取引の側にも設定したオンライン利用の増加は PSI に現れ、オンラインの割合の PSI は5月の 0.0119 から12月の 0.1602 まで上がり、11月には 0.1 を超えました。ただし、その成績への寄与は、この実験では切り分けていません。この架空データでは、全取引の分布の PSI は、成績の大きな低下が起きた時期に、その低下に見合う動きを示さなかったことになります。
スコアの PSI が動かなかった一方で、アラートの割合は大きく下がりました。基準の期間では約 0.5% でしたが、型Bが増えた6〜8月に、5月の 0.4256% から8月の 0.1840% まで下がり、12月には 0.0852% でした。ただし、型Bがまだ無い5月にも、すでに約 0.5% より低く出ています。基準のしきい値は、学習に使った期間そのもののスコアで決めているので、学習の期間の外ではスコアが低めに出る、という過学習(学習に使った期間のデータに合わせすぎること)の影響が入りうると考えられますが、この章では確かめていません。5月の水準からさらに大きく下がったことが、この架空データで変化と重なった動きです。しきい値を超える割合が変わったこと自体は、スコアの高い領域の分布が変わったということで、上の PSI の区切り方では、その変化が小さな値にしかならなかった、と読むのが正確です。不正の割合はほぼ変わっていないので、固定のモデルが新しい型の不正を高いスコアにしていない可能性が考えられます。次の節で、型ごとにどれだけアラートになったかを確かめます。ただし、アラートの減少は、現場では「不正が減った」とも読めてしまいます。アラートの割合の低下は、それだけで成績の低下を意味するわけではなく、「調べるべき変化が起きた」という合図として扱い、次の節の無作為の点検や、遅れて届くラベルで確かめる必要があります。
この結果から、ラベルを待たない監視は、全取引の分布だけでなく、次のような不正の側に近い指標を組み合わせるのが良いと考えています。
- アラートの割合と、措置ごと(保留・拒否)の件数の推移
- スコアの上位の取引に限った特徴量の分布(アラートになった取引の中身が変わっていないか)
- 本人の申告・問い合わせの件数と、そのうちアラートになっていなかったものの割合
- ルールごとのアラートの件数(あるルールだけが急に減る・増える)
- 新しい商品・経路・端末の種類など、学習の期間に無かった値の割合
新しい手口はラベルにも残りにくい、無作為の点検で偏りを補う
再学習には、新しい手口のラベルが要ります。ところが、アラートになった取引だけを調べていると、モデルが見逃した新しい手口は、調査の記録にほとんど残りません。第2章で扱った選択の偏りが、手口の変化と組み合わさると、再学習しても新しい手口を覚えられない、という問題になります。前の節で作った固定のモデルのアラート(基準の期間で固定したしきい値を超えた取引)を調べた場合に、型ごとにどれだけの不正がラベルとして確定するかを数えたのが次のコードです。あわせて、アラートにならなかった取引から 1% を無作為に選んで点検した場合も数えました。ここでは、調査や点検をした取引は必ず正しく不正かどうかを判定できる、と置いています。そのため、表の「アラートで確定」は不正でアラートになった件数で、「型ごとの再現率」はそれを型ごとの不正の件数で割った値です。実際の調査では見抜けない不正もあるので、確定する件数はこれより少なくなりえます。
rows, n_audit = [], 0
for m in range(4, N_MONTH):
    t = data[data.month == m]
    alert = (t.score >= cut).to_numpy()
    audit = (~alert) & (rng.random(len(t)) < 0.01)     # アラート以外から1%を無作為に点検
    n_audit += int(audit.sum())
    for ft in ["A", "B"]:
        f = (t.ftype == ft).to_numpy()
        rows.append({"月": m + 1, "型": ft, "不正": int(f.sum()),
                     "アラートで確定": int((f & alert).sum()),
                     "点検で確定": int((f & audit).sum()),
                     "どちらでも未確定": int((f & ~alert & ~audit).sum())})
cov = pd.DataFrame(rows).groupby("型")[["不正", "アラートで確定", "点検で確定", "どちらでも未確定"]].sum()
cov["型ごとの再現率"] = (cov["アラートで確定"] / cov["不正"]).round(3)
print(cov.to_string())
print("点検した件数", n_audit, "アラートの件数", int((data[data.month >= 4].score >= cut).sum()))
| 型 | 不正の件数 | アラートで確定 | 点検で確定 | どちらでも未確定 | 型ごとの再現率 |
|---|---|---|---|---|---|
| 型A | 403 | 348 | 0 | 55 | 0.864 |
| 型B | 506 | 3 | 4 | 499 | 0.006 |
5〜12月の型Aの不正 403 件のうち、アラートで確定したのは 348 件(型ごとの再現率 0.864)でした。型Bの不正 506 件のうち、アラートで確定したのは 3 件だけです。調査の結果だけを学習のラベルにすると、型Bはほとんど「不正の例」として記録に現れず、確定しなかった型Bを正当として扱えば、型Bを正当な取引として覚えさせることになります。アラート以外から 1% を無作為に点検すると、点検の件数は 1,980 件で、アラートの件数 439 件の約4.5倍になりましたが、点検で見つかった型Bは 4 件でした。不正が 0.5% しかない取引から無作為に選ぶと、見つかる不正の件数は少なくなります。
この結果は、無作為の点検が無意味だということではありません。点検で見つかる件数は少なくても、「アラートにならなかった取引の中に、どのくらいの割合で不正があるか」を偏りなく見積もるための基本的な手段は、無作為の点検です。調査した取引だけから見積もった数字は、調べ方の偏りを含むおそれがあります。無作為に選んだ取引は、選ばれる確率が分かっていて0より大きいので、点検で正しく判定できるという前提のもとで、その確率の逆数で重み付ければ、アラートにならなかった不正の件数(見逃しの件数)を偏りなく推定でき、学習にも重み付きで使えます。例えば 1% の無作為の点検なら、点検で見つかった1件は、アラートにならなかった取引の中のおよそ100件分にあたるとみなします。この章の例では、点検で見つかった型Bは 4 件で、アラートにならなかった型Bはおよそ400件と見積もられます。実際の件数は503件(表の「点検で確定」と「どちらでも未確定」の合計)で、件数が少ないと見積りの誤差が大きくなることが分かります。
見積もった件数を、件数の分かっている全取引やアラート以外の取引の件数で割った割合も偏りなく推定できます。一方、推定した不正の総数で割る見逃しの率は、別に推定の誤差を見積もる必要があります。点検の割合を上げれば件数は増えますが、この例でも 1% の点検でアラートの約4.5倍の取引を調べることになり、調査の過負荷につながります。点検の割合と期間は、推定に必要な件数と調査の能力の両方を見ながら決める必要があります。
実務では、無作為の点検に加えて、次のような経路で、アラートにならなかった不正のラベルを集めます。これらを組み合わせて、再学習のラベルの偏りを小さくしていきます。
- 本人の申告・チャージバックなど、遅れて届くラベル(アラートの有無に関係なく届く)
- アラートのしきい値より少し低いスコアの帯からの抽出の調査
- 一部の取引をしきい値にかかわらず通して経過を見る対照の群(措置の影響を測る設計。損失を伴うので範囲と期間を限る)
- ルールや調査担当の気づきから見つかった新しい手口の事例
ルールで先に対応してモデルに取り込む流れと、敵対的な変化への守る側の対処
新しい手口が見つかったとき、モデルの再学習を待っていては間に合わないことがあります。十分な件数のラベルが集まり、確定し、再学習と検証と承認を経てモデルを入れ替えるまでには、数週間から数か月かかることがあります。その間の被害を抑えるには、第3章で扱ったルールが向いています。ルールは、検証・承認・配信の体制が整っていれば短い期間で追加でき、何を判定しているかを説明できます。
本コラムでは、新しい手口への対応を次の順で進める流れを想定しています。まず、調査担当や顧客の申告から新しい手口の兆しが見つかったら、その手口に固有の条件でルールを作り、保留(追加の確認)として入れます。次に、そのルールのアラートを調べた結果をラベルとして記録し、適合率と件数を見ながら条件を調整します。ラベルが十分に集まったら、その手口を表す特徴量を足してモデルを学習し直し、モデルがその手口を捉えられることを確かめてから、ルールを廃止するか、単独で保留にするルールから、調査の参考情報として示すだけのルールに変えます。ルールを足したままにすると台帳が膨らみ続けるので(第3章)、モデルに取り込んだ時点で見直す決まりにしておくのが良いと考えています。
この流れでは、ルールは新しい手口の「ラベルを集める仕組み」の役割も果たします。前の節で見たとおり、モデルが見逃している手口は、モデルのアラートを調べているだけではラベルが集まりません。新しい手口に向けたルールのアラートを調べることで、その手口の例が記録に残り、次の再学習に使えるようになります。
不正検知の変化の中には、相手が検知を避けるように行動を変えることで起きるものがあります。本コラムでは、これを敵対的な変化と呼びます。自然に起きる顧客の行動の変化と違い、検知の仕組みの性質に合わせて変化が起きるので、ある特徴が効かなくなると、その特徴に頼っていた判定がまとめて効かなくなることがあります。どう避けられるかの具体はここでは扱わず、守る側が取れる対処だけを書きます。
- 複数の方式の併用:ルール・教師あり学習・教師なしの異常検知(第6章)・ネットワーク分析(第7章)を組み合わせ、1つの方式や1つの特徴に頼らない
- 詳細を外に出さない:ルールの条件・しきい値・特徴量の一覧は、社内でも触れられる人を限り、顧客への説明は定型の理由に留める(説明とのつり合いは第11章、権限の管理は第12章)
- 無作為の点検を混ぜる:スコアにかかわらず一部の取引を調べ、判定の外側で起きていることを見る
- 反応の監視:あるルールやしきい値を変えた直後に、どの型の取引がどう増減したかを見る
- 変更の頻度:しきい値やルールを、決まった時期だけでなく、必要に応じて見直せる体制にしておく
このうち、複数の方式の併用と無作為の点検は、この章のコードの結果ともつながります。教師あり学習のモデルは、学習した手口の特徴に強く依存するので、その特徴を持たない不正には弱くなります。教師なしの異常検知や、つながりで見る分析は、ラベルの無い新しい手口の手がかりになることがあり、無作為の点検は、どの方式も捉えていない不正の割合を見積もる手段になります。
再学習の手順と承認、作り直したモデルを入れ替えるまで
再学習は、学習のコードを実行し直すだけの作業ではありません。新しいモデルが古いモデルより良いことを、検知の指標と、防いだ不正・誤って止めた正当な取引の見積りの両方で確かめ、入れ替えの影響を見積もり、承認を得て、入れ替えた後も監視する、という一続きの手順です。再学習のきっかけには、決まった周期(毎月・四半期ごと)と、監視の指標がしきい値を超えたとき、新しい手口に対応したいとき、の3つがあります。周期で回しながら、きっかけがあれば前倒しする、という組み合わせが運用しやすいと考えています。
| 段階 | やること | 確かめること | 主な担当 |
|---|---|---|---|
| 学習の記録の準備 | ラベルが確定した期間で手前に切る。ラベルの出どころ(調査の結果・申告・点検)を区別して記録する | 確定していない取引を正当として入れていないか | データ分析 |
| 学習 | 同じ手順・同じ特徴量の定義で学習する。学習の期間の長さを何通りか試す | 特徴量の定義が判定の時点と一致しているか(第5章) | データ分析 |
| オフラインの比較 | 新旧のモデルを、同じ直近の評価の期間で比べる | 平均適合率・上位K件の適合率と再現率・型ごとの再現率(第8章) | データ分析・不正対策 |
| 運用への影響の見積り | 同じしきい値でのアラートの件数・措置ごとの件数を見積もる | 調査の能力を超えないか、しきい値の調整が要るか(第9章) | 不正対策・調査の責任者 |
| 承認 | 比較の結果・影響・戻し方を記録し、決められた承認者が承認する | 変更の記録と版の管理(第12章) | リスク管理・事業の責任者 |
| 入れ替えと監視 | 影の運用や一部の取引での試行(第12章)を経て入れ替える。入れ替え後の数週間は監視を強める | アラートの割合・措置の件数・申告の件数 | 不正対策・エンジニア |
手順の中で落ちやすいのは、運用への影響の見積りです。新しいモデルは、スコアの分布が古いモデルと違うことが多く、同じしきい値のままではアラートの件数が大きく変わることがあります。この章のコードで、毎月の再学習のモデルと固定のモデルとで、同じ上位 0.5% の再現率がまったく違ったように、モデルが変わればしきい値の意味も変わります。しきい値は、モデルを入れ替えるたびに、調査の能力と一緒に決め直すものとして扱います。
もう1つは、戻し方です。新しいモデルで予期しない誤検知が増えたときに、前の版へすぐ戻せるよう、前の版のモデルとしきい値を残しておき、戻す判断の基準(何がどれだけ悪化したら戻すか)を承認の時点で決めておきます。
経営判断、再学習と監視を運用の費用として最初から見込む
経営の視点で最も大事なのは、不正検知のモデルを「一度作れば終わる投資」として扱わないことです。この章の架空データでは、学習し直さないモデルは、学習の期間の終わりから9か月後の12月には、上位 0.5% のアラートが不正の約1割しか捉えない状態になりました。実際の取引でどの速さで古くなるかは、業種・商品・手口によって違い、この架空データの速さを当てはめることはできません。ただ、手口や顧客の行動が変わり続ける限り、作ったままのモデルは古くなる方向に進みやすいと考えています。
この判断を誤ると、序章で整理した損失の型のうち、形骸化(ルールやモデルが更新されず、手口の変化に置いていかれる)が起き、それに伴って見逃しによる被害が増えることが起きえます。この章のコードのように、アラートの件数が減ることで「不正が減った」と読まれると、調査の人員や監視の予算が削られ、変化への気づきがさらに遅れる、という悪循環も起きえます。逆に、変化に合わせてしきい値だけを下げて件数を戻そうとすると、誤検知による機会損失と顧客の離反、調査の過負荷が増えるおそれがあります。再学習と監視の体制は、これらの損失をまとめて抑えるための費用です。
予算と体制に落とすときは、次の項目を、導入の計画の段階から運用の費用として見込んでおくのが良いと考えています。
| 項目 | 中身 | KPI の例 | 見直しの周期 |
|---|---|---|---|
| 監視 | アラートの割合・措置の件数・スコアと特徴量の分布・申告の件数を見張る | 監視の指標がしきい値を超えてから確認するまでの日数 | 日次・週次 |
| ラベルの収集 | 調査の結果・申告・チャージバックを出どころつきで記録する。無作為の点検を続ける | ラベルが確定するまでの日数、無作為の点検の件数 | 月次 |
| 再学習 | 周期での再学習と、きっかけによる前倒しの再学習 | 前回の再学習からの経過日数、新旧の比較の結果 | 月次・四半期 |
| ルールの追加と廃止 | 新しい手口へのルールの追加と、モデルに取り込んだ後の廃止 | 新しい手口を把握してからルールを入れるまでの日数 | 随時・四半期 |
| 承認と記録 | モデル・ルール・しきい値の変更の承認と版の管理 | 承認の記録の欠け、前の版へ戻した回数 | 変更のつど |
KPI は、成果そのものではなく、変化への追従の速さを測るものを選んでいます。不正検知の成果は、防いだ不正と誤って止めた正当な取引の両方で測るものですが(第8・9章)、その数字はラベルの遅れの分だけ後からしか分かりません。追従の速さの KPI は、その遅れを待たずに、体制が機能しているかを確かめるための先行の指標です。モデルの監視と再学習の一般的な進め方は、弊社コラム「機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで」で扱っています。
不正検知のモデルは、手口の変化・顧客の行動の変化・商品や経路の変更・検知そのものへの適応によって、運用中に成績が下がることがあります。本コラムの架空データでは、学習し直さないモデルの成績は手口の入れ替わりとともに大きく下がり、毎月の再学習でも、ラベルの遅れや新しい型の見分けにくさのため、追従は遅れました。この架空データでは、全取引の分布の PSI はオンラインの割合の変化を示した一方、不正の中身の入れ替わりでは小さな値のままで、変化と重なって大きく動いたのは、固定したしきい値を超える取引の割合でした(その原因は切り分けていません)。新しい手口はアラートの調査だけではラベルに残りにくいので、無作為の点検・遅れて届くラベル・ルールを組み合わせて記録を集め、再学習を承認つきの手順として回す体制を、最初から見込んでおくことが必要です。第11章では、検知の理由をどう説明し、誤検知が特定の顧客に偏っていないかをどう確かめるかを扱います。
この章を深めたい方への参考書籍
『機械学習デザインパターン』(Valliappa Lakshmanan、Sara Robinson、Michael Munn 著、鷲崎弘宜、竹内広宜、名取直毅、吉岡信和 訳、オライリー・ジャパン):機械学習の実務でくり返し出てくる問題と解き方を、パターンとして整理した本です。運用の章に、作ったモデルを継続して評価するパターンと、再学習のきっかけを決める考え方が含まれており、この章で扱った監視と再学習を、不正検知以外の例も含めて一般的な形で確かめられます。
『事例でわかるMLOps 機械学習の成果をスケールさせる処方箋』(杉山阿聖、太田満久、久井裕貴 編著、講談社):機械学習のモデルを運用し続けるための技術・手順・体制を、国内の事例とともに解説した本です。機械学習システムのモニタリングや、事業の意思決定に役立つモニタリングを扱う節があり、この章の後半で触れた監視の項目の選び方や、再学習を承認つきの手順として回す体制を考える手がかりになります。
第11章 検知の理由の説明と公平性、誤検知が顧客に与える影響
第10章では、手口の変化や顧客の行動の変化でモデルが古くなること、ラベルを待たずにスコアや特徴量の分布のずれを監視すること(ただし全取引の分布のずれだけでは手口の変化を捉えきれない場合があること)、再学習の手順と承認を運用の費用として最初から見込むことを扱いました。ここまでの章は、不正の疑いをどれだけ正しく順位づけし、限られた調査の能力にどう振り向けるかという、検知する側の効率の話が中心でした。この章では、検知の結果を受け取る調査担当と、措置(保留・拒否など)の影響を受ける顧客の側から仕組みを見直します。
この章で扱うのは次の内容です。後半は、架空の取引の記録を使い、実行したコードと結果で確かめます。
- 説明が要る相手(調査担当・顧客・加盟店・監査や規制当局・経営)と、それぞれに何を示すか
- アラートの理由を定型の文で示す理由コードと、ルールの理由とモデルの理由の違い
- SHAP で1件のアラートの理由の上位3つを取り出して定型の文に直す方法と、全体の重要度
- 説明の限界(寄与は因果ではない、相関した特徴量やモデルの作り直しで理由が入れ替わる)
- 顧客に理由を詳しく示すことと、検知を避ける手がかりを与えないことのつり合い
- 誤検知が顧客に与える影響と、群ごとの偽陽性率で測る公平性
- 公平性の指標どうしが同時には満たせない場合があることと、属性を使わなくても偏りが入る経路
- 異議の申し立てと救済の手続き、人による確認の位置づけ、経営判断
この章の主張は、誤検知の偏りを群ごとに測ることです。そのうえで、誤検知が保留や拒否につながって止められた顧客が、正当であることを示せる救済の手続きを、検知を本番に入れる前に用意しておきます。誤検知は全体の件数で見ると小さな割合でも、特定の顧客の群に集中することがあります。本コラムの架空データでは、モデルに地域の情報を一切入れていないのに、評価期間の誤検知60件のうち56件が「地域2」の顧客に集まりました。地域2は評価期間の取引の3割ほどを占める群です。ただし地域2は、正当な取引でも不正に多い特徴(普段と違う時間帯・新しい端末)が出やすいように本コラムが作った群で、この結果は偏りが出る条件をわざと再現した例です。この例が示すのは、偏りはモデルの入力に属性を入れたかどうかでは決まらない場合があり、群ごとに測らなければ見えない、という点です。
説明が要る相手と、相手ごとに示すもの
不正検知の説明は、誰に向けるかで中身がまったく変わります。モデルの説明というと、特徴量の重要度のグラフを思い浮かべることが多いように思いますが、そのグラフが役に立つ相手は、データ分析の担当と、モデルの妥当性を確かめる立場の人に限られます。アラートを1件ずつ処理する調査担当には「この取引のどこがおかしいのか」が、止められた顧客には「なぜ止められ、どうすれば使えるようになるのか」が要ります。同じ「説明」という言葉で、目的も粒度も違う複数の要求をまとめてしまうと、どの相手にも合わない説明を作ることになります。
説明が要る相手は、大きく5つに分けられます。調査担当は、アラートの理由を見て、どこから確認を始めるかを決めます。顧客は、取引が止まった理由と、取引を再開するための手続きを知る必要があります。加盟店は、自店の取引が拒否された場合や、チャージバック(第1章)の判定に関わる場合に、何が起きたかを知る必要があります。監査や規制当局は、判定の方法が文書化され、決めたとおりに運用され、記録が残っているかを確かめます。経営は、検知の仕組みが事業の損失と顧客の信頼にどう効いているかを判断します。
相手ごとに示すものを、次の表にまとめました。
| 説明の相手 | 知りたいこと | 示すもの | 示す粒度 | 示さないもの |
|---|---|---|---|---|
| 調査担当 | この取引のどこがおかしいか。どこから確認するか | 理由コードの上位3つ程度と、その根拠になった値(普段の額との比、初めての端末かどうか など)。同じ顧客の直近の取引 | 1件ごと | モデルの内部の数値そのもの(寄与の生の値は補助にとどめる) |
| 顧客 | なぜ止められたか。どうすれば使えるか | 止めたこと、確認の手続き、問い合わせの窓口、再開までの見込み。理由は一般的な水準の言葉で | 1件ごと | 判定に使った条件・しきい値・スコア |
| 加盟店 | なぜ自店の取引が拒否されたか。何をすればよいか | 拒否の区分、追加の認証の要否、問い合わせの経路 | 取引ごと・期間の集計 | 個別の顧客の情報、判定の条件の詳細 |
| 監査・規制当局 | 決めたとおりに判定し、記録しているか | 判定の方法の文書、ルールとモデルの版、しきい値の変更の記録、判定の時点の入力と措置の記録、群ごとの誤検知の測定の結果 | 仕組み全体と、抜き取った個別の記録 | (求められた範囲はすべて示せるようにしておく) |
| 経営 | 損失の型ごとに何が起きているか | 防いだ不正と誤って止めた正当な取引の件数、調査の滞留、群ごとの誤検知の差、異議の申し立ての件数と結果 | 月次・四半期の集計 | 個別の取引の詳細 |
表の「示さないもの」の列は、隠すための列ではありません。相手が判断に使えない情報を渡すと、説明が長くなって要点が伝わらなくなること、そして顧客や外部に判定の条件を細かく渡すと検知を避ける手がかりになることの2つを考えた結果です。2つ目の点は、後の節で改めて扱います。監査や規制当局に対しては、求められた範囲をすべて示せるように記録を残しておくのが前提で、記録の残し方は第12章で扱います。
理由コード、アラートの理由を定型の文で示す、ルールの理由とモデルの理由の違い
調査担当に理由を示す方法としてよく使われるのが、理由コードです。理由コードは、アラートの理由を「R01 普段の額を大きく超える取引」「R02 初めて使われた端末からの取引」のように、番号と定型の文の組で示すものです。定型にしておくと、調査担当は文を読み慣れて素早く判断でき、調査の記録にも同じ言葉で残せます。理由コードごとに確認の手順(どの記録を見るか、顧客にどう確認するか)を決めておけば、調査の手順書と結びつけることもできます。
理由コードは、後から集計できることにも価値があります。どの理由コードのアラートが、調査の結果どれだけ不正だったかを数えれば、理由コードごとの適合率が分かります。適合率の低い理由コードが多いなら、その理由に対応するルールや特徴量を見直す必要があります。また、異議の申し立てを受けた取引の理由コードを集計すれば、どの理由で正当な顧客を止めていることが多いかが分かります。理由を自由な文章で書いていると、分類や表記をそろえる手間がかかり、同じ基準で集計しにくくなります。
理由コードを設計するときは、コードの数を絞ることが大切だと考えています。理由が細かすぎると調査担当が覚えきれず、粗すぎると確認の手順に結びつきません。目安としては、特徴量1つに1つのコードを割り当てるのではなく、「額」「時間帯」「端末・接続」「頻度」「相手(加盟店・受取口座)」「登録の情報との不一致」のように、確認の手順が同じになるものを1つにまとめるやり方が扱いやすいように思います。
理由コードの中身は、アラートを出したのがルールかモデルかで性質が変わります。ルール(第3章)で出したアラートの理由は、ルールそのものです。「1時間に一定の回数を超える取引」というルールで出たアラートなら、理由はそのルールで、条件を満たしたかどうかは誰が見ても同じ答えになります。一方、機械学習のモデル(第4章)で出したアラートのスコアは、多くの特徴量の組み合わせから計算されていて、どの特徴量がどれだけ効いたかは、判定そのものには書かれていません。そこで、モデルの出力を、説明の手法が定める基準に沿って特徴量ごとの寄与に分解します。後で使う SHAP は、その分解の方法の1つです。
この違いは、説明の確かさの違いにつながります。ルールの理由は判定そのものなので、正しいか正しくないかがはっきりしています。モデルの理由は、手法が定める基準での分解なので、どの手法・どの基準で分解するかによって答えが変わります。計算が近似かどうかも手法によって違い、この章で使う木のモデル向けの計算は、その手法の定義のもとで寄与を厳密に計算するものです。ただし厳密に計算できても、モデルを作り直したときの乱数によって、モデルそのものが変わり、理由も変わることがあります。この章の後半のコードでは、乱数の種だけを変えて作り直した2つのモデルで、同じアラートの理由の1位が入れ替わる割合を測ります。
| 観点 | ルールの理由 | モデルの理由(SHAP などで計算) |
|---|---|---|
| 理由の出どころ | 判定の条件そのもの | モデルの出力を、手法が定める基準で特徴量ごとの寄与に分解したもの(近似かどうかは手法による) |
| 同じ取引に対する安定性 | ルールが同じなら常に同じ | 計算の方法・モデルの作り直し・相関した特徴量によって変わりうる |
| 理由の数 | 満たしたルールの数だけ | すべての特徴量に寄与が付く。上位いくつを示すかを決める必要がある |
| 理由の意味 | 「この条件を満たした」 | 「この特徴量の値が、モデルの出力を基準値(学習に使ったデータでのモデルの出力の平均にあたる値)からこれだけ押し上げた」 |
| 監査での示しやすさ | 条件の文書と判定の記録で示せる | 計算の方法・モデルの版・寄与の記録を合わせて残す必要がある |
| 向いている用途 | 規制上の要件、既知の手口、顧客への一般的な説明 | 調査担当への手がかり、ルールや特徴量の見直しの材料 |
表の「理由の意味」の行が、とくに誤解されやすい点です。モデルの理由として「普段の額の6倍の取引」と示されたとき、それは「額が普段の6倍だから不正と判定した」という意味ではありません。「額の比という特徴量の値が、モデルの出力を基準値から押し上げた量が、他の特徴量より大きかった」という意味です。基準値は、平均の値を並べた架空の1件の取引のスコアではなく、学習に使ったデータ全体でのモデルの出力の平均にあたる値です。この違いが実務で効いてくるのは、調査担当が理由を判定の根拠そのものと受け取り、理由に書かれた点だけを確かめて終わってしまう場合です。理由コードは確認を始める場所を示すもので、確認の範囲を限るものではない、という位置づけを調査の手順書に書いておく必要があります。
架空の取引の記録を作り、勾配ブースティングで不正のスコアを出す
ここからは、コードで理由の取り出し方と公平性の測り方を確かめます。この章のデータは、他の章とは独立に作った架空の合成データです。実際の取引の記録よりずっと単純で、合成データでの成績は、実際の取引での成績の目安にはなりません。顧客3,000人・120日分の取引を、次の性質を持たせて乱数で作りました。
- 顧客ごとの普段の行動:額の水準(相対値)、1日あたりの取引の回数、よく使う時間帯を顧客ごとに変える
- 顧客の群:顧客の7割を「地域1」、3割を「地域2」とする。地域2の顧客は、正当な取引でも時間帯のばらつきが大きく、新しい端末からの取引が多い(地域1の2%に対して7%)という性質を持たせる。地域の情報は検知のモデルには入れず、後で偏りを測るためだけに使う
- 不正:300件の乗っ取りの出来事を、地域に関係なく無作為に選んだ顧客に起こし、それぞれ短い時間に1〜5件の取引を続ける。不正な取引は額が大きく、深夜が多く、新しい端末や初めての加盟店の種類が多い
- 時間の流れ:最初の30日は顧客の普段の額を知るための期間とし、31〜90日目を学習用、91〜120日目を評価用にする
不正に多い特徴は、正当な取引にも一定の割合で現れるようにしています。地域2の性質は、ある群の顧客が正当な理由で普段と違って見える取引をしやすい状況を、単純にまねたものです。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261112)
N_CUST, DAYS = 3000, 120

# 顧客ごとの普段の行動。地域は検知のモデルには入れない(後で偏りを測るためだけに使う)
cust = pd.DataFrame({
    "cust": np.arange(N_CUST),
    "region": rng.choice(["地域1", "地域2"], size=N_CUST, p=[0.7, 0.3]),
    "level": rng.lognormal(0.0, 0.5, N_CUST),        # 額の水準(相対値)
    "rate": rng.gamma(2.0, 0.25, N_CUST),            # 1日あたりの取引の回数
    "usual_hour": rng.normal(14, 3, N_CUST) % 24,     # よく使う時間帯
})
r2 = (cust["region"] == "地域2").to_numpy()
cust["hour_sd"] = np.where(r2, 4.0, 2.0)             # 地域2は時間帯のばらつきが大きい
cust["p_newdev"] = np.where(r2, 0.07, 0.02)          # 地域2は正当でも新しい端末が多い

# 正当な取引:顧客ごとの回数だけ、その顧客の普段の行動から取引を作る
n = rng.poisson(cust["rate"] * DAYS)
c = cust.loc[np.repeat(cust.index, n)].reset_index(drop=True)
m = len(c)
hour = rng.normal(c["usual_hour"], c["hour_sd"]) % 24
legit = pd.DataFrame({
    "cust": c["cust"], "t": rng.integers(0, DAYS, m) * 24 + hour,
    "amount": c["level"] * rng.lognormal(0.0, 0.6, m),
    "new_device": rng.random(m) < c["p_newdev"],
    "new_mcat": rng.random(m) < 0.05, "fraud": 0})
print("正当な取引の件数", len(legit))
# 不正:乗っ取られた顧客の口座で、短い時間に1〜5件の取引が続く
n_inc = 300
inc_cust = rng.choice(N_CUST, n_inc, replace=True)
frows = []
for c in inc_cust:
    k = rng.integers(1, 6)
    start_day = rng.integers(30, DAYS)
    start_hour = rng.uniform(0, 24) if rng.random() < 0.5 else rng.uniform(0, 5)
    t = start_day * 24 + start_hour + np.cumsum(rng.exponential(0.7, k))
    frows.append(pd.DataFrame({
        "cust": c, "t": t,
        "amount": cust.loc[c, "level"] * rng.lognormal(1.0, 0.7, k),
        "new_device": rng.random(k) < 0.55,
        "new_mcat": rng.random(k) < 0.45, "fraud": 1}))
tx = pd.concat([legit] + frows, ignore_index=True)
tx = tx.sort_values(["cust", "t"]).reset_index(drop=True)
tx = tx.merge(cust[["cust", "region", "usual_hour"]], on="cust")
print("全取引", len(tx), "不正", int(tx["fraud"].sum()),
      "不正の割合", round(tx["fraud"].mean() * 100, 3), "%")
実行した結果、正当な取引は180,962件、不正を含めた全取引は181,877件、不正は915件で、不正の割合は0.503%になりました。次のコードで特徴量を作り、勾配ブースティング(第4章)で学習します。特徴量は、取引の額の相対値(amount)、最初の30日の中央値との比(amt_ratio)、普段の時間帯からのずれ(hour_gap)、深夜かどうか(night)、その取引より前の24時間の取引の件数(cnt_24h。その取引自身は含めない)、初めての端末かどうか(new_device)、初めての加盟店の種類かどうか(new_mcat)の7つです。特徴量の作り方の考え方は第5章で扱っています。学習には lightgbm 4.6.0 を使いました。後のグラフの日本語の表示には japanize-matplotlib 1.1.3 を使い、本コラムの実行環境(Python 3.14.3)で動くことを確かめています。別の環境では、同じ版でも動かない場合があります。
# 特徴量:判定の時点で分かる情報だけで作る
tx["hour"] = tx["t"] % 24
gap = np.abs(tx["hour"] - tx["usual_hour"])
tx["hour_gap"] = np.minimum(gap, 24 - gap)            # 普段の時間帯からのずれ
tx["night"] = (tx["hour"] < 5).astype(int)
cnt = np.zeros(len(tx), dtype=int)    # この取引より前の24時間の件数(この取引は含めない)
for _, idx in tx.groupby("cust").indices.items():
    t = tx["t"].to_numpy()[idx]
    cnt[idx] = np.arange(len(t)) - np.searchsorted(t, t - 24)
tx["cnt_24h"] = cnt
warm = tx[tx["t"] < 30 * 24].groupby("cust")["amount"].median()
tx["amt_ratio"] = tx["amount"] / tx["cust"].map(warm)  # 最初の30日の中央値との比
tx = tx[(tx["t"] >= 30 * 24) & tx["amt_ratio"].notna()].copy()
tx["new_device"] = tx["new_device"].astype(int)
tx["new_mcat"] = tx["new_mcat"].astype(int)

FEATS = ["amount", "amt_ratio", "hour_gap", "night", "cnt_24h",
         "new_device", "new_mcat"]
train = tx[tx["t"] < 90 * 24]
test = tx[tx["t"] >= 90 * 24].copy()
print("学習用", len(train), "不正", int(train["fraud"].sum()),
      "/ 評価用", len(test), "不正", int(test["fraud"].sum()))
import lightgbm as lgb
from sklearn.metrics import average_precision_score

def fit(seed):
    m = lgb.LGBMClassifier(n_estimators=300, learning_rate=0.05,
                           num_leaves=15, min_child_samples=40,
                           colsample_bytree=0.7, subsample=0.8,
                           subsample_freq=1, random_state=seed, verbose=-1)
    return m.fit(train[FEATS], train["fraud"])

model = fit(1)
test["score"] = model.predict_proba(test[FEATS])[:, 1]
thr = test["score"].quantile(0.995)                   # 上位0.5%をアラートにする
test["alert"] = (test["score"] >= thr).astype(int)
tp = int(((test["alert"] == 1) & (test["fraud"] == 1)).sum())
print("lightgbm", lgb.__version__)
print("平均適合率", round(average_precision_score(test["fraud"], test["score"]), 3))
print("アラート", int(test["alert"].sum()), "うち不正", tp,
      "適合率", round(tp / test["alert"].sum(), 3),
      "再現率", round(tp / test["fraud"].sum(), 3))
学習用は90,999件(うち不正611件)、評価用は45,631件(うち不正290件)でした。評価用の取引にスコアを付けると、平均適合率は0.695でした。評価期間のスコアの上位0.5%にあたる229件をアラートにすると(評価期間が終わった後に、その期間の取引をまとめて並べて選ぶ形で、運用でのしきい値の決め方とは違います)、そのうち169件が不正で、適合率は0.738、再現率は0.583でした。評価の指標の読み方は第8章、しきい値の決め方は第9章で扱っているので、ここでは、この229件のアラートについて「理由」と「誰に誤検知が集まったか」を調べる材料として使います。
SHAP で1件のアラートの理由を取り出し、定型の文に直す
モデルのスコアを特徴量ごとの寄与に分ける方法として、ここではSHAPを使います。SHAP は、Lundberg と Lee の2017年の論文(NIPS 2017、Advances in Neural Information Processing Systems 第30巻に収録)で提案された枠組みで、1件の予測について、各特徴量がその予測をどれだけ押し上げたか、押し下げたかを数値で割り当てます。論文の要旨を自分の言葉でまとめると、基準値に特徴量ごとの寄与を足し合わせると説明の対象のモデルの出力になる形の説明の方法を1つの族として整理し、その中で望ましい性質を同時に満たすものが1つに決まることを示したうえで、それを計算する方法を提案した、というものです。考え方の元は、協力ゲームの理論で、複数の参加者が生んだ成果を各参加者に公平に分ける方法(シャープレイ値)にあります。
決定木を組み合わせたモデル(勾配ブースティングなど)では、木の構造を使って寄与を速く、厳密に計算する方法が用意されていて、Python の shap ライブラリでは TreeExplainer がそれにあたります。今回は shap 0.52.0 を既定の設定で使いました。lightgbm の2値分類のモデルでは、寄与はスコアそのもの(0〜1)ではなく、スコアを対数オッズに変換した値の単位で出ます。対数オッズは、スコア \(p\) を \(\log\frac{p}{1-p}\) に直した値で、言い換えると「不正である見込みと、そうでない見込みの比」の対数です。スコア0.5が0、スコア0.99が約4.6にあたります。基準値に7つの寄与を足すと、その取引の対数オッズになります。そのため、寄与の数値をそのまま「スコアが0.1上がった」とは読めません。次のコードでは、寄与の大きい順に上位3つの特徴量を取り出し、押し上げた向きの寄与だけを定型の文に当てはめます。寄与が正であっても、特徴量の値が大きいことやフラグが1であることは保証されないので、文は寄与の向きではなく実際の値から作ります。初めての端末かどうかのようなフラグは、値が1のときと0のときで別の文を用意しました。
import shap
import warnings
warnings.filterwarnings("ignore", message="LightGBM binary")

explainer = shap.TreeExplainer(model)
sv = explainer.shap_values(test[FEATS])
if isinstance(sv, list):
    sv = sv[1]
print("shap", shap.__version__)

# 文は実際の値から作る(寄与が正でも、値が大きいとは限らないため)
TEMPLATE = {
    "amount": "取引の額の相対値が{:.1f}",
    "amt_ratio": "普段の額の{:.1f}倍の取引",
    "hour_gap": "普段の時間帯から{:.1f}時間ずれている",
    "cnt_24h": "この取引より前の24時間に{:.0f}件の取引",
}
FLAG_TEXT = {  # 値が0のときの文, 値が1のときの文
    "night": ("深夜ではない時間帯の取引", "深夜の時間帯の取引"),
    "new_device": ("使ったことのある端末からの取引", "初めて使われた端末からの取引"),
    "new_mcat": ("使ったことのある加盟店の種類", "初めて使う加盟店の種類"),
}

def text_of(f, val):
    if f in FLAG_TEXT:
        return FLAG_TEXT[f][int(val)]
    return TEMPLATE[f].format(val)

def reasons(i, top=3):
    contrib = pd.Series(sv[i], index=FEATS).sort_values(ascending=False)
    out = []
    for f, v in contrib.head(top).items():
        if v > 0:
            out.append((f, round(v, 2), text_of(f, test[f].iloc[i])))
    return out

pos = np.argsort(-test["score"].to_numpy())
for rank in [0, 30]:
    i = pos[rank]
    print(f"--- スコア{rank + 1}位 score={test['score'].iloc[i]:.3f} 不正={test['fraud'].iloc[i]}")
    for f, v, text in reasons(i):
        print(f"  {f:10s} 寄与{v:+.2f}  {text}")
# アラートの理由の上位3つに、値が0のフラグが正の寄与で入った件数
al = np.where(test["alert"].to_numpy() == 1)[0]
n_zero = sum(1 for i in al for f, v, _ in reasons(i)
             if (f in FLAG_TEXT) & (test[f].iloc[i] == 0))
print("アラート", len(al), "件の理由のうち、値が0のフラグが正の寄与で入った数", n_zero)
実行した結果、スコアが1位のアラート(スコア1.000、実際に不正)の理由の上位3つは、次のとおりでした。
hour_gap、寄与+4.27:普段の時間帯から10.1時間ずれているamt_ratio、寄与+3.61:普段の額の6.2倍の取引new_device、寄与+3.39:初めて使われた端末からの取引
スコアが31位のアラート(スコア0.994、実際に不正)も、同じ3つの特徴量が上位に並び、時間帯のずれは8.5時間、額は普段の6.3倍でした。この形の文なら、調査担当は「普段と違う時間帯に、普段の6倍の額を、初めての端末で」という組み合わせを読み取り、まず端末の登録の記録と、同じ顧客の直近の取引から確認を始める、という手順に結びつけられます。
コードの最後では、229件のアラートの理由の上位3つの中に、値が0のフラグ(初めてではない端末など)が正の寄与で入った数を数えました。本コラムの架空データでは0件でしたが、データやモデルが変わっても起こらないとは限らないので、値から文を作る形にしておきます。
定型の文を作るときの注意は3つあります。1つ目は、押し下げた向きの寄与も記録に残すことです。「よく使う加盟店の種類なのでスコアが下がった」という情報は、調査担当が不正でないと判断する材料になります。今回のコードでは顧客向けを想定せず、上位3つのうち押し上げた向きのものだけを文にしましたが、調査の画面には押し下げた要因も並べる設計が考えられます。2つ目は、文の中の数値の出どころを明確にすることです。「普段の額の6.2倍」の「普段」は、最初の30日の中央値という定義で、定義は特徴量の台帳(第5章)に書いておきます。3つ目は、寄与を計算したときのモデルの版と計算の方法を、アラートの記録と一緒に残すことです。後で同じアラートの理由を問われたとき、モデルが更新されていると、同じ計算をしても同じ理由が出るとは限りません。
前の節で、理由コードは確認の手順が同じになるものを1つのまとまりにすると書きました。この章のコードの特徴量を、そのまとまりに割り当てると次のようになります。コードでは特徴量ごとに文を作りましたが、調査担当に示すときは、まとまりの単位に寄せて示す設計が考えられます。
| 特徴量 | 理由コードのまとまり | 確認を始める記録の例 |
|---|---|---|
| amount(額の相対値) | 額 | 同じ顧客の過去の取引の額 |
| amt_ratio(普段の額との比) | 額 | 同じ顧客の過去の取引の額 |
| hour_gap(普段の時間帯からのずれ) | 時間帯 | 同じ顧客の過去の取引の時間帯 |
| night(深夜) | 時間帯 | 同じ顧客の過去の取引の時間帯 |
| new_device(初めての端末) | 端末・接続 | 端末の登録の記録、認証の記録 |
| cnt_24h(その取引より前の24時間の件数) | 頻度 | 同じ顧客の直近の取引の並び |
| new_mcat(初めての加盟店の種類) | 相手(加盟店・受取口座) | 相手の加盟店の種類と、顧客の普段の利用先 |
全体の重要度を2つの方法で比べる
1件ごとの理由とは別に、モデル全体でどの特徴量が効いているかを知りたい場面があります。モデルの妥当性の確認や、監査への説明、特徴量の見直しの優先順位を決めるときです。ここでは2つの方法で全体の重要度を出して比べます。1つは、評価用のすべての取引について SHAP の寄与の絶対値を平均したものです。もう1つは、scikit-learn の permutation_importance で、ある特徴量の値だけを取引のあいだで無作為に並べ替えたときに、平均適合率がどれだけ下がるかを測るものです(並べ替えの重要度)。下のコードは、全体の重要度に続けて、額の相対値の寄与を正当な取引と不正な取引に分けて集計し、さらに乱数の種だけを変えて作り直したモデルで理由の1位が変わるかも調べています。理由の1位の結果は次の節で扱います。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib
from sklearn.inspection import permutation_importance

g_shap = pd.Series(np.abs(sv).mean(axis=0), index=FEATS)
pi = permutation_importance(model, test[FEATS], test["fraud"],
                            scoring="average_precision", n_repeats=3,
                            random_state=0)
imp = pd.DataFrame({"SHAPの平均絶対値": g_shap,
                    "並べ替えで下がる平均適合率": pi.importances_mean,
                    "その標準偏差": pi.importances_std}, index=FEATS)
imp = imp.sort_values("SHAPの平均絶対値")
print(imp.round(3).iloc[::-1])
# 額の相対値の寄与を、正当な取引と不正な取引に分けて見る
a_sv = pd.Series(sv[:, FEATS.index("amount")], index=test.index)
for lab, d in a_sv.groupby(test["fraud"]):
    print("amountの寄与", "不正" if lab == 1 else "正当", "件数", len(d),
          "平均", round(d.mean(), 3), "絶対値の平均", round(d.abs().mean(), 3),
          "負の割合", round((d < 0).mean(), 3))

fig, ax = plt.subplots(figsize=(7, 4))
ax.barh(imp.index, imp["SHAPの平均絶対値"], color="#002E73")
ax.set_xlabel("SHAP値の絶対値の平均(評価用の全取引)")
ax.set_title("特徴量ごとの寄与の大きさ")
fig.savefig("ch11_shap_global.png", dpi=120, bbox_inches="tight")
# 乱数の種だけを変えたモデルで、同じアラートの理由の1位が変わるか
top_a =np.array(FEATS)[sv[al].argmax(axis=1)]
for seed in [2, 3, 4, 5, 6]:
    m_b = fit(seed)
    sv_b = shap.TreeExplainer(m_b).shap_values(test[FEATS].iloc[al])
    if isinstance(sv_b, list):
        sv_b = sv_b[1]
    top_b = np.array(FEATS)[sv_b.argmax(axis=1)]
    ap_b = average_precision_score(test["fraud"], m_b.predict_proba(test[FEATS])[:, 1])
    print("種", seed, "平均適合率", round(ap_b, 3),
          "理由の1位が一致しない割合", round((top_a != top_b).mean(), 3))
    if seed == 2:
        print(pd.crosstab(pd.Series(top_a, name="モデルAの1位"),
                          pd.Series(top_b, name="モデルBの1位"), margins=True))
print("額と額の比の相関", round(test["amount"].corr(test["amt_ratio"]), 3))
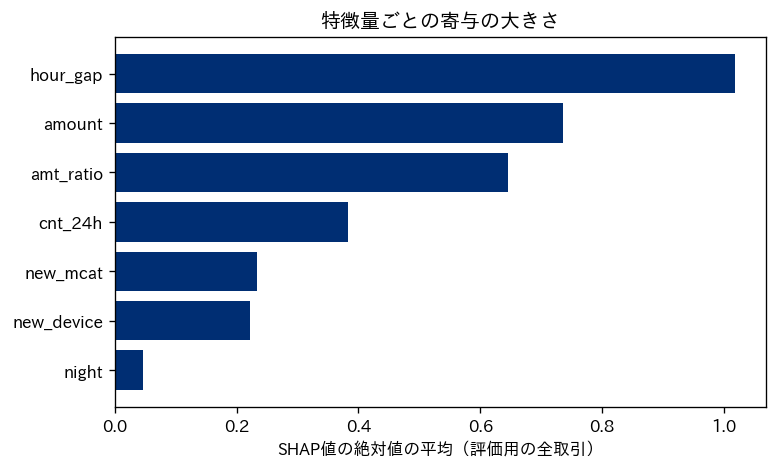
2つの方法の結果を、次の表に並べました。
| 特徴量 | SHAPの平均絶対値 | SHAPでの順位 | 並べ替えで下がる平均適合率(3回の平均) | その標準偏差 | 並べ替えでの順位 |
|---|---|---|---|---|---|
| hour_gap(普段の時間帯からのずれ) | 1.017 | 1 | 0.279 | 0.015 | 1 |
| amount(額の相対値) | 0.735 | 2 | 0.030 | 0.004 | 7 |
| amt_ratio(普段の額との比) | 0.645 | 3 | 0.137 | 0.012 | 3 |
| cnt_24h(その取引より前の24時間の件数) | 0.383 | 4 | 0.111 | 0.004 | 4 |
| new_mcat(初めての加盟店の種類) | 0.233 | 5 | 0.098 | 0.002 | 5 |
| new_device(初めての端末) | 0.222 | 6 | 0.165 | 0.009 | 2 |
| night(深夜) | 0.047 | 7 | 0.037 | 0.001 | 6 |
本コラムの架空データでは、時間帯のずれが2つの方法とも1位でしたが、額の相対値はSHAPで2位、並べ替えでは7位と、順位が大きく食い違いました。初めての端末も、SHAPで6位、並べ替えで2位と食い違っています。2つの方法は、測っているものが違います。SHAP の平均絶対値は、正当な取引を含むすべての取引で、スコア(対数オッズの単位)を上下どちらの向きにどれだけ動かしたかの平均です。並べ替えの重要度は、その特徴量の情報を壊したときに、不正を上位に並べる力(平均適合率)がどれだけ落ちるかを測っています。
額の相対値の寄与を、正当な取引と不正な取引に分けて確かめました。正当な取引45,341件では、寄与の絶対値の平均が0.734、寄与が負(スコアを下げる向き)だった割合が0.575、寄与の平均は-0.03でした。不正な取引290件では、絶対値の平均が0.936、負の割合が0.117、平均は0.832でした。評価用の取引のほとんどは正当な取引なので、SHAP の平均絶対値0.735は、正当な取引でスコアを上げたり下げたりした寄与の大きさでほぼ決まっていることになります。
ただし、平均適合率は取引のスコアの順位で決まる量で、寄与の大きさの平均とは別のものです。SHAP の平均絶対値と並べ替えの重要度は異なる量を測っているので、順位が食い違ったことだけからは、その原因を特定できません。仮説としては、額の相対値と普段の額との比は相関係数が0.718と強く関係していて、片方を壊しても、もう片方がある程度同じ情報を持っていることが、並べ替えでの値が小さくなった理由の1つとして考えられます(特徴量を外して学習し直す実験では確かめていません)。
並べ替えの重要度は3回の並べ替えの平均で、標準偏差は額の相対値で0.004、最も大きい時間帯のずれでも0.015でした。この標準偏差は、モデルと評価用のデータを固定したまま並べ替えだけを繰り返したときのばらつきで、データの取り方や学習のし直しによる変動は含みません。額の相対値(7位、0.030)と、すぐ上の深夜(6位、0.037)との差は0.007で、額の相対値の標準偏差の2倍に満たないので、下位の細かい順位には意味を持たせないほうが安全です。今回の3回の並べ替えでは、額の相対値の並べ替えの重要度は低い値でした。
この食い違いから言えるのは、「どの特徴量が重要か」という問いに、方法を書かずに答えてはいけない、ということです。監査や経営に全体の重要度を示すときは、どの方法で、どのデータ(評価用の全取引か、アラートだけか)について、何の単位で計算したかを必ず添えます。特徴量の重要度の計算方法の違いや、それぞれの手法の詳しい性質は、弊社コラム「AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド」で扱っています。
説明の限界、寄与は因果ではなく、理由は作り直しで入れ替わる
SHAP の寄与は、「このモデルが、この取引に、このスコアを付けた理由」を分解したものです。「この取引が不正になった原因」ではありません。例えば、初めての端末の寄与が大きいという結果は、モデルが初めての端末を不正の手がかりとして使っていることを示すだけで、初めての端末から取引すると不正になるという因果を示すものではありません。正当な顧客が機種を変えた直後の取引も、初めての端末からの取引です。寄与の大きい特徴量を、顧客の行動を制限する理由(「新しい端末からの取引を禁止する」など)に直接使うと、正当な顧客の不便を大きく増やすことになります。
もう1つの限界は、理由が安定しないことです。前のコードの後半では、乱数の種だけを変えて(他の設定・データはまったく同じ)モデルを作り直し、229件のアラートそれぞれについて、元のモデル(モデルA)と理由の1位が一致するかを調べました。まず、種を2にしたモデルBとの1組を詳しく見ます。モデルBの平均適合率は0.673で、モデルA(0.695)と大きくは変わりません。それでも、229件のうち36件、割合にして0.157のアラートで、理由の1位が入れ替わりました。内訳を次の表に示します。
| モデルAの理由の1位 | モデルAで1位だった件数 | モデルBでも同じ1位 | モデルBで1位が変わった件数 | モデルBでの入れ替わり先 |
|---|---|---|---|---|
| hour_gap(時間帯のずれ) | 138件 | 138件 | 0件 | なし |
| new_device(初めての端末) | 63件 | 34件 | 29件 | hour_gap に20件、amt_ratio に8件、new_mcat に1件 |
| amt_ratio(普段の額との比) | 22件 | 20件 | 2件 | hour_gap に2件 |
| new_mcat(初めての加盟店の種類) | 6件 | 1件 | 5件 | new_device に4件、amt_ratio に1件 |
| 合計 | 229件 | 193件 | 36件 | 入れ替わりの割合は0.157 |
この1組だけでは、入れ替わりの割合が偶然大きく出た可能性を否定できないので、種を3〜6に変えた4つのモデルでも同じ比較をしました。種2〜6の5つのモデルでは、平均適合率は0.671〜0.688、理由の1位が一致しない割合は0.135〜0.175でした。本コラムの架空データでは、種を変えるたびに、アラートの1割強から2割弱で理由の1位が入れ替わったことになります。ただし、これは5つの種で試した範囲の値で、データやモデルの設定が変われば割合も変わりえます。
種2のモデルBとの比較では、モデルAで時間帯のずれが1位だった138件は、モデルBでもすべて1位のままでした(モデルBでは他の特徴量から22件が移って、時間帯のずれが1位のアラートは160件になりました)。一方、初めての端末が1位だったアラートは、63件のうち29件で1位が別の特徴量に変わりました。不正な取引では、時間帯のずれ・額の比・初めての端末が同時に現れることが多いように作っているので、どれを1位にするかが、木の作られ方の小さな違いで変わったと考えられます(原因を切り分ける実験はしていません)。調査担当にとっては、同じ取引の理由がモデルの更新の前後で「初めての端末」から「時間帯のずれ」に変わることになり、理由コードごとの集計(どの理由のアラートが不正だったか)も、モデルの更新をまたぐと連続しなくなります。
この結果は合成データでの試行にすぎませんが、理由が作り直しで入れ替わりうることを前提にすると、実務では次の3つが有効だと考えています。1つ目は、理由を1つだけでなく上位の複数(3つ程度)で示し、1位の入れ替わりに左右されにくくすることです。2つ目は、似た情報を持つ特徴量を、理由コードの段階で1つのまとまり(「額」「時間帯」「端末・接続」)に寄せ、まとまりの単位で示すことです。3つ目は、モデルを更新するときに、更新の前後で理由の分布がどう変わったかを確かめ、調査担当に知らせることです。説明の手法そのものの限界の詳しい議論は、弊社コラム「AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド」に送ります。
顧客にどこまで理由を示すか、説明の責任と検知を避ける手がかりのつり合い
止められた顧客に理由を伝えることは、顧客の納得と信頼のために大切です。一方で、不正検知では、判定の理由を詳しく示すほど、不正をはたらこうとする側にとって、どの条件を避ければ止められないかの手がかりになります。第10章で扱った敵対的な変化は、検知の仕組みに合わせて相手が行動を変えることでした。理由を細かく外に出すことは、その変化を手助けすることになりかねません。
このつり合いを取るために、相手ごとに理由の粒度を分ける考え方が有効だと考えています。調査担当には、内部の理由コードと根拠の値をすべて示します。顧客には、止めたこと、確認のための手続き、問い合わせの窓口、再開までの見込みをはっきり伝え、理由は「普段のご利用と異なるパターンが確認されたため」のような一般的な水準にとどめます。適用される法令が求める説明を確保したうえで、判定に使った条件・しきい値・スコアの値は、顧客に向けた一般の通知には含めません。本人から法令にもとづく説明や開示の請求があった場合の対応は、一般の通知とは分けて、法務と決めておきます。加盟店にも、個別の判定の条件ではなく、拒否の区分と、追加の認証の要否を示します。
ただし、理由を一般的な水準にとどめることは、説明の責任を果たさなくてよいという意味ではありません。顧客が正当であることを示す道筋(後の節で扱う救済の手続き)がはっきりしていること、問い合わせを受けた人が内部の理由コードを見て具体的に対応できること、そして判定の方法と記録が監査や規制当局に対して示せる状態にあることが、詳しい理由を外に出さない代わりに必要です。個人データを使った自動化された判定について、どこまでの説明が法令上求められるかは、国や地域によって異なり、第14章で扱います。
誤検知が顧客に与える影響
誤検知は、正当な取引をアラートにすることで、それだけでは取引を止めたことにはなりません。検知する側から見ると「調査担当の手間が1件増えた」ことですが、誤検知が保留や拒否の措置につながると、顧客から見ると取引ができなかったという出来事になります。本コラムでは、正当な取引をアラートにすることを「誤検知」、そのうち保留や拒否にしたものを「誤って止めた取引」と呼び分けます。誤検知が顧客に与える影響は、それがどの措置につながったかによって大きく違います。保留(追加の認証や確認を求める)であれば、顧客は手続きの手間を負ったうえで取引を続けられます。拒否であれば、その取引はその場ではできません。口座やアカウントの利用を止める措置になると、給与の受け取りや生活に必要な支払いにまで影響が及ぶことがあります。
誤検知の影響を考えるときに押さえておきたいのは、影響が一度の取引で終わらないことです。止められた顧客は、問い合わせの電話や窓口への来訪、本人であることを示す書類の提出といった手続きの負担を負います。急ぎの支払いができなかった場合、その先の取引相手との関係にも影響が出ます。そして、何度も止められた顧客は、別のサービスに移ることがあります。序章で固定した損失の型でいえば、誤って止めた取引は「誤検知による機会損失」と「顧客の離反」の2つを同時に生みます。
| 措置 | 誤検知のときに顧客に起きること | 顧客の負担 | 事業の損失の型 | 和らげる手立て |
|---|---|---|---|---|
| 保留(追加の認証) | 取引の途中で追加の確認を求められる | 手続きの手間、取引の遅れ | 誤検知による機会損失(途中でやめる顧客) | 手間の少ない認証の方法、確認の画面での明確な案内 |
| 拒否 | その取引ができない | 別の手段での支払い、取引相手への説明 | 誤検知による機会損失、顧客の離反 | 拒否の直後に連絡し、確認後すぐ再開できる道筋 |
| 口座・アカウントの利用停止 | すべての取引ができない | 生活や事業の支払いへの影響、書類の提出、来訪 | 顧客の離反、苦情の増加、評判の低下 | 停止の判断に人の確認を入れる、解除までの期限の目安を示す |
| 事後の調査 | 取引は通るが、後から確認の連絡が来る | 問い合わせへの対応 | 調査の過負荷(件数が多い場合)、顧客の離反(連絡が多い場合) | 連絡の対象を絞る、連絡の文面を定型にする |
誤検知を「適合率」や「偽陽性率」という全体の数字だけで見ていると、この影響は見えません。偽陽性率が全体では小さな値でも、それが同じ顧客に繰り返し起きていたり、特定の顧客の群に集中していたりすれば、その顧客にとっての体験は大きく損なわれます。次の節では、この「集中」を群ごとに測ります。本コラムの例では取引の単位で群の差を測っていて、同じ顧客への繰り返しは集計していません。実務では、誤検知を受けた顧客の割合や、顧客ごとの誤検知の回数も合わせて測ることが考えられます。
公平性、群ごとの偽陽性率を測り、偏りの出どころと代わりの変数を探す
不正検知での公平性は、検知の仕組みが、特定の顧客の群に対して、他の群より不利な扱い(誤ってアラートにされやすく、その結果、確認を多く求められたり止められたりしやすい など)をしていないか、という問題です。不正検知では、誤検知が措置につながると顧客にとっての不利益になるので、公平性はまず「群ごとの偽陽性率(正当な取引のうち、誤ってアラートにされた割合)」の差として測るのが分かりやすいと考えています。次のコードで、評価用の取引を地域1と地域2に分けて、共通のしきい値(評価期間のスコアの上位0.5%)での偽陽性率・再現率・適合率を比べ、さらに全体の偽陽性率と、正当な取引・誤検知になった取引それぞれの特徴量の平均を群ごとに出します。
def by_group(df, thr_map):
    out = []
    for g, d in df.groupby("region"):
        a = d["score"] >= thr_map[g]
        legit_n = (d["fraud"] == 0).sum()
        fp = (a & (d["fraud"] == 0)).sum()
        tpg = (a & (d["fraud"] == 1)).sum()
        out.append({"群": g, "取引": len(d), "不正": int(d["fraud"].sum()),
                    "偽陽性率%": round(fp / legit_n * 100, 3),
                    "再現率": round(tpg / d["fraud"].sum(), 3),
                    "適合率": round(tpg / max(a.sum(), 1), 3)})
    return pd.DataFrame(out)

common = by_group(test, {"地域1": thr, "地域2": thr})
print("共通のしきい値\n", common.to_string(index=False))
lg = test[test["fraud"] == 0]
fp_rows = lg[lg["alert"] == 1]
print("全体の偽陽性率%", round(len(fp_rows) / len(lg) * 100, 3))
cols = ["new_device", "hour_gap", "night", "amt_ratio"]
print("正当な取引の平均\n", lg.groupby("region")[cols].mean().round(3))
print("誤検知の件数\n", fp_rows.groupby("region").size())
print("誤検知の平均\n", fp_rows.groupby("region")[cols].mean().round(3))
実行した結果を次の表にまとめました。
| 群 | 評価用の取引 | うち不正 | 偽陽性率 | 再現率 | 適合率 | 誤検知の件数 |
|---|---|---|---|---|---|---|
| 地域1 | 31,447件 | 203件 | 0.013% | 0.557 | 0.966 | 4件 |
| 地域2 | 14,184件 | 87件 | 0.397% | 0.644 | 0.500 | 56件 |
地域2の偽陽性率は0.397%で、地域1の0.013%のおよそ30倍でした。評価用の取引に占める地域2の割合は3割ほどですが、誤検知60件のうち56件が地域2に集まり、地域2のアラートは半分が誤検知(適合率0.500)でした。モデルには地域の情報を入れていないので、モデルが地域を見て判定を変えたわけではありません。正当な取引の特徴量の平均を群ごとに比べると、偏りの出どころが見えます。地域2の正当な取引は、初めての端末からの取引の割合が0.073(地域1は0.022)、普段の時間帯からのずれの平均が3.203時間(地域1は1.590時間)、深夜の取引の割合が0.056(地域1は0.007)でした。普段の額との比の平均は、地域1が1.216、地域2が1.226で、ほとんど差がありませんでした。地域2の正当な顧客は、不正に多い特徴を正当な理由で持ちやすいように作ってあります。
誤検知になった取引そのものも確かめました。地域2の誤検知56件では、普段の時間帯からのずれの平均が7.954時間(地域2の正当な取引全体では3.203時間)、深夜の割合が0.50、初めての端末の割合が0.50、普段の額との比の平均が2.899でした。地域2の誤検知は、初めての端末だけで説明できるものではなく、半分は初めての端末ではない取引で、時間帯のずれの大きさが目立ちます。どの特徴量がどれだけ誤検知を生んだかを因果として切り分けることはしていませんが、本コラムの架空データでは、地域2で正当な取引でも大きくなりやすいように作った時間帯のずれ・深夜・初めての端末が、誤検知の取引でも大きく出ていました。地域1の誤検知は4件しかなく、平均を比べる意味は小さいので、ここでは扱いません。
この結果は、偏りが出るように作った架空データでのものです。ただ、同じ仕組みは実際の取引でも起きえます。不正に多い特徴(普段と違う時間帯・新しい端末・普段と違う場所 など)を、正当な理由で持ちやすい顧客の群があり、その群が顧客の属性や地域と結びついていれば、属性をモデルに入れていなくても誤検知はその群に集まる、という仕組みです。実際の取引でそうした差がどの程度あるかは、自社のデータで群ごとに測るまで分かりません。
属性をモデルの入力から外すことは、公平性を保証しません。モデルの入力にある特徴量が、属性と関係していれば、その特徴量が属性の代わり(代理の変数)として働くからです。次のコードの前半では、検知に使った7つの特徴量だけから「地域2かどうか」をロジスティック回帰で当てられるかを調べました。後半では、地域2の偽陽性率を地域1と同じ水準にそろえるように、地域2だけしきい値を変えた場合の成績を出し、2つの場合を図にしています。
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

# 地域をモデルに入れていなくても、特徴量から地域がどれだけ当たるか
y_r = (train["region"] == "地域2").astype(int)
lr = LogisticRegression(max_iter=1000).fit(train[FEATS], y_r)
print("特徴量から地域2を当てるAUC",
      round(roc_auc_score((test["region"] == "地域2").astype(int),
                          lr.predict_proba(test[FEATS])[:, 1]), 3))

# 地域2の偽陽性率を地域1と同じ水準にそろえるしきい値を探す
fpr1 = common.loc[common["群"] == "地域1", "偽陽性率%"].iloc[0] / 100
s2 = test.loc[(test["region"] == "地域2") & (test["fraud"] == 0), "score"]
thr2 = s2.quantile(1 - fpr1)
adj = by_group(test, {"地域1": thr, "地域2": thr2})
print("地域2だけしきい値を変えた場合\n", adj.to_string(index=False))

fig, axes = plt.subplots(1, 2, figsize=(9, 3.8))
x = np.arange(2)
for ax, col in zip(axes, ["偽陽性率%", "再現率"]):
    ax.bar(x - 0.2, common[col], 0.4, color="#002E73", label="共通のしきい値")
    ax.bar(x + 0.2, adj[col], 0.4, color="#999999", label="地域2だけ変えたしきい値")
    ax.set_xticks(x, common["群"])
    ax.set_title(col.replace("%", "(%)"))
h, lab = axes[0].get_legend_handles_labels()
fig.legend(h, lab, loc="lower center", ncol=2, bbox_to_anchor=(0.5, -0.06))
fig.savefig("ch11_group_fpr.png", dpi=120, bbox_inches="tight")
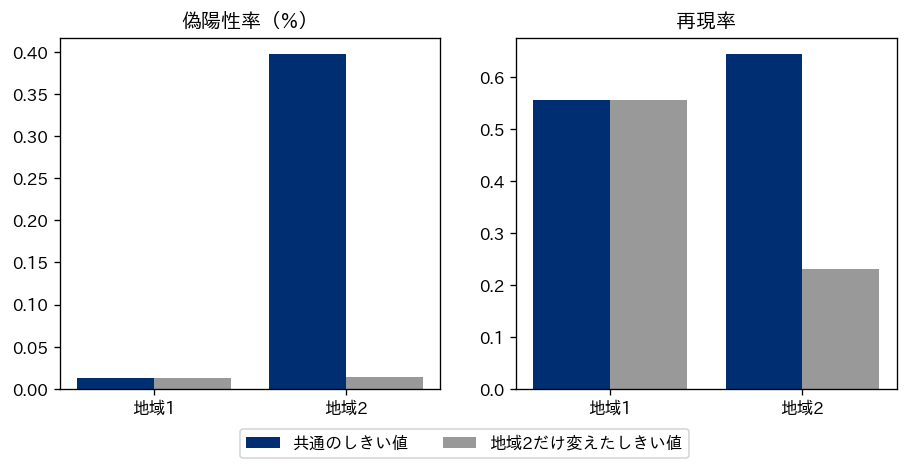
7つの特徴量から地域2を当てた AUC(ROC曲線の下の面積。0.5なら当てずっぽうと同じ)は0.716で、特徴量が地域の情報をある程度持っていることが分かります。地域をモデルから外しても、時間帯のずれや初めての端末を通じて、地域と関係した判定になりうるということです。
では、地域2の偽陽性率を下げればよいかというと、そこには別の問題があります。地域2だけしきい値を上げて偽陽性率を地域1(0.013%)とほぼ同じ0.014%にそろえると、地域2の再現率は0.644から0.230に下がりました。地域2の取引の誤検知は減りますが、地域2の取引で、アラートにできない不正(見逃し)が増えます。地域2の適合率は0.909になり、偽陽性率と適合率は地域1に近づきましたが、再現率では大きな差が開きました。1つの公平性の指標をそろえると、別の指標の差が開くことがあるわけです。
なお、ここでの2つのしきい値は、どちらも評価期間のスコアを使って決めています。とくに地域2だけ変えたしきい値は、評価期間の正解(どれが正当な取引か)まで使って決めたものです。どちらも正解が分かった後の事後の分析で、運用での成績の見積もりではありません。運用で使うなら、しきい値を決める期間と成績を測る期間を、時間で分ける必要があります(評価の切り方は第8章、しきい値の決め方は第9章)。
このような指標どうしのつり合いは、研究でも理論的に示されています。Kleinberg・Mullainathan・Raghavan の2017年の論文(第8回 Innovations in Theoretical Computer Science 会議の論文集、LIPIcs 第67巻、論文番号43)は、リスクのスコアについての3つの公平性の条件を定め、ごく限られた場合を除いて、3つを同時に満たすことはできないことを示しました。例外は、完全に予測できる場合(どの人が該当するかが確実に分かる場合)と、群のあいだで実際の該当の割合が等しい場合です。3つの条件は、群ごとの較正(同じスコアの人のうち該当する人の割合が、どの群でもそのスコアに合うこと)、該当しない人への均衡(該当しない人に付くスコアの平均が群のあいだで等しいこと)、該当する人への均衡(該当する人に付くスコアの平均が群のあいだで等しいこと)です。
Chouldechova の2017年の論文(Big Data 誌、第5巻第2号、153〜163ページ)は、再犯の予測の道具を題材に、群のあいだで実際の該当の割合が異なる場合には、いくつかの公平性の基準を同時には満たせないことを示しています。どちらも不正検知を題材にした論文ではありませんが、スコアにしきい値を引いて判定する仕組みに共通する性質を扱っています。
本コラムの合成データの例は、しきい値を変えたときに指標がどう動くかを示したもので、これらの論文の定理を実証したものではありません。
公平性の主な指標を、不正検知での意味とともに次の表にまとめました。
| 指標 | 何を群のあいだで比べるか | 不正検知での意味 | 差が大きいときに起きること |
|---|---|---|---|
| 偽陽性率の差 | 正当な取引のうち、誤ってアラートにされた割合 | 正当な取引が誤って調査の対象になる割合。顧客への影響は、それがどの措置につながったかで別に測る | 措置につながる場合、特定の群の顧客の手間と離反が増える |
| 再現率の差 | 不正な取引のうち、アラートにできた割合 | 不正な取引を調査の対象として拾える割合 | 特定の群の取引で見逃しが増える |
| 適合率の差 | アラートのうち、実際に不正だった割合 | アラートを受けたときに、それが本当に不正である見込み | 特定の群のアラートが調査担当に軽く扱われるおそれがある |
| アラートの割合の差 | 取引のうち、アラートにされた割合 | 確認を求められる頻度 | 不正の割合が群で違う場合、差があっても不当とは限らない |
| スコアの較正の差 | 同じスコアの取引で、実際に不正だった割合 | スコアの意味が群によって違わないか(第4章の較正) | 同じスコアでも群によって不正の見込みが違い、しきい値の意味がずれる |
どの指標を優先するかは、データから自動的には決まりません。正当な取引が誤ってアラートにされる不利益を重く見るなら偽陽性率の差を、不正な取引をアラートにできる度合いを重く見るなら再現率の差を優先することになり、それは事業として何を守るかの判断です。また、群ごとにしきい値を変えることは、それ自体が群によって扱いを変えることになるので、採るかどうかは法務・コンプライアンスと確認したうえで判断する必要があります。偏りを下げる手立てとしては、しきい値を変える前に、偏りの出どころの特徴量を見直すことが考えられます。今回の例では、地域2の誤検知で目立ったのは時間帯のずれと深夜でした。そこで、時間帯のずれを、その顧客自身の時間帯のばらつきを基準に「その顧客にとって珍しいか」で測り直す、といった特徴量の設計(第5章)が、検討する手立ての1つになります。本章ではこの手立てを試していないので、どれだけ偏りが下がるかは確かめていません。
異議の申し立てと救済の手続き、人による確認の位置づけ
どれだけ検知を改善しても、誤検知はゼロにはなりません。そのため、誤検知が保留や拒否につながって止められた顧客が正当であることを示し、取引や口座の利用を取り戻せる手続き(救済の手続き)を、検知の仕組みの一部として設計しておく必要があります。救済の手続きが無い、あるいは分かりにくい状態で誤検知が起きると、顧客は問い合わせ先も分からないまま取引ができない状態に置かれ、その経験は顧客の離反と苦情に直結します。
救済の手続きで決めておくことを、次の表にまとめました。
| 決めておくこと | 中身 | 担当の例 |
|---|---|---|
| 顧客への通知 | 止めたことを、いつ、どの経路で、どの文面で知らせるか | 顧客対応・不正対策 |
| 申し立ての窓口 | 電話・アプリ・窓口など、顧客が正当であることを申し出る経路と受付の時間 | 顧客対応 |
| 確認の方法 | 本人であること・取引が本人の意思であることを、どの方法で確かめるか | 不正対策・調査担当 |
| 判断の期限 | 申し立てから判断までの目安の時間。利用停止の場合はとくに短くする | 不正対策・事業の責任者 |
| 判断する人の権限 | 誰が解除を判断できるか。自動の判定を人が覆せるか | リスク管理・不正対策 |
| 結果の記録と反映 | 申し立ての結果をラベルとして残し、ルール・モデル・許可の扱いの見直しに戻す | 調査担当・データ分析 |
| 繰り返しの防止 | 正当と確認された顧客が同じ理由で何度も止められないようにする手当て(確認済みの記録の参照など) | 不正対策・データ分析 |
| 集計と報告 | 申し立ての件数・認められた割合・判断までの時間を、群ごとにも集計して経営に報告する | リスク管理 |
表の「繰り返しの防止」は見落とされやすい項目です。正当と確認された顧客が、同じ特徴を持つ次の取引でまた止められると、救済の手続きを何度も通ることになります。一方で、確認済みの顧客を一律に検知の対象から外すと、その顧客の口座が後で乗っ取られたときに見逃すことになるので、確認済みの記録を「一定の期間、同じ理由のスコアを割り引く」といった限定つきの扱いにする設計が考えられます。具体的な扱いは、見逃しと誤検知の損失の比(第9章)で決めます。
人による確認の位置づけも、救済と合わせて決めておきます。不正検知では、スコアが中間の取引や、口座の利用停止のような顧客への影響が大きい措置について、自動の判定の後に人が確認する設計がよく取られます。人による確認は、モデルが苦手な事情(顧客から事前に届いた連絡、正当な共有 など)を判断に入れられる点で意味があります。ただし、第9章で扱ったアラート疲れが起きると、人による確認は形だけになり、モデルの判定をそのまま追認する手続きに変わります。人による確認を入れるなら、確認の件数が調査の能力の範囲に収まっていること、確認した人が判定を覆した割合を記録して、覆す判断が実際に行われているかを見ることが必要です。
経営判断、誤検知の偏りを測り、救済の手続きを先に用意する
この章で扱った論点を、経営の判断に置き換えます。第1に、誤検知の偏りを測る仕組みを、検知を本番に入れる前から用意することです。本コラムの架空データでは、全体の偽陽性率は0.132%と小さな値でした。ところが群に分けると、地域2の偽陽性率は0.397%で、誤検知の9割以上が地域2に集まっていました。偏りは、群ごとに測らなければ見えません。
どの群で測るか(地域・年齢層・利用の経路・新規の顧客かどうか など)は、法令で配慮が求められる属性の扱いも含めて、法務・コンプライアンスと一緒に決めます。測定に使う属性の情報をどう取得し、どう保管するかも決めておきます。偏りの測定だけに使うといった利用の範囲は、個人データの扱いとして決める事項です(第14章)。
第2に、救済の手続きを、検知の精度を上げることより先に用意することです。誤検知はゼロにならないので、救済の手続きが無い状態で検知を厳しくすると、誤って止めた顧客の不利益だけが増えていきます。救済の手続きの件数と結果は、検知の仕組みが顧客にどう効いているかを示す、数少ない外からの計器になります。
この章の論点を、序章で固定した損失の型に当てはめると次のようになります。
- 顧客の離反:誤検知が特定の群に集中し、それが保留や拒否につながると、その群の顧客が止められる経験を繰り返し、利用をやめる。全体の偽陽性率が小さくても起きる
- 誤検知による機会損失:救済の手続きが遅いと、正当と確認できるまでの間の取引が失われる
- 見逃しによる被害:偏りを下げるために特定の群のしきい値を上げると、その群の不正の再現率が下がる
- 調査の過負荷:理由コードが無い、あるいは理由が不安定だと、調査担当がアラートごとに確認の始め方を考えることになり、1件あたりの時間が延びる
- 形骸化:人による確認がアラート疲れで追認になると、救済も確認も形だけになる
- 規制上の義務の不履行:判定の方法・理由・記録を監査や規制当局に示せない
これを KPI の仕組みに落とすなら、全体の適合率と再現率に加えて、群ごとの偽陽性率とその差、異議の申し立ての件数・認められた割合・判断までの時間、理由コードごとの適合率、人による確認で判定を覆した割合を、月次で経営に報告する項目に入れることが考えられます。予算としては、救済の手続きの窓口と、申し立てを判断する人員を、検知の仕組みの費用の一部として見込みます。AIを使った判定について社内のルールをどう作るかの一般論は、弊社コラム「AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで」で扱っています。
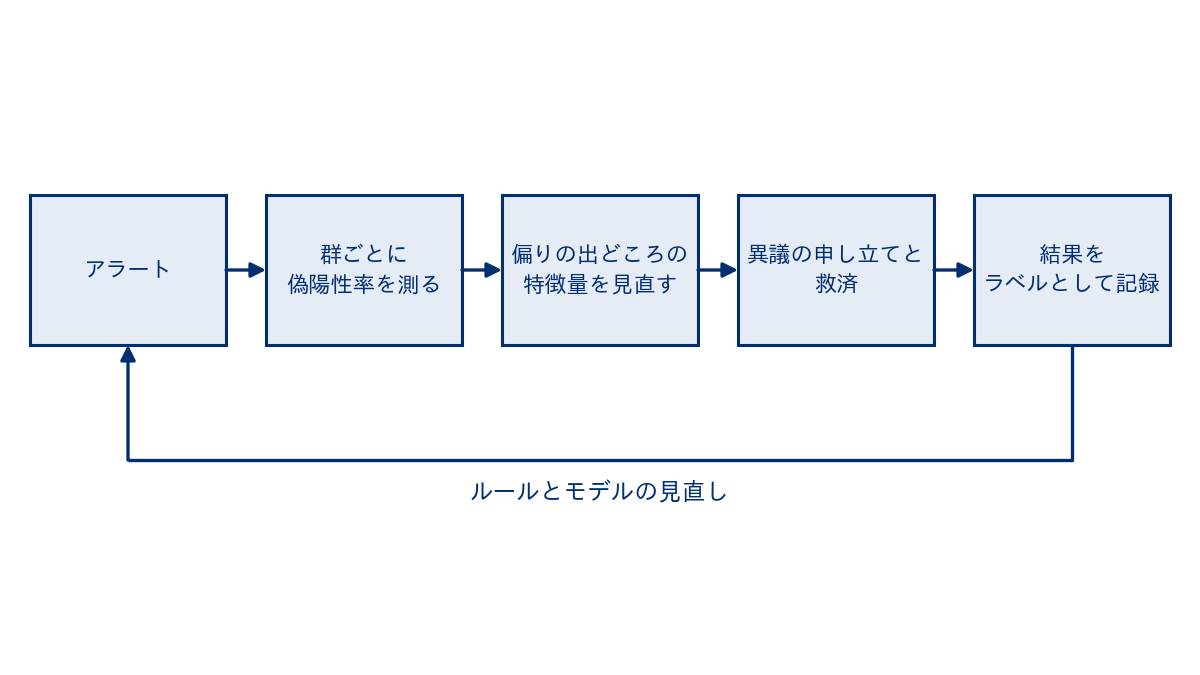
この図は、アラートが出てから見直しに戻るまでの1回の流れの例です。救済の手続きそのものは、偏りを測る前、検知を本番に入れる前に用意しておきます。
この章では、相手ごとに示す説明を分けること、理由コードで調査担当に確認の始め方を示すこと、SHAP の理由は計算の方法やモデルの作り直しで変わりうるので上位の複数とまとまりの単位で示すこと、そして本コラムの架空データでは、誤検知の偏りは属性をモデルに入れなくても生じうること、群ごとに測らなければ見えないことを確かめました。偏りを1つの指標でそろえると別の指標の差が開くことがあり、どれを優先するかは事業の判断で、救済の手続きはその判断の前に用意しておくものです。次の第12章では、ここまでの判定・理由・記録を本番のシステムでどう動かし、障害のときにどう扱うかを扱います。
この章を深めたい方への参考書籍
『機械学習を解釈する技術 予測力と説明力を両立する実践テクニック』(森下光之助、技術評論社):並べ替えの重要度、部分依存、個別の条件つき期待値、SHAP を、線形回帰との対比から順に解説した本です。この章で比べた SHAP と並べ替えの重要度が、それぞれ何を測っているかを手を動かしながら確かめるのに向いています。
『XAI「説明可能なAI」 そのとき人工知能はどう考えたのか?』(大坪直樹ほか、リックテレコム):AIになぜ説明が必要かという問題設定から、説明の手法の全体像、実装、ビジネスで求められる説明の力までを扱った本です。この章の前半で扱った、説明を誰に何のために示すかを考える材料になります。
第12章 システムの構成と運用、リアルタイムの判定・監視・障害時の扱い
第11章では、アラートの理由を誰にどう示すか、誤検知が特定の顧客に偏っていないかを測ることを扱いました。ここまでの章で、ルール、教師あり学習、特徴量、異常検知、ネットワーク分析、評価、しきい値、再学習、説明と、検知の中身を順に組み立ててきました。この章では、それらを毎日の取引の流れの中で動かし続けるためのシステムの構成と運用を扱います。
この章で扱うのは次の内容です。後半の一部は、架空の取引の記録を使い、実行したコードと結果で確かめます。
- 判定のタイミング(取引の承認の前・直後・一括で後から)と、それぞれの制約
- システムを構成する要素(取引の受け口・特徴量の計算と保管・ルールの実行・モデルの推論・判定の統合・ケース管理・記録)
- 特徴量の計算の分担と、学習のときと判定のときで定義をそろえること
- 1件の判定にかかる時間と、モデルの大きさの関係
- 監視の項目(検知の質・データ・システム)と、入力のデータの障害の見つけ方
- 障害のときに通すのか止めるのか、ルールだけでの運転
- 新しいモデルの試し方(影の運用、チャンピオンとチャレンジャー)
- 変更の管理、記録と監査、権限と情報の管理、内製と外部のサービスや製品を比べる観点
この章の主張は2つです。1つ目は、判定が返らないときに取引を通すのか止めるのかと、判定の時点の入力・スコア・ルール・措置を何で残すのかは、モデルを作る前に決めておくべき設計の要件だという点です。どちらも障害や監査の場面で初めて問われ、そのときに後から足すことはできません。2つ目は、学習のときと判定のときの特徴量の定義のずれは、評価で確かめた成績と本番の成績が食い違う原因になるという点です。本コラムの架空データでは、直前1時間の取引の回数を「自分自身を含めて数える」というだけのずれで、上位0.5%のアラート158件のうち49件が入れ替わりました。この例では再現率は 0.820 から 0.840 にわずかに上がりましたが、上がるか下がるかは、本番で実際の値を突き合わせるまで分かりません。
判定のタイミング、承認の前・直後・一括で後から
不正検知のシステムを設計するときに最初に決めるのは、取引のどの時点で判定するかです。判定のタイミングは大きく3つに分けられます。1つ目は、取引を承認する前に判定する方式です。カードの決済の承認や送金の実行の前に、スコアを計算してルールを当て、承認・保留・拒否のどれにするかを決めます。この節では、承認と同時に取引の実行が確定し、後から取り消せない取引を念頭に置いて説明します。その場合、その取引を止められるのはこの方式だけですが、判定に使える時間は取引の処理全体の応答の時間の一部に限られます。顧客が決済の画面で待っている間、あるいは加盟店の端末が応答を待っている間に判定を終える必要があります。
2つ目は、取引を承認した直後に判定する方式です。取引はいったん通し、数秒から数分のうちにスコアを計算して、疑いが強ければ口座やカードの利用を一時的に止める、顧客に確認の連絡をする、調査に回すといった措置を取ります。承認と同時に実行が確定する取引では、1件目の取引は止められませんが、同じ口座やカードで続く2件目以降を止められる可能性があります。カードの決済のように、承認(オーソリ)と売上の確定(キャプチャー)が分かれていて、確定の前に承認を取り消せる仕組みがある取引や、商品の発送の前に止められる注文では、承認の直後の判定でも、売上の確定や発送の前であればその取引に介入できる場合があります。どの段階まで介入できるかは、取引の種類と仕組みによって違うので、自社の取引ごとに確かめる必要があります。応答の時間の制約が緩いので、承認の前の判定では間に合わない重い集計や、外部の情報の照会を使えます。
3つ目は、一括で後から調べる方式です。1日の終わりや週に1回、取引の記録をまとめて読み込み、スコアを計算して調査の対象を選びます。取引そのものは止められませんが、時間をかけた集計、つながりの分析(第7章)、教師なしの異常検知(第6章)のような計算の重い方法を使えます。マネー・ローンダリングの疑いのように、1件ではなく一定の期間の取引の流れで判断する検知は、この方式で行われることが多いと考えています。
| 判定のタイミング | 応答の時間の制約 | 使えるデータ | 止められるか | 向いている検知 |
|---|---|---|---|---|
| 承認の前に判定する | 厳しい。取引の処理全体の応答の時間の中で終える | その時点で参照できる集計と、取引そのものの情報に限られる | 止められる(承認・保留・拒否を選べる) | カードの不正利用、不正送金、アカウントの乗っ取りの直後の取引 |
| 承認の直後に判定する | 中程度。数秒から数分 | 重い集計や外部の情報の照会も使える | 承認と同時に確定する取引では、その取引は止められない。続く取引や口座の利用は止められる。売上の確定や発送の前に取り消せる取引では、その取引にも介入できる場合がある | 連続して起きる不正、確認の連絡で被害の拡大を防げる型 |
| 一括で後から調べる | 緩い。時間から日の単位 | 一定の期間の取引の流れ、つながり、確定したラベル | 止められない。調査と事後の措置につなげる | マネー・ローンダリングの疑い、組織的な不正、社内の不正 |
実際のシステムでは、3つのタイミングを組み合わせることが多いと考えています。承認の前には軽いルールと軽いモデルで明らかに危ない取引だけを止め、承認の直後に重いモデルで続く取引を見張り、夜間の一括の処理でつながりや長い期間の流れを調べる、という分担です。どの不正をどのタイミングで見るかは、第1章で整理した不正の種類と、第9章で扱った措置の4つ(承認・保留・拒否・事後の調査)の組み合わせで決まります。止める必要がない不正まで承認の前の判定に載せると、応答の時間の制約の中で使える特徴量が減る分、かえって成績が下がる場合があると考えています。
本コラムでは、承認の前に判定する方式をリアルタイム判定と呼びます。この章の後半で扱う判定にかかる時間、障害のときの扱い、特徴量の参照は、主にリアルタイム判定で問題になります。一括で後から調べる方式では、時間の制約よりも、どの時点のデータで判定したかを後から再現できることが重要になります。
構成の要素、取引の受け口から記録まで
不正検知のシステムは、モデル1つで成り立っているわけではありません。取引を受け取る部分から、判定の結果を記録する部分まで、いくつもの要素がつながって1つの仕組みになっています。序章で定義したとおり、本コラムでは不正検知を「見つけるだけでなく、その後の措置と調査までを含めた仕組み」として扱っています。システムの構成も、モデルの推論の部分だけでなく、措置と調査と記録まで含めて考える必要があります。
| 構成の要素 | 役割 | 設計で決めること | 関わる章 |
|---|---|---|---|
| 取引の受け口 | 決済・送金・ログイン・申込などの取引を受け取り、判定に渡す | どの取引を判定の対象にするか、応答の時間の上限、判定が返らないときの扱い | この章 |
| 特徴量の計算と保管 | 顧客の普段の行動や直近の回数などを計算し、判定のときに参照できるように保管する | 一括で作る特徴量とリアルタイムで作る特徴量の分担、定義の一致、更新の頻度 | 第5章、この章 |
| ルールの実行 | 人が決めた条件を当て、該当するかを返す | ルールの版、適用の順番、ルールだけでの運転の可否 | 第3章 |
| モデルの推論 | 特徴量からスコアを計算する | モデルの版、応答の時間、較正の有無、新しいモデルの試し方 | 第4章、第10章 |
| 判定の統合 | ルールの結果とスコアをまとめ、しきい値に照らして措置を決める | しきい値の版、措置の段階(承認・保留・拒否・事後の調査)、理由コード | 第9章、第11章 |
| ケース管理 | アラートを調査担当に割り当て、調査の経過と結論を記録する | 優先順位、調査の結果をラベルとして戻す経路 | 第2章、第9章 |
| 記録 | 判定の時点の入力・スコア・ルール・措置を残す | 残す項目、保存の期間、改ざんの防止、取り出し方 | この章、第14章 |
この表で見落とされやすいのは、ケース管理と記録です。モデルの開発に予算と時間を使い、調査の結果を入力する画面や、判定の記録を後から取り出す仕組みが後回しになると、第2章で扱った「調査の結果をラベルとして残す」流れが途切れます。ラベルが残らなければ、第10章で扱った再学習もできません。構成の要素は、どれか1つが欠けると、その先の運用が回らなくなるという意味で相互に依存しています。
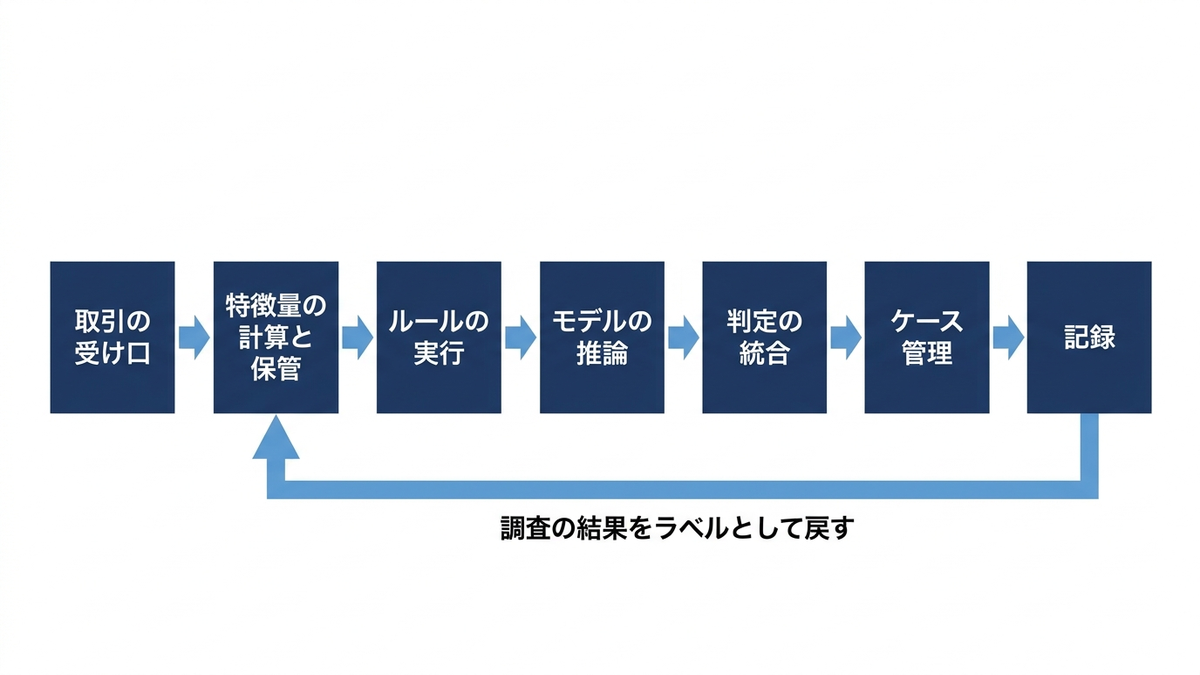
要素の分け方は、組織の体制とも対応します。ルールの台帳は不正対策の担当が、モデルはデータ分析の担当が、ケース管理は調査の担当が、取引の受け口と記録は情報システムの担当が持つ、といった分担になることが多いと考えています。要素の境目で、誰が何を変えてよいかを決めておかないと、ある担当の変更が別の担当の要素を壊すことがあります。この点は、後の節の変更の管理で扱います。体制の全体は第13章で扱います。
機械学習のシステムでは、モデルのコードそのものは全体のごく一部で、データの収集・特徴量の計算・設定・監視・提供の仕組みのほうがはるかに大きく、保守の負担もそこに溜まりやすいことが指摘されています。Sculley らが2015年の NIPS(現在の NeurIPS)で発表した論文(機械学習のシステムに隠れた技術的負債)は、この問題を整理した代表的な文献です。不正検知のシステムでも、モデルの精度を上げる作業より、周辺の要素を保守する作業のほうが、運用の期間を通じて大きな割合を占めることを見込んでおく必要があります。
特徴量の計算の分担、一括の集計とリアルタイムの集計を同じ定義にする
第5章で扱ったとおり、特徴量の設計は、ラベルの質や学習の方法、しきい値と並んで、不正検知の成績を左右する重要な要素です。顧客の普段の額との比、直前1時間や24時間の取引の回数、初めての端末かどうかといった特徴量は、1件の取引の情報だけでは計算できず、その顧客の過去の取引を参照する必要があります。リアルタイム判定では、この参照を応答の時間の制約の中で終えなければなりません。そのため、特徴量の計算は、時間をかけて一括で作っておくものと、取引が届くたびにその場で更新するものに分けるのが一般的です。
一括で作る特徴量は、顧客の過去90日の額の中央値、よく使う加盟店の種類、過去の調査の結果のように、変化がゆっくりで、計算に多くの過去の記録を使うものです。夜間などにまとめて計算し、判定のときにすぐ引ける場所に置いておきます。リアルタイムで作る特徴量は、直前1時間の回数や合計、直前の取引からの経過時間のように、数分の遅れでも意味が変わってしまうものです。取引が届くたびに、顧客ごとの集計を更新します。第5章の速度の特徴は、多くの場合こちらに入ります。
この分担で起きやすい問題は、学習のときと判定のときで、同じ名前の特徴量が少し違う計算になってしまうことです。学習のときは、蓄積した取引の記録から pandas などで一括に特徴量を作ります。判定のときは、別の担当が別の言語で書いた処理が、取引が届くたびに特徴量を更新します。2つの処理が「直前1時間の回数」という同じ名前の特徴量を作っていても、細部の決めごとが違うことがあります。たとえば、自分自身の取引を含めるかどうか、窓の境目を含めるかどうか、時刻をどのタイムゾーンで扱うかです。こうした細部が違えば、モデルは学習のときに見たことのない値を受け取ります。この学習のときと判定のときの成績の差は、訓練と提供のずれ(training-serving skew)と呼ばれます。Google の機械学習の実務の指針(Zinkevich による Rules of Machine Learning)は、これを学習のときと提供のときの成績の差と定義し、学習の処理と判定の処理でコードを共有すること、判定のときに使った特徴量を記録して学習に使うことを勧めています。
ここから、架空の合成データでこの問題を確かめます。合成したのは、顧客2,000人の60日分の取引の記録です。顧客ごとに額の水準と取引の頻度を変え、正当な取引でも2%の割合で新しい端末からの取引が出るようにしました。不正は120人の顧客に、短い間隔で1〜4件続く、普段の2〜6倍の額の取引として入れ、その6割を新しい端末からにしました。取引の額は単位の無い相対値です。この合成データは実際の取引の記録よりはるかに単純で、ここで出る成績は実際の成績の目安にはなりません。示したいのは、システムの作り方で成績や時間がどう変わるかという仕組みです。
# ---- ブロック1:架空の取引の記録を作る ----
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np, pandas as pd

rng = np.random.default_rng(20261112)
n_cust, n_days = 2000, 60
level = rng.lognormal(0.0, 0.6, n_cust)          # 顧客ごとの額の水準(相対値)
rate = rng.gamma(2.0, 0.4, n_cust)               # 1日あたりの取引の回数
rows = []
for c in range(n_cust):
    n = rng.poisson(rate[c] * n_days)
    t = np.sort(rng.uniform(0, n_days * 86400, n))
    amt = level[c] * rng.lognormal(0.0, 0.4, n)
    newdev = rng.random(n) < 0.02                # 正当でも新しい端末は一定の割合で出る
    for i in range(n):
        rows.append((c, t[i], amt[i], newdev[i], 0))
# 不正:一部の顧客で、短時間に普段より大きな額の取引が続く
for c in rng.choice(n_cust, 120, replace=False):
    t0 = rng.uniform(0, n_days * 86400)
    for k in range(rng.integers(1, 5)):
        rows.append((c, t0 + k * rng.uniform(60, 900), level[c] * rng.uniform(2, 6),
                     rng.random() < 0.6, 1))
df = pd.DataFrame(rows, columns=["cust", "ts", "amount", "new_device", "fraud"])
df = df[df["ts"] < n_days * 86400].sort_values("ts").reset_index(drop=True)
df["day"] = (df["ts"] // 86400).astype(int)
df["hour"] = (df["ts"] % 86400) / 3600
df["new_device"] = df["new_device"].astype(int)
print("取引の件数:", len(df), " 不正の件数:", df["fraud"].sum(),
      " 不正の割合:", round(df["fraud"].mean() * 100, 3), "%")
実行すると、取引は94,693件、うち不正は297件(0.314%)になりました。次に、同じ「直前1時間の取引の回数」を、一括の集計とリアルタイムの集計の2通りで作ります。一括の集計は、顧客ごとに時刻で並べた記録から、1時間前より後に起きた自分より前の取引を数えます。リアルタイムの集計は、取引が1件届くたびに顧客ごとの窓を更新して数えます。後者は、判定のときに特徴量を更新する処理を簡単に真似たものです。
# ---- ブロック2:一括の集計とリアルタイムの集計を同じ定義にする ----
from collections import deque, defaultdict

def batch_count_1h(d):
    # 一括の集計:同じ顧客の、直前1時間(自分自身は含めない)の取引の回数
    out = np.zeros(len(d), dtype=int)
    for c, g in d.groupby("cust"):
        ts = g["ts"].to_numpy()
        out[g.index] = np.arange(len(ts)) - np.searchsorted(ts, ts - 3600, side="right")
    return out

def online_count_1h(d, include_self=False):
    # リアルタイムの集計:取引が届くたびに顧客ごとの窓を更新する
    win, out = defaultdict(deque), np.zeros(len(d), dtype=int)
    for i, (c, t) in enumerate(zip(d["cust"].to_numpy(), d["ts"].to_numpy())):
        q = win[c]
        while len(q) > 0:                         # 1時間より前の取引を窓から外す
            if q[0] > t - 3600:
                break
            q.popleft()
        if include_self:
            q.append(t)
        out[i] = len(q)
        if not include_self:
            q.append(t)
    return out

df["cnt_1h"] = batch_count_1h(df)
same = online_count_1h(df)
skew = online_count_1h(df, include_self=True)
print("定義が同じ場合に値が一致した割合:", round((same == df["cnt_1h"]).mean() * 100, 2), "%")
print("自分自身を含めた場合に値が一致した割合:", round((skew == df["cnt_1h"]).mean() * 100, 2), "%")
定義が同じ場合は、94,693件すべてで2つの値が一致しました(一致した割合 100.0%)。リアルタイムの集計を「届いた取引を先に窓に入れてから数える」ように変え、自分自身を含めて数えると、一致した割合は 0.0% になりました。すべての取引で値が1だけ大きくなるためです。コードの上では、窓に入れる行と数える行の順番が入れ替わっただけの違いです。このような違いは、2つの処理を別々の担当が書くと、どちらの担当も誤りと気づかないまま残りやすいと考えています。
この1のずれが判定にどう響くかを確かめます。最初の10日を「普段の額」を決めるための予備期間、次の30日(10〜39日目)を学習の期間、残りの20日を評価の期間としました。「普段の額」は、顧客ごとに予備期間の取引の額の中央値で固定し、予備期間に取引の無い顧客には予備期間の全取引の中央値を使います。学習や評価の取引から見て未来の取引や、その取引自身が「普段の額」に混ざらないようにするためです。そのうえで、勾配ブースティング(lightgbm 4.6.0)を、正しい定義の回数で学習しました。評価の期間の取引に、正しい定義の回数を渡した場合と、自分自身を含めた回数を渡した場合で、スコアの上位0.5%をアラートにして比べます。
# ---- ブロック3:学習したモデルに、ずれた定義の値を渡すとどうなるか ----
import lightgbm as lgb

pre = df[df["day"] < 10]                         # 学習の期間より前の予備期間(0〜9日目)
med = pre.groupby("cust")["amount"].median()     # 予備期間で固定した「普段の額」
fill = pre["amount"].median()                    # 予備期間に取引の無い顧客に使う値
df["amt_ratio"] = df["amount"] / df["cust"].map(med).fillna(fill)
df["night"] = ((df["hour"] < 5) | (df["hour"] >= 23)).astype(int)
df["cnt_1h_skew"] = skew
feats = ["amt_ratio", "cnt_1h", "night", "new_device"]
train, test = df[df["day"].between(10, 39)], df[df["day"] >= 40].copy()

def fit(cols, n_trees):
    m = lgb.LGBMClassifier(n_estimators=n_trees, learning_rate=0.05, num_leaves=31,
                           verbose=-1, random_state=0, n_jobs=4, deterministic=True)
    return m.fit(train[cols], train["fraud"])

def top_alerts(score, share=0.005):
    k = int(round(len(score) * share))           # 上位0.5%をアラートにする
    flag = np.zeros(len(score), dtype=bool)
    flag[np.argsort(-score)[:k]] = True
    return flag

champ = fit(feats, 200)
ok = top_alerts(champ.predict_proba(test[feats])[:, 1])
x_bad = test[feats].copy()
x_bad["cnt_1h"] = test["cnt_1h_skew"]           # 判定のときだけ自分自身を含めて数えた値
bad = top_alerts(champ.predict_proba(x_bad)[:, 1])
y = test["fraud"].to_numpy() == 1
print("アラートの件数:", ok.sum(), " 2つの定義で共通のアラート:", (ok & bad).sum())
print(f"同じ定義  再現率 {y[ok].sum() / y.sum():.3f}  適合率 {y[ok].mean():.3f}")
print(f"ずれた定義 再現率 {y[bad].sum() / y.sum():.3f}  適合率 {y[bad].mean():.3f}")
only_bad = bad & ~ok                             # ずれた定義でだけアラートになった取引
print("ずれた定義だけのアラート:", only_bad.sum(), " うち正しい回数が0:",
      (test["cnt_1h"].to_numpy()[only_bad] == 0).sum(), " うち不正:", y[only_bad].sum())
| 判定のときに渡した「直前1時間の回数」 | アラートの件数 | 再現率 | 適合率 |
|---|---|---|---|
| 学習のときと同じ定義(自分自身を含めない) | 158 | 0.820 | 0.519 |
| ずれた定義(自分自身を含める) | 158 | 0.840 | 0.532 |
この表と、この章のほかの表の再現率は、断りの無い限り、評価の期間に合成した不正100件(合成データの中の真の不正で、ラベルの遅れも選択の偏りも無い)を分母にしています。この表のアラートは、評価の期間のスコアの上位0.5%です。評価の期間の取引は31,645件、うち不正は100件でした。アラートの件数はどちらも158件ですが、2つの定義で共通していたアラートは109件で、残りの49件は入れ替わりました。ずれた定義でだけアラートになった49件の内訳を見ると、うち11件は正しく数えれば直前1時間の回数が0の取引で、49件のうち不正は5件でした。再現率は 0.820 から 0.840 に、適合率は 0.519 から 0.532 に、この例ではわずかに上がりました。不正100件のうちで拾えた件数の差は2件で、評価の期間の不正の少なさを考えると、ずれた定義のほうが良いと読める差ではありません。
この結果で注意したいのは、成績が上がったか下がったかよりも、評価で確かめたときと同じ判定が本番で再現されていないことです。評価のときに検証したのは「自分自身を含めない」回数で動くモデルで、本番で動いているのは、3分の1近いアラートが入れ替わった別の判定です。ずれによって成績が下がることもあれば、この例のように変わらないか上がることもあり、特徴量のずれがあっても木の分岐の先が変わらなければ、判定がまったく変わらないこともあります。どちらに転ぶかは、判定のときの値を記録して突き合わせるまで分かりません。特徴量の定義のずれは、評価で確かめた成績の保証を外してしまう原因になる、と考えておく必要があります。
この問題への対策は3つあります。1つ目は、特徴量の定義を1か所に書き、学習の処理と判定の処理が同じ定義から計算するようにすることです。2つ目は、判定のときに実際に使った特徴量の値を記録し、それを学習に使うか、少なくとも一括で作った値と突き合わせることです。上のコードの「一致した割合」のような照合を、定期的な点検として回すことができます。3つ目は、過去のある時点の特徴量を、その時点で分かっていた情報だけで作り直せるようにすることです。第5章で扱ったリーク(情報の漏れ)を防ぐのも、この仕組みです。
この3つをまとめて提供する仕組みは特徴量ストアと呼ばれます。オープンソースの特徴量ストアの1つである Feast の公式ドキュメントは、学習のための過去の特徴量を取り出すオフラインストアと、本番で低い遅延で特徴量を返すオンラインストアを構成の部品として挙げ、ある時点で正しい(未来の値が混ざらない)特徴量の集まりを作れることを機能として説明しています。特徴量ストアの製品を使うかどうかに関わらず、「特徴量の定義を1つにする」「判定のときの値を残す」「過去の時点の値を作り直せる」の3つは、不正検知のシステムが満たすべき要件として考えておく必要があります。
判定にかかる時間、モデルの大きさと応答の予算
リアルタイム判定では、取引の処理全体の応答の時間のうち、不正検知に使える時間が決まっています。本コラムでは、この割り当てを応答の予算と呼びます(取引の処理全体にかかる時間を「応答の時間」、そのうち不正検知に割り当てた上限を「応答の予算」と書き分けます)。応答の予算の中には、特徴量の参照、ルールの実行、モデルの推論、判定の統合、ネットワークの往復の時間がすべて入ります。モデルを大きくすれば成績が上がる可能性がありますが、推論の時間も延びます。どこまで大きくしてよいかは、成績と時間の両方を測ってから決める必要があります。
ここでは、勾配ブースティングの木の本数を 50・200・800・2,000 本と変え、1件の判定にかかる時間を測りました。1件の判定は、辞書に置いた「普段の額」を顧客の番号で引き(予備期間に取引の無い顧客には、評価のときと同じ補完の値を使います)、額との比を計算して4つの特徴量の並びを作り、モデルで推論するところまでとしました。辞書は特徴量の保管場所の代わりで、実際のシステムでは別のサーバーへの問い合わせになり、その往復の時間が加わります。測るのは評価の期間から選んだ300件で、測る前に30件を動かしておき、300件それぞれの時間の中央値と、遅い側の1%(99パーセンタイル。300件のうち99%の判定がこの時間以内に終わる境目で、遅い1%の平均ではありません)を出しました。この測定を5回繰り返し、5回の中央値を本文と表と図の値にしています。
# ---- ブロック4:モデルの大きさと1件の判定にかかる時間 ----
import time
from sklearn.metrics import average_precision_score

store = {c: v for c, v in med.items()}           # 特徴量の保管場所の代わり(辞書)
sample = test.sample(300, random_state=1)[["cust", "amount", "cnt_1h", "night", "new_device"]]

def judge(m, c, a, n1, ni, nd):
    x = np.array([[a / store.get(int(c), fill), n1, ni, nd]])  # 特徴量の参照
    return m.booster_.predict(x, num_threads=1)                 # モデルの推論

lat = []
for n_trees in [50, 200, 800, 2000]:
    m = fit(feats, n_trees)
    ap = average_precision_score(test["fraud"], m.predict_proba(test[feats])[:, 1])
    for row in sample.to_numpy()[:30]:            # 測る前に何度か動かしておく
        judge(m, *row)
    meds, p99s = [], []
    for r in range(5):                            # 5回測って中央値を取る
        each = []
        for row in sample.to_numpy():
            t0 = time.perf_counter()
            judge(m, *row)
            each.append((time.perf_counter() - t0) * 1000)
        meds.append(np.median(each))
        p99s.append(np.percentile(each, 99))
    lat.append((n_trees, ap, np.median(meds), np.median(p99s)))
    print(f"木の本数 {n_trees:4d}  平均適合率 {ap:.3f}  1件の中央値 {np.median(meds):.3f} ミリ秒"
          f"  遅い側の1% {np.median(p99s):.3f} ミリ秒"
          f"(5回の中央値: {', '.join(f'{v:.3f}' for v in meds)})")
| 木の本数 | 平均適合率 | 1件の判定時間の中央値(ミリ秒) | 遅い側の1%の判定時間(ミリ秒) |
|---|---|---|---|
| 50 | 0.797 | 0.019 | 0.028 |
| 200 | 0.781 | 0.044 | 0.101 |
| 800 | 0.766 | 0.070 | 0.388 |
| 2,000 | 0.757 | 0.181 | 0.794 |
図は、表と同じ値を matplotlib で描いたものです(描画のコードは省略しました)。時間の値は、本コラムの実行環境(8論理コアの Windows の計算機、Python 3.14、lightgbm 4.6.0、推論は1スレッド)で測ったものです。測ったときには、ほかの計算も同じ計算機で動いていました。計算機の性能と負荷で値は変わり、同じ計算機でも測るたびに変わります。本文に載せた結果の実行でも、5回の測定ごとの中央値は、200本で 0.020〜0.044 ミリ秒、800本で 0.037〜0.083 ミリ秒、2,000本で 0.128〜0.267 ミリ秒と、それぞれ2倍ほどの幅で動きました。コードを仕上げる途中の別の実行では、遅い側の1%が200本より50本のほうで大きく出たこともあり、遅い側の値は、とくに負荷の揺れの影響を強く受けます。数字そのものより、増え方の傾向を読む必要があります。
傾向としては、木の本数が増えるほど1件の判定時間は延び、2,000本の中央値は50本の9倍あまりになりました。一方で、評価の期間の平均適合率は 0.797・0.781・0.766・0.757 で、木を増やすほどむしろ下がりました。本コラムの架空データは特徴量が4つしかない単純なもので、学習の設定(学習率など)も木の本数に合わせて調整していないので、木を増やすと学習の期間のデータに合わせすぎた可能性がありますが、そこまでは確かめていません。実際のデータで同じ結果になるとは限りませんが、モデルを大きくする前に、成績が本当に上がるかと、時間がどれだけ延びるかを並べて確かめる、という手順はどのデータでも使えます。
応答の予算を考えるときは、中央値より遅い側の値を見る必要があります。1日に数十万件の取引があれば、遅い側の1%でも数千件になります。その取引が応答の予算を超えれば、次の節で扱う障害のときの扱いが働き、判定を使わずに通すか止めることになります。図の灰色の線のように、遅い側の値は中央値より大きく、揺れも大きくなります。実際のシステムでは、ここに特徴量の保管場所への問い合わせやネットワークの往復の時間が加わり、遅い側の値はさらに延びます。応答の予算は、中央値ではなく遅い側の値で守れるかどうかで設計し、本番に近い負荷で測ってから決めるのが安全だと考えています。
判定の時間を短くする方法には、モデルを小さくする以外にも、重い特徴量を事前に計算しておく、承認の前には軽いモデルだけを使い重いモデルは承認の直後に回す、問い合わせの回数を減らすために必要な特徴量を1か所にまとめて置く、といったものがあります。どれも、判定のタイミングと特徴量の計算の分担を見直すことになり、前の2つの節で決めたことと一緒に考える必要があります。
監視の項目、検知の質・データ・システムの3つの層
本番で動き始めた不正検知のシステムは、毎日監視する必要があります。監視の項目は、検知の質、データ、システムの3つの層に分けて考えると整理しやすくなります。検知の質は、アラートの件数や適合率のように、検知の働きを技術の面から表す指標です。アラートの件数は主に運用の量と変化の兆しを、適合率や把握できた見逃しの件数は成果の一部を表すもので、不正検知の成果そのものは、防いだ不正と誤って止めた正当な取引を合わせて判断します(第8章・第9章)。データは、特徴量の元になる入力が正しく届いているかを表す指標です。システムは、応答の時間や判定の失敗の件数のように、仕組みそのものが動いているかを表す指標です。モデルの手口への追従を見る監視(概念ドリフトの監視)は第10章で扱ったので、ここではシステムの運用の目で見る項目を中心にします。
| 層 | 監視の項目 | 何が分かるか | 分かるまでの遅れ |
|---|---|---|---|
| 検知の質 | アラートの件数とアラート率、措置ごとの件数(承認・保留・拒否・事後の調査) | しきい値やモデルの急な変化、手口の急増 | すぐに分かる |
| 検知の質 | 適合率(調査の結果で不正だった割合)、見逃しの件数(後から届いた申告やチャージバック) | 検知の成果を判断する材料の一部 | 調査の完了やラベルの確定を待つので、日から月の単位で遅れる |
| 検知の質 | 誤って止めた正当な取引の件数、顧客からの問い合わせや苦情の件数 | 誤検知による機会損失と顧客の離反の兆し | 数日の単位で遅れる |
| データ | 取引の件数、特徴量ごとの欠損の割合、値の分布(平均や割合)、スコアの分布 | 入力のデータの障害、仕様の変更、取り込みの漏れ | すぐに分かる |
| データ | 一括で作った特徴量とリアルタイムで作った特徴量の照合の結果 | 訓練と提供のずれ | 照合の頻度による |
| システム | 応答の時間(中央値と遅い側の値)、判定が時間内に返らなかった件数、エラーの件数 | 応答の予算の超過、障害 | すぐに分かる |
| システム | ルールだけでの運転に切り替わった時間と件数 | 障害のときの扱いが働いた範囲 | すぐに分かる |
この表で大事なのは、「分かるまでの遅れ」の列です。成果を判断する材料になる適合率と見逃しは、第2章で扱ったラベルの遅れのため、すぐには分かりません。見逃しは、顧客の申告やチャージバックが届いて初めて分かり、数週間から数か月後になることもあります。一方で、データの層とシステムの層の指標は、取引が届いた時点で計算できます。障害の多くは、検知の質の指標が動く前に、データの層の指標に現れます。
この点を、架空データで確かめます。評価の期間(40〜59日目)のうち、52〜54日目の3日間だけ、端末の情報が届かなくなり、すべての取引で「新しい端末かどうか」が0になったと想定しました。取引の受け口の仕様の変更や、外部から受け取る情報の障害で、こうしたことが起きる場合があります。そのうえで、日ごとのアラート率、新しい端末の割合、スコアの平均を計算し、平常時とみなした40〜49日目の平均と標準偏差から、平均±3標準偏差の管理の幅を決めて、幅を外れた日に警告を出すことにしました。
# ---- ブロック5:日ごとの監視と、入力のデータの障害 ----
thr = np.quantile(champ.predict_proba(train[feats])[:, 1], 0.995)   # 学習の期間で上位0.5%の境目
mon = test.copy()
broken = mon["day"].between(52, 54)
mon.loc[broken, "new_device"] = 0               # 52〜54日目:端末の情報が届かなくなった想定
mon["score"] = champ.predict_proba(mon[feats])[:, 1]
mon["alert"] = mon["score"] >= thr
daily = mon.groupby("day").agg(件数=("score", "size"), アラート率=("alert", "mean"),
                               新端末の割合=("new_device", "mean"), スコアの平均=("score", "mean"))
daily[["アラート率", "新端末の割合"]] *= 100
ref = daily.loc[40:49]                          # 40〜49日目を平常時の基準にする
limits = {}
for col in ["アラート率", "新端末の割合", "スコアの平均"]:
    mu, sd = ref[col].mean(), ref[col].std()
    limits[col] = (mu - 3 * sd, mu + 3 * sd)
    daily[col + "の警告"] = (daily[col] < mu - 3 * sd) | (daily[col] > mu + 3 * sd)
pd.set_option("display.width", 200)
print(daily.round(3).to_string())
for col, (lo, hi) in limits.items():
    print(f"{col}の管理の幅: {lo:.4f} 〜 {hi:.4f}")
y_m, b = mon["fraud"].to_numpy() == 1, broken.to_numpy()
intact = champ.predict_proba(test[feats])[:, 1] >= thr          # 端末の情報が届いていた場合
print("52〜54日目の不正:", (y_m & b).sum(), " 拾えた件数 情報あり:", (y_m & b & intact).sum(),
      " 情報なし:", (y_m & b & mon["alert"].to_numpy()).sum())
| 監視の項目 | 平常時から決めた管理の幅 | 52〜54日目の値 | 警告 |
|---|---|---|---|
| アラート率(その日の取引の件数に対するアラートの割合、%) | 上限 1.4347(下限は計算上マイナスで、実質は0) | 0.188、0.322、0.766 | 出なかった |
| 新しい端末の割合(コードの出力と図では「新端末の割合」、%) | 1.1212〜3.6686 | 0.000、0.000、0.000 | 3日とも出た |
| スコアの平均 | 上限 0.0112(下限は計算上マイナス) | 0.001、0.002、0.003 | 出なかった |
新しい端末の割合は、平常時(40〜49日目)は 1.689〜3.184% で動いていましたが、52〜54日目は3日とも 0.000% になり、管理の幅の下限 1.1212% を割って警告が出ました。一方で、アラート率は 0.188%・0.322%・0.766% で、平常時(40〜49日目)の値(0.064〜1.311%)の範囲に収まり、警告は出ませんでした。スコアの平均も警告を出しませんでした。本コラムの架空データでは、1日の取引が約1,600件、不正は1日に数件しかないので、アラート率はもともと日によって大きく揺れます。44日目には不正が重なってアラート率が 1.311% まで上がっており、この日を含めて管理の幅を決めたため、幅はさらに広くなっています。この揺れの中では、端末の情報が欠けたことを、アラート率の変化として見分けることはできませんでした。
端末の情報が欠けたことで、どれだけ見逃しが増えたかも数えました。52〜54日目の不正は19件で、端末の情報が届いていた場合にアラートになるのは13件、届かなかった場合は12件でした。本コラムの架空データでは、端末の情報が欠けたために見逃した不正は、3日間で1件増えただけです。この架空データでは、不正の多くが額の大きさと連続でも見分けられるように合成してあるためと考えられますが、この理由までは確かめていません。実際のデータで、端末の情報への依存が大きいモデルであれば、見逃しはもっと増えることも、ほとんど増えないこともあります。
この結果から言えるのは、アラートの件数だけを監視していると、入力のデータの障害を見落とすことがある、ということです。障害の間に入った不正は、検知の手がかりの1つを失った状態で判定されています。それによる見逃しが実際に起きていたとしても、分かるのは後で顧客の申告が届いたときです。入力の特徴量ごとの欠損の割合や値の分布を監視していれば、障害の当日に気づき、取り込みを直す、影響を受けた期間の取引を一括で調べ直す、といった対処ができます。
管理の幅の決め方には注意が要ります。この例では、平常時のアラート率の揺れが大きく、平均±3標準偏差で決めた幅では、下向きの変化を見分けられませんでした。警告の出方は、指標の分布の偏り、基準にした期間、見つけたい変化の向きによって変わり、条件によっては逆に誤った警告が増えることもあります。幅を狭くすると、正常な揺れで警告が出続け、監視の担当が警告を見なくなります。第9章で扱ったアラート疲れと同じことが、監視の警告でも起きます。指標ごとに、揺れの大きさと、見落としたときの損失の大きさを考えて幅を決め、警告が出たときに誰が何を確かめるかの手順まで決めておく必要があります。手口の変化を見る分布のずれの指標は、第10章で扱いました。
障害のときの扱い、判定が返らないときに通すのか止めるのか
不正検知のシステムも、ほかのシステムと同じように止まることがあります。特徴量の保管場所が応答しない、モデルの推論の処理が落ちる、ネットワークが遅れて応答の予算を超える、といった場合です。リアルタイム判定では、判定が時間内に返らなかった取引をどう扱うかを、あらかじめ決めておかなければなりません。決めていなければ、障害が起きたその場で誰かが判断することになり、判断を待つ間、取引が止まるか、何も確かめずに通ることになります。
判定が返らないときの扱いは、大きく3つに分けられます。1つ目はすべて通す扱いで、障害を理由に正当な取引を止めることは避けられますが、その間はアラートを1件も出せないので、不正はすべて見逃しになり、通した不正による被害が顧客や加盟店に及ぶおそれがあります。2つ目はすべて止める扱いで、不正は通しませんが、正当な取引もすべて止まります。3つ目は、モデルを使わずにルールだけで判定する扱いです。ルールは特徴量の保管場所やモデルの推論の処理に頼らずに動くように作っておけば、モデルが使えないときの代わりになります。第3章で、ルールによる検知を後の章の比較の基準(ベースライン)にしましたが、障害のときの代わりの判定としても、ルールは役に立ちます。
この3つを、架空データの評価の期間で比べます。ここで比べるのは、モデルの推論だけが止まり、特徴量は平常どおり取得できる場合です。例のルールは「普段の額」と「直前1時間の回数」を使うので、特徴量の保管場所そのものの障害でも動くかは、このコードでは確かめていません。また、この例に限り、アラートになった取引はすべて止める(拒否する)ものとして数えます。モデルによる判定は、学習の期間のスコアで上位0.5%にあたる値をしきい値にしました。ルールは「額が普段の3倍以上」または「直前1時間に2件以上の取引があり、かつ新しい端末から」の2つの条件のどちらかに当たればアラートにする、という簡単なものです。この条件の値と、不正の合成のしかた(額の倍率・件数・新しい端末の割合)は、合成データに合わせた説明用の値で、実際の運用で使う値ではありません。後の節で扱うとおり、実際のルールの条件としきい値は、知る必要のある人に限って扱うものです。
# ---- ブロック6:障害のときの運転と、新しいモデルの試し方 ----
yt = test["fraud"].to_numpy() == 1
rule = ((test["amt_ratio"] >= 3) | ((test["cnt_1h"] >= 2) & (test["new_device"] == 1))).to_numpy()
modes = {"モデルで判定": champ.predict_proba(test[feats])[:, 1] >= thr,
         "ルールだけで判定": rule,
         "すべて通す": np.zeros(len(test), dtype=bool),
         "すべて止める": np.ones(len(test), dtype=bool)}
for name, flag in modes.items():
    prec = yt[flag].mean() if flag.sum() > 0 else float("nan")
    print(f"{name:8s} アラート {flag.sum():6d}  再現率 {yt[flag].sum() / yt.sum():.3f}"
          f"  適合率 {prec:.3f}  止めた正当な取引 {(flag & ~yt).sum():6d}")

# 新しいモデルの試し方:影の運用と、一部の顧客だけで試す方法
chall = fit(feats + ["hour"], 200)            # 挑戦者:時刻そのものを足したモデル
s_ch = champ.predict_proba(test[feats])[:, 1]
s_cl = chall.predict_proba(test[feats + ["hour"]])[:, 1]
print(f"影の運用(全件で両方の点数を記録)  再現率 現行 {yt[top_alerts(s_ch)].sum() / yt.sum():.3f}"
      f"  挑戦者 {yt[top_alerts(s_cl)].sum() / yt.sum():.3f}")
arm = rng.random(n_cust) < 0.1                  # 顧客の10%だけ挑戦者で判定する
in_arm = arm[test["cust"].to_numpy()]
print("挑戦者の側の不正の件数:", yt[in_arm].sum(), " 現行の側:", yt[~in_arm].sum())
thr_cl = np.quantile(chall.predict_proba(train[feats + ["hour"]])[:, 1], 0.995)  # 挑戦者自身の境目
diffs, undefined = [], 0
for k in range(1000):                           # 顧客の割り当てをやり直して差のばらつきを見る
    a = (rng.random(n_cust) < 0.1)[test["cust"].to_numpy()]
    if yt[a].sum() == 0:                        # その側に不正が無いと再現率は定義できない
        undefined += 1
        continue
    r1 = yt[a & (s_cl >= thr_cl)].sum() / yt[a].sum()
    r0 = yt[~a & (s_ch >= thr)].sum() / yt[~a].sum()
    diffs.append(r1 - r0)
print("再現率を定義できなかった割り当て:", undefined, "回 / 1000回")
print("定義できた割り当てでの再現率の差の95%の範囲:",
      np.round(np.percentile(diffs, [2.5, 97.5]), 3))
| 判定の方法 | アラートの件数 | 再現率 | 適合率 | 止めた正当な取引の件数 |
|---|---|---|---|---|
| モデルで判定(平常時) | 143 | 0.800 | 0.559 | 63 |
| ルールだけで判定 | 271 | 0.720 | 0.266 | 199 |
| すべて通す | 0 | 0.000 | (アラートが無い) | 0 |
| すべて止める | 31,645 | 1.000 | 0.003 | 31,545 |
この表の「モデルで判定」は、学習の期間のスコアで決めたしきい値を使っているので、評価の期間の上位0.5%でアラートにした前の表(158件、再現率 0.820)とはアラートの件数と再現率が違います。再現率の分母は、どの行も評価の期間の不正100件です。モデルで判定した場合は、143件のアラートで評価の期間の不正100件のうち80件を拾い、正当な取引63件を止めました。ルールだけで判定した場合は、271件のアラートで72件を拾い、正当な取引199件を止めました。本コラムの架空データでは、ルールだけの運転は、モデルより拾える不正が8件少なく、止める正当な取引が3倍あまりに増えました。すべて通すと不正100件をすべて見逃し、すべて止めると正当な取引31,545件をすべて止めます。実際のデータでは、モデルとルールの差はもっと大きくなることも、小さくなることもあります。それでも、ルールだけの運転が、すべて通す扱いとすべて止める扱いの間のどこに位置するかを、自社のデータで事前に測っておくことは、障害のときの扱いを決める根拠になります。
どの扱いを選ぶかは、取引の種類ごとに、見逃しによる被害と、誤検知による機会損失・顧客の離反のどちらが重いかで決めることになります。少額で件数の多い決済では、短い障害の間はすべて通し、事後に一括で調べる扱いが選択肢になります。一度の取引の影響が大きい送金や、取り消しの難しい取引では、ルールだけで判定し、ルールに当たったものは保留にして追加の確認を求める、という扱いが考えられます。すべて止める扱いは、正当な取引をすべて止めるので、顧客と加盟店への影響が大きくなります。どの扱いにするかは、取引の性質と、許容できる損失の大きさに応じて決めることになります。
| 決めておくこと | 内容 |
|---|---|
| 障害とみなす条件 | 応答の予算を何ミリ秒超えたら、あるいは何件続けて失敗したら、障害のときの扱いに切り替えるか |
| 取引の種類ごとの扱い | すべて通す・ルールだけで判定する・すべて止めるのどれにするか。保留にした取引の確認の方法 |
| 切り替えと戻しの権限 | 自動で切り替えるか、誰の判断で切り替えるか。平常時の判定に戻す条件と承認者 |
| 障害の間の記録 | どの取引がどの扱いで処理されたかを残し、障害の後に一括で調べ直せるようにする |
| 障害の後の調べ直し | 障害の間に通した取引を、復旧したモデルでまとめて判定し直し、疑いの強いものを調査に回す |
| 連絡 | 顧客対応・加盟店・調査担当・経営への連絡の経路と、連絡する障害の大きさの基準 |
| 訓練 | 切り替えの手順を定期的に試し、ルールだけの運転が実際に動くことを確かめる |
この表の最後の訓練は、見落とされやすい項目です。障害のときにだけ使うルールだけの運転は、平常時には動かないので、いつの間にか動かなくなっていても気づきません。ルールが参照していた項目の名前が変わっていた、ルールの版が古いまま残っていた、といったことは、障害が起きて初めて分かります。切り替えの手順を定期的に実際に動かして確かめることを、運用の計画に入れておく必要があります。
新しいモデルの試し方、影の運用とチャンピオンとチャレンジャー
第10章で扱った再学習や、特徴量を足した新しいモデルを本番に入れるときは、過去のデータでの評価だけで切り替えないことが大切です。第8章で扱ったとおり、過去のデータでの評価には限界があります。本番の取引の流れの中で、特徴量が学習のときと同じように計算されるか、応答の時間が予算に収まるか、スコアの分布が想定どおりか、といったことは、本番で動かしてみないと分かりません。そこで、新しいモデルを、措置に影響しない形か、影響を一部に限った形で、本番で試す方法が使われます。
1つ目は影の運用です。新しいモデルを本番の取引の流れに並べて動かし、すべての取引でスコアを計算して記録しますが、措置には使いません。措置は今のモデルのスコアで決めます。顧客に影響を与えずに、本番の入力で新しいモデルがどう振る舞うかを確かめられます。実際の処理に使われるのは今のモデルの判定なので、新しいモデルだけが止めるべきだと判定し、今のモデルが承認した取引は、そのまま通ります。その取引が本当に不正だったかは、通した後のラベルが届くまで分かりません。
2つ目はチャンピオンとチャレンジャーです。今のモデル(チャンピオン)で大部分の取引を判定し、一部の取引だけを新しいモデル(チャレンジャー)で判定して、措置まで新しいモデルの判定で行います。新しいモデルの判定で措置を取った後の結果を比べられるので、影の運用では分からない、措置を含めた成果に近づけます。ただし、措置を取っても、不正かどうかがすべて分かるわけではありません。止めた取引は、通していたらどうなったかが観測できず、通した取引にも申告されないものや確定していないものがあります。比べるには、追加の調査と、ラベルの遅れや欠けへの手当て(第2章の選択の偏り)が必要です。一方で、新しいモデルが今のモデルより悪かった場合は、その一部の取引で被害や誤検知が増えます。割り当てる割合は、試したい差の大きさと、許容できる損失の大きさで決めることになります。効果の測り方の一般論は、弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」で扱っています。
架空データで、2つの方法の違いを確かめます。コードは、前の節(障害のときの扱い)に載せたブロック6の後半です。チャレンジャーとして、今のモデルの4つの特徴量に、取引の時刻そのものを足したモデルを作りました。影の運用として評価の期間のすべての取引で2つのモデルのスコアを計算し、それぞれ上位0.5%をアラートにした場合の再現率を比べます。次に、顧客の10%をチャレンジャーに割り当てた場合に、チャレンジャーの側に入る不正の件数を数えます。さらに、顧客の割り当てを1,000回やり直し、チャレンジャーの側と今のモデルの側の再現率の差がどれだけ揺れるかを調べました。割り当ての比較では、2つのモデルのスコアの尺度が同じとは限らないので、それぞれのモデルの学習の期間のスコアで上位0.5%にあたる値を、そのモデルのしきい値にしています。割り当てによっては、チャレンジャーの側に不正が1件も入らず、その側の再現率を計算できない(分母が0になる)ことがあるので、その回は差の計算から外し、回数を別に数えました。
| 試し方 | 比べられる不正の件数 | 結果 |
|---|---|---|
| 影の運用(評価の期間のすべての取引で両方のスコアを記録) | 100件(どちらのモデルも同じ100件で比べる) | それぞれ評価の期間の上位0.5%をアラートにした再現率は、今のモデルが 0.820、チャレンジャーが 0.790 |
| チャンピオンとチャレンジャー(顧客の10%をチャレンジャーに割り当て) | チャレンジャーの側 3件、今のモデルの側 97件 | それぞれのモデルの学習の期間で決めたしきい値でアラートにし、割り当てを1,000回やり直した。チャレンジャーの側に不正が入らず再現率を計算できなかったのは16回。計算できた984回での再現率の差の95%の範囲は -0.421〜0.216(再現率の分母はそれぞれの側に入った不正) |
影の運用では、同じ100件の不正で2つのモデルを比べられるので、再現率の差(0.820 と 0.790)を直接読めます。この架空データでは、取引の時刻は不正と関係が無いように合成したので、時刻を足しても成績は上がらず、わずかに下がりました。一方で、顧客の10%をチャレンジャーに割り当てると、20日間の評価の期間でチャレンジャーの側に入った不正は3件でした。3件では、1件拾えたかどうかで再現率が 0.33 ずつ動きます。割り当てをやり直すと、1,000回のうち16回はチャレンジャーの側に不正が1件も入らず、再現率そのものを計算できませんでした。計算できた回でも、再現率の差は -0.421 から 0.216 の範囲で揺れ、2つのモデルのどちらが良いかを判断することはできませんでした。
この結果は、不正検知でチャンピオンとチャレンジャーを使うときの難しさを表しています。不正は件数が少ないので、一部の取引に割り当てると、比べられる不正の件数がさらに少なくなります。差を読み取れるだけの件数が集まるまでに、長い期間がかかります。そのうえ、ラベルの遅れのため、集まった取引の結果が分かるのはさらに後です。実務では、まず影の運用で、本番の入力での振る舞い、応答の時間、スコアの分布、今のモデルとの判定の重なりを確かめ、大きな問題が無いことを見てから、チャンピオンとチャレンジャーで措置を含めた成果を測る、という順番が考えられます。割り当てる割合と期間は、比べたい差の大きさと不正の件数から事前に見積もっておく必要があります。少ない件数での指標のばらつきは、第8章でも扱いました。
2つの方法のどちらでも、新しいモデルへの切り替えは、手順として決めておく必要があります。誰が成績を確かめ、誰が承認し、問題が出たときに誰がどの手順で元のモデルに戻すのかを、切り替えの前に決めます。本コラムでは、第10章の再学習の手順と第13章の責任分担に合わせ、判断の材料はデータ分析の担当がまとめ、承認は事業の責任者がリスク管理に相談して行い、切り替えの作業はデータ分析の担当と情報システムの担当が担う、という分担を例として置いています。元のモデルにすぐ戻せるように、前の版のモデルと、そのモデルが使っていた特徴量の定義としきい値を、一緒に残しておくことも必要です。
変更の管理・記録・権限、判定の時点を後から再現できるようにする
不正検知のシステムでは、ルール、モデル、しきい値、特徴量の定義が、それぞれ別の頻度で変わります。ルールは新しい手口に合わせて週の単位で足されることがあり、しきい値は調査の能力に合わせて調整され、モデルは月の単位で学習し直されます。これらの変更は、どれも検知の結果を変えます。変更の記録が無いと、ある日にアラートの件数が急に増えたとき、それが手口の変化によるものか、誰かがしきい値を変えたためか、特徴量の取り込みの障害かを切り分けられません。
変更の管理では、ルール・モデル・しきい値・特徴量の定義のそれぞれに版の番号を付け、いつ・誰が・何を・なぜ変えたか、誰が承認したかを記録します。本番に入れる前に、過去のデータでアラートの件数と成績がどう変わるかを確かめ、その結果も変更の記録に残します。第3章で扱ったルールの台帳と、第10章で扱った再学習の手順は、この変更の管理の一部です。この記録があれば、変更の前後で監視の項目がどう動いたかを照らし合わせることができます。
記録と監査の目的で残すのは、判定の時点の情報です。どの取引に、どの版のモデルとルールとしきい値を使い、どの特徴量の値を入力して、どのスコアになり、どのルールに当たり、どの措置を取ったか。この記録があれば、後から顧客の問い合わせや監査に対して、その取引がなぜ止められたのか(あるいは通されたのか)を、その時点の情報で説明できます。後から更新された顧客の情報や、新しい版のモデルで計算し直したスコアでは、当時の判定を説明できません。第2章で扱った「判定の時点で使えた情報を、その時点の値のまま残す」という記録の設計は、ここでも同じように求められます。判定の時点で使った特徴量の値の記録は、前の節で触れたとおり、訓練と提供のずれを点検する材料にもなります。
| 記録する項目 | 内容 | 使いみち |
|---|---|---|
| 取引の識別子と日時 | 取引を一意に特定する番号と、判定した時刻 | ほかの記録との突き合わせ |
| 入力した特徴量の値 | 判定のときに実際に使った値(後から計算し直した値ではない) | 判定の再現、訓練と提供のずれの点検、学習のデータ |
| モデル・ルール・しきい値の版 | その判定に使ったそれぞれの版の番号 | 変更の前後の比較、判定の再現 |
| スコアと当たったルール | モデルのスコア、該当したルールの一覧、理由コード | 顧客や監査への説明(第11章)、調査の優先順位 |
| 措置 | 承認・保留・拒否・事後の調査のどれにしたか、障害のときの扱いが働いたか | 措置ごとの件数の監視、誤って止めた取引の把握 |
| 調査の経過と結論 | 調査の担当、確認した内容、不正かどうかの結論と日付 | ラベル(第2章)、適合率の計算、ルールの見直し |
| 顧客とのやりとり | 追加の認証の結果、問い合わせ、異議の申し立てと結論 | 救済の手続き(第11章)、顧客の離反の把握 |
記録の保存の期間や、法令が求める確認や記録の義務は、業種と取引の種類によって異なります。マネー・ローンダリング対策の法令が求める記録などは第14章で扱います。システムの設計では、法令が求める期間を満たすことに加え、モデルの学習と評価に必要な期間のデータを、判定の時点の値のまま取り出せることを要件にしておく必要があります。
変更の管理と記録に加えて、権限と情報の管理も決めておく必要があります。不正検知のルールやしきい値の詳細は、外に出ると検知を避ける手がかりになります。第10章で扱った敵対的な変化への備えとして、ルールの条件、しきい値の値、モデルが重視している特徴量の詳細は、知る必要のある人に限って扱う必要があります。第11章で扱ったとおり、顧客に示す理由も、説明の責任を果たしつつ、検知を避ける手がかりにならない水準に留めることになります。
社内でも、権限を分けることが大切です。ルールやしきい値を変更できる人、変更を承認する人、判定の記録を閲覧できる人、調査の結論を入力できる人を分け、それぞれの操作を記録します。1人の担当者がルールの変更と承認の両方をできる状態や、特定の顧客を判定の対象から外す許可リストを1人で変えられる状態は、社内の不正の入口にもなりえます。第1章で扱った社内の不正は、不正検知のシステムそのものにも起こりうると考えておく必要があります。
判定の記録には、取引の内容、端末や接続の情報、調査のメモなど、個人に関わる情報が多く含まれます。閲覧できる人を限り、閲覧の記録を残し、学習や分析に使うときは必要な項目だけを取り出す、といった扱いを決めておきます。個人データの取り扱いの法令上の整理は第14章で扱います。
| 操作 | 扱う人の例 | 決めておくこと |
|---|---|---|
| ルール・しきい値の変更 | 不正対策の担当 | 変更の申請と承認を別の人にする。変更の前に過去のデータで影響を確かめる |
| モデルの切り替え | 承認は事業の責任者(リスク管理に相談する)。切り替えの作業はデータ分析の担当と情報システムの担当 | データ分析の担当が影の運用の結果と比較の材料をまとめ、事業の責任者が承認してから切り替える。元に戻す手順を決めておく |
| 許可リスト・拒否リストの変更 | 不正対策の担当 | 理由と期限を記録する。定期的に見直す |
| 判定の記録の閲覧 | 調査担当、監査 | 閲覧できる範囲を役割で限る。閲覧の記録を残す |
| 障害のときの切り替え | 運用の当番と責任者 | 切り替えの条件と承認者、戻す条件を事前に決める |
内製・外部委託・製品やクラウドのサービスの利用を比べる観点
不正検知の仕組みを用意する方法は、第13章と同じく、おおまかに3つに分けます。社内でルールとモデルと仕組みを作る内製、開発や運用を外部の会社に依頼する外部委託、不正検知の製品やクラウドのサービスを利用する方法です。3つ目には、パッケージ製品を導入する場合と、クラウド事業者の不正検知のサービスや機械学習の基盤を使う場合が含まれます。実際には、製品の上に自社のルールを足す、クラウドの機械学習の基盤で自社のモデルを動かす、といった組み合わせにする場合もあります。どれが良いかは、取引の量、求められる応答の時間、社内のデータ分析と開発の体制、規制や監査への対応の要件で変わり、一概には言えません。この節では、どの方法を選ぶ場合にも確かめる観点を、この章で扱ったシステムの面から整理します。料金と個別の製品の評価は扱いません。委託や体制の面からの比べ方は第13章で扱います。
| 観点 | 確かめること |
|---|---|
| 判定のタイミングと応答の時間 | 承認の前の判定に使えるか。応答の時間の中央値だけでなく遅い側の値を、自社の取引の量に近い負荷で示せるか |
| 使えるデータと特徴量 | 自社の取引の記録、端末の情報、過去の調査の結果を入力にできるか。特徴量を自社で定義して足せるか。学習のときと判定のときで同じ定義になるか |
| モデルと評価 | どのデータで学習し、どの方法で評価したか。評価を時間で切っているか(第8章)。自社のデータで影の運用ができるか |
| ルールとの組み合わせ | 自社のルールを足せるか。ルールの版と変更の記録が残るか。ルールだけでの運転ができるか |
| 障害のときの扱い | 判定が返らないときの扱いを自社で決められるか。障害の通知と記録の方法 |
| 再学習と監視 | 誰が、どの頻度で、どのラベルを使って学習し直すか。監視の項目を自社で見られるか(第10章) |
| 説明と記録 | 理由コードを出せるか(第11章)。判定の時点の入力・スコア・版を取り出せるか |
| データの扱い | データをどこに置き、誰が見られるか。個人データの扱いが自社の方針と法令に合うか(第14章) |
| 出口 | やめるときに、記録と学習のデータ、ルールの定義を取り出せるか |
この表のうち、最後の出口は導入のときに見落とされやすい観点です。判定の記録や調査の結果が委託先や製品・サービスの中にしか無いと、依頼先や製品を替えるときに過去のラベルが持ち出せず、新しい仕組みで学習し直せなくなることがあります。どの方法を選ぶ場合でも、判定の記録と調査の結果は自社が取り出せる形で持つ、という要件を最初に決めておくのが安全だと考えています。導入の進め方とベンダーに確かめることの全体は、第13章で扱います。
経営の判断、障害時の扱いと記録を最初から設計に入れる
この章で扱った決めごとは、どれも障害や監査、モデルの切り替えといった、平常時には起きない場面で問われます。そのため、システムの開発の予算と期間がモデルの精度に集中し、障害のときの扱い、記録、監視、変更の管理が後回しになりやすいと考えています。しかし、これらは後から足すのが難しい要素です。判定の時点の入力を記録していなかった期間のデータは、後から作り直せません。障害のときの扱いを決めていなければ、最初の障害の日に、誰も判断できないまま取引が止まるか、すべて通ることになります。
この章の内容を、序章で整理した6つの損失の型に当てはめると、次のようになります。
- 見逃しによる被害:障害のときにすべて通す扱いを続けた期間の不正や、入力のデータの障害に気づかなかった期間の不正
- 誤検知による機会損失:障害のときにすべて止める扱いを選んだ期間の正当な取引や、訓練と提供のずれで、評価のときとは別の判定が動いて生じうる誤検知(増えるか減るかは、判定のときの値を突き合わせるまで分からない)
- 調査の過負荷:障害の後に、通した取引をまとめて調べ直す作業や、変更の記録が無いために原因の切り分けにかかる作業
- 顧客の離反:応答の時間の超過や障害で決済が失敗した顧客、理由を説明できないまま止められた顧客
- 形骸化:ルールだけの運転を試していないために、障害のときに代わりの判定が動かない状態
- 規制上の義務の不履行:適用される法令などが求める記録を残せず、保存や報告などの義務を果たせないおそれ(判定の時点の記録が無く、監査や当局の求めに判定の理由を示せない状態を含む。どの記録が義務になるかは第14章)
経営として決めておくべきことは、3つにまとめられます。1つ目は、取引の種類ごとの障害のときの扱いと、それを切り替える権限です。見逃しと機会損失のどちらを重く見るかは事業の判断であり、システムの担当だけに任せるべきものではありません。2つ目は、判定の時点の入力・スコア・ルール・措置を残す記録の設計と、その保存の期間です。これは監査と規制への備えであると同時に、再学習と評価の材料でもあります。3つ目は、監視と変更の管理と障害の訓練を、運用の費用と体制として予算に入れることです。KPI としては、アラートの件数や適合率に加えて、応答の時間の遅い側の値、判定が時間内に返らなかった件数、ルールだけでの運転に切り替わった時間、入力のデータの欠損の割合を、システムの健全さの指標として経営の報告に含めることが考えられます。
この章では、不正検知を毎日の取引の流れの中で動かし続けるためのシステムの構成と運用を扱いました。判定のタイミングによって使えるデータと止められるかどうかが決まり、学習のときと判定のときで特徴量の定義がずれると、本コラムの架空データではアラート158件のうち49件が入れ替わり、評価で確かめたのとは別の判定が動くことになりました。アラートの件数だけの監視では入力のデータの障害を見落とすことがあり、障害のときの扱いと判定の時点の記録は、最初から設計に入れておく必要があります。新しいモデルは影の運用で本番の振る舞いを確かめてから、件数の見積もりをしたうえで一部の取引で試すのが現実的です。次の第13章では、ここまでの章の内容を、どの不正から始め、どう PoC を設計し、どの体制で進めるかという導入の進め方にまとめます。
この章を深めたい方への参考書籍
『機械学習システムデザイン:実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習を本番のシステムとして動かすときの、データの扱い、特徴量、デプロイ、監視、継続的な学習を一通り扱っています。この章の訓練と提供のずれ、リアルタイムの推論と一括の推論の分担、本番でのモデルの試し方を、不正検知に限らない一般的な形で深められます。
『AIエンジニアのための機械学習システムデザインパターン』(澁井雄介 著、翔泳社):学習したモデルを推論のシステムとして提供するときの構成を、パターンとして整理した本です。同期と非同期の推論、一括の推論、推論の記録と監視、本番での新しいモデルの試し方、障害のときに処理を切り離す仕組みなど、この章の構成の要素を実装の側から考えるときの手がかりになります。
『データ指向アプリケーションデザイン:信頼性、拡張性、保守性の高い分散システム設計の原理』(Martin Kleppmann 著、斉藤太郎 監訳、玉川竜司 訳、オライリー・ジャパン):データを扱うシステムの信頼性・拡張性・保守性を、データベース、一括処理、ストリーム処理まで広く扱っています。取引が届くたびに集計を更新するリアルタイムの特徴量や、障害のときの振る舞い、記録の設計を、システムの原理から理解するのに役立ちます。
第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
第12章では、判定のタイミングと構成の要素、新しいモデルを判定に使わずに試す方法、障害のときに通すのか止めるのかを先に決めておくことを扱いました。第1章から第12章は、不正検知を「どの不正を、どのデータで、どの方法で見つけ、どう評価し、誰がどう調査して止め、どう動かし続けるか」という順に説明してきました。この章では、それを自社のどの不正から、どの順番で、誰の責任で入れていくかを扱います。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- どの不正から始めるかの選び方(被害の大きさ・件数・ラベルの有無・措置を取れるか・規制上の要請で採点する方法)
- 最終の KPI から検知の KPI と調査の KPI へ分解する考え方
- 今のルールの成績を測るところから始める現状の把握
- 本格導入の前に限られた範囲で試す段階の設計(期間・評価の方法・合格の条件・出口を、始める前に決める)と、その段階で止まる型
- 効果の見立て方(金額ではなく、率と件数の型で書く)と、段階的な展開
- 役割と責任分担、三つの防衛線の考え方の中での不正検知の置き場所
- 内製と外部委託・製品の利用の分担、業界での情報の共有、人材、最初の90日の計画、形骸化の型、経営判断
この章の主張は、PoC(概念実証)の出口と、成果の測り方を、始める前に決めておくことです。PoC は Proof of Concept の略で、本格導入の前に、限られた範囲で使えるかどうかを確かめる小さな試しのことです。出口とは「何が確かめられたら次へ進み、何が確かめられなければやめるか」の決まりを指します。不正検知の場合、PoC は過去の取引の記録にモデルを当てて成績を出すところで終わりやすく、「過去のデータでは再現率が高かったが、本番で調査の担当者が見られる件数に収まるのか、誤って止める正当な取引がどれだけ増えるのかが分からない」という状態で止まることが多いように思います。序章と第8章・第9章で扱ったとおり、不正検知の成果と呼べるのは、見つけて防いだ不正と、誤って止めた正当な取引の両方を数えたうえでの差です。この数え方を PoC の計画に最初から組み込むことが、この章の中心になります。
どの不正から始めるか、5つの観点で採点して最初の対象を決める
不正検知の導入でよく起きるのは、「話題になっている不正」から手を付けることです。報道や業界の注意喚起で目にした手口は社内の関心を集めやすく、最初の題材に選ばれやすいものです。ただ、第1章で扱ったとおり、不正の種類によって、損失を誰が負うのか、ラベルがどれだけ集まるのか、見つけたあとに何ができるのかが大きく違います。最初の対象でつまずくと、その結果が「不正検知の高度化はうちでは効かない」という社内の評価になり、次の対象に進めなくなります。最初の対象は、取り組む価値があることと、成果を確かめやすいことの両方で選ぶ必要があります。
本コラムでは、候補の不正を次の5つの観点で採点する方法を考えます。採点の観点は、第1章から第12章で扱った論点を、どの不正から始めるかの判断に置き換えたものです。
- 被害の大きさ:その不正を防げなかったときの1件あたりの損失と、顧客や取引先への影響の重さ。金額で比べるのではなく、自社の他の不正と比べた相対的な大きさで付ける(第1章)
- 件数:一定の期間に、その不正がどれだけの件数起きているか、または起きていると見込まれるか。件数が少なすぎると、成果を確かめるのに長い期間がかかる(第8章)
- ラベルの有無:その不正について、不正だったかどうかの記録が、取引と結び付けられる形で残っているか。確定までにどれだけの遅れがあるか(第2章)
- 措置を取れるか:疑いのある取引を見つけたときに、保留・拒否・事後の調査のどれかを実際に取れるか。判定のタイミングと、止めたときの顧客への影響(第9章・第12章)
- 規制上の要請:その不正への対応が、法令やガイドラインで求められているか(第14章)
5つのうち、被害の大きさと規制上の要請は「取り組む価値」を、件数とラベルの有無は「確かめやすさ」を、措置を取れるかは「成果に変えられるか」を表します。被害が大きくても、措置を取れない不正は、見つけたことを損失の削減に変えられません。たとえば、取引の承認の前に判定できず、後から気づいても取り戻す手段が無い型の不正では、検知の精度を上げても、防げる被害は限られます。この場合、最初の一歩は検知のモデルを作ることではなく、判定のタイミングを前に出せるか、事後の調査で何ができるかを、業務とシステムの側で確かめることになります。
採点の目安を次の表にまとめました。点数の付け方は本コラムが考えた例で、業界の規格や公的な指針で定められたものではありません。各観点を1点から3点で付け、合計点だけで決めるのではなく、「ラベルの有無」と「措置を取れるか」のどちらかに1点が付く不正は、最初の対象から外す、という使い方を想定しています。ただし、規制上の要請が強い不正は、点数にかかわらず対応が必要なので、PoC の対象とは別に、ルールの整備(第3章)として進めます。
| 観点 | 3点 | 2点 | 1点 | 確かめ方(主に情報を持つ人) |
|---|---|---|---|---|
| 被害の大きさ | 1件あたりの損失が自社の不正の中で大きく、顧客への影響も重い | 1件あたりの損失は中程度、または顧客への影響が限られる | 1件あたりの損失が小さく、顧客への影響もほとんど無い | 被害の記録、チャージバックや補償の記録の件数と相対的な大きさ(不正対策・経理) |
| 件数 | 一定の期間に、成果を確かめるのに足りる件数の不正が起きている | 件数はあるが、成果を確かめるには数か月分を集める必要がある | 件数が非常に少なく、現実的な期間で成果を確かめられない | 被害の記録、調査の記録、本人からの申告の件数(不正対策・調査担当) |
| ラベルの有無 | 不正だったかどうかの記録が取引と結び付けて残り、確定までの遅れも把握できている | 記録はあるが、取引との結び付けが手作業で、遅れの長さが分からない | 記録がほとんど無いか、取引と結び付けられない | 調査の記録の項目、チャージバックの記録と取引の識別子の対応(調査担当・データ分析) |
| 措置を取れるか | 承認の前に判定でき、保留や拒否を取れる。止めたときの顧客への連絡の手順もある | 承認の前には判定できないが、直後の判定と事後の調査で被害を小さくできる | 見つけても取れる措置がほとんど無い | 判定のタイミング、措置の手順書、顧客対応の手順(事業の責任者・情報システム・顧客対応) |
| 規制上の要請 | 法令やガイドラインで、検知・確認・届出などの対応が求められている | 業界団体の指針や取引先との契約で、対応が求められている | 明示の要請は無い | 所管官庁のガイドライン、業界団体の指針、契約(コンプライアンス・法務) |
表の「ラベルの有無」に2点が付く不正、つまり記録はあるが取引との結び付けが手作業の不正では、注意が要ります。第2章で扱ったとおり、ラベルは確定までに遅れがあり、止めた取引や調査しなかった取引には、不正だったかどうかが分からないまま残るものがあります(後日の申告などで分かる場合もあります)。止めなかった場合にどれだけの被害が出たかも、直接には観測できません。記録が取引と結び付かないと、過去のデータで成績を測ることも、本番での成果を数えることもできません。この場合の最初の一歩は、モデルを作ることではなく、調査の結果を取引の識別子と結び付けて残す仕組みを作ることになります。この作業は地味ですが、ルールの成績を測ることにも、後の機械学習にも使えるので、検知の方式とは別に価値があります。
採点は、不正対策・調査担当・事業の責任者・コンプライアンス・データ分析が同じ表を見ながら行うのがよいと考えています。被害の大きさと件数は不正対策と調査担当が、措置を取れるかは事業の責任者と情報システムが、規制上の要請はコンプライアンスが、ラベルの有無はデータ分析と調査担当が、それぞれ最もよく知っています。データ分析の担当者や外部のベンダーだけで採点すると、「確かめやすさ」の観点は正しく付いても、「措置を取れるか」の観点が業務の実態とずれることがあります。
現状の把握と KPI の木、今のルールの成績を測ってから目標を分解する
最初の対象が決まったら、新しい方式を考える前に、今の検知の成績を測ります。多くの組織には、すでに何らかのルールや、担当者の目による確認があります。ところが、そのルールが出したアラートのうち何件が実際に不正だったのか(適合率)、実際の不正のうち何件をアラートにできていたのか(再現率)、1日に何件のアラートが出て、そのうち何件を調査できていたのかが、記録として集計されていないことが多いように思います。ルールを入れた時点では成績を確かめていても、その後の手口の変化や取引の量の変化に合わせて測り直していない、という場合もあります。
今の成績を測らないまま新しい方式を試すと、PoC の結果を何と比べればよいかが決まりません。第3章で扱ったとおり、ルールだけの検知は、後の比較の基準(ベースライン)になります。新しいモデルの成績が良く見えても、それが今のルールより良いのか、今のルールと同じ不正を拾っているだけなのかは、同じ期間・同じ評価の方法でルールの成績を出して初めて分かります。現状の把握で集める数字は、次のとおりです。
- ルールごとのアラートの件数、そのうち調査した件数、調査で不正と判断された件数。不正と判断された件数を調査した件数で割った割合が、調査した範囲でのルールごとの適合率になる(調査しなかったアラートは未確定として別に数える)
- 対象の取引の期間(取引の日付で区切る)とラベルを確かめる期限を固定したうえで、その期間の取引のうち期限までに不正と確認された件数と、そのうちどれかのルールでアラートになっていた件数。後者を前者で割った割合が、確認済みの不正に対する再現率になる(アラートにならなかった不正は、本人の申告やチャージバックで後から見つかったものになる。期限までに確定しなかった取引の件数も残しておく)
- 1日あたりのアラートの件数と、そのうち調査できた件数、調査されずに流れた件数(第9章の調査の能力と滞留)
- 保留や拒否にした取引のうち、後から正当と分かった件数と、その顧客からの問い合わせや苦情の件数(誤って止めた取引)
- アラートから調査の完了まで、調査の完了から顧客への連絡までにかかった時間
これらの数字は、測ろうとすると記録が足りないことが分かる場合があります。とくに、アラートにならなかった不正の件数は、本人の申告やチャージバックの記録と取引を結び付けないと数えられません。止めた取引のうち後から正当と分かった件数も、顧客対応の記録と結び付けないと数えられません。記録が足りないこと自体が、現状の把握の重要な結果です。足りない記録を残し始めることは、PoC の前に入れておくべき作業になります。
今の成績が分かったら、何をどこまで改善するのかを決めます。本コラムでは、そのための道具としてKPI の木を使います。KPI の木は、事業の最終の目標を表す KPI を頂点に置き、それを分解できる中間の KPI へ、さらに個々の施策が直接動かせる KPI へと枝分かれさせて書いた図です。不正検知では、頂点に置く最終の KPI は1つではなく、少なくとも「不正による被害」と「誤って止めた正当な取引」の2つになります。片方だけを頂点に置くと、もう片方を犠牲にした改善が成果に見えてしまいます。しきい値の調整だけで片方の指標を優先すると、もう片方の指標や調査の負荷が悪化するおそれがあるからです。たとえば、しきい値を下げてアラートを増やすと誤検知が増え、アラートが調査の能力を超えれば、見られないまま流れるアラートが増えて、被害がかえって増えることもあります。
2つの最終の KPI は、それぞれ検知の KPI と調査の KPI に分解できます。本章では、不正による被害を、措置によって防げず、軽減もできずに残った被害として数えます。これは「不正の件数」と「防げなかった割合」と「1件あたりの被害の大きさ」に分けて考えられます。防げなかった割合は、さらに、アラートにできなかったもの(見逃し)、アラートになったが調査されなかったか調査が間に合わなかったもの、調査で不正と判断したが措置が間に合わなかったものの3つに分けられます。前の2つは、それぞれ検知の再現率と、調査の能力と速さで決まります。3つ目の措置が間に合わなかったもの(措置の不成立)は、検知の KPI と調査の KPI とは別に、措置の手順の側の指標として数えます(次の表の中間の KPI の内訳)。誤って止めた正当な取引は、「アラートの件数」と「アラートのうち正当だった割合(1から適合率を引いたもの)」と「そのうち保留や拒否にした割合」に分けて考えられます。調査の KPI は、この2つの枝の両方にかかります。調査の能力が足りないとアラートが見られないまま流れて被害が増え、調査が遅いと保留にした正当な取引の顧客を長く待たせることになります。つまり、調査の能力と速さは、不正による被害と、誤って止めた正当な取引の待ち時間の両方に効きます。
KPI の木の各階層を、誰が持ち、どう測るかを次の表にまとめました。指標の例は本コラムが挙げた一般的なもので、自社の事業の形に合わせて置き換えて使うことを想定しています。
| 階層 | 指標の例 | 主に持つ人 | 測り方 | 注意すること |
|---|---|---|---|---|
| 最終の KPI | 措置で防げずに残った不正による被害の件数と相対的な大きさ、誤って止めた正当な取引の件数と割合 | 経営(どの水準まで減らすかを決める)・事業の責任者(KPI の木を設計し承認する) | 月次・四半期の集計。ラベルが確定するまでの遅れの分だけ、後から数字が動く | 2つを必ず並べて報告する。どちらか片方だけを目標にしない |
| 中間の KPI | 不正の件数、防げなかった不正の割合(見逃し・調査の遅れ・措置の不成立の内訳)、保留や拒否にした取引の割合、顧客からの問い合わせや苦情の件数 | リスク管理・不正対策・顧客対応 | 週次・月次の集計。不正の種類ごと、経路ごとに分けて見る | 不正の件数は手口の流行や取引の量でも動くので、検知の成果とそのまま結び付けない |
| 検知の KPI | 上位 K 件や上位 K% での適合率と再現率、平均適合率、額の相対値で重み付けた再現率(第8章) | データ分析・不正対策 | ラベルが確定した期間で、時間で切った評価で測る(第8章) | 再現率だけ・適合率だけを単独で目標にしない。アラートの件数と一緒に見る |
| 調査の KPI | 1日のアラートの件数、調査の完了までの時間、滞留の件数、調査されずに流れた件数(第9章) | 調査担当・不正対策 | ケース管理の記録から日次で集計する | 調査の速さだけを追うと、確認が形だけになるおそれがある(アラート疲れ。第9章) |
| ガードレールの指標(分解の階層の外に置き、並べて測る) | 特定の顧客の群での誤検知の偏り(第11章)、異議の申し立ての件数、判定が返らなかった取引の件数(第12章) | コンプライアンス・顧客対応・情報システム | 月次の集計。PoC と展開の各段階で、主な KPI と同時に測る | 主な KPI が改善しても、ここが悪化したら合格にしない |
表の最後の行に置いたガードレールの指標は、検知の改善が別の場所に損失を生んでいないかを見張るための指標です。第11章で扱ったとおり、全体の誤検知が減っても、特定の地域や属性の顧客に誤検知が偏ることがあります。第12章で扱ったとおり、モデルを大きくして判定に時間がかかるようになると、判定が返らない取引が増えることがあります。ガードレールの指標は、主な KPI と同じ期間に同時に測り、事前に決めた範囲を超えて悪化したら、主な KPI が改善していても合格にしない、という使い方をします。
KPI の木は、データ分析の担当者のためだけの図ではありません。経営にとっては、不正検知の予算が、被害と誤って止める取引のどちらを、どれだけ動かすための投資なのかを示す図になります。調査担当にとっては、自分たちの作業の速さと正確さが、最終の KPI のどこにつながるかを説明する図になります。調査の人員を検知の一部として予算化する(第9章)ときの根拠も、この木の上の調査の枝に書けます。
PoC の設計、過去のデータでの評価で止めず影の運用まで進める
最初の対象と KPI の木が決まったら、PoC を設計します。本コラムでいう不正検知の PoC は、本格的にすべての取引へ出す前に、限られた期間と範囲で「この対象の不正について、この方式が、今のルールより、決めた KPI を改善するか」を確かめる段階です。PoC で確かめるのは「AIが使えるか」という漠然とした問いではありません。始める前に、何を確かめ、どの結果なら次へ進み、どの結果ならやめるかを、文書にして関係者で合意しておく必要があります。
不正検知の PoC は、進め方によって大きく2つの型に分かれます。1つ目は、過去の取引の記録とラベルを使って、モデルの成績を測るところまでで終わる型です。本コラムでは「過去のデータでの評価で止まる型」と呼びます。2つ目は、過去のデータでの評価に加えて、本番の取引にモデルを並べて動かし、判定には使わずにスコアだけを記録して、今のルールと比べるところまで進める型です。第12章で扱った影の運用(判定には使わず、スコアだけを記録して比べる方法)を PoC に組み込む型で、本コラムでは「影の運用まで進める型」と呼びます。
過去のデータでの評価には、意味があります。第8章で扱ったとおり、時間で切った評価データで、候補の方式が今のルールに勝てるかを確かめれば、本番に出す前に見込みの無い方式を落とせます。ただし、過去のデータでの評価には限界があります。過去のデータのラベルは、過去のルールと調査の判断で作られているので、過去のルールが拾わなかった型の不正は、ラベルが付かないまま正当として残っていることがあります(第2章の選択の偏り)。過去に止めた取引は、止めなかったらどうなったかが分かりません。本番では、特徴量の計算が判定の時点に間に合うか、判定にかかる時間が許される範囲に収まるか、といった制約も加わります(第12章)。過去のデータでの評価だけで PoC を終えると、こうした点が確かめられないまま本格導入の判断を迫られます。
影の運用まで進める型では、本番の取引に対してモデルのスコアを記録し、今のルールのアラートと並べて、一定の期間後にラベルが確定したところで比べます。このとき、モデルのスコアが高いのに今のルールではアラートにならなかった取引の一部を、調査担当が追加で確認すると、モデルが新しく拾える不正があるかどうかを、ラベルの確定を待たずに確かめられます。逆に、今のルールではアラートになったのにモデルのスコアが低い取引も、何件かを確認しておくと、モデルが見落とす型が分かります。この追加の確認は、調査の能力を使うので、確認する件数の上限を PoC の計画に書いておきます。
ただし、影の運用ではモデルによる措置を実際には取らないので、モデルを使ったときに誤って止める取引の件数、保留の待ち時間、苦情、顧客の離反は実測できません。影の運用で確かめられるのは、ラベルが確定した取引での検知の成績、仮の措置の方針を当てはめたときに誤って止めることになる取引の見込みの件数、判定にかかる時間などです。顧客への実際の影響は、次の段階の限られた範囲での運用で確かめます。
PoC の設計で最初に決めておきたい項目を、次の表にまとめました。どの項目も、本コラムの各章で扱った論点を、PoC の計画書の欄に置き換えたものです。
| 決める項目 | 中身 | 決めずに始めると起きること | 関連する章 |
|---|---|---|---|
| 対象 | 対象の不正の種類、対象の取引(経路・商品・顧客の範囲)、対象の期間 | 試す途中で対象が広がり、期間内に結論が出ない | 第1章・第2章 |
| 比べる相手 | 今のルール(ベースライン)。ルールが無ければ、担当者の目による確認の記録 | 何より良いのかが決まらず、成績の数字の意味が定まらない | 第3章 |
| 過去のデータでの評価の方法 | 時間で切った評価データ、ラベルが確定するだけの時間がたった期間、指標(上位 K 件の適合率と再現率・平均適合率)、ルールに勝つ条件 | ランダムに切った評価で成績が良く見え、本番で再現しない | 第8章 |
| 影の運用の方法 | スコアを記録する取引の範囲、期間とその期間に見込まれる不正の件数、追加で確認する件数の上限、判定の時間の測り方 | 過去のデータでは良かったが、本番の取引で同じ成績が出るかが分からない | 第10章・第12章 |
| 合格の条件 | 調査の能力に合わせたアラートの件数のもとで、今のルールより見つけられる不正がどれだけ増えるか(適合率と再現率を併記)。仮の措置の方針を当てはめたときに誤って止めることになる取引の見込みの件数と、ガードレールの指標の悪化の上限 | 「再現率が上がった」という数字は出ても、次へ進むかを判断できない | 第8章・第9章・第11章 |
| 運用の条件 | 判定にかかる時間、特徴量が判定の時点で計算できるか、障害のときの扱い、再学習の頻度 | 成績は出たが、本番の判定の時間や特徴量の計算に追いつかない | 第10章・第12章 |
| 出口 | 合格したら次に何をするか(調査の順位づけに使う・対象を広げる)、不合格なら何をするか(特徴量の見直し・対象の変更・中止) | 結果が出ても次の判断ができず、PoC を延長し続ける | 本章 |
| 判断する人 | 出口の判断を誰が行うか(合格の条件の値は事業の責任者・不正対策・データ分析が決め、出口の承認は事業の責任者など) | 結果の解釈が立場によって分かれ、結論が出ない | 本章 |
この表で最も大事なのは、「合格の条件」と「出口」の2つです。合格の条件は、再現率のような1つの数字ではなく、「調査の能力に合わせて決めたアラートの件数のもとで、今のルールより見つけられる不正の件数が事前に決めた幅以上に増え、仮の措置の方針を当てはめたときに誤って止めることになる取引の見込みの件数とガードレールの指標の悪化が事前に決めた上限の内に収まる」という形で書きます。同じ評価の対象でアラートの件数をそろえると、適合率と再現率はどちらも見つけられた不正の件数に比例して動くので、2つを別々の条件にせず、見つけられた不正の件数で判断し、適合率と再現率を併記します。第9章で扱ったとおり、しきい値を下げれば再現率は上げられるので、アラートの件数をそろえずに比べた再現率は、方式の良し悪しを表しません。アラートの件数をそろえるには、たとえば「今のルールと同じ件数」や「調査担当が1日に確認できる件数」を基準にします。
合格の条件の値そのものは、対象の不正の件数と、事業にとって意味のある改善の大きさで決まるので、本コラムでは具体的な値を示しません。第8章で扱ったとおり、不正の件数が少ないと、平均適合率のような指標は評価データの取り方によって大きくばらつきます。少ない件数で小さな差を確かめようとすると、差が偶然のばらつきの内に収まってしまい、どちらとも判断できない結果になります。合格の条件を決めるときは、評価の期間に見込まれる不正の件数と、そのもとでの指標のばらつきの幅(第8章のブートストラップで出す区間)を一緒に見て、確かめられる差の大きさに収まっているかを確かめます。
出口は、合格した場合と不合格だった場合の両方を書きます。合格した場合の出口は、次の段階への移行です。本コラムでは、最初の移行先を「スコアで調査の順位を付ける」段階にすることを勧めます(段階的な展開の節で扱います)。不合格だった場合の出口は、結果の中身によって分かれます。過去のデータでの評価で今のルールに勝てなかったなら特徴量やデータの見直しへ、過去のデータでは勝ったのに影の運用で差が出なかったなら評価データの切り方や選択の偏りの見直しへ、判定の時間や特徴量の計算が間に合わなかったならシステムの設計の見直しへ、という具合です。「不合格なら期間を延ばしてもう少し試す」は、出口として書かないほうがよいと考えています。延長を出口にすると、何が足りなかったのかを分析しないまま期間だけが延び、PoC が終わらなくなります。
PoC が本格導入に進まずに止まる理由は、ここまでの項目を決めずに始めたことにあることが多いように思います。不正検知でとくに起きやすいと考えているのは、次の3つの止まり方です。1つ目は、過去のデータでの評価だけで報告書を作り、影の運用や本番への接続の段取りが無いまま終わる止まり方です。2つ目は、アラートの件数をそろえずに再現率だけを比べ、「再現率が上がった」と報告したものの、そのしきい値では調査の能力を大きく超えることが後から分かる止まり方です。3つ目は、PoC を外部のベンダーに任せ、ベンダーの環境で出た成績を受け取ったものの、自社の評価データで測り直す人がいないまま判断を迫られる止まり方です。どれも、始める前の設計で手を打てるものです。
効果の見立て、金額ではなく率と件数の型で書く
PoC の計画を通すにも、展開の予算を得るにも、効果の見立てが求められます。このとき、効果をいきなり金額で書こうとすると、根拠の薄い前提を掛け合わせた数字が一人歩きしやすくなります。本コラムでは、効果の見立てを金額ではなく、率と件数の型で書くことを勧めます。金額への換算は、各社の事業の責任者と経理が、自社の被害の記録と取引の条件で行えばよく、不正検知の計画書の段階で金額を置く必要はないと考えています。
金融庁が2026年3月に公表した「AIディスカッションペーパー(第1.1版)」は、金融機関等へのアンケートやヒアリング、官民の意見交換の内容を整理した文書で、AIへの投資の効果の測り方にも触れています。29ページでは、実証実験(PoC)の段階の案件は、収益化の目途が立つまでの間、利用者や利用件数などの特性に応じた KPI を設定して計画と比べることも考えられる、という趣旨が書かれています。同じ箇所には、業務の「削減時間」を KPI にする従来のやり方が、業務の進め方そのものを変える AIの評価にはなじまない可能性がある、との指摘が官民の意見交換であったことも書かれています。不正検知の場合も、調査の時間の削減だけを効果にすると、見逃しと誤検知の変化が抜け落ちます。
見立ての骨格は、KPI の木の末端から上へ積み上げる形で書けます。たとえば、対象の不正について、調査担当が1日に確認できる件数をアラートの上限としたとき、今のルールの適合率と再現率に対して、新しい方式でどの程度の幅の改善があれば、アラートにできずに見逃す不正の件数がどれだけ減り、アラートのうち正当な取引の件数がどれだけ減るかを、幅を持たせて計算しておきます。改善の幅は PoC の前には分からないので、見立ての段階では「この程度の改善があれば、最終の KPI がこれだけ動く」という形で置きます。こうしておくと、PoC の合格の条件を、「事業にとって意味のある最小の改善」として決める根拠にもなります。
見立ての数字を書くときに避けたいのは、公開の事例や研究の数字を、そのまま自社の効果として書くことです。第14章で扱うとおり、公開の事例の数字は、その会社の、そのサービスの、その条件での値です。研究の数字も、その研究が使ったデータ・評価の方法・実験の条件での値です。どちらも自社の取引で同じ値が出る根拠にはなりません。ベンダーが示す再現率や誤検知の削減の率も同じで、第8章で扱った「ベンダーの示す数字を読むときに聞くこと」で、評価の条件を確かめてから扱います。見立ての数字は、自社の今のルールの成績と、PoC の結果から作り、「この PoC の期間・この対象の不正・この取引の範囲では」という限定を付けて書きます。
見立ての対象は、序章で整理した6つの損失の型に沿って考えると、漏れが少なくなります。次の表は、6つの損失の型それぞれについて、何を数え、導入の前にどこから数字を取り、導入の後に何と比べるかをまとめたものです。
| 損失の型 | 数えるもの(率・件数) | 導入の前の数字の取り方 | 導入の後に比べるもの |
|---|---|---|---|
| 見逃しによる被害 | 確認済みの不正のうち、アラートにできなかった件数と割合(見逃し)。額の相対値で重み付けた割合。この行では、アラートにしたが調査の遅れや措置の不成立で防げなかった被害も並べて数えるが、見逃しとは別の欄に分ける | 現状の把握で集めた、アラートにならなかった不正の件数(本人の申告・チャージバックとの結び付け)と、アラートになったが防げなかった不正の件数(ケース管理の記録) | 同じ期間の長さ・同じ対象での同じ割合。ラベルが確定するまで待ってから比べる |
| 誤検知による機会損失 | 保留や拒否にした取引のうち、後から正当と分かった件数と、取引全体に対する割合 | 保留・拒否の記録と、顧客対応の記録の結び付け | 同じ割合。保留のうち追加の認証で通った件数も分けて数える |
| 調査の過負荷 | 1日のアラートの件数と調査の能力の比、調査されずに流れた件数、滞留の件数 | ケース管理の記録(無ければ PoC の前に記録を始める) | 同じ指標。アラートの件数が調査の能力の内に収まっているか |
| 顧客の離反 | 止められた正当な顧客のうち、その後に利用をやめた顧客の割合、問い合わせや苦情の件数 | 顧客対応の記録と、利用の継続の記録 | 同じ指標。特定の顧客の群に偏っていないか(第11章) |
| 形骸化 | ルールやモデルを最後に見直してからの期間、成績を測り直した間隔、使われていないルールの本数 | ルールの台帳(第3章)。台帳が無ければ作るところから始める | 導入の後、決めた間隔で成績を測り直し、ルールとモデルを見直しているか |
| 規制上の義務の不履行 | 確認・届出・記録の義務に関わる手続きのうち、期限内に終えた件数の割合、監査での指摘の件数 | コンプライアンスと内部監査の記録 | 同じ指標。検知の方式を変えたことで、記録や届出の手続きが抜けていないか(第14章) |
表の「見逃しによる被害」と「誤検知による機会損失」の行は、必ず並べて報告します。片方だけが改善したと報告すると、序章で述べた「成果は両方を数えたうえでの差」という考え方から外れます。報告の書式の段階で、2つの行を同じ表に並べる形に決めておくと、片方だけを成果として示す報告を防げます。アラートの件数や再現率は、この2つの行を説明するための補助の数字として、別の欄に置きます。
表の「導入の後に比べるもの」は、前後の変化を見張るための指標です。取引の構成・季節・不正の起きる頻度も前後で変わるので、変化をそのまま導入の効果と判断するときは、比べる相手(同じ時期に新しい方式を使わなかった範囲など)や構成の変化も確かめます。顧客の離反の行も、止められた後に利用をやめた顧客の中には、止められたこと以外の理由でやめた顧客が含まれることを前提に読みます。
「規制上の義務の不履行」の行は、検知の方式を変えるときに見落とされやすい行です。金融庁のマネー・ローンダリング及びテロ資金供与対策に関するガイドライン(2026年3月31日の版)は、取引モニタリングについて、自らのリスク評価を反映したシナリオや敷居値などの抽出基準を設け、届出の状況などを踏まえてその有効性を分析し、改善を図ることを、対応が求められる事項として挙げています(Ⅱ-2(3)(ⅲ))。ルールを機械学習のスコアに置き換えるときも、どの基準で抽出しているのかを説明でき、その有効性を検証した記録が残る形にしておく必要があります。この点の詳細は第14章で扱います。
段階的な展開、ルールの整理からスコアによる順位づけ、自動の措置へ
PoC に合格しても、すぐにモデルのスコアで取引を自動で止めることは避けるべきだと考えています。PoC は、限られた期間・対象・取引の範囲で行ったもので、手口が変わったとき、季節や販促で取引の量が変わったとき、新しい商品や経路が加わったときの動きまでは含んでいません。第10章で扱ったとおり、モデルは時間とともに古くなります。本コラムでは、スコアの使い方を、影響の小さい使い方から大きい使い方へ、段階を分けて広げることを勧めます。
最初の段階は、ルールの整理です。モデルを入れる前に、今のルールを台帳にまとめ(第3章)、成績の低いルールや、他のルールと同じ取引ばかりを拾っているルールを見直します。この段階は、モデルを使わなくても誤検知を減らし、調査の能力に余裕を作れることがあります。次の段階は、スコアで調査の順位を付ける使い方です。アラートを出す基準は今のルールのままにし、調査担当が確認する順番だけをスコアの高い順に並べ替えます。この使い方では、スコアで取引を直接止めることはしないので、顧客への影響を小さく抑えやすくなり、調査担当がスコアの当たり外れを日々の作業の中で確かめられます。ただし、調査の能力が限られていれば、順番を変えると実際に調査される取引や調査の時刻が変わり、保留にした正当な取引の待ち時間も変わりえます。そのため、この段階でも、長く滞留したアラートの件数と保留の待ち時間を確かめます。その次の段階で、スコアを使ってアラートそのものを出す、つまりルールでは拾えない取引をスコアでアラートにする使い方に進みます。最後の段階が、スコアに応じた自動の措置で、第9章で扱った段階的な措置(低いスコアは通す・中間は追加の認証を求める保留・高いスコアは止める)を、承認の前の判定に組み込みます。
展開の段階を次の表にまとめました。段階の区切り方は本コラムが考えた例で、事業の規模や対象の不正によって変わります。
| 段階 | スコアの使い方 | 主に確かめること | 次の段階へ進む条件 | 主に判断する人 |
|---|---|---|---|---|
| ルールの整理 | 使わない。今のルールを台帳にまとめ、成績を測って見直す | ルールごとの適合率とアラートの件数、重複するルール | 台帳と成績の記録がそろい、ベースラインの成績が出た | 不正対策 |
| 調査の順位づけ | 今のルールのアラートを、スコアの高い順に並べて調査する | スコアの上位で不正が多く見つかるか。調査担当がスコアを使えるか | 上位のアラートで適合率が今の順番より高いことが、ラベルの確定後に確かめられた。長く滞留したアラートの件数と保留の待ち時間が悪化していない | 不正対策・事業の責任者 |
| スコアによるアラート | ルールで拾えない取引のうち、スコアの高いものをアラートにして事後の調査に回す | 新しく拾えた不正の件数、アラートの件数が調査の能力の内に収まるか | 見逃しの減り方と誤検知の増え方が合格の条件の内に収まった | 事業の責任者 |
| 自動の措置 | 承認の前に判定し、スコアに応じて承認・保留・拒否を自動で決める | 誤って止めた正当な取引の割合、顧客の問い合わせ、判定の時間、障害のときの扱い | (最終段階。監視と再学習を続ける) | 経営・事業の責任者 |
表の「調査の順位づけ」の段階は、不正検知に特有の、使いやすい中間の段階だと考えています。ここでは、アラートを出す基準も、スコアで直接止める取引も変えないので、誤検知による機会損失や顧客の離反の型の損失は増えにくいと考えています(調査の順番が変わることによる待ち時間の変化は、前述のとおり確かめます)。一方で、調査担当が限られた時間で確認できるアラートの中に、不正が多く含まれるようになれば、調査の過負荷と見逃しの両方に効く可能性があります。調査担当にとっては、スコアがどんな取引を高く評価するのかを日々の作業の中で知る機会になり、第11章で扱った理由コードの使い勝手を確かめる場にもなります。
「自動の措置」の段階に進むときは、第12章で扱った障害のときの扱い(判定が返らないときに通すのか止めるのか)と、変更の管理、記録と監査の仕組みが動いていることを確かめてから進みます。また、止められた顧客が正当だと示す道筋(第11章の異議の申し立てと救済の手続き)を、この段階より前に用意しておきます。自動で止める範囲を広げるときは、誤って止めた取引の件数と、影響を受けた顧客の数(同じ顧客を重ねて数えない人数)を確かめます。
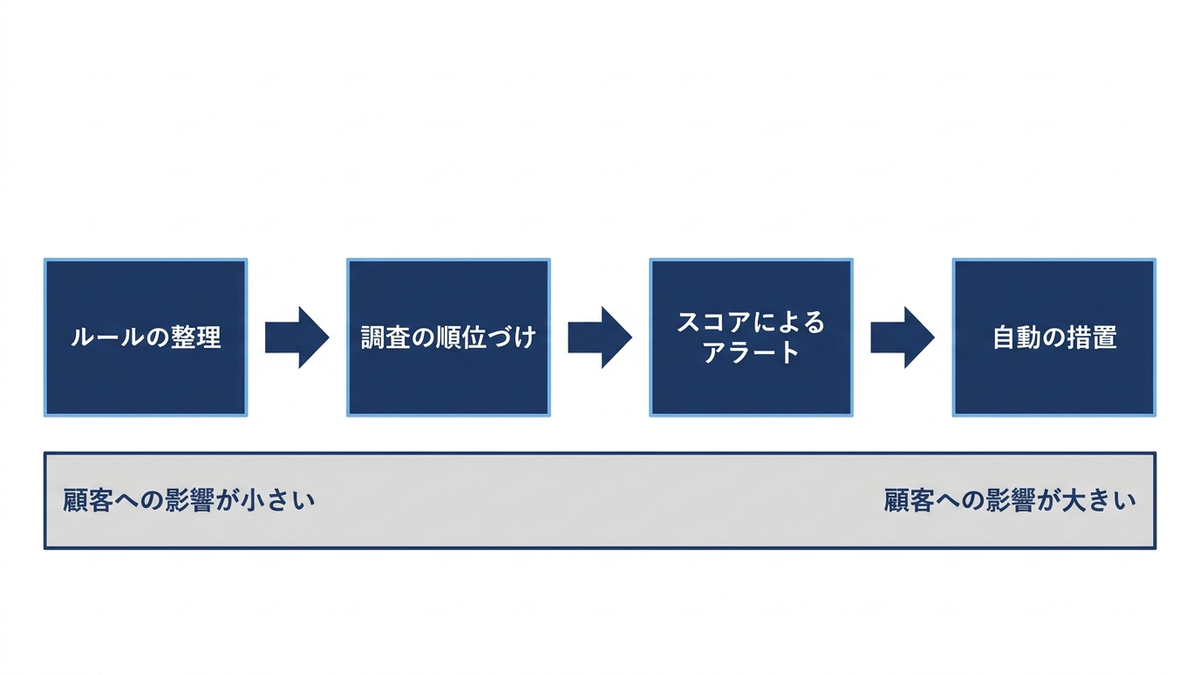
役割と責任分担、三つの防衛線の中で不正検知をどこに置くか
不正検知の導入に関わる人は、モデルを作る人よりずっと多くなります。検知の結果は調査担当の作業になり、止めた取引は顧客対応の問い合わせになり、取引の記録は個人データの取り扱いに関わり、検知の基準は規制や監査で説明を求められるからです。本コラムでは、関わる役割を次の13に分けて考えます。役割の名前は一般的なものにしてあり、組織によっては1人が複数の役割を兼ねます。
- 経営:不正検知への投資の方針・予算・リスクの許容の水準(どの不正を、どの水準まで減らすか)を決める
- 事業の責任者:担当する商品やサービスの不正検知の目的と KPI の木、PoC の出口、展開の段階の移行を承認する
- リスク管理:全社のリスクの評価の中で不正のリスクを位置づけ、モデルのリスクの管理(独立した検証)を担う
- 不正対策:ルールの台帳、しきい値、措置の方針を持ち、検知の運用を主導する
- コンプライアンス:法令やガイドラインが求める確認・届出・記録の要件を示し、検知の仕組みがそれを満たすかを確かめる
- 顧客対応:止められた顧客からの問い合わせ、本人への確認の連絡、異議の申し立ての受け付けを担う
- 調査担当:アラートを確認して不正かどうかを判断し、その結果を記録する
- データ分析:現状の成績の測定、特徴量とモデルの作成、評価、効果の報告を担う
- エンジニア:特徴量の計算、モデルの推論、ルールの実行、記録の仕組みを作る
- 情報システム:データ基盤、システムの運用と監視、障害のときの対応、情報セキュリティを担う
- 法務:個人データの利用目的や第三者への提供、外部との契約の内容を確かめる(第14章)
- 内部監査:検知と調査の仕組みが、決めたとおりに動き、有効に機能しているかを独立した立場から確かめる
- 外部のベンダー:不正検知の製品やクラウドのサービスの提供、場合によってはモデルの開発と運用を担う
この13の役割で、主な作業ごとの責任分担を表にしたのが次の表です。この4つの区分の考え方は RACI と呼ばれ、フレームワークとしての一般的な使い方は弊社コラム『経営とAIの打ち手を導く戦略フレームワーク大全179選』で扱っています。ここでは不正検知の導入に当てはめた表を示します。表の割り振りは本コラムが考えた例で、組織の大きさや既存の体制によって変わります。
表の記号の意味は次のとおりです。
- R:実行する(作業を担う)
- A:最終的に責任を持つ(承認する)。各行に1つだけ置く。R の列が空の行は、A が実行も兼ねる
- C:相談を受ける(意見を出す)
- I:結果を知らされる
表が横に広くなるので、列名は次の略称で書いてあります。
- 事業=事業の責任者、リスク=リスク管理、不正=不正対策、コンプラ=コンプライアンス、顧客=顧客対応、調査=調査担当
- 分析=データ分析、エンジ=エンジニア、情シス=情報システム、監査=内部監査、外部=外部のベンダー
| 作業 | 経営 | 事業 | リスク | 不正 | コンプラ | 顧客 | 調査 | 分析 | エンジ | 情シス | 法務 | 監査 | 外部 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 対象の不正の選定と採点 | I | A | C | R | R | C | R | R | I | C | I | I | C |
| リスクの許容の水準の決定 | A | R | R | C | C | I | I | C | I | I | I | I | I |
| KPI の木の設計と承認 | C | A | C | R | C | C | C | R | I | I | I | I | I |
| 今のルールの成績の測定 | I | I | C | A | I | C | R | R | R | C | I | I | I |
| 調査の結果を残す記録の設計 | I | I | C | A | C | C | R | R | R | R | C | I | C |
| 個人データの利用と規制上の要件の確認 | I | A | C | C | R | I | I | C | C | C | R | I | C |
| PoC の合格の条件と出口 | I | A | C | R | C | C | C | R | C | I | I | I | C |
| モデルの作成と過去のデータでの評価 | I | I | C | C | I | I | C | A | R | I | I | I | R |
| モデルの独立した検証 | I | I | A | C | C | I | I | C | I | I | I | I | C |
| 影の運用と追加の確認 | I | I | I | A | I | I | R | R | R | R | I | I | C |
| しきい値と措置の方針の決定 | C | A | C | R | C | C | C | R | I | I | C | I | I |
| 出口の判断と展開の段階の移行 | I | A | C | R | C | C | C | R | C | C | I | I | I |
| 異議の申し立てと救済の手続き | I | A | I | C | C | R | R | I | I | I | C | I | I |
| 再学習したモデルの承認 | I | A | C | C | I | I | I | R | C | I | I | I | C |
| 監視と障害のときの対応 | I | I | C | C | I | I | I | R | R | A | I | I | R |
| 検知と調査の仕組みの監査 | I | I | I | C | C | I | C | C | I | C | I | A | I |
| 効果の報告(見逃しと誤検知を並べて書く) | I | A | C | R | C | C | C | R | I | I | I | I | C |
表は、A の列だけを拾って読むと、誰が何を承認するかが分かります。この表で意図して置いたのは、次の4つの割り振りです。1つ目は、目的と出口に関わる行(対象の選定・KPI の木の設計と承認・PoC の合格の条件と出口・しきい値と措置の方針・出口の判断・再学習したモデルの承認・効果の報告)の A を、データ分析ではなく事業の責任者にしたことです。しきい値を決めることは、見逃しと誤検知のどちらをどれだけ許すかを決めることで、技術の判断ではなく事業の判断です。
その上位にある、どの不正をどの水準まで減らすかというリスクの許容の水準だけは、経営が A を持ちます。KPI の木は、経営が決めた水準を受けて事業の責任者が設計し、承認します。
再学習したモデルの承認は、第10章の再学習の手順の表で承認の担当をリスク管理と事業の責任者に置いたことに合わせ、A を事業の責任者、リスク管理を C にしました。データ分析の担当者は、その判断の材料(アラートの件数ごとの適合率と再現率、調査の能力、指標のばらつきの幅)をまとめる R を担い、不正対策は行によって R か C として加わります。
2つ目は、「モデルの作成と過去のデータでの評価」の A を外部のベンダーではなく社内のデータ分析にし、「モデルの独立した検証」の A をリスク管理にしたことです。モデルを作る作業(R)は外部に任せる場合でも、納められたモデルを社内の評価データで評価し直す人は社内に置いておく必要があると考えています。さらに、作った人とは別の立場の人が検証する仕組みを置きます。金融庁の AIディスカッションペーパー(第1.1版)の30ページには、モデルの開発者と独立した検証者が本番に使う前の検証や継続的な性能の監視を行っている先があった、という事例が紹介されています。
3つ目は、「調査の結果を残す記録の設計」と「影の運用と追加の確認」で、調査担当に R を置いたことです。調査担当は、ラベルを作る人であり、スコアを日々使う人でもあります。記録の項目が調査の実務に合っていないと、記録が残らないか、残っても後の学習に使えない形になります。4つ目は、「異議の申し立てと救済の手続き」の R を顧客対応と調査担当にしたことです。止められた顧客の声が最初に届くのは顧客対応なので、そこで受けた申し立てを調査担当が確かめ、結果をラベルの修正に戻す流れにしました。
表の A は各行に1つだけ置きました。A が2つある行は、承認する人が2人いることになり、意見が割れたときに決まらなくなります。逆に、A が無い行は、誰も承認しないまま作業が進むか、作業が止まります。表を自社の組織に当てはめるときは、まず各行の A が1人に決まっているかを確かめ、次に R を担う人の工数が確保されているかを確かめることを勧めます。とくに、調査担当・データ分析・不正対策の R が多くの行に並ぶので、日々の調査の業務と兼任で回せる量かどうかを先に見積もっておきます。
役割を組織の中に置くときの考え方として、金融機関では三つの防衛線の考え方がよく使われます。金融庁のマネー・ローンダリング及びテロ資金供与対策に関するガイドライン(2026年3月31日の版)は、Ⅲ-3「経営管理(三つの防衛線等)」で、営業・管理・監査の各部門の役割と責任を、経営陣の責任の下で明確にする一つの方法として、この考え方で整理しています。同ガイドラインでは、第1の防衛線は顧客と直接接する営業部門、第2の防衛線はコンプライアンス部門やリスク管理部門などの管理部門、第3の防衛線は内部監査部門を指すとされています。第2の防衛線には、取引モニタリングシステムなどを所管するシステム部門や、専門性を持つ人材の確保を担う人事部門も含まれるとされています。
同じ名前の考え方は内部監査人協会(The IIA)も示しており、IIA は2020年に「三つの防衛線」を見直した「3ラインモデル」を公表し、2026年7月にはその後継となる文書(協会としての考え方を示す意見表明の文書。英語名は Statement of Position)を公表しています。本コラムでは、名称の違いには立ち入らず、ガイドラインの整理に沿って説明します。
不正検知をこの考え方の中に置くと、次のようになると考えています。取引の現場で不正の疑いに最初に直面し、措置を取るのは事業の側(第1の防衛線)です。不正検知の仕組みそのもの、つまりルール・モデル・しきい値・調査の運用は、事業の側に置く場合も、管理部門の側に置く場合もあり、組織によって分かれます。どちらに置く場合も、ルールやモデルの有効性を作った人とは別の立場から確かめる役割(第2の防衛線)と、仕組み全体が決めたとおりに動いているかを独立して確かめる役割(第3の防衛線)を分けておくことが大事です。前の表で、モデルの独立した検証の A をリスク管理に、仕組みの監査の A を内部監査に置いたのは、この分け方に合わせたためです。金融機関以外の事業でも、作る人・確かめる人・監査する人を分けるという考え方は、そのまま使えます。
内製と外部委託・製品の利用、何を外に任せ、何を社内に残すか
不正検知の仕組みを用意する方法は、おおまかに3つに分かれます。社内でルールとモデルと仕組みを作る内製、開発や運用を外部の会社に依頼する外部委託、不正検知の製品やクラウドのサービスを利用する方法です。実際には、判定の仕組みは製品を使い、ルールの見直しと評価は社内で担う、といった組み合わせにする場合もあります。本コラムでは、製品やサービスどうしの優劣は扱わず、3つの方法を選ぶときの観点を一般論として整理します。
| 観点 | 内製 | 外部委託 | 製品・クラウドのサービスの利用 |
|---|---|---|---|
| 立ち上げの速さ | 人とデータ基盤がそろっていれば速いが、無ければ遅い | 依頼先の体制しだい。要件を決める時間が要る | 用意された機能の範囲なら速いことが多い |
| 自社の取引への合わせやすさ | 自社の取引の特徴や手口に合わせた特徴量を作りやすい | 契約で決めた範囲で合わせられる | 製品が用意した設定と特徴量の範囲に限られることがある |
| 学習に使えるデータ | 自社の記録が中心。利用の権限を確かめた外部のデータを組み合わせられるかどうかで範囲が変わる。不正の件数が少ないと学習が難しい | 自社の記録だけ(依頼先が他のデータを持ち込む場合は、その扱いを確かめる) | 製品によっては、複数の利用者のデータを使ったモデルやスコアが提供される。その範囲と条件は製品の公式の説明で確かめる |
| 評価と改善の主導権 | 社内にある | 評価の方法とデータを社内に持たないと外部に寄る | 評価の方法とデータを社内に持たないと製品の画面の数字に寄る |
| 説明と監査への対応 | ルールとモデルの中身を社内で説明できる | 成果物の文書を契約で決めておく必要がある | 判定の理由をどこまで出せるかは製品による |
| 社内に必要な人 | データ分析・エンジニアを継続して確保する | 依頼の内容を決め、納品物を評価できる人 | 設定と連携を担う人と、成績を評価できる人 |
| やめるとき・替えるとき | 担当者の異動や退職で止まるおそれ | 成果物(モデル・ルール・記録)の扱いを契約で決めていないと引き継げない | 判定の記録や調査の結果が製品の中にしか無いと、替えた後に比べられない |
表の「学習に使えるデータ」の行は、不正検知に特有の論点です。不正は件数が少ないので、1社の記録だけでは、モデルの学習に足りる数の不正が集まらないことがあります。金融庁の AIディスカッションペーパー(第1.1版)は、金融機関等を対象にした2024年の実態調査をもとに従来型の AIの使われ方を整理しており、10ページでは、マネー・ローンダリング対策の取引モニタリングについて、個社の学習データの不足で本番での利用が難しかった例と、ルールとの併用や複数社での開発・データの活用の動きを紹介しています。同ペーパーの23ページにも、実際の不正の件数が少ないので自社のデータだけでは学習データとして不十分、という課題の声が挙げられています。自社の記録だけで足りるか、外部のデータを使うか(内製で組み合わせるか、外部のデータを使うサービスを選ぶか)は、対象の不正の件数と、第1章で扱った手口の共通性(他社でも同じ型の不正が起きているか)で考えることになります。
表のどの列を選ぶ場合も、社内に残しておきたいものは共通しています。KPI の木と成果の定義、調査の結果を含む判定の記録、過去のデータでの評価に使う評価データ、成績を測り直す主導権の4つです。これらを社内に持っていれば、方式を替えても、依頼先や製品を替えても、同じ物差しで比べられます。前述のガイドラインも、IT システムの活用(Ⅱ-2(3)(ⅵ))の対応が求められる事項として、外部に委託する場合や共同のシステムを使う場合でも、自らの取引の特徴やリスクを分析し、必要に応じて独自の追加の対応を検討することを挙げています。外部委託先の管理(Ⅲ-3(4))では、委託する業務について委託先の態勢を検証することを求めています。
外部のベンダーに依頼する場合、あるいは製品を選ぶ場合に確かめておきたいことを、次の表にまとめました。表の中身は第8章から第12章で扱った論点を、ベンダーへの質問に置き換えたものです。答えの良し悪しを決める基準は自社の対象と体制によって変わるので、表は質問の一覧として使うことを想定しています。
| 確かめる領域 | 聞くこと | 答えが曖昧なときに起きること | 関連する章 |
|---|---|---|---|
| 評価の方法 | 示された成績は、どのデータで、どの期間で、ランダムに切ったのか時間で切ったのか。アラートの件数(しきい値)をいくつにしたときの適合率と再現率か | 成績の数字が自社の取引で再現せず、導入の後に誤検知が多いと分かる | 第8章 |
| ラベルの扱い | 自社の調査の結果やチャージバックの記録を、どの形で受け取り、学習に戻すのか。ラベルの遅れをどう扱うのか | 調査の結果がモデルに反映されず、同じ誤検知が続く | 第2章・第9章 |
| 再学習と監視 | 再学習の頻度と手順、成績の低下をどう検知するのか、再学習したモデルを誰が承認するのか | 手口が変わっても気づかず、モデルが古くなる | 第10章 |
| 説明 | 1件のアラートについて、調査担当にどんな理由を示せるのか。監査や当局への説明に使える文書があるか | 調査担当がスコアを信用できず、使われなくなる。監査で説明できない | 第11章 |
| 障害のとき | 判定が返らないときの既定の動き(通すか止めるか)、復旧までの手順、その間の記録 | 障害のときに全件を通すか全件を止めるかの事態になる | 第12章 |
| データと記録 | 送るデータの範囲、保管の場所と期間、他の利用者のモデルに使われるかどうか、契約が終わったときの記録の返却 | 個人データの扱いが利用目的の範囲を超えるおそれ。乗り換えのときに記録が残らない | 第12章・第14章 |
表の「評価の方法」の行は、とくに PoC の段階で効きます。ベンダーが示す成績を受け取るだけでなく、自社の評価データ(時間で切り、ラベルが確定した期間のもの)を自社で用意し、同じ条件で今のルールと比べる設計にしておくことを勧めます。製品の機能で成績を集計する場合は、指標の定義とアラートの件数のそろえ方が自社の KPI の木と合っているかを、その製品の公式の説明書で確かめてから使います。
外部に依頼する範囲と、社内に残す範囲は、契約の段階で文書にしておきます。社内と外部の役割、判定の記録・学習したモデル・ルールといった成果物をどう管理するか、取引の記録や顧客のデータをどの範囲で渡し、どう扱ってもらうか、といった項目です。契約の条件そのものは本コラムの範囲を超えるので書きませんが、不正検知の開発を依頼する場合は、成果を事前に約束しにくいこと、成果の測り方を自社の定義に合わせる必要があること、判定の基準の詳細を外に出さない必要があること(第10章の敵対的な変化)のように、決まった仕様のシステムを納める場合とは違う論点が出やすいと考えています。AIの社内ルールや規制との関係は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
業界での情報の共有と人材、1社では集まらない知識をどう補うか
不正の手口は、1社の中だけで見ていると、気づくのが遅れることがあります。ある会社で起きた型の不正が、少し遅れて別の会社でも起きる、ということがあるからです。前述のガイドラインは、Ⅰ-3「業界団体や中央機関等の役割」で、個々の金融機関による情報収集だけでは限界がある場合があるとし、業界団体や中央機関などが当局と連携して、参考になる情報や対応の事例を共有することや、必要かつ適切な場合にはシステムの共同運用を促すことが重要だとしています。不正検知の導入の計画では、自社が加わっている業界団体や、取引先(カード会社・決済代行・加盟店など)との間で、どんな情報を受け取れ、どんな情報を出す必要があるかを、早い段階で確かめておきます。情報の共有には個人データの第三者への提供の論点が伴うので、どの情報をどの根拠で共有できるかの詳細は第14章で扱います。
人材の面では、不正検知に要る知識が2つの領域にまたがることが、導入の難しさの1つになっています。1つは不正の知識で、どんな手口があり、調査で何を確かめ、どの記録が証拠になるかを知っていることです。もう1つはデータ分析の知識で、不均衡なデータでの評価、ラベルの遅れ、時間で切った評価、リークの防ぎ方などを知っていることです。不正の知識だけでは、モデルの成績の数字が意味を持つ条件を確かめられず、データ分析の知識だけでは、モデルが拾った取引が調査に値するかを判断できません。両方を1人が持つことは多くないので、本コラムでは、不正対策や調査担当とデータ分析の担当者が同じ PoC の中で作業し、互いの判断の根拠を言葉にして記録する体制を勧めます。
前述のガイドラインは、Ⅲ-5「職員の確保、育成等」で、職員の役割に応じた知識と専門性の確保と、継続的な研修、その効果の確認を求めており、全社の疑わしい取引の届出の状況や管理部門に寄せられた気づきを営業部門に還元することも挙げています。不正検知に当てはめると、調査担当が見つけた新しい手口の気づきをデータ分析の担当者に渡し、データ分析の担当者がスコアの傾向や成績の変化を調査担当に返す、という双方向の還元を、定例の場として決めておくことになります。この場は、第10章で扱った手口の変化への追従の入口にもなります。
最初の90日の計画と形骸化の型、週ごとに何を決め、何を残すか
ここまでの内容を、導入を決めてから最初の90日(およそ13週)の計画に落とします。次の表は、本コラムが考えた計画の例です。90日で、1つの対象の不正について、現状の把握、過去のデータでの評価、影の運用を終え、出口を判断するところまでを範囲にしています。実際の期間は、調査の結果が取引と結び付けて残っているか、ラベルが確定するまでの遅れがどれだけあるか、影の運用のための仕組みを作るのにどれだけかかるかで大きく変わるので、週の区切りは目安です。
ラベルの遅れが長い不正では、影の運用の期間のラベルが90日の内に確定しないことがあります。その場合は、追加の確認で得た調査の結果で中間の判断をし、最終の判断はラベルが確定してから行う、という2段の判断を計画に書いておきます。
また、表では影の運用を3週間にしていますが、不正の件数が少ない対象では、この期間に集まる不正の件数が少なすぎて、モデルと今のルールの差を読み取れないことがあります(第8章・第12章)。影の運用を始める前に、その期間に見込まれる不正の件数を見積もっておき、差を読み取れなかった場合も、出口を期間の延長にはせず、追加の確認の結果で中間の判断をする形にしておきます。ただし、スコアの高い取引を選んで確かめる追加の確認は、モデルが新しく拾える不正を探すことには使えても、件数の不足や選び方の偏りを解消するものではありません。中間の判断では有効性の合格とはせず、続けるための実行の見込みと、追加の検証が要るかどうかを判断します。
| 週 | 主な作業 | 決めること | 残すもの | 主に担う役割 |
|---|---|---|---|---|
| 第1週・第2週 | 候補の不正の洗い出しと採点、記録の項目の棚卸し | 最初の対象の不正と、対象の取引の範囲 | 採点の表、記録の項目の一覧(調査の結果と取引が結び付くか) | 事業の責任者・不正対策・調査担当・コンプライアンス・データ分析 |
| 第3週・第4週 | 今のルールの成績の測定、KPI の木とガードレールの指標の設計、個人データの扱いと規制上の要件の確認 | ベースラインの成績、主な KPI、ガードレールの指標 | ルールごとの成績の表、KPI の木、法務とコンプライアンスの確認の記録 | 不正対策・データ分析・調査担当・法務・コンプライアンス |
| 第5週 | PoC の計画書の作成と承認 | 比べる相手・評価の方法・アラートの件数のそろえ方・合格の条件・影の運用の範囲・出口・判断する人 | 承認された PoC の計画書 | データ分析・不正対策・事業の責任者 |
| 第6週から第8週 | 評価データの作成(時間で切り、ラベルが確定した期間)、特徴量とモデルの作成、過去のデータでの評価、独立した検証 | 影の運用に進めるモデル(ルールに勝ったもの) | 過去のデータでの評価の結果、モデルの版、検証の記録 | データ分析・エンジニア・リスク管理・外部のベンダー |
| 第7週から第9週 | 影の運用の仕組み(スコアの記録・判定の時間の測定)の準備 | スコアを記録する取引の範囲、追加で確認する件数の上限 | スコアの記録の仕組み、判定の時間の記録 | エンジニア・情報システム・不正対策 |
| 第10週から第12週 | 影の運用、スコアの上位でルールのアラートにならなかった取引の追加の確認 | (期間中は結果を見て条件を変えない) | スコアの記録、追加の確認の結果、ガードレールの指標の記録 | 調査担当・データ分析・不正対策 |
| 第13週 | 分析と出口の判断(ラベルの確定が間に合わない場合は中間の判断) | 調査の順位づけの段階へ進むか、特徴量やデータの見直しか、対象の変更か、中止か | 判断の記録と理由、効果の報告(見逃しと誤検知を並べて書く)、次の段階の計画の案 | 事業の責任者・不正対策・データ分析 |
表の第6週から第9週は、過去のデータでの評価と、影の運用の仕組みの準備を並行して進める形にしています。評価が終わってから仕組みを作り始めると、その分だけ影の運用の開始が遅れ、PoC が90日に収まりません。過去のデータでの評価でどのモデルも今のルールに勝てなかった場合は、影の運用に進まず、第13週を待たずに出口の判断に移ります。その場合でも、第3週・第4週で測ったルールの成績と、見つかった記録の不足は、ルールの整理の段階の材料として残ります。PoC が不合格でも、何も残らない計画にはしないことが大事です。
第13週の出口の判断では、PoC の計画書に書いた出口のどれに当たるかを確かめるだけにし、その場で新しい合格の条件を作らないようにします。結果を見てから条件を変えると、PoC が何を確かめたのかが分からなくなります。条件を変える必要があると分かった場合は、それを次の PoC の計画書に書き、改めて承認を得ます。
導入がうまく進んでも、その後に検知の仕組みが形だけになることがあります。序章で整理した損失の型のうち、形骸化は導入の後に時間をかけて進むので、導入の時点で型を知っておき、防ぐ仕組みを最初から入れておくのがよいと考えています。本コラムでは、ここまでの章の論点から、不正検知が形骸化する型を次の表に整理しました。
| 形骸化の型 | 何が起きるか | 最初から入れておく仕組み | 関連する章 |
|---|---|---|---|
| ルールが増え続ける | 手口が出るたびにルールを足し、廃止しないので、誤検知が増え、どのルールが効いているかが分からなくなる | ルールの台帳、担当、見直しの時期、廃止の基準 | 第3章 |
| モデルが古くなる | 導入の時点の成績のまま見直されず、手口の変化に置いていかれる | ラベルを待たない監視、再学習の手順と承認、成績を測り直す間隔 | 第10章 |
| アラートが見られない | アラートが調査の能力を超え、古いものから見られずに流れる。確認が形だけになる | しきい値を調査の能力と一緒に決める仕組み、滞留の監視 | 第9章 |
| 調査の結果が戻らない | 調査の判断が記録されず、ラベルにもルールの見直しにも使われない | 調査の記録の項目、ラベルへの取り込みの流れ | 第2章・第9章 |
| スコアが使われない | 調査担当がスコアの理由を理解できず、スコアを見ずに従来どおりの順で確認する | 理由コード、調査担当との定例の還元の場 | 第11章 |
| 担当が1人 | ルールやモデルを分かっている担当者が異動すると、見直しが止まる | 手順の文書、少なくとも2人が担える体制 | 本章 |
| 成果を測らない | 導入の時点で成果を確かめた後、測り直さないので、効果が薄れても気づかない | 見逃しと誤検知を並べた定期の報告、無作為の点検(第10章) | 第8章・第10章 |
| 検証が作った人の中で閉じる | モデルを作った人だけが成績を確かめ、独立した検証や監査が入らない | 独立した検証、内部監査の計画への組み込み | 本章・第14章 |
表の型は、どれも導入の後に気づくと手間がかかるものです。ルールの台帳が無いまま何年も運用すると、どのルールを消してよいかを判断する材料が無くなります。調査の結果を記録しないまま運用すると、後からモデルを作ろうとしたときにラベルが無いことに気づきます。どの型も、導入の最初の90日の中で、記録の項目と担当と見直しの時期を決めておけば防ぎやすくなります。
経営判断、PoC の出口と成果の測り方を先に決める
この章の内容を、経営の判断に置き換えます。不正検知の導入で経営が決めることは、どの方式やどの製品を使うかではなく、どの不正を、どの水準まで、どの条件で、誰の責任で減らすかです。とくに、PoC の出口と成果の測り方を始める前に決めることと、成果を見逃しと誤検知の両方を並べて報告させることの2つは、経営の判断として明文化しておくのがよいと考えています。
判断を誤ったときの損失は、序章で整理した6つの損失の型で整理できます。最初の対象を「話題の不正」で選び、措置を取れない不正に投資すると、見つけても防げず、不正による被害が減りません。アラートの件数をそろえずに再現率だけで合格を決めると、本番でアラートが調査の能力を超え、調査の過負荷から、アラートになっても防げない不正が増えるおそれがあります。被害だけを最終の KPI にすると、しきい値が下がり続け、誤検知による機会損失と顧客の離反が増えるおそれがあります。PoC の出口を決めずに始めると、PoC が延長され、成果が確かめられないまま続く形骸化になりやすくなります。検知の方式を変えるときにコンプライアンスと内部監査を外すと、抽出の基準を説明できず、記録が残らない形になり、規制上の義務の不履行につながるおそれがあります。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- どの不正を、どの水準まで減らすのか(リスクの許容の水準)を経営として決め、事業の責任者が設計する KPI の木の頂点に被害と誤って止めた正当な取引の両方を置く
- PoC の計画書に、比べる相手(今のルール)・アラートの件数のそろえ方・合格の条件・出口・判断する人を書くことを、PoC の予算を付ける条件にする
- 成果は見逃しと誤検知を同じ表に並べて報告し、アラートの件数や再現率は補助の数字として別の欄に置くことを、報告の書式として決める
- 過去のデータでの評価で終わらせず、影の運用まで進めることを PoC の標準にする
- 判定の記録・調査の結果・評価データ・成果の定義を社内に持ち、外部のベンダーや製品を替えても同じ物差しで比べられるようにする
- モデルを作る人・独立して検証する人・監査する人を分け、内部監査の計画に検知と調査の仕組みを入れる
予算の面では、不正検知の予算をモデルの開発や製品の利用だけに付けるのではなく、調査の結果を残す記録の整備、今のルールの成績の測定、調査の人員、導入の後に成績を測り続ける作業にも付けることを勧めます。これらは目に見える機能の形をとらない作業ですが、ここに予算と人の時間が付いていないと、PoC の結果の意味が定まらず、展開の判断ができません。体制の面では、事業の責任者と不正対策が PoC の最初から関わり、合格の条件と出口を自分の言葉で承認することを、導入の条件にするのがよいと考えています。データ分析の担当者だけで進んだ PoC は、過去のデータでの成績が良くても、調査の能力や措置の手順とどうつながるのかを説明できず、展開の段階で目的から見直すことになりやすいからです。
この章の要点をまとめると、最初の対象は取り組む価値(被害の大きさ・規制上の要請)と確かめやすさ(件数・ラベルの有無)と成果に変えられるか(措置を取れるか)で選び、今のルールの成績を測ってから、被害と誤って止めた正当な取引の両方を頂点に置いた KPI の木で目標を分解します。PoC は過去のデータでの評価と影の運用の2段で設計し、アラートの件数をそろえた比べ方・合格の条件・出口・判断する人を始める前に決め、効果は率と件数の型で書きます。展開はルールの整理から調査の順位づけ、スコアによるアラート、自動の措置へと段階を分け、作る人・確かめる人・監査する人を分けた体制で運用します。次の第14章では、マネー・ローンダリング対策・クレジットカード・個人データ・EU の規制とガイドライン、公開事例と最新の動向を扱います。
Anagraftでは、不正検知を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『データで話す組織 プロジェクトを成功に導く「課題発見、人材、データ、施策実行」4つの力』(大城信晃、油井志郎、小西哲平、伊藤徹郎、落合桂一、宮田和三郎 著、技術評論社):版元のページでは2023年11月の発売で、データの活用を進める組織に要る力を、課題発見・人材・データ・施策実行の4つに分け、デジタル化・データ分析・AIとデータサイエンスの順に段階を踏んで進める考え方を示しています。章立ても、現状の把握とデジタル化、データ分析のチームの組成、AIの応用の順になっています。この章で扱った、今のルールの成績と記録の不足を測るところから始め、段階を分けて展開する進め方を、不正検知に限らないデータ活用の組織づくりとして考え直すときの手がかりになります。
『データ分析失敗事例集 失敗から学び、成功を手にする』(尾花山和哉、ホクソエム 編、共立出版):国立国会図書館の書誌では2023年8月の刊行で、データサイエンティストの経験をもとに、データ分析のプロジェクトが失敗した事例を集めた本とされています。この章で扱った、PoC が本格導入に進まずに止まる型や、導入の後に形骸化する型を、不正検知以外の分析のプロジェクトの事例と照らし合わせて考えるときに参考になります。
第14章 規制とガイドライン、公開事例と最新動向
第13章では、どの不正から検知を始めるかの選び方、KPI の木、PoC の出口、役割の分担を扱いました。第1章から第13章は、不正検知を自社の判断で設計し、動かし続けるための話でした。ただ、不正検知の設計には、自社だけでは決められない前提があります。法令が事業者に課している確認・記録・届出の義務、監督官庁や業界団体のガイドラインが求める体制、個人データを扱うときの制限、海外の規制です。この章では、それらを一次情報で確かめた範囲で整理し、あわせて企業や団体が公表している不正検知の取り組み、研究で使われる公開データセット、最近の動向をまとめます。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- マネー・ローンダリング対策の法令と、金融庁のガイドラインが求める取引モニタリングの位置づけ
- FATF(金融活動作業部会)の相互審査と、日本の審査の時期
- 複数の金融機関の取引の分析を引き受ける為替取引分析業の制度
- クレジットカードの不正利用の防止に関する割賦販売法の規定と、業界のセキュリティガイドライン
- インターネットバンキングの不正送金・フィッシングと、口座の不正利用への対応
- 不正検知のために個人データを使うときの個人情報保護法の規定
- EU の決済サービスの規制・一般データ保護規則・AI規則での不正検知の扱い
- 公開事例、公開データセット、最近の動向、規制の対応が形だけになる型と経営判断
法令の条番号・施行日、ガイドラインの版と公表日は、2026年11月12日に e-Gov 法令検索・金融庁・財務省・個人情報保護委員会・EUR-Lex などの公式の資料を開いて確かめました。法令とガイドラインはこの後も改正されることがあるので、実際の対応の前には最新の版を確かめてください。また、本コラムは法律の助言ではありません。自社の取引が法令のどの規定に当たるかは、所管の官庁の資料と専門家の判断で確かめる必要があります。
この章の主張は、法令上の義務と顧客の信頼を、検知の設計の後から合わせるのではなく、設計の前提に置くことです。第1章で、損失の型の1つとして「規制上の義務の不履行」を挙げました。確認・記録・届出の義務は、検知の精度とは別に、仕組みとして果たせているかが問われます。精度の高いモデルを作っても、判定の時点の記録が残っていなければ、監督官庁や監査に説明できません。
この章で何度も出てくるマネー・ローンダリング(資金洗浄)は、警察白書の説明では、一般に、犯罪で得た収益の出所や真の所有者を分からないようにして、捜査機関による収益の発見や検挙を逃れようとする行為で、口座や決済の手段を経由して資金を移すことなどが含まれます(第1章の表も参照)。その対策の法令とガイドラインの多くは金融機関を対象にしていますが、カードの加盟店や EC の事業者、個人データを扱うすべての事業者に関わる規定もあります。どの規定がどの事業者に関わるかの目安を次の表にまとめました。表は本コラムが整理した目安で、実際に対象になるかは、それぞれの法令の定義と所管の官庁の資料で確かめる必要があります。
| 規定やガイドライン | 主に関わる事業者 | この章で扱う節 |
|---|---|---|
| 犯罪収益移転防止法 | 法律が「特定事業者」と定める事業者(銀行などの金融機関、資金移動業者、クレジットカード等を交付する事業者など) | マネー・ローンダリング対策の法令 |
| 金融庁のマネー・ローンダリング及びテロ資金供与対策に関するガイドライン | 金融庁が所管する金融機関等 | 金融庁のガイドライン |
| 資金決済法の為替取引分析業 | 複数の金融機関の委託を受けて為替取引を分析する事業者と、委託する金融機関等 | FATF の相互審査と為替取引分析業 |
| 割賦販売法とクレジットカード・セキュリティガイドライン | カード会社、カードの加盟店(EC の事業者を含む)、決済代行業者など | クレジットカードの不正利用の防止 |
| 金融庁の要請、犯罪収益移転防止法施行規則の情報共有の規定 | 預金取扱金融機関など | 不正送金と口座の不正利用 |
| 個人情報保護法 | 個人情報を取り扱う事業者(業種を問わない) | 不正検知のための個人データの利用 |
| EU の決済サービス指令と委任規則、一般データ保護規則、AI規則 | EU の域内で決済のサービスを提供する事業者、域内の本人の個人データを扱う事業者、域内で AIシステムを提供・利用する事業者など | EU の規制 |
マネー・ローンダリング対策の法令、取引時確認・記録・疑わしい取引の届出
日本のマネー・ローンダリング対策の中心になる法律は、犯罪収益移転防止法(正式な題名は「犯罪による収益の移転防止に関する法律」、平成19年法律第22号)です。この法律は、銀行・資金移動業者・クレジットカード事業者などを「特定事業者」として、顧客の確認、記録の保存、疑わしい取引の届出などの義務を課しています(第1条の目的規定)。不正検知との関係で押さえておきたい規定を、e-Gov 法令検索の条文で確かめた範囲で次の表にまとめました。
| 規定 | 条番号 | 内容の要旨 | 不正検知の設計との関係 |
|---|---|---|---|
| 取引時確認 | 第4条 | 特定事業者は、法律の別表で定める取引を行うときに、本人特定事項(自然人は氏名・住居・生年月日)、取引を行う目的、職業や事業の内容、法人の実質的支配者を確認する。なりすましの疑いがある取引や、確認の事項を偽っていた疑いがある顧客との取引などは、より厳格な確認の対象になり、一定の額を超える財産の移転を伴う場合には資産と収入の状況も確認する(第4条第2項) | なりすましの疑いを判断する材料が、検知の仕組みから出てくることがある。確認の結果は顧客の属性として検知に使われる |
| 確認記録の作成と保存 | 第6条 | 取引時確認をしたら直ちに確認記録を作り、契約が終了した日などから7年間保存する | 確認記録は第2章の「判定の時点で使えた情報」の一部になる |
| 取引記録等の作成と保存 | 第7条 | 特定業務に係る取引を行ったら、少額の取引など政令で定める取引を除き、取引の期日と内容などの記録を作り、7年間保存する | 検知と調査の土台になる記録で、第12章の記録の設計とつながる |
| 疑わしい取引の届出 | 第8条 | 取引で受け取った財産が犯罪による収益である疑いがあるかなどを判断し、疑いがあると認められる場合は速やかに行政庁に届け出る。判断は、取引時確認の結果、取引の態様、国家公安委員会が作る犯罪収益移転危険度調査書の内容を勘案し、主務省令で定める項目に従って行う(第8条第3項)。届出をしようとすることや、したことを顧客に漏らしてはならない(第8条第4項) | 検知の仕組みは届出の判断の入口になる。届出の事実を顧客に示せないので、第11章の顧客への説明にも制約がかかる |
| 取引時確認等を的確に行うための措置 | 第11条 | 確認した情報を最新の内容に保つ措置を講じ、教育訓練、規程の作成、統括管理する者の選任などに努める | ルールやモデルの台帳、担当、見直しの記録は、この体制の一部として説明できるようにしておく |
第8条の疑わしい取引の届出は、不正検知の仕組みと最も直接につながる規定です。条文は「疑いがあるかどうかを判断し」と書いており、事業者に判断の責任を負わせています。アラートは不正の確定ではない(本コラムの用語の定義)ので、アラートが出たことだけで届出をするのでも、アラートが出なかったから判断しなくてよいのでもありません。検知の仕組みは、判断の対象を漏れなく拾い、判断に要る材料を調査担当に渡す役割を担います。第9章で扱った調査の能力の上限は、届出の判断の質にも直接響きます。アラートが調査の能力を超えて見られないまま流れると、届出の判断が遅れたり、判断をしないまま取引が過ぎたりするおそれがあり、見逃しによる被害に加えて、規制上の義務の不履行の型の損失につながるおそれがあります。条文がアラートの扱いまで定めているわけではないので、自社の運用への当てはめは、法務・コンプライアンスの部署と確認する必要があります。
犯罪収益移転防止法は改正が続いている法律です。2026年11月12日に e-Gov 法令検索の改正履歴を見ると、現在の条文は2026年8月12日施行の版で、令和8年法律第34号(犯罪による収益の移転防止に関する法律の一部を改正する法律)と令和8年法律第64号(金融商品取引法及び資金決済に関する法律の一部を改正する法律)による改正の一部が未施行と表示されていました。未施行の改正の日付は、性質の違うものが混ざっています。
- 確定した日付:令和8年法律第64号による改正で、2027年4月1日と2027年10月1日の日付が示されているもの(e-Gov の改正履歴に施行日についての注記は無い。後の節で扱う犯罪収益移転防止法施行規則の改正の2027年4月1日とは別の改正)
- 政令で定める日の上限:令和8年法律第34号による改正で、「公布の日から起算して一年を超えない範囲内において政令で定める日」とされているもの。e-Gov には上限にあたる2027年6月9日が表示されているが、実際の施行日は政令で決まる
- 条件つきの日付:令和8年法律第64号による改正で、「令和8年法律第34号の施行の日又はこの法律の施行の日のいずれか遅い日」とされているもの。e-Gov には2027年7月22日が表示されているが、第34号の施行日によって決まる条件つきの日付である
本コラムでは、令和8年法律第34号の施行日を定める政令は確認していません。未施行の改正の中身も、確かめた範囲を超えるので書きません。自社の対応を考えるときは、施行日ごとにどの規定が変わるかを、所管の官庁の資料で確かめてください。
金融庁のガイドライン、リスクベースのアプローチと取引モニタリングの位置づけ
金融庁は、金融機関等に向けて「マネー・ローンダリング及びテロ資金供与対策に関するガイドライン」を公表しています。2026年11月12日に確かめた最新の版は、2026年3月31日付で改正されたものです。金融庁の公表によると、2026年1月19日から2月19日まで改正の案を公表して意見を募り、18の個人・団体から52件の意見が寄せられたうえで改正し、関連する FAQ(よくあるご質問)も同じ日に改正しました。金融庁の「マネー・ローンダリング等及び金融犯罪対策の取組と課題(2026年7月)」は、この改正の主な点として、要請文を踏まえた改正、外部委託先の管理の明確化、「対応が期待される事項」と「先進的な取組み事例」の整理の3つを挙げています。
ガイドラインの土台になっている考え方が、リスクベース・アプローチです。ガイドラインのⅠ-1は、金融機関等が自らが直面しているリスクを適時・適切に特定・評価し、リスクに見合った低減措置を講ずることを「リスクベース・アプローチ」と呼び、金融機関等にとって当然に実施していくべき事項(ミニマム・スタンダード)と位置づけています。不正検知に置き換えると、すべての取引を同じ強さで見張るのではなく、自社の商品・取引の形・地域・顧客の属性ごとにリスクを評価し、リスクの高いところに検知と調査の能力を厚く配る、という考え方です。第13章で扱った「どの不正から始めるか」の採点も、この考え方と同じ向きにあります。
取引モニタリングは、ガイドラインのⅡ-2の「(3)リスクの低減」の中の「(ⅲ)取引モニタリング・フィルタリング」に書かれています。ガイドラインは、個々の顧客に着目する顧客管理のほかに、取引そのものに着目して異常な取引や制裁対象の取引を検知する方法があり、両方を組み合わせて実効性を高めることが有効だとしています。そのうえで「対応が求められる事項」として、取引モニタリングについて次の3つを挙げています。
- 自らのリスク評価を反映したシナリオ(どんな取引を検知の対象にするかの条件)・敷居値(しきい値)などの抽出の基準を設定すること
- 検知の結果や疑わしい取引の届出の状況を踏まえて、届出をした取引の特徴や今の抽出の基準の有効性を分析し、基準を改善すること
- 検知した取引の疑わしさの度合いやリスクの動向に応じて、適切なリスク低減措置を講ずること
この3つは、本コラムの第3章(ルールの台帳と見直し)、第9章(しきい値と調査の結果をルールの見直しに戻す流れ)、第10章(手口の変化への追従)で扱った内容と重なります。ガイドラインはシナリオや敷居値の「設定」だけでなく、届出の状況を踏まえた「有効性の分析」と「改善」までを求めているので、ルールを作って終わりにする運用は、ガイドラインの求める体制に届かないおそれがあります。自社の運用への当てはめは、法務・コンプライアンスと確認する必要があります。第3章で述べたルールの廃止の基準と変更の記録は、この「改善」を後から説明する材料になります。
ガイドラインには、IT システムとデータについての節もあります。「(ⅵ)IT システムの活用」は、IT システムの導入にあたって設計と運用がリスクの動向に見合っているかを検証し、導入後も定期的に検証すること、内部監査や外部監査などの独立した検証を通じて有効性を検証すること、外部委託や共同システムを使う場合も自らの取引の特徴を分析して追加の対応を検討することを求めています。「(ⅶ)データ管理(データ・ガバナンス)」は、IT システムに使う顧客情報や確認記録・取引記録のデータについて、網羅性と正確性の観点から適切なデータが使われているかを定期的に検証すること、疑わしい取引の届出の件数(国・地域別、顧客属性別などの内訳)などを分析できる形で整理しておくことを求めています。さらに「(5)新技術の活用」では、取引時確認や疑わしい取引の検知・届出の場面で AIなどの新技術が導入されていることに触れ、自らの規模や特性を踏まえて活用の余地と有効性を検討することを求めています。
ガイドラインの「(ⅶ)データ管理」が求めている網羅性と正確性の検証は、第2章で扱ったデータの品質の問題(重複・時刻のずれ・欠損・試験用の取引)と同じものです。検知のモデルの精度を議論する前に、モデルに入るデータが取引の全体を漏れなく映しているかを確かめることが、ガイドラインの上でも求められていることになります。外部の製品やクラウドのサービスを使う場合にも、ガイドラインは自らの取引の特徴を分析することを求めているので、「製品に任せているので中身は分からない」という状態は、第13章で扱ったベンダーに確かめることの表を使って避ける必要があります。
FATF の相互審査と為替取引分析業、国際的な評価と分析の共同化
金融庁のガイドラインがリスクベース・アプローチを「当然に実施していくべき事項」と書く背景には、FATF(金融活動作業部会)の存在があります。FATF は、マネー・ローンダリングとテロ資金供与の対策の国際的な基準(勧告)を作り、加盟国がその基準をどこまで守り、実際に効果を上げているかを、加盟国どうしで審査し合う枠組みを運営しています。この審査を相互審査と呼びます。ガイドラインのⅠ-1も、リスクベース・アプローチは FATF の勧告などの中心的な項目だと書いています。
日本に対する第4次の相互審査の報告書は、2021年8月30日に FATF から公表されました。同じ日の財務大臣談話によると、報告書は日本について、国際協力などの分野で良い結果を示しているとしたうえで、「重点フォローアップ国」との結論になりました。金融庁の「取組と課題(2026年7月)」は、この報告書の指摘も踏まえて、金融庁が2021年4月に、ガイドラインに基づく基礎的な態勢の整備を2024年3月末までに完了させるよう金融機関等に要請したと説明しています。同じ資料は、ほぼすべての金融機関等で基礎的な態勢の整備が完了し、今は自らが整備した態勢の有効性を検証する段階にあるとしています。
次の第5次の対日相互審査については、金融庁の同じ資料が、オンサイト審査(審査団が来日して行う審査)が2028年6月に予定されていると書いています。財務省の広報誌「ファイナンス」2026年5月号の連載(第1回)では、法令の整備の状況に関する自己申告書の提出と書面審査が2027年秋から始まり、有効性の評価に関する自己申告書の提出が2028年初め、オンサイト審査が2028年6月、FATF の全体会合での採択が2029年2月という予定が示されています。同じ連載は、第4次の審査から法令の有効性の評価が始まったと説明しています。金融庁の同じ資料は、金融機関等に対して、自らが整備した態勢の有効性を検証し、その結果を踏まえて改善することを求めているとしています。
相互審査とは別に、複数の金融機関の取引の分析を外部の専門の事業者が引き受ける制度があります。資金決済に関する法律(平成21年法律第59号)の第2条第21項は、複数の金融機関等の委託を受けて、その金融機関等が行う為替取引について、次のいずれかを業として行うことを「為替取引分析業」と定めています。
- 外国為替及び外国貿易法の第17条各号に掲げる支払等に係る為替取引に当たるかを分析し、結果を通知すること
- 国際連合安全保障理事会決議第千二百六十七号等を踏まえ我が国が実施する財産の凍結等に関する特別措置法(平成26年法律第124号)の財産凍結等対象者などに係る為替取引に当たるかを分析し、結果を通知すること
- 犯罪収益移転防止法の第8条第1項の判断(疑わしい取引かどうかの判断)に必要な分析を行い、結果を通知すること
為替取引分析業は、第63条の23で主務大臣の許可を受けた者でなければ行えません。業務方法書には、扱う情報の種類と内容、取得の方法と管理を定め(第63条の29)、業務で知り得た秘密を漏らしたり、業務以外の目的に使ったりしてはならないと定めています(第63条の31)。金融庁の公表によると、この制度を含む令和4年の資金決済法等の改正に係る政令は2023年6月1日から施行されました。金融庁はその後、資金決済法第63条の23に基づいて為替取引分析業者を許可したことを公表しており、例えば2024年5月29日には株式会社マネー・ローンダリング対策共同機構を許可したと公表しています。
金融庁が国会への法案提出の際に公表した説明資料は、この制度を、預金取扱金融機関等から委託を受けて取引モニタリングなどを共同化して実施する事業者に許可制を導入し、業務運営の質を確保するものと説明しています。背景として、銀行界で取引モニタリングなどの共同化による高度化・効率化の検討が進んでいたことを挙げています。不正検知の設計から見ると、複数の金融機関が分析の業務を共同化し、専門性や分析のノウハウを活用する制度と読めます。金融機関をまたいで取引を追跡する分析にどう使えるかは、本コラムでは確かめていません。一方で、条文(第2条第21項第3号)は、犯罪収益移転防止法の第8条第1項の判断に必要な分析を外部の事業者が行い、結果を金融機関等に通知する形を定めています。分析を委ねた場合に判断と届出がどう扱われるかは、本コラムでは条文の当てはめまで確かめていないので、委ねる前に法務・コンプライアンスと確認する必要があります。そのうえで、外部の分析の結果を受け取ったときに、自社の調査担当がどう判断し、その判断をどう記録するかは、委ねる前に決めておく必要があります。
クレジットカードの不正利用の防止、割賦販売法とセキュリティガイドライン
クレジットカードの不正利用の防止は、割賦販売法(昭和36年法律第159号)に規定があります。第35条の17の15は、クレジットカード等購入あっせんに係る販売業者と役務提供事業者(いわゆる加盟店)に対して、経済産業省令で定める基準に従い、利用者によるクレジットカード番号等の不正な利用を防止するために必要な措置を講じることを義務づけています。カード番号等の漏えいなどを防ぐ適切な管理の措置は、第35条の16に定められています。e-Gov 法令検索で2026年11月12日に確かめた割賦販売法の現在の条文は、2025年6月1日施行の版でした。
法律は「必要な措置」と書くだけで、具体的に何をすればよいかは書いていません。その実務上の指針になっているのが、クレジット取引セキュリティ対策協議会(事務局は日本クレジット協会)がまとめている「クレジットカード・セキュリティガイドライン」です。ガイドライン自身の「4-2 割賦販売法との関係性」は、経済産業省の「割賦販売法(後払分野)に基づく監督の基本方針」で、このガイドラインに掲げる措置が割賦販売法で義務づけられた漏えいと不正利用の防止の措置の実務上の指針と位置づけられており、ガイドラインの措置か、それと同等以上の措置を講じていれば「必要かつ適切な措置」を講じているとみなされる、と説明しています。
2026年11月12日に日本クレジット協会の公式の資料で確かめた最新の版は、2026年3月の6.1版です。協議会の改訂の説明資料によると、2025年3月の協議会の本会議で承認された6.0版で EC 加盟店を対象とする指針対策(EC 加盟店のシステムとウェブサイトの脆弱性対策、適切な不正ログイン対策、EMV 3-Dセキュアの導入。EMV 3-Dセキュアの中身は後の段落で説明します)を追加し、6.1版は指針対策の追加や変更が無く、各事業者の理解を促す取り組みを記載した版だとされています。
ガイドラインは、EC 加盟店の不正利用対策の基本を「線の考え方」と呼んでいます。不正利用はカード決済のときだけでなく、ウェブサイトの利用を始めてから商品を受け渡すまでの間に起きるので、カード決済の前(不正ログインへの対策)、決済のとき(EMV 3-Dセキュアの導入、オーソリゼーション処理(カード会社への承認の照会)の体制の整備、加盟店契約上の善良なる管理者の注意義務の履行)、決済の後のそれぞれで対策を講じる、という考え方です。不正が目立った加盟店(ガイドラインの本体の用語で不正顕在化加盟店。後で触れる事例集を紹介した協議会の改訂の説明資料は「不正多発加盟店」という語を使っている)には、類似の不正の発生を防ぐための対策の追加も求めています。本コラムの第1章で、不正検知を防止・検知・対応の3つの段で整理しましたが、「線の考え方」は同じことを取引の流れに沿って書いたものと読めます。
EMV 3-Dセキュアについて、ガイドラインは、カード会社(イシュアー)がカード会員の端末の情報などを使ってなりすましのリスクを判断し、必要に応じてパスワードの入力などを求める本人認証の手法だと説明しています。EC 加盟店は、原則として決済のたびに EMV 3-Dセキュアで認証を行うことが求められますが、加盟店が講じるほかの不正利用対策の内容や効果に応じて、カード番号の登録のときに認証する運用や、加盟店のリスク判断で認証する運用も認められるとしています。さらに、イシュアーのリスクベース認証(取引のリスクを判定し、リスクに応じて追加の認証を求めるかを決める仕組み)の精度を上げるため、加盟店は端末の情報などをより多くイシュアーに渡せるよう、データの項目を設定できる体制を整えることが求められています。ここで出てくる「リスクに応じて追加の認証を求める」という考え方は、第9章の段階的な措置(低いスコアは通す・中間は追加の認証・高いスコアは止める)と同じ形をしています。
ガイドラインの附属文書には、加盟店などが行う属性・行動分析(取引の属性や利用者の行動から不正の疑いを判定する仕組み)を効果的に導入・運用するための共通の考え方を示した「属性・行動分析ガイダンス(附属文書19)」があります。ガイドラインの用語集は、カード会社がオーソリゼーションの情報などで不正利用を検知する仕組みを「オーソリモニタリング」と呼び、属性・行動分析のベンダーが提供するサービスと区別しています。2026年3月の改訂では、EC 加盟店向けの導入ガイド(附属文書20)に「不正利用の抑止を実現する加盟店の事例集」が別紙として加えられました。協議会の改訂の説明資料は、事例の共通点として次の3つを挙げています。
- 不正の抑止や承認率の向上という動機を持つきっかけがあり、属性・行動分析の導入そのものが目的ではないこと
- ガイダンスに示された留意すべき要素をほぼすべて実践していること
- 一定の人員を確保していること(十分に確保できない状況でも、選択と集中で結果を出していること)
「承認率」は取引の通りやすさを示す指標ですが、誤検知による機会損失そのものではありません。承認されなかった取引には不正の疑い以外の理由のものも含まれ、承認された取引には通ってしまった不正も含まれうるので、正当な取引を誤って止めた件数と、不正が通った件数は分けて確かめる必要があります。業界のガイドラインの事例でも、不正の抑止と承認率の向上の両方が動機として挙げられています。
統計の扱いについて一言添えます。協議会の改訂の説明資料には、日本クレジット協会の集計による不正利用の被害の推移が載っています。本コラムは金額を書かない方針なので比率だけを挙げると、2025年の被害は、被害額で見た前年比が92.0%(8%の減少)で、被害額の構成比では93.1%を番号盗用による被害が占めていました。国内の被害の統計の読み方は、第1章で扱っています。
不正送金と口座の不正利用、金融庁の要請と金融機関の間の情報共有
インターネットバンキングの不正送金と、詐欺の被害金の受け皿になる口座の不正利用は、2025年から2026年にかけて行政の対応が大きく動いた分野です。金融庁の「取組と課題(2026年7月)」は、警察庁の「令和7年におけるサイバー空間をめぐる脅威の情勢等について」を引いて、インターネットバンキングに係る不正送金の発生件数が2025年は4,747件(前年は4,369件)で、発生件数が前年より増えたと書いています。同じ資料は警察庁の特殊詐欺の統計を引いて、特殊詐欺の被害の総額のうち振込で被害金を渡した型が57.8%を占め、そのうちインターネットバンキングを使ったものが60.2%だったとしています。
金融庁が2025年から2026年にかけて取った主な対応を、同じ資料で確かめた範囲で次の表にまとめました。
| 時期 | 対応 | 内容の要旨 | 不正検知の設計との関係 |
|---|---|---|---|
| 2025年7月 | インターネット取引サービスへの不正アクセス・不正取引の対策の要請 | フィッシングに耐性のある多要素認証の導入などの対策の強化を、所管の金融機関に要請した。2025年10月に金融商品取引業者等向けの監督指針を改正した。同じ資料(2026年7月)は、2026年上期に預金取扱金融機関や暗号資産交換業者などの監督指針と事務ガイドラインを改正したと書いている | 認証の強さは、第9章の段階的な措置で「保留(追加の認証)」に回した取引が本当に止まるかを左右する |
| 2025年9月 | 預貯金口座の不正利用等の防止の対策の一層の強化の要請(警察庁と連名) | 2024年8月の要請を踏襲したうえで、インターネットバンキングの申込みのときの確認と注意喚起、初期の利用限度の適切な設定、利用開始後や限度の引上げのときの確認と注意喚起などを加えた | 申込みや限度の変更の時点も、検知の対象の取引(本コラムの用語の定義)に含めて設計する |
| 2025年11月〜12月 | 要請への対応状況のフォローアップのアンケート | 口座売買などの違法性の周知や口座の不正利用の態様の分析は進んだ一方、オンライン取引のアクセス環境に着目した不審な取引の検知や、検知した不正な取引の適時の保留・制限など、システムの対応を要する項目の進み方は限られていた | 検知と、検知した後の措置(保留・拒否)の双方について、システムの対応の進み具合を確かめる必要がある |
| 2025年度 | 取引モニタリングの検知能力の横断的な調査(委託調査) | 規模や特性の違う8つの預金取扱金融機関と協働し、共通のテストシナリオとテストデータで各社の取引モニタリングシステムの検知の状況を比べた。取引の行動にアクセスの情報(IP アドレス・端末の情報など)や顧客の属性を組み合わせる多層的な検知を要するシナリオでは、検知率(共通のテストシナリオに対する値で、本コラムの用語では特定の条件での再現率にあたる)が全体に低い傾向だった | 第5章の特徴量(端末・接続の情報と顧客の普段との差)を組み合わせられるかを、自社の検知でも確かめる |
| 2026年6月 | 犯罪収益移転防止法施行規則の改正(2027年4月1日施行) | 預貯金取扱事業者に、犯罪や犯罪収益の移転に利用された、またはそのおそれがあると認めた口座について、情報の適正な取扱いと安全管理の措置を定めたうえで必要な情報を他の預貯金取扱事業者に提供すること、提供を受けた情報を整理・分析して必要な措置を講じることを、努力義務として定めた | 他社から届く情報を、自社の検知の特徴量やリストにどう取り込むかを決めておく |
表の委託調査について、金融庁の資料は、取引モニタリングを強める方向として次の4つを挙げています。
- 多層的な検知ルールの検討
- 検知ルールの機動的な管理
- 即時性の高い取引モニタリングの体制の構築
- AIや統計分析の活用
AIの活用については、直ちにルールによる検知を置き換えるわけではないとしたうえで、アラートの優先順位づけなどから段階的に導入し、説明可能性の確保、定期的なモデルの検証、AIのリスクへの対応策の整備をしながら進めることが有用だと書いています。また、アクセスの情報をサイバーセキュリティの部署が持ち、マネー・ローンダリング対策の部署が使えていない場合があるとして、部署の間の連携が欠かせないと指摘しています。本コラムの第13章で扱った段階的な展開(ルールの整理、スコアで調査の順位づけ、自動の措置)と、第12章で扱ったリアルタイムの判定は、この方向と重なります。なお、委託調査の「検知率」は共通のテストシナリオに対する値で、本コラムの用語でいえば特定の条件での再現率にあたり、誤検知の量と合わせて読む必要があります。
表の最後の行の情報共有について、金融庁の資料によると、預金取扱金融機関が不正利用口座の情報を相互に共有する枠組みの情報共有システムは、全国銀行協会の100%子会社である株式会社マネー・ローンダリング対策共同機構が補助事業者として構築し、2027年3月までに構築して同年4月から稼働を始める準備を進めているとされています。施行規則の改正の施行日(2027年4月1日)と稼働の予定は、同じ時期になっています。
犯罪収益移転防止法そのものの改正も進んでいます。2026年4月3日に内閣が国会へ提出した「犯罪による収益の移転防止に関する法律の一部を改正する法律案」について、警察庁が公表した概要の資料によると、主な内容は、預貯金通帳の不正な譲渡などに対する罰則の引上げ、通常の商取引などの正当な理由がないのに、他人名義の口座に振り込まれた財産を別の口座へ移すよう有償で依頼する行為(いわゆる送金バイト)に対する罰則の創設、警察が金融機関の協力を得て架空名義の口座を開設し、入金された財産の送金を防ぐ措置などを講じる制度の創設の3つです。衆議院の審査経過によると、この法律案(内閣提出第51号)は可決され、2026年6月10日に令和8年法律第34号として公布されました。e-Gov 法令検索の改正履歴では、この改正法による改正が2026年7月10日に一部施行済みで、残りは「公布の日から起算して一年を超えない範囲内において政令で定める日」に施行されるものとして、上限にあたる2027年6月9日が表示されています。施行日を定める政令と、どの規定がどの日に施行されるかは、本コラムでは確かめていません。
不正検知のための個人データの利用、利用目的と第三者提供の制限
不正検知は、取引の記録・端末の情報・顧客の属性など、個人データを大量に使う仕組みです。日本では、個人情報の保護に関する法律(平成15年法律第57号。以下、個人情報保護法)が基本になります。2026年11月12日に e-Gov 法令検索で確かめた現在の条文は、2026年11月2日施行の版です。不正検知の設計に関わる主な規定を、条文と個人情報保護委員会の「個人情報の保護に関する法律についてのガイドライン(通則編)」(平成28年11月、令和8年6月一部改正)で確かめた範囲で次の表にまとめました。
| 規定 | 条番号 | 内容の要旨 | 不正検知の設計との関係 |
|---|---|---|---|
| 利用目的の特定 | 第17条 | 個人情報を取り扱うときは利用目的をできる限り特定する。変更は、変更前の目的と関連性を有すると合理的に認められる範囲に限る | 不正の防止・検知に使うことを、利用目的に含めておくことが考えられる。後から加える場合は、変更前の目的との関連性の範囲に収まるかを確かめる必要がある(当てはめは所管の資料と専門家の確認が前提) |
| 利用目的による制限と例外 | 第18条 | 本人の同意なく、特定した利用目的の達成に必要な範囲を超えて取り扱ってはならない。法令に基づく場合(第3項第1号)、人の生命・身体・財産の保護のために必要で本人の同意を得ることが困難な場合(同項第2号)などは例外になる | 例外に当たるかは場面ごとに判断されるので、不正検知の利用は例外に頼らず、利用目的で手当てしておくのが安全だと考えられる(当てはめは所管の資料と専門家の確認が前提) |
| 利用目的の通知・公表と明示 | 第21条第1項・第2項 | 取得したら、あらかじめ公表している場合を除き、速やかに利用目的を本人に通知するか公表する(第1項)。契約書などの書面(電磁的記録を含む)に記載された個人情報を本人から直接取得する場合は、あらかじめ本人に利用目的を明示する(第2項。人の生命・身体・財産の保護のために緊急に必要な場合を除く) | プライバシーポリシーなどに、不正の防止のための利用を明記する |
| 第三者提供の制限と例外 | 第27条 | 本人の同意なく個人データを第三者に提供してはならない。法令に基づく場合(第1項第1号)、人の生命・身体・財産の保護のために必要で本人の同意を得ることが困難な場合(同項第2号)などは例外になる | 他社との不正の情報の共有、ベンダーへのデータの提供は、この条と委託の扱いを確かめてから設計する |
通則編のガイドラインの3-1-5は、第18条第3項第2号(人の生命・身体・財産の保護)に当たる事例として、「事業者間において、暴力団等の反社会的勢力情報、振り込め詐欺に利用された口座に関する情報、意図的に業務妨害を行う者の情報について共有する場合」や、不正送金などの金融犯罪の被害の事実に関する情報を、関連する犯罪の被害の防止のために他の事業者に提供する場合を挙げています。第27条第1項第2号の例外の考え方は、ガイドラインの3-6-1に書かれています。ただ、これらの例外に当たるかどうかは、「本人の同意を得ることが困難」かどうかを含めて個別の場面で判断されるものです。前の節で見た犯罪収益移転防止法施行規則の改正は、金融庁の資料によると、情報を提供する側の金融機関が個人情報保護法などの違反や守秘義務の違反を問われる懸念があると情報共有が進まないので、法令上の根拠を置くために行われたと説明されています。
個人情報保護法は改正の途中にあります。令和8年法律第56号(個人情報の保護に関する法律等の一部を改正する法律)は2026年7月17日に公布されましたが、2026年11月12日時点では未施行です。e-Gov 法令検索の改正履歴では、この改正法による改正が2つに分けて未施行と表示されています。1つは2027年1月17日の日付で、施行日についての注記が無い、確定した日付として表示されています。もう1つは「公布の日から起算して二年を超えない範囲内において政令で定める日」とされているもので、e-Gov には上限にあたる2028年7月16日が表示されていますが、実際の施行日は政令で決まります。個人情報保護委員会の改正法のページ(2026年10月14日更新)には施行期日を定める政令の記載が無く、政令・規則・ガイドラインは検討中とされています。どの規定がいつ施行されるかを本コラムでは確かめていないので、改正の中身を前提にした書き方はしません。不正検知の設計に関わる改正があるかどうかは、施行の前に委員会の公表資料で確かめる必要があります。
個人データについて、不正検知に特有の注意点が2つあります。1つは、第11章で扱った顧客への説明との関係です。個人情報保護法は、本人からの開示の請求などの手続きを定めていますが、犯罪収益移転防止法の第8条第4項は、疑わしい取引の届出をしようとすることや、したことを顧客に漏らすことを禁じています。顧客への説明や開示の手続きを設計するときは、両方の法令を同時に満たす運用を、法務と一緒に決めておく必要があります。もう1つは、データを長く持つことと、持ちすぎないことのつり合いです。犯罪収益移転防止法は確認記録と取引記録を7年間保存することを求めていますが(第6条・第7条)、検知のモデルの学習のために、法令が求める範囲を超えて個人データを持ち続けてよいかは別の問題で、利用目的と保存の期間の方針で決めることになります。
第11章では、誤検知が特定の属性や地域の顧客に偏る問題と、その対処として群ごとにしきい値を変える考え方を扱いました。属性によって判定の基準を変えることが、どの法令やガイドラインの上でどう扱われるかは、本コラムでは確かめていません。群の分け方に使う情報の種類(要配慮個人情報に当たるものを含むか)、顧客への説明、EU の域内の顧客が含まれる場合の一般データ保護規則の扱いを含めて、方針を決める前に法務・コンプライアンスの部署と確認する事項として扱う必要があります。
EU の規制、強力な顧客認証と取引リスク分析・自動化された決定・AI規則
EU の規制は、EU の域内で決済のサービスを提供する事業者や、域内の顧客の個人データを扱う事業者に関わります。また、不正検知を規制の中でどう位置づけるかを条文で明確に書いている例として、日本の事業者にとっても設計の参考になります。ここでは EUR-Lex で条文を確かめた3つの規制を扱います。
1つ目は決済のサービスの規制です。EU の決済サービス指令(指令2015/2366。いわゆる PSD2)の第97条第1項は、支払人がオンラインで支払口座にアクセスするとき、電子的な支払いを始めるとき、遠隔の経路で決済の不正などのリスクを伴いうる行為をするときに、決済サービスの提供者が強力な顧客認証を適用するよう加盟国に求めています。強力な顧客認証は、第4条第30号で、知識(利用者だけが知っているもの)・所持(利用者だけが持っているもの)・生体(利用者自身の特徴)の3つの種類のうち2つ以上の要素を使い、1つが破られても他の信頼性が損なわれないよう独立させた認証と定義されています。
この指令の細則を定めたのが、強力な顧客認証と安全な通信の規制技術基準を定める委任規則(委任規則2018/389)で、2019年9月14日から適用されています(第38条)。不正検知との関係で重要なのは次の3つの条です。
- 第2条(一般的な認証の要件):決済サービスの提供者は、無権限の支払いや不正な支払いを検知できる取引モニタリングの仕組みを持つ。仕組みは、利用者の普段の使い方に典型的な要素を考慮した支払いの分析に基づき、少なくとも、漏えいや盗難にあった認証要素のリスト、支払いの額、決済のサービスで知られた不正のシナリオ、認証の手続きでのマルウェアの感染の兆候などを考慮する
- 第18条(取引リスク分析):遠隔の電子的な支払いのうち、取引モニタリングの仕組みでリスクが低いと判定したものは、強力な顧客認証を適用しないことが認められる。リスクが低いとされるには、取引の種類ごとに第19条の方法で算定する不正率が附属書の基準以下であること、取引の額が附属書の上限を超えないこと、リアルタイムのリスク分析で定められた兆候が見つからないことを、すべて満たす必要がある。判定は、リスクの要素を組み合わせて取引ごとのリスクのスコアにして行う
- 第19条(不正率の算定):不正率は、取引の種類ごとに、直近90日間の遠隔の取引について、強力な顧客認証を行った取引と免除した取引の両方を含めて、額の合計に対する無権限・不正な取引の額の合計の比として算定する。件数の割合とは異なる
第18条は免除の条件を定めた条ですが、本コラムが第3章から第9章で扱ってきた考え方に近い内容を条文にした例です。顧客ごとの普段との差(第5章)、端末の情報、既知の手口のルール(第3章)を組み合わせて取引ごとのスコアを作り(第4章)、リスクの低い取引は追加の認証なしに通す(第9章の段階的な措置)という形です。しかも、免除を使える条件に、第19条の方法で算定する自社の不正率が基準以下であることが入っています。委任規則の第3条は、第18条の免除を使う場合に、方法論・モデル・報告した不正の割合を少なくとも毎年監査し、免除を使い始めた最初の年と少なくとも3年ごとには独立した外部の監査人が監査することを求めています。自社の不正率と監査が、顧客の利便(追加の認証を省けるか)に直接つながる仕組みになっています。
EU では、決済サービス指令を改める動きも進んでいます。欧州委員会は決済サービス規則(PSR)と第3次決済サービス指令(PSD3)を提案し、欧州議会の2025年11月27日の発表によると、理事会と欧州議会の交渉担当者は暫定的な合意に達しました(正式な採択は本コラムでは確認していません)。発表は、暫定合意の内容として、決済サービスの提供者が受取人の名前と識別子の一致を確かめ、食い違いがあれば支払いの指図を拒んで支払人に知らせること、強力な顧客認証とリスクの評価を行うこと、受け手側の提供者が疑わしい取引を凍結すること、適切な不正防止の仕組みを導入していない提供者は顧客の損失を負担することなどを挙げています。暫定合意の内容では、不正防止の仕組みを持っているかどうかが損失を誰が負うかに結びつけられており、正式に採択されれば、第1章で扱った損失の負担の構造を変えうる論点です。欧州議会の立法の進み具合を示すページ(2026年10月25日更新)では、決済サービス規則は「採択に近い」状態とされ、正式な採択・官報への掲載・適用の日は書かれていませんでした。本コラムでは合意の後の条文を確かめていないので、条番号や適用の時期は書きません。
2つ目は一般データ保護規則(規則2016/679。いわゆる GDPR)です。第22条第1項は、本人に法的な効果を生じさせる、または同様に重大な影響を及ぼす決定について、プロファイリング(個人データを自動的に処理して、その人の経済状況・行動・所在などを分析・予測すること。第4条第4号)を含む自動化された処理だけに基づく決定に服さない権利を定めています。第2項は、次の3つの場合を例外としています。
- 契約の締結や履行に必要な場合
- EU や加盟国の法令が認め、本人の権利を守る適切な措置も定めている場合
- 本人の明示的な同意がある場合
契約と同意の場合には、少なくとも人による関与を求める権利、意見を述べる権利、決定に異議を唱える権利を保障する措置を講じることが求められます(第3項)。前文(考慮事項)の第71項は、EU の機関や国の監督機関の規則や基準に従って行われる不正と脱税の監視・防止の目的を、法令で明示的に認められた自動化された決定の例として挙げています。前文の第47項は、不正の防止のために厳密に必要な個人データの処理は、管理者の正当な利益にもあたるとしています。
不正検知の設計で言えば、スコアだけで取引を自動的に拒否し、口座を止める運用は、第22条の「自動化された処理だけに基づく決定」にあたるかを検討する必要が出てきます。第11章で扱った異議の申し立てと救済の手続き、人による確認の位置づけは、第22条第3項が求める措置と同じ向きの設計です。本コラムの措置の4つの区分(承認・保留・拒否・事後の調査)のうち、どの区分を人の確認なしに自動で行うかを、規制の観点からも決めておくことになります。
3つ目は EU の AI規則(規則2024/1689)です。AI規則は、附属書Ⅲに高リスクの AIシステムの分野を列挙しています。その第5号(必須の民間サービス・公共サービスへのアクセス)の(b)は、自然人の信用力の評価や信用スコアの設定に使う AIシステムを高リスクとしつつ、「金融の不正の検知の目的で使う AIシステム」を除外しています。前文の第58項も、金融サービスの提供での不正の検知の目的で EU の法令が定める AIシステムは、この規則の下で高リスクとみなされるべきではないとしています。附属書Ⅲ第5号(b)の文言では、金融の不正の検知の目的で使う AIシステムが、この号の高リスクの列挙から除かれています。自社のシステムへの当てはめ(同じシステムを与信の判断にも使う場合や、附属書Ⅲのほかの分野に当たる場合を含む)は、本コラムでは確かめていないので、別に検討が要ります。EUR-Lex の書誌の情報によると、AI規則は2026年7月27日から規則2026/1744による一部改正が反映されています。本コラムで確かめた附属書Ⅲと前文の文言は EUR-Lex で公開されている当初の官報の本文のもので、2026年11月12日に見た書誌の改正の一覧には、附属書Ⅲの改正は挙がっていませんでした。AIの社内ルールと規制の全体像は、弊社コラム「AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで」で扱っています。
ここまでの規定のうち代表的なものを、不正検知の仕組みの4つの段に対応させたのが次の概念図です。図に載せていない規定(割賦販売法とカードのガイドライン、個人情報保護法など)も、それぞれの段に関わります。
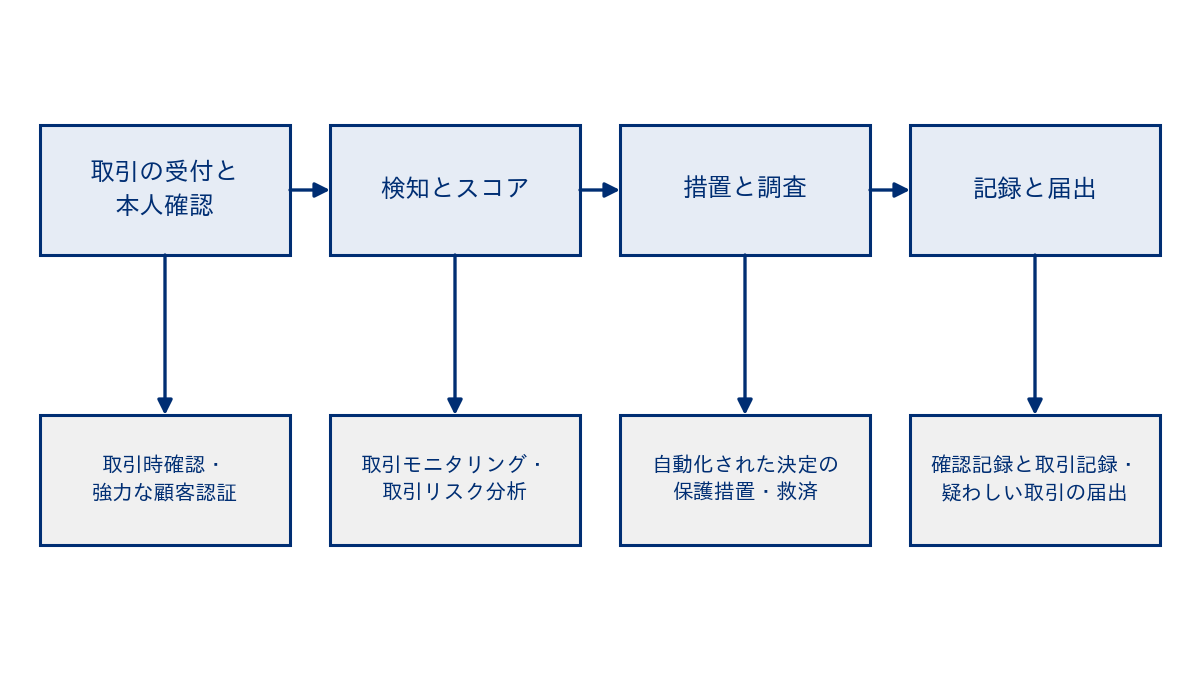
公開事例と公開データセット、企業と公的機関の取り組みと研究の数字の読み方
不正検知の取り組みを、企業や公的機関が公式の資料で公表している例を5つ挙げます。内容は、それぞれの資料に書かれていることだけで、資料が報告する指標や結果は、その限定条件と合わせて紹介します。取り組みどうしを比べたり、評価したりする意図はありません。また、公表された取り組みは公表の時点のもので、今もその形で運用されているとは限りません。
| 公表した主体と時期 | 対象 | 手法と運用 | 資料に書かれた結果と限定条件 |
|---|---|---|---|
| メルペイの機械学習チームの公式技術ブログ(2020年9月8日)。アラートの絞り込みの記事 | ルールエンジンが検知した取引 | ルールで検知した取引を機械学習のシステムに入力し、不正と判定したものだけを人が監視ツールで確認する。しきい値は、捉える不正の範囲の低下を抑えながら誤検知の割合を下げる値を選ぶ。検知の件数と誤検知の割合を、状況に応じて調整する事業上のパラメータとして扱う | 記事中の件数と誤検知の割合の数字は仮の値と明記されており、実運用の実測値は示されていない |
| メルペイの機械学習チームの公式技術ブログ(2020年9月8日)。ネットワーク分析の記事 | 集団による不正な決済 | 顧客のアカウントを点、出品者から購入者への取引を線とする向きのあるネットワークを作り、次数やクラスター係数などの指標で疑わしい集団が起きている範囲を見つけ、取引ごとのスコアを出す機械学習のモデルと組み合わせる | 特定の形のネットワークで疑わしい取引やアカウントがある確率が高いことが分かったとしているが、定量的な評価の結果は書かれていない |
| Ant Financial Services Group の研究者らの論文(Liu らの2018年の論文、CIKM 2018) | 決済の基盤(Alipay)での悪意のあるアカウント | アカウントと端末の種類の違う点からなるネットワークに、グラフニューラルネットワークを適用する。攻撃する側の弱点として、端末の集中と活動の集中に着目したとしている | arXiv の要旨では、比較した方法に対して期間を通じて安定して良い成績だったとしているが、要旨には具体的な数字は無い |
| 金融庁の委託調査(2025年度。金融庁の「取組と課題(2026年7月)」が概要を紹介) | 預金取扱金融機関の取引モニタリング | 規模や特性の違う8つの預金取扱金融機関と協働し、共通のテストシナリオとテストデータで各社の検知の状況を比べた | アクセスの情報や顧客の属性を組み合わせる多層的な検知を要するシナリオでは、共通のテストシナリオの検知率(特定の条件での再現率にあたる)が全体に低い傾向だったとしている。本コラムは報告書の本体を開いておらず、紹介の範囲だけを書いた |
| クレジット取引セキュリティ対策協議会(2026年3月)。EC 加盟店向けの事例集 | 不正の抑止を実現した EC 加盟店の対策 | 資料が「不正多発加盟店」と呼ぶ加盟店のうち、不正の抑止を実現した加盟店の対策の状況を、属性・行動分析の導入と組織の体制の整備の観点から調べ、事例集にまとめた | 共通点として、動機があること、ガイダンスの留意すべき要素をほぼすべて実践していること、一定の人員を確保していることを挙げる。人的リソースの制約がある中で、AI・機械学習のモデルを使った属性・行動分析で不正利用の発生率や承認率を改善した加盟店も複数確認されたとしている |
本コラムの各章との関係でいえば、メルペイのアラートの絞り込みの記事は、ルールで検知した後の絞り込みに機械学習を使い、検知の件数と誤検知の割合を事業上のパラメータとして扱うと書いており、第9章で扱ったアラートの量と調査の能力のつり合いと同じ論点を扱っています。ネットワーク分析の記事と Liu らの論文は、第7章のつながりの分析にあたります。金融庁の委託調査はアクセスの情報や顧客の属性を組み合わせる検知を、協議会の事例集は人員と留意すべき要素の実践を、それぞれの資料の中で取り上げています。
公開事例を読むときの注意も挙げておきます。企業の技術ブログの数字は、メルペイの記事が明記しているように仮の値のこともあります。論文の結果は、その論文のデータと条件での値です。公的な調査の「検知率」は、共通のテストシナリオに対する値です。どれも、自社で同じ方法を入れたときに期待できる成果の目安にはなりません。自社での効果は、第13章で扱った PoC と影の運用で、誤って止めた正当な取引と合わせて確かめる必要があります。
不正検知の研究では、公開されたデータセットが使われます。本コラムのコードはすべて架空の合成データで書いており、公開データセットはダウンロードしていません。ここでは、提供元の公式の登録情報や論文で確かめた範囲で、代表的な2つを紹介します。
| データセット | 提供元と出所 | 中身 | 利用条件 | 読むときの注意 |
|---|---|---|---|---|
| クレジットカードの不正の検知のデータ(OpenML の登録名は creditcard) | Worldline と ULB(ブリュッセル自由大学)の機械学習グループの共同研究で集められた。作成者は Dal Pozzolo ら | 2013年9月の2日間に欧州のカード会員が行ったカードの取引。284,807件のうち不正は492件(約0.17%。OpenML の説明では0.172%)。入力の項目は、主成分分析で変換した28個の数値と、経過の秒数、取引の額で、元の項目は機密のため提供されていない | OpenML の登録情報の licence の欄は Public。Kaggle での配布の条件と、商用利用の可否は確かめていない | 2日間だけのデータで、長期の変化や季節性の評価には期間が足りない。元の業務の項目が分からないので、それに基づく特徴量の設計(第5章)には制約がある |
| Elliptic のデータ | Weber らの2019年の論文(KDD 2019 の金融の異常検知のワークショップの資料として arXiv に公開)で紹介された | ビットコインの取引を点、支払いの流れを線とする時系列のネットワーク。arXiv の要旨では、20万件を超える取引の点と23万4千本の向きのある線があり、各点に166個の特徴量がある(一部は非公開のデータに基づく) | 本コラムでは公式の配布ページで利用条件を確かめていない | 論文の要旨では、比べた方法のうちランダムフォレストが違法な取引の予測で最も良かったとしている。暗号資産の取引のデータで、銀行やカードの取引にそのまま当てはまるとは限らない |
このほかにも、決済の取引のデータを合成したデータセットや、データ分析のコンペティションで配布された電子商取引の不正のデータセットなどが研究で使われていますが、本コラムでは公式のページで件数と利用条件を確かめられなかったので、中身は書きません。
研究の数字を読むときに確かめたいことを挙げます。まず、どの指標かです。不正の割合が約0.17%のデータでは、すべてを正当と答えるだけで正解率は99.8%を超えるので、正解率は多数を占める正当な取引に引っ張られて高くなりえます。ROC 曲線の下の面積だけでは、実際に運用するしきい値での誤検知の件数や適合率、調査の負荷は分かりません。不均衡なデータでの指標の読み方は第8章で扱っています。次に、評価データの切り方です。ランダムに切ったのか、時間で切ったのかで、成績は変わります(第8章)。最後に、データそのものの性質です。期間・地域・取引の種類・不正の定義が自社と違えば、同じ方法でも成績は変わります。公開データセットでの成績は「そのデータセット・その条件での値」であり、自社の取引で期待できる成績として読むことはできません。ベンダーが公開データセットでの成績を示した場合も、同じ読み方が要ります。
最近の動向、生成AIによるなりすまし・本人確認の見直し・調査の支援
2026年11月の時点で、不正検知の前提を変えうる動きを3つ挙げます。どれも、公的機関の資料や論文で確かめた範囲に限ります。
1つ目は、生成AIを使ったなりすましです。金融庁の「AIディスカッションペーパー(第1.1版)」(2026年3月)は、金融犯罪対策の節で、生成AIの進展で自然な日本語の文面・音声・映像を作れるようになり、犯罪の手口が巧妙になって金融機関等と顧客を取り巻くリスクが広がる傾向にあると書いています。挙げられている例は次の3つです。
- AIが作ったメールやフィッシングサイトによる詐欺の巧妙化
- 特定の人物になりすました偽の動画や偽の音声による詐欺
- 偽の証明書類や虚偽の取引情報を本物のように示す詐欺
そのうえで、従来の本人確認の手続きや認証の仕組みでは実在の人物との見分けが難しくなるおそれが指摘されているとしています。同じペーパーは、金融機関等へのヒアリングの結果として、取引モニタリングで過去の取引記録を学習して検知ルールの高度化に使うことを模索している先がある一方、自社だけでは学習データが限られて十分な精度が得られず本番での利用を見送った先、ルールによる検知との併用を検討する先、同じ業態の数社が共同でモデルを開発する先があったことも紹介しています。
2つ目は、本人確認の方法の見直しです。金融庁が2026年10月9日に金融機関等に向けて公表した要請は、非対面の本人確認で、本人確認書類の画像や顧客の容貌の画像に不自然な点が無いかを改めて確認することを求めています。あわせて、犯罪収益移転防止法施行規則の改正で、本人確認書類の画像の送信を受ける方法を廃止し、IC チップの情報の読取りに原則として一本化する改正が2027年4月1日に施行されることに触れ、施行日を待たずにできるだけ早く対応することを求めています。要請と改正の内容は、どちらも非対面の本人確認の画像に関わるものです。
不正検知の設計から見ると、本人確認の方法が変わると、第2章で扱った「判定の時点で使えた情報」も変わります。申込のときの検知のモデルが本人確認の結果を特徴量として使っている場合には、確認の方法が変わる日の前後で特徴量の意味が変わり、第10章で扱った入力の分布の変化が起きる可能性があります。制度の変更の日付は前もって分かるので、監視の計画に組み込んでおくことができます。
3つ目は、大規模言語モデルを調査の支援に使う研究です。例えば、Naik らの2025年の論文(arXiv に公開された査読前の論文)は、疑わしい取引の届出のための報告の文章を作る作業を、計画・犯罪の類型の判定・外部の情報の収集・法令への適合の確認を受け持つ複数のエージェントで支援する枠組みを提案しています。要旨は、大規模言語モデルには事実と違う内容を作ること、犯罪の類型との対応の弱さ、説明可能性の低さという問題があるとし、人の調査担当が下書きを確認して直す形をとっています。要旨には定量的な評価の結果は書かれていません。ここで紹介した論文は査読前のものであり、本コラムで確かめた範囲では、調査の支援に使ったときの効果を自社で期待できる水準として示した資料は見つかっていません。
大規模言語モデルを調査の支援に使う場合に注意したいのは、第11章と本章の前半で扱った説明と記録の義務です。調査担当の判断は、疑わしい取引の届出の判断として記録に残り、監督官庁や監査に説明する対象になります。モデルが作った下書きを確かめずに使うと、根拠の無い記述が記録に残るおそれがあります。また、調査の記録には個人データが多く含まれるので、外部のサービスにデータを送るときは、個人情報保護法の第三者提供と委託の扱いを確かめる必要があります。下書きの作成や記録の要約から始め、判断そのものは人が行う、という段階を踏むのが現実的だと考えています。
規制の対応が形だけになる型と、経営の判断
規制とガイドラインへの対応は、書類の上では整っていても、実際の検知と調査の質につながっていないことがあります。本章で確かめた規定と、第1章から第13章の内容を合わせて、形だけになる型を次の表にまとめました。型の分け方は、本コラムが考えたもので、公的な分類ではありません。
| 形だけになる型 | 起きること | 関わる規定や資料 | 防ぎ方 |
|---|---|---|---|
| シナリオや敷居値を設定したまま見直さない | 手口が変わってもルールが残り、誤検知や見逃しが増えるおそれがある(形骸化) | 金融庁のガイドラインのⅡ-2(3)(ⅲ)の抽出の基準の有効性の分析と改善 | ルールの台帳に見直しの時期と廃止の基準を書き、届出の結果と照らして見直す(第3章・第10章) |
| アラートが調査の能力を超えて、見られないまま流れる | 届出の判断が遅れる、または判断をしないまま取引が過ぎるおそれがある(調査の過負荷。規制上の義務の不履行につながりうる) | 犯罪収益移転防止法の第8条の届出の判断 | しきい値を調査の能力と一緒に決め、滞留を KPI にする(第9章) |
| データの網羅性と正確性を確かめない | 一部の経路の取引がモニタリングに入っていないことに気づかない(見逃しによる被害) | 金融庁のガイドラインのⅡ-2(3)(ⅶ)のデータ管理 | 取引の件数を元の記録と突き合わせ、仕様の変更を監視する(第2章・第12章) |
| 外部の製品や分析に任せたまま、自社の取引を分析しない | 自社の取引の特徴に合わない設定のまま動く。外部の分析の結果を受けても判断の記録が残らない | 金融庁のガイドラインのⅡ-2(3)(ⅵ)、資金決済法の為替取引分析業 | ベンダーに確かめることの表で中身を確かめ、受け取った結果の判断の手順を決める(第13章) |
| 判定の時点の記録が残らない | なぜ止めたか、なぜ通したかを後から説明できない(規制上の義務の不履行につながりうる) | 犯罪収益移転防止法の第6条・第7条の確認記録と取引記録、金融庁のガイドラインのⅡ-2(3)(ⅳ)の記録の保存、EU の取引リスク分析の監査 | 法令が求める記録に加えて、判断を後から検証するための記録(入力・スコア・ルール・措置を判定の時点の値で)を設計する(第12章) |
| 自動の拒否に救済の道筋が無い | 正当な顧客が止められたまま解決できない(顧客の離反) | 一般データ保護規則の第22条の対象となる決定を、同条第2項の契約または同意の例外で行う場合の、第3項の人による関与と異議の権利 | 異議の申し立ての窓口と、人が確認する手順を先に用意する(第11章) |
| 不正の防止に使うことを利用目的に入れていない | 集めたデータを検知に使えない、または後から使って問題になる | 個人情報保護法の第17条・第18条・第21条 | 利用目的とプライバシーポリシーに不正の防止を明記し、他社との共有の根拠を確かめる |
経営の判断としては、法令上の義務と顧客の信頼を、不正検知の設計の前提に置くことを勧めます。具体的には、次の3つを、検知の方式やベンダーを選ぶ前に決めておくことです。
- 自社の事業に関わる法令の義務(取引時確認・記録・疑わしい取引の届出・カードの不正利用の防止の措置・個人データの利用目的)と、それぞれを仕組みのどこで果たすか
- どの措置を人の確認なしに自動で行い、止めた顧客をどう救済するか
- 制度の変更(本人確認の方法の変更・情報共有の枠組みの稼働・改正法の施行)の日付と、それに合わせた監視と見直しの計画
これを誤ったときの損失は、本コラムの6つの型で整理できます。義務を仕組みに組み込まずにモデルの精度だけを追うと、記録や届出の不備が残り、規制上の義務の不履行の型の損失につながるおそれがあります(自社への当てはめは法務・コンプライアンスと確認します)。救済の道筋を用意しないまま自動の拒否を広げると、誤検知による機会損失に加えて顧客の離反が起きるおそれがあります。制度の変更を監視の計画に入れないと、モデルが変化に置いていかれる形骸化が起きるおそれがあります。予算と体制の面では、法令への対応を検知の仕組みとは別の「コンプライアンスの費用」として扱うのではなく、記録の設計・調査の人員・ルールとモデルの見直し・監査を、不正検知の運用の費用として一体で見込むのがよいと考えています。KPI には、第9章の検知と調査の指標に加えて、届出の判断までの日数、見直しを予定どおり行ったルールの割合、救済の申し立てへの回答の日数のように、義務を果たせているかを示す指標を入れておくと、形だけの対応に気づきやすくなります。
この章の要点をまとめると、犯罪収益移転防止法の取引時確認・記録・疑わしい取引の届出、金融庁のガイドラインの取引モニタリングの有効性の分析と改善、割賦販売法とクレジットカード・セキュリティガイドラインの不正利用の防止の措置、個人情報保護法の利用目的と第三者提供の制限、EU の取引リスク分析と自動化された決定の規定は、多くが、不正検知の仕組みのどこかの段に関わる要求を置いています。2027年4月には本人確認の方法の変更と、金融機関の間の不正利用口座の情報共有の仕組みの稼働が予定されており、制度の側も動き続けています。条文や版は確かめた日付つきで読み、未施行の改正や、EU の決済サービス規則のように暫定合意の段階のものは、自社の設計の確定した前提にしないことが大切です。終章では、第1章から第14章の内容を、不正検知を使い続けるための考え方としてまとめます。
この章を深めたい方への参考書籍
『詳説犯罪収益移転防止法:組織犯罪との戦い』(中崎隆 著、九段金融・IT研究所):書名のとおり犯罪収益移転防止法を解説した本です。2026年11月12日に NDL サーチの個別の書誌で確かめた範囲では、九段金融・IT研究所が2026年に刊行した版があり、書誌の版表示は第5版です。同じ著者の同じ書名の本は、以前の版では中央経済社から刊行されており、版によって出版者が異なります。本章で要旨だけを示した規定を、改正の経緯とあわせて確かめるときの手がかりになります。
『逐条解説犯罪収益移転防止法』(犯罪収益移転防止制度研究会 編著、東京法令出版):犯罪収益移転防止法を条文ごとに解説した本です。本章の表で要旨を示した第4条・第6条・第7条・第8条・第11条を、条文の順に読み合わせるときの手がかりになります。2023年9月の版は、それ以降の法改正を反映していないので、改正後の条文は e-Gov 法令検索で確かめながら読む必要があります。
終章 不正検知を使い続けるために
本コラムでは、序章で示した4つの流れに沿って、不正検知の目的とデータの基礎(第1章・第2章)、検知の方式(第3章から第7章)、評価と運用の設計(第8章から第11章)、定着と規制(第12章から第14章)を順に見てきました。全体を通した考えは、序章で述べたとおり、どの不正をどの水準まで減らしたいのか、アラートを誰が1日に何件まで調べられるのか、調査の結果をどう記録に残すかを先に決めることです。そのうえで、いまあるルールの成績を測るところから小さく始め、比較の基準に勝てる方式だけを足していきます。最後に、各章の要点を、章の並びに沿ってまとめ直します。
章をまたいで見えること
第1に、不正検知は目的から逆に組み立てます。対象とする不正によって、1件の被害の大きさ、件数、止められるタイミング、関わる規制が違い、目的が違えば求める検知の速さも評価の指標も変わります(第1章)。検知に使うラベルは、不正の実態をそのまま表すものではありません。不正かどうかは遅れて確定し、止めた取引や調査しなかった取引の真のラベルは分からないことがあるため、調査の結果を記録に残す仕組みが、後の学習と評価の前提になります(第2章)。
第2に、検知の方式は、単純なものから比べて選びます。各章の考察から、方式の候補を絞るための目安を次のように整理しました。実際の選択は、自社の取引の記録で比べて確かめます。
- どの方式を選ぶにしても:いまあるルールの適合率と再現率を測り、比較の基準として置く(第3章)
- 不正と確定した取引の記録がある程度たまっているとき:教師あり学習でスコアを作り、ルールと比べる。スコアを確率として使うなら較正を確かめる(第4章)
- モデルの成績を上げたいとき:モデルの種類を替える前に、顧客の普段との差や直近の回数といった特徴量を見直す。判定の時点で使えない情報が混ざっていないかを確かめる(第5章)
- ラベルが無い、または新しい手口に備えたいとき:教師なしの異常検知を、調査の入口として使う(第6章)
- 組織的な不正や、名義を変えた繰り返しが疑われるとき:口座、端末、連絡先のつながりを見る。名寄せのデータが前提になり、つながりは止める根拠ではなく調査の材料として使う(第7章)
本コラムで動かしたコードはいずれも架空の合成データによるもので、数値はその条件での一例にすぎません。実際の取引の記録は合成データより複雑なため、自社の記録で確かめ直す必要があります。
第3に、検知の成績は、適合率と再現率の組で見て、調査の能力と合わせてしきい値を決めます。不正が極端に少ないデータでは、正解率は成績の目安になりません。評価に使う取引は時間で区切り、ラベルが確定するだけの時間がたった期間で確かめます(第8章)。しきい値は、調査の担当者が確認できる件数と、見逃しと誤検知それぞれの損失を見て決め、アラートが調査の能力を超えていないかを見続けます(第9章)。手口と顧客の行動は変わっていくので、ラベルを待たずに見られる指標(アラートの割合や、スコアと特徴量の分布)を監視し、再学習の手順を決めておきます。ただし、全取引の分布の指標だけでは、成績が下がるような変化を見逃すことがあるため、確定したラベルによる成績の確認と組み合わせます(第10章)。アラートの理由は、相手に応じて示す範囲を決め、誤検知が特定の顧客に偏っていないかを測り、誤って止められた顧客が正当であると示せる手続きを用意します(第11章)。
第4に、検知の仕組みは、動き続けるものとして扱います。判定を取引の承認の前に行うのか後に行うのかで、使えるデータと応答に許される時間が変わります。判定の時点の入力、スコア、適用したルール、措置を記録に残し、判定の仕組みが止まったときに取引を通すのか止めるのかを先に決めておきます(第12章)。導入は、対象の不正を絞り、PoC(概念実証)の出口の条件と成果の測り方を先に決めて進めます(第13章)。不正検知には法令とガイドラインが関わり、その内容は改正されていきます。法令上の義務は検知の設計の前提に置き、条文や版は確かめた日付とともに読みます。すでに施行されている規定、公布されたが施行の前の規定、合意や審議の段階にある案は、区別して扱います。公開された事例や研究の数字は、対象の取引や条件ごとに読み、そのまま自社に当てはめないようにします(第14章)。
使い続けるための最小の仕組み
不正検知を使い続けるための仕組みは、大がかりなものである必要はありません。本コラムで扱った内容から、最小の形を挙げると次のようになります。
- 対象とする不正と、減らしたい水準、誤って止めてよい取引の上限が決まっている
- アラートごとの調査の結果(不正だったか、正当だったか、まだ確定していないか、いつ確定したか)と、後から判定を改めた履歴が、集計できる形で残っている
- ルールの台帳があり、ルールごとのアラートの件数と適合率を定期的に数えている
- しきい値が、調査の担当者が確認できる件数と合わせて決められ、滞留を見る担当が決まっている
- アラートの割合、スコアの分布、成績の推移を監視し、モデルとルールを見直す時期と担当が決まっている
- 誤って止められた顧客が申し出る窓口と、解除までの手順が決まっている
- 判定の仕組みが止まったときの扱いと、判定の記録の保存の方法が決まっている
- 関係する法令とガイドラインの要件が、法務やコンプライアンスの確認を経て、検知の設計に反映されている
この8つの条件がそろっていれば、使っている方式がルールだけであっても、高度な検知へ進むための運用の土台はできていると考えています。反対に、高度なモデルを使っていても、減らしたい不正、調査の結果の記録、しきい値を決める手順、成績を見る担当が決まっていなければ、検知が効いているのかを確かめ続けることが難しくなります。モデルを高度にするのは、上の8項目が回り始めてからで遅くないと考えています。まず自社で、上の8項目のうち欠けているものを確かめることをお勧めします。1つ目(対象とする不正と水準)は残りの項目を決める前提になり、2つ目(調査の結果の記録)は成績を測るための材料になるので、この2つから整えます。
経営が見るべきこと
経営の立場から不正検知の取り組みを見るときは、アラートの件数や検知率だけの報告よりも、次の問いに答えられるかを確かめることをお勧めします。
- 結論の出たアラートのうち、調査の結果として不正と確定した割合はどれだけか。まだ結論の出ていないアラートは、どれだけ残っているか
- 確定した不正のうち、検知の仕組みが先に見つけたものと、顧客の申告で後から分かったものの割合はどうか
- 見つけた不正のうち、措置によって実際に被害を防げたものはどれだけか
- 止めた取引のうち、顧客からの申し出や調査によって後から正当と分かったものはどれだけあり、その顧客はその後も利用を続けているか
- 調査されないまま期限を過ぎたアラートは何件あるか
- ルールとモデルを最後に見直したのはいつか
不正と確定した割合は、結論の出たアラートに限って数えれば適合率に当たります。結論の出ていないアラートが多いときは、その割合を併せて見ます。調査の対象に選ばれたアラートに偏りがあれば、この値にも偏りが入ります。検知の仕組みが先に見つけた不正の割合は、把握できた不正の範囲での再現率に近い値です。申告も調査もされなかった不正は分母に入らないため、実際の再現率はこれより低いことがあります。どちらの割合も、ラベルが確定するまでの遅れがあるため、直近の期間の値は後から変わります。比べるときは、同じ対象と同じ数え方で、ラベルが確定した期間どうしを比べます(第8章)。
被害を防げた不正の割合は、検知と防止の違いを見るためのものです。アラートにできても、措置が間に合わなければ被害は防げません。後から正当と分かった取引の数は、誤検知による機会損失と顧客の離反を見るためのものです。止めた取引のすべてについて正当だったかどうかが分かるわけではないので、この数は下限として読みます。期限を過ぎたアラートの件数は、調査の能力とアラートの件数のつり合いが崩れていないかを見る手がかりになります。最後に見直した時期は、取り組みが形だけになっていないかを確かめるためのものです。再現率(検知率と呼ばれることがあります)だけが高く報告されているときは、しきい値を下げてアラートを増やした結果ではないか、適合率と調査の滞留はどうなっているかを、あわせて確かめることをお勧めします。
不正検知は、一度仕組みを作れば終わる取り組みではなく、手口の変化、商品や経路の追加、規制の改正に合わせて見直し続ける取り組みです。見直しを続けるための人員と手間を、あらかじめリスク管理と事業の業務と予算の中に位置づけておくことが、取り組みを続けるための条件だと考えています。本コラムが、自社の取引と顧客に合った不正検知を組み立てるための材料になれば幸いです。
Anagraftでは、不正検知を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 不正検知の役割と事業での位置づけ、不正の種類と損失の構造
『COSO不正リスク管理ガイド』第2版(八田進二・橋本尚 監訳、堺咲子・城内将人・真柳元 訳、日本内部監査協会):COSO と ACFE が2023年に公表した不正リスク管理の手引きの第2版の訳書で、日本語版は2026年3月に発行されました。目次は、不正リスクのガバナンス、不正リスク評価、不正統制活動、不正調査と是正措置、不正リスク管理モニタリング活動の5つの章で構成されています。COSO の発表では、第2版でデータ分析に関する記述が広げられたとされています。不正への備えを、検知の仕組みだけでなく、組織の統制と見直しの仕組みとして捉えるときの土台になります。
『企業不正の調査実務 徴候の検知から調査技術、事後処理まで』第2版(KPMG Forensic & Risk Advisory 編、中央経済社):書名のとおり、不正の徴候の検知から調査の技術、事後の処理までを扱う実務書で、2025年12月に第2版が出ています。主な対象は社内の不正ですが、アラートの後の調査と、その結果を再発の防止につなげる流れを考えるときの参考になります。
第2章 不正検知に使うデータ、取引の記録とラベルの遅れ・不均衡の扱い
『改訂新版 エンジニアのためのデータ分析基盤入門 基本編』(斎藤友樹、技術評論社):データ分析基盤の整備・運用・活用を扱う本で、データの品質の管理を、問題を防ぐ・見つける・直すという観点で整理しています。この章で扱った重複・時刻のずれ・仕様の変更のような品質の問題を、分析の段階ではなく記録を作り蓄える側の仕組みとしてどう扱うかを考えるときの土台になります。2026年4月には同じ著者による実践編も発売されています。
『Human-in-the-Loop機械学習 人間参加型AIのための能動学習とアノテーション』(Robert(Munro)Monarch 著、上田隼也、角野為耶、伊藤寛祥 訳、共立出版):人がデータにラベルを付ける工程(アノテーション)と、どのデータに人の判断を割り当てるかを選ぶ能動学習を扱う本です。不正検知では、調査担当の確認の結果は、顧客の申告などと並んでラベルを作る情報源の1つです。どの取引を人が確認するかの選び方がラベルの偏りを生むこと、人の判断の揺れがラベルの誤りになることを、ラベルを作る工程の設計として考える手がかりになります。
第3章 ルールによる検知、しきい値と速度のルールでベースラインを作る
『データマイニングの基礎』(元田浩・津本周作・山口高平・沼尾正行 共著、オーム社):情報処理学会が編集する教科書の1冊で、データから規則を見つけ出すデータマイニングの手法を体系的に扱っています。この章で使った決定木のように、データから人が読める規則を作る方法の考え方を、基礎から確かめるのに向いています。
『集合知プログラミング』(Toby Segaran 著、當山仁健・鴨澤眞夫 訳、オライリー・ジャパン):データから推薦・分類・最適化などを行う手法を、コードを書きながら説明する本で、第7章が決定木によるモデリングにあてられています。決定木の分け方の仕組みと、木を規則として読む考え方を、手を動かして確かめたい方に向いています。掲載のコードは刊行当時の環境で書かれています。
第4章 教師あり学習による検知、不均衡なデータで不正の確率を見積もる
『Pythonではじめる機械学習:scikit-learnで学ぶ特徴量エンジニアリングと機械学習の基礎』(Andreas C.Müller, Sarah Guido 著、中田秀基 訳、オライリー・ジャパン):この章で使った scikit-learn で、線形モデル・決定木・決定木のアンサンブル法などを動かしながら、教師あり学習の考え方と過学習を学べます。クラス分類器の不確実性の推定(予測した確率の読み方)や、評価の基準とスコアの章もあり、この章のコードを自分のデータに置き換えるときの土台になります。
『統計的学習の基礎:データマイニング・推論・予測』(Trevor Hastie, Robert Tibshirani, Jerome Friedman 著、杉山将, 井手剛, 神嶌敏弘, 栗田多喜夫, 前田英作 監訳、井尻善久 他訳、共立出版):教師あり学習の手法を、数理の側から体系的に説明した教科書です。この章で引いた勾配ブースティングの論文の著者である Friedman が著者の1人で、この章で扱った手法がなぜそう動くのかを、式に立ち返って理解したいときに向いています。
第5章 特徴量の設計、取引の履歴から集計と速度の特徴を作る
『機械学習のための特徴量エンジニアリング』(Alice Zheng, Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン):数値データ・カテゴリ変数などの特徴量の作り方を、原理とPythonの実装の両面から説明した本です。種類の多いカテゴリ変数について説明する節があり、この章の加盟店や端末を数に置き換える考え方の背景を確かめられます。
『Kaggleで勝つデータ分析の技術』(門脇大輔, 阪田隆司, 保坂桂佑, 平松雄司 著、技術評論社):分析コンペの手法を題材に、特徴量の作成、集約して統計量をとる方法、時系列データの扱い、リーク、時系列データのバリデーションを章や節を立てて説明した本です。この章の時間窓の集計や、過去の不正の割合による置き換えと漏れの防ぎ方を、より一般的な形で学べます。
第6章 教師なしの異常検知、ラベルの無い不正を外れ方から探す
『入門 機械学習による異常検知 Rによる実践ガイド』(井手剛 著、コロナ社):正規分布に従うデータ・従わないデータからの異常検知、性能評価の方法、不要な次元を含むデータ、時系列データの異常検知を、R のコードとともに順に扱った入門書です。この章で扱った統計的な外れ値の考え方を、分布の仮定から手を動かしながら確かめるのに向いています。性能評価の章は、ラベルが少ない場面での評価を考えるときの参考になります。
『異常検知と変化検知』(井手剛・杉山将 著、講談社):機械学習プロフェッショナルシリーズの1冊で、ホテリングの T2 法、近傍法、混合分布、サポートベクトルデータ記述法、密度比推定などによる異常検知と変化検知を、数式で体系的に整理しています。この章の手法の比較の背景にある考え方を、もう一段深く理解したい読者に向いています。手口の変化に関わる変化検知も含むため、第10章の内容とのつながりもあります。
第7章 つながりで見る不正、口座・端末・住所のネットワーク分析
『Pythonで学ぶネットワーク分析 ColaboratoryとNetworkXを使った実践入門』(村田剛志 著、オーム社):本章のコードと同じ NetworkX を使う、ネットワーク分析の入門書です。版元の目次によると、連結成分を含む基礎の用語、さまざまな中心性、コミュニティの抽出を章や節として扱っています。連結成分や中心性を自社の記録で試す前の準備に向いています。
『ネットワーク分析 第2版』(鈴木努 著、共立出版):シリーズ「Rで学ぶデータサイエンス」の第8巻で、統計の言語 R を使ってネットワーク分析を扱った本です。この章では Python の networkx を使いましたが、つながりの指標を別の道具と別の説明で確かめたいときの参考になります。
『グラフニューラルネットワーク』(佐藤竜馬 著、講談社):機械学習プロフェッショナルシリーズの1冊で、題名のとおりグラフニューラルネットワークを主題にした専門書です。この章で考え方だけを紹介したグラフニューラルネットワークを、実務で検討するかどうかを判断する前に、何ができて何が難しいのかを知る材料になります。
第8章 検知の評価、適合率・再現率・PR曲線と評価データの切り方
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):機械学習の評価指標を、事業の KPI とのつながりから解説した本です。版元の目次によれば、二値分類の章で混同行列・正解率・適合率・再現率・F値・ROC曲線のAUC・PR曲線の下の面積などを扱い、ビジネスインパクトの期待値計算やコスト考慮型学習の節もあります。この章で扱った指標の選び方を、事業の目的から逆算して考えるのに向いています。
『ブートストラップ入門』(汪金芳・桜井裕仁 著、共立出版):シリーズ「Rで学ぶデータサイエンス」の第4巻として刊行された、ブートストラップの入門書です。この章では、評価の指標のばらつきを復元抽出で見積もる方法を簡単に使いましたが、その考え方と、区間の作り方の違いや注意点を体系的に確かめるのに役立ちます。
第9章 しきい値と調査の運用、アラートの量と調査能力のつり合い
『意思決定分析と予測の活用 基礎理論からPython実装まで』(馬場真哉 著、講談社):予測の結果をもとに、損失や利得を考えてどの行動を選ぶかを決める意思決定分析を、基礎の理論から Python の実装まで扱った本です。この章のコスト考慮型の判定のように、スコアと損失の見積もりから措置を選ぶ考え方を、不正検知に限らない一般的な枠組みとして学べます。
『待ち行列理論の基礎と応用』(川島幸之助 監修、塩田茂雄・河西憲一・豊泉洋・会田雅樹 著、共立出版):到着と処理の能力の関係から、待ち時間や滞留の長さを求める待ち行列の理論の教科書です。この章の調査の待ち行列のシミュレーションで見た、到着が能力に近づくと滞留が急に増える現象を、理論の側から理解する助けになります。
『ザ・ゴール 企業の究極の目的とは何か』(エリヤフ・ゴールドラット 著、三本木亮 訳、ダイヤモンド社):工場の生産を題材に、全体の成果は最も能力の小さい工程(制約)で決まるという考え方を説明した本です。人による調査を経て措置を決める運用では、調査の工程が処理の能力の制約になり、滞留によって不正を止める機会を失うことがあります。しきい値やモデルだけでなく、調査の能力と措置の設計を併せて見直すというこの章の主張を、業務の設計の観点から考える手がかりになります。
第10章 手口の変化への追従、概念ドリフトの監視と再学習
『機械学習デザインパターン』(Valliappa Lakshmanan、Sara Robinson、Michael Munn 著、鷲崎弘宜、竹内広宜、名取直毅、吉岡信和 訳、オライリー・ジャパン):機械学習の実務でくり返し出てくる問題と解き方を、パターンとして整理した本です。運用の章に、作ったモデルを継続して評価するパターンと、再学習のきっかけを決める考え方が含まれており、この章で扱った監視と再学習を、不正検知以外の例も含めて一般的な形で確かめられます。
『事例でわかるMLOps 機械学習の成果をスケールさせる処方箋』(杉山阿聖、太田満久、久井裕貴 編著、講談社):機械学習のモデルを運用し続けるための技術・手順・体制を、国内の事例とともに解説した本です。機械学習システムのモニタリングや、事業の意思決定に役立つモニタリングを扱う節があり、この章の後半で触れた監視の項目の選び方や、再学習を承認つきの手順として回す体制を考える手がかりになります。
第11章 検知の理由の説明と公平性、誤検知が顧客に与える影響
『機械学習を解釈する技術 予測力と説明力を両立する実践テクニック』(森下光之助、技術評論社):並べ替えの重要度、部分依存、個別の条件つき期待値、SHAP を、線形回帰との対比から順に解説した本です。この章で比べた SHAP と並べ替えの重要度が、それぞれ何を測っているかを手を動かしながら確かめるのに向いています。
『XAI「説明可能なAI」 そのとき人工知能はどう考えたのか?』(大坪直樹ほか、リックテレコム):AIになぜ説明が必要かという問題設定から、説明の手法の全体像、実装、ビジネスで求められる説明の力までを扱った本です。この章の前半で扱った、説明を誰に何のために示すかを考える材料になります。
第12章 システムの構成と運用、リアルタイムの判定・監視・障害時の扱い
『機械学習システムデザイン:実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習を本番のシステムとして動かすときの、データの扱い、特徴量、デプロイ、監視、継続的な学習を一通り扱っています。この章の訓練と提供のずれ、リアルタイムの推論と一括の推論の分担、本番でのモデルの試し方を、不正検知に限らない一般的な形で深められます。
『AIエンジニアのための機械学習システムデザインパターン』(澁井雄介 著、翔泳社):学習したモデルを推論のシステムとして提供するときの構成を、パターンとして整理した本です。同期と非同期の推論、一括の推論、推論の記録と監視、本番での新しいモデルの試し方、障害のときに処理を切り離す仕組みなど、この章の構成の要素を実装の側から考えるときの手がかりになります。
『データ指向アプリケーションデザイン:信頼性、拡張性、保守性の高い分散システム設計の原理』(Martin Kleppmann 著、斉藤太郎 監訳、玉川竜司 訳、オライリー・ジャパン):データを扱うシステムの信頼性・拡張性・保守性を、データベース、一括処理、ストリーム処理まで広く扱っています。取引が届くたびに集計を更新するリアルタイムの特徴量や、障害のときの振る舞い、記録の設計を、システムの原理から理解するのに役立ちます。
第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
『データで話す組織 プロジェクトを成功に導く「課題発見、人材、データ、施策実行」4つの力』(大城信晃、油井志郎、小西哲平、伊藤徹郎、落合桂一、宮田和三郎 著、技術評論社):版元のページでは2023年11月の発売で、データの活用を進める組織に要る力を、課題発見・人材・データ・施策実行の4つに分け、デジタル化・データ分析・AIとデータサイエンスの順に段階を踏んで進める考え方を示しています。章立ても、現状の把握とデジタル化、データ分析のチームの組成、AIの応用の順になっています。この章で扱った、今のルールの成績と記録の不足を測るところから始め、段階を分けて展開する進め方を、不正検知に限らないデータ活用の組織づくりとして考え直すときの手がかりになります。
『データ分析失敗事例集 失敗から学び、成功を手にする』(尾花山和哉、ホクソエム 編、共立出版):国立国会図書館の書誌では2023年8月の刊行で、データサイエンティストの経験をもとに、データ分析のプロジェクトが失敗した事例を集めた本とされています。この章で扱った、PoC が本格導入に進まずに止まる型や、導入の後に形骸化する型を、不正検知以外の分析のプロジェクトの事例と照らし合わせて考えるときに参考になります。
第14章 規制とガイドライン、公開事例と最新動向
『詳説犯罪収益移転防止法:組織犯罪との戦い』(中崎隆 著、九段金融・IT研究所):書名のとおり犯罪収益移転防止法を解説した本です。2026年11月12日に NDL サーチの個別の書誌で確かめた範囲では、九段金融・IT研究所が2026年に刊行した版があり、書誌の版表示は第5版です。同じ著者の同じ書名の本は、以前の版では中央経済社から刊行されており、版によって出版者が異なります。本章で要旨だけを示した規定を、改正の経緯とあわせて確かめるときの手がかりになります。
『逐条解説犯罪収益移転防止法』(犯罪収益移転防止制度研究会 編著、東京法令出版):犯罪収益移転防止法を条文ごとに解説した本です。本章の表で要旨を示した第4条・第6条・第7条・第8条・第11条を、条文の順に読み合わせるときの手がかりになります。2023年9月の版は、それ以降の法改正を反映していないので、改正後の条文は e-Gov 法令検索で確かめながら読む必要があります。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 日本クレジット協会 クレジットカード不正利用被害の集計結果について、2026年第2四半期の構成比と前期比と発生率
https://www.j-credit.or.jp/information/statistics/download/toukei_03_f.pdf - 日本クレジット協会 クレジットカード不正利用被害の集計結果について、2026年第2四半期の構成比と前期比と発生率
https://www.j-credit.or.jp/information/statistics/download/toukei_03_g.pdf - 日本クレジット協会 年間の不正利用発生率 2023年0.051%・2024年0.047%・2025年0.038%
https://www.j-credit.or.jp/information/statistics/download/toukei_03_4_h.pdf - 日本クレジット協会 年間の不正利用発生率 2023年0.051%・2024年0.047%・2025年0.038%
https://www.j-credit.or.jp/information/statistics/download/toukei_03_4_i.pdf - クレジットカード・セキュリティガイドライン 6.1版、2026年3月、線の考え方、カード決済前と決済時と決済後
https://www.j-credit.or.jp/security/pdf/Creditcardsecurityguidelines_6.1_published.pdf - 警察庁 令和7年におけるサイバー空間をめぐる脅威の情勢等について、不正送金の発生件数4,747件、手口の約9割がフィッシング、フィッシング報告件数245万4,297件
https://www.npa.go.jp/publications/statistics/cybersecurity/data/R7/R07_cyber_jousei.pdf - 警察庁 令和8年上半期の同資料、不正送金の発生件数253件、2026年5月の遠隔操作ソフトを使う新しい手口の被害の急増
https://www.npa.go.jp/publications/statistics/cybersecurity/data/R8kami/R08_kami_cyber_jousei.pdf - 国家公安委員会 犯罪収益移転危険度調査書 2025年11月、疑わしい取引の届出の通知件数約85万件、預金取扱金融機関の商品が悪用の約6割、預貯金通帳等の譲渡等の検挙件数
https://www.npa.go.jp/sosikihanzai/jafic/nenzihokoku/risk/risk071127.pdf - 日本損害保険協会 保険金不正請求への対応のページ
https://www.sonpo.or.jp/about/efforts/reduction/fuseiseikyu/ - 日本公認会計士協会 監査基準報告書240 財務諸表監査における不正、最終改正2024年9月26日、不正な財務報告と資産の流用、A1項の動機・プレッシャーと機会と姿勢・正当化
https://jicpa.or.jp/specialized_field/2-24-240-2-20250723.pdf - 監査基準報告書240の改正の公開草案が2026年8月10日に公表
https://jicpa.or.jp/specialized_field/20260810cde.html - Visa の加盟店向け紛争対応の手引き 2026年10月版、紛争の流れ、4つの区分、不正の区分の定義、規則と契約が優先
https://bd.visa.com/dam/VCOM/global/support-legal/documents/merchants-dispute-management-guidelines.pdf - Visa の紛争の定義(イシュアーからアクワイアラーへの取引の差し戻し)
https://www.visa.com/en-us/support/business/dispute-resolution - 不正のトライアングルは Cressey の横領の研究に基づく、3つの要素の説明
https://www.acfe.com/fraud-resources/fraud-101-what-is-fraud - Cressey の著書『Other People’s Money』1953年初版
https://openlibrary.org/works/OL6834774W - 参考書籍『COSO不正リスク管理ガイド』第2版 八田進二・橋本尚 監訳、堺咲子・城内将人・真柳元 訳、日本内部監査協会、2026年3月
https://www.iiajapan.com/leg/data/list/bk_coso_frm_guide_2.html - 日本公認会計士協会の監査基準報告書の一覧 2026年10月19日現在で、240の最新版は2024年9月26日改正
https://jicpa.or.jp/specialized_field/publication/kansa/ - COSO と ACFE が不正リスク管理の手引きの第2版を2023年に公表、データ分析の記述を拡充
https://www.coso.org/fraud-risk-management
第2章
- チャージバックは国際ブランドが定める手続きで、会員の申し出を受けて会員側のカード会社が加盟店側のカード会社経由の請求を取り消す制度であり、使える理由は国際ブランドの定めで限られる(吉元利行氏の論文)
https://www.j-credit.or.jp/information/download/ccr_03/ccr_paper_3-3.pdf - 改訂新版 エンジニアのためのデータ分析基盤入門 基本編(斎藤友樹 著、技術評論社、2024年11月)
https://ndlsearch.ndl.go.jp/books/R100000002-I033761159 - 改訂新版 エンジニアのためのデータ分析基盤入門 基本編(斎藤友樹 著、技術評論社、2024年11月)
https://gihyo.jp/book/2024/978-4-297-14563-7 - 同じ著者による実践編が2026年4月に発売
https://gihyo.jp/book/2026/978-4-297-15499-8 - 同じ著者による実践編が2026年4月に発売
https://ndlsearch.ndl.go.jp/books/R100000002-I034653982 - Human-in-the-Loop機械学習 人間参加型AIのための能動学習とアノテーション(Robert(Munro)Monarch 著、上田隼也、角野為耶、伊藤寛祥 訳、共立出版、2023年12月)
https://ndlsearch.ndl.go.jp/books/R100000002-I033212200
第3章
- scikit-learn の決定木は CART を最適化した方法を使っている
https://scikit-learn.org/stable/modules/tree.html - class_weight の balanced は、全体の件数をクラスの数とそのクラスの件数の積で割った値を重みにする
https://scikit-learn.org/stable/modules/generated/sklearn.tree.DecisionTreeClassifier.html - 直近1時間の回数はその取引自身を含み、その取引より後を数えない
https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.rolling.html - 『集合知プログラミング』Toby Segaran 著、當山仁健・鴨澤眞夫 訳、オライリー・ジャパン、2008年
https://www.oreilly.co.jp/books/9784873113647/
第4章
- ランダムフォレストは Breiman の2001年の論文で示された手法
https://doi.org/10.1023/A:1010933404324 - 勾配ブースティングは Friedman の2001年の論文で体系化された
https://doi.org/10.1214/aos/1013203451 - HistGradientBoostingClassifier は特徴量の値を区間に分けて計算を速める方式で LightGBM に着想を得た
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.HistGradientBoostingClassifier.html - SMOTE は Chawla らの2002年の論文(Journal of Artificial Intelligence Research 第16巻)で示された
https://doi.org/10.1613/jair.953 - SMOTE は少数側の取引と近くの少数側の取引の間に人工の取引を作る
https://imbalanced-learn.org/stable/references/generated/imblearn.over_sampling.SMOTE.html - 多数側を減らした学習のスコアを削減の割合で補正する式は Dal Pozzolo らの2015年の論文でベイズの定理から導かれた式(式(4))として示されている
https://dalpozz.github.io/static/pdf/SSCI_calib_final_noCC.pdf - 同論文の書誌
https://doi.org/10.1109/SSCI.2015.33 - 最初の確認に使った二次資料
https://arxiv.org/abs/2410.18144 - 等調回帰は Zadrozny と Elkan の2002年の論文(KDD 2002)などで扱われている
https://doi.org/10.1145/775047.775151 - プラットの方法は Platt の1999年の論文で示された
https://scikit-learn.org/stable/modules/calibration.html - 表の形のデータでは木の手法が深層学習より良い成績だった(Grinsztajn らの2022年の論文、45のデータセット、1万件程度の中規模のデータ)
https://arxiv.org/abs/2207.08815 - 平均適合率はしきい値ごとの適合率を再現率の増分で重み付けして平均したもので、直線で結んだPR曲線の面積とは異なる
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html - 参考書籍『Pythonではじめる機械学習:scikit-learnで学ぶ特徴量エンジニアリングと機械学習の基礎』
https://www.oreilly.co.jp/books/9784873117980/
第5章
- pandas の時間窓の集計では closed を指定しない場合の既定は右端を含む窓で、closed に left を指定すると右端を含まない窓になる
https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.rolling.html - HistGradientBoostingClassifier は欠損値を前処理なしで扱える
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.HistGradientBoostingClassifier.html - 並べ替えによる重要度は特徴量の値を無作為に並べ替えて成績の下がり幅を測る
https://scikit-learn.org/stable/modules/permutation_importance.html - TargetEncoder は学習用のデータを既定で5つに分けて交差の手順で置き換え、答えの情報の漏れを防ぐ
https://scikit-learn.org/stable/modules/preprocessing.html#target-encoder - 平均適合率はしきい値ごとの適合率を再現率の増え幅で重み付けた平均で、PR曲線の下の面積を台形で近似した値とは異なる
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html - 学習のときに無かった値は、すべての列を0にするなどの扱いを決めておく
https://scikit-learn.org/stable/modules/generated/sklearn.preprocessing.OneHotEncoder.html - 書籍『機械学習のための特徴量エンジニアリング』Alice Zheng, Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン
https://www.oreilly.co.jp/books/9784873118680/ - 書籍『Kaggleで勝つデータ分析の技術』門脇大輔, 阪田隆司, 保坂桂佑, 平松雄司 著、技術評論社
https://gihyo.jp/book/2019/978-4-297-10843-4
第6章
- Liu・Ting・Zhou の2008年の論文(Isolation Forest、第8回 IEEE データマイニング国際会議)
https://doi.org/10.1109/ICDM.2008.17 - Isolation Forest の仕組み(無作為に項目と分割の値を選んで切り離す・外れは道のりが短い)と、1本の木の標本の数の既定が最大256件
https://scikit-learn.org/stable/modules/outlier_detection.html - Isolation Forest の仕組み(無作為に項目と分割の値を選んで切り離す・外れは道のりが短い)と、1本の木の標本の数の既定が最大256件
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.IsolationForest.html - Breunig・Kriegel・Ng・Sander の2000年の論文(局所外れ値因子、ACM SIGMOD 2000)
https://doi.org/10.1145/342009.335388 - Schölkopf らの2001年の論文(1クラスSVM、Neural Computation 誌 第13巻第7号)
https://doi.org/10.1162/089976601750264965 - Hinton・Salakhutdinov の2006年の論文(自己符号化器で次元を縮める、Science 誌 第313巻)
https://doi.org/10.1126/science.1127647 - Newcomb が1881年に American Journal of Mathematics 誌で先頭の桁の偏りを指摘したこと
https://doi.org/10.2307/2369148 - Nigrini の1996年の論文(納税の申告の点検への応用、Journal of the American Taxation Association 第18巻第1号)
https://doi.org/10.2308/jata-6148128 - Nigrini の2012年の著書(Wiley)が、版元の紹介によれば、ベンフォードの法則を使った監査と不正の点検の方法と応用例を扱っていること
https://www.wiley.com/en-us/Benford%27s+Law%3A+Applications+for+Forensic+Accounting%2C+Auditing%2C+and+Fraud+Detection-p-9781118152850 - NIST の統計の手引きの箱ひげ図では、四分位点から四分位範囲の1.5倍の位置に内側の境界を置き、その外側の点を個別に描くこと
https://itl.nist.gov/div898/handbook/eda/section3/boxplot.htm - 1クラスSVM の nu は学習データのうち境界の外に出る割合の上限を決める値であること
https://scikit-learn.org/stable/modules/generated/sklearn.svm.OneClassSVM.html - 『入門 機械学習による異常検知 Rによる実践ガイド』井手剛 著、コロナ社
https://ndlsearch.ndl.go.jp/books/R100000002-I026092656 - 『入門 機械学習による異常検知 Rによる実践ガイド』井手剛 著、コロナ社
https://www.coronasha.co.jp/np/isbn/9784339024913/ - 『異常検知と変化検知』井手剛・杉山将 著、講談社
https://ndlsearch.ndl.go.jp/books/R100000002-I026619229 - 『異常検知と変化検知』井手剛・杉山将 著、講談社
https://www.kspub.co.jp/book/detail/1529083.html
第7章
- 犯罪収益移転危険度調査書の概要版(令和7年11月)は、架空・他人名義の口座が主要な犯罪のインフラになっていると述べている
https://www.npa.go.jp/sosikihanzai/jafic/nenzihokoku/risk/gaiyou2025.pdf - 犯罪収益移転危険度調査書の概要版(令和7年11月)は、架空・他人名義の口座が主要な犯罪のインフラになっていると述べている
https://www.npa.go.jp/sosikihanzai/jafic/nenzihokoku/nenzihokoku.htm - Blondel らの2008年の論文のルーヴァン法はモジュラリティを大きくするようにまとめる方法
https://doi.org/10.1088/1742-5468/2008/10/P10008 - Blondel らの2008年の論文のルーヴァン法はモジュラリティを大きくするようにまとめる方法
https://iopscience.iop.org/article/10.1088/1742-5468/2008/10/P10008 - networkx にルーヴァン法の関数があり、結果は乱数のシードで変わりうる
https://networkx.org/documentation/stable/reference/algorithms/generated/networkx.algorithms.community.louvain.louvain_communities.html - Kipf と Welling の論文はグラフ畳み込みネットワークを示し、arXiv 初版2016年9月、ICLR 2017 の会議論文
https://arxiv.org/abs/1609.02907 - Weber らの2019年の論文は KDD 2019 の金融の異常検知のワークショップで発表され、Elliptic のデータセットを公開し4つの方法を比べた
https://arxiv.org/abs/1908.02591 - 平均適合率は、再現率が増えた分を重みにして適合率を平均した値で、PR曲線の点を直線で結んで面積を求める方法とは計算が異なる
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html - 2部グラフの線の数は異なる会員と識別子の組の数で、同じ会員が同じ端末を何度使っても線は1本
https://networkx.org/documentation/stable/reference/classes/generated/networkx.Graph.add_edge.html - 参考書籍『Pythonで学ぶネットワーク分析 ColaboratoryとNetworkXを使った実践入門』村田剛志 著、オーム社、2019年
https://www.ohmsha.co.jp/book/9784274224256/ - 参考書籍『ネットワーク分析 第2版』鈴木努 著、共立出版、2017年、シリーズ「Rで学ぶデータサイエンス」第8巻
https://ndlsearch.ndl.go.jp/books/R100000002-I028161654 - 参考書籍『グラフニューラルネットワーク』佐藤竜馬 著、講談社、2024年、機械学習プロフェッショナルシリーズ
https://ndlsearch.ndl.go.jp/books/R100000002-I033435603
第8章
- Davis と Goadrich の2006年の論文、PR曲線とROC曲線の関係、第23回機械学習国際会議の予稿集 233〜240ページ
https://doi.org/10.1145/1143844.1143874 - Davis と Goadrich の2006年の論文、PR曲線とROC曲線の関係、第23回機械学習国際会議の予稿集 233〜240ページ
https://lirias.kuleuven.be/retrieve/4d31f86a-d811-4938-87c7-a8bb4441aa6c - Saito と Rehmsmeier の2015年の論文、PLOS ONE 第10巻第3号 e0118432、2015年3月4日公開
https://doi.org/10.1371/journal.pone.0118432 - Saito と Rehmsmeier の2015年の論文、PLOS ONE 第10巻第3号 e0118432、2015年3月4日公開
https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0118432 - Fawcett の2006年の解説論文、Pattern Recognition Letters 第27巻第8号 861〜874ページ、AUC は無作為に選んだ陽性1件が陰性1件より高いスコアを得る確率と同じ
https://doi.org/10.1016/j.patrec.2005.10.010 - scikit-learn の平均適合率の計算式、補間をせず台形の公式とは異なる
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html - 参考書籍 評価指標入門 データサイエンスとビジネスをつなぐ架け橋、高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社
https://ndlsearch.ndl.go.jp/books/R100000002-I032637452 - 参考書籍 評価指標入門 データサイエンスとビジネスをつなぐ架け橋、高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社
https://gihyo.jp/book/2023/978-4-297-13314-6 - 参考書籍 ブートストラップ入門、汪金芳・桜井裕仁 著、共立出版、Rで学ぶデータサイエンス第4巻
https://ndlsearch.ndl.go.jp/books/R100000002-I023229764
第9章
- Elkan の2001年の論文、第17回人工知能国際合同会議の論文集の973〜977ページ
https://www.ijcai.org/Proceedings/2001-2 - 期待される損失が最も小さいクラスを選ぶのが最適な判定である、という枠組み
https://cseweb.ucsd.edu/~elkan/rescale.pdf
第10章
- Gama らの2014年の概説、概念ドリフトへの適応の方法の整理、ACM Computing Surveys 第46巻第4号
https://doi.org/10.1145/2523813 - Dal Pozzolo らの2018年の論文、IEEE のニューラルネットワークと学習システムの論文誌 第29巻第8号、不均衡・概念ドリフト・ラベルが確定するまでの遅れが同時にある問題として定式化し直し、まとめて扱う学習の方法を提案
https://doi.org/10.1109/TNNLS.2017.2736643 - Dal Pozzolo らの2018年の論文、IEEE のニューラルネットワークと学習システムの論文誌 第29巻第8号、不均衡・概念ドリフト・ラベルが確定するまでの遅れが同時にある問題として定式化し直し、まとめて扱う学習の方法を提案
https://api.semanticscholar.org/graph/v1/paper/DOI:10.1109/TNNLS.2017.2736643?fields=title,abstract,year,authors,openAccessPdf - PSI は信用スコアのモデルの監視で使われてきた指標
https://scholarworks.wmich.edu/dissertations/3208/ - 平均適合率は scikit-learn の average_precision_score の値で、しきい値ごとの適合率を再現率の増分で重み付けて足したもの
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html - 参考書籍『機械学習デザインパターン』Valliappa Lakshmanan、Sara Robinson、Michael Munn 著、鷲崎弘宜、竹内広宜、名取直毅、吉岡信和 訳、オライリー・ジャパン、2021年10月
https://www.oreilly.co.jp/books/9784873119564/ - 参考書籍『事例でわかるMLOps 機械学習の成果をスケールさせる処方箋』杉山阿聖、太田満久、久井裕貴 編著、講談社、2024年9月
https://www.kspub.co.jp/book/detail/5369562.html
第11章
- SHAP は Lundberg と Lee の2017年の論文で提案された枠組み
https://arxiv.org/abs/1705.07874 - SHAP の論文は NIPS 2017、Advances in Neural Information Processing Systems 第30巻に収録
https://papers.nips.cc/paper_files/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html - Kleinberg・Mullainathan・Raghavan の2017年の論文は、リスクのスコアの3つの公平性の条件を、ごく限られた場合を除いて同時には満たせないことを示した
https://drops.dagstuhl.de/entities/document/10.4230/LIPIcs.ITCS.2017.43 - Kleinberg・Mullainathan・Raghavan の2017年の論文は、リスクのスコアの3つの公平性の条件を、ごく限られた場合を除いて同時には満たせないことを示した
https://arxiv.org/abs/1609.05807 - Chouldechova の2017年の論文は、群のあいだで該当の割合が異なる場合に、いくつかの公平性の基準を同時に満たせないことを示した
https://doi.org/10.1089/big.2016.0047 - Chouldechova の2017年の論文は、群のあいだで該当の割合が異なる場合に、いくつかの公平性の基準を同時に満たせないことを示した
https://arxiv.org/abs/1703.00056 - TreeExplainer は木のモデルの寄与を厳密に計算する
https://shap.readthedocs.io/en/latest/generated/shap.TreeExplainer.html - 参考書籍『機械学習を解釈する技術 予測力と説明力を両立する実践テクニック』森下光之助、技術評論社
https://gihyo.jp/book/2021/978-4-297-12226-3 - 参考書籍『XAI「説明可能なAI」 そのとき人工知能はどう考えたのか?』大坪直樹ほか、リックテレコム
https://ci.nii.ac.jp/ncid/BC08425271
第12章
- 機械学習のシステムではモデルのコードは全体のごく一部で周辺の仕組みが大きいことを Sculley らが2015年の NIPS(現在の NeurIPS)の論文で指摘した
https://papers.nips.cc/paper_files/paper/2015/hash/86df7dcfd896fcaf2674f757a2463eba-Abstract.html - Google の機械学習の実務の指針は訓練と提供のずれを学習のときと提供のときの成績の差と定義し、コードの共有と判定のときの特徴量の記録を勧めている
https://developers.google.com/machine-learning/guides/rules-of-ml - Feast の公式ドキュメントはオフラインストアとオンラインストアを部品として挙げ、ある時点で正しい特徴量の集まりを作れると説明している
https://docs.feast.dev/ - カードの決済では承認と売上の確定が分かれ、確定の前に承認を取り消せる仕組みがある
https://docs.stripe.com/payments/place-a-hold-on-a-payment-method - 影の運用では実際の処理に使われるのは今のモデルの判定である
https://docs.aws.amazon.com/sagemaker/latest/dg/shadow-tests.html - 書籍 機械学習システムデザイン
https://www.oreilly.co.jp/books/9784814400409/ - 書籍 AIエンジニアのための機械学習システムデザインパターン
https://github.com/shibuiwilliam/ml-system-in-actions - 書籍 データ指向アプリケーションデザイン
https://www.oreilly.co.jp/books/9784873118703/
第13章
- 金融庁のマネー・ローンダリング及びテロ資金供与対策に関するガイドラインの最新版は2026年3月31日の版で、同日から適用されている
https://www.fsa.go.jp/news/r7/amlcft/20260331/20260331.html - 金融庁のマネー・ローンダリング及びテロ資金供与対策に関するガイドラインの最新版は2026年3月31日の版で、同日から適用されている
https://www.fsa.go.jp/news/r7/amlcft/20260331/02.pdf - 金融庁は2026年3月にAIディスカッションペーパーの第1.1版を公表した
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp.html - 金融庁は2026年3月にAIディスカッションペーパーの第1.1版を公表した
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp_version1.1.pdf - 内部監査人協会は2020年に三つの防衛線を見直した3ラインモデルを公表した
https://www.theiia.org/en/content/position-papers/2020/the-iias-three-lines-model-an-update-of-the-three-lines-of-defense/ - 内部監査人協会は2026年7月に3ラインモデルの後継となる文書を公表した
https://www.theiia.org/ThreeLines - 参考書籍『データで話す組織 プロジェクトを成功に導く「課題発見、人材、データ、施策実行」4つの力』大城信晃、油井志郎、小西哲平、伊藤徹郎、落合桂一、宮田和三郎 著、技術評論社、2023年11月
https://gihyo.jp/book/2023/978-4-297-13843-1 - 参考書籍『データ分析失敗事例集 失敗から学び、成功を手にする』尾花山和哉、ホクソエム 編、共立出版、2023年8月
https://ndlsearch.ndl.go.jp/books/R100000002-I032948968
第14章
- 犯罪収益移転防止法は平成19年法律第22号、第1条の目的規定で特定事業者による確認・記録の保存・疑わしい取引の届出
https://laws.e-gov.go.jp/law/419AC0000000022 - 為替取引分析業の第3号は犯罪収益移転防止法第8条第1項の判断に必要な分析と結果の通知、委ねた場合の判断と届出の扱いは確かめていない
https://laws.e-gov.go.jp/law/421AC0000000059 - マネー・ローンダリングは一般に犯罪で得た収益の出所や真の所有者を分からないようにして発見や検挙を逃れようとする行為
https://www.npa.go.jp/hakusyo/r04/honbun/html/yt200000.html - 犯罪収益移転防止法の改正法律案は内閣提出第51号、2026年4月3日提出、可決、2026年6月10日に法律第34号として公布
https://www.shugiin.go.jp/internet/itdb_iinkai.nsf/html/gianrireki/221_221_kakuho_51.htm - 送金バイトの罰則は通常の商取引等の正当な理由がないのにという条件つき
https://www.npa.go.jp/laws/kokkai/20260403/05_sankousiryou.pdf - 為替取引分析業は預金取扱金融機関等から委託を受けて取引モニタリング等を共同化して実施する事業者に許可制を導入、銀行界で共同化の検討が加速
https://www.fsa.go.jp/common/diet/208/03/setsumei.pdf - 委任規則2018の389の第19条の不正率の算定、取引の種類ごと、90日間、強力な顧客認証と免除の両方、額の比
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32018R0389 - ガイドラインのⅡ-2(3)(ⅳ)記録の保存
https://www.fsa.go.jp/news/r7/amlcft/20260331/02.pdf - 個人情報保護法第21条第2項の書面での直接取得の明示と緊急の場合の例外
https://laws.e-gov.go.jp/law/415AC0000000057 - 第4次から法令の有効性の評価が始まった、金融機関等に有効性検証を求めている
https://www.mof.go.jp/public_relations/finance/202605/202605l.html - 金融庁のマネー・ローンダリング及びテロ資金供与対策に関するガイドラインの最新版は2026年3月31日付の改正、意見募集は1月19日から2月19日、18の個人・団体から52件、FAQ も同日改正・同日適用
https://www.fsa.go.jp/news/r7/amlcft/20260331/20260331.html - 改正の主な点は要請文を踏まえた改正、外部委託先の管理の明確化、対応が期待される事項と先進的な取組み事例の整理
https://www.fsa.go.jp/policy/amlcftcpt/02.pdf - FATF の第4次対日相互審査報告書は2021年8月30日公表、国際協力などで良い結果、重点フォローアップ国
https://www.mof.go.jp/policy/international_policy/convention/fatf/fatfhoudou_20210830_2.html - 令和4年資金決済法等改正に係る政令は2023年6月1日施行
https://www.fsa.go.jp/news/r4/sonota/20230526/20230526.html - 2024年5月29日に株式会社マネー・ローンダリング対策共同機構を資金決済法第63条の23に基づき許可
https://www.fsa.go.jp/news/r5/sonota/20240529/20240529.html - 割賦販売法は昭和36年法律第159号、第35条の17の15の不正な利用の防止、第35条の16の適切な管理、現在の条文は2025年6月1日施行の版
https://laws.e-gov.go.jp/law/336AC0000000159 - クレジットカード・セキュリティガイドラインの4-2 割賦販売法との関係性、監督の基本方針で実務上の指針と位置づけ、同等以上の措置で必要かつ適切な措置とみなされる
https://www.j-credit.or.jp/security/pdf/Creditcardsecurityguidelines_6.1_published.pdf - 最新版は2026年3月の6.1版、6.0版は2025年3月の本会議で承認され EC 加盟店の指針対策として脆弱性対策・不正ログイン対策・EMV 3-Dセキュアの導入を追加、6.1版は指針対策の追加変更なし
https://www.j-credit.or.jp/security/pdf/Creditcardsecurityguidelines_6.1_revisionpoint.pdf - 犯罪収益移転防止法施行規則の改正命令は2026年6月26日公布、2027年4月1日施行、預貯金取扱事業者の努力義務の2点
https://www.fsa.go.jp/news/r7/sonota/20260626/20260626.html - 通則編ガイドラインの3-1-5の事例(反社会的勢力情報・振り込め詐欺に利用された口座・業務妨害を行う者の情報の共有、不正送金等の金融犯罪被害の事実の情報の提供)と3-6-1の第27条第1項第2号の説明、表紙は平成28年11月・令和8年6月一部改正
https://www.ppc.go.jp/personalinfo/legal/guidelines_tsusoku/ - 令和8年法律第56号は2026年7月17日公布、政令・規則・ガイドラインは検討中、施行期日の政令の記載なし(2026年10月14日更新)
https://www.ppc.go.jp/personalinfo/legal/r8kaiseihogohou/ - プロファイリングの定義は一般データ保護規則の第4条第4号
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32016R0679 - EU 決済サービス指令は指令2015の2366、第97条第1項の強力な顧客認証の3つの場面、第4条第30号の定義
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32015L2366 - 決済サービス規則と第3次決済サービス指令の合意、受取人の名前と識別子の照合、疑わしい取引の凍結、不正防止の仕組みが無い場合の損失の負担、正式な採択が必要
https://www.europarl.europa.eu/news/en/press-room/20251121IPR31540/payment-services-deal-more-protection-from-online-fraud-and-hidden-fees - 決済サービス規則は採択に近い状態、2025年11月27日の暫定合意、正式採択と適用日の記載なし
https://www.europarl.europa.eu/legislative-train/theme-an-economy-that-works-for-people/file-revision-of-eu-rules-on-payment-services - EU AI 規則は規則2024の1689、附属書Ⅲ第5号(b)で金融の不正の検知の目的の AI システムを除外、前文の第58項
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32024R1689 - EU AI 規則は2026年7月27日から規則2026の1744で一部改正、改正の一覧に附属書Ⅲは無い
https://eur-lex.europa.eu/legal-content/EN/ALL/?uri=CELEX:32024R1689 - メルペイの機械学習チームのアラートの絞り込みの記事、2020年9月8日、ルールの後段の機械学習、しきい値の選び方、数字は仮の値
https://engineering.mercari.com/blog/entry/alertfiltering-ml/ - メルペイの機械学習チームのネットワーク分析の記事、2020年9月8日、点と線、指標、定量的な評価なし
https://engineering.mercari.com/blog/entry/complex-network-ml/ - Liu らの2018年の論文、Ant Financial Services Group、CIKM 2018、2077から2085頁
https://doi.org/10.1145/3269206.3272010 - Liu らの論文の要旨、Alipay、アカウントと端末のネットワーク、端末の集中と活動の集中、期間を通じて安定して良い成績、具体的な数字なし
https://arxiv.org/abs/2002.12307 - クレジットカードの不正の検知のデータ、Worldline と ULB の共同研究、作成者は Dal Pozzolo ら、2013年9月の2日間、284,807件のうち不正492件、約0.17%で OpenML の説明では0.172%
https://www.openml.org/api/v1/json/data/1597 - Weber らの2019年の論文、Elliptic のデータ、KDD 2019 の金融の異常検知のワークショップ、20万件超の点と23万4千本の線、166個の特徴量、ランダムフォレストが最良
https://arxiv.org/abs/1908.02591 - 金融庁の AI ディスカッションペーパー第1.1版(2026年3月)の金融犯罪対策の節、生成AIによる文面・音声・映像、ディープフェイク、偽の証明書類、本人確認をすり抜ける可能性の指摘
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp_version1.1.pdf - 金融庁の2026年10月9日の要請、非対面の本人確認の画像の確認、施行規則改正で画像の送信を受ける方法を廃止し IC チップの読取りに原則一本化、2027年4月1日施行、施行日を待たない対応
https://www.fsa.go.jp/news/r8/sonota/20261009/20261009.html - Naik らの2025年の論文、arXiv の査読前の論文、疑わしい取引の報告の文章の作成を複数のエージェントで支援、大規模言語モデルの問題点、人が確認、定量的な結果は要旨に無い
https://arxiv.org/abs/2509.08380 - 参考書籍 詳説犯罪収益移転防止法 組織犯罪との戦い、中崎隆 著、九段金融・IT研究所、2026年、版表示は第5版
https://ndlsearch.ndl.go.jp/books/R100000002-I034956203 - 参考書籍 逐条解説犯罪収益移転防止法、犯罪収益移転防止制度研究会 編著、東京法令出版、2023年9月
https://ndlsearch.ndl.go.jp/books/R100000002-I033011816