こんにちは、Anagraftの伊藤です。
今回は、レコメンドをどう理解し、どう自社の売場とマーケティングの仕組みに組み込むかを整理しました。ここでのレコメンドは、顧客の選択を助けるために商品やコンテンツの候補を選んで示す仕組みのうち、主に顧客や閲覧中の商品に合わせて候補を変えるものを指します。ECサイトの「この商品を見た人はこんな商品も見ています」、動画や音楽の配信サービスの「あなたへのおすすめ」、メールで届く商品の案内など、推薦は多くの顧客接点に入り込んでいます。推薦の導入を検討する場面では、次のような問いが、マーケティングやEC運営の担当者だけでなく、事業の責任者や経営層にも届くことが多いように思います。
- レコメンドを入れれば売上は上がるのか
- 推薦エンジンの製品を入れるべきか、自社で作るべきか
- 推薦の製品やサービスの提供会社(ベンダー)が報告する「推薦経由の購買」、つまり推薦の枠から選ばれて買われた分を、効果として信じてよいのか
- 新商品や新規の顧客にも、推薦は効くのか
本コラムでは、こうした問いに答えるための材料を、推薦の目的とデータの基礎、推薦の方式、評価の設計、運用と定着の4つのまとまりに分けて並べました。
この題材を選んだ理由は、レコメンドが「履歴を集めてアルゴリズムを入れれば売上が伸びる取り組み」と受け取られて、アルゴリズムの選択と推薦経由の購買の数字だけが議論され、推薦で何を増やしたいのか、効果をどう測るのかが決まらないまま進むことが多いように思うためです。
推薦が無くても買われた商品を推薦の成果に数えれば、効果は大きく見えます。人気の商品ばかりを推薦すれば、短期のクリックは増えても、品揃えの幅が顧客に伝わらなくなることがあります。的外れな推薦や、個人データの扱いが分かりにくい推薦は、顧客の信頼を損ねることがあります。こうした状態で投資を重ねたときに出る損失を、本コラムでは6つの型に分けて整理し、各章で使います(序章で説明します)。
本コラムでは、推薦システムの原論文、法令と所管官庁のガイドライン、公的機関や企業が公開している資料など、公開されている一次情報を根拠にしました。第2章から第12章では、架空の合成データ(顧客の購買や閲覧のログを乱数で作ったもの)に対して実際にPythonのコードを動かし、その出力とグラフを載せています。架空のデータで得た数値は、その条件での一例であり、一般的な性能の目安ではありません。
想定している読者は、レコメンドの導入や改善を任された方、あるいはそれを決める立場の方です。担当者としては、ECサイトやアプリの運営、マーケティングやCRM(顧客との関係を管理する取り組み)、DX推進を担う方と、行動ログを分析するデータサイエンティストの方を念頭に置いています。判断する立場としては、推薦の仕組みへの投資を決める事業の責任者や経営層の方を念頭に置いています。機械学習の専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その方法で何が分かり、推薦の判断にどうつながるか」「経営はどう判断するか」を意識して書きました。
本コラムに出てくる企業や団体の取り組みは、その企業や団体が公開した資料を開いて確かめたものに限っています。推薦エンジンの製品やクラウドサービスの料金、開発の費用、売上の増加額、弊社の支援の条件には触れていません。例題で価格や売上を扱う箇所は、単位の無い「相対値」で書いています。個人データの取り扱いや法令の解釈については、法務の担当者や所管の官庁、専門家に確認していただく前提で書いています。
各章の題と、その章で答える問いは「全体の地図」の表にまとめています。本コラムで使う用語の定義も、同じ「全体の地図」の表にまとめています。

目次
- 序章 レコメンドは何を予測して何を決める仕組みか
- 全体の地図
- 第1章 レコメンドの役割と事業での位置づけ、検索・ランキング・パーソナライゼーションとの違い
- 推薦が事業に効く5つの経路、発見の支援・回遊・購買点数・継続利用・在庫の消化
- 推薦の目的と KPI の型、短期の KPI と長期の KPI のずれ
- 推薦の枠の種類と、それぞれで何を推薦するか
- 検索・ランキング・パーソナライゼーション・広告配信・CRM のセグメント配信との違い
- 推薦の方式の全体像、ルール・協調フィルタリング・内容ベース・深層学習
- 業種別の推薦の対象と注意点、EC・配信・ニュース・求人・旅行・金融
- 推薦システムの研究の歴史、Tapestry・GroupLens・商品間の協調フィルタリング・Netflix Prize
- よくある3つの誤解、推薦を入れれば売上が上がる・精度が高いほど良い・推薦経由の購買が効果
- 経営の損失の型、推薦の判断を誤ると何を失うか
- 経営判断、どの枠で何を増やすための推薦かを決める
- この章を深めたい方への参考書籍
- 第2章 推薦に使うデータ、購買・閲覧の履歴と暗黙のフィードバックの扱い
- 第3章 人気順とルールによる推薦、まずベースラインを作る
- ベースラインの種類、人気順・期間を区切った人気順・カテゴリ内の人気順・新着・ランダム
- 架空の購買ログを作る、ジャンルの好み・人気の偏り・発売と人気の衰え
- 評価の決まりを先に決める、後の30日を当てる適合率@10と再現率@10
- 4つのベースラインを比べる、人気を数える期間の長さと履歴の多さによる違い
- アソシエーション分析、同時に買われる商品を支持度・信頼度・リフト値で測る
- 架空のバスケットで確かめる、信頼度は人気商品に引っ張られ、リフト値はかごの少ない組で振れる
- 業務の知識によるルール、在庫や利益を考えた並べ替え、除外のルール
- 手の込んだ推薦がベースラインに勝てないことがある、研究で報告されている再現性の問題
- 経営としての判断、人気順との比較を常に置く
- この章のまとめ
- この章を深めたい方への参考書籍
- 第4章 協調フィルタリング、似た顧客と似た商品から推薦する
- 協調フィルタリングの考え方、行動の似かただけで推薦する
- ユーザーベースとアイテムベース、何が違い、どちらから始めるか
- 類似度の測り方、コサイン類似度・ジャッカード係数・ピアソンの相関
- 架空の購買ログを作り、商品×商品の類似度を計算する
- アイテムベースの推薦を人気順と比べる、近傍の数 K と類似度の選び方
- 推薦に出る商品の偏り、正規化をしないと人気順に近づく
- 「この商品を買った人は」の作り方と、説明のしやすさを運用に生かす
- 計算量と更新、毎晩の一括計算と差分の更新
- 研究の流れ、GroupLens から商品間の協調フィルタリングへ
- 経営の判断、まずアイテムベースで説明できる推薦を作る
- この章のまとめ
- この章を深めたい方への参考書籍
- 第5章 行列分解、潜在因子で好みを表す
- 第6章 内容ベースとハイブリッド、商品の属性と説明文を使う
- 内容ベースの考え方、商品の中身から顧客の関心を推し量る
- 説明文を数値にする、TF-IDFの考え方
- 顧客の関心の表し方、関心を示した商品の特徴をまとめる
- 架空の購買ログで確かめる、購買が0件の新商品を協調フィルタリングは推薦できない
- ハイブリッド推薦の型、重み付き・切り替え・混合・特徴の結合
- 乱数の種を変えて確かめる、変わらなかったことと変わったこと
- 文章の埋め込みと画像の特徴、TF-IDFの先にある方法
- 商品の属性データの整備、質が下がると内容ベースの成績も下がるかを確かめる
- 内容ベースの弱点、似たものばかりで新しい発見が無い
- 経営の判断、商品の属性データの整備に投資する
- この章のまとめ
- この章を深めたい方への参考書籍
- 第7章 深層学習による推薦、2つの塔のモデルから系列の推薦まで
- 深層学習が推薦に使われる理由、多様な特徴・大規模・系列
- 埋め込み、顧客と商品をベクトルで表す
- 2つの塔のモデル、顧客の塔と商品の塔に分ける理由
- ニューラル協調フィルタリングと再検証、複雑にすれば勝つとは限らない
- 系列推薦、閲覧の順番から次を予測する
- 架空の閲覧の系列を作り、深層学習を使わない3つの基準を置く
- 小さな2つの塔のモデルと系列のモデルを torch で学習させる
- この架空データでは、学習に使う顧客が少ないと単純な数え上げが深層学習を上回った
- 大規模な事例として公表された論文、動画の推薦とアプリストアの推薦
- 深層学習が向く条件と向かない条件
- 経営の判断、基準に勝てるかを確かめてから複雑にする
- この章のまとめ
- この章を深めたい方への参考書籍
- 第8章 オフライン評価、適合率・再現率・NDCGと評価データの切り方
- 第9章 オンライン評価、A/Bテストとバンディットで効果を確かめる
- 第10章 コールドスタートと探索、新しい商品と新しい顧客への推薦
- 第11章 推薦の偏りと多様性、人気の偏り・フィルターバブル・公平性
- 推薦で起きる偏りの種類、人気・露出・位置・同調
- 偏りが強まる循環、推薦→露出→購買→学習→推薦
- 架空の合成データで循環を再現する、顧客と商品の作り方と4つの指標
- 5通りの推薦を90日まわす、人気に比例・関連度順・MMRによる並べ替え
- 1人のリストの多様性と品揃え全体の集中は別のもの、MMRが集中を和らげなかった理由
- 人気の重みを下げると何が起きるか、購買の量と集中のつり合い
- 多様性・新規性・セレンディピティ・網羅率、精度以外の指標の測り方
- フィルターバブルとエコーチェンバー、研究の結論は分かれている
- 出品者・作り手の側の公平性、市場型のサービスで考えること
- 精度と多様性のつり合いの決め方、ガードレールの指標を置く
- 経営の判断、品揃えの幅を KPI に入れる
- この章のまとめ
- この章を深めたい方への参考書籍
- 第12章 システムの構成と運用、候補の生成・並べ替え・監視と再学習
- 第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
- 推薦を入れる枠の選び方、4つの観点で採点して最初の1枠を決める
- KPI の木、最終の KPI から推薦の枠の KPI へ分解する
- PoC の設計、期間・評価の方法・合格の条件・出口を始める前に決める
- PoC が止まる8つの型、オフラインで止まる型と推薦経由で数える型
- 効果の見立て、金額ではなく率と件数の型で書く
- 段階的な展開、1枠から複数の枠、チャネルの横断へ
- 役割と責任分担、誰が決め、誰が作業し、誰に相談し、誰に知らせるか
- 内製と外部委託・製品の利用、何を外に任せ、何を社内に残すか
- 最初の90日の計画、週ごとに何を決め、何を残すか
- 経営判断、PoC の出口と効果の測り方を先に決める
- この章を深めたい方への参考書籍
- 第14章 プライバシーと規制、公開事例と最新動向
- 推薦と個人情報保護法、利用目的に「分析して推薦する」ことを書く
- 個人関連情報と仮名加工情報、推薦のデータを3つの概念で整理する
- 2026年7月公布の改正法、推薦に関わりうる項目と施行の時期
- 電気通信事業法の外部送信規律、対象になる事業とならない事業
- EU の一般データ保護規則、プロファイリングと異議を述べる権利
- EU のデジタルサービス法、推薦システムの透明性を求める規定
- 日本のデジタルプラットフォームの法律と、推薦の理由の表示
- 公開事例と公開データセット、研究の数字の読み方
- 生成AIによる推薦、研究の現状と現場での限界
- 形骸化の型と経営判断、法令と顧客の信頼を推薦の設計の前提にする
- この章を深めたい方への参考書籍
- 終章 レコメンドを使い続けるために
- 本コラムで紹介した書籍一覧
- 第1章 レコメンドの役割と事業での位置づけ、検索・ランキング・パーソナライゼーションとの違い
- 第2章 推薦に使うデータ、購買・閲覧の履歴と暗黙のフィードバックの扱い
- 第3章 人気順とルールによる推薦、まずベースラインを作る
- 第4章 協調フィルタリング、似た顧客と似た商品から推薦する
- 第5章 行列分解、潜在因子で好みを表す
- 第6章 内容ベースとハイブリッド、商品の属性と説明文を使う
- 第7章 深層学習による推薦、2つの塔のモデルから系列の推薦まで
- 第8章 オフライン評価、適合率・再現率・NDCGと評価データの切り方
- 第9章 オンライン評価、A/Bテストとバンディットで効果を確かめる
- 第10章 コールドスタートと探索、新しい商品と新しい顧客への推薦
- 第11章 推薦の偏りと多様性、人気の偏り・フィルターバブル・公平性
- 第12章 システムの構成と運用、候補の生成・並べ替え・監視と再学習
- 第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
- 第14章 プライバシーと規制、公開事例と最新動向
- 参考情報
序章 レコメンドは何を予測して何を決める仕組みか
顧客に商品を勧める方法には、昔から2つの基本的なやり方があります。1つは、売場や担当者が商品を選んで並べるやり方です。店頭の売れ筋の棚や、編集者が選んだ特集のページがこれに当たります。もう1つは、売上の順位や新着の順など、決まった規則で全員に同じ並びを見せるやり方です。人が選ぶやり方は、商品の知識や季節感を反映しやすい一方で、顧客1人ひとりに合わせることは難しく、手間にも限りがあります。規則で並べるやり方は、手間がかからず、誰にでも同じ結果を返せる一方で、顧客ごとの好みの違いには応えられません。
本コラムの主題であるレコメンド(推薦)は、顧客の選択を助けるために、商品やコンテンツの候補を選んで示す仕組みです。全員に同じ人気順を示すことも広い意味では推薦に含まれますが、本コラムが主に扱うのは、多くの顧客の購買や閲覧の履歴、商品の属性をデータとして使い、顧客や閲覧中の商品に合わせて異なる並びを作る推薦です。この推薦は、人が選ぶやり方と規則で並べるやり方の間を埋めることを狙います。
人気順の推薦は、比較の基準(ベースライン)として扱います。
レコメンドは、協調フィルタリングや深層学習といったアルゴリズムの話として語られることが多くあります。しかし、レコメンドの価値を決めるのは、アルゴリズムの予測の精度そのものではなく、推薦が無かった場合と比べて、顧客の購買や継続利用がどれだけ増えたかだと考えています。仮の例として、顧客がいずれ買うつもりだった商品を推薦の枠(サイトやメールで推薦を表示する場所)に出せば、推薦経由の購買は増えますが、推薦が無くてもその商品は買われていたかもしれません。反対に、顧客が知らなかった商品との出会いは、推薦経由の購買の数が少なくても、追加の購買につながる可能性があります。ただし、別の導線から買われたかもしれない分や、別の商品の購買が置き換わっただけの分もありうるため、その増加分は推薦が無い場合と比べて確かめる必要があります。そのため本コラムでは、推薦の取り組みを、予測の技術と、推薦で何を増やすかを決め、その増え方を測るところまでを含むものとして扱います。
レコメンドを支える3つの考え方
推薦の方式は、人気とルールによる推薦、行動の似かたによる推薦、商品の中身による推薦の3つに分けて考えると整理しやすくなります。1つ目の人気とルールによる推薦は、売れ筋の順位や「一緒に買われることが多い商品」の集計、業務の知識による規則で推薦する方法で、第3章で扱います。単純ですが、他の方式と比べるときのベースラインとして欠かせません。2つ目の行動の似かたによる推薦は、多くの顧客の購買や閲覧の履歴から、好みの似た顧客や、一緒に関心を持たれやすい商品を見つけて推薦する方法です。協調フィルタリング(第4章)、行列分解(第5章)、深層学習による推薦(第7章)がこれに当たります。3つ目の商品の中身による推薦は、商品の属性や説明文と、顧客が過去に関心を示した商品の似かたから推薦する方法で、第6章で扱います。履歴の少ない新しい商品も推薦できる一方で、似たものばかりが並びやすくなります。なお、深層学習は、ここでは行動の似かたを使う方式の1つとして扱います(方式の一覧は第1章、詳しくは第7章で述べます)。
3つの考え方は、外れ方が違います。たとえば人気による推薦は、どの顧客にも同じ商品を出すので、好みの違う顧客には的外れになりやすくなります。商品の属性を併用せず行動の履歴だけに頼る推薦は、履歴の無い商品を推薦できません(第10章)。商品の中身による推薦は、属性のデータが不正確だと、関係の無い商品を並べます(第6章)。すべての推薦の枠で最も新しい方式を選ぶ必要はなく、推薦の枠の目的と、手元にある履歴の量に応じて、どの方式を使うか、どう組み合わせるかを選びます。候補となる商品を協調フィルタリングで選び、在庫や利益の規則で並べ替える、という組み合わせも選べます(第3章・第12章)。
どの方式を選ぶにしても、その前提になるのが、推薦で何を増やしたいのかと、手元のデータが顧客の関心を表しているのかという2つの問いです。何を増やしたいのかは、推薦の枠ごとに違います。商品ページの関連商品では購買点数を、トップページのおすすめでは回遊や継続利用を増やしたいかもしれません(第1章)。データが関心を表しているかは、ログの意味で決まります。買われなかった商品は、嫌われたのではなく、顧客に見えていなかっただけかもしれません(第2章)。方式を選ぶ前に、この2つを先に確かめることが、レコメンドの取り組みの出発点になります。
予測から効果の確認へ
推薦の予測を事業の成果につなぐには、さらに3つの取り決めが要ります。第1に、評価の方法です。過去のログで推薦の当たり具合を測るオフライン評価は、方式を絞り込むのに役立ちますが、評価データの切り方を誤ると、推薦を作るためのデータに、予測したい時点より後の行動が入り込み、成績が実際より良く見えます(第8章)。最終的な効果は、実際の顧客を推薦ありと推薦なしに分けて比べるA/Bテストなどで確かめます(第9章)。第2に、新しいものの扱いです。履歴の多い商品ばかりを推薦すると、新しい商品の評価がいつまでもたまりません。新しい商品にどの程度の表示の機会を割くか、履歴の少ない新しい顧客には何を手がかりに推薦するかを決めておきます(第10章)。第3に、偏りと運用の監視です。推薦が人気の商品に集中していないか、推薦の質が落ちていないかを測り続け、推薦の仕組みが止まったときの代わりの推薦も決めておきます(第11章・第12章)。
この3つの取り決めが無いまま推薦のアルゴリズムだけを入れると、PoC(試験導入)では「推薦経由の購買が多かった」という結果が出ても、それが推薦の効果なのかが分からず、本番の投資の判断につながりにくいと考えています。本コラムでは、アルゴリズムの説明に加えて、評価と運用にも章を立てて扱います。なお、推薦に顧客の購買や閲覧の履歴を使うことには、個人データの取り扱いに関する法令が関わります。推薦の設計の前提として、法令の条文と所管官庁の資料で確認できた範囲を第14章で整理します。
決めないことで出る損失の型
推薦の方式を選ぶとき、推薦の仕組みを導入して運用するときに起きうる損失は、金額ではなく型で整理すると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。
- 機会損失:買われたはずの商品が顧客に見えず、購買や継続利用の機会を逃します。
- 効果の過大評価:推薦が無くても買われた分まで推薦の成果と数え、投資の判断を誤ります。
- 品揃えの偏り:推薦が一部の人気商品に集中し、在庫や売場の幅が顧客に伝わらなくなります。
- 顧客の離反:的外れな推薦、しつこい推薦、個人データの扱いが分かりにくい推薦によって、顧客の信頼を失い、配信の停止、データの利用への同意の撤回、退会につながります。
- 形骸化:推薦の枠が見られないまま放置される、あるいは効果が測られないまま運用が続きます。
- 二重投資:共通にできるデータや仕組みまで、チャネルや部署ごとに別々に整え、同じ開発と保守の手間を何度もかけます。
どの損失が自社で目立っているかを見れば、どこから着手するかの見当が付きます。効果の過大評価が疑われるなら、推薦経由の購買の数字を一度脇に置き、推薦ありと推薦なしを比べる仕組みを作ることから始めます(第9章)。品揃えの偏りが目立つなら、推薦に出ている商品の数と、売上の上位の商品への集中の度合いを数えます(第11章)。形骸化が起きているなら、新しいアルゴリズムを探す前に、推薦の枠が表示された回数と、その枠で何が起きたかのログが残っているかを確かめます(第2章)。すべての推薦の枠を一度に高度なアルゴリズムに切り替える必要はない、というのが本コラムの考えです。
レコメンドは、目的と効果の測り方から始める
レコメンドで最初に決めるべきことは、どのアルゴリズムを使うかではなく、推薦の枠ごとに何を増やしたいのかと、その増え方を推薦が無い場合と比べてどう測るか、そしてそのためにどのログを残すかだと考えています。そのうえで人気順などの単純な推薦から小さく始め、比較の基準に勝てる方式だけを残していきます。目的が決まれば、評価の指標が決まります。ログの設計と蓄積は、オフライン評価とオンライン評価の共通の土台になります(オンライン評価では、比べる群の分け方や期間も別に設計します)。比較の基準が決まれば、複雑なアルゴリズムに投資する理由を、数字で社内に説明できるようになります。
本コラムは、次の4つの流れで進みます。
- 推薦の目的とデータの基礎:事業の中での推薦の位置づけと、推薦に使うデータの意味を整理します(第1章・第2章)。
- 推薦の方式:人気順とルール、協調フィルタリング、行列分解、内容ベースとハイブリッド、深層学習による推薦を、実行したコードとともに見ます(第3章から第7章)。
- 評価の設計:オフライン評価、A/Bテストとバンディット、コールドスタートと探索、偏りと多様性を扱います(第8章から第11章)。
- 運用と定着:システムの構成と運用、導入の進め方と体制、プライバシーと規制、公開事例と最新の動向を扱います(第12章から第14章)。
経営判断に関わる方には、投資の進め方として、推薦の製品や開発に予算を付ける前に、次の4つを確かめる順序をお勧めします。
- 推薦の枠ごとに、何を増やしたいのかが決まっているか
- 推薦が表示された記録と、その後の行動の記録が残っているか
- 人気順などの単純な推薦と比べる仕組みがあるか
- 推薦ありと推薦なしを比べて効果を測る方法が決まっているか
この順序であれば、投資の前提を社内に説明でき、効果が出なかったときにも原因を切り分けやすくなると考えています。反対に、推薦エンジンを先に全チャネルへ広げ、目的と効果の測り方を後回しにすると、推薦経由の購買の数字は積み上がっても、それが投資に見合うのかを誰も答えられないおそれがあります。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、レコメンドを含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章を、序章で示した4つのまとまりに分けて構成しています。
- 推薦の目的とデータの基礎(第1章・第2章):推薦が事業の何に効くのかと、推薦に使うデータの意味
- 推薦の方式(第3章から第7章):比較の基準になる単純な推薦から、行動の似かた、商品の中身、深層学習を使う推薦まで
- 評価の設計(第8章から第11章):過去のログでの評価、実際の顧客での効果の確認、新しいものの扱い、推薦の偏り
- 運用と定着(第12章から第14章):システムの構成と運用、導入の進め方と体制、プライバシーと規制、公開事例と最新の動向
第2章から第12章には、架空の合成データ(乱数で作った顧客の購買や閲覧のログ)で実際に動かしたPythonのコードと、その結果を載せています。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | レコメンドの役割と事業での位置づけ、検索・ランキング・パーソナライゼーションとの違い | 推薦は事業の何を増やすための仕組みで、検索や広告配信とは何が違うのか。どの枠で何を増やすか |
| 第2章 | 推薦に使うデータ、購買・閲覧の履歴と暗黙のフィードバックの扱い | 購買や閲覧の履歴は顧客の関心をどこまで表すのか。どのログを残すべきか |
| 第3章 | 人気順とルールによる推薦、まずベースラインを作る | 売れ筋の順位や「一緒に買われる商品」の集計で、どこまで推薦できるか。比較の基準をどう作るか |
| 第4章 | 協調フィルタリング、似た顧客と似た商品から推薦する | 多くの顧客の行動の似かたから、どう推薦を作り、どこで外れるか |
| 第5章 | 行列分解、潜在因子で好みを表す | 顧客と商品を少数の「好みの軸」で表すと何ができ、何が分からなくなるか |
| 第6章 | 内容ベースとハイブリッド、商品の属性と説明文を使う | 履歴の少ない商品を、属性や説明文でどう推薦し、行動の似かたとどう組み合わせるか |
| 第7章 | 深層学習による推薦、2つの塔のモデルから系列の推薦まで | 深層学習の推薦はどんな条件で効き、単純な方式に勝てるかをどう確かめるか |
| 第8章 | オフライン評価、適合率・再現率・NDCGと評価データの切り方 | 過去のログで推薦をどう評価し、評価データの切り方で何が変わるか |
| 第9章 | オンライン評価、A/Bテストとバンディットで効果を確かめる | 推薦の効果を、推薦ありの群と推薦なしの群を比べた差としてどう測るか(A/Bテスト)。候補の中から良い推薦を試しながら選ぶにはどうするか(バンディット) |
| 第10章 | コールドスタートと探索、新しい商品と新しい顧客への推薦 | 履歴の無い商品と顧客に、どう推薦を出し、どれだけ試す枠を割くか |
| 第11章 | 推薦の偏りと多様性、人気の偏り・フィルターバブル・公平性 | 推薦が人気の商品に集中する仕組みと、品揃えの幅をどう測り保つか |
| 第12章 | システムの構成と運用、候補の生成・並べ替え・監視と再学習 | 推薦の仕組みをどう組み立て、推薦の質をどう監視し続けるか |
| 第13章 | 導入の進め方と体制、目的の設計・PoC・内製と外部の分担 | どの推薦の枠から始め、試験導入(PoC、概念実証)をどう設計し、誰が何を担うか |
| 第14章 | プライバシーと規制、公開事例と最新動向 | 推薦に個人データを使うときに確かめる法令は何か。公開された事例と研究から何が読み取れるか |
本コラムで使う用語は、次の表の意味に固定しています。特定の章だけで使う用語は、その章の中で定義します。適合率・再現率・NDCG などの評価の指標の定義は第8章にまとめています。コードのある各章は、章ごとに別々に作った架空の合成データを使っているため、同じ名前の数値(人気の上位の商品が占める割合など)でも章によって値が違います。再現率や適合率などの指標も、章によって数え方(顧客ごとの平均か、全顧客の合算かなど)が違うことがあり、各章の本文にその章の数え方を書いています。
| 用語 | 本コラムでの意味 |
|---|---|
| レコメンド(推薦) | 顧客の選択を助けるために、商品やコンテンツの候補を選んで示す仕組み。本コラムでは主に、顧客や閲覧中の商品に合わせて候補を変える推薦を扱い、全員に同じ並びを示す人気順の推薦は比較の基準(ベースライン)として扱う。「レコメンド」と「推薦」は同じ意味で使う |
| 推薦の枠 | サイト・アプリ・メールなどで推薦の結果を表示する場所。商品ページの「この商品を見た人は」、トップページの「おすすめ」など |
| アイテム | 推薦の対象。商品・記事・動画・求人など。本コラムでは代表例として「商品」と書くことが多い |
| 明示的なフィードバック | 顧客が自分で示した評価。星の数・いいね・低評価など |
| 暗黙のフィードバック | 購買・閲覧・クリック・視聴時間など、行動から間接的に分かる関心。買われなかった・見られなかったことは、嫌われた証拠ではない(見えていなかっただけかもしれない) |
| ベースライン | 比較の基準となる単純な推薦。人気順・最近の人気順・ランダムなど |
| 協調フィルタリング | 多くの顧客の行動の似かたから推薦する方法。商品の中身は使わない |
| 内容ベース | 商品の属性や説明文と、顧客が過去に関心を示した商品の属性の似かたから推薦する方法 |
| オフライン評価 | 過去のログを使って、推薦がその後の行動をどれだけ当てたかを測ること |
| オンライン評価 | 実際の顧客に推薦を出して、行動の差を測ること。A/Bテストなど |
| 推薦経由の購買 | 推薦の枠に表示された商品が、その枠から選ばれて買われた分。推薦の枠がどれだけ使われているかの目安にはなるが、推薦が無くても買われた分を含むので、推薦の効果とは別のもの |
| 推薦の効果 | A/Bテストなどで推薦が無い場合と比べて確かめた、購買率・継続率などの行動の差。増える場合だけでなく減る場合も含む。推薦経由の購買の数そのものではない。新しい推薦と従来の推薦を比べた差は「方式を替えた効果」と呼んで区別する |
| KPI | 重要な業績の指標。推薦では、推薦の枠ごとに増やしたい行動(クリック率・購買率・継続率など)を指す |
| A/Bテスト | 顧客を無作為に2つ以上の群に分け、推薦あり・なし、あるいは異なる推薦を出して、行動の差を比べる方法(第9章) |
| コールドスタート | 履歴の無い新しい顧客や新しい商品について、推薦が難しくなる問題 |
| 相対値 | 例題で価格や売上を表すときに使う、単位の無い仮の数。金額ではなく、何を基準にした数かは各例題で示す |
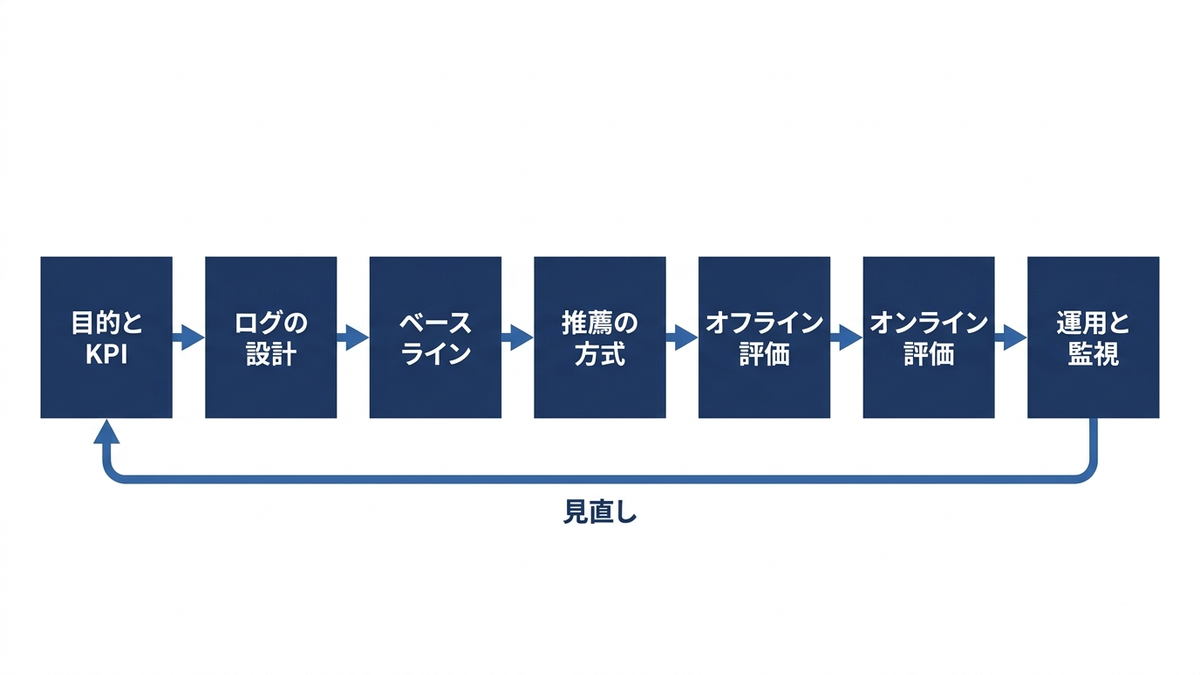
次の図は、レコメンドの取り組みを進める順序を示したものです。
第1章 レコメンドの役割と事業での位置づけ、検索・ランキング・パーソナライゼーションとの違い
この章では、推薦の手法に入る前に、推薦が事業のどこに効き、何を増やすために置くのかを整理します。推薦の仕組みは、協調フィルタリングでも深層学習でも、最終的には「ある顧客に、ある場所で、どの商品をどの順番で見せるか」を決めるものです。その決め方が良いかどうかは、手法の新しさでは決まりません。どの場所で、どの行動を増やすために置いたのかが先に決まっていなければ、良し悪しを判断する基準が無いからです。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 推薦が事業に効く経路(発見の支援・回遊・購買点数・継続利用・在庫の消化)
- 推薦の目的と KPI(重要な業績の指標)の型(クリック率・購買率・購買点数・継続率・顧客の生涯価値)と、短期の KPI と長期の KPI のずれ
- 推薦の枠の種類(商品ページ・トップページ・カート・メール・プッシュ通知・店頭)と、それぞれで何を推薦するか
- 検索・ランキング・パーソナライゼーション・広告配信・CRM のセグメント配信との違い
- 推薦の方式の全体像(ルール・協調フィルタリング・内容ベース・深層学習)
- 業種別の推薦の対象と注意点、推薦システムの研究の歴史
- よくある誤解、経営の損失の型、経営判断
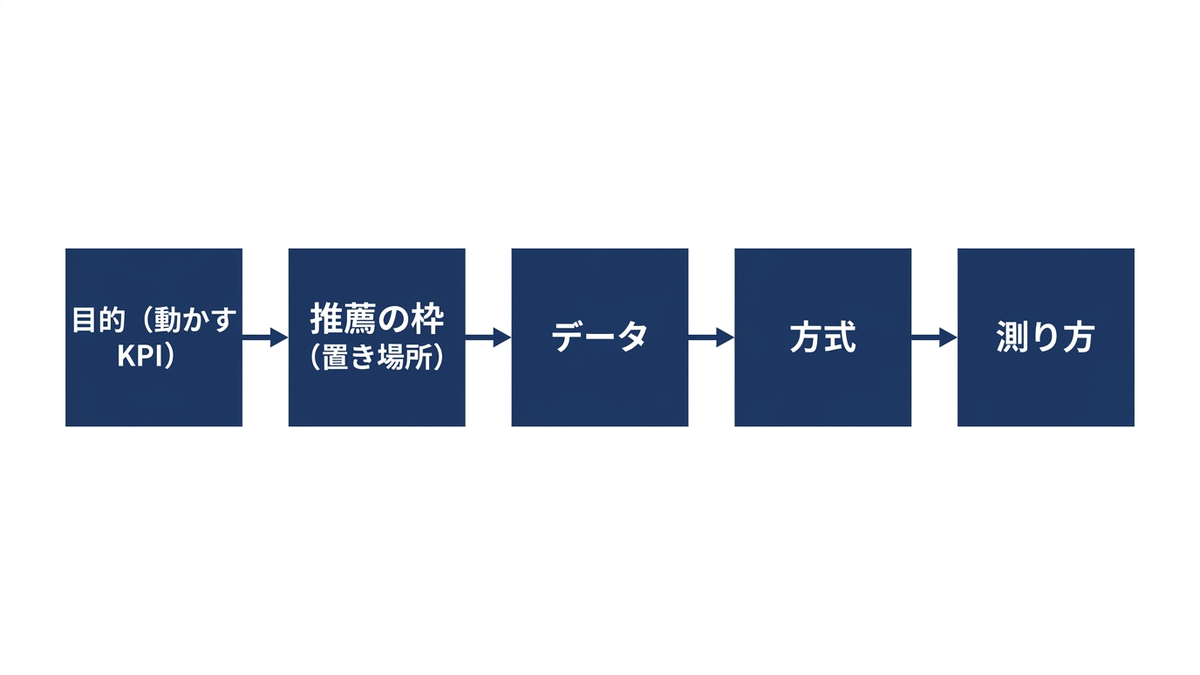
この章の主張は、推薦の目的(どの KPI を動かすか)と置き場所(どの推薦の枠か)を、手法を選ぶ前に決めることです。推薦の枠とは、サイト・アプリ・メールなどで推薦の結果を表示する場所のことで、商品ページの「この商品を見た人はこんな商品も見ています」や、トップページの「おすすめ」がその例です。目的と置き場所が決まると、使うデータ(第2章)、比べる基準(第3章)、手法(第4章から第7章)、測り方(第8章・第9章)が順に決まります。逆に、手法から先に決めると、精度の数字は出ても、それが事業の何を増やしたのかを説明できなくなります。次の図は、このうち比べる基準(第3章)を省き、目的から測り方までの順序を示したものです。
推薦が事業に効く5つの経路、発見の支援・回遊・購買点数・継続利用・在庫の消化
推薦は、置いただけで売上を生む仕組みではありません。推薦が事業に効くとすれば、顧客の行動のどこかを変えることを通じてです。本コラムでは、推薦が事業に効く経路を5つに分けて考えます。経路を分けるのは、経路ごとに増やしたい行動が違い、測る指標も、向く推薦の枠も違うからです。
1つ目は発見の支援です。品揃えが多いと、顧客は自分に合う商品を自分で探しきれません。検索の言葉を思いつかない商品や、存在を知らない商品は、検索でも一覧でも見つかりにくくなります。推薦は、顧客がまだ知らない商品を目の前に出すことで、探す手間を減らします。2つ目は回遊です。商品ページやコンテンツの末尾に関連する商品を並べると、顧客がサイトやアプリの中で次の商品へ移り、滞在が延びる可能性があります。回遊そのものは売上ではありませんが、発見の機会を増やす経路になります。
3つ目は購買点数です。注文を確定する前のカートで一緒に使う商品を示すと、その注文に含まれる商品の数が増えることがあります。購入の完了画面で補充の商品や付属品を示す場合は、確定した注文の点数は増えないので、一定期間内の追加の購買が増えるかどうかで見ます。4つ目は継続利用です。定額制の動画・音楽の配信や会員制のサービスでは、毎回の購買よりも、顧客が使い続けるかどうかが事業を左右します。Netflix の技術者が2007年に書いた論文(Bennett と Lanning の論文。Netflix Prize の解説)は、加入者が関心を持てる作品に出会えることを、サービスの継続に関わる課題として位置づけています。5つ目は在庫の消化です。人気の商品だけが売れ、それ以外の商品が倉庫に残ると、在庫の負担が増えます。推薦は、売れ筋以外の商品を、関心を持ちそうな顧客に届ける経路になりえます。
5つの経路と、それぞれで増やしたい行動・測る指標・向く推薦の枠を次の表にまとめました。表の「向く推薦の枠」は本コラムが整理した目安で、どの枠がどの経路に効くかは、事業と顧客によって変わります。
| 経路 | 増やしたい行動 | 測る指標の例 | 向く推薦の枠の例 | 外れやすい点 |
|---|---|---|---|---|
| 発見の支援 | 顧客がまだ知らない商品の閲覧・購買 | 推薦された商品のうち、その顧客が初めて見た商品の割合、購買率 | トップページ、メール | 人気の商品ばかり出すと、発見にならない |
| 回遊 | 商品ページからの次の閲覧 | 推薦の枠のクリック率、1回の訪問での閲覧数 | 商品ページ、記事の末尾 | 閲覧は増えても購買につながらないことがある |
| 購買点数 | その注文に含まれる商品の数、購入後の追加の購買 | カートでは1回の注文あたりの点数、購入の完了画面では一定期間内の追加の購買の率 | カート、購入の完了画面 | 無関係な商品を足すと、購入の手続きを妨げる |
| 継続利用 | 次の訪問・次の視聴・契約の継続 | 継続率、一定期間内の再訪率、利用の日数 | トップページ、プッシュ通知 | 効果が出るまで時間がかかり、短期の指標に表れにくい |
| 在庫の消化 | 売れ筋以外の商品の購買 | 推薦された商品の網羅率、在庫の回転 | カテゴリの一覧、メール | 顧客に合わない商品を押し付けると、離反を招く |
表の網羅率は、品揃えのうち、推薦で一度でも顧客に示された商品の割合のことで、詳しい定義と測り方は第11章で扱います。表の右端の列に書いたとおり、どの経路にも外れやすい点があります。とくに注意したいのは、経路どうしがぶつかる場合です。在庫の消化を急いで売れ残りの商品を推薦の上位に並べると、顧客にとっては関心の薄い商品が増え、発見の支援や継続利用の経路を損ねることがあります。どの経路を主に狙い、どの経路を守るべき制約として置くかを、推薦を設計する最初の段階で決めておく必要があります。
推薦の目的と KPI の型、短期の KPI と長期の KPI のずれ
経路が決まると、推薦で動かしたい KPI が決まります。推薦の文脈で使われる KPI は、おおむね次の5つの型に分けられます。
- クリック率:推薦の枠で商品を表示した回数に対する、クリックされた回数の割合
- 購買率:推薦の枠を見た顧客のうち、決めた期間内に購買した顧客の割合(推薦した商品の単位で数える場合は、別の指標として名前を分ける)
- 購買点数:1回の購買に含まれる商品の数、または一定期間の購買の点数
- 継続率:一定期間のあとも利用・契約を続けている顧客の割合
- 顧客の生涯価値:1人の顧客が取引の期間を通じてもたらす価値(弊社コラム「顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで」で扱っています)
研究の側でも、推薦の事業上の価値をどう測るかは整理されています。Jannach と Jugovac の2019年の論文(推薦システムの事業上の価値の測り方を、公表された実地の試験から整理した論文)は、測り方を、クリック率・採用と購買への転換・売上・売上の分布への影響・利用者の関与と行動の5つに分けて整理しています。同じ論文は、実地の報告ではクリック率の増加が成果としてよく使われる一方で、それが推薦の長期の事業上の価値をどこまで表すかには疑問が残りうる、と指摘しています。
この指摘は、短期の KPI と長期の KPI のずれとして整理できます。クリック率や購買率は、推薦を変えた直後から観測でき、A/Bテスト(第9章)で差を測りやすい指標です。一方で、継続率や顧客の生涯価値は、観測の期間を長く取る必要があることが多く、その間に季節や他の施策の影響も混ざります。どの指標でも、差を判断できるまでの期間は、対象の人数・ばらつき・確かめたい差の大きさによって変わるので、観測の期間は始める前に決めておきます。測りやすい短期の指標だけで推薦を選ぶと、次のようなずれが起きることがあります。
- 目を引く商品や値引きの商品を上位に出すとクリック率は上がるが、購買にはつながらない
- すでに買うつもりだった商品を推薦すると購買率は高く見えるが、推薦が無くても買われた分が多い(第9章で扱う効果の過大評価)
- 同じジャンルの商品ばかり出すと短期の購買は増えるが、顧客が飽きて継続率が下がる
- 通知やメールを増やすと短期の再訪は増えるが、配信の停止やアプリの削除が増える
このずれに対して本コラムが考える手当ては、KPI を1つに絞らず、「最適化する KPI」と「悪化させてはいけない KPI」を組にして決めることです。たとえば、商品ページの推薦でクリック率を最適化するなら、購買率と返品率を悪化させてはいけない KPI として置き、メールの推薦で購買率を最適化するなら、配信の停止率を悪化させてはいけない KPI として置く、という具合です。KPI の型と、それぞれの測りやすさ・ずれの起きやすさを次の表にまとめました。
| KPI の型 | 何を表すか | 観測に要する期間 | 測りやすさ | ずれが起きやすい場面 |
|---|---|---|---|---|
| クリック率 | 推薦への関心 | 短い(表示とクリックはその場で記録される) | 高い。推薦の枠ごとに数えられる | 目を引くだけの商品が上位に来る |
| 購買率 | 推薦から購買への転換 | 短いから中程度(購買までの期間をどこまで待つかを決める) | 高い。ただし推薦が無くても買われた分を含む | 買うつもりだった商品を推薦して成果に見える |
| 購買点数 | 1回・一定期間の購買の広がり | 1回の注文なら短い、一定期間なら中程度 | 中程度。他の施策の影響が混ざる | 値引きの同時購買で点数だけ増える |
| 継続率 | 利用・契約の継続 | 継続を数える期間による(長く取ることが多い) | 低い。長い期間の比較が要る | 短期の指標を追った結果、気付かないうちに下がる |
| 顧客の生涯価値 | 取引の期間を通じた価値 | 長い | 低い。推定のモデルが要る | 推定の前提が変わると値が大きく動く |
表の「観測に要する期間」は本コラムの整理した目安で、差を判断できるまでの期間はこれとは別に、対象の人数と確かめたい差の大きさで決まります(第9章)。表の「測りやすさ」が高い指標ほど、推薦の改善の判断に使われやすくなります。しかし、継続率や顧客の生涯価値を最終の目標とする事業では、表の上のほうの指標だけを見ていると、最終の目標とのずれに気付きにくくなります。本コラムでは、短期の指標を日々の判断に使いながら、四半期ごとなどの間隔で長期の指標を確かめ、短期の指標の改善が長期の指標を損ねていないかを点検する運用を考えます。KPI を最終の目標から推薦の枠ごとの指標へ分解する方法(KPI の木)は第13章で扱います。
推薦の枠の種類と、それぞれで何を推薦するか
同じ顧客に対しても、推薦の枠が違えば、推薦すべき商品は違います。商品ページを見ている顧客は、いま見ている商品に関心を持っています。カートに商品を入れた顧客は、買う商品をほぼ決めています。メールを開いた顧客は、サイトの外にいて、特定の商品を探しているわけではありません。推薦の枠ごとに、顧客がどんな状態にあり、何を手がかりに推薦できるかが違うので、推薦の中身も変える必要があります。
代表的な推薦の枠を、顧客の状態・推薦の手がかり・推薦する商品の例・主な KPI で整理したのが次の表です。表に挙げた推薦の中身は、本コラムが一般的な考え方として整理した例で、どの枠で何を推薦するのがよいかは、品揃えと顧客によって変わります。
| 推薦の枠 | 顧客の状態 | 推薦の手がかり | 推薦する商品の例 | 主な KPI |
|---|---|---|---|---|
| 商品ページ | 特定の商品に関心を持って見ている | いま見ている商品 | 似た商品、比べられる商品、一緒に使う商品 | クリック率、回遊 |
| トップページ | 目的がはっきりしないまま訪れている | その顧客の過去の閲覧・購買 | その顧客の好みに合いそうな商品、新着の商品 | クリック率、発見の支援、継続率 |
| カート | 買う商品をほぼ決めているが、注文は確定していない | カートの中の商品 | 一緒に使う商品、消耗品・付属品 | その注文の購買点数 |
| 購入の完了画面 | 注文を確定した直後 | いま買った商品 | 補充の商品、付属品 | 一定期間内の追加の購買の率 |
| メール | サイトの外にいて、商品を探していない | 過去の購買・閲覧、前回の訪問からの時間 | 補充の時期が来た商品、関心のジャンルの新着 | 開封率、購買率、配信の停止率 |
| プッシュ通知 | アプリの外にいて、通知を受け取る | 過去の利用、時刻 | 続きのコンテンツ、関心の強い新着 | 再訪率、通知の停止率 |
| 店頭(売場・端末・接客) | 店にいて、実物を見ている | 会員の購買の履歴、売場の在庫 | 売場にある関連の商品 | 購買点数、来店の継続 |
表のメールの行の開封率は、配信したメールのうち開かれた割合です。表の中で、枠ごとの違いが最も大きいのは「推薦の手がかり」の列です。商品ページとカートでは、いま見ている商品やカートの中身という強い手がかりがあり、その商品と一緒に買われやすい商品や似た商品を出す方式(第3章で扱う、一緒に買われる商品の組み合わせを集計するアソシエーション分析や、第4章で扱う、商品どうしの似かたから推薦するアイテムベースの協調フィルタリング)が使いやすい枠です。トップページとメールでは、その場の手がかりが弱く、顧客の過去の行動から好みを推し量る方式(第4章・第5章)が中心になります。店頭では、推薦の結果を出せる場所が限られ、在庫が売場にあるかどうかという制約が加わります。
メールとプッシュ通知は、顧客が推薦を求めていない場面に推薦を届ける枠である点に注意が要ります。サイトの中の推薦の枠は、顧客が見なければ何も起きませんが、メールや通知は顧客の注意を取りに行きます。的外れな推薦や、頻度の高すぎる配信は、配信の停止・通知の停止・アプリの削除という形で、その枠そのものを失う結果になりえます。メールと通知の枠では、購買率と並べて、停止率を悪化させてはいけない KPI として必ず置いておくことを勧めます。メールの配信に関わる法令の確認も要りますが、メールの配信の規制は本コラムの範囲外とし、扱いません。推薦と個人データの関係は第14章で扱います。
もう1つ、複数の推薦の枠を同時に持つときに考えておきたいのが、枠どうしの重なりです。商品ページにも、カートにも、メールにも同じ商品が繰り返し出ると、顧客にはしつこく見えます。枠ごとに別々の担当者が推薦を作ると、この重なりに誰も気付かないことがあります。推薦の枠の一覧を作り、枠ごとの目的・KPI・担当者・推薦の方式を1枚の表で管理しておくと、重なりと、後で扱う二重投資を防ぎやすくなります。
検索・ランキング・パーソナライゼーション・広告配信・CRM のセグメント配信との違い
推薦は、似た仕組みと混同されやすい言葉です。社内で「レコメンドを入れる」と言ったとき、ある人は検索の結果の並べ替えを、ある人はメールのセグメント配信を、ある人は広告の出し分けを思い浮かべていることがあります。言葉の範囲がずれたまま進めると、誰が担当し、何で測り、どの予算から出すかが決まりません。ここでは、推薦と、隣にある5つの仕組みの違いを整理します。
情報の研究では、推薦の源流の1つである情報フィルタリングと、検索の研究である情報検索の関係が早くから論じられてきました。Belkin と Croft の1992年の論文(情報フィルタリングと情報検索の関係を論じた論文。Communications of the ACM 誌に掲載)は、題名で、両者が同じ硬貨の表と裏の関係にあるのかを問いかけています。本コラムの言葉でいえば、検索は顧客が入力した言葉という明示的な要求に応える仕組みで、推薦は顧客が要求を言葉にしていない場面で、過去の行動などから関心を推し量って商品を示す仕組みです。
ランキングは、候補の商品を何らかの基準で順に並べることです。検索の結果の並べ替えも、推薦の結果の並べ替えも、ランキングの一種です。売上の順位表のように、誰が見ても同じ順番になるランキングもあれば、顧客ごとに順番が変わるランキングもあります。パーソナライゼーションは、顧客ごとに画面・内容・順番・案内を変えることの総称で、推薦はその代表的な手段ですが、画面の配置や表示する文言を顧客ごとに変えることもパーソナライゼーションに含まれます。
広告配信と CRM のセグメント配信は、推薦と同じく「誰に何を見せるか」を決めますが、目的と決め方が違います。広告配信は、広告主がお金を払って、自社の商品を見せたい相手に届ける仕組みで、何を見せるかの候補は広告主の出稿で決まります。CRM のセグメント配信は、顧客を属性や購買の履歴でグループ(セグメント)に分け、グループごとに同じ内容を届ける仕組みです。推薦は、自社が表示できる商品の中から、顧客の過去の行動や閲覧中の商品などを手がかりに候補を選ぶ点で、両者と違います。推薦には、人気順のように全員に共通のものも、顧客ごとに変えるものもあります。6つの仕組みを次の表で比べました。表の「ランキング(順位表)」の行では、売上の順位表のように、誰が見ても同じ順番になるランキングを取り上げます。表の整理は本コラムが比較のために作ったもので、実際の製品やサービスでは、これらの機能が組み合わされていることがよくあります。
| 仕組み | きっかけ | 何を見せるかの候補 | 顧客ごとの違い | 主な判断基準 | 主な担当の例 |
|---|---|---|---|---|---|
| 推薦 | 顧客が要求を言葉にしていない場面 | 自社が表示できる商品(枠や条件で絞ることがある) | 全員に共通の場合も、1人ずつ違う場合もある | その顧客が関心を持ちそうか | EC 運営、マーケティング、データ分析 |
| 検索 | 顧客が入力した言葉 | 言葉に合う商品 | 同じ言葉なら原則同じ(顧客ごとに並べ替える場合もある) | 入力された言葉に合っているか | EC 運営、エンジニア |
| ランキング(順位表) | 一覧・カテゴリのページ | カテゴリ内の商品 | 原則同じ | 売上・閲覧などの集計 | EC 運営、商品部 |
| パーソナライゼーション | 画面の表示 | 画面の配置・文言・商品 | 1人ずつ、またはグループごとに違う | 顧客に合った体験か | マーケティング、EC 運営 |
| 広告配信 | 広告の枠の表示 | 広告主が出稿した商品・広告 | 配信の対象の条件で違う | 広告主の目的(表示・クリック・購買) | 広告の担当、広告代理店 |
| CRM のセグメント配信 | 配信の計画 | 企画した内容 | グループごとに同じ | グループに合った内容か | CRM、マーケティング |
表から分かるとおり、推薦・検索・ランキングは「商品を並べる」仕組みとして技術の多くを共有します。第12章で扱う候補の生成と並べ替えの構成は、検索の仕組みとほぼ同じ形をしています。一方で、判断基準が違うので、同じ並べ替えの仕組みを使っても、評価の仕方は変わります。検索では、入力された言葉に合う商品が上位にあるかを測り、推薦では、顧客が後に関心を示した商品が上位にあったか、推薦が無い場合と比べて行動が増えたかを測ります(第8章・第9章)。
この区別が経営上の意味を持つのは、予算と担当の重なりを見つけるときです。検索の改善、CRM の配信の高度化、広告の出し分け、推薦の導入を、別々の部署で、別々のベンダーと、別々の顧客データで進めると、同じデータの整備や仕組みの開発が重なります。表の6つは、どれも顧客の行動のデータを使って「誰に何を見せるか」を決める点で共通しています。顧客の行動のデータと商品のデータを共通の基盤に置き、その上で推薦・検索・配信を作り分ける形にすると、後で扱う二重投資の損失を減らせると考えています。
推薦の方式の全体像、ルール・協調フィルタリング・内容ベース・深層学習
推薦の方式は多くありますが、本コラムでは大きく4つに分けて扱います。1つ目はルールと人気順で、「よく売れている順」「新着の順」「この商品を買った人には付属品を出す」のように、集計や業務の知識で推薦を決める方式です(第3章)。2つ目は協調フィルタリングで、多くの顧客の行動の似かたから推薦を決める方式です(第4章・第5章)。商品の中身を使わず、「この商品を買った人は、あの商品も買っている」という行動の重なりだけを使います。
3つ目は内容ベースで、商品の属性・説明文と、顧客が過去に関心を示した商品の属性の似かたから推薦を決める方式です(第6章)。行動の履歴が少ない新しい商品でも、属性があれば推薦できます。4つ目は深層学習による推薦で、顧客と商品をベクトル(数の並び)で表し、行動の順番や多様な特徴をまとめて学習する方式です(第7章)。実際の推薦では、これらを組み合わせて使うことが多く、組み合わせ方は第6章のハイブリッド推薦と第12章のシステムの構成で扱います。
序章では推薦を支える考え方で3つに分け、深層学習を行動の似かたを使う方式の1つとして扱いました。この章では、使うデータと運用の違いを比べるために、説明の都合で深層学習を4つ目の方式として分けます。
深層学習は学習の方法の分類で、行動の履歴にも商品の中身にも使えます。たとえば van den Oord らの2013年の論文(NIPS 2013)は、利用の履歴が無い楽曲について、音声から推薦に使う特徴を深層学習で予測する方法を示しています。
4つの方式(協調フィルタリングは、近傍の方式と行列分解の2行に分けました)を、使うデータ・得意な場面・苦手な場面・説明のしやすさで比べたのが次の表です。表の評価は一般的な傾向として本コラムが整理したもので、どの方式が自社に合うかは、データの量と、推薦の枠の目的で変わります。
| 方式 | 使うデータ | 得意な場面 | 苦手な場面 | 説明のしやすさ | 扱う章 |
|---|---|---|---|---|---|
| ルール・人気順 | 売上・閲覧の集計、業務の知識 | データが少ない立ち上げ、比較の基準 | 顧客ごとの好みの違い | 高い(「よく売れています」) | 第3章 |
| 協調フィルタリング(近傍の方式。似た顧客・似た商品を探して推薦する) | 顧客と商品の行動の履歴 | 商品ページの関連商品、購買の履歴が十分にある商品 | 新しい商品・新しい顧客、行動の少ない商品 | 比較的高い(「この商品を買った人は」) | 第4章 |
| 協調フィルタリング(行列分解) | 顧客と商品の行動の履歴 | 行動が疎な(まばらな)データでの好みの推定 | 新しい商品・新しい顧客 | 低い(学習した軸に名前が付くとは限らない) | 第5章 |
| 内容ベース | 商品の属性・説明文、顧客の関心 | 新しい商品、属性で選ばれる商品 | 似た商品ばかりになる、新しい発見が少ない | 高い(「この特徴を持つ商品です」) | 第6章 |
| 深層学習 | 行動の履歴・順番、多様な特徴 | 大規模なデータ、閲覧の順番に意味がある場面 | データが少ない場面、運用の体制が無い場面 | 低い(学習したベクトルが何を表すかを追いにくい) | 第7章 |
表で強調しておきたいのは、方式の並びが「後ろほど優れている」という順番ではないことです。第3章で扱うとおり、人気順は単純ですが、推薦の比較の基準として外せない方式です。先に挙げた Jannach と Jugovac の論文がクリック率を扱う節(2.2.1節)で紹介している実地の試験の中には、ニュースの推薦で、新しい記事ほど重みを大きくした単純な人気順が、試した方式の中で成績の良いものの1つだったという Kirshenbaum らの報告や、ニュースの個人ごとの推薦について、話題性の高い記事が出た日には人気順のほうが個人ごとの推薦をクリックの数で上回った日があったという Das らの報告が含まれています。どちらも特定のサービス・特定の時期の結果で、2つの報告が示しているのは、それらの試験では人気順が良い成績を出した場合があった、という範囲です。一般に人気順が優れているという意味ではありません。本コラムでは、これらの報告を、人気順のような単純な方式を比較の基準に置く必要を考える材料として扱います。データの量が少ない、商品の入れ替わりが速い、説明が求められるといった条件では、単純な方式のほうが運用しやすいことが多いと考えています。方式を選ぶ順番は、ルールと人気順で基準を作り、それに勝てるかどうかを確かめながら協調フィルタリング、内容ベース、深層学習へ進むのが安全です。
業種別の推薦の対象と注意点、EC・配信・ニュース・求人・旅行・金融
推薦の考え方は業種をまたいで共通ですが、推薦の対象(アイテム)の性質は業種によって大きく違います。商品が何度も買われるのか一度きりなのか、在庫に限りがあるのか、新しさが価値を持つのか、推薦する側に法令上の義務があるのか、といった違いが、使えるデータと、守るべき制約を変えます。ここでは、6つの業種について、推薦の対象と注意点を整理します。企業ごとの取り組みや効果の数字は扱わず、対象の性質から考えられる一般的な注意点に限ります。公表された企業の事例は第14章で、そのページに書かれている範囲だけ扱います。
EC では、推薦の対象は商品で、品揃えが多く、同じ顧客が繰り返し購買します。消耗品のように同じ商品を何度も買うものと、家電のように一度買えばしばらく買わないものが混ざっているので、購入済みの商品を推薦から外すか、補充の時期に合わせて推薦するかを、商品の種類ごとに決める必要があります。動画・音楽の配信では、対象は作品や楽曲で、定額制の場合は1回ごとの購買ではなく、視聴の量と継続が事業を左右します。前に挙げた Netflix の論文で、関心を持てる作品に出会えることが継続に関わる課題とされているように、継続を支えることが推薦の位置づけの中心になります。
ニュースでは、記事の価値が時間とともに急に下がります。新しい記事には行動の履歴がほとんど無いので、協調フィルタリングだけでは推薦しにくく、内容ベースや新しさの重み付けが要ります(第6章・第10章)。また、関心の合う記事だけを出し続けると、読者が目にする話題が狭くなるという懸念があり、多様性の扱い(第11章)が問われやすい業種です。求人では、推薦される側の求人にも、応募を受ける企業の都合があり、求職者が関心を持つだけでは成立しません。人気の求人に応募が集中すると、企業の側の負担が増え、他の求人には応募が来なくなるので、双方の都合を考えた推薦になります。
旅行では、1人の顧客の購買の頻度が低く、行き先・日程・人数という、その時々の条件で選ばれる商品が変わります。過去の購買の履歴よりも、検索の条件や閲覧中の内容という文脈の手がかりが重くなり、宿や便の空きという在庫の制約も加わります。金融では、推薦が法令の義務と関わる場合があります。金融商品取引法第40条第1号は、適合性の原則と呼ばれる規定で、顧客の知識・経験・財産の状況・契約の目的に合わない勧誘によって、投資者の保護が損なわれないようにすることを金融商品取引業者等に求めています。推薦の表示が勧誘に当たるかどうかは個別の判断になるので、金融の商品の推薦では、設計の段階で法務・コンプライアンスの担当者と確かめておく必要があります。
6つの業種の推薦の対象と注意点を次の表にまとめました。表の注意点は本コラムが対象の性質から整理したもので、各業種の推薦がすべてこの形になるという意味ではありません。
| 業種 | 推薦の対象 | 対象の性質 | 主な注意点 | 関連する章 |
|---|---|---|---|---|
| EC・小売 | 商品 | 品揃えが多い、繰り返し購買される商品と一度きりの商品が混ざる | 購入済みの商品の扱い、在庫切れの除外、補充の時期 | 第2章・第3章 |
| 動画・音楽の配信 | 作品・楽曲 | 定額制では視聴の量と継続が重要、作品の入れ替わりがある | 短期の視聴と長期の継続のずれ、同じジャンルへの偏り | 第9章・第11章 |
| ニュース | 記事 | 価値が時間とともに急に下がる、新しい記事に履歴が無い | 新しさの扱い、話題の多様性 | 第6章・第10章・第11章 |
| 求人 | 求人 | 求職者と企業の双方の都合で成立する、人気の求人に応募が集中する | 応募の集中、双方の都合の調整 | 第11章 |
| 旅行 | 宿・便・ツアー | 購買の頻度が低い、日程・人数で選ぶ商品が変わる、空きに限りがある | 文脈(検索の条件)の重視、在庫の制約 | 第2章・第12章 |
| 金融 | 金融の商品・サービス | 顧客の状況に合わない商品の勧誘が問題になりうる | 適合性の原則(金融商品取引法第40条)、推薦の表示が勧誘に当たるかの確認 | 第14章 |
表の6つの業種に共通する点もあります。どの業種でも、推薦の枠のログだけでは、その枠に表示しなかった商品に顧客がどう反応したかは観測できません。検索や一覧から同じ商品が閲覧・購買された記録があっても、その商品を推薦の枠に出した場合の反応と同じとは限りません。この性質は第2章で露出の偏りとして扱い、評価の方法(第8章・第9章)と偏りの扱い(第11章)にもつながります。業種によって推薦の形は違っても、「表示したものと、その結果」を記録しておくことは、すべての業種に必要な準備だと考えています。
推薦システムの研究の歴史、Tapestry・GroupLens・商品間の協調フィルタリング・Netflix Prize
前に継続利用の経路で挙げた Bennett と Lanning の論文(Netflix Prize の解説)は、推薦システムが1990年代の初めから開発されてきたと述べています。初期の研究が扱ったのは、大量に届く電子メールやネットニュースの記事から、読む価値のある文書を選り分けるという問題でした。ここでは、本コラムの後の章につながる4つの節目を、原論文と公式の資料で書誌を確かめた範囲で紹介します。
1つ目は、1992年に Communications of the ACM 誌に載った Goldberg らの論文で、Xerox のパロアルト研究所などの著者が、Tapestry という仕組みを述べたものです。論文の題名には、協調フィルタリング(collaborative filtering)という言葉が入っています。後で紹介する GroupLens の論文は、Tapestry を、多くの人が文書に評価を付けられ、読み手がどの評価者の意見に注目するかを選べる仕組みとして紹介し、ただし1つの拠点の中で評価を共有する一体型の仕組みで、複数の人の評価を集計する問い合わせは持たなかったと説明しています。
2つ目は、1994年の ACM のコンピュータ支援による協調作業の会議(CSCW ’94)で発表された Resnick らの論文で、GroupLens という、ネットニュースの記事を協調フィルタリングで選ぶ仕組みを述べたものです。論文の要旨によれば、利用者が読んだ記事に評価を付け、評価を集める側の仕組みが「過去に意見が一致した人どうしは、これからも意見が一致するだろう」という経験則にもとづいて、利用者がまだ読んでいない記事の評価を予測します。似た顧客の行動から推薦するという、第4章で扱うユーザーベースの協調フィルタリングの考え方が、ここで具体的な仕組みとして示されています。
3つ目は、2003年に IEEE Internet Computing 誌に載った Linden・Smith・York の論文で、Amazon.com の推薦に使われた商品間(item-to-item)の協調フィルタリングを述べたものです。論文は、顧客と似た顧客を探す従来の方式では、顧客と商品の数が非常に多いサイトで計算が追いつかないことを問題とし、顧客ごとではなく、商品ごとに一緒に買われやすい商品の表(似た商品の表)を前もってオフラインで計算しておく方式を示しています。推薦を出す時点の計算は、その顧客が買った・評価した商品の数にだけ依存し、品揃えの大きさや顧客の総数には依存しないと説明されています。この考え方は、第4章のアイテムベースの協調フィルタリングと、第12章の一括の計算とリアルタイムの計算の分担につながります。
4つ目は、Netflix Prize です。Bennett と Lanning の論文は、データマイニングの競技会である KDD Cup の2007年の会合で発表されたものです。この論文によれば、Netflix は2006年10月に、匿名化した映画の評価のデータセットを公開し、自社の推薦の仕組み(Cinematch)の予測の精度を上回る仕組みの開発を、研究者に呼びかけました。公開されたデータと競技の設計は次のとおりです。
- データの量:約48万人の加入者による、約1万8千本の作品への1億件を超える評価
- 評価の形:1から5の整数の星
- 精度の測り方:予測した評価と実際の評価のずれ(平均二乗誤差の平方根)
- 大賞の条件:評価の予測の誤差(平均二乗誤差の平方根)を、Cinematch よりさらに10%小さくすること。購買や推薦の採用の率の改善ではない
同じ論文によれば、採点用のデータには利用者ごとの最も新しい評価を取り分け、過去の評価から将来の評価を予測させる設計にしていました。論文は、これを事業上の目的の反映だとしています。この考え方は、第8章で扱う時間で切る評価に近い発想です。競技の中で発展した手法は第5章で扱います。
4つの節目を次の表にまとめました。書誌は各論文の出版社のページと原文で確かめたものです。
| 年 | 節目 | 著者・発表の場 | 示されたこと | つながる章 |
|---|---|---|---|---|
| 1992年 | Tapestry | Goldberg・Nichols・Oki・Terry、Communications of the ACM 誌 35巻12号 | 他の人の評価を使って文書を選り分ける仕組み。題名に協調フィルタリングの語を含む | 第4章 |
| 1994年 | GroupLens | Resnick・Iacovou・Suchak・Bergstrom・Riedl、CSCW ’94 | 過去に意見が一致した人どうしの評価から、未読の記事の評価を予測する | 第4章 |
| 2003年 | 商品間の協調フィルタリング | Linden・Smith・York、IEEE Internet Computing 誌 7巻1号 | 似た商品の表をオフラインで計算し、大規模なサイトで即時に推薦する | 第4章・第12章 |
| 2006年から | Netflix Prize | Bennett・Lanning、KDD Cup 2007 の会合の論文 | 評価のデータセットを公開し、予測の精度の改善を競う | 第5章・第8章 |
この歴史から読み取れることの1つは、研究の関心が「評価の予測の精度」から「推薦が事業に何をもたらすか」へ広がってきたことです。Netflix Prize は評価の予測の誤差を競う設計でしたが、先に挙げた Jannach と Jugovac の2019年の論文は、研究の多くが過去のデータでの予測を目標にしていることに対して、その測り方が事業上の価値をどこまで評価できるかは問われ続けている、と整理しています。本コラムが第8章でオフライン評価の限界を、第9章でオンライン評価を扱うのは、この流れを踏まえたものです。
よくある3つの誤解、推薦を入れれば売上が上がる・精度が高いほど良い・推薦経由の購買が効果
推薦の導入の議論では、いくつかの誤解が繰り返し出てくるように思います。ここでは、判断を誤らせやすい3つを取り上げます。
1つ目は「推薦を入れれば売上が上がる」という誤解です。推薦は、顧客の行動のどこかを変えることを通じて事業に効くので、どの経路で、どの推薦の枠で、どの行動を増やすのかが決まっていなければ、効いたかどうかを判断する基準が定まりません。推薦の価値は、品揃えの広さ・顧客の数・枠を見る顧客の数・推薦の質などの条件に左右されます。たとえば、見られない場所に推薦の枠を置いても行動は変わらず、品揃えが少なく顧客が自分で全部見られる事業では、発見の支援の余地は小さくなります。
2つ目は「精度が高いほど良い」という誤解です。ここでいう精度は、過去のログで、顧客が後に買った商品を推薦がどれだけ当てたか(オフライン評価の指標)を指すことが多いのですが、当てやすい商品の中には、推薦が無くても買われる商品が含まれうるという問題があります。どの程度含まれるかは事業と推薦の枠によって違い、オフライン評価の限界は第8章で、推薦が無い場合との比べ方は第9章で扱います。よく売れている商品や、顧客がすでに買うと決めている商品を推薦すると、評価のデータによっては精度の数字が高く出ることがありますが、推薦が行動を変えた分は小さいかもしれません。さらに、精度を上げるための複雑な方式は、計算と運用の負担を増やし、推薦の理由を説明しにくくします。精度の数字は方式の比較の目安として使い、最終の判断は推薦が無い場合と比べた行動の差(第9章)で行うのが安全だと考えています。
3つ目は「推薦経由の購買が推薦の効果」という誤解で、本コラムで最も注意したい点です。推薦経由の購買(売上)とは、全体の地図で定めたとおり、推薦の枠に表示された商品が、その枠から選ばれて買われた分のことです。推薦経由の購買には、推薦が無くても、検索や一覧から同じ商品を見つけて買われたはずの分が含まれます。推薦経由の購買をそのまま推薦の効果と数えると、効果を過大に評価するおそれがあります。一方で、推薦をきっかけに後日や別の商品の購買が増えた分は、推薦経由の購買に数えられないこともあります。推薦経由の購買だけから、事業全体の購買が増えたか減ったかは判断できません。本コラムでは、全体の地図で定めたとおり、推薦の効果を「推薦が無かった場合と比べて増えた行動」と定義し、A/Bテストなどで推薦が無い場合と比べて確かめた差だけを効果と呼びます。差は増える場合も、変わらない場合も、減る場合もあり、どれも確かめる対象です。測り方は第9章で扱います。
3つの誤解と、それぞれの正しい捉え方・確かめ方を次の表にまとめました。
| 誤解 | なぜ誤りか | 正しい捉え方 | 確かめ方 | 扱う章 |
|---|---|---|---|---|
| 推薦を入れれば売上が上がる | 推薦は経路を通じてしか効かず、枠が見られなければ行動は変わらない | どの枠で、どの行動を増やすかを先に決める | 枠の表示回数・閲覧の割合を確かめ、目的の KPI を決める | 本章・第13章 |
| 精度が高いほど良い | 当てやすい商品の中には、推薦が無くても買われる商品が含まれうる(第8章・第9章) | 精度は方式の比較の目安で、最終の判断ではない | 人気順との比較、推薦が無い場合との比較 | 第3章・第8章 |
| 推薦経由の購買が効果 | 推薦が無くても買われた分を含む | 推薦が無い場合と比べた行動の差だけが効果(増加も減少も確かめる) | A/Bテストで推薦あり・なしを比べる | 第9章 |
経営の損失の型、推薦の判断を誤ると何を失うか
推薦の判断を誤ったときの損失は、金額の大きさよりも、どんな型の損失が起きるかで捉えておくと、対策を決めやすくなります。本コラムでは、推薦の判断の誤りから生じる損失を、次の6つの型に分けて扱います。各型の文言は序章と同じです。
- 機会損失:買われたはずの商品が顧客に見えず、購買や継続利用の機会を逃します。
- 効果の過大評価:推薦が無くても買われた分まで推薦の成果と数え、投資の判断を誤ります。
- 品揃えの偏り:推薦が一部の人気商品に集中し、在庫や売場の幅が顧客に伝わらなくなります。
- 顧客の離反:的外れな推薦、しつこい推薦、個人データの扱いが分かりにくい推薦によって、顧客の信頼を失い、配信の停止、データの利用への同意の撤回、退会につながります。
- 形骸化:推薦の枠が見られないまま放置される、あるいは効果が測られないまま運用が続きます。
- 二重投資:共通にできるデータや仕組みまで、チャネルや部署ごとに別々に整え、同じ開発と保守の手間を何度もかけます。
6つの型は、この章で扱った論点と結び付いています。機会損失は、推薦の枠と目的を決めずに、関心を持ちそうな商品を見せられないときに起きます。効果の過大評価は、3つ目の誤解から直接生じます。推薦経由の購買を効果と数えて投資を続けると、推薦が無い場合と比べた差が分からないまま、投資の判断が進みます。品揃えの偏りは、短期のクリック率だけを追ったときに起きやすく、第11章で扱います。顧客の離反は、メールやプッシュ通知の枠で、停止率を見ずに配信を増やしたときに起きやすい型です。
形骸化は、推薦を入れること自体が目的になったときに起きます。推薦の枠を作ったあと、誰もクリック率や効果を見ず、推薦の中身が古いまま放置されると、その枠は画面の場所を取るだけになります。二重投資は、検索・推薦・CRM の配信・広告の出し分けを、部署ごとに別々のベンダーと別々のデータで進めたときに起きます。序章で整理した6つの損失の型と、この章の論点のつながり、起きやすい場面、最初に打てる手を次の表にまとめました。
| 損失の型 | この章のどの論点とつながるか | 起きやすい場面 | 最初に打てる手 |
|---|---|---|---|
| 機会損失 | 推薦の枠と目的 | 品揃えが多いのに、人気順の一覧しか無い | 発見の支援を狙う枠を決め、人気順と比べる |
| 効果の過大評価 | 3つ目の誤解 | 推薦経由の購買を報告の数字にしている | 効果の定義を決め、A/Bテストで測る |
| 品揃えの偏り | 短期の KPI と長期の KPI のずれ | クリック率だけで推薦を選んでいる | 網羅率など品揃えの幅の指標を並べて見る |
| 顧客の離反 | メール・プッシュ通知の枠 | 配信の頻度を増やし続けている | 停止率を悪化させてはいけない KPI として置く |
| 形骸化 | 1つ目の誤解 | 推薦の枠の担当者と KPI が決まっていない | 枠ごとに担当者・KPI・点検の時期を決める |
| 二重投資 | 隣の仕組みとの違い | 検索・推薦・配信を部署ごとに別々に進めている | 顧客と商品のデータの基盤を共通にする |
経営判断、どの枠で何を増やすための推薦かを決める
この章の内容を経営の判断に落とすと、推薦の導入で最初に決めることは、方式でもベンダーでもなく、「どの推薦の枠で、何を増やすための推薦か」です。これを決めずに推薦エンジンを選ぶと、ベンダーの提案を比べる基準が無く、導入したあとに効果を測る基準も無くなります。逆に、枠と目的が決まっていれば、ベンダーに対しても「この枠で、この KPI を、推薦が無い場合と比べてどう測るか」を問うことができます。
具体的には、次の4つを1枚の表にして、経営と事業の責任者が合意しておくことを勧めます。1つ目は、推薦を置く枠の一覧と、それぞれの枠の目的(5つの経路のどれを狙うか)です。2つ目は、枠ごとの最適化する KPI と、悪化させてはいけない KPI の組です。3つ目は、推薦の効果の定義と測り方で、推薦経由の購買ではなく、推薦が無い場合と比べた差で測ることを、予算の判断の前に決めておきます。4つ目は、枠ごとの担当者と、短期の指標と長期の指標を点検する時期です。
予算と体制の面では、推薦を「仕組みを入れる一度きりの投資」ではなく、「枠ごとに効果を測りながら改善を続ける運用」として捉えることが大事だと考えています。最初の段階では、1つの枠に絞り、人気順を比較の基準として置き、推薦が無い場合と比べた差を測れる状態を作ることに予算を充てます。効果が確かめられた枠から、別の枠・別のチャネルへ広げ、そのときに顧客と商品のデータの基盤を共通にしておくと、二重投資を避けられます。導入の進め方と体制は第13章で扱います。
KPI の仕組みの面では、推薦の報告の数字を、推薦経由の購買から、推薦の効果(推薦が無い場合と比べた差)と、品揃えの幅・停止率などの悪化させてはいけない指標へ置き換えることが要ります。推薦経由の購買は、推薦の枠がどれだけ使われているか(枠の利用度)の目安としては役に立ちますが、それを推薦の成果として予算の判断に使うと、効果の過大評価の損失につながります。報告の数字の置き換えは、推薦を導入する前に決めておかないと、導入したあとでは「数字が下がった」と受け取られやすくなります。
この章の要点をまとめると、推薦は発見の支援・回遊・購買点数・継続利用・在庫の消化という経路を通じて事業に効き、どの経路を狙うかによって、置くべき推薦の枠と動かすべき KPI が変わります。短期の KPI と長期の KPI はずれることがあるので、最適化する KPI と悪化させてはいけない KPI を組にし、推薦の効果は推薦経由の購買ではなく、推薦が無い場合と比べた差で測ります。次の第2章では、推薦に使うデータとして、購買・閲覧の履歴と暗黙のフィードバックの扱いを整理します。
この章を深めたい方への参考書籍
『推薦システム実践入門』(風間正弘、飯塚洸二郎、松村優也 著、オライリー・ジャパン):2022年5月刊で、副題は「仕事で使える導入ガイド」です。版元の目次では、推薦システムのプロジェクト、推薦システムの UI/UX、推薦アルゴリズムの概要と詳細、実システムへの組み込み、推薦システムの評価の章が並び、付録に Netflix Prize が置かれています。この章で扱った、推薦の枠の選び方と、推薦を事業に組み込む順番を、実務の導入の流れの中で確かめるときに参考になります。
『ロングテール 「売れない商品」を宝の山に変える新戦略』(クリス・アンダーソン 著、篠森ゆりこ 訳、早川書房):NDL サーチでは、ハヤカワ文庫 NF の1冊として2014年5月に刊行された版が確認できます。品揃えの多いネットの事業で、売れ筋以外の多くの商品が持つ意味を論じた本で、この章で扱った発見の支援と在庫の消化という推薦の経路を、事業の戦略の側から考えるときの手がかりになります。
第2章 推薦に使うデータ、購買・閲覧の履歴と暗黙のフィードバックの扱い
第1章では、推薦を「どの枠で、何を増やすための仕組みか」から決めること、推薦の目的によって追う KPI が変わることを扱いました。目的が決まると、次に問題になるのは、その目的に向けて何のデータを使って推薦を作るかです。推薦の方法は第3章から第7章で扱いますが、どの方法も、入力になるデータの意味を取り違えると、計算が正しくても的外れな推薦になります。この章では、推薦に使うデータの種類と、その中で最もよく使われる購買・閲覧の履歴をどう読み、どう記録し、どう数えるかを扱います。
この章で扱うのは次の内容です。後半は、架空の購買ログ(顧客3,000人・商品500点・180日)を作り、実行したコードと結果で確かめます。
- 推薦に使うデータの種類(行動ログ・顧客の属性・商品の属性・文脈)と、それぞれで分かること
- 明示的なフィードバックと暗黙のフィードバックの違い、買われなかったことが「嫌い」の証拠にならない理由
- 顧客×商品の行列がほとんど空であること(疎行列)と、その持ち方
- 少数の商品に購買が集中する分布(ロングテール)と、少数の顧客に購買が集中する分布
- 表示されなかった商品は選ばれようがないという露出の偏り
- 閲覧・カート・購買の重み付けと、古い行動ほど軽く数える時間の減衰
- 表示のログ・推薦の枠・順位を残すログの設計
- ボットのアクセスや記録の重複など、データの品質の問題
この章の主張は、推薦のデータは「何が起きたか」だけでなく「何が見えていたか」とセットで初めて意味を持つ、ということです。買われなかった商品が嫌われていたのか、そもそも見えていなかったのかは、購買の記録だけでは区別できません。この章では、購買の件数だけでは「好まれていない」と「見られていない」を区別できないことを架空データの数字で示し、そのうえで、区別に必要な表示のログは後から作り直せないので、推薦を作る前に記録を始める必要がある理由を述べます。個人データとしての取り扱いの詳細は第14章、評価のためのデータの切り方は第8章で扱います。
推薦に使うデータの種類、行動ログ・顧客の属性・商品の属性・文脈
推薦に使うデータは、大きく4つに分けられます。1つ目は行動ログで、顧客がサイトやアプリ、店舗で何をしたかの記録です。商品が表示された、クリックされた、商品ページが閲覧された、カートに入れられた、購入された、星やいいねで評価された、といった出来事が、顧客・商品・日時と一緒に1行ずつ残ります。2つ目は顧客の属性で、会員登録の情報(年代・地域など)や、会員のランク、初回の購入日などです。3つ目は商品の属性で、カテゴリ・ブランド・価格帯・発売日・説明文・画像など、商品マスタに入っている情報です。4つ目は文脈で、行動が起きたときの時刻・曜日・端末・場所・流入元(検索・広告・メールなど)を指します。
4つのうち、協調フィルタリング(第4章)や行列分解(第5章)が主に使うのは行動ログで、商品の属性を主に使うのが内容ベース(第6章)です。顧客の属性と文脈は、履歴の少ない顧客への推薦(第10章)や、並べ替えの段階の特徴(第12章)で使われることが多いデータです。どのデータが手元にあり、どの粒度で、どの期間ぶん残っているかによって、選べる推薦の方法が変わります。次の表に、データの種類ごとに分かることと注意点を整理しました。
| データの種類 | 具体例 | 分かること | 注意点 |
|---|---|---|---|
| 行動ログ(表示) | 推薦の枠や検索結果に、どの商品が何番目に表示されたか | 顧客にとって何が見えていたか | 記録していなければ、後から作り直せない |
| 行動ログ(クリック・閲覧) | 商品ページの閲覧、推薦の枠のクリック、閲覧時間 | 関心を持った可能性のある商品。購買より件数が多い | 誤クリックや比較のための閲覧も混ざる。ボットの影響を受けやすい |
| 行動ログ(カート・お気に入り) | カートへの追加、お気に入りへの登録 | 購入を検討した商品 | カートに入れたまま放置されることも多い |
| 行動ログ(購買) | 注文、数量、返品・キャンセル | 実際にお金を払った商品。最も強い関心の手がかり | 件数が少ない。贈答品のように本人の好みでない購買も混ざる |
| 行動ログ(評価) | 星の数、いいね、低評価、レビュー | 顧客が自分で示した好き嫌い | 評価を付ける顧客は一部に限られ、付ける商品も偏る |
| 顧客の属性 | 年代、地域、会員のランク、登録日 | 履歴の少ない顧客のおおまかな傾向 | 属性だけでは個人の好みは分からない。個人データとしての取り扱いが要る |
| 商品の属性 | カテゴリ、ブランド、価格帯、発売日、説明文、画像 | 商品どうしの似かた。履歴の無い新商品の位置づけ | 商品マスタの入力の揺れや欠けがそのまま推薦の質に出る |
| 文脈 | 時刻、曜日、端末、場所、流入元 | 同じ顧客でも場面で変わる関心 | 文脈を細かく分けるほど、1つの場面あたりのデータが減る |
表の1行目に置いた表示のログは、ほかの行と性質が違います。クリックや購買は「顧客が何をしたか」の記録ですが、表示は「顧客に何を見せたか」の記録で、サイトの側の行動です。推薦の結果を後から評価するとき、表示のログが無いと、クリックされなかった商品が「見せたのに選ばれなかった」のか「そもそも見せていなかった」のかを区別できません。この点は、後の節で数字を使って確かめます。
明示的なフィードバックと暗黙のフィードバック、買われなかったことは嫌いの証拠ではない
行動ログのうち、顧客の好みを表す記録は2つに分けて考えます。明示的なフィードバックは、星の数・いいね・低評価のように、顧客が自分で示した評価です。好きか嫌いかが記録そのものに表れており、低評価のように「嫌い」をはっきり示す記録も含まれます。これに対して、暗黙のフィードバックは、購買・閲覧・クリック・視聴時間のように、行動から間接的に分かる関心です。顧客は好みを表明したわけではなく、推薦の側が行動から関心を推し量ります。
実際の EC や配信のサービスで大量に貯まるのは、暗黙のフィードバックのほうです。星を付ける顧客は一部ですが、閲覧や購買は、計測できる範囲であれば、顧客に評価の入力を求めずに記録できます(どこまで記録できるかは、計測の仕組み・顧客の同意の状態・顧客を識別できるかどうかによって変わります)。そのため、推薦の多くは暗黙のフィードバックで作られます。ただし、暗黙のフィードバックには大きな制約があります。記録に残るのは「した」ことだけで、「しなかった」ことの意味が分からない点です。ある顧客がある商品を買わなかったとき、その理由は、嫌いだったから、見たが今は要らなかったから、すでに別の店で買ったから、そもそも商品が目に入らなかったから、のどれでもありえます。本コラムの定義(全体の地図)のとおり、買われなかった・見られなかったことは「嫌い」の証拠ではありません。
この性質は研究でも前提として扱われています。Hu・Koren・Volinsky の2008年の論文(IEEE のデータマイニングの国際会議 ICDM 2008 で発表された、暗黙のフィードバックの協調フィルタリングの論文)は、暗黙のフィードバックでは嫌われた商品の確かな証拠が得られないことを出発点に、観測の有無や回数に応じた確信度(どれだけ確かか)を添えて扱う方法を示した研究です(論文の書誌)。この方法の中身は第5章で扱います。暗黙のフィードバックで記録の無い升目を、明示的な低評価と同じ確かさで扱うと、見えていなかった商品まで嫌われた商品として学習してしまうおそれがあります。
| 観点 | 明示的なフィードバック | 暗黙のフィードバック |
|---|---|---|
| 例 | 星の数、いいね、低評価、レビュー | 購買、閲覧、クリック、カート、視聴時間 |
| 件数 | 少ない(評価を付ける顧客は一部) | 多い(計測できる範囲では、評価の入力を求めずに記録できる) |
| 「嫌い」の記録 | 低評価などで記録される | 記録されない。しなかったことの理由は分からない |
| 強さの表し方 | 星の数など、顧客が決めた段階 | 回数・時間・行動の種類から推し量る |
| 主な偏り | 評価を付ける顧客と、付けられる商品が偏る | 表示された商品にしか行動が起きない(露出の偏り) |
| 推薦での使い方 | 評価の値を予測する問題として扱われてきた | 関心を持ちそうな商品を上位に並べる問題として扱うことが多い |
明示的な評価の値を予測する問題は、推薦の研究の初期から長く扱われてきました(その流れは第1章と第5章で触れます)。一方、EC の現場で推薦の目的になるのは、評価の値を当てることよりも、顧客が次に関心を持つ商品を上位に並べることです。この違いは、評価の方法(第8章)にも関わります。
架空の購買ログを作り、顧客×商品の行列を疎行列で持つ
ここからは、架空の購買ログを作って、推薦のデータの性質を確かめます。この章で使うのは、乱数で作った架空の合成データで、実際の EC のログよりずっと単純です。顧客は3,000人、商品は500点、期間は180日で、商品は10のジャンルに分けました。現実のログの性質を簡単に再現するために、次の4つの規則を入れています。
- 顧客ごとにジャンルの好みがある(多くの顧客は少数のジャンルに好みが偏る)
- 商品ごとに人気があり、人気は少数の商品に偏る(パレート分布という、裾の長い分布から作った)
- 顧客ごとに閲覧の回数が違い、少数のよく見る顧客と、多数のあまり見ない顧客がいる(対数正規分布から作った)
- 顧客は「好み×人気」に比例した確率で商品を閲覧し、好みのジャンルの商品ほどカートに入れやすく、カートに入れた商品の4割を購入する
閲覧した日は、180日の中から一様に選びました。購入するかどうかは顧客の好みとだけ結びつけ、商品の人気とは結びつけていません。この設定は、後の節で露出の偏りを確かめるときに意味を持ちます。顧客と商品は番号だけで表し、実在の企業や商品を連想させる名前は使っていません。この章の数値は、すべて1つの乱数の種(20261110)での結果で、本コラムのほかの章とは別に作ったデータのものです。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261110)
N_CUST, N_ITEM, N_GENRE, N_DAY = 3000, 500, 10, 180

genre = rng.integers(0, N_GENRE, N_ITEM)                  # 商品ごとのジャンル
pop = rng.pareto(1.2, N_ITEM) + 1.0                        # 商品の人気(少数に偏る)
pref = rng.dirichlet(np.full(N_GENRE, 0.3), N_CUST)        # 顧客ごとのジャンルの好み
n_view = np.ceil(rng.lognormal(3.0, 1.0, N_CUST)).astype(int)  # 顧客ごとの閲覧回数

rows = []
for c in range(N_CUST):
    w = pref[c, genre] * pop                               # 好み×人気で見る商品が決まる
    items = rng.choice(N_ITEM, size=n_view[c], p=w / w.sum())
    days = rng.integers(0, N_DAY, n_view[c])
    p_cart = 0.05 + 0.5 * pref[c, genre[items]]            # 好みのジャンルほどカートに入れる
    cart = rng.random(n_view[c]) < p_cart
    buy = cart & (rng.random(n_view[c]) < 0.4)             # カートの4割が購買
    rows.append(pd.DataFrame({"顧客": c, "商品": items, "日": days,
                              "カート": cart, "購買": buy}))
log = pd.concat(rows, ignore_index=True)
print("閲覧", len(log), "件/カート", int(log["カート"].sum()), "件/購買", int(log["購買"].sum()), "件")
print("1人あたり閲覧の中央値", int(np.median(n_view)), "平均", round(n_view.mean(), 1))
# 出力:
# 閲覧 98364 件/カート 20476 件/購買 8196 件
# 1人あたり閲覧の中央値 21 平均 32.8
できたログは、閲覧98,364件、カート20,476件、購買8,196件でした。1行が1回の閲覧で、その閲覧のあとにカートに入れたか、購入したかを列で持たせています。顧客1人あたりの閲覧は中央値で21件、平均で32.8件です。平均が中央値より大きいのは、よく見る少数の顧客が平均を引き上げているためです。
推薦の方法の多くは、このログを「顧客×商品の行列」に直して使います。行に顧客、列に商品を取り、顧客がその商品を買った回数を升目に入れた表です。3,000人×500点なら升目は150万個ありますが、1人の顧客が買う商品はほんの一部なので、ほとんどの升目は0になります。このように大部分が0の行列を疎行列と呼び、0でない升目の位置と値だけを記録する形で持つのがふつうです。次のコードでは、scipy の csr_array で購買と閲覧の行列を作りました(コードは scipy 1.16.3 で実行しています)。scipy の公式ドキュメント(2026年11月に確かめた v1.18.0 の版)によれば、行の番号・列の番号・値の3つの配列から作ることができ、同じ升目に重なった値は足し合わされます。また、scipy は疎行列を「行列」として扱う従来の書き方から「配列」として扱う書き方へ移行しつつあり、従来の書き方は今後の版で非推奨にする見込みだと説明しているので、ここでは配列の側を使いました。
from scipy.sparse import csr_array

buys = log[log["購買"]]
R = csr_array((np.ones(len(buys)), (buys["顧客"], buys["商品"])), shape=(N_CUST, N_ITEM))
R.sum_duplicates()
V = csr_array((np.ones(len(log)), (log["顧客"], log["商品"])), shape=(N_CUST, N_ITEM))
V.sum_duplicates()
cells = N_CUST * N_ITEM
print("行列の升目", cells, "/購買のある升目", R.nnz, f"密度{R.nnz / cells:.4%}")
print("閲覧のある升目", V.nnz, f"密度{V.nnz / cells:.4%}")
dense_mb = cells * 8 / 1e6
sparse_mb = (R.data.nbytes + R.indices.nbytes + R.indptr.nbytes) / 1e6
print(f"購買の行列を普通の配列で持つと{dense_mb:.1f}MB、疎行列では{sparse_mb:.2f}MB")
# 出力:
# 行列の升目 1500000 /購買のある升目 7052 密度0.4701%
# 閲覧のある升目 62762 密度4.1841%
# 購買の行列を普通の配列で持つと12.0MB、疎行列では0.14MB
結果を表にまとめます。密度は、すべての升目のうち0でない升目の割合です。
| 行列 | 升目の数 | 0でない升目 | 密度 | 読み方 |
|---|---|---|---|---|
| 購買の行列 | 1,500,000 | 7,052 | 0.4701% | 1人の顧客が買ったことのある商品は、500点のうち平均で2〜3点(同じ商品を2回以上買っても1点と数える) |
| 閲覧の行列 | 1,500,000 | 62,762 | 4.1841% | 閲覧まで広げると、0でない升目は購買の約9倍になる |
購買の行列で0でない升目は7,052個で、密度は約0.47%でした。購買の件数8,196件より升目の数が少ないのは、同じ顧客が同じ商品を2回以上買った分が同じ升目に足し合わされたためで、差の1,144件が2回目以降の購買に当たります。閲覧の行列は密度が約4.18%で、購買の約9倍の升目が埋まっています。購買だけでは顧客1人あたり平均2〜3点の手がかりしか無いのに対し、閲覧まで使えば手がかりが大きく増える、というのが、閲覧のような弱い行動を推薦に使う動機の1つです。ただし、閲覧は購買より関心の確かさが低い手がかりなので、後の節で扱う重み付けが必要になります。
疎行列で持つことは、計算機の資源の面でも意味があります。この例では、購買の行列を普通の配列(升目ごとに8バイトの数)で持つと12.0MB、疎行列では0.14MBでした。顧客や商品の数が大きくなると、普通の配列で持つ大きさは顧客の数と商品の数の掛け算で増えるので、計算機に載せにくくなります。この疎さは、推薦の方法の選び方にも影響します。1人が買う商品が少ないほど、2人の顧客が共通に買った商品も少なくなるので、「似た顧客」を直接探す方法は、データが疎なほど手がかりが足りなくなります。この問題への対処は、第4章(協調フィルタリング)と第5章(行列分解)で扱います。
ロングテール、少数の商品と少数の顧客に購買が集中する
次に、購買が商品と顧客のあいだにどう散らばっているかを見ます。売れる商品が一部に集中し、多数の商品は少しずつしか売れない場合、購買数の多い順に商品を並べて棒グラフにすると、左端に高い棒が少し立ち、右に向かって低い棒が長く続きます。この長く続く右側の部分をロングテール(長い尾)と呼びます。この章の架空データは、商品の人気を裾の長い分布から作っているので、この形になるように設定してあります。次のコードで、どれだけ集中しているかを数えました。
item_cnt = np.asarray(R.sum(axis=0)).ravel()               # 商品ごとの購買数
cust_cnt = np.asarray(R.sum(axis=1)).ravel()               # 顧客ごとの購買数
s = np.sort(item_cnt)[::-1]
top20 = s[: int(N_ITEM * 0.2)].sum() / s.sum()
print("上位20%(100点)の商品が占める購買の割合", round(top20, 3))
print("上位10点の割合", round(s[:10].sum() / s.sum(), 3), "/下位50%(250点)の割合", round(s[250:].sum() / s.sum(), 3))
print("購買0件の商品", int((item_cnt == 0).sum()), "点/購買1〜4件の商品", int(((item_cnt >= 1) & (item_cnt <= 4)).sum()), "点")
print("商品の購買数 最大", int(s[0]), "中央値", int(np.median(item_cnt)))
print("購買0件の顧客", int((cust_cnt == 0).sum()), "人/1件の顧客", int((cust_cnt == 1).sum()), "人",
      "/10件以上の顧客", int((cust_cnt >= 10).sum()), "人")
print("顧客の購買数 中央値", int(np.median(cust_cnt)), "平均", round(cust_cnt.mean(), 2), "最大", int(cust_cnt.max()))
top10c = np.sort(cust_cnt)[::-1][: N_CUST // 10].sum() / cust_cnt.sum()
print("購買数の多い上位10%の顧客が占める購買の割合", round(top10c, 3))
# 出力:
# 上位20%(100点)の商品が占める購買の割合 0.668
# 上位10点の割合 0.317 /下位50%(250点)の割合 0.14
# 購買0件の商品 5 点/購買1〜4件の商品 108 点
# 商品の購買数 最大 611 中央値 8
# 購買0件の顧客 714 人/1件の顧客 713 人 /10件以上の顧客 151 人
# 顧客の購買数 中央値 2 平均 2.73 最大 64
# 購買数の多い上位10%の顧客が占める購買の割合 0.415
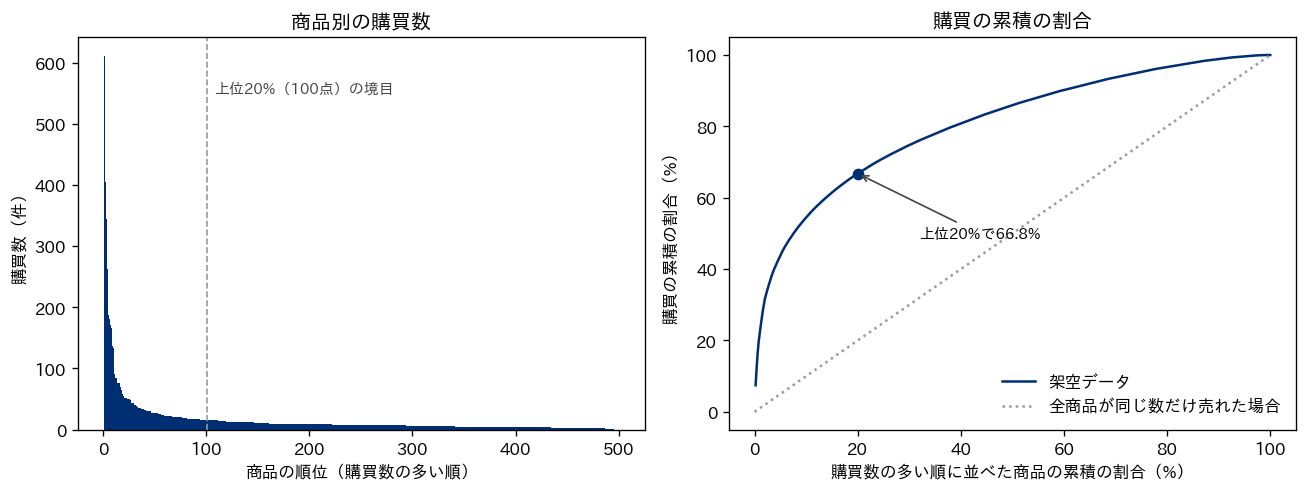
上の図の左は、商品別の購買数を多い順に並べたものです。最も売れた商品は611件で、商品の購買数の中央値は8件でした。右は、購買数の多い順に商品を足していったときに、全体の購買の何%に達するかを示した曲線です。全商品が同じ数だけ売れたなら点線の対角線になりますが、この架空データでは、上位20%(100点)の商品で購買の66.8%を占めました。上位10点だけで31.7%に達し、逆に下位50%(250点)の商品を合わせても14.0%にとどまります。購買が0件の商品は5点、1〜4件の商品は108点ありました。
顧客の側にも同じような偏りがあります。次の図の左は、顧客1人あたりの購買数の分布です(30件以上は30にまとめています)。
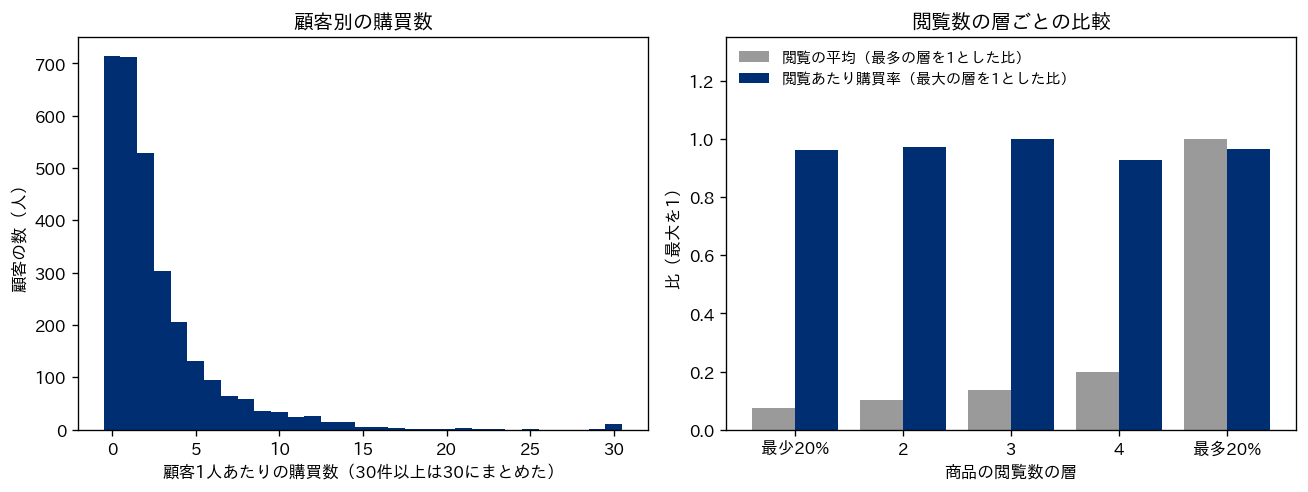
3,000人のうち、180日間に1件も買わなかった顧客が714人、1件だけ買った顧客が713人で、合わせて半分近くになります。購買数の中央値は2件、平均は2.73件で、10件以上買った顧客は151人、最も多い顧客は64件でした。購買数の多い上位10%の顧客(300人)が、全体の購買の41.5%を占めています。結果を次の表にまとめます。
| 集中の見方 | 本コラムの架空データでの値 | 推薦への影響 |
|---|---|---|
| 上位20%(100点)の商品が占める購買の割合 | 66.8% | この期間の購買の3分の2が上位100点に集まっているので、人気順を比較の相手に置く。ただし同じ期間で数えた値で、将来の購買を当てられるかは別の期間で確かめる(第3章のベースライン) |
| 上位10点の商品が占める購買の割合 | 31.7% | 行動ログから学ぶ推薦は、少数の人気商品を推しやすい(第11章) |
| 下位50%(250点)の商品が占める購買の割合 | 14.0% | 半数の商品は、1点あたりの購買が少なく、似かたを測る手がかりが乏しい |
| 購買0件・1〜4件の商品 | 5点・108点 | 行動ログだけでは推薦しにくい。商品の属性で補う(第6章・第10章) |
| 購買0件・1件の顧客 | 714人・713人 | 購買だけでは好みが分からない顧客が多い。閲覧や文脈で補う |
| 上位10%の顧客が占める購買の割合 | 41.5% | 購買を1件ずつ数える評価では、評価の数字が、よく買う少数の顧客の結果に引っ張られる(顧客ごとの値を同じ重みで平均する評価とは区別する。第8章) |
表の数字は、本コラムの架空データで、人気の分布と閲覧の回数の分布を設定して作った結果です。どれだけ集中するかは業種・品揃え・期間で変わり、上位20%で何%という値が一般に決まっているわけではありません。自社のデータでは、同じ計算をして集中の度合いを確かめることを勧めます。そのうえで、この集中から推薦について言えることが2つあります。1つは、人気の集中が強いほど、単純な人気順の推薦が強い比較の相手になることです。第3章でベースラインとして人気順を必ず置くのは、このためです。もう1つは、行動ログだけから学ぶ推薦は、行動の多い人気商品ほど学習の材料が多いので、人気商品を推しやすくなることです。推薦が売れ筋に集中すると、序章で整理した6つの損失の型のうち、品揃えの偏り(推薦が一部の人気商品に集中し、在庫や売場の幅が顧客に伝わらなくなること)につながります。この循環は第11章で扱います。
表示されなかったものは選ばれようがない、露出の偏り
暗黙のフィードバックを読むうえで最も大事なのが、露出の偏りです。顧客が商品を閲覧したり購入したりできるのは、その商品が検索結果・カテゴリの一覧・推薦の枠・広告などで目に入った場合だけです。言いかえれば、行動ログは「顧客の好み」と「顧客に何が見えていたか」の掛け算の結果で、見えていなかった商品にはどれほど好みに合っていても行動が記録されません。サイトの上部や推薦の枠の上位に出る商品は見られやすく、品揃えの奥にある商品は見られにくいので、行動の記録はサイトの見せ方の影響を強く受けます。
この問題は研究でも扱われています。Liang・Charlin・McInerney・Blei の2016年の論文(Web の国際会議 WWW 2016 の論文。arXiv で公開)は、消費されなかった商品を一律に扱わず、顧客がその商品に触れたかどうか(露出)を、直接は観測できない変数としてデータから推し量る考え方を示しました(arXiv の論文ページ)。この章では、モデルの中身ではなく、ログの読み方としてこの考え方を使います。
露出の偏りがログにどう表れるかを、架空データで確かめました。この章の架空データでは、顧客がどの商品を閲覧するかは「好み×人気」で決まり、閲覧したあとに買うかどうかは好みだけで決まり、人気とは関係しないように作ってあります。ここでの人気は、サイトの見せ方も含めた「目に入りやすさ」の代わりだと考えてください。商品を閲覧数で5つの層に分け、層ごとの購買を比べました。
item_view = np.asarray(V.sum(axis=0)).ravel()               # 商品ごとの閲覧数
tier = pd.qcut(item_view, 5, labels=["閲覧 最少20%", "2", "3", "4", "閲覧 最多20%"])
t = pd.DataFrame({"層": tier, "閲覧": item_view, "購買": item_cnt})
g = t.groupby("層", observed=True).agg(商品数=("閲覧", "size"), 閲覧の平均=("閲覧", "mean"),
                                       購買の平均=("購買", "mean"), 閲覧の合計=("閲覧", "sum"), 購買の合計=("購買", "sum"))
g["閲覧あたり購買率"] = g["購買の合計"] / g["閲覧の合計"]
print(g[["商品数", "閲覧の平均", "購買の平均", "閲覧あたり購買率"]].round(3).to_string())
zero = item_cnt == 0
print("購買0件の商品の閲覧数 中央値", int(np.median(item_view[zero])), "/全商品の中央値", int(np.median(item_view)))
# 出力(最後の行):
# 購買0件の商品の閲覧数 中央値 58 /全商品の中央値 88
| 商品の閲覧数の層 | 商品数 | 閲覧の平均 | 購買の平均 | 閲覧あたり購買率 |
|---|---|---|---|---|
| 閲覧 最少20% | 107 | 48.6 | 4.05 | 0.083 |
| 2 | 96 | 67.6 | 5.69 | 0.084 |
| 3 | 99 | 89.7 | 7.76 | 0.086 |
| 4 | 99 | 131.0 | 10.51 | 0.080 |
| 閲覧 最多20% | 99 | 654.8 | 54.64 | 0.083 |
先に断っておくと、この比較は新しい事実を見つける実験ではなく、仕組みの確認です。架空データを「閲覧したあとに買うかどうかは人気と関係しない」ように作ったので、閲覧あたりの購買率は層によらずほぼ同じになると見込める設定で、1つの乱数の種ではその通りになりました。ただし、購入は顧客のジャンルの好みで決まるので、層ごとに閲覧する顧客の好みが違えば、購買率も層によって多少変わりえます。実際のデータで閲覧あたりの購買率が層によらず一定になるという意味ではなく、実際には、人気の商品は品質や価格の理由で本当に選ばれやすいこともあります。また、この架空データの閲覧は「好み×人気」で決まるので、閲覧数の層は、露出の多さだけでなく、その商品を好む顧客の多さも含んでいます。
そのうえで、結果の読み方を示します。層の商品数が96点から107点とそろっていないのは、同じ閲覧数の商品を同じ層にまとめるためです。閲覧の最も多い層の商品は、1点あたり平均54.64件買われ、最も少ない層の4.05件の約13倍でした。購買の件数だけを見ると、最多の層の商品のほうがはるかに好まれているように見えます。一方で、閲覧1件あたりの購買率は、どの層も0.080から0.086の間でした。上の図の右でも、灰色の閲覧の平均は層によって大きく違うのに、ネイビーの閲覧あたり購買率はほぼ同じ高さです。購買率がほぼ同じなので、この架空データでは、購買の件数の差は「見られた回数」の差でほぼ説明できます。それでも、購買の件数だけを見れば「好まれ方」の差に見えてしまいます。
補足として、購買が0件だった5点の商品は、閲覧数の中央値が58件で、全商品の中央値88件より少ない商品でした。これは、閲覧が少ない商品ほど購買も0件になりやすいという上の結果を言いかえたもので、5点と少ないので、それ自体を独立した根拠とはしません。
ここで示したかったのは、購買の件数だけでは「好まれていない」と「見られていない」を区別できず、区別するには閲覧のような露出に近い記録が要る、ということです。そして、閲覧も厳密には露出ではありません。閲覧は商品ページを開いた記録で、その前に一覧や推薦の枠で商品を見たが開かなかった、という情報は含まれていません。それを記録するのが表示のログで、後の節で扱います。
露出の偏りは、推薦の学習と評価の両方に影響します。学習の面では、推薦の枠の上位に出た商品ほど行動が増え、行動が増えた商品ほど次の学習で上位に出る、という循環が起きます(第11章)。評価の面では、過去の推薦で表示された商品ほど過去のログで「当たり」に数えられやすいので、過去の推薦に似た推薦ほど過去のログでの成績が良く見えます(第8章)。どちらも、表示のログがあれば、何がどれだけ見せられていたかを集計して程度を推し量る手がかりになります。表示のログが無いと、その手がかり自体が得られません。
行動の重み付けと時間の減衰、閲覧と購買をどう数えるか
暗黙のフィードバックを推薦に使うときは、閲覧・カート・購買といった種類の違う行動を、1つの「関心の強さ」の数にまとめることが多くなります。そのときに決める必要があるのが、行動の種類ごとの重みと、古い行動をどれだけ軽く数えるか(時間の減衰)です。どちらにも決まった正解は無く、推薦の目的と、行動の件数の多さで決めることになります。
次のコードでは、例として、閲覧1回を1、カートへの追加を3、購買を5と重みを置き、さらに半減期30日の減衰を掛けました。半減期30日とは、30日前の行動は今日の行動の半分、60日前の行動は4分の1の重さで数える、という意味です。式で書くと、期間の最後の日(179日目)から数えて \(d\) 日前の行動に \(0.5^{d/30}\) を掛けます。閲覧の多い順に300番目の顧客を1人選び、閲覧の回数だけで数えた場合、重みを付けた場合、重みと減衰の両方を付けた場合で、関心の強い商品の上位がどう変わるかを比べました。この重みと半減期は説明のために置いた例で、根拠のある推奨値ではありません。
W = {"閲覧": 1.0, "カート": 3.0, "購買": 5.0}               # 例として置いた重み
log["重み"] = W["閲覧"] + W["カート"] * log["カート"] + W["購買"] * log["購買"]
HALF = 30                                                  # 半減期30日
log["減衰"] = 0.5 ** ((N_DAY - 1 - log["日"]) / HALF)
log["重み×減衰"] = log["重み"] * log["減衰"]
c = int(np.argsort(n_view)[-300])                          # 閲覧の多い順に300番目の顧客
mine = log[log["顧客"] == c].groupby("商品").agg(閲覧=("日", "size"), 購買=("購買", "sum"),
                                                  最後の日=("日", "max"), 重み=("重み", "sum"), 重み減衰=("重み×減衰", "sum"))
print("顧客", c, "の閲覧", int(n_view[c]), "件・商品", len(mine), "点")
for col in ["閲覧", "重み", "重み減衰"]:
    top = mine.sort_values([col, "最後の日"], ascending=False).head(5)
    print(col, "で数えた上位5点", list(top.index))
print(mine.sort_values("重み減衰", ascending=False).head(8).round(2).to_string())
# 出力(抜粋):
# 顧客 2145 の閲覧 73 件・商品 42 点
# 閲覧 で数えた上位5点 [345, 111, 88, 306, 493]
# 重み で数えた上位5点 [111, 88, 124, 107, 345]
# 重み減衰 で数えた上位5点 [111, 107, 59, 378, 88]
選んだのは顧客2145で、180日間に73件閲覧し、閲覧した商品は42点でした。数え方ごとの上位5点は、閲覧の回数だけで数えると商品345・111・88・306・493、重みを付けると商品111・88・124・107・345、重みと減衰を付けると商品111・107・59・378・88になり、3つの数え方で共通して上位5点に残ったのは商品111と88の2点だけでした(同じ値のときは最後に行動した日が新しい順に並べています)。重みと減衰で数えた上位8点の内訳は次のとおりです。
| 商品 | 閲覧(回) | 購買(回) | 最後に行動した日 | 重み(合計) | 重み×減衰(合計) |
|---|---|---|---|---|---|
| 商品111 | 7 | 1 | 172 | 15.0 | 9.48 |
| 商品107 | 1 | 1 | 142 | 9.0 | 3.83 |
| 商品59 | 1 | 0 | 173 | 4.0 | 3.48 |
| 商品378 | 1 | 0 | 165 | 4.0 | 2.89 |
| 商品88 | 6 | 1 | 168 | 14.0 | 2.29 |
| 商品345 | 8 | 0 | 161 | 8.0 | 2.09 |
| 商品387 | 1 | 0 | 145 | 4.0 | 1.82 |
| 商品493 | 4 | 0 | 179 | 7.0 | 1.56 |
閲覧の回数だけで数えると1位だった商品345は、8回閲覧されましたが一度も買われておらず、重みを付けると5位、減衰も付けると6位に下がりました。逆に、1回閲覧してそのまま買った商品107は、閲覧の回数では上位に入りませんが、重みを付けると4位、減衰も付けると2位に上がります。商品59と商品378は、1回閲覧してカートに入れた(重み4)だけの商品ですが、最近の行動なので減衰を付けると上位に入りました。商品88は6回閲覧して1回買っていますが、減衰を付けると5位に下がりました。表の「最後に行動した日」は最後に閲覧した日で、購入した日とは限りません。
この例から、重みと減衰の決め方が推薦の中身を直接変えることが分かります。決めるときの考え方を整理すると、次のようになります。
- 購買を重くするほど、確かな関心を重視できるが、購買の少ない顧客では閲覧の情報が相対的に反映されにくくなる
- 閲覧を重くするほど、閲覧の情報をより強く反映できるが、比較のための閲覧や誤クリックも関心として数える
- 半減期を短くするほど、最近の関心の変化に追いつくが、過去の確かな好みを忘れやすい
- 買い替えまでの期間が長い商品(家電・家具など)は、購入済みの商品と同じものを推薦し続けると的外れになる。購入済みの除外は第3章のルールで扱う
重みと半減期は、勘で決めるのではなく、候補をいくつか用意して、過去のログで後の行動をどれだけ当てるか(第8章のオフライン評価)を比べ、最後はオンライン評価(第9章)で確かめるのがよいと考えています。重みを決めること自体が、「この推薦の枠で何を増やしたいのか」という第1章の問いに答えることでもあります。たとえば、購買の点数を増やしたい枠と、新しいジャンルとの出会いを増やしたい枠では、同じ重みが合うとは限りません。
ログの設計、表示・推薦の枠・順位を残す
ここまでの節で、行動ログを読むには「何が見えていたか」の記録が要ることを見てきました。推薦の仕組みを作る前に決めておきたいのが、ログに何を残すかです。注文のデータは基幹のシステムに、閲覧のデータはアクセス解析のツールに残っていても、推薦の評価と改善に必要になる次の3つの記録は、意識して設計しなければ残りません。自社のログにこの3つがあるかを、推薦を作る前に確かめておく必要があります。
1つ目は表示のログです。推薦の枠・検索結果・カテゴリの一覧に、どの商品を何番目に表示したかの記録で、1回の表示で複数の商品が並ぶなら、並んだ商品をすべて残します。2つ目は推薦の枠の識別です。同じ商品のクリックでも、商品ページの「この商品を見た人は」の枠から来たのか、トップページの「おすすめ」から来たのか、検索から来たのかで意味が違います。クリックや購買の記録に、どの枠の、どの表示から来たかを結びつけておく必要があります。3つ目は、その表示を作った推薦の版です。推薦の方法や設定を変えたとき、どの表示がどの版で作られたかが分からないと、変更の前後を比べられません。A/Bテスト(第9章)では、顧客がどちらの群に割り当てられたかの記録も要ります。
これらの記録が要る理由は、後の章の評価に直結します。表示のログがあれば、クリック率(表示された回数に対するクリックの割合)を推薦の枠ごと・順位ごとに出せますし、表示されたのに選ばれなかった商品と、表示されなかった商品を区別できます。順位の記録があれば、順位ごとのクリック率を集計できます。ただし、順位ごとのクリック率の差には、上の順位に関心を持たれやすい商品が並んでいたことによる差も含まれるので、上の順位ほどクリックされやすいという位置の偏り(第11章)そのものの大きさは、順位の記録だけでは分けられません。Wang らの2018年の論文(検索とデータマイニングの国際会議 WSDM 2018 で発表された、個人向けの検索での位置の偏りの推定の論文)は、表示の順位を無作為に入れ替える方法と、通常のクリックからクリックのモデルを置いて推定する方法を比べています。本コラムでは、この論文を手がかりに、位置そのものの影響を推し量るには、順位の記録に加えて、こうした実験かモデルの仮定が要ると整理しています。
推薦の効果(第9章)を測るには、表示のログとは別に、推薦を出す群と出さない群(あるいは新旧の推薦の群)を無作為に分ける比べ方の設計と、群ごとの購買などの結果の記録が要ります。Kohavi らの2009年の論文(Web での比較実験の進め方を整理した論文。データマイニングの学術誌に掲載)は、要旨で、無作為に分けた比較実験を、変更と顧客の行動の因果関係を確かめる最良の科学的な設計と述べています。群を無作為に分けて結果を群ごとに記録していれば、商品ごとの表示のログが無くても、群の比較から効果を推定できます。逆に、表示のログや推薦経由の購買の記録がいくらあっても、それだけでは推薦が無かった場合との差は分かりません。表示のログは、推薦の枠ごと・商品ごとに、何が見せられ何が選ばれたかを読み解くための記録で、効果を測るための群の記録とは役割が違います。
過去のログから新しい推薦を評価する方法(第9章で考え方だけを扱うオフ方策評価)は、過去の表示に加えて、その表示がどれだけの確率で選ばれたか(選択確率)と、その確率を決めた条件の記録を前提にしています。さらに、評価したい新しい推薦が選ぶ商品を、過去の推薦も0でない確率で表示していた必要があります。Sachdeva・Su・Joachims の2020年の論文(データマイニングの国際会議 KDD 2020 に採択された論文。arXiv で公開)は、過去の推薦がすべての選択肢に0でない確率を与えていない場合に、確率で重み付けする方法がうまく働かなくなる問題を扱っています。
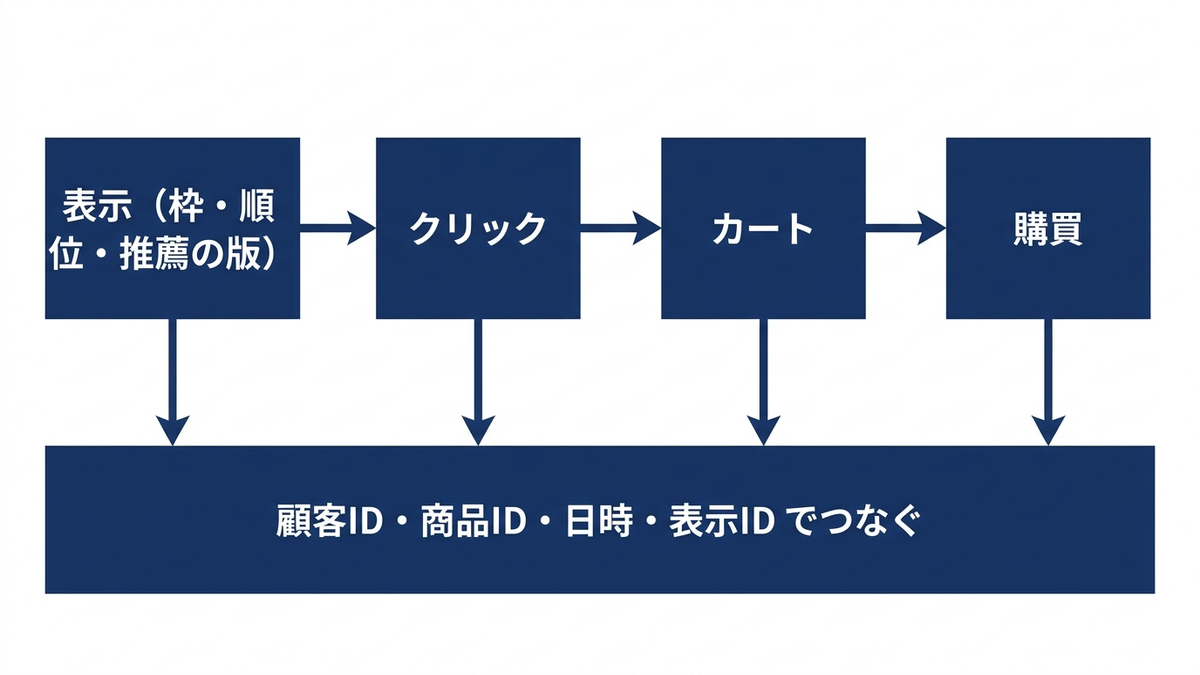
上の図は、表示からクリック・カート・購買までをIDでつなぐ流れを示したもので、群の割り当ては入れていません。群の割り当ては、表示とは別に記録します(次の表の2行目)。
記録する項目を、次の表に整理しました。表の項目名は例で、自社のシステムの名前に合わせて読み替えてください。
| 記録の種類 | 残す項目の例 | 後で何に使うか | 残さないと起きること |
|---|---|---|---|
| 表示 | 表示ID、日時、顧客ID(または端末のID)、推薦の枠、表示した商品と順位、推薦の版、A/Bテストの群、その表示を選んだ確率と確率を決めた条件 | クリック率、順位ごとのクリック率の集計(位置の偏りを推し量る材料)、露出の偏りの集計、オフ方策評価 | 選ばれなかったのか見えなかったのかを区別できない |
| 群の割り当て | 顧客ID、割り当てた群、割り当てた日時、割り当ての方法 | 推薦あり・なし(新旧)の群の比較による推薦の効果の推定(第9章) | 推薦が無かった場合との差を測れない |
| クリック・閲覧 | 日時、顧客ID、商品ID、どの表示IDから来たか、流入元、端末 | 推薦の枠ごとのクリックの集計、閲覧の重み付け | どの枠の表示から閲覧に至ったかを集計できない |
| カート・購買 | 日時、顧客ID、商品ID、数量、注文ID、どの表示IDから来たか | 推薦の枠ごとの推薦経由の購買の集計、群ごとの結果の集計 | 推薦経由かどうかを後から結びつけられない |
| 返品・キャンセル | 注文ID、商品ID、日時、理由の区分 | 関心の確かさの補正、品質の確認 | 返品された商品まで「好まれた」と学習する |
| 商品マスタの変更 | 商品ID、変更日、カテゴリ・価格帯・在庫の状態 | 当時の条件での評価、在庫切れの除外 | 在庫切れや販売終了の商品を推薦する |
| 推薦の設定の変更 | 版、変更日、変更の内容、担当者 | 変更の前後の比較、障害の切り分け | 成績が変わった理由を追えない |
表示のログは、件数が多くなります。1回の表示で10点並べれば、閲覧の10倍の行が増えることもあります。保存の量を抑えるために、表示のログは一定期間で集計して捨てる、一部の顧客だけ詳細に残す、といった設計もありえますが、何を捨てたかを記録しておかないと、後の評価で偏りの原因になります。どの粒度で、どの期間残すかは、評価に必要な期間(第8章)と、個人データの保存期間の方針(第14章)の両方から決める必要があります。
データの品質の問題、ボット・重複・返品・社内の閲覧
行動ログには、顧客の関心を表さない記録が混ざります。代表的なものは、検索エンジンの巡回や価格の自動収集のようなボットのアクセス、通信の再送や画面の再読み込みによる同じ記録の重複、返品やキャンセルされた注文、従業員が業務で商品ページを確認した閲覧、テストのための注文です。これらは件数として目立たなくても、推薦の材料を偏らせます。
どれだけ影響するかを、架空データで確かめました。前の節までのログに、全商品500点をそれぞれ20回ずつ閲覧するボット1体(閲覧10,000件)と、ログの3%の行が二重に送られた重複を加え、汚れたログを作りました。
bot = pd.DataFrame({"顧客": N_CUST, "商品": np.tile(np.arange(N_ITEM), 20),
                    "日": rng.integers(0, N_DAY, N_ITEM * 20), "カート": False, "購買": False})
dup = log.sample(frac=0.03, random_state=1)[["顧客", "商品", "日", "カート", "購買"]]
dirty = pd.concat([log[["顧客", "商品", "日", "カート", "購買"]], bot, dup], ignore_index=True)
v_clean = log.groupby("商品").size().reindex(range(N_ITEM), fill_value=0)
v_dirty = dirty.groupby("商品").size().reindex(range(N_ITEM), fill_value=0)
print("ボット1体の閲覧", len(bot), "件/二重送信", len(dup), "件")
print("閲覧数の上位50点の入れ替わり", 50 - len(set(v_clean.nlargest(50).index) & set(v_dirty.nlargest(50).index)), "点")
low = v_clean.nsmallest(100).index
print("閲覧の少ない100点で、汚れたログでの閲覧が何倍か 中央値", round(float((v_dirty[low] / v_clean[low].clip(lower=1)).median()), 2))
b_clean = int(log["購買"].sum()); b_dirty = int(dirty["購買"].sum())
print("購買の件数", b_clean, "→", b_dirty, f"({b_dirty / b_clean - 1:.1%}増)")
per_cust = dirty.groupby("顧客").size()
print("1人あたり閲覧の99.9パーセント点", int(per_cust.quantile(0.999)), "/最大", int(per_cust.max()))
# 出力:
# ボット1体の閲覧 10000 件/二重送信 2951 件
# 閲覧数の上位50点の入れ替わり 0 点
# 閲覧の少ない100点で、汚れたログでの閲覧が何倍か 中央値 1.44
# 購買の件数 8196 → 8451 (3.1%増)
# 1人あたり閲覧の99.9パーセント点 452 /最大 10000
二重に送られた行は2,951件でした。閲覧数の上位50点の顔ぶれは、汚れたログでも1点も入れ替わりませんでした。全商品に同じ20回を足す限り、どの2つの商品の閲覧数の差も変わらないので、ボットの一律の加算だけでは順位は変わりません。重複も加えた今回の結果でも、上位50点の顔ぶれは変わりませんでした。影響が大きいのは閲覧の少ない商品の比率で、閲覧の少ない100点について商品ごとに増加の倍率(汚れたログでの閲覧÷元の閲覧)を計算すると、その中央値は1.44倍でした。ロングテールの側の商品ほど、少しの雑音で数字が大きく動きます。購買の件数は、重複によって8,196件から8,451件へ3.1%増えました。推薦の効果の測定(第9章)で購買率の差を見るとき、数%の重複は無視できない大きさになりえます。
見分け方の手がかりも、この結果に表れています。汚れたログで顧客ごとの閲覧の件数を数えると、99.9パーセント点(3,001の顧客IDのうち上から0.1%付近)は452件なのに、最大は10,000件でした。人の行動として考えにくい件数の顧客IDは、ボットの候補として調べる対象になります。ただし、件数のしきい値だけでボットを判定すると、よく利用する本物の顧客を誤って除くおそれもあるので、短い時間に大量の閲覧があるか、すべての商品を順番に見ているか、といった行動の形も合わせて確かめる必要があります。品質の問題と対処を、次の表にまとめました。
| 品質の問題 | 推薦への影響 | 見分け方の例 | 対処の例 |
|---|---|---|---|
| ボットのアクセス | 閲覧の少ない商品の数字が膨らむ。人気の判定がずれる | 顧客IDごとの件数の分布の外れ値、短時間の大量の閲覧、全商品を順に見る形 | 除外の条件を決めて記録し、除外した件数を毎日数える |
| 同じ記録の重複 | 購買・閲覧の件数が水増しされる。効果の測定がずれる | 同じ顧客・商品・日時(秒まで)の行、同じ注文IDの行 | 記録ごとに一意のIDを付け、取り込みの段階で重複を除く |
| 返品・キャンセル | 購入後の状況を無視して、好みの強い証拠として扱ってしまう(返品の理由は配送・サイズ・注文の間違いなどもあり、嫌いとは限らない) | 注文と返品の記録の突き合わせ、返品の理由の区分 | 返品の理由に応じて、購買の重みを下げるか除く |
| 社内の閲覧・テストの注文 | 特定の商品の閲覧や購買が増える | 社内のネットワークや従業員のアカウント、テスト用のアカウント | 社内のアクセスとテストの注文に印を付けて除く |
| 商品IDの揺れ | 同じ商品の行動が別々の商品として分かれる | 色違い・サイズ違い・再入荷で別のIDになっていないか | 推薦で使う単位(色違いをまとめるか)を決め、対応表を持つ |
| 贈答品・代理の購買 | 本人の好みでない商品から推薦する | 贈答用の包装の指定、届け先が本人と違う注文 | 重みを下げる。ただし判別できない場合も多い |
データの品質は、推薦の仕組みを作った後も変わり続けます。サイトの改修でログの形式が変わる、新しいボットが来る、といったことは珍しくありません。除外した件数や、1日あたりの記録の件数を毎日数えて、急な変化に気づける形にしておくことが、推薦の監視(第12章)の土台になります。データの品質の管理を組織としてどう進めるかは、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。
個人データの取り扱いの入口
推薦に使う購買・閲覧の履歴は、会員IDと結びつけて持つことが多く、顧客1人ひとりの関心や生活の様子を映すデータです。法令上どう扱う必要があるか(利用目的の示し方、ほかの事業者への提供、外部のツールへの送信など)は、第14章で、公式の条文とガイドラインを確かめた範囲で扱います。この章では、データの設計の段階で決めておきたいことだけを挙げます。
- 推薦に使う目的を決め、その目的に要る項目と期間に絞って記録する(「念のため全部残す」にしない)
- 分析や学習では、氏名や連絡先を含めず、推薦の用途で使うIDに置き換えた形でデータを扱う
- 表示のログ・行動ログの保存期間と、期間を過ぎたデータの扱いを決めておく
- データにアクセスできる人と用途を限り、誰がいつ使ったかを記録する
- 健康・家族の状況など、顧客が知られたくないと感じやすい関心が推薦から読み取れてしまわないかを確かめる
最後の点は、法令の問題であると同時に、顧客の信頼の問題でもあります。推薦の結果が顧客の画面に出る以上、推薦は「この会社は自分について何を知っているか」を顧客に見せることになります。正確な推薦であっても、顧客が個人データの扱いに不安を覚えれば、損失の型でいう顧客の離反(顧客の信頼を失い、配信の停止や同意の撤回、退会につながること)を招きます。どの関心を推薦に使わないかを、データの設計の段階で決めておくことを勧めます。
経営の判断、表示のログを最初から残す
この章の内容を、経営の判断に置き換えます。推薦のデータで経営が決めるべきことは、どの推薦の方法を選ぶかより前に、「推薦の評価に必要な記録を、推薦を作る前から残しているか」だと考えています。表示のログ・推薦の枠・順位・推薦の版の記録は、推薦のエンジンを入れた後から作り直すことができません。記録を始めた日より前の期間については、推薦が何を見せ、そこから何が選ばれたのかを、後から確かめようがないからです。あわせて、推薦の効果を測るための群の割り当ての記録も、推薦を出し始める前に設計しておく必要があります。
データの扱いを誤ったときの損失を、序章で整理した6つの損失の型に当てはめます。6つの型は、機会損失(買われたはずの商品が顧客に見えない)、効果の過大評価(推薦が無くても買われた分まで推薦の成果と数える)、品揃えの偏り(推薦が一部の人気商品に集中する)、顧客の離反(的外れな推薦や個人データの扱いの分かりにくさで顧客の信頼を失う)、形骸化(推薦の枠が見られない、効果が測られないまま運用が続く)、二重投資(共通にできるデータや仕組みをチャネルや部署ごとに別々に整える)です。この章のデータの扱いでは、次のようになります。
| データの扱いでの誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 表示のログを残さずに推薦を入れる | 機会損失(選ばれなかったのか見えなかったのかを区別できず、見えていなかった商品を外し続ける)、形骸化(推薦の枠が見られているかを測れないまま運用が続く) | 推薦を入れる前に、表示・枠・順位・版の記録を始める |
| 推薦を出した顧客と出さなかった顧客の群の記録を残さない | 効果の過大評価(推薦経由の購買を、推薦が無くても買われた分と区別できないまま推薦の成果と数える) | A/Bテストの群と推薦の版を表示のログに記録する(第9章) |
| 買われなかった商品を嫌われた商品として扱う | 機会損失(見られていなかっただけの商品が推薦から外れ続ける) | 閲覧・表示の記録と合わせて読む。露出の少ない商品を別に確かめる |
| 購買の件数だけで人気を判定し、そのまま推薦に使う | 品揃えの偏り(売れ筋への集中が強まる) | 購買の集中の度合いを定期的に測り、推薦の網羅率も見る(第11章) |
| 行動の重みや減衰を検証せずに決める | 顧客の離反(買い終えた商品や昔の関心を推し続けると、的外れな推薦が増え、顧客の離反につながりうる) | 候補をオフライン評価で比べ、オンライン評価で確かめる |
| ボット・重複・返品を除かずに使う | 機会損失(雑音で閲覧の少ない商品の数字が動き、推薦の判断を誤る)、形骸化(数字が信用されず、推薦の成績が見られなくなる) | 除外の条件と除外した件数を毎日記録する |
| チャネルや部署ごとに別のIDとログの形式で記録する | 二重投資(推薦の仕組みをチャネルごとに作り直す) | 顧客ID・商品ID・ログの項目を全社でそろえる |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 推薦の枠を作る前に、表示のログ(枠・順位・推薦の版・A/Bテストの群)を残すことを、開発の要件に入れる
- クリックや購買の記録に、どの表示から来たかを結びつける項目を持たせる
- 顧客IDと商品IDの体系、ログの項目の名前を、EC・アプリ・店舗・メールなどのチャネルで共通にする
- ボット・重複・返品・社内の閲覧の除外の条件を決め、除外した件数を毎日の数字として見る
- 推薦に使う目的・項目・保存期間・使わない関心を、法務と一緒に決めておく(第14章)
予算の面では、推薦のエンジンの導入費用だけでなく、ログの設計と記録の仕組みの改修、記録の保存の費用を最初から見込む必要があります。ログの改修は目に見える成果を生まないので後回しにされやすいのですが、これを省くと、推薦の枠ごと・商品ごとに何が見せられ何が選ばれたかを分析できず、第8章のオフライン評価でも過去の推薦の影響を読み解けません。推薦の効果そのものは、これとは別に、群を無作為に分けて比べる設計と群ごとの結果の記録(第9章)で測ります。表示のログと群の記録の両方がそろって、推薦に投資を続けるかどうかを判断する根拠になると考えています。
この章のまとめ
この章では、推薦に使うデータの種類と、購買・閲覧の履歴という暗黙のフィードバックの読み方を扱いました。本コラムの架空データ(顧客3,000人・商品500点・180日)では、顧客×商品の購買の行列の密度は約0.47%で、上位20%の商品が購買の66.8%を占め、購買0件か1件の顧客が半数近くいました。また、閲覧の多い商品ほど購買の件数が多いのに、閲覧あたりの購買率は層によらずほぼ同じで、購買の件数の差は「見られた回数」の差から来ていました(この結果は、架空データをそのように設定し、1つの乱数の種で確かめたものです)。買われなかったことは嫌いの証拠ではなく、それを区別するには表示のログが要り、表示のログは推薦を作る前から残す必要があります。次の第3章では、こうして整えたデータを使って、人気順とルールによる推薦を作り、後の章のすべての方法と比べる基準(ベースライン)にします。
この章を深めたい方への参考書籍
『ビッグデータ分析・活用のためのSQLレシピ データ加工から売上・ユーザー把握、レポーティング等々の各種データ分析まで』(加嵜長門・田宮直人 著、マイナビ出版):SQL によるデータ分析の手法をレシピの形で集めた本です(2017年刊)。出版書誌データベース(Books)の内容紹介によれば、売上の把握、ユーザーの把握、Web サイトでの行動の把握のためのデータの抽出を章ごとに扱い、レコメンドも取り上げる場面の1つに挙げられています。この章で扱った行動ログの集計(顧客別・商品別の件数、集中の度合い)を、自社のデータベースで実際に出すときの手がかりになります。
『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ・渡部徹太郎・伊藤徹郎 著、技術評論社):データを集めて使える形に整える基盤の作り方を、データ・システム・組織の面から扱う本です(2021年刊)。版元の目次によれば、データの品質を生成元で担保する考え方や、マスタ・共通ID・履歴の整備、ログの収集の注意点を扱う節があります。この章の後半で扱った、ログの設計と、チャネルをまたいだIDの統一・データの品質の管理を、基盤の側から確かめるのに向いています。
第3章 人気順とルールによる推薦、まずベースラインを作る
第2章では、推薦に使うデータの中心が購買・閲覧などの暗黙のフィードバックであり、買われなかった商品は嫌われたのではなく見えていなかっただけかもしれないこと、購買は少数の商品に集中しやすいことを確かめました。この章からは、そのデータを使って実際に推薦を作ります。最初に作るのは、協調フィルタリングや深層学習ではなく、人気順や業務のルールによる単純な推薦です。
単純な推薦から始める理由は、それが後で作るすべての推薦の比較の基準になるからです。この比較の基準となる単純な推薦を、本コラムではベースラインと呼びます。どれほど手の込んだ推薦でも、人気順を並べただけの推薦と比べて成績が上がらなければ、少なくとも成績の面では、作る手間と運用の負担に見合いにくくなります。逆に、人気順との差が分かっていれば、ベンダーの推薦エンジンを評価するときにも「人気順と比べてどれだけ良いのか」という同じ物差しで話ができます。
この章で扱うのは次の内容です。後半では、架空の合成データを使い、実行したコードと結果で確かめます。
- ベースラインの種類(全体の人気順・期間を区切った人気順・カテゴリ内の人気順・新着・ランダム)と、それぞれが何を前提にしているか
- 架空の購買ログで4つのベースラインを作り、後の30日の購買をどれだけ当てるかを、適合率@10・再現率@10で比べた結果
- 同時に買われる商品を見つけるアソシエーション分析と、支持度・信頼度・リフト値の意味
- 信頼度だけで並べると人気商品ばかりが上位に来る問題を、架空のバスケットで確かめた結果
- 業務の知識によるルール、在庫や利益を考えた並べ替え、除外のルール
- 手の込んだ推薦がベースラインに勝てないことが研究でも報告されている点と、経営としての判断
この章の主張は、推薦の仕組みを入れる前に、人気順を中心としたベースラインを作り、その成績を物差しとして常に横に置くことです。人気順に勝てない推薦は、少なくとも当てる成績の面では、入れる根拠が弱くなります。ただし、新商品を知らせる枠のように当てること以外を目的にした推薦もあり、最終的な判断は推薦の目的(第1章)とオンラインの評価(第9章)で行います。評価の指標の詳しい定義と評価データの切り方は第8章で、協調フィルタリングは第4章で扱います。
ベースラインの種類、人気順・期間を区切った人気順・カテゴリ内の人気順・新着・ランダム
ベースラインにはいくつかの種類があり、それぞれ「顧客は何を買いやすいか」について違う前提を置いています。最も単純なのは全体の人気順で、集計の期間の中で最も多く買われた商品から順に、全員に同じ商品を示します。顧客ごとの違いを一切使わないので、パーソナライゼーション(顧客ごとに出し分けること。第1章)の要素はありません。それでも、購買が少数の商品に集中する分布(第2章で扱ったロングテール)の下では、多くの顧客がその人気商品を買うので、何も考えずに選ぶランダムよりはるかによく当たります。
期間を区切った人気順は、直近の7日・30日などに限って購買を数える方法です。季節の商品や新商品のように、売れ方が時間とともに変わる品揃えでは、全期間で数えると、すでに売れなくなった過去の人気商品が上位に残ります。期間を区切ると、いま売れている商品を示せますが、期間を短くしすぎると購買の件数が減り、たまたま数件売れた商品が上位に入りやすくなります。
カテゴリ内の人気順は、顧客がよく買うカテゴリ(ジャンル・売場)を履歴から決め、その中の人気順を示す方法です。顧客ごとの違いを、カテゴリという粗い単位で取り入れたものと言えます。商品ページの推薦の枠で「同じカテゴリの売れ筋」を出すのも、この一種です。新着は、発売日や登録日が新しい順に示す方法で、購買の履歴をまったく使いません。新しい商品を知ってもらう目的には合いますが、顧客が買いそうかどうかは考えていません。ランダムは、商品を無作為に選ぶ方法です。この章では推薦としてではなく、「何も考えずに選んだら、どれくらい当たるか」という、無作為に選んだ場合の水準を知るための比較の基準として使います。ランダムの成績は理論上の下限ではなく、ランダムを下回る推薦もありえます。
この5つを、前提と向き不向きで整理すると次の表のようになります。
| ベースライン | 置いている前提 | 必要なデータ | 向いている場面 | 外れやすい場面 |
|---|---|---|---|---|
| 全体の人気順 | 多くの人が買うものは、誰でも買いやすい | 商品ごとの購買の数だけ | 履歴の無い新しい顧客、トップページの売れ筋の枠 | 売れ方が時間とともに変わる品揃え、好みが大きく分かれる品揃え |
| 期間を区切った人気順 | いま売れているものは、この先も売れやすい | 日付つきの購買の数 | 季節の商品・新商品の入れ替わりが多い品揃え | 購買の件数が少なく、短い期間では数がぶれる場合 |
| カテゴリ内の人気順 | 顧客はよく買うカテゴリの売れ筋を買いやすい | 購買の数、商品のカテゴリ、顧客の履歴 | カテゴリごとに好みがはっきり分かれる品揃え | 履歴が少なくカテゴリを決められない顧客、カテゴリをまたいで買う顧客 |
| 新着 | 新しいものを知りたい顧客がいる | 発売日・登録日 | 新商品を知らせる専用の枠 | 顧客が買いそうかどうかを当てる目的 |
| ランダム | 前提なし | 商品の一覧だけ | 無作為に選んだ場合の水準を知るための比較 | 推薦としては使わない |
ベースラインは1つに絞らず、少なくとも全体の人気順と期間を区切った人気順の2つを置くのがよいと考えています。全体の人気順は誰でも理解できる最も分かりやすい基準で、期間を区切った人気順は「いま売れているもの」という、現場の担当者が手作業で作る売れ筋の枠に近い基準だからです。後で作る推薦がこの2つに勝って初めて、「単純な集計では届かない部分を当てている」と言えます。なお、新着は購買を当てるためではなく新しい商品を紹介するための方法なので、この章の成績の比較には入れていません。
架空の購買ログを作る、ジャンルの好み・人気の偏り・発売と人気の衰え
ここからは、架空の購買ログで4つのベースラインを作り、成績を比べます。使うのは、乱数で作った架空の合成データです。第2章のデータとは別に、この章のために独立に作りました。顧客3,000人、商品400点、ジャンル8つ、期間150日の購買のログで、現実のログの性質のうち次の4つを簡単に入れてあります。
- 顧客ごとのジャンルの好み:顧客ごとに8つのジャンルへの好みの比率を持たせ、多くの顧客は少数のジャンルに好みが偏るようにしました
- 商品の人気の偏り:商品ごとの基本の人気をパレート分布という裾の長い分布から取り、少数の商品に購買が集中するようにしました
- 発売と人気の衰え:3割の商品は期間の途中で発売され、どの商品も発売の後は日がたつにつれて人気が下がっていくようにしました
- 顧客ごとの買い物の多さ:よく買う顧客とほとんど買わない顧客がいるように、顧客ごとに1日あたりの購買の件数の平均を変えました
ある日にある顧客が商品を買うとき、どの商品を選ぶかは「その日の商品の人気」と「その顧客のその商品のジャンルへの好み」の掛け算に比例する確率で決めました。実際の購買のログは、価格・在庫・販促・推薦そのものの影響を受けるので、これよりずっと複雑です。数値はすべて本コラムの架空データでの値で、実在のサイトで期待できる成績を表すものではありません。
この章のコードは numpy と pandas だけで書いており、載せたコードは、前半(購買ログとベースライン)と後半(バスケットとアソシエーション分析)のそれぞれを上からつなげて実行すると、本文と同じ結果になることを確かめています。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261110)
N_CUST, N_ITEM, N_GENRE, N_DAY = 3000, 400, 8, 150
genre = rng.integers(0, N_GENRE, N_ITEM)                  # 商品のジャンル
base_pop = rng.pareto(1.2, N_ITEM) + 0.05                 # 人気の偏り(少数の商品に集中)
launch = np.where(rng.random(N_ITEM) < 0.3,               # 3割の商品は期間の途中で発売
                  rng.integers(0, N_DAY, N_ITEM), 0)
life = rng.uniform(20, 120, N_ITEM)                       # 発売後に人気が落ちていく速さ
pref = rng.dirichlet(np.full(N_GENRE, 0.3), N_CUST)      # 顧客ごとのジャンルの好み
activity = rng.gamma(1.5, 1.0, N_CUST)                    # 顧客ごとの買い物の多さ

rows = []
for d in range(N_DAY):
    age = d - launch
    pop_d = np.where(age >= 0, base_pop * np.exp(-np.maximum(age, 0) / life), 0.0)
    n_buy = rng.poisson(activity * 0.12)                  # その日の購買の件数
    for c in np.nonzero(n_buy)[0]:
        w = pop_d * pref[c, genre]
        items = rng.choice(N_ITEM, size=n_buy[c], p=w / w.sum())
        rows += [(c, i, d) for i in items]
log = pd.DataFrame(rows, columns=["customer", "item", "day"]).drop_duplicates()
log["genre"] = genre[log["item"]]
print("購買の行数", len(log), "顧客数", log["customer"].nunique(), "商品数", log["item"].nunique())
print("期間の途中で発売された商品", int((launch > 0).sum()), "点")
# 出力:
# 購買の行数 78857 顧客数 2965 商品数 400
# 期間の途中で発売された商品 127 点
同じ顧客が同じ日に同じ商品を2回選んだ行は1行にまとめたので、購買の行数は78,857行になりました。150日の間に1回も買わなかった顧客が35人いるため、購買のある顧客は2,965人です。期間の途中で発売された商品は127点でした。購買が上位の商品にどれだけ集中しているかは、次の節以降のコードの出力で確かめます。
評価の決まりを先に決める、後の30日を当てる適合率@10と再現率@10
ベースラインを比べる前に、何をもって「当たった」とするかを決めておきます。ここでは、150日のうち最初の120日を学習の期間、最後の30日を評価の期間とし、学習の期間のデータだけで推薦を作って、評価の期間の購買をどれだけ当てるかを測りました。時間で区切るのは、推薦を作る時点では将来の購買は分からないという、実際の運用と同じ条件にするためです。ランダムに切った評価との違いは、第8章で扱います。
当てる対象は、評価の30日の間に顧客が初めて買った商品としました。学習の期間にすでに買った商品は、推薦の一覧から除き、当たりにも数えません。また、推薦は学習の期間の最後の日に1回だけ作る設定にしたので、その時点でまだ発売されていない商品(評価の期間の30日の間に発売される商品)は推薦の候補に入れず、当たりにも数えません。評価の期間に発売された商品も扱うには、推薦を毎日作り直す設計が必要です。消耗品の買い直しのように、同じ商品を繰り返し買うことが多い品揃えでは、この決め方は変える必要があります。推薦の一覧は顧客ごとに10点とし、次の2つの指標で成績を測りました。
- 適合率@10:推薦した10点のうち、評価の期間に実際に買われた商品の割合です。10点のうち1点が当たれば0.1になります
- 再現率@10:評価の期間に顧客が初めて買った商品のうち、推薦の10点に入っていた商品の割合です。買った商品が4点で、そのうち1点が推薦に入っていれば0.25になります
式で書くと、顧客 \(u\) の推薦の上位10点の集合を \(R_u\)、評価の期間に初めて買った商品の集合を \(T_u\) として、適合率@10は \(|R_u \cap T_u| / 10\)、再現率@10は \(|R_u \cap T_u| / |T_u|\) です。言葉で言い換えると、どちらも分子は「推薦して当たった商品の数」で、分母が「推薦した数」か「買われた数」かの違いです。この2つを顧客ごとに計算し、評価の期間に初めて買った商品のある顧客の全員で平均しました。つまり、この章の適合率@10・再現率@10は、顧客ごとの値の平均で、評価の期間に初めて買った商品だけを当たりとして数えたものです。第8章で扱う定義と考え方は同じですが、数え方の条件はこの章のもので、他の章の数値とはデータも条件も違うため、そのまま比べることはできません。@の後ろの数字は、推薦の一覧の上位何点までを見るかを表します。指標の詳しい性質と、順位まで考える NDCG などの指標は第8章で扱います。
SPLIT, K = 120, 10
train = log[log["day"] < SPLIT]
test = log[log["day"] >= SPLIT]
bought = train.groupby("customer")["item"].apply(set).to_dict()
available = launch < SPLIT                                # 推薦する時点で発売済みの商品だけを候補にする
avail_set = set(np.nonzero(available)[0])
truth = {}                                                # 評価の30日に初めて買った、発売済みの商品
for c, g in test.groupby("customer"):
    new = (set(g["item"]) - bought.get(c, set())) & avail_set
    if new:
        truth[c] = new
print("候補の商品", len(avail_set), "点/評価の対象の顧客", len(truth), "人(うち学習の期間に購買なし", sum(c not in bought for c in truth), "人)")

def top_k(score, c):
    s = score.copy()
    s[list(bought.get(c, set()))] = -np.inf              # 購入済みの商品は除外する
    s[~available] = -np.inf                              # 推薦する時点で未発売の商品も除外する
    return np.argsort(-s, kind="stable")[:K]

def evaluate(score_of):
    prec, rec = [], []
    for c, t in truth.items():
        hit = len(set(top_k(score_of(c), c)) & t)
        prec.append(hit / K)
        rec.append(hit / len(t))
    return np.mean(prec), np.mean(rec)
# 出力: 候補の商品 373 点/評価の対象の顧客 2261 人(うち学習の期間に購買なし 15 人)
推薦の候補は、400点のうち推薦の時点で発売済みの373点です。評価の対象になったのは2,261人で、そのうち15人は学習の期間に1回も買っていない、評価の期間に初めて現れた顧客です。関数 top_k は、商品ごとの点数を受け取り、その顧客がすでに買った商品と、まだ発売されていない商品の点数を負の無限大にしてから、点数の高い順に10点を返します。点数が同じ商品の並びは商品の番号の順に固定して、実行のたびに結果が変わらないようにしました。関数 evaluate は、顧客ごとに点数を返す関数を受け取り、適合率@10と再現率@10の平均を返します。以後、どのベースラインも「顧客を受け取って商品ごとの点数を返す関数」として書けば、同じ物差しで比べられます。後の章で作る協調フィルタリングや行列分解も、この形に合わせれば同じ評価にかけられるので、評価の部品を推薦の方式から切り離して先に作っておくことには実務上の意味があると考えています。
4つのベースラインを比べる、人気を数える期間の長さと履歴の多さによる違い
学習の期間のデータから、4つのベースラインを作りました。ランダムは、商品ごとに一様乱数の点数を1回だけ振り、全員に同じ並び(購入済みの商品は顧客ごとに除く。以下の人気順も同じ)を示すものです。乱数の1回の抽選での値なので、抽選をやり直せば値は少し変わります。全期間の人気順は学習の期間の120日の購買の数、最近30日の人気順は学習の期間の最後の30日(91日目から120日目)の購買の数を点数にしました。ジャンル内の人気順は、次の3つの手順で作りました。まず、顧客ごとに、学習の期間で最もよく買ったジャンルを決めます。次に、そのジャンルの商品を最近30日の人気順で先に並べます。そのジャンルの商品だけで10点に満たない場合は、残りを他のジャンルの最近30日の人気順で埋めます。学習の期間に購買の無い顧客には、最近30日の人気順をそのまま示しました。
def count_items(df):
    return np.bincount(df["item"], minlength=N_ITEM).astype(float)

pop_all = count_items(train)                              # 全期間の人気順
pop_30 = count_items(train[train["day"] >= SPLIT - 30])   # 最近30日の人気順
rand_score = np.random.default_rng(1).random(N_ITEM)      # ランダム(1回の抽選)
fav = train.groupby("customer")["genre"].agg(lambda s: s.value_counts().idxmax()).to_dict()

def genre_score(c):                                       # よく買うジャンルの中の最近30日の人気順
    if c not in fav:
        return pop_30
    return pop_30 + (genre == fav[c]) * 1e6

methods = {
    "ランダム": lambda c: rand_score,
    "全期間の人気順": lambda c: pop_all,
    "最近30日の人気順": lambda c: pop_30,
    "ジャンル内の人気順": genre_score,
}
result = {}
for name, f in methods.items():
    p, r = evaluate(f)
    result[name] = (p, r)
    print(f"{name: <10} 適合率@10 {p:.4f}  再現率@10 {r:.4f}")
cnt = np.sort(pop_all)[::-1]
top_all, top_30 = set(np.argsort(-pop_all)[:10]), set(np.argsort(-pop_30)[:10])
print("上位20%の商品が占める購買の割合", round(cnt[: N_ITEM // 5].sum() / cnt.sum(), 3),
      "/全期間と最近30日の上位10点の重なり", len(top_all & top_30), "点")
# 出力:
# ランダム       適合率@10 0.0047  再現率@10 0.0174
# 全期間の人気順    適合率@10 0.0400  再現率@10 0.1802
# 最近30日の人気順  適合率@10 0.0564  再現率@10 0.2553
# ジャンル内の人気順  適合率@10 0.0685  再現率@10 0.2891
# 上位20%の商品が占める購買の割合 0.814 /全期間と最近30日の上位10点の重なり 7 点
結果を表にまとめます。表の値は、評価の対象の2,261人に限った平均です。評価の期間に何も買わなかった顧客や、すでに買った商品しか買わなかった顧客は含まないので、全顧客に推薦したときの当たる割合や購買率ではありません。右の列は、全期間の人気順の適合率@10を1としたときの比です。次の図の数値は小数第3位までの表示です。
| ベースライン | 適合率@10 | 再現率@10 | 全期間の人気順との比(適合率@10) |
|---|---|---|---|
| ランダム | 0.0047 | 0.0174 | 0.12 |
| 全期間の人気順 | 0.0400 | 0.1802 | 1.00 |
| 最近30日の人気順 | 0.0564 | 0.2553 | 1.41 |
| ジャンル内の人気順 | 0.0685 | 0.2891 | 1.71 |
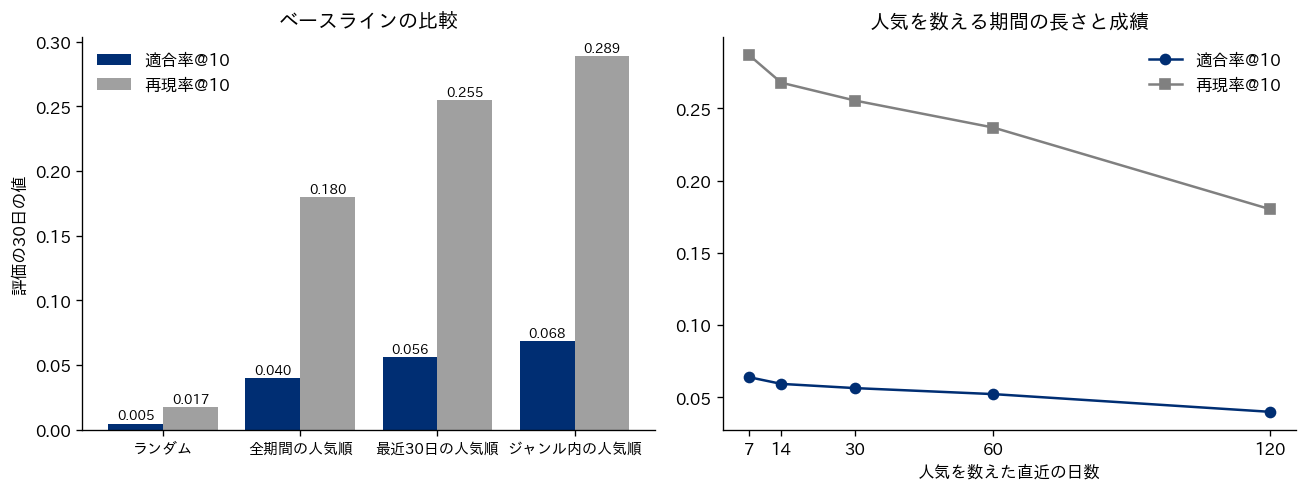
この架空データでは、ランダムの適合率@10は0.0047で、10点を推薦しても当たるのは平均で0.05点ほどです。全期間の人気順は0.0400で、ランダムの約8.5倍になりました。顧客ごとの違いを何も使っていない人気順でも、購買が一部の商品に集中しているだけで、ランダムよりはるかによく当たります。手の込んだ推薦の成績を「ランダムより何倍良い」と説明されても意味が薄いのは、このためです。比べる相手は、ランダムではなく人気順であるべきです。出力の最後の行のとおり、学習の期間の購買のうち、売れた数で上位20%に入る80点の商品が81.4%を占めていました。第2章でも上位20%の商品の割合を示していますが、第2章とこの章は別々に作った架空データで、人気の偏りの設定が違うので、割合の値も違います。どちらも少数の商品に購買が集中する形を持っている、という点だけが共通です。
最近30日の人気順は0.0564で、全期間の人気順の1.41倍でした。この架空データでは、3割の商品が期間の途中で発売され、どの商品も発売の後は人気が下がっていくので、全期間で数えると、すでに売れなくなった商品が上位に残ります。同じ出力の行のとおり、全期間の人気順と最近30日の人気順の上位10点のうち、重なっていたのは7点でした。全体の上位10点にも違いがあったことになります。ただし、推薦の一覧は顧客ごとに購入済みの商品を除いてから作るので、全体で11位以下の商品も繰り上がって推薦に入ります。成績の差は、この3点の違いだけでなく、繰り上がる商品の違いも反映したものです。
ジャンル内の人気順は0.0685で、4つの中で最も高く、全期間の人気順の1.71倍でした。この架空データは、顧客ごとのジャンルの好みに従って購買が起きるように作ってあるので、よく買うジャンルを手がかりにすると成績が上がるのは、作り方からして自然な結果です。実際のデータで同じ差が出るかどうかは、顧客の好みがどれだけカテゴリに沿って分かれているかによります。ここで大事なのは、ジャンルという粗い単位で顧客を分けるだけの、ルールと集計だけの推薦でも、ここまで成績が動くということです。協調フィルタリングや行列分解のような手の込んだ推薦を自社で評価するときは、全期間の人気順だけでなく、ジャンル内の人気順のような強いベースラインを自社のデータで作り、それを超えられるかどうかを目安にするのがよいと考えています。
続いて、最近30日の人気順が全期間の人気順より良かったので、人気を数える期間の長さを7日から120日まで変えて、成績がどう動くかを確かめました。あわせて、ジャンル内の人気順が、学習の期間の購買の数(履歴の多さ)によってどう変わるかも、顧客を3つに分けて調べました。架空データなので、顧客ごとの本当の好みの軸(最も好むジャンル)が分かっています。そこで、履歴から決めた「最もよく買ったジャンル」が本当に最も好むジャンルと一致した顧客の割合(ジャンルの一致率)も出しました。実際のデータでは本当の好みは分からないので、この一致率は計算できません。
for w in [7, 14, 30, 60, 120]:
    pw = count_items(train[train["day"] >= SPLIT - w])
    p, r = evaluate(lambda c: pw)
    print(f"直近{w:>3}日で数えた人気順  適合率@10 {p:.4f}  再現率@10 {r:.4f}")
c7 = count_items(train[train["day"] >= SPLIT - 7])
print("学習の期間の購買", len(train), "行/直近7日", int(c7.sum()), "行/直近7日の10位の商品", int(np.sort(c7)[::-1][9]), "件")

n_hist = train.groupby("customer").size()                 # 学習の期間の購買の数
for lo, hi, lab in [(0, 0, "履歴0件"), (1, 4, "履歴1〜4件"), (5, 9999, "履歴5件以上")]:
    cs = [c for c in truth if lo <= n_hist.get(c, 0) <= hi]
    sub_p = {}
    for name in ["最近30日の人気順", "ジャンル内の人気順"]:
        f = methods[name]
        sub_p[name] = np.mean([len(set(top_k(f(c), c)) & truth[c]) / K for c in cs])
    ok = [fav[c] == pref[c].argmax() for c in cs if c in fav]   # よく買うジャンルが本当の好みと一致したか
    agree = f"{np.mean(ok):.3f}" if ok else "対象なし"
    print(f"{lab}({len(cs)}人) 最近30日の人気順 {sub_p['最近30日の人気順']:.4f}  ジャンル内の人気順 {sub_p['ジャンル内の人気順']:.4f}  ジャンルの一致率 {agree}")
# 出力:
# 直近  7日で数えた人気順  適合率@10 0.0640  再現率@10 0.2868
# 直近 14日で数えた人気順  適合率@10 0.0594  再現率@10 0.2677
# 直近 30日で数えた人気順  適合率@10 0.0564  再現率@10 0.2553
# 直近 60日で数えた人気順  適合率@10 0.0523  再現率@10 0.2366
# 直近120日で数えた人気順  適合率@10 0.0400  再現率@10 0.1802
# 学習の期間の購買 63047 行/直近7日 3808 行/直近7日の10位の商品 87 件
# 履歴0件(15人) 最近30日の人気順 0.0667  ジャンル内の人気順 0.0667  ジャンルの一致率 対象なし
# 履歴1〜4件(132人) 最近30日の人気順 0.0523  ジャンル内の人気順 0.0364  ジャンルの一致率 0.508
# 履歴5件以上(2114人) 最近30日の人気順 0.0566  ジャンル内の人気順 0.0705  ジャンルの一致率 0.709
この架空データでは、人気を数える期間が短いほど成績が良く、直近7日で数えた人気順の適合率@10は0.0640で、最近30日の0.0564を上回りました。直近120日は全期間と同じなので、0.0400です。発売の後に人気が下がり続け、途中で新しい商品が発売されるように作ったデータなので、直近の売れ方ほど将来の売れ方に近い、という結果になりました。データの作り方から出た結果で、1つの乱数の種での値です。
出力のとおり、この架空データでは学習の期間の120日に63,047行の購買があり、直近7日だけでも3,808行の購買を数えられました。直近7日で購買の数が10位の商品でも87件売れており、上位10点はどれも80件を超える購買にもとづく並びでした。購買の件数が少ない品揃えで期間を短くすると、商品ごとの購買の数が数件ずつになり、たまたま売れた商品が上位に入りやすくなります。この架空データではその状況を試していません。
期間の長さは決め打ちにせず、自社のデータで何通りか試して決めるのがよいと考えています。ただし、この例では5通りの期間をすべて同じ最後の30日で評価しています。この結果を見て期間を選び、その成績をそのまま最終の成績として報告すると、評価のデータに合わせて選んだ分だけ成績がよく見えます。実務では、期間の長さは検証用の期間で選び、選ぶのに使っていない後の期間で最終の評価をします。
履歴の多さで分けると、別の傾向が見えます。学習の期間に5件以上買った2,114人では、ジャンル内の人気順(0.0705)が最近30日の人気順(0.0566)を上回りました。一方で、1件から4件しか買っていない132人では、ジャンル内の人気順は0.0364で、最近30日の人気順の0.0523を下回りました。ジャンルの一致率を見ると、1件から4件の顧客では0.508で、5件以上の顧客の0.709より低くなっていました。履歴の少ない顧客ほど、履歴から決めたジャンルが本当の好みとずれている割合が高く、そのずれたジャンルに10点を寄せていることになります。ただし、このずれが成績の低さをどれだけ説明するかは、ここでは確かめていません。履歴の無い15人は、どちらの方式でも最近30日の人気順を示すので、同じ値になります。履歴の少ない顧客には人気順を、履歴の多い顧客にはジャンル内の人気順を出す、という切り替えのルールも、ベースラインの一種として作れます。新しい顧客への推薦の問題(コールドスタート)は、第10章で詳しく扱います。
アソシエーション分析、同時に買われる商品を支持度・信頼度・リフト値で測る
人気順が「多くの人が買う商品」を示すのに対して、商品ページやカートの推薦の枠では「この商品と一緒に買われやすい商品」を示したい場面が多くあります。そのための古典的な方法が、アソシエーション分析です。1回の買い物でかごに入った商品の組(バスケット)を大量に集め、「商品 A を買う人は商品 B も買う」という形の規則(アソシエーション規則)を見つけます。この問題は、Agrawal・Imieliński・Swami の1993年の論文(ACM SIGMOD の国際会議の予稿集)で導入されました。翌1994年の Agrawal と Srikant の論文(VLDB の国際会議の予稿集)は、この問題を解く速い計算方法として Apriori と呼ばれる方法を示しており、その序論では、バーコードの普及で小売業が大量の販売データ(バスケットデータ)を集められるようになったことを、この問題の背景として挙げています。
規則の強さは、主に次の3つの数で測ります。ここでは「商品 A を買ったかごに商品 B も入る」という規則を A→B と書き、A を前、B を後と呼びます。
- 支持度:全部のかごのうち、A と B が両方入っているかごの割合です。その組み合わせがどれだけよく起きるかを表します
- 信頼度:A が入っているかごのうち、B も入っているかごの割合です。観測したかごの中で、A と一緒に B がどれくらいの割合で買われていたかを表します。推薦したときに B が買われる割合ではありません
- リフト値:信頼度を、B の支持度(全部のかごのうち B が入っているかごの割合)で割った値です。A を買ったという条件で、B の入りやすさが普段の何倍になるかを表します
式で書くと、かご全体での A の割合を \(P(A)\)、A と B が両方入る割合を \(P(A \cap B)\) として、支持度は \(P(A \cap B)\)、信頼度は \(P(A \cap B) / P(A)\)、リフト値は \(P(A \cap B) / (P(A) P(B))\) です。言葉で言い換えると、リフト値が1なら、A を買ったかどうかは B の買われやすさと関係が無く、1より大きければ一緒に買われやすく、1より小さければ一緒には買われにくい関係です。支持度と信頼度の2つは、上の1994年の論文が問題を述べる部分で定義しており、利用者が決めた最小の支持度と最小の信頼度を超える規則をすべて見つけることを、規則を見つける問題としています。リフト値の式は前と後を入れ替えても同じ値になるので、A→B と B→A のリフト値は等しくなります。
3つの数の違いは、推薦の枠に出す商品を選ぶうえで大きな意味を持ちます。信頼度は「一緒に買われた割合」なので一見すると推薦に向いていそうですが、後の商品 B がもともと多くのかごに入る人気商品なら、A と関係が無くても信頼度は高くなります。次の節で、この問題を架空のバスケットで確かめます。
架空のバスケットで確かめる、信頼度は人気商品に引っ張られ、リフト値はかごの少ない組で振れる
架空のバスケットを3万かご作りました。この節のデータは、前半の購買ログとは別に独立に作ったものです。商品は60点で、商品01が最もよく売れ、番号が大きいほど売れにくくなるように、商品ごとにかごに入る確率を決めました。各商品は基本的には互いに関係なく、独立にかごに入ります。そのうえで、一緒に買われやすい組を3つ仕込みました。商品21があるかごには25%の確率で商品22を加え、同じように商品30には商品31を、商品45には商品46を加えます。さらに、代わりに買われやすい組(どちらか片方を買えば足りる組)として、商品05があるかごからは70%の確率で商品06を外しました。どの組が本当に関係しているかを作り手が知っているので、分析の結果が正しいかを確かめられます。実際の買い物では、こうした関係は分からないことに注意が必要です。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261110)
N_BASKET, N_ITEM = 30000, 60
names = np.array([f"商品{i + 1:02d}" for i in range(N_ITEM)])
p = 0.45 * (np.arange(1, N_ITEM + 1) ** -0.9)             # 商品01が最も売れ、番号が大きいほど売れにくい
X = rng.random((N_BASKET, N_ITEM)) < p                     # 各商品が独立にかごに入る
# 一緒に買われやすい組(前の商品があると、後の商品が25%の確率で追加される)
for a, b in [(20, 21), (29, 30), (44, 45)]:                # 商品21→22、商品30→31、商品45→46
    X[:, b] |= X[:, a] & (rng.random(N_BASKET) < 0.25)
# 代わりに買われやすい組(商品05があると商品06が70%の確率で外れる)
X[:, 5] &= ~(X[:, 4] & (rng.random(N_BASKET) < 0.70))
X = X.astype(np.int32)
print("バスケット数", N_BASKET, "1かごあたりの平均点数", round(X.sum(1).mean(), 2))
print("商品01の支持度", round(X[:, 0].mean(), 4), "商品22の支持度", round(X[:, 21].mean(), 4))
# 出力:
# バスケット数 30000 1かごあたりの平均点数 2.56
# 商品01の支持度 0.4459 商品22の支持度 0.0348
1かごあたりの平均の点数は2.56点で、最もよく売れる商品01は全体の44.59%のかごに入っています。仕込んだ組の後の商品である商品22が入るかごは3.48%です。次に、すべての商品の組について支持度・信頼度・リフト値を計算しました。商品の組ごとに、両方が入ったかごの数を数える必要があります。かごを行、商品を列にした0と1の表 X からは、行列の計算を1行書くだけで(コードの X.T @ X)、2つの商品が同じかごに入った回数の表を一度に作れます。両方が入ったかごが30かごに満たない組は、偶然の影響が大きいので外しました。最後に、同じ計算を最初の1,000かごだけで行い、かごの数が少ないときに結果がどう変わるかも確かめました。
def make_rules(X):
    nb = X.shape[0]
    co = X.T @ X                                           # 2商品が同じかごに入った回数
    n = np.diag(co).astype(float)                          # 各商品が入ったかごの数
    rows = []
    for a in range(X.shape[1]):
        for b in range(X.shape[1]):
            if (a == b) | (co[a, b] == 0):
                continue
            support = co[a, b] / nb                        # A と B が一緒に入る割合
            confidence = co[a, b] / n[a]                   # A が入ったかごのうち B も入る割合
            lift = confidence / (n[b] / nb)                # B の普段の入りやすさとの比
            rows.append((names[a], names[b], int(co[a, b]), support, confidence, lift))
    return pd.DataFrame(rows, columns=["前", "後", "かご数", "支持度", "信頼度", "リフト値"])

rules = make_rules(X)
MIN_COUNT = 30                                             # 30かご未満の組は偶然の影響が大きいので外す
kept = rules[rules["かご数"] >= MIN_COUNT]
fmt = {"支持度": "{:.4f}".format, "信頼度": "{:.3f}".format, "リフト値": "{:.2f}".format}
print("--- 信頼度の上位5件(30かご以上)")
print(kept.sort_values("信頼度", ascending=False).head(5).to_string(index=False, formatters=fmt))
print("--- リフト値の上位5件(30かご以上)")
print(kept.sort_values("リフト値", ascending=False).head(5).to_string(index=False, formatters=fmt))
print("--- リフト値の下位3件(30かご以上)")
print(kept.sort_values("リフト値").head(3).to_string(index=False, formatters=fmt))
small = make_rules(X[:1000])                               # 最初の1,000かごだけで計算
print("--- 1,000かごだけで計算したリフト値の上位5件(かご数の下限なし)")
print(small.sort_values("リフト値", ascending=False).head(5).to_string(index=False, formatters=fmt))
top20 = kept.sort_values("信頼度", ascending=False).head(20)
print("信頼度の上位20件で後が商品01の件数", int((top20["後"] == "商品01").sum()),
      "/リフト値", round(top20["リフト値"].min(), 2), "〜", round(top20["リフト値"].max(), 2))
for a, b in [("商品21", "商品22"), ("商品30", "商品31"), ("商品45", "商品46")]:
    conf = kept[(kept["前"] == a) & (kept["後"] == b)]["信頼度"].iloc[0]
    print(f"{a}→{b} の信頼度の順位", int((kept["信頼度"] > conf).sum()) + 1, "位/", len(kept), "組")
top10s = small.sort_values("リフト値", ascending=False).head(10)
print("1,000かごのリフト値の上位10件", [f"{a}→{b}({n})" for a, b, n in zip(top10s["前"], top10s["後"], top10s["かご数"])])
# 出力:
# --- 信頼度の上位5件(30かご以上)
#    前    後  かご数    支持度   信頼度 リフト値
# 商品44 商品01  230 0.0077 0.480 1.08
# 商品10 商品01  803 0.0268 0.476 1.07
# 商品45 商品01  214 0.0071 0.475 1.06
# 商品42 商品01  227 0.0076 0.474 1.06
# 商品55 商品01  183 0.0061 0.473 1.06
# --- リフト値の上位5件(30かご以上)
#    前    後  かご数    支持度   信頼度  リフト値
# 商品45 商品46  111 0.0037 0.246 14.09
# 商品46 商品45  111 0.0037 0.212 14.09
# 商品30 商品31  153 0.0051 0.241  9.50
# 商品31 商品30  153 0.0051 0.201  9.50
# 商品21 商品22  230 0.0077 0.258  7.43
# --- リフト値の下位3件(30かご以上)
#    前    後  かご数    支持度   信頼度 リフト値
# 商品06 商品05   77 0.0026 0.031 0.29
# 商品05 商品06   77 0.0026 0.024 0.29
# 商品08 商品27   32 0.0011 0.016 0.66
# --- 1,000かごだけで計算したリフト値の上位5件(かご数の下限なし)
#    前    後  かご数    支持度   信頼度  リフト値
# 商品45 商品46    9 0.0090 0.391 15.65
# 商品46 商品45    9 0.0090 0.360 15.65
# 商品58 商品30    3 0.0030 0.231 12.15
# 商品30 商品58    3 0.0030 0.158 12.15
# 商品59 商品29    3 0.0030 0.214 11.28
# 信頼度の上位20件で後が商品01の件数 20 /リフト値 1.02 〜 1.08
# 商品21→商品22 の信頼度の順位 73 位/ 1158 組
# 商品30→商品31 の信頼度の順位 95 位/ 1158 組
# 商品45→商品46 の信頼度の順位 83 位/ 1158 組
# 1,000かごのリフト値の上位10件 ['商品45→商品46(9)', '商品46→商品45(9)', '商品58→商品30(3)', '商品30→商品58(3)', '商品59→商品29(3)', '商品29→商品59(3)', '商品41→商品53(2)', '商品53→商品41(2)', '商品59→商品51(2)', '商品51→商品59(2)']
出力の先頭の2つの表(信頼度の上位5件とリフト値の上位5件)を、次の表にまとめて並べました。どちらも、両方が入ったかごが30かご以上の1,158組の中での順位です。
| 並べ方 | 規則(前→後) | かご数 | 支持度 | 信頼度 | リフト値 |
|---|---|---|---|---|---|
| 信頼度の1位 | 商品44→商品01 | 230 | 0.0077 | 0.480 | 1.08 |
| 信頼度の2位 | 商品10→商品01 | 803 | 0.0268 | 0.476 | 1.07 |
| 信頼度の3位 | 商品45→商品01 | 214 | 0.0071 | 0.475 | 1.06 |
| 信頼度の4位 | 商品42→商品01 | 227 | 0.0076 | 0.474 | 1.06 |
| 信頼度の5位 | 商品55→商品01 | 183 | 0.0061 | 0.473 | 1.06 |
| リフト値の1位 | 商品45→商品46 | 111 | 0.0037 | 0.246 | 14.09 |
| リフト値の2位 | 商品46→商品45 | 111 | 0.0037 | 0.212 | 14.09 |
| リフト値の3位 | 商品30→商品31 | 153 | 0.0051 | 0.241 | 9.50 |
| リフト値の4位 | 商品31→商品30 | 153 | 0.0051 | 0.201 | 9.50 |
| リフト値の5位 | 商品21→商品22 | 230 | 0.0077 | 0.258 | 7.43 |
信頼度の上位5件は、すべて後が商品01でした。出力の末尾の行のとおり、信頼度の上位20件まで広げても、20件すべての後が商品01で、そのリフト値は1.02から1.08の間でした。この架空データでは各商品が基本的に独立にかごに入り、商品01は全体の44.59%のかごに入るので、どの商品を前にしても、信頼度はおおむね0.45前後になります。リフト値が1に近いということは、前の商品を買ったかどうかと、商品01が買われるかどうかに、ほとんど関係が無いということです。この規則に従って「商品44を買った人に商品01を推薦する」と、推薦の枠には、推薦が無くてもかごの半数近くに入っている商品が並び、推薦経由の購買の数だけでは推薦の効果が分からない状態になりかねません。この例で計算したのは信頼度とリフト値だけで、推薦の効果(推薦によって増えた購買)は測っていません。増えた分を測るには、推薦を出した場合と出さない場合を比べる必要があります。推薦経由の購買の数を推薦の効果と取り違える問題(効果の過大評価)は、第9章で扱います。
リフト値で並べると、上位5件は、仕込んだ3つの組だけで占められました。リフト値は前と後を入れ替えても同じ値なので、商品45と商品46、商品30と商品31は、両方の向きが並んでいます。一方で、仕込んだ組の3つの向き(商品21→商品22、商品30→商品31、商品45→商品46)の信頼度は0.24から0.26ほどで(逆向きの規則は表のとおり0.20から0.21ほど)、出力の末尾の行のとおり、30かご以上の1,158組の中での信頼度の順位は、商品21→商品22が73位、商品30→商品31が95位、商品45→商品46が83位でした。信頼度だけで上位を選ぶと、本当に一緒に買われやすい組は、人気商品を後に置いた規則に押し出されて上位に入りません。
出力のとおり、リフト値の下位には、代わりに買われやすい組として仕込んだ商品05と商品06が、リフト値0.29で並びました。一緒に買われにくい組は、カートの推薦の枠のように「一緒に買うもの」を示す場所では、候補から外す目安になります。この架空データで仕込んだのは、片方を買えばもう片方は要らない、という関係でした。ただし、リフト値が低い組を「代わりになる商品」と見なしてよいかどうかは、商品の中身を見て人が判断する必要があります。
ただし、リフト値にも弱点があります。かごの数が少ない組では、偶然によって極端に大きな値が出ることです。最初の1,000かごだけで計算したリフト値の上位5件は、出力の4つ目の表のとおりで、次の表に抜き出しました。
| 順位 | 規則(前→後) | かご数 | リフト値 | 仕込んだ組か |
|---|---|---|---|---|
| 1位 | 商品45→商品46 | 9 | 15.65 | 仕込んだ組 |
| 2位 | 商品46→商品45 | 9 | 15.65 | 仕込んだ組 |
| 3位 | 商品58→商品30 | 3 | 12.15 | 仕込んでいない |
| 4位 | 商品30→商品58 | 3 | 12.15 | 仕込んでいない |
| 5位 | 商品59→商品29 | 3 | 11.28 | 仕込んでいない |
3位から5位は、仕込んでいない組が、わずか3かごの同時購買だけでリフト値11から12に達したものです。出力の最後の行(括弧の中は両方が入ったかごの数)のとおり、1,000かごでのリフト値の上位10件のうち、仕込んだ組は商品45と商品46の2件だけで、残りの8件は両方が入ったかごが2かごか3かごの、仕込んでいない組でした。3万かごで30かご以上に限った前の表では、上位5件がすべて仕込んだ組だったので、この架空データでは、データの量と下限の置き方で結果が大きく変わりました。
売れにくい商品どうしは、もともとかごに入る割合が小さいので、偶然に2回か3回一緒に買われただけで、リフト値の分母(2つの商品の割合の積)に比べて分子が大きくなります。そのため、実務でアソシエーション分析を使うときは、支持度(または両方が入ったかごの数)に下限を置き、そのうえでリフト値の高い順に並べる、という2段の手順にするのがよいと考えています。下限をどこに置くかに決まった答えは無く、下限を高くすれば偶然の組は減りますが、売れにくい商品どうしの組が分析から消え、推薦が人気商品の周りに偏ります。この章の例では30かごとしましたが、自社のデータでは、下限を何通りか変えて、上位に並ぶ組を担当者が見て納得できるかを確かめて決めるのが現実的だと考えています。
3つの数の使い分けを、次の表にまとめます。
| 数 | 何が分かるか | 推薦の枠での使い方 | 単独で使ったときの落とし穴 |
|---|---|---|---|
| 支持度 | その組み合わせがどれだけよく起きるか | 偶然の組を外すための下限として使う | 人気商品どうしの組ばかりが上位になる |
| 信頼度 | 前の商品を買った人のうち、後の商品も買った割合 | リフト値で選んだ組の中で、どれだけ一緒に買われているかの目安にする | 後が人気商品なら、関係が無くても高くなる |
| リフト値 | 前の商品を買った条件で、後の商品の買われやすさが普段の何倍か | 支持度の下限を置いたうえで、上位の組を候補にする | かごの少ない組で、偶然に極端な値が出る |
この節では、1回の買い物を単位として同時の購買を集計し、顧客ごとの好みは使っていません。アソシエーション分析そのものは1回の買い物に限らず、1993年の論文も、一定の期間に顧客が買った商品をまとめたデータにも使えると述べています。ここでは、1回の買い物を単位にした場合との違いとして説明します。顧客をまたいで「この商品を買った人はこの商品も買っている」という関係を、かごではなく顧客の購買の履歴全体で測る方法が、第4章で扱う協調フィルタリング(商品どうしの似かた)です。第4章では、人気商品が類似の上位に入り込む問題とその正規化を扱いますが、この節で見た信頼度と人気商品の問題は、それと同じ根を持っています。
業務の知識によるルール、在庫や利益を考えた並べ替え、除外のルール
ここまでの人気順とアソシエーション分析は、購買のデータから推薦を作る方法でした。実際の推薦の枠には、データとは別に、業務の知識や事業の都合から決まるルールが必ず入ります。ルールは大きく3つの種類に分けられます。1つ目は、業務の知識による推薦そのもので、売場の担当者が「この商品にはこの付属品」「この季節にはこの特集」と決めて並べるものです。2つ目は、データから作った推薦の並びを、在庫・利益・販促の都合で並べ替えるものです。3つ目は、推薦してはいけない商品を一覧から外す、除外のルールです。
業務の知識による推薦は、データの少ない新しい商品や、組み合わせが仕様で決まっている商品(本体と専用の付属品など)に強みがあります。購買のデータからアソシエーション分析で付属品を見つけるには、ある程度の購買が貯まるのを待たなければなりませんが、担当者は発売の日から組み合わせを知っています。一方で、担当者が手で作るルールは、商品の数が増えると作りきれず、作った後の見直しも滞りがちです。ルールが誰の判断で、いつ作られ、いつまで有効かを記録しておかないと、季節の終わった特集が推薦の枠に残り続けるといったことが起きます。
並べ替えのルールは、たとえば在庫の多い商品や利益の割合の高い商品を、推薦の並びの中で少し上に上げるものです。事業の側から見れば自然な要望ですが、顧客が買いたい商品より事業が売りたい商品を優先しすぎると、推薦が的外れになり、推薦の枠が見られなくなる(顧客の離反・形骸化)おそれがあります。並べ替えを入れるなら、データから作った並びに対してどの程度の重みで加えるかを決め、並べ替えを入れた場合と入れない場合の成績を比べられるようにしておくのがよいと考えています。この比べ方の考え方は、オフラインでは第8章、実際の顧客で確かめる A/Bテストは第9章で扱います。
除外のルールは、推薦の質と顧客の信頼を守るための最低限の決まりです。代表的なものを次の表にまとめました。この章のコードでも、購入済みの商品を除く処理を関数 top_k に入れています。
| 除外のルール | 外す理由 | 外さなかったときに起きること | 決めておくこと |
|---|---|---|---|
| 購入済みの商品 | 耐久財など、同じ商品を2度買うことが少ない | 買ったばかりの商品を推薦し続け、推薦の枠が的外れに見える | 買い直しの多い消耗品を例外にするか、何日たったら再び推薦するか |
| 在庫切れ・販売終了の商品 | 推薦しても買えない | クリックしても買えず、推薦の枠と在庫の両方への信頼を失う | 在庫の情報をどの頻度で推薦に反映するか、入荷予定の商品を残すか |
| 年齢制限のある商品 | 法令や社内の基準で、対象の顧客に販売・表示できない | 法令や社内の基準に反する表示になるおそれがある | 年齢の分からない顧客をどう扱うか、どの推薦の枠に適用するか |
| 顧客が「興味なし」とした商品 | 顧客が明示的に示した意思 | 顧客の意思を無視していると受け取られ、顧客の離反につながる | どの期間、どの範囲(その商品だけか、同じカテゴリまでか)で外すか |
| 表示に配慮が要る商品 | 健康・体の悩みなど、他人に見られたくない購買がある | 家族と共有する端末やメールで表示され、顧客に不快感を与える | どのカテゴリを配慮の対象にし、どの推薦の枠やチャネルで出さないか |
除外のルールは、推薦の方式を人気順から協調フィルタリングや深層学習へ変えても、そのまま必要です。推薦の方式とは切り離して、推薦の結果に必ずかける後処理として作っておくと、方式を入れ替えるたびにルールを作り直さずに済みます。推薦の仕組み全体を、候補の生成・並べ替え・業務のルールによる後処理に分けて組み立てる構成は、第12章で詳しく扱います。年齢制限や個人データの扱いに関わる法令の確認は第14章で扱います。
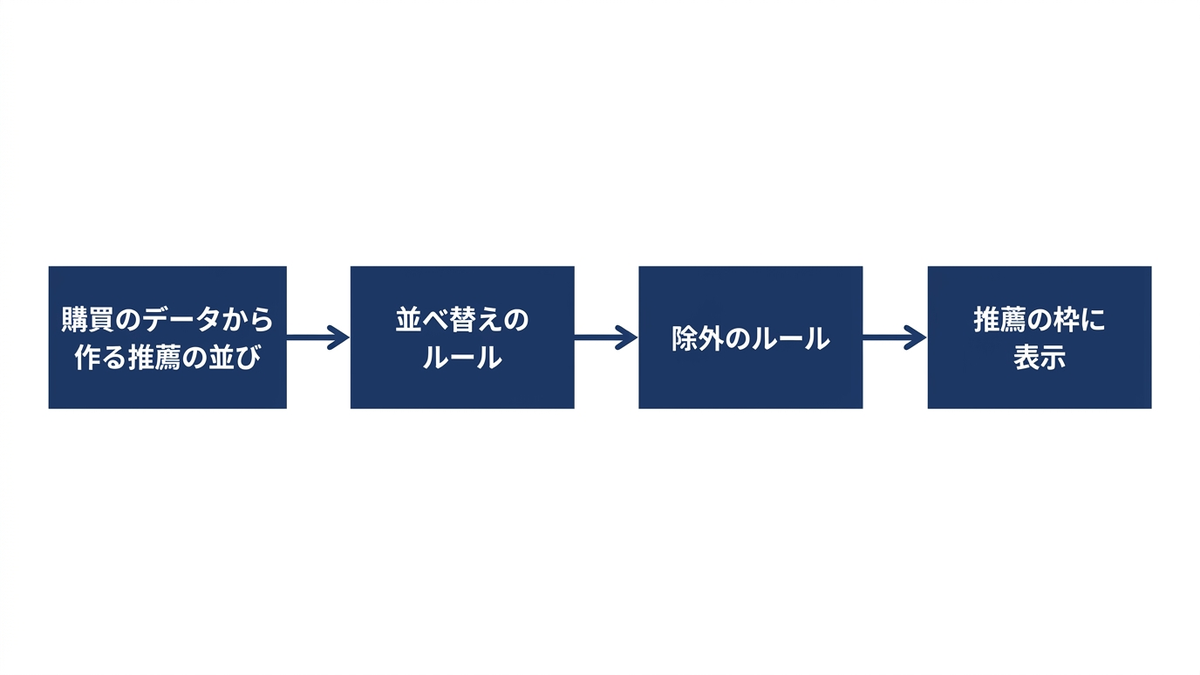
手の込んだ推薦がベースラインに勝てないことがある、研究で報告されている再現性の問題
ベースラインを必ず置くべき理由は、実務の都合だけではありません。推薦システムの研究でも、新しく提案された手の込んだ方法が、単純な方法に勝てていなかったという報告が出ています。よく知られているのが、Ferrari Dacrema・Cremonesi・Jannach の2019年の論文(推薦システムの国際会議 RecSys 2019 の予稿集)です。要旨によれば、深層学習による推薦の方法18個のうち再現できたのは7個で、そのうち6個は比較的単純な方法に負けることが多く、単純なベースラインに明確に勝った残る1個も、よく調整した線形の方法には一貫しては勝てませんでした。
もう1つ、Rendle・Zhang・Koren の2019年の論文(arXiv で公開)は、比較の相手となるベースラインの調整の甘さを取り上げています。映画の評価の公開データセット(MovieLens 10M)で、基本的な行列分解を丁寧に設定し直すと、多くの論文が報告していたベースラインの値も新しい方法の報告値も上回った、という内容です。これは映画の評価点を予測する誤差を比べた結果で、この章のように買われる商品の上位を当てる課題とは評価の課題が違います。
これらの論文の数字は、それぞれの論文が使った公開データセットと条件での結果で、自社のデータで同じことが起きるとは限りません。ただ、実務への示唆ははっきりしています。新しい推薦の方式が「従来の方式より良い」と言われたときは、比べた相手が何で、その相手が十分に調整されていたかを確かめる必要があります。ベンダーの推薦エンジンの評価や、社内の分析担当が作った推薦の評価でも同じで、比べた相手が手を抜いたベースラインなら、差は見かけのものかもしれません。この章の例でも、全期間の人気順と比べるか、ジャンル内の人気順と比べるかで、後から作る推薦の「改善幅」は大きく変わります。比べる相手は、手を抜かずに作った最も強いベースラインにするべきだと考えています。行列分解は第5章、深層学習による推薦とその再検証の報告は第7章で扱います。
経営としての判断、人気順との比較を常に置く
経営の目線で見ると、ベースラインは「新しい推薦の方式が、人気順と比べてどれだけ良いか」を測るための物差しです。方式を替えた効果(人気順と比べた差)と、推薦の効果(推薦が無い場合と比べた差)は別のもので、後者は A/Bテストなどで確かめます(第9章)。物差しが無いまま推薦の仕組みを入れると、推薦の枠を経由した購買の数がそのまま成果として報告されがちですが、その中には、人気順を並べておくだけでも買われた分が含まれています。この章のアソシエーション分析の例で見た、推薦が無くてもかごの半数近くに入る商品01を推薦の枠に並べると、推薦経由の購買の数だけでは推薦の効果が分からなくなる、という構造と同じです。この例でも、推薦によって増えた購買は測っていません。人気順との差を見ずに投資を続けると、手の込んだ仕組みの開発と運用に予算を使いながら、人気順と変わらない推薦を出し続けることになりかねません。
ベースラインの判断を誤ったときに起きる損失を、序章で整理した6つの損失の型に沿って整理すると、次の表のようになります。6つの型は、機会損失(買われたはずの商品が顧客に見えない)、効果の過大評価(推薦が無くても買われた分まで推薦の成果と数える)、品揃えの偏り(推薦が一部の人気商品に集中する)、顧客の離反(的外れ・しつこい推薦で信頼を失う)、形骸化(推薦の枠が見られない、効果が測られないまま放置される)、二重投資(チャネルや部署ごとに別々の仕組みを作る)です。
| 判断の誤り | 起きやすい損失の型 | 防ぐための決まり |
|---|---|---|
| ベースラインを置かずに推薦の仕組みを入れる | 効果の過大評価(人気順でも買われた分まで推薦の成果と数える) | 新しい推薦は、必ず人気順と同じ物差しで比べてから採用する |
| ランダムや手を抜いた人気順とだけ比べる | 効果の過大評価、二重投資(人気順と変わらない仕組みに開発と運用の予算を使う) | 期間を区切った人気順・カテゴリ内の人気順まで含めた、最も強いベースラインと比べる |
| 信頼度だけで「一緒に買われる商品」を選ぶ | 機会損失(本当に一緒に買われる商品が上位に出ない)、品揃えの偏り(人気商品ばかりが並ぶ) | 支持度の下限を置いたうえでリフト値で選ぶ |
| 売りたい商品を優先する並べ替えを強くかけすぎる | 顧客の離反(的外れな推薦が続く)、形骸化(推薦の枠が見られなくなる) | 並べ替えの重みを決め、入れた場合と入れない場合の成績を比べる |
| 除外のルールを推薦の方式ごとに作る | 二重投資、顧客の離反(ある推薦の枠だけ購入済みや在庫切れの商品が出る) | 除外のルールを全部の推薦の枠に共通の後処理として持つ |
| 手で作ったルールを見直さない | 形骸化(季節の終わった特集や販売終了の商品が残る) | ルールごとに作った人・作った日・有効期限を記録する |
体制と KPI の仕組みに落とすなら、次の3つを最初に決めておくのがよいと考えています。1つ目は、推薦の成績の報告に、ベースラインの成績を必ず並べることです。報告の形式を「推薦の方式の成績」と「人気順の成績」とその差の3つの数字に固定しておけば、新しい方式が人気順と比べてどれだけ良いかが毎回見えます。推薦が無い場合と比べた効果は、これとは別に A/Bテストで確かめます。2つ目は、ベースラインそのものを、誰がどの頻度で作り直すかを決めることです。人気順は単純ですが、集計の期間やカテゴリの決め方を放置すると、比べる相手として弱くなります。3つ目は、新しい推薦の方式を検討するとき、ベンダーにも社内の担当にも「自社のデータで、期間を区切った人気順とカテゴリ内の人気順に比べてどれだけ良いか」を示すことを、検討を進める条件にすることです。ここで比べるのはオフラインの成績で、最終的な判断はオンラインの比較で行う必要があります。オフラインの評価の限界は第8章で扱います。推薦の効果の測り方は第9章で、PoC の出口の決め方は第13章で扱います。
この章のまとめ
この章では、推薦の比較の基準となるベースラインを作りました。本コラムの架空データでは、ランダムの適合率@10が0.0047だったのに対し、全期間の人気順は0.0400、最近30日の人気順は0.0564、ジャンル内の人気順は0.0685で、顧客ごとの違いを粗く使うだけのルールと集計でも、成績は大きく動きました(1つの乱数の種で作った架空データでの値です)。アソシエーション分析では、信頼度で並べると上位20件すべてが人気商品の商品01を後に置いた規則になり、そのリフト値は1.02から1.08で、仕込んだ「一緒に買われやすい組」はリフト値で並べたときに初めて上位に並びました。かごの少ない組ではリフト値が偶然に大きくなるので、支持度の下限を置いてからリフト値で選ぶ必要があります。次の第4章では、顧客の購買の履歴全体から商品どうしの似かたを測る協調フィルタリングを作り、第4章のために別に作った架空データの上で、この章と同じ考え方の人気順と比べます。データが違うので、この章の表の数値と第4章の数値をそのまま比べることはできません。
この章を深めたい方への参考書籍
『戦略的データサイエンス入門 ビジネスに活かすコンセプトとテクニック』(Foster Provost、Tom Fawcett 著、竹田正和 監訳、オライリー・ジャパン):データ分析をビジネスの問題の解決にどう結びつけるかを、手法の考え方から説明する本です。版元の目次によれば、第12章に共起とアソシエーション(一緒に発生する項目の見つけ方)の節があり、意外性の測り方としてリフトとレバレッジを扱っています。この章で扱った、信頼度だけでなくリフト値で組を選ぶ考え方を、ビジネスの意思決定の側から確かめるのに向いています。
『データマイニングの基礎』(元田浩・津本周作・山口高平・沼尾正行 著、情報処理学会 編、オーム社):情報処理学会が編む IT Text の1冊で、2006年に刊行された教科書です。版元の目次によれば、第2章のデータマイニングの基礎的な手法の中に相関ルール(アソシエーション規則)の節があり、決定木や最近傍法などの手法と並べて扱っています。第5章では知識の精度評価も扱っており、この章のアソシエーション分析を、データマイニングの手法の全体の中に位置づけて学ぶのに役立ちます。
第4章 協調フィルタリング、似た顧客と似た商品から推薦する
第3章では、人気順・期間を区切った人気順・ジャンル内の人気順といったベースラインを作り、後の30日の購買をどれだけ当てるかを適合率@10と再現率@10で測りました。人気順は単純ですが、比べる相手としては手ごわく、それに勝てない推薦は入れる意味が薄い、というのが第3章の結論でした。この章では、人気順の次に試すことの多い方法として、協調フィルタリングを扱います。
協調フィルタリングは、多くの顧客の行動の似かただけを手がかりに推薦する方法です。商品の説明文や属性は使いません。この章で扱う内容は次のとおりです。
- 協調フィルタリングの考え方と、ユーザーベース(似た顧客から推薦する)とアイテムベース(似た商品から推薦する)の違い
- 類似度の測り方(コサイン類似度・ジャッカード係数・ピアソンの相関)と、それぞれが向くデータ
- 架空の購買ログで、商品×商品の類似度を計算してアイテムベースの推薦を作り、人気順と比べた結果
- 近傍の数 K(各商品について残す似た商品の数)を変えたときの成績
- 「この商品を買った人はこんな商品も」の作り方と、人気商品が類似の一覧に入り込む問題
- 計算量と更新のしかた(毎晩の一括計算と差分の更新)
- GroupLens の論文と、商品間の協調フィルタリングの論文で確かめた研究の流れ
この章の主張は、最初に作る協調フィルタリングは、商品どうしの類似にもとづくアイテムベースにするのがよい、ということです。理由は、推薦の理由を「この商品を買った人がよく買っている商品です」と説明しやすいこと、類似度の表を夜間にまとめて作っておけば表示のときの計算が軽いこと、そして、本コラムの架空データでは、類似度を正規化すると人気順より幅の広い商品が推薦に出たことの3つです(正規化で推薦の幅が広がることが、どのデータでも保証されるわけではありません)。この勧めは、成績の優劣ではなく、運用と説明のしやすさにもとづくものです。後の節でユーザーベースとも成績を比べますが、調整をしていない1回の比較なので、優劣の根拠にはしません。ただし、正規化を誤ると、推薦の一覧は人気順とほとんど変わらなくなります。この点を、実行したコードの結果で確かめます。
協調フィルタリングの考え方、行動の似かただけで推薦する
協調フィルタリングの出発点は、「過去に同じものを選んだ人どうしは、これからも同じものを選びやすい」という経験則です。顧客Aと顧客Bがこれまでに買った商品の多くが重なっていれば、Bが買っていてAがまだ買っていない商品は、Aにとっても関心を持ちやすい候補だと考えます。この考え方は、商品が何であるかを知らなくても使えます。本でも食品でも動画でも、顧客×商品の行動の記録さえあれば、同じ計算で推薦を作れます。
第2章で扱ったとおり、行動の記録は顧客×商品の行列として表せます。行が顧客、列が商品で、買った升目に1、買っていない升目に0を入れた行列です。協調フィルタリングは、この行列の行どうし(顧客どうし)か、列どうし(商品どうし)の似かたを測ります。行どうしを比べるのがユーザーベース、列どうしを比べるのがアイテムベースの協調フィルタリングです。どちらも、比べた結果から「似ている相手」を数人(数点)選び、その相手の行動を足し合わせて推薦を作るので、近傍法(メモリベース法)とも呼ばれます。
ここで注意したいのは、この行列の0の意味です。第2章で見たように、購買や閲覧のような暗黙のフィードバックでは、買っていないことは嫌いの証拠ではありません。商品が目に入らなかっただけかもしれません。協調フィルタリングは、1が付いた升目の重なりから似かたを測るので、0の升目は「分からない」として扱うのが基本です。0を「嫌い」として扱う設計にすると、露出の少なかった商品が不当に低く評価されます。
協調フィルタリングが外れやすい場面も、最初に押さえておきます。1つ目は、履歴の無い新しい商品と新しい顧客です。履歴の無い新商品は、重なりを測る材料が無いので、購買から作る類似度では推薦の候補にできません。新しい顧客は、本人の履歴による個人別の推薦が難しくなりますが、いま見ている商品を起点にした商品ページの推薦なら出せます(コールドスタート。第10章で扱います)。2つ目は、履歴が極端に少ない商品です。購買者が数人しかいない商品どうしは、偶然の重なりで類似度が高く出ることがあります。3つ目は、人気商品です。多くの顧客が買う商品は、どの商品とも重なりやすいので、正規化をしないと、どの商品の類似商品の一覧にも入りやすくなります。この3つ目は、後の節で実際に計算して確かめます。
ユーザーベースとアイテムベース、何が違い、どちらから始めるか
ユーザーベースの協調フィルタリングは、推薦したい顧客と購買の重なりが大きい顧客を K 人選び、その K 人が買っていて本人が買っていない商品を、選んだ人数(または類似度の合計)で並べます。アイテムベースは、顧客が買った商品それぞれについて、似ている商品を K 点ずつ引き、その類似度を足し合わせて並べます。同じ行列を使い、どちらも「似ている相手の行動を足す」点は同じですが、事業で使うときの性質はかなり違います。
| 観点 | ユーザーベース(似た顧客から推薦) | アイテムベース(似た商品から推薦) |
|---|---|---|
| 類似度の表の大きさ | 顧客の数×顧客の数。顧客が増えるほど大きくなる | 商品の数×商品の数。顧客が増えても表の大きさは変わらない |
| 表示のときの計算 | 本人と似た顧客を探し、その顧客の購買を集める。顧客が多いと重い | 本人が買った商品の類似の一覧を引いて足すだけ。本人の購買の数に比例する |
| 説明のしやすさ | 「あなたと似た顧客が買っています」。似た顧客は個人を特定できる形では見せられないので、具体的に説明しにくい | 「この商品を買った人がよく買っています」。元になった商品を名指しできる |
| 更新の頻度 | 顧客の好みは購買のたびに変わるので、表がすぐ古くなる | 商品どうしの関係は比較的ゆっくり変わるので、夜間の一括更新でも使えることが多い |
| データの量との関係 | 購買の少ない顧客は似た顧客を正しく選べない | 購買の少ない商品は似た商品を正しく選べない。顧客が数点しか買っていなくても推薦は作れる |
| 商品ページの推薦の枠への使いやすさ | 顧客が分からないと使えない | 見ている商品だけで類似商品の一覧を作れる(購買から作れば「この商品を買った人は」、閲覧から作れば「この商品を見た人は」)。ログインしていない顧客にも出せる |
表のうち、計算と説明のしやすさは、アイテムベースを最初に選ぶ大きな理由になります。商品の数が顧客の数よりずっと少ない事業(数百万人の顧客に数万点の商品のような場合)では、商品×商品の表は顧客×顧客の表よりはるかに小さく、前もって計算して保存しておけます。表示のときは、顧客が買った商品の行を引いて足し合わせるだけなので、応答の速さが求められる推薦の枠でも使いやすくなります。逆に、商品の数が顧客の数より多い事業(投稿型のサービスで、投稿の数が利用者の数を上回る場合など)では、この関係が逆転することがあり、どちらが軽いかは実際の数で確かめる必要があります。
説明のしやすさは、精度とは別の価値です。推薦の理由を「あなたが先週買った商品Aと一緒に買われています」と示せれば、顧客は推薦を自分で判断しやすくなり、社内でも、推薦の枠に何が出ているかを商品部や EC 運営の担当者が確かめやすくなります。推薦が的外れだったときに、元になった商品と類似度の表のどの行が原因かをたどれることは、運用のうえで大きな利点だと考えています。推薦の理由の表示のしかたと規制との関係は第14章で扱います。
類似度の測り方、コサイン類似度・ジャッカード係数・ピアソンの相関
アイテムベースの中心は、2つの商品がどれだけ似ているかを1つの数で表す類似度です。購買の記録(買った・買わないの0と1)を使う場合、最も素朴な測り方は、2つの商品を両方買った顧客の数(共起の数)をそのまま使うことです。ただし、共起の数は、購買者の多い人気商品ほど大きくなります。どの商品から見ても、人気商品との共起の数は大きくなりやすいので、正規化して人気の影響を割り引くのが普通です。
代表的な正規化が、コサイン類似度です。商品ごとに「どの顧客が買ったか」を表す0と1の列(顧客の数だけ要素のあるベクトル)を作り、2本のベクトルのなす角の余弦(コサイン)を類似度とします。0と1のデータでは、商品 \(i\) の購買者の数を \(n_i\)、商品 \(i\) と \(j\) を両方買った顧客の数を \(c_{ij}\) として、\(\cos(i,j) = c_{ij} / \sqrt{n_i n_j}\) になります。言葉で言えば、共起の数を、2つの商品の購買者の数を掛けて平方根を取った値(幾何平均)で割った値です。人気商品は \(n_j\) が大きいので、共起の数が大きくても割り引かれます。
ジャッカード係数は、2つの商品の購買者の集合の重なりを、集合の和の大きさで割った値です。式では \(c_{ij} / (n_i + n_j – c_{ij})\) で、「どちらかを買った顧客のうち、両方を買った顧客の割合」と言い換えられます。0から1の値を取り、購買の記録のような0と1のデータに向いた測り方です。
この章のコードでは、購買の記録を使うので、ピアソンの相関と調整したコサイン類似度は計算せず、共起の数・コサイン類似度・ジャッカード係数の3つを比べます。2つを計算しない理由は、この段落の後で説明します。
ピアソンの相関は、星の数のような明示的な評価のデータで使われることが多い測り方です。商品どうしの類似度として使う場合は、2つの商品を両方評価した顧客について、それぞれの商品の平均の評価を引いてから相関を取ります。これと似た測り方に、調整したコサイン類似度があります。こちらは商品の平均ではなく、各顧客の平均の評価を引いてからコサインを取るので、「甘めに付ける人」と「辛めに付ける人」の採点の癖を打ち消せます。商品の平均を引くのがピアソンの相関、顧客の平均を引くのが調整したコサイン類似度で、引く平均が違う別の測り方です。
どちらも購買の0と1のデータに当てはめることはできますが、列全体で平均を引くと、0の升目の大半が「分からない」であるデータで0を負の評価として扱うことになり、第2章で見た暗黙のフィードバックの性質と合いません。たとえば、ある商品の列の平均が0.01なら、平均を引いたあとは、買った升目が0.99、買っていない升目が-0.01になり、買っていないだけの升目が小さな負の評価に変わります。これが、この章で2つを計算しない理由です。
| 類似度 | 計算のしかた(言葉で) | 向くデータ | 人気商品の扱い | 注意点 |
|---|---|---|---|---|
| 共起の数 | 2つの商品を両方買った顧客の数 | 件数をそのまま見たいとき(集計表として) | 割り引かない。人気商品がどの一覧にも入る | 推薦の並べ替えにそのまま使うと人気順に近くなる |
| コサイン類似度 | 共起の数を、2つの商品の購買者の数の幾何平均で割る | 購買・閲覧・評価のどれにも使える | 購買者の数の平方根で割り引く | 購買者が数人の商品どうしで偶然高い値が出ることがある |
| ジャッカード係数 | 両方を買った顧客の数を、どちらかを買った顧客の数で割る | 購買・閲覧のような0と1のデータ | 購買者の数の和で割り引く | 回数や評価の強さを使えない |
| ピアソンの相関(商品どうし) | 両方を評価した顧客について、商品ごとの平均を引いた評価どうしの相関 | 星の数のような明示的な評価 | 商品ごとの評価の高さの違いを打ち消す | 0と1の購買データで列全体の平均を引くと、0を負の評価として扱うことになる |
| 調整したコサイン類似度 | 顧客ごとの平均を引いた評価どうしのコサイン | 星の数のような明示的な評価 | 顧客ごとの評価の付け方の癖(甘め・辛め)を打ち消す | ピアソンの相関とは引く平均が違う。0と1の購買データには向かない |
アイテムベースの協調フィルタリングを比べた古典的な研究として、Sarwar らの2001年の論文(第10回の World Wide Web の国際会議で発表された、商品間の協調フィルタリングの手法を調べた論文)があります。この論文は、類似度の計算方法として、コサイン類似度・相関にもとづく類似度・調整したコサイン類似度の3つを節に分けて取り上げています。論文の定義では、相関にもとづく類似度は両方を評価した顧客について商品ごとの平均を引き、調整したコサイン類似度は顧客ごとの平均を引いて、顧客による採点の尺度の違いを補正しています。どの類似度が良いかは、データの種類(評価か購買か)と事業の目的で変わるので、自社のデータで比べて決めるのがよいと考えています。
架空の購買ログを作り、商品×商品の類似度を計算する
ここからは、架空の購買ログで実際に計算します。このログは乱数で作った架空の合成データで、実際の購買ログよりずっと単純です。データの作り方は次のとおりです。章ごとに別の架空データを使っており、この章の数値は他章の数値とは比べられません。
- 規模:顧客は3,000人、商品は400点、期間は180日です。商品は8つのジャンルに50点ずつ属し、ジャンルの中はさらに5点ずつのシリーズ(同じ系統の商品のまとまり)に分かれています
- 好みの偏り:顧客ごとにジャンルの好みを乱数で持たせ、少数のジャンルに好みが偏りやすい設定にしました
- 人気の偏り:商品ごとに人気の重みを付け、少数の商品に購買が集中するようにしました
- 購買の回数と日付:顧客ごとに購買の回数をばらつかせ、購買の日付は180日の中から乱数で選びました
購買の1回ごとの選び方は、次の段落の規則に従います。
購買の1回ごとに、顧客は4割の確率で、すでに買った商品と同じシリーズの商品を買い足し、残りの6割は好みのジャンルの中から人気の重みに従って選ぶ、という規則にしました。この「同じシリーズを買い足す」規則は、商品どうしの関係が購買の重なりに現れる状況を簡単に再現するために入れたものです。協調フィルタリングがこの規則を見つけられるかを確かめることが、この節の目的の1つです。逆に言えば、後で見るアイテムベースの成績は、この規則を入れたデータでの結果であり、実際のログに同じ強さの関係があるとは限りません。
import numpy as np
import pandas as pd
import scipy.sparse as sp

rng = np.random.default_rng(20261110)
N_USER, N_ITEM, N_GENRE, N_DAY = 3000, 400, 8, 180
item_genre = np.repeat(np.arange(N_GENRE), N_ITEM // N_GENRE)      # 商品ごとのジャンル(各50点)
item_series = np.arange(N_ITEM) // 5                               # 5点ずつのシリーズ(同じジャンルの中)
pop_w = (rng.permutation(N_ITEM) + 1.0) ** -0.8                    # 人気の偏り(少数の商品に集中)
user_pref = rng.dirichlet(np.full(N_GENRE, 0.3), N_USER)           # 顧客ごとのジャンルの好み
n_buy = 1 + rng.poisson(np.exp(rng.normal(1.5, 0.8, N_USER)))     # 顧客ごとの購買回数

rows = []
for u in range(N_USER):
    days = np.sort(rng.integers(0, N_DAY, n_buy[u]))
    owned = []
    for d in days:
        same = False
        if owned:
            same = rng.random() < 0.4                              # 4割は持っている商品と同じシリーズから
        if same:
            s = item_series[rng.choice(owned)]
            cand = np.where(item_series == s)[0]
        else:                                                      # 残りは好みのジャンルから
            cand = np.where(item_genre == rng.choice(N_GENRE, p=user_pref[u]))[0]
        i = rng.choice(cand, p=pop_w[cand] / pop_w[cand].sum())
        owned.append(i)
        rows.append((u, i, d))
log = pd.DataFrame(rows, columns=["customer", "item", "day"])
print("購買の件数", len(log), "顧客", log.customer.nunique(), "商品", log["item"].nunique())
# 出力: 購買の件数 21476 顧客 3000 商品 400
購買は合わせて21,476件で、400点の商品はすべて1回以上買われました。次に、最初の150日を学習の期間、最後の30日を評価の期間に分け、学習の期間の購買から顧客×商品の疎行列を作ります。疎行列は、0の升目を記録せず、1の升目の位置だけを持つ行列の形式です。scipy の公式ドキュメントによれば、ここで使う CSR 形式(行ごとに圧縮した形式)は、行の切り出しや行列どうしの積が速く、列の切り出しは遅いという性質があります。同じ商品を2回以上買った場合も1と数えました。
評価の当て方は第3章と同じにしました。評価の期間に顧客が初めて買った商品(学習の期間に買っていない商品)を正解とし、学習の期間に1回以上買っていて、評価の期間に初めて買った商品が1点以上ある顧客を評価の対象にします。適合率@10と再現率@10は、顧客ごとに計算してから評価の対象の顧客全員で平均した値で、当たりは評価の期間に初めて買った商品だけで数えました。第8章では指標の定義と評価の切り方を詳しく扱いますが、この章の値はここに書いた数え方によるもので、他章の値と並べて比べるものではありません。そのうえで、商品×商品の類似度を3通り計算します。共起の数は、疎行列を転置して元の行列に掛けるだけで求まります(\(X^{\top}X\)。顧客の行列 \(X\) の列どうしの内積が、2つの商品を両方買った顧客の数になります)。
train = log[log.day < 150]
test = log[log.day >= 150]
X = sp.csr_matrix((np.ones(len(train)), (train.customer, train["item"])), shape=(N_USER, N_ITEM))
X.sum_duplicates(); X.data[:] = 1.0                                # 同じ商品を何度買っても1と数える
print("学習の購買", len(train), "評価の購買", len(test), "疎行列の密度", round(X.nnz / (N_USER * N_ITEM), 4))
truth = {}
for u, g in test.groupby("customer"):
    new = set(g["item"]) - set(X[u].indices)                       # 学習期間に買っていない商品だけを正解にする
    if (X[u].nnz > 0) & (len(new) > 0):
        truth[u] = new
eval_users = np.array(sorted(truth))
print("評価する顧客", len(eval_users))

n_i = np.asarray(X.sum(axis=0)).ravel()                            # 商品ごとの購買者の数
co = (X.T @ X).tocsr()                                             # 2つの商品を両方買った顧客の数
co.setdiag(0); co.eliminate_zeros()
inv = sp.diags(1.0 / np.sqrt(np.maximum(n_i, 1)))
cos = (inv @ co @ inv).toarray()                                   # コサイン類似度
co_d = co.toarray()
jac = co_d / np.maximum(n_i[:, None] + n_i[None, :] - co_d, 1)     # ジャッカード係数
print("共起が1以上の商品の組の割合", round(co.nnz / (N_ITEM * (N_ITEM - 1)), 4))
# 出力:
# 学習の購買 17921 評価の購買 3555 疎行列の密度 0.0113
# 評価する顧客 1490
# 共起が1以上の商品の組の割合 0.2708
学習の期間の購買は17,921件、評価の期間の購買は3,555件でした。疎行列の密度(全升目のうち1が入っている割合)は0.0113で、顧客×商品の升目のおよそ99%が0です。評価の対象になった顧客は1,490人でした。一方、商品の組で見ると、共起が1以上ある組は全体の27.08%ありました。顧客×商品の行列はほとんど空でも、商品×商品の表は400×400と小さく、4分の1以上の組に何らかの重なりがある、という対比は、アイテムベースが扱いやすい理由の1つです。
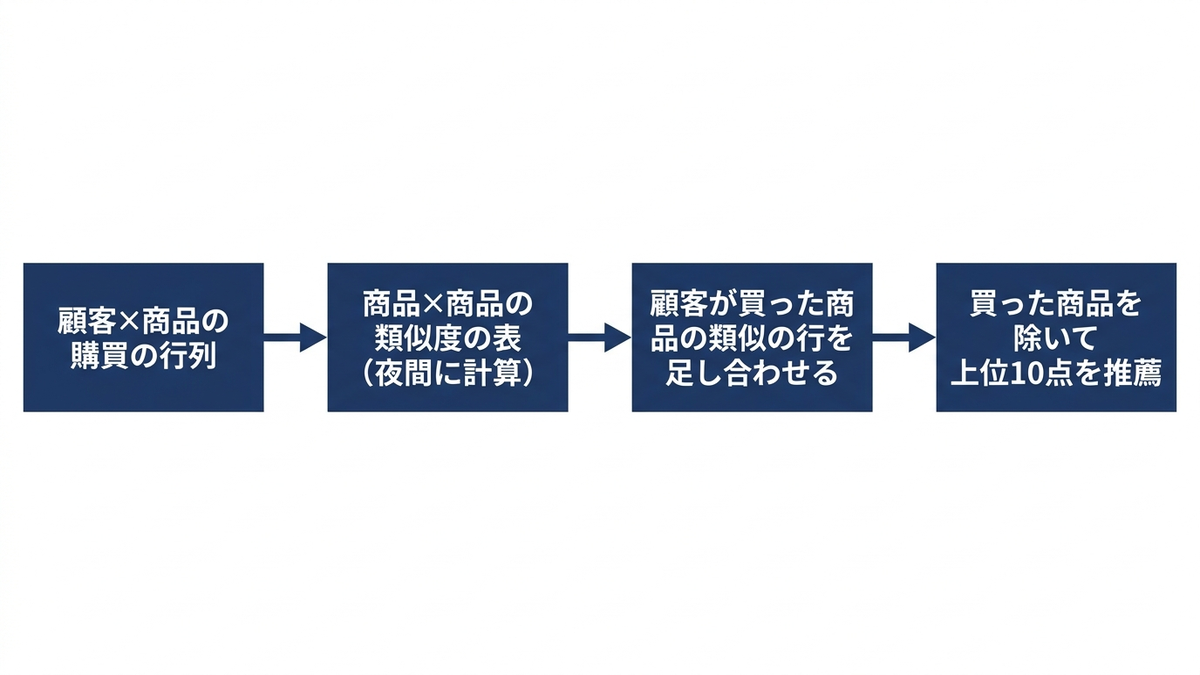
アイテムベースの推薦を人気順と比べる、近傍の数 K と類似度の選び方
類似度の表ができたら、推薦を作ります。顧客が学習の期間に買った商品の行を類似度の表から取り出して足し合わせ、その合計が大きい順に並べます。行列で書けば、顧客の行列 \(X\) に類似度の表 \(S\) を掛けた \(XS\) の各行が、顧客ごとの推薦の点数です。ここで、類似度の表の各行(ある商品から見た類似の一覧)について、上位 K 点だけを残してそれ以外を0にします。この K が近傍の数で、商品ごとに「似た商品を何点まで使うか」を表します。学習の期間に買った商品は推薦から除き、点数が同じ商品は人気の高い順に並べました。比べる相手は、第3章と同じ考え方の人気順(学習の期間の購買者の数の順)です。
def keep_topk(S, k):
    S = S.copy()
    if k < S.shape[0] - 1:
        low = np.argsort(-S, axis=1)[:, k:]                        # 各商品の行で上位K個より下を0にする
        np.put_along_axis(S, low, 0.0, axis=1)
    return S

def recommend(scores, n=10):
    scores = scores + 1e-9 * n_i / n_i.max()                       # 同点は人気順で並べる
    scores[X[eval_users].toarray() > 0] = -np.inf                  # 買った商品は出さない
    return np.argsort(-scores, axis=1)[:, :n]

def evaluate(rec):
    hit = np.array([len(set(r) & truth[u]) for r, u in zip(rec, eval_users)])
    size = np.array([len(truth[u]) for u in eval_users])
    return hit.mean() / rec.shape[1], (hit / size).mean()

Xe = X[eval_users]
rec_pop = recommend(np.tile(n_i.astype(float), (len(eval_users), 1)))
p, r = evaluate(rec_pop)
print(f"人気順: 適合率@10 {p:.4f} 再現率@10 {r:.4f}")

pop_rank = (-n_i).argsort().argsort() + 1                          # 人気の順位(1が最も売れた商品)
def describe(rec):
    p, r = evaluate(rec)
    return p, r, np.median(pop_rank[rec]), len(np.unique(rec))
res = []
for name, S in [("共起の数", co_d), ("コサイン類似度", cos), ("ジャッカード係数", jac)]:
    for k in [5, 10, 20, 50, 100, N_ITEM - 1]:
        rec = recommend(Xe @ keep_topk(S, k))
        p, r, med, cov = describe(rec)
        res.append([name, k, p, r, med, cov])
res = pd.DataFrame(res, columns=["類似度", "K", "適合率@10", "再現率@10", "推薦の人気順位の中央値", "推薦に出た商品の数"])
print(res.round(4).to_string(index=False))
print("人気順", [round(float(v), 4) for v in describe(rec_pop)])
# 出力(抜粋。全体は本文の表):
# 人気順: 適合率@10 0.0264 再現率@10 0.1849
#      類似度   K  適合率@10  再現率@10  推薦の人気順位の中央値  推薦に出た商品の数
#     共起の数   5  0.0426  0.2937         11.0        275
#  コサイン類似度  20  0.0422  0.2835         83.0        397
# 人気順 [0.0264, 0.1849, 6.0, 17.0]
近傍の数 K を5・10・20・50・100・全部(399点。自分以外のすべての商品)と変え、3つの類似度で適合率@10と再現率@10を求めた結果を、次の表にまとめます。
| 近傍の数 K | 共起の数 適合率@10 | 共起の数 再現率@10 | コサイン類似度 適合率@10 | コサイン類似度 再現率@10 | ジャッカード係数 適合率@10 | ジャッカード係数 再現率@10 |
|---|---|---|---|---|---|---|
| 5 | 0.0426 | 0.2937 | 0.0407 | 0.2750 | 0.0409 | 0.2767 |
| 10 | 0.0384 | 0.2635 | 0.0421 | 0.2856 | 0.0403 | 0.2703 |
| 20 | 0.0370 | 0.2549 | 0.0422 | 0.2835 | 0.0413 | 0.2757 |
| 50 | 0.0374 | 0.2580 | 0.0425 | 0.2854 | 0.0426 | 0.2829 |
| 100 | 0.0381 | 0.2612 | 0.0439 | 0.2946 | 0.0438 | 0.2902 |
| 全部(399) | 0.0383 | 0.2629 | 0.0443 | 0.2985 | 0.0435 | 0.2880 |
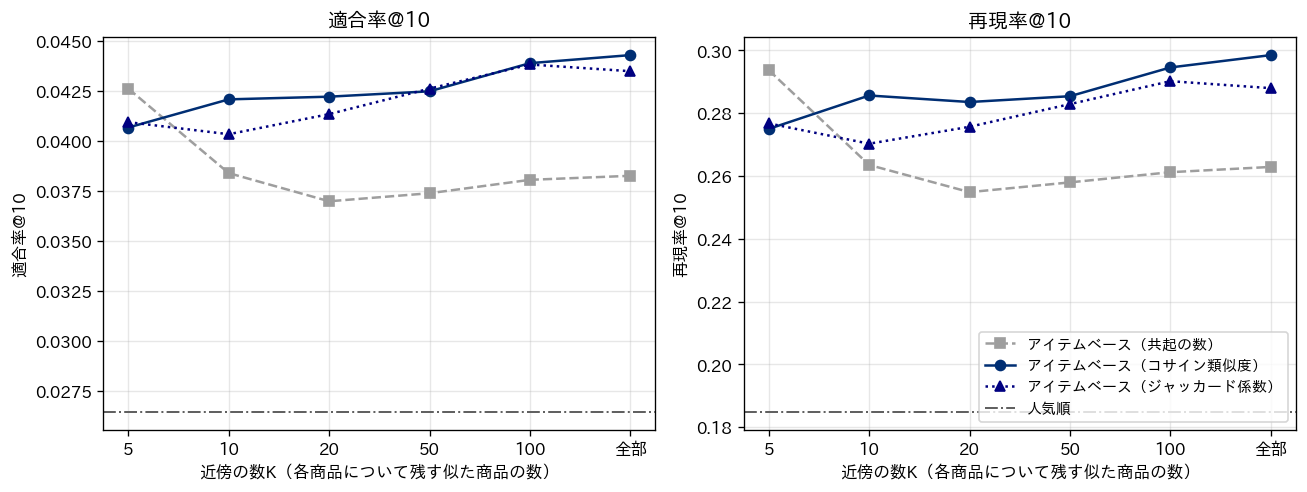
表と図から読み取れることは3つあります。1つ目は、この架空データでは、アイテムベースの推薦がどの類似度・どの K でも人気順を上回ったことです。人気順の適合率@10は0.0264、再現率@10は0.1849でしたが、アイテムベースは適合率@10が0.0370から0.0443、再現率@10が0.2549から0.2985の範囲に入りました。適合率@10の0.0443は、推薦した10点のうち平均で0.44点が評価の期間に買われたことを表します。再現率@10の0.2985は、評価の期間に初めて買った商品のうち、平均で約3割が推薦の10点に入っていたことを表します。前の節で述べたとおり、このデータには「同じシリーズを買い足す」規則を入れているので、アイテムベースが人気順を上回ったのは、その規則を購買の重なりから拾えたためだと考えられますが、規則を外したデータでは確かめていません。また、これは1つの乱数の種で作ったデータでの結果です。実際のデータで同じ差が出るとは限らず、差が出るかどうかは自社のデータで人気順と比べて確かめるしかありません。
2つ目は、近傍の数 K の影響です。コサイン類似度では、適合率@10は K を増やすほどわずかに上がり、全部を使ったときに0.0443で最も高くなりました(再現率@10は K が10から50の間で0.2856、0.2835、0.2854と上下しています)。共起の数では逆に K が5のときが最も高く(適合率@10が0.0426)、K が20まで下がり、その後わずかに戻りました。この架空データでは、コサイン類似度の K を小さく絞っても成績は上がらなかったことになります。K を絞る目的は、成績を上げることだけではありません。類似度の表を保存する大きさと表示のときの計算を減らすこと、偶然の重なりで生じた弱い類似を推薦に混ぜないことも目的になります。ただし、保存の大きさが減るのは、上位 K 件だけを疎行列や一覧の形で持つ場合です。掲載したコードの keep_topk は密な行列のまま値を0にしているだけなので、この最小の例では保存の大きさは変わりません。どの K が良いかはデータによって変わるので、K は決め打ちにせず、いくつかの値で成績と計算の手間を比べて選ぶのがよいと考えています。なお、この節は K による変化を観察したものです。実際に採用する K を選ぶときは、K を選ぶための検証の期間と、最終の成績を測る評価の期間を分けます。同じ30日で K を選び、その成績をそのまま報告すると、評価が楽観的になります。
3つ目は、成績の数字では、類似度どうしの差が一貫していないことです。K が5のときは共起の数の適合率@10が0.0426で、コサイン類似度の0.0407より高くなっていますが、K を全部にすると共起の数が0.0383、コサイン類似度が0.0443で、コサイン類似度が上回ります(再現率@10も0.2629と0.2985です)。K の選び方しだいで順位が入れ替わるので、成績の数字だけでは類似度を選びにくいことになります。一方で、推薦の中身を見ると、2つはまったく違う商品を出していました。それを次の節で確かめます。なお、ここでの適合率@10と再現率@10は、学習と評価を時間で分けた1回の評価の値です。評価の切り方や指標の詳しい扱いは第8章で、実際の顧客に出したときの効果の測り方は第9章で扱います。この章の数字は、推薦が無かった場合と比べて購買が増えたことを示すものではありません。
推薦に出る商品の偏り、正規化をしないと人気順に近づく
前のコードでは、適合率と再現率のほかに、推薦した商品の人気の順位の中央値(学習の期間の購買者の数で並べた順位。1位が最も多く買われた商品)と、評価の対象の顧客全員への推薦の上位10点に1回でも出た商品の数も数えました。人気の順位の中央値は、全顧客への推薦の上位10枠を延べで並べて取った中央値なので、多くの顧客に推薦された商品は、その回数だけ数えられます。K が20のときの結果と、後の節で計算するユーザーベースの結果を、次の表にまとめます。
| 推薦の方法 | 適合率@10 | 再現率@10 | 推薦した商品の人気順位の中央値 | 推薦に出た商品の数(400点中) |
|---|---|---|---|---|
| 人気順 | 0.0264 | 0.1849 | 6位 | 17点 |
| アイテムベース(共起の数、K=20) | 0.0370 | 0.2549 | 8位 | 275点 |
| アイテムベース(コサイン類似度、K=20) | 0.0422 | 0.2835 | 83位 | 397点 |
| アイテムベース(ジャッカード係数、K=20) | 0.0413 | 0.2757 | 75位 | 397点 |
| ユーザーベース(似た顧客50人) | 0.0367 | 0.2581 | 28位 | 395点 |
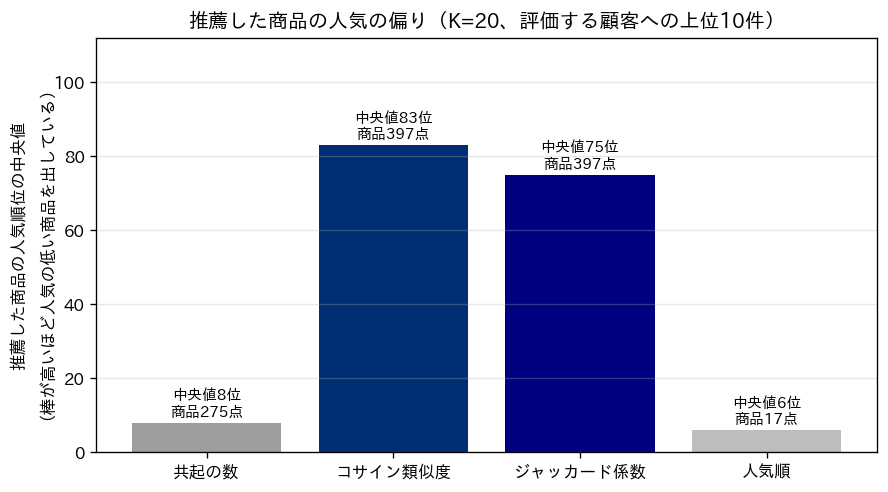
人気順は、どの顧客にもほぼ同じ上位の商品を出すので、推薦に出た商品は400点のうち17点にとどまり、人気順位の中央値は6位でした。共起の数をそのまま使ったアイテムベースは、推薦に出た商品こそ275点に広がりましたが、人気順位の中央値は8位で、人気順の6位とほとんど変わりません。推薦の当たりやすさ(適合率@10は0.0370)は人気順の0.0264より高いものの、推薦に出る商品の人気の偏りは人気順に近い、ということです。どの商品から見ても人気商品との共起の数が大きいので、推薦の上位が人気商品で埋まるためです。コサイン類似度とジャッカード係数では、人気順位の中央値が83位と75位まで下がり、400点のうち397点が誰かの推薦に出ました。正規化によって、人気商品に引っ張られず、顧客の購買に固有の関係を持つ商品が上位に来るようになったと読めます。
個別の商品で見ると、違いはもっとはっきりします。次のコードは、学習の期間の人気が60位の商品を例に、「この商品を買った人は」の上位5点を、共起の数とコサイン類似度で並べたものです。あわせて、400点のすべてについて上位5点を並べ、延べ2,000枠のうち同じシリーズの商品が占める割合を求めました。
target = int(np.where(pop_rank == 60)[0][0])                       # 人気60位の商品を例にする
print(f"例の商品{target}(ジャンル{item_genre[target]}・シリーズ{item_series[target]}・購買者{int(n_i[target])}人)")
for name, S in [("共起の数", co_d), ("コサイン類似度", cos)]:
    top = np.argsort(-S[target])[:5]
    print(name)
    for j in top:
        print(f"  商品{j} ジャンル{item_genre[j]} シリーズ{item_series[j]} 人気{pop_rank[j]}位 共起{int(co_d[target, j])} 値{S[target, j]:.3f}")
same = lambda S: np.mean([np.mean(item_series[np.argsort(-S[i])[:5]] == item_series[i]) for i in range(N_ITEM)])
print("上位5件の延べ枠に占める同じシリーズの割合 共起の数", round(same(co_d), 3), "コサイン類似度", round(same(cos), 3))
# 出力:
# 例の商品165(ジャンル3・シリーズ33・購買者51人)
# 共起の数
#   商品190 ジャンル3 シリーズ38 人気4位 共起15 値15.000
#   商品309 ジャンル6 シリーズ61 人気1位 共起9 値9.000
#   商品189 ジャンル3 シリーズ37 人気7位 共起8 値8.000
#   商品166 ジャンル3 シリーズ33 人気216位 共起8 値8.000
#   商品183 ジャンル3 シリーズ36 人気11位 共起7 値7.000
# コサイン類似度
#   商品166 ジャンル3 シリーズ33 人気216位 共起8 値0.257
#   商品167 ジャンル3 シリーズ33 人気282位 共起6 値0.217
#   商品168 ジャンル3 シリーズ33 人気347位 共起5 値0.211
#   商品169 ジャンル3 シリーズ33 人気234位 共起6 値0.198
#   商品190 ジャンル3 シリーズ38 人気4位 共起15 値0.128
# 上位5件の延べ枠に占める同じシリーズの割合 共起の数 0.349 コサイン類似度 0.57
| 順位 | 共起の数で並べた商品 | その商品の人気順位 | 同じシリーズか | コサイン類似度で並べた商品 | その商品の人気順位 | 同じシリーズか |
|---|---|---|---|---|---|---|
| 1 | 商品190(共起15) | 4位 | 違う(同じジャンル) | 商品166(0.257) | 216位 | 同じ |
| 2 | 商品309(共起9) | 1位 | 違う(別のジャンル) | 商品167(0.217) | 282位 | 同じ |
| 3 | 商品189(共起8) | 7位 | 違う(同じジャンル) | 商品168(0.211) | 347位 | 同じ |
| 4 | 商品166(共起8) | 216位 | 同じ | 商品169(0.198) | 234位 | 同じ |
| 5 | 商品183(共起7) | 11位 | 違う(同じジャンル) | 商品190(0.128) | 4位 | 違う(同じジャンル) |
例の商品165は、学習の期間に51人が買った商品です。共起の数で並べると、上位5点のうち4点が人気11位以内の商品で、2位にはジャンルの違う人気1位の商品が入りました。人気1位の商品は多くの顧客が買っているので、商品165を買った顧客の中にも買った人が9人いた、というだけのことです。コサイン類似度で並べると、上位4点が同じシリーズ33の商品(商品166から169)になり、どれも人気が200位より下の商品でした。この架空データでは「同じシリーズを買い足す」規則を入れているので、コサイン類似度の一覧のほうが、データを作った規則に沿った関係を拾えています。400点全体で見ても、各商品の上位5点、延べ2,000枠に占める同じシリーズの商品の割合は、共起の数で0.349、コサイン類似度で0.57でした(「上位5点に同じシリーズが1点以上入る商品の割合」とは別の数です)。
この結果は、商品ページの「この商品を買った人はこんな商品も」の枠を作るときの注意点を示しています。共起の数をそのまま並べると、多くの商品ページの上位に同じ人気商品が入りやすく、トップページの人気ランキングに近い枠になる場合があります。この架空データでも、共起の数の推薦には275点の商品が出ており、人気商品以外がまったく出なくなるわけではありませんが、推薦した商品の人気順位の中央値は8位で、露出は人気商品に偏っていました。序章で整理した6つの損失の型(機会損失・効果の過大評価・品揃えの偏り・顧客の離反・形骸化・二重投資)でいえば、推薦が一部の人気商品に集中する品揃えの偏りにつながり、ほかの商品と顧客の接点が減って機会損失につながる可能性もあります。ただし、購買の機会が実際に失われたかどうかは、この実験では確かめていません。推薦が露出を通じて偏りを強める循環は、第11章で扱います。
一方で、正規化を強くしすぎると、購買者が数人しかいない商品どうしが、偶然の重なりで高い類似度を持つことがあります。コサイン類似度で2人しか買っていない商品どうしが、1人の重なりで0.5になる、といった場合です。実務では、購買者の数が一定以上の商品だけを類似の候補にする、共起の数が一定以上の組だけを残す、類似度に共起の数に応じた割引をかける、といった工夫を組み合わせることが多いように思います。どの工夫をどの強さで入れるかは、推薦の一覧を商品部や EC 運営の担当者と一緒に見て、違和感のある組が出ていないかを確かめながら決めるのがよいと考えています。
「この商品を買った人は」の作り方と、説明のしやすさを運用に生かす
アイテムベースの類似度の表は、それ自体が商品ページの推薦の枠になります。顧客が見ている商品の行を引いて、類似度の高い順に数点を並べれば、購買の重なりから作った表なら「この商品を買った人はこんな商品も」の一覧になります。「この商品を見た人は」と表示するなら、閲覧の重なりから作った表が必要です。顧客の履歴を使わないので、ログインしていない顧客にも、初めて訪れた顧客にも出せます。顧客ごとの推薦(トップページの「あなたへのおすすめ」など)は、前の節のように、顧客が買った商品の行を足し合わせて作ります。同じ1つの表から、商品ページの枠と顧客ごとの枠の両方を作れることは、仕組みを1つにまとめるうえで利点になります。
作るときに決めておくことを、次の表にまとめます。
| 決めること | 選択肢の例 | 決めないと起きること |
|---|---|---|
| どの行動で類似度を作るか | 購買・カートへの追加・閲覧のどれか、または重みを付けて合わせる | 行動によって一覧の性格が変わる(比べた候補や買い足しの候補が混ざることがあるが、共起だけでは関係の種類を確定できない)。枠の目的と合わない一覧になる |
| 類似度の正規化 | コサイン類似度・ジャッカード係数・共起の数の割引 | 人気商品がどの一覧にも入る |
| 候補にする商品の条件 | 購買者の数の下限・共起の数の下限 | 購買者の少ない商品どうしの偶然の組が上位に来る |
| 近傍の数 K と表示の数 | 表に残す数(例:50点)と、枠に出す数(例:10点) | 表が大きくなりすぎる、または候補が足りず枠が埋まらない |
| 除外のルール | 購入済み(未購入の商品を見つけてもらう枠の場合)・在庫切れ・年齢制限・同じ商品の色違い | 買ったばかりの商品や買えない商品が並び、顧客に不信感を与える |
| 理由の表示 | 「この商品を買った人がよく買っています」「あなたが見た商品Aに関連」 | 推薦の根拠が顧客にも社内にも分からない |
このうち、どの行動で類似度を作るかは、枠の目的に直結します。購買の重なりから作った一覧には、買い足す商品(この架空データのシリーズの買い足しのようなもの)が入りやすく、カートや購入完了の画面の枠に合う場合があります。閲覧の重なりから作った一覧には、同じ用途の比べた候補が入りやすく、代わりの商品を示す商品ページの枠に合う場合があります。ただし、共起は「同じ顧客が両方を買った(見た)」ことしか表さず、比べて迷ったのか、一緒に使うのかといった関係の種類までは、共起だけでは確定できません。この章の購買の共起も、同じ注文や同時の使用を条件にしていません。同じアイテムベースでも、どの行動を数えるかで一覧の性格が変わるので、枠ごとに目的を決めてから作るのがよいと考えています。行動の重み付けと時間の減衰の考え方は第2章で扱いました。
除外のルールと理由の表示は、顧客の受け止め方を大きく左右します。理由の表示への納得感は、オフラインの精度の数字だけでは測れません。一方、除外のルールは推薦の候補を変えるので、オフラインの評価の値にも影響します。この章のコードも、学習の期間に買った商品を除いてから上位10点を選んでおり、除くかどうかで当たりの数が変わります。未購入の商品を見つけてもらうことが目的の枠で、買ったばかりの商品と同じものを推薦し続けると、顧客は推薦をしつこい、的外れだと感じます。反対に、消耗品の補充や同じ作品の再視聴のように、繰り返しの購買や利用を促す枠では、購入済みの商品も推薦の対象になり、購買の周期などに応じて出し方を決めます。理由の表示は、推薦がどういう根拠で出ているかを顧客に伝え、推薦を信頼してもらう手がかりになります。アイテムベースは元になった商品を名指しできるので、理由を表示しやすい方法です。第3章で扱った業務のルール(在庫・利益・除外)は、協調フィルタリングの後段にそのまま組み合わせられます。
計算量と更新、毎晩の一括計算と差分の更新
アイテムベースとユーザーベースの計算の手間を、同じ架空データで比べました。商品×商品のコサイン類似度(400×400)と、顧客×顧客のコサイン類似度(3,000×3,000)を、どちらも顧客×商品の疎行列 \(X\) から表を作り終えるまで(購買者の数の集計・共起の計算・正規化・密な表への変換)を同じ手順の関数で計算して時間を測り、ユーザーベースの推薦(似た顧客50人の購買を類似度で重み付けして足し合わせる)も作って成績を求めました。
import time
def cosine_table(A):                                               # Aの行どうしのコサイン類似度の表をXから作る
    n = np.asarray(A.sum(axis=1)).ravel()
    d = sp.diags(1.0 / np.sqrt(np.maximum(n, 1)))
    S = (d @ (A @ A.T) @ d).toarray()
    np.fill_diagonal(S, 0.0)
    return S
t0 = time.perf_counter()
cos_i = cosine_table(X.T.tocsr())                                  # 商品×商品(400×400)
t1 = time.perf_counter()
cos_u = cosine_table(X)                                            # 顧客×顧客(3000×3000)
t2 = time.perf_counter()
print("類似度の表の大きさ 商品", cos_i.shape, "顧客", cos_u.shape)
print(f"計算時間 商品×商品 {t1 - t0:.3f}秒 顧客×顧客 {t2 - t1:.3f}秒(この計算機での値)")
U = keep_topk(cos_u, 50)[eval_users]                               # 似た顧客50人の購買を足し合わせる
rec_u = recommend(np.asarray(U @ X.toarray()))
p, r, med, cov = describe(rec_u)
print(f"ユーザーベース(似た顧客50人): 適合率@10 {p:.4f} 再現率@10 {r:.4f} 人気順位の中央値 {med} 商品の数 {cov}")
# 出力:
# 類似度の表の大きさ 商品 (400, 400) 顧客 (3000, 3000)
# 計算時間 商品×商品 0.004秒 顧客×顧客 0.065秒(この計算機での値)
# ユーザーベース(似た顧客50人): 適合率@10 0.0367 再現率@10 0.2581 人気順位の中央値 28.0 商品の数 395
本コラムの実行環境では、同じ手順で測った計算時間は、商品×商品の類似度が0.004秒、顧客×顧客が0.065秒でした。計算時間は計算機によって変わり、同じ計算機でも実行のたびに少し変わります(時間以外の出力は、実行し直しても同じになります)。時間の値は、この規模・この計算機での目安です。表の升目の数で比べると、商品×商品は16万、顧客×顧客は900万で、表の大きさに約56倍の差があります。この倍率は表の大きさの比で、計算時間の比とは一致しません。計算時間は表の大きさだけでは決まらないためです。この差は、顧客の数が増えるほど広がります。商品の数が変わらなければ商品×商品の表の大きさは変わりませんが、顧客×顧客の表は顧客の数の2乗で大きくなります。成績の面でも、この架空データのユーザーベース(似た顧客50人)は、適合率@10が0.0367、再現率@10が0.2581で、コサイン類似度のアイテムベース(K=20で0.0422と0.2835)を下回りました。ただし、ユーザーベースは近傍の人数や重みの付け方を調整していないので、この比較はアイテムベースとユーザーベースの優劣を一般に示すものではありません。
計算の手間の考え方は、Amazon.com の技術者らが2003年に IEEE Internet Computing 誌に発表した、商品間の協調フィルタリングの論文(Linden・Smith・York の論文)に整理されています。要点は、時間のかかる類似商品の表を前もってオフラインで作っておけば、表示のときの計算は顧客が買った商品の数で決まり、顧客の総数や品揃えの大きさにはほとんど左右されない、ということです。表を作る計算そのものは重くなりうるものの、多くの顧客の購買が少ないため実際には抑えられる、とも述べています。
実際の運用では、類似度の表を毎晩まとめて計算し直す一括の更新が、最初の形として扱いやすいと考えています。商品どうしの関係は、顧客の好みに比べてゆっくり変わることが多いので、1日に1回の更新でも大きくは古びません。一方で、新商品の追加やセールのような急な変化には、一括の更新だけでは追いつけないことがあります。その場合は、次のような差分の更新を組み合わせます。
- 共起の数と商品ごとの購買者の数を集計表として持ち、顧客がある商品を初めて買ったときに、その商品の購買者の数を1増やし、その顧客がすでに買っている商品との共起の数を更新する。同じ商品の買い直しでは人数を増やさない(この章では同じ商品を何度買っても1と数えているため。コサイン類似度は、この2つから計算し直せる)
- 新商品は、購買がある程度たまるまで類似度の表に入れず、内容ベース(第6章)や露出の保証枠(第10章)で補う
- 古い購買の重みを時間とともに下げ、季節の移り変わりで関係が変わったことを表に反映する
- 顧客ごとの推薦は、表示のときに最新の購買を使って足し合わせる(表は夜間のもの、足し合わせは表示のとき、と分ける)
最後の項目は、アイテムベースの構成上の利点です。類似度の表は夜間に作り、顧客ごとの足し合わせは表示のときに行えば、顧客が今日買った商品も、その場で推薦に反映できます。商品が数万点を超えて表を全部持てなくなった場合の、候補の生成と並べ替えの2段階の構成や、近い商品を速く探す方法は第12章で扱います。
研究の流れ、GroupLens から商品間の協調フィルタリングへ
協調フィルタリングの研究の初期の例として、GroupLens の論文(Resnick らが1994年の ACM の CSCW の会議で発表した論文)があります。この論文が扱ったのは、ネットニュースの記事の推薦です。利用者が読んだ記事を評価し、評価を集めるサーバーが、過去に意見の合った人どうしはまた意見が合うだろう、という経験則にもとづいて、まだ読んでいない記事の点数を予測する仕組みを示しています。利用者が仮名で評価を入れることでプライバシーを守れる、という設計にも触れています。この経験則は、この章の最初の節で述べた協調フィルタリングの出発点そのものです。
その後、顧客の数が大きくなるにつれて、顧客どうしを比べる方法の計算の重さが問題になり、商品どうしを比べる方法が研究されました。前の節で触れた Sarwar らの2001年の論文と、Linden らの2003年の論文は、その流れの代表的なものです。Linden らの論文は、顧客をクラスターに分ける方法や、キーワード・カテゴリ・著者で検索する方法とも比べ、商品間の方法は購買の少ない顧客にも推薦を作れると述べています。なお、これらの論文が示す成果は、それぞれの論文のデータと条件のもとでのものであり、自社で同じ結果が出ることを意味しません。
| 論文(著者・年) | 発表先 | この章との関係 |
|---|---|---|
| GroupLens の論文(Resnick・Iacovou・Suchak・Bergstrom・Riedl、1994年) | 1994年の ACM の CSCW の会議の予稿集(175〜186ページ) | ネットニュースの記事の評価から点数を予測する協調フィルタリングの仕組み |
| 商品間の協調フィルタリングの手法を調べた論文(Sarwar・Karypis・Konstan・Riedl、2001年) | 第10回 World Wide Web 国際会議の予稿集(285〜295ページ) | アイテムベースの協調フィルタリングと、類似度の計算方法の比べ方 |
| Amazon.com の商品間の協調フィルタリングの論文(Linden・Smith・York、2003年) | IEEE Internet Computing 誌 第7巻第1号(76〜80ページ) | 類似商品の表をオフラインで作り、表示のときの計算を軽くする構成 |
協調フィルタリングは、その後、顧客と商品を少数の軸で表す行列分解(第5章)や、深層学習による推薦(第7章)へと発展しました。それでも、近傍法のアイテムベースは、計算が軽く、説明しやすく、比べる基準としても使えるので、最初に作る推薦として今も意味があると考えています。研究の歴史の全体像は第1章で扱いました。
経営の判断、まずアイテムベースで説明できる推薦を作る
この章の内容を、経営の判断に置き換えます。協調フィルタリングを入れるときに経営が決めるべきことは、どのアルゴリズムが最新かではなく、「どの推薦の枠で、どの行動の似かたを使い、何を確かめてから次の段階に進むか」だと考えています。最初の一歩としては、商品×商品の類似度の表を作り、商品ページの「この商品を買った人は」の枠と、顧客ごとの推薦の両方に使うアイテムベースの推薦を勧めます。計算が軽く、推薦の理由を説明でき、社内の担当者が一覧を見て良し悪しを判断できるからです。
協調フィルタリングの判断を誤ったときの損失を、序章で整理した6つの損失の型に当てはめると、次のようになります。6つの型は、機会損失(買われたはずの商品が顧客に見えない)・効果の過大評価(推薦が無くても買われた分まで推薦の成果と数える)・品揃えの偏り(推薦が一部の人気商品に集中する)・顧客の離反(的外れ・しつこい推薦で信頼を失う)・形骸化(推薦の枠が見られない、効果が測られないまま放置される)・二重投資(チャネルや部署ごとに別々の仕組みを作る)です。
| 判断の誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 共起の数をそのまま並べて「この商品を買った人は」の枠を作る | 品揃えの偏り(多くの商品ページの上位に同じ人気商品が入りやすい)。ほかの商品との接点が減り、機会損失につながる可能性もある(本章の実験では購買の機会の損失までは確かめていない) | コサイン類似度などで正規化し、推薦に出た商品の数と人気順位の中央値を毎回確かめる |
| 人気順と比べずに協調フィルタリングを入れる | 形骸化(人気順より良いかどうかの効果が測られないまま、運用が続く) | 導入前に人気順との比較を同じ評価の決まりで行う(第3章) |
| 推薦経由の購買(推薦の枠から選ばれて買われた分)の件数を、協調フィルタリングの効果として報告する | 効果の過大評価(推薦が無くても買われた分まで数える) | 効果は A/Bテストで推薦が無い場合と比べて確かめる(第9章) |
| 未購入の商品を見つけてもらう枠で、購入済みの商品や在庫切れの商品を除かずに出す | 顧客の離反(しつこい、的外れだと感じさせる) | 枠の目的に合わせた除外のルールを協調フィルタリングの後段に入れる(未購入の商品の発見が目的の枠では購入済みを除き、再購入を促す枠では購買の周期などに応じて扱う) |
| 説明できない複雑な方法から始める | 形骸化(推薦の中身を誰も確かめられず、不具合に気づけない) | まずアイテムベースで推薦の理由をたどれる仕組みを作り、それを基準に複雑な方法を比べる |
| 商品ページ・メール・アプリで別々に類似度の表を作る | 二重投資(同じ計算を部署ごとに作り、結果も食い違う) | 同じ行動データ・同じ集計期間で作る表は1つを共有し、枠ごとの違いは除外と並べ替えのルールで表す。購買と閲覧のように別の行動や目的が要る場合は、集計の仕組みを共通にしたうえで表を分ける |
予算と体制の面では、アルゴリズムの開発よりも、類似度の表を毎晩作り直す仕組み、除外のルール、推薦の一覧を人が確かめる手順に、最初から人と時間を割くことが大切だと考えています。KPI としては、適合率@10や再現率@10のようなオフラインの指標だけでなく、推薦に出た商品の数や人気順位の中央値のような「推薦の幅」の指標を一緒に見ることを勧めます。この章の架空データでは、共起の数とコサイン類似度の適合率@10は、K が5のときは共起の数が上、K が20では0.0370と0.0422でコサイン類似度が1割強上と、K の取り方で順位が入れ替わりました。これに対して、K が20のときの推薦に出た商品の数は275点と397点、人気順位の中央値は8位と83位で、精度の指標の差よりも推薦の幅の差のほうがはるかに大きく、品揃えへの影響はまったく違いました。精度の指標だけで方法を選ぶと、この違いを見落とします。推薦の幅の指標の詳しい扱いは第11章で、導入の進め方と体制は第13章で扱います。
この章のまとめ
この章では、多くの顧客の行動の似かたから推薦する協調フィルタリングを、ユーザーベースとアイテムベースに分けて扱いました。本コラムの架空データ(顧客3,000人・商品400点・180日、同じシリーズを買い足す規則を含む)では、商品×商品のコサイン類似度によるアイテムベースの推薦は、適合率@10が0.0422(K=20)で、人気順の0.0264を上回りました。共起の数をそのまま使った場合とコサイン類似度の場合の適合率@10は、K の取り方で順位が入れ替わりました(K が5では共起の数が0.0426でコサイン類似度の0.0407より上、K が20では0.0370と0.0422でコサイン類似度が1割強上)。一方で、推薦した商品の人気順位の中央値は、共起の数では8位と人気順に近く、コサイン類似度の83位とは推薦の中身がまったく違いました。類似度の表は商品の数で大きさが決まり、夜間に作っておけば表示のときの計算は軽く、推薦の理由も「この商品を買った人がよく買っています」と説明できます。次の第5章では、顧客と商品を少数の軸(潜在因子)で表す行列分解を扱い、近傍法のアイテムベースと比べて成績と説明のしやすさがどう変わるかを見ていきます。
この章を深めたい方への参考書籍
『情報推薦システム入門 理論と実践』(Dietmar Jannach、Markus Zanker、Alexander Felfernig、Gerhard Friedrich 著、田中克己・角谷和俊 監訳、共立出版):推薦システムの理論を体系的にまとめた教科書の訳書です(2012年刊)。NDL サーチの目次によれば、協調型推薦の章がユーザベースの最近傍推薦から始まっており、この章で扱った近傍法の協調フィルタリングを、類似度の選び方や他の方式との関係まで含めて確かめるのに役立ちます。
『推薦システム 統計的機械学習の理論と実践』(Deepak K. Agarwal、Bee-Chung Chen 著、島田直希・大浦健志 訳、共立出版):推薦システムを統計的機械学習の立場から扱う教科書の訳書です(2018年刊)。NDL サーチの目次によれば、第1章で、ウェブのサービスに推薦システムを入れるときの留意点として、アルゴリズム上の工夫と最適化の指標を取り上げています。この章の近傍法から一歩進んで、推薦を統計のモデルとして組み立て、何を最適化するかを考えるのに役立ちます。
第5章 行列分解、潜在因子で好みを表す
第4章では、商品×商品のコサイン類似度からアイテムベースの協調フィルタリングを作り、「この商品を買った人はこんな商品も」という説明のしやすい推薦が、人気順を上回りうることを確かめました。アイテムベースは、2つの商品を一緒に買った顧客がいることを手がかりにするので、一緒に買われた記録の少ない商品どうしの関係は捉えにくいという弱点があります。この章では、顧客と商品を、それぞれ少数の数の並び(好みの軸)で表し、その軸を通して「まだ買っていない商品への関心」を推し量る方法として、行列分解を扱います。
この章で扱うのは次の内容です。後半は、架空の合成データ(顧客2,000人×商品400点・180日の購買ログ)を使い、実行したコードと結果で確かめます。
- 行列分解の考え方(顧客×商品の行列を、顧客の軸と商品の軸の掛け算で近似する)と、特異値分解との関係
- 星の数のような明示的な評価に対する行列分解と、購買のような暗黙のフィードバックに対する行列分解の違い(好みと確信度を分けて扱う考え方)
- 交互最小二乗法で行列分解を学習する仕組みと、numpy だけで書いた実装
- 因子の数を変えたときの再現率@10 を、人気順・アイテムベースと比べた結果
- 正則化の強さと過学習の関係、因子の数の選び方
- 学習した因子が、データを作ったときの「真の好みの軸」とどれだけ対応するか(合成データだから確かめられること)
- 解釈の限界と、経営の判断
この章の主張は2つです。1つは、行列分解は疎な(ほとんどの升目が空の)購買の行列からでも好みの軸を学べるが、その成績は因子の数と正則化の強さの選び方で大きく変わり、選び方を誤るとアイテムベースはおろか人気順にも負けるということです。もう1つは、学習した軸は好みの情報を含んでいても、1本1本の軸に「ジャンル」のような名前が付くとは限らないということです。精度がどれだけ上がるかと、説明しにくくなることの釣り合いをどう取るかは、技術ではなく事業の判断だと考えています。この章に載せたコードは numpy・scipy・scikit-learn だけを使っており、5つのまとまりを上から順につなげて実行すると、本文と同じ結果になることを確かめています。推薦専用のライブラリは使っていません。図は同じ計算の結果を matplotlib で描いたもので、描く処理は掲載していません。
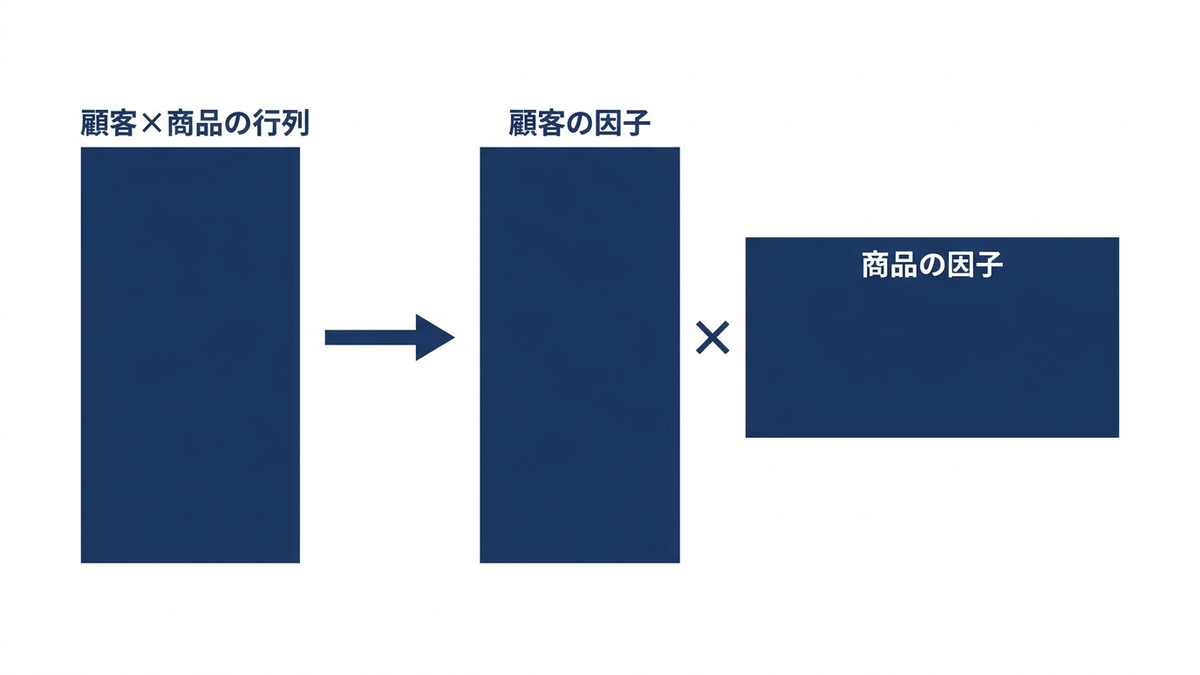
行列分解の考え方、顧客と商品を少数の軸で表す
第2章で見たとおり、購買の履歴は、行に顧客、列に商品を取った大きな表(顧客×商品の行列)に置き直せます。顧客が商品を買っていれば升目に回数を入れ、買っていなければ空のままにします。商品が数百点あっても、1人の顧客が買うのはそのうちの数点から数十点なので、この行列のほとんどの升目は空です。推薦とは、この空の升目のうち、顧客が関心を持ちそうなものを当てる作業だと言い換えられます。
行列分解は、この大きな行列を、2つの細長い行列の掛け算で近似する方法です。顧客ごとに少数の数(たとえば5個)の並びを、商品ごとにも同じ個数の数の並びを用意し、ある顧客とある商品の数の並びを掛け合わせて足した値(内積)が、その顧客のその商品への関心を表すように学習します。この数の並びを潜在因子と呼び、1つの並びに含まれる数の個数を因子の数と呼びます。「潜在」とは、データに直接書かれていない(観測されていない)という意味です。式で書くと、顧客 \(u\) の因子を \(x_u\)、商品 \(i\) の因子を \(y_i\) として、関心の予測は \(\hat{r}_{ui} = x_u^\top y_i\) です。言葉で言えば、「顧客の軸ごとの好みの強さ」と「商品の軸ごとの当てはまりの強さ」を掛けて合計した値が、関心の予測になります。
この表し方の利点は、空の升目にも予測の値が入ることです。顧客の因子は、その顧客が買った商品から学ばれ、商品の因子は、その商品を買った顧客から学ばれます。いったん両方の因子が決まれば、その顧客がまだ買っていない商品についても内積を計算でき、値の大きい順に並べれば推薦の候補になります。顧客Aと顧客Bが同じ商品を1点も買っていなくても、似た因子を持つ商品をそれぞれ買っていれば、2人の因子は近くなります。第4章のアイテムベースが「同じ顧客に一緒に買われた」という直接の記録を必要とするのに対して、行列分解は、因子を介した間接の関係も使える、というのが考え方の違いです。
因子の数は、顧客や商品の数よりずっと小さく取ります。顧客2,000人×商品400点の行列には80万個の升目がありますが、因子の数を5にすると、学習する数は(2,000+400)×5で1万2千個です。少ない数で大きな行列を表そうとするので、モデルは購買の中から繰り返し現れる大きな傾向(多くの顧客に共通する好みの型)だけを拾い、個々の偶然の購買は拾いにくくなります。この「要約する力」が、疎な行列から好みを推し量る手がかりになると同時に、細かい事情を落とす原因にもなります。
特異値分解との関係にも触れておきます。特異値分解は、どんな行列も「直交する軸の組」と「軸ごとの重み(特異値)」に分ける線形代数の方法で、重みの大きい軸から k 本だけを残すと、元の行列を k 本の軸で最もよく近似した行列(二乗誤差の意味で最適な低ランク近似)が得られます。行列分解の推薦は、この低ランク近似の考え方を出発点にしています。ただし、購買の行列のように空の升目が大半を占める場合、空の升目を「0」と決めて特異値分解をそのまま当てると、買わなかったことをすべて「関心が無い」と扱うことになります。そこで推薦の行列分解では、損失の関数を工夫し、反復の計算で因子を求めるのがふつうです。特異値分解そのものの考え方は、弊社コラム『データの構造を読み解く多変量解析、主成分分析・因子分析からクラスター分析まで』で扱っています。
| 観点 | アイテムベース(第4章) | 行列分解(この章) |
|---|---|---|
| 何を学ぶか | 商品と商品の類似度(一緒に買われた度合い) | 顧客と商品それぞれの潜在因子(少数の数の並び) |
| 推薦の点数の作り方 | 顧客が買った商品に似た商品の類似度を足す | 顧客の因子と商品の因子の内積 |
| 使える関係 | 同じ顧客に一緒に買われたという直接の記録 | 因子を介した間接の関係も使う |
| 説明のしやすさ | 「この商品を買ったので」と言える | 因子の組み合わせから点数が高く出た理由を、そのまま言葉にしにくい |
| 調整する設定 | 類似度の種類、近傍の数 | 因子の数、正則化の強さ、確信度の重み、反復の回数 |
| 新しい顧客・商品 | 買われた記録が無い商品は類似度が計算できない | 因子を学ぶ記録が無いので同じく扱えない(第10章) |
表の「使える関係」の違いは考え方の違いで、間接の関係を使えることが、そのまま成績の高さにつながるわけではありません。後の節で見るとおり、この章の架空データでは、この違いはアイテムベースとの成績の差としては現れませんでした。
明示的な評価の行列分解と、暗黙のフィードバックの行列分解
行列分解が推薦の方法として広く知られるきっかけになった出来事の1つが、Netflix Prize です。Netflix 社の Bennett と Lanning が2007年に KDD Cup 2007 の論文集に寄せた論文によれば、同社は2006年10月に、匿名化した映画の評価1億件超を公開し、自社の推薦の仕組み(Cinematch)の予測精度を上回る方式を広く募りました。公開されたのは、無作為に選んだ48万人超の会員が、1万8千本弱の映画に付けた1から5の整数の星の評価(と評価した日付)で、1998年10月から2005年12月までに集めたものです。精度の指標は、予測した星の数と実際の星の数の差を二乗して平均し、その平方根を取った値(二乗平均平方根誤差、RMSE)です。賞の条件は、この指標で Cinematch の値からさらに10%改善した方式に大賞を出す、というものでした。同じ論文は、評価の新しいほうの一部を残して評価に使うことについて、過去の評価から将来の評価を当てるという事業の目的を反映した、と説明しています。評価用のデータを時間で切る考え方は第8章で扱います。
このコンテストの流れの中で、行列分解の手法をまとめた解説として知られるのが、Koren・Bell・Volinsky の2009年の論文(推薦システムの行列分解の手法の解説。IEEE Computer 誌の第42巻第8号、30〜37ページ)です。また、次に紹介する Hu らの2008年の論文は、先行研究の整理の中で、観測された評価だけを正則化つきで近似する行列分解のモデルが近年よく使われ、Netflix のデータセットでの結果は近傍の方法(第4章のような類似度にもとづく方法)より一貫して良い傾向にある、と述べています。ここでいう結果は、星の評価を当てる精度を、その公開データセットとその条件で測ったものです。自社の購買のデータで同じ順位になることを意味するものではありません。
星の数のような明示的なフィードバックでは、評価が付いている升目だけを使って行列分解を学習できます。星5は好き、星1は嫌い、という情報が両方そろっていて、評価の付いていない升目は「分からない」として学習から外せるからです。損失の関数は、評価の付いた升目について「予測と実際の差の二乗」を合計し、因子が大きくなりすぎないように因子の大きさの二乗に重み \(\lambda\) を掛けて足したものになります。この \(\lambda\) を掛けた項を正則化の項と呼び、後の節で詳しく扱います。
一方、EC の購買や閲覧のような暗黙のフィードバックでは、事情が違います。Hu・Koren・Volinsky の2008年の論文(暗黙のフィードバックのデータに対する協調フィルタリング。第8回 IEEE データマイニング国際会議 ICDM 2008、263〜272ページ)は、テレビ番組の推薦の仕組みを作った経験から、暗黙のフィードバックの性質を整理しています。本コラムの言葉で要約すると、行動が観測されなかったことは嫌いの証拠にならず、観測された行動も好みの確かな証拠とは限らない、ということです。そのうえで論文は、行動の回数は好みの強さよりも、その観測をどれだけ信頼できるかを表すものとして扱う、という立場を取ります。詳しい整理は論文の第1節にあります。
この整理にもとづいて、論文は升目ごとに2つの量を分けます。1つは行動の有無 \(p_{ui}\) で、顧客 \(u\) が商品 \(i\) に1回でも行動していれば1、していなければ0とします。論文はこれを英語で preference(好み)と呼んでいますが、本コラムでは、顧客の好みの強さと混同しないように「行動の有無」と呼びます。もう1つは確信度 \(c_{ui}\) で、行動の回数 \(r_{ui}\) を使って \(c_{ui} = 1 + \alpha r_{ui}\) とします。言葉で言えば、「買ったかどうか」を当てる対象にし、「何回買ったか」はその升目をどれだけ重く見るかの重みに回す、という分け方です。買っていない升目も、確信度1という小さな重みで「行動の有無が0」として学習に入ります。論文の実験では \(\alpha = 40\) が良い結果だったと書かれていますが、これはその論文のデータでの値です。本コラムのコードでは \(\alpha = 10\) としました。
損失の関数は、すべての升目について「確信度×(行動の有無から予測を引いた値)の二乗」を足し、正則化の項を加えたものです。観測されなかった升目も含めるので、顧客2,000人×商品400点なら80万個の項があり、実際のサービスでは数十億個になりえます。論文は、この項の多さのために、明示的な評価でよく使われた確率的勾配降下法(1件ずつ少しずつ因子を直す方法)が使いにくいと指摘し、次の節で扱う交互最小二乗法を、データの大きさに比例する計算量で解く工夫とともに示しています。論文の要旨によれば、この方法はテレビ番組の推薦の仕組みで使われ、論文は、このモデルが出す推薦に説明を付ける新しい方法も提案しています。
| 観点 | 明示的な評価の行列分解 | 暗黙のフィードバックの行列分解 |
|---|---|---|
| 升目に入る値 | 星の数など、好き嫌いの強さ | 購買・閲覧の回数、視聴時間など |
| 当てる対象 | 評価の値そのもの | 行動の有無(0 か 1) |
| 値の大きさの使い方 | 当てる対象そのもの | 確信度(升目の重み)に回す |
| 空の升目の扱い | 分からないものとして学習から外せる | 小さな重みで「行動の有無が0」として学習に入れる |
| よく使われる学習の方法 | 確率的勾配降下法、交互最小二乗法 | 交互最小二乗法(全升目を扱う工夫が要る) |
| EC での典型 | レビューの星を集めているサービス | 購買・閲覧のログしか無い多くの EC |
EC の多くは、星の評価をすべての購買について集めているわけではなく、手元にあるのは購買と閲覧のログです。そのため、本コラムでは暗黙のフィードバックの行列分解を実装します。第2章で確かめた「買われなかったことは嫌いの証拠ではない」という性質を、損失の関数の上で「小さな重みの0」として扱う、というのがこの方法の要点だと考えています。
交互最小二乗法、片方を止めてもう片方を解くことを繰り返す
行列分解の学習では、顧客の因子と商品の因子の両方を同時に求める必要があります。予測は顧客の因子と商品の因子の掛け算なので、両方を同時に動かすと損失の関数は複雑な形になり、一度に最小の点を求める公式はありません。ところが、商品の因子を固定してしまえば、顧客1人ぶんの因子を求める問題は、ふつうの重み付きの最小二乗法(回帰の係数を求めるのと同じ計算)になり、式1本で答えが出ます。逆に、顧客の因子を固定すれば、商品の因子も同じように式で求まります。
交互最小二乗法(英語の alternating least squares の頭文字で ALS とも呼ばれます)は、この性質を使って、「商品の因子を止めて、すべての顧客の因子を解き直す」と「顧客の因子を止めて、すべての商品の因子を解き直す」を交互に繰り返す方法です。Hu らの論文は、どちらか一方を固定すると損失の関数は二次式になり、最小の点がすぐに計算できること、そして交互に解き直すたびに損失の関数の値が下がることが保証されることを述べています。最初は因子を小さな乱数で置きます。何回繰り返すかは設定の1つです。Hu らの論文では典型的な回数として10回が挙げられており、本コラムのコードも10回に固定しました。この章の各設定が10回で十分に落ち着いたかどうか(損失の値の推移)は確かめていません。
顧客 \(u\) の因子を解く式は、商品の因子を並べた行列を \(Y\)、顧客 \(u\) の確信度を対角に並べた行列を \(C^u\)、行動の有無を並べたベクトルを \(p(u)\) として、\(x_u = (Y^\top C^u Y + \lambda I)^{-1} Y^\top C^u p(u)\) です。言葉で言えば、「確信度で重みを付けた最小二乗法の答えに、正則化で少し0の側へ引き戻す力を加えたもの」です。この式の \(Y^\top C^u Y\) をそのまま計算すると、顧客1人ごとに全商品を走査することになります。Hu らの論文は、確信度が1でない(行動のあった)商品は顧客ごとにごく一部しか無いことに着目し、全員に共通の \(Y^\top Y\) を一度だけ計算して、行動のあった商品の分だけを足し込む工夫で計算を速くしています。本コラムのコードもこの工夫に従いました。
交互最小二乗法には、顧客ごと・商品ごとの計算が互いに独立しているという性質もあります。顧客の因子を解き直す段階では、顧客1人ずつの計算は他の顧客の結果を待たずにできるので、計算機を並べて同時に処理しやすくなります。大規模なサービスで交互最小二乗法がよく使われる理由の1つは、この並べやすさだと考えています。システムの構成と計算の分担は第12章で扱います。
架空の購買ログを作り、評価の決まりと比べる相手を用意する
ここからは、架空の合成データで確かめます。この章のデータは、他の章とは別に、この章のために作りました。顧客は2,000人、商品は400点、期間は180日です。データを作るときに、5本の「真の好みの軸」を持たせました。商品にはそれぞれ主なジャンル(ジャンル1〜5のどれか)があり、商品の真の因子は、主なジャンルの軸に1.0、ほかの軸に0.1が載る形です。顧客の真の好みは、5つのジャンルへの配分(足すと1になる5つの数)で、ディリクレ分布という確率分布から取りました。分布の設定(集中度0.3)は、顧客ごとの配分が一部のジャンルに偏りやすくなるように選びました。本章の「好み」「好みの軸」は、第4章までの「関心」と同じく、顧客がどの商品に心を向けやすいかを指します。
購買は、商品の人気と、顧客の好みと商品の真の因子の合いかたの両方で決まるようにしました。商品の人気は、順位の0.8乗に反比例させ、少数の商品に購買が集中する形にしてあります。顧客ごとの購買の回数は、平均18のポアソン分布に2を足した数で、1回ごとの購買の日付は180日の中から一様に選びました。最初の150日を学習の期間、後の30日を評価の期間とし、時間で切っています。この架空データは、現実のログより単純です。現実の購買には、季節や新商品の投入による人気の移り変わり、消耗品を一定の間隔で買い直すような時間に沿った行動、ジャンルでは表せない好みの違いがあり、好みの軸が5本だけということもありません。合成データを使うのは、「真の好みの軸」が分かっているので、学習した因子がそれをどれだけ捉えたかを後で確かめられるからです。以下の数値はすべて、1つの乱数の種(20261110)で作ったこのデータでの結果で、第3章・第4章とは別のデータなので、他の章の数値とは比べられません。
import numpy as np
import scipy.sparse as sp

rng = np.random.default_rng(20261110)
N_USER, N_ITEM, N_GENRE, N_DAY = 2000, 400, 5, 180

genre = rng.integers(0, N_GENRE, N_ITEM)                  # 商品ごとの主なジャンル
item_true = np.full((N_ITEM, N_GENRE), 0.1)
item_true[np.arange(N_ITEM), genre] = 1.0                 # 商品の真の因子(主なジャンルに強く載る)
user_true = rng.dirichlet(np.full(N_GENRE, 0.3), N_USER)  # 顧客の真の好み(ジャンルの配分)
pop = 1.0 / (np.arange(1, N_ITEM + 1) ** 0.8)             # 人気の偏り(少数の商品に集中)
pop = pop[rng.permutation(N_ITEM)]

n_buy = rng.poisson(18, N_USER) + 2                       # 顧客ごとの購買の回数
rows, cols, days = [], [], []
for u in range(N_USER):
    w = pop * np.exp(4.0 * item_true @ user_true[u])      # 人気 × 好みの合いかた
    items = rng.choice(N_ITEM, n_buy[u], p=w / w.sum())
    rows += [u] * n_buy[u]; cols += list(items); days += list(rng.integers(0, N_DAY, n_buy[u]))
log = np.array([rows, cols, days]).T
train, test = log[log[:, 2] < 150], log[log[:, 2] >= 150]  # 最初の150日で学習、後の30日で評価
R = sp.csr_matrix((np.ones(len(train)), (train[:, 0], train[:, 1])), shape=(N_USER, N_ITEM))
R.sum_duplicates()                                        # 同じ商品を複数回買えば回数が入る
print("購買", len(log), "件 学習", len(train), "件 評価", len(test), "件")
print("学習の行列の密度", round(R.nnz / (N_USER * N_ITEM), 4))
# 出力:
# 購買 39876 件 学習 33319 件 評価 6557 件
# 学習の行列の密度 0.0352
購買は全部で39,876件で、そのうち学習の期間(最初の150日)が33,319件、評価の期間(後の30日)が6,557件でした。学習の期間の顧客×商品の行列で、1回以上の購買がある升目の割合(密度)は0.0352、つまり升目の約3.5%にしか値が入っていません。同じ商品を2回以上買った場合は、升目に回数が入ります。この回数が、前の節の確信度 \(c_{ui} = 1 + \alpha r_{ui}\) の \(r_{ui}\) になります。
次に、評価の決まりと比べる相手を用意します。評価の指標は、第3章・第4章と同じ考え方の再現率@10 です。顧客ごとに、学習の期間に買っていない商品の中から点数の高い順に10点を推薦し、評価の期間にその顧客が初めて買った商品のうち、推薦の10点に入っていた割合を求めて、顧客全体で平均します。学習の期間に買った商品は推薦から外し、評価の期間に初めて買った商品が1点以上ある顧客だけを評価の対象にしました。第4章とは違い、学習の期間に1回以上買っていることは評価の対象の条件にしていません。つまり、ここでは顧客ごとの再現率@10 を求めてから平均する形で数えており、第8章の定義と同じ考え方ですが、評価の対象の顧客の選び方が章ごとに違うので、数値を他の章と比べることはできません。指標の定義と使い分けの詳細は第8章で扱います。
比べる相手は2つです。1つは人気順で、学習の期間に買われた回数の多い順に、全員に同じ並びを推薦します。もう1つはアイテムベースの協調フィルタリングで、商品×商品のコサイン類似度を計算し、顧客が買った商品に似た商品の類似度を足した値を点数にします。第4章の実装とは別にこの章で書き直した簡単な版で、近傍の数を絞る処理は入れていません。
bought = [set(R[u].indices) for u in range(N_USER)]
truth = {}
for u, i, d in test:
    if i not in bought[u]:                                # 学習期間に買っていない商品だけを当てる対象にする
        truth.setdefault(u, set()).add(i)

def recall_at_10(score):
    s = score.copy()
    s[R.nonzero()] = -np.inf                              # 学習期間に買った商品は推薦しない
    top = np.argsort(-s, axis=1)[:, :10]
    rec = [len(set(top[u]) & truth[u]) / len(truth[u]) for u in truth]
    return float(np.mean(rec))

item_pop = np.asarray(R.sum(axis=0)).ravel()
score_pop = np.tile(item_pop, (N_USER, 1))                # 人気順:全員に同じ並び
B = (R > 0).astype(float)
norm = np.sqrt(np.asarray(B.sum(axis=0)).ravel()) + 1e-9
S = (B.T @ B).toarray() / np.outer(norm, norm)            # 商品×商品のコサイン類似度
np.fill_diagonal(S, 0)
score_item = (B @ S)                                      # 買った商品に似た商品の類似度の合計
print("評価の対象の顧客", len(truth), "人")
print("人気順 再現率@10", round(recall_at_10(score_pop), 4))
print("アイテムベース 再現率@10", round(recall_at_10(np.asarray(score_item)), 4))
# 出力:
# 評価の対象の顧客 1806 人
# 人気順 再現率@10 0.1811
# アイテムベース 再現率@10 0.2425
評価の対象になった顧客は1,806人でした。人気順の再現率@10 は0.1811、アイテムベースは0.2425です。顧客ごとに、評価の期間に初めて買った商品の種類のうち推薦の10点に入っていた割合を求め、それを平均すると、人気順では約18%、アイテムベースでは約24%だった、ということです。この2つの値が、この章の行列分解が超えるべき基準になります。人気順が0.18と低くない値になるのは、この架空データで少数の商品に購買を集中させたからで、第3章で見た「人気順は手ごわい比べる相手」という性質がこのデータでも出ています。
交互最小二乗法を numpy で実装し、因子の数を変えて比べる
交互最小二乗法を numpy で実装します。関数 als は、購買の回数の疎行列 R と因子の数 f を受け取り、顧客の因子 X と商品の因子 Y を返します。確信度の重み alpha は10、正則化の強さ lam は既定で1、反復の回数は10回としました。内側のループの1行1行が、前の節の式に対応しています。BtB が全員に共通の \(Y^\top Y\) で、行動のあった商品の分だけ \(Y^\top (C^u – I) Y\) を足し込み、正則化の \(\lambda I\) を加えて連立方程式を解きます。右辺は、行動の有無が1の升目(行動のあった商品)だけが残るので、その分だけ確信度を掛けて足しています。同じ関数を、顧客と商品の役割を入れ替えて商品の因子にも使います。
そのうえで、正則化の強さを1と100の2通り、因子の数を2・5・10・20・40・80の6通りに変えて学習し、それぞれの再現率@10 を求めました。
def als(R, f, alpha=10.0, lam=1.0, n_iter=10, seed=0):
    g = np.random.default_rng(seed)
    X = g.normal(0, 0.01, (R.shape[0], f))                # 顧客の因子
    Y = g.normal(0, 0.01, (R.shape[1], f))                # 商品の因子
    Rc, Rt = R.tocsr(), R.T.tocsr()
    for _ in range(n_iter):
        for A, Bm, M in ((X, Y, Rc), (Y, X, Rt)):         # 片方を固定してもう片方を解く
            BtB = Bm.T @ Bm
            for u in range(M.shape[0]):
                idx, r = M.indices[M.indptr[u]:M.indptr[u + 1]], M.data[M.indptr[u]:M.indptr[u + 1]]
                c = 1.0 + alpha * r                       # 確信度(買った回数が多いほど大きい)
                By = Bm[idx]
                lhs = BtB + (By.T * (c - 1.0)) @ By + lam * np.eye(f)
                A[u] = np.linalg.solve(lhs, (By.T * c).sum(axis=1))  # 行動の有無 p=1 の項だけが右辺に残る
    return X, Y

res = {}
for lam in [1.0, 100.0]:                                  # 正則化の強さ(後の節で詳しく見る)
    for f in [2, 5, 10, 20, 40, 80]:
        X, Y = als(R, f, lam=lam)
        res[(lam, f)] = recall_at_10(X @ Y.T)
        print(f"正則化{lam:5.0f} 因子の数{f:3d} 再現率@10 {res[(lam, f)]:.4f}")
# 出力:
# 正則化    1 因子の数  2 再現率@10 0.2014
# 正則化    1 因子の数  5 再現率@10 0.2448
# 正則化    1 因子の数 10 再現率@10 0.2248
# 正則化    1 因子の数 20 再現率@10 0.1856
# 正則化    1 因子の数 40 再現率@10 0.1309
# 正則化    1 因子の数 80 再現率@10 0.0667
# 正則化  100 因子の数  2 再現率@10 0.1986
# 正則化  100 因子の数  5 再現率@10 0.2456
# 正則化  100 因子の数 10 再現率@10 0.2456
# 正則化  100 因子の数 20 再現率@10 0.2456
# 正則化  100 因子の数 40 再現率@10 0.2456
# 正則化  100 因子の数 80 再現率@10 0.2454
結果を表にまとめます。
| 因子の数 | 再現率@10(正則化1) | 再現率@10(正則化100) |
|---|---|---|
| 2 | 0.2014 | 0.1986 |
| 5 | 0.2448 | 0.2456 |
| 10 | 0.2248 | 0.2456 |
| 20 | 0.1856 | 0.2456 |
| 40 | 0.1309 | 0.2456 |
| 80 | 0.0667 | 0.2454 |
| (比べる相手)人気順 | 0.1811 | 0.1811 |
| (比べる相手)アイテムベース | 0.2425 | 0.2425 |
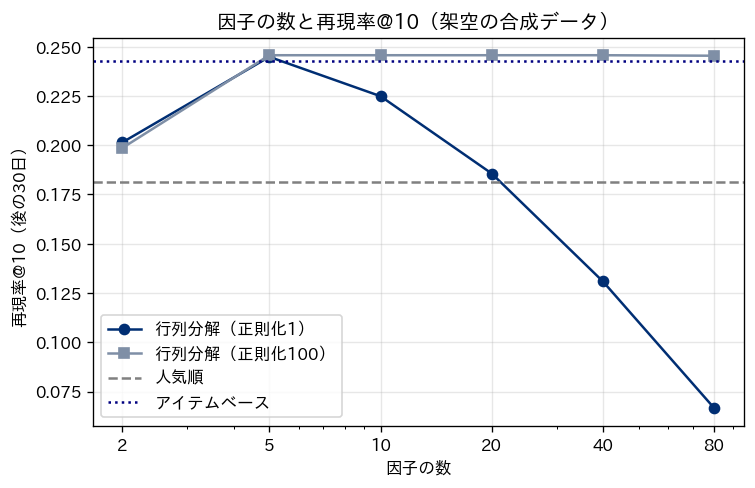
表と図から、3つのことが読み取れます。1つ目は、因子の数が2では、どちらの正則化でも再現率@10 が0.20前後にとどまり、アイテムベースの0.2425に届かないことです。この架空データの好みの軸は5本なので、2本の軸では好みの違いを表しきれません。それでも人気順の0.1811は上回っています。2本の軸がそれぞれ何を捉えているかは、この実験では確かめていません。
2つ目は、正則化が1のとき、因子の数が5で最も高い0.2448になり、そこから因子を増やすほど成績が下がることです。因子の数が20では0.1856まで下がって人気順とほぼ同じになり、40では0.1309、80では0.0667で、人気順を大きく下回りました。因子を増やすと、モデルは学習の期間の購買をより細かく再現できるようになりますが、その細かさは、評価の期間の購買を当てる力にはつながらず、むしろ偶然の購買まで覚え込んで外れるようになります。これを過学習と呼び、次の節で確かめます。
3つ目は、正則化を100に強めると、因子の数が5から80のどれでも、再現率@10 が0.2454〜0.2456でほぼ同じになったことです。正則化を強くすると、多すぎる因子の数を選んでも成績が崩れませんでした。この架空データでは、行列分解の最高値は0.2456で、アイテムベースの0.2425をわずかに上回りましたが、差は0.003ほどです。差が偶然の範囲かどうかを見るには、評価の対象の1,806人それぞれについて2つの方式の再現率の差を求め、その差の不確かさを確かめる必要があります。方法としては、顧客を単位に選び直して計算し直す方法(ブートストラップ)などがありますが、この章では確かめていません。この結果から言えるのは、「この架空データでは、設定を適切に選べば行列分解はアイテムベースと同じ程度の成績になり、設定を誤ると人気順にも負ける」ということです。行列分解がアイテムベースより常に優れる、という結論は、このデータからは出せません。
計算時間についても触れておきます。本コラムの実行環境では、同じ計算機で他の計算が同時に動いていたため、学習にかかった秒数が実行のたびに大きく変わり、安定した値を示せませんでした。そのため、秒数は本文に載せていません。計算量の考え方としては、交互最小二乗法の1回の解き直しでは、因子の数を辺の長さとする正方行列の連立方程式を顧客と商品の数だけ解きます。連立方程式1つを解く手間は、ふつうの解き方では因子の数の3乗に比例して増えるので、因子の数を増やすと計算量は因子の数の増え方より速く増えます。顧客数百万人・商品数十万点の規模になれば、計算機の構成と計算の分担を設計する必要があります(第12章)。
正則化と過学習、学習の期間を当て直す力と後の30日を当てる力
前の節で、正則化が1のまま因子を増やすと成績が下がりました。その理由を確かめるために、因子の数を40に固定し、正則化の強さを0.01・1・100・1000の4通りに変えて、2つの再現率@10 を比べました。1つは、学習に使った購買そのものを、推薦の上位10点でどれだけ当て直せるか(学習の再現率@10。計算を軽くするため最初の500人で求めました)、もう1つは、これまでと同じ、評価の期間に初めて買った商品を当てる再現率@10 です。あわせて、学習した因子から作った予測の行列(顧客×商品)を特異値分解し、最大の特異値の1%を超える特異値がいくつあるかを数えました。これは、予測の行列が実質的に何本の軸で表されているかの目安です。
def recall_train(score, n=500):
    top = np.argsort(-score[:n], axis=1)[:, :10]          # 学習に使った購買をどれだけ当て直せるか
    return float(np.mean([len(set(top[u]) & bought[u]) / len(bought[u]) for u in range(n)]))

for lam in [0.01, 1.0, 100.0, 1000.0]:
    X, Y = als(R, 40, lam=lam)
    sv = np.linalg.svd(X @ Y.T, compute_uv=False)        # 予測の行列の特異値
    print(f"因子40 正則化{lam:7.2f} 学習の再現率@10 {recall_train(X @ Y.T):.4f} 評価の再現率@10 {recall_at_10(X @ Y.T):.4f}",
          "最大の1%を超える特異値の数", int((sv > 0.01 * sv[0]).sum()))
# 出力:
# 因子40 正則化   0.01 学習の再現率@10 0.6196 評価の再現率@10 0.1228 最大の1%を超える特異値の数 40
# 因子40 正則化   1.00 学習の再現率@10 0.6190 評価の再現率@10 0.1309 最大の1%を超える特異値の数 40
# 因子40 正則化 100.00 学習の再現率@10 0.2991 評価の再現率@10 0.2456 最大の1%を超える特異値の数 5
# 因子40 正則化1000.00 学習の再現率@10 0.2142 評価の再現率@10 0.1812 最大の1%を超える特異値の数 1
| 正則化の強さ(因子の数40) | 学習の再現率@10 | 評価の再現率@10 | 最大の1%を超える特異値の数 | 読み取れること |
|---|---|---|---|---|
| 0.01 | 0.6196 | 0.1228 | 40 | 学習の購買はよく当て直すが、後の30日は人気順より外れる(過学習) |
| 1 | 0.6190 | 0.1309 | 40 | 0.01とほぼ同じ。この強さでは過学習を抑えられていない |
| 100 | 0.2991 | 0.2456 | 5 | 学習の当て直しは下がるが、後の30日の成績は最も高い |
| 1000 | 0.2142 | 0.1812 | 1 | 実質的な軸の数の目安が1になり、再現率@10 は人気順(0.1811)に近い値になる |
正則化が0.01と1のとき、学習の再現率@10 は0.62前後と高く、最初の500人について、顧客ごとに学習の期間に買った商品の種類のうち上位10点に入った割合を平均すると、約62%でした。ところが、評価の再現率@10 は0.12〜0.13で、人気順の0.1811を下回りました。
ただし、2つの再現率@10 は定義が違います。学習の再現率@10 は、学習に使った購買を推薦から外さず、分母を学習の期間に買った商品の数にしたもので、評価の再現率@10 は、学習の期間に買った商品を推薦から外し、分母を評価の期間に初めて買った商品の数にしたものです。そのため、0.62と0.12という数の大小を、そのまま過学習の程度として読むことはできません。見るべきは向きです。正則化を1から100に強めると、学習の再現率@10 は下がり、評価の再現率@10 は上がりました(100から1000に強めると、後で見るとおり両方とも下がります)。この1から100の範囲での逆の動きが、学習に使った購買を覚え込むことと後の30日を当てることが別の力であることを示しています。
学習に使った購買をよく覚えているのに、後の30日の購買は当てられない、という食い違いは、過学習と呼ばれる状態でよく見られる形です。ただし、これは反復を10回で止めた状態での比較で、反復を増やした場合や損失の値の推移は確かめていません。40本の軸を自由に使えると、モデルは「この顧客はこの3点を買った」という個々の記録まで軸に書き込み、それ以外の商品の点数は意味の薄い値になっていると考えられます。
正則化を100に強めると、学習の再現率@10 は0.2991まで下がる代わりに、評価の再現率@10 は0.2456に上がりました。正則化は、因子の値が大きくなることに罰を与えるので、少数の記録にしか支えられていない軸の値は0の側へ押し戻され、多くの顧客に共通する大きな傾向を表す軸だけが残ります。特異値の数がそれと整合していて、因子の数を40にしても、最大の1%を超える特異値は5個でした。予測の行列で実質的に使われている軸の数の目安は5本で、データを作ったときの真の好みの軸の数と一致しています。前の節で、正則化100では因子の数を5から80のどれにしても成績がほぼ同じでした。特異値の数を数えたのは因子の数40の場合だけですが、その結果は、余分な軸が正則化で縮み、実質的に5本の軸のモデルになっていたという見方と整合します。
さらに正則化を1000まで強めると、最大の1%を超える特異値は1個になり(実質的な軸の数の目安が1)、評価の再現率@10 は0.1812で、人気順の0.1811に近い値になりました。ただし、再現率が近いことだけでは、推薦される商品やその並びが人気順と同じかどうかは分かりません。上位10点の重なりや、因子と人気の相関は確かめていません。正則化は強すぎても弱すぎてもいけない、ということがこの表から分かります。
この結果は、設定の選び方についての実務上の注意にもつながります。正則化の強さや因子の数のように、学習の前に人が決める設定をハイパーパラメータと呼びます。ハイパーパラメータは、学習の成績(学習の再現率@10)を見て選んではいけません。学習の成績は正則化を弱くするほど良く見えるからです。評価の期間とは別に、学習の期間の終わりの一部を検証用に取り分け、その検証用の成績で選び、最後に評価の期間で一度だけ確かめる、という手順が安全です。この章の例では、説明を簡単にするために評価の期間の成績を見ながら設定を比べているので、表の最高値0.2456は楽観的な値です。評価の切り方は第8章で扱います。
学習した因子は真の好みの軸と対応するか、合成データで確かめる
行列分解の説明では、「因子はジャンルや好みの傾向を表す」と言われることがあります。合成データでは真の好みの軸が分かっているので、これがどこまで当たっているかを確かめられます。因子の数を5、正則化を1として学習し、2つの見方で真の軸と比べました。1つは、学習した5本の因子をまとめて使ったときに、真の軸1本1本をどれだけ説明できるか(線形回帰の決定係数。1に近いほどよく説明できる)です。もう1つは、学習した因子1本1本と真の軸1本1本の相関で、各因子が特定の真の軸と1対1に対応しているかを見ます。さらに、交互最小二乗法の最初の乱数(初期値)を変えて2回学習し、結果を比べました。
from sklearn.linear_model import LinearRegression
for seed in [0, 1]:
    X, Y = als(R, 5, seed=seed)
    r2 = [LinearRegression().fit(X, user_true[:, k]).score(X, user_true[:, k]) for k in range(N_GENRE)]
    corr = np.corrcoef(X.T, user_true.T)[:5, 5:]          # 学習した因子5本 × 真の軸5本の相関
    print(f"初期値{seed}: 真の軸を因子5本で説明できる割合(決定係数)", np.round(r2, 3))
    print(f"初期値{seed}: 各因子と最も相関の強い真の軸との相関の絶対値", np.round(np.abs(corr).max(axis=1), 3))
    if seed == 0:
        corr0, X0, Y0 = corr, X, Y
print("初期値0と初期値1の因子1どうしの相関", round(float(np.corrcoef(X0[:, 0], X[:, 0])[0, 1]), 3))
print("再現率@10 初期値0", round(recall_at_10(X0 @ Y0.T), 4), "初期値1", round(recall_at_10(X @ Y.T), 4))
light = np.array([len(bought[u]) for u in range(N_USER)]) <= 10
r2_light = LinearRegression().fit(X0[light], user_true[light, 0]).score(X0[light], user_true[light, 0])
print("学習期間の購買が10点以下の顧客", int(light.sum()), "人 真の軸1の決定係数", round(r2_light, 3))
# 出力:
# 初期値0: 真の軸を因子5本で説明できる割合(決定係数) [0.742 0.748 0.723 0.731 0.744]
# 初期値0: 各因子と最も相関の強い真の軸との相関の絶対値 [0.773 0.556 0.556 0.644 0.705]
# 初期値1: 真の軸を因子5本で説明できる割合(決定係数) [0.741 0.748 0.723 0.731 0.744]
# 初期値1: 各因子と最も相関の強い真の軸との相関の絶対値 [0.716 0.658 0.535 0.655 0.645]
# 初期値0と初期値1の因子1どうしの相関 -0.261
# 再現率@10 初期値0 0.2448 初期値1 0.2454
# 学習期間の購買が10点以下の顧客 286 人 真の軸1の決定係数 0.679
| 見方 | 初期値0 | 初期値1 |
|---|---|---|
| 真の軸を因子5本で説明できる割合(決定係数、真の軸1〜5) | 0.742、0.748、0.723、0.731、0.744 | 0.741、0.748、0.723、0.731、0.744 |
| 各因子と最も相関の強い真の軸との相関の絶対値(因子1〜5) | 0.773、0.556、0.556、0.644、0.705 | 0.716、0.658、0.535、0.655、0.645 |
| 再現率@10 | 0.2448 | 0.2454 |
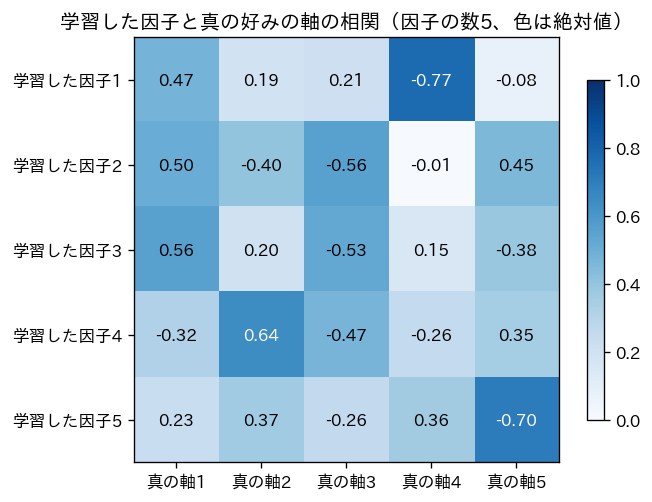
1つ目の見方では、5本の因子をまとめて使うと、真の軸それぞれについて、各ジャンルへの好みの配分の顧客間のばらつきの約72〜75%を線形回帰で説明できました。回帰の当てはめと決定係数の計算に同じ顧客を使っているので、これは未知の顧客への予測の性能を示す値ではありません。学習した因子は、顧客ごとの好みの配分の情報をかなりの程度含んでいます。学習の期間の購買は顧客1人あたり平均約17件(33,319件を2,000人で割った値)しかないことを考えると、疎な行列から好みを推し量るという行列分解の考え方は、この架空データでは働いていると言えます。一方で、真の軸のばらつきの25%前後は説明できていません。何がこの残りを生んでいるかは、この実験では切り分けていません。この合成データでは、学習の期間に買った商品が10点以下(同じ商品の買い直しは1点と数える)の顧客286人に限ると、真の軸1の決定係数は0.679で、全員の0.742より低くなりました。ただし、この顧客群では回帰を当てはめ直しており、決定係数の分母になる真の軸のばらつきも全員の場合とは違うので、購買が少ないほど推し量りが粗くなると言い切れる比較ではありません。
2つ目の見方では、様子が違います。図のとおり、学習した因子1本1本は、複数の真の軸と中程度の相関を持っており、1対1にきれいに対応してはいません。各因子と最も相関の強い真の軸との相関の絶対値は、図の初期値0では0.56〜0.77(2つの初期値を合わせると0.54〜0.77)で、因子1は真の軸4と-0.77、因子5は真の軸5と-0.70のように比較的強く結びつくものもありますが、因子2や因子3は0.56前後で、複数の軸が混ざっています。符号が負になっているのは、軸の向きが逆に学ばれたということです。行列分解では、顧客の因子と商品の因子の同じ番号の因子をそろって反転しても予測は変わらないので、向きに意味はありません。
初期値を変えた2回目の学習では、決定係数はほぼ同じで、再現率@10 も0.2448と0.2454でほとんど変わりませんでした。ところが、初期値0の因子1と初期値1の因子1の相関は-0.261で、同じ「因子1」という名前でも別のものを表しています。行列分解では、顧客の因子と商品の因子の軸の向きを同時に同じだけ回しても(数学の言葉では同じ直交変換を施しても)、内積(予測)はまったく変わりません。予測の性能を決めるのは5本の軸が張る空間全体で、その空間の中でどの向きを「因子1」と呼ぶかは、初期値などの偶然で決まります。
この結果から言えるのは、学習した因子の空間は好みの情報を含んでいても、1本1本の軸に「ジャンル1の好み」のような名前が付くとは限らない、ということです。この確かめ方ができたのは、データを自分で作り、真の好みの軸を知っていたからです。実際のデータでは、真の軸は分からないので、学習した因子が何を表しているかを同じ方法で確かめることはできません。因子の値が大きい商品を並べて眺め、「この軸は特定のジャンルの商品に寄っている」のように解釈を試みることはできますが、それは解釈の仮説であり、初期値や学習の期間を変えると軸の向きごと変わりうることを前提に扱う必要があります。
因子の数と正則化の選び方、実務で決めておくこと
ここまでの結果を、実務で設定を選ぶときの手順に置き直します。この章の架空データでは、因子の数より正則化の強さのほうが成績を大きく左右しました。正則化が弱いと、因子の数を増やすほど成績が崩れ、正則化が適切なら、因子の数を多めに取っても成績はほぼ変わりませんでした。この結果がそのまま自社のデータに当てはまるとは限りませんが、設定を選ぶときに、因子の数だけを動かして正則化を固定したまま比べる、という手順は避けたほうがよいと考えています。
設定を選ぶときに決めておくことを、次の表にまとめました。
| 決めておくこと | 決めないと起きること | 決め方の例 |
|---|---|---|
| 検証用のデータの切り方 | 評価の期間の成績を見ながら設定を選び、成績を楽観的に報告する | 学習の期間の終わりの一部を検証用に取り分け、評価の期間は最後に一度だけ使う(第8章) |
| 正則化の強さの候補 | 弱い正則化のまま因子を増やし、人気順より悪い推薦を出す | 0.01から1000のように桁を変えて候補を並べ、因子の数と組み合わせて比べる |
| 因子の数の候補 | 「多いほど精度が上がる」と考えて計算量だけが増える | 少ない数から始め、検証用の成績が頭打ちになる点を探す |
| 確信度の重み | 購買の回数の多い一部の商品に推薦が引っ張られる | 重みを数通り試す。回数の上限を設ける、対数を取るなどの変換も候補にする |
| 比べる相手 | 行列分解の成績が良いのか悪いのか判断できない | 人気順とアイテムベースを同じ評価の決まりで並べる(第3章・第4章) |
| 初期値による違い | 1回の学習の偶然の結果を、手法の成績と取り違える | 初期値を変えて数回学習し、成績のばらつきを確かめる |
確信度の重み \(\alpha\) について補足します。この章では10に固定しましたが、Hu らの論文の実験では40が良い結果だったと書かれています。値の良し悪しはデータの性質(購買の回数がどれだけ偏っているか)によるので、論文の値をそのまま使わず、検証用のデータで選ぶ設定の1つとして扱う必要があります。購買の回数には、業務用の大量購入や、同じ消耗品の定期的な買い直しのように、好みの強さとは別の事情で大きくなるものが混ざります。第2章で扱った行動の重み付け(閲覧と購買をどう数えるか)と同じく、確信度に何を入れるかは、データの意味を決める作業でもあります。
因子の数の目安として「好みの軸の数」を知りたくなることがありますが、実際のデータでは真の軸の数は分かりません。この章の架空データで、正則化を適切にしたときに実質的な軸が5本に落ち着いたのは、データを5本の軸で作ったからです。実際のデータでは、検証用の成績が頭打ちになる因子の数を探すのが現実的で、その数を「この市場の好みの軸の数」と読み替えないことが大切だと考えています。
行列分解が外れるところと、解釈の限界
行列分解には、アイテムベースと共通する弱点と、行列分解に特有の弱点があります。共通の弱点は、新しい顧客と新しい商品です。因子は購買の記録から学ぶので、履歴だけでは、記録の無い顧客や商品の特徴を学べません。学習の時点で行列に無かった新しい顧客や商品には、そもそも因子がありません。行列には含まれていても学習の期間に記録が1件も無い顧客や商品は、この章の実装では、正則化によって因子が0のベクトルになり、推薦の点数も0になります(この章のデータにそうした顧客や商品があるかは数えていません)。新しい商品を推薦する方法は、商品の属性を使う内容ベース(第6章)と、コールドスタートと探索(第10章)で扱います。
行列分解に特有の弱点は、前の節で見た解釈の難しさです。アイテムベースなら「この商品を買ったので、この商品をおすすめします」と、推薦の理由を顧客が知っている商品で示せます。行列分解では、推薦の点数は5本や40本の軸の内積なので、そのまま理由として示せる言葉がありません。Hu らの論文は、この種のモデルが出す推薦に説明を付ける方法を提案していますが、説明を付けるには追加の工夫と計算が要ります。推薦の理由の表示と規制の関係は第14章で扱います。
もう1つは、時間の変化です。この章のコードは、学習の期間の購買を1つの行列にまとめて学習しており、150日のどの時点の購買かを区別していません。顧客の好みが季節や生活の変化で移ると、古い購買にもとづく因子は今の好みからずれていきます。学習の期間の長さを決める、古い購買の重みを下げる(第2章の時間の減衰)、定期的に学習し直す(第12章)といった対処が要ります。
行列分解が向く条件と向かない条件を、次の表にまとめます。表の中身は、この章の実験と、ここまでの議論から整理したもので、どの条件でも成り立つ規則ではありません。
| 条件 | 行列分解が向く場合 | 行列分解が向かない場合 |
|---|---|---|
| データの量 | 多くの顧客が、それぞれある程度の数の商品を買っている | 顧客の大半が1〜2点しか買っておらず、因子を学ぶ材料が無い |
| 行列の疎らさ | 一緒に買われた記録が少なく、アイテムベースの類似度が粗い | 商品の数が少なく、一緒に買われた記録が十分にある(アイテムベースで足りることが多い) |
| 説明の必要 | 推薦の理由を示さなくてよい枠(トップページの並びなど) | 理由を示すことが顧客の納得に欠かせない枠 |
| 新しさ | 商品の入れ替わりが比較的ゆっくり | 新商品が毎日大量に入る(内容ベースやコールドスタートの対処が要る) |
| 体制 | 設定の選び方と評価の手順を持つ担当者がいる | 設定を誰も見直さず、既定値のまま動かすことになる |
経営の判断、精度の上がり方と説明しにくさの釣り合いを決める
この章の内容を、経営の判断に置き換えます。行列分解を入れるかどうかで経営が決めるべきことは、「精度が上がるか」だけではなく、「精度が上がるとしても、推薦の理由を言葉で説明しにくくなることを受け入れるか」だと考えています。この章の架空データでは、設定を適切に選んだ行列分解の再現率@10 は0.2456で、アイテムベースの0.2425とほぼ同じでした。この0.2456は、評価の期間の成績を見ながら選んだ設定での値(楽観的な値)で、1つの乱数の種での結果です。アイテムベースの側は設定を調整していません。差がこの程度なら、理由を示せるアイテムベースを選ぶ判断にも十分な根拠があります。逆に、自社のデータで行列分解がアイテムベースをはっきり上回るなら、推薦の理由を示さなくてよい枠から使う、という分け方が考えられます。
判断を誤ったときの損失を、序章で整理した6つの損失の型(機会損失・効果の過大評価・品揃えの偏り・顧客の離反・形骸化・二重投資)に当てはめると、次のようになります。
| 判断の誤り | 起こりうる損失の型 | 防ぎ方 |
|---|---|---|
| 正則化を見直さないまま因子を増やし、人気順より悪い推薦を出す | 機会損失につながるおそれ(顧客が後に買う商品を推薦の枠で取りこぼす。購買への影響は推薦が無い場合との比較で確かめる) | 人気順・アイテムベースとの比較を常に並べ、検証用のデータで設定を選ぶ |
| オフラインの再現率@10 の向上や、行列分解の推薦の枠から買われた件数を、そのまま推薦の効果として報告する | 効果の過大評価(推薦が無くても買われた分まで推薦の成果と数える) | オフラインの成績は方式どうしを比べる材料にとどめ、推薦の効果は推薦が無い場合と比べるオンラインの比較で測る(第9章) |
| 強すぎる正則化で、実質的に人気順と同じ推薦を「個人に合わせた推薦」として出す | 品揃えの偏り(人気商品に推薦が集中する)、形骸化(個人に合わせた推薦としての効果が測られないまま運用が続く) | 推薦された商品の種類の数や、人気順との重なりを監視する(第11章・第12章) |
| 理由を示せない推薦を、理由の説明が欠かせない枠に入れる | 顧客の離反(的外れな推薦や、理由の分からない推薦で信頼を失う) | 枠ごとに説明の必要を決め、必要な枠ではアイテムベースなど理由を示せる方法を使う |
| サイト・アプリ・メールなどのチャネルや部署ごとに、購買の行列の作成と行列分解の学習を別々に組む | 二重投資(共通にできるデータや仕組みを別々に整え、同じ開発と保守の手間を何度もかける) | 購買の行列と学習の仕組みは共通にし、枠ごとに変えるのは推薦の並べ方の設定にとどめる |
表とは別に、因子の転用について補足します。行列分解の顧客の因子は、顧客を少数の数で表したものなので、マーケティングの顧客の分類(セグメント)に使えそうに見えます。しかし、この章で確かめたとおり、軸の向きは初期値で変わり、1本1本の軸が特定の好みに対応するとは限りません。学習し直すたびに「因子1が高い顧客」の顔ぶれが入れ替わりうる数を、部署をまたいで使う顧客の分類にすると、分類の意味が説明できないまま施策が積み上がることになります。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 行列分解を入れる枠ごとに、推薦の理由を示す必要があるかを、事業の責任者が先に決める
- 行列分解の成績は、人気順とアイテムベースを同じ評価の決まりで並べた表で報告させる。比べる相手の無い精度の報告は受け取らない
- 設定(因子の数・正則化の強さ・確信度の重み)を選んだ手順と、検証用のデータの切り方を記録として残させる
- オフラインの成績の差が小さいときは、運用と説明のしやすさを優先し、オンラインの比較(第9章)で差を確かめてから切り替える
- 因子を推薦以外の用途(顧客の分類など)に転用するときは、軸の意味が学習のたびに変わりうることを前提に、別途検討する
予算と体制の面では、行列分解の導入は、計算の仕組みよりも、設定を選び直し、比べる相手と並べて評価し続ける担当者の時間に費用がかかると考えています。交互最小二乗法そのものは、この章のように数十行で書けますが、正則化の強さを誤ると人気順より悪くなることを、この章の結果は示しています。設定を一度決めて放置するのではなく、再学習のたびに検証用の成績と比べる相手との差を確かめる手順を、運用の中に組み込むことが必要です。
この章のまとめ
この章では、顧客と商品を少数の潜在因子で表す行列分解を扱いました。暗黙のフィードバックでは、Hu らの2008年の論文の考え方に従い、買ったかどうか(行動の有無)を当てる対象、買った回数を確信度に分け、交互最小二乗法で学習しました。本コラムの架空の合成データ(顧客2,000人×商品400点。1つの乱数の種での結果)では、因子の数5・正則化1で再現率@10 は0.2448、正則化100では因子の数5〜80のどれでも0.2454〜0.2456となり、アイテムベースの0.2425とほぼ同じでした。一方、正則化1のまま因子を80に増やすと0.0667まで下がり、人気順の0.1811を大きく下回りました。学習した5本の因子で、真の好みの軸それぞれの顧客間のばらつきの約72〜75%を線形回帰で説明できましたが、1本1本の軸は真の軸と1対1には対応せず、初期値を変えると軸の向きごと変わりました。次の第6章では、商品の属性や説明文と、顧客が過去に関心を示した商品の属性の似かたから推薦する内容ベースと、それを協調フィルタリングと組み合わせるハイブリッド推薦を扱います。
この章を深めたい方への参考書籍
『行列プログラマー Pythonプログラムで学ぶ線形代数』(Philip N. Klein 著、松田晃一・弓林司・脇本佑紀・中田洋・齋藤大吾 訳、オライリー・ジャパン):ベクトル・行列・基底から始めて、Python のプログラムを書きながら線形代数を学ぶ本です。版元の目次によれば、第11章が特異値分解で、低ランク行列による行列の近似や、最適なランク k 近似の節があります。この章で触れた「大きな行列を少数の軸で近似する」という考え方を、線形代数の側から手を動かして確かめるのに向いています。
『スパース性に基づく機械学習』(冨岡亮太 著、講談社):機械学習プロフェッショナルシリーズの1冊で、L1ノルムなどの正則化によって、少数の要素だけを使う解(スパースな解)を得る方法を扱う本です。版元の目次によれば、第8章がトレースノルム正則化に基づく機械学習です。この章で見た「正則化が余分な軸を縮める」という現象を、正則化の理論の側から理解したい方に向いています。数式の多い専門書です。
第6章 内容ベースとハイブリッド、商品の属性と説明文を使う
第4章と第5章では、多くの顧客の購買の似かたから推薦する協調フィルタリングと、顧客と商品を少数の軸で表す行列分解を扱いました。どちらも商品の中身を見ずに、誰が何を買ったかという履歴だけから推薦を組み立てる方法です。そのため、発売したばかりで誰もまだ買っていない商品は、どれほど顧客の好みに合っていても推薦の候補に上がりにくくなります。この章では、商品の属性や説明文を使って推薦する方法と、それを協調フィルタリングと組み合わせる方法を扱います。
この章で扱う内容は次のとおりです。
- 商品の中身から推薦する考え方と、そのために要るデータ
- 説明文を数値にする方法(TF-IDF)と、顧客の関心の表し方
- 架空の購買ログでの、人気順・協調フィルタリング・内容ベースの比較(既存の商品と新商品に分けて測る)
- ハイブリッド推薦の型(重み付き・切り替え・混合・特徴の結合)と、その成績のつり合い
- 文章の埋め込みや画像の特徴を使う発展
- 商品の属性データ(商品マスタ)の品質が推薦の成績を左右すること
- 内容ベースの弱点と、経営の判断
この章の主張は2つです。1つは、購買の履歴が1件も無い商品でも、属性や説明文が登録されていれば内容ベースで推薦の候補にできるが、属性データの質が低いとその効き目は限られる、ということです。もう1つは、協調フィルタリングと内容ベースの組み合わせ方と重みによって、全体の当たりやすさと新商品の扱いが変わり、どの組み合わせ方が良いかはデータによって変わるので、推薦の枠の目的を決めたうえで自社のデータで比べて選ぶ必要がある、ということです。どちらも、実行したコードの結果で示します。
経営の側で先に決めることは、次の2つだと考えています。
- 新商品を推薦の枠でどれだけ見せたいかの目標を決め、推薦の成績を既存の商品と新商品に分けて報告させる
- 商品の属性データの項目ごとに、登録と更新の責任者を決める
新しい商品・新しい顧客への推薦の全体像(コールドスタート)と、探索の考え方は第10章で扱います。
内容ベースの考え方、商品の中身から顧客の関心を推し量る
内容ベースの推薦は、全体の地図の定義のとおり、商品の属性・説明文と、顧客が過去に関心を示した商品の属性の似かたから推薦する方法です。Pazzani と Billsus の2007年の解説(Brusilovsky らが編んだ論文集『The Adaptive Web』の1章、Springer の Lecture Notes in Computer Science 第4321巻)も、内容ベースの推薦を、商品の説明と顧客の関心のプロファイル(関心の特徴をまとめたもの)にもとづいて商品を推薦する仕組みとして説明しています。協調フィルタリングが「この商品を買った人は、あの商品も買っている」という顧客どうしの行動の重なりを手がかりにするのに対し、内容ベースは「この顧客はこういう特徴の商品に関心を示してきたので、同じ特徴を持つ別の商品にも関心を持ちそうだ」と考えます。
手がかりにする商品の中身は、業種によってさまざまです。EC や小売なら、カテゴリ・ブランドの区分・素材・色・サイズ・価格帯・説明文、書籍や動画なら、ジャンル・作り手・あらすじ・キーワード、求人なら、職種・勤務地・必要な技能・仕事の説明文が候補になります。商品の画像から取り出した特徴(色合いや形)を使うこともあります。どれを使うかは、顧客が商品を選ぶときに実際に気にしている特徴は何か、という問いから決めることになります。
内容ベースが協調フィルタリングと違う点は、推薦を組み立てるのに他の顧客の行動を必要としないことです。ある顧客の推薦は、その顧客自身の履歴(または本人が申告した好み)と商品の属性だけで決まります。このため、次の2つの場面で役に立ちます。1つは、発売したばかりで購買の履歴がほとんど無い商品を推薦の候補に入れたい場面です。属性さえ登録されていれば、1件も買われていない商品でも、関心の近い顧客に推薦できます。もう1つは、推薦の理由を商品の特徴で説明したい場面です。「過去にご覧になったジャンル1の商品に近い特徴を持つ商品です」のように、理由を属性の言葉で示せます。
一方で、内容ベースは商品の属性データに書かれていないことを知りません。顧客が商品を選ぶ理由が、属性として登録されていない特徴(使い心地・評判・流行)にある場合、内容ベースはそれを捉えられません。また、他の顧客の行動を見ないので、「同じジャンルの中でどの商品がよく買われているか」という人気の情報も、そのままでは使いません。この性質が実際の成績にどう表れるかは、後の節の架空データで確かめます。協調フィルタリングと内容ベースの違いを次の表にまとめます。
| 観点 | 協調フィルタリング(第4章・第5章) | 内容ベース(この章) |
|---|---|---|
| 手がかり | 多くの顧客の購買・閲覧の重なり | 商品の属性・説明文と、その顧客が関心を示した商品の属性 |
| 要るデータ | 顧客×商品の行動ログ(十分な量に加え、鮮度や露出の偏りへの配慮が要る) | 商品の属性データ(商品マスタ)と、その顧客の行動ログ |
| 履歴の無い新商品 | 購買が貯まるまで推薦しにくい | 属性が登録されていれば推薦の候補にできる |
| 履歴の少ない新しい顧客 | 推薦しにくい | 推薦しにくい(関心を推し量る材料が少ない) |
| 人気の情報 | 行動の重なりを通じて自然に入る | そのままでは入らない |
| 意外な発見 | 他の顧客の行動を通じて、属性の違う商品も出てくる | 似た属性の商品に偏りやすい |
| 推薦の理由の説明 | 「この商品を買った人は」の形で説明する | 「この特徴が近い」の形で説明する |
| 成績を左右するもの | 行動ログの量と、露出の偏り(第2章) | 商品の属性データの網羅性と正確さ |
表のとおり、新しい顧客については、内容ベースも協調フィルタリングと同じく推薦しにくい点に注意が必要です。内容ベースが補えるのは主に新しい商品の側で、新しい顧客には、人気順や、最初の数回の行動、好みを尋ねる質問などで対処します(第10章)。Pazzani と Billsus の解説も、顧客が好みのジャンルなどを自分で選んで登録する方法(利用者による設定)を紹介しており、同時に、顧客に手間をかけさせることや、好みが変わったときに登録が追いつきにくいことを限界として挙げています。
説明文を数値にする、TF-IDFの考え方
商品の属性のうち、カテゴリや色のように値の種類が決まっているものは、「その値を持つなら1、持たないなら0」という列に分けて数値にできます。扱いが難しいのは説明文のような自由な文章です。説明文を推薦に使う最も基本的な方法が、文章を単語の出現の仕方で表す方法で、その代表が TF-IDF です。TF は単語の出現頻度(term frequency)、IDF は逆文書頻度(inverse document frequency)の略です。
TF-IDF の考え方は、2つの掛け算で単語の重みを決めることです。1つ目の TF は、その商品の説明文の中に、その単語が何回出てくるかです。何度も出てくる単語ほど、その商品を表す単語だと考えます。2つ目の IDF は、その単語を含む商品の割合が小さいほど大きくなる値で、割合の逆数を対数にしたものが基本の形です(後で式を示します)。「送料」「人気」のように、ほとんどの商品の説明文に出てくる単語は、商品どうしを見分ける手がかりになりません。そこで、多くの商品に出てくる単語ほど重みを小さくし、一部の商品にしか出てこない単語ほど重みを大きくします。単語の重み付けは、文書を探し出す情報検索の分野で研究されてきた方法で、たとえば Salton と Buckley の1988年の論文(文書の自動検索のための単語の重み付けの方法を整理した論文)があります。推薦では、検索の「文書」を商品の説明文に、「検索の言葉」を顧客の関心に置き換えて使います。
本コラムのコードで使う scikit-learn の TfidfVectorizer は、公式ドキュメントによれば、単語の数え上げ(CountVectorizer)と TF-IDF の重み付け(TfidfTransformer)を1つにまとめた道具です。既定の設定では、IDF は \( \mathrm{idf}(t) = \log\frac{1+n}{1+\mathrm{df}(t)} + 1 \) で計算されます。ここで \(n\) は文書(この章では商品の説明文)の数、\(\mathrm{df}(t)\) は単語 \(t\) を含む文書の数です。言葉で言えば、「全商品のうち、その単語を含む商品の割合が小さいほど値が大きくなる」重みで、分子と分母に1を足すのは、0で割ることを避けるためだと説明されています。さらに既定では、商品ごとの重みの並び(ベクトル)を、長さが1になるように割ります。これにより、説明文が長い商品ほど値が大きくなる、という偏りを抑えます。
TF-IDF で表した2つの商品の似かたは、第4章で扱ったコサイン類似度で測れます。長さを1にそろえてあるので、2つのベクトルの内積がそのままコサイン類似度になります。共通の珍しい単語を多く含む商品どうしほど、類似度が高くなります。
TF-IDF は単語の出現の回数と、その単語を含む商品の割合だけを使うので、言葉の意味そのものは扱いません。「軽量」と「軽い」は別の単語として数えられ、同じ意味だとは分かりません。日本語の説明文で単語ごとの TF-IDF を使う場合は、文章を単語に区切る処理(形態素解析)も前もって必要です。なお、TfidfVectorizer には、単語ではなく、連続する数文字の並びを単位にする設定もあり、その場合は単語に区切らずに数値にできます。単語の区切り方や表記の揺れの扱いを含む文章の数値化の詳細は、弊社コラム『ビジネスの声を数字に変える、自然言語処理とテキストマイニングの実践ガイド』で扱っています。
顧客の関心の表し方、関心を示した商品の特徴をまとめる
商品を TF-IDF のベクトルで表したら、次は顧客の関心を同じ形のベクトルで表します。最も簡単な方法は、その顧客が過去に買った(あるいは閲覧した)商品のベクトルを足し合わせ、長さを1にそろえることです。足し合わせてから長さをそろえるので、買った商品のベクトルの平均をとってから長さをそろえるのと同じ向きになります。こうして作った顧客のベクトルと、まだ買っていない各商品のベクトルのコサイン類似度を計算し、値の高い順に推薦します。
この単純な方法には、決めておくべき点がいくつかあります。
- どの行動を関心とみなすか:購買だけを使うか、閲覧やカートへの追加も使うか。行動ごとの重み付けの考え方は第2章で扱いました
- 古い行動をどう扱うか:数年前に買った商品と昨日買った商品を同じ重さで足すか、新しい行動ほど重くするか(時間の減衰)
- 関心が複数あるときにどうするか:ジャンル1とジャンル5の両方に関心がある顧客のベクトルを1本にまとめると、両者の中間の、どちらにも当てはまらない商品が上位に来ることがある
- 関心が無かったことをどう扱うか:見たが買わなかった商品を、関心が無い証拠として差し引くか。第2章で見たとおり、暗黙のフィードバックでは、買わなかったことは嫌いの証拠とは限らない
この章のコードでは、学習期間に買った商品を1回ずつ同じ重さで足すという最も単純な形にしています。実際の推薦では、上の4つの点を推薦の枠の目的に合わせて決めることになります。たとえば、商品ページの「似た商品」の枠なら顧客の関心ではなく、いま見ている1つの商品のベクトルとの類似度で並べれば足ります。トップページの「おすすめ」の枠なら、顧客の関心を表すベクトルが要ります。
架空の購買ログで確かめる、購買が0件の新商品を協調フィルタリングは推薦できない
ここからは、架空の合成データで、内容ベースが新商品をどこまで推薦できるかを確かめます。顧客2,000人・商品400点(うち新商品40点)・180日の購買ログを乱数で作りました。商品にはそれぞれ8つのジャンルのうち1つの主なジャンルがあり、3割の商品はもう1つの副ジャンルを持ちます。顧客にはジャンルごとの好みの強さを持たせ、好みに合うジャンルの商品ほど買われやすくしました。さらに、商品ごとに人気の強さを持たせ、少数の商品に購買が集中するようにしています。新商品40点は140日目から149日目の間に発売され、発売前は買われません。発売直後の新商品は目立つ場所に置かれていると想定し、買われやすさを3倍にしました。現実の購買ログは、季節・価格・在庫・販促の影響を受けるので、この合成データよりずっと複雑です。数値は本コラムの架空データでの値で、実在のサイトの成績を表すものではありません。
# ブロック1:架空の商品と購買ログを作る
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np

rng = np.random.default_rng(20261110)
N_USER, N_OLD, N_NEW, N_GENRE, N_DAY = 2000, 360, 40, 8, 180
N_ITEM = N_OLD + N_NEW
genre = rng.integers(0, N_GENRE, N_ITEM)                 # 商品の主なジャンル
sub = np.where(rng.random(N_ITEM) < 0.3, rng.integers(0, N_GENRE, N_ITEM), -1)  # 3割は副ジャンルを持つ
G = np.zeros((N_ITEM, N_GENRE))
G[np.arange(N_ITEM), genre] = 1.0
G[sub >= 0, sub[sub >= 0]] += 0.5
pop = rng.pareto(1.5, N_ITEM) + 0.1                      # 人気の偏り(少数の商品に集中)
release = np.zeros(N_ITEM, int)
release[N_OLD:] = rng.integers(140, 150, N_NEW)          # 新商品は140〜149日目に発売
pref = rng.dirichlet(np.full(N_GENRE, 0.3), N_USER)      # 顧客ごとのジャンルの好み

logs = []
for u in range(N_USER):
    n = rng.poisson(10) + 1
    for d in np.sort(rng.integers(0, N_DAY, n)):
        w = (pref[u] @ G.T) ** 2 * pop * (release <= d)  # 好み・人気・発売済みかで買われやすさが決まる
        w[N_OLD:] *= 3.0                                  # 新商品は発売直後に目立つ
        logs.append((u, rng.choice(N_ITEM, p=w / w.sum()), d))
logs = np.array(logs)
print("購買の件数", len(logs), "顧客", N_USER, "商品", N_ITEM, "うち新商品", N_NEW)
# 出力:
# 購買の件数 21867 顧客 2000 商品 400 うち新商品 40
次に、商品の説明文を作ります。実際の説明文の代わりに、ジャンルごとに15個ずつの単語と、どのジャンルにも出てくる20個の共通の単語を用意し、各商品の説明文を「主なジャンルの単語6個・共通の単語4個・副ジャンルがあればその単語3個」から乱数で選んで作りました。単語は「g0語00」のような記号的な名前にしています。実際の説明文に当てはめるなら、ジャンルの単語は「その商品群に特有の言葉」、共通の単語は「多くの商品に出てくるありふれた言葉」に当たります。これを TF-IDF で数値にしました。説明文は商品の発売時に登録され、評価の始まる時点で使えるものとして扱っています。
# ブロック2:商品の説明文を作り、TF-IDF で数値にする
from sklearn.feature_extraction.text import TfidfVectorizer

WORDS = [[f"g{g}語{k:02d}" for k in range(15)] for g in range(N_GENRE)]   # ジャンルごとの語
COMMON = [f"共通語{k:02d}" for k in range(20)]                            # どのジャンルにも出る語

def describe(i, noise, r):
    toks = list(r.choice(WORDS[genre[i]], 6)) + list(r.choice(COMMON, 4))
    if sub[i] >= 0:
        toks += list(r.choice(WORDS[sub[i]], 3))
    for j in range(len(toks)):                            # 各語を確率 noise で、乱数で選んだジャンルの語に置き換える(元と同じジャンルの語になることもある)
        if r.random() < noise:
            toks[j] = r.choice(WORDS[r.integers(0, N_GENRE)])
    return " ".join(toks)

docs = [describe(i, 0.0, np.random.default_rng(7 + i)) for i in range(N_ITEM)]
tfidf = TfidfVectorizer(token_pattern=r"\S+")
T = tfidf.fit_transform(docs)                             # 商品×語の行列(各行は長さ1に正規化)
print("説明文の例", docs[0])
print("語の数", T.shape[1], "商品あたりの平均の語の種類", round(T.getnnz(axis=1).mean(), 1))
idf = dict(zip(tfidf.get_feature_names_out(), tfidf.idf_))
print("idf の例", {k: round(float(idf[k]), 2) for k in ["共通語00", WORDS[0][0], WORDS[3][5]]})
# 出力:
# 説明文の例 g6語14 g6語09 g6語10 g6語13 g6語08 g6語11 共通語16 共通語04 共通語01 共通語06
# 語の数 140 商品あたりの平均の語の種類 9.6
# idf の例 {'共通語00': 2.59, 'g0語00': 4.6, 'g3語05': 4.16}
出力のとおり、語の種類は全部で140(ジャンルの単語120と共通の単語20)、1つの商品の説明文に含まれる語の種類は平均9.6でした。IDF の例を見ると、共通の単語「共通語00」は2.59、ジャンルの単語「g0語00」は4.6、「g3語05」は4.16で、多くの商品に出てくる共通の単語ほど重みが小さくなっています。同じジャンルの単語どうしでも値が違うのは、説明文を乱数で作ったため、その単語を含む商品の数が単語ごとに違うからです。商品どうしの類似度を測るときに、共通の単語の影響が小さくなり、ジャンルの単語が効くということです。
続いて、0日目から149日目までの購買で学習し、150日目から179日目までの30日間の購買で評価するように、時間で区切りました。評価の切り方を時間で区切る理由は第8章で詳しく扱います。学習期間の購買から3つの推薦を作ります。人気順は学習期間に買われた人数の多い順、協調フィルタリングは第4章と同じ商品どうしのコサイン類似度によるアイテムベースの推薦、内容ベースは前の節で説明した、顧客の関心のベクトルと商品の TF-IDF のベクトルのコサイン類似度による推薦です。
# ブロック3:学習と評価を時間で分け、3つの推薦を作る
from scipy import sparse
from sklearn.preprocessing import normalize

SPLIT = 150                                               # 0〜149日目で学習、150〜179日目で評価
tr, te = logs[logs[:, 2] < SPLIT], logs[logs[:, 2] >= SPLIT]
X = sparse.csr_matrix((np.ones(len(tr)), (tr[:, 0], tr[:, 1])), shape=(N_USER, N_ITEM))
X.data[:] = 1.0                                           # 何回買っても1と数える
train_cnt = np.asarray(X.sum(axis=0)).ravel()           # 商品ごとの、学習期間に買った顧客の数(購入者数)
print("学習期間の購買が0件の新商品", int((train_cnt[N_OLD:] == 0).sum()), "/", N_NEW,
      " 新商品の学習期間の購入者数の中央値", float(np.median(train_cnt[N_OLD:])))

S_cf = (normalize(X.T.tocsr()) @ normalize(X.T.tocsr()).T).toarray()   # 商品×商品のコサイン類似度
np.fill_diagonal(S_cf, 0.0)
score_cf = X @ S_cf                                       # アイテムベースの協調フィルタリング
profile = normalize(X @ T)                                # 顧客の関心=買った商品の TF-IDF の和を正規化
score_cb = (profile @ T.T).toarray()                      # 内容ベース(顧客の関心と商品のコサイン類似度)
score_pop = np.tile(train_cnt, (N_USER, 1)).astype(float) # 人気順
# 出力:
# 学習期間の購買が0件の新商品 11 / 40  新商品の学習期間の購入者数の中央値 1.5
出力のとおり、新商品40点のうち11点は学習期間に1件も買われておらず、新商品を学習期間に買った顧客の数(購入者数)の中央値は1.5人でした。同じ顧客が同じ商品を何回買っても1人と数えています。発売から評価期間の始まりまでの日数が短いので、新商品の多くは履歴がほとんど無い状態で評価期間を迎えます。
評価には再現率@10 を使います。各顧客に10件を推薦し、評価期間に顧客が初めて買った商品(学習期間に買っていない商品)のうち、10件の中に入っていたものの割合です。ここでは、評価期間に初めて買った商品だけを正解とし、全顧客の正解の数を足し合わせて分母に、当たった数を足し合わせて分子にして数えました(全顧客の合算)。第8章の定義は顧客ごとに割合を出してから平均するものなので、この章の数え方とは違います。また、架空データも章ごとに別に作っているので、この章の数値を他の章の再現率@10 と比べることはできません。定義の違いと他の指標は第8章で扱います。ここでは、全体の再現率@10 に加えて、正解を新商品に限った再現率@10(新商品の再現率@10)と、推薦した10件のうち新商品が占める割合も出しました。
# ブロック4:再現率@10 を、既存の商品と新商品に分けて測る
truth = {}
for u, i, d in te:
    truth.setdefault(u, set()).add(i)
users = [u for u in truth if X[u].nnz > 0]                # 学習期間にも購買がある顧客だけを評価
bought = X.tolil().rows

zero = train_cnt == 0                                     # 学習期間に1件も買われていない商品

def evaluate(score, k=10):
    hit_all = hit_new = n_all = n_new = new_in_top = zero_in_top = 0
    for u in users:
        s = score[u].copy()
        s[bought[u]] = -np.inf                            # 学習期間に買った商品は除く
        top = np.argsort(-s, kind="stable")[:k]
        t = truth[u] - set(bought[u])                     # 評価期間に初めて買った商品が正解
        tn = {i for i in t if i >= N_OLD}
        n_all += len(t); hit_all += len(t & set(top))
        n_new += len(tn); hit_new += len(tn & set(top))
        new_in_top += int((top >= N_OLD).sum()); zero_in_top += int(zero[top].sum())
    return hit_all / n_all, hit_new / n_new, new_in_top / (k * len(users)), zero_in_top

n_t = sum(len(truth[u] - set(bought[u])) for u in users)
n_tn = sum(len({i for i in truth[u] - set(bought[u]) if i >= N_OLD}) for u in users)
print("評価する顧客", len(users), "正解の組", n_t, "うち新商品", n_tn, f"({n_tn / n_t:.3f})")
res = {}
for name, sc in [("人気順", score_pop), ("協調フィルタリング", score_cf), ("内容ベース", score_cb)]:
    res[name] = evaluate(sc)
    print(f"{name}: 再現率@10 全体{res[name][0]:.3f} 新商品{res[name][1]:.3f}",
          f"上位10件に占める新商品{res[name][2]:.3f} 購買0件の商品が上位10件に入った回数{res[name][3]}")
# 出力:
# 評価する顧客 1694 正解の組 2643 うち新商品 665 (0.252)
# 人気順: 再現率@10 全体0.134 新商品0.000 上位10件に占める新商品0.000 購買0件の商品が上位10件に入った回数0
# 協調フィルタリング: 再現率@10 全体0.314 新商品0.002 上位10件に占める新商品0.001 購買0件の商品が上位10件に入った回数0
# 内容ベース: 再現率@10 全体0.114 新商品0.089 上位10件に占める新商品0.077 購買0件の商品が上位10件に入った回数417
実行した結果を表にまとめます。評価したのは、学習期間と評価期間の両方に購買がある顧客1,694人で、正解(評価期間に初めて買った商品)の組は2,643組、そのうち新商品が665組(25.2%)でした。
| 推薦の方法 | 全体の再現率@10 | 新商品の再現率@10 | 推薦10件に占める新商品の割合 | 学習期間の購買0件の商品を推薦した回数 |
|---|---|---|---|---|
| 人気順 | 0.134 | 0.000 | 0.000 | 0 |
| 協調フィルタリング(アイテムベース) | 0.314 | 0.002 | 0.001 | 0 |
| 内容ベース(TF-IDF) | 0.114 | 0.089 | 0.077 | 417 |
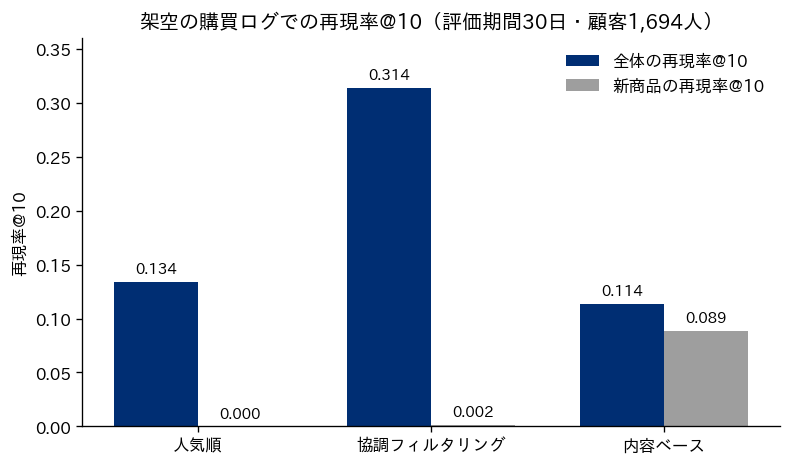
この結果から、3つのことが読み取れます。1つ目は、全体の再現率@10 では、協調フィルタリングが0.314で最も高く、内容ベースの0.114は人気順の0.134にも届かなかったことです(内容ベースと人気順の大小は、後の節で見るとおり乱数の種によって入れ替わりました)。この架空データでは、商品の買われやすさが顧客の好みだけでなく商品の人気の強さでも決まるようにしてあります。内容ベースは顧客の関心に近いジャンルの商品を選びますが、同じジャンルの中でどれがよく買われているかを見ないので、あまり買われない商品も上位に入れてしまいます。協調フィルタリングは行動の重なりを通じて好みと人気の両方を捉えるので、この条件で成績が高くなったと考えられますが、人気の効き目を外したデータでは確かめていません。
2つ目は、新商品については結果が逆転したことです。評価期間の正解の25.2%は新商品でしたが、協調フィルタリングの新商品の再現率@10 は0.002で、新商品をほとんど推薦できていません。推薦10件に占める新商品の割合も0.001でした。新商品は学習期間の購入者が少ないので、協調フィルタリングでは他の商品と一緒に買われた情報が乏しく、類似度による点数が低くなりやすいため、この例では推薦の上位に入りにくくなりました。人気順は類似度を使いませんが、購入者数が少ない新商品は順位が低くなり、新商品を1つも推薦していません。内容ベースは新商品の再現率@10 が0.089で、推薦10件のうち7.7%を新商品が占めました。ただし、新商品の再現率についてのこの結果は、乱数の種によって大きく変わります。後の節で示すとおり、種を変えると、新商品が学習期間に少しでも買われて協調フィルタリングが新商品をかなり当てる場合もありました。
3つ目は、学習期間に1件も買われていない商品の扱いです。協調フィルタリングと人気順は、こうした商品を一度も推薦しませんでした(推薦した回数0)。内容ベースは、のべ417回、誰かの推薦10件にこうした商品を入れています。説明文さえあれば、履歴がまったく無い商品でも推薦の候補にできる、という内容ベースの性質が数字に表れています。協調フィルタリングは購買の重なりから類似度を計算するので、購買が0件の商品は類似度が0になり、推薦の候補に上がりません。これはデータの作り方によらない、計算の仕組みから来る性質です。ただし、新商品の再現率@10 の0.089という値は、正解の新商品のうち1割弱しか当てられていないということでもあります。内容ベースは新商品を推薦の候補に入れる道を開きますが、それだけで新商品の推薦が十分になるわけではありません。
この比較は、既存の商品で高い成績を出す推薦と、新商品を扱える推薦が、この架空データのこの乱数の種では別のものだったことを示しています。全体の再現率だけを見て協調フィルタリングを選ぶと、新商品が推薦の枠にほとんど出てこないという問題は、全体の数字に隠れて見えません。全体の再現率@10 の分母のうち、新商品は4分の1にすぎないからです。推薦の成績は、既存の商品と新商品のように、事業として扱いを分けたい商品の区分ごとに分けて測る必要があると考えています。
ハイブリッド推薦の型、重み付き・切り替え・混合・特徴の結合
前の節の結果は、協調フィルタリングと内容ベースがそれぞれ別の場面で強いことを示していました。そこで、2つを組み合わせて両方の長所を得ようとするのが ハイブリッド推薦 です。Burke の2002年の論文(利用者のモデル化と適応を扱う学術誌の第12巻に掲載)は、内容ベース・協調フィルタリング・知識ベース(業務の知識による推薦)などの方法を組み合わせたハイブリッドの推薦について、実際に作られたものと考えうるものの組み合わせ方を広く整理しています。本コラムでは、実務で検討することの多い組み合わせ方を、次の4つの型に分けて考えます。この4つは、Burke の整理をそのまま写したものではなく、本コラムが実務向けに言い換えて選んだものです(たとえば表の「特徴の結合」の説明は、Burke の論文の定義と完全には一致しません)。
| 型 | 組み合わせ方 | 向く場面 | 注意点 |
|---|---|---|---|
| 重み付き | 2つの推薦の点数を、重みを付けて足し合わせて並べる | 両方の推薦がどの商品にも点数を出せるとき | 点数の尺度がそろっていないと、片方が結果を支配する。重みの決め方で結果が大きく変わる |
| 切り替え | 条件によってどちらの推薦を使うかを切り替える(例:履歴の少ない商品は内容ベースの点数を使う) | 使い分けの条件がはっきりしているとき | 切り替えの境目(何件の履歴で切り替えるか)を決める必要がある。2つの点数が同じ並びの中で比べられることになる |
| 混合 | 推薦の枠の一部を一方、残りを他方の推薦で埋める(例:10件のうち2件を内容ベース) | 枠の中で役割を分けたいとき | 枠をいくつずつ割り当てるかを決める必要がある。枠の数だけ一方の推薦の上位が押し出される |
| 特徴の結合 | 商品の属性を、行動のデータと一緒に1つのモデルの入力に入れる | 行動のデータが多く、モデルを作り込めるとき | モデルが複雑になり、なぜその推薦になったかを説明しにくくなる。深層学習のモデルでよく使われる(第7章) |
重み付きの型では、2つの推薦の点数の尺度をそろえることが最初の問題になります。協調フィルタリングの点数(類似度の合計)と内容ベースの点数(コサイン類似度)は、取りうる値の範囲が違います。そのまま足すと、値の大きい側がほとんど結果を決めてしまいます。この章のコードでは、顧客ごとに全商品を点数の順に並べ、順位を0から1の値に直してから足し合わせました。同じ点数の商品には、同じ順位(同点の商品が占める順位の平均)を与えています。重みを a とし、協調フィルタリングの順位の値に a を、内容ベースの順位の値に 1-a を掛けて足します。a=1 は協調フィルタリングだけ、a=0 は内容ベースだけです。
切り替えの型は、学習期間の購入者が5人未満の商品については内容ベースの順位の値を、それ以外の商品については協調フィルタリングの順位の値を使う形にしました。混合の型は、推薦の10件のうち m 件を内容ベースの上位から、残りの 10-m 件を協調フィルタリングの上位から取る形で、m を1・2・3と変えました。出力の各行は、全体の再現率@10、新商品の再現率@10、推薦10件に占める新商品の割合の順で、切り替えと混合の行には、学習期間の購買0件の商品が誰かの推薦10件に入った回数も添えています。
# ブロック5:重み付き・切り替え・混合のハイブリッド
from scipy.stats import rankdata

def rank01(score):                                        # 顧客ごとに 0〜1 の順位の値へ直す(同点には平均の順位)
    r = rankdata(score, method="average", axis=1)
    return (r - 1) / (score.shape[1] - 1)

R_cf, R_cb = rank01(score_cf), rank01(score_cb)
sweep = []
for a in np.round(np.arange(0, 1.01, 0.1), 1):
    sweep.append((a, *evaluate(a * R_cf + (1 - a) * R_cb)))   # a は協調フィルタリングの重み
    print(f"重み a={a}: 再現率@10 全体{sweep[-1][1]:.3f} 新商品{sweep[-1][2]:.3f} 新商品の割合{sweep[-1][3]:.3f}")

is_new = train_cnt < 5                                    # 学習期間の購入者が5人未満の商品
switch = np.where(is_new[None, :], R_cb, R_cf)            # 履歴の少ない商品だけ内容ベースの値を使う
res["切り替え"] = evaluate(switch)
def show(name, v):                                        # 全体・新商品の再現率、新商品の割合、購買0件の商品が上位10件に入った回数
    print(f"{name}: 再現率@10 全体{v[0]:.3f} 新商品{v[1]:.3f} 新商品の割合{v[2]:.3f} 購買0件の商品が上位10件に入った回数{int(v[3])}")

show("切り替え(購入者5人未満の商品は内容ベース)", res["切り替え"])

def mixed(m, k=10):                                       # 上位10件のうち m 件を内容ベースの枠にする
    out = np.zeros_like(score_cf)
    for u in users:
        cf, cb = score_cf[u].copy(), score_cb[u].copy()
        cf[bought[u]] = cb[bought[u]] = -np.inf
        top_cf = list(np.argsort(-cf, kind="stable")[:k - m])
        top_cb = [i for i in np.argsort(-cb, kind="stable") if i not in top_cf][:m]
        out[u, top_cf + top_cb] = np.arange(k, 0, -1)     # 並び順を値にして evaluate に渡す
    return out

for m in [1, 2, 3]:
    res[f"混合{m}"] = evaluate(mixed(m))
    show(f"混合(10件のうち{m}件を内容ベース)", res[f"混合{m}"])
# 出力:
# 重み a=0.0: 再現率@10 全体0.114 新商品0.089 新商品の割合0.077
# 重み a=0.1: 再現率@10 全体0.144 新商品0.074 新商品の割合0.031
# 重み a=0.2: 再現率@10 全体0.166 新商品0.066 新商品の割合0.025
# 重み a=0.3: 再現率@10 全体0.183 新商品0.057 新商品の割合0.020
# 重み a=0.4: 再現率@10 全体0.206 新商品0.050 新商品の割合0.016
# 重み a=0.5: 再現率@10 全体0.226 新商品0.032 新商品の割合0.011
# 重み a=0.6: 再現率@10 全体0.243 新商品0.026 新商品の割合0.008
# 重み a=0.7: 再現率@10 全体0.262 新商品0.014 新商品の割合0.005
# 重み a=0.8: 再現率@10 全体0.283 新商品0.006 新商品の割合0.002
# 重み a=0.9: 再現率@10 全体0.302 新商品0.003 新商品の割合0.001
# 重み a=1.0: 再現率@10 全体0.314 新商品0.002 新商品の割合0.001
# 切り替え(購入者5人未満の商品は内容ベース): 再現率@10 全体0.296 新商品0.014 新商品の割合0.031 購買0件の商品が上位10件に入った回数268
# 混合(10件のうち1件を内容ベース): 再現率@10 全体0.303 新商品0.006 新商品の割合0.009 購買0件の商品が上位10件に入った回数57
# 混合(10件のうち2件を内容ベース): 再現率@10 全体0.287 新商品0.018 新商品の割合0.017 購買0件の商品が上位10件に入った回数108
# 混合(10件のうち3件を内容ベース): 再現率@10 全体0.280 新商品0.027 新商品の割合0.025 購買0件の商品が上位10件に入った回数152
実行した結果のうち、主なものを表にまとめます。重み a は0から1まで0.1刻みで動かし、すべての値を上の出力に載せましたが、表には一部だけを載せ、全体は後の図に示します。
| 推薦の方法 | 全体の再現率@10 | 新商品の再現率@10 | 推薦10件に占める新商品の割合 |
|---|---|---|---|
| 協調フィルタリングだけ(重み a=1.0) | 0.314 | 0.002 | 0.001 |
| 重み付き a=0.9 | 0.302 | 0.003 | 0.001 |
| 重み付き a=0.8 | 0.283 | 0.006 | 0.002 |
| 重み付き a=0.7 | 0.262 | 0.014 | 0.005 |
| 重み付き a=0.5 | 0.226 | 0.032 | 0.011 |
| 内容ベースだけ(重み a=0.0) | 0.114 | 0.089 | 0.077 |
| 切り替え(購入者5人未満の商品は内容ベース) | 0.296 | 0.014 | 0.031 |
| 混合(10件のうち1件を内容ベース) | 0.303 | 0.006 | 0.009 |
| 混合(10件のうち2件を内容ベース) | 0.287 | 0.018 | 0.017 |
| 混合(10件のうち3件を内容ベース) | 0.280 | 0.027 | 0.025 |
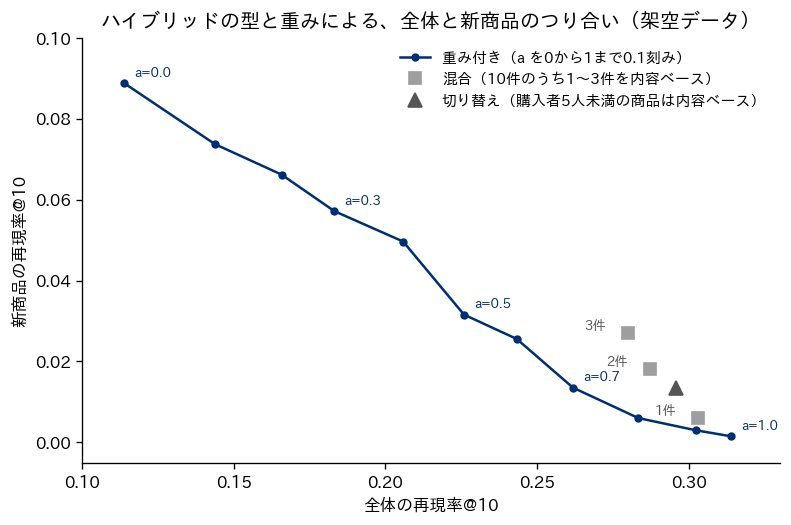
図の線は、重み付きの型で a を0から1まで動かしたときの、全体の再現率@10 と新商品の再現率@10 の組を結んだものです。この架空データのこの乱数の種では、a を大きくするほど全体の再現率は上がり、新商品の再現率は下がりました。両方が同時に最も高くなる重みはなく、重みを選ぶことは、全体の当たりやすさと新商品の扱いのどちらをどれだけ取るかを選ぶことになります。a=0.5 では、全体の再現率は協調フィルタリングだけの0.314から0.226まで下がり、新商品の再現率は0.032にとどまりました。
混合の型は、この乱数の種では、近い全体の成績の重み付きより新商品の再現率が高くなりました。混合で10件のうち3件を内容ベースにした場合、全体の再現率は0.280、新商品の再現率は0.027で、重み付き a=0.7(全体0.262・新商品0.014)より両方とも高くなっています。混合で2件の場合(0.287・0.018)も、全体の近い重み付き a=0.8(0.283・0.006)より新商品の再現率が高くなりました。混合で1件の場合は、重み付き a=0.9 と全体の再現率がほぼ同じ(0.303 と0.302)で、新商品の再現率は0.006と0.003でした。差はいずれも0.02以下と小さく、次の節で乱数の種を変えて確かめます。
混合が有利になった理由は、本コラムでは切り分けて確かめていません。考えられる仕組みとしては、混合の型は協調フィルタリングの上位の大部分をそのまま残し、内容ベースの上位の商品を決まった件数だけ枠に入れるのに対し、重み付きの型では順位の値を足し合わせる過程で、片方だけで上位の商品がもう片方の低い順位に引き下げられることがある、という違いがあります。
切り替えの型は、全体の再現率0.296・新商品の再現率0.014で、重み付き a=0.8 と a=0.9 の間の全体の再現率で、新商品の再現率はそれより高くなりました。推薦10件に占める新商品の割合は0.031と、混合の3件(0.025)より高いのに、新商品の再現率は混合の3件より低くなっています。この理由も切り分けて確かめていませんが、切り替えでは、履歴の少ない商品の内容ベースの順位の値が、履歴のある商品の協調フィルタリングの順位の値と同じ並びの中で比べられる、という仕組みの違いがあります。切り替えの境目(この例では購入者5人)を変えれば、結果も変わります。
この結果は、この架空データ・この乱数の種と、この章で選んだ組み合わせ方の細部(順位の値への直し方、混合の枠の取り方)のもとでの比較です。点数を順位ではなく最大値で割ってそろえる、混合の内容ベースの枠を新商品だけから選ぶ、といった違いで結果は変わりえます。一般に混合の型が重み付きの型より優れている、という意味ではありません。ここから言えるのは、ハイブリッドにすれば両方の長所が自動的に得られるわけではなく、組み合わせ方と重みによって、全体の成績と新商品の扱いが変わる、ということです。どのつり合いを選ぶかは、推薦の枠の目的(既存の商品の購買を増やしたいのか、新商品を顧客に知ってもらいたいのか)から決める必要があります。また、ここで比べたのはオフライン評価の数字で、実際の顧客の行動が増えるかどうかは、第9章で扱うオンライン評価で確かめる必要があります。
乱数の種を変えて確かめる、変わらなかったことと変わったこと
ここまでの数値は、すべてブロック1の default_rng(20261110) という1つの乱数の種で作った架空データでの結果です。差が小さい比較は、データを作るときの偶然で入れ替わるかもしれません。そこで、ブロック1の種の数字だけを1・2・3・4に替え、ブロック1からブロック5まで(ハイブリッドを比べるコードまで)をそのまま実行し直しました。説明文を作るコード(ブロック2)の種は変えていないので、変わるのは商品のジャンル・人気・顧客の好み・購買ログです。掲載したコードの種を替えれば、同じ結果を再現できます。
| 乱数の種 | 人気順の全体の再現率@10 | 協調フィルタリングの全体/新商品 | 内容ベースの全体/新商品 | 購買0件の商品を推薦した回数(協調フィルタリング/内容ベース) | 混合3件の全体/新商品 | 重み付き a=0.7 の全体/新商品 |
|---|---|---|---|---|---|---|
| 20261110(本文の種) | 0.134 | 0.314/0.002 | 0.114/0.089 | 0/417 | 0.280/0.027 | 0.262/0.014 |
| 1 | 0.111 | 0.313/0.149 | 0.122/0.111 | 0/829 | 0.291/0.160 | 0.275/0.138 |
| 2 | 0.117 | 0.272/0.094 | 0.137/0.158 | 0/490 | 0.258/0.130 | 0.233/0.088 |
| 3 | 0.118 | 0.264/0.026 | 0.124/0.164 | 0/668 | 0.249/0.068 | 0.253/0.098 |
| 4 | 0.132 | 0.320/0.129 | 0.109/0.059 | 0/597 | 0.286/0.119 | 0.279/0.116 |
5つの種のすべてで変わらなかったのは、次の2点です。1つは、全体の再現率@10 で協調フィルタリングが人気順と内容ベースを上回ったことです。もう1つは、学習期間に1件も買われていない商品を、協調フィルタリングは一度も推薦せず(5つの種とも0回)、内容ベースは推薦したことです。前者は、前の節で述べたとおり、計算の仕組みから来る性質です。後者の回数は、種によってのべ417回から829回まで動きました。
一方で、種によって変わったことも多くありました。
- 新商品の再現率@10:協調フィルタリングは種によって0.002から0.149まで大きく動き、内容ベースを上回った種(1と4)もありました。協調フィルタリングは、新商品が学習期間に1件でも買われれば、その商品と他の商品の類似度を計算できます。種によって新商品の買われ方が違うことが影響した可能性がありますが、本コラムでは切り分けていません
- 内容ベースと人気順の全体の再現率:本文の種では内容ベースが人気順に届きませんでしたが、種1・2・3では内容ベースが上回りました
- 混合3件と重み付き a=0.7 の比較:5つの種のうち4つで混合が全体・新商品の両方で上回りましたが、種3では重み付きが両方で上回りました
この確認から、本コラムの架空データで言えるのは、「購買が0件の商品は協調フィルタリングでは推薦できず、内容ベースなら推薦の候補にできる」ということまでです。新商品をどちらがよく当てるか、どのハイブリッドの型が良いかは、データによって入れ替わりました。5つの種でも数は少なく、実際のデータは合成データよりずっと複雑です。組み合わせ方と重みは、自社のデータで、既存の商品と新商品に分けて成績を測ってから選ぶ必要があると考えています。
推薦の枠の中で新商品をどれだけ見せるかは、探索の問題でもあります。新商品は検索や商品一覧から買われることもありますが、履歴に依存する推薦だけでは、新商品が推薦の枠に十分に出ず、履歴が集まりにくくなる場合があります。属性による推薦のほか、新着の枠や探索の枠で補うことが考えられます。新商品に一定の枠を割り当てる方法や、バンディットを使って探索する方法は、第10章で扱います。
文章の埋め込みと画像の特徴、TF-IDFの先にある方法
TF-IDF は、単語の出現の回数と、その単語を含む商品の割合を使う方法で、言葉の意味そのものは扱わないので、前の節で触れたとおり、同じ意味の別の言葉を同じものとして扱えません。説明文の書き手が商品ごとに違い、同じ特徴を「軽量」「軽い」「持ち運びやすい」とばらばらに書いている場合、TF-IDF ではこれらの商品の類似度が低く出てしまいます。
この弱点を補う方法の1つが、文章の埋め込みです。文章の埋め込みとは、文章の意味をベクトル(数百次元程度の数の並び)で表す方法で、意味の近い文章ほどベクトルどうしが近くなるように作られます。大量の文章で事前に学習したモデルを使い、商品の説明文を埋め込みのベクトルに直してから、TF-IDF の代わりに顧客の関心との類似度を計算します。言い回しが違っても意味が近い説明文どうしを近いと判定できるので、説明文の書き方が統一されていない商品群では有効なことがあります。注意点は3つあります。1つ目は、事前学習のモデルを動かすぶん、計算の負担が増えることです。2つ目は、ベクトルの各次元に意味が付いていないので、なぜ似ていると判定したのかを説明しにくいことです。3つ目は、モデルが学習した文章の分野と商品の分野がずれていると、類似度が業務の感覚と合わないことがあることです。本コラムでは、事前学習済みのモデルを使った埋め込みは実行していません。文章を埋め込みに直す方法の詳細は、弊社コラム『ビジネスの声を数字に変える、自然言語処理とテキストマイニングの実践ガイド』で扱っています。
画像の特徴も、内容ベースの手がかりになります。衣料品や家具のように、見た目が選ぶ理由になる商品では、画像から取り出した特徴(色合い・形・柄)のベクトルで類似度を測る方法があります。画像の特徴の取り出し方は深層学習の領域で、深層学習による推薦の全体像は第7章で扱います。商品の属性を数値にする方法の違いを、次の表にまとめます。
| 方法 | 何を捉えるか | 要るもの | 説明のしやすさ | 向く場面 |
|---|---|---|---|---|
| 構造化された属性(カテゴリ・色・サイズなど) | 商品マスタに登録された値の一致 | 整った商品マスタ | 高い(「同じカテゴリ」と言える) | 属性の項目が業務で決まっている商品群 |
| TF-IDF | 説明文に出てくる単語の重なり | 説明文と、日本語を単語単位で扱うなら単語の区切りの処理 | 高い(共通の単語を示せる) | 説明文の書き方がある程度そろっている商品群 |
| 文章の埋め込み | 説明文の意味の近さ | 事前学習のモデルと、それを動かす計算の環境 | 低い(次元に意味が無い) | 説明文の言い回しが商品ごとにばらばらな商品群 |
| 画像の特徴 | 見た目の近さ | 商品の画像と、特徴を取り出すモデル | 低い(似た画像を並べて見せることはできる) | 見た目が選ぶ理由になる商品群 |
どの方法を使う場合でも、商品の中身を表すデータが整っていないと、内容ベースの効き目は限られると考えています。次の節では、説明文の質を落としたときに成績がどう変わるかを架空データで確かめます。
商品の属性データの整備、質が下がると内容ベースの成績も下がるかを確かめる
内容ベースの推薦は、商品の属性データに書かれていることしか知りません。説明文が空の商品、別のジャンルの言葉で書かれた商品、カテゴリの登録を誤った商品は、顧客の関心と正しく照らし合わせられません。そこで、説明文の質を人為的に落としたときに、内容ベースの成績がどう変わるかを確かめました。説明文の各単語を、決めた確率で、乱数で選んだジャンルの単語に置き換えます。選ばれたジャンルが元のジャンルと同じになることもあるので、置き換えの確率が、そのまま商品の中身と無関係になった単語の割合になるわけではありません。置き換える前の単語の選び方は同じにして、置き換えの確率だけを0・0.2・0.4・0.6・0.8と変えました。置き換えの確率0のときは、前の節までと同じ説明文になります。この実験は、本文の乱数の種(20261110)の購買ログで、1種類の劣化(でたらめな単語への置き換え)を1回ずつ試したものです。
# ブロック6:説明文の質を落とすと内容ベースはどうなるか
for noise in [0.0, 0.2, 0.4, 0.6, 0.8]:
    docs2 = [describe(i, noise, np.random.default_rng(7 + i)) for i in range(N_ITEM)]   # 同じ乱数で語を選び、置き換えだけを変える
    T2 = TfidfVectorizer(token_pattern=r"\S+").fit_transform(docs2)
    s2 = (normalize(X @ T2) @ T2.T).toarray()
    e = evaluate(s2)
    print(f"置き換えの確率{noise}:内容ベースの再現率@10 全体{e[0]:.3f} 新商品{e[1]:.3f}")
# 出力:
# 置き換えの確率0.0:内容ベースの再現率@10 全体0.114 新商品0.089
# 置き換えの確率0.2:内容ベースの再現率@10 全体0.112 新商品0.081
# 置き換えの確率0.4:内容ベースの再現率@10 全体0.107 新商品0.093
# 置き換えの確率0.6:内容ベースの再現率@10 全体0.076 新商品0.059
# 置き換えの確率0.8:内容ベースの再現率@10 全体0.035 新商品0.026
| 説明文の単語を置き換える確率 | 内容ベースの全体の再現率@10 | 内容ベースの新商品の再現率@10 |
|---|---|---|
| 0(前の節までと同じ説明文) | 0.114 | 0.089 |
| 0.2 | 0.112 | 0.081 |
| 0.4 | 0.107 | 0.093 |
| 0.6 | 0.076 | 0.059 |
| 0.8 | 0.035 | 0.026 |
この架空データでは、置き換えの確率が0.4までは、全体の再現率@10 は0.114から0.107へと小さく下がるだけで、新商品の再現率は0.089・0.081・0.093と上下しました。新商品は40点しかなく、正解の組も665組に限られるので、この程度の上下が置き換えの影響なのか、限られた件数による揺れなのかは、この1回の実験からは区別できません。置き換えの確率が0.6になると、全体は0.076・新商品は0.059に、0.8では全体0.035・新商品0.026まで下がりました。この架空データでは、置き換えの確率が0.4から0.6の間で、掲載した TF-IDF の方式の成績が下がり始め、0.6と0.8では大きく下がりました(0.5は試していません)。これは置き換えの確率についての結果で、実際に中身と無関係になった単語の割合や、実務で内容ベースが使えなくなる境目を示すものではありません。
この実験が示したのは、属性データの質が下がると内容ベースの成績も下がる、という方向までです。置き換えの確率が0.4まで成績がほとんど動かなかったのは、この架空データの説明文ではジャンルの単語がはっきり分かれているためと推測されますが、ジャンルの重なりを変えたデータでは確かめていません。また、この実験は同じ方式のまま説明文だけを変えたもので、手法どうしは比べていません。
実際の商品の説明文は、ジャンルの境目があいまいで、ありふれた言葉も多いので、同じ割合の誤りでも影響はこれより大きいことがあると考えています。逆に、カテゴリのような構造化された属性が正しく登録されていれば、説明文の質が低くても補える場合があります。
内容ベースは属性データに書かれたことしか使わないので、顧客の好みを見分ける情報が属性データに足りなければ、その効き目は限られると考えています。Pazzani と Billsus の解説も、限界を扱う節で、顧客が好む商品と好まない商品を見分けるだけの情報が商品の中身に無ければ、どの内容ベースの推薦も良い推薦を出せない、という趣旨を述べています。
商品の属性データは、推薦のために作られたものではないことが多く、推薦に使おうとして初めて欠けや揺れが見つかります。整備の観点を次の表にまとめました。
| 観点 | 起きやすい問題 | 推薦への影響 | 確かめ方の例 |
|---|---|---|---|
| 網羅性 | 説明文やカテゴリが空のままの商品がある。新商品ほど登録が遅れる | 属性の無い商品は内容ベースで推薦できない。新商品を補うはずの内容ベースが新商品で効かない | 属性の項目ごとの空欄の割合を、発売時期別に数える |
| 正確さ | カテゴリの登録の誤り、別の商品の説明文の流用 | 的外れな推薦が出て、顧客の信頼を損なう | 抜き取りで人が確かめる。カテゴリと説明文の単語の食い違いを探す |
| 表記の揺れ | 同じ色や素材が部署・取引先ごとに別の書き方で登録されている | 同じ特徴の商品どうしが似ていないと判定される | 属性の値の一覧を出し、同じ意味の別表記をまとめる辞書を作る |
| 粒度 | カテゴリが粗すぎる(「雑貨」だけ)、細かすぎる(1カテゴリに1商品) | 粗いと何でも似ていると判定され、細かいと何も似ていないと判定される | カテゴリごとの商品数の分布を見る |
| 鮮度 | 販売終了・仕様変更が属性に反映されない | 買えない商品や古い仕様の商品を推薦する | 属性の最終更新日と、販売状態の突き合わせ |
| 持ち主 | 誰が属性を登録・更新するのかが決まっていない | 上の問題が直されないまま放置される | 属性の項目ごとに、登録と更新の責任者を決める |
表の最後の行の「持ち主」が、他の5つの問題を直し続けられるかを左右すると考えています。商品の属性データは、商品部・EC 運営・取引先など、推薦の担当とは別の部署が登録していることが多いからです。データの品質と管理の体制の作り方は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。
内容ベースの弱点、似たものばかりで新しい発見が無い
内容ベースには、商品の属性データの質のほかにも、構造上の弱点があります。最もよく知られているのは、顧客が過去に関心を示した商品と似た商品ばかりを推薦し、新しい発見が生まれにくいことです。ジャンル1の商品ばかり買ってきた顧客には、ジャンル1の商品ばかりが推薦されます。顧客がジャンル3にも関心を持ちうるとしても、内容ベースはそれを知る手がかりを持ちません。協調フィルタリングなら、「ジャンル1を買う人の中にはジャンル3も買う人が多い」という他の顧客の行動を通じて、ジャンル3の商品が推薦に出てくることがあります。
この弱点は、推薦の枠によって問題の大きさが違います。商品ページの「似た商品」の枠では、似ていることがそのまま目的なので、弱点になりません。トップページの「おすすめ」やメールの推薦のように、顧客に新しい商品を知ってもらうことが目的の枠では、似たものばかりの推薦は顧客に飽きられ、枠が見られなくなるおそれがあります(この章の実験では、飽きや枠の利用の減り方は測っていません。確かめるには、枠の利用や継続利用の推移を見る必要があります)。推薦の多様性・新規性の測り方と、多様性を加える並べ替えの方法は、第11章で扱います。
内容ベースの弱点を、次の4つにまとめておきます。
- 似たものばかりになる:過去の関心の範囲の外にある商品を推薦しにくい
- 属性に無い理由を捉えられない:使い心地・評判・流行のように、属性として登録されていない理由で商品が選ばれる場合に外れる
- 人気の情報を使わない:同じ関心の中でよく買われる商品を見分けられない。この章の本文の乱数の種の架空データでは、全体の成績が人気順にも届かなかった(種によっては上回った)
- 行動の履歴も申告された好みも無い顧客には効きにくい:顧客の関心を表す材料が無いので、その顧客に合わせた推薦が難しい(この章の実験では、学習期間に購買のある顧客だけを評価しており、新しい顧客は測っていません)
この4つのうち、3つ目は、協調フィルタリングや人気順と組み合わせることで補えます。前の節までのハイブリッドの結果は、主にこの3つ目を補う例です。4つ目は、人気順や、好みを尋ねる質問で補うことになりますが、この章の実験では評価していません(第10章)。1つ目は、多様性を加える並べ替えや探索の枠で補うことになります。2つ目は、属性の項目を増やす(顧客のレビューの言葉を属性として取り込むなど)か、行動のデータに頼る部分を残すことで補います。
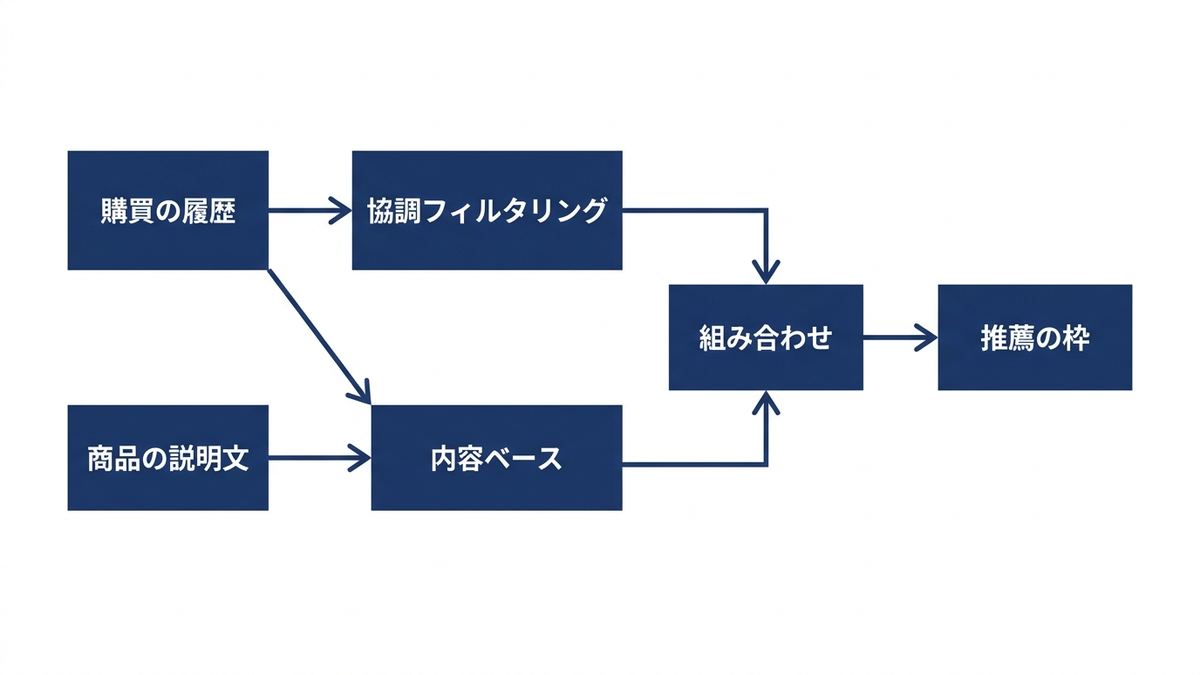
経営の判断、商品の属性データの整備に投資する
この章の内容を、経営の判断に置き換えます。内容ベースとハイブリッドの推薦について経営が決めるべきことは、どの手法を使うかよりも、「商品の属性データを推薦に使える状態に保つために、誰が、どれだけの手間をかけるか」だと考えています。この章の架空データ(本文の乱数の種での1回の実験)では、説明文の単語を置き換える確率を0.6以上にすると、内容ベースの成績は大きく下がりました。成績は手法にも左右されますが、内容ベースは属性データに書かれたことしか使わないので、手法を作り込むことと並んで、属性データを推薦に使える質に保つことが欠かせないと考えています。属性データの整備は、推薦の開発の予算とは別の、商品部や EC 運営の業務として予算と担当を持たせる必要があります。
判断を誤ったときの損失を、序章で整理した6つの損失の型(機会損失・効果の過大評価・品揃えの偏り・顧客の離反・形骸化・二重投資)に当てはめると、次のようになります。
| 判断の誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 全体の再現率だけで協調フィルタリングを選び、新商品の扱いを測らない | 機会損失(売りたい新商品が推薦の枠に出てこない) | 既存の商品と新商品に分けて成績を測る。新商品の推薦の扱いを目標に入れる |
| 商品の属性データの整備を推薦の担当任せにする | 形骸化(属性の欠けや誤りが直されず、内容ベースが効かないまま動き続ける) | 属性の項目ごとに登録と更新の責任者を決め、空欄の割合を定期的に測る |
| 属性の誤りを放置したまま推薦に使う | 顧客の離反(的外れな推薦が信頼を損なう) | 新しく推薦に使う属性は、抜き取りで正しさを確かめてから使う |
| 内容ベースだけで「おすすめ」の枠を作る | 品揃えの偏り・顧客の離反(似たものばかりで飽きられるおそれ) | 協調フィルタリングや人気順と組み合わせ、多様性を測る(第11章) |
| ハイブリッドの重みを、オフラインの全体の成績だけで決める | 効果の過大評価(オフラインの数字を推薦の効果と取り違える) | 重みは枠の目的に合わせて候補を絞り、A/Bテストで、従来の推薦と比べた差(方式を替えた効果)を確かめる(第9章) |
| サイト・アプリ・メールで別々に商品の属性を整え、別々の内容ベースを作る | 二重投資 | 商品の属性データを全社で1つにまとめ、どの推薦の枠からも同じものを使う |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 新商品を推薦の枠でどれだけ見せたいかを、事業の目標(新商品の売上の比率、発売から一定期間の購買の件数など)として先に決め、推薦の成績を既存の商品と新商品に分けて報告させる
- 商品の属性データの項目ごとに、登録と更新の責任者を決め、空欄の割合・誤りの割合を定期的に測る
- 新商品の発売の手続きの中に、推薦に使う属性の登録を組み込み、発売の時点で属性がそろっている状態にする
- ハイブリッドの組み合わせ方と重みは、推薦の枠の目的を踏まえて候補を絞り、最後はオンライン評価で選ぶ
- 商品の属性データを、チャネルや部署ごとに作らず、全社で1つにまとめる
3つ目の、発売の手続きに属性の登録を組み込むことは、小さな手間で効く対策だと考えています。この章の架空データ(本文の乱数の種)では、新商品40点のうち11点は評価期間を迎えた時点で学習期間の購買が0件でした。この章で扱った方法(人気順・協調フィルタリング・内容ベースとその組み合わせ)の中で、購買が0件の商品を推薦の候補に入れられたのは、属性データを使う内容ベースだけでした。属性の登録が発売より遅れれば、発売直後で購買が0件の新商品は、この章で扱った方法では候補に上がらず、新着の枠や探索の枠(第10章)のような別の手段に頼ることになります。
この章のまとめ
この章では、商品の属性と説明文を使う内容ベースの推薦と、それを協調フィルタリングと組み合わせるハイブリッド推薦を扱いました。本コラムの架空データ(本文の乱数の種)では、全体の再現率@10 は協調フィルタリングが0.314で最も高く、新商品の再現率@10 は協調フィルタリングの0.002に対して内容ベースが0.089でした。乱数の種を5通りにして確かめると、全体の再現率で協調フィルタリングが上回ること、学習期間に1件も買われていない商品を協調フィルタリングは推薦せず内容ベースは推薦することは変わりませんでしたが、新商品をどちらがよく当てるかは種によって入れ替わりました。ハイブリッドでは、本文の種で混合の型が近い全体の成績の重み付きより新商品の再現率が高くなりましたが、差は小さく、種3では逆になりました。組み合わせ方と重みは、細部の取り方とデータによって結果が変わるので、自社のデータで比べて選ぶ必要があります。また、本文の乱数の種の架空データでは、説明文の単語を置き換える確率を0.6以上にすると内容ベースの成績は大きく下がり、1つの種・1種類の劣化の実験で、属性データの質が下がると内容ベースの成績も下がるという方向が見えました(成績は属性データの質と手法の両方に左右され、手法どうしの比較はしていません)。次の第7章では、商品や顧客の特徴と行動のデータを1つのモデルで扱う、深層学習による推薦を扱います。
この章を深めたい方への参考書籍
『情報検索の基礎』(Christopher D. Manning、Prabhakar Raghavan、Hinrich Schütze 著、岩野和生、黒川利明、濱田誠司、村上明子 訳、共立出版):Manning らによる情報検索の教科書の訳書です(2012年刊)。この章で使った単語の重み付けやコサイン類似度は、文書を探し出す情報検索の分野で使われてきた方法です。商品の説明文を推薦に使うときに、その土台となる情報検索の考え方をまとめて学ぶ入口になります。
『情報アクセス技術入門 情報検索・多言語情報処理・テキストマイニング・情報可視化』(前田亮、西原陽子 共著、森北出版):情報検索の仕組み(索引付け・検索モデル)からテキストマイニングまでを、入門の水準でまとめた本です。説明文を単語に区切って索引を作り、文書どうしを比べる流れを、この章より広い範囲で見渡すのに役立ちます。
第7章 深層学習による推薦、2つの塔のモデルから系列の推薦まで
第6章では、商品の属性と説明文から推薦する内容ベースと、協調フィルタリングと組み合わせるハイブリッド推薦を扱い、履歴の少ない商品を属性で補えることを確かめました。第4章から第6章までの方法は、顧客と商品の関係を、類似度の計算や行列の分解といった比較的単純な仕組みで表していました。この章では、ニューラルネットワーク(多数の層を重ねた関数で入力と出力の関係を学習する仕組み)を使う深層学習の推薦を扱います。
この章で扱うのは次の内容です。後半では、架空の閲覧の系列を使い、torch(PyTorch)で小さなモデルを学習させて、深層学習を使わない方法と比べます。
- 深層学習が推薦に使われる理由(多様な特徴を入れられる・大規模な商品を扱える・閲覧の順番を扱える)
- 顧客や商品をベクトルで表す埋め込みの考え方
- 顧客の塔と商品の塔に分ける2つの塔のモデルと、それが大規模な推薦で使われる理由
- ニューラル協調フィルタリングと、その後の再検証で行列分解に及ばないと報告されたこと
- 閲覧や購買の順番から次を予測する系列推薦(GRU4Rec・SASRec・BERT4Rec)
- 大規模な事例として公表された論文(動画の推薦・アプリストアの推薦)
- 深層学習が向く条件と向かない条件、経営判断
この章の主張は、深層学習は「商品の数が多い」「特徴が多様」「順番に意味がある」という条件で力を発揮する一方で、条件が揃わないところでは単純な方法に勝てないことがある、という点です。だからこそ、人気順・アイテムベース・単純な数え上げといった基準を先に置き、それに勝てるかを確かめてから複雑にする順番を勧めます。本コラムの架空データでも、深層学習を使わない単純な数え上げが、学習に使える顧客が少ないときには深層学習のモデルを上回りました。評価の切り方と指標の詳しい扱いは第8章、候補の生成と並べ替えのシステム構成は第12章で扱います。
深層学習が推薦に使われる理由、多様な特徴・大規模・系列
第5章の行列分解は、顧客×商品の行列だけから好みの軸を学びました。実際の推薦では、行列に入らない情報も推薦の手がかりになります。顧客の側には、年齢層・地域・端末・流入元・閲覧の時刻、商品の側には、カテゴリ・価格帯(相対的な位置づけ)・説明文・画像・発売日があります。行列分解にこれらを足すには工夫が要りますが、ニューラルネットワークでは、種類の違う情報をそれぞれ数値のベクトルに変えて同じモデルに入れることが比較的素直にできます。これが1つ目の理由です。
2つ目の理由は規模です。商品が数百万点、顧客が数億人という規模になると、顧客と全商品の組み合わせを毎回計算することはできません。後で扱う2つの塔のモデルは、顧客と商品を同じ空間のベクトルに置き、近いベクトルを探す問題に置き換えることで、膨大な商品の中から候補を短時間で絞れる形にします。近いベクトルを速く探す近似最近傍探索と、候補の生成から並べ替えへ進む2段階の構成は、第12章で扱います。
3つ目の理由は順番です。第4章のアイテムベースや第5章の行列分解は、顧客が「何を見たか・買ったか」の集合を使い、「どの順番で見たか」は使いません。しかし、カメラ本体を買った人が次にレンズや記録媒体を見る、ドラマの第1話を見た人が次に第2話を見る、というように、直前の行動が次の行動を強く左右する場面があります。こうした順番を扱う推薦を系列推薦と呼び、言語の処理で発達したニューラルネットワークの部品を、推薦向けに手を加えて応用できます。代表的な部品は2つあります。回帰型のネットワークは、系列を古い順に1つずつ読み、それまでに読んだ内容を内部の状態として持ち越しながら次を予測する仕組みです。注意機構は、系列の中のどの過去の要素に重みを置くかを学習する仕組みで、これを中心に組み立てたモデルが Transformer です。
一方で、深層学習の推薦には、学習に多くのデータと計算が要る、調整すべき設定(層の数・ベクトルの次元・学習率(1回の更新で数値をどれだけ動かすかの設定)など)が多い、なぜその商品を推薦したのかを説明しにくい、という性質があります。この3つの理由と3つの性質のどちらが勝つかは、商品と顧客の規模、使える特徴、順番の意味の強さで決まります。この章の後半のコードと表で、その見分け方を具体的に扱います。
埋め込み、顧客と商品をベクトルで表す
深層学習の推薦の土台になるのが埋め込みです。埋め込みは、顧客や商品のように番号でしか区別できないものを、数十から数百の数値の並び(ベクトル)で表す方法です。たとえば商品Aを32個の数値で表し、商品Bも32個の数値で表すと、2つのベクトルの内積(対応する数値どうしを掛けて足したもの)やコサイン類似度で、2つの商品の近さを測れます。埋め込みの数値は人が決めるのではなく、データから学習させます。何を近づけるかは学習の目的で決まり、たとえば「一緒に見られる商品どうしを近づける」ように学習させる設計もあれば、「顧客のベクトルと、その顧客が次に見た商品のベクトルの内積を大きくする」ように学習させる設計もあります。
この考え方は、第5章の行列分解の潜在因子と同じ発想です。行列分解では、顧客のベクトルと商品のベクトルの内積が、その顧客がその商品に関心を持つ度合いを表すように学習させました。深層学習の推薦では、このベクトルを作る部分を、層を重ねたニューラルネットワークに置き換えたり、商品の番号だけでなく属性や説明文からもベクトルを作ったりします。つまり、埋め込みは行列分解を特別な場合として含む、より広い枠組みだと捉えることができます。
実装の面では、torch には番号をベクトルに変える部品(nn.Embedding)が用意されており、商品の数×ベクトルの次元の表を持っておき、番号に対応する行を取り出す仕組みになっています。この表の数値が学習で更新されます。後のコードでも、商品の番号を32次元のベクトルに変える部分にこの部品を使いました。
埋め込みについて、読み違えやすい点を2つ挙げます。1つは、埋め込みの各次元に意味があるとは限らないことです。第5章で見たとおり、学習で得られた軸に「ジャンル」「価格帯」のような名前が付くとは限りません。もう1つは、埋め込みの近さが何を表すかは、使ったログの種類(閲覧か購買か)、入力と正解の組み方、学習の目的によって変わることです。たとえば、閲覧のログで「直前の商品から次の商品を当てる」ように学習させる設計なら「続けて見られやすい」近さに近づき、購買のログで「同じ注文に入った商品どうしを近づける」ように学習させる設計なら「一緒に買われやすい」近さに近づきます。後のコードの2つの塔のモデルは、見た商品のベクトルの平均を使うので順番を入れ替えても結果は変わらず、学習するのも商品どうしの近さではなく、顧客と商品の内積です。どの行動の近さを推薦に使いたいのかは、第1章で整理した推薦の目的と、第2章で扱ったデータの意味づけから先に決める必要があります。
2つの塔のモデル、顧客の塔と商品の塔に分ける理由
2つの塔のモデル(Two-Tower)は、顧客を表すベクトルを作るネットワーク(顧客の塔)と、商品を表すベクトルを作るネットワーク(商品の塔)を別々に持ち、2つのベクトルの内積でその顧客にとっての商品の点数を出すモデルです。顧客の塔には、顧客がこれまでに見た商品・買った商品・属性・閲覧の時刻などを入れ、商品の塔には、商品の番号・カテゴリ・説明文などを入れます。2つの塔は、出口で同じ次元のベクトルを出すように作り、実際に見られた(買われた)商品の点数が、見られなかった商品の点数より高くなるように一緒に学習させます。
2つの塔に分ける最大の理由は、計算の分担にあります。商品の塔は顧客と無関係に計算できるので、全商品のベクトルを事前に一括で計算して保存しておけます。推薦を出すときは、その顧客のベクトルだけを計算し、保存してある商品のベクトルの中から内積の大きいものを探せば済みます。このとき、内積の大きいものを探す処理は、近似最近傍探索の道具で高速にできます。顧客と商品を1つのネットワークに一緒に入れて点数を出すモデルでは、商品の数だけネットワークを計算し直す必要があり、商品が数百万点あれば、推薦のたびにそれを行うことは現実的ではありません。
2つの塔のモデルを大規模な推薦に使った例として、Yi らの2019年の論文(Google の研究者による、第13回 ACM 推薦システム国際会議 RecSys 2019 の論文)があります。Google Research の公開ページの要旨によれば、この論文は2つの塔のニューラルネットワークで、商品の塔に多様な商品の特徴を入れて大規模な商品の集合から推薦の候補を取り出す構成を扱っています。学習では、同じミニバッチ(一度にまとめて学習に使う組)の中の他の商品を「見られなかった商品」として扱う方法がよく使われますが、論文はこの取り方が、商品の人気がべき乗則に従う(少数の商品に人気が集中する)場合に偏りを生み、成績を下げうることを指摘し、ストリーミングのデータから商品の出現頻度を推定して偏りを補正する方法を提案しています。要旨では、この仕組みを YouTube の大規模な推薦の候補の取り出しに使い、ライブでの A/Bテストで推薦の質が改善したと報告しています。ただし、何と比べた改善かは要旨には書かれておらず、推薦が無い場合と比べた推薦の効果を示したものかどうかも要旨からは分かりません。また、他のサービスで同じ改善が得られることを意味するものでもありません。
2つの塔のモデルには、構造から来る限界もあります。顧客と商品は、出口のベクトルの内積でしか出会わないので、「この顧客がこの商品のこの特徴に強く反応する」といった細かい組み合わせは表しにくくなります。そのため、2つの塔のモデルのような計算の軽いモデルで候補を絞り、その候補だけを、顧客と商品の特徴を細かく組み合わせられる別のモデルで並べ替える、という分担が考えられます。後の節で紹介する YouTube の論文も、候補を絞るモデルと並べ替えるモデルの2段階の構成を示しています。この分担は第12章で扱います。
ニューラル協調フィルタリングと再検証、複雑にすれば勝つとは限らない
深層学習の推薦の研究で広く知られた論文に、He らの2017年の論文「ニューラル協調フィルタリング」(第26回 World Wide Web 国際会議 WWW 2017)があります。arXiv の要旨によれば、この論文は、行列分解で顧客のベクトルと商品のベクトルの内積を取る部分を、多層パーセプトロン(層を重ねたニューラルネットワーク)に置き換え、暗黙のフィードバックから顧客と商品の関係を学習する枠組みを提案しました。内積という決まった計算の代わりに、関係の形そのものをデータから学ばせれば、より複雑な好みを表せるはずだ、という考え方です。
これに対して、Rendle らの2020年の論文(第14回 ACM 推薦システム国際会議 RecSys 2020。題名は「ニューラル協調フィルタリングと行列分解の再検討」という意味)は、元の論文の実験をやり直しています。この章に関わる論点は2つです。1つは、設定の値(ハイパーパラメータ)を丁寧に選び直すと、単純な内積のほうが多層パーセプトロンより成績がよかったと arXiv の要旨が報告していることです。もう1つは計算の負担で、要旨は、内積なら大量の商品から上位の候補を速く探す手法を使えるのに対し、多層パーセプトロンで点数を出す方式は本番の推薦では計算の負担が大きいと述べています。この負担が問題になるのは、主に大量の商品から短い時間で候補を探す場面で、候補を絞った後の並べ替えまで多層パーセプトロンが使えないという意味ではない、と本コラムでは読んでいます。
この2つの論文から読み取れるのは、「深層学習だから勝つ」わけではないということです。新しい手法の論文では、提案手法の設定は丁寧に調整される一方で、比べる相手の古い手法の調整が十分でないことがあり、比べる相手を丁寧に調整し直すと結論が変わることがあります。比較の基準を丁寧に作る必要があるという論点は、第3章でベースラインについて扱いました。自社で深層学習の推薦を検討するときも、ベンダーや社内の担当者が示す比較で、基準の側(人気順・アイテムベース・行列分解)がどこまで調整されているかを確かめることが大切だと考えています。
系列推薦、閲覧の順番から次を予測する
系列推薦は、顧客の行動を時間の順に並べた系列として扱い、次に見る(買う)商品を予測する推薦です。第4章のアイテムベースが「この顧客がこれまでに見た商品の集まり」に似た商品を推薦するのに対して、系列推薦は「直前に何を見たか」「どんな順番で見てきたか」を手がかりにします。ログインせずに閲覧する顧客のように、過去の長い履歴が無く、今のセッション(一続きの閲覧)だけが手がかりになる場面でも使える点が特徴です。
系列推薦の代表的な研究を3つ挙げます。いずれも原論文の書誌を arXiv と出版社のページで確かめた範囲で紹介します。
| 手法 | 論文 | 仕組み | 特徴 |
|---|---|---|---|
| GRU4Rec | Hidasi らの2016年の論文(深層学習の国際会議 ICLR 2016。セッションに基づく推薦を回帰型ニューラルネットワークで行う論文) | 回帰型ニューラルネットワーク(系列を1つずつ読みながら内部の状態を更新するネットワーク)でセッションの閲覧を読み、次の商品を予測する | 長い履歴の代わりに短いセッションのデータから推薦する。要旨では、順位づけに合わせた損失関数(予測の当たり外れを数値にしたもので、学習はこれを小さくする方向に進む)などの実用上の修正も加えたとしている |
| SASRec | Kang と McAuley の2018年の論文(データマイニングの国際会議 ICDM 2018) | 自己注意機構(系列の中のどの過去の行動に重みを置くかを学習する仕組み)で過去の行動を重みづけし、次の商品を予測する | 要旨では、回帰型ネットワークのように長い範囲の関係を捉えつつ、マルコフ連鎖(直前の少数の行動だけで次を決める古典的な方法)のように少数の関連する行動に頼ることを狙うとしている |
| BERT4Rec | Sun らの2019年の論文(情報と知識の管理の国際会議 CIKM 2019) | 双方向の Transformer で、系列の一部の商品を隠し、前後の文脈から隠した商品を当てるように学習する | 左から右へ一方向に読む方法に対して、学習では系列の中の前後両方の文脈を使う。次の商品を予測するときは、原論文の第3.6節によれば、履歴の末尾に予測用の印(隠した位置を示す記号)を置き、その位置の商品を当てる形にするので、まだ起きていない閲覧を使うわけではない |
GRU4Rec の名前に入っている GRU は、ゲート付き回帰ユニット(Gated Recurrent Unit)の略で、回帰型ネットワークの部品の1つです。torch の公式ドキュメントでも、nn.GRU は入力の系列に多層のゲート付き回帰ユニットを適用する部品として説明されています。この章のコードでは、この部品を使った小さな系列のモデルを学習させます。なお、表の論文に書かれた精度は、それぞれの論文が使った公開データセットとその条件での値であり、自社のデータで同じ差が出ることを意味しません。公開データセットの数字の読み方は第14章で扱います。
系列推薦を考えるときに大切なのは、自社の商品で「順番に意味があるか」を先に確かめることです。シリーズものの本や動画、本体と付属品、旅行の予約から現地の手配へ、といった商品では、直前の行動が次を強く左右します。一方で、日用品のまとめ買いのように順番にほとんど意味が無い場合は、系列推薦を使っても、順番を見ない方法と大きな差が出ないことがあります。この見極めは、後で見るとおり、深層学習を使わない単純な数え上げでも確かめられます。
架空の閲覧の系列を作り、深層学習を使わない3つの基準を置く
ここからは、架空の合成データでコードを動かして確かめます。データは、顧客3,000人が商品300点を閲覧した系列で、乱数のシードを固定して作りました。商品は10のジャンル(ジャンル1〜ジャンル10)に30点ずつ属し、商品ごとの人気には偏りを持たせています(人気の順位の0.8乗に反比例する重み)。顧客ごとにジャンルの好みを乱数で決め、1人あたり8〜30回の閲覧を作りました。
この章の題材として、次に見る商品が直前の商品に依存する規則を入れています。各商品について、同じジャンルの中から「続けて見られやすい商品」を2つ決めておき、閲覧のたびに確率0.5でそのどちらかへ進み、残りの確率0.5では顧客の好みと商品の人気に沿って商品を選びます。本体を見た顧客が付属品を見る、シリーズの1作目を見た顧客が2作目を見る、という関係を単純にまねたものです。つまりこのデータは、直前の商品による移り方と、顧客の好み・商品の人気による選び方を半々に混ぜた規則で作っています。顧客の好みは顧客ごとに違うので、全顧客で共通の「直前の商品→次の商品」の回数の表だけでは表しきれず、それより前の閲覧から好みを推し量る余地が残ります。実際の閲覧のログはこれよりずっと複雑で、移り方も好みもこのような単純な形をしているとは限りません。以下の数値はすべて本コラムの架空データでの値です。
# ブロック1:架空の閲覧の系列を作る
import time
import numpy as np
import torch
import torch.nn as nn

rng = np.random.default_rng(20261110)
torch.manual_seed(20261110)
torch.set_num_threads(4)

N_USERS, N_ITEMS, N_GENRES = 3000, 300, 10
genre = np.arange(N_ITEMS) // (N_ITEMS // N_GENRES)        # 商品0〜29がジャンル1、30〜59がジャンル2…
pop = 1.0 / np.arange(1, N_ITEMS + 1) ** 0.8               # 人気の偏り(少数の商品に閲覧が集中)
pop = pop[rng.permutation(N_ITEMS)]
# 次に見る商品の規則:各商品に、同じジャンルの「続けて見られやすい商品」を2つ決める
succ = np.zeros((N_ITEMS, 2), dtype=int)
for i in range(N_ITEMS):
    same = np.where((genre == genre[i]) & (np.arange(N_ITEMS) != i))[0]
    succ[i] = rng.choice(same, 2, replace=False)
P_FOLLOW = 0.5                                             # 直前の商品の規則に従う確率

seqs, days = [], []
for u in range(N_USERS):
    taste = rng.dirichlet(np.full(N_GENRES, 0.3))          # 顧客ごとのジャンルの好み
    w = pop * taste[genre]
    w = w / w.sum()
    n = rng.integers(8, 31)                                # 1人あたり8〜30回の閲覧
    s = [rng.choice(N_ITEMS, p=w)]
    for _ in range(n - 1):
        if rng.random() < P_FOLLOW:
            s.append(int(succ[s[-1], rng.integers(2)]))
        else:
            s.append(int(rng.choice(N_ITEMS, p=w)))
    d0 = rng.integers(0, 150)
    days.append(d0 + np.sort(rng.integers(0, 30, n)))       # 閲覧の日付(180日の中)
    seqs.append(np.array(s))
print("顧客", N_USERS, "人/商品", N_ITEMS, "点/閲覧", sum(len(s) for s in seqs), "回")
cnt = np.bincount(np.concatenate(seqs), minlength=N_ITEMS)
print("上位20%の商品が占める閲覧の割合", round(np.sort(cnt)[::-1][:60].sum() / cnt.sum(), 3))
# 出力:
# 顧客 3000 人/商品 300 点/閲覧 56697 回
# 上位20%の商品が占める閲覧の割合 0.474
閲覧は合計56,697回で、上位20%(60点)の商品が閲覧の47.4%を占めました。閲覧の日付も作っていますが、この章では使っていません。評価は、各顧客の最後の閲覧を当てる対象として取り分け、それより前の閲覧だけで学習する切り方にしました。顧客ごとに最後の行動を残すこの切り方は分かりやすい一方で、顧客によって最後の閲覧の日付が違うため、ある顧客の最後の閲覧より後の日付の他の顧客の行動が学習に入りうるという弱点があります。時間で切る評価との違いと、将来の情報が漏れる問題は第8章で扱います。
指標は再現率@10です。この例では1人につき当てる対象が1件なので、再現率@10は「最後の閲覧が、推薦の上位10件に入っていた顧客の割合」になります(この場合はヒット率と同じ値です)。ここでは、顧客ごとに最後の閲覧1件が上位10件に入ったかどうかを1か0で数え、顧客3,000人で平均しました。第8章の再現率@K(顧客ごとに、正解のうち上位K件に入った割合)を、正解が1人1件の場合に当てはめた形です。第6章の再現率@10は全顧客の正解を合算した割合で数えており、数え方もデータも違うので、この章の数値と章をまたいで比べることはできません。指標の定義と使い分けは第8章で扱います。なお、すでに見た商品を推薦から除く処理はしていません。閲覧では同じ商品を見直すことがよくあるためです。見た商品や買った商品を推薦から除くかどうかは、見直しや買い直しを促したいか、消耗品のようにくり返し買われる商品か、といった推薦の目的と商品の性質に応じて決めます。
深層学習のモデルを作る前に、深層学習を使わない3つの基準を置きます。1つ目は全体の人気順(第3章)、2つ目は商品×商品のコサイン類似度によるアイテムベース(第4章)です。3つ目は「直前の商品の数え上げ」で、学習用の系列の中で「商品Xの次に商品Yが見られた回数」を数えた表を作り、各顧客の直前の商品の行で回数の多い順に推薦するものです。これは、直前の1つの状態だけで次が決まると考えるマルコフ連鎖の考え方を、回数を数えるだけで実装したものです。
# ブロック2:評価の切り方と、深層学習を使わない3つの基準
from scipy import sparse
train = [s[:-1] for s in seqs]                             # 各顧客の最後の閲覧を当てる対象にする
target = np.array([s[-1] for s in seqs])
K = 10

def recall_at_k(score):                                    # score:顧客×商品の点数
    top = np.argsort(-score, axis=1)[:, :K]
    return float((top == target[:, None]).any(axis=1).mean())

tr_cnt = np.bincount(np.concatenate(train), minlength=N_ITEMS).astype(float)
s_pop = np.tile(tr_cnt, (N_USERS, 1))                      # 人気順
rows = np.concatenate([np.full(len(s), u) for u, s in enumerate(train)])
X = sparse.csr_matrix((np.ones(len(rows)), (rows, np.concatenate(train))), shape=(N_USERS, N_ITEMS))
X.data[:] = 1.0                                            # 見たかどうか(0か1)
norm = np.sqrt(np.asarray(X.multiply(X).sum(axis=0))).ravel() + 1e-9
S = (X.T @ X).toarray() / np.outer(norm, norm)             # 商品×商品のコサイン類似度
np.fill_diagonal(S, 0)
s_item = X @ S                                             # アイテムベース
T = np.zeros((N_ITEMS, N_ITEMS))                           # 直前の商品→次の商品の回数
for s in train:
    np.add.at(T, (s[:-1], s[1:]), 1)
last = np.array([s[-1] for s in train])
s_markov = T[last] + 1e-6 * tr_cnt                         # 同点は人気順で並べる
res = {"人気順": recall_at_k(s_pop), "アイテムベース": recall_at_k(np.asarray(s_item)),
       "直前の商品の数え上げ": recall_at_k(s_markov)}
for k, v in res.items():
    print(f"{k} 再現率@10 {v:.4f}")
# 出力:
# 人気順 再現率@10 0.1673
# アイテムベース 再現率@10 0.3150
# 直前の商品の数え上げ 再現率@10 0.6247
人気順の再現率@10は0.1673、アイテムベースは0.3150、直前の商品の数え上げは0.6247でした。アイテムベースは顧客の好みのジャンルを捉えるので人気順のおよそ2倍になり、直前の商品の数え上げは、データに入れた規則のうち「直前の商品による移り方」の部分をそのまま捉えるので、さらにその2倍近くになりました。この差は、架空データにそういう規則を入れたから生じたもので、実際の自社のデータでどの程度の差が出るかは、データを測ってみないと分かりません。逆に言えば、直前の商品の数え上げとアイテムベースの差を測ることは、自社の商品で「順番に意味があるか」を、深層学習を使う前に安く調べる手がかりになります。ただし、この2つは順番の扱いだけでなく、使う履歴の範囲(直前の1件か、それまでの全部か)と点数の出し方も違うので、差のすべてを順番の寄与とみなすことはできません。初めの見当をつける手がかりとして使い、必要なら、同じモデルで履歴の順番を入れ替えて成績が変わるかを比べます。
小さな2つの塔のモデルと系列のモデルを torch で学習させる
次に、深層学習のモデルを2つ作ります。どちらも、学習用の系列から「それまでの閲覧(直近10件まで)」と「その次に見た商品」の組を切り出して学習させます。直近10件に満たない場合は、詰め物の番号(商品の番号の外の値)で埋めます。顧客3,000人の学習用の系列から、50,697組ができました。
# ブロック3:学習用の組(それまでの閲覧と次の閲覧)を作る
W, PAD = 10, N_ITEMS                                       # 直近10件まで使う。足りない分は詰め物
def window(s):
    h = list(s[-W:])
    return [PAD] * (W - len(h)) + h

def make_pairs(user_ids):
    H, Y = [], []
    for u in user_ids:
        s = train[u]
        for t in range(1, len(s)):
            H.append(window(s[:t]))
            Y.append(s[t])
    return torch.tensor(H), torch.tensor(Y)

H_all, Y_all = make_pairs(range(N_USERS))
H_test = torch.tensor([window(s) for s in train])           # 評価:最後の閲覧の直前までを入力
print("学習用の組", len(Y_all), "組")
# 出力: 学習用の組 50697 組
1つ目は2つの塔のモデルです。顧客の塔は、それまでに見た商品の埋め込み(32次元)の平均を取り、2層のネットワークに通して顧客のベクトルにします。商品の塔は、商品の番号の埋め込みを2層のネットワークに通して商品のベクトルにします。顧客のベクトルと全商品のベクトルの内積が点数です。顧客の塔は見た商品の平均を取るので、閲覧の順番は使いません。前の節で説明した2つの塔のモデルとは違い、この実装では顧客の属性や閲覧の時刻、商品の属性は入れていません(架空データにそうした特徴を作っていないためです)。2つ目は系列のモデルで、直近10件の閲覧を古い順にゲート付き回帰ユニット(GRU)で読み、最後の時点の内部の状態から次の商品の点数を出します。こちらは順番を使います。
学習は、正解の商品の点数が全300点の中で高くなるように、交差エントロピー(正解の商品に高い確率を割り当てるほど小さくなる損失)を最小にします。商品が300点しかないので、全商品の点数を毎回計算しています。商品が数百万点ある実務では全商品の計算はできないため、前の節で触れたように、一部の商品だけを「見られなかった商品」として使う工夫が要ります。学習の更新の回数は、どちらのモデルも最大512組ずつ400回にそろえました(組を一巡するごとに最後に端数の組が出るので、その回だけ512組より少なくなります)。
# ブロック4:2つの塔のモデルと系列のモデル(GRU)の定義
D = 32
class TwoTower(nn.Module):
    def __init__(self):
        super().__init__()
        self.emb_u = nn.Embedding(N_ITEMS + 1, D, padding_idx=PAD)   # 顧客の塔の入力(見た商品)
        self.user = nn.Sequential(nn.Linear(D, 64), nn.ReLU(), nn.Linear(64, D))
        self.emb_i = nn.Embedding(N_ITEMS, D)                        # 商品の塔の入力(商品の番号)
        self.item = nn.Sequential(nn.Linear(D, 64), nn.ReLU(), nn.Linear(64, D))
    def forward(self, h):
        m = (h != PAD).float().unsqueeze(-1)
        u = self.user((self.emb_u(h) * m).sum(1) / m.sum(1).clamp(min=1))   # 見た商品の平均
        v = self.item(self.emb_i.weight)                                     # 全商品のベクトル
        return u @ v.T                                                       # 内積が点数

class SeqGRU(nn.Module):
    def __init__(self):
        super().__init__()
        self.emb = nn.Embedding(N_ITEMS + 1, D, padding_idx=PAD)
        self.gru = nn.GRU(D, 64, batch_first=True)          # 閲覧を古い順に読む
        self.out = nn.Linear(64, N_ITEMS)
    def forward(self, h):
        o, _ = self.gru(self.emb(h))
        return self.out(o[:, -1])                           # 最後の時点から次の商品を予測
学習の関数は、2つのモデルで共通にしました。乱数のシードをモデルごとに同じ値に戻してから学習させ、学習が終わったら、各顧客の最後の閲覧の直前までを入力にして全商品の点数を出し、再現率@10を計算します。
# ブロック5:学習の関数 fit と、2つのモデルの学習
def fit(model, H, Y, steps=400, bs=512):                   # 更新の回数をそろえて学習する
    opt = torch.optim.Adam(model.parameters(), lr=0.005)
    g = torch.Generator().manual_seed(20261110)
    done = 0
    while done < steps:
        perm = torch.randperm(len(Y), generator=g)
        for b in range(0, len(Y), bs):
            i = perm[b:b + bs]
            loss = nn.functional.cross_entropy(model(H[i]), Y[i])
            opt.zero_grad(); loss.backward(); opt.step()
            done += 1
            if done == steps:
                break
    model.eval()
    with torch.no_grad():
        return recall_at_k(model(H_test).numpy())

for name, M in [("2つの塔のモデル", TwoTower), ("系列のモデル(GRU)", SeqGRU)]:
    t0 = time.time()
    torch.manual_seed(20261110)
    res[name] = fit(M(), H_all, Y_all)
    print(f"{name} 再現率@10 {res[name]:.4f} 学習 {time.time() - t0:.1f}秒")
# 出力:
# 2つの塔のモデル 再現率@10 0.3190 学習 5.5秒
# 系列のモデル(GRU) 再現率@10 0.6303 学習 10.1秒
5つの方法の結果を、ブロック2とブロック5の出力から次の表にまとめます。出力の「学習」の秒数は、モデルを作るところから、学習、顧客3,000人の点数の計算と再現率@10の計算までを合わせた時間で、表では「学習と評価の時間」と書きました。本コラムの実行環境(CPU、4スレッド)での値で、同じ計算機で他の処理が動いていると変わります。同じコードを同じ計算機・同じ乱数の種で2回実行したところ、再現率@10はすべて小数点以下4桁まで一致し、学習の時間だけが実行のたびに少し変わりました。
この結果には限定が2つあります。どの結果も1つの乱数の種(20261110)で作ったデータと学習での結果で、種を変えての確認はしていません。また、顧客ごとに最後の閲覧を取り分ける切り方なので、実際の運用の時点を再現しない簡易な比較です。この章の差は、当てた顧客の人数の差を3,000で割って求めました(たとえば系列のモデルは1,891人、数え上げは1,874人で、差は17人、0.0057です)。表の4桁の値どうしを引くと0.0056になりますが、人数から求めた差は0.0057です。差が小さい箇所(2つの塔のモデルとアイテムベースの0.0040、系列のモデルと数え上げの0.0057)は、種を変えると入れ替わる程度の差かもしれません。
| 方法 | 深層学習 | 閲覧の順番 | 再現率@10 | 学習と評価の時間 |
|---|---|---|---|---|
| 人気順 | 使わない | 使わない | 0.1673 | 数えるだけ |
| アイテムベース | 使わない | 使わない | 0.3150 | 類似度の計算だけ |
| 直前の商品の数え上げ | 使わない | 直前の1件だけ使う | 0.6247 | 数えるだけ |
| 2つの塔のモデル | 使う | 使わない(見た商品の平均) | 0.3190 | 5.5秒 |
| 系列のモデル(GRU) | 使う | 直近10件を順に使う | 0.6303 | 10.1秒 |
この結果から読み取れることは3つあります。1つ目は、閲覧の順番を使わない2つの塔のモデル(0.3190)が、同じく順番を使わないアイテムベース(0.3150)とほぼ同じ水準にとどまったことです。どちらも顧客がこれまでに見た商品の集まりから好みを捉えているので、この架空データでは、ニューラルネットワークにしたことによる上積みはほとんどありませんでした。2つの塔のモデルの利点は、前の節で見たとおり、属性などの多様な特徴を入れられることと大規模な商品の集合から候補を取り出しやすいことにあり、この例のように商品が300点で特徴が商品の番号だけの場合には、その利点が出る場面がありません。
2つ目は、順番を使う系列のモデル(0.6303)が、順番を使わないアイテムベースと2つの塔のモデル(人気順も順番を使いませんが、ここでは除きます)を大きく上回ったことです。これはデータに入れた規則を捉えた結果で、この架空データのように順番に意味がある場合には、順番を使う方法を選ぶ価値があることを示しています。3つ目は、系列のモデルの上積みが、深層学習を使わない直前の商品の数え上げ(0.6247)に対しては0.0057しかなかったことです。この架空データでは、順番に関わる部分が直前の1件だけで決まる規則で作ってあるので、その部分は数え上げでも捉えられます。直近10件を読める系列のモデルが数え上げより有利になりうるのは、それより前の閲覧から顧客の好みを推し量る部分ですが、この実験ではその寄与を切り分けていないので、差が小さかった理由は確かめていません。実際のデータで、より前の閲覧や閲覧の組み合わせが次の行動に効いている場合には、系列のモデルが数え上げとの差を広げる可能性がありますが、それはデータで確かめるまで分かりません。
この架空データでは、学習に使う顧客が少ないと単純な数え上げが深層学習を上回った
深層学習のモデルは、学習に使えるデータが少ないときに弱くなりがちです。これを確かめるために、学習に使う顧客を最初の100人・300人・1,000人に絞り、直前の商品の数え上げと系列のモデルを学習し直しました。評価は前と同じく顧客3,000人全員の最後の閲覧で行い、入力にはその顧客の最後の閲覧の直前までを使います。系列のモデルの更新の回数は、顧客の数によらず400回にそろえました(データが少ないほど同じ組を何度もくり返し学習することになります)。3,000人の値は前の節の結果です。この比べ方では、学習に使うデータの量と同時に、評価する顧客のうち学習に加わった顧客の割合も変わります。100人で学習した場合、評価する3,000人のうち2,900人は学習に一度も使っていない顧客で、3,000人で学習した場合は全員が学習に加わった顧客です(どちらの場合も、当てる対象の最後の閲覧そのものは学習に入れていません)。学習に加わっていない顧客への成績だけを調べたいなら、評価用の顧客を固定して学習から外す設計が向いています。
# ブロック6:学習に使う顧客の数を変える
print("顧客数", "直前の商品の数え上げ", "系列のモデル(GRU)")
size_res = []
for n in [100, 300, 1000]:
    T_n = np.zeros((N_ITEMS, N_ITEMS))
    for s in train[:n]:
        np.add.at(T_n, (s[:-1], s[1:]), 1)
    cnt_n = np.bincount(np.concatenate(train[:n]), minlength=N_ITEMS)
    r_mk = recall_at_k(T_n[last] + 1e-6 * cnt_n)
    H_n, Y_n = make_pairs(range(n))
    torch.manual_seed(20261110)
    r_gru = fit(SeqGRU(), H_n, Y_n)
    size_res.append((n, r_mk, r_gru))
    print(n, len(Y_n), "組", round(r_mk, 4), round(r_gru, 4))
size_res.append((N_USERS, res["直前の商品の数え上げ"], res["系列のモデル(GRU)"]))
# 出力:
# 顧客数 直前の商品の数え上げ 系列のモデル(GRU)
# 100 1602 組 0.5057 0.3777
# 300 5034 組 0.5723 0.467
# 1000 16988 組 0.6043 0.6023
| 学習に使った顧客の数 | 学習用の組の数 | 直前の商品の数え上げの再現率@10 | 系列のモデル(GRU)の再現率@10 | 差(系列のモデルから数え上げを引いた値) |
|---|---|---|---|---|
| 100人 | 1,602組 | 0.5057 | 0.3777 | -0.1280 |
| 300人 | 5,034組 | 0.5723 | 0.4670 | -0.1053 |
| 1,000人 | 16,988組 | 0.6043 | 0.6023 | -0.0020 |
| 3,000人 | 50,697組 | 0.6247 | 0.6303 | 0.0057 |
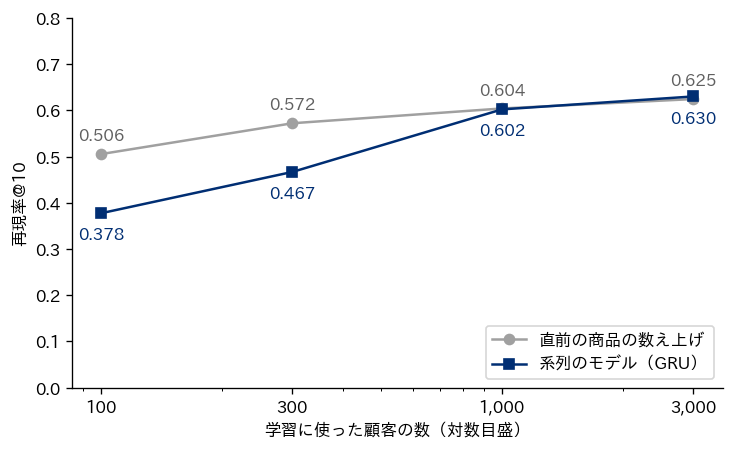
学習に使った顧客が100人のとき、系列のモデルの再現率@10は0.3777で、直前の商品の数え上げの0.5057を0.1280下回りました。300人でも0.1053下回り、1,000人でほぼ並び(差は-0.0020)、3,000人でも系列のモデルが0.0057上というほぼ並んだ結果でした(前の節で書いたとおり、種を変えると入れ替わりうる差です)。数え上げは「商品Xの次に商品Yが見られた回数」を数えるだけなので、少ないデータでもそのまま規則を拾えます。一方、系列のモデルは、埋め込みや GRU の内部の数値(この例の小さなモデルでも47,948個。後のブロック7で数えています)をデータから決める必要があり、データが少ないと、学習に加わっていない顧客にも当てはまる規則を十分に学べていない可能性があります。ただし、この実験は学習用の組での成績と比べていないので、過学習が原因かどうか、設定や学習の進み方の問題かどうかは切り分けていません。
ここで注意したいのは、この結果が「深層学習は1,000人を超えれば勝つ」という目安にはならないことです。勝ち負けが入れ替わる境目は、商品の数、規則の複雑さ、モデルの大きさ、学習の設定で変わりえます。学習の設定の影響を見るために、更新の回数だけを400回から600回に変えて、系列のモデルを学習し直しました。次のブロック7は、ブロック1からブロック6までに続けて実行するものです。使うのはブロック5までに定義した関数とデータで、ブロック6の結果は使いません。
# ブロック7:更新の回数を600回にして比べ直す
print("系列のモデル(GRU)の学習する数値の個数", sum(p.numel() for p in SeqGRU().parameters()))
print("更新600回の系列のモデル(GRU)")
for n in [100, 300, 1000, N_USERS]:
    H_n, Y_n = make_pairs(range(n))
    torch.manual_seed(20261110)
    print(n, round(fit(SeqGRU(), H_n, Y_n, steps=600), 4))
# 出力:
# 系列のモデル(GRU)の学習する数値の個数 47948
# 更新600回の系列のモデル(GRU)
# 100 0.3663
# 300 0.4307
# 1000 0.5823
# 3000 0.635
更新を600回にすると、系列のモデルの再現率@10は、100人で0.3663、300人で0.4307、1,000人で0.5823と、400回のとき(0.3777・0.4670・0.6023)よりいずれも下がり、3,000人では0.6350と400回のとき(0.6303)より上がりました。1,000人では、400回ならほぼ並んでいた数え上げ(0.6043)との差が、600回では0.0220に開いています。データが少ないまま同じ組をくり返し学習すると、学習用の組への当てはまりすぎ(過学習)が起きることがありますが、この実験では学習用の組での成績を測っていないので、下がった原因が過学習かどうかは確かめていません。勝ち負けの並び(1,000人までは数え上げが上、3,000人では系列のモデルがわずかに上)は400回のときと同じで、変わったのは差の大きさです。1,000人での差は-0.0020から-0.0220に開き、この架空データでは、更新の回数という学習の設定1つで差の大きさが変わりました(表と図の数値は400回の結果です)。これは1つの乱数の種での結果で、種を変えての確認はしていません。この例から言えるのは、「データが少ない段階では、単純な方法が深層学習を上回ることがあり、どちらが上かは自社のデータで比べないと分からない」ということまでです。
実務では、推薦を始めたばかりのサービス、商品の入れ替わりが激しくて1つの商品あたりの履歴が貯まらない売場、顧客の数が限られる法人向けの取引などで、学習に使えるデータが少ない状況が起きます。こうした状況で深層学習から入ると、開発の手間をかけたのに単純な方法より成績が悪い、という結果になりかねません。基準の方法を先に作り、データが増えるにつれて定期的に比べ直し、深層学習が基準を上回った時点で切り替える、という段取りが現実的だと考えています。
大規模な事例として公表された論文、動画の推薦とアプリストアの推薦
深層学習の推薦を大規模なサービスで使った例は、企業の研究者による論文として公表されています。ここでは、書誌を出版社の DOI と論文の公開ページで確かめた2つを紹介します。内容は論文の要旨と、システムの構成を説明した節を確かめた範囲に限ります。どちらの論文の改善も、論文が比べた相手(従来の方式や別のモデル)との差であり、推薦が無い場合と比べた推薦の効果ではありません。改善の大きさは論文の条件での値として扱います。
1つ目は、Covington らの2016年の論文(Google の研究者による YouTube の動画推薦の論文。第10回 ACM 推薦システム国際会議 RecSys 2016)です。Google Research の公開ページの要旨で確かめた範囲で、この章に関わるのは構成の点です。膨大な動画の中から候補を絞るモデルと、絞った候補を並べ替えるモデルの2段階に分け、どちらにも深層学習を使っています。この章の2つの塔のモデルの節で触れた「計算の軽いモデルで候補を絞り、別のモデルで並べ替える」分担は、この論文が示した構成と同じ考え方です。
2つ目は、Cheng らの2016年の論文(Google の研究者による、推薦のための「広いモデル」と「深いモデル」を組み合わせる論文。推薦システムのための深層学習のワークショップ DLRS 2016)です。一言でいえば、過去によく出た特徴の組み合わせを覚えるのが得意な部分と、似た特徴から類推するのが得意な部分を、1つのモデルにまとめて一緒に学習させる方法です。
arXiv の要旨によれば、覚える役を担う「広い部分」は線形のモデル(特徴ごとの重みを足し合わせるだけの単純なモデル)で、特徴どうしを掛け合わせた組み合わせをそのまま記憶します(たとえば「ある種類のアプリを入れた人は、別のあるアプリも入れやすい」のような組み合わせです。この例は本コラムによる言い換えです)。類推の役を担う「深い部分」は深層のネットワークで、ほとんどの顧客で空欄になる特徴(まばらな特徴)を少ない次元の埋め込みに変え、学習で見たことのない組み合わせにも当てはめます(これを一般化と呼びます)。要旨は、深い部分だけでは、顧客と商品のやり取りがまばらな場合に類推が行きすぎて、関連の薄い商品を推薦することがあると述べています。そのうえで、10億人を超える利用者と100万を超えるアプリを持つアプリストア(Google Play)で実装し、オンラインの実験で、広い部分だけ、深い部分だけのモデルと比べてアプリの獲得が有意に増えたと報告しています。この比較はモデルどうしの比較で、推薦が無い場合と比べたものではありません。また、論文の第2節は、問い合わせを受けるとまず候補を取り出し、その候補を並べ替えるという推薦の仕組みの全体を説明したうえで、論文が扱うのは並べ替えのモデルだとしています。
この2つの論文に共通するのは、深層学習を「1つのモデルですべてを解く」ものとしてではなく、候補の生成と並べ替えという段階の中に、それぞれの得意な形で組み込んでいる点です。また、どちらも利用者と商品の数が非常に多いサービスでの話であり、この章の架空データのような数百点の商品とはまったく規模が違います。論文で報告された改善は、そのサービスのその条件で、その時点の比較の相手に対して得られたものです。自社の規模で同じ構成が要るのか、同じ改善が得られるのかは、論文からは分かりません。システムの構成としての候補の生成と並べ替えは、第12章で扱います。
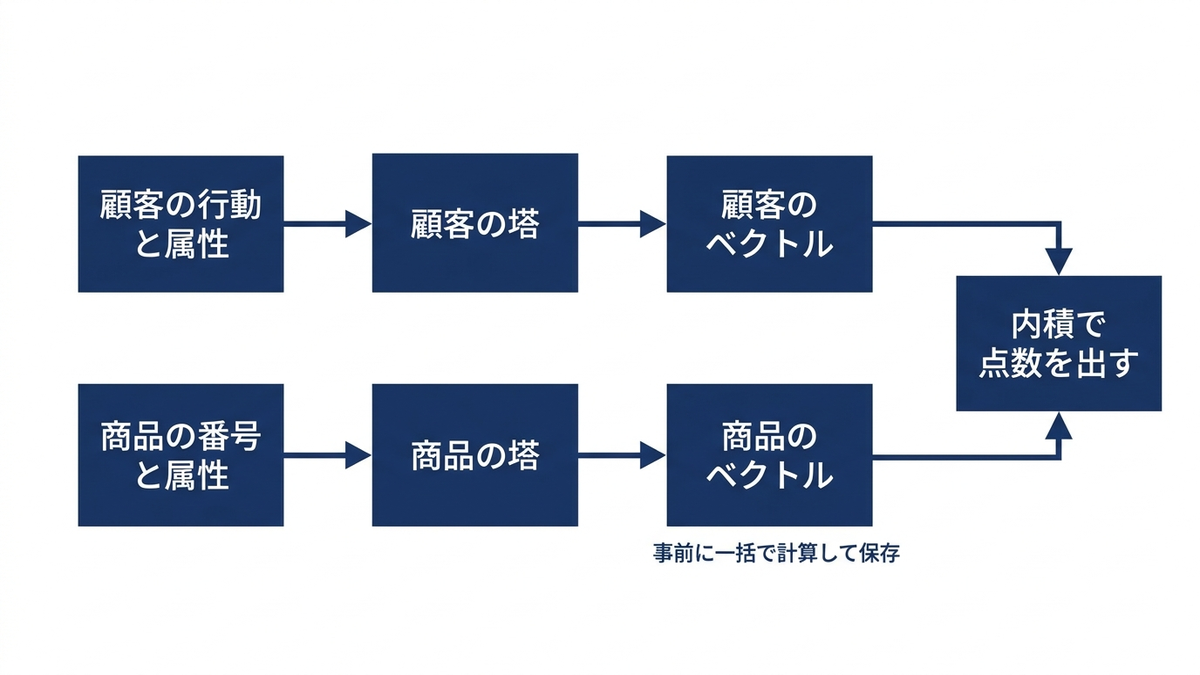
深層学習が向く条件と向かない条件
ここまでの論文と架空データの結果を踏まえて、深層学習の推薦が向く条件と向かない条件を、次の表に整理しました。表は本コラムが考えた整理で、条件がそろえば必ず深層学習が勝つ、という意味ではありません。どの条件でも、最後は基準の方法との比較で決めることになります。
| 観点 | 深層学習が向きやすい条件 | 深層学習が向きにくい条件 | 確かめ方 |
|---|---|---|---|
| データの量 | 顧客と行動の記録が多く、1つの商品あたりの履歴も十分にある | サービスを始めたばかり、顧客が少ない、商品の入れ替わりが激しい | 学習に使うデータを減らして、基準の方法と成績を比べる(この章の後半の比較) |
| 商品の数 | 全商品の点数を毎回計算すると、推薦を出すまでの時間が許容範囲に収まらない | 全商品の点数を毎回計算しても、推薦を出すまでの時間が許容範囲に収まる | 推薦の候補を出すのに要る計算の時間を測る(第12章)。何点からを多いとみなすかの基準は、推薦の枠で許される応答の時間から自社で決める |
| 使える特徴 | 属性・説明文・画像・文脈(時刻・端末)など多様で、推薦に効きそうなものが多い | 顧客と商品の番号と行動の記録しかない | 特徴を足したモデルと足さないモデルを比べる |
| 順番の意味 | 直前の行動が次を強く左右する(シリーズもの・本体と付属品・セッション中の回遊) | 順番にほとんど意味が無い(日用品のまとめ買いなど) | 直前の商品の数え上げとアイテムベースの差を、初めの見当をつける手がかりとして測る。必要なら同じモデルで履歴の順番を入れ替えて比べる |
| 運用の体制 | モデルの学習・監視・再学習を担える人と計算の環境がある | 担当者が少なく、計算の環境も限られる | 再学習の頻度と、障害のときの代わりの推薦を決められるか(第12章) |
| 説明の必要 | 推薦の理由の説明があまり求められない枠 | 「この商品を見た人は」のように理由を示したい枠、説明が求められる業種 | 推薦の枠ごとに、理由の表示が要るかを決める(第14章) |
表の6つの観点のうち、最初に確かめるべきなのはデータの量と順番の意味だと考えています。この2つは、深層学習を使わずに、数え上げとアイテムベースの比較や、データを減らした比較で、安く見当をつけられるからです。商品の数と使える特徴は、2つの塔のモデルのような構成が要るかどうかを決め、運用の体制と説明の必要は、作ったモデルを使い続けられるかどうかを決めます。
説明の必要については、補足しておきます。第4章のアイテムベースは「この商品と一緒によく見られている」という理由をそのまま示せますが、深層学習のモデルの点数は、埋め込みの内積や GRU の内部の状態から出てくるので、なぜその商品の点数が高いのかを言葉で示すのは難しくなります。推薦の枠によっては、理由が示せないことが顧客の不信感につながる場合があると考えられます(本コラムでは測っていません)。推薦の理由の表示と規制の関係は第14章、説明の手法の詳細は弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』で扱っています。深層学習の実装の一般論は、弊社コラム『Python実務で必ず使うディープラーニングレシピ100選』で扱っています。
経営の判断、基準に勝てるかを確かめてから複雑にする
この章の内容を、経営の判断に置き換えます。深層学習の推薦について経営が決めるべきことは、「深層学習を使うかどうか」ではなく、「何に対して、どれだけ勝てば、複雑にする価値があるとみなすか」だと考えています。深層学習のモデルは、開発の手間、計算の環境、学習と監視と再学習を担う人、推薦の理由を説明しにくくなることへの対応を必要とします。これらを負担してでも複雑にするかどうかは、人気順・アイテムベース・単純な数え上げといった基準に対して、どれだけの上積みがあるかで判断すべきです。そして、その上積みが本当に事業の成果につながるかは、オフラインの再現率ではなく、第9章で扱うオンライン評価で、実際の顧客の行動の差として確かめる必要があります。このとき、深層学習の推薦と従来の推薦(基準の方法)を比べた差は「方式を替えた効果(従来の推薦と比べた差)」であり、推薦が無い場合と比べた推薦の効果とは別のものです。どちらを測るのかを、比べる相手と一緒に決めておきます。
深層学習の推薦の判断を誤ったときの損失を、序章で整理した6つの損失の型(機会損失・効果の過大評価・品揃えの偏り・顧客の離反・形骸化・二重投資)に当てはめると次のようになります。
| 判断の誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 基準の方法を作らずに深層学習から入る | 形骸化(基準に負けていても気づかないまま、効果が測られずに運用が続く)、機会損失(基準より当たらない推薦を出し、買われたはずの商品が見えなくなる) | 人気順・アイテムベース・数え上げの基準を先に作り、同じ評価で比べる |
| ベンダーや担当者の示す比較を、基準の調整を確かめずに受け入れる | 効果の過大評価(調整の甘い基準に勝っただけの成績を本当の上積みと思い込む) | 基準の側の設定をどう選んだかを報告させる。同じデータ・同じ評価の切り方で比べ直す |
| データが少ない段階で深層学習に切り替える | 機会損失(単純な方法より当たらない推薦を出し、買われたはずの商品が見えなくなる) | データを減らした比較で、基準を上回る規模を確かめてから切り替える |
| オフラインの再現率の上積みだけで本番に入れる | 効果の過大評価(過去のログで当たった分を、本番で増える行動と取り違える) | オンライン評価で、従来の推薦と比べた差を確かめる(第9章) |
| 理由を示せない推薦を、理由の表示が求められる枠に入れる | 顧客の離反(なぜ勧められたか分かりにくい推薦が続き、顧客の信頼を失う) | 枠ごとに理由の表示の要否を決め、要る枠ではアイテムベースなど理由を示せる方法を残す |
| チャネルや部署ごとに別々の深層学習のモデルを作る | 二重投資(同じ学習の仕組みを何度も作り、保守する) | 埋め込みや学習の仕組みを共通にし、枠ごとの違いは並べ替えと業務ルールで出す(第12章)。推薦が人気商品に偏っていないかは、作り方とは別に、モデルごとに測る(第11章) |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 深層学習の推薦を検討するときは、人気順・アイテムベース・単純な数え上げなどの基準を先に作り、同じデータ・同じ評価の切り方で比べた結果を判断の材料にする
- 複雑にする条件を、「基準に対してオフラインの指標でどれだけ上回り、オンライン評価で従来の推薦と比べた差がどれだけ確かめられたら切り替える」という形で、開発を始める前に決めておく
- データが増えるにつれて基準との比較を定期的にやり直す計画を立て、比較の結果を予算の見直しの時期に合わせて報告させる
- 深層学習のモデルを入れる場合も、障害や成績の悪化のときに切り替える代わりの推薦(人気順など)を残しておく
- 理由の表示が要る推薦の枠と要らない枠を分け、要る枠に理由を示しにくいモデルを入れるかどうかを、事業責任者と法務を交えて判断する
予算と体制の面では、深層学習の推薦は、モデルを作るときより、作ったあとに学習・監視・再学習を続ける費用と人の手間が大きくなることが多いと考えられます(本コラムでは測っていません)。開発の予算だけで判断せず、運用を続ける体制を最初から見込んでおく必要があります。監視と再学習の設計は第12章、MLOps の一般論は弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。
この章のまとめ
この章では、深層学習による推薦として、顧客や商品をベクトルで表す埋め込み、顧客の塔と商品の塔に分けて大規模な商品の集合から候補を取り出しやすくする2つの塔のモデル、閲覧の順番から次を予測する系列推薦を扱いました。ニューラル協調フィルタリングの再検証では、丁寧に調整した内積が多層パーセプトロンを上回ったと報告されており、深層学習だから勝つわけではありません。本コラムの架空の閲覧の系列(顧客3,000人・商品300点)では、1つの乱数の種での結果ですが、順番を使わない2つの塔のモデルの再現率@10(0.3190)はアイテムベース(0.3150)とほぼ同じで、順番を使う系列のモデル(0.6303)は深層学習を使わない直前の商品の数え上げ(0.6247)をわずかに上回るだけでした。学習に使う顧客を100人・300人に減らすと、数え上げが系列のモデルを0.10以上上回りました。深層学習は、基準の方法を先に作り、それに勝てることを自社のデータで確かめてから入れるものだと考えています。次の第8章では、ここで使った再現率@10を含むオフライン評価の指標と、評価データの切り方を扱います。
この章を深めたい方への参考書籍
『深層学習 改訂第2版』(岡谷貴之 著、講談社):機械学習プロフェッショナルシリーズの1冊で、版元の目次によれば、ネットワークの基本構造と学習の方法から始めて、系列データのためのネットワークの章と、集合・グラフのためのネットワークと注意機構の章を設けています。この章で使った GRU のような回帰型のネットワークと、SASRec や BERT4Rec の土台になる注意機構の仕組みを、推薦に限らない深層学習の側から確かめるのに向いています。データが少ない場合の学習の章もあり、この章の架空データの条件で、学習に使う顧客が少ないときに深層学習のモデルが単純な数え上げを下回った結果を考える手がかりになります。
『ゼロから作るDeep Learning 2 自然言語処理編』(斎藤康毅 著、オライリー・ジャパン):版元の目次によれば、単語をベクトルで表す word2vec の章、回帰型ニューラルネットワーク(RNN)とゲート付き RNN の章、注意機構(Attention)の章があり、付録で GRU を扱っています。文章の単語の並びを扱うための仕組みですが、単語を商品に、文章を閲覧の系列に置き換えると、この章の埋め込みと系列推薦の考え方にそのままつながります。ライブラリに頼らず仕組みを自分で組み立てながら学ぶ構成なので、深層学習のモデルが中で何をしているかを理解したい方に向いています。
第8章 オフライン評価、適合率・再現率・NDCGと評価データの切り方
第3章から第7章では、人気順とルール、協調フィルタリング、行列分解、内容ベースとハイブリッド、深層学習と、推薦の作り方を順に見てきました。各章では「後の期間の購買をどれだけ当てたか」で方式を比べてきましたが、その比べ方そのものの決まりごとは、簡単に触れるだけにしていました。この章では、過去のログを使って推薦の良し悪しを測るオフライン評価を、指標と評価データの切り方の両面から扱います。
この章で扱うのは次の内容です。後半は、架空の購買ログ(顧客3,000人・商品400点・180日)を使い、実行したコードと結果で確かめます。
- オフライン評価で分かること、分からないこと
- 適合率@K・再現率@K・ヒット率・MAP・NDCG・MRR が何を測り、どこで外れるか
- 評価データの3つの切り方(無作為に切る・顧客ごとに最後の購買を残す・時間で切る)と、将来の情報の漏れ
- 負例(顧客が買っていない商品)を一部だけ使うサンプリングした評価の問題
- 精度以外の指標(網羅率・多様性・新規性)の入口
- オフラインの成績とオンラインの成果が一致しない理由と、経営の判断
この章の主張は、評価データを時間で切らない評価は、将来の情報を学習に漏らし、方式の順位まで入れ替えてしまうことがある、という点です。商品の人気が時間とともに移るように作った本コラムの架空データでは、無作為に切った評価で1位だったアイテムベースの推薦が、時間で切った評価では、単純な「最近30日の人気順」に負けました。もう1つの主張は、オフラインの指標は方式の候補を絞るための道具であり、推薦を入れるかどうかの最終の判断には使わない、ということです。最終の判断に使う推薦の効果の測り方は、第9章で扱います。
オフライン評価の役割と限界、過去のログは過去の推薦の影響を受けている
オフライン評価は、過去のログを学習用と評価用に分け、学習用のログだけで作った推薦が、評価用のログにある実際の行動(購買・クリックなど)をどれだけ当てたかを測る方法です。実際の顧客に推薦を出さずに済むので、何十通りもの方式や設定を、短い時間で、顧客に迷惑をかけずに比べられます。第3章から第7章で、人気順・アイテムベース・行列分解などを比べたのも、すべてこの方法でした。方式の候補を絞り込む段階では、オフライン評価に代わる手段はほとんどありません。
一方で、オフライン評価には構造的な限界があります。1つ目は、過去のログが、過去の推薦や売場の並べ方の影響を受けていることです。第2章で扱ったとおり、表示されなかった商品は選ばれようがありません。過去にトップページで目立つ位置に出ていた商品は、ログの中で購買が多くなり、その商品を推薦する方式はオフライン評価で有利になります。2つ目は、ログにあるのは「推薦が無い状態で(あるいは以前の推薦のもとで)顧客が実際に買ったもの」だという点です。オフライン評価で「当たった」商品は、新しい推薦を出さなくても買われた商品かもしれません。新しい推薦が、顧客が自分では見つけなかった商品を見つけさせたかどうかは、過去のログの購買に推薦が当たったかを照らし合わせるだけの評価では測れません。
2つ目の点は、序章と全体の地図で定義した「推薦の効果」と直接つながります。本コラムでは、推薦の効果を「推薦が無かった場合と比べて増えた行動」と定義しました。オフライン評価が測っているのは、後の行動を当てる力であって、推薦が無かった場合との差ではありません。オフラインの適合率が高い推薦は、顧客がどうせ買う商品を先回りして並べているだけ、ということもありえます。その推薦の「当たり」を推薦の効果として数えると、6つの損失の型のうちの効果の過大評価になります。オフライン評価の数字は、方式の候補を比べる材料として使い、効果の大きさとしては報告しないことが必要です。
3つ目は、評価のしかたの選び方しだいで結果が変わることです。どの指標を使うか、上位何件(K)までを見るか、評価用のログをどう切り出すか、正解をどう決めるか(購買だけか、クリックも含めるか)で、方式の順位が変わることがあります。この章の後半のコードで、評価データの切り方だけを変えると方式の順位が入れ替わることを示します。オフライン評価の数字を受け取ったら、その数字の大きさより先に、評価のしかたを確かめる必要があります。
推薦の指標、適合率@K・再現率@K・ヒット率・MAP・NDCG・MRR
推薦の結果は、顧客ごとに上位から並べた商品の一覧です。推薦の枠には決まった数(例えば10点)しか並べられないので、指標も「上位K件の中に、評価期間に実際に買われた商品(以下、正解)がどれだけ入ったか」を数えるのが基本です。指標の名前に付く「@10」は、上位10件で数えたという意味です。ここでは、よく使われる6つの指標を、式と言葉の両方で整理します。式の中の \(K\) は見る件数、\(T_u\) は顧客 \(u\) の正解の商品の集まり、\(|T_u|\) はその数、\(\mathrm{rel}_k\) は上から \(k\) 番目の推薦が正解なら1、そうでなければ0を表します。
適合率@K は、上位K件のうち正解だった割合で、\(\frac{1}{K}\sum_{k=1}^{K}\mathrm{rel}_k\) です。言い換えると、推薦の枠に並べた10点のうち、何点が実際に買われたかです。再現率@Kは、正解のうち上位K件に入った割合で、分母が \(|T_u|\) になります。顧客が評価期間に買った商品のうち、何割を推薦の枠で拾えたかを表します。正解が1点しかない顧客では、再現率@K は「当たったか、外れたか」の1か0になり、これはヒット率@K(上位K件に正解が1点でも入っていれば1とする指標)と同じになります。
本コラムでは、この章の定義を次のように固定します。どの指標も、顧客ごとに計算してから、評価の対象の顧客で平均します(全顧客の当たりの数を合算してから割るのではありません)。正解は、評価用のログでその顧客が買った商品で、学習用のログで買った商品は推薦の候補から外します。他の章では、説明の目的に合わせて、全顧客の合算で数える(第6章)など別の計算をしている場合があり、その場合はその章で計算の仕方を明記しています。
上の3つは、上位K件の中の順番を区別しません。1位で当てても10位で当てても同じ1点です。実際の推薦の枠では、上の位置ほど見られやすいことが多いので、順番を考える指標も使います。MRR(平均逆順位)は、最初に正解が現れた順位の逆数を顧客ごとに出して平均したもので、1位で当てれば1、2位なら0.5、10位なら0.1です。MAP(平均適合率の平均)は、まず顧客ごとに、正解が現れた位置ごとの「そこまでの適合率」を足し、正解の数で割ります。正解の数がKより多い顧客はKで割り、こうして出した値を顧客で平均したものが MAP です。
NDCG(正規化割引累積利得)は、正解の商品に、順位が下がるほど小さくなる重みを掛けて足し合わせ(割引累積利得、DCG)、それを「正解を上から全部並べた理想の並び」で計算した値(IDCG)で割ったものです。式で書くと \(\mathrm{DCG@K}=\sum_{k=1}^{K}\frac{\mathrm{rel}_k}{\log_2(k+1)}\)、\(\mathrm{NDCG@K}=\mathrm{DCG@K}/\mathrm{IDCG@K}\) です。言葉で言えば、「正解を上の方に並べているほど高く、理想の並びなら1になる指標」です。累積利得とその割引・正規化の考え方は、Järvelin と Kekäläinen の2002年の論文(ACM Transactions on Information Systems 誌の第20巻第4号)で、検索の結果の評価のために提案されたもので、この論文は関連の強さを段階で付けた評価(例えば「とても関連する」「やや関連する」)を扱えるように作られています。推薦では、購買を1、閲覧だけを0.5のように行動の重みを段階にして使うこともできます。
6つの指標を次の表にまとめました。
| 指標 | 言葉で言い換えると | 順番を区別するか | 外れやすい場面 | 使いどころ |
|---|---|---|---|---|
| 適合率@K | 並べたK点のうち、実際に買われた割合 | しない | 正解の少ない顧客では上限が低い(正解1点ならK=10で最大0.1) | 枠の中の「無駄打ち」の少なさを見る |
| 再現率@K | 買われた商品のうち、K点の中で拾えた割合 | しない | 正解の数がKより多い顧客では、全部の枠で当てても上限が \(K/|T_u|\) になり1に届かない | 顧客の関心をどれだけ取りこぼしていないかを見る |
| ヒット率@K | K点の中に1点でも当たりがあった顧客の割合 | しない | 2点目以降の当たりを数えない | 正解が1点の評価(最後の購買を残す評価など) |
| MAP@K | 当たりが出た位置ごとの適合率の平均を、さらに顧客で平均した値 | する | 値の意味を直観的に説明しにくい | 複数の正解を上位に集められているかを見る |
| MRR@K | 最初の当たりの順位の逆数の平均 | する(最初の当たりだけ) | 2点目以降の当たりを見ない | 複数の候補の中で、最初の当たりをどれだけ早く見つけられるかを見る |
| NDCG@K | 当たりを上に並べているほど高く、理想の並びで1になる値 | する | 割引のかけ方(対数)が実際の枠の見られ方と合うとは限らない | 上の位置ほど見られる枠。行動の重みを段階で付けたいとき |
どの指標を使うかは、推薦の枠の形で決めるのがよいと考えています。商品ページの下に10点を横に並べる枠なら、10点のどこで当てても見られる可能性があるので、再現率@10 やヒット率@10 が合います。スマートフォンの画面で上から1点ずつ縦に並び、下の方はほとんど見られない枠なら、順番を区別する NDCG や MRR が合います。通知やメールの件名のように1点しか見せない枠なら、上位1件だけを見るヒット率@1(1位が当たったかどうか)が合います。MRR@10 は2位以下の当たりにも点を与えるので、1点しか見せない枠の評価には向きません。指標を1つに絞る必要はありませんが、方式を選ぶときに主に見る指標を1つ、事前に決めておかないと、都合の良い指標を後から選ぶことになります。
もう1つ、K の値も枠に合わせて決めます。枠に6点しか並ばないのに @20 で評価すると、実際には表示されない7位から20位の当たりまで成績に入ります。本コラムでは、第3章から第7章でも @10 を使い、指標の読み方を章のあいだで揃えました。ただし、章ごとに別の架空データを使っているので、方式の成績を比べるのは同じデータ・同じ評価の手順の中だけで、章をまたいで数値を比べることはできません。
評価データの3つの切り方と、時間で切らないと将来の情報が漏れる理由
指標と同じくらい結果を左右するのが、ログを学習用と評価用にどう切り分けるかです。よく使われる切り方は、次の3つです。
- 無作為に切る:全部の購買から2割を無作為に抜き出して評価用にし、残りの8割で推薦を作ります。機械学習の一般的な評価の習慣に近く手軽ですが、評価用の購買と同じ日やそれより後の日の購買が、学習用に大量に残ります。
- 顧客ごとに最後の購買を残す:顧客ごとに最後の購買を1件だけ評価用にします(英語の研究では leave-one-out と呼ばれることがあります)。顧客1人ずつについて見れば「過去から次の1件を当てる」形ですが、顧客Aの最後の購買の日より後に起きた、別の顧客Bの購買は学習用に入ります。
- 時間で切る:ある日付で全体を切り、その日より前を学習用、後を評価用にします。
本コラムでは、3つ目を時間で切る評価と呼びます。本番の推薦は、その時点までのログで作り、それより後の顧客の行動に対して出すので、時間で切る評価が本番の使い方に最も近い形です。
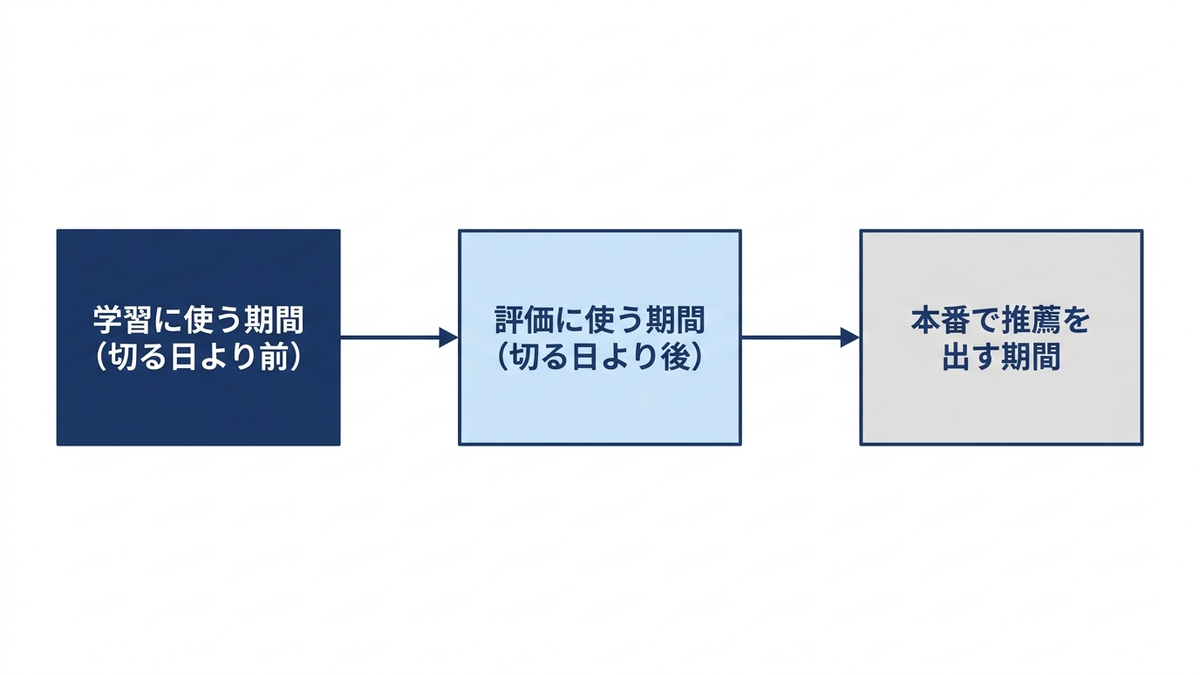
無作為に切る評価と、最後の購買を残す評価で問題になるのが、将来の情報の漏れです。ここでいう漏れとは、評価の時点では手に入らないはずの情報(評価用の購買より後に起きた行動)が、学習用のログに入り込むことです。漏れがあると、推薦は「将来どの商品が売れるか」を一部知った状態で作られるので、評価の値や方式の順位がゆがみ、本番の性能を見誤る原因になります。ゆがみの向きは一定ではなく、成績が良く出る方式もあれば、後のコードの結果のように、切り方によっては成績が下がる方式もあります。とくに、商品の人気が時間とともに移り変わる場合(新商品の発売・季節・流行)には、将来の人気を知っているかどうかで成績が大きく変わります。
この問題は研究でも指摘されています。Ji らの論文(ACM Transactions on Information Systems 誌、2023年、第41巻第3号、論文番号75。arXiv では2020年10月に初版、2022年10月に第4版を公開)は、学習用と評価用の分け方が全体の時間軸を無視していると、予測の時点では手に入らないはずの行動からモデルが学んでしまう、と論じています。この章に関わる結論を要約すると、将来のデータが学習に入ると精度は上がる場合も下がる場合もあり、モデルどうしの優劣の順が予測できない形で変わる、というものです。この結論は、その論文が使った公開データセットとモデルの条件のもとでのものです。
3つの切り方の性質を、次の表にまとめます。
| 切り方 | 評価用にするもの | 将来の情報の漏れ | 向いている用途 | 注意点 |
|---|---|---|---|---|
| 無作為に切る | 全購買から無作為に選んだ一部(例えば2割) | 大きい。評価用の購買と同じ時期・後の時期の購買が学習に入る | 時間の影響が小さいと確かめられた場合の、手早い比較 | 人気が移る商品では、将来の人気を知った成績になる |
| 顧客ごとに最後の購買を残す | 各顧客の最後の1件 | ある。他の顧客の、より後の購買が学習に入る | 顧客ごとに「次の1件」を当てる系列の推薦の比較 | 正解が1件なので、適合率の上限が低く、再現率とヒット率が同じになる |
| 時間で切る | ある日付より後のすべての購買 | 無い(切る日より前のログだけで学習する) | 本番の推薦の成績の見積もり。方式を選ぶ最終段のオフライン評価 | 切る日によって結果が変わる。評価期間に新しく現れた顧客・商品は扱いが別になる(第10章) |
架空の購買ログを作る、時間とともに人気が移る
ここからは、3つの切り方で評価の結果がどう変わるかを、コードで確かめます。この章のデータは、他の章とは独立に作った架空の合成データで、実際の購買ログよりずっと単純です。顧客3,000人・商品400点・180日分の購買を、次の4つの性質を持たせて乱数で作りました。
- 顧客ごとのジャンルの好み:商品を8つのジャンルに分け、顧客ごとに好むジャンルの偏りを持たせる
- 商品の人気の偏り:商品ごとに人気の大きさを対数正規分布(大半は小さな値で、ごく一部だけが非常に大きな値になる分布)から取り、少数の商品に購買が集まるようにする
- 時間とともに人気が移る:商品ごとに「人気が最も高くなる日」と「人気が続く長さ」を持たせ、その日を中心に人気が上がって下がる形にする
- 購買の回数:顧客ごとに180日間の購買の回数を変え(2回から80回)、同じ商品は買い直さない
購買の1件ごとに、その日の商品の人気と、顧客のジャンルの好みを掛け合わせた重みで、買う商品を1点選んでいます。
import numpy as np
import pandas as pd
import scipy.sparse as sp

rng = np.random.default_rng(20261110)
N_USER, N_ITEM, N_GENRE, DAYS = 3000, 400, 8, 180
genre = rng.integers(0, N_GENRE, N_ITEM)                  # 商品のジャンル
base = rng.lognormal(0.0, 1.0, N_ITEM)                    # 商品ごとの人気の偏り
peak = rng.uniform(-60, DAYS + 30, N_ITEM)                # 人気が最も高くなる日
width = rng.uniform(20, 45, N_ITEM)                       # 人気が続く長さ(日)
t = np.arange(DAYS)[:, None]
pop = base * np.exp(-0.5 * ((t - peak) / width) ** 2)     # 日ごとの商品の人気(180日×400点)
pref = rng.dirichlet(np.full(N_GENRE, 0.3), N_USER)       # 顧客ごとのジャンルの好み
n_buy = np.clip(rng.poisson(rng.lognormal(2.3, 0.6, N_USER)), 2, 80)

rows = []
for u in range(N_USER):
    owned = []
    for d in np.sort(rng.integers(0, DAYS, n_buy[u])):    # 購買の日付
        w = pop[d] * pref[u, genre]
        w[owned] = 0                                      # 同じ商品は買い直さない
        i = int(rng.choice(N_ITEM, p=w / w.sum()))
        owned.append(i)
        rows.append((u, i, int(d)))
log = pd.DataFrame(rows, columns=["user", "item", "day"])
print("購買", len(log), "件/顧客", log.user.nunique(), "人/商品", log.item.nunique(), "点")
print("顧客×商品の行列の密度", round(len(log) / (N_USER * N_ITEM), 4))
first = log[log.day < 150].item.value_counts().index[:10]
recent = log[(log.day >= 120) & (log.day < 150)].item.value_counts().index[:10]
late = log[log.day >= 150]
print("最後の30日の購買のうち、0〜149日目の人気上位10点が占める割合", round(late.item.isin(first).mean(), 3))
print("最後の30日の購買のうち、120〜149日目の人気上位10点が占める割合", round(late.item.isin(recent).mean(), 3))
# 出力:
# 購買 35089 件/顧客 3000 人/商品 394 点
# 顧客×商品の行列の密度 0.0292
# 最後の30日の購買のうち、0〜149日目の人気上位10点が占める割合 0.017
# 最後の30日の購買のうち、120〜149日目の人気上位10点が占める割合 0.176
実行した結果、購買は35,089件、購買のあった商品は400点のうち394点で、顧客×商品の行列の密度(全部の組み合わせのうち購買があった組の割合)は0.0292でした。コードの最後の2行は、人気が移っていることを確かめるための計算です。最後の30日(150〜179日目)の購買のうち、0〜149日目の期間全体で人気上位だった10点が占める割合は0.017(1.7%)しかありませんでした。一方、直前の30日(120〜149日目)の人気上位10点は、最後の30日の購買の0.176(17.6%)を占めました。この架空データでは、長い期間の人気より、直前の人気の方が、次の期間の購買をよく表しています。
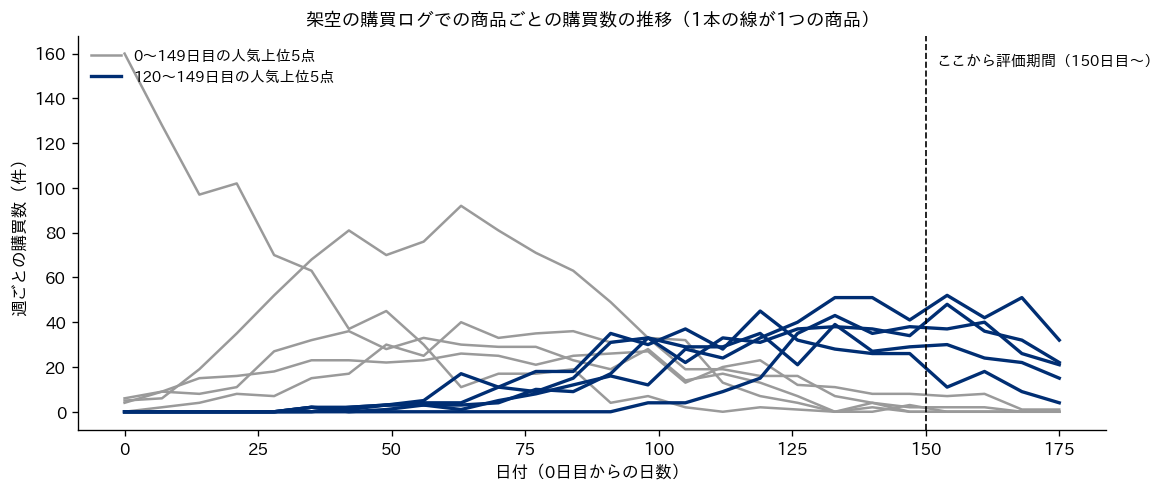
上の図は、商品ごとの週ごとの購買数の推移です。灰色の線は0〜149日目の期間全体で人気上位だった5点、ネイビーの線は120〜149日目の人気上位5点(灰色の5点と重なるものを除く)です。灰色の商品の多くは期間の前半に人気の山があり、評価期間(150日目以降、点線より右)にはほとんど買われていません。ネイビーの商品は100日目前後から伸び、評価期間にも買われ続けています。なお、最後の点は179日目までの5日分なので、他の週より少なく出ています。
3つの切り方と3つの推薦を、同じ指標で比べる
次に、3つの切り方と、比べる3つの推薦を用意します。無作為に切る方法は購買の2割を評価用にし、時間で切る方法は150日目で切りました(0〜149日目が学習用、150〜179日目が評価用)。推薦は、第3章で扱った人気順(学習用のログ全体の購買数の順)と最近30日の人気順(学習用のログの最後の30日の購買数の順)、第4章で扱ったアイテムベースの協調フィルタリング(顧客が買った商品とのコサイン類似度の合計の順)の3つです。各方式の中身の詳細は、それぞれの章を参照してください。
def split_random(log, frac=0.2, seed=1):                  # 購買1件ごとに無作為に2割を評価へ
    m = np.random.default_rng(seed).random(len(log)) < frac
    return log[~m], log[m]

def split_last(log):                                      # 顧客ごとに最後の1件を評価へ
    test = log.groupby("user").tail(1)
    return log.drop(test.index), test

def split_time(log, cut=150):                             # 150日目より前で学習、後で評価
    return log[log.day < cut], log[log.day >= cut]

def to_matrix(df):
    return sp.csr_matrix((np.ones(len(df)), (df.user, df.item)), shape=(N_USER, N_ITEM))
def rec_popular(train):                                   # 学習データ全体の人気順
    c = np.bincount(train.item, minlength=N_ITEM).astype(float)
    return np.tile(c, (N_USER, 1))

def rec_recent(train, span=30):                           # 学習データの最後の30日の人気順
    r = train[train.day > train.day.max() - span]
    c = np.bincount(r.item, minlength=N_ITEM).astype(float)
    return np.tile(c, (N_USER, 1))

def rec_itemcf(train):                                    # アイテムベース(コサイン類似度)
    X = to_matrix(train)
    cnt = np.asarray(X.sum(axis=0)).ravel()
    S = (X.T @ X).toarray() / (np.sqrt(np.outer(cnt, cnt)) + 1e-9)
    np.fill_diagonal(S, 0)
    return np.asarray(X @ S)
指標の計算では、学習用のログで買った商品を推薦の候補から外したうえで上位10点を選び、6つの指標を顧客ごとに出して平均します。評価の対象は、学習用のログに購買の履歴があり、評価用のログに正解がある顧客です。あわせて、評価の対象の顧客の上位10点に1回でも現れた商品の数を商品の総数で割った網羅率も出しています。
def evaluate(score, train, test, K=10):
    score = score.copy()
    score[to_matrix(train).nonzero()] = -np.inf           # 学習期間に買った商品は推薦しない
    has_hist = np.bincount(train.user, minlength=N_USER) > 0
    truth = test[has_hist[test.user]].groupby("user").item.apply(set)
    users = truth.index.to_numpy()
    top = np.argsort(-score[users], axis=1, kind="stable")[:, :K]
    disc = 1 / np.log2(np.arange(2, K + 2))               # 順位ごとの割引
    res = []
    for u, rec in zip(users, top):
        T = truth[u]
        hit = np.array([i in T for i in rec], dtype=float)
        n_rel = min(len(T), K)
        ap = (np.cumsum(hit) / np.arange(1, K + 1) * hit).sum() / n_rel
        mrr = 1 / (np.argmax(hit) + 1) if hit.any() else 0.0
        res.append([hit.sum() / K, hit.sum() / len(T), float(hit.any()),
                    ap, mrr, (hit * disc).sum() / disc[:n_rel].sum()])
    out = pd.DataFrame(res, columns=["適合率@10", "再現率@10", "ヒット率@10", "MAP@10", "MRR@10", "NDCG@10"]).mean()
    out["評価した顧客"] = len(users)
    out["網羅率"] = len(np.unique(top)) / N_ITEM
    return out
splits = {"無作為": split_random(log), "最後の1件": split_last(log), "時間": split_time(log)}
recs = {"人気順": rec_popular, "最近30日の人気順": rec_recent, "アイテムベース": rec_itemcf}
table = []
for sname, (train, test) in splits.items():
    for rname, f in recs.items():
        r = evaluate(f(train), train, test)
        table.append({"切り方": sname, "推薦": rname, **r.round(4).to_dict()})
table = pd.DataFrame(table)
pd.set_option("display.width", 200)
print(table.to_string(index=False))
tr, te = splits["時間"]
hh = np.bincount(tr.user, minlength=N_USER) > 0
print("時間で切った評価:評価期間に購買のあった顧客", te.user.nunique(), "人/学習期間に履歴が無く外した顧客",
      int((~hh[te.user.unique()]).sum()), "人")
print("評価期間に買われ、学習期間には一度も買われていない商品", len(set(te.item) - set(tr.item)), "点(外していない)")
# 出力(切り方ごとの9行の表は本文の表に転記した。末尾の2行は次のとおり):
# 時間で切った評価:評価期間に購買のあった顧客 2324 人/学習期間に履歴が無く外した顧客 3 人
# 評価期間に買われ、学習期間には一度も買われていない商品 3 点(外していない)
実行した結果を、次の表にまとめます。直前のコードの最後の2つの print は、時間で切った評価で評価の対象から外した顧客の数と、学習期間に一度も買われていない商品の数を出すもので、その結果はこの節の後半で使います。
| 切り方 | 推薦 | 評価した顧客 | 適合率@10 | 再現率@10 | ヒット率@10 | MAP@10 | MRR@10 | NDCG@10 | 網羅率 |
|---|---|---|---|---|---|---|---|---|---|
| 無作為 | 人気順 | 2,448 | 0.0449 | 0.1614 | 0.3619 | 0.0691 | 0.1615 | 0.1156 | 0.0525 |
| 無作為 | 最近30日の人気順 | 2,448 | 0.0257 | 0.0872 | 0.2267 | 0.0360 | 0.0946 | 0.0630 | 0.0450 |
| 無作為 | アイテムベース | 2,448 | 0.0886 | 0.2958 | 0.5523 | 0.1406 | 0.2923 | 0.2199 | 0.5650 |
| 最後の1件 | 人気順 | 3,000 | 0.0120 | 0.1197 | 0.1197 | 0.0293 | 0.0293 | 0.0500 | 0.0625 |
| 最後の1件 | 最近30日の人気順 | 3,000 | 0.0228 | 0.2280 | 0.2280 | 0.0825 | 0.0825 | 0.1159 | 0.0525 |
| 最後の1件 | アイテムベース | 3,000 | 0.0252 | 0.2517 | 0.2517 | 0.0964 | 0.0964 | 0.1323 | 0.5900 |
| 時間 | 人気順 | 2,321 | 0.0163 | 0.0652 | 0.1504 | 0.0095 | 0.0215 | 0.0273 | 0.0600 |
| 時間 | 最近30日の人気順 | 2,321 | 0.0466 | 0.1955 | 0.3891 | 0.0816 | 0.1739 | 0.1330 | 0.0500 |
| 時間 | アイテムベース | 2,321 | 0.0396 | 0.1625 | 0.3266 | 0.0602 | 0.1228 | 0.1027 | 0.5250 |
表から、3つのことが読み取れます。1つ目は、切り方によって方式の順位が入れ替わったことです。NDCG@10 で見ると、無作為に切った評価ではアイテムベース(0.2199)、人気順(0.1156)、最近30日の人気順(0.0630)の順でした。顧客ごとに最後の1件を残した評価では、アイテムベース(0.1323)、最近30日の人気順(0.1159)、人気順(0.0500)の順でした。時間で切った評価では、最近30日の人気順(0.1330)、アイテムベース(0.1027)、人気順(0.0273)の順になり、1位が入れ替わりました。無作為に切った評価だけを見て方式を選んでいれば、この架空データでは、本番に近い条件で劣る方式を選んでいたことになります。なお、このデータは商品の人気が時間とともに移るように作ってあるので、最近の人気順が時間で切った評価で強くなるのは、データをそう作ったことの帰結でもあります。また、表の値は1つの乱数の種で作ったデータでの結果です。
2つ目は、人気順とアイテムベースでは、無作為に切った評価の数字が高く出たことです。この2つの方式では、表の6つの精度の指標のどれでも、無作為に切った評価の値が3つの切り方の中で最も高くなりました。アイテムベースの NDCG@10 は、無作為に切った評価の0.2199に対して、時間で切った評価では0.1027で、半分以下でした。無作為に切ると、評価用の購買と同じ時期の購買が学習用に残ります。人気順はその時期の売れ筋を含む購買数で並べられ、アイテムベースはその時期に一緒に買われた商品の組を類似度に取り込めます。どちらも、時間で切った評価では手に入らない情報です。
逆に、最近30日の人気順は、無作為に切った評価では、6つの精度の指標のどれでも3つの方式の中で最も低くなりました。切り方どうしで比べると、再現率@10・ヒット率@10・MAP@10・NDCG@10 では無作為に切った評価の値が3つの切り方の中で最も低い一方、適合率@10 と MRR@10 では、顧客ごとに最後の1件を残した評価の値の方が低くなっています。無作為に切った評価で低く出るのは、評価用の購買が180日全体に散らばっているので、最後の30日の売れ筋を並べても、それより前の時期の正解を当てられないからです。
ここまでの差を読むときには注意が要ります。切り方を変えると、学習用のログだけでなく、評価期間・評価の対象の顧客(表の「評価した顧客」)・顧客1人あたりの正解の数も変わります。この比較の数値の差には、将来の情報の漏れに加えて、こうした評価の対象と正解の分布の違いも含まれているので、差の全部を漏れの大きさとして読むことはできません。
3つ目は、NDCG@10 で見ると、顧客ごとに最後の1件を残した評価の値が、3つの方式のどれでも、無作為に切った評価と時間で切った評価の値の間に入ったことです(ほかの指標ではそうならないものもあり、例えばアイテムベースのヒット率@10 は、最後の1件を残した評価の0.2517が3つの切り方の中で最も低い値です)。顧客1人ずつで見れば過去から次の1件を当てる形ですが、他の顧客の後の購買が学習に入るので、この架空データでは、アイテムベースが最近30日の人気順を上回りました(NDCG@10 で0.1323と0.1159)。また、この切り方では正解が1件だけなので、表のとおり、再現率@10 とヒット率@10 が同じ値になり、MAP@10 と MRR@10 も同じ値になり、適合率@10 はヒット率の10分の1になっています。指標が多く並んでいても、切り方によっては同じことを別の名前で数えているだけ、ということがあります。
網羅率にも違いがあります。網羅率は、評価の対象の顧客(切り方ごとに2,448人・3,000人・2,321人)の上位10点で数えているので、切り方どうしの比較では対象の人数の違いも値に影響しえます。人気順と最近30日の人気順は、評価の対象の顧客にほぼ同じ10点を並べるので、網羅率は0.045から0.0625(400点のうち18点から25点)にとどまりました。アイテムベースは、顧客ごとに違う商品を並べるので、3つの切り方で0.5250から0.5900(210点から236点)でした。時間で切った評価では、アイテムベースは精度で最近30日の人気順に負けましたが(NDCG@10 で0.1027と0.1330)、網羅率では0.5250と0.0500で、品揃えの幅をはるかに広く推薦の枠に出していることになります。精度の指標だけで方式を選ぶと、この差は見えません。網羅率と多様性は第11章で詳しく扱います。
ここでの結論は、本コラムの架空データの、この条件のもとでのものです。人気の移り方は商材によって違うので、切り方による差がどれだけ出るかも、自社のログで確かめるまでは分かりません。確かめ方は単純で、同じ方式を無作為に切った評価と時間で切った評価の両方にかけ、数字と順位がどれだけ動くかを見ればよいと考えています。
時間で切る評価にも、決めておくべきことが3つあります。
- 切る日:評価期間に大型の販促や季節の行事が入ると、その期間に特有の購買が正解になり、方式の順位がその期間の事情で決まってしまいます。切る日を2〜3通りにずらして評価し、順位が安定しているかを見るのが安全だと考えています。
- 評価期間に初めて現れた顧客と商品の扱い:学習用のログに履歴の無い顧客は、アイテムベースでは推薦を作れないので、本コラムのコードでは評価の対象から外しました(時間で切った評価では、評価期間に購買のあった2,324人のうち、学習期間に履歴の無い3人を外し、対象は2,321人です。商品は外しておらず、評価期間に買われた商品のうち学習期間に一度も買われていない3点も正解に含めています)。外した顧客への推薦はコールドスタートの問題として、第10章で扱います。
- 外した人数と点数の報告:評価の対象から何人・何点を外したかを、結果と一緒に必ず添えます。
サンプリングした評価、負例を一部だけ使うと何が起きるか
推薦の研究や製品の資料では、全商品を並べて順位を出す代わりに、正解の商品1点と、顧客が買っていない商品を無作為に選んだもの(負例)を例えば100点混ぜ、その101点の中で正解が何位に来るかで評価することがあります。商品が数百万点ある場合に、全商品の順位を出す計算を省くための工夫です。本コラムではこれをサンプリングした評価と呼びます。
この評価のしかたには問題があることが、Krichene と Rendle の2020年の論文(KDD 2020、ACM SIGKDD の第26回の国際会議の予稿集、1748〜1757ページ)で示されています。この章に関わる結論を要約すると、負例を抜き出して計算した指標では、全商品で計算した場合と方式の優劣が食い違うことがあるので、指標の計算では抜き出しを避けるべきだ、というものです(抜き出す必要がある場合の補正も、その論文で提案されています)。
この章の架空データでも、時間で切った評価で、正解の組(顧客と評価期間に買った商品の組)ごとに負例を100点抜き出し、サンプリングしたヒット率@10 と、全商品で並べたヒット率@10 を比べました。負例は、その顧客が学習期間にも評価期間にも買っていない商品から選んでいます。全商品で並べる側でも、同じ顧客が評価期間に買ったほかの正解の商品は順位の計算から外し、両側で比べる商品の集まりの条件を揃えました。こうすると、2つの値の違いは、負例を100点に絞ったことだけから生じます。
train, test = splits["時間"]
X_tr = to_matrix(train)
has_hist = np.bincount(train.user, minlength=N_USER) > 0
pairs = test[has_hist[test.user]]
bought = to_matrix(log).toarray() > 0                     # 学習・評価のどちらかで買った商品
r_neg = np.random.default_rng(7)
negs = []
for u in pairs.user:                                      # 正解1点ごとに、買っていない商品を100点抜き出す
    cand = np.flatnonzero(~bought[u])
    negs.append(r_neg.choice(cand, 100, replace=False))
negs = np.array(negs)
samp = []
for rname, f in recs.items():
    s = f(train)
    s[X_tr.nonzero()] = -np.inf
    s_pos = s[pairs.user, pairs.item]
    s_neg = s[pairs.user.to_numpy()[:, None], negs]
    rank_s = (s_neg > s_pos[:, None]).sum(axis=1)          # 101点の中での順位(0が1位)
    above = (s[pairs.user] > s_pos[:, None]) & ~bought[pairs.user]
    rank_f = above.sum(axis=1)                             # 全商品の中での順位(ほかの正解は両側とも外す)
    samp.append({"推薦": rname, "サンプリングしたヒット率@10": round((rank_s < 10).mean(), 4),
                 "全商品で並べたヒット率@10": round((rank_f < 10).mean(), 4)})
print("正解の組", len(pairs), "件")
print(pd.DataFrame(samp).to_string(index=False))
# 出力:
# 正解の組 5831 件
#        推薦  サンプリングしたヒット率@10  全商品で並べたヒット率@10
#       人気順           0.2039          0.0665
# 最近30日の人気順           0.4810          0.1909
#   アイテムベース           0.3907          0.1622
実行した結果、正解の組は5,831件で、ヒット率@10 は次のようになりました。ここでのヒット率は、正解の組1件ごとに「その正解が上位10位以内に入ったか」を数えたもので、顧客ごとに数えた前の表のヒット率とは単位が違います。また、点数が正解と同じ商品は、正解より上には数えない扱いにしています。
| 推薦 | サンプリングしたヒット率@10(101点の中) | 全商品で並べたヒット率@10 | サンプリングした値と全商品で並べた値の比 |
|---|---|---|---|
| 人気順 | 0.2039 | 0.0665 | 約3.1倍 |
| 最近30日の人気順 | 0.4810 | 0.1909 | 約2.5倍 |
| アイテムベース | 0.3907 | 0.1622 | 約2.4倍 |
この架空データでは、3つの方式の順位(最近30日の人気順、アイテムベース、人気順)は、サンプリングした評価と全商品で並べた評価で変わりませんでした。一方、値の大きさは大きく変わり、サンプリングした値は全商品で並べた値の約2.4〜3.1倍でした。方式どうしの差の見え方も変わります。全商品で並べた評価では、アイテムベースは人気順の約2.4倍(0.1622と0.0665)でしたが、サンプリングした評価では約1.9倍(0.3907と0.2039)でした。最近30日の人気順とアイテムベースの差は、全商品で並べると0.0287、サンプリングすると0.0903です。これらは1つの乱数の種(データの生成と負例の抜き出しの両方)での結果で、商品400点・負例100点という条件のもとでのものです。
この結果は、Krichene と Rendle の論文の指摘のうち、順位の入れ替わりまでは再現していません。順位が保たれるかどうかはデータと方式の組み合わせによるので、この架空データで保たれたことは、サンプリングした評価が安全だという根拠にはなりません。実務での教訓は2つあると考えています。1つは、ベンダーの資料や論文で「ヒット率@10 が0.6」のような数字を見たときに、全商品で並べた値か、負例を何点抜き出した値かを確かめることです。この架空データでは、同じ推薦でも評価のしかたで値が約2.4〜3.1倍違いました。もう1つは、自社で評価するときは、全商品で並べて計算できる規模であれば、サンプリングを使わないことです。この章のコードは商品400点のデータで、全商品で並べて計算しています。
精度以外の指標、網羅率・多様性・新規性の入口
ここまでの指標は、どれも「後の購買を当てたか」を測るものでした。しかし、後の購買を当てることだけを目指すと、推薦は売れ筋の商品に集まりやすくなります。売れ筋の商品は評価用のログに正解として多く現れるので、人気の商品を並べる方式が当たりの数で有利になる場合があるからです。個々の顧客にとっては、売れ筋でも好みに合わない商品はあります。「3つの切り方と3つの推薦を、同じ指標で比べる」の節の表で、人気順の網羅率が0.06前後にとどまったのは、その極端な例です。そこで、精度と並べて、推薦の中身の広がりを測る指標も見ます。
| 指標 | 何を測るか | この章のコードでの扱い | 詳しく扱う章 |
|---|---|---|---|
| 網羅率 | 全商品のうち、誰かの推薦の枠に1回でも出た商品の割合 | 評価の対象の顧客の上位10点に現れた商品の数を商品の総数で割った | 第11章 |
| 多様性 | 1人の顧客に並べた商品どうしがどれだけ似ていないか | 扱っていない | 第11章 |
| 新規性 | 顧客にとってなじみの薄い(人気が低い・まだ知らない)商品をどれだけ含むか | 扱っていない | 第11章 |
| 新しい商品の露出 | 発売されたばかりの商品が推薦の枠に出た回数 | 扱っていない | 第10章 |
これらの指標は、精度の指標と同じ評価の手順の中で一緒に出しておくのがよいと考えています。精度がわずかに高い方式が、網羅率では大きく劣る、ということは3つの切り方の節の表でも起きています。どちらを優先するかは、推薦の枠の目的(第1章)と品揃えの方針で決まることで、オフラインの数字が自動的に決めるものではありません。精度と多様性のつり合いの決め方は、第11章で扱います。
オフラインの成績とオンラインの成果が一致しない理由
時間で切った評価で、網羅率も確かめたうえで選んだ方式でも、実際に顧客に出したときの成果(クリック率・購買率・推薦の効果)が、オフラインの順位どおりになるとは限りません。その理由は、この章で見てきた限界を、オンラインの側から言い直したものです。主な理由を次の表に整理しました。
| 理由 | 何が起きるか | オフライン評価の側でできること |
|---|---|---|
| 過去のログが過去の推薦・売場の影響を受けている | 以前に目立つ位置に出ていた商品を推薦する方式が、オフラインで有利になる | 表示のログ(何をどこに出したか)を残し、露出の偏りを把握する(第2章) |
| 当たりと効果は別のもの | どうせ買われる商品を並べる方式が、オフラインで高い成績を取る | オフラインの数字を効果として報告しない。効果は A/Bテストで測る(第9章) |
| 推薦が顧客の行動そのものを変える | 新しい推薦で見つかった商品は、過去のログに正解として現れていない | 過去の購買との照合による評価では測れないことを前提に、候補を複数残してオンラインで比べる |
| 指標と KPI がずれている | 上位10点の当たりを増やしても、枠のクリックや購買点数が増えるとは限らない | 枠の形(見られる位置・点数)に合わせて指標と K を選ぶ |
| 将来の情報の漏れ | 無作為に切った評価の成績が、本番で出ない | 時間で切る評価を最終段の比較に使う |
| 評価期間の特殊事情 | 販促や季節の偏りで、たまたまその期間に合った方式が選ばれる | 切る日を複数ずらして順位の安定を確かめる |
この表のうち、「当たりと効果は別のもの」と「推薦が顧客の行動そのものを変える」の2つは、この章で扱った、過去のログの購買に推薦が当たったかを照らし合わせる評価では、どう工夫しても取り除けません。過去のログから新しい推薦の成果を推定する方法(オフ方策評価)は別にあり、過去の推薦の選び方の確率で重みを付ける方法(逆確率重み付け)では、過去の推薦がどの商品をどれだけの確率で出していたかの記録、または精度の良い推定が要ります。顧客の反応をモデルで予測して成果を見積もる方法もありますが、そのモデルが正確であることが前提になります。どの方法も、記録と仮定がそろって初めて使えるものです。逆確率重み付けの考え方は第9章で扱います。オフライン評価で候補を2〜3に絞り、最終の判断はオンラインで推薦が無い場合との差を測って行う、という分担が現実的だと考えています。A/Bテストを含む効果検証の基礎は、弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』で扱っています。
評価の手順を決めて残す、評価の設計書に書く項目
この章で見たとおり、オフライン評価の数字は、指標・K・切り方・評価の対象・負例の扱いによって大きく変わります。社内のデータ分析の担当者とベンダーとで、あるいは半年前の評価と今の評価とで、これらが違っていれば、数字を並べても比べたことになりません。評価の手順は、方式を作る前に文書として決めておき、すべての比較で同じ手順を使うのがよいと考えています。設計書に書く項目を次にまとめます。
- 主に見る指標を1つと、併せて見る指標(例:主は再現率@10、併せて NDCG@10 と網羅率)
- K の値と、それが推薦の枠の何点に対応するか
- 正解の定義(購買だけか、クリックやカート投入も含めるか。返品された購買を除くか)
- 切り方と切る日(時間で切る。切る日を複数ずらす場合はその日付)
- 評価の対象から外す顧客と商品(学習期間に履歴が無い顧客、評価期間の新商品など)と、その人数・点数
- 学習期間に買った商品を推薦の候補から外すかどうか
- 負例を抜き出さず全商品で並べること(抜き出すなら、その数と補正の有無)
- 比べる基準(人気順・最近の人気順。第3章)を必ず同じ手順に含めること
最後の項目は、とくに重要だと考えています。新しい方式の成績を単独で「再現率@10 が0.16」と出されても、それが良いのか悪いのかは分かりません。同じ手順で計算した人気順と最近の人気順の値が並んでいて初めて、判断の材料になります。この章の架空データでは、時間で切った評価で、アイテムベースは最近30日の人気順に負けていました。基準を並べずに評価していれば、この事実は見えなかったことになります。
経営の判断、オフラインの指標を最終の判断に使わない
この章の内容を、経営の判断に置き換えます。経営が受け取る推薦の評価の報告には、オフライン評価の数字が並ぶことがあります。そこで確かめるべきことは、数字の大きさより先に、その数字がどの手順で計算されたか、という点です。評価の判断を誤ったときの損失を、序章で整理した6つの損失の型に当てはめると、次のようになります。
| 評価での誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| オフラインの当たりの数を、推薦の効果として予算の根拠にする | 効果の過大評価 | オフラインの数字は候補の絞り込みにだけ使い、効果は A/Bテストで測る |
| 無作為に切った評価で方式を選ぶ | 機会損失(本番で劣る方式を選ぶおそれがあり、買われたはずの商品が見えなくなる) | 時間で切る評価を最終段の比較の条件にする |
| 精度の指標だけで方式を選ぶ | 品揃えの偏り(売れ筋ばかりが並ぶ) | 網羅率などを同じ報告に並べる |
| サンプリングした評価の数字を、他社や製品の数字と比べる(数字が大きく見えるまま比べ、推薦の成績を実際より高く見積もって、導入の判断の根拠にする) | 効果の過大評価 | 全商品で並べた値か、負例を何点抜き出したかを確かめる |
| 人気順などの基準を並べずに評価する | 形骸化(複雑な仕組みが入るが、単純な方式に勝っているかが分からないまま運用される) | 評価の設計書に基準を必ず含める |
| 部署やベンダーごとに別々の評価の手順を使う | 二重投資(同じ比較を手順を変えて何度も行い、結果を突き合わせられない) | 評価の手順を全社で1つに決め、評価用のデータと計算のコードを共有する |
経営として決めておくのがよいと考えることを、次にまとめます。
- 推薦の評価の報告には、評価の手順(指標・K・切り方・切る日・評価の対象)と、人気順などの基準の値を必ず添えさせる
- 方式の採否は、オフライン評価では候補を絞るところまでとし、最終の判断はオンラインで推薦が無い場合との差を測ってから行う(第9章)
- ベンダーの推薦エンジンを比べるときは、自社のログを時間で切った同じ評価用データと同じ手順で、全商品で並べて計算させる
- 評価の手順と評価用のデータを社内の資産として持ち、方式やベンダーが替わっても同じ物差しで比べられるようにする
予算の面では、推薦の方式そのものの開発とは別に、評価の仕組み(評価用のデータの切り出し・指標の計算・基準との比較を毎回同じ手順で回す仕組み)を作る手間を見込んでおく必要があります。この仕組みが無いと、方式を替えるたびに評価をやり直すことになり、評価のしかたが毎回少しずつ違って、改善したのかどうかが分からなくなります。評価の仕組みを推薦の運用の中に組み込む方法は、第12章で扱います。
この章のまとめ
この章では、オフライン評価の指標(適合率@K・再現率@K・ヒット率・MAP・NDCG・MRR)と、評価データの切り方を扱いました。本コラムの架空データ(1つの乱数の種で作ったもの)では、無作為に切った評価で NDCG@10 が0.2199と最も高かったアイテムベースが、時間で切った評価では0.1027となり、最近30日の人気順(0.1330)に負けました。また、この条件(商品400点)で負例を100点だけ抜き出したサンプリングした評価では、ヒット率@10 が全商品で並べた値(ほかの正解を外す条件を揃えた値)の約2.4〜3.1倍に出ました。オフライン評価は、時間で切り、全商品で並べ、基準と同じ手順で比べたうえで、方式の候補を絞るために使うものです。次の第9章では、絞った候補を実際の顧客に出し、推薦が無い場合と比べて行動が増えたかを測るオンライン評価(A/Bテストとバンディット)を扱います。
この章を深めたい方への参考書籍
『情報アクセス評価方法論 検索エンジンの進歩のために』(酒井哲也 著、コロナ社):検索の結果をどう評価するかを体系的に扱った本です。版元の目次によれば、適合率や平均適合率、逆順位、段階的な関連の強さを扱う nDCG などの基本の指標から、評価用データの作り方、統計的な検定までを扱っています。この章で紹介した NDCG は検索の結果の評価のために提案された指標なので、その考え方と、他の指標との使い分けを確かめるのに向いています。
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):データ分析のコンペティションでの手法をまとめた本です。版元の目次によれば、レコメンドの評価指標の節、データのリーク(漏れ)の節、時系列のデータでのバリデーション(評価データの切り方)の節があります。この章で扱った、時間で切らないと将来の情報が漏れる問題を、推薦以外の予測の課題も含めて確かめるのに役立ちます。
第9章 オンライン評価、A/Bテストとバンディットで効果を確かめる
第8章では、過去のログを使って推薦が後の行動をどれだけ当てたかを測るオフライン評価を扱い、評価データを時間で切らないと将来の情報が漏れること、そして過去のログは過去の推薦の影響を受けているので、オフラインの成績だけでは最終の判断に使えないことを確かめました。この章では、その先の段階として、実際の顧客に推薦を出して行動の差を測るオンライン評価を扱います。
この章で扱うのは次の内容です。後半は、架空の顧客の行動のシミュレーションと、クリック率の異なる5つの推薦の案のシミュレーションを使い、実行したコードと結果で確かめます。
- 推薦の効果の定義と、推薦経由の購買の数が効果にならない理由
- A/Bテストの設計(分け方の単位・指標・期間・必要な人数)
- 推薦あり・なしの購買の差と信頼区間を、架空のシミュレーションで計算する方法
- 必要な人数を検出力分析で見積もる方法
- バンディット(ε-greedy・UCB・トンプソン抽出)の考え方と、A/Bテストとの使い分け
- 過去のログから新しい推薦を評価するオフ方策評価の考え方
- A/Bテストの落とし穴(途中で止める・指標が多い・新奇効果・推薦の枠どうしの干渉)と、経営の判断
この章の主張は、推薦の効果は「推薦しなくても買われた分」を除いて測る、ということです。推薦の枠から買われた商品の数は、推薦がどれだけ使われているかを示す数字ではありますが、推薦の効果ではありません。本コラムで推薦の効果と呼ぶのは、顧客を偶然で分け、推薦を出した群と出さなかった群を比べて確かめた差です。すでにある推薦を新しい推薦に替える場合のように、従来の推薦を出した群と比べた差は、比べる相手を明記して「方式を替えた効果(従来の推薦と比べた差)」と呼び、推薦の効果とは区別します。
この章のコードは numpy・scipy・statsmodels だけで書いており(グラフの描画のコードは載せていません)、載せたまとまりは、前半の5つ(A/Bテスト)と後半の3つ(バンディット)を、それぞれ上から順につなげて実行すると本文と同じ結果になることを確かめています。
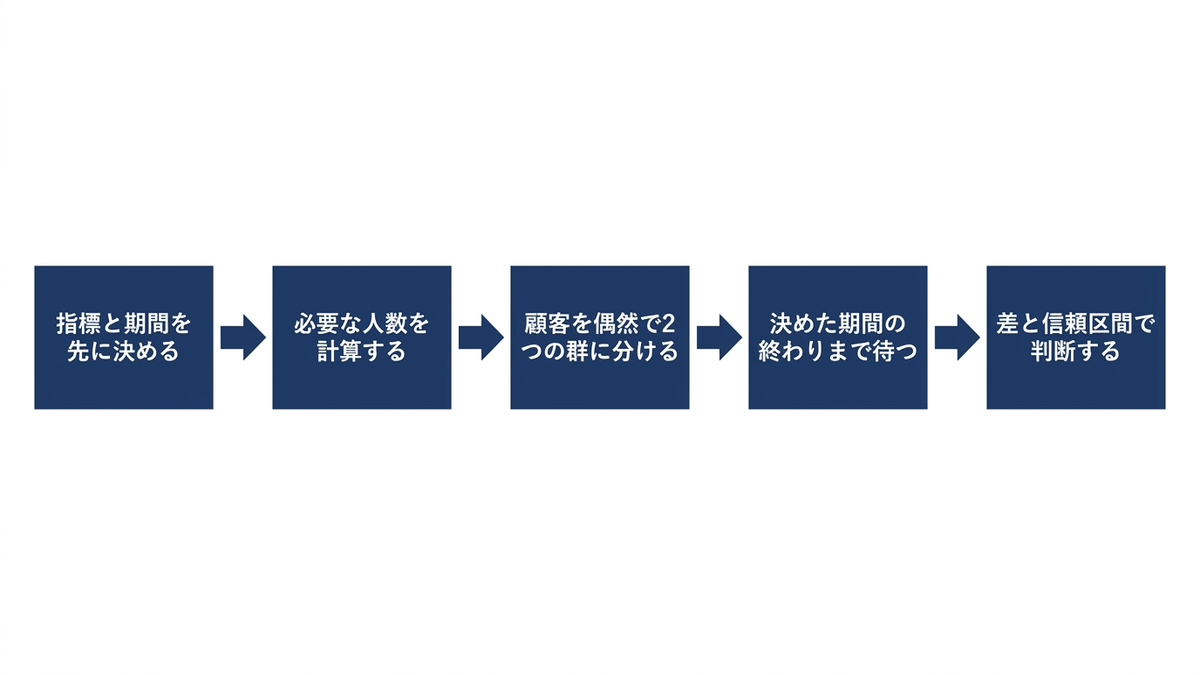
推薦の効果の定義、推薦が無くても買われた分を除く
本コラムでは、全体の地図で定義したとおり、推薦の効果を「推薦が無かった場合と比べて増えた行動(購買・クリック等)」とし、推薦経由の購買の数そのものではない、としています。この定義は言葉としては単純ですが、実務の報告ではよく取り違えられます。推薦エンジンの管理画面やアクセス解析の画面には、「推薦の枠からクリックされた数」「推薦の枠を経由した購買の数」「推薦経由の購買の割合」のような数字が並ぶことが多く、これがそのまま推薦の成果として報告されがちだからです。
推薦経由の購買の数が効果にならない理由は、推薦の枠に出る商品の多くが、もともと顧客が買いそうな商品だからです。第4章や第5章の方法は、顧客が関心を持ちそうな商品を上位に出すように作られています。関心が高い商品は、推薦の枠が無くても、検索やカテゴリの一覧、お気に入り、再訪問から買われる可能性があります。推薦の枠があると、その一部が「推薦の枠から買われた」という記録に置き換わるだけで、全体の購買は増えていないことがあります。推薦の枠は、ほかの入口から来るはずだった購買を自分の枠に付け替えることがある、ということです。
この取り違えは、序章で整理した6つの損失の型でいう効果の過大評価に当たります。推薦が無くても買われた分まで推薦の成果と数えると、推薦への投資が実際より大きな成果を生んでいるように見え、追加の投資や枠の拡大の判断が誤った根拠の上に立つことになります。逆に、推薦経由の数字が伸びないことを理由に、実際には効果のある推薦を止めてしまう誤りも起こりえます。どちらも、推薦が無かった場合の行動を見ていないことから起きます。
推薦が無かった場合の行動は、同じ顧客について同時に観察することはできません。推薦を見た顧客が、推薦を見なかったらどう行動したかは、原理的に観察できないからです。そこで、顧客を偶然で2つの群に分け、一方には推薦を出し、もう一方には出さないという比較をします。偶然で分ければ、2つの群は推薦の有無以外の点で平均的にそろうので、2つの群の行動の差を推薦の効果と見なせます。これがA/Bテスト(ランダム化比較試験をウェブやアプリの施策に当てはめたもの)の考え方です。効果検証の考え方の基礎は、弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』で扱っています。
なお、比べる相手は「推薦なし」とは限りません。すでに人気順の推薦を出している枠で新しい推薦を試すなら、比べる相手は人気順の推薦で、測れるのは「人気順から新しい推薦に替えたことによる差」、つまり方式を替えた効果(従来の推薦と比べた差)です。推薦の効果(推薦なしと比べた差)と、方式を替えた効果は別の問いで、同じ A/Bテストの仕組みで測れても、報告するときは比べる相手を必ず書き添えます。そのため、A/Bテストを始める前に、何と何を比べるのかを言葉で書いておく必要があります。
A/Bテストの設計、分け方の単位・指標・期間・人数を先に決める
A/Bテストは、始める前に決めておくことが多い方法です。始めてから決めると、結果を見ながら都合のよい指標や期間を選ぶことになり、偶然の差を効果と取り違えやすくなります。推薦の A/Bテストで先に決めておく項目を、次の表にまとめました。
| 決めておく項目 | 主な選択肢 | 決めないと起きること | 推薦での注意 |
|---|---|---|---|
| 比べる相手 | 推薦なし・人気順の推薦・従来の推薦 | 何の効果を測ったのか説明できない | 「推薦の効果」と「方式を替えた効果」を分けて書く |
| 分け方の単位 | 顧客・セッション(1回の訪問)・ページの表示 | 同じ顧客が両方の群を見て、差が薄まる | 推薦は再訪問や購買の積み重ねに効くので、顧客の単位で分けることが多い |
| 主な指標(1つ) | 顧客あたりの購買の数・購買した人の割合・クリック率 | 指標を後から選び、偶然の差を拾う | 推薦の枠のクリック率だけを主な指標にしない(付け替えでも上がる) |
| 守りの指標 | 返品の率・ページの表示の速さ・ほかの枠の購買・退会の率 | 主な指標は上がったが、別の所で損をしていたことに気づかない | ほかの推薦の枠や検索からの購買が減っていないかを見る |
| 期間 | 1週間の倍数(曜日の偏りを均す) | 途中で止めて偶然の差を効果と読む | 新奇効果(物珍しさによる一時的な増加)が落ち着く長さを見込んで、始める前に期間を決める(途中で見て終わらせない) |
| 必要な人数 | 検出力分析で計算する | 効果があっても見つからない、または見つからないことを効果なしと読む | 購買は低い率の事象なので、多くの人数が要ることが多い |
| 判断の基準 | 差の信頼区間・有意水準・事業上の最小の差 | 結果を見てから「十分な差」を決める | 統計的に有意でも、事業上意味のある大きさかを別に問う |
分け方の単位は、推薦の A/Bテストで最初に迷う項目です。ページの表示ごとに推薦あり・なしを切り替えると、同じ顧客が両方を見ることになり、推薦で関心を持った商品を推薦なしのページで買う、といった混ざり合いが起きます。推薦の効果は、その場のクリックだけでなく、後日の再訪問や購買にも現れることがあるので、顧客の単位で分け、期間中は同じ顧客が同じ群に居続けるようにするのが基本だと考えています。ログインしない顧客が多いサイトでは、顧客を識別する手がかり(ブラウザの識別子など)が端末ごとに分かれ、同じ人が別の群に入ることがあります。同じ人の行動が両方の群に混ざると、2つの群の違いが薄まるので、この混ざり合いは差を小さく見せる方向に働くと考えられます。結果を読むときに覚えておく必要があります。
指標は、推薦の目的(第1章)から選びます。主な指標は1つに絞り、それ以外は守りの指標として、悪化していないかを見るために使います。推薦の枠のクリック率は、推薦が見られているかを知る数字としては役に立ちますが、主な指標には向きません。前の節で述べたとおり、推薦の枠のクリックは、ほかの入口から来るはずだった行動の付け替えでも増えるからです。顧客あたりの購買の数や、購買した人の割合のように、サイト全体の行動で測る指標のほうが、付け替えの影響を受けにくくなります。
架空の顧客の行動で、推薦経由の購買とA/Bテストで測った効果を比べる
ここからは、架空の合成データで確かめます。顧客4万人と商品300点を作り、顧客にはジャンルの好み(6つのジャンルへの好みの配分)、商品にはジャンルと人気の偏り(少数の商品に人気が集中する分布)、顧客ごとには買いやすさ(4週間に買う数の期待値)を持たせました。顧客は偶然で2万人ずつに分け、一方を推薦あり(処置群)、もう一方を推薦なし(対照群)とします。推薦ありの顧客には、その顧客が買いそうな上位5点を推薦の枠に出します。
行動の規則は次のとおりです。どちらの群の顧客も、推薦が無くても起きる購買(ふだんの購買)をします。推薦ありの顧客では、ふだん買う予定だった商品が推薦の枠にあれば、そのうち6割を推薦の枠から買うことにしました。これが付け替えです。さらに、推薦された5点のそれぞれを、推薦が無ければ買わなかったのに追加で買う確率(2%に、買いやすさに応じた係数を掛けた値)を入れ、これを推薦による本当の追加の購買とします。シミュレーションなので、どの購買が追加で起きたものかが分かり、本当の効果と、さまざまな数え方の結果を突き合わせられます。実際のログでは、どの購買が推薦によって増えた分かは分かりません。また、この合成データは実際のログより単純で、時期による変動・顧客どうしの影響・推薦の枠の位置の違いなどは入れていません。
import numpy as np
from scipy import stats
from statsmodels.stats.proportion import confint_proportions_2indep, proportions_ztest, proportion_effectsize
from statsmodels.stats.power import NormalIndPower

# ---- ブロック1:架空の顧客と商品を作る ----
rng = np.random.default_rng(20261110)
N_CUST, N_ITEM, N_GENRE = 40000, 300, 6
cust_genre = rng.dirichlet(np.full(N_GENRE, 0.3), N_CUST)      # 顧客ごとのジャンルの好み
item_genre = rng.integers(0, N_GENRE, N_ITEM)                   # 商品のジャンル
item_pop = rng.pareto(1.2, N_ITEM) + 1.0                        # 商品の人気の偏り
item_pop = item_pop / item_pop.sum()
activity = rng.gamma(0.6, 0.25, N_CUST)                         # 顧客ごとの買いやすさ(4週間の購買数の期待値)
group = rng.permutation(np.repeat([0, 1], N_CUST // 2))          # 0=推薦なし(対照群) 1=推薦あり(処置群)
print("顧客", N_CUST, "人/商品", N_ITEM, "点/推薦あり", int(group.sum()), "人")

# 顧客ごとの「この商品を選ぶ確率」(ジャンルの好み×人気)
def choice_prob(i):
    w = cust_genre[i, item_genre] * item_pop
    return w / w.sum()
# 出力: 顧客 40000 人/商品 300 点/推薦あり 20000 人
次のまとまりで、4週間の行動を顧客ごとにシミュレーションします。n_via が推薦の枠を経由した購買の数、n_extra が推薦によって増えた購買の数(シミュレーションだから分かる値)です。
# ---- ブロック2:4週間の行動をシミュレーションする ----
K_REC = 5           # 推薦の枠に出す商品の数
P_VIA_REC = 0.6     # もともと買う予定の推薦商品を、推薦の枠から買う確率
P_EXTRA = 0.02      # 推薦された5点のそれぞれを、推薦が無ければ買わなかったのに追加で買う確率
n_buy = np.zeros(N_CUST, int)       # 購買の数
n_via = np.zeros(N_CUST, int)       # 推薦の枠を経由した購買の数
n_extra = np.zeros(N_CUST, int)     # 推薦によって増えた購買の数(シミュレーションだから分かる真の値)
for i in range(N_CUST):
    p = choice_prob(i)
    k = rng.poisson(activity[i])                                  # 推薦が無くても起きる購買
    items = rng.choice(N_ITEM, size=k, p=p) if k > 0 else np.array([], int)
    n_buy[i] = k
    if group[i] == 1:
        rec = np.argsort(-p)[:K_REC]                              # その顧客が買いそうな上位5点を推薦
        in_rec = np.isin(items, rec)
        n_via[i] = int((in_rec & (rng.random(k) < P_VIA_REC)).sum())   # 推薦が無くても買った分の一部が枠を経由
        extra = int((rng.random(K_REC) < P_EXTRA * min(1.0, 4 * activity[i])).sum())
        n_extra[i] = extra
        n_via[i] += extra                                          # 追加の購買はすべて枠を経由
        n_buy[i] += extra
bought = (n_buy > 0).astype(int)
t, c = group == 1, group == 0
print("真の追加購買(推薦あり群の合計)", int(n_extra[t].sum()))
# 出力: 真の追加購買(推薦あり群の合計) 847
同じシミュレーションの結果を、3つの数え方で数えます。(a)は推薦の枠を経由した購買の数で、管理画面に出やすい数字です。(b)は推薦ありの群の中で、推薦の枠から1回でも買った人(推薦によって追加で買った分を含む)と、1回も買わなかった人の1人あたりの購買の数を比べるもので、「推薦を使った人はよく買う」という報告の形です。(c)は A/Bテストで、推薦ありの群と推薦なしの群の1人あたりの購買の数の差に、95%信頼区間(偶然のばらつきを考えたときに、本当の差が入っていると考えられる幅)を付けたものです。ここでの区間は、差を中心に標準誤差(差の推定のばらつきの大きさ)の1.96倍を上下に足し引きした、正規近似の区間です。あわせて、購買した人の割合(購買率)の差と、その信頼区間も計算しました。検定の方法の細かい選び方は、コードのコメントに書いています。
結果の読み方に使う3つの言葉(p 値・有意水準・有意)を確認しておきます。p 値は、本当は差が無いとしたときに、観測した差と同じかそれ以上に大きな差が偶然出る確率です(差が無い確率そのものではありません)。この p 値があらかじめ決めた基準(有意水準。多くは5%)を下回ったとき、その差を「有意」、つまり偶然では説明しにくい差と判断します。有意かどうかは差の大きさそのものではないので、事業上意味のある大きさかどうかは別に確かめます。
# ---- ブロック3:3つの数え方を比べる ----
per1000 = lambda x: 1000 * x
via_total = int(n_via[t].sum())
print("(a) 推薦の枠を経由した購買の数(推薦あり群)", via_total, "/1,000人あたり", round(per1000(n_via[t].mean()), 1))
clicker = t & (n_via > 0)
nonclicker = t & (n_via == 0)
print("(b) 枠から買った人", int(clicker.sum()), "人の1人あたり購買", round(n_buy[clicker].mean(), 3),
      "/枠から買わなかった人", int(nonclicker.sum()), "人", round(n_buy[nonclicker].mean(), 3))
diff = n_buy[t].mean() - n_buy[c].mean()
se = np.sqrt(n_buy[t].var(ddof=1) / t.sum() + n_buy[c].var(ddof=1) / c.sum())
lo, hi = diff - 1.96 * se, diff + 1.96 * se
print("(c) A/Bテスト 1人あたり購買 推薦あり", round(n_buy[t].mean(), 4), "推薦なし", round(n_buy[c].mean(), 4))
print("    差(1,000人あたり)", round(per1000(diff), 1), "95%区間", round(per1000(lo), 1), "〜", round(per1000(hi), 1))
w = stats.ttest_ind(n_buy[t], n_buy[c], equal_var=False)   # ばらつきが等しいと仮定しないウェルチのt検定
print("    ウェルチのt検定 p値", f"{w.pvalue:.1e}")
print("    真の追加購買(1,000人あたり)", round(per1000(n_extra[t].mean()), 1))
print("    (a) のうち推薦が無くても起きた購買の割合", round(1 - n_extra[t].sum() / via_total, 3))

# 購買した人の割合(購買率)の差と信頼区間
x1, x0 = int(bought[t].sum()), int(bought[c].sum())
n1, n0 = int(t.sum()), int(c.sum())
ci = confint_proportions_2indep(x1, n1, x0, n0, method="wald", compare="diff")   # 既定はnewcomb。ここでは正規近似のwald
z, pz = proportions_ztest([x1, x0], [n1, n0])
print("購買率 推薦あり", round(x1 / n1, 4), "推薦なし", round(x0 / n0, 4),
      "差", round(x1 / n1 - x0 / n0, 4), "95%区間", round(ci[0], 4), "〜", round(ci[1], 4), "p値", f"{pz:.1e}")
# 出力:
# (a) 推薦の枠を経由した購買の数(推薦あり群) 1648 /1,000人あたり 82.4
# (b) 枠から買った人 1524 人の1人あたり購買 1.294 /枠から買わなかった人 18476 人 0.099
# (c) A/Bテスト 1人あたり購買 推薦あり 0.19 推薦なし 0.1503
#     差(1,000人あたり) 39.8 95%区間 30.8 〜 48.7
#     ウェルチのt検定 p値 3.0e-18
#     真の追加購買(1,000人あたり) 42.4
#     (a) のうち推薦が無くても起きた購買の割合 0.486
# 購買率 推薦あり 0.1568 推薦なし 0.1265 差 0.0302 95%区間 0.0234 〜 0.0371 p値 4.1e-18
結果を表にまとめます。購買の数は、推薦ありの群の顧客1,000人あたりに直しています。
| 数え方 | 結果 | この数字が表すもの | 推薦の効果と呼べるか |
|---|---|---|---|
| (a)推薦の枠を経由した購買の数 | 1,000人あたり82.4(合計1,648) | 推薦の枠がどれだけ使われたか。推薦が無くても起きた購買の付け替えを含む | 呼べない |
| (b)枠から買った人と買わなかった人の比較 | 1人あたり1.294と0.099 | もともとよく買う人ほど推薦の枠からも買う、という顧客の違いに加え、購買したかどうかという結果で群を分けたことによる差 | 呼べない |
| (c)A/Bテストで測った差 | 1,000人あたり39.8(95%区間30.8〜48.7) | 推薦ありと推薦なしの群の差。推薦が無くても買われた分を除いた値 | 呼べる |
| (参考)真の追加購買 | 1,000人あたり42.4(合計847) | シミュレーションだから分かる本当の効果 | 実際のログでは分からない |
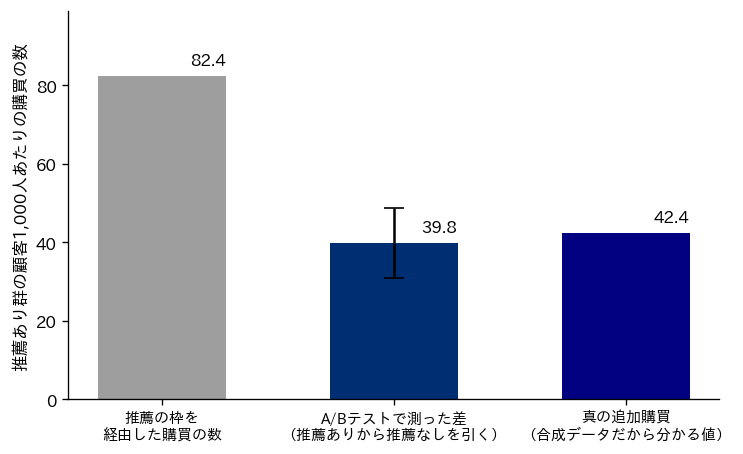
本コラムの架空データでは、推薦の枠を経由した購買は1,000人あたり82.4でしたが、本当に推薦によって増えた購買は42.4で、推薦の枠を経由した購買のうち48.6%(0.486)は推薦が無くても起きた購買でした。推薦の枠を経由した購買の数をそのまま効果と報告すると、この例では効果を約2倍に見積もることになります。A/Bテストで測った差は39.8で、95%信頼区間は30.8から48.7でした。真の値42.4はこの区間の中にあり、A/Bテストは推薦の枠を経由した購買の数よりずっと本当の効果に近い値を示しました。推薦の枠を経由した購買のうち、付け替えがどれだけの割合を占めるかは、推薦の対象・枠の位置・顧客の買い方によって変わるので、この48.6%という値は本コラムの架空データでの値で、実際のサイトでの割合を表すものではありません。また、ここまでの数値は乱数の種を1つに固定した1回のシミュレーションの結果で、種を変えれば値は少しずつ変わります。
(b)の比較は、もっと大きくずれます。推薦の枠から買った人の1人あたりの購買は1.294で、買わなかった人の0.099の約13倍です。しかし、この差の大部分は推薦の効果ではありません。もともと買い物の多い顧客ほど、推薦の枠に買う予定の商品が出る機会も多く、推薦の枠から買う人に入りやすいからです。さらに、この比較は購買の結果で群を分けています。推薦の枠から買った人は定義上かならず1回以上買っており、買わなかった人の側には、期間中に何も買わなかった人がすべて入ります。もとの買いやすさが同じ顧客どうしでも、この分け方だけで差が生じます。このシミュレーションでは、推薦が増やした購買は1,000人あたり42.4ですが、(b)の比較は「推薦を使う人はよく買う」という顧客の違いを、推薦の働きと取り違えさせます。「推薦を利用した顧客は、利用しなかった顧客の何倍買っている」という報告は、効果の過大評価の典型だと考えています。
購買率で見ても、推薦ありの群は0.1568、推薦なしの群は0.1265で、差は0.0302(95%信頼区間0.0234〜0.0371)でした。どちらの指標でも p 値は非常に小さく、偶然では説明しにくい差です。ただし、この例は推薦の効果がはっきり出るように作ったシミュレーションで、1群2万人で十分に差が見えました。実際の効果の大きさは自社の顧客・商品・推薦の枠によって異なり、これより小さいこともありえます。効果が小さい場合に何人必要かを、次の節で見積もります。
必要な人数を見積もる、検出力分析
A/Bテストで差を見つけられるかどうかは、効果の大きさと人数で決まります。効果が小さいと、人数が少ないうちは偶然のばらつきに埋もれて、効果があっても「有意な差なし」と出ます。始める前に、見つけたい差の大きさを決め、それを見つけるのに必要な人数を計算しておくのが検出力分析です。検出力は、本当に差があるときに、検定がその差を有意と判定できる確率のことで、0.8(80%)に置くことが多くあります。
計算に使う材料は、見つけたい差の大きさ・有意水準・検出力の3つです。見つけたい差は、元の率によってばらつきの大きさが違うので、ばらつきに対する差の大きさにそろえた値(効果量)に直してから計算します。statsmodels というライブラリには、この効果量を求める関数と、効果量・有意水準・検出力から必要な人数を求める関数が用意されています。次のコードでは、前の節の推薦なしの群の購買率0.1265を元の率として、それを相対で2%・5%・10%・20%上げる差を、有意水準5%・検出力80%で見つけるのに必要な1群あたりの人数を計算しました。
# ---- ブロック4:必要な人数(検出力分析) ----
base = x0 / n0
analysis = NormalIndPower()
for lift in [0.02, 0.05, 0.10, 0.20]:
    es = proportion_effectsize(base * (1 + lift), base)
    n = analysis.solve_power(effect_size=es, alpha=0.05, power=0.8, ratio=1.0, alternative="two-sided")
    print(f"購買率{base:.4f}を相対{lift:.0%}上げる差を検出 1群あたり", int(np.ceil(n)), "人")
for pb in [0.02, 0.10]:
    es = proportion_effectsize(pb * 1.05, pb)
    n = analysis.solve_power(effect_size=es, alpha=0.05, power=0.8)
    print(f"もとの率{pb}を相対5%上げる差 1群あたり", int(np.ceil(n)), "人")
# 出力:
# 購買率0.1265を相対2%上げる差を検出 1群あたり 273295 人
# 購買率0.1265を相対5%上げる差を検出 1群あたり 44275 人
# 購買率0.1265を相対10%上げる差を検出 1群あたり 11294 人
# 購買率0.1265を相対20%上げる差を検出 1群あたり 2933 人
# もとの率0.02を相対5%上げる差 1群あたり 315161 人
# もとの率0.1を相対5%上げる差 1群あたり 57756 人
| 元の率 | 見つけたい差(相対) | 見つけたい差(率の差) | 1群あたりの必要な人数 |
|---|---|---|---|
| 0.1265 | 20% | 約0.025 | 2,933 |
| 0.1265 | 10% | 約0.013 | 11,294 |
| 0.1265 | 5% | 約0.006 | 44,275 |
| 0.1265 | 2% | 約0.003 | 273,295 |
| 0.10 | 5% | 0.005 | 57,756 |
| 0.02 | 5% | 0.001 | 315,161 |
表から2つのことが読み取れます。1つは、見つけたい差を半分にすると、必要な人数はおよそ4倍になることです。購買率0.1265を相対20%上げる差なら1群2,933人で足りますが、10%なら11,294人、5%なら44,275人、2%なら273,295人が必要でした。もう1つは、元の率が低いほど多くの人数が要ることです。同じ相対5%の差でも、元の率が0.10なら1群57,756人、0.02なら315,161人でした。推薦の枠のクリック率やメールからの購買率のように、元の率が数%以下の指標では、小さな改善を確かめるのに非常に多くの人数が要ります。
この計算は、経営の判断に直結します。月に数千人しか訪れない枠で、相対数%の改善を A/Bテストで確かめようとしても、何か月かけても確かめきれないことがあります。その場合の選択肢は、見つけたい差を大きくする(小さな改善は確かめないと割り切る)、人数の多い枠や指標で試す、期間を延ばす、のいずれかです。「有意な差が出なかった」という結果を「効果が無かった」と読むのも誤りで、人数が足りなければ、効果があっても見つからないのが当然です。検出力分析は、A/Bテストを始める前に、その枠で確かめられる差の大きさを知るための道具だと考えています。検定と区間推定の基礎は、弊社コラム『データから正しく結論を導く統計学のまとめ』で扱っています。
途中で何度も結果を見て止めると、偶然の差を効果と読む
A/Bテストでよく起きる誤りの1つが、途中の結果を毎日見て、有意になった時点で止めることです。この章のコードで使っている通常の検定の p 値と信頼区間は、人数をあらかじめ決めておき、その人数に達したときに1回だけ見ることを前提にした数字です。この通常の検定のまま、途中で何度も見て有意になったら止める、というやり方をすると、本当は差が無くても、どこかで偶然有意になる機会が増え、差が無いのに有意と判定する割合(誤検出の率)が、設定した有意水準を上回りえます。途中で見ることを織り込んで誤検出の率を抑える逐次的な検定の方法もあり、この節の最後で触れます。
この影響を、A/A テスト(2つの群に同じものを出すテスト。差は本当は0)で確かめました。1日に各群500人ずつ、購買率0.10の顧客が来ることにして、28日間のテストを4,000回くり返しました。最終日だけ見る場合、毎日見て一度でも有意になったら止める場合、週に1回見る場合で、「有意な差あり」と判定された割合を数えています。
# ---- ブロック5:途中で何度も結果を見て止めるとどうなるか(A/Aテスト) ----
rng2 = np.random.default_rng(20261110)
SIMS, DAYS, PER_DAY, P = 4000, 28, 500, 0.10
xa = rng2.binomial(PER_DAY, P, (SIMS, DAYS)).cumsum(axis=1)
xb = rng2.binomial(PER_DAY, P, (SIMS, DAYS)).cumsum(axis=1)
nn = PER_DAY * np.arange(1, DAYS + 1)
pool = (xa + xb) / (2 * nn)
zz = (xa / nn - xb / nn) / np.sqrt(pool * (1 - pool) * 2 / nn)
sig = np.abs(zz) > 1.96
print("A/Aテスト(差が本当は0)で、最終日だけ見て有意になった割合", round(sig[:, -1].mean(), 3))
print("毎日見て、一度でも有意になったら止めた場合に有意になった割合", round(sig.any(axis=1).mean(), 3))
print("週に1回(7・14・21・28日目)見た場合", round(sig[:, [6, 13, 20, 27]].any(axis=1).mean(), 3))
# 出力:
# A/Aテスト(差が本当は0)で、最終日だけ見て有意になった割合 0.055
# 毎日見て、一度でも有意になったら止めた場合に有意になった割合 0.279
# 週に1回(7・14・21・28日目)見た場合 0.134
最終日に1回だけ見た場合、差が本当は0なのに有意と判定された割合は0.055で、有意水準の5%に近い値でした。ところが、毎日見て一度でも有意になったら止めると、その割合は0.279になりました。差が無いテストの約4回に1回で「効果あり」と判定してしまうということです。週に1回見る場合でも0.134で、5%の約2.7倍でした。この数字は本コラムのシミュレーションの条件(28日・1日各群500人・購買率0.10)での値で、見る回数や人数が違えば値も変わります。
途中で見ながら止めることの問題は、研究でも扱われています。Johari・Pekelis・Walsh の論文(arXiv で公開。逐次的な分析を A/Bテストに持ち込むことを扱った論文)は、結果を見ながら止める時点を決める使い方では通常の p 値と信頼区間が当てにならなくなることを出発点に、いつ止めても有効な p 値と信頼区間(常に有効な推論)を提案しています。要旨では、この方法を商用の A/Bテストの基盤に適用したことも報告しています。実務での対処は、人数と期間を先に決めて最後に1回だけ判断するか、途中で見ることを前提にした逐次的な検定の方法を最初から選んでおくか、のどちらかだと考えています。
バンディット、試しながら良い案に寄せていく
A/Bテストは、比べる案に決まった割合(多くは均等)で顧客を配り、期間の終わりまで配分を変えません。そのため、テストの期間中は、劣った案にも同じだけ顧客を配り続けます。例えば、推薦の案が5つあり、そのうち1つだけが良い案なら、期間中の顧客の5分の4は劣った案を見ることになります。この期間中の取りこぼしを減らす考え方が、バンディット(多腕バンディット)です。名前は、当たりの確率が違う複数のスロットマシン(腕)のどれを引くかを、引きながら学んでいく問題にたとえたものです。
バンディットでは、配分を固定せず、それまでの結果を見ながら、良さそうな案に多くの顧客を配っていきます。ただし、今のところ良さそうな案だけを出し続けると、最初に運悪く低い成績が出た案は二度と試されず、本当は良い案を見逃すことがあります。今わかっている良い案を使うこと(活用)と、まだよく分からない案を試すこと(探索)のつり合いをどう取るかが、バンディットの方法の違いになります。探索と活用の考え方そのものと、新しい商品の推薦への応用は第10章で扱うので、この章では、効果を確かめる方法としての A/Bテストとの比較に絞ります。代表的な方法を次の表にまとめました。
| 方法 | 考え方 | 確かめた原典 | 使うときの注意 |
|---|---|---|---|
| ε-greedy | 確率 ε で無作為に案を選び、残りは今のところ平均が最も高い案を選ぶ | Auer らの2002年の論文(Machine Learning 誌)で、よく知られた単純な方法として説明されている | ε を固定すると、探索をやめないので一定の取りこぼしが続く |
| UCB(UCB1) | 平均に「まだ試した回数が少ない分の上乗せ」を足し、その値が最も大きい案を選ぶ | Auer らの2002年の論文(Machine Learning 誌)。取りこぼしが対数的にしか増えない方法として示された | クリック率のように小さい率では、上乗せが大きく効いて探索が長引くことがある(下のシミュレーション) |
| トンプソン抽出 | 各案のクリック率についての確率分布から1つずつ値を引き、最も大きい値の案を選ぶ | Thompson の1933年の論文(Biometrika 誌)。Chapelle と Li の2011年の論文(NIPS 2011)が実験で性能を検証 | 結果の反映が遅れても配分が偶然でばらけるので扱いやすいとされる |
トンプソン抽出(トンプソン・サンプリング)は、Thompson が1933年に Biometrika 誌に発表した論文(題名は「2つの標本から見て、未知の確率の一方がもう一方を上回る見込みについて」の意味)にさかのぼる方法です。クリックするか・しないかのような二値の結果なら、各案のクリック率の分布をベータ分布で表せます。ベータ分布は0から1の間の値の確からしさを表す分布で、クリック数と表示数を数えるだけで更新できます。表示のたびに、各案のベータ分布から値を1つ引き、引いた値が最も大きい案を出します。試した回数の少ない案は分布の幅が広いので、ときどき大きな値が出て試され、成績が良い案ほど多く選ばれます。Chapelle と Li の2011年の論文(NIPS 2011)は、シミュレーションと、ディスプレイ広告の選択・Yahoo! のトップページのニュース記事の推薦という2つの実データで、トンプソン抽出が UCB などの他の方法と比べて遜色ない、場合によってはそれを上回る結果を示したと報告しています。同じ論文は、実際のシステムでは結果がまとめて遅れて届くことに触れ、その遅れの影響もシミュレーションで調べています。これらは論文の条件での結果で、どのサイトでも同じ順位になるという意味ではありません。
トンプソン抽出とA/Bテストの累積の損失を比べる
クリック率の異なる5つの推薦の案(案1から案5。クリック率は0.030・0.034・0.038・0.042・0.046で、案5が最良)を用意し、推薦を3万回表示する間に、どれだけクリックを取りこぼすかを比べました。取りこぼしは、毎回の表示で「最良の案5を出していれば得られたクリック率」と「実際に出した案のクリック率」の差を足し合わせたもので、累積の損失(リグレット)と呼ばれます。比べたのは、5案に均等に配る A/Bテスト、最初の1万回だけ5案に均等に配り、その時点で率が最も高かった案に以後固定する方法(表・図・コードでは「A/Bテストを1万回で打ち切り勝者に固定」と呼びます。前の節までの効果を測って説明するための A/Bテストとは目的が違い、ここでは配り方の1つとして比べます)、ε-greedy(ε=0.1)、UCB1、トンプソン抽出の5つです。乱数による結果のばらつきを均すため、それぞれ300回くり返して平均しました(乱数の種は1つに固定しています)。クリック率の値は説明のために置いた架空の値です。
前の節で、推薦の枠のクリック率は A/Bテストの主な指標に向かないと書きました。ここでクリック率を使うのは、バンディットで選ぶのが同じ推薦の枠の中の案どうしで、どの案を出しても同じ枠のクリックを取り合うので、ほかの入口からの付け替えの違いが案の比較を大きくゆがめにくいと考えたからです。ただし、選ばれた案が購買を増やしたかどうかは、購買のような枠の外の指標で別に確かめる必要があります。
import numpy as np

# ---- ブロック6:クリック率の異なる5つの推薦の案 ----
CTR = np.array([0.030, 0.034, 0.038, 0.042, 0.046])   # 案1〜案5の真のクリック率(現場では未知)
T, R, K = 30000, 300, len(CTR)                          # 表示の回数、くり返しの回数、案の数
best = CTR.max()
rng = np.random.default_rng(20261110)
rows = np.arange(R)

def run(policy):
    clicks = np.zeros((R, K)); shows = np.zeros((R, K))
    regret = np.zeros(T)                                 # 各時点までに取りこぼしたクリックの期待値(R回の平均)
    loss = np.zeros(R)
    for t in range(T):
        arm = policy(t, clicks, shows)
        c = rng.random(R) < CTR[arm]
        shows[rows, arm] += 1
        clicks[rows, arm] += c
        loss += best - CTR[arm]
        regret[t] = loss.mean()
    return regret, shows, clicks
次のまとまりが、配り方(方策)の定義です。どの関数も、それまでのクリック数と表示数を受け取り、300回のくり返しのそれぞれで、次に出す案の番号を返します。
# ---- ブロック7:配り方の定義と実行 ----
def uniform(t, clicks, shows):                           # A/Bテスト:5案に均等に配る
    return np.full(R, t % K)

def eps_greedy(t, clicks, shows, eps=0.1):               # ε-greedy:10%は無作為、90%は今のところ最良の案
    rate = clicks / np.maximum(shows, 1)
    arm = rate.argmax(axis=1)
    explore = rng.random(R) < eps
    arm[explore] = rng.integers(0, K, explore.sum())
    return arm

def thompson(t, clicks, shows):                          # トンプソン抽出:ベータ分布から引いて最大の案
    draw = rng.beta(1 + clicks, 1 + shows - clicks)
    return draw.argmax(axis=1)

def ucb1(t, clicks, shows):                              # UCB1:平均に「まだ確かでない分」を足して最大の案
    if t < K:
        return np.full(R, t)
    bonus = np.sqrt(2 * np.log(t) / shows)
    return (clicks / shows + bonus).argmax(axis=1)

fixed = {}                                               # 1万回の時点で決めた勝者を覚えておく
def explore_commit(t, clicks, shows, n_test=10000):     # A/Bテストを1万回で打ち切り、以後は勝った案だけ
    if t < n_test:
        return np.full(R, t % K)
    if t == n_test:
        fixed["arm"] = (clicks / shows).argmax(axis=1)   # 1万回の時点の率で勝者を決め、以後は変えない
    return fixed["arm"]

results = {}
for name, pol in [("A/Bテスト(均等配分)", uniform), ("A/Bテストを1万回で打ち切り勝者に固定", explore_commit),
                  ("ε-greedy(ε=0.1)", eps_greedy), ("UCB1", ucb1), ("トンプソン抽出", thompson)]:
    results[name] = run(pol)
    reg, shows, clicks = results[name]
    share = shows.mean(axis=0) / T
    print(f"{name}: 累積の損失(取りこぼしたクリックの期待値){reg[-1]:.1f}",
          "/1万回時点", round(reg[9999], 1), "/案ごとの表示の割合", np.round(share, 3))
# 出力:
# A/Bテスト(均等配分): 累積の損失(取りこぼしたクリックの期待値)240.0 /1万回時点 80.0 /案ごとの表示の割合 [0.2 0.2 0.2 0.2 0.2]
# A/Bテストを1万回で打ち切り勝者に固定: 累積の損失(取りこぼしたクリックの期待値)116.3 /1万回時点 80.0 /案ごとの表示の割合 [0.071 0.076 0.113 0.231 0.509]
# ε-greedy(ε=0.1): 累積の損失(取りこぼしたクリックの期待値)87.8 /1万回時点 44.2 /案ごとの表示の割合 [0.042 0.052 0.107 0.197 0.603]
# UCB1: 累積の損失(取りこぼしたクリックの期待値)207.8 /1万回時点 73.5 /案ごとの表示の割合 [0.151 0.171 0.196 0.222 0.26 ]
# トンプソン抽出: 累積の損失(取りこぼしたクリックの期待値)79.4 /1万回時点 42.3 /案ごとの表示の割合 [0.032 0.05  0.087 0.208 0.622]
UCB1 は、Auer らの論文の図1に示された形にならいました。最初に各案を1回ずつ出し、その後は、各案の平均の報酬に「全体の試行回数の自然対数の2倍を、その案の試行回数で割った値の平方根」を足した値が最も大きい案を出します。論文は、足す項が平均の報酬の片側の信頼区間の大きさに関わる、と説明しています。結果を表にまとめます。
| 配り方 | 累積の損失(3万回) | 累積の損失(1万回の時点) | 案5(最良)を出した割合 | 案1(最も低い)を出した割合 |
|---|---|---|---|---|
| A/Bテスト(均等配分) | 240.0 | 80.0 | 0.200 | 0.200 |
| A/Bテストを1万回で打ち切り勝者に固定 | 116.3 | 80.0 | 0.509 | 0.071 |
| ε-greedy(ε=0.1) | 87.8 | 44.2 | 0.603 | 0.042 |
| UCB1 | 207.8 | 73.5 | 0.260 | 0.151 |
| トンプソン抽出 | 79.4 | 42.3 | 0.622 | 0.032 |
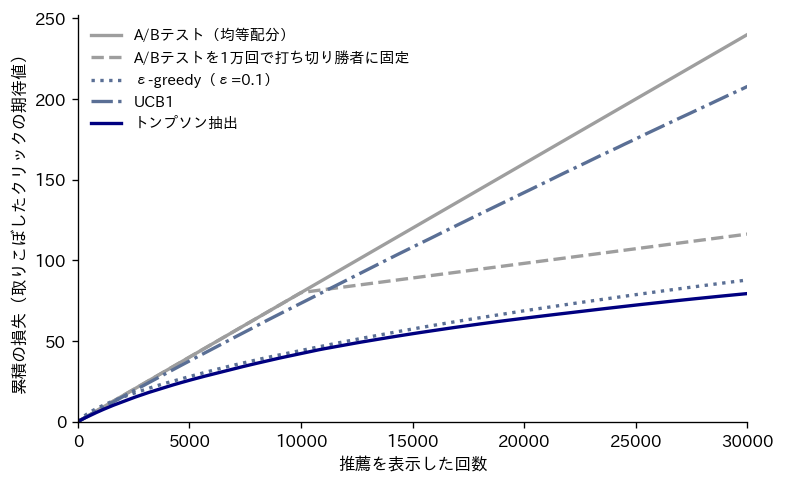
本コラムのシミュレーションでは、5案に均等に配る A/Bテストの累積の損失は3万回で240.0でした。均等配分では毎回の取りこぼしの期待値が一定なので、損失は表示の回数に比例して増え続けます。トンプソン抽出は79.4で、均等配分の約3分の1でした。トンプソン抽出は最良の案5に表示の62.2%を配り、最も低い案1には3.2%しか配っていません。ε-greedy は87.8で、トンプソン抽出に近い値でした。「A/Bテストを1万回で打ち切り勝者に固定」する方法は116.3で、打ち切った後は損失の増え方が緩やかになりましたが、ε-greedy やトンプソン抽出よりは大きくなりました。固定した後に損失が増えるのは、1万回の時点の勝者が案5ではなかったくり返しの分です。UCB1 は207.8で、均等配分に近い値にとどまりました。この条件では、クリック率が0.03〜0.046と小さく、案どうしの差も小さく、UCB1 は3万回の終わりまで5案にかなり均等に近い配分を続けました(最良の案5に配った割合は0.260)。これは本コラムの条件での結果で、UCB の仲間の方法一般の優劣を示すものではありません。
この比較だけを見ると、バンディットが A/Bテストより常に良いように見えますが、そうではありません。次のまとまりで、「最良の案を見つけられたか」と「各案のクリック率をどれだけ正確に推定できたか」を数えました。
# ---- ブロック8:最良の案を見つけられたか ----
reg, shows, clicks = results["A/Bテスト(均等配分)"]
rate = clicks / shows
print("均等配分で最後に率が最も高かった案が真の最良(案5)だった割合", round((rate.argmax(axis=1) == K - 1).mean(), 3))
se = np.sqrt(rate[:, 4] * (1 - rate[:, 4]) / shows[:, 4] + rate[:, 3] * (1 - rate[:, 3]) / shows[:, 3])
print("均等配分で案5と案4の差が両側5%で有意になった割合", round((np.abs(rate[:, 4] - rate[:, 3]) / se > 1.96).mean(), 3))
print("1万回で打ち切ったとき、勝者が案5だった割合", round((fixed["arm"] == K - 1).mean(), 3))
_, shows_t, clicks_t = results["トンプソン抽出"]
print("トンプソン抽出で最も多く表示した案が案5だった割合", round((shows_t.argmax(axis=1) == K - 1).mean(), 3))
print("トンプソン抽出の案ごとの表示回数の平均", np.round(shows_t.mean(axis=0)).astype(int))
r1 = clicks_t[:, 0] / np.maximum(shows_t[:, 0], 1)
print("トンプソン抽出での案1のクリック率の推定値 5%点〜95%点", np.round(np.percentile(r1, [5, 95]), 4))
r1u = rate[:, 0]
print("均等配分での案1のクリック率の推定値 5%点〜95%点", np.round(np.percentile(r1u, [5, 95]), 4))
print("期待クリック数 全部を案5に出した場合", round(best * T, 1), "/均等配分", round(CTR.mean() * T, 1))
# 出力:
# 均等配分で最後に率が最も高かった案が真の最良(案5)だった割合 0.853
# 均等配分で案5と案4の差が両側5%で有意になった割合 0.177
# 1万回で打ち切ったとき、勝者が案5だった割合 0.663
# トンプソン抽出で最も多く表示した案が案5だった割合 0.853
# トンプソン抽出の案ごとの表示回数の平均 [  963  1505  2622  6238 18672]
# トンプソン抽出での案1のクリック率の推定値 5%点〜95%点 [0.0133 0.0358]
# 均等配分での案1のクリック率の推定値 5%点〜95%点 [0.0265 0.0335]
# 期待クリック数 全部を案5に出した場合 1380.0 /均等配分 1140.0
3万回の後に最良の案5を当てられた割合は、均等配分(最後に率が最も高かった案)でもトンプソン抽出(最も多く表示した案)でも0.853で、同じでした。「A/Bテストを1万回で打ち切り勝者に固定」する方法では0.663で、約3回に1回は案5ではない案に固定していました。1万回の時点では各案に2,000回ずつしか表示しておらず、表示の回数が少ないほど率の推定のばらつきは大きくなります。均等配分で3万回(各案6,000回)表示しても、案5と次点の案4の差(クリック率で0.004)が両側5%で有意になったのは0.177、つまり2割に届きませんでした。前の節の検出力分析のとおり、小さな率の小さな差を確かめるには、この程度の表示の回数では足りません。
一方で、各案のクリック率の推定の正確さは、均等配分のほうが上でした。案1のクリック率(真の値は0.030)の推定値は、均等配分では300回のくり返しの5%点から95%点が0.0265〜0.0335に収まりましたが、トンプソン抽出では0.0133〜0.0358と広く散らばりました。トンプソン抽出は案1を平均963回しか表示しておらず(均等配分では6,000回)、表示の回数が少ないほど推定の幅は広がります。バンディットは期間中の取りこぼしを減らす代わりに、劣った案についての情報をあまり集めません。「どの案がどれだけ良いか」を後から説明する必要がある場合や、劣った案が別の顧客層では良いかもしれない場合には、この情報の少なさが問題になります。また、配分が途中で変わるので、単純に「案ごとの平均」を比べると、時期によるクリック率の変化と配分の変化が混ざり、偏った比較になることがあります。
A/Bテストとバンディットの使い分け
シミュレーションの結果を踏まえ、2つの方法の使い分けを次の表に整理しました。
| 観点 | A/Bテスト(均等配分) | バンディット(トンプソン抽出など) |
|---|---|---|
| 主な目的 | 効果の大きさを確かめ、説明する | 期間中の取りこぼしを減らしながら良い案に寄せる |
| 期間中の損失 | 劣った案にも同じだけ配り続ける(本コラムのシミュレーションでは最も大きかった) | 良い案を早く学習できれば、期間中の取りこぼしを減らせる(本コラムの条件では、UCB1 は均等配分に近い損失にとどまった) |
| 各案の効果の推定 | どの案にも同じ回数の表示を確保できる(推定の精度は、各案の反応率のばらつきにも左右される) | 劣った案の推定は粗くなる |
| 効果の検定・信頼区間 | 標準的な方法がそのまま使える | 配分が変わるので、通常の検定をそのまま当てはめにくい |
| 主な指標 | 購買・継続のような遅れて出る指標も扱える(期間の終わりに測る) | クリックのようにすぐ結果が出る指標に向く。遅れて出る指標では配分の更新が遅れる |
| 向く場面 | 推薦の方式の切り替え、投資判断の根拠づくり、長期の指標の確認 | 見出し・画像・並べ方の候補の選択、入れ替わりの早い候補(ニュース・キャンペーン) |
推薦の方式を替える(人気順から協調フィルタリングに替える、新しいモデルを入れる)ような判断は、予算と体制の判断につながるので、効果の大きさを信頼区間つきで示せる A/Bテストが向くと考えています。一方、推薦の枠の見出しの文言や、候補の中から何を先頭に出すかのように、効果の大きさの説明より期間中の成果が大事で、すぐ結果が出る選択には、バンディットが向きます。両者を組み合わせ、バンディットで候補を絞り込んだ後に、残った案と従来の推薦を A/Bテストで比べ、方式を替えた効果(従来の推薦と比べた差)を確かめる、という進め方も考えられます。また、バンディットを入れた推薦の仕組み全体の効果を知りたいときは、「バンディットを使う群」と「使わない群」を A/Bテストで比べることになります。
オフ方策評価、過去のログから新しい推薦を評価する考え方
A/Bテストには、実際の顧客に新しい推薦を出す必要があり、時間がかかり、劣った推薦を出した群では取りこぼしが起きます。そこで、実際に出す前に、過去のログから「新しい推薦を出していたらどうなったか」を推定したい、という要望が生まれます。これがオフ方策評価です。方策は「どの顧客に何を推薦するかの決め方」のことで、オフは「いま動いている方策とは別の方策を、その方策を動かさずに評価する」という意味です。
第8章で見たとおり、過去のログは過去の推薦の影響を受けています。過去の推薦が出さなかった商品については、顧客の反応が記録されていません。新しい推薦が、過去の推薦とは違う商品を出すなら、その商品への反応はログに無いので、単純には評価できません。この問題への1つの答えが、逆確率重み付けの考え方です。過去の推薦がある商品をある顧客に出した確率が分かっていれば、ログに残った反応の1件1件に「新しい推薦がその場面でその商品を出す確率」を「過去の推薦がその商品を出した確率」で割った重みを掛けて数え直すことで、新しい推薦を出していた場合の反応を推定できます。過去の推薦が出す確率の低かった商品への反応ほど重みが大きくなり、確率の低いものは、その分だけ多くの同じような場面を代表している、と考えて数え直すわけです。
この考え方が成り立つには、過去の推薦が、出す商品を確率的に選んでいて、その確率がログに残っている必要があります。加えて、新しい推薦が出しうる商品は、同じ条件の顧客に対して、過去の推薦も0より大きい確率で出していたことが必要です。過去の推薦が一度も出す可能性の無かった商品への反応は、この方法では推定できません。また、過去の推薦が出す確率がごく小さい商品があると、重みが極端に大きくなり、推定のばらつきが大きくなります(Swaminathan と Joachims の2015年の arXiv の論文は、確率が0に近い場面があるとこの推定量のばらつきに上限が無くなると述べ、重みを一定の値で頭打ちにする工夫を提案しています)。
ログの推薦が確率的に選ばれていることを前提にする、より単純な別の方法もあります。Li・Chu・Langford・Wang の2011年の論文(WSDM 2011。文脈つきバンディットによるニュース記事の推薦の手法を、偏りなくオフラインで評価する方法の論文)は、新しい方策が選ぶ案とログの案が一致した場面だけを使って評価する再生の方法を示しました。前提は2つで、個々の場面(顧客の訪問とその反応)が互いに独立に同じ分布から生じていることと、記録のための方策が各時点で案を一様に無作為に選んでいたことです。Li らは、この前提のもとで偏りの無い評価になることを示し、Yahoo! のトップページで集めた大規模なニュース記事の推薦のデータで検証しています。この再生の方法は、重みを付けて数え直す逆確率重み付けとは別の方法です。
Li らは、2つ目の前提(一様に無作為に選ぶこと)は、選ぶ確率の分かっている無作為な方策なら一般に緩められるが、使えるデータの効率は下がるとも述べています。また、1つ目の前提(互いに独立に同じ分布から生じること)については、新しい記事が入れ替わることや、同じ顧客が何度も訪れることなどで、実際のデータはこの前提から外れうることに触れています。
逆に言えば、いつも「スコアが最も高い商品」を決まって出してきた推薦のログからは、出されなかった商品についての情報がほとんど取れず、オフ方策評価は難しくなります。将来オフ方策評価を使いたいなら、推薦の一部に確率的な選び方を入れ、出した確率をログに残しておくことが前提になります。第2章で表示のログを最初から残すことを勧めたのと同じく、推薦の枠・順位に加えて、その推薦を出した確率を残しておくことは、後の評価の選択肢を広げる投資だと考えています。オフ方策評価は A/Bテストの代わりではなく、A/Bテストに進める候補を絞り込むための道具として使うのが安全です。
A/Bテストの落とし穴、推薦で特に気をつけること
途中で止める問題のほかにも、推薦の A/Bテストで起きやすい落とし穴があります。次の表にまとめました。
| 落とし穴 | 起きること | 対処の例 |
|---|---|---|
| 途中で何度も見て止める | 差が無くても有意になりやすい(本コラムのシミュレーションでは、毎日見ると0.279) | 人数と期間を先に決める。途中で見るなら逐次的な検定を最初から選ぶ |
| 指標が多い | 指標を増やすほど、差が無くてもどれかが偶然有意になる確率が上がる(多重比較の問題。有意水準5%で互いに独立な20の指標を見れば、1つ以上が有意になる確率は約64%) | 主な指標を1つに決める。ほかは守りの指標として扱い、偶然の差を拾っていないか慎重に読む |
| 新奇効果 | 推薦の枠が新しく目立つ間だけクリックが増え、慣れると戻ることがある | 期間を始める前に長めに決め、その期間の中で週ごとの差の推移も確かめる |
| 推薦の枠どうしの干渉 | ある枠の推薦が良くなると、別の枠や検索からの購買が減る | サイト全体の購買を主な指標にする。ほかの枠の購買を守りの指標にする |
| 同時に走る別のテスト | 別の部署のテストと同じ顧客が重なり、同時に受ける施策どうしが影響し合う(相互作用がある)場合には、測る効果が変わる | テストごとに独立に振り分ける。テストの台帳を全社で1つにして重なりを把握し、影響し合うと疑われるテストどうしは分けるか、相互作用が無いかを確かめる |
| 群の人数の偏り | 振り分けやログの不具合で、群の人数が設計の比と合わない | 結果を読む前に、群の人数が設計の比と合っているかを確かめる |
| 顧客の識別の揺れ | 端末を替えた同じ顧客が別の群に入り、差が薄まる | ログインした顧客で分ける。揺れの程度を把握しておく |
新奇効果は、推薦の A/Bテストで見落とされやすい落とし穴です。新しい推薦の枠や新しい見た目の推薦は、最初は目新しさからクリックされやすく、テストの最初の1〜2週間だけを見ると、効果が大きく見えることがあります。逆に、顧客が慣れた見た目を変えると、最初は戸惑いから成績が下がり、慣れると戻ることもあります。観察の期間(1週間の倍数で長めに)と終了の条件を始める前に決めておき、その期間の中で週ごとの差の推移も確かめるのがよいと考えています。推移を見ながら終わる時点を決めると、前の節で見た途中で止める問題と同じことが起きるからです。
推薦の枠どうしの干渉も、推薦に特有の問題です。商品ページの推薦を良くすると、その枠のクリックや購買は増えても、カートの推薦や検索からの購買が減って、サイト全体ではほとんど増えていないことがあります。これは、効果の定義の節で述べた付け替えが、枠と枠の間で起きている状態です。推薦の枠の担当者が自分の枠の数字だけで成果を報告すると、各枠の成果の合計がサイト全体の増加を大きく上回る、ということが起こりえます。主な指標をサイト全体の購買にし、ほかの枠の購買を守りの指標にしておくことで、この干渉に気づけます。
同時に走る別のテストとの重なりは、それだけで結果をゆがめるわけではありません。Microsoft の実験基盤のチームが2023年に公開した記事は、ある製品群で同時に走っていたテストの組を1日分調べたところ、相互作用が検出された例はごく少なかったと報告し、多くの場合はテストごとに独立に振り分けて同時に走らせ、影響し合うと疑われるテストだけを分けることを勧めています。テストを分けると1つのテストに使える人数が減り、差を見つけにくくなるからです。同じ記事は、結果は製品やテストによって違うので、自社でも相互作用を確かめるよう勧めています。推薦の枠と、同じ商品ページの見た目のテストのように、同じ顧客の同じ行動に触れるテストどうしは、相互作用を疑ってかかるのがよいと考えています。
A/Bテストは、短期の指標の差を確かめるのは得意ですが、長期の指標は苦手です。推薦が顧客の継続利用や生涯価値(弊社コラム『顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで』で扱っています)に与える影響は、数週間のテストでは見えません。短期の購買を増やす推薦が、似た商品ばかりを勧めて長期的には顧客の関心を狭めることもありえます(推薦の偏りと多様性は第11章で扱います)。長期の影響を確かめたい場合は、一部の顧客を長く推薦なしのままにしておく群を残しておく方法があります。この群は、推薦の効果(推薦なしと比べた差)を継続して測るための基準になります。推薦なしの群を置けない枠では、従来の推薦の群を残し、方式を替えた効果(従来の推薦と比べた差)として測ります。
経営の判断、効果の測り方を予算の判断の前に決める
この章の内容を、経営の判断に置き換えます。推薦に予算を付けるとき、経営が最初に決めるべきことは、推薦の精度の目標ではなく、「推薦の効果を何と比べて、どの指標で、何人で、いつ測るか」だと考えています。効果の測り方を決めないまま推薦を導入すると、管理画面に出やすい推薦経由の購買の数が効果として報告されてしまうおそれがあり、本コラムの架空データで見たように、実際の効果を大きく上回る数字が成果として扱われかねません。その数字を根拠に推薦の枠を広げ、追加の開発に予算を付ける判断は、誤った前提の上に立つことになります。
評価の判断を誤ったときの損失を、序章で整理した6つの損失の型に当てはめると次のようになります。
| 評価での誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 推薦経由の購買の数を効果として報告する | 効果の過大評価 | 推薦の効果は推薦なしの群との差で、方式を替えた効果は従来の推薦の群との差で、比べる相手を明記して報告させる |
| 推薦を使った顧客と使わなかった顧客を比べる | 効果の過大評価 | 顧客を偶然で分けた群どうしで比べる |
| 人数が足りないテストで「効果なし」と判断して推薦を止める | 機会損失 | 始める前に検出力分析で、確かめられる差の大きさを示させる |
| 途中の結果を見て止め、偶然の差で方式を切り替える | 効果の過大評価、二重投資(効果の無い仕組みに作り替えが重なる) | 人数と期間を先に決め、決めた時点で1回だけ判断する |
| 枠ごとの数字だけで成果を測る | 効果の過大評価、二重投資(枠や部署ごとに成果を別々に主張できると、それぞれが自分の枠のための仕組みを別に作る判断につながりうる) | サイト全体の指標を主な指標にし、テストの台帳を全社で1つにする |
| 効果を測らないまま推薦を動かし続ける | 形骸化 | 推薦なしの群(置けない枠では従来の推薦の群)を長く残し、比べる相手を明記して効果を継続して測る |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 推薦の効果は推薦なしの群との差、方式を替えた効果は従来の推薦の群との差として、比べる相手と信頼区間を明記して報告させる。推薦経由の購買の数は、推薦がどれだけ使われているかの数字として別に扱う
- A/Bテストの主な指標・守りの指標・期間・必要な人数・判断の基準を、テストを始める前に文書にして承認する
- 見つけたい差の大きさ(事業上意味のある最小の差)を事業責任者が決め、その差を確かめるのに必要な人数と期間から、テストの計画と予算を立てる
- テストの台帳を全社で1つにし、部署や枠をまたいだテストの重なりを管理する
- 推薦の効果を継続して測るため、一部の顧客を推薦なしのまま残す群(置けない枠では従来の推薦の群)を設け、その分の取りこぼしを効果を測るための費用として認める
- 将来オフ方策評価を使う可能性があるなら、推薦の一部に確率的な選び方を入れ、出した確率をログに残す
予算の面では、A/Bテストの期間中の取りこぼし(劣った群に配った顧客の分)と、推薦なしの群を長く残す分の取りこぼしを、効果を確かめるための費用として最初から見込んでおく必要があります。これを惜しんで、全員に推薦を出してしまうと、偶然で分けた比べる相手の群が無くなり、推薦の効果を後から確かめることが難しくなります。推薦ベンダーから効果の報告を受ける場合も、その数字が推薦経由の購買の数なのか、推薦なしの群と比べた差なのか、比べた群は偶然で分けたのかを、まず確かめる必要があります。試験導入(PoC)の段階での効果の測り方と合格の条件の決め方は、第13章で扱います。
この章のまとめ
この章では、推薦の効果を、推薦が無くても買われた分を除いて測る方法を扱いました。本コラムの架空データでは、推薦の枠を経由した購買は1,000人あたり82.4でしたが、本当に推薦で増えた購買は42.4で、A/Bテストで測った差は39.8(95%信頼区間30.8〜48.7)でした。推薦の枠から買った人と買わなかった人の比較は、もともとよく買う顧客の違いを推薦の働きと取り違えさせます。A/Bテストは、比べる相手・分け方の単位・指標・期間・人数を先に決めて行い、購買率0.1265を相対5%上げる差を確かめるには1群44,275人が必要でした。途中で毎日結果を見て止めると、差が無くても約28%のテストで有意になりました。バンディットは良い案を学習できれば期間中の取りこぼしを減らせますが(本コラムの条件では、トンプソン抽出の累積の損失は均等配分の約3分の1、UCB1 は均等配分に近い値でした)、劣った案の推定は粗くなるので、効果の説明と投資判断には A/Bテストが向くと考えています。次の第10章では、履歴の無い新しい商品と新しい顧客への推薦と、探索をどう推薦の仕組みに組み込むかを扱います。
この章を深めたい方への参考書籍
『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』(Ron Kohavi、Diane Tang、Ya Xu 著、大杉直也 訳、ドワンゴ):オンラインの比較実験(A/Bテスト)を、実験の実行と分析、結果の信頼性、実験の基盤と組織の文化まで扱う本です(2021年刊)。この章で扱った、指標の選び方・途中で止める問題・結果を疑って確かめる姿勢を、推薦に限らないオンライン実験の全体の中で確かめるのに向いています。
『データ分析の力 因果関係に迫る思考法』(伊藤公一朗 著、光文社):光文社新書の1冊で、版元の紹介によれば、ランダム化比較試験・RD デザイン・パネル・データ分析などの因果関係に迫る方法を、数式を使わずに具体例で説明する本です(2017年刊)。この章の「推薦を使った人と使わなかった人を比べても効果は分からない」という論点を、推薦の外の事例で理解し直すのに役立ちます。
『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』(齋藤優太、安井翔太 著、ホクソエム 監修、技術評論社):版元の目次によれば、バンディットのデータセットと評価の道具、明示的・暗黙のフィードバックを使った推薦の構築、IPS 推定量(逆確率重み付けの推定量)の評価、因果効果を考えたランキングを扱う本です(2021年刊)。この章で考え方だけを紹介したオフ方策評価を、推薦の文脈で実装まで確かめるのに向いています。
第10章 コールドスタートと探索、新しい商品と新しい顧客への推薦
第9章では、推薦の効果は推薦が無かった場合と比べて確かめる必要があること、A/Bテストで均等に配分する代わりに、成績の良さそうな案へ表示を寄せながら確かめるバンディットという考え方があることを扱いました。この章では、そのバンディットの考え方を、推薦の中でも特に扱いにくい「履歴の無いもの」に当てはめます。第3章から第7章で見た方法のうち、人気順・協調フィルタリング・行列分解・深層学習は、過去の行動の記録から学ぶ方法です(第6章の内容ベースは商品の属性を使うので、この章でも新しい商品への対処として使います)。行動の記録だけから学ぶ方法では、記録が無い新しい商品や新しい顧客について、その商品やその顧客に固有の表現(好みや特徴をとらえた数値)を学べません。新しい顧客にも人気順なら出せますが、それは誰にでも同じ推薦です。
この章で扱うのは次の内容です。後半は、毎日新しい商品が加わる架空のシミュレーションと、新しい顧客の最初の数回の購買を使った架空の実験で、実行したコードと結果を示します。
- コールドスタートが起きる3つの場面(新しい顧客・新しい商品・新しいサービス)と、それぞれで使える情報
- 新しい顧客への対処(人気順・顧客の属性・最初の数回の行動・質問で好みを聞く)
- 新しい商品への対処(内容ベース・似た商品の履歴・露出の保証枠)
- 探索と活用の考え方と、推薦の枠以外の経路が無いまま人気順だけで推薦し続けると、新しい商品の評価が貯まらない理由
- 新商品の枠・トンプソン抽出による探索を、人気順と比べたシミュレーション
- 顧客や商品の特徴を使う文脈つきバンディット(LinUCB の考え方)
- 新商品を売りたい・在庫を消化したいといった事業上の制約との関係と、経営判断
この章の主張は、推薦の並び順を過去の実績(クリック数や購買数)だけで決めていて、推薦の枠以外の経路からも新しいものが見られない場合は、新しいものを意図して表示しない限り評価が貯まらないので、探索のための表示を「推薦の精度を下げる無駄」ではなく「将来の推薦の材料を買う投資」として、枠と予算を決めて扱うべきだ、ということです。本コラムの架空のシミュレーションでは、探索の枠を設けても、残りの枠をクリック数の順に並べたままでは全体のクリック率は上がらず、表示回数を考えに入れた推定クリック率の順に並べ替えたときに大きく上がりました。
このことを、人気順と、新商品の枠だけを設けた方式・並べ方だけを変えた方式と比べた数字で示します。
コールドスタートの3つの場面、何が無くて何が使えるか
コールドスタートは、全体の地図で定義したとおり、履歴の無い新しい顧客・新しい商品について推薦が難しい問題です。協調フィルタリングは「多くの顧客の行動の似かた」から推薦するので、行動が1件も無い顧客は、行動の履歴から他の顧客との似かたを判断できず、誰にも買われていない商品も、行動の履歴から他の商品との似かたを判断できません。行列分解や、顧客や商品の ID ごとに埋め込みを学ぶ形の2つの塔のモデル(顧客と商品を別々の仕組みで数値の並びに変える形。第7章)でも、学習のときに行動が無かった顧客や商品には、意味のある潜在因子や埋め込み(どちらも、顧客や商品の好みや特徴を表す数値の並び)が学ばれません。2つの塔のモデルで商品の属性や説明文を入力に使う形にすれば、学習のときに無かった商品にも、その属性から埋め込みを計算できます。コールドスタートの研究は古くからあり、たとえば Schein らの2002年の論文(情報検索の国際会議 SIGIR で発表)は、題名のとおりコールドスタートの推薦の方法と、その評価の指標を扱っています。
コールドスタートは、何が新しいかによって3つの場面に分けて考えると整理しやすくなります。場面によって、使える情報と打てる手が違うからです。
| 場面 | 無いもの | 使える情報 | 主な対処 | 起きやすい損失の型 |
|---|---|---|---|---|
| 新しい顧客 | その顧客の行動の履歴 | 全体の人気・流入元(検索語・広告・紹介元)・登録時の属性・最初の数回の閲覧や購買・質問への回答 | 人気順から始め、最初の行動で好みを推定して切り替える。必要なら好みを質問する | 顧客の離反(最初の推薦が的外れで、2回目の来訪が無い) |
| 新しい商品 | その商品への行動の履歴 | 商品の属性・説明文・画像、同じシリーズや同じ作り手の商品の履歴、販売計画 | 内容ベースで似た商品の顧客に出す。露出の保証枠で表示を確保し、反応を集める | 機会損失(良い新商品が誰にも見えない)、品揃えの偏り |
| 新しいサービス | 顧客と商品の両方の履歴 | 商品の属性、業務の知識によるルール、他のサービスで同意を得て使える情報 | ルールと内容ベースから始め、表示ログを最初から残して、行動が貯まったら協調フィルタリングへ移る | 形骸化(効果を測らないままルールの推薦が続く) |
3つの場面に共通するのは、「行動が無いので推薦できない」と「推薦しないので行動が貯まらない」が互いの原因になっていることです。新しい顧客は、最初の推薦が的外れなら行動せずに去ることがあり、そうなればその顧客の好みは分からないままです。新しい商品は、検索や特集など推薦の枠以外の経路からも見られない場合には、推薦の枠に出なければクリックも購買も起きず、いつまでも「履歴の少ない商品」のままです。この循環を断つには、推薦の側から意図して情報を取りに行く必要があります。この章の後半で扱う探索は、その取りに行き方の1つです。
新しいサービスの場面は、この章では深入りしません。顧客も商品も履歴が無い段階では、第3章のルールと人気順、第6章の内容ベースから始めるのが現実的で、そのときに第2章で扱った表示ログ(どの枠で、何を、何位に出したか)を最初から残しておくことが、後で協調フィルタリングや探索に移るための前提になります。以下では、新しい顧客と新しい商品を順に扱います。
新しい顧客への対処、人気順から始めて最初の数回の行動で切り替える
新しい顧客に対して最初に使える推薦は、第3章で扱った人気順です。人気順は個人の好みを使いませんが、多くの顧客が買う商品は新しい顧客にも買われやすいので、何も無いよりは当たります。ただし、人気順は全員に同じものを出すので、好みが人気の中心から外れた顧客には当たりません。そこで、顧客について分かることが少しでも増えたら、それを使って推薦を切り替えていくことになります。使える情報には、次のようなものがあります。
- 流入元:どの検索語・広告・紹介元から来たか。来訪の時点で分かり、関心のジャンルの手がかりになる
- 登録時の属性:年代・地域などを顧客が登録した場合。好みとの結び付きは商材によって強くも弱くもなる
- 最初の数回の行動:最初に閲覧・購買した商品のジャンル・属性。本人の行動なので手がかりとしては強いが、行動が起きるまで使えない
- 質問への回答:登録時や初回の来訪時に、好みのジャンルや関心を選んでもらう。行動を待たずに分かるが、回答の手間が離脱の原因になりうる
属性を使うときは注意が要ります。年代や性別のような属性で推薦を変えると、属性から好みを決めつけることになり、外れた顧客には不快に感じられることがあります。属性の取り扱いと個人データの利用目的の考え方は第14章で扱います。この章では、行動と質問の2つを、架空の実験で人気順と比べます。新しい顧客に何を質問するか(どの商品を評価してもらうか)の選び方は研究の主題にもなっており、たとえば Rashid らの2002年の論文(知的ユーザーインタフェースの国際会議 IUI で発表)は、題名のとおり推薦システムで新しい顧客の好みを学ぶ方法を扱っています。
次のコードでは、顧客2,000人・商品300点・ジャンル10の架空の合成データを作りました。商品にはそれぞれジャンルと人気の大きさがあり、人気は少数の商品に集中するようにしています。顧客には「どのジャンルをどれだけ好むか」を乱数で持たせ、多くの顧客が1〜2ジャンルに好みが偏るようにしました。各顧客は、好みと人気の積に比例した確率で、同じ商品を重ねずに20回購買します。実際の購買ログはこれよりはるかに複雑で、この合成データは性質を単純にしたものです。そのうえで、最初の k 回の購買だけを見て10点を推薦し、その次の5回の購買のうち推薦した10点に入っていた割合を、3つの方法で比べました。
この割合は「次の5回の購買に対する再現率@10」で、この章では以下、短く「的中率」と書きます。計算は第8章の再現率@10 と同じで、第8章の「正解」を「その顧客の次の5回の購買」に置き換えたものです。1件でも当たった顧客の割合(ヒット率)とは別の数です。どの顧客も正解が5点なので、全顧客を合算した割合と顧客ごとの割合の平均は一致します。この章の架空データは他の章と別に作ったもので、他の章の再現率@10 の値とは比べられません。
import numpy as np

# 架空の顧客と商品:好みのジャンルと人気の偏り
rng = np.random.default_rng(20261110)
N_USER, N_ITEM, N_GENRE, N_BUY = 2000, 300, 10, 20
genre = rng.integers(0, N_GENRE, N_ITEM)                 # 商品のジャンル
pop = 1 / np.arange(1, N_ITEM + 1) ** 0.8                # 少数の商品に購買が集中する人気の偏り
pop = rng.permutation(pop)
pref = rng.dirichlet(np.full(N_GENRE, 0.3), N_USER)      # 顧客ごとのジャンルの好み(1〜2ジャンルに偏る)
w = pref[:, genre] * pop                                 # 顧客×商品の買われやすさ
g = rng.gumbel(size=w.shape)                             # 重複なしで購買の順番を作る
order = np.argsort(-(np.log(w) + g), axis=1)[:, :N_BUY]  # 顧客ごとに20回の購買(古い順)

# 最初の k 回の購買だけを見て推薦し、次の5回を当てる
share = np.bincount(genre, weights=pop, minlength=N_GENRE) / pop.sum()   # 全体のジャンルの構成
def evaluate(k, method):
    hits = 0
    for u in range(N_USER):
        seen, future = order[u, :k], order[u, k:k + 5]
        if method == "人気順":
            score = pop.copy()
        elif method == "最初の行動":                       # 見たジャンルの割合で人気順を重み付け
            cnt = np.bincount(genre[seen], minlength=N_GENRE)
            est = (cnt + 2 * share) / (k + 2)                # 行動が少ないうちは全体の構成に寄せる
            score = est[genre] * pop
        else:                                                # 質問:最も好きなジャンルを1つ答えてもらう
            score = pop * np.where(genre == pref[u].argmax(), 1.0, 0.05)
        score[seen] = -1                                     # 買った商品は推薦しない
        top = np.argsort(-score)[:10]
        hits += np.isin(future, top).sum()
    return hits / (N_USER * 5)

ks = [0, 1, 2, 3, 5, 10]
for m in ["人気順", "最初の行動", "質問で好みを聞く"]:
    print(m, [round(float(evaluate(k, m)), 3) for k in ks])
# 出力:
# 人気順 [0.25, 0.232, 0.222, 0.21, 0.199, 0.158]
# 最初の行動 [0.241, 0.266, 0.284, 0.289, 0.299, 0.29]
# 質問で好みを聞く [0.326, 0.314, 0.307, 0.301, 0.286, 0.262]
「最初の行動」は、それまでに買った商品のジャンルの割合で好みを推定し、人気に掛け合わせて並べる方法です。行動が少ないうちは推定がぶれるので、全体のジャンルの構成を2回分の購買として混ぜ、行動が増えるほど本人の行動の割合に近づくようにしました。「質問で好みを聞く」は、最も好きなジャンルを1つだけ答えてもらい、そのジャンルの商品を優先して人気順に並べる方法です。この架空データでは、顧客は自分の好みを正しく答えるものとしています。実行した結果を表にまとめます。
| 推薦の前に観察した購買の回数 | 人気順 | 最初の行動 | 質問で好みを聞く |
|---|---|---|---|
| 0回 | 0.250 | 0.241 | 0.326 |
| 1回 | 0.232 | 0.266 | 0.314 |
| 2回 | 0.222 | 0.284 | 0.307 |
| 3回 | 0.210 | 0.289 | 0.301 |
| 5回 | 0.199 | 0.299 | 0.286 |
| 10回 | 0.158 | 0.290 | 0.262 |
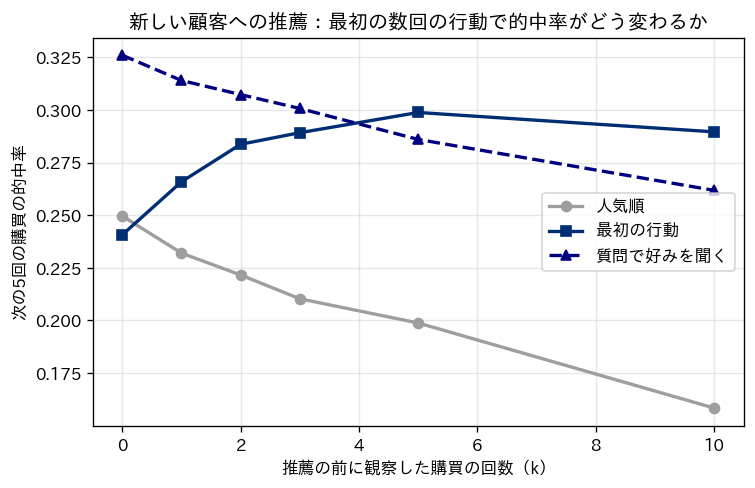
本コラムの架空データでは、3つのことが読み取れます。1つ目は、行動が1件も無い時点(0回)では、質問で好みを聞く方法の的中率が0.326で、人気順の0.250を上回ったことです。行動を待たずに好みが分かれば、最初の推薦から人気順より当てられます。2つ目は、最初の行動を使う方法は、0回の時点では人気順とほぼ同じ(0.241)ですが、1回の購買で0.266、3回で0.289と、人気順を上回っていったことです。この架空データでは、最初の数回の行動が、新しい顧客の推薦の手がかりとして効きました。3つ目は、5回以上観察すると、最初の行動を使う方法(5回で0.299)が質問で好みを聞く方法(0.286)を上回ったことです。この実験の設計では、質問で使うのは「最も好きなジャンル1つ」だけで、行動を使う方法は買ったジャンルの割合をそのまま使うので、2番目以降に好きなジャンルも推薦に反映されます。複数のジャンルへの関心を反映できることが差の一因と考えられますが、どの部分がどれだけ効いたかは、この実験では切り分けていません。また、観察した回数ごとに、当てる対象の「次の5回」も入れ替わるので、表の行どうしの比較は、同じ購買を当てた成績の比較ではありません。
人気順の的中率が、観察した回数が増えるほど下がっている点にも触れておきます。この架空データは、顧客が人気の高い商品から先に買いやすいように作っており、買った商品は推薦から外すので、回数が進むほど残りの購買は人気順の上位から外れていきます。つまり、この低下はデータの作り方から出た結果です。この架空データでは、人気順は顧客の購買が進むほど当たりにくくなりました。
この結果は、架空データの単純な設定による、1つの乱数の種(乱数の出方を固定する数。シードとも呼びます)での結果で、実際のサービスで質問がどれだけ当たるかは分かりません。現実には、質問への回答の手間で登録をやめる顧客が出ること、顧客が自分の好みを正しく答えるとは限らないこと、ジャンルの粒度が粗いと回答が推薦に効かないことがあります。質問を入れるかどうかは、回答による離脱と、最初の推薦の的中の改善を、第9章の A/Bテストで比べて決める必要があると考えています。実務の手順としては、来訪の直後は人気順(流入元が分かればそのジャンルの人気順)から始め、閲覧や購買が数回起きたら、その行動に基づく推薦へ切り替える、という段階を用意しておくのが扱いやすいと考えています。
新しい商品への対処、内容ベース・似た商品の履歴・露出の保証枠
新しい商品のコールドスタートには、大きく3つの対処があります。1つ目は内容ベースです。第6章で扱ったとおり、商品の属性や説明文は追加した日から分かるので、その属性が似た商品に関心を示した顧客へ推薦できます。2つ目は、似た商品の履歴を借りることです。同じシリーズの前作、同じ作り手の別の商品、同じカテゴリで価格帯の近い商品など、業務の知識で「この新商品はあの商品に近い」と言える場合は、その商品の推薦の対象を新商品の最初の推薦先に使えます。3つ目は、露出の保証枠です。推薦の枠の一部を新商品のために確保し、履歴が無くても新商品がまとまって表示されるようにします。ただし、新商品の群に枠を割り当てるだけでは、商品1点ごとの最低の表示回数は保証されません(この章のシミュレーションの枠も、枠の中の商品をランダムに選んでいます)。1点ごとに保証するには、表示の少ない商品を優先するといった制御が別に要ります。
1つ目と2つ目は「誰に出すか」を決める方法で、3つ目は「どれだけ出すか」を決める方法です。内容ベースで良い推薦先が分かっても、推薦の並び順が過去のクリック数や購買数で決まっている限り、新商品は上位に入れず、表示されません。逆に、露出の保証枠で表示を確保しても、誰に出すかを考えなければ、関心の無い顧客に見せて反応が取れず、新商品の評価を不当に低く見積もることになります。2つの方法は組み合わせて使うものだと考えています。ただし、この章のシミュレーションで確かめるのは「どれだけ出すか」の側(枠と探索)だけで、新商品を顧客を区別せずに表示しています。「誰に出すか」との組み合わせは、この章の数字では確かめていません。
| 対処 | 必要なもの | 分かること | 外れやすいところ |
|---|---|---|---|
| 内容ベース | 整った商品の属性・説明文(第6章) | 新商品に関心を持ちそうな顧客 | 属性が似ていても売れ方が違う商品がある。属性データの品質に左右される |
| 似た商品の履歴を借りる | シリーズ・作り手・カテゴリなどの対応関係 | 前作や近い商品と同じ顧客層 | 前作と顧客層が違う新商品では外れる。対応付けを人が保守する手間がかかる |
| 露出の保証枠 | 推薦の枠の一部と、新商品とみなす期間の決まり | 実際に表示したときの反応(クリック率・購買率) | 本来の並び順が表示回数を考えないクリック数の順だと、枠で反応が良くても上位に入れず、枠から出たとたんに表示されなくなることがある。商品1点ごとの表示回数は、別の制御をしない限り保証されない |
| 探索のアルゴリズム(バンディット) | 表示とクリックのログ、推定の更新の仕組み | 反応の推定と、その推定の不確かさ | 短期のクリック率を下げる期間がある。目的の指標の選び方を誤ると偏る |
表の1〜3行目が上で述べた3つの対処で、最後の行が、次の節から扱う探索の考え方です。露出の保証枠は、探索を「枠」という分かりやすい形で行う方法だと言えます。
探索と活用、知っているものだけを推薦すると新しいものの評価が貯まらない
探索と活用は、バンディットの問題で使われる言葉です。活用は、これまでの記録で最も成績が良いと分かっている選択肢を選ぶことで、探索は、記録が少なく成績がよく分からない選択肢を、情報を得るためにあえて選ぶことです。推薦に当てはめると、活用は「過去によくクリックされた商品を出す」こと、探索は「表示の記録が少ない商品を出して、反応を確かめる」ことです。
活用だけを続けると何が起きるかは、人気順を例にすると分かりやすくなります。人気順は、過去のクリック数や購買数の多い順に並べます。上位の商品は表示されるのでクリックが増え、さらに上位に留まります。下位の商品と新しい商品は表示されないのでクリックが0のままで、上位に上がる機会がありません。表示されなかった商品のクリックが0なのは、第2章で扱ったとおり「嫌われた」証拠ではなく「見えていなかった」だけですが、人気順はその区別をしません。そのため、推薦の並び順を人気順だけで決めていて、推薦の枠以外(検索・特集など)からも新しい商品が見られない場合は、新しい商品の評価は貯まりません。
反対に、探索だけを続ける(たとえば毎回ランダムに推薦する)と、成績の悪い商品にも同じだけ表示を割くので、全体のクリック率は下がります。探索と活用のつり合いをどう取るかが、バンディットの問題の中心です。第9章で扱ったように、代表的な考え方には、一定の割合だけランダムに選ぶ ε-greedy、記録の少ない選択肢を楽観的に見積もる UCB、推定の不確かさに応じて確率的に選ぶトンプソン抽出があります。トンプソン抽出の原典と考え方は第9章に譲ります。この章では、Chapelle と Li の2011年の論文(機械学習の国際会議 NIPS、現在の NeurIPS の論文集に収録)が、実験の結果をもとに、トンプソン抽出を他の方法と比べるときの基準の1つに加えることを勧めている点だけ紹介します。この章のシミュレーションでも、トンプソン抽出を比べる方式の1つに入れました。
推薦の探索には、第9章の A/Bテストやバンディットと違う点が2つあります。1つは、選択肢が増え続けることです。A/Bテストでは比べる案が最初に決まっていますが、推薦では毎日新しい商品が加わり、古い商品は飽きられたり販売を終えたりします。もう1つは、選択肢の数が多いことです。商品は数百から数百万あり、全部を均等に探索することはできません。この2つの点を入れたシミュレーションを、次の節で作ります。
毎日新商品が加わるシミュレーション、5つの推薦の方式を60日間動かす
次のコードで、架空の合成データによるシミュレーションを作りました。設定は次のとおりです。商品は100点で始まり、毎日3点ずつ新商品が加わり、60日後には280点になります。商品にはそれぞれ「本当のクリック率」があり、ベータ分布(0から1の間の値をとる確率分布で、割合を表すのによく使われます)から、平均がおよそ3%になるように乱数で決めました。新商品も既存の商品と同じ分布から決めているので、新商品の中にも既存の商品よりクリックされやすいものが一定の割合で含まれます。また、商品は古くなるほど少しずつ飽きられ、本当のクリック率は1日ごとに1%ずつ下がるようにしました。サイトには1日2,000回の訪問があり、訪問ごとに推薦の枠に5つの商品を出し、顧客は各商品を本当のクリック率に従ってクリックします。推薦の側は本当のクリック率を知らず、表示とクリックの記録だけを使います。記録は1日の終わりにまとめて更新する、毎晩の一括計算を想定しています。実際のサイトでは、顧客ごとの好み・推薦の枠の中の位置・季節などが絡むので、この設定はそれらを省いた単純なものです。
この設定の限界をもう1つ書いておきます。後で説明する率順とトンプソン抽出は、過去の表示とクリックをすべて同じ重みで足し合わせ、古い記録を割り引く処理(忘却)を入れていません。クリック率が時間とともに下がるこの設定では、今のクリック率への追従が遅れることがあり、この最小の例はその対処を省いています。
import numpy as np

# 架空の商品と、毎日加わる新商品
N_INIT, NEW_PER_DAY, DAYS = 100, 3, 60
VISITS, SLOTS, NEW_AGE = 2000, 5, 7          # 1日の訪問数・推薦の枠の数・新商品とみなす日数
N_ALL = N_INIT + NEW_PER_DAY * DAYS
born = np.concatenate([np.full(N_INIT, -30), np.repeat(np.arange(DAYS), NEW_PER_DAY)])

def make_items(seed):
    rng = np.random.default_rng(seed)
    base_ctr = rng.beta(2, 60, N_ALL)        # 商品ごとの本当のクリック率(顧客からは見えない)
    return rng, base_ctr

def true_ctr(base_ctr, day):
    age = np.maximum(day - born, 0)
    return base_ctr * 0.99 ** age             # 古くなるほど少しずつ飽きられる
比べた推薦の方式は次の5つです。このうち「率順(枠なし)」は、新商品枠の有無と並べ方の違いを切り分けるために足した対照です。
- 人気順:直近14日のクリック数の多い順に5つを出す。全員に同じ5つを出す
- 新商品枠:5つの枠のうち4つは人気順、残りの1つは追加から7日以内の新商品の中からランダムに出す(4つの枠に出ている商品は除き、同じ商品を2つの枠に重ねて出さない)
- 率順(枠なし):新商品枠を設けず、5つとも推定クリック率(次の項目で説明)の順に出す
- 新商品枠+率順:新商品枠と同じく1つを新商品に割り当てるが、残りの4つを、クリック数ではなく推定クリック率(クリック数を表示回数で割った値を、表示が少ないうちは全体の平均に寄せたもの)の順に出す
- トンプソン抽出:商品ごとのクリック率の推定の不確かさをベータ分布で表し、訪問ごとにその分布から1つずつ値を引いて、値の大きい5つを出す
開始前の履歴として、既存の100点にはそれぞれ300回ずつ表示した記録を持たせ、新商品は記録0回から始めます。トンプソン抽出と推定クリック率は、記録の無い商品を「既存の商品の平均くらい」とみなして始めるように、事前分布(記録が無いときの見込み)の平均を既存の商品の平均クリック率に合わせました。このシミュレーションでは推薦の枠の中の位置によるクリックのされやすさの違いを入れていないので、新商品枠を5つのうち何番目に置くかは結果に影響しません。
def simulate(seed, method, new_slots=1):
    rng, base_ctr = make_items(seed)
    imp = np.zeros(N_ALL); clk = np.zeros(N_ALL)
    imp[:N_INIT] = 300                        # 開始前の履歴:既存の商品だけ各300回表示
    clk[:N_INIT] = rng.binomial(300, true_ctr(base_ctr, -1)[:N_INIT])
    recent = [clk.copy()]                     # 人気順は直近14日のクリック数で並べる
    prior_b = imp[:N_INIT].sum() / clk[:N_INIT].sum() - 1   # 事前分布 Beta(1, b) の平均を既存商品の平均に合わせる
    rec = {"ctr": [], "new_share": [], "best_ctr": []}
    first_week_imp = np.zeros(N_ALL)
    for day in range(DAYS):
        avail = np.where(born <= day)[0]
        p = true_ctr(base_ctr, day)
        is_new = (day - born[avail]) < NEW_AGE
        if method == "人気順":
            pop = np.sum(recent[-14:], axis=0)[avail]
            top = avail[np.argsort(-pop, kind="stable")[:SLOTS]]
            shown = np.tile(top, (VISITS, 1))
        elif method in ("新商品枠", "新商品枠+率順", "率順(枠なし)"):
            if method == "新商品枠":
                pop = np.sum(recent[-14:], axis=0)[avail]
            else:                             # 推定クリック率の順(枠で集めた評価もここに入る)
                pop = (1 + clk[avail]) / (1 + prior_b + imp[avail])
            if method == "率順(枠なし)":
                new_slots = 0                 # 対照:新商品枠を設けず、5つとも推定クリック率の順
            top = avail[np.argsort(-pop, kind="stable")[:SLOTS - new_slots]]
            new_items = avail[is_new & ~np.isin(avail, top)]   # 通常の枠に出す商品は新商品枠から除く
            pick = new_items[np.argsort(rng.random((VISITS, len(new_items))), axis=1)[:, :new_slots]]
            shown = np.hstack([np.tile(top, (VISITS, 1)), pick])
        else:                                 # トンプソン抽出
            a = 1 + clk[avail]; b = prior_b + imp[avail] - clk[avail]
            draw = rng.beta(a, b, size=(VISITS, len(avail)))
            shown = avail[np.argpartition(-draw, SLOTS, axis=1)[:, :SLOTS]]
        click = rng.random(shown.shape) < p[shown]
        d_imp = np.bincount(shown.ravel(), minlength=N_ALL)
        d_clk = np.bincount(shown.ravel(), weights=click.ravel(), minlength=N_ALL)
        imp += d_imp; clk += d_clk; recent.append(d_clk)
        young = (day - born) < NEW_AGE
        first_week_imp += d_imp * young
        rec["ctr"].append(click.mean())
        rec["new_share"].append(d_imp[young].sum() / shown.size)
        rec["best_ctr"].append(np.sort(p[avail])[-SLOTS:].mean())   # 本当のクリック率を知っていた場合
    newborn = np.flatnonzero((born >= 0) & (born <= DAYS - NEW_AGE))   # 最初の7日間を観察し終えた新商品
    good = newborn[base_ctr[newborn] >=np.quantile(base_ctr, 0.9)]
    rec["seen"] = (first_week_imp[newborn] >= 100).mean()            # 最初の7日で100回以上表示された割合
    rec["good_seen"] = (first_week_imp[good] >= 100).mean()
    rec["n_newborn"], rec["n_good"] = len(newborn), len(good)
    return rec
最後の数行では、新商品が追加から7日の間に100回以上表示されたかどうかを数えています。100回は、クリック率3%の商品ならクリックが平均3回ほど起きる回数で、反応の有無をおおまかに確かめるための目安として本コラムが置いた値です。対象は、60日目(最終日)までに7日間の観察を終えた新商品(追加が54日目以前のもの)162点と、そのうち本当のクリック率が全商品の上位10%に入る「本当に良い新商品」20点です。次のコードで5つの方式を動かしました。比べる基準として、毎日その日に本当のクリック率が最も高い5つを出し続けた場合(本当のクリック率を知っていた場合)の値も、同じ期間ごとに出しています。
SEED = 20261110
methods = [("人気順", 1), ("新商品枠", 1), ("率順(枠なし)", 0), ("新商品枠+率順", 1), ("トンプソン抽出", 1)]
res = {m: simulate(SEED, m, k) for m, k in methods}
for m, r in res.items():
    c = np.array(r["ctr"])
    print(m, f"クリック率 {c.mean():.4f}(1〜10日目 {c[:10].mean():.4f}・51〜60日目 {c[-10:].mean():.4f})",
          f"新商品の表示の割合 {np.mean(r['new_share']):.3f}",
          f"100回以上表示 {r['seen']:.3f}({r['n_newborn']}点中) 良い新商品 {r['good_seen']:.3f}({r['n_good']}点中)")
b = np.array(res["人気順"]["best_ctr"])                 # 同じ期間で比べる上限の目安
print("本当のクリック率を知っていた場合", f"{b.mean():.4f}(1〜10日目 {b[:10].mean():.4f}・51〜60日目 {b[-10:].mean():.4f})")
# 出力:
# 人気順 クリック率 0.0360(1〜10日目 0.0463・51〜60日目 0.0275) 新商品の表示の割合 0.000 100回以上表示 0.000(162点中) 良い新商品 0.000(20点中)
# 新商品枠 クリック率 0.0355(1〜10日目 0.0452・51〜60日目 0.0281) 新商品の表示の割合 0.200 100回以上表示 1.000(162点中) 良い新商品 1.000(20点中)
# 率順(枠なし) クリック率 0.0443(1〜10日目 0.0539・51〜60日目 0.0346) 新商品の表示の割合 0.000 100回以上表示 0.000(162点中) 良い新商品 0.000(20点中)
# 新商品枠+率順 クリック率 0.0700(1〜10日目 0.0585・51〜60日目 0.0819) 新商品の表示の割合 0.423 100回以上表示 1.000(162点中) 良い新商品 1.000(20点中)
# トンプソン抽出 クリック率 0.0756(1〜10日目 0.0616・51〜60日目 0.0905) 新商品の表示の割合 0.301 100回以上表示 0.735(162点中) 良い新商品 1.000(20点中)
# 本当のクリック率を知っていた場合 0.0813(1〜10日目 0.0719・51〜60日目 0.0957)
結果を表にまとめます。クリック率は、その期間に出したすべての推薦の表示のうちクリックされた割合です。表の5つの方式は、どれも本当のクリック率を知らずに記録だけで選んでいるので、同じ期間で比べれば、本当のクリック率を知っていた場合の期待クリック率(選んだ5つの本当のクリック率の平均で、乱数で決まった実際のクリックの割合ではありません)が上限の目安になります。表の5つの方式の値は乱数で決まった実際のクリックの割合なので、短い期間では偶然わずかに上回ることもありえます。表の「新商品の表示の割合」は、推薦の表示全体のうち、追加から7日以内の商品が占める割合です(7日を過ぎた商品は含めません)。その上限の目安は、全期間で0.0813、1〜10日目で0.0719、51〜60日目で0.0957でした。新商品が加わり続けるので、上限の目安も期間によって変わります。表の数値は、1つの乱数の種(乱数の出方を固定する数。シードとも呼びます)20261110での結果です。
| 推薦の方式 | 全期間のクリック率 | 1〜10日目 | 51〜60日目 | 新商品(追加から7日以内)の表示の割合 | 最初の7日で100回以上表示された新商品の割合(162点中) | 本当に良い新商品のうち同じ割合(20点中) |
|---|---|---|---|---|---|---|
| 人気順 | 0.0360 | 0.0463 | 0.0275 | 0.000 | 0.000 | 0.000 |
| 新商品枠 | 0.0355 | 0.0452 | 0.0281 | 0.200 | 1.000 | 1.000 |
| 率順(枠なし) | 0.0443 | 0.0539 | 0.0346 | 0.000 | 0.000 | 0.000 |
| 新商品枠+率順 | 0.0700 | 0.0585 | 0.0819 | 0.423 | 1.000 | 1.000 |
| トンプソン抽出 | 0.0756 | 0.0616 | 0.0905 | 0.301 | 0.735 | 1.000 |
本コラムの架空データでは、まず人気順の新商品の表示の割合は、表のとおり全期間で0.000でした。割合は0を下回らないので、60日間のどの日も新商品が表示されなかったことになります(率順(枠なし)も同じく0.000です)。162点の新商品は、1点も100回以上表示されることがなく、本当に良い新商品20点も同じでした。人気順は、表示された商品だけがクリックを集めるので、開始時点で上位にいた商品が上位に留まり続けます。その商品も古くなって飽きられていくので、クリック率は1〜10日目の0.0463から51〜60日目の0.0275まで下がりました。同じ期間の上限の目安は0.0719から0.0957へ上がっており、新しく良い商品が毎日加わっているのに、推薦はそれを1つも拾えていません。推薦の並び順を過去のクリック数だけで決め、推薦の枠以外の経路を持たないこのシミュレーションの条件では、新しい商品は探索しない限り推薦されませんでした。
次に、新商品枠は、表示の20%を新商品に割り当てたので、新商品162点はすべて最初の7日で100回以上表示されました。枠の中の商品はランダムに選んでいるので、1点ごとの最低の回数を保証する仕組みではありませんが、今回の結果では、新商品の露出を確保するという目的は果たせました。ところが、全体のクリック率は0.0355で、人気順の0.0360とほとんど変わらず、51〜60日目には人気順と同じように0.0281まで下がりました。枠で新商品を表示しても、残りの4つの枠は人気順(直近14日のクリック数の順)のままなので、新商品は枠の中で多少クリックされても、毎日2,000回の表示を受けている上位の商品のクリック数には届きません。新商品の表示の割合がちょうど0.200なのは、7日以内の新商品が残りの4つの枠に一度も入らなかったことを表しています。7日たって新商品とみなされなくなると、新商品枠からも外れます。
では、並べ方をクリック数から推定クリック率に替えるだけで良いのかを確かめるのが、対照の率順(枠なし)です。率順(枠なし)の全期間のクリック率は0.0443で、人気順の0.0360より上がりましたが、新商品の表示の割合は0のままでした。この方式は、既存の商品のうち表示を重ねてクリック率が下がった商品を入れ替えることはできますが、記録の無い新商品は「既存の商品の平均くらい」とみなされるので、平均より成績の良い既存の商品を押しのけて上位に入ることがなく、表示されません。並べ方を替えるだけでは、新商品の探索は起きませんでした。
新商品枠+率順は、新商品枠と同じ1つの枠を使いながら、残りの4つを推定クリック率の順に並べたものです。全期間のクリック率は0.0700で、新商品枠だけ(0.0355)とも、率順だけ(0.0443)とも大きく違いました。新商品の表示の割合(追加から7日以内の商品の表示だけを数えた割合)が0.423と、新商品枠の分の20%を大きく超えているのは、枠でクリック率が高いと分かった新商品が、7日以内のうちから推定クリック率の順で残りの4つの枠にも入ったためです。7日を過ぎた後の新商品の表示は、このコードでは数えていません。この架空データでは、人気順の0.0360に対して、新商品枠だけでは同じ水準(0.0355)、率順の並べ方だけでは小幅な上昇(0.0443)に留まり、組み合わせたときに0.0700まで上がりました。新商品枠だけの方式でも、枠で得たクリックは直近14日のクリック数に加わっていますが、表示回数を考えに入れないクリック数の順では、表示の少ない新商品は上位に入りにくかったということです。枠で集めた反応を、表示回数で割った推定クリック率として並び順に反映したときに、探索に使った表示が全体のクリック率に結び付きました。
トンプソン抽出は、全期間のクリック率が0.0756で5つの中で最も高く、同じ全期間の上限の目安0.0813に近い値でした。51〜60日目でも0.0905で、同じ期間の上限の目安0.0957との差は、新商品枠+率順(0.0819)より小さくなっています。新商品の表示の割合は0.301で、新商品枠+率順より少ないのに、クリック率は高くなりました。最初の7日で100回以上表示された新商品は162点中の73.5%で、残りは最初の7日間の表示が100回未満でした(このコードに表示を打ち切る処理は無く、8日目以降も抽出の対象に残ります)。本当に良い新商品20点はすべて100回以上表示されています。トンプソン抽出は、表示を少し出して反応が悪かった新商品には表示が回りにくくなり、反応の良い新商品に表示を寄せるので、同じ探索でも表示の使い方の効率が良くなります。
結果がシードと枠の数でどう変わるか、探索の量の決め方
1回のシミュレーションの結果は、乱数の出方に左右されます。そこで、商品の本当のクリック率を作る乱数のシードを1から5に変えて、同じ比較を5回くり返しました。あわせて、新商品に割り当てる枠を1つから2つに増やした場合も、同じ5つのシードで試しました。
for m, k in methods + [("新商品枠", 2), ("新商品枠+率順", 2)]:
    v = [np.mean(simulate(s, m, k)["ctr"]) for s in range(1, 6)]
    print(m, f"枠{k}", np.round(v, 4), f"平均 {np.mean(v):.4f}")
# 出力:
# 人気順 枠1 [0.0373 0.0426 0.0525 0.0478 0.0502] 平均 0.0461
# 新商品枠 枠1 [0.0336 0.0393 0.0491 0.0449 0.0463] 平均 0.0426
# 率順(枠なし) 枠0 [0.041  0.0474 0.0524 0.0491 0.0541] 平均 0.0488
# 新商品枠+率順 枠1 [0.0637 0.065  0.0704 0.0669 0.0635] 平均 0.0659
# トンプソン抽出 枠1 [0.0676 0.0708 0.0758 0.0718 0.0683] 平均 0.0709
# 新商品枠 枠2 [0.0333 0.0396 0.0464 0.0398 0.0418] 平均 0.0402
# 新商品枠+率順 枠2 [0.0565 0.0579 0.0626 0.0597 0.0565] 平均 0.0586
「枠1」などは新商品に割り当てた枠の数で、人気順とトンプソン抽出では使っていません(表示の都合で1と出しています)。
| 推薦の方式 | シード1〜5の全期間のクリック率(新商品枠1つ) | 5回の平均 | 新商品枠を2つにしたときのシード1〜5 | 5回の平均(枠2つ) |
|---|---|---|---|---|
| 人気順 | 0.0373、0.0426、0.0525、0.0478、0.0502 | 0.0461 | なし | なし |
| 新商品枠 | 0.0336、0.0393、0.0491、0.0449、0.0463 | 0.0426 | 0.0333、0.0396、0.0464、0.0398、0.0418 | 0.0402 |
| 率順(枠なし) | 0.0410、0.0474、0.0524、0.0491、0.0541 | 0.0488 | なし | なし |
| 新商品枠+率順 | 0.0637、0.0650、0.0704、0.0669、0.0635 | 0.0659 | 0.0565、0.0579、0.0626、0.0597、0.0565 | 0.0586 |
| トンプソン抽出 | 0.0676、0.0708、0.0758、0.0718、0.0683 | 0.0709 | なし | なし |
シードを変えた5回でも、方式の順番はおおむね変わりませんでした。5回のどのシードでも、新商品枠は人気順をわずかに下回り、新商品枠+率順とトンプソン抽出は人気順・率順(枠なし)を大きく上回り、トンプソン抽出が新商品枠+率順を上回りました。率順(枠なし)は、4回は人気順を上回りましたが、シード3では0.0524と人気順の0.0525をわずかに下回りました。人気順の値が0.0373から0.0525まで動くのは、開始時点でどの商品が上位にいたかに結果が強く依存するためで、人気順の成績が運に左右されやすいことも表しています。
枠の数を2つに増やすと、新商品枠+率順のクリック率は5つのシードのすべてで下がり、5回の平均は0.0659から0.0586になりました。新商品枠も、5回の平均は0.0426から0.0402に下がりました(シード2だけは0.0393から0.0396にわずかに上がっています)。この架空データでは、2つ目の枠はランダムな新商品の表示を増やし、全体のクリック率を下げる方向に働きました。枠を増やすと全体のクリック率が下がる場合があり、探索の量は多ければ良いとは限りません。
必要な探索の量は、新商品が加わる速さ、1点あたり評価に要る表示の回数、推薦の枠の表示の総量で決まると考えています。新商品が1日に何点加わり、何日を新商品とみなすかで、枠に入る新商品の数が決まり、それで枠の表示の総量を割ったものが、1点あたりに回る表示の回数になります。これが評価に要る回数を大きく超えるなら枠を減らせますし、足りなければ枠を増やすか、トンプソン抽出のように反応の悪い商品への表示を早めに減らす方式を選ぶことになります。
この例で見積もると、1日に新商品は3点、新商品とみなす期間は7日なので、枠に入る新商品はおよそ21点です。枠1つの表示2,000回を分けると1点あたり1日約95回、7日で約670回の表示が回り、本コラムが置いた100回の目安を大きく超えます。新商品が1日に数百点加わるサービスなら、同じ枠1つでは1点あたりの表示が足りなくなります。こうした量の見積もりが、探索の枠を予算として決めるときの根拠になると考えています。
この結果の限界も書いておきます。このシミュレーションでは、全員が同じ好みを持ち、商品の本当のクリック率は日々の飽きを除いて変わらないものとしています。実際には顧客ごとに好みが違うので、ある商品のクリック率は顧客によって違い、平均のクリック率だけを推定する方法では足りません。また、推薦の枠の中の位置によってクリックのされやすさが変わること(位置の偏り。第11章)や、クリックはされても購買にはつながらない商品があることも入れていません。数字は本コラムの架空データでの値で、実際のサービスでの改善の幅を表すものではありません。
探索の方式の性質を、次の表にまとめます。表の「向く条件」「注意点」は、ここまでの架空データの結果と、各方式の仕組みから整理したもので、どの方式が常に優れるという意味ではありません。
| 探索の方式 | 仕組み | 向く条件 | 注意点 |
|---|---|---|---|
| 人気順だけ(探索なし) | 過去のクリック数・購買数の順 | 商品の入れ替わりが少なく、評価がすでに貯まっている | 新商品・下位の商品の評価が貯まらない。結果が開始時点の上位に左右される |
| 露出の保証枠 | 枠の一部を新商品に固定で割り当てる | 業務の担当者に説明しやすい形で始めたい。新商品の露出を約束する必要がある | 本コラムの架空データでは、本来の並び順がクリック数の順のままだと全体のクリック率は上がらなかった。枠の量を決める根拠が要る |
| ε-greedy | 一定の割合だけランダムに選ぶ | 実装を最小にしたい | 反応の悪い商品にも同じだけ探索を割く |
| UCB | 記録の少ない商品を楽観的に見積もる | 探索の量を推定の不確かさで決めたい | 商品が多いと、記録の少ない商品ばかりが選ばれる期間が長くなりうる |
| トンプソン抽出 | 推定の不確かさに応じて確率的に選ぶ | 反応の良し悪しが早く分かる商品に表示を寄せたい | 顧客ごとに推薦が揺れるので、表示ログで何を出したかを必ず残す。事前分布の置き方で初期の探索の量が変わる |
| 文脈つきバンディット(LinUCB など) | 顧客や商品の特徴を使って反応を予測し、その不確かさで探索する | 顧客ごとに好みが違い、特徴が使える | 特徴の設計と、学習の仕組みの運用が必要になる |
文脈つきバンディット、LinUCBの考え方
前の節のシミュレーションは、全員が同じ好みを持つものとして、商品ごとに1つのクリック率を推定しました。実際には、同じ商品でも顧客によってクリック率が違います。顧客や商品の特徴(文脈)を使って、「この顧客にこの商品を出したときの反応」を予測しながら探索する方法を、文脈つきバンディットと呼びます。
文脈つきバンディットを推薦に使った代表的な研究が、Li・Chu・Langford・Schapire の2010年の論文(ウェブの国際会議 WWW 2010 で発表)です。この論文は、ニュース記事の推薦を文脈つきバンディットの問題として扱い、LinUCB と呼ばれる方法を示しました。考え方を言葉で表すと次のようになります。記事ごとに、顧客の特徴(たとえば顧客の属性や過去の関心を表す数値の並び)から反応を予測する線形のモデルを持ちます。予測には、データが少ないほど大きくなる「不確かさの幅」が付きます。推薦のときは、予測した反応にこの幅を足した値(楽観的に見積もった値)が最も大きい記事を選びます。データの少ない記事や、その記事にとって珍しい特徴の顧客ほど幅が大きく見積もられ、探索として選ばれやすくなります。反応が返ってくるたびにモデルを更新すると、幅は縮み、活用に寄っていきます。前の節の UCB を、顧客の特徴ごとに行うものと考えると分かりやすいと思います。
論文の評価は、Yahoo! のトップページのニュースの枠(Today Module)の3,300万件を超えるイベントのデータを使い、過去のランダムな表示の記録から方式の成績を見積もるオフラインの方法で行われています。その見積もりで、文脈を使わない標準的なバンディットの方法と比べてクリック率が相対的に12.5%高かったと報告されており、データが少ないほどこの差が大きくなったとも書かれています。これはオフラインの評価での推定値で、オンラインの実験の結果でも、クリックの総数の増加でもありません。また、その論文のデータとその評価の条件での値で、他のサービスで同じ改善が得られることを意味しません。この論文は、イベントが互いに独立に同じ分布から生じ、各記事を一様にランダムに表示した記録がある、といった前提を満たす場合に、新しい方式をその記録からオフラインで偏りなく評価できることも示しており(第4節の定理1)、第9章で触れたオフ方策評価の考え方につながっています。
新しい顧客や新しい商品の推薦では、文脈つきバンディットには、使い方によっては次の利点があります。新しい顧客は、流入元や最初の行動を特徴として入れれば、最初から顧客ごとに違う推薦を出せます。新しい商品は、商品の属性を特徴に入れ、商品の間で係数の一部を共有する型であれば、自分の履歴が無くても、属性が似た商品の反応から予測の出発点を得られます。
ただし、新しい商品についての利点は型によって違います。上で説明した記事ごとに独立したモデルを持つ型では、ある記事のモデルは他の記事の反応から学ばないので、新しい記事の予測の出発点にはなりません。論文は続けて、すべての記事で共有する係数を加えた型も示しており、新しい商品の出発点を得られるのはこちらの型です。
その一方で、どの特徴を使うかの設計、特徴の作り方の保守、学習の仕組みの運用が必要になり、前の節の単純な方式より手間がかかります。まず露出の保証枠や商品ごとのトンプソン抽出で探索の仕組みと表示ログを整え、顧客ごとの好みの違いが大きいことが分かってから文脈つきバンディットへ進む、という順番が扱いやすいと考えています。
事業上の制約との関係、新商品を売りたい・在庫を消化したい
探索の議論は、クリック率を目的にすると分かりやすくなりますが、実際の推薦には事業上の目的と制約が加わります。新商品の販売の立ち上げを早めたい、季節の商品を時期のうちに売り切りたい、在庫の多い商品を消化したい、取引先との約束で一定の露出が必要、といったものです。こうした目的は、探索と同じく「今のクリック率が最も高い商品」以外を表示させる方向に働きます。
ここで区別しておきたいのは、探索と販売の促進は目的が違うということです。探索は、反応が分からない商品について情報を得るために表示するもので、反応が悪いと分かれば表示を減らします。販売の促進は、反応にかかわらず特定の商品を売るために表示するもので、反応が悪くても表示を続けることがあります。2つを同じ「新商品枠」にまとめると、反応が悪いと分かった新商品にも枠を使い続け、探索の効率が落ちます。逆に、販売の促進のつもりで入れた枠を探索の成果で評価すると、目的に合わない判断になります。枠を設けるときは、その枠が探索のためのものか、販売の促進のためのものかを決め、評価の指標も分けておくことを勧めます。
在庫の消化を推薦で行う場合は、さらに注意が要ります。在庫の多い商品を推薦の上位に固定すると、顧客の関心と関係の無い推薦が増え、推薦の枠そのものがクリックされなくなるおそれがあります。在庫や利益を考えた並べ替えは第3章で扱ったルールの一種で、推薦の結果に後から加える処理として、どの程度まで並び順を変えてよいかの上限を決めておくのが安全だと考えています。新商品の露出の保証が品揃えの偏りを和らげる面については、第11章で網羅率の指標とあわせて扱います。
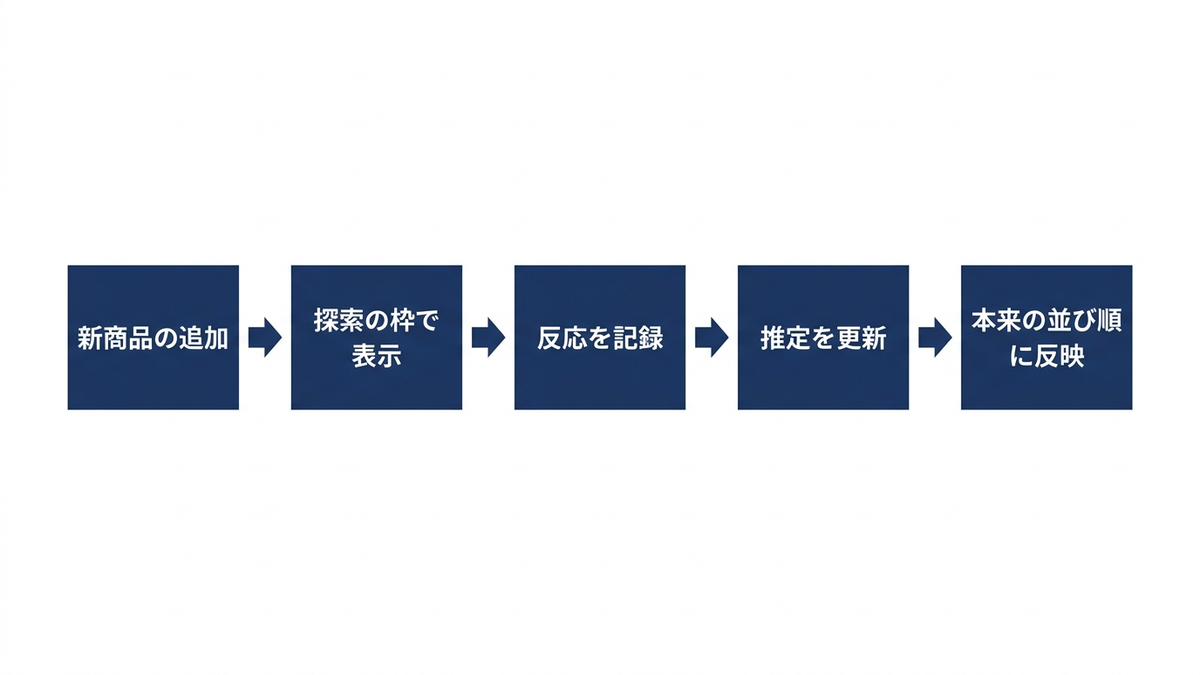
経営の判断、探索の枠を投資として予算化する
この章の内容を、経営の判断に置き換えます。探索は、短期のクリック率や購買率を一時的に下げることがあります。本コラムの架空データでも、新商品枠を1つから2つに増やすと、新商品枠+率順の全体のクリック率は5つのシードのすべてで下がりました。推薦の担当者が短期の KPI(重要な業績の指標)だけで評価される体制では、探索の表示は「成績を下げる無駄」に見え、削られていきます。その結果が、人気順のシミュレーションで見た、新商品が1点も表示されない状態です。探索を続けるには、探索に使う表示を「将来の推薦の材料を買うための投資」として、経営が枠と期間を決めて認める必要があると考えています。
コールドスタートと探索の判断を誤ったときの損失を、序章で整理した6つの損失の型に当てはめると次のようになります。
| 判断の誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 人気順だけで推薦し、探索の表示を設けない | 機会損失(良い新商品が誰にも見えない)、品揃えの偏り | 新商品に表示を割り当てる枠か、探索のアルゴリズムを最初から入れる |
| 新商品枠を設けたが、本来の枠の並び順は表示回数を考えないクリック数の順のままにする | 機会損失、形骸化(枠はあるのに、良い新商品が枠の外の並び順に入らない) | 枠で集めた反応を、表示回数を考えた推定クリック率などとして本来の枠の並び順に反映する(本コラムの架空データの全期間のクリック率は、人気順0.0360に対して、枠だけは同じ水準の0.0355、並べ方の変更だけは小幅な上昇の0.0443、両方をそろえると0.0700) |
| 探索の枠を必要以上に大きくする | 顧客の離反(関心の無い商品が増え、推薦が見られなくなる) | 新商品の加わる速さと、評価に要る表示の回数から枠の量を見積もる |
| 新しい顧客にも既存の顧客と同じ推薦を出し続ける | 顧客の離反(最初の推薦が的外れで再訪しない) | 人気順から始め、最初の数回の行動で推薦を切り替える段階を用意する |
| 探索の枠と販売の促進の枠を区別しない | 効果の過大評価(促進の枠経由の購買を推薦の成果と数える)、形骸化 | 枠の目的を分け、それぞれの指標を決める。効果は第9章の方法で確かめる |
| 部署ごとに別々の新商品の推薦の仕組みを作る | 二重投資 | 探索の枠と表示ログの設計を全社で共通にする |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 推薦の枠の表示のうち、探索(新商品・記録の少ない商品)に使う割合と期間を、予算として決める。割合は新商品の加わる速さと評価に要る表示の回数から見積もる
- 探索の枠で集めた反応を、表示回数を考えた形で本来の推薦の並び順に反映する仕組みがあることを確かめる。本コラムの架空データでは、クリック数の順のままの枠は、新商品の露出は確保できても、探索に使った表示が全体のクリック率に結び付かなかった
- 探索の運用を、短期のクリック率だけでなく、新商品が評価されるまでの日数・推薦の表示のうち新商品の割合といった運用の指標で見る。探索が購買をどれだけ増やしたか(探索の効果)はこれらの指標では分からないので、探索を行わない条件と比べる A/Bテスト(第9章)で確かめる
- 新しい顧客について、最初の推薦から行動に基づく推薦へ切り替える段階と、質問を入れるかどうかの判断を、第9章の A/Bテストで比べて決める
- 探索の枠と、販売の促進・在庫の消化の枠を分け、それぞれの目的と指標を決めておく
予算の面では、探索に使う表示は、広告の出稿と同じように「表示の量を使って情報を得る」投資だと見ることができます。広告の出稿量を効果と照らして決めるのと同じく、探索の量も、新商品が評価されるまでの日数といった運用の指標と、探索を行わない条件と比べて確かめた購買の差と照らして見直すことになります。この章のシミュレーションで測ったのは表示とクリックだけで、購買への効果は測っていません。探索を投資として扱うには、表示ログに、推薦の方式の名前・候補・表示した商品・順位・モデルの版を残し、探索専用の枠がある場合は枠の種別も残しておくことが前提になります。トンプソン抽出のように1つの選び方で探索と活用を兼ねる方式では、表示ごとに探索か活用かを分けられないので、方式の名前と候補の記録が後の分析の手がかりになります。表示ログの設計は第2章、運用の中での監視は第12章で扱います。
この章のまとめ
この章では、新しい顧客・新しい商品・新しいサービスの3つの場面でコールドスタートを整理し、探索と活用の考え方を扱いました。本コラムの架空データの、1つの乱数の種での結果として、新しい顧客について、質問で好みを聞くと行動が無い時点から人気順より当たり(的中率0.326と0.250)、最初の数回の行動を使うと購買を重ねるほど人気順を上回りました。毎日新商品が加わるシミュレーションでは、人気順だけの推薦は60日間で新商品を1点も100回以上表示できず、クリック率は0.0463から0.0275へ下がりました。新商品枠は露出を確保しましたが、残りの枠をクリック数の順のままにするとクリック率は人気順と変わらず(0.0355)、枠を設けずに推定クリック率の順に替えるだけでは新商品は表示されず(0.0443)、両方を組み合わせると0.0700、トンプソン抽出では0.0756になりました(1つのシードでの値。シードを変えた5回でも順番はおおむね同じでした)。推薦の並び順を過去の実績だけで決めていて、推薦の枠以外から新しいものが見られない場合は、新しいものを意図して探索しない限り評価が貯まらないので、探索の枠を投資として予算化し、その反応を本来の推薦の並び順に反映する仕組みとあわせて設計することが必要だと考えています。次の第11章では、推薦が人気の商品へ集中していく偏りと、多様性・網羅率の測り方を扱います。
この章を深めたい方への参考書籍
『バンディット問題の理論とアルゴリズム』(本多淳也・中村篤祥 著、講談社):機械学習プロフェッショナルシリーズの1冊で、版元の目次によれば、確率的バンディット問題の方策とリグレット(取りこぼした報酬)の解析、最適腕識別と A/Bテスト、線形モデル上のバンディット問題、バンディット手法の応用までを扱います(2016年刊)。この章で紹介した探索と活用の考え方や、LinUCB のような線形モデルを使う方法を、理論の側から確かめるのに向いています。
『ウェブ最適化ではじめる機械学習 A/Bテスト、メタヒューリスティクス、バンディットアルゴリズムからベイズ最適化まで』(飯塚修平 著、オライリー・ジャパン):版元の目次によれば、A/Bテストをベイズ統計で扱う章から始めて、テスト中の損失に向き合う方法としてのバンディットアルゴリズム、組合せのバンディット、ロジスティック回帰上のトンプソン抽出(付録)までを扱う本です(2020年刊)。この章のトンプソン抽出のシミュレーションを、実装の側から自分で組み直してみるときの手引きになります。
第11章 推薦の偏りと多様性、人気の偏り・フィルターバブル・公平性
第10章では、知っている商品だけを推薦し続けると新しい商品の評価が貯まらないこと、そのため新商品に露出の枠を割り当てたり、トンプソン抽出で探索したりする必要があることを扱いました。この章では、同じ問題を品揃え全体の側から見ます。推薦は、どの商品が顧客の目に触れるかを決める仕組みです。推薦の枠から買われるのは目に触れた商品だけで、購買の履歴だけで学習する推薦では、買われた商品だけが次の学習のデータになります。そのため推薦は、自分が作った偏りを、次の推薦でさらに強めることがあります。
この章で扱う内容は次のとおりです。後半は、架空の合成データ(顧客2,000人・商品300点)で推薦と購買のくり返しをシミュレーションし、実行したコードと結果で確かめます。
- 推薦で起きる偏りの種類(人気の偏り・露出の偏り・位置の偏り・同調)
- 推薦→露出→購買→学習→推薦という循環が、偏りを強める仕組み
- ランダム・人気に比例・関連度順・MMR による並べ替えなど5通りの推薦を90日まわしたときの、購買の集中(ジニ係数)と網羅率の推移
- 1人の推薦リストの多様性を上げる並べ替え(MMR)が、品揃え全体の集中を必ずしも和らげないこと
- 多様性・新規性・セレンディピティ・網羅率の指標と、その測り方
- フィルターバブル・エコーチェンバーの研究と、その結論が分かれていること
- 出品者・作り手の側の公平性と、精度と多様性のつり合いの決め方
この章の主張は、推薦と購買が一部の人気商品に集中し、品揃えの残りが顧客の目に触れにくくなることがあり、精度の指標だけではその集中を把握できないので、購買の集中と網羅率を精度と並べて測り、品揃えの幅を KPI に入れるべきだということです。そして、本コラムの架空データでは、MMR の重みを0.7にして1人ひとりの推薦リストの中身を散らしても、全員が同じ人気商品に寄っていく集中が和らいだとは言えず、重みをさらに強めても集中の下がりかたは小さく、その分だけ購買が減ったことを数字で示します。この架空データで集中を大きく和らげたのは、関連度に掛ける人気の重みを下げることでした。そこから、集中が見られる場合は、何を基準に商品を並べているか(人気の重みの付け方を含む)まで点検するのがよい、というのがこの章の考えです。
推薦で起きる偏りの種類、人気・露出・位置・同調
推薦の偏りと一口に言っても、起きる場所と原因が違う複数のものが混ざっています。まず、推薦が一部の人気商品に集中する人気の偏りがあります。Abdollahpouri らの2019年の論文(人気の偏りを推薦後の並べ替えで管理する方法の論文。arXiv の 1901.07555 で公開)は、多くの推薦システムで、人気の商品が頻繁に推薦され、人気の低いニッチな商品はほとんど、あるいはまったく推薦されない、という問題を人気の偏りと呼んでいます。人気の偏りは、推薦の手法が人気を直接使っている場合(人気順・人気を重みに入れた関連度)だけでなく、協調フィルタリングのように購買の履歴から似かたを計算する場合にも起きます。購買の多い商品ほど、多くの顧客の履歴に現れ、似ている商品として選ばれやすいからです。
2つ目は、第2章で扱った露出の偏りです。推薦の枠から顧客が買えるのは、その枠で目に触れた商品だけです。推薦の枠に出なかった商品は、その枠を通じて買われる機会がありません(検索や広告など、他の経路から買われることはあります)。推薦の枠のログには「見せた商品の中で何が買われたか」しか残らないので、見せなかった商品が買われなかったことは、その商品が好まれないことの証拠になりません。3つ目は位置の偏りで、推薦の枠の上のほうに出た商品ほど見られやすく、クリックされやすいことです。Joachims らの2017年の論文(偏りのあるフィードバックから偏りの無い並べ替えを学習する方法。WSDM 2017)は、検索の順位による位置の偏りがクリックの数に強く影響するため、クリックのデータをそのまま学習に使うと最適でない結果になると述べています。4つ目は同調で、他の顧客の評価や「人気」の表示を見て、顧客自身の選択が多数派に寄っていくことです。
4つの偏りを、起きる場所・原因・放置したときに起きることで整理すると、次の表のようになります。
| 偏りの種類 | 起きる場所 | 主な原因 | 放置したときに起きること | 測り方の例 |
|---|---|---|---|---|
| 人気の偏り | 推薦の手法 | 人気を重みに使う、購買の多い商品ほど履歴に現れて似ている商品に選ばれやすい | 推薦が一部の商品に集中し、品揃えの残りが見えなくなる | 推薦された回数・購買の数のジニ係数、購買上位10%の商品が占める購買の割合 |
| 露出の偏り | データ(ログ) | 見せた商品しか買われない。見せなかった商品の関心が記録されない | 「買われなかった」を「好まれない」と取り違え、次の推薦でも見せなくなる | 商品ごとの表示の回数、表示0回の商品の割合 |
| 位置の偏り | 推薦の枠の画面 | 上の順位ほど見られやすい | 上に出したから売れた分を、商品の魅力と取り違える | 順位ごとのクリック率、順位を入れ替えた試験 |
| 同調 | 顧客の選択 | 人気の表示・評価の数・ランキングを見て多数派に寄る | 人気がさらに人気を呼び、評価そのものが人気の影響を受ける | 人気の表示の有無で分けた試験 |
この4つは独立ではありません。人気の偏りで推薦が人気商品に寄ると、露出の偏りで人気商品のログだけが貯まり、位置の偏りで上に出た人気商品がさらにクリックされ、同調で人気の表示がそれを後押しします。表の「測り方の例」の列は、それぞれの偏りに気づくための入口で、第2章で勧めた表示のログ(どの枠の何位に何を出したか)が残っていないと、露出の偏りと位置の偏りは測れません。
偏りが強まる循環、推薦→露出→購買→学習→推薦
推薦の偏りが厄介なのは、1回で終わらず循環することです。推薦の手法が商品を選び(推薦)、選ばれた商品が顧客の目に触れ(露出)、目に触れた商品の一部が買われ(購買)、その購買のログで手法が学習し直し(学習)、次の推薦が決まります。この輪を1周するたびに、前の周で多く見せた商品のデータが増え、次の周でもその商品が選ばれやすくなります。
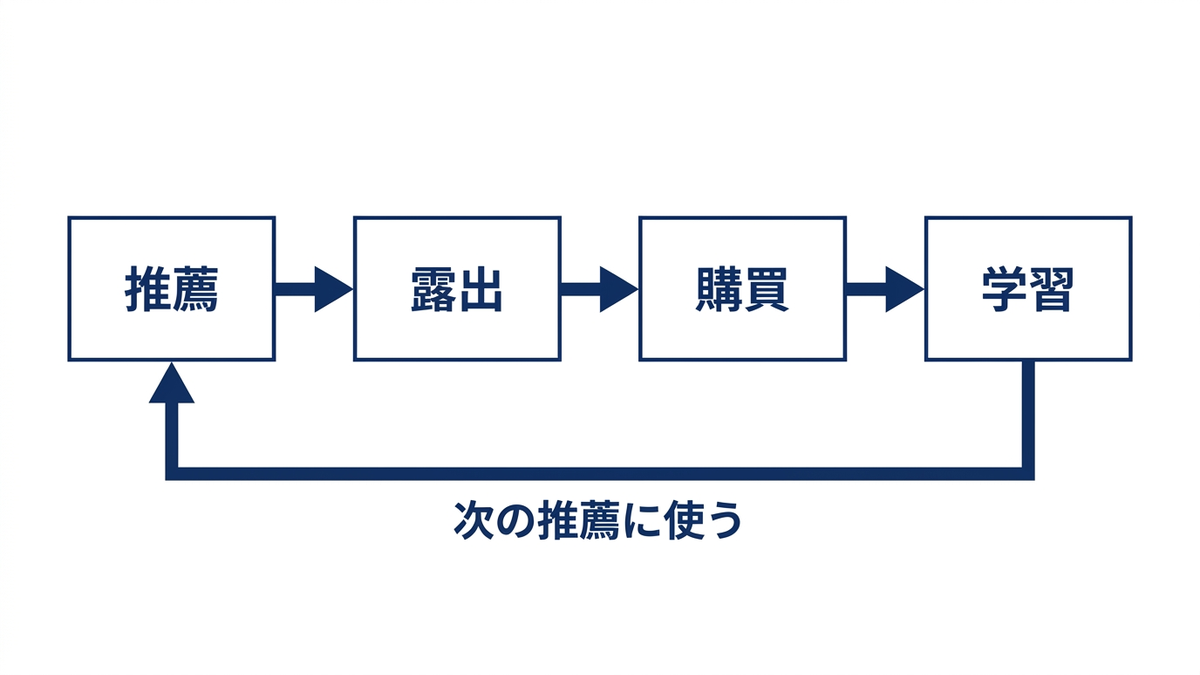
Chaney らの2018年の論文(推薦システムのアルゴリズムによる交絡が利用者の行動を均質にし、効用を下げることを示した論文。RecSys 2018)は、推薦の影響をすでに受けた利用者のデータで推薦を学習し直すことの害を、シミュレーションで調べた研究です。その条件では、効用(利用者にとっての満足)が増えないまま利用者の行動が均質になったと報告しています。ここでいう交絡は、推薦が購買に影響し、その購買のデータで推薦の良さを測るため、推薦の影響と顧客の本来の好みが区別できなくなることを指します。
Fleder と Hosanagar の2009年の論文(推薦システムが売上の多様性に与える影響を扱った論文。Management Science 誌)も、同じ問題を売上の側から扱い、推薦が売上の多様性を増やすのか減らすのかを、数式のモデルとシミュレーションで調べています。この章に関係するのは、履歴に基づく推薦は履歴の少ない商品を推薦しにくく、人気の商品をさらに人気にする方向に働きうる、という指摘です。ただし、これは論文のモデルの条件のもとでの結論で、論文自身も推薦の設計の選び方で結果が変わるとしており、すべての推薦で多様性が下がると言っているわけではありません。
次の節からは、この循環を架空のデータで再現し、推薦のしかたによって購買の集中がどう変わるかを確かめます。
架空の合成データで循環を再現する、顧客と商品の作り方と4つの指標
ここからは、架空の合成データで推薦と購買のくり返しを再現します。顧客は2,000人、商品は300点、商品は10のジャンルに分かれます。顧客と商品には、それぞれ8つの数からなる「好みの方向」を持たせました。商品の方向は、ジャンルごとに決めた中心の方向にばらつきを加えたもので、顧客の方向は、顧客ごとのジャンルの好み(少数のジャンルに偏るように作りました)で中心の方向を混ぜ合わせたものです。顧客が商品を推薦の枠の1位で見たときに買う確率は、顧客と商品の方向がどれだけそろっているかと、商品そのものの魅力で決まります。この確率は、シミュレーションの中の「真の値」で、推薦する側には分かりません。推薦する側が使えるのは、過去の購買のログと、商品の特徴(コードの V。実際のサービスで商品の属性から作る特徴に当たるもの)です。顧客の真の好み(U)、商品そのものの魅力(appeal)、買う確率(p_buy)は推薦には使いません。
推薦を始める前の状態として、30日分の購買を作りました。顧客は1日に2点の商品を偶然見て、真の確率に従って買うかどうかが決まります。この30日分の購買の数を、推薦を始めるときの各商品の「人気」の初期値にします。乱数のシード(乱数の出方を固定する数で、同じ数を使えば何度実行しても同じ結果になります)は固定しています。なお、この架空データは、実際の購買のログよりずっと単純です。顧客の好みは時間とともに変わらず、季節や在庫切れ、価格の変化、推薦の枠以外から買う経路(検索・広告・店舗)は入れていません。以下の数字は、すべてこの架空データのもので、実在のサービスの値ではありません。
import numpy as np

rng = np.random.default_rng(20261110)
N_USER, N_ITEM, N_GENRE, DIM = 2000, 300, 10, 8
center = rng.normal(0, 1, (N_GENRE, DIM))                  # ジャンルごとの「好みの方向」
item_genre = rng.integers(0, N_GENRE, N_ITEM)
V = center[item_genre] + 0.6 * rng.normal(0, 1, (N_ITEM, DIM))
V /= np.linalg.norm(V, axis=1, keepdims=True)              # 商品の特徴(長さ1)
pref = rng.dirichlet(np.full(N_GENRE, 0.3), N_USER)        # 顧客ごとのジャンルの好み
U = pref @ center + 0.3 * rng.normal(0, 1, (N_USER, DIM))
U /= np.linalg.norm(U, axis=1, keepdims=True)              # 顧客の好み(長さ1)
appeal = rng.normal(0.0, 0.5, N_ITEM)                      # 商品そのものの魅力
# 顧客uが商品iを推薦の枠の1位で見たときに買う確率(真の値。推薦する側には分からない)
p_buy = 1 / (1 + np.exp(-(-4.5 + 3.0 * U @ V.T + appeal[None, :])))
print("顧客", N_USER, "人 商品", N_ITEM, "点 ジャンル", N_GENRE)
print("買う確率の平均", round(float(p_buy.mean()), 4), "最大", round(float(p_buy.max()), 4))

# 推薦を始める前の30日分の購買(顧客が自分で商品を探して買った分)
init_pop = np.zeros(N_ITEM)
init_owned = np.zeros((N_USER, N_ITEM), bool)
for day in range(30):
    browse = rng.integers(0, N_ITEM, (N_USER, 2))          # 1日に2点を偶然見る
    hit = rng.random((N_USER, 2)) < p_buy[np.arange(N_USER)[:, None], browse]
    uu = np.repeat(np.arange(N_USER), 2).reshape(N_USER, 2)[hit]
    np.add.at(init_pop, browse[hit], 1)
    init_owned[uu, browse[hit]] = True
print("推薦を始める前の30日の購買", int(init_pop.sum()), "件",
      "購買のある顧客", int(init_owned.any(1).sum()), "人")
# 出力:
# 顧客 2000 人 商品 300 点 ジャンル 10
# 買う確率の平均 0.0292 最大 0.4112
# 推薦を始める前の30日の購買 3522 件 購買のある顧客 1659 人
買う確率の平均は0.0292、最大は0.4112でした。推薦を始める前の30日で3,522件の購買があり、2,000人のうち1,659人に1件以上の購買があります。残りの341人は購買の履歴が無い状態で推薦を始めることになり、第10章で扱ったコールドスタートの顧客に当たります。
次に、推薦の偏りを測る指標を定義します。この章のシミュレーションでは、次の4つを使いました。
- ジニ係数:商品ごとの購買の数がどれだけ一部の商品に集中しているか。0なら全商品が同じ数だけ買われ、1に近いほど少数の商品に集中している
- 網羅率:品揃えのうち、1回でも誰かに推薦された商品の割合。数える期間が長いほど値は上がるので、期間を決めて数える。この章のシミュレーションでは、記録した日の1日分で数えた
- リスト内の多様性:1人に出した推薦10点が、互いにどれだけ似ていないか。1から「10点の中の2点ずつの似かたの平均」を引いた値
- 新規性:推薦した商品が、どれだけ人気の低い商品か。商品の人気の割合の対数にマイナスを付けた値の平均で、人気の低い商品を多く推薦するほど大きくなる
ジニ係数は、もともと所得の不平等を測る指標で、商品ごとの購買の数を小さい順に並べて計算します。式で書くと、小さい順に並べた購買の数を \(x_1 \le x_2 \le \dots \le x_n\) として \(G = \sum_{i=1}^{n} (2i-n-1)x_i \,/\, (n \sum_{i=1}^{n} x_i)\) です。言葉で言えば、順位が上の商品ほど大きな重みを付けて足し合わせ、全部の商品が同じ数だけ売れた場合に0、1つの商品だけが売れた場合に1に近づくように割ったものです。あわせて、購買の数の上位10%の商品(この例では30点)が購買全体の何割を占めるかも出しました。こちらのほうが、経営の報告では直感的に伝わりやすいと考えています。
S = np.clip(V @ V.T, 0, None)                              # 商品どうしの似かた(0〜1)

def gini(x):
    x = np.sort(np.asarray(x, float))
    n = len(x)
    return float((2 * np.arange(1, n + 1) - n - 1) @ x / (n * x.sum()))

def top_share(x, frac=0.1):
    x = np.sort(np.asarray(x, float))[::-1]
    return float(x[: int(len(x) * frac)].sum() / x.sum())

def list_metrics(rec, pop):
    expo = np.bincount(rec.ravel(), minlength=N_ITEM)       # 商品ごとに推薦された回数
    coverage = float((expo > 0).mean())                    # 網羅率:1回でも推薦された商品の割合
    k = rec.shape[1]
    sims = S[rec[:, :, None], rec[:, None, :]].sum((1, 2)) - k
    ild = float((1 - sims / (k * (k - 1))).mean())         # リスト内の多様性:1-平均の似かた
    share = (pop + 1) / (pop + 1).sum()
    novelty = float((-np.log2(share[rec])).mean())         # 新規性:人気の低い商品ほど大きい
    return coverage, ild, novelty

print("推薦前の購買のジニ係数", round(gini(init_pop), 3),
      "上位10%の商品が占める購買の割合", round(top_share(init_pop), 3))
# 出力:
# 推薦前の購買のジニ係数 0.349 上位10%の商品が占める購買の割合 0.239
推薦を始める前の購買のジニ係数は0.349、上位10%の商品が占める割合は0.239でした。顧客が偶然見た商品から買っているだけでも、商品の魅力と顧客の好みの偏りによって、ある程度の集中があります。この値が、推薦を始めたあとの集中を比べる出発点になります。
5通りの推薦を90日まわす、人気に比例・関連度順・MMRによる並べ替え
比べる推薦のしかたは、次の5通りです。どれも、1人に1日10点を推薦し、すでに買った商品は推薦しません。推薦の枠には位置の偏りを入れ、k 位に出た商品が見られる度合いを \(1/\log_2(k+1)\) としました(1位を1として、2位は約0.63、10位は約0.29)。これは第8章の NDCG で使われる割り引きと同じ形を借りたもので、実際の枠での見られ方を測った値ではありません。
| 推薦のしかた | 商品の選び方 | 人気の使い方 | この章での位置づけ |
|---|---|---|---|
| ランダム | 購入済みを除いた商品から無作為に10点 | 使わない | 偏りの比較の基準 |
| 人気に比例 | その時点の購買の数に1を足した値を重みにして、重複なしに10点を抜き出す | 人気そのものを抜き出しの重みに使う | 人気に頼る推薦が循環でどう偏るか |
| 関連度順 | 顧客の関心との合い方 ×(購買の数に1を足した値の0.5乗)の大きい順に10点 | 購買の数に1を足した値の0.5乗を掛ける | 個人に合わせつつ人気も使う、よくある関連度 |
| 関連度順+MMR | 関連度順の点数を、MMR で並べ替えて10点(MMR の重み0.7) | 関連度順と同じ | 1人のリストの中の似た商品を減らす |
| MMR+人気の重み0 | 顧客の関心との合い方だけを関連度にして、MMR で並べ替え | 使わない | 人気の重みを外したときに何が変わるか |
関連度順の「顧客の関心」は、顧客が過去に買った商品の方向を足し合わせたもので、第6章の内容ベースの推薦で、関心を示した商品の属性の平均を顧客の関心とする考え方と同じ形です。購買の履歴が無い顧客は、関心が全商品に対して同じ値になるので、人気の大きい順の推薦になります。
MMR(Maximal Marginal Relevance の略)は、検索結果の並べ替えと、要約に使う文の選び方の方法です。Carbonell と Goldstein が1998年に SIGIR(情報検索の国際会議)で発表しました。要旨によれば、問い合わせとの関連性と情報の新しさを組み合わせ、関連性を保ちながら重複を減らすことを狙っています。推薦に当てはめると、10点を1点ずつ選ぶたびに、「関連度」から「すでに選んだ商品とどれだけ似ているか」を差し引いた値が最も大きい商品を選びます。式で書くと、重みを \(\lambda\) として \(\lambda \times \text{関連度} – (1-\lambda) \times \text{選んだ商品との似かたの最大}\) を最大にする商品を次に選ぶ、という手順です。\(\lambda\) が1なら関連度順と同じで、小さくするほど似た商品が続かなくなります。
K = 10
POS = 1 / np.log2(np.arange(K) + 2)                        # 位置の偏り:下の順位ほど見られにくい

def relevance(pop, owned, beta):
    prof = owned.astype(float) @ V                          # 買った商品の特徴の和を顧客の関心とする
    prof /= np.linalg.norm(prof, axis=1, keepdims=True) + 1e-9
    match = (prof @ V.T + 1) / 2                            # 関心との合い方(0〜1)
    return match * ((pop + 1) ** beta)[None, :]             # 合い方 × 人気のbeta乗

def recommend(policy, pop, owned, r, lam, beta):
    # lam(MMRの重み)は 0 より大きく 1 以下で使う。0 にすると除外の印(-inf)が NaN になり、除外が効かない
    if policy == "ランダム":
        score = r.random((N_USER, N_ITEM))
    elif policy == "人気に比例":
        gumbel = -np.log(-np.log(r.random((N_USER, N_ITEM))))
        score = np.log(pop + 1)[None, :] + gumbel          # 人気に比例した確率で10点を抜き出す
    else:
        score = relevance(pop, owned, beta)
    score = np.where(owned, -np.inf, score)                # 購入済みは出さない
    if lam >= 1.0:
        return np.argsort(-score, axis=1)[:, :K]
    rel = score / score.max(1, keepdims=True)              # 関連度を0〜1にそろえる
    maxsim = np.zeros((N_USER, N_ITEM))                    # 選んだ商品との似かたの最大
    rec = np.zeros((N_USER, K), int)
    for k in range(K):
        mmr = lam * rel - (1 - lam) * maxsim               # MMR:関連度から「似た商品が既にある」分を引く
        j = mmr.argmax(1)
        rec[:, k] = j
        rel[np.arange(N_USER), j] = -np.inf
        maxsim = np.maximum(maxsim, S[j])
    return rec
「人気に比例」の推薦では、人気の対数にガンベル分布という乱数を足して上位10点を取っています。これは、購買の数に1を足した値に比例する確率で商品を抜き出すための手順です。ただし10点を重複なしに抜き出すので、ある商品が最終的な10点に入る確率まで、重みにちょうど比例するわけではありません。本コラムでは、次の短いコードで、商品3点の小さな例について、この手順で1位に来る割合が人気に比例することを10万回の試行で確かめました。人気の比が1:2:3のとき、1位に来た割合は0.169・0.332・0.499で、人気に比例した値の0.167・0.333・0.5とほぼ一致しました。確かめたのは1位の選ばれ方だけです。
import numpy as np

# 人気の対数にガンベル乱数を足して最大を取ると、人気に比例した確率で1位が決まることの確認
r = np.random.default_rng(20261110)
pop = np.array([1.0, 2.0, 3.0])
n = 100000
g = -np.log(-np.log(r.random((n, 3))))
top = np.argmax(np.log(pop)[None, :] + g, axis=1)
print("人気の比 1:2:3 のとき1位に来た割合", np.round(np.bincount(top, minlength=3) / n, 3))
print("人気に比例した理論値", np.round(pop / pop.sum(), 3))
# 出力:
# 人気の比 1:2:3 のとき1位に来た割合 [0.169 0.332 0.499]
# 人気に比例した理論値 [0.167 0.333 0.5  ]
次のコードで、5通りの推薦をそれぞれ90日まわしました。毎日、全顧客に10点ずつ推薦し、位置の偏りを掛けた真の確率で購買が決まります。買われた商品は人気が1ずつ上がり、顧客の購入済みに加わって、翌日の推薦に使われます。これが、前の節の循環(推薦→露出→購買→学習→推薦)をそのまま再現した部分です。15日ごとに、累積の購買のジニ係数と、その日の推薦の網羅率などを記録しました。ジニ係数は、推薦を始める前の30日分の購買も含めた累積で計算しています。
def simulate(policy, lam=1.0, beta=0.5, days=90, seed=1):
    r = np.random.default_rng(seed)
    pop, owned = init_pop.copy(), init_owned.copy()
    total, log = 0, []
    for d in range(days):
        rec = recommend(policy, pop, owned, r, lam, beta)
        buy = r.random(rec.shape) < p_buy[np.arange(N_USER)[:, None], rec] * POS[None, :]
        users = np.repeat(np.arange(N_USER), K).reshape(N_USER, K)[buy]
        day_buy = np.bincount(rec[buy], minlength=N_ITEM)
        pop += day_buy                                     # 売れた商品の人気が上がり、次の推薦に効く
        owned[users, rec[buy]] = True
        total += int(day_buy.sum())
        if (d + 1) % 15 == 0:
            cov, ild, nov = list_metrics(rec, pop)
            log.append((d + 1, total, gini(pop), top_share(pop), cov, ild, nov))
    return log

PLANS = {"ランダム": ("ランダム", 1.0, 0.5), "人気に比例": ("人気に比例", 1.0, 0.5),
         "関連度順": ("関連度", 1.0, 0.5), "関連度順+MMR": ("関連度", 0.7, 0.5),
         "MMR+人気の重み0": ("関連度", 0.7, 0.0)}
results = {}
for name, (policy, lam, beta) in PLANS.items():
    results[name] = simulate(policy, lam, beta)
    print(f"--- {name}")
    for row in results[name]:
        print("  {}日目 累積の購買{} 購買のジニ{:.3f} 上位10%の割合{:.3f} "
              "網羅率{:.3f} リスト内の多様性{:.3f} 新規性{:.2f}".format(*row))
# 出力(人気に比例・関連度順の15日目の行と、各推薦の90日目の行):
# 人気に比例        15日目 累積の購買5535 購買のジニ0.512 上位10%の割合0.375 網羅率1.000 リスト内の多様性0.769 新規性7.69
# 関連度順          15日目 累積の購買9880 購買のジニ0.789 上位10%の割合0.787 網羅率0.107 リスト内の多様性0.592 新規性4.81
# ランダム         90日目 累積の購買22848 購買のジニ0.302 上位10%の割合0.219 網羅率1.000 リスト内の多様性0.818 新規性8.47
# 人気に比例        90日目 累積の購買34037 購買のジニ0.649 上位10%の割合0.494 網羅率0.993 リスト内の多様性0.750 新規性7.49
# 関連度順          90日目 累積の購買38547 購買のジニ0.860 上位10%の割合0.863 網羅率0.183 リスト内の多様性0.506 新規性5.96
# 関連度順+MMR     90日目 累積の購買38448 購買のジニ0.860 上位10%の割合0.867 網羅率0.360 リスト内の多様性0.770 新規性5.87
# MMR+人気の重み0  90日目 累積の購買46070 購買のジニ0.297 上位10%の割合0.218 網羅率1.000 リスト内の多様性0.534 新規性8.24
90日目の値を表にまとめます。「90日間の購買の合計」は、このシミュレーションの中の推薦経由の購買(推薦の枠に表示された商品が、その枠から選ばれて買われた分)の件数です。網羅率は90日目の1日分で数えた値です。新規性は、大きいほど人気の低い商品を多く推薦していることを表す単位の無い数で、推薦のしかたどうしを比べるためにだけ使います(300点の人気がすべて同じだった場合の値は、2を底とする300の対数で約8.2です)。約8.2は目安で、上限ではありません。人気に偏りがあると、人気の低い商品1点あたりの値が大きくなるので、全商品をほぼ均等に推薦するランダムの新規性(8.47)のように、約8.2より大きい値も出ます。なお、新規性の基準にした人気は、それぞれの推薦のしかたで90日目の購買まで足した後の累積の購買の数です。推薦のしかたごとに基準の人気の分布が違うので、共通の物差しで測った値ではなく、おおまかな傾向を見るための数として扱ってください。このシミュレーションでは推薦の枠以外から買う経路を入れていないので、この件数は、序章と第9章で定義した推薦の効果(推薦が無かった場合と比べて増えた購買)ではありません。同じ顧客と商品の世界で、推薦のしかただけを入れ替えたときの購買の量の比較として読んでください。
| 推薦のしかた | 90日間の購買の合計 | 購買のジニ係数 | 購買上位10%の商品が占める購買の割合 | 網羅率 | リスト内の多様性 | 新規性 |
|---|---|---|---|---|---|---|
| 推薦を始める前(参考) | なし | 0.349 | 0.239 | なし | なし | なし |
| ランダム | 22,848 | 0.302 | 0.219 | 1.000 | 0.818 | 8.47 |
| 人気に比例 | 34,037 | 0.649 | 0.494 | 0.993 | 0.750 | 7.49 |
| 関連度順 | 38,547 | 0.860 | 0.863 | 0.183 | 0.506 | 5.96 |
| 関連度順+MMR | 38,448 | 0.860 | 0.867 | 0.360 | 0.770 | 5.87 |
| MMR+人気の重み0 | 46,070 | 0.297 | 0.218 | 1.000 | 0.534 | 8.24 |
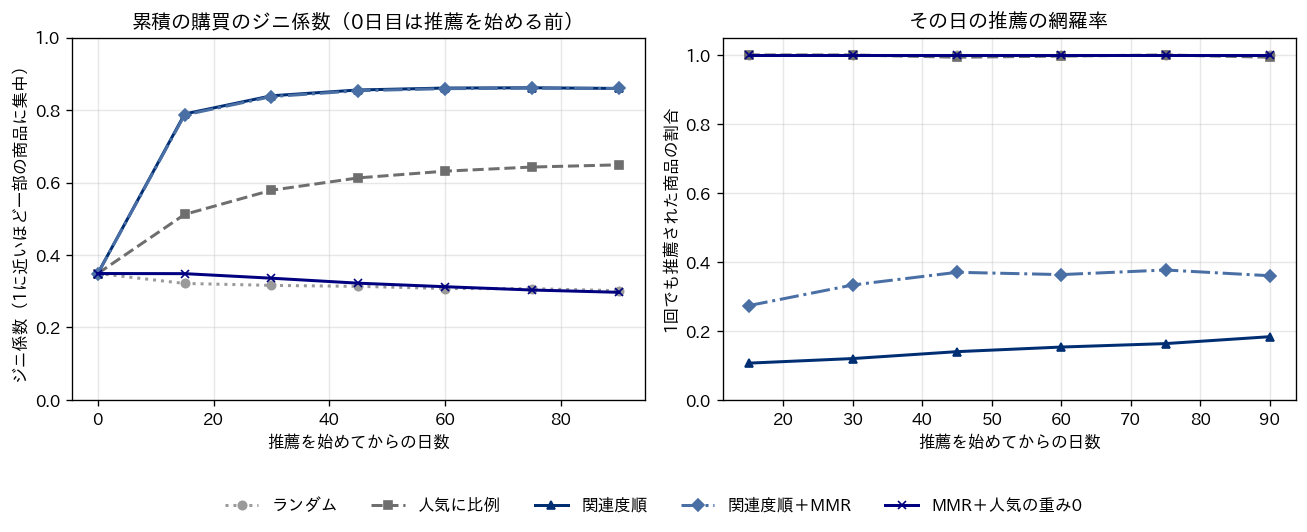
上の図の左は累積の購買のジニ係数、右はその日の推薦の網羅率の推移です(凡例は図の下)。左の図で、関連度順と関連度順+MMR の2本の線はほぼ重なり、ランダムと MMR+人気の重み0 の2本も近い値で重なっています。右の図では、ランダム・人気に比例・MMR+人気の重み0 の3本が1.0付近で重なっています。
この結果から読み取れることは3つあります。1つ目は、人気に比例した推薦では、循環を重ねるにつれて購買が上位へ集中していくことです。ジニ係数は推薦を始める前の0.349から、15日目に0.512、90日目に0.649まで上がり、上位10%の商品が占める割合は0.239から0.494に増えました。人気に比例した重みで抜き出すので、網羅率は0.993と、ほぼすべての商品が誰かには推薦されています。それでも、人気の高い商品ほど多くの顧客に出て売れ、売れるとさらに出る、という循環で集中が進みました。全商品が推薦の枠に出ていることと、購買が偏らないことは別のことです。
2つ目は、関連度順では集中がさらに強く、速く進んだことです。ジニ係数は15日目に0.789、90日目に0.860で、上位10%の商品が購買の86.3%を占めました。網羅率は0.183で、その日に誰にも推薦されなかった商品が8割を超えます。関連度に人気の0.5乗を掛けているので、関心に合う商品の中でも人気の高い商品が上位に来て、全員が似た商品を見ることになります。一方で、90日間の購買の合計は38,547件で、ランダム(22,848件)や人気に比例(34,037件)より多くなりました。この架空データでは、関連度順は購買の量を増やしましたが、その購買は少数の商品に集中しました。精度の指標だけを見ていると、この集中には気づきません。
3つ目は、ランダムな推薦では集中が推薦前より少し和らいだことです(ジニ係数0.349から0.302)。ただし、購買の合計は5通りの中で最も少ない22,848件です。偏りが小さいことは、それだけでは良い推薦を意味しません。
1人のリストの多様性と品揃え全体の集中は別のもの、MMRが集中を和らげなかった理由
この章のシミュレーションで最も注意して読みたいのが、関連度順+MMR の結果です。MMR を加えると、リスト内の多様性は関連度順の0.506から0.770に上がり、網羅率も0.183から0.360へとおよそ2倍になりました。1人ひとりに出す10点は、互いに似ていない商品の組み合わせになっています。それなのに、購買のジニ係数は掲載した桁(小数第3位)で関連度順と同じ0.860、購買上位10%の商品が占める割合は0.863に対して0.867で、MMR の重み0.7のこの設定では、購買の集中のはっきりした改善は確かめられませんでした。
MMR の仕組みから言えるのは、MMR が直すのは「1人のリストの中の重複」だということです。MMR は、すでに選んだ商品と似た商品を後回しにしますが、関連度の点数そのもの(関心との合い方 × 人気の0.5乗)は変えません。コードのとおり、同じ方向の商品どうしでは、人気の高い商品ほど関連度が高くなります。そのため、1人の10点がいろいろな方向に散らばっても、それぞれの方向で上位に来るのは人気の高い商品です。集中がほぼ変わらなかったのは、顧客が違っても方向ごとの人気の商品が共通なので、全体としては同じ商品に購買が集まったためだと考えていますが、この実験ではその経路を直接は測っていません。また、ジニ係数は商品ごとの購買の数を小さい順に並べ替えて計算するので、売れた商品の顔ぶれが入れ替わっても同じ値になりえます。新たに推薦に出るようになった商品がそれぞれ何件買われたかは、この実験では集計していません。言えるのは、品揃え全体で見た購買の集中の度合いが、ほぼ同じだったということまでです。
MMR の重み0.7という1つの設定だけで結論を出さないよう、重みを0.5と0.3に強めた場合も、同じ90日のシミュレーションで回しました。次のコードの前半です。後半は、次の節で使う乱数のシード2での確かめです。
for lam in [0.5, 0.3]:                                     # 1.0と0.7は前のコードで計算済み
    last = simulate("関連度", lam=lam, beta=0.5)[-1]
    print("MMRの重み{:.1f}(人気の重み0.5) 90日の購買{} 購買のジニ{:.3f} 上位10%の割合{:.3f} "
          "網羅率{:.3f} リスト内の多様性{:.3f}".format(lam, last[1], last[2], last[3], last[4], last[5]))
for lam, beta in [(1.0, 0.5), (0.7, 0.25), (0.7, 0.1)]:   # 乱数の種2での確かめ
    last = simulate("関連度", lam=lam, beta=beta, seed=2)[-1]
    print("種2 MMRの重み{:.1f} 人気の重み{:.2f} 90日の購買{} 購買のジニ{:.3f}".format(lam, beta, last[1], last[2]))
# 出力:
# MMRの重み0.5(人気の重み0.5) 90日の購買36274 購買のジニ0.840 上位10%の割合0.819 網羅率0.510 リスト内の多様性0.893
# MMRの重み0.3(人気の重み0.5) 90日の購買31208 購買のジニ0.813 上位10%の割合0.771 網羅率0.693 リスト内の多様性0.925
# 種2 MMRの重み1.0 人気の重み0.50 90日の購買38353 購買のジニ0.860
# 種2 MMRの重み0.7 人気の重み0.25 90日の購買44076 購買のジニ0.840
# 種2 MMRの重み0.7 人気の重み0.10 90日の購買53806 購買のジニ0.727
| MMR の重み(人気の重み0.5) | 90日間の購買の合計 | 購買のジニ係数 | 購買上位10%の商品が占める購買の割合 | 網羅率(90日目の1日分) | リスト内の多様性 |
|---|---|---|---|---|---|
| 1.0(関連度順と同じ) | 38,547 | 0.860 | 0.863 | 0.183 | 0.506 |
| 0.7 | 38,448 | 0.860 | 0.867 | 0.360 | 0.770 |
| 0.5 | 36,274 | 0.840 | 0.819 | 0.510 | 0.893 |
| 0.3 | 31,208 | 0.813 | 0.771 | 0.693 | 0.925 |
MMR の重みを0.5、0.3と強めると、購買のジニ係数は0.840、0.813と少しずつ下がり、網羅率は0.510、0.693まで上がりました。MMR を強めれば、品揃え全体の集中もいくらかは和らぎます。ただし、重み0.3でもジニ係数は0.813で、上位10%の商品が購買の77.1%を占めています。一方で、90日間の購買の合計は関連度順の38,547件から、重み0.3では31,208件まで減りました。この架空データでは、MMR を強めることは、購買を減らしながら集中を少しだけ和らげる手段でした。次の節で見る人気の重みを下げる方法とは、結果の出かたが違います。
この現象は、研究でも指摘されています。前に挙げた Fleder と Hosanagar の2009年の論文は、1人ひとりにとっての多様性が上がっても、全体で見た多様性は下がりうることを示しています。推薦が1人ひとりを新しい商品へ押し出しても、全員を同じ商品へ押し出すことがありうる、という説明です。Adomavicius と Kwon の2012年の論文(並べ替えの工夫で推薦の全体の多様性を上げる方法。IEEE の知識工学・データ工学の論文誌)は、精度を同程度に保ちながら、全利用者にわたる推薦の多様性を上げる並べ替えの方法を提案しています。この論文がいう全体の多様性(aggregate diversity)は、全利用者への推薦を合わせたときに何種類の商品が推薦されたかに関わる考え方で、この章の網羅率に近い見方です。
実務への示唆として、「多様性を上げる施策を入れた」という報告を受けたときは、その多様性が1人のリストの中の多様性なのか、品揃え全体への広がりなのかを確かめる必要があると考えています。本コラムの架空データでは、MMR の重み0.7でリスト内の多様性と推薦の網羅率が上がっても、購買の集中はほぼ変わらず、重みを0.3まで強めても集中の下がりかたは小さいものでした。
人気の重みを下げると何が起きるか、購買の量と集中のつり合い
前の節の表で、MMR+人気の重み0 は、購買のジニ係数が0.297と推薦前(0.349)より低く、網羅率は1.000でした。90日間の購買の合計も46,070件で、関連度順(38,547件)より多くなっています。この架空データでは、関連度から人気の重みを外すと、集中が和らぐだけでなく購買も増えました。ただし、人気の重みは0か0.5かの二択ではありません。次のコードでは、MMR の重みを0.7に固定し、人気の重み(関連度に掛ける人気のべき乗の指数)を0.5・0.25・0.1・0の4通りに変えて、90日目の値を比べました。
sweep = []
for beta in [0.5, 0.25, 0.1, 0.0]:
    last = simulate("関連度", lam=0.7, beta=beta)[-1]
    sweep.append((beta, last[1], last[2], last[3], last[4]))
    print("人気の重み{:.2f} 90日の購買{} 購買のジニ{:.3f} 上位10%の割合{:.3f} 網羅率{:.3f}".format(
        beta, last[1], last[2], last[3], last[4]))

# 乱数の種を2に変えて、人気の重み0.5と0の結果の向きを確かめる
for seed in [2]:
    for beta in [0.5, 0.0]:
        last = simulate("関連度", lam=0.7, beta=beta, seed=seed)[-1]
        print("確認 seed{} 人気の重み{:.1f} 90日の購買{} 購買のジニ{:.3f}".format(seed, beta, last[1], last[2]))
# 出力:
# 人気の重み0.50 90日の購買38448 購買のジニ0.860 上位10%の割合0.867 網羅率0.360
# 人気の重み0.25 90日の購買43522 購買のジニ0.843 上位10%の割合0.781 網羅率0.277
# 人気の重み0.10 90日の購買52954 購買のジニ0.735 上位10%の割合0.529 網羅率0.673
# 人気の重み0.00 90日の購買46070 購買のジニ0.297 上位10%の割合0.218 網羅率1.000
# 確認 seed2 人気の重み0.5 90日の購買38654 購買のジニ0.860
# 確認 seed2 人気の重み0.0 90日の購買46068 購買のジニ0.306
| 人気の重み(MMR の重み0.7) | 90日間の購買の合計 | 購買のジニ係数 | 購買上位10%の商品が占める購買の割合 | 網羅率 |
|---|---|---|---|---|
| 0.5 | 38,448 | 0.860 | 0.867 | 0.360 |
| 0.25 | 43,522 | 0.843 | 0.781 | 0.277 |
| 0.1 | 52,954 | 0.735 | 0.529 | 0.673 |
| 0 | 46,070 | 0.297 | 0.218 | 1.000 |
上の表は、人気の重みごとの90日目の値を並べたもので、数値は直前のコードの出力と同じです。人気の重みを0.5から下げていくと、購買は増え、ジニ係数は下がりました。購買が最も多かったのは人気の重み0.1の52,954件で、このときのジニ係数は0.735です。人気の重みを0まで下げると、ジニ係数は0.297まで下がりましたが、購買は46,070件に減りました。この架空データでは、人気の重みを少しだけ残した点で購買が最も多く、集中を最も和らげる点とは一致しませんでした。数字で言い換えると、人気の重みを0.5から0.1へ下げる間は、購買が38,448件から52,954件に増え、ジニ係数も0.860から0.735に下がって、両方が良い方向に動きました。0.1から0へ下げる間は、ジニ係数は0.297までさらに下がりましたが、購買は46,070件に減りました。
ここまでの数字は、シミュレーションの乱数のシードを1にした、1つの乱数の種での結果です。そこで、シードを2に変えて、人気の重み0.5・0.25・0.1・0の4通りすべてと、MMR 無しの関連度順を回し直しました(人気の重み0.5と0は上のコードの後半、0.25・0.1と関連度順は前の節で MMR の重みを変えたコードの後半です)。結果は次の表のとおりで、シード2でも、人気の重みを下げるとジニ係数が下がり、購買が最も多いのは人気の重み0.1でした。確かめたシードは1と2の2つだけなので、この向きが他のシードでも必ず同じになるとまでは言えません。
| 推薦のしかた | シード1の購買の合計 | シード1のジニ係数 | シード2の購買の合計 | シード2のジニ係数 |
|---|---|---|---|---|
| 関連度順(MMR 無し・人気の重み0.5) | 38,547 | 0.860 | 38,353 | 0.860 |
| MMR 0.7・人気の重み0.5 | 38,448 | 0.860 | 38,654 | 0.860 |
| MMR 0.7・人気の重み0.25 | 43,522 | 0.843 | 44,076 | 0.840 |
| MMR 0.7・人気の重み0.1 | 52,954 | 0.735 | 53,806 | 0.727 |
| MMR 0.7・人気の重み0 | 46,070 | 0.297 | 46,068 | 0.306 |
この結果を読むときに、限定条件を落とさないことが大切です。観察した結果として言えるのは、この設定では、人気の重みを0.5から0.1へ下げる範囲では、人気の重みを大きくした条件ほど購買が少なく、集中が強かったということです。
その理由については、測っていない仮説として次のように考えています。この架空データでは、顧客が商品を買う確率は顧客と商品の方向のそろい方で大きく決まるように作っています。そのため、人気が「商品の良さ」よりも「多く見せた結果」を多く含み、人気の重みを大きくすると、関心に合わない人気商品を出す分だけ購買が減ったのではないかという仮説です。この実験ではその寄与を測っていません。人気は、商品の魅力・顧客の好み・推薦の位置・購入済みの除外など、いくつもの影響を受けて決まるためです。実際のサービスでは、人気が商品の品質や売れ筋を反映している度合いはこの架空データより大きいことも小さいこともあり、どの人気の重みが良いかはデータによって変わります。この章の数字から「人気の重みは0.1が良い」と読むことはできません。読み取れるのは、人気の重みは購買の量と集中の両方を動かすつまみで、その最適な位置は、第9章の A/Bテストのように、実際の顧客で購買と集中の両方を測って決める必要がある、ということです。
もう1つ、前の節の表で MMR+人気の重み0 のリスト内の多様性が0.534と、人気の重み0.5のとき(0.770)より低かったことにも触れておきます。コードの仕組みとして言えるのは、人気の重みを外すと、関連度は関心との合い方だけで決まる、ということです。そのため関心に近い方向の商品ばかりが高い点数になり、MMR の重み0.7では似た商品を十分に外しきれなかったのではないか、という仮説を立てていますが、この理由はこの実験では確かめていません(似かたの分布などは測っていません)。品揃え全体への広がり(網羅率・ジニ係数)と、1人のリストの中の多様性は、この例でも別々に動きました。どちらを KPI にするかで、良いとされる推薦が変わります。
多様性・新規性・セレンディピティ・網羅率、精度以外の指標の測り方
第8章で扱った適合率@K・再現率@K・NDCG は、推薦がどれだけ当たったかを測る精度の指標です。この章のシミュレーションで見たとおり、精度の指標だけでは、推薦が品揃えのどこに偏っているかは分かりません。推薦の研究では、精度以外の性質を測る指標が提案されてきました。Ge らの2010年の論文(網羅率とセレンディピティで推薦システムを評価する方法。RecSys 2010)は、推薦システムの評価の多くが予測の精度だけに注目していることを挙げ、網羅率とセレンディピティの2つを取り上げて、測り方と、2つの間のトレードオフを論じています。Ziegler らの2005年の論文(話題の多様化による推薦リストの改善。WWW 2005)は、推薦リストの話題の多様性を測るリスト内類似度という指標を導入し、話題を散らす並べ替えが平均の精度を下げる一方で、利用者の満足を高めたと報告しています。Vargas と Castells の2011年の論文(推薦システムの新規性と多様性の指標における順位と関連性。RecSys 2011)は、新規性と多様性の評価の指標どうしの関係が明確に整理されておらず、推薦の順位や、推薦した商品が顧客に合っているかを考えない指標が多いことを指摘しています。
この章で使った指標と、その他の代表的な指標を、測る単位(1人のリストか、品揃え全体か)とあわせて整理すると次の表になります。
| 指標 | 何を測るか | 測る単位 | 計算に要るデータ | 注意点 |
|---|---|---|---|---|
| 精度(再現率@K・NDCG など) | 推薦が後の購買をどれだけ当てたか | 1人ごとに測って平均 | 推薦の結果と、後の購買のログ | 人気商品を出すだけで高くなりやすい(第8章) |
| リスト内の多様性 | 1人に出した推薦どうしがどれだけ似ていないか | 1人のリスト | 商品どうしの似かた(属性・ジャンル・特徴) | 上げても品揃え全体の集中は変わらないことがある(この章の架空データ) |
| 網羅率 | 決めた期間(1日・1週・1か月など)に、品揃えのうち誰かに推薦された商品の割合 | 品揃え全体 | 推薦の結果(表示のログ) | 期間が長いほど値が上がるので、比べるときは期間をそろえる。1回でも出れば数えるので、ごく少数の顧客に出しただけでも上がる |
| 集中の度合い(ジニ係数・購買上位10%の商品が占める割合) | 推薦や購買が一部の商品にどれだけ集まっているか | 品揃え全体 | 商品ごとの推薦の回数・購買の数 | 網羅率が高くても集中は進みうる(この章の人気に比例の結果) |
| 新規性 | 推薦した商品が、どれだけ人気の低い・知られていない商品か | 1人ごとに測って平均 | 商品ごとの人気(購買・閲覧の数) | 人気の低い商品を出すだけで上がり、関心に合うかは測らない |
| セレンディピティ | 顧客が自分では見つけなかったが、関心に合う商品を推薦できたか | 1人ごとに測って平均 | 「予想される推薦」の基準と、顧客の反応 | 「予想外」の基準の決め方で値が変わる。定義を先に決める |
実務では、これらをすべて追う必要はないと考えています。最低限、精度の指標と並べて、品揃え全体の集中(ジニ係数か、購買上位10%の商品が占める購買の割合)と網羅率の2つを毎月の報告に入れることを勧めます。網羅率は、数える期間(たとえば「その月の1か月分」)を一度決めたら変えずに使い、月ごとの値を同じ期間どうしで比べます。2つとも、表示のログと購買のログがあれば計算でき、推薦の手法の中身を知らない経営層にも意味が伝わります。リスト内の多様性やセレンディピティは、商品どうしの似かたの定義や「予想外」の基準を決める必要があり、測る目的がはっきりしてから加えるのがよいと考えています。
フィルターバブルとエコーチェンバー、研究の結論は分かれている
推薦の偏りの話題では、フィルターバブルという言葉がよく使われます。Nguyen らの2014年の論文(推薦システムの利用が内容の多様性に与える影響を調べた論文。WWW 2014)によれば、この言葉は Eli Pariser が作ったもので、オンラインの個人化が人々を多様な視点や内容から実質的に切り離してしまう可能性を表しています。似た言葉にエコーチェンバーがあり、後で挙げる Flaxman らの論文の題名のように、フィルターバブルと並べて論じられます。本コラムでは、エコーチェンバーを、似た意見の人どうしで情報がやりとりされ、同じ意見が反響するように強まっていく状態を指す言葉として使います。どちらも、ニュースや政治的な意見の文脈で論じられることが多く、商品の推薦とは場面が違いますが、推薦が顧客の見る範囲を狭めるかどうかという問いは共通しています。
この問いについて、研究の結論は一様ではありません。主な研究を、対象と結果の要旨で並べると次のようになります。
- Nguyen らの2014年の論文:映画の推薦サービスの利用者の記録を長い期間で追い、推薦システムが利用者に示す商品の範囲が時間とともにわずかに狭まっていたこと、推薦された商品を実際に消費した利用者の群では、狭まりかたが小さかったことを報告しています。時間の経過に伴う変化と、利用者の群どうしの違いを見た観察の結果です
- Bakshy らの2015年の論文(Facebook 上で思想的に多様なニュースと意見に触れることを調べた論文。Science 誌):米国の Facebook 利用者1,010万人の匿名化したデータで調べ、思想の異なる立場の内容に触れる機会を狭める要因としては、アルゴリズムによるニュースフィードの順位付けよりも、利用者自身の選択のほうが強い役割を果たしていたと報告しています
- Flaxman らの2016年の論文(フィルターバブル・エコーチェンバーとオンラインのニュース消費を扱った論文。Public Opinion Quarterly 誌):米国の利用者5万人の閲覧の履歴で調べ、ソーシャルネットワークと検索エンジンが個人間の思想の距離の拡大と結びつく一方で、自分が好まない側の情報に触れる機会の増加とも結びついていたこと、観察された関連の大きさは比較的小さいことを報告しています
- Chaney らの2018年の論文:シミュレーションで、推薦の影響を受けたデータで学習を続けると、効用を増やさないまま利用者の行動が均質になることを示しています
これらの研究は、対象のサービス(映画・ソーシャルメディア・ニュースの閲覧)、データ(観察データ・シミュレーション)、測った「多様性」の定義がそれぞれ違います。そのため、「推薦はフィルターバブルを生む」とも「生まない」とも、一般論として断定できないと考えています。読み取れるのは、推薦が見る範囲を狭める方向の力は条件によって働きうること、ただしその大きさは、顧客自身の選択や、推薦以外の経路(検索・ホームページへの直接の訪問など)との兼ね合いで変わる、ということです。自社の推薦について知るには、一般論ではなく自社のデータを見る必要があります。顧客ごとに購買するジャンルの幅の推移を監視し、その変化が推薦によるものかどうかは、季節・品揃え・顧客の構成の変化と区別するために、同じ時期に推薦を出さない群を設けた A/Bテスト(第9章)などで確かめます。推薦を始める前と後を比べるだけでは、推薦の影響と他の変化を区別できません。
同調の偏りについても、実験の研究があります。Salganik らの2006年の論文(人工の音楽市場で成功の不平等と予測のしにくさを調べた実験。Science 誌)は、14,341人の参加者が、他の参加者の選択を知る条件と知らない条件で未知の曲をダウンロードする実験を行い、他人の選択の影響を強めるほど、成功の不平等と予測のしにくさの両方が増したと報告しています。曲の質だけで成功が決まるわけではなかった、という結果です。「人気の商品」「売れています」の表示は、この同調を強める側に働く可能性があります。
出品者・作り手の側の公平性、市場型のサービスで考えること
ここまでは、主に顧客と品揃えの側から偏りを見てきました。複数の出品者が商品を並べる市場型のサービス(モール型の EC、宿泊の予約サイト、求人の仲介、動画や音楽の配信など)では、推薦の偏りは出品者・作り手の側の問題にもなります。推薦の枠に出るかどうかが、出品者の売上や、作り手が続けられるかどうかに直接影響するからです。
Burke の2017年の論文(推薦の多面的な公平性。機械学習の公平性・説明責任・透明性のワークショップ FAT/ML 2017 でポスター発表)は、推薦の公平性は、場面によって複数の立場の人を同時に考える必要がある多面的な概念になりうる、と論じています。この章に引き寄せて言えば、推薦の利用者(顧客)にとっての公平性と、推薦される側(出品者・作り手)にとっての公平性は、別々に考える必要がある、ということです。
顧客の側の公平性については、Abdollahpouri らの2019年のもう1つの論文(推薦における人気の偏りの不公平さ。arXiv の 1907.13286 で公開)が、利用者を人気の商品への関心の度合いでニッチ型・多様型・人気作重視型の3つの群に分け、映画のデータセットで、多くの推薦の手法で、利用者が人気の低い商品に関心を持っていても推薦が人気の商品に極端に集中していた、と報告しています。この結果は映画のデータセットでの結果で、他の商品やサービスで同じ程度の差が出るとは限りません。それでも、ニッチな関心を持つ顧客ほど、人気に寄った推薦で自分の関心とずれた商品を見せられやすい、という見方は、自社の推薦を点検するときの観点になると考えています。
出品者・作り手の側の公平性を点検する観点を、次の表にまとめました。
| 点検の観点 | 何を見るか | 測り方の例 | 決めておくこと |
|---|---|---|---|
| 露出の配分 | 推薦の枠に出る回数が、一部の出品者・作り手に集中していないか | 出品者ごとの表示の回数のジニ係数、表示の回数の上位10%の出品者が占める表示の割合 | どの程度の集中まで許すか、新規の出品者に露出を保証するか(第10章) |
| 露出と成果の比 | 表示の回数に対して購買が少ない出品者が、さらに露出を減らされていないか | 出品者ごとの表示あたりの購買の率と、翌月の表示の回数の関係 | 露出を減らす判断の基準と、見直しの頻度 |
| 位置の配分 | 上の順位がいつも同じ出品者に占められていないか | 順位ごとの出品者の内訳 | 上位の枠の入れ替えのルール |
| 説明と異議の受付 | 出品者が、自分の商品が推薦されにくい理由を問い合わせられるか | 問い合わせの件数と回答の記録 | 説明の範囲と窓口。法令の要請は第14章 |
| 自社商品の扱い | 運営者自身の商品と、他の出品者の商品を同じ基準で推薦しているか | 自社商品と他社商品の、表示あたりの購買の率と表示の回数の比較 | 同じ基準で並べることを社内のルールにするか |
市場型のサービスの推薦の透明性に関わる法令が何を求めているかは、第14章で扱います。AIの公平性を社内のルールとしてどう定め、誰が確認するかは、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
精度と多様性のつり合いの決め方、ガードレールの指標を置く
この章のシミュレーションで見たとおり、推薦のしかたを変えると、購買の量と集中の度合いは一緒に動き、ときに逆の方向に動きます。どこでつり合いを取るかは、手法の問題ではなく、事業として何を優先するかの判断です。本コラムでは、次の手順で決めることを考えています。
- 推薦を入れる前に、主となる KPI(購買の数・購買率など)を1つと、品揃えの幅の KPI を2つ(集中の指標として購買のジニ係数か購買上位10%の商品が占める割合のどちらか1つ、それに数える期間を固定した網羅率)を決める
- 品揃えの幅の KPI に、悪化を許す限度(ガードレール)を置く。たとえば「購買上位10%の商品が占める購買の割合を、推薦を入れる前の値より一定以上は上げない」のように決める
- オフライン評価で、人気の重みや MMR の重みを変えた複数の案について、精度の指標と品揃えの幅の指標を並べて出し、ガードレールを守れる案に絞る
- 絞った案を A/Bテストにかけ、主となる KPI とガードレールの KPI の両方を測る(第9章)。ガードレールを破った案は、主となる KPI が良くても採らない
- 採った案でも、品揃えの幅の KPI を毎月追い、循環で集中が進んでいないかを確かめる
手順の3で、オフライン評価だけで決めないことには理由があります。第8章で扱ったとおり、過去のログは過去の推薦の影響を受けているので、過去に多く見せた人気商品ほど「当たった」ことになりやすく、人気に寄った案が良く見えがちです。この章のシミュレーションで、関連度順の集中が15日目にはすでにジニ係数0.789まで進んでいたように、循環の影響は短い期間でも表れます。オフライン評価の精度が少し下がる案でも、A/Bテストで購買が減らず、集中が和らぐなら、採る価値があると考えています。
手順の2のガードレールの限度をいくつにするかは、本コラムでは決められません。品揃えの広さが事業の価値そのもの(専門店・ロングテールの品揃えを売りにするサービス)なのか、売れ筋を確実に届けることが価値なのかで、許せる集中の度合いが違うからです。限度は、商品部・マーケティング・経営で話し合って決め、根拠とともに記録しておくのがよいと考えています。
経営の判断、品揃えの幅を KPI に入れる
この章の内容を、経営の判断に置き換えます。推薦の偏りを放置したときに起きる損失を、序章で整理した6つの損失の型に当てはめると、次の表のようになります。
| 偏りの放置で起きること | 損失の型 | 防ぎ方 |
|---|---|---|
| 推薦が人気商品に集中し、残りの商品が誰の目にも触れなくなる | 品揃えの偏り、機会損失(買われたはずの商品が見えない) | 購買のジニ係数か購買上位10%の商品が占める割合と、網羅率を KPI に入れ、ガードレールを置く |
| 人気商品の売上を、推薦の手柄として数える | 効果の過大評価(推薦が無くても売れた人気商品を推薦の成果と数える) | 推薦の効果は A/Bテストで測る(第9章)。推薦経由の購買の数で評価しない |
| 同じ商品ばかり、似た商品ばかりを見せ続ける | 顧客の離反(的外れ・しつこいと感じさせる) | リスト内の多様性と、顧客ごとのジャンルの幅の推移を見る |
| 品揃えの幅の指標を測らず、精度の指標だけで推薦を入れ替える | 形骸化(推薦の質の一面しか測られない) | 精度と品揃えの幅の指標を並べて毎月報告する |
| 部署ごとに別の推薦を作り、それぞれが自部署の売れ筋を押し出す | 二重投資、品揃えの偏り | 品揃えの幅の KPI とガードレールを全社でそろえる |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 推薦の KPI に、購買の数・購買率などの主となる KPI と並べて、品揃えの幅の KPI(購買のジニ係数か購買上位10%の商品が占める割合のどちらか1つと、数える期間を固定した網羅率の2つ)を入れる
- 品揃えの幅の KPI に、悪化を許す限度を置き、その限度を商品部・マーケティングと合意して記録する
- 推薦のしかたを変えるときは、A/Bテストで主となる KPI と品揃えの幅の KPI の両方を確かめてから採る
- 「多様性を上げた」という報告を受けたら、1人のリストの多様性か、品揃え全体の広がりかを確かめる
- 市場型のサービスでは、出品者ごとの露出の配分を定期的に点検し、点検の結果と対応を記録する
予算と体制の面では、品揃えの幅の KPI を測るために、第2章で勧めた表示のログ(どの顧客に、どの枠の何位で、何を出したか)が欠かせません。表示のログが無いと、網羅率も露出の配分も計算できず、偏りに気づくのは、売場の商品が売れ残り始めてからになります。品揃えの幅の KPI は、推薦の担当だけでなく、在庫と仕入れを預かる商品部が見る数字として位置づけると、推薦の偏りが在庫や売場の幅の問題として議論されるようになると考えています。
この章のまとめ
この章では、推薦が人気の偏り・露出の偏り・位置の偏り・同調によって偏り、推薦→露出→購買→学習→推薦の循環でその偏りを強めうることを扱いました。本コラムの架空の合成データでは、人気に比例した推薦で購買のジニ係数が推薦前の0.349から90日目に0.649まで上がり、関連度順では0.860に達して、上位10%の商品が購買の86.3%を占めました。MMR の重み0.7で1人のリストの多様性を0.506から0.770に上げても、購買のジニ係数は0.860のままで、品揃え全体の集中が和らいだとは言えませんでした。MMR の重みを0.3まで強めるとジニ係数は0.813まで下がりましたが、購買は減りました。集中を大きく和らげたのは関連度に掛ける人気の重みを下げることで、購買が最も多くなる人気の重み(0.1)と、集中が最も小さくなる人気の重み(0)は一致しませんでした。人気の重みを下げたときの向き(ジニ係数が下がり、購買が最も多いのは人気の重み0.1)は、乱数のシード1と2の両方で同じでした。MMR の重みを0.5・0.3に強めた結果は、シード1だけで確かめたものです。精度だけでなく、品揃えの幅を KPI に入れ、ガードレールを置いて A/Bテストで確かめることが、偏りへの備えになると考えています。次の第12章では、こうした推薦を毎日動かし続けるためのシステムの構成と、推薦の質を監視する仕組みを扱います。
この章を深めたい方への参考書籍
『フィルターバブル インターネットが隠していること』(イーライ・パリサー 著、井口耕二 訳、早川書房):フィルターバブルという言葉を広めた本の文庫版です(ハヤカワ文庫NF、2016年。2012年刊の『閉じこもるインターネット』の改題)。NDL サーチの内容紹介によれば、個人の検索の傾向などから情報を取捨選択して表示するインターネットのフィルタリングの技術が、偏った情報ばかりに触れさせる可能性に警鐘を鳴らす本です。この章で見たように研究の結論は分かれていますが、問題の立て方の出発点として読む価値があると考えています。
『あなたを支配し、社会を破壊する、AI・ビッグデータの罠』(キャシー・オニール 著、久保尚子 訳、インターシフト):データサイエンティストの著者が、アルゴリズムが社会に及ぼす悪影響を取り上げた本です(2018年刊。原書名は Weapons of Math Destruction)。NDL サーチに載る目次には、良いモデルと悪いモデル、大学ランキングが多様性を奪う仕組み、弱みにつけこむオンライン広告などの章があります。モデルの出力が人の行動を変え、その行動がまたモデルの入力になる循環を考えるうえで、この章の推薦の循環と通じる論点を扱っています。
第12章 システムの構成と運用、候補の生成・並べ替え・監視と再学習
第11章では、精度だけを追うと推薦が人気の商品に集中し、品揃えの幅が狭まることがあること、そのため網羅率や多様性を精度と並べて測る必要があることを扱いました。第3章から第11章までは、どの方法で推薦を作り、どう評価し、どんな偏りに気をつけるかという「推薦の中身」の話でした。この章では、その推薦を毎日、すべての顧客に、決まった時間の中で出し続けるための「仕組み」の話をします。
この章で扱うのは次の内容です。
- 候補の生成・並べ替え・業務ルールによる後処理という3つの段の構成と、その理由
- 全商品を毎回並べ替えられない理由(商品の数と計算時間の関係を、実行したコードで確かめる)
- 近似最近傍探索の考え方と、公式の資料で確かめたライブラリ・論文
- 業務ルール(購入済み・在庫切れ・ジャンルの上限)と、障害のときの代わりの推薦の組み込み方
- 一括の計算とリアルタイムの計算の分担、特徴量の管理とログの設計
- 監視の項目(推薦の質・データ・システム)と閾値の決め方、再学習の頻度と手順
- 内製・クラウドの推薦サービス・パッケージ製品を比べるときの観点と、経営の判断
この章の主張は、推薦の仕組みには、最初から「推薦の質を測る監視」と「推薦が出せないときの代わりの推薦」を入れておくべきだ、ということです。推薦は、モデルの更新や顧客ごとの出し分けが止まっても、画面は正常に表示されることがあります。推薦の枠に何かしらの商品が並び続ける作りになっていれば、モデルの更新が止まっていても、顧客の好みが渡らない不具合があっても、外からは気づきにくいのです。後半では、架空の運用データを使い、どの監視の項目がどの障害を何日目に見つけるかを、実行したコードで確かめます。この章のコードは numpy・scikit-learn・matplotlib だけで書いており、推薦専用のライブラリは使っていません。
3つの段の構成、候補の生成・並べ替え・業務ルールによる後処理
推薦の仕組みは、多くの場合、1つのモデルが全商品に点数を付けて上から並べる、という単純な形にはなっていません。商品が数十万点、顧客が数百万人という規模になると、顧客がページを開くたびに全商品の点数を細かく計算することが、時間の面でも計算機の面でも難しくなるからです。そこで、まず軽い計算で全商品から数百点程度の候補に絞り込みます。そのうえで、その候補だけを重い計算で丁寧に並べ直します。この2段で組む構成は、公開された論文でも説明されています(この節の後半で紹介します)。本コラムでは、前半の絞り込みを候補の生成、後半の並べ直しを並べ替えと呼びます。英語では前者を candidate generation(あるいは retrieval)、後者を ranking と呼ぶことが多いです。
実際の仕組みでは、この2段の核(候補の生成と並べ替え)の後に、業務ルールによる後処理が続きます。本コラムでは、この3つをまとめて「3つの段」と呼び、以降はこの呼び方にそろえます。購入済みの商品を外す、在庫切れの商品を外す、年齢制限のある商品を条件に合わない顧客に出さない、同じジャンルばかりにならないよう上限を設ける、といった処理です。第3章で扱った除外のルールや、第11章で扱った多様性を加えた並べ替えは、この段で入ることが多くなります。3つの段の役割を次の表にまとめました。扱う点数や時間の目安は、規模や業種によって大きく違うので、表の値は桁の感覚をつかむための例です。
| 段 | 役割 | 扱う点数の例 | 使う方法の例 | 重視すること |
|---|---|---|---|---|
| 候補の生成 | 全商品から、その顧客に関係のありそうな商品を大まかに拾う | 全商品(数万〜数百万点)から数百点へ | アイテムベースの類似(第4章)、埋め込みの近さ(第5章・第7章)、人気順・新着(第3章)、同じカテゴリ | 取りこぼさないこと、速いこと |
| 並べ替え | 候補を、その顧客がその場で選びそうな順に細かく並べる | 数百点から数十点へ | 顧客・商品・文脈(時刻・端末)の特徴を多く使う学習モデル | 順位の正しさ(第8章の NDCG など) |
| 業務ルールによる後処理 | 出してはいけないものを外し、事業の方針を反映する | 数十点から枠に出す数点〜十数点へ | 購入済み・在庫切れ・年齢制限の除外、ジャンルの上限、販促の固定枠 | 規則が確実に守られること、説明できること |
この構成には、計算時間のほかにも利点があります。1つは、段ごとに担当と改善の手を分けられることです。候補の生成は取りこぼしの少なさ、並べ替えは順位の正しさ、後処理は規則の確実さ、と測るものが違うので、どの段で成績が落ちているかを切り分けられます。もう1つは、複数の候補の出どころを混ぜられることです。埋め込みの近さで拾った候補、人気の商品、新着の商品、閲覧中の商品と同じカテゴリの商品を合わせて並べ替えに渡せば、1つの方法の弱点(新しい商品を拾えない、似たものばかりになる)を別の方法で補えます。後の節で、この混ぜ方が業務ルールとどう関わるかを、コードで確かめます。
注意したいのは、並べ替えは候補の中からしか選べないことです。候補の生成で拾われなかった商品は、並べ替えのモデルがどれほど優れていても推薦されません。第10章で扱った新しい商品が推薦されない問題や、第11章で扱った人気の偏りは、候補の生成の段で起きていることも多いと考えています。候補の生成の取りこぼしは、並べ替えの成績(候補の中での順位の正しさ)だけを見ていると見えません。候補の生成の段そのものの再現率を別に測る必要があります。ここでいう候補の生成の再現率は、評価の期間にその顧客が実際に買った商品(正解)のうち、候補の生成が拾った数百点の中に入っていた割合です。第8章の再現率@K は最終的に示した上位 K 点で数えるのに対し、こちらは並べ替えの前の候補の全体で数える点が違います。
2段で組む核の部分は、公開された論文でも説明されています。Covington・Adams・Sargin の2016年の論文(第10回 ACM 推薦システム国際会議 RecSys 2016 で発表された、動画配信サービスの深層学習による推薦の論文)は、推薦の仕組みが候補の生成と並べ替えの2つのニューラルネットワークでできていると説明しています。候補の生成は利用者の視聴の履歴などを入力にして、膨大な動画の中から数百本を取り出し、並べ替えはその候補に点数を付けて、最終的に数本を利用者に示す、という「漏斗」の形です。論文の構成図には、「ほかの候補の出どころ」(other candidate sources)という箱も描かれています。深層学習のモデルの中身は第7章で扱ったので、本章ではこの構成の考え方だけを借ります。論文の図では候補の生成に入る動画の数が数百万(millions)の規模で示されており、数万点の商品を扱う EC とは規模が違いますが、「軽い計算で絞り、重い計算で並べる」という分担は、規模が小さくても計算時間の見積もりの出発点になると考えています。
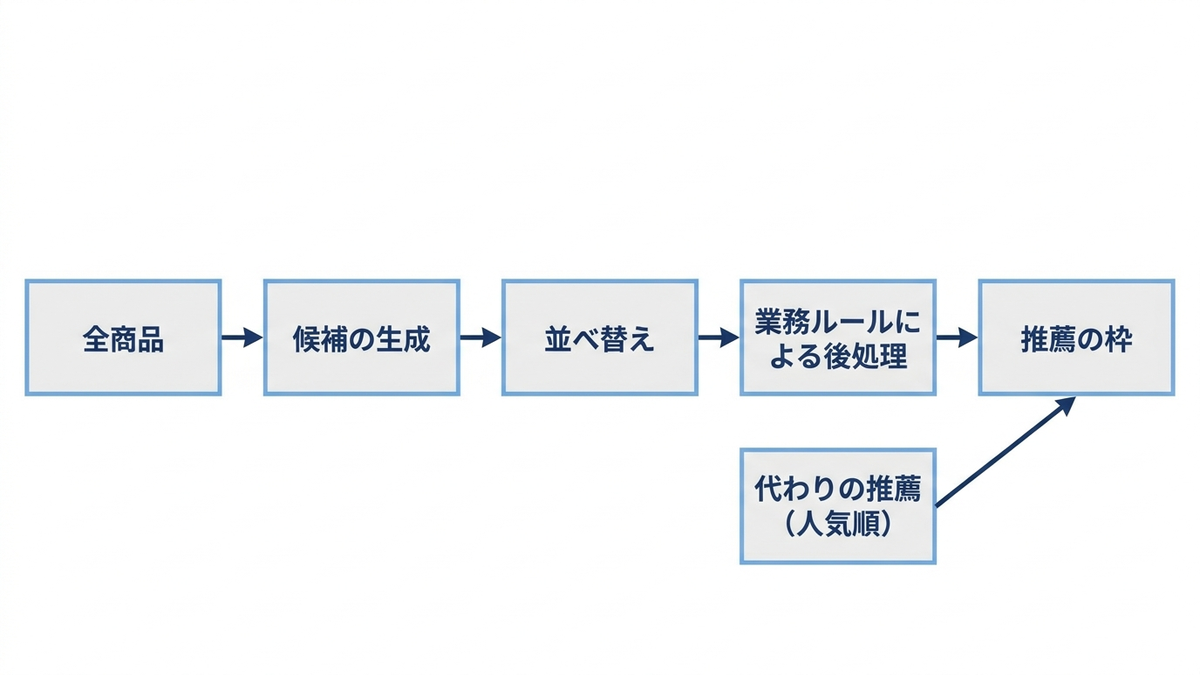
全商品を毎回並べ替えられない理由、商品の数と計算時間を測る
段を分ける理由のうち、計算時間について、実行したコードで桁の感覚を確かめます。ここでは、第5章や第7章のモデルが学習したような「埋め込み」(顧客と商品を数十〜数百の数の組で表したもの。詳しくは第7章)がすでにあるとして、顧客の埋め込みと全商品の埋め込みの内積(掛けて足した値。大きいほど相性が良いとみなす)を計算し、上位10点を選ぶ時間を測ります。内積を全商品について計算して選ぶやり方を、本コラムでは全探索と呼びます。
使うのは、乱数で作った架空の合成データです。商品は20のジャンルに分かれ、同じジャンルの商品は埋め込みが近くなるようにし、顧客はそれぞれ好むジャンルの近くに置きました。実際の推薦のモデルが学習した埋め込みは、これほどきれいにジャンルごとにまとまるとは限らず、実際のログから学んだものより単純です。商品の数を1,000点・1万点・5万点・20万点、埋め込みの次元(数の組の長さ)を32と128に変え、顧客200人分をまとめて計算する時間を3回測って中央値を取りました。
import time
import numpy as np
# ---- 1. 架空の埋め込み(商品はジャンルのまとまりを持つ。顧客は好むジャンルの近くにいる)
rng = np.random.default_rng(20261110)
N_GENRE = 20

def make_embeddings(n_items, n_users, dim):
    centers = rng.normal(0, 1, (N_GENRE, dim))
    genre = rng.integers(0, N_GENRE, n_items)
    items = centers[genre] + 0.6 * rng.normal(0, 1, (n_items, dim))
    fav = rng.integers(0, N_GENRE, n_users)                  # 顧客ごとに好むジャンル
    users = centers[fav] + 0.8 * rng.normal(0, 1, (n_users, dim))
    items /= np.linalg.norm(items, axis=1, keepdims=True)
    users /= np.linalg.norm(users, axis=1, keepdims=True)
    return items.astype(np.float32), users.astype(np.float32)

def exact_topk(users, items, k=10):
    s = users @ items.T                                      # 全商品との内積を計算する
    idx = np.argpartition(-s, k, axis=1)[:, :k]
    order = np.argsort(-np.take_along_axis(s, idx, axis=1), axis=1)
    return np.take_along_axis(idx, order, axis=1)

# ---- 2. 全探索の計算時間を、商品の数と埋め込みの次元を変えて測る(3回測って中央値)
N_QUERY = 200
print("全探索で上位10件を選ぶ時間(顧客200人分をまとめて計算。3回の中央値と最小・最大)")
results = {}
for dim in [32, 128]:
    for n_items in [1_000, 10_000, 50_000, 200_000]:
        items, users = make_embeddings(n_items, N_QUERY, dim)
        exact_topk(users[:10], items)                        # 1回目の準備の時間を除くための空打ち
        ts = []
        for _ in range(3):
            t0 = time.perf_counter()
            exact_topk(users, items)
            ts.append(time.perf_counter() - t0)
        med = float(np.median(ts))
        results[(dim, n_items)] = med
        print(f"次元{dim:4d} 商品{n_items:7d}点: 中央値 {med * 1000:8.1f} ms"
              f"(1人あたり {med / N_QUERY * 1000:.3f} ms)"
              f" 最小 {min(ts) * 1000:.1f} 最大 {max(ts) * 1000:.1f}")
実行した結果を、顧客1人あたりの時間に直して表にまとめます。ここでの1人あたりの時間は、200人分をまとめて計算した時間を200で割った換算の値で、1人の顧客がページを開いたときの応答の時間ではありません。表の値は、本コラムの実行環境(Windows の一般的な計算機で、Python 3.14 と numpy 2.4 を使い、ほかの処理と並行して動かした状態)での値で、計算機の性能や同時に動いている処理によって変わります。この計算機ではほかの計算も同時に動いていたため、同じスクリプトを5回実行すると、たとえば次元32・商品20万点の1人あたりの時間は 1.339〜2.240 ミリ秒と、最大で1.7倍ほどぶれました。そこで表には、5回の実行の中央値(各実行の中では3回測った中央値)と、5回の最小〜最大を載せます。図も、表と同じ5回の実行の中央値で描きました。
| 商品の数 | 次元32の1人あたりの換算時間(5回の中央値) | 次元128の1人あたりの換算時間(5回の中央値) | 次元32の5回の最小〜最大 |
|---|---|---|---|
| 1,000点 | 0.010 ミリ秒 | 0.016 ミリ秒 | 0.008〜0.025 ミリ秒 |
| 1万点 | 0.075 ミリ秒 | 0.167 ミリ秒 | 0.071〜0.133 ミリ秒 |
| 5万点 | 0.347 ミリ秒 | 0.483 ミリ秒 | 0.324〜0.597 ミリ秒 |
| 20万点 | 1.566 ミリ秒 | 1.863 ミリ秒 | 1.339〜2.240 ミリ秒 |
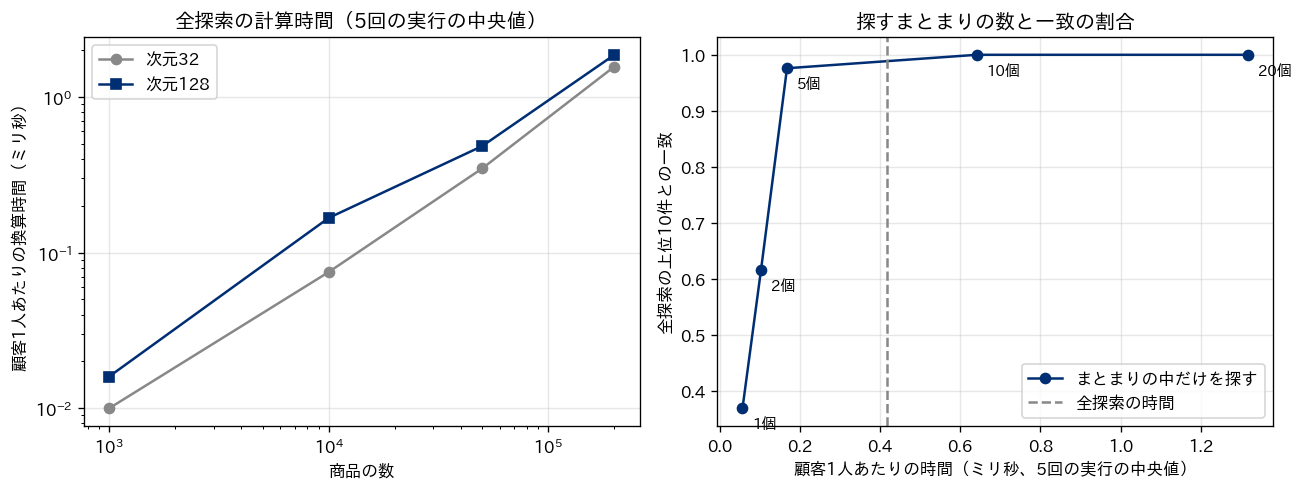
左の図のとおり、全探索の時間は商品の数が増えるほど増えました。5回の中央値で見ると、商品が1万点から20万点へ20倍になると、次元32では1人あたり0.075ミリ秒から1.566ミリ秒へ約21倍、次元128では0.167ミリ秒から1.863ミリ秒へ約11倍になっています。1,000点のときは時間が短く、実行ごとのぶれ(次元32で0.008〜0.025ミリ秒)が値そのものに比べて大きいので、増え方の比べ方からは外しました。scikit-learn の公式ドキュメントも、近い点を探す方法の説明の中で、全探索は点の数が少ないときには十分に速いが、点の数が増えるとすぐに実用的でなくなる、と述べています。一方、次元を32から128へ4倍にしたときの時間の違いは、中央値どうしで1万点では約2.2倍、20万点では約1.2倍で、実行ごとのぶれ(5回の最小〜最大)と重なっていました。この測り方では、次元が時間にどれだけ効くかについて、はっきりした傾向は読み取れません。
商品20万点で1人あたり2ミリ秒に満たない時間は、短く見えます。しかし、これは並べ替えの前の、内積1つで点数を付けるだけの軽い計算です。並べ替えのモデルは、顧客・商品・文脈の特徴を数十〜数百使う重いモデルであることが多く、1点あたりの計算は内積よりずっと重くなります。さらに、推薦の枠は1つのページに複数あり、アクセスが集中する時間帯には同時に多くの顧客の推薦を計算する必要があります。ページの表示にかけられる時間のうち、推薦に割り当てられるのは一部です。全商品を重いモデルで並べ替える構成は、商品の数が増えるほど時間の予算に収まらなくなるので、軽い計算で数百点に絞る段が必要になります。
近似最近傍探索、探す範囲を絞って速くする
候補の生成の段そのものも、商品の数や求められる応答の時間、使える計算機によっては、全探索では間に合わなくなります。そこで使われるのが近似最近傍探索です。最近傍探索は、ある点(顧客の埋め込み)に最も近い点(商品の埋め込み)を探すことで、近似最近傍探索は、本当に最も近い点を必ず見つけることを諦める代わりに、探す範囲を絞って速く見つける方法です。英語の approximate nearest neighbor search の頭文字を取って ANN と呼ばれることも多いです。先ほどの動画配信の論文も、提供のときには近似最近傍探索の照会(原文は approximate nearest neighbor lookup)で数百本の候補を作る、と説明しています。
近似最近傍探索にはいくつかの方式があります。分かりやすいのは、商品の埋め込みをあらかじめいくつかのまとまり(クラスタ)に分けておき、顧客に近いまとまりの中だけを探す方式です。GitHub の facebookresearch の組織で公開されているライブラリ Faiss の公式の解説ページは、この方式を IndexIVFFlat という名前で説明しています。空間をまとまり(ボロノイ領域。それぞれのまとまりの中心に最も近い点の集まりで、空間を区切った領域)に分け、検索のときは問い合わせの点が属するまとまりと、その近くのいくつかのまとまりの中だけを比べます。まとまりの数を nlist、1回の検索で調べるまとまりの数を nprobe と呼び、nprobe を増やすほど結果は正確になるが時間がかかり、nprobe を nlist と同じにすれば全探索と同じ結果になる、と説明されています。
この考え方を、scikit-learn の k 平均法でまとまりを作り、numpy だけで書いて確かめます。商品5万点・次元64の架空の埋め込みを100のまとまりに分け、顧客500人について、調べるまとまりの数を1・2・5・10・20個と変えたときに、全探索で選んだ上位10点のうち何割を見つけられるか(一致の割合)と、1人あたりの時間を測りました。調べるまとまりは、k 平均法がまとまりを作るときと同じく、まとまりの中心との距離が近い順に選びます。商品と顧客の埋め込みは長さを1にそろえてあるので、距離が近い商品と内積が大きい商品は一致します。比べやすいように、全探索も顧客を1人ずつ処理し、上位10件の選び方(上位だけを取り出してから並べる書き方)もまとまりの中を探すときと同じにしています。前の表は200人分をまとめて計算した時間を200で割った値で、次元も違うので、前の表と次の表の時間はそのまま比べられません。速さの比較は、同じ表の中で、同じ書き方で測った値どうしで行います。次の表の時間も、前の表と同じ5回の実行の中央値です。
from sklearn.cluster import KMeans
# ---- 3. 候補の生成で絞る:商品をまとまり(クラスタ)に分け、近いまとまりの中だけを探す
N_ITEMS, DIM, N_LIST = 50_000, 64, 100
items, users = make_embeddings(N_ITEMS, 500, DIM)
km = KMeans(n_clusters=N_LIST, n_init=1, random_state=0).fit(items)
centroids = km.cluster_centers_.astype(np.float32)
members = [np.where(km.labels_ == c)[0] for c in range(N_LIST)]
truth = exact_topk(users, items)

def top10(s, k=10):
    idx = np.argpartition(-s, k)[:k]                         # 上位10件だけを選び、その中を並べる
    return idx[np.argsort(-s[idx])]

def ivf_topk(u, n_probe, k=10):
    near = np.argsort(((centroids - u) ** 2).sum(axis=1))[:n_probe]  # 中心との距離が近いまとまりを n_probe 個選ぶ
    cand = np.concatenate([members[c] for c in near])        # その中の商品だけを候補にする
    return cand[top10(items[cand] @ u, k)], len(cand)

def run_exact_loop():
    for u in users:
        top10(items @ u)                                     # 全探索も同じ選び方で比べる

print()
print(f"商品{N_ITEMS}点・次元{DIM}・まとまり{N_LIST}個。顧客500人を1人ずつ処理")
ts = []
for _ in range(3):
    t0 = time.perf_counter(); run_exact_loop(); ts.append(time.perf_counter() - t0)
t_exact = float(np.median(ts))
print(f"全探索: 1人あたり {t_exact / 500 * 1000:.3f} ms(3回の最小 {min(ts) / 500 * 1000:.3f} 最大 {max(ts) / 500 * 1000:.3f})")
rows = []
for n_probe in [1, 2, 5, 10, 20]:
    ts, hits, ncand = [], 0, 0
    for rep in range(3):
        t0 = time.perf_counter()
        for i, u in enumerate(users):
            top, nc = ivf_topk(u, n_probe)
            if rep == 0:
                hits += len(set(top) & set(truth[i])); ncand += nc
        ts.append(time.perf_counter() - t0)
    t = float(np.median(ts))
    recall = hits / (500 * 10)
    rows.append((n_probe, recall, t / 500 * 1000, ncand / 500))
    print(f"探すまとまり{n_probe:2d}個: 全探索の上位10件との一致 {recall:.3f}"
          f" 1人あたり {t / 500 * 1000:.3f} ms 平均の候補数 {ncand / 500:.0f}点"
          f"(3回の最小 {min(ts) / 500 * 1000:.3f} 最大 {max(ts) / 500 * 1000:.3f})")
# 出力(抜粋。1回目の実行。時間は実行ごとに変わるので本文の表は5回の中央値):
# 全探索: 1人あたり 0.450 ms(3回の最小 0.444 最大 0.472)
# 探すまとまり 1個: 全探索の上位10件との一致 0.369 1人あたり 0.057 ms 平均の候補数 521点
# 探すまとまり 5個: 全探索の上位10件との一致 0.976 1人あたり 0.168 ms 平均の候補数 2515点
# 探すまとまり20個: 全探索の上位10件との一致 1.000 1人あたり 1.413 ms 平均の候補数 9994点
| 調べるまとまりの数 | 平均の候補数 | 全探索の上位10件との一致 | 1人あたりの時間(5回の中央値) | 時間の5回の最小〜最大 |
|---|---|---|---|---|
| 1個 | 521点 | 0.369 | 0.057 ミリ秒 | 0.055〜0.081 ミリ秒 |
| 2個 | 1,041点 | 0.615 | 0.103 ミリ秒 | 0.072〜0.149 ミリ秒 |
| 5個 | 2,515点 | 0.976 | 0.168 ミリ秒 | 0.140〜0.314 ミリ秒 |
| 10個 | 5,027点 | 1.000 | 0.641 ミリ秒 | 0.615〜0.669 ミリ秒 |
| 20個 | 9,994点 | 1.000 | 1.317 ミリ秒 | 1.170〜1.413 ミリ秒 |
| 全探索(5万点すべて) | 50,000点 | 1.000 | 0.418 ミリ秒 | 0.396〜0.534 ミリ秒 |
調べるまとまりを5個にすると、5万点のうち平均2,515点だけを調べて、全探索の上位10件の97.6%を見つけ、時間は5回の中央値で全探索の0.418ミリ秒に対して0.168ミリ秒(約4割、速さにして約2.5倍)でした。まとまりを1個にすると時間はさらに短くなりますが、一致は0.369まで下がり、上位10件の6割以上を取りこぼします。精度と速さのつり合いを、調べるまとまりの数という1つのつまみで決められることが分かります。一方で、まとまりを10個・20個にすると、調べる点数は全体の1割・2割なのに、時間は全探索より長くなりました(0.641・1.317ミリ秒)。原因は測っていません。これは numpy で書いた簡易な実装での値です。専用のライブラリでの時間は、本コラムでは測っていません。
この結果には、注意すべき限定条件が3つあります。1つ目は、この架空データの埋め込みが20のジャンルにきれいにまとまっているので、まとまりに分ける方式が効きやすい条件だったことです。Faiss の解説ページも、例で nprobe を10にしたら正しい答えと一致したことについて、データの分布によるところがあると断っています。実際の埋め込みでは、同じ一致の割合を得るのに、もっと多くのまとまりを調べる必要があるかもしれません。2つ目は、時間は実行ごとにぶれることです。表の最小〜最大の列のとおり、5回の実行で、全探索の1人あたりの時間は0.396〜0.534ミリ秒、まとまり5個は0.140〜0.314ミリ秒の幅で動きました。掲載したコードを1回実行して出る時間は、表の中央値とは違う値になります。3つ目は、k 平均法の計算の細かな順序の違いによって、まとまりの分け方がわずかに変わることです。5回の実行と、掲載したコードだけをつないだ実行を合わせると、調べるまとまり2個の一致は0.614〜0.616の範囲で動き、平均の候補数が1点違う回もありました。一致の割合は、本番の埋め込みで必ず測り直す必要があります。
近似最近傍探索の方式やライブラリは、ほかにもあります。公式の資料や論文の書誌で確かめた範囲で、次の表にまとめました。製品やライブラリの優劣はデータや条件で変わるので、ここでは比べません。この章のコードでは、これらのライブラリは使っていません(実行環境に入っていないため)。
| 方式・ライブラリ | 考え方 | 確かめた資料 |
|---|---|---|
| まとまりに分けて探す方式(転置ファイル。IVF と略される) | 商品の埋め込みをまとまりに分け、近いまとまりの中だけを比べる | Faiss の公式の解説ページ(IndexIVFFlat、nlist と nprobe) |
| 直積量子化 | 埋め込みを短い符号に圧縮して、メモリを減らし、距離の計算を速くする | Jégou・Douze・Schmid の2011年の論文(IEEE のパターン解析と機械知能の論文誌 TPAMI、第33巻第1号) |
| 階層的なグラフで探す方式(HNSW) | 近い点どうしをつないだグラフを何層にも重ね、上の粗い層から下の細かい層へたどって探す | Malkov と Yashunin の論文(arXiv で2016年に初版、IEEE のパターン解析と機械知能の論文誌 TPAMI、2020年、第42巻第4号) |
| Faiss | 上の方式を含む、多くの近似最近傍探索を実装したライブラリ。GPU での高速化も扱う | Johnson・Douze・Jégou の論文(arXiv で2017年に初版、IEEE Transactions on Big Data 誌、2021年、第7巻第3号)と公式の GitHub |
| ScaNN | 内積が最大になる点を探すことに向けて、探す範囲の絞り込みと量子化を組み合わせたライブラリ | 公式の GitHub の説明(Guo らの2020年の機械学習国際会議 ICML の論文を引用) |
近似最近傍探索を入れるときに決めることは、どこまでの取りこぼしを許すかです。前の節で見たとおり、並べ替えは候補の中からしか選べないので、候補の生成の段で取りこぼした商品は推薦されません。取りこぼしが一部の商品(たとえば、まとまりの境目にある商品や新しい商品)に偏ると、第11章で扱った品揃えの偏りの原因にもなります。全探索との一致の割合を、近似最近傍探索の設定を変えるたびに、本番の埋め込みの一部で測る手順を、運用に組み込んでおくことを勧めます。なお、先ほどの動画配信の論文は、その仕組みでは A/Bテストの結果が近似最近傍探索の方式の選び方にあまり左右されなかった、とも書いています。これはその仕組みとその条件での観察で、どの事業でも方式の選び方が成果に影響しないことを意味するものではありません。
業務ルールと代わりの推薦、出してはいけないものと出せないときの備え
並べ替えの後には、業務ルールによる後処理が入ります。ここで起きやすいのが、候補の生成・並べ替え・後処理を別々に作り込んだ結果、後処理で候補が足りなくなる問題です。たとえば、同じジャンルの商品は3点までという多様性のルールを入れても、候補の生成が埋め込みの近さだけで数百点を拾っていると、候補のほとんどが顧客の好むジャンル1つに偏り、ルールを当てた後に枠を埋める商品が残らないことがあります。
この問題を、架空のデータで確かめます。商品5,000点・顧客1,000人の埋め込みを作り、商品の約8%を在庫切れ、顧客ごとに15点を購入済みにしました。推薦は3つの段で作ります。1つ目の段は埋め込みの内積で候補を拾い、2つ目の段は内積に人気の対数を少し足した点数で並べ直し(実務では別の学習モデルを使う段です)、3つ目の段で購入済み・在庫切れを除き、同じジャンルは3点までにして10点を選びます。また、推薦が作れないときに出す代わりの推薦として、在庫のある人気順から購入済みを除いたものを用意しました。
import time
import numpy as np
# ---- 架空の商品と顧客(埋め込み・ジャンル・在庫・購入済み)
rng = np.random.default_rng(20261110)
N_ITEMS, N_USERS, DIM, N_GENRE = 5_000, 1_000, 32, 20
centers = rng.normal(0, 1, (N_GENRE, DIM))
genre = rng.integers(0, N_GENRE, N_ITEMS)
item_vec = centers[genre] + 0.6 * rng.normal(0, 1, (N_ITEMS, DIM))
item_vec /= np.linalg.norm(item_vec, axis=1, keepdims=True)
fav = rng.integers(0, N_GENRE, N_USERS)
user_vec = centers[fav] + 0.8 * rng.normal(0, 1, (N_USERS, DIM))
user_vec /= np.linalg.norm(user_vec, axis=1, keepdims=True)
popularity = rng.zipf(1.6, N_ITEMS).clip(1, 500).astype(float)   # 前日までの販売数(人気の偏り)
in_stock = rng.random(N_ITEMS) > 0.08                            # 約8%が在庫切れ
bought = [set(rng.choice(N_ITEMS, 15, replace=False)) for _ in range(N_USERS)]
popular_list = np.argsort(-popularity)                           # 代わりの推薦(人気順)

def recommend(u, k=10, n_cand=200, max_per_genre=3, n_pop=100):
    # 1段目 候補の生成:埋め込みの内積で上位 n_cand 点+人気の上位 n_pop 点を合わせる
    s = item_vec @ user_vec[u]
    cand = np.argpartition(-s, n_cand)[:n_cand]
    if n_pop > 0:
        cand = np.union1d(cand, popular_list[:n_pop])
    # 2段目 並べ替え:内積に人気の対数を少し足した点数で並べ直す(実務では別の学習モデル)
    score2 = s[cand] + 0.05 * np.log(popularity[cand])
    cand = cand[np.argsort(-score2)]
    # 3段目 業務ルール:購入済み・在庫切れを除き、同じジャンルは3点まで
    out, per_genre, removed = [], {}, {"購入済み": 0, "在庫切れ": 0, "ジャンルの上限": 0}
    for i in cand:
        if i in bought[u]:
            removed["購入済み"] += 1; continue
        if not in_stock[i]:
            removed["在庫切れ"] += 1; continue
        if per_genre.get(genre[i], 0) >= max_per_genre:
            removed["ジャンルの上限"] += 1; continue
        out.append(int(i)); per_genre[genre[i]] = per_genre.get(genre[i], 0) + 1
        if len(out) == k:
            break
    return out, removed
次のコードは、推薦を出す入口(serve)の例です。推薦の計算で障害が起きたとき、時間の予算(ここでは50ミリ秒)を超えたとき、業務ルールを当てた後に10点に満たなかったときに、代わりの推薦を出し、どの理由で代わりの推薦を出したかを記録します。ただし、この例の時間の判定は、推薦の計算が終わるのを待ってから、かかった時間が予算を超えていたかを調べる簡易なものです。計算が80ミリ秒かかれば、80ミリ秒待ってから代わりの推薦を返すので、応答を50ミリ秒以内に打ち切る仕組みにはなっていません。実際の仕組みで応答の時間を守るには、待つ時間に上限を設け、上限に達したら計算の終わりを待たずに代わりの推薦を返す作りにする必要があります。そのうえで、候補の拾い方を3通りに変えて、10点に満たない顧客が何人出るかを数え、最後に50人に1人の割合で障害を起こして、出した推薦の内訳を数えました。
def fallback(u, k=10):
    # 代わりの推薦:在庫のある人気順から購入済みを除く
    return [int(i) for i in popular_list if in_stock[i] if i not in bought[u]][:k]

def serve(u, fail=False, budget_ms=50):
    t0 = time.perf_counter()
    try:
        if fail:
            raise RuntimeError("埋め込みの読み込みに失敗")      # 障害を模擬する
        rec, removed = recommend(u)
        if (time.perf_counter() - t0) * 1000 > budget_ms:
            return fallback(u), "時間切れで人気順"
        if len(rec) < 10:
            return fallback(u), "件数不足で人気順"
        return rec, "通常"
    except RuntimeError:
        return fallback(u), "障害で人気順"

for n_cand, n_pop in [(200, 0), (1000, 0), (200, 100)]:
    total = {"購入済み": 0, "在庫切れ": 0, "ジャンルの上限": 0}
    short = 0
    for u in range(N_USERS):
        rec, removed = recommend(u, n_cand=n_cand, n_pop=n_pop)
        short += len(rec) < 10
        for key in total:
            total[key] += removed[key]
    print(f"候補 埋め込み{n_cand}点+人気{n_pop}点: 10点に満たない顧客 {short}人/1,000人",
          "外した数の平均", {key: round(v / N_USERS, 2) for key, v in total.items()})
rec, how = serve(0)
print("顧客0 の推薦:", rec, how, "ジャンル:", [int(genre[i]) for i in rec])
rec, how = serve(0, fail=True)
print("障害時の顧客0 の推薦:", rec, how)
modes = {}
for u in range(N_USERS):
    _, how = serve(u, fail=(u % 50 == 0))                         # 50人に1人の割合で障害を起こす
    modes[how] = modes.get(how, 0) + 1
print("1,000人に出した推薦の内訳:", modes)
# 出力:
# 候補 埋め込み200点+人気0点: 10点に満たない顧客 990人/1,000人 外した数の平均 {'購入済み': 0.59, '在庫切れ': 16.56, 'ジャンルの上限': 178.63}
# 顧客0 の推薦: [1396, 1877, 2680, 4001, 4664, 2448, 847, 2341, 1854, 1146] 通常 ジャンル: [1, 1, 1, 7, 18, 18, 7, 15, 4, 7]
# 1,000人に出した推薦の内訳: {'障害で人気順': 20, '通常': 980}
実行した結果を表にまとめます。
| 候補の拾い方 | 10点に満たない顧客(1,000人中) | 購入済みで外した数の平均 | 在庫切れで外した数の平均 | ジャンルの上限で外した数の平均 |
|---|---|---|---|---|
| 埋め込みの上位200点だけ | 990人 | 0.59点 | 16.56点 | 178.63点 |
| 埋め込みの上位1,000点だけ | 0人 | 0.68点 | 18.42点 | 196.76点 |
| 埋め込みの上位200点+人気の上位100点 | 0人 | 0.58点 | 16.08点 | 171.47点 |
埋め込みの上位200点だけを候補にすると、1,000人中990人で10点を埋められませんでした。外した数の平均を見ると、ジャンルの上限で178.63点が外れており、候補200点のほとんどが同じジャンルだったことが分かります。この架空データでは、顧客はそれぞれ1つのジャンルを好み、そのジャンルの商品は約250点あるので、上位200点がほぼそのジャンルで埋まるのは当然の結果です。候補を1,000点に広げるか、人気の上位100点を別の出どころとして混ぜると、10点に満たない顧客は0人になりました。人気の候補を混ぜるやり方は、候補の数を300点前後に保ったまま、別のジャンルの商品を並べ替えに渡せます。
代わりの推薦の動きも確かめました。顧客0の推薦は、通常の経路ではジャンルが1・7・18・15・4にまたがる10点で、同じジャンルは3点までに収まっていました。障害を起こしたときは、在庫のある人気順の10点に切り替わり、顧客1,000人のうち50人に1人の割合で障害を起こしたときの内訳は、通常980件・障害で人気順20件でした。この例では時間切れは起きていません。
この例から言えることは2つあります。1つは、業務ルールは候補の生成と一緒に設計する必要があることです。後処理で外す条件が増えるほど、候補の生成は多めに、かつ複数の出どころから拾う必要があります。多様性のルールを後から足したら、推薦の枠が空いたり、気づかないうちに大半の顧客が代わりの推薦を見ていたりする、ということが起こりえます。もう1つは、代わりの推薦を出した件数とその理由を記録することです。代わりの推薦は障害の影響を隠すための仕組みでもあるので、記録が無いと、推薦が止まっていることに誰も気づかなくなります。代わりの推薦を出した割合そのものを、後で扱う監視の項目に入れておくことを勧めます。
代わりの推薦に人気順を使うのは、第3章で扱ったベースラインであり、どの顧客にもすぐに出せて、極端に外れることが少ないからです。ただし、代わりの推薦にも業務ルール(購入済み・在庫切れ・年齢制限の除外)は当てる必要があります。障害のときこそ、在庫切れの商品や出してはいけない商品が並ばないようにしておかないと、顧客の離反につながります。なお、この例の代わりの推薦は、購入済みと在庫切れの除外は当てていますが、通常の経路の「同じジャンルは3点まで」は当てていません。障害のときに緩めてもよい条件(多様性のためのジャンルの上限など)と、緩めてはいけない条件(購入済み・在庫切れ・年齢制限の除外など)を分けて決めておくことを勧めます。代わりの推薦の一覧は、通常の推薦とは別の、単純で止まりにくい経路(前日に計算して保存しておいた一覧など)で用意しておくのが安全だと考えています。
一括の計算とリアルタイムの計算の分担、特徴量の管理とログの設計
推薦の計算を、いつ行うかも設計の分かれ目です。大きく分けると、夜間などにすべての顧客の推薦をまとめて計算して保存しておき、ページが開かれたら保存した結果を読み出す「一括の計算」と、ページが開かれたその場で計算する「リアルタイムの計算」があります。その中間として、行動が起きるたびに数分以内に一部の情報だけを更新するやり方もあります。どれか1つを選ぶのではなく、段ごとに分担を決めることが多いと考えています。
| 計算のしかた | 向いている処理 | 利点 | 弱点 |
|---|---|---|---|
| 一括の計算(毎晩など) | モデルの学習、商品どうしの類似の表(第4章)、顧客ごとの推薦の一覧、代わりの推薦の人気順 | 重い計算ができる。結果を確かめてから出せる。止まっても前日の結果が残る | その日の行動が反映されない。来訪しない顧客の分まで計算する |
| 数分以内の更新 | 直近の閲覧・購入の履歴、在庫の状態、商品ごとの直近の人気 | その日の行動や在庫切れを反映できる | 行動のログを流し続ける仕組みが要る。データの遅れや欠けを監視する必要がある |
| リアルタイムの計算(表示のたび) | 候補の生成(近似最近傍探索)、並べ替え、業務ルールの後処理 | 閲覧中の商品や時刻・端末などの文脈を使える | 時間の予算に収める必要がある。障害がそのまま推薦の枠に出る |
商品ページの「この商品を見た人は」のように、閲覧中の商品だけで決まる推薦は、商品どうしの類似の表を一括で計算しておけば、表示のときは表を引くだけで済みます。トップページの「おすすめ」のように顧客ごとに変わる推薦は、顧客ごとの一覧を一括で計算しておく方法と、表示のたびに候補の生成と並べ替えを行う方法があります。前者は計算が単純で止まりにくい一方、その日に初めて見た商品や、昨日から在庫切れになった商品を反映できません。後者は反映が早い一方、時間の予算と障害への備えが要ります。在庫切れや購入済みの除外のように、反映が遅れると顧客の離反につながる処理だけは、一括で作った一覧にも表示の直前に当てる、という分担がよく使われると考えています。
もう1つの論点は、特徴量の管理です。並べ替えのモデルは、顧客の直近の購買の数、商品の直近の人気、閲覧中の商品のジャンルといった特徴量を使います。学習のときは過去のログから特徴量を作り、表示のときはその場のデータから同じ特徴量を作るので、2つの作り方がずれると、学習のときの成績が本番で出なくなります。Google の Zinkevich が公開している機械学習の実務の指針(機械学習のルール集)は、学習のときと提供のときの成績の差を「訓練と提供のずれ」(training-serving skew)と呼び、提供のときに使った特徴量をログに残して学習に使うこと(ルール29)、学習と提供の処理でコードをできるだけ共有すること(ルール32)を勧めています。特徴量を1か所で計算して学習と提供の両方に配る仕組みは、特徴量ストアと呼ばれることがあります。
ログの設計は、第2章で扱ったとおり、推薦の評価にとって欠かせません。運用の側から見て、推薦を1回出すたびに残しておきたい項目を次に挙げます。
- いつ、どの顧客(仮名の識別子)に、どの推薦の枠で、どの商品を、何位に出したか(表示のログ)
- どのモデルの版、どの設定(候補の数、近似最近傍探索の設定、業務ルールの版)で作った推薦か
- 通常の推薦か、代わりの推薦か。代わりの推薦なら、その理由(障害・時間切れ・件数不足)
- A/Bテストのどの群に割り当てたか(第9章)
- 並べ替えに使った特徴量の値(訓練と提供のずれを確かめるため)
- 計算にかかった時間
表示のログとクリック・購買のログを、推薦を出した回ごとの識別子でつなげられるようにしておくと、後から「どの版の推薦が、どの枠で、どれだけ選ばれたか」を集計できます。モデルの版と設定が残っていないと、成績が落ちたときに、何を変えたせいなのかを切り分けられません。個人データの扱いの規律は第14章で扱います。
推薦の監視、推薦の質・データ・システムの3つの層
推薦の仕組みの監視は、一般的なシステムの監視(動いているか、速いか)だけでは足りません。冒頭で述べたとおり、推薦はモデルの更新が止まっても、顧客の好みが渡らない不具合があっても、推薦の枠に何かしらの商品を出し続けます。システムとしては正常に動いているので、応答の時間やエラーの率だけを見ていると、推薦の質が落ちていることに気づけません。そこで、監視の項目を、推薦の質・データ・システムの3つの層に分けて考えます。
| 層 | 監視の項目の例 | 見つけられる障害の例 |
|---|---|---|
| 推薦の質 | 推薦の枠のクリック率・購買率、比較用の人気順とのクリック率の比、網羅率(1日に推薦の枠に出た商品の種類の数を、全商品の数で割った値。第11章のその日の網羅率と同じ考え方)、上位の商品への集中、代わりの推薦を出した割合 | モデルの更新が止まった、顧客の好みが渡らない、推薦が一部の商品に偏った |
| データ | ログの件数、特徴量の欠けの割合、特徴量の分布の変化、学習に使ったデータの最終日、新しい商品の登録の件数 | ログの収集が欠けた、特徴量の作り方が変わった、学習のデータが古いまま |
| システム | 応答の時間、エラーの率、時間切れの率、計算の処理(一括の計算・再学習)が終わった時刻 | 計算機の性能不足、処理の失敗、障害 |
推薦の質の層で役に立つ項目の1つと考えているのが、比較用の人気順とのクリック率の比です。顧客の一部(たとえば1割〜2割)をあらかじめ比較用の群に固定し、その顧客にはモデルの推薦ではなく人気順を出し続け、モデルの推薦のクリック率をその群のクリック率で割ります。推薦の枠のクリック率そのものは、季節・曜日・販促・天候などの需要の動きで上下するので、下がったときにモデルの問題なのか需要の問題なのかを、クリック率だけでは区別できません。同じ日に同じ需要のもとで出した人気順と比べれば、2つの群のクリック率が同じ倍率で動く分は割り算で打ち消される、と期待して使います。ただし、需要の動きが2つの群に同じ倍率で効くとは限りません(たとえば、販促の対象が人気順の商品に偏っていれば、人気順の群のほうが大きく動きます)。比は共通の動きの影響を抑える手がかりの1つで、比だけで下がった原因を特定することはできません。ここで測っているのは、モデルの推薦が人気順よりどれだけ選ばれているか、つまり「人気順と比べた差」です。全体の地図で定義した推薦の効果(推薦が無かった場合と比べて増えた行動)ではありません。人気順も推薦の一種なので、比が1.4でも、推薦の枠そのものが購買を増やしているかどうかは、この比からは分かりません。推薦の効果は、推薦を出さない群と比べる A/Bテスト(第9章)で別に測ります。比較用の群を持ち続けることは、比べる相手を人気順にした小さな比較を、運用の間ずっと続けることに当たります。比較用の群に入った顧客にはモデルの推薦を出さないので、モデルの推薦が人気順より良い場合には、その分の機会損失が生じます。群の大きさは、比の揺れの小ささと機会損失のつり合いで決める必要があります。
監視の閾値を架空の運用データで確かめる
どの監視の項目が、どの障害を、何日目に見つけるかを、架空の運用のシミュレーションで確かめます。商品500点(20のジャンル)・顧客3,000人の推薦の枠を90日間動かしたことにして、毎日平均2,000人が来訪し、各顧客に10点を推薦します。顧客にはジャンルの好みがあり、商品には人気の偏りと、10日ほどで入れ替わる流行を持たせました。モデルは再学習した日の商品の魅力を知っていて、それと顧客の好みで並べる、という単純な設定です。実際のモデルは、再学習した日でも商品の魅力を正確には知りません。顧客3,000人のうち約2割を最初に比較用の群に固定し、その顧客が来訪したときは前日の販売数の人気順を出します。この節のクリック率は、その日に表示した商品1点あたりにクリックされた割合(来訪1回あたりではない)で数えました。
この運用に、3つの障害を入れました。30日目と31日目にはログの4割が届かず(クリックの有無や群とは関係なく、無作為に欠けるようにしました。監視の項目は、届いたログだけから数えます)、40日目からは再学習の処理が黙って止まり(モデルは39日目の状態のまま)、75日目からは顧客の好みがモデルに渡らない不具合で、全員に同じ一覧が出ます。最初の30日は助走として記録せず、記録を始めてからの最初の28日を平常時とみなし、各項目の平均から標準偏差の3倍を引いた値を下限にしました。
import numpy as np
# ---- 1. 架空の推薦の枠の運用を90日分シミュレーションする
N_ITEMS, N_GENRE, N_USERS, K, DAYS = 500, 20, 3000, 10, 90
HOLDOUT = 0.2                                   # 顧客の2割には人気順を出し続けて比べる

def simulate(retrain_every=1, stop_retrain_day=DAYS, bug_day=DAYS, log_loss_days=(), seed=20261110):
    rng = np.random.default_rng(seed)
    genre = rng.integers(0, N_GENRE, N_ITEMS)
    pop = rng.zipf(1.6, N_ITEMS).clip(1, 200).astype(float)   # 少数の商品に人気が集中する
    base_appeal = 0.6 * (np.log(pop) - np.log(pop).mean())
    trend = np.zeros(N_ITEMS)                                 # 商品ごとの流行(日ごとに移る)
    fav = rng.dirichlet(np.full(N_GENRE, 0.3), N_USERS)      # 顧客ごとのジャンルの好み
    hold_user = rng.random(N_USERS) < HOLDOUT                 # 比較用の群は顧客ごとに最初に固定する
    model_appeal = base_appeal.copy()                         # モデルが最後に学習した時点の魅力
    yesterday_sales = pop.copy()
    rows = []
    for d in range(-30, DAYS):                                # 最初の30日は助走として記録しない
        trend = 0.9 * trend + rng.normal(0, 0.35, N_ITEMS)    # 流行は10日ほどで入れ替わる
        appeal = base_appeal + trend
        retrain = (d % retrain_every == 0)
        if d >= stop_retrain_day:
            retrain = False                                   # 再学習の処理が黙って止まった
        if retrain:
            model_appeal = appeal.copy()
        n = int(rng.normal(2000, 100))                        # その日に来た顧客の数(平均2,000人)
        users = rng.choice(N_USERS, n, replace=False)
        is_hold = hold_user[users]                            # その日に来た比較用の群の顧客
        true_logit = -6.0 + appeal[None, :] + 6.0 * fav[users][:, genre]
        p = 1 / (1 + np.exp(-true_logit))                     # 本当のクリック確率
        score = model_appeal[None, :] + 6.0 * fav[users][:, genre]
        if d >= bug_day:
            score = np.repeat(model_appeal[None, :], n, axis=0)  # 顧客の好みが渡らない不具合
        rec = np.argsort(-score, axis=1)[:, :K]
        pop_list = np.argsort(-yesterday_sales)[:K]           # 前日の販売数の人気順
        rec[is_hold] = pop_list                               # 比較用の顧客には人気順
        clicked = rng.random((n, K)) < np.take_along_axis(p, rec, axis=1)
        keep = np.ones(n, bool)
        if d in log_loss_days:
            keep = rng.random(n) > 0.4                     # ログの4割が無作為に届かなかった日
        m, h = (~is_hold) & keep, is_hold & keep           # 届いたログだけで数える
        ctr_m = clicked[m].mean(); ctr_h = clicked[h].mean()
        coverage = len(np.unique(rec[m])) / N_ITEMS
        events = int(keep.sum() * K)
        if d >= 0:
            rows.append((d, ctr_m, ctr_h, ctr_m / ctr_h, coverage, events))
        yesterday_sales = rng.poisson(20 * np.exp(appeal))     # サイト全体の前日の販売数(推薦以外の経路も含む)
    return np.array(rows)
次のコードで、平常時の28日から下限を決め、下限を割った日を項目ごとに数えます。人気順との比は日ごとの揺れが大きいので、7日移動平均(その日までの7日間の平均)も作り、平常時の7日移動平均から下限を決めました。最後に、障害を入れずに、再学習の間隔を1日・7日・28日と変えたときの成績も比べています。
# ---- 2. 障害を入れた運用:30・31日目にログが欠ける/40日目から再学習が止まる/75日目に不具合
log = simulate(stop_retrain_day=40, bug_day=75, log_loss_days=(30, 31))
base = log[:28]                                             # 最初の28日を平常時の基準にする
names = {1: "推薦のクリック率", 3: "人気順との比", 4: "網羅率", 5: "ログの件数"}
limits = {}
for c, nm in names.items():
    mu, sd = base[:, c].mean(), base[:, c].std(ddof=1)
    limits[c] = mu - 3 * sd
    print(f"{nm}: 平常時の平均 {mu:.4f} 標準偏差 {sd:.4f} 下限 {mu - 3 * sd:.4f}")
print()
for c, nm in names.items():
    bad = [int(d) for d, v in zip(log[:, 0], log[:, c]) if v < limits[c]]
    print(f"{nm} が下限を割った日: {bad[:12]}{' ほか' if len(bad) > 12 else ''}(計{len(bad)}日)")
# 人気順との比の7日移動平均(日ごとの揺れをならす)。下限は平常時の7日移動平均から決める
ma = np.convolve(log[:, 3], np.ones(7) / 7, mode="valid")  # ma[i] は i〜i+6 日目の平均
ma_days = np.arange(6, DAYS)
ma_base = ma[:28 - 6]
ma_lo = ma_base.mean() - 3 * ma_base.std(ddof=1)
first_ma = next((int(d) for d, v in zip(ma_days, ma) if v < ma_lo), None)
print(f"人気順との比の7日移動平均: 平常時の平均 {ma_base.mean():.4f} 標準偏差 {ma_base.std(ddof=1):.4f} 下限 {ma_lo:.4f} 最初に割った日 {first_ma}")
h = log[:, 2]
print(f"比較用の人気順のクリック率(90日): 最小 {h.min():.4f}({int(h.argmin())}日目) 最大 {h.max():.4f}({int(h.argmax())}日目)")
print(f"同じく平常時の28日: 最小 {h[:28].min():.4f} 最大 {h[:28].max():.4f}")
for d in [0, 27, 30, 31, 39, 42, 45, 50, 55, 60, 66, 74, 75, 89]:
    r = log[d]
    print(f"日{int(r[0]):2d}: 推薦 {r[1]:.4f} 人気順 {r[2]:.4f} 比 {r[3]:.2f} 網羅率 {r[4]:.3f} ログ {int(r[5])}")

# ---- 3. 再学習の間隔を変えたとき(障害なし)
print()
for every in [1, 7, 28]:
    r = simulate(retrain_every=every)
    print(f"再学習を{every:2d}日ごと: 90日の推薦のクリック率の平均 {r[:, 1].mean():.4f}"
          f" 人気順との比の平均 {r[:, 3].mean():.3f} 比の最小 {r[:, 3].min():.3f}")
# 出力(抜粋):
# 推薦のクリック率: 平常時の平均 0.1425 標準偏差 0.0134 下限 0.1023
# 推薦のクリック率 が下限を割った日: [42, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54] ほか(計44日)
# 網羅率 が下限を割った日: [75, 76, 77, 78, 79, 80, 81, 82, 83, 84, 85, 86] ほか(計15日)
# ログの件数 が下限を割った日: [30, 31](計2日)
# 人気順との比の7日移動平均: 平常時の平均 1.2665 標準偏差 0.0908 下限 0.9941 最初に割った日 66
# 日45: 推薦 0.0993 人気順 0.1216 比 0.82 網羅率 0.370 ログ 21100
# 再学習を28日ごと: 90日の推薦のクリック率の平均 0.0974 人気順との比の平均 0.989 比の最小 0.631
平常時の28日から決めた下限と、下限を割った日を表にまとめます。
| 監視の項目 | 平常時の平均 | 平常時の標準偏差 | 下限(平常時の平均から標準偏差の3倍を引いた値) | 下限を割った最初の日 | 下限を割った日数(90日中) |
|---|---|---|---|---|---|
| 推薦のクリック率 | 0.1425 | 0.0134 | 0.1023 | 42日目 | 44日 |
| 人気順との比(日ごと) | 1.2814 | 0.1213 | 0.9175 | 45日目 | 26日 |
| 人気順との比(7日移動平均) | 1.2665 | 0.0908 | 0.9941 | 66日目 | (最初の日だけを記録) |
| 網羅率 | 0.3236 | 0.0182 | 0.2691 | 75日目 | 15日 |
| ログの件数 | 20,134 | 962 | 17,249 | 30日目 | 2日 |
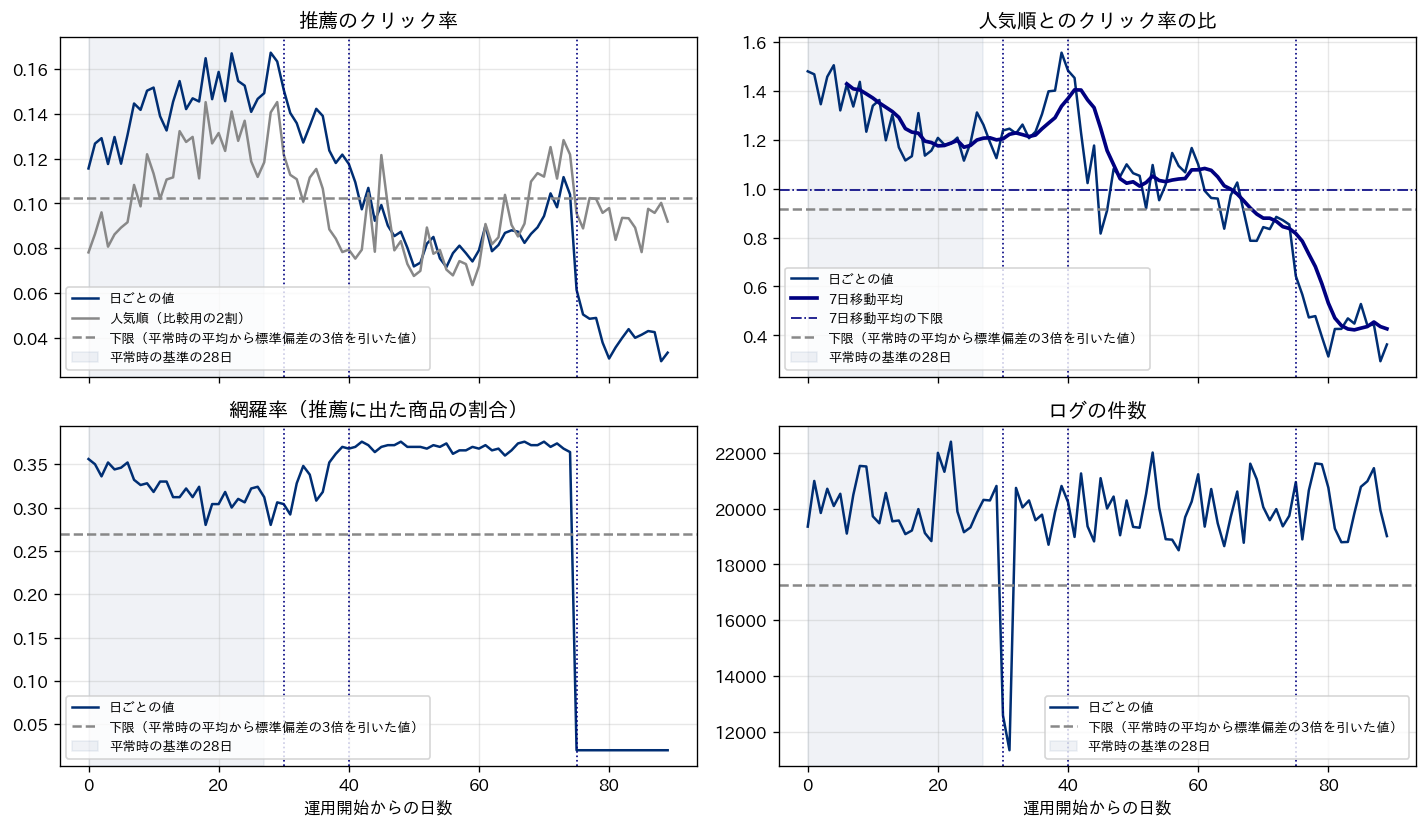
表と図から、項目ごとに見つけられる障害が違うことが分かります(いずれも1つの乱数の種で作った架空データでの結果です)。30日目と31日目のログの欠けを見つけたのは、ログの件数だけでした。この例ではログがクリックの有無と関係なく無作為に欠けるように作ったので、クリック率はほとんど変わりませんでした(30日目0.1508、31日目0.1405)。クリックした顧客のログや特定の端末のログが偏って欠ければ、クリック率も動きます。網羅率は届いたログから数えているので、30日目0.304、31日目0.292と少し下がりましたが、下限は割りませんでした。75日目の不具合(全員に同じ一覧が出る)は、網羅率が平常時の平均0.324から0.020へ一気に落ち、その日のうちに見つかりました。一方、40日目からの再学習の停止では、網羅率は0.37前後で、下がりませんでした。モデルが古くなっても、顧客ごとに違う一覧を出し続けていたからです。再学習の停止を推薦の質の項目で見つけたのは、クリック率と人気順との比でした。
再学習の停止は、少しずつ効いてくる障害です。最初に下限を割ったのは推薦のクリック率で、停止から2日後の42日目でした(0.0974)。人気順との比は39日目に1.56でしたが、42日目に1.23、45日目に0.82まで下がり、日ごとの比は45日目に下限を割りました。ただし、その後の比は50日目1.06、55日目1.02、60日目1.10と1前後で揺れ、下限を割ったのは45・46日目と、64日目および67日目以降でした。7日移動平均が下限を割ったのは66日目で、この例では、ならしたことで日ごとの比より見つけるのが遅くなりました(7日移動平均と日ごとの比は下限の決め方が違い、下限の値も0.9941と0.9175なので、同じ条件で比べたものではありません)。
クリック率だけに頼らない理由は、クリック率が需要の動きでも上下するからです。比較用の人気順のクリック率は、再学習の停止の影響を受けませんが、39日目0.0783、45日目0.1216、50日目0.0676と日によって大きく動き、平常時の28日の間でも0.0782から0.1453まで、90日では最小0.0635(59日目)まで動いていました。39日目から50日目にかけて、推薦のクリック率は0.1218から0.0719へ約4割下がり、同じ間に人気順のクリック率も0.0783から0.0676へ下がっていました。比は1.56から1.06へ下がっており、需要の動きと重なりながらも、モデルが人気順に対して持っていた差が、平常時の1.28前後からほぼ無くなったことを示しています。この例では需要の動きによる誤報は起きていませんが、クリック率が下がったときに、それがモデルの問題なのか需要の問題なのかを、クリック率だけで切り分けることはできません。一方で、この架空データでは、比にしても日ごとのばらつきは小さくなりませんでした。表の平常時の標準偏差を平均で割ると、推薦のクリック率は約9.4%、比は約9.5%で、ほぼ同じです。比は、需要の動きとモデルの問題を見分ける手がかりの1つにはなりますが、この例では比の下限だけでは再学習の停止をすぐには見つけられませんでした。
なお、再学習の停止は、本来は推薦の質の項目を待たずに、システムとデータの層の項目(再学習の処理が最後に成功した時刻、モデルの更新日時、学習に使ったデータの最終日)で、止まったその日に直接見つけるべきものです。このシミュレーションではそれらを模擬していないので、推薦の質の項目で見つかるまでの日数だけを示しました。処理が止まったことを直接見る監視と、推薦の質への影響を見る監視は、併せて置くのがよいと考えています。75日目に不具合が起きた後は、比は0.64、89日目には0.36まで下がり、モデルの推薦が人気順より悪くなっていました。この架空データでは、人気順は前日の販売数(推薦以外の経路の購買も含む)から作っており、その日の需要をよく反映する強い比較の相手です。この条件では、比が1を下回った状態は、代わりの推薦(人気順)に切り替えたほうが成績が良いことを意味します。人気順の作り方が違えば、この読み方も変わります。
この結果から、監視の閾値について次のことが言えると考えています。まず、1つの項目ですべての障害は見つけられないので、推薦の質・データ・システムのそれぞれに項目を置く必要があります。次に、日ごとの値は揺れるので、揺れの大きい項目は移動平均を取るか、「3日続けて下限を割ったら」のような条件を付けて、1日だけの揺れで警報が鳴り続けないようにします。ただし、ならすと見つけるのが遅れることがあります。この例の7日移動平均は日ごとの比より21日遅れましたが、これはこの例の下限の決め方(日ごととは別に決めた下限)での値で、窓の長さや下限の決め方をそろえた比較はしていません。網羅率やログの件数のように、障害が起きると一気に変わる項目は日ごとの値で見ます。また、この例では平常時の28日の間に、比が0日目の1.48から27日目の1.26へ下がる流れがありました(図の右上)。平常時の値そのものが動いていると、その動きの分だけ標準偏差が大きくなり、下限が低めに決まります。この例でその影響がどれだけあったかは測っていません。最後に、下限は平常時のデータから決め、季節の変わり目や大きな販促の後には決め直します。この例の平均から標準偏差の3倍を引くという決め方は、管理図(工程の値を時間の順に並べ、平常時の幅を外れた点を異常の兆しとして見つける図)で使われる考え方を借りた1つの例で、数字そのものは架空データの値です。
監視の結果、何をするかも先に決めておきます。人気順との比が下限を割ったら、まず再学習の処理が最後に成功した時刻と学習のデータの最終日を確かめ、網羅率が急に落ちたら、直前に変えた設定やコードを確かめ、代わりの推薦を出した割合が上限を超えたら、障害の記録と業務ルールで外れた数を確かめ、原因が分からないまま比が1を下回り続けるなら、代わりの推薦に切り替える、という手順です。警報を受けた人が何をすればよいか決まっていない監視は、警報が鳴っても対応されないまま、形骸化しやすいと考えています。
再学習の頻度と手順、間隔を決めて安全に入れ替える
同じシミュレーションで、障害を入れずに再学習の間隔を変えた結果が次の表です。この架空データでは、商品の流行が10日ほどで入れ替わるように作ってあります。この表も、1つの乱数の種での結果です。
| 再学習の間隔 | 90日の推薦のクリック率の平均 | 人気順との比の平均 | 人気順との比の最小 |
|---|---|---|---|
| 1日ごと | 0.1336 | 1.343 | 1.115 |
| 7日ごと | 0.1187 | 1.194 | 0.914 |
| 28日ごと | 0.0974 | 0.989 | 0.631 |
再学習の間隔を28日にすると、90日の平均で人気順との比は0.989となり、モデルの推薦は人気順とほとんど変わらない成績になりました。最も悪い日には0.631まで下がり、人気順より3割以上悪い日がありました。7日ごとでも、比が1を下回る日がありました。この結果は、流行が10日ほどで入れ替わるという架空データの設定から来ているもので、実際にどの間隔が良いかは、商品の入れ替わりの速さや、顧客の好みの変わりやすさによって違います。新商品が毎日大量に入るサービスと、定番の商品が長く売れるサービスとでは、適した間隔が違うことが考えられます。
自社に合った間隔は、次のような方法で見積もれます。過去のログで、ある日に学習したモデルを、その後1日目・7日目・28日目の行動でオフライン評価し(第8章の時間で切る評価)、日が経つにつれて成績がどれだけ落ちるかを測ります。成績の落ち方が速ければ間隔を短くし、ほとんど落ちなければ間隔を長くして計算の負担を減らします。間隔を短くするほど計算の負担と、入れ替えの失敗の機会は増えるので、短ければ短いほど良いわけではありません。
再学習で作ったモデルを本番に入れる手順も、事前に決めておく必要があります。新しいモデルが前のモデルより悪くなっていることもあるので、自動で入れ替える場合でも、確かめる関門を置きます。手順の例を次の表にまとめました。
| 手順 | 中身 | 止める条件の例 |
|---|---|---|
| 1. データの確認 | 学習に使うデータの件数・最終日・欠けの割合を確かめる | 件数が平常時より大きく少ない、最終日が古い |
| 2. 学習とオフライン評価 | 時間で切った評価で、再現率@10 などを前のモデル・人気順と比べる(第8章) | 前のモデルより明らかに悪い、人気順を下回る |
| 3. 推薦の中身の確認 | 網羅率・上位の商品への集中・代わりの推薦になる顧客の割合を確かめる | 網羅率が急に下がった、特定の商品に集中した |
| 4. 一部の顧客で試す | 新しいモデルを顧客の一部にだけ出し、前のモデルと比べる(第9章) | クリック率・人気順との比が前のモデルより悪い |
| 5. 全体への切り替え | 全体に広げ、前のモデルはすぐ戻せるように残しておく | 監視の項目が下限を割ったら(代わりの推薦の割合は上限を超えたら)前のモデルに戻す |
表の5番目の「すぐ戻せる」ことは、手順の中でも大事な点だと考えています。モデル・設定・業務ルールの版を残し、前の版に戻す操作を誰がどの条件で行うかを決めておけば、入れ替えの失敗が長引くのを防げます。Sculley らの2015年の論文(ニューラル情報処理システム国際会議 NIPS 2015 で発表された、機械学習のシステムの隠れた技術的負債を論じた論文)は、機械学習のシステムには特有の保守の負担がたまりやすいと指摘しています。要旨が挙げる要因には、隠れたフィードバックの経路、データへの依存、外部の環境の変化などがあります。推薦では、自分の推薦によって生じた行動を次の学習に使う場合に、自分の推薦が次の学習のデータを作るというフィードバックの経路ができます(第11章)。版の管理と、戻す手順と、監視は、この負担を小さくするための基本の道具です。モデルの監視と再学習の一般論は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。
内製・クラウドの推薦サービス・パッケージ製品を比べる観点
推薦の仕組みを用意する方法は、大きく3つあります。自社のエンジニアが作る内製、クラウド事業者が提供する推薦のサービス(データを渡すと学習と推薦の提供を行うもの)、EC の基盤やマーケティングの道具に組み込まれたパッケージ製品です。どれが良いかは、自社の規模・人材・推薦の枠の数・求める自由度によって変わるので、本コラムでは優劣を決めません。料金も書きません。代わりに、比べるときの観点を次の表にまとめました。表の各欄は、検討のときに確かめるべき問いの形で書いています。
| 観点 | 確かめる問い | 関わる章 |
|---|---|---|
| 使えるデータ | 表示のログ・閲覧・購買・商品の属性のうち、どれを入力にできるか。自社のデータを外部に渡すことになるか | 第2章・第14章 |
| 推薦の方式と調整の自由度 | どの方式で推薦しているかが説明されているか。業務ルール(除外・ジャンルの上限・販促の固定枠)を自社で設定できるか | 第3章〜第7章 |
| 評価のしやすさ | 推薦の結果と表示のログを取り出して、自社でオフライン評価できるか。人気順と比べられるか | 第8章 |
| 効果の測り方 | 推薦を出さない群と比べる A/Bテストを自社の設計で行えるか。製品の画面に出る推薦経由の購買の数が推薦の効果と同じではないことを踏まえて確かめられるか | 第9章 |
| 新しい商品・新しい顧客 | 履歴の無い商品や顧客をどう扱うか。探索の枠を設定できるか | 第10章 |
| 偏りと多様性 | 網羅率や上位の商品への集中を測れるか。多様性の調整ができるか | 第11章 |
| 運用と監視 | 再学習の頻度を選べるか。監視の項目を取り出せるか。障害のときの代わりの推薦を設定できるか | 本章 |
| チャネルの広がり | サイト・アプリ・メール・店頭など、複数のチャネルで同じ仕組みを使えるか | 第1章・第13章 |
| 人材と引き継ぎ | 運用に必要な人材を社内に置けるか。製品を替えるときに、データと学んだことを持ち出せるか | 第13章 |
どの方法を選んでも、表の「評価のしやすさ」と「効果の測り方」を自社で確かめられることが前提になると考えています。推薦の仕組みを外部の製品に任せても、その推薦が人気順より良いのか、推薦が無い場合より行動を増やしているのかを確かめる責任は、自社に残ります。製品の画面に出る推薦経由の購買(推薦の枠から選ばれて買われた分)は、推薦が無くても買われた分を含んでいるので、それだけで導入の判断をすると効果の過大評価になりえます。また、チャネルや部署ごとに別々の製品を入れると、同じ顧客に別々の推薦が出て、データとノウハウが分かれます。導入の進め方と体制は第13章で扱います。
経営の判断、監視と代わりの推薦を最初から入れる
この章の内容を、経営の判断に置き換えます。推薦の仕組みで経営が決めるべきことは、どのライブラリや製品を使うかよりも、「推薦の質を誰が、どの項目で、どの頻度で見て、下限を割ったら何をするか」と「推薦が出せないときに何を出すか」を、仕組みを作る最初の段階で決めておくことだと考えています。推薦はモデルの更新や顧客ごとの出し分けが止まっても画面は正常に表示されることがあるので、監視と代わりの推薦を後回しにすると、推薦の質が落ちたまま誰も気づかない期間が生まれます。
運用の判断を誤ったときの損失を、序章で整理した6つの損失の型(機会損失・効果の過大評価・品揃えの偏り・顧客の離反・形骸化・二重投資)に当てはめると、次のようになります。
| 運用での誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 応答の時間とエラーの率だけを監視し、推薦の質を見ていない | 形骸化(推薦の更新が止まっても気づかない)、機会損失 | 人気順との比・網羅率・代わりの推薦の割合を監視の項目に入れ、再学習の成功時刻など処理の停止を直接見る項目と併せて置く |
| 候補の生成の取りこぼしを測っていない | 機会損失(並べ替えに届かない商品は推薦されない)、品揃えの偏り | 候補の生成の段の再現率と、近似最近傍探索の全探索との一致の割合を測る |
| 業務ルールを候補の生成と別に足していく | 機会損失(推薦の枠が埋まらず、気づかないうちに代わりの推薦ばかりになる) | 業務ルールで外れる数を測り、候補の数と出どころを合わせて設計する |
| 障害のときの代わりの推薦に業務ルールを当てていない | 顧客の離反(在庫切れ・購入済み・出してはいけない商品が並ぶ) | 代わりの推薦にも同じ除外のルールを当て、止まりにくい経路で用意する |
| 再学習の間隔を根拠なく決め、入れ替えの関門が無い | 機会損失(古いモデルのまま)、顧客の離反(悪いモデルに入れ替わる) | 成績の落ち方から間隔を見積もり、関門と戻す手順を決める |
| 製品の画面の推薦経由の購買の数で継続を判断する | 効果の過大評価 | 推薦の効果は推薦を出さない群との A/Bテスト(第9章)で測る。人気順を出し続ける群との比は、人気順と比べた差を見る監視として別に使う |
| チャネルや部署ごとに別々の推薦の仕組みを入れる | 二重投資 | ログの設計と監視の項目を全社でそろえ、仕組みを共有する |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 推薦の質の監視の項目(人気順との比・網羅率・代わりの推薦の割合)と、それぞれの警報の条件(下がって困る項目は下限、代わりの推薦の割合のように増えて困る項目は上限、急な変化の条件)・確かめる頻度・担当者を、推薦の仕組みを作る前に決める
- 比較用の群(人気順を出し続ける顧客の一部)の大きさを決め、モデルの推薦が人気順より良い場合に生じる機会損失を、人気順と比べた差を確かめ続けるための費用として予算に入れる。推薦の効果(推薦が無い場合との差)は、推薦を出さない群との A/Bテストで、期間を決めて別に測る
- 障害のときの代わりの推薦と、それに当てる業務ルールを決め、切り替えの判断を誰が行うかを決める
- 再学習の間隔の根拠(成績の落ち方の測定)と、入れ替えの関門・戻す手順を文書にする
- 表示のログ・モデルの版・代わりの推薦の理由を残すログの設計を、全社の推薦の枠で共通にする
予算の面では、推薦のモデルを作る費用だけでなく、監視の仕組み、比較用の群、ログの基盤、再学習と入れ替えの運用にかかる人手を、最初から見込んでおく必要があります。これらは推薦の精度を直接は上げませんが、推薦の働きを確かめ続け、推薦が止まったときの損失を小さくするための費用です。KPI の面では、推薦の枠のクリック率だけでなく、人気順との比のように、推薦の仕組みそのものの働きを表す指標を、事業の報告に載せることを勧めます。
この章のまとめ
この章では、推薦を毎日出し続けるための仕組みとして、候補の生成・並べ替え・業務ルールによる後処理の構成と、監視と再学習を扱いました。本コラムの架空の合成データと実行環境では、全探索の時間は商品の数が増えるほど増え、商品5万点を100のまとまりに分けて5個だけ調べると、全探索の上位10件の97.6%を、同じ書き方の全探索の約4割の時間(5回の実行の中央値どうしで比べた値)で見つけられました(numpy での簡易な実装では、調べるまとまりを10個以上にすると全探索より遅くなりました)。
業務ルールは候補の生成と合わせて設計しないと、枠が埋まらずに代わりの推薦ばかりになることがあり、顧客がそれぞれ1つのジャンルだけを好むように作った架空データで、埋め込みの上位200点だけを候補にした例では、1,000人中990人で10点を埋められませんでした。
架空の運用のシミュレーション(1つの乱数の種での結果)では、ログの欠けはログの件数で、全員に同じ一覧が出る不具合は網羅率で、再学習の停止は推薦の質の項目では推薦のクリック率(停止から2日後)と日ごとの人気順との比(5日後)で見つかり、1つの項目ですべての障害は見つけられませんでした。人気順との比を7日移動平均でならすと、見つかったのは停止から26日後で、ならすことの遅れも見えました(日ごととは下限の決め方が違う比較です)。再学習の停止そのものは、処理の成功時刻などで直接見る監視を併せて置くべきだと考えています。人気順との比は人気順と比べた差であり、推薦の効果は推薦を出さない群との比較で別に測る必要があります。次の第13章では、こうした仕組みを、どの推薦の枠から、どの順番で、誰の責任で入れていくかという、導入の進め方と体制を扱います。
この章を深めたい方への参考書籍
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習を事業のシステムとして設計・運用するための本です。版元の目次によれば、モデルのデプロイと予測サービス、データ分布のシフトと監視(監視と可観測性の節を含む)、実現場での継続学習とテストの章があります。この章で扱った一括の計算とリアルタイムの計算の分担、監視の項目、再学習の頻度を、推薦に限らない一般的な形で体系立てて確かめるのに向いています。
『AIエンジニアのための機械学習システムデザインパターン』(澁井雄介 著、翔泳社):学習したモデルを本番で動かすときの構成を、パターンの形で整理した本です(2021年刊)。著者が公開している本書のサンプルコードの一覧では、一括の推論・同期と非同期の推論・予測のキャッシュといった推論の提供のパターン、予測のログと監視のパターン、サーキットブレーカー(障害の連鎖を止める仕組み)・シャドウ方式の A/Bテストといった運用のパターンが章ごとに並んでいます。この章の代わりの推薦や入れ替えの手順を、実装の形で考えるときの手がかりになります。
第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
第12章では、推薦の仕組みを候補の生成と並べ替えの2段階で組むこと、推薦の質・データ・システムの3つを監視すること、障害のときに人気順へ切り替える代わりの推薦を最初から入れておくことを扱いました。第1章から第12章は、推薦を「何のために、どのデータで、どの方法で作り、どう評価し、どう動かし続けるか」の話でした。この章では、それを自社のどの推薦の枠から、どの順番で、誰の責任で入れていくかを扱います。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 最初に推薦を入れる枠の選び方(流入の量・購買への近さ・品揃えの広さ・データの量で採点する方法)
- 最終の KPI から推薦の枠の KPI へ分解する考え方と、推薦が悪さをしていないかを見張る指標
- 本格導入の前に限られた範囲で試す段階の設計(期間・評価の方法・合格の条件・出口を、始める前に決める)と、その段階で止まる型
- 効果の見立て方(金額ではなく、率と件数の型で書く)
- 1枠から複数の枠、チャネルを横断する推薦へと広げる段階的な展開
- 経営・事業責任者・マーケティング・EC 運営・商品部・データ分析・エンジニア・情報システム・法務・外部のベンダーの役割と責任分担
- 内製と外部委託・製品の利用の分担、最初の90日の計画、経営判断
この章の主張は、PoC(試験導入、概念実証)の出口と、効果の測り方を、始める前に決めておくことです。PoC は Proof of Concept の略で、本格導入の前に、限られた範囲で使えるかどうかを確かめる小さな試しのことです。出口とは「何が確かめられたら次へ進み、何が確かめられなければやめるか」の決まりを指します。推薦の場合、PoC は過去のログを使ったオフライン評価だけで終わりやすく、「再現率は人気順より高かったが、売場に出したら何が増えたのか分からない」という状態で止まることが多いように思います。第8章で扱ったとおり、オフライン評価の成績はオンラインの成果と一致するとは限りません。第9章で扱ったとおり、推薦の効果と呼べるのは、推薦が無かった場合と比べて変わった行動(増えた場合も減った場合も)だけで、今の推薦と比べた差は「方式を替えた効果」と呼んで区別します。この2つを PoC の計画に最初から組み込むことが、この章の中心になります。
推薦を入れる枠の選び方、4つの観点で採点して最初の1枠を決める
推薦の導入でよく起きるのは、「目立つ場所」から手を付けることです。トップページの「おすすめ」は社内の誰もが目にするので、最初の題材に選ばれやすい場所です。ただ、第1章の枠の表のとおり、トップページはその場の手がかりが弱く、特定の商品を探しているとは限らない顧客も訪れる枠で、そうした場合には推薦が購買にどれだけ近いかが測りにくくなります。最初の1枠でつまずくと、その結果が「推薦はうちでは効かない」という社内の評価になり、次の枠に進めなくなります。最初の1枠は、効果が出る余地があることと、効果を確かめやすいことの両方で選ぶ必要があります。
本コラムでは、候補の枠を次の4つの観点で採点する方法を考えます。採点の観点は、第1章から第12章で扱った論点を、どの枠から始めるかの判断に置き換えたものです。
- 流入の量:その枠が置かれたページを、一定の期間にどれだけの顧客(同じ顧客を重ねて数えない人数)が訪れるか。A/Bテストを顧客の単位で分ける場合、必要な人数は顧客の数で数えるので、表示の回数は補助の情報になる。訪れる顧客が少ない枠では、A/Bテストで差を確かめるのに長い期間がかかる(第9章)
- 購買への近さ:その枠を見る顧客が、商品を比べて選んでいる段階にいて、推薦で選ぶ商品が変わりうるか。第1章の枠の表のとおり、商品ページの顧客は見ている商品に関心を持っていて選ぶ商品が変わる余地があり、カートの顧客は購買の手続きには近いが買う商品をほぼ決めているので選択を変える余地は小さい(第1章)
- 品揃えの広さ:推薦の対象になる商品がどれだけ多く、顧客が自力で見つけにくいか。商品が少なければ、人気順や手作業の並べ方で足りることがある(第3章)
- データの量:その枠の推薦に使える行動ログが、顧客ごと・商品ごとにどれだけあるか。表示のログが残っているか(第2章)
4つのうち、購買への近さと品揃えの広さは「効果が出る余地」を、流入の量とデータの量は「確かめやすさ」を表します。購買への近さを「購買の手続きに近い枠ほど高い点」と読むと、カートの枠が最も有望に見えます。ただ、カートに商品を入れた顧客は買う商品をほぼ決めているので(第1章)、推薦経由の購買の数は多く見えても、推薦が無かった場合との差は小さい場合があります。一方で、一緒に使う商品や補充の商品を示すと1回の購買に含まれる商品の数が増えることがある(第1章)ので、購買点数を増やす目的であれば、カートの枠も候補になります。第9章で扱った、推薦の枠を経由した購買の数と A/Bテストで測った差の違いが、枠の選び方の段階で効いてきます。採点では、購買への近さを「推薦経由の購買の数が多い枠」と読み替えず、箇条書きの定義のとおり「推薦が顧客の選択を変えうる枠」として付けることを勧めます。
採点の目安を次の表にまとめました。点数の付け方は本コラムが考えた例で、業界の規格や公的な指針で定められたものではありません。各観点を1点から3点で付け、合計点だけで決めるのではなく、「確かめやすさ」の2つの観点(流入の量とデータの量)のどちらかに1点が付く枠は、最初の1枠から外す、という使い方を想定しています。
| 観点 | 3点 | 2点 | 1点 | 確かめ方(主に情報を持つ人) |
|---|---|---|---|---|
| 流入の量 | 多くの顧客が訪れ、数週間の A/Bテストで差を確かめるのに必要な顧客の数を、各群で確保できる見込み | 顧客は訪れるが、必要な顧客の数を集めるには数か月かかる見込み | 訪れる顧客が少なく、現実的な期間で差を確かめられない | アクセス解析の、枠が置かれたページを訪れた顧客の数(重ねて数えない人数)と表示の回数、第9章の必要な人数の計算(EC 運営・データ分析) |
| 購買への近さ | 顧客が商品を比べている段階の枠で、推薦で選ぶ商品が変わりうる | 商品への関心はあるが、比べる候補がまだ絞れていない段階の枠(選ぶ商品が変わる余地はあるが、購買に結びつくまでの道のりが長い) | 次のどちらかの枠。特定の商品を探していない段階の枠、または買う商品をほぼ決めていて推薦で選択が変わる余地が小さい段階の枠(購買点数を増やす目的なら別に検討する) | 枠ごとのクリック率と、クリックの後の購買の割合(EC 運営・マーケティング)。ただし、これは今の利用の状況を示す数字で、選択を変える余地があるかの見当を付ける材料にとどまる。推薦で増えた分は A/Bテストで確かめる |
| 品揃えの広さ | 商品が多く、検索や分類だけでは顧客が見つけにくい | 商品は多いが、分類がはっきりしていて探しやすい | 商品が少なく、全体を一覧で見せられる | 商品の数、商品別の購買のかたより(第2章のロングテール)(商品部) |
| データの量 | 表示・クリック・購買のログが枠と順位つきで残っており、顧客ごとの履歴も十分ある | 購買のログはあるが、表示のログが無いか、枠と順位が残っていない | 購買のログも少なく、新しい顧客・新しい商品が大半 | ログの項目の一覧、顧客ごとの購買数の分布(データ分析・エンジニア) |
表の「データの量」に2点が付く枠、つまり購買のログはあるが表示のログが無い枠では、注意が要ります。第2章で扱ったとおり、表示されなかった商品は選ばれようがないので、表示のログが無いと、推薦が何を見せ、そのうち何が選ばれたかを後から確かめられません。この場合の最初の一歩は推薦のモデルを作ることではなく、表示のログを推薦の枠と順位つきで残し始めることになります。群ごとの購買の比較そのものは、群の割り当てと購買の記録があればできますが、どの商品をどの順位で見せたときに何が選ばれたかを調べるには表示のログが要ります。ログを残す作業は地味ですが、A/Bテストの結果の原因を調べることとオフライン評価の土台になるので、推薦の導入とは別に価値があります。
「データの量」に1点が付く枠、つまり新しい顧客や新しい商品が大半を占める枠では、第10章で扱ったコールドスタートの問題が正面から出ます。この枠を最初に選ぶと、協調フィルタリングや行列分解の良さが出にくく、人気順との差が小さくなりがちです。そうした枠は、内容ベースや人気順を組み合わせる設計が要るので、2枠目以降に回すのがよいと考えています。
採点は、EC 運営・マーケティング・商品部・データ分析が同じ表を見ながら行うのがよいと考えています。流入の量と購買への近さは EC 運営とマーケティングが、品揃えの広さは商品部が、データの量はデータ分析とエンジニアが、それぞれ最もよく知っています。データ分析の担当者や外部のベンダーだけで採点すると、「確かめやすさ」の観点は正しく付いても、「効果が出る余地」の観点が売場の実態とずれることがあります。
KPI の木、最終の KPI から推薦の枠の KPI へ分解する
最初の1枠が決まったら、その枠の推薦で何を増やすのかを決めます。第1章で扱ったとおり、推薦の目的はクリック率・購買率・購買点数・継続率・顧客の生涯価値などに分かれ、短期の KPI と長期の KPI はずれることがあります。枠の推薦の担当者がクリック率だけを追い、事業の責任者が売上や継続率を見ていると、推薦の改善が事業の成果につながっているのかを誰も説明できなくなります。本コラムでは、この食い違いを防ぐ道具としてKPI の木を使います。
KPI の木は、事業の最終の目標を表す KPI を頂点に置き、それを掛け算や足し算で分解できる中間の KPI へ、さらに個々の施策が直接動かせる KPI へと枝分かれさせて書いた図です。たとえば、EC の売上は「購買した顧客の数」と「顧客1人あたりの購買の額」に分けられ、後者はさらに「購買の回数」と「1回あたりの購買点数」と「1点あたりの単価」に分けられます。推薦の枠の KPI は、この木の末端のどこかにつながっていなければなりません。商品ページの「この商品を見た人は」の枠であれば、主につながるのは「1回あたりの購買点数」や「商品ページからの購買率」です。メールの推薦であれば、「購買の回数」や「継続して購買する顧客の割合」につながります。
KPI の木を作るときに大事なのは、推薦の枠の KPI を「推薦経由の購買の数」で書かないことです。推薦経由の購買には、推薦が無くても買われた分が含まれます(第9章)。木の末端に置く推薦の枠の KPI は、A/Bテストで推薦あり・推薦なし(または新しい推薦・今の推薦)の群を比べたときの差として測れる形で書きます。たとえば「商品ページを見た顧客の、その訪問での購買点数の平均」は、推薦ありの群と推薦なしの群で比べられます。一方、「推薦の枠をクリックした後の購買の数」は、推薦なしの群には推薦の枠が無いので比べられません。比べられない KPI は、枠の状態を見る参考の数字としては使えますが、効果の判断には使えません。
KPI の木の各階層を、誰が持ち、どう測るかを次の表にまとめました。指標の例は本コラムが挙げた一般的なもので、自社の事業の形に合わせて置き換えて使うことを想定しています。
| 階層 | 指標の例 | 主に持つ人 | 測り方 | 注意すること |
|---|---|---|---|---|
| 最終の KPI | 売上・粗利・継続して購買する顧客の数 | 経営・事業責任者 | 月次・四半期の集計 | 季節・販促・価格の変更など推薦以外の要因で大きく動くので、推薦の効果の判断には直接使わない |
| 中間の KPI | 購買した顧客の数・顧客1人あたりの購買の回数・1回あたりの購買点数・継続率 | マーケティング・EC 運営 | 週次・月次の集計。顧客の群ごとに分けて見る | どの推薦の枠がどの中間の KPI に効くかを、木の上で線で結んでおく |
| 推薦の枠の KPI | その枠が置かれたページを訪れた顧客の購買率・購買点数(その枠のクリック率は、推薦なしの群では測れないので、新旧の推薦を比べる場合にだけ使う) | EC 運営・データ分析 | A/Bテストで、推薦ありと推薦なし(または新旧の推薦)の群の差を測る(第9章) | クリック率は購買につながらないクリックでも上がるので、単独で合格の条件にしない |
| ガードレールの指標(分解の階層の外に置き、並べて測る) | 返品の率・メールの配信停止の率・推薦された商品の網羅率・人気上位の商品への集中の度合い(網羅率と集中の度合いは第11章。推薦された商品の網羅率は推薦なしの群では数えられないので、新旧の推薦を比べる場合に使う。推薦なしの群と比べるときは、購買された商品の集中の度合いなど両方の群で数えられるものを使う) | EC 運営・商品部・データ分析 | A/Bテストの各群で、主な KPI と同時に測る | 主な KPI が上がっても、ここが悪化したら合格にしない |
表の最後の行に置いたガードレールの指標は、推薦が事業に悪さをしていないかを見張るための指標です。推薦の改善は、主な KPI を上げる一方で、別の場所に損失を生むことがあります。クリック率を上げるために扇情的な商品や値引きの商品ばかりを推薦すると、返品が増えたり、顧客1人あたりの粗利が下がったりするおそれがあります。メールの推薦の頻度を上げると、短期の購買が増える場合でも、配信停止が増えて、後の接点を失うおそれがあります。第11章で扱ったとおり、精度だけを追うと推薦が一部の人気商品に集中し、品揃えの偏りという損失につながることがあります。ガードレールの指標は、主な KPI と同じ A/Bテストの中で同時に測り、事前に決めた範囲を超えて悪化したら、主な KPI が上がっていても合格にしない、という使い方をします。
KPI の木は、推薦の担当者のためだけの図ではありません。経営や事業の責任者にとっては、推薦の予算がどの中間の KPI を動かすための投資なのかを示す図になります。推薦の担当者にとっては、自分の改善が事業のどこにつながるかを説明する図になります。推薦の枠を2つ目、3つ目と増やすときも、同じ木の上で「この枠はどの枝を伸ばすためのものか」を書き足していくと、枠どうしで同じ顧客の同じ購買を取り合う設計(第9章で扱った枠どうしの干渉)に気付きやすくなります。
前の表の4つの階層のつながりを、分解の向きに沿ってまとめると次のとおりです。
- 最終の KPI(売上・継続して購買する顧客の数など)を、中間の KPI に分解する
- 中間の KPI(購買した顧客の数・購買の回数・購買点数など)を、推薦の枠の KPI に分解する
- 推薦の枠の KPI(枠が置かれたページを訪れた顧客の購買率・購買点数)を、A/Bテストで測る
- ガードレールの指標(返品・配信停止・網羅率など)は、この分解の外に置き、推薦の枠の KPI と同じ A/Bテストの中で並べて測る
PoC の設計、期間・評価の方法・合格の条件・出口を始める前に決める
最初の1枠と KPI の木が決まったら、PoC を設計します。本コラムでいう推薦の PoC は、本格的に全顧客へ出す前に、限られた期間と範囲で「この枠で、この推薦の方法が、決めた KPI を推薦なし(または今の推薦)より増やすか」を確かめる段階です。PoC で確かめるのは「推薦が使えるか」という漠然とした問いではありません。始める前に、何を確かめ、どの結果なら次へ進み、どの結果ならやめるかを、文書にして関係者で合意しておく必要があります。
推薦の PoC は、2つの段に分けて設計するのがよいと考えています。1段目は、過去のログを使ったオフライン評価です。第8章で扱ったとおり、時間で切った評価データで、候補の推薦の方法が人気順などのベースラインに勝てるかを確かめます。ここでベースラインに勝てない方法は、売場に出す前に落とせます。2段目は、実際の顧客の一部に推薦を出すオンライン評価です。第9章で扱った A/Bテストで、推薦ありの群と推薦なし(または今の推薦)の群の KPI の差を測ります。推薦なしの群と比べた差が推薦の効果で、今の推薦の群と比べた差は方式を替えた効果(従来の推薦と比べた差)です。どちらも比べる相手を明記して報告します。効果と呼べるのは、この2段目で確かめた差だけです。1段目だけで PoC を終えると、効果は確かめられていません。
PoC の設計で最初に決めておきたい項目を、次の表にまとめました。どの項目も、本コラムの各章で扱った論点を、PoC の計画書の欄に置き換えたものです。
| 決める項目 | 中身 | 決めずに始めると起きること | 関連する章 |
|---|---|---|---|
| 対象 | 推薦の枠・対象の顧客(新しい顧客を含めるか)・対象の商品(在庫切れや年齢制限の商品の除外) | 試す途中で対象が広がり、期間内に結論が出ない | 第1章・第3章 |
| 比べる相手 | 人気順などのベースライン、または今動いている推薦 | 何より良いのかが決まらず、成績の数字の意味が定まらない | 第3章・第8章 |
| オフライン評価の方法 | 時間で切った評価データ、指標(再現率@K・NDCG など)、ベースラインに勝つ条件 | ランダムに切った評価で成績が良く見え、売場で再現しない | 第8章 |
| オンライン評価の方法 | 群の分け方(顧客の単位で分ける)、主な KPI、ガードレールの指標、期間、必要な人数 | 推薦経由の購買の数を効果と呼んでしまう。途中で結果を見て止めてしまう | 第9章 |
| 合格の条件 | 主な KPI の差の下限と、その差のばらつきの幅(信頼区間)の扱い。ガードレールの指標の悪化の上限 | 「クリック率が上がった」という数字は出ても、次へ進むかを判断できない | 第9章・第11章 |
| 運用の条件 | 推薦の更新の頻度、応答の時間、障害のときの代わりの推薦 | 成績は出たが、毎日の更新や表示の速さに追いつかない | 第12章 |
| 出口 | 合格したら次に何をするか(対象の顧客を広げる・次の枠へ進む)、不合格なら何をするか(方法の見直し・枠の変更・中止) | 結果が出ても次の判断ができず、PoC を延長し続ける | 本章 |
| 判断する人 | 出口の判断を誰が行うか(合格の条件の値は事業責任者とデータ分析が決め、出口の承認は事業責任者など) | 結果の解釈が立場によって分かれ、結論が出ない | 本章 |
この表で最も大事なのは、「オンライン評価の方法」「合格の条件」「出口」の3つです。合格の条件は、クリック率のような1つの数字ではなく、「主な KPI の差が事前に決めた下限を超え、ガードレールの指標の悪化が事前に決めた上限の内に収まる」という形で書きます。下限の値そのものは、その枠の流入の量と、事業にとって意味のある差の大きさで決まるので、本コラムでは具体的な値を示しません。第9章で扱ったとおり、検出したい差が小さいほど、必要な人数は多くなり、期間は長くなります。流入の少ない枠で小さな差を確かめようとすると、PoC の期間が現実的な長さに収まらないので、合格の条件の下限と期間は、必要な人数の計算と一緒に決めます。計画書には、差について次の3つを書いておくと、読む人の解釈がそろいます。
- 合格の下限:事業にとって意味のある最小の差
- 検出したい差:必要な人数の計算に使う差の大きさ
- 下限を超えたかの見方:差の推定値で見るのか、差のばらつきの幅(信頼区間。第9章)の下側の端で見るのか
合格の下限と検出したい差は、同じ値にすることも別の値にすることもあります。
A/Bテストの期間については、第9章で扱った落とし穴を計画書にそのまま書いておきます。結果を毎日見て、差が出た日に止めると、偶然の差を効果と見誤りやすくなります。期間は始める前に決め、曜日の偏りを避けるために週の単位で取ります。新しい推薦の枠は、物珍しさでしばらくクリックが増えることがあるので(新奇効果)、期間の最初の数日だけで判断しないことも書いておきます。
出口は、合格した場合と不合格だった場合の両方を書きます。合格した場合の出口は、推薦を出す顧客の割合を段階的に広げることと、次の枠の検討に進むことです。不合格だった場合の出口は、結果の中身によって分かれます。オフライン評価でベースラインに勝てなかったなら方法の見直しへ、オフラインでは勝ったのにオンラインで差が出なかったなら、枠の選び方や表示の仕方の見直しへ、ガードレールの指標が悪化したなら、多様性や除外のルールの見直しへ、という具合です。「不合格なら期間を延ばしてもう少し試す」は、出口として書かないほうがよいと考えています。延長を出口にすると、何が足りなかったのかを分析しないまま期間だけが延び、PoC が終わらなくなります。
PoC が止まる8つの型、オフラインで止まる型と推薦経由で数える型
ここまでの項目を決めずに始めると、PoC が本格導入に進まずに止まることがあります。推薦の PoC が止まる理由を、本コラムはここまでの章の論点から次の8つの型に整理しました。表の型は、どれも PoC を始める前の設計で手を打てるものです。右端の列は、序章で整理した6つの損失の型のどれにつながるかを示します。
| 止まる型 | 何が起きるか | 始める前に打てる手 | つながる損失の型 |
|---|---|---|---|
| オフラインで止まる | 過去のログでの再現率や NDCG は良かったが、売場に出す段取りが無く、効果が確かめられないまま報告書で終わる | オンライン評価の段(A/Bテストの枠・期間・指標)を最初の計画に入れる | 形骸化 |
| 比べる相手が無い | 推薦の成績だけを示し、人気順との比較が無いので、良いのか悪いのか判断できない | 人気順などのベースラインを必ず比べる相手に置く | 効果の過大評価 |
| 推薦経由で数える | 推薦の枠からの購買の数を効果として報告し、後で推薦なしの群と比べると差が小さいと分かる | 推薦の効果を A/Bテストの差で定義し、計画書に書く | 効果の過大評価 |
| 流入が足りない | 訪れる顧客の少ない枠を選び、期間内に差を確かめられる人数が集まらない | 枠の採点で流入の量を確かめ、必要な人数を計算してから始める | 形骸化 |
| 表示のログが無い | 何をどの順位で見せ、何が選ばれたかが残っておらず、表示の中身や順位ごとの反応を確かめにくい。原因の分析や改善の手が限られる | 表示のログが無い場合は、90日の計画の第1週より前に、推薦の枠と順位つきでログを貯める期間を取る | 機会損失・形骸化 |
| つなぎ先が無い | 推薦の結果は計算できたが、サイトやメールの配信の仕組みに載せる手段が無い | PoC の段階で、推薦の結果を枠に渡す方法と更新の頻度を決めておく | 形骸化 |
| 運用する人がいない | PoC を外部に任せたため、本番で再学習や監視を担う人が社内にいない | 運用を担う社内の担当者を PoC の段階から参加させる | 形骸化・二重投資 |
| 部署ごとに試す | EC・アプリ・メール・店舗の部署が別々に推薦の PoC を行い、ログと評価の方法がそろわない | KPI の木と評価の方法を部署をまたいで共通にし、PoC の結果を同じ形式で残す | 二重投資 |
表の中で、推薦に特有と考えられるのは「オフラインで止まる」型と「推薦経由で数える」型です。推薦は、過去のログさえあればデータ分析の担当者の手元で成績を計算できるので、PoC がオフライン評価だけで完結しやすい性質があります。オフライン評価は方法を絞り込むためには役に立ちますが、第8章で扱ったとおり、過去のログは過去の推薦や売場の並べ方の影響を受けており、新しい推薦を出したときに顧客がどう動くかまでは分かりません。オフラインの成績が良いことは、オンラインで試す価値があることの根拠にはなっても、効果の根拠にはなりません。
「推薦経由で数える」型は、ベンダーの推薦エンジンを試す場合にも起きやすい型です。製品の画面やアクセス解析で「推薦経由の購買の数」を集計した場合、その数字は推薦の枠がどれだけ使われているかを知るには役に立ちます。ただ、それを推薦の効果として社内に報告すると、効果の過大評価になります。ベンダーの推薦を試すときも、自社で推薦なし(または今の推薦)の群を残し、同じ期間の KPI の差で判断する設計にしておくことを勧めます。製品の機能で群を分ける場合は、群の分け方と指標の定義が自社の KPI の木と合っているかを、その製品の公式の説明書で確かめてから使います。
効果の見立て、金額ではなく率と件数の型で書く
PoC の計画を通すにも、展開の予算を得るにも、効果の見立てが求められます。このとき、効果をいきなり金額で書こうとすると、根拠の薄い前提を掛け合わせた数字が一人歩きしやすくなります。本コラムでは、効果の見立てを金額ではなく、率と件数の型で書くことを勧めます。金額への換算は、各社の事業責任者と経理が、自社の単価と粗利で行えばよく、推薦の計画書の段階で金額を置く必要はないと考えています。
見立ての骨格は、KPI の木の末端から上へ積み上げる形で書けます。ある枠の推薦の効果は、おおまかに「その枠が置かれたページを訪れる顧客の数」と「その顧客1人あたりの KPI の差」の掛け算で表せます。後者は A/Bテストで測る値で、PoC の前には分からないので、見立ての段階では「この程度の差があれば、中間の KPI がこれだけ動く」という形で、差の大きさを幅で置きます。たとえば、商品ページを訪れた顧客の購買点数の平均が、推薦なしの群に比べて一定の割合だけ増えた場合に、全体の購買点数がどれだけ動くかを、幅を持たせて計算しておきます。こうしておくと、PoC の合格の条件の下限を、「事業にとって意味のある最小の差」として決める根拠にもなります。
見立ての数字を書くときに避けたいのは、公開の事例や研究の数字を、そのまま自社の効果として書くことです。第14章で扱うとおり、公開の事例の効果の数字は、その会社の、そのサービスの、その条件での値です。研究の数字も、その研究が使ったデータ(公開データセットの場合も、企業のサービスのログや実際のサービスでの実験の場合もあります)・評価の方法・実験の条件での値です。どちらも自社の枠で同じ値が出る根拠にはなりません。見立ての数字は、自社の枠の導入の前の記録と、PoC の結果から作り、「この PoC の期間・この枠・この顧客の群では」という限定を付けて書きます。
見立ての対象は、序章で整理した6つの損失の型に沿って考えると、漏れが少なくなります。次の表は、序章と同じ名前の6つの損失の型それぞれについて、何を数え、導入の前にどこから数字を取り、導入の後に何と比べるかをまとめたものです。
| 損失の型 | 数えるもの(率・件数) | 導入の前の数字の取り方 | 導入の後に比べるもの |
|---|---|---|---|
| 機会損失 | 参考の指標として、在庫のある商品のうち、一定の期間に推薦や検索の結果に一度も表示されなかった商品の割合(見つけられる機会の偏りを見るもので、見えなかったために失われた購買そのものではない) | 表示のログ(無ければ PoC の前に取り始める) | 推薦ありの群となしの群で、同じ割合を参考に見る(検索の結果への表示も含めて数えるので、推薦なしの群でも数えられる)。購買の機会が増えたかは、両方の群に共通の対象の顧客の購買率・購買点数の差で確かめる |
| 効果の過大評価 | 推薦経由の購買の数と、A/Bテストで測った差から見積もった増えた購買の件数(信頼区間つき)を、別の欄に並べたもの | (導入の前には無い。計画書に効果の定義を書く) | 報告書の効果の数字が、A/Bテストの差で書かれているか |
| 品揃えの偏り | 推薦された商品の網羅率、購買の上位の商品への集中の度合い(第11章) | 人気順や今の推薦での同じ指標 | 推薦ありの群での同じ指標と、在庫の消化の偏り |
| 顧客の離反 | メールの配信停止の率、推薦の非表示の操作の率、問い合わせの件数 | 今の配信・表示での同じ指標 | 推薦ありの群での同じ指標 |
| 形骸化 | 推薦の枠の表示の率(枠が置かれたページの訪問のうち、推薦が実際に表示された割合)・クリック率の推移、効果を測り直した間隔 | (導入の前には無い) | 導入の後、決めた間隔で A/Bテストを繰り返しているか |
| 二重投資 | 部署・チャネルごとに別々に作った推薦の仕組みとログの数 | 既存の推薦の仕組みの一覧 | 共通のログと評価の仕組みに載った枠の数 |
表の「効果の過大評価」の行は、数字そのものより、報告の仕方を確かめる行です。推薦の導入の後、社内の報告書に「推薦経由の購買」が効果として書かれていないかを、事業責任者が確かめます。推薦経由の購買の数は、推薦の枠の利用の状況を見る数字として報告してよく、効果の数字とは別の欄に置きます。この区別を報告書の書式の段階で決めておくと、後で効果の数字が大きく見えすぎていたと分かったときの社内の混乱を避けられます。
「形骸化」の行は、導入の後に効く行です。推薦は、一度 A/Bテストで効果を確かめても、顧客の好みや品揃えが変わるにつれて効果が変わります。第12章で扱った監視で推薦の質を日々見ることに加え、推薦なしの群を少しだけ残し続け、効果を測り続ける設計にしておくと、効果が薄れたときに気付けます。人気順の群を残す方法もありますが、その群と比べて測れるのは人気順と比べた差(方式を替えた効果)で、推薦の効果ではありません。推薦の効果は推薦なしの群で測ります(測り方は第9章、運用での扱いは第12章)。残す群の割合を大きくすると、その分だけ推薦を受けない顧客が増えるので、割合は事業責任者とデータ分析が相談して決めます。
段階的な展開、1枠から複数の枠、チャネルの横断へ
PoC に合格しても、すぐにすべての顧客とすべての枠に推薦を広げるのは避けるべきだと考えています。PoC の A/Bテストは、限られた期間・枠・顧客の群で行ったもので、季節や販促の時期、新しい顧客の割合が変わったときの動きまでは含んでいません。本コラムでは、推薦を出す顧客の割合と、推薦を入れる枠の数を、段階を分けて広げることを勧めます。
展開の段階を次の表にまとめました。段階の区切り方は本コラムが考えた例で、事業の規模や枠の数によって変わります。
| 段階 | 範囲 | 主に確かめること | 次の段階へ進む条件 | 主に判断する人 |
|---|---|---|---|---|
| PoC | 1枠・顧客の一部(A/Bテストの群) | 主な KPI の差と、ガードレールの指標 | 合格の条件を満たし、出口として展開が承認された | 事業責任者 |
| 1枠の全面展開 | 1枠・推薦なしの群を少し残して大半の顧客 | PoC の差が、季節や販促の時期をまたいでも続くか。運用の条件(更新・速度・障害のときの切り替え) | 残した群との差が続き、監視と代わりの推薦が動いている | 事業責任者 |
| 複数の枠 | 同じサイトやアプリの他の枠 | 枠ごとの KPI の差と、枠どうしの干渉(同じ購買の取り合い) | 枠ごとの A/Bテストの結果と、KPI の木の上での枠の役割の分担がそろった | 事業責任者・マーケティング |
| チャネルの横断 | サイト・アプリ・メール・店頭などのチャネルをまたぐ推薦 | チャネルごとの顧客の識別と、ログ・評価の方法の共通化。顧客への説明と同意(第14章) | 共通のログ・評価・監視の仕組みに載せられることを確かめた | 経営 |
表の「1枠の全面展開」で推薦なしの群を少し残すのは、展開の後も効果を測り続けるためです。この群を残さず、推薦を一部の顧客で止めて比べる実験も後から設けなければ、効果を確かめにくくなり、推薦経由の数に頼った説明に戻りやすくなります。人気順の群を別に残すと、推薦の方法を改良したときの比べる相手になります(その群との差の扱いは前の節のとおり)。
「複数の枠」の段階で気を付けたいのは、枠どうしの干渉です。商品ページの枠とカートの枠とメールの枠が、同じ顧客に同じ商品を推薦していると、どの枠が購買を生んだのかを枠ごとの数字で切り分けられません。枠ごとに A/Bテストを行う場合も、他の枠の状態を固定するか、枠の組み合わせで群を分けるかを、データ分析と相談して決めます。KPI の木の上で、それぞれの枠がどの枝を伸ばすためのものかを書き分けておくと、枠どうしで同じ役割を取り合う設計を避けやすくなります。
「チャネルの横断」の段階では、二重投資の損失の型に気を付けます。EC の部署・アプリの部署・メールの部署・店舗の部署が、それぞれ別のベンダーに依頼し、別のログと別の推薦の仕組みを作っていくと、同じ顧客に対してチャネルごとに食い違った推薦が出るうえ、第12章で扱った監視と再学習を、チャネルごとに作り直すことになります。最初の1枠の段階から、表示のログの項目・顧客と商品の識別子・評価の方法・監視の指標を、他の枠やチャネルでも使える形で決めておくと、2枠目以降の手間が小さくなります。チャネルをまたいで顧客の行動をつなぐ場合は、利用目的の示し方や外部への送信の扱いなど、第14章で扱う法令と顧客への説明の論点が増えるので、この段階では法務が計画の最初から関わります。
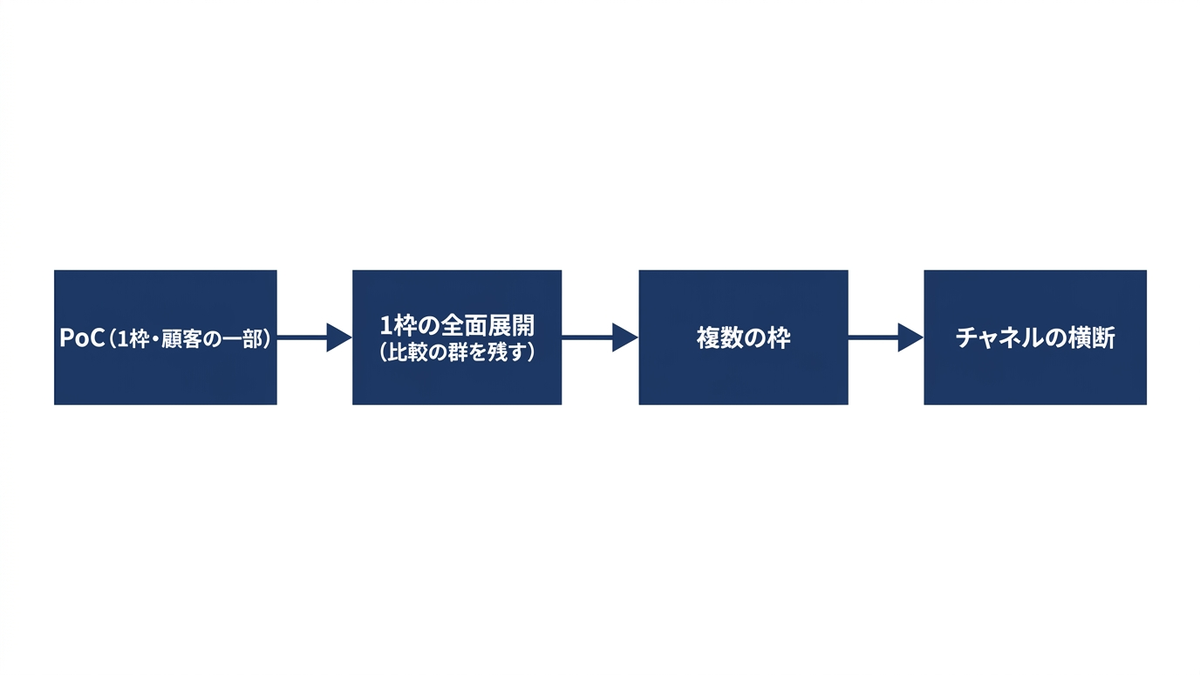
役割と責任分担、誰が決め、誰が作業し、誰に相談し、誰に知らせるか
推薦の導入に関わる人は、推薦のモデルを作る人より多くなります。推薦の枠はサイトやアプリの設計に関わり、推薦される商品は品揃えと在庫に関わり、顧客の行動ログは個人データの取り扱いに関わるからです。本コラムでは、関わる役割を次の10に分けて考えます。役割の名前は一般的なものにしてあり、組織によっては1人が複数の役割を兼ねます。
- 経営:推薦への投資の方針・予算・チャネルを横断する展開を決める
- 事業責任者:推薦の目的と KPI の木、PoC の出口、展開の段階の移行を承認する
- マーケティング:顧客の群・メールやプッシュ通知の推薦・販促との調整を担う
- EC 運営:推薦の枠の設計と表示、サイトやアプリの運用、A/Bテストの実施を担う
- 商品部:商品の属性データの整備、推薦から外す商品のルール、品揃えと在庫の観点からの確認を担う
- データ分析:KPI の設計の補助、オフライン評価、A/Bテストの設計と分析、効果の報告を担う
- エンジニア:推薦の計算の仕組み、ログの収集、推薦の結果を枠に渡す仕組みを担う
- 情報システム:データ基盤・顧客データの管理・情報セキュリティを担う
- 法務:個人データの利用目的・顧客への説明・外部への送信の扱いを確かめる(第14章)
- 外部のベンダー:推薦の製品やクラウドのサービスの提供、場合によっては推薦のモデルの開発と運用を担う
この10の役割で、主な作業ごとの責任分担を表にしたのが次の表です。表の記号は、R(実行する。作業を担う)、A(最終的に責任を持つ。承認する。各行に1つだけ)、C(相談を受ける。意見を出す)、I(結果を知らされる)を表します。この4つの区分の考え方は RACI と呼ばれ、フレームワークとしての一般的な使い方は弊社コラム『経営とAIの打ち手を導く戦略フレームワーク大全179選』で扱っています。ここでは推薦の導入に当てはめた表を示します。表の割り振りは本コラムが考えた例で、組織の大きさや既存の体制によって変わります。
| 作業 | 経営 | 事業責任者 | マーケティング | EC 運営 | 商品部 | データ分析 | エンジニア | 情報システム | 法務 | 外部のベンダー |
|---|---|---|---|---|---|---|---|---|---|---|
| 推薦の枠の選定と採点 | I | A | R | R | R | R | C | I | I | C |
| KPI の木とガードレールの指標の設計 | C | A | R | R | C | R | I | I | I | I |
| 表示のログの設計と収集 | I | I | C | C | I | A | R | R | C | C |
| 個人データの利用目的と顧客への説明の確認 | I | A | C | C | I | C | C | C | R | C |
| 商品の属性データと除外のルール | I | I | C | C | A | C | R | I | C | I |
| PoC の合格の条件と出口 | I | A | C | C | C | R | C | I | I | C |
| 推薦のモデルの作成とオフライン評価 | I | I | I | I | C | A | R | I | I | R |
| A/Bテストの実施と分析 | I | C | C | R | I | A | R | I | I | C |
| 出口の判断と展開の段階の移行 | I | A | C | C | C | R | C | I | C | I |
| 推薦の監視と障害のときの切り替え | I | I | I | C | I | C | A | R | I | R |
| 効果の報告(推薦経由の数と効果を分けて書く) | I | A | C | C | I | R | I | I | I | C |
| チャネルを横断する展開 | A | R | R | R | C | R | R | R | C | C |
この表で意図して置いたのは、次の3つの割り振りです。1つ目は、推薦の目的と出口に関わる行(枠の選定・KPI の木・PoC の合格の条件と出口・出口の判断・効果の報告)の A を、データ分析ではなく事業責任者にしたことです。推薦は事業の KPI を動かすための手段であり、どの KPI を増やし、どの結果なら次へ進むかは、事業に責任を持つ人が決めるものだと考えています。データ分析の担当者は、その判断の材料(必要な人数・差の信頼区間・オフライン評価の結果)をまとめる R を担います。
2つ目は、「推薦のモデルの作成とオフライン評価」と「A/Bテストの実施と分析」の A を、外部のベンダーではなく社内のデータ分析にしたことです。モデルを作る作業(R)は外部に任せる場合でも、納められた推薦を社内の評価データで評価し直し、A/Bテストの結果を分析する人は社内に置いておく必要があると考えています。評価を外部にすべて任せると、推薦経由の数を効果として受け取ってしまう「推薦経由で数える」型に陥りやすくなります。
3つ目は、「商品の属性データと除外のルール」の A を商品部にし、「個人データの利用目的と顧客への説明の確認」の R を法務にしたことです。推薦から外す商品(在庫切れ・年齢制限・取り扱いをやめる商品など)を決めるのは、品揃えに責任を持つ商品部です。第6章で扱ったとおり、商品の属性データの品質は内容ベースの推薦の成績に直接効くので、その整備の責任も商品部に置きました。個人データの扱いは、第14章で扱う法令に関わるので、法務が確かめる作業(R)を担い、事業責任者が承認する形にしました。
表の A は各行に1つだけ置きました。A が2つある行は、承認する人が2人いることになり、意見が割れたときに決まらなくなります。逆に、A が無い行は、誰も承認しないまま作業が進むか、作業が止まります。表を自社の組織に当てはめるときは、まず各行の A が1人に決まっているかを確かめ、次に R を担う人の工数が確保されているかを確かめることを勧めます。とくに、データ分析とエンジニアの R が多くの行に並ぶので、兼任で回せる量かどうかを先に見積もっておきます。
内製と外部委託・製品の利用、何を外に任せ、何を社内に残すか
推薦の仕組みを用意する方法は、おおまかに3つに分かれます。社内で推薦のモデルと仕組みを作る内製、推薦の開発や運用を外部の会社に依頼する外部委託、推薦の製品やクラウドのサービスを利用する方法です。実際には、推薦の計算はクラウドのサービスを使い、評価と運用は社内で担う、といった組み合わせにする場合もあります。本コラムでは、製品やサービスどうしの優劣は扱わず、3つの方法を選ぶときの観点を一般論として整理します。
| 観点 | 内製 | 外部委託 | 製品・クラウドのサービスの利用 |
|---|---|---|---|
| 立ち上げの速さ | 人とデータ基盤がそろっていれば速いが、無ければ遅い | 依頼先の体制しだい。要件を決める時間が要る | 用意された機能の範囲なら速いことが多い |
| 自社の事情への合わせやすさ | 合わせやすい | 契約で決めた範囲で合わせられる | 製品が用意した設定の範囲に限られる |
| 評価と改善の主導権 | 社内にある | 評価の方法とデータを社内に持たないと外部に寄る | 評価の方法とデータを社内に持たないと製品の画面の数字に寄る |
| 社内に必要な人 | データ分析・エンジニアを継続して確保する | 依頼の内容を決め、納品物を評価できる人 | 設定・連携を担う人と、効果を評価できる人 |
| ログとデータの扱い | 社内で管理する | 渡すデータの範囲と扱いを契約で決める | 製品に送るデータの範囲と扱いを利用規約と契約で確かめる(第14章) |
| やめるとき・替えるとき | 担当者の異動や退職で止まるおそれ | 成果物(モデル・コード・ログ)の扱いを契約で決めていないと引き継げない | 表示のログや評価の結果が製品の中にしか無いと、替えた後に比べられない |
表のどの列を選ぶ場合も、社内に残しておきたいものは共通しています。KPI の木と効果の定義、表示のログ、オフライン評価に使う評価データ、A/Bテストの設計と分析の主導権の4つです。これらを社内に持っていれば、推薦の方法を替えても、依頼先や製品を替えても、同じ物差しで比べられます。逆に、表示のログや評価の結果が外部のサービスの中にしか無いと、替えた後の推薦が前より良いのか悪いのかを確かめられず、乗り換えの判断そのものができなくなります。
外部に依頼する範囲と、社内に残す範囲は、契約の段階で文書にしておきます。社内と外部の役割、ログ・学習したモデル・評価の結果といった成果物をどう管理するか、顧客の行動データをどの範囲で渡し、どう扱ってもらうか、といった項目です。契約の条件そのものは本コラムの範囲を超えるので書きませんが、推薦の開発を依頼する場合は、効果を事前に約束しにくいこと、効果の測り方を自社の定義に合わせる必要があることのように、決まった仕様のシステムを納める場合とは違う論点が出やすいと考えています。次の段階へ進むための社内の承認の条件を、PoC の出口と同じ言葉でそろえておくと、外部とのやりとりと社内の判断がずれにくくなります。AIの社内ルールや規制との関係は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
内製を選ぶ場合に見落としやすいのは、推薦のモデルを作る工数より、ログの整備・評価・運用の工数のほうが長く続くことです。第12章で扱った監視と再学習、この章で扱った A/Bテストの繰り返しは、導入の後もずっと続きます。最初のモデルを作った担当者が異動すると止まる、という状態を避けるために、評価と運用の手順を文書にし、少なくとも2人が担える体制にしておくことを勧めます。
本コラムでは推薦の導入率の数字は示しません。他社の導入の状況より、自社の枠で推薦が無かった場合と比べて何が増えるかを確かめることのほうが、導入の判断には直接役に立つと考えています。
最初の90日の計画、週ごとに何を決め、何を残すか
ここまでの内容を、導入を決めてから最初の90日(およそ13週)の計画に落とします。次の表は、本コラムが考えた計画の例です。90日で、1枠の PoC のオフライン評価とオンライン評価を終え、出口を判断するところまでを範囲にしています。実際の期間は、表示のログがすでにあるか、推薦の結果を枠に渡す仕組みを作るのにどれだけかかるか、枠の流入の量で A/Bテストに何週かかるかで大きく変わるので、週の区切りは目安です。表示のログが無い場合は、ログを貯める期間がこの表の前に入ります。
| 週 | 主な作業 | 決めること | 残すもの | 主に担う役割 |
|---|---|---|---|---|
| 第1週・第2週 | 候補の枠の洗い出しと採点、ログの項目の棚卸し | 最初の1枠と、対象の顧客・商品 | 採点の表、ログの項目の一覧(表示のログの有無) | 事業責任者・EC 運営・マーケティング・商品部・データ分析 |
| 第3週 | KPI の木とガードレールの指標の設計、個人データの扱いの確認 | 主な KPI、ガードレールの指標、利用目的の示し方に問題が無いか | KPI の木、法務の確認の記録 | 事業責任者・データ分析・法務 |
| 第4週 | PoC の計画書の作成と承認、必要な人数の計算 | 比べる相手・評価の方法・合格の条件・期間・出口・判断する人 | 承認された PoC の計画書 | データ分析・事業責任者 |
| 第5週から第7週 | 評価データの作成(時間で切る)、ベースラインと候補の推薦の作成、オフライン評価 | オンラインで試す推薦の方法(本コラムの例では、原則としてベースラインに勝ったもの。どれも勝てなかった場合は、人気順を推薦なしと比べる案も含める) | オフライン評価の結果、推薦の方法の版 | データ分析・エンジニア・外部のベンダー |
| 第6週から第8週 | 推薦の結果を枠に渡す仕組み、表示のログ、群の割り当て、障害のときの代わりの推薦の準備 | 群の分け方、推薦の更新の頻度 | 群の割り当ての記録の仕組み、表示のログ | エンジニア・EC 運営・情報システム |
| 第9週から第12週 | A/Bテストの実施(期間は週の単位で事前に決めたとおり)、ガードレールの指標の監視 | (期間中は結果を見て止めない。ガードレールの指標の大きな悪化だけは止める基準を事前に決めておく) | 群ごとの KPI とガードレールの指標の記録 | EC 運営・データ分析 |
| 第13週 | 分析と出口の判断 | 1枠の全面展開へ進むか、方法の見直しか、枠の変更か、中止か | 判断の記録と理由、効果の報告(推薦経由の数と効果を分けて書く)、次の段階の計画の案 | 事業責任者・データ分析 |
表の第5週から第8週は、オフライン評価と、推薦を枠に出す仕組みの準備を並行して進める形にしています。オフライン評価が終わってから仕組みを作り始めると、その分だけ A/Bテストの開始が遅れ、PoC が90日に収まりません。オフライン評価でどの方法も人気順に勝てなかった場合は、人気順そのものを推薦の枠に出し、推薦なしの状態と比べる A/Bテストに切り替えることもできます。人気順やルールの推薦(第3章)を枠に出したときに、枠が無い状態より KPI が上がるかどうかは、試してみなければ分からないので、その差を確かめること自体に意味があると考えています。
第9週から第12週の A/Bテストの期間中は、結果を見て止めないことを原則にします。ただし、ガードレールの指標が大きく悪化した場合(たとえば問い合わせや配信停止が急に増えた場合)は、顧客の離反を防ぐために止める必要があります。止める基準は、主な KPI の結果とは別に、計画書の段階で決めておきます。第13週の出口の判断では、PoC の計画書に書いた出口のどれに当たるかを確かめるだけにし、その場で新しい合格の条件を作らないようにします。結果を見てから条件を変えると、PoC が何を確かめたのかが分からなくなります。条件を変える必要があると分かった場合は、それを次の PoC の計画書に書き、改めて承認を得ます。
経営判断、PoC の出口と効果の測り方を先に決める
この章の内容を、経営の判断に置き換えます。推薦の導入で経営が決めることは、どの推薦の方法やどの製品を使うかではなく、どの枠で何を増やすために、どの条件で、誰の責任で進めるかです。とくに、PoC の出口と効果の測り方を始める前に決めることと、効果の数字を推薦経由の数ではなく推薦が無かった場合との差で報告させることの2つは、経営の判断として明文化しておくのがよいと考えています。
判断を誤ったときの損失は、序章で整理した6つの損失の型で整理できます。PoC の出口を決めずに始めると、PoC が延長され、効果が確かめられないまま続く形骸化になりやすくなります。部署ごとに別々に PoC を行えば、似た検討が繰り返される二重投資になりやすくなります。推薦経由の購買の数を効果として報告させると、推薦が無くても買われた分まで推薦の成果と数える効果の過大評価になり、推薦への投資の判断を誤ります。表示のログを残さずに始めると、どの商品が顧客の目に触れていなかったかを後から確かめられず、機会損失の手がかりを失います。ガードレールの指標を置かずにクリック率だけを追わせると、推薦が一部の人気商品や値引きの商品に集中する品揃えの偏りや、しつこい推薦による顧客の離反につながります。導入の後に効果を測り続ける仕組みを置かないと、推薦の枠が見られなくなっても気付かない形骸化につながります。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- PoC の計画書に、比べる相手・オンライン評価の方法・合格の条件・出口・判断する人を書くことを、PoC の予算を付ける条件にする
- 推薦の効果は A/Bテスト等で推薦が無い場合と比べた差で報告し、推薦経由の数は別の欄に置くことを報告の書式として決める
- KPI の木の上で、推薦の枠がどの中間の KPI を動かすための投資かを示させ、ガードレールの指標を合格の条件に含める
- 表示のログ・評価データ・効果の定義を社内に持ち、外部のベンダーや製品を替えても同じ物差しで比べられるようにする
- 推薦なしの群を少し残し続け、効果を測り続けることを、展開の計画と予算に含める(人気順の群との差の扱いは効果の見立ての節のとおり)
- 最初の1枠の段階から、ログ・識別子・評価・監視の仕組みを他の枠やチャネルでも使える形で作り、部署ごとの作り直しを避ける
予算の面では、推薦の予算をモデルの開発や製品の利用だけに付けるのではなく、表示のログの整備・商品の属性データの整備・A/Bテストの実施と分析・導入の後に効果を測り続ける作業にも付けることを勧めます。これらは目に見える機能の形をとらない作業ですが、ここに予算と人の時間が付いていないと、PoC の結果の意味が定まらず、展開の判断ができません。体制の面では、事業責任者が PoC の最初から関わり、合格の条件と出口を自分の言葉で承認することを、導入の条件にするのがよいと考えています。データ分析の担当者だけで進んだ PoC は、オフラインの成績が良くても、事業の KPI のどこにつながるのかを説明できず、展開の段階で目的から見直すことになりやすいからです。
この章の要点をまとめると、最初の1枠は効果が出る余地(購買への近さ・品揃えの広さ)と確かめやすさ(流入の量・データの量)で選び、KPI の木で推薦の枠の KPI を最終の KPI につなげ、ガードレールの指標で悪さを見張ります。PoC はオフライン評価とオンライン評価の2段で設計し、比べる相手・合格の条件・出口・判断する人を始める前に決め、効果は推薦が無かった場合との差として、率と件数の型で書きます。展開は1枠から複数の枠、チャネルの横断へと段階を分け、表示のログ・評価データ・効果の定義は、内製・外部委託・製品の利用のどれを選んでも社内に残します。次の第14章では、推薦と個人データに関わる法令と規制、推薦の透明性、公開事例と生成AIによる推薦の動向を扱います。
Anagraftでは、レコメンドを含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『データドリブン思考 データ分析・AIを実務に活かす』(河本薫 著、ダイヤモンド社):2022年1月刊。版元の紹介では、データを集める仕組みや分析の人材をそろえるだけでは事業の価値につながらないという立場から、データ分析と AIを実務に活かすための考え方を解説しています。この章で扱った、推薦の目的を事業の KPI につなげ、分析の結果を誰がどう判断に使うかを決める進め方を、推薦に限らないデータ活用の一般論として考え直すときの手がかりになります。
『AI・データ分析プロジェクトのすべて ビジネス力×技術力=価値創出』(大城信晃 監修・著、マスクド・アナライズ、伊藤徹郎、小西哲平、西原成輝、油井志郎 著、技術評論社):版元のページでは2020年12月の発売で、AIやデータ分析のプロジェクトを、技術だけでなくビジネスの面から扱い、案件の獲得と外部の資源の検討、データのリスク管理と契約、プロジェクトの立ち上げと管理、分析結果の評価と改善、プロジェクトの継続性までを章立てにしています。この章で扱った PoC の計画書と出口、社内と外部の役割の分け方を、データ分析のプロジェクトの進め方の中で整理し直すときに参考になります。
第14章 プライバシーと規制、公開事例と最新動向
第13章では、推薦を入れる枠を流入の量・購買への近さ・品揃えの広さ・データの量で選び、PoC の出口と効果の測り方を始める前に決めておくことを扱いました。ここまでの章は、推薦を「どう作り、どう測り、どう入れるか」の話でした。この章では、その前提になる2つのことを扱います。1つは、推薦に顧客の購買や閲覧の履歴を使うことに関わる法令です。もう1つは、企業が公表している推薦システムの事例と研究の動向を、どこまで自社の判断に使ってよいかという読み方です。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 個人情報保護法の利用目的の特定・個人関連情報・仮名加工情報と、推薦に使うデータの関係
- 2026年7月に公布された個人情報保護法の改正法のうち、推薦に関わりうる項目
- 電気通信事業法の外部送信規律と、その対象になる事業・ならない事業
- EU の一般データ保護規則(GDPR)のプロファイリングの定義と、異議を述べる権利・自動化された決定の規定
- EU のデジタルサービス法(DSA)の推薦システムの透明性の規定と、EU AI規則について確かめた範囲
- 日本のデジタルプラットフォームに関する2つの法律と、推薦の理由の表示
- 企業が論文で公表した推薦システムの事例、公開データセット、生成AIを推薦に使う研究の読み方
- 推薦の仕組みが形骸化する型と、経営判断
この章の主張は2つです。1つは、法令と顧客の信頼を、推薦のアルゴリズムを選ぶ前の設計の条件として扱うことです。利用目的に推薦のための分析を書いていない、外部のツールに送っている情報を説明していない、という状態で精度の高い推薦を作っても、後から作り直しになるおそれがあります。もう1つは、公開事例や論文の数字を、その企業・そのデータ・その条件での結果として読むことです。生成AIによる推薦の研究も、この読み方の延長として扱います。どちらも、推薦の仕組みに予算を付ける前に確かめておくべきことだと考えています。
なお、この章で扱う法令の記述は、2026年11月10日から11日にかけて e-Gov 法令検索・個人情報保護委員会・総務省・EUR-Lex の一次情報を開いて確かめた範囲に限ります。条文の要旨は本コラムの言葉で書いたもので、法令の正式な解釈ではありません。自社のサービスが規定の対象になるかどうか、どの措置が必要かは、所管官庁のガイドラインと Q&A を確かめたうえで、法務の担当者や専門家と判断してください。
推薦と個人情報保護法、利用目的に「分析して推薦する」ことを書く
推薦に使う購買や閲覧の履歴が、会員番号や氏名と結び付いて管理されている場合、その履歴は個人情報保護法でいう個人情報として扱うことになります。同法の第2条第1項は、個人情報を、生存する個人に関する情報で、氏名・生年月日その他の記述等によって特定の個人を識別できるもの(他の情報と容易に照合でき、それによって特定の個人を識別できることになるものを含む)などと定めています。会員の購買履歴は、それ単体では誰のものか分からなくても、社内の会員台帳と容易に照合できるなら、この定義に当てはまりうるということです。
個人情報を扱う事業者(個人情報取扱事業者)に最初にかかる義務は、利用目的の特定です。第17条第1項は、個人情報を取り扱うに当たって、利用の目的をできる限り特定しなければならないと定め、第18条第1項は、あらかじめ本人の同意を得ないで、特定した利用目的の達成に必要な範囲を超えて個人情報を取り扱ってはならないと定めています。第21条第1項は、個人情報を取得した場合は、あらかじめ利用目的を公表している場合を除いて、速やかに利用目的を本人に通知するか公表しなければならないと定めています。
推薦との関係で押さえておきたいのは、個人情報保護委員会の「個人情報の保護に関する法律についてのガイドライン(通則編)」の 3-1-1 の記述です。同ガイドラインは、本人から得た情報から本人の行動・関心等の情報を分析する場合には、どのような取扱いが行われているかを本人が予測・想定できる程度に利用目的を特定しなければならない、という趣旨を示しています。そのうえで、具体的に特定している例として、閲覧履歴や購買履歴等を分析して趣味・嗜好に応じた新商品・サービスの広告に利用する、という書き方を挙げ、特定していない例として「事業活動に用いるため」「マーケティング活動に用いるため」を挙げています。同ガイドラインの表紙の記載は「平成28年11月(令和8年6月一部改正)」で、本コラムはこの版を開いて確かめました。
購買や閲覧の履歴から本人の関心を推定して行う推薦は、「本人から得た情報から本人の関心を分析する」取扱いに当たります(全員に同じ並びを示す人気順や新着順は、この意味での分析をしていません)。プライバシーポリシーの利用目的が「サービスの向上のため」「マーケティングのため」のような書き方に留まっている場合は、推薦のために購買や閲覧の履歴を分析することが本人に予測できる書き方になっているかを、法務の担当者と確かめておくことを勧めます。ガイドラインの例は広告への利用の例ですが、サイト内の推薦の枠・推薦のメール・プッシュ通知に履歴の分析を使う場合も、どの履歴を分析して何に使うかを書いておくほうが、本人が予測できる範囲に収まりやすいと考えています。
利用目的を後から変える場合の制約も、推薦の計画に関わります。第17条第2項は、利用目的を変更する場合には、変更前の利用目的と関連性を有すると合理的に認められる範囲を超えて行ってはならないと定めています。第21条第3項は、利用目的を変更した場合は、変更された利用目的を本人に通知するか公表しなければならないと定めています。たとえば、購買の記録を「配送と決済のため」だけに使うと書いて集めてきた事業者が、その記録を推薦のための分析にも使おうとする場合、変更が関連性のある範囲に収まるかを検討する必要があります。推薦の仕組みを作り始めてからこの問題に気づくと、過去の履歴を学習に使えるかどうかが決まらず、計画が止まります。第2章で扱った表示ログ・行動ログの設計と同じ時期に、利用目的の書き方も見直しておくのがよいと考えています。
個人関連情報と仮名加工情報、推薦のデータを3つの概念で整理する
推薦に使うデータには、会員情報と結び付いた個人情報のほかに、ログインしていない閲覧者の Cookie に結び付いた閲覧履歴のように、事業者の手元では特定の個人を識別できない情報もあります。2020年の改正(令和2年法律第44号。2022年4月1日に全面施行)で、こうした情報を扱う区分が整理されました。推薦の担当者が押さえておきたいのは、個人関連情報と仮名加工情報の2つです。
個人関連情報は、第2条第7項で、生存する個人に関する情報であって、個人情報・仮名加工情報・匿名加工情報のいずれにも該当しないもの、と定義されています。個人情報保護委員会の資料は、電話番号・メールアドレス(氏名を含まないもの)・Cookie ID 等に結び付いた個人に関する情報は、他の情報と容易に照合して特定の個人を識別できる場合を除き、個人情報に該当せず個人関連情報とされる、と説明しています。第31条第1項は、提供先が個人関連情報を個人データとして取得することが想定されるときに、本人の同意が得られていることなどを確かめずに提供してはならない、と定めています。ここでいう個人データは、個人情報のうち、検索できるように整理された集まり(個人情報データベース等)を構成するものです(第16条第3項)。会員台帳や購買のデータベースに入っている個人情報は、通常これに当たります。推薦の文脈では、自社で集めた閲覧履歴を外部の事業者に渡し、その事業者が手元の会員情報と結び付ける場合に、この規定を確かめる必要があります。
仮名加工情報は、第2条第5項で、氏名などの記述等の一部や個人識別符号の全部を削除する(復元できる規則性の無い方法で置き換えることを含む)などの措置を講じて、他の情報と照合しない限り特定の個人を識別できないように加工して得られる個人に関する情報、と定義されています。仮名加工情報の扱いは第41条に定められています。推薦の担当者にとっての要点は、次の2つにまとめられます。
- 社内の分析に使う場合:氏名や連絡先を外した購買の記録を、推薦の手法の比較や分析に使う場面がこれに当たりえます。利用目的の変更の制限(第17条第2項)は適用されず(第41条第9項)、変更後の利用目的は本人への通知ではなく公表で足ります(同条第4項の読み替え)。ただし、作成は委員会規則の基準に沿って行い、削除した情報は安全に管理します
- してはならないこと:原則として第三者に渡すこと、本人を識別するために他の情報と照合すること、含まれる連絡先を使って本人に連絡することは禁じられています(第41条第6項から第8項)
つまり、仮名加工情報は社内の分析を進めやすくする区分で、顧客に推薦を届ける用途の区分ではありません。
3つの概念は、互いに重ならない分類ではありません。第41条第3項が「仮名加工情報(個人情報であるものに限る)」と書き、第42条が個人情報でない仮名加工情報を別に定めているとおり、仮名加工情報は個人情報に当たる場合があります。氏名を外した記録でも、作成した事業者の手元に元の会員台帳や削除した情報があれば、その事業者にとっては個人情報でもある、という関係が生じえます。一方、個人関連情報は、定義上、個人情報・仮名加工情報・匿名加工情報のいずれにも当たらないものです。
3つの概念を、推薦の場面に当てはめて次の表にまとめました。どれに当たるかは、データの持ち方・照合の可否・社内の管理の実態で決まるので、表の「推薦での典型的な場面」は例であり、その場面のデータが必ずその概念に当たるという意味ではありません。
| 概念 | 条文上の位置 | 推薦での典型的な場面 | 推薦の設計で確かめること |
|---|---|---|---|
| 個人情報 | 第2条第1項。利用目的の特定(第17条)・目的外利用の制限(第18条)・通知や公表(第21条) | 会員番号と結び付いた購買履歴・閲覧履歴を使って、会員ごとに推薦を出す | 利用目的に、履歴を分析して推薦に使うことが本人に予測できる形で書かれているか |
| 個人関連情報 | 第2条第7項。提供先で個人データになることが想定される提供の確認(第31条) | ログインしていない閲覧者の Cookie ID に結び付いた閲覧履歴を、外部の事業者へ渡す | 提供先がその情報を会員情報などと結び付けるか。結び付けるなら本人の同意の確認が要る |
| 仮名加工情報 | 第2条第5項。作成・安全管理・利用の制限(第41条) | 氏名や連絡先を削除・置換した購買の記録を、社内で推薦の手法の比較や分析に使う | 作成の基準に沿って加工したか。第三者に渡さない・本人を識別するために照合しない・連絡に使わない運用になっているか |
表の3行目について補足します。仮名加工情報は、社内の分析に使いやすくする区分ですが、第41条第8項は、仮名加工情報に含まれる連絡先その他の情報を、電話・郵便・電子メール等で連絡するために利用してはならないと定めています。推薦の手法を比べる分析に仮名加工情報を使うことと、推薦の結果を顧客個人に届ける(メールで送る、サイトで表示する)ことは別の取扱いです。仮名加工情報を本人を識別するために会員情報と照合し直して配信に使うことは、第41条第7項の照合の禁止に触れます。個人ごとの配信には、仮名加工情報ではなく、特定した利用目的の範囲で取得・利用している配信用の個人データを使う必要があります。分析用のデータと配信用のデータを、同じテーブルで管理していると、この区別が曖昧になります。第12章で扱ったシステムの構成の中で、分析の環境と配信の環境を分けておくことは、この点でも意味があると考えています。
2026年7月公布の改正法、推薦に関わりうる項目と施行の時期
個人情報保護法は、2020年の改正法の附則で、施行後3年ごとに見直すことになっています。この見直しに基づく「個人情報の保護に関する法律等の一部を改正する法律」(令和8年法律第56号)が、2026年7月17日に公布されました。施行の時期は、確定した日と期限を分けて読む必要があります。改正法の附則第1条は、次のように定めています。
- 主要な部分:公布の日から起算して2年を超えない範囲内で、政令で定める日に施行する
- 一部の規定(同条第3号に列挙された、公示送達や罰則の一部などの改正規定):公布の日から起算して6か月を経過した日に施行する
e-Gov 法令検索の改正履歴では、2026年11月10日時点で、この改正法による改正が「2027年1月17日」と「2028年7月16日」の2つの日付で未施行として表示されていました。前者は6か月を経過した日に当たります。一方、主要な部分の施行日は政令で定めることになっており、2026年11月11日に個人情報保護委員会の改正法のページを開いた時点では、施行期日を定める政令についての記載はありませんでした。そのため本コラムでは、主要な部分は「公布から2年以内(2028年7月まで)の政令で定める日」に施行されるものとして扱い、2028年7月16日を確定した施行日としては扱いません。政令・委員会規則・ガイドラインは、同委員会が検討を続けていると同委員会のページに書かれています(2026年10月14日更新の記載)。
概要資料に挙げられた改正内容のうち、推薦に関わりうると本コラムが考えたものを、次の表にまとめました。表の「内容」は概要資料の記述を本コラムの言葉で短くしたもので、条文の正確な要件ではありません。また、改正後の条番号は概要資料に書かれたもので、施行前の時点の e-Gov の現行条文には反映されていません。
| 改正の項目 | 内容(概要資料の要旨) | 推薦に関わりうる点 |
|---|---|---|
| 統計作成等の例外(第30条の2・第31条の3) | 統計情報等の作成(統計作成等と整理できる AI開発等を含む)にだけ使われることが担保されているなどの条件で、本人の同意なしの第三者提供等を認める。公表や書面の合意などの規律を伴う | 複数の事業者のデータを持ち寄って分析する場面の選択肢になりうる。特定の顧客に推薦を出すことが対象になるかは、政令・規則・ガイドラインで確かめる(表の下の補足) |
| 特定の個人に働きかけが可能となる個人関連情報(第31条の2) | 住所・電話番号・メールアドレス・Cookie ID 等の、特定の個人に連絡できる記述等を含む個人関連情報について、不適正な利用と不正な取得を禁止する | Cookie ID に結び付いた閲覧履歴など、個人情報に当たらないとして扱ってきた情報にも、不適正な利用の禁止がかかる |
| 16歳未満の者の個人情報(第35条第9項・第10項、第40条の2 など) | 本人が16歳未満の場合、同意の取得や通知等の対象を法定代理人とすることを明文化し、利用停止等の請求の要件を緩和し、未成年者の最善の利益を優先して考慮する責務の規定を設ける | 未成年の利用者がいるサービスでは、推薦のための分析の同意・通知の相手と、利用停止の請求への対応を見直す必要がありうる |
| 課徴金(第148条の3から第148条の17) | 重大な違反行為で個人の権利利益が侵害された場合等に、違反行為で得た財産的利益等に相当する額の課徴金の納付を命じる | 違反の代償が、是正の勧告や命令だけでなく金銭的な負担にも及びうる |
表の1行目の統計作成等の例外について補足します。概要資料が想定しているのは、特定の個人との対応関係が排斥された統計情報等を作る取扱いです。特定の顧客に推薦を出すことは、個人ごとに結果を返す取扱いなので、これとは別のものと本コラムは考えています。この例外が推薦のどの段階に使えるかは、政令・規則・ガイドラインが出てから確かめる必要があります。
表の2行目は、推薦の担当者にとって見落としやすい項目です。これまでの個人関連情報の規律は、概要資料の説明によれば、提供先で個人データになることが想定される第三者提供だけを対象としていました。改正後は、Cookie ID 等の連絡に使える記述等を含む個人関連情報についても、不適正な利用と不正な取得が禁じられます。概要資料の想定事例は、偽りの説明で取得した情報の提供や、詐欺的な広告への誘導など、悪質な例が中心です。通常の推薦がすぐに当てはまると読むのは早いと考えますが、「個人情報ではないから規律の外」という整理が改正後も通用するとは限らない、という点は押さえておく必要があります。
16歳未満の者の項目は、動画・音楽・ゲーム・学習のサービスのように、未成年の利用者がいる推薦の枠で関わります。概要資料は、本人が16歳未満であることを事業者が知らないことについて正当な理由がある場合などを例外として挙げています。年齢を確かめる仕組みが無いサービスで、どこまでの対応が求められるかは、今後の規則やガイドラインで確かめる必要があります。推薦の設計の段階で、利用者の年齢の情報を持っているか、持っていないならどう扱うかを、法務の担当者と整理しておくことを勧めます。
電気通信事業法の外部送信規律、対象になる事業とならない事業
推薦の仕組みを外部のツールやサービスで動かす場合、利用者のブラウザやアプリから、閲覧した商品・クリック・端末の識別子などの情報が、外部の事業者のサーバーに送られることがあります。こうした送信について、利用者に知らせることを求めるのが、電気通信事業法の外部送信規律です。総務省のページによれば、この規律は2022年6月の電気通信事業法の改正で設けられ、2023年6月16日に施行されました。ここでいう「外部」は利用者の端末の外という意味で、総務省の FAQ(問1-16)は、サービスを提供する事業者自身のサーバーへの送信も含まれると回答しています。
根拠は電気通信事業法の第27条の12です。要旨は、対象の役務を提供する事業者が、利用者の端末から外部へ利用者に関する情報を送らせる場合(条文の語では情報送信指令通信を行う場合)には、あらかじめ、送られる情報の内容と送信先などを利用者に通知するか、利用者が容易に知り得る状態に置かなければならない、というものです。対象の役務の範囲は、総務省令で定められています(次の段落)。ただし、送られる情報が次のいずれかに当たる場合は、通知等は要りません。
- サービスを画面に正しく表示するためなど、利用に必要なものとして総務省令で定める情報
- 事業者が自ら発行した識別符号を、自らのサーバーに送る場合のもの
- 利用者が送信に同意している情報
- 利用者の求めに応じて送信や利用を止める措置(オプトアウト)を講じてその方法を知らせている場合に、利用者が停止を求めていない情報
推薦の担当者にとって大事なのは、どの事業が対象になるかです。条文の対象は、電気通信事業者または第三号事業を営む者のうち、総務省令で定める電気通信役務を提供する者です。FAQ の問1-17 は、電気通信事業者であっても、その事業者のすべての役務が対象になるわけではないと回答しています。総務省の外部送信規律の FAQ(問1-9)は、対象となる電気通信役務を、ブラウザやアプリを通じて提供される次の4種類のいずれかとしています。
- 利用者間のメッセージの媒介等
- SNS・電子掲示板・動画共有サービス・オンラインショッピングモール等
- オンライン検索サービス
- ニュース配信・気象情報配信・動画配信・地図等の各種情報のオンライン提供
同じ FAQ の問1-12と問1-13は、自社のウェブサイトで自社の商品を販売する小売業者について、小売業の遂行の手段として電気通信を用いているに過ぎないため、外部送信規律は適用されない、と回答しています。一方、問1-14は、インターネット経由で複数の店舗の商品を購入できる「場」を提供するオンラインショッピングモールは電気通信事業に該当し、外部送信規律が適用される、と回答しています。つまり、自社の商品の販売の手段として通信を使っているだけの EC サイトの推薦の枠と、複数の出品者が参加するモールや、動画・ニュースの配信サービスの推薦の枠とでは、この規律の適用が分かれます。自社の EC サイトでも、利用者が投稿できる掲示板やレビューの共有、情報の配信など、上の4種類に当たりうる機能を加えている場合は、自社の商品の販売だけとは言えなくなる可能性があるので、総務省の FAQ と照らして個別に確かめる必要があります。
対象になる事業で、外部の推薦サービスや計測のツールのタグを置いている場合は、そのタグが何の情報をどこに送っているかを一覧にし、通知・公表・同意・オプトアウトのどれで対応するかを決めておく必要があります。対象にならない事業でも、外部のツールに何が送られているかを把握していないことは、個人情報保護法の第三者提供や個人関連情報の確認、顧客への説明の点で問題になりえます。外部のツールの一覧を作っておくことは、規律の対象かどうかに関わらず、推薦の仕組みを管理するうえで有効だと考えています。次の図は、推薦に使うデータの流れと、各段階で確かめる事項のうち、一部の論点を示したものです。
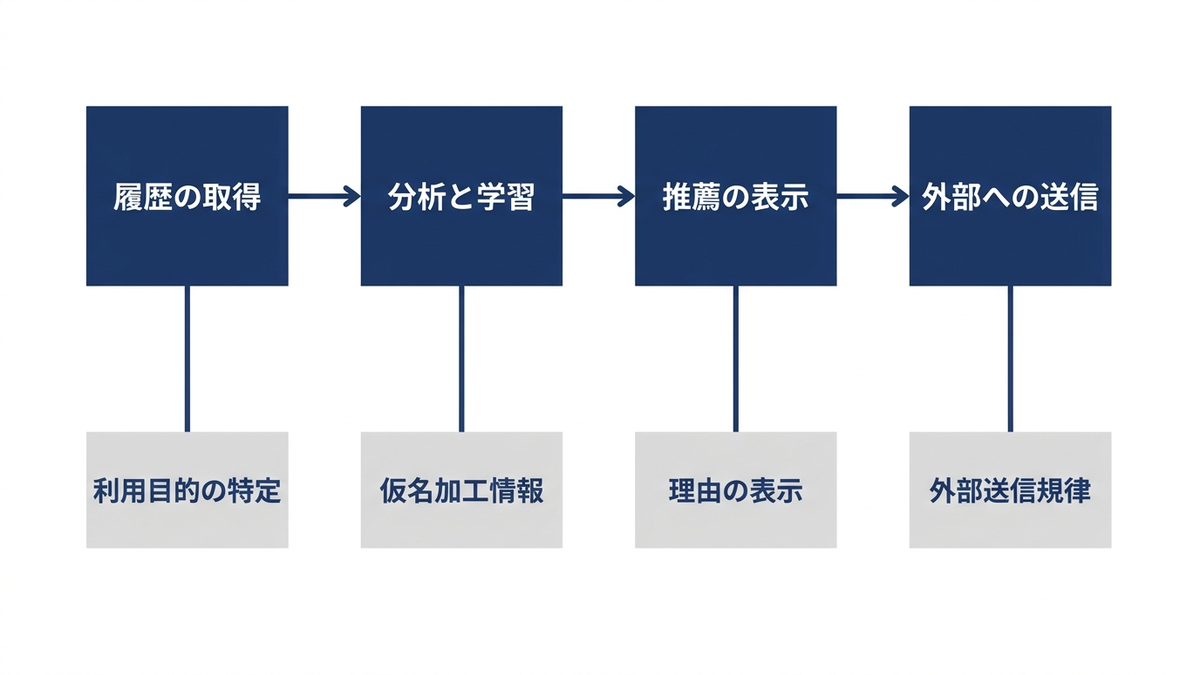
EU の一般データ保護規則、プロファイリングと異議を述べる権利
EU の域内の顧客に推薦を出す場合は、EU の一般データ保護規則(GDPR。規則(EU)2016/679)が関わりえます。同規則は2016年4月27日に採択され、第99条で2018年5月25日から適用されています。EUR-Lex の書誌の頁では、2026年11月10日時点で、本文の訂正(正誤)のほかに、欧州委員会による改正の提案が2件(文書番号 COM(2025)501 と COM(2025)837)関連文書として掲載されていました。本コラムはこれらの提案の中身を確かめていないので、以下は2016年の採択時の本文で確かめた範囲です。
適用の範囲は第3条が定めています。推薦に関わる要旨は次の2つです(第3項は、国際公法によって加盟国の法が適用される場所についての規定です)。1つは、EU 域内にある管理者や処理者の拠点の活動に関連する処理で、処理が域内で行われるかどうかを問いません(第1項)。もう1つは、EU 域内に拠点が無い管理者や処理者による、EU 域内にいる本人の個人データの処理で、その本人への商品やサービスの提供(支払いの有無を問わない)か、域内で行われる本人の行動の監視に関連するものです(第2項)。EU 域内に拠点が無い日本の事業者でも、EU 域内の顧客に向けて商品を売り、その顧客の閲覧や購買の履歴を推薦に使う場合には、この第2項に当たるかを確かめる必要があります。具体的な当てはめは、欧州データ保護会議の指針などを確かめて判断する必要があります(本コラムは指針の中身を確かめていません)。
推薦との関係で最初に押さえる語は、プロファイリングです。第4条第4号は、プロファイリングを、自然人に関する一定の個人的な側面を評価するために個人データを用いる、あらゆる形式の自動化された処理と定義し、その例として、職務の遂行・経済状況・健康・個人的な嗜好・関心・信頼性・行動・位置や移動の分析や予測を挙げています。購買や閲覧の履歴から顧客の関心を推定して推薦を出すことは、この定義の「嗜好」「関心」の分析や予測に当てはまりうると本コラムは考えます。
次に、異議を述べる権利です。第21条第2項は、個人データがダイレクトマーケティングの目的で処理される場合、本人は、そのマーケティングのための処理(ダイレクトマーケティングに関係する範囲のプロファイリングを含む)に、いつでも異議を述べる権利を持つと定めています。同条第3項は、本人が異議を述べた場合、個人データはその目的のために処理されてはならないと定めています。同条第4項は、遅くとも本人との最初の連絡の時点で、この権利を明示的に知らせ、他の情報と分けて明確に示すことを求めています。GDPR が自社の処理に適用される場合には(第3条の要旨は上のとおり)、推薦のメールのように、ダイレクトマーケティングの性格が強い推薦の枠で、この権利に応じられる仕組み(推薦のための処理を止める手段)を用意しておく必要があります。
第22条は、自動化された処理のみに基づく決定のうち、本人に法的な効果を生じさせるもの、または同様に本人に重大な影響を及ぼすものについて、本人がその対象とされない権利を定めています。契約の締結や履行に必要な場合、EU や加盟国の法で認められた場合、本人が明示的に同意した場合は例外とされ、契約と同意の場合には、人の関与を得る権利や異議を述べる権利などの保護措置を講じることが求められます。商品の推薦の多くは、表示する商品の順番を変えるもので、ただちに「法的な効果」や「同様の重大な影響」に当たると読むのは早いと考えます。一方で、与信・保険・求人のように、推薦の結果が契約の条件や機会の有無に直結する領域では、第22条の検討が必要になる場面がありうるので、推薦の対象と使い方を法務の担当者と確かめておくことを勧めます。
EU のデジタルサービス法、推薦システムの透明性を求める規定
推薦そのものを名指しで規律しているのが、EU のデジタルサービス法(DSA。規則(EU)2022/2065)です。同規則は2022年10月19日に採択され、原則として2024年2月17日から適用されています(第93条。一部の規定は2022年11月16日から)。超大規模オンラインプラットフォームに指定された事業者には、それより早く適用される場合があります。指定の通知を受けてから4か月後の日が2024年2月17日より前に来る場合は、その4か月後の日から適用されます(第92条)。適用の日と対象は、この節の後の表にまとめました。
DSA の第3条(s)は、推薦システムを、オンラインプラットフォームが、そのオンライン上の画面で利用者に特定の情報を示したり優先して表示したりするために使う、全部または一部が自動化されたシステムと定義しています。利用者が始めた検索の結果として示すものや、表示する情報の相対的な順番や目立たせ方を決めるものも含まれます。ここでいうオンラインプラットフォームは、第3条(i)で、利用者の求めに応じて情報を保存し、公衆に広めるホスティングサービスとされています。自社の商品だけを売る EC サイトがこの定義に当たるかどうかは、本コラムでは確かめていません。複数の出品者が参加するマーケットプレイスや SNS のように、利用者が投稿した情報を公衆に広める事業かどうかを、個別に確かめる必要があります。
この定義のうえで、推薦システムの透明性を求めるのが第27条です。要旨は次のとおりです。
- 推薦システムを使うオンラインプラットフォームの提供者は、利用規約の中で、推薦システムで使う主要なパラメータと、利用者がそれを変更したり影響を与えたりできる選択肢を、平易で分かりやすい言葉で示す(第1項)
- 主要なパラメータの説明は、なぜその情報が利用者に示されるのかを説明するもので、少なくとも、示す情報を決めるうえで最も重要な基準と、それらのパラメータの相対的な重要度の理由を含む(第2項)
- 表示の順番を決める推薦システムに複数の選択肢がある場合は、利用者がいつでも好みの選択肢を選び直せる機能を、情報が優先表示されている画面の該当箇所から直接かつ容易に使えるようにする(第3項)
零細企業・小企業に当たるオンラインプラットフォームの提供者には、第27条を含む節(オンラインプラットフォームに追加される規定)が適用されません(第19条。第24条第3項を除く。零細企業・小企業は EU の勧告 2003/361/EC の定義による)。除外されるのはこの節の規定で、DSA の全体ではありません。ただし、超大規模オンラインプラットフォームに指定された場合は、企業の規模に関わらず適用されます。推薦の担当者がまず確かめることは、自社のサービスがオンラインプラットフォームに当たるか、当たるなら零細・小企業の除外を受けるか、の2点です。
第38条は、超大規模オンラインプラットフォームと超大規模オンライン検索エンジンの提供者に、第27条の要件に加えて、推薦システムごとに、GDPR の第4条第4号が定めるプロファイリングに基づかない選択肢を少なくとも1つ用意することを求めています。超大規模の基準は、第33条第1項で、EU 域内の月間の平均の利用者が4,500万以上で、同条第4項に基づき指定されたもの、とされています。つまり、規模の大きなプラットフォームでは、個人の嗜好や関心の評価に基づかない推薦の選択肢を、利用者が選べるようにしておくことが求められます。「履歴を使わない」と「プロファイリングに基づかない」は同じ意味ではありません。履歴を使わなくても、登録した属性などの個人データから嗜好を評価して並べ替えれば、プロファイリングに当たりうるからです。個人ごとの調整を加えない人気順や新着順は、プロファイリングに基づかない選択肢の例として考えられます。
DSA には、推薦と隣り合う広告の規定もあります。第26条第3項は、オンラインプラットフォームの提供者が、GDPR 第9条第1項の特別な種類の個人データ(健康・信条など)を用いたプロファイリングに基づいて広告を表示してはならないと定めています。推薦の枠と広告の枠を同じ仕組みで動かしている場合は、どちらの規定が関わるかを分けて確かめておく必要があります。
EU AI規則(規則(EU)2024/1689)は、2024年8月1日に発効しました。EUR-Lex の書誌の頁では、2026年7月27日に別の規則(規則(EU)2026/1744)によって一部が改正されたことが示されていました。適用の日程や、どの AIシステムがどの義務の対象になるかは改正後の本文で確かめる必要があり、本コラムが確かめた範囲では、推薦システムが同規則のどの義務に当たるかは整理できていません。AIの規制と社内ルールの全体は、弊社コラム「AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで」で扱っています。
| 法令 | 推薦に関わる主な規定 | 対象 | 適用・施行 | 推薦の設計で確かめること |
|---|---|---|---|---|
| 個人情報保護法 | 利用目的の特定(第17条)、目的外利用の制限(第18条)、通知・公表(第21条)、個人関連情報(第31条)、仮名加工情報(第41条) | 個人情報取扱事業者など | 2026年11月10日に e-Gov で確かめた現行条文。令和8年法律第56号による改正は未施行(主要な部分は公布から2年以内の政令で定める日) | 利用目的の書き方、外部への提供、分析用データの区分 |
| 電気通信事業法の外部送信規律 | 情報送信指令通信に係る通知等(第27条の12) | 電気通信事業者または第三号事業を営む者のうち、総務省令で定める電気通信役務(SNS・モール・検索・ニュースや動画の配信など)を提供する者 | 2023年6月16日施行 | 外部のタグが送る情報の一覧と、通知・公表・同意・オプトアウトのどれで対応するか |
| EU の一般データ保護規則 | プロファイリングの定義(第4条第4号)、異議を述べる権利(第21条)、自動化された決定(第22条) | EU 域内の拠点の活動に関連する処理と、域外の事業者が EU 域内にいる本人に商品やサービスを提供する、または域内での行動を監視することに関連する処理(第3条) | 2018年5月25日から適用 | ダイレクトマーケティングの推薦を止める手段、重大な影響を持つ領域での推薦の扱い |
| EU のデジタルサービス法 | 推薦システムの定義(第3条(s))、透明性(第27条)、プロファイリングに基づかない選択肢(第38条) | 第27条:オンラインプラットフォームの提供者(零細・小企業は、第27条を含む節の規定から第19条で除外。超大規模に指定された場合を除く)。第38条:超大規模オンラインプラットフォームと超大規模オンライン検索エンジンの提供者 | 原則2024年2月17日から適用 | 利用規約での主要なパラメータの説明、利用者が選べる推薦の選択肢 |
| 透明化法 | 提供条件等の開示。順位を付けて表示する場合の主要な事項(第5条) | 経済産業大臣が指定した特定デジタルプラットフォーム提供者(第4条) | 2021年2月1日施行 | 順位の決め方の主要な事項の開示。広告費などの支払いが順位に影響しうる場合はその旨 |
| 取引デジタルプラットフォーム法 | 取引デジタルプラットフォーム提供者の努力義務(第3条) | 取引デジタルプラットフォーム提供者 | 2022年5月1日施行 | 販売業者との連絡・表示への苦情への対応(推薦そのものの規定ではない) |
表の GDPR の行の「対象」は、第3条の要旨を短くしたものです。EU 域内に拠点が無い日本の事業者がどの場合に GDPR の対象になるかの具体的な当てはめは、第3条の本文と欧州データ保護会議の指針を確かめて判断する必要があります。
日本のデジタルプラットフォームの法律と、推薦の理由の表示
日本にも、推薦や検索の順位の決め方に触れた法律があります。特定デジタルプラットフォームの透明性及び公正性の向上に関する法律(令和2年法律第38号。以下「透明化法」)です。e-Gov の改正履歴によれば、2020年6月3日に公布され、2021年2月1日に施行されました。
透明化法の第4条第1項は、経済産業大臣が、政令で定める事業の区分ごとに、売上額の総額・利用者の数などの指標で政令で定める規模以上のデジタルプラットフォームを提供する事業者を、特定デジタルプラットフォーム提供者として指定すると定めています。指定された提供者は、第5条第2項により、出品者などの商品等提供利用者と、一般の利用者のそれぞれに、提供条件として一定の事項を開示しなければなりません。その中に、プラットフォームの場で、一般利用者が検索で求める商品等の情報その他の情報に順位を付けて表示する場合の、順位を決めるために用いられる主要な事項があります。出品者から提供者への広告宣伝の費用その他の支払いが順位に影響しうる場合は、その旨も含みます。同項第2号は、一般利用者に対して、一般利用者の検索・閲覧・購入のデータ(商品等購入データ)を取得・使用する場合の内容と条件の開示も求めています。
取引デジタルプラットフォームを利用する消費者の利益の保護に関する法律(令和3年法律第32号。以下「取引デジタルプラットフォーム法」)は、e-Gov の改正履歴によれば2022年5月1日に施行されました。第1条は、取引デジタルプラットフォームを利用して行われる通信販売に係る取引の適正化と紛争の解決の促進に関し、提供者の協力を確保し、消費者の利益を保護することを目的としています。第3条は、提供者に、消費者が販売業者等と円滑に連絡できるようにする措置などの努力義務を定めています。この法律は推薦の仕組みそのものを規律するものではありませんが、モール型の事業で推薦の枠に出品者の商品を出す場合、推薦した商品の表示に関する苦情を受け付けて調べる体制は、同条の措置と関わりうると考えています。
どちらの法律も、対象は指定を受けた提供者やモール型の事業者に限られます。自社の商品だけを売る事業者にただちにかかる規定ではありません。ただ、透明化法の「順位を決めるために用いられる主要な事項」と、DSA の「推薦システムの主要なパラメータ」は、どちらも「なぜこの順番で示されるのか」を利用者に説明できる状態を求めている点で共通しています。規制の対象かどうかに関わらず、自社の推薦の順位を何で決めているかを1枚の文書で説明できる状態にしておくことは、顧客の離反と社内の説明の両方に備えることになると考えています。
法令の対象かどうかに関わらず、推薦の理由を顧客に示すことは、推薦への信頼を保つ手段になりえます。「この商品を見た人はこんな商品も見ています」「最近見た商品に似た商品」「あなたが購入した商品と一緒に買われています」のように、推薦の枠の見出しに理由を添える方法は、第4章で扱ったアイテムベースの協調フィルタリングとの相性がよい方法です。行列分解や深層学習のように、理由を一言で表しにくい方式では、何の履歴を使っているかを示すことが、判断の材料の一部を説明する方法になります。ただし、使っているデータの種類と、その商品が選ばれた理由は同じではありません。DSA の第27条第2項が求める主要な基準と相対的な重要度の説明を満たすかどうかは、別に判断が要ります。説明の手法そのものは、弊社コラム「AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド」で扱っています。
理由の表示と並べて考えたいのが、顧客が推薦を調整・停止できる仕組みです。DSA の第27条第3項と第38条の考え方を、規制の対象でない事業者が自社の設計に取り入れる場合の項目を、次の表にまとめました。表の項目は本コラムが考えた設計の例で、法令がこの形を求めているという意味ではありません。表の右端の列には、序章で整理した6つの損失の型のうち、その項目で防ぎたいものを入れました。序章の定義では、個人データの扱いが分かりにくい推薦やしつこい推薦による信頼の喪失は「顧客の離反」に含まれるので、多くの行がこの型になります。6つの型に直接当たらない行は、その旨を書きました。
| 設計の項目 | 具体例 | 関わる法令の考え方 | 防ぎたい損失の型 |
|---|---|---|---|
| 推薦の理由を枠に添える | 「最近見た商品に似た商品」「一緒に買われている商品」のように、使っている履歴の種類を見出しで示す | DSA 第27条第2項(なぜ示されるかの説明)、透明化法第5条(順位の主要な事項) | 顧客の離反(個人データの扱いが分かりにくい推薦) |
| 個人の嗜好の評価に基づかない選択肢 | 「おすすめ順」と並べて、個人ごとの調整を加えない「人気順」「新着順」を選べるようにする | DSA 第38条(プロファイリングに基づかない選択肢) | 顧客の離反(推薦の並びを自分で選べないことへの不満) |
| 推薦のための処理を止める手段 | マイページで推薦メールの停止・閲覧履歴の削除・履歴を推薦に使わない設定を用意する | GDPR 第21条(ダイレクトマーケティングへの異議) | 顧客の離反(しつこい推薦による配信停止・退会) |
| 推薦に使わない情報を決める | 健康・信条など配慮が要る情報を推定したり推薦に使ったりしない。配慮が要る商品群を推薦の対象から外すルールを置く | DSA 第26条第3項(特別な種類の個人データによる広告の禁止)、個人情報保護法の要配慮個人情報(第2条第3項) | 顧客の離反(健康や信条を推定されていると感じさせる推薦) |
| 未成年の利用者への配慮 | 年齢の情報がある場合、未成年向けの推薦の対象と頻度を分ける | 令和8年改正法の16歳未満の者の規定(未施行)、DSA 第28条(未成年の保護) | 6つの型には直接当たらない(法令への対応として置く) |
表の4行目は、推薦の担当者が見落としやすい点です。協調フィルタリングや行列分解は、商品の中身を使わずに行動の似かたから推薦するので、健康に関わる商品や、信条を推測させる書籍などを買った顧客に、関連する商品を次々に推薦することがあります。顧客の側から見ると、事業者が自分の健康状態や信条を推定しているように見え、顧客の離反につながりえます。個人情報保護法の要配慮個人情報(第2条第3項)は、人種・信条・社会的身分・病歴などの記述等が含まれる個人情報で、購買履歴そのものがただちにこれに当たるわけではありません。それでも、配慮が要る商品群については、次の3つを分けて検討しておくことを勧めます。1つ目は推薦の対象にするか(推薦の後処理、つまり第12章で扱った業務ルールによる後処理で外すか)、2つ目はその購買を他の商品の推薦の計算に使うか、3つ目はどう表示するか(理由の見出しを添えるか)です。理由の見出しを外しても、配慮が要る商品の推薦や、その購買の情報の利用は続くので、3つ目だけでは1つ目・2つ目の代わりになりません。
なお、表の5行目の DSA 第28条は、未成年がアクセスできるオンラインプラットフォームの提供者に、未成年のプライバシー・安全・セキュリティを高い水準で確保するための適切で比例的な措置を求める規定です。本コラムでは同条の第1項の書き出しを確かめた範囲で表に入れており、同条の他の項の中身は確かめていません。
公開事例と公開データセット、研究の数字の読み方
推薦システムの事例は、企業の発表資料や記事で数多く紹介されていますが、手法・データ・評価の条件まで書かれたものは多くないように思います(本コラムでは件数を数えていません)。本コラムでは、企業の担当者が著者に入り、学会の査読を経て公表された論文から、第1章・第4章・第7章で扱ったもの(Amazon の商品間の協調フィルタリング、Netflix Prize、YouTube の深層学習による推薦など)と重ならない3件を選びました。内容は、学会の公式ページ・arXiv の要旨・Crossref の書誌で確かめた範囲に限り、本文の詳細までは読んでいません。
1件目は、Yahoo! JAPAN のニュースの推薦です(Okura らの2017年の論文。KDD 2017、データマイニングの国際会議)。課題は、ニュースは候補がすぐに入れ替わるので、ID に基づく協調フィルタリングが使いにくいことでした。方法は、記事と利用者をそれぞれ深層学習で埋め込み(第7章)にして、近さで並べるものです。記事の側には自己符号化器(文章を圧縮して復元するように学ぶ仕組み)の一種、利用者の側には閲覧の順序を順に読み込む再帰型ニューラルネットワークを使っています。会議の公式ページの要旨によれば、過去のデータでのオフライン評価に加えて本番でも試し、それまで使っていた語に基づく方法と比べて、クリック率が23%、合計の利用時間が10%改善したとされます。比率か差か、どの期間で測ったかは要旨にありません。この数字は、そのサービス・その時期での方式を替えた効果(従来の推薦と比べた差)で、推薦が無い場合と比べた推薦の効果ではありません。
2件目は、Pinterest の推薦です(Ying らの2018年の論文。KDD 2018)。PinSage と呼ぶ方法で、同サービスのピンとボードを点、それらのつながりを線とするグラフから、グラフ畳み込みネットワーク(つながりの構造を持つデータに使う深層学習の一種)とランダムウォーク(つながりを無作為にたどって近い点を探す手順)を組み合わせて埋め込みを学習します。arXiv の要旨によれば、グラフの規模は点が30億、線が180億です。比較した方法より質の高い推薦が得られたとしていますが、評価の方法ごとの数字と、A/Bテストの比較の相手は要旨にありません。
3件目は、Alibaba の EC の推薦です(Wang らの2018年の論文。KDD 2018)。対象は中国の消費者間取引のサービスである Taobao で、行動の履歴から商品のグラフを作り、商品の埋め込みを学習して商品どうしの類似度に使います。arXiv の要旨が挙げる課題は、規模(拡張性)・疎(記録のある顧客と商品の組み合わせがごく一部に限られること。第2章)・コールドスタートの3つで、商品に付随する情報(論文ではサイド情報と呼ぶ)を加えて後の2つに対処したとしています。要旨によれば、オフラインの実験ではサイド情報を加えた方法が加えない方法を上回り、オンラインの A/Bテストでは従来の方法よりクリック率が改善したとされます。第6章で扱った内容ベースとのハイブリッドや、第10章で扱ったコールドスタートの考え方が、大規模な実システムで使われた例として読めます。
| 事例 | 公表の形 | 推薦の対象 | 手法の要点 | 要旨に書かれた評価 | 本コラムの章とのつながり |
|---|---|---|---|---|---|
| Yahoo! JAPAN のニュース | Okura らの論文(KDD 2017) | ニュース記事 | 記事の埋め込み(自己符号化器の変種)と、閲覧の順序による利用者の表現(再帰型ニューラルネットワーク)の近さで並べる | オフライン評価と、本番の語に基づく方法との比較(クリック率と利用時間の改善) | 第7章(埋め込み・系列推薦)、第10章(候補がすぐ入れ替わる問題) |
| Ying らの論文(KDD 2018) | 同サービスのピン | ピンとボードのグラフに対するグラフ畳み込みネットワークで埋め込みを学習 | オフラインの指標・利用者による評価・A/Bテスト(要旨に数字の内訳は無い) | 第7章(埋め込み)、第12章(大規模な計算) | |
| Alibaba の EC(Taobao) | Wang らの論文(KDD 2018) | 商品 | 行動の履歴から作った商品のグラフの埋め込みに、サイド情報を加える | オフラインの実験と、従来の方法とのオンラインの A/Bテスト(クリック率の改善) | 第6章(ハイブリッド)、第10章(コールドスタート) |
要旨から読み取れる範囲では、3件ともオフラインの評価に加えて、本番の利用者での評価に触れています。比べる相手が要旨に書かれているのは2件で、Yahoo! JAPAN は「それまで本番で使っていた語に基づく方法」、Alibaba は「従来の推薦の方法」です。Pinterest は、A/Bテストで何と比べたのかが要旨にありません。第9章で扱ったとおり、推薦の効果は推薦が無い場合と比べた差です。従来の推薦と比べた改善は、方式を替えた効果(従来の推薦と比べた差)で、両者は別の問いです。事例の数字を読むときは、何と比べた改善か、どの指標か、どの期間か、の3点を確かめることを勧めます。
もう1つの注意は、論文になる事例には偏りがありうることです。まず確かな範囲で言えば、本章で選んだ3件は、いずれも大規模なサービスで、新しい方法が比較した方法を上回ったと報告している事例で、うまくいかなかった試みや小規模なサービスの事例を代表するものではありません。そのうえで、本コラムは調査で確かめたわけではありませんが、学会で発表されるのは、規模が大きく、新しい手法で、比較の結果が良かった事例が中心になりやすく、うまくいかなかった試みや人気順に勝てなかった試みは論文になりにくいように思います。そのため、公開事例だけを見ると、複雑な手法が常に効くという印象を持ちやすくなると考えています。第3章で扱った「ベースラインに勝てない推薦」の議論と合わせて、公開事例は「この規模・このデータ・この比較ではこうだった」という参考として読み、自社の判断は自社のデータでの比較で行うのがよいと考えています。
推薦の研究で広く使われている公開データセットの1つが、ミネソタ大学の GroupLens 研究グループが提供する MovieLens です。GroupLens の公式ページは、新しい研究に推奨するものとして MovieLens 32M(2023年10月に収集、2024年5月に公開)を挙げ、教育と開発に推奨するものとして、時間とともに内容が変わる Latest 系のデータセットを挙げています。Latest 系は、内容が変わるため研究の結果の報告には適さないと同ページに書かれています。
MovieLens 32M の説明書(README)によれば、このデータセットは、200,948人の利用者による87,585本の映画への32,000,204件の評価(星5段階、0.5刻み)と、2,000,072件のタグの付与を含みます。期間は1995年1月9日から2023年10月12日で、利用者は少なくとも20件の評価をした人から無作為に選ばれ、属性の情報は含まれていません。利用の条件として、研究目的での利用を認めたうえで、商用や収益を生む目的での利用には GroupLens の教員の事前の許可が要ること、論文で使う場合は Harper と Konstan の論文(ACM の対話型知能システムの論文誌、第5巻第4号)を引用することなどが定められています。社内の検証で MovieLens を使う場合も、事業の目的の利用に当たるかどうかを、説明書の条件で確かめる必要があります。
公開データセットでの精度を、自社の推薦の期待値として読むことはできません。理由は少なくとも次の4つです。
- データの性質が違う:MovieLens は明示的な評価(星の数)のデータで、評価を多く付けた利用者に絞られています。EC の購買や閲覧の暗黙のフィードバック(第2章)とは、疎の度合いも偏りも違います
- 評価の切り方が違う:同じデータセットでも、ランダムに切るか時間で切るか、負例を一部だけ使うか(第8章)で、同じ手法の数字が変わりえます
- 比較の相手が違う:論文ごとに比較するベースラインと、その調整の丁寧さが違い、再現性の問題が報告されています(第3章)
- オフラインの数字である:公開データセットでの精度は、過去のログを当てた度合いで、推薦が無い場合と比べた行動の増加(推薦の効果)ではありません(第8章・第9章)
研究の数字は、手法の相対的な特徴(どんな条件で強いか、計算量はどうか)を知る手がかりとして使い、自社の期待値は、自社のログでのオフライン評価と、A/Bテストで確かめるのがよいと考えています。ベンダーが提案資料で公開データセットでの精度を示した場合も、同じ読み方をします。
生成AIによる推薦、研究の現状と現場での限界
2022年ごろから、大規模言語モデルを推薦に使う研究が増えているように見えます(本コラムでは件数を数えていません)。本コラムでは、生成AIによる推薦を、大規模言語モデルに顧客の履歴や商品の情報を文章として与え、推薦する商品を選ばせたり並べさせたり、推薦の理由を文章で示させたりする方法の総称として使います。ここでは、書誌を確かめた4本の論文(そのうち要旨まで確かめたのは3本。1本は生成AI以前からある会話型の推薦の調査論文)から、研究がどこまで進み、どこに限界が報告されているかを整理します。
Geng らの2022年の論文(RecSys 2022、推薦システムの国際会議)は、P5 と呼ぶ枠組みを提案しました。arXiv の要旨によれば、行動の記録やレビューなどを文章に直して1つの言語モデルで学習させ、系列推薦やレビューの生成のように別々の仕組みで扱ってきた課題を、共通の形で扱うものです。プロンプト(モデルへの指示文)の工夫で、その課題の例を示さずに予測する(ゼロショット)か、少数の例だけで予測できるとしています。
このほか、大規模言語モデルを推薦の課題に合わせて追加学習する研究として Bao らの2023年の論文(RecSys 2023)があります。本コラムで確かめたのは Crossref の書誌(著者・会議・掲載頁)だけで、要旨は確かめていないため、内容は紹介しません。
限界を示した研究として、Hou らの2024年の論文(ECIR 2024、情報検索の欧州の国際会議)があります。arXiv の要旨によれば、別の推薦モデルが選んだ候補を、大規模言語モデルにゼロショットで並べ替えさせる設定で調べ、過去の行動の順序を捉えにくいこと、商品の人気と候補を示す位置によって並べ方が偏りうることを報告しています。プロンプトの工夫などでこれらを和らげられること、複数の推薦モデルから候補を集めた場合には従来の推薦モデルに迫りうることも述べていますが、常に上回るとは書かれていません。
会話型の推薦(対話を通じて好みを聞き出しながら推薦する方式)については、Jannach らの2022年の調査論文(ACM Computing Surveys)が研究を整理しています。arXiv に置かれた著者版の初版は2020年4月で、その要旨は大規模言語モデルに触れていません。本コラムでは、会話型の推薦を、生成AIを使う方式に限られない、より前からある研究の流れとして位置づけ、生成AIによる推薦の背景として紹介します。確かめたのは書誌と arXiv の要旨だけなので、中身には立ち入りません。
これらの研究と、本コラムの各章で扱った論点から、生成AIによる推薦を現場で使う場合の論点を次の表にまとめました。表の「現場での論点」は本コラムの考えで、研究で確かめられた結論ではありません。
| 使い方 | 研究で示されていること | 現場での論点 | 関わる章 |
|---|---|---|---|
| 候補を並べ替えさせる | ゼロショットでも従来のモデルに迫りうる条件がある一方、候補の位置と人気による偏りが報告されている(Hou らの論文) | 1回の推薦あたりの計算の時間と負荷、同じ入力でも結果が変わりうること、人気の偏りを強めないか | 第11章・第12章 |
| 推薦の課題を文章の課題として学習させる | 複数の推薦の課題を1つの枠組みで扱い、少数の例で予測できるとする提案がある(P5) | 公開データセットでの結果で、自社のデータで同じ成績が出るとは限らない。人気順・アイテムベースと比べる | 第3章・第8章 |
| 推薦の理由を文章で示す | 本コラムでは確かめた研究が無い | 示した理由が実際の推薦の根拠と一致しているかを確かめにくい。事実と違う理由を示すおそれ | 本章(推薦の理由の表示) |
| 対話で好みを聞き出す | 生成AI以前からある会話型の推薦の研究を整理した調査論文がある(Jannach らの論文。本コラムは書誌と要旨のみ確かめ、中身は未確認) | 新しい顧客のコールドスタートの手段になりうるが、聞き出した内容の利用目的の特定と、外部の生成AIのサービスへ送る情報の管理が要る | 第10章、本章(個人情報保護法) |
現場での限界として、本コラムが特に挙げておきたいのは2つです。1つは、顧客の履歴を外部の生成AIのサービスに送る場合のデータの扱いです。履歴を文章にしてプロンプトに入れることは、個人情報保護法の第三者提供・委託と、利用目的の範囲に関わりうるので、使う前に法務の担当者と確かめる必要があります。外部送信規律は、利用者の端末から情報を送らせる指令を対象とする規定なので、自社のサーバーから生成AIのサービスへ送る処理が、それだけで同規律の対象になるとは限りません。一方、利用者のブラウザやアプリから直接、外部の生成AIのサービスへ情報を送らせる作りにする場合は、同規律の対象の事業かどうかを確かめる必要があります。もう1つは、評価です。生成AIによる推薦も、第3章で扱った人気順と、第4章で扱ったアイテムベースに勝てるかを、自社のログでのオフライン評価と A/Bテストで確かめるという手順は変わりません。新しさを理由に比較の手順を省くと、効果の過大評価につながりえます。既存の推薦の仕組みを残したまま、比較をせずに別の仕組みを並べて持つことになれば、二重投資にもなりえます。
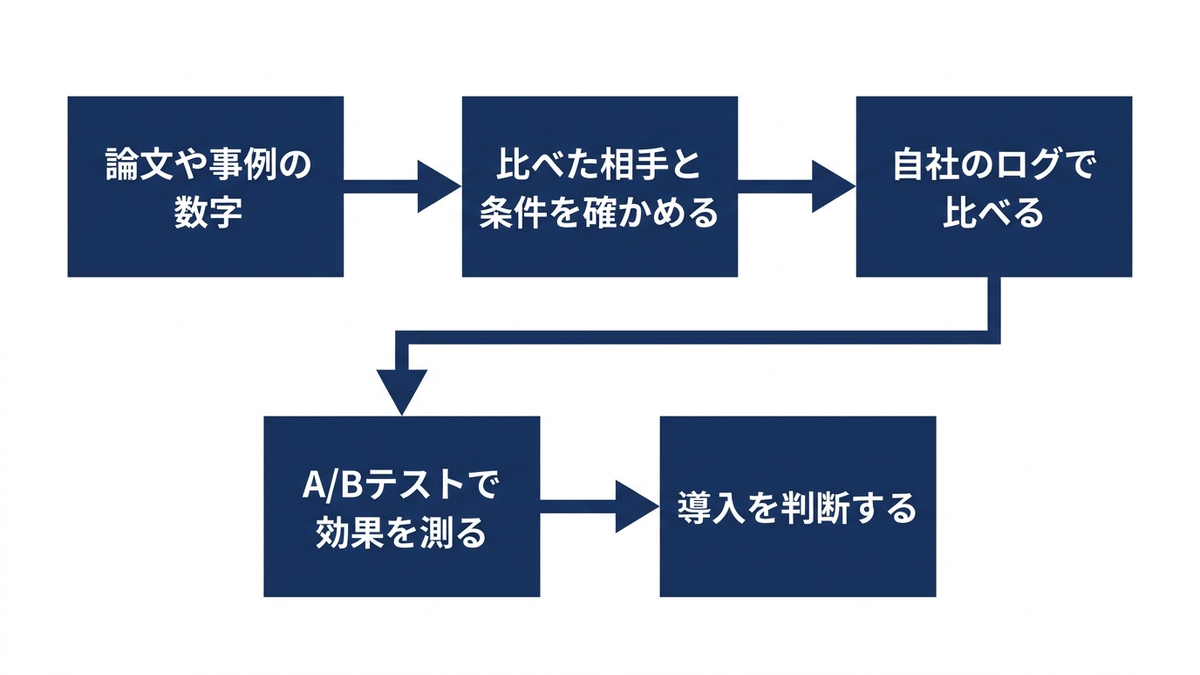
形骸化の型と経営判断、法令と顧客の信頼を推薦の設計の前提にする
法令への対応と、推薦の仕組みそのものは、どちらも作った後に放置されると形骸化します。プライバシーポリシーは推薦を始めたときのまま、外部のタグは誰が置いたか分からないまま、推薦の枠は見られているかどうか測られないまま、という状態です。本コラムの各章の論点と、この章の法令の論点から、推薦の仕組みが形骸化する型を次の表に整理しました。
| 形骸化の型 | 何が起きるか | 気づくための指標・点検 | 手を打つ担当 |
|---|---|---|---|
| 利用目的が古いまま | 推薦の枠やデータの使い方を増やしたのに、利用目的の記載が推薦を始めた時点のまま | 推薦の枠・使う履歴の一覧と、利用目的の記載を年に1回以上突き合わせる | 法務・データ分析 |
| 外部のタグが把握されていない | 推薦や計測のために置いたタグが増え、何がどこに送られているか誰も説明できない | タグの一覧(送る情報・送信先・目的・置いた部署)を作り、変更のたびに更新する | EC 運営・情報システム |
| 推薦の理由が説明できない | 方式を変えたのに、順位の決め方の説明や推薦の枠の見出しが前の方式のまま | 方式を変えるときの手順に、説明文の見直しを入れる | マーケティング・エンジニア |
| 停止の手段が機能していない | 推薦メールの停止や履歴を使わない設定を用意したが、別の仕組みからの配信が止まらない | 停止を設定した試験用のアカウントで、全ての推薦の枠と配信を定期的に確かめる | マーケティング・エンジニア |
| 推薦の枠の成果を確かめていない | 枠は表示されているが、クリック率や推薦の効果を測っておらず、人気順より良いのかどうか分からないまま運用が続く | 枠ごとのクリック率や人気順との比など複数の項目を組み合わせた監視と、再学習の処理が最後に成功した時刻など処理の停止を直接見る監視を併せて置く(第12章。1つの項目だけでは見つけにくい障害がある)。定期的な A/Bテスト(第9章。推薦の効果は推薦なしの群と比べて測る) | データ分析・事業責任者 |
| 事例を追いかけて比較を省く | 新しい手法の公開事例を見て方式を入れ替えるが、自社のデータで比較していない | 方式を変える前に、人気順と現行の方式とのオフライン評価と A/Bテストを必須にする | 事業責任者・データ分析 |
表の上の4行は、法令と顧客の信頼に関わる型、下の2行は推薦の質に関わる型です。前者は、一度整えても、推薦の枠や外部のツールが増えるたびに崩れていきます。推薦の枠を増やす・方式を変える・外部のツールを入れる、という変更の手続きの中に、利用目的・外部送信・説明文の見直しを組み込んでおくことが、形骸化を防ぐための方法だと考えています。第13章で扱った最初の90日の計画では、第3週に法務が加わって個人データの扱いを確かめることにしています。その確認を1回で終わらせず、変更の手続きのたびに繰り返す形にしておくことを勧めます。
この章の論点を誤ったときの経営上の損失は、序章で整理した6つの損失の型のうち、主に顧客の離反・二重投資・形骸化に現れます。利用目的に推薦のための分析が書かれていないまま推薦を始め、後から利用目的を見直すことになれば、過去の履歴を学習に使えるかどうかの検討が必要になり、推薦の仕組みの作り直しにつながりえます。チャネルや部署ごとに、外部の推薦サービスや計測のツールを別々に入れていると、外部送信の説明も、停止の手段も、部署ごとに作ることになり、二重投資が法令の対応にまで広がります。健康や信条を推定させる推薦、停止を求めたのに届く推薦メールは、顧客の信頼を損ない、配信の停止やデータの利用への同意の撤回、退会という形の顧客の離反につながるおそれがあります。
これを予算と体制の仕組みに落とすには、次の3つを推薦の計画の最初の段階で決めておくのがよいと考えています。
- 推薦の設計の承認の条件に、法令の確認を入れる:推薦の枠を増やす・使う履歴を増やす・外部のツールを入れるときは、利用目的の記載、外部送信の説明、停止の手段を法務の担当者が確かめたことを、承認の条件にする
- 推薦の仕組みの台帳を1つにする:推薦の枠・方式・使う履歴・外部のツール・説明文を、全社で1つの台帳にまとめ、変更のたびに更新する。台帳を持つ部署と責任者を決める
- 顧客の信頼を KPI に入れる:推薦の枠ごとのクリック率や購買率と並べて、推薦メールの停止率・履歴を使わない設定の利用率・推薦に関する問い合わせや苦情の件数と内容を、監視する指標として置く。設定の利用率は、設定を見つけやすくしただけでも上がるので、単純に下げる目標にはせず、画面の変更・配信の量・苦情の内容と合わせて読む
3つ目の KPI は、第1章で扱った短期の KPI と長期の KPI のずれに対応するものです。推薦の頻度を上げ、使う履歴を増やせば、短期のクリック率は上がることがあります。一方で、停止率や苦情が増えていれば、推薦の枠そのものと、顧客が個人データを提供してくれる関係を失いつつある可能性があります。推薦の成果を報告するときは、クリック率や推薦の効果の数字と、顧客の信頼に関わる数字を同じ表に並べることを勧めます。
この章では、推薦に履歴を使うときに関わる国内の主な法令(個人情報保護法とその改正法、電気通信事業法の外部送信規律。あわせて透明化法と取引デジタルプラットフォーム法)と EU の規則(一般データ保護規則、デジタルサービス法)を、一次情報で確かめた範囲で整理しました。あわせて、公開事例・公開データセット・生成AIによる推薦の研究は、比べた相手と条件を確かめて読み、自社の判断は自社のログでの比較で行うことを扱いました。第1章から続けてきた推薦の目的・データ・方式・評価・運用・導入の論点を、法令と顧客の信頼という前提の上に置くことが、推薦を事業の仕組みとして使い続けるための条件だと考えています。
この章を深めたい方への参考書籍
『外部送信規律スピード対応マニュアル』(山下大介 著、日経BP):2023年6月に施行された電気通信事業法の外部送信規律への対応を、ウェブサイトやアプリの運営者に向けてまとめた本です(2023年刊。副題は「Web/アプリ運営者必見」)。本章で扱った、外部のタグが送る情報の一覧づくりと、通知・公表・同意・オプトアウトのどれで対応するかを決める作業を、実務の手順として確かめるのに向いています。
『おそろしいビッグデータ』(山本龍彦 著、朝日新聞出版):副題「超類型化AI社会のリスク」のとおり、データから個人を推定して類型に当てはめて扱うことのリスクを論じた新書です。本章で扱った GDPR のプロファイリングの規定や、推薦が顧客の信頼を損なう問題を、法と社会の側から考える手がかりになります。2017年の刊行で、その後の法改正は反映されていないので、制度の現状は本章で示した一次情報と合わせて読むことを想定しています。
終章 レコメンドを使い続けるために
本コラムでは、序章で示した4つの流れに沿って、推薦の目的とデータの基礎(第1章・第2章)、推薦の方式(第3章から第7章)、評価の設計(第8章から第11章)、運用と定着(第12章から第14章)を順に見てきました。全体を通した考えは、序章で述べたとおり、推薦の枠ごとに何を増やしたいのかと、その増え方を推薦が無い場合と比べてどう測るか、そのためにどのログを残すかを先に決めることです。そのうえで単純な推薦から小さく始め、比較の基準に勝てる方式だけを残していきます。最後に、各章の要点を、レコメンドを使い続けるための判断の順序としてまとめ直します。
章をまたいで見えること
第1に、推薦は目的から逆に組み立てます。推薦の枠ごとに、購買点数を増やしたいのか、回遊や継続利用を増やしたいのか、新しい商品を知ってもらいたいのかが違い、目的が違えば推薦すべき商品も評価の指標も変わります(第1章)。推薦に使う購買や閲覧の履歴は、顧客の関心をそのまま表すものではありません。買われなかった商品は、顧客に見えていなかっただけかもしれないため、推薦が表示された記録を残しておくことが、後の評価の前提になります(第2章)。
第2に、推薦の方式は、単純なものから比べて選びます。各章の考察から、方式の候補を絞るための目安を次のように整理しました。本コラムの架空の合成データでは、行列分解も深層学習による推薦も、単純な方式と同じ程度の成績か、設定によってはそれを下回る成績でした。実際の選択は自社のログで比べて確かめます。
- どの方式を選ぶにしても:人気順などの単純な推薦を比較の基準として置き、それに勝てるかを確かめる(第3章)
- 行動の履歴がある程度たまっていて、推薦の理由を説明したいとき:顧客の購買や閲覧の履歴から求めた、商品どうしの似かたによる協調フィルタリングが候補になる(第4章)
- 履歴がまばらで、似かたを直接数えにくいとき:顧客と商品を少数の好みの軸で表す行列分解が候補になる(第5章)
- 履歴の少ない新しい商品にも推薦を出したいとき:商品の属性や説明文を使う内容ベースと、その組み合わせが候補になる(第6章)
- データが大規模で、閲覧の順序や多様な特徴を使いたいとき:深層学習による推薦が候補になるが、単純な方式に勝てるかを確かめてから使う(第7章)
本コラムで動かしたコードはいずれも架空の合成データによるもので、数値はその条件での一例にすぎません。実際の購買や閲覧のログは合成データより複雑なため、自社のログで確かめ直す必要があります。
第3に、推薦の評価は、オフラインとオンラインの2段で行います。過去のログでの評価は、評価データを時間で切り、将来の情報が混ざらないようにしたうえで、方式を絞り込むために使います(第8章)。推薦の効果は、推薦ありと推薦なしを比べるA/Bテストなどで確かめ、推薦経由の購買の数をそのまま効果とは呼びません(第9章)。新しい商品や新しい顧客には、試すための枠を意図して割き(第10章)、推薦が人気の商品に集中していないかを、推薦に出た商品の数や集中の度合いで測ります(第11章)。
第4に、推薦の仕組みは、動き続けるものとして扱います。顧客の好み、品揃え、季節によって、推薦の当たり具合は変わっていきます。候補の生成と並べ替えに分けた構成で計算を抑え、推薦の質とデータとシステムを監視し、推薦の仕組みが止まったときに人気順へ切り替える手順を決めておきます(第12章)。導入は、推薦の枠を流入の量・購買への近さ・品揃えの広さ・データの量の4つの観点で絞り、PoC(試験導入)の出口の条件と効果の測り方を先に決めて進めます(第13章)。推薦に個人データを使うことには法令が関わり、顧客の信頼は推薦の前提です。公開された事例や、生成AIによる推薦を含む研究の数字は、対象のサービスや条件ごとに読み、そのまま自社に当てはめないようにします(第14章)。
使い続けるための最小の仕組み
レコメンドを使い続けるための仕組みは、大がかりなものである必要はありません。本コラムで扱った内容から、最小の形を挙げると次のようになります。
- 推薦の枠ごとに、増やしたい行動とそれを測る指標(KPI)、その枠で推薦しない商品の規則が決まっている
- 推薦が表示された記録(どの顧客に、どの枠で、どの商品を、何番目に出したか)と、その後の行動の記録が残っている
- 人気順などの単純な推薦が、比較の基準として常に用意されている
- 推薦ありと推薦なしを比べて効果を測る方法と、その結果を見る担当が決まっている
- 新しい商品と新しい顧客に、どれだけの枠を割くかが決まっている
- 推薦に出た商品の数や集中の度合い、推薦の質を定期的に数え、仕組みを見直す時期と担当が決まっている
- 推薦に使う個人データの範囲と利用目的が、法務の確認を経て決まり、顧客に示されている
この7つの条件がそろっていれば、使っている方式が単純な人気順であっても、高度な推薦へ進むための運用の土台はできていると考えています。反対に、高度なアルゴリズムを使っていても、目的、表示と行動の記録、比べる方法、結果を見る担当が決まっていなければ、推薦が効いているのかを確かめ続けることが難しくなり、推薦の枠が放置されるおそれがあります。アルゴリズムを高度にするのは、上の7項目が回り始めてからで遅くないと考えています。まず自社で、上の7項目のうち欠けているものを確かめることをお勧めします。1つ目(推薦の枠ごとの目的とKPI)は、残りの6項目を決める前提になるので、ここから整えます。
経営が見るべきこと
経営の立場からレコメンドの取り組みを見るときは、推薦経由の購買の数の報告よりも、次の問いに答えられるかを確かめることをお勧めします。推薦ありと推薦なしを比べたとき、購買率や継続率にどれだけの差があったか。その差は、期間を延ばし、別の季節に同じ比較をしても続いているか。推薦に出ている商品は品揃えのどれだけを占め、売上の上位の商品にどれだけ集中しているか。推薦に使う個人データの範囲は、顧客に示した利用目的の範囲に収まっているか。推薦を始めてから、配信の停止や苦情、退会は増えていないか。
1つ目の差は、顧客を無作為に分けるA/Bテストなどで比べた場合に、推薦の効果の推定値になります。推定値なので、差が小さい場合や、顧客の数が少ない場合には、偶然の範囲に収まることがあります(第9章)。比べるときは、同じ期間と同じ対象で、差の大きさと、偶然によるばらつきを考えた幅(信頼区間)を併記します。2つ目の問いは、新しい推薦が珍しいことで一時的に反応が増える影響や、季節による違いに左右されずに、差が続くかを確かめるためのものです。残りの3つの問いは、取り組みが短期の数字だけでなく、品揃えの幅と顧客の信頼を保っているかどうかを見る手がかりになります。
レコメンドは、一度仕組みを作れば終わる取り組みではなく、品揃えの変化、顧客の好みの変化、新しいチャネルの追加に合わせて見直し続ける取り組みです。見直しを続けるための手間を、あらかじめマーケティングと事業の業務と予算の中に位置づけておくことが、取り組みを続けるための条件だと考えています。本コラムが、自社の顧客と品揃えに合ったレコメンドを組み立てるための材料になれば幸いです。
Anagraftでは、レコメンドを含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 レコメンドの役割と事業での位置づけ、検索・ランキング・パーソナライゼーションとの違い
『推薦システム実践入門』(風間正弘、飯塚洸二郎、松村優也 著、オライリー・ジャパン):2022年5月刊で、副題は「仕事で使える導入ガイド」です。版元の目次では、推薦システムのプロジェクト、推薦システムの UI/UX、推薦アルゴリズムの概要と詳細、実システムへの組み込み、推薦システムの評価の章が並び、付録に Netflix Prize が置かれています。この章で扱った、推薦の枠の選び方と、推薦を事業に組み込む順番を、実務の導入の流れの中で確かめるときに参考になります。
『ロングテール 「売れない商品」を宝の山に変える新戦略』(クリス・アンダーソン 著、篠森ゆりこ 訳、早川書房):NDL サーチでは、ハヤカワ文庫 NF の1冊として2014年5月に刊行された版が確認できます。品揃えの多いネットの事業で、売れ筋以外の多くの商品が持つ意味を論じた本で、この章で扱った発見の支援と在庫の消化という推薦の経路を、事業の戦略の側から考えるときの手がかりになります。
第2章 推薦に使うデータ、購買・閲覧の履歴と暗黙のフィードバックの扱い
『ビッグデータ分析・活用のためのSQLレシピ データ加工から売上・ユーザー把握、レポーティング等々の各種データ分析まで』(加嵜長門・田宮直人 著、マイナビ出版):SQL によるデータ分析の手法をレシピの形で集めた本です(2017年刊)。出版書誌データベース(Books)の内容紹介によれば、売上の把握、ユーザーの把握、Web サイトでの行動の把握のためのデータの抽出を章ごとに扱い、レコメンドも取り上げる場面の1つに挙げられています。この章で扱った行動ログの集計(顧客別・商品別の件数、集中の度合い)を、自社のデータベースで実際に出すときの手がかりになります。
『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ・渡部徹太郎・伊藤徹郎 著、技術評論社):データを集めて使える形に整える基盤の作り方を、データ・システム・組織の面から扱う本です(2021年刊)。版元の目次によれば、データの品質を生成元で担保する考え方や、マスタ・共通ID・履歴の整備、ログの収集の注意点を扱う節があります。この章の後半で扱った、ログの設計と、チャネルをまたいだIDの統一・データの品質の管理を、基盤の側から確かめるのに向いています。
第3章 人気順とルールによる推薦、まずベースラインを作る
『戦略的データサイエンス入門 ビジネスに活かすコンセプトとテクニック』(Foster Provost、Tom Fawcett 著、竹田正和 監訳、オライリー・ジャパン):データ分析をビジネスの問題の解決にどう結びつけるかを、手法の考え方から説明する本です。版元の目次によれば、第12章に共起とアソシエーション(一緒に発生する項目の見つけ方)の節があり、意外性の測り方としてリフトとレバレッジを扱っています。この章で扱った、信頼度だけでなくリフト値で組を選ぶ考え方を、ビジネスの意思決定の側から確かめるのに向いています。
『データマイニングの基礎』(元田浩・津本周作・山口高平・沼尾正行 著、情報処理学会 編、オーム社):情報処理学会が編む IT Text の1冊で、2006年に刊行された教科書です。版元の目次によれば、第2章のデータマイニングの基礎的な手法の中に相関ルール(アソシエーション規則)の節があり、決定木や最近傍法などの手法と並べて扱っています。第5章では知識の精度評価も扱っており、この章のアソシエーション分析を、データマイニングの手法の全体の中に位置づけて学ぶのに役立ちます。
第4章 協調フィルタリング、似た顧客と似た商品から推薦する
『情報推薦システム入門 理論と実践』(Dietmar Jannach、Markus Zanker、Alexander Felfernig、Gerhard Friedrich 著、田中克己・角谷和俊 監訳、共立出版):推薦システムの理論を体系的にまとめた教科書の訳書です(2012年刊)。NDL サーチの目次によれば、協調型推薦の章がユーザベースの最近傍推薦から始まっており、この章で扱った近傍法の協調フィルタリングを、類似度の選び方や他の方式との関係まで含めて確かめるのに役立ちます。
『推薦システム 統計的機械学習の理論と実践』(Deepak K. Agarwal、Bee-Chung Chen 著、島田直希・大浦健志 訳、共立出版):推薦システムを統計的機械学習の立場から扱う教科書の訳書です(2018年刊)。NDL サーチの目次によれば、第1章で、ウェブのサービスに推薦システムを入れるときの留意点として、アルゴリズム上の工夫と最適化の指標を取り上げています。この章の近傍法から一歩進んで、推薦を統計のモデルとして組み立て、何を最適化するかを考えるのに役立ちます。
第5章 行列分解、潜在因子で好みを表す
『行列プログラマー Pythonプログラムで学ぶ線形代数』(Philip N. Klein 著、松田晃一・弓林司・脇本佑紀・中田洋・齋藤大吾 訳、オライリー・ジャパン):ベクトル・行列・基底から始めて、Python のプログラムを書きながら線形代数を学ぶ本です。版元の目次によれば、第11章が特異値分解で、低ランク行列による行列の近似や、最適なランク k 近似の節があります。この章で触れた「大きな行列を少数の軸で近似する」という考え方を、線形代数の側から手を動かして確かめるのに向いています。
『スパース性に基づく機械学習』(冨岡亮太 著、講談社):機械学習プロフェッショナルシリーズの1冊で、L1ノルムなどの正則化によって、少数の要素だけを使う解(スパースな解)を得る方法を扱う本です。版元の目次によれば、第8章がトレースノルム正則化に基づく機械学習です。この章で見た「正則化が余分な軸を縮める」という現象を、正則化の理論の側から理解したい方に向いています。数式の多い専門書です。
第6章 内容ベースとハイブリッド、商品の属性と説明文を使う
『情報検索の基礎』(Christopher D. Manning、Prabhakar Raghavan、Hinrich Schütze 著、岩野和生、黒川利明、濱田誠司、村上明子 訳、共立出版):Manning らによる情報検索の教科書の訳書です(2012年刊)。この章で使った単語の重み付けやコサイン類似度は、文書を探し出す情報検索の分野で使われてきた方法です。商品の説明文を推薦に使うときに、その土台となる情報検索の考え方をまとめて学ぶ入口になります。
『情報アクセス技術入門 情報検索・多言語情報処理・テキストマイニング・情報可視化』(前田亮、西原陽子 共著、森北出版):情報検索の仕組み(索引付け・検索モデル)からテキストマイニングまでを、入門の水準でまとめた本です。説明文を単語に区切って索引を作り、文書どうしを比べる流れを、この章より広い範囲で見渡すのに役立ちます。
第7章 深層学習による推薦、2つの塔のモデルから系列の推薦まで
『深層学習 改訂第2版』(岡谷貴之 著、講談社):機械学習プロフェッショナルシリーズの1冊で、版元の目次によれば、ネットワークの基本構造と学習の方法から始めて、系列データのためのネットワークの章と、集合・グラフのためのネットワークと注意機構の章を設けています。この章で使った GRU のような回帰型のネットワークと、SASRec や BERT4Rec の土台になる注意機構の仕組みを、推薦に限らない深層学習の側から確かめるのに向いています。データが少ない場合の学習の章もあり、この章の架空データの条件で、学習に使う顧客が少ないときに深層学習のモデルが単純な数え上げを下回った結果を考える手がかりになります。
『ゼロから作るDeep Learning 2 自然言語処理編』(斎藤康毅 著、オライリー・ジャパン):版元の目次によれば、単語をベクトルで表す word2vec の章、回帰型ニューラルネットワーク(RNN)とゲート付き RNN の章、注意機構(Attention)の章があり、付録で GRU を扱っています。文章の単語の並びを扱うための仕組みですが、単語を商品に、文章を閲覧の系列に置き換えると、この章の埋め込みと系列推薦の考え方にそのままつながります。ライブラリに頼らず仕組みを自分で組み立てながら学ぶ構成なので、深層学習のモデルが中で何をしているかを理解したい方に向いています。
第8章 オフライン評価、適合率・再現率・NDCGと評価データの切り方
『情報アクセス評価方法論 検索エンジンの進歩のために』(酒井哲也 著、コロナ社):検索の結果をどう評価するかを体系的に扱った本です。版元の目次によれば、適合率や平均適合率、逆順位、段階的な関連の強さを扱う nDCG などの基本の指標から、評価用データの作り方、統計的な検定までを扱っています。この章で紹介した NDCG は検索の結果の評価のために提案された指標なので、その考え方と、他の指標との使い分けを確かめるのに向いています。
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):データ分析のコンペティションでの手法をまとめた本です。版元の目次によれば、レコメンドの評価指標の節、データのリーク(漏れ)の節、時系列のデータでのバリデーション(評価データの切り方)の節があります。この章で扱った、時間で切らないと将来の情報が漏れる問題を、推薦以外の予測の課題も含めて確かめるのに役立ちます。
第9章 オンライン評価、A/Bテストとバンディットで効果を確かめる
『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』(Ron Kohavi、Diane Tang、Ya Xu 著、大杉直也 訳、ドワンゴ):オンラインの比較実験(A/Bテスト)を、実験の実行と分析、結果の信頼性、実験の基盤と組織の文化まで扱う本です(2021年刊)。この章で扱った、指標の選び方・途中で止める問題・結果を疑って確かめる姿勢を、推薦に限らないオンライン実験の全体の中で確かめるのに向いています。
『データ分析の力 因果関係に迫る思考法』(伊藤公一朗 著、光文社):光文社新書の1冊で、版元の紹介によれば、ランダム化比較試験・RD デザイン・パネル・データ分析などの因果関係に迫る方法を、数式を使わずに具体例で説明する本です(2017年刊)。この章の「推薦を使った人と使わなかった人を比べても効果は分からない」という論点を、推薦の外の事例で理解し直すのに役立ちます。
『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』(齋藤優太、安井翔太 著、ホクソエム 監修、技術評論社):版元の目次によれば、バンディットのデータセットと評価の道具、明示的・暗黙のフィードバックを使った推薦の構築、IPS 推定量(逆確率重み付けの推定量)の評価、因果効果を考えたランキングを扱う本です(2021年刊)。この章で考え方だけを紹介したオフ方策評価を、推薦の文脈で実装まで確かめるのに向いています。
第10章 コールドスタートと探索、新しい商品と新しい顧客への推薦
『バンディット問題の理論とアルゴリズム』(本多淳也・中村篤祥 著、講談社):機械学習プロフェッショナルシリーズの1冊で、版元の目次によれば、確率的バンディット問題の方策とリグレット(取りこぼした報酬)の解析、最適腕識別と A/Bテスト、線形モデル上のバンディット問題、バンディット手法の応用までを扱います(2016年刊)。この章で紹介した探索と活用の考え方や、LinUCB のような線形モデルを使う方法を、理論の側から確かめるのに向いています。
『ウェブ最適化ではじめる機械学習 A/Bテスト、メタヒューリスティクス、バンディットアルゴリズムからベイズ最適化まで』(飯塚修平 著、オライリー・ジャパン):版元の目次によれば、A/Bテストをベイズ統計で扱う章から始めて、テスト中の損失に向き合う方法としてのバンディットアルゴリズム、組合せのバンディット、ロジスティック回帰上のトンプソン抽出(付録)までを扱う本です(2020年刊)。この章のトンプソン抽出のシミュレーションを、実装の側から自分で組み直してみるときの手引きになります。
第11章 推薦の偏りと多様性、人気の偏り・フィルターバブル・公平性
『フィルターバブル インターネットが隠していること』(イーライ・パリサー 著、井口耕二 訳、早川書房):フィルターバブルという言葉を広めた本の文庫版です(ハヤカワ文庫NF、2016年。2012年刊の『閉じこもるインターネット』の改題)。NDL サーチの内容紹介によれば、個人の検索の傾向などから情報を取捨選択して表示するインターネットのフィルタリングの技術が、偏った情報ばかりに触れさせる可能性に警鐘を鳴らす本です。この章で見たように研究の結論は分かれていますが、問題の立て方の出発点として読む価値があると考えています。
『あなたを支配し、社会を破壊する、AI・ビッグデータの罠』(キャシー・オニール 著、久保尚子 訳、インターシフト):データサイエンティストの著者が、アルゴリズムが社会に及ぼす悪影響を取り上げた本です(2018年刊。原書名は Weapons of Math Destruction)。NDL サーチに載る目次には、良いモデルと悪いモデル、大学ランキングが多様性を奪う仕組み、弱みにつけこむオンライン広告などの章があります。モデルの出力が人の行動を変え、その行動がまたモデルの入力になる循環を考えるうえで、この章の推薦の循環と通じる論点を扱っています。
第12章 システムの構成と運用、候補の生成・並べ替え・監視と再学習
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習を事業のシステムとして設計・運用するための本です。版元の目次によれば、モデルのデプロイと予測サービス、データ分布のシフトと監視(監視と可観測性の節を含む)、実現場での継続学習とテストの章があります。この章で扱った一括の計算とリアルタイムの計算の分担、監視の項目、再学習の頻度を、推薦に限らない一般的な形で体系立てて確かめるのに向いています。
『AIエンジニアのための機械学習システムデザインパターン』(澁井雄介 著、翔泳社):学習したモデルを本番で動かすときの構成を、パターンの形で整理した本です(2021年刊)。著者が公開している本書のサンプルコードの一覧では、一括の推論・同期と非同期の推論・予測のキャッシュといった推論の提供のパターン、予測のログと監視のパターン、サーキットブレーカー(障害の連鎖を止める仕組み)・シャドウ方式の A/Bテストといった運用のパターンが章ごとに並んでいます。この章の代わりの推薦や入れ替えの手順を、実装の形で考えるときの手がかりになります。
第13章 導入の進め方と体制、目的の設計・PoC・内製と外部の分担
『データドリブン思考 データ分析・AIを実務に活かす』(河本薫 著、ダイヤモンド社):2022年1月刊。版元の紹介では、データを集める仕組みや分析の人材をそろえるだけでは事業の価値につながらないという立場から、データ分析と AIを実務に活かすための考え方を解説しています。この章で扱った、推薦の目的を事業の KPI につなげ、分析の結果を誰がどう判断に使うかを決める進め方を、推薦に限らないデータ活用の一般論として考え直すときの手がかりになります。
『AI・データ分析プロジェクトのすべて ビジネス力×技術力=価値創出』(大城信晃 監修・著、マスクド・アナライズ、伊藤徹郎、小西哲平、西原成輝、油井志郎 著、技術評論社):版元のページでは2020年12月の発売で、AIやデータ分析のプロジェクトを、技術だけでなくビジネスの面から扱い、案件の獲得と外部の資源の検討、データのリスク管理と契約、プロジェクトの立ち上げと管理、分析結果の評価と改善、プロジェクトの継続性までを章立てにしています。この章で扱った PoC の計画書と出口、社内と外部の役割の分け方を、データ分析のプロジェクトの進め方の中で整理し直すときに参考になります。
第14章 プライバシーと規制、公開事例と最新動向
『外部送信規律スピード対応マニュアル』(山下大介 著、日経BP):2023年6月に施行された電気通信事業法の外部送信規律への対応を、ウェブサイトやアプリの運営者に向けてまとめた本です(2023年刊。副題は「Web/アプリ運営者必見」)。本章で扱った、外部のタグが送る情報の一覧づくりと、通知・公表・同意・オプトアウトのどれで対応するかを決める作業を、実務の手順として確かめるのに向いています。
『おそろしいビッグデータ』(山本龍彦 著、朝日新聞出版):副題「超類型化AI社会のリスク」のとおり、データから個人を推定して類型に当てはめて扱うことのリスクを論じた新書です。本章で扱った GDPR のプロファイリングの規定や、推薦が顧客の信頼を損なう問題を、法と社会の側から考える手がかりになります。2017年の刊行で、その後の法改正は反映されていないので、制度の現状は本章で示した一次情報と合わせて読むことを想定しています。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- Bennett と Lanning の2007年の論文、Netflix Prize の解説
https://www.cs.uic.edu/~liub/KDD-cup-2007/proceedings/The-Netflix-Prize-Bennett.pdf - van den Oord らの2013年の論文、利用の履歴が無い楽曲について音声から推薦に使う特徴を深層学習で予測する
https://proceedings.neurips.cc/paper_files/paper/2013/hash/b3ba8f1bee1238a2f37603d90b58898d-Abstract.html - Jannach と Jugovac の2019年の論文、推薦システムの事業上の価値の測り方
https://doi.org/10.1145/3370082 - Jannach と Jugovac の2019年の論文、推薦システムの事業上の価値の測り方
https://arxiv.org/abs/1908.08328 - Belkin と Croft の1992年の論文、情報フィルタリングと情報検索の関係
https://doi.org/10.1145/138859.138861 - Goldberg らの1992年の論文、Tapestry
https://doi.org/10.1145/138859.138867 - Tapestry は多くの人が評価を付けられ、読み手が注目する評価者を選べる
https://presnick.people.si.umich.edu/papers/cscw94/GroupLens.htm - Resnick らの1994年の論文、GroupLens、CSCW ’94
https://doi.org/10.1145/192844.192905 - Linden・Smith・York の2003年の論文、Amazon.com の商品間の協調フィルタリング
https://doi.org/10.1109/MIC.2003.1167344 - Linden・Smith・York の2003年の論文、Amazon.com の商品間の協調フィルタリング
https://www.cs.umd.edu/~samir/498/Amazon-Recommendations.pdf - 金融商品取引法第40条第1号、適合性の原則
https://laws.e-gov.go.jp/law/323AC0000000025 - 推薦システム実践入門(風間正弘、飯塚洸二郎、松村優也 著、オライリー・ジャパン)、2022年5月刊、副題 仕事で使える導入ガイド、目次の章立てと付録 Netflix Prize
https://ndlsearch.ndl.go.jp/books/R100000002-I032106805 - 推薦システム実践入門(風間正弘、飯塚洸二郎、松村優也 著、オライリー・ジャパン)、2022年5月刊、副題 仕事で使える導入ガイド、目次の章立てと付録 Netflix Prize
https://www.oreilly.co.jp/books/9784873119663/ - ロングテール 「売れない商品」を宝の山に変える新戦略(クリス・アンダーソン 著、篠森ゆりこ 訳、早川書房)、ハヤカワ文庫 NF、2014年5月刊
https://ndlsearch.ndl.go.jp/books/R100000002-I025441914
第2章
- Hu・Koren・Volinsky の2008年の論文(暗黙のフィードバックの協調フィルタリング、ICDM 2008)
https://doi.org/10.1109/ICDM.2008.22 - 同論文の要旨は、暗黙のフィードバックには好みの直接の入力が無く、とくに嫌っている商品の十分な証拠が無いと述べ、確信度が大きく違う好き嫌いの手がかりとして扱う方法を提案している
http://yifanhu.net/PUB/cf.pdf - Liang・Charlin・McInerney・Blei の2016年の論文(WWW 2016
https://arxiv.org/abs/1510.07025 - Wang らの2018年の論文(WSDM 2018
https://storage.googleapis.com/gweb-research2023-media/pubtools/4120.pdf - Kohavi らの2009年の論文(Web での比較実験の進め方を整理した論文)は、無作為に分けた比較実験を変更と顧客の行動の因果関係を確かめる最良の設計として説明している
https://exp-platform.com/Documents/controlledExperimentDMKD.pdf - Sachdeva・Su・Joachims の2020年の論文(KDD 2020 に採択)は、過去の推薦がすべての選択肢に0でない確率を与えていない場合に、確率で重み付けする方法がうまく働かなくなる問題を扱う
https://arxiv.org/abs/2006.09438 - scipy の csr_array は行番号・列番号・値の3つの配列から作れ、同じ升目の値は足し合わされる
https://docs.scipy.org/doc/scipy/reference/generated/scipy.sparse.csr_array.html - scipy は疎行列の行列の書き方から配列の書き方へ移行しつつあり、行列の書き方は今後の版で非推奨にする見込み
https://docs.scipy.org/doc/scipy/reference/generated/scipy.sparse.csr_matrix.html - 『ビッグデータ分析・活用のためのSQLレシピ データ加工から売上・ユーザー把握、レポーティング等々の各種データ分析まで』(加嵜長門・田宮直人 著、マイナビ出版、2017)
https://ndlsearch.ndl.go.jp/books/R100000002-I028038893 - 『ビッグデータ分析・活用のためのSQLレシピ データ加工から売上・ユーザー把握、レポーティング等々の各種データ分析まで』(加嵜長門・田宮直人 著、マイナビ出版、2017)
https://www.books.or.jp/book-details/9784839961268 - 『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ・渡部徹太郎・伊藤徹郎 著、技術評論社、2021)
https://ndlsearch.ndl.go.jp/books/R100000002-I031840097 - 『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ・渡部徹太郎・伊藤徹郎 著、技術評論社、2021)
https://gihyo.jp/book/2021/978-4-297-12445-8
第3章
- Agrawal・Imieliński・Swami の1993年の論文(大規模な取引データからアソシエーション規則を見つける問題を導入)
https://doi.org/10.1145/170035.170072 - Agrawal と Srikant の1994年の論文(Apriori を提案
https://www.vldb.org/conf/1994/P487.PDF - Ferrari Dacrema・Cremonesi・Jannach の2019年の論文(RecSys 2019
https://arxiv.org/abs/1907.06902 - Ferrari Dacrema・Cremonesi・Jannach の2019年の論文(RecSys 2019
https://doi.org/10.1145/3298689.3347058 - Rendle・Zhang・Koren の2019年の論文(MovieLens 10M で報告されていたベースラインは最適でなく、丁寧に設定した行列分解が報告値と新手法の報告値を上回った
https://arxiv.org/abs/1905.01395 - 参考書籍『戦略的データサイエンス入門 ビジネスに活かすコンセプトとテクニック』(Foster Provost、Tom Fawcett 著、竹田正和 監訳、オライリー・ジャパン、2014年)
https://ndlsearch.ndl.go.jp/books/R100000002-I025570538 - 参考書籍『戦略的データサイエンス入門 ビジネスに活かすコンセプトとテクニック』(Foster Provost、Tom Fawcett 著、竹田正和 監訳、オライリー・ジャパン、2014年)
https://www.oreilly.co.jp/books/9784873116853/ - 参考書籍『データマイニングの基礎』(元田浩・津本周作・山口高平・沼尾正行 著、情報処理学会 編、オーム社、2006年)
https://ndlsearch.ndl.go.jp/books/R100000002-I000008416343 - 参考書籍『データマイニングの基礎』(元田浩・津本周作・山口高平・沼尾正行 著、情報処理学会 編、オーム社、2006年)
https://www.ohmsha.co.jp/book/9784274203480/ - 1993年の論文が、取引のデータは一定の期間に顧客が買った商品をまとめたものでもよいと述べている
https://www.cs.columbia.edu/~gravano/Qual/Papers/14%20-%20Mining%20association%20rules%20between%20sets%20of%20items%20in%20large%20databases.pdf - Rendle らの MovieLens 10M の比較は評価点の予測誤差を比べたもの
https://arxiv.org/html/1905.01395v1
第4章
- Linden・Smith・York の2003年の論文、IEEE Internet Computing 誌 第7巻第1号 76〜80ページ
https://doi.org/10.1109/MIC.2003.1167344 - Linden らの論文の内容 表示のときの計算は顧客の総数や品揃えの大きさに依らず顧客が買った商品の数で決まる 類似商品の表はオフラインで作る 最悪で商品の数の2乗と顧客の数の積 実際は商品の数と顧客の数の積に近い コサインを一般的な方法として挙げる 購買の少ない顧客にも推薦を作
https://www.cs.umd.edu/~samir/498/Amazon-Recommendations.pdf - GroupLens の論文 Resnick・Iacovou・Suchak・Bergstrom・Riedl 1994年 ACM の CSCW の会議の予稿集 175〜186ページ
https://doi.org/10.1145/192844.192905 - GroupLens の論文の内容 ネットニュースの記事の推薦 評価を集めるサーバーが過去に意見の合った人どうしはまた合うという経験則で点数を予測 仮名での評価でプライバシーを守る
https://api.openalex.org/works/doi:10.1145/192844.192905 - GroupLens の論文の著者がミネソタ大学などの研究者であること
https://grouplens.org/about/what-is-grouplens/ - Sarwar・Karypis・Konstan・Riedl の2001年の論文 第10回 World Wide Web 国際会議の予稿集 285〜295ページ
https://doi.org/10.1145/371920.372071 - Sarwar らの論文がコサイン類似度 相関にもとづく類似度 調整したコサイン類似度の3つを節に分けて取り上げていること
https://files.grouplens.org/papers/www10_sarwar.pdf - scipy の CSR 形式は行の切り出しと行列どうしの積が速く 列の切り出しは遅い
https://docs.scipy.org/doc/scipy/reference/generated/scipy.sparse.csr_matrix.html - 参考書籍 情報推薦システム入門 理論と実践 Dietmar Jannach、Markus Zanker、Alexander Felfernig、Gerhard Friedrich 著 田中克己・角谷和俊 監訳 共立出版 2012年
https://ndlsearch.ndl.go.jp/books/R100000002-I023728777 - 参考書籍 推薦システム 統計的機械学習の理論と実践 Deepak K. Agarwal、Bee-Chung Chen 著 島田直希・大浦健志 訳 共立出版 2018年
https://ndlsearch.ndl.go.jp/books/R100000002-I028908452
第5章
- Bennett と Lanning の2007年の論文(Netflix Prize の概要
https://www.cs.uic.edu/~liub/KDD-cup-2007/proceedings/The-Netflix-Prize-Bennett.pdf - Koren・Bell・Volinsky の2009年の論文、推薦システムの行列分解の手法の解説、IEEE Computer 誌第42巻第8号30〜37ページ
https://doi.org/10.1109/MC.2009.263 - Hu・Koren・Volinsky の2008年の論文、ICDM 2008、263〜272ページ
https://doi.org/10.1109/ICDM.2008.22 - Hu らの論文の要旨と内容(テレビ番組の推薦の経験、否定のフィードバックが無い、雑音が多い、数値は確信度を表す、好み p と確信度 c=1+αr、α=40 が良い結果、交互最小二乗法、各段階で損失が下がる、データの大きさに比例する計算量、YᵀY を共通に計算する工夫
http://yifanhu.net/PUB/cf.pdf - 決定係数は、当てはめる値の平均からのばらつきのうち回帰で説明できる割合(1から残差の二乗和÷全体の二乗和を引いた値)
https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.LinearRegression.html - 架空データの購買には同じ商品の買い直しが含まれる(復元抽出)
https://numpy.org/doc/2.4/reference/random/generated/numpy.random.Generator.choice.html - 特異値分解で重みの大きい k 本を残すと二乗誤差の意味で最適な低ランク近似になる
https://www.oreilly.co.jp/books/9784873117775/ - 参考書籍『行列プログラマー Pythonプログラムで学ぶ線形代数』Philip N. Klein 著、松田晃一・弓林司・脇本佑紀・中田洋・齋藤大吾 訳、オライリー・ジャパン
https://ndlsearch.ndl.go.jp/books/R100000002-I027614758 - 参考書籍『スパース性に基づく機械学習』冨岡亮太 著、講談社(機械学習プロフェッショナルシリーズ)
https://www.kspub.co.jp/book/detail/1529106.html
第6章
- Pazzani と Billsus の2007年の解説は、内容ベースの推薦を商品の説明と顧客の関心のプロファイルにもとづく仕組みとして説明している
https://doi.org/10.1007/978-3-540-72079-9_10 - Pazzani と Billsus の解説を収めた論文集の編者は Brusilovsky ら
https://doi.org/10.1007/978-3-540-72079-9_10 - Burke の2002年の論文は、内容ベース・協調フィルタリング・知識ベースなどを組み合わせたハイブリッドの推薦について、実際のものと考えうるものを広く整理している
https://doi.org/10.1023/A:1021240730564 - Salton と Buckley の1988年の論文は、文書の自動検索のための単語の重み付けの方法を整理した論文
https://doi.org/10.1016/0306-4573(88 - scikit-learn の TfidfVectorizer は単語の数え上げと TF-IDF の重み付けを1つにまとめたもの
https://scikit-learn.org/stable/modules/feature_extraction.html - ハイブリッドの順位の値は、同じ点数の商品に同点が占める順位の平均を与えて計算した
https://docs.scipy.org/doc/scipy-1.16.0/reference/generated/scipy.stats.rankdata.html - TfidfVectorizer は既定で単語の出現回数を使い、単語ではなく文字の並びを単位にする設定もある
https://scikit-learn.org/stable/modules/generated/sklearn.feature_extraction.text.TfidfVectorizer.html - 参考書籍『情報検索の基礎』(Christopher D. Manning、Prabhakar Raghavan、Hinrich Schütze 著、岩野和生、黒川利明、濱田誠司、村上明子 訳、共立出版、2012年)
https://ndlsearch.ndl.go.jp/books/R100000002-I023731702 - 参考書籍『情報アクセス技術入門 情報検索・多言語情報処理・テキストマイニング・情報可視化』(前田亮、西原陽子 共著、森北出版、2017年)
https://ndlsearch.ndl.go.jp/books/R100000002-I028449501
第7章
- Yi らの2019年の論文、2つの塔のモデルによる大規模な商品の集合からの推薦の候補の取り出しと、ミニバッチ内の商品を負例に使うときの偏りの補正(RecSys 2019)
https://doi.org/10.1145/3298689.3346996 - Yi らの2019年の論文、2つの塔のモデルによる大規模な商品の集合からの推薦の候補の取り出しと、ミニバッチ内の商品を負例に使うときの偏りの補正(RecSys 2019)
https://research.google/pubs/sampling-bias-corrected-neural-modeling-for-large-corpus-item-recommendations/ - He らの2017年の論文、ニューラル協調フィルタリング(WWW 2017)
https://doi.org/10.1145/3038912.3052569 - He らの2017年の論文、ニューラル協調フィルタリング(WWW 2017)
https://arxiv.org/abs/1708.05031 - Rendle らの2020年の論文、ニューラル協調フィルタリングと行列分解の再検討(RecSys 2020)
https://doi.org/10.1145/3383313.3412488 - Rendle らの2020年の論文、ニューラル協調フィルタリングと行列分解の再検討(RecSys 2020)
https://arxiv.org/abs/2005.09683 - Hidasi らの2016年の論文 GRU4Rec、セッションに基づく推薦を回帰型ニューラルネットワークで行う(ICLR 2016)
https://arxiv.org/abs/1511.06939 - Kang と McAuley の2018年の論文 SASRec、自己注意機構による系列推薦(ICDM 2018)
https://doi.org/10.1109/ICDM.2018.00035 - Kang と McAuley の2018年の論文 SASRec、自己注意機構による系列推薦(ICDM 2018)
https://arxiv.org/abs/1808.09781 - Sun らの2019年の論文 BERT4Rec、双方向の Transformer で隠した商品を前後の文脈から当てる(CIKM 2019)
https://doi.org/10.1145/3357384.3357895 - Sun らの2019年の論文 BERT4Rec、双方向の Transformer で隠した商品を前後の文脈から当てる(CIKM 2019)
https://arxiv.org/abs/1904.06690 - Sun らの2019年の論文 BERT4Rec、双方向の Transformer で隠した商品を前後の文脈から当てる(CIKM 2019)
https://arxiv.org/html/1904.06690v2 - Covington らの2016年の論文、YouTube の動画推薦(RecSys 2016)
https://doi.org/10.1145/2959100.2959190 - Covington らの2016年の論文、YouTube の動画推薦(RecSys 2016)
https://research.google/pubs/deep-neural-networks-for-youtube-recommendations/ - Cheng らの2016年の論文、広いモデルと深いモデルの組み合わせ(DLRS 2016)
https://doi.org/10.1145/2988450.2988454 - Cheng らの2016年の論文、広いモデルと深いモデルの組み合わせ(DLRS 2016)
https://arxiv.org/abs/1606.07792 - Cheng らの2016年の論文、広いモデルと深いモデルの組み合わせ(DLRS 2016)
https://arxiv.org/html/1606.07792v1 - torch の nn.Embedding は番号に対応するベクトルを取り出す表、詰め物の番号は学習で更新されない
https://docs.pytorch.org/docs/2.15/generated/torch.nn.Embedding.html - torch の nn.GRU は入力の系列に多層のゲート付き回帰ユニットを適用する部品
https://docs.pytorch.org/docs/2.15/generated/torch.nn.GRU.html - 参考書籍『深層学習 改訂第2版』岡谷貴之 著、講談社
https://ndlsearch.ndl.go.jp/books/R100000002-I031901202 - 参考書籍『深層学習 改訂第2版』岡谷貴之 著、講談社
https://www.kspub.co.jp/book/detail/5133323.html - 参考書籍『ゼロから作るDeep Learning 2 自然言語処理編』斎藤康毅 著、オライリー・ジャパン
https://ndlsearch.ndl.go.jp/books/R100000002-I029088558 - 参考書籍『ゼロから作るDeep Learning 2 自然言語処理編』斎藤康毅 著、オライリー・ジャパン
https://www.oreilly.co.jp/books/9784873118369/
第8章
- Järvelin と Kekäläinen の2002年の論文(累積利得による検索の評価、ACM Transactions on Information Systems 誌 第20巻第4号)
https://doi.org/10.1145/582415.582418 - Ji らの論文(推薦のオフライン評価でのデータの漏れの研究、ACM Transactions on Information Systems 誌 2023年 第41巻第3号 論文番号75)
https://arxiv.org/abs/2010.11060 - Ji らの論文(推薦のオフライン評価でのデータの漏れの研究、ACM Transactions on Information Systems 誌 2023年 第41巻第3号 論文番号75)
https://arxiv.org/html/2010.11060v4 - 過去の推薦の選び方の確率で重みを付ける方法(逆確率重み付け)は過去の選択確率の記録か精度の良い推定が要り、顧客の反応をモデルで予測する方法はそのモデルが正確であることが前提になること
https://www.microsoft.com/en-us/research/wp-content/uploads/2016/02/double_robust.pdf - Krichene と Rendle の2020年の論文(サンプリングした推薦の指標の研究、KDD 2020、1748〜1757ページ)
https://doi.org/10.1145/3394486.3403226 - Krichene と Rendle の2020年の論文(サンプリングした推薦の指標の研究、KDD 2020、1748〜1757ページ)
https://research.google/pubs/on-sampled-metrics-for-item-recommendation/ - 『情報アクセス評価方法論 検索エンジンの進歩のために』酒井哲也 著、コロナ社
https://ndlsearch.ndl.go.jp/books/R100000002-I026367161 - 『情報アクセス評価方法論 検索エンジンの進歩のために』酒井哲也 著、コロナ社
https://www.coronasha.co.jp/np/isbn/9784339024968/ - 『Kaggleで勝つデータ分析の技術』門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社
https://ndlsearch.ndl.go.jp/books/R100000002-I029976550 - 『Kaggleで勝つデータ分析の技術』門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社
https://gihyo.jp/book/2019/978-4-297-10843-4
第9章
- Thompson の1933年の論文(Biometrika 誌)、トンプソン抽出の原典
https://academic.oup.com/biomet/article/25/3-4/285/200862 - Auer らの2002年の論文(Machine Learning 誌)、UCB1 と ε-greedy
https://doi.org/10.1023/A:1013689704352 - Auer らの2002年の論文(Machine Learning 誌)、UCB1 と ε-greedy
https://homes.di.unimi.it/~cesabian/Pubblicazioni/ml-02.pdf - Chapelle と Li の2011年の論文(NIPS 2011)、トンプソン抽出の実験による検証
https://proceedings.neurips.cc/paper/2011/hash/e53a0a2978c28872a4505bdb51db06dc-Abstract.html - Li・Chu・Langford・Wang の2011年の論文(WSDM 2011)、再生の方法によるオフライン評価
https://doi.org/10.1145/1935826.1935878 - Li・Chu・Langford・Wang の2011年の論文(WSDM 2011)、再生の方法によるオフライン評価
https://arxiv.org/abs/1003.5956 - Johari らの2017年の論文(KDD 2017)、A/Bテストの途中の確認
https://doi.org/10.1145/3097983.3097992 - Johari・Pekelis・Walsh の論文(arXiv)、逐次的な分析を A/Bテストに持ち込む論文、常に有効な p 値と信頼区間
https://arxiv.org/abs/1512.04922 - statsmodels の NormalIndPower の solve_power は、1つを空けると残りから値を求める
https://www.statsmodels.org/stable/generated/statsmodels.stats.power.NormalIndPower.solve_power.html - proportion_effectsize は2つの割合の平方根の逆正弦の差を2倍した値
https://www.statsmodels.org/stable/generated/statsmodels.stats.proportion.proportion_effectsize.html - confint_proportions_2indep の差の区間の既定の方法は newcomb、wald も選べる
https://www.statsmodels.org/stable/generated/statsmodels.stats.proportion.confint_proportions_2indep.html - scipy の ttest_ind で equal_var=False はウェルチの t 検定
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.ttest_ind.html - 逆確率重み付けの重みは新しい方策の確率を記録側の方策の確率で割った値で、確率が0に近い場面があると推定のばらつきに上限が無くなり、重みの頭打ちが提案されている(Swaminathan と Joachims の2015年の arXiv の論文)
https://arxiv.org/abs/1502.02362 - Microsoft の実験基盤のチームの2023年の記事、同時に走るテストの相互作用
https://www.microsoft.com/en-us/research/group/experimentation-platform-exp/articles/a-b-interactions-a-call-to-relax/ - 書籍『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』(Ron Kohavi、Diane Tang、Ya Xu 著、大杉直也 訳、ドワンゴ、2021年)
https://ndlsearch.ndl.go.jp/books/R100000002-I031325604 - 書籍『データ分析の力 因果関係に迫る思考法』(伊藤公一朗 著、光文社、2017年)
https://ndlsearch.ndl.go.jp/books/R100000002-I028081131 - 書籍『データ分析の力 因果関係に迫る思考法』(伊藤公一朗 著、光文社、2017年)
https://books.kobunsha.com/book/ISBN9784334039868.html - 書籍『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』(齋藤優太、安井翔太 著、ホクソエム 監修、技術評論社、2021年)
https://ndlsearch.ndl.go.jp/books/R100000002-I031576667 - 書籍『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』(齋藤優太、安井翔太 著、ホクソエム 監修、技術評論社、2021年)
https://gihyo.jp/book/2021/978-4-297-12224-9
第10章
- Schein らの2002年の論文(SIGIR)はコールドスタートの推薦の方法と評価の指標を扱う
https://doi.org/10.1145/564376.564421 - Rashid らの2002年の論文(IUI)は推薦システムで新しい顧客の好みを学ぶ方法を扱う
https://doi.org/10.1145/502716.502737 - Chapelle と Li の2011年の論文は、シミュレーションと実データでトンプソン抽出が遜色ない成績で、実装が簡単なので比較の基準として勧める
https://papers.nips.cc/paper/2011/hash/e53a0a2978c28872a4505bdb51db06dc-Abstract.html - Li・Chu・Langford・Schapire の2010年の論文(WWW 2010)は、ニュース記事の推薦を文脈つきバンディットとして扱い LinUCB を示した
https://arxiv.org/abs/1003.0146 - Chapelle と Li の論文のトンプソン抽出の手順には、表示を打ち切る規則は無い
https://papers.neurips.cc/paper/4321-an-empirical-evaluation-of-thompson-sampling.pdf - 2つの塔のモデルで商品の属性や説明文を入力に使う形にすれば、学習のときに無かった商品にも埋め込みを計算できる
https://docs.cloud.google.com/architecture/implement-two-tower-retrieval-large-scale-candidate-generation - 参考書籍 バンディット問題の理論とアルゴリズム(本多淳也・中村篤祥 著、講談社、機械学習プロフェッショナルシリーズ、2016年8月)
https://www.kspub.co.jp/book/detail/1529175.html - 参考書籍 ウェブ最適化ではじめる機械学習(飯塚修平 著、オライリー・ジャパン、2020年11月)
https://www.oreilly.co.jp/books/9784873119168/
第11章
- Abdollahpouri らの2019年の論文は、人気の商品が頻繁に推薦され、ニッチな商品はほとんど推薦されない問題を人気の偏りと呼ぶ
https://arxiv.org/abs/1901.07555 - Joachims らの2017年の論文は、検索の順位による位置の偏りがクリックの数に強く影響し、クリックをそのまま学習に使うと最適でない結果になると述べる
https://doi.org/10.1145/3018661.3018699 - Chaney らの2018年の論文は、推薦に触れた利用者のデータで評価・学習することが有害な循環を生み、シミュレーションで効用を増やさないまま行動が均質になることを示した
https://doi.org/10.1145/3240323.3240370 - Fleder と Hosanagar の2009年の論文の3つの結果
https://doi.org/10.1287/mnsc.1080.0974 - MMR は Carbonell と Goldstein が1998年に SIGIR で発表した、関連性と情報の新しさを組み合わせて重複を減らす並べ替えの方法
https://doi.org/10.1145/290941.291025 - Adomavicius と Kwon の2012年の論文は、精度に偏った研究で多様性が見過ごされてきたとし、精度を同程度に保ちながら全利用者にわたる多様性を上げる並べ替えを提案
https://doi.org/10.1109/TKDE.2011.15 - Ge らの2010年の論文は、網羅率とセレンディピティを取り上げ、測り方とトレードオフを論じる
https://doi.org/10.1145/1864708.1864761 - Ziegler らの2005年の論文は、リスト内類似度の指標を導入し、話題を散らす並べ替えが平均の精度を下げる一方で満足を高めたと報告
https://doi.org/10.1145/1060745.1060754 - Vargas と Castells の2011年の論文は、新規性と多様性の指標どうしの関係が整理されておらず、順位や関連性を考えない指標が多いと指摘
https://doi.org/10.1145/2043932.2043955 - フィルターバブルは Eli Pariser が作った言葉で、個人化が多様な視点や内容から人々を切り離す可能性を表す
https://doi.org/10.1145/2566486.2568012 - Nguyen らの2014年の論文が調べたのは映画の推薦サービス MovieLens の利用者の長期の記録で、推薦が示す商品の範囲の時間に伴う変化と、推薦を消費した利用者の群との違いを見た観察の結果
https://grouplens.org/blog/taking-recommendations-improves-consumption-diversity-a-surprise-result-from-exploring-the-filter-bubble-and-movielens/ - Bakshy らの2015年の論文は、米国の Facebook 利用者1,010万人のデータで、異なる立場の内容に触れる機会を狭める要因としてアルゴリズムの順位付けより利用者自身の選択が強かったと報告
https://doi.org/10.1126/science.aaa1160 - Flaxman らの2016年の論文は、米国の利用者5万人の閲覧の履歴で、思想の距離の拡大と、好まない側の情報に触れる機会の増加の両方と結びつき、効果は比較的小さいと報告
https://doi.org/10.1093/poq/nfw006 - Salganik らの2006年の論文は、14,341人の人工の音楽市場の実験で、他人の選択の影響を強めると成功の不平等と予測のしにくさが増したと報告
https://doi.org/10.1126/science.1121066 - Burke の2017年の論文は、推薦の公平性が複数の立場の人を同時に考える多面的な概念になりうるとし、公平性を考慮した推薦システムの分類と構成を示す
https://arxiv.org/abs/1707.00093 - Abdollahpouri らの2019年のもう1つの論文は、利用者をニッチ型・多様型・人気作重視型に分け、映画のデータセットで人気の低い商品に関心がある利用者にも推薦が人気商品に極端に集中したと報告
https://arxiv.org/abs/1907.13286 - 参考書籍『フィルターバブル インターネットが隠していること』イーライ・パリサー 著、井口耕二 訳、早川書房、ハヤカワ文庫NF 459、2016年3月
https://ndlsearch.ndl.go.jp/books/R100000002-I027135101 - 参考書籍『あなたを支配し、社会を破壊する、AI・ビッグデータの罠』キャシー・オニール 著、久保尚子 訳、インターシフト、2018年7月
https://ndlsearch.ndl.go.jp/books/R100000002-I029025609
第12章
- Covington・Adams・Sargin の2016年の論文(動画配信サービスの深層学習による推薦)
https://doi.org/10.1145/2959100.2959190 - Covington・Adams・Sargin の2016年の論文(動画配信サービスの深層学習による推薦)
https://research.google.com/pubs/archive/45530.pdf - scikit-learn の公式ドキュメントは、全探索は点の数が少ないときには十分に速いが、点の数が増えるとすぐに実用的でなくなると述べている
https://scikit-learn.org/stable/modules/neighbors.html - Faiss の公式の解説ページは IndexIVFFlat を、空間をまとまり(ボロノイ領域)に分け、問い合わせの点のまとまりと近くのまとまりの中だけを比べる方式と説明している
https://github.com/facebookresearch/faiss/wiki/Faster-search - Faiss は Meta の研究者らが公開しているライブラリ
https://github.com/facebookresearch/faiss - Johnson・Douze・Jégou の論文(arXiv で2017年に初版、IEEE Transactions on Big Data 誌、2021年、第7巻第3号)
https://arxiv.org/abs/1702.08734 - Johnson・Douze・Jégou の論文(arXiv で2017年に初版、IEEE Transactions on Big Data 誌、2021年、第7巻第3号)
https://doi.org/10.1109/TBDATA.2019.2921572 - 直積量子化
https://doi.org/10.1109/TPAMI.2010.57 - Malkov と Yashunin の論文(arXiv で2016年に初版、IEEE のパターン解析と機械知能の論文誌 TPAMI、2020年、第42巻第4号)
https://arxiv.org/abs/1603.09320 - Malkov と Yashunin の論文(arXiv で2016年に初版、IEEE のパターン解析と機械知能の論文誌 TPAMI、2020年、第42巻第4号)
https://doi.org/10.1109/TPAMI.2018.2889473 - ScaNN は内積が最大になる点を探すことに向けて、探す範囲の絞り込みと量子化を組み合わせたライブラリ
https://github.com/google-research/google-research/tree/master/scann - Zinkevich の機械学習のルール集
https://developers.google.com/machine-learning/guides/rules-of-ml - Sculley らの2015年の論文(NIPS 2015、機械学習のシステムの隠れた技術的負債)
https://papers.nips.cc/paper_files/paper/2015/hash/86df7dcfd896fcaf2674f757a2463eba-Abstract.html - 参考書籍『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン
https://ndlsearch.ndl.go.jp/books/R100000002-I033001073 - 参考書籍『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン
https://www.oreilly.co.jp/books/9784814400409/ - 参考書籍『AIエンジニアのための機械学習システムデザインパターン』澁井雄介 著、翔泳社、2021年刊
https://ndlsearch.ndl.go.jp/books/R100000002-I031419179 - 参考書籍『AIエンジニアのための機械学習システムデザインパターン』澁井雄介 著、翔泳社、2021年刊
https://github.com/shibuiwilliam/ml-system-in-actions
第13章
- 参考書籍『データドリブン思考 データ分析・AIを実務に活かす』河本薫 著、ダイヤモンド社、2022年1月刊
https://www.diamond.co.jp/book/9784478115114.html - 参考書籍『AI・データ分析プロジェクトのすべて ビジネス力×技術力=価値創出』大城信晃 監修・著、マスクド・アナライズ、伊藤徹郎、小西哲平、西原成輝、油井志郎 著、技術評論社
https://gihyo.jp/book/2021/978-4-297-11758-0
第14章
- 個人情報保護法の第2条第1項の個人情報の定義(容易に照合できる場合を含む)
https://laws.e-gov.go.jp/law/415AC0000000057 - 通則編ガイドラインの3の1の1で、行動や関心を分析する場合は本人が予測できる程度に利用目的を特定する趣旨と、閲覧履歴や購買履歴を分析して広告に使う例、事業活動やマーケティング活動に用いるためは特定していない例
https://www.ppc.go.jp/personalinfo/legal/guidelines_tsusoku/ - 2020年の改正法は2022年4月1日に全面施行、附則で3年ごとの見直し
https://www.ppc.go.jp/files/pdf/260717_kaiseihounitsuite.pdf - 令和8年法律第56号は2026年7月17日公布
https://www.ppc.go.jp/personalinfo/legal/r8kaiseihogohou/ - 令和8年改正法の附則第1条、主要な部分は公布から2年を超えない範囲内で政令で定める日、同条第3号の規定は公布から6か月を経過した日に施行
https://www.ppc.go.jp/files/pdf/260717_houritsu.pdf - 外部送信規律は2022年6月の電気通信事業法の改正で設けられ2023年6月16日に施行
https://www.soumu.go.jp/main_sosiki/joho_tsusin/d_syohi/gaibusoushin_kiritsu.html - 電気通信事業法の第27条の12の内容と、通知等が要らない4つの場合
https://laws.e-gov.go.jp/law/359AC0000000086 - 対象となる電気通信役務の4種類
https://www.soumu.go.jp/main_sosiki/joho_tsusin/d_syohi/gaibusoushin_kiritsu_00002.html - 一般データ保護規則の第3条の適用範囲、域内の拠点の活動に関連する処理と、域外の事業者による域内の本人への商品やサービスの提供か行動の監視に関連する処理
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32016R0679 - EUR-Lex に正誤のほか欧州委員会の改正提案2件が関連文書として掲載
https://eur-lex.europa.eu/legal-content/EN/ALL/?uri=CELEX:32016R0679 - デジタルサービス法は規則2022の2065、2022年10月19日採択、第93条で原則2024年2月17日から適用、一部は2022年11月16日から
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32022R2065 - EU AI規則は規則2024の1689、2024年8月1日に発効、2026年7月27日に規則2026の1744で一部改正
https://eur-lex.europa.eu/legal-content/EN/ALL/?uri=CELEX:32024R1689 - 透明化法は令和2年法律第38号、2020年6月3日公布、2021年2月1日施行
https://laws.e-gov.go.jp/law/502AC0000000038 - 取引デジタルプラットフォーム法は令和3年法律第32号、2022年5月1日施行
https://laws.e-gov.go.jp/law/503AC0000000032 - Okura らの2017年の論文、Yahoo! JAPAN のニュースの推薦、KDD 2017
https://doi.org/10.1145/3097983.3098108 - Okura らの論文の手法の構成と、語に基づく方法と比べたクリック率23%と利用時間10%の改善
https://www.kdd.org/kdd2017/papers/view/embedding-based-news-recommendation-for-millions-of-users - Ying らの2018年の論文、Pinterest の PinSage、KDD 2018
https://arxiv.org/abs/1806.01973 - Wang らの2018年の論文、Taobao の商品の埋め込み、KDD 2018
https://arxiv.org/abs/1803.02349 - MovieLens の公式ページ、32M は新しい研究に推奨、Latest 系は教育と開発向けで研究結果の報告には不適
https://grouplens.org/datasets/movielens/ - MovieLens 32M の件数、期間、利用者の選び方、利用条件
https://files.grouplens.org/datasets/movielens/ml-32m-README.html - Harper と Konstan の論文、ACM の対話型知能システムの論文誌、第5巻第4号
https://doi.org/10.1145/2827872 - Geng らの2022年の論文、P5、RecSys 2022
https://arxiv.org/abs/2203.13366 - Bao らの2023年の論文、TALLRec、RecSys 2023
https://doi.org/10.1145/3604915.3608857 - Hou らの2024年の論文、ECIR 2024、順序を捉えにくいこと、人気と位置の偏り、従来モデルに挑みうる
https://arxiv.org/abs/2305.08845 - Jannach らの2022年の会話型推薦の調査論文、ACM Computing Surveys
https://doi.org/10.1145/3453154 - 参考書籍 外部送信規律スピード対応マニュアル、山下大介 著、日経BP、2023年
https://ndlsearch.ndl.go.jp/books/R100000002-I032940500 - 参考書籍 おそろしいビッグデータ、山本龍彦 著、朝日新聞出版、朝日新書、2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I028608020