こんにちは、Anagraftの伊藤です。
今回は、外観検査、つまり製品や部品の表面と形を見て欠陥の有無を判定する検査に、データから学習したモデルを使う方法を、どう理解し、どう自社の工程と品質保証の仕組みに組み込むかを整理しました。本コラムでは、カメラで撮った画像を使う自動の外観検査を主に扱い、その判定の一部または全部に機械学習や深層学習のモデルを使う仕組みを外観検査AIと呼びます。外観検査の自動化を検討する場面では、次のような問いが、品質保証や生産技術の担当者だけでなく、工場の責任者や経営層にも届くことが多いように思います。
- 目視検査をAIに置き換えられるか
- どの工程から始めればよいか
- 不良の画像がほとんど無いが、学習できるのか
- PoC(試験導入)では精度が高かったのに、ラインで使われないのはなぜか
本コラムでは、こうした問いに答えるための材料を、検査と判定基準の基礎、撮像と判定の技術、評価と運用の設計、導入と定着の4つのまとまりに分けて並べました。
この題材を選んだ理由は、外観検査AIが「画像を集めてAIのモデルを作れば目視検査が要らなくなる取り組み」と受け取られて、モデルの精度だけが議論され、判定基準や撮像の条件、ラインでの扱いが決まらないまま終わることが多いように思うためです。何を不良とするかが検査員によって揺れていれば、その判定を教師にしたモデルも揺れます。欠陥が画像に写っていなければ、どのモデルでも見つけられません。検査が生産の速度に追いつかなければ、ラインに置けません。AIの判定が信用されなければ、人が全数を見直すことになり、二重に手間がかかります。こうした状態で投資を重ねると、流出、過検出、判定のばらつき、タクトの超過、形骸化、二重投資という形で損失が出ます。
本コラムでは、品質管理と検査の用語の規格、抜取検査の規格、カメラの評価と通信の規格、手法の原論文、公的機関や企業が公開している資料など、読者が自分で開いて確かめられる一次情報を根拠にしました。規格の本文は有料のものが多いため、規格については、規格団体が公開している規格の一覧(目録)の記載と、公開されている概要の範囲で書いています。第2章、第4章から第10章、第12章では、架空の合成画像や架空のスコアに対して実際にPythonのコードを動かし、その出力とグラフを載せています。架空のデータで得た数値は、その条件での一例であり、一般的な性能の目安ではありません。
想定している読者は、外観検査の自動化を任された方、あるいはそれを決める立場の方です。品質保証や品質管理の担当者の方、生産技術や検査工程の責任者の方、DX推進の担当者の方、画像のデータを分析するデータサイエンティストの方、そして検査の自動化を求められて、何から決めるかを判断しなければならない工場の責任者や経営層の方を念頭に置いています。画像処理や機械学習の専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その方法で何が分かり、検査の判定にどうつながるか」「経営はどう判断するか」を意識して書きました。
本コラムに出てくる企業や団体の取り組みは、その企業や団体が公開した資料を開いて確かめたものに限っています。装置やカメラの価格、検査の費用、製品やサービスの料金、弊社の支援の条件には触れていません。例題で費用を扱う箇所は、単位の無い「相対コスト」で書いています。出荷の可否を決める品質保証の判断や、法令・顧客との取り決めで定められた検査の扱いについては、品質保証の責任者や所管の官庁、顧客、専門家に確認していただく前提で書いています。
各章の題と、その章で答える問いは「全体の地図」の表にまとめています。本コラムで使う用語の定義も、同じ「全体の地図」の表にまとめています。

目次
- 序章 外観検査AIは何を見つけて何を決める仕組みか
- 全体の地図
- 第1章 外観検査の役割と品質管理での位置づけ、目視検査から自動検査まで
- 第2章 欠陥の定義と判定基準、限度見本と検査員の判定のばらつき
- 第3章 撮像の設計、カメラ・レンズ・照明で欠陥を写る状態にする
- 第4章 ルールベースの画像処理、二値化・差分・特徴量で何ができるか
- 第5章 教師あり学習による欠陥の分類と検出、CNNから物体検出・領域分割まで
- 第6章 良品だけで学ぶ異常検知、オートエンコーダからPatchCoreまで
- 第7章 少ないデータで学ぶ工夫、データ拡張・転移学習・合成データ
- 第8章 検査の精度の評価、見逃しと過検出としきい値の決め方
- 第9章 速度と精度の両立、タクトタイムに収める推論の設計
- 第10章 人とAIの協調運用、判定の保留・再検査・根拠の示し方
- 第11章 検査ラインへの組み込み、PLC・MES・トレーサビリティとのつなぎ方
- 第12章 運用と保守、照明の劣化・品種の追加・モデルの再学習への対応
- 第13章 導入の進め方と体制、対象工程の選定・PoC・検査員の役割
- 第14章 公開事例と最新動向、規格・公開データセット・基盤モデルの活用
- 終章 外観検査AIを使い続けるために
- 本コラムで紹介した書籍一覧
- 第1章 外観検査の役割と品質管理での位置づけ、目視検査から自動検査まで
- 第2章 欠陥の定義と判定基準、限度見本と検査員の判定のばらつき
- 第3章 撮像の設計、カメラ・レンズ・照明で欠陥を写る状態にする
- 第4章 ルールベースの画像処理、二値化・差分・特徴量で何ができるか
- 第5章 教師あり学習による欠陥の分類と検出、CNNから物体検出・領域分割まで
- 第6章 良品だけで学ぶ異常検知、オートエンコーダからPatchCoreまで
- 第7章 少ないデータで学ぶ工夫、データ拡張・転移学習・合成データ
- 第8章 検査の精度の評価、見逃しと過検出としきい値の決め方
- 第9章 速度と精度の両立、タクトタイムに収める推論の設計
- 第10章 人とAIの協調運用、判定の保留・再検査・根拠の示し方
- 第11章 検査ラインへの組み込み、PLC・MES・トレーサビリティとのつなぎ方
- 第12章 運用と保守、照明の劣化・品種の追加・モデルの再学習への対応
- 第13章 導入の進め方と体制、対象工程の選定・PoC・検査員の役割
- 第14章 公開事例と最新動向、規格・公開データセット・基盤モデルの活用
- 参考情報
序章 外観検査AIは何を見つけて何を決める仕組みか
製品の外観検査には、昔から2つの基本的なやり方があります。1つは、検査員が製品を目で見て判定する目視検査です。もう1つは、カメラで撮った画像から、人が書いたルール(明るさのしきい値、面積、形)で欠陥を見つける画像処理の検査です。目視検査は、形や見え方が多様な欠陥にも対応しやすい場合がある一方で、検査員の疲れや経験、基準の受け取り方によって判定がばらつき、人手の確保にも限りがあります。ルールによる画像処理は、処理を速くしやすく、同じ画像には同じ判定を返す作りにできる一方で、ルールで書ける欠陥にしか対応できず、照明や位置が少し変わるだけで過検出が増えることがあります。本コラムの主題である外観検査AIは、外観検査の判定の一部または全部に、データから学習したモデル(機械学習・深層学習)を使う仕組みです。良品と不良品の画像、あるいは良品の画像だけから「良品らしさ」をデータで学び、ルールで書きにくい欠陥の判定にモデルを使うことで、この2つのやり方の間を埋めることを狙います。
外観検査AIは、カメラ、照明、深層学習のモデルといった技術の話として語られることが多くあります。しかし、外観検査AIの価値を決めるのは、モデルの精度そのものではなく、流出(見逃した不良が後工程や顧客に届くこと)と過検出(良品を不良と判定して廃棄や再検査が増えること)の損失が、検査の人手を含めて減るかどうかだと考えています。仮の例として、ある種類の不良の見逃しをゼロに近づけるためにしきい値を厳しくすると、良品を不良とする判定が増え、その確認に人手がかかります。モデルの判定が正しくても、不良と判定された製品が排出されず、記録にも残らなければ、検査の役目を果たしたことにはなりません。そのため本コラムでは、外観検査AIの取り組みを、判定の技術と、判定に基づいて製品の扱い(良品として流す・排出する・人が確かめる)を決めるところまでを含むものとして扱います。
外観検査AIを支える3つの判定の方法
外観検査で画像から欠陥を判定する方法は、ルールベースの画像処理、教師あり学習、良品学習の3つに分けて考えると整理しやすくなります。1つ目のルールベースの画像処理は、人が明るさや面積のしきい値、良品の画像との差などのルールを書いて判定する方法で、第4章で扱います。位置と形が安定し、周りとの明るさの差がはっきり写る欠陥には、この方法で足りる場合があります。2つ目の教師あり学習は、良品と不良品(とその種類)のラベルを付けた画像から学ぶ方法で、第5章で扱います。欠陥の種類まで見分けたいときに向きますが、不良の画像が十分に集まることが前提になります。3つ目の良品学習は、良品の画像だけから「いつもの見た目」を学び、それから外れたものを異常とする方法で、第6章で扱います。不良が少ない工程や、まだ見たことの無い欠陥が出うる工程で使いやすい一方で、欠陥の種類までは分かりません。
判定の3つの方法は、求められるデータの量も、誤判定したときの影響も違います。すべての工程で3つのうち最も新しい方法を選ぶ必要はなく、対象の欠陥と、手元にある画像の数に応じて、どの方法を使うか、どう組み合わせるかを選びます。位置決めや寸法の計測はルールで行い、欠陥の判定だけを学習したモデルで行う、という組み合わせも選べます(第4章)。
判定の3つの方法のどれを選ぶにしても、その前提になるのが、何を不良とするかと、欠陥が画像に写っているかという2つの問いです。何を不良とするかは、限度見本や判定基準として決まっているはずですが、検査員によって受け取り方が違うことがあります(第2章)。基準が揺れていれば、その判定を教師にしたモデルも揺れます。欠陥が画像に写っているかは、カメラ、レンズ、照明の組み合わせで決まります(第3章)。写っていない欠陥は、どれほど高度なモデルでも見つけられません。判定の方法を選ぶ前に、この2つを先に確かめることが、外観検査AIの取り組みの出発点になります。
判定から製品の扱いへ
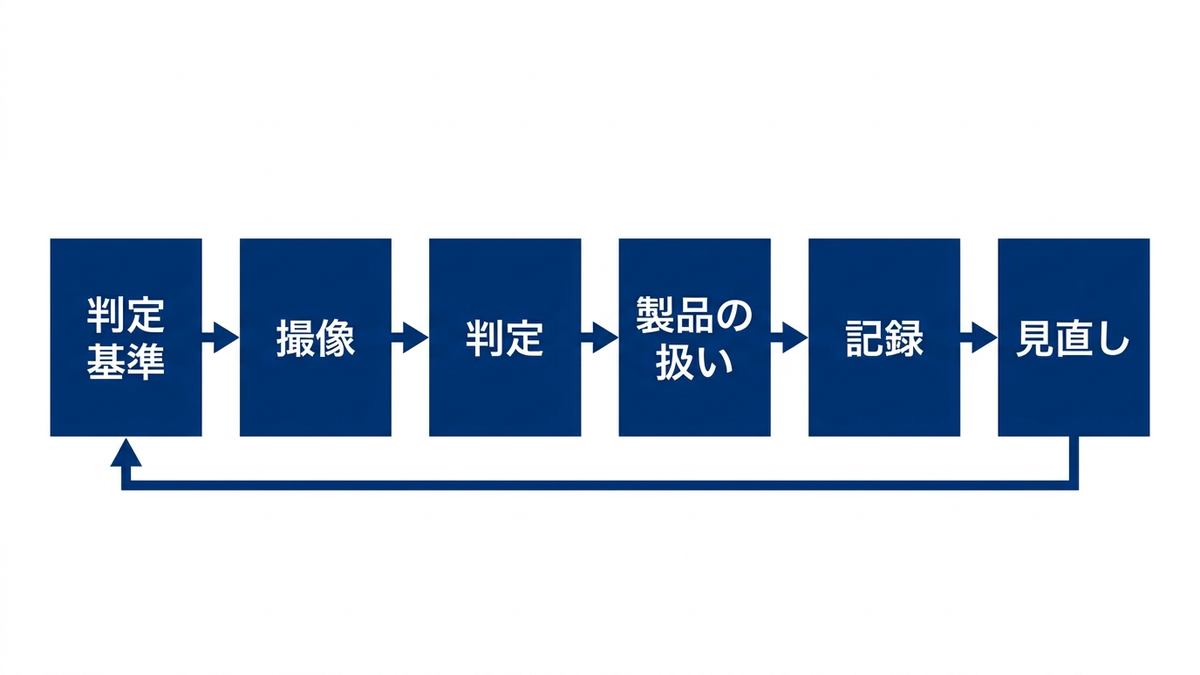
モデルの判定を検査の結果につなぐには、さらに3つの取り決めが要ります。第1に、しきい値の決め方です。同じモデルでしきい値を動かす場合には、見逃しを減らす設定では過検出が増えやすく、過検出を減らす設定では見逃しが増えやすいという兼ね合いがあります。撮像やモデルを改善すれば両方を減らせることもありますが、残った兼ね合いのどこに設定を置くかは、技術だけでは決まりません。見逃しをどこまで許すかは、顧客との取り決めや製品の用途を前提に、品質保証の責任者が決める事柄です(第8章)。第2に、人との役割分担です。判定のスコアがあらかじめ決めた保留の範囲に入る製品や、画像が検査の条件を満たさない製品を人の判断に回す設計にすると、人が見る数を絞りながら、流出を抑えられる場合があります(第10章)。第3に、ラインと記録への組み込みです。判定を排出の機構につなぎ、どの製品をどのモデルのどの版で判定したかを後から追えるように記録します(第11章)。
この3つの取り決めが無いまま判定のモデルだけを作ると、PoC(試験導入)では「精度が高かった」という結果が出ても、本番の運用につながりにくいと考えています。本コラムでは、モデルの精度に加えて、判定のあとの製品の扱いと記録にも章を立てて扱います。なお、外観検査AIを入れることは、法令や顧客との取り決めで定められた検査を省いてよい理由にはなりません。出荷の可否の最終的な責任は、品質保証の体制にあります(第1章)。
決めないことで出る損失の型
外観検査の方法を選ぶとき、外観検査AIを導入して運用するときに確かめたい損失は、金額ではなく型で捉えると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。
- 流出:見逃した不良が後工程や顧客に届きます。顧客の工程や市場で見つかると、選別や回収の手間が大きくなることがあります。
- 過検出:良品を不良と判定し、廃棄や手直し、再検査が増えます。
- 判定のばらつき:検査員、時間帯、工場によって、何を不良とするかの基準がずれます。
- タクトの超過:検査が生産の速度に追いつかず、仕掛品の滞留やラインの停止につながります。速度が足りないことを理由に、法令・顧客との取り決め・適用する規格で必要とされる検査を省くことはできません。
- 形骸化:AIの判定が信用されず、確かめる目的や終える条件が決まらないまま、人による全数の見直しが常態になり、二重に手間がかかります。
- 二重投資:共通にできる要件やデータまで、工程や工場ごとに別々に整え、同じ開発と保守の手間を何度もかけます。
どの損失が自社で目立っているかを見れば、どこから着手するかの見当が付きます。流出が目立つなら、流出した不良の種類を数え、その欠陥が今の撮像の条件で写っているかを確かめることから始めます(第3章)。過検出が目立つなら、過検出の多い欠陥の区分で判定基準が揺れていないかを確かめ(第2章)、しきい値の決め方を見直します(第8章)。形骸化が起きているなら、新しいモデルを作る前に、AIの判定と人の判定が食い違った製品を集めて、食い違いの理由を数えます(第10章)。すべての工程を一度にAIの検査に切り替える必要はなく、切り替えようとすべきでもない、というのが本コラムの考えです。
外観検査AIは、判定基準と撮像から始める
外観検査AIで最初に決めるべきことは、どの深層学習のモデルを使うかではなく、何を不良とするかの基準と、その欠陥を写す撮像の条件、そしてAIの判定のあとに製品をどう扱い、誰が何を確かめるかだと考えています。そのうえで小さく始め、本番の画像と人の判定を集めながら見直し続けます。判定基準が決まれば、教師データのラベルが決まります。撮像の条件をそろえ、その状態が保たれているかを確かめ続ければ、学習と評価に使う画像のばらつきを抑えやすくなります。判定のあとの扱いが決まれば、評価の基準(見逃し率の上限をいくつにし、そのもとで過検出をどこまで減らすか)が決まります。
本コラムは、次の4つの流れで進みます。
- 検査と判定基準の基礎:品質管理の中での外観検査の位置づけと、欠陥の定義、検査員の判定のばらつきを整理します(第1章・第2章)。
- 撮像と判定の技術:カメラと照明の設計、ルールベースの画像処理、教師あり学習、良品学習、データが少ないときの工夫を、実行したコードとともに見ます(第3章から第7章)。
- 評価と運用の設計:見逃しと過検出の評価としきい値の決め方、タクトに収める推論、人とAIの役割分担、検査ラインと記録への組み込みを扱います(第8章から第11章)。
- 導入と定着:運用と保守、導入の進め方と体制、公開事例と最新の動向を扱います(第12章から第14章)。
経営判断に関わる方にとって、投資の進め方については、装置とモデルに予算を付ける前に、次の4つを確かめる順序をお勧めします。
- 対象の工程で、流出と過検出がどれだけ起きているか
- 判定基準が、文書と限度見本でそろっているか
- 狙う欠陥が、画像に写るか
- AIの判定のあとに確かめる人と、記録の仕組みがあるか
この順序であれば、投資の前提を社内に説明でき、効果が出なかったときにも原因を切り分けやすくなります。反対に、カメラとモデルを先に全工程に広げ、判定基準と判定のあとの扱いを後回しにすると、画像は集まっても判定が信用されず、人の検査と二重に手間がかかるおそれがあります。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、検査工程を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章を、序章で示した4つのまとまりに分けて構成しています。
- 検査と判定基準の基礎(第1章・第2章):検査の役割と、何を不良とするかの基準
- 撮像と判定の技術(第3章から第7章):欠陥を画像に写す方法と、画像から判定する3つの方法、データが少ないときの工夫
- 評価と運用の設計(第8章から第11章):見逃しと過検出の評価、判定の速さ、人との役割分担、ラインと記録への組み込み
- 導入と定着(第12章から第14章):運用と保守、導入の進め方と体制、公開事例と最新の動向
第2章、第4章から第10章、第12章には、架空の合成画像や架空のスコアで実際に動かしたPythonのコードと、その結果を載せています。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | 外観検査の役割と品質管理での位置づけ、目視検査から自動検査まで | 検査は品質管理の中で何を担い、外観検査はどこに位置づくのか。どの工程で何を止める検査か |
| 第2章 | 欠陥の定義と判定基準、限度見本と検査員の判定のばらつき | 何を不良とするかをどう決め、検査員の判定のばらつきをどう測るか |
| 第3章 | 撮像の設計、カメラ・レンズ・照明で欠陥を写る状態にする | 狙う欠陥を画像に写すには、カメラ・レンズ・照明をどう選ぶか |
| 第4章 | ルールベースの画像処理、二値化・差分・特徴量で何ができるか | 人が書いたルールで、どの欠陥が見つかり、どこで外れるか |
| 第5章 | 教師あり学習による欠陥の分類と検出、CNNから物体検出・領域分割まで | 不良の画像から学ぶ方法(画像を見分ける深層学習のモデル、CNN)は、どんな条件で使え、何が分かるか。欠陥の場所や範囲まで示す方法もある |
| 第6章 | 良品だけで学ぶ異常検知、オートエンコーダからPatchCoreまで | 不良の画像が少ないとき、良品の画像だけから欠陥をどう見つけるか(オートエンコーダ・PatchCore はその代表的な手法の名前) |
| 第7章 | 少ないデータで学ぶ工夫、データ拡張・転移学習・合成データ | 画像が少ないとき、データを増やす工夫はどこまで効くか |
| 第8章 | 検査の精度の評価、見逃しと過検出としきい値の決め方 | 検査の精度をどの指標で評価し、しきい値をどう決め、見逃し率をどう確かめるか |
| 第9章 | 速度と精度の両立、タクトタイムに収める推論の設計 | 生産の間隔(タクトタイム)に検査を追いつかせ、各製品の判定を期限までに終えるには、画像の大きさとモデルをどう選ぶか |
| 第10章 | 人とAIの協調運用、判定の保留・再検査・根拠の示し方 | 人とAIの役割をどう分け、迷う製品をどう人に回すか |
| 第11章 | 検査ラインへの組み込み、PLC・MES・トレーサビリティとのつなぎ方 | 判定を、ラインを制御する装置(PLC)による排出と、生産の記録の仕組み(MES)にどうつなぎ、後から追える状態(トレーサビリティ)をどう作るか |
| 第12章 | 運用と保守、照明の劣化・品種の追加・モデルの再学習への対応 | 本番の画像の変化をどう測り、いつどうモデルを見直すか |
| 第13章 | 導入の進め方と体制、対象工程の選定・PoC・検査員の役割 | どの工程から始め、試験導入(PoC、概念実証)をどう設計し、誰が何を担うか |
| 第14章 | 公開事例と最新動向、規格・公開データセット・基盤モデルの活用 | 公開された事例と研究から何が読み取れ、技術はどう動いているか |
本コラムで使う用語は、次の表の意味に固定しています。規格で定義のある用語は、各章で規格の原文や公開されている範囲に当たり、本コラムの定義との違いがあれば示します。特定の章だけで使う用語は、その章の中で定義します。
| 用語 | 本コラムでの意味 |
|---|---|
| 外観検査 | 製品・部品の表面や形を目で見て、またはカメラで撮った画像で調べ、欠陥の有無を判定すること。人が見る場合は目視検査と呼ぶ |
| 外観検査AI | 外観検査の判定の一部または全部に、データから学習したモデル(機械学習・深層学習)を使う仕組み。ルールを人が書く画像処理は、ルールベースの画像処理と呼んで区別する |
| 欠陥 | 製品の表面や形に現れた、意図しない状態(傷・打痕・異物・汚れ・欠け・バリ・色むら・変形など)。欠陥があっても、判定基準の範囲内なら良品と判定される |
| 不良(不良品) | 判定基準に照らして、出荷できない、または後工程に流せないと判定されたもの。欠陥の有無は事実、不良は判定の結果として区別する |
| 判定基準 | 何を不良とするかの決まり。限度見本、寸法の許容差、欠陥の大きさや数の上限などで表す |
| 正解(ラベル) | 評価や学習のために、判定基準に照らして人が確かめて決めた、その製品の扱い(良品か不良か、どの欠陥か)。画像に付けたものをラベルと呼ぶ。人が付けるので、正解そのものが揺れることがある(第2章) |
| 見逃し | 正解が不良である製品を、検査が良品と判定すること。見逃し率は、正解が不良である製品のうち、良品と判定された割合 |
| 過検出 | 正解が良品である製品を、検査が不良と判定すること。過検出率は、正解が良品である製品のうち、不良と判定された割合 |
| 教師あり学習 | 良品と不良(とその種類)のラベルが付いた画像から学ぶ方法 |
| 良品学習 | 異常検知(いつもと違うものを見つけること)のうち、良品の画像だけから「いつもの見た目」を学び、それから外れたもの(異常)を見つける方法。異常が欠陥か、不良かは判定基準に照らして別に決める。良品学習だけでは、欠陥の種類は直接には判定しない |
| 撮像 | カメラ・レンズ・照明・搬送・トリガー(撮るタイミングを決める信号)を組み合わせて、検査用の画像を得ること |
| タクトタイム | 必要な生産数に合わせて決める、製品1個(または1単位)あたりの生産の間隔。検査は、仕組み全体としてこの間隔に追いつき、各製品の判定を排出などに必要な期限までに終える必要がある。1台で1個ずつ順に処理する構成では、1個の検査をこの間隔の中に収めることになる |
| 判定の保留 | 判定のスコアがあらかじめ決めた保留の範囲に入るとき、画像が検査の条件を満たさないとき、判定が期限までに返らないときに、AIの判定を確定させず人の判断に回すこと。保留の範囲は人が設計する |
| 相対コスト | 例題で使う単位の無いコスト。金額ではない |
第1章 外観検査の役割と品質管理での位置づけ、目視検査から自動検査まで
外観検査AIの話は、カメラやモデルの選び方から始まることが多いように思います。けれども、検査を自動にする前に、その検査が品質管理の仕組みの中でどこに置かれ、何を止めるためにあるのかを決める必要があります。この章では、外観検査を品質管理の全体の中に置き直し、コードを載せずに表と文で整理します。
この章で扱う内容は次のとおりです。
- 品質管理の中で検査が果たす役割と、検査が果たせない役割
- 検査の種類(受入検査・工程内検査・最終検査、全数検査と抜取検査)
- 外観検査で見るもの(表面の欠陥・形・印字・組付け)
- 目視検査の特徴と限界
- 自動検査の方式(ルールベースの画像処理・教師あり学習・良品学習)の比較
- 抜取検査の規格と、全数検査を選ぶ場面
- 品質マネジメントの規格(ISO 9001・IATF 16949)と検査の関係
- よくある誤解と、経営の損失の型、経営判断
この章の主張は1つです。検査は品質を作りません。品質は設計と工程で作り込むもので、検査はその結果を確かめ、基準から外れたものが次の工程や顧客へ流れるのを止める役目を負います。外観検査AIも、この役目のどこを受け持つのかを先に決めなければ、精度の高いモデルを作っても使い道が定まらないと考えています。
品質管理の中での検査の役割、検査は品質を作らない
製造業の品質管理は、大きく分けると3つの働きから成ると整理できます。1つ目は、製品が求められる性能や見た目を満たすように設計すること。2つ目は、設計どおりのものを安定して作れるように、材料・設備・作業の方法・作業者の技能を管理すること。3つ目は、作ったものが基準を満たしているかを確かめ、満たしていないものを取り除くことです。検査は3つ目の働きにあたります。この3つの働きの外側に、検査の結果を受けて出荷するかどうかを決める判断があります。後の表では、この判断を4行目に分けて示します。
この整理から分かるのは、検査が品質そのものを上げるわけではないという点です。検査で不良を取り除けば、顧客に届く不良は減ります。しかし、工程で作られる不良の数は検査をしても変わりません。不良の数を減らすには、不良が生まれる原因(材料のばらつき・設備の摩耗・作業の手順の乱れなど)を工程の側で取り除く必要があります。検査は、工程が作った結果を後から選り分ける仕組みであり、選り分けた不良は廃棄・手直し・再検査のどれかの手間になります。
それでも検査が欠かせないのは、どれだけ工程を管理しても、不良をゼロにし続けることは難しいからです。材料のロットが変わる、設備の部品が摩耗する、新しい作業者が入る、といった変化は日々起きます。検査は、工程の管理をすり抜けた不良を止める最後の網であると同時に、工程の状態を知らせる計器でもあります。ある欠陥が急に増えたことを検査が捉えれば、それは工程のどこかで変化が起きた合図になります。
本コラムでは、検査が持つこの2つの働きを、次のように呼び分けます。不良を次の工程や顧客へ流さない働きを「止める働き」、検査の結果を工程に戻して不良の原因を取り除く働きを「知らせる働き」と呼びます。外観検査AIを入れるとき、検討は止める働きの精度(見逃しをどれだけ減らせるか)に集中しやすいように思いますが、知らせる働きをどう使うかを決めておかないと、不良は検査で取り除かれ続けるだけで、工程の側の改善につながりません。
| 品質管理の働きと出荷の判断 | 主に担う部門 | 不良に対して何をするか | 検査との関係 |
|---|---|---|---|
| 設計で作り込む | 設計・開発 | 不良が起きにくい形・材料・公差(寸法などに許される幅)を決める | 検査で何を見るか、判定基準の元になる |
| 工程で作り込む | 製造・生産技術 | 不良の原因(材料・設備・作業)を管理して発生を減らす | 検査の結果(知らせる働き)を受けて工程を直す |
| 検査で止める | 品質保証・品質管理・製造 | 基準を満たさないものを取り除く | 検査そのもの(止める働き) |
| 出荷を決める(3つの働きの外側の判断) | 品質保証 | 検査と記録をもとに出荷の可否を判断する | 検査の結果は判断の材料であり、判断そのものではない |
表の最後の行は、この後の章でも繰り返し触れる点です。検査の結果、つまり「この製品は不良と判定された」という情報は、出荷するかどうかを決めるための材料です。出荷の可否を最終的に決め、その責任を負うのは品質保証の体制です。外観検査AIが判定を出すようになっても、この責任の所在は変わりません。AIの判定を出荷の判断にどう使うかは、品質保証の体制が決めることになります。
検査の種類、受入検査・工程内検査・最終検査と、全数検査・抜取検査
検査は、どこで行うかと、どれだけ見るかの2つの軸で分けて考えると整理しやすくなります。どこで行うかの軸では、受入検査・工程内検査・最終検査の3つに分けるのが一般的です。受入検査は、外部から購入した材料や部品を受け入れるときに行う検査です。工程内検査は、製造の途中の工程で、次の工程に流してよいかを確かめる検査です。最終検査は、製品が完成した段階で、出荷してよいかを確かめる検査です。
どれだけ見るかの軸では、全数検査と抜取検査の2つに分けます。全数検査は、対象のすべての製品を1個ずつ検査する方法です。抜取検査は、ロット(同じ条件で作られたひとまとまり)から決められた数の製品を抜き取って検査し、その結果からロット全体を受け入れるか、受け入れないかを決める方法です。抜取検査では、抜き取らなかった製品の1個1個が良品か不良かは分かりません。抜取検査は、あらかじめ決めた抜取の方式に従ってロットを受け入れるかどうかを決めるための道具で、ロットの品質を推定することが主な目的ではありません。米国の国立標準技術研究所(NIST)の統計の手引きも、抜取検査の目的をこのように説明しています。また、一部から全体を判断するので、その判断が外れることもあります。工程の変化を傾向で見張るために一部を抜き出して調べることもありますが、それはロットの受け入れを決める抜取検査とは別の目的です。
上の説明は、規格の定義を写したものではなく、本コラムでの使い方です。社内の文書で用語を定めるときは、現行の規格の本文で確かめてください。生産管理で使う用語は日本産業規格の JIS Z 8141(生産管理用語)にまとめられており、日本規格協会が公開していた冒頭部分で、2022年3月22日に改正された JIS Z 8141(2022年)が2001年の版を置き換えたことを確かめました。この規格の、検査に関わる用語の定義の本文は確かめていません。
2つの軸を組み合わせると、次の表のようになります。どの組み合わせを選ぶかは、検査にかけられる手間と、不良が流れたときの影響の大きさで決まります。
| 検査を行う場所 | 検査の目的 | 全数検査を選びやすい場面 | 抜取検査を選びやすい場面 | 外観検査AIの使われ方の例 |
|---|---|---|---|---|
| 受入検査 | 購入した材料・部品の品質を確かめる | 部品の不良が後工程で大きな手戻りになるとき | 供給元の品質が安定していて、記録で確かめられるとき | 部品の表面の傷・汚れ・印字の確認 |
| 工程内検査 | 次の工程に不良を流さない。工程の変化を早く知る | 後工程で付加価値が大きく積み上がるとき | 工程が安定していて、ロット単位の受け入れの判断で足りるとき | 加工直後の欠け・バリ、塗装のむら、組付けの抜け |
| 最終検査 | 出荷してよいかを確かめる | 顧客に届く不良の影響が大きいとき | 工程内検査で十分に確かめており、最終検査は確認にとどめるとき | 完成品の外観、ラベル・印字、梱包の状態 |
外観検査AIの検討では、最終検査を対象にする案が最初に挙がりやすいように思います。顧客に届く直前で止めるので、効果が分かりやすいからです。しかし、最終検査で見つかった不良は、すでにすべての工程の手間をかけ終えたものです。同じ欠陥を工程内検査で見つけられれば、後の工程の手間をかけずに済み、工程の変化にも早く気づけます。どの場所の検査を自動にするかは、対象工程の選び方として第13章で改めて扱います。
外観検査で見るもの、表面の欠陥・形・印字・組付け
外観検査は、製品・部品の表面や形を目で見て、またはカメラで撮った画像で調べ、欠陥の有無を判定することです。本コラムでは、カメラで撮った画像を使う自動の外観検査を主に扱い、人が見る場合は目視検査と呼びます。外観検査で見るものは、大きく4つに分けられます。
- 表面の欠陥:傷・打痕・異物・汚れ・欠け・バリ・色むらなど、製品の表面に現れた意図しない状態
- 形:寸法・変形・反り・穴の位置など、製品の形が決められた範囲に収まっているか
- 印字・表示:文字や記号・ラベルが正しく、読める状態で付いているか
- 組付け:部品が正しい位置に、正しい向きで、決められた数だけ付いているか
この4つは、画像のどこを見て、何と比べれば判定できるかが違います。表面の欠陥は、どこに現れるか分からないものを広い範囲から探す作業で、欠陥の種類や大きさも一定しません。形は、決められた寸法や形と比べる作業で、比べる相手(図面や良品の形)がはっきりしています。印字は、決められた文字列と照合する作業です。組付けは、決められた位置に決められた部品があるかを確かめる作業です。比べる相手がはっきりしている検査ほど、人が書いた規則(ルールベースの画像処理)で判定しやすく、どこに何が現れるか分からない検査ほど、データから学ぶ方法が候補になります。この違いは、後の節の方式の比較と、第4章から第6章の内容につながります。
ここで、本コラムで固定して使う2つの言葉を確かめておきます。欠陥は、製品の表面や形に現れた意図しない状態のことです。不良(不良品)は、判定基準に照らして出荷できない、または後工程に流せないと判定されたもののことです。欠陥があっても、基準の範囲内であれば良品と判定されます。欠陥の有無は事実、不良は判定の結果です。外観検査AIが見つけるのは、まず欠陥の候補です。とくに良品の画像だけから学ぶ方法が捉えるのは、学んだ良品の見た目から外れたもので、許される範囲の良品のばらつきや撮像の条件の変化でも外れることがあります。候補が本当に欠陥か、さらに不良にあたるかは、画像と判定基準に照らして確かめます。判定基準の決め方と、限度見本・検査員の判定のばらつきは、第2章で扱います。
目視検査の特徴と限界、人の検査はなぜ揺れるのか
外観検査の多くは、今も人の目で行われています。目視検査には、一般に次のような強みがあるといわれます。ここに挙げるのは一般論で、検査の内容や検査員の経験によって当てはまらない場合があります。
- 初めて見る種類の欠陥にも気づける場合がある
- 製品を手に取り、角度を変えて見られる
- 判定基準の言葉にしにくい微妙な違いを、経験で見分けられる場合がある
- 品種が変わっても、比較的すぐに対応できる場合がある
外観検査AIを検討するときは、この強みのどこを AIが引き継げて、どこを引き継げないかを考える必要があります。
一方で、目視検査には限界があることも、長く研究されてきました。米国のサンディア国立研究所が2012年に公開した、同研究所の See 氏による報告書(SAND2012-8590)は、1950年代以降に発表された目視検査の文献212件を整理した総説です。本コラムではこの報告書の本文を開き、次の点を確かめました。数字は、報告書がそれぞれの元の研究から引いているもので、その研究の課題と条件での値です。自社の検査員の見逃し率として読み替えることはできません。
- 報告書は、検査の誤りは減らせてもなくせないとし、Swain・Guttmann の1983年の整理を引いて、比較的単純な合否の判定でも誤りの率の下限は1,000回に1回程度と見積もられているとしています。複雑な作業では、それより高くなるとしています
- 検査の文献では、さまざまな種類の検査作業で20〜30%の誤りの率がしばしば引かれていると述べ(Drury と Fox の1975年の整理)、全数検査をしてもすべての欠陥が見つかるわけではないとしています
- 長い時間にわたって、まれにしか現れない信号を見張り続けると成績が下がる現象(ビジランスの低下)を取り上げ、実験では作業を始めてから20〜35分ほどで低下がおおむね出そろうとする研究を引いています。ただし、この現象が実際の検査作業にどこまで当てはまるかは、作業の組み立て方によるとしています
- 不良の率が低いほど検査の成績が下がるという研究を挙げています。ある紙と鉛筆の検査課題では、不良の率を16%から0.25%まで下げると、見つけた欠陥が減り、過検出が増えたとしています。別の研究では、この影響は検査員が自分のペースで作業する条件に限られた可能性があるとしています
- 検査の成績に影響する要因として、作業の内容・環境・個人・組織・社会の各面を挙げています。個人の面の例として、検査員が最近経験した欠陥の種類・頻度・位置にもとづく思い込みを挙げています。社会の面の例として、差し戻す品物の数を減らしてほしいという製造の側からの暗黙の圧力が、境界にある品物を受け入れる方向に判定を傾けることを挙げています
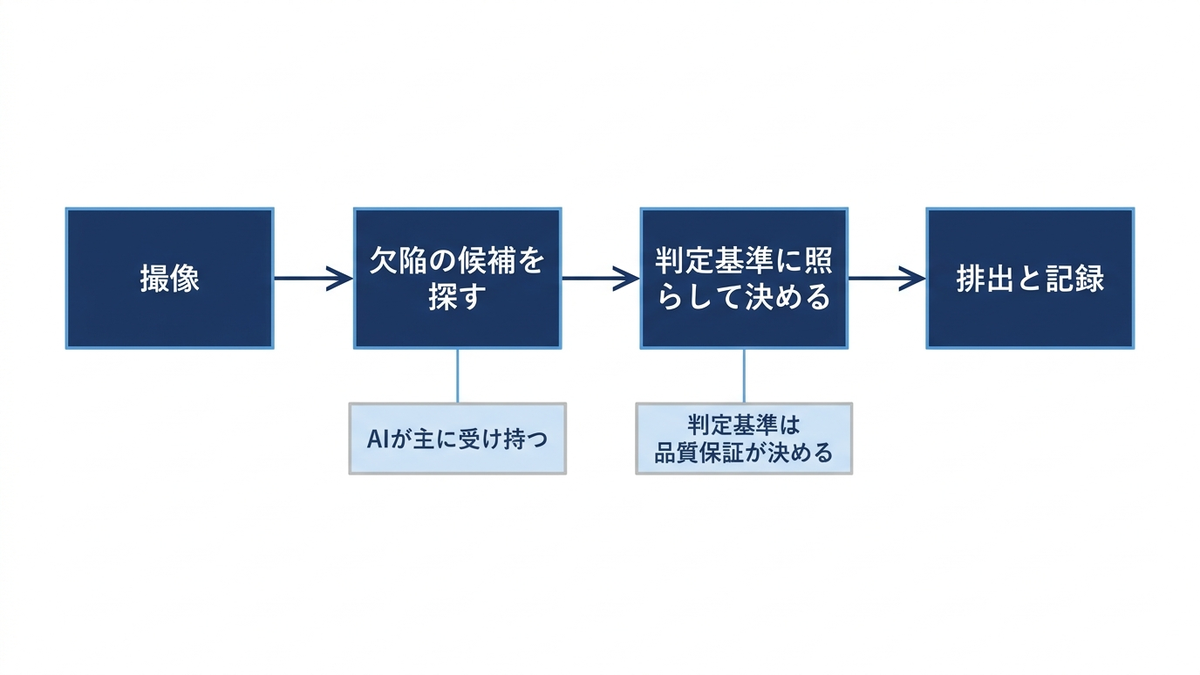
報告書は、検査の作業を「探す」と「決める」の2つに分けて考える Drury のモデルを、検査の最も広く知られたモデルとして紹介しています。探すとは、製品の上で欠陥の候補を見つけることで、決めるとは、見つけた候補を基準に照らして合格か不合格かを判断することです。この分け方は、外観検査AIを考えるうえでも役に立ちます。AIが主に受け持つのは「探す」の部分で、欠陥の候補を見つけ、手法によってはその位置と異常の度合いも示します。「決める」の部分も、定めた判定基準に沿う範囲で AIに自動で行わせることはできますが、判定基準そのものを決めて承認することと、判定の結果を出荷の判断に使う責任は、品質保証の体制が負います。また「決める」には判定基準が要り、基準があいまいなまま AIに学習させると、AIの判定も揺れます。判定基準の決め方は第2章で、AIと人がどう判定を分け合うかは第10章で扱います。
この節で確かめたことを、目視検査が揺れる理由として整理すると、次の3つになります。1つ目は、報告書が引く研究に、まれな信号を長い時間見張り続けると成績が下がる例があること。2つ目は、不良がまれな課題で、見つけた欠陥が減り過検出が増えた例があること。3つ目は、検査員の判断が、基準だけでなく、最近経験した欠陥の種類・頻度・位置にもとづく思い込みや、差し戻しを減らしてほしいという製造の側からの暗黙の圧力の影響も受けることです。これらは、報告書が引く研究のそれぞれの課題と条件で見られたもので、実際の検査作業にどこまで当てはまるかは、作業の組み立て方(作業の時間・休憩・自分のペースで進めるかどうかなど)によります。そのうえで、これらは検査員の努力不足というより、人の注意と判断の性質や、職場の仕組みに関わるものだと考えています。報告書が挙げる要因には、作業の時間の長さ・不良の率・組織からの圧力のように、検査員個人の努力では変えにくいものが含まれます。そのため、検査員を増やしたり注意を促したりするだけでは、揺れは小さくなりにくいと考えています。
自動検査の方式の比較、ルールベースの画像処理・教師あり学習・良品学習
カメラで撮った画像から欠陥を見つける自動検査は、判定の仕方で大きく3つの方式に分けられます。本コラムの全体を通して使う分け方なので、ここで比べておきます。各方式の詳しい中身と、実際に動かした結果は、第4章から第6章で扱います。
1つ目は、ルールベースの画像処理です。人が規則を書いて判定する方式で、たとえば「明るさが一定の値より暗い画素が、決められた面積以上まとまっていたら傷とする」「良品の画像と重ねて、差が大きい場所を欠陥とする」といった規則を組み合わせます。外観検査AIと呼ぶものには含めず、本コラムでは「ルールベースの画像処理」と呼んで区別します。2つ目は、教師あり学習です。良品と不良(とその種類)のラベルが付いた画像から、モデルが見分け方を学びます。3つ目は、良品学習です。異常検知のうち、良品の画像だけから学ぶ方法を指します。良品の画像だけから「いつもの見た目」を学び、それから外れたものを異常とします。ここでいう異常は、いつもの見た目から外れているという意味で、欠陥の候補にあたります。異常とされたものが不良かどうかは、判定基準で決めます。欠陥の種類までは分かりません。
| 比べる点 | ルールベースの画像処理 | 教師あり学習 | 良品学習(異常検知の一種) |
|---|---|---|---|
| 判定の決め方 | 人が規則としきい値を書く | ラベル付きの画像からモデルが学ぶ | 良品の画像からいつもの見た目を学び、外れを異常とする |
| 判定を作るのに要る画像 | 規則としきい値を作るための良品・不良の画像(欠陥の見え方が安定している場合は、多くなくてよい) | 欠陥の種類ごとに、ラベルを付けた不良の画像がまとまった数 | 良品の画像がまとまった数(不良の画像は学習には使わない) |
| 評価に要る画像 | 規則を作った画像とは別の、良品と不良の評価用の画像 | 学習に使った画像とは別の、良品と不良の評価用の画像 | 学習に使った画像とは別の、良品と不良の評価用の画像 |
| 得意な場面 | 位置・形・明るさが安定していて、欠陥を規則で言い表せる | 欠陥の種類を見分けたい。不良の画像が十分に集まる | 不良が少ない。どんな欠陥が出るか事前に分からない |
| 外れやすい場面 | 照明や位置のずれ、良品の模様のばらつきで過検出が増える | 学習に無かった種類の欠陥を見逃しやすい | 良品の見た目のばらつきが大きいと、良品を異常としやすい |
| 判定の根拠の示しやすさ | 規則として説明できる | 根拠を示すには追加の手法が要る | 位置を推定できる手法では、異常の度合いの地図で候補の場所を示せる(不良の理由の説明とは別) |
| 品種の追加への対応 | 品種ごとに規則としきい値を作り直す | 品種ごとに不良の画像を集め直すことが多い | 品種ごとに良品の画像を集めて学習し直す |
| 詳しく扱う章 | 第4章 | 第5章 | 第6章 |
表の「評価に要る画像」の行のとおり、判定を作るための画像と、判定の成績を確かめるための画像は別のものです。評価に使う不良の画像の数は、方式によってではなく、どの水準の見逃し率まで確かめたいか(どれだけの確からしさで言いたいか)によって決まります。その考え方は第8章で扱います。この表は、3つの方式のどれが優れているかを示すものではありません。どの方式が合うかは、見たい欠陥と、集められる画像と、求める判定の細かさで決まります。また、実際の検査では、1つの方式だけで組むとは限りません。たとえば、製品の位置合わせや寸法の計測はルールベースの画像処理で行い、表面の欠陥の判定には良品学習を使い、良品学習で異常とされたものの種類を教師あり学習で見分ける、という組み合わせも考えられます。組み合わせの型は第4章で扱います。
3つの方式に共通する前提が1つあります。どの方式も、画像に欠陥が写っていなければ見つけられません。照明の当て方が合っていない、カメラの解像度が足りない、ピントが合っていない、といった撮像(カメラ・レンズ・照明・搬送を組み合わせて検査用の画像を得ること)の問題は、モデルを工夫しても取り戻せないことが多いと考えています。撮像の設計は第3章で扱います。
抜取検査の規格と、全数検査を選ぶ場面
抜取検査は、ロットから一部を抜き取って検査し、ロット全体を受け入れるかどうかを決める方法です。どれだけ抜き取り、何個まで不良を許すかは、勘で決めるものではなく、統計的な考え方に基づく規格が用意されています。代表的なものが、国際規格の ISO 2859 の系列です。ISO 2859-1 は、計数値(良品か不良かを数える)の検査について、合格品質限界(AQL)を指標にして整理したロットごとの抜取の方式を扱う規格です。ISO のページは、1つの工程や1つの供給元から続けて作られるロットを想定した規格だと説明しています。AQL の厳密な定義は規格の本文によるので、ここでは書きません。
社内の手順書で ISO 2859-1 を引いている場合は、どの版を前提にしているかを確かめ直す必要があります。この規格は2026年に改訂されたためです。ISO の規格の目録(2026年10月の時点の保存版)では、第3版の ISO 2859-1(2026年)が2026年1月に発行され、旧版の ISO 2859-1(1999年)は廃止の扱いになっていました。新しい版で何が変わったかは、規格の本文を確かめていないので書きません。
日本産業規格では、JIS Z 9015 の系列が計数値の抜取検査を扱う規格として知られています。社内で使うときは、JISC の検索で現在の版と状態を確かめてください。本コラムの執筆時点(2026年11月9日)には JISC と日本規格協会のページが開けず、JIS Z 9015-1 の現在の版・対応する国際規格の版・ISO 2859-1 の改訂を受けた見直しの有無を確かめられませんでした。抜取の方式の具体的な表と手順は、本コラムでは扱わず、これらの規格の本文に譲ります。
抜取検査と全数検査のどちらを選ぶかは、次のような条件で考えると整理しやすくなります。
| 条件 | 全数検査が向く | 抜取検査が向く |
|---|---|---|
| 不良が流れたときの影響 | 1個でも流れると安全や機能に関わる、顧客に大きな影響がある | 影響が限られ、ロット単位の品質の水準を保てば足りる |
| 検査が製品を壊すか | 壊さない(外観検査の多くはこちら) | 壊す・消耗させる検査(強度の試験など)は全数にできない |
| 1個あたりの検査の手間 | 小さい、または自動にできる | 大きく、全数では生産の速度に追いつかない |
| 工程の安定 | 不安定で、ロットの中でも不良がばらつく | 安定していて、ロットの品質が均一とみなせる |
| 顧客との取り決め | 全数検査を求められている | 抜取の方式と合格の条件が取り決められている |
外観検査の自動化と、この選び方は深く関わっています。目視の全数検査は人手がかかるので、人手が足りない工程では抜取に切り替えるか、全数のまま人を増やすかの選択を迫られます。自動の外観検査は1個あたりの検査の手間を小さくできるので、これまで抜取にしていた工程を全数検査に切り替える、という選択肢が生まれます。ただし、全数検査にしても、自動の検査そのものに見逃しがあれば、不良は流れます。前の節で見たように、人の全数検査でもすべての欠陥が見つかるわけではありません。自動の全数検査も同じで、見逃し率がどれだけかを測って確かめることが前提になります。見逃し率の確かめ方は第8章で扱います。
なお、法令や顧客との取り決め、業界の規格で検査の方法が定められている製品(医薬品・医療機器・自動車部品・食品など)では、抜取か全数か、目視か自動かを、自社だけで決められない場合があります。そうした検査を外観検査AIに置き換えられるかどうかは、本コラムでは判断しません。所管の官庁や規格の定め、顧客との取り決めを確かめたうえで、品質保証の体制が判断することになります。
品質マネジメントの規格と検査、ISO 9001 と IATF 16949
ISO 9001 は品質マネジメントシステムの国際規格で、認証を受けている企業では、外観検査もこの規格に沿った仕組みの中で行われます。ISO 9001 は、製品そのものの検査の方法を細かく定める規格ではなく、品質を管理する仕組み(誰が何を決め、どう記録し、どう改善するか)について要求事項を定めた規格です。外観検査AIも、この仕組みの中に置かれる道具の1つになります。
ISO 9001 も2026年に改訂されており、認証を受けている組織は新しい版への移行が必要になります。ISO の目録(2026年10月の時点の保存版)では、第6版の ISO 9001(2026年)が2026年9月に発行され、ISO 9001(2015年)は2026年9月16日に廃止の扱いになっていました。ISO のページは、新しい版が要求事項を分かりやすくすることに重点を置き、品質の文化とリーダーシップの大切さを強調し、リスクと機会を分けて扱うと説明しています。また、認証を受けている組織は、認証の周期の中で定められた期間内に新しい版へ移行する必要があり、詳しくは認証機関に問い合わせるよう案内しています。
日本産業規格では JIS Q 9001 が ISO 9001 に対応します。外観検査は、JIS Q 9001 の「8.6 製品及びサービスのリリース」と「8.7 不適合なアウトプットの管理」の2つの項目に深く関わる活動です。項目の名前のとおり、前者は製品やサービスを次へ渡す(リリースする)ことに、後者は要求を満たさないアウトプットの扱いに関わります。
本コラムで確かめたのは、JIS Q 9001 の2015年の版の目次にこの2つの項目の名前と番号があることまでで、要求事項の文言は確かめていません。この2015年の版には、2025年3月に気候変動に関する追補を反映した版(JIS Q 9001(2025年))が出ています。ISO 9001(2026年)に合わせた JIS の改正が出たか、新しい版で項目の番号や中身がどう変わったかは、確かめていません。
自動車産業には、ISO 9001 に業界固有の要求を加えた IATF 16949 があります。自動車部品の外観検査を自動にする場合、その変更は IATF 16949 に沿った品質マネジメントシステムの中での手順の変更になります。また、取引先の自動車メーカーごとの要求(顧客固有の要求)が関わることもあるので、検査の方法を変える前に取引先との取り決めを確かめる必要があります。IATF 16949 の要求事項の本文は確かめていないので、検査に関わる個々の条項には触れません。
IATF 16949 は改訂の途中です。国際自動車タスクフォース(IATF)の公式ページと告知で確かめた範囲では、次のとおりです。
- 現行の IATF 16949(2016年)は、それまでの ISO/TS 16949(2009年)を置き換えたもの
- 2026年7月の告知では、第2版の発行を2027年の半ばに予定(日程は目安)
- 改訂の重点の1つに新製品の立ち上げの管理があり、その中で変更の管理を構造立てて進めることを挙げている
- 改訂の重点には、ほかに顧客固有の要求の扱いの見直しも含まれる
外観検査AIの導入は、検査の方法の変更そのものです。認証を受けている自動車部品のメーカーでは、第2版の発行の時期を見ながら、検査の変更の手順を見直すことになると考えています。
品質マネジメントの規格から外観検査AIについて言えることは、次の2点だと考えています。1つ目は、検査の方法を変えることは、品質マネジメントシステムの中の手順を変えることだという点です。目視から自動へ切り替えるとき、あるいはモデルを更新するときには、手順書・記録・承認の流れを社内の決まりに沿って更新する必要があります。変更の管理は第12章で扱います。2つ目は、検査の結果を記録として残し、後から追えるようにしておくことです。どの製品を、いつ、どの方法で、どう判定したかが追えなければ、不適合が見つかったときに影響の範囲を絞れません。記録とトレーサビリティは第11章で扱います。
よくある誤解、AIを入れれば不良が減る・目視をすぐゼロにできる・精度99%で十分など
外観検査AIの検討の場では、いくつかの誤解が繰り返し出てくるように思います。ここでは5つを取り上げます。どれも、この章で整理した検査の役割から考えると、どこがずれているかが分かります。
1つ目は、「AIを入れれば不良が減る」という誤解です。検査は品質を作らないので、AIの検査を入れても、工程で作られる不良の数は変わりません。変わるのは、不良が後工程や顧客へ流れる数と、良品を不良とする数です。不良そのものを減らしたいなら、検査の結果を工程に戻す知らせる働きを使い、原因を工程で取り除く必要があります。AIの検査は、欠陥の種類・位置・発生の時刻を記録として残しやすいので、知らせる働きを強めるのには向いていると考えています。ただし、それは記録を工程の改善に使う仕組みを作った場合に限られます。
2つ目は、「目視検査をすぐにゼロにできる」という誤解です。前の節で見たように、目視検査には初めて見る欠陥に気づける強みがあり、AIはそれを完全には引き継げません。また、AIの判定が正しいかを確かめるには、人の判定と並べて比べる期間が要ります。進め方としては、AIが先に見て、迷うものや不良とされたものを人が確かめる、という形から始め、人が見る範囲を少しずつ絞っていく方法が考えられます。協調の型は第10章で、並行稼働の期間を含む展開の進め方は第13章で扱います。
3つ目は、「精度99%で十分」という誤解です。不良が少ない工程では、正解率(全体のうち正しく判定できた割合)は役に立ちにくい指標です。たとえば、製品の1%だけが不良という架空の条件を考えると、すべてを良品と判定するだけで正解率は99%になりますが、このとき不良は1個も見つかっていません。見るべきなのは、正解(判定基準に照らして人が確かめて決めた、その製品の扱い)が不良である製品のうち良品と判定されたものの割合(見逃し率)と、正解が良品である製品のうち不良と判定されたものの割合(過検出率)を分けた数字です。どちらをどこまで許すかは、流出と過検出のどちらの損失が大きいかで決まります。評価の指標としきい値の決め方は第8章で扱います。
4つ目は、「PoC で精度が高ければ、ラインでもそのまま使える」という誤解です。PoC(本格的な導入の前に、小さな範囲で効果を確かめる試行)で使う画像は、限られた期間・品種・ロットから集めたものになりやすく、本番のラインで起きる照明の変化・品種の追加・材料のロットの違いを含まないことがあります。PoC の精度は、その画像と条件での値です。ラインに入れるかどうかは、本番に近い条件で集めた評価用のデータで確かめてから判断することになります。評価用のデータの切り方は第8章、本番での変化への対応は第12章、PoC の設計は第13章で扱います。
5つ目は、「AIの判定で出荷を決めてよい」という誤解です。この章の最初の節で確かめたように、検査の結果は出荷の判断の材料であり、出荷の可否を最終的に決め、その責任を負うのは品質保証の体制です。AIの判定が出るようになっても、それをどう出荷の判断に使うか(AIが良品とした製品をそのまま流すのか、人の確認を挟むのか)は、品質保証の体制が決めることです。人と AIの判定の分け方は第10章で扱います。
| よくある誤解 | どこがずれているか | 代わりに確かめること | 扱う章 |
|---|---|---|---|
| AIを入れれば不良が減る | 検査は不良を取り除くが、不良の発生は減らさない | 検査の記録を工程の改善に戻す仕組みがあるか | 第1章・第11章 |
| 目視検査をすぐにゼロにできる | 人は初めて見る欠陥にも気づける場合がある。AIの判定を人の判定と比べる期間が要る | 人が見る範囲をどの順で絞るか、並行稼働の期間をどう取るか | 第10章・第13章 |
| 精度99%で十分 | 不良が少ないと、正解率は不良を見つける力を表さない | 見逃し率と過検出率を分けて測っているか | 第8章 |
| PoC の精度が高ければラインでも使える | PoC の画像は本番の変動(照明・品種・ロット)を含まないことがある | 本番に近い条件の評価用データで確かめたか | 第8章・第12章・第13章 |
| AIの判定で出荷を決めてよい | 出荷の可否の責任は品質保証の体制にある | AIの判定を出荷の判断にどう使うかを品質保証が決めたか | 第1章・第10章 |
経営の損失の型と経営判断、どの工程で何を止める検査かを決める
外観検査の判断を誤ったときの損失は、金額ではなく型で捉えておくと、どの工程で何を優先するかを決めやすくなります。本コラムでは、損失の型を次の6つに固定して使います。
| 損失の型 | 何が起きるか | 起きやすい原因 | 検査の設計で効く手当て |
|---|---|---|---|
| 流出 | 見逃した不良が後工程や顧客に届く | 見逃し率を測っていない。撮像で欠陥が写っていない | 見逃し率の目標の上限を品質保証と決め、判定を作った画像とは別の評価用の画像で確かめる。守れないときは撮像・方式・人との分担を見直す(第3章・第8章) |
| 過検出 | 良品を不良と判定し、廃棄・手直し・再検査が増える | 流出を恐れてしきい値を厳しくしすぎる。良品の見た目のばらつき | 過検出率を流出と分けて測り、保留の範囲を人に回す(第8章・第10章) |
| 判定のばらつき | 検査員・時間帯・工場によって基準がずれる | 判定基準や限度見本があいまい。検査員ごとの基準の違い | 基準をそろえてから AIに学ばせる(第2章) |
| タクトの超過 | 検査が生産の速度に追いつかずラインを止める | 撮像・画像の転送・推論(学習したモデルで画像を判定する処理)・判定の出力・排出までの時間を、タクトから逆算していない | 速度の要件を最初に決める(第9章) |
| 形骸化 | AIの判定が信用されず、人が全数を見直す | 根拠が示されない。過検出が多い。運用の変化で精度が落ちる | 判定の根拠を示し、変化を監視する(第10章・第12章) |
| 二重投資 | 工程や工場ごとにばらばらの仕組みを作る | 記録の項目や判定の出力の形を共通にしていない | 記録の項目とラインとのつなぎ方を共通にする(第11章・第13章) |
この6つは、互いに引っ張り合う関係にあります。流出を減らそうとしきい値を厳しくすれば、過検出が増えます。過検出が増えれば、人が見直す量が増え、やがて AIの判定が信用されなくなる形骸化につながります。精度を上げようと大きなモデルを使えば、タクトの超過が起きやすくなります。工程ごとの事情に合わせた設備が要る場合でも、記録やラインとのつなぎ方のように共通にできる部分まで工程ごとに別々に作ると、重複した投資と保守が生じることがあります。経営の側が決めるべきなのは、どの型の損失をどこまで許すかの優先順位であり、その優先順位が決まって初めて、技術の側はしきい値やモデルの大きさを選べると考えています。
損失の型を予算や体制に落とすときは、型ごとに「誰がその損失を数えるか」を決めておくことが役に立ちます。流出は品質保証が顧客からの苦情や後工程からの差し戻しで数え、過検出は、人が判定基準に照らして良品と確かめた製品のうち検査が不良としたものの数を、確かめた良品の数とあわせて数え(過検出率を出すには、この分母が要ります)、過検出が引き起こした廃棄・手直し・再検査の件数は影響の大きさを示す数として別に記録し、タクトの超過はラインの停止の回数と時間で数える、という具合です。数える担当が決まっていない損失は、導入の前後で比べられず、効果を判断できません。効果の見立て方は第13章で扱います。
この章の内容を、経営の判断に落とすと次のようになります。外観検査AIの導入を決める前に、まず「どの工程で、何を止めるための検査か」を決めることです。これを決めずにモデルの精度の比較から始めると、PoC で高い精度が出ても、その精度が流出と過検出のどちらの損失をどれだけ減らすのかが分からず、ラインに入れるかどうかを判断できないことが多いように思います。
決めておきたいことを、次の確認の一覧にまとめました。
- その検査は、受入検査・工程内検査・最終検査のどれか。止める働きと知らせる働きのどちらを主に期待するか
- 止めたい欠陥は何か。その欠陥が流れたとき、後工程と顧客にどんな影響があるか
- 全数検査か抜取検査か。法令・顧客との取り決め・業界の規格で検査の方法が定められていないか
- 判定基準(何を不良とするか)は、検査員の間でそろっているか(第2章)
- 6つの損失の型のうち、どれを最も避けたいか。見逃し率と過検出率の許容の範囲を、品質保証と製造で合意できているか
- AIの判定を出荷の判断にどう使うかを、品質保証の体制が決めているか
- 検査の方法を変えるときの手順書・記録・承認の流れが、品質マネジメントシステムの中で決まっているか
この一覧のうち、最初の2つは技術の検討より前に、経営と品質保証と製造が一緒に決めることです。どの工程を最初の対象にするかを採点して選ぶ方法は、第13章で扱います。外観検査AIは、判定の精度そのものではなく、決めた損失の型がどれだけ減るかで評価する仕組みだと考えています。
この章では、検査は品質を作らず、工程で作り込んだ結果を確かめて不良を止める役目と、工程に変化を知らせる役目を持つことを確かめました。そのうえで、検査の種類、目視検査の限界、自動検査の3つの方式、抜取検査と全数検査の選び方、品質マネジメントの規格との関係、損失の型を整理しました。次の第2章では、何を不良とするかという判定基準の決め方と、限度見本、検査員の判定のばらつきを扱います。
この章を深めたい方への参考書籍
『ビジュアル品質管理の基本』第5版(内田治、日本経済新聞出版社):日経文庫の1冊で、2016年に出た第5版です。書名のとおり品質管理の基本を扱う入門書で、この章で扱った、検査を品質管理の全体の中に置き直す見方を確かめるときの土台になると考えています。
『品質保証と自働化:源流検査による不良ゼロの仕組み』(平野裕之、日刊工業新聞社):「新IE」入門シリーズの1冊で、書名のとおり、源流検査によって不良をなくす仕組みを主題にした本です。2001年の本ですが、検査は品質を作らないという、この章の主張を工程の側から考えるときの手がかりになると考えています。
第2章 欠陥の定義と判定基準、限度見本と検査員の判定のばらつき
第1章では、検査は品質を作るものではなく、工程で作り込んだ品質から外れたものが後工程や顧客に流れるのを止めるものだと整理し、どの工程で何を止めるための検査かを先に決める必要があることを確かめました。検査で何を止めるかが決まったら、次に決めるのは「何を不良とするか」です。外観検査AIは、人が付けた「良品」「不良」のラベルから学ぶか、良品として集めた画像から学びます。本章でいうラベルは、画像ごとに人が付けた判定(良品・不良や欠陥の種類)のことで、AIの学習と評価に使う教師データの判定です。どちらの学び方の場合も、何を良品とし何を不良とするかという判定基準が揺れていれば、学習に使う画像とラベルも揺れ、AIの判定も揺れます。
この章では、次の内容を扱います。
- 欠陥と不良の区別と、欠陥の種類ごとの写り方の違い
- 判定基準の表し方(大きさ・数・場所・重要度)
- 限度見本の作り方と、更新・保管・劣化の管理
- 目視検査を官能検査の一種として扱う考え方
- 検査員どうし、同じ検査員の時間による判定のばらつきを、一致率とカッパ係数で数える方法(実行したコードと結果)
- ラベル付けの手順と、経営としての判断
この章の主張は、AIを入れる前に判定基準をそろえる必要がある、ということです。判定の精度を見逃し率や過検出率で評価する方法は第8章で扱います。評価では、AIの判定を「正解のラベル」と突き合わせます。本章でいう正解は、判定基準に照らして正しい判定のことです。実際には、その正解も人が判定基準を当てはめて付けるので、人によって揺れます。この章では、評価の前提になる正解のラベルそのものがどれだけ揺れているかを扱います。
欠陥と不良を分けて扱う
本コラムでは、全体の地図で定義したとおり、欠陥を「製品の表面や形に現れた、意図しない状態」、不良を「判定基準に照らして出荷できない、または後工程に流せないと判定されたもの」として区別します。欠陥があるかどうかは製品の状態についての事実で、不良かどうかはその事実を判定基準に当てはめた結果です。たとえば、長さ0.2mm の浅い傷がある部品は「欠陥あり」ですが、判定基準が「目立つ面で長さ0.5mm を超える傷は不良」であれば良品と判定されます。同じ傷が、組み付けたあとに見えなくなる面にあれば、さらに緩い基準で判定されることもあります。
この区別を曖昧にしたまま検査の仕組みを作ると、いくつかの混乱が起きます。1つ目は、「傷を見つけるAI」と「不良を見つけるAI」を同じものとして扱ってしまうことです。欠陥を見つけることと、見つけた欠陥が基準を超えるかを決めることは別の仕事で、前者は撮像と画像の処理の問題、後者は基準の問題です。2つ目は、記録の混乱です。検査の記録に「傷」とだけ書かれていると、それが「傷があったので不良にした」のか「傷はあったが基準の範囲内だったので良品にした」のかが後から分かりません。AIの学習に使うラベルを過去の記録から作るときに、この区別が無いと、同じ程度の傷が不良にも良品にも数えられてしまいます。
そのため、検査の記録やラベルは、少なくとも「欠陥の有無と種類」「欠陥の程度(大きさ・数・場所)」「判定の結果(良品・不良)」の3つを分けて残すのがよいと考えています。欠陥の種類と程度は事実の記録で、判定の結果は基準を当てはめた記録です。基準が後から変わっても、事実の記録が残っていれば、新しい基準で判定し直したラベルを作れます。判定の結果だけが残っている場合は、基準が変わるたびにラベルを付け直すことになります。
欠陥の種類と写り方の違い
外観検査で扱う欠陥にはさまざまな種類がありますが、カメラで撮ったときの写り方は種類によって大きく違います。写り方が違えば、見つけやすい照明も、画像の処理の方法も、検査員の判定のばらつきやすさも違います。次の表は、本コラムで扱う代表的な欠陥の種類を、写り方の特徴と、判定の基準を決めるときに問題になりやすい点で整理したものです。写り方の欄は一般的な傾向を書いたもので、実際の写り方は材料・表面の仕上げ・照明・カメラの位置で変わります。照明の当て方と写り方の対応は第3章で扱います。
| 欠陥の種類 | どんな状態か | 画像での写り方の傾向 | 判定の基準で問題になりやすい点 |
|---|---|---|---|
| 傷 | 表面に付いた線状のへこみ・こすれ | 細い線として写る。向きと照明の当たり方で見え方が大きく変わる | 長さ・幅・深さのどれで判定するか。浅い傷と表面の模様の区別 |
| 打痕 | ぶつかってできた点状・面状のへこみ | 明暗の変化として写る。正面からの照明では写りにくいことがある | へこみの深さが画像の明暗から読みにくい。傷との区別 |
| 異物 | 表面に付いた、または材料に入り込んだ別のもの | 周りと色や明るさが違う点・塊として写る | 大きさの下限。付着しているだけで拭けば取れるものの扱い |
| 汚れ | 油・指紋・しみなどの付着 | 境目のぼやけた明暗・色の変化として写る | 境目がはっきりしないので大きさを測りにくい。異物・色むらとの区別 |
| 欠け | 角や縁が欠けた状態 | 輪郭の形の乱れとして写る | どの部位の欠けを許すか。寸法の許容差との関係 |
| バリ | 加工のあとに縁に残ったはみ出し | 輪郭の外側への出っ張りとして写る。真上からは写りにくいことがある | 高さの上限。機能に影響する部位かどうか |
| 色むら | 色や光沢が面の中で均一でない状態 | ゆるやかな明暗・色の変化として写る | どこからが「むら」かの境目が最もあいまいになりやすい。照明と見る角度で変わる |
| 変形 | 反り・ねじれ・つぶれなど形の変化 | 平面の画像では写りにくく、輪郭や影の変化として間接的に写る | 寸法の計測で判定するか、見た目で判定するか |
表の右の列を見ると、欠陥の種類によって、基準を決めるときの難しさが違うことが分かります。傷・欠け・バリは、長さや高さのような寸法で基準を書きやすい欠陥です。一方で、汚れと色むらは境目がぼやけているので、大きさを測ること自体が難しく、「目立つかどうか」という見た目の判断に頼りやすくなります。目立つかどうかの判断は人によって違いやすく、後の節のコードでは、この違いが判定のばらつきにどう表れるかを架空のデータで確かめます。
欠陥の種類を分類するときに、もう1つ決めておきたいのが、種類の名前の付け方です。同じ欠陥を、ある検査員は「傷」、別の検査員は「すり傷」「線傷」と呼ぶと、記録を集計したときに別の欠陥として数えられます。種類の名前の一覧を決め、それぞれの名前に「どんな状態を指すか」の説明と代表的な写真を付けておくと、名前の揺れを減らせます。この一覧は、後で扱う教師あり学習のクラス(分類の答えの種類)の元にもなります。
判定基準の表し方、大きさ・数・場所・重要度
判定基準は、「どんな欠陥が、どの程度なら不良か」を決めたものです。本コラムでは、判定基準を次の4つの要素の組み合わせで書くことを考えます。
- 大きさ:欠陥の長さ・幅・面積・高さ・深さ。どの寸法で測るかも決める
- 数:1つの製品、あるいは決まった面積の中に、いくつまでなら許すか
- 場所:製品のどの面・どの部位にあるか。目立つ面と目立たない面、機能に関わる部位とそうでない部位で基準を分ける
- 重要度:その欠陥が製品の機能・安全・外観にどれだけ影響するか
この4つを組み合わせると、たとえば「意匠面(製品の外から見える面)の傷は、長さ0.5mm を超えるものが1つでもあれば不良。裏面の傷は、長さ2mm を超えるものが3つ以上あれば不良」のように書けます。数値はここでの説明のために置いたもので、実際の値は製品の用途と顧客との取り決めで決まります。
重要度については、欠陥を製品への影響の大きさで区分し、区分ごとに判定の厳しさや検査の方法を変える考え方があります。日本の品質管理では「重欠点」「軽欠点」のような言葉で欠点を区分する考え方が使われることがありますが、こうした区分の用語の定義は JIS の用語規格を開いて確かめる必要があります。執筆時点(2026年11月9日)では、日本産業標準調査会(JISC)の規格の検索のシステムと、日本規格協会の規格の販売サイトがともにメンテナンスのため停止しており、本コラムでは現行の JIS での定義を確かめられませんでした。そのため、ここでは特定の規格の区分名ではなく、本コラムの言葉で「重要度」として扱います。
| 重要度の区分(本コラムの例) | どんな欠陥か | 判定の考え方 | 検査の方法の考え方 |
|---|---|---|---|
| 重要度の高い欠陥 | 製品の機能や安全に影響しうる欠陥(機能に関わる部位の欠け・異物など) | 大きさにかかわらず1つでもあれば不良とする場合がある | 見逃しを最も避けたいので、自動の検査に人の確認を重ねることを検討する |
| 重要度が中程度の欠陥 | 機能には影響しないが、顧客が使うときに目に付く欠陥(意匠面の傷・汚れなど) | 大きさ・数・場所で基準を決める | 基準の境目に近いものは、判定の保留として人に回す(第10章) |
| 重要度の低い欠陥 | 組み付けたあとに見えなくなる面の軽い欠陥など | 基準を緩め、記録だけ残すこともある | 過検出による廃棄を増やさないよう、厳しくしすぎない |
区分の数と名前は、業種や顧客との取り決めで変わります。大事なのは、区分ごとに「見逃したときの影響」と「過検出したときの影響」が違うことを、基準の段階で書き分けておくことです。ここで、何を不良とするかを定める判定基準そのものと、承認された判定基準に照らした見逃しと過検出の配分の調整は、別のものとして扱います。重要度の高い欠陥では見逃しの影響が大きいので、判定基準はそのままに、AIの検出のしきい値や人による確認の条件を、多少の過検出を許してでも見逃しを減らす側に置きます。重要度の低い欠陥で同じことをすると、過検出が増え、良品の廃棄や手直しが増えます。この「どちらの誤りを避けたいか」は、第8章で扱うしきい値の決め方にそのままつながります。
判定基準を文章と数値だけで書き切るのは、実際には難しいことが多いと考えています。「長さ0.5mm を超える傷」は書けても、「目立つ汚れ」「気になる色むら」を数値で書くのは難しいからです。そこで、文章と数値で書ききれない部分を、実物の見本で示すのが限度見本です。
限度見本の作り方と管理
限度見本は、良品と不良の境目にある程度の欠陥を持つ実物(あるいはその写真)を、判定の基準として保管しておくものです。検査員は、目の前の製品の欠陥を限度見本と見比べ、限度見本より軽ければ良品、重ければ不良と判定します。文章で「目立つ汚れ」と書くより、境目の実物を見せたほうが、検査員の間の解釈の違いを減らしやすくなります。外観検査AIにとっても、限度見本は「基準の境目がどこにあるか」を示す数少ない手がかりで、学習や評価に使う画像のラベルを付けるときの拠り所になります。
限度見本を作るときは、次の点を決めておくのがよいと考えています。
- 欠陥の種類ごと・重要度の区分ごと・場所ごとに用意する。1つの見本ですべての欠陥の基準を表すことはできない
- 境目の「すぐ良品側」と「すぐ不良側」の2つを並べて用意すると、境目の位置が伝わりやすい
- 誰が承認した見本かを明記する。品質保証の部門が承認し、必要に応じて顧客と合意したものを正とする
- 番号と版を付け、どの製品・どの部位・どの欠陥の種類に使う見本かを台帳で管理する
- 見るときの条件(照明の明るさ・見る距離・見る角度・見る時間)を見本と一緒に決める
最後の「見るときの条件」も、見本そのものと同じくらい重要です。同じ限度見本でも、明るい照明の下で近くから見るのと、暗めの照明の下で離れて見るのとでは、欠陥の見え方が変わります。限度見本と製品を同じ条件で見比べなければ、見本を用意した意味が薄れます。カメラで撮る自動の検査でも同じで、限度見本を撮った条件と、ラインで製品を撮る条件がそろっていなければ、見本の画像は基準として使えません。撮像の条件を固定して記録する考え方は第3章で扱います。
限度見本は、作ったあとの管理も大切です。実物の見本は、触ったり光に当てたりするうちに傷が増えたり、色があせたり、汚れが付いたりして、見本そのものが変わっていきます。見本が変われば、それと見比べる判定の基準も知らないうちに動きます。次の表は、限度見本の管理で決めておきたい項目を整理したものです。
| 管理の項目 | 決めておくこと | 決めていないと起きること |
|---|---|---|
| 保管 | 保管の場所・容器・光や湿気を避ける方法、持ち出しの記録 | 見本が傷んだり、紛失したりして、基準の拠り所が無くなる |
| 点検と更新 | 見本の状態を確かめる周期、取り替える条件、取り替えたときの承認 | 見本の劣化に気付かず、基準が少しずつ動く |
| 版の管理 | 見本の番号と版、どの版がいつから有効か、古い版の扱い | 工場や直(勤務の組)ごとに違う版の見本が使われる |
| 写真の記録 | 見本を決まった条件で撮った写真と、撮った条件の記録 | 実物が劣化したときに元の状態が分からない。AIのラベル付けで見本を参照できない |
| 基準の変更 | 顧客の要求や不具合を受けて基準を変えるときの手続き、検査員への周知 | 新しい基準と古い基準の判定が混ざり、記録とラベルに一貫性が無くなる |
| 複数の拠点 | 同じ製品を複数の工場で検査するときの見本の配り方と照合 | 工場ごとに基準がずれ、同じ製品が工場によって良品にも不良にもなる |
写真の記録は、実物の見本の劣化に備える意味と、AIのラベル付けで見本を参照できるようにする意味の両方があります。とくに、基準を変更したときに、変更の前と後の見本の写真が残っていれば、過去の画像のラベルをどちらの基準で付けたかを後から確かめられます。基準の変更は、AIのモデルの変更管理(第12章)とも結びつきます。基準を変えたときは、その変更がモデルの判定にどう影響するかを確かめ、必要に応じてモデル・しきい値・判定のルールを更新して評価し直す必要があります。不良かどうかを学習したモデルをそのまま使い続ければ、AIは古い基準で判定し続けるおそれがあります。一方で、欠陥の種類や大きさを出すモデルと、合否を決めるルールを分けた構成であれば、モデルは変えずにルールやしきい値の変更で対応できる場合もあります。
目視検査は官能検査の一種として扱う
人の感覚を使って製品の品質を判定する検査は、一般に官能検査と呼ばれます。目視による外観検査は、視覚を使う官能検査の一種と考えられます。官能検査では、判定する人そのものが測定の道具になるので、道具としての人のばらつき(人による違い、同じ人の時間による違い、疲れや体調による違い)を前提にして、判定の方法と記録を設計する必要があります。
官能評価の方法と用語を定めた JIS もあるとされますが、前の節で書いたとおり、執筆時点では JISC と日本規格協会のサイトが停止しており、本コラムでは規格の有無・現行の版・内容のいずれも開いて確かめられませんでした。そのため、ここでは規格の中身には触れず、官能検査を扱うときに一般に問題になる点を、外観検査に当てはめて整理します。
- 検査員の選び方と訓練:色の見え方や視力に個人差があるので、検査員を選ぶときと定期的に、限度見本を使った判定の確認を行う
- 判定の条件の固定:照明・見る距離・見る角度・1個あたりの時間・休憩の取り方を決めておく
- 判定の記録:誰が・いつ・どの条件で判定したかを残す。後で判定のばらつきを数えるときに必要になる
- 判定の一致の確認:同じ製品を複数の検査員が判定し、一致の度合いを定期的に測る
最後の「判定の一致の確認」が、この章の後半のコードで扱う内容です。検査員の判定がどれだけそろっているかは、感覚で語られることが多いものの、数字で測ることができます。数字で測っておけば、基準のすり合わせや限度見本の見直しの前と後で、判定がどれだけそろったかを比べられます。外観検査AIを入れるときにも、AIと検査員の判定の一致を同じ方法で測れます。
判定のばらつきを数える、一致率とカッパ係数
ここからは、架空の検査員3名(検査員A・B・C)が、同じ製品300個を目視で判定した結果を合成し、判定のばらつきを数えます。実在の製品・検査員のデータではなく、乱数で作った架空のデータです。また、本物の目視検査の判定は、ここで置いた単純な仕組みよりずっと複雑であることを断っておきます。製品300個のうち、およそ半分は欠陥の無い製品で、残りに傷・打痕・異物・汚れ・色むらのいずれかが1つあります。欠陥の程度は、限度見本の程度を1.0とした相対値で持たせ、1.0を超えたら不良、というのがこの架空の工場の判定基準です。この章の最初の節で記録に残す項目として挙げた「欠陥の程度」は大きさ・数・場所の組み合わせでしたが、コードでは説明を簡単にするため、それらを限度見本との比べ方で1つの数にまとめたもの(限度見本比)として置いています。
検査員は、欠陥の程度をそのまま読み取れるわけではありません。コードでは、検査員が「見えた程度」を、本当の程度に乱数のずれを掛けたものとして作りました。ずれの大きさは欠陥の種類で変え、境目のぼやけた汚れと色むらは大きく、異物は小さくしています。さらに、3人の頭の中の基準(見えた程度がいくつを超えたら不良とするか)を、検査員Aは0.9、検査員Bは1.0、検査員Cは1.2と少しずつずらしました。検査員Aは厳しめ、検査員Cは甘めに判定する設定です。これらの値はすべて説明のために置いたもので、実際の検査員の特性を測ったものではありません。欠陥の無い製品は、この架空データではどの検査員も必ず良品と判定する設定にしており、実際の目視検査で起こりうる「欠陥の無い製品を不良と判定する」誤りは入れていません。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
from statsmodels.stats.inter_rater import cohens_kappa, fleiss_kappa, aggregate_raters

rng = np.random.default_rng(20261109)
N = 300
TYPES = ["欠陥なし", "傷", "打痕", "異物", "汚れ", "色むら"]
kind = rng.choice(TYPES, N, p=[0.5, 0.12, 0.1, 0.08, 0.1, 0.1])
# 欠陥の程度。限度見本の程度を 1.0 とした相対値(欠陥なしは 0)
sev = np.where(kind == "欠陥なし", 0.0, rng.lognormal(0.0, 0.45, N))
# 見え方のあいまいさ。汚れ・色むらは境目がぼやけて程度を読み違えやすい設定
BLUR = {"欠陥なし": 0.0, "傷": 0.15, "打痕": 0.15, "異物": 0.08, "汚れ": 0.30, "色むら": 0.40}
blur = np.array([BLUR[k] for k in kind])


def judge(thr, scale=1.0, blur_map=None):
    """検査員1人分の判定。見えた程度がしきい値を超えたら不良(1)"""
    b = blur if blur_map is None else np.array([blur_map[k] for k in kind])
    seen = sev * np.exp(rng.normal(0.0, 1.0, N) * b * scale)
    return (seen > thr).astype(int)


RATERS = ["検査員A", "検査員B", "検査員C"]
THR = {"検査員A": 0.9, "検査員B": 1.0, "検査員C": 1.2}   # 頭の中の基準が少しずつ違う
J = pd.DataFrame({r: judge(THR[r]) for r in RATERS})
J["種類"] = kind
J["程度"] = sev
print(J.groupby("種類")[RATERS].mean().round(2).reindex(TYPES))
print("不良と判定した数", J[RATERS].sum().to_dict())
コードは Python 3.14.3、numpy 2.4.3、pandas 3.0.1、statsmodels 0.14.6 で実行しました。乱数のシード(乱数の出方を決める値)を固定しているので、同じ環境で実行すれば同じ結果になります。本コラムでも2回実行し、出力が一致することを確かめました。実行した結果、製品300個の内訳は、欠陥なしが140個、傷が39個、打痕が36個、異物が29個、汚れが26個、色むらが30個でした。3人が不良と判定した数は、検査員Aが92個、検査員Bが78個、検査員Cが65個です。欠陥の種類ごとに、不良と判定した割合を並べると次のようになりました。
| 欠陥の種類 | 個数 | 検査員A | 検査員B | 検査員C |
|---|---|---|---|---|
| 欠陥なし | 140 | 0.00 | 0.00 | 0.00 |
| 傷 | 39 | 0.67 | 0.59 | 0.46 |
| 打痕 | 36 | 0.56 | 0.44 | 0.44 |
| 異物 | 29 | 0.66 | 0.55 | 0.41 |
| 汚れ | 26 | 0.50 | 0.42 | 0.38 |
| 色むら | 30 | 0.47 | 0.40 | 0.30 |
同じ製品を見ているのに、不良と判定した数は検査員Aと検査員Cで27個違います。欠陥のある5種類では、どの種類でも検査員Aの割合が最も高く、検査員Cが最も低いか同じ(打痕は検査員Bと検査員Cがともに0.44)で、頭の中の基準の違いがそのまま表れています。この表だけでは、3人の判定が「どの製品で」食い違ったのかは分かりません。そこで、2人ずつの判定を突き合わせて、一致の度合いを数えます。
最も単純な指標は一致率で、2人の判定が同じだった製品の割合です。ただし、一致率には弱点があります。良品がほとんどの工程では、2人とも「全部良品」と答えるだけで一致率は高くなります。そこで使われるのがカッパ係数です。カッパ係数は、2人の判定が偶然でも一致する割合を差し引いて、偶然を超えた一致がどれだけあるかを表す指標で、研究者の Cohen(コーエン)が1960年に教育と心理の測定を扱う学術誌に発表した論文が原典です(このため2人の判定を比べるものはコーエンのカッパ係数と呼ばれます)。式で書くと次のとおりです。
\( \kappa = \dfrac{p_o – p_e}{1 – p_e} \)
ここで \( p_o \) は実際に一致した割合(一致率)、\( p_e \) は2人がそれぞれの割合で独立に「不良」「良品」と答えたときに偶然一致する割合です。言葉で言い換えると、「偶然では説明できない一致の余地のうち、実際にどれだけ一致したか」の割合です。2人の判定が完全に一致すれば1、偶然と同じ程度にしか一致しなければ0になり、偶然より一致しなければ負の値になります。ただし、2人がすべての製品を同じ1つの区分(たとえば全部良品)に判定した場合は、\( p_o \) も \( p_e \) も1になって式の分母が0になり、カッパ係数は定義できません。本章で計算した組み合わせでは、この場合は起きていません。3人以上の判定をまとめて扱うには、研究者の Fleiss(フライス)が1971年に Psychological Bulletin 誌に発表した方法(フライスのカッパ係数)を使います。どちらも statsmodels の statsmodels.stats.inter_rater に関数があり、次のコードではコーエンのカッパ係数を手計算でも求めて、statsmodels の値と一致することを確かめています。
def pair_stats(x, y):
    """2人の判定の一致率とコーエンのカッパ係数(手計算と statsmodels)"""
    tab = pd.crosstab(x, y).reindex(index=[0, 1], columns=[0, 1], fill_value=0).values
    n = tab.sum()
    po = np.trace(tab) / n                                   # 実際に一致した割合
    pe = (tab.sum(axis=1) * tab.sum(axis=0)).sum() / n**2    # 偶然でも一致する割合
    k_hand = (po - pe) / (1 - pe)
    k_sm = cohens_kappa(tab, return_results=False)
    return po, pe, k_hand, k_sm


rows = []
for a, b in [("検査員A", "検査員B"), ("検査員A", "検査員C"), ("検査員B", "検査員C")]:
    for name, m in [("全300個", np.ones(N, bool)), ("欠陥あり", kind != "欠陥なし")]:
        po, pe, kh, ks = pair_stats(J.loc[m, a], J.loc[m, b])
        rows.append([a + "と" + b, name, m.sum(), po, pe, kh, ks])
print(pd.DataFrame(rows, columns=["組", "対象", "個数", "一致率", "偶然の一致",
                                  "カッパ(手計算)", "カッパ(statsmodels)"]).round(3))


def fleiss(df):
    """3人以上の判定をまとめたフライスのカッパ係数と、全員一致の割合"""
    table, _ = aggregate_raters(df.values, n_cat=2)
    return fleiss_kappa(table, method="fleiss"), (df.nunique(axis=1) == 1).mean()


print("全300個", np.round(fleiss(J[RATERS]), 3))
near = (sev > 0.8) & (sev < 1.25)                 # 限度見本の程度に近い製品
by_type = {}
for k in TYPES[1:]:
    m = (kind == k)
    by_type[k] = fleiss(J.loc[m, RATERS])
    print(k, m.sum(), "個", "うち限度見本に近い", (m & near).sum(), "個", np.round(by_type[k], 3))
far = (kind != "欠陥なし") & ~near
print("限度見本に近い", near.sum(), "個", np.round(fleiss(J.loc[near, RATERS]), 3))
print("限度見本から遠い", far.sum(), "個", np.round(fleiss(J.loc[far, RATERS]), 3))
2人ずつの組について、製品300個すべてで数えた場合と、欠陥のある160個だけで数えた場合を並べたのが次の表です。表の「カッパ係数」は、手計算と statsmodels の値が小数第3位まで一致したので、1つの列にまとめています。
| 組 | 対象 | 個数 | 一致率 | 偶然の一致 | カッパ係数 |
|---|---|---|---|---|---|
| 検査員Aと検査員B | 全300個 | 300 | 0.907 | 0.593 | 0.771 |
| 検査員Aと検査員B | 欠陥あり | 160 | 0.825 | 0.498 | 0.651 |
| 検査員Aと検査員C | 全300個 | 300 | 0.890 | 0.610 | 0.718 |
| 検査員Aと検査員C | 欠陥あり | 160 | 0.794 | 0.486 | 0.599 |
| 検査員Bと検査員C | 全300個 | 300 | 0.897 | 0.636 | 0.716 |
| 検査員Bと検査員C | 欠陥あり | 160 | 0.806 | 0.502 | 0.611 |
全300個で数えると、一致率はどの組も0.89〜0.91で、9割の製品で判定がそろっているように見えます。しかし、このうち140個は欠陥の無い製品で、この架空データでは誰が見ても良品と判定する設定です。判定が分かれうるのは欠陥のある160個だけで、そこに絞ると一致率は0.79〜0.83に下がり、カッパ係数も0.60〜0.65に下がります。検査員Aと検査員Cの組では、欠陥のある製品の約2割で判定が食い違っています。
この比較から言えるのは、一致率やカッパ係数は、どの製品を集めて数えたかで値が大きく変わる、ということです。良品が多い工程の製品をそのまま集めて数えると、判定の食い違いが薄まって見えます。カッパ係数は偶然の一致を差し引く指標ですが、それでも対象の集め方の影響を受けます。検査員の判定のばらつきを測るときは、欠陥のある製品、とくに基準の境目に近い製品を意図して含めた評価用の製品の組(評価用のセット)を作り、そのセットで測るのがよいと考えています。評価用のセットの作り方は、AIの評価用データの作り方(第8章)と同じ考え方です。
カッパ係数の値が「いくつ以上なら十分か」の目安は、本コラムでは一次資料を開いて確かめられていないので示しません。上で見たとおり、値は対象の製品の集め方でも動くので、他社や文献の数字をそのまま当てはめることもできません。どの値を下回ったら限度見本や基準を見直すかは、自社の評価用のセットで測った検査員どうしの値を出発点にして、品質保証の部門が決めるのがよいと考えています。そのうえで、同じセットで測り直したときに値が上がったか下がったかを見る、という比べ方をすれば、目安の値が無くても基準のすり合わせの効果を確かめられます。ただし、すり合わせに使った製品を何度も判定すると、検査員がその製品を覚えてしまい、値が実際より高く出るおそれがあります。すり合わせに使っていない製品でも測ること、境目の近くの製品を多く含めたセットでの値と、実際の生産の製品構成での値を分けて報告することが必要だと考えています。
どの欠陥のどの程度でばらつくか
次に、3人の判定をまとめてフライスのカッパ係数で数え、欠陥の種類ごと、欠陥の程度ごとに分けて見ます。あわせて、3人全員の判定がそろった製品の割合(全員一致の割合)も出しました。
| 対象 | 個数 | フライスのカッパ係数 | 全員一致の割合 |
|---|---|---|---|
| 全300個 | 300 | 0.735 | 0.847 |
| 傷 | 39 | 0.651 | 0.744 |
| 打痕 | 36 | 0.777 | 0.833 |
| 異物 | 29 | 0.676 | 0.759 |
| 汚れ | 26 | 0.583 | 0.692 |
| 色むら | 30 | 0.299 | 0.500 |
| 限度見本に近い(程度が0.8を超え1.25未満) | 62 | 0.161 | 0.371 |
| 限度見本から遠い(欠陥ありのうち上記以外) | 98 | 0.905 | 0.929 |
欠陥の種類で見ると、色むらのカッパ係数が0.299で最も低く、3人の判定がそろったのは30個のうち半分でした。汚れも0.583で、傷・打痕・異物より低くなっています。境目のぼやけた欠陥ほど判定がばらつくように架空データを作ったので、その設定どおりの結果です。一方で、異物は見え方のあいまいさを最も小さく置いたのに、カッパ係数は0.676で、打痕の0.777より低くなりました。異物では、見え方のずれよりも、3人の頭の中の基準の違い(0.9・1.0・1.2)のほうが判定の違いに効いた可能性があります(ここでは確かめていません)。各種類の個数は26〜39個と少ないので、1〜2個の判定の違いで値はかなり動きます。種類の間の細かな順位は、この1回の乱数での結果として読む必要があります。
欠陥の程度で分けると、違いはさらにはっきりします。程度が限度見本に近い(0.8を超え1.25未満の)62個では、フライスのカッパ係数は0.161、全員一致の割合は0.371で、3人の判定がそろったのは4割に届きませんでした。限度見本から遠い98個では、カッパ係数は0.905、全員一致の割合は0.929です。判定のばらつきは、製品全体に薄く広がっているのではなく、基準の境目の近くに集まっています。
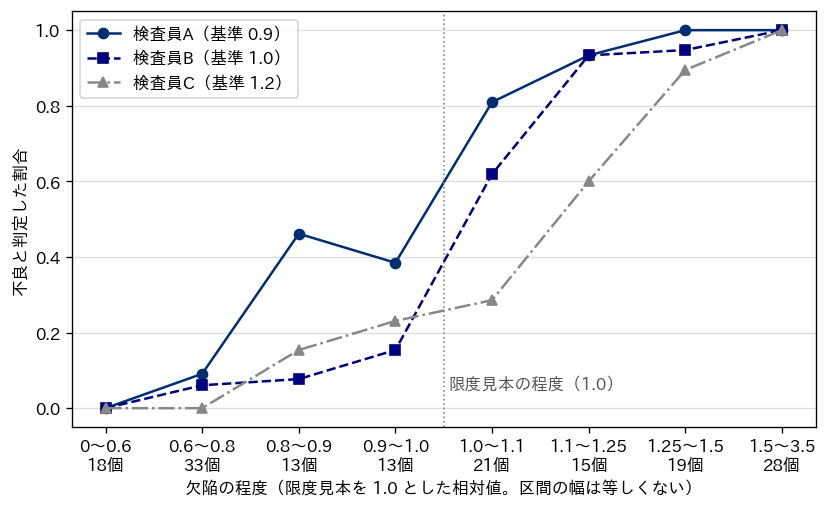
上の図は、欠陥のある160個を程度で区切り、区間ごとに各検査員が不良と判定した割合を示したものです。凡例は図の左上に置き、横軸の各区間の下に、その区間に入った製品の数を添えました。区間の幅は等しくなく、限度見本の程度に近いところを細かく区切っています。区間ごとの製品の数は13〜33個で、割合は1〜2個の判定の違いで大きく動きます。たとえば、検査員Aの線が0.8〜0.9の区間(0.46)より0.9〜1.0の区間(0.38)で下がっているのは、どちらも13個の区間で、不良と判定した数が6個と5個で、差は1個だけです。程度が上がると割合が下がる理由があるのではなく、少ない個数による揺れと読むのが適切だと考えています。程度が0.6以下の区間では3人ともほぼ良品と判定し、1.5を超える区間では3人とも不良と判定しています。その間、とくに限度見本の程度(1.0)をはさむ0.8〜1.25の区間で、3人の線が大きく離れています。程度が1.0〜1.1の区間では、検査員Aが不良と判定した割合は0.81、検査員Bは0.62、検査員Cは0.29でした。基準どおりなら、この区間はすべて不良です。
この結果を外観検査AIの側から見ると、2つのことが言えます。1つ目は、AIの学習や評価で問題になるのは、基準の境目の近くの製品だということです。本コラムの架空データでは、程度が1.5を超えた製品は3人全員が不良と判定し、ラベルは揺れませんでした。ラベルが揺れるのは境目の近くで、そこはAIの判定も難しい範囲だと考えられます(本章ではAIの判定は試していません)。ラベルの揺れと判定の難しさが同じ範囲に重なりうるので、境目の近くの製品のラベルは、とくに丁寧に付ける必要があると考えています。2つ目は、境目の近くの製品をAIがどう判定したかを評価するときに、「正解」として使う検査員のラベル自体が揺れているということです。検査員Aのラベルを評価の基準にするか、検査員Cのラベルを評価の基準にするかで、同じAIの見逃し率と過検出率は違う値になります。
同じ検査員の時間による変化と、基準をそろえた後の変化
判定のばらつきは、検査員どうしの間だけでなく、同じ検査員の中でも起きます。疲れや慣れで、朝と夕方で判定が変わることがあります。そこで、検査員Aが同じ300個を別の時間帯にもう一度判定する場面を作りました。2回目は、疲れで見え方のずれが1.3倍に大きくなり、頭の中の基準が0.9から1.0へ少し甘くなる、という設定です。実際の検査でこれを測るときは、検査員に前回の判定や製品の並び順が分からないようにしてから判定し直してもらう必要があります。
続けて、判定基準をそろえる取り組みをした後の判定も作りました。欠陥の種類ごとに限度見本を用意し、検査員の間で境目のすり合わせを行った結果、3人の頭の中の基準が0.97・1.0・1.03に近づき、見え方のずれも全体に小さくなった、という設定です。ずれをどれだけ小さくするかは説明のために置いた値で、限度見本やすり合わせの効果の大きさを示すものではありません。
# 同じ検査員Aが、同じ300個を別の時間帯にもう一度判定する(並び順は伏せる想定)
# 疲れで見え方のあいまいさが1.3倍、基準が 0.9 から 1.0 へ少し甘くなる設定
A2 = judge(1.0, scale=1.3)
po, pe, kh, ks = pair_stats(J["検査員A"], pd.Series(A2))
print("検査員Aの1回目と2回目 全300個 一致率", round(po, 3), "カッパ", round(ks, 3))
m = kind != "欠陥なし"
po, pe, kh, ks = pair_stats(J.loc[m, "検査員A"], pd.Series(A2[m], index=J.index[m]))
print("検査員Aの1回目と2回目 欠陥あり 一致率", round(po, 3), "カッパ", round(ks, 3))
print("判定が変わった製品", int((J["検査員A"].values != A2).sum()), "個",
      "うち1回目が不良で2回目が良品", int(((J["検査員A"].values == 1) & (A2 == 0)).sum()), "個")

# 限度見本を種類ごとにそろえ、基準のすり合わせをした後の判定(同じ製品で判定し直す)
THR2 = {"検査員A": 0.97, "検査員B": 1.0, "検査員C": 1.03}
BLUR2 = {"欠陥なし": 0.0, "傷": 0.08, "打痕": 0.08, "異物": 0.05, "汚れ": 0.12, "色むら": 0.15}
K = pd.DataFrame({r: judge(THR2[r], blur_map=BLUR2) for r in RATERS})
print("そろえた後 全300個", np.round(fleiss(K), 3))
by_type2 = {k: fleiss(K.loc[kind == k]) for k in TYPES[1:]}
for k in TYPES[1:]:
    print("そろえた後", k, np.round(by_type2[k], 3))
print("そろえた後 限度見本に近い", np.round(fleiss(K.loc[near]), 3))
cm = kind == "色むら"                               # 色むらで、前と後で判定が変わった数
print("色むら 判定が変わった延べ数", int((J.loc[cm, RATERS].values != K.loc[cm].values).sum()),
      "/", cm.sum() * 3)
for name, D in [("前", J.loc[cm, RATERS]), ("後", K.loc[cm])]:
    print("色むら", name, "全員一致の製品", int((D.nunique(axis=1) == 1).sum()),
          "個 不良の延べ数", int(D.values.sum()))
print("そろえた後 不良と判定した数", K.sum().to_dict())
実行した結果、検査員Aの1回目と2回目の判定は、全300個で一致率0.883、カッパ係数0.718でした。欠陥のある160個に絞ると、一致率0.781、カッパ係数0.56です。判定が変わった製品は35個で、そのうち22個は1回目に不良と判定し、2回目に良品と判定したものでした。2回目は基準が甘くなる設定にしたので、不良から良品へ変わる向きが多くなっています。同じ人が同じ製品を見ても、時間帯によって欠陥のある製品の2割強で判定が変わる、というのがこの架空データでの結果です。実際の検査では、この「同じ検査員の中のばらつき」は、検査員どうしのばらつきと比べて見落とされやすいと考えています。検査員どうしの違いは並べて比べれば見えますが、同じ人の時間による違いは、意図して同じ製品を判定し直さないと見えないからです。
基準をそろえた後の結果は、次の表のとおりです。そろえる前と後で、同じ製品300個を判定し直しています。
| 対象 | フライスのカッパ係数(そろえる前) | フライスのカッパ係数(そろえた後) | 全員一致の割合(そろえる前) | 全員一致の割合(そろえた後) |
|---|---|---|---|---|
| 全300個 | 0.735 | 0.819 | 0.847 | 0.893 |
| 傷 | 0.651 | 0.861 | 0.744 | 0.897 |
| 打痕 | 0.777 | 0.851 | 0.833 | 0.889 |
| 異物 | 0.676 | 0.810 | 0.759 | 0.862 |
| 汚れ | 0.583 | 0.732 | 0.692 | 0.808 |
| 色むら | 0.299 | 0.299 | 0.500 | 0.500 |
| 限度見本に近い(62個) | 0.161 | 0.330 | 0.371 | 0.500 |
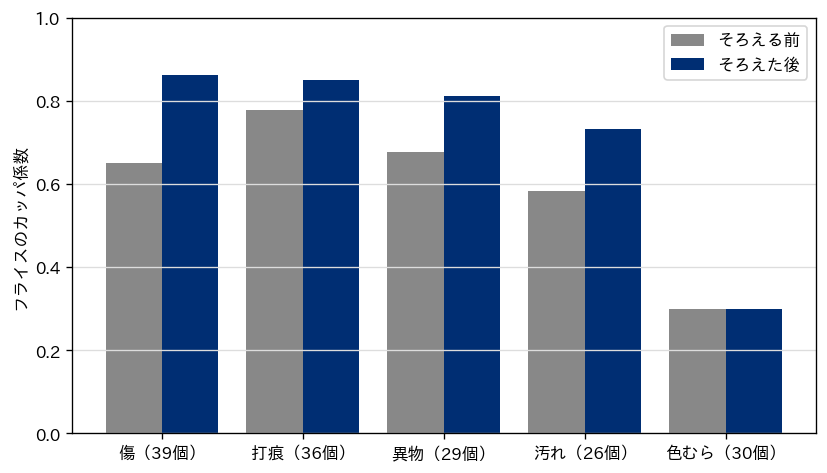
上の図は、欠陥の種類ごとのフライスのカッパ係数を、そろえる前(灰色)と後(ネイビー)で並べたものです。凡例は図の右上に置きました。全300個のカッパ係数は0.735から0.819に上がり、傷・打痕・異物・汚れはいずれも上がりました。3人が不良と判定した数も、そろえる前は92・78・65個と最大27個の差があったのが、そろえた後は84・77・81個で差は7個に縮まりました。
一方で、色むらのカッパ係数は0.299のままで、全員一致の割合も0.500から変わりませんでした。
色むらは、境目の近くに製品が集まっている欠陥です。2つ目のコードの出力によれば、色むらの30個のうち16個が、程度が限度見本に近い範囲(0.8を超え1.25未満)に入っていました。ほかの種類は、傷が39個中14個、打痕が36個中11個、異物が29個中9個、汚れが26個中12個で、近い範囲に入る割合は色むらが最も高くなっています。境目のすぐ近くにある製品では、見え方のずれを小さくしても、少し残ったずれで境目のどちら側に入るかが変わりえます。
値が同じになったのは、判定が変わらなかったからではありません。3つ目のコードの出力によれば、色むらの30個に3人が付けた延べ90の判定のうち、30の判定が前と後で変わっていました。それでも値が同じになった理由は、計算で確かめられます。3人の判定がそろった製品は、前も後も15個でした。不良と判定した延べ数も、前も後も90のうち35でした。3人で良品・不良の2つに分けるときのフライスのカッパ係数は、この2つの数だけで決まります。実際に一致した度合いは、製品ごとに3人がそろったか(2対1に割れたか)だけで決まり、偶然の一致の度合いは、不良と判定した延べ数の割合だけで決まるからです。2つの数が前と後で同じだったので、カッパ係数も全員一致の割合も同じ値になりました。
限度見本に近い62個全体で見ても、カッパ係数は0.161から0.330に上がったものの、3人の判定がそろったのは半分にとどまりました。
この設定では、頭の中の基準の違いと見え方のずれを小さくしても、境目の近くの製品で判定の食い違いが残りました。ただし、そろえた後にも見え方のずれが残るように置いたのは本コラムの設定で、実際の限度見本やすり合わせでどこまで食い違いを減らせるかは、自社の評価用のセットで別に確かめる必要があります。この残りを扱う方法は、大きく2つ考えられます。1つは、境目の近くを「判定の保留」として別の扱いにすることで、AIと人の協調の設計(第10章)で扱います。もう1つは、境目の近くに製品が多く集まる欠陥について、基準そのものを見直すことです。色むらのように見た目の判断に頼る欠陥で、多くの製品が境目に集まっているなら、境目の位置を顧客と相談して動かす、あるいは測定器で色を数値として測る方法に切り替える、といった検討が必要になります。
なお、良品・不良の2つではなく、「良品・軽微・不良」のような順序のある3段階以上で判定する場合には、隣どうしの段の食い違いを、離れた段の食い違いより軽く数える重み付きのカッパ係数(Cohen が1968年に Psychological Bulletin 誌で示したもの)が使えます。statsmodels の cohens_kappa にも、重みの付け方を指定する引数があります。本コラムのコードでは2段階の判定だけを扱っています。
ラベル付けの手順、AIの教師データの品質は判定基準で決まる
ここまでの結果を、外観検査AIの教師データ(学習と評価に使う、正解のラベルが付いた画像)の作り方に当てはめます。教師あり学習(第5章)では、画像ごとに「良品」「不良」や欠陥の種類のラベルを人が付けます。良品学習(第6章)でも、学習に使う「良品」の画像を選ぶ段階と、評価に使う画像に正解を付ける段階で、人の判定が入ります。どちらの場合も、ラベルを付ける人の判定がばらついていれば、教師データにもそのばらつきが入ります。
次のコードでは、架空の工場の判定基準(程度が1.0を超えたら不良)をそのまま当てはめた判定を「正解のラベル」とし、検査員1人だけでラベルを付けた場合と、3人の多数決でラベルを付けた場合に、正解のラベルと食い違う数を数えました。現実には正解のラベルも人が付けるので揺れますが、架空データでは本当の程度が分かっているので、揺れの無い正解を置くことができます。あわせて、欠陥のある160個に3人が欠陥の種類の名前を付ける場面を作り、種類のラベルがどれだけそろうかを数えています。種類の名前は、傷と打痕、汚れと色むらを互いに取り違えやすい設定にしました(取り違える確率は架空の値です)。
# AI の教師データにするラベル。限度見本どおりなら「程度が 1.0 を超えたら不良」
rule = (sev > 1.0).astype(int)
for name, D in [("そろえる前", J[RATERS]), ("そろえた後", K)]:
    vote = (D.sum(axis=1) >= 2).astype(int)               # 3人の多数決
    diff = {r: int((D[r].values != rule).sum()) for r in RATERS}
    print(name, "限度見本の基準と食い違うラベルの数", diff,
          "多数決", int((vote.values != rule).sum()),
          "うち基準では不良なのに良品", int(((vote.values == 0) & (rule == 1)).sum()))
    split = (D.nunique(axis=1) > 1).sum()
    print(name, "3人の判定が割れた製品", int(split), "個")

# 欠陥の種類のラベル付け。欠陥のある160個に、3人が種類の名前を付ける
# 傷と打痕、汚れと色むらは取り違えやすい設定(取り違える確率は架空の値)
MIX = {"傷": ["打痕", 0.15], "打痕": ["傷", 0.15], "汚れ": ["色むら", 0.20],
       "色むら": ["汚れ", 0.20], "異物": ["汚れ", 0.05]}
d = kind != "欠陥なし"
names = TYPES[1:]
L = np.empty((d.sum(), 3), dtype=object)
for j in range(3):
    for i, k in enumerate(kind[d]):
        other, p = MIX[k]
        L[i, j] = other if rng.random() < p else k
codes = np.vectorize(names.index)(L)
table, _ = aggregate_raters(codes, n_cat=len(names))
print("種類のラベル 160個 フライスのカッパ", round(fleiss_kappa(table), 3),
      "全員一致", round(float((pd.DataFrame(L).nunique(axis=1) == 1).mean()), 3))
for k in names:
    m = kind[d] == k
    print(k, "全員一致の割合", round(float((pd.DataFrame(L[m]).nunique(axis=1) == 1).mean()), 3))
| ラベルの付け方 | そろえる前(300個中) | そろえた後(300個中) |
|---|---|---|
| 検査員Aだけで付ける | 19 | 11 |
| 検査員Bだけで付ける | 15 | 16 |
| 検査員Cだけで付ける | 28 | 16 |
| 3人の多数決で付ける | 16 | 9 |
| 多数決のうち、基準では不良なのに良品とした数 | 10 | 6 |
| 3人の判定が割れた製品 | 46 | 32 |
表の数字は、正解のラベルと食い違ったラベルの数です。そろえる前に検査員Cだけでラベルを付けると、300個のうち28個が基準と食い違いました。3人の多数決にすると16個に減りますが、そのうち10個は、基準では不良なのに良品のラベルが付いた製品です。このラベルでAIを学習させれば、AIは「この程度の欠陥は良品」と学び、見逃しの原因になると考えられます(本章のコードはラベルの食い違いを数えただけで、AIの学習は行っていません)。評価に使えば、AIがこれらを基準どおり不良と判定したときに、過検出として数えられてしまいます。基準をそろえた後は、多数決で食い違うのは9個、そのうち基準では不良なのに良品としたのは6個に減りました。
多数決の効き方は一様ではありません。本コラムの架空データでは、そろえる前の多数決は、検査員Bだけで付けた場合より1個多く、1人で付ける場合より必ず減るわけではありませんでした。そろえた後は、多数決が3人のどの1人よりも少なくなりました。なお、検査員Bだけで付けた場合は、そろえる前より後のほうが1個多くなっています。この1個の増減は乱数の揺れの範囲と考えられます(確かめていません)。この1回の乱数の結果では、多数決にすることと基準をそろえることは別の効き方をし、そろえる前は多数決にしても正解のラベルに近づくとは限りませんでした。
欠陥の種類のラベルは、160個でフライスのカッパ係数が0.66、3人の名前がそろった割合(全員一致の割合)は0.594でした。種類ごとの全員一致の割合は、異物が0.966と高い一方、傷0.538・打痕0.472・汚れ0.500・色むら0.533で、取り違えやすい設定にした組み合わせでは半分前後しかそろいませんでした。種類のラベルが揺れていると、教師あり学習で種類を分類するAIにとって、傷と打痕の境目を学ぶ妨げになり、分類の性能を下げる可能性があります(本章ではAIの学習は行っていません)。種類の判別が本当に必要か(不良かどうかだけ分かれば足りるのか、種類ごとに後工程の処置が違うのか)を先に決め、必要なら種類の名前の定義と代表の写真をそろえてからラベルを付けるのがよいと考えています。
この結果を踏まえて、ラベル付けの手順として次の流れを考えています。
- 判定基準と欠陥の種類の名前の一覧を文書にし、限度見本とその写真を用意する
- ラベルを付ける人を決め、基準の境目に近い製品を含めた評価用のセットで、一致の度合い(カッパ係数・全員一致の割合)を測る
- 一致の度合いが低い欠陥の種類・程度の範囲について、限度見本の追加や基準の言い換えを行い、すり合わせに使っていない製品も含めて測り直す
- 本番のラベル付けでは、境目の近くの製品を複数の人で判定し、割れたものは品質保証の担当者が限度見本と照らして決める
- ラベルと一緒に、欠陥の種類と程度、誰がいつどの基準の版で付けたかを記録する
- 定期的に評価用のセットで一致の度合いを測り直し、同じ人の時間による変化も確かめる
4つ目の「割れたものを品質保証の担当者が決める」は、多数決で機械的に決めるより手間がかかります。それでも、境目の近くはAIにとっても難しい範囲だと考えられるので(本章ではAIの学習は行っていません)、そこのラベルの質がAIの判定の質を左右すると考えています。ただし、品質保証の担当者の判定も1人の人の判定なので、ばらつきが無いわけではありません。担当者の判定と限度見本の写真を一緒に残し、後から確かめられるようにしておきます。ラベル付けを支える道具や、ラベルを付ける手間の見積もりは第5章、少ないラベルで学ぶ工夫は第7章で扱います。
この章の2つの図は、次のコードで描きました。図には matplotlib 3.10.8 と、日本語の文字を表示するための japanize-matplotlib 1.1.3 を使っています(どちらも実行環境で版を確かめました)。japanize-matplotlib 1.1.3 は内部で distutils を読み込んでいます(導入されたファイルで確かめました)。Python の公式文書によれば distutils は Python 3.12 で標準ライブラリから外され、setuptools が引き続き提供しています。本コラムの実行環境には setuptools 82.0.1 が入っていました。手元で読み込みに失敗する場合は、setuptools が入っているかを確かめてください。図1の横軸の区間ごとの個数と割合も、このコードの出力です。ここまでのコードの続きに置いて実行すると、図は実行したフォルダの1つ上のフォルダに保存されます(savefig の行)。保存先は手元の環境に合わせて書き換えてください。
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

# 図1 欠陥の程度ごとに、各検査員が不良と判定した割合
edges = [0, 0.6, 0.8, 0.9, 1.0, 1.1, 1.25, 1.5, 3.5]
mid = [f"{a}〜{b}" for a, b in zip(edges[:-1], edges[1:])]
bins = pd.cut(sev[d], edges)
cnt = pd.Series(bins).value_counts(sort=False).tolist()     # 区間ごとの製品の数
print("区間ごとの個数", cnt)
fig, ax = plt.subplots(figsize=(8, 4.5))
for r, c, mk, ls in zip(RATERS, ["#002E73", "#000080", "#888888"], ["o", "s", "^"],
                        ["-", "--", "-."]):
    rate = pd.Series(J.loc[d, r].values).groupby(bins, observed=False).mean()
    print(r, rate.round(2).tolist())
    ax.plot(mid, rate.values, marker=mk, color=c, linestyle=ls, label=f"{r}(基準 {THR[r]})")
ax.set_xticks(range(len(mid)), [f"{m}\n{n}個" for m, n in zip(mid, cnt)])
ax.axvline(3.5, color="#888888", linestyle=":", linewidth=1)
ax.text(3.55, 0.05, "限度見本の程度(1.0)", color="#555555")
ax.set_xlabel("欠陥の程度(限度見本を 1.0 とした相対値。区間の幅は等しくない)")
ax.set_ylabel("不良と判定した割合")
ax.legend(loc="upper left")
ax.grid(axis="y", color="#dddddd")
fig.savefig("../ch02_judgement_by_severity.png", dpi=120, bbox_inches="tight")

# 図2 欠陥の種類ごとのフライスのカッパ係数(そろえる前と後)
x = np.arange(len(names))
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.bar(x - 0.2, [by_type[k][0] for k in names], 0.4, color="#888888", label="そろえる前")
ax.bar(x + 0.2, [by_type2[k][0] for k in names], 0.4, color="#002E73", label="そろえた後")
ax.set_xticks(x, [f"{k}({(kind == k).sum()}個)" for k in names])
ax.set_ylabel("フライスのカッパ係数")
ax.set_ylim(0, 1)
ax.legend(loc="upper right")
ax.grid(axis="y", color="#dddddd")
fig.savefig("../ch02_kappa_by_type.png", dpi=120, bbox_inches="tight")
print("図を保存しました")
経営の判断、AIの前に基準をそろえる
この章の内容を、経営の判断に置き換えます。外観検査AIの導入を検討するときに、最初に予算と時間が向かうのは、カメラやモデルや計算機であることが多いと考えています。しかし、この章の架空データでは、何を不良とするかの基準が検査員の間で揺れていると、ラベルも揺れ、正解のラベルと食い違うものが出ることを確かめました。そのラベルで学習・評価すれば、揺れはAIの判定と評価の数字にも入ると考えられます(本章ではAIの学習は行っていません)。基準が揺れたままAIを入れると、AIの判定がどの検査員の基準に近いかによって、現場から「AIは見すぎる」「AIは見逃す」という正反対の評価が同時に出ることもありえます。
判定基準をそろえないまま進めたときの損失を、本コラムの6つの損失の型で整理すると次のようになります。本章ではAIの学習は行っていないので、AIに関わる欄は、起きうることとして書いています。
| 損失の型 | 判定基準が揺れていると起きうること | 先に打つ手 |
|---|---|---|
| 流出 | 甘い基準で付けたラベルで学んだAIが、基準では不良の製品を良品と判定するおそれがある | 境目の近くのラベルを複数の人で付け、割れたものは品質保証が決める |
| 過検出 | 厳しい基準で付けたラベルで学んだAIが、良品を不良と判定し、廃棄・手直し・再検査が増えるおそれがある | 重要度の区分ごとに、どちらの誤りを避けたいかを基準に書き分ける |
| 判定のばらつき | 検査員・時間帯・工場によって判定が変わり、それがAIの学習と評価にも持ち込まれる | 限度見本と見るときの条件をそろえ、一致の度合いを定期的に測る |
| タクトの超過 | 境目の近くの製品を人が見直す件数が読めず、検査が生産の速度に追いつかない | 境目の近くに集まる製品の割合を測り、保留の件数を見積もる(第9章・第10章) |
| 形骸化 | AIの判定が、ある検査員の感覚と合わないため信用されず、人が全数を見直す | AIと検査員の一致を、検査員どうしの一致と同じ方法で測り、比べて示す |
| 二重投資 | 工場ごとに違う限度見本と基準でラベルを付け、工場ごとに別のモデルを作る | 限度見本の版と基準を工場の間でそろえ、ラベルの付け方を共通にする |
表の最後の行の二重投資は、複数の工場で同じ製品を作っている場合にとくに起きやすいと考えています。工場ごとに限度見本の版が違えば、同じ製品の画像に工場ごとに違うラベルが付きます。その場合、1つのモデルを工場の間で共通に使うには、ラベルや判定のルールの食い違いをそろえる作業が先に必要になります。限度見本の版と基準をそろえることは、品質保証の仕事であると同時に、AIへの投資を工場の間で共有するための前提にもなります。
経営として決めておきたいことは、次の4つだと考えています。
- 判定基準と限度見本の持ち主を品質保証の部門とし、基準の変更の手続きと承認者を決める
- AIの導入の計画の最初の段階に、判定基準の見直しと、検査員の一致の度合いの測定を入れ、そのための人の時間と予算を確保する
- 一致の度合い(カッパ係数・全員一致の割合)を、検査の品質の指標として定期的に報告させる
- AIの判定を評価するときは、検査員どうしの一致の度合いと並べて示し、AIに人以上の一致を求める場合はその根拠を品質保証と決める
最後の項目について、数字の例で補足します。ここで使う0.6は良し悪しの目安ではなく、本章の架空データで欠陥のある製品に絞ったときの2人ずつのカッパ係数(0.60〜0.65)に近い値です。検査員どうしのカッパ係数が0.6程度の欠陥で、AIと検査員の一致が0.6程度だったとき、それを「AIの精度が低い」と読むのは適切ではありません。正解として使ったラベル自体が、その程度にしかそろっていないからです。同じ理由で、この一致の度合いだけからは、AIの精度が高いとも低いとも判断できません。検査員どうしの一致の度合いは、ラベルの信頼性を点検するための情報として使い、AIの性能は、品質保証が確かめた正解のラベルに対する見逃し率・過検出率で別に評価します(第8章)。逆に、AIの評価の数字が高く出ても、それが1人の検査員のラベルとの一致であれば、その検査員の基準のずれまでAIが学んでいる可能性があります。出荷の可否を決める最終的な責任は品質保証の体制にあり、AIの判定はその体制の中で使う道具の1つです。何を不良とするかを決めるのはAIではなく、品質保証の部門と、顧客との取り決めです。
この章では、欠陥と不良を分けて扱い、判定基準を大きさ・数・場所・重要度で表し、文章で書ききれない部分を限度見本で示して管理することを整理しました。本コラムの架空データ(検査員3名・製品300個、1つのシード)では、判定のばらつきは基準の境目の近くに集まり、限度見本に近い62個ではフライスのカッパ係数が0.161でした。基準をそろえた設定では全体のカッパ係数が0.735から0.819に上がり、多数決のラベルが基準と食い違う数は16個から9個に減りましたが、色むらのように境目の近くに製品が集まる欠陥では判定の割れが残りました。次の第3章では、判定の前提になる「欠陥が画像に写っている状態」を作るための、カメラ・レンズ・照明の設計を扱います。
この章を深めたい方への参考書籍
『官能評価の理論と方法:現場で使う官能評価分析』(井上裕光 著、日科技連出版社):官能評価分析の考え方と方法を、現場で使う立場から解説した本です(2012年刊)。国立国会図書館の目次によれば、第1章は官能評価分析の概論で、「同じ結果にならない」という現象から説き起こしています。目視検査を官能検査として捉え直し、検査員の判定のばらつきをどう扱うかを考える手がかりになります。
『IATF 16949のための統計的品質管理:SPC・MSA・抜取検査・多変量解析』(内田治 編著、行武晋一・伊藤侑也・永井夏織・宮本秀徳 著、日科技連出版社):副題のとおり、工程の管理(SPC)、測定システムの解析(MSA)、抜取検査、多変量解析といった統計的な方法を、自動車産業の品質マネジメントの規格の文脈で扱った本です(2023年刊)。この章で扱った判定のばらつきを、測定システムの評価という枠組みで捉えるときの参考になります。
第3章 撮像の設計、カメラ・レンズ・照明で欠陥を写る状態にする
第2章では、何を不良とするかの判定基準をそろえ、限度見本と検査員の判定のばらつきを確かめる方法を扱いました。判定基準が決まると、次に決めるのは「その基準で不良になる欠陥を、画像の上でどう見える状態にするか」です。この章では、カメラ・レンズ・照明・搬送・トリガーを組み合わせて検査用の画像を得る撮像の設計を扱います。
この章の主張は1つです。画像に写っていない欠陥は、どの画像処理でも、どの学習のモデルでも見つけられません。撮像は、その後に続くすべての判定の精度の上限を決める工程だと考えています。外観検査AIの検討は、モデルの選び方から始まりがちですが、欠陥と背景の見た目の差(コントラスト)が小さい画像からは、どれほど工夫したモデルでも安定した判定は得にくくなります。逆に、照明と光学系の工夫で欠陥がはっきり写るようになれば、第4章で扱うルールベースの画像処理で足りる場合もあります。
この章では、コードを載せずに、次の内容を表と計算例で説明します。
- 撮像を構成する5つの要素(カメラ・レンズ・照明・搬送・トリガー)と、それぞれで決めること
- 視野と画素数と不良とする最小の欠陥の大きさから、1画素が製品の上で何ミリメートルに当たるかを計算する方法(計算例は本コラムで計算した値)
- エリアカメラとラインカメラの違いと選び方
- レンズの焦点距離・ピントの合う奥行き・テレセントリックレンズの考え方
- 光の当て方ごとに写りやすい欠陥の対応
- 色と偏光の使い方
- カメラの性能を比べるための規格と、カメラをつなぐ通信の規格
- 撮像の条件を固定して記録する方法と、経営判断
画像処理の手法は第4章で、検査の速度とタクトタイムへの収め方は第9章で扱います。この章では、画像を得るところまでに範囲を絞ります。
撮像を構成する5つの要素、カメラ・レンズ・照明・搬送・トリガー
本コラムでは、撮像を5つの要素の組み合わせとして考えます。カメラは、光を受けて画素ごとの明るさの値に変える装置です。レンズは、製品から来た光をカメラの撮像素子(光を電気の信号に変える部品)の上に像として結ばせる部品です。照明は、製品に光を当てて、欠陥と背景の見え方に差を作る部品です。搬送は、製品をカメラの前に運び、決まった位置と向きで止める(または決まった速さで流す)仕組みです。トリガーは、製品が撮るべき位置に来たことを知らせて、撮影の瞬間を決める信号です。
5つの要素は、どれも画像の写り方に関わります。そのうえで本コラムでは、照明を、欠陥と背景の差を作るうえでとくに効く要素の1つと考えています。カメラとレンズは、その差を損なわずに受け取る役割が中心ですが、後の節で扱うように、カメラの向きと照明の向きの関係、レンズの解像の力やピントの合う奥行き、カメラの側に付ける偏光板なども、差の出方を左右します。搬送とトリガーは「毎回同じ条件で撮る」ことを支える要素で、ここがぶれると、製品の位置・向き・ピントが1枚ごとに変わり、良品の画像のばらつきが大きくなります。第6章で扱う良品学習は「いつもの見た目」から外れたものを異常とする方法なので、良品の見た目のばらつきが大きいと、欠陥でない違いまで異常として拾いやすくなると考えられます。搬送とトリガーの安定は、後の章のモデルの成績にもつながります。
5つの要素で決めることを、次の表にまとめました。表の右の列は、その要素の決め方を誤ったときに、序章で整理した6つの損失の型のどれにつながりやすいかを示しています。
| 要素 | 役割 | 決めること | 決め方を誤ると起きること | つながりやすい損失の型 |
|---|---|---|---|---|
| カメラ | 光を画素ごとの明るさの値に変える | 画素数・エリアカメラかラインカメラか・白黒かカラーか・露光時間・撮影の速さ | 不良とする最小の欠陥にかかる画素が少なく、写っても安定した判定に必要な情報が得られない場合がある | 流出 |
| レンズ | 製品の像を撮像素子の上に結ぶ | 焦点距離・撮影の距離・絞り・テレセントリックレンズを使うか | 高さのある製品の一部がぼける、位置によって大きさが変わって見える | 流出・過検出 |
| 照明 | 欠陥と背景の見え方に差を作る | 光の当て方(向きと広がり)・色・明るさ | 欠陥が背景に埋もれる、良品の模様や反射を欠陥と見誤る | 流出・過検出 |
| 搬送 | 製品を決まった位置と向きでカメラの前に運ぶ | 止めて撮るか流しながら撮るか・位置決めの方法・速さ | 位置や向きが毎回変わり、良品の画像のばらつきが大きくなる | 過検出・タクトの超過 |
| トリガー | 撮影の瞬間を決める | 製品を検知するセンサー・照明を光らせる時刻と露光の時刻の合わせ方 | 製品の一部が視野から外れる、撮り漏れが起きる | 流出・タクトの超過 |
表のとおり、5つの要素はどれか1つを最適にすれば済むものではなく、互いに条件を縛り合います。たとえば、流しながら撮る搬送を選ぶと、製品が露光の間に動いてぶれるので、露光時間を短くする必要が出ます。露光時間を短くすると、画像が暗くなるので、照明を強くするか、レンズの絞りを開ける必要が出ます。絞りを開けると、ピントの合う奥行きの範囲が狭くなります。この連鎖を順に追って、全体として成り立つ組み合わせを探すのが撮像の設計です。
分解能の考え方、視野と画素数と不良とする最小の欠陥の大きさ
撮像の設計で最初に計算するのが分解能です。本コラムでは、分解能を「画像の1画素が、製品の上で何ミリメートルの大きさに当たるか」の意味で使います(光学の分野では、2つの点を見分けられる最小の間隔の意味でも使われますが、ここでは画素の大きさの意味に限ります)。1画素の大きさは、カメラが写す範囲である視野の幅を、その方向の画素数で割ると求まります。
\( p = L / N \)
ここで \( p \) は1画素あたりの製品の上での大きさ、\( L \) は視野の幅、\( N \) はその方向の画素数です。言葉で言い換えると、「視野の幅を画素の数で等分した1つ分が、1画素の大きさ」です。本コラムで計算すると、視野の幅 100 ミリメートルを横 2,000 画素で写すとき、1画素は 0.05 ミリメートル(50 マイクロメートル)に当たります。同じ 2,000 画素で視野を 200 ミリメートルに広げると、1画素は 0.1 ミリメートルになり、細かい欠陥は写りにくくなります。
次に、判定基準で不良とする最小の欠陥の大きさを、何画素に写したいかを決めます。欠陥があっても判定基準の範囲内なら良品と判定されるので、ここで使う大きさは、欠陥のうち不良と判定される境目の大きさです。以下、これを「不良とする最小の欠陥の大きさ」と呼びます。欠陥が1画素より小さいと、その画素の明るさは欠陥と背景の平均のような値になり、背景との差が薄まります。欠陥が1画素ちょうどでも、欠陥が画素の境目にまたがると2画素に薄く分かれて写ることがあります。そのため、不良とする最小の欠陥には複数の画素をかけておくのが安全です。何画素かけるかは、欠陥と背景の差の大きさ・雑音の量・判定の方法によって変わり、決まった値はありません。本コラムでは、計算例として「不良とする最小の欠陥の幅に4画素をかける」と置きます。これは計算の例として置いた値で、規格や文献で定められた値ではありません。必要な画素数は、次の式で求まります。
\( N = n \times L / d \)
ここで \( n \) は不良とする最小の欠陥にかけたい画素数、\( d \) は不良とする最小の欠陥の大きさです。言葉で言い換えると、「視野の幅の中に、不良とする最小の欠陥がいくつ並ぶかを数え、それに欠陥1つあたりにかけたい画素数を掛けたもの」が必要な画素数です。本コラムで計算した例を、次の表にまとめました。
| 視野の幅 | 不良とする最小の欠陥の大きさ | 欠陥にかける画素数 | 必要な画素数(その方向) | 1画素の大きさ |
|---|---|---|---|---|
| 100 ミリメートル | 0.2 ミリメートル | 4画素 | 2,000 画素 | 0.05 ミリメートル |
| 100 ミリメートル | 0.2 ミリメートル | 2画素 | 1,000 画素 | 0.1 ミリメートル |
| 100 ミリメートル | 0.1 ミリメートル | 4画素 | 4,000 画素 | 0.025 ミリメートル |
| 100 ミリメートル | 0.5 ミリメートル | 4画素 | 800 画素 | 0.125 ミリメートル |
| 200 ミリメートル | 0.2 ミリメートル | 4画素 | 4,000 画素 | 0.05 ミリメートル |
| 300 ミリメートル | 0.2 ミリメートル | 4画素 | 6,000 画素 | 0.05 ミリメートル |
この表から読み取れることは2つあります。1つ目は、不良とする最小の欠陥の大きさを半分にすると、必要な画素数はその方向で2倍になることです(表の1行目と3行目)。縦と横の両方で2倍になるので、画像全体の画素の数は4倍になります。2つ目は、視野を広げても同じ欠陥を見つけたいなら、視野に比例して画素数が要ることです(表の1行目・5行目・6行目)。画素の数が増えると、1枚の画像のデータの量・転送の時間・処理の時間が増えます。本コラムで計算すると、横 2,000 画素・縦 1,500 画素の白黒の画像は、1画素を1バイト(明るさを256段階で表す場合)とすると 1枚 3 メガバイトで、毎秒10枚撮れば毎秒 30 メガバイトのデータが流れます。この量が、第9章で扱う推論の時間と、第11章で扱う画像の保存の容量を決める出発点になります。
ここで大切なのは、「不良とする最小の欠陥の大きさ」をどこから持ってくるかです。これは撮像の担当者が決めるものではなく、第2章で決めた判定基準から持ってきます。判定基準に「直径 0.3 ミリメートル以上の異物は不良」とあれば、0.3 ミリメートルの異物が確実に写る分解能が要ります。判定基準が「目で見て気になる傷」のように大きさで書かれていないと、撮像の設計は出発点を持てません。撮像の検討の前に、第2章の判定基準が、欠陥の種類に応じて大きさ・数・位置・色や濃淡の差などで、限度見本とともに書けているかを確かめておくことを勧めます。
もう1つ注意したいのは、計算で出した画素数が、そのまま見つけられる欠陥の大きさを保証するわけではないことです。レンズの解像の力が撮像素子の画素の細かさに追いついていなければ、画素が細かくても像そのものがぼけています。ピントが外れていれば、欠陥は広がって薄く写ります。照明で欠陥と背景の差が作れていなければ、何画素かけても欠陥は背景に埋もれます。分解能の計算は「必要条件を確かめる計算」で、十分かどうかは、限度見本と実際の不良品を撮った画像で確かめる必要があります。
エリアカメラとラインカメラ、止めて撮るか流して撮るか
産業用のカメラは、撮像素子の画素の並び方で大きく2つに分かれます。エリアカメラは、画素が縦と横に面として並んだ撮像素子を持ち、1回の露光で四角い1枚の画像を撮ります。ラインカメラ(ラインスキャンカメラとも呼ばれます)は、画素が1列(または数列)に並んだ撮像素子を持ち、1回の露光で細長い1行ぶんの画像を撮ります。ラインカメラで面の画像を得るには、製品かカメラのどちらかを動かしながら、1行ずつ撮った画像を順に積み重ねます。
エリアカメラは、製品を止めて撮る場合や、製品が視野に収まる大きさの場合に使いやすい方式です。1枚の画像で製品の全体が写るので、位置決めや形の確認と、表面の欠陥の検査を同じ画像で行えます。一方で、流れている製品を撮ると、露光の間に製品が動いた距離だけ像がぶれます。本コラムで計算すると、毎秒 500 ミリメートルで流れる製品を露光時間 100 マイクロ秒で撮ると、露光の間に製品は 0.05 ミリメートル動きます。1画素を 0.05 ミリメートルにした場合、ぶれは1画素ぶんです。露光時間を 1 ミリ秒にすると、ぶれは 0.5 ミリメートル、つまり10画素ぶんになり、0.2 ミリメートルの欠陥は判別しにくくなります。ぶれを1画素より小さく抑えるには、露光時間を短くするか、照明を短い時間だけ強く光らせる方法(ストロボ)を使います。どちらも画像が暗くなりやすいので、照明の明るさとの兼ね合いになります。
ラインカメラは、連続して流れる帯状の製品(フィルム・紙・布・鋼板など)や、円筒の製品を回しながら表面を一周撮る場合に向いています。1行ずつ撮るので、流れの方向にはいくらでも長い画像が作れ、幅の方向にだけ多くの画素を並べれば広い幅を細かく撮れます。本コラムで計算すると、幅 300 ミリメートルの帯を 0.05 ミリメートルの細かさで撮るには、幅の方向に 6,000 画素が要ります。ラインカメラで気をつけるのは、流れの方向の画素の大きさが、製品の速さと1行を撮る周期で決まることです。
\( T = p / v \)
ここで \( T \) は1行を撮る周期、\( p \) は流れの方向にそろえたい1画素の大きさ、\( v \) は製品の速さです。言葉で言い換えると、「製品が1画素ぶん進む時間ごとに1行を撮る」ということです。本コラムで計算すると、毎秒 500 ミリメートルで流れる製品を、流れの方向にも 0.05 ミリメートルの細かさで撮るには、1行を 100 マイクロ秒ごと、つまり毎秒 10,000 行の速さで撮る必要があります。製品の速さが毎秒 1,000 ミリメートルになれば、毎秒 20,000 行が要ります。製品の速さが変わるのに行を撮る周期が一定のままだと、画像は流れの方向に伸びたり縮んだりします。回転の検出器(エンコーダ)の製造元である Encoder Products Company の解説ページは、ラインカメラでは撮影の周期を製品の移動と同期させることが重要で、そうしないと画像が縮んだり伸びたりして歪むと説明しています。同じページは、エンコーダの信号で各露光のタイミングを決めることも説明しています。搬送の速さが一定とみなせない工程では、搬送の動きを検出した信号に合わせて1行ずつ撮る設計を検討することになります。
2つの方式の違いを、次の表にまとめました。
| 観点 | エリアカメラ | ラインカメラ |
|---|---|---|
| 1回の露光で撮れるもの | 四角い1枚の画像 | 細長い1行の画像 |
| 向いている製品 | 視野に収まる大きさの部品、止めて撮れる製品 | 帯状に連続して流れる製品、円筒を回して撮る製品、幅の広い製品 |
| 搬送との関係 | 止めて撮るか、短い露光やストロボで流しながら撮る | 製品とカメラが相対的に動いていることが前提。相対的な移動に合わせて1行ずつ撮る |
| 流れの方向の画素の大きさ | 撮像素子の画素とレンズで決まる | 製品の速さと1行を撮る周期で決まる |
| トリガーの考え方 | 製品1個ごとに1回の撮影の合図 | 製品の先端の検知と、エンコーダによる1行ごとの合図 |
| 照明に求められること | 視野の面全体を均一に照らす | 細い1行の範囲を強く均一に照らす |
| 注意すること | 露光の間のぶれ、視野の端の明るさの低下 | 速さの変動による画像の伸び縮み、蛇行(帯状の製品が流れながら左右に振れること)、照明の明るさ不足 |
どちらを選ぶかは、製品の形と搬送の形でおおむね決まります。部品を1個ずつ治具に載せて検査する工程ならエリアカメラ、巻き取りの工程やコンベヤで連続して流れる工程ならラインカメラ、という分け方が出発点になります。ただし、製品が大きく、エリアカメラ1台では不良とする最小の欠陥に必要な分解能が取れない場合は、カメラを複数台並べるか、ラインカメラで撮るか、製品やカメラを動かして何枚かに分けて撮るか、のいずれかを選ぶことになります。どれを選んでもデータの量と処理の時間は増えるので、第9章で扱うタクトタイムの計算と一緒に決める必要があります。
カメラにはこのほかに、白黒かカラーか、表面の高さを測る3次元の方式を使うか、といった選択があります。白黒とカラーの選び方は後の「色と偏光」の節で扱います。表面の高さを測る3次元の計測は、凹みや膨らみのように高さの違いそのものが欠陥になる場合の選択肢になりますが、方式が多岐にわたるため、本コラムでは扱いません。
レンズの考え方、焦点距離・被写界深度・テレセントリックレンズ
レンズで最初に決めるのは、視野の大きさと撮影の距離です。同じカメラで同じ距離から撮るなら、焦点距離の短いレンズほど広い範囲が写り、焦点距離の長いレンズほど狭い範囲が大きく写ります。視野の幅は前の節の分解能の計算で決めているので、レンズの選び方は「カメラの撮像素子の大きさと、装置の中で確保できる撮影の距離から、その視野が得られる焦点距離を選ぶ」という順になります。撮影の距離は、照明を置く場所や、製品の出し入れのための隙間にも縛られるので、レンズだけでは決められません。
次に考えるのが被写界深度です。被写界深度は、ピントを合わせた位置から製品が手前や奥にずれても、必要な画質を保てる奥行きの範囲です。光学部品の供給元の技術資料(エドモンド・オプティクスのイメージングリソースガイド。被写界深度の節)は、被写界深度を、ピントを合わせ直さずに所望の画質(決めた細かさの縞模様を、決めたコントラストで写せること)を保てる範囲として説明し、次の性質を挙げています。
- 見分けたい細部が小さいほど、被写界深度は浅くなる
- レンズの F ナンバー(絞りの値。大きいほど絞った状態)を大きくすると、被写界深度は深くなる
- ただし F ナンバーを大きくしすぎると、回折(光が細い隙間や縁を回り込んで広がる性質)によって、ピントの合った位置でも解像できる細かさが粗くなる
- レンズの倍率を小さくすると、また同じレンズ・同じ絞りで撮影の距離を長くすると、被写界深度は深くなる方向になる
この性質から、被写界深度の設計には2つのつり合いがあることが分かります。1つは、細かい欠陥を見たいほど被写界深度が浅くなることです。分解能を上げるために倍率を上げると、ピントの合う奥行きは狭くなります。もう1つは、絞りを絞って被写界深度を深くすると、レンズを通る光が減って画像が暗くなり、絞りすぎると細部がぼけることです。暗くなった分を露光時間で補うと、流れている製品ではぶれが増えます。高さのある製品や、搬送で上下に揺れる製品を撮るときは、必要な奥行きの範囲を先に決め、その範囲で必要な細かさが写るかを、テスト用の図柄や実際の製品で確かめる必要があります。
寸法の計測や、位置が前後に揺れる製品の検査で使われるのが、テレセントリックレンズです。同じ技術資料は、テレセントリックレンズを次のように説明しています。普通のレンズは、物がレンズから遠ざかるほど小さく写ります。同じ技術資料はこの性質を視差(見る位置や距離によって見え方が変わること)と呼び、視差のために、物の位置が前後にずれると写る大きさが変わって計測の精度が下がると説明しています。テレセントリックレンズは、物がレンズからの距離によらず同じ大きさに写るように設計されたレンズで、ベルトコンベアの上での位置の変動などで起きる計測の誤差を抑えられます。同じ技術資料は、テレセントリックレンズで写せる視野の大きさが物の位置によらず一定であることには、計測の用途での利点と欠点の両方があるとしています。利点は、いま述べたとおり、製品の位置が前後にずれても写る大きさが変わらないことです。欠点の中身として、同じリソースガイドの別の節(4.3節「テレセントリックレンズのサイズ的規制」)は、次の点を挙げています。
- 写せる視野の大きさは、製品の側のレンズの直径で制約される
- 広い視野が要るほど、製品の側のレンズを大きくする必要がある
- 倍率を小さくする場合も製品の側のレンズを大きくする必要があり、レンズ全体が大きく重くなる
- そのため、重さや大きさに制約のある装置では導入が難しくなる
つまり、製品の広い範囲を一度に撮りたい検査では、テレセントリックレンズは選びにくくなります。
同じ技術資料は、テレセントリックレンズが普通のレンズより本質的に被写界深度が深いと考えるのは誤りだとも書いています。そのうえで、被写界深度の大きさは最終的には使う光の波長とレンズの F ナンバーに依存するとし、テレセントリックレンズの利点は、ピントがずれたときのぼけ方が前後で対称になるため、実用上使える奥行きの範囲を広く取りやすいことだと説明しています。ここでの波長と F ナンバーは、レンズの種類を比べるときの話で、実際に使える奥行きは、前に挙げた倍率・見分けたい細部の大きさ・必要なコントラストによっても変わります。テレセントリックレンズを選ぶ理由は「大きさが変わって写ると困る」ことにあり、「ピントの範囲を広げたい」ことだけでは選ぶ理由になりにくいと考えています。
レンズについて決めることを、次の表にまとめました。
| 決めること | 何に効くか | 大きくすると(長くすると)起きること | 確かめ方 |
|---|---|---|---|
| 焦点距離 | 視野の大きさと撮影の距離 | 同じ距離なら視野が狭くなり、細かく写る | 視野の幅が分解能の計算どおりになっているかを目盛りの付いた板で確かめる |
| 撮影の距離 | 装置の大きさ、照明を置く場所、被写界深度 | 同じレンズ・同じ絞りなら被写界深度は深くなる方向になるが、装置が大きくなる | 照明と製品の出し入れの隙間を含めて装置の図面で確かめる |
| F ナンバー(絞り) | 被写界深度・明るさ・解像の限界 | 被写界深度は深くなるが、暗くなり、絞りすぎると細部がぼける | 必要な奥行きの範囲の両端で、不良とする最小の欠陥が写るかを確かめる |
| テレセントリックレンズを使うか | 位置の前後の変動による写る大きさの変化 | 写る大きさは一定になるが、写せる視野は製品の側のレンズの直径で制約され、広い視野ではレンズが大きく重くなる | 製品を前後にずらして撮り、写る大きさが変わらないかを確かめる |
レンズの解像の力は、カメラの画素の細かさと釣り合っている必要があります。画素の細かいカメラに解像の力の足りないレンズを付けると、画素の数は多くても像はぼけたままになります。カメラとレンズは別々に選ばれることが多いので、組み合わせたときに不良とする最小の欠陥が何画素で、どの程度のコントラストで写るかを、実際の製品か、限度見本で確かめるのが確実です。
照明方式・色・偏光の選び方、欠陥が写りやすい当て方の対応表
照明は、欠陥と背景の見え方に差を作る要素です。広島県立総合技術研究所の西部工業技術センターは、画像検査用の照明の導入を紹介したページ(2020年4月掲載。広島県の公開ページ)で、照明の形状・発光色・位置関係などによって撮像結果は全く異なり、画像の質が検査の精度に大きく影響すると述べています。同じページには、同センターが導入した照明が、次のように挙げられています。
- 形状:バー・ローアングル・フラット・フラットドーム・ドーム・同軸
- 発光色:白・赤・緑・青
本コラムでは、光を当てる向きと広がりの組み合わせを照明方式と呼びます。
照明方式を理解するための土台になるのが、明視野と暗視野の区別です。照明の供給元の技術セミナーの資料(オプテックス・エフエー「画像処理用LED照明の基礎知識」、2021年。公開資料)は、製品に当たった光を2つに分けて説明しています。正反射(鏡のように入った角度と同じ角度で跳ね返る向き)や正透過(透明な物を光がまっすぐ通り抜ける向き)の方向に進む光が直接光、それ以外の方向に散らばる光が散乱光です。カメラが直接光を受け取るように照明を置く撮り方が明視野照明法で、カメラの向きと照明の光の向きをずらして散乱光を受け取る撮り方が暗視野照明法です。明視野では、平らで光沢のある面は明るく、傷や凹みのように面の向きが変わった所は直接光がカメラから逸れて暗く写ります。暗視野では、平らな面は暗く、傷や縁のように光を散らす所が明るく写ります。
同じ資料は、照明の形ごとの特徴と用途の例を示しています。その内容を本コラムの言葉で短くまとめると、次のようになります。
- リング照明:輪の形に光源を並べ、輪の穴からカメラがのぞくように置く。中心の明るさの均一さを生かした印字の検査や、浅い角度から当てる使い方(ローアングル)での傷・打痕・縁の検出に使われる
- バー照明:棒の形の照明。当てる角度を自由に決めやすく、傷・凹み・異物の検査や印字の検査など幅広く使われる
- ドーム照明:内側が光を拡散する面になったドームで光を跳ね返し、多くの方向から照らす。段差や丸みのある製品でも影の少ない画像が得られ、光沢や凹凸の影響を抑えた検査に使われる
- バックライト照明:製品の背面から照らす面の照明。輪郭を影絵として写す寸法の検査や、半透明の製品の透過の検査に使われる
- 同軸照明(同軸落射照明とも呼ばれる):半分の光を通して半分を反射する鏡(ハーフミラー)を使い、カメラの向きと同じ向きから光を当てる。平らで光沢のある面では傷のある所だけ正反射の光が弱まり、傷を暗く写せる
同じ資料にある撮像例をもとに、欠陥の種類と照明方式の対応を次の表にまとめました。「写りやすい欠陥・特徴」と「見え方」の列は資料の説明を本コラムの言葉で書いたものです。右端の「本コラムが考える注意点」の列は、資料に書かれたものではなく、明視野と暗視野の原理から本コラムが考えたもので、確かめる候補として挙げています。どの製品でも表の通りに写るわけではありません。製品の材質・表面の状態(光沢の有無・ざらつき)・形によって写り方は変わるので、表は試す順番を決める出発点として使い、実際の製品で確かめる必要があります。
| 照明方式 | 明視野か暗視野か | 写りやすい欠陥・特徴 | 見え方 | 本コラムが考える注意点 |
|---|---|---|---|---|
| 同軸照明(同軸落射) | 明視野 | 平らな面の傷・打痕、プリント基板の配線の図柄、位置合わせ | 平らで光沢のある面が明るく、傷・凹み・欠けで面の向きが変わった所が暗く写る | 正反射の光を見る方式なので、曲面や凹凸の多い面では、欠陥でない所も暗く写る範囲が広がりうる |
| ローアングル照明(浅い角度から当てるリング・バー) | 暗視野 | 不透明な面の傷・打痕、縁、刻印 | 平らな面が暗く、傷や縁で散らばった光が明るく写る | 散乱の少ない浅い傷は光りにくく、ざらついた面では面そのものの散乱も明るく写りうる |
| リング照明 | 当てる角度による | 印字(中心の明るさの均一さを生かす)、浅い角度で当てたときの傷・打痕・縁 | 照らす範囲の中心の明るさが均一になりやすい | 当てる角度で明視野にも暗視野にもなるので、どちらで使うかを先に決める |
| バー照明 | 置き方で明視野にも暗視野にもなる | 傷・凹み・異物、印字、位置決め、向きの判別 | 当てる角度で見え方を変えられる | 置き方の自由度が高い分、角度と距離を記録しておかないと装置ごとに見え方がずれうる |
| ドーム照明 | 多方向からの拡散光 | 段差や丸みのある製品の外観、凹凸のある面の印字 | 多方向から照らすので影が少なく、表面の光沢や凹凸の影響が抑えられる | 凹凸の影響を抑える方式なので、凹凸そのものが欠陥の場合は差が小さくなりうる |
| バックライト(透過) | 透過 | 輪郭を影絵として写す寸法の検査、透明な製品の傷、透明・半透明の製品の中の異物 | 製品が影絵として写る。透明な製品の中の異物は暗く写る | 影絵を写す方式なので、不透明な製品の表面の欠陥は写らない |
表と同じ資料の説明から分かるのは、同じ欠陥でも、製品の表面の状態によって向く照明方式が変わることです。同じ資料は、傷の検出について、不透明な製品ではローアングル照明で傷を光らせ、光沢のある製品では同軸照明で傷を暗く写す、という例を示しています(41ページ)。適する方式は光沢の有無だけで決まるわけではなく、後の事例のように、同じ製品を両方の照明で撮り比べる場合もあります。同じ資料には、ボタン電池の表面を同軸照明とローアングル照明で撮り比べた事例があります。対象は、傷・打痕・縁の欠け・刻印の不良の4種類です。同軸照明では、傷・打痕・欠けが黒く、刻印の不良が白く写りました。ローアングル照明では逆に、傷・打痕・縁が白く、刻印の不良が黒く写りました。なお、資料の注記によれば、この事例の傷・打痕・縁の欠けは実験用に付けたものです。この事例では、同じ照明方式の中でも、欠陥の種類によって白く写るものと黒く写るものに分かれていました。この事例のように、検査したい欠陥の種類によっては、別の照明で撮り分ける必要が出る場合があります。これは1つの事例で示された見え方で、どの製品にも同じことが起きるとは限りません。
照明方式の検討は、次の順に進めると整理しやすいと考えています。
- 第2章の判定基準から、見つけたい欠陥の種類と、不良とする最小の大きさを書き出す
- 製品の表面の状態(光沢があるか、ざらついているか、透明か)と形(平らか、曲面か、段差があるか)を確かめる
- 欠陥ごとに、明視野と暗視野のどちらで差が大きくなりそうかを考え、上の表から試す照明方式を2〜3つ選ぶ
- 限度見本と、実際の不良品・良品を、選んだ照明方式で撮り比べ、欠陥と背景の明るさの差を確かめる
- 良品のばらつき(色・模様・光沢の個体差)で欠陥と同じような明るさの差が出ていないかを確かめる
- 装置の中に照明を置く場所と、搬送の条件で、その当て方が再現できるかを確かめる
5つ目の確かめは、とくに重要な点だと考えています。欠陥がはっきり写る照明方式が、良品の模様や個体差も同じように強調してしまうことがあります。その場合、ルールベースの画像処理でも学習のモデルでも過検出が増えます。欠陥と背景の差だけでなく、良品どうしのばらつきの大きさも合わせて見て、照明方式を選ぶ必要があります。
同じ資料は、照明の選定のまとめとして、照明を買えば簡単にコントラストの高い画像が得られるわけではなく、検査の内容に応じて照明の形状・照射の角度・波長を選ぶ必要があること、その際に設備の中の照明の設置の空間と搬送の条件を事前に確かめる必要があることを挙げています。照明方式は、製品と欠陥を実際に撮って比べながら決めるもので、カタログの上だけで決められるものではないと考えています。
照明方式で光を当てる向きを決めたら、次に光の色(波長)を考えます。前の節で引いた照明の供給元の技術セミナーの資料は、同じ製品を白・赤・緑・青の照明で撮ったカラー画像と白黒画像を並べ、照明の色によって写り方が変わることを示しています。印字の検査では、背景と印字の明るさに差が出る照明の色を選ぶとしています。透明・半透明の製品の中の異物を背面からの光で見る場合には、製品を通り抜け、かつ異物には吸収される色の光を選ぶことで、異物を黒く写せると説明しています。
同じ資料は、工場の自動化の分野で使われる光の波長の範囲として、紫外(365 ナノメートル付近)から可視光を経て赤外(1,650 ナノメートル付近)までを図で示しています。そのうえで、カメラと人の目では見える範囲と感度が違うため、カメラで撮った画像と目で見た印象には違いが生じること、目で見たのと同じ画像を撮るのではなく、画像処理のしやすい画像を撮ることが重要であることを述べています。この考え方は、外観検査AIにもそのまま当てはまると考えています。学習のモデルに見せる画像は、人が見て自然な画像である必要はなく、欠陥と良品の差が大きく、良品どうしのばらつきが小さい画像であるほど判定は安定しやすくなります。
白黒のカメラとカラーのカメラの選び方も、この考え方の延長で決めます。欠陥が色の違い(色むら・変色・異なる色の異物)として現れ、明るさの差だけでは区別しにくい場合は、カラーのカメラが候補になります。欠陥が明るさの差として写せる場合は、照明の色を選んで白黒のカメラで撮る方法も候補になります。どちらが向くかは欠陥と製品の色の組み合わせで変わるので、限度見本を両方の方式で撮り比べて決めるのが確実です。なお、同じ資料の質疑の回答には、光源の波長によってもピントの位置が変わるので、照明の色を変えたらピントを合わせ直すよう求める記述があります。照明の色を変えるときは、ピントの確認も合わせて行う必要があります。
光沢のある製品では、照明の光が鏡のように跳ね返って画像の一部が白く飛び、そこにある欠陥が見えなくなることがあります。同じ資料は、照明の側とカメラの側に偏光板(特定の向きに振動する光だけを通す板)を取り付けることで、正反射の光による白飛びを抑えられると説明しています。光沢のある製品の上の印字の検査でも、偏光板でぎらつきを抑えて撮る方法が示されています。光学部品の供給元の別の資料(エドモンド・オプティクスの偏光の技術の解説)は、光源に偏光板を付け、レンズの側には向きを直交させた偏光板を付けることで、強く反射する部分を抑える例を示しています。偏光板の向きによって効き方が変わるので、向きを調整し、決めた向きを記録しておく必要があります。同じ解説は、偏光板1枚を通すと光の強さは理論上50%、実際には60〜65%近く減ると書いています。通り抜けて残る光は、理論上は半分、実際には35〜40%ほどになります。カメラに届く光の量が減るので、照明の明るさや露光時間を見直す必要があります。
色と偏光について決めることを、次の表にまとめました。
| 決めること | 選択肢 | 向いている場面 | 確かめること |
|---|---|---|---|
| 照明の色(波長) | 白・赤・緑・青、紫外・赤外 | 背景と欠陥(印字・異物)の明るさの差を広げたいとき | 限度見本を複数の色で撮り、差が最も大きく、良品のばらつきが小さい色を選ぶ。色を変えたらピントを合わせ直す |
| カメラの方式 | 白黒・カラー | カラーは欠陥が色の違いとして現れるとき。白黒は照明の色の工夫で明るさの差として写せるとき | 色の違いの欠陥が白黒でも区別できるかを撮り比べる |
| 偏光板を使うか | 使わない・照明とカメラの両方に付ける | 光沢のある面で正反射の光による白飛びやぎらつきが欠陥を隠すとき | 白飛びが消えるか、暗くなった分を照明と露光時間で補えるか |
カメラの性能と接続の規格、EMVA 1288・GigE Vision・USB3 Vision・GenICam
カメラを選ぶときに、各社の仕様書の数字をそのまま並べて比べると、測り方が違うために比べられないことがあります。この問題に対して、欧州マシンビジョン協会(EMVA)が作っている規格が EMVA 1288 です。2026年11月9日に EMVA の公式ページで確かめた時点で、最新の版は Release 4.0 で、2021年6月に効力が生じたとされています。Release 4.0 の文書(General の文書の表紙の日付は2021年6月16日)は、2016年12月30日に効力が生じた Release 3.1 に置き換わるものです。
Release 4.0 の General の文書の前書きを本コラムの言葉で短くまとめると、EMVA 1288 は、マシンビジョンに使うカメラと撮像素子の仕様の値と特性のデータを、統一した方法で測り、計算し、示すための規格です。カメラを比べたい人や、撮像素子やカメラの性能の値からシステム全体の性能を計算したい人に役立つことが、規格の目的として挙げられています。文書は無料で公開されています。Release 4 からは文書が2つに分かれ、明るさに対して出力が比例する(線形な)カメラを対象とする Linear の文書と、より広い種類のカメラに使える General の文書になりました。General の文書は、偏光・多波長(マルチスペクトル)・距離の計測(Time-of-Flight)のように複数のチャンネルを持つ撮像も考慮に入れたと説明しています。
General の文書の目次には、次の項目が並んでいます。
- 感度と雑音(信号対雑音比:信号の大きさが雑音の何倍あるか、信号の飽和:光が強すぎて値がそれ以上増えなくなること、検出できる最小の光の量)
- 暗電流(光が当たっていなくても生じる信号)とその温度による変化
- 画素ごとのむら(空間的な不均一性。暗いときのむらを表す DSNU と、光が当たったときの感度のむらを表す PRNU)と、欠陥のある画素
外観検査の観点から見ると、これらの項目は「暗い欠陥や小さな明るさの差を雑音に埋もれさせずに写せるか」「画素ごとのむらが、欠陥のような模様として写らないか」を比べる材料になります。たとえば、露光時間を短くして画像が暗くなる流しながらの撮像では、少ない光でどれだけ雑音の少ない画像が得られるかが効いてきます。一方で、規格の前書きは、仕様書に載せるデータが代表値か、個別の製品の値か、保証値かは規格では定めず、データを公表する側がその性質を明示すべきだとしています。規格に沿った数字であっても、それが代表値なのか保証値なのかを確かめてから比べる必要があります。
EMVA 1288 の数字で比べられるのは、カメラ単体の性能です。照明・レンズ・製品の表面と組み合わせたときに欠陥がどう写るかまでは分かりません。規格の数字は候補を絞る段階で使い、最後は実際の製品と限度見本を撮って決める、という順番が現実的だと考えています。
カメラと計算機をつなぐ部分にも、業界の規格があります。代表的なものが、米国の自動化の業界団体 A3(Association for Advancing Automation)が管理する GigE Vision と USB3 Vision、そして EMVA が取りまとめる GenICam です。これらの規格は、カメラの製造元とソフトの作り手が違っても、決められた方法でつながり、同じ方法で設定を変えられるようにするためのものです。
A3 の公式ページによると、GigE Vision は、ギガビットのイーサネット(工場や事務所で広く使われる有線のネットワーク)の通信の方式を使ったカメラの接続の規格で、異なる製造元のハードとソフトがつながって動くことを目的にしています。同じページは、標準的なケーブルで最長 100 メートルまで伝送できることを利点として挙げています。同じページによると、2026年4月17日に、この規格を作る技術委員会が新しい版 3.0 を承認しました。版 3.0 は、遅れの小さい通信の技術を使った新しい画像の送り方を加えたものとされています。それまでの版の履歴は、後の表の欄に記しました。
外観検査の判断にとっての要点は、承認されたのは規格の版であり、その版に対応した機器が手に入るかとは別の事柄だということです。本コラムで確かめたのは、版 3.0 が技術委員会で承認されたことまでで、版 3.0 に対応したカメラや受け取る側の機器がどの程度入手できるかは確かめていません。装置を発注するときは、実際に使うカメラが対応する版を確かめる必要があります(この節の最後の段落で扱います)。
同じく A3 の公式ページによると、USB3 Vision は、パソコンや組込みの機器に広く備わる USB 3.x の接続を使ったカメラの規格で、2026年11月9日に確かめた時点で版 1.2 です。受動的なケーブルで 5 メートルまで、電源と信号を1本のケーブルで送れることが特徴として挙げられています。
GenICam は、EMVA の公式ページで、接続の技術の違いによらず、あらゆる種類の機器に共通のプログラムの呼び出し方(プログラミングのインターフェース)を提供することを目標にした規格と説明されています。A3 の GigE Vision のページは、GigE Vision のカメラがどの機能を持つかを、GenICam の規格の一部である GenApi(機器の機能の記述の書式を定めた部分)に沿った、XML という形式の説明ファイルで記述すると説明しており、USB3 Vision のページも GenICam を使うことを挙げています。つまり、イーサネットや USB を使ったカメラとの接続と画像の送り方は GigE Vision・USB3 Vision などの規格が決め、カメラがどの機能を持つかの記述と、その機能を呼び出す方法は GenICam が共通にする、という分担になっています。次の表には、この3つの接続の規格に加えて、前の段落までで扱った EMVA 1288(性能の測り方の規格)も並べました。
| 規格 | 管理する団体 | 何を決めるか | 公式ページで確かめた版・特徴(2026年11月9日時点) |
|---|---|---|---|
| GigE Vision | A3 | イーサネットを使ったカメラの接続と画像の送り方 | 2026年4月17日に技術委員会が版 3.0 を承認(それまでの版は2011年11月の版 2.0、2018年8月の版 2.1、2022年6月の版 2.2)。対応する機器の入手のしやすさは確かめていない。標準的なケーブルで最長 100 メートル |
| USB3 Vision | A3 | USB 3.x を使ったカメラの接続 | 版 1.2。受動的なケーブルで 5 メートルまで電源と信号を1本で送れる |
| GenICam | EMVA(作業部会は、日本・米国・欧州・中国の業界団体のいずれかの会員企業に開かれている) | 接続の方式によらない、カメラの機能の記述と呼び出し方 | GigE Vision・USB3 Vision のカメラの機能の記述に使われる |
| EMVA 1288 | EMVA | カメラと撮像素子の性能の測り方と示し方 | Release 4.0(2021年6月に効力)。文書は無料で公開 |
経営の観点から見て、これらの規格が意味を持つのは、工場や工程ごとにばらばらの装置を入れる二重投資を避けたいときです。カメラの接続と設定の方法が規格にそろっていれば、カメラを別の製造元の製品に替えても、画像を受け取るソフトの側を作り直す範囲を小さくできる可能性があります。装置を発注するときに、どの規格に対応したカメラを使い、設定をどの形で残すかを仕様に書いておくことを勧めます。規格の版まで書く場合は、規格の最新の版の番号をそのまま書くのではなく、実際に使うカメラと受け取る側のソフトがどの版に対応しているかを製造元の資料で確かめ、その版を書くのが確実だと考えています。ただし、規格に対応していることと、検査に必要な性能が出ることは別の問題で、性能は前の節の EMVA 1288 の数字と実際の撮像で確かめる必要があります。速度の要件と、画像の送り方が検査の時間に与える影響は、第9章で扱います。
撮像の条件の固定と記録、照明の強さ・露光時間・位置決め
撮像の設計が終わったら、その条件を固定し、記録に残します。外観検査AIでは、学習に使った画像と本番で撮る画像の条件がそろっていることが、判定を安定させる前提になります。照明の明るさが少し変わる、カメラの位置が少しずれる、レンズに汚れが付く、といった変化は、人の目にはほとんど分からなくても、画像の明るさや模様の写り方を変え、良品学習のモデルでは「いつもと違う」と判定され、過検出の原因になりえます。本番で起きる変化の監視と再学習は第12章で扱うので、ここでは撮像の条件をどう固定し、何を記録するかを扱います。
固定するものは、大きく3つに分けて考えると整理しやすいと考えています。1つ目は光学系の配置で、カメラ・レンズ・照明・製品の位置関係(距離・角度・高さ)です。これは治具やブラケットで機械的に固定し、調整した後は動かないようにします。2つ目はカメラと照明の設定の値で、露光時間・ゲイン(信号の増幅の倍率)・照明の明るさ・絞りとピントの位置です。これらは設定ファイルとして残し、版を付けて管理します。3つ目は製品の位置決めで、製品がいつも同じ位置と向きで撮られるようにする治具・突き当て・搬送の止め方です。位置決めの精度が足りない分は、第4章で扱うルールベースの画像処理で位置を合わせ直す方法もあります。
撮像の条件として記録しておきたい項目を、次の表にまとめました。項目は本コラムが考えたもので、規格で定められたものではありません。
| 項目 | 記録する内容 | なぜ残すか | 見直す時機 |
|---|---|---|---|
| 光学系の配置 | カメラ・照明と製品の距離と角度、取り付けの図面と写真 | 装置の移設や部品の交換の後に同じ配置に戻すため | 装置の移設・部品の交換・衝突などの事故の後 |
| カメラの設定 | 露光時間・ゲイン・画像の大きさ・トリガーの方式を含む設定ファイルとその版 | 学習に使った画像と本番の画像の条件をそろえるため | 設定を変えるたび(変更の承認を通す) |
| レンズの設定 | 焦点距離・絞り・ピントの位置 | 被写界深度と明るさを再現するため | レンズの交換・清掃の後 |
| 照明の設定 | 照明方式・色・明るさの設定値・偏光板の有無と向き | 欠陥と背景の差を再現するため | 照明の交換・明るさの調整の後 |
| 基準の画像 | 決まった基準の板(白い板や目盛りの付いた板)と限度見本を、決まった時機に撮った画像と、その明るさの値 | 照明の劣化・レンズの汚れ・位置のずれを、変化として測るため | 始業時など、決めた周期ごと |
| 位置決めの方法 | 治具・突き当て・搬送の止め方と、許される位置のずれの範囲 | 良品の画像のばらつきを小さく保つため | 品種の追加・治具の交換の後 |
この表の中でとくに大切なのは、基準の画像です。照明の明るさは時間とともに少しずつ変わることがあり、その変化は毎日の画像を見ていても気付きにくいものです。始業時に決まった基準の板を撮り、その明るさの値を記録しておけば、変化を数字で追えます。この記録は、第12章で扱う変化の監視の入力にもなります。設定の値を変えるときは、第12章で扱う変更管理の手続きを通し、変更の前後で限度見本の写り方が変わっていないかを確かめてから本番に戻すことを勧めます。
撮像の条件の記録は、第11章で扱うトレーサビリティ(どの製品を、どの条件で撮り、どのモデルのどの版で判定したかを後から追える状態)の一部にもなります。判定の記録にカメラの設定の版を残しておけば、後で流出が見つかったときに、その製品を撮ったときの条件を確かめられます。
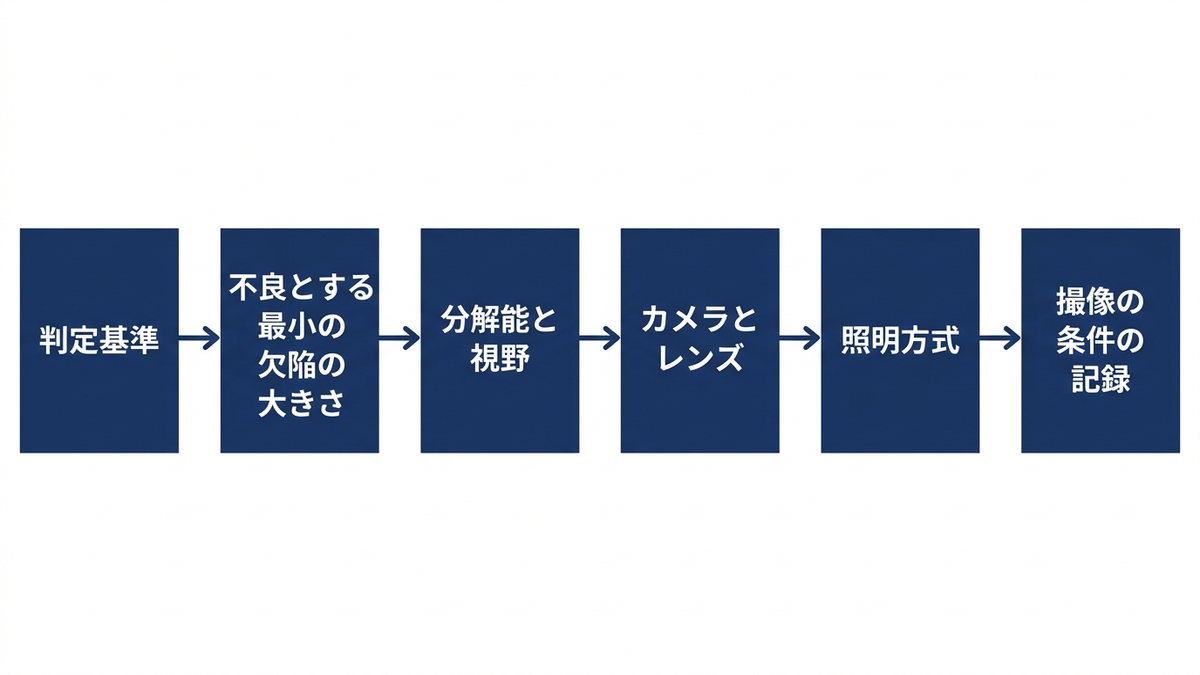
撮像の設計を進める順番を、次の図にまとめました。図は判断の順序を示したもので、5つの要素のうち搬送とトリガーは、カメラとレンズや照明方式を決めるときの前提の条件として扱い、箱には入れていません。
経営判断、撮像の検討に先に時間を使う
この章の内容を経営の判断に置き換えます。外観検査AIの導入では、学習のモデルの選び方や精度の数字に目が向きやすく、撮像の検討は装置の付属品の手配のように扱われがちです。しかし、この章で見てきたとおり、分解能・被写界深度・照明方式の組み合わせで、どの欠陥が画像に写るかが決まり、写っていない欠陥はどのモデルでも見つけられません。撮像は、その後の判定の精度の上限を決める工程です。撮像の検討に先に時間と予算を使うことは、導入の手戻りを小さくするための判断の1つだと考えています。この節の最後の段落で述べるとおり、写るかどうかを確かめないまま開発に進むと、撮像からやり直すときに、それまでの画像の収集とラベル付けも作り直しになりかねないからです。
撮像の判断を誤ったときの損失は、序章で整理した6つの損失の型で整理できます。
- 流出:分解能が足りない、照明方式が合わないなどの理由で不良とする最小の欠陥が写らず、モデルの改良では取り戻せない見逃しが残る
- 過検出:照明が良品の模様や個体差を強調し、良品を不良と判定する件数が増え、廃棄・手直し・再検査が増える
- 判定のばらつき:工場や装置ごとに照明の角度や設定が違い、同じ製品でも装置によって判定がずれる
- タクトの超過:必要以上に画素数を増やした、露光が長すぎるなどの理由で、撮像と転送が生産の速さに追いつかない
- 形骸化:撮像の条件が少しずつ変わって過検出が増え、AIの判定が信用されなくなり、人が全数を見直すようになる
- 二重投資:工程や工場ごとに、接続の方式も設定の残し方も違う装置を入れ、後からそろえ直す
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 撮像の検討を、モデルの検討より前の独立した工程として計画に入れ、限度見本と実際の不良品・良品を撮り比べる期間を確保する
- 撮像の検討の入力として、第2章の判定基準を、見つけたい欠陥の種類と、不良とする最小の大きさで書いた形で渡す
- 撮像の検討の合格の条件を「限度見本の欠陥が、決めた画素数とコントラストで写ること」「良品のばらつきで欠陥と同じような差が出ないこと」のように先に決める
- 装置の仕様に、カメラの接続の規格、設定ファイルの残し方、基準の画像の撮り方を書き込み、工場や工程の間でそろえる
- 撮像の条件の変更は、品質保証が関わる変更管理の手続きを通すことを決める
予算の面では、撮像の検討の費用を「装置を買う前の試し撮り」として小さく扱わないことを勧めます。照明やレンズを替えて撮り比べる試作の段階で、欠陥が十分な差で写ることを確かめておけば、その後のモデルの開発は「写っている欠陥をどう判定するか」という問題に絞られます。逆に、写るかどうかを確かめないまま開発に進むと、PoC の終盤になって撮像からやり直すことになり、それまでの画像の収集とラベル付けも作り直しになりかねません。導入の進め方と PoC の設計は第13章で扱います。
この章のまとめ
この章では、撮像をカメラ・レンズ・照明・搬送・トリガーの5つの要素の組み合わせとして捉え、判定基準で不良とする最小の欠陥の大きさから分解能を計算し、エリアカメラとラインカメラ、レンズの被写界深度とテレセントリックレンズ、照明方式と色と偏光を選び、撮像の条件を固定して記録する流れを扱いました。分解能の計算は必要条件を確かめるもので、十分かどうかは限度見本と実際の製品を撮って確かめる必要があります。カメラの性能は EMVA 1288、接続と設定の方法は GigE Vision・USB3 Vision・GenICam という規格で、比べたりそろえたりできます。次の第4章では、こうして得た画像に対して、二値化・差分・特徴量といったルールベースの画像処理で何ができ、どこで外れるかを、実行したコードと結果で確かめます。
この章を深めたい方への参考書籍
『マシンビジョンライティング 基礎編 改訂版』(増村茂樹、産業開発機構):マシンビジョンの画像処理システムにおける照明の技術を、基礎から扱う本です(2018年刊)。同じ著者の実践編・発展編・応用編と続くシリーズの1冊目にあたり、この章で扱った明視野と暗視野、照明方式の選び方の背景にある考え方を深める手がかりになります。
『マシンビジョンシステムにおける周辺機器・製品の選び方・使い方』(月刊画像ラボ編集部 編集、日本工業出版):副題に挙げられているとおり、レンズ・フィルター・照明・画像入力ボード・ケーブル・画像処理ソフトウェア・画像処理装置の基本を扱う、月刊画像ラボの別冊です(2019年刊)。この章で扱ったカメラの周辺の機器を、装置を組み立てる側から確かめるときの手がかりになります。
第4章 ルールベースの画像処理、二値化・差分・特徴量で何ができるか
第3章では、カメラ・レンズ・照明・搬送の組み合わせで、欠陥が画像の上で見える状態を作る撮像の設計を扱いました。撮像で欠陥が写ったとして、次に決めるのは、その画像から「不良かどうか」をどう判定するかです。この章では、学習を使わず、人が判定の条件を書く「ルールベースの画像処理」を扱います。欠陥が周りとの十分な明るさの差を持って写っている場合には、位置と形が安定した欠陥の多くはルールで判定でき(条件は次の段落で述べます)、ルールで足りる所に学習のモデルを持ち込むと、かえって保守の手間と説明の手間が増えることがあります。
この章では、次の内容を扱います。
- 前処理(平滑化・明るさの正規化)と二値化、とくに大津の方法が向く画像と向かない画像
- ラベリングとブロブ解析による、欠陥の面積と形の判定
- テンプレートマッチングによる位置決めと、良品画像との差分
- エッジ検出と寸法の計測
- 架空の合成画像で、どの欠陥がルールで見つかり、どれが外れるか、位置ずれと明るさの変化で過検出がどう増えるかを、実行したコードと結果で確かめる
- ルールで書ける欠陥と書けない欠陥、品種ごとのパラメータの保守、学習のモデルと組み合わせる型、経営の判断
この章の主張は、欠陥が周りと十分な明るさの差を持って写っていれば、位置と形が安定した欠陥はルールで足り、学習のモデルはルールで書けない部分に使う、というものです。ただし、ルールが安定して働くのは、撮像の条件(位置・明るさ)がそろっているか、ルールの側でそのずれを補正している場合に限られます。この2つの限定条件を、後半のコードで数字として示します。後半の実験では、形と長さの決まった傷でも、周りとの明るさの差が模様の振れと同じくらいしかないと、位置を補正してもルールでは確実に見つけられない例が出てきます。
ルールベースの画像処理は、人が判定の条件を書く検査
ルールベースの画像処理は、画像の画素の明るさに対して、人が決めた順番で処理をかけ、最後に「この条件を満たしたら不良」という判定を下す方法です。典型的な流れは、前処理でノイズを減らして明るさをそろえ、二値化で欠陥らしい画素とそれ以外を分け、つながった画素の塊ごとに面積や形を測り、その値を判定基準と比べる、というものです。面積・形・位置のように、画像から計算して判定に使う数値を、この章では特徴量と呼びます。章題の「特徴量で何ができるか」は、この数値を判定基準と比べて良否を決めることを指しています。判定の条件はすべて人が書くので、なぜ不良と判定したかを「面積が何画素を超えたから」「凸性がいくつを下回ったから」と数字で説明できます。この説明のしやすさは、品質保証の部門や顧客に判定の根拠を示すときに大きな利点になります。
一方で、ルールは書いた条件の外にある欠陥を見つけられません。たとえば「暗い点の面積」で異物を判定するルールは、明るい異物や、周りとの明るさの差が小さい淡い汚れには反応しません。また、ルールのしきい値は撮像の条件に強く依存し、照明が少し暗くなる、部品の置かれる位置が少しずれる、といった変化で判定が大きく変わることがあります。第1章で整理した自動検査の方式のうち、ルールベースの画像処理は「条件を書ける欠陥には強く、書けない欠陥には弱い」という性格を持つ方式だと考えています。
本コラムの用語の定義では、判定の一部または全部に学習したモデルを使う仕組みを外観検査AIと呼び、ルールを人が書く方法をルールベースの画像処理と呼んで区別しています。実際の検査装置では、この2つを1台の中で組み合わせる構成があり、その型は章の後半で整理します。
この章で扱う処理を、何が分かるか、何が要るか、どこで外れるかで整理したのが次の表です。表の「外れやすい場面」は、後半のコードで確かめるものと、一般論として挙げるものが混ざっています。コードで確かめたものは、その節で数字を示します。
| 処理 | 何が分かるか | 要る条件 | 外れやすい場面 |
|---|---|---|---|
| 平滑化 | 画素ごとの細かいノイズを均した画像 | 欠陥がノイズより大きいこと | 欠陥が細い線や1〜2画素の点で、均すと消えてしまうとき |
| 明るさの正規化 | 照明の強さの違いをそろえた画像 | 基準にする領域(部品の内側など)が決められること | 欠陥が基準の領域の明るさそのものを変えてしまうとき |
| 二値化 | 欠陥らしい画素とそれ以外の境目 | 欠陥と背景の明るさが分かれていること | 明るさの差が小さい欠陥、模様が欠陥と同じ明るさを持つ表面 |
| ラベリングとブロブ解析 | つながった画素の塊ごとの面積・形・位置 | 二値化で欠陥が1つの塊として取れていること | 二値化で欠陥がちぎれる・背景とつながるとき |
| テンプレートマッチング | 基準の画像が今の画像のどこにあるか(位置決め) | 位置決めの手がかりになる形(輪郭・印)があること | 回転や大きさの変化があるとき、似た形が複数あるとき |
| 良品画像との差分 | 良品と違う場所 | 位置と明るさがそろっていること | 位置ずれ・照明の変化・良品のばらつきが大きい製品 |
| エッジ検出と寸法の計測 | 輪郭の位置、径・長さ・形のずれ | 輪郭がはっきり写っていること | 輪郭がぼける・影や反射が輪郭に重なるとき |
ここからは、架空の合成画像を使って、それぞれの処理が何をするかを確かめます。画像は96画素四方で、暗い背景の上に、布地の織り目のような縦横の縞の模様を持つ円い部品(半径34画素)が写っている、という設定です。この部品は実在の製品ではなく、本コラムで説明のために作った架空の合成画像で、実際の製品の画像よりずっと単純です。欠陥は次の4種類を描き足しました。
- 異物:半径1.5〜2.5画素の、周りより0.30暗い小さな点
- 傷:長さ16〜28画素、幅1画素ほどの、周りより0.06〜0.10暗い細い線
- 汚れ:広がりが標準偏差6画素の、中心で周りより0.07暗い淡いむら
- 欠け:部品の縁を半径4〜7画素の円で削ったもの
明るさは0から1の範囲で表し、背景は0.15、部品は0.60を中心に、縞の模様で上下に最大0.08ほど振れます。すべての画素に標準偏差0.02のノイズを足しました。位置ずれと明るさの変化を後で試せるよう、部品の中心を動かす引数と、画像全体の明るさに掛ける倍率の引数を持たせています。乱数のシード(乱数の出方を決める値。同じ値なら毎回同じ画像が出る)は固定しています。
コードでは、良品を30枚作って「しきい値を決めるための良品」とし、別の良品30枚の平均を「差分の基準にする良品の平均画像」としました。良品の画像を平均すると、ノイズは小さくなり(30枚の平均なら標準偏差でおよそ30の平方根分の1)、模様と部品の形が主に残ります。実際の検査でも、基準の画像を1枚の良品ではなく、複数の良品から作る方法があります。1枚だけだと、その1枚が持っていたノイズや小さなばらつきまで基準に入ってしまうからです。
import numpy as np
from scipy import ndimage as ndi
from skimage import filters, measure, feature

N, R, BG = 96, 34, 0.15                 # 画像の大きさ・部品の半径・背景の明るさ
TYPES = ["良品", "異物", "傷", "汚れ", "欠け"]


def scene(rng, defect="良品", dy=0, dx=0, gain=1.0):
    y, x = np.mgrid[0:N, 0:N].astype(float)
    cy, cx = 48 + dy, 48 + dx                       # 位置ずれは部品ごと動かす
    part = np.hypot(y - cy, x - cx) <= R
    tex = 0.05 * np.sin(2 * np.pi * (x - cx) / 5) + 0.03 * np.sin(2 * np.pi * (y - cy) / 11)
    img = np.where(part, 0.60 + tex, BG)            # 布地のような模様のある円い部品
    a, d = rng.uniform(0, 2 * np.pi), rng.uniform(0, 20)
    py, px = cy + d * np.sin(a), cx + d * np.cos(a)
    if defect == "異物":                            # 小さく濃い点
        img[np.hypot(y - py, x - px) <= rng.uniform(1.5, 2.5)] -= 0.30
    if defect == "傷":                              # 細く薄い線
        t, L = rng.uniform(0, np.pi), rng.uniform(16, 28)
        u = (x - px) * np.cos(t) + (y - py) * np.sin(t)
        v = -(x - px) * np.sin(t) + (y - py) * np.cos(t)
        img[(np.abs(v) <= 0.6) & (np.abs(u) <= L / 2) & part] -= rng.uniform(0.06, 0.10)
    if defect == "汚れ":                            # 広く淡いむら
        img -= 0.07 * np.exp(-((y - py) ** 2 + (x - px) ** 2) / (2 * 6.0 ** 2)) * part
    if defect == "欠け":                            # 縁が欠ける
        by, bx = cy + R * np.sin(a), cx + R * np.cos(a)
        img[np.hypot(y - by, x - bx) <= rng.uniform(4, 7)] = BG
    return img * gain + rng.normal(0, 0.02, img.shape)


rng = np.random.default_rng(20261109)
calib = [scene(rng) for _ in range(30)]            # しきい値を決める良品30枚
ref = np.mean([scene(rng) for _ in range(30)], axis=0)   # 差分の基準にする良品の平均画像
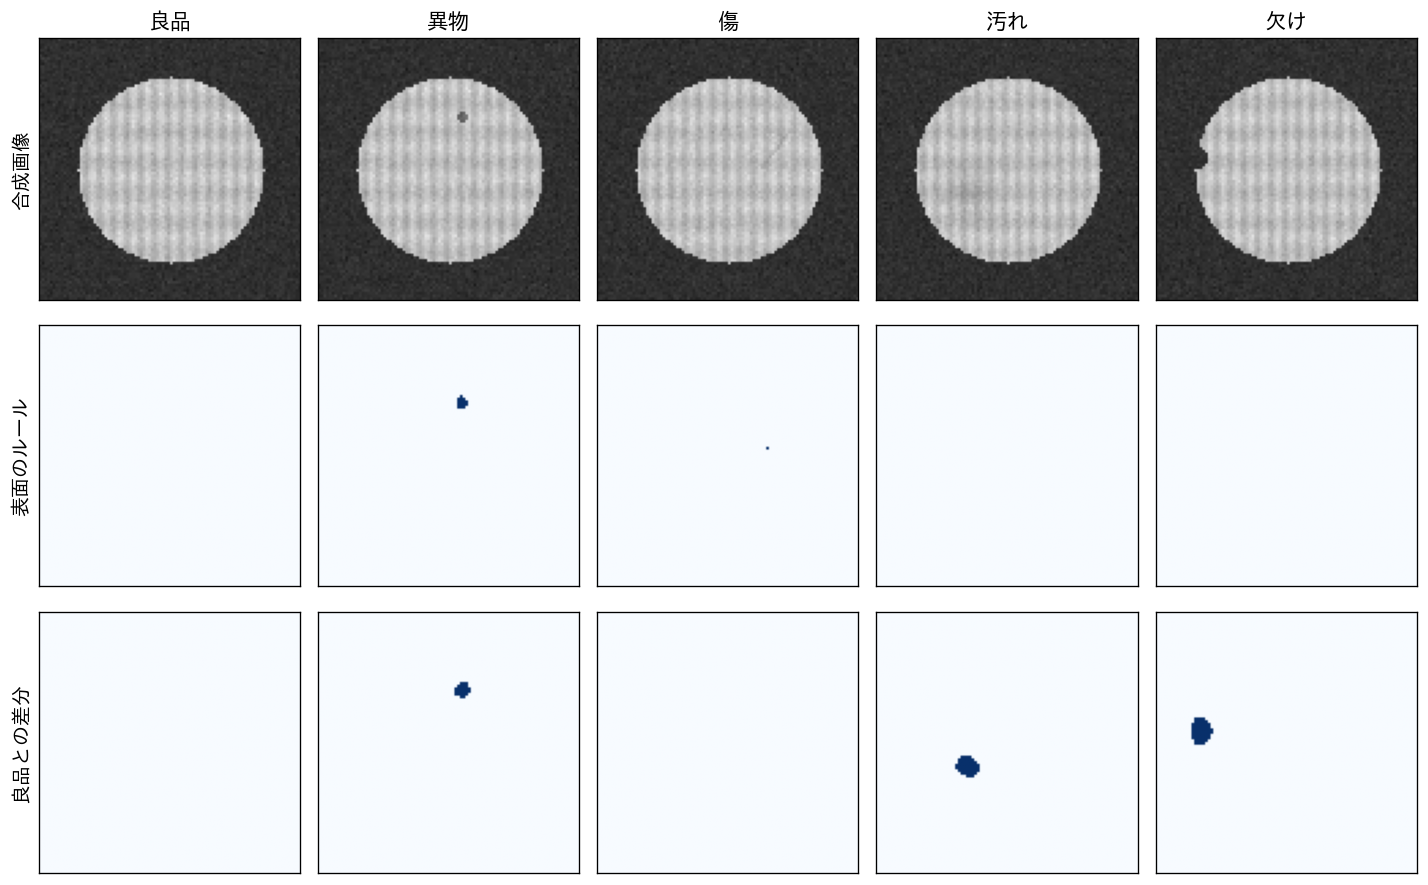
上の図の1段目が、良品と4種類の欠陥の合成画像の例です。異物と欠けは目で見てもすぐ分かりますが、傷と汚れは模様に紛れて見えにくくなっています。2段目と3段目は、後で説明する2つのルールの二値化の結果です。
前処理・二値化・ブロブ解析、大津の方法が向く画像と向かない画像
二値化は、画素の明るさがしきい値より大きいか小さいかで、画像を白と黒の2つに分ける処理です。欠陥の画素とそれ以外を分けることも、部品と背景を分けることもできます。問題は、しきい値をいくつにするかです。しきい値を人が固定値で決めると、照明が少し変わっただけで分け方がずれます。そこで、画像の明るさの分布(ヒストグラム)からしきい値を自動で決める方法が使われます。その代表が大津の方法で、大津(Otsu)が1979年に IEEE のシステム・人間・サイバネティクスの論文誌(第9巻第1号)に発表した論文が原典です。画素を明るい群と暗い群に分けたとき、2つの群の平均の離れ具合(群の間の分散)が最も大きくなるしきい値を選ぶ方法で、明るさの分布が2つの山に分かれている画像に向いています。
前処理として、二値化の前に平滑化をかけるのが一般的です。平滑化は、画素の明るさを周りの画素と平均して、細かいノイズを均す処理です。ここではガウシアンフィルタ(近い画素ほど重く、遠い画素ほど軽く重み付けして平均する処理)を使いました。平滑化の強さは標準偏差(sigma)で決まり、大きくするほどノイズは減りますが、細い傷や小さな点も一緒に薄まります。どこまで均すかは、見つけたい最小の欠陥の大きさで決めることになり、第3章で扱った分解能の考え方とつながります。
次のコードは、大津の方法で部品と背景を分け、つながった画素に番号を振り、最も大きい塊を部品として取り出して、その面積と形を測るものです。後半では、部品の内側だけに大津の方法を使うと何が起きるかを確かめています。
def part_mask(img):
    s = filters.gaussian(img, sigma=1)
    t = filters.threshold_otsu(s)                   # 明暗の2群を最もよく分けるしきい値
    fill = ndi.binary_fill_holes(s > t)             # 部品の中の暗い穴も部品に含める
    lab = measure.label(fill)                       # つながった画素に番号を振る
    rp = max(measure.regionprops(lab), key=lambda r: r.area)
    return lab == rp.label, rp, t


for name in ["良品", "欠け"]:
    m, rp, t = part_mask(scene(np.random.default_rng(1), name))
    print(name, "しきい値", round(t, 3), "面積", int(rp.area), "凸性", round(rp.solidity, 3),
          "円相当径", round(rp.equivalent_diameter_area, 2))

# 部品の内側だけで大津の方法を使うと、良品でも模様が半分に割れる
img = calib[0]
m, rp, t = part_mask(img)
inner = ndi.binary_erosion(m, iterations=4)
t_in = filters.threshold_otsu(img[inner])
blobs = measure.label(inner & (img < t_in))
print("良品の内側での大津のしきい値", round(t_in, 3), "暗い側の画素の割合",
      round((img[inner] < t_in).mean(), 3), "塊の数", blobs.max())
実行した結果、良品の画像では大津の方法のしきい値は0.37で、背景の0.15と部品の0.60のほぼ中間に来ました。部品の面積は3,620画素、円相当径(同じ面積の円の直径)は67.89画素で、半径34画素の円として作った部品の大きさとよく合っています。欠けのある画像では、しきい値は0.36、面積は3,596画素、凸性は0.979で、良品の0.987より小さくなりました。凸性は、scikit-image(本コラムでは0.26.0で実行)の公式ドキュメントでは、領域の画素の数と、その領域を包む凸の図形(へこみの無い図形)の画素の数の比と説明されています。円のようにへこみの無い形では1に近く、縁が欠けてへこむと小さくなるので、欠けの判定に使えます。
コードの中で ndi.binary_fill_holes を使い、部品の中にできた穴を埋めてから塊を数えている点には理由があります。fill = ndi.binary_fill_holes(s > t) を fill = s > t に置き換え、章のコードを先頭から実行し直すと、暗い異物の点がしきい値より暗いため部品の中の穴になり、後で説明する表面のルールは、その穴を検査の範囲から外します。本コラムで実行した結果では、このとき基準の条件での異物の検出率(正解が不良である製品のうち、検査が不良と判定できた割合。1から見逃し率を引いた値。詳しくは第8章)は0.36にとどまり、穴を埋めると同じ条件で1.00になりました。ルールベースの画像処理では、「検査する範囲」を作る処理そのものが欠陥を範囲の外に追い出してしまうことがある、という例です。範囲を作る処理を変えたときは、欠陥の入った画像で、欠陥が範囲に残っているかを確かめる必要があると考えています。
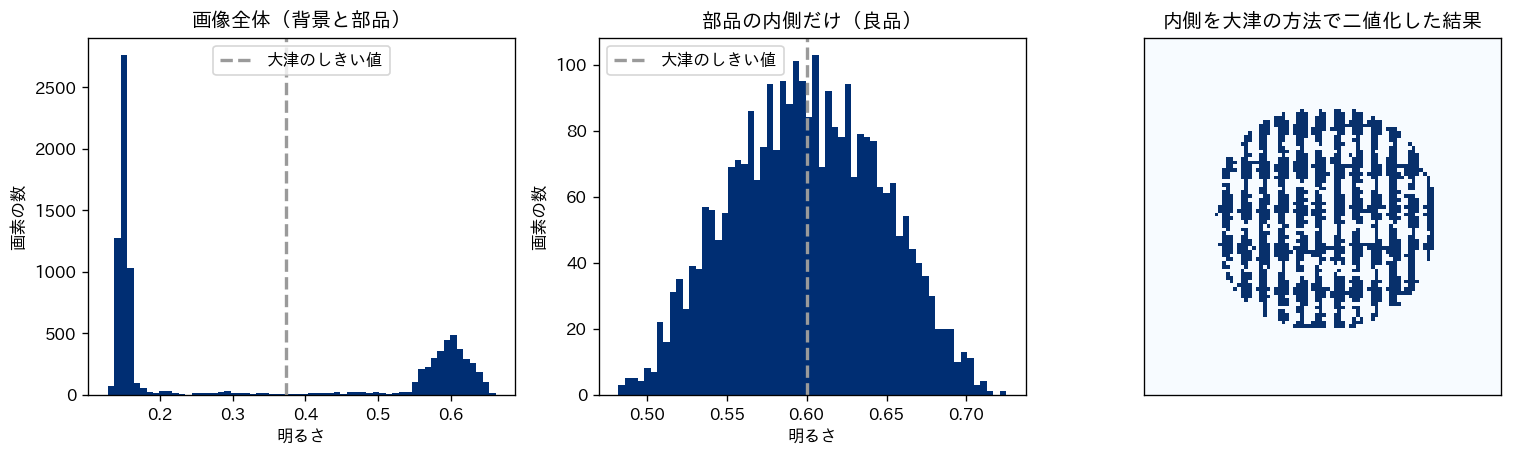
上の図の左は、画像全体の明るさのヒストグラムです。背景の山と部品の山がはっきり分かれているので、大津の方法のしきい値は2つの山の間に来ます。中央は、部品の内側(縁から4画素削った範囲)だけのヒストグラムで、山は1つしかありません。それでも大津の方法はしきい値を1つ返し、実行した結果では0.6でした。暗い側に入った画素の割合は0.503で、良品の模様がちょうど半分に割られ、右の図のように11個の塊ができました。この画像は良品なので、本来は欠陥の塊は0個のはずです。
この結果が示すのは、大津の方法は「画像を2つに分けると最もよく分かれる位置」を必ず返す、ということです。画像に欠陥が無くても、分布が2つの山になっていなくても、しきい値は出てきます。そのため、大津の方法のしきい値で二値化した結果をそのまま「欠陥」とみなすと、良品の模様を欠陥と判定する過検出が起きます。大津の方法は、部品と背景のように明るさが2つにはっきり分かれる対象を切り分けるのに使い、表面の小さな欠陥の判定には、次に述べるように周りの明るさとの差を使うか、良品との差分を使うのが安全だと考えています。
二値化の結果は、白と黒の画素が並んだだけのものです。これを「欠陥が何個あって、それぞれどのくらいの大きさか」に変えるのがラベリングです。ラベリングは、隣り合う白い画素を1つの塊とみなして、塊ごとに番号を振る処理です。ここでのラベルは、本コラムの用語でいう正解(ラベル)ではなく、塊に付ける番号のことです。scikit-image の measure.label は、公式ドキュメントによれば、つながりの判定を指定しない場合、2次元の画像では上下左右と斜めの8方向の隣をつながりとみなします。番号を振った塊ごとに、面積・位置・外接する長方形・凸性・円相当径などを測ることをブロブ解析と呼びます(ブロブは塊のこと)。
ブロブ解析で測った値は、そのまま判定基準と対応づけられます。第2章で扱った判定基準は「直径何ミリ以上の異物は不良」「長さ何ミリ以上の傷は不良」のように、欠陥の大きさと数で書かれることがあり、ブロブの長さを実際の長さに、面積を実際の面積に換算すれば、その基準を直接ルールにできます。画素が正方形で、1画素当たりの長さが \(s\) なら、画素で測った長さには \(s\) を、画素の数で測った面積には \(s^2\)(\(s\) の2乗)を掛けます。「直径何ミリ」のような基準に面積から近づけるなら、円相当径のように、どの寸法を使うかも決めておく必要があります。1画素当たりの長さは、第3章で扱った視野と画素の数の関係で決まります。判定基準をそのまま数式に置き換えられることが、ルールベースの画像処理の最大の強みだと考えています。
この章のコードでは、表面の欠陥を見るルールとして、平滑化した画像から、周りの明るさ(9画素四方の中央値)を引いた「周りとの差」を作り、それが-0.06より小さい画素を暗い画素として二値化しました。そのうえでラベリングして、最も大きい塊の面積を得点にしています。周りの明るさを引くのは、照明のむらや部品の場所による明るさの違いを打ち消し、小さな暗い点や線だけを浮かび上がらせるためです。大津の方法を部品の内側に使ったときと違い、この方法では良品の模様はほとんど暗い画素になりません。
テンプレートマッチングと良品画像との差分、撮像の条件を変えて比べる
もう1つの代表的な方法が、良品の画像との差分です。検査する画像から良品の画像を引き、差が大きい場所を欠陥とみなします。良品と違う所はすべて浮かび上がるので、欠陥の種類ごとにルールを書かなくても、異物・汚れ・欠けをまとめて拾えるのが利点です。一方で、差分が意味を持つのは、検査する画像と良品の画像の位置と明るさがそろっている場合だけです。部品が1画素ずれれば輪郭と模様の位置がずれ、その全体が差として現れます。照明が少し明るくなれば、部品の全体が差として現れます。
そこで、差分の前に位置と明るさをそろえる処理を入れます。位置をそろえるのに使うのがテンプレートマッチングです。基準の画像の一部(テンプレート)を、検査する画像の上でずらしながら重ね、最もよく重なる位置を探します。scikit-image の feature.match_template は、公式ドキュメントによれば、各位置での画像とテンプレートの相関係数(-1から1の値)を計算するもので、高速フーリエ変換を使って計算を速くしています。相関係数は明るさの全体の倍率に影響されにくいので、照明が少し変わっても位置を探せます。明るさは、部品の内側の明るさの中央値を基準の画像にそろえるように、画像全体に倍率を掛けて補正しました。
次のコードでは、ここまでの処理を4つのルールの得点にまとめ、良品30枚で出た得点の最大値を、それぞれのルールのしきい値にしています。良品で一度も出なかった大きさの得点が出たら不良と判定する、という決め方です。
- 形(凸性):部品の凸性が良品より小さいかを見る。欠けを狙ったルール
- 表面(局所差):部品の内側で、周りより暗い塊の面積を見る。異物と傷を狙ったルール
- 差分(補正なし):良品の平均画像との差が0.05を超える塊の面積を見る
- 差分(位置と明るさを補正):テンプレートマッチングで位置を、部品の内側の中央値で明るさをそろえてから、同じ差分を見る
def score_shape(img):                               # 欠けを見るルール
    return 1 - part_mask(img)[1].solidity


def score_surface(img):                             # 表面の暗い点・線を見るルール
    m = ndi.binary_erosion(part_mask(img)[0], iterations=4)
    s = filters.gaussian(img, sigma=1)
    res = s - ndi.median_filter(s, size=9)          # 周りの明るさとの差
    lab = measure.label(m & (res < -0.06))
    return max([r.area for r in measure.regionprops(lab)], default=0)


def score_diff(img, align=False):                   # 良品の平均画像との差分
    if align:                                       # 位置決めと明るさの補正
        tpl = ref[16:80, 16:80]
        hit = feature.match_template(img, tpl)
        r0, c0 = np.unravel_index(np.argmax(hit), hit.shape)
        img = ndi.shift(img, (16 - r0, 16 - c0), order=0, mode="nearest")
        m = part_mask(img)[0]
        img = img * np.median(ref[m]) / np.median(img[m])
    d = np.abs(filters.gaussian(img, sigma=1.5) - filters.gaussian(ref, sigma=1.5))
    lab = measure.label(d > 0.05)
    return max([r.area for r in measure.regionprops(lab)], default=0)


RULES = {"形(凸性)": score_shape, "表面(局所差)": score_surface,
         "差分(補正なし)": score_diff,
         "差分(位置と明るさを補正)": lambda im: score_diff(im, align=True)}
LIMIT = {k: max(f(im) for im in calib) for k, f in RULES.items()}  # 良品30枚の最大値
print({k: round(float(v), 4) for k, v in LIMIT.items()})
実行した結果、良品30枚から決めたしきい値は、形のルールでは凸性の低下が0.0158(凸性にして約0.984)、表面のルールでは面積1画素でした。差分の2つのルールは0で、良品30枚のどれにも、平均画像との差が0.05を超える画素の塊はありませんでした。つまり差分のルールは、差が0.05を超える塊が1つでもあれば不良と判定します。
続けて、3つの撮像の条件で、評価用の良品100枚と、4種類の欠陥をそれぞれ50枚ずつ作り、4つのルールで判定しました。乱数のシードは条件ごとに同じ値から始めていますが、位置ずれや明るさの倍率を決めるときに乱数を余分に使うので、欠陥の位置や形・ノイズは条件ごとに変わります。つまり、同じ画像に撮像の条件だけを変えた比較ではなく、条件ごとに別の画像群を作った比較です。条件は次の3つです。
- 基準の条件:部品の位置も明るさもしきい値を決めた良品と同じ
- 位置ずれ:部品の中心が上下左右にそれぞれ最大3画素ずれる
- 明るさの変化:画像全体の明るさが0.85倍から1.15倍の間で変わる
位置ずれは搬送や位置決めの治具のばらつきを、明るさの変化は照明の劣化や外光の変化を、単純化して置いたものです。どの程度のずれが実際のラインで起きるかは、搬送と照明の仕組みによって違います。ここでの±3画素や±15%は、説明のために置いた値です。
CONDS = {"基準の条件": dict(), "位置ずれ(±3画素)": dict(shift=3),
         "明るさの変化(±15%)": dict(gain=0.15)}
rows = {}
for cname, c in CONDS.items():
    rg = np.random.default_rng(7)
    flags = {k: {t: [] for t in TYPES} for k in RULES}
    for t in TYPES:
        for _ in range(100 if t == "良品" else 50):
            sh = c.get("shift", 0)
            dy, dx = rg.integers(-sh, sh + 1, 2) if sh else (0, 0)
            g = rg.uniform(1 - c["gain"], 1 + c["gain"]) if "gain" in c else 1.0
            im = scene(rg, t, dy, dx, g)
            for k, f in RULES.items():
                flags[k][t].append(f(im) > LIMIT[k])
    for k in RULES:
        rows[(cname, k)] = {t: np.mean(flags[k][t]) for t in TYPES}
        r = rows[(cname, k)]
        print(cname, k, "過検出率", round(r["良品"], 2),
              "検出率", {t: round(float(r[t]), 2) for t in TYPES[1:]})
    # 3つのルールのどれかが不良と言えば不良とする組み合わせ
    use = ["形(凸性)", "表面(局所差)", "差分(位置と明るさを補正)"]
    comb = {t: np.mean(np.any([flags[k][t] for k in use], axis=0)) for t in TYPES}
    print(cname, "組み合わせ", "過検出率", round(float(comb["良品"]), 2),
          "検出率", {t: round(float(comb[t]), 2) for t in TYPES[1:]})
結果を次の表にまとめました。過検出率は、良品100枚のうち不良と判定した割合です。検出率は、正解が不良である製品のうち、検査が不良と判定できた割合です(1から見逃し率を引いた値。詳しくは第8章)。この実験では、描き足した欠陥はどれも判定基準を超える大きさとして、その欠陥を描き足した50枚を正解が不良の画像として扱い、そのうちルールが不良と判定した割合を検出率としています。「組み合わせ」は、形・表面・差分(位置と明るさを補正)の3つのルールのどれか1つでも不良と判定したら不良とする判定です。
| 撮像の条件 | ルール | 過検出率 | 異物の検出率 | 傷の検出率 | 汚れの検出率 | 欠けの検出率 |
|---|---|---|---|---|---|---|
| 基準の条件 | 形(凸性) | 0.03 | 0.04 | 0.06 | 0.02 | 1.00 |
| 基準の条件 | 表面(局所差) | 0.01 | 1.00 | 0.64 | 0.04 | 0.00 |
| 基準の条件 | 差分(補正なし) | 0.00 | 1.00 | 0.00 | 1.00 | 1.00 |
| 基準の条件 | 差分(位置と明るさを補正) | 0.00 | 1.00 | 0.00 | 1.00 | 1.00 |
| 基準の条件 | 組み合わせ | 0.04 | 1.00 | 0.66 | 1.00 | 1.00 |
| 位置ずれ(±3画素) | 形(凸性) | 0.03 | 0.06 | 0.08 | 0.04 | 1.00 |
| 位置ずれ(±3画素) | 表面(局所差) | 0.01 | 1.00 | 0.58 | 0.10 | 0.00 |
| 位置ずれ(±3画素) | 差分(補正なし) | 0.99 | 1.00 | 1.00 | 1.00 | 1.00 |
| 位置ずれ(±3画素) | 差分(位置と明るさを補正) | 0.00 | 1.00 | 0.00 | 1.00 | 1.00 |
| 位置ずれ(±3画素) | 組み合わせ | 0.04 | 1.00 | 0.60 | 1.00 | 1.00 |
| 明るさの変化(±15%) | 形(凸性) | 0.02 | 0.00 | 0.02 | 0.04 | 1.00 |
| 明るさの変化(±15%) | 表面(局所差) | 0.06 | 1.00 | 0.58 | 0.20 | 0.06 |
| 明るさの変化(±15%) | 差分(補正なし) | 0.65 | 1.00 | 0.68 | 0.94 | 1.00 |
| 明るさの変化(±15%) | 差分(位置と明るさを補正) | 0.00 | 1.00 | 0.00 | 1.00 | 1.00 |
| 明るさの変化(±15%) | 組み合わせ | 0.08 | 1.00 | 0.60 | 1.00 | 1.00 |
この表から、本コラムの架空の合成画像について、次のことが読み取れます。まず、どのルールにも得意な欠陥と苦手な欠陥がありました。形のルールは欠けを50枚すべて見つけましたが、表面の欠陥にはほとんど反応しません。表面のルールは異物をすべて見つけ、傷も基準の条件で50枚のうち32枚を不良と判定しました(検出率0.64)が、汚れは0.04しか見つけられませんでした。汚れは広く淡いむらなので、9画素四方の中央値を引く「周りとの差」では、周りも一緒に暗くなっていて差が出にくいと考えられます。逆に、差分のルールは汚れをすべて見つけましたが、傷は1枚も見つけられませんでした。差分の前にかけた平滑化(sigma 1.5)で、幅1画素ほどの薄い線が均され、差が0.05に届かなかったと考えられます。この2つの理由づけは、ルールの作りから考えたもので、中間の画像を1枚ずつ測って確かめたものではありません。
次に、どのルールでも傷を確実には見つけられませんでした。組み合わせの判定でも、傷の検出率は基準の条件で0.66、位置ずれと明るさの変化の条件で0.60です。傷は周りより0.06〜0.10暗いだけで、縞の模様の振れ(最大0.08ほど)と同じくらいの明るさの差しかありません。この架空の合成画像の傷は、撮像の段階で模様と見分けにくい状態にあり、ルールのしきい値を下げると良品の模様も拾いやすくなると考えられます(しきい値を動かした実験はしていません)。また、この傷の幅は約1画素で、第3章で計算例として置いた「最小の欠陥の幅に4画素をかける」という目安より粗い写し方でもあります。傷を確実に見つけられなかった原因は、明るさの差と分解能の両方にあると考えられます。第3章で扱ったように、傷を見つけたいなら、まず照明の当て方で傷と模様の明るさの差を大きくし、傷の幅に十分な画素をかける撮像にするのが先だと考えています。
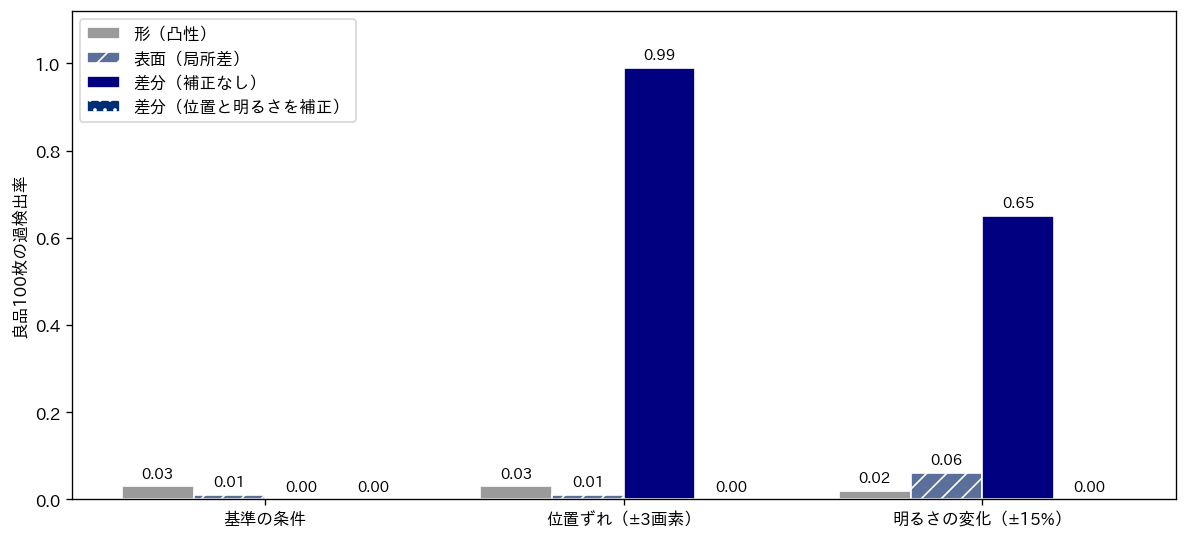
位置ずれと明るさの変化で、過検出が増える仕組み
上の図は、条件ごとの良品の過検出率を並べたものです。最も大きく変わったのは、補正をしない差分のルールでした。基準の条件では過検出率0.00でしたが、位置ずれの条件では0.99、明るさの変化の条件では0.65になりました。位置ずれの条件では、良品100枚のうち99枚を不良と判定したことになります。部品の輪郭と縞の模様が数画素ずれると、その全体が平均画像との差として現れるためです。位置ずれの条件で、補正なしの差分の傷の検出率が1.00になっているのも、傷を見つけたのではなく、ほとんどの画像を不良と判定した結果です。検出率だけを見て「傷も見つけられる」と読むと誤ります。検出率は必ず過検出率と並べて読む必要があります。
テンプレートマッチングで位置を、部品の内側の中央値で明るさをそろえた差分のルールは、3つの条件のどれでも過検出率0.00で、異物・汚れ・欠けの検出率は1.00のままでした。この架空の合成画像では、位置ずれは平行移動だけ、明るさの変化は全体の倍率だけです。試した各条件の評価用の良品100枚では、補正の後の差が判定のしきい値(0.05)を超える画素はありませんでした。ただし、これはしきい値より小さい差が残っていないことまでは意味しません。実際のラインでは、部品の回転・傾き、照明のむら(場所による明るさの違い)、反射の変化など、平行移動と倍率だけでは打ち消せない変化が起きます。その場合、補正の後にも差が残り、過検出が増えます。補正で何を打ち消せて何が残るかは、自社の撮像の条件で確かめる必要があります。
表面のルールは、周りの明るさを引いているので位置ずれにはほとんど影響を受けませんでしたが、明るさの変化の条件では過検出率が0.01から0.06に上がりました。周りとの差のしきい値を-0.06という明るさの絶対値で決めているので、明るさの倍率が変わると模様の振れの大きさも変わり、しきい値を超える画素が出やすくなったと考えられます。明るさは0.85倍から1.15倍の両側に振れており、どちらの側で過検出が出たかは確かめていません。しきい値を明るさの倍率に合わせて変えるか、先に明るさを正規化すれば、この影響を小さくできる可能性がありますが、本コラムではその実験はしていません。ルールのしきい値を明るさの絶対値で決めるか、相対値で決めるかは、照明の変化にどれだけ強いかを左右する設計の分かれ目です。
組み合わせの判定は、どの条件でも過検出率が0.04〜0.08でした。3つのルールのどれか1つが不良と言えば不良とするので、それぞれのルールが不良と判定した良品が合わさる方向に働き、組み合わせの過検出率は、組み合わせに入れた3つの単独のルールのどの過検出率より小さくはなりません。ルールを足すほど見つかる欠陥の種類は増えますが、過検出は減らない、という関係です。どのルールを足すかは、見逃しと過検出のどちらの損失が大きいかで決まり、その評価の方法は第8章で扱います。なお、ここでの過検出率は良品100枚、検出率は各50枚で数えたもので、1枚の判定の違いで過検出率は0.01、検出率は0.02動きます。小さな差は、乱数による違いの範囲と読むのが適切です。
エッジ検出と寸法の計測
外観検査には、欠陥を見つけるだけでなく、寸法を測って許容差に入っているかを確かめる用途もあります。寸法の計測では、部品の輪郭の位置を正確に求めることが基本になります。輪郭は明るさが急に変わる場所なので、明るさの変化の大きさを計算して輪郭を取り出すエッジ検出を使います。代表的な方法が Canny の方法で、Canny が1986年に IEEE のパターン解析と機械知能の論文誌(第8巻第6号)に発表した論文が原典です。平滑化した画像で明るさの変化の向きと大きさを求め、輪郭を細い線として取り出し、2つのしきい値で弱い輪郭のつながりを判定する、という手順を踏みます。
次のコードは、Canny の方法で取り出した輪郭の画素のうち外周の近くにあるものに、最小二乗法で円を当てはめ、部品の半径を求めるものです。あわせて、当てはめた円から輪郭の画素が最も大きく離れた距離を求めています。縁に欠けがあれば、その部分の輪郭は円から内側に大きく離れるので、この距離は欠けの判定にも使えます。
def radius_by_edge(img):
    e = feature.canny(img, sigma=2)                 # 明るさが急に変わる画素
    yy, xx = np.nonzero(e)
    m = np.hypot(yy - yy.mean(), xx - xx.mean()) > R - 6   # 外周の近くだけ使う
    yy, xx = yy[m], xx[m]
    A = np.column_stack([xx, yy, np.ones_like(xx)])
    b = xx ** 2 + yy ** 2
    cx2, cy2, c = np.linalg.lstsq(A, b, rcond=None)[0]       # 円の当てはめ
    r = np.sqrt(c + (cx2 / 2) ** 2 + (cy2 / 2) ** 2)
    return r, np.abs(np.hypot(xx - cx2 / 2, yy - cy2 / 2) - r).max()


rg = np.random.default_rng(11)
for name, g in [("良品・基準", 1.0), ("良品・明るさ0.85倍", 0.85), ("欠け・基準", 1.0)]:
    out = np.array([radius_by_edge(scene(rg, name.split("・")[0], gain=g)) for _ in range(30)])
    print(name, "半径の平均", round(out[:, 0].mean(), 2), "標準偏差", round(out[:, 0].std(), 3),
          "円からの最大のずれの平均", round(out[:, 1].mean(), 2),
          "最小", round(out[:, 1].min(), 2), "最大", round(out[:, 1].max(), 2))
実行した結果、良品30枚で求めた半径の平均は33.93画素、標準偏差は0.011画素でした。部品は半径34画素の円として作っているので、作った値との差は0.07画素ほどで、ばらつきは1画素の100分の1ほどです。画像の画素は整数の位置にしかありませんが、多くの輪郭の画素に円を当てはめたこの合成画像では、半径の推定値の標準偏差は0.011画素でした。明るさを0.85倍にした良品30枚でも、半径の平均と標準偏差は、表示した桁に丸めると同じ値でした。ただし、使った Canny の方法のしきい値は、scikit-image の公式ドキュメントによれば、指定しない場合は画像のデータ型の最大値の10%と20%という固定の値です。明るさの倍率が変わると明るさの変化の大きさも変わるので、もっと暗くなる、輪郭がぼやけるなどの条件では、輪郭がしきい値を下回って取り出せなくなる場合があります。今回の倍率と輪郭のはっきりさで同じ結果になった、と限定して読む必要があります。
欠けのある画像30枚では、半径の平均は33.70画素で良品より小さく、円から輪郭が最も大きく離れた距離の平均は4.68画素でした。良品では同じ距離の平均が0.77画素でした。1枚ごとに見ても、良品30枚の最大は0.81画素(明るさ0.85倍の良品30枚では0.83画素)、欠けのある30枚の最小は3.15画素で、この各30枚の中では良品と欠けの値は重なりませんでした。ただし、欠けの大きさを半径4〜7画素の円として作った架空の合成画像での結果で、もっと小さな欠けでは重なる可能性があります。寸法の計測と形の判定は、同じ輪郭の情報から両方を引き出せます。ただし、この結果は輪郭がはっきり写る架空の合成画像での値です。実際の部品では、輪郭のぼけ・影・反射・ばりが輪郭の位置をずらすので、寸法の精度は撮像(とくに照明の当て方とレンズ)で決まる部分が大きく、第3章で扱った内容がそのまま効いてきます。また、ここで求めたのは画素の単位の値で、実際の長さにするには、既知の寸法を持つ基準の物を撮って換算の係数を求める校正が要ります。
ルールで書ける欠陥と書けない欠陥
ここまでの結果と、ルールベースの画像処理の性格を合わせて、欠陥ごとにルールで書きやすいかを整理しました。表の「この章の架空の合成画像での結果」の列は、上のコードで実行した結果で、それ以外の列は一般論です。自社の製品にこの表を当てはめるときは、欠陥ごとに、明るさの差・大きさ・位置と形の安定性の3つを確かめるのがよいと考えています。
| 欠陥 | ルールで書きやすい条件 | ルールで書きにくい条件 | 向いているルール | この章の架空の合成画像での結果 |
|---|---|---|---|---|
| 異物(点状) | 背景との明るさの差が大きく、大きさの基準が決まっている | 異物の色や明るさが毎回違う、模様と同じ明るさ | 周りとの差の二値化とブロブ解析 | 表面のルールでどの条件でも検出率1.00 |
| 傷(線状) | 照明で傷が明るく、あるいは暗く浮き上がる | 模様や筋と同じくらいの明るさの差しかない | 周りとの差に加え、線の長さ・向きの条件 | 組み合わせでも検出率0.60〜0.66 |
| 汚れ(面状のむら) | 位置と明るさがそろい、良品との差分が使える | 良品にも色むらがあり、どこまでが許容か曖昧 | 位置と明るさを補正した良品との差分 | 補正した差分で検出率1.00 |
| 欠け(形の欠損) | 部品の輪郭がはっきり写り、形が決まっている | 柔らかい・形が毎回違う製品 | 二値化した部品の凸性、輪郭への円や線の当てはめ | 形のルールでどの条件でも検出率1.00 |
| 寸法の外れ | 輪郭がはっきり写り、許容差が数値で決まっている | 輪郭がぼける・ばりや影が重なる | エッジ検出と当てはめ | 寸法の外れを検出する実験はしていない(良品30枚の半径のばらつきは標準偏差0.011画素) |
| 色むら・質感の違い | 色や明るさの範囲で基準を書ける | 「見た目の違和感」としか表せない | 色の範囲の二値化(書けない場合は学習のモデル) | この章では試していない |
この表から、ルールで書けるかどうかを分ける要素は少なくとも2つあると考えています。1つは、欠陥と周りの明るさの差が、模様やノイズの振れより十分に大きく写っているかです。傷は長さという数値で基準を書けますが、この章の実験では明るさの差が足りず、ルールでは確実に見つけられませんでした。もう1つは、判定基準が数値で表せるかです。第2章で扱った限度見本でしか表せない欠陥、つまり「この程度の色むらは許容、これは不良」と見本と比べて決めている欠陥は、ルールのしきい値に置き換えにくく、学習のモデルが役に立つ場面です。逆に、判定基準が「直径何ミリ以上」「長さ何ミリ以上」のように数値で決まり、かつ欠陥が周りとの明るさの差を持って写っている欠陥は、ルールで書いたほうが判定の根拠を説明しやすくなります。
品種ごとのパラメータとルールの保守
ルールベースの画像処理の弱点は、パラメータの数が多く、品種や撮像の条件が変わるたびに調整が要ることです。この章のコードだけでも、後の表に挙げるように多くの値を人が決めています。品種ごとにどの設定を使うかを管理し、撮像の条件や判定基準が違う品種には別の設定を用意することになります。共通の設定を使える品種もありますが、品種が増えるほど、管理する設定の数も増えやすくなります。新しい品種を追加するたび、照明を交換するたびに、どのパラメータを見直すかを決めておかないと、調整は担当者の経験に頼ることになり、担当者が異動すると誰も直せないルールが残ります。
この章のコードで決めた値を、保守の観点で分けると次のようになります。
| パラメータ | この章のコードでの値 | 何で決まるか | 見直すきっかけ |
|---|---|---|---|
| 平滑化の強さ | sigma 1(表面)、1.5(差分)、2(エッジ) | 見つけたい最小の欠陥の大きさと、ノイズの大きさ | カメラ・レンズの交換、判定基準の最小の大きさの変更 |
| 周りの明るさを取る範囲 | 9画素四方 | 模様の周期と、見つけたい欠陥の大きさ | 品種の追加(模様が変わる) |
| 暗い画素のしきい値 | 周りより0.06暗い | 欠陥と模様の明るさの差 | 照明の交換・劣化、品種の追加 |
| 差分のしきい値 | 0.05 | 良品どうしのばらつき | 基準の良品画像の作り直し、材料のロットの変化 |
| 判定のしきい値 | 良品30枚の得点の最大値 | 良品の得点の分布 | 過検出・見逃しの増加、良品の追加 |
| テンプレートの範囲 | 中央の64画素四方 | 位置決めの手がかりになる形 | 品種の追加、治具の変更 |
保守を続けられるようにするには、パラメータを品種ごとの設定として1か所にまとめ、変えたときの日付・理由・確かめた結果を記録しておくことが有効だと考えています。また、この章で使った「良品の得点の最大値をしきい値にする」決め方は、良品の画像を追加すれば機械的に決め直せます。人の勘でしきい値を決めるより、良品の画像からしきい値を決める手順を決めておくほうが、担当者が変わっても同じ結果を再現できます。ただし、良品30枚の最大値は、たまたま30枚の中に入った良品のばらつきで決まるので、枚数が少ないと、本番では良品の得点がしきい値を超えることがあります。この章の実験でも、基準の条件で形のルールの過検出率が0.03、表面のルールが0.01になっており、30枚に現れなかった良品のばらつきが評価用の良品100枚には現れたと読めます。しきい値を決める良品の枚数と、本番での過検出の関係は、第8章の評価の考え方で扱います。照明の劣化や品種の追加にどう対応するかの運用の全体は第12章で扱います。
学習のモデルと組み合わせる型
実際の検査装置では、ルールベースの画像処理と学習のモデルを1台の中で組み合わせる構成があります。組み合わせ方は、工程の中のどこをルールにして、どこを学習のモデルにするかで、いくつかの型に分けて考えると整理しやすくなります。
| 組み合わせの型 | ルールが担う部分 | 学習のモデルが担う部分 | 向いている場面 |
|---|---|---|---|
| 前処理をルールにする | 位置決め・明るさの補正・検査する範囲の切り出し | 切り出した範囲の良否の判定 | 部品の位置や明るさがばらつき、学習のモデルに余計な変化を見せたくないとき |
| 寸法と形をルールにする | 寸法の計測・欠けの判定 | 表面の欠陥(傷・汚れ・色むら)の判定 | 寸法の許容差が数値で決まり、表面の基準は限度見本で決まっているとき |
| ルールで候補を拾い、学習のモデルで絞る | 欠陥らしい塊を広めに拾う | 拾った塊が本当の欠陥か、模様・ほこりかを判別する | ルールでは過検出が多く、候補の数が少なければ判別の負担が小さいとき |
| 学習のモデルで拾い、ルールで判定する | 拾った欠陥の大きさ・数を判定基準と比べる | 欠陥の場所を見つける | 欠陥は見つけにくいが、判定基準は大きさと数で書けるとき |
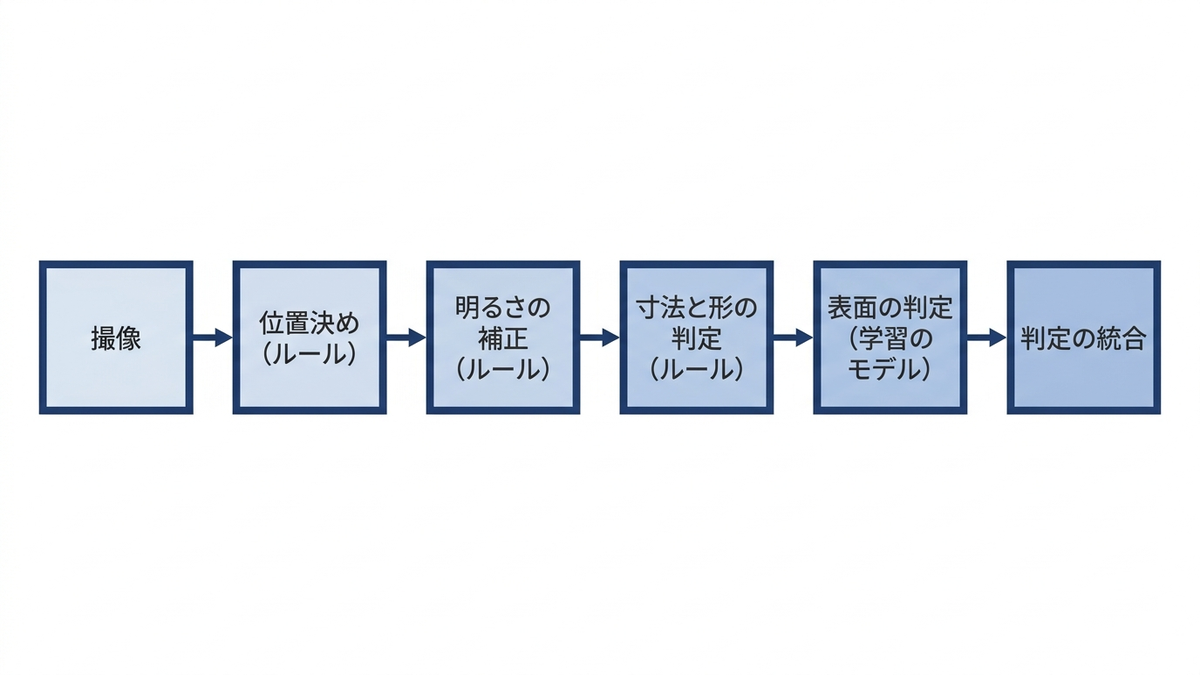
この章の実験の結果は、1つ目の型の意味を示しています。補正をしない差分は、位置ずれで良品の99%を不良と判定しましたが、位置と明るさを補正すると過検出は0になりました。学習のモデルも、学習に使った画像と本番の画像で位置や明るさがずれていれば、同じように判定が崩れるおそれがあります。位置決めと明るさの補正のように、何をすべきかがはっきりしている処理はルールで行い、学習のモデルには判定基準を数値で書きにくい部分だけを任せる、という分担を考えています。この分担には、学習のモデルに要る画像の数を減らせる可能性があり、判定の根拠も説明しやすくなると考えています(この章の実験では学習のモデルは使っていません)。教師あり学習による欠陥の分類と検出は第5章、良品の画像だけで学ぶ方法は第6章で扱います。
3つ目の型(ルールで候補を拾い、学習のモデルで絞る)は、ルールの過検出を学習のモデルで減らす使い方です。この章の実験で、組み合わせの判定の過検出率が0.04〜0.08あったように、どれか1つでも不良なら不良とする組み合わせでは、ルールを足しても過検出は減りません。候補を拾う段階では見逃さないことを優先してしきい値を緩め、絞る段階で模様やほこりを良品に戻す、という分け方です。この型では、ルールの段階で見逃した欠陥は学習のモデルに届きません。ルールの段階の見逃しが全体の見逃し率の下限になり、絞る段階で学習のモデルが本当の欠陥を良品に戻してしまえば、見逃しはさらに増えます。そのため、見逃し率は2つの段階を通して評価する必要があります。
経営の判断、ルールで足りる所にAIを使わない
外観検査を自動化するとき、経営として先に決めるべきことは、「どの欠陥をルールで判定し、どの欠陥に学習のモデルを使うか」の線引きだと考えています。学習のモデルは、ルールで書けない欠陥を見つけられる可能性がある一方で、学習用の画像を集める手間、ラベルを付ける手間、判定の根拠を説明する手間、本番の変化に合わせて学習し直す手間がかかります。判定基準が数値で書け、位置と形が安定している欠陥にまで学習のモデルを使うと、ルールなら数字で説明できた判定が説明しにくくなり、品質保証の部門や顧客への説明の負担が増えます。
一方で、ルールベースの画像処理にも、この章の実験で見たような限界があります。判断を誤ったときの損失を、本コラムで使う損失の型に当てはめると次のようになります。
| 判断の誤り | 起こりやすい損失の型 | 避けるための考え方 |
|---|---|---|
| 位置と明るさの補正を入れずに差分のルールを使う | 過検出(この章の実験では位置ずれで良品の99%を不良と判定)、形骸化(人が全数を見直す) | 差分の前に位置決めと明るさの補正を入れ、本番の位置ずれ・明るさの変化の幅で過検出率を確かめる |
| ルールで書けない欠陥をルールで判定しようとする | 流出(傷のように模様と見分けにくい欠陥を見逃す) | まず撮像で明るさの差を作れるか確かめ、作れなければ学習のモデルを検討する |
| ルールで足りる欠陥に学習のモデルを使う | 二重投資(既存のルールとの役割分担を決めずに、同じ判定のために学習のモデルを重ねて入れ、2つの仕組みを保守する場合)、判定の根拠を説明しにくくなる | 判定基準が数値で書ける欠陥はルールで判定し、学習のモデルは書けない部分に限る |
| パラメータの保守の手順を決めない | 判定のばらつき(品種や工場でしきい値がずれる)、二重投資(工場ごとに別のルールを作る) | パラメータを品種ごとの設定として1か所にまとめ、変更の記録と、良品の画像から決め直す手順を残す |
| ルールを足し続ける | 過検出の増加、タクトの超過(処理が増えて検査が生産の速度に追いつかない) | ルールを足すたびに過検出率と処理時間を測り、ルールを足すか学習のモデルに置き換えるかを判断する |
予算と体制の面では、ルールベースの画像処理を「一度作れば終わり」の仕組みとして見込まないことが大切だと考えています。品種の追加や照明の交換のたびにパラメータの見直しが要るので、その作業の担当と時間を、導入のときから運用の費用として見込んでおく必要があります。また、どの欠陥をルールで、どの欠陥を学習のモデルで判定しているかの一覧を、品質保証の部門と共有しておくと、検査の範囲の抜けを品質保証の側から点検できます。出荷の可否の最終的な責任は品質保証の体制にあり、ルールベースの画像処理も学習のモデルも、その判断の材料を出す道具として位置づけるものです。
この章では、学習を使わずに人が判定の条件を書くルールベースの画像処理を扱いました。本コラムの架空の合成画像では、形のルールは欠け、表面のルールは異物、位置と明るさを補正した差分は汚れを、3つの撮像の条件のどれでも50枚すべて見つけた一方、模様と同じくらいの明るさの差しかない傷はどのルールでも確実には見つけられませんでした。また、補正をしない差分は位置ずれで良品の99%を不良と判定しました。欠陥が周りと十分な明るさの差を持って写り、位置と形が安定し、判定基準が数値で書ける欠陥はルールで判定し、撮像の条件のずれはルールの側で補正します。そのうえで、ルールで書けない欠陥にだけ学習のモデルを使う、という線引きが、保守と説明の手間を抑えると考えています。次の第5章では、ルールで書けない欠陥のうち、不良の画像が集まるものについて、教師あり学習で欠陥を分類・検出する方法を扱います。
この章を深めたい方への参考書籍
『ディジタル画像処理[改訂第二版]』(奥富正敏 編集委員長ほか執筆、画像情報教育振興協会):画像処理の基礎理論から手法、アルゴリズム、各分野での応用事例までを扱う専門書として、発行元の公益財団法人画像情報教育振興協会(CG-ARTS)が紹介している教科書です。この章で扱った平滑化・二値化・エッジ検出のような処理を、原理から体系的に学び直すときの土台になります。
『OpenCVによる画像処理入門[改訂第3版]』(小枝正直・上田悦子・中村恭之 著、講談社):画像処理のライブラリ OpenCV を使った入門書で、国立国会図書館の目次によれば、平滑化フィルタ処理・エッジ検出フィルタ処理の節を含むフィルタ処理の章、形状特徴パラメータ・ラベリング処理の節を含む2値画像処理の章、画像間演算の節を含む複数画像の利用の章があります。この章のコードは scikit-image で書きましたが、同じ処理を OpenCV で組むときの手引きになります。
第5章 教師あり学習による欠陥の分類と検出、CNNから物体検出・領域分割まで
第4章では、ルールベースの画像処理で、二値化・ラベリング・良品画像との差分によって欠陥を見つける方法を扱い、位置と形が安定した欠陥はルールで足りる一方で、模様のある表面や位置ずれ・照明の変化には弱いことを確かめました。この章では、ルールを人が書く代わりに、良品と不良のラベルが付いた画像からモデルに判定のしかたを学ばせる教師あり学習を扱います。教師あり学習は、欠陥の種類まで見分けたいときに効く一方で、学習に使う不良の画像が十分に集まることが前提になります。この章では、次の内容を順に扱います。
- 教師あり学習の3つの型(画像分類・物体検出・セグメンテーション)と、それぞれで分かること・ラベル付けの手間の違い
- 畳み込みニューラルネットワークの考え方
- 架空の合成画像で小さな畳み込みニューラルネットワークを学習させ、混同行列で見逃しと過検出を読む例
- 不良が少ないこと(クラスの不均衡)への対処と、不良の画像の枚数が足りないときに起きること
- 学習に無い欠陥が来たときに起きること
- 物体検出・セグメンテーションの代表的な手法と、ラベル付けの道具と手順
- 教師あり学習が向く条件と向かない条件、経営の判断
教師あり学習の3つの型、画像分類・物体検出・セグメンテーション
外観検査で使う教師あり学習は、モデルが何を答えるかによって、大きく3つの型に分けて考えると整理しやすくなります。1つ目は画像分類で、1枚の画像に対して「良品」「傷」「異物」のような種類を答えます(1枚に複数の種類を答える分類もありますが、この章では1枚に1種類を答える分類を扱います)。2つ目は物体検出で、画像の中の欠陥の位置を四角い枠(バウンディングボックス)で囲み、枠ごとに欠陥の種類を答えます。3つ目はセグメンテーション(領域分割)で、画像の画素の1つ1つについて、欠陥か背景か、どの種類の欠陥かを答えます。答えが細かくなるほど、判定基準に使える情報は増えますが、学習に使う画像に付けるラベルの手間も増えます。
この違いは、判定基準の書き方と直接つながっています。第2章で扱ったように、判定基準には「傷があれば不良」のように欠陥の有無だけで決めるものと、「長さ何ミリ以上の傷が、製品の機能面にあれば不良」のように欠陥の大きさ・数・場所で決めるものがあります。画像分類は欠陥の有無と種類は答えますが、欠陥の場所と大きさは答えません。物体検出は、枠の位置と大きさから、欠陥のおおよその場所・大きさ・数が分かります。セグメンテーションは、欠陥の画素の数から面積を、形から長さや幅を求められるので、大きさで決める判定基準に最も近い答えを返します。ただし、求まるのはまず画像の上での面積や長さ(画素の数)で、ミリメートルなどの実寸で判定するには、画素と実寸の対応(第3章で扱う分解能)・撮影の条件・輪郭の誤差を確かめる必要があります。
| 型 | モデルが答えること | 学習に付けるラベル | ラベル付けの手間 | 判定基準とのつながり | 向いている場面 |
|---|---|---|---|---|---|
| 画像分類 | 画像1枚に1つの答え(良品か、どの種類の欠陥か) | 画像ごとの種類 | 小さい(画像を見て種類を選ぶ) | 欠陥の有無と種類で決める基準 | 1枚に写る範囲が狭く、欠陥が1枚に1つ程度の部品。撮像で検査する範囲を小さく切り出せる場合 |
| 物体検出 | 欠陥ごとの枠の位置・大きさと種類 | 欠陥ごとに枠を描き、種類を選ぶ | 中くらい(欠陥の数だけ枠を描く) | 欠陥の数・おおよその場所・大きさで決める基準 | 広い視野の中に欠陥が点在する製品、欠陥の数を数えたい場合 |
| セグメンテーション | 画素ごとの答え(欠陥の形と面積) | 欠陥の輪郭を画素の単位で塗る | 大きい(輪郭を正確に塗る) | 欠陥の面積・長さ・形で決める基準 | 面積や長さの上限で合否が決まる欠陥、細長い傷やむらのように枠では形を表せない欠陥 |
表の「ラベル付けの手間」は、作業の重さの順を示したもので、時間を測った値ではありません。どの型を選ぶかは、手法の新しさではなく、自社の判定基準が何で決まっているかから逆算するのがよいと考えています。判定基準が「欠陥の種類」だけで決まるなら画像分類で足り、わざわざ輪郭を塗るラベル付けをする必要はありません。逆に、判定基準が面積や長さで決まっているのに画像分類を選ぶと、モデルが「傷あり」と答えたあとに、その傷が基準を超えているかを人が確かめ直すことになります。
3つの型は組み合わせて使うこともできます。たとえば、物体検出で欠陥の候補の枠を見つけ、枠の中だけを画像分類のモデルで種類に分ける、あるいは枠の中だけをセグメンテーションして面積を測る、といった使い方です。また、第4章で扱ったように、製品の位置決めや検査する範囲の切り出しをルールベースの画像処理で行い、切り出した範囲だけを画像分類にかける、という組み合わせも考えられます。この章のコードでは、最も単純な画像分類を扱います。
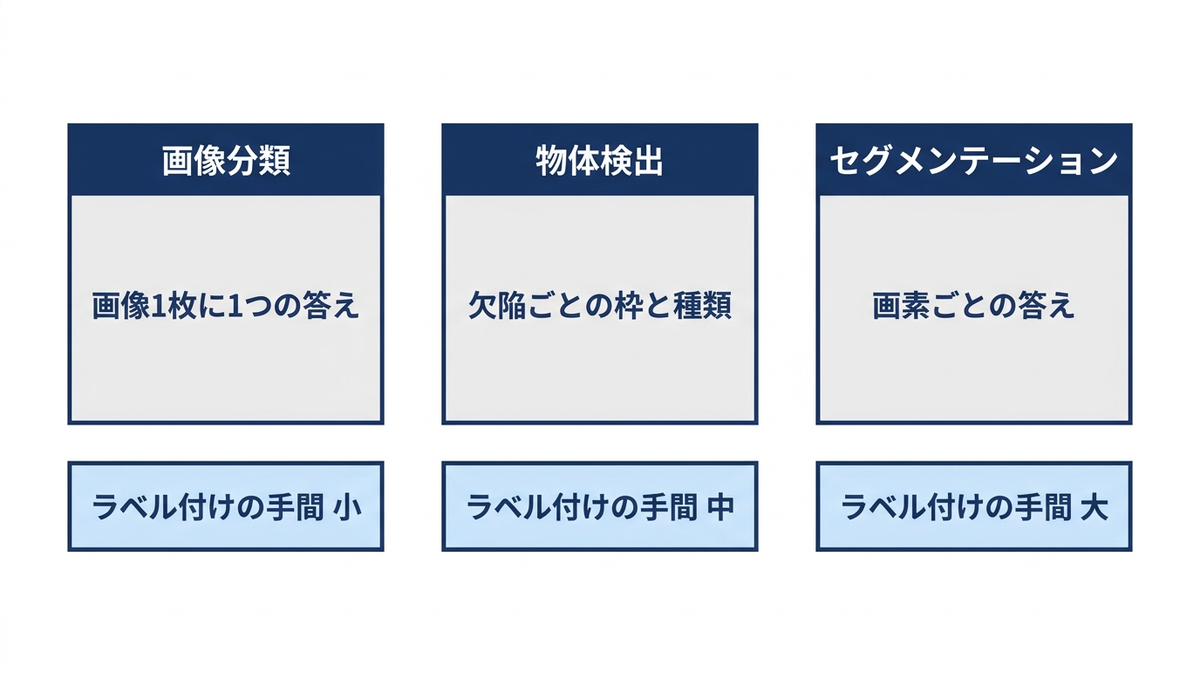
畳み込みニューラルネットワークの考え方
画像を使う教師あり学習で広く使われているのが、畳み込みニューラルネットワーク(英語の略称は CNN)です。よく引かれる論文の1つに、LeCun らが1998年に Proceedings of the IEEE 誌(86巻11号)に発表した、勾配に基づく学習を文書の認識に当てはめた論文があります(本コラムでは書誌だけを確かめました)。ここでは、外観検査の判断に必要な範囲に絞って、仕組みを平易に説明します。
畳み込みニューラルネットワークの中心にあるのは、画像の上に小さな窓(フィルタ。たとえば3×3画素)を少しずつずらしながら当てて、窓の中の画素の並び方が、フィルタが表す模様にどれだけ似ているかを計算する処理です。これを畳み込みと呼びます。畳み込みの層を何段も重ねるのは、手前の層で捉えた縁や点のような小さな模様を、後ろの層で組み合わせて、「細い暗い線」「縁が丸く欠けた形」のような、より大きな模様として捉えられるようにするためです。フィルタの値は人が決めるのではなく、ラベルの付いた画像から、正解と答えが合うように学習で決まります。第4章のルールベースの画像処理で、人がしきい値やテンプレートを決めていた部分を、データから決めていると考えると分かりやすいと思います。
畳み込みのあとには、プーリングと呼ばれる処理で画像を縮めることが多く、たとえば重ならない2×2画素ごとに最大の値だけを残すと、画像の縦横は半分になります。縮めることで、計算の量が減るとともに、模様の位置が少しずれても同じように反応しやすくなります。最後に、画像全体のどこかで、どのフィルタがどれだけ強く反応したかをまとめ、その値から「良品」「傷」「異物」「欠け」それぞれの確からしさを計算します。ここでいう確からしさは、4つの種類への配分を合計が1になるように直した値で、学習した4つの種類の中でどれに近いかを表すものです。モデルの答えは、確からしさが最も大きい種類です。
外観検査の判断に関わる性質として、次の3つを押さえておくとよいと考えています。1つ目に、同じフィルタを画像の全体に当てるので、欠陥が画像のどこに写っていても同じように反応しやすく、位置ずれには比較的強い性質があります。2つ目に、フィルタは学習に使った画像に写っていた模様に合わせて決まるので、学習に無い種類の欠陥や、学習のときと違う照明・表面の模様には、どう反応するかが保証されません。3つ目に、モデルの中身はフィルタの数値の集まりで、ルールのように人が読んで確かめることは難しく、なぜその判定になったかを示すには別の手立てが要ります(判定の根拠の示し方は第10章で扱います)。畳み込みニューラルネットワークの層の種類や学習の方法の一般論は、弊社コラム『Python実務で必ず使うディープラーニングレシピ100選』で扱っています。
架空の合成画像で、小さな畳み込みニューラルネットワークを学習させる
ここからは、架空の合成画像で小さな畳み込みニューラルネットワークを学習させ、結果を読みます。画像は64画素四方の白黒で、布地の織り目のような模様のある表面を numpy で作り、そこに欠陥を描き足しました。欠陥の種類は、細い暗い線(傷)、小さな暗い点(異物)、画像の縁が半円状に暗く欠けた形(欠け)の3つで、欠陥の無いものを良品とします。全体の地図の定義では、欠陥の有無は事実、不良は判定基準に照らした判定の結果で、欠陥があっても基準の範囲内なら良品と判定されることがあります。この章の合成画像には基準の範囲内の欠陥は作っておらず、欠陥を描いた画像はすべて不良として扱います。以下で「不良の画像」と書くのは、欠陥を描いた画像のことです。なお、合成画像は章ごとに別々に作っており、同じ「異物」「傷」「汚れ」という名前でも、他の章の合成画像とは描き方が違います。どれも本コラムのために乱数で作った架空の合成画像で、実際の製品の画像よりずっと単純です。実際の製品では、表面の模様・反射・欠陥の形がはるかに多様で、ここでの結果をそのまま実際の検査の精度として読むことはできません。
実際の画像に近づけるため、いくつかのばらつきを入れました。表面の模様の細かさと位置、画像全体の明るさは1枚ごとに乱数で変え、画素ごとのノイズも足しています。欠陥の濃さ(表面との明るさの差)も乱数で変え、薄い欠陥は見つけにくくなるようにしました。さらに、第6章との橋渡しとして、学習には使わない4つ目の欠陥「汚れ」(ぼんやりと広がった薄い染み)も30枚作りました。乱数のシード(乱数の出方を決める値。同じ値なら毎回同じ乱数が出る)は固定しています。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import time
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(0)
torch.set_num_threads(4)
rng = np.random.default_rng(20261109)
S = 64                                      # 画像は64画素四方
CLASSES = ["良品", "傷", "異物", "欠け"]


def surface():
    """布地のような織り目の模様に、明るさのばらつきとノイズを足した表面"""
    y, x = np.mgrid[0:S, 0:S]
    f = rng.uniform(0.35, 0.5)
    ph = rng.uniform(0, 2 * np.pi, 2)
    img = 0.5 + 0.08 * np.sin(f * x + ph[0]) * np.sin(f * y + ph[1])
    img = img + rng.uniform(-0.08, 0.08) + rng.normal(0, 0.03, (S, S))
    return img, y, x
def make(label):
    img, y, x = surface()
    c = rng.uniform(0.08, 0.3)              # 欠陥の濃さ(小さいほど見つけにくい)
    if label == "傷":                        # 細い線
        th = rng.uniform(0, np.pi)
        cx, cy = rng.uniform(16, 48, 2)
        half = rng.uniform(5, 12)
        d = np.abs((x - cx) * np.sin(th) - (y - cy) * np.cos(th))
        t = (x - cx) * np.cos(th) + (y - cy) * np.sin(th)
        img = img - c * ((d < 0.8) & (np.abs(t) < half))
    if label == "異物":                      # 小さな点
        cx, cy = rng.uniform(8, 56, 2)
        r = rng.uniform(1.5, 3.0)
        img = img - 1.5 * c * (((x - cx) ** 2 + (y - cy) ** 2) < r ** 2)
    if label == "欠け":                      # 縁が半円状に欠ける
        pos, r = rng.uniform(12, 52), rng.uniform(3, 6)
        cx, cy = [(pos, 0), (pos, S - 1), (0, pos), (S - 1, pos)][rng.integers(4)]
        img[((x - cx) ** 2 + (y - cy) ** 2) < r ** 2] = 0.1
    if label == "汚れ":                      # 学習に入れない欠陥(ぼんやりした染み)
        cx, cy = rng.uniform(16, 48, 2)
        r = rng.uniform(5, 9)
        img = img - 0.8 * c * np.exp(-((x - cx) ** 2 + (y - cy) ** 2) / (2 * r * r))
    return np.clip(img, 0, 1).astype(np.float32)


def dataset(labels, counts):
    X = [make(lab) for lab, n in zip(labels, counts) for _ in range(n)]
    y = [k for k, n in enumerate(counts) for _ in range(n)]
    return torch.tensor(np.stack(X))[:, None], torch.tensor(y)


X_tr, y_tr = dataset(CLASSES, [400, 40, 40, 40])   # 欠けは後で枚数を絞って使う
X_te, y_te = dataset(CLASSES, [200, 20, 20, 10])
X_new, _ = dataset(["汚れ"], [30])
print("学習用", np.bincount(y_tr.numpy()), "評価用", np.bincount(y_te.numpy()))
学習用の画像は良品400枚・傷40枚・異物40枚・欠け40枚、評価用は良品200枚・傷20枚・異物20枚・欠け10枚です。評価用では良品が8割を占め、不良が少ない形にしました。欠けは学習用を40枚作っておき、主な実験ではそのうち20枚だけを使い、後の節で枚数を変えて比べます。評価用の画像は学習用とは別に作ったもので、学習には一度も使っていません。次の図は、評価用の画像と汚れの画像から、種類ごとに3枚ずつ並べたものです。欠陥には濃いものも薄いものもあり、たとえば傷の列の一番下の画像は薄い傷の例です。
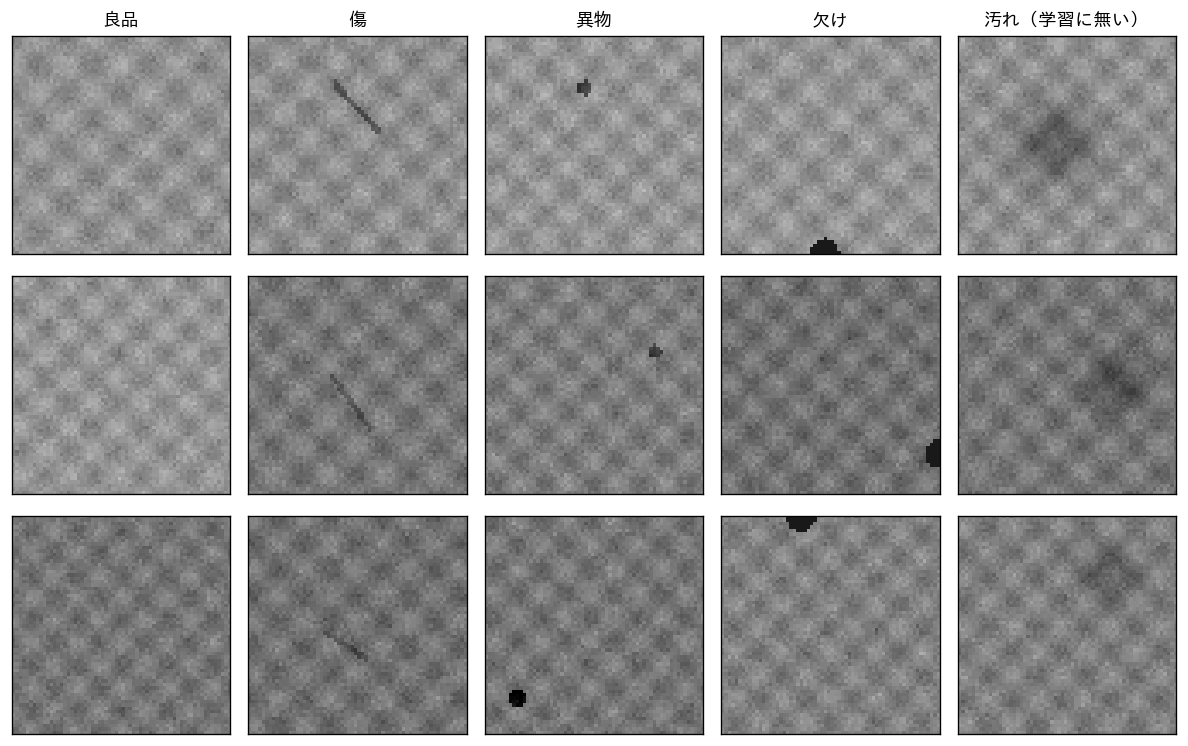
モデルは、畳み込みの層を3つ重ねた小さなものにしました。1層目は3×3画素のフィルタを8枚、2層目は16枚、3層目は32枚使い、1層目と2層目のあとでプーリングによって画像の縦横を半分にします。最後に、画像全体の中で各フィルタが最も強く反応した値だけを取り出し、その32個の値から4つの種類の確からしさを計算します。最も強い反応だけを取り出したのは、欠陥が画像の一部分にしか写らないためで、欠陥が画像のどこにあっても、どこかで強く反応すれば答えに効くようにしています。学習で決める値(パラメータ)は全部で6,020個で、実際に使われる画像認識のモデルに比べるとかなり小さなモデルです。PyTorch は2.13.0の CPU 版で実行しました。
class SmallCNN(nn.Module):
    def __init__(self, n_class=4):
        super().__init__()
        self.c1 = nn.Conv2d(1, 8, 3, padding=1)     # 3×3 のフィルタを8枚
        self.c2 = nn.Conv2d(8, 16, 3, padding=1)
        self.c3 = nn.Conv2d(16, 32, 3, padding=1)
        self.fc = nn.Linear(32, n_class)

    def forward(self, x):
        x = (x - 0.5) / 0.1                          # 明るさの基準をそろえる
        x = F.max_pool2d(F.relu(self.c1(x)), 2)     # 64 → 32 画素
        x = F.max_pool2d(F.relu(self.c2(x)), 2)     # 32 → 16 画素
        x = F.relu(self.c3(x))
        x = F.adaptive_max_pool2d(x, 1).flatten(1)  # 画像のどこかで強く反応したか
        return self.fc(x)
次のコードは、学習と評価の関数です。
def train(X, y, mode, seed=0, epochs=15):
    torch.manual_seed(seed)
    model = SmallCNN()
    opt = torch.optim.Adam(model.parameters(), lr=3e-3)
    w = len(y) / (4 * torch.bincount(y, minlength=4).float())   # 件数に反比例する重み
    loss_fn = nn.CrossEntropyLoss(weight=w if mode == "重み付け" else None)
    for ep in range(epochs):
        if mode == "サンプリング":                # 少ないクラスを多く引く
            idx = torch.tensor(list(torch.utils.data.WeightedRandomSampler(
                w[y], num_samples=len(y), replacement=True)))
        else:
            idx = torch.randperm(len(y))
        for b in range(0, len(y), 32):
            j = idx[b:b + 32]
            opt.zero_grad()
            loss_fn(model(X[j]), y[j]).backward()
            opt.step()
    return model


def evaluate(model, X, y):
    with torch.no_grad():
        pred = model(X).argmax(1).numpy()
    cm = np.zeros((4, 4), dtype=int)
    for t, p in zip(y.numpy(), pred):
        cm[t, p] += 1
    return cm
学習の関数 train は、学習用の画像を32枚ずつに分けて、モデルの答えと正解のずれ(損失)が小さくなるようにフィルタの値を少しずつ直す処理を、全体で15回くり返します。引数 mode は、次の節で説明する不良の少なさへの対処のしかたを選ぶもので、「補正なし」「重み付け」「サンプリング」の3通りを比べます。関数 evaluate は、評価用の画像に対するモデルの答えを数えて、混同行列(次の節で説明する、正解と判定の組み合わせごとの枚数の表)を作ります。
クラスの不均衡への対処と、混同行列での見逃しと過検出の読み方
外観検査のデータでは、ほとんどの画像が良品で、不良の画像は少ないのがふつうです。分類の答えの種類をクラスと呼び、クラスごとの画像の枚数が大きく偏っている状態をクラスの不均衡と呼びます。不均衡なデータでそのまま学習させると、モデルは「迷ったら良品」と答えるほうが、学習用の画像全体での誤りが少なくなるので、少ない不良を良品と判定しやすくなります。検査の言葉でいえば、見逃しが増える方向に偏ります。
対処の方法として、ここでは2つを試しました。1つ目は重み付けで、学習のときに、少ないクラスの画像を間違えたときの損失を大きく数えます。PyTorch の公式ドキュメントは、損失関数 CrossEntropyLoss の引数 weight をクラスごとの重みとして説明し、学習用のデータが不均衡なときにとくに役立つと書いています。ここでは各クラスの重みを、そのクラスの枚数に反比例するように決めました。主な実験の学習用は良品400枚・傷40枚・異物40枚・欠け20枚なので、欠けの1枚は良品の1枚の20倍の重みで数えられます。2つ目はサンプリングで、学習のときに画像を引く確率を、少ないクラスほど高くします。公式ドキュメントによれば、WeightedRandomSampler は、与えた重みに比例する確率で画像の番号を引く仕組みで、ここでは重み付けと同じ値を確率の重みにし、同じ画像を何度でも引けるように(復元抽出で)使いました。どちらも、画像そのものを増やすのではなく、少ない不良の画像を学習の中で目立たせる方法です。
結果は、正解率の1つの数字ではなく、混同行列で読みます。混同行列は、行に正解の種類、列にモデルの判定を取り、組み合わせごとの枚数を数えた表です。対角線(行と列が同じ種類の升目)が正しく判定できた枚数で、それ以外が取り違えです。あわせて使う再現率は、正解がその種類だった画像のうち、正しくその種類と判定した割合です。また、全体の地図の用語に合わせて、正解(ラベル)が不良である画像を良品と判定した枚数を見逃し、正解が良品である画像を不良と判定した枚数を過検出として数えます。次のコードの report 関数は、混同行列からこの3つ(種類ごとの再現率・見逃し・過検出)と全体の正解率を出すものです。
このコードで、補正なし・重み付け・サンプリングの3通りでモデルを学習させ、評価用の画像250枚で結果を数えます。続けて、学習に使っていない汚れの画像30枚を、重み付けのモデルに見せています(後の節で読みます)。
def report(cm):
    recall = cm.diagonal() / cm.sum(1)
    miss = cm[1:, 0].sum()                 # 不良を良品と判定(見逃し)
    over = cm[0, 1:].sum()                 # 良品を不良と判定(過検出)
    print("  再現率", dict(zip(CLASSES, recall.round(2).tolist())))
    print("  見逃し", miss, "/", cm[1:].sum(), "  過検出", over, "/", cm[0].sum(),
          "  正解率", round(cm.diagonal().sum() / cm.sum(), 3))


keep = (y_tr != 3) | (torch.cumsum(y_tr == 3, 0) <= 20)   # 欠けは20枚だけ使う
X20, y20 = X_tr[keep], y_tr[keep]
print("主な実験の学習用", np.bincount(y20.numpy()))
models, cms = {}, {}
for mode in ["補正なし", "重み付け", "サンプリング"]:
    t0 = time.time()
    models[mode] = train(X20, y20, mode)
    cms[mode] = evaluate(models[mode], X_te, y_te)
    print(mode, "学習の時間", round(time.time() - t0, 1), "秒")
    print(cms[mode])
    report(cms[mode])
print("パラメータの数", sum(p.numel() for p in models["補正なし"].parameters()))

# 学習に無い欠陥(汚れ)30枚を、重み付けのモデルに見せる
with torch.no_grad():
    p_new = F.softmax(models["重み付け"](X_new), 1)
    p_ok = F.softmax(models["重み付け"](X_te[y_te == 0]), 1)
print("汚れ30枚の判定", dict(zip(CLASSES, np.bincount(p_new.argmax(1).numpy(), minlength=4).tolist())))
print("汚れの最大確率の中央値", round(p_new.max(1).values.median().item(), 3),
      " 0.9以上の枚数", int((p_new.max(1).values >= 0.9).sum()))
print("良品200枚の最大確率の中央値", round(p_ok.max(1).values.median().item(), 3))
混同行列の取り違えは、次の3つに分けて読むと、損失の型と結びつけやすくなります。1つ目は良品の列に入った不良(見逃し)、2つ目は良品の行で良品以外の列に入ったもの(過検出)、3つ目は不良どうしの取り違え(たとえば異物を傷と判定)です。3つ目が出荷の可否に影響するかどうかは、判定基準によります。判定基準が欠陥の種類に依らず「欠陥があれば不良」と決まっている場合には、種類を取り違えても不良という判定は変わりません。一方、第2章で扱ったように欠陥の種類ごとに基準が違う場合には、種類を取り違えると別の種類の基準が当てはめられるので、良品か不良かの判定を誤ることがあります(どちらの種類の基準でも不良になる場合には、判定は変わりません)。また、欠陥の種類ごとに原因の工程を探す使い方をしている場合には、原因の調査を誤った方向に向けます。
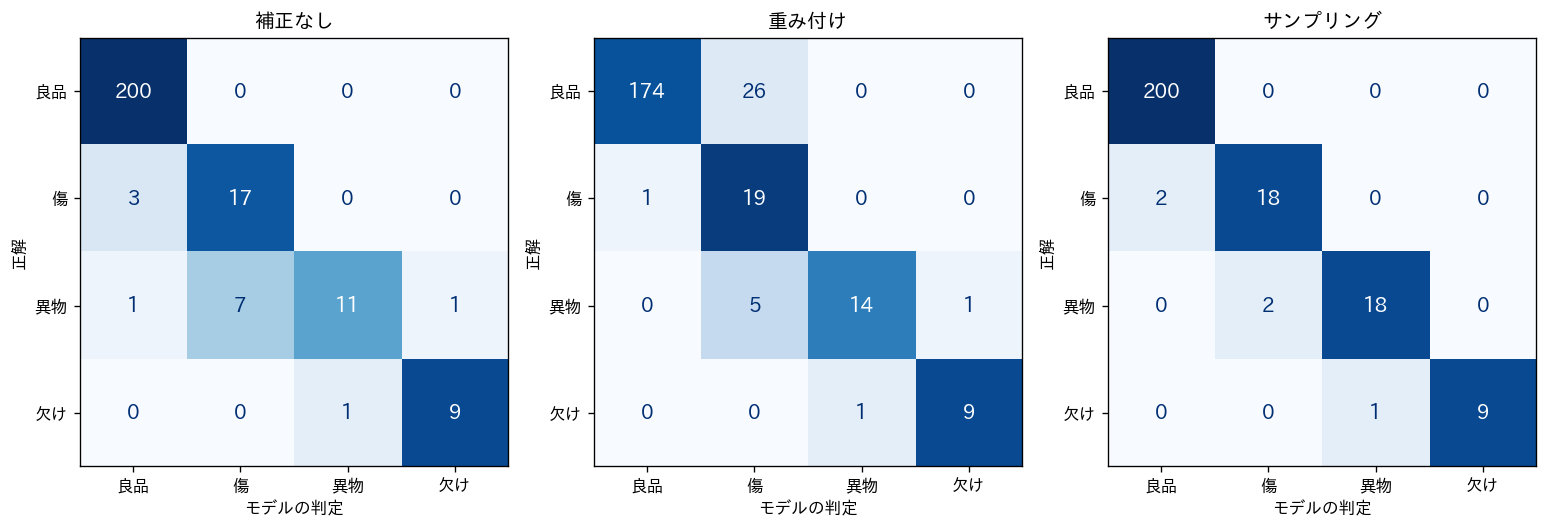
実行した結果を、検査の言葉に置き換えて表にしました。見逃しは不良50枚のうち良品と判定した枚数、過検出は良品200枚のうち不良と判定した枚数です。
| 指標 | 補正なし | 重み付け | サンプリング |
|---|---|---|---|
| 見逃し(不良50枚のうち) | 4 | 1 | 2 |
| 過検出(良品200枚のうち) | 0 | 26 | 0 |
| 傷の再現率 | 0.85 | 0.95 | 0.90 |
| 異物の再現率 | 0.55 | 0.70 | 0.90 |
| 欠けの再現率 | 0.90 | 0.90 | 0.90 |
| 異物を傷と判定した枚数(異物20枚のうち) | 7 | 5 | 2 |
| 全体の正解率 | 0.948 | 0.864 | 0.980 |
補正なしのモデルは、全体の正解率が0.948で、数字だけを見ると悪くありません。しかし不良50枚のうち4枚を良品と判定しており、異物は20枚のうち11枚しか正しく判定できず、7枚を傷と判定しました。異物の取り違えは、良品の側より傷の側に多く出ています。良品200枚はすべて良品と判定したので、正解率は高く見えますが、これは良品が評価用の8割を占めていることによるものです。
重み付けのモデルは、見逃しが1枚に減り、傷の再現率は0.95、異物は0.70に上がりました。その代わりに、良品200枚のうち26枚を傷と判定し、過検出が0枚から26枚に増えて、全体の正解率は0.864に下がっています。良品の取り違えの26枚は、すべて傷の側に出ました。少ないクラスを重く数えると、モデルの答えが不良の側に寄りうることを示す例です。サンプリングのモデルは、見逃し2枚・過検出0枚で、異物の再現率も0.90まで上がり、3通りの中では最もつり合いの取れた結果になりました。
ただし、この結果は本コラムの架空データでの1回の学習の結果で、評価用の不良は50枚、欠けは10枚しかありません。欠けの再現率の0.90は、10枚のうち1枚の違いで0.10動きます。しかも1つのシード(学習の乱数の出方)での結果で、次の節で示すとおり、同じ重み付けでもシードを変えると過検出が0枚になる場合がありました。サンプリングが重み付けより良いという一般的な結論は、この結果からは言えません。言えるのは、同じ画像・同じモデルでも、不良の少なさへの対処のしかたや学習の乱数の出方によって、見逃しと過検出の配分が大きく変わりうる、ということです。どの配分を選ぶかは、見逃しと過検出のどちらの損失が大きいかで決まり、それを数字で決める方法(見逃し率の上限を守るしきい値の選び方など)は第8章で扱います。評価用のデータの切り方(同じ製品やロットの画像が学習用と評価用に混ざらないようにすること)も、第8章で扱います。
この表から引き出しておきたい点がもう1つあります。全体の正解率は、3通りのうち重み付けが最も低い一方で、見逃しは重み付けが最も少なくなっています。正解率の高さでモデルを選ぶと、見逃しの多いモデルを選んでしまうことがあります。外観検査のモデルを比べるときは、まず見逃しと過検出の枚数を見て、次に欠陥の種類ごとの再現率を見る順が、損失の型と結びつけやすいと考えています。
なお、PyTorch の CPU 版で、乱数のシードと計算に使うスレッドの数を固定して同じコードを2回実行し、2回の混同行列と、学習に無い欠陥の結果が一致することを確かめました(学習にかかった時間だけは実行のたびに変わりました)。別の計算機や別の版の PyTorch では、計算の細かな順序の違いから結果が変わる可能性があります。
不良の画像が少ない欠陥は、全体の正解率では気付きにくい
クラスの不均衡への対処は、少ない不良の画像を学習の中で目立たせる工夫で、不良の画像そのものが増えるわけではありません。では、ある欠陥の画像がもっと少なかったら何が起きるかを、欠けを例に確かめました。良品・傷・異物の学習用の枚数はそのままにして、学習に使う欠けの画像を5枚・10枚・20枚・40枚と変え、それぞれ重み付けでモデルを学習させ、評価用の欠け10枚の再現率を数えます。1回の学習の結果は乱数の出方(モデルの初期値や画像を引く順番)に左右されるので、学習のときのシードを3通り変えて、3回の値と平均を出しました。評価用の画像は、どの枚数でも同じものを使っています。
for n_kake in [5, 10, 20, 40]:
    keep_n = (y_tr != 3) | (torch.cumsum(y_tr == 3, 0) <= n_kake)
    rec, rows, acc, over = [], [], [], []
    for seed in [0, 1, 2]:                     # 重み付け、シードは3通り
        cm = evaluate(train(X_tr[keep_n], y_tr[keep_n], "重み付け", seed=seed), X_te, y_te)
        rec.append(cm[3, 3] / cm[3].sum())
        rows.append(cm[3].tolist())            # 欠け10枚の判定の内訳
        acc.append(round(float(cm.diagonal().sum() / cm.sum()), 3))   # 全体の正解率
        over.append(int(cm[0, 1:].sum()))      # 過検出(良品200枚のうち)
    print("欠けの学習枚数", n_kake, "欠けの再現率", np.round(rec, 2).tolist(),
          "平均", round(float(np.mean(rec)), 2), "欠け10枚の判定(良品・傷・異物・欠け)", rows)
    print("  全体の正解率", acc, "過検出", over)
本コラムの実行環境では、欠けの枚数1つあたり(3回の学習で)10秒から1分ほどかかり、時間は実行のたびに変わりました。欠けの枚数を変えると、良品・傷・異物も含めたモデル全体を学習し直すことになるので、欠けの結果だけでなく、全体の正解率と過検出も数えています。実行した結果を表にしました。
| 学習に使った欠けの枚数 | 欠けの再現率(シード3通り) | 3回の平均 | 欠け10枚のうち異物と判定した枚数(3回) | 欠け10枚のうち良品と判定した枚数(3回) | 全体の正解率(3回) | 過検出(良品200枚のうち、3回) |
|---|---|---|---|---|---|---|
| 5 | 0.3、0.4、0.3 | 0.33 | 7、2、6 | 0、1、0 | 0.948、0.944、0.948 | 0、0、1 |
| 10 | 0.9、0.9、1.0 | 0.93 | 1、1、0 | 0、0、0 | 0.964、0.956、0.980 | 0、0、0 |
| 20 | 0.9、1.0、1.0 | 0.97 | 1、0、0 | 0、0、0 | 0.864、0.968、0.964 | 26、0、0 |
| 40 | 1.0、1.0、1.0 | 1.00 | 0、0、0 | 0、0、0 | 0.952、0.968、0.956 | 0、0、0 |
表のとおり、学習に使った欠けが5枚のときは、再現率は3回とも0.3から0.4にとどまり(0.3、0.4、0.3)、平均は0.33でした。欠けの多くは異物と判定され(3回の合計で15枚)、傷と判定されたものもありました。10枚にすると平均は0.93に上がり、20枚では0.97、40枚では3回とも1.0でした。この架空データでは、欠けも異物も表面より暗い丸い部分として描いており、欠けの見本が少ないときの取り違えは、主に異物の側に出ました。
この結果で見ておきたいのは、欠けの画像が少ないことが、全体の正解率にはほとんど表れなかったことです。欠けが5枚のときの全体の正解率は0.944から0.948で、40枚のときの0.952から0.968と数ポイントしか違いません。評価用の250枚のうち欠けは10枚なので、欠けの再現率が1.0から0.3に下がっても、ほかの種類の判定が同じなら、全体の正解率は0.028しか下がらない計算です。この実験では、欠けの枚数による全体の正解率の差は、シードによる差(欠けが20枚のときの0.864から0.968)より小さく出ました。不良の画像が少ない欠陥は、その欠陥の行だけを見ないと判定が崩れていることに気付けません。
表からは、もう1つ分かることがあります。欠けが20枚・シード0の結果は、前の節の重み付けの結果と同じもので、過検出が26枚出ていますが、同じ20枚でもシード1・2では過検出は0枚でした。前の節で見た重み付けの過検出の26枚は、1つのシードでの結果で、学習の乱数の出方によって大きく変わる数字だったことになります。前の節の3通りの比較も1つのシードでの結果なので、補正のしかたによる違いと、乱数の出方による違いを、この章の実験だけでは分けきれていません。
この実験では、欠けが良品と判定されたのは12回の評価を通じて1枚だけでした。この架空データの欠けは、表面より暗い値(0.1)で塗った濃い欠陥なので、そのことが関係している可能性がありますが、欠けの濃さを変えた実験はしておらず、理由は確かめていません。薄く写る欠陥で画像が少ない場合に、良品と判定されて見逃しが増えるかどうかも、この章では試していません。また、「10枚で十分」という数字は、この単純な合成画像・このモデル・評価用の欠け10枚での結果で、実際の製品で必要な枚数の目安にはなりません。評価用の欠けが10枚しかないことも、再現率の数字を粗くしています(見逃し率を確かめるのに必要な不良の数は第8章で扱います)。データが少ないときの工夫(データ拡張など)は第7章で扱います。
学習に無い欠陥にも、高い確からしさを出すことがある
この章のモデルは、学習した4つのクラスのどれかを必ず答える作りで、「分からない」と答えて保留にする仕組みは付けていません。そのため、学習に無い種類の欠陥が来ても、4つの中から最も近いものを選びます。これを確かめるため、学習に使っていない汚れ(ぼんやりと広がった薄い染み)の画像30枚を、重み付けのモデルに見せました。
実行した結果、汚れの30枚はすべて「傷」と判定されました。良品と判定したものは無かったので、この例では汚れが良品として流れることはありませんでしたが、種類は誤っています。より注意が要るのは、モデルの確からしさの値です。モデルが出す4つのクラスの確からしさ(合計が1になるように変換した値)のうち最大のものを見ると、汚れの30枚では中央値が0.986で、30枚のうち29枚が0.9以上でした。比較のために同じモデルで評価用の良品200枚を見ると、最大の確からしさの中央値は0.643でした。この良品200枚には、前の節で見たとおり傷と判定された26枚も含まれています。また、ここでの中央値は PyTorch の median で求めたもので、公式ドキュメントによれば、枚数が偶数のときは中央の2つの値のうち小さいほうを返します(30枚なら小さいほうから15番目、200枚なら100番目の値)。この架空データのこのモデルでは、学習に無い欠陥のほうが、評価用の良品よりも高い確からしさで判定されたことになります。
この結果から、確からしさが高いことを「モデルが正しく判定できている」印として使うことはできない、と考えています。確からしさは、学習した4つのクラスの中でどれに近いかを表すだけで、学習に無いものが来たかどうかは表しません。汚れがなぜ「良品」でも「異物」でもなく「傷」に寄ったのかは、このモデルの中身からは確かめられません。汚れがもっと薄ければ「良品」と判定されて見逃しになる可能性もありますが、その条件はこの章では試していません。
実際のラインでは、学習のときに無かった種類の欠陥が後から現れることは避けられません。材料の変更、設備の不具合、新しい工程の追加などで、それまで見たことのない欠陥が出ることがあります。教師あり学習の分類だけで検査を組むと、そうした欠陥は既知の種類のどれかか良品に振り分けられ、そのことに気付く手立てがありません。そのため、教師あり学習の分類と、良品の画像だけから「いつもと違う」を見つける良品学習を組み合わせる、あるいは確からしさや良品学習の異常の度合いから判定の保留を設けて人に回す、といった設計が必要になると考えています。ただし、この例では汚れ30枚のうち29枚の最大の確からしさが0.9以上だったので、確からしさが低いものだけを保留にする方法では、この汚れの大半は拾えません。保留や良品学習を足しても未知の欠陥を必ず見つけられるわけではなく、組み合わせた仕組み全体で、学習に無い欠陥をどれだけ拾えるかを確かめる必要があります。良品学習は第6章で、判定の保留の設計は第10章で扱います。
物体検出とセグメンテーションの代表的な手法
この章のコードは画像分類だけを扱いましたが、実際の外観検査では、欠陥の位置や大きさを知りたいことが多く、物体検出やセグメンテーションが使われます。ここでは、代表的な手法を原論文の書誌で確かめた範囲で紹介します。本コラムではこれらの手法を実行していません。
物体検出の代表的な手法の1つが、Redmon らが2016年に CVPR(コンピュータビジョンの国際会議)で発表した YOLO です。論文の要旨によれば、物体検出を、画像全体から枠の位置と種類の確からしさを1つのニューラルネットワークで一度に予測する問題として扱い、処理が非常に速いことを特徴としています。もう1つの系統として、Ren らが2015年に arXiv で公開した Faster R-CNN があります。要旨によれば、物体がありそうな領域の候補を出すネットワークと、候補の中を判定するネットワークが畳み込みの特徴を共有する仕組みで、候補を出してから判定する2段階の方法です。1段階と2段階の違いについて、Lin らが2017年に ICCV(コンピュータビジョンの国際会議)で発表した論文は、要旨で、1段階の方法は速く単純になりうる一方、その時点までは精度で2段階の方法に及んでいなかった、と整理しています。
この Lin らの論文は、クラスの不均衡の観点からも外観検査に関わりがあります。論文が提案したフォーカルロスは、大量の易しい背景の例が学習を支配しないよう、難しい例を重く扱う損失関数で、その効果を確かめた1段階の検出の手法は RetinaNet と名付けられています(下の表ではこの名前で載せています)。外観検査の画像も、欠陥の部分は画像のごく一部で、ほとんどは背景(良品の表面)なので、同じ種類の不均衡を抱えています。この章の重み付けやサンプリングと同じく、少ないものを学習の中で目立たせるための工夫の1つです。
セグメンテーションの代表的な手法の1つが、Ronneberger らが2015年に arXiv で公開し、医用画像の国際会議 MICCAI 2015 の論文集(Springer の LNCS 9351巻、234から241ページ。著者の公式ページによる)に掲載された U-Net です。要旨によれば、画像を縮めながら文脈を捉える経路と、それと対になって画像を元の大きさに戻しながら位置を正確にする経路から成るネットワークで、データの水増し(データ拡張)を強く使うことで、少ない画像からでも学習できることを示しています。生物医学の画像のために提案された手法ですが、「画素ごとに答える」「少ない画像を水増しして学習する」という考え方は、画素の単位で欠陥の形を求めたい外観検査のセグメンテーションにも当てはまります。データ拡張の使い方は第7章で扱います。物体検出とセグメンテーションを組み合わせ、検出した物体ごとに形の領域(マスク)を出す方法として、He らが2017年に ICCV で発表した Mask R-CNN もあります。要旨によれば、Faster R-CNN に、物体ごとの形の領域を予測する分岐を足したものです。
| 手法 | 型 | 原論文の書誌(確かめた範囲) | 要旨から分かる特徴 |
|---|---|---|---|
| YOLO | 物体検出(1段階) | Redmon ほか、CVPR 2016 | 画像全体から枠と種類を1つのネットワークで一度に予測する。速さを重視 |
| Faster R-CNN | 物体検出(2段階) | Ren ほか、arXiv 2015 | 領域の候補を出すネットワークと判定のネットワークが特徴を共有する |
| RetinaNet(フォーカルロス) | 物体検出(1段階) | Lin ほか、ICCV 2017 | 易しい例の損失を小さく数え、背景との不均衡に対処する |
| U-Net | セグメンテーション | Ronneberger ほか、MICCAI 2015(LNCS 9351巻) | 縮める経路と戻す経路の対で画素ごとに答える。少ない画像とデータ拡張で学習 |
| Mask R-CNN | 物体検出とセグメンテーションの組み合わせ | He ほか、ICCV 2017 | Faster R-CNN に物体ごとの形の領域を予測する分岐を足す |
論文で示された速さや精度の数字は、その論文が使った公開データセット(日常の写真の物体など)と計算機での値で、外観検査の画像で同じ数字が出ることを意味しません。この表は、手法がどんな考え方で何を答えるかを知るためのもので、自社の検査にどれを使うかは、自社の画像で比べて決める必要があります。
これらの手法は、オープンソースのライブラリとして実装が公開されていることが多く、自分で一から作ることは少なくなっています。ただし、実装の利用条件(ライセンス)は確かめる必要があります。たとえば Ultralytics 社は、YOLO の名を付けたモデルと実装を公開しています。同社の公式ドキュメントは、物体検出・インスタンスセグメンテーション(物体ごとの領域分割)・セマンティックセグメンテーション(画素ごとの種類分け)・画像分類などの作業を扱えると説明しています。同社のライセンスのページは、オープンソースのライセンス(AGPL-3.0)と、企業向けの別のライセンスの2つを示しています。どちらが当てはまり、どんな条件が付くかは使い方によって変わるので、本コラムでは条件の中身には立ち入りません。検査装置やラインの仕組みにオープンソースの実装を組み込むときは、技術の比較と同じ時期に、提供元の公式の情報をもとに、利用の条件を法務・情報システムの担当と確かめておくことが必要です。
ラベル付けの道具と手順、教師データの品質は判定基準で決まる
ラベルの品質は、教師あり学習のモデルの学習と評価の信頼性を大きく左右します。第2章で扱ったように、同じ画像を見ても検査員によって判定がばらつくことがあり、そのばらつきはラベルにもそのまま入ります。ラベルがばらついていれば、モデルはばらついた基準を学び、評価用のラベルがばらついていれば、評価の数字そのものが信用できなくなります。
ラベル付けには、画像を表示して、種類を選ぶ・枠を描く・輪郭を塗る作業を行う専用の道具(アノテーションツールと呼ばれるもの)を使うのが一般的です。オープンソースのものも商用のものもあり、選ぶときには、必要な型(分類・枠・輪郭)に対応しているか、複数の人で作業を分けて結果を突き合わせられるか、ラベルを学習に使う形式で書き出せるか、画像を社外に出さずに使えるか、を確かめるとよいと考えています。最後の点は、製品の画像が社外秘にあたる場合にとくに重要です。
ラベル付けの手順は、一般論として次のように進めるのがよいと考えています。
- 判定基準と限度見本から、ラベルの種類(クラス)と、境界の付け方(どこまでを傷の枠に含めるか、薄い汚れを欠陥とするか)を書いたラベル付けの手引きを作る
- 少ない枚数(数十枚程度)を複数の人で同じようにラベル付けし、一致しない画像を集めて、手引きを直す
- 手引きが固まってから、本格的にラベル付けを始める。一部の画像は複数の人で重ねてラベル付けし、一致の度合いを測り続ける
- 判断に迷った画像には「保留」の印を付け、品質保証の担当者が判定基準に照らして決める。決めた結果は手引きに書き足す
- ラベルには、誰がいつ付けたか、どの版の手引きに従ったかを残す
手順の2と3で測る一致の度合いは、第2章のカッパ係数の考え方で測れます。また、物体検出やセグメンテーションでは、欠陥の種類だけでなく、枠や輪郭の位置にもばらつきが出ます。とくにセグメンテーションでは、欠陥と背景の境目がぼやけている場合に、どこまでを欠陥として塗るかが人によって違いやすく、その違いは、面積で合否を決める判定基準にそのまま響きます。輪郭をどこで引くかも、手引きに書いておく必要があります。
ラベル付けは、データ担当だけで進める作業ではありません。何が不良かを決めているのは品質保証と検査員なので、手引きを作る段階から品質保証と検査員が関わり、データ担当は道具の準備と結果の集計を担う、という分担が適切だと考えています。ラベル付けの作業量は、型(分類・枠・輪郭)と画像の枚数で大きく変わるので、試験導入(PoC)の計画を立てる段階で見込んでおく必要があります(試験導入の進め方は第13章で扱います)。
| 工程 | 主に担う役割 | 決めること・残すもの | 決めていないと起きること |
|---|---|---|---|
| ラベル付けの手引きを作る | 品質保証・検査員(データ担当が支える) | クラスの種類、境界の付け方、保留の扱い | 人によって基準が違うラベルが混ざり、判定のばらつきをモデルが学ぶ |
| 試しのラベル付けと突き合わせ | 検査員(複数)・データ担当 | 一致しなかった画像と、直した手引きの版 | 不一致に気付かないまま大量にラベルを付け、後で付け直しになる |
| 本格的なラベル付け | 検査員・ラベル付けの担当 | ラベル、付けた人と日付、手引きの版 | どの版の基準のラベルかが分からず、基準を変えたときに直す範囲が分からない |
| 保留の判定 | 品質保証 | 保留にした画像の判定と、その理由 | 迷った画像を各自の判断で振り分け、境界付近のラベルがばらつく |
| 一致の度合いの監視 | データ担当 | 重ねてラベル付けした画像での一致率・カッパ係数 | ラベルの品質の変化に気付かない |
教師あり学習が向く条件と、経営の判断
ここまでの内容をもとに、教師あり学習が外観検査に向く条件と向かない条件を整理します。教師あり学習が効くのは、見つけたい欠陥の種類が決まっていて、それぞれの種類の不良の画像を学習に十分な枚数集められる場合です。逆に、不良がめったに出ない、どんな欠陥が出るか事前に分からない、という場合には、教師あり学習だけで検査を組むのは難しくなります。どれくらいの枚数があれば十分かは、欠陥の見えやすさ・表面の模様・必要な見逃し率によって変わり、本コラムでは一般的な目安の数字を示せません。前の節の欠けの枚数の実験は、本コラムの架空データでの1つの例です。
| 観点 | 教師あり学習が向く条件 | 教師あり学習が向かない条件 | 向かないときの選択肢 |
|---|---|---|---|
| 不良の画像の集まり方 | 欠陥の種類ごとに、学習と評価に使える枚数が集まる | 不良がめったに出ず、種類によっては数枚しかない | 良品学習(第6章)、データを増やす工夫(第7章) |
| 欠陥の種類 | 種類が決まっていて、新しい種類が出にくい | 材料や工程の変更で、見たことのない欠陥が出る | 良品学習との組み合わせ、判定の保留(第10章) |
| 判定に必要な答え | 欠陥の種類を見分ける必要がある(原因の工程を探す、種類ごとに基準が違う)。良品か不良かの2つに分ける教師あり学習も成り立つ | 答えの細かさだけでは決まらない。良品か不良かだけが分かればよい場合は、教師あり学習も良品学習も選択肢になる | 不良の画像の集まり方と求める見逃し率・過検出率で、良品学習(第6章)・ルールベースの画像処理(第4章)と比べる |
| 欠陥の写り方 | 形や見え方にばらつきがあり、ルールでは書ききれない | 位置と形が安定し、明るさの差だけで見分けられる | ルールベースの画像処理(第4章) |
| 判定基準の安定 | 判定基準と限度見本が決まっていて、検査員の判定がそろっている | 判定基準が揺れていて、検査員どうしで判定が一致しない | 先に判定基準をそろえる(第2章) |
| 品種の数 | 品種が少ないか、品種が違っても欠陥の見え方が似ている | 品種が多く、品種ごとに表面が大きく違う | 品種ごとの学習の手間を見込む、少ないデータの工夫(第7章) |
実際の現場では、教師あり学習と他の方法を組み合わせることが多いと考えています。たとえば、第4章のルールベースの画像処理で製品の位置を合わせて検査する範囲を切り出し、第6章の良品学習で「いつもと違う」ものを拾い、拾ったものだけを教師あり学習で種類に分ける、という組み合わせです。この組み合わせなら、良品学習が未知の欠陥への備えの1つになり、教師あり学習は種類の判別が要るところにだけ使えます。ただし、良品学習を足しても未知の欠陥を必ず拾えるわけではないので、組み合わせた仕組み全体で評価する必要があります。どの組み合わせが合うかは、表の観点を自社の工程に当てはめて決めることになります。
経営の判断として、教師あり学習を導入するかどうかを決めるときに、経営が最初に確かめるべきことは、モデルの種類ではなく、見つけたい欠陥ごとに不良の画像がどれだけ集まるか、そして集める仕組みがあるかだと考えています。不良の画像が十分に集まらない欠陥に教師あり学習を使うと、この章の架空データの実験で欠けの画像を5枚しか学習に使わなかったときのように、その欠陥だけ再現率が大きく下がることがあります。しかも、評価に使える不良の画像も少ないので、評価の数字そのものが少ない枚数に左右され、どれだけ見逃すかを確かめることも難しくなります。そうしたモデルをラインに入れると、見逃しによる流出や、過検出による再検査の増加と、それが続いた場合の形骸化につながるおそれがあります(この章の実験は、流出や形骸化そのものを確かめたものではありません)。
判断を誤ったときの損失を、本コラムの6つの損失の型で整理すると次のようになります。
| 判断の誤り | 起こる損失の型 | 避けるための判断 |
|---|---|---|
| 不良の画像が少ない欠陥を、教師あり学習だけで検査する | 流出、形骸化 | 欠陥ごとの不良の画像の枚数を先に数え、足りない欠陥は良品学習・判定の保留で補う |
| 全体の正解率でモデルを選ぶ | 流出 | 見逃しと過検出を分けて報告させ、見逃しの上限を品質保証と決める(第8章) |
| 不良の少なさへの対処を、見逃しだけを見て決める | 過検出、形骸化 | 過検出で増える再検査・廃棄の量も同時に見る |
| 学習に無い欠陥への備えを置かない | 流出 | 良品学習との組み合わせ、判定の保留、新しい欠陥の画像を残す仕組みを入れる |
| ラベル付けの手引きを作らずに、検査員ごとにラベルを付ける | 判定のばらつき | 品質保証が手引きを持ち、一致の度合いを測り続ける |
| 工場や品種ごとに、別々の道具・別々のラベルの基準で学習させる | 二重投資 | ラベルの種類と手引きを工場の間でそろえ、道具を共通にする |
| 検査の時間を考えずに大きなモデルや大きな画像を選ぶ | タクトの超過 | 速度の要件を最初に決める(第9章) |
予算と体制の面では、教師あり学習の予算を、モデルの開発だけでなく、不良の画像を集めて残す仕組み(ラインで不良と判定された製品の画像を、判定の結果とともに保存する仕組み)と、ラベル付けの手間にも付けておく必要があると考えています。ラベル付けの手間は、モデルを作る最初の一度だけでなく、新しい欠陥が出たとき、判定基準が変わったとき、品種が増えたときにも生じます。また、教師あり学習のモデルが出した判定を、出荷の可否の最終的な判断としてそのまま使うことはできません。出荷の可否の責任は品質保証の体制にあり、モデルは判定の材料の1つとして、どこまでをモデルの判定で進め、どこから人が判断するかを品質保証と決めておくことが前提になります。
この章では、教師あり学習の3つの型(画像分類・物体検出・セグメンテーション)を、何が分かるかとラベル付けの手間で比べ、架空の合成画像で小さな畳み込みニューラルネットワークを学習させました。本コラムの架空データでは、補正なしのモデルは正解率0.948でも不良50枚のうち4枚を見逃し、重み付けで見逃しを1枚に減らすと過検出が26枚に増えるなど、不良の少なさへの対処で見逃しと過検出の配分が大きく変わりました。ただし、重み付けの過検出は学習の乱数を変えると0枚になる場合もあり、1回の学習の数字だけでは方法の良し悪しを決められません。また、学習に無い汚れの画像は30枚すべてが「傷」と判定され、確からしさの中央値は0.986でした。教師あり学習は、不良の画像が十分に集まり、欠陥の種類を見分ける必要がある場合に使い、学習に無い欠陥への備えを別に置くのが適切だと考えています。次の第6章では、不良の画像が少ない場合や未知の欠陥に備える場合に使う、良品の画像だけで学ぶ異常検知を扱います。
この章を深めたい方への参考書籍
『画像認識』(原田達也 著、講談社):機械学習プロフェッショナルシリーズの1冊(2017年刊)で、版元の目次によれば、局所特徴・統計的特徴抽出・分類から、畳み込みニューラルネットワーク・物体検出の章、セマンティックセグメンテーションを含む「さらなる話題」の章までを扱っています。この章で平易に説明した畳み込みや物体検出の仕組みを、理論から学び直すのに向いています。
『Pythonで学ぶ画像認識』(田村雅人、中村克行 著、インプレス):機械学習実践シリーズの1冊(2023年刊)で、国立国会図書館の目次によれば、画像処理の基礎知識・深層学習を使う準備・画像分類・物体検出などの章があり、畳み込みニューラルネットワークや物体検出の手法を実装しながら学ぶ構成です。この章では実行しなかった物体検出を、自分の手で動かして確かめたいときの手引きになります。
第6章 良品だけで学ぶ異常検知、オートエンコーダからPatchCoreまで
第5章では、良品と不良のラベルが付いた画像から学ぶ教師あり学習で、欠陥の種類を分類する方法を扱いました。教師あり学習は、欠陥の種類ごとに十分な数の不良画像が集まる場合には強い方法ですが、不良がめったに出ない工程や、これまでに見たことのない欠陥が出うる工程では、学習に使う不良画像そのものが足りません。この章では、良品の画像だけから「いつもの見た目」を学び、それから外れたものを異常とする良品学習を扱います。前半で良品学習の考え方と手法の系統を整理し、後半では架空の合成画像を使って、再構成型と近傍型の2つの方法を実行したコードと結果で比べます。
良品学習の考え方、不良の画像が無くても良品との違いを数にする
本コラムでは、良品学習(異常検知のうち、良品の画像だけで学ぶもの)を「良品の画像だけから『いつもの見た目』を学び、それから外れたものを異常とする方法」と定義しています。教師あり学習が「傷とはこういうもの」「異物とはこういうもの」を学ぶのに対して、良品学習は「良品とはこういうもの」だけを学びます。この章で扱う方法は、モデルの学習には不良画像を使いません。ただし、見逃しの評価や、本番でのしきい値の検討には、別に不良の評価用の画像が必要です(第8章)。その代わりに、良品学習の出力は「どれくらい良品らしくないか」を表す1つの数(本コラムでは異常の度合いと呼びます)と、画像の中のどこが良品らしくないかを示す地図であり、欠陥の種類までは分かりません。
良品学習が効くのは、次のような条件の工程だと考えています。
- 不良の発生がまれで、欠陥の種類ごとに数十枚から数百枚の不良画像を集めるのに長い期間がかかる
- これまでに出たことのない欠陥(新しい材料・新しい設備・工程の変更で現れるもの)も止めたい
- 良品の見た目が安定しており、良品どうしの違いが欠陥より小さい
- 欠陥の種類の判別は後工程や人が行えばよく、検査では「流してよいか、止めて確かめるか」を決められればよい
逆に、良品の見た目のばらつきが大きい工程(自然素材の模様、品種ごとに見た目が大きく違う製品など)や、欠陥の種類によって処置が変わるので種類まで判別したい工程では、良品学習だけでは足りません。第5章の教師あり学習と組み合わせる、あるいは良品学習を「止めて人が確かめる候補を選ぶ」役割に限る、といった使い方になります。
良品学習で注意したいのは、「異常」と「不良」が同じではないことです。第2章で整理したとおり、欠陥があっても判定基準の範囲内であれば良品です。良品学習が見つけるのは「学習した良品と違う見た目」であり、それが判定基準に照らして不良かどうかは別に決める必要があります。学習に使った良品の画像に、判定基準の範囲内の小さな欠陥が含まれていれば、モデルはそれを「いつもの見た目」として学びます。逆に、学習に使った良品が限度見本より厳しい選び方で集められていれば、判定基準の範囲内の欠陥まで異常として拾い、過検出が増えます。どの良品を学習に使うかが、そのまま判定の基準の一部になるということです。
手法の4つの系統、再構成・分布・近傍・知識蒸留
画像の良品学習の手法は数多く提案されていますが、「良品らしさ」をどう測るかで大きく4つの系統に分けて考えると整理しやすくなります。1つ目は再構成型で、良品の画像を一度小さな情報に縮めてから元に戻すモデルを学習させ、戻した画像と元の画像の差(再構成誤差)を異常の度合いにします。2つ目は特徴の分布型で、画像の区画ごとに特徴を取り出し、良品での特徴の分布を確率の分布として当てはめ、その分布から外れた区画を異常とします。3つ目は近傍型で、良品の区画の特徴をそのまま記憶しておき、検査する画像の区画ごとに最も近い良品の区画を探し、その距離を異常の度合いにします。4つ目は知識蒸留型で、良品の画像で「教師」のネットワークの出力をまねるように「生徒」のネットワークを学習させ、生徒が教師をまねできない区画を異常とします。
再構成型の代表はオートエンコーダです。オートエンコーダは、入力を小さな数の並びに縮める部分(符号化器)と、そこから入力を復元する部分(復号器)を組み合わせたニューラルネットワークで、入力そのものを正解として学習させます。良品だけで学習させると、良品の見た目はよく復元できる一方、学習で見たことのない欠陥はうまく復元できず、そこに大きな差が残る、というのが考え方です。Bergmann らの2019年の論文(第14回の国際会議 VISIGRAPP の予稿集に収録)は、外観の欠陥の領域を良品学習で切り出す課題で、画素ごとの差を測る再構成誤差の代わりに、明るさ・コントラスト・構造を局所の領域で比べる指標(SSIM)を損失に使うオートエンコーダを提案しています。この論文は、画素ごとの差では、復元がわずかにずれた輪郭に大きな差が出る一方、明るさがあまり変わらない欠陥を見逃すことがある、と指摘しています。
特徴の分布型の代表は PaDiM です。Defard らの2020年の論文(ICPR 2020 の第1回産業向け機械学習のワークショップに採択)は、事前学習済みの畳み込みニューラルネットワークで区画ごとの特徴を取り出し、良品の区画の特徴を多変量の正規分布(複数の数の組が、平均の周りにどう散らばるかを表す釣り鐘形の分布)で表すことで、異常の検出と位置の特定を同時に行う方法を示しました。近傍型の代表が、この章の題に入れたPatchCoreです。Roth らの2022年の論文(CVPR 2022、予稿集の14318〜14328ページ。CVF Open Access の論文ページ)は、良品の区画の特徴を集めた記憶(メモリバンク。特徴を保存しておく一覧)を作り、検査する画像の区画のうち最も近い良品の区画から最も遠いものの距離を、画像の異常の度合いにする方法を示しました。知識蒸留型の例としては、Bergmann らの2020年の論文(CVPR 2020)があり、自然画像の区画で事前学習した教師のネットワークの出力を、良品の画像だけで複数の生徒のネットワークにまねさせ、生徒の出力が教師から外れる度合いと、生徒どうしのばらつきを異常の度合いにしています。
| 系統 | 代表的な手法(原論文) | 「良品らしさ」の測り方 | 事前学習済みのネットワーク | 外れやすい場面 |
|---|---|---|---|---|
| 再構成型 | オートエンコーダ(SSIM を損失に使う例は Bergmann ら、2019年) | 元の画像と、縮めて戻した画像の差 | 使わない形でも作れる | モデルが欠陥まで復元してしまう場合、薄く広い欠陥、輪郭のわずかなずれ |
| 特徴の分布型 | PaDiM(Defard ら、2020年) | 区画ごとの良品の特徴の分布からの外れ | 使う(原論文) | 位置合わせがずれて区画ごとの分布が崩れる場合 |
| 近傍型 | PatchCore(Roth ら、2022年) | 最も近い良品の区画との距離 | 使う(原論文) | 良品の見た目のばらつきを学習の良品が覆っていない場合 |
| 知識蒸留型 | 教師と生徒のネットワーク(Bergmann ら、2020年) | 生徒が教師の出力をまねできない度合い | 教師に使う(原論文) | 良品の中に教師と生徒の出力が合いにくい模様がある場合 |
表の「外れやすい場面」の列は、各手法の考え方から本コラムが整理したもので、原論文がそれぞれ同じことを書いているわけではありません。表の4つの系統のうち3つは、原論文では大規模な画像で事前学習したネットワークの特徴を使っています。PatchCore の論文も、ImageNet(自然画像を集めた大規模なデータセット)で学習したモデルの特徴と外れ値の検出を組み合わせる方法が当時の高性能な方法だったことを述べたうえで、その流れを発展させたものとして PatchCore を位置づけています。PaDiM や PatchCore では、良品学習の「学習」は、良品の画像でネットワークの重みを学習させることではなく、事前学習済みのネットワークが取り出す特徴の中で、良品の分布や代表の特徴を記録することを指します。一方、再構成型や知識蒸留型では、良品の画像でネットワークの重みを学習させます。
PatchCore の仕組み、原論文で確かめた範囲
PatchCore は後のコードで簡易版を作るので、原論文で確かめた範囲で仕組みを少し詳しく見ておきます。論文の方法は次の4つの段階からなります。
- 区画の特徴を取り出す:ImageNet で学習済みの ResNet 系のネットワーク(論文では WideResNet-50 など。ResNet・WideResNet-50 はネットワークの型の名前で、ここでは ImageNet の画像で学習済みのものを使う)の中間の層(4段のうち2段目と3段目)から特徴の地図を取り出し、各位置の特徴を周りの近い位置の特徴とまとめて、区画ごとの特徴にする
- 記憶を作る:良品の画像のすべての区画の特徴を集めて記憶(メモリバンク)にする
- 記憶を間引く:記憶の中から、全体をなるべく偏りなく覆うように代表の区画を選ぶ(コアセットの抽出。コアセットは、全体の形をよく表す小さな部分集合のこと)。選ぶ計算を速くするために、特徴をランダムな線形の写像(乱数で作った掛け算の表)で少ない数の並びに縮めてから選ぶ
- 判定する:検査する画像の区画ごとに記憶の中で最も近い区画との距離を求め、その最大値をもとに画像の異常の度合いを出す。区画ごとの距離を並べたものを入力の画像の大きさまで拡大し、ぼかしたものを異常の地図にする
1つ目の段階で中間の層を使う理由について、論文は、浅い層の特徴は一般的すぎ、深い層の特徴は ImageNet の分類に偏りすぎるので、その間の層を使う、という考え方を述べています。特徴を周りとまとめるのは、区画が見る範囲を広げつつ、小さな位置のずれに強くするためと説明されています。3つ目の段階の間引き方は、記憶の中から1つずつ、それまでに選んだ区画から最も遠い区画を選んでいく貪欲法の近似です。貪欲法は、その場その場で最も良く見える1つを選び続ける方法です。論文では、記憶を何%まで間引いたかを「PatchCore-1%」のように表しています。4つ目の段階では、最大の距離をそのまま使うより、最も近い区画の周りの記憶の密度に応じて重みを付け直すほうが安定したと書かれています。異常の地図は、双線形の補間(隣り合う値の間を直線でなめらかにつなぐ拡大の方法)で拡大したあと、幅(σ)4のガウス関数(中心ほど重みが大きい釣り鐘形の重み)でぼかしたとされています。
論文は、公開データセットの MVTec AD(公開データセットの詳細は第14章で扱います)で、画像単位の AUROC が最大で99.6%に達したと報告しています。AUROC は、不良の画像と良品の画像を1枚ずつ組にしたとき、不良の画像のほうに高い異常の度合いを付ける割合(同じ値の組は半分の0.5組として数える)で、1に近いほど両者をよく分けられていることを表します(意味と限界は第8章で扱います)。論文の表では、記憶を25%・10%・1%に間引いた場合の画像単位の AUROC が、それぞれ99.1%・99.0%・99.0%でした。記憶を100分の1に間引いても、この公開データセットのこの条件では成績がほとんど落ちなかった、ということです。ただし、これはその公開データセットの撮影条件と欠陥の種類での値で、自社の工程で同じ精度が出ることを示すものではありません。
この章で作る PatchCore 型の簡易版は、上の4つの段階のうち2つ目から4つ目の考え方(区画の記憶・貪欲法による間引き・最も近い区画との距離)だけをなぞったものです。本コラムの簡易版は、1つ目の段階の「大規模な画像で事前学習したネットワークの特徴」を使っていません。本コラムの実行環境では事前学習済みの重みをダウンロードしないので、区画の特徴には、区画の画素の値をそのまま並べたものを使いました。重みの付け直しも省いています。本物の PatchCore は事前学習済みのネットワークが取り出す特徴の上で距離を測り、簡易版は画素の値の上で距離を測るので、何を「近い」とみなすかが違います。本コラムでは本物の PatchCore を実行していないので、後で示す簡易版の結果(とくに弱点)が、そのまま本物の PatchCore に当てはまるとは言えません。
架空の合成画像で2つの方法を作る、オートエンコーダとPatchCore型の簡易版
ここからは、良品学習の2つの方法を実際に動かして比べます。使うのは、numpy で作った架空の合成画像で、第5章の合成画像とは別に作ったものです。第5章とは欠陥の描き方も違い、この章の「異物」は明るい点、「傷」は幅1画素の暗い線、「汚れ」は薄く広い暗いしみです。64画素四方の白黒の画像に、布地の織り目のような周期の模様と、細かいノイズを入れました。模様の位置(位相)と全体の明るさは1枚ごとに少しずつ変え、良品どうしにも小さな違いがあるようにしています。欠陥は、細い暗い線(傷)、小さな明るい点(異物)、薄く広いしみ(汚れ)の3種類で、1枚に1つずつ描き足しました。欠陥を描き足した画素には印(マスク)を付け、後で異常の地図が欠陥の位置を指しているかを確かめるのに使います。実際の製品の画像は、照明のむら・部品の位置ずれ・材料のばらつき・欠陥の形の多様さを含み、この合成画像よりずっと複雑です。この章の結果は、その単純な合成画像での結果です。
画像の枚数は、学習用の良品200枚、しきい値の目安を取るための検証用の良品40枚、評価用の良品60枚、評価用の不良60枚(傷・異物・汚れが20枚ずつ)です。学習には不良を1枚も使いません。この合成画像には判定基準の範囲内の欠陥は作っておらず、欠陥を描いた画像はすべて不良として扱います。乱数のシード(乱数の出方を決める値。同じ値なら毎回同じ乱数が出る)は本コラムの共通の決まりどおり固定しています。
import numpy as np

rng = np.random.default_rng(20261109)
S = 64
yy, xx = np.mgrid[0:S, 0:S].astype(float)


def make_good(n, gain=1.0):
    """良品:織り目のような周期模様+細かいノイズ。位相と明るさは1枚ずつ少し変える"""
    imgs = np.empty((n, S, S))
    for i in range(n):
        px, py, pz = rng.uniform(0, 8, 3)
        b = rng.uniform(0.97, 1.03) * gain
        img = (0.55 + 0.10 * np.sin(2 * np.pi * (xx + px) / 8) * np.sin(2 * np.pi * (yy + py) / 8)
               + 0.04 * np.sin(2 * np.pi * (xx + yy + pz) / 5))
        imgs[i] = img * b + rng.normal(0, 0.03, (S, S))
    return imgs


def add_defect(img, kind, size=None):
    """欠陥を1つ描き足し、欠陥の画素の印(マスク)も返す"""
    out, mask = img.copy(), np.zeros((S, S), bool)
    cy, cx = rng.uniform(12, S - 12, 2)
    if kind == "傷":                                 # 細い暗い線
        ang, half = rng.uniform(0, np.pi), rng.uniform(8, 14)
        t = np.linspace(-half, half, 200)
        ys = np.clip(np.round(cy + t * np.sin(ang)).astype(int), 0, S - 1)
        xs = np.clip(np.round(cx + t * np.cos(ang)).astype(int), 0, S - 1)
        mask[ys, xs] = True
        out[mask] -= 0.25
    if kind == "異物":                               # 小さな明るい点
        r = size if size is not None else rng.uniform(2.0, 3.0)
        mask = (yy - cy) ** 2 + (xx - cx) ** 2 <= r ** 2
        out[mask] += 0.30 if size is None else 0.20
    if kind == "汚れ":                               # 薄く広いしみ
        sg = rng.uniform(4, 6)
        blob = np.exp(-((yy - cy) ** 2 + (xx - cx) ** 2) / (2 * sg ** 2))
        out -= 0.12 * blob
        mask = blob > 0.3
    return out, mask
train = make_good(200)                              # 学習用の良品200枚
val = make_good(40)                                 # しきい値の目安を取る良品40枚
test_good = make_good(60)                           # 評価用の良品60枚
test_bad, masks, kinds = [], [], []
for kind in ["傷", "異物", "汚れ"]:
    for img in make_good(20):
        d, m = add_defect(img, kind)
        test_bad.append(d); masks.append(m); kinds.append(kind)
test_bad, masks, kinds = np.array(test_bad), np.array(masks), np.array(kinds)
print("学習", len(train), "枚/検証", len(val), "枚/評価の良品", len(test_good), "枚/評価の不良", len(test_bad), "枚")
print("欠陥の画素の割合(不良1枚あたりの平均)", round(masks.mean() * 100, 2), "%")
実行した結果、不良1枚あたりで欠陥の印が付いた画素は、平均で画像全体の1.8%でした。欠陥は画像のごく一部にしかありません。汚れの印は、しみの濃さが最も濃い所の3割以上の範囲に付けています。
1つ目の方法は、小さな畳み込みオートエンコーダの再構成誤差を使う方法です。torch(本コラムでは2.13.0 の CPU 版で実行)で定義した小さな畳み込みオートエンコーダです。符号化器は、畳み込みの層を3つ重ねて、64画素四方の画像を8画素四方・8枚の特徴の地図(合わせて512個の数)に縮めます。復号器は、その逆の操作で64画素四方の画像に戻します。入力は4,096個の画素の値なので、真ん中の通り道は入力の8分の1の大きさです。通り道を狭くするのは、良品に共通する模様だけを覚えさせ、一枚ごとの細かい違い(欠陥を含む)を通しにくくするためです。良品200枚を20枚ずつに分け、元の画像と戻した画像の画素ごとの差の2乗の平均(再構成誤差)が小さくなるように、60回くり返して学習させました。
import torch
import torch.nn as nn

torch.manual_seed(20261109)
torch.set_num_threads(4)


class AE(nn.Module):
    def __init__(self):
        super().__init__()
        self.enc = nn.Sequential(                    # 64→32→16→8 画素と小さくしていく
            nn.Conv2d(1, 16, 4, 2, 1), nn.ReLU(),
            nn.Conv2d(16, 32, 4, 2, 1), nn.ReLU(),
            nn.Conv2d(32, 8, 4, 2, 1), nn.ReLU())    # ここが狭い通り道(8×8×8=512個の数)
        self.dec = nn.Sequential(                    # 8→16→32→64 画素に戻す
            nn.ConvTranspose2d(8, 32, 4, 2, 1), nn.ReLU(),
            nn.ConvTranspose2d(32, 16, 4, 2, 1), nn.ReLU(),
            nn.ConvTranspose2d(16, 1, 4, 2, 1))

    def forward(self, x):
        return self.dec(self.enc(x))


def to_t(a):
    return torch.tensor(a, dtype=torch.float32).unsqueeze(1)


ae = AE()
opt = torch.optim.Adam(ae.parameters(), lr=2e-3)
xt = to_t(train)
for ep in range(60):
    perm = torch.randperm(len(xt))
    for k in range(0, len(xt), 20):
        b = xt[perm[k:k + 20]]
        loss = ((ae(b) - b) ** 2).mean()
        opt.zero_grad(); loss.backward(); opt.step()
    if ep % 20 == 19:
        print("エポック", ep + 1, "再構成誤差", round(loss.item(), 5))
学習中の再構成誤差は、20回目で0.00435、40回目で0.00311、60回目で0.0028でした(最後の20枚の組での値)。学習が終わったら、評価する画像を通して戻した画像との差の2乗を画素ごとに求め、少しぼかして(ガウス関数の幅2画素)異常の地図にします。画像1枚の異常の度合いは、その地図の最大値にしました。この地図を作る関数(ae_maps)は、後の評価のコードの先頭で定義しています。
2つ目の方法は、PatchCore の考え方をなぞった簡易版で、区画を記憶する方法です。画像を8画素四方の区画に切り分けます。区画は2画素ずつずらして切り出すので、1枚から縦横29個ずつ、合わせて841個の区画ができます。前に書いたとおり、本コラムでは事前学習済みのネットワークを使わないので、区画の特徴は、区画の64個の画素の値をそのまま並べたものです。
良品200枚から取り出した168,200個の区画を、そのまま全部記憶すると、検査のたびに比べる相手が多くなります。そこで、無作為に選んだ20,000個の候補から、互いに遠い区画を順に選ぶ貪欲法で2,000個を選び、これを記憶にしました(もとの区画の約1.2%)。選ぶ計算だけは、原論文にならって、特徴をランダムな線形の写像で16次元に縮めてから行っています。検査では、評価する画像の841個の区画それぞれについて、記憶の2,000個の中で最も近い区画との距離を求めます。各区画の距離を、その区画が覆う8画素四方の画素に配り、複数の区画が重なる画素では平均を取って、64画素四方の異常の地図にしました。区画の位置と画素の位置がずれないようにするためです。画像の異常の度合いは地図の最大値にしました。
P, STEP = 8, 2                                       # 8×8画素の区画を2画素ずつずらして切り出す
G = (S - P) // STEP + 1                              # 縦横29個ずつの区画


def patches(imgs):
    t = torch.tensor(imgs, dtype=torch.float32).unsqueeze(1)
    u = nn.functional.unfold(t, P, stride=STEP)      # (枚数, 64, 841)
    return u.transpose(1, 2)                         # (枚数, 841, 64):区画ごとに64個の画素値が特徴


bank_all = patches(train).reshape(-1, P * P)         # 良品200枚×841区画
g = torch.Generator().manual_seed(20261109)
pool = bank_all[torch.randperm(len(bank_all), generator=g)[:20000]]
proj = torch.randn(P * P, 16, generator=g) / 4       # 選ぶときだけ16次元に縮めて速くする
pz = pool @ proj
sel = [0]
dmin = torch.cdist(pz, pz[:1]).squeeze(1)
for _ in range(1999):                                # 互いに遠い区画から順に選ぶ(貪欲法)
    j = int(torch.argmax(dmin))
    sel.append(j)
    dmin = torch.minimum(dmin, torch.cdist(pz, pz[j:j + 1]).squeeze(1))
bank = pool[sel]                                     # 記憶する良品の区画2,000個
print("記憶した区画", len(bank), "個(候補", len(bank_all), "個から)")


def pc_maps(imgs):
    f = patches(imgs)
    d = torch.stack([torch.cdist(fi, bank).min(dim=1).values for fi in f])   # (枚数, 841)
    cols = d.unsqueeze(1).repeat(1, P * P, 1)        # 区画の距離を、その区画の64画素に配る
    num = nn.functional.fold(cols, (S, S), P, stride=STEP)
    den = nn.functional.fold(torch.ones_like(cols), (S, S), P, stride=STEP)
    return (num / den).squeeze(1).numpy(), d.reshape(len(imgs), G, G).numpy()   # 重なった区画は平均
2つの方法の結果、汚れの見え方が大きく違った
同じ評価用の画像(良品60枚・不良60枚)で2つの方法を比べました。評価には、前に説明した画像単位の AUROC(不良の画像と良品の画像を1枚ずつ組にしたとき、不良の画像のほうに高い異常の度合いを付ける割合。同じ値の組は0.5組として数える)と、画素単位の AUROC(不良60枚の全画素について、欠陥の印のある画素に高い値を付けているか)を使いました。あわせて、検証用の良品40枚の異常の度合いの99%点を「目安のしきい値」とし、これを超えた画像の枚数も数えました。40枚しかないので、この99%点は事実上40枚の中の最大値に近い値です。しきい値の本来の決め方は第8章で扱うので、ここでの99%点は2つの方法を同じ物差しで見るための仮の値です。次のコードの先頭では、オートエンコーダの異常の地図を作る関数も定義しています。
from scipy import ndimage


def ae_maps(imgs):
    with torch.no_grad():
        rec = ae(to_t(imgs)).squeeze(1).numpy()
    err = (imgs - rec) ** 2
    return np.array([ndimage.gaussian_filter(e, 2) for e in err]), rec


from sklearn.metrics import roc_auc_score


def score_all(fn):
    out = {}
    for name, imgs in [("val", val), ("good", test_good), ("bad", test_bad)]:
        mp = fn(imgs)[0]
        out[name] = (mp.reshape(len(imgs), -1).max(axis=1), mp)
    return out


res = {"オートエンコーダ": score_all(ae_maps), "PatchCore型の簡易版": score_all(pc_maps)}
for meth, r in res.items():
    sg, sb = r["good"][0], r["bad"][0]
    lim = np.quantile(r["val"][0], 0.99)             # 検証用の良品の99%点(目安のしきい値)
    print("==", meth)
    print("  画像単位のAUROC(全欠陥)", round(roc_auc_score(np.r_[np.zeros(60), np.ones(60)], np.r_[sg, sb]), 3))
    for kind in ["傷", "異物", "汚れ"]:
        k = kinds == kind
        auc = roc_auc_score(np.r_[np.zeros(60), np.ones(k.sum())], np.r_[sg, sb[k]])
        print("  ", kind, "AUROC", round(auc, 3), "目安を超えた枚数", int((sb[k] > lim).sum()), "/", int(k.sum()))
    print("  良品で目安を超えた枚数", int((sg > lim).sum()), "/ 60")
    pix = roc_auc_score(masks.ravel(), r["bad"][1].ravel())
    print("  画素単位のAUROC(不良60枚)", round(pix, 3))
    for kind in ["傷", "異物", "汚れ"]:
        k = kinds == kind
        print("   ", kind, "画素単位のAUROC", round(roc_auc_score(masks[k].ravel(), r["bad"][1][k].ravel()), 3))
実行した結果を次の表にまとめました。
| 評価の項目 | オートエンコーダ | PatchCore型の簡易版 |
|---|---|---|
| 画像単位の AUROC(不良60枚すべて) | 0.861 | 1.0 |
| 画像単位の AUROC(傷20枚) | 0.993 | 1.0 |
| 画像単位の AUROC(異物20枚) | 1.0 | 1.0 |
| 画像単位の AUROC(汚れ20枚) | 0.591 | 1.0 |
| 目安のしきい値を超えた不良(傷・異物・汚れ) | 18枚・20枚・0枚(各20枚中) | 20枚・20枚・20枚(各20枚中) |
| 目安のしきい値を超えた良品(60枚中) | 1枚 | 0枚 |
| 画素単位の AUROC(不良60枚) | 0.856 | 0.979 |
| 画素単位の AUROC(傷・異物・汚れ、各20枚) | 0.995・1.0・0.874 | 0.992・0.999・0.998 |
オートエンコーダは、傷と異物はよく見分けた一方で、汚れの AUROC は0.591で、良品と見分けがほとんど付いていません。目安のしきい値を超えた汚れは20枚中0枚でした。下の図の左の散布図でも、汚れの異常の度合いは良品とほぼ同じ高さに並んでいます。汚れは、薄く広いしみで、周りとの明るさの差がゆるやかです。オートエンコーダが汚れのしみまである程度戻してしまい、元の画像と戻した画像の差が小さくなった可能性がありますが、本コラムでは戻した画像の中身までは調べていないので、理由は確かめていません。Bergmann らの2019年の論文が指摘した「明るさがあまり変わらない欠陥を、画素ごとの差では見逃すことがある」という弱点と同じ向きの結果です。ただし、本コラムではその論文が提案した SSIM の損失は試していないので、SSIM で汚れが見えるようになるかは確かめていません。
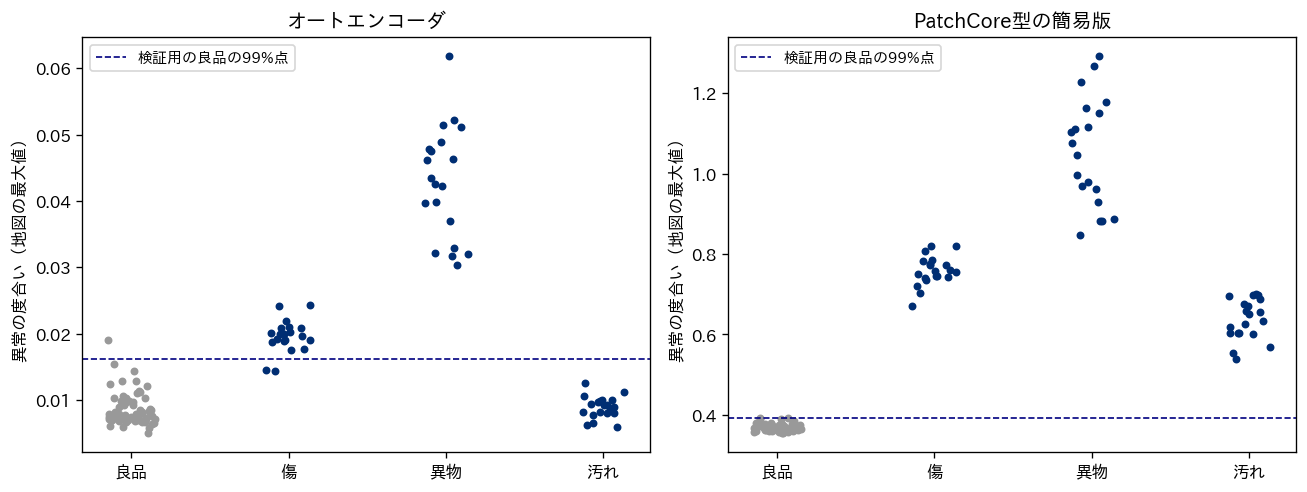
PatchCore 型の簡易版は、この評価用の画像では3種類の欠陥をすべて良品と分けました。考えられる理由は、汚れで暗くなった区画の画素の値が、記憶した良品のどの区画とも離れていたことですが、本コラムでは区画ごとの距離の中身までは調べておらず、確かめていません。しかし、この「すべて分けた」という結果を、PatchCore 型が優れている証拠として読むのは早すぎます。合成画像の良品は、明るさのばらつきを±3%に抑えた、非常にそろった画像です。画素の値で距離を測る簡易版は、良品がそろっているほど小さな違いにも敏感になる可能性があります。次の節の照明の変化の結果は、この見方と矛盾しませんが、原因は確かめていません。
異常の地図を並べたのが次の図です。1段目が入力の画像、2段目が欠陥の印(正解)、3段目と4段目が2つの方法の異常の地図で、色が濃いほど異常の度合いが高い所です。地図の色の濃さの基準は方法ごとに別にしているので、方法の間で濃さそのものは比べられません。オートエンコーダの地図は、傷と異物の位置をくっきり示す一方、汚れの位置はうっすらとしか示していません。また、良品の画像でも、織り目に沿った斜めの縞が薄く出ています。欠陥の無い所でも、模様に沿って再構成誤差が残っているということです。PatchCore 型の簡易版の地図は、区画の大きさ(8画素)の分だけ広がり、欠陥より太めに出ます。画素単位の AUROC を欠陥の種類ごとに分けると、傷(0.995と0.992)と異物(1.0と0.999)ではほとんど差が無く、汚れ(0.874と0.998)で差が開きました。全体の差(0.856と0.979)は、この合成画像では汚れの位置の示し方の違いから来ている部分が大きいと読めます。
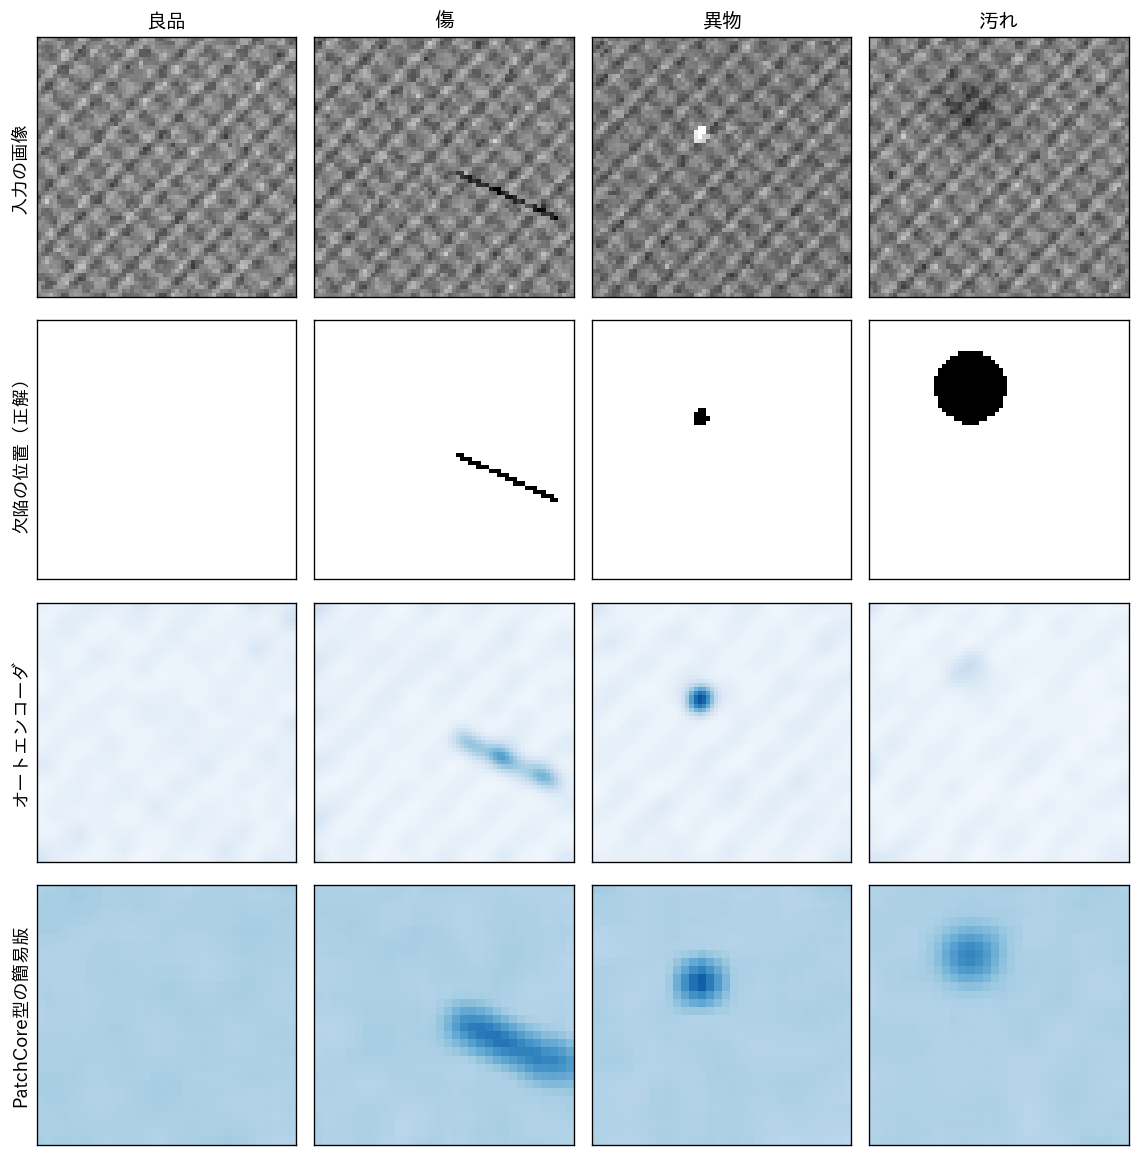
この地図は、第10章で扱う判定の根拠の示し方の材料になります。良品学習は欠陥の種類を答えませんが、どこが良品らしくないかは地図で示せます。検査員が地図を見て「この位置のこの見た目なら判定基準の範囲内」と判断できれば、人が最終の判定を下す運用の中で使えます。
良品学習が外れやすい場面、照明の変化・小さな欠陥・論理的な異常
次に、良品学習にとって条件が厳しくなりそうな状況として、「良品の見た目が変わったとき」と「欠陥が小さいとき」の2つを、本コラムの合成画像で作って確かめました。1つ目は、照明が10%明るくなった状況で、欠陥の無い良品を40枚作りました。2つ目は、小さな異物で、半径1.0・1.5・2.0・3.0画素の明るい点(明るさの差は前の異物より小さい0.20)を30枚ずつ作りました。どちらも、しきい値の目安は前の節と同じ検証用の良品の99%点を使っています。
bright = make_good(40, gain=1.10)                    # 照明が10%明るくなった良品
small = {}
for r_ in [1.0, 1.5, 2.0, 3.0]:
    small[r_] = np.array([add_defect(img, "異物", size=r_)[0] for img in make_good(30)])
for meth, fn in [("オートエンコーダ", ae_maps), ("PatchCore型の簡易版", pc_maps)]:
    lim = np.quantile(res[meth]["val"][0], 0.99)
    sb_ = fn(bright)[0].reshape(40, -1).max(axis=1)
    print("==", meth, "明るい良品で目安を超えた枚数", int((sb_ > lim).sum()), "/ 40")
    sg = res[meth]["good"][0]
    for r_, imgs in small.items():
        s_ = fn(imgs)[0].reshape(30, -1).max(axis=1)
        auc = roc_auc_score(np.r_[np.zeros(60), np.ones(30)], np.r_[sg, s_])
        print("   異物の半径", r_, "画素 AUROC", round(auc, 3), "目安を超えた枚数", int((s_ > lim).sum()), "/ 30")
| 状況 | オートエンコーダ | PatchCore型の簡易版 |
|---|---|---|
| 照明が10%明るい良品で目安を超えた枚数(40枚中) | 4枚 | 40枚 |
| 半径1.0画素の異物(AUROC、目安を超えた枚数/30枚) | 0.549、0枚 | 0.993、27枚 |
| 半径1.5画素の異物 | 0.829、1枚 | 1.0、30枚 |
| 半径2.0画素の異物 | 0.956、13枚 | 1.0、30枚 |
| 半径3.0画素の異物 | 1.0、30枚 | 1.0、30枚 |
照明が10%明るくなっただけで、PatchCore 型の簡易版は良品40枚のすべてを異常と判定しました。欠陥は1つも無いので、これはすべて過検出です。考えられる理由は、画素の値をそのまま特徴にしているため、全体が明るくなるとどの区画も記憶の良品から離れることですが、区画ごとの距離までは調べておらず、本コラムでは確かめていません。オートエンコーダは40枚中4枚(10%)でした。照明が変わらない評価用の良品では60枚中1枚(約1.7%)だったので、オートエンコーダでも過検出は増えています。簡易版の40枚すべてと比べれば少ない、というのがこの結果の正確な読み方で、オートエンコーダが照明の変化に強いとまでは言えません。まとめると、オートエンコーダは簡易版より照明の変化の影響が小さかったものの、照明が変わらないときより過検出は増えました。この結果が、オートエンコーダが汚れを見分けにくかったことと同じ原因によるものかは、確かめていません。
小さな異物では、逆の結果になりました。オートエンコーダは半径1.0画素の異物を良品とほとんど見分けられず(AUROC 0.549)、半径2.0画素でも目安を超えたのは30枚中13枚でした。簡易版は半径1.0画素でも30枚中27枚が目安を超えています。コードの上では、オートエンコーダの地図は幅2画素のぼかしをかけているので、1〜2画素の小さな差は周りと平均されて薄まります。簡易版は区画の64個の画素の値で距離を測るので、1つの画素の違いもそのまま距離に入ります。簡易版の小さな点への敏感さも、照明の10%の変化で全数を過検出したことも、画素の値の違いへの敏感さによると考えられますが、本コラムでは確かめていません。
この2つの結果から言えるのは、どちらの方法が優れているかではなく、「何に敏感で、何に鈍いか」が方法によって違い、その違いが過検出と見逃しの配分を決める、ということです。本物の PatchCore は事前学習済みのネットワークの特徴を使い、原論文は特徴を周りとまとめることで小さな位置のずれに強くすると説明していますが、照明の変化への強さは本コラムでは確かめていません。どの方法を使う場合でも、自社の撮像の条件で起こりうる変化(照明の劣化・季節による周りの明るさ・材料のロットの違い)を含めた良品の画像で、過検出がどれだけ出るかを確かめる必要があります。照明の劣化などの本番での変化の監視は第12章で、撮像の条件の固定と記録は第3章で扱っています。
ここまでの実行結果と手法の考え方から、良品学習が外れやすい場面を3つに整理します。1つ目は、良品の見た目のばらつきが大きい場面です。良品学習は「学習した良品と違う」ものを異常とするので、学習の良品が本番の良品のばらつきを十分に覆っていなければ、覆っていない良品を異常と判定し、過検出が増えるおそれがあります。この章の実験で、照明が10%明るくなっただけで簡易版が良品40枚すべてを異常とした結果がその例です。照明の劣化、材料のロットによる色の違い、季節による周りの明るさ、部品の置き方のわずかなずれは、本番では避けられません。学習用の良品は、短い期間に1つのロットから集めるのではなく、こうした変動を含むように期間・ロット・ラインをまたいで集める必要があります。
2つ目は、欠陥が小さい、あるいは良品との違いが薄い場面です。この章のオートエンコーダは、半径1画素の異物と、薄く広い汚れを、良品とほとんど見分けられませんでした。この章のコードでも PatchCore の原論文でも、画像の異常の度合いは地図の最大値をもとに決めています。この決め方では、欠陥が作る値が、良品のふだんのばらつきが作る値より大きくならない限り、良品と見分けられません。この章では撮像を変える実験はしておらず、同じ半径1画素の異物を簡易版は見分けているので、この章の結果だけから「撮像が先」とは言えません。そのうえで、第3章で扱う考え方として、手法を替える前に撮像を確かめることが有効だと考えています。欠陥が画像の上で何画素の大きさに写り、周りとどれだけ明るさが違うかは、カメラ・レンズ・照明で決まります(第3章)。写り方が足りない欠陥を、しきい値を下げるなどモデルの側の工夫で拾おうとすると、良品のばらつきまで拾って過検出が増えるおそれがあります。
3つ目は、一つ一つの部分は良品と同じ見た目なのに、組み合わせや数や配置が違う場面です。部品が1つ足りない、向きが逆、ラベルの位置が入れ替わっている、といった異常で、本コラムではこれを論理的な異常と呼びます。この章の簡易版のように、位置を区別せずに良品の区画と照らし合わせる方法では、区画そのものが良品と同じ見た目なら、数や配置の違いを捉えにくくなります。PaDiM は区画の位置ごとに良品の分布を作るので、別の位置では普通の見た目でもその位置では異常になる場合があり、この点の扱いは方法によって違います。この章の簡易版も、区画を1つずつ記憶の区画と比べるだけなので、区画の並び方の違いは測っていません。部品の有無や数や位置が判定の中心になる検査では、良品学習だけに頼らず、ルールベースの画像処理の計測(第4章)や物体検出(第5章)と組み合わせるほうが確かめやすいと考えています。良品学習の研究で使われる公開データセットは第14章で扱います。
| 外れやすい場面 | 本コラムの実行結果で見えたこと | まず確かめること | 組み合わせる手段 |
|---|---|---|---|
| 良品の見た目のばらつきが大きい | 照明が10%明るい良品で、簡易版は40枚すべてを異常とした | 学習の良品が、期間・ロット・ライン・撮像の条件の変動を含んでいるか | 撮像の条件の固定(第3章)、変化の監視と再学習(第12章) |
| 欠陥が小さい、薄い | オートエンコーダは半径1画素の異物と薄い汚れを見分けにくかった | 欠陥が画像の上で何画素に写り、周りとどれだけ違うか | 分解能・照明の見直し(第3章)、教師あり学習(第5章) |
| 論理的な異常(数・配置・組み合わせ) | この章では試していない | 判定基準が「見た目」か「数・位置」か | ルールベースの計測(第4章)、物体検出(第5章) |
良品学習の出力を判定につなげる、しきい値・保留・教師あり学習との分担
良品学習のモデルが出すのは、異常の度合いという1つの数と、その地図です。これを検査の判定(良品として流す・不良として止める)にするには、しきい値を決める必要があります。この章では検証用の良品の99%点を仮の目安にしましたが、本来は、見逃し率の上限を品質保証と決めたうえで、過検出がどれだけ出るかを見て決めます。その決め方と、評価に使う不良の数の考え方は第8章で扱います。
良品学習は、教師あり学習と比べて「欠陥の種類が分からない」「異常であっても不良とは限らない」という2つの性質を持つので、判定を1本のしきい値で決めきらず、迷う範囲を人に回す設計と相性が良いと考えています。異常の度合いが十分に低いものは良品として流し、十分に高いものは止め、その間は判定を保留して検査員が地図を見て決める、という形です。ただし、これは品質保証が承認した検査の手順の範囲で、異常の度合いを工程内の振り分けに使う場合の話です。異常の度合いが低いことだけで出荷してよいとは判断せず、法令・顧客との取り決め・業界の規格で必要な検査と判定は別に行います。保留の幅の決め方は第10章で扱います。保留で人が判断した結果(この異常は判定基準の範囲内だった、この異常は不良だった)を記録していけば、不良画像が少しずつたまり、やがて種類ごとの教師あり学習に移れるようになります。
良品学習と教師あり学習の分担の例を、次の表にまとめました。どの組み合わせにするかは、欠陥の種類ごとの不良画像の集まり方と、欠陥の種類によって処置が変わるかどうかで決まります。
| 段階 | 良品学習の役割 | 教師あり学習の役割 | 人の役割 |
|---|---|---|---|
| 立ち上げ(不良画像がほとんど無い) | いつもと違うものを拾い、止めるか保留にする | 使わない | 保留を判定し、結果と画像を記録する |
| 不良画像がたまり始めた | 引き続き、いつもと違うものを拾う | 画像が十分にたまった欠陥の種類だけ、種類を判別する | 保留と、種類が判別できなかったものを判定する |
| 主な欠陥の種類で画像がそろった | 学習に無い新しい欠陥を拾う見張りとして残す | 主な欠陥の種類を判別し、処置を分ける | 新しい欠陥と保留を判定し、判定基準を更新する |
表の3段目で良品学習を残しているのは、教師あり学習は学習した欠陥の種類のどれかにしか答えられないからです(第5章)。これまでに出たことのない欠陥が来たとき、教師あり学習は最も近い種類に当てはめるか、良品と答えてしまうことがあります。良品学習を見張りとして並べておけば、「どの種類にも当てはまらないが、いつもとは違う」ものを人に回せます。
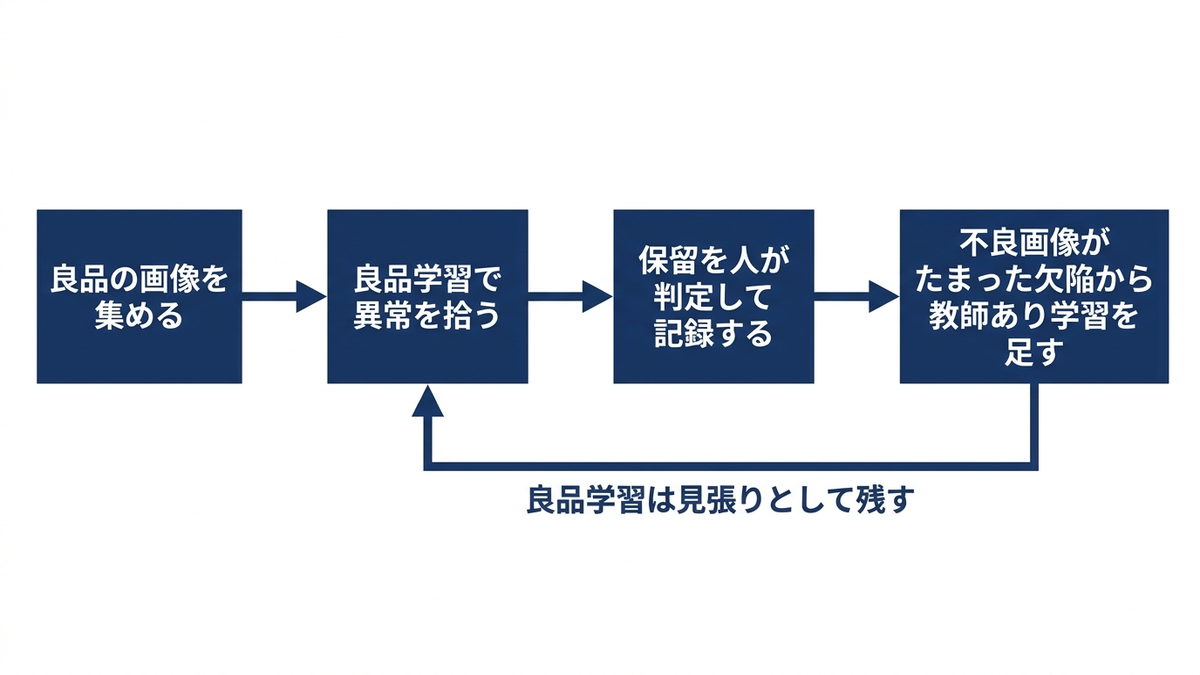
オープンソースの実装、Anomalib を公式で確かめた範囲
本物の PatchCore や PaDiM を自社の画像で試すときには、論文の著者や研究機関が公開している実装を使うのが一般的です。その1つが Anomalib で、異常検知の手法を集めた深層学習のライブラリです。2026年11月9日に GitHub の公式のリポジトリを確かめた時点で、リポジトリは open-edge-platform の組織の下にあり(以前の openvinotoolkit の組織の住所を開くと、こちらへ転送されます)、ライセンスは Apache License 2.0 でした。最新のリリースは2026年10月6日公開の v2.7.0 です(Anomalib の公式リポジトリ)。README は、最新の異常検知の手法を集め、比較・開発・実装に使えるようにすることを目的に掲げ、手法の実装が PyTorch Lightning(PyTorch で学習の手順を整理するためのライブラリ)を土台にしていること、多くのモデルを OpenVINO(Intel の推論の高速化の道具)の形式に書き出せることを書いています。README の使用例には、Patchcore・Padim・Stfpm といった手法の名前が出てきます。
v2.7.0 のリリースノートには、CPU 用などの導入の指定で必要な PyTorch の版を2.10以上、torchvision を0.25以上に引き上げたことが書かれています。本コラムの実行環境には torchvision が入っていないので、Anomalib は導入も実行もしていません。ここに書いたのは公式のリポジトリとリリースノートを開いて確かめた範囲です。Anomalib を紹介した論文として、Akcay らの2022年の論文があり、README の引用の欄では IEEE の画像処理の国際会議(ICIP 2022)の予稿集の1706〜1710ページとされています。
オープンソースの実装を使うときに確かめておきたいのは、次の点です。
- ライブラリのライセンスと、そこから読み込む事前学習済みの重みのライセンス(重みは別の条件で配布されていることがある)
- 使う版の固定(版が上がると、既定の設定や書き出しの方法が変わることがある。v2.7.0 でも古い書き出しの方法が取り除かれている)
- 評価の指標の定義(同じ名前の指標でも、版によって計算の仕方が直されることがある。v2.7.0 のリリースノートにも指標の計算の修正が載っている)
- ライン側の計算機で動かす形式への書き出しと、その推論時間(第9章)
事前学習済みの重みの利用条件は、ライブラリのライセンスとは別に、重みの配布元ごとに確かめる必要があります。本コラムでは個々の重みの利用条件は確かめていません。商用の検査装置に組み込む前に、法務・知的財産の担当と利用条件を確かめておく必要があります。AIの利用に関する社内ルールの作り方は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
経営の判断、良品の画像を集める仕組みから始める
良品学習は不良画像を必要としない代わりに、良品の画像の質がそのまま結果を決めます。学習用の良品に、気づかないうちに不良が混ざっていれば、モデルが混ざった不良の特徴を「いつもの見た目」として取り込み、同じ種類の欠陥を見逃すおそれがあります。逆に、良品の選び方が限度見本より厳しすぎれば、判定基準の範囲内の欠陥まで異常として拾い、過検出が増えます。学習用の良品は、ラインから流れてきた画像を無差別に使うのではなく、判定基準(第2章)に照らして良品と判定されたものから選ぶ必要があります。
良品の画像を集める仕組みとしては、次のような項目を最初に決めておくのがよいと考えています。
- どの工程のどのカメラの画像を残すか
- 画像ごとに、撮像の条件(照明の強さ・露光時間・位置決め)をどう記録するか
- その画像が良品と判定された根拠(目視検査の結果、後工程の検査の結果、出荷後の不具合の有無)をどう結びつけるか
- 期間・ロット・ライン・品種をまたいで、どれだけの枚数を学習用に取り分けるか
- 学習に使った画像の一覧と、その時点の撮像の条件とモデルの版を、後から追える形で残すか
- 学習用・しきい値を決める検証用・評価用の画像を、日付やロットで分けて混ぜないようにするか
この章のコードでも、学習用の良品200枚、しきい値の目安を取る検証用の良品40枚、評価用の良品60枚を別々に作りました。同じ良品を学習としきい値の決定の両方に使うと、学習した画像には異常の度合いが低く出やすいので、しきい値が低くなりすぎ、本番で過検出が増えるおそれがあります。本コラムではこの比較は試していません。しきい値を決めるデータと評価のデータの分け方は第8章で、記録の項目とトレーサビリティは第11章で扱います。データの管理を組織として行う考え方は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。
良品学習の導入で経営が決めることは、手法の選択よりも先に、良品の画像を集めて管理する仕組みに予算と人を付けるかどうかだと考えています。良品学習は不良画像を待たずに始められる点が利点ですが、その利点は、判定済みの良品の画像が、撮像の条件の記録とともに十分な期間・ロットにわたって集まっていることが前提です。この前提が欠けたまま試験導入(PoC)を行うと、短い期間の良品で学習したモデルが、PoC の期間中はよく当たり、本番で照明やロットが変わった途端に過検出を出す、という形になりやすいと考えています。
判断を誤ったときの損失を、本コラムで使う6つの損失の型に当てはめると次のようになります。
| 判断の誤り | 起こる損失の型 | 線引きの考え方 |
|---|---|---|
| 学習用の良品が本番の変動を含んでいない | 過検出、形骸化(過検出が続き、人が全数を見直すようになる) | 期間・ロット・撮像の条件をまたいで良品を集め、変動を含む良品で過検出を確かめてから本番に入れる |
| 学習用の良品に不良が混ざっている | 流出 | 判定基準に照らして良品と判定されたものだけを学習に使い、その根拠を残す |
| 写りの悪い欠陥をモデルの工夫で拾おうとする | 過検出、タクトの超過(重いモデルや多重の処理で検査が遅れる) | 先に撮像を見直し、欠陥が写る条件を作る(第3章) |
| 良品学習の異常をそのまま不良とみなす | 過検出、判定のばらつき(異常と判定基準の関係が人によって解釈される) | 保留の範囲を設け、品質保証の体制で承認された判定基準に従って、権限を持つ検査員が判定する |
| 工程ごとに別々の良品画像の集め方・モデルを作る | 二重投資 | 画像の保存・記録の項目・撮像の条件の記録を工程の間でそろえる |
予算の面では、モデルを作る費用だけでなく、良品の画像の保存と選別、撮像の条件の記録、保留を判定する検査員の時間を、運用の費用として最初から見込んでおく必要があります。出荷の可否の最終的な責任は品質保証の体制にあり、良品学習のモデルはその判断の材料をそろえる道具です。法令や顧客との取り決めで方法が定められた検査は、その定めに従って行います。良品学習で置き換えられるかどうかは、その定めの側で決まるもので、モデルの成績だけで決めることはできません。良品学習のモデルを入れる場合も、その位置づけ(どの検査の、どの判断の材料にするか)を品質保証の手順の中で決めてから入れるのが適切だと考えています。
この章では、良品の画像だけから「いつもの見た目」を学ぶ良品学習を、再構成型・特徴の分布型・近傍型・知識蒸留型の4つの系統に分けて整理し、オートエンコーダと PatchCore 型の簡易版を合成画像で比べました。本コラムの架空の合成画像では、オートエンコーダは傷と異物をよく見分けた一方で薄く広い汚れと半径1画素の異物をほとんど見分けられず、画素の値を特徴にした簡易版は3種類の欠陥をすべて見分けた一方で、照明が10%明るくなった良品40枚をすべて異常としました。どちらが優れているかではなく、何に敏感で何に鈍いかが方法によって違い、それが見逃しと過検出の配分を決める、というのがこの章の結果です。本物の PatchCore は事前学習済みのネットワークの特徴を使うので、簡易版の結果はそのまま当てはまりません。良品学習を入れるときは、判定済みの良品の画像を、本番の変動を含めて集める仕組みから始め、異常の度合いを保留と人の判定につなげるのが現実的だと考えています。次の第7章では、不良画像が少ないときに教師あり学習を助ける、データ拡張・転移学習・合成データを扱います。
この章を深めたい方への参考書籍
『Pythonによる異常検知』(曽我部東馬 著、曽我部完 監修、オーム社):機械学習による異常検知の仕組みを誤差関数を軸に解説した入門書で、版元の目次によれば、非時系列データの異常検知の章でオートエンコーダを、深層学習による異常検知の章で anoGAN や表面の検査などの応用事例を扱っています。この章の再構成型の考え方を、コードを動かしながら確かめるのに向いています。
『まるごと学べる異常検知の実践知』(中村謙太 著、技術評論社):異常検知の理論と実装を、教師あり学習・教師なし学習・統計モデリングの手法に分けて整理し、その使い分けを解説した本です(2025年刊)。版元の目次の章立ては1変数・計数・多変数などのデータの種類ごとの手法で、画像に特化した章はありませんが、前処理と性能評価の章を含み、良品学習と教師あり学習のどちらを使うかを考える手がかりになります。
第7章 少ないデータで学ぶ工夫、データ拡張・転移学習・合成データ
第5章では、良品と不良のラベルが付いた画像から小さな畳み込みニューラルネットワークを学習させる教師あり学習を、第6章では良品の画像だけから「いつもの見た目」を学ぶ良品学習を扱いました。どちらの方法も、学習に使う画像の量と、その画像が本番のラインの見え方をどれだけ含んでいるかに結果が左右されます。製造の現場では、不良は少なく、品種は多く、新製品は立ち上げの時点で画像が無いので、学習用の画像が足りない状態から始まることが多いと考えています。この章では、少ない画像で学ぶための工夫のうち、中心になる次の3つを扱います。あわせて、関連する2つの考え方(自己教師あり学習と少数事例の学習)も後半で短く整理します。
- 手元の画像を加工して学習用の画像を増やすデータ拡張
- 別の大きなデータで学習済みのモデルを出発点にする転移学習
- 欠陥を描き足すなどして画像そのものを作る合成データ
前半では、架空の合成画像を使って、各クラス20枚という少ない学習データに対して、データ拡張の有無で小さな畳み込みニューラルネットワークの成績がどう変わるかを、シード(乱数の出し方を決める番号)を変えて5回くり返した実行結果で示します。同じ設定でも乱数によって結果が変わるので、5回の平均と幅で読むためです。続いて、別の品目の画像で事前に学習させたモデルを出発点にする実験と、欠陥を描き足した画像を足す実験も、同じ架空の画像で行います。後半では、事前学習・自己教師あり学習・少数事例の学習・合成データの考え方を原論文で確かめた範囲で整理し、最後にデータを集める仕組みと経営の判断を扱います。この章の主張は、本コラムの架空データでは、データを増やす工夫は本番の画像で起きる変動を再現する加工のときに大きく効き、再現できない部分は残った、という点です。データ拡張には学習データへの過剰な当てはまりを抑える働きもあり、本番の変動を再現することだけが効く条件ではありません。どの加工が妥当かは、本番を代表する評価用の画像で確かめる必要があると考えています。
なぜ外観検査では学習用の画像が足りなくなるのか
外観検査で学習用の画像が足りなくなる理由は、大きく3つに分けられます。1つ目は、不良そのものが少ないことです。工程が安定しているラインほど不良の発生は少なく、ある欠陥の種類の画像が1か月に数枚しか集まらないこともあります。教師あり学習は欠陥の種類ごとに画像が要るので、発生の少ない欠陥ほど学習用の画像がそろいません。2つ目は、品種が多いことです。同じラインで形や色の違う品種を作り分けている場合、品種ごとに良品の見た目が違うので、品種ごとに学習用の画像を集めると、1品種あたりの枚数は少なくなります。3つ目は、新製品の立ち上げです。量産が始まる前には、その製品の良品の画像も不良の画像もほとんどありません。
枚数が足りないことに加えて、もう1つの問題があります。少ない画像は、本番のラインで起きる見た目の変動を含んでいないことが多い、という問題です。たとえば、立ち上げの数日に集めた画像は、その数日の照明の明るさ・材料のロット・カメラの位置で撮られています。本番では、照明の劣化や周囲の明るさの変化、材料のロットの切り替え、搬送のずれによる製品の向きや位置の違いが加わります。学習用の画像がこうした変動を含んでいなければ、学習したモデルは、学習用と同じ条件の評価では高い成績を出しても、本番では外れることがあります。撮像の条件の固定は第3章、本番で起きる変化の監視は第12章で扱いますが、この章で扱う工夫は、どれも「本番の変動をどこまで学習の段階で含められるか」という問いへの答え方の違いとして読むことができます。
この章で扱う中心の3つの工夫と、関連する2つの考え方について、それぞれが補うものを先に表にまとめておきます。
| 工夫 | 何を補うか | 要るもの | 外れやすい場面 |
|---|---|---|---|
| データ拡張 | 手元の画像にない向き・明るさ・位置などの変動 | 本番でどんな変動が起きるかの知識と、少数の実画像 | 本番に無い変動を加えたとき、欠陥の見た目まで変えてしまう加工を使ったとき |
| 転移学習 | 画像の基本的な模様(縁・線・点など)を見分ける力 | 別の大きなデータで学習済みのモデルと、その利用条件の確認 | 元のデータと検査の画像が大きく違うとき、利用条件が自社の用途に合わないとき |
| 自己教師あり学習 | ラベルの無い画像から、画像の特徴をつかむ力 | ラベルの無い大量の画像(ラインで撮りためた良品など) | 前提に置いた加工が欠陥の見分けに合わないとき |
| 少数事例の学習 | 新しいクラスを数枚で見分ける力 | 似た課題で学習したモデル | 新しいクラスが学習した課題と似ていないとき |
| 合成データ | 発生の少ない欠陥の画像そのもの | 欠陥の形・大きさ・写り方の知識、良品の画像 | 作った欠陥と本物の欠陥の見た目が違うとき |
どの工夫も、本番の画像を集めることの代わりにはならず、集まるまでの間をつなぐもの、あるいは集めた画像を有効に使うためのものだと考えています。この点は、後半の経営の判断の節で改めて扱います。
データ拡張は本番で起きる変動に合わせて選ぶ
データ拡張は、手元の画像に回転・反転・明るさの変更・ノイズの付加などの加工を施し、加工した画像も学習に使う方法です。学習のたびに加工の仕方を乱数で変えれば、同じ20枚の画像からでも、毎回少しずつ違う画像をモデルに見せることができます。画像のデータ拡張を整理した総説(Shorten と Khoshgoftaar、Journal of Big Data 誌、2019年)は、データ拡張を、限られたデータの問題に対してデータの側から手当てする方法と位置づけ、幾何的な変換・色の空間での変換・画像の一部の消去・画像どうしの混合・敵対的生成ネットワーク(GAN)による生成など、多くの種類を取り上げています。
外観検査でデータ拡張を選ぶときの基準は、加工の種類の多さではなく、その加工が本番のラインで起きる変動を再現しているかどうかだと考えています。製品が搬送の向きによって回って写るなら回転(反転は、回転とは別の鏡に映したような変換なので、反転した見た目でもラベルが変わらない検査対象に限る)、照明の明るさが日によって変わるなら明るさの変更、カメラの位置が少しずれるなら平行移動が、本番の変動に当たります。逆に、本番では起きない変動を加えても、モデルが本番で当たるようになるとは限りません。さらに注意が要るのは、加工によって欠陥の見た目が変わり、画像のラベルと中身が合わなくなる場合です。たとえば、画像の一部を塗りつぶす加工は、小さな異物をちょうど塗りつぶしてしまうと、「異物」のラベルが付いた画像に異物が写っていない状態を作ります。色の変化そのものが欠陥である「色むら」を扱うときに色を大きく変える加工をする、向きに意味がある部品(左右で形の違う部品の取り付けの向きの誤りを見る検査など)で反転をかける、といった例も同じ種類の問題です。
外観検査でよく使われる加工と、それが当たる本番の変動、使うときの注意を次の表にまとめました。表の「使うときの注意」の列は、本コラムの考えとして書いたものです。
| 加工 | 当たる本番の変動 | 使うときの注意 |
|---|---|---|
| 回転 | 搬送や置き方による製品の向きの違い、欠陥の向きの違い | 向きそのものを判定する検査(取り付けの向き、印字の向き)では使わない |
| 反転 | 左右・上下の形が対称な製品での欠陥の向きの違い(回転とは別の変換) | 左右で形の違う部品や文字など、反転すると別の見た目になるものには使わない |
| 平行移動・切り出し | 位置決めのずれ、欠陥の位置の違い | 切り出しで欠陥が画像の外に出ると、ラベルと中身が合わなくなる |
| 明るさ・コントラストの変更 | 照明の劣化、周囲の光、材料の反射の違い | 本番で起きうる範囲を測ってから幅を決める。薄い汚れが消えるほど変えない |
| 色の変更 | 材料のロットによる色の違い、照明の色の違い | 色むら・変色を欠陥として見る検査では、欠陥と同じ程度の色の変化を加えない |
| ノイズ・ぼかし | カメラのノイズ、焦点の甘さ、製品の振動 | 微小な欠陥が消えるほど強くかけない |
| 一部の消去 | 欠陥の一部が隠れて写る場合など | 小さな欠陥を消してしまい、ラベルと中身が合わなくなることがある |
表の右の列の注意は、どれも「その加工をした画像に、元のラベルをそのまま付けてよいか」という問いに言い換えられます。加工した画像を何枚か抜き出して、検査員がラベルを付け直したら同じラベルになるかを確かめることが、データ拡張の設計の最初の点検として有効だと考えています。
架空の合成画像と小さな畳み込みニューラルネットワークを用意する
ここからは、データ拡張の効き方をコードで確かめます。使うのは numpy で作った架空の合成画像で、32画素四方の灰色の画像に、布地のような細かい格子の模様を描き、そこに3種類の欠陥を描き足しました。実際の製品の画像は、この合成画像よりはるかに複雑で、欠陥の種類も写り方も多様です。ここでの結果は、仕組みを確かめるための例として読む必要があります。
- 良品:布地の模様と、画像ごとに位置のずれた格子、細かなノイズだけ
- 傷:向きがばらばらの、少し曲がった細い暗い線
- 異物:小さな暗い点
- 汚れ:ぼやけた薄い暗がり
そのうえで、照明の明るさの変動を入れました。学習用の画像は「短い期間に集めたので明るさがそろっている」という設定にして、明るさを0.95倍から1.05倍の範囲で乱数で変えています。評価用には2種類を用意しました。1つは学習用と同じく明るさのそろった画像(明るさがそろった評価用)、もう1つは「本番では照明の明るさが日によって変わる」という設定で、明るさを0.8倍から1.2倍の範囲で変えた画像(本番の変動を含む評価用)です。どちらも各クラス100枚、合わせて400枚で、学習用とは別の乱数で作りました。乱数のシードは本コラムの共通の決まりどおり固定しています。
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F

# ---- ブロック1:架空の合成画像を作る ----
S = 32
CLASSES = ["良品", "傷", "異物", "汚れ"]
yy, xx = np.mgrid[0:S, 0:S].astype(float)


def make_image(rng, label, gain_range):
    p1, p2 = rng.uniform(0, 2 * np.pi, 2)                  # 布目の位置のずれ
    img = 0.5 + 0.08 * np.sin(np.pi * xx / 2 + p1) * np.sin(np.pi * yy / 2 + p2)
    img += rng.normal(0, 0.03, (S, S))
    cx, cy = rng.uniform(8, 24, 2)
    if label == 1:                                         # 傷:向きがばらばらの曲がった細い線
        th, bend = rng.uniform(0, np.pi), rng.uniform(-0.05, 0.05)
        t = np.linspace(-1, 1, 40) * rng.uniform(5, 10)
        px = cx + t * np.cos(th) - bend * t**2 * np.sin(th)
        py = cy + t * np.sin(th) + bend * t**2 * np.cos(th)
        d = np.sqrt((xx[..., None] - px)**2 + (yy[..., None] - py)**2).min(-1)
        img -= rng.uniform(0.12, 0.25) * np.exp(-d**2 / 0.6)
    if label == 2:                                         # 異物:小さな暗い点
        r = rng.uniform(1.2, 2.2)
        img -= rng.uniform(0.2, 0.35) * np.exp(-((xx - cx)**2 + (yy - cy)**2) / (2 * r * r))
    if label == 3:                                         # 汚れ:ぼやけた薄い暗がり
        r = rng.uniform(4, 7)
        img -= rng.uniform(0.08, 0.14) * np.exp(-((xx - cx)**2 + (yy - cy)**2) / (2 * r * r))
    img *= rng.uniform(*gain_range)                        # 照明の明るさの変動
    return np.clip(img, 0, 1)
作った画像の例が次の図です。上の段は明るさ1.0倍、下の段は明るさ0.8倍で、下の段は本番で照明が暗くなった日の画像に当たります。明るさが0.8倍になると画像全体が暗くなり、良品と汚れ(ぼやけた薄い暗がり)の暗さの差が小さくなります。
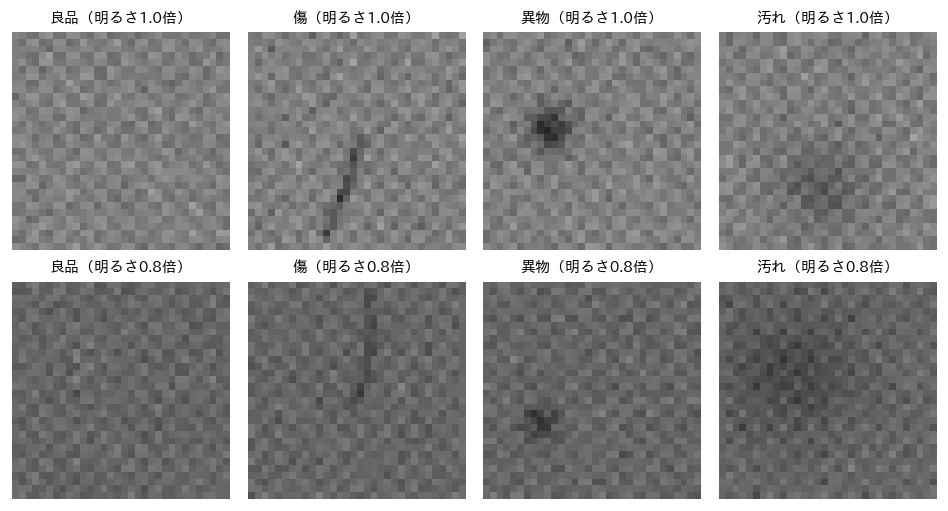
分類のモデルには、畳み込みの層を3つ重ねた小さな畳み込みニューラルネットワークを使いました。畳み込みニューラルネットワークの仕組みは第5章で扱ったので、ここでは要点だけを書きます。入力の画像は、すべての画像に同じ式(0.5を引いて0.1で割る)を当てて、画素の値の数値の範囲をそろえています。画像ごとに明るさを測って補正することはしていないので、照明の明るさの違いはそのままモデルに入ります。最後の層では、画像の中で最も強く反応した場所の値を使って4つのクラスを判定します。欠陥は画像の一部にしか写らないので、画像全体の平均より最も強い反応を使うほうが、この例では学習が進みやすいためです。次のコードの前半は、クラスごとに指定した枚数の画像を作って torch で扱える形にまとめる関数と、評価用の2つの画像の集まりを作る部分で、後半がモデルの定義です。
def make_set(rng, n_per_class, gain_range):
    X = [make_image(rng, c, gain_range) for c in range(4) for _ in range(n_per_class)]
    y = np.repeat(np.arange(4), n_per_class)
    return torch.tensor(np.array(X), dtype=torch.float32)[:, None], torch.tensor(y)


GAIN_TRAIN = (0.95, 1.05)   # 短い期間に集めた学習用の画像は明るさがそろっている
GAIN_LINE = (0.80, 1.20)    # 本番のラインでは照明の明るさが日によって変わる
rng_test = np.random.default_rng(20261109)
X_same, y_same = make_set(rng_test, 100, GAIN_TRAIN)
X_line, y_line = make_set(rng_test, 100, GAIN_LINE)


# ---- ブロック2:小さな CNN とデータ拡張 ----
class SmallCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.c1 = nn.Conv2d(1, 8, 3, padding=1)
        self.c2 = nn.Conv2d(8, 16, 3, padding=1)
        self.c3 = nn.Conv2d(16, 16, 3, padding=1)
        self.fc = nn.Linear(16, 4)

    def forward(self, x):
        x = (x - 0.5) / 0.1                                # 入力の大きさをそろえる(全画像で同じ式)
        x = F.max_pool2d(F.relu(self.c1(x)), 2)
        x = F.max_pool2d(F.relu(self.c2(x)), 2)
        x = F.relu(self.c3(x))
        return self.fc(x.amax(dim=(2, 3)))                 # 画像の中で最も強い反応を使う
データ拡張の関数は、学習の途中で取り出した16枚の画像に、指定した加工を乱数で施します。用意した加工は4種類です。
- 反転・回転:左右の反転、上下の反転、縦横の入れ替えをそれぞれ半分の確率で行う(組み合わせると90度ずつの回転も含まれる)
- 明るさ:画像全体を0.8倍から1.2倍の範囲で乱数の倍率で明るく、あるいは暗くする
- ノイズ:画素ごとに小さな乱数を足す
- 一部の消去:画像の中の12画素四方を、その画像の平均の明るさで塗りつぶす
明るさの加工で掛ける倍率(0.8倍から1.2倍)は、本番の変動を含む評価用の画像の明るさの幅に合わせて選びました。本番で起きる明るさの変動の幅を、事前に測って知っている、という設定です。ただし、学習用の画像にはもともと0.95倍から1.05倍の倍率が掛かっているので、加工した後の明るさは、基準の画像に対して0.76倍から1.26倍の範囲になり、評価用の0.8倍から1.2倍とは範囲も分布も少し違います。
次のコードの後半は、学習と評価の関数です。学習は、学習用の画像から16枚を無作為に取り出して加工し、モデルの重みを1回更新する、という手順を200回くり返します。学習用の画像の枚数にかかわらず更新の回数をそろえたのは、設定の違いだけを比べるためです。評価では、正解率に加えて、欠陥のある画像(傷・異物・汚れ)を良品と判定した割合と、良品を欠陥ありと判定した割合も数えます。第8章で扱う見逃し率と過検出率に近いものですが、同じではありません。全体の地図の見逃しは、正解が不良である製品を良品と判定することです。この章の架空の画像には判定基準を置いていないので、欠陥のある画像をすべて数えています。欠陥の種類を取り違えたものも数えていない、簡単な数え方です。
def augment(xb, kinds):
    n = len(xb)
    if "反転回転" in kinds:                                # 向きを変える
        xb = torch.where(torch.rand(n, 1, 1, 1) < 0.5, xb.flip(3), xb)
        xb = torch.where(torch.rand(n, 1, 1, 1) < 0.5, xb.flip(2), xb)
        xb = torch.where(torch.rand(n, 1, 1, 1) < 0.5, xb.transpose(2, 3), xb)
    if "明るさ" in kinds:                                  # 照明の明るさの変動をまねる
        xb = xb * torch.empty(n, 1, 1, 1).uniform_(0.8, 1.2)
    if "ノイズ" in kinds:
        xb = xb + 0.02 * torch.randn_like(xb)
    if "消去" in kinds:                                    # 一部を塗りつぶす(欠陥を消すことがある)
        xb = xb.clone()
        for i in range(n):
            a, b = torch.randint(0, S - 12, (2,)).tolist()
            xb[i, :, a:a + 12, b:b + 12] = xb[i].mean()
    return xb


def train(X, y, kinds, seed, steps=200):
    torch.manual_seed(seed)
    model = SmallCNN()
    opt = torch.optim.Adam(model.parameters(), lr=3e-3)
    for _ in range(steps):
        idx = torch.randint(0, len(X), (16,))
        loss = F.cross_entropy(model(augment(X[idx], kinds)), y[idx])
        opt.zero_grad()
        loss.backward()
        opt.step()
    return model.eval()


def evaluate(model, X, y):
    with torch.no_grad():
        pred = model(X).argmax(1)
    acc = (pred == y).float().mean().item()
    miss = ((y > 0) & (pred == 0)).sum().item() / (y > 0).sum().item()    # 欠陥ありを良品と判定
    over = ((y == 0) & (pred > 0)).sum().item() / (y == 0).sum().item()   # 良品を欠陥ありと判定
    recall = [((y == c) & (pred == c)).sum().item() / (y == c).sum().item() for c in range(4)]
    return acc, miss, over, recall
データ拡張の有無で、本番の変動を含む画像の成績がどう変わるか
比べた設定は6つです。各クラス20枚の学習用の画像に対して、データ拡張なし、反転・回転だけ、明るさとノイズだけ、反転・回転と明るさとノイズ、それに一部の消去を加えたもの、の5つを試しました。比較のために、データ拡張なしで学習用の画像を各クラス200枚に増やした設定も加えています。200枚の学習用の画像も、20枚のときと同じく明るさのそろった画像です。それぞれの設定で、学習用の画像を作る乱数とモデルの初期値を決めるシードを1から5まで変えて5回学習させ、平均と最小・最大を出しました。
torch.set_num_threads(4)
SETTINGS = [("拡張なし(各20枚)", 20, []),
            ("反転・回転(各20枚)", 20, ["反転回転"]),
            ("明るさ+ノイズ(各20枚)", 20, ["明るさ", "ノイズ"]),
            ("反転・回転+明るさ+ノイズ(各20枚)", 20, ["反転回転", "明るさ", "ノイズ"]),
            ("上に加えて一部を消去(各20枚)", 20, ["反転回転", "明るさ", "ノイズ", "消去"]),
            ("拡張なし(各200枚)", 200, [])]
for name, n, kinds in SETTINGS:
    rows = []
    for s in [1, 2, 3, 4, 5]:                              # シードを変えて5回
        X_tr, y_tr = make_set(np.random.default_rng(20261109 + s), n, GAIN_TRAIN)
        m = train(X_tr, y_tr, kinds, seed=s)
        rows.append((evaluate(m, X_same, y_same), evaluate(m, X_line, y_line)))
    a_same = np.array([r[0][0] for r in rows])
    a_line = np.array([r[1][0] for r in rows])
    miss = np.array([r[1][1] for r in rows])
    over = np.array([r[1][2] for r in rows])
    rec = np.array([r[1][3] for r in rows])
    print(name)
    print("  明るさがそろった評価用の正解率 平均 %.3f 最小 %.3f 最大 %.3f" % (a_same.mean(), a_same.min(), a_same.max()))
    print("  本番の変動を含む評価用の正解率 平均 %.3f 最小 %.3f 最大 %.3f" % (a_line.mean(), a_line.min(), a_line.max()))
    print("  本番の変動を含む評価用 欠陥を良品と判定した割合 平均 %.3f 最小 %.3f 最大 %.3f" % (miss.mean(), miss.min(), miss.max()))
    print("  本番の変動を含む評価用 良品を欠陥と判定した割合 平均 %.3f 最小 %.3f 最大 %.3f" % (over.mean(), over.min(), over.max()))
    print("  本番の変動を含む評価用 クラスごとの再現率の平均", [round(v, 3) for v in rec.mean(0)])
本コラムの実行環境(torch 2.13.0 の CPU 版)では、1回の実行を90秒以内に収めるため、同じコードを設定ごとに分けて実行しました。各設定の乱数は設定ごとにシードで決めているので、分けて実行しても、上のコードを続けて実行しても結果は同じになる作りにしてあります。実行した結果は次の表のとおりです。
| 設定 | 明るさがそろった評価用の正解率(平均) | 本番の変動を含む評価用の正解率(平均) | 本番の変動を含む評価用の正解率(最小から最大) | 欠陥を良品と判定した割合(本番の変動を含む評価用、平均) | 良品を欠陥ありと判定した割合(本番の変動を含む評価用、平均) |
|---|---|---|---|---|---|
| 拡張なし(各20枚) | 0.965 | 0.580 | 0.533〜0.615 | 0.097 | 0.334 |
| 反転・回転(各20枚) | 0.963 | 0.596 | 0.535〜0.675 | 0.080 | 0.334 |
| 明るさ+ノイズ(各20枚) | 0.915 | 0.884 | 0.820〜0.945 | 0.029 | 0.000 |
| 反転・回転+明るさ+ノイズ(各20枚) | 0.925 | 0.924 | 0.808〜0.973 | 0.021 | 0.000 |
| 上に加えて一部を消去(各20枚) | 0.932 | 0.903 | 0.770〜0.978 | 0.037 | 0.000 |
| 拡張なし(各200枚) | 0.986 | 0.633 | 0.592〜0.670 | 0.074 | 0.328 |
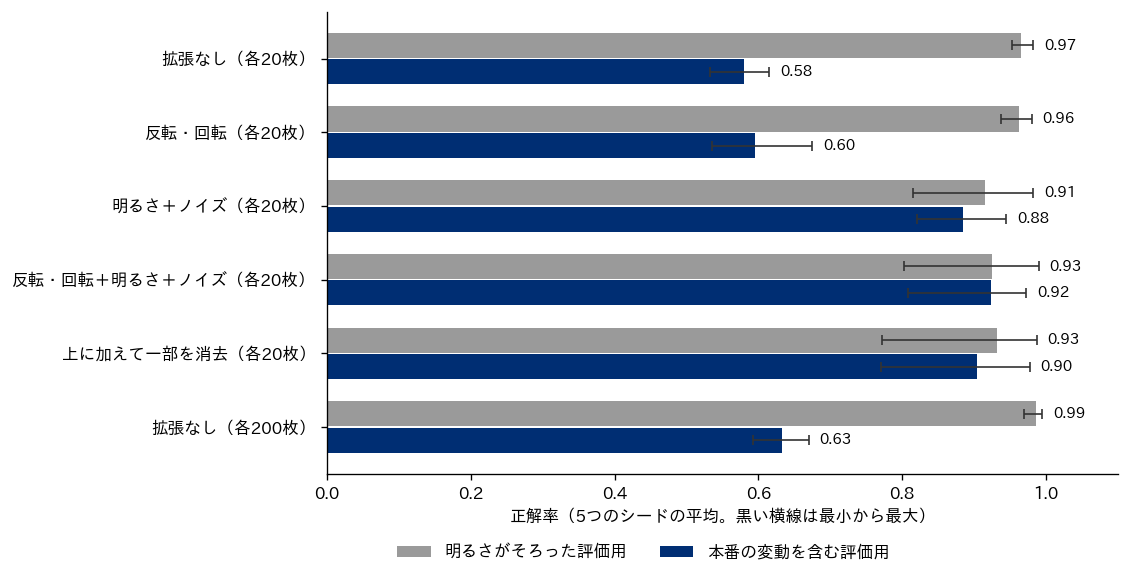
最も目立つのは、データ拡張なしの設定での2つの評価用の差です。学習用と同じく明るさのそろった評価用では正解率が0.965でしたが、本番の変動を含む評価用では0.580まで下がりました。誤りは1か所に偏らず、良品のうち欠陥ありと判定した割合は0.334(5回の平均)、クラスごとの再現率(そのクラスの画像のうち正しく判定できた割合)は良品0.666、傷0.408、異物0.534、汚れ0.712でした。傷と異物では、欠陥の種類を取り違えた判定も多く含まれています。明るさのそろった画像だけで学んだモデルは、画像全体の明るさが変わると、欠陥の有無や種類の手がかりを読み違えた可能性があります。学習用と同じ条件で集めた評価用の画像だけで成績を測ると、この落ち込みは見えません。
次に、どの加工が効いたかを見ます。反転・回転だけを加えた設定は、本番の変動を含む評価用の正解率が0.596で、拡張なしの0.580とほとんど変わりませんでした。この架空の画像では、傷の向きは学習用の画像の中でもすでにばらばらで、照明の明るさの変動は反転・回転では再現できないからです。明るさとノイズを加えた設定では、本番の変動を含む評価用の正解率は0.884に上がり、良品を欠陥ありと判定した割合は5回とも0でした。反転・回転と明るさとノイズを組み合わせた設定は0.924で、この例では最も高い平均でした。本番の変動(ここでは照明の明るさの変動)を再現する加工だけが、本番の変動を含む評価用の成績を大きく変えた、ということです。
一方で、明るさの加工には代償も見えます。明るさのそろった評価用の正解率は、拡張なしの0.965に対して、明るさとノイズを加えた設定では0.915、反転・回転と明るさとノイズの設定では0.925に下がりました。5回の幅も広がっており、反転・回転と明るさとノイズの設定では、本番の変動を含む評価用の正解率が最も低いシードで0.808、最も高いシードで0.973でした。加工で見せる画像の幅が広がった分、200回の更新では学習が十分に進まないシードがあった可能性があります。どこまで学習を続ければ安定するかは、この章では確かめていません。
一部の消去を加えた設定は、本番の変動を含む評価用の正解率の平均が0.903で、消去を加えない設定の0.924より少し低く、欠陥のある画像を良品と判定した割合は0.021から0.037に増えました。5回のシードの幅が広く、差は1回の当たり外れで入れ替わる程度の大きさなので、この結果だけから「消去は悪い」とは言えません。ただ、12画素四方の消去は、32画素四方の画像に対して小さな異物を塗りつぶしうる大きさで、加工がラベルと中身を食い違わせる仕組みを持っていることは、コードを読めば分かります。加工の効果を測るときは、欠陥の種類ごとの成績も見ておく必要があります。
最後に、データ拡張なしで学習用の画像を各クラス200枚に増やした設定です。明るさのそろった評価用の正解率は0.986で6つの設定の中で最も高い一方、本番の変動を含む評価用では0.633にとどまりました。学習用の画像を10倍に増やしても、その画像が本番の変動を含んでいなければ、本番の変動を含む評価用の成績はほとんど上がらなかった、ということです。この架空の例では、各クラス20枚に本番の変動を再現する加工をしたほうが、本番の変動を含まない200枚より、本番の変動を含む評価用の成績が高くなりました。ただし、これは明るさの変動の幅を知っていて、それに近い幅で加工できたという、データ拡張に有利な設定での結果です。また、更新の回数を200回に固定した今回の条件での結果で、学習用の画像1枚が学習に使われる回数は、各20枚では平均40回、各200枚では平均4回でした。更新の回数を増やした場合まで同じ結果になるかは確かめていません。本番の変動の種類や幅を知らなければ、同じ効果は期待できません。
この節の結果をまとめると、本コラムの架空の合成画像では、データ拡張は本番の変動を再現する加工のときに大きく効き、再現しない加工ではほとんど効かず、学習用の画像の枚数を増やしても本番の変動を含まなければ効果は小さかった、ということです。どの加工が本番の変動に当たるかは、モデルの側からは分かりません。照明の明るさが日によってどれだけ変わるか、製品がどの向きで流れてくるか、位置決めがどれだけずれるかを、撮像の担当者と生産技術の担当者が測って知っていることが、データ拡張の前提になります。
なお、torch の学習は、同じシードでも計算機や実行の条件によって結果が少し変わることがあります。本コラムの実行環境で、反転・回転と明るさとノイズの設定を2回実行したところ、5回のシードの正解率はすべて同じ値になりました(差は0)。同じ環境の再実行では一致しましたが、別の計算機や torch の別の版でどの程度値が変わるかは確かめていません。また、この章の枚数(各3枚・各20枚など)は学習用の枚数です。見逃し率を確かめる評価に何個の不良が要るかは、第8章の計算が別に要ります。
転移学習、別の品目で学んだモデルを出発点にする
転移学習は、ある課題で学習させたモデルを、別の課題の出発点として使う方法です。画像の分野でよく使われるのは、一般の写真を大量に集めたデータで学習させた畳み込みニューラルネットワークの重みを出発点にして、自社の少ない画像で学習を続ける(微調整する、ファインチューニングとも呼ぶ)やり方です。一般の写真の大規模なデータの代表例が ImageNet で、Deng らが2009年の CVPR で発表した論文で、物の名前の階層に沿って大量の画像を集めたデータベースとして提案されました。
なぜ別のデータで学んだ重みが役に立つのかについては、Yosinski らの2014年の論文(NIPS 2014)が手がかりになります。この論文は、自然の画像で学習させた畳み込みニューラルネットワークでは、入力に近い層は縁や色のかたまりのような、多くの画像に共通する特徴を学び、出力に近い層ほど元の課題に固有の特徴になることを、層ごとに重みを移す実験で調べました。要旨によれば、元の課題から離れた課題の特徴を移した場合でも、乱数から始めるより良い結果になることがあり、微調整の後もその効果が残ることがあると報告しています。外観検査の画像は一般の写真とは見た目が大きく違いますが、縁・線・点といった基本的な模様を見分ける部分は共有できる可能性がある、というのが転移学習を使う理由です。
本コラムの実行環境では、学習済みの重みのダウンロードはしていません。そのため、この節の実験では、一般の写真で学習させたモデルの代わりに、別の品目の架空の合成画像で小さな畳み込みニューラルネットワークを自分で事前に学習させ、それを出発点にしました。一般の写真の大規模なデータで学習させた本物の学習済みモデルとは、学習に使った画像の量も種類もまったく違うので、ここでの結果は「出発点の重みが課題に近いかどうかで、微調整の結果がどう変わるか」という仕組みを見るための例として読む必要があります。
学習済みのモデルを実際に使うときには、利用条件の確認も要ります。PyTorch の画像用のライブラリ torchvision の公式ドキュメントは、学習済みの重みについて、学習に使ったデータに由来する独自のライセンスや利用条件を持つ場合があり、使用の許可があるかを確かめるのは利用者の責任だと注意しています。同じドキュメントは、学習済みの重みごとに、学習のときに使った前処理(画像の大きさや明るさのそろえ方)があり、違う前処理で使うと精度が下がったり誤った出力になったりしうることも書いています。社内の検査に使うモデルの出発点を選ぶときは、精度だけでなく、利用条件と前処理の決まりを、導入の前に確かめておく必要があります。
実験では、布地の品目とは別に、金属の表面のような横方向の細い筋目の模様を持つ「別の品目」の架空の画像を作りました。別の品目にも、長い直線の傷・小さな点・大きなむらの3種類の欠陥と良品の4クラスを置き、各クラス150枚で事前に学習させます。別の品目は2通り用意しました。1つは、欠陥が暗く写る「似た品目」で、布地の品目の欠陥(暗い線・暗い点・暗がり)と写り方が似ています。もう1つは、同じ形の欠陥が明るく写る「似ていない品目」です。事前学習のときもデータ拡張(反転・回転と明るさとノイズ)を入れています。
# ---- ブロック4:別の品目(金属の筋目)の画像を作る ----
def make_metal(rng, label, sign):
    img = 0.55 + 0.06 * np.sin(2 * np.pi * yy / 3 + rng.uniform(0, 6.3))   # 横方向の細い筋目
    img += 0.04 * rng.normal(0, 1, (S, 1)) + rng.normal(0, 0.03, (S, S))
    cx, cy = rng.uniform(8, 24, 2)
    if label == 1:                                         # 長い直線の傷
        th = rng.uniform(0, np.pi)
        d = np.abs((xx - cx) * np.sin(th) - (yy - cy) * np.cos(th))
        along = np.abs((xx - cx) * np.cos(th) + (yy - cy) * np.sin(th))
        img += sign * 0.2 * np.exp(-d**2 / 0.6) * (along < 9)
    if label == 2:                                         # 小さな点
        img += sign * 0.3 * np.exp(-((xx - cx)**2 + (yy - cy)**2) / 3.0)
    if label == 3:                                         # 大きなむら
        img += sign * 0.12 * np.exp(-((xx - cx)**2 + (yy - cy)**2) / 50.0)
    return np.clip(img * rng.uniform(0.8, 1.2), 0, 1)


AUG = ["反転回転", "明るさ", "ノイズ"]
# sign=-1:欠陥が暗く写る(布地の品目と似た写り方)、sign=+1:欠陥が明るく写る(似ていない写り方)
SOURCES = {"似た品目": -1, "似ていない品目": 1}
pres = {}
for src_name, sign in SOURCES.items():
    rng_src = np.random.default_rng(20261209)
    X_src = torch.tensor(np.array([make_metal(rng_src, c, sign) for c in range(4) for _ in range(150)]),
                         dtype=torch.float32)[:, None]
    y_src = torch.tensor(np.repeat(np.arange(4), 150))
    pre = train(X_src, y_src, AUG, seed=100, steps=300)    # 事前学習は品目ごとに1回だけ
    pres[src_name] = pre
    print("%s 事前学習の元の品目での正解率 %.3f" % (src_name, evaluate(pre, X_src, y_src)[0]))
    print("%s 事前学習のままで布地の品目を判定した正解率 %.3f" % (src_name, evaluate(pre, X_line, y_line)[0]))
次に、布地の品目の学習用の画像を各クラス3枚と10枚の2通りで用意し、乱数から学習する場合(ゼロから学習)と、2つの事前学習の重みを出発点に微調整する場合を比べました。微調整でも、ゼロから学習する場合でも、データ拡張(反転・回転と明るさとノイズ)を入れ、更新の回数は100回にそろえています。評価は、データ拡張の節と同じ本番の変動を含む評価用の400枚です。
# ---- ブロック5:事前学習の重みを出発点に、布地の品目の少ない画像で微調整する ----
def finetune(X, y, seed, init, steps=100):
    torch.manual_seed(seed)
    model = SmallCNN()
    if init is not None:
        model.load_state_dict(init.state_dict())           # 事前学習の重みを出発点にする
    opt = torch.optim.Adam(model.parameters(), lr=2e-3)
    for _ in range(steps):
        idx = torch.randint(0, len(X), (16,))
        loss = F.cross_entropy(model(augment(X[idx], AUG)), y[idx])
        opt.zero_grad()
        loss.backward()
        opt.step()
    return model.eval()


for n in [3, 10]:
    for name, init in [("ゼロから学習", None), ("似た品目から微調整", pres["似た品目"]),
                       ("似ていない品目から微調整", pres["似ていない品目"])]:
        acc = []
        for s in [1, 2, 3, 4, 5]:
            X_tr, y_tr = make_set(np.random.default_rng(20261309 + s), n, GAIN_TRAIN)
            acc.append(evaluate(finetune(X_tr, y_tr, s, init), X_line, y_line)[0])
        acc = np.array(acc)
        print("各%d枚 %s 本番の変動を含む評価用の正解率 平均 %.3f 最小 %.3f 最大 %.3f" % (n, name, acc.mean(), acc.min(), acc.max()))
この節のコードも、1回の実行を90秒以内に収めるため、本コラムの実行環境では事前学習と、各3枚・各10枚の微調整を分けて実行しました。事前学習の結果は、事前学習に使った元の品目の画像そのもので測った正解率(学習データの上での値)が、似た品目では0.937、似ていない品目では0.848でした。事前学習したモデルを微調整せずにそのまま布地の品目の判定に使うと、似た品目のモデルは本番の変動を含む評価用で正解率0.945、似ていない品目のモデルは0.250でした。微調整の結果は次の表のとおりです。
| 出発点 | 各3枚の正解率(平均) | 各3枚の正解率(最小から最大) | 各10枚の正解率(平均) | 各10枚の正解率(最小から最大) |
|---|---|---|---|---|
| ゼロから学習 | 0.632 | 0.365〜0.880 | 0.718 | 0.640〜0.805 |
| 似た品目から微調整 | 0.979 | 0.965〜0.988 | 0.961 | 0.913〜0.998 |
| 似ていない品目から微調整 | 0.823 | 0.725〜0.870 | 0.840 | 0.767〜0.870 |
ゼロから学習した場合、各3枚では正解率の平均が0.632で、5回の幅は0.365から0.880と非常に広くなりました。3枚ずつの画像では、どの3枚を引いたか、重みの初期値がどうだったかで結果が大きく変わる、ということです。各10枚にすると平均は0.718に上がりました。データ拡張の節の各20枚の結果(反転・回転と明るさとノイズで0.924)とは、更新の回数(200回と100回)と学習用の画像を作る乱数が違うので、この2つの数字は直接は比べられません。
似た品目の重みから微調整した場合は、各3枚で0.979、各10枚で0.961と高く、5回の幅も狭くなりました。ただし、これには注意が要ります。似た品目のモデルは、微調整しなくても布地の品目で0.945の正解率を出しています。この実験の「似た品目」は、欠陥の種類の並びも写り方も布地の品目とほぼ同じに作ったもので、事前学習の段階でほとんど同じ課題を解いていたことになります。各3枚の微調整の平均が各10枚より少し高かった理由は、この実験では切り分けていません。枚数が少ないほど良いという意味ではありません。現実の検査で、ここまで課題の近い事前学習のモデルが手に入ることは多くないと考えています。
似ていない品目の重みから微調整した場合は、各3枚で0.823、各10枚で0.840でした。微調整しないままでは0.250(4クラスで当てずっぽうに答えたのと同じ水準)だったモデルが、少ない画像の微調整でゼロから学習するより高い成績になったのは、欠陥の明るさが逆でも、線・点・むらの形を見分ける部分が共有できたためと考えられます。Yosinski らの論文の要旨にある「離れた課題の特徴でも乱数から始めるより良いことがある」という報告と、向きとしては合う結果です。ただし、似た品目から微調整した場合(0.961から0.979)との差は大きく、出発点の重みが課題に近いかどうかで結果が大きく変わりました。
この節の結果も、本コラムの架空の合成画像での5回の平均です。一般の写真で学習させた本物の学習済みモデルを外観検査の画像に使ったときに同じ程度の効果が出るかは、この実験からは分かりません。転移学習を検討するときは、候補の学習済みモデルごとに、自社の本番の変動を含む評価用の画像で、ゼロから学習した場合と比べて確かめることが要ると考えています。
自己教師あり学習と少数事例の学習、ラベルの無い画像と数枚の画像を生かす
転移学習の出発点になる事前学習には、ラベルの付いた大きなデータを使う方法のほかに、ラベルの無い画像だけで学ぶ方法があります。これを自己教師あり学習と呼びます。画像そのものから正解を機械的に作り、その正解を当てる課題でモデルを学習させる方法の総称です。代表的な例の1つが、Chen らの2020年の論文(ICML 2020、SimCLR と呼ばれる方法)で、同じ画像に異なるデータ拡張を施した2枚を「同じ画像から来たもの」として近づけ、別の画像から来たものとは遠ざけるように学ばせます。この論文の要旨は、データ拡張の組み合わせ方が、学習の課題を有効なものにするうえで決定的な役割を果たすと述べています。He らの2020年の論文(CVPR 2020、MoCo と呼ばれる方法)も、同じく画像どうしを比べる考え方で、ラベルの無い画像から特徴を学ぶ方法です。
外観検査の観点から見ると、自己教師あり学習の魅力は、ラインで撮りためた大量の良品の画像を、ラベルを付けずに使える点にあります。ただし、ここでもデータ拡張の選び方が結果を左右します。たとえば、色を大きく変える加工で「同じ画像」とみなす学習をすると、モデルは色の違いを無視する特徴を学ぶことになり、色むらを欠陥として見たい検査には合わない特徴になる可能性があります。前の節の表の「使うときの注意」は、自己教師あり学習の加工を選ぶときにもそのまま当てはまると考えています。
良品の画像だけから欠陥を見つける良品学習(第6章)と、自己教師あり学習を組み合わせた研究もあります。Li らの2021年の論文(CVPR 2021、CutPaste と呼ばれる方法)は、良品の画像から一部を切り取って別の場所に貼り付ける加工で「いつもと違う画像」を作り、良品と見分ける課題でモデルを学習させてから、良品だけを使った異常検知に使う方法を提案し、公開データセットの MVTec AD(工業製品の画像を集めた異常検知の公開データセット。第14章で扱います)で結果を報告しています。この方法は、次の節で扱う合成データ(欠陥を描き足す方法)とも重なる考え方です。論文で報告された数字は、そのデータセット・その条件での値で、自社のラインでの精度の見込みとして読むことはできません。公開データセットと研究の数字の読み方は第14章で扱います。
もう1つの考え方が、少数事例の学習(Few-shot 学習)です。正解の付いた少数の事例から新しいクラスや課題を学ぶ問題の設定を指す広い言葉で、ここでは、似た課題でモデルをあらかじめ学習させておく代表的な方法を2つ紹介します。Snell らが2017年に発表した Prototypical Networks は、クラスごとに数枚の画像の特徴の平均(代表点)を作り、新しい画像を最も近い代表点のクラスに分ける方法です。Finn らの2017年の論文(ICML 2017、MAML と呼ばれる方法)は、少ない画像で数回だけ学習し直せば新しい課題に合うように、モデルの出発点そのものを学習させる方法です。外観検査では、新しい欠陥の種類が見つかったときに、数枚の画像でその種類を判定に加えたい、という場面で考え方が使える可能性があります。ただ、どちらの方法も「似た課題でたくさん学習しておく」ことが前提で、その似た課題のデータをどこから持ってくるかという問題は残ります。
| 方法 | 使う画像 | 外観検査で期待できる使い道 | 注意する点 |
|---|---|---|---|
| ラベル付きの大きなデータでの事前学習 | 一般の写真などのラベル付きの大きなデータ | 少ない検査の画像での微調整の出発点 | 元のデータと検査の画像の違い、学習済みの重みの利用条件 |
| 自己教師あり学習 | ラベルの無い画像(ラインで撮りためた良品など) | 自社の画像に近い特徴を、ラベル付けなしで学ぶ | 前提に置くデータ拡張が、欠陥の見分けを消さないか |
| 少数事例の学習 | 似た課題の多数のクラスの画像と、新しいクラスの数枚 | 新しい欠陥の種類を数枚で判定に加える | 似た課題のデータの入手、数枚の画像での評価の不確かさ |
| 良品からの合成の異常での学習 | 良品の画像と、それを加工した「いつもと違う画像」 | 不良の画像が無い段階での良品学習 | 作った異常と本物の欠陥の見た目の違い |
表のどの方法についても、数枚の画像で学んだモデルを数枚の画像で評価しても、成績の確かさはほとんど分かりません。評価には、学習に使っていない、本番の変動を含んだ画像が十分な数だけ要ります。見逃し率を確かめるのに必要な不良の数の考え方は第8章で扱います。
合成データ、欠陥を描き足す・CGで作る・生成モデルで作る
発生の少ない欠陥の画像が集まらないとき、画像そのものを作る方法があります。本コラムでは、作り方を3つに分けて考えます。1つ目は、良品の画像に欠陥を描き足す方法で、傷なら線、異物なら点を、画像処理で良品の画像に重ねます。2つ目は、製品の形の3次元のデータと照明・カメラの条件から、コンピュータグラフィックス(CG)で画像を作る方法です。3つ目は、敵対的生成ネットワークや拡散モデルのような生成モデルに、欠陥のある画像を作らせる方法です。
どの作り方にも共通する限界は、作った欠陥の見た目が、本物の欠陥の見た目と同じとは限らないことです。描き足す方法では、欠陥の形・濃さ・縁のぼやけ方を人が決めるので、人が知っている欠陥の見た目しか作れません。CG では、製品の表面の質感や照明の反射を本物どおりに再現するには手間がかかります。Tobin らの2017年の論文は、ロボットが物体をつかむための物体の位置の推定で、CG の画像の質感や照明を本物らしくするのではなく、わざとばらばらに変えて学習させ、本物のカメラの画像で使えることを示しました(ドメインランダム化と呼ばれる考え方)。本物に似せきれないなら、変動の幅を広げて、本物がその幅の中に入るようにする、という考え方で、データ拡張と同じ発想です。生成モデルで作る方法は、本物の欠陥の画像がある程度ないと生成モデル自体を学習させにくく、作った画像が本物の欠陥の写り方を正しく表しているかを確かめる手間も残ります。
良品学習の分野では、欠陥を描き足す方法が学習の一部として使われています。Zavrtanik らの2021年の論文(ICCV 2021、DRAEM と呼ばれる方法)は、検査対象の学習用の画像には良品だけを使い、そこに外部の模様の画像(論文の主な実験では、模様の画像を集めた公開データセットの DTD)から作った異常を重ねた画像で、画像を元の良品の姿に戻すニューラルネットワーク(第6章のオートエンコーダに近い役割)と、異常の場所を見分けるニューラルネットワークを一緒に学習させる方法を提案し、MVTec AD と、表面の欠陥の検出の公開データセット(DAGM と呼ばれるもの)で結果を報告しています。前の節の CutPaste も、良品の一部を切り貼りして異常を作る方法です。どちらも、作った異常が本物の欠陥と見た目が違っても、良品から外れたものを見つける力を育てるために使う、という位置づけです。
ここでは、欠陥を描き足す方法を、データ拡張の節と同じ架空の画像で試します。以下では、データ拡張の節の生成方法で作った架空の欠陥を、便宜上「本物の欠陥」と呼びます。本物の欠陥(データ拡張の節で作った、曲がった傷・ぼやけた異物・中心ほど濃い汚れ)に対して、描き足す欠陥は、わざと単純な形にしました。傷はまっすぐな線、異物は縁のくっきりした円、汚れは一様な濃さの円です。人が欠陥の見た目を単純化して描くと、こうなりがちだという設定です。2つの見た目の違いを、コードで置いた値で次の表にまとめました。明るさの値は、良品の地の明るさ(約0.5)からどれだけ暗くするかで、どれも架空の設定です。
| 欠陥の種類 | 本物の欠陥の見え方 | 描き足した欠陥の見え方 | 主な違い |
|---|---|---|---|
| 傷 | 少し曲がった細い線。長さは約10〜20画素、暗さは0.12〜0.25の間で画像ごとに変わり、線の縁はなだらかにぼやける | まっすぐな線。長さは約14画素、暗さは0.18で一定、線の縁はくっきり切れる | 曲がり方、暗さのばらつき、縁のぼやけ方 |
| 異物 | 小さな点で、中心が最も暗く周りに向かってなだらかに薄くなる。広がりと暗さ(0.2〜0.35)は画像ごとに変わる | 半径約1.6画素の円で、円の中は一様に0.28暗く、縁はくっきり切れる | 縁のぼやけ方、中心から外への濃さの変化、暗さのばらつき |
| 汚れ | ぼやけた薄い暗がりで、中心ほど濃い。広がりと暗さ(0.08〜0.14)は画像ごとに変わる | 半径5画素の円で、円の中は一様に0.10暗く、縁ははっきりしている | 中心から外への濃さの変化、縁のはっきりさ |
学習用の画像は、良品20枚に、本物の欠陥と描き足した欠陥を組み合わせて作ります。比べたのは4つの組み合わせで、どれも良品は20枚、データ拡張(反転・回転と明るさとノイズ)は入れたまま、評価は本番の変動を含む評価用の400枚で行いました。
- 本物の欠陥を種類ごとに3枚だけ使う(発生の少ない欠陥の画像が数枚しか無い状態)
- 本物の欠陥の各3枚に、描き足した欠陥を種類ごとに20枚加える
- 描き足した欠陥の各20枚だけを使い、本物の欠陥は使わない
- 比較のために、本物の欠陥を種類ごとに20枚使う
次のコードは、描き足す関数、学習用の画像を組み立てる関数、4つの組み合わせを5回ずつ学習して評価する部分です。データ拡張の節の最初の3つのコードブロック(画像の生成、モデル、データ拡張・学習・評価の関数)の定義の続きに実行します。使う加工の一覧(AUG)は、転移学習の節のコードと同じものを、このコードの中で4つの組み合わせの直前に定義し直しているので、転移学習の節のコードを実行していなくても動きます。
# ---- ブロック6:良品の画像に、単純な形の欠陥を描き足す ----
def paint_defect(rng, good, label):
    img = good.copy()
    cx, cy = rng.uniform(8, 24, 2)
    if label == 1:                                         # 傷:まっすぐな線(本物は曲がっている)
        th = rng.uniform(0, np.pi)
        d = np.abs((xx - cx) * np.sin(th) - (yy - cy) * np.cos(th))
        along = np.abs((xx - cx) * np.cos(th) + (yy - cy) * np.sin(th))
        img -= 0.18 * ((d < 0.7) & (along < 7))
    if label == 2:                                         # 異物:縁のくっきりした円(本物はぼやけている)
        img -= 0.28 * (((xx - cx)**2 + (yy - cy)**2) < 2.5)
    if label == 3:                                         # 汚れ:一様な濃さの円(本物は中心ほど濃い)
        img -= 0.10 * (((xx - cx)**2 + (yy - cy)**2) < 25)
    return np.clip(img, 0, 1)


def build(seed, n_real, n_synth):
    rng = np.random.default_rng(20261409 + seed)
    goods = [make_image(rng, 0, GAIN_TRAIN) for _ in range(20)]   # 良品20枚
    real = [make_image(rng, c, GAIN_TRAIN) for c in (1, 2, 3) for _ in range(n_real)]
    synth = [paint_defect(rng, goods[rng.integers(20)], c) for c in (1, 2, 3) for _ in range(n_synth)]
    X = np.array(goods + real + synth)
    y = [0] * 20 + [c for c in (1, 2, 3) for _ in range(n_real)] + [c for c in (1, 2, 3) for _ in range(n_synth)]
    return torch.tensor(X, dtype=torch.float32)[:, None], torch.tensor(y)


AUG = ["反転回転", "明るさ", "ノイズ"]                    # 転移学習の節と同じ加工
CASES = [("本物の欠陥 各3枚", 3, 0), ("本物の欠陥 各3枚+描き足した欠陥 各20枚", 3, 20),
         ("描き足した欠陥 各20枚だけ", 0, 20), ("本物の欠陥 各20枚", 20, 0)]
for name, n_real, n_synth in CASES:
    rows = []
    for s in [1, 2, 3, 4, 5]:
        X_tr, y_tr = build(s, n_real, n_synth)
        rows.append(evaluate(train(X_tr, y_tr, AUG, seed=s), X_line, y_line))
    acc, miss, over = [np.array([r[k] for r in rows]) for k in range(3)]
    print(name, "正解率 平均 %.3f 最小 %.3f 最大 %.3f" % (acc.mean(), acc.min(), acc.max()))
    print("  欠陥を良品と判定した割合 %.3f 良品を欠陥と判定した割合 %.3f" % (miss.mean(), over.mean()))
    print("  クラスごとの再現率の平均", np.array([r[3] for r in rows]).mean(0).round(3))
実行した結果は次の表のとおりです(それぞれシードを変えた5回の平均)。
| 学習用の欠陥の画像 | 正解率(平均) | 正解率(最小から最大) | 欠陥を良品と判定した割合(平均) | 良品を欠陥ありと判定した割合(平均) | 傷の再現率 | 異物の再現率 | 汚れの再現率 |
|---|---|---|---|---|---|---|---|
| 本物の欠陥 各3枚 | 0.248 | 0.240〜0.250 | 0.983 | 0.020 | 0.012 | 0.000 | 0.000 |
| 本物の欠陥 各3枚+描き足した欠陥 各20枚 | 0.914 | 0.850〜0.967 | 0.035 | 0.010 | 0.888 | 0.828 | 0.950 |
| 描き足した欠陥 各20枚だけ | 0.861 | 0.738〜0.957 | 0.081 | 0.000 | 0.824 | 0.766 | 0.854 |
| 本物の欠陥 各20枚 | 0.946 | 0.913〜0.990 | 0.032 | 0.000 | 0.864 | 0.978 | 0.942 |
本物の欠陥が種類ごとに3枚しか無い設定では、モデルはほぼすべての画像を良品と判定しました。欠陥のある画像を良品と判定した割合は0.983(5回の平均)で、検査としては役に立ちません。良品20枚に対して欠陥が各3枚という偏りの大きい学習データで、「迷ったら良品」と答えるほうが学習の誤差が小さくなったためと考えられます。クラスの不均衡への対処(重み付けなど)は第5章で扱いましたが、この例ではそうした対処はしていません。
そこに描き足した欠陥を各20枚加えると、正解率は0.914に上がり、欠陥のある画像を良品と判定した割合は0.035に下がりました。描き足した欠陥だけで学習した設定でも、正解率は0.861でした。単純な形の描き足しでも、「布地の模様の中に暗い線・点・暗がりがあるかどうか」という手がかりはモデルに伝わった、ということです。
一方で、本物の欠陥を各20枚使った設定と比べると差があります。異物の再現率は、本物の各20枚では0.978でしたが、描き足した欠陥だけでは0.766、本物の各3枚を加えても0.828でした。描き足した異物は縁のくっきりした円で、本物の異物(ぼやけた点)とは見た目が違います。描き足した欠陥だけで学んだモデルは、欠陥のある画像を良品と判定した割合も0.081で、本物の各20枚の0.032より高くなりました。異物では再現率の低下が見られました。描き足した異物の形や濃さが本物と違うことが影響した可能性はありますが、組み合わせごとに学習用の画像の枚数やクラスの比率も違うので、見た目の違いがどれだけ寄与したかは、この実験では切り分けていません。
この結果も、本コラムの架空の合成画像での5回の平均で、5回の幅は広く、描き足した欠陥だけの設定では最も低いシードで0.738でした。また、この例の「本物の欠陥」自体が numpy で作った単純な画像で、描き足した欠陥との違いは、実際の欠陥と描き足した欠陥の違いより小さいと考えられます。実際のラインで同じ程度の効果が出るとは読めません。合成データを使うときは、評価には必ず本物の欠陥の画像を使い、欠陥の種類ごとに成績を見ることが要ると考えています。
| 作り方 | 要るもの | 向いている場面 | 限界 |
|---|---|---|---|
| 良品に欠陥を描き足す | 良品の画像、欠陥の形・大きさ・濃さの知識 | 形の単純な欠陥(線状の傷・点状の異物)、立ち上げの時期 | 人が知っている見た目しか作れない。縁のぼやけ方・質感が本物と違いやすい |
| CG で作る | 製品の3次元のデータ、照明・カメラの条件、表面の質感の設定 | 形状が決まった部品、欠陥の位置や向きを網羅したいとき | 表面の質感・反射の再現に手間がかかる。本物に似せきれない部分が残る |
| 生成モデルで作る | 生成モデルを学習させるための本物の画像 | ある程度の本物の欠陥の画像があり、変化を増やしたいとき | 本物の画像が少ないと生成モデル自体を学習させにくい。作った画像の確かめに手間がかかる |
合成データの使いどころは、本物の欠陥の画像が集まるまでの立ち上げの時期と、発生が非常に少なく、本物の画像がいつまでも十分に集まらない欠陥の種類だと考えています。どちらの場合も、合成データで学んだモデルを本物の欠陥の画像で評価し、本物の画像が集まるにつれて、本物の画像の割合を増やしていく進め方が現実的です。生成AIによる不良の画像の生成の動向は、第14章で扱います。
データを集める仕組み、ラインから不良の画像を残す
ここまでの3つの実験で分かったのは、本コラムの架空の合成画像では、どの工夫も、効いたのは条件が合った範囲に限られた、ということです。データ拡張は、本番の変動の幅を知っていて、それに近い幅で加工できたときに効きました。転移学習は、似た品目からの出発点では各3枚で正解率0.979と大きく効きましたが、それは事前学習の課題が布地の品目とほぼ同じだったためで、似ていない品目からの出発点では0.823にとどまりました。合成データは、本物の欠陥が数枚しか無い状態を大きく改善した一方、本物の画像で学んだ場合には届きませんでした(見た目の違いがどれだけ寄与したかは切り分けていません)。なお、3つの実験のどれも、本番の変動を含む本物の画像で学習した場合は試していません。そのうえで、少ないデータで学ぶ工夫は、本物の画像を集める仕組みと組み合わせて初めて長く使えるものになると考えています。これは実験で確かめたことではなく、上の結果を踏まえた本コラムの考えです。
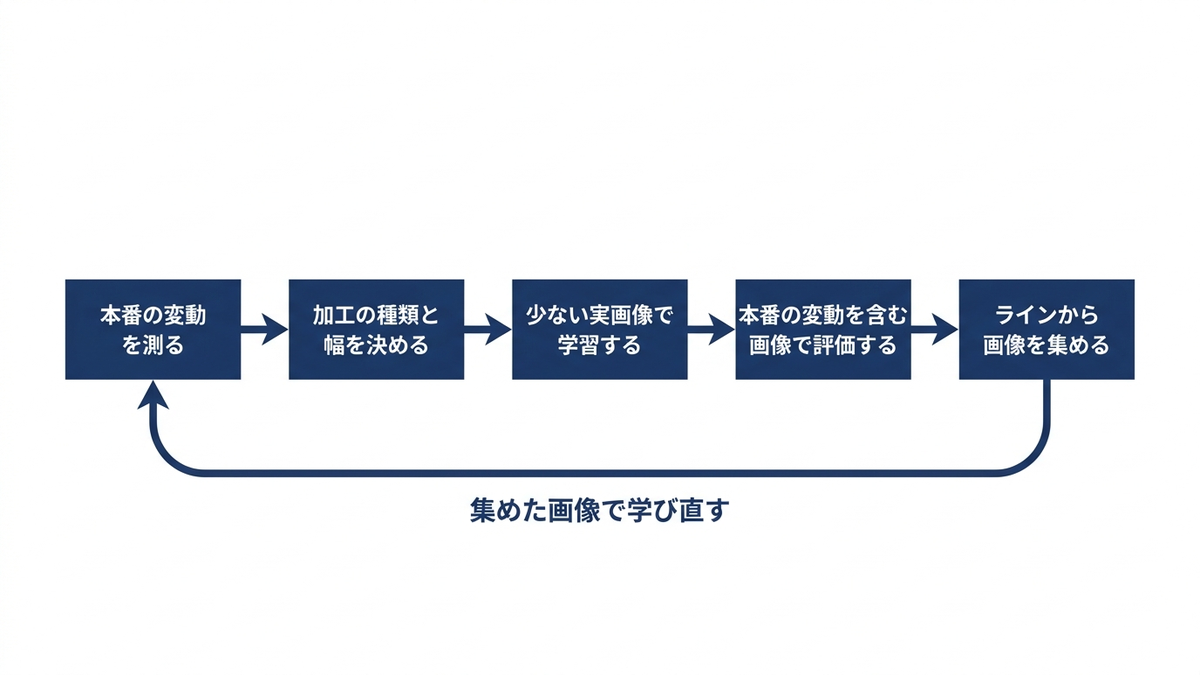
ラインから画像を集める仕組みには、次の要素が要ると考えています。
- 検査で不良と判定した画像と、判定の保留(AIが良品とも不良とも決めきれず、人の判断に回したもの)になった画像を、すべて残す
- 良品と判定した画像も、日ごと・ロットごとに一定の枚数を抜き出して残す(本番の変動を知るため)
- 画像に、撮った日時・ライン・品種・ロット・撮像の条件(照明の強さ・露光時間)・モデルの版を付けて残す
- 検査員が確かめた結果(本当に不良だったか、欠陥の種類は何か)を、同じ画像に結びつけて残す
- 後工程や顧客で見つかった不良(見逃した不良が後工程や顧客に届く流出の例)を、その製品の検査の画像までさかのぼって結びつける(さかのぼれるのは画像を保存している製品に限られるので、さかのぼりたい期間は全数の画像を残すかを決めておく)
- 集めた画像の枚数を、欠陥の種類ごと・品種ごとに数えて、定期的に確かめる
この中で見落としやすいのは、良品と判定した画像を抜き出して残すことと、流出した不良を検査の画像までさかのぼることです。良品と判定した画像を抜き出して残すだけでは、残していない製品で後から不良が見つかったときに、その検査の画像には戻れません。どの期間・どの製品の画像を全数残すかは、保存の容量と合わせて決める必要があります(第11章)。不良と判定した画像だけを残していると、モデルが見逃した不良の画像は1枚も残りません。見逃した不良こそ、モデルが学ぶべき画像です。流出した不良を検査の画像までたどれるようにするには、製品の識別子と画像を結びつけて記録する必要があり、この記録の仕組みは第11章で扱います。判定の保留になった画像を人が確かめて学習に戻す流れは第10章、本番の画像の変化の監視と再学習は第12章で扱います。
集めた画像は、学習用と評価用に分けて管理します。評価用の画像は、日付やロットで分けて、学習に使った画像と同じ製品・同じ日の画像が混ざらないようにします。この章の実験で、学習用と同じ明るさの評価用だけを見ていたら本番での落ち込みが見えなかったように、評価用の画像が本番の変動を含んでいるかどうかが、評価の信頼性を決めます。評価用のデータの切り方は第8章で詳しく扱います。
| 集める画像 | 残す理由 | 主に関わる役割 |
|---|---|---|
| 不良と判定した画像 | 欠陥の種類ごとの学習用の画像を増やす | 検査員(種類の確認)、データ担当(保存の設定) |
| 判定の保留になった画像 | モデルが迷う画像を人の判断つきで学習に戻す | 検査員、品質保証 |
| 良品と判定した画像の抜き出し | 本番の変動(明るさ・向き・ロットの違い)を知る、見逃しを後から探す | データ担当、生産技術 |
| 流出した不良の画像 | モデルが見逃した欠陥を特定し、学習と評価に加える | 品質保証、データ担当 |
| 撮像の条件の記録 | データ拡張の幅を決める、変化の原因を追う | 生産技術、撮像の担当者 |
経営の判断、判断の誤りの型と投資の順番の考え方
少ないデータで学ぶ工夫は、技術としては手軽に試せます。データ拡張は数行のコードで加えられ、学習済みのモデルを出発点にすることも一般的になりました。そのため、PoC の段階で「画像は少ないが、データ拡張と転移学習で十分な精度が出た」という結果が出ることがあります。この章の実験が示したのは、その「十分な精度」を、どんな評価用の画像で測ったかが重要だということです。学習用と同じ条件で集めた評価用の画像だけで測った精度は、本番の変動を含む画像での精度より高く出ることがあります。
この節の内容は、実験で確かめたことではなく、この章の実験の結果と一般的な検査の運用を踏まえた本コラムの考えです。判断を誤ったときの損失を、序章で整理した6つの損失の型に当てはめると、次のように整理できます。
| 判断の誤り | 起こる損失の型 | 避けるための考え方 |
|---|---|---|
| 学習用と同じ条件の評価用の画像だけで精度を測り、導入を決める | 過検出(照明の変化で良品を不良と判定する)、流出、形骸化 | 評価用の画像は、日・ロット・照明の条件を変えて集め、本番の変動を含める |
| 本番の変動を知らずにデータ拡張の加工を選ぶ | 過検出、流出(欠陥を消す加工でラベルと中身が食い違う) | 撮像と生産技術の担当者が変動の幅を測り、加工の幅をそれに合わせる |
| 学習済みのモデルの利用条件を確かめずに使う | 二重投資(後から作り直しになる) | 重みの利用条件を、導入の前に法務・情報システムの担当者と確かめる |
| 合成データだけで学んだモデルを、本物の欠陥で評価せずに使う | 流出(本物と見た目の違う欠陥を見逃す) | 評価には必ず本物の欠陥の画像を使い、欠陥の種類ごとに成績を見る |
| 見逃した不良の画像が残らない仕組みで運用する | 流出(同じ種類の欠陥の見逃しをくり返す) | 良品と判定した画像の抜き出しと、流出した不良の画像へのさかのぼりを仕組みにする |
| 工程や品種ごとに別々の画像の保存の仕組みを作る | 二重投資 | 画像と記録の形式を工程・品種の間でそろえる |
経営として決めておきたいのは、予算の配分の順番だと考えています。本コラムの考えとしては、少ないデータで学ぶ工夫に予算を付ける前に、ラインから画像を集める仕組み(画像の保存、製品の識別子との結びつけ、検査員の確認の結果の記録、流出した不良のさかのぼり)に予算と人の時間を付けることを勧めます。集めた画像で学び直した場合の効果は、この章の実験では確かめていません。データを増やす工夫は、集める仕組みが動き出すまでの立ち上げの時期をつなぐものとして位置づけ、PoC の計画にも「本番の変動を含む評価用の画像をいつまでに何枚集めるか」を入れておくのがよいと考えています。PoC の出口の決め方は第13章で扱います。
体制の面では、データ拡張の幅を決める材料(照明の明るさの変動、製品の向き、位置決めのずれ)を持っているのは、撮像の担当者と生産技術の担当者です。データ担当だけでモデルの学習を進めると、本番で起きる変動の知識がモデルに入りません。データ拡張の加工の一覧と幅を、撮像の条件の記録と一緒に、撮像・生産技術・データ担当の3者で決める場を最初に設けておくことを勧めます。合成データを使う場合も、描き足す欠陥の見た目が本物に近いかを判断できるのは、日々不良を見ている検査員です。検査員は、判定基準の持ち主として、合成データの点検にも関わる役割を持つと考えています。
品質保証の面では、少ないデータで学んだモデルを使うかどうかの判断は、モデルの成績の数字だけでは決められません。どの評価用の画像で、どれだけの数の不良で成績を確かめたか、その評価用の画像が本番の変動を含んでいるかを、品質保証の担当者が確かめたうえで、出荷の判定の仕組みのどこに組み込むかを決める必要があります。少ないデータで学んだモデルを、立ち上げの時期には人の目視検査と並べて使い、判定の保留の範囲を広めに取る運用(第10章)から始めるのが現実的だと考えています。
この章では、少ない画像で学ぶ工夫として、データ拡張・転移学習・合成データを、架空の合成画像での実行結果と原論文で確かめた範囲で扱いました。本コラムの架空の合成画像では、データ拡張は本番の変動(ここでは照明の明るさの変動)を再現する加工のときに本番の変動を含む評価用の成績を大きく上げ、再現しない加工ではほとんど効かず、本番の変動を含まない画像を10倍に増やしても本番の変動を含む評価用の成績は小さくしか上がりませんでした。別の品目で事前に学習した重みから微調整すると、各3枚・各10枚の少ない画像でもゼロから学習するより高い成績になりましたが、その差は事前学習の品目が布地の品目に似ているかどうかで大きく変わりました。描き足した欠陥は、本物の欠陥が数枚しか無い状態を大きく改善しましたが、異物などでは本物の画像で学んだ場合に届きませんでした。これらの結果を踏まえ、本コラムでは、どの工夫も本番の画像を集める仕組みの代わりにはならず、画像を集める仕組みに先に投資し、少ないデータで学ぶ工夫は立ち上げの時期をつなぐものとして使うのがよいと考えています。次の第8章では、こうして学んだモデルの精度を、見逃しと過検出の言葉で評価し、しきい値を決める方法を扱います。
この章を深めたい方への参考書籍
『転移学習』(松井孝太、熊谷亘 著、講談社):機械学習プロフェッショナルシリーズの1冊(2024年刊)です。版元の目次によれば、ドメイン適応の理論と方法、事前学習済みモデル、メタ学習、少数ショット学習、ドメイン汎化などの章があります。この章で扱った「学習した条件と本番の条件の違い」を、ドメイン適応・ドメイン汎化という枠組みで理論から学びたいデータ分析の担当者に向く専門書です。
『Kaggleに挑む深層学習プログラミングの極意』(小嵜耕平、秋葉拓哉、林孝紀、石原祥太郎 著、講談社):機械学習の競技会を題材にした深層学習の実践書(2023年刊)です。版元の目次によれば、画像分類の章にデータ拡張の節と、事前学習とファインチューニングを扱う節があります。この章で試したデータ拡張と微調整を、実際の画像の分類の課題で手を動かしながら確かめたい方に向いています。
第8章 検査の精度の評価、見逃しと過検出としきい値の決め方
第5章から第7章では、教師あり学習・良品学習・少ないデータで学ぶ工夫を扱い、画像からモデルを学習させる方法を見てきました。第6章の良品学習のように、モデルは画像ごとに「不良らしさ」の数値を出すことが多く、分類のモデルでも、不良のクラスの確からしさを不良らしさの数値として使えます。モデルが出すのは数値であって、良品か不良かの判定ではありません。数値のどこに線を引くか(しきい値)を決め、その線で判定したときにどれだけ見逃し、どれだけ過検出するかを確かめて、初めて検査に使えるかどうかが分かります。この章では、検査の精度をどう測り、しきい値をどう決めるかを扱います。
この章で扱うのは次の内容です。後半は、架空の検査スコア(良品9,800個・不良200個)を使い、実行したコードと結果で確かめます。
- 混同行列を検査の言葉(見逃し・過検出)に置き換える読み方
- 不良が少ないときに正解率が役に立たない理由
- ROC 曲線・適合率と検出率の曲線・AUROC が何を表し、どこで外れるか
- しきい値の2つの決め方(見逃し率の上限を守る、見逃しと過検出の相対コストで選ぶ)
- 見逃し率を確かめるのに必要な不良の数(二項分布の信頼限界)
- 評価用データの切り方と、検査員の判定との比べ方
この章の主張は、精度を1つの数字で語らず、「見逃し率の上限を品質保証と決め、それを守ったうえで過検出を最小にする」ことです。そして、その上限を守れているかどうかは、評価に使った不良の数によって確かめられる範囲が決まる、という点を数字で示します。運用を始めたあとの監視は第12章で扱います。この章のコードは、numpy・pandas・scipy・scikit-learn だけで書いており、載せた3つのまとまり(検査スコアとしきい値、信頼限界、評価用データの分け方)は、それぞれ単独で上から実行すると本文と同じ結果になることを確かめています。
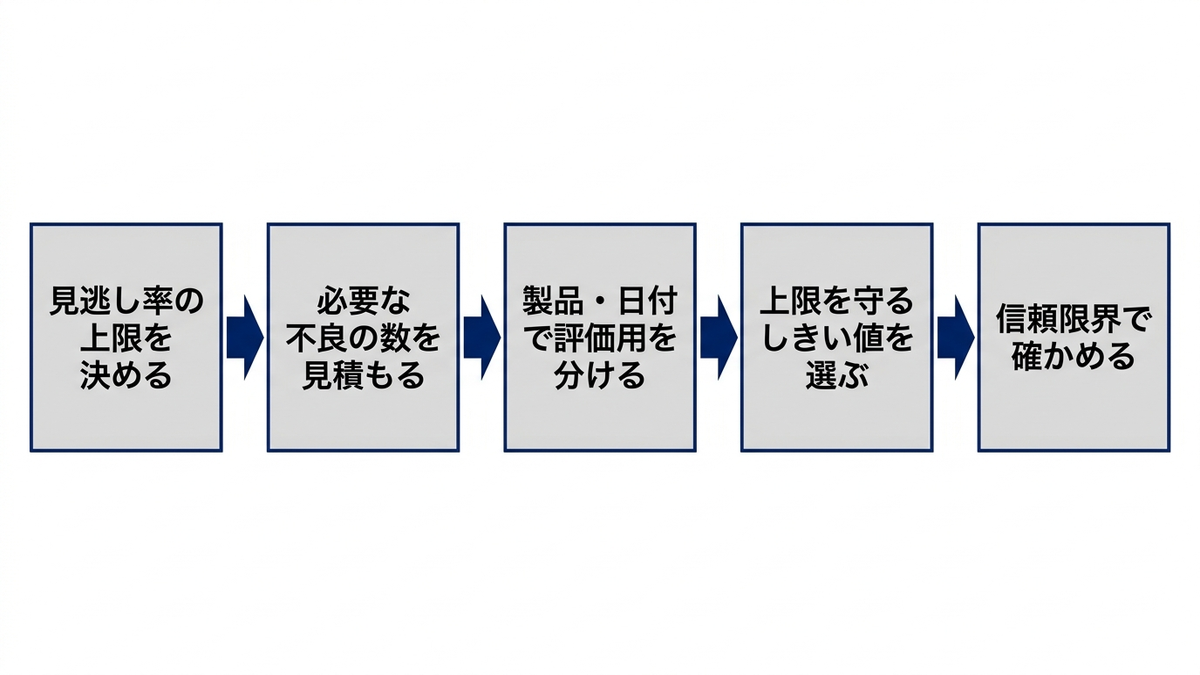
混同行列を検査の言葉に置き換える、見逃しと過検出
判定の結果を数えるときの基本の表が、混同行列です。行に正解(不良か良品か)、列に検査の判定(不良と判定したか良品と判定したか)を取り、4つの升目に件数を入れます。ここでいう正解は、全体の地図で定義したとおり、判定基準に照らして人が確かめて決めた扱いのことで、ラベルとも呼びます。この章で「実際の状態」と書くときも、この正解のことを指します。機械学習の教科書では、不良を「陽性」、良品を「陰性」と呼び、升目を真陽性・偽陰性・偽陽性・真陰性と呼びます。この呼び方は、どちらを陽性にするかで意味が入れ替わるので、検査の現場では混乱のもとになります。本コラムでは、地図の定義のとおり、正解が不良である製品を、検査が良品と判定することを見逃し、正解が良品である製品を、検査が不良と判定することを過検出と呼び、次の表のように置き換えます。
| 正解(実際の状態)/検査の判定 | 不良と判定 | 良品と判定 |
|---|---|---|
| 正解が不良 | 正しく不良と判定(機械学習の用語では真陽性) | 見逃し(偽陰性)。後工程や顧客への流出につながるおそれがある |
| 正解が良品 | 過検出(偽陽性)。廃棄・手直し・再検査が増える | 正しく良品と判定(真陰性) |
この表から、検査で追うべき2つの割合が決まります。見逃し率は、正解が不良の製品のうち、検査が良品と判定した割合です。過検出率は、正解が良品の製品のうち、検査が不良と判定した割合です。どちらも正解の行ごとに割る点が大事で、見逃し率の分母は正解が不良の製品の数、過検出率の分母は正解が良品の製品の数です。分母が違うので、2つの割合は同じ表から出しても大きさがまったく違い、不良が良品よりずっと少ない検査では、見逃し率は少ない件数で大きく動き、過検出率は小さな割合でも件数が多くなります。
機械学習の用語との対応も確かめておきます。「正解が不良の製品のうち、検査が不良と判定した割合」は、1から見逃し率を引いた値で、本コラムではこれを検出率と呼びます。不良を陽性としたとき、機械学習では同じものを再現率・感度・真陽性率と呼びますが、この章では以後、検出率だけを使います。機械学習でいう偽陽性率は過検出率と同じものです。適合率は「検査が不良と判定したもののうち、正解が不良だった割合」で、分母が判定の列になるので、見逃し率・過検出率とは性質が違います。適合率は、再検査に回ってきた品物の中に、どれだけ本当の不良が含まれるかを表すので、再検査の手間の見積もりに使えます。
見逃しと過検出は、序章で整理した6つの損失の型のうち、それぞれ流出と過検出に当たります。どちらも0にできれば理想ですが、次の節以降で見るとおり、同じモデルでしきい値を動かすと、一般に片方を減らすともう片方が増える関係(トレードオフ)にあります。件数で見ると、しきい値を少し動かしても片方だけが変わり、もう片方は変わらない区間もあります。検査の精度の評価とは、この2つの割合のつり合いを、自社の損失の大きさに照らして決める作業だと考えています。
架空の検査スコアを作り、正解率が役に立たない理由を確かめる
ここからは、架空の検査スコアを使って確かめます。第5章から第7章のモデルが出す「不良らしさ」の数値を、本コラムでは検査スコアと呼びます。この章では画像からモデルを学習させる代わりに、スコアそのものを乱数で作りました。良品9,800個と不良200個、合わせて1万個で、不良の割合は2%です。この例では、判定基準に照らして欠陥のある製品をすべて不良とし、欠陥の無い製品を良品とします。良品のスコアは平均0・標準偏差1の正規分布から取り、不良は欠陥の種類で3つに分けて、種類ごとに平均を変えました。大きな傷(120個)は平均6、小さな異物(60個)は平均4、薄い汚れ(20個)は平均2.5で、標準偏差はどれも1です。薄い汚れのように写りにくい欠陥ほどスコアが良品に近くなる、という設定で、実際のモデルのスコアの分布はこれより複雑です。数値は本コラムの架空データのものであり、実在の工程の精度を表すものではありません。
import numpy as np
import pandas as pd
from sklearn.metrics import roc_auc_score, average_precision_score

rng = np.random.default_rng(20261109)
N_GOOD = 9800
DEFECT_TYPES = {"大きな傷": (120, 6.0), "小さな異物": (60, 4.0), "薄い汚れ": (20, 2.5)}
good = rng.normal(0.0, 1.0, N_GOOD)                     # 良品のスコア
parts, kinds = [], []
for name, (n, mu) in DEFECT_TYPES.items():
    parts.append(rng.normal(mu, 1.0, n))                # 不良のスコア(種類ごとに平均が違う)
    kinds += [name] * n
bad = np.concatenate(parts)
kinds = np.array(kinds)
score = np.concatenate([good, bad])
y = np.concatenate([np.zeros(N_GOOD, int), np.ones(len(bad), int)])   # 1が不良
print("良品", N_GOOD, "個/不良", len(bad), "個")
# 出力: 良品 9800 個/不良 200 個
次に、しきい値を1つ決めて判定し、混同行列の4つの升目と、正解率・見逃し率・過検出率を出します。スコアがしきい値以上なら不良と判定します。しきい値は3.0と2.0の2通りを試しました。
def judge(t):
    pred = (score >= t).astype(int)                     # スコアがしきい値以上なら不良と判定
    tp = int(((pred == 1) & (y == 1)).sum()); fn = int(((pred == 0) & (y == 1)).sum())
    fp = int(((pred == 1) & (y == 0)).sum()); tn = int(((pred == 0) & (y == 0)).sum())
    return tp, fn, fp, tn

for t in [3.0, 2.0]:
    tp, fn, fp, tn = judge(t)
    print(f"しきい値{t}: 不良を不良{tp} 見逃し{fn} 過検出{fp} 良品を良品{tn}",
          f"正解率{(tp + tn) / len(y):.4f} 見逃し率{fn / (tp + fn):.3f} 過検出率{fp / (fp + tn):.4f}")
print("全部を良品と判定したときの正解率", round(N_GOOD / len(y), 4))
print("AUROC", round(roc_auc_score(y, score), 4), "平均適合率", round(average_precision_score(y, score), 4))
# 出力:
# しきい値3.0: 不良を不良172 見逃し28 過検出10 良品を良品9790 正解率0.9962 見逃し率0.140 過検出率0.0010
# しきい値2.0: 不良を不良192 見逃し8 過検出227 良品を良品9573 正解率0.9765 見逃し率0.040 過検出率0.0232
# 全部を良品と判定したときの正解率 0.98
# AUROC 0.9946 平均適合率 0.9456
結果を表にまとめます。
| 判定のしかた | 見逃し(不良200個中) | 過検出(良品9,800個中) | 正解率 | 見逃し率 | 過検出率 |
|---|---|---|---|---|---|
| しきい値3.0 | 28 | 10 | 0.9962 | 0.140 | 0.0010 |
| しきい値2.0 | 8 | 227 | 0.9765 | 0.040 | 0.0232 |
| すべてを良品と判定(何も検査しない) | 200 | 0 | 0.98 | 1.000 | 0 |
この表から、正解率が検査の評価に向かない理由が3つ読み取れます。1つ目は、何も検査せずにすべてを良品と判定しても、正解率が0.98になることです。不良が2%しかないので、不良を1個も見つけない判定でも正解率は98%に達します。「正解率98%」という報告は、この架空データでは何もしないのと同じ水準です。2つ目は、しきい値3.0の正解率0.9962が、しきい値2.0の0.9765より高いのに、見逃しは28個と8個で、3.0のほうが3倍以上多いことです。正解率は良品を正しく通した件数に引っ張られるので、不良が少ない検査では、見逃しを増やして過検出を減らすほうが正解率が上がることがあります。3つ目は、正解率は見逃しと過検出を区別しない1つの数字なので、流出と過検出のどちらの損失が増えたのかが分からないことです。
第1章で触れた「精度99%で十分」という誤解は、ここから生まれると考えています。この架空データでは、しきい値3.0の正解率は99%を超えていますが、不良の14%を見逃しています。精度の報告を受けたら、その数字が正解率なのか、見逃し率・過検出率なのか、評価に使った不良と良品がそれぞれ何個だったのかを、まず確かめる必要があります。
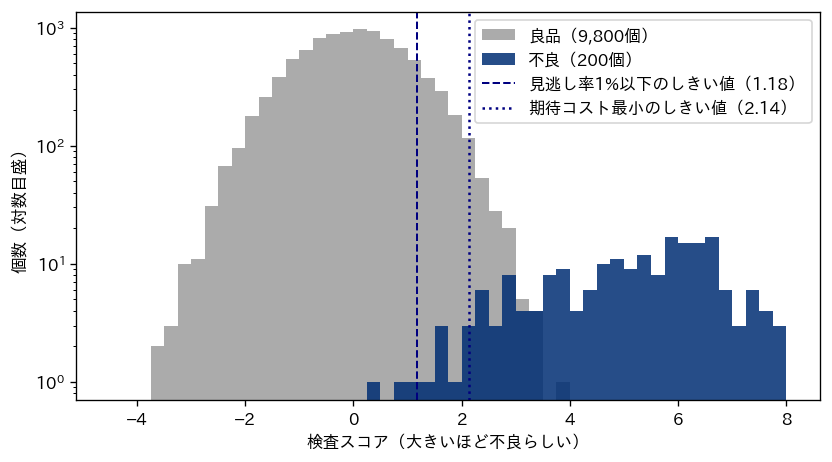
上の図は、良品と不良のスコアの分布を重ねたものです。縦軸は個数の対数目盛にしてあり、数の少ない不良の分布も見えるようにしました。良品の分布の右の裾と、不良の分布の左の裾が重なっています。この重なりの中にしきい値を置く限り、見逃しと過検出の両方を0にすることはできません。図の2本の縦の線は、後の節で説明する2つの決め方で選んだしきい値です。
ROC曲線・適合率と検出率の曲線・AUROC、しきい値に依らない指標で分かること・分からないこと
しきい値を1つ決めて出す見逃し率・過検出率に対して、しきい値をすべての値に動かしたときの成績をまとめて表す方法があります。代表的なものがROC曲線(ROC は英語の receiver operating characteristic の略です)です。scikit-learn の公式ドキュメントの説明によれば、ROC 曲線は、判定のしきい値を変えながら、横軸に過検出率、縦軸に検出率(1から見逃し率を引いた値)を取って描いた曲線です。左上の角(過検出率0・検出率1)に近いほど、見逃しと過検出を同時に小さくできるモデルです。ROC 曲線の下の面積を AUROC(AU は英語の area under(下の面積)の略です。ROC-AUC とも書きます)と呼び、1に近いほど良く、スコアが当て推量と変わらなければ0.5になります。ROC 分析の考え方を整理した入門の論文としては、Fawcett の2006年の論文(Pattern Recognition Letters 誌)があります。
もう1つが、適合率と検出率の曲線です(機械学習では適合率・再現率曲線と呼ばれます)。横軸に検出率、縦軸に適合率を取り、しきい値を動かして描きます。この曲線を1つの数字にまとめたものが平均適合率で、1に近いほど、見逃しを減らしても再検査に回る品物の中の良品が増えにくいモデルです。scikit-learn では average_precision_score で計算できます。公式ドキュメントによれば、この関数は曲線の点と点の間を直線でつながずに計算しており、直線でつないで面積を求める方法は値が良く出すぎることがある、と注意しています。
次の図は、この章の架空データの ROC 曲線と、適合率と検出率の曲線です。前の節のコードの出力のとおり、AUROC は0.9946、平均適合率は0.9456でした。
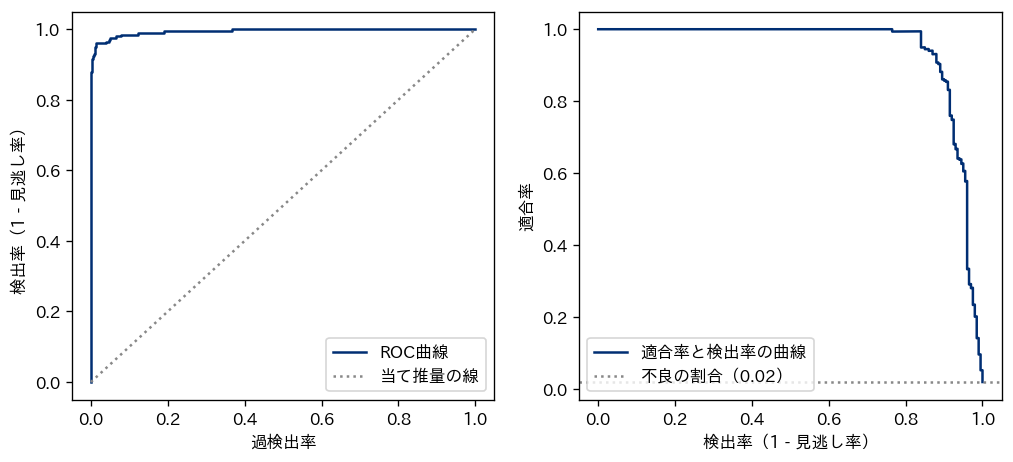
AUROC の0.9946は、1にかなり近い値です。ROC 曲線も左上の角に張り付いて見えます。それでも、前の節で見たとおり、しきい値3.0では不良の14%を見逃し、しきい値2.0でも4%を見逃しています。AUROC が高いことと、検査に使えるしきい値で見逃しが十分に少ないことは、別のことです。AUROC はすべてのしきい値の成績をならした数字なので、実際に使う1つのしきい値での見逃し率と過検出率は教えてくれません。
ROC 曲線にはもう1つ、不良が少ないときに良く見えすぎるという性質があります。横軸の過検出率は良品の数で割った割合なので、良品が9,800個あると、過検出が100個増えても横軸は約0.01しか動きません。前の節の表のとおり、しきい値2.0では過検出率0.0232で検出率が0.96(見逃し率0.040)に達しており、図の左側では曲線がほぼ上に上がりきって見えますが、過検出率0.0232は良品の中の227個です。不良200個の検査で過検出が200個あれば、不良と判定したものの半分前後が良品ということになり、再検査の手間は大きくなります。右の適合率と検出率の曲線では、検出率を1に近づけるにつれて適合率が急に下がっていく様子が見え、この負担が読み取れます。Saito と Rehmsmeier の2015年の論文(PLOS ONE 誌)は、陽性と陰性の数が大きく偏ったデータでは、ROC 曲線より適合率と検出率の曲線のほうが分類器の評価に多くの情報を与える、と結論しています。
指標の意味と使いどころを、次の表に整理しました。
| 指標 | 何が分かるか | しきい値 | 不良が少ないときの注意 | 検査での使いどころ |
|---|---|---|---|---|
| 正解率 | 全体のうち正しく判定した割合 | 1つに決めて計算 | すべてを良品と判定するだけで、良品の割合と同じ正解率になる | 単独では使わない |
| 見逃し率 | 正解が不良の製品のうち良品と判定した割合 | 1つに決めて計算 | 分母の不良が少ないので、1個の差で大きく動く | 品質保証と上限を決める主役の指標 |
| 過検出率 | 良品のうち不良と判定した割合 | 1つに決めて計算 | 割合は小さくても件数は多くなる。件数でも報告する | 再検査・廃棄の量の見積もり |
| 適合率 | 不良と判定したもののうち実際に不良だった割合 | 1つに決めて計算 | 不良の割合が変わると値が変わる | 再検査に回るもののうち本当の不良の割合 |
| AUROC | しきい値をすべて動かしたときの見分ける力の総合 | 決めずに計算 | 良く見えすぎることがある。実際のしきい値での見逃しは分からない | モデルの候補を比べる入口 |
| 平均適合率 | 適合率と検出率の曲線をまとめた数字 | 決めずに計算 | 不良の割合が違う評価用データどうしでは比べにくい | 不良が少ないときのモデルの比較 |
モデルの候補を比べる段階では AUROC や平均適合率を使ってよいと考えていますが、検査に入れるかどうかの判断は、実際に使うしきい値での見逃し率と過検出率(と、その件数)で行うべきだと考えています。なお、研究の論文で公開データセットに対して報告される AUROC は、そのデータセットとその条件での値で、自社のラインで同じ値が出ることを意味しません。公開データセットの数字の読み方は第14章で扱います。
しきい値の2つの決め方、見逃し率の上限を守るか、相対コストで選ぶか
しきい値の決め方には、大きく2つの考え方があります。1つは、見逃し率に上限を決め、その上限を守るしきい値のうち過検出が最も少ないものを選ぶ方法です。もう1つは、見逃し1件と過検出1件の損失の大きさを相対コストとして置き、見逃しと過検出の相対コストの合計が最も小さくなるしきい値を選ぶ方法です。合計を検査した個数で割れば、この例の1万個での1個あたりの平均コストになるので、合計を最小にすることは平均コストを最小にすることと同じです。ただし、この平均コストは、この例の不良の割合(2%)と欠陥の種類の構成のもとでの値です。本番の工程で不良の割合や欠陥の構成が違えば、相対コストの合計が最小になるしきい値も変わるので、本番の不良の割合と欠陥の構成を反映して計算し直す必要があります。
次のコードでは、しきい値を-1.0から5.0まで0.01刻みで動かして、それぞれの見逃し・過検出の件数と割合を表にしました。そのうえで、(1)見逃し率1%以下を守るしきい値のうち最も高いもの(しきい値が高いほど過検出は少ないので、これが過検出の最も少ない選び方になります)と、(2)見逃し1件の相対コストを5・20・100・500、過検出1件を1と置いたときに合計が最小になるしきい値を求めました。相対コストは単位の無い数で、金額ではありません。
ts = np.round(np.arange(-1.0, 5.0001, 0.01), 2)
rows = []
for t in ts:
    tp, fn, fp, tn = judge(t)
    rows.append([t, fn, fp, fn / (tp + fn), fp / (fp + tn)])
tab = pd.DataFrame(rows, columns=["しきい値", "見逃し", "過検出", "見逃し率", "過検出率"])
ok = tab[tab["見逃し率"] <= 0.01]                       # (1) 見逃し率1%以下を守る
t1 = ok["しきい値"].max()
print("(1) 見逃し率1%以下で最も高いしきい値")
print(tab[tab["しきい値"] == t1].round(4).to_string(index=False))
for c_miss in [5, 20, 100, 500]:                           # (2) 相対コストで期待コストを最小に
    cost = c_miss * tab["見逃し"] + 1 * tab["過検出"]
    i = cost.idxmin()
    print(f"(2) 見逃し{c_miss}:過検出1 のとき", tab.loc[i].round(4).to_dict(), "相対コスト", int(cost[i]))
tab["相対コスト100"] = 100 * tab["見逃し"] + tab["過検出"]
t2 = tab.loc[tab["相対コスト100"].idxmin(), "しきい値"]
実行した結果を表にまとめます。
| 決め方 | しきい値 | 見逃し(不良200個中) | 過検出(良品9,800個中) | 見逃し率 | 過検出率 | 相対コストの合計 |
|---|---|---|---|---|---|---|
| (1)見逃し率1%以下を守る | 1.18 | 2 | 1,203 | 0.010 | 0.1228 | なし |
| (2)見逃し5:過検出1 | 2.60 | 17 | 37 | 0.085 | 0.0038 | 122 |
| (2)見逃し20:過検出1 | 2.14 | 8 | 143 | 0.040 | 0.0146 | 303 |
| (2)見逃し100:過検出1 | 2.14 | 8 | 143 | 0.040 | 0.0146 | 943 |
| (2)見逃し500:過検出1 | 1.18 | 2 | 1,203 | 0.010 | 0.1228 | 2,203 |
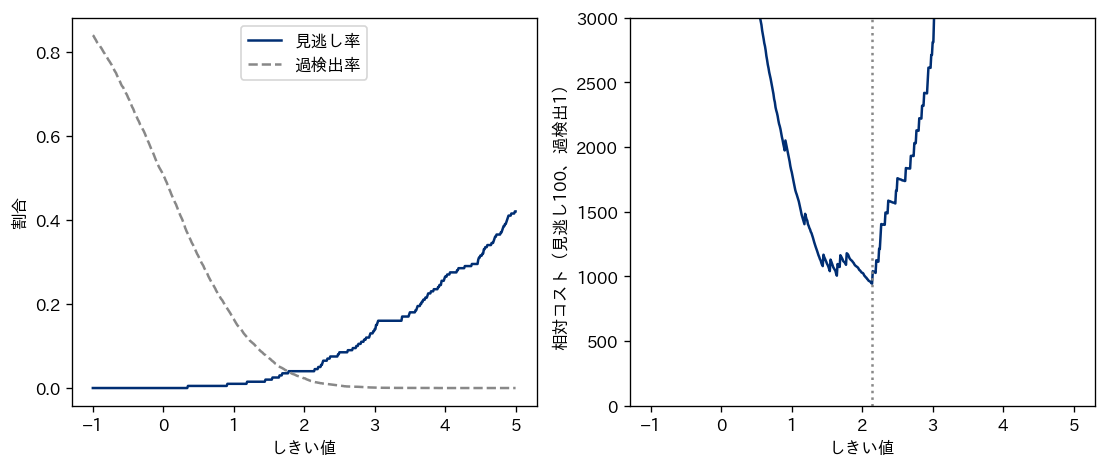
左の図のとおり、しきい値を上げると見逃し率は下がらず、過検出率は上がりません(スコアがしきい値以上を不良とする判定なので、しきい値を上げて不良と判定される製品が増えることはありません)。2つの線は途中で交わり、全体としては片方を下げるともう片方が上がる関係にあります。ただし、件数が有限なので、片方だけが変わる区間もあります。前の節の表と上の表を比べると、しきい値を2.0から2.14に上げたとき、見逃しは8個のまま、過検出だけが227個から143個に減っています。右の図は、見逃し1件の相対コストを100と置いたときの合計で、しきい値2.14で最小の943になりました。
この結果から、2つの決め方の性質が見えます。なお、ここでいう「見逃し率1%以下」は、この架空データの不良200個の上で数えた値で、新しい製品に対して見逃し率1%以下を保証するものではありません(保証との違いは後の節で扱います)。(1)の見逃し率1%以下を守る決め方では、しきい値は1.18まで下がり、良品の12%にあたる1,203個を不良と判定します。見逃しを2個に抑える代わりに、再検査か廃棄の対象が大きく増えます。(2)の相対コストで選ぶ決め方では、見逃しの相対コストが20でも100でもしきい値は同じ2.14で、見逃しは8個(4%)残ります。見逃しの相対コストを500まで上げると、(1)と同じ1.18になりました。相対コストの置き方でしきい値が変わるので、(2)の決め方は、相対コストの根拠を説明できるときにだけ使えると考えています。
ここで注意したいのは、(2)の決め方では、見逃しの相対コストを100と置いても見逃し率4%のしきい値が選ばれることです。相対コストの合計が最小であっても、見逃し率が顧客との取り決めや社内の品質基準で許される範囲に収まっているとは限りません。流出の損失には、後工程での手戻りや顧客への流出だけでなく、取引の信頼の低下のように相対コストの数字に置きにくいものも含まれます。そのため、本コラムでは、(1)の見逃し率の上限を先に決めて制約とし、その上限を守るしきい値の中で、過検出が最も少ないもの、あるいは相対コストの合計が最も小さいものを選ぶ、という順番を勧めます。精度の1つの数字ではなく、見逃し率の上限を守ったうえで過検出を最小にする、というのがこの章の主張です。
見逃し率の上限を守った結果、過検出が多すぎて運用できない場合(この例の1,203個のように)は、しきい値の工夫では解決しません。モデルを改善するか、撮像を見直して欠陥が写るようにするか(第3章)、迷う範囲を人の再検査に回すか(第10章)を考えることになります。
見逃し率は、欠陥の種類ごとにも分けて見る必要があります。見逃し率を1つの数字で見ると、どの欠陥を見逃しているかが隠れるからです。次のコードで、2つのしきい値での見逃しを欠陥の種類ごとに数えました。
for t in [t1, t2]:
    print(f"しきい値{t} の種類ごとの見逃し")
    for name in DEFECT_TYPES:
        s = bad[kinds == name]
        print(" ", name, len(s), "個中", int((s < t).sum()), "個を見逃し", f"見逃し率{(s < t).mean():.3f}")
| 欠陥の種類 | 個数 | しきい値1.18での見逃し | しきい値1.18での見逃し率 | しきい値2.14での見逃し | しきい値2.14での見逃し率 |
|---|---|---|---|---|---|
| 大きな傷 | 120 | 0 | 0.000 | 0 | 0.000 |
| 小さな異物 | 60 | 0 | 0.000 | 2 | 0.033 |
| 薄い汚れ | 20 | 2 | 0.100 | 6 | 0.300 |
しきい値2.14では、全体の見逃し率は4%ですが、薄い汚れに限ると20個中6個、30%を見逃しています。全体の見逃し率は、数の多い大きな傷が0個だったことで薄められています。実際の検査では、欠陥の種類によって流出したときの影響が違います。ただし、許される見逃し率は欠陥の説明だけからは決まりません。外観の欠陥にも顧客から厳しい要求がある場合があるので、欠陥ごとの影響と、適用される顧客との取り決めや社内の要求事項を確かめたうえで、品質保証の部門が許容の条件を定めます。そのうえで、見逃し率の上限は、第2章で本コラムの言葉として扱った「重要度」(欠陥が製品の機能・安全・外観にどれだけ影響するかによる区分)に合わせて、欠陥の種類ごとに決めることを勧めます。そのためには、評価用データの不良に、欠陥の種類のラベルが付いている必要があります。
欠陥の種類ごとに分けると、1つの種類あたりの不良の数は少なくなります。この例の薄い汚れは20個しかなく、1個の差で見逃し率が5ポイント動きます。次の節では、少ない不良の数で見逃し率をどこまで確かめられるかを扱います。
見逃し率を確かめるのに必要な不良の数、見逃しが0件でも安心できない理由
前の節の(1)では、評価用の不良200個のうち見逃しが2個だったので、見逃し率は1%でした。しかし、この1%は200個という限られた不良で数えた値で、同じ工程から別の200個を取れば、見逃しは0個にも5個にもなりえます。品質保証の立場で知りたいのは、「この評価の結果から、本当の見逃し率がどこまで大きい可能性を否定できないか」です。これを表すのが、見逃し率の上側の信頼限界です。
不良1個ごとに見逃すかどうかが独立に決まり、見逃す確率が一定だと考えると、n 個の不良のうち見逃す個数は二項分布に従います。二項分布は、1回ごとに「起きる・起きない」が一定の確率で決まる試行を n 回くり返したとき、起きた回数がどう散らばるかを表す分布です。二項分布の割合の信頼区間の求め方の1つが、クリッパー・ピアソン法(Clopper と Pearson が1934年に Biometrika 誌に発表した方法)です。米国の国立標準技術研究所(NIST)の工学統計ハンドブックは、二項分布に基づく正確な方法として、見逃しが k 個だったとき、二項分布で「見逃しが k 個以下になる確率」が \(\alpha/2\) になる割合を上限とする、という定め方を示しています。ここで \(\alpha\) は、1から信頼度を引いた値で、信頼度95%なら0.05です。上限だけを問題にする片側の信頼限界では、\(\alpha/2\) の代わりに \(\alpha\) を使います。
見逃しが0個のときは、この式は簡単になります。n 個の不良を1個も見逃さない確率は \((1-p)^n\) なので、片側95%の上限 \(p_U\) は \((1-p_U)^n = 0.05\) を解いて \(p_U = 1-0.05^{1/n}\) になります。言葉で言えば、「本当の見逃し率がこの値だったら、n 個を1個も見逃さないことは5%以下の確率でしか起きない」という境目の値です。0.05の自然対数はおよそ-3.0なので、この値は n が大きいとき、3を n で割った値に近くなります。
次のコードで、評価に使った不良の数 n と見逃しの個数 k ごとに、見逃し率の片側95%の上限を計算しました。scipy の公式ドキュメントによれば、binomtest の結果の proportion_ci で method="exact" を指定すると、クリッパー・ピアソン法の区間が求められます。ここでは、ベータ分布の分位点で片側の上限を計算し、両側90%の区間の上端(片側95%の上限と同じ値になる)と照らし合わせました。
import numpy as np
from scipy import stats

# 見逃しが k 件だったときの、見逃し率の上側の信頼限界(クリッパー・ピアソン法)
def upper(k, n, conf=0.95):
    if k == n:
        return 1.0
    return stats.beta.ppf(conf, k + 1, n - k)           # 片側の上限

print("不良n個を検査して見逃しk件のときの片側95%上限")
for n in [30, 50, 100, 200, 300, 500, 1000, 3000]:
    print(n, [round(float(upper(k, n)), 4) for k in [0, 1, 2]])

# scipy の binomtest の exact(クリッパー・ピアソン)と照らし合わせる
r = stats.binomtest(2, 200).proportion_ci(confidence_level=0.90, method="exact")
print("両側90%の区間(上端は片側95%上限と同じ)", round(r.low, 4), round(r.high, 4))
print("k=0 の式 1-(0.05)^(1/n) で n=300", round(1 - 0.05 ** (1 / 300), 4))

# 見逃し0件で上限を p 以下にするのに要る不良の数
for p in [0.05, 0.01, 0.005, 0.001]:
    n = int(np.ceil(np.log(0.05) / np.log(1 - p)))
    print(f"上限{p}以下に要る不良の数(見逃し0件)", n, "確かめ", round(float(upper(0, n)), 6), round(float(upper(0, n - 1)), 6))

# 不良299個を集めたとき、本当の見逃し率が p なら見逃し0個で終わる確率
for p in [0.001, 0.005, 0.009]:
    print(f"本当の見逃し率{p}で299個を1個も見逃さない確率", round((1 - p) ** 299, 3))
# 出力(抜粋):
# 両側90%の区間(上端は片側95%上限と同じ) 0.0018 0.0311
# k=0 の式 1-(0.05)^(1/n) で n=300 0.0099
実行した結果を表にまとめます。表の値は片側95%の上限です。評価に使った不良の数と見逃しの個数から見て、本当の見逃し率がこの値程度まで高い可能性は排除できない、ということを表します(この値を超える見逃し率は、信頼度95%で否定できます)。
| 評価に使った不良の数 | 見逃し0個のときの上限 | 見逃し1個のときの上限 | 見逃し2個のときの上限 |
|---|---|---|---|
| 30 | 9.50% | 14.86% | 19.53% |
| 50 | 5.82% | 9.14% | 12.06% |
| 100 | 2.95% | 4.66% | 6.16% |
| 200 | 1.49% | 2.35% | 3.11% |
| 300 | 0.99% | 1.57% | 2.08% |
| 500 | 0.60% | 0.95% | 1.25% |
| 1,000 | 0.30% | 0.47% | 0.63% |
| 3,000 | 0.10% | 0.16% | 0.21% |
前の節の(1)のしきい値1.18は、不良200個のうち2個を見逃したので、見逃し率は1%でした。表の不良200個・見逃し2個の行を見ると、上限は3.11%です。つまり、この評価の結果からは「本当の見逃し率は3%程度かもしれない」という可能性を否定できず、「見逃し率1%以下」を確かめたことにはなりません。しかも、この3.11%は、しきい値を評価用データと関係なく先に決めていた場合の値です。しきい値1.18は、同じ200個の不良を見ながら「見逃しが2個に収まる」ように選んだ値なので、新しい不良で確かめれば、本当の見逃し率の上限は3.11%より高くなる可能性があります。しきい値を選ぶデータと、見逃し率を確かめるデータを分ける理由は、次の節で扱います。scipy の binomtest で求めた両側90%の区間は0.0018から0.0311で、上端は表の値と一致しました。
見逃しが0個だった場合でも同じです。不良を30個集めて1個も見逃さなかった、という試験導入(PoC)の結果は、見逃し率が9.5%程度である可能性を否定できません。見逃し0個で上限を目標以下にするのに要る不良の数を計算すると、次のようになりました。
| 確かめたい見逃し率の上限(片側95%) | 見逃し0個で必要な不良の数 | 目安(3を上限で割った値) |
|---|---|---|
| 5% | 59 | 60 |
| 1% | 299 | 300 |
| 0.5% | 598 | 600 |
| 0.1% | 2,995 | 3,000 |
見逃し率1%以下を95%の信頼度で確かめるには、評価用データに不良が少なくとも299個あり、そのすべてを不良と判定できる必要があります。299個は「1個も見逃さなかった場合に限って足りる最小の数」で、1個でも見逃せば足りなくなり、必要な数はさらに増えます(表のとおり、見逃し1個なら300個でも上限は1.57%です)。また、299個を集めれば確かめられる、という意味でもありません。コードの最後の3行で計算したとおり、本当の見逃し率が0.5%のモデルでも、299個を1個も見逃さずに終わる確率は0.223(約2割)しかなく、本当の見逃し率が0.1%でも0.741です。本当の見逃し率が上限に近いモデルほど、この評価に通りにくくなるので、評価用の不良は最小の数より余裕を持って集める計画にするのが現実的だと考えています。不良の割合が2%の工程なら、不良299個を集めるには、単純に割り算をすると約1万5千個の製品の画像が要ります。さらに、前の節で見たように欠陥の種類ごとに上限を決めるなら、この数が種類ごとに要ります。
この計算は、不良1個ごとの見逃しが独立で、見逃す確率が一定という前提に立っています。この章の架空データは、見逃しやすさの違う3種類の不良を120個・60個・20個と個数を決めて作っているので、見逃しの個数は厳密にはこの前提の二項分布と一致しません。前の節の結果(不良200個で見逃し2個)に当てた上限は、この前提を置いたときの計算例です。実際には、同じロットや同じ日の不良は似た写り方をすることが多く、似た不良ばかりを集めても、独立な不良を同じ数だけ集めたことにはならないと考えています。評価用の不良は、ロット・日付・欠陥の種類が偏らないように集めることが必要です。また、この計算は評価に使った不良の範囲で見逃し率を確かめるもので、評価用データに無い種類の欠陥の見逃しは何も教えてくれません。検定と区間推定の基礎は、弊社コラム『データから正しく結論を導く統計学のまとめ』で扱っています。
経営の側から見ると、この表は「PoC の評価にどれだけの不良が必要か」を決める根拠になります。不良が集まらない欠陥について、少ない数の評価で「見逃し0件だった」と報告を受けて量産に入ると、流出の損失を確かめないまま抱えることになります。不良が足りないときは、評価の期間を延ばすか、目視検査と並行して稼働させる期間を設けて不良を集めながら確かめる(第13章)、という計画が必要です。
評価用データの切り方、同じ製品の画像が学習と評価に混ざる漏れを防ぐ
見逃し率や過検出率は、学習に使っていない評価用データで測る必要があります。ここで起きやすいのが、学習用と評価用を画像1枚ごとに無作為に分けてしまう誤りです。外観検査では、同じ製品を複数の位置や角度から撮る、同じ製品を検査をやり直すたびに撮り直す、1枚の大きな画像を小さな区画に切って学習に使う、といったことがよくあります。画像1枚ごとに分けると、同じ製品の別の画像が学習用と評価用の両方に入り、モデルは「この製品の見た目」を覚えるだけで評価用の画像を当てられてしまいます。こうした、評価用の答えにつながる情報が学習側に入り込むことを、本コラムでは漏れと呼びます。
scikit-learn の公式ドキュメントは、同じ患者から複数の標本を取った医療データのように、標本がグループごとに互いに依存している場合には、学習に使っていないグループに対してモデルがどれだけ当たるかを測るべきだとし、評価用の標本が学習用には一切含まれないグループから来るように分ける必要がある、と説明しています。そのための道具として、同じグループが学習と評価の両方に入らないように分ける GroupKFold などが用意されています。外観検査では、このグループに当たるのが製品の個体です。
漏れがどれだけ評価を良く見せるかを、架空の特徴量で確かめました。製品300個を1個あたり5枚ずつ撮ったと考え、画像ごとに8つの特徴量を作ります。製品ごとに見た目の癖を乱数で持たせ、同じ製品の5枚は癖が同じで、撮影ごとの小さなばらつきだけが違う設定です。製品の約2割を乱数で不良とし、不良の製品は2つの特徴量がずれるようにしました。分類には、近い画像5枚の多数決で判定する k 近傍法を使い、画像1枚ごとに無作為に3割を評価用にする分け方と、製品単位で3割の製品を評価用にする分け方(GroupShuffleSplit)を、乱数のシードを変えて5回ずつ比べました。
import numpy as np
from sklearn.model_selection import train_test_split, GroupShuffleSplit
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import roc_auc_score

# 製品300個を1個あたり5枚ずつ撮った架空の特徴量(同じ製品の画像は互いによく似る)
rng = np.random.default_rng(20261109)
N_PROD, SHOTS, DIM = 300, 5, 8
is_bad = rng.random(N_PROD) < 0.2                       # 製品ごとに不良かどうか
prod_vec = rng.normal(0, 1, (N_PROD, DIM))              # 製品ごとの見た目の癖
prod_vec[is_bad, :2] += 1.5                             # 不良は2つの特徴がずれる
X = np.repeat(prod_vec, SHOTS, axis=0) + rng.normal(0, 0.2, (N_PROD * SHOTS, DIM))
y = np.repeat(is_bad.astype(int), SHOTS)
group = np.repeat(np.arange(N_PROD), SHOTS)             # どの製品の画像か

def evaluate(tr, te):
    m = KNeighborsClassifier(n_neighbors=5).fit(X[tr], y[tr])
    return roc_auc_score(y[te], m.predict_proba(X[te])[:, 1])

idx = np.arange(len(y))
res_r, res_g = [], []
for s in range(5):
    tr, te = train_test_split(idx, test_size=0.3, random_state=s, stratify=y)
    res_r.append(evaluate(tr, te))                      # 画像単位で無作為に分ける
    tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.3, random_state=s).split(X, y, group))
    res_g.append(evaluate(tr, te))                      # 製品単位で分ける
    print("学習と評価の両方に入った製品の数", len(set(group[tr]) & set(group[te])))
print("画像単位で分けたAUROC", np.round(res_r, 3), "平均", round(np.mean(res_r), 3))
print("製品単位で分けたAUROC", np.round(res_g, 3), "平均", round(np.mean(res_g), 3))
# 出力(最後の2行):
# 画像単位で分けたAUROC [0.993 0.996 0.99  0.986 0.982] 平均 0.989
# 製品単位で分けたAUROC [0.816 0.726 0.774 0.846 0.716] 平均 0.776
| 評価用データの分け方 | AUROC(5回) | AUROC の平均 | この数字が表すもの |
|---|---|---|---|
| 画像1枚ごとに無作為に分ける | 0.993、0.996、0.990、0.986、0.982 | 0.989 | 学習で見た製品の別の画像を当てる力(漏れを含む) |
| 製品単位で分ける | 0.816、0.726、0.774、0.846、0.716 | 0.776 | 学習で見ていない製品を見分ける力 |
画像1枚ごとに分けると AUROC の平均は0.989でしたが、製品単位で分けると0.776まで下がりました。製品単位で分けたときは、5回とも学習と評価の両方に入った製品は0個であることをコードで確かめています。この架空データでは、画像1枚ごとに分けたときの高い値は、同じ製品の別の画像が学習側にあったことによるもので、新しい製品を見分ける力を表していません。ラインで判定するのは毎回新しい製品なので、検査の評価に使うべきは製品単位で分けた値です。製品単位で分けた5回の値は0.716から0.846まで幅があり、評価用の製品が90個程度だと分け方によって結果が大きく動くことも分かります。
製品の個体のほかにも、学習と評価を分けるべき単位があります。ラインで使うモデルは、学習したあとの日付・ロットの製品を判定するので、評価も「学習より後の日付・ロット」で行うのが実際の使い方に近いと考えています。分ける単位の候補を次の表にまとめます。
| 分ける単位 | 混ざると起きること | 分け方の例 |
|---|---|---|
| 製品の個体 | 同じ製品の別の位置・別の撮り直し・切り出した区画が両方に入り、製品の見た目を覚えただけで当たる | 製品の識別子をグループにして分ける |
| 日付・時期 | 同じ日の照明や材料の状態を覚え、後の日の画像で外れる | ある日付より前を学習、後を評価にする |
| ロット | 同じロットの材料の色や表面の癖を覚える | ロット番号をグループにして分ける |
| ライン・カメラ・工場 | 別のラインに展開したときの成績が分からない | 展開する予定がある場合は、ラインごとに評価用を分けて成績を出す |
| 不良の発生の事象 | 同じ原因で続けて出た不良が両方に入り、似た不良だけを当てる | 同じ事象の不良をまとめて1つのグループにする |
漏れを防ぐには、画像を集める段階から、製品の識別子・撮影日時・ロット・ライン・カメラを画像と一緒に記録しておく必要があります。記録が無いと、後から分け方を直せません。記録項目の設計は第11章で扱います。もう1つ、評価用データは一度決めたら固定し、しきい値やモデルを何度も調整するための材料にしないことも大切です。評価用データを見ながらしきい値を何度も選び直すと、その評価用データに合わせ込んだ結果になり、次の新しいデータでは同じ成績が出ないことがあります。しきい値を選ぶためのデータと、最後に成績を確かめるためのデータは分けておくのが安全だと考えています。この章の例では、説明を簡単にするために同じ1万個でしきい値を選び、成績も出しているので、出した見逃し率は楽観的な値です。
検査員の判定と比べるときの注意、正解の付け方と対応のある比較
外観検査AIの導入では、「いまの目視検査より良いか」を問われることが多くなります。このとき、AIの見逃し率と、別の時期に別の品物で測った検査員の見逃し率を並べるだけでは、比べたことになりません。品物が違えば、含まれる欠陥の種類や難しさが違うからです。比べるなら、同じ品物の集まりを AIと検査員の両方が判定し、同じ正解に照らして数える必要があります。
最初の問題は、正解をどう付けるかです。第2章で見たとおり、検査員の判定は人によっても時間によってもばらつきます。正解を1人の検査員の判定で付けると、AIの成績は「その検査員とどれだけ一致したか」になり、その検査員の癖まで正解として扱うことになります。正解は、限度見本に照らして複数の熟練者が時間をかけて判定し、意見が分かれたものは協議で決める、拡大して観察する、寸法を測るなど、ふだんの検査より手間をかけた方法で付けることを勧めます。正解の付け方そのものを記録しておかないと、後でモデルを入れ替えたときに成績を比べられません。
次の問題は、比べ方です。同じ品物を AIと検査員の両方が判定すると、品物ごとに「両方が正しい」「AIだけが正しい」「検査員だけが正しい」「両方が誤り」の4通りに分かれます。どちらが優れているかの手がかりになるのは、片方だけが正しかった件数の差です。両方が正しい品物や両方が誤った品物は、比べる材料になりません。このような比べ方に使う統計の方法として、マクネマー検定があります。マクネマー検定は、「AIだけが正しかった件数」と「検査員だけが正しかった件数」を比べ、その差が偶然の範囲を超えているかを調べる検定です。statsmodels というライブラリの公式ドキュメントにも、この検定を計算する関数の説明があり、二項分布で正確に計算する方法を選べることが書かれています。不良についての比較なら、片方だけが見逃した不良の数を比べることになるので、ここでも不良の数が少ないと差を確かめられません。
3つ目は、見逃しと過検出を一緒に比べることです。AIのしきい値を下げれば、見逃しは検査員より少なくできても、過検出が検査員よりずっと多くなることがあります。片方の割合だけを比べて「AIのほうが見逃しが少ない」と報告すると、過検出の増加が隠れます。比べるときは、AIの見逃し率を検査員と同じ水準にそろえたときの過検出率、あるいは過検出率をそろえたときの見逃し率、という形で比べるのが公平だと考えています。その場合も、AIのしきい値は比べるための最終の評価用データとは別の調整用のデータで決めて固定し、そのあとで共通の最終の評価用データで比べます。最終の評価用データで検査員の結果を見ながらしきい値を動かすと、前の節で避けるよう述べた合わせ込みになります。
比較の設計で決めておく項目を、次の表にまとめました。
| 決めておく項目 | 決めないと起きること | 決め方の例 |
|---|---|---|
| 比べる品物の集まり | 品物の難しさの違いを、AIと検査員の差と取り違える | 同じ品物を両方が判定する。日付・ロット・欠陥の種類が偏らないように選ぶ |
| 正解の付け方 | 1人の検査員の癖が正解になり、AIがその癖を覚えるほど成績が良く見える | 限度見本に照らした複数の熟練者の判定と協議、拡大観察・計測 |
| 検査員の条件 | 検査員の成績が、人・時間帯・疲れで変わることを見落とす | 複数の検査員・複数の時間帯で判定してもらい、ばらつきの幅を出す(第2章) |
| 比べる指標 | 片方の割合だけを比べ、もう片方の悪化が隠れる | 見逃し率と過検出率を両方、件数つきで報告する |
| 比べ方 | 別々の品物で測った割合を並べて差を論じる | 同じ品物での対応のある比較(片方だけが正しかった件数) |
| 不良の数 | 見逃しの差が偶然の範囲か分からない | 片方だけが誤る割合の見込みと、確かめたい差の大きさから、比較に必要な品物の数を別に設計する(見逃し率の上限を確かめる前の節の表は、この比較には使えない) |
検査員の判定が人によってばらつくことは、AIと比べるうえでの障害であると同時に、AIを入れる理由の1つにもなります。6つの損失の型のうち、判定のばらつき(検査員・時間帯・工場によって基準がずれる)は、AIの判定では、同じモデルに同じ画像を入れれば同じスコアが出るのがふつうなので、判定の基準そのものが人や時間帯でずれることは起きにくくなります。ただし、これは画像が同じ場合に限った話で、照明の劣化やカメラの位置ずれで画像そのものが変われば、同じ製品でもスコアは変わります。撮像のばらつきは別に残るので、撮像の条件の固定(第3章)と変化の監視(第12章)が要ります。また、判定のしかたがそろうことと、そろった基準が正しいかどうかは別の問題です。教師あり学習では、学習に使ったラベル、つまりラベルを付けた人の基準の偏りが判定に影響します(人の基準を完全に再現するわけではありません)。良品学習でも、どの画像を良品として学習に使うかの選び方と、しきい値の設定に、人の基準が反映されます。ばらつきをそろえる効果を得るには、第2章で扱ったように、AIの前に判定基準をそろえておく必要があります。
経営の判断、見逃し率の上限を品質保証と決める
この章の内容を、経営の判断に置き換えます。外観検査AIの評価で経営が決めるべきことは、モデルの精度の目標値ではなく、「どの欠陥について、見逃し率の上限をいくつにし、それを何個の不良で確かめるか」だと考えています。見逃し率の上限は、流出したときの影響、顧客との取り決め、社内の品質基準に関わるので、データ担当や装置のメーカーが決めるものではなく、品質保証の部門が案を作り、経営が承認するものです。出荷の可否の最終的な責任は品質保証の体制にあり、AIの評価の数字はその判断の材料の1つです。法令や顧客との取り決め、業界の規格で検査の方法が定められている製品では、AIの評価の結果だけで検査の方法を変えられるわけではありません。
評価の判断を誤ったときの損失を、6つの損失の型に当てはめると次のようになります。
| 評価での誤り | 起こる損失の型 | 防ぎ方 |
|---|---|---|
| 正解率だけで「精度99%」と判断して導入する | 流出(見逃し率を確かめていない) | 見逃し率と過検出率を件数つきで報告させる |
| 少ない不良で「見逃し0件」を確かめたことにする | 流出(本当の見逃し率の上限が高いまま) | 見逃し率の上側の信頼限界で判断する。必要な不良の数を先に見積もる |
| 見逃しを減らすためにしきい値を下げすぎる | 過検出、形骸化(再検査が追いつかず、人が全数を見直すようになる) | 見逃し率の上限を守る範囲で過検出を最小にする。過検出が多すぎればモデル・撮像・人の再検査の分担を見直す |
| 画像1枚ごとに分けた評価で量産に入る | 流出、形骸化(本番で成績が落ち、AIの判定が信用されなくなる) | 製品・日付・ロットで分けた評価を求める |
| 欠陥の種類をまとめた見逃し率で判断する | 流出(数の少ない種類の見逃しが隠れる) | 欠陥の種類ごと、重要度の区分ごとに上限を決める |
| 工程や工場ごとにばらばらの評価のしかたを使う | 判定のばらつき、二重投資 | 評価の手順(正解の付け方・分け方・指標)を全社でそろえる |
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 欠陥の種類ごと、重要度の区分ごとに、見逃し率の上限を品質保証の部門が案として作り、経営が承認する
- その上限を確かめるのに必要な不良の数を、PoC の計画の段階で見積もり(見逃し0個の場合の最小の数より余裕を持たせる)、評価の期間と予算に入れる
- 評価の報告は、見逃し率と過検出率を、件数・評価に使った不良と良品の数・上側の信頼限界と一緒に出させる
- 評価用データは製品・日付・ロットで学習用と分け、正解の付け方を記録として残させる
- 過検出の件数を、再検査の人手で処理できる量と照らし合わせ、処理できなければ人の再検査の分担(第10章)を設計してから導入する
予算の面では、モデルの開発だけでなく、評価用の不良を集める期間と、正解を付ける熟練者の時間を最初から見込んでおく必要があります。不良の少ない工程ほど、評価用の不良を集めるのに時間がかかり、その間は目視検査と並行して稼働させることになります。この期間を短く見積もると、確かめていない見逃し率のまま量産に入ることになります。運用を始めたあとに、見逃し率・過検出率・保留の率をどう監視し続けるかは、第12章で扱います。
この章のまとめ
この章では、検査の精度を、見逃し率と過検出率という2つの割合で評価し、しきい値を決める方法を扱いました。本コラムの架空データ(良品9,800個・不良200個)では、何も検査しなくても正解率は0.98になり、AUROC が0.9946と高くても、しきい値によっては不良の14%を見逃していました。しきい値は、見逃し率の上限を先に決め、それを守る範囲で過検出を最小にする順番で選ぶことを勧めます。ただし、不良200個で見逃し2個(見逃し率1%)という結果からは、見逃し率の上限は3.11%までしか言えません。しかも、しきい値を同じデータで選んでいるので、実際の上限はこれより高い可能性があります。見逃し率1%以下を95%の信頼度で確かめるには、1個も見逃さないことを条件に、最小でも不良299個が必要でした。評価用データは製品・日付・ロットで学習用と分け、検査員と比べるときは同じ品物で比べる必要があります。次の第9章では、こうして決めた判定を、生産のタクトタイムの中に収めるための推論の設計を扱います。
この章を深めたい方への参考書籍
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標と KPI の関係から始めて、回帰・二値分類・多クラス分類の評価指標を扱う本です。版元の目次によれば、二値分類の章に混同行列・正解率・適合率・再現率・ROC-AUC・PR-AUC の節があり、ビジネスインパクトの期待値の計算やコストを考慮した学習の節も設けられています。この章で扱った、正解率を使わない理由と、相対コストからしきい値を選ぶ考え方を、評価指標の側から体系立てて確かめるのに向いています。
『サンプルサイズの決め方』(永田靖 著、朝倉書店):統計ライブラリーの1冊で、版元の紹介によれば、検出力とサンプルサイズ(標本の数)の設計を扱う本です(2003年刊)。この章で計算した「見逃し率を確かめるのに必要な不良の数」を、評価の計画を立てる段階で、統計の考え方から見積もり直すのに役立ちます。
第9章 速度と精度の両立、タクトタイムに収める推論の設計
第8章では、見逃し率の上限を品質保証と決め、そのうえで過検出を小さくするしきい値を選ぶ方法を扱いました。そこで選んだモデルとしきい値は、検査ラインの上で、決められた時間の中で毎回答えを出せなければ使えません。ラインはタクトタイム(必要な生産数に合わせて決める生産の間隔)で動いています。検査は、仕組み全体としてこの間隔に追いつき、各製品の判定を排出などに必要な期限までに終える必要があり、検査だけが遅れれば、製品が検査の前で詰まるか、検査を飛ばして流すかのどちらかになります。この章では、タクトタイムから検査に使える時間を逆算し、その時間に収まるように画像の大きさとモデルの大きさを選ぶ方法を扱います。
この章で扱うのは次の内容です。
- タクトタイムから、撮像・転送・前処理・推論・判定の出力・排出の時間を割り振る考え方
- 推論にかかる時間を決める要素(画像の大きさ・モデルの大きさ・計算機)
- 小さな CNN で画像の大きさと層の数を変えたときの推論時間と検出の成績を実際に測り、タクトに収まる組み合わせを選ぶ例
- 画像を区画に分けて処理する工夫と、関心のある領域だけを見る工夫
- ライン側の計算機(エッジ)とサーバー・クラウドの分担
- モデルを軽くする方法(量子化・枝刈り・蒸留)の考え方
- ラインカメラと連続処理、経営の判断
この章の主張は、推論の時間は画像の大きさとモデルの大きさと計算機でほぼ決まるので、必要な検出の性能の要件と並べて速度の要件も PoC の前に決め、両方を満たす画像・モデル・計算機を逆算して選ぶべきだ、というものです。速度の要件を後から確かめると、PoC で精度の高かったモデルがラインの速度に追いつかず、作り直しになるおそれがあると考えています。
タクトタイムから検査に使える時間を逆算する
検査が満たすべき時間の条件は、2つに分けて考えます。1つ目は処理量の条件で、検査の仕組み全体として、製品が届く間隔(タクトタイム)に追いつくことです。2つ目は締切の条件で、各製品の判定が、その製品が排出の位置に届くまでなど、排出に必要な期限までに出ることです。1台の計算機で1個ずつ順に処理し、前の製品の処理が終わるまで次の製品に手を付けない構成では、1個の製品が検査の位置に来てから次の製品が来るまでの間に、カメラが画像を撮り、画像を計算機に送り、前処理をし、モデルが推論し、判定の結果をライン側の制御装置に返し、不良なら排出機構を動かす、という一連の処理を終える必要があります。この構成では、モデルの推論に使える時間は、タクトタイムから他の処理の時間を引いた残りです。さらに、処理の時間は毎回少しずつばらつくので、平均ではなく、遅いほうに外れたときでも間に合うように余裕を残す必要があります。
次の表は、1個あたりの処理を6つの処理と余裕に分け、それぞれの時間を何が決めるかを整理したものです。表の「架空の割り振りの例」の列は、製品ごとの処理を重ねずに1個ずつ順に処理する構成で、タクトタイムを1,000ミリ秒と置いたときの説明用の数字で、実在のラインで測った値ではありません。実際の割り振りは、搬送の方式・カメラ・通信の方式・計算機・排出機構によって大きく変わるので、自社のラインで1つずつ測って埋めるものです。
| 処理 | 時間を決める主な要素 | 架空の割り振りの例(タクト1,000ミリ秒) | 測り方の例 |
|---|---|---|---|
| 撮像 | 製品の位置決め・停止の有無、露光時間、照明の点灯の時間、1個あたりの撮像の回数 | 150ミリ秒 | トリガー信号から、カメラのセンサーからの読み出しが終わるまでの時刻を記録する |
| 転送 | 画像の画素数と色の数、カメラの通信の方式、ケーブルとネットワーク | 80ミリ秒 | 読み出しの終わりから計算機のメモリに画像がそろうまでを測る。読み出しと転送が重なって分けられない場合は、撮像と転送をまとめて測る |
| 前処理 | 位置合わせ・切り出し・縮小・明るさの正規化の内容 | 40ミリ秒 | 前処理の関数の前後で時刻を取る |
| 推論 | 画像の大きさ、モデルの大きさ、計算機、一度に処理する枚数 | 250ミリ秒以内(この章で扱う) | モデルの呼び出しの前後で時刻を取り、多数回の分布を見る |
| 判定の出力 | しきい値との比較、ライン側の制御装置への信号の送り方 | 30ミリ秒 | 判定の確定から制御装置が信号を受け取るまでを測る |
| 排出 | 検査の位置から排出の位置までの距離と搬送の速さ、排出機構の動作時間 | 200ミリ秒 | 排出の指示から動作完了までを測る |
| 余裕 | 処理時間のばらつき、まれに起きる遅れ | 250ミリ秒 | 遅いほうの分位点(99%点など)と中央値の差から決める |
この表で、推論に割り振れる時間が「タクトの4分の1」程度に縮んでいることに注意が必要です。架空の例では、タクトが1,000ミリ秒あっても、モデルに使えるのは250ミリ秒です。さらに、1個の製品を複数の向きから撮る場合や、1個の製品を複数の区画に分けて推論する場合には、1枚あたりに使える時間はその回数で割ったものになります。速度の要件は「タクトタイム」ではなく「1枚の画像あたりの推論に使える時間」として、最初に数字で決めておくことが必要です。カメラの製品資料には、センサーからの読み出しの時間とカメラから計算機への転送の時間を分けて示し、読み出しの途中から転送を始める仕組みを説明しているものもあります。撮像と転送の境目は機種によって違うので、どの時点からどの時点までを測ったかを、測った値と一緒に記録しておく必要があります。
なお、すべての処理を1個ずつ順番に行う必要はありません。前の製品の推論をしている間に次の製品を撮像する、というように処理を重ねて流せば(パイプライン処理)、1個あたりの間隔は最も遅い処理の時間で決まるようになります。推論を複数の計算機や複数の処理の流れで並列に行う構成では、1個の製品の処理時間がタクトタイムを超えても、仕組み全体の処理量がタクトタイムに追いついていれば、ラインは止まりません。たとえば1秒間隔で製品が届き、撮像から判定まで2秒かかる場合でも、2個の製品を同時に扱えれば処理量は追いつきます。ただしその場合でも、1個の撮像から排出までの合計の時間は短くならないので、締切の条件、つまり各製品の判定が排出の位置に届くまでに出るかは、処理量とは別に確かめる必要があります。また、検査の位置と排出の位置の間に何個の製品が並ぶか、どの判定をどの製品に結びつけるかを、ライン側で正しく管理する必要があります。判定と製品を結びつける仕組みは第11章で扱います。
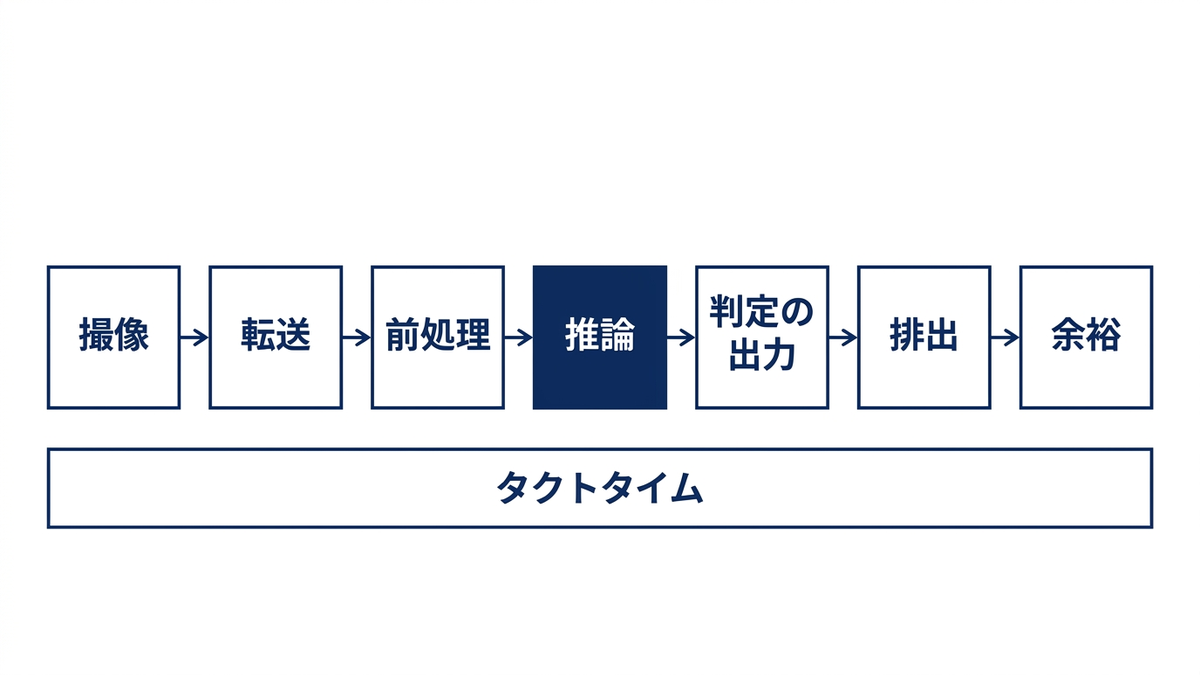
推論の時間を決める3つの要素
推論の時間を決める要素は、大きく分けると画像の大きさ、モデルの大きさ、計算機の3つです。画像の大きさは、縦と横の画素数で決まります。畳み込みニューラルネットワーク(CNN。第5章で扱った、画像の小さな範囲ごとに同じ計算を繰り返して特徴を取り出すモデル)では、最初の層の計算量は画素の数に比例するので、縦と横をそれぞれ2倍にすると、画素の数は4倍になり、その層の計算量も4倍になります。モデルの大きさは、層の数と各層の幅(チャンネルの数)で決まり、層を足すほど、また幅を広げるほど計算量が増えます。計算機は、同じ計算をどれだけ速くこなせるかを決めます。計算機の速さを左右するのは、主に次の3つです。
- 計算機の種類(CPU・GPU・推論用の専用の装置)
- 使える計算の単位(コア)の数
- ほかの処理と計算機を分け合っているかどうか
この3つのうち、画像の大きさは第3章で扱った分解能と直接つながっています。画像を縮小すれば推論は速くなりますが、1画素が製品の上で受け持つ長さが大きくなり、小さな欠陥が周りの画素と平均されて薄くなります。つまり、画像の大きさを決めることは、見つけられる最小の欠陥の大きさを決めることでもあります。速度のために画像を縮小するときは、検出したい最小の欠陥が縮小後の画像で何画素になり、背景との明るさの差がどれだけ残るかを、必ず確かめる必要があります。
モデルの大きさは、精度との釣り合いで決まります。大きなモデルほど複雑な見た目の違いを学べる可能性がありますが、そのぶん推論は遅くなり、学習に要る画像の枚数も増えることが多くなります。外観検査では、見るべき欠陥が限られ、背景の見た目が撮像の設計でそろえられている場合が多いので、画像認識の一般的な課題に使われる大きなモデルが必要になるとは限りません。どの程度の大きさで足りるかは、自社の画像で、小さなモデルから順に試して確かめるのが確実だと考えています。
この章では、推論1回にかかる時間を推論時間と呼び、ミリ秒で表します。推論時間は、モデルを呼び出してから判定のもとになるスコアが出るまでの時間で、撮像・転送・前処理の時間は含めません。推論時間を測るときは、1回だけ測るのではなく、何百回も測って分布を見ます。計算機は、ほかの処理との取り合いや、計算機の内部の状態によって、同じ計算でも時間が変わるからです。ラインの設計では、中央値(真ん中の値)だけでなく、遅いほうの値(たとえば99%点、100回のうち遅いほうから1〜2番目あたりの値)が要件に収まるかを確かめる必要があります。
架空の合成画像で、画像の大きさと層の数を変えて検出の成績を比べる
ここからは、画像の大きさと層の数を変えたときに、検出の成績と推論時間がどう変わるかを、実行したコードと結果で確かめます。使う画像は、numpy で作った架空の合成画像です。金属の表面のような横方向の細かい筋とノイズを持つ128画素四方の画像に、3種類の欠陥を1つずつ描き足しました。実際の製品の画像は、形・模様・照明の映り込みがずっと複雑で、この合成画像はそれより単純です。この章の数字は、すべてこの架空の合成画像での値です。
- 異物:半径0.8〜1.6画素の、周りより暗い点
- 傷:幅1画素、長さ15〜30画素の、周りより少し明るい細い線
- 汚れ:半径6〜10画素の、周りよりわずかに暗い、境目のぼやけた広い領域
学習用に良品300枚と不良300枚(3種類の欠陥を100枚ずつ)、しきい値を決めるための良品300枚、評価用に良品300枚と不良300枚を作りました。良品と不良が半数ずつなのは、検出の成績を少ない枚数で比べやすくするためで、実際のラインの不良の割合とは関係がありません。乱数のシードは固定しているので、同じコードで同じ画像が作れます。
import os, time
import numpy as np
import torch
import torch.nn as nn
from sklearn.metrics import roc_auc_score

torch.set_num_threads(4)
OUT = os.path.join(os.path.dirname(os.path.abspath(__file__)), "..", "_out", "ch09")
os.makedirs(OUT, exist_ok=True)

# ---- 架空の合成画像(金属の表面のような細かい筋)を 128 画素四方で作る ----
rng = np.random.default_rng(20261109)
N = 128


def surface():
    y = np.arange(N)[:, None]
    streak = rng.normal(0, 1, (N, 1)) * 0.04           # 行ごとに明るさが少し違う筋
    img = 0.55 + streak + 0.02 * np.sin(y / 3.0 + rng.uniform(0, 6.3))
    return img + rng.normal(0, 0.03, (N, N))            # 細かいノイズ


def add_defect(img, kind):
    yy, xx = np.mgrid[0:N, 0:N]
    cy, cx = rng.integers(16, N - 16, 2)
    if kind == "異物":                                   # 点状の暗い異物(半径 0.8〜1.6 画素)
        r = rng.uniform(0.8, 1.6)
        img[(yy - cy) ** 2 + (xx - cx) ** 2 <= r * r] -= 0.15
    if kind == "傷":                                     # 幅 1 画素の細い傷
        length = rng.integers(15, 31)
        ang = rng.uniform(0, np.pi)
        for t in np.linspace(-length / 2, length / 2, length * 2):
            py, px = int(round(cy + t * np.sin(ang))), int(round(cx + t * np.cos(ang)))
            if (0 <= py < N) & (0 <= px < N):
                img[py, px] += 0.10
    if kind == "汚れ":                                   # 淡く広い汚れ(半径 6〜10 画素)
        r = rng.uniform(6, 10)
        img -= 0.06 * np.exp(-((yy - cy) ** 2 + (xx - cx) ** 2) / (2 * (r / 2) ** 2))
    return img
次のコードで、学習用・しきい値用・評価用の画像の組を作り、画素数を減らす関数と、層の数を変えられる CNN を定義します。画素数を減らす関数(shrink)は、隣り合う画素をまとめて平均し、128画素四方の画像を64画素四方・32画素四方にします。同じ視野を、画素数の少ないカメラで撮った場合に近い画像になります。CNN は、「畳み込み・正規化・活性化・縮小」の4つの処理を1段として、その段を2〜4回重ねたものです。1段ごとに縦横の大きさが半分になり、最後に画像全体の中で最も強く反応した値を取り出して、良品か不良かの2つに分けます。各段のチャンネルの数は16にそろえました。この章でいう「層の数」は、この段を何回重ねたかの数で、表と図では「2段」「4段」のように書きます。
def make_set(n_good, n_bad):
    kinds = ["異物", "傷", "汚れ"]
    X, y, k = [], [], []
    for i in range(n_good):
        X.append(surface()); y.append(0); k.append("良品")
    for i in range(n_bad):
        kd = kinds[i % 3]
        X.append(add_defect(surface(), kd)); y.append(1); k.append(kd)
    return np.array(X, dtype=np.float32), np.array(y), np.array(k)


X_tr, y_tr, k_tr = make_set(300, 300)                  # 学習用
X_va, _, _ = make_set(300, 0)                           # しきい値を決める良品
X_te, y_te, k_te = make_set(300, 300)                  # 評価用


def shrink(X, size):                                    # 画素をまとめて平均し、画素数の少ない画像にする
    f = N // size
    return X.reshape(len(X), size, f, size, f).mean(axis=(2, 4))


# ---- 層の数(畳み込みの段の数)を変えられる小さな CNN ----
def make_cnn(depth, ch=16):
    layers, c_in = [], 1
    for d in range(depth):
        layers += [nn.Conv2d(c_in, ch, 3, padding=1), nn.BatchNorm2d(ch), nn.ReLU(), nn.MaxPool2d(2)]
        c_in = ch
    layers += [nn.AdaptiveMaxPool2d(1), nn.Flatten(), nn.Linear(ch, 2)]
    return nn.Sequential(*layers)
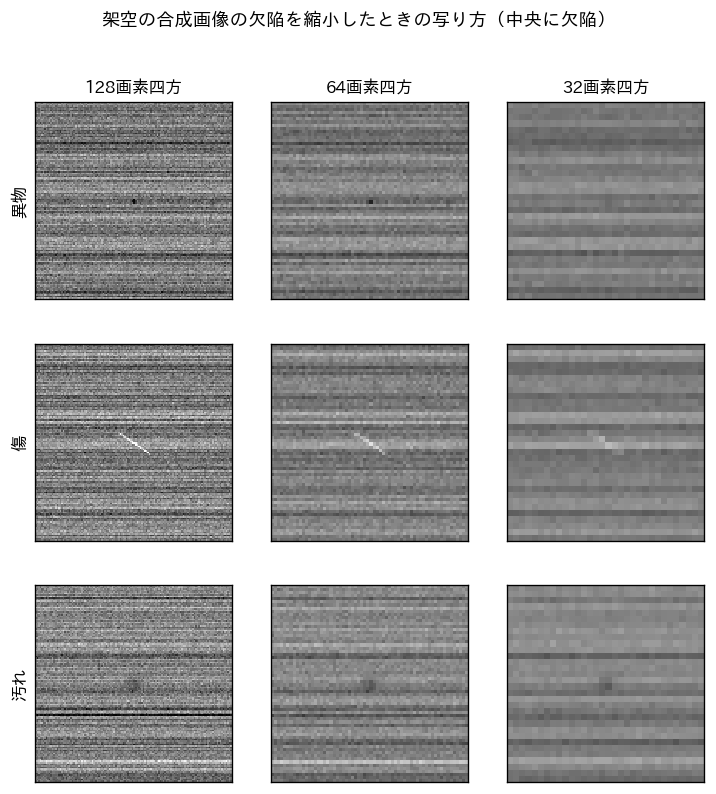
上の図は、同じ作り方で欠陥を画像の中央に描いた例を、3つの大きさに縮小して並べたものです(この図だけは欠陥の位置と大きさを固定して作りました)。128画素四方では、異物は数画素の暗い点として見えますが、32画素四方では、16画素分(縦4画素×横4画素)が1画素に平均されるので、点の暗さが周りに薄まり、筋の模様とほとんど区別できません。傷も32画素四方では薄くなります。一方、汚れは広い領域なので、縮小しても形が残ります。縮小は細かいノイズも平均して消すので、汚れのように広く淡い欠陥は、縮小したほうがかえって見やすくなる場合があります。
次のコードで、画像の大きさ(32・64・128画素四方)と層の数(2・3・4段)の9通りの組み合わせについて、CNN を学習させ、評価用の画像で成績を出しました。しきい値は、しきい値用の良品300枚のスコアの98%点(良品の98%がそれより下に来る値)に置きました。過検出率の目安をおおよそ2%に先に固定し、見逃し率は結果として測る、ということです。第8章の、見逃し率の上限を先に決めてから過検出を小さくする手順とは向きが逆で、ここでは9通りを同じ考え方の動作点で比べやすくするためにこの置き方を選びました。ただし、評価用の良品で測った実際の過検出率は、後の表のとおり組み合わせによって1.3〜4.7%にばらつき、完全にはそろっていません。成績は、欠陥の種類ごとの見逃し率、3種類の見逃し率の平均(表では「見逃し率(全体)」)、過検出率、AUROC(しきい値を動かしたときの見分けやすさを1つの数にしたもの。第8章)で示します。評価用の不良は種類ごとに100枚ずつなので、3種類の平均は、不良300枚全体のうち良品と判定した割合、つまり全体の地図で定義した見逃し率と同じ値になります。
def train_eval(size, depth, epochs=12):
    torch.manual_seed(20261109 + size * 10 + depth)
    to_t = lambda X: torch.tensor(shrink(X, size))[:, None]
    a, v, b = to_t(X_tr), to_t(X_va), to_t(X_te)
    mean, std = a.mean(), a.std()
    a, v, b = (a - mean) / std, (v - mean) / std, (b - mean) / std
    ya = torch.tensor(y_tr)
    model = make_cnn(depth)
    opt = torch.optim.Adam(model.parameters(), lr=3e-3)
    for ep in range(epochs):
        model.train()
        perm = torch.randperm(len(a))
        for i in range(0, len(a), 32):
            idx = perm[i:i + 32]
            loss = nn.functional.cross_entropy(model(a[idx]), ya[idx])
            opt.zero_grad(); loss.backward(); opt.step()
    model.eval()
    with torch.inference_mode():
        sv = torch.softmax(model(v), dim=1)[:, 1].numpy()
        p = torch.softmax(model(b), dim=1)[:, 1].numpy()
    th = np.quantile(sv, 0.98)                          # 良品の 98% が下に来る値をしきい値にする
    pred = (p > th).astype(int)
    miss = {kd: float((pred[k_te == kd] == 0).mean()) for kd in ["異物", "傷", "汚れ"]}
    fa = float((pred[y_te == 0] == 1).mean())
    auc = roc_auc_score(y_te, p)
    torch.save({"state": model.state_dict(), "mean": float(mean), "std": float(std)},
               os.path.join(OUT, f"model_s{size}_d{depth}.pt"))
    n_par = sum(q.numel() for q in model.parameters())
    return miss, fa, auc, n_par


for size in [32, 64, 128]:
    for depth in [2, 3, 4]:
        miss, fa, auc, n_par = train_eval(size, depth)
        allm = np.mean(list(miss.values()))
        print(size, depth, n_par, miss, round(allm, 3), round(fa, 3), round(auc, 3))
実行した結果が次の表です(torch 2.13.0 の CPU 版で実行)。学習は画像の大きさと層の数の組み合わせごとに乱数のシードを決めているので、組み合わせの順番を変えても同じ結果になります。同じコードを2回実行し、32画素四方の3つの組み合わせで成績が小数点以下3桁まで一致することを確かめました。表のパラメータ数は、モデルが学習で決める数の個数です。
| 画像の大きさ | 層の数 | パラメータ数 | 見逃し率(異物) | 見逃し率(傷) | 見逃し率(汚れ) | 見逃し率(全体) | 過検出率 | AUROC |
|---|---|---|---|---|---|---|---|---|
| 32画素四方 | 2段 | 2,578 | 0.72 | 0.06 | 0.10 | 0.293 | 0.013 | 0.888 |
| 32画素四方 | 3段 | 4,930 | 0.71 | 0.11 | 0.07 | 0.297 | 0.017 | 0.913 |
| 32画素四方 | 4段 | 7,282 | 0.83 | 0.23 | 0.26 | 0.440 | 0.013 | 0.857 |
| 64画素四方 | 2段 | 2,578 | 0.41 | 0.09 | 0.35 | 0.283 | 0.017 | 0.909 |
| 64画素四方 | 3段 | 4,930 | 0.48 | 0.09 | 0.09 | 0.220 | 0.037 | 0.927 |
| 64画素四方 | 4段 | 7,282 | 0.48 | 0.10 | 0.06 | 0.213 | 0.027 | 0.920 |
| 128画素四方 | 2段 | 2,578 | 0.24 | 0.02 | 0.72 | 0.327 | 0.027 | 0.855 |
| 128画素四方 | 3段 | 4,930 | 0.27 | 0.08 | 0.26 | 0.203 | 0.013 | 0.940 |
| 128画素四方 | 4段 | 7,282 | 0.26 | 0.04 | 0.04 | 0.113 | 0.047 | 0.950 |
表から読み取れることは3つあります。1つ目は、異物の見逃し率が画像の大きさで大きく変わることです。32画素四方では、どの層の数でも異物の7割以上を見逃しました(0.71〜0.83)。64画素四方では0.41〜0.48、128画素四方では0.24〜0.27まで下がっています。前の図で見たとおり、小さな点は縮小で周りと平均されて薄くなり、32画素四方では、層の数を変えた3通りのモデルのどれでも取り戻せませんでした。画像を小さくして速度を稼ぐと、最も小さい欠陥から順に見えなくなる、ということです。
2つ目は、128画素四方の2段のモデルが、汚れの72%を見逃したことです。同じ128画素四方でも、3段では0.26、4段では0.04まで下がりました。この CNN は、1段ごとに画像を半分に縮めながら3画素四方の範囲を見ていくので、段の数が少ないと、一度に見渡せる範囲が狭くなります。半径6〜10画素の淡い汚れは、2段のモデルが見渡せる範囲より大きく、筋の模様との違いをつかめなかったと考えられます(この解釈は、見渡せる範囲を変えた追加の実験では確かめていません)。32画素四方では汚れは数画素の大きさになるので、2段のモデルでも見逃し率は0.10でした。必要な層の数は、欠陥の大きさが画素数にしてどれくらいかで変わります。
3つ目は、層を増やせば必ず良くなるわけではないことです。32画素四方では、4段のモデルの見逃し率(全体)が0.440で、2段・3段の約0.29より悪くなりました。32画素四方の画像を4回半分にすると2画素四方まで縮むので、細かい情報が残らなかった可能性があります。この表は1つのシード・1回の学習の結果で、評価用の不良は種類ごとに100枚しかありません。見逃し率の0.01は不良1枚にあたるので、数ポイントの差は乱数で入れ替わりうる差として読む必要があります。画像の大きさで異物の見逃しが変わることと、128画素四方の2段で汚れを見逃すことは、今回試した組み合わせでは差の大きい傾向でした。ただし、組み合わせごとに初期値のシードが違う1回ずつの学習なので、学習のばらつきと組み合わせの効果を切り分けてはいません。組み合わせの効果として確かめるには、シードを変えた複数回の学習で比べる必要があります。
もう1つ、この表の使い方には限定があります。9通りの比較とこの後の組み合わせの選定には、同じ評価用の画像を使っています。評価用の画像の成績を見て組み合わせを選ぶと、選んだ組み合わせの成績は、選定に使っていない画像での成績より良く出やすくなります。この章の選定は候補を絞る手順の例で、最終的な性能の確認ではありません。実際には、選んだ組み合わせを、選定に使っていない別の評価用の画像で確かめ直す必要があります。
推論時間を測る、計算機で変わる値の扱い方
次に、学習したモデルの推論時間を測りました。測り方は次のとおりです。1枚の画像(画像と同じ大きさの乱数)をモデルに入れ、20回の空回し(最初の数回は計算機の準備で遅くなることがあるため)のあと、100回の呼び出しの時間を測って中央値と99%点を出します。これを5回くり返し、5回の中央値をさらに中央値でまとめます。この計測は、本コラムの執筆に使った計算機(Intel Core Ultra 7 258V、論理コア8、Windows 11、Python 3.14.3、torch 2.13.0 の CPU 版)で行いました。計測の間、この計算機では他の処理が同時に動いていたため、計測の値は回によって大きく変わりました。そこで、計測のコードを日を置かずに3回実行し、3回の値の中央値を本文と表に載せ、3回の幅も添えています。下のコードの lo と hi は1回の実行の中の5回のくり返しの幅で、表の「3回の実行での幅」とは別のものです。3回の実行の出力を記録しておき、組み合わせごとに中央値の中央値・最小・最大と、99%点の中央値・最小・最大を別に集計しました。
計算機によって、推論時間は数倍から数十倍変わることがあります。ここに載せる値は、この計算機・この条件での値で、ラインに置く計算機での値ではありません。読み取ってほしいのは値そのものではなく、画像の大きさ・層の数・推論に使うスレッドの数で推論時間がどう変わるかの傾向と、測り方の手順です。
def load(size, depth):
    ck = torch.load(os.path.join(OUT, f"model_s{size}_d{depth}.pt"))
    m = make_cnn(depth)
    m.load_state_dict(ck["state"])
    return m.eval()


def measure(model, x, reps=100, warm=20, rounds=5):
    """1 回の呼び出しの時間(ミリ秒)を reps 回測り、中央値と 99% 点を出す。これを rounds 回くり返す"""
    med, p99 = [], []
    with torch.inference_mode():
        for r in range(rounds):
            for i in range(warm):
                model(x)
            t = []
            for i in range(reps):
                t0 = time.perf_counter()
                model(x)
                t.append((time.perf_counter() - t0) * 1000)
            med.append(np.median(t)); p99.append(np.quantile(t, 0.99))
    return float(np.median(med)), float(np.median(p99)), float(min(med)), float(max(med))


for threads in [1, 4]:
    torch.set_num_threads(threads)
    for size in [32, 64, 128]:
        for depth in [2, 3, 4]:
            x = torch.randn(1, 1, size, size)
            med, p99, lo, hi = measure(load(size, depth), x)
            print(size, depth, threads, round(med, 3), round(p99, 3), round(lo, 3), round(hi, 3))
torch.set_num_threads は、PyTorch の公式ドキュメントによれば、CPU で1つの計算を分けて並列に処理するときのスレッド(同時に動かす処理の流れ)の数を決める設定です。1と4の2通りで測りました。結果は次の表のとおりです。「乗算と加算の回数」は、畳み込みの層で行う掛け算と足し算の組の回数を式で数えたもので、計算機によらない値です。
| 画像の大きさ | 層の数 | 乗算と加算の回数 | 推論時間の中央値(1スレッド) | 推論時間の中央値(4スレッド) | 3回の実行での中央値の幅(4スレッド) | 99%点(4スレッド) | 3回の実行での99%点の幅(4スレッド) |
|---|---|---|---|---|---|---|---|
| 32画素四方 | 2段 | 約74万 | 0.59ミリ秒 | 0.68ミリ秒 | 0.39〜1.38ミリ秒 | 2.15ミリ秒 | 0.76〜5.58ミリ秒 |
| 32画素四方 | 3段 | 約88万 | 0.65ミリ秒 | 0.76ミリ秒 | 0.49〜2.60ミリ秒 | 1.92ミリ秒 | 1.04〜9.11ミリ秒 |
| 32画素四方 | 4段 | 約92万 | 0.72ミリ秒 | 0.87ミリ秒 | 0.78〜3.52ミリ秒 | 2.35ミリ秒 | 1.22〜10.38ミリ秒 |
| 64画素四方 | 2段 | 約295万 | 1.84ミリ秒 | 1.22ミリ秒 | 0.90〜2.74ミリ秒 | 2.73ミリ秒 | 1.50〜7.60ミリ秒 |
| 64画素四方 | 3段 | 約354万 | 2.08ミリ秒 | 1.73ミリ秒 | 0.86〜1.83ミリ秒 | 4.82ミリ秒 | 1.52〜6.19ミリ秒 |
| 64画素四方 | 4段 | 約369万 | 2.00ミリ秒 | 1.46ミリ秒 | 1.19〜1.92ミリ秒 | 4.24ミリ秒 | 2.06〜5.55ミリ秒 |
| 128画素四方 | 2段 | 約1,180万 | 5.72ミリ秒 | 2.73ミリ秒 | 1.86〜7.41ミリ秒 | 5.94ミリ秒 | 2.95〜20.18ミリ秒 |
| 128画素四方 | 3段 | 約1,416万 | 5.60ミリ秒 | 3.22ミリ秒 | 1.93〜5.90ミリ秒 | 6.23ミリ秒 | 3.30〜14.22ミリ秒 |
| 128画素四方 | 4段 | 約1,475万 | 6.09ミリ秒 | 4.12ミリ秒 | 1.93〜4.65ミリ秒 | 9.24ミリ秒 | 2.94〜10.81ミリ秒 |
99%点は、1回の実行の中の100回の測定から出すので、遅いほうから1〜2番目の測定でほぼ決まり、たまたま遅れた1回で大きく動きます。表の99%点の欄は、各回の中で5回くり返して出した99%点の中央値を、さらに3回の実行で中央値にしたもので、右の欄はその3回の幅です。
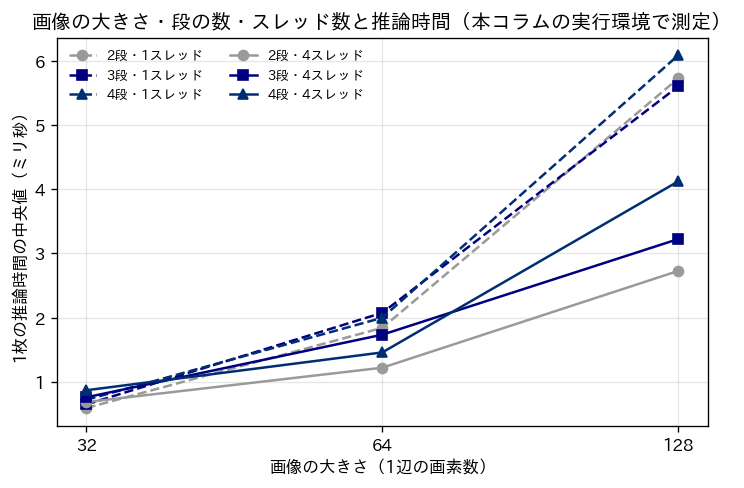
この表と図から、次のことが読み取れます。
- 画像の大きさの影響が最も大きい。1スレッドでは、2段のモデルで32画素四方の0.59ミリ秒から128画素四方の5.72ミリ秒へ、約10倍になった
- 計算の回数ほどには時間が増えない。2段のモデルの乗算と加算の回数は、32画素四方から128画素四方で16倍になるが、時間は1スレッドで約10倍、4スレッドで約4倍だった。小さなモデルでは、計算そのもの以外の決まった手間(呼び出しの準備など)が時間の一部を占めるためと考えられる
- 層の数の影響は、画像の大きさより小さい。この CNN は2段目以降、1段ごとに画像が半分になるので、3段目・4段目を足しても計算は増えにくく、128画素四方で2段から4段にしても、乗算と加算の回数は約1,180万から約1,475万へ、約1.25倍にしかならない。時間は、3回の中央値の組で見ると、1スレッドでは5.72ミリ秒から6.09ミリ秒、4スレッドでは2.73ミリ秒から4.12ミリ秒(約1.5倍)だった。ただし4スレッドの3回の幅は2段で1.86〜7.41ミリ秒、4段で1.93〜4.65ミリ秒と重なっており、この差は確かではない
- 推論に使うスレッドの数を増やせば速くなるとは限らない(計算機のコアの数は変えていない)。3回の中央値の組で見ると、32画素四方では4スレッドのほうが1スレッドより長く(2段で0.68ミリ秒と0.59ミリ秒)、128画素四方では4スレッドのほうが短かった(2段で2.73ミリ秒と5.72ミリ秒)。ただし、どちらの差も3回の幅と重なっており(32画素四方・2段の4スレッドは0.39〜1.38ミリ秒、128画素四方・2段は1スレッドが3.68〜5.85ミリ秒、4スレッドが1.86〜7.41ミリ秒)、この環境の3回の計測では、スレッドを増やした効果が画像の大きさで違う傾向が見えた、という程度にしか言えない。何スレッドで動かすかは、ラインに置く計算機で、スレッドの数ごとに測って決める必要がある
- 回による変動が大きい。同じ組み合わせでも、3回の実行で中央値が数倍違うことがあった(128画素四方・2段の4スレッドで1.86〜7.41ミリ秒)
最後の点は、ラインの設計で最も注意が必要な点です。推論時間は、同じ計算機・同じモデルでも、同時に動いている他の処理によって変わります。ラインに置く計算機で、画像の保存・通信・画面の表示など、本番と同じ処理を同時に動かした状態で測らないと、本番の推論時間は分かりません。開発用の計算機で測った値をそのまま要件の判断に使うのは避けるべきだと考えています。
タクトに収まる組み合わせを選ぶ
速度と精度の両方の表がそろったので、要件に合う組み合わせを選びます。最初の表の架空の例では、1個あたりの推論に使える時間は250ミリ秒でした。この章の小さな CNN は、どの組み合わせでも1枚あたりの99%点が10ミリ秒を下回った(3回の中央値で9.24ミリ秒以下)ので、1個を1枚で見るなら9通りすべてが速度の要件を満たし、選ぶ根拠は精度だけになります。そこで、要件がきつくなる場面として、1個の製品を128画素四方の区画25枚に分けて、1枚ずつ順に推論する場合を考えます。250ミリ秒を25枚で割ると、1枚あたりに使える時間は10ミリ秒です。このように、1個あたりの時間を撮像の回数と区画の数で割って、1枚あたりの要件に直します。ここでは次の3つの架空の要件を置きました。数字はこの架空の合成画像に合わせて置いたもので、推奨の値ではありません。
- 見逃し率(3種類の欠陥の平均)が0.15以下
- 過検出率が0.05以下
- 1枚の推論時間の99%点が10ミリ秒以下(4スレッド)
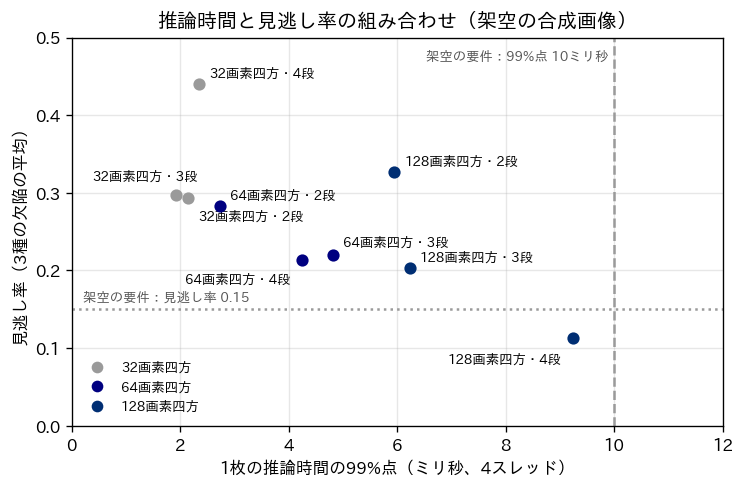
図の左下ほど、速くて見逃しが少ない組み合わせです。9通りのうち、見逃し率の要件を満たしたのは128画素四方・4段(0.113)だけで、その過検出率は0.047、推論時間の99%点は9.24ミリ秒でした。3つの要件をすべて満たす候補はこの組み合わせだけですが、この結果には次の5つの留保が付きます。
- 速度の余裕が無い。99%点の9.24ミリ秒は3回の実行の中央値で、3回の幅は2.94〜10.81ミリ秒だった。3回のうち1回は10ミリ秒を超えており、ラインに置く計算機で測り直したときに要件を外れる可能性がある
- 過検出率にも余裕が無い。0.047は評価用の良品300枚のうち14枚にあたり、上限の0.05に近い。他の8通りは0.013〜0.037だった。しきい値はどの組み合わせも同じ手順(しきい値用の良品の98%点)で置いたが、しきい値用の良品と評価用の良品でスコアの出方が少しずれ、128画素四方・4段では評価用の良品の過検出率が4.7%になった。しきい値を同じ過検出率にそろえた比較ではないので、見逃し率の0.113は、そのぶん低めに出ている可能性がある。ただし、しきい値によらない見分けやすさの指標である AUROC も9通りの中で最も高い(0.950)ので、モデルそのものの見分ける力も高いと読める
- 平均で合格でも、最も小さい欠陥の見逃しが残る。見逃し率の0.113は3種類の平均で、欠陥ごとに見ると、汚れ0.04・傷0.04に対して、異物は0.26、つまり4個に1個を見逃している
- 1枚ごとの時間が要件内でも、25枚の合計が250ミリ秒に収まるとは限らない。各枚の99%点が10ミリ秒以下でも、25枚を続けて処理した合計の99%点は、各枚の99%点を足したものとは一致しない。遅れは続けて起きることもある。代表値で候補になったら、25枚を続けて処理した合計の時間を多数回測り、250ミリ秒を超えた割合と、超えたときの扱い(後の節の判定の保留)を確かめる必要がある
- 表の見逃し率・過検出率は画像1枚(区画1枚)あたりの値で、製品1個あたりの値ではない。25区画のどれか1つでも不良と判定したら製品を排出する集め方では、製品単位の過検出率は区画単位よりずっと大きくなる。区画ごとの判定が互いに独立と仮定した計算例では、区画あたり14/300(約0.047)の過検出率は、製品単位では約0.697になる。区画あたり0.001なら、製品単位では約0.025である。要件は、画像単位か製品単位かと、区画の判定を製品の判定にどう集めるかを決めてから置く必要がある
3つ目の留保は、要件の決め方そのものの問題です。見逃し率を欠陥の種類の平均で要件にすると、前の節で見た「最も小さい欠陥から見えなくなる」ことが平均に隠れます。異物の流出が許されない製品なら、この組み合わせは合格ではありません。見逃し率の要件は、欠陥の種類ごと、少なくとも最も小さい欠陥と最も重い欠陥について、品質保証と個別に決める必要があると考えています。
このように、精度の要件を満たす組み合わせが速度の要件の境目にしか無い場合、取れる手は次の4つに分けて考えると整理しやすいと考えています。
- 計算機を変える:コアの多い計算機や GPU を使う。費用と保守の手間が増える
- 見る範囲を減らす:製品の中で欠陥が出る領域だけを切り出し、画素数を減らさずに推論する画素の総数を減らす(次の節)
- モデルを軽くする:量子化・枝刈り・蒸留などで、同じ画像の大きさのまま計算を減らす(後の節)
- 要件を見直す:見逃しを許せない欠陥と、許せる欠陥を分け、欠陥ごとに要件を変える。この例の異物のように平均では見えない見逃しを、要件の上で見えるようにすることにもなる。見直せるのは、法令・顧客との取り決め・業界の規格で定められた要求を満たす範囲だけで、品質保証と決め直す必要がある
どの手が使えるかは、ラインと製品によって変わります。ただし、画像を縮小して速度を稼ぐ手は、この例では異物の見逃しを大きく増やしました。最小の欠陥の大きさから画像の大きさの下限を先に決め、その下限より小さくしない範囲で他の手を組み合わせるのが、順序として安全だと考えています。
区画に分ける工夫、関心のある領域とラインカメラの連続処理
高い分解能が要る検査では、カメラが撮る画像が、この章の例よりずっと大きくなることがあり、そのまま CNN に入れると計算が重くなります。その場合の方法の1つが、画像を同じ大きさの区画(タイル)に分けて、区画ごとに推論する方法です。区画に分ければ、縮小せずに元の分解能のまま欠陥を見られます。その代わり、区画の数だけ推論の回数が増えます。また、製品の位置が毎回ほぼ同じに決まっているなら、欠陥が出る領域や、判定基準で見ることになっている領域(関心のある領域)だけを切り出して推論すれば、画像の残りの部分の計算を省けます。
次のコードは、512画素四方の画像を128画素四方の16区画に分け、先ほどの128画素四方・4段のモデルで推論する時間を、4つのやり方で比べたものです。関心のある領域は、画像の中央の4区画と置きました。
torch.set_num_threads(4)
m = load(128, 4)
big = torch.randn(1, 1, 512, 512)
tiles = big.unfold(2, 128, 128).unfold(3, 128, 128).reshape(-1, 1, 128, 128)   # 16 区画
cases = {
    "全体を128に縮小して1回": lambda: m(nn.functional.avg_pool2d(big, 4)),
    "16区画を1枚ずつ16回": lambda: [m(tiles[i:i + 1]) for i in range(16)],
    "16区画をまとめて1回": lambda: m(tiles),
    "関心のある4区画だけをまとめて1回": lambda: m(tiles[[5, 6, 9, 10]]),
}
for name, f in cases.items():
    class W(nn.Module):
        def forward(self, x):
            return f()
    med, p99, lo, hi = measure(W(), None)
    print(name, round(med, 3), round(p99, 3))
こちらも3回実行し、3回の中央値を載せました。計測の区間に何が入っているかは、やり方によって違います。区画への切り出し(tiles を作る処理)は4つとも計測の外で済ませていますが、「縮小して1回」は縮小の処理を、「関心のある4区画だけ」は4区画を選び出す処理を、計測の区間に含んでいます。表の時間は、モデルの呼び出しだけの時間ではなく、それぞれのやり方の1回の呼び出しにかかった時間です。
| やり方 | 推論する画素の総数 | 推論時間の中央値 | 99%点 | 3回の実行での中央値の幅 | 分解能 |
|---|---|---|---|---|---|
| 全体を128画素四方に縮小して1回 | 128×128 | 3.71ミリ秒 | 6.97ミリ秒 | 1.76〜5.05ミリ秒 | 1画素が受け持つ長さが縦横それぞれ4倍になる(16画素を1画素に平均) |
| 16区画を1枚ずつ16回 | 512×512 | 54.31ミリ秒 | 133.41ミリ秒 | 32.95〜121.34ミリ秒 | 元のまま |
| 16区画をまとめて1回 | 512×512 | 29.03ミリ秒 | 52.28ミリ秒 | 27.05〜37.68ミリ秒 | 元のまま |
| 関心のある4区画だけをまとめて1回 | 256×256 | 9.03ミリ秒 | 15.18ミリ秒 | 6.62〜10.57ミリ秒 | 元のまま(他の12区画は見ない) |
16区画を1枚ずつ16回推論すると、中央値で54.31ミリ秒かかり、99%点は133.41ミリ秒まで伸びました。同じ16区画を1回の呼び出しにまとめる(バッチ処理)と、中央値は29.03ミリ秒に下がりました。呼び出しのたびにかかる決まった手間が1回分で済むことと、まとめた計算を並列に処理しやすいことによると考えられます。中央の4区画だけをまとめて推論すると9.03ミリ秒で、16区画をまとめた場合の約3分の1でした。全体を縮小すれば3.71ミリ秒と最も速くなりますが、前の節で見たとおり、小さな欠陥を見逃しやすくなります。
区画に分けるときには、注意点が2つあります。1つは、区画の境目にかかった欠陥です。欠陥が2つの区画に分かれると、どちらの区画でも欠陥の一部しか写らず、見逃しやすくなります。基本は、区画を少し重ねて切り、境目の付近も必ずどれかの区画の内側に入るようにすることです(重なりの分だけ推論の量は増える)。区画ごとのスコアを製品全体でまとめて判定する処理は、製品としての判定を出すための集め方で、それだけでは境目で分かれた欠陥の見逃しは解消しません。この章の CNN は区画ごとに1つのスコアを出すだけで、境目をまたぐ特徴を後から計算し直す仕組みを持たないからです。もう1つは、関心のある領域だけを見る方法の前提です。この方法は、製品の位置決めが安定していて、欠陥が出る場所、あるいは見るべき場所が判定基準で決まっている場合に使えます。位置がずれれば、見るべき場所が領域の外に出てしまいます。位置合わせを第4章で扱ったルールベースの画像処理で行い、その結果で切り出す領域を決める、という組み合わせが考えられます。どの領域を見なくてよいかは、技術の判断ではなく判定基準の判断なので、品質保証と決める必要があります。
ここまでは、製品1個ごとに1枚の画像を撮るエリアカメラ(第3章)を前提にしてきました。フィルムや紙・鋼板・布地のように切れ目なく流れてくる製品や、円筒形の製品を回しながら撮る場合には、1行ずつ画像を撮るラインカメラを使うことがあります(第3章)。ラインカメラでは、製品が流れるにつれて行が積み重なり、長い画像が途切れなく届きます。このとき、速度の要件は「1個あたり」ではなく「一定の長さの画像を、その長さが流れてくる時間の中で処理し終えること」になります。
連続処理では、届いた行を一定の行数ごとに区切って1枚の区画にし、区画ごとに推論します。区画の境目にかかった欠陥を見逃さないように、前の区画と少し重ねて区切ります。重ねて区切ると、次の区画がそろうまでの間隔は、区画の行数ではなく、重なりを除いた新しい行が届く時間になります。たとえば区画が H 行、重なりが O 行で、毎秒 R 行が届くなら、間隔は \( (H – O) / R \) 秒、つまり新しく届く行数を1秒に届く行数で割った時間で、区画全体が届く時間 \( H / R \) 秒より短くなります。区画の処理に使える時間はこの短いほうです。
区画の処理がこの間隔を一時的に超えるだけなら、まだ処理していない区画は計算機のメモリ(待ち行列)にたまり、次の区画が早く終われば取り戻せます。待ち行列に置ける量には上限があるので、遅れが続いたり、平均の処理時間がこの間隔を上回ったりすると、たまる量が増え続け、いずれ上限に届きます。上限に届けば、画像を捨てるか、ラインを止めるかのどちらかになります。そのため、連続処理では、平均の処理時間が間隔に収まっていることに加えて、遅いほうの処理時間が続いたときに、待ち行列の上限までに取り戻せるかを確かめる必要があります。
連続処理には、もう1つ考えることがあります。欠陥が見つかったときに、それが製品のどの位置かを、搬送の位置の情報(たとえば搬送の装置から届く移動量の信号)と結びつけて記録することです。切れ目のない製品では、欠陥の位置がそのまま後工程での切り分けや手直しの位置になるので、判定の結果よりも位置の記録のほうが重要になる場合があります。位置の記録と後工程への引き渡しは、第11章で扱う記録の仕組みの一部です。
エッジとサーバー・クラウドの分担
推論をどこの計算機で行うかも、速度の設計の一部です。本コラムでは、ラインの近くに置いて検査装置とつながっている計算機をエッジと呼び、工場の中のサーバーや、インターネットの先にあるクラウドの計算機と区別します。タクトの中で判定を返す推論は、ネットワークの遅れや途切れの影響を受けにくいエッジで行うのが基本だと考えています。ネットワークの先で推論すると、画像を送る時間と結果を受け取る時間が加わり、ネットワークが混んだり途切れたりすると、その分だけ判定が遅れるからです。
一方で、タクトに縛られない処理は、エッジ以外に置けます。たとえば、全数の画像とスコアの保管、モデルの再学習、スコアの分布の監視、複数のラインの結果の集計は、タクトの中で終える必要のない処理です。これらをサーバーやクラウドに置けば、エッジの計算機は推論と判定の出力だけに専念できます。分担の考え方を次の表にまとめました。表の「許される遅れ」の列は、タクトに縛られない処理として切り離す場合の設定の例で、一般的な値ではありません。スコアの急な変化が流出につながる工程では、監視にも早い検知が要ります。どこまで遅れてよいかは、遅れたときの影響と、対応しなければならない期限から決めるものです。
| 処理 | 許される遅れ | 置き場所の考え方 | 止まったときの影響 |
|---|---|---|---|
| 推論・判定の出力 | タクトの中(ミリ秒単位など) | エッジ | 検査が止まる。ラインを止めるか製品を保留にするか、適用できる承認済みの代わりの検査に切り替える(第11章) |
| 判定の結果と画像の記録 | 数秒から数分(エッジに一時保管できる場合) | エッジで一時保管し、サーバーへ送る | 記録が欠ける。トレーサビリティに穴が開く(第11章) |
| 判定の保留を人が見る画面 | 数秒から数十秒 | エッジ、またはライン近くの端末 | 保留の滞留。人の再検査が追いつかない(第10章) |
| スコアの分布や保留の率の監視 | 数時間から1日 | サーバー・クラウド | 変化に気づくのが遅れる(第12章) |
| 再学習と評価 | 数日から数週間 | サーバー・クラウド | モデルの更新が遅れる(第12章) |
エッジに置くモデルは、学習に使った環境とは別の形式や別の実行の仕組みで動かすことがあります。たとえば ONNX は、公式サイトによれば、拡張できる計算グラフのモデルの定義と、フレームワークをまたいで使える組み込みの演算の集まりを定め、異なる道具の間でモデルを共有できるようにする取り組みです。形式を変えるときは、変換の前後で同じ画像に対するスコアがそろっているか、推論時間がどう変わったかを、ラインに置く計算機で確かめ直す必要があります。本コラムでは、ONNX への変換やその実行は試していません。
モデルを軽くする3つの方法、量子化・枝刈り・蒸留
画像の大きさを保ったまま推論を速くする方法として、モデルを軽くする方法がよく知られています。代表的なものは量子化・枝刈り・蒸留の3つです。どれも、軽くした分だけ精度が下がる可能性があるので、軽くしたモデルで第8章の評価をやり直し、見逃し率の上限を守れているかを確かめる必要があります。
量子化は、モデルの中の数を、通常の32ビットの小数より少ないビット数(たとえば8ビットの整数)で表す方法です。Jacob らの2018年の論文(CVPR 2018)は、推論を整数の演算だけで行えるようにする量子化の方式と、それに合わせた学習の手順を提案し、携帯端末の CPU で、精度と推論の遅れの釣り合いが良くなったと報告しています。PyTorch では、量子化の機能の置き場所が変わりつつあります。PyTorch 2.13 の公式ドキュメントは、量子化の開発を torchao という別のライブラリに集約していると述べ、従来の torch.ao.quantization を削除する予定であることと、torchao への移行の方法を案内しています。本コラムの実行環境(torch 2.13.0)で確かめたところ、torch.ao.quantization の関数はまだ呼び出せましたが、呼び出すと、将来削除されるという警告が出ました。torchao は導入していないので、本コラムでは量子化を実行していません。量子化を検討するときは、使う版の公式ドキュメントを確かめてから選ぶ必要があります。
枝刈りは、モデルの重みのうち、判定への寄与が小さいものを0にして取り除く方法です。Han らの2016年の論文(ICLR 2016)は、枝刈り・重みの値の共有(量子化)・符号化を組み合わせてモデルの保存の大きさを減らす方法を提案し、その論文の条件(ImageNet の画像分類のモデル)では、精度を落とさずに保存の大きさを35〜49分の1にしたと報告しています。ただし、PyTorch の枝刈りの公式チュートリアルの方法は、重みを0にする目印(マスク)を付けるもので、チュートリアルには、それだけでモデルが速く、小さくなるとは書かれていません。0が多い重みを速く計算するには、それに対応した計算の仕組みが要ります。枝刈りで速くなるかどうかは、使う計算機と仕組みで測って確かめる必要があります。
蒸留は、大きなモデル(教師)の出力をまねるように小さなモデル(生徒)を学習させる方法です。Hinton らの2015年の論文は、複数のモデルの組や大きなモデルが持つ知識を、使いやすい1つの小さなモデルに移す方法を示しました。外観検査では、PoC で精度を確かめた大きなモデルをもとに、ラインの速度に収まる小さなモデルを作る場面で使える考え方です。3つの方法の違いを次の表にまとめました。
| 方法 | 何を変えるか | 速くなる条件 | 確かめること |
|---|---|---|---|
| 量子化 | 数を表すビット数を減らす | 計算機と実行の仕組みが、少ないビット数の演算に対応していること | 軽くしたモデルの見逃し率・過検出率、ラインに置く計算機での推論時間 |
| 枝刈り | 重みの一部を0にして取り除く | 0の多い重みを省いて計算できる仕組みを使うこと、または層やチャンネルを丸ごと取り除くこと | 保存の大きさと推論時間が実際に減ったか、精度が落ちていないか |
| 蒸留 | 小さなモデルを、大きなモデルの出力をまねるように学習させる | 小さなモデルの構造そのものが軽いこと | 教師のモデルと比べて見逃し率・過検出率がどう変わり、要件の範囲を保てるか。同じ小さなモデルを蒸留なしで学習した場合とも比べる |
この章の実験の結果を踏まえると、モデルを軽くする前に、画像の大きさと見る範囲を見直すほうが効く場合があります。この章の小さな CNN では、乗算と加算の回数の大部分が、画像が大きい1段目と2段目にありました。最も重いのは2段目です。1段目は入力が1チャンネルなので、画像は最も大きくても計算は2段目の4分の1で済みます。128画素四方・2段では、合計の約1,180万回のうち、1段目が約236万回(約2割)、2段目が約944万回(約8割)です。4段にしても、1段目と2段目で合計の約8割を占め、3段目と4段目は合わせて約2割です。軽くする対象を選ぶなら、この例では2段目のような、画像がまだ大きく、チャンネルも多い段が先になります。これとは別に、画像の大きさを32画素四方から128画素四方に変えると、画素の数が16倍になり、乗算と加算の回数も約16倍になりました。ただし、これは計算の回数の内訳で、層ごとの時間は測っていません。実際の時間の内訳は、計算の回数だけでなく、メモリの読み書きや呼び出しの手間でも変わるので、どこに時間がかかっているかを先に測り、時間のかかっている部分から手を付けるのが確実だと考えています。
経営の判断、速度の要件を精度の要件と一緒に最初に決める
速度の設計を誤ったときの損失は、本コラムの6つの損失の型に当てはめると、次のように整理できます。
| 速度の設計の誤り | 起こる損失の型 | 起こり方 | 防ぎ方 |
|---|---|---|---|
| 推論が遅く、タクトに収まらない | タクトの超過 | 検査の前で製品が詰まり、ラインの速度を落とすか止めることになる | 1枚あたりの推論に使える時間を、最初に数字で決める |
| 遅れたときに検査を飛ばして流す | 流出 | 推論が間に合わなかった製品が、判定されないまま後工程に流れる | 間に合わなかった製品は良品として流さず、判定の保留として人が見る扱いにする(第10章) |
| 速度のために画像を縮小しすぎる | 流出 | 小さな欠陥が画像に写らず、どのモデルでも見つからなくなる | 最小の欠陥の大きさから、画像の大きさの下限を先に決める |
| 開発用の計算機の値で判断する | タクトの超過、形骸化 | 本番の計算機で遅くなり、判定が遅れ、結局人が全数を見直す | ラインに置く計算機で、本番と同じ処理を同時に動かして測る |
| 工程ごとに別々の計算機と仕組みを選ぶ | 二重投資 | 工程ごとに速度の検証と保守の手間を何度もかける | 計測の手順と計算機の選び方を、工程の間でそろえる |
この表のうち、とくに見落とされやすいのが2行目の「遅れたときに検査を飛ばして流す」です。推論が間に合わなかった製品をどう扱うかを決めていないと、ラインを止めないために、判定の無い製品が良品として流れる運用になりかねません。間に合わなかった製品は良品として流さず、判定の保留として人が見る側に回す(判定の保留の設計は第10章、判定が返らない製品をラインで保留・排出に回す仕組みは第11章で扱います)、と最初に決めておくことが必要だと考えています。この扱いは、品質保証の体制が承認する検査の手順の一部です。
経営として最初に決めるべきことは、必要な検出の性能の要件と並べて、速度の要件を PoC の前に決めておくことです。具体的には、タクトタイム、1個あたりの撮像の回数、そこから逆算した1枚あたりの推論に使える時間、判定の締切(排出の位置に届くまでなど)、そして間に合わなかった製品の扱いを、PoC を始める前に決めておくことです。並列に処理する構成を取るなら、処理量がタクトタイムに追いつくことと、各製品の判定が締切に間に合うことを、分けて要件にします。PoC で使う計算機が、ラインに置く予定の計算機と違う場合は、PoC の評価の項目に「ラインに置く計算機での推論時間の99%点」を入れておく必要があります。PoC の段階で精度だけを評価し、速度を後から確かめると、本コラムの架空の例でいえば、精度の要件を満たす唯一の組み合わせが速度の要件の境目にある、という状況に後から気づくことになります。そこから計算機を買い直すか、画像とモデルを選び直すかの判断になり、どちらも予算と日程の作り直しにつながります。
予算の面では、計算機を選ぶ判断を、モデルの精度の議論から切り離さないことが大切だと考えています。推論が速い計算機を選べば、画像の大きさやモデルの大きさの選択の幅が広がり、精度を上げる余地が生まれます。逆に、計算機を先に安く決めてしまうと、その計算機に収まる範囲でしか画像とモデルを選べず、精度の上限がそこで決まります。計算機の選定は、生産技術・品質保証・データ担当が、速度と精度の両方の表を並べて一緒に決めるのが適切だと考えています。
この章では、タクトタイムから推論に使える時間を逆算し、画像の大きさと層の数を変えたときの推論時間と検出の成績を測って、要件に収まる組み合わせを選ぶ方法を扱いました。本コラムの架空の合成画像と小さな CNN では、画像を縮小すると最も小さい異物から見逃しが増え、128画素四方でも層の数が少ないと広く淡い汚れを見逃しました。推論時間は画像の大きさで大きく変わり、同じ組み合わせでも実行のたびに数倍変わることがありました。検出の性能の要件と並べて、処理量と判定の締切の2つに分けた速度の要件を PoC の前に決め、選定に使っていない画像とラインに置く計算機で確かめ直すことが、速度と精度を両立させる出発点だと考えています。次の第10章では、AIが決めきれない範囲を人に回す判定の保留と、人と AIの協調運用を扱います。
この章を深めたい方への参考書籍
『エッジAI導入の手引き 生産設備/機器制御への組み込み』(出澤純一、菅原志門 著、日刊工業新聞社):副題のとおり生産設備や機器の制御に AIを組み込むことを主題にした本で、ニュースサイト「ニュースイッチ」に掲載された本書の抜粋記事の紹介によれば、クラウドで動かす AIの弱点を補うものとしてエッジ AIの定義と特徴を示し、課題の見つけ方から実装までを整理しています。この章で扱ったエッジとサーバー・クラウドの分担を、自社の設備に当てはめて考えるときの手引きになります。
『深層ニューラルネットワークの高速化』(佐藤竜馬 著、技術評論社):ML Systems のシリーズの1冊で、版元の目次によれば、量子化と低精度計算・枝刈り・蒸留・低ランク近似・高速なアーキテクチャ・チューニングのためのツールなどの章があります。この章では考え方の紹介に留めた量子化・枝刈り・蒸留を、手法ごとに詳しく学び、どの手法が自社の計算機で効くかを見極めるときに役立ちます。
第10章 人とAIの協調運用、判定の保留・再検査・根拠の示し方
第9章では、タクトタイムから検査に使える時間を逆算し、画像の大きさとモデルの大きさを選んで推論を時間内に収める設計を扱いました。時間内に判定を出せるようになっても、その判定をすべてそのまま出荷の可否につなげてよいかは別の問題です。外観検査AIのスコアには、良品とも不良とも決めきれない範囲が残ることが多く、その範囲をどう扱うかで、流出と過検出と人手の配分が大きく変わります。この章では、その範囲を人にどう回し、人がどう確かめ、確かめた結果をどう仕組みに戻すかを扱います。
この章で扱うのは次の内容です。
- 人とAIの協調の3つの型と、それぞれが向く工程
- 2つのしきい値で「良品」「保留」「不良」に分ける設計
- 架空の検査スコアで、保留の幅を変えたときの人が見る数と、残る見逃し率・過検出率を計算した結果
- 判定の根拠の示し方(異常の度合いの地図と欠陥の位置の枠)と、その限界
- 人がAIの判定に引きずられる問題
- 検査員の作業の設計と、再検査の結果を学習に戻す流れ
- 経営の判断
この章の主張は、全部をAIに任せるのでも、人が全数を見直すのでもなく、AIのスコアだけでは決めきれない範囲を人に回す設計にすることが、流出と人手の両方を減らす現実的な形だということです。ただし、出荷の可否を決める責任は品質保証の体制にあり、AIに移るものではありません。この章で扱う設計は、その責任を果たすために、人が見るべきものを絞り、判断の材料をそろえる仕組みとして位置づけています。
人とAIの協調の3つの型
外観検査で人とAIを組み合わせる形は、誰が先に見て、誰が何を確かめるかで、大きく3つの型に分けて考えると整理しやすくなります。1つ目は「AIが先に見て、人が確かめる」型です。AIがすべての製品を判定し、不良と判定したものだけを人が見直して、本当に不良かを確かめます。過検出で良品を捨てる量を減らせますが、AIが良品と判定した不良(見逃し)は人の目に触れないまま流れます。2つ目は「人が見て、AIが見落としを拾う」型です。これまでどおり検査員が全数を見て、そのあとにAIがもう一度判定し、人が良品とした中からAIが怪しいとしたものを拾い直します。人の見逃しを補えますが、人の作業の量は減りません。
3つ目が、この章で中心に扱う「AIの判定の保留を人に回す」型です。AIのスコアが十分に低いものは良品、十分に高いものは不良としてAIが判定し、その間の決めきれない範囲だけを人に回します。本コラムでは、スコアがあらかじめ決めた保留の範囲に入るとき、画像が検査の条件を満たさないとき(ピントが合っていない、明るさが範囲を外れているなど)、あるいは判定が期限までに返らないときに、AIの判定を確定させず人の判断に回すことを判定の保留と呼びます。保留の範囲はAIが決めるものではなく、人が設計するものです。保留になった製品を人が見て良否を決めることを再検査と呼びます。
この型では、人が見る数を絞りつつ、スコアが保留の範囲に入ったものには人の判断を入れられるので、人の再検査が十分に正確であれば、見逃しと人手の両方を抑えやすい型です。人の再検査の見逃しが多いと、保留を広げることでかえって見逃しが増えることは、後の節の計算で示します。
ただし、スコアが保留の範囲より低く、良品と判定された不良は、この型でも人の目に触れません。人が一部だけを見る1つ目と3つ目の型では、人の目に触れない製品が残ります。人が全数を見る2つ目の型でも、人とAIの両方が見逃した不良は流れます。どの型を選んでも見逃しが残りうることを、先に確かめておく必要があります。
| 協調の型 | 人が見るもの | 減らせる損失 | 残る弱点 | 向いている場面 |
|---|---|---|---|---|
| AIが先に見て、人が確かめる | AIが不良と判定したもの | 過検出(良品の廃棄・手直し) | AIの見逃しは人の目に触れない | 見逃しより過検出の損失が目立つ工程、AIが不良と判定したものの当たり外れを人の目で確かめながら使いたい場合 |
| 人が見て、AIが見落としを拾う | 全数(従来どおり) | 流出(人の見逃し) | 人の作業の量は減らない。人がAIを当てにして手を抜くと効果が薄れる | 流出の影響が大きく、まず人の見逃しを補いたい工程、AIの評価がまだ十分でない時期 |
| AIの判定の保留を人に回す | AIのスコアが中間の範囲にあるもの | 人手と、決めきれない範囲での見逃し・過検出 | スコアが保留の範囲の外にある誤った判定は人の目に触れない。保留が多すぎると人手が足りない | AIの評価が済み、スコアの分布が安定している工程 |
型は工程ごとに選び、時期によって移していくものだと考えています。導入の初期にどちらの型から入るかは、どちらの損失が大きい工程かで分かれます。過検出の損失が大きく、流出の影響が比較的小さい工程(後工程に別の検査があり、見逃した不良がそこで止まる工程など)では、「AIが先に見て、人が確かめる」型から入り、AIが不良と判定したものの当たり外れを人が確かめながら使う形が考えられます。ただし、この型ではAIの見逃しが人の目に触れないので、後工程の検査や抜き取りで見逃しを確かめる手段を別に持っておく必要があります。一方、流出の損失が大きい工程では、この型から入ると、AIの評価が済む前に流出が起きても気付けません。流出の損失が大きい工程では、導入の初期は「人が見て、AIが見落としを拾う」型で人の判定とAIの判定を並べて記録し、その記録で第8章の方法により見逃し率と過検出率を確かめてから、「AIの判定の保留を人に回す」型に移る、という順です。移る条件(どれだけの期間、どれだけの数の不良で確かめたら移るか)は、品質保証の部門が決め、記録に残しておく必要があります。この順を飛ばして、評価の済んでいないモデルで最初から人の目を外すと、流出が起きても気付く手段が無くなります。
どの型でも、AIの判定を最終的な出荷の可否としてそのまま使うかどうかは、品質保証の体制が決めることです。法令・顧客との取り決め・業界の規格で検査の方法や記録が定められている製品では、それに従う必要があり、本コラムではそうした検査をAIで置き換えられるとは書きません。この章の設計は、定められた検査の外側で、人が見る範囲をどう絞るかについての考え方として読んでください。
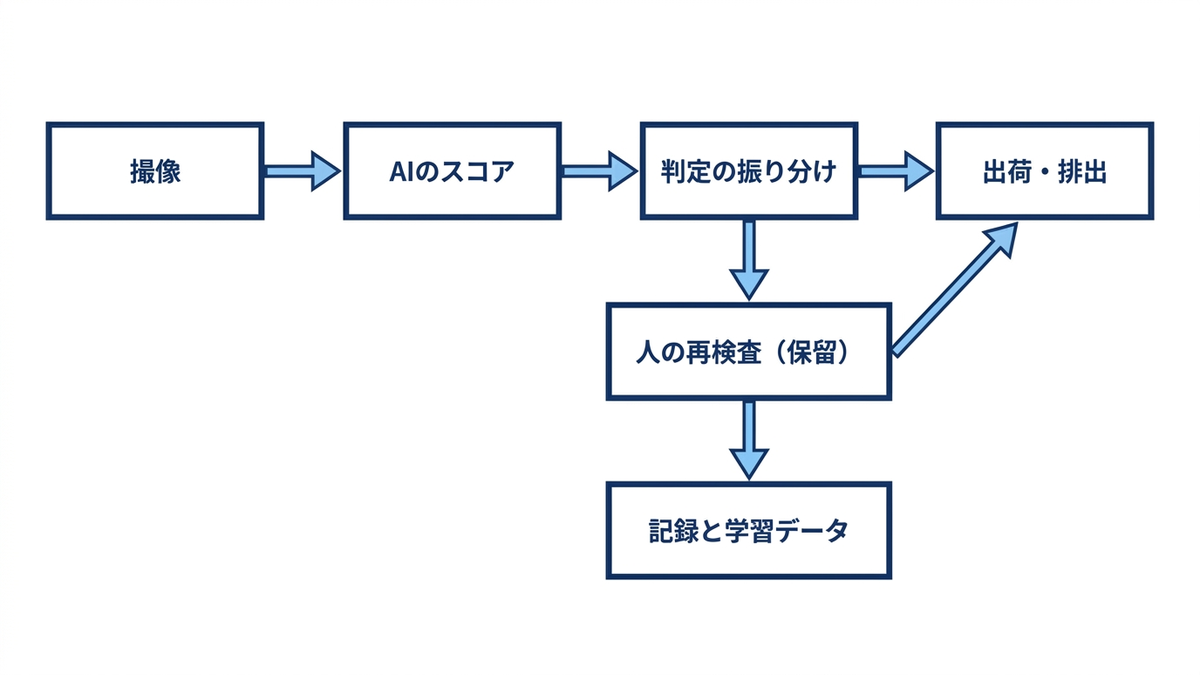
2つのしきい値で良品・保留・不良に分ける
判定の保留を設計する方法は単純です。AIが出す異常の度合いのスコア(第6章の良品学習のスコアでも、第5章の教師あり学習が出す不良らしさのスコアでもかまいません。どちらも、そのままでは確率として読めない値です)に、しきい値を1つではなく2つ置きます。下側のしきい値より低いものは良品、上側のしきい値以上のものは不良、その間は保留として人に回します。しきい値が1つのときは、境目のすぐ近くにある製品も、どちらかに機械的に振り分けられます。2つにすると、境目の近くの製品だけを人の判断に回せます。2つのしきい値の間の幅を、本コラムでは保留の幅と呼びます。保留の幅を0にすれば、しきい値が1つの判定と同じになります。
保留の幅を広げるほど、人が見る数は増えます。その代わりに、AIが誤りやすい境目の製品を人が見るので、AIだけで判定したときより見逃しも過検出も減ることが期待できます。ただし、それは人の再検査がAIより正確な場合に限ります。人も疲れれば見逃しますし、AIの示した判定に引きずられることもあります。保留の幅は、人が確かめられる数の上限、人の再検査の見逃しの度合い、見逃しと過検出のそれぞれの損失の大きさを並べて決める必要があります。次の節から、この関係を架空のスコアで計算して確かめます。
2つのしきい値がそれぞれ何に効くかを整理しておきます。下側のしきい値は、それより低いものを人の目に触れずに良品として流すので、主に見逃しに効きます。上側のしきい値は、それ以上のものを人の目に触れずに不良として排出するので、主に過検出に効きます。ただし、2つは独立には決められません。最終的な見逃し率には、保留になった不良を人が見逃す分が加わり、上側のしきい値を上げれば保留に入る不良が増えて、その分も人の見逃しの対象になります。最終的な過検出率にも、保留になった良品を人が不良と判定する分が加わります。そのため、上下のしきい値を組み合わせて、人の誤りを含めた最終的な見逃し率・過検出率と、人が確かめる数を同時に確かめる必要があります。本章のこの後の計算では、見逃し率の上限と人が確かめる数の上限を必ず守る条件として置き、過検出は相対コストの中で重さを付けて扱います。過検出にも上限を設ける工程では、同じ形で条件を1つ足します。
ここからは、架空の検査スコアで計算します。第8章とは独立に作った数字で、架空の1日分として良品9,500個と不良500個のスコアを乱数で作りました。スコアは単位の無い値で、大きいほど不良らしいことを表します。良品のスコアは、平均0・標準偏差(ばらつきの大きさ)1の正規分布(平均を中心に左右対称に広がる、釣り鐘の形の分布)から取りました。不良は2つの群に分け、350個(7割)ははっきりした欠陥で平均4.0・標準偏差1.0、150個(3割)は微妙な欠陥で平均1.8・標準偏差0.8のスコアを持つ設定にしました。微妙な欠陥の不良は良品のスコアと大きく重なるので、しきい値を1つにするとどこかで見逃しか過検出が出ます。実在の検査では、スコアの分布の形はモデルと製品と撮像の条件で決まり、ここでの形はあくまで説明のために置いたものです。乱数のシード(乱数の出方を決める値)は固定しています。
import numpy as np

rng = np.random.default_rng(20261109)
N_GOOD, N_BAD = 9500, 500                       # 架空の1日分(良品9,500個・不良500個)
good = rng.normal(0.0, 1.0, N_GOOD)              # 良品のスコア
n_clear = int(N_BAD * 0.7)                       # はっきりした欠陥の不良(350個)
bad = np.concatenate([rng.normal(4.0, 1.0, n_clear),
                      rng.normal(1.8, 0.8, N_BAD - n_clear)])  # 微妙な欠陥の不良(150個)
print("良品のスコアの分位点 50%,95%,99%,99.9%", np.quantile(good, [0.5, 0.95, 0.99, 0.999]).round(2))
print("不良のスコアの分位点 1%,5%,25%,50%", np.quantile(bad, [0.01, 0.05, 0.25, 0.5]).round(2))
# 出力:
# 良品のスコアの分位点 50%,95%,99%,99.9% [0.02 1.66 2.31 3.01]
# 不良のスコアの分位点 1%,5%,25%,50% [0.41 1.03 2.34 3.36]
実行した結果、良品のスコアの95%点(下から数えて95%の位置の値)は1.66、99%点は2.31でした。不良のスコアの25%点は2.34で、不良の4分の1は良品の99%点とほぼ同じか、それより低いスコアしか持っていません。この重なりが、しきい値を1つにしたときに見逃しと過検出の両方を同時には小さくできない理由です。
保留の幅を変えると、人が見る数と見逃し率・過検出率はどう変わるか
次のコードは、2つのしきい値で良品・保留・不良に分け、保留になった製品を人が再検査したときに残る見逃し率と過検出率を計算する関数です。計算の前提は次の4つです。
- 人の再検査にも誤りがあり、保留になった不良のうち5%を人が見逃す(架空の率)
- 保留になった良品のうち2%を人が不良と判定する(架空の率)
- 人の誤りは、件数に率を掛けた期待値(平均で何件になるか)で数える
- 見逃し率は不良500個のうち最終的に良品とされた割合、過検出率は良品9,500個のうち最終的に不良とされた割合(本コラムの共通の定義どおり)
関数の引数の lo が下側のしきい値、hi が上側のしきい値です。
def evaluate(lo, hi, h_miss=0.05, h_fa=0.02):
    """lo 未満は良品、hi 以上は不良、その間は保留にして人が見る(人の誤りは期待値で数える)"""
    g_hold = ((good >= lo) & (good < hi)).sum()
    b_hold = ((bad >= lo) & (bad < hi)).sum()
    miss = (bad < lo).sum() + b_hold * h_miss       # AI が通した不良+人が見逃した不良
    over = (good >= hi).sum() + g_hold * h_fa       # AI が弾いた良品+人が弾いた良品
    return dict(保留の数=int(g_hold + b_hold), 保留率=(g_hold + b_hold) / (N_GOOD + N_BAD),
                見逃し率=miss / N_BAD, 過検出率=over / N_GOOD)


C = 1.6                                           # しきい値を1つにするときの値
for w in [0.0, 0.5, 1.0, 1.5, 2.0, 2.5, 3.0]:
    r = evaluate(C - w / 2, C + w / 2)
    print(f"幅{w:.1f} 保留{r['保留の数']:5d}個 ({r['保留率']*100:5.1f}%) "
          f"見逃し率{r['見逃し率']*100:5.2f}% 過検出率{r['過検出率']*100:5.2f}%")
しきい値を1つにするときの値を1.6に置き、その値を中心に保留の幅を0から3.0まで広げました。たとえば幅2.0は、下側のしきい値0.6、上側のしきい値2.6です。実行した結果は次の表のとおりです。
| 保留の幅 | 下側のしきい値 | 上側のしきい値 | 保留の数(人が見る数) | 保留率 | 見逃し率 | 過検出率 |
|---|---|---|---|---|---|---|
| 0.0(しきい値1つ) | 1.6 | 1.6 | 0個 | 0.0% | 10.60% | 5.77% |
| 0.5 | 1.35 | 1.85 | 607個 | 6.1% | 8.72% | 3.42% |
| 1.0 | 1.1 | 2.1 | 1,254個 | 12.5% | 6.11% | 1.89% |
| 1.5 | 0.85 | 2.35 | 1,966個 | 19.7% | 3.93% | 1.31% |
| 2.0 | 0.6 | 2.6 | 2,765個 | 27.7% | 3.04% | 0.93% |
| 2.5 | 0.35 | 2.85 | 3,636個 | 36.4% | 2.61% | 0.93% |
| 3.0 | 0.1 | 3.1 | 4,659個 | 46.6% | 2.96% | 1.00% |
しきい値1つの判定では、見逃し率が10.60%、過検出率が5.77%でした。保留の幅を1.0にすると、人が見る数は1日1,254個(全体の12.5%)になり、見逃し率は6.11%、過検出率は1.89%に下がりました。幅2.0では人が見る数が2,765個(27.7%)に増え、見逃し率は3.04%、過検出率は0.93%です。この設定では、幅2.0までは広げるほど見逃し率と過検出率の両方が下がりましたが、下がり方は次第に小さくなり、幅2.5から3.0にかけては、人が見る数が1,000個以上増えたのに、見逃し率は2.61%から2.96%に、過検出率は0.93%から1.00%に、かえって少し上がりました。
上がった理由は、幅を広げると、AIだけでも正しく判定できていた製品まで人が見ることになるからです。上側のしきい値を3.1まで上げると、はっきりした欠陥の不良の一部も保留に入り、それを人が5%の率で見逃します。同じように、下側のしきい値を下げると、AIだけで良品と判定できていた良品の一部も保留に入り、それを人が2%の率で不良と判定します。保留を広げることは、AIの誤りを人の判断で置き換えることであり、人の判断のほうが正確な範囲でだけ得になる、ということです。本コラムの架空のスコアと架空の人の誤りの率での結果ですが、この構造そのものは、人の再検査にも誤りがある限り、保留の幅をどう決めるかを考えるうえで押さえておくべき点だと考えています。
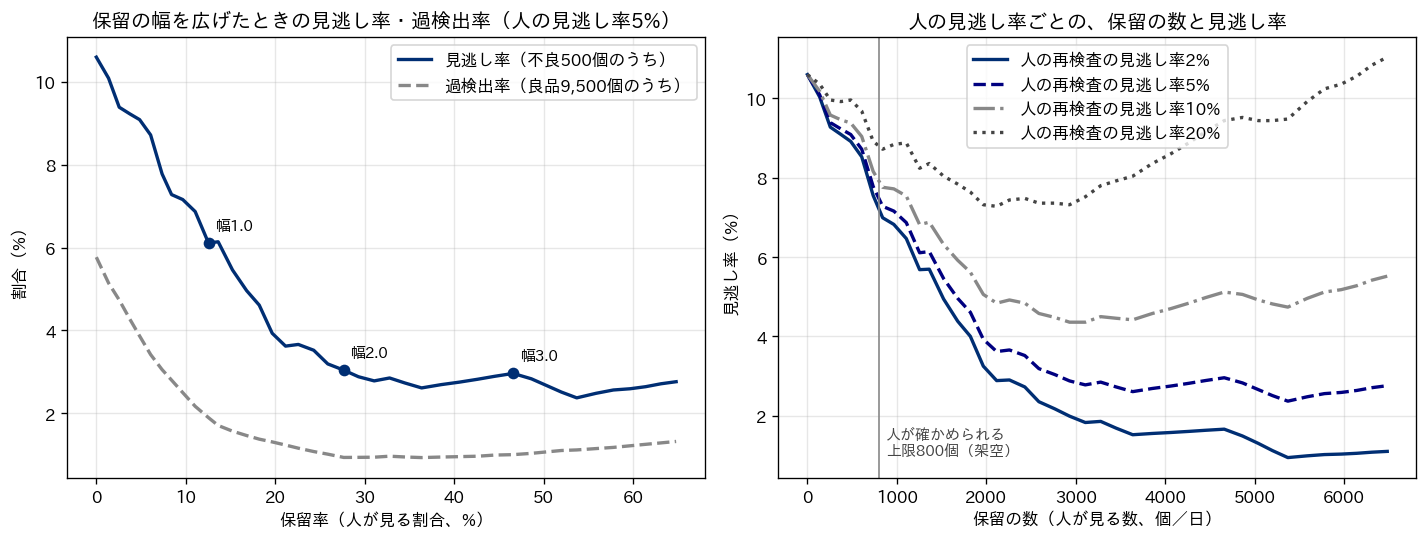
人の再検査の見逃し率は、検査員の熟練・欠陥の見えやすさ・作業の量・時間帯によって変わります。そこで、人の見逃し率を2%・5%・10%・20%の4通りに変えて、保留の幅ごとの見逃し率を計算しました。人の過検出の率は2%のままです。上の図の右側が、保留の幅を0から4.0まで細かく変えた結果です。
for hm in [0.02, 0.05, 0.10, 0.20]:
    m = [evaluate(C - w / 2, C + w / 2, h_miss=hm)["見逃し率"] * 100 for w in [0.0, 2.0, 4.0]]
    print(f"人の見逃し率{hm*100:3.0f}% 見逃し率 幅0.0:{m[0]:5.2f}% 幅2.0:{m[1]:5.2f}% 幅4.0:{m[2]:5.2f}%")
print("幅4.0の保留の数", evaluate(C - 2.0, C + 2.0)["保留の数"], "個")
| 人の再検査の見逃し率(架空) | 見逃し率(幅0.0) | 見逃し率(幅2.0、保留2,765個) | 見逃し率(幅4.0、保留6,481個) |
|---|---|---|---|
| 2% | 10.60% | 2.18% | 1.10% |
| 5% | 10.60% | 3.04% | 2.76% |
| 10% | 10.60% | 4.48% | 5.52% |
| 20% | 10.60% | 7.36% | 11.04% |
人の見逃し率が2%なら、保留の幅を4.0まで広げると見逃し率は1.10%まで下がりました。一方、人の見逃し率が20%だと、幅2.0では7.36%に下がるものの、幅4.0では11.04%になり、保留を作らないしきい値1つの判定(10.60%)より悪くなりました。幅4.0では1日6,481個、全体の65%近くを人が見ることになります。この計算では、人の見逃し率は作業の量によらず一定と置いており、作業の量が増えたときに人の見逃し率がどう変わるかは、本コラムでは測っていません。
この結果から言えるのは、保留の幅を決める前に、人の再検査の見逃し率を測っておく必要がある、ということです。測り方は、第8章で扱った評価の考え方と同じで、不良であることが分かっている製品(限度見本や、過去に確定した不良品)を、検査員にどれが試験品かを知らせずに保留の流れに混ぜて、何個を見逃したかを数えます。試験品には識別の印や番号を付けて追跡し、判定の結果によらず全数を回収して、出荷の流れに混ざらないようにします。出荷の流れから切り離した場で、提示の順番を知らせずに行う方法もあります。人の見逃し率を測らずに「人が見れば安心」として保留の幅を広げると、人手を増やしたのに流出が減らない、という結果になりかねません。人の判定のばらつきの測り方は、第2章で扱っています。
人の処理能力の上限の中で、2つのしきい値を決める
ここまでの計算を、しきい値を決める手順にまとめます。経営と品質保証の側で決めておくべき入力は、1日に人が確かめられる数の上限と、見逃し・過検出・人の確認の1件あたりの重さです。本コラムでは金額を使わず、単位の無い相対コストで重さを置きます。ここでは、見逃し1件を50、過検出1件を2、人の確認1件を0.5とし、人が確かめられる数の上限を1日800個、品質保証が決めた見逃し率の上限を8%としました(いずれも架空)。次のコードは、下側と上側のしきい値の組み合わせを0.1刻みで総当たりし、人が見る数の上限と見逃し率の上限の両方を満たす組み合わせのうち、相対コストの合計が最も小さいものを探します。見逃し率の上限を先に条件として置き、その中で相対コストを比べる順にしています。比較のため、保留を作らない(しきい値1つの)判定の中で最も相対コストが小さいものも求めています。
CAP = 800                                          # 1日に人が確かめられる数(架空)
MISS_MAX = 0.08                                    # 品質保証が決めた見逃し率の上限(架空)
COST_MISS, COST_OVER, COST_CHECK = 50, 2, 0.5      # 相対コスト(単位なし)


def total_cost(r):
    return (COST_MISS * r["見逃し率"] * N_BAD + COST_OVER * r["過検出率"] * N_GOOD
            + COST_CHECK * r["保留の数"])


best, single = None, None
for lo in np.round(np.arange(-1.0, 3.01, 0.1), 1):
    for hi in np.round(np.arange(lo, 5.01, 0.1), 1):
        r = evaluate(lo, hi)
        if (r["保留の数"] > CAP) | (r["見逃し率"] > MISS_MAX):
            continue                                 # 人の上限か見逃し率の上限を超える組み合わせは除く
        cand = (total_cost(r), lo, hi, r)
        if best is None:
            best = cand
        elif cand[0] < best[0]:
            best = cand
        if lo == hi:                                 # 保留を作らない(しきい値1つ)場合の最良
            if single is None:
                single = cand
            elif cand[0] < single[0]:
                single = cand
for name, (cost, lo, hi, r) in [("保留あり(上限の中で最良)", best), ("しきい値1つで最良", single)]:
    print(f"{name} lo={lo:.1f} hi={hi:.1f} 保留{r['保留の数']}個 見逃し率{r['見逃し率']*100:.2f}% "
          f"過検出率{r['過検出率']*100:.2f}% 相対コスト{cost:.0f}")
| 判定の設計 | 下側のしきい値 | 上側のしきい値 | 保留の数 | 見逃し率 | 過検出率 | 相対コストの合計 |
|---|---|---|---|---|---|---|
| 保留あり(人が見る数1日800個以内・見逃し率8%以下で最良) | 1.3 | 1.9 | 735個 | 7.78% | 3.05% | 2,892 |
| しきい値1つ(見逃し率8%以下で最良) | 1.3 | 1.3 | 0個 | 7.40% | 10.24% | 3,796 |
実行した結果、人が見る数を1日800個以内、見逃し率を8%以下に収める条件では、下側のしきい値1.3・上側のしきい値1.9で保留が735個になる組み合わせが最良で、見逃し率7.78%、過検出率3.05%、相対コストの合計は2,892でした。保留を作らないしきい値1つの判定で見逃し率8%以下を守るには、しきい値を1.3まで下げる必要があり、見逃し率7.40%、過検出率10.24%、相対コストの合計は3,796になりました。この架空の設定では、同じ見逃し率の上限を守るのに、しきい値1つでは良品の1割強を不良とし、保留を作れば人が1日735個を確かめる代わりに過検出率を3.05%に抑えられた、ということです。
選ばれた組み合わせの見逃し率は7.78%で、上限の8%に近い値です。表のしきい値1つ(1.3)の7.40%のように、これより低い見逃し率の組み合わせもありますが、見逃し1件の重さを50と置いたこの設定では、過検出や人の確認が増える重さのほうが大きいと計算されました。見逃し率をさらに下げたいなら、取りうる手は次の3つです。
- しきい値を下げて、過検出の増加を受け入れる
- 人が確かめられる数を増やして、保留を広げる(前の節の表のとおり、保留を2,000個以上に広げれば見逃し率は3%台まで下がりました)
- AIのスコアそのものを改善する(撮像やモデルを見直す)
どれを選ぶかは、品質保証が見逃し率の上限を見直すか、見逃し1件の重さを置き直すかで決まります。
なお、ここで示した率は、しきい値の探索に使ったのと同じ架空の1日分のスコアの上での値です。実際の運用では、探索で選んだしきい値を固定し、探索に使っていない別の期間・ロットの評価用データで見逃し率と過検出率を確かめる必要があります。不良の数が少ないと見逃し率の推定には大きな幅が出るので、上限を満たしたかどうかは、第8章で扱った信頼限界の考え方で判断します。
この計算で大事なのは、出てきたしきい値の値ではなく、入力の決め方です。見逃し1件と過検出1件の重さの比、人が確かめられる数の上限、人の再検査の見逃し率は、どれもAIの側では決められず、品質保証・製造・検査の現場が決めるものです。ここで置いた50・2・0.5や800個、見逃し率の上限8%は説明のための値で、推奨の値ではありません。また、相対コストの合計を最小にする考え方は、見逃し率の上限という品質保証の要求を満たしたうえで使うものです。上のコードで見逃し率の上限を除外の条件に入れたのはこのためで、第8章で扱ったように、まず見逃し率の上限を品質保証と決め、それを満たす組み合わせの中で、人手と過検出のつり合いを相対コストで比べる、という順が適切だと考えています。上限を満たす組み合わせが1つも無いときは、しきい値の選び方ではなく、人の上限・撮像・モデルのどれかを見直す必要があるという信号です。
判定の根拠の示し方、異常の度合いの地図と欠陥の位置の枠
保留になった製品を人が再検査するとき、画像を1枚見せて「良品か不良か」と問うだけでは、人は画面の全体を一から探すことになります。AIが画像のどこを異常と見たかを示せば、人はその場所を重点的に確かめられます。外観検査AIでよく使われる示し方は2つあります。1つはヒートマップで、画像の各位置の異常の度合いを色の濃さで示した地図です。第6章で扱った良品学習の手法の多くは、画像全体のスコアに加えて、位置ごとの異常の度合いを出せます。もう1つは欠陥の位置の枠で、ヒートマップの値が一定の水準を超えた領域を四角で囲んで示します。枠は、第5章で扱った物体検出のモデルなら直接出力されます。
ここでは、numpy と scipy だけで、良品との差からヒートマップと枠を作る簡単な例を示します。布地のような模様の架空の表面(64画素四方)を作り、良品50枚の平均とばらつきを求めておきます。検査する画像と良品の平均との差を良品のばらつきで割り、なめらかにしたものをヒートマップとします。枠を描く水準は、平均とばらつきを求めた50枚とは別に良品50枚を新しく作り、それぞれのヒートマップの最大値を求めて、その99%点にしました(平均を作った画像そのもので水準を決めると、良品のずれを小さく見積もりやすいためです)。検査する画像は2枚で、例1は細い傷を描き足したもの、例2は小さな異物(暗い点)を描き足したうえで、照明のむら(右へ行くほど明るくなる変化)を加えたものです。いずれも架空の合成画像で、実際の製品の画像よりずっと単純です。また、この例のヒートマップは良品の平均との差で作った簡単なもので、第6章の手法が出す地図そのものではありません。
import numpy as np
from scipy import ndimage

rng = np.random.default_rng(20261109)
S = 64
yy, xx = np.mgrid[0:S, 0:S]


def surface():
    """布地のような模様の架空の表面(明るさ0〜1)"""
    weave = 0.5 + 0.08 * np.sin(xx * 0.9) * np.sin(yy * 0.9)
    return weave + rng.normal(0, 0.03, (S, S))


goods = np.stack([surface() for _ in range(50)])  # 良品50枚
mu, sd = goods.mean(axis=0), goods.std(axis=0) + 1e-6


def heatmap(img):
    """良品の平均からのずれを良品のばらつきで割り、なめらかにした異常の度合いの地図"""
    return ndimage.gaussian_filter(np.abs(img - mu) / sd, sigma=1.5)


def boxes(hm, level):
    lab, n = ndimage.label(hm > level)
    return [(s[0].start, s[0].stop, s[1].start, s[1].stop) for s in ndimage.find_objects(lab)]


# 良品のヒートマップの最大値から、枠を描く水準を決める
level = np.quantile([heatmap(surface()).max() for _ in range(50)], 0.99)

scratch = surface()                                # 例1:細い傷
for t in range(30):
    scratch[20 + t // 3, 12 + t] -= 0.25
spot_light = surface() + 0.15 * (xx / S)           # 例2:小さな異物+照明のむら
spot_light[44:47, 44:47] -= 0.3

results = {}
for name, img in [("傷", scratch), ("異物と照明のむら", spot_light)]:
    hm = heatmap(img)
    results[name] = (img, hm, boxes(hm, level))
    print(name, "最大値", round(hm.max(), 2), "枠の数", len(results[name][2]),
          "枠(行の始め,終わり,列の始め,終わり)", results[name][2][:5])
print("枠を描く水準", round(level, 2))
hm2 = results["異物と照明のむら"][1]
print("異物の位置の値", round(hm2[45, 45], 2), "右端の列(56〜63)の平均", round(hm2[:, 56:].mean(), 2),
      "左端の列(0〜7)の平均", round(hm2[:, :8].mean(), 2))
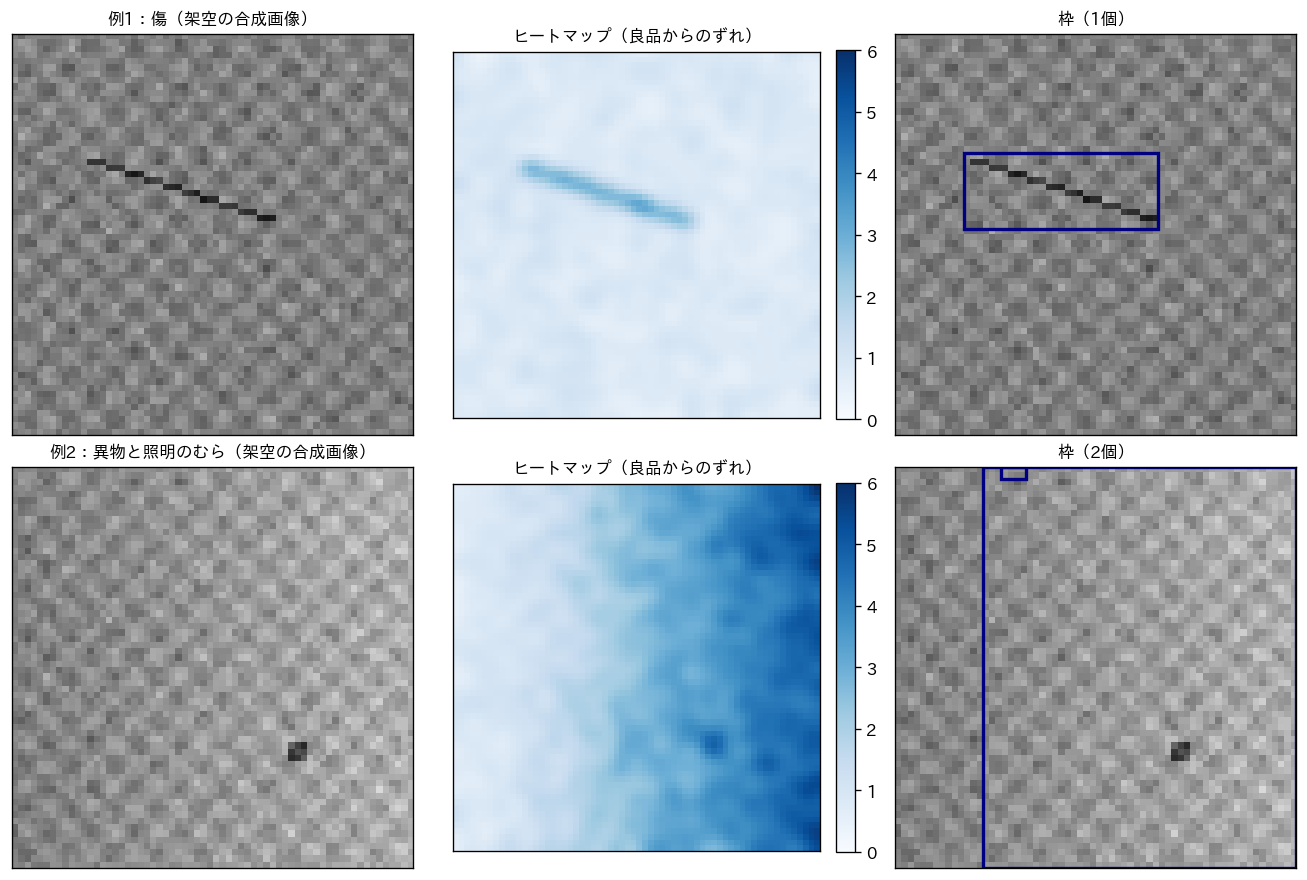
実行した結果、枠を描く水準は1.58でした。例1(傷)は、ヒートマップの最大値が3.18で、枠は1個、行19〜30・列11〜41の範囲を囲みました(コードの出力は終わりの位置を1つ先まで含めた形で示しています)。傷を描き足したのは行20〜29・列12〜41で、枠はその傷と、なめらかにした分だけ周りに広がった縁を含んでいます。人はこの枠の中を見れば傷を確かめられます。例2(異物と照明のむら)は、ヒートマップの最大値が5.96と例1より大きく、枠は2個出ました。ただし、大きいほうの枠は行0〜63・列14〜63、つまり画像の右側の大部分を囲んでおり、小さいほうの枠は画像の上端の行0〜1・列17〜20にある小さな領域で、異物の位置ではありませんでした。異物の位置のヒートマップの値は4.84でしたが、照明のむらで明るくなった右端の列(56〜63)の平均も4.76あり、異物と照明のむらの区別が付いていません。左端の列(0〜7)の平均は0.86でした。
この例から言えるのは、ヒートマップと枠は、AIが「良品と違う」と見た場所を示すもので、その場所に欠陥があることを示すものではない、ということです。この簡易版では、例2のように撮像の条件が変わると、ヒートマップは欠陥ではなく照明の変化を強く示しました。第6章で扱った手法(PatchCore など)で同じことがどの程度起きるかは、この章では確かめていません。手法によって照明の変化への反応は違いうるので、自社のモデルで、照明や位置をわざと変えた良品の画像を流して確かめておく必要があります。例2では、異物(行44〜46・列44〜46)は大きいほうの枠の中に入っていますが、枠が画像の右側の大部分に広がったため、異物の位置を絞り込めていません。もう1つの小さな枠は、異物の無い上端を指しています。この例で人の見落としを測ったわけではありませんが、枠が場所を絞り込めないときや、欠陥の無い場所を指すときに、人が枠の中だけを見て判断すると、欠陥を見落とすおそれがあると考えています。根拠の図を示すときは、元の画像も必ず並べ、枠の外も確かめる手順にしておく必要があります。また、この簡易版の例2のように画像の広い範囲が異常と示されたときは、欠陥だけでなく撮像の条件の変化も疑って確かめるのが適切だと考えています。撮像の条件の固定は第3章で、本番での変化の監視は第12章で扱います。
根拠の示し方の手法そのもの(画像のどこが判定に効いたかを計算する方法の種類と、その使い分けや限界)は、弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』で扱っています。この章では、検査の現場で人に見せるときの使い方に絞り、次の表にまとめました。
| 示すもの | 人が分かること | 外れやすい場面 | 示すときの手当て |
|---|---|---|---|
| 元の画像 | 製品の実際の見た目 | 撮像の条件で欠陥が写っていないことがある | 必ず表示する。可能なら別の角度・照明の画像も並べる |
| ヒートマップ | AIが良品と違うと見た場所と、その強さ | 照明のむら・位置ずれ・良品のばらつきでも濃くなる | 元の画像と並べるか、半透明で重ねる。色の濃さの目盛りを固定する |
| 欠陥の位置の枠 | 重点的に見るべき場所 | 枠の外の欠陥を見落とす。枠が広すぎて場所を示せない | 枠の外も確かめる手順にする。枠が一定の広さを超えたら撮像の異常を疑う表示を出す |
| スコアと保留の理由 | スコアが保留の範囲のどこに位置するか、画像の条件で保留になったか | スコアの数字を確率として読まれる | 「確率」と書かず、保留の範囲の中での位置として示す |
| 過去の似た判定の例 | 同じような見た目を過去にどう判定したか | 似た例が無い新しい欠陥では示せない | 限度見本の画像と並べて示す(限度見本は第2章) |
人がAIの判定に引きずられる問題
人にAIの判定や根拠を見せることには、引きずられるという代償があります。自動化された仕組みの出力に人が頼りすぎる傾向は自動化バイアスと呼ばれ、ヒューマンファクター(人と機械の関わりを扱う研究分野)で研究されてきました。Parasuraman と Manzey が2010年に Human Factors 誌(52巻3号)に発表した総説は、自動化に関わる慢心と自動化バイアスの実験研究を整理したものです。要旨の範囲で要点をまとめると、支援の仕組みが不完全なとき、人は仕組みが知らせなかった問題を見落とすことも、仕組みの誤った指示に従ってしまうこともあり、この傾向は熟練者にも見られ、訓練だけで防げるものではないとされています。この章の設計に引き寄せると、人の注意や訓練に頼るだけでなく、画面と手順の側で引きずられにくくする必要がある、ということになります。
この要旨は外観検査を対象にしたものではなく、外観検査の再検査でどの程度の影響が出るかは、本コラムでは確かめていません。それでも、保留の再検査に当てはめると、2つの誤りの形が考えられます。AIが「やや良品寄り」と示した保留の製品を、人が深く見ずに良品とすることと、AIの枠が示した場所に気を取られ、枠の外の欠陥を見落とすことです。後者が起きうる状況(枠が場所を絞り込めない、欠陥の無い場所を指す)は、前の節の例2で示しました。ただし、例2で人の見落としそのものを測ったわけではありません。
この影響の大きさを、架空の率で計算しました。保留の幅2.0(下側0.6、上側2.6)で、AIの仮の判定(保留の中で、しきい値1つのときの値1.6より低ければ「良品寄り」、高ければ「不良寄り」)を人に見せた場合を考えます。良品寄りと示された保留の不良は人が20%の率で見逃し、不良寄りと示された保留の不良は5%の率で見逃す、と置きました。仮の判定を見せない場合は、どちらも5%です。
def miss_with_hint(lo, hi, miss_lean_good=0.20, miss_lean_bad=0.05):
    b_low = ((bad >= lo) & (bad < C)).sum()         # 保留のうち AI が良品寄りと示した不良
    b_high = ((bad >= C) & (bad < hi)).sum()        # 保留のうち AI が不良寄りと示した不良
    miss = (bad < lo).sum() + b_low * miss_lean_good + b_high * miss_lean_bad
    return miss / N_BAD, int(b_low), int(b_high)


lo2, hi2 = C - 1.0, C + 1.0
m_hint, b_low, b_high = miss_with_hint(lo2, hi2)
print("幅2.0 仮の判定を見せない(人の見逃し5%)", round(evaluate(lo2, hi2)["見逃し率"] * 100, 2), "%")
print("幅2.0 仮の判定を見せる(良品寄りの保留で20%)", round(m_hint * 100, 2), "%")
print("保留に入った不良 良品寄り", b_low, "個 不良寄り", b_high, "個")
# 出力:
# 幅2.0 仮の判定を見せない(人の見逃し5%) 3.04 %
# 幅2.0 仮の判定を見せる(良品寄りの保留で20%) 4.39 %
# 保留に入った不良 良品寄り 45 個 不良寄り 99 個
実行した結果、保留に入った不良は144個で、そのうち45個が良品寄り、99個が不良寄りと示される位置にありました。仮の判定を見せない場合の見逃し率は3.04%、見せて良品寄りの保留での人の見逃しが20%に上がった場合は4.39%で、見逃しの期待値は約15個から約22個に増えます。ここで置いた20%は説明のための架空の値で、実際にどれだけ上がるかは検査員・欠陥・画面の作りによって変わり、本コラムでは測っていません。測るなら、前の節と同じく、不良と分かっている製品を混ぜ、仮の判定を見せる場合と見せない場合で人の見逃し率を比べる方法が考えられます。
自動化バイアスへの手当てとして、検査の現場で取りうるものを挙げます。
- 保留の再検査では、AIの仮の判定(良品寄り・不良寄り)を最初の画面に出さず、人がまず自分で判定してからAIの根拠を見られるようにする
- 枠を示す場合も、枠の外を確かめたことを記録する手順にする
- 不良と分かっている製品を一定の割合で保留の流れに混ぜ、人の見逃し率を定期的に測る
- 人の判定とAIの判定が食い違ったものを記録し、どちらが正しかったかを後で確かめる
最初の手当ては、人が自分の目で判定する価値を保つためのものですが、根拠を見せないと人が画面の全体を探す手間は増えます。どちらを優先するかは、欠陥の種類と人の作業の量で変わるので、比べて決める必要があります。なお、AIの規制の文脈でも、この傾向は扱われています。欧州連合のAIに関する規則(規則(EU)2024/1689)の第14条は、高リスクのAIシステムについて人による監督を求めており、その第4項(b)で、監督を担う人が、AIシステムの出力に自動的に頼る、あるいは頼りすぎる傾向(自動化バイアス)を自覚し続けられるようにすることを挙げています。外観検査AIがこの規則の高リスクのAIシステムに当たるかどうかは用途によるので、本コラムでは判断しません。規制と社内ルールの詳細は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
検査員の作業の設計、見る順番・休憩・画面
保留の再検査は、目視検査と同じく人の作業です。人の見逃し率が保留の設計を左右することは前の節で見たとおりなので、再検査の作業の設計は、モデルの設計と同じ重さで扱う必要があると考えています。目視検査の疲労やばらつきの一般的な性質は第1章と第2章で扱っているので、ここでは保留の再検査に固有の点を、次の表にまとめました。表の中身は本コラムが考える設計の観点で、効果の大きさを確かめたものではありません。
| 設計の観点 | 決めること | 決めていないと起きること |
|---|---|---|
| 1人が1日に見る数 | 人が確かめられる数の上限(保留の幅の入力になる) | 保留が上限を超えた日に、確かめ方が浅くなる |
| 保留が上限を超えたときの扱い | 超えた分を不良側に倒す、ラインの速度を落とす、応援を呼ぶ、などの手順 | 超えた分が確かめられないまま良品として流れる |
| 見る順番 | スコアの高い順か、届いた順か | スコアの順に並べると、後半の製品を「たぶん良品」と見る先入観が生まれうる |
| 休憩と交代 | 連続して見る時間の上限、交代の間隔 | 時間帯によって人の見逃し率が変わり、保留の設計の前提が崩れる |
| 画面 | 元の画像・ヒートマップ・枠・限度見本の並べ方、拡大の方法、表示する順番 | 根拠の図に引きずられる、枠の外を見ない |
| 現物の確認 | 画像で決めきれないときに現物を見る手順と、その置き場 | 画像だけで無理に判定し、判定のばらつきが増える |
| 判定の選択肢 | 良品・不良に加え「判断できない(上位者へ)」を選べるようにするか | 迷った製品が担当者ごとに別の側へ倒れる |
表の2行目の「保留が上限を超えたときの扱い」は、とくに先に決めておく必要があります。材料のロットが変わった日や照明の具合が悪い日には、スコアの分布が動き、保留が急に増えることがあります。そのとき、確かめきれない分を黙って良品として流す運用になっていると、保留の仕組みが一番必要な日に流出を招きます。超えた分は不良側に倒して後で確かめる、ラインの速度を落とす、のような手順を、品質保証と製造で事前に決めておくのが安全だと考えています。保留の数が急に増えたこと自体は、撮像やモデルの変化を知らせる信号でもあり、その監視は第12章で扱います。ラインの停止や排出の仕組みとのつなぎ方は第11章で扱います。
推論の失敗や時間切れでAIの判定が返らない製品も、良品として流さず、保留として排出して人が確かめます。ただし、計算機の不具合などで判定が返らない状態が続くと、流れてくる製品がすべて保留になり、人が確かめられる数の上限をすぐに超えます。上限を超えたら、保留の再検査の流れで受け続けようとせず、第11章で扱う停止時の手順に移ります。その手順は、超えた分を不良側に倒す、ラインの速度を落とす、ラインを止めて品質保証が事前に承認した代わりの検査(目視検査など)に切り替える、の順に考えます。どの段階で次へ移るかを、品質保証と製造であらかじめ決めておく必要があります。
再検査の結果を学習に戻す流れ
保留の再検査は、スコアが保留の範囲に入った製品、つまりAIのスコアだけでは決めきれなかった製品に、人が正解のラベルを付ける作業でもあります。この結果を記録して学習に戻せば、AIが苦手な境目の製品のデータが増え、次のモデルで保留を減らせる可能性があります。ただし、戻し方を誤ると、人の誤りや偏りをそのまま学習させることになります。再検査の結果を学習に戻すときに残しておきたい項目を、次の表にまとめました。
| 残す項目 | 中身 | 学習・評価での使い道 |
|---|---|---|
| 製品の識別子と画像 | どの製品のどの画像か(撮像の条件の版も) | 学習データの元。撮像の条件の違うデータを混ぜないための区別 |
| AIのスコアとモデルの版 | 判定したモデルの版と、そのスコア | どの版でどのスコアの範囲が保留になったかの集計。新旧のモデルの比較 |
| 人の判定と判定者 | 良品・不良・判断できない、判定した人、判定の時刻 | ラベル。人ごとの判定のばらつきの確認 |
| 欠陥の種類と位置 | 不良と判定した場合の欠陥の種類と、画像上の位置 | 教師あり学習のラベル(第5章)、ヒートマップの当たり外れの確認 |
| 確定の方法 | 画像だけで判定したか、現物を見たか、上位者が確定したか | ラベルの確からしさの区別。現物で確定したものを評価用に優先する |
| AIの判定との一致 | 人の判定とAIの仮の判定が一致したか | 自動化バイアスの兆候の確認、食い違いの振り返り |
学習に戻すときの注意が2つあります。1つは、保留の製品だけで学習データを作ると、境目の製品ばかりが増え、データの偏りが生まれることです。評価用のデータは、保留の製品だけでなく、AIが良品・不良と判定した製品からも一定の割合で抜き取って人が確かめたものを含める必要があります(抜き取った製品の画像を残す方針は第11章の画像の保存の方針と合わせて決めます)。スコアが保留の範囲より低く良品と判定された中の見逃しは、そうして抜き取らない限り見つからないからです。もう1つは、人の判定にも誤りがあることです。画像だけで判定したラベルと、現物で確定したラベルを区別して残し、評価には確からしさの高いほうを使います。ただし、ラベルの確かさだけでなく、評価用のデータが本番の製品・欠陥の種類・撮像の条件を偏りなく含んでいることも必要で、現物で確かめた製品だけを集めると、どれを現物で確かめたかの選び方による偏りが残りえます。また、同じ製品の画像が学習用と評価用の両方に入らないよう、製品の単位で、どちらに使うかを先に決めて固定しておきます。ラベルの付け方とその品質は第2章で、少ないデータでの学習の工夫は第7章で、再学習の判断と手順は第12章で扱います。モデルの運用と再学習の一般論は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。
この流れは、時間とともに保留を減らす仕組みになりえます。再検査の結果で学習し直したモデルが境目の製品をよりよく判定できるようになれば、同じ見逃し率の上限で保留の幅を狭められます。ただし、狭めてよいかは、学習し直したモデルを固定した評価用のデータで旧モデルと比べ、人の見逃し率も含めて確かめてから決めることで、保留が減ったこと自体を改善の証拠として扱わないことが大切です。
経営の判断、人を外さず人が見る範囲を絞る
この章の内容を、経営の判断に置き換えます。外観検査AIを入れるときに経営が決めることは、人を検査から外すかどうかではなく、人がどの範囲を見るかを、誰がどの数字で決めるかです。判定の保留の設計には、人が確かめられる数の上限、人の再検査の見逃し率、見逃し1件と過検出1件の重さの比が入力として要り、どれもAIの開発の側では決められません。本コラムの架空の計算では、人の再検査の見逃し率が2%なら保留を広げるほど見逃し率が下がり、20%なら広げすぎるとしきい値1つの判定より悪くなりました。人の作業の質が、AIの設計の結果を逆転させうるということです。
判断を誤ったときの損失は、本コラムの6つの損失の型で整理できます。
| 判断の誤り | 起こる損失の型 | 決めておくこと |
|---|---|---|
| 保留を作らず、AIの判定だけで出荷と排出を決める | 流出、過検出 | どの範囲を人が見るかを、見逃し率の上限から品質保証が決める |
| 保留を人の処理能力より広くとる | 流出(確かめきれない分が流れる)、タクトの超過 | 人が確かめられる数の上限と、超えたときの手順 |
| 人の再検査の見逃し率を測らない | 流出、判定のばらつき | 不良と分かっている製品を混ぜて定期的に測る |
| AIの根拠の図を見せ、それだけで判定させる | 流出(枠の外・照明の変化) | 元の画像を必ず並べ、枠の外も確かめる手順 |
| AIを信用せず、人が全数を見直す運用に戻る | 形骸化 | AIが判定した範囲の当たり外れを抜き取りで確かめ、結果を検査員と共有する |
| 工程ごとに別々の保留の画面と記録を作る | 二重投資 | 記録の項目と画面の基本の形を工場の間でそろえる |
これを踏まえて、経営として決めておくのがよいと考えることを挙げます。
- 保留の再検査を、検査員の正式な作業として人員の計画に入れ、1日に確かめられる数の上限を製造・品質保証と合意する
- 見逃し率の上限と、見逃し・過検出・人の確認の重さの比を、品質保証が決めて記録に残す(AIの開発の側に任せない)
- 人の再検査の見逃し率を測る仕組み(不良と分かっている製品を混ぜる)と、抜き取りでAIの判定を確かめる仕組みに、予算と時間を付ける
- 保留が上限を超えた日の手順を、事前に決めて検査員に周知する
- 再検査の結果を記録し、学習と評価に戻す流れを、検査の仕組みの一部として最初から作る
予算の面では、AIのモデルと装置だけでなく、保留を確かめる人の時間、人の見逃し率を測る手間、再検査の結果を記録して学習に戻す仕組みを、運用の費用として最初から見込んでおく必要があります。この部分を見込まずに「AIを入れたので検査員を減らせる」と計画すると、保留を確かめる人手が足りなくなり、確かめきれない分が流れるか、AIを信用しない運用に戻るか、のどちらかになりやすいと考えています。出荷の可否の最終的な責任を品質保証の体制が持つことは、AIを入れても変わりません。人を外すのではなく、人が見る範囲をAIで絞り、人が見るべきものに人の時間を使う、という位置づけで計画することが、外観検査AIを長く使われるものにすると考えています。体制と検査員の役割は第13章で扱います。
この章では、人とAIの協調を3つの型に分け、AIの判定の保留を人に回す型を中心に、2つのしきい値で良品・保留・不良に分ける設計を扱いました。本コラムの架空のスコア(良品9,500個・不良500個)では、保留の幅を広げると人が見る数が増える代わりに見逃し率と過検出率が下がりましたが、人の再検査の見逃し率が高いと、保留を広げすぎることで、かえって見逃し率が上がりました。判定の根拠を示すヒートマップと枠は、本コラムの簡易版では照明のむらのような撮像の変化にも反応し、欠陥の位置を絞り込めませんでした。そうした場合に備えて、元の画像と並べて枠の外も確かめる手順が要ります。保留の幅の入力になる人の処理能力と見逃し率、見逃しと過検出の重さの比は、品質保証と現場が決めるものです。次の第11章では、ここで決めた判定と保留を、PLC・排出の仕組み・記録の仕組みにつないで、検査ラインに組み込む方法を扱います。
この章を深めたい方への参考書籍
『ヒューマンエラー 完訳版』(ジェームズ・リーズン 著、十亀洋 訳、海文堂出版):人がなぜ誤るかを扱った書籍の訳書で、原題は Human Error です(2014年刊)。保留の再検査で人の見逃し率が設計を左右すること、人の判定にも誤りがある前提で仕組みを作ることを考えるときに、人の誤りの種類と起こり方を整理する手がかりになります。
『品質とヒューマンファクター 安全と安心の考え方』(日本ヒューマンファクター研究所 編、日科技連出版社):日本ヒューマンファクター研究所が編んだ、品質とヒューマンファクター(人の要因)を書名のとおり安全と安心の考え方から扱う本です(2012年刊)。この章で扱った、人の判定を品質保証の仕組みの中にどう位置づけるかを考えるときに、品質の側から人の要因を捉える手がかりになります。
第11章 検査ラインへの組み込み、PLC・MES・トレーサビリティとのつなぎ方
第10章では、AIが決めきれない範囲を判定の保留として人に回し、人が見る数と残る見逃しのつり合いを取る方法を扱いました。どれほど判定の設計が整っていても、その判定がラインの排出の機構に届かず、どの製品をどう判定したかの記録が残らなければ、不良品はそのまま後工程に流れ、後から原因を追うこともできません。この章では、外観検査の装置を生産ラインに組み込み、ラインを制御する機器や工場の情報システムとつなぐための考え方を扱います。
この章では、コードを載せずに、次の内容を表と概念図で説明します。
- 検査装置とラインの関係(撮像のきっかけ・判定の出力・排出の機構・ラインの停止)
- ラインを制御する PLC との信号のやりとりと、通信の方式(規格団体の公式の資料で確かめた範囲)
- 製造の実行を管理するシステム(MES)や品質管理のシステムに残す記録の項目
- どの製品を、どのモデルのどの版で判定したかを後から追える状態(トレーサビリティ)の作り方
- 画像の保存の方針と容量の見積もり
- ネットワークと情報セキュリティの考え方
- 装置が止まったときに代わりの検査(目視検査など)へ切り替える手順
- 経営判断
この章の主張は1つです。ラインで流出を防ぎ、結果を後から追える検査の工程にするには、外観検査AIの判定を、排出や隔離の動作と記録の仕組みにつなぐ必要があると考えています。判定の精度を上げる工夫は第5章から第10章で扱いましたが、判定の結果が「不良品をラインから外す」という動作と、「何をどう判定したかを残す」という記録に変わらなければ、ラインの検査の工程としては働きません。排出を人が担う場合でも、判定がその人の動作と記録につながっていることが条件になります。この章では、精度の話をいったん離れ、判定を動作と記録につなぐ部分を順に見ていきます。
検査装置とラインの関係、撮像のきっかけから排出と停止まで
生産ラインに組み込まれた外観検査の装置は、単独で動くのではなく、ラインの流れに合わせて動きます。本コラムでは、ラインの中での検査の1回分の流れを、撮像のきっかけ・撮像・判定・判定の出力・排出・記録の6つに分けて考えます。撮像のきっかけは、製品が決められた位置に来たことを知らせる信号です。多くの場合、搬送路に付けた光電センサーや、ラインを制御する機器からの指令がきっかけになります。撮像は、そのきっかけを受けてカメラが画像を撮る工程で、照明の点灯の時間と露光の時間をきっかけに合わせる必要があります(撮像の設計は第3章で扱いました)。判定は、撮った画像から良品・保留・不良を決める工程で、第5章から第10章で扱った方法がここに入ります。
判定の出力は、決めた結果をラインの側に伝える工程です。ここで伝える相手は、ラインの動きを制御している機器で、多くの工場では後で説明する PLC がその役を担います。排出は、不良と判定された製品をラインから外す工程で、空気を吹き付けて外す、押し出す、搬送路を切り替えて別の箱に落とす、といった機構が使われます。保留と判定された製品を人の再検査の場所に送るのも、排出の機構の役目です。記録は、判定の結果と、その判定に使った画像・スコア・モデルの版などを、後から追える形で残す工程です。
この6つのうち、精度の検討に比べて見落とされやすいのが、判定の出力と排出と記録の3つです。PoC(本格導入の前に行う小さな試し)は、撮りためた画像を後からまとめて判定して精度を測る形で行われることがあります。保存した画像での評価でも計算の時間は測れますが、精度の評価だけでは、実際のラインでの応答の期限や、判定の結果がどの製品のものか、排出の機構が間に合うかまでは確かめられません。ところが、ラインに組み込むと、判定は決められた時間の中で返らなければならず、しかもその判定が、いま排出の機構の前を通っている製品のものでなければなりません。速度の設計は第9章で扱いました。この章では、判定がどの製品のものかを取り違えずに排出と記録につなぐ部分を扱います。
もう1つ、検査装置がラインを止める権限を持つかどうかを決めておく必要があります。不良が続けて出たとき、あるいは装置そのものが異常になったときに、検査装置がラインを止める信号を出すのか、警報だけを出して人が止めるのかは、ラインの設計の段階で決めておく事柄です。止める権限を持たせると流出は防ぎやすくなりますが、過検出が多い状態ではラインが頻繁に止まり、タクトの超過と同じ損失を生みます。どちらにするかは、品質保証の部門と製造の部門が一緒に決め、変えるときの承認の手順も合わせて決めておくのがよいと考えています。
検査装置とラインの間でやりとりする主な信号を、次の表にまとめました。信号の名前は本コラムが一般論として付けたもので、特定の装置や規格の名前ではありません。
| 信号 | 向き | 中身 | 決めていないと起きること |
|---|---|---|---|
| 撮像のきっかけ | ライン側から検査装置へ | 製品が撮像の位置に来たこと。製品の識別子を一緒に渡すこともある | 撮り損ね・二重の撮像が起き、画像と製品の対応がずれる |
| 準備完了 | 検査装置からライン側へ | 検査装置が次の製品を受け付けられる状態であること | 装置が処理中のまま次の製品が来て、判定が抜ける |
| 判定の結果 | 検査装置からライン側へ | 良品・保留・不良の区分(必要なら欠陥の種類) | 排出の機構が動かず、不良品が後工程に流れる |
| 判定の完了 | 検査装置からライン側へ | 判定の結果が確定したこと。結果を読み取ってよい時点を知らせる | ライン側が前の製品の結果を読み、別の製品を排出する |
| 装置の異常 | 検査装置からライン側へ | カメラの応答なし・照明の異常・判定の時間切れなど | 判定できない製品が良品として流れる |
| 品種の切り替え | ライン側から検査装置へ | 次に流れる品種の番号(判定の条件とモデルの切り替えに使う) | 別の品種のモデルで判定し、過検出や見逃しが急に増える |
| 停止の要求 | 検査装置からライン側へ(権限を持たせる場合) | 不良の連続・装置の異常によるラインの停止の要求 | 止めるべきときに止まらない、あるいは止める必要のないときに止まる |
表の中でとくに大事なのは、装置の異常の信号です。検査装置が判定を返せなかった製品を、ライン側が「不良の信号が来なかったので良品」として扱う設計になっていると、装置が止まっている間に流れた製品はすべて良品として出ていきます。判定の結果が返ってこなかった製品は良品として扱わず、保留として排出して人が確かめる設計にしておくことが、流出を防ぐ最初の手当てだと考えています。この考え方は、後の「装置の故障・停止時の扱い」の節で改めて扱います。
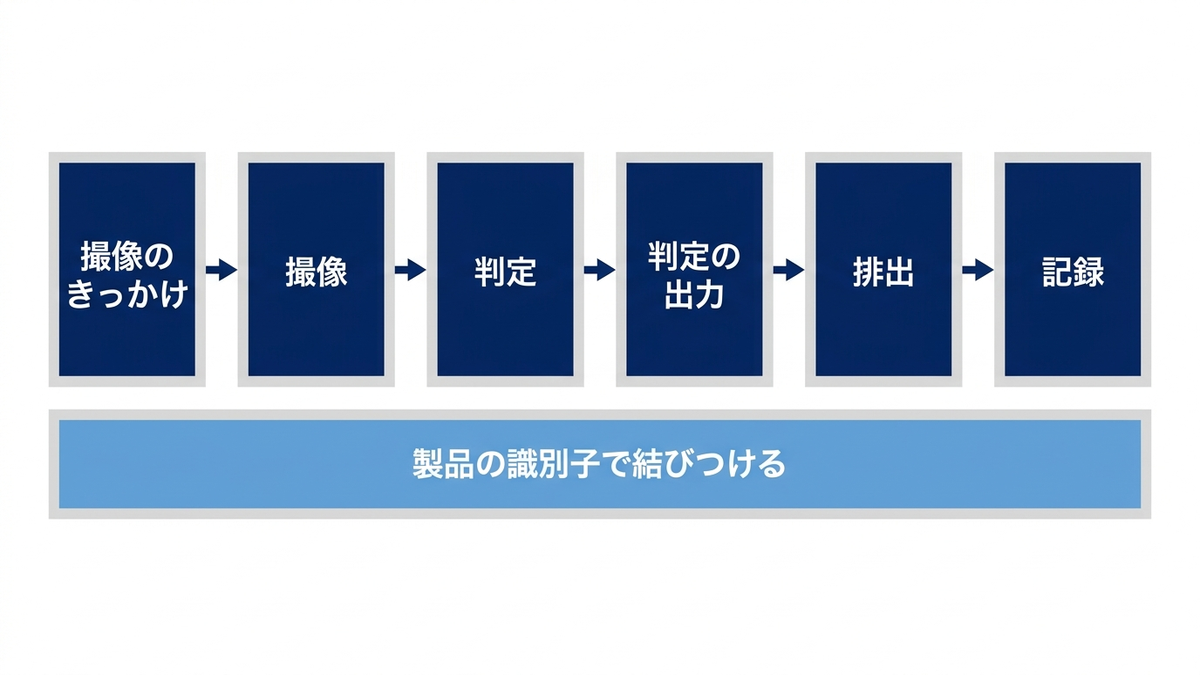
PLC との信号のやりとり、通信の方式と判定・製品の取り違えの防止
PLC(プログラマブルロジックコントローラ)は、工場の機械やラインを制御するための専用の計算機です。センサーやスイッチからの入力を受け、あらかじめ書いたプログラムに従って、モーター・空気の弁・表示灯などへの出力を決めます。PLC のプログラムの書き方は国際規格 IEC 61131 の第3部(プログラミング言語)で定められており、PLC のプログラムの共通化に取り組む団体 PLCopen は、この規格、とくに第3部を活動の基礎に置くと説明しています。外観検査の装置をラインに組み込むとき、検査装置の相手になるのは多くの場合この PLC です。検査装置は判定の結果を PLC に渡し、PLC がその結果を見て排出の機構を動かします。
検査装置と PLC の間の信号のやりとりには、大きく分けて2つの形があります。1つは、検査装置の入出力の端子と PLC の入出力の端子を電線で直接つなぎ、「電圧がかかっているかどうか」の2つの状態で信号を伝える形です。本コラムでは、これを接点の入出力と呼びます。撮像のきっかけ・判定の完了・良品か不良かといった少数の信号を、1本の線に1つの意味を割り当てて伝えます。仕組みが単純で、PLC の側の設定も分かりやすい一方で、伝えられる情報の量は線の本数で決まります。欠陥の種類やスコアの値、製品の識別子のような情報を送るには向きません。
もう1つは、産業用のネットワークを使い、数値や文字列を含む情報をまとめて送る形です。工場の機器どうしをつなぐネットワークには、規格団体ごとに複数の方式があります。次の表は、本コラムで公式の資料を開いて確かめた範囲で、代表的なものを整理したものです。製品の比較や優劣を示すものではなく、どの方式を使うかは、ラインですでに使っている PLC と機器に合わせて決めるのが一般的です。
| 方式 | 推進している団体 | 団体の公式の資料に書かれていること(本コラムの要約) |
|---|---|---|
| EtherNet/IP | ODVA | 一般の Ethernet と TCP/IP の技術に、上位の層として CIP(Common Industrial Protocol)を組み合わせた産業用のネットワークの方式 |
| PROFINET | PI(PROFIBUS・PROFINET を推進する団体) | Ethernet を基盤にした産業用の通信の規格。TCP/IP の通信を並行して行える機能や、安全に関わるデータ(PROFIsafe)を標準の入出力のデータと同じネットワークで送る仕組みが紹介されている |
| CC-Link IE | CC-Link 協会 | CC-Link の系列の第2世代で、2008年に仕様が公開された、1Gbps の Ethernet を基盤にした方式。第3世代として2018年に CC-Link IE TSN が公開されている |
| OPC UA | OPC Foundation | 機器や基本ソフトに依存しない、サービス指向の通信の枠組み。情報の意味を表す情報モデルの仕組みと、暗号化・署名・証明書による認証の仕組みを持つ |
表に書いたのは、各団体の公式の資料で確かめた範囲です。通信の周期や、PLC の側からどのような形で値を読み書きするかといった詳細は、本コラムでは確かめていません。一般論としては、検査装置がラインで使っている方式に対応していれば、接点の入出力では送りにくい判定の結果・欠陥の種類・スコアの値・製品の識別子を、ネットワークを通じて PLC とやりとりできるようにする、という使い方が考えられます。具体的な方式と設定は、使っている PLC と検査装置の資料で確かめる必要があります。
4つ目の OPC UA は、性格が少し違います。OPC Foundation の OPC UA の紹介ページの説明では、OPC UA は PLC からクラウドのサーバーまでさまざまな機器と基本ソフトの上で動くとされ、情報モデルの仕組みについては「データを情報に変える」という趣旨で説明されています。
ここからは本コラムの解釈です。上の説明を、数値そのものだけでなく、その数値が何を意味するか(どの装置の、どの検査の、どの結果か)を決まった形で表して伝える仕組みを持つ、という意味に受け取っています。
同じ紹介ページによれば、通信の形としては、要求を受けて結果を返す形(クライアントとサーバー)と、送り手が受け手を知らずに情報を流す形(出版と購読)の両方が用意されています。
外観検査に関わるところでは、OPC Foundation と、機械工業の団体である VDMA のマシンビジョンの部会が共同で、画像による検査の装置を表すための OPC UA の情報モデル(コンパニオン仕様と呼ばれる、業種や機器ごとの取り決め)に取り組んでおり、公式のページではその仕様を公開済みとしています。OPC Foundation の公式の参照ページで確かめた範囲では、その第1部の番号は OPC 40100-1 で、版は1.0、公開日は2019年8月1日です。題名には、制御・設定の管理・レシピ(品種ごとの検査の条件)の管理・結果の管理の4つが並んでいます。適用範囲の節には、画像による検査の装置を生産の制御の仕組みと情報システムに分かりやすく統合することを目指す、と書かれています。同じ節で、やりとりの相手として例に挙げられているのは次のものです。
- 別の画像による検査の装置
- 工程ごとの PLC と、ラインの制御の機器
- MES、SCADA(監視制御のシステム)、ERP(基幹業務のシステム)
- データ分析の仕組み
この仕様の中身の詳細は本コラムでは確かめていません。ここでは、検査装置の制御・品種ごとの条件・判定の結果を共通の形で表すための取り決めがある、ということまでを紹介します。
どの方式を選ぶにしても、決めておきたいことは共通しています。どの信号をどの順で送るか(たとえば、判定の結果を書き込んでから判定の完了を知らせる)、判定が決められた時間内に返らなかったときにライン側がどう扱うか、品種の切り替えをどちらが主導するか、の3つです。これらは通信の方式の違いよりも、ラインの設計として決める事柄です。PLC のプログラムを担当する生産技術の担当者と、検査装置を担当する担当者が別々に作業すると、この取り決めが文書に残らず、それぞれが自分の側の都合で決めてしまうことが多いように思います。信号の一覧と順番、時間切れのときの扱いを1枚の表にまとめ、双方が署名して保管しておくことを勧めます。
信号の取り決めと並んで、ラインに組み込むときに起きやすい誤りの1つが、判定の結果と製品の取り違えです。撮像の位置と排出の位置は、多くの場合、搬送路の上で離れています。撮像してから判定が返るまでの間にも製品は進み、その間に次の製品が撮像の位置に来ます。判定の結果が「いま撮った製品」ではなく「少し前に撮った製品」のものであることを、ラインの側が正しく追えていないと、不良品ではなく隣の良品を排出してしまいます。この場合、不良品の流出と良品の誤った排出が同時に起きます。AIの判定そのものは正しくても起きる誤りで、誤って排出された良品には再検査などの処置が要り、過検出と同じ型の損失(廃棄・手直し・再検査の増加)につながります。
取り違えを防ぐ方法は、大きく2つあります。1つは位置の追跡で、PLC の側で、撮像の位置から排出の位置までに何個の製品が並んでいるかを数え、判定の結果を順番に送っていく方法です。搬送の速度が一定で、製品の間隔がそろっているラインでは、この方法で十分なことが多いと考えられます。ただし、途中で製品が詰まる・抜き取られる・手で戻されると、数がずれ、以後の判定がすべて1個ずれて伝わります。もう1つは識別子による対応づけで、製品やそれを載せる治具に識別子(製品の番号・二次元コード・RFID(無線で読み取る札)など)を付け、撮像のきっかけと判定の結果と排出の指令のすべてに同じ識別子を付けて送る方法です。識別子があれば、途中で数がずれても、どの判定がどの製品のものかを確かめられます。
識別子を使う場合も、位置の追跡を使う場合も、取り違えが起きていないかを確かめる仕組みを入れておくのがよいと考えています。たとえば、排出の機構の直後にもう1つセンサーを置いて、排出の指令を出した製品が本当に外れたかを確かめる方法があります。また、定期的に、わざと欠陥を付けた試験用の製品(第2章で扱った限度見本と同じ考え方で作るもの)を流し、検査装置が不良と判定し、排出の機構がその製品を外し、記録にその製品の識別子と判定が残っていることを、端から端まで確かめる方法もあります。後者は、判定の精度だけでなく、判定の出力・排出・記録がつながっていることまで確かめられる点で、日々の始業の点検に入れておく価値があると考えています。
MES と品質管理のシステム、判定を工場の記録につなぐ項目
PLC が受け取った判定の結果は、排出の機構を動かすために使われ、多くの場合そこで役目を終えます。PLC は機械を制御するための機器で、何万個分の判定の履歴や画像を長く保管し、後から検索するための仕組みではないからです。判定の結果を工場の記録として残すには、その上にある情報システムにつなぐ必要があります。その役を担うのが、MES(製造の実行を管理するシステム)や、品質の記録を管理するシステムです。MES は、製造の指示・進み具合・使った材料・設備の状態・品質の記録などを、工場の現場の単位で管理する仕組みとして使われています。
工場の中の情報システムの役割の分け方については、国際規格の考え方があります。計測と自動化の団体 ISA が定めた ISA-95 と呼ばれる規格群で、ISA の ISA-95 の紹介ページでは IEC 62264 とも呼ばれると説明されています。同じページでは、ISA-95 を、物流や業務のシステムと製造の制御のシステムをつなぐための国際的な規格群と説明し、工場の仕組みを5つの階層に分けて示しています。レベル0が物理的な生産の工程、レベル1がセンサーや弁など工程を感じ取り動かす機器、レベル2が PLC などの制御のシステム、レベル3が MES や SCADA を含む製造の運用の管理、レベル4が ERP を含む事業の計画と物流です。ISA のページによれば、この規格は主にレベル3とレベル4の間のつなぎを扱っています。
この規格群の第1部は、2026年11月9日に ISO の目録の IEC 62264-1 のページで確かめた時点で、IEC 62264-1(2013年)の第2版が発行済みとされ、2003年の第1版を置き換えています。目録の要旨では、第1部は製造の運用の管理の領域(レベル3)とその活動、レベル3の中とレベル3・レベル4の間でやりとりする内容を記述するものとされています。規格は改訂されることがあるので、使う時点で目録の状態を確かめ直す必要があります。本コラムでは規格の本文を確かめていないので、要旨と ISA の説明に書かれた範囲を超えては紹介しません。
この階層に外観検査を当てはめると、カメラと照明はレベル1に近い機器、PLC はレベル2、判定の履歴を受け取る MES や品質の記録のシステムはレベル3にあたります。外観検査AIの判定を行う計算機は、ラインの横に置かれて PLC とやりとりするのでレベル2の近くに置かれることが多い一方で、その記録はレベル3の仕組みに渡す必要があります。つまり、検査装置は2つの階層の両方とつながる装置だと考えるのが分かりやすいと考えています。PLC には短い時間で少ない情報(良品か不良か)を返し、MES には少し遅れてもよいので多くの情報(識別子・スコア・欠陥の位置・モデルの版・画像の保存先)を渡す、という分け方です。
この2つの経路を分けておくと、MES やネットワークに一時的な不具合があっても、排出の機構は動き続けられます。逆に、判定の結果を MES に書き込んでから PLC に返す、という1本の経路にしてしまうと、MES の応答が遅れただけで、判定が排出に必要な期限に間に合わなくなり、ラインが止まります。記録を MES に渡す経路では、検査装置の側に記録を一時的にためておく場所を持たせ、MES に届いたことを確かめてから消す、という作りにしておくと(届いたことの確かめ方は後の「装置の故障・停止時の扱い」の節で扱います)、通信が切れている間の記録が失われにくくなります。
次に、記録の項目を考えます。MES や品質の記録のシステムに何を残すかは、後で何を確かめたいかで決まります。外観検査AIの記録で確かめたいことは、主に4つあると考えています。1つ目は、出荷した製品の1つに問題が見つかったときに、その製品をいつ、どの装置で、どう判定したかを示すこと。2つ目は、ある時期に判定の傾向が変わったときに、その原因が製品の側の変化か、撮像の条件の変化か、モデルの変更かを切り分けること(変化の監視は第12章で扱います)。3つ目は、判定の保留や再検査の結果を集めて、次の学習に使うこと(第10章)。4つ目は、検査の工程が決められた手順どおりに動いていたことを、品質保証の部門や顧客に示すことです。
この4つの目的から、最低限残したい項目を次の表のように考えています。項目の名前は本コラムの言葉で書いたもので、特定のシステムや規格の項目の名前ではありません。どの項目を残すかは品質保証の部門が決め、情報システムの部門がそれを記録する仕組みを作る、という分担を想定しています(役割の分担の表は第13章)。
| 項目 | 何を残すか | 主な使い道 |
|---|---|---|
| 製品の識別子 | 製品に固有の番号、あるいは治具の番号と装填の回次の組み合わせなど、製品を1つに特定できるもの。あわせてロットの番号 | 出荷した製品から検査の記録をたどる鍵 |
| 検査の記録の番号 | 検査の1回ごとに付ける一意の番号(同じ製品を再検査した場合も別の番号にする) | 再検査の区別、MES に届いた記録の欠落・重複の照合 |
| 検査の日時 | 撮像した時刻(記録を書き込んだ時刻とは分ける) | 時間帯による判定の傾向の確認、他の記録との突き合わせ |
| 装置とラインの識別子 | どの工場・ライン・検査装置・カメラで撮ったか | 装置ごとの判定の傾向の比較、装置の故障の影響の範囲の特定 |
| 品種の番号 | 判定に使った品種の区分 | 品種の取り違えの確認 |
| 判定の結果 | 良品・保留・不良の区分と、欠陥の種類(分かる場合) | 不良の数の集計、排出の指令との突き合わせ |
| 排出と最終の処置 | 排出の指令を出したか、排出の後のセンサーで外れたことを確かめたか、その時刻、再検査の後の最終の処置(出荷・手直し・廃棄など) | 判定どおりに製品が扱われたことの確認。出荷の記録を別のシステムで管理する場合は、製品の識別子でその記録と結びつける |
| スコアとしきい値 | 異常の度合いのスコアの値と、そのときのしきい値(保留の幅を含む) | しきい値の見直し(第8章・第10章)、スコアの分布の監視(第12章) |
| 欠陥の位置 | 欠陥と判定した場所の座標や枠、ヒートマップの保存先 | 人の再検査での確認、判定の根拠の説明(第10章) |
| モデルの版 | 判定に使ったモデルの版の番号と、前処理の設定の版 | 判定の傾向が変わったときの切り分け、トレーサビリティ |
| 撮像の条件の版 | 露光の時間・照明の強さ・カメラの設定をまとめた条件の版(第3章) | 撮像の条件の変更と判定の傾向の対応づけ |
| 画像の保存先 | 画像を保存した場合の保存先と、保存しなかった場合はその理由の区分 | 後からの見直し、再学習の素材 |
| 人の再検査の結果 | 保留・不良とされた製品を人が見た結果と、見た人・時刻 | AIと人の判定の不一致の集計、教師データの追加 |
| 装置の状態 | 判定の時間切れ・カメラの異常など、正常に判定できなかったことの印 | 判定できなかった製品の洗い出し、目視への切り替えの記録 |
この表の中で、外観検査AIでとくに重視したい項目は、スコアとしきい値・モデルの版・撮像の条件の版の3つです。ルールベースの画像処理でも、傷の面積などの数値としきい値を扱い、条件の版を管理する必要がありますが、学習したモデルは、同じ画像に対しても版が変われば違うスコアを出すことがあります。しかも、その違いは人がプログラムを読んで確かめられる形では現れません。どの判定がどのモデルの版で出たのかが記録に無いと、判定の傾向が変わったときに、それがモデルの更新によるものなのか、製品や撮像の変化によるものなのかを切り分けられません。
スコアの値を残すことにも意味があります。判定の結果(良品・保留・不良)だけを残していると、しきい値を変えたときに、過去の製品がどう判定されていたかを計算し直せません。スコアが残っていれば、新しいしきい値を過去の記録に当てはめて、保留や不良の数がどれだけ変わるかを事前に見積もれます。ただし、モデルの版が変わるとスコアの尺度そのものが変わることがあるので、版をまたいでスコアを比べるときは注意が要ります。
時刻の扱いにも注意が要ります。撮像した時刻・判定が返った時刻・記録を書き込んだ時刻は、通信の遅れや一時的な記録のためこみによってずれます。検査装置・PLC・MES の時計が互いに合っていないと、記録を突き合わせたときに前後関係が逆転することもあります。工場の中の機器の時計を同じ基準に合わせる仕組みを入れ、記録には撮像した時刻を主に使う、と決めておくのが安全だと考えています。
トレーサビリティ、どの製品をどのモデルのどの版で判定したかを追える状態
本コラムでは、トレーサビリティを、ある製品について、いつ・どの装置で・どの撮像の条件で撮り・どのモデルのどの版で判定し・その結果どう扱ったか(出荷したか、排出したか、人が見直したか)を、後から追える状態と定義して使います。製造業でトレーサビリティというと、材料のロットから製品・出荷先までをたどる仕組みを指すことが多く、外観検査の記録はその一部に組み込まれる形になります。この章で扱うのは、そのうちの検査の部分です。
トレーサビリティには、2つの向きがあります。1つは製品からたどる向きで、顧客から問題の連絡があった製品の識別子から、その製品の検査の記録・画像・判定に使ったモデルの版を引き出すものです。もう1つは条件からたどる向きで、あるモデルの版や撮像の条件に問題が見つかったときに、その版や条件で判定したすべての製品を洗い出すものです。後者は、たとえば、ある日のモデルの更新で特定の欠陥の見逃しが増えていたことが後から分かった場合に、その更新以降に良品と判定して出荷した製品の範囲を特定するために使います。範囲が特定できれば、確かめるべき製品を絞れます。範囲が特定できなければ、問題が起きた可能性のある期間の製品をすべて対象にするしかなく、影響が大きくなります。
条件からたどる向きのトレーサビリティを成り立たせるには、モデルの版と撮像の条件の版が、それぞれ一意の番号で管理されている必要があります。モデルのファイルを上書きして更新する運用では、版の番号が変わらないまま中身が変わり、記録の上では同じ版で判定したように見えてしまいます。モデルを更新するときは、新しい版の番号を付け、旧い版を消さずに保管し、どの日時からどの装置で新しい版を使い始めたかを記録する、という手順を決めておく必要があります。モデルと撮像の条件の変更管理の手順は、第12章で扱います。
トレーサビリティは、出荷の可否の判断を AIに任せるためのものではありません。むしろ、判定に AIを使っていても、出荷の可否の最終的な責任は品質保証の体制にあることを、記録で裏付けるための仕組みだと考えています。法令・顧客との取り決め・業界の規格で、検査の記録の項目や保管の期間が定められている製品では、その定めが優先します。本コラムではそれらの定めの中身を確かめていないので、対象の製品の定めは、所管の官庁・規格の団体・顧客との取り決めの文書で確かめてください。
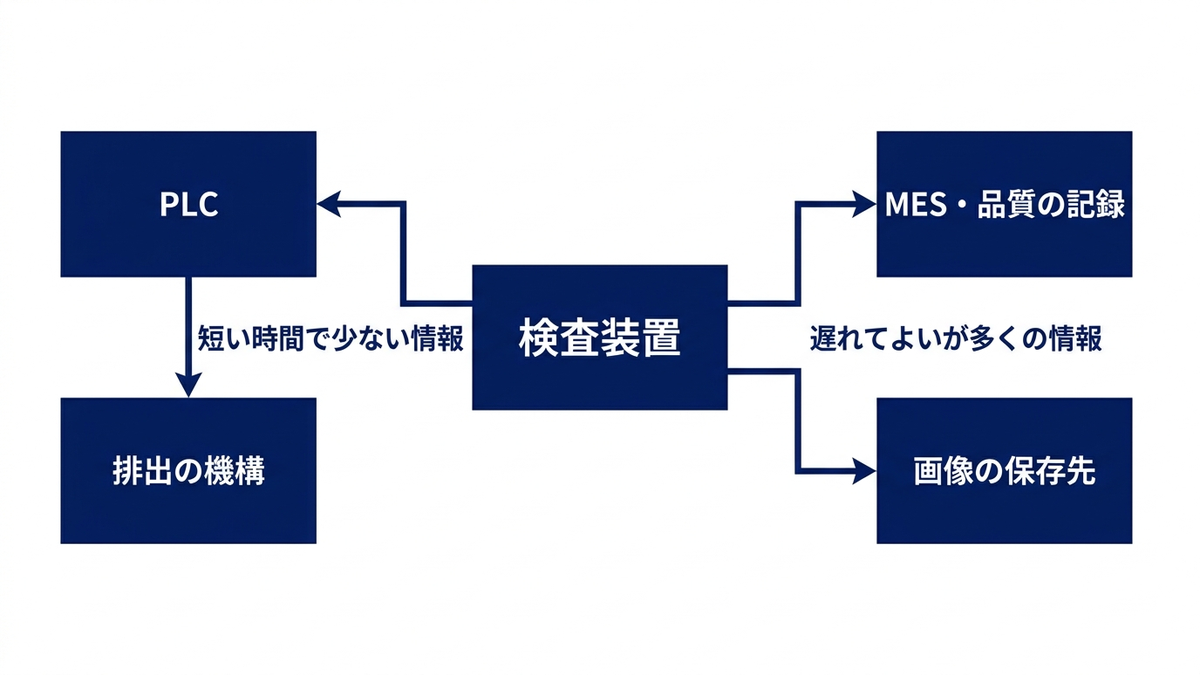
画像の保存の方針、全数・不良だけ・抽出と容量の考え方
記録の項目のうち、量が最も大きくなるのが画像です。判定の結果やスコアは1件あたりの量が小さいので、何年分でも保管しやすいのに対して、画像は1枚ごとの量が大きく、全数を残すと保存の場所がすぐに足りなくなります。そこで、どの画像を、どの大きさで、どれだけの期間残すかを、方針として決めておく必要があります。本コラムでは、保存の方針を全数の保存・不良と保留だけの保存・抽出による保存の3つに分けて考えます。
容量の見当をつけるために、架空の条件で計算してみます。横2,448画素・縦2,048画素、1画素を8ビット(1バイト)で表す白黒の画像を、圧縮せずに保存すると、1枚は5,013,504バイト、約5.01メガバイトになります。この画像を2秒に1個のタクトで、1日16時間撮ると、1日の検査の数は28,800個です。全数を圧縮せずに残すと1日あたり約144.4ギガバイト、1年に250日動かすと約36.1テラバイトになります。同じ条件で、AIが不良と判定する率を0.5%と置くと不良は1日144個で約0.72ギガバイト、保留と判定する率を3%と置くと保留は1日864個で約4.33ギガバイト、残りの良品と判定した27,792個から1%を抽出すると1日278個で約1.39ギガバイトです。また、画像を縦横それぞれ約5分の1(横512画素・縦428画素)に縮めて全数を残すと、1日あたり約6.31ギガバイトになります。これらは本コラムが架空の条件で計算した値で、実際の容量は画像の大きさ・色の数・圧縮の方式・カメラの台数で大きく変わります。
この架空の条件では、全数を元の大きさで残すかどうかで、必要な容量が1桁から2桁変わりました。実際の差は、上に挙げた条件によって変わります。どの方針を選ぶかは、何のために画像を残すのかで決まります。3つの方針の違いを、次の表にまとめました。
| 保存の方針 | 残す画像 | できること | できないこと・注意点 |
|---|---|---|---|
| 全数の保存 | 判定したすべての製品の画像 | 保管の期間内に限り、製品と画像の対応が保たれていれば、流出の連絡があった製品の画像を後から確かめられる。見逃しの画像を学習に使える | 容量が最も大きい。保管の期間を決めないと増え続ける |
| 不良と保留だけの保存 | 不良・保留と判定した製品の画像 | 容量が小さい。過検出の見直しと、保留の再検査の結果を学習に戻すことができる | 良品と判定した製品の画像が残らないので、見逃しを後から画像で確かめられない |
| 抽出による保存 | 不良と保留の全数に加えて、良品から一定の割合や時間の間隔で抜き出した画像 | 良品の見た目の変化(照明の劣化など)を後から追える。良品学習の学習データを更新できる | 抽出から漏れた製品の見逃しは画像で確かめられない。抽出の規則を記録に残す必要がある |
外観検査AIの運用では、不良と保留だけの保存では足りないことが多いと考えています。第6章で扱った良品学習のモデルは良品の画像から学ぶので、良品の画像が残らないと、良品の見た目が変わったときにモデルを更新する材料がありません。また、第12章で扱う変化の監視では、良品の画像の明るさやスコアの分布の変化を見ます。そのため、少なくとも抽出による保存を基本にし、全数を残すかどうかは、流出の影響の大きさと容量の兼ね合いで決めるのが現実的だと考えています。
ここでいう良品からの抽出は、第10章で扱った評価用の抜き取り(AIが良品・不良と判定した製品からも一定の割合で抜き取り、人が確かめる仕組み)と同じ仕組みとして扱うことを勧めます。抜き取った製品は、画像を残すと同時に人が確かめ、その結果を記録の項目の「人の再検査の結果」に残します。こうすると、抜き取った画像は、良品の見た目の変化を追う材料にも、AIの判定の当たり外れを確かめる評価用のデータにもなります。抜き取りの割合は、評価に要る数と、変化の監視・学習に要る数の多いほうに合わせて決めます。ただし、再学習に使った製品の画像は、更新した後のモデルを評価するデータからは外します。学習に使った画像で評価すると、性能を実際より高く見積もるからです(評価用のデータの切り方は第8章、再学習の手順は第12章)。
容量を抑える方法としては、元の大きさの画像は一定の期間だけ残し、その後は縮小した画像か欠陥の周りを切り出した画像だけを残す、という段階的な保管もあります。ただし、縮小や切り出しをすると、後から別のモデルで判定し直したり、小さな欠陥を確かめたりすることはできなくなります。圧縮の方式についても、画素の値が変わる圧縮を使うと、その画像で学習したモデルが本番の画像とわずかに違う画像で学ぶことになります。学習に使う予定の画像は、画素の値を変えない圧縮で残すか、本番の判定と同じ前処理を通したものを残すのが安全です。
保管の期間は、品質保証の部門が決める事柄です。製品の保証の期間、顧客との取り決め、業界の規格や法令で求められる記録の保管の期間がある場合は、それが下限になります。画像にはライン作業者の手や顔が写り込むこともあるので、写り込みがある場合の扱いも、社内の情報の管理の規則に沿って決めておく必要があります。データの品質と保管の管理を組織として行う考え方は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。
ネットワークと情報セキュリティ、制御の系と情報の系を分ける
検査装置を PLC と MES の両方につなぐと、制御のネットワーク(PLC や機器がつながるネットワーク)と情報のネットワーク(MES や事務の計算機がつながるネットワーク)の間に、検査装置という接点が生まれます。この接点の作り方を誤ると、情報のネットワークで起きた問題(不正なプログラムの侵入や、大量の通信による混雑)が、制御のネットワークに及び、ラインが止まるおそれがあります。検査装置は、画像の転送のために大きな通信の量を使うことがあるので、制御の信号と同じ経路に画像を流すと、PLC との信号のやりとりが遅れることもあります。
工場の制御の仕組みの情報セキュリティについては、国際規格の ISA/IEC 62443 の規格群があります。ISA の ISA/IEC 62443 の紹介ページでは、この規格群を、産業の自動化と制御のシステム(IACS と略されます)を守るための要求事項と手順を定めたものと説明しています。また、情報の技術と運用の技術の間の隔たりをつなぐ全体的な取り組みであり、資産の持ち主・自動化の製品の供給者・システムを組み上げる事業者・サービスの提供者のそれぞれに要求を定める「責任の分担」を基本の考え方に置いている、とされています。ページには、用語と考え方、資産の持ち主のための要求、設計のためのリスクの評価、システムの要求、製品の開発の要求など、部ごとの文書が並んでいます。本コラムでは各部の本文を確かめていないので、規格の具体的な要求には踏み込みません。自社の仕組みを規格に照らして確かめる場合は、規格の本文と、制御システムの情報セキュリティに詳しい専門家の助言に当たる必要があります。
この「責任の分担」の考え方は、外観検査AIの導入に当てはめやすいと考えています。検査装置は、装置のメーカー・ソフトウェアを作る事業者・ラインに組み込む事業者・工場の情報システムの部門が、それぞれ一部を担うことが多い仕組みです。誰がどこまでの情報セキュリティに責任を持つのかが決まっていないと、たとえば、装置の基本ソフトの更新を誰も行わないまま何年も使われる、という状態になりやすくなります。一般論として、導入の前に次のことを決めておくのがよいと考えています。
- 制御のネットワークと情報のネットワークを分け、検査装置からどちらへ何を流すかを決める
- 画像の転送を、PLC との信号のやりとりと別の経路にするか、通信の量の上限を決める
- 検査装置から外部(インターネット)へ直接つなぐかどうかと、つなぐ場合の経路を決める
- 装置の基本ソフトとソフトウェアの更新を、誰が、どの頻度で、どの手順で行うかを決める
- 保守のための遠隔の接続を認めるか、認める場合は誰が、いつ、どの経路で接続したかを記録する
- モデルの版の入れ替えを、誰が、どの承認を経て行うかを決める(第12章)
最後の項目は、情報セキュリティと品質保証の両方に関わります。判定基準(何を不良とするかの決まり)を変えていなくても、モデルを入れ替えると判定の結果が変わることがあります。そのため、モデルの入れ替えには変更管理と性能の確かめ直しが要り、権限のない人が入れ替えられる状態は、情報セキュリティの問題であると同時に、品質保証の問題でもあります。AIの社内の規則づくりの考え方は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
装置の故障・停止時の扱い、代わりの検査へ切り替える手順
検査装置は、いつか必ず止まります。カメラの故障、照明の切れ、計算機の不具合、ネットワークの断絶、モデルのファイルの破損など、原因はさまざまです。装置が止まったときにラインをどう扱うかを決めていないと、2つの悪い結果のどちらかになります。1つは、装置が止まっていることに気付かないまま、判定されていない製品が流れ続けることで、これは流出につながります。もう1つは、装置が止まるたびにラインも止め、復旧まで生産が止まることで、これはタクトの超過と同じ損失になります。
前者を防ぐには、先に述べたとおり、判定の結果が返らなかった製品を良品として扱わない設計にしておくことが基本です。そのうえで、装置が止まったことをライン側が確実に知る仕組み(装置の異常の信号、あるいは一定の時間ごとに装置が正常であることを知らせる信号が途絶えたことの検出)を入れておきます。後者を避けるには、装置が止まっている間の代わりの検査の手順を決めておく必要があります。代わりの検査は、対象の欠陥を見つけられる力と、ラインの速度に見合う処理の量を持ち、その製品に求められる検査の要求を満たすものでなければなりません。本コラムでは、こうした条件を満たし、品質保証の部門が事前に承認した代わりの検査に切り替える、と考えます。目視検査はその有力な候補ですが、微小な欠陥のように目視では見つけにくいものもあるので、いつでも目視で代わりになるとは限りません。代わりの検査が成り立たない場合は、ラインを止めるか、その間の製品を隔離して後で検査します。
代わりの検査として目視検査を使う場合に大事なのは、AIを導入した後も目視で判定できる人と手順を残しておくことです。AIの導入とともに目視の検査員をすべて別の仕事に移し、限度見本も手順書も更新しないままにすると、装置が止まったときに誰も判定できません。第13章で扱うように、検査員を判定基準の持ち主として残しておくことは、この切り替えの手順を成り立たせるための条件でもあります。また、切り替えている間に目視で判定した製品は、記録の上で AIが判定した製品と区別できるようにしておく必要があります。トレーサビリティの観点からは、「この期間のこの製品は目視で判定した」という記録が残っていることが大切です。
止まり方ごとの扱いの例を、次の表にまとめました。どの扱いを選ぶかは、ラインと製品によって変わるので、表は検討の出発点として使うものです。
| 止まり方 | 気付く方法 | 止まっている間の扱い(例) | 復旧後に確かめること |
|---|---|---|---|
| カメラ・照明の故障 | 画像が来ない・画像の明るさが範囲外になる | ラインを止めるか、検査の位置の手前で製品をためて目視検査に回す | 撮像の条件が元に戻ったかを試験用の製品で確かめる |
| 判定の計算機の不具合 | 判定が決められた時間内に返らない | 判定が返らなかった製品(推論の失敗・時間切れ)を保留として排出し、人が確かめる。保留の量が人の確かめられる上限を超えたら、表の下の段落の停止時の手順へ移る | 判定が返らなかった製品がすべて保留か不良に回ったかを記録で確かめる |
| MES との通信の断絶 | 記録の書き込みが失敗する | 排出は続け、記録は検査装置の側にためておく。ためておける時間を事前に決めておき、それを超えそう、あるいは検査装置の側への書き込みも失敗する場合は、記録できない製品を保留として隔離するか、ラインを止める | 検査の記録の番号ごとに、送った側と MES の側で番号と中身を突き合わせ、欠落と重複が無いかを確かめる。件数の照合は補助に使う |
| モデルの読み込みの失敗 | 装置の起動時の自己点検で失敗する | 品質保証が承認した代わりの検査(目視検査など)で生産するか、ラインを止める | 正しい版のモデルが読み込まれたかを、版の番号と試験用の製品で確かめる |
| 排出の機構の故障 | 排出の後のセンサーで、外したはずの製品が残っている | ラインを止める。止められない場合は、後工程の手前で人が抜き取る | 故障の間に流れた不良品の範囲を記録から洗い出す |
| 判定の傾向の急な変化 | 不良や保留の率が急に増える・減る(第12章の監視) | 過検出が疑われる場合は、判定は続けつつ抽出した製品を人が確かめる。重要な欠陥の見逃しが疑われる場合は、変化が始まった後の製品を保留として隔離し、ラインを止めるかを品質保証が判断する | 原因(製品・撮像・モデル)を切り分け、影響の範囲を記録から特定する |
表の2行目には、第10章とのつなぎ目があります。判定の計算機が止まると、止まっている間に流れる製品はすべて判定が返らない製品になり、保留として人に回す数は、止まっている時間が長いほど増え、第10章で決めた人が確かめられる数の上限を超えるおそれがあります。本コラムでは、第10章と同じく、次の順序で扱います。
- 判定が返らない製品(推論の失敗・時間切れ)は、良品として流さず、保留として排出して人が確かめる
- その保留の量が、人が確かめられる上限を超えたら、停止時の手順へ移る。停止時の手順は、超えた分を不良側に倒して後で確かめる、ラインの速度を落とす、ラインを止めて品質保証が承認した代わりの検査へ切り替える、の3つで、どれをどの順で選ぶかを品質保証と製造で事前に決めておく
どの段階でも、判定が返らない製品を良品として流さないことは変えません。
表の最後の行は、装置が止まってはいないのに、判定がおかしくなっている状態です。この状態は、装置の異常の信号では捉えられません。不良や保留の率が急に増えれば過検出が、急に減れば見逃しが疑われますが、とくに減った場合は、「不良が減った」と好意的に受け取られると、気付くのが遅れるおそれがあります。判定の率が急に変わったときに誰が確かめるかを、装置の故障と同じように手順に入れておくことを勧めます。変化の監視の方法は第12章で扱います。
切り替えの手順は、作っただけでは使えません。目視検査に切り替える訓練を、年に数回程度、実際に装置を止めて行っておくと、手順書の抜けや、限度見本の置き場所が分からないといった問題が事前に見つかります。この訓練は、検査員が判定の技能を保つ機会にもなります。
経営判断、判定を排出と記録につなげて初めて検査になる
この章の内容を経営の判断に置き換える前に、ここまでの内容を、ラインに組み込む前に決めておくことの一覧として整理します。どの項目も、決めないまま導入すると、後から決め直すためにラインの改造や記録の作り直しが要るものです。誰が決めるかの列は一般的な分担の例で、体制と役割の詳細は第13章で扱います。
| 決めること | 主に決める部門 | 決めていないと起きる損失の型 |
|---|---|---|
| 信号の一覧と順番、時間切れのときの扱い | 生産技術(PLC の担当と検査装置の担当) | 流出(判定の抜け)、取り違えによる良品の誤った排出(過検出と同じ型の損失) |
| 判定が返らない製品の扱い(良品として扱わない) | 品質保証・生産技術 | 流出 |
| 検査装置にラインを止める権限を持たせるか | 品質保証・製造 | 流出、あるいはタクトの超過 |
| 製品の識別子と位置の追跡の方法 | 生産技術・情報システム | 流出と、良品の誤った排出(取り違え。過検出と同じ型の損失) |
| 記録の項目と、MES・品質の記録のシステムへの渡し方 | 記録の項目は品質保証が決め、渡し方と仕組みは情報システムが作る | 形骸化(記録が使えず判定が信用されない) |
| モデルの版と撮像の条件の版の番号の付け方 | 品質保証・データ担当 | 判定のばらつき(版による違いが追えない) |
| 画像の保存の方針と保管の期間 | 方針と保管の期間は品質保証が決め、保存の場所は情報システムが用意する | 流出(後から確かめられない) |
| ネットワークの分け方と更新の責任 | 情報システム・生産技術 | タクトの超過(ラインの停止) |
| 代わりの検査(目視検査など)への切り替えの手順と訓練 | 品質保証・製造・検査員 | 流出、あるいはタクトの超過 |
| 工程や工場をまたいだ記録の形式の統一 | 経営・情報システム | 二重投資 |
この一覧を、経営の判断に置き換えます。外観検査AIの導入の予算を、カメラ・照明・計算機・モデルの開発だけに配分すると、PLC のプログラムの変更・排出の機構・MES とのつなぎ込み・画像の保存の場所・切り替えの手順と訓練の準備が足りなくなるおそれがあります。この章で見てきたとおり、後者が欠けると、判定の精度がどれほど高くても検査の仕組みとしては働きません。PoC で精度が確かめられた後に、ラインへの組み込みの段階で予算と期間が足りなくなり、導入が止まる、という進み方は避けたいところです。
判断を誤ったときの損失は、本コラムで使う6つの損失の型(流出・過検出・判定のばらつき・タクトの超過・形骸化・二重投資。第1章で整理しました)で整理できます。判定が返らない製品を良品として扱う設計や、判定と製品の取り違えは、流出に直結します。取り違えは、同時に良品の誤った排出も生み、過検出と同じ型の損失(再検査・手直し・廃棄の増加)になります。MES への書き込みを PLC への応答の経路に入れてしまうと、通信の遅れがタクトの超過になります。記録にモデルの版やスコアが残っていないと、判定の傾向が変わったときに原因を説明できず、現場は AIの判定を信用しなくなり、人が全数を見直す形骸化に向かいます。工程や工場ごとに検査装置のメーカーやつなぎ方を別々に決めると、記録の形式がばらばらになり、後から統一するための二重投資が生まれます。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 外観検査AIの導入の予算と計画に、PLC・排出の機構・MES とのつなぎ込み・画像の保存・切り替えの手順と訓練を、最初から含める
- PoC の合格の条件に、判定の精度だけでなく、ラインの速度での判定の出力・排出・記録が端から端までつながることを含める(PoC の設計は第13章)
- 判定が返らない製品を良品として扱わないことを、品質保証の方針として明文化する
- 記録の項目(とくにモデルの版・撮像の条件の版・スコア)と画像の保存の方針を、工場をまたいで共通にする
- AIを導入した後も、目視で判定できる検査員と限度見本と手順書を残し、切り替えの訓練に時間を割り当てる
この中で、最後の項目は、人手を減らすという導入の目的と矛盾するように見えるかもしれません。しかし、目視の判定の力を残さない導入は、装置が止まったときに検査そのものが止まる仕組みを作ることになります。法令・顧客との取り決め・規格で定められた検査は維持したうえで、人の役割を、全数を見ることから、保留の製品の確認・評価用の抜き取りの確認・異常時の対応・代わりの検査へ移していく、と考えるのが、導入の目的と矛盾しない形だと考えています。
この章のまとめ
この章では、外観検査AIの判定を生産ラインに組み込むために、撮像のきっかけ・撮像・判定・判定の出力・排出・記録の6つの流れを決め、PLC との信号の一覧と順番、判定と製品を取り違えないための位置の追跡と識別子、MES や品質の記録のシステムへの記録の項目、画像の保存の方針、ネットワークの分け方、装置が止まったときの代わりの検査(目視検査など)への切り替えを扱いました。とくに、判定が返らなかった製品を良品として扱わないこと、記録にモデルの版・撮像の条件の版・スコアを残してトレーサビリティを確保することが、流出と形骸化を防ぐ要になります。次の第12章では、ラインに組み込んだ後に起きる照明の劣化・品種の追加・新しい欠陥といった変化をどう測り、モデルの再学習と変更管理にどうつなぐかを扱います。
この章を深めたい方への参考書籍
『実践的MES導入ガイド 製造実行システムが工場を強くする』(エンジニアリング協会「次世代スマート工場」研究会 著、佐藤知一・阿部洋平 編、近代科学社Digital):MES とは何か、何ができるか、導入の進め方、工場の設備の機器と MES の関係、データを使った製造と MES までを章ごとに扱った本です(2026年刊)。この章で扱った、検査の判定の記録を MES にどう渡し、工場の記録の中にどう位置づけるかを考える手がかりになります。
『制御システムセキュリティ入門 Society 5.0/Industry 4.0時代に向けて社会インフラをいかに守るか』(池上祐太・河田芳秀 著、満永拓邦 監修、NTT出版):制御システムを構成する機器、制御システムのネットワークと通信方式、制御のための通信の取り決め(プロトコル)、サイバー攻撃、リスクの管理、対応の体制と具体的な対策を章を分けて解説した本です(2020年刊)。この章で一般論として扱った、検査装置を制御の系と情報の系の両方につなぐときの情報セキュリティを考える手がかりになります。
第12章 運用と保守、照明の劣化・品種の追加・モデルの再学習への対応
第11章では、検査装置の判定を排出の機構と記録につなぎ、どの製品をどのモデルのどの版で判定したかを後から追える状態にする方法を扱いました。ラインに組み込んで稼働を始めると、次に問題になるのは、稼働を始めた日の条件が、その後も同じとは限らないことです。照明は使ううちに明るさが変わることがあり、レンズには汚れが付き、材料のロットは入れ替わり、新しい品種が加わります。この章では、稼働を始めたあとに起きる変化を、どう測り、どう判断し、どう直すかを扱います。
本コラムでは、学習に使った画像と本番で撮れる画像の性質が、時間とともにずれていくことをドリフトと呼びます。ずれに合わせてモデルを学習し直すことを再学習、モデル・しきい値・撮像の条件を変えるときに、変える前に影響を確かめ、承認し、記録を残す手続きを変更管理と呼びます。
この章の主張は1つです。本番の画像は、稼働を始めた日から少しずつ変わっていくものとして扱い、変化を測る仕組みを最初から検査の仕組みに入れておく必要があると考えています。稼働を始めた日の見逃し率と過検出率は、その日の撮像の条件と、その日までに集めた画像での値にすぎません。この主張を確かめるために、この章では次の内容を扱います。
- 本番で起きる変化の種類と、それぞれが画像と判定にどう現れるか
- 変化を測る4つの指標(入力画像の明るさ・スコアの分布・判定の保留の率・人の判定との不一致率)
- 架空の合成画像で照明が少しずつ暗くなる状況を作り、異常の度合いのスコアの分布の変化を、日ごとの平均・分位点・2標本コルモゴロフ・スミルノフ検定で捉えるコード
- 照明を戻す・しきい値を変える・学び直す、という直し方の比べ方
- 再学習の判断と手順(評価用データの固定・旧モデルとの比較・承認)と、品種の追加への対応
- モデルと撮像の条件の変更管理と、AIの品質の管理に関する公的な指針
- 経営の判断
この章では、判定基準に照らすと不良であるもの(架空データでは、欠陥を描き足した画像)を「正解が不良のもの」、そうでないものを「正解が良品のもの」と呼び、AIが不良と判定したものとは区別して書きます。欠陥の有無は事実、不良は判定の結果という、本コラムの用語の定義に合わせるためです。
本番で起きる変化と、画像と判定への現れ方
外観検査の仕組みは、撮像・前処理・モデル・しきい値・判定の出力がつながって動いています。このうちどこか1か所が変わるだけで、判定の結果は変わります。ここで大事なのは、変化の多くが「モデルの外」で起きることです。モデルのパラメータは誰も触っていないのに、照明が暗くなった、カメラの取り付けが少しずれた、材料の色合いが変わった、といった理由で、モデルに入る画像が学習のときと違うものになります。
変化には、ゆっくり進むものと、ある日を境に起きるものがあります。照明の明るさの変化やレンズの汚れは、日々わずかずつ進むことが多く、1日単位で見比べても気づきにくい変化です。カメラの位置ずれや照明の交換、材料のロットの切り替えは、ある日を境に起きる変化です。品種の追加や新しい欠陥の出現は、変化というより、モデルが学んでいない対象が来るという問題です。それぞれの変化を、画像への現れ方と判定への影響、気づくための指標と合わせて表にしました。表の内容は一般的な整理で、どの変化がどの程度の頻度で起きるかは工程と設備によって違います。
| 変化 | 起き方 | 画像への現れ方 | 判定への影響(良品学習のモデルの場合) | 気づくための指標 |
|---|---|---|---|---|
| 照明の明るさの変化 | ゆっくり進む | 画像全体が暗く、または明るくなる。欠陥と背景の明るさの差も変わる | 良品のスコアが上がり、過検出が増える。差が小さくなった欠陥は見逃しやすくなる | 入力画像の明るさ、スコアの分布 |
| レンズ・カバーの汚れ | ゆっくり進む | 画像がぼやける、同じ位置に影や点が写る | 細かい欠陥が写らなくなる。汚れの位置で過検出が出る | 画像の鮮明さ、不良と判定した位置のかたより |
| カメラ・治具の位置ずれ | ある日を境に起きる | 製品の写る位置や角度が変わる | 位置に敏感なモデルでは良品のスコアが上がる | 製品の位置(輪郭の位置)、スコアの分布 |
| 材料のロット・季節 | 切り替えの日に起きる、季節で揺れる | 色合い・表面の模様・反射が変わる | 良品のばらつきが学習の範囲を外れると過検出が増える | ロットごとのスコアの分布、保留の率 |
| 新しい欠陥 | 工程の変化に伴って現れる | 学習のときに無かった見た目の欠陥が写る | 良品学習では、良品の見た目から十分に外れる欠陥なら異常として出る可能性があるが、スコアがしきい値に届かない欠陥は見逃しうる。教師あり学習では既知の種類に振り分けられるおそれがある | 人の判定との不一致率、保留の率 |
| 品種の追加 | 計画して起きる | 形・模様・色の違う製品が写る | 学習していない品種では、良品がそのまま不良と判定されることがある | 品種ごとのスコアの分布(品種の切り替えを記録しておく) |
表の右端の列にあるように、変化に気づくための指標の多くは、正解(その製品が判定基準に照らして良品か不良か)が分からなくても計算できるものです。見逃し率と過検出率そのものは、正解が分からないと計算できません。本番では不良はまれで、良品と判定したものの中に見逃しがあったかどうかは、後工程や顧客からの返品で初めて分かることが多いので、見逃し率の変化を待ってから動くのでは遅すぎます。正解が無くても計算できる指標で、先に変化に気づく仕組みが要ります。
変化を測る4つの指標
運用中に毎日(あるいはロットごと・シフトごとに)集計する指標として、次の4つを持っておくのがよいと考えています。前の2つは画像とモデルの出力だけから計算でき、後の2つは第10章で扱った判定の保留と人の再検査の仕組みがあれば計算できます。
| 指標 | 何が分かるか | 正解のラベル | 集計の例 | 注意点 |
|---|---|---|---|---|
| 入力画像の明るさ | 照明・露光・汚れなど、撮像の側の変化 | 要らない | 画像全体、または製品の決まった領域の平均の明るさを日ごとに | 製品の色の違いでも動く。品種ごとに分けて見る |
| スコアの分布 | モデルに入る画像が、学習のときと比べてどれだけ違うか | 要らない | 異常の度合いのスコアの平均・中央値・95%点と、基準の分布との検定 | 分布が動いた理由までは分からない |
| 判定の保留の率 | 保留の範囲(2つのしきい値の間)に入る画像が増えたか | 要らない | 保留に回した割合を日ごとに | しきい値を変えると基準の値も変わる |
| 人の判定との不一致率 | モデルの判定が、検査員の判定とずれてきたか | 人の判定を正解の代わりに使う | AIが良品か不良かを判定した製品のうち、抜き取りなどで人も見たものについて、判定が違った割合。保留に回した製品は、人の再検査の結果として別に集計する | 人の判定にもばらつきがある(第2章)。人が見る製品の選び方でかたよる |
この4つは、産業技術総合研究所の機械学習品質マネジメントガイドライン(第4版)が運用時のモニタリングとして挙げる分類と対応させて考えることができます。同ガイドラインは、運用時のモニタリングの作業として、精度のモニタリング・KPI のモニタリング・モデルの出力のモニタリング・入力データのモニタリングの4つを挙げ、精度のモニタリングは正解の集め方(一定期間後に自動で正解が手に入るか、人手でラベルを付けるか、ラベル付けが難しいか)によって方法が分かれると整理しています。入力画像の明るさは入力データのモニタリング、スコアの分布と保留の率はモデルの出力のモニタリング、人の判定との不一致率は人手でラベルを付ける場合の精度のモニタリングに当たると考えています。この対応づけは本コラムの整理で、ガイドラインが外観検査について個別に書いているものではありません。
同ガイドラインは、データの分布が時間とともに変わる現象(コンセプトドリフト)を検知する手法を、正解のラベルを使うかどうかで分けて表にしており、ラベルを使わない検知の例として、データの分布に統計的な仮説検定を当てる方法や、モデルの確信度のスコアを使う方法を挙げています。次の節からのコードは、このうち「モデルの出力するスコアの分布に検定を当てる」方法を、架空の合成画像で試したものです。
架空の合成画像で、照明が少しずつ暗くなる状況を作る
ここからは、架空の合成画像を使って、照明が少しずつ暗くなったときに何が起きるかを確かめます。画像は32画素四方で、金属の表面のような縦の筋の模様に、撮像のたびのノイズを足したものです。不良には「傷」(横に走る明るい線)と「異物」(暗い点)の2種類を描き足しました。どちらも numpy で作った架空の合成画像で、実際の製品の画像よりずっと単純です。照明の強さは、稼働を始めた日(0日目)を1.0として、0日目から59日目までの60日間で0.95まで、つまり5%暗くなる設定にしました。これは説明のために置いた架空の設定で、実際の照明の明るさがどれくらいの期間でどれだけ変わるかは、照明の種類・使い方・使用時間によって違い、本コラムでは確かめていません。乱数のシードは固定しているので、同じ環境で実行すれば同じ結果になります。本コラムの実行環境は Python 3.14.3・numpy 2.4.3・scipy 1.16.3 です。
import numpy as np
from scipy import ndimage, stats

rng = np.random.default_rng(20261109)
N = 32
yy, xx = np.mgrid[0:N, 0:N]
BASE = 0.5 + 0.06 * np.sin(2 * np.pi * xx / 5.0)          # 金属の表面のような縦の筋
BASE = BASE + 0.03 * ndimage.gaussian_filter(rng.normal(0, 1, (N, N)), 1.0)


def make_image(light, defect=None):
    """light は照明の強さ(稼働開始の日を1.0とする)"""
    img = BASE + rng.normal(0, 0.02, (N, N))              # 撮像のたびのノイズ
    if defect == "傷":
        r, c0 = rng.integers(6, 26), rng.integers(4, 14)
        length = rng.integers(6, 14)
        img[r, c0:c0 + length] += rng.uniform(0.08, 0.16)
    if defect == "異物":
        r, c = rng.integers(5, 27, 2)
        img -= rng.uniform(0.12, 0.25) * np.exp(-((yy - r) ** 2 + (xx - c) ** 2) / 2.0)
    img = img * light * rng.normal(1.0, 0.01)             # 照明の強さと、日々のわずかな揺れ
    return np.clip(img, 0, 1)


def make_set(n_good, n_bad, light):
    imgs, labels = [], []
    for _ in range(n_good):
        imgs.append(make_image(light)); labels.append(0)
    for k in range(n_bad):
        imgs.append(make_image(light, ["傷", "異物"][k % 2])); labels.append(1)
    return np.array(imgs), np.array(labels)
判定に使うモデルは、良品の画像だけから学ぶ、ごく単純なものにしました。良品300枚から画素ごとの明るさの平均と標準偏差を覚え、新しい画像の各画素が平均から標準偏差の何倍外れているかを求め、3画素四方でならしたうえで、外れの大きい上位5画素の平均を「異常の度合いのスコア」とします。第6章で扱ったオートエンコーダや PatchCore 型の方法よりずっと単純ですが、「良品の見た目を覚えて、そこからの外れを数える」という良品学習の骨格は同じです。このモデルは画素の明るさそのものを覚えているので、照明の変化に敏感です。実際のモデルが照明の変化にどれだけ敏感かは、モデルの作り方と前処理(明るさをそろえる処理を入れるかどうか)によって違います。
しきい値は、学習に使っていない良品500枚のスコアから決めました。良品500枚のスコアから推定した99.5%点(上位約0.5%に当たる境界)を超えたら「不良」、98%点から99.5%点の間なら「判定の保留」としています。推定した値なので、運用中の良品がこの値を超える割合がちょうど0.5%になるとは限らず、別の評価用データで確かめる必要があります。この良品500枚のスコアは、運用中にスコアの分布を比べるときの基準の分布としても使います。あわせて、正解が良品のもの1,000枚・正解が不良のもの100枚の評価用データを作り、稼働を始めた時点の見逃し率と過検出率を測りました。この評価用データは、後で直し方を比べるときにも同じものを使うので、「固定する評価用データ」と呼びます。
class GoodModel:
    """良品の画像の画素ごとの平均と標準偏差を覚え、外れの大きさをスコアにする"""

    def fit(self, goods):
        self.mu = goods.mean(axis=0)
        self.sd = goods.std(axis=0) + 1e-6
        return self

    def score(self, imgs):
        z = np.abs((imgs - self.mu) / self.sd)
        z = ndimage.uniform_filter(z, size=(1, 3, 3))      # 3画素四方でならす
        flat = z.reshape(len(imgs), -1)
        return np.sort(flat, axis=1)[:, -5:].mean(axis=1)  # 外れの大きい上位5画素の平均


train_good, _ = make_set(300, 0, 1.0)                     # 稼働開始前に集めた良品300枚
model_v1 = GoodModel().fit(train_good)
val_good, _ = make_set(500, 0, 1.0)                       # しきい値を決めるための良品500枚
ref_scores = model_v1.score(val_good)                     # 監視の基準にするスコアの分布
th_ng = np.quantile(ref_scores, 0.995)                    # これを超えたら不良
th_hold = np.quantile(ref_scores, 0.98)                   # これを超えたら判定の保留
print("不良のしきい値", round(th_ng, 3), "保留のしきい値", round(th_hold, 3))
eval_x, eval_y = make_set(1000, 100, 1.0)                 # 固定する評価用データ
s = model_v1.score(eval_x)
print("稼働開始時の見逃し率", round(np.mean(s[eval_y == 1] <= th_ng), 3),
      "過検出率", round(np.mean(s[eval_y == 0] > th_ng), 3))
# 出力:
# 不良のしきい値 1.912 保留のしきい値 1.767
# 稼働開始時の見逃し率 0.02 過検出率 0.007
実行した結果、不良のしきい値は1.912、保留のしきい値は1.767になりました。稼働を始めた時点の固定する評価用データでは、見逃し率は0.02(正解が不良のもの100枚のうち2枚を不良と判定しなかった)、過検出率は0.007(正解が良品のもの1,000枚のうち7枚を不良と判定)でした。この節以降の見逃し率と過検出率は、保留を使わずに、不良のしきい値だけで「不良」と「それ以外」の2つに分けたときの値です。不良と判定しなかったものには、運用では保留に回るものも含まれます。この値は、この架空の合成画像と、この単純なモデルでの値で、実際の検査で期待できる値ではありません。以下では、この状態から照明だけが少しずつ暗くなったときに、何がどう変わるかを見ていきます。
日ごとの平均・分位点・コルモゴロフ・スミルノフ検定で捉える
稼働を始めてから60日間、毎日200個(うち正解が不良のもの4個)を検査する状況を再現しました。日ごとに、入力画像の平均の明るさ、スコアの平均・中央値・95%点、不良と判定した率、保留の率を記録します。95%点は、その日のスコアを小さい順に並べたときに、下から95%の位置にある値(上から5%目の値)です。このように「下から何%の位置にある値」を分位点と呼び、中央値は50%点に当たります。平均だけでなく分位点も見るのは、分布の端のほうだけが動く変化を捉えるためです。不良と判定した率は、正解が不良のもの(1日200個のうち4個、つまり2%)を不良と判定した分と、正解が良品のものを不良と判定した過検出の分の合計です。本番では、どれが正解が不良のものかはその場では分からないので、観測できるのはこの合計の率です。
あわせて、その日のスコアの分布が基準の分布(稼働前の良品500枚のスコア)と同じと言えるかを、2標本コルモゴロフ・スミルノフ検定(以下、KS 検定)で調べました。KS 検定は、2組の値の集まり(統計では標本と呼びます。ここでは「その日のスコア」と「基準のスコア」)が、同じ分布から出てきたものと言えるかを調べる方法です。検定では、まず「差は無い」と仮に置き、その仮定のもとで今の結果がどれくらい起こりにくいかを調べます。この、まず仮に置く出発点を帰無仮説と呼びます。scipy の公式ドキュメントによれば、scipy.stats.ks_2samp は、既定の両側の検定では「2つの分布が同じ」を帰無仮説とし、2つの標本の経験分布関数(値を小さい順に並べて、ある値以下の割合を表した階段状の関数)の差の絶対値の最大値を統計量(KS 統計量)とします。KS 統計量は0から1の値を取り、2つの分布が離れるほど大きくなります。p 値は、2つが同じ分布から得られたと仮定したときに、今回以上に大きな KS 統計量が得られる確率で、小さいほど「同じ分布とは考えにくい」ことを示します。逆に、p 値が大きいことは、差を検出できなかったことを示すだけで、2つの分布が同じだと確かめられたことにはなりません。
DAYS = 60
log = []
day_scores = {}
for d in range(DAYS):
    light = 1.0 - 0.05 * d / (DAYS - 1)                  # 60日で5%暗くなる
    x, y = make_set(196, 4, light)                       # 1日200個、うち不良4個
    sc = model_v1.score(x)
    day_scores[d] = sc[y == 0]
    ks = stats.ks_2samp(sc, ref_scores)                  # 基準の分布との比較
    log.append({"日": d, "照明": light, "明るさ": x.mean(),
                "平均": sc.mean(), "中央値": np.median(sc), "95%点": np.quantile(sc, 0.95),
                "不良と判定": np.mean(sc > th_ng),
                "保留": np.mean((sc > th_hold) & (sc <= th_ng)),
                "KS統計量": ks.statistic, "p値": ks.pvalue})
for r in log:
    if r["日"] % 5 == 0:
        print(f'{r["日"]:2d}日目 明るさ{r["明るさ"]:.3f} 平均{r["平均"]:.2f} 中央値{r["中央値"]:.2f} '
              f'95%点{r["95%点"]:.2f} 不良{r["不良と判定"]:.3f} 保留{r["保留"]:.3f} '
              f'KS{r["KS統計量"]:.3f} p{r["p値"]:.2g}')
出力のうち、5日おきの値を表にしました。
| 稼働を始めてからの日数 | 入力画像の平均の明るさ | スコアの平均 | スコアの中央値 | スコアの95%点 | 不良と判定した率 | 保留の率 | KS 統計量 | p 値 |
|---|---|---|---|---|---|---|---|---|
| 0日目 | 0.503 | 1.53 | 1.49 | 1.74 | 0.020 | 0.015 | 0.071 | 0.45 |
| 5日目 | 0.500 | 1.55 | 1.49 | 1.72 | 0.025 | 0.010 | 0.058 | 0.7 |
| 10日目 | 0.498 | 1.56 | 1.50 | 1.82 | 0.020 | 0.050 | 0.073 | 0.42 |
| 15日目 | 0.496 | 1.59 | 1.54 | 1.81 | 0.025 | 0.065 | 0.205 | 1e-05 |
| 20日目 | 0.494 | 1.65 | 1.60 | 1.93 | 0.055 | 0.125 | 0.366 | 1.6e-17 |
| 30日目 | 0.489 | 1.76 | 1.71 | 2.09 | 0.200 | 0.175 | 0.573 | 5.3e-44 |
| 40日目 | 0.485 | 1.92 | 1.85 | 2.27 | 0.410 | 0.285 | 0.784 | 1.8e-88 |
| 55日目 | 0.479 | 2.17 | 2.14 | 2.59 | 0.830 | 0.110 | 0.931 | 2e-138 |
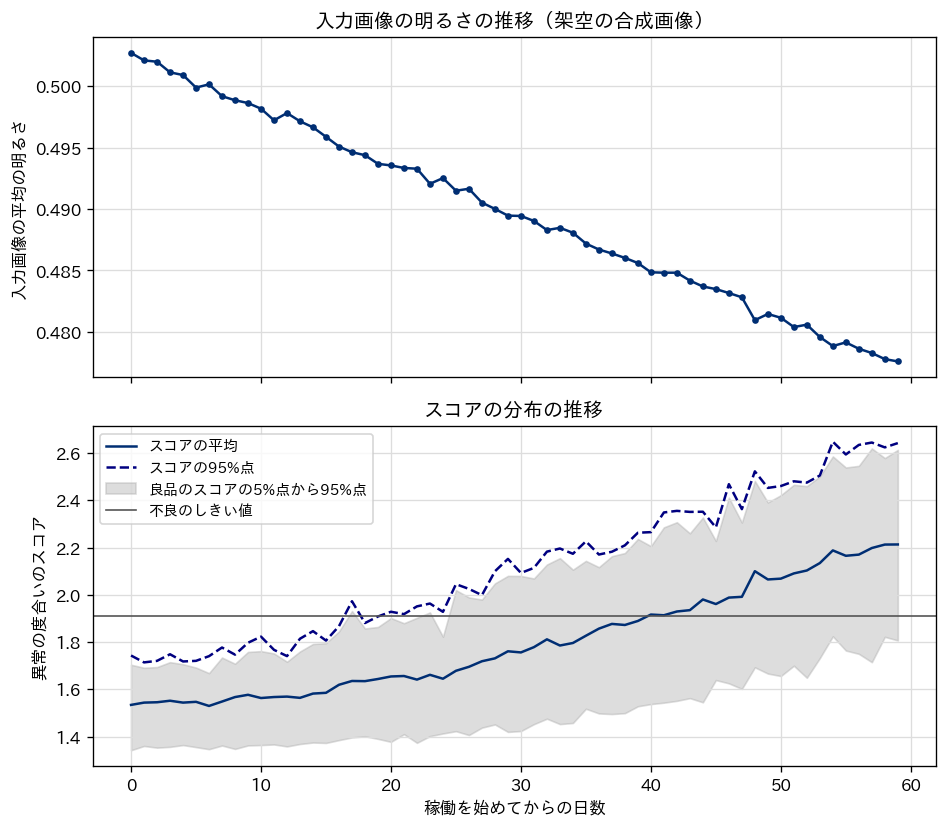
上の図の上段が入力画像の平均の明るさ、下段がスコアの分布の推移です。入力画像の明るさは0日目の0.503から55日目の0.479へ、照明の設定どおり少しずつ下がりました。日ごとの差はごくわずかで、1日だけを前の日と比べても、変化に気づくのは難しい大きさです。一方、スコアの分布は日を追って上にずれ、スコアの平均は1.53から2.17に、95%点は1.74から2.59に上がりました。下段の灰色の帯(良品だけのスコアの5%点から95%点の範囲)も上にずれており、スコアの分布のずれは、正解が不良のものが増えたことだけでは説明できない変化だと分かります。この架空のモデルは画素の明るさを覚えているので、良品の画像が全体に暗くなると、すべての画素が「平均から外れた」と数えられ、スコアが上がります。
この結果、不良と判定した率は、0日目の0.020から、20日目に0.055、30日目に0.200、40日目に0.410、55日目に0.830まで増えました。正解が不良のものは毎日2%なので、増えた分のほとんどは過検出です。判定の保留の率は、0日目の0.015から40日目の0.285まで増えたあと、55日目には0.110に下がっています。保留の率が下がったのは状況が良くなったからではなく、良品のスコアが保留の範囲を通り過ぎて、不良のしきい値を超える側に移ったためです。保留の率は「上がったら注意」だけでなく、「上がったあとに下がった」ときにも、不良と判定した率と合わせて読む必要があります。
どの指標で、いつ気づけるか
次に、どの指標を見ていれば、いつ変化に気づけたかを比べました。日ごとの指標は、変化が無くても偶然に揺れます。1日だけ条件を超えたら警報を出すと、偶然の揺れで警報が増えるので、ここでは「条件が3日続けて成り立った日」を気づいた日としました。条件は次の4つです。
- 入力画像の明るさ:最初の5日の平均より1%以上暗い
- KS 検定:p 値が0.01未満
- 保留の率:基準の約2倍の3%を超える(しきい値の決め方から、変化が無ければ保留の率はおよそ1.5%になる)
- 不良と判定した率:5%を超える(変化が無ければ、正解が不良のものの2%に過検出の0.5%前後を足した程度になる)。条件の置き方で気づく日が変わるので、3%を超える条件でも数えた
def first_day(cond, run=3):
    """条件が run 日続けて成り立った最初の日(続いた最後の日)を返す"""
    cnt = 0
    for r in log:
        cnt = cnt + 1 if cond(r) else 0
        if cnt >= run:
            return r["日"]
    return None


b0 = np.mean([r["明るさ"] for r in log[:5]])             # 最初の5日の明るさの平均
print("明るさが最初の5日より1%以上下がった日", first_day(lambda r: r["明るさ"] < b0 * 0.99))
print("KS検定のp値が0.01未満の日", first_day(lambda r: r["p値"] < 0.01))
print("保留の率が基準の2倍(3%)を超えた日", first_day(lambda r: r["保留"] > 0.03))
print("不良と判定した率が5%を超えた日", first_day(lambda r: r["不良と判定"] > 0.05))
print("不良と判定した率が3%を超えた日", first_day(lambda r: r["不良と判定"] > 0.03))
early = [r["p値"] for r in log[:5]]
print("最初の5日のp値", [f"{p:.2g}" for p in early])
| 見ていた指標 | 条件 | 気づいた日(条件が3日続いた日) | その日の不良と判定した率 |
|---|---|---|---|
| 入力画像の明るさ | 最初の5日の平均より1%以上暗い | 16日目 | 0.040 |
| KS 検定 | p 値が0.01未満 | 15日目 | 0.025 |
| 保留の率 | 3%を超える | 15日目 | 0.025 |
| 不良と判定した率 | 5%を超える | 22日目 | 0.065 |
| 不良と判定した率 | 3%を超える | 18日目 | 0.040 |
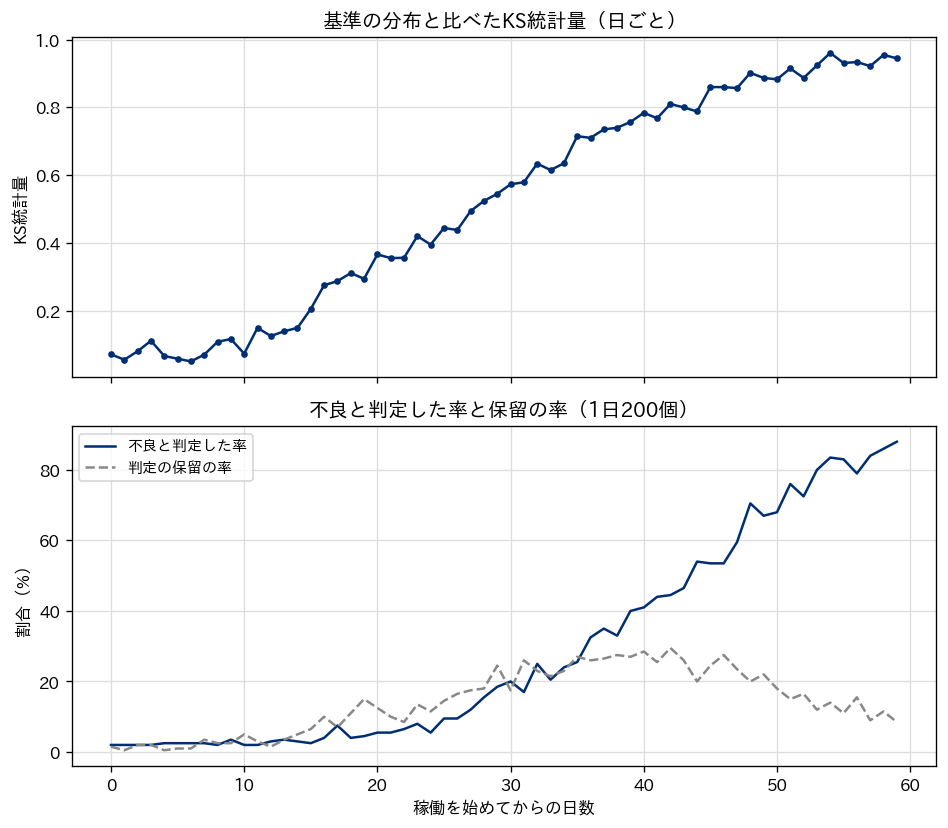
実行した結果、入力画像の明るさで16日目、KS 検定と保留の率で15日目に変化に気づけました。不良と判定した率だけを見ていた場合、5%を超える条件では22日目で、入力画像の明るさ・スコアの分布・保留の率を見ていた場合より1週間ほど遅くなりました。不良と判定した率の条件を3%に下げると18日目で、差は2日から3日に縮まります。条件を下げるほど早く気づけますが、変化が無い時期の偶然の揺れ(0日目は0.020、5日目は0.025)にも近づくので、警報が増えやすくなります。どれだけ遅れるかは条件の置き方で変わるということで、この比較で言えるのは、本コラムの架空データ(60日で5%暗くなる設定)と、ここで置いた条件では、不良と判定した率より、入力画像の明るさ・スコアの分布・保留の率のほうが先に変化を捉えた、ということまでです。15日目の時点では、不良と判定した率はまだ0.025で、0日目の0.020と見分けがつきません。不良と判定した率は17日目に一度0.075まで上がりましたが、翌日は0.040に戻っており、1日だけの値では偶然の揺れと区別できませんでした。つまり、過検出が目に見えて増える前に、正解が無くても計算できる指標で変化を捉えられた、ということです。過検出が増えてから気づく場合、それまでの間に良品の廃棄や再検査が積み上がり、現場では「最近 AIがよく止める」という不信が生まれやすくなります。
この比較からは、注意しておくべき点も3つ分かります。1つ目は、検定の p 値は偶然でも小さくなることです。最初の5日の p 値は0.45・0.76・0.31・0.056・0.54で、照明はほとんど変わっていないのに、3日目には0.056まで下がっています。毎日検定を繰り返せば、変化が無くても、いずれ p 値が0.01を下回る日が出ます。ここで「3日続けて」という条件を付けたのは、この偶然の警報を減らすためです。2つ目は、p 値は件数が多いほど小さくなりやすいことです。1日に何千個も検査するラインでは、品質に影響しないほど小さなずれでも p 値は小さくなります。p 値だけで判断せず、KS 統計量(ずれの大きさ)やスコアの平均・分位点の動きを並べて見るのが安全だと考えています。3つ目は、どの指標も「何かが変わった」ことは教えてくれても、何が変わったかまでは教えてくれないことです。この例では入力画像の明るさが同時に下がっていたので照明を疑えますが、明るさが変わらずにスコアだけが動いたなら、位置ずれ・汚れ・材料の変化を順に疑うことになります。原因を絞るには、入力画像の明るさのように撮像の側の変化を直接測る指標を、スコアの分布と並べて持っておくことが役に立ちます。
ここで使った条件(1%・0.01・3%・5%・3日続けて)は、説明のために置いた値で、推奨の値ではありません。実際の値は、稼働を始めてから最初の数週間の指標の揺れ方を見て、偶然の揺れでは超えにくい値を選ぶことになります。警報が多すぎれば誰も見なくなり、少なすぎれば変化を見逃します。警報の条件そのものも、後で述べる変更管理の対象として版で管理するのがよいと考えています。
直し方を固定した評価用データで比べる
変化に気づいたら、次は直し方を決めます。この例で考えられる直し方は、照明を交換して元の明るさに戻す、旧モデルのまましきい値だけを上げる、直近の良品の画像でモデルを学び直す、の3つです。比べるために、何もしない場合を加えた4つを、固定する評価用データで評価しました。評価用データは2種類用意しています。1つは稼働を始めた時点の条件(照明1.0)で作った固定する評価用データ、もう1つは59日目(最後の日)の照明(0.95)の条件で新しく作った評価用データ(正解が良品のもの1,000枚・正解が不良のもの100枚)です。照明を交換して元に戻した場合は、照明1.0の条件で新しく作った評価用データで評価しました。学び直しには、直近の照明の条件で集めた良品300枚を使い、しきい値は同じ条件の良品500枚の99.5%点で決め直しています。架空データなので、直近の良品300枚が本当に良品であることは分かっていますが、実際には人が確かめて良品と確定した画像だけを使う必要があります。
light_now = log[-1]["照明"]
eval_old_x, eval_old_y = eval_x, eval_y                   # 稼働開始時の条件の評価用データ
eval_new_x, eval_new_y = make_set(1000, 100, light_now)   # 今の照明の条件の評価用データ


def rates(model, th, x, y):
    s = model.score(x)
    return np.mean(s[y == 1] <= th), np.mean(s[y == 0] > th)


recent_good, _ = make_set(300, 0, light_now)              # 直近に集め、人が良品と確かめた300枚
model_v2 = GoodModel().fit(recent_good)
val2, _ = make_set(500, 0, light_now)
th_v2 = np.quantile(model_v2.score(val2), 0.995)
th_v1b = np.quantile(model_v1.score(val2), 0.995)         # 旧モデルのしきい値だけ上げる
eval_rest_x, eval_rest_y = make_set(1000, 100, 1.0)       # 照明を交換して元に戻した条件
cases = [("A 何もしない(旧モデル・旧しきい値)", model_v1, th_ng),
         ("B 旧モデルのしきい値だけ上げる", model_v1, th_v1b),
         ("C 直近の良品で学び直す(新モデル)", model_v2, th_v2)]
for name, m, th in cases:
    mo, fo = rates(m, th, eval_old_x, eval_old_y)
    mn, fn = rates(m, th, eval_new_x, eval_new_y)
    print(f"{name}: しきい値{th:.2f} 旧条件 見逃し{mo:.3f} 過検出{fo:.3f} "
          f"/今の条件 見逃し{mn:.3f} 過検出{fn:.3f}")
mr, fr = rates(model_v1, th_ng, eval_rest_x, eval_rest_y)
print(f"D 照明を交換して元に戻す(旧モデル・旧しきい値): 見逃し{mr:.3f} 過検出{fr:.3f}")
| 直し方 | しきい値 | 稼働開始時の条件での見逃し率 | 稼働開始時の条件での過検出率 | 今の照明の条件での見逃し率 | 今の照明の条件での過検出率 |
|---|---|---|---|---|---|
| A 何もしない(旧モデル・旧しきい値) | 1.91 | 0.020 | 0.007 | 0.000 | 0.874 |
| B 旧モデルのしきい値だけ上げる | 2.97 | 0.500 | 0.000 | 0.360 | 0.003 |
| C 直近の良品で学び直す(新モデル) | 1.89 | 0.000 | 0.952 | 0.020 | 0.008 |
照明を交換して元に戻した場合(D)は、評価用データが上の表と違う(照明1.0の条件で新しく作ったもの)ので、上の表の A から C と同じ列には並べず、別の表にしました。
| 直し方 | しきい値 | 評価に使ったデータ | 見逃し率 | 過検出率 |
|---|---|---|---|---|
| D 照明を交換して元に戻す(旧モデル・旧しきい値) | 1.91 | 照明1.0の条件で新しく作った評価用データ(正解が良品のもの1,000枚・正解が不良のもの100枚) | 0.000 | 0.001 |
何もしない場合(A)、今の照明の条件では、正解が良品のものの87.4%を不良と判定しました。正解が不良のものは1枚も見逃していませんが、これは正解が良品のものも含めてほとんどすべてを不良と判定しているからで、検査として機能していません。旧モデルのまましきい値だけを上げた場合(B)、今の条件での過検出率は0.003に下がりましたが、見逃し率は0.360に上がりました。正解が不良のもの100枚のうち36枚を不良と判定しなかったことになります。しきい値を上げると、暗くなった良品の画像と一緒に、スコアが低めの、正解が不良のものも「良品」の側に入ってしまうためです。過検出が増えたときに、しきい値だけを上げて警報を静かにするのは、過検出を見逃しに置き換える操作になりうるということです。
直近の良品で学び直した場合(C)、今の条件での見逃し率は0.020、過検出率は0.008で、稼働を始めた時点の値(見逃し率0.02、過検出率0.007)とほぼ同じ水準に戻りました。ただし、この新モデルを稼働開始時の条件の画像に当てると、過検出率は0.952になります。新モデルは「暗くなった照明」を前提にした良品の見た目を覚えたので、照明を交換して元の明るさに戻した途端に、今度は逆向きのずれが起きるということです。照明を交換して元に戻した場合(D)は、旧モデル・旧しきい値のままで、見逃し率0.000、過検出率0.001でした。Dの評価用データは照明1.0の条件で新しく作ったもので、稼働開始時の固定する評価用データ(見逃し率0.02)とは正解が不良のものの画像が違うので、見逃し率の0.02と0.000の差は、この件数(正解が不良のもの100枚)では偶然の範囲と読むのが適切です。
この比較から、本コラムの架空データでの結果として、次の順で考えるのがよいと考えています。まず、撮像の条件を元に戻せる変化(照明の明るさ・レンズの汚れ・カメラの位置)は、モデルを触らずに撮像の側を直します。モデルを学び直すと、劣化した撮像の条件をモデルが前提として覚えてしまい、次に撮像の側を直したときに再び学び直しが要ります。照明の交換やレンズの清掃を保全の計画に入れ、交換の時期を入力画像の明るさの推移から決めるのも、1つの方法です。撮像の条件を戻せない変化(材料の恒久的な切り替え・品種の追加)では、学び直しを検討します。しきい値だけを動かすのは、固定する評価用データで見逃し率が悪化しないことを確かめたうえでの、限られた場面にとどめるべきだと考えています。
ただし、この比較の根拠は、画素の明るさをそのまま覚える単純なモデルと、画像全体が一様に暗くなるという1種類の変化だけです。画像ごとに明るさをそろえる前処理(たとえば画像の平均の明るさで割る処理)を入れたモデルでは、一様な明るさの変化はスコアに出にくくなり、A から C の結果も、学び直したモデルで起きた逆向きのずれも、ここで示したものとは変わりうると考えています。一方、暗くなったことで暗い部分の信号がノイズに埋もれる場合や、白飛び・黒つぶれ、ぼけで欠陥の情報が撮像の段階で失われた場合は、単純な明るさの補正では取り戻せません。そのため、前処理を入れたモデルでも、入力画像の明るさを監視し、撮像の側を直せる変化は撮像を直す、という順は変わらないと考えています。前処理を入れたモデルでの比較は、本コラムでは実行していません。
最後に、前の節で置いた警報の条件が、照明が変わらないときにどれだけ誤って警報を出すかを確かめました。KS 検定の基準の分布は良品だけのスコアですが、毎日の比較の相手は正解が良品のもの196個と正解が不良のもの4個を混ぜたスコアです。照明が変わらなくても、正解が不良のものが混ざる分だけ2つの分布は同じとは限らず、p 値には照明の変化だけでなく、この構成の違いも反映されます。そこで、照明を1.0のまま300日分を作り、同じ比較をしたときに条件を満たす日がどれだけ出るかを数えました。
null_p, null_rate = [], []
for _ in range(300):                                      # 照明1.0のままの300日
    x, y = make_set(196, 4, 1.0)
    sc = model_v1.score(x)
    null_p.append(stats.ks_2samp(sc, ref_scores).pvalue)
    null_rate.append(np.mean(sc > th_ng))
null_p, null_rate = np.array(null_p), np.array(null_rate)
run3_p = sum((null_p[i:i + 3] < 0.01).all() for i in range(len(null_p) - 2))
run3_r = sum((null_rate[i:i + 3] > 0.03).all() for i in range(len(null_rate) - 2))
print("変化なし300日 p値0.01未満の日の割合", round(np.mean(null_p < 0.01), 3),
      "3日続いた回数", run3_p)
print("変化なし300日 不良と判定した率が3%超の日の割合", round(np.mean(null_rate > 0.03), 3),
      "3日続いた回数", run3_r)
print("変化なし300日 不良と判定した率が5%超の日の割合", round(np.mean(null_rate > 0.05), 3))
実行した結果、照明が変わらない300日のうち、KS 検定の p 値が0.01を下回った日の割合は0.013、不良と判定した率が3%を超えた日の割合は0.010、5%を超えた日の割合は0.0でした。どちらの条件も、3日続けて成り立ったことは300日の中で一度もありませんでした。この架空データでは、正解が不良のものが2%混ざることによる p 値の偏りは小さく、「3日続けて」の条件を付ければ、照明が変わらない期間に警報が出ることはほとんどなかった、ということです。ただし、正解が不良のものの割合が日によって大きく変わる工程や、良品のばらつきが大きい工程では、この結果は変わりえます。実際には、しきい値を決める良品のデータとは別に、通常の稼働の構成(正解が不良のものが混ざる割合を含む)を反映した監視用の基準のデータを用意し、変化が無い期間の誤警報の率を確かめてから警報の条件を決めるのが確実だと考えています。
再学習の判断と手順、品種の追加と新しい欠陥
再学習は、見逃し率と過検出率を変える操作なので、モデルを作り直す作業というより、検査の仕組みを変える作業として扱う必要があります。機械学習品質マネジメントガイドライン(第4版)は、運用中の追加学習の形態を、追加学習の結果を運用環境の外で品質検査してから明示的に更新して反映する形と、運用中に人手の検査を介さずに自動で更新する形の2つに分けています。前者については、更新するかどうかの判断の基準、追加に使うデータの集め方と準備の方法、更新前の品質の確かめ方を、運用を始めるまでに設計しておくことを挙げています。後者については、品質が劣化したモデルがそのまま運用に反映される危険が高いので、監視の仕組みと劣化したときの対処を運用体制に組み込んでおくことが重要だとしています。外観検査では、出荷の可否に関わる判定を人の確認なしに自動で変える仕組みは避け、前者の形で運用するのが適切だと考えています。
前者の形で再学習を進めるときの手順を、次のようにまとめました。
- きっかけを記録する:どの指標が、いつから、どれだけ変わったか。撮像の側を直せる変化ではないかを先に確かめた結果も残す
- 学習に使う画像を集める:直近の画像のうち、人が良品と確かめたもの(教師あり学習なら、人が欠陥の種類を確かめたもの)。どの期間・どのロットの画像を使い、どれを除いたかを記録する
- 新しいモデルを作り、しきい値を決め直す:しきい値の決め方(何%点を使うか、見逃し率の上限をいくつにするか)は第8章の考え方に合わせ、旧モデルと同じ決め方にする
- 固定する評価用データで旧モデルと比べる:稼働開始時の条件の評価用データと、今の条件の評価用データの両方で、見逃し率と過検出率を並べる。旧モデルが正しく判定できていた不良を、新モデルが見逃していないかを1件ずつ確かめる
- 並行稼働で確かめる:一定の期間、新モデルを判定には使わずに並べて動かし、旧モデル・人の判定との食い違いを見る
- 承認して切り替える:品質保証の責任者が比べた結果を見て承認し、承認を受けてデータ担当が切り替えを実行し、切り替えた日時と版を記録する。問題があったときに旧モデルへ戻す手順も決めておく
手順4の「旧モデルが正しく判定できていた不良を、新モデルが見逃していないか」は、同ガイドラインも、更新前に正しく答えていた入力に更新後に誤った答えを出す問題に配慮が必要な場合があると書いている点です。全体の見逃し率が同じでも、以前は見つけていた種類の欠陥を新モデルが見逃すようになっていれば、品質保証の側から見れば後退です。そのために、評価用データは再学習のたびに作り直すのではなく、固定しておき、新しく見つかった欠陥の画像を足していく形で育てるのがよいと考えています。評価用データに使う画像を学習に混ぜないことも、第8章で扱った評価の漏れを防ぐうえで欠かせません。ただし、固定した評価用データの結果を見ながらモデルやしきい値を何度も調整すると、学習に直接混ぜなくても、そのデータに合わせ込んだ結果になりえます。固定した評価用データは過去の性能が保たれているかを確かめる用途と位置づけ、調整に使うデータと、調整には使わない最終確認用のデータを分けておくのが安全だと考えています。
品種の追加は、計画して起きる変化なので、ドリフトの監視とは別に、品種を立ち上げる手順の中に組み込めます。新しい品種の良品の画像を、量産の前から(試作や立ち上げの期間に)集め、品種ごとにモデルを分けるか、1つのモデルで複数の品種を扱うかを決めます。品種ごとに分ければ、ある品種の学び直しが他の品種の判定に影響しませんが、管理するモデルの数が増えます。そのうえで監視や再学習の仕組みまで品種ごとに別々に作ると、二重投資につながるおそれがあります。1つのモデルで扱えば、管理は1つで済みますが、品種を足すたびに全品種の評価をやり直す必要があります。どちらを選ぶ場合も、判定の記録に品種の識別子を残し(第11章)、スコアの分布や保留の率を品種ごとに分けて監視できるようにしておくことが前提になります。品種を混ぜて集計すると、品種の構成比が変わっただけで分布が動き、本当の変化と見分けられなくなるためです。
新しい欠陥は、品種の追加と違って予告なく現れます。良品学習のモデルであれば、見た目が良品と違う限り異常として出てくる可能性がありますが、教師あり学習のモデルは、学んでいない欠陥を既知のどれかの種類に振り分けるか、良品と判定するおそれがあります。人の判定との不一致率と、保留に回した画像の中身を定期的に見直し、見慣れない欠陥が混ざっていないかを確かめる作業を、運用の手順に入れておく必要があります。新しい欠陥が見つかったら、その画像を固定する評価用データに足し、判定基準(限度見本)にも反映します(第2章)。
モデルと撮像の条件の変更管理、公的な指針との関係
外観検査の判定は、モデルだけでなく、撮像の条件・前処理・しきい値・判定基準の組み合わせで決まります。このどれかを変えれば判定が変わるので、モデルの版だけを管理しても、検査の仕組みの版を管理したことにはなりません。次の項目をまとめて1つの「検査の仕組みの版」として管理するのがよいと考えています。
| 版で管理する項目 | 具体的な中身の例 | 変えたときに確かめること | 承認する役割の例 | 変更を実行する役割の例 |
|---|---|---|---|---|
| 撮像の条件 | 照明の種類と明るさの設定、露光時間、カメラとレンズ、取り付け位置、照明やレンズの交換・清掃の履歴 | 入力画像の明るさとスコアの分布が、変更前の基準の範囲に戻ったか | 品質保証 | 生産技術 |
| 前処理 | 位置合わせ、明るさの補正、切り出す領域 | 固定する評価用データでの見逃し率と過検出率 | 品質保証 | データ担当 |
| モデル | 学習に使った画像の範囲、学習の手順、モデルのファイル | 旧モデルとの比較(全体と、旧モデルが見つけていた、正解が不良のものの1件ずつ) | 品質保証 | データ担当 |
| しきい値 | 不良のしきい値、保留の範囲、決め方 | 見逃し率の上限を守っているか(第8章)、保留の量を人が見きれるか(第10章) | 品質保証 | データ担当 |
| 監視の条件 | 監視する指標、警報の条件、基準の分布 | 変化が無い期間に警報が出すぎないか | 品質保証 | データ担当 |
| 評価用データ | 固定する評価用データの中身と、足した画像の記録 | 学習に使った画像が混ざっていないか | 品質保証 | データ担当 |
この表の「承認する役割」と「変更を実行する役割」は例で、実際の分担は組織によって違います。本コラムでは、再学習したモデルへの切り替えを含め、検査の仕組みの版の切り替えは品質保証が承認し、データ担当(撮像の条件は生産技術)が実行する分担で書いています。役割と責任の分担表は第13章で扱います。大事なのは、どの項目を変えるときにも、変える前に影響を確かめ、承認を得て、何をいつ変えたかを記録することです。第11章で扱ったように、判定の記録に「検査の仕組みの版」を残しておけば、後から不良の流出が見つかったときに、どの版で判定した製品が影響を受けたかを絞り込めます。
品質マネジメントシステムの要求事項を定めた国際規格 ISO 9001 は、ISO の目録によれば、2026年9月に第6版(ISO 9001(2026年))が発行され、それまでの ISO 9001(2015年)は2026年9月16日に廃止の扱いになっています。ISO の目録は、2015年版の認証を受けている組織に、新しい版への移行の取り決めを認証機関に確かめるよう促しています。品質マネジメントシステムの規格は、一般に、製品やプロセスの変更を計画的に行い、その結果を確かめて記録することを求めていますが、2026年版のどの条項が変更の管理をどう定めているかは、本コラムでは規格の本文を確かめていません。自社の品質マネジメントシステムで検査の仕組みの変更をどう扱うかは、自社の品質マニュアルと、認証機関・顧客との取り決めに合わせて決める必要があります。法令・顧客との取り決め・業界の規格で検査の方法が定められている製品では、再学習やしきい値の変更が、それらの取り決めの上で「工程の変更」に当たるかどうかも、品質保証の部門が確かめる必要があります。
AIの品質の管理については、前に触れた産業技術総合研究所の機械学習品質マネジメントガイドラインが、国内で公開されている指針の1つです。産業技術総合研究所の公式ページによれば、最新は第4版で、日本語版は2023年12月12日に公開され、2024年4月4日に4.2.0版が公開されています。第1版は2020年6月に公開されています。
同ガイドラインの前書きによれば、NEDO(新エネルギー・産業技術総合開発機構)からの受託事業の一部としてまとめられたもので、法令や公的指針との関係では拘束力を持たず、採用するかどうかは企業が主体的に選ぶものと位置づけられています。
同ガイドラインは、運用時の品質については、運用状況の継続的なモニタリングと記録(入力・出力・内部の状態の記録、システムの改修の記録、外部の環境の変化の記録)と、運用時品質の維持性(運用を始めた時点の品質が運用期間を通じて保たれること)を内部品質の項目として挙げています。外部の環境の変化の例として、入力データの採り方や採る条件が変わる場合や、検知すべき状況や判定基準が変わる場合を挙げ、システムを改修しない場合でも影響を検討して記録に残すことが重要だとしています。外観検査に当てはめれば、照明の交換やカメラの位置の調整、限度見本の改訂も、モデルを触らない変化として記録の対象になると考えています。
機械学習のモデルの監視・再学習・版の管理を、外観検査に限らない一般論として扱う場合は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。この章では、外観検査に固有の点として、撮像の条件を版の管理に含めること、撮像の側を直せる変化はモデルより先に撮像を直すこと、再学習の可否を品質保証が固定する評価用データで判断すること、の3つを強調しておきます。
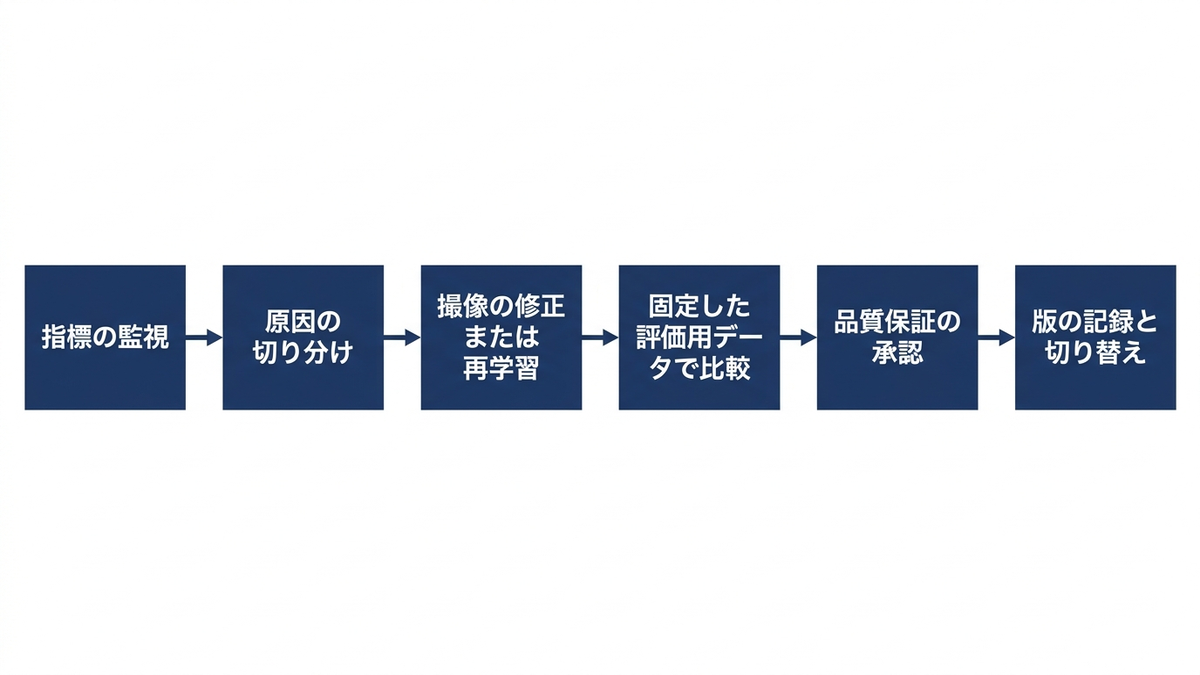
経営の判断、変化を測る仕組みを最初から入れる
運用と保守について経営が判断すべきことは、モデルの精度を上げる投資よりも先に、変化を測る仕組みと、変化に気づいたあとに直す体制を、導入の計画に最初から含めるかどうかだと考えています。本コラムの架空データでは、照明が60日で5%暗くなるだけで、40日目には不良と判定した率が0.410(正解が不良のものは2%)になりました。本コラムの架空データ(60日で5%暗くなる設定)と、説明のために置いた警報の条件では、不良と判定した率だけを見ていれば気づくのは22日目(5%を超える条件)か18日目(3%を超える条件)で、入力画像の明るさ・スコアの分布・保留の率を見ていれば15日目から16日目に気づけました。何日遅れるかは条件の置き方で変わる架空の設定での値ですが、変化を測る指標を持っているかどうかで、損失が積み上がる前に動けるかどうかが変わる、という構図は、実際の検査でも起こりうると考えています。
運用中の変化を放置したとき、またはまずい直し方をしたときの損失を、本コラムの6つの損失の型に当てはめると次のようになります。
| 起きること | 損失の型 | 防ぐための仕組み |
|---|---|---|
| 照明やレンズの変化で良品のスコアが上がり、不良と判定する率が増える | 過検出(廃棄・手直し・再検査の増加) | 入力画像の明るさとスコアの分布の日々の監視、照明の交換・レンズの清掃の計画 |
| 過検出を静めるためにしきい値だけを上げ、正解が不良のものを良品と判定する | 流出 | しきい値の変更も変更管理の対象にし、固定する評価用データで見逃し率を確かめてから承認する |
| AIの判定が頻繁に外れ、検査員が全数を見直すようになる | 形骸化 | 変化に気づいたら原因と対処を記録して現場に伝える、人の判定との不一致率を見る |
| ラインや工場ごとに撮像の条件の管理と再学習の基準がばらばらになる | 判定のばらつき | 検査の仕組みの版の管理と、再学習の手順を共通にする |
| 過検出が増えて再検査が追いつかず、ラインを止める | タクトの超過 | 保留の率と再検査の量の監視、保留の量を人が見きれる範囲に収める(第10章) |
| 品種や工程ごとに別々の監視と再学習の仕組みを作る | 二重投資 | 監視の指標と変更管理の手順を、品種・ライン・工場の間で共通にする |
予算の面では、導入の費用だけでなく、運用の費用を最初から見込んでおく必要があります。運用の費用には、日々の指標を見る人の時間、保留と人の再検査の時間、照明の交換やレンズの清掃などの撮像の保守、再学習のための画像の確認とラベル付け、固定する評価用データの維持、並行稼働の期間の人手が含まれます。これらを見込まずに導入すると、稼働を始めた直後は良い成績でも、数か月後に変化への対応が追いつかず、AIの判定を信用しない運用に戻ってしまうおそれがあります。
体制の面では、変化に気づく役割(指標を毎日見る人)、原因を切り分ける役割(撮像の側か、材料か、モデルか)、直す役割(撮像の側は生産技術、モデルとしきい値はデータ担当)、承認する役割(品質保証)を、導入の時点で決めておくことが必要です。再学習したモデルへの切り替えも、品質保証が承認し、データ担当が実行します。出荷の可否に関わる判定の基準を変えるかどうかの最終的な判断は、品質保証の体制が持つものであり、再学習の結果が良さそうに見えても、データ担当や装置の供給元だけの判断で切り替えるべきではありません。工場の外の装置メーカーやシステムの供給元に保守を任せる場合も、監視の指標と変更管理の記録を自社で見られるようにし、承認は自社の品質保証が行う形にしておくのが適切だと考えています。
この章では、稼働を始めたあとに起きる変化と、その測り方・直し方を扱いました。本コラムの架空の合成画像では、照明が60日で5%暗くなるだけで良品のスコアの分布が上にずれ、不良と判定した率は55日目に0.830まで増えました。この設定と、説明のために置いた警報の条件では、入力画像の明るさ・KS 検定・保留の率で15日目から16日目に変化に気づけた一方、不良と判定した率だけでは18日目(3%を超える条件)から22日目(5%を超える条件)まで気づけませんでした。直し方では、しきい値だけを上げると見逃し率が0.360まで悪化し、直近の良品で学び直すと今の条件では元の水準に戻る代わりに、照明を元に戻した条件では過検出率が0.952になりました。変化を測る指標を最初から入れ、撮像の側を直せる変化は撮像を直し、再学習は固定する評価用データでの比較と品質保証の承認を経て行う、というのがこの章の結論です。次の第13章では、ここまでの章で扱った撮像・モデル・評価・運用を、どの工程から、どのような体制で導入していくかを扱います。
この章を深めたい方への参考書籍
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習のシステムを本番で動かし続けるための設計を扱った本で、版元の目次によれば、データ分布のシフトの種類・検出・対処と監視を扱う章と、継続学習と実環境でのテストを扱う章があります。この章で扱ったスコアの分布の監視や、再学習の頻度と切り替え前の確かめ方を、外観検査に限らない一般論として整理するのに向いています。
『機械学習工学』(石川冬樹・丸山宏 編著、柿沼太一・竹内広宜・土橋昌・中川裕志・原聡・堀内新吾・鷲崎弘宜 著、講談社):機械学習を使うシステムの開発と運用を工学として扱った本で、版元の目次によれば、性能低下につながる入出力の変化を検知する方法と、推論性能の低下やその予兆への対処を扱う運用の章や、品質に関するガイドラインを扱う品質の章があります。この章で触れた機械学習品質マネジメントガイドラインのような品質の考え方と、運用時の変化への対処を合わせて学ぶのに向いています。
第13章 導入の進め方と体制、対象工程の選定・PoC・検査員の役割
第12章では、本番の画像は照明の劣化・カメラの位置ずれ・材料のロット・品種の追加によって変わることを前提に扱うこと、その変化を入力画像の明るさ・スコアの分布・保留の率・人の判定との不一致率で測る仕組みを最初から入れておくこと、再学習と撮像条件の変更を版の管理と承認の手続きに載せることを扱いました。ここまでの第1章から第12章は、外観検査AIを「どう作り、どう動かし、どう保つか」の話でした。この章では、それをどの工程から、どの順番で、誰の責任で入れていくかを扱います。
この章はコードを載せず、表と概念図で説明します。扱う内容は次のとおりです。
- 最初に手を付ける工程の選び方(流出の影響・検査の人手・欠陥の写りやすさ・品種の数などで採点する方法)
- 本番に入れる前に限られた範囲で試す段階の設計(期間・評価用データ・合格の条件・出口を、始める前に決める)と、その段階で止まる型
- 効果の見立て方(流出・過検出・検査の工数を、金額ではなく件数・時間・相対コストの型で書く)
- 1工程から1ライン、工場へと広げる段階的な展開と、人とAIを並べて動かす期間
- 経営・工場長・品質保証・製造・生産技術・検査員・データ担当・情報システム・外部の装置メーカーの役割と責任分担
- 検査員を判定基準の持ち主として残す理由と、技能の継承
- 内製と外部委託の分担、最初の90日の計画、経営判断
この章の主張は2つです。1つは、PoC(試験導入、概念実証)の出口を、始める前に決めておくことです。PoC は Proof of Concept の略で、本格導入の前に、限られた範囲で使えるかどうかを確かめる小さな試しのことで、出口とは「何が確かめられたら次へ進み、何が確かめられなければやめるか」の決まりです。もう1つは、検査員を AIに置き換えられる作業者として扱うのではなく、判定基準の持ち主として体制の中に残すことです。前者は「PoC の精度は高かったのにラインで使われない」を防ぐため、後者は第2章で扱った判定基準と、第10章で扱った保留の判断を支える人を失わないために必要だと考えています。
対象工程の選定、5つの観点で採点して最初の1工程を決める
外観検査AIの導入でよく起きるのは、「人手が足りない工程」から順に手を付けることです。人手の不足は導入の動機として正当ですが、それだけで選ぶと、欠陥がそもそもカメラで写りにくい工程や、品種が多くて学習用の画像が集まらない工程を最初に選んでしまうことがあります。最初の1工程でつまずくと、その結果が「外観検査AIはうちでは使えない」という社内の評価になり、2工程目以降に進めなくなります。最初の1工程は、効果が大きいことと、確かめやすいことの両方で選ぶ必要があります。
本コラムでは、候補の工程を次の5つの観点で採点する方法を考えます。採点の観点は、第1章から第12章で扱った論点を、導入の可否の判断に置き換えたものです。
- 流出の影響:その工程で見逃した不良が、後工程や顧客に届いたときに何が起きるか(第1章)
- 検査の人手:その工程の目視検査に、どれだけの人と時間がかかっているか、人を確保し続けられるか
- 欠陥の写りやすさ:対象の欠陥が、照明とカメラを工夫すれば安定して写る状態にできるか(第3章)
- 判定基準のそろい方:限度見本があり、検査員どうしの判定がそろっているか(第2章)
- 品種の数と変わる頻度:扱う品種が多いか、品種の切り替えや新製品の追加がどれだけ頻繁か(第7章・第12章)
5つのうち、流出の影響と検査の人手は「効果の大きさ」を、欠陥の写りやすさ・判定基準のそろい方・品種の数は「確かめやすさ」を表します。効果が大きくても確かめにくい工程は、最初の1工程ではなく、2工程目以降に回すのがよいと考えています。逆に、確かめやすくても効果が小さい工程は、PoC には向いていても、展開する価値が小さく、社内で次の予算を得る根拠になりにくくなります。
採点の目安を次の表にまとめました。点数の付け方は本コラムが考えた例で、規格や公的な指針で定められたものではありません。各観点を1点から3点で付け、合計点だけで決めるのではなく、「確かめやすさ」の3つの観点に1点が1つでもある工程は、最初の1工程から外す、という使い方を想定しています。品種の観点が2点の工程で、品種を代表的なものに絞って PoC を行う場合は、残りの品種に広げるときの手間(品種ごとの画像の収集と評価)を、PoC の計画書に書き添えておきます。
| 観点 | 3点 | 2点 | 1点 | 確かめ方 |
|---|---|---|---|---|
| 流出の影響 | 顧客に届くと、回収・顧客の工程の停止・安全に関わるおそれがある | 後工程で見つかるが、手直しや再検査の手間が大きい | 後工程で確実に見つかり、手直しも小さい | 過去の流出の件数と内容、顧客からの指摘の記録(品質保証) |
| 検査の人手 | 専任の検査員が複数の勤務帯で張り付いており、確保が難しい | 兼任の作業者が検査も担っている | 検査の時間が短く、人の負担が小さい | 検査の工数の記録、勤務表(製造) |
| 欠陥の写りやすさ | 試しに撮った画像で、検査員が画像だけを見て欠陥を判別できる | 照明やカメラの角度を変えれば写るが、条件が定まっていない | 画像では判別できず、手で触る・角度を変えて見るなどの動作が要る | 試し撮りの画像を検査員が判定した結果(生産技術・検査員) |
| 判定基準のそろい方 | 限度見本があり、検査員どうしの判定の一致を測って、事前に決めた水準を満たしている | 限度見本はあるが、一致を測ったことがないか、測った結果が水準に届いていない | 限度見本が無く、判定が検査員の経験に頼っている | 限度見本の有無、第2章の一致率・カッパ係数(品質保証) |
| 品種の数と変わる頻度 | 品種が少なく、切り替えもまれ | 品種は多いが、見た目が似ていて同じ撮像条件で撮れる | 品種が多く、見た目が大きく違い、新製品の追加も頻繁 | 品種の一覧と、過去1年の品種の追加の件数(生産技術) |
表の「欠陥の写りやすさ」の確かめ方として挙げた「検査員が画像だけを見て判別できるか」は、採点の中でも手早く、効果が大きい確かめ方だと考えています。第3章で扱ったとおり、写っていない欠陥はどのモデルでも見つかりません。候補の工程で、良品と不良品を数十個ずつ試しに撮り、その画像を検査員に見せて判定してもらえば、モデルを作る前に「この撮り方で判定できる情報が画像に含まれているか」の当たりが付きます。検査員が画像を見て判別できない欠陥を、AIが判別できるようになることを最初の工程で期待するのは、確かめる対象が多すぎます。
「判定基準のそろい方」に1点が付く工程は、AIを入れる前に基準をそろえる作業から始める必要があります。第2章で扱ったように、検査員どうしの判定がそろっていなければ、学習に使うラベルも、評価に使う正解もそろいません。この場合の最初の一歩は AIの PoC ではなく、限度見本の整備と、検査員どうしの判定の一致を測ることになります。その作業自体が、判定のばらつきという損失の型を減らす効果を持つので、AIの導入とは別に価値があります。
「品種の数と変わる頻度」も、最初の1工程では見落とされやすい観点です。PoC では代表的な1品種で試すことが多く、その品種で良い結果が出ても、ラインで実際に流れる品種が数十あれば、品種ごとに画像を集め、評価し直す手間が残ります。第12章で扱った品種の追加への対応が、導入の直後から毎月のように発生する工程では、PoC の結果だけでは展開の手間が見えません。採点の段階で、品種の一覧と追加の頻度を生産技術の担当者に出してもらい、PoC で試す品種がライン全体のどれだけを占めるかを書き添えておくことを勧めます。
採点は、品質保証・製造・生産技術・検査員・データ担当が同じ表を見ながら行うのがよいと考えています。流出の影響は品質保証が、検査の人手は製造が、欠陥の写りやすさは生産技術と検査員が、判定基準のそろい方は品質保証と検査員が、品種の数は生産技術が、それぞれ最もよく知っています。データ担当や外部の装置メーカーだけで採点すると、「確かめやすさ」の観点は正しく付いても、「効果の大きさ」の観点が実態とずれることがあります。
PoC の設計、期間・評価用データ・合格の条件・出口を始める前に決める
最初の1工程が決まったら、PoC を設計します。本コラムでいう PoC は、本番のラインに組み込む前に、限られた期間と範囲で「この工程の、この欠陥を、この撮像とこの方法で、決めた条件を満たす精度で判定できるか」を確かめる段階です。PoC で確かめるのは「AIが使えるか」という漠然とした問いではありません。始める前に、何を確かめ、どの結果なら次へ進み、どの結果ならやめるかを、文書にして関係者で合意しておく必要があります。
PoC の設計で最初に決めておきたい項目を、次の表にまとめました。どの項目も、本コラムの各章で扱った論点を、PoC の計画書の欄に置き換えたものです。
| 決める項目 | 中身 | 決めずに始めると起きること | 関連する章 |
|---|---|---|---|
| 対象 | 工程・品種・欠陥の種類。対象に含めない欠陥も書く | 試す途中で対象が広がり、期間内に結論が出ない | 第1章・第2章 |
| 期間 | 撮像の検討・画像の収集・学習・評価のそれぞれの期間と、全体の締め切り | 画像の収集が延び、評価の期間が無くなる | 第3章・第7章 |
| 評価用データ | 評価に使う良品と不良の数、集める期間・ロット・ライン、正解の付け方(誰が限度見本に照らして判定するか) | 学習に使った画像と似た画像で評価して、結果が良く見える | 第2章・第8章 |
| 合格の条件 | 見逃し率の上限と、その上限を守ったときの過検出率の上限。保留を使うなら保留の率の上限 | 「精度が高い」という数字は出ても、使えるかどうかを判断できない | 第8章・第10章 |
| 速度の条件 | タクトタイムから逆算した、1個あたりに使える検査の時間 | 精度は出たが、ラインの速度に追いつかない | 第9章 |
| 出口 | 合格したら次に何をするか(並行稼働へ進む)、不合格なら何をするか(撮像の見直し・対象の絞り込み・中止) | 結果が出ても次の判断ができず、PoC を延長し続ける | 本章 |
| 判断する人 | 出口の判断を誰が行うか(合格の条件の値と結果の確認は品質保証の責任者、出口の承認は工場長など) | 結果の解釈が立場によって分かれ、結論が出ない | 本章 |
この表で最も大事なのは、「合格の条件」と「出口」の2つです。合格の条件は、第8章で扱ったとおり、正解率のような1つの数字ではなく、見逃し率の上限を守ったうえで過検出率がどこまで下がるか、という形で書きます。たとえば「評価用データの不良について見逃しが一定の件数以下で、そのときの良品の過検出率が一定の割合以下」のように、見逃しと過検出を分けて書きます。数字そのものは、工程の流出の影響と、過検出が出たときの再検査の手間で決まるので、本コラムでは具体的な値を示しません。値を決めるのは品質保証の責任者で(後の責任分担の表では R)、その値を含む計画と出口を承認するのは工場長です(同じ表で A)。データ担当は、その値を確かめるのに必要な不良の数(第8章で扱った信頼限界の考え方)を示す役割を担います。
評価用データについては、第8章で扱った「学習と評価に同じ製品の画像が混ざらないように、日付・ロット・ラインで分ける」ことを、PoC の計画書にそのまま書いておきます。PoC の期間が短いと、同じ日に同じロットから撮った画像を学習と評価に分けてしまいがちです。この切り方では、ロットや日による変動を評価できず、本番の性能を過大に見積もるおそれがあります。評価用データは、学習用の画像を集め終えたあとの別の期間に集めるか、少なくとも別のロットから集めることを、計画の段階で決めておきます。
出口は、合格した場合と不合格だった場合の両方を書きます。合格した場合の出口は、本番のラインで人の目視検査と並べて AIを動かす期間(後の節で扱う並行稼働)に進むことです。不合格だった場合の出口は、結果の中身によって分かれます。欠陥が画像に写っていなかったなら撮像の見直しへ、特定の欠陥の種類だけが見逃されたならその欠陥を AIの評価の対象から外して残りで続けるか、それとも中止するか、という具合です。AIの対象から外した欠陥は、既存の目視検査などで引き続き見ます。AIの対象を絞ることは、必要な検査の項目を減らすことではありません。「不合格なら期間を延ばしてもう少し試す」は、出口として書かないほうがよいと考えています。延長を出口にすると、何が足りなかったのかを分析しないまま期間だけが延び、PoC が終わらなくなります。
ここまでの項目を決めずに始めると、PoC が本番に進まずに止まることがあります。外観検査AIの場合に PoC が止まる理由を、本コラムはここまでの章の論点から次の型に整理しました。表の型は、どれも PoC を始める前の設計で手を打てるものです。
| 止まる型 | 何が起きるか | 始める前に打てる手 | つながる損失の型 |
|---|---|---|---|
| 出口が無い | 結果が良くても悪くても次の判断ができず、PoC を延長し続ける | 合格の条件と出口と判断する人を計画書に書く | 二重投資(PoC が工程ごとにばらばらに続く) |
| 評価が甘い | 学習と評価に似た画像が混ざり、PoC の精度が本番で再現しない | 評価用データを別の期間・別のロットから集める | 流出・形骸化 |
| 正解がそろわない | 検査員によって正解のラベルがずれ、精度の数字の意味が定まらない | 限度見本を整え、正解を付ける人と手順を決める | 判定のばらつき |
| 撮像が本番と違う | 試験室で撮った画像で PoC を行い、ラインの振動・照明・速度で同じ画像が撮れない | PoC の画像をできる限りラインの上か、ラインと同じ条件で撮る | 過検出・タクトの超過 |
| 速度を測っていない | 精度は出たが、ラインの速度で処理が追いつかない | タクトから逆算した時間の条件を合格の条件に入れる | タクトの超過 |
| つなぎ先が無い | 判定は出るが、排出・記録・停止の仕組みにつながらない | PoC の段階で、第11章の記録項目と排出の方法を決めておく | 形骸化 |
| 運用する人がいない | PoC を外部に任せたため、本番で再学習や品種の追加を担う人が社内にいない | 運用を担う社内の担当者を PoC の段階から参加させる | 形骸化・二重投資 |
表の中で、外観検査AIに特有と考えられるのは「撮像が本番と違う」型です。第3章で扱ったとおり、外観検査の精度の上限は撮像で決まります。試験室で、照明とカメラを丁寧に合わせ、製品を止めて撮った画像は、ラインの上で、製品が動き、周囲の光が入り、振動のある状態で撮った画像とは違います。PoC を試験室の画像だけで行うと、モデルの性能というより撮像の条件の違いによって、本番で過検出や見逃しが増えることがあります。PoC の画像をラインの上で撮るのが難しい場合でも、少なくとも評価用データの一部はラインの上で撮り、試験室の画像との結果の差を確かめておくことを勧めます。
「運用する人がいない」型は、外部に PoC を委託した場合に起きやすい型です。PoC の段階では、撮像の検討からモデルの学習と評価までを外部の装置メーカーや開発会社がまとめて行うことが多く、それ自体は合理的な分担です。ただ、本番に入ると、第12章で扱った照明の劣化・品種の追加・再学習への対応が、工程によっては頻繁に発生します。その対応のたびに外部に依頼するのか、社内で担うのかを PoC の段階で決めておかないと、本番に入ったあとで対応が遅れ、AIの判定が信用されなくなり、人が全数を見直す形骸化につながります。内製と外部委託の分担は、後の節で扱います。
効果の見立て、流出・過検出・検査の工数を件数と時間と相対コストで書く
PoC の計画を通すにも、展開の予算を得るにも、効果の見立てが求められます。このとき、効果をいきなり金額で書こうとすると、根拠の薄い単価を掛け合わせた数字が一人歩きしやすくなります。本コラムでは、効果を金額ではなく、件数・時間・相対コスト(単位なしのコスト)の型で書くことを勧めます。金額への換算は、各社の経理と品質保証の部門が、自社の単価で行えばよく、外観検査AIの計画書の段階で金額を置く必要はないと考えています。
見立ての対象は、序章で整理した6つの損失の型に沿って考えると、漏れが少なくなります。次の表は、6つの損失の型と、それとは別に数える検査の工数について、何を数え、導入の前にどこから数字を取り、導入の後に何と比べるかをまとめたものです。
| 見立ての対象 | 数えるもの | 導入の前の数字の取り方 | 導入の後に比べるもの |
|---|---|---|---|
| 流出 | 後工程・顧客で見つかった不良の件数と、その内容 | 品質保証の記録(顧客からの指摘、後工程からの差し戻し) | 同じ期間の長さ・同じ品種での件数を、生産数・検査数と並べて比べる。件数が少ない場合は期間を長く取る |
| 過検出 | 不良と判定されたが、再検査で良品と分かった件数と、その再検査の時間 | 目視検査で不良とした品の再検査の記録(記録が無ければ PoC の期間に取り始める) | AIの判定での過検出の件数と、再検査の時間 |
| 判定のばらつき | 検査員どうし・勤務帯どうしの判定の一致の度合い | 第2章の方法で、同じ製品を複数の検査員が判定した結果 | 同じ基準の試料(限度見本や正解を確かめた製品)に対する AIの判定と限度見本の判定の一致 |
| タクトの超過 | 検査が原因でラインが止まった回数と時間、検査の待ちの時間 | 製造の稼働の記録 | 同じ記録での回数と時間 |
| 形骸化 | 計画に無いのに人が AIの判定を見直した件数の割合(保留の確認や計画した抜き取りの確認は含めない) | (導入の前には無い) | 並行稼働の後に、計画外の見直しの割合が下がっているか |
| 二重投資 | 工程・工場ごとに別々に作った撮像・モデル・記録の仕組みの数 | 既存の検査装置と仕組みの一覧 | 共通の仕組みに載った工程の数 |
| 検査の工数(損失の型とは別に数える) | 目視検査にかかる時間と人数 | 勤務表と検査の工数の記録 | 導入の前の目視検査の総人時から、導入の後に残る目視検査・保留の確認・不良と判定したものの確認(過検出を含む)・抜き取りの確認の総人時を引いた差 |
表の最後の行のとおり、検査の工数の削減は「過検出」と「流出」の行とは別に数えます。目視検査にかかっていた時間のうち、AIが判定することで人が見なくてよくなった時間が、工数の削減です。ただし、第10章で扱ったとおり、AIの判定を保留にして人に回す範囲が残るので、検査員の工数がゼロになるわけではありません。工数の見立ては、導入の前の目視検査の総人時から、導入の後に残る作業の総人時を引いた差として書きます。残る作業には、AIの対象外の目視検査、保留の確認、不良と判定したものの確認(本当の不良と過検出の両方)、抜き取りの確認が入り、同じ作業を二重に数えないようにします。正解のラベルの付与や装置の保守の工数は、検査の工数とは別の枠で書きます。保留の率と過検出率は PoC の結果から見積もれますが、本番のラインで同じ率になるとは限らないので、見立ては幅を持たせて書いておきます。
相対コストを使う場合は、第8章で扱った考え方に沿って、見逃し1件と過検出1件のコストの比を、品質保証と製造で合意しておきます。たとえば、本コラムが置いた仮の例として「見逃し1件のコストは過検出1件のコストの数倍から数百倍」のように幅で置き(この幅は出典のある目安ではなく、値は各社が自社の工程で決めるものです)、その幅のどこを取っても結論が変わらないかを確かめます。比の値は工程によって大きく違い、顧客に届くと安全に関わる部品と、後工程で確実に見つかる外観の軽い欠陥とでは、同じ比にはなりません。比を1つの値に決めきれないこと自体は問題ではなく、幅の中で判断が変わるかどうかを確かめることが大事だと考えています。
効果の見立てを書くときに避けたいのは、公開の事例や研究の数字を、そのまま自社の効果として書くことです。第14章で扱うとおり、公開の事例の効果の数字は、その会社の、その工程の、その条件での値で、研究の数字は公開データセットでの値です。どちらも自社の工程で同じ値が出る根拠にはなりません。見立ての数字は、自社の工程の導入の前の記録と、PoC の結果から作り、「PoC の評価用データでは」「この期間の記録では」という限定を付けて書きます。
段階的な展開、1工程から1ライン、工場へ。並行稼働の期間を置く
PoC に合格しても、すぐに目視検査を外して AIだけで判定する形に切り替えるのは避けるべきだと考えています。PoC の評価用データは、限られた期間・ロット・品種から集めたもので、本番のラインで起きる変動のすべてを含んではいません。本コラムでは、PoC のあとに、本番のラインで AIと人の目視検査を同時に動かし、両者の判定を突き合わせる期間を置くことを勧めます。これを並行稼働と呼びます。並行稼働の間、その工程の外観検査の判定は従来どおり人の目視検査で行い、AIの判定は記録するだけにします。
並行稼働で確かめることは、PoC で確かめたことの「本番での再現」です。具体的には、AIと人の判定が食い違った製品を集め、どちらが限度見本に照らして正しかったかを品質保証と検査員が確かめます。AIだけが不良とした製品は過検出の候補で、人だけが不良とした製品は AIの見逃しの候補です。どちらも、件数と内容を週ごとに集計します。ただし、食い違った製品だけを見ても、AIと人がそろって良品とした不良や、そろって不良とした良品は見つかりません。見逃し率と過検出率を求めるには、判定が一致した製品からも決めた方法で抜き取って正解を確かめ、正解が不良のもの・良品のものの数を分母にします。抜き取りの対象・方法・数は並行稼働の計画に書き、移行の判断では第8章で扱った信頼限界も合わせて見ます。人の判定が限度見本とずれていた例も見つかるので、並行稼働は AIの評価であると同時に、目視検査の判定のばらつきを測る機会にもなります。
並行稼働の期間は、本番で起きる変動を一通り経験できる長さにします。材料のロットの切り替え、勤務帯の違い、品種の切り替え、季節による温度や湿度の変化などのうち、その工程で効く変動を一通り含む期間です。どれだけの長さが要るかは工程によって違うので、本コラムでは具体的な期間を示しません。期間を決めるときは、第8章で扱った「見逃し率を確かめるのに必要な不良の数」を目安にします。不良が少ない工程では、見逃し率を確かめるのに必要な数の不良が集まるまでに長い期間がかかり、その期間は並行稼働を続ける必要があります。
並行稼働のあとの展開は、次のように段階を分けて進めるのがよいと考えています。
| 段階 | 範囲 | その工程の外観検査の判定に使うもの | 次の段階へ進む条件 | 主に判断する人 |
|---|---|---|---|---|
| PoC | 1工程・代表的な品種・試験室またはラインで撮った画像 | (本番の判定はしない) | 合格の条件を満たし、出口として並行稼働が承認された | 品質保証の責任者・工場長 |
| 並行稼働 | 1工程の本番のライン | 人の目視検査(AIの判定は記録だけ) | 食い違いの確認と、一致した製品からの抜き取りの確認を合わせて求めた見逃し率と過検出率が、信頼限界も含めて合格の条件の範囲に収まった | 品質保証の責任者 |
| 部分の切り替え | 1工程で、AIが良品と判定したものの一部を人が見ない形にする | AIの判定と、保留を人が見た結果(第10章) | 保留の率・人の見直しの割合・流出の件数が計画どおり | 品質保証の責任者(工場長は相談を受ける) |
| 1ライン | 同じラインの他の工程・他の品種 | 工程ごとに、上の段階を経たもの | 工程ごとの記録と、共通の仕組み(記録・監視)がそろった | 工場長 |
| 工場・複数の工場 | 他のライン・他の工場 | 同上 | 撮像・記録・監視の仕組みを共通にできることを確かめた | 経営 |
表の「部分の切り替え」は、並行稼働から AIだけの判定へ一度に切り替えるのではなく、AIの判定を使う範囲を少しずつ広げる段階です。第10章で扱った保留の仕組みを使い、AIがはっきり良品と判定したものだけを人が見ない対象にし、保留と不良は引き続き人が見ます。そのうえで、人が見ない対象から一定の割合を無作為に抜き取り、人が見て確かめる手順を残しておくと、AIが良品と判定したものに含まれる不良の割合を本番で測り続けることができます。この割合は、正解が不良のもの全体に占める見逃しの割合(見逃し率)とは分母が違います。見逃し率を推定するには、保留と不良と判定したものを人が確かめた結果と、抜き取りの割合を合わせて計算します。法令・顧客との取り決め・業界の規格で検査の方法が定められている製品では、この切り替えができるかどうかは、それらの定めと顧客との取り決めによって決まります。本コラムは、そうした検査を AIで置き換えられるとは書きません。切り替えの可否は品質保証の体制が、定めと取り決めを確かめたうえで判断するものです。表の3列目は、その工程の外観検査の判定に何を使うかを示したもので、出荷の承認そのものではありません。出荷の承認は、外観検査以外に必要な検査の結果も含めて、品質保証が承認した手順に従います。
1ラインから工場、複数の工場へ広げる段階で気を付けたいのは、二重投資の損失の型です。工程ごとに別の装置メーカーに依頼し、別の記録の仕組み・別の監視の画面を作っていくと、第11章で扱った記録とトレーサビリティ、第12章で扱った変化の監視を、工程ごとに作り直すことになります。最初の1工程の段階から、記録の項目・画像の保存の方針・監視の指標・モデルの版の管理を、他の工程でも使える形で決めておくと、2工程目以降の手間が小さくなります。
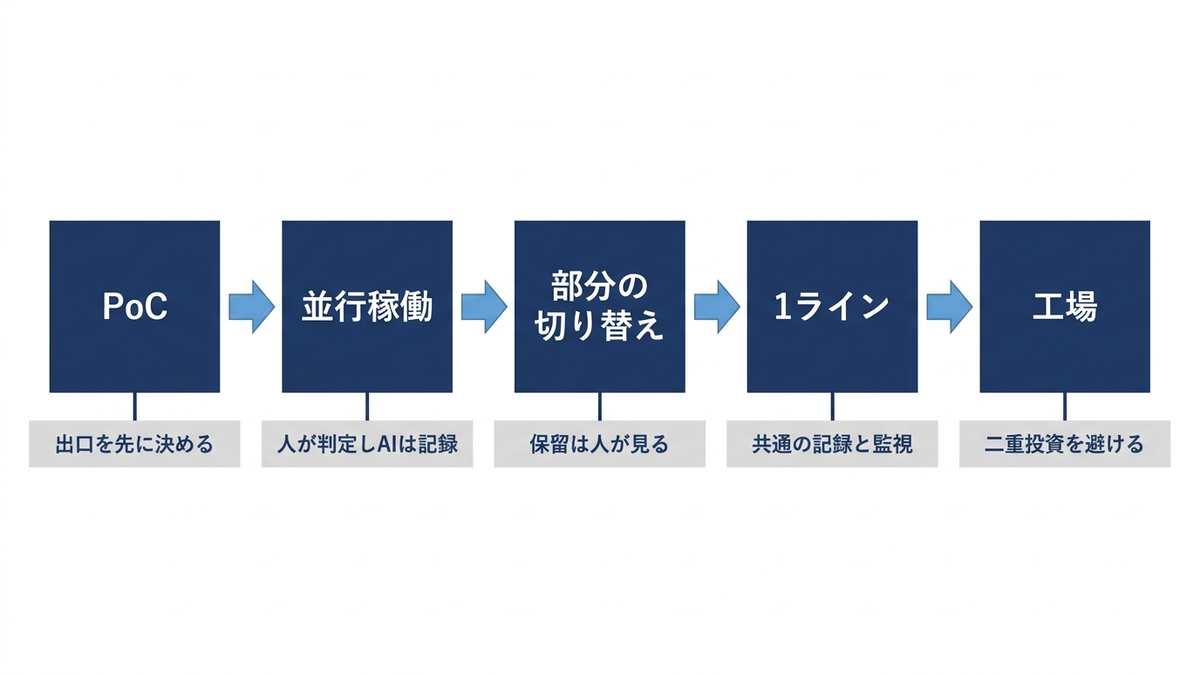
役割と責任分担、誰が決め、誰が作業し、誰に相談し、誰に知らせるか
外観検査AIの導入に関わる人は、AIの開発に関わる人より多くなります。撮像はラインの設備に関わり、判定は品質保証の仕組みに関わり、記録は工場の情報システムに関わるからです。本コラムでは、関わる役割を次の9つに分けて考えます。役割の名前は一般的なものにしてあり、組織によっては1人が複数の役割を兼ねます。
- 経営:導入の方針・予算・複数の工場への展開を決める
- 工場長:対象工程の選定・PoC の出口・並行稼働への移行を承認する
- 品質保証:判定基準と合格の条件を決め、出荷の可否の仕組みに責任を持つ
- 製造:ラインの稼働と検査の工数を管理し、並行稼働の運用を担う
- 生産技術:撮像の設計・装置の設置・ラインとのつなぎを担う
- 検査員:限度見本に照らした判定と、正解のラベルの付与・食い違いの確認を担う
- データ担当:画像の収集・モデルの学習と評価・変化の監視を担う
- 情報システム:記録の仕組み・ネットワーク・情報セキュリティを担う
- 外部の装置メーカー:撮像の機器・検査装置・場合によってはモデルの開発を担う
この9つの役割で、主な作業ごとの責任分担を表にしたのが次の表です。表の記号は、R(実行する。作業を担う)、A(最終的に責任を持つ。承認する。各行に1つだけ)、C(相談を受ける。意見を出す)、I(結果を知らされる)を表します。この4つの区分の考え方は RACI と呼ばれ、フレームワークとしての一般的な使い方は弊社コラム『経営とAIの打ち手を導く戦略フレームワーク大全179選』で扱っています。ここでは外観検査AIの導入に当てはめた表を示します。表の割り振りは本コラムが考えた例で、組織の大きさや既存の体制によって変わります。
| 作業 | 経営 | 工場長 | 品質保証 | 製造 | 生産技術 | 検査員 | データ担当 | 情報システム | 外部の装置メーカー |
|---|---|---|---|---|---|---|---|---|---|
| 対象工程の選定 | I | A | R | R | R | C | C | I | C |
| 判定基準と限度見本の整備 | I | I | A | C | C | R | C | I | I |
| PoC の合格の条件と出口 | I | A | R | C | C | C | R | I | C |
| 撮像の設計と装置の設置 | I | I | C | C | A | C | C | I | R |
| 正解のラベルの付与 | I | I | A | I | I | R | R | I | I |
| モデルの学習と評価 | I | I | C | I | C | C | A | I | R |
| 並行稼働の運用と食い違いの確認 | I | I | A | R | C | R | R | I | C |
| 部分の切り替えの判断 | I | C | A | C | C | C | R | I | I |
| 記録とトレーサビリティの仕組み(記録の項目と保管の期間を決め、仕組みを作る) | I | I | A | C | C | I | R | R | C |
| 変化の監視と原因の切り分け | I | I | C | I | C | C | A | I | R |
| 再学習の実行と、再学習したモデルへの切り替えの承認 | I | I | A | I | C | C | R | I | C |
| 撮像条件・しきい値の変更の承認 | I | C | A | C | R | C | R | I | C |
| 工場全体・複数の工場への展開 | A | R | C | C | R | I | R | C | C |
この表で意図して置いたのは、次の3つの割り振りです。1つ目は、次の7行の A をすべて品質保証にしたことです。
- 判定基準と限度見本の整備
- 正解のラベルの付与
- 並行稼働の運用と食い違いの確認
- 部分の切り替えの判断
- 再学習の実行と、再学習したモデルへの切り替えの承認
- 撮像条件・しきい値の変更の承認
- 記録とトレーサビリティの仕組み
記録については、第11章で扱ったとおり、記録の項目と保管の期間を決めるのは品質保証で、その仕組みを作るのは情報システムとデータ担当(R)です。第12章で扱ったとおり、再学習したモデルの結果が良さそうに見えても、データ担当や外部の装置メーカーだけの判断で切り替えず、品質保証が承認して切り替えます。外観検査AIが何を不良とするかは、モデルではなく判定基準が決めます。判定基準と、それに基づく出荷の可否の仕組みに責任を持つのは品質保証の体制であり、その責任をデータ担当や外部の装置メーカーに移さないためにこの割り振りにしました。2つ目は、検査員を「正解のラベルの付与」と「並行稼働の食い違いの確認」の R に置いたことです。これについては次の節で扱います。3つ目は、「モデルの学習と評価」と「変化の監視と原因の切り分け」の A を、外部の装置メーカーではなく社内のデータ担当にしたことです。作業そのもの(R)は外部に任せる場合でも、納められたモデルを社内の評価用データで評価し直し、変化の原因を切り分ける人は社内に置いておく必要があると考えています。その評価の結果を受け入れて本番のモデルを切り替えるかどうかの承認は、上のとおり品質保証が行います。
表の A は各行に1つだけ置きました。A が2つある行は、承認する人が2人いることになり、意見が割れたときに決まらなくなります。逆に、A が無い行は、誰も承認しないまま作業が進むか、作業が止まります。表を自社の組織に当てはめるときは、まず各行の A が1人に決まっているかを確かめ、次に R を担う人の工数が確保されているかを確かめることを勧めます。なお、「部分の切り替えの判断」の行で R をデータ担当にしたのは、並行稼働の食い違いの集計と、見逃し率の信頼限界(第8章)を判断の材料としてまとめる作業を想定したためで、判断そのものは A の品質保証が行います。
検査員の役割、判定基準の持ち主として体制に残す
外観検査AIの導入の目的として「検査員を減らす」ことが掲げられることがあります。検査の人手の不足が導入の動機である以上、目視検査に使う時間を減らすことは正当な目標です。ただ、検査員を「AIに置き換える作業者」として扱い、導入とともに体制から外していくと、外観検査AIを支える仕組みの中で、代わりの利かない役割が失われると考えています。本コラムでいう検査員の役割は、製品を1個ずつ見て判定する作業だけではなく、次の4つを含みます。
- 判定基準の持ち主:限度見本に照らして、どこからが不良かを判断できる人。限度見本の更新や、新しい欠陥の扱いを品質保証と決める場に、現物を知る立場で参加する(第2章)
- 正解を付ける人:学習と評価に使う画像に、限度見本に照らした正解のラベルを付ける。ラベルの誤りや検査員どうしの不一致は、学習と評価の信頼性を損なう(第2章・第5章)
- 保留を判断する人:AIが決めきれない範囲を見て、良品か不良かを決める(第10章)
- 変化に最初に気付く人:AIの判定と自分の見た目が合わなくなったとき、照明の劣化・材料の変化・新しい欠陥に気付く(第12章)
この4つの役割は、AIの導入によって無くなるのではなく、むしろ重要になると考えています。AIは学習によって得た判定の規則を当てはめますが、その規則が社内の判定基準を忠実に再現している保証はなく、判定基準そのものを決めることもできません。新しい欠陥が現れたとき、それを不良とするかどうかを決めるのは品質保証の体制で、その判断に現物の見え方を持ち込めるのは検査員です。保留を判断する人がいなければ、第10章で扱った保留の仕組みは成り立ちません。正解を付ける人がいなければ、第12章で扱った再学習のための新しいラベルが作れません。
検査員の側から見ると、AIの導入によって仕事の中身が変わります。全数を同じ注意で見続ける仕事から、AIが保留にしたもの・AIと食い違ったもの・抜き取りで確かめるものを、より注意して見る仕事に移ります。第10章で扱ったとおり、人が AIの判定に引きずられる問題があるので、AIの判定を見せる順番や画面の作りは、検査員の判断が AIに寄りすぎないように設計する必要があります。仕事の中身が変わることは、導入の計画の段階で検査員に説明し、並行稼働の期間に、新しい仕事の手順を検査員と一緒に作っていくことを勧めます。検査員が自分の判定と AIの判定の食い違いを確かめる作業は、並行稼働の中心的な作業でもあります。
技能の継承の観点からも、検査員を体制に残す意味があります。2026年版ものづくり白書で厚生労働省が紹介した独立行政法人労働政策研究・研修機構の調査では、技能継承が必要と考えている製造業の企業(従業員30人以上)に取り組みを複数回答で尋ねたところ、「再雇用や勤務延長などにより高年齢者従業員に継続して勤務してもらう」が最も多く、54.8%でした。この結果は検査を含む技能全般についてのもので、外観検査に限ったものではありませんが、技能の継承を熟練者が働き続けることに頼る企業が多いという点は、熟練した検査員の判断を早めに限度見本とラベルの形で残しておく理由になると考えています。
外観検査AIの導入は、熟練した検査員の判断を、限度見本・正解のラベル・保留の判断の記録という形で残す機会になります。熟練者が「なぜこれを不良とし、これを良品とするか」を説明しながらラベルを付けていくと、その説明は限度見本の補足として残り、若い検査員の教育にも使えます。逆に、熟練者が退職したあとで導入を始めると、正解を付けられる人がいない、という状態から始めることになります。人手の不足を理由に導入を急ぐ場合でも、熟練者がいるうちに判定基準とラベルを整えることを、導入の計画の最初に置くことを勧めます。
内製と外部委託の分担、何を外に任せ、何を社内に残すか
外観検査AIの導入では、撮像の機器・検査装置・モデルの開発を、外部の装置メーカーや開発会社に依頼することが多いと思われます。撮像の設計には照明と光学の専門の知識が要り、検査装置をラインに組み込むには機械と制御の知識が要るので、それらを1社の社内でそろえるのは容易ではありません。外部に任せること自体は合理的で、問題になるのは、何を外に任せ、何を社内に残すかを決めないまま任せることです。
本コラムでは、内製と外部委託の分担を、作業の種類ごとに次のように考えます。これは一般論で、社内の体制や工程の数によって変わります。
| 作業 | 外部に任せやすいもの | 社内に残したいもの | 理由 |
|---|---|---|---|
| 判定基準と限度見本 | (任せない) | 判定基準の決定・限度見本の管理 | 何を不良とするかは品質保証の体制が決める |
| 撮像の設計 | 照明・カメラ・レンズの選定、試し撮り、装置の設計 | 撮像の条件の記録と、条件を変えるときの承認 | 撮像の条件の変更は判定に直接効く(第3章・第12章) |
| 正解のラベルの付与 | ラベル付けの道具の用意、作業の補助 | 限度見本に照らした最終の正解 | 正解の誤りや不一致は、学習と評価の信頼性を損なう |
| モデルの学習 | 手法の選定・学習・調整 | 評価用データの保管と、評価の結果を受け入れるかの判断 | 評価用データを社内に持っていれば、モデルを替えても同じ基準で比べられる |
| ラインへの組み込み | 装置の設置・PLC(工場の機械を決めた順序で動かす制御装置。詳しくは第11章)との信号のやりとり | 記録の項目と保存の方針、停止時の手順 | 記録とトレーサビリティは品質保証の仕組みの一部(第11章) |
| 運用と保守 | 装置の保守・再学習の作業 | 変化の監視の指標と、再学習の判断 | 変化に気付いて判断する人が社内にいないと対応が遅れる(第12章) |
表の中で、とくに社内に残しておきたいのは評価用データです。評価用データは、本番の工程から集め、限度見本に照らして正解を付けた画像の集まりで、モデルの良し悪しを判断する物差しになります。評価用データを社内で保管し、外部から納められるモデルを毎回同じ評価用データで評価する仕組みにしておけば、依頼先を替えても、モデルの手法を替えても、同じ物差しで比べられます。評価用データを外部の手元にしか置いていないと、納められたモデルの評価の結果を、社内で確かめ直すことができません。ただし、同じ評価用データの結果を見ながらモデルやしきい値の調整を繰り返すと、そのデータにだけ合った結果になるおそれがあります。モデルを比べるための固定のデータ、調整に使うデータ、調整には使わない最後の評価のデータを分けておき、本番の変化を映した新しい評価用データも時期を決めて足していきます。
外部に依頼する範囲と、社内に残す範囲は、契約の段階で文書にしておきます。社内と外部の役割と、画像・ラベル・学習したモデル・評価の結果といった成果物をどう管理するか、再学習を依頼するときに何を渡し何を受け取るか、といった項目です。契約の条件そのものは本コラムの範囲を超えるので書きませんが、AIの開発を依頼する場合は、学習に使うデータの扱い・学習したモデルの扱い・性能を事前に約束しにくいことのように、決まった仕様の装置を納める場合とは違う論点が出やすいと考えています。次の段階へ進むための社内の承認の条件を、PoC の出口と同じ言葉でそろえておくと、外部とのやりとりと社内の判断がずれにくくなります。AIの社内ルールや規制との関係は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
最初の90日の計画、週ごとに何を決め、何を残すか
ここまでの内容を、導入を決めてから最初の90日(およそ13週)の計画に落とします。次の表は、本コラムが考えた計画の例です。90日で PoC の結論を出し、並行稼働に進むかどうかを判断するところまでを範囲にしています。実際の期間は、画像を集める速さ(不良の出る頻度)と、撮像の検討にかかる時間で大きく変わるので、週の区切りは目安です。不良が少ない工程では、評価用データを集める期間がこの表より長くなります。
| 週 | 主な作業 | 決めること | 残すもの | 主に担う役割 |
|---|---|---|---|---|
| 第1週・第2週 | 候補の工程の洗い出しと採点、導入の前の記録の収集 | 最初の1工程と、対象の欠陥・品種 | 採点の表、流出・過検出・検査の工数の導入前の記録 | 品質保証・製造・生産技術・検査員 |
| 第3週・第4週 | 限度見本の確認、検査員どうしの判定の一致の測定、試し撮り | 判定基準を整える必要があるか、画像だけで判別できるか | 一致の測定の結果、試し撮りの画像と検査員の判定 | 品質保証・検査員・生産技術 |
| 第5週 | PoC の計画書の作成と承認 | 期間・評価用データ・合格の条件・速度の条件・出口・判断する人 | 承認された PoC の計画書 | 品質保証・データ担当・工場長 |
| 第6週から第8週 | 撮像の条件の決定、学習用の画像の収集と正解のラベルの付与 | 撮像の条件(照明・露光・位置決め) | 撮像の条件の記録、ラベル付きの学習用の画像 | 生産技術・外部の装置メーカー・検査員 |
| 第9週・第10週 | 評価用データの収集(学習用とは別の期間・ロット)、モデルの学習 | 評価用データの中身(不良の数・ロット) | 社内で保管する評価用データ、モデルの版 | 検査員・データ担当・外部の装置メーカー |
| 第11週・第12週 | 評価、速度の測定、食い違った画像の確認 | 合格の条件を満たしたか | 評価の結果(見逃し・過検出・保留の件数と率、撮像から判定の出力までの所要時間と、連続して流したときの処理能力) | データ担当・品質保証・検査員 |
| 第13週 | 出口の判断 | 並行稼働へ進むか、撮像の見直しか、対象の絞り込みか、中止か | 判断の記録と理由、並行稼働の計画の案 | 工場長・品質保証 |
表の第3週と第4週に置いた「限度見本の確認」と「検査員どうしの判定の一致の測定」は、PoC を始める前の作業です。ここで判定基準のばらつきが大きいと分かった場合は、PoC の開始を遅らせてでも、基準をそろえる作業を先に行います。この判断は計画の遅れに見えますが、基準がそろわないまま PoC を進めて、評価の結果の意味が定まらないまま13週を使うより、手戻りは小さいと考えています。
第13週の出口の判断では、PoC の計画書に書いた出口のどれに当たるかを確かめるだけにし、その場で新しい合格の条件を作らないようにします。結果を見てから条件を変えると、PoC が何を確かめたのかが分からなくなります。条件を変える必要があると分かった場合は、それを次の PoC の計画書に書き、改めて承認を得ます。判断の記録には、結果の数字だけでなく、評価用データの中身(不良の数・ロット・期間)を必ず添えます。後で並行稼働の結果と比べるときに、何と比べているのかが分かるようにするためです。
経営判断、PoC の出口を先に決め、検査員を外さない
この章の内容を、経営の判断に置き換えます。外観検査AIの導入で経営が決めることは、どのモデルを使うかではなく、どの工程から、どの条件で、誰の責任で進めるかです。とくに、PoC の出口を始める前に決めることと、検査員を判定基準の持ち主として体制に残すことの2つは、経営の判断として明文化しておくのがよいと考えています。
判断を誤ったときの損失は、序章で整理した6つの損失の型で整理できます。PoC の出口を決めずに始めると、PoC が工程ごとに延長されて続き、似た検討が工程ごとに繰り返される二重投資になります。評価用データを学習用と同じ期間から集めると、期間やロットの変動を評価できず、本番の性能を過大に見積もるおそれがあり、見逃しによる流出か、過検出による再検査の増加につながります。並行稼働を置かずに切り替えると、本番の変動で判定が揺れたときに AIの判定が信用されなくなり、人が全数を見直す形骸化につながります。検査員を体制から外すと、保留を判断する人と正解を付ける人がいなくなり、判定のばらつきが測れなくなり、新しい欠陥への対応が遅れます。速度の条件を PoC で確かめないと、タクトの超過でラインを止めることになります。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- PoC の計画書に、合格の条件・出口・判断する人を書くことを、PoC の予算を付ける条件にする
- 出荷の可否の仕組みの責任は品質保証の体制に置き、AIの判定を使う範囲を広げる判断も品質保証が行うことを明文化する
- 並行稼働の期間を計画と予算に含め、PoC の合格からすぐに目視検査を外さない
- 検査員の工数を、AIの導入で減らす分だけでなく、正解のラベル・保留の判断・食い違いの確認に使う分として計画に入れる
- 評価用データを社内で保管し、外部から納められるモデルを社内の評価用データで評価する仕組みを作る
- 最初の1工程の段階から、記録・監視・版の管理を他の工程でも使える形で作り、工程ごとの作り直しを避ける
予算の面では、外観検査AIの予算を装置とモデルの開発だけに付けるのではなく、限度見本の整備・正解のラベルの付与・評価用データの収集と保管・並行稼働の運用にも付けることを勧めます。これらは目に見える装置の形をとらない作業ですが、ここに予算と人の時間が付いていないと、PoC の結果の意味が定まらず、本番への移行の判断ができません。体制の面では、品質保証の責任者が PoC の最初から関わることを、導入の条件にするのがよいと考えています。品質保証が関わらないまま進んだ PoC は、合格しても、出荷の可否の仕組みに組み込む段階で、判定基準や評価の方法を一から見直すことになりやすいからです。
この章の要点をまとめると、最初の1工程は効果の大きさ(流出の影響・検査の人手)と確かめやすさ(欠陥の写りやすさ・判定基準のそろい方・品種の数)で選び、PoC は合格の条件・出口・判断する人を始める前に決め、合格したら並行稼働を経て AIの判定を使う範囲を少しずつ広げます。効果は金額ではなく件数・時間・相対コストの型で書き、出荷の可否と再学習したモデルへの切り替えの承認は品質保証が担い、検査員は判定基準の持ち主・正解を付ける人・保留を判断する人・変化に最初に気付く人として体制に残します。次の第14章では、公開データセットと研究の動向、基盤モデルの活用、公開事例を扱い、それらの数字を条件つきで読む方法を整理します。
Anagraftでは、検査工程を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『AIプロジェクトの管理』(Malini Jain Runtasewee、Adrián González Sánchez 著、鈴木駿、高山洪銘、中島於菟 訳、オライリー・ジャパン):2026年10月刊の訳書で、版元の紹介では、アイデアの創出から PoC、本番の運用までのプロジェクトの管理を、要件定義・評価指標・データの品質・モデルの評価・ガバナンス・関係者の調整の観点で解説しています。この章で扱った PoC の計画書と出口の決め方を、プロジェクトの管理の一般的な枠組みの中で整理し直すときに参考になります。
『AIプロジェクトマネージャのための機械学習工学』(吉岡信和、鷲崎弘宜、内平直志、竹内広宜 著、科学情報出版):2023年1月刊の設計技術シリーズの1冊で、第1章の「AIシステムの開発概論」から始まり、機械学習を使うシステムの開発を、プロジェクトの管理者に向けて扱っています。この章で扱った、外部に任せる作業と社内に残す判断の分け方を、機械学習のシステムの開発の進め方として考えるときの手がかりになります。
第14章 公開事例と最新動向、規格・公開データセット・基盤モデルの活用
第13章では、対象工程の選定から PoC(試験導入)の設計、段階的な展開、検査員を判定基準の持ち主として残す体制までを扱いました。導入を検討する段階では、社外の情報、つまり研究の論文や公開データセットでの成績、他社の公開事例、新しい技術の発表を参考にする場面が多くなります。この章では、そうした社外の情報を、自社の判断の材料として使うための読み方を扱います。
この章では、コードを載せずに、表と概念図で次の内容を説明します。
- 研究で使われる代表的な公開データセットの提供元・中身・利用条件(公式のページと原論文で確かめた範囲)
- 論文に書かれた成績の数字の読み方と、その数字が自社の現場の期待値にならない理由
- 良品学習の研究の流れと、学習に使う画像を減らす方向の研究
- 画像と文章を一緒に学んだ大規模なモデル(基盤モデル)を外観検査に使う研究と、その限界
- 生成AIを不良画像の生成や検査の周辺の業務に使う考え方
- 企業・公的機関が公式に公表している外観検査AIの事例と、その読み方
- AIに関する規格・規制との関係
- 社外の情報を取り入れたときに起きやすい形骸化の型と、経営判断
この章の主張は1つです。公開データセットの成績も、他社の事例の数字も、その条件のもとでの値であり、自社の工程にそのまま当てはめることはできないと考えています。社外の情報は「何が可能になりつつあるか」と「どこで外れやすいか」を知る材料として使い、自社の工程での期待値は、第8章の評価の方法で自社の画像を使って確かめる必要があります。
研究で使われる公開データセット、MVTec AD から VisA まで
外観検査AIの研究、とくに良品学習(異常検知)の研究では、手法どうしを同じ条件で比べるために、誰でも入手できる公開データセットが使われます。公開データセットは、画像と、どの画像が良品でどの画像に欠陥があるか、欠陥がどの位置にあるかという正解の情報をまとめたものです。論文に書かれた成績は、ほとんどがこうした公開データセットで測った値です。ここでは、良品学習の研究で使われることが多い4つを、提供元の公式のページと原論文で確かめた範囲で紹介します。
最も広く使われてきたのが、MVTec AD です。画像処理のソフトウェア製品を扱う MVTec Software 社が公開しており、Bergmann らの2019年の論文(コンピュータビジョンの国際会議 CVPR で発表)で提案されました。本章では、論文を発表した場を示すために、国際会議や学術誌の名前を略称のまま添えます(CVPR・ECCV はコンピュータビジョン、AAAI は人工知能の国際会議です)。公式のページによると、MVTec AD は産業の検査を想定した異常検知の手法を比べるためのデータセットで、5,000枚を超える高解像度の画像を含みます。画像は15の品目に分かれ、品目は物体と表面の模様の2つの種類に分かれます。原論文の要旨では画像の数を5,354枚とし、欠陥は傷・打痕・汚れ・構造の変化など70種類を超えるとしています。各品目には、欠陥の無い学習用の画像と、評価用の画像があります。評価用の画像には、さまざまな欠陥を含む画像と欠陥の無い画像の両方が入っており、すべての欠陥に画素単位の位置の正解が付いています。
同じ MVTec Software 社は、MVTec LOCO AD も公開しています。Bergmann らの2022年の論文(国際誌 International Journal of Computer Vision に掲載)で提案されたもので、公式のページによると、5つの品目の3,644枚の画像を含みます。特徴は、欠陥を2つの種類に分けている点です。1つは傷・打痕・汚れのような構造的な異常で、もう1つは論理的な異常です。論理的な異常は、部品そのものには傷が無くても、あってよい部品が誤った位置にある、あるべき部品が無い、といった決まりごとに反する状態を指します。組付けの検査で問われるのは後者であることが多く、第6章で良品学習の弱点として挙げた論理的な異常を測るためのデータセットだといえます。
2025年には、MVTec AD 2 が公開されました。Heckler-Kram らの論文は、まず arXiv(研究者が論文を査読の前に公開できるサイト)に投稿され、その後、2026年3月に国際誌 International Journal of Computer Vision に掲載されました(2026年11月9日に論文の識別番号の登録情報で確認)。論文によると、8つの品目の8,000枚を超える高解像度の画像からなり、透明な物体・暗視野照明や透過照明での撮像・非常に小さな欠陥など、従来より難しい場面を集めています。評価用のデータは分かれています。正解の付いた公開の評価用データがある一方で、正解を公開しない評価用データもあり、こちらは提供元の評価用のサーバーで採点を受けます。正解を公開しない評価用データの一部には、学習用の画像に無い照明の条件も含まれています。
もう1つ、VisA(Visual Anomaly の略)があります。Zou らの2022年の論文で提案され、GitHub の amazon-science という組織の公開リポジトリで配布されています。リポジトリの説明によると、論文はコンピュータビジョンの国際会議 ECCV で発表されたもので、画像は10,821枚で、そのうち良品が9,621枚、欠陥のある画像が1,200枚です。画像は12の品目に分かれ、品目は次の3つの群に4種類ずつ入っています。
- プリント基板(4種類)
- 1枚の画像に同じ物が複数写るもの(カプセル・ろうそく・マカロニ2種類)
- 1枚に1つの物が写るもの(カシューナッツ・チューインガム・スナック菓子2種類)
VisA でも、欠陥のある画像には画素単位の位置の正解が付いています。
| データセット | 提供元 | 品目の数 | 画像の数 | 特徴 | 利用条件 |
|---|---|---|---|---|---|
| MVTec AD | MVTec Software 社 | 15 | 5,354枚(原論文の要旨。公式のページは5,000枚超と記載) | 物体と表面の模様。欠陥は70種類を超える。画素単位の正解 | CC BY-NC-SA 4.0。商用の目的での利用は認められていない |
| MVTec LOCO AD | MVTec Software 社 | 5 | 3,644枚 | 構造的な異常と論理的な異常(部品の欠落・誤った位置など) | CC BY-NC-SA 4.0。商用の目的での利用は認められていない |
| MVTec AD 2 | MVTec Software 社 | 8 | 8,000枚を超える(原論文の要旨) | 透明・暗視野や透過照明・微小な欠陥。正解を公開しない評価用データは提供元のサーバーで採点し、学習に無い照明の条件を含む | CC BY-NC-SA 4.0(原論文の記載。公式のページは開けなかった) |
| VisA | GitHub の amazon-science の公開リポジトリ | 12 | 10,821枚(良品9,621枚、欠陥1,200枚) | 基板・複数の物が写る画像・食品。画素単位の正解 | CC BY 4.0(リポジトリの記載) |
利用条件には、とくに注意が要ります。MVTec AD と MVTec LOCO AD の公式のページは、データを CC BY-NC-SA 4.0(クリエイティブ・コモンズの表示・非営利・継承の条件)で公開しているとし、商用の目的で使うことは認められないと明記しています。自社の製品の開発や、販売する検査装置の学習にこれらのデータセットを使えるとは限らず、公式のページは、判断に迷う場合は提供元に問い合わせるよう案内しています。VisA は、リポジトリの説明で CC BY 4.0(表示の条件)での公開とされていますが、自社での使い方が条件に合うかは、ライセンスの条文と自社の法務の確認で決めるべきものです。MVTec AD 2 は、本コラムの執筆時点で公式のページを開けませんでしたが、原論文が CC BY-NC-SA 4.0 で公開すると書いています。データセットの公式のページは次のとおりです。MVTec AD、MVTec LOCO AD、MVTec AD 2 の原論文、VisA のリポジトリ。いずれにしても、公開データセットは研究の比較のための道具であり、自社の検査の学習用のデータの代わりにはならないと考えておくのが安全です。
研究の数字の読み方、AUROC が高くても自社の期待値にはならない
論文の成績は、多くの場合、公開データセットの品目ごとに AUROC(第8章で扱った、しきい値を動かしたときの見逃しと過検出の関係を1つの数にまとめた指標)を計算し、その平均で示されます。たとえば、第6章で扱った PatchCore を提案した Roth らの2022年の論文(CVPR)は、要旨で、MVTec AD での画像単位の異常検知の AUROC が最大で99.6%に達したと報告しています。この数字は、MVTec AD という特定のデータセットの、その論文の条件での値です。
こうした数字を自社の期待値として読めない理由は、少なくとも4つあります。
- 撮像の条件が違う。MVTec AD 2 のように照明の変化を含むものもあるが、自社のラインで起きる照明の変化・位置ずれ・汚れ(第3章・第12章)の種類や範囲が十分に再現されているとは限らない
- 欠陥の定義が違う。公開データセットの「欠陥」は提供元が決めたもので、自社の判定基準(第2章)で不良になるもの・ならないものとは一致しない
- 指標が違う。AUROC はしきい値を決める前の指標で、ラインで必要な「見逃し率の上限を守ったときの過検出率」(第8章)とは別のものである
- 品目の平均である。平均が高くても、自社の品目に近い一部の品目では低いことがある
研究の側でも、既存のデータセットの成績が頭打ちになっていることが指摘されています。MVTec AD 2 の論文は要旨で、MVTec AD と VisA では欠陥の位置を当てる成績(AU-PRO という指標)の上位の手法どうしの差が1ポイント未満に縮まっている一方で、MVTec AD 2 では平均の AU-PRO が60%を下回るとしています。先に紹介したとおり、MVTec AD 2 は透明な物体・暗視野や透過照明・微小な欠陥・照明の変化といった難しい場面を集めたデータセットです。ただし、MVTec AD・VisA と MVTec AD 2 とでは、品目・欠陥・撮像・評価の方法がすべて違うので、この差がどの条件の違いから生じたかを、この比較だけで切り分けることはできません。本コラムとしては、既存のデータセットで頭打ちに見える成績が、場面を変えれば大きく違いうることを示す例として読み、撮像の条件が成績に効く可能性を考える材料にとどめます。
論文や製品の説明に書かれた数字を読むときに確かめたい点を、次の表にまとめました。
| 確かめる点 | なぜ確かめるか | 自社で代わりに測るもの(章) |
|---|---|---|
| どのデータセットの、どの品目の値か | 品目によって成績の差が大きく、平均だけでは自社に近い品目の値が分からない | 自社の品目ごとの評価(第8章) |
| 画像単位の指標か、位置の指標か | 不良の判定に使うのか、欠陥の位置を示すのに使うのかで、見るべき指標が違う | 判定の成績と、根拠の示し方(第8章・第10章) |
| しきい値を決めた後の値か | AUROC はしきい値を決める前の指標で、ラインでの見逃し率・過検出率は分からない | 見逃し率の上限を守ったときの過検出率(第8章) |
| 学習に何枚の画像を使ったか | 少数の画像での成績か、多数の画像での成績かで意味が変わる | 自社で集められる良品・不良の枚数(第7章) |
| 撮像の条件が評価で変わっているか | 照明や位置が変わったときの成績の下がり方は、多くのデータセットでは測られていない | 本番の変化の監視(第12章) |
| 推論の時間と計算機の条件 | 成績の高い手法が、タクトタイムに収まるとは限らない | タクトから逆算した推論の時間(第9章) |
| 事前学習の重みとデータの利用条件 | 研究で使える条件と、商用の検査で使える条件は違うことがある | ライセンスの確認(本章) |
この表の「自社で代わりに測るもの」の列が、研究の数字を読んだあとに必ず行う作業です。研究の数字は、手法を選ぶ候補を絞る段階では役に立ちますが、自社の評価の代わりにはなりません。PoC の合格の条件(第13章)を論文の数字から決めることは避け、自社の画像と判定基準で測った値で決めることが必要だと考えています。
手法の動向、良品学習の発展と学習に使う画像を減らす研究
良品学習の研究は、第6章で整理した系統、つまり再構成型・特徴の分布型・近傍型・知識蒸留型などに沿って発展してきました。MVTec AD の原論文の要旨では、提案の時点で、畳み込みのオートエンコーダ、敵対的生成ネットワーク、事前学習済みの畳み込みニューラルネットワークの特徴を使う方法、古典的な画像処理の方法を比べ、改善の余地が大きいとしていました。その後に発表された PatchCore の論文は、要旨で、成績の高い方法は ImageNet(大規模な画像のデータセット)で学習したモデルの特徴と外れ値の検出を組み合わせたものだとし、その流れを発展させる形で提案されています。
近年の研究の方向の1つは、学習に使う画像を減らすことです。MVTec AD でも、品目ごとに欠陥の無い学習用の画像をまとまった数だけ用意する形をとっています。これに対し、良品の画像を数枚しか使わない(少数の事例の学習)、あるいは対象の品目の画像を1枚も使わずに判定する(ゼロショットと呼ばれる)研究も行われています(後の節で紹介する WinCLIP など)。PatchCore の論文も、要旨で、少ない画像での設定でも成績を確かめたとしています。品種が多く、品種ごとに画像を集める手間が大きい工程では、この方向の研究が実用に近づけば、立ち上げの手間を減らせる可能性があります。ただし、少ない画像で学習させた場合は、良品のばらつきを十分に学べないおそれがあり、第7章で扱ったデータの少なさの問題がなくなるわけではありません。
もう1つの方向は、組付けの検査で問われる論理的な異常への対応です。MVTec LOCO AD のように、部品の欠落や位置の誤りを含むデータセットが公開されたことで、傷のような局所的な欠陥だけでなく、画像全体の構成の正しさを判定できるかを、手法どうしで比べられるようになりました。部品の有無や位置のように決まりごとが明確なものは、第4章で扱ったルールベースの画像処理で書けることも多く、研究の進み具合とは別に、ルールで足りるかを先に確かめる考え方は変わりません。
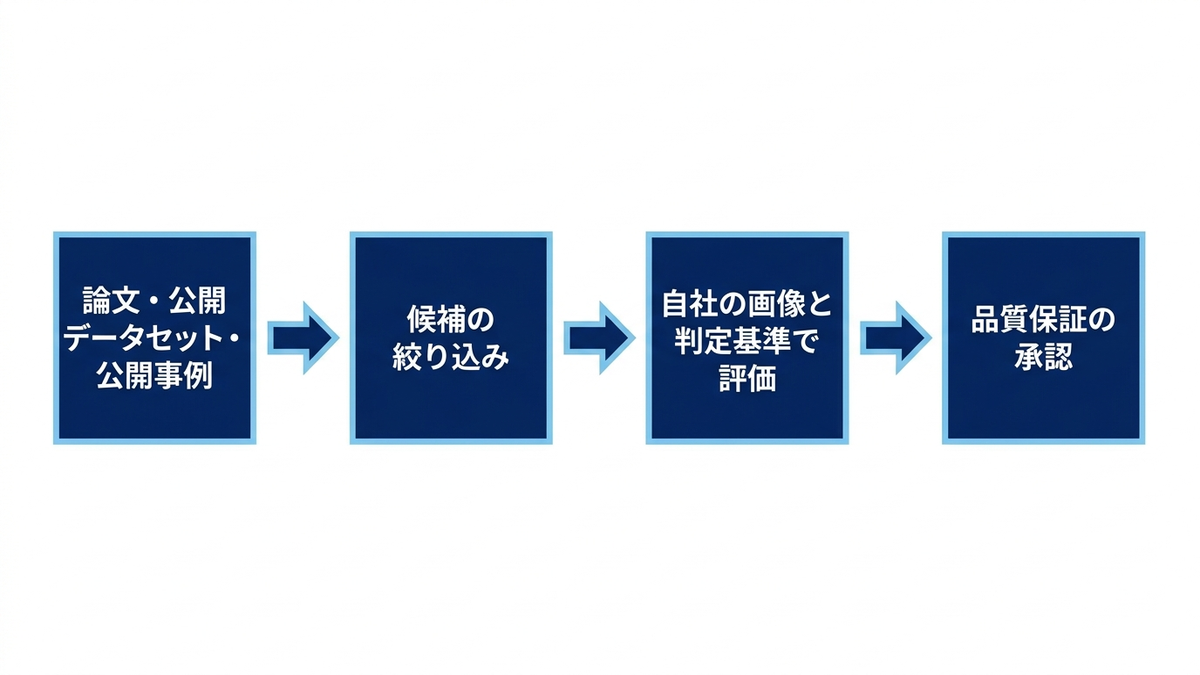
基盤モデルと視覚と言語のモデル、文章で欠陥を指定する方法
最近の研究で注目されているのが、基盤モデルを外観検査に使う方法です。基盤モデルは、非常に多くのデータで事前に学習させ、さまざまな用途に転用できるようにした大規模なモデルを指します。外観検査に関係が深いのは、画像と文章を一緒に学んだ視覚と言語のモデルです。代表的な CLIP(Radford らが2021年に arXiv で発表)は、インターネットから集めた4億組の画像と文章の組を使い、どの文章がどの画像に付いていたかを当てる課題で事前学習したモデルです。要旨によると、学習のあとは、文章で概念を指定するだけで、個別のデータセットでの学習なしに別の課題に転用できます。外観検査に当てはめると、「傷のある金属の板の写真」のような文章と画像の近さを測る、という使い方になります。
この考え方を異常検知に使った研究の1つが、WinCLIP です。Jeong らの2023年の論文(CVPR)が提案したもので、検査の課題ごとの学習をせずに判定する設定(ゼロショット)と、良品の画像を少数だけ使う設定を扱います。CLIP に、正常と異常を表す言葉の工夫と、画像を小さな窓に分けて文章と比べる仕組みを加えた方法です。ここでいう異常の判定は「その画像に異常があるか」を当てる成績、位置の推定は「画像のどこが異常か」を画素ごとに当てる成績です。要旨によると、追加の調整なしのゼロショットで、MVTec AD での異常の判定の AUROC が91.8%、位置の推定が85.1%、VisA ではそれぞれ78.1%と79.6%で、良品の画像を1枚使う拡張版では MVTec AD で93.1%と95.2%、VisA で83.8%と96.4%でした。
この数字も、先の節と同じく、公開データセットでのその論文の条件での値です。そのうえで、数字の並びから読み取れることがあります。同じ手法でも、MVTec AD と VisA で成績が大きく違うこと、自社の画像を使わない設定と1枚使う設定でも差があることです。自社の画像を使わずに判定できるという性質は、立ち上げの初期に「どこに異常の候補がありそうか」を見る道具としては魅力がありますが、出荷の判定の基準として使えるかは、自社の画像と判定基準で確かめるまで分かりません。
さらに、画像を見て文章で答える大規模な視覚と言語のモデルを使う研究もあります。Gu らの論文(arXiv の記載では AAAI 2024 に採録。採録は、学会の審査に通って採用されたことを指します)が提案した AnomalyGPT は、画像の特徴を取り出すモデルと大規模言語モデルを組み合わせたもので、論文の実装では、PandaGPT(画像を扱える大規模言語モデルの1つ)の事前学習済みのパラメータを初期値に使っています。異常のある画像を模擬的に作ってその説明文と組にした学習用のデータで調整し、画像に異常があるか、どこにあるかを対話の形で答えさせます。要旨によると、VisA で学習したモデルを、対象の品目の良品の画像1枚を参照する形で MVTec AD に転用した設定で、正解率が86.1%、画像単位の AUC が94.1%、画素単位の AUC が95.3%でした。正解率は判定が当たった画像の割合、画像単位の AUC は「この画像に異常があるか」、画素単位の AUC は「異常の位置」を当てる成績で、それぞれ別のものを測っています。要旨は、この方法では人がしきい値を設定する必要がないとしています。その場合でも、モデルの判定が自社の判定基準のどこで良品と不良を分けているかを確かめ、モデル・入力の画像・指示の文・出力の版を記録しておく必要があります。これは、次の限界の3つ目と関わります。
こうした基盤モデルを使う方法を現場で使うときの限界も、整理しておきます。
- 判定の基準を文章で書き切れない。自社の判定基準は限度見本(第2章)で決まっていることが多く、「どの大きさの傷までは良品か」を文章で正確に伝えるのは難しい
- 推論の時間と計算機の負担が大きい。大規模なモデルは、タクトタイム(第9章)に収めるのが難しいことがある
- 答えが変わる理由を追いにくい。モデルの更新や指示の文の違いで判定が変わる場合、変更管理(第12章)の対象が増える
- 事前学習の重みの利用条件を確かめる必要がある。研究で公開された重みが、商用の検査に使える条件で配布されているとは限らない
こうした点から、基盤モデルを使う方法は、現時点では、出荷の判定を任せるものとしてではなく、立ち上げ時の候補の絞り込みや、人の判定を助ける補助として位置づけるのが現実的だと考えています。判定のしきい値を人が決めない方法であっても、見逃し率の上限を守れるかを確かめ、その結果を品質保証の体制で承認する手順は変わりません。
生成AIの活用、不良画像の生成と検査の周辺の業務
生成AIの使い道は、大きく2つに分けて考えると整理しやすくなります。1つは、学習用のデータを作る使い道、つまり不良の画像を生成する方法です。もう1つは、検査の周辺の業務、つまり検査の手順や記録の整理を助ける使い道です。
不良の画像を生成する研究の例として、Hu らの論文(arXiv の記載では AAAI 2024 に採録)が提案した AnomalyDiffusion があります。要旨によると、少数の実際の不良の画像から、異常の画像とその位置を示すマスクの組を生成する拡散モデル(画像の生成に使われる手法の1つ)で、大規模なデータで事前学習した画像の生成のモデル(論文では潜在拡散モデルと呼んでいます)の知識を使って、生成の自然さを高めています。不良のデータが足りないことが産業の検査の制約になっているという問題意識から、生成したデータで後段の検査の成績が上がると報告しています。第7章で扱ったとおり、生成した不良の画像は、本番で起きる欠陥の写り方を再現できる範囲でだけ役に立ちます。生成した画像だけで評価用のデータを作ると、モデルが生成の癖を学んで成績が実際より高く見えるおそれがあるので、評価には実際の不良の画像を使うことが必要です。
検査の周辺の業務での使い道の例として、BMW グループが2025年4月28日に公式のニュースルームで発表した、レーゲンスブルク工場の試行のプロジェクト「GenAI4Q」があります。発表によると、車両の型式や装備の組み合わせなどの車両のデータと、車両ごとの生産の実時間のデータから、車両ごとの検査の項目の一覧を作り、スマートフォンのアプリの中で適切な順番に並べ、音声の認識と書き起こしで所見の記録を助けるものです。発表は、この工場では1日におよそ1,400台が生産されていること、完成した車両の最終の検査は訓練を受けた専門の担当者が行うことを書いています。なお、プロジェクトの名前には生成AIを示す GenAI の語が入っていますが、発表の本文はこの仕組みを学習に基づく分析の道具と説明しており、どのような生成のモデルを使っているかは書いていません。
検査の手順書や検査記録の要約に大規模言語モデルを使う場合は、要約が限定条件を落としたり、記録に無いことを書き足したりするおそれがあります。生成された文章を検査の記録の正本にせず、元の記録(画像・判定・スコア・モデルの版。第11章)を正本として残し、生成した文章は人が確かめてから使うという分担にしておくのがよいと考えています。
公開事例の読み方、企業と公的機関が公表している外観検査AI
他社の事例は、自社の検討の材料として役に立ちます。ただし、事例として公表される情報は、公表した企業や機関が選んだ範囲に限られます。ここでは、外観検査AIの取り組みを4件紹介します。3件は企業や大学が自ら公式のページで公表したもので、1件は公的機関である農研機構の事業の資料に載った、企業(キユーピー)を代表機関とする研究課題です。内容は、それぞれのページに書かれていることだけで、本コラムによる優劣の評価はしません。
1件目は、BMW グループの取り組みです。同社が2023年11月27日に公式のページで公開した記事によると、自社で開発したAIQX(Artificial Intelligence Quality Next の略)という仕組みは、組立のコンベヤに沿って置いたカメラとセンサーのデータを、アルゴリズムとAIで実時間に分析し、結果を作業者の端末に返すものです。記事は、組立の工程で仕様の違いの判別・部品の付け忘れの確認・異常の検出に使えると説明し、前を流れる車両に三角表示板が付いているかをカメラで確かめ、食い違いを作業者と生産の仕組みに知らせる例を挙げています。同じ記事は、AIQX の一部として、ディンゴルフィング工場で座席に付けたマイクで走行中の音を記録し、AIで分析と分類を行う音の検査も紹介しています。記事に効果の数字は書かれていません。
2件目は、キユーピーを代表機関とする研究開発の課題です。農研機構のサイトで公開されている、令和2年度のイノベーション創出強化研究推進事業の課題の資料によると、課題名は「低価格・高精度・高速食品原料外観・内部AI検査装置の研究開発」で、研究期間は令和2年度から令和4年度の3年間です。外観に加えて内部も検査できる原料の検査装置を開発し、原料や食品のメーカーにも提供することを目的とし、キユーピー・産業技術総合研究所・ブレインパッドが参画しています。資料に書かれた最終目標は、原料の中の1cm以下の虫の検出、40品種以上の原料の検査への対応、コンベヤの速度を毎分15mから25mに上げる処理能力の向上、装置の小型化などです。これらは研究の目標であり、達成の結果ではありません。
3件目は、デンソー九州と九州工業大学の共同開発です。両者が2025年8月27日に発表した資料によると、熱交換器の製造工程の外観検査の効率化を目指して、ディープラーニングを使った外観検査の仕組みを共同で開発し、デンソー九州で新設予定の製造ラインに実装する予定としています。資料は、撮像の条件・タクトタイム・歩留まりといった実装の環境の制約に合わせて推論の条件を調整できる設計であることを特長に挙げ、今後の取り組みとして、異なる製品や工程への展開と、異常の検出から予兆保全への応用などを挙げています。資料に検査の成績の数字は書かれていません。
4件目は、富士電機の取り組みです。同社が2025年12月2日に公式のページで発表した内容によると、「低圧遮断器の欠陥形状を正確に計測可能なAI外観検査装置の開発」が電機工業技術功績者表彰の優秀賞を受けました。発表によると、この装置は良品の画像だけからAIのモデルを作る異常検知のAIを使い、筐体の傷など、大きさや形に厳しい判定基準が設けられている箇所の目視検査を自動化するものです。同社の工場の生産の現場で約4か月検証した結果として、「不良の見逃しは無く」、「過検知率」も熟練の検査員と同等以下に抑えられたと書いています。「過検知率」は同社の発表の語で、本コラムの過検出率(良品を不良と判定した割合)に近い語ですが、発表には算定の方法が書かれておらず、同じ定義かは確かめられません。この結果は、その工場のその製品の、約4か月の検証という条件での同社の発表です。
| 公表者 | 公表の時期 | 対象 | 手法として書かれていること | 成績や目標として書かれていること |
|---|---|---|---|---|
| BMW グループ | 2023年11月27日 | 自動車の組立(仕様の判別・付け忘れの確認・異常の検出)、完成車の音の検査 | カメラとセンサーのデータをAIで実時間に分析し、作業者に返す | 記載なし |
| キユーピーを代表機関とする研究課題(農研機構の資料) | 令和2年度の採択課題(研究期間は令和2年度から令和4年度) | 食品の原料の外観と内部の検査 | AIのアルゴリズムと画像処理の改良、電磁波による内部の異物の検出 | 目標として、1cm以下の虫の検出、40品種以上への対応、コンベヤの速度を毎分15mから25mへ |
| デンソー九州・九州工業大学 | 2025年8月27日 | 熱交換器の製造工程の外観検査 | ディープラーニング。実装の環境の制約に合わせて推論の条件を調整できる設計 | 記載なし(新設予定のラインに実装予定) |
| 富士電機 | 2025年12月2日 | 低圧遮断器の外観検査(筐体の傷など) | 良品の画像だけからモデルを作る異常検知のAI | 同社の工場での約4か月の検証で、不良の見逃しは無く、同社が「過検知率」と呼ぶ指標(算定の方法は発表に記載なし)は熟練の検査員と同等以下(同社の発表) |
各事例の公表元のページは次のとおりです。BMW グループのAIQX の記事、農研機構のサイトの研究課題の資料、デンソー九州と九州工業大学の発表、富士電機の発表。
4件を並べて分かるのは、事例ごとに公表されている情報の種類が違うことです。仕組みの説明だけで数字の無いもの、研究の目標を示したもの、検証の結果を示したものがあり、同じ表の同じ列に並べても、比べられる情報にはなりません。事例を自社の検討に使うときは、少なくとも、対象の製品と欠陥、撮像の方法、判定の仕組み(人がどこで関わるか)、成績の数字があるならその条件(期間・数・比べた相手)を確かめることが必要です。たとえば「見逃しが無かった」という結果は、検証の期間に出た不良の数が少なければ、見逃し率が低いことを十分には示しません。第8章で扱ったとおり、不良が0件見逃されたときにも、見逃し率の上側の信頼限界は不良の数で決まります。公表された事例の数字を、自社の目標値として借りてくることは避けるべきだと考えています。
規格・規制との関係、AIの規制と品質保証の仕組み
外観検査AIは、品質マネジメントの仕組みの中で使われる道具の1つです。第1章で扱った品質マネジメントの規格や、第12章で扱った機械学習の品質の管理の指針、変更管理の考え方は、AIを使う場合にも、検査の工程の管理として当てはまります。AIを使うからといって、検査の判定基準・記録・変更の承認といった品質保証の仕組みが不要になるわけではありません。
一方で、AIそのものを対象とする規制も作られています。欧州連合では、2024年にAIに関する規則(規則(EU)2024/1689)が定められました。
この規則は、その後の改正の規則(EU)2026/1744 によって、リスクが高いとされるAIシステムに関する規定の適用の時期が改められ、区分に応じて2027年12月2日と2028年8月2日からとされました。どちらも、2026年11月9日に欧州連合の法令のデータベース(EUR-Lex)で条文を開いて確かめた範囲です(規則(EU)2024/1689、規則(EU)2026/1744)。
この規則がどのようなAIの使い方にどのような義務を課すか、外観検査の用途が対象になるかは、用途や製品の種類によって変わるので、本コラムでは扱いません。AIに関する規制と、社内のルールの作り方は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
法令・顧客との取り決め・業界の規格で検査の方法が定められている製品(医薬品・医療機器・自動車部品・食品など)では、AIを使うかどうか以前に、その取り決めが何を求めているかを、条文・所管の官庁や規格の団体の資料・顧客との契約で確かめることが必要です。本コラムでは、そうした定められた検査をAIで置き換えられるとは書きません。AIを入れる場合も、定められた検査は定められたとおりに行い、AIはその前後で人の判断を助ける位置に置く、という形から検討するのが安全だと考えています。
形骸化の型、社外の情報を取り入れたときに起きやすいこと
社外の情報、とくに研究の数字や他社の事例は、導入の判断を後押しする力が強い一方で、使い方を誤ると、序章で整理した損失の型につながります。とくに起きやすいのが形骸化、つまりAIの判定が信用されず、人が全数を見直すようになる状態です。次の表は、社外の情報の使い方ごとに、起きやすいことと、それが行き着く損失の型を整理したものです。
| 社外の情報の使い方 | 起きやすいこと | 行き着く損失の型 | 手当て(章) |
|---|---|---|---|
| 論文の AUROC を PoC の合格の条件にする | 公開データセットでは高い成績が、自社の画像では出ず、合格の条件を満たせないまま PoC が延びる | 形骸化・二重投資 | 自社の画像で測った見逃し率と過検出率で条件を決める(第8章・第13章) |
| 他社の事例の数字を自社の目標にする | 条件の違う数字を目標にし、達成できない理由が分からない | 形骸化 | 自社の工程の現状の見逃し・過検出を先に測る(第1章・第13章) |
| ゼロショットの方法を、自社の判定基準との合い方を確かめないまま出荷の判定に使う | 自社の判定基準とずれた判定が出て、検査員が全数を見直す | 流出・過検出・形骸化 | 補助や候補の絞り込みに留め、判定の保留を設ける(第10章) |
| 公開データセットで学習したモデルをそのまま使う | 利用条件に反するおそれ。自社の欠陥の定義とずれた判定が出て、検査員が全数を見直す | 形骸化(利用条件によっては運用を続けられなくなるおそれもある) | 利用条件を確かめ、自社の画像で学習・評価する(本章・第7章) |
| 新しい手法が出るたびに乗り換える | 評価用のデータと承認の手順が毎回作り直しになる | 二重投資・判定のばらつき | 候補の比較に使う検証用のデータを固定し、最後に選定に使っていない評価用のデータで確かめ、旧モデルとの比較と承認を経て切り替える(第8章・第12章) |
| 大規模なモデルを、推論の時間を測らないままラインの判定に使う | 推論が間に合わず、検査がラインを止める | タクトの超過 | タクトから逆算した推論の時間で選ぶ(第9章) |
表の中で共通しているのは、社外の情報を「結論」として使っていることです。社外の情報は、自社で何を確かめるべきかを教えてくれる「問い」として使うと、損失を避けやすくなります。新しい手法が出たときは、自社の固定した検証用のデータで候補を比べ、採用の候補が決まった段階で、選定に使っていない最終の評価用のデータでも確かめ、旧モデルと比べてから切り替える、という手順を決めておけば、研究の進み具合に振り回されずに済みます。同じデータで候補選びを繰り返すと、そのデータに合わせた選び方になり、成績が実際より高く見えるおそれがあるためです。
経営判断、研究と事例の数字をそのまま自社に当てはめない
この章の内容を、経営の判断に置き換えます。外観検査AIの分野では、研究の進み方が速く、新しい手法や製品の発表、他社の事例の公表が続いています。経営として決めることは、新しい情報をどれだけ早く取り入れるかではなく、社外の情報を自社の判断に変換する手順を持つことだと考えています。
判断を誤ったときの損失は、序章で整理した6つの型で整理できます。研究の数字を自社の期待値として PoC の目標にすると、達成できないまま PoC が延び、ラインに入っても判定が信用されず形骸化します。他社の事例の「見逃しが無かった」を自社の目標にすると、検証に必要な不良の数を見積もらないまま合格を判断し、流出を招くおそれがあります。基盤モデルを、自社の判定基準との合い方や処理の時間を十分に評価しないまま出荷の判定に使うと、過検出・流出・タクトの超過につながるおそれがあります。新しい手法が出るたびに工程や工場ごとに別の仕組みを作ると、二重投資になります。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- PoC の合格の条件は、論文や他社の事例の数字ではなく、自社の画像と判定基準で測った見逃し率と過検出率で決める
- 新しい手法や製品を試すときに使う、自社のデータ(日付・ロット・ラインで分けたもの。第8章)を固定して持つ。候補の比較に繰り返し使う検証用のデータと、採用を決める前に一度だけ使う最終の評価用のデータを分けておく
- 公開データセットや事前学習の重みを使う場合は、利用条件を法務と確かめる手順を設ける
- 基盤モデルや生成AIは、まず候補の絞り込み・記録の整理・人の判定の補助として使い、出荷の判定に使うかは評価と品質保証の承認を経て決める
- 研究と事例の動向を追う担当を決め、年に数回、自社の評価用のデータで新しい手法を試す時間と計算機を予算に入れる
予算の面では、新しい手法の導入そのものより、評価用のデータの整備と維持に予算を付けることを勧めます。評価用のデータが固定されていれば、研究の動向が変わっても、どの手法が自社の工程で使えるかを同じ物差しで判断できます。逆に、評価用のデータが無いと、社外の数字に頼るほかなくなり、判断の根拠が自社の外に移ります。出荷の可否の最終的な責任は品質保証の体制にあり、社外の情報はその判断の材料の1つに留まります。
この章のまとめ
この章では、MVTec AD・MVTec LOCO AD・MVTec AD 2・VisA の4つの公開データセットの提供元・中身・利用条件を確かめた範囲で整理し、論文の成績はそのデータセットのその条件での値であり、自社の期待値にはならないことを確かめました。基盤モデルを使う WinCLIP や、大規模な視覚と言語のモデルを使う方法、不良の画像を生成する方法は、立ち上げの手間を減らす可能性がある一方で、判定基準を文章で書き切れない・推論の時間・利用条件といった限界があり、現時点では補助として位置づけるのが現実的だと考えています。企業・公的機関の公開事例は、公表された情報の種類と条件がそれぞれ違うので、数字を借りずに、対象・撮像・判定の仕組み・条件を確かめる材料として使うことが必要です。社外の情報を自社の判断に変える鍵は、固定した評価用のデータを持つことです。
この章を深めたい方への参考書籍
『製造DX推進のための外観検査自動化ガイドブック』(阿部淑人、シーエムシー・リサーチ):外観検査の自動化を、製造の DX を進める立場から解説したガイドブックです(2022年刊)。この章で扱った公開事例を読むときに、対象・撮像・判定の仕組みのどこを確かめるべきかを、自動化の進め方の全体の中で整理する手がかりになります。
『基盤モデルとロボットの融合 マルチモーダルAIでロボットはどう変わるのか』(河原塚健人・松嶋達也、講談社):大規模でマルチモーダルな基盤モデルを、ロボットにどう使うかを解説した本です(2025年刊)。題材はロボットですが、この章で扱った視覚と言語のモデルを含む基盤モデルの考え方と、それを現実の機械の判断に組み込むときの課題を知る手がかりになります。
終章 外観検査AIを使い続けるために
本コラムでは、序章で示した4つの流れに沿って、検査と判定基準の基礎(第1章・第2章)、撮像と判定の技術(第3章から第7章)、評価と運用の設計(第8章から第11章)、導入と定着(第12章から第14章)を順に見てきました。全体を通した考えは、序章で述べたとおり、何を不良とするかの基準と、その欠陥を写す撮像の条件、AIの判定のあとに製品をどう扱い誰が何を確かめるかを先に決め、本番の画像と人の判定を集めながら見直し続けることです。最後に、各章の要点を、外観検査AIを使い続けるための判断の順序としてまとめ直します。
章をまたいで見えること
第1に、外観検査は品質を作るものではなく、工程で作り込んだ品質が守られているかを確かめ、流出を止めるものです。どの工程で何を止めるための検査かを決めることが、検査の方法を選ぶ前の出発点になります(第1章)。何を不良とするかの基準は、限度見本と文書でそろえ、検査員の判定がどれだけ一致しているかを数えて確かめます(第2章)。基準が揺れたままでは、その判定を教師にしたモデルも揺れるため、AIを入れる前に基準をそろえることが、AIの性能を確かめる前提になると考えています。
第2に、判定の技術は、写る欠陥から逆に組み立てます。狙う欠陥が画像に写るかどうかは、カメラ、レンズ、照明の組み合わせで決まり(第3章)、写っていない欠陥はどの方法でも見つけられません。判定の方法の選び分けは、次のように整理できます。
- 位置と形が安定し、明るさの差がはっきり写る欠陥:ルールベースの画像処理で足りることがある(第4章)
- 不良の画像が十分に集まり、欠陥の種類を見分けたいとき:教師あり学習が候補になる(第5章)
- 不良の画像が少ないときや、まだ見たことの無い欠陥が出うるとき:良品学習が候補になる(第6章)
データを増やす工夫は、本番の画像で起きる変動を再現できる範囲で効くと考えています(第7章)。本コラムで動かしたコードはいずれも架空の合成画像や架空のスコアによるもので、数値はその条件での一例にすぎません。実際の製品の画像は合成画像より複雑なため、自社の画像で確かめ直す必要があります。
第3に、判定は、評価の基準と製品の扱いが決まって初めて検査の結果になります。精度の1つの数字ではなく、見逃し率と過検出率を分けて数え、見逃し率の上限をどこに置くかを品質保証と決め、そのもとで過検出を減らすしきい値を選びます(第8章)。検査の仕組み全体を生産の間隔(タクトタイム)に追いつかせ、各製品の判定を、撮像から排出までの時間の内訳の中で期限に間に合わせます(第9章)。スコアがあらかじめ決めた保留の範囲に入る製品を人の判断に回し、人とAIの役割を分けます(第10章)。判定を排出の機構と記録につなぎ、どの製品をどのモデルのどの版で判定したかを後から追えるようにします(第11章)。
第4に、本番の画像は変わるものとして扱います。照明の劣化、レンズの汚れ、材料のロット、品種の追加によって、モデルが学んだ画像と本番の画像がずれていくことがあります。変化の種類と頻度は工程と設備によって違うため、変化を測る仕組みを運用の最初から入れ、再学習とその承認の手順を決めておきます(第12章)。導入は、流出の影響、検査の人手、欠陥の写りやすさなどで対象の工程を絞り、PoC(試験導入)の出口の条件を先に決めて進めます。検査員は、AIに置き換わる人ではなく、判定基準の持ち主として残すことが大切だと考えています(第13章)。公開された事例と研究の数字は、対象の製品や条件ごとに読み、そのまま自社に当てはめないようにします(第14章)。
使い続けるための最小の仕組み
外観検査AIを使い続けるための仕組みは、大がかりなものである必要はありません。本コラムで扱った内容から、最小の形を挙げると次のようになります。
- 対象の工程と、捉えたい欠陥の種類と、判定基準(限度見本を含む)の一覧がある
- 撮像の条件(照明の強さ・露光時間・位置)が記録され、変えるときの手順が決まっている
- 見逃し率の上限と、それを確かめる評価用の画像の組が決まっている
- AIが不良または保留とした製品を誰が確かめ、どう扱うかが決まっている。AIが良品と判定した製品についても、確かめる対象の選び方と、後工程や顧客で見つかった不良の情報の集め方が決まっている
- 製品ごとの判定の結果と、使ったモデルの版が記録されている
- 本番の画像の変化と、AIと人の判定の食い違いを定期的に数え、モデルを見直す時期と担当が決まっている
- モデル・しきい値・判定基準・撮像の条件を変えるときは、品質保証が確かめて承認し、その記録が残る
この7つの条件がそろっていれば、使っている方法が単純なルールベースの画像処理であっても、外観検査AIへ進むための運用の土台はできていると考えています。反対に、高度なモデルを使っていても、上の7項目が欠けていれば、判定が信用されずに人が全数を見直すことになり、検査の手間がかえって増えるおそれがあります。モデルを高度にするのは、上の7項目が回り始めてからで遅くないと考えています。まず自社で、上の7項目のうち欠けているものを確かめ、1つ目の「対象の工程と、捉えたい欠陥の種類と、判定基準の一覧」から整えることをお勧めします。
経営が見るべきこと
経営の立場から外観検査AIの取り組みを見るときは、モデルの精度の報告よりも、次の問いに答えられるかを確かめることをお勧めします。対象の工程で、後工程や顧客で見つかった不良の件数は、導入の前と比べてどう変わったか。良品を不良と判定して廃棄・手直し・再検査に回した数は、どう変わったか。人が確かめている製品の数と、そのうちAIの判定と人の判定が食い違ったものはどれだけあるか。判定基準とモデルの版の変更は、記録と承認を経て行われているか。
1つ目の流出の件数は、結果の指標です。不良がもともと少ない工程では、件数の変化が偶然の範囲に収まることがあります(第8章)。比べるときは、同じ対象の範囲と期間で、生産数か検査数を併記し、品種ごとにも比べます。増減だけで効果の有無を判断せず、生産の条件や材料の変化も併せて見ます。後ろの3つの問いは、取り組みが検査の判定と運用を変えているかどうかを見る手がかりになります。
外観検査AIは、一度仕組みを作れば終わる取り組みではなく、製品の追加、材料と工程の変化、検査員の入れ替わりに合わせて見直し続ける取り組みです。見直しを続けるための手間を、あらかじめ品質保証の業務と予算の中に位置づけておくことが、取り組みを続けるための条件だと考えています。本コラムが、自社の工程と品質保証の仕組みに合った外観検査AIを組み立てるための材料になれば幸いです。
Anagraftでは、検査工程を含むデータとAIの活用について、課題の特定から、テーマの選定とKPIの設計、PoC、本番への導入、運用と改善、内製化まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 外観検査の役割と品質管理での位置づけ、目視検査から自動検査まで
『ビジュアル品質管理の基本』第5版(内田治、日本経済新聞出版社):日経文庫の1冊で、2016年に出た第5版です。書名のとおり品質管理の基本を扱う入門書で、この章で扱った、検査を品質管理の全体の中に置き直す見方を確かめるときの土台になると考えています。
『品質保証と自働化:源流検査による不良ゼロの仕組み』(平野裕之、日刊工業新聞社):「新IE」入門シリーズの1冊で、書名のとおり、源流検査によって不良をなくす仕組みを主題にした本です。2001年の本ですが、検査は品質を作らないという、この章の主張を工程の側から考えるときの手がかりになると考えています。
第2章 欠陥の定義と判定基準、限度見本と検査員の判定のばらつき
『官能評価の理論と方法:現場で使う官能評価分析』(井上裕光 著、日科技連出版社):官能評価分析の考え方と方法を、現場で使う立場から解説した本です(2012年刊)。国立国会図書館の目次によれば、第1章は官能評価分析の概論で、「同じ結果にならない」という現象から説き起こしています。目視検査を官能検査として捉え直し、検査員の判定のばらつきをどう扱うかを考える手がかりになります。
『IATF 16949のための統計的品質管理:SPC・MSA・抜取検査・多変量解析』(内田治 編著、行武晋一・伊藤侑也・永井夏織・宮本秀徳 著、日科技連出版社):副題のとおり、工程の管理(SPC)、測定システムの解析(MSA)、抜取検査、多変量解析といった統計的な方法を、自動車産業の品質マネジメントの規格の文脈で扱った本です(2023年刊)。この章で扱った判定のばらつきを、測定システムの評価という枠組みで捉えるときの参考になります。
第3章 撮像の設計、カメラ・レンズ・照明で欠陥を写る状態にする
『マシンビジョンライティング 基礎編 改訂版』(増村茂樹、産業開発機構):マシンビジョンの画像処理システムにおける照明の技術を、基礎から扱う本です(2018年刊)。同じ著者の実践編・発展編・応用編と続くシリーズの1冊目にあたり、この章で扱った明視野と暗視野、照明方式の選び方の背景にある考え方を深める手がかりになります。
『マシンビジョンシステムにおける周辺機器・製品の選び方・使い方』(月刊画像ラボ編集部 編集、日本工業出版):副題に挙げられているとおり、レンズ・フィルター・照明・画像入力ボード・ケーブル・画像処理ソフトウェア・画像処理装置の基本を扱う、月刊画像ラボの別冊です(2019年刊)。この章で扱ったカメラの周辺の機器を、装置を組み立てる側から確かめるときの手がかりになります。
第4章 ルールベースの画像処理、二値化・差分・特徴量で何ができるか
『ディジタル画像処理[改訂第二版]』(奥富正敏 編集委員長ほか執筆、画像情報教育振興協会):画像処理の基礎理論から手法、アルゴリズム、各分野での応用事例までを扱う専門書として、発行元の公益財団法人画像情報教育振興協会(CG-ARTS)が紹介している教科書です。この章で扱った平滑化・二値化・エッジ検出のような処理を、原理から体系的に学び直すときの土台になります。
『OpenCVによる画像処理入門[改訂第3版]』(小枝正直・上田悦子・中村恭之 著、講談社):画像処理のライブラリ OpenCV を使った入門書で、国立国会図書館の目次によれば、平滑化フィルタ処理・エッジ検出フィルタ処理の節を含むフィルタ処理の章、形状特徴パラメータ・ラベリング処理の節を含む2値画像処理の章、画像間演算の節を含む複数画像の利用の章があります。この章のコードは scikit-image で書きましたが、同じ処理を OpenCV で組むときの手引きになります。
第5章 教師あり学習による欠陥の分類と検出、CNNから物体検出・領域分割まで
『画像認識』(原田達也 著、講談社):機械学習プロフェッショナルシリーズの1冊(2017年刊)で、版元の目次によれば、局所特徴・統計的特徴抽出・分類から、畳み込みニューラルネットワーク・物体検出の章、セマンティックセグメンテーションを含む「さらなる話題」の章までを扱っています。この章で平易に説明した畳み込みや物体検出の仕組みを、理論から学び直すのに向いています。
『Pythonで学ぶ画像認識』(田村雅人、中村克行 著、インプレス):機械学習実践シリーズの1冊(2023年刊)で、国立国会図書館の目次によれば、画像処理の基礎知識・深層学習を使う準備・画像分類・物体検出などの章があり、畳み込みニューラルネットワークや物体検出の手法を実装しながら学ぶ構成です。この章では実行しなかった物体検出を、自分の手で動かして確かめたいときの手引きになります。
第6章 良品だけで学ぶ異常検知、オートエンコーダからPatchCoreまで
『Pythonによる異常検知』(曽我部東馬 著、曽我部完 監修、オーム社):機械学習による異常検知の仕組みを誤差関数を軸に解説した入門書で、版元の目次によれば、非時系列データの異常検知の章でオートエンコーダを、深層学習による異常検知の章で anoGAN や表面の検査などの応用事例を扱っています。この章の再構成型の考え方を、コードを動かしながら確かめるのに向いています。
『まるごと学べる異常検知の実践知』(中村謙太 著、技術評論社):異常検知の理論と実装を、教師あり学習・教師なし学習・統計モデリングの手法に分けて整理し、その使い分けを解説した本です(2025年刊)。版元の目次の章立ては1変数・計数・多変数などのデータの種類ごとの手法で、画像に特化した章はありませんが、前処理と性能評価の章を含み、良品学習と教師あり学習のどちらを使うかを考える手がかりになります。
第7章 少ないデータで学ぶ工夫、データ拡張・転移学習・合成データ
『転移学習』(松井孝太、熊谷亘 著、講談社):機械学習プロフェッショナルシリーズの1冊(2024年刊)です。版元の目次によれば、ドメイン適応の理論と方法、事前学習済みモデル、メタ学習、少数ショット学習、ドメイン汎化などの章があります。この章で扱った「学習した条件と本番の条件の違い」を、ドメイン適応・ドメイン汎化という枠組みで理論から学びたいデータ分析の担当者に向く専門書です。
『Kaggleに挑む深層学習プログラミングの極意』(小嵜耕平、秋葉拓哉、林孝紀、石原祥太郎 著、講談社):機械学習の競技会を題材にした深層学習の実践書(2023年刊)です。版元の目次によれば、画像分類の章にデータ拡張の節と、事前学習とファインチューニングを扱う節があります。この章で試したデータ拡張と微調整を、実際の画像の分類の課題で手を動かしながら確かめたい方に向いています。
第8章 検査の精度の評価、見逃しと過検出としきい値の決め方
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標と KPI の関係から始めて、回帰・二値分類・多クラス分類の評価指標を扱う本です。版元の目次によれば、二値分類の章に混同行列・正解率・適合率・再現率・ROC-AUC・PR-AUC の節があり、ビジネスインパクトの期待値の計算やコストを考慮した学習の節も設けられています。この章で扱った、正解率を使わない理由と、相対コストからしきい値を選ぶ考え方を、評価指標の側から体系立てて確かめるのに向いています。
『サンプルサイズの決め方』(永田靖 著、朝倉書店):統計ライブラリーの1冊で、版元の紹介によれば、検出力とサンプルサイズ(標本の数)の設計を扱う本です(2003年刊)。この章で計算した「見逃し率を確かめるのに必要な不良の数」を、評価の計画を立てる段階で、統計の考え方から見積もり直すのに役立ちます。
第9章 速度と精度の両立、タクトタイムに収める推論の設計
『エッジAI導入の手引き 生産設備/機器制御への組み込み』(出澤純一、菅原志門 著、日刊工業新聞社):副題のとおり生産設備や機器の制御に AIを組み込むことを主題にした本で、ニュースサイト「ニュースイッチ」に掲載された本書の抜粋記事の紹介によれば、クラウドで動かす AIの弱点を補うものとしてエッジ AIの定義と特徴を示し、課題の見つけ方から実装までを整理しています。この章で扱ったエッジとサーバー・クラウドの分担を、自社の設備に当てはめて考えるときの手引きになります。
『深層ニューラルネットワークの高速化』(佐藤竜馬 著、技術評論社):ML Systems のシリーズの1冊で、版元の目次によれば、量子化と低精度計算・枝刈り・蒸留・低ランク近似・高速なアーキテクチャ・チューニングのためのツールなどの章があります。この章では考え方の紹介に留めた量子化・枝刈り・蒸留を、手法ごとに詳しく学び、どの手法が自社の計算機で効くかを見極めるときに役立ちます。
第10章 人とAIの協調運用、判定の保留・再検査・根拠の示し方
『ヒューマンエラー 完訳版』(ジェームズ・リーズン 著、十亀洋 訳、海文堂出版):人がなぜ誤るかを扱った書籍の訳書で、原題は Human Error です(2014年刊)。保留の再検査で人の見逃し率が設計を左右すること、人の判定にも誤りがある前提で仕組みを作ることを考えるときに、人の誤りの種類と起こり方を整理する手がかりになります。
『品質とヒューマンファクター 安全と安心の考え方』(日本ヒューマンファクター研究所 編、日科技連出版社):日本ヒューマンファクター研究所が編んだ、品質とヒューマンファクター(人の要因)を書名のとおり安全と安心の考え方から扱う本です(2012年刊)。この章で扱った、人の判定を品質保証の仕組みの中にどう位置づけるかを考えるときに、品質の側から人の要因を捉える手がかりになります。
第11章 検査ラインへの組み込み、PLC・MES・トレーサビリティとのつなぎ方
『実践的MES導入ガイド 製造実行システムが工場を強くする』(エンジニアリング協会「次世代スマート工場」研究会 著、佐藤知一・阿部洋平 編、近代科学社Digital):MES とは何か、何ができるか、導入の進め方、工場の設備の機器と MES の関係、データを使った製造と MES までを章ごとに扱った本です(2026年刊)。この章で扱った、検査の判定の記録を MES にどう渡し、工場の記録の中にどう位置づけるかを考える手がかりになります。
『制御システムセキュリティ入門 Society 5.0/Industry 4.0時代に向けて社会インフラをいかに守るか』(池上祐太・河田芳秀 著、満永拓邦 監修、NTT出版):制御システムを構成する機器、制御システムのネットワークと通信方式、制御のための通信の取り決め(プロトコル)、サイバー攻撃、リスクの管理、対応の体制と具体的な対策を章を分けて解説した本です(2020年刊)。この章で一般論として扱った、検査装置を制御の系と情報の系の両方につなぐときの情報セキュリティを考える手がかりになります。
第12章 運用と保守、照明の劣化・品種の追加・モデルの再学習への対応
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン):機械学習のシステムを本番で動かし続けるための設計を扱った本で、版元の目次によれば、データ分布のシフトの種類・検出・対処と監視を扱う章と、継続学習と実環境でのテストを扱う章があります。この章で扱ったスコアの分布の監視や、再学習の頻度と切り替え前の確かめ方を、外観検査に限らない一般論として整理するのに向いています。
『機械学習工学』(石川冬樹・丸山宏 編著、柿沼太一・竹内広宜・土橋昌・中川裕志・原聡・堀内新吾・鷲崎弘宜 著、講談社):機械学習を使うシステムの開発と運用を工学として扱った本で、版元の目次によれば、性能低下につながる入出力の変化を検知する方法と、推論性能の低下やその予兆への対処を扱う運用の章や、品質に関するガイドラインを扱う品質の章があります。この章で触れた機械学習品質マネジメントガイドラインのような品質の考え方と、運用時の変化への対処を合わせて学ぶのに向いています。
第13章 導入の進め方と体制、対象工程の選定・PoC・検査員の役割
『AIプロジェクトの管理』(Malini Jain Runtasewee、Adrián González Sánchez 著、鈴木駿、高山洪銘、中島於菟 訳、オライリー・ジャパン):2026年10月刊の訳書で、版元の紹介では、アイデアの創出から PoC、本番の運用までのプロジェクトの管理を、要件定義・評価指標・データの品質・モデルの評価・ガバナンス・関係者の調整の観点で解説しています。この章で扱った PoC の計画書と出口の決め方を、プロジェクトの管理の一般的な枠組みの中で整理し直すときに参考になります。
『AIプロジェクトマネージャのための機械学習工学』(吉岡信和、鷲崎弘宜、内平直志、竹内広宜 著、科学情報出版):2023年1月刊の設計技術シリーズの1冊で、第1章の「AIシステムの開発概論」から始まり、機械学習を使うシステムの開発を、プロジェクトの管理者に向けて扱っています。この章で扱った、外部に任せる作業と社内に残す判断の分け方を、機械学習のシステムの開発の進め方として考えるときの手がかりになります。
第14章 公開事例と最新動向、規格・公開データセット・基盤モデルの活用
『製造DX推進のための外観検査自動化ガイドブック』(阿部淑人、シーエムシー・リサーチ):外観検査の自動化を、製造の DX を進める立場から解説したガイドブックです(2022年刊)。この章で扱った公開事例を読むときに、対象・撮像・判定の仕組みのどこを確かめるべきかを、自動化の進め方の全体の中で整理する手がかりになります。
『基盤モデルとロボットの融合 マルチモーダルAIでロボットはどう変わるのか』(河原塚健人・松嶋達也、講談社):大規模でマルチモーダルな基盤モデルを、ロボットにどう使うかを解説した本です(2025年刊)。題材はロボットですが、この章で扱った視覚と言語のモデルを含む基盤モデルの考え方と、それを現実の機械の判断に組み込むときの課題を知る手がかりになります。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- ISO 2859-1(2026年)は第3版で2026年1月に発行
https://www.iso.org/standard/2859-1 - ISO 2859-1(2026年)は第3版で2026年1月に発行
https://web.archive.org/web/20261027093226/https://www.iso.org/standard/2859-1 - ISO 2859-1(1999年)は2026年1月22日に廃止
https://www.iso.org/standard/1141.html - ISO 2859-1(1999年)は2026年1月22日に廃止
https://web.archive.org/web/20261019095151/https://www.iso.org/standard/1141.html - ISO 9001(2026年)は第6版で2026年9月に発行
https://www.iso.org/standard/9001 - ISO 9001(2026年)は第6版で2026年9月に発行
https://web.archive.org/web/20261028023442/https://www.iso.org/standard/9001 - ISO 9001(2015年)は2026年9月16日に廃止
https://www.iso.org/standard/62085.html - ISO 9001(2015年)は2026年9月16日に廃止
https://web.archive.org/web/20261029221314/https://www.iso.org/standard/62085.html - JIS Q 9001(2015年)は2015年11月20日改正、ISO 9001(2015年)に対応、2020年に確認
https://webdesk.jsa.or.jp/preview/pre_jis_q_09001_000_000_2015_j_ed30_ch.pdf - ISO 9001(2015年)への2024年の気候変動に関する追補に対応する JIS Q 9001(2025年)が2025年3月21日に発行
https://www.jab.or.jp/cms/uploads/25-NINSYS0030_R1_ddcc0b0973.pdf - 抜取検査の目的はロットを受け入れるかどうかを決めることで、ロットの品質の推定が主な目的ではない
https://www.itl.nist.gov/div898/handbook/pmc/section2/pmc21.htm - JIS Z 8141(2022年)生産管理用語は2022年3月22日改正、2001年の版を置き換え
https://webdesk.jsa.or.jp/preview/pre_jis_z_08141_000_000_2022_j_ed10_ch.pdf - IATF 16949(2016年)第1版は ISO/TS 16949(2009年)第3版を置き換え、ISO と連携して ISO 9001 との整合を保つ
https://www.iatfglobaloversight.org/iatf-169492016/about/ - IATF は2024年10月に IATF 16949 の改訂の開始を告知
https://www.iatfglobaloversight.org/ - IATF の2026年7月の告知で、第2版の改訂の重点5つ、発行は2027年半ばの予定、移行の期限は ISO 9001 の移行の期限に合わせる、日程は目安
https://www.iatfglobaloversight.org/wp/wp-content/uploads/2026/07/Stakeholder-Communique-SC-2026-005_IATF-16949-2nd-Edition-status.pdf - See の2012年の報告書 SAND2012-8590 は1950年代以降の目視検査の文献212件の総説
https://www.osti.gov/servlets/purl/1055636 - See の2012年の報告書 SAND2012-8590 は1950年代以降の目視検査の文献212件の総説
https://web.archive.org/web/20260130012712id_/https://www.osti.gov/servlets/purl/1055636 - ビジュアル品質管理の基本 第5版、内田治 著、日本経済新聞出版社、2016年、日経文庫
https://ndlsearch.ndl.go.jp/books/R100000002-I027467877 - 品質保証と自働化 源流検査による不良ゼロの仕組み、平野裕之 著、日刊工業新聞社、2001年
https://ndlsearch.ndl.go.jp/books/R100000002-I000003052272
第2章
- コーエンのカッパ係数の原典は Cohen の1960年の論文
https://doi.org/10.1177/001316446002000104 - フライスのカッパ係数は Fleiss が1971年に Psychological Bulletin 誌に発表
https://doi.org/10.1037/h0031619 - 重み付きのカッパ係数は Cohen が1968年に Psychological Bulletin 誌で示した
https://doi.org/10.1037/h0026256 - statsmodels の inter_rater に cohens_kappa と fleiss_kappa と aggregate_raters がある
https://www.statsmodels.org/stable/generated/statsmodels.stats.inter_rater.cohens_kappa.html - statsmodels の inter_rater に cohens_kappa と fleiss_kappa と aggregate_raters がある
https://www.statsmodels.org/stable/generated/statsmodels.stats.inter_rater.fleiss_kappa.html - 官能評価の方法と用語の JIS の現行の版と内容
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=Z9080 - 官能評価の方法と用語の JIS の現行の版と内容
https://webdesk.jsa.or.jp/preview/pre_jis_z_09080_000_000_2004_j_ed10_ch.pdf - distutils は Python 3.12 で標準ライブラリから外され、setuptools が引き続き提供する
https://docs.python.org/3.14/whatsnew/3.12.html - JIS Z 9080 の日本規格協会の書誌情報(Codex の指摘で示された確認日と状態)
https://webdesk.jsa.or.jp/books/W11M0090/index/?bunsyo_id=JIS+Z+9080%3A2004 - 参考書籍 官能評価の理論と方法
https://ndlsearch.ndl.go.jp/books/R100000002-I023551890 - 参考書籍 IATF 16949のための統計的品質管理
https://ndlsearch.ndl.go.jp/books/R100000002-I032591214 - カッパ係数の値の大きさの目安(Landis と Koch の1977年の論文の書誌は Crossref で確認したが、本文を開いていないので目安の値は書いていない
https://doi.org/10.2307/2529310
第3章
- ラインカメラは撮影の周期を製品の移動と同期させる必要があり、同期しないと画像が縮んだり伸びたりして歪む
https://www.encoder.com/machine-vision - 被写界深度の説明と性質(細部が小さいほど浅い・F ナンバーを大きくすると深い・大きくしすぎると回折で解像が粗くなる・倍率を小さく、作動距離を長くすると深くなる方向)
https://www.edmundoptics.jp/knowledge-center/application-notes/imaging/depth-of-field-and-depth-of-focus/ - テレセントリックレンズは物の距離によらず同じ大きさに写り、視差による計測の誤差を抑える
https://www.edmundoptics.jp/knowledge-center/application-notes/imaging/advantages-of-telecentricity/ - テレセントリックレンズの欠点として、写せる視野は製品の側のレンズの直径で制約され、広い視野や小さい倍率ではレンズが大きく重くなり、重さや大きさに制約のある装置では導入が難しい
https://www.edmundoptics.jp/knowledge-center/application-notes/imaging/telecentric-lens-size-control/ - RoCEv2 は多くの主要なネットワークの接続部品が備え、処理の負荷が小さく、送れる量が大きく、遅れが小さい
https://www.automate.org/vision/vision-standards/vision-standards-gige-vision - 光源に偏光板、レンズ側に向きを直交させた偏光板を付けて強い反射を抑える例
https://www.edmundoptics.jp/knowledge-center/application-notes/illumination/successful-light-polarization-techniques/ - 傷の検出は不透明な製品にローアングル照明、光沢のある製品に同軸照明
https://www.optex-fa.jp/online_learning2021/textbox/d1_text.pdf - 広島県立総合技術研究所 西部工業技術センターは、照明の形状・発光色・位置関係などで撮像結果は全く異なり、画像の質が検査の精度に大きく影響すると述べている
https://www.pref.hiroshima.lg.jp/soshiki/28/syoumei.html - EMVA 1288 の最新は Release 4.0 で2021年6月に効力
https://www.emva.org/standards-technology/emva-1288/ - EMVA 1288 の版の一覧(4.0 の General と Linear、3.1、3.0、A2.01、A1.03)
https://www.emva.org/standards-technology/emva-1288/emva-standard-1288-downloads-2/ - Release 4.0 General の表紙の日付は2021年6月16日
https://www.emva.org/wp-content/uploads/EMVA1288General_4.0Release.pdf - USB3 Vision は USB 3.x を使う規格で版 1.2
https://www.automate.org/a3-content/usb3-vision-standard - GenICam は接続の技術によらず、あらゆる機器に共通のプログラミングのインターフェースを提供することが目標
https://www.emva.org/standards-technology/genicam/ - 参考書籍『マシンビジョンライティング 基礎編 改訂版』増村茂樹 著、産業開発機構、2018年7月、ISBN 978-4-86028-299-8
https://ndlsearch.ndl.go.jp/books/R100000002-I029629463 - 参考書籍『マシンビジョンシステムにおける周辺機器・製品の選び方・使い方』月刊画像ラボ編集部 編集、日本工業出版、2019年10月、ISBN 978-4-8190-3119-6、月刊画像ラボ別冊
https://ndlsearch.ndl.go.jp/books/R100000002-I029983605
第4章
- 大津の方法の原典は1979年にIEEEのシステム・人間・サイバネティクスの論文誌の第9巻第1号に発表された論文
https://doi.org/10.1109/TSMC.1979.4310076 - 大津の方法は2群の間の分散が最大になるしきい値を選ぶ方法
https://scikit-image.org/docs/stable/auto_examples/segmentation/plot_thresholding.html - 大津の方法は2群の間の分散が最大になるしきい値を選ぶ方法
https://scikit-image.org/docs/stable/api/skimage.filters.html - Canny の方法の原典は1986年にIEEEのパターン解析と機械知能の論文誌の第8巻第6号に発表された論文
https://doi.org/10.1109/TPAMI.1986.4767851 - Canny の方法の手順は平滑化、変化の向きと大きさ、細線化、2つのしきい値によるつながりの判定
https://scikit-image.org/docs/stable/api/skimage.feature.html - scikit-image の凸性は領域の画素の数と凸の図形の画素の数の比
https://scikit-image.org/docs/stable/api/skimage.measure.html - 参考書籍 ディジタル画像処理 改訂第二版、画像情報教育振興協会
https://ndlsearch.ndl.go.jp/books/R100000002-I030296231 - 参考書籍 ディジタル画像処理 改訂第二版、画像情報教育振興協会
https://www.cgarts.or.jp/books_detail/eip_2/ - 参考書籍 ディジタル画像処理 改訂第二版、画像情報教育振興協会
https://www.cgarts.or.jp/books/ip/ - 参考書籍の表記は奥富正敏 編集委員長ほか執筆、画像情報教育振興協会
https://www.cgarts.or.jp/wp-content/uploads/2024/09/dip_02-3_profile.pdf - 参考書籍 OpenCVによる画像処理入門 改訂第3版、小枝正直・上田悦子・中村恭之 著、講談社
https://ndlsearch.ndl.go.jp/books/R100000002-I032509569
第5章
- LeCun らの1998年の論文、Proceedings of the IEEE 誌86巻11号
https://doi.org/10.1109/5.726791 - Redmon らの YOLO、CVPR 2016
https://openaccess.thecvf.com/content_cvpr_2016/html/Redmon_You_Only_Look_CVPR_2016_paper.html - Ren らの Faster R-CNN、2015年に arXiv で公開
https://arxiv.org/abs/1506.01497 - Lin らの論文、ICCV 2017
https://openaccess.thecvf.com/content_iccv_2017/html/Lin_Focal_Loss_for_ICCV_2017_paper.html - Ronneberger らの U-Net、2015年に arXiv で公開、MICCAI 2015 の論文集に掲載
https://arxiv.org/abs/1505.04597 - U-Net は MICCAI 2015 の論文集、Springer の LNCS 9351巻、234から241ページ
https://lmb.informatik.uni-freiburg.de/people/ronneber/u-net/ - PyTorch の median は、枚数が偶数のとき中央の2つの値のうち小さいほうを返す
https://docs.pytorch.org/docs/2.13/generated/torch.median.html - He らの Mask R-CNN、ICCV 2017
https://openaccess.thecvf.com/content_iccv_2017/html/He_Mask_R-CNN_ICCV_2017_paper.html - PyTorch の CrossEntropyLoss の weight はクラスごとの重みで、学習用のデータが不均衡なときにとくに役立つ
https://docs.pytorch.org/docs/2.13/generated/torch.nn.CrossEntropyLoss.html - WeightedRandomSampler は与えた重みに比例する確率で番号を引く
https://docs.pytorch.org/docs/2.13/data.html - Ultralytics の公式ドキュメントでは、物体検出・インスタンスセグメンテーション・セマンティックセグメンテーション・画像分類などの作業を扱える
https://docs.ultralytics.com/tasks/ - Ultralytics のライセンスのページは、オープンソースのライセンス(AGPL-3.0)と企業向けの別のライセンスの2つを示している
https://www.ultralytics.com/license - 『画像認識』(原田達也 著、講談社)、機械学習プロフェッショナルシリーズ、2017年刊
https://ndlsearch.ndl.go.jp/books/R100000002-I028164363 - 『画像認識』(原田達也 著、講談社)、機械学習プロフェッショナルシリーズ、2017年刊
https://www.kodansha.co.jp/book/products/0000147663 - 『Pythonで学ぶ画像認識』(田村雅人、中村克行 著、インプレス)、機械学習実践シリーズ、2023年刊
https://ndlsearch.ndl.go.jp/books/R100000002-I032692922
第6章
- Bergmann らの2019年の論文は第14回 VISIGRAPP の予稿集に収録され、オートエンコーダの損失に SSIM を使い外観の欠陥の領域を切り出す方法を提案した
https://arxiv.org/abs/1807.02011 - Bergmann らの2019年の論文は第14回 VISIGRAPP の予稿集に収録され、オートエンコーダの損失に SSIM を使い外観の欠陥の領域を切り出す方法を提案した
https://doi.org/10.5220/0007364503720380 - PaDiM は Defard らの2020年の論文で ICPR 2020 の産業向け機械学習のワークショップに採択され事前学習済みの CNN の区画の特徴を多変量の正規分布で表す
https://arxiv.org/abs/2011.08785 - PatchCore は Roth らの2022年の論文で CVPR 2022 の予稿集の14318〜14328ページ
https://openaccess.thecvf.com/content/CVPR2022/html/Roth_Towards_Total_Recall_in_Industrial_Anomaly_Detection_CVPR_2022_paper.html - PatchCore は Roth らの2022年の論文で CVPR 2022 の予稿集の14318〜14328ページ
https://arxiv.org/abs/2106.08265 - 知識蒸留型の例として Bergmann らの2020年の論文(CVPR 2020)、教師と複数の生徒のネットワーク
https://arxiv.org/abs/1911.02357 - 知識蒸留型の例として Bergmann らの2020年の論文(CVPR 2020)、教師と複数の生徒のネットワーク
https://doi.org/10.1109/CVPR42600.2020.00424 - Anomalib は open-edge-platform の組織のリポジトリで Apache License 2.0、旧 openvinotoolkit の住所は転送される
https://github.com/open-edge-platform/anomalib - Anomalib の最新リリースは2026年10月6日公開の v2.7.0、CPU 用などの指定で PyTorch 2.10 以上・torchvision 0.25 以上を要求、古い ONNX の書き出しを除去、指標 AUPR の計算を修正
https://github.com/open-edge-platform/anomalib/releases/tag/lib/v2.7.0 - Anomalib を紹介した Akcay らの2022年の論文は ICIP 2022 の予稿集の1706〜1710ページ
https://arxiv.org/abs/2202.08341 - PaDiM は区画の位置ごとに良品の分布を作る
https://arxiv.org/html/2011.08785v1 - 書籍『Pythonによる異常検知』曽我部東馬 著、曽我部完 監修、オーム社、2021年
https://ndlsearch.ndl.go.jp/books/R100000002-I031278478 - 書籍『Pythonによる異常検知』曽我部東馬 著、曽我部完 監修、オーム社、2021年
https://www.ohmsha.co.jp/book/9784274225413/ - 書籍『まるごと学べる異常検知の実践知』中村謙太 著、技術評論社、2025年
https://ndlsearch.ndl.go.jp/books/R100000002-I034358026 - 書籍『まるごと学べる異常検知の実践知』中村謙太 著、技術評論社、2025年
https://gihyo.jp/book/2025/978-4-297-15226-0
第7章
- 画像のデータ拡張を整理した総説(Shorten と Khoshgoftaar、Journal of Big Data 誌、2019年)
https://doi.org/10.1186/s40537-019-0197-0 - 画像のデータ拡張を整理した総説(Shorten と Khoshgoftaar、Journal of Big Data 誌、2019年)
https://api.semanticscholar.org/graph/v1/paper/DOI:10.1186/s40537-019-0197-0?fields=title,abstract,year,venue,authors - ImageNet は Deng らが2009年の CVPR で発表した、物の名前の階層に沿って画像を集めたデータベース
https://doi.org/10.1109/CVPR.2009.5206848 - Yosinski らの2014年の論文(NIPS 2014)
https://arxiv.org/abs/1411.1792 - torchvision の公式ドキュメントは、学習済みの重みが学習データ由来の独自のライセンスや利用条件を持ちうること、使用の許可の確認は利用者の責任であること、重みごとの前処理と違う前処理で精度が下がりうることを書いている
https://docs.pytorch.org/vision/stable/models.html - Chen らの2020年の論文(ICML 2020、SimCLR)
https://arxiv.org/abs/2002.05709 - He らの2020年の論文(CVPR 2020、MoCo)
https://arxiv.org/abs/1911.05722 - Li らの2021年の論文(CVPR 2021、CutPaste)
https://arxiv.org/abs/2104.04015 - Li らの2021年の論文(CVPR 2021、CutPaste)
https://doi.org/10.1109/CVPR46437.2021.00954 - Snell らが2017年に発表した Prototypical Networks
https://arxiv.org/abs/1703.05175 - Finn らの2017年の論文(ICML 2017、MAML)
https://arxiv.org/abs/1703.03400 - Tobin らの2017年の論文
https://arxiv.org/abs/1703.06907 - Zavrtanik らの2021年の論文(ICCV 2021、DRAEM)
https://arxiv.org/abs/2108.07610 - Zavrtanik らの2021年の論文(ICCV 2021、DRAEM)
https://doi.org/10.1109/ICCV48922.2021.00822 - 参考書籍 転移学習 松井孝太 熊谷亘 著 講談社 2024年
https://www.kspub.co.jp/book/detail/5332931.html - 参考書籍 Kaggleに挑む深層学習プログラミングの極意 小嵜耕平 秋葉拓哉 林孝紀 石原祥太郎 著 講談社 2023年
https://ndlsearch.ndl.go.jp/books/R100000002-I032608933 - 参考書籍 Kaggleに挑む深層学習プログラミングの極意 小嵜耕平 秋葉拓哉 林孝紀 石原祥太郎 著 講談社 2023年
https://www.kspub.co.jp/book/detail/5305133.html
第8章
- ROC 曲線は判定のしきい値を変えながら横軸に過検出率、縦軸に検出率を取って描く曲線
https://scikit-learn.org/stable/modules/model_evaluation.html - 平均適合率を計算する関数は曲線の点と点の間を直線でつながずに計算し、直線でつないで面積を求める方法は値が良く出すぎることがある
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html - ROC 分析の入門の論文として Fawcett の2006年の論文(Pattern Recognition Letters 誌)
https://doi.org/10.1016/j.patrec.2005.10.010 - Saito と Rehmsmeier の2015年の論文(PLOS ONE 誌)は、陽性と陰性の数が大きく偏ったデータでは ROC 曲線より適合率と再現率の曲線のほうが評価に多くの情報を与えると結論
https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0118432 - クリッパー・ピアソン法は Clopper と Pearson が1934年に Biometrika 誌に発表した方法
https://academic.oup.com/biomet/article-lookup/doi/10.1093/biomet/26.4.404 - scipy の binomtest の結果の proportion_ci で method に exact を指定するとクリッパー・ピアソン法の区間が求められる
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats._result_classes.BinomTestResult.proportion_ci.html - NIST の工学統計ハンドブックは二項分布に基づく正確な方法として、見逃しが k 個以下になる確率が α/2 になる割合を上限とする定め方を示す
https://www.itl.nist.gov/div898/handbook/prc/section2/prc241.htm - scikit-learn の公式ドキュメントは、グループごとに依存した標本では評価用の標本が学習用に含まれないグループから来るように分ける必要があると説明し、GroupKFold は同じグループが学習と評価の両方に入らないようにする
https://scikit-learn.org/stable/modules/cross_validation.html - GroupShuffleSplit で製品単位に分けた
https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GroupShuffleSplit.html - マクネマー検定は片方だけが正しかった件数どうしを比べる検定で、statsmodels の関数では二項分布で正確に計算する方法を選べる
https://www.statsmodels.org/stable/generated/statsmodels.stats.contingency_tables.mcnemar.html - 『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社、2023年
https://ndlsearch.ndl.go.jp/books/R100000002-I032637452 - 『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社、2023年
https://gihyo.jp/book/2023/978-4-297-13314-6 - 『サンプルサイズの決め方』永田靖 著、朝倉書店、2003年、統計ライブラリー
https://www.asakura.co.jp/detail.php?book_code=12665
第9章
- PyTorch 2.13 の公式ドキュメントは、量子化の開発を torchao に集約し、torch.ao.quantization を削除する予定と述べ、移行の方法を案内している
https://docs.pytorch.org/docs/2.13/quantization.html - torchao は量子化などを扱う別のライブラリ
https://docs.pytorch.org/ao/stable/index.html - Jacob らの2018年の論文(CVPR 2018)は、整数の演算だけで推論する量子化の方式と学習の手順を提案し、携帯端末の CPU で精度と推論の遅れの釣り合いが良くなったと報告
https://arxiv.org/abs/1712.05877 - Jacob らの2018年の論文(CVPR 2018)は、整数の演算だけで推論する量子化の方式と学習の手順を提案し、携帯端末の CPU で精度と推論の遅れの釣り合いが良くなったと報告
https://openaccess.thecvf.com/content_cvpr_2018/html/Jacob_Quantization_and_Training_CVPR_2018_paper.html - Han らの2016年の論文(ICLR 2016)は枝刈り・量子化・符号化を組み合わせ、ImageNet の画像分類のモデルで精度を落とさずに保存の大きさを35〜49分の1にしたと報告
https://arxiv.org/abs/1510.00149 - PyTorch の枝刈りの公式チュートリアルは重みに0の目印を付ける方法で、それだけで速く小さくなるとは書かれていない
https://docs.pytorch.org/tutorials/intermediate/pruning_tutorial.html - Hinton らの2015年の論文は、複数のモデルの組や大きなモデルの知識を小さなモデルに移す方法(蒸留)を示した
https://arxiv.org/abs/1503.02531 - ONNX は拡張できる計算グラフのモデルの定義と、フレームワークをまたいで使える組み込みの演算を定め、道具の間でモデルを共有できるようにする取り組み
https://onnx.ai/about.html - torch.set_num_threads は CPU で1つの計算を並列に処理するスレッドの数を決める設定
https://docs.pytorch.org/docs/2.13/generated/torch.set_num_threads.html - カメラの製品資料には、センサーからの読み出しの時間と計算機への転送の時間を分けて示し、読み出しの途中から転送を始める仕組みを説明しているものもある
https://docs.baslerweb.com/acquisition-timing-information - 参考書籍『エッジAI導入の手引き 生産設備/機器制御への組み込み』出澤純一、菅原志門 著、日刊工業新聞社
https://ndlsearch.ndl.go.jp/books/R100000002-I032268973 - 参考書籍『エッジAI導入の手引き 生産設備/機器制御への組み込み』出澤純一、菅原志門 著、日刊工業新聞社
https://newswitch.jp/p/33245 - 参考書籍『深層ニューラルネットワークの高速化』佐藤竜馬 著、技術評論社
https://gihyo.jp/book/2024/978-4-297-14309-1 - 参考書籍『深層ニューラルネットワークの高速化』佐藤竜馬 著、技術評論社
https://ndlsearch.ndl.go.jp/en/books/R100000002-I033644401
第10章
- Parasuraman と Manzey の2010年の総説(Human Factors 誌52巻3号)は、自動化に関わる慢心と自動化バイアスの実験研究を整理したもの
https://doi.org/10.1177/0018720810376055 - Parasuraman と Manzey の2010年の総説(Human Factors 誌52巻3号)は、自動化に関わる慢心と自動化バイアスの実験研究を整理したもの
https://pubmed.ncbi.nlm.nih.gov/21077562/ - 欧州連合の AI に関する規則(規則(EU)2024/1689)の第14条は高リスクの AI システムに人による監督を求め、第4項(b)で自動化バイアスを自覚し続けられるようにすることを挙げている
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=OJ:L_202401689 - 参考書籍『ヒューマンエラー 完訳版』(ジェームズ・リーズン 著、十亀洋 訳、海文堂出版、2014年、原題 Human Error)
https://ndlsearch.ndl.go.jp/books/R100000002-I025578480 - 参考書籍『品質とヒューマンファクター 安全と安心の考え方』(日本ヒューマンファクター研究所 編、日科技連出版社、2012年)
https://ndlsearch.ndl.go.jp/books/R100000002-I024016268
第11章
- PLC のプログラミング言語は IEC 61131 の第3部で定められ、PLCopen はこの規格を活動の基礎に置く
https://plcopen.org/iec-61131-3 - EtherNet/IP は一般の Ethernet と TCP/IP に上位の層として CIP を組み合わせた方式で、ODVA が推進する
https://www.odva.org/technology-standards/key-technologies/ethernet-ip/ - PROFINET は Ethernet を基盤にした産業用の通信の規格で、TCP/IP の通信を並行して行える機能や、安全に関わるデータを PROFIsafe で標準の入出力のデータと同じネットワークで送る仕組みが紹介されている
https://www.profibus.com/technology/profinet/ - CC-Link IE は CC-Link の系列の第2世代で2008年に仕様公開、1Gbps の Ethernet が基盤
https://www.cc-link.org/ja/cclink/index.html - OPC UA は機器や基本ソフトに依存しないサービス指向の枠組みで、情報モデルの仕組み、暗号化・署名・証明書による認証、クライアントとサーバーの形、出版と購読の形を持つ
https://opcfoundation.org/about/opc-technologies/opc-ua/ - OPC Foundation と VDMA のマシンビジョンの部会が画像検査装置の OPC UA コンパニオン仕様に取り組み、仕様は公開済み
https://opcfoundation.org/markets-collaboration/machine-vision/ - その第1部は OPC 40100-1、版1.0、公開日2019年8月1日
https://reference.opcfoundation.org/MachineVision/v100/docs/ - 適用範囲は生産の制御の仕組みと情報システムへの統合で、相手として別の検査装置・工程の PLC・ラインの制御の機器・MES・SCADA・ERP・データ分析が例示される
https://reference.opcfoundation.org/MachineVision/v100/docs/1 - ISA-95 は業務のシステムと製造の制御のシステムをつなぐ国際的な規格群で、IEC 62264 とも呼ばれ、5つの階層に分ける
https://www.isa.org/standards-and-publications/isa-standards/isa-95-standard - IEC 62264-1 は2013年の第2版が発行済みで2003年の第1版を置き換え、レベル3の活動とレベル3・レベル4の間のやりとりを記述する
https://www.iso.org/standard/57308.html - ISA/IEC 62443 は産業の自動化と制御のシステムを守るための要求事項と手順を定め、責任の分担を基本の考え方に置く
https://www.isa.org/standards-and-publications/isa-standards/isa-iec-62443-series-of-standards - 参考書籍『実践的MES導入ガイド』
https://ndlsearch.ndl.go.jp/books/R100000002-I034939039 - 参考書籍『実践的MES導入ガイド』
https://www.kindaikagaku.co.jp/book_list/detail/9784764907959/ - 参考書籍『制御システムセキュリティ入門』
https://ndlsearch.ndl.go.jp/books/R100000002-I030261851 - 参考書籍『制御システムセキュリティ入門』
https://ci.nii.ac.jp/ncid/BB29896235
第12章
- 産業技術総合研究所の機械学習品質マネジメントガイドラインの最新は第4版で、日本語版は2023年12月12日に公開、4.2.0版は2024年4月4日に公開、第1版は2020年6月に公開
https://www.digiarc.aist.go.jp/publication/aiqm/ - 産業技術総合研究所の機械学習品質マネジメントガイドラインの最新は第4版で、日本語版は2023年12月12日に公開、4.2.0版は2024年4月4日に公開、第1版は2020年6月に公開
https://www.digiarc.aist.go.jp/publication/aiqm/guideline-rev4.html - 産業技術総合研究所の機械学習品質マネジメントガイドラインの最新は第4版で、日本語版は2023年12月12日に公開、4.2.0版は2024年4月4日に公開、第1版は2020年6月に公開
https://www.digiarc.aist.go.jp/publication/aiqm/AIQuality-requirements-rev4.2.0.0113-signed.pdf - ISO 9001 の現行は第6版 ISO 9001(2026年)で、2026年9月に発行
https://www.iso.org/standard/9001 - ISO 9001 の現行は第6版 ISO 9001(2026年)で、2026年9月に発行
https://web.archive.org/web/20261028023442/https://www.iso.org/standard/9001 - ISO 9001(2015年)は2026年9月16日に廃止の扱い、新しい版への移行は認証機関に確かめるよう促している
https://www.iso.org/standard/62085.html - ISO 9001(2015年)は2026年9月16日に廃止の扱い、新しい版への移行は認証機関に確かめるよう促している
https://web.archive.org/web/20261029221314/https://www.iso.org/standard/62085.html - scipy の ks_2samp は既定の両側検定で2つの分布が同じことを帰無仮説とし、経験分布関数の差の絶対値の最大値を統計量とする
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.ks_2samp.html - numpy の quantile は既定で並べた標本の隣接する値を補間するので、推定した99.5%点を超える割合は運用でちょうど0.5%になるとは限らない
https://numpy.org/doc/2.4/reference/generated/numpy.quantile.html - 参考書籍『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』Chip Huyen 著、江川崇・平山順一 訳、オライリー・ジャパン
https://www.oreilly.co.jp/books/9784814400409/ - 参考書籍『機械学習工学』石川冬樹・丸山宏 編著、柿沼太一ほか 著、講談社
https://www.kspub.co.jp/book/detail/5285862.html
第13章
- 2026年版ものづくり白書は2026年5月29日に閣議決定され国会に報告された
https://www.mhlw.go.jp/stf/houdou/newpage_00229.html - 技能継承を進めるための取組として再雇用や勤務延長などで高年齢の従業員に継続勤務してもらう割合が最も高く54.8%
https://www.mhlw.go.jp/content/11801500/001704747.pdf - 労働政策研究・研修機構の調査は2026年5月公表、2025年11月から12月に実施、製造業の指定11業種で従業員30人以上の企業が対象、54.8%の設問の対象は技能継承が必要と考えている企業4,262社、技能者の定義に検査を含む
https://www.jil.go.jp/press/documents/20260527.pdf - 参考書籍『AIプロジェクトの管理』、Malini Jain Runtasewee、Adrián González Sánchez 著、鈴木駿、高山洪銘、中島於菟 訳、オライリー・ジャパン、2026年10月刊
https://ndlsearch.ndl.go.jp/books/R100000002-I034967824 - 参考書籍『AIプロジェクトの管理』、Malini Jain Runtasewee、Adrián González Sánchez 著、鈴木駿、高山洪銘、中島於菟 訳、オライリー・ジャパン、2026年10月刊
https://www.oreilly.co.jp/books/9784814401864/ - 参考書籍『AIプロジェクトマネージャのための機械学習工学』、吉岡信和、鷲崎弘宜、内平直志、竹内広宜 著、科学情報出版、2023年1月刊、設計技術シリーズ、第1章 AIシステムの開発概論
https://ndlsearch.ndl.go.jp/books/R100000002-I032588255
第14章
- MVTec AD は MVTec Software 社が公開する異常検知の評価用データセットで、15の品目に分かれた5,000枚を超える高解像度の画像を含み、すべての欠陥に画素単位の正解が付く
https://www.mvtec.com/research-teaching/datasets/mvtec-ad - MVTec AD は MVTec Software 社が公開する異常検知の評価用データセットで、15の品目に分かれた5,000枚を超える高解像度の画像を含み、すべての欠陥に画素単位の正解が付く
https://web.archive.org/web/20261008055836/https://www.mvtec.com/research-teaching/datasets/mvtec-ad - MVTec AD と MVTec LOCO AD の利用条件は CC BY-NC-SA 4.0 で、商用の目的での利用は認められていない
https://www.mvtec.com/research-teaching/datasets/mvtec-loco-ad - MVTec AD と MVTec LOCO AD の利用条件は CC BY-NC-SA 4.0 で、商用の目的での利用は認められていない
https://web.archive.org/web/20260825003029/https://www.mvtec.com/research-teaching/datasets/mvtec-loco-ad - MVTec AD の原論文は Bergmann らの2019年の CVPR 論文
https://openaccess.thecvf.com/content_CVPR_2019/html/Bergmann_MVTec_AD_–_A_Comprehensive_Real-World_Dataset_for_Unsupervised_Anomaly_CVPR_2019_paper.html - MVTec LOCO AD は5つの品目の3,644枚
https://doi.org/10.1007/s11263-022-01578-9 - MVTec AD 2 は Heckler-Kram らが2025年3月に arXiv に投稿(その時点では査読中)
https://arxiv.org/abs/2503.21622 - MVTec AD 2 の評価用データは、正解の付いた公開の評価用データと、正解を公開せず提供元のサーバーで採点する評価用データに分かれ、後者の一部に学習に無い照明の条件を含む
https://arxiv.org/html/2503.21622v1 - MVTec AD 2 の論文は2026年3月9日に International Journal of Computer Vision に掲載
https://doi.org/10.1007/s11263-026-02743-0 - MVTec AD 2 の公式のデータセットのページの記載
https://www.mvtec.com/research-teaching/datasets/mvtec-ad-2 - VisA は12の品目・10,821枚(良品9,621枚、欠陥1,200枚)
https://github.com/amazon-science/spot-diff - PatchCore の論文は Roth らの2022年の CVPR 論文
https://openaccess.thecvf.com/content/CVPR2022/html/Roth_Towards_Total_Recall_in_Industrial_Anomaly_Detection_CVPR_2022_paper.html - WinCLIP は Jeong らの2023年の CVPR 論文
https://openaccess.thecvf.com/content/CVPR2023/html/Jeong_WinCLIP_Zero-Few-Shot_Anomaly_Classification_and_Segmentation_CVPR_2023_paper.html - CLIP は Radford らが2021年に arXiv で発表
https://arxiv.org/abs/2103.00020 - AnomalyGPT は Gu らの論文で、arXiv の記載では AAAI 2024 に採録
https://arxiv.org/abs/2308.15366 - AnomalyGPT は Gu らの論文で、arXiv の記載では AAAI 2024 に採録
https://arxiv.org/html/2308.15366 - AnomalyDiffusion は Hu らの論文で、arXiv の記載では AAAI 2024 に採録
https://arxiv.org/abs/2312.05767 - BMW グループの GenAI4Q(2025年4月28日の発表)
https://newsroom.bmwgroup.com/global/artificial-intelligence-as-a-quality-booster - BMW グループの AIQX(2023年11月27日の記事)
https://www.bmwgroup.com/en/news/general/2023/aiqx.html - キユーピーを代表機関とする令和2年度イノベーション創出強化研究推進事業の課題
https://www.naro.go.jp/brain/innovation/theme/files/17_inov_saiyou_R02_ouyou10_02017B.pdf - デンソー九州と九州工業大学が2025年8月27日に外観検査AIの共同開発を発表
https://www.kyutech.ac.jp/archives/025/202508/press250827.pdf - 富士電機の「低圧遮断器の欠陥形状を正確に計測可能なAI外観検査装置の開発」が2025年度(第74回)電機工業技術功績者表彰の優秀賞
https://www.fujielectric.co.jp/about/technology/news/detail/1205425_4826.html - 欧州連合の AI に関する規則(規則の番号 2024/1689)は2024年5月21日の理事会の決定を経た2024年6月13日付の規則で、2024年7月12日に官報に掲載
https://eur-lex.europa.eu/eli/reg/2024/1689/oj - 欧州連合の AI に関する規則(規則の番号 2024/1689)は2024年5月21日の理事会の決定を経た2024年6月13日付の規則で、2024年7月12日に官報に掲載
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=OJ:L_202401689 - 規則を改める規則(EU)2026/1744 が2026年7月24日に官報に掲載され、前文でリスクが高いとされる AI システムの規定の適用の時期を2027年12月2日と2028年8月2日に改めるとしている
https://eur-lex.europa.eu/eli/reg/2026/1744/oj - 参考書籍『製造DX推進のための外観検査自動化ガイドブック』(阿部淑人 著、シーエムシー・リサーチ、2022年1月)
https://ndlsearch.ndl.go.jp/books/R100000002-I033324404 - 参考書籍『基盤モデルとロボットの融合 マルチモーダルAIでロボットはどう変わるのか』(河原塚健人・松嶋達也 著、講談社、2025年8月)
https://ndlsearch.ndl.go.jp/books/R100000002-I034257782