こんにちは、Anagraftの伊藤です。
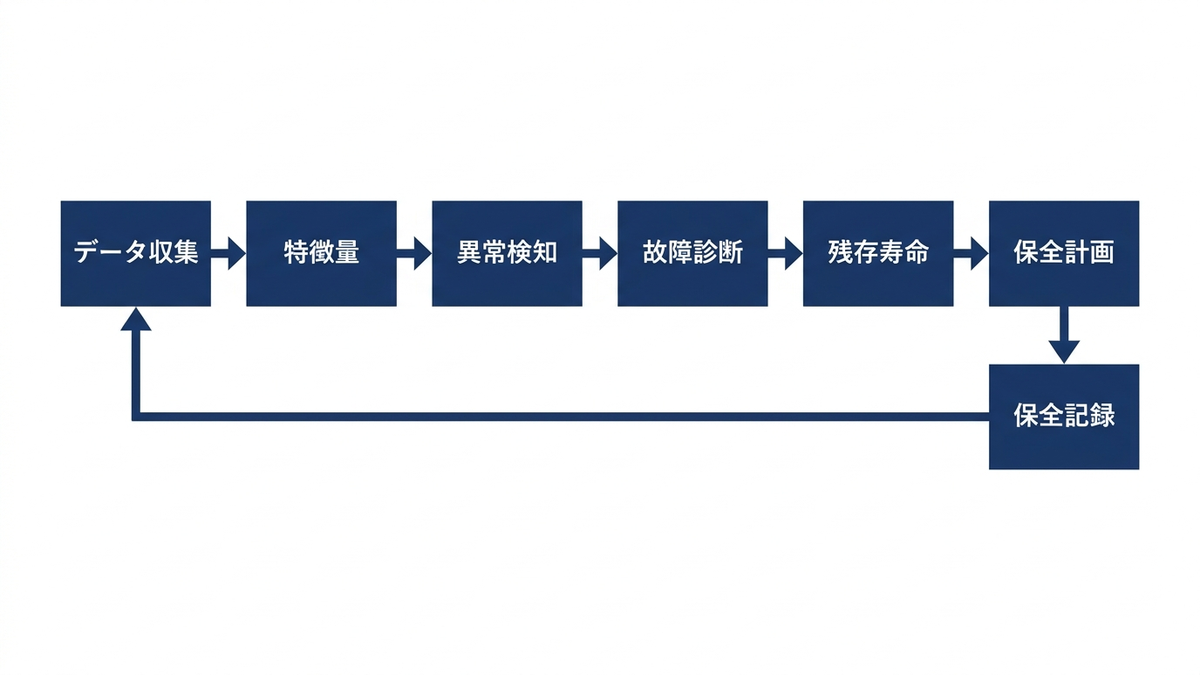
今回は、予知保全、つまり設備の状態をセンサーや点検のデータで監視し、故障や性能の低下の兆候を捉えて、故障の前に保全を行う方式を、どう理解し、どう自社の設備と業務に組み込むかを整理しました。本コラムでは、状態を監視するだけでなく、異常の進み方や残りの寿命を予測して保全の時期を決めるところまでを予知保全と呼びます。設備のデータを集めて分析する取り組みが広がるにつれて、「どの設備から始めればよいか」「集めた振動や温度のデータから何が分かるのか」「機械学習のモデルで故障を予測できると言われたが、本当に保全の役に立つのか」「試験導入(PoC)では当たったのに、現場で使われないのはなぜか」といった問いが、保全部門やデータ分析の担当者だけでなく、工場の責任者や経営層にも届くようになりました。本コラムでは、こうした問いに答えるための材料を、保全と信頼性の基礎、データと予測の技術、予測から保全計画へ、導入と定着の4つのまとまりに分けて並べました。
この題材を選んだ理由は、予知保全が「センサーを付けてAIのモデルを作れば故障が無くなる取り組み」と受け取られて、予測の精度だけが議論され、保全の判断や計画が変わらないまま終わることが多いように思うためです。予測がどれほど当たっても、警報が出たあとに誰が何を判断し、いつ作業するかが決まっていなければ、突発停止は減りません。誤報が続けば、警報そのものが無視されるようになります。反対に、すべての設備を予知保全の対象にしようとすると、監視の仕組みに見合う効果が出ない設備にまで手間がかかります。こうした状態で投資を重ねると、突発停止、過剰保全、安全と環境の事故、品質の不良、警報の形骸化、二重投資という形で損失が出ます。
本コラムでは、保全の用語や状態監視の規格、信頼性工学の考え方、異常検知や寿命予測の手法の原論文、公的機関や企業が公開している資料など、読者が自分で開いて確かめられる一次情報を根拠にしました。規格の本文は有料のものが多いため、規格については、規格団体が公開している規格の一覧(目録)の記載と、公開されている概要の範囲で書いています。第2章、第4章から第9章では、架空のデータに対して実際にPythonのコードを動かし、その出力とグラフを載せています。架空のデータで得た数値は、その条件での一例であり、一般的な性能の目安ではありません。
想定している読者は、予知保全の導入を任された方、あるいはそれを決める立場の方です。保全部門や生産技術の担当者の方、DX推進の担当者の方、設備のデータを分析するデータサイエンティストの方、そして「予知保全をやれ」と言われて何から決めるかを判断しなければならない工場の責任者や経営層の方を念頭に置いています。信号処理や機械学習の専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その手法で何が分かり、保全の判断にどうつながるか」「経営はどう判断するか」を意識して書きました。
本コラムに出てくる企業や団体の取り組みは、その企業や団体が公開した資料を開いて確かめたものに限っています。設備や部品の価格、保全の費用、製品やサービスの料金、弊社の支援の条件には触れていません。例題で費用を扱う箇所は、単位の無い「相対コスト」で書いています。設備の安全に関わる判断や、法令で定められた点検の扱いについては、所管の官庁や設備メーカー、専門家に確認していただく前提で書いています。
目的別の入口の目安を挙げておきます。保全の方式の違いと予知保全の位置づけを整理したい場合は第1章、故障の型と信頼性の基礎は第2章、センサーとデータの集め方は第3章が中心になります。振動データの信号処理は第4章、異常の検知は第5章、原因の診断は第6章、残りの寿命の推定は第7章、予測の評価と警報の設計は第8章、保全計画の最適化は第9章で扱っています。予知保全を作業指示や保全記録とつなぐ方法は第10章、物理モデルとデジタルツインの使い方は第11章、導入の進め方は第12章、体制と人材は第13章、公開事例と最新の動向は第14章が入口になります。本コラムで使う用語の定義は「全体の地図」の表にまとめています。

目次
- 序章 予知保全は何を予測して何を決める仕組みか
- 全体の地図
- 第1章 保全の方式と予知保全の位置づけ、事後保全から状態基準保全まで
- 第2章 故障のしくみと信頼性の基礎、故障モード・寿命分布・故障率
- 第3章 センサーとデータ収集、振動・温度・電流・稼働ログの集め方
- 第4章 振動データの信号処理と特徴量、FFTと包絡線解析で状態を数値にする
- 第5章 異常検知の手法、しきい値・管理図・機械学習で「いつもと違う」を見つける
- 第6章 故障診断、異常の原因を分類して故障モードと結びつける
- 第7章 残存寿命の推定、劣化モデル・回帰・生存分析
- 第8章 予測の評価と警報の設計、見逃し・誤報・リードタイム
- 第9章 保全計画の最適化、交換時期と点検周期と作業の割当を数理モデルで決める
- 第10章 予知保全を業務に組み込む、作業指示・保全記録・設備台帳とのつなぎ方
- 第11章 物理モデルとデジタルツインの併用、故障データの不足を補う
- 第12章 予知保全の導入の進め方、対象設備の選定・PoC・効果の見立て
- 第13章 体制と人材、保全部門・データ担当・現場の役割と技能の継承
- 第14章 公開事例と最新動向、規格・業界の取り組み・生成AIの活用
- 終章 予知保全を続けるために
- 本コラムで紹介した書籍一覧
- 第1章 保全の方式と予知保全の位置づけ、事後保全から状態基準保全まで
- 第2章 故障のしくみと信頼性の基礎、故障モード・寿命分布・故障率
- 第3章 センサーとデータ収集、振動・温度・電流・稼働ログの集め方
- 第4章 振動データの信号処理と特徴量、FFTと包絡線解析で状態を数値にする
- 第5章 異常検知の手法、しきい値・管理図・機械学習で「いつもと違う」を見つける
- 第6章 故障診断、異常の原因を分類して故障モードと結びつける
- 第7章 残存寿命の推定、劣化モデル・回帰・生存分析
- 第8章 予測の評価と警報の設計、見逃し・誤報・リードタイム
- 第9章 保全計画の最適化、交換時期と点検周期と作業の割当を数理モデルで決める
- 第10章 予知保全を業務に組み込む、作業指示・保全記録・設備台帳とのつなぎ方
- 第11章 物理モデルとデジタルツインの併用、故障データの不足を補う
- 第12章 予知保全の導入の進め方、対象設備の選定・PoC・効果の見立て
- 第13章 体制と人材、保全部門・データ担当・現場の役割と技能の継承
- 第14章 公開事例と最新動向、規格・業界の取り組み・生成AIの活用
- 参考情報
序章 予知保全は何を予測して何を決める仕組みか
設備の保全には、昔から2つの基本的なやり方があります。1つは、故障してから修理するやり方です。もう1つは、決まった期間や稼働時間ごとに点検し、部品を交換するやり方です。前者は、故障が起きるまで部品を使い切れる一方で、止まる時期を選べません。後者は、止まる時期を計画できる一方で、まだ使える部品を交換したり、点検の間に進んだ劣化を見逃したりすることがあります。本コラムの主題である予知保全は、この2つの間を埋める考え方です。設備の状態をセンサーや点検のデータで監視し、故障や性能の低下の兆候を捉えて、故障の前に、予測の不確かさと作業に要る余裕を見込んだうえで、必要になる時期に近いところで保全を行います。状態を測って状態に応じて保全する方式は状態基準保全と呼ばれ、本コラムでは、そのうち異常の進み方や残りの寿命を予測して保全の時期を決めるものを予知保全と呼びます(規格上の語の範囲は第1章で確かめます)。
予知保全は、振動や温度のセンサー、データを集める通信、機械学習のモデルといった技術の話として語られることが多くあります。しかし、予知保全の価値を決めるのは、予測の精度そのものではなく、予測によって保全の判断が変わるかどうかです。仮の例として、交換の部品の通常の手配に4週間かかるなら、故障の兆候を3週間前に捉えても、故障の前の交換には間に合いません。予備品を持っておくか、計画的に止めて別の手当てをするかを、前もって決めておく必要があります。兆候を正しく捉えても、警報を受け取った人が「いつもの誤報だろう」と判断すれば、作業は行われません。予測が当たっても、作業の計画に反映されなければ、保全の結果は変わりません。本コラムでは、予知保全を「データから将来の状態を予測し、その予測に基づいて保全の時期と内容を決める仕組み」と捉え、予測と判断の両方を扱います。
予知保全を支える3つの分析
予知保全の仕組みがデータから答える問いは、現在の異常の検知、原因の診断、将来の状態の予測の3つに分けて考えると整理しやすくなります。1つ目は、今の状態がいつもと違うかどうかです。これを本コラムでは異常検知と呼び、第5章で扱います。異常検知は将来の予測そのものではなく、予測の前段として変化を捉える役割を持ちます。2つ目は、いつもと違うとしたら、どの部品のどの故障なのかです。これを故障診断と呼び、第6章で扱います。故障診断は原因の特定です。3つ目は、このまま使い続けると、あとどれくらいで機能を果たせなくなるか、あるいは保全が必要な水準に達するかです。これを残存寿命の推定と呼び、第7章で扱います。将来の状態の予測にあたるのは、この3つ目です。この3つは、求められるデータの量も、外れたときの影響も違います。異常検知は正常なときのデータがあれば始められますが、故障診断には故障ごとの事例や物理の知識が要ります。残存寿命の推定に要る情報は方法によって違い、似た設備が故障に至るまでの記録から学ぶ方法のほか、劣化の進み方を表すモデルと、寿命の終わりとする水準を決めて先を読む方法があります(第7章)。すべての設備で3つを順にそろえる必要はなく、対象の設備と故障に応じて、どの分析まで使うかを選びます。
この3つの前提になるのが、どの故障を捉えたいのかという問いです。設備の故障には、使い始めに多い故障、時期を問わず偶然に起きる故障、使い続けるうちに摩耗や疲労で増える故障といった型があります(第2章)。兆候が現れてから故障に至るまでに時間がある故障であれば、予知保全で間に合う可能性がありますが、兆候が無いまま突然起きる故障は、モデルを高度にしても、予測で間に合わせることはできません。何を測るか(第3章)、どう数値にするか(第4章)は、捉えたい故障の型と故障の現れ方から逆に決まります。
予測から保全の判断へ
予測を保全の判断につなぐには、さらに3つの取り決めが要ります。第1に、警報の出し方です。同じモデルで警報のしきい値を動かす場合には、見逃しを減らす設定では誤報が増えやすく、誤報を減らす設定では見逃しが増えやすいという兼ね合いがあります。測り方やモデルを改善すれば両方を減らせることもありますが、残った兼ね合いのどこに設定を置くかは、技術だけでは決まりません。法令や安全上の要求を前提に、保全の現場と責任者が決める事柄です(第8章)。第2に、保全計画への反映です。残存寿命の予測に幅があることを前提に、いつ交換するか、どの作業を誰がどの停止の時間枠で行うかを決めます(第9章)。第3に、業務の流れへの組み込みです。警報から作業指示、作業、記録までを既存の保全業務の中に位置づけ、作業の記録が次の予測の材料として戻ってくるようにします(第10章)。
この3つが無いまま予測のモデルだけを作ると、試験導入では「当たった」という結果が出ても、本番の運用につながりにくいと考えています。本コラムでは、モデルの精度に加えて、警報を受け取ったあとの判断と作業の流れを同じ重さで扱います。なお、予知保全を入れることは、法令で定められた点検を省いてよい理由にはなりません(第1章)。
決めないことで出る損失の型
保全の方式を選ぶとき、予知保全を導入して運用するときに確かめたい損失は、金額ではなく型で捉えると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。
- 突発停止:計画していない停止によって、生産や供給が止まります。止まる時期を選べないため、代わりの手配や復旧の作業も急ぎになります。
- 過剰保全:まだ使える部品を交換したり、必要の無い点検を繰り返したりします。
- 安全と環境の事故:設備の破損が、人の安全や環境に関わる事故につながることがあります。
- 品質の不良:設備の性能の低下に気づかないまま生産を続け、不良品を作り続けることがあります。
- 警報の形骸化:誤報が続くと、警報が出ても確かめられなくなり、本当の兆候も見過ごされます。
- 二重投資:部門や工場ごとに別々の監視の仕組みやデータの基盤を作り、同じ手間を何度もかけます。
どの損失が自社で目立っているかを見れば、どこから着手するかの見当が付きます。突発停止が目立つなら、停止の影響が大きく、兆候から故障までに時間のある設備を選んで監視を始めます。過剰保全が目立つなら、時間基準で交換している部品について、故障の記録に加えて、故障せずに交換した部品や稼働中の部品の使用時間と交換の理由も集め、交換の周期を見直すことから始めます(第2章・第9章)。警報の形骸化が起きているなら、新しいモデルを作る前に、今の警報の誤報と見逃しを数えます(第8章)。すべての設備を一度に予知保全に切り替える必要はなく、切り替えようとすべきでもない、というのが本コラムの考えです。
予知保全は、対象の選定と判断の流れから始める
予知保全で最初に決めるべきことは、どの機械学習のモデルを使うかではなく、どの設備のどの故障を捉えるかと、警報を受け取ったあとに誰が何を判断していつ作業するかだと考えています。そのうえで小さく測り始め、保全の記録を次の予測に戻しながら見直し続けます。対象の設備と故障が決まれば、測るものと測り方が決まります。判断の流れが決まれば、予測の評価の基準(何日前までに、どれくらいの誤報で知らせればよいか)が決まります。記録の品質を確かめ、モデルと保全計画を評価して更新していけば、現場に合うように改善を重ねられます。
本コラムは、次の4つの流れで進みます。
- 保全と信頼性の基礎:保全の方式の違いと予知保全の位置づけ、故障の型と寿命の分布を整理します(第1章・第2章)。
- データと予測の技術:センサーとデータの集め方、振動データの信号処理、異常検知、故障診断、残存寿命の推定を、実行したコードとともに見ます(第3章から第7章)。
- 予測から保全の計画へ:予測の評価と警報の設計、交換時期と作業の割当の最適化、作業指示と保全記録とのつなぎ方を扱います(第8章から第10章)。
- 導入と定着:物理モデルとデジタルツインの併用、導入の進め方、体制と人材、公開事例と最新の動向を扱います(第11章から第14章)。
経営判断に関わる方にとって、この点は設備への投資の進め方に直結します。監視の仕組みに予算を付ける前に、対象の設備で止まると何が起きるか、狙う故障に兆候が現れるか、警報を受けて作業する人と時間枠が確保できるかを確かめる順序であれば、投資の前提を社内に説明でき、効果が出なかったときにも原因を切り分けやすくなります。反対に、センサーとデータの基盤を先に全設備に広げ、対象の故障と判断の流れを後回しにすると、データは集まっても使い道が決まらず、維持の手間だけが残るおそれがあります。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、設備データの活用の構想づくりから、対象設備の選定、異常検知や寿命予測のモデルの開発、保全計画の最適化、保全業務への組み込みと社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。第1章と第2章で、保全と信頼性の基礎を整理します。保全の方式の違いと予知保全の位置づけを第1章で、故障の型・寿命の分布・故障率と、故障モードの整理の手法を第2章で扱います。第3章から第7章では、データと予測の技術を扱います。センサーとデータの集め方を第3章で、振動データの信号処理と特徴量を第4章で、異常検知を第5章で、故障診断を第6章で、残存寿命の推定を第7章で扱います。
第8章から第10章では、予測を保全の計画と業務につなぎます。予測の評価と警報の設計を第8章で、交換時期と点検周期と作業の割当の最適化を第9章で、作業指示・保全記録・設備台帳とのつなぎ方を第10章で扱います。第11章から第14章では、導入と定着を扱います。物理モデルとデジタルツインの併用を第11章で、導入の進め方を第12章で、体制と人材を第13章で、公開事例と最新の動向を第14章で扱います。第2章と第4章から第9章には、架空のデータで実際に動かしたPythonのコードと、その結果を載せています。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | 保全の方式と予知保全の位置づけ、事後保全から状態基準保全まで | 保全にはどんな方式があり、予知保全はどこに位置づくのか。どの設備にどの方式を選ぶか |
| 第2章 | 故障のしくみと信頼性の基礎、故障モード・寿命分布・故障率 | 故障にはどんな型があり、どの型なら予測が効くのか。故障の記録から何が分かるか |
| 第3章 | センサーとデータ収集、振動・温度・電流・稼働ログの集め方 | どの故障をどのセンサーで捉えるのか。データをどう集め、どうつなぐか |
| 第4章 | 振動データの信号処理と特徴量、FFTと包絡線解析で状態を数値にする | 振動の波形から、故障の兆候をどんな数値として取り出すか |
| 第5章 | 異常検知の手法、しきい値・管理図・機械学習で「いつもと違う」を見つける | 故障のデータが少ないときに、いつもと違う状態をどう見つけるか |
| 第6章 | 故障診断、異常の原因を分類して故障モードと結びつける | 見つけた異常の原因を、どう絞り込み、保全員にどう示すか |
| 第7章 | 残存寿命の推定、劣化モデル・回帰・生存分析 | あとどれくらい使えるかを、どんな方法で、どれくらいの幅で予測するか |
| 第8章 | 予測の評価と警報の設計、見逃し・誤報・リードタイム | 予測をどの指標で評価し、警報のしきい値と警報の段階をどう決めるか |
| 第9章 | 保全計画の最適化、交換時期と点検周期と作業の割当を数理モデルで決める | いつ交換し、どの作業を誰がどの時間枠で行うかを、どう決めるか |
| 第10章 | 予知保全を業務に組み込む、作業指示・保全記録・設備台帳とのつなぎ方 | 警報から作業と記録までを、既存の保全業務にどう組み込むか |
| 第11章 | 物理モデルとデジタルツインの併用、故障データの不足を補う | 故障のデータが足りないとき、物理の知識とシミュレーションで何を補えるか |
| 第12章 | 予知保全の導入の進め方、対象設備の選定・PoC・効果の見立て | どの設備から始め、試験導入(PoC、概念実証)をどう設計し、効果をどう見立てるか |
| 第13章 | 体制と人材、保全部門・データ担当・現場の役割と技能の継承 | 誰が何を担い、熟練者の判断をどう残し、最初の90日をどう進めるか |
| 第14章 | 公開事例と最新動向、規格・業界の取り組み・生成AIの活用 | 公開された事例から何が読み取れ、規格と技術はどう動いているか |
本コラムで使う用語は、次の表の意味に固定しています。規格によって範囲が違う用語(予知保全・状態基準保全など)は、第1章で規格の原文に当たり、本コラムの定義との違いを示します。故障率・打ち切り・P-F 間隔のように特定の章だけで使う用語は、その章の中で定義します。
| 用語 | 本コラムでの意味 |
|---|---|
| 事後保全 | 故障してから修理する方式 |
| 予防保全 | 故障する前に保全を行う方式の総称。時間基準保全と状態基準保全を含む |
| 時間基準保全(TBM) | 決まった時間・稼働時間・回数ごとに点検・交換する方式 |
| 状態基準保全(CBM) | 設備の状態を測り、状態に応じて保全する方式 |
| 状態監視 | 設備の状態を測る行為(振動・温度・電流などの測定と記録)。状態基準保全という方式を支える手段 |
| 予知保全 | 状態基準保全のうち、データから将来の状態(異常の進行・残存寿命)を予測して保全の時期を決めるもの |
| 異常検知 | いつもの状態と違うことを見つけること。原因までは特定しない |
| 故障診断 | 異常の原因(どの部品のどの故障モードか)を特定すること |
| 残存寿命(RUL) | 今の時点から、機能を果たせなくなる、あるいは保全が必要な水準に達するまでの残りの時間・稼働時間。何をもって寿命の終わりとするかは章ごとに明記する |
| 故障モード | 故障の現れ方(例として、軸受の外輪のはく離、ベルトの摩耗、絶縁の劣化) |
| 警報 | 予知保全の仕組みが保全員に出す通知 |
| 誤報 | 故障の兆候が無いのに出た警報。データで数えるときの数え方は第8章で決める |
| 見逃し | 故障の前に警報が出なかったこと。警報は出たが作業に要る時間を確保できなかったものは、見逃しとは分けて数える(第8章) |
| リードタイム | 警報から故障(あるいは機能の停止)までの時間 |
| 保全計画 | どの設備に、いつ、どの保全(点検・交換・修理)を、誰が行うかを決めた計画 |
| 相対コスト | 例題で使う単位の無いコスト。金額ではない |
第1章 保全の方式と予知保全の位置づけ、事後保全から状態基準保全まで
予知保全は、保全の方式の1つです。保全の方式には、故障してから直す方式、決まった周期で点検や交換をする方式、設備の状態を測って状態に応じて手を打つ方式などがあり、予知保全はその中の1つの選択肢にすぎません。予知保全を始めるときに最初に決めるべきことは、どのアルゴリズムを使うかではなく、自社のどの設備にどの方式を当てるかです。この章では、保全の方式を分類し、規格の用語で予知保全がどこに位置づけられるかを確かめたうえで、方式ごとの向き不向きと、方式を設備ごとに選ぶときの経営の判断を扱います。
この章では、次の順に扱います。
- 保全の方式の全体像と、本コラムで使う言葉の範囲
- 国際電気標準会議(IEC)の用語集で確かめた範囲での、各方式の定義と語の範囲の違い
- 方式ごとの向き不向きと、予知保全が向かない設備
- 信頼性中心保全(RCM)の考え方の起源
- TPM と自主保全・計画保全の関係
- アセットマネジメントの国際規格である ISO 55000 系との関係と、法令で定められた点検
- よくある誤解と、方式の選び方を誤ったときの損失の型
- 方式を設備ごとに選ぶための経営判断
保全の方式の全体像と本コラムで使う言葉の範囲
保全の方式は、大きく「故障が起きてから手を打つ方式」と「故障が起きる前に手を打つ方式」に分けて考えると整理しやすくなります。前者が事後保全で、本コラムでは「故障してから修理する方式」の意味で使います。後者は一般に予防保全と呼ばれ、さらに「いつ手を打つか」を何で決めるかによって2つに分かれます。1つは、決まった時間・稼働時間・回数ごとに点検や交換をする時間基準保全(TBM)です。もう1つは、設備の状態を測り、状態に応じて保全する状態基準保全(CBM)です。
本コラムでいう予知保全は、状態基準保全のうち、データから将来の状態(異常の進行や残存寿命)を予測して保全の時期を決めるものを指します。状態基準保全には、測った値があらかじめ決めた基準値を超えたら手を打つ、という「今の状態」だけを見る運用も含まれます。予知保全は、そこから一歩進めて「このまま進むと、いつごろ保全が必要な水準に達するか」を見積もり、その見積もりを保全の段取り(部品の手配・作業員の確保・計画停止の時間枠の確保)に使う運用です。予知保全を支える分析(異常検知・故障診断・残存寿命の推定)は第5章から第7章で、予測を保全計画に変える方法は第9章で扱います。
保全の方式には、故障の前後で手を打つ方式のほかに、設備そのものを変える方式もあります。故障の起きにくい構造に改める、保全しやすい構造に改める、新しい設備を設計する段階で過去の故障の記録を反映する、といった活動です。日本では改良保全・保全予防という語で呼ばれることがありますが、次の節「IEC の用語集で確かめる、JIS は未確認」で書くとおり、本コラムでは JIS の定義の原文を確かめられていないため、この章では「設備を変える方式」として本コラムの範囲で説明します。予知保全は「今ある設備をどう見張るか」の方式なので、設備を変える方式とは役割が違います。予知保全の仕組みで同じ故障モードの警報が繰り返し出る設備は、見張りを続けるより設計を改めた方がよい場合があり、方式の選び方はこの2つを行き来しながら決めることになります。
この章の議論の前提として、本コラムの用語の範囲を表にまとめておきます。用語の定義は全体の地図の表と同じで、規格上の用語との違いは次の節で確かめます。
| 方式 | 本コラムでの意味 | いつ手を打つかを決めるもの | 必要な情報 |
|---|---|---|---|
| 事後保全 | 故障してから修理する方式 | 故障の発生 | 故障したことが分かる仕組み、修理の手順と部品 |
| 時間基準保全(TBM) | 決まった時間・稼働時間・回数ごとに点検・交換する方式 | 暦の日数、稼働時間、動作の回数 | 周期を決める根拠(故障の記録、メーカーの推奨) |
| 状態基準保全(CBM) | 設備の状態を測り、状態に応じて保全する方式 | 現在の状態の評価、あるいは将来の状態の予測にもとづく判断 | 状態を表す測定値と、手を打つ基準 |
| 予知保全 | 状態基準保全のうち、データから将来の状態を予測して保全の時期を決めるもの | 予測した将来の状態(異常の進行・残存寿命) | 状態の測定値の履歴、劣化の進み方の知識、予測の誤差の見積もり |
| 設備を変える方式(改良保全・保全予防と呼ばれることがある) | 故障しにくい・保全しやすい設備に改める活動 | 故障の記録の分析、設備の更新や新設の機会 | 故障の原因と故障モードの記録 |
表の方式どうしの上下関係を、本コラムの用語でまとめると次のとおりです。
- 故障が起きてから手を打つ方式:事後保全
- 故障が起きる前に手を打つ方式:予防保全。時間基準保全と状態基準保全の2つに分かれる
- 状態基準保全のうち、将来の状態を予測して保全の時期を決めるもの:予知保全
- 設備そのものを変える方式:上の3つとは別の、設備を改める活動
IEC の用語集で確かめる、JIS は未確認
保全の方式の名前は、規格によって範囲が少しずつ違います。社内で「予防保全」「状態監視保全」「予知保全」といった語を使うとき、人によって思い浮かべる範囲が違うと、どの設備をどの方式で管理しているかの集計がずれます。そこで、本コラムでは国際規格の用語集である IEC 60050-192(国際電気技術用語集のうち、ディペンダビリティ(総合信頼性)の部)の項目を、IEC が公開している用語データベース Electropedia の内容で確かめました。項目ごとに改訂の日付が付いているため、参照するときは各項目の最新の内容を確かめる必要があります。
確かめた範囲で、保全の方式に関わる4つの項目の要点は次のとおりです。予防保全(英語は preventive maintenance)は、劣化を和らげ故障の確率を下げるために行う保全と定義され、注記で状態基準保全と時間計画保全を参照するよう示しています。事後保全の対訳が付いている項目(英語は corrective maintenance)は、フォールトを検出した後に、元の状態に戻すために行う保全と定義されています。ここでいうフォールトは、内部の状態によって、求められたとおりに機能を果たせない状態を指します。IEC の注記では、フォールトは故障だけでなく、設計や製造などライフサイクルの前の段階の不備から生じるものも含むとされる語です。状態基準保全に当たる項目(英語は condition-based maintenance)は、物理的な状態の評価にもとづく予防保全と定義され、日本語の対訳は「状態監視保全」でした。注記には、状態の評価は運転員による観察、計画に沿った評価、システムのパラメータの状態監視のいずれでもよい、という趣旨が書かれています。
時間基準保全に関連する項目(英語は scheduled maintenance)は、定めた時間の計画に従って行う保全と定義され、日本語の対訳は「時間計画保全」でした。注記には、時間計画保全の中で事後保全が必要なことが見つかる場合がある、と書かれています。この定義は「予定に従って行う」ことを指しており、本コラムの時間基準保全(時間や回数を基準に処置を決める方式)と同じものとは限りません。点検を予定どおり行うことと、時間と状態のどちらを基準に処置を決めるかは、分けて考える必要があります。本コラムでは、この4項目の前後に並ぶ保全の項目もいくつか開きましたが、開いた範囲には予知保全(predictive maintenance)を見出しとする項目はありませんでした。IEC の用語集全体の中で予知保全という語が別の項目で定義されているかどうかは、本コラムでは確かめていません。
この確認から分かることが2つあります。1つは、IEC の用語では、本コラムで状態基準保全と呼ぶものは予防保全の一部として位置づけられていることです。予知保全については、確かめた範囲の IEC の項目に見出しが無かったため、規格の定義から位置づけを導くことはできません。本コラムでは、予知保全を状態基準保全の一部として、将来の状態を予測するものと定義して使います。これは本コラムの定義であり、IEC で確かめた結果ではありません。もう1つは、IEC の状態基準保全には、運転員の目視や決まった周期での点検による状態の評価も含まれることです。センサーを付けていなくても、巡回点検で状態を見て判断していれば状態基準保全の一種になります。予知保全を始めるときに「今は状態基準保全をしていない」と思い込まず、既存の点検で状態を見ている部分を先に棚卸しすると、データ化の候補が見つかりやすくなります。なお、本コラムでは、IEC の対訳の「状態監視保全」と本コラムの「状態基準保全」を同じ保全の方式を指す語として扱います。第3章で扱う「状態監視」は、この方式のために設備の状態を測る行為を指す語として使い分けます。
日本産業規格では、JIS Z 8115(ディペンダビリティ(総合信頼性)用語)と JIS Z 8141(生産管理用語)が保全の用語を扱っています。日本産業標準調査会(JISC)の規格の検索では、JIS Z 8115 は最新の改正が2019年3月20日、最新の確認が2023年10月20日、JIS Z 8141 は最新の改正が2022年3月22日、最新の確認が2026年10月20日と表示されていました。どちらも JISC のサイトで本文を閲覧できますが、閲覧には利用者の登録とログインが必要で、本コラムではこの手順を取っていません。このため、2つの規格に書かれている各用語の定義の原文は確かめておらず、本文では JIS の定義を引いていません。社内の用語を JIS にそろえる場合は、JISC で本文を開いて確かめる必要があります。
規格によって語の範囲が違う点を、確かめた範囲で表にまとめます。表の「JIS」の列は、上に書いた理由で定義の原文を確かめていないため、すべて「未確認」としています。規格どうしの定義の比較を終えた表ではなく、IEC で確かめた範囲を示す表です。
| 本コラムの語 | IEC 60050-192 の項目(確かめた範囲) | IEC の日本語の対訳 | JIS Z 8115・JIS Z 8141(定義は未確認) | 範囲の違いで注意すること |
|---|---|---|---|---|
| 事後保全 | 192-06-06。フォールトの検出後に元の状態に戻すための保全 | 事後保全 | 未確認 | IEC は「故障してから」ではなく「フォールトを検出してから」と書いている。点検で見つけた不具合の修理も含みうる |
| 予防保全 | 192-06-05。劣化を和らげ故障の確率を下げるための保全 | 予防保全 | 未確認 | 注記で時間計画保全と状態基準保全を参照している上位の語 |
| 時間基準保全(TBM) | 関連する項目として 192-06-12。定めた時間の計画に従って行う保全 | 時間計画保全 | 未確認 | IEC の定義は予定に従うことを指し、処置の基準が時間か状態かは定めていない。予定どおりの点検で状態を見て処置を決める場合は状態基準保全に当たりうる |
| 状態基準保全(CBM) | 192-06-07。物理的な状態の評価にもとづく予防保全 | 状態監視保全 | 未確認 | 運転員の観察や周期的な点検による評価も含む。センサーの有無で決まらない |
| 予知保全 | 確かめた範囲の項目には見出しとして無い | (確かめた範囲には無い) | 未確認 | 本コラムでは状態基準保全のうち将来の状態を予測するもの、と定義して使う |
| 信頼性中心保全(RCM) | 192-06-08。故障の確率と影響にもとづいて保全の作業と頻度を決める体系的な方法 | 信頼性中心保全、信頼性重視保全 | 未確認 | 方式の1つではなく、方式を選ぶための方法 |
表の最後の行が示すように、信頼性中心保全は事後保全や状態基準保全と並ぶ「方式」ではなく、設備ごとにどの方式を当てるかを決める「方法」です。本コラムで「方式は設備ごとに選ぶ」と書くときの考え方の土台はここにあり、次の2つの節で方式ごとの向き不向きと信頼性中心保全の起源を扱います。
方式ごとの向き不向き:故障の影響・故障の型・監視できるか・費用の型
どの方式が優れているかは、設備によって変わります。本コラムでは、方式を選ぶときの観点を次の4つに絞って考えます。
- 故障の影響:その設備が止まったときに、生産、安全と環境、品質にどれだけの影響が出るか
- 故障の型:使った時間とともに故障しやすくなる摩耗型か、使った時間に関係なく偶然に起きる偶発型か、使い始めに多い初期型か(故障の型の詳細は第2章で扱います)
- 監視できるか:故障の前に兆候が現れ、それを測る手段があり、兆候から故障までに手を打てるだけの時間があるか
- 費用の型:どの方式を選ぶとどの種類の費用が発生するか。金額ではなく、何に費用がかかるかの種類で比べる
次の表は、この4つの観点で方式を比べた本コラムの整理です。規格や調査の結果ではなく、方式の性質から考えた一般論の目安として示します。
| 方式 | 故障の影響 | 故障の型 | 監視できるか | 費用の型 | 向いている設備の例 |
|---|---|---|---|---|---|
| 事後保全 | 安全・環境・品質への影響が許容でき、止まっても影響が小さい。予備機と切り替えの機能が確実に働く、あるいはすぐ直せる | 型を問わない(とくに偶発型で兆候が無いもの) | 監視できなくてよい | 修理の費用と、停止している間の損失。対象の故障モードへの予防の点検や交換を省ける場合がある | 予備のある小型のポンプ、照明、交換が容易な消耗品 |
| 時間基準保全(TBM) | 影響が中から大で、止めたくない | 摩耗型で、寿命のばらつきが小さい | 監視できない、または監視する手段の方が高くつく | 周期ごとの点検・交換の費用。まだ使える部品の交換(過剰保全)が起きやすい | 寿命がそろっている消耗部品、法令や基準で周期が決まっている点検 |
| 状態基準保全(CBM) | 影響が中から大 | 摩耗型で寿命のばらつきが大きい、あるいは劣化が徐々に進むもの | 兆候が現れ、測れて、兆候から故障まで手を打つ時間がある | 測定の仕組みと点検の人手。異常と判断したときの保全 | 回転機の軸受、潤滑油の劣化、熱で劣化する部品 |
| 予知保全 | 影響が大きく、計画外の停止を避けたい | 劣化が徐々に進み、進み方に規則性がある | 状態の測定値を継続して集められ、予測に使える履歴がある | データの収集と分析の仕組み、予測を扱う人の体制。予測の誤差と、警報の誤報・見逃しへの対応 | 止めると生産全体に影響する主要な回転機、交換の段取りに時間がかかる設備 |
| 設備を変える方式 | 同じ故障が繰り返し起きている | 型を問わない | 監視の可否を問わない | 設計の変更・改造・更新の費用 | 同じ故障モードが繰り返し記録されている設備 |
表の「向いている設備の例」は一般論の例で、同じ種類の設備でも使われ方と故障の影響によって向く方式は変わります。たとえば同じポンプでも、故障したときの安全・環境・品質への影響が許容でき、予備機と切り替えの機能が確実に働くことを確かめられる場所では、対象の故障モードへの事後保全が候補になります。工程の要で止まるとライン全体が止まる場所では予知保全の候補になります。方式は設備の種類ではなく、その設備がその場所で果たしている役割で決まる、と考えると判断を誤りにくくなります。また、1台の設備でも故障モードごとに方式を組み合わせることがあります。たとえば、同じ設備の軸受は状態基準保全で見張り、消耗部品は時間基準保全で交換する、という組み合わせです。
表から読み取れる大事な点は、予知保全が効くには「劣化が徐々に進み、その兆候を測れ、兆候から故障までに手を打つ時間がある」という条件がそろっている必要があることです。兆候が現れずに突然壊れる故障モードは、状態を測っても兆候が得られないため、予測の手法では捉えにくくなります。兆候が現れても、故障までの時間が短すぎて部品の手配や作業員の確保が間に合わない場合は、故障の前に計画して交換する用途には使いにくくなります。その場合に、停止や運転条件の変更の判断に使えるかは別に検討します。兆候が現れてから機能を失うまでの時間の考え方は、第2章で P-F 間隔として扱います。
費用の型の列も、方式の選び方に関わります。事後保全は、対象の故障モードへの予防の点検や交換を省ける場合がある代わりに、止まっている間の損失がそのまま出ます。法令で定められた点検のように、事後保全を選んでも省けない点検もあります。時間基準保全は計画が立てやすい代わりに、まだ使える部品を交換する過剰保全が起きやすくなります。予知保全では、状態基準保全と同じ測定の仕組みに加えて、予測のモデルを作って維持する負担と、予測を読んで判断する人の体制の負担が加わります。どの方式も費用がゼロになるわけではなく、どの種類の費用を引き受けるか、という観点で比べられます。
信頼性中心保全(RCM)の考え方の起源
設備ごとに方式を選ぶという考え方を体系にしたものが、信頼性中心保全です。IEC 60050-192 の項目 192-06-08 は、信頼性中心保全を、故障の確率と影響にもとづいて保全の作業とその頻度を決める体系的な方法と定義しています。注記には、検討はシステムのどの階層でも行えること、使うデータは故障モード影響致命度解析(FMECA)のような分析や、故障の報告と是正の仕組みのような経験から得られること、検討の結果が設計や手順の見直しにつながりうることが書かれています。
この考え方の起源としてよく挙げられるのが、F. S. Nowlan と H. F. Heap による1978年の仕事です。米国の運輸研究委員会(TRB)の文献データベース TRID には、2人が1978年1月の IEEE の信頼性・保全性シンポジウム(米国ロサンゼルス)で発表した「Reliability-Centered Maintenance」という論文の記録があります。抄録の要点は、複雑な設備の重要な品目ごとに、当てはまり、かつ効果のある予防保全の作業を選ぶというものです。抄録は計画保全の作業を次の4種類に整理しています。
- 機能故障の兆候(潜在的な故障)を見つけるための点検
- 許容される使用期間を超える前の再生(オーバーホール)
- 許容される使用期間を超える前の廃棄(交換)
- 運転する側からは見えない、すでに起きている故障を見つけるための点検
抄録によると、予防保全の作業がどれも当てはまらない品目も多く、当てはまっても効果が無ければ計画に入れない、という考え方です。航空輸送の業界の考え方を発展させたものとされています。ここまでの内容は、複雑な設備を対象にした1978年の論文の抄録に書かれていることで、一般の工場設備に同じように当てはまるかどうかを本コラムで確かめたものではありません。
上の4種類の作業を本コラムの言葉に置き換えると、1つ目は状態基準保全、2つ目と3つ目は時間基準保全、4つ目は隠れた故障を見つける点検に当たります。そして「どの作業も当てはまらない品目」は、事後保全か、設備を変える方式を選ぶことになります。予知保全は1つ目の作業を、データと予測で強化したものと位置づけられます。この抄録の考え方を工場設備に当てはめるなら、予知保全は「すべての設備に広げるもの」ではなく、1つ目の作業が当てはまり、かつ効果がある品目に絞って使うもの、と見るのが自然だと考えています。
なお、Nowlan と Heap は同じ1978年に、米国の国防総省の後援で同名の報告書をまとめたとされ、米国の国防技術情報センター(DTIC)が所蔵しているとされます。本コラムの執筆時点(2026年10月)では DTIC のページを開けなかったため、報告書の書誌は確かめられていません。本文では、書誌を確かめられた1978年のシンポジウムの論文の抄録だけを根拠にしています。
TPM と自主保全・計画保全の関係
日本の製造業で保全の方式を考えるとき、TPMとの関係を整理しておく必要があります。公益社団法人日本プラントメンテナンス協会(JIPM)のTPM の紹介のページによると、TPM は生産システムのあらゆるロスをゼロにすることを目指した生産保全の仕組みで、「全員参加の生産保全」や「総合的生産保全」と呼ばれ、JIPM が1971年に提唱したものです。同じページの定義の要点は、災害や不良や故障といったロスを未然に防ぐ仕組みを、生産部門だけでなく全部門が参加する小集団の活動で作ることにあります。また、JIS Z 8141 の2001年版で TPM が定義されていることにも触れています。
TPM の中で、運転を担う部門が行う保全が自主保全です。JIPM が運営する自主保全士の認定制度のページは、自主保全士を「設備に強いオペレーター」として認定する制度で、製造オペレーターに求められる知識と技能について、製造部門が受け持つ保全の一部の機能や管理技術を評価する尺度を定めている、と説明しています。同じページは、自主保全に必要な能力の1つとして設備の日常保全(自主保全活動)を挙げています。つまり自主保全は、設備の日常の保全を、保全の専門部門ではなく設備を使う製造部門が担う活動です。日常の保全の中身として清掃・点検・給油などが挙げられることが多いですが、これは本コラムの補足で、上のページで確かめた記述ではありません。これに対して、保全部門が計画を立てて行う保全は、TPM の文脈では計画保全と呼ばれることがあります。本コラムでは計画保全の定義を JIPM の公式ページで確かめられなかったため、ここでは「保全部門が計画的に行う保全」という一般的な意味で使います。
予知保全と TPM の関係で大事なのは、自主保全で運転員が日々見ている設備の状態が、予知保全にとっても重要な情報源だという点です。前の節で見たとおり、IEC の定義では運転員の観察による状態の評価も状態基準保全に含まれます。運転員が五感で得る気づき(音やにおいの変化など)は、センサーでは捉えにくい兆候を含むことがあります。予知保全の仕組みを入れるときに、自主保全の点検の記録をデータの対象から外してしまうと、すでにある状態の情報を捨てることになります。逆に、センサーのデータで見張れる項目が増えれば、自主保全の点検の項目を見直し、運転員がより気づきの必要な点に時間を使えるようにできます。
保全部門の側から見ると、予知保全は計画保全の精度を上げる道具です。警報が出てから作業を計画するまでの流れ、作業の結果を記録して次の予測に生かす流れは、計画保全の業務そのものです。予知保全を計画保全の業務の外に別の仕組みとして作ると、警報は出ても作業の計画に反映されない、という状態になりやすくなります。予知保全を業務に組み込む方法は第10章で、TPM を含む体制と人材は第13章で扱います。
ISO 55000 系(アセットマネジメント)と法令で定められた点検
保全の方式の選び方は、設備を組織の資産としてどう管理するかという、より大きな枠組みの中に位置づけられます。その国際規格が ISO 55000 系です。ISO の目録で確かめると、ISO 55000(2024年)はアセットマネジメントの用語・概要・原則を扱う規格で、第2版として2024年7月に発行され、状態は「発行済み」でした。同じ目録の説明では、ISO 55000 が概要・基本原則・用語を示し、ISO 55001 がアセットマネジメントシステムの要求事項を定め、ISO 55002 が ISO 55001 を適用するための指針を示す、という関係になっています。
ISO 55001 は第2版(2024年)が2024年7月に発行されています。ISO 55002 は第2版(2018年)が2018年11月に発行されたもので、目録の段階は「改訂予定」となっており、置き換わる予定の版として ISO/DIS 55002 が開発中と表示されていました(2026年10月30日に目録で確認)。DIS は、国際規格の案(規格案)の段階にあることを示す記号です。ISO 55002 は2026年10月の時点で改訂の作業中なので、これから参照する場合は目録で最新の状態を確かめる必要があります。
ISO 55000 系は、特定の保全の方式を指定する規格ではありません。目録の説明によると、資産の管理の目的を組織の目的とそろえること、資産のライフサイクル全体を通じて戦略的に管理すること、アセットマネジメントシステムを使って継続的に改善し価値を実現することが要素として挙げられています。本コラムの言葉に置き換えると、ISO 55000 系は「どの設備にどれだけの手間と費用をかけるかを、組織の目的に照らして決め、その決め方を仕組みとして回す」ための枠組みです。設備ごとに保全の方式を選ぶことは、この枠組みの中の具体的な判断の1つに当たります。
予知保全を始める組織にとっての実務上の意味は、予知保全の導入の判断を、個々の設備の技術的な可否だけでなく、組織全体の資産の管理の方針の中で行うということです。たとえば、工場ごとにデータの定義や接続の仕様をそろえずに予知保全の仕組みを別々に作ると、同じ種類の設備の状態を比べにくく、仕組みを使い回すことも難しくなり、重複した投資につながることがあります。アセットマネジメントの枠組みで「どの設備群に、どの方式を、どの順に当てるか」を先に決めておくと、こうした重複を避けやすくなります。導入の対象の選び方は第12章で扱います。
保全の方式を設備ごとに選べるといっても、自社の判断だけでは変えられない点検があります。その代表が法令で定められた点検です。e-Gov 法令検索の労働安全衛生法の第45条第1項は、事業者は、ボイラーその他の機械等で政令で定めるものについて、厚生労働省令で定めるところにより、定期に自主検査を行い、その結果を記録しておかなければならない、と定めています。同条の第2項は、政令で定める機械等についての特定自主検査について、所定の資格を持つ事業者本人(法人の場合は代表者か役員)が自ら行うか、自社で使用する有資格の労働者に実施させるか、登録を受けた検査業者に実施させるか、のいずれかによることを定めています。
こうした法令に基づく点検は、何をどの周期で誰が行うかが法令や省令で決められており、予知保全の仕組みを入れたことを理由に省略したり周期を延ばしたりできるものではありません。本コラムでは、法令で定められた点検を予知保全で置き換えられるとは考えていません。どの設備がどの法令のどの点検の対象になるか、点検の方法をどこまで変えられるかは、所管の官庁の資料や専門家に個別に確かめる必要があります。予知保全は、法令で定められた点検に加えて、点検と点検の間の状態の変化を捉える目的で使う、と位置づけるのが安全です。
安全に関わる判断全般についても同じ考え方を取ります。予知保全の仕組みが「異常なし」と判断していても、運転員や保全員が異常を感じたときに設備を止める判断を妨げてはいけません。予測の結果は保全員の判断の材料であり、安全に関わる最終の判断を仕組みに任せる設計にはしない、というのが本コラムの立場です。警報の段階と対応の手順の設計は第8章で扱います。
予知保全が向かない設備と、判断に要る故障の記録
方式ごとの向き不向きの表から、予知保全が向かない設備の型を取り出しておきます。どれも「予知保全をしてはいけない」という意味ではなく、「予知保全を入れても判断が変わらないか、費用に見合う効果が出にくい」という意味です。
- 止まっても影響が小さい設備。安全・環境・品質への影響が許容でき、予備機と切り替えの機能が確実に働く設備、あるいは故障してもすぐに交換できる設備は、事後保全で足りることが多い
- 兆候が現れずに突然壊れる故障モードが主な設備。電子部品の偶発的な故障のように、使った時間や状態の変化と関係なく起きる故障には、状態を測っても予測が効きにくい
- 兆候から故障までの時間が、部品の手配や作業の準備にかかる時間より短い設備。予測が当たっても、手を打つ前に故障する
- 寿命のばらつきが小さく、時間基準保全で十分に管理できている消耗部品。予測を入れても交換の時期がほとんど変わらない
- 状態の測定値を継続して集める手段が無い、あるいは測るための仕組みの方が設備そのものより手間がかかる設備
- 同じ故障モードが繰り返し起きていて、設計を改めれば故障そのものを無くせる設備。見張りを続けるより、設備を変える方式を先に検討する
これらの型に当てはまるかどうかを判断するには、設備ごとの故障の記録が必要です。どの故障モードが、どれくらいの頻度で、どんな兆候を伴って起きたかを知る手がかりとして、自社の設備の記録は重要です。記録が足りない場合は、設計の情報、メーカーの試験の結果、似た設備の知見で補うことになりますが、自社の使い方に当てはまるかどうかと、その不確かさを確かめる必要があります。故障の記録が無い状態で予知保全の対象を選ぶと、予測の手法の議論ばかりが進み、肝心の「この設備に予測が効くか」が分からないまま投資が進むことになります。故障の記録の読み方は第2章で、記録の残し方は第10章で扱います。
よくある誤解と、方式の選び方を誤ったときの損失の型
予知保全の導入の議論でよく見られる誤解を3つ取り上げます。いずれも、この章で見てきた「方式は設備ごとに選ぶ」という考え方から外れたときに起きやすいものです。
| 誤解 | どこが誤りか | 代わりに考えること | 起きやすい損失の型 |
|---|---|---|---|
| すべての設備を予知保全にすべきだ | 予知保全が効くのは、劣化が徐々に進み、兆候を測れ、手を打つ時間がある故障モードに限られる。1978年の Nowlan と Heap の論文の抄録でも、複雑な設備を対象に、予防保全の作業がどれも当てはまらない品目も多いとされている | 設備ごとに故障の影響・故障の型・監視できるかを評価し、予知保全を当てる設備を絞る | 過剰保全、二重投資 |
| AIを入れれば故障が無くなる | 予測は故障の時期を見積もるもので、故障そのものを無くすものではない。故障の時期の予測には誤差があり、予測から警報を出す判断には誤報や見逃しが起きる可能性を前提にする必要がある。予測を保全の作業に変える計画と体制が無ければ、当たった予測も生かされない | 予測の誤差と、警報の誤報・見逃しを前提に、警報を受けて誰が何をするかを決める。故障を無くしたい場合は設備を変える方式も検討する | 突発停止、警報の形骸化 |
| センサーを付ければ終わりだ | センサーのデータは、どの故障モードを捉えるためのものかが決まっていないと、判断に使えない。データを読む人、警報を受けて作業を決める人、結果を記録する人がいなければ、データは溜まるだけになる | 測る前に、捉えたい故障モードと、捉えたあとの作業を決める。保全記録の仕組みを一緒に作る | 警報の形骸化、二重投資 |
3つの誤解に共通するのは、予知保全を「技術を入れれば効果が出るもの」と捉えている点です。この章で見てきたとおり、予知保全は保全の方式の1つであり、効果が出るかどうかは、その方式が当てはまる設備を選べているか、予測を保全の作業に変える流れがあるかで決まります。第3章で扱う「測る前に捉える故障モードを決める」という考え方も、3つ目の誤解への対策です。
保全の方式の選び方を誤ると、経営上どのような損失になるかを、序章で整理した6つの損失の型で整理します。金額ではなく、どの種類の損失が起きるかで考えます。
| 損失の型 | 方式の選び方で起きる典型 | 経営として見ること |
|---|---|---|
| 突発停止 | 故障の影響が大きい設備を事後保全のままにしている。兆候があるのに見張っていない | 計画外の停止の件数と停止時間を、設備ごとに把握しているか |
| 過剰保全 | 寿命のばらつきが大きい部品を短い周期で一律に交換している。影響の小さい設備に予知保全の仕組みを入れている | まだ使える部品の交換や、判断に使われていない点検がどれだけあるか |
| 安全と環境の事故 | 安全に関わる設備の判断を予測の仕組みだけに任せる。法令で定められた点検を予知保全で置き換えたと考える | 法令に基づく点検が予知保全とは別に確実に行われているか |
| 品質の不良 | 止まりはしないが性能が落ちる劣化を見張っていない | 不良の原因の中に、設備の劣化によるものがどれだけあるか |
| 警報の形骸化 | 予知保全が当てはまらない設備にも警報を出し、誤報が続いて警報が見られなくなる | 警報のうち、作業につながったものの割合を見ているか |
| 二重投資 | 部門や工場ごとに、データの定義や接続の仕様をそろえずに予知保全の仕組みを別々に作る | 方式の選び方とデータの仕組みを、組織として1つの方針で決めているか |
この表で特に注意したいのは、損失の型どうしが引き換えの関係になりやすいことです。突発停止を減らそうとして時間基準保全の周期を短くすると、過剰保全が増えやすくなります。予知保全の警報の感度を上げて見逃しを減らそうとすると、誤報が増えて警報の形骸化が起きやすくなります。方式の選び方は、どの損失をどこまで受け入れるかの判断でもあり、その判断は保全部門だけで行わず、生産・品質と安全の責任者も加わって決める必要があります。誰が承認するかは第12章・第13章で扱い、予知保全の対象設備の選定は工場長が承認し、予算と対象の拡大(ラインや工場への展開)は経営が判断する、という分担にしています。誤報と見逃しの釣り合いを相対コストで決める方法は第8章で扱います。
経営判断:方式を設備ごとに選ぶ
この章の結論を経営の判断に落とすと、「予知保全を導入するかどうか」を全社一律に決めるのではなく、「どの設備のどの故障モードにどの方式を当てるか」を設備ごとに決め、必要なら方式を組み合わせる、ということになります。その判断のために、経営として最低限そろえておきたいものを3つ挙げます。
1つ目は、設備の一覧と、設備ごとの故障の影響の評価です。どの設備が止まると何が止まるか、安全と環境と品質にどう影響するかが、設備ごとに分かっている必要があります。2つ目は、設備ごとの故障の記録です。故障の型と兆候の有無を判断する手がかりとして、自社の記録は重要です。記録が無い設備については、まず記録を取り始めることが、予知保全の導入より先の仕事になります。3つ目は、方式の選び方を決めて見直す場です。保全部門・生産部門・品質と安全の責任者が参加し、設備ごとの方式を決め、年に1回など決まった周期で見直します。この場で決めた方式のうち、予知保全の対象設備の選定は工場長が承認し、予算と対象の拡大は経営が判断します(第12章・第13章)。ISO 55000 系の枠組みは、この場を組織の仕組みとして位置づけるときの参考になります。
予算の面では、予知保全の費用を設備ごとの方式の選択と結びつけて扱うことが有効だと考えています。予知保全の仕組みにかかる費用を「デジタル化の投資」として保全の費用と別に扱うと、どの設備で事後保全や時間基準保全から予知保全に切り替え、その結果どの種類の損失が減る見込みなのかが見えなくなります。設備ごとに次の4つを並べて判断すると、予知保全への投資を保全計画全体の中で評価できます。
- 今の方式
- 切り替える方式
- 減らしたい損失の型
- 増える費用の型
効果の見立て方は第12章で扱います。
この章では、保全の方式を分類し、IEC の用語では状態基準保全が予防保全に含まれることを確かめました。予知保全は確かめた範囲の IEC の項目に見出しが無かったため、本コラムで状態基準保全の一部として定義しました。方式ごとの向き不向きを4つの観点で比べ、予知保全が効くのは劣化が徐々に進み、兆候を測れ、手を打つ時間がある故障モードに限られることを見ました。経営として取りかかる最初の仕事は、設備の一覧と、設備ごとの故障の記録の有無を確かめることです。次の第2章では、方式を選ぶための土台になる故障のしくみと信頼性の基礎、つまり故障の型・寿命分布・故障率を、架空のデータを使ったコードで確かめます。
この章を深めたい方への参考書籍
『実務者のための製品・設備のライフサイクルメンテナンス入門』(髙田祥三 著、森北出版):製品や設備のメンテナンス計画の考え方と手順を、ライフサイクルの視点から体系的に解説した入門書です。版元の目次では、劣化と故障、劣化・故障予測、基本メンテナンス計画、設備診断技術、TPM までを1冊で扱っており、この章で扱った方式の全体像を、計画の立て方まで含めて確かめるのに向いています。
『リスクベースメンテナンス入門-RBM-』(日本学術振興会・産学連携第180委員会「リスクベース設備管理」テキスト編集分科会 編、養賢堂):故障の起きやすさと影響の大きさ(リスク)にもとづいて保全の重点を決める考え方を、基本から適用の手順まで説明した入門書です。この章で書いた「方式は設備ごとに、故障の影響と故障の型で選ぶ」という考え方を、リスクの評価の手順として深めるのに向いています。
第2章 故障のしくみと信頼性の基礎、故障モード・寿命分布・故障率
第1章では、保全の方式を事後保全・時間基準保全・状態基準保全・予知保全に分け、どの方式を選ぶかは設備ごとに決めるものだと確かめました。この章では、その選び方の土台になる「設備はどのように壊れるか」を扱います。同じ「故障」でも、使い始めてすぐに起きやすいもの、いつ起きるか分からないもの、使い込むほど起きやすくなるものがあり、どの型の故障が多いかによって、交換の時期を決めて守る保全が効くのか、状態を測って兆候を捉える保全が効くのかが変わります。この章の前半では、故障率の考え方と3つの故障の型、信頼性の基本の指標(MTBF・MTTR・アベイラビリティ)を説明します。中盤では、架空の故障時間データに scipy でワイブル分布を当てはめて故障の型を判定する例と、観測の途中で記録が切れている(打ち切りのある)データを扱う例を、実際に実行した結果で示します。後半では、故障の起き方を整理する故障モード影響解析(FMEA)と故障の木解析(FTA)、兆候が現れてから機能が失われるまでの時間(P-F 間隔)を扱い、故障モードと兆候の対応を表にまとめます。残存寿命の予測そのものは第7章、最適な交換周期の計算は第9章で扱います。
故障率とは何か、「今まで動いていた設備が次の瞬間に壊れる起こりやすさ」
信頼性の分野で使う故障率は、日常の「よく壊れる」とは少し違う、はっきりした定義を持つ量です。米国国立標準技術研究所(NIST)が公開している統計の手引き(NIST/SEMATECH e-Handbook of Statistical Methods)の8.1.2.3節では、故障率を「その時点まで故障せずに生き残っている個体が、その時点で故障する瞬間的な割合」として説明しています。ここで大事なのは「生き残っている個体のうちで」という条件です。100台のポンプのうち、すでに壊れた台は分母から外れ、まだ動いている台だけを母数にして、次の短い時間に何台壊れるかを数えます。
式で書くと、故障率 \( h(t) \) は、時刻 \( t \) の故障の密度 \( f(t) \) を、その時刻まで故障していない割合(信頼度)\( R(t) \) で割ったもの、つまり \( h(t) = f(t) / R(t) \) です。言い換えると、「時刻 \( t \) の直後に壊れる台数」を「時刻 \( t \) にまだ動いている台数」で割った値を、時間の長さあたりに直したものです。本コラムでは、故障率を「1,000時間あたり」で表します。1,000時間あたり0.2という値は、瞬間的な故障率を1,000時間あたりに換算したもので、故障の回数や故障する確率そのものではありません。故障率がその1,000時間のあいだ一定だとすると、その時点で動いている部品が次の1,000時間のうちに故障する確率は \( 1 – \exp(-0.2) \) で、約18.1%になります(NIST の手引き8.1.2.3節の、故障率と信頼度の関係から計算しました)。
故障率が時間とともにどう変わるかは、保全の方式を選ぶうえで最も重要な情報の1つです。故障率が稼働時間とともに上がっていく設備なら、ある時間が来る前に交換すれば故障を減らせます。故障率が時間によらず一定の設備では、交換しても新品の故障率は古い設備と同じなので、時間を決めて交換しても故障は減りません。故障率が下がっていく設備では、むしろ新品に替えたことで故障が起きやすい時期に戻してしまいます。時間基準保全が効くかどうかは、故障率の形で決まります。
なお、NIST の手引きは、修理しながら使い続ける設備(修理可能な系)については、縦軸を「故障率」ではなく「修理の発生率(故障の発生率)」として読むべきだと注意しています。1台の設備を修理して使い続けるときの「故障の起こり方」と、同じ型の部品を多数並べたときの「1個の寿命の分布」は、厳密には別の対象です。本章のワイブル分布の当てはめは後者、つまり「交換したら新品に戻る部品(軸受・ベルト・シール等)の寿命」を対象にしています。
3つの故障の型とバスタブ曲線
故障率の時間的な変わり方は、大きく3つの型に分けて説明されます。NIST の手引きの8.1.2.4節は、多くの機械・電子の系でくり返し観察されてきた形として、故障率を縦軸、時間を横軸にとったバスタブ曲線を紹介しています。使い始めの「初期故障期」には故障率が高く、急速に下がります。その後の長い「偶発故障期」では故障率がほぼ一定になります。最後の「摩耗故障期」では、材料の摩耗や劣化によって故障率が上がっていきます。曲線の形が浴槽(バスタブ)の断面に似ているので、この名前があります。
3つの型には、それぞれ典型的な原因があります。初期故障は、製造や組み立ての不良、据え付けの誤り、初期のなじみ不足など、「最初から弱い個体」が早い時期にふるい落とされることで起きます。偶発故障は、外から加わる予期しない負荷(異物の混入、電源の異常、操作の誤り)など、稼働時間とは関係の薄い原因で起きます。摩耗故障は、軸受の転がり疲れ、ベルトやシールの摩耗、絶縁材の熱による劣化など、使った時間や回数に応じて進む劣化で起きます。
ただし、NIST の手引き自身も、平らな期間が寿命の大半を占めることを「望ましい」形として書いており、すべての設備がこの形になるとは述べていません。実際の設備では、初期故障がほとんど無いもの、摩耗故障期に入る前に更新されるもの、偶発故障だけが目立つものもあります。バスタブ曲線は「故障率の変わり方には型がある」ことを示す説明の道具として使い、自社の設備がどの形かは、故障の記録から確かめる必要があります。その確かめ方を、この章の後半のコードで示します。
次の図は、3つの型の故障率を足し合わせると、バスタブの形になることを確かめるために描いたものです。初期故障・偶発故障・摩耗故障がそれぞれ独立に起きる(どれか1つが起きたら故障する)という架空の設定で、各成分を後で説明するワイブル分布の故障率で表しました。合計の故障率(太線)は、使い始めに高く、2,000時間で0.075、6,000時間で0.090(いずれも1,000時間あたり)と低い水準にとどまったあと、10,000時間で0.262、14,000時間で0.831と急に上がります。
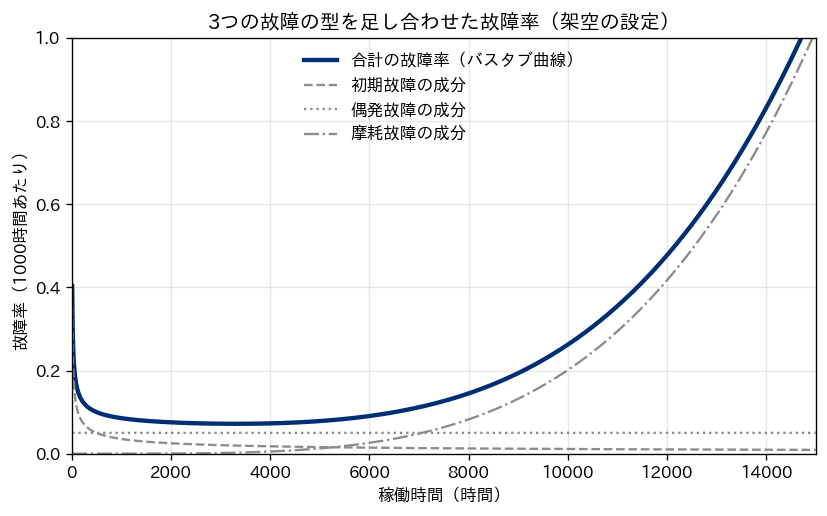
この図のもとになった計算では、稼働時間ごとに合計の故障率、3つの成分の内訳、最も大きい成分(同率なら両方)を出力しました。結果を表にまとめます。
| 稼働時間 | 合計の故障率(1,000時間あたり) | 内訳(初期故障・偶発故障・摩耗故障) | 最も大きい成分 | この時期に効く保全の考え方 |
|---|---|---|---|---|
| 50時間 | 0.208 | 0.158・0.050・0.000 | 初期故障 | 据え付けと試運転の確認、初期の点検を手厚くする |
| 500時間 | 0.100 | 0.050・0.050・0.000 | 初期故障・偶発故障(同率) | 初期の不具合の記録を設計・購買に戻す |
| 2,000時間 | 0.075 | 0.025・0.050・0.000 | 偶発故障 | 偶発故障の成分には、時間で交換する効果を期待しにくい。原因(外乱)を減らす、兆候を監視する |
| 6,000時間 | 0.090 | 0.014・0.050・0.026 | 偶発故障 | 摩耗故障の成分も無視できない大きさになっている。交換の方策は3つの成分を合わせて評価する |
| 10,000時間 | 0.262 | 0.011・0.050・0.201 | 摩耗故障 | 交換の時期を決める、劣化の進み方を測る |
| 14,000時間 | 0.831 | 0.009・0.050・0.772 | 摩耗故障 | 交換を先送りすると故障率が急に上がる |
表の右端の列は、成分の大きさから導いた保全の考え方の目安で、計算の結果そのものではありません。本コラムの架空の設定では、14,000時間の故障率は2,000時間の約11倍になりました。どの時期にどの成分が大きいかが分かれば、「初期は据え付けの品質」「中盤は外乱の管理と監視」「終盤は交換の時期」と、手を打つ場所を分けられます。
MTBF・MTTR・アベイラビリティ、平均の数字が言えることと言えないこと
設備の信頼性を1つの数字で表すとき、よく使われるのが MTBF(故障から次の故障までの平均の稼働時間)と MTTR(故障してから直るまでの平均の時間)です。修理して使い続ける設備では、ある期間の MTBF は、その期間の稼働時間の合計を故障の回数で割って求めます。NIST の手引きの8.1.7.1節は、故障の発生率が時間によらず一定とみなせる場合(統計の言葉で同次ポアソン過程と呼ぶモデル)について、MTBF が故障の発生率の逆数になることを示しています。日本の信頼性の用語の規格としては JIS Z 8115 がありますが、本コラムでは JIS Z 8115 の原文を開いて確かめられなかったため、MTBF・MTTR・アベイラビリティの規格上の正式な名称と語の範囲は確かめていません。ここでは計算の中身を例で示します。
アベイラビリティは、設備が「使いたいときに使える状態にある」割合です。稼働と修理をくり返す設備では、長い期間で見たとき、稼働している時間の割合は平均の稼働時間と平均の修理時間の比で決まり、\( A = \mathrm{MTBF} / (\mathrm{MTBF} + \mathrm{MTTR}) \) と書けます。言葉にすると「1回の故障の周期のうち、動いている時間が占める割合」です。本章の例では、MTTR を修理そのものにかかった時間とし、修理以外の停止(計画停止や部品待ち)は含めていません。実際の稼働率と比べるときは、何を停止時間に含めたかをそろえる必要があります。
最初のブロックで、ワイブル分布の当てはめに使う3つの設備群の架空の故障時間データを作ります。MTBF・MTTR・アベイラビリティの計算は、後の「アベイラビリティの計算とバスタブ曲線の数値を確かめる」の節で行います。この章のコードはすべて同じ乱数の流れを使うので、載せた順に上から1つのファイルにつなげて実行すると、本文と同じ数字が出ます(グラフを描くコードは省略しています)。
import numpy as np
from scipy import stats
from scipy.special import gamma as G

rng = np.random.default_rng(20261030)

# 設備群ごとの「真の」形状パラメータと尺度パラメータ(稼働時間。架空の設定)
truth = {"設備群A": (0.7, 3000.0), "設備群B": (1.0, 5000.0), "設備群C": (3.0, 4000.0)}
n = 30
data = {}
for name, (k, lam) in truth.items():
    data[name] = lam * rng.weibull(k, n)   # 30台が故障するまでの稼働時間
    t = data[name]
    print(f"{name} 台数 {n} 平均 {t.mean():.0f} 最短 {t.min():.1f} 最長 {t.max():.0f}")
# 出力:
# 設備群A 台数 30 平均 4930 最短 0.1 最長 33424
# 設備群B 台数 30 平均 5498 最短 183.6 最長 15789
# 設備群C 台数 30 平均 3394 最短 1462.1 最長 5947
この時点では、3つの設備群それぞれについて、30台ぶんの故障までの稼働時間を作っただけです。設備群Aは、平均は4,930時間ですが、最短0.1時間で壊れた台と、33,424時間もった台が混ざっていて、ばらつきが極端に大きくなっています。設備群Cは、最短1,462時間・最長5,947時間と、故障の時期が狭い範囲に集まっています。この違いが、次の節で説明する形状パラメータの違いです。
ワイブル分布、形状パラメータで故障の型を読む
部品の寿命の分布を表すのによく使われるのが、ワイブル分布です。スウェーデンの Waloddi Weibull が1951年に Journal of Applied Mechanics(第18巻第3号、293〜297ページ)に発表した論文で、幅広い問題に当てはまる分布として示したものです。ワイブル分布には、形状パラメータ \( k \) と尺度パラメータ \( \lambda \) の2つがあり、信頼度(その時間まで故障していない割合)は \( R(t) = \exp(-(t/\lambda)^k) \)、故障率は \( h(t) = (k/\lambda)(t/\lambda)^{k-1} \) と書けます(NIST の手引き8.1.6.2節の式を、本コラムの記号に置き換えました)。
故障率の式を言葉にすると、「故障率は稼働時間の \( k-1 \) 乗に比例する」となります。このため、形状パラメータが1より小さいと、指数が負になって故障率は時間とともに下がります(初期故障型)。ちょうど1だと指数が0になって故障率は一定です(偶発故障型。このとき、ワイブル分布は指数分布と同じになります)。1より大きいと故障率は時間とともに上がります(摩耗故障型)。尺度パラメータは、全体の約63.2%が故障するまでの時間で、寿命の長さの目安です。1つの分布で3つの故障の型をすべて表せるので、「この部品はどの型か」を形状パラメータという1つの数で読めるのが、ワイブル分布が保全で広く使われる理由です。
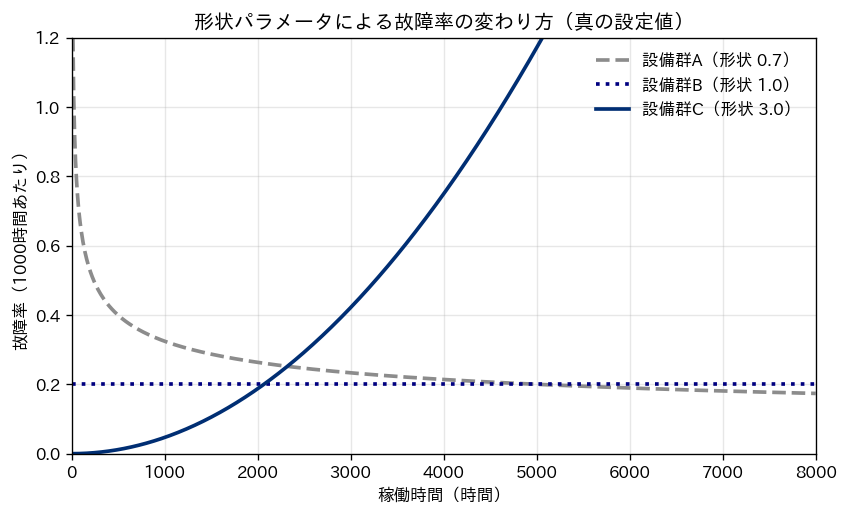
次の図は、3つの設備群の真の設定値(形状0.7・1.0・3.0)の故障率を描いたものです。設備群Aは使い始めに故障率が高く、時間とともに下がります。設備群Bは一定です。設備群Cは、初めはほとんど故障しませんが、1,000時間から3,000時間にかけて故障率が急に上がります。本文の式で計算すると、設備群Cの故障率(1,000時間あたり)は1,000時間で約0.05、2,000時間で約0.19、3,000時間で約0.42で、2,000時間を少し過ぎたところで設備群Bの一定の値0.2を上回ります。
| 形状パラメータ | 故障率の変わり方 | 故障の型 | 時間を決めた交換の効果 | 状態を測る保全の効果 |
|---|---|---|---|---|
| 1より小さい | 時間とともに下がる | 初期故障型 | 逆効果になりうる(新品に戻すと故障しやすい時期に戻る) | 据え付け直後の監視は有効。根本は製造・据え付けの品質 |
| 1に近い | ほぼ一定 | 偶発故障型 | 効きにくい(故障率が一定なら、新品も古い品も同じ起こりやすさ) | 兆候が先に現れる故障なら有効。兆候なく突然起きる故障には効かない |
| 1より大きい | 時間とともに上がる | 摩耗故障型 | 有効(寿命のばらつきが小さいほど効く) | 兆候が測れて、対応の時間がある故障なら有効 |
表の「寿命のばらつき」は、形状パラメータで読めます。形状パラメータが大きいほど、寿命の長さに比べたばらつきは小さく、故障の時期が狭い範囲に集まります。設備群C(形状3.0)の故障時間が最短1,462時間・最長5,947時間に集まり、設備群A(形状0.7)の故障時間が極端にばらついていたのは、その例です。
この表で注意したいのは、偶発故障型の行です。故障率が一定でも、故障の前に振動や温度の変化といった兆候が現れるなら、状態を測る保全で捉えられます。時間を決めた交換が効かないことと、状態を測る保全が効かないことは別の話です。逆に、摩耗故障型でも、寿命のばらつきが小さく、交換の作業が簡単な部品なら、時間を決めた交換で十分なことがあります。表の2つの列を合わせて見ると、予知保全が効果を出しやすいのは、摩耗故障型で寿命のばらつきが大きい部品(交換の時期を時間で決めにくい)か、兆候が先に現れる偶発故障(時間を決めた交換が効きにくい)だと考えています。
コードで確かめる、故障時間データからワイブル分布を推定して型を判定する
ここからは、先ほど作った架空の故障時間データ(各設備群30台)に、scipy の weibull_min.fit でワイブル分布を当てはめます。故障時間は0から始まるものとして、位置のパラメータは0に固定しました。台数は、故障の記録が多くない場合の例として30台としました。推定した形状パラメータがどれだけ確かかを見るため、30台の中から重複を許して30台を選び直して推定し直す計算(ブートストラップ)を500回行い、形状パラメータの95%区間を出しました。判定のルールは、区間全体が1より下なら初期故障型、区間全体が1より上なら摩耗故障型、区間が1をまたぐなら「偶発故障型と区別できない」としました。この判定は、30台を同じ条件で使われた1つの集団とみなせ、ワイブル分布が当てはまるという前提の上でのもので、区間が分布の当てはまりのよさや故障の原因の正しさを保証するものではありません。
def fit_shape(t):
    k, _, lam = stats.weibull_min.fit(t, floc=0)   # 位置は0に固定
    return k, lam

def judge(lo, hi):
    if hi < 1.0:
        return "初期故障型(故障率が下がる)"
    if lo > 1.0:
        return "摩耗故障型(故障率が上がる)"
    return "偶発故障型と区別できない"

B = 500
for name, t in data.items():
    k, lam = fit_shape(t)
    boot = []
    for _ in range(B):                              # 台を選び直して推定し直す
        boot.append(fit_shape(rng.choice(t, size=len(t), replace=True))[0])
    lo, hi = np.percentile(boot, [2.5, 97.5])
    print(f"{name} 形状 {k:.2f}(95%区間 {lo:.2f}〜{hi:.2f}) 尺度 {lam:.0f} 判定 {judge(lo, hi)}")
# 出力:
# 設備群A 形状 0.54(95%区間 0.42〜0.72) 尺度 2853 判定 初期故障型(故障率が下がる)
# 設備群B 形状 1.08(95%区間 0.86〜1.49) 尺度 5659 判定 偶発故障型と区別できない
# 設備群C 形状 3.12(95%区間 2.66〜4.09) 尺度 3804 判定 摩耗故障型(故障率が上がる)
| 設備群 | 真の形状 | 推定した形状 | 95%区間 | 真の尺度(時間) | 推定した尺度(時間) | 判定 |
|---|---|---|---|---|---|---|
| 設備群A | 0.7 | 0.54 | 0.42〜0.72 | 3,000 | 2,853 | 初期故障型 |
| 設備群B | 1.0 | 1.08 | 0.86〜1.49 | 5,000 | 5,659 | 偶発故障型と区別できない |
| 設備群C | 3.0 | 3.12 | 2.66〜4.09 | 4,000 | 3,804 | 摩耗故障型 |
本コラムの架空データ(この1回の乱数。区間はブートストラップ500回から求めたもの)では、3つの設備群とも、判定は真の型と食い違いませんでした。ただし、推定の幅は小さくありません。設備群Aの推定値0.54は真の値0.7からかなり離れていて、95%区間の上端0.72がかろうじて真の値を含んでいます。設備群Bの区間は0.86〜1.49と広く、形状が1(偶発故障型)なのか、1より大きい(弱い摩耗故障型)のか、1より小さい(弱い初期故障型)のかを、この30台からは決められません。たとえば形状1.3程度の弱い摩耗故障型も、この区間に含まれます。このため「偶発故障型と区別できない」という表現にしました(本コラムでは、真の形状が1.3の場合の計算はしていません)。設備群Cは区間が2.66〜4.09で、1から十分に離れているので、摩耗故障型と判定できました。
この結果から言えるのは、故障の型の判定には、ある程度の台数の故障の記録が要るということです。本コラムでは台数を変えた計算はしていませんが、台数が少なければ区間はさらに広がり、判定できない設備群が増えると考えられます。判定できないときに「偶発故障型だから時間で交換しても無駄」と結論するのは早すぎます。判定できないこと自体を記録し、記録を集め続けるか、部品の劣化の物理(第11章)から型を推し量るかを決めることになります。
型が分かると、平均の数字の読み方も変わります。MTBF や平均寿命は分かりやすい数字ですが、「平均寿命まではまず壊れない」という意味ではありません。どれだけの割合が平均寿命より前に壊れるかは、形状パラメータで変わります。次のコードは、3つの真の設定について、平均寿命(ワイブル分布の平均。尺度パラメータにガンマ関数の値を掛けたもの)と、その時点までに故障する割合、全体の10%が故障するまでの時間(B10寿命)を計算したものです。
for name, (k, lam) in truth.items():
    mean_life = lam * G(1 + 1 / k)                   # 平均寿命
    frac = 1 - np.exp(-(mean_life / lam) ** k)       # 平均寿命までに故障する割合
    b10 = lam * (-np.log(0.9)) ** (1 / k)            # 10%が故障する時間
    print(f"{name} 形状 {k} 平均寿命 {mean_life:.0f} 平均寿命までの故障割合 {frac:.1%} B10寿命 {b10:.0f}")
# 出力:
# 設備群A 形状 0.7 平均寿命 3797 平均寿命までの故障割合 69.3% B10寿命 120
# 設備群B 形状 1.0 平均寿命 5000 平均寿命までの故障割合 63.2% B10寿命 527
# 設備群C 形状 3.0 平均寿命 3572 平均寿命までの故障割合 50.9% B10寿命 1889
設備群B(形状1.0、偶発故障型)では、平均寿命5,000時間の時点で63.2%がすでに故障しています。設備群A(形状0.7、初期故障型)では69.3%です。設備群Aの平均寿命は3,797時間ですが、全体の10%は120時間までに壊れます。平均寿命だけを見て「3,800時間くらいは持つ」と考えると、大きく外れます。設備群C(形状3.0、摩耗故障型)でも、平均寿命3,572時間の時点で約半分(50.9%)が壊れていて、10%が壊れるのは1,889時間です。
保全計画の立場から見ると、本コラムの3つの設定では、「平均寿命で交換する」という決め方をすると、交換の前に5割から7割(50.9%〜69.3%)が故障する計画になります。故障を何割まで許すかを先に決め、その割合に対応する時間(B10寿命など)で考える方が、計画の意味がはっきりします。何割を許すかは、安全上の要求や適用される法令の点検の義務を満たすことを前提に責任者が条件を定め、その範囲で、故障したときの影響(突発停止・安全と環境の事故・品質の不良)と、早めに交換する無駄(過剰保全)を比べて決めることになり、その計算は第9章で扱います。
打ち切りのあるデータ、壊れていない設備の記録を捨てない
実際の故障の記録には、まだ壊れていない設備が必ず含まれます。観測を締めた時点で動いている設備は、「少なくともこの時間までは壊れなかった」としか分かりません。予防保全で故障の前に交換した部品も、記録の上では同じく打ち切りになります(推定で扱うときの注意は後で述べます)。このように、途中までしか寿命が分からない記録を「打ち切り」と呼びます。NIST の手引きの8.1.3.1節は、決めた時間で試験を終える場合(タイプI)と、決めた台数が故障するまで続ける場合(タイプII)の打ち切りを説明し、打ち切りのあるデータでも、最尤推定(手元のデータが最も起こりやすくなるようにパラメータの値を決める方法)などの方法でモデルを当てはめて故障率を推定できると書いています。また、別の故障モードで壊れた個体を、注目する故障モードについては打ち切りとして扱える、とも書いています。ただし、この説明の中で、別の故障モードには「独立した」という限定が付いています。
打ち切りが故障と無関係に起きる場合、打ち切りの記録を捨てたり、打ち切りの時点を故障の時点とみなしたりすると、寿命の推定は短く出る向きにずれます。長くもつ個体ほど観測の締めの時点で生き残っている確率が高く、その個体を除くと短い寿命ばかりが残るからです。次のコードでは、真の形状3.0・尺度4,000時間の部品60台について、設置の時期がばらばらで、観測を締めた時点までの稼働時間が1,000〜5,000時間に散らばっているという架空の状況を作り、3つの扱い方で推定を比べました。scipy では、stats.CensoredData に故障した記録(uncensored)と打ち切りの記録(right)を分けて渡すと、fit が打ち切りを考慮した最尤推定を行います。本コラムでは scipy 1.16.3 で実行しました。この例では、故障時間 T と観測を締めた時点 C を互いに無関係に(独立に)作っています。兆候を見て交換した部品のように、交換の時期が故障のしやすさと関係する場合は、この扱い方の前提が成り立たないことがあり、別の検討が要ります。
k_true, lam_true = 3.0, 4000.0
m = 60
T = lam_true * rng.weibull(k_true, m)       # 本当の故障時間(観測者には一部しか見えない)
C = rng.uniform(1000, 5000, m)               # 観測を締めた時点までの稼働時間
obs = np.minimum(T, C)
failed = T <= C
print(f"台数 {m} 故障 {failed.sum()} 打ち切り {(~failed).sum()}")

def summary(k, lam):
    return lam * G(1 + 1 / k), lam * (-np.log(0.9)) ** (1 / k)

results = {}
results["真の値"] = (k_true, lam_true)
results["故障した台だけ"] = fit_shape(obs[failed])
results["打ち切りを故障とみなす"] = fit_shape(obs)
cd = stats.CensoredData(uncensored=obs[failed], right=obs[~failed])
k_c, _, lam_c = stats.weibull_min.fit(cd, floc=0)
results["打ち切りを正しく扱う"] = (k_c, lam_c)
for name, (k, lam) in results.items():
    mean_life, b10 = summary(k, lam)
    print(f"{name: <12} 形状 {k:.2f} 尺度 {lam:.0f} 平均寿命 {mean_life:.0f} B10寿命 {b10:.0f}")
# 出力:
# 台数 60 故障 21 打ち切り 39
# 真の値          形状 3.00 尺度 4000 平均寿命 3572 B10寿命 1889
# 故障した台だけ      形状 2.97 尺度 2888 平均寿命 2578 B10寿命 1355
# 打ち切りを故障とみなす  形状 2.57 尺度 2726 平均寿命 2420 B10寿命 1134
# 打ち切りを正しく扱う   形状 2.88 尺度 4009 平均寿命 3574 B10寿命 1836
60台のうち故障が観測できたのは21台で、残りの39台は打ち切りでした。結果を表にまとめます。
| 扱い方 | 形状 | 尺度(時間) | 平均寿命(時間) | B10寿命(時間) | 平均寿命の真の値に対する割合 |
|---|---|---|---|---|---|
| 真の値 | 3.00 | 4,000 | 3,572 | 1,889 | 100% |
| 故障した台だけ | 2.97 | 2,888 | 2,578 | 1,355 | 約72% |
| 打ち切りを故障とみなす | 2.57 | 2,726 | 2,420 | 1,134 | 約68% |
| 打ち切りを正しく扱う | 2.88 | 4,009 | 3,574 | 1,836 | 約100% |
この1回の乱数では、故障した21台だけで推定すると、平均寿命は2,578時間で、真の値3,572時間の約72%にとどまりました。打ち切りの時点を故障とみなすと2,420時間(約68%)で、B10寿命も1,134時間と、真の値1,889時間を大きく下回りました。打ち切りを正しく扱った推定は、平均寿命3,574時間、B10寿命1,836時間で、真の値とほぼ一致しました。注意したいのは、「故障した台だけ」の形状パラメータが2.97と真の値に近いことです。故障の型の判定(形状)は合っていても、寿命の長さ(尺度)が約3割短く出ています。この1回の乱数では、型が合っているように見えたため、尺度のずれに気づきにくい例になりました。
上の表で、真の値と3つの扱い方を並べると、打ち切りを正しく扱った推定のほかの2つは、尺度・平均寿命・B10寿命のいずれも真の値より短く出ています。この誤りを保全計画に持ち込むと、まだ十分に使える部品を早めに交換することになり、序章で整理した6つの損失の型のうち過剰保全に当たります。これは本コラムの架空データで確かめた1つの例です。本例のように打ち切りが故障と無関係に起きる設定では、打ち切りの記録を除くと長くもった個体が抜けるので、短く出る向きにずれます。打ち切りの割合や打ち切りの起き方を変えた計算は、本コラムではしていません。カプラン・マイヤー法など、分布を仮定しない生存分析の方法は第7章と弊社コラム『顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで』で扱います。
アベイラビリティの計算とバスタブ曲線の数値を確かめる
ここで、先に説明したアベイラビリティの計算を、架空の「ポンプP」の12回の故障の記録で行います(第3章に出てくる設備とは別の、この章だけの架空の設備です)。故障と故障の間の稼働時間と、故障ごとの修理時間を乱数で作り、MTBF・MTTR・アベイラビリティを出したうえで、MTTR を半分にした場合と MTBF を2倍にした場合を比べました。
up = 2500 * rng.weibull(1.2, 12)                 # ポンプPの故障と故障の間の稼働時間(12回)
down = rng.lognormal(np.log(6), 0.5, 12)          # 故障ごとの修理時間
mtbf = up.sum() / len(up)
mttr = down.sum() / len(down)
avail = mtbf / (mtbf + mttr)
print(f"稼働時間の合計 {up.sum():.0f} 修理時間の合計 {down.sum():.1f} 故障回数 {len(up)}")
print(f"MTBF {mtbf:.0f} MTTR {mttr:.1f} アベイラビリティ {avail:.4f}")
mttr2 = mttr / 2
print(f"MTTR を半分にした場合 {mtbf / (mtbf + mttr2):.4f}")
print(f"MTBF を2倍にした場合 {2 * mtbf / (2 * mtbf + mttr):.4f}")
# 出力:
# 稼働時間の合計 23455 修理時間の合計 72.0 故障回数 12
# MTBF 1955 MTTR 6.0 アベイラビリティ 0.9969
# MTTR を半分にした場合 0.9985
# MTBF を2倍にした場合 0.9985
ポンプPの稼働時間の合計は23,455時間、故障は12回なので、MTBF は1,955時間です。修理時間の合計は72.0時間で、MTTR は6.0時間、アベイラビリティは0.9969になりました。MTTR を半分にした場合と MTBF を2倍にした場合は、どちらも0.9985で、同じ値です。アベイラビリティの式は \( 1 / (1 + \mathrm{MTTR}/\mathrm{MTBF}) \) と書き直せるので、効くのは MTTR と MTBF の比だけです。故障を半分に減らすこと(MTBF を2倍にすること)と、修理の時間を半分にすることは、アベイラビリティに対しては同じ効果を持ちます。
この性質は、予知保全の効果を考えるときに役に立ちます。予知保全は故障そのものを減らすだけでなく、故障の前に兆候を捉えることで、部品の手配・人の手配を前もって済ませ、止まっている時間を短くする効果も持ちえます。ただし、部品待ちの短縮は、本章の MTTR(部品待ちを含めない修理の時間)には表れないので、部品待ちを含めた停止時間で別に評価する必要があります。なお、アベイラビリティが同じでも、故障の回数が多い設備では品質の不良や安全と環境の事故の機会がそれだけ増えるので、2つの改善が経営上まったく同じ価値を持つわけではありません。
最後のブロックは、この章の初めに示したバスタブ曲線の図と表のもとになった計算です。初期故障(形状0.5)・偶発故障(形状1.0)・摩耗故障(形状5.0)の3つの成分の故障率を、ワイブル分布の故障率の式で計算して足し合わせ、稼働時間ごとに合計・内訳・最も大きい成分を出力しました。500時間では初期故障と偶発故障が同じ値になるので、同率のときは両方を出すようにしています。尺度パラメータの値は、図の形が分かりやすくなるように選んだ架空の設定です。
def hazard(t, k, lam):
    return (k / lam) * (t / lam) ** (k - 1)

parts = {"初期故障": (0.5, 200000.0), "偶発故障": (1.0, 20000.0), "摩耗故障": (5.0, 12000.0)}
for t in [50, 500, 2000, 6000, 10000, 14000]:
    hs = {p: hazard(t, k, lam) for p, (k, lam) in parts.items()}
    total = sum(hs.values())
    hmax = max(hs.values())
    top = "・".join(p for p in hs if np.isclose(hs[p], hmax))   # 同率なら両方を出す
    each = " ".join(f"{p} {h * 1000:.3f}" for p, h in hs.items())
    print(f"稼働 {t:>6} 時間 合計 {total * 1000:.3f} 内訳 {each} 最大 {top}")
# 出力:
# 稼働     50 時間 合計 0.208 内訳 初期故障 0.158 偶発故障 0.050 摩耗故障 0.000 最大 初期故障
# 稼働    500 時間 合計 0.100 内訳 初期故障 0.050 偶発故障 0.050 摩耗故障 0.000 最大 初期故障・偶発故障
# 稼働   2000 時間 合計 0.075 内訳 初期故障 0.025 偶発故障 0.050 摩耗故障 0.000 最大 偶発故障
# 稼働   6000 時間 合計 0.090 内訳 初期故障 0.014 偶発故障 0.050 摩耗故障 0.026 最大 偶発故障
# 稼働  10000 時間 合計 0.262 内訳 初期故障 0.011 偶発故障 0.050 摩耗故障 0.201 最大 摩耗故障
# 稼働  14000 時間 合計 0.831 内訳 初期故障 0.009 偶発故障 0.050 摩耗故障 0.772 最大 摩耗故障
この計算で、3つの成分を「足し合わせる」ことができるのは、3つの原因がそれぞれ独立に起き、どれか1つが起きれば故障するという仮定を置いたからです。実際の部品では、初期の不良が摩耗を早めるといった原因どうしの関係があるので、この足し算は説明のための単純化です。それでも、自社の故障の記録を故障モードごとに分けてワイブル分布を当てはめると、故障率が下がる型か上がる型かが、モードごとに違って見えてくることがあります。分布の当てはめで分かるのは故障率の増減の型までで、据え付け不良や摩耗といった原因は、点検や分解の調査の結果と照らし合わせて確かめます。故障モードを分けずにまとめて当てはめると、型の違う故障が混ざって、1つのワイブル分布がうまく当てはまらなかったり、推定した形状パラメータの解釈が難しくなったりすることがあります。故障モードを記録することが、型の判定の前提になります。
FMEA と FTA、故障の起き方を整理する2つの方法
寿命の分布は「どの時期に壊れやすいか」を教えてくれますが、「何がどう壊れて、何が起きるか」は教えてくれません。それを整理するのが FMEA と FTA です。どちらも国際電気標準会議(IEC)の信頼性の技術委員会(TC 56)が規格を出しています。IEC の公式の規格目録(IEC Webstore)で確かめたところ、FMEA の規格は IEC 60812(2018年、第3版。2018年8月10日発行)で、2006年の第2版を置き換えたものです。FTA の規格は IEC 61025(2006年、第2版。2006年12月13日発行)です。どちらも目録上の「安定日」(次に見直すまで内容を変えない予定の年)は2029年と表示されていました(2026年10月30日に確認)。
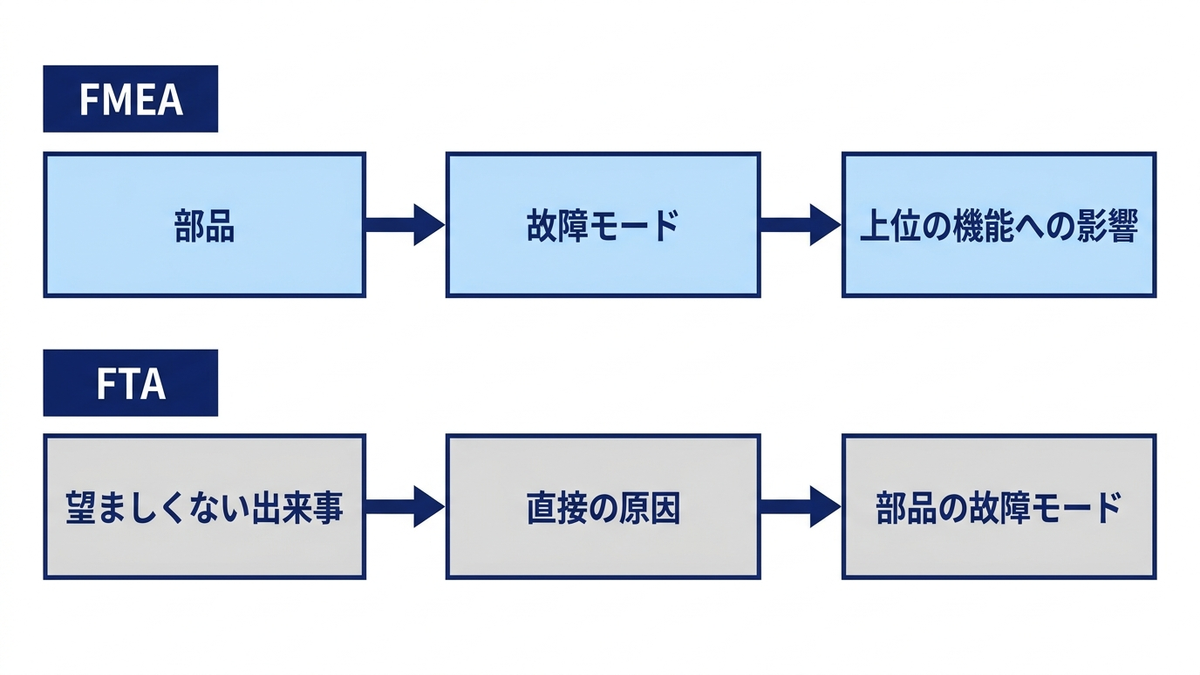
FMEA(故障モード影響解析)は、部品やシステムの構成要素を1つずつ取り上げ、「この部品にはどんな故障モードがありうるか」「その故障モードが起きると、上位の機能にどんな影響が出るか」を表にまとめていく方法です。部品から上に向かって考えるので、ボトムアップの方法と呼ばれます。IEC 60812(2018年)の目録の説明では、故障モードの重大さを評価に加えた変形(FMECA)も同じ規格で扱っていること、FMEA は安全の分析にも使えるが、汎用の規格なので安全への適用について具体的な手引きは示さない、と書かれています。
FTA(故障の木解析)は、逆に、望ましくない出来事(たとえば「ポンプPが送水できない」)を頂上に置き、それを引き起こす原因を「かつ」「または」の論理でつないで下へ分解していく方法です。頂上から下に向かって考えるので、トップダウンの方法と呼ばれます。IEC 61025(2006年)の目録の説明では、この規格は FTA の手法そのものと、解析を行うための適用の手引き、記号の決まりを扱うとされています。
| 観点 | FMEA | FTA |
|---|---|---|
| 規格(IEC の目録で確認) | IEC 60812(2018年、第3版) | IEC 61025(2006年、第2版) |
| 考える向き | 部品の故障モードから上位への影響へ(ボトムアップ) | 望ましくない出来事から原因へ(トップダウン) |
| 出発点 | 設備の部品表・構成 | 避けたい出来事(停止・事故・品質不良) |
| 得意なこと | 故障モードの洗い出しの漏れを減らす | 複数の原因の組み合わせで起きる事象を整理する |
| 予知保全での使い道 | 監視する故障モードと兆候を決める(第3章のセンサー選び、第6章の診断ルールの出発点) | 重大な出来事につながる経路のうち、監視で兆候を捉え、その後の停止や補修で影響を抑えられるものを探す |
| 苦手なこと | 複数の故障の組み合わせを表しにくい | 部品の数が多いと木が大きくなりすぎる |
予知保全の準備としては、まず FMEA で設備の主な故障モードを洗い出し、故障モードごとに「影響の大きさ」「起こりやすさ」「兆候が先に現れるか」を書き込んでおくと、何を測るべきかが決まります。この表は、第6章で故障診断のルールを作るときの出発点にもなります。FMEA の表を作るのは保全員と設計・生産技術の担当者の仕事で、データ分析の担当者だけでは作れません。
P-F 間隔、兆候が現れてから故障するまでの時間
状態を測る保全が成り立つかどうかは、「兆候が現れてから、実際に機能を失うまでに、どれだけ時間があるか」で決まります。保全の分野では、兆候が測れるようになった時点を潜在故障(P)、機能を失った時点を機能故障(F)と呼び、その間の時間を P-F 間隔と呼ぶ考え方があります。この考え方の原典の文献は、本コラムでは開いて確かめられなかったため、ここでは考え方の説明にとどめます(信頼性中心保全の起源については第1章で扱います)。
P-F 間隔の考え方から、状態を測る保全について2つのことが言えます。1つは、点検や測定の間隔が P-F 間隔より長いと、兆候が現れてから故障するまでの間に一度も測らないことがあり、兆候を捉えそこなうということです。もう1つは、兆候を捉えてから保全を終えるまでの時間(部品の手配・作業の計画・停止の調整)が、P-F 間隔から「兆候が現れてから実際に捉えるまでの遅れ」を差し引いた残りの時間に収まらないと、捉えても間に合わないということです。警報から故障までの時間(リードタイム)が、保全の準備に間に合うかどうかの評価は第8章で扱います。
P-F 間隔は、同じ故障モードでも、どの兆候で捉えるかによって長さが変わります。より早い時期に現れる兆候で捉えられれば、それだけ P-F 間隔は長くなり、保全の準備に使える時間が増えます。どの兆候でどれだけ前に捉えられるかは、故障モードと測定の方法の組み合わせごとに違うので、次の表のように整理しておくと、センサーの選び方(第3章)につながります(振動の周波数の分析で何が捉えられるかは第4章で扱います)。なお、表の「想定される故障の型(記録で確かめる)」の列と「捉えられる兆候の例」の列は、表の使い方を示すために置いた見込みで、本コラムで個々の故障モードについて資料を開いて確かめたものではありません。
| 故障モードの例 | 想定される故障の型(記録で確かめる) | 捉えられる兆候の例 | 主な測定 | 扱う章 |
|---|---|---|---|---|
| 転がり軸受の外輪・内輪のはく離 | 摩耗故障型(転がり疲れ) | 振動の特定の周波数の成分の増加、温度の上昇 | 振動・温度 | 第3・4章 |
| 回転体のアンバランス・軸のミスアライメント | 据え付け後の初期、または偶発 | 回転の周波数とその倍数の振動の増加 | 振動 | 第4・6章 |
| ベルト・シールの摩耗 | 摩耗故障型 | 張力の低下、漏れ、温度の変化 | 点検・温度・電流 | 第3章 |
| モータの巻線の絶縁の劣化 | 摩耗故障型(熱による劣化) | 絶縁抵抗の低下、電流の波形の変化 | 電流・絶縁の測定 | 第3章 |
| 潤滑油の劣化・異物の混入 | 摩耗故障型または偶発 | 油の中の摩耗粉の増加、粘度の変化 | 潤滑油の分析 | 第3章 |
| 電子部品の突然の故障 | 偶発故障型 | 兆候が現れにくいことが多い | (状態を測る保全が効きにくい) | 第1章 |
個々の設備では、使い方や環境によって型も兆候も変わります。自社の設備について、この表の左の3列を FMEA の結果と故障の記録で埋め直すことが、予知保全の対象を決める作業の中心になります。
経営判断、故障の記録が無ければ型は分からない
この章で見てきたとおり、時間で交換する保全が効くか、状態を測る保全が効くかは、故障の型に大きく左右されます。ただし故障の型は選ぶ材料の1つで、兆候が測れるか、兆候から故障までに対応の時間があるか、故障の影響の大きさもあわせて確かめます。そして、自社の設備の型を寿命のデータで確かめるには、故障の記録が欠かせません。ワイブル分布の当てはめには、少なくとも次の記録が要ります。
- 故障した日時(稼働時間)
- どの部品のどの故障モードだったか
- その部品を設置した時期
- 故障の前に交換した部品の交換の時期(打ち切りの記録)
本コラムの架空データ(いずれも乱数1回分)でも、設備群B(30台)の故障の記録では形状パラメータの区間が0.86〜1.49と広く、型を決められませんでした。打ち切りの例では60台のうち39台が打ち切りの記録で、その39台を捨てて故障した21台だけで推定すると、平均寿命は真の値の約72%(約3割短い値)になりました。
記録の不足は、序章で整理した6つの損失の型のうち、過剰保全と突発停止の2つにつながります。1つは過剰保全です。本コラムの架空データでは、打ち切りの記録を捨てると寿命を短く見積もる向きにずれたので、同じことが自社の記録で起きれば、まだ使える部品を交換し続けることになりえます。もう1つは突発停止です。偶発故障型の部品に時間基準の交換を続け、兆候の監視をしないままにすると、交換の直後でも故障は起き続けます。どちらも、故障の型を知らないまま方式を決めたことから起きます。予知保全への投資を検討する前に、まず故障モードと交換の履歴を記録する仕組みを整え、記録を予算と体制の中に位置づけることが、最初に決めることだと考えています。記録の項目と保全記録の仕組みは第10章で、そこで紹介する規格 ISO 14224 の考え方とあわせて扱います。
もう1つの判断は、FMEA を誰が作り、どの頻度で見直すかです。FMEA の表は、保全員・設計・生産技術の知識を集めて作るもので、設備の改造や故障の発生に合わせて更新しないと、監視の対象と実際の故障がずれていきます。部門ごと・工場ごとに別の形式で作ると、故障モードの名前がそろわず、記録を集めても型の判定がしにくくなります。形式がそろわないと、データの整備や分析の作業が部門ごとに重なることがあり、6つの損失の型のうち二重投資につながりえます。故障モードの呼び方を全社でそろえることは、型の判定と二重投資の両方に関わるので、手間に比べて効果の大きい施策になることが多いように思います。
この章で見てきた、故障の記録から保全の方式を選ぶまでの流れを、順に並べると次のようになります。
- 故障モードと交換の記録を残す
- 故障モードごとに寿命分布を当てはめる
- 形状パラメータから故障の型を判定する
- 故障の型と、兆候の測りやすさ・対応の時間・故障の影響の大きさに合わせて保全の方式を選ぶ
この章では、故障の型の考え方と、故障の記録から型を判定する方法を確かめました。要点は、故障の型によって効く保全の方式が変わり、その型を知るには故障モードごとの記録と打ち切りの記録が欠かせないということです。次の第3章では、捉えたい故障モードが決まった後に、振動・温度・電流・稼働ログをどう測り、どう集めるかを扱います。
この章を深めたい方への参考書籍
『入門信頼性工学:確率・統計の信頼性への適用 第2版』(福井泰好 著、森北出版):版元の紹介によると、アベイラビリティや保全性設計などの用語と概念を解説し、統計学の考え方や計算方法を信頼性にどう当てはめるかを扱う入門書です。本章で扱った故障率や寿命分布、アベイラビリティの考え方を、教科書の順序で学び直したい方に向いています。
『確率・統計から始めるエンジニアのための信頼性工学:身近な故障から宇宙開発まで』(山本久志 編著、秋葉知昭・竹ケ原春貴・深津敦・古井光明 共著、コロナ社):書名のとおり、確率と統計から入って信頼性工学へ進む本で、版元の紹介では宇宙開発の分野の安全と信頼性設計の事例も紹介されています。本章のワイブル分布の当てはめの背景にある統計の考え方を確かめたい方に向く内容です。
第3章 センサーとデータ収集、振動・温度・電流・稼働ログの集め方
第2章では、故障には初期・偶発・摩耗の型があり、故障モードごとに現れる兆候が違うこと、潜在的な故障の兆候が検出できるようになってから機能が失われるまでの間隔(P-F 間隔)の長さによって、監視で間に合うかどうかが決まることを確かめました。この章では、その兆候を実際にデータとして手元に集める工程を扱います。予知保全の仕組みは、どれほど高度な分析を載せても、入ってくるデータが捉えたい故障の兆候を含んでいなければ働きません。分析の手法の前に、何を、どこで、どの細かさで測るかを決める必要があります。
この章で扱う状態監視は、設備の物理的な状態や運転に関わる値を測って、劣化や異常の兆候を把握する行為を指します。運転中に測るものだけでなく、絶縁抵抗の測定のように設備を止めて測るものも含みます。第1章で扱った状態基準保全は保全の方式の名前で、状態監視で得た結果に応じて保全を行う方式です。状態監視は、状態基準保全と予知保全の両方の土台になる測定の部分に当たります。この章では、次の順に書きます。
- 測る前に捉えたい故障モードを決めるという出発点
- 状態監視の手法の一覧と、それぞれが捉えやすい故障の対応
- 振動の測り方と評価基準
- 温度・電流・超音波・潤滑油の測り方
- 稼働ログや制御システムのデータとの結合
- 通信と標準、エッジとクラウドの分担
- データの品質
- 経営の側で決めるべきこと
信号の処理と特徴量の作り方は第4章で扱います。この章で引く規格の目録と公開資料は、2026年10月30日に開いたものです。ただし ISO の目録は ISO のサイトから直接取得できなかったため、インターネット上の保存版(アーカイブ)を開いて確かめました。保存版の日付は規格ごとに違います。多くは2026年10月に保存されたものですが、それ以外の日付の保存版を使った規格には、本文の該当箇所にその日付を書いています。
測る前に、捉えたい故障モードを決める
センサーの選定から始めると、多くの場合「付けられるところに付けられるものを付ける」計画になります。振動計を全設備に付ける、温度計を増やす、といった計画は分かりやすい一方で、付けたセンサーのデータが、実際に止まると困る故障の兆候を捉えているかどうかは確かめられないまま進みがちです。本コラムでは、順序を逆にして、設備ごとに「どの故障モードを、どれくらい前に捉えたいか」を先に決め、その兆候が現れる物理量と場所からセンサーを選ぶ方が、手戻りが小さいと考えています。
故障モードを先に決めると、測る物理量が絞られます。後で紹介する NASA の保全の手引きは、振動の監視で見る対象として、次の故障や状態を挙げています。
- 摩耗、アンバランス(回転体の質量の偏り)、ミスアライメント(軸の芯ずれ)、機械的な緩み
- 軸受の損傷、ベルトやプーリーの欠陥、歯車の損傷
- キャビテーション(液体の中で気泡ができてはつぶれる現象)、構造の共振、疲労
一方で、同じ手引きは、接続部の緩みや汚れによる発熱、相間の不平衡、絶縁の劣化といった電気的な故障を、電気的な状態監視や赤外線サーモグラフィで捉える対象として扱っています。同じ「モータ」という設備でも、捉えたい故障モードによって必要なセンサーがまったく違うということです。故障モードの洗い出しは、第2章で扱った FMEA(故障モードとその影響を表に整理する手法)の表が出発点になります。
もう1つ先に決めておきたいのが、「どれくらい前に捉えたいか」です。兆候を捉えてから部品を手配し、作業者と停止の時間枠を確保して交換するまでに、何日かかるかを保全の担当者に確かめます。本コラムでは、この日数を「必要な先行時間」(兆候を見つけてから処置を終えるまでに最低限要る時間)と呼びます。処置の機会が計画停止などに限られる設備では、その機会までの日数も必要な先行時間に含めます。P-F 間隔が必要な先行時間より長いだけでは足りません。巡回や定期の測定では、兆候が検出できるようになってから実際に測って見つけるまでに、最大で測定を繰り返す間隔1回分の遅れが出ます。この発見の遅れと必要な先行時間を足しても P-F 間隔の中に収まる頻度を選ぶ必要があります。部品の調達に数週間かかる設備で、故障の数時間前にしか現れない兆候を監視しても、計画的な保全にはつながりません。一方で、緩やかな劣化を追う要約した値(特徴量)は、秒ごとに保存しなくてよい場合があります。ただし振動の波形を取る速さは、劣化の進む速さではなく、捉える信号の周波数から決めます。この2つは後の振動の節で分けて扱います。
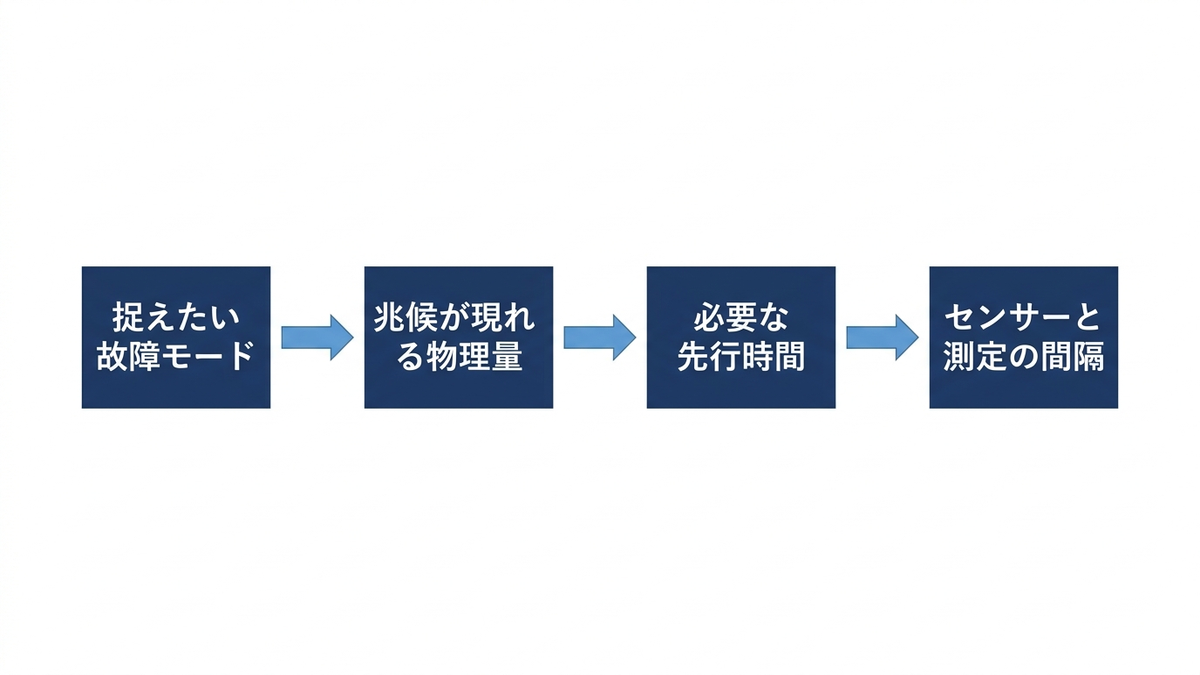
設備ごとに、次の4つを1行ずつ表にしておくと、後で述べるセンサーや測定の設定を決めるときの根拠になります。
- 捉えたい故障モード
- 兆候が現れる物理量
- 必要な先行時間
- 測定の間隔(測定を繰り返す間隔、1回の記録の長さ、波形のサンプリング周波数)
この表は、センサーの選定、測定点、サンプリングの設定、データの保存期間のそれぞれを決めるときに参照します。この表は、保全部門と生産部門と分析の担当者が一緒に作るものです。分析の担当者だけで作ると、故障モードの洗い出しが一般論にとどまり、保全部門だけで作ると、データの細かさと保存の負担の釣り合いが見落とされることが多いように思います。表の雛形は、この章の最後の節で示します。
状態監視の手法の一覧と、捉えやすい故障の対応
状態監視の進め方の全体を示す国際規格が ISO 17359(機械の状態監視と診断の一般指針)です。ISO の目録(2026年10月に保存された保存版)によると、現行は第3版の ISO 17359(2018年)で、2018年1月に発行され、2023年に見直しのうえ確認されています(それ以前の ISO 17359(2011年)は廃止)。目録の要旨は、機械の状態監視の計画を立てるときに考えるべき一般的な手順の指針を示し、その過程で必要になる関連規格への参照を含む、すべての機械に適用できる文書だと説明しています。本コラムでは規格の本文を開いていないので、本文の手順や付属書の中身には触れません。手順の考え方を学ぶ入口として、番号を押さえておけば十分だと考えています。
手法と、それが捉えやすい故障の対応については、公開されている資料として、NASA の 信頼性中心保全の手引き(施設と付帯設備向け、2008年9月の最終版)が具体的です。この手引きは第6章で、予知の試験と点検(PT&I)の手法として、次の6つを挙げています。
- 振動の監視と解析
- 赤外線サーモグラフィ
- 超音波の雑音の検出
- 潤滑油と摩耗粒子の分析
- 電気的な状態監視
- 非破壊試験
そのうえで表6-1で、ポンプ・電動機・ディーゼル発電機・変圧器などの機器ごとに、どの手法が当てはまるかを示しています。下の表は、その記述をもとに、本コラムの言葉で整理し直したものです。表には、6つの手法のうち非破壊試験を除く5つと、表6-1に別の項目として出てくる「軸受の温度と解析」「運転性能の監視」の2つを合わせた7行を載せました。非破壊試験は、表6-1では厚さの測定として復水器・熱交換器・タンクと配管に当てはまるとされていて、回転機の運転中の監視を中心にするこの表とは対象が違うため、載せていません。表6-1にはこのほかにも項目があり、表の中では関係の近い行にまとめています。施設の設備を対象にした手引きなので、自社の設備にそのまま当てはまるとは限らない点に注意が要ります。
| 手法(手引きの6つの手法のうち5つと、表6-1の2項目) | 何を測るか | 捉えやすい故障・状態の例(NASA の手引きの記述) | 当てはまる機器の例(手引きの表6-1) | 留意点 |
|---|---|---|---|---|
| 振動の監視と解析 | 軸受箱などの振動(加速度・速度・変位) | 摩耗、アンバランス、ミスアライメント、機械的な緩み、軸受の損傷、ベルトやプーリーの欠陥、歯車の損傷、キャビテーション、構造の共振、疲労 | ポンプ、電動機、ディーゼル発電機、重機やクレーン | 低速(毎分120回転未満)・回転数が変わる機械・往復動の機械は効果的な監視が非常に難しいとされる |
| 赤外線サーモグラフィ | 表面の温度の分布(非接触の熱画像) | 通電中の電気設備の発熱、汚れや緩みによる接続部の不均一な発熱、断熱材の不良 | 表6-1では、タンクと配管を除く全機器に当てはまる | 施設の点検では、正確な温度よりも同種の部品どうしの温度差を見る定性的な点検が中心 |
| 超音波の雑音の検出 | 20〜100 kHz の空中を伝わる音を可聴域に変換 | 気体の漏れ、コロナ放電、潤滑不足や軽微な欠陥による軸受の共振 | ポンプ、電動機、弁、熱交換器、変圧器など | 蒸気トラップの点検が代表的な用途として挙げられている。軸受の監視では第一の選択ではなく、狭い帯域の振動解析が勧められている |
| 潤滑油と摩耗粒子の分析 | 油の性状、汚染、油に含まれる摩耗粒子 | 機械の摩耗の進み具合、潤滑油の劣化、異物や水の混入 | ポンプ、電動機、ディーゼル発電機、重機やクレーン(油・燃料の分析は変圧器も) | 採取と分析の周期は、持ち運び型の振動計で測る場合の周期と同程度とされる |
| 電気的な状態監視(モータ電流の解析を含む) | 電流・電圧の波形とスペクトル、絶縁抵抗など | 回転子の導体の不具合(電源周波数のすぐ両側に現れる成分(側帯波)として現れる)、相間の不平衡、絶縁の劣化、接続部の高抵抗 | 電動機、遮断器、電気系統、変圧器 | モータ電流の解析は、運転中に離れた場所から、設備に触れずに測れる方法として紹介されている |
| 軸受の温度 | 軸受部の温度 | 軸受の異常に伴う発熱 | ポンプ、電動機、ディーゼル発電機、重機やクレーン | 表6-1では「軸受の温度と解析」として、振動の監視と同じ機器に当てはまるとされている |
| 運転性能の監視 | 流量・圧力・温度差・消費電力などのプロセスの値 | 効率の低下、熱交換器の汚れ | ポンプ、電動機、ディーゼル発電機、復水器、熱交換器、変圧器 | 制御システムが既に持っている値を使えることが多い |
上の表には載せていませんが、アコースティックエミッション(材料の内部でき裂が進むときに出る弾性波を捉える手法)は、NASA の手引きでは第6章の手法の一覧には入っておらず、付録Fの相関表で、大きな金属の容器の疲労や応力腐食割れの兆候を、超音波の画像化と組み合わせて確かめる例として出てきます。本コラムで確かめたのはこの1つの例までで、どんな設備で使われることが多いかは確かめていません。
手引きは、1つの手法に頼らず、複数の手法のデータを互いに突き合わせて、検出の確率を高めるべきだとしています(手引きの5.3.1節)。たとえば、潤滑油の摩耗粒子の濃度があらかじめ決めた限度を超えたときに、振動のデータと照らし合わせる、という使い方です。予知保全の仕組みを設計するときも、1台の設備に1つのセンサーという前提に縛られず、主となる手法と、それを裏づける手法を組み合わせて考える方が、誤報(故障の兆候が無いのに出た警報)を減らしやすいと考えています。警報の設計は第8章で扱います。
手法を選ぶときには、「常時監視か、定期的な巡回測定か」も同時に決めます。センサーを設備に固定して連続で測る常時監視は、変化を早く捉えられる一方で、センサーと通信の仕組みを設備の台数分だけ用意する必要があります。保全員が持ち運び型の測定器で決まった周期に回る巡回測定は、1つの測定器で多くの設備を測れる一方で、測定の間に起きた変化は捉えられません。P-F 間隔が長い故障モードには巡回測定で足りることが多く、P-F 間隔が短い故障モードや、止まると影響が大きい設備には常時監視が向く、という分け方が出発点になります。
振動の測り方、測定点・取り付け方・サンプリングの考え方
回転機の状態監視で最もよく使われるのが振動です。NASA の手引きも、振動の監視を予知の試験と点検の中で最も一般的な手法だと書いています。振動のデータの良し悪しは、分析の手法よりも先に、どこに、どう取り付けて、どの細かさで測るかでほぼ決まります。ここでは、測定点・取り付け方・サンプリングの3つに分けて考え方を整理します。
測定点は、故障の兆候となる力が伝わってくる場所、つまり軸受に近い場所に置くのが基本です。回転軸を支える軸受の力は、軸受箱を通じて設備の外側に伝わるので、軸受箱の上で、伝わる経路が短く硬い場所を選びます。カバーや薄い板の上に付けると、その板自体の振動を拾ってしまい、軸受の状態とは関係の薄いデータになりがちです。また、振動は方向によって現れ方が違うので、どの方向(軸に対して水平・垂直・軸方向)を測るかも、捉えたい故障モードに合わせて決めます。
測定点を決めたら、毎回同じ場所で測れるようにすることが大切です。NASA の手引きは、測定点に印を付けないことと、測る人が毎回変わることが重なると、振動のデータの再現性が大きく下がると書いています。そのうえで、測定点ごとに磁石が付く円盤を接着剤で固定し、「振動の測定点、塗装しないこと」と表示する方法を示しています。巡回測定で持ち運び型の測定器を使う場合も、測る場所と方向が毎回そろっていなければ、値の変化が設備の変化なのか、測り方の違いなのかを区別できません。
取り付け方は、測れる周波数の上限に効いてきます。NASA の手引きは、平らな面に磁石で取り付けた加速度計(振動の加速度を測るセンサー)で使える周波数の上限はおよそ 5 kHz だったという米海軍の結果を紹介し、特殊な加速度計と接触媒体(加速度計・磁石・取り付けの円盤の間に挟んで振動を伝えやすくするもの)を使えば 20 kHz までの正確な測定ができる、と書いています。手で押し当てる探触子は、正確に測れる周波数の上限を大きく下げるとも書かれています。高い周波数の成分に現れる兆候を狙うなら、取り付け方を先に決めないと、狙った兆候がそもそもデータに入りません。
常時監視のためにセンサーを恒久的に固定する方法について、施設の設備を対象にしたこの手引きは、信号の伝達を高くしたい場合に必要になることがあるが、一般に費用対効果が低い方法だとしています。一方で、止まると影響が大きい設備や、P-F 間隔が短い故障モードを狙う設備では、前の節で書いたとおり常時監視が向くことがあり、どちらを選ぶかは設備ごとに決めます。ここに挙げた周波数の上限や費用対効果の評価は2008年の手引きが紹介するもので、今の製品にそのまま当てはまるとは限りません。測れる帯域と再現性は取り付け方で変わるので、採用する機器の仕様と設置の条件で確かめます。
サンプリング周波数(1秒間に何回値を記録するか)は、捉えたい現象の最も高い周波数から決めます。一般に、標本化定理と呼ばれる原理により、記録できる周波数の上限はサンプリング周波数の半分までとされ、それより高い成分は低い周波数の成分に化けて紛れ込むことがあります(エイリアシング)。そのため、捉えたい周波数の2倍より十分に高いサンプリング周波数を取るのが一般的な設計です。その上で、サンプリング周波数の半分を超える成分が化けて紛れ込まないように、アナログの信号を数値に変換する(標本化する)前に、その成分をアナログのフィルタで抑えます。軸受の欠陥による周波数がどのくらいになるかは、回転数と軸受の寸法から計算でき、その式は第4章で扱います。
サンプリング周波数とは別に、「どれくらいの長さを、どれくらいの間隔で測るか」も決めます。設備や機器によって違いますが、例として、振動の波形を数秒から数十秒記録し、それを数分から数時間ごとに繰り返す、という形があります。1回の記録の長さは、第4章で扱う周波数の分解能(見分けられる周波数の細かさ)に効き、測定を繰り返す間隔は、劣化の進み方を追える細かさに効きます。NASA の手引きは、劣化が始まる時点と、それが最初に検出される時点は一致することが少ないとして、点検の作業の間隔は最初は保守的に(短めに)決めるべきだとしています。手引きは続けて、その2つの時点の間に少なくとも3回の保全の作業を行うべきだとも書いていますが、この回数の根拠や数え方は、同じ箇所には書かれていません。手引きのいう2つの時点の間は、劣化の始まりから最初の検出までで、本コラムの P-F 間隔(検出できるようになってから機能故障まで)とは区間が違います。そのため、次に書く「複数回測れるようにする」は、手引きの記述を参考にした本コラムの目安です。測定を繰り返す間隔は、想定する P-F 間隔の中で何度か測れるように置き、記録が貯まってから実際の劣化の進み方を見て見直す、という順序が現実的だと考えています。
運転条件をそろえることも、振動のデータでは欠かせません。同じ設備でも、回転数や負荷が変われば振動の大きさは変わります。NASA の手引きが、回転数が変わる機械を効果的に監視しにくい例に挙げているのは、このためです。振動の値を記録するときに、同じ時刻の回転数・負荷・運転モードも一緒に記録しておけば、後で条件ごとに比べることができます。条件ごとに「いつもの状態」を決める方法は第5章で扱います。
振動の評価基準、ISO 10816 系から ISO 20816 系への置き換え
振動の値が「大きいか小さいか」を判断する目安として、ISO は機械の振動の測定と評価の規格を出しています。以前は、軸受箱などの回転しない部分で測る ISO 10816 系と、回転軸の振動を測る ISO 7919 系が別々にありましたが、本コラムで目録を確かめた第1部と第3部では、両者をまとめた ISO 20816 系の部に置き換えられています。第2部・第4部以降の各部の状態は、本コラムでは確かめていません。古い社内基準や測定器の設定に ISO 10816 の番号が残っていることがあるので、自社が使う部の番号と状態を確かめておくことが大切です。ISO の目録の保存版(2026年10月に保存されたページ)で確かめた範囲を、下の表にまとめました。
| 規格 | 対象 | 目録で確かめた状態 | 置き換えの関係 |
|---|---|---|---|
| ISO 10816-1(1995年) | 回転しない部分で測る機械の振動の評価の一般指針 | 廃止 | ISO 20816-1(2016年)に改訂された |
| ISO 20816-1(2016年) | 機械の振動の測定と評価の一般指針。回転する部分・回転しない部分の両方の測定を扱い、軸の振動の絶対値と相対値の測定にも適用 | 発行済み。見直しの結果は「改訂する」で、目録には、作成中の ISO/FDIS 20816-1(最終の原案)で数か月のうちに置き換えられる見込みと表示 | ISO 7919-1(1996年)と ISO 10816-1(1995年)を置き換えた |
| ISO 10816-3(2009年) | 出力 15 kW を超え、定格の回転数が毎分120〜15,000回転の産業機械(その場での測定) | 廃止 | ISO 20816-3(2022年)に改訂された |
| ISO 20816-3(2022年) | 出力 15 kW を超え、回転数が毎分120〜30,000回転の、連結された産業機械(その場での測定) | 発行済み。見直しの結果は「改訂する」で、目録には、作成中の ISO 20816-3 で数か月のうちに置き換えられる見込みと表示 | ISO 7919-3(2009年)と ISO 10816-3(2009年)を置き換えた |
ISO 20816-3(2022年)の目録の要旨には、この規格の使い方を考えるうえで大事な限定が書かれています。対象は、定常の運転状態で、軸・軸受・軸受台・軸受箱で測った広い帯域の振動であり、受け入れの試験と運転中の監視の両方に関わる、という点です。一方で、歯車や転がり軸受を持つ機械も対象に含むが、それらの歯車や軸受の状態の診断までは扱わない、とも書かれています。また、ISO 20816-1(2016年)の目録の要旨は、一般的な評価の基準を、振動の大きさと振動の変化の両方で示すとしています。つまり、本コラムで目録を確かめた第1部と第3部の評価の区分(振動の大きさをいくつかの段階に分けて評価する仕組み)は、機械の振動の全体の大きさと変化を評価するための指針であり、軸受のどこにどんな損傷があるかを特定するものではありません。軸受の損傷の診断には、第4章で扱う周波数の分析が別に必要になります。
評価の区分の具体的な数値(振動の速度で何 mm/s までなら良好か、といった境界)は、規格の本文に機械の種類ごとに書かれています。本コラムでは規格の本文を開いていないので、数値は載せません。社内の基準に使う場合は、購入した規格の本文で、自社の機械がどの種類に当たるかを確かめてから使う必要があります。また、本コラムで開いた目録の保存版(2026年10月に保存されたもの)では、ISO 20816-1 と ISO 20816-3 はどちらも改訂の作業中と表示されていました。その後に新しい版が発行されている可能性がありますが、本コラムでは新しい版の目録を開けなかったため、発行の有無と適用範囲の変化は確かめていません。使う前に ISO の目録で最新の状態を確かめ、新しい版が出たときに社内の基準を見直す担当を決めておくと、古い数値を使い続ける事態を防ぎやすくなります。
規格の基準値は、設備ごとの「いつもの値」の代わりにはならない点にも注意が要ります。規格の区分は、多くの機械に共通する目安として作られています。個々の設備では、据え付けの条件や運転の条件によって、正常なときの値が規格の区分の中のどこにあるかが違います。正常なときの値が低い設備では、規格の区分の境界に達するよりずっと前に、値の増え方から劣化の兆候を読み取れることがあります。規格の区分は「多くの機械に共通する、振動の大きさと変化を評価するための指針」、設備ごとの基準は「その設備でいつもと違う変化を見つける目安」として、役割を分けて使うのが扱いやすいと考えています。規格の境界より下にあることは、運転を続けてよいことの保証にはなりません。運転を続けるかどうかは、次のものを踏まえて判断します。
- 設備に固有の条件
- メーカーの基準
- 設備に付いている保護装置の設定
- ほかの点検の結果
温度・電流・超音波・潤滑油を測るときの考え方
温度は、制御のために既に温度計が付いている設備も多く、その値を状態監視に回すだけで始められることがあります。赤外線サーモグラフィは、温度の分布を画像として捉える方法で、NASA の手引きは、触れずに離れた場所から測れるので、通電中の電気設備の発熱箇所を見つけるのに特に向いていると説明しています。手引きによると、施設の点検で必要になることが多いのは、正確な温度を測る定量的な点検ではなく、同じ種類の部品どうしの温度差や、いつもの温度の範囲からの外れを見る定性的な点検です。たとえば三相の回路で1つの相だけが熱くなっていれば、接続部の緩みや汚れを疑う手がかりになります。正確な温度を測るには、物体の表面の放射の性質や反射、周囲の環境の影響を理解して補正する必要がある、とも書かれています。
電流は、モータで動く設備では、モータの電源の配線から測れる点が強みです。NASA の手引きは、モータ電流の解析を、運転中に離れた場所から、設備に触れずに試験できる方法として紹介しています。挟み込み式の電流計と FFT(信号を周波数の成分に分ける計算。第4章)の解析器で電流の時間の波形と周波数の成分を集め、回転子の導体の不具合が電源の周波数の両側に側帯波として現れる、と説明しています。電源の回路・モータ・モータが動かす側の部品まで診断できるとも書かれています。振動計を付けにくい場所にある設備や、高温・水がかかるなどでセンサーを付けにくい設備では、盤の中で測れる電流が有力な選択肢になります。
超音波の検出器は、NASA の手引きによると 20〜100 kHz の範囲の音を捉え、人の耳に聞こえる音に変換します。気体の漏れや、コロナ放電(高い電圧の部分で起きる放電)、潤滑不足や軽微な欠陥による軸受の共振といった、高い周波数の現象を聞き分けるのに使われます。圧縮空気や蒸気の漏れの点検は、効果が見えやすい用途として挙げられています。一方で、手引きは、軸受の監視では空中を伝わる超音波は第一の選択ではないとしています。超音波の検出器が聞くのは 20 kHz より上の音ですが、軸受の欠陥の多くは 5 kHz より低い振動として現れ、そうした欠陥は超音波の検出器では捉えられないためです。手引きは、軸受の監視には狭い帯域の振動解析(特定の狭い周波数の範囲に絞って見る解析)を勧めています。超音波ですべての軸受の欠陥を捉えられるわけではないので、対象に応じて振動解析などと併用します。
潤滑油の分析は、油を採取して分析する方法なので、常時監視ではなく定期的な採取が中心になります。NASA の手引きは、潤滑油の分析で分かることを、機械の摩耗の状態・潤滑油自体の状態・汚染の有無の3つに分け、この3つは互いに関係していて、油の劣化や汚染を放置すれば機械の摩耗につながる、と書いています。採取の周期は、持ち運び型の振動計で測る場合の周期と同程度とされ、1年以上の履歴がある機械では、四半期ごとや半年ごとに行うのが典型的だと書かれています。油の量が少なく交換が簡単な設備では、分析するより時間で交換した方が手間が少ない場合がある、という指摘もあります。どの手法でも、「測ることそのものの手間」と「得られる判断の価値」を比べて選ぶという考え方は共通です。
稼働ログ・PLC・MES のデータと結び付ける
センサーの値だけでは、その値が「どんな運転の状態のときに測られたか」が分かりません。同じ振動の値でも、設備が全速で動いているときと、立ち上げの途中とでは意味が違います。そこで、設備の制御システムや生産管理のシステムが持っている稼働の記録と結び付ける必要があります。PLC(プログラマブルロジックコントローラ。設備の動作を制御する専用の小型の計算機)は、運転・停止の状態や回転数の指令、負荷、アラームの履歴といった運転の記録を持っています。MES(製造実行システム。工場の中の生産の実行を管理するシステム)は、どの時間にどの製品をどれだけ作ったか、段取り替えはいつだったか、といった生産の記録を持っています。保全の記録を管理するシステム(第10章)には、過去にいつどの部品を交換したかが入っています。
| データの出どころ | 持っている主な情報 | 時刻の細かさの例 | 結合のキー | 結合するときの注意 |
|---|---|---|---|---|
| 状態監視のセンサー | 振動・温度・電流などの測定値 | 波形はミリ秒より細かく、要約した値は分から時間の単位 | 設備の識別番号と時刻 | センサーの取り付け位置と方向を、設備の識別番号とともに台帳に残す |
| PLC などの制御システム | 運転・停止の状態、回転数、負荷、設定値、アラーム | 秒より細かいことが多い | 設備の識別番号と時刻 | 制御システムの時計がセンサーの時計とずれていないかを確かめる |
| MES などの生産管理のシステム | 製品の品種、生産数、段取り替え、計画の停止 | 分から時間の単位、作業の単位 | ライン・設備の識別番号と時間帯 | システムの中の設備の呼び名と、センサーの台帳の呼び名をそろえる |
| 保全の記録 | 点検・修理・交換の日時、故障モード、処置 | 日の単位、作業の単位 | 設備の識別番号と日付 | 記録が入力された日時ではなく、作業をした日時を使う |
結合でいちばん手間がかかるのは、技術よりも「呼び名をそろえる」作業であることが多いように思います。同じポンプが、制御システムではタグの名前で、生産管理のシステムではラインの番号で、保全の記録では設備の台帳の番号で呼ばれている、という状態は珍しくありません。設備の階層(工場・ライン・設備・部品)と識別番号を1つの台帳にまとめ、各システムの呼び名との対応表を持っておくと、後の分析で結合をやり直す手間が大きく減ります。設備の台帳の作り方は第10章で、データの管理の体制は弊社コラム「データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで」で扱っています。
稼働の記録は、後で異常検知のモデルを作るときに「正常な期間」を選ぶためにも使います。立ち上げ・停止・段取り替えの最中のデータを正常の学習に混ぜると、正常の範囲が広がりすぎて、本当の異常を異常と判定しにくくなります。また、保全の作業の直後のデータは、区別して扱う必要があります。部品の交換や修理の後は、値の水準そのものが変わることがあります。NASA の手引きも、大きな保全や修理、使い方の変更の後には基準の値を取り直すべきだとしています(手引きの7.1節)。作業の直後の落ち着かない期間は印を付けて分けます。保全の担当者が点検の結果と運転の記録で健全で安定したことを確かめた後に、交換後の状態に合わせて正常の基準やモデルを更新するかどうかを判断します。ここまでは学習に使うデータの話です。この期間や、センサーの不具合が疑われる期間にも測定と記録は続けますが、その間の判定や警報を出すのか止めるのかは、運用の規則として先に決めておきます(警報の設計は第8章)。どの期間を学習に使い、どの期間を除くかを決めるためにも、稼働と保全の記録との結合は最初から設計に入れておく必要があります。
通信と標準、OPC UA と ISO 13374 のデータ処理の6つのブロック
センサーや制御システムのデータを集めるときに、設備のメーカーや制御機器のメーカーごとに違う方式でつないでいると、設備が増えるたびに個別の作り込みが要ります。工場の機器をネットワークでつないでデータを集める仕組みはIIoT(産業用のモノのインターネット)と呼ばれ、そこでは機器の間のやり取りを標準の方式にそろえることが、二重投資を避ける手段になります。
産業用の機器の間のデータのやり取りで広く参照されている標準の1つが、OPC UA です。OPC Foundation の公式ページは、OPC UA を、2008年に公開された、特定の機器や基本ソフトに依存しないサービス指向の仕組みとして説明しています。同じページによると、組み込みの小さな制御装置からクラウドの基盤までの上で動くこと、データに意味づけをする情報モデルの枠組みを持ち、それを業界ごとの団体が拡張していること、通信の暗号化・メッセージへの署名・証明書による認証・監査といった安全のための仕組みを備えていることが特徴として挙げられています。また、送り手が受け手を知らなくても多数の相手にデータを配れる出版・購読型(PubSub)の方式も用意されている、と書かれています。どの通信の方式を採るかは、既に入っている制御機器が何に対応しているかで決まる部分が大きいので、ここでは「方式を工場ごと・部門ごとにばらばらに決めない」ことを押さえておけば十分だと考えています。
集めたデータを、どんな処理の順番を経て保全の判断に変えるかについては、ISO 13374(機械の状態監視と診断のデータ処理・通信・表示)が枠組みを示しています。ISO の目録の保存版で確かめた4つの部を、下の表にまとめました。
| 部 | 扱う内容(目録の要旨の範囲) | 目録で確かめた発行と見直し | 確かめた保存版の日付 |
|---|---|---|---|
| ISO 13374-1(2003年) | 状態監視と診断の情報のデータ処理・通信・表示に関わるソフトウェアの仕様の一般的な指針 | 2003年3月発行。2025年に見直しのうえ確認 | 2026年10月 |
| ISO 13374-2(2007年) | データ処理。開かれた状態監視と診断の仕組みが従うべき参照用の情報モデルと処理モデルの要件 | 2007年7月発行。2021年に確認済み | 2024年3月 |
| ISO 13374-3(2012年) | 通信。参照用の情報と処理の仕組みのためのデータ通信の要件 | 2012年2月発行の第1版。2023年に確認済み | 2024年3月 |
| ISO 13374-4(2015年) | 表示。技術的な解析と意思決定の支援のための情報の表示の要件 | 2015年12月発行。2021年に確認済み | 2025年11月 |
表の右端の列が2026年10月でない部(第2部・第3部・第4部)は、その日付より後の見直しの結果を確かめていないので、2026年10月時点の状態は確かめていません。
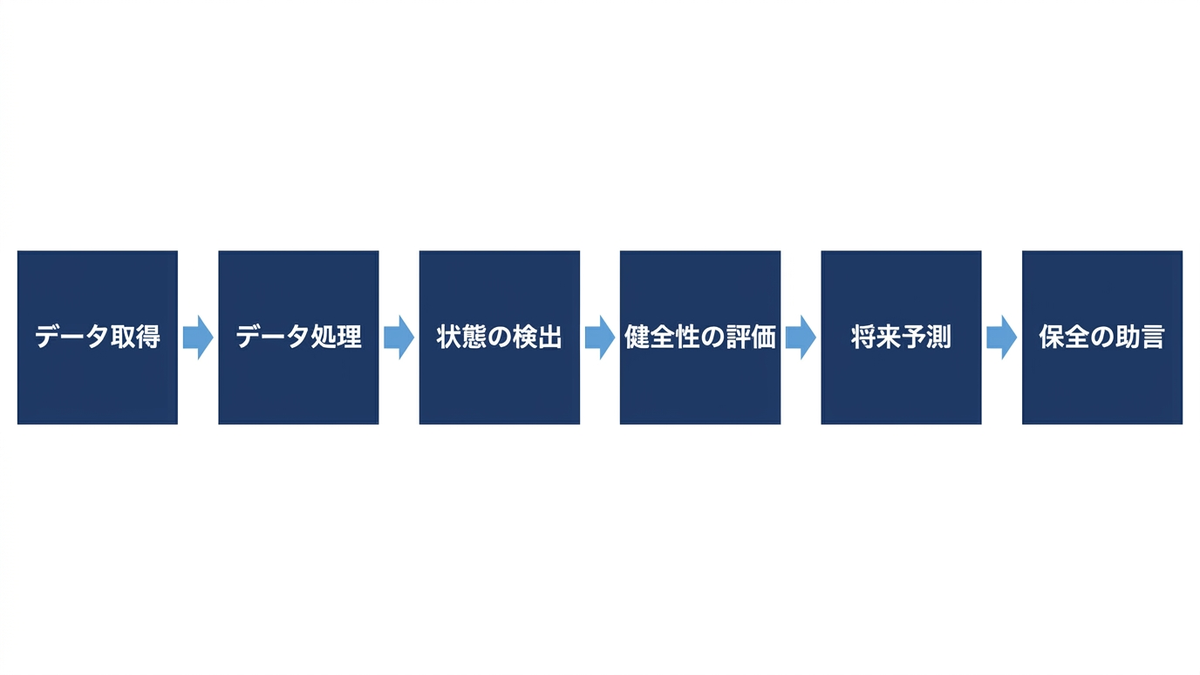
この規格を実装する仕様として OSA-CBM を公開している MIMOSA(機械の情報管理の開かれた標準を推進する業界団体)は、公式ページで、ISO 13374 が状態監視の仕組みの6つの機能のブロックを定めており、OSA-CBM はその6つのブロックとブロックの間のつなぎ方を記述したものだと説明しています。ブロックの名称は、MIMOSA が2006年に公開した発表資料に示されています。ISO 13374 の規格の本文は開いていないので、下の表の名称は MIMOSA の資料にもとづくもので、各ブロックの役割の説明は本コラムの言葉で書いた一般的な説明です。
| 順番 | ブロックの名称(MIMOSA の資料の英語名) | 本コラムでの言い換え | 本コラムで扱う章 |
|---|---|---|---|
| 1 | Data Acquisition | データ取得。センサーの信号を数値の記録にする | 第3章 |
| 2 | Data Manipulation | データ処理。信号の処理をして特徴量を作る | 第4章 |
| 3 | State Detection | 状態の検出。いつもの状態と違うかを判定する | 第5章 |
| 4 | Health Assessment | 健全性の評価。今の状態の良し悪しを評価し、故障の原因を診断する | 第6章 |
| 5 | Prognostic Assessment | 将来予測。この先の状態や残存寿命を予測する。第8章の題の「予測の評価」(予測の当たり外れを確かめること)とは別の意味 | 第7章 |
| 6 | Advisory Generation | 保全の助言。保全の行動や運転の変更を提案する | 第8章・第9章 |
この6つのブロックの分け方は、本コラムの章立てとほぼ重なります。実務で役に立つのは、仕組みを作るときに「今作ろうとしているのはどのブロックか」「ブロックの間で何を受け渡すか」をはっきりさせられる点です。たとえば、データ取得とデータ処理を設備のメーカーの装置に任せ、状態の検出から先を自社で作る、という分担を考えるときに、ブロックの境目が受け渡しの約束事を決める単位になります。どこか1つのブロックだけを高度にしても、前後のブロックが追いついていなければ、保全の判断は変わりません。
エッジとクラウドの分担
集めたデータをどこで処理するかも、計画の初めに決めておきたい論点です。設備の近くに置いた計算機(エッジ)で処理するか、データを工場の外のクラウドに送って処理するか、という分担です。振動の波形のように細かいデータは、1台の設備からでも1日に大量に出るので、すべてをそのままクラウドに送ると、通信と保存の負担が大きくなります。一方で、エッジだけで処理すると、複数の工場の設備を横に並べて比べたり、モデルをまとめて更新したりしにくくなります。
| 処理の内容 | エッジに置く理由 | クラウドに置く理由 | 本コラムが考える出発点 |
|---|---|---|---|
| 波形の記録と特徴量の計算 | 生の波形の量が多く、送る前に要約した方が通信の負担が小さい | 後で別の特徴量を計算し直せる | エッジで特徴量にし、生の波形は一部だけ送るか、エッジに一定期間残す |
| 停止に直結する保護の判定 | 通信が切れても動き続ける必要がある | (向かない) | 既存の保護の仕組み(制御システムや保護装置)に任せ、予知保全の仕組みには持たせない |
| 異常検知・診断・残存寿命の推定 | 結果をすぐに現場に返せる | 複数の設備のデータでモデルを作り、まとめて更新できる | 学習はクラウド、判定はどちらでもよい |
| 長期の保存と横断の分析 | (向かない) | 工場や設備を横断して比べられる | クラウドか社内の共通の基盤に置く |
表の2行目は、特に注意が要る点です。設備の安全を守るための停止の判断は、予知保全の仕組みとは別に、制御システムや保護の装置が担っていることが多いと考えられます。予知保全の仕組みは、保全の計画を立てるための情報を出すものであり、設備を止める判断そのものを任せる仕組みとして設計しない方がよいと考えています。法令で定められた点検(定期的な自主検査など)も同じで、本コラムでは、予知保全のセンサーがそうした点検を置き換えるものとは扱いません。
エッジに残す生の波形の期間も、あらかじめ決めておきます。異常が見つかったときに、その前後の生の波形を見返して診断したい場面は多いのですが、すべての波形を永く残すと保存の負担が大きくなります。たとえば「要約した特徴量は長く残し、生の波形は直近の一定期間と、異常の判定が出た前後だけ残す」といった規則を決めておくと、診断に必要なデータを残しつつ、保存の量を抑えられます。どの期間を残すかは、第2章で扱った P-F 間隔と、診断にかかる日数から逆算して決めるのが筋だと考えています。
データの品質、欠測・時刻のずれ・センサーの故障
予知保全のデータでは、設備の故障より先に、センサーや通信の不具合が起きることが珍しくありません。次のような不具合は、データの上では「設備の異常」と区別がつきにくい形で現れます。
- センサーが外れかけている
- 配線が傷んでいる
- 通信が途切れた
- 計算機の時計がずれた
誤報の原因を調べたら、設備ではなくセンサーの側の問題だった、という事態を減らすには、データの品質を確かめる仕組みを最初から入れておく必要があります。
| 品質の問題 | データでの現れ方の例 | 確かめ方の例 | 対処の例 |
|---|---|---|---|
| 欠測 | 一定時間の値が無い、記録の件数が減る | 設備ごとに期待される記録の件数と実際の件数を毎日比べる | 欠測の期間を印として残し、補完した値と区別する |
| 時刻のずれ | 停止の記録と振動の低下の時刻が合わない | 運転・停止の切り替わりの時刻を、センサーと制御システムで突き合わせる | 各機器の時計を共通の時刻の基準に合わせ、時刻のタイムゾーンを記録に残す |
| センサーの外れ・緩み・配線の不良 | 値が急に跳ねる、ゼロや一定値に張り付く、ほかのセンサーと動きが合わない | 同じ設備の複数のセンサーの動きを比べる、値が一定のまま続く時間を数える | 品質の異常の疑いとして印を付け、正常の学習への利用を保留する。設備の異常の可能性は別に現地で確かめる。その間の判定の扱いは運用で決めておく |
| 測定の範囲の飽和 | 値が上限で切れる | 測定器の上限に張り付いた件数を数える | 測定の範囲の設定を見直す |
| センサーの交換・設定の変更 | 交換の前後で値の水準が段差のように変わる | 保全の記録の交換日と値の段差を突き合わせる | 交換・設定の変更を台帳に記録し、前後で正常の基準を作り直す |
| 運転条件の混在 | 同じ設備で値の分布が複数の山に分かれる | 稼働の記録の運転モードごとに分布を分けて見る | 運転条件ごとに分けて分析する(第5章) |
表の右端の対処に共通するのは、「データを直す」より先に「何が起きたかを記録に残す」ことです。欠測を前後の値でつないで埋めたり、跳ねた値を消したりすると、データは見た目にはきれいになりますが、後で誤報の原因を調べるときの手がかりが無くなります。元の値と、補完や除外をした印を両方残しておく方が、仕組みを改善していくときに役に立ちます。
時刻のずれは、気づかれにくいわりに影響が大きい問題です。センサーの記録と制御システムの記録の時計が数分ずれているだけで、「停止の直前に振動が増えた」のか「停止の直後に記録が乱れた」のかを取り違えることがあります。複数のシステムのデータを結び付ける場合は、どの時計を基準にするか、記録の時刻がどのタイムゾーンで書かれているか、夏時間のある地域の工場をどう扱うかを、データを集め始める前に決めておく必要があります。
データの品質は、一度確かめれば終わりではありません。センサーの交換、制御システムの更新、ネットワークの変更があるたびに、品質の問題は新しく起きます。毎日の記録の件数、値が一定のまま続いている時間、センサーどうしの動きの食い違いといった、品質の指標を自動で見張り、異常があれば保全とデータの担当に知らせる仕組みを、予知保全の仕組みの一部として持っておくのがよいと考えています。データの品質の管理の一般論は、弊社コラム「データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで」で扱っています。
経営判断、測る前に捉える故障モードを決める
センサーとデータ収集は、予知保全の投資の中でも目に見えやすい部分です。センサーの台数、通信の設備、データの基盤と、数えやすいものが並ぶため、「どれだけ付けたか」が進み具合の指標になりがちです。しかし、付けたセンサーの台数は、保全の判断がどれだけ変わったかとは別のものです。経営の側で確かめるべきなのは、「どの設備の、どの故障モードを、どれくらい前に捉えるために、このセンサーを付けるのか」が設備ごとに説明されているかどうかです。
この部分の判断を誤ったときの経営上の損失は、序章で整理した6つの損失の型のうち、主に次の4つの形で表れます。
- 突発停止:止まると影響が大きい故障モードの兆候が、付けたセンサーのデータに入っておらず、監視しているはずの設備が予告なく止まる
- 警報の形骸化:取り付け方や運転条件の記録が不十分で、データの揺れによる誤報が続き、警報が見られなくなる
- 二重投資:工場や部門ごとに別々のセンサー・通信の方式・データの置き場を選び、後で横断して使えず作り直しになる
- 過剰保全:必要以上に細かい頻度で多くの設備を測り、データの量に見合う判断が生まれないまま、データの管理の手間と、データの揺れを確かめに行く不要な点検の作業が増える
これを防ぐために、本コラムでは、センサーの導入の前に、設備ごとに次のような測定の計画表を作り、保全部門・生産部門・データ担当の3者で合意しておくことが有効だと考えています。表の例は記入の仕方を示すための架空の設備で、値は実在の設備の推奨値ではありません。表の設備は、ほかの章のコードに出てくる架空の設備とは別のものです。
| 設備 | 捉えたい故障モード | 兆候が現れる物理量 | 必要な先行時間 | 手法と測り方 | 測定の間隔(繰り返しの間隔・1回の記録の長さ・サンプリング周波数) | あわせて記録する稼働の情報 | 判断する人 |
|---|---|---|---|---|---|---|---|
| ポンプC | 軸受の損傷 | 軸受箱の振動 | 部品の手配と停止の調整にかかる日数 | 軸受箱に加速度計を固定して常時監視 | 繰り返しの間隔は、発見の遅れと必要な先行時間を足しても P-F 間隔に収まり、P-F 間隔の中で複数回測れるように決める。記録の長さは必要な周波数の分解能から、サンプリング周波数は軸受の欠陥による周波数から決める | 回転数、吐出の圧力、運転・停止 | 保全部門の担当 |
| ポンプC | モータの巻線の絶縁の劣化 | 電気的な特性 | 同上 | 定期の電気的な測定 | 計画停止の周期を基本とし、発見の遅れと必要な先行時間を足しても P-F 間隔に収まるかを確かめる。収まらなければ臨時の測定や方式の見直しを考える(波形は記録しない) | 運転時間 | 電気の保全の担当 |
| 送風機A | アンバランス、ミスアライメント | 軸受箱の振動 | 次の計画停止までの日数 | 持ち運び型の測定器で巡回測定(測定点に印) | 巡回の周期は、発見の遅れと必要な先行時間を足しても P-F 間隔に収まるように決める。サンプリング周波数は回転数から決める | 回転数、負荷 | 保全部門の担当 |
| 受電盤B | 接続部の緩みによる発熱 | 表面の温度の相間の差 | 次の停電の作業までの日数 | 赤外線サーモグラフィによる定期の点検 | 点検の周期は、発見の遅れと必要な先行時間を足しても P-F 間隔に収まるように決める(熱画像を1回ずつ記録) | 点検時の負荷の電流 | 電気の保全の担当 |
この表を作る途中で、「捉えたい故障モードが決まらない設備」や「測定の手段で確保できる先行時間が、保全に必要な時間より短い設備」が見つかることがあります。そうした設備は、予知保全の対象にするかどうかを見直します。時間基準保全や事後保全に移すかどうかは自動的には決まらないので、故障モードと故障の影響を評価し直し、各方式が使える条件(故障の影響の大きさ、兆候を測れるかなど。第1章)を満たすものを選びます(保全の方式の選び方は第1章、対象の選定は第12章)。センサーを付ける前にこの判断ができれば、付けたのに使われないセンサーを減らせます。予算の面では、センサーの台数で予算を組むのではなく、「この表の行の数」と「各行で防ぎたい損失の型」で予算の要否を説明する形にすると、投資の判断と保全の判断が結び付きやすくなると考えています。
この章では、予知保全のデータを集める工程を扱いました。要点は次の4つです。
- 測る前に、設備ごとに捉えたい故障モードと必要な先行時間を決め、その兆候が現れる物理量と手法を選ぶ
- 振動では、測定点・取り付け方・サンプリングがデータの質を決める
- 振動の規格は、本コラムで確かめた第1部と第3部では ISO 20816 系に置き換えられている。目録の保存版の時点では改訂の作業中だったので、使う前に最新の版を確かめる
- 稼働や保全の記録と結び付け、データの品質を見張る仕組みを最初から入れる
次の第4章では、集めた振動のデータから、FFT と包絡線解析で故障の兆候を数値にする方法を、実際に計算したコードとともに扱います。
この章を深めたい方への参考書籍
『機械システムの状態監視と診断技術』(日本機械学会 編、井上剛志・兵藤行志 編著、榊田均ほか 共著、コロナ社):機械の状態監視と診断を、ISO の規格の体系の概論から説き起こしている本です。この章で番号と状態だけを確かめた状態監視の規格群が、全体としてどう組み立てられているかを知る手がかりになります。
『温度計測:基礎と応用』(計測自動制御学会温度計測部会 編、コロナ社):温度とは何かという定義から、温度の測り方の基礎と応用までを扱う本です。この章で触れた、正確な温度を測るときに表面の性質や環境の影響を補正する必要がある点を、計測の側から確かめられます。
第4章 振動データの信号処理と特徴量、FFTと包絡線解析で状態を数値にする
第3章では、どの故障モードを捉えたいかを先に決め、それに合ったセンサー・測定点・サンプリング周波数を選ぶことを確かめました。この章では、集めた振動の波形を、保全の判断に使える数値に変える方法を扱います。加速度センサーが1秒間に数万回記録した値をそのまま眺めても、設備がどういう状態にあるかは読み取れません。波形の大きさや尖り方を表す時間領域の特徴量、どの周波数の成分が強いかを表す周波数領域の特徴量、そして転がり軸受の傷が出す周期的な衝撃を取り出す包絡線解析を順に説明します。そのうえで、架空の回転機の振動信号を Python で合成し、正常のときと外輪に傷があるときで、数値と図がどう変わるかを実行した結果で示します。「いつもと違う」をどう判定するかは第5章で扱い、この章では判定の材料になる数値を作るところまでを扱います。
なぜ生の波形ではなく特徴量で見るのか
振動の波形は、時刻ごとの加速度(あるいは速度・変位)の値の並びです。サンプリング周波数が 20 kHz なら、1秒間に2万個の値が並びます。この並びには、次のような成分が重なっています。
- 回転の成分
- 歯車やベルトの成分
- 電気的なノイズ
- 周りの設備から伝わる振動
- 軸受や部品の傷が出す成分
この章でいう傷は、軸受の欠陥(はく離など)を指します。後で説明する「軸受の欠陥周波数」は、この傷が出す衝撃の繰り返しの周波数のことです。傷が小さいうちは、その成分は全体の中でわずかなので、波形の図を見ても傷の成分を見分けにくい場合があります。この章の後半の計算(乱数で作った架空の信号を使います)でも、この1回の乱数では、初期の傷を入れた波形の実効値は正常のときより6%大きいだけでした。
そこで、波形から少数の数値を計算し、その数値の動きで状態を追います。この少数の数値を特徴量と呼びます。特徴量には、波形全体の大きさ(実効値)、最も大きな振れ(ピーク値)、尖り方(波高率・尖度)のように時間の並びのまま計算するものと、波形を周波数ごとの成分に分けてから、特定の周波数の強さを読むものがあります。後者の代表が、この章で扱うFFT(高速フーリエ変換。波形を周波数ごとの成分に分ける計算を速く行う方法)による周波数の分析と、包絡線解析(衝撃の繰り返しの周期を取り出す処理)です。
特徴量で見ることには、データの量を減らす以上の意味があります。よい特徴量は、故障の物理と結びついています。たとえば、転がり軸受の外輪に傷があると、転動体(玉やころ)がその傷を通るたびに小さな衝撃が出ます。衝撃の繰り返しの周波数は、軸受の寸法と回転数から計算できます。計算で求まる周波数の成分が強くなっていれば、「外輪の傷の可能性がある」と、原因の候補まで言えます。一方、深層学習のように生の波形から直接学ぶ方法は、特徴量を人が設計しなくてよい代わりに、判断の根拠を保全員に説明しにくいという面があります。また、「どの故障か」の正解を付けた例で故障の種類を学ばせる方式(教師あり)では、学習に使える故障の例が少ないと当てになりにくくなります(この比較は章の後半で表にまとめます)。
この章の主張は、振動の数値化は「故障の物理に結びついた特徴量」から始めるのがよい、というものです。これは本コラムの架空データの計算と、一般論としての比較に基づく考えで、深層学習との優劣を計算で確かめたものではありません。保全員が「この数値が上がったら、この部品を疑う」と読める形にしておけば、第5章の異常検知や第6章の故障診断の結果を、現場の判断に結びつけやすくなると考えています。
時間領域の特徴量、実効値・ピーク値・波高率・尖度
時間領域の特徴量は、波形を周波数に分けずに、値の並びのまま計算する数値です。計算が軽く、センサーの側(エッジ)でも計算しやすいので、多くの状態監視の仕組みで最初に使われます。代表的なものを4つ説明します。
実効値(RMS)は、値を2乗して平均し、平方根をとったものです。式で書くと \( x_{\mathrm{rms}} = \sqrt{\frac{1}{N}\sum_{i=1}^{N} x_i^2} \) で、言葉で言えば「振動のエネルギーの大きさを、振幅の単位で表したもの」です。波形全体の大きさを1つの数で表すので、振動全体が大きくなる異常には素直に反応します。一方で、短い衝撃が時々混ざるだけの異常では、平均の中に埋もれて動きが小さくなります。
ピーク値は、記録の中で絶対値が最も大きい値です。衝撃に敏感ですが、たまたま入ったノイズ1つでも大きく動きます。波高率(クレストファクタ)はピーク値を実効値で割った値 \( \mathrm{CF} = x_{\mathrm{peak}} / x_{\mathrm{rms}} \) で、「全体の大きさに比べて、どれだけ尖った振れがあるか」を表します。尖度は、値の分布の裾の重さを表す統計量で、値を平均からの差の4乗で平均し、分散の2乗で割って求めます。値が正規分布(ガウス分布)に従うノイズだけなら尖度は3になり、まれに大きな値が出る(衝撃が混ざる)と3より大きくなります。なお、scipy の stats.kurtosis は既定では3を引いた値(超過尖度)を返すので、本コラムのコードでは fisher=False を指定して、正規分布で3になる定義に合わせました。
この章の後半の1回の計算では、初期の傷に対して、波高率と尖度は実効値より大きな割合で動きました(実効値は約6%、波高率は約23%、尖度は約8%の増加)。ただし、後の節で書くとおり、乱数を変えたくり返しをしていないので、この1回の結果だけでは、変化の再現性や、正常時のばらつきと比べてどの程度の差なのかは判断できず、傷による変化と言い切れません。また、波高率は実効値で、尖度は分散の2乗で割って正規化した値なので、衝撃だけでなく、背景の振動やノイズの分布にも左右されます。傷が長い期間をかけて進むときに4つの特徴量がそれぞれどう推移するかは、本コラムでは計算で確かめていません。ここでは「波高率や尖度は、1回の値の大小よりも、同じ測定点での時間の推移で読む」という点を押さえておきます。
軸受の欠陥周波数、外輪・内輪・転動体・保持器
転がり軸受は、次の4つの部品でできています。
- 外輪
- 内輪
- 転動体(玉やころ)
- 保持器(転動体の間隔を保つ部品)
どこかに傷(はく離・圧痕など)があると、転動体が傷の上を通るたびに衝撃が出ます。衝撃の繰り返しの周波数は傷の場所によって違い、軸受の寸法と回転数から計算できます。この周波数を軸受の欠陥周波数と呼びます。英語の資料や振動の解析ソフトでは、次の略称がよく使われます。
- BPFO:外輪の傷を転動体が通る周波数
- BPFI:内輪の傷を転動体が通る周波数
- BSF:転動体の自転の周波数
- FTF:保持器の回転の周波数
式は、軸受の寸法を表す次の4つの量で書けます。
- 転動体の数 \( z \)
- 転動体の直径 \( D_w \)
- ピッチ円径 \( d_m \)(転動体の中心が描く円の直径)
- 接触角 \( \alpha \)(転動体が軌道に当たる向きの角度)
外輪が止まり内輪が回転周波数 \( f_r \) で回る場合、外輪の欠陥周波数は \( f_{o} = \frac{z}{2} f_r \left(1 – \frac{D_w}{d_m}\cos\alpha\right) \) です。言葉で言えば、「保持器の回転の周波数(転動体が公転する周波数)に、転動体の数を掛けたもの」です。外輪の1点を、1秒間に何個の転動体が通過するかを数えていることになります。保持器・外輪・内輪・転動体の自転の4つの式は、軸受の振動の解析を扱った米国特許(SKF Aerospace France SAS を権利者とする US 9,464,671 B2、2016年)の明細書の本文で、同じ記号の形で「理論式」として示されているのを、Google Patents に掲載された本文で確かめました(式は回転周波数に対する比として書かれています)。
内輪の欠陥周波数の式は、保持器の式からも導けます。内輪は保持器に対して「回転周波数から保持器の回転の周波数を引いた」速さで回るので、内輪の1点を1秒間に通る転動体の数は、その速さに転動体の数を掛けたものです。整理すると \( f_{i} = \frac{z}{2} f_r \left(1 + \frac{D_w}{d_m}\cos\alpha\right) \) となり、外輪の式の括弧の中の符号が逆になった形です。外輪と内輪の欠陥周波数を足すと、ちょうど「転動体の数×回転周波数」になります。
転動体に傷がある場合は、傷が外輪と内輪の両方に当たるので、自転の周波数の2倍とその整数倍が現れます。この「2倍」の扱いは、振動計測機器メーカーの IMV の Web サイトに置かれている、振動診断のセミナー用の教科書の第3版の公開資料(第7章の311〜312ページ)で確かめました。この資料は、第3版の購入者向けの正誤の案内で「修正部分2」として示されていたものです。同じ教科書は2026年3月31日に第4版が発行されていますが、本コラムでは第4版の該当箇所は確かめていません。この第3版の資料には、次の内容も書かれています。
- 軸受が摩耗して内輪が偏心すると、回転周波数の整数倍の成分が出る
- 外輪の傷では、「転動体の数×公転の周波数」とその整数倍が出る
- 内輪の傷では、内輪の1点が転動体と当たる基本の周波数とその整数倍が出る
- 軸に静的な荷重が大きくかかる条件では、内輪の傷の衝撃の強さが1回転ごとに強弱をくり返す(回転周波数で変調される)ため、基本の周波数の両側に、回転周波数だけ離れた成分が並ぶ(この成分を側帯波と呼ぶ)
次のコードは、架空の軸受(転動体9個、転動体の径がピッチ円径の0.2倍、接触角0)を毎分1,800回転(回転周波数30 Hz)で回した場合の欠陥周波数を計算したものです。寸法の値は計算の見通しをよくするために選んだ架空の値で、実在の軸受の型番には対応させていません。実際の設備で使うときは、軸受メーカーが公開している型番ごとの寸法表や計算ページから値を取ります(たとえば JTEKT は、型番を選ぶと転動体の通過周波数を計算するページを公開しています)。
import numpy as np
from scipy import signal, stats

fs = 20000                      # サンプリング周波数 [Hz]
T = 1.0                         # 1回の記録の長さ [s]
fr = 1800 / 60                  # 軸の回転周波数 [Hz](毎分1,800回転)
z, ratio, alpha = 9, 0.2, 0.0   # 転動体の数、転動体の径÷ピッチ円径、接触角 [rad]

c = ratio * np.cos(alpha)
ftf = fr / 2 * (1 - c)                  # 保持器の回転周波数
bpfo = z * fr / 2 * (1 - c)             # 外輪の傷を転動体が通る周波数
bpfi = z * fr / 2 * (1 + c)             # 内輪の傷を転動体が通る周波数
bsf = fr / (2 * ratio) * (1 - c ** 2)   # 転動体の自転の周波数
for name, f in [("回転", fr), ("保持器", ftf), ("外輪", bpfo),
                ("内輪", bpfi), ("転動体の自転", bsf), ("転動体の傷 2倍", 2 * bsf)]:
    print(f"{name:10s} {f:7.1f} Hz  回転の {f / fr:5.2f} 倍")
実行した結果は次の表のとおりです。外輪の欠陥周波数は 108 Hz で、回転周波数のちょうど3.6倍です。回転周波数の整数倍にならない点が重要で、回転周波数の整数倍に現れる成分(前の段落の資料にある、摩耗による偏心の成分など)と、周波数の位置で区別できます。
| 欠陥の場所 | 現れる周波数の式(基本の成分) | 本コラムの架空の軸受での値 | 回転周波数の何倍か |
|---|---|---|---|
| (参考)回転 | \( f_r \) | 30.0 Hz | 1.00 |
| 保持器 | \( \frac{1}{2} f_r (1 – \frac{D_w}{d_m}\cos\alpha) \) | 12.0 Hz | 0.40 |
| 外輪 | \( \frac{z}{2} f_r (1 – \frac{D_w}{d_m}\cos\alpha) \) | 108.0 Hz | 3.60 |
| 内輪 | \( \frac{z}{2} f_r (1 + \frac{D_w}{d_m}\cos\alpha) \) | 162.0 Hz | 5.40 |
| 転動体の自転 | \( \frac{d_m}{2 D_w} f_r (1 – (\frac{D_w}{d_m}\cos\alpha)^2) \) | 72.0 Hz | 2.40 |
| 転動体の傷(自転の2倍) | 自転の周波数の2倍 | 144.0 Hz | 4.80 |
この式には前提があります。式は転動体が滑らずに転がるとして導いたもので、表の値は外輪が止まって内輪だけが回り、回転数が記録の間に一定である場合のものです。特許の本文も、これらの式を「理論式」と呼び、片方の輪だけが回る場合として示しています。実際の測定では、ピークの位置が計算値とわずかにずれることがあり得るので、計算値ちょうどの1点ではなく、前後に少し幅を持たせて読むのが実務的です。本コラムのコードでも、衝撃の間隔を1%の標準偏差でわずかに揺らし、ピークを計算値の前後2 Hz の幅で読んでいます。回転数が大きく変わる設備(インバータで速度を変えるポンプ・ファン、起動と停止を繰り返す設備)では、欠陥周波数も回転数に比例して動きます。この場合は、回転数を同時に記録して「回転の何倍か」で読み直すことが必要になります。
架空の回転機の振動信号を合成する
次に、架空の回転機の振動信号を numpy で合成します。本コラムの信号はすべて架空のデータで、実在の設備の測定値ではありません。信号の値は、加速度センサーの加速度を単位なしの相対値で表したものとして置きました。正常の信号は、回転の1倍(30 Hz)と2倍(60 Hz)の正弦波に、測定のノイズ(正規分布の乱数)を足したものにしました。外輪に傷がある信号は、これに「傷を転動体が通るたびの衝撃」を足します。衝撃は、軸受やハウジング(軸受を収めて支える外側の部品)の構造の共振が、ぶつかった瞬間に鳴って速く減衰する形にしました。共振は、構造が叩かれたときに、その構造に固有の周波数で振動する現象です。鐘を叩くと決まった高さの音が鳴るのと同じで、この例では共振の周波数を 3 kHz と置きました。衝撃の間隔は外輪の欠陥周波数 108 Hz の逆数(約9.26ミリ秒)で、そこに1%の揺らぎを入れています。衝撃の大きさを変えて、「初期の傷」と「進行した傷」の2つを作りました。共振の周波数・減衰の速さ・ノイズの大きさは、図と数値の見通しをよくするために選んだ架空の設定です。
rng = np.random.default_rng(20261030)
t = np.arange(int(fs * T)) / fs


def base_signal():
    """正常な回転機:回転の1倍と2倍の成分に、測定のノイズを足す"""
    shaft = 0.30 * np.sin(2 * np.pi * fr * t) + 0.10 * np.sin(2 * np.pi * 2 * fr * t + 0.5)
    return shaft + rng.normal(0, 0.20, t.size)


def impacts(amp, f_def, f_res=3000.0, decay=800.0, slip=0.01):
    """傷を転動体が通るたびの衝撃。f_res [Hz] の共振が減衰しながら鳴る"""
    x = np.zeros(t.size)
    ring = np.arange(200) / fs                        # 1回の衝撃の長さ 10 ms
    shape = np.exp(-decay * ring) * np.sin(2 * np.pi * f_res * ring)
    tk = 0.002
    while tk < T:
        n0 = int(tk * fs)
        m = min(ring.size, t.size - n0)
        x[n0:n0 + m] += amp * shape[:m]
        tk += (1 / f_def) * (1 + rng.normal(0, slip))  # 間隔をわずかに揺らす
    return x


normal = base_signal()
early = base_signal() + impacts(0.6, bpfo)       # 外輪の傷(初期)
advanced = base_signal() + impacts(1.5, bpfo)    # 外輪の傷(進行)
signals = {"正常": normal, "外輪の傷(初期)": early, "外輪の傷(進行)": advanced}
合成した波形の先頭の50ミリ秒を、正常と進行した傷で並べたのが次の図です。進行した傷の波形には、点線の位置(最初の衝撃から約9.26ミリ秒ごと)に鋭い振れが繰り返し出ています。点線は揺らぎを入れる前の間隔で引いているので、後ろの衝撃ほど点線とわずかにずれます。
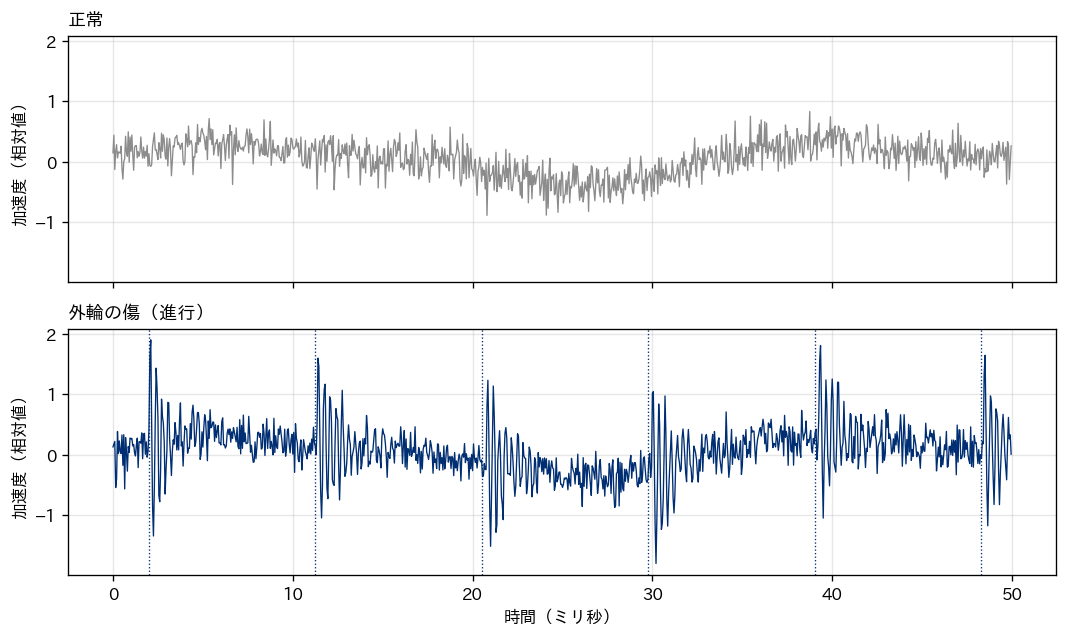
進行した傷では衝撃が目で見えますが、初期の傷ではノイズに埋もれて、波形の図からは見分けにくくなります。次の節で、まず時間領域の特徴量がどこまで動くかを確かめます。
時間領域の特徴量を計算すると何が分かるか
3つの信号(正常・初期の傷・進行した傷)について、実効値・ピーク値・波高率・尖度を計算しました。
def time_features(x):
    rms = np.sqrt(np.mean(x ** 2))                  # 実効値
    peak = np.max(np.abs(x))                        # ピーク値
    return rms, peak, peak / rms, stats.kurtosis(x, fisher=False)  # 波高率、尖度


print("状態              実効値  ピーク値  波高率  尖度")
for name, x in signals.items():
    rms, peak, cf, ku = time_features(x)
    print(f"{name:12s} {rms:7.3f} {peak:8.3f} {cf:7.2f} {ku:6.2f}")
結果は次の表のとおりです。
| 状態 | 実効値 | ピーク値 | 波高率 | 尖度 |
|---|---|---|---|---|
| 正常 | 0.301 | 1.051 | 3.49 | 2.61 |
| 外輪の傷(初期) | 0.319 | 1.369 | 4.29 | 2.81 |
| 外輪の傷(進行) | 0.407 | 2.141 | 5.27 | 4.58 |
表の値は、どれも乱数1回分の信号から計算したものです。乱数を変えたくり返しは行っていません。この1回の乱数では、初期の傷で、実効値は0.301から0.319へ約6%上がっただけです。波高率は3.49から4.29、尖度は2.61から2.81へ上がりました。進行した傷になると、実効値は約35%上がり(0.407)、尖度は4.58まで上がります。正常の尖度が3より小さい2.61なのは、回転の正弦波が混ざっているためです(正弦波だけの尖度は1.5で、正規分布の3より小さくなります)。このように、尖度の「3」という目安は、ノイズだけの信号の場合の値で、回転の成分が強い信号ではもともと3から外れます。尖度の絶対値で正常か異常かを決めず、同じ設備・同じ測定点の過去の値と比べることが必要です。
この1回の乱数では、初期の傷に対して時間領域の4つの特徴量はいずれも正常より大きくなりました。ただし、尖度(2.61から2.81)やピーク値(1.051から1.369)の差が、正常時のばらつきと比べてどの程度のものかは、この1回の結果だけでは判断できず、傷による変化と言い切れません。変化そのものも小さく、実際の設備のように負荷や回転数の変動で特徴量が日々ゆれる条件では、この程度の変化はゆれの中に埋もれる可能性があります。しかも、これらの数値は「何かが変わった」ことは示しても、「どの部品か」は示しません。実効値が6%上がった原因が、外輪の傷なのか、負荷が少し増えただけなのかは、この表からは区別できません。そこで周波数の情報を使います。
FFTで周波数ごとの振幅を見る、窓関数と周波数分解能
FFT は、一定の長さの波形を、いろいろな周波数の正弦波の重ね合わせとみなし、各周波数の正弦波の振幅を求める計算です。結果を、横軸に周波数・縦軸に振幅をとって描いたものをスペクトルと呼びます。回転の整数倍の成分や歯車のかみ合いのように、周期的に繰り返す現象は、スペクトルの決まった位置に山として現れます。
FFT を使うときに押さえておく点が2つあります。1つは周波数の刻みと周波数分解能、もう1つは窓関数です。先に2つの語の違いを書いておくと、周波数の刻みは「結果が何 Hz おきに並ぶか」、周波数分解能は「近い周波数の2つの成分を分けて読めるかどうか」です。
記録の長さを \( T \) 秒とすると、ゼロ埋め(記録の後ろに0を足して長くする処理)をしない場合、FFT の結果は \( 1/T \) Hz 刻みの周波数で得られます。1秒の記録なら1 Hz 刻み、0.1秒なら10 Hz 刻みです。一方、周波数分解能は、刻みだけでなく、次の段落で説明する窓関数が山の幅を広げる度合いにも左右されます。ゼロ埋めは、SciPy の解説では、結果の周波数の並びを細かくし直す処理として説明されており(第3章のサンプリング周波数のように、時間の側で測る回数を増やす話ではありません)、測った記録そのものが長くなるわけではありません。そのため、刻みが細かいことと、近い2つの成分を分けて読めることは同じではありません。近い周波数の2つの成分を分けたいときや、欠陥周波数の位置を細かく確かめたいときは、記録を長くする必要があります。ただし、記録を長くすると、その間に回転数が変わる影響を受けやすくなります。
窓関数は、切り出した波形の両端に掛ける重みです。FFT は、切り出した波形が繰り返し続くものとして計算するので、切り出しの両端で波形がつながらないと、本来の周波数の山が周りの周波数ににじみます(このにじみを漏れ、リーケージと呼びます)。両端を滑らかに0に近づける重み(ハン窓など)を掛けてから FFT をすると、このにじみを抑えられます。その代わり、山そのものの幅は広がります(SciPy 1.16 の信号処理の解説)。
次のコードでは、ハン窓を掛け、窓で減った分を補正して、正の周波数の側だけの振幅(片側の振幅)に換算しました。FFT は計算の上で、1つの成分の大きさを、正の周波数の側と、それを折り返した負の周波数の側に半分ずつ分けて表します。そのため、正の側だけにまとめるときは2倍します。ただし、直流(0 Hz)と、記録の点数が偶数のときの最も高い周波数(サンプリング周波数の半分で、ナイキスト周波数と呼びます)の成分には、足し込む相手が無いので、2倍にしません。
def amp_spectrum(x):
    w = np.hanning(x.size)                          # ハン窓
    X = np.fft.rfft((x - x.mean()) * w)
    f = np.fft.rfftfreq(x.size, 1 / fs)
    a = np.abs(X) / w.sum()
    if x.size % 2 == 0:
        a[1:-1] *= 2                                # 片側の振幅に換算(直流とナイキストは2倍にしない)
    else:
        a[1:] *= 2
    return f, a


def amp_at(f, a, f0, tol=2.0):
    """f0 の前後 tol [Hz] の中の最大の振幅"""
    sel = (f >= f0 - tol) & (f <= f0 + tol)
    return a[sel].max()


print("状態              回転1倍   外輪1倍  2.5〜3.5 kHz の最大")
for name, x in signals.items():
    f, a = amp_spectrum(x)
    band = (f >= 2500) & (f <= 3500)
    print(f"{name:12s} {amp_at(f, a, fr):8.3f} {amp_at(f, a, bpfo):8.3f} {a[band].max():10.3f}")
結果は次の表のとおりです(これも乱数1回分の結果です)。この1回の乱数では、回転の1倍の振幅は3つの信号でほぼ同じ(0.299〜0.305)でした。外輪の欠陥周波数 108 Hz の振幅は、正常0.006、初期の傷0.005で、初期の傷では正常と区別できません。進行した傷でも0.018で、回転の1倍の振幅(0.300)と比べるとごく小さい値です。一方、共振を置いた 2.5〜3.5 kHz の帯域の最大値は、正常0.010、初期の傷0.023、進行した傷0.043と、傷が進むほど大きくなりました。
| 状態 | 回転1倍(30 Hz)の振幅 | 外輪1倍(108 Hz)の振幅 | 2.5〜3.5 kHz の最大の振幅 |
|---|---|---|---|
| 正常 | 0.305 | 0.006 | 0.010 |
| 外輪の傷(初期) | 0.299 | 0.005 | 0.023 |
| 外輪の傷(進行) | 0.300 | 0.018 | 0.043 |
正常と初期の傷のスペクトルを 0〜5 kHz で重ねたのが次の図です。左端の大きな山が回転の1倍(30 Hz)、その右の小さな山が2倍(60 Hz)です。初期の傷では、3 kHz 付近がわずかに盛り上がっていますが、108 Hz の位置に目立つ山はありません。
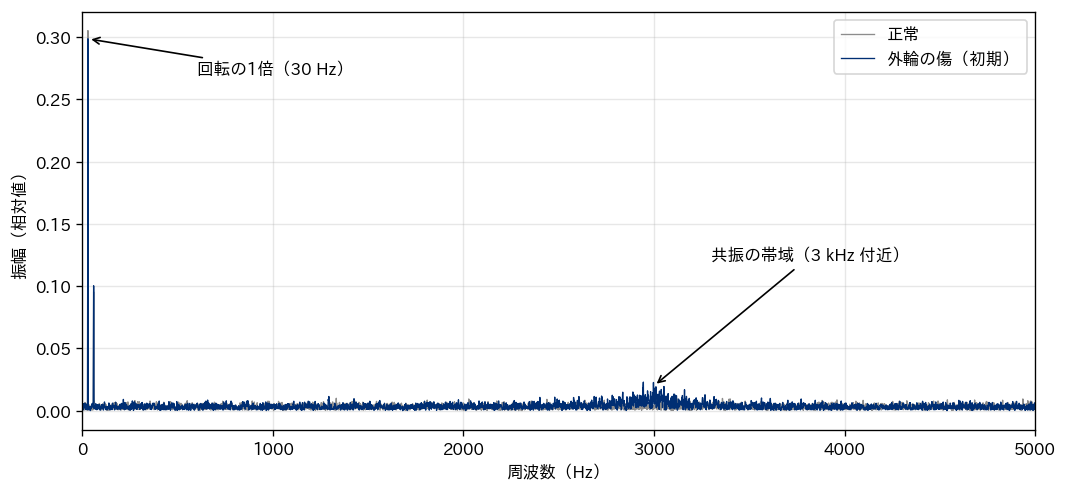
本コラムの合成信号で、欠陥周波数の位置に山が出なかった理由は次のとおりです。衝撃は、それ自体が 108 Hz で振動しているのではなく、約9.26ミリ秒の間隔(1秒間に約108回)で「構造の共振を鳴らす」ものです。そのため、エネルギーは共振の周波数の周りに散らばり、この合成信号では欠陥周波数の位置にほとんど出ませんでした。欠陥周波数の情報は、共振の振動の「大きさの変わり方(1秒間に約108回、強くなって減衰する)」の中に入っています。これを取り出すのが、次の節の包絡線解析です。この説明は、衝撃が共振を鳴らすという本コラムの合成信号の設定のもとでのもので、実機のすべての傷で欠陥周波数の位置に成分が出ないと言っているわけではありません。
周波数の刻みについても、記録の長さを変えて確かめました。サンプリング周波数 20 kHz で、ゼロ埋めをせずに記録の長さを0.1秒から2秒まで変えたときの刻みと、108 Hz に最も近い刻みの周波数は次のとおりです。
print("記録の長さ  周波数の刻み  外輪1倍に最も近い刻みの周波数")
for TT in (0.1, 0.25, 0.5, 1.0, 2.0):
    N = int(fs * TT)
    df = fs / N
    near = np.round(bpfo / df) * df
    print(f"{TT:6.2f} s  {df:8.2f} Hz  {near:8.2f} Hz")
| 記録の長さ | FFT の周波数の刻み | 外輪1倍(108 Hz)に最も近い刻みの周波数 |
|---|---|---|
| 0.1 秒 | 10.00 Hz | 110.00 Hz |
| 0.25 秒 | 4.00 Hz | 108.00 Hz |
| 0.5 秒 | 2.00 Hz | 108.00 Hz |
| 1 秒 | 1.00 Hz | 108.00 Hz |
| 2 秒 | 0.50 Hz | 108.00 Hz |
0.1秒の記録では刻みが10 Hz になり、108 Hz の成分は 110 Hz の位置に読まれます。10 Hz 刻みでは、外輪(108 Hz)と、たとえば回転の4倍(120 Hz)を分けて読むのも際どくなります。2つの成分を実際に分けられるかどうかは、刻みだけでなく窓関数による山の幅にも左右されます。記録の長さは、「どの周波数とどの周波数を分けたいか」から逆算して決めるのがよいと考えています。サンプリング周波数(どこまで高い周波数を測れるか)の決め方は第3章で扱いました。
包絡線解析で衝撃の繰り返しを取り出す
包絡線解析は、次の3つの手順で行います。
- 帯域通過フィルタ(決めた周波数の範囲の成分だけを通し、それより低い成分と高い成分を弱める計算)で、衝撃が鳴らす共振の帯域だけを通す(この例では 2〜4 kHz)。回転の成分や低い周波数のノイズはここで除かれる
- フィルタを通した波形の包絡線(振動の山をなぞった外形の線)を求める。ここではヒルベルト変換で解析信号(元の波形に、位相を90度ずらした波形を虚部として組み合わせた複素数の信号)を作り、その絶対値をとる
- 包絡線を FFT して、包絡線スペクトルを求める。衝撃の繰り返しの周波数とその整数倍が山として現れる
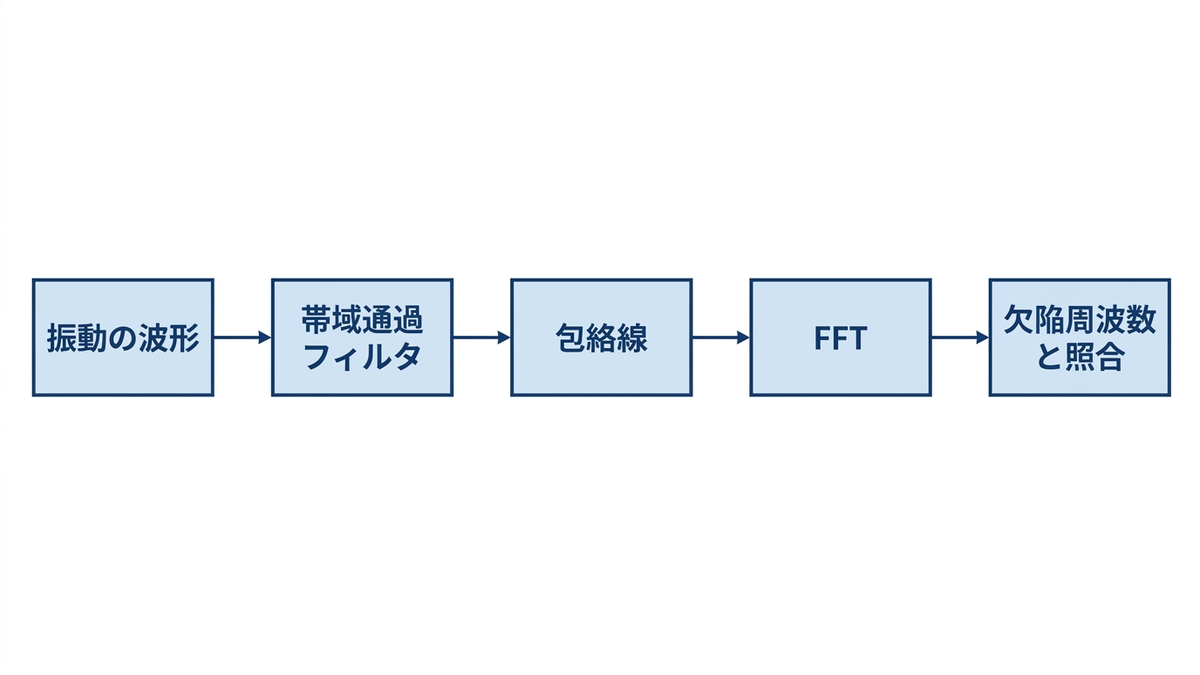
手順2の解析信号は、scipy の signal.hilbert で求められます。包絡線は、共振の振動が「1秒間に約108回、強くなって減衰する」という大きさの変わり方だけを表すので、その周波数を FFT で読めば、衝撃の繰り返しの周波数が分かります。
def envelope_spectrum(x, band=(2000, 4000)):
    sos = signal.butter(4, band, btype="bandpass", fs=fs, output="sos")
    xb = signal.sosfiltfilt(sos, x)                 # 共振の帯域だけ通す
    env = np.abs(signal.hilbert(xb))                # ヒルベルト変換で包絡線
    return amp_spectrum(env)


print("状態              回転1倍  外輪1倍  外輪2倍  外輪3倍")
for name, x in signals.items():
    f, a = envelope_spectrum(x)
    vals = [amp_at(f, a, fr)] + [amp_at(f, a, k * bpfo) for k in (1, 2, 3)]
    print(f"{name:12s} " + " ".join(f"{v:8.4f}" for v in vals))

f, a = envelope_spectrum(early)
sel = (f > 5) & (f < 500)
idx, _ = signal.find_peaks(a[sel], distance=20)
top = idx[np.argsort(a[sel][idx])[::-1][:6]]
print("初期の傷の包絡線スペクトル 5〜500 Hz の山 上位6本")
for i in top:
    print(f"  {f[sel][i]:6.1f} Hz  振幅 {a[sel][i]:.4f}")

f0, a0 = envelope_spectrum(normal)
print(f"正常の包絡線スペクトル 161 Hz の前後2 Hz の最大  {amp_at(f0, a0, 161):.4f}")
結果は次の表のとおりです。この1回の乱数では、初期の傷の包絡線スペクトルで、外輪の欠陥周波数 108 Hz の振幅が0.0799になり、正常の0.0039の約20倍でした。2倍(216 Hz)と3倍(324 Hz)にも、0.0615と0.0426の山が出ています。普通の FFT では、108 Hz の位置の振幅(正常0.006、初期の傷0.005)で正常と区別できなかった初期の傷が、包絡線スペクトルでは欠陥周波数の位置にはっきり現れました。進行した傷では、108 Hz の振幅が0.2647まで大きくなりました。回転の1倍(30 Hz)の位置は、3つの信号とも0.004〜0.005で、この例の包絡線には 30 Hz 付近の強い変動は見られません。包絡線スペクトルの 30 Hz の値は、通した帯域の振動の大きさが 30 Hz で変わる度合いを表すもので、元の波形の回転の成分の大きさとは別の量です。フィルタで回転の成分がどれだけ弱まったかを確かめるには、包絡線にする前の波形で、フィルタを通す前と後を比べる必要があります(本コラムではこの比較はしていません)。
| 状態 | 回転1倍(30 Hz) | 外輪1倍(108 Hz) | 外輪2倍(216 Hz) | 外輪3倍(324 Hz) |
|---|---|---|---|---|
| 正常 | 0.0050 | 0.0039 | 0.0032 | 0.0026 |
| 外輪の傷(初期) | 0.0038 | 0.0799 | 0.0615 | 0.0426 |
| 外輪の傷(進行) | 0.0049 | 0.2647 | 0.1774 | 0.1163 |
正常と初期の傷の包絡線スペクトルを 0〜500 Hz で並べたのが次の図です。破線は、計算で求めた外輪の欠陥周波数 108 Hz と、その2〜4倍(216・324・432 Hz)の位置です。図でも、初期の傷の山は4本とも破線の位置に立っています。
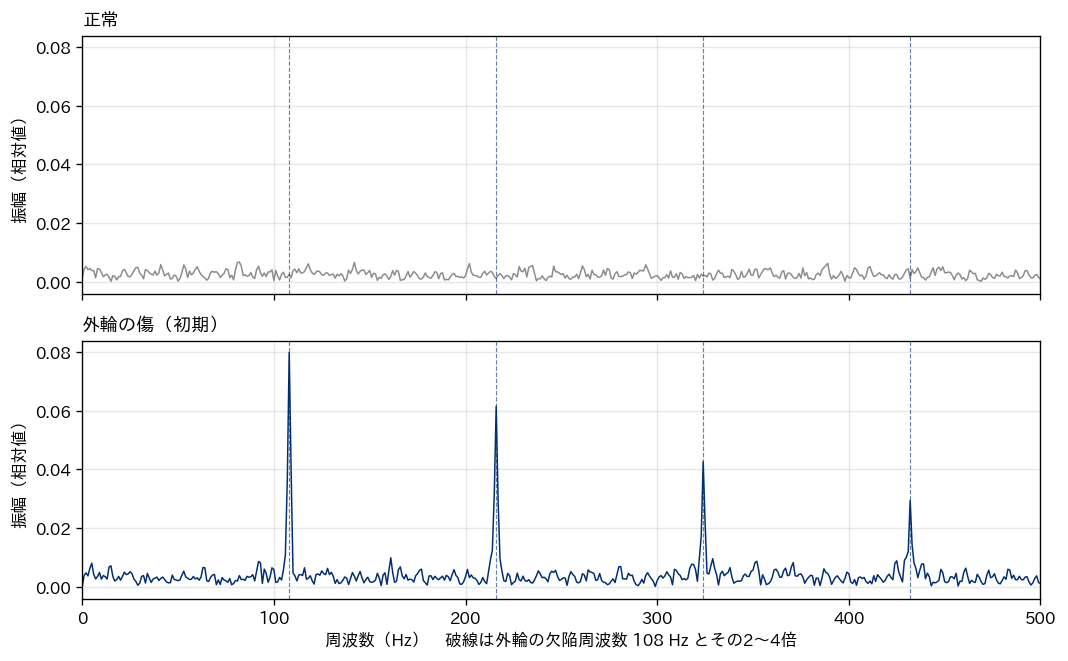
この1回の乱数では、初期の傷の包絡線スペクトルで、5〜500 Hz の範囲の山を大きい順に6本並べると、108.0 Hz(0.0799)、216.0 Hz(0.0615)、324.0 Hz(0.0426)、432.0 Hz(0.0294)、161.0 Hz(0.0099)、352.0 Hz(0.0087)でした。
5番目の 161 Hz は、内輪の欠陥周波数 162 Hz に近い位置です。振幅0.0099は、外輪の1倍(0.0799)の8分の1ほどですが、同じ計算で正常の信号の 161 Hz の前後2 Hz の最大を求めると0.0038で、その約2.6倍あります。この架空データでは、どの信号にも内輪の傷の衝撃を入れていないので、この 161 Hz の山は、作り方の上では内輪の傷による山ではありません。何がこの山を作ったのかは、本コラムの計算では切り分けていません。実際の設備で同じくらいの山が出た場合に、傷によるものかノイズによるものかは、この1回の結果からは決められません。
この1回の乱数の上位6本の山を、内輪の欠陥周波数の位置と照らし合わせると次のとおりです。1倍(162 Hz)の近くにあるのは 161 Hz の1本です。2倍(324 Hz)の位置には 324 Hz の山がありますが、324 Hz は外輪の欠陥周波数の3倍と同じ位置なので、このスペクトルからは、外輪と内輪のどちらの成分かを区別できません。3倍(486 Hz)の山は、上位6本に入っていません。486 Hz の位置の振幅そのものは、このコードでは求めていません。この合成例では内輪の傷の衝撃を入れていないので、486 Hz の山が上位6本に現れないことは、作り方と食い違いません。
この合成例では、内輪の傷が無いことは作り方から分かっています。一方、実際の設備で同じスペクトルを見た場合は、内輪の欠陥周波数の近くに山が1本あるだけでは、内輪の傷があるとも無いとも決められません。確かめに使いたい2倍の位置が外輪の3倍と重なっていて、判断の材料にならないためです。また、本コラムのコードは山を振幅の大きい順に並べているだけで、傷の有無を判定する基準は設けていません。そのため本コラムでは、161 Hz の山を傷の判断の材料にはしていません。
この例から分かるのは、欠陥周波数の近くに山が1本あるだけで判断せず、「基本の周波数と、その2倍・3倍が並んで立っているか」「正常のときと比べて大きくなったか」をあわせて見ることの大切さです。161 Hz の山は、「正常のときと比べて大きくなったか」は満たしますが、「基本の周波数と、その2倍・3倍が並んで立っているか」は、2倍の位置が外輪の3倍と重なり、3倍の 486 Hz の振幅は求めていないため、確かめられません。
6番目の 352 Hz(0.0087)は、欠陥周波数の表に挙げた6つの周波数のどの整数倍にも当たりませんが、この結果だけでは、この山が何によるものかは確定できません。
包絡線解析には、外れる場面もあります。通す帯域の選び方を誤ると、衝撃の成分が入らず、山が出ません。この例では、合成のときに共振を 3 kHz に置いているので、その周りの帯域を選びました。実際の設備では共振の周波数を事前に知らないことが多く、正常時と異常時のスペクトルの比較や、試験的な打撃などで帯域を探すことになります。また、歯車のかみ合いのように、軸受以外にも衝撃を出す部品が近くにあると、その繰り返しの周波数も包絡線スペクトルに出ます。どの山がどの部品のものかを、軸受・歯車・羽根などの部品ごとに計算した周波数の表と照らし合わせて読む必要があります。
特徴量の一覧と、深層学習で生の波形から学ぶ方法との比較
この章で扱った特徴量を、何が分かるか・どの故障に効くか・どこで外れるかで整理したのが次の表です。「効く故障の例」の列には、この章の架空データの計算(この1回の乱数)で値の動きを確かめたものと、本文で挙げた IMV の資料に書かれているものだけを書き、どちらによるかを括弧で示しました。この章で計算した傷は外輪の傷だけです。「振動全体が大きくなる異常」「衝撃型の異常」のような分類名は、本コラムで整理のために使う一般的な呼び方で、根拠は括弧の中に書いたものです。また、ピーク値・波高率・尖度の上昇は、前の節で書いたとおり、この1回の結果だけでは傷による変化と言い切れません。自社の設備に当てはめるときは、第3章で決めた「捉えたい故障モード」と照らし合わせて、使う特徴量を選びます。
| 特徴量 | 何が分かるか | 効く故障の例(根拠) | どこで外れるか | 計算の重さ |
|---|---|---|---|---|
| 実効値 | 振動全体の大きさ | 振動全体が大きくなる異常(本コラムの計算では、外輪の進行した傷で約35%上昇) | 初期の衝撃型の異常は平均に埋もれる。原因の場所は分からない | 軽い |
| ピーク値 | 最大の振れ | 衝撃型の異常(本コラムの計算では、外輪の傷で上昇) | 偶然のノイズ1つで動く | 軽い |
| 波高率 | 全体に比べた尖り | 衝撃型の異常(本コラムの計算では、外輪の傷で上昇) | 回転の成分が強いと動きにくい。値の大小より推移で読む | 軽い |
| 尖度 | まれな大きな値の多さ | 衝撃型の異常(本コラムの計算では、外輪の傷で上昇) | 回転の成分で3から外れる。同じ測定点の過去と比べる | 軽い |
| FFT の特定の周波数の振幅 | 回転の1倍・2倍などの周期成分の強さ | 回転周波数の整数倍に出る異常(IMV の資料では、軸受の摩耗による偏心の例) | 本コラムの例の初期の傷では、欠陥周波数の付近に目立つ山が出なかった(実機での現れ方は条件による)。回転数が変わると位置が動く | 中程度 |
| 高い周波数の帯域の中の最大の振幅 | 選んだ帯域の中で最も強い周波数の成分の大きさ(帯域全体の強さを見るには、帯域の中の成分を合計する別の計算が要る) | 衝撃が構造の共振を鳴らす異常(本コラムの計算では、外輪の傷で上昇) | 場所は分からない。帯域の選び方に左右される | 中程度 |
| 包絡線スペクトルの欠陥周波数の振幅 | 衝撃の繰り返しの周波数 | 外輪の傷(本コラムで計算)。内輪・転動体の傷も欠陥周波数は式で計算できるが、包絡線スペクトルの山は本コラムでは計算していない | 通す帯域を誤ると出ない。軸受の寸法と回転数が要る | やや重い |
この表から分かるとおり、1つの特徴量ですべての故障を捉えることはできません。実務では、軽い特徴量(実効値・尖度など)を常に計算して変化を見張り、変化が出たときや定期的に、FFT と包絡線解析で原因の候補を絞る、という2段の使い方が考えられます。軽い特徴量はセンサーの側で計算して送り、波形そのものは一定の間隔や異常の兆候があったときだけ送る、という分担は、通信と保存の量を抑えるうえでも有効だと考えています(エッジとクラウドの分担は第3章で扱いました)。
特徴量を人が設計する代わりに、生の波形やスペクトルの画像を深層学習のモデルに入れ、正常と異常、あるいは故障の種類を直接学ばせる方法もあります。この方法は、人が思いつかない特徴を見つけられる可能性がある一方で、故障の例に「どの故障か」の正解を付けて学ばせる方式(教師ありの分類)では学習に多くの故障の例が要り、故障の例が集まりにくい設備では使いにくいことがあります。深層学習にも、正常のデータを中心に学ぶ異常検知の方式があります(たとえば Ruff らの2018年の論文は、正常のクラスのデータだけで学習させる実験を示しています)。ただし、その方式でも、実際の故障を検出できるかの検証は別に要ります。次の表は、教師ありの分類を念頭に置いた、一般論としての比較です。どちらが優れているかは、設備・データの量・故障の例の数によって変わるので、表は「どの条件でどちらを選ぶか」を考えるための材料として作りました。
| 観点 | 物理に結びついた特徴量 | 深層学習で生の波形から故障を分類する(教師あり) |
|---|---|---|
| 必要な故障の例 | 少なくてもよい(欠陥周波数は寸法と回転数から計算できる) | 多く要る。故障の例が少ない設備では学習が難しい(正常のデータを中心に学ぶ方式は別) |
| 根拠の説明 | 本コラムの架空データの初期の傷なら、この1回の乱数で「包絡線スペクトルの外輪の欠陥周波数の山が正常時の約20倍になった」と言える(20倍は本例の値で、警報や交換の基準ではない) | モデルが何を見たかの説明に別の手法が要る |
| 新しい設備への展開 | 欠陥周波数の計算式は、寸法と回転数を入れ替えれば共通に使える。包絡線解析の帯域や判定の基準は、設備・測定点ごとに確かめ直す | 設備や測定点が変わると学習し直しが要ることがある |
| 未知の特徴の発見 | 人が設計した範囲に限られる | 人が思いつかない特徴を拾える可能性がある |
| 運用の手間 | 計算は軽く、センサーの側でも動かしやすい | 学習と再学習の仕組み、計算の資源が要る |
本コラムでは、最初は物理に結びついた特徴量から始め、故障の記録が貯まって特徴量で捉えきれない故障が見えてきたときに、深層学習を補助として試す順序がよいと考えています。特徴量を使う方法でも、第5章の異常検知や第6章の分類のモデルには機械学習を使えます。「特徴量か機械学習か」ではなく、「機械学習に何を入れるか」の選択だと考えると整理しやすくなります。
経営の判断、特徴量を保全員が読める形にする
信号処理の選択は、技術の細部に見えて、序章で整理した6つの損失の型のうち、突発停止・警報の形骸化・過剰保全・二重投資の4つに結びつくと考えています。
- 突発停止:軽い特徴量だけで見張っていると、初期の軸受の傷のように実効値がほとんど動かない異常に気づかず、気づいたときには傷が進行していて、計画外の停止につながるおそれがあります
- 警報の形骸化:尖度やピーク値のような敏感な特徴量に固定のしきい値を置くと、負荷の変化や偶然のノイズで警報が多く出て、警報が無視されるようになるおそれがあります
- 過剰保全:原因の場所が分からないまま警報を出すと、保全員は軸受・カップリング・基礎のどれを点検すべきか判断できず、念のための部品交換が増えるおそれがあります
- 二重投資:工場や部門ごとに特徴量の定義が違い、定義どうしの対応関係も整えていないと、後で仕組みを統合するときに追加の整備が必要になるおそれがあります(次の段落の3つ目)
この損失を避けるために、経営として決めておきたいことが3つあると考えています。1つ目は、特徴量を「保全員が読める形」で出すことを、システムの要件に入れることです。「異常スコア0.87」ではなく、本コラムの架空データの初期の傷(この1回の乱数)で出たような「外輪の欠陥周波数の成分が正常時の約20倍」という形で示せれば、保全員は軸受を疑い、点検や交換の準備を検討できます(20倍は本例の値で、一般的な警報や交換の基準ではありません)。2つ目は、欠陥周波数の計算に要る情報(軸受の型番と寸法、回転数)を、設備台帳の項目として整えることです。この情報が無いと、包絡線解析をしても山の意味が読めません(設備台帳との結びつけは第10章で扱います)。3つ目は、工場や部門ごとに別々の特徴量の定義を作らないことです。同じ「振動値」でも、加速度の実効値か速度の実効値か、どの帯域か、どの長さの記録かが違えば比べられません。設備や用途によって定義を使い分けることはあり得ますが、共通にすべき項目と、定義どうしの対応関係を整えないまま仕組みを入れると、後で統合するときに追加の整備が必要になり、二重投資につながるおそれがあります。
この章のまとめ
振動の波形は、実効値・ピーク値・波高率・尖度のような時間領域の特徴量で変化を見張り、FFT と包絡線解析で原因の候補を絞る、という2段で数値にできます。本コラムの架空データ(乱数1回分)では、外輪の初期の傷に対して実効値は約6%しか上がらず、普通の FFT でも欠陥周波数の位置に山は出ませんでしたが、包絡線スペクトルでは 108 Hz で正常の約20倍となり、その2倍・3倍の周波数にも明瞭な山が現れました。次の第5章では、こうして作った特徴量を使って、「いつもと違う」をしきい値・管理図・機械学習でどう判定するかを扱います。
この章を深めたい方への参考書籍
『続 回転機械の振動』(副題「実機の振動問題と振動診断」。松下修己・田中正人・小林正生・古池治孝・神吉博 共著、コロナ社):回転機械の振動の続編として、すべり軸受・転がり軸受・磁気軸受のロータの振動と、事例を通じた診断の考え方を扱った本です。版元の目次によると、転がり軸受のロータの振動の章にエンベロープ(包絡線)処理と軸受の損傷の波形・FFT 解析の節があり、回転機械の振動の信号処理にも1章が割かれています。この章で架空のデータで確かめた欠陥周波数と包絡線解析を、実機の振動の問題の中で位置づけ直すのに向いています。
『音・振動のスペクトル解析』(金井浩 著、日本音響学会 編、コロナ社、音響テクノロジーシリーズ 5):離散的フーリエ変換・時間窓・解析信号とヒルベルト変換など、スペクトル解析の基礎を物理的な意味とあわせて体系的に解説した本です。この章では計算の手順だけを示した周波数分解能・窓関数・ヒルベルト変換を、数式の裏付けから理解したい方に向いています。1999年の刊行の本です。
第5章 異常検知の手法、しきい値・管理図・機械学習で「いつもと違う」を見つける
第4章では、振動の波形を実効値・尖度・周波数スペクトル・包絡線スペクトルといった特徴量に直し、設備の状態を数値で表す方法を確かめました。この章では、その数値を見て「いつもと違う」と判定する方法を扱います。本コラムの定義では、異常検知は「いつもの状態と違う」ことを見つけることで、原因までは特定しません。原因を特定する故障診断は第6章で、警報を出したあとの誤報と見逃しの評価は第8章で扱います。この章では、固定のしきい値、管理図、複数のセンサーをまとめて見る統計量、機械学習の手法を順に説明し、架空の設備の多変量センサーデータで、それぞれがどの時点で劣化に気づくかを実行して比べます。
この章の結論は次のとおりです。予知保全の異常検知は、故障の事例がほとんど無いところから始まることが多く、正常な期間のデータだけから「いつも」を学ぶ手法が出発点になります。本コラムの架空データでは、複数のセンサーをまとめて見る統計量(T2 統計量と Q 統計量)が、本コラムで試した1つの機械学習の手法(Isolation Forest)より早く劣化に気づきました。乱数を変えて30回くり返した検知日の中央値で比べると、高めに置いた固定しきい値を除いた手法の間の差は最大で約12日(144.1日目から155.7日目)でした。高めに置いた固定しきい値だけは172.3日目と遅れましたが、これは手法の性質というより値の置き方によるもので、低めに置くと154.5日目でした。一方、稼働条件(負荷)で補正した T2 と補正しない T2 の差は約1日にとどまりました。
本コラムの架空データでは、誤報は、学習期間に無かった稼働条件の期間にだけ出ており、Isolation Forest とセンサーごとの管理図で出ました。この結果から、手法を選ぶことに加えて、学習期間に無い稼働条件が来たときの扱いを決めておく必要がある、と考えています。
故障のデータが少ないことを前提にする
機械学習で分類のモデルを作るときは、正常と故障の両方の事例をたくさん集め、その違いを学ばせるのが基本です。ところが設備の保全では、この前提が成り立たないことが少なくありません。重要な設備ほど、故障させないように時間基準保全で早めに部品を替えていることが多く、故障まで運転した記録はわずかしか残りません。故障が起きても、その前後のセンサーデータが保存されていない、保存されていても故障の時刻や故障モードが記録と結びついていない、ということもよくあります。同じ型の設備が何十台もあれば故障の事例も集まりますが、1台しかない専用の設備では、分類のモデルを学ばせるのに足りる数の故障の事例を集められない場合があります。
そこで異常検知では、正常に動いている期間のデータだけを使い、「正常のときの値の範囲やまとまり方」を学んでおき、そこから外れたものを異常とみなす考え方をとります。故障の事例を学ばなくてよいので、データの集め始めから使えます。その代わり、異常と判定されたものが故障の兆候なのか、単に「学習した期間には無かった稼働条件」なのかは区別できません。たとえば、正常のデータを夏に集めて冬に使えば、気温の違いで軸受の温度が下がっただけでも「いつもと違う」と判定されることがあります。異常検知の結果は「保全員が確かめるべき候補」であり、作業の指示そのものではない、という位置づけを最初に決めておくことが大切です。
正常から学ぶ手法を使うときに決めておくことは、次の3つです。1つ目は、正常とみなす期間(学習期間)をどこにするかです。設置直後の慣らし運転の期間や、修理の直後の期間は、値が落ち着いていないことがあるので外すことが多いと考えています。2つ目は、どの程度外れたら異常とするかのしきい値です。これは誤報と見逃しの釣り合いで決まり、第8章で詳しく扱います。3つ目は、稼働条件(負荷・回転数・製品の品種)が変わったときに、正常の範囲をどう扱うかです。この3つの決め方は、手法を選ぶより先に、保全部門と生産部門で合意しておく必要があります。
| 状況 | 使える手法の型 | 必要なデータ | 注意点 |
|---|---|---|---|
| 故障の事例がほとんど無い | 正常から学ぶ異常検知(しきい値・管理図・多変量の統計量・Isolation Forest など) | 正常に動いている期間のデータ | 異常の原因までは分からない。学習期間に無かった運転は異常に見える |
| 故障の事例がある程度ある | 正常と故障を分ける分類(第6章) | 故障モードの記録と結びついたデータ | 学習に無い故障モードは当てられない |
| 故障まで運転した記録が複数台ぶんある | 残存寿命の推定(第7章) | 劣化の始まりから故障までの軌跡 | 何をもって寿命の終わりとするかの定義が要る |
固定しきい値と規格の基準値
最も単純な異常検知は、センサーの値ごとに上限(必要なら下限)を決めておき、それを超えたら警報を出す方法です。これを本コラムでは固定しきい値と呼びます。軸受の温度が決まった値を超えたら、振動の実効値が決まった値を超えたら、という形です。値の意味が保全員にそのまま伝わり、制御システムの警報の機能だけでも作れるので、多くの設備ですでに使われています。
しきい値の決め方には、大きく2つあります。1つは、設備メーカーの取扱説明書や、第3章で紹介した振動の評価基準のような外部の基準値を使う方法です。外部の基準値は、多くの設備に共通する目安として作られているので、個々の設備の「いつも」の値から見ると高めに置かれていることがあります。外部の基準値を超えた時点では、すでに劣化がかなり進んでいるという場合もあります。もう1つは、その設備自身の正常な期間の値から決める方法です。こちらは次の節の管理図の考え方につながります。
固定しきい値の弱点は、センサーごとに独立に判定することにあります。温度も振動も電流も、どれも単独では上限を超えていないが、3つが同時に少しずつ上がっている、という状態は見落とします。逆に、稼働条件の変化で1つの値だけが一時的に上がると、それだけで警報が出ます。センサーの数が増えるほど、個別のしきい値の数も増え、どれかが偶然超える確率も上がります。この章の後半のコードでは、この弱点が実際にどう現れるかを確かめます。
管理図で「ふだんのばらつき」を測る
固定しきい値を、その設備自身の正常な期間のばらつきから決める考え方を体系にしたものが管理図です。管理図はもともと製造の品質管理の道具で、工程が安定しているときの値の中心と、偶然のばらつきで起こりうる範囲を線で示し、その範囲を外れた点を「偶然では説明しにくい原因がある」しるしとして扱います。日本産業規格では、シューハート管理図について JIS Z 9020-2(管理図の第2部、シューハート管理図)が定められています(本コラムでは、日本産業標準調査会のデータベースで、2025年9月22日に改正された版が最新であることを確かめました。この日付は、本コラムが確かめた版を示すためのものです)。管理図を品質管理の手順として正式に使う場合は、この規格で使い方の規定を確かめることになります。本コラムでは、規格の細かな規定には立ち入らず、考え方だけを設備の監視に当てはめます。
管理図の基本の形は、中心線と、上下2本の管理限界線です。米国の国立標準技術研究所(NIST)が公開している統計の手引きでは、管理限界は、工程が安定している限りほとんどすべての点がその内側に入るように選ぶと説明されています。また、標準偏差の3倍の位置に管理限界を置く「3シグマ限界」が一般的であり、値が正規分布に従う場合、上下どちらかに外れる確率は合わせて0.0027程度になる、とされています。ただし同じ手引きは、この確率の水準そのものに必然性は無く、原因を探しに行く手間とのかね合いで決めるものだとも書いています。設備の監視に当てはめると、管理限界の位置は「確かめに行く保全員の手間」と「劣化を見落とす危険」の釣り合いで決まる、ということになります。
管理図を設備のセンサーに使うときは、品質管理の場合と違う点がいくつかあります。1つ目は、データの間隔が細かいことです。製品の検査は抜き取りで1日数回ということも多いのに対し、センサーは秒単位でも記録できます。細かいデータをそのまま1点ずつ判定すると、すぐ隣どうしの値がよく似ているため、偶然の振れが続けて限界を超えることが増えます。2つ目は、稼働条件で値の水準が変わることです。負荷の高い品種を作っているときは振動も温度も上がるので、品種の切り替えがあるだけで値が段差状に動きます。3つ目は、劣化がゆっくり進むことです。1点だけ大きく外れるより、少しずつ水準が上がっていく変化の方が多く、1点ごとの判定では気づきにくい形をしています。この章のコードでは、4時間ごとの値を使い、3回の観測で続けて管理限界を超えたら(最初の超過から3回目の観測までは8時間)警報とする判定のルールを置きました。このルールは本コラムの例題のために決めたもので、規格が定めるものではありません。
複数のセンサーをまとめて見る、マハラノビス距離とT2統計量とQ統計量
センサーが複数あるとき、それぞれに管理図を作るだけでは、センサーどうしの関係を見ることができません。設備のセンサーの値は、互いに強く結びついていることがよくあります。この章の後半の架空の例では、負荷が上がると、モータの電流も、振動も、軸受の温度も、ポンプの吐出圧力も一緒に上がる関係を置きました。実際の設備では、どの値がどの向きに一緒に動くかは、設備の種類や回転数・流量・弁の操作・制御の方式によって違うので、稼働条件ごとに確かめる必要があります。このような「一緒に動く」という関係が正常の姿であり、そこから外れた動き、たとえば電流は変わらないのに振動と温度だけが上がる、という状態は、それぞれの値が管理限界の内側にあっても異常のしるしになりえます。
この関係を使うのが、マハラノビス距離とホテリングの T2 統計量です。マハラノビス距離は、正常なときのデータのばらつきの大きさと、センサーどうしの相関(一緒に動く度合い)を考えに入れて、ある時点の値が正常のまとまりの中心からどれだけ離れているかを測る距離です。正常なときに一緒に動く方向へのずれは小さく数え、正常なときにはまず起きない方向へのずれは大きく数えます。T2 統計量は、この距離の2乗にあたる量で、t 統計量を複数の変数に広げたものとして、Hotelling が1931年に学術誌 The Annals of Mathematical Statistics(第2巻第3号)で示しました。NIST の手引きでは、T2 は複数の変数をまとめて監視する管理図の土台になる統計量として紹介されています。
式で書くと、正常期の平均のベクトルを \( \mu \)、正常期のばらつきと相関をまとめた行列(分散共分散行列)を \( S \) として、時点 t の値のベクトル \( x_t \) について \( T^2 = (x_t – \mu)^\top S^{-1} (x_t – \mu) \) です。言葉で言えば、「平均からのずれを、正常期のばらつきと相関で割り戻して、1つの数にまとめたもの」です。センサーの値の組が多変量正規分布(正規分布を複数の変数に広げたもの)に従い、正常期の平均とばらつきが十分正確に分かっている場合には、T2 は自由度がセンサーの数のカイ2乗分布に従うので、そこから管理限界を決められます。実際には平均とばらつきは学習期間のデータから推定するので、この管理限界は推定の誤差を無視した近似です。カイ2乗分布は、平均0・標準偏差1の正規分布に従う互いに独立な値を2乗して足し合わせたものが従う分布で、自由度は足し合わせた値の数を表します。統計の数表(あるいは scipy などの関数)から、「正常なら外れる確率が0.0027になる値」を読み取れる、と理解しておけば十分です。
センサーが数十本ある場合は、主成分分析で正常期のデータの主な動き方(主成分)を取り出し、その動き方で説明できない残りの大きさを見る方法もあります。この残りの2乗和を Q 統計量と呼び、Jackson と Mudholkar が1979年に学術誌 Technometrics(第21巻第3号)で主成分分析の残差を監視する手順として示しました。この章のコードの T2 は、4つのセンサーすべてについて、相関を考えに入れた中心からの隔たりを測るので、主な動き方から外れる変化も T2 に含まれます。これに対し、Q は第1主成分(主な動き方)で説明できない残りの大きさだけを測り、「いつもと違う動き方をしていないか」を見ます。主成分分析そのものの考え方は、弊社コラム「データの構造を読み解く多変量解析、主成分分析・因子分析からクラスター分析まで」で扱っています。
| 手法 | 何を見るか | 得意な変化 | 苦手な変化・注意点 | 保全員への説明のしやすさ |
|---|---|---|---|---|
| 固定しきい値 | センサーごとの値の大きさ | 1つの値が大きく上がる変化 | 小さな変化、複数の値が少しずつ動く変化 | そのまま伝わる |
| 管理図(センサーごと) | 正常期のばらつきからの外れ | 1つの値の水準の変化 | 稼働条件で水準が変わるとばらつきが大きく見積もられる | 中心線と限界線で示せる |
| T2 統計量 | 相関を考えに入れた中心からの距離 | 複数の値の同時の変化、相関の崩れ | どのセンサーが原因かは別に調べる必要がある | 1つの数になるので、内訳の表示が要る |
| Q 統計量 | 主な動き方で説明できない残り | いつもと違う動き方 | 残す主成分の数で結果が変わる | T2 と同じく内訳の表示が要る |
| Isolation Forest | データの中での孤立のしやすさ | 分布の形を仮定しにくいデータ | 学習期間に無かった稼働条件を異常とみなしやすい | スコアの意味を説明しにくい |
機械学習の手法、Isolation Forest・One-Class SVM・オートエンコーダ
正常なデータだけから学ぶ機械学習の手法も、いくつか広く使われています。代表的なものを3つ紹介します。いずれも、統計量の手法と同じく「正常のまとまり」を学んで、そこから外れたものを異常とみなす点は共通しています。違いは、正常のまとまりの形を、平均と相関で表すか、もっと柔軟な形で表すかにあります。
Isolation Forest は、Liu、Ting、Zhou の3人が2008年の IEEE のデータマイニングの国際会議(ICDM)で発表した手法です。データの中からランダムに1つの変数を選び、その最小値と最大値の間でランダムに区切る、という分割をくり返すと、ほかのデータから離れた点は少ない回数で1つだけに切り分けられます。この「切り分けるまでの回数」を多数の木で平均し、回数が少ないものほど異常らしいとみなします。scikit-learn の公式ドキュメントでも、この仕組みで異常のスコアを返すと説明されています。分布の形(正規分布かどうか)を仮定しない点が利点で、変数どうしの関係が直線的でない場合にも使えます。
One-Class SVM は、Schölkopf らが2001年に学術誌 Neural Computation(第13巻第7号)で示した手法で、正常なデータの大部分を囲む境界を学習し、境界の外側を異常とみなします。オートエンコーダは、入力をいったん少ない数の値に圧縮してから元に戻すように学習するニューラルネットワークで、Hinton と Salakhutdinov が2006年に科学誌 Science(第313巻第5786号)で、この形のネットワークでデータの次元を減らす方法を示しました。異常検知に使うときは、正常なデータだけで学習させ、元に戻したときの誤差が大きいものを異常とみなします。「元に戻せない残りの大きさを見る」という点で、前の節の Q 統計量(主な動き方で説明できない残り)と考え方の上では近い手法です。
機械学習の手法は、センサーの数が多く関係が複雑な場合や、振動の波形のようにそのままでは統計量を作りにくいデータで力を発揮します。その一方で、スコアの意味を保全員に説明しにくいこと、学習の設定(木の数、境界の滑らかさ、ネットワークの大きさ)で結果が変わること、学習期間に無かった稼働条件をそのまま異常とみなしやすいことに注意が要ります。次の節のコードでは、この最後の点が実際に現れます。時系列データ一般の異常検知の考え方は、弊社コラム「ビジネスデータの予測に効く時系列分析、基礎から実務まで」で扱っています。
架空の設備のデータを作り、手法ごとに判定する
ここからは、ここまでの手法を架空の設備のデータに当てはめ、劣化に気づく時点と誤報の回数を比べます。データはすべて乱数で作った架空のもので、実在の設備の測定値ではありません。対象は「ポンプ1号」という架空のポンプで、振動・軸受の温度・モータの電流・吐出圧力の4つのセンサーの値を、単位の無い相対値として置きました(正常で負荷が最も高いときにおよそ100になる数)。実際の振動の速度や温度の数値を表すものではありません。物理量の数値を使わなかったのは、実在の設備の基準値と取り違えられないようにするためです。データの設定は次のとおりです。
- 記録の間隔と期間:4時間ごとに180日間(1,080点)
- 品種と負荷率:品種Aは負荷率0.7、品種Bは1.0で、1〜3日ごとにどちらかを抽選で選び直す(同じ品種が続けて選ばれ、3日を超えて続くこともある)。4つのセンサーの値は、どれも負荷率にほぼ比例して上下する
- 新しい品種:75日目から83日目の手前までの8日間だけ、それまで作ったことの無い品種(負荷率0.5)を作る。この期間の設備は正常で、劣化はしていない
- 劣化:110日目から始まり、180日目に向けて加速する。劣化の度合いは110日目に0、180日目に1となる2次関数で、180日目の時点で振動に40、温度に12が上乗せされる。電流はわずかに上がり、圧力はわずかに下がる
- 記録の期間の終わり:記録の期間は180日目で終わり、劣化の度合いはこの日に1(この章で置いた劣化の最大)になるように置いた。最後の記録はその4時間前(179.83日目)で、そこでの劣化の度合いは約0.995。この章では、180日目を故障の日とも交換の水準に達した日とも定めていない
- 学習期間:0日目から60日目の手前まで(正常とみなして「いつも」を学ぶ期間)
- 正常の評価期間:60日目から110日目の手前まで(誤報を数えるための期間)
# ---- ブロック1:架空の設備(ポンプ1号)のデータを作る ----
import numpy as np
import pandas as pd
rng = np.random.default_rng(20261030)
n_day, per_day = 180, 6                      # 180日、4時間ごとに1点
day = np.arange(n_day * per_day) / per_day   # 経過日数

# 負荷率:品種Aは0.7、品種Bは1.0。1〜3日ごとに選び直す(同じ品種が続くこともある)
load = np.empty_like(day)
i = 0
while i < len(day):
    span = rng.integers(6, 19)
    load[i:i + span] = rng.choice([0.7, 1.0])
    i += span
load[(day >= 75) & (day < 83)] = 0.5         # 学習期間に無かった新しい品種
load = load + rng.normal(0, 0.02, len(day))

# 劣化:110日目から始まり、180日目に向けて加速する(0から1)
deg = np.clip((day - 110) / 70, 0, None) ** 2

df = pd.DataFrame({
    "振動": 50 + 50 * load + 40 * deg + rng.normal(0, 3.0, len(day)),
    "温度": 60 + 40 * load + 12 * deg + 3 * np.sin(2 * np.pi * day)
            + rng.normal(0, 1.5, len(day)),
    "電流": 40 + 60 * load + 3 * deg + rng.normal(0, 1.0, len(day)),
    "圧力": 30 + 70 * load - 4 * deg + rng.normal(0, 1.5, len(day)),
})
df["日"], df["負荷"] = day, load
cols = ["振動", "温度", "電流", "圧力"]
train = df["日"] < 60                         # 学習期間(正常とみなす)
normal_eval = (df["日"] >= 60) & (df["日"] < 110)   # 誤報を数える正常期間
print("点数", len(df), "学習", train.sum(), "正常の評価", normal_eval.sum())
print(df.loc[train, cols].corr().round(2))
# 出力:
# 点数 1080 学習 360 正常の評価 300
#       振動    温度    電流    圧力
# 振動  1.00  0.85  0.92  0.91
# 温度  0.85  1.00  0.92  0.91
# 電流  0.92  0.92  1.00  0.98
# 圧力  0.91  0.91  0.98  1.00
学習期間の4つのセンサーの相関係数は0.85から0.98で、どれも強く一緒に動いています。負荷の切り替えが値の動きの大部分を占めているためです。次の図は、4つのセンサーの180日間の推移です。薄い青の帯が学習期間、灰色の帯が新しい品種を作った8日間、破線が劣化の始まる110日目を示しています。
図を見ると、品種の切り替えで値が段差状に上下しており、劣化による上昇は、その段差より小さい変化として始まっていることが分かります。振動の値は、劣化の後半(150日目以降)になってようやく、品種Bのときのいつもの水準(100前後)をはっきり上回るようになります。新しい品種の期間は、4つのセンサーがそろって学習期間より低い値になっています。
判定の共通のルールとして、4時間ごとの観測で3回続けてしきい値を超えたら警報を出すことにしました。最初に超えた観測から3回目の観測までは8時間で、観測と観測の間も超えていたかどうかは分かりません。110日目以降の最初の警報の時点を「検知日」、正常の評価期間に出た警報の回数を「誤報」として数えます(3回続けて超えた状態が続く間は1回と数えます)。比べる判定の置き方は次のとおりです。
- 固定しきい値:外部の目安を想定して、振動が140、温度が110を超えたら警報とする架空の値
- 固定しきい値(低め):固定しきい値の結果は置いた値で決まるので、比べるために置いた値。振動が115、温度が112を超えたら警報とする。この値は、管理図の上限(振動115.0、温度112.4)とほぼ同じ位置にある。「低め」と呼んでいるのは振動のしきい値を140から115に下げたためで、温度は管理図の上限に合わせたので、110から112へわずかに上がっている
- 管理図(4センサー個別):4つのセンサーそれぞれについて、学習期間の平均から標準偏差の3倍の位置に上下の管理限界を置き、どれか1つでも外れたら警報とする
- T2、Q、Isolation Forest、負荷で補正した T2:このあとのブロックで、計算のしかたとあわせて説明する
# ---- ブロック2:判定の共通ルール(3点続けて超えたら警報) ----
def first_alarm(flag, start_day=110):
    """start_day 以降で、3回の観測で続けて超えた最初の日"""
    f = pd.Series(flag).rolling(3).sum().to_numpy() == 3
    hit = np.where(f & (df["日"].to_numpy() >= start_day))[0]
    return round(df["日"].iloc[hit[0]], 2) if len(hit) else None

def false_alarms(flag):
    """正常の評価期間で、3点続けて超えた回数(連続は1回と数える)"""
    f = pd.Series(flag).rolling(3).sum().to_numpy() == 3
    f = f & normal_eval.to_numpy()
    starts = f & ~np.r_[False, f[:-1]]
    return int(starts.sum()), sorted(set(np.floor(df["日"][starts]).astype(int)))

results = {}

# ---- ブロック3:固定しきい値と、センサーごとの管理図(3シグマ) ----
fixed = (df["振動"] > 140) | (df["温度"] > 110)       # 外部の目安を想定した架空の値
results["固定しきい値"] = fixed.to_numpy()
fixed_low = (df["振動"] > 115) | (df["温度"] > 112)   # 低めに置いた場合
results["固定しきい値(低め)"] = fixed_low.to_numpy()

mu, sd = df.loc[train, cols].mean(), df.loc[train, cols].std()
ucl, lcl = mu + 3 * sd, mu - 3 * sd
print("管理限界の上限", ucl.round(1).to_dict())
print("管理限界の下限", lcl.round(1).to_dict())
chart = ((df[cols] > ucl) | (df[cols] < lcl)).any(axis=1)
results["管理図(4センサー個別)"] = chart.to_numpy()
# 出力:
# 管理限界の上限 {'振動': 115.0, '温度': 112.4, '電流': 116.3, '圧力': 118.4}
# 管理限界の下限 {'振動': 66.3, '温度': 73.0, '電流': 61.7, '圧力': 55.6}
振動の管理限界の上限は115.0、下限は66.3になりました。学習期間の振動の標準偏差は8.1で、この大部分は劣化ではなく品種の切り替え(負荷率0.7と1.0の差)から来ています。センサーごとの管理図は、稼働条件による値の動きもばらつきとして数えてしまうので、管理限界が広くなり、劣化による小さな上昇は限界の内側に隠れます。
次に、T2 統計量と Q 統計量を計算します。T2 の管理限界は、4つの値が多変量正規分布に従い、平均と分散共分散行列の推定の誤差を無視できると仮定したときに、正常な点が外れる確率が0.0027(3シグマ限界と同じ水準)になる値として、自由度4のカイ2乗分布から求めました。ただし、この架空データは負荷率0.7と1.0の期間が混ざった形に作ってあるので、この仮定はそのままは成り立たず、管理限界は近似の目安です。Q 統計量の計算では、まず4つのセンサーを標準化します。標準化は、各センサーの値から学習期間の平均を引き、標準偏差で割って、単位や大きさの違うセンサーを同じ物差しにそろえる処理です。次に主成分分析で、4つのセンサーがそろって動く方向(第1主成分)を取り出します。この方向だけで、学習期間のばらつきの93.6%を説明できました(この割合を寄与率と呼びます)。Q 統計量は、第1主成分で説明できない残りの2乗和です。Q の管理限界は、学習期間の Q の値の99.73%点としました。
# ---- ブロック4:ホテリングの T2 統計量と、主成分分析の Q 統計量 ----
from scipy import stats

X = df[cols].to_numpy()
m, S = X[train].mean(axis=0), np.cov(X[train].T)
Sinv = np.linalg.inv(S)
d = X - m
df["T2"] = np.einsum("ij,jk,ik->i", d, Sinv, d)
t2_lim = stats.chi2.ppf(1 - 0.0027, df=len(cols))
print("T2 の管理限界 %.2f" % t2_lim)
results["T2"] = (df["T2"] > t2_lim).to_numpy()

Z = (X - m) / X[train].std(axis=0, ddof=1)    # 標準化してから主成分分析
w, V = np.linalg.eigh(np.cov(Z[train].T))
P = V[:, np.argsort(w)[::-1][:1]]             # 第1主成分だけを残す
print("第1主成分の寄与率 %.3f" % (w.max() / w.sum()))
resid = Z - Z @ P @ P.T
df["Q"] = (resid ** 2).sum(axis=1)
q_lim = np.quantile(df.loc[train, "Q"], 1 - 0.0027)
print("Q の管理限界 %.2f" % q_lim)
results["Q"] = (df["Q"] > q_lim).to_numpy()
# 出力:
# T2 の管理限界 16.25
# 第1主成分の寄与率 0.936
# Q の管理限界 1.43
Isolation Forest も、学習期間のデータだけで学習させ、Q と同じく、学習期間のスコアの99.73%点(学習期間の点のうち、しきい値を上に超えるものが0.27%になる値)をしきい値にしました。T2 の管理限界も、正常な点が外れる確率を0.0027とする値なので、T2、Q、Isolation Forest の3つとも、0.0027という目標の値に合わせたことになります。scikit-learn の IsolationForest には、異常とみなす点の割合を決める引数 contamination があり、公式ドキュメントでは既定値が ‘auto’(原論文と同じ方法でしきい値を決める設定)とされていますが、ここではその既定の方法は使っていません。
ただし、目標の値を合わせても、この比較は、実際の誤報の起こりやすさを手法どうしで同じにそろえた比較ではありません。T2 は理論の分布(カイ2乗分布)から、Q と Isolation Forest は学習期間の値から管理限界を決めており、センサーごとの管理図は4つのどれか1つが外れたら警報にしています。さらに、警報は3回続けて超えたときに出すので、1点ごとに超える確率と、警報が出る頻度は別のものです。実際、この1回の乱数では、学習期間の360点のうち管理限界を超えた点は、T2 が0点、Q と Isolation Forest がそれぞれ1点でした。
あわせて、稼働条件を考えに入れた方法として「負荷で補正した T2」も試しました。これは、学習期間のデータから各センサーの値と負荷率の直線の関係を求め(回帰と呼びます。この例では、負荷率が1上がると振動は49.7、電流は60.2上がる、という関係になりました)、負荷率で説明できない残りについて T2 を計算する方法です。
# ---- ブロック5:Isolation Forest ----
from sklearn.ensemble import IsolationForest

iso = IsolationForest(n_estimators=200, random_state=0).fit(X[train])
df["IF"] = -iso.score_samples(X)              # 大きいほど異常らしい
if_lim = np.quantile(df.loc[train, "IF"], 1 - 0.0027)
print("IF のしきい値 %.3f" % if_lim)
results["Isolation Forest"] = (df["IF"] > if_lim).to_numpy()

# ---- ブロック6:負荷で補正した T2(条件ごとの正常を回帰で表す) ----
A = np.c_[np.ones(len(df)), df["負荷"]]
coef, *_ = np.linalg.lstsq(A[train], X[train], rcond=None)
R = X - A @ coef                              # 負荷で説明できない残り
mr, Sr = R[train].mean(axis=0), np.cov(R[train].T)
dr = R - mr
df["T2補正"] = np.einsum("ij,jk,ik->i", dr, np.linalg.inv(Sr), dr)
results["T2(負荷で補正)"] = (df["T2補正"] > t2_lim).to_numpy()
print("負荷1.0あたりの増え方", {c: round(float(v), 1) for c, v in zip(cols, coef[1])})
# 出力:
# IF のしきい値 0.644
# 負荷1.0あたりの増え方 {'振動': 49.7, '温度': 40.4, '電流': 60.2, '圧力': 68.9}
検知の時点と誤報の回数を比べる
7つの判定の方法の結果をまとめます。「振動の上乗せ分」は、検知日の時点で劣化によって振動に上乗せされていた量(相対値)で、小さいほど劣化が小さいうちに気づいたことを表します。
# ---- ブロック7:検知の時点と誤報の回数を並べる ----
rows = []
for name, flag in results.items():
    fa, days = false_alarms(flag)
    t = first_alarm(flag)
    g = ((t - 110) / 70) ** 2 if t else None
    rows.append([name, t, round(180 - t, 1) if t else None,
                 round(40 * g, 1) if t else None, fa, days])
out = pd.DataFrame(rows, columns=["手法", "検知日", "180日目までの日数",
                                  "振動の上乗せ分", "正常期間の誤報", "誤報の日"])
print(out.to_string(index=False))
print("学習期間の振動の標準偏差 %.1f" % sd["振動"])
# 出力:
#               手法    検知日  180日目までの日数  振動の上乗せ分  正常期間の誤報     誤報の日
#           固定しきい値 173.33         6.7     32.7        0       []
#       固定しきい値(低め) 154.67        25.3     16.3        0       []
#     管理図(4センサー個別) 154.67        25.3     16.3        0       []
#               T2 148.50        31.5     12.1        0       []
#                Q 151.17        28.8     13.8        0       []
# Isolation Forest 157.50        22.5     18.4        2 [75, 81]
#        T2(負荷で補正) 146.33        33.7     10.8        0       []
# 学習期間の振動の標準偏差 8.1
| 手法 | 検知日 | 記録の期間の終わり(180日目)までの日数 | 振動の上乗せ分 | 正常期間の誤報 |
|---|---|---|---|---|
| 固定しきい値(振動140・温度110) | 173.33日目 | 6.7日 | 32.7 | 0回 |
| 固定しきい値(低め、振動115・温度112) | 154.67日目 | 25.3日 | 16.3 | 0回 |
| 管理図(4センサー個別) | 154.67日目 | 25.3日 | 16.3 | 0回 |
| T2 | 148.50日目 | 31.5日 | 12.1 | 0回 |
| Q | 151.17日目 | 28.8日 | 13.8 | 0回 |
| Isolation Forest | 157.50日目 | 22.5日 | 18.4 | 2回(75日目・81日目) |
| T2(負荷で補正) | 146.33日目 | 33.7日 | 10.8 | 0回 |
この1回の乱数では、振動140・温度110の固定しきい値が劣化に気づいたのは173.33日目で、記録の期間の終わり(180日目)までの残りは6.7日でした(コードの出力の列「180日目までの日数」は、この残りの日数です)。これと比べると、センサーごとの管理図(154.67日目)は約19日、T2(148.50日目)は約25日、負荷で補正した T2(146.33日目)は約27日早く気づいています。振動の上乗せ分で比べると、振動140・温度110の固定しきい値は32.7、負荷で補正した T2 は10.8で、後者は学習期間の振動の標準偏差(8.1)の1.3倍ほどの上昇のうちに気づいたことになります。固定しきい値を低めの値(振動115・温度112)に置くと、検知日は154.67日目で、管理図と同じでした。固定しきい値が遅かったのは、手法の性質というより、値を高めに置いたことによるものです。この低めの置き方で誤報が出なかったのは、上限だけを見ていて、新しい品種の期間のように値が下がる変化には反応しないためです。Isolation Forest は157.50日目で、センサーごとの管理図より遅く、さらに正常の評価期間に2回の誤報を出しました。誤報の日は75日目と81日目で、どちらも新しい品種を作っていた8日間に当たります。
次の図は、振動の値、T2 統計量、Isolation Forest のスコアを並べ、それぞれのしきい値と検知の時点を示したものです。
真ん中の T2 の図では、新しい品種の期間(灰色の帯)にも値が少し上がっていますが、管理限界は超えていません。一方、下の Isolation Forest の図では、新しい品種の期間にスコアがしきい値を大きく超えています。この違いは、次の散布図で確かめられます。
灰色の点(0〜110日目の正常な期間)は、負荷率0.7・1.0・0.5の3つのかたまりに分かれ、右上がりの1本の線の上に並んでいます。負荷率0.5のかたまり(左下)は学習期間には無かったものですが、4つのセンサーの「一緒に動く」関係の延長線上にあります。T2 がこのかたまりで管理限界を超えなかったのは、相関の方向へのずれを小さく数える仕組みのためと考えられます。Isolation Forest がこのかたまりを異常とみなしたのは、学習期間のデータが無い場所にある点を少ない回数で切り分けやすい仕組みのためと考えられます。紺の点(150日目以降の劣化の後半)は、同じ電流の値に対して振動が上にずれており、一緒に動く関係から外れています。振動の管理図の上限(点線)だけを見ると、紺の点の一部はまだ上限の下にありますが、相関の崩れとして見れば、灰色のかたまりとの違いがはっきりしています。
1回の乱数の結果だけでは偶然の差かもしれないので、同じ比較を乱数を変えて30回くり返しました。再現の手順は次のとおりです。掲載したコードのデータを作る部分と判定の部分をそのまま関数にまとめ、乱数のシードを20261030から20261059まで1つずつ変えて30回実行し、手法ごとに検知日と誤報の回数を集めます。しきい値の決め方・判定のルール・Isolation Forest の設定(木の数200、random_state=0)は1回目と同じです。あわせて、各回の誤報について、3回続けて超えた時点が75日目から84日目の手前(新しい品種の期間とその直後)に入っているかを数えました。次の表の検知日の中央値・最小・最大は、検知できた回だけで集計しています(未検知が1回あった振動140・温度110の固定しきい値は、残りの29回で集計しました)。
| 手法 | 検知日の中央値 | 検知日の最小 | 検知日の最大 | 未検知の回数 | 誤報の合計 | 誤報が出た回 |
|---|---|---|---|---|---|---|
| 固定しきい値(振動140・温度110) | 172.3日目 | 158.3日目 | 178.3日目 | 1回 | 0回 | 0回 |
| 固定しきい値(低め、振動115・温度112) | 154.5日目 | 147.3日目 | 163.7日目 | 0回 | 0回 | 0回 |
| 管理図(4センサー個別) | 155.7日目 | 148.7日目 | 165.2日目 | 0回 | 11回 | 3回 |
| T2 | 145.2日目 | 139.3日目 | 149.3日目 | 0回 | 0回 | 0回 |
| Q | 144.1日目 | 137.2日目 | 151.2日目 | 0回 | 0回 | 0回 |
| Isolation Forest | 154.9日目 | 143.3日目 | 170.2日目 | 0回 | 42回 | 30回 |
| T2(負荷で補正) | 144.5日目 | 139.3日目 | 148.3日目 | 0回 | 0回 | 0回 |
30回のくり返しでも、検知日の中央値は T2・Q・負荷で補正した T2 が144〜145日目、低めの固定しきい値・センサーごとの管理図・Isolation Forest が155日目前後、振動140・温度110の固定しきい値が172日目でした。振動140・温度110の固定しきい値は、30回のうち1回、180日目までに一度も警報を出しませんでした。誤報は、Isolation Forest が30回のすべてで出し(合計42回)、センサーごとの管理図が30回のうち3回で出しました(合計11回)。この53回の誤報は、すべて75日目から84日目の手前、つまり新しい品種の期間とその直後に入っていました。各回で最も早く気づいた手法を数えると、Q が18回、負荷で補正した T2 が17回、補正しない T2 が10回で(同じ日に並んだものはどちらも数えています)、ほかの手法が最も早かった回はありませんでした。負荷で補正した T2 と補正しない T2 の差は、検知日の中央値で約1日(144.5日目と145.2日目)、誤報はどちらも0回で、この例では補正の効果はほとんど現れませんでした。
この結果は、架空データの作り方に強く依存しています。このデータは、4つのセンサーが負荷率に直線的に比例し、劣化がその比例の関係を崩す形で進むように作りました。相関の崩れを見る T2 と Q に有利に働きうる作り方です。センサーどうしの関係が直線的でない設備や、劣化が相関の関係を崩さずに全体の水準を上げる形で進む設備では、順序が変わる可能性があります(その条件での計算はしていません)。また、Isolation Forest の結果は、木の数やしきい値の決め方を変えると変わり、One-Class SVM やオートエンコーダは実行していません。本コラムの架空データでの比較から言えるのは、「機械学習の手法を使えば早く気づける」とは限らないこと、そして、学習期間に無かった稼働条件が、手法によっては誤報の原因になること、の2点です。
正常の定義を稼働条件ごとに分け、定期的に見直す
本コラムの架空データでは、誤報はすべて学習期間に無かった稼働条件(新しい品種)の期間に出ました。実際の設備でも、品種・負荷・回転数・外気温・原料のロットなど、設備の状態とは関係なくセンサーの値を動かすものは、誤報の主な原因の1つになりやすいと考えています。こうした稼働条件を正常の定義に組み込む方法は、大きく3つあります。
- 条件ごとに分ける:条件ごとに正常のデータを分け、条件ごとに別の管理図や T2 を作る。品種が数種類しかなく、品種の情報が制御システムから取れる場合に向いている
- 条件で補正する:この章のコードの「負荷で補正した T2」のように、条件を表す変数で各センサーの値を回帰し、条件で説明できない残りだけを監視する。条件が連続的に変わる場合(回転数を細かく変える設備など)に向いている
- 条件のそろった時間帯だけを見る:条件が安定している時間帯(定格の回転数で一定時間運転している間など)だけを切り出して判定する。判定の機会は減るが、仕組みは単純になる
この章のコードでは、負荷で補正した T2 は、補正しない T2 と比べて検知日も誤報もほとんど変わりませんでした。この架空データは、負荷による動きが4つのセンサーで同じ向きにそろうように作ってあり、補正しない T2 もその方向の動きを小さく数えます。補正の効果がほとんど現れなかったのは、このデータの作り方によるものと考えています。負荷による動きがセンサーごとにばらばらな設備では結果が変わる可能性がありますが、その計算はしていません。
どの方法でも、学習期間に無かった稼働条件が来たときの扱いを決めておく必要があります。この章のコードの新しい品種の期間のように、正常なのに異常と判定されることもあれば、逆に、条件の補正が外挿(学習した範囲の外側への当てはめ)になって、劣化を見落とすこともあります。新しい品種の立ち上げや、設備の改造・部品の交換の直後は、警報をすぐに作業指示にせず、「正常の定義を広げる候補の期間」として保全員と生産部門で確かめてから、学習データに加えるかどうかを決める運用が有効だと考えています。
正常の定義は、一度作れば終わりではありません。軸受の交換やオーバーホールの後は、振動の水準そのものが変わることがあります。季節によって外気温が変わり、温度の基準が動くこともあります。見直しのきっかけは、定期(たとえば四半期ごと)と、出来事(部品の交換・修理・改造・品種の追加)の2種類で決めておくと運用しやすくなります。見直すときに注意したいのは、劣化がゆっくり進んでいる最中のデータを「正常」として学習データに加えてしまうことです。そうすると、劣化した状態が新しい「いつも」になり、その後の劣化に気づくのが遅れます。点検で問題が見つからなかったことだけでは、ゆっくり進む劣化が含まれていないとは言い切れません。学習データに加える期間は、点検の結果・稼働条件・保全の記録を照らし合わせて正常と判断し、その根拠を記録したうえで採用すると、劣化した期間が混ざる危険を抑えられると考えています。モデルを入れ替えるときの監視の仕組みは、弊社コラム「機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで」で扱っています。
| 見直しのきっかけ | 起きること | やること | 決める人 |
|---|---|---|---|
| 部品の交換・オーバーホール | 値の水準が変わる | 交換後、値が落ち着き、点検の結果などから正常と判断した期間を新しい学習期間の候補にする | 保全部門 |
| 品種・稼働条件の追加 | 学習に無い稼働条件で誤報が出る | 条件ごとの正常を追加する。確かめるまで警報の扱いを分ける | 保全部門と生産部門 |
| 季節の変化 | 温度の基準が動く | 外気温を条件の変数に加えるか、季節ごとの正常を作る | データ担当 |
| 定期の見直し(四半期など) | ゆっくりした変化が積み重なる | 誤報と見逃しの記録を見て、しきい値と学習期間を確かめる | 案:保全部門、承認:工場長、設定:データ担当 |
| センサーの交換・校正 | 値がずれる、段差ができる | 交換の記録を残し、前後のデータを分けて扱う | 保全部門 |
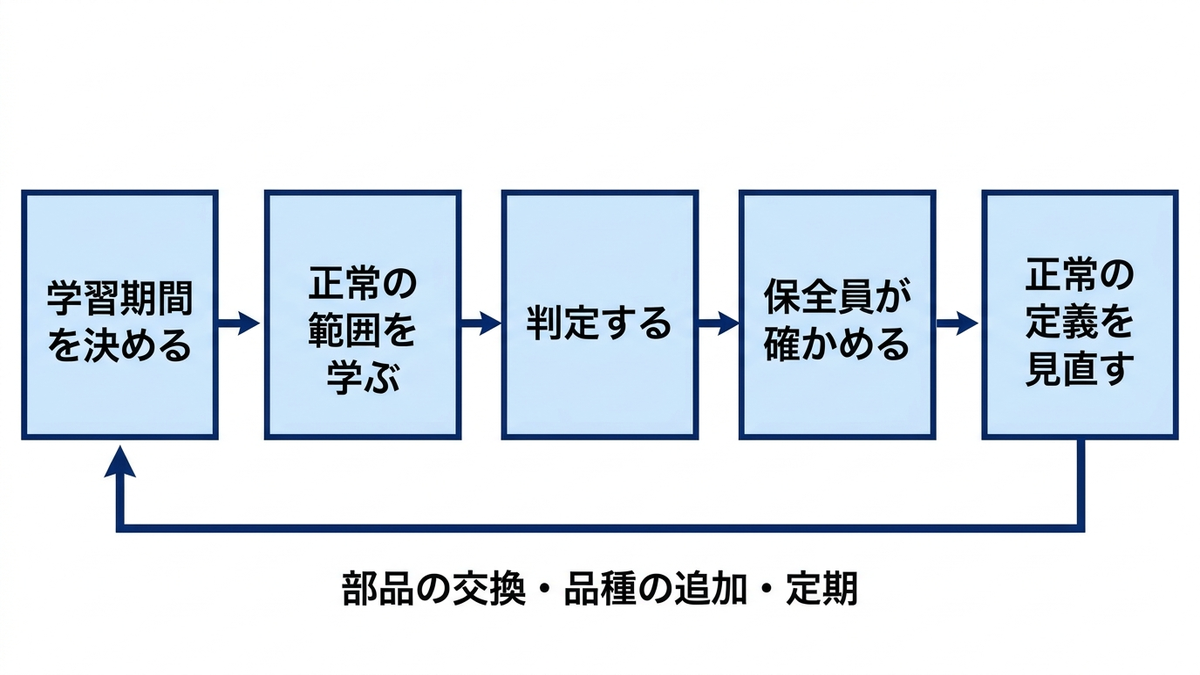
経営の判断、最初はしきい値と管理図から始める
異常検知の手法の選び方を誤ると、序章で整理した6つの損失の型のうち、主に次の3つが現れます。
- 警報の形骸化:稼働条件の変化のたびに誤報が出る仕組みは、警報への信頼が下がり、本当の劣化の警報でも確かめに行くのが遅れるおそれがある。この章のコードで、Isolation Forest が新しい品種の期間に出した誤報は、その形にあたる
- 突発停止:固定しきい値を高めに置いてそれだけに頼ると、劣化がかなり進むまで気づけない。この章の架空データでは、気づいたのは180日目(この章で置いた劣化が最大になる日)の6.7日前だった。実際の設備で同じように気づくのが遅れれば、部品の手配や停止の計画が間に合わないおそれがある
- 二重投資:工場や部門ごとに別々の異常検知の仕組みを入れると、共通の定義や連携の方針が無いと、正常の定義の作り方も誤報の扱いもばらばらになりやすく、横並びで比べることや学びを共有することが難しくなる
この章の結論として、異常検知は、センサーごとのしきい値と管理図から始め、センサーどうしの相関が強い設備では T2 や Q のような多変量の統計量に広げ、それでも説明しきれない複雑な関係がある場合に機械学習の手法を検討する、という順序が有効だと考えています。理由は、手法が単純なほど、なぜ警報が出たかを保全員に説明でき、正常の定義の見直しも保全部門の中で回せるからです。本コラムの架空データでは、多変量の統計量が、本コラムで試した1つの機械学習の手法(Isolation Forest)より早く気づき、誤報も少ない結果になりましたが、これはデータの作り方と設備によって変わりうるので、手法を決める前に、自社の設備の過去のデータで検知の時点と誤報の回数を比べることを勧めます。検知の時点を比べるには、保全の記録から劣化の始まりや部品の交換の時期が後から分かっている事例を選ぶ必要があります。そうした事例が無い場合は、正常な期間の誤報の回数から比べ始めることになります。
| 導入の段階 | 使う手法 | 前提として必要なもの | 次の導入の段階に進む目安 |
|---|---|---|---|
| 1 | 固定しきい値、センサーごとの管理図 | 正常な期間のデータ、稼働条件の記録 | 警報が劣化に追いつかない、センサーが増えて管理しきれない |
| 2 | 条件ごとの管理図、T2・Q 統計量 | 品種・負荷などの稼働条件のデータ、センサーの相関 | 関係が直線的でない、波形のような高次元のデータを使いたい |
| 3 | Isolation Forest、One-Class SVM、オートエンコーダなど | 多くの正常データ、モデルを保守する担当 | (この導入の段階でも、1・2の手法の結果と並べて比べ続ける) |
経営として決めておくことは、手法の名前ではなく、次の3つです。1つ目は、警報を受けて誰が確かめ、どこまでを保全員の判断に任せるかです。異常検知は原因を特定しないので、警報は「確かめるべき候補」として扱い、安全に関わる判断を仕組みの警報だけに任せないことが前提になります。法令で定められた点検を、異常検知の仕組みで置き換えられるものとして扱わないことも同じです。2つ目は、誤報をどこまで許容するかです。これは、確かめに行ける保全員の人数と手間に加えて、見逃したときに起こりうる損失(突発停止、安全と環境の事故、品質の不良)の大きさを併せて決めます。誤報と見逃しの釣り合いの評価は第8章で扱います。3つ目は、正常の定義を誰がいつ見直すかで、これを決めずに仕組みを入れると、数か月で誤報が増えて使われなくなる危険があります。見直しでしきい値を変えるときは、保全部門が案を作り、工場長が承認し、データ担当が設定を変える、という分担にそろえます(体制は第13章で扱います)。
この章では、正常なデータだけから「いつも」を学ぶ異常検知の手法を、固定しきい値・管理図・多変量の統計量・機械学習の順に確かめました。本コラムの架空データでは、多変量の統計量が劣化に早く気づく一方、学習期間に無かった稼働条件が、手法によっては誤報の原因になりました。異常検知は「いつもと違う」ことを知らせるだけで、何が起きているかまでは教えてくれません。次の第6章では、異常の原因を分類し、軸受の外輪の欠陥やアンバランスといった故障モードと結びつける故障診断を扱います。
この章を深めたい方への参考書籍
『入門 機械学習による異常検知 Rによる実践ガイド』(井手剛 著、コロナ社):正規分布に従うデータでのホテリングの T2 による異常検知から始め、分布がひと山にならない場合の近傍法やクラスタリング、性能評価の方法、主成分分析による異常検知とホテリングの T2 との関係までを、手順に沿って説明しています。この章で扱った「正常から学んで、異常の度合いを数値にし、しきい値を決める」という流れを、数式と実行例で確かめたい方に向いています。
『異常検知と変化検知』(井手剛・杉山将 著、講談社):ホテリングの T2 法、近傍法、サポートベクトルデータ記述法、部分空間法による変化検知、密度比推定など、異常検知と変化検知の代表的な手法を短い章に分けて解説しています。この章で紹介しきれなかった手法の位置づけや、「急な外れ」だけでなく「変わり目」を捉える考え方を広く知りたい方に向いています。
第6章 故障診断、異常の原因を分類して故障モードと結びつける
第5章では、正常なときのデータだけから「いつもの状態」を学び、しきい値・管理図・機械学習で「いつもと違う」を見つける方法を比べました。異常検知が出す答えは「違う」か「違わない」かで、なぜ違うのかまでは教えてくれません。保全員が実際に動くには、どの部品を見に行き、どの交換部品を手配し、どれくらい急ぐかを決める必要があり、そのためには異常の原因の候補を絞る必要があります。この章では、異常の原因をどの部品のどの故障の現れ方かまで特定する故障診断を扱います。前半で診断の3つの考え方と、診断の手がかりになる特徴量と故障の現れ方の対応を整理し、後半では架空の特徴量データに分類モデルを当てはめ、次の4つを実行したコードと結果で確かめます。
- 結果の読み方
- 故障の事例が少ないときの扱い
- 学習に無い故障が来たときの扱い
- 診断結果を保全員にどう示すか
異常検知と故障診断は、答える問いが違う
本コラムでは、異常検知を「いつもの状態と違うことを見つけること」、故障診断を「異常の原因、つまりどの部品のどの故障モードかを特定すること」と定義しています。ここでいう原因は、異常が見られる部品と、その故障モードまでを指します。故障モードを引き起こした発生の原因(潤滑の不良や取り付けの不良など)とは区別して扱います。発生の原因は、第2章で扱った FMEA(故障モード影響解析)の表では「原因」の欄に書くもので、その確定には、現物の調査が別に必要です。両者は同じセンサーデータを使うことが多いものの、答える問いが違います。異常検知は「今、点検に行くべきか」に答え、故障診断は「点検に行ったら、何を確かめ、何を持っていくべきか」に答えます。異常検知だけでも警報は出せますが、警報を受けた保全員は、原因を一から調べることになります。
原因の候補が絞れているかどうかで、保全の段取りは大きく変わります。たとえば回転機で振動が大きくなったとき、原因が回転体の質量の偏り(アンバランス)であれば、釣り合いを取り直す作業になります。軸と軸の芯のずれ(ミスアライメント)であれば、芯出しの作業になります。軸受の損傷であれば、交換用の軸受と、交換のための停止時間の確保が必要になります。同じ「振動が大きい」という異常でも、必要な人・部品・停止時間が違うので、診断の精度は保全計画の精度にそのままつながります。
この章で扱う故障モードは、全体の地図で定義したとおり、故障の現れ方を指します。軸受の外輪のはく離、内輪のはく離、アンバランス、ミスアライメントは、それぞれ別の故障モードです。故障診断の出力は、この故障モードの候補と、その確からしさです。異常検知と故障診断は順番に使うことが多く、まず異常検知で「いつもと違う」ものを拾い、拾ったものについて故障診断で原因の候補を出し、最後に保全員が現物を確かめて作業を決める、という流れになります。ただし、この章の実験は、異常検知を通さずにすべての測定を診断にかける設定にしており、そのため診断の答えの候補に「正常」も含めています。
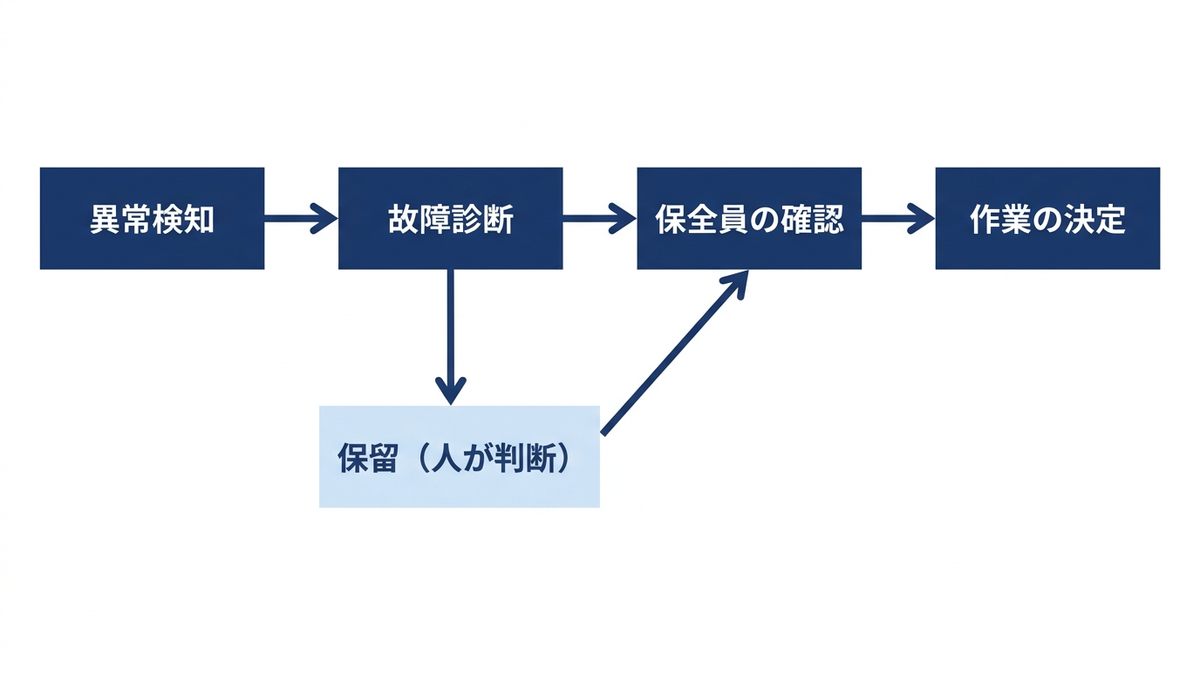
故障診断の3つの考え方、ルール・事例・機械学習
故障診断の進め方は、大きく3つに分けて考えると整理しやすくなります。1つ目はルールベースで、「1X(回転周波数)の振幅が大きく、軸方向が小さければアンバランスを疑う」のように、専門家の知識を条件の形で書き下します。2つ目は事例ベースで、過去に原因が確定した事例の特徴量を蓄えておき、今回の測定値に最も近い事例を探して、その事例で確定した故障モードを候補として示します。3つ目は機械学習の分類で、原因が分かっている測定データを教師データ(正解のラベルが付いた学習用のデータ)として分類モデルを学習させ、新しい測定値がどの故障モードに当たるかを出力させます。
3つは対立するものではなく、組み合わせて使うことが多いと考えています。ルールは事例が無くても作れるうえ、保全員が中身を読めるので、診断の出発点に向いています。一方で、条件の数が増えると互いに矛盾したり、稼働条件の違いを書き切れなくなったりします。事例ベースは、保全記録に原因と処置が残っていれば、すぐに「似た事例」として示せます。機械学習の分類は、多数の特徴量の組み合わせから境界を引けますが、原因が確定した故障の事例が十分に無いと十分な性能で学習させにくく、学習に無い故障には正しく答えられません。この章のコードでは機械学習の分類を中心に扱いますが、後半で示すように、確信度が低いものや学習データから遠いものを保留にする仕組み、つまりルールと人の判断を組み合わせる形にして使います。
| 考え方 | 何を使うか | 向いている場面 | 外れやすい場面 | 保全員への示し方 |
|---|---|---|---|---|
| ルールベース | 専門家の知識を書き下した条件(FMEA の表、振動診断の経験則) | 故障の事例が少ない立ち上げの時期、原因と兆候の関係がよく知られた故障モード | 条件が増えて矛盾したとき、稼働条件で兆候の出方が変わるとき | どの条件に当てはまったかを示す |
| 事例ベース | 原因が確定した過去の事例と、その時の特徴量 | 保全記録に原因と処置が残っている設備、似た設備が多い工場 | 事例が無い故障モード、設備の改造で特徴量の基準が変わったとき | 最も近い過去の事例と、その時の処置を示す |
| 機械学習の分類 | 確定した故障モードのラベルが付いた測定データ | 同じ型の設備が多く、故障の事例がある程度たまっている場合 | 学習に無い故障、事例が数件しかない故障モード、測定条件の変化 | 候補の順位と確からしさ、効いた特徴量を示す |
診断の手がかりになる特徴量と故障モードの対応
どの考え方を使うにしても、診断の材料になるのは第4章で作った特徴量です。回転機の振動では、故障モードごとに、どの周波数のどの方向に兆候が出やすいかがある程度知られています。振動解析の手法を整理した総説(Chu ほか、Heliyon 誌、2024年)は、振動の周波数ごとに疑われる故障を表にまとめています。その表では、アンバランスは回転周波数の1倍(1X)に現れ、主に半径方向に出るとされています。ミスアライメントは、2倍・3倍の成分が大きいこと、軸方向の振動が大きいことが特徴として挙げられています。転がり軸受の損傷は、外輪や内輪の欠陥に対応する周波数(第4章で式を示した BPFO・BPFI)に現れ、時間波形には高い周波数の衝撃が出るとされ、包絡線の処理(エンベロープ処理)が軸受の故障の検出に広く使われていると書かれています。
この対応を、この章で使う特徴量の言葉に置き換えたのが次の表です。表の「この章の架空データでの設定」の列は、後のコードで架空データを作るときに、上の総説の記述と第4章の考え方に沿って置いた設定で、実在の設備で測った値ではありません。実在の設備では、回転数・負荷・測定点・設備の構造によって兆候の出方が変わるので、表は診断の出発点として使い、自社の設備で確かめた結果で書き換えていくものだと考えています。
| 故障モード | 兆候が出やすい特徴量 | 主な方向・測定位置 | この章の架空データでの設定 |
|---|---|---|---|
| アンバランス | 1X振幅 | 主に半径方向 | 1X振幅を故障の進み具合に応じて大きくする |
| ミスアライメント | 2X振幅(1X も大きくなることがある) | 軸方向が大きい | 2X振幅と軸方向比(軸方向の振動と半径方向の振動の比)を大きくし、1X も少し大きくする |
| 外輪の欠陥 | 包絡線スペクトルの BPFO の成分、尖度 | 軸受の近くの測定点 | 包絡BPFO と尖度を大きくする |
| 内輪の欠陥 | 包絡線スペクトルの BPFI の成分、尖度 | 軸受の近くの測定点 | 包絡BPFI と尖度を大きくする(外輪より弱く出る設定) |
| 正常 | どの特徴量も平常の範囲 | なし | 1X振幅・2X振幅は負荷率に比例し、ばらつきを持たせる |
この章でいう外輪の欠陥・内輪の欠陥は、第4章で「外輪の傷」「内輪の傷」と呼んだもの(はく離などの軸受の欠陥)と同じものを指します。内輪の欠陥を「外輪より弱く出る設定」にしたのは、診断が難しい故障モードを1つ含めて、分類モデルの弱いところを見えるようにするためです。どちらの欠陥がどの程度読み取りにくいかは、本コラムでは一次資料で確かめておらず、ここでの強弱は架空データの設定として置いたものです。
なお、軸受の故障の分類を試せる公開データとして、ケース・ウェスタン・リザーブ大学の軸受データセンターが、正常な軸受と、内輪・転動体・外輪に人工的な欠陥を付けた軸受の振動データを公開しています。公式ページによれば、2馬力の電動機を使い、負荷と回転数を変えて、軸受の近くと離れた位置で加速度を測ったものです。本コラムのコードはこのデータを使わず、架空データで完結させています。
架空の特徴量データを作り、設備で分けて学習する
ここからは、架空の回転機(ポンプやファンのような、電動機で軸を回す設備)24台から集めた特徴量のデータを作り、分類モデルを試します。1件の行は、ある設備のある時点の1回の測定から計算した7つの特徴量と、保全員が現物を確かめて確定した故障モード(正解のラベル)です。正常の測定が900件、アンバランスが70件、ミスアライメントが60件、外輪の欠陥が40件、内輪の欠陥が30件で、故障の事例が正常よりずっと少ない形にしました。故障の行には「故障の進み具合」を0.2〜1.0の一様乱数で持たせ、進み具合が小さいものは正常との区別が付きにくくなるようにしています。稼働条件として負荷率(0.5〜1.0)も乱数で持たせ、1X振幅と2X振幅は負荷率に比例して変わる設定です。乱数のシード(乱数の出方を決める値。同じ値なら毎回同じ乱数が出る)は本コラムの共通の決まりどおり固定しています。
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261030)
CLASSES = ["正常", "アンバランス", "ミスアライメント", "外輪の欠陥", "内輪の欠陥"]
COUNTS = [900, 70, 60, 40, 30]          # 故障の事例は少ない
FEATS = ["実効値", "1X振幅", "2X振幅", "軸方向比", "尖度", "包絡BPFO", "包絡BPFI"]


def make_rows(label, n, machines):
    load = rng.uniform(0.5, 1.0, n)               # 負荷率(稼働条件)
    sev = rng.uniform(0.2, 1.0, n)                # 故障の進み具合(正常は使わない)
    a1 = 1.0 * load + rng.normal(0, 0.15, n)
    a2 = 0.3 * load + rng.normal(0, 0.06, n)
    ax = 0.35 + rng.normal(0, 0.07, n)
    ku = 3.0 + rng.normal(0, 0.25, n)
    eo = rng.gamma(2.0, 0.05, n)
    ei = rng.gamma(2.0, 0.05, n)
    if label == "アンバランス":                    # 1X が半径方向に大きい
        a1 += 1.2 * sev
    if label == "ミスアライメント":                # 2X と軸方向が大きい
        a1 += 0.4 * sev
        a2 += 0.7 * sev
        ax += 0.5 * sev
    if label == "外輪の欠陥":                      # 衝撃で尖度、包絡線に BPFO
        ku += 2.0 * sev
        eo += 0.5 * sev
    if label == "内輪の欠陥":                      # 包絡線に BPFI(外輪より弱く出る設定)
        ku += 1.2 * sev
        ei += 0.3 * sev
    rms = np.sqrt(a1**2 + a2**2) + 0.3 * (ku - 3.0) + rng.normal(0, 0.1, n)
    df = pd.DataFrame(np.column_stack([rms, a1, a2, ax, ku, eo, ei]), columns=FEATS)
    df["故障モード"] = label
    df["設備ID"] = rng.choice(machines, n)
    return df
7つの特徴量のうち6つは、第4章で扱った時間領域と周波数領域の特徴量から選びました。軸方向比だけは第4章に出てこない特徴量で、軸方向と半径方向の2方向を測る場合に作れるものです。7つの特徴量の意味は次のとおりです。
- 実効値:振動全体の大きさ
- 1X振幅:回転周波数の1倍の成分の大きさ
- 2X振幅:回転周波数の2倍の成分の大きさ
- 軸方向比:軸方向の振動と半径方向の振動の比
- 尖度:波形にとがった衝撃が混ざっている度合い
- 包絡BPFO:包絡線スペクトルの外輪の欠陥周波数の位置の成分の大きさ
- 包絡BPFI:包絡線スペクトルの内輪の欠陥周波数の位置の成分の大きさ
第4章は加速度センサーの加速度の信号を扱いましたが、この章では実効値と振幅を、振動の大きさを速度(mm/s)に換算した値として置きました。包絡BPFO・包絡BPFI は、包絡線スペクトルの成分の大きさを、単位の無い相対値として置いています。軸方向比は比、尖度は無次元の値で、どれも架空の値です。また、コードの中の実効値(rms)の式は、実効値を1X振幅・2X振幅・尖度と関係づけるために置いた架空データの生成式で、実際の波形から実効値を求める式ではありません。尖度は、正常の行では3前後に置きました。第4章で見たとおり、3は目安にすぎず、回転の成分が混ざると正常でも3より小さく出ることがあります。この架空データでは、説明を簡単にするために3前後に置いています。
次のコードで、正常と4つの故障モード、合わせて5つの診断の答え(クラス)のデータを作ってつなぎ、クラスごとの平均を出しました。コードと表では、正常も「故障モード」の列に入れていますが、正常は故障モードではありません。
data = pd.concat([make_rows(c, k, np.arange(24)) for c, k in zip(CLASSES, COUNTS)],
                 ignore_index=True)
print(data.groupby("故障モード", sort=False)[FEATS].mean().round(2))
| 故障モード | 実効値 | 1X振幅 | 2X振幅 | 軸方向比 | 尖度 | 包絡BPFO | 包絡BPFI |
|---|---|---|---|---|---|---|---|
| 正常 | 0.80 | 0.77 | 0.23 | 0.35 | 3.00 | 0.10 | 0.10 |
| アンバランス | 1.45 | 1.44 | 0.24 | 0.35 | 2.97 | 0.09 | 0.11 |
| ミスアライメント | 1.22 | 1.01 | 0.68 | 0.68 | 2.99 | 0.11 | 0.09 |
| 外輪の欠陥 | 1.15 | 0.76 | 0.21 | 0.36 | 4.17 | 0.38 | 0.10 |
| 内輪の欠陥 | 0.95 | 0.72 | 0.24 | 0.34 | 3.57 | 0.11 | 0.23 |
平均で見ると、故障モードごとに大きくなる特徴量が違うことが分かります。アンバランスは1X振幅が1.44で正常の0.77の約2倍、ミスアライメントは2X振幅(0.68)と軸方向比(0.68)が正常の約3倍と約2倍です。外輪の欠陥は尖度が4.17、包絡BPFO が0.38で、内輪の欠陥は尖度が3.57、包絡BPFI が0.23です。ただし、これは平均であり、故障の進み具合が小さい行は正常に近い値を持つので、1件ずつ見ると正常と重なる行がかなりあります。実効値は、どの故障でも正常より大きくなっています。実効値の増大だけでは、どの故障モードかを1つに決められません。実効値だけを監視していると「何かおかしい」までは分かっても、候補を絞るには他の特徴量が要ります。
分類モデルには、scikit-learn(本コラムでは1.9.0で実行)のランダムフォレストを使いました。ランダムフォレストは、データの一部を無作為に選んで作った決定木(条件の分岐で分類する木)をたくさん作り、それぞれの判定を平均して答えを出す方法で、Breiman が2001年に Machine Learning 誌に発表した論文が原典です。特徴量の大きさをそろえる前処理が要らず、特徴量どうしの組み合わせによる境界も引けるので、最初に試す分類モデルとして使われることが多い方法です。
評価用のデータの切り方には注意が必要です。同じ設備の測定は、故障していてもいなくても、設備ごとの癖が似た値として現れます。行を無作為に学習用と評価用に分けると、同じ設備の似た測定が両方に入り、評価が実際より良く見えることがあります。ここでは、24台のうち設備18〜23の6台を評価用として学習に使わず、残りの18台で学習しました。実在のデータで、新しく監視を始めた設備に対しても診断が当たるかを確かめるときの切り方で、ここでは設備IDが学習用と評価用で重ならない分け方の手順を示しています。ただし、この架空データは、特徴量を作ったあとで設備IDを行ごとに無作為に割り当てただけで、設備ごとの癖は入れていません。そのため、ここでの結果から、設備の違いに対して診断がどれだけ当たるかは確かめられていません。評価用のデータの切り方の詳しい考え方は、第8章で扱います。
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import confusion_matrix, classification_report

test_ids = np.arange(18, 24)                       # 設備18〜23は学習に使わない
is_test = data["設備ID"].isin(test_ids)
X_tr, y_tr = data.loc[~is_test, FEATS], data.loc[~is_test, "故障モード"]
X_te, y_te = data.loc[is_test, FEATS], data.loc[is_test, "故障モード"]
print("学習", len(X_tr), "件/評価", len(X_te), "件")
print(y_te.value_counts().reindex(CLASSES))

models = {}
for cw in [None, "balanced"]:
    m = RandomForestClassifier(n_estimators=300, min_samples_leaf=2,
                               class_weight=cw, random_state=0)
    m.fit(X_tr, y_tr)
    models[cw] = m
    pred = m.predict(X_te)
    print("class_weight =", cw)
    print(pd.DataFrame(confusion_matrix(y_te, pred, labels=CLASSES),
                       index=CLASSES, columns=CLASSES))
    print(classification_report(y_te, pred, labels=CLASSES, digits=2, zero_division=0))
実行した結果、学習用は817件、評価用は283件になりました。評価用の内訳は、正常225件、アンバランス28件、ミスアライメント16件、外輪の欠陥8件、内輪の欠陥6件です。故障の事例は評価用の中でも58件しかなく、とくに内輪の欠陥は6件です。この件数では、1件の当たり外れで割合が十数ポイント動くので、以下の結果は傾向として読む必要があります。コードでは、ランダムフォレストを2通りの設定で学習させています。1つはクラスの重みを指定しない設定、もう1つは故障の事例の少なさを補う設定(class_weight="balanced")で、後者の意味は次の節で説明します。
混同行列で、どの故障をどの故障と取り違えたかを見る
分類の結果は、正解率の1つの数字ではなく、混同行列で見ます。混同行列は、行に実際の故障モード、列にモデルの診断を取り、それぞれの組み合わせが何件あったかを数えた表です。対角線(行と列が同じ故障モードの升目)が正しく診断できた件数で、それ以外の升目が取り違えです。故障診断では、どの故障をどの故障と取り違えたかによって、保全の損失の型が変わるので、升目ごとに読む必要があります。予知保全の警報の評価に使う適合率と再現率は第8章で詳しく扱いますが、ここでは故障モードごとの「再現率」を、実際にその故障だった行のうち正しく診断できた割合、「適合率」を、モデルがその故障と診断した行のうち実際にその故障だった割合として使います。
まず、クラスの重みを指定しない設定の混同行列です。
| 実際の故障モード(行)/モデルの診断(列) | 正常 | アンバランス | ミスアライメント | 外輪の欠陥 | 内輪の欠陥 | 再現率 |
|---|---|---|---|---|---|---|
| 正常 | 223 | 1 | 0 | 0 | 1 | 0.99 |
| アンバランス | 14 | 14 | 0 | 0 | 0 | 0.50 |
| ミスアライメント | 0 | 0 | 16 | 0 | 0 | 1.00 |
| 外輪の欠陥 | 2 | 0 | 0 | 6 | 0 | 0.75 |
| 内輪の欠陥 | 2 | 0 | 0 | 0 | 4 | 0.67 |
全体の正解率は0.93で、数字だけを見ると良い結果に見えます。しかし、これは正常の225件がほぼすべて正常と診断されたことによるもので、故障の58件に限ると、故障を正常と判定した行が18件(アンバランス14件、外輪の欠陥2件、内輪の欠陥2件)あります。とくにアンバランスは28件のうち半分の14件を正常と判定しました。この架空データでは、正常でも負荷率が高いと1X振幅が大きくなる設定にしています。そこで、評価用のデータの1X振幅を確かめるコードを足しました。
pred0 = models[None].predict(X_te)
a1x = X_te["1X振幅"].values
ub = (y_te == "アンバランス").values
print("アンバランスを正常と判定した行の1X振幅の平均", a1x[ub & (pred0 == "正常")].mean().round(2))
print("アンバランスを正しく判定した行の1X振幅の平均", a1x[ub & (pred0 == "アンバランス")].mean().round(2))
print("正常の行の1X振幅の90%点", np.quantile(a1x[(y_te == "正常").values], 0.9).round(2))
実行した結果、正常と判定したアンバランスの14件の1X振幅の平均は1.15で、正しく判定した14件の平均1.67より小さく、正常の行の1X振幅の90%点(上位1割の境目)の1.04を少し上回る程度でした。正常と判定したアンバランスは、1X振幅が正常の上の端と重なる範囲にあった、ということです。実在の設備でも、稼働条件によって特徴量の平常の値が動く場合には、同じ種類の取り違えが起こりうると考えています。第5章で扱った「稼働条件ごとに正常を定義する」考え方を診断に当てはめることも考えられますが、この章では負荷率で補正した実験はしていません。
一方、故障どうしの取り違え(たとえば外輪の欠陥を内輪の欠陥と診断する)は、この設定では起きていません。故障モードどうしは、大きくなる特徴量が違うように架空データを作ったので、故障であることさえ分かれば種類は見分けやすかった、ということです。正解率の0.93という数字は、この「故障を正常と判定する」取り違えを覆い隠しています。故障診断のモデルを評価するときは、全体の正解率ではなく、故障モードごとの再現率と、故障を正常と判定した件数を最初に見るべきだと考えています。
故障の事例が少ないとき、重みで補うと何が変わるか
正常が多く故障が少ないデータでは、分類モデルは「迷ったら正常」と答えるほうが全体の正解率が上がるので、少ない故障を正常と判定しやすくなります。これをクラスの不均衡(クラスは分類の答えの種類のこと)と呼びます。対処の方法はいくつかあり、少ない故障の事例を重く扱う、多い正常の事例を間引く、少ない故障の事例を水増しする、などがあります。ここでは最も手軽な、少ない故障の事例を重く扱う方法を試しました。scikit-learn の公式ドキュメントによれば、class_weight="balanced" は、各クラスの重みをそのクラスの件数に反比例するように自動で決める設定です。この例の学習データは正常675件、内輪の欠陥24件なので、内輪の欠陥の1件は正常の1件の約28倍の重みで扱われます。
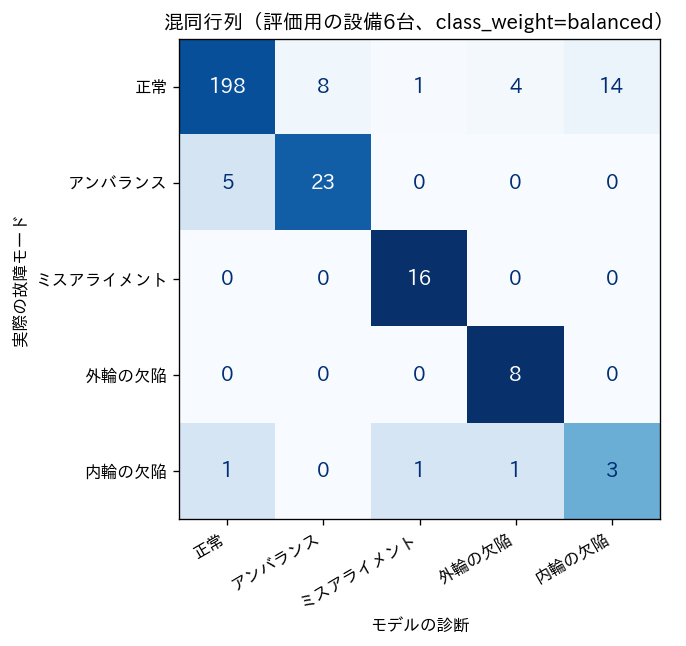
上の図は、重みで補った設定の混同行列です。数字を表にして、補わない設定と並べました。
| 故障モード | 再現率(補わない設定) | 再現率(重みで補った設定) | 適合率(補わない設定) | 適合率(重みで補った設定) |
|---|---|---|---|---|
| 正常 | 0.99 | 0.88 | 0.93 | 0.97 |
| アンバランス | 0.50 | 0.82 | 0.93 | 0.74 |
| ミスアライメント | 1.00 | 1.00 | 1.00 | 0.89 |
| 外輪の欠陥 | 0.75 | 1.00 | 1.00 | 0.62 |
| 内輪の欠陥 | 0.67 | 0.50 | 0.80 | 0.18 |
| 全体の正解率 | 0.93 | 0.88 | なし | なし |
| 故障を正常と判定した件数(故障58件中) | 18 | 6 | なし | なし |
| 正常を故障と判定した件数(正常225件中) | 2 | 27 | なし | なし |
この1回の乱数では、重みで補うと、故障を正常と判定した件数は18件から6件に減りました。アンバランスの再現率は0.50から0.82に、外輪の欠陥は0.75から1.00に上がっています。その代わりに、正常を故障と判定した件数が2件から27件に増え、全体の正解率は0.93から0.88に下がりました。とくに内輪の欠陥は、正常の14件を内輪の欠陥と診断したので、モデルが「内輪の欠陥」と答えた17件のうち実際に内輪の欠陥だったのは3件で、適合率は0.18です。内輪の欠陥の再現率は0.67から0.50に下がっており、件数が6件しかないこの故障モードでは、重みで補っても改善しませんでした。
この結果は、本コラムの架空データでの1回の分割・1つのシードの結果で、評価用の故障は58件、内輪の欠陥は6件、外輪の欠陥は8件しかありません。再現率は1〜2件の差で大きく動くので、重みで補えば必ず良くなるとは読めず、「故障を正常と判定する件数」と「正常を故障と判定する件数」の配分が変わった、と読むのが正確です。どちらの設定を選ぶかは、どちらの取り違えの損失が大きいかで決まります。故障を正常と判定すれば、突発停止や、軸受の損傷が進んだ場合の二次的な損傷につながります。正常を故障と判定すれば、点検の空振り、つまり過剰保全につながり、続けば保全員が診断を信用しなくなり、警報の形骸化につながります。なお、警報の単位で数える誤報・見逃しと、その相対コストからしきい値を選ぶ方法は第8章で扱います。この章の数字は診断の1件ずつの取り違えで、警報の件数とは別に数えています。この章で確かめておきたいのは、正解率の高さだけでモデルを選ぶと、故障を正常と判定する件数の多いモデルを選んでしまうことがある、という点です。
事例の水増しや、似た設備のデータを借りる方法も、故障の事例が少ない場合の選択肢です。ただし、どの方法も「無いデータを作る」か「別の設備のデータを使う」ことになるので、評価は必ず実際の故障の事例で行う必要があります。物理モデルやシミュレーションで故障のデータを補う考え方は第11章で扱います。
どの特徴量が診断に効いているか、重要度の2つの測り方
診断のモデルを保全員に使ってもらうには、モデルがどの特徴量を手がかりにしているかを示し、それが故障の物理と合っているかを確かめる必要があります。ランダムフォレストには、学習の過程で、その特徴量による分岐がクラスの混ざり具合(不純度)をどれだけ減らしたかを、その分岐を通る学習データの割合と組み合わせて集計し、木の間で平均して合計が1になるようにそろえた「不純度による重要度」が備わっています。もう1つの測り方として、評価用のデータで1つの特徴量の値だけを行の間で並べ替えて(その特徴量の情報を壊して)、分類の成績がどれだけ下がるかを見る「並べ替えによる重要度」があります。次のコードは、重みで補った設定のモデルについて両方を出したものです。並べ替えによる重要度の成績には、故障モードごとの再現率の平均(balanced_accuracy)を使い、件数の少ない故障の取り違えも成績に効くようにしました。
from sklearn.inspection import permutation_importance

model = models["balanced"]
imp = pd.Series(model.feature_importances_, index=FEATS)
perm = permutation_importance(model, X_te, y_te, n_repeats=20,
                              random_state=0, scoring="balanced_accuracy")
pi = pd.Series(perm.importances_mean, index=FEATS)
print(pd.DataFrame({"不純度による重要度": imp.round(3),
                    "並べ替えによる重要度": pi.round(3)}).sort_values("並べ替えによる重要度",
                                                                ascending=False))
| 特徴量 | 不純度による重要度 | 並べ替えによる重要度 | 架空データでの役割 |
|---|---|---|---|
| 尖度 | 0.157 | 0.187 | 外輪・内輪の欠陥で大きくなる |
| 1X振幅 | 0.161 | 0.149 | アンバランスで大きくなる |
| 包絡BPFO | 0.167 | 0.121 | 外輪の欠陥で大きくなる |
| 包絡BPFI | 0.117 | 0.100 | 内輪の欠陥で大きくなる |
| 2X振幅 | 0.136 | 0.059 | ミスアライメントで大きくなる |
| 実効値 | 0.093 | 0.004 | どの故障でも大きくなる |
| 軸方向比 | 0.168 | -0.004 | ミスアライメントで大きくなる |
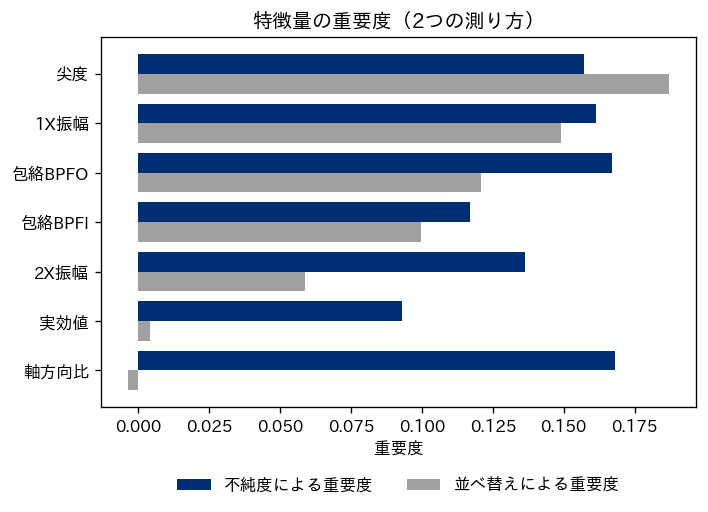
2つの測り方で、順位が大きく違う特徴量があります。軸方向比は、不純度による重要度では0.168で7つの中で最も大きい値ですが、並べ替えによる重要度は-0.004で、ほぼ0です。軸方向比は、この架空データではミスアライメントのときだけ大きくなる設定にしています。同じミスアライメントでは2X振幅も大きくなる設定なので、軸方向比の情報を壊しても、モデルが2X振幅から同じ判断をしている可能性があります。そこで、2X振幅を特徴量から除いて学習し直し、軸方向比の並べ替えによる重要度を測りました(次のコード)。この1回の乱数では、軸方向比の並べ替えによる重要度は-0.004から0.146に上がりました。2X振幅と軸方向比の情報が重なっていたことと合う結果です。scikit-learn の公式ドキュメントも、相関した特徴量の一方を並べ替えると、モデルはもう一方から同じ情報を得られるので、両方の重要度が実際より低く出ることがある、と注意しています。同じドキュメントは、不純度による重要度について、値の種類が多い特徴量を過大に評価する偏りがあることと、学習データに過剰に合わせたモデルでは未知のデータで役に立たない特徴量にも高い値を付けることがあることを書いています。
X_tr2, X_te2 = X_tr.drop(columns="2X振幅"), X_te.drop(columns="2X振幅")
m2 = RandomForestClassifier(n_estimators=300, min_samples_leaf=2,
                            class_weight="balanced", random_state=0).fit(X_tr2, y_tr)
perm2 = permutation_importance(m2, X_te2, y_te, n_repeats=20,
                               random_state=0, scoring="balanced_accuracy")
pi2 = pd.Series(perm2.importances_mean, index=X_tr2.columns)
print("2X振幅を除いたときの軸方向比の並べ替えによる重要度", round(pi2["軸方向比"], 3))
実効値は、不純度による重要度では0.093ありますが、並べ替えによる重要度は0.004です。実効値の増大だけでは故障モードを1つに決められない、という前の節の見立てと矛盾しない結果ですが、理由はそれだけとは限りません。この架空データでは、実効値を1X振幅・2X振幅・尖度から作っているので、実効値の情報はこれらの特徴量と重なっています。軸方向比と同じく、モデルが他の特徴量から同じ情報を得られるため、実効値を並べ替えても成績が下がりにくかった可能性もあります。
この結果から言えるのは、重要度の数字を「この特徴量が故障の原因だ」と読んではいけない、ということです。重要度は、そのモデルがそのデータで何を手がかりにしたかを示すだけで、2つの測り方でも答えが変わります。重要度は、モデルが故障の物理と合わない特徴量(たとえば測定した日付や設備ID)に頼っていないかを点検する道具として使うのが適切だと考えています。特徴量の重要度やその他の説明の手法の詳しい使い分けは、弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』で扱っています。
学習に無い故障が来たときの扱い
分類モデルは、学習した5つのクラス(正常と4つの故障モード)のどれかを必ず答えます。学習に無い故障、たとえば転動体(軸受の玉やころ)の欠陥や、潤滑の不良が起きても、モデルは5つの中から最も近いものを答えてしまいます。また、この例は1件の測定に1つの答えを選ぶ分類で、複数の故障が同時に起きている場合は扱っていません。モデルの「正常」という答えは、学習した4つの故障モードのどれにも当たらないと判定したという意味で、学習に無い故障まで含めて設備が健全であることを保証するものではありません。実際の設備では、すべての故障モードの事例がそろうことはまず無いので、学習に無い故障が来る前提で仕組みを作る必要があります。
ここでは、学習に無い故障の架空データとして、「尖度と実効値は大きくなるが、包絡BPFO にも包絡BPFI にも成分が出ない」故障を30件、評価用の6台で作りました。衝撃は出ているのに、外輪や内輪の欠陥周波数には現れないという設定で、転動体の欠陥のように、欠陥周波数が外輪・内輪と違う故障を想定したものです(あくまで架空の設定です)。この設定は、既知のどの故障モードとも特徴量の組み合わせが違うので、次の保留の条件に引っかかりやすい、つまり保留の仕組みに有利な設定である可能性があります。既知の故障によく似た兆候を出す未知の故障では、保留にできる件数はこれより少なくなる可能性があります。そのうえで、診断の出力に次の2つの保留の条件を足しました。
- 確信度:ランダムフォレストが出す確からしさの最大値が0.6未満なら「保留(確信度が低い)」とする
- 学習データからの距離:特徴量を標準化(平均0・標準偏差1にそろえる)したうえで、学習データの中で最も近い5件までの平均の距離(k近傍法と同じ近さの測り方)を求める。学習データの1件ずつについては、自分自身を除いた最も近い5件で同じ距離を求めておき(コードで6件を求めて先頭の1件を除いているのはこのため)、その99%点を超えたら「保留(学習データから遠い)」とする。学習データのどれとも似ていない測定を見つけるための条件
両方の条件に当たった測定は、「保留(学習データから遠い)」として数えます(コードで、遠いほうの判定を後から上書きしているため)。
from sklearn.neighbors import NearestNeighbors

new = make_rows("正常", 30, np.arange(18, 24))     # 正常をもとに別の故障を作る
sev = rng.uniform(0.4, 1.0, 30)
new["尖度"] += 2.5 * sev                          # 衝撃はあるが
new["実効値"] += 0.75 * sev                       # BPFO にも BPFI にも出ない
new["故障モード"] = "学習に無い故障"

mu, sd = X_tr.mean(), X_tr.std()
nn_z = NearestNeighbors(n_neighbors=5).fit((X_tr - mu) / sd)
d_tr = nn_z.kneighbors((X_tr - mu) / sd, n_neighbors=6)[0][:, 1:].mean(axis=1)
d_lim = np.quantile(d_tr, 0.99)                    # 学習データの99%点を距離の上限に


def judge(X):
    proba = model.predict_proba(X)
    top = proba.max(axis=1)
    d = nn_z.kneighbors((X - mu) / sd)[0].mean(axis=1)
    lab = model.classes_[proba.argmax(axis=1)].astype(object)
    lab[top < 0.6] = "保留(確信度が低い)"
    lab[d > d_lim] = "保留(学習データから遠い)"
    return lab, top, d


for name, X in [("評価用の既知の故障・正常", X_te), ("学習に無い故障", new[FEATS])]:
    lab, top, d = judge(X)
    print(name, len(X), "件")
    print(pd.Series(lab).value_counts())
print("距離の上限", round(d_lim, 2))
lab_te = judge(X_te)[0]
print(pd.crosstab(y_te.values, lab_te).reindex(CLASSES))
lab_new = model.predict(new[FEATS])
print("確信度の判定を入れないときの分類先")
print(pd.Series(lab_new).value_counts())
保留の条件を入れないと、学習に無い故障の30件は、正常に15件、内輪の欠陥に8件、外輪の欠陥に7件と分類されました。半分は正常と判定され、残りの半分は外輪か内輪の欠陥と診断されたので、実際とは違う故障モードを前提に、点検や交換の準備を進めるおそれがあります。保留の条件を入れると、30件のうち17件が「保留(学習データから遠い)」、8件が「保留(確信度が低い)」になり、内輪の欠陥と診断されたまま残ったのは5件でした。この1回の乱数では、30件のうち25件を「モデルには分からない」として人の判断に回せたことになります。距離の上限は、標準化した特徴量の空間で2.51でした。
保留の条件には代償もあります。評価用の既知のデータ283件に同じ条件を当てた結果が次の表です。
| 実際の故障モード | 正しく診断 | 別の故障モードと診断 | 正常と診断 | 保留(確信度が低い) | 保留(学習データから遠い) |
|---|---|---|---|---|---|
| 正常(225件) | 176 | 9 | なし | 40 | 0 |
| アンバランス(28件) | 19 | 0 | 4 | 5 | 0 |
| ミスアライメント(16件) | 14 | 0 | 0 | 1 | 1 |
| 外輪の欠陥(8件) | 7 | 0 | 0 | 0 | 1 |
| 内輪の欠陥(6件) | 2 | 0 | 1 | 3 | 0 |
正常の225件のうち、故障と判定されたものは保留を入れる前の27件から9件(アンバランス4件、内輪の欠陥4件、外輪の欠陥1件)に減りましたが、その代わりに40件が「確信度が低い」として保留になりました。283件のうち保留は51件(確信度が低い49件、学習データから遠い2件)で、約18%です。保留が多すぎると、人が確かめる件数が増え、仕組みを入れた意味が薄れます。保留の基準(ここでは確信度0.6と距離の99%点)は、人が確かめられる件数と、誤った診断で動いたときの損失を見比べて決めるものです。この例で使った0.6や99%点は、説明のために置いた値で、推奨の値ではありません。決め方の方向としては、保全員が1日に確かめられる件数から、許せる保留の件数を逆算することが考えられます。
なお、ランダムフォレストの確からしさは、scikit-learn の公式ドキュメントによれば、各決定木の葉に入った学習データのうち同じクラスの割合を、木の間で平均したものです。そのまま「故障である確率」として読めるように調整(較正)された値ではありません。保全員に示すときは「確率90%」とは書かず、「候補の順位」と「モデルの確信度の目安」として示すほうが誤解が少ないと考えています。
診断結果を保全員にどう示すか
保全員は、自分の経験と現物の状態で診断を確かめてから作業を決めます。保全員が診断を確かめられるよう、診断の画面や帳票には、モデルの答えだけでなく、保全員が自分で確かめられる根拠を一緒に示す必要があります。次のコードは、候補の上位3つと確信度、各特徴量が正常時の平均からどれだけずれているか(正常時の標準偏差の何倍か)を並べた「診断票」の例です。1件目は評価用の外輪の欠陥の行から最初の1件を選んだもので、2件目は評価用の内輪の欠陥のうち内輪の欠陥と判定されなかった行の最初の1件です。
base = X_tr[y_tr == "正常"]


def sheet(case):
    p = pd.Series(model.predict_proba(case)[0], index=model.classes_)
    print("候補(確からしさ)")
    print(p.sort_values(ascending=False).head(3).round(2))
    z = ((case.iloc[0] - base.mean()) / base.std()).round(1)
    print("正常時からのずれ(標準偏差の何倍か)")
    print(pd.DataFrame({"今回の値": case.iloc[0].round(2),
                        "正常時の平均": base.mean().round(2), "ずれ": z}))


sheet(X_te[y_te == "外輪の欠陥"].iloc[[0]])         # 外輪の欠陥の最初の1件
inner = X_te[(y_te == "内輪の欠陥").values & (lab_te != "内輪の欠陥")]
print("内輪の欠陥のうち内輪の欠陥と判定されなかった行の判定", list(lab_te[(y_te == "内輪の欠陥").values & (lab_te != "内輪の欠陥")]))
sheet(inner.iloc[[0]])                              # 取り違えた最初の1件
実行した結果、1件目(外輪の欠陥)は、候補の1位が外輪の欠陥で確信度0.99、2位が正常で0.01、3位が内輪の欠陥で0.00でした。各特徴量のずれは次の表のとおりです。
| 特徴量 | 今回の値 | 正常時の平均 | ずれ(正常時の標準偏差の何倍か) |
|---|---|---|---|
| 実効値 | 1.31 | 0.80 | 2.1 |
| 1X振幅 | 0.61 | 0.77 | -0.7 |
| 2X振幅 | 0.17 | 0.23 | -0.8 |
| 軸方向比 | 0.40 | 0.35 | 0.8 |
| 尖度 | 4.72 | 2.99 | 7.0 |
| 包絡BPFO | 0.49 | 0.10 | 5.4 |
| 包絡BPFI | 0.08 | 0.10 | -0.4 |
この表を見れば、保全員は「尖度は正常時の標準偏差の7.0倍、包絡線スペクトルの外輪の欠陥周波数の成分は5.4倍ほど正常から離れている一方、内輪の欠陥周波数の成分は離れていない。この測定の1X振幅と2X振幅には、アンバランスやミスアライメントで典型的に見られる増大は見られない」と読み取れます。これは、前に示した「兆候が出やすい特徴量」の表と照らし合わせれば、モデルを使わなくても確かめられる根拠です。モデルの答えと、保全員が知っている故障の物理とが合っていれば、保全員はモデルを信用しやすくなります。合っていなければ、それはモデルの誤りか、学習に無い故障か、測定の不具合を疑う手がかりになります。
1件目は確信度が0.99と高く、診断票が最も単純に読める例です。診断票が役に立つのは、むしろモデルの答えが怪しいときなので、2件目も示します。評価用の内輪の欠陥6件のうち、内輪の欠陥と判定されなかったのは4件で、3件が「保留(確信度が低い)」、1件が「正常」でした。2件目はそのうち最初の1件(保留になった行)で、候補の1位は外輪の欠陥で確信度0.55、2位は正常で0.22、3位は内輪の欠陥で0.22でした。確信度が0.6未満なので保留になりましたが、1位の候補は実際の故障モードと違います。
| 特徴量 | 今回の値 | 正常時の平均 | ずれ(正常時の標準偏差の何倍か) |
|---|---|---|---|
| 実効値 | 0.74 | 0.80 | -0.3 |
| 1X振幅 | 0.55 | 0.77 | -1.0 |
| 2X振幅 | 0.21 | 0.23 | -0.3 |
| 軸方向比 | 0.36 | 0.35 | 0.1 |
| 尖度 | 3.41 | 2.99 | 1.7 |
| 包絡BPFO | 0.37 | 0.10 | 3.7 |
| 包絡BPFI | 0.23 | 0.10 | 1.8 |
この行では、包絡BPFO が正常時の標準偏差の3.7倍、包絡BPFI が1.8倍、尖度が1.7倍ほど正常から離れており、外輪と内輪の両方の欠陥周波数に成分が出ています。この架空データでは、内輪の欠陥の行の包絡BPFO には欠陥の成分を足しておらず、正常と同じばらつきだけを持たせています。この行は、そのばらつきがまれに大きく出た例で、しかも「取り違えた行の最初の1件」として選んだので、外れた値の側に偏った例です。保全員がこの診断票を見れば、「外輪か内輪かは特徴量だけでは決めきれない、軸受のどこかに欠陥がある可能性」として受け取り、現物の確認や包絡線スペクトルの図そのものを見て判断することになります。モデルの1位の候補だけを伝えていれば、外輪の欠陥と決めて動いていたかもしれない例です。
診断票には、次の項目を入れるとよいと考えています。
- 候補の故障モードの上位2〜3件と、確信度の目安
- 候補ごとの根拠になる特徴量の値と、正常時からのずれ(実際には包絡線スペクトルの図も添える)
- 保留の条件に当たったかどうか(確信度が低い、学習データから遠い)
- 同じ設備や同じ型の設備で、過去に同じ故障モードと確定した事例と、その時の処置
- 現物で確かめるべき点(聴音、触診、温度、潤滑の状態など)
最後の2つは、モデルの出力ではなく、保全記録と FMEA の表から引いてくる情報です。診断票は、モデルの答えを保全員に「伝える」ものではなく、保全員の判断の材料を1枚にまとめるものとして作るのが適切だと考えています。
FMEA の表を診断ルールの出発点にする
原因が確定した故障の事例が自社の設備にほとんど無い立ち上げの時期には、その少ない事例だけで、十分な診断の性能を持つ分類モデルを学習させ、その性能を確かめることは難しくなります。そのため、立ち上げの時期にはルールを出発点にするのが現実的だと考えています。その時期の診断の出発点として使えるのが、第2章で扱った FMEA の表です。FMEA の表には、部品ごとに起こりうる故障モード、その原因、影響、検出の方法が書かれています。この「検出の方法」の欄に、この章の特徴量の言葉で兆候を書き足すと、そのまま診断のルールの下書きになります。
| FMEA の表の欄 | 診断のルールでの使い方 | この章の例 |
|---|---|---|
| 部品 | どの測定点の特徴量を見るか | 軸受の近くの測定点 |
| 故障モード | 診断の答えの候補(分類のクラス) | 外輪のはく離 |
| 原因 | 保全員に示す、確かめるべき点 | 潤滑の不良、取り付けの不良など |
| 影響 | 診断の答えの緊急度、保留にしたときの扱い | 停止に至るなら保留でも点検を急ぐ |
| 検出の方法 | ルールの条件(どの特徴量がどう変わるか) | 包絡BPFO と尖度が大きくなる |
ルールから始めて、保全記録に原因が確定した事例がたまってきたら、その事例で機械学習の分類を学習させ、ルールと分類の答えを並べて示す、という順に進めるのが現実的だと考えています。ルールと分類の答えが食い違う事例は、ルールの書き足しか、分類モデルの誤りのどちらかを示しているので、保全員とデータ担当が一緒に確かめる材料になります。逆に、診断の運用から分かったこと(このルールでは見分けられなかった、この兆候は別の故障でも出た)を FMEA の表に書き戻すことで、FMEA の表も使うほど正確になっていきます。保全記録に原因と処置を残す仕組みは第10章で扱います。
経営の判断、確信度が低いときは人が判断する
故障診断のモデルを導入するときに先に決めるべきことは、モデルの精度の目標よりも、「モデルの答えをどこまで使い、どこから人が判断するか」の線引きだと考えています。保留の基準(確信度や学習データからの距離の上限)と、保留になったものの扱いは運用の基準なので、第13章で整理した警報のしきい値の分担にそろえて、保全部門が案を作り、工場長が承認し、データ担当が設定を変えます。経営が判断するのは、保留を確かめる人手などの運用の費用を含む予算と、診断の仕組みを、いまのラインの外(別のライン・工場全体・複数の工場)へ広げるかどうかです。同じライン・同じ工場の中で同じ型の設備に広げるところまでは、工場長が承認します。
本コラムの架空データでは、重みで補うかどうかで、故障を正常と判定する件数と正常を故障と判定する件数の配分が大きく変わりました。保留の条件を入れると、保留の条件に引っかかりやすいように作った架空の故障では、30件のうち25件を人の判断に回せました。一方で、既知のデータでも約18%が保留になりました。どちらの数字も、説明用に置いた保留の基準(確信度0.6、距離の99%点)で決まった結果です。本コラムの架空データで比べた設定(重みで補うかどうかと、保留の条件を入れるかどうか)では、どれを選んでも取り違えの件数は0にならず、故障を正常と判定する件数と正常を故障と判定する件数の配分が変わりました。保留の条件を入れた設定では、それに加えて、既知のデータ283件のうち51件を人が確かめる負担が生じました。
診断を誤ったときの損失は、序章で整理した6つの損失の型に当てはめると次のように整理できます。
| 診断の誤りの種類 | 起こる損失の型 | 線引きの考え方 |
|---|---|---|
| 故障を正常と判定する | 突発停止、安全と環境の事故、品質の不良 | 停止や安全に関わる故障モードは、確信度が低ければ保留にして点検する |
| 正常を故障と判定する | 過剰保全、警報の形骸化 | 保留の件数を、保全員が確かめられる件数に収める |
| 故障の種類を取り違える | 過剰保全(別の部品の交換)、突発停止(本当の原因が残る) | 交換の前に、診断票の根拠を保全員が現物で確かめる |
| 学習に無い故障を既知の故障と答える | 突発停止、過剰保全 | 学習データから遠いものは必ず保留にする |
診断の誤りとは別に、体制の面の損失もあります。工場ごとに別々の診断の仕組みを作ると、6つの型のうち二重投資(部門や工場ごとに別々の仕組みを作り、同じ手間を何度もかけること)につながります。これを避けるには、特徴量の定義と故障モードの分類を工場の間でそろえておくことが有効だと考えています。
とくに、安全に関わる設備の診断を、モデルの答えだけで決める運用にはするべきではありません。法令で定められた点検は、予知保全や故障診断の仕組みとは別に、定められたとおりに行う必要があります。故障診断のモデルは、保全員が見るべきものの優先順位を付け、判断の材料をそろえる道具として位置づけ、確信度が低いものと学習データから遠いものは人が判断する、という線引きを最初に決めておくことが、診断の仕組みを長く使われるものにすると考えています。予算の面では、モデルを作る費用だけでなく、保留になったものを保全員が確かめる時間と、保全記録に原因を確定して残す手間を、運用の費用として最初から見込んでおく必要があります。保留を確かめた結果を記録に残し、次の学習と性能の確かめ直しに使えば、保留を減らせる可能性があります。この章のコードでは、記録を足して学習し直したときに保留の件数がどう変わるかは確かめていないので、モデルを更新したら、保留の割合と、診断を誤った割合を併せて確かめる必要があります。
この章では、異常検知の次に行う作業として、異常の原因を故障モードまで絞る故障診断を扱いました。本コラムの架空データ(評価用の故障58件、1回の分割・1つのシード)では、全体の正解率が0.93と高くても故障の58件のうち18件を正常と判定しており、重みで補うと故障を正常と判定した件数は6件に減った代わりに、正常を故障と判定した件数が2件から27件に増えました。学習に無い故障には、確信度と学習データからの距離による保留の条件を入れることで、この1回の乱数では30件のうち25件を人の判断に回せました。ただし、この件数は、既知の故障と特徴量の組み合わせが違う、保留の仕組みに有利な設定の架空の故障で、説明用に置いた保留の基準を使って出したものです。診断のモデルは、候補と根拠を保全員に示し、確信度が低いときは人が判断する形で使うのが適切だと考えています。進め方としては、故障の事例が少ない立ち上げの時期には FMEA の表の「検出の方法」の欄からルールの下書きを作り、保留の基準と保留になったものの扱いを決めてから、事例がたまるにつれて分類モデルを足していく順が現実的だと考えています。次の第7章では、診断で原因を絞った故障が、あとどれくらいで機能を果たせなくなるかを推定する、残存寿命の推定を扱います。
この章を深めたい方への参考書籍
『はじめてのパターン認識』(平井有三 著、森北出版):パターン認識の入門書で、版元の目次によれば、ベイズの識別規則、k最近傍法、線形識別関数、サポートベクトルマシン、識別器の組み合わせによる性能強化などの章があります。この章で使った分類モデルの考え方や、k最近傍法のようにデータの間の距離を使う識別の基礎を学ぶのに向いています。
『Pythonではじめる機械学習』(Andreas C.Müller, Sarah Guido 著、中田秀基 訳、オライリー・ジャパン):scikit-learn を使った機械学習の入門書で、版元の目次によれば、決定木のアンサンブル法、クラス分類器の不確実性推定、交差検証、多クラス分類の評価基準などの節があります。この章で使ったランダムフォレストの学習と評価、確信度の扱いを、自社のデータで試すときの手引きになります。
第7章 残存寿命の推定、劣化モデル・回帰・生存分析
第6章では、異常の原因を分類し、検知した異常をどの故障モードに結びつけるかを扱いました。原因の候補が絞れると、次に保全の担当者が知りたくなるのは「あとどれくらい持つのか」です。軸受の外輪のはく離が始まっていると分かっても、明日止めるべきか、次の計画停止まで待てるかで、手配する部品も人も変わります。この章では、今の時点から機能を果たせなくなるまで、あるいは保全が必要な水準に達するまでの残りの時間である残存寿命(RUL)を推定する方法を扱います。
扱う方法は3つです。健全性を表す指標の動きに曲線を当てはめて先へ延ばす劣化モデル、似た設備の履歴から特徴量と残存寿命の関係を学ぶ回帰、寿命の記録から「ある年齢まで動いた設備が次の期間に寿命の終わりを迎える確率」を求める生存分析です。架空の設備60台の劣化の記録を作り、Python で3つを実行して、予測の当たり方と予測の幅の当たり方を確かめます。結論を先に書くと、本コラムの架空データのこの1回の乱数では、点の予測の誤差を日数で見ると、劣化モデルでは寿命の終わりに近いほど小さくなり、回帰ではほぼ横ばいののち寿命の90%の時点で小さくなりました。一方、残りの寿命に対する割合で見ると、どちらの方法でもむしろ大きくなりました。予測の幅に実際の値が入った台数は、どの出し方でも名目の割合に届かない時点があり、係数の不確かさだけから出した幅は特に狭くなりました。幅を使う前に幅そのものを検証する必要がありました。
残存寿命は「何をもって寿命の終わりとするか」で決まる
同じ設備でも、寿命の終わりの定義を変えると残存寿命の数字が変わります。たとえばポンプの軸受であれば、「振動の実効値が評価基準の警告の水準を超えた時点」「異音が出て運転員が気づく時点」「焼き付いて回らなくなる時点」のどれを終わりとするかで、残りの日数は数十日単位でずれることがあります。予測の数字だけが報告書に載り、終わりの定義が書かれていないと、保全計画を立てる側は「何に間に合わせればよいのか」が分かりません。
ここでいう機能故障は、設備が要求される機能・性能を満たせなくなった状態を指します。焼き付いて回らなくなるのはその一例で、動いていても、必要な吐出量や圧力を出せなくなれば機能故障に当たります(NASA の信頼性中心保全の手引きの4.1.2節は、劣化した状態で動いていても要求を満たしていれば機能故障ではない、という趣旨で定義しています)。
実務では、機能故障を寿命の終わりにすると、学習に使える記録がほとんど集まりません。重要な設備ほど、機能故障に至るまで運転させずに途中で交換するからです。そのため、多くの場合は「保全が必要な水準」を寿命の終わりとして定義します。測っている健全性の指標が、あらかじめ決めたしきい値に達した時点を「寿命の終わり」とみなす方法です。健全性の指標には、第4章・第5章で作った数値(振動の実効値、包絡線スペクトルの欠陥周波数の成分、温度の上昇幅など)を使います。
この定義なら、交換した設備の記録のうち、対象の指標がしきい値に達したことを確かめてから交換したものは、到達の事例として学習に使えます。しきい値に達する前に計画で交換したものや、別の理由で交換したものは、到達の事例とは区別し、「交換した日までは達していなかった」という記録(後で扱う打ち切り)として扱います。
一方で、しきい値の決め方を誤ると、残存寿命の予測がどれだけ正確でも、機能故障には間に合わなくなります。しきい値は、故障モードごとに、機能故障に至るまでに残しておきたい日数から決めることになります。この章では、交換の水準から機能故障に至るまでの日数を「機能故障までの猶予」と呼びます。第2章の P-F 間隔の考え方で言えば、潜在故障(劣化の兆候が測れるようになった状態で、まだ機能故障には至っていないもの)を見つけてから機能故障に至るまでの時間のうち、どこまでを保全の準備に使うかを決めることに当たります。
本コラムのこの章では、寿命の終わりを次のように定義します。健全性指標は単位のない数で、劣化していない状態では0.1前後、劣化が進むほど大きくなります。この指標が1.0に初めて達した日を「交換の水準への到達」とし、ある時点から到達の日までの運転日数を残存寿命とします。現実の設備で言えば、1.0は「この水準になったら交換する」と保全部門が決めた値に当たります。到達した時点で設備が止まるわけではなく、要求される機能・性能を満たせなくなる時点(機能故障)ではありません。交換の水準を超えて使い続けた場合に、機能故障に至るおそれが高まる、という位置づけです。第8章では架空データ上の機能故障の出来事を「故障」と呼んで警報を評価しますが、この章の「交換の水準への到達」とは別のものです。
| 寿命の終わりの定義 | 例 | 記録の集まりやすさ | 保全の判断との関係 |
|---|---|---|---|
| 機能故障(要求される機能・性能を満たせなくなった) | 軸受の焼き付き、モータの絶縁破壊(止まった・回らない例) | 集まりにくい(重要な設備ほど壊す前に替える) | 突発停止そのもの。予測が外れたときの損失が大きい |
| 保全が必要な水準に達した時点 | 健全性指標がしきい値を超えた、評価基準の警告の水準を超えた | 到達を確かめて交換した記録も使えるので集まりやすい(到達前の交換は区別する) | しきい値の決め方しだいで、機能故障までの猶予が変わる |
| 性能の低下が許容を超えた時点 | ポンプの吐出量の低下、熱交換器の効率の低下 | 運転データから作れる | 品質の不良やエネルギーの増加として現れる。許容の値が要求される性能そのものであれば、機能故障と同じ時点になる |
| 品質の不良が出始めた時点 | 工具の摩耗で寸法が外れ始めた | 検査の記録と結びつければ作れる | 品質の不良の損失を基準に交換時期を決める |
どの定義を選ぶかは、データ分析の担当者だけで決めることではありません。保全部門が「どの状態になったら作業するか」を決め、その基準をデータの言葉(どの指標がいくつを超えたら)に翻訳したものが寿命の終わりの定義になります。定義を決めずにモデルを作り始めると、学習用の記録の「寿命の終わりの日」が人や時期によってばらばらになり、予測の数字の意味が揃いません。
3つの方法は、使うデータと答える問いが違う
残存寿命を推定する方法は数多く提案されていますが、使うデータの形で大きく3つに分けると整理しやすくなります。1つめの劣化モデルは、1台の設備の健全性指標の推移に曲線(直線・指数・べき乗など)を当てはめ、その曲線がしきい値に届く時点を先へ延ばして求める方法です。必要なのはその設備自身の指標の履歴と、しきい値の定義です。劣化がどのような形で進むかについての知識(たとえば「この故障モードでは指標がほぼ指数的に増える」)が曲線の形として入ります。
2つめの回帰は、似た設備が寿命の終わりまで運転された記録(英語で run-to-failure と呼ばれる、故障あるいは寿命の終わりまでの全期間の記録)を何台分も集めて使う方法です。「ある時点の特徴量」と「その時点からの残存寿命」の組を学習用の例として切り出し、特徴量から残存寿命を予測するモデルを作ります。線形回帰でも、決定木を組み合わせた手法でも、深層学習でも、この枠組みは同じです。劣化の形を人が決めなくてよい代わりに、寿命の終わりまで至った記録がある程度の台数そろっていることが前提になります。
3つめの生存分析は、個々の設備の指標の推移ではなく、「何日目に寿命の終わりを迎えたか」「何日目までは迎えずに動いていたか」という記録だけから、設備の集団としての寿命の分布を推定する方法です。観測の途中で記録が切れた設備(まだ動いている設備など)も、「少なくともここまでは寿命の終わりを迎えなかった」という情報として使えるのが特徴です。この「途中で記録が切れること」を打ち切りと呼びます。答えられるのは「この年齢まで動いた設備が、次の30日で寿命の終わりを迎える確率」のような集団の確率です。年齢だけから推定する場合(この章のコードのワイブル分布の推定がそうです)は、目の前の1台の劣化の進み方は反映されません。負荷などの条件を説明変数として加える方法として比例ハザードモデルがあります。ハザードとは、その時点まで寿命の終わりを迎えていない設備が、次の瞬間に迎える勢いのことで、比例ハザードモデルは、説明変数がこの勢いを何倍にするかを推定します。その倍率は説明変数の値だけで決まり、時間によらず一定だという前提を置くモデルなので、たとえば負荷の影響が使い始めと寿命の終わり近くで違うような設備では、前提が合っているかを確かめてから使います。
| 方法 | 何が分かるか | 必要なデータ | どこで外れやすいか | 保全の判断への使い方 |
|---|---|---|---|---|
| 劣化モデル | その設備の指標がしきい値に届くまでの日数と、その幅 | その設備の健全性指標の履歴、しきい値、劣化の形についての知識 | 劣化の初期(指標がほとんど動いていない時期)、劣化の形が想定と違うとき、途中で進み方が変わったとき | 個々の設備について、次の計画停止までもつかを判断する |
| 回帰 | 特徴量から見た残存寿命と、その幅 | 似た設備の run-to-failure の記録(何台分も)、時点ごとの特徴量 | 学習した設備と使い方・環境が違う設備、学習に無い故障モード、寿命の終わりまで至った記録が少ないとき | 同じ型の設備が多数あるとき、台ごとの優先順位を付ける |
| 生存分析 | ある年齢まで動いた設備が、次の期間に寿命の終わりを迎える確率 | 設置日・寿命の終わりの日・観測を締めた日(打ち切りを含む) | 個々の設備の状態の違いを反映できない(説明変数を入れない場合) | 状態を測っていない設備の交換周期、予備品の数の見積もり、劣化モデルや回帰の結果の目安 |
3つは互いに置き換えるものではなく、組み合わせて使うことが多い方法です。状態を測っている重要な設備には劣化モデルや回帰を使い、測っていない設備や台数の多い消耗部品には生存分析で年齢に応じた確率を使う、という分担が考えられます。また、劣化モデルで1台の予測を出すときに、似た設備の履歴から曲線の係数の範囲やばらつきの大きさを借りてくる方法もあります。部品の劣化の信号から残存寿命の分布をベイズ的な方法で求める研究としては、Gebraeel らの2005年の論文(IIE Transactions、第37巻第6号)がよく知られています(本コラムでは書誌を確かめた範囲で紹介し、手法の細部には立ち入りません)。ベイズ的な方法は一般に、似た設備の履歴を事前の知識として持ち、その設備自身の観測値が増えるにつれて予測を更新していく考え方をとります。本コラムのコードでは、ベイズ的な更新までは行わず、似た設備の履歴から「日々の揺らぎの大きさ」だけを借りる形にしました。
架空の設備60台の run-to-failure データを作る
ここからは架空のデータで3つの方法を実行します。データは次の考え方で作りました。設備は60台で、すべて同じ型の回転機を想定しています。各設備の健全性指標は、劣化していないときに0.1前後で、運転日数とともに指数的に増えます。指数の速さ(劣化の速さ)は設備ごとに違い、負荷率が高い設備ほど速くなるようにしました。そのうえで、日々の小さな揺らぎが積み重なる成分(運転の条件の変化などで、劣化の進み方が日によって少しずつ速くなったり遅くなったりする分)と、測定のばらつきを加えています。指標が交換の水準1.0に初めて達した日を寿命の終わりとし、各設備の記録はそこで終わります。この到達の日は、測定のばらつきを加える前の指標(コードの hi_true)で決め、予測には測定のばらつきを含む観測値(hi_obs)を使います。そのため、観測値が到達の日より前に1.0を超えることがあり、次のコードで数えると、60台のうち26台がそうでした。式で書くと、健全性指標を \( h(t) = 0.1 + \theta \, e^{\beta t + W(t)} \) としました。\( \theta \) は劣化の初期の大きさ、\( \beta \) は劣化の速さ、\( W(t) \) は日々の揺らぎを積み重ねた成分で、言葉で言えば「劣化していない水準0.1の上に、日を追うごとに一定の割合で膨らむ劣化分が乗り、その膨らみ方が日々少しずつ揺れる」という形です。
健全性指標は単位のない数で、特定の物理量(振動の加速度や温度)を表すものではありません。現実のデータでは、第4章で作った振動の特徴量や、第5章の異常の度合いを表すスコアなどを組み合わせて、このような「劣化とともに一方向に動く指標」を作ってから残存寿命の推定に入ることが多いと考えています。指数的に増える形は、本コラムの架空データの設定です。現実の設備の劣化がこの形で進むとは限らず、故障モードによっては直線的に進むものや、ある時点で急に進み方が変わるものもあります。60台のうち40台を学習用(似た設備の履歴として使う)、20台を評価用(予測の当たり方を確かめる)に分けました。次のコードがデータの生成です。グラフの日本語の表示に使う japanize_matplotlib は、別に入れる追加のパッケージです。本コラムの実行環境(Python 3.14.3、japanize-matplotlib 1.1.3)では、このパッケージが Python 3.12 で標準ライブラリから外された distutils を読み込んでおり、setuptools(82.0.1)が入っていたことで動きました。setuptools の無い環境では読み込みで止まるおそれがあるので、その場合は setuptools を入れるか、matplotlib で日本語のフォントを直接指定してください。
# ---- ブロック1:架空の run-to-failure データを作る ----
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib

rng = np.random.default_rng(20261030)
N_UNIT, THRESH, BASE = 60, 1.0, 0.1   # 台数、交換の水準、劣化前の水準

units, rows = [], []
for u in range(N_UNIT):
    load = rng.uniform(0.5, 1.0)                            # 負荷率(架空)
    theta = np.exp(rng.normal(np.log(0.02), 0.3))           # 劣化の初期の大きさ
    beta = rng.normal(0.010, 0.0015) * (0.6 + 0.8 * load)   # 劣化の速さ(負荷が高いほど速い)
    t = np.arange(0, 2000)
    walk = np.cumsum(rng.normal(0, 0.012, t.size))          # 日々の揺らぎが積み重なる分
    hi_true = BASE + theta * np.exp(beta * t + walk)
    assert hi_true[-1] >= THRESH
    fail = int(np.argmax(hi_true >= THRESH))    # 交換の水準に初めて達した日を寿命の終わりとする
    hi_obs = hi_true[:fail + 1] + rng.normal(0, 0.01, fail + 1)   # 測定のばらつき
    units.append({"unit": u, "load": load, "fail_day": fail})
    rows.append(pd.DataFrame({"unit": u, "day": t[:fail + 1], "hi": hi_obs}))
units = pd.DataFrame(units)
hist = pd.concat(rows, ignore_index=True)
train_ids, test_ids = list(range(40)), list(range(40, 60))   # 学習用40台、評価用20台

print("交換の水準に達するまでの日数(60台):最短 %d・中央値 %d・最長 %d"
      % (units.fail_day.min(), units.fail_day.median(), units.fail_day.max()))
print("負荷率と到達までの日数の相関係数 %.2f" % np.corrcoef(units.load, units.fail_day)[0, 1])
early = hist[(hist.hi >= THRESH) & (hist.day < hist.unit.map(units.fail_day))].unit.nunique()
print("観測値が到達の日より前に1.0以上になった設備 %d台(60台のうち)" % early)
実行した結果、60台が交換の水準に達するまでの日数は、最短214日・中央値320日・最長528日でした。負荷率と到達までの日数の相関係数は-0.48で、負荷が高い設備ほど早く交換の水準に達する傾向がデータに入っています。次のコードでは、学習用の40台の軌跡を図に描き、あわせて劣化モデルの関数を用意します。
# ---- ブロック2:劣化の軌跡を描き、劣化モデル(指数)で外挿する関数を用意する ----
fig, ax = plt.subplots(figsize=(8, 4.5))
for u in train_ids:
    h = hist[hist.unit == u]
    ax.plot(h.day, h.hi, color="#002E73" if u < 5 else "#BBBBBB", lw=0.8 if u < 5 else 0.5)
ax.axhline(THRESH, color="#000080", ls="--", lw=1.2, label="交換の水準(1.0)")
ax.set_xlabel("運転日数")
ax.set_ylabel("健全性指標(大きいほど劣化)")
ax.legend(loc="upper left")
fig.savefig("../ch07_trajectories.png", dpi=120, bbox_inches="tight")
plt.close(fig)

from scipy.optimize import curve_fit


def curve(t, a, b):
    return BASE + np.exp(a + b * t)


def degradation_rul(day, hi, sigma=0.0, n_sim=2000, horizon=1200, seed=1):
    """sigma=0 なら係数の不確かさだけ、sigma>0 なら今後の揺らぎも足して幅を出す"""
    p, cov = curve_fit(curve, day, hi, p0=(np.log(0.02), 0.01), maxfev=20000)
    g = np.random.default_rng(seed)
    sims = g.multivariate_normal(p, cov, n_sim)
    now, goal = day.max(), np.log(THRESH - BASE)
    k = np.arange(1, horizon + 1)
    path = sims[:, [0]] + sims[:, [1]] * (now + k)            # 対数で見た劣化の道筋
    path = path + np.cumsum(g.normal(0, sigma, (n_sim, horizon)), axis=1)
    hit = path >= goal
    rul_sim = np.where(hit.any(axis=1), hit.argmax(axis=1) + 1, horizon)
    point = max((goal - p[0]) / p[1] - now, 0)
    lo, up = np.percentile(rul_sim, [10, 90])
    return point, lo, up, p
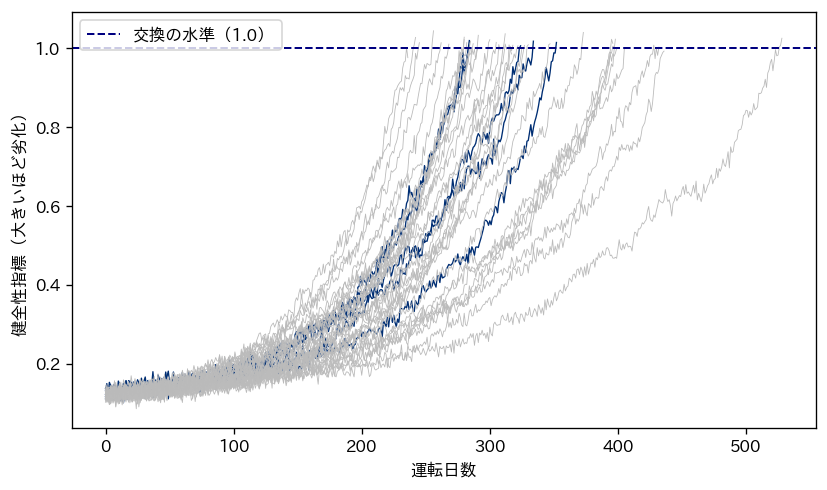
図は学習用の40台の健全性指標の軌跡で、5台を濃い色で、残りを灰色で描いています。どの設備も最初の100日ほどは0.1から0.2の間でほとんど動かず、その後に曲がり始めて、200日から530日ほどの間に1.0の破線に達しています。この図から読み取れることが2つあります。1つは、劣化の初期には指標がほとんど動かないので、その時点の指標だけを見ても「どの設備が早く交換の水準に達するか」の差がほとんど見えないことです。もう1つは、同じ型の設備でも到達までの日数が2倍以上ばらつくことです。「この型は平均して何日もつ」という数字だけで交換日を決めると、早く劣化する設備では交換の前に交換の水準を超え、遅く劣化する設備ではまだ使える状態で交換することになります。前者は、交換の水準を超えて使い続けた場合に機能故障に至り突発停止となるおそれがあり、後者は過剰保全の損失です。
関数 degradation_rul は、観測した日と指標の値を受け取り、指数の曲線を最小二乗法で当てはめて、その曲線が1.0に届く日を予測します。予測の幅は、当てはめた係数の不確かさ(係数の推定値がどれくらいぶれうるか)から係数の組を2,000通り引き、それぞれの組で1.0に届く日を求めて、その10%点と90%点を取ることで出しています。10%点は「10回に1回はこれより早く届く日」、90%点は「10回に9回はこれより早く届く日」と読みます。引数 sigma に正の値を渡すと、これに加えて、今後の日々の揺らぎも乱数で足してから1.0に届く日を求めます。係数の不確かさだけで幅を出すか、今後の揺らぎも含めるかで幅がどう変わるかを、後で比べます。
劣化モデルで1台の残存寿命を外挿し、幅を付ける
今後の揺らぎを足すには、その大きさを決める必要があります。評価用の設備自身の短い履歴からは推定しにくいので、学習用の40台の履歴から「日々の揺らぎの大きさ」を見積もりました。この見積もりは近似の方法によるもので、後で示すとおり、データを作るときに設定した値より小さく出ました。そのため、この章ではこの値を目安として使い、それで出した幅が実際に当たるかを、後で評価用の20台で数えて確かめます。
見積もりの仕組みは、当てはめた曲線からのずれを、近い観測どうしと離れた観測どうしで比べ、離れた日数に応じて増える分だけを取り出すというものです。測定のばらつきは離れた日数によらずほぼ同じ大きさで効くので、この比べ方でその寄与を近似的に抑えられます。厳密には差し引けません。対数に直すと、測定のばらつきは指標が小さいときほど大きく効くからです。また、コードは観測を指標の値で絞ってから「40個先の観測」と比べているので、絞った後に抜けた日がある設備では、40日より離れた組が混ざります。掲載したコードとは別に本コラムで数えたところ、40個離れた組の約6%がそうでした。同じく掲載したコードとは別に、日付で組を合わせて計算し直しても、推定値は下のコードの結果(0.0071)と大きくは変わりませんでした。続けて、評価用の1台目(設備41)について、寿命の50%・70%・90%の時点まで観測したところで残存寿命を予測し、図に描きました。
# ---- ブロック3:揺らぎの大きさを推定し、1台について外挿する ----
# 学習用40台から「日々の揺らぎ」の大きさを推定する(10個離れた観測どうしの差と、40個離れた観測どうしの差のばらつきを比べる)
v = []
for u in train_ids:
    h = hist[(hist.unit == u) & (hist.hi > BASE + 0.15)]
    p, _ = curve_fit(curve, h.day, h.hi, p0=(np.log(0.02), 0.01), maxfev=20000)
    d = np.log(np.clip(h.hi.values - BASE, 1e-3, None)) - (p[0] + p[1] * h.day.values)
    v.append(((d[40:] - d[:-40]).var() - (d[10:] - d[:-10]).var()) / 30)
SIGMA = float(np.sqrt(max(np.median(v), 0)))
print("学習用の40台から推定した日々の揺らぎ(対数の標準偏差)%.4f" % SIGMA)

u0 = test_ids[0]
h0 = hist[hist.unit == u0]
f0 = int(units.fail_day[u0])
fig, axes = plt.subplots(1, 3, figsize=(13, 4), sharey=True)
for ax, frac in zip(axes, [0.5, 0.7, 0.9]):
    cut = int(f0 * frac)
    obs = h0[h0.day <= cut]
    point, lo, up, p = degradation_rul(obs.day.values, obs.hi.values, SIGMA)
    print("設備%d・寿命の%d%%の時点(%d日目):予測 %.0f日(10%%点 %.0f・90%%点 %.0f)、実際 %d日"
          % (u0 + 1, frac * 100, cut, point, lo, up, f0 - cut))
    tt = np.arange(0, f0 + 200)
    ax.scatter(obs.day, obs.hi, s=2, color="#BBBBBB", label="観測した値")
    ax.plot(tt, curve(tt, *p), color="#002E73", lw=1.5, label="当てはめた劣化モデル")
    ax.axhline(THRESH, color="#000080", ls="--", lw=1)
    ax.axvspan(cut + lo, cut + up, color="#002E73", alpha=0.15, label="到達日の幅(10〜90%点)")
    ax.axvline(f0, color="#555555", lw=1, ls=":", label="実際の到達日")
    ax.set_title("寿命の%d%%の時点まで観測" % (frac * 100))
    ax.set_xlabel("運転日数")
    ax.set_ylim(0, 1.6)
axes[0].set_ylabel("健全性指標")
axes[0].legend(loc="upper left", fontsize=8)
fig.savefig("../ch07_extrapolation.png", dpi=120, bbox_inches="tight")
plt.close(fig)
学習用の40台から推定した日々の揺らぎ(対数の標準偏差)は0.0071でした。データを作るときに設定した値は0.012なので、推定値は設定より小さく出ています。この差がどこから来るかは、本コラムでは切り分けていません。現実のデータでは設定の値(正解)が分からないので、推定した揺らぎが小さすぎるかどうかは、後で行うように「幅に実際の値が入ったか」を数えて確かめるしかありません。
設備41の予測は次のとおりです。
| 観測した時点 | 運転日数 | 予測した残存寿命 | 幅の10%点 | 幅の90%点 | 実際の残存寿命 |
|---|---|---|---|---|---|
| 寿命の50% | 193日目 | 208日 | 192日 | 228日 | 193日 |
| 寿命の70% | 270日目 | 116日 | 108日 | 125日 | 116日 |
| 寿命の90% | 347日目 | 51日 | 45日 | 57日 | 39日 |
寿命の50%の時点(193日目)では、予測は208日で、実際の193日より15日長めでしたが、幅(192〜228日)の端に実際の値がかろうじて入りました。70%の時点では予測と実際がどちらも116日で一致しています。ところが90%の時点では、予測51日・幅45〜57日に対して、実際は39日でした。図の右端のパネルでは、実際の到達日を示す点線が、幅を表す帯より左にあります。到達の直前に劣化が想定より速く進んだため、それまでの軌跡に当てはめた曲線では追いつけなかったことになります。この設備について「幅の10%点の45日後までは大丈夫」と判断して交換を計画していれば、交換の6日前に交換の水準を超えていました。
この1台の例から分かるのは、劣化モデルの予測の幅は「曲線の形が正しく、今後の揺らぎの大きさを正しく見積もった」という前提のうえで出た幅だということです。10%点から90%点までの幅は、前提が正しくても、10回に2回は実際の値が幅の外に出る幅です。そのため、1台が幅の外で交換の水準に達したことだけでは、前提が現実と合わなかったとは判断できません。偶然なのか、幅の出し方が系統的に狭いのかは、複数の設備で、幅に入った割合と外れ方(早い側に外れたか、遅い側に外れたか)を数えて確かめます。評価用の20台でまとめて確かめる前に、もう1つの方法である回帰を用意します。
似た設備の履歴から回帰で予測し、評価用の20台で比べる
回帰では、学習用の40台の履歴から学習用の例を切り出します。1台の設備について、運転40日目から交換の水準に達する前日まで10日おきに「その時点で観測できた特徴量」と「その時点からの残存寿命」の組を作りました。特徴量は次の4つです。
- 直近10日の健全性指標の平均
- 直近30日の指標の傾き(100日あたりの増え方)
- 負荷率
- その時点の運転日数
モデルには scikit-learn の勾配ブースティングの回帰(GradientBoostingRegressor)を使いました。勾配ブースティングは、小さな決定木を1本ずつ順に足していき、それまでの木で外れた分を次の木で埋めていく手法です。損失関数に分位点の損失(loss="quantile")を指定して、10%点・50%点・90%点を予測するモデルを3つ学習しました。scikit-learn の公式ドキュメントでは、この指定で分位点の回帰ができ、予測区間を作る例が示されています。
分位点の回帰は、「平均的な値」ではなく「この値を下回る割合が10%になる値」のような分布の位置を直接予測する方法です。10%点の予測は「10回に1回はこれより早く交換の水準に達する日数」に当たります。50%点のモデルが点の予測(中央値)に当たり、10%点と90%点のモデルの予測の間が、予測の幅になります。劣化モデルのように曲線の形を決めなくてよく、幅も学習用の例のばらつきから直接決まるのが特徴です。
# ---- ブロック4:特徴量から残存寿命を回帰で予測する(分位点の回帰) ----
from sklearn.ensemble import GradientBoostingRegressor


def features(h, cut, load):
    w = h[(h.day <= cut) & (h.day > cut - 30)]
    slope = np.polyfit(w.day, w.hi, 1)[0] * 100      # 直近30日の傾き(100日あたり)
    return [w.hi.tail(10).mean(), slope, load, cut]


X, y = [], []
for u in train_ids:
    h, f, ld = hist[hist.unit == u], units.fail_day[u], units.load[u]
    for cut in range(40, f, 10):                     # 1台から10日おきに学習例を切り出す
        X.append(features(h, cut, ld))
        y.append(f - cut)
X, y = np.array(X), np.array(y)
models = {q: GradientBoostingRegressor(loss="quantile", alpha=q, n_estimators=300,
                                       max_depth=3, learning_rate=0.05, random_state=0).fit(X, y)
          for q in (0.1, 0.5, 0.9)}
print("回帰の学習例 %d件(学習用の40台から切り出し)" % len(y))
学習用の40台から切り出した学習用の例は1,154件でした。ここで注意が要るのは、学習用の例を切り出した設備と、評価に使う設備を分けていることです。同じ設備から切り出した例を学習と評価の両方に入れると、その設備の劣化の速さをモデルが「覚えて」しまい、評価の結果が実際より良く見えます。評価用のデータの切り方は第8章で詳しく扱います。
評価用の20台それぞれについて、寿命の50%・70%・90%の時点まで観測したところで、3通りの予測を出しました。劣化モデルで係数の不確かさだけから幅を出したもの、劣化モデルで今後の揺らぎも含めて幅を出したもの、回帰の3つです。劣化モデルの2つは点の予測が同じで、幅の出し方だけが違います。どの予測も、その時点までの観測だけを使っています。なお、寿命の50%・70%・90%という時点は、到達の日が分かった後で比べるために置いた事後の評価用の時点です。実際の運用中は、今が寿命の何%に当たるかは分からないので、予測を始める時期や更新する時期の良し悪しを評価したものではありません。それぞれについて、次の値を数えました。
- 点の予測の外れ方(平均絶対誤差。予測と実際の差の大きさの平均)と、それを実際の残存寿命の平均で割った誤差の割合
- 幅の平均
- 実際の残存寿命が幅に入った台数
- 予測した日より前に交換の水準に達した台数
- 幅の下限(10%点)の日より前に交換の水準に達した台数
# ---- ブロック5:評価用20台で3通りの予測と幅を比べる ----
res = []
for u in test_ids:
    h, f, ld = hist[hist.unit == u], units.fail_day[u], units.load[u]
    for frac in (0.5, 0.7, 0.9):
        cut = int(f * frac)
        obs = h[h.day <= cut]
        a_pt, a_lo, a_up, _ = degradation_rul(obs.day.values, obs.hi.values)
        d_pt, d_lo, d_up, _ = degradation_rul(obs.day.values, obs.hi.values, SIGMA)
        xf = np.array([features(h, cut, ld)])
        r_lo, r_pt, r_up = (models[q].predict(xf)[0] for q in (0.1, 0.5, 0.9))
        for name, pt, lo, up in (("劣化モデル・係数だけの幅", a_pt, a_lo, a_up),
                                 ("劣化モデル・揺らぎ込みの幅", d_pt, d_lo, d_up), ("回帰", r_pt, r_lo, r_up)):
            res.append({"方法": name, "時点": frac, "実際": f - cut, "予測": pt, "下限": lo, "上限": up})
res = pd.DataFrame(res)
res["誤差"] = (res["予測"] - res["実際"]).abs()
res["幅に入った"] = (res["下限"] <= res["実際"]) & (res["実際"] <= res["上限"])
res["予測日より前に到達"] = res["実際"] < res["予測"]
res["下限日より前に到達"] = res["実際"] < res["下限"]
res["幅"] = res["上限"] - res["下限"]
summary = res.groupby(["方法", "時点"], sort=False).agg(
    平均絶対誤差=("誤差", "mean"), 幅の平均=("幅", "mean"),
    幅に入った台数=("幅に入った", "sum"), 予測日より前に到達=("予測日より前に到達", "sum"),
    下限日より前に到達=("下限日より前に到達", "sum"))
summary["誤差の割合%"] = 100 * summary["平均絶対誤差"] / res.groupby(["方法", "時点"], sort=False)["実際"].mean()
pd.set_option("display.width", 200)
print(summary.round(1).to_string())
print("実際の残存寿命の平均(時点別)", res[res["方法"] == "回帰"].groupby("時点")["実際"].mean().round(1).to_dict())
実行した結果を表にまとめます。評価用の設備は各時点で20台です。実際の残存寿命の平均は、寿命の50%の時点で166.4日、70%の時点で100.3日、90%の時点で33.8日でした。表は、本コラムの架空データのこの1回の乱数での結果です。
| 方法 | 観測した時点 | 平均絶対誤差(日) | 誤差の割合(%) | 幅の平均(日) | 幅に入った台数 | 予測日より前に到達 | 下限日より前に到達 |
|---|---|---|---|---|---|---|---|
| 劣化モデル・係数だけの幅 | 寿命の50% | 16.3 | 9.8 | 15.7 | 8 | 10 | 8 |
| 劣化モデル・揺らぎ込みの幅 | 寿命の50% | 16.3 | 9.8 | 26.6 | 11 | 10 | 5 |
| 回帰 | 寿命の50% | 15.4 | 9.2 | 63.0 | 18 | 10 | 1 |
| 劣化モデル・係数だけの幅 | 寿命の70% | 11.6 | 11.5 | 4.8 | 6 | 9 | 7 |
| 劣化モデル・揺らぎ込みの幅 | 寿命の70% | 11.6 | 11.5 | 17.5 | 9 | 9 | 6 |
| 回帰 | 寿命の70% | 15.7 | 15.7 | 38.9 | 15 | 12 | 4 |
| 劣化モデル・係数だけの幅 | 寿命の90% | 6.5 | 19.4 | 1.5 | 3 | 12 | 11 |
| 劣化モデル・揺らぎ込みの幅 | 寿命の90% | 6.5 | 19.4 | 9.9 | 12 | 12 | 6 |
| 回帰 | 寿命の90% | 8.5 | 25.2 | 17.1 | 11 | 11 | 7 |
表の読み方を、3つの点に分けて書きます。1つめは点の予測の当たり方です。平均絶対誤差(日)は、劣化モデルでは16.3日・11.6日・6.5日と寿命の終わりに近いほど小さくなりました。回帰では15.4日・15.7日とほぼ横ばいののち、90%の時点で8.5日に下がっています。ただし、残りの寿命そのものが166.4日・100.3日・33.8日と短くなっていくので、日数で測った誤差は残りが短いほど小さくなりやすい性質があります。誤差の割合で見ると、劣化モデルは9.8%・11.5%・19.4%、回帰は9.2%・15.7%・25.2%で、どちらも寿命の終わりに近いほど大きくなりました。「終わりに近いほど予測が当たるようになる」とは言えず、残りの日数に対しては粗くなる、というのがこの1回の乱数での結果です。方法の比較では、寿命の50%の時点で2つはほぼ同じで(16.3日と15.4日)、70%・90%の時点では劣化モデルの方が小さくなりました。ただし、このデータは指数の劣化の形で作ってあり、劣化モデルにとって有利な条件です。劣化の形が想定と違う設備では、この順位は変わりうると考えておく必要があります。
2つめは幅の当たり方です。10%点から90%点までの幅であれば、理屈の上では20台のうち16台前後で実際の値が幅に入るはずです。係数の不確かさだけで幅を出した劣化モデルは、幅に入った台数が8台・6台・3台にとどまり、寿命の90%の時点では幅の平均がわずか1.5日でした。この実装では、係数の不確かさを、curve_fit が返す共分散(係数の推定値がどれくらいぶれうるかを表す数の表)から計算しているので、観測が増えるほど係数だけから出した幅は狭くなりました。ただし、この計算は、曲線からのずれが日ごとに独立だとみなしています。このデータのずれには日々の揺らぎが積み重なった成分があるので、計算上のぶれは、係数が実際に推定できている確かさより小さく出ている可能性があります。本コラムでは、この点を確かめていません。これとは別に、係数が正確に分かったとしても、実際の設備ではそこから先の日々の揺らぎで到達の日がずれます。係数だけから出した幅には、このずれが入っていません。
今後の揺らぎを含めると、幅は26.6日・17.5日・9.9日に広がり、幅に入った台数は11台・9台・12台に増えましたが、それでも16台には届きませんでした。届かなかった原因は確かめていません。なお、前の節で見たとおり、学習用の40台から推定した揺らぎの大きさ(0.0071)は、データを作るときに設定した値(0.012)より小さく出ていました。揺らぎが小さく見積もられていれば、幅は狭くなる方向に働きます。回帰の幅は寿命の50%の時点で63.0日と広く、幅に入った台数は18台でした。70%の時点では15台とほぼ想定どおりでしたが、90%の時点では11台に下がっています。
3つめは、保全の判断に直結する数字です。「予測日より前に到達」の列は、点の予測の日に交換を計画したときに、交換の前に交換の水準を超えてしまう台数に当たります。どの方法でも20台のうち9〜12台で、ほぼ半数でした。回帰の点の予測は50%点(中央値)を狙って学習したものなので、半数前後が予測より早く交換の水準に達するのは想定どおりです。劣化モデルの点の予測は、当てはめた曲線が1.0に届く日で、今後の揺らぎや係数の不確かさを含めた到達日の分布の中央値として計算したものではありません。この1回の乱数では、結果的に半数前後になりました。機能故障までの猶予が、交換の準備に要る日数より短い設備では、これが突発停止につながりえます。その猶予は、この架空データには含めていません。「下限日より前に到達」の列は、幅の10%点の日に交換を計画したときに、その前に交換の水準に達する台数です。幅が正しく見積もられていれば20台のうち2台前後になるはずですが、係数だけの幅では7〜11台、揺らぎ込みの幅でも5〜6台、回帰では1台・4台・7台でした。
この結果から言えることは、本コラムの架空データのこの1回の乱数では、点の予測の精度が十分に高く見える方法でも、幅の出し方しだいでは「10%点で交換すれば9割は交換の水準の前に交換できる」という期待が成り立たない、ということです。幅を保全の判断に使う前に、学習に使っていない設備で「幅に実際の値が何台入ったか」「下限より前に何台が交換の水準に達したか」を数えて、幅が名目どおりの意味を持っているかを確かめる必要があります。名目どおりでなければ、幅を広げる補正を入れてから使います。たとえば、学習に使っていない設備での外れ方から、下限をどれだけ前にずらせば名目の割合になるかを決める方法です。この場合は、補正の量を決めるのに使う設備と、補正した後の幅が名目どおりかを確かめる設備を分けます。補正の量を決めた設備で補正後の当たり方を数えると、実際よりよく当たって見えやすいからです。なお、回帰の90%の時点で幅に入った台数が下がった理由は、本コラムでは切り分けていません。
生存分析で、年齢から次の期間に寿命の終わりを迎える確率を出す
劣化モデルと回帰は、健全性指標を測っていることが前提でした。一方、設備の台数が多い消耗部品や、センサーを付けていない設備では、手元にあるのは「いつ設置し、いつ寿命の終わりを迎えたか(あるいはまだ動いているか)」という記録だけのことがよくあります。この記録から寿命の分布を推定するのが生存分析です。代表的な推定の方法であるカプラン・マイヤー推定は、寿命の終わりが起きるたびに、その時点でまだ観測を続けている設備のうち何割が残ったかを掛け合わせて、「その日までに寿命の終わりを迎えていない割合」の曲線を作る方法です。生存分析の基本の考え方と、カプラン・マイヤー推定の手順は、弊社コラム「顧客の離脱と生涯価値を測る、コホート分析から解約予測とLTVに基づく施策の優先順位まで」で、顧客の解約を例に詳しく説明しました。ここでは、設備の保全に使うときの要点に絞ります。
生存分析で最も大事なのは、打ち切りの扱いです。観測を締めた時点でまだ動いている設備は、「寿命の終わりまでの日数」が「少なくとも締めた日まで」としか分かりません。寿命の終わりを観測した設備だけで平均寿命を出すと、長く動いている設備が抜けるので、寿命を短く見積もります。逆に、まだ動いている設備を「締めた日に寿命の終わりを迎えた」とみなしても、やはり短く見積もります。寿命の終わりを機能故障と定義している場合は、予防交換した部品も同じで、交換した時点で打ち切りとして扱います。保全の記録に「交換した理由(機能故障したのか、予防のために替えたのか)」が残っていないと、この区別ができません。保全記録に残す項目は第10章で扱います。
ただし、状態に基づく予防交換が多い記録では注意が要ります。カプラン・マイヤー推定やこの後のワイブル分布の当てはめは、打ち切りが寿命と無関係に起きる(独立な打ち切り)ことを前提にしています。劣化の兆候を見て交換した部品は、寿命の終わりが近いものほど交換されやすいので、この前提が成り立たず、そのまま打ち切りとして扱うと推定が偏るおそれがあります。statsmodels の SurvfuncRight の公式ドキュメントにも、独立な打ち切りが成り立たない場合に、説明変数を条件にすれば独立とみなせるなら、その説明変数を渡して補正できるという引数の説明があります。状態に基づく予防交換が多い記録では、交換の理由と交換した時点の状態を記録に残し、それを考慮した解析にする必要があります。この後のコードでは、観測を締めるまでの日数が設置日の乱数だけで決まるので、打ち切りの時点は寿命と無関係に決まります。
次のコードでは、60台の設置日を暦の上の0〜500日目の間でばらばらにし、暦の700日目で観測を締めたことにしました。その時点で交換の水準に達していない設備は打ち切りになります。そのうえで、打ち切りを考慮したワイブル分布(第2章で扱った寿命の分布です)を最尤推定で当てはめました。最尤推定は、手元の記録が得られる確率が最も高くなるように分布のパラメータを決める方法で、打ち切りの設備は「少なくともその日までは到達しなかった」確率として計算に入ります。この分布から、「ある年齢まで交換の水準に達していない設備が、次の30日で達する確率」と「その年齢からの残存寿命の中央値」を求めました。あわせて、statsmodels の SurvfuncRight でカプラン・マイヤー推定を行い、PHReg で負荷率を説明変数にした比例ハザードモデルを当てはめています。statsmodels の公式ドキュメントでは、どちらも右側の打ち切りを扱えると説明されています。
# ---- ブロック6:生存分析(打ち切りのある記録から、条件つきの到達の確率を出す) ----
from scipy.optimize import minimize
from statsmodels.duration.survfunc import SurvfuncRight
from statsmodels.duration.hazard_regression import PHReg

start = rng.uniform(0, 500, N_UNIT)              # 設置した日(暦の上の日)
window = 700 - start                             # 暦の700日目で観測を締める
time = np.minimum(units.fail_day.values, window)
event = (units.fail_day.values <= window).astype(int)   # 1=到達を観測、0=打ち切り
print("交換の水準への到達を観測 %d台、打ち切り %d台" % (event.sum(), (1 - event).sum()))


def negloglik(par):
    k, lam = np.exp(par)                         # 形状と尺度(正の値にするため対数で探す)
    z = (time / lam) ** k
    return -np.sum(event * (np.log(k / lam) + (k - 1) * np.log(time / lam)) - z)


k_hat, lam_hat = np.exp(minimize(negloglik, x0=[np.log(2), np.log(400)], method="Nelder-Mead").x)
print("ワイブル分布(打ち切りを考慮):形状 %.2f・尺度 %.0f日" % (k_hat, lam_hat))
S = lambda t: np.exp(-(t / lam_hat) ** k_hat)
for age in (200, 300, 400):
    print("%d日まで到達していない設備が、次の30日で到達する確率 %.1f%%"
          % (age, 100 * (1 - S(age + 30) / S(age))))
    r = np.arange(0, 1000)
    print("  この年齢の設備の残存寿命の中央値(年齢だけから)%d日" % r[np.argmax(S(age + r) / S(age) <= 0.5)])
続けて、同じ記録からカプラン・マイヤー推定と比例ハザードモデルを求め、図に描きます。
# ---- ブロック7:カプラン・マイヤー推定と比例ハザードモデルで確かめる ----
sf = SurvfuncRight(time, event)
for t0 in (300, 400):
    print("カプラン・マイヤー推定で%d日まで到達していない割合 %.2f(ワイブル分布 %.2f)"
          % (t0, sf.surv_prob[np.searchsorted(sf.surv_times, t0, side="right") - 1], S(t0)))
cox = PHReg(time, units.load.values.reshape(-1, 1), status=event).fit()
print("比例ハザードモデル:負荷率が0.1上がるとハザードは %.2f倍(95%%区間 %.2f〜%.2f)"
      % tuple(np.exp(0.1 * v) for v in (cox.params[0], *cox.conf_int()[0])))

fig, ax = plt.subplots(figsize=(8, 4.5))
ax.step(np.r_[0, sf.surv_times], np.r_[1, sf.surv_prob], where="post", color="#002E73", label="カプラン・マイヤー推定")
tt = np.linspace(0, time.max(), 300)
ax.plot(tt, S(tt), color="#888888", ls="--", label="ワイブル分布(最尤推定)")
ax.set_xlabel("運転日数")
ax.set_ylabel("交換の水準に達していない設備の割合")
ax.legend(loc="lower left")
fig.savefig("../ch07_survival.png", dpi=120, bbox_inches="tight")
plt.close(fig)
実行した結果、交換の水準への到達を観測したのは50台、打ち切りは10台でした。打ち切りを考慮したワイブル分布の形状パラメータは5.15、尺度は356日です。形状パラメータが1より大きいことは、年齢とともに寿命の終わりを迎えやすくなる摩耗型であることを示します(第2章)。この分布から求めた条件つきの確率と残存寿命の中央値は次のとおりです。
| その年齢まで交換の水準に達していない設備 | 次の30日で達する確率 | その年齢からの残存寿命の中央値 |
|---|---|---|
| 運転200日 | 5.3% | 136日 |
| 運転300日 | 23.2% | 63日 |
| 運転400日 | 56.3% | 26日 |
図の紺の階段状の線がカプラン・マイヤー推定、灰色の破線がワイブル分布です。カプラン・マイヤー推定は分布の形を仮定せずにデータから直接作った曲線で、300日まで交換の水準に達していない割合は0.61、400日では0.10でした。ワイブル分布ではそれぞれ0.66と0.16で、本コラムの架空データでは、ワイブル分布の方がやや長めの寿命を示しています。300日では0.61と0.66で差は小さい一方、400日では0.10と0.16で、割合で見ると差が大きくなっています。台数が少なくなる尾の部分は、どちらの推定も不確かになるので、注意して読む必要があります。分布の形を仮定する推定と仮定しない推定を並べて描き、どこでどれだけずれているかを確かめるのは、どちらか一方だけで判断しないための基本の確認です。
比例ハザードモデルでは、負荷率が0.1上がるとハザードが1.51倍になる、という結果でした(95%信頼区間は1.22〜1.87倍)。データを作るときに負荷が高いほど劣化が速くなるように設定したので、その設定が到達の記録の側から見えたことになります。比例ハザードモデルは Cox が1972年に示した方法で、説明変数がハザードを何倍にするかを、寿命の分布の形を決めずに推定できます。
生存分析の結果は、劣化モデルや回帰の結果とは性質が違います。表の「運転300日の設備の残存寿命の中央値63日」は、年齢だけから推定したワイブル分布の結果なので、運転300日まで交換の水準に達していない設備すべてに同じ値が出ます。目の前の設備の健全性指標が0.15なのか0.8なのかは反映されません(比例ハザードモデルのように説明変数を入れれば、負荷などの条件の違いは反映できます)。そのため、生存分析は個々の設備の交換日を決める道具というより、次のような場面で使う道具だと考えています。
- 状態を測っていない設備や部品の、交換の周期の目安を決める(最適な周期の計算は第9章で扱います)
- 来月に寿命の終わりを迎えそうな台数の見込みから、予備品の数や保全員の手配を見積もる
- 劣化モデルや回帰の予測が、集団としての寿命の分布から大きく外れていないかを確かめる目安にする
- 負荷・設置場所・製造の時期などの条件で寿命の長さが違うかを、比例ハザードモデルで確かめる
公開データセットで手法を試すときに知っておきたいこと
残存寿命の推定の手法を試すための公開データとして、よく使われるものに、NASA のエイムズ研究センターの Prognostics Center of Excellence(PCoE)が公開している「Turbofan Engine Degradation Simulation」があります。NASA の予測用データの公開ページによると、このデータは航空機のターボファンエンジンのシミュレーター(C-MAPSS)で作られた劣化のデータで、運転の条件と故障モードの組み合わせを変えた4つのデータの組から成り、故障の進み方を表すセンサーの信号が記録されています。同じページは、この公開場所に置かれたデータの多くが、正常な状態から故障の状態までの時系列であると説明しています。
NASA のデータカタログ(data.nasa.gov)の説明によると、各データの組は学習用と評価用に分かれており、学習用では故障が大きくなってシステムが故障するまでの時系列が、評価用では故障よりいくらか前で切れた時系列が収められ、評価用については正解の残存寿命(あと何サイクル運転できるか)が別に付いています。同じ説明によると、各時系列はそれぞれ別のエンジンの記録で、同じ型のエンジンを多数そろえた集団のデータとみなせる、とされています。各行は1回の運転サイクルの記録で、エンジンの番号(unit number)・サイクル数・3つの運転設定・センサーの測定値が並んでいます。4つの組の内訳は次の表のとおりです。
| データの組 | 学習用の軌跡の数 | 評価用の軌跡の数 | 運転の条件 | 故障モード |
|---|---|---|---|---|
| FD001 | 100 | 100 | 1つ(海面高度) | 1つ(高圧圧縮機の劣化) |
| FD002 | 260 | 259 | 6つ | 1つ(高圧圧縮機の劣化) |
| FD003 | 100 | 100 | 1つ(海面高度) | 2つ(高圧圧縮機の劣化、ファンの劣化) |
| FD004 | 248 | 249 | 6つ | 2つ(高圧圧縮機の劣化、ファンの劣化) |
このデータの作り方は、Saxena・Goebel・Simon・Eklund の2008年の論文(予知保全と健全性管理に関する国際会議 PHM08 の予稿)に書かれています。本コラムのコードは架空のデータで完結させており、このデータは使っていません。公開データで手法を試すときに気をつけたいのは、次の点だと考えています。まず、これはシミュレーションで作られたデータで、実在の設備の記録ではありません。次に、どのデータの組でも、学習用の全エンジンが故障まで運転されています。現実の工場では、重要な設備ほど故障の前に交換するので、故障まで至った記録が何百台分もそろうことは多くありません。公開データで良い精度が出た手法が、自社の設備でも同じ精度になるとは限らない理由の1つです。
NASA のページは次のとおりです(どちらも英語のページです)。NASA の予測用データの公開ページ/data.nasa.gov の C-MAPSS のデータの説明
予測の幅を保全の判断にどう使うか
残存寿命の予測を保全計画に使うときは、点の予測ではなく幅(とくに下限)と、保全の準備に要る日数とを比べて判断します。たとえば、部品の手配に14日、保全員の手配と計画停止の調整に7日かかる設備を考えます。この2つが順に進む(部品が届いてから人と停止の日を決める)場合は合わせて21日、並行して進められる場合は長い方の14日が、交換を決めなければならない期限の目安です。下限がこの日数ちょうどになってから手配を始めると、準備が終わるのは下限の日と同じになり、下限の見込みより早く劣化が進んだときに備える日数が残りません。さらに、予測を見直すのが7日おきであれば、次の見直しまでに下限が7日ほど縮みます。そのため、予測の下限が「準備に要る日数に、見直しの間隔と安全側に足す日数を加えた日数」に近づいた時点で手配を始める、という使い方になります。ここでいう安全側に足す日数は、下限の見込みの外れや作業の遅れに備えて上乗せする日数で、機能故障までの猶予とは別のものです。たとえば安全側に足す日数を仮に7日と置くと、準備が順に進む設備では、21日に見直しの間隔の7日と安全側に足す日数の7日を加えた35日が、手配を始める目安の日数になります。安全側に足す日数の実際の値は、設備ごとの手配の実績などから決めます。下限を使うのは、評価の結果で見たとおり、点の予測の日に合わせると、本コラムの架空データのこの1回の乱数では半数前後が交換の前に交換の水準に達したからです。ただし、下限も幅の当たり方を確かめたうえで使います。同じ評価で、係数だけから出した幅では、下限の日より前に20台のうち7〜11台が交換の水準に達しており、下限を使えば足りるとは限りません(確かめ方は前の節で扱いました)。
ただし、下限を低めに取るほど、まだ使える部品を早めに交換することになり、過剰保全が増えます。幅の下限を10%点にするか5%点にするかは、まず安全上の要求、法令、設備の運用の基準を満たすことを前提にし、その範囲の中で、交換の水準を超えて使い続けることで失うもの(機能故障に至った場合の突発停止など)と早めに交換して失うもの(部品の残りの寿命、作業の手間)の相対的な重さ、準備に要る日数、幅の当たり方を確かめた結果を考え合わせて決めます。この相対的な重さをどう置き、点検の周期や交換の時期をどう最適化するかは第9章で扱います。第9章では、残存寿命を機能故障までの時間として置いて計算するので、この章の残存寿命(交換の水準への到達まで)とは寿命の終わりの置き方が違います。この章の予測を第9章の計算に使うときは、機能故障までの猶予をどう見込むかを先に決めておく必要があります。警報としていつ出すか(警報の段階と誤報・見逃しの評価)は第8章で扱います。この章では、幅の使い方を判断の型として次の表にまとめます。
| 予測の状態 | 読み方 | 保全の対応の例 |
|---|---|---|
| 下限が、準備に要る日数に見直しの間隔と安全側に足す日数を加えた日数より十分に長い | 当面は交換の水準に達しない見込みが高い | 監視を続ける。次の定期の見直しで予測を更新する |
| 下限が、準備に要る日数に見直しの間隔と安全側に足す日数を加えた日数に近づいた | 次の見直しを待つと、下限側の見込みでは準備が間に合わなくなるおそれがある | 部品の在庫を確かめ、手配を始める。計画停止の候補日を決める |
| 下限が準備に要る日数を切った | 下限側の見込みでは、準備が終わる前に交換の水準に達するおそれがある | 交換の日を決め、必要なら点検の頻度を上げる。保全員が現物を確かめる |
| 幅が極端に広い | データが少ない、劣化の初期で指標がほとんど動いていない | 予測で日付を決めず、時間基準の点検や生存分析の目安と併用する |
| 幅が極端に狭い | モデルの前提のうえでの幅で、現実の揺らぎを含んでいない可能性がある | 学習に使っていない設備で幅の当たり方を確かめるまで、下限をそのまま使わない |
| 監視中に、健全性指標が当てはめた曲線の推移から大きく外れた | 劣化の進み方が変わった、別の故障モードが起きている可能性がある | 予測をいったん止め、保全員が現物を確かめる。故障診断(第6章)に戻る。外れたかどうかを判断するために、残存寿命の幅とは別に、健全性指標の推移についての幅を用意しておく |
| 交換の水準に達した後で、実際の到達日が予測の幅の外だったと分かった | その1台だけでは偶然か前提の誤りかは分からない | 外れた記録(どの設備で、どちら側に、どれだけ外れたか)を残し、複数の設備で幅に入った割合を数えて見直す |
表の「幅が極端に狭い」の行と最後の行は、本コラムの評価の結果から入れたものです。この1回の乱数では、係数の不確かさだけで出した幅は、観測が増えるほど狭くなり、寿命の終わりに近いほど「確かそうに見えて外れる」予測になりました。予測の数字が確かそうに見えるときほど、幅の当たり方を確かめた記録があるかを問うことが大切だと考えています。また、安全に関わる設備や、法令で定められた点検の対象になっている設備では、残存寿命の予測は点検の時期を決める材料の1つにとどまり、法令の点検を置き換えるものではありません。
経営の判断:点の予測で交換日を決めない
残存寿命の予測は、経営層に報告されるときに「あと何日」という1つの数字になりがちです。しかし本コラムの架空データのこの1回の乱数では、点の予測の日に合わせて交換を計画すると、評価用の20台のうちおよそ半数(9〜12台)が、その前に交換の水準に達しました。ここでの半数は、機能故障の台数ではなく、交換の水準を先に超えてしまう台数です。機能故障までの猶予が交換の準備に要る日数より短い設備では、これが突発停止のおそれにつながります。点の予測で交換日を決める運用は、予測の精度がどれだけ高く見えても、この猶予に頼る運用になりうるということです。逆に、外れるのを恐れて下限を極端に低く取ると、まだ使える部品を交換する過剰保全が増えます。どちらに倒すかは、データ分析の担当者ではなく、突発停止と過剰保全のどちらの損失をどれだけ避けたいかを決められる立場の人が判断することです。
経営の判断として押さえたいのは、次の点です。
- 残存寿命の報告を受けるときは、寿命の終わりの定義(何が起きたら寿命か)と、予測の幅(とくに下限)を必ず一緒に受け取る
- 寿命の終わりを交換の水準で定義しているなら、その水準から機能故障に至るまでの日数(機能故障までの猶予)を、保全部門がどう見ているかを確認する
- 幅の当たり方を、学習に使っていない設備で確かめた記録があるかを確認する。無ければ、その幅は判断に使える状態にない
- 下限を何%点に置くかは、安全上の要求・法令・設備の運用の基準を満たす範囲で、序章で整理した6つの損失の型のうちどれを重く見るか(突発停止・過剰保全・安全と環境の事故・品質の不良)、準備に要る日数、幅の当たり方を確かめた結果から決め、保全部門と合意する
- 準備に要る日数(部品の手配・保全員の手配・計画停止の調整。順に進むか並行できるかも含めて)を設備ごとに把握する。予測の下限がこれより短いと、下限側の見込みでは間に合わないおそれがある。下限は確定した期限ではないので、見直しの間隔と安全側に足す日数を加えた日数で手配の開始を決める
- 予測が外れたときに、その記録(どの設備で、どれだけ外れたか)を残し、次のモデルの見直しに使う仕組みを予算と体制に入れる
序章で整理した6つの損失の型のうち、もう1つ気をつけたいのが警報の形骸化です。幅の狭すぎる予測に基づいて警報を出すと、「予測の日より前に交換の水準を超えた」「予測の日を過ぎても超えない」という経験が保全員の側に積み重なり、予測そのものが信用されなくなります。一度信用を失った予測を現場に使ってもらうのは、最初に使ってもらうより難しいことが多いように思います。予測の幅を正直に示し、外れた記録も含めて共有する運用は、予知保全を続けるための投資だと考えています。また、工場や部門ごとに別々の残存寿命の仕組みを作ると、寿命の終わりの定義や幅の出し方が揃わず、結果を比べることも、外れた記録をまとめて次に活かすこともできません。寿命の終わりの定義と評価の手順だけでも全社で揃えておくことが、二重投資を避ける第一歩になります。
残存寿命は、何をもって寿命の終わりとするかを決めて初めて意味を持つ数字です。劣化モデル・回帰・生存分析は、使うデータと答える問いが違います。本コラムの架空データのこの1回の乱数では、点の予測の日数の誤差は、劣化モデルでは寿命の終わりに近いほど小さくなり、回帰ではほぼ横ばいののち寿命の90%の時点で小さくなりました。一方、残りの寿命に対する割合では、どちらの方法でも大きくなりました。予測の幅に実際の値が入った台数は、どの出し方でも名目の割合に届かない時点があり、下限の日に交換を計画しても、その前に交換の水準に達する設備が少なくありませんでした。予測の幅をどう評価し、どの警報をいつ出すかは、第8章で誤報・見逃し・リードタイムの言葉に置き換えて扱います。
この章を深めたい方への参考書籍
『JMPによる信頼性工学:製品の寿命予測とデータ解析』(廣野元久・遠藤幸一 著、日本規格協会):寿命データの扱い方と寿命の分布から始まり、統計ソフトの JMP の例を使って信頼性のデータ解析を説明する本です。副題のとおり製品の寿命予測を主題にしており、この章のワイブル分布の当てはめや打ち切りの扱いを、実際の解析の手順として確かめたい方に向いています。
『医薬統計のための生存時間データ解析』(David Collett 著、宮岡悦良 監訳、共立出版):医学研究の生存時間データの解析を扱う教科書の訳書で、生存時間データの特徴、生存関数とハザード関数から説明が始まります。例は医学の研究ですが、打ち切りの扱いや生存関数・ハザード関数の考え方は、設備の寿命の記録に置き換えて読むことができるので、この章の生存分析を理屈から学びたい方に向いています。
第8章 予測の評価と警報の設計、見逃し・誤報・リードタイム
第7章では、健全性指標の劣化から残存寿命を推定し、点ではなく幅で出したうえで保全の判断に使う考え方を確かめました。異常検知・故障診断・残存寿命の推定の結果は、点検の箇所を選ぶ、交換の時期や部品の手配を決める、といった用途にも使われます。この章では、それらの結果を「保全員に警報を出すかどうか」という判断につなげる場面を扱い、その警報をどう評価し、どう設計するかを説明します。モデルの精度を表す数字が高くても、警報が故障の直前にしか出なければ部品の手配も作業の段取りも間に合いませんし、誤報が多ければ保全員は警報を見なくなります。
この章では、機械学習の評価で使う混同行列や適合率・再現率を予知保全の言葉(誤報・見逃し)に置き換え、警報から故障までの時間であるリードタイムを評価に組み込む方法を説明します。そのうえで、架空の設備群のデータを使ってしきい値を動かしたときの誤報・見逃し・リードタイムを計算し、誤報と見逃しの相対コストから警報のしきい値を選ぶ例を、実行したコードと結果で示します。後半では、誤報が続いて警報が無視される問題と、それを扱うアラーム管理の規格、警報の段階と対応の手順を整理します。
混同行列を予知保全の言葉に置き換える
分類のモデルの評価では、予測と実際の組み合わせを4つのマスに数えた表を使います。これを混同行列と呼びます(混同行列そのものは第6章で故障モードの分類の評価に使いました)。予知保全の警報に当てはめると、「警報を出したか・出さなかったか」と「その後に故障が起きたか・起きなかったか」の組み合わせになります。警報を出して実際に故障が起きた場合が正しい警報、警報を出したのに故障が起きなかった場合が誤報、警報を出さなかったのに故障が起きた場合が見逃し、警報を出さず故障も起きなかった場合が平常です。本コラムでは用語の定義どおり、誤報を「故障の兆候が無いのに出た警報」、見逃しを「故障の前に警報が出なかったこと」と呼びます。ただし、過去の記録から「兆候が無かったか」を直接確かめることはできないので、この章では定義を数えるための数え方として、警報から一定の期間(後で述べる予測の窓。コードでは60日)の終わりまで追跡して、そのうちに故障が起きなかった警報を誤報と数えます。これは兆候の有無を判定したものではなく、本物の劣化の兆候を捉えた警報でも、故障が窓の外であれば誤報に数えられます。見逃しも同じ窓で数え、故障当日を含む過去60日に警報が1件も出ていなかった故障を見逃しと数えます。61日以上前にしか警報が出ていなかった故障も、見逃しに入ります。
機械学習の評価でよく使う指標のうち、予知保全の判断に直接つながるのは適合率と再現率の2つです。適合率は「出した警報のうち、本当に故障につながったものの割合」で、保全員から見れば「出た警報の何回に1回が、その後の故障につながったか」に当たります。この章の正解は「警報の後、決めた期間のうちに故障が起きたか」なので、ここでいう適合率から「警報を受けて点検したら異常が見つかった割合」は分かりません。点検で異常が見つかった割合(点検での異常の確認率)は、保全記録から数える別の指標として扱います。なお、後のコードの表では、予測の窓の終わりまで追跡できず誤報かどうか分からない警報(判定保留)を、適合率の分母から除いて計算します。再現率は「起きた故障のうち、事前に警報が出ていたものの割合」で、保全部門から見れば「故障の何割を事前に捉えられたか」に当たります。適合率が低いと誤報が多く、再現率が低いと見逃しが多いことになります。2つは多くの場合、引き換えの関係にあります。警報のしきい値を下げれば捉えられる故障は増えますが、誤報も増えます。
| 機械学習の評価の語 | 予知保全の言葉 | 保全の現場での意味 | 多すぎるときの損失の型 |
|---|---|---|---|
| 真陽性(予測あり・実際あり) | 正しい警報 | 警報が出て、予測の窓のうちに故障が起きた(手を打てたかどうかは、リードタイムと保全の結果で別に見る) | (損失ではない。ただしリードタイムが短いと間に合わない) |
| 偽陽性(予測あり・実際なし) | 誤報 | 警報が出たが、予測の窓のうちに故障は起きなかった(点検で異常が見つかったかどうかとは別) | 過剰保全・警報の形骸化 |
| 偽陰性(予測なし・実際あり) | 見逃し | 警報が出ないまま故障した | 突発停止・安全と環境の事故・品質の不良 |
| 真陰性(予測なし・実際なし) | 平常 | 警報も故障もない | (損失ではない) |
| 適合率 | 警報の当たりの割合 | 出た警報のうち、本当に故障につながったものの割合 | 低いと誤報が多い |
| 再現率 | 故障の捕捉率 | 起きた故障のうち、事前に警報が出ていたものの割合 | 低いと見逃しが多い |
機械学習の評価でよく報告される正解率(全体のうち予測が当たった割合)だけでは、故障がまれなデータで警報の実用性を判断できません。設備の大半の時間は正常なので、「いつも警報を出さない」モデルでも正解率は非常に高くなるからです。たとえば1日ごとに判定する仕組みで、故障の前の判定が全体の1%しかなければ、何も警報を出さないモデルの正解率は99%になります。ROC曲線の下の面積であるROC-AUC(しきい値を動かしたときの見分ける力をまとめた1つの数字)も、しきい値を1つに決めた後の運用の姿(1か月に何回の誤報が出るか、故障の何日前に警報が出るか)を直接は表しません。評価の報告では、正解率やROC-AUCだけでなく、誤報の件数・見逃しの件数・リードタイムを並べることが有効だと考えています。
何を1件と数えるか、判定の単位と予測の窓を先に決める
混同行列のマスを数える前に、「何を1件と数えるか」を決める必要があります。予知保全のデータは、1台の設備について毎日(あるいは毎時)スコアが並ぶ時系列です。1日ごとの判定をそのまま1件として数えると、故障の前の30日間ずっと警報が出ていた場合に「正しい警報30件」と数えることになり、保全員が受け取る通知の数とも、捉えた故障の数とも合いません。本コラムでは、評価の単位を2つに分けて数えることを勧めます。故障の側は「故障1件ごとに、その前に警報が出ていたか」で数え、警報の側は「ひと続きの警報を1件として、その後に故障が起きたか」で数えます。保全員が受け取るのはひと続きの警報で、経営が知りたいのは捉えた故障の数だからです。
次に、「警報が当たった」とみなす時間の幅を決めます。本コラムではこれを予測の窓と呼びます。警報が出てから何日以内に故障が起きれば正しい警報とみなすか、という幅です。窓を長くとれば、たまたま出た警報でも後に故障が起きて「当たり」と数えられやすくなり、適合率も再現率も見かけ上よくなります。窓を短くとれば、早めに出た有益な警報まで誤報と数えてしまいます。予測の窓は、対象の故障モードの劣化が進む速さ(第2章で扱った P-F 間隔の考え方)と、保全の準備に要する日数から決めるのが筋だと考えています。窓の長さを変えると評価の数字が変わるので、報告には窓の長さを必ず添えます。
予測の窓を決めると、窓の終わりまで追跡できていない警報の扱いも決める必要があります。たとえば記録が終わる日の20日前に出た警報は、その後の40日に故障が起きたかどうかが分かりません。これを「窓のうちに故障しなかった」として誤報に数えると、確かめていないものを誤報と呼ぶことになります。本コラムのコードでは、窓のうちに故障が起きていれば正しい警報、窓の終わりまで追跡して故障が無ければ誤報とし、窓の終わりまで追跡できず、それまでに故障も起きていない警報は「判定保留」として、誤報にも正しい警報にも数えません。記録が終わった時点で、まだ結果が分からないこの状態は、第7章で扱った生存分析(ある出来事が起きるまでの時間を扱う統計の方法)では「打ち切り」と呼ばれるものと同じ形です。
さらに、ひと続きの警報をどう区切るかも決めます。スコアがしきい値をまたいで上下すると、短い間隔で警報が出たり消えたりします。これをすべて別の警報として数えると、保全員の受け取る件数が実態より多くなります。本コラムのコードでは、前の超過から7日以内にまた超えた場合は同じ警報の続きとみなしました。この「まとめる日数」も、実際の警報の仕組みの設計(同じ設備から同じ警報を何日間は再通知しないか)と合わせて決めるものです。
| 決めること | 決め方の目安 | 決めないと起きること |
|---|---|---|
| 判定の単位(何を1件と数えるか) | 故障の側は故障1件、警報の側はひと続きの警報1件 | 日ごとの判定を数えると、件数が保全員の受け取る通知の数と合わない |
| 予測の窓(何日以内の故障を当たりとするか) | 劣化が進む速さ(P-F 間隔)と保全の準備に要する日数 | 窓を長くすると、偶然の警報まで当たりに数えられる |
| 必要なリードタイム(何日前なら間に合うか) | 部品の手配・作業者の手配・計画停止の調整に要する日数 | 直前の警報も「捉えた」と数えられ、実際には突発停止と変わらない |
| 追跡しきれない警報の扱い(窓の終わりまで記録が無い警報) | 判定保留として、誤報にも正しい警報にも数えない | 確かめていない警報まで誤報に数えられ、誤報の件数が膨らむ |
| 警報のまとめ方(何日以内の再発を同じ警報とするか) | 通知の仕組みの再通知の間隔 | 同じ異常で警報が何度も数えられ、誤報の件数が膨らむ |
| 評価の期間と設備 | しきい値を決めたデータとは別の期間・別の設備 | しきい値を決めたデータで評価すると、成績がよく見える |
リードタイムを評価に入れる、警報が保全の準備に間に合うか
予知保全の警報の価値は、警報から故障までの間に、保全の準備ができるかどうかで決まります。交換部品を倉庫から出す、無ければ発注する、作業者を手配する、生産計画と調整して計画停止の時間を確保する、といった準備には日数がかかります。故障の1日前に出た警報は、混同行列の上では正しい警報ですが、準備が間に合わなければ実質は突発停止と変わりません。そこで、評価の前に「何日前に警報が出れば間に合うか」という必要なリードタイムを決め、故障を「間に合う警報があった」「警報はあったが間に合わなかった」「警報が無かった(見逃し)」の3つに分けて数えることを勧めます。本コラムのコードでは、必要なリードタイムを7日としました。
リードタイムは、平均だけでなく分布で見ます。平均が20日でも、半分の故障では5日前にしか警報が出ていないかもしれません。保全計画(第9章)に入力するときは、「警報が出た故障のうち、何割が7日以上前に出たか」「最も短いリードタイムは何日か」が判断の材料になります。また、リードタイムは長ければ長いほどよいわけでもありません。あまりに早く出る警報は、保全員から見ると「いつまでたっても故障しない警報」になり、誤報と区別がつきにくくなります。第7章で扱った残存寿命の幅(健全性指標が交換の水準に達するまでの日数の幅)は、この早すぎる警報を「いつ頃までに何をすべきか」に置き換えるのに使えます。第7章の寿命の終わりは交換の水準への到達で、この章で数える「故障」(架空データの上で機能が失われる出来事)とは別のものです。
必要なリードタイムは、故障モードと保全の体制によって変わります。消耗品の交換のように部品が手元にあり作業も短いものは数日で足りますが、特注の部品や外部の業者の手配が要るものは数週間から数か月を要することがあります。同じ設備でも、故障モードごとに必要なリードタイムを分けて置くのが実務的だと考えています。保守部品の在庫を持つかどうかで必要なリードタイムが変わる点は、弊社コラム「在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで」で扱った在庫の考え方とつながります。
評価用データの切り方、時間で分け、設備で分ける
警報のしきい値やモデルを決めたデータと、評価するデータは分けます。これは機械学習の評価の基本ですが、予知保全のデータでは分け方を間違えやすい事情があります。データが時系列で、同じ設備の隣り合う日のスコアはよく似ており、1回の故障の前には何十日分もの「故障の前」のデータが並ぶからです。日ごとのデータを無作為に学習用と評価用に分けると、同じ故障の前の29日目が学習用に、30日目が評価用に入ります。モデルはその故障の劣化の様子を学習用の側で見ているので、評価用の側でも当てられるのは当然で、評価の成績は実際に運用したときより良く出ます。このように、評価のときに本来は手に入らない情報が混ざることを、データの漏れ(リーク)と呼びます。
漏れを防ぐ基本は2つです。1つは時間で分けることで、ある日付より前のデータでしきい値やモデルを決め、その日付より後のデータで評価します。運用では過去のデータで決めた仕組みを未来に当てはめるので、評価もその形にそろえます。もう1つは設備で分けることで、一部の設備のデータで決め、残りの設備で評価します。新しく導入する設備や、まだ故障の記録が無い設備に仕組みを広げるときの成績を見積もるには、こちらが近い形になります。どちらも、学習に使ったデータと同じ故障を評価に入れない、という点をねらっています。
ただし、日付で区切っただけでは、同じ故障が両側に入らないことは保証されません。境目の少し前に出た警報が当たりか誤報かは、境目の後に故障が起きたかどうかで決まるからです。境目の前の警報を数えるときに境目の後の故障を見てしまうと、しきい値を決める側に未来の情報が入ります。これを防ぐには、しきい値を決める期間の中で、予測の窓の終わりまで追跡できた警報だけを誤報・正しい警報に数え、追跡できていない警報は判定保留にします。あるいは、境目の前後に予測の窓の長さの空白の期間を置き、そこに入る警報と故障を両側から外します。scikit-learn には、時間の順を守って分ける TimeSeriesSplit と、同じグループ(ここでは同じ設備)を学習用と評価用に分けて入れない GroupKFold が用意されています(本コラムの実行環境の scikit-learn 1.9.0 で、両方が読み込めることを確かめました)。TimeSeriesSplit は時間の順に分ける機能で、故障ごとに分けることまでは自動では行いません。学習用と評価用の間を空ける引数 gap があることも同じ環境で確かめましたが、空ける量(データの行の数。日ごとのデータなら日数)は予測の窓に合わせて自分で決める必要があります。
無作為な分割のほかにも、漏れはさまざまな形で入ります。代表的なものを表にまとめます。どれも、評価のときには使えても、運用のその時点では手に入らない情報を使っている点が共通しています。
| 漏れの型 | 具体例 | 防ぎ方 |
|---|---|---|
| 同じ故障の前のデータが学習用と評価用に分かれる | 日ごとのデータを無作為に分ける | 時間で分ける。設備で分ける |
| 境目の後の故障で、境目の前の警報を判定する | しきい値を決める期間の終わり近くに出た警報を、その期間の後に起きた故障で「正しい警報」と数える | しきい値を決める期間の中で予測の窓の終わりまで追跡できた警報だけを数え、残りは判定保留にする。または境目の前後に予測の窓の長さの空白を置く |
| 未来のデータを使った前処理 | 全期間の平均と標準偏差でスコアを標準化する。前後の日を使う移動平均をとる | 前処理の統計量は、しきい値を決める期間のデータだけで計算する。移動平均は過去の日だけで計算する |
| 故障の後に分かる情報を特徴量に入れる | 保全記録の「交換した部品」や「停止時間」を、故障の前の判定に使う | 特徴量ごとに「いつの時点で分かる値か」を確かめる |
| 評価用データでしきい値を決める | 評価の成績が最もよくなるしきい値を選び、その成績を報告する | しきい値を決める期間と、成績を報告する期間を分ける |
| 保全で故障を防いだ記録を「故障しなかった」と扱う | 警報を受けて部品を交換した設備を、正常のデータとして学習する | 保全記録と結び付け、予防の交換で終わった記録を区別する(第10章) |
最後の行は、予知保全を運用し始めた後に特有の問題です。警報を受けて部品を交換すれば、故障は起きません。その記録だけを見ると「警報を出したのに故障しなかった」、つまり誤報に見えます。運用を始めた後の評価では、警報の後に何をしたか(点検だけか、交換したか、交換した部品に劣化の跡があったか)を保全記録から引いて、誤報と「警報が効いて故障を防いだ」を区別する必要があります。保全記録で「点検で異常が無かった警報」を数える方法は、この章の予測の窓による数え方とは判定の根拠が違うので、両者の誤報の件数は一致しないことがあります。この記録の残し方は第10章で扱います。本章のコードは、警報を受けても何もしなかった場合の記録(故障まで運転した記録)を評価する形にしています。
コード:架空の設備群の健全性スコアと故障の記録を作る
ここからは、架空のデータで警報を評価します。設備40台を2年(730日)にわたって監視し、各設備について1日1つの健全性スコアが得られる設定です。健全性スコアは、第5章で扱ったような異常検知の手法が出す「いつもとの違いの大きさ」を想定した単位なしの数です。設定は次のとおりです。
- 正常時のスコアは、平均0・標準偏差1でゆらぐ
- 故障の前には、劣化が始まってから故障するまでの15〜90日の間に、スコアが指数的に上がっていく
- 上昇の大きさを決める係数を、故障ごとに3〜7の間でばらつかせる(式の形の都合で、故障の前日に達する上昇はこの係数の約0.81倍から約0.97倍で、劣化の期間が短いほど小さい)
- 故障の2割は、前ぶれの無い突発型(スコアが上がらないまま故障する)とする
- 故障と関係のない一時的な上振れ(1〜3日続く、高さ2.5〜5の上振れ)を、平均で120日に1回入れる。稼働条件の切り替えや、センサーの一時的な乱れを想定したもの
- 故障した設備は交換・修理によって新品同様に戻り、次の故障まで150〜450日運転する
どれも説明のために作った架空のデータで、実在の設備の値ではありません。スコアは単位の無い数として作ったので、振動の周波数や温度のような物理量の設定はしていません。乱数のシードは固定しているので、同じ環境で実行すれば同じ結果になります。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")

# ===== ブロック1:架空の設備群の健全性スコアと故障の記録を作る =====
import numpy as np
import pandas as pd

rng = np.random.default_rng(20261030)
N_EQ, N_DAY = 40, 730          # 設備40台、2年分の日次スコア

scores, failures = [], []
for e in range(N_EQ):
    s = rng.normal(0.0, 1.0, N_DAY)                 # 正常時のゆらぎ
    t = int(rng.uniform(30, 400))                   # 最初の故障日
    while t < N_DAY:
        onset = int(rng.uniform(15, 90))            # 劣化が始まってから故障までの日数
        amp = rng.uniform(3.0, 7.0)                 # 上昇の大きさを決める係数
        if rng.random() < 0.2:
            amp = 0.0                               # 2割は前ぶれの無い突発型の故障
        d = np.arange(onset)
        rise = amp * (np.exp(3.0 * d / onset) - 1) / (np.exp(3.0) - 1)
        lo = t - onset
        s[max(lo, 0):t] += rise[max(-lo, 0):]       # 故障に向けてスコアが上がる
        failures.append((e, t, amp == 0.0))
        t += int(rng.uniform(150, 450))             # 交換後、次の故障まで
    for _ in range(rng.poisson(N_DAY / 120)):       # 故障と無関係な一時的な上振れ
        a = int(rng.integers(0, N_DAY - 3))
        s[a:a + int(rng.integers(1, 4))] += rng.uniform(2.5, 5.0)
    scores.append(s)

scores = np.array(scores)
fail = pd.DataFrame(failures, columns=["eqp", "day", "sudden"])
print("設備", N_EQ, "台・", N_DAY, "日、故障", len(fail), "件(うち突発型", int(fail.sudden.sum()), "件)")
print("1年目の故障", (fail.day < 365).sum(), "件、2年目の故障", (fail.day >= 365).sum(), "件")
実行すると、2年間の故障は95件(うち突発型20件)で、1年目に46件、2年目に49件でした。設備1台あたり2年で平均2件余りの故障が起きる設定です。
図1は、そのうちの設備4(設備の番号は1から数えています。コードの中の番号 eqp は0から数えるので、設備4は eqp が3の設備です)について、2年分のスコアと故障の日(太い縦線)と、しきい値を4.0としたときの警報の開始日(三角の印)を描いたものです。この設備は2年間に4回故障しました(45日目・238日目・476日目・689日目)。238日目の故障の前には223日目に警報が出ており、リードタイムは15日でした。689日目の故障の前には685日目に警報が出ていますが、リードタイムは4日で、必要なリードタイムの7日に届きません。45日目と476日目の故障の前には、しきい値を超えるスコアの上昇がなく、警報は出ていません。287日目と607日目の警報は、その後60日以内に故障が起きていないので、予測の窓を60日とした評価では誤報と数えられます。607日目の警報から689日目の故障までは82日で、スコアの形からは607日目の上昇が一時的な上振れなのか劣化の始まりなのかを、この図だけでは区別できません。予測の窓の長さで、同じ警報が誤報にも正しい警報にもなりうることが分かります。
コード:しきい値を動かして誤報・見逃し・リードタイムを数える
次のコードは、前の節で決めた数え方をそのまま関数にしたものです。alarm_starts は、スコアがしきい値を超えた日のうち、前の超過から7日を超えて離れた日を警報の開始日として返します。引数 hold は、何日続けて超えたら警報にするかの持続条件で、既定は1日(1日でも超えれば警報)です。
# ===== ブロック2:警報を作り、誤報・見逃し・リードタイムを数える =====
WINDOW, NEED, MERGE = 60, 7, 7   # 予測の窓60日、必要なリードタイム7日、7日以内の再発は同じ警報

def alarm_starts(s, th, hold=1):
    """スコアが th を hold 日続けて超えた日を警報の開始日として返す"""
    over = s > th
    run = np.convolve(over.astype(int), np.ones(hold, dtype=int))[:len(s)] >= hold
    days = np.flatnonzero(run)
    starts, last = [], -10**9
    for d in days:
        if d - last > MERGE:          # 前の超過から MERGE 日を超えて離れたら新しい警報
            starts.append(d)
        last = d
    return np.array(starts, dtype=int)
evaluate は、設備ごとに警報の開始日と故障の日を突き合わせて数えます。警報の側は、開始日から60日以内(予測の窓)に同じ設備で故障が起きていれば正しい警報、窓の終わりまで追跡して故障が無ければ誤報、窓の終わりまで追跡できない警報は判定保留と数えます。故障の側は、故障当日を含む過去60日に出た最も早い警報からのリードタイムを測り、7日以上なら「間に合う」、7日未満なら「間に合わない」、警報が無ければ「見逃し」と数えます。前ぶれの無い突発型の故障に、無関係な警報がたまたま先行した件数も別に数えています。この件数は、評価の数え方がどれだけ偶然の当たりを含んでいるかの目安になります。引数 d_from と d_to は、評価する期間を絞るためのもので、後で時間で分けた評価に使います。d_to の日とそれ以降の故障は、警報の判定にも使いません。故障当日の警報も「故障の前の警報」に含めていますが、日ごとのデータなので、同じ日の警報と故障のどちらが先だったかは確かめられません。
def evaluate(th, hold=1, d_from=0, d_to=N_DAY):
    """d_to より前の日に分かっている記録だけで数える(d_to 以降の故障は使わない)"""
    n_alarm = n_false = n_pend = n_ok = n_late = n_miss = n_luck = 0
    leads = []
    for e in range(N_EQ):
        st_all = alarm_starts(scores[e], th, hold)
        st_all = st_all[st_all < d_to]
        st = st_all[st_all >= d_from]  # 数える期間に始まった警報
        fe = fail[(fail.eqp == e) & (fail.day < d_to)]
        fd = fe.day.to_numpy()
        for a in st:
            n_alarm += 1
            if np.any((fd >= a) & (fd <= a + WINDOW)):
                continue               # 窓の中で故障した(正しい警報)
            if a + WINDOW >= d_to:
                n_pend += 1            # 窓の終わりまで追跡できていない(判定保留)
            else:
                n_false += 1           # 窓の終わりまで追跡して故障なし(誤報)
        for f, sudden in zip(fd, fe.sudden):
            if f < d_from:
                continue
            before = st_all[(st_all <= f) & (st_all >= f - WINDOW)]  # 故障当日を含む過去 WINDOW 日
            if len(before) == 0:
                n_miss += 1           # 故障当日を含む過去 WINDOW 日に警報なし
                continue
            n_luck += int(sudden)     # 前ぶれの無い故障に、無関係な警報がたまたま先行した
            lead = f - before.min()
            leads.append(lead)
            if lead >= NEED:
                n_ok += 1
            else:
                n_late += 1           # 警報は出たが準備に間に合わない
    return dict(th=th, alarm=n_alarm, false=n_false, pend=n_pend, ok=n_ok, late=n_late,
                miss=n_miss, luck=n_luck, leads=np.array(leads))
しきい値を2.5から6.0まで0.5刻みで動かし、件数を並べます。表の「判定保留」は、記録の終わり(2年目の最後の日)までに予測の窓が終わらず、故障も起きていない警報の件数です。「適合率」は、判定保留を除いた警報のうち誤報でなかったものの割合で、判定できた警報が0件のときは算出しません。「間に合う再現率」は、95件の故障のうち、7日以上前に警報が出ていたものの割合です。混同行列の節で定義した再現率(事前に警報が出ていた故障の割合)を、間に合った警報に限って数え直したもので、間に合わなかった警報は捉えた数に入れていません。以下の結果は、どれも本コラムの架空データについて、この1回の乱数で得たものです。
# ===== ブロック3:しきい値を動かして並べる =====
rows = []
for th in np.arange(2.5, 6.01, 0.5):
    r = evaluate(th)
    n_fail = r["ok"] + r["late"] + r["miss"]
    judged = r["alarm"] - r["pend"]   # 判定できた警報(警報0件なら適合率は算出不可)
    rows.append(dict(しきい値=th, 警報=r["alarm"], 判定保留=r["pend"], 誤報=r["false"],
                     適合率=round(1 - r["false"] / judged, 3) if judged else np.nan,
                     間に合う=r["ok"], 間に合わない=r["late"], 見逃し=r["miss"],
                     再現率_間に合う=round(r["ok"] / n_fail, 3), 突発型に先行=r["luck"],
                     リードタイム中央値=float(np.median(r["leads"])) if len(r["leads"]) else np.nan))
tab = pd.DataFrame(rows)
pd.set_option("display.width", 200)
print(tab.to_string(index=False))

# リードタイムの分布(しきい値ごと)
for th in [3.0, 4.0, 5.0]:
    lv = evaluate(th)["leads"]
    print("しきい値 %.1f のリードタイム 件数 %d 最小 %d 25%% %.1f 中央 %.1f 75%% %.1f 最大 %d"
          % (th, len(lv), lv.min(), np.percentile(lv, 25), np.median(lv),
             np.percentile(lv, 75), lv.max()))
実行した結果を次の表にまとめます。
| しきい値 | 警報 | 判定保留 | 誤報 | 適合率 | 間に合う | 間に合わない | 見逃し | 間に合う再現率 | 突発型に先行 | リードタイムの中央値(日) |
|---|---|---|---|---|---|---|---|---|---|---|
| 2.5 | 442 | 26 | 271 | 0.349 | 82 | 4 | 9 | 0.863 | 11 | 37.0 |
| 3.0 | 317 | 16 | 167 | 0.445 | 76 | 9 | 10 | 0.800 | 10 | 20.0 |
| 3.5 | 257 | 14 | 135 | 0.444 | 61 | 15 | 19 | 0.642 | 5 | 15.0 |
| 4.0 | 208 | 14 | 105 | 0.459 | 48 | 25 | 22 | 0.505 | 5 | 11.0 |
| 4.5 | 163 | 9 | 70 | 0.545 | 41 | 26 | 28 | 0.432 | 5 | 9.0 |
| 5.0 | 122 | 8 | 44 | 0.614 | 29 | 27 | 39 | 0.305 | 2 | 7.0 |
| 5.5 | 80 | 3 | 23 | 0.701 | 20 | 27 | 48 | 0.211 | 2 | 6.0 |
| 6.0 | 50 | 1 | 10 | 0.796 | 11 | 24 | 60 | 0.116 | 1 | 4.0 |
しきい値を上げると、誤報は2.5のときの271件から6.0のときの10件まで減り、適合率は0.349から0.796に上がりました。判定保留は、しきい値2.5で26件、4.0で14件あり、これらは誤報にも正しい警報にも入れていません。その一方で、見逃しは9件から60件に増え、7日以上前に警報が出た故障(間に合う)は82件から11件に減りました。リードタイムの中央値も37.0日から4.0日に縮みます。本コラムの架空データでは、劣化が進むにつれてスコアが上がるように作っているので、しきい値を上げると劣化が進んでから警報が出て、警報が出ても準備が間に合わない故障が増えたと考えられます。「間に合わない」の件数は、しきい値2.5で4件、4.0で25件、5.5で27件と、しきい値を上げるにつれて増えてから横ばいになりました(6.0では24件)。「間に合う」が減った分の行き先は、しきい値の高さで変わりました。しきい値を2.5から4.0に上げる間は、「間に合う」が82件から48件に減り、「間に合わない」が4件から25件に、「見逃し」が9件から22件に増えて、両方に移っています。しきい値を5.5から6.0に上げる間は、「間に合わない」が27件から24件とほぼ変わらず、「見逃し」が48件から60件に増えており、主に「見逃し」に移っています。
図2は、しきい値を0.25刻みで動かしたときの誤報・見逃し・間に合わない警報の件数です。誤報の曲線と見逃しの曲線は、しきい値5.0と5.25の間で交わりました。誤報は低いしきい値で急に増え、見逃しは高いしきい値でゆるやかに増えます。このように、誤報と見逃しを両方ゼロにするしきい値は無く、どこかで引き換えを決める必要があります。
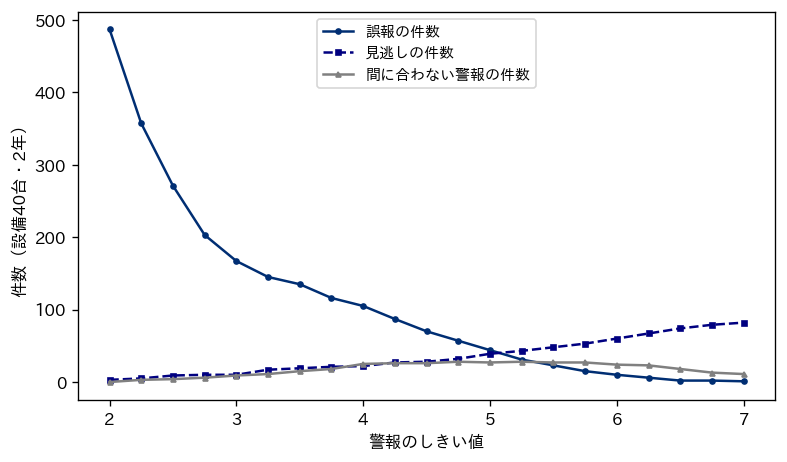
表の「突発型に先行」の列にも注意が必要です。前ぶれの無い突発型の故障は20件ありますが、しきい値2.5では、そのうち11件の前60日以内に、故障と無関係な警報がたまたま出ていました。評価の数え方の上では、この11件は「警報が出ていた故障」に入ります。しきい値を下げて警報を多く出すと、偶然の当たりが増えて再現率が見かけ上よくなる、ということです。実際には、これらの警報は突発型の故障の兆候を捉えたものではありません。評価の報告では、警報の後の点検で見つかった異常が故障と同じ故障モードだったかを、保全記録で確かめる必要があります。
リードタイムの分布も、しきい値によって大きく変わりました。次の表は、しきい値3.0・4.0・5.0で、警報が出ていた故障のリードタイムの分布です。
| しきい値 | 警報が出ていた故障(件) | 最小(日) | 25%点(日) | 中央値(日) | 75%点(日) | 最大(日) |
|---|---|---|---|---|---|---|
| 3.0 | 85 | 0 | 13.0 | 20.0 | 36.0 | 60 |
| 4.0 | 73 | 1 | 5.0 | 11.0 | 27.0 | 57 |
| 5.0 | 56 | 1 | 3.0 | 7.0 | 13.5 | 57 |
しきい値4.0では、警報が出ていた73件のうち4分の1は、リードタイムが5日以下でした。中央値の11日だけを見ると「おおむね間に合う」ように見えますが、必要なリードタイムを7日とすると、4分の1以上の故障では準備が間に合いません。しきい値3.0の最小0日は、故障の当日に初めて警報が出た例です。リードタイムの最大が60日に近い値になっているのは、予測の窓を60日にとったためで、窓より前に出た警報は数えていません。リードタイムの分布の上の端は、窓の長さで決まる部分がある点に注意が要ります。
コード:誤報と見逃しの相対コストから、期待コストが最小のしきい値を選ぶ
誤報と見逃しの引き換えを決めるには、それぞれの重みが要ります。ここでは、誤報1件(予測の窓のうちに故障が起きなかった警報。その警報で行う点検1回分)の相対コストを1、間に合う警報を受けて行う計画保全1件の相対コストを3とし、見逃し1件(突発停止)の相対コストを5・20・50の3通りに変えて計算します。間に合わない警報は、準備ができないまま故障するので、見逃しと同じ相対コストとしました。この章でこれ以降「見逃し1件の相対コスト」と呼ぶもの(表の列名と文中の両方)は、見逃した故障と、警報が間に合わなかった故障の、どちらにも1件ごとに掛ける相対コストを指します。見逃しと間に合わない警報の数え方は、これまでどおり分けたままです。判定保留の警報は、誤報かどうかが分からないので相対コストに入れていません。どれも単位の無い相対コストで、金額ではありません。見逃しの相対コストを3通りに変えたのは、同じデータでも、突発停止の重さによって選ぶべきしきい値が変わることを見るためです。期待コストは、合計の相対コストを設備・年の数(設備40台×2年=80)で割った、設備1台・1年あたりの平均です。
この計算には、楽観に寄った仮定が1つ入っています。間に合う警報があった故障は、すべて計画保全で防げたとみなして相対コスト3を当てています。実際には、警報から何を点検し、何を交換すれば故障を防げるかが決まっていなければ、警報が先に出ていても故障は防げません。前の節で見た、突発型の故障に無関係な警報がたまたま先行したものも、この計算では「間に合う」に入り、計画保全で防げたことになっています。したがって、以下の期待コストは「間に合う警報があった故障を全件防げたと仮定した、評価用の損失」で、保全の施策の効果をそのまま表すものではありません。
# ===== ブロック4:相対コストで期待コストが最小のしきい値を選ぶ =====
C_FALSE, C_PLAN = 1.0, 3.0      # 誤報1件の点検、間に合った警報で行う計画保全
YEARS = N_EQ * N_DAY / 365      # 設備・年の数

def cost(r, c_miss):
    # 間に合う警報があった故障は、すべて計画保全で防げたと仮定する(評価用の損失)
    # 間に合わない警報は突発停止と同じ扱いにする。判定保留の警報は入れない
    return (r["false"] * C_FALSE + r["ok"] * C_PLAN
            + (r["late"] + r["miss"]) * c_miss)

grid = np.round(np.arange(2.0, 7.01, 0.1), 2)
curves = {}
for c_miss in [5.0, 20.0, 50.0]:
    vals = []
    for th in grid:
        vals.append(cost(evaluate(th), c_miss) / YEARS)
    vals = np.array(vals)
    curves[c_miss] = vals
    k = int(np.argmin(vals))
    r = evaluate(grid[k])
    print("見逃しの相対コスト %4.0f:最適しきい値 %.1f 期待コスト %.2f /設備・年"
          "(警報 %d 誤報 %d 間に合う %d 間に合わない %d 見逃し %d 突発型に先行 %d)"
          % (c_miss, grid[k], vals[k], r["alarm"], r["false"], r["ok"], r["late"],
             r["miss"], r["luck"]))

# 何もしない(事後保全)ときの比較:すべての故障が突発停止
for c_miss in [5.0, 20.0, 50.0]:
    print("事後保全のみ 見逃しの相対コスト %4.0f:期待コスト %.2f /設備・年"
          % (c_miss, len(fail) * c_miss / YEARS))
実行した結果を次の表にまとめます。「事後保全のみ」は、警報を一切使わず、95件の故障をすべて突発停止として扱った場合の期待コストです。
| 見逃し1件の相対コスト(間に合わない故障にも適用) | 期待コストが最小のしきい値 | 期待コスト(設備・年あたり) | 警報 | 誤報 | 間に合う | 間に合わない | 見逃し | 突発型に先行 | 事後保全のみの期待コスト |
|---|---|---|---|---|---|---|---|---|---|
| 5 | 5.1 | 5.71 | 108 | 34 | 26 | 29 | 40 | 2 | 5.94 |
| 20 | 2.6 | 9.40 | 409 | 246 | 82 | 4 | 9 | 11 | 23.75 |
| 50 | 2.1 | 10.71 | 655 | 431 | 92 | 0 | 3 | 17 | 59.38 |
表の「警報」は判定保留を含む警報の総数、「突発型に先行」は、間に合う・間に合わないに数えた故障のうち、前ぶれの無い突発型の故障の件数です。見逃し1件の相対コストが20のとき、期待コストが最小になるしきい値は2.6で、期待コストは設備・年あたり9.40でした(しきい値2.8でも、小数第2位まで同じ9.40でした)。この設定のもとで、しきい値を選んだのと同じ全期間のデータの上で比べると、事後保全のみの23.75の半分以下です。
この比較には注意が2つあります。1つは、表の「突発型に先行」の11件で、間に合う82件のうち10件と、間に合わない4件のうち1件の合計で、どれも無関係な警報がたまたま先行したものです。もう1つは、同じデータで選んで同じデータで測った値なので、後の節で見るように楽観を含みやすいことです。警報の仕組みを作って維持する手間も、この相対コストには入っていません。
見逃しの相対コストが50になると、最適なしきい値は2.1まで下がり、誤報を431件出してでも見逃しを3件に抑える方が、この設定では期待コストが小さくなりました。反対に、見逃しの相対コストが5のときは、最適なしきい値は5.1と高く、期待コストは5.71で、事後保全のみの5.94とほとんど変わりません。この設定の計算では、突発停止が軽い設備に警報の仕組みを入れても、期待コストはほとんど下がりませんでした。
第1章で扱った「すべての設備を予知保全にしない」という判断を、この計算の形で考えることができます。
なお、この計算では、警報が出ても7日前に届かなかった故障を突発停止と同じ扱いにしています。突発停止かどうかを、保全の準備に要する日数を基準に分けた数え方です。第7章の残存寿命は、健全性指標が交換の水準に達するまでの時間として定義しており、この章の「故障」(架空データの上で機能が失われる出来事)とは別のものを数えています。
上の表は最小の点だけを示していますが、最小の点の周りで期待コストがどう変わるかも見ておきます。実行した結果では、見逃しの相対コストが20のとき、しきい値2.1から3.1までの期待コストは9.40から10.01の間に収まり、ほぼ平らでした。しきい値3.2では10.94、3.4では12.09と上がっていきます。最小の点そのものより、この平らな範囲のどこを選ぶかを、警報の総数(保全員が対応できる件数)で決めるのが実務的だと考えています。平らな範囲の中では、しきい値を上げれば誤報が減り、期待コストはほとんど変わらないからです。
ここで、最適なしきい値の警報の件数を、保全員の仕事量に置き換えてみます。警報が出た時点では、それが正しい警報か誤報かは分からないので、保全員が対応するのは誤報だけでなく警報の全件です。見逃しの相対コストが20のときの警報409件(設備40台・2年)は、1年あたり約205件、週にならすと約3.9件で、そのうち誤報の246件は週にならすと約2.4件です。見逃しの相対コストが50のときの警報655件は、週にならすと約6.3件で、そのうち誤報の431件は週に約4.1件になります。期待コストの計算は誤報1件を点検1回の相対コスト1として数えていますが、誤報が続くことで保全員が警報を軽く扱うようになる損失(警報の形骸化)は、この計算に入っていません。経営の判断の節で扱うように、警報の件数には、相対コストとは別に「現場が受け止められる上限」を置く必要があります。
コード:持続条件の効果と、時間で分けた評価
誤報を減らす方法として、しきい値を上げる以外に、持続条件(何日続けて超えたら警報にするか)を付ける方法があります。故障と無関係な一時的な上振れは1〜3日で消えるので、2日続けて超えたときだけ警報にすれば、一部の上振れによる誤報を除けるはずです。次のコードの前半は、しきい値3.5と4.0で、持続条件を1日と2日にして比べたものです。後半は、評価用データの切り方の節で述べた時間での分割で、1年目の終わりまでに分かっている記録だけで期待コストが最小のしきい値を選び(見逃しの相対コストは20)、そのしきい値を2年目に当てはめたときの成績を確かめます。evaluate に d_to として1年目の終わりを渡すので、2年目の故障は1年目の警報の判定に使われず、1年目の終わりの60日に出て故障がまだ起きていない警報は判定保留になります。
# ===== ブロック5:持続条件(2日続けて超えたら警報)を付けたとき =====
for th in [3.5, 4.0]:
    for hold in [1, 2]:
        r = evaluate(th, hold=hold)
        print("しきい値 %.1f 持続 %d日:警報 %d 判定保留 %d 誤報 %d 間に合う %d 間に合わない %d 見逃し %d リード中央値 %.1f"
              % (th, hold, r["alarm"], r["pend"], r["false"], r["ok"], r["late"], r["miss"],
                 np.median(r["leads"])))


# ===== ブロック6:時間で分けて、1年目で決めたしきい値を2年目で確かめる =====
Y1, Y2 = (0, 365), (365, N_DAY)
eq_years = N_EQ * 1.0          # 各期間は1年
for c_miss in [20.0]:
    v1 = np.array([cost(evaluate(th, d_from=Y1[0], d_to=Y1[1]), c_miss) for th in grid]) / eq_years
    v2 = np.array([cost(evaluate(th, d_from=Y2[0], d_to=Y2[1]), c_miss) for th in grid]) / eq_years
    k1, k2 = int(np.argmin(v1)), int(np.argmin(v2))
    print("1年目で選んだしきい値 %.1f:1年目の期待コスト %.2f、2年目に当てはめた期待コスト %.2f"
          % (grid[k1], v1[k1], v2[k1]))
    print("2年目だけで選び直した場合のしきい値 %.1f:2年目の期待コスト %.2f" % (grid[k2], v2[k2]))
    for name, (a, b) in [("1年目", Y1), ("2年目", Y2)]:
        r = evaluate(grid[k1], d_from=a, d_to=b)
        print("  しきい値 %.1f の%s:警報 %d 判定保留 %d 誤報 %d 間に合う %d 間に合わない %d 見逃し %d"
              % (grid[k1], name, r["alarm"], r["pend"], r["false"], r["ok"], r["late"], r["miss"]))
持続条件の結果は次の表のとおりです。
| しきい値 | 持続条件 | 警報 | 判定保留 | 誤報 | 間に合う | 間に合わない | 見逃し | リードタイムの中央値(日) |
|---|---|---|---|---|---|---|---|---|
| 3.5 | 1日 | 257 | 14 | 135 | 61 | 15 | 19 | 15.0 |
| 3.5 | 2日 | 125 | 6 | 53 | 33 | 25 | 37 | 8.0 |
| 4.0 | 1日 | 208 | 14 | 105 | 48 | 25 | 22 | 11.0 |
| 4.0 | 2日 | 94 | 5 | 32 | 24 | 25 | 46 | 6.0 |
持続条件を2日にすると、しきい値3.5では誤報が135件から53件に減りましたが、見逃しは19件から37件に増え、間に合う警報は61件から33件に減りました。リードタイムの中央値も15.0日から8.0日に縮みました。本コラムの架空データのこの1回の乱数では、持続条件は誤報だけでなく、劣化の早い時期の正しい警報も削りました。理由としては、劣化が始まったばかりのスコアは日ごとのゆらぎに比べて上昇が小さく、しきい値をまたいで上下するため、2日続けて超えるのが劣化の進んだ後になる、ということが考えられます。ただし、この理由はこの章では確かめていません(劣化の初期のスコアの動きを個別に調べた計算はしていません)。持続条件が有効かどうかは、誤報の原因となる上振れの長さと、劣化の初期のスコアの動き方によって決まります。持続条件を付けるなら、この表のように見逃しとリードタイムへの影響も同時に確かめる必要があります。日ごとのゆらぎを抑えるには、持続条件のほかに、スコアそのものを過去数日の移動平均にしてから判定する方法もあります(この章では計算していません)。
時間で分けた評価では、1年目の終わりまでに分かっている記録だけで選んだしきい値は2.1で、1年目の期待コストは設備・年あたり9.12でした。同じしきい値を2年目に当てはめると、期待コストは8.95になりました。2年目のデータだけで選び直した場合(しきい値2.6)の2年目の期待コストは8.65です。期待コストは小さいほどよい値で、ここでも前の節と同じく、間に合う警報があった故障を全件防げたと仮定した評価用の損失です。しきい値2.1の件数は次の表のとおりです。
| 期間 | 警報 | 判定保留 | 誤報 | 間に合う | 間に合わない | 見逃し |
|---|---|---|---|---|---|---|
| 1年目(しきい値を選んだ期間) | 326 | 50 | 193 | 44 | 0 | 2 |
| 2年目(当てはめた期間) | 329 | 44 | 194 | 48 | 0 | 1 |
期間の境目をまたぐ警報と故障は、次のように扱っています。
- 1年目の終わりに出た警報は、2年目の故障を使わずに判定します。1年目のうちに故障が起きていなければ、判定保留になります。表の1年目の判定保留50件は、1年目の終わりの60日に出て、1年目の終わりまでに故障が起きていない警報です。しきい値を選ぶ時点では誤報かどうか分からないので、選択には使っていません
- 2年目の初めの故障は、故障当日を含む過去60日に1年目のうちに出た警報があれば、「警報が出ていた故障」として数えます。運用の中でも、2年目の故障の時点では1年目の警報はすでに出ているからです
- 表の2年目の判定保留44件は、記録の終わりの60日に出た警報です
しきい値を選んだデータの上で測った成績は、一般に、次の期間に当てはめた成績より良く出やすいとされます。選んだデータの偶然の並びに合わせてしきい値を決めているので、同じデータで測った成績には、その分の楽観が含まれやすいからです。この例では反対に、2年目に当てはめた期待コスト(8.95)の方が、1年目の上での期待コスト(9.12)より小さく、悪化は見られませんでした。2年目だけで選び直した場合の8.65と比べると、1年目で選んだしきい値を当てはめた分だけ2年目の期待コストは大きくなっていますが、その差は0.30です。これは1回の比較で、2年目の故障の件数(49件)も1年目(46件)と違うので、この結果から「時間で分けても期待コストは悪化しない」とは言えず、偶然との区別もついていません。
また、この1回の乱数では、2年目の最適なしきい値(2.6)は1年目のもの(2.1)と違いました。この架空データは2年間で生成の仕組みを変えていないので、この違いは、故障の件数が年に50件ほどしかないことによる偶然のばらつきと考えられます。故障の件数が少ないうちは、最適なしきい値そのものが年ごとに動きうる、ということです。実際の設備では、これに加えて稼働条件の変化やセンサーの交換による変化も入ります。
警報疲れとアラーム管理の規格
誤報が続くと、保全員は警報を確かめずに流すようになります。この状態を、本コラムでは警報疲れと呼びます。警報疲れが進むと、正しい警報も見落とされるので、警報の仕組みは事実上止まったのと同じになります。序章で整理した6つの損失の型のうち「警報の形骸化」がこれに当たります。前の節の計算では、見逃しの相対コストを20としたとき、期待コストが最小のしきい値でも、設備40台で週に約3.9件の警報が出て、そのうち約2.4件が誤報でした(相対コストを50としたときは、警報が週に約6.3件、そのうち誤報が約4.1件でした)。その件数を保全員が毎回点検できるのか、点検しきれずに後回しが常態になるのかで、仕組みの価値は大きく変わります。
警報の数と質を管理する考え方は、プロセス産業(化学・石油・電力などの連続運転のプラント)の運転員向けの警報について、規格として整理されています。国際規格の IEC 62682(プロセス産業のアラームシステムの管理)は、IEC の目録で、第2版が2022年12月8日に発行されたことを確かめました。目録の比較版の説明では、前の版は2014年の第1版です。目録の適用範囲の説明を要約すると、プロセス産業で制御システムを通じて運転員に示す警報について、アラームシステムの管理の原則と手順を扱い、連続・バッチ・ディスクリートのプロセスに適用できるとされています。
計測・制御の団体である ISA(International Society of Automation)が定めた ISA-18.2(2016年版。プロセス産業のアラームシステムの管理)も、同じ主題を扱っています。ISA の ISA-18 シリーズの公式ページでは、ISA-18.2 の版は2016年版だけが挙げられており、警報のライフサイクル全体を扱う規格と説明されています。同じページの説明では、運転員を煩わせるだけの警報(ニューサンスアラーム)や、短時間に警報が殺到する状態(アラームフラッド)を減らすことが、運転員が本当に急ぐべき問題に集中するために必要だとされています。同じページには、ISA-18.2 の使い方を補う技術報告書も並んでおり、この章の内容に近いものは次のとおりです。
- アラームの基本方針(ISA-TR18.2.1、2018年)
- アラームの識別と合理化(ISA-TR18.2.2、2016年)
- アラームシステムの監視・評価・監査(ISA-TR18.2.5、2022年)
- 警報ではない通知の指針(ISA-TR18.2.8、2023年)
IEC 62682 と ISA-18.2 の規格本体は、制御システムを通じて運転員に出す警報を主な対象にしたもので、予知保全の仕組みが保全員に出す警報をそのまま対象にしているとは、目録と公式ページの説明からは読み取れません。一方、技術報告書の ISA-TR18.2.8 は、公式ページの説明では、保全員・技術者・管理者のように運転員以外の人に向けた、警報ではない通知を扱うとされています。予知保全の通知の扱いを考えるうえで補足的に参考になりますが、この章ではその本文を確かめていません。また、この章では規格の本文(条文)を確かめていません。そのうえで、公式ページの説明から読み取れる「警報をライフサイクルとして管理する」「運転員を煩わせるだけの警報を減らす」「監視・評価・監査を続ける」という考え方は、予知保全の警報にも借りられると考えています。本コラムでは、その考え方を予知保全の警報の設計に当てはめ、次の4つを勧めます(4つの項目は規格の条文の要約ではなく、本コラムの提案です)。
- 警報の基本方針を文書にする(何を警報にし、何を警報にしないか、誰がどう対応するかを先に決める)
- 警報1つ1つについて、なぜ必要か・誰が何をするか・何分(何日)以内に対応するかを決め、決められない警報は出さない(合理化)
- 警報の件数・誤報の割合・対応までの時間を継続して監視し、定期的に見直す
- 点検で異常が無いと分かっている警報を一時的に保留する手順と、保留を解く手順を決めておく
2つ目の「対応が決められない警報は出さない」という考え方は、予知保全でとくに大切だと考えています。「スコアが高い」という通知だけを出し、何を見ればよいか・いつまでに何をすればよいかを決めていない警報は、受け取った保全員にとって判断の材料になりません。第6章の故障診断の結果(どの故障モードの可能性が高いか)と、第7章の残存寿命の幅(いつ頃までに対応すべきか)を警報に添えることは、この合理化の一部として位置づけられます。なお、IEC 62682 に対応する日本産業規格(JIS)があるかどうかは、この章では確かめていません。
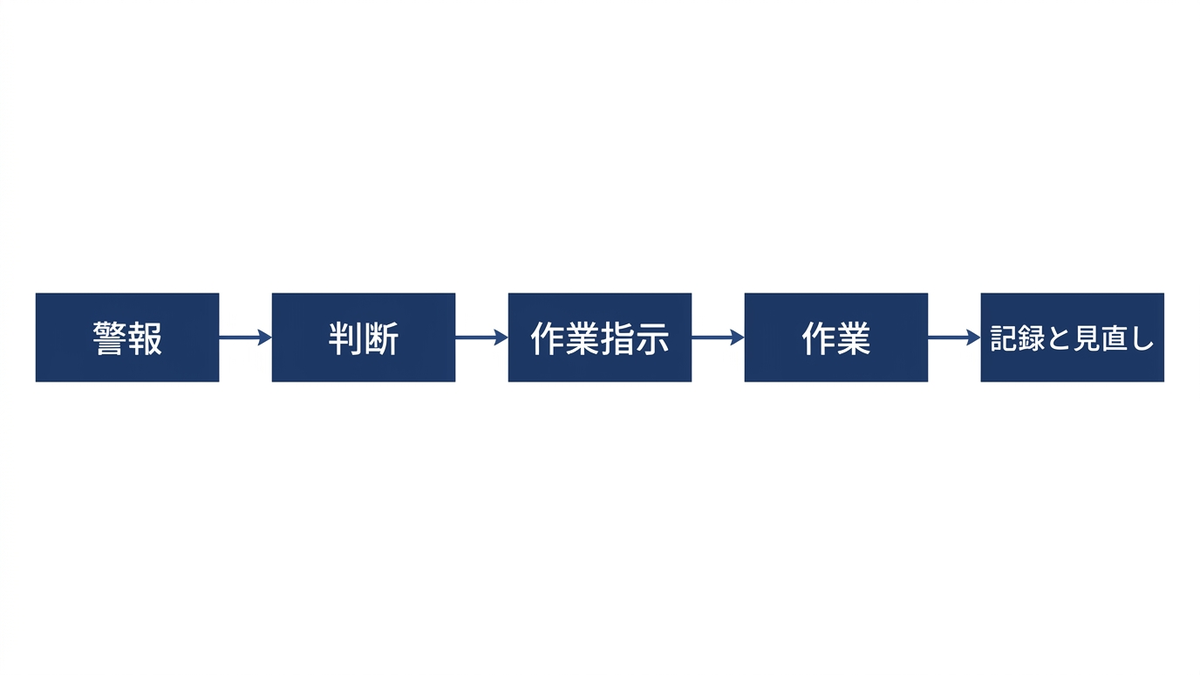
警報の段階と対応の手順を決める
警報を1種類にすると、「すぐに止めるべき異常」と「次の計画停止で見ればよい兆候」が同じ通知になり、保全員はどれから手を付ければよいか分かりません。警報をいくつかの警報の段階に分け、その段階ごとに誰が・いつまでに・何をするかを決めておくことを勧めます。本コラムでは、警報の段階として注意・警告・停止の3つの例を示します。警報の段階の名前や数は、既存の監視システムや社内の呼び方に合わせて変えて構いません。
| 警報の段階 | 出す条件の例 | 受け取る人 | 対応の期限の例 | 対応の手順の例 |
|---|---|---|---|---|
| 注意 | スコアが低めのしきい値を超えた。残存寿命の幅の下限が、必要なリードタイムより十分長い | 保全の担当者(まとめて確認) | 次の定例の打ち合わせまで | 傾向を確認し、次の巡回点検で重点的に見る。部品の在庫を確かめる |
| 警告 | スコアが高めのしきい値を超えた。残存寿命の幅の下限が、必要なリードタイムに近づいた | 保全の担当者と、保全計画の担当者 | 数日以内 | 点検の作業指示を出す。点検で異常を確かめたら、部品と作業者を手配し、計画停止の枠を確保する |
| 停止 | スコアが急に上がった。複数の指標が同時に悪化した。点検で進行した損傷を確かめた | 保全の責任者と、生産の責任者 | その日のうち | 運転の継続の可否を人が判断する。止める場合は生産と調整して停止の手順を進める |
表の警報の段階のうち「停止」でも、止めるかどうかを決めるのは人です。予知保全の仕組みは判断の材料を出すもので、設備の停止や運転の継続を自動で決めるものとして設計しないことを勧めます。とくに、安全に関わる停止(人や環境に危害が及ぶおそれがあるときの停止)は、既存の安全装置・安全計装システムと、法令に基づく点検と手順が受け持つものです。予知保全の警報は、それらを置き換えるものではなく、その手前で保全の準備を早めるためのものとして位置づけます。表の「対応の期限の例」も、その期限までなら安全に運転を続けられるという猶予を示すものではありません。実際の期限は、故障したときの影響と、対応に使える時間から設備ごとに決めます。また、この章のコードで行った相対コストの比較は、安全上・法令上の条件を満たしたうえで、残った選択肢の中から選ぶための材料です。安全上の条件を相対コストと引き換えにして決めることはしません。
警報の段階を分けると、警報の段階ごとに誤報と見逃しを別々に評価できるようになります。警報の段階が「注意」のものは早く出ることが大事なので、誤報がほかの警報の段階より多くなることを許し、「停止」のものは誤報が少ないことを重く見る、というように、警報の段階ごとに許容する誤報の件数を変えられます。ただし、「注意」の警報も保全員の手間を使うので、経営の判断の節で述べる誤報の許容量(現場が対応できる警報の件数の上限)の中に含めて数えます。前の節のコードに当てはめるなら、「注意」には低めのしきい値(たとえば期待コストが平らな範囲の下の端)、「警告」には高めのしきい値を当てる、という使い分けが考えられますが、この警報の段階ごとの評価は本章では計算していません。警報の段階ごとの件数・誤報の割合・対応までの日数を月ごとに集計し、保全部門の定例の場で見直すことが、警報疲れを防ぐ運用の中心になると考えています。
モデルの劣化を監視し、しきい値を見直す
しきい値は、一度決めたら終わりではありません。時間で分けた評価で見たように、故障の件数が少ないうちは、最適なしきい値そのものが期間ごとに動きます。加えて、運用を続けるうちに、設備の稼働条件(生産品目・負荷・回転数)の変化、センサーの交換や取り付け位置の変更、部品の仕様の変更などで、スコアの分布が変わることがあります。スコアの分布が変われば、同じしきい値でも誤報と見逃しの件数が変わります。
監視する指標は、警報の評価に使ったものと同じものを、月ごとに追うのが分かりやすいと考えています。警報の件数・誤報の割合・故障の件数・見逃しの件数・リードタイムの分布です。ただし、見逃しは故障が起きて初めて分かり、故障の件数は少ないので、月ごとの変化だけで判断すると偶然のばらつきに振り回されます。警報の件数や、正常な期間のスコアの分布(平均や上位の分位点)のように、故障を待たずに毎日分かる指標を先行して見る方が、変化に早く気づけます。正常な期間のスコアの分布がずれてきたら、第5章で扱った「正常の定義」の更新を検討する合図になります。
モデルの監視と再学習の仕組みそのもの(データの分布の変化の検知、再学習の頻度、モデルの版の管理)は、弊社コラム「機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで」で扱いました。予知保全に固有の点は、正解(故障したかどうか)が分かるまでに時間がかかり、しかも警報を受けて保全をすれば正解そのものが観測されなくなることです。前の節で述べたように、運用を始めた後の評価には、警報の後に何をしたかを保全記録から引く必要があります。
| 見る指標 | 分かるまでの時間 | 変化したときに疑うこと | 見直す人の例 |
|---|---|---|---|
| 警報の件数(警報の段階ごと) | 毎日 | 稼働条件の変化。センサーの不具合。しきい値の不適合 | 保全の担当者 |
| 誤報の割合(予測の窓で数えたもの) | 警報から予測の窓の日数が過ぎた後(この章の数え方では60日後) | 一時的な上振れの増加。正常の定義のずれ | 保全の担当者とデータの担当者 |
| 点検で異常が見つからなかった警報の割合 | 点検の後、数日 | 警報の条件と点検の項目の食い違い。点検で見えない部位の劣化 | 保全の担当者 |
| 正常な期間のスコアの分布 | 毎日 | センサーの交換・取り付け位置の変更。生産品目の変化 | データの担当者 |
| リードタイムの分布 | 故障の後 | 劣化の進み方の変化。故障モードの構成の変化 | 保全の責任者とデータの担当者 |
| 見逃しの件数 | 故障の後 | 新しい故障モードの発生。監視していない部位の故障 | 保全の責任者 |
経営の判断、誤報の許容量を現場と決める
この章の計算から、経営の判断に関わる点を4つ挙げます。1つ目は、警報のしきい値は技術の担当者だけで決めるものではなく、「突発停止1件の重さ(見逃した故障と、警報が間に合わなかった故障)」と「誤報1件の重さ」という経営の判断を入力にして決まるものだということです。本コラムの架空データでは、見逃し1件の相対コストを5・20・50と変えるだけで、最適なしきい値は5.1・2.6・2.1と大きく動きました。突発停止がどれだけ重いか(生産・供給の損失、安全と環境の事故、品質の不良につながるか)は、設備ごとに経営と生産部門が決めるべきことで、その値が決まらないうちは、しきい値も決まりません。
2つ目は、誤報の許容量、つまり現場が対応できる警報の件数の上限を、保全の現場と先に決めることです。期待コストの計算は、警報の件数がいくら多くても点検が実行される前提に立っています。実際には、保全員の人数と時間には限りがあり、それを超える警報は点検されずに流され、警報の形骸化につながります。警報が出た時点では正しい警報か誤報かは分からないので、上限は誤報の件数ではなく、対応する警報の総数で置く必要があります。「設備40台で、警報の段階ごとの対応の手間を見込んで、週に何件までの警報なら全件に対応できるか」という上限を先に保全部門と決め、その上限の中で期待コストが最も小さいしきい値を選ぶ、という順で決めるのが実務的だと考えています。しきい値そのものは、保全部門が案を作り、工場長が承認し、データ担当が設定を変える、という分担を想定しています(役割の分担は第13章で扱います)。誤報の件数で上限を置く場合は、通常の業務と正しい警報への対応に使う時間を差し引いた余力として決めます。上限を超える警報が出る設定しか選べないなら、それは仕組みの改善(スコアの改良や、警報の段階の分け方の見直し)か、保全の体制の見直し(人員や外部の委託)が必要だという判断材料になります。
3つ目は、見逃しの重さが小さい設備には、予知保全の警報を入れても効果が小さい場合があることです。本コラムの架空データで見逃しの相対コストを5とした計算では、最適なしきい値を選んでも、期待コスト(間に合う警報があった故障を全件防げたと仮定した評価用の損失)は事後保全のみとほとんど変わりませんでした。警報の仕組みは、作るのにも維持するのにも手間がかかります。どの設備を対象にするかの判断(第12章)では、この計算を設備ごとに当てはめ、効果が見込めない設備を外すことが、二重投資や過剰保全を避けることにつながります。
4つ目は、評価の報告の形を決めることです。PoC(試行)の報告で「異常検知の精度は95%」のような1つの数字が出てきたら、それが正解率なのか、適合率なのか、再現率なのか、何を1件と数えたのか、予測の窓は何日か、しきい値を決めたデータと評価したデータは分かれているか、を確かめる必要があります。報告には、少なくとも次の項目をそろえることを求めるのがよいと考えています。
- 評価に使った期間と設備、しきい値を決めた期間と設備(分かれているか)
- 予測の窓の長さと、必要なリードタイムの長さ
- 故障の件数と、そのうち間に合う警報があった件数・間に合わなかった件数・見逃しの件数
- 警報の総数と誤報の件数を、設備1台・1か月あたりのように保全員の仕事量に換算した値(予測の窓の終わりまで追跡できなかった判定保留の件数も添える)
- リードタイムの分布(中央値だけでなく、短い側の分位点と最小値)
- 見逃しと誤報の相対コストを変えたときに、結論(どのしきい値がよいか)が変わるか
この章の要点は3つです。第一に、予知保全の警報は、正解率やROC-AUCだけでなく、故障1件ごとに「間に合う警報があったか・間に合わなかったか・見逃したか」と、ひと続きの警報1件ごとに「誤報だったか」を数え、リードタイムの分布を添えて評価します。予測の窓や警報のまとめ方を変えると数字が変わり、窓の終わりまで追跡できない警報は判定保留になるので、数え方を先に決めて報告に添えます。第二に、本コラムの架空データでは、しきい値を上げると誤報は減り、見逃しと間に合わない警報が増え、リードタイムは縮みました。見逃しと誤報の相対コストを決めれば期待コストが最小のしきい値を選べますが、この1回の乱数では、その答えは見逃しの重さで大きく動きました。この期待コストは、間に合う警報があった故障を全件防げたと仮定した評価用の損失です。時間で分けて評価するときは、しきい値を選ぶ期間の外の故障を判定に使わないようにします。1年目の記録だけで選んだしきい値を2年目に当てはめると、期待コスト(小さいほどよい値)は1年目の上の9.12に対して2年目は8.95で、悪化は見られませんでしたが、1回の比較なので偶然との区別はついていません。第三に、誤報が続くと警報疲れが起き、警報の仕組みは止まったのと同じになります。現場が対応できる警報の件数の上限を現場と決め、警報の段階(注意・警告・停止)を分けて対応の手順を決め、件数とリードタイムを継続して見直します。次の第9章では、こうして出した警報と残存寿命の予測を入力にして、交換の時期と点検の周期、保全員への作業の割当を数理モデルで決める方法を扱います。
この章を深めたい方への参考書籍
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標とKPIの関係から始め、回帰・二値分類・多クラス分類の評価指標を扱う本で、二値分類の章では適合率・再現率に加えて、ビジネスへの影響の期待値の計算やコストを考慮した学習も取り上げています。この章で行った、誤報と見逃しの相対コストから期待コストを計算してしきい値を選ぶ考え方を、評価指標の側から体系立てて確かめるのに向いています。
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):データ分析のコンペティションで使われる技術をまとめた本で、モデルの評価の章では、時系列データの検証の方法やグループごとに分ける交差検証を、タスクと評価指標の章ではデータの漏れ(リーク)を扱っています。この章の「時間で分ける・設備で分ける」という評価用データの切り方と、漏れの防ぎ方を、具体的な手順で確かめるのに役立ちます。
第9章 保全計画の最適化、交換時期と点検周期と作業の割当を数理モデルで決める
第8章では、警報のしきい値を動かしたときの誤報と見逃しの件数、警報から故障までのリードタイムを数え、誤報と見逃しの相対コストから期待コストが最小になるしきい値を選びました。警報が「間に合う」ことを確かめた次に要るのは、その警報や予測を受けて、どの設備を、いつ、誰が保全するかを決めることです。この章では、その決め方を数理モデルとして書き下ろします。前半では、信頼性工学で古くから使われてきた取替方策(部品をいつ交換するかの決め方)を取り上げ、寿命の分布と交換の相対コストから予防保全の最適周期を数値計算します。中ほどでは、普段は動かない装置の隠れた故障を見つけるための点検周期を扱います。後半では、予知保全が出した残存寿命の予測を入力にします。保全員の人数と計画停止の時間枠という制約のもとで複数の設備の作業を割り当てる、小さな混合整数計画(0か1のように整数の値しか取らない変数を含む最適化の問題)を解きます。
この章のコードは、すべて架空の部品と設備のデータで書きました。寿命の分布の形・相対コスト・作業時間・人数は、計算の仕組みを示すために置いた値で、特定の設備や業界の典型値ではありません。コストはすべて単位のない相対コストで、予防交換1回を1とした比で書いています。結果の数字は、本コラムの架空データでの条件つきの値です。この章の例題では、寿命の終わりを「部品や設備が故障して機能を果たせなくなる時点」(機能故障)とし、残存寿命もその時点までの残りの日数として扱います。第7章の残存寿命は「交換の水準への到達」までの日数で、寿命の終わりの置き方がこの章とは違います。式の考え方そのものは、信頼性工学とオペレーションズ・リサーチの教科書や講義資料で扱われている標準的なものです。
取替方策の3つの型、事後取替・年齢取替・ブロック取替
部品の交換の決め方は、大きく3つの型に分けて整理されることが多いです。1つ目は事後取替で、部品が壊れるまで使い、壊れたら交換します。第1章で整理した事後保全を、部品の交換に当てはめたものです。2つ目は年齢取替で、部品ごとに使い始めてからの時間(年齢)を数え、決めた年齢 \( T \) に達したら壊れていなくても交換し、それより前に壊れたらその時点で交換して年齢を0に戻します。3つ目はブロック取替で、部品の年齢に関係なく、決めた周期 \( T \) ごとに一斉に交換し、その間に壊れたものはその都度交換します。年齢取替は部品ごとに使用時間を管理する必要があり、ブロック取替は暦の上の周期だけで管理できる代わりに、直前に交換したばかりの部品も周期が来れば交換します。
保全の方策を数理モデルとして扱った古典の1つに、Barlow と Hunter が1960年に学術誌『Operations Research』(第8巻第1号、90〜100ページ)に発表した論文「Optimum Preventive Maintenance Policies」があります。この論文の書誌は DOI の登録情報(Crossref)で確かめましたが、論文の本文には当たっていないため、この論文がどの方策をどこまで扱ったかは本コラムでは書きません。ノルウェー科学技術大学の講義資料や、年齢取替の最適性の基準を論じた論文では、年齢取替とブロック取替を並べて、長期の単位時間あたりの期待コスト(以下「コスト率」と呼びます)を最小にする周期を求める問題として説明しています。
| 取替方策 | 交換のきっかけ | 管理に要るもの | 向いている場面 | 弱いところ |
|---|---|---|---|---|
| 事後取替 | 部品が壊れたとき | 故障の検知と予備品 | 故障したときの安全・環境・生産への影響を評価し、許容できると判断した部品。故障率が時間とともに増えない部品は年齢による予防交換の効果が小さく、影響を評価したうえでの候補になる | 突発停止をそのまま受ける |
| 年齢取替 | 部品の年齢が \( T \) に達したとき、またはそれ以前に壊れたとき | 部品ごとの使用時間の記録 | 摩耗で故障率が上がり、事後交換の相対コストが予防交換より大きい部品 | 使用時間を部品ごとに数え続ける手間 |
| ブロック取替 | 暦の上の周期 \( T \) が来たとき(途中の故障はその都度交換) | 周期の予定表 | 同じ部品が多数あり、まとめて交換すると段取りが減る場合 | 交換したばかりの部品も周期が来れば交換する |
| 状態基準・予測による取替 | 状態の測定値や予測がしきい値に達したとき | 状態の監視と予測、判断の手順 | 劣化が測れて、警報から故障までに準備の時間がある部品 | 測定と予測の仕組みの維持が要る |
表の最後の行は、取替方策の古典的な3つの型には入りませんが、予知保全が目指す交換の決め方を同じ列で並べるために加えました。年齢取替とブロック取替でも、部品の種類や寿命の分布ごとに周期を変えることはできます。この章の例題では、「部品の寿命はばらつくが、その分布は分かっている」という前提で、同じ寿命の分布と交換の相対コストを持つ部品に共通の周期を設定します。状態基準・予測による取替は、部品ごとの状態や予測を見て交換の時期を個別に決めます。この章の前半で年齢取替を計算しておく理由は、周期で交換したときのコストの水準を知っておくためです。この章では年齢取替と予知保全を同じ例題で直接は比べていません。周期で交換するだけで突発停止の多くを防げる部品なら、状態を監視する仕組みを追加しても、上乗せの効果は小さいことがあります。
年齢取替の最適周期、寿命の分布と相対コストの比から決める
この章の取替方策の計算では、交換した部品は新品と同じ状態に戻り、各部品の寿命は互いに独立に同じ分布に従う、と置きます。年齢取替のコスト率は、「1回の交換周期にかかる費用の期待値」を「1回の交換周期の長さの期待値」で割って求めます。予防交換の相対コストを \( c_p \)、故障してからの事後交換の相対コストを \( c_f \)、部品が時刻 \( t \) まで壊れずに残る確率(信頼度)を \( R(t) \)、それまでに壊れる確率を \( F(t) = 1 – R(t) \) とすると、コスト率は \( C(T) = \dfrac{c_p R(T) + c_f F(T)}{\int_0^T R(t)\,dt} \) と書けます。分子は、年齢 \( T \) まで壊れずに残れば予防交換の費用、それまでに壊れれば事後交換の費用がかかることを、確率で重みづけたものです。分母は、交換周期の長さの期待値で、部品が年齢 \( T \) と故障のどちらか早いほうで交換されることから、信頼度を0から \( T \) まで積分した値になります。この形は、ノルウェー科学技術大学の講義資料(Rausand らの教科書『System Reliability Theory』(2021年)の第12章に基づく要約)と、ダラム大学の Coolen-Schrijner と Coolen の論文で、記号は違いますが同じ式として示されているのを確かめました。
寿命の分布には、第2章で扱ったワイブル分布を使います。形状パラメータが1より大きいと故障率が時間とともに上がる(摩耗型)ことを表し、1なら故障率が一定(偶発型)です。次のコードでは、架空の部品の寿命を形状2.5・尺度400日のワイブル分布とし、事後交換の相対コストを予防交換の5倍に置きました。以下、事後交換の相対コストを予防交換の相対コストで割った値を「費用比」と呼びます。この例の費用比は5です。コスト率の分母の積分は scipy の数値積分で、最小化は区間を指定した1変数の最適化で求めています。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
from scipy import integrate, optimize
from scipy.special import gamma

# 部品の寿命はワイブル分布(形状 beta・尺度 eta、単位は稼働日)と仮定する
beta, eta = 2.5, 400.0
cp, cf = 1.0, 5.0          # 予防交換と事後交換の相対コスト(比は 1 対 5)

def R(t, b=beta, e=eta):
    """信頼度(t 日まで壊れずに残る確率)"""
    return np.exp(-(t / e) ** b)

def cost_rate(T, b=beta, e=eta, c_p=cp, c_f=cf):
    """年齢取替の長期の単位時間あたり期待コスト"""
    num = c_p * R(T, b, e) + c_f * (1.0 - R(T, b, e))
    den = integrate.quad(lambda t: R(t, b, e), 0.0, T)[0]
    return num / den

mttf = eta * gamma(1.0 + 1.0 / beta)
print("平均寿命 MTTF %.1f 日" % mttf)
print("事後取替だけのコスト率 %.5f" % (cf / mttf))

res = optimize.minimize_scalar(cost_rate, bounds=(10.0, 1500.0), method="bounded")
T_opt = res.x
print("最適な交換年齢 T* %.1f 日" % T_opt)
print("T* でのコスト率 %.5f" % res.fun)
print("T* までに壊れる確率 %.3f" % (1.0 - R(T_opt)))
print("事後取替に対するコスト率の比 %.3f" % (res.fun / (cf / mttf)))
for T in [150, 200, 250, 300, 400, 600]:
    print("T=%4d 日 コスト率 %.5f" % (T, cost_rate(T)))
# 出力:
# 平均寿命 MTTF 354.9 日
# 事後取替だけのコスト率 0.01409
# 最適な交換年齢 T* 197.2 日
# T* でのコスト率 0.00866
# T* までに壊れる確率 0.157
# 事後取替に対するコスト率の比 0.614
# (T ごとのコスト率は本文に記載)
実行した結果、この部品の平均寿命は354.9日で、壊れるまで使う事後取替だけのコスト率は0.01409でした。事後取替では交換1回ごとに相対コスト5がかかり、それが平均354.9日に1回起きるので、5を354.9で割った値になります。年齢取替のコスト率は交換年齢197.2日で最小になり、そのときのコスト率は0.00866、事後取替だけのときの0.614倍でした。最適な交換年齢は平均寿命のおよそ56%に当たり、その年齢までに壊れてしまう部品は15.7%残ります。つまり、最適な周期で交換しても、部品の6本に1本ほどは周期の前に壊れて事後交換になる、という計算です。
もう1つ読み取れるのは、この例では最適な周期の近くでコスト率の曲線が平らだということです。交換年齢を150日にしても250日にしても、コスト率は0.00908と0.00898で、最小値0.00866との差は5%ほどに収まります。一方、400日まで延ばすと0.01129、600日では0.01355まで上がり、事後取替だけのときに近づきます。曲線が平らな範囲がある場合には、計算上の最適値を1日単位で守るよりも、計画停止の暦や他の部品の交換と合わせやすい周期をその範囲から選ぶほうが運用しやすいと考えています。谷の広さは形状と費用比で変わり、他の条件で同じように平らかはこの章では確かめていないので、自社の部品では条件ごとに曲線を描いて確かめる必要があります。どこまで外しても損が小さいかを曲線で示しておくと、現場と周期を相談するときの材料になります。
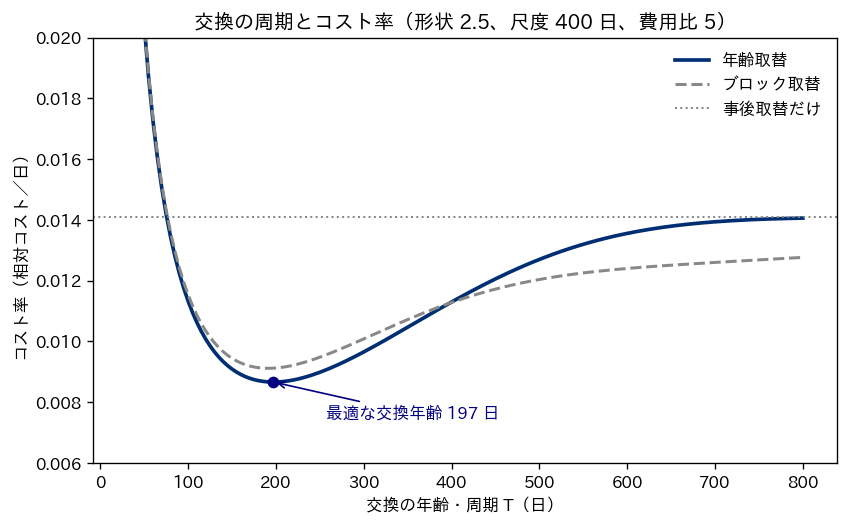
図は、横軸に交換の年齢(ブロック取替では周期)、縦軸にコスト率をとって、年齢取替(実線)・ブロック取替(破線)・事後取替だけの水準(点線)を並べたものです。グラフを描くコードは省略しました。交換の周期が短すぎると、まだ使える部品を頻繁に交換するので、コスト率は急に上がります。周期が長すぎると、交換する前に壊れる部品が増え、事後取替だけの水準に近づきます。その間の谷の底が最適な周期です。
最適周期は何に左右されるか、形状パラメータと費用比
最適な交換年齢は、寿命の分布の形と費用比(事後交換の相対コスト÷予防交換の相対コスト)で大きく変わります。次のコードは、形状パラメータを1.0・1.5・2.5・3.5、費用比を2・5・10・20と変えて、最適な交換年齢と、そのときのコスト率が事後取替だけのときの何倍になるかを一覧にしたものです。形状1.0は故障率が一定の指数分布で、この場合のコスト率は交換年齢を延ばすほど下がり続け、有限の最適な年齢がありません(理由は表の後で説明します)。そこで形状1.0は計算をせずに「なし」と表示させました。それ以外の形状で最適な年齢が探索の上限の近くに出た場合は、上限より先に最適な年齢がある可能性もあるので、「最適な年齢が無い」とは判定せず、探索範囲の再確認が必要と表示させます。今回の16通りでは、この表示は出ませんでした。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
from scipy import integrate, optimize
from scipy.special import gamma

eta, cp = 400.0, 1.0          # 尺度 400 日、予防交換の相対コスト 1
UPPER = 4000.0                # 探索の上限(尺度の10倍)


def cost_rate(T, b, cf):
    R = lambda t: np.exp(-(t / eta) ** b)
    den = integrate.quad(R, 0.0, T)[0]
    return (cp * R(T) + cf * (1.0 - R(T))) / den


print("形状 費用比 最適年齢T* T*/尺度 T*までの故障確率 事後取替比")
for b in [1.0, 1.5, 2.5, 3.5]:
    for ratio in [2, 5, 10, 20]:
        cf = cp * ratio
        if b == 1.0:                    # 故障率が一定(指数分布)なら、理論上は予防交換に得が無い
            print("%.1f %3d    なし(事後取替と同じ)" % (b, ratio))
            continue
        res = optimize.minimize_scalar(cost_rate, bounds=(1.0, UPPER),
                                       args=(b, cf), method="bounded")
        rtf = cf / (eta * gamma(1.0 + 1.0 / b))     # 事後取替だけのコスト率
        if res.x > 0.95 * UPPER:        # 上限の近く:最適が無いとは言えない。範囲を広げて確かめる
            print("%.1f %3d    上限の近く(探索範囲の再確認が必要)" % (b, ratio))
            continue
        pf = 1.0 - np.exp(-(res.x / eta) ** b)
        print("%.1f %3d  %7.1f  %.2f  %.3f  %.3f" % (b, ratio, res.x, res.x / eta, pf, res.fun / rtf))
実行した結果の16通りから抜粋して表にまとめます。形状1.0の4通りは1行にまとめ、形状1.5と形状2.5の費用比10、形状3.5の費用比2と費用比10の行は省きました。「事後取替比」の列は、最適な年齢で年齢取替をしたときのコスト率が、事後取替だけのときの何倍かを表します。1に近いほど、年齢取替をしても得るものが少ないことを意味します。
| 形状パラメータ | 費用比 | 最適な交換年齢(日) | 最適な年齢÷尺度 | その年齢までに壊れる確率 | 事後取替比 |
|---|---|---|---|---|---|
| 1.0 | 2〜20 | なし | なし | なし | 1(事後取替と同じ) |
| 1.5 | 2 | 869.9 | 2.17 | 0.960 | 0.998 |
| 1.5 | 5 | 270.2 | 0.68 | 0.426 | 0.890 |
| 1.5 | 20 | 90.4 | 0.23 | 0.102 | 0.612 |
| 2.5 | 2 | 353.4 | 0.88 | 0.520 | 0.921 |
| 2.5 | 5 | 197.2 | 0.49 | 0.157 | 0.614 |
| 2.5 | 20 | 105.0 | 0.26 | 0.035 | 0.283 |
| 3.5 | 5 | 207.8 | 0.52 | 0.096 | 0.490 |
| 3.5 | 20 | 132.8 | 0.33 | 0.021 | 0.190 |
表から読み取れることは3つあります。1つ目は、形状1.0、つまり故障率が時間によらず一定の部品では、費用比をいくら大きくしても有限の最適な交換年齢が無いことです。コスト率の式に指数分布の信頼度を入れると、コスト率は交換年齢を延ばすほど下がり続け、事後取替だけの水準に近づきます。故障率が一定なら、使い込んだ部品も新品も、次の1日に壊れる確率は同じです。そのため、壊れる前に新品へ替えても故障は減らず、交換の費用だけが増えます。ダラム大学の論文は、古典的な年齢取替のモデルで有限の最適な年齢が存在する条件を、故障率の極限値と費用・平均寿命の関係として示しています。その条件を満たさなければ予防交換をしないほうがよい、とも書いています。形状パラメータが1より大きいワイブル分布は故障率が上がり続けるので、この条件を満たします。第2章で故障の型を見分けたことが、ここで交換の方式を選ぶ根拠になります。
2つ目は、費用比が大きいほど早めに交換するのが得になることです。形状2.5では、費用比2のときの最適な年齢は尺度の0.88倍ですが、費用比20では0.26倍まで早まります。事後交換の相対コストには、部品の費用だけでなく、突発停止で失う生産・二次被害・安全の確保にかかる手間が入ります。したがって、同じ部品でも、止まると影響の大きい設備に付いているものほど早めに交換する、という結論になります。3つ目は、形状が1.5のように1に近い部品では、費用比が小さいと年齢取替の得がほとんど無いことです。形状1.5・費用比2では事後取替比が0.998で、最適な年齢も尺度の2倍を超え、その年齢までにほとんどの部品が壊れてしまいます。
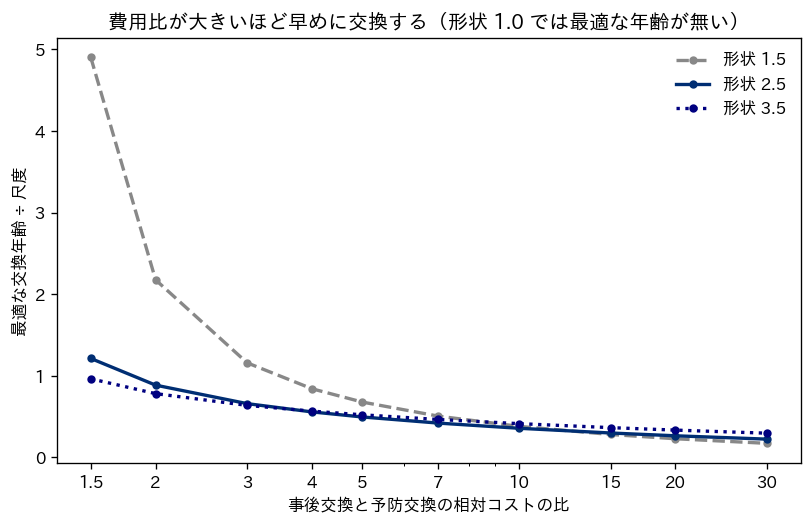
図は、費用比を細かく変えて、形状1.5・2.5・3.5のそれぞれで最適な交換年齢(尺度で割った値)を描いたものです。費用比が小さい側では形状による差が大きく、とくに形状1.5の線だけが大きく離れています。この例の費用比10と20では、実行した結果、3本とも尺度の0.2〜0.5倍の範囲に入りました。ただし、3本の差は費用比が大きくなるほど縮むわけではなく、費用比10では最大でおよそ0.06、費用比20ではおよそ0.1でした。費用比が小さい側の離れ方から、この例では、故障率の上がり方がゆるい部品ほど、費用比の見積もりの誤りが周期を大きく動かすと読み取れます。周期を決める前に、形状パラメータの推定(第2章)と費用比の見積もりのどちらがより不確かかを確かめ、不確かなほうの値を動かして周期がどれだけ変わるかを見ておくのが安全です。
ブロック取替と比べる、更新関数を数値で解く
ブロック取替のコスト率は、周期 \( T \) ごとの一斉交換の費用 \( c_p \) と、周期の間に起きる事後交換の費用を足して、周期の長さで割ったものです。周期の間に起きる故障の回数の期待値は、更新関数 \( M(T) \) と呼ばれる量で、コスト率は \( C(T) = \dfrac{c_p + c_f M(T)}{T} \) と書けます。この式も、前の節で挙げたノルウェー科学技術大学の講義資料で確かめました。更新関数は、一度壊れて交換した部品がまた壊れる回数まで数えます。形状1のワイブル分布(指数分布)なら \( M(T) = T / \eta \) と簡単に書けますが、この例の形状2.5のワイブル分布では、更新関数を数値的に解きます。次のコードでは、1日刻みで「t 日までの故障の回数の期待値」を前から順に積み上げて数値で解きました。部品は年齢取替と同じもの(形状2.5・尺度400日、費用比5)です。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np

# 年齢取替と同じ部品(形状 2.5・尺度 400 日、費用比 5)でブロック取替を計算する
beta, eta, cp, cf = 2.5, 400.0, 1.0, 5.0
dt = 1.0                                   # 1 日刻みで離散化
t = np.arange(0.0, 1201.0, dt)
F = 1.0 - np.exp(-(t / eta) ** beta)
f = np.diff(F)                             # 各1日の間に初めて壊れる確率

# 更新関数 M(t):t 日までの故障(事後交換)の回数の期待値
# M(n) = F(n) + sum_k f(k) M(n-k) を前から順に解く
M = np.zeros(len(t))
for n in range(1, len(t)):
    M[n] = F[n] + np.dot(f[:n], M[n - 1::-1][:n])

T = t[1:]
block = (cp + cf * M[1:]) / T              # ブロック取替のコスト率
k = int(np.argmin(block))
print("ブロック取替の最適周期 %.0f 日" % T[k])
print("そのときのコスト率 %.5f" % block[k])
print("周期内の事後交換の期待回数 %.3f" % M[k + 1])
for d in [150, 200, 250, 300]:
    print("周期 %d 日 コスト率 %.5f" % (d, block[d - 1]))
# 出力:
# ブロック取替の最適周期 191 日
# そのときのコスト率 0.00911
# 周期内の事後交換の期待回数 0.148
# 周期 150 日 コスト率 0.00944
# 周期 200 日 コスト率 0.00912
# 周期 250 日 コスト率 0.00947
# 周期 300 日 コスト率 0.01008
実行した結果、ブロック取替の最適周期は191日で、コスト率は0.00911でした。年齢取替の最適値0.00866より5%ほど高くなります。周期の中で事後交換が起きる回数の期待値は0.148回です。ブロック取替のほうが高くつくのは、周期の途中で壊れて新品に替えた部品も、周期が来れば年齢に関係なく交換するからです。その代わり、ブロック取替は部品ごとの使用時間を数えなくてよく、同じ部品が多数ある設備では一度の停止でまとめて交換できます。計算上の差が5%程度であれば、段取りの手間や停止の回数を減らせるブロック取替を選ぶ判断もありえます。どちらを選ぶかは、コスト率の差と、管理の手間・停止の回数の差を並べて決めることになります。
隠れた故障の点検周期、普段は動かない装置をどう見張るか
ここまでの取替方策は、故障すればすぐに分かる部品を前提にしていました。一方、予備のポンプの起動回路、非常停止の回路、安全弁、保護リレーのように、普段は動かず、必要になったときに初めて働く装置があります。こうした装置の故障は、動かそうとするまで分かりません。この「隠れた故障」に対しては、交換の周期ではなく、壊れていないかを確かめる点検(機能を試す試験)の周期を決めることになります。信頼性中心保全(RCM)の考え方を示した Nowlan と Heap の1978年の報告書も、運転員には見えない形ですでに起きている故障を見つけるための点検を、保全の作業の1つとして扱っています。
点検の周期を \( T \) とし、点検と点検の間で装置が壊れたまま気づかれていない時間の割合の平均を考えます。ノルウェー科学技術大学の安全計装システム(異常のときに設備を安全な状態へ止める計装の仕組み)の講義資料(Lundteigen と Rausand)では、点検の間隔のうち装置が機能を果たせない状態にある確率の平均を、壊れている確率 \( F(t) \) を点検の間隔で平均した値として定義しています。
この計算の前提は次の3つです。同じ講義資料も、点検のたびに新品と同じ状態に戻ることを、この平均を長期の平均として扱う条件に挙げています。
- 点検で、対象の故障をすべて見つける
- 見つけた故障は直ちに修理か交換をして、新品と同じ状態に戻す
- 点検と復旧にかかる時間は無視する
ここでの故障の率 \( \lambda \) は、装置の故障全体の率ではなく、点検でしか見つからない故障(安全計装システムの場合は、安全側に働かず、自己診断でも検出されない危険側の故障)が起きる率です。この故障が一定の率 \( \lambda \) で起きる(指数分布。どの時点でも次の1日に壊れる確率が同じ分布)と置くと、この平均は \( 1 – \dfrac{1 – e^{-\lambda T}}{\lambda T} \) になり、\( \lambda T \) が小さいときはおよそ \( \lambda T / 2 \) です。上の前提のもとでは、点検の直後は壊れている確率が0で、次の点検の直前に最も高くなるので、平均すると間隔の半分ぶんの故障率がかかる、と読めます。
次のコードは、平均故障間隔を2000日と置いた架空の保護装置で、点検の間隔と平均の不稼働率の関係、許容する不稼働率から逆算した点検の間隔を求めたものです。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
from scipy import optimize

# 普段は動かない保護装置(例:予備ポンプの起動回路)の隠れた故障
# 故障は一定の率で起き(指数分布)、点検したときにだけ見つかる
mtbf = 2000.0                 # 平均故障間隔 2000 日(架空)
lam = 1.0 / mtbf


def mean_unavail(T):
    """点検間隔 T 日のあいだ、装置が壊れたまま気づかれていない時間の割合の平均"""
    x = lam * T
    return 1.0 - (1.0 - np.exp(-x)) / x


print("点検間隔 平均不稼働率 近似 lam*T/2")
for T in [7, 30, 90, 180, 365]:
    print("%4d 日  %.4f  %.4f" % (T, mean_unavail(T), lam * T / 2.0))

for target in [0.005, 0.01, 0.02]:
    T = optimize.brentq(lambda s: mean_unavail(s) - target, 0.1, 5000.0)
    print("許容する不稼働率 %.3f -> 点検間隔 %.1f 日" % (target, T))
実行した結果を表にまとめます。
| 点検の間隔(日) | 平均の不稼働率 | 近似 \( \lambda T / 2 \) |
|---|---|---|
| 7 | 0.0017 | 0.0018 |
| 30 | 0.0075 | 0.0075 |
| 90 | 0.0222 | 0.0225 |
| 180 | 0.0437 | 0.0450 |
| 365 | 0.0859 | 0.0912 |
本コラムの架空の装置では、30日ごとに点検すると、壊れたまま気づかれていない時間の割合は平均0.75%で、1年ごとの点検にすると8.59%まで上がります。許容する不稼働率から逆算すると、0.5%に抑えるには20.1日、1%なら40.3日、2%なら81.1日の間隔で点検する計算になりました。点検の間隔を半分にすると不稼働率もほぼ半分になる、という比例の関係が、間隔の短い範囲で成り立っています。間隔が長くなると近似 \( \lambda T / 2 \) は実際の値より大きめに出ますが、許容する不稼働率が数%以下の範囲では、近似でも周期の見当はつきます。
ここで決めるべきなのは「許容する不稼働率」で、これは数理モデルの外から与える値です。保護装置が働かないときに何が起きるか(序章で整理した6つの損失の型のうち、安全と環境の事故に当たるか、突発停止にとどまるか)で、許容できる水準は大きく変わります。また、この計算は点検が完全に故障を見つけ、点検の作業そのものでは装置を止めない、という単純化をしています。点検中に装置が使えなくなる時間や、点検で故障を見逃す確率を入れると、点検を頻繁にするほど不稼働率が下がるとは限りません。さらに、法令で定められた点検の周期があるものは、その定めに従うことが前提です。本コラムでは、ここで示した計算で法定の点検の周期を延ばせる、とは扱いません。
予知保全の予測を作業計画に変える、混合整数計画による割当
ここからは、予知保全が出した残存寿命の予測を、実際の作業の予定に変える方法を扱います。この章の年齢取替やブロック取替の例題は、同じ部品に共通の周期を当てはめる計画でした。予知保全では、設備ごとに「あと何日もちそうか」の予測が出るので、設備ごとに作業日を決められます。ただし、作業日は自由に選べるわけではありません。生産を止めて作業できるのは計画停止の時間枠がある日に限られ、保全員の人数にも上限があります。予測の幅(第7章で扱った区間と同じ考え方で、この章では機能故障までの日数について出した幅)も考えなければなりません。こうした条件をまとめて扱うために、混合整数計画を使います。混合整数計画は、0か1のように整数の値しか取らない変数を含む最適化の問題で、「設備 j の作業を何日目の枠に入れるか」を0か1の変数で表せます。
予測が作業の予定になるまでの流れは、次の順に整理できます。実際の計画づくりでは、3つ目の割当の最適化に、計画停止の時間枠・保全員の人数・保守部品の在庫などが条件として入ります。この章の例題のモデルに入れたのは、計画停止の時間枠と保全員の人数だけで、保守部品の在庫は入れていません(在庫の扱いは後の節の表で整理します)。
- 残存寿命の予測(平均と幅)を設備ごとに受け取る
- 作業日ごとの期待コストを計算する
- 条件のもとで作業日を割り当てる(割当の最適化)
- 保全員と管理者が計画の案を確認する
- 作業の予定として確定する
例題の設定は次のとおりです。
- 架空の設備8台(設備A〜設備H)について、残存寿命の予測が平均と標準偏差で出ているとします。残存寿命の終わりは、章の冒頭で決めたとおり、設備が故障して機能を果たせなくなる時点です
- 計画の期間は14日で、計画停止の時間枠は3日目・7日目・10日目・14日目の4回、1枠の長さは8時間です
- 保全員が3人の場合と2人の場合の2通りを、別々に解きます
- 各設備の作業には、作業時間と必要人数が決まっています。1つの作業は、必要人数がそろった状態で、作業時間のあいだ途切れずに続けます
- 枠の8時間を1時間ごとに区切り、どの1時間でも、作業中の人数の合計が保全員の人数を超えないようにします。人時(人数×時間)の合計だけを上限に収めても、2人の作業が重なって時間内に終わらないことがあるためです
- 設備を割り当てた日に作業すると、その日までに壊れていれば事後交換の相対コスト、壊れていなければ予防交換の相対コスト1がかかります
- 壊れずに作業日を迎えた場合は、さらに「捨てる寿命」の損失を足します。作業日に残っていた寿命の日数を新品の想定寿命30日で割った値で、残り10日で交換すれば、予防交換の相対コストの3分の1を損失として数える置き方です。予測は幅を持つので、損失はその期待値(壊れていた場合は0として平均した値)で数えます
- 14日の中で作業しない設備は「計画の外に送る」として、15日目に作業したのと同じ期待コストをかけます
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
from scipy.stats import norm
import pulp

# ---- ブロック1:架空の設備8台と、残存寿命の予測(平均と標準偏差、単位は日)
rng = np.random.default_rng(20261030)
eq = pd.DataFrame({
    "設備": ["設備" + c for c in "ABCDEFGH"],
    "予測平均": rng.uniform(3, 24, 8).round(1),
    "幅の係数": rng.choice([0.15, 0.30, 0.45], 8),       # 予測の不確かさの大きさ
    "故障の相対コスト": rng.choice([5, 10, 20], 8),     # 予防交換1回を 1 としたとき
    "作業時間": rng.choice([2, 3, 4, 6], 8),             # 時間
    "必要人数": rng.choice([1, 2], 8),
})
eq["予測の標準偏差"] = (eq["予測平均"] * eq["幅の係数"]).round(1)
eq["人時"] = eq["作業時間"] * eq["必要人数"]
print(eq.drop(columns="幅の係数").to_string(index=False))

windows = [3, 7, 10, 14]             # 計画停止の時間枠がある日(14日間の計画)
H = 8                                # 1枠の長さ 8 時間
CP, LIFE = 1.0, 30.0                 # 予防交換の相対コスト、新品の想定寿命(日)
DEFER = 15                           # 計画の外に送ると 15 日目の作業とみなす


def p_fail(j, day):
    """設備 j が day 日目までに壊れる確率(予測を正規分布とみなす)"""
    return norm.cdf(day, eq.loc[j, "予測平均"], eq.loc[j, "予測の標準偏差"])


def cost(j, day):
    """設備 j の作業を day 日目に置いたときの期待相対コスト"""
    mu, sd = eq.loc[j, "予測平均"], eq.loc[j, "予測の標準偏差"]
    p, z = p_fail(j, day), (mu - day) / sd
    left = (mu - day) * norm.cdf(z) + sd * norm.pdf(z)   # 作業日に残る寿命の期待値(壊れていれば 0)
    return p * eq.loc[j, "故障の相対コスト"] + (1 - p) * CP + CP * left / LIFE
このコードが出力した設備の一覧は次の表のとおりです。予測の標準偏差は、予測平均に0.15・0.30・0.45のいずれかを掛けて作りました。設備Eと設備Gは予測平均が20日を超えていますが、標準偏差も10日前後と大きく、早めに壊れる可能性を残しています。残存寿命の予測を正規分布とみなしたのは、例題を短くするための単純化です。第7章のような劣化モデルや回帰の方法を使う場合は、寿命の終わりを機能故障(あるいは保全が必要な水準)に置き直した予測を入力にし、分布の形もその予測に合わせます。第7章の「交換の水準への到達」までの予測をそのまま入れると、交換の水準に達する確率を故障の確率として数えることになるためです。
| 設備 | 予測平均(日) | 予測の標準偏差(日) | 故障の相対コスト(事後交換の相対コスト) | 作業時間(時間) | 必要人数 | 人時 |
|---|---|---|---|---|---|---|
| 設備A | 12.8 | 5.8 | 5 | 2 | 2 | 4 |
| 設備B | 15.9 | 2.4 | 5 | 6 | 1 | 6 |
| 設備C | 7.1 | 2.1 | 5 | 4 | 2 | 8 |
| 設備D | 13.0 | 2.0 | 20 | 2 | 2 | 4 |
| 設備E | 23.6 | 10.6 | 20 | 2 | 2 | 4 |
| 設備F | 8.3 | 1.2 | 5 | 2 | 2 | 4 |
| 設備G | 22.0 | 9.9 | 5 | 3 | 1 | 3 |
| 設備H | 16.7 | 2.5 | 10 | 3 | 2 | 6 |
次に、割当の問題を PuLP(Python で最適化の問題を書くためのライブラリ)で書きます。変数 \( s_{jth} \) は「設備 j の作業を t 日目の枠の h 時間目から始めるなら1、そうでなければ0」、変数 \( y_j \) は「設備 j を計画の外に送るなら1」です。設備 j の作業を t 日目の枠に入れるかどうかは、\( s_{jth} \) を開始の時間 h について足した値 \( x_{jt} \) で表せます。目的関数は、全設備の期待相対コストの合計です。制約は2種類で、各設備はどれか1つの枠に入るか計画の外に送られる(足して1)、各枠の1時間ごとに、その時間に作業中の設備の必要人数の合計が保全員の人数を超えない、の2つです。同じ関数に計画を渡すと(引数 fixed)、その計画のまま、枠の時間内に保全員を割り付けて作業を終えられるかを調べられるようにしました。PuLP は 3.3.2 で確認しました。PuLP は 4.0(2026年9月公開)で、同梱していた CBC ソルバー(混合整数計画を解く計算プログラム)と PULP_CBC_CMD を廃止しているため、このコードをそのまま動かすには pip install pulp==3.3.2 のように版を指定して入れる必要があります。続く2つ目のコードは、次の節で説明する比較のための計画と、結果の表示です。
# ---- ブロック2:割当の混合整数計画(PuLP 3.3.2 に同梱の CBC で解く)
def solve(staff, fixed=None):
    """fixed に計画(設備→日)を渡すと、その計画が枠の時間内に収まるかを調べる"""
    J = list(eq.index)
    dur = {j: int(eq.loc[j, "作業時間"]) for j in J}
    S = [(j, t, h) for j in J for t in windows for h in range(H - dur[j] + 1)]
    m = pulp.LpProblem("maint", pulp.LpMinimize)
    s = pulp.LpVariable.dicts("s", S, cat="Binary")          # t 日目の枠の h 時間目に始める
    y = pulp.LpVariable.dicts("defer", J, cat="Binary")       # 計画の外に送る
    x = {(j, t): pulp.lpSum(s[j, t, h] for h in range(H - dur[j] + 1))
         for j in J for t in windows}
    m += (pulp.lpSum(cost(j, t) * x[j, t] for j in J for t in windows)
          + pulp.lpSum(cost(j, DEFER) * y[j] for j in J))
    for j in J:                                               # 各設備は1回だけ
        m += pulp.lpSum(x[j, t] for t in windows) + y[j] == 1
        if fixed is not None:                                 # 計画を固定して調べる
            m += (y[j] == 1) if fixed[j] == DEFER else (x[j, fixed[j]] == 1)
    for t in windows:                                         # 各時間に作業中の人数の上限
        for k in range(H):
            m += pulp.lpSum(int(eq.loc[j, "必要人数"]) * s[j, tt, h] for (j, tt, h) in S
                            if tt == t if h <= k < h + dur[j]) <= staff
    m.solve(pulp.PULP_CBC_CMD(msg=False))
    plan, start = {j: DEFER for j in J}, {}
    for key in S:
        if s[key].value() > 0.5:
            plan[key[0]], start[key[0]] = key[1], key[2]
    return pulp.LpStatus[m.status], plan, start
続けて、比較のための素朴な計画を作る関数と、3つの計画の期待相対コスト・故障件数の期待値・枠ごとの人時・枠の時間内に収まるかと、最適化した計画の作業の時間帯を表示する部分です。上のコードに続けて実行します。
# ---- ブロック3:点の予測だけで決める素朴な計画と比べる
def naive(margin):
    """予測平均から margin 日を引いた日以前の、最も遅い枠に置く(人数は見ない)"""
    plan = {}
    for j in eq.index:
        ok = [t for t in windows if t <= eq.loc[j, "予測平均"] - margin]
        plan[j] = ok[-1] if ok else windows[0]
    return plan


def report(label, plan, staff):
    total = sum(cost(j, plan[j]) for j in eq.index)
    nf = sum(p_fail(j, plan[j]) for j in eq.index)
    load = [int(sum(eq.loc[j, "人時"] for j in eq.index if plan[j] == t)) for t in windows]
    fit = "収まる" if solve(staff, fixed=plan)[0] == "Optimal" else "収まらない"
    days = " ".join("%s=%d" % (eq.loc[j, "設備"][-1], plan[j]) for j in eq.index)
    print("%s 期待相対コスト %6.2f 故障件数の期待値 %.2f 人時 %s 枠の時間内に %s | %s"
          % (label, total, nf, load, fit, days))


print("PuLP", pulp.__version__)
for staff in [3, 2]:
    status, plan, start = solve(staff)
    print("保全員 %d 人(1枠 %d 時間) 解の状態 %s" % (staff, H, status))
    report("最適化", plan, staff)
    report("点の予測", naive(0), staff)
    report("3日早めた点の予測", naive(3), staff)
    for j in eq.index:                                        # 最適化した計画の作業の時間帯
        if plan[j] != DEFER:
            print("  %s %2d日目 %d〜%d時間目 %d人" % (eq.loc[j, "設備"], plan[j], start[j],
                  start[j] + eq.loc[j, "作業時間"], eq.loc[j, "必要人数"]))
この定式化は、作業を時間枠に割り当てる問題の基本の形です。変数の数は、作業を始める時間の候補が設備8台と枠4つの組み合わせで192個、計画の外に送る変数が8個の、合わせて200個です。制約は、各設備を1回だけ割り当てる8本と、枠4つ×8時間の人数の上限32本です。実行した結果、保全員3人・2人の最適化の解の状態はいずれも Optimal(最適解が得られた)でした。ここでは作業の始まりを1時間単位で区切りました。作業時間がすべて1時間の整数倍なので、この例ではそれで足りますが、30分単位の作業があれば区切りを細かくする必要があります。
作業の順序(ある作業が終わらないと次の作業に入れない)や、同じラインの設備を同時に止めてはいけない、といった条件を足すと、変数と制約が増えて問題は難しくなり、解く時間も延びます。こうした定式化の型は、弊社コラム「数理最適化の定式化パターン集」で整理しています。
点の予測で決めた計画と比べる
最適化した計画の良し悪しを見るために、2つ目のコードでは、予測の平均だけを見て作業日を決める素朴な計画を2つ作って比べました。以下の表と図では、この素朴な計画を「点の予測」と呼びます。1つは「予測平均以前の、最も遅い枠に入れる」計画で、予測をそのまま信じて寿命を使い切ろうとするものです。もう1つは、余裕を見て「予測平均より3日前の日以前の、最も遅い枠に入れる」計画です。どちらも保全員の人数は見ずに日を決め、あとから枠ごとの人時と、枠の時間内に保全員を割り付けて作業を終えられるかを調べます。
実行した結果を表にまとめます。「故障件数の期待値」は、計画した作業日より前に壊れる確率を8台ぶん足したもので、この計画で何台が作業の前に突発停止しそうかを表します。「枠の時間内に収まるか」は、作業の重なりと必要人数を考えて、各枠の8時間の中に保全員を割り付けて作業を終えられるかを、割当のコードに計画を固定して渡して調べた結果です。この列が「収まらない」の行は、そのままでは実行できない計画で、その行の期待相対コストと故障件数の期待値は、仮に実行できたとした場合の値です。
| 計画の決め方 | 保全員 | 期待相対コスト | 故障件数の期待値 | 枠ごとの人時(3・7・10・14日目) | 枠の時間内に収まるか |
|---|---|---|---|---|---|
| 最適化 | 3人 | 11.90 | 0.25 | 19・8・12・0 | 収まる |
| 点の予測 | 3人 | 20.57 | 1.75 | 0・12・8・19 | 収まる |
| 3日早めた点の予測 | 3人 | 16.08 | 0.65 | 12・4・16・7 | 収まる |
| 最適化 | 2人 | 12.09 | 0.33 | 16・14・9・0 | 収まる |
| 点の予測 | 2人 | 20.57 | 1.75 | 0・12・8・19 | 収まらない |
| 3日早めた点の予測 | 2人 | 16.08 | 0.65 | 12・4・16・7 | 収まらない |
本コラムの架空データでは、予測平均をそのまま信じて寿命を使い切ろうとする計画は、期待相対コストが20.57、作業の前に壊れる設備が平均1.75台でした。保全員が2人の場合は、14日目の枠に19人時の作業が集まり、使える16人時(2人×8時間)を超えるので、枠の時間内に収まりません。3日の余裕を見ると、期待相対コストは16.08、故障件数の期待値は0.65台まで下がりました。ただし、この計画も保全員2人では枠の時間内に収まりません。10日目の枠には、1人で6時間かかる設備Bと、2人で行う設備D・設備H(合わせて5時間)が入ります。2人の作業の間は設備Bを進められないので、全部で11時間かかり、8時間の枠に入りません。人時の合計(16人時)だけを見ると上限ちょうどで収まって見えるため、人時だけで確かめると見落とす例です。
最適化した計画は、保全員3人で期待相対コスト11.90・故障件数の期待値0.25台、2人でも12.09・0.33台で、どちらもどの1時間でも作業中の人数が保全員の人数以内に収まる時間割になっています。たとえば保全員2人の計画の7日目の枠は、設備Aを1〜3時間目、設備Hを3〜6時間目、設備Dを6〜8時間目と、2人の作業を順に並べています(時間は枠の始まりから数えたもの)。保全員を3人から2人に減らしたときの悪化は、期待相対コストでは11.90から12.09への小さな差で、故障件数の期待値は0.25台から0.33台へ増えました。2つの解を比べると、作業日が変わったのは設備G(3日目から10日目へ)と設備H(10日目から7日目へ)の2台で、他の6台は同じ日のままでした。また、保全員3人・2人のどちらの解でも、14日目の枠には作業が入っていません。設備ごとに各枠の期待相対コストを、掲載したコードとは別に実行して出力させて確かめると、この例では8台のどれも、14日目に置いたときの期待相対コストが、3日目・7日目・10日目のうち最も小さい日より大きくなっていました。ここに書いたのは2つの解と計算の結果として見えた事実だけで、なぜそうなったかは、本コラムでは調べていません。
この比較には大きな限定があります。期待相対コストは、最適化の目的関数と同じ式で評価しており、しかも予測を正規分布とみなす同じモデルの上で計算しています。同じ制約を満たす計画どうしで比べれば、最適化した計画の期待相対コストが小さいのは作り方から見て当然の結果で、実際の設備で効果が出ることを示したものではありません。故障件数の期待値は目的関数とは別の指標で、最適化はこれを直接は最小にしていません。この例では併せて減りましたが、故障の相対コストや捨てる寿命の損失の置き方によっては、期待相対コストが最小の計画で故障件数が最小になるとは限りません。また、保全員2人の場合、比べた2つの素朴な計画は枠の時間内に収まらず、そのままでは実行できません。表の値は、仮に実行できたとした場合の期待相対コストです。比べた相手によって差の大きさも変わります。予測平均をそのまま信じる計画との比は1.7倍ほど(保全員2人で20.57と12.09)ですが、3日の余裕を見た計画との比は1.3倍ほど(16.08と12.09)です。
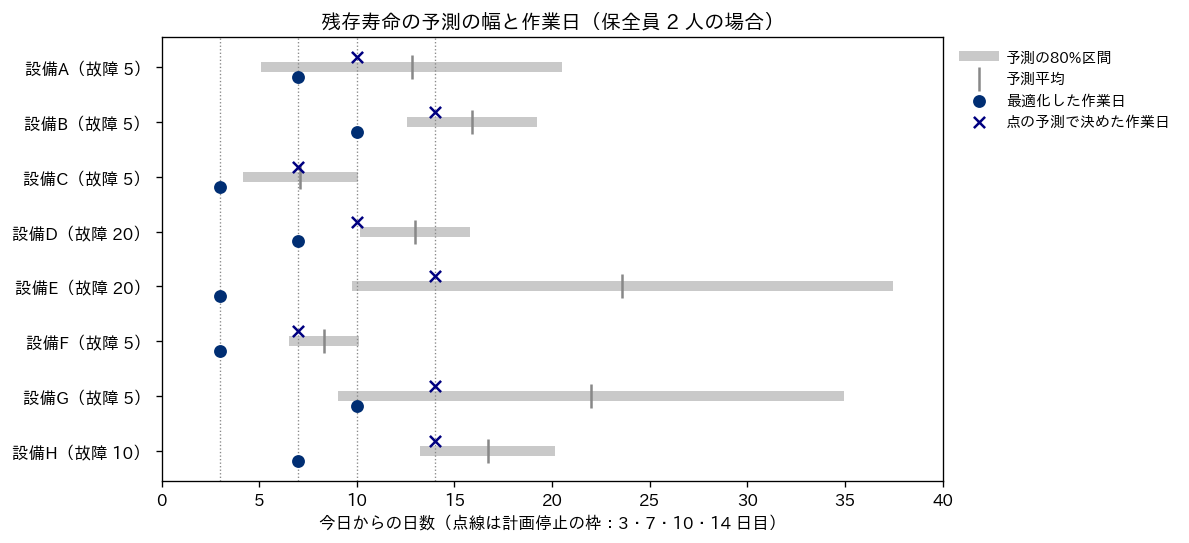
図は、保全員2人の場合について、各設備の残存寿命の予測の80%区間(灰色の帯)と予測平均(縦線)、最適化した作業日(丸)と点の予測で決めた作業日(×)を並べたものです。縦軸の設備名の括弧内の数字は、故障の相対コスト(事後交換の相対コスト)です。設備ごとに内訳を見ると、最適化の考え方が分かります。
| 設備 | 故障の相対コスト(事後交換の相対コスト) | 最適化の作業日 | その日までに壊れる確率 | 点の予測の作業日 | その日までに壊れる確率 |
|---|---|---|---|---|---|
| 設備A | 5 | 7 | 0.159 | 10 | 0.315 |
| 設備B | 5 | 10 | 0.007 | 14 | 0.214 |
| 設備C | 5 | 3 | 0.025 | 7 | 0.481 |
| 設備D | 20 | 7 | 0.001 | 10 | 0.067 |
| 設備E | 20 | 3 | 0.026 | 14 | 0.183 |
| 設備F | 5 | 3 | 0.000 | 7 | 0.139 |
| 設備G | 5 | 10 | 0.113 | 14 | 0.210 |
| 設備H | 10 | 7 | 0.000 | 14 | 0.140 |
この表は、保全員2人の場合の設備ごとの内訳を、別に実行して出力させたものです。目立つのは設備Cと設備Eです。設備Cは予測平均が7.1日で、点の予測の計画では7日目の枠に入りますが、その日までに壊れる確率は0.481で、ほぼ半分の確率で作業の前に止まります。予測を左右対称の正規分布とみなしているので、作業日が予測平均とちょうど重なると、壊れる確率は5割になります。この例でほぼそれに当たるのは設備Cだけで、点の予測の計画の他の7台は、その日までに壊れる確率が0.067〜0.315でした。設備Eは予測平均が23.6日と遠い先ですが、予測の標準偏差が10.6日と大きく、故障の相対コストも20と大きいので、最適化の計画では3日目の枠で早めに作業します。捨てる寿命の損失を払ってでも、幅の下側で壊れる危険を避けたほうが期待コストが小さい、という判断です。予測の平均が同じでも、幅と事後交換の相対コストによって作業日が変わることが、点の予測だけで決める計画との違いです。
この例題には、いくつかの単純化があります。予測を正規分布で表したので、ごくわずかですが寿命が負になる確率も含んでいます。作業の前に故障した場合は、その故障の相対コストだけを数え(捨てる寿命の損失は数えません)、故障した設備の修理に保全員の手が取られて他の作業が遅れる影響は入れていません。予防交換の相対コストは全設備で1にしました。実務で使うときは、これらを自社の条件に合わせて変え、結果が単純化にどれだけ左右されるかを確かめる必要があります。
単純化の影響の一部を見るために、感度の確認を1つ加えました。保全員2人の3つの計画は、そのまま正規分布の予測で作ります。評価のときだけ、「本当の残存寿命」を予測とは違う分布から乱数で引き、作業日より前に壊れたかを数えました。手順は次のとおりです。
- 本当の残存寿命も正規分布とし、平均を予測平均の0.8倍にした場合、標準偏差を予測の標準偏差の2倍にした場合、その両方の場合の3通りを置きました。比べるために、予測どおり(倍率1)の場合も同じ手順で計算しました
- 乱数は numpy の
default_rng(20261030)を1つ作り、表の上から順に4通りぶん、続けて引きました。1通りごとに、設備8台の残存寿命を1組として20,000組引き、0.1日未満の値は0.1日にそろえました - 各組で、作業日より前に壊れた設備には事後交換の相対コストを、壊れなかった設備には予防交換の相対コスト1と捨てる寿命の損失(本当の残存寿命から作業日を引いた日数÷30)を数え、8台の合計を20,000組で平均しました
- 計画は、掲載した割当のコードの
solve(2)・naive(0)・naive(3)で作ったものです。この評価のコードは掲載していません。手順はこの箇条書きに書いたものがすべてです
評価の数え方は最適化の式と同じですが、乱数で平均を取っていることと、0.1日未満の値を0.1日にそろえたことから、「予測どおり」の行の値は上の表と小数点以下でわずかにずれます。また、上で見たとおり、2つの素朴な計画は保全員2人では枠の時間内に収まらないので、この表の値も、仮に実行できたとした場合のものです。
| 本当の残存寿命の分布 | 計画の決め方 | 平均の相対コスト | 作業前に壊れた台数の平均 |
|---|---|---|---|
| 予測どおり | 最適化 | 12.12 | 0.33 |
| 予測どおり | 点の予測 | 20.60 | 1.75 |
| 予測どおり | 3日早めた点の予測 | 16.09 | 0.65 |
| 平均が予測より2割短い | 最適化 | 14.74 | 0.85 |
| 平均が予測より2割短い | 点の予測 | 39.77 | 4.25 |
| 平均が予測より2割短い | 3日早めた点の予測 | 27.42 | 1.70 |
| 幅が予測の2倍 | 最適化 | 18.70 | 1.13 |
| 幅が予測の2倍 | 点の予測 | 30.20 | 2.72 |
| 幅が予測の2倍 | 3日早めた点の予測 | 25.08 | 1.58 |
| 平均が2割短く幅が2倍 | 最適化 | 24.42 | 1.88 |
| 平均が2割短く幅が2倍 | 点の予測 | 41.43 | 4.14 |
| 平均が2割短く幅が2倍 | 3日早めた点の予測 | 33.99 | 2.55 |
本コラムの架空データでは、予測が外れると、どの計画でも相対コストと作業前の故障が増えました。最適化した計画も、平均が2割短く幅が2倍の場合には、作業前に壊れる台数の平均が0.33台から1.88台に増えています。この3通りのずらし方では、最適化した計画の値が3つの計画の中で最も小さいままでしたが、これは3通りを試した結果で、どんな外れ方でも同じになるとは言えません。予測の外れ方は、平均の偏りと幅の不足の2つに分けて扱う必要があります。予測が系統的に長めに出ている(平均が短い側に外れる)場合は、幅を広げるだけでは平均の偏りが残るので、過去の記録と突き合わせて平均の偏りを補正します。あわせて、予測の幅が実際のばらつきを覆えているかを過去の記録で検証し、足りなければ幅を調整してから計画に入れることが考えられます。
数理モデルの外にある条件、部品の在庫・生産計画・安全
保全計画は、保全部門だけでは決まりません。数理モデルを作るときに、外から与える条件を整理しておくと、どこまでをモデルに入れ、どこからを人が判断するかを決めやすくなります。主なものを次の表にまとめました。
| 外から与える条件 | 誰と決めるか | モデルへの入れ方の例 | 詳しく扱う場所 |
|---|---|---|---|
| 保守部品の在庫と調達の期間 | 資材・購買 | 部品が届く日より前の枠には作業を置けない制約 | 弊社コラム「在庫と発注量を決める数理モデル」 |
| 計画停止の時間枠 | 生産管理 | 作業を置ける日と時間の上限 | 弊社コラム「生産スケジューリングの数理最適化」 |
| 保全員の人数と技能 | 保全部門の管理者 | 各時間に作業できる人数の上限、作業ごとに必要な技能 | 第13章 |
| 事後交換の相対コストと費用比 | 経営・工場長・安全の担当 | 目的関数の係数 | 第12章(重要度の評価) |
| 許容する不稼働率 | 安全の担当・設備の所管部門 | 点検の周期を逆算する目標値 | この章の点検周期の節 |
| 法令で定められた点検 | 法令の所管・社内の安全の担当 | モデルで動かさない固定の予定として先に入れる | 各法令の定めと所管官庁の資料 |
保守部品の在庫は、保全計画と強く結びついています。予知保全で交換の時期が事前に分かれば、部品を必要な時期に合わせて手配でき、常に多めに持っておく必要が減る可能性があります。逆に、予測の幅が広いうちは部品を手元に置いておかなければならず、在庫の水準は予測の精度に左右されます。部品の在庫の決め方は、弊社コラム「在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで」で扱っています。また、計画停止の時間枠は生産計画の側が決めるもので、保全の都合だけで増やせるものではありません。生産と保全の予定を一緒に組む方法は、弊社コラム「生産スケジューリングの数理最適化、ディスパッチングルールからジョブショップまで」に送ります。
安全に関わる条件は、モデルの最適化の対象にしないことが大切だと考えています。法令で定められた点検や、安全の担当が決めた点検の周期は、コストの最小化で動かす変数ではなく、先に予定に入れて固定する条件として扱います。数理モデルが出した計画は、保全員と管理者が確認し、現場の事情(部品の状態の見た目、他の工事との干渉、天候など)を踏まえて採否を決めるものです。モデルは計画の案を早く、漏れなく作る道具で、計画を承認する役割は人に残します。
経営判断:予測を計画に変えて初めて効果が出る
予知保全の仕組みを入れても、予測が出るだけで作業の予定が変わらなければ、突発停止も保全の手間も減りません。この章の例題では、予測の精度は変えずに作業日の決め方だけを変えて、期待相対コストを比べました。同じ予測のもとでの計算ですが、保全員2人の場合で、予測平均以前の最も遅い枠に作業を置く計画との差は1.7倍ほど、3日の余裕を見た計画との差は1.3倍ほどでした(この2つの計画は保全員2人では枠の時間内に収まらず、実行できたと仮定した値との比です)。これは同じモデルの上で計算した比較で、実際の設備での効果を示したものではありません。この章で示せたのは、本コラムの架空データでは、同じ予測のもとで作業日の決め方だけを変えてもこの程度の差が計算上は出た、という範囲です。そのうえで、予測が出ても作業日の決め方が変わらなければ効果は出にくいと考えています。経営の立場から見ると、次の判断がこの章の内容に当たります。
| 判断を誤ったときの損失の型 | この章で関係する誤り | 経営が決めること |
|---|---|---|
| 突発停止 | 予測平均以前の最も遅い枠に作業を置き、壊れる確率が高い日を選んでしまう | 予測の幅を使って作業日を決めることを、保全計画の作り方として定める |
| 過剰保全 | 故障率が一定の部品にも周期で交換する、周期を必要以上に短くする | 部品ごとに故障の型を確かめてから交換の方式を選ぶよう求める |
| 安全と環境の事故 | 保護装置の点検の周期をコストだけで延ばす | 許容する不稼働率と法定の点検を、最適化で動かさない条件として先に決める |
| 品質の不良 | 交換を先送りして、劣化した状態で生産を続ける | 品質に効く設備は、事後交換の相対コストに不良の影響を含めて見積もる |
| 警報の形骸化 | 警報が出ても作業の枠が無く、対応が後回しになる | 警報から作業の予定に入るまでの手順と、使える計画停止の枠を確保する |
| 二重投資 | 工場ごとに別の計画の道具やモデルを作る | 相対コストの付け方と計画の作り方を、全社で共通にする |
とくに大切なのは、事後交換の相対コスト、つまり「その設備が止まると何がどれだけ困るか」を、経営と現場が一緒に見積もることです。年齢取替の感度の計算では、費用比によって最適な周期が大きく変わりました。数理モデルは、与えた相対コストのもとでの最良の計画を出しますが、相対コストそのものを決めることはできません。見積もりには、保全部門・生産部門・安全の担当など関係する部門が加わり、影響の見落としが無いかを互いに確かめることが有効だと考えています。設備の重要度を全社の基準で評価する方法は第12章で扱います。
この章では、年齢取替とブロック取替の最適周期を、寿命の分布と相対コストの比から数値で求め、故障率が一定の部品では予防交換に得が無いことを確かめました。隠れた故障に対しては、許容する不稼働率から点検の周期を逆算できることを示しました。さらに、残存寿命の予測の幅を入力にした混合整数計画で、各時間の作業人数と計画停止の枠の制約のもとで作業日と時間帯を決めると、本コラムの架空データでは、点の予測だけで決める計画より期待相対コストも作業前の故障の期待値も小さくなりました。ただし、これは予測を正規分布とみなす同じモデルの上で計算した比較で、実際の設備での効果を示したものではありません。また、保全員2人の場合、比べた点の予測の計画は枠の時間内に収まらず、その値は仮に実行できたとした場合のものです。人時の合計だけで確かめると、時間内に終わらない計画を見落とすことも、同じ例で確かめました。予測が外れる場合については、本当の寿命の分布を3通りにずらした感度の計算をしただけで、実際の設備の記録では確かめていません。第10章では、こうして決めた計画を作業指示・保全記録・設備台帳とつなぎ、日々の保全業務に組み込む方法を扱います。
この章を深めたい方への参考書籍
『Maintenance Theory of Reliability』(Toshio Nakagawa、Springer):年齢取替・ブロック取替・点検の方策など、保全の方策を確率モデルとして体系的に扱った専門書です。この章で使ったコスト率の考え方を、修理や不完全な保全などの条件に広げたモデルまで追うことができます。英語の書籍です。
『信頼性・保全性の数理』(三根久・河合一 著、朝倉書店):信頼性と保全性を確率論の立場から扱った日本語の教科書です。寿命の分布や更新の考え方など、この章の計算の土台になる数学を確かめたいときの参照先になります。1982年の刊行です。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治 著、講談社):線形計画・整数計画の定式化と解き方を基礎から解説した教科書です。この章の作業の割当のような0か1の変数を使うモデルを、自社の条件に合わせて組み替えるときの手引きになります。
第10章 予知保全を業務に組み込む、作業指示・保全記録・設備台帳とのつなぎ方
第9章では、残存寿命の予測を入力にして、交換の時期と点検の周期と保全員への作業の割当を数理モデルで決める方法を扱いました。計画ができても、その計画が作業指示として保全員に届き、作業の結果が記録として戻ってこなければ、予知保全は一度きりの分析で終わります。この章では、警報と計画を日々の保全業務に組み込むための仕組みを扱います。
この章では、次の内容を、コードを載せずに表と概念図で説明します。
- 警報が出てから作業が終わり、記録が残り、振り返りが行われるまでの業務の流れと、各工程の役割
- その流れを支える設備台帳と設備の階層、保全業務を管理する情報システム(CMMS・EAM と呼ばれるもの。中身は後の節で説明します)の役割
- 保全記録に残す項目と、石油・天然ガス・石油化学の分野で信頼性と保全のデータの集め方を定めた国際規格 ISO 14224 の考え方(規格の目録で確かめた範囲)
- 保全記録が次の予測の教師データになる仕組み。この章では、学習に使うデータと評価に使うデータの両方を指して教師データと呼びます(学習に使うデータは、機械学習のモデルに正解を教えるためのデータです)
- 自由記述の記録を分類して使える形にする方法
- 既存の巡回点検や定期点検との統合
- 経営判断
この章の主張は1つです。予知保全の精度は、モデルの工夫だけでなく、保全員が残す記録の質にも大きく左右されると考えています。第5章から第8章で扱った異常検知・故障診断・残存寿命の推定・警報の評価は、どれも「過去にどの設備で何が起き、どう処置したか」という記録を前提にしていました。その記録を作るのは日々の保全業務であり、記録を残す手間を業務の中に組み込めるかどうかが、予知保全を続けられるかどうかを分けると考えています。
警報から振り返りまで、予知保全を組み込んだ保全業務の流れ
予知保全を入れても、保全業務そのものの骨格は大きく変わりません。変わるのは、作業のきっかけです。事後保全では故障が、時間基準保全では暦や稼働時間が作業のきっかけになります。予知保全では、センサーのデータから出た警報や、残存寿命の予測から立てた計画がきっかけになります。きっかけが変わるので、その後の「誰が判断し、誰が作業を指示し、誰が記録するか」を、改めて決め直す必要があります。
本コラムでは、予知保全を組み込んだ保全業務の流れを、警報・判断・作業指示・作業・記録・振り返りの6つに分けて考え、これを業務の工程と呼びます。業務の工程は、警報の重さの区分である警報の段階(注意・警告・停止)とは別のものです。警報の工程は、第8章で設計した警報の段階(注意・警告・停止)に沿って、仕組みが保全員に通知を出す工程です。判断は、その警報が本物の兆候か、誤報か、今すぐ動くべきか、次の計画停止まで待てるかを決める工程です。作業指示は、判断の結果を「どの設備に、いつ、何を、誰が、どの部品を使って行うか」という形にして作業者に渡す工程です。作業は、実際の点検・調整・交換・修理です。記録は、作業で分かったこと(実際に何が起きていたか、何をしたか、どれだけ止まったか)を残す工程です。振り返りは、記録を集めて、警報が当たっていたか、判断が適切だったか、モデルやしきい値を直す必要があるかを確かめる工程です。
この6つの業務の工程のうち、予知保全の仕組みを作る側が見落としやすいのは、判断と記録と振り返りの3つです。警報の精度を上げることには多くの労力が割かれますが、警報を受け取った保全員が何を見て判断するのか、作業のあとに何を書けばよいのかが決まっていないと、警報は作業につながらず、作業の結果はモデルに戻りません。第8章の数え方(将来の故障の発生に基づく評価)で数える誤報・見逃し・リードタイムは、記録の工程で、警報の有無にかかわらず監視している設備で起きた故障や異常とその日時が残っていなければ、そもそも計算できません。これとは別に、本章で扱う点検の所見に基づく警報の確認結果(後の節で説明します)は、警報が出た設備で実際に何が見つかったかが残っていなければ出せません。
各工程で誰が何をするかを、次の表にまとめました。役割の名前は一般的なものにしてあり、組織によっては1人が複数の役割を兼ねます。体制と人材の詳細は第13章で扱うので、ここでは業務の流れに沿った分担だけを示します。警報のしきい値は、保全部門が案を作り、工場長が承認し、データ担当が仕組みの設定を変える、という分担にしています(第13章)。
| 業務の工程 | 主に担う役割 | この工程で決めること | この工程で残すもの | 決めていないと起きること |
|---|---|---|---|---|
| 警報 | 予知保全の仕組み(しきい値は保全部門が案を作り、工場長が承認し、データ担当が設定する) | 警報の段階(注意・警告・停止)ごとのしきい値と、通知の宛先 | 警報の日時・設備・警報の段階(注意・警告・停止)・根拠となった値 | 誰も見ない通知が増え、警報の形骸化につながる |
| 判断 | 保全部門の担当者・責任者 | 本物の兆候か、誤報か、いつ動くか | 判断の結果と理由(誤報の疑いと判断したならその根拠)。後の保全記録の項目の表には含めておらず、どこに残すかは運用で決める | 判断が担当者の頭の中にだけ残り、判断と点検の所見を後から突き合わせられない |
| 作業指示 | 保全部門の計画担当 | 作業の内容・日時・担当者・部品・停止の要否 | 作業指示の番号と、どの警報から生まれたか | 警報と作業が結びつかず、警報の効果を測れない |
| 作業 | 保全員・外部の作業者 | 現場で見つかった状態に応じた処置 | 実際の状態・処置・交換した部品・作業時間 | 何をしたかが分からず、同じ故障の再発を追えない |
| 記録 | 保全員(入力)・保全部門の責任者(確認) | 故障モード・原因・処置の分類 | 決められた項目に沿った保全記録 | 自由記述だけが残り、分類や確認の手間が増え、統一した基準で集計しにくくなる |
| 振り返り | 保全部門・データ担当・生産部門(しきい値の変更は工場長が承認) | しきい値・モデル・点検周期を直すか | 警報の当たり外れの集計と、直した内容 | モデルが古いまま使われ、第8章の数え方での誤報や見逃しが増えるおそれがある |
この表で強調したいのは、右から2列目の「この工程で残すもの」です。予知保全の仕組みは、警報の工程で残した値と、記録の工程で残した実際の状態を突き合わせることで、初めて自分の当たり外れを知ることができます。どちらか一方が欠けると、振り返りの工程で比べるものが無くなります。
もう1つ、判断の工程を人が担うことを明示しておきます。警報は「いつもと違う」あるいは「残存寿命が短い」という情報を出すだけで、設備を止めるか、作業者を危険な場所に入れるか、安全に関わる判断までは決めません。第6章で扱ったように、診断の確信度が低いときは人が判断します。とくに安全に関わる判断は、予知保全の仕組みに任せるのではなく、保全部門の責任者が警報を材料の1つとして決めるという分担にしておくことが必要だと考えています。
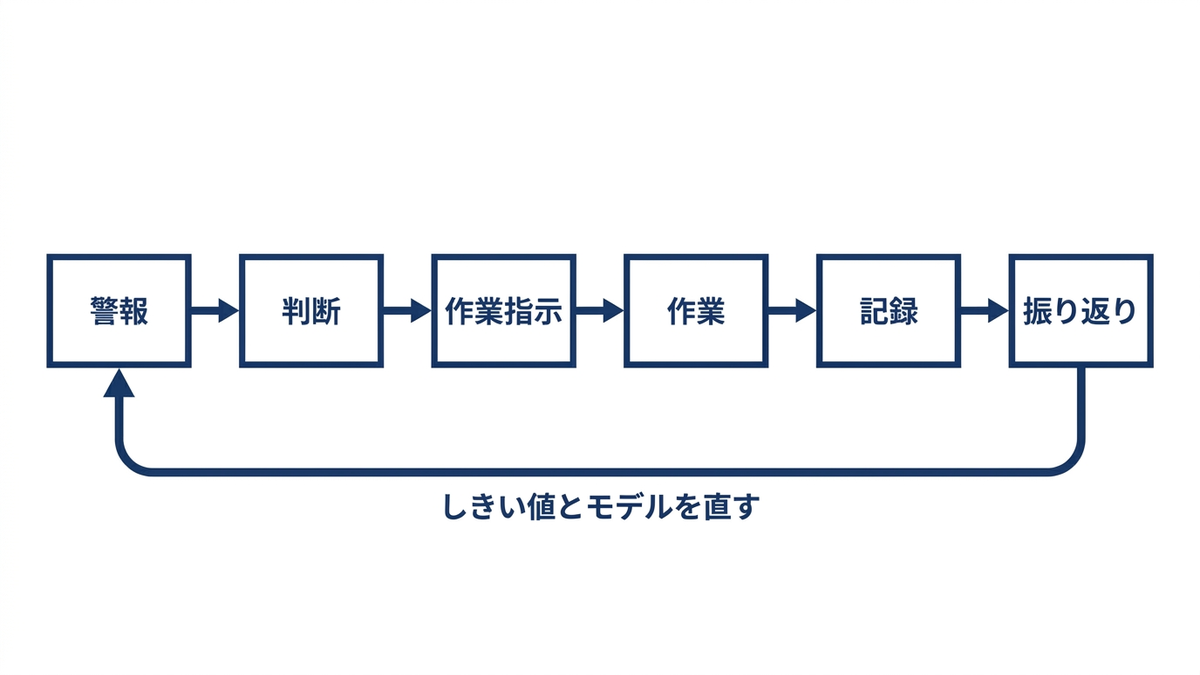
設備台帳と設備の階層、警報と記録を同じ設備に結びつける
業務の流れの中で、警報・作業指示・保全記録の3つを結びつける鍵になるのが設備台帳です。設備台帳は、工場にあるすべての設備に一意の番号(設備番号)を振り、名称・設置場所・型式・設置日・仕様・重要度などを1か所にまとめた一覧です。予知保全の仕組みが出す警報にも、保全員が書く作業記録にも、同じ設備番号が付いていれば、あとから「この設備で出た警報」と「この設備で行った作業」を機械的に突き合わせられます。逆に、警報の側はセンサーの名前で、記録の側は現場で呼び慣れた設備の通称で書かれていると、両者をつなぐ作業が人手頼みになり、振り返りが続かなくなります。
設備台帳を作るときに決めておきたいのが、設備の階層です。本コラムでは、工場・ライン・設備・部品の4つの段を基本の形として考えます。工場は拠点、ラインは製品を作る一連の工程、設備はラインを構成する機械(ポンプ・ファン・コンベヤ・圧縮機など)、部品は保全の作業で交換や修理の単位になるもの(軸受・シール・ベルト・モータなど)です。階層を決めておくと、警報や記録を「部品の単位」で集めることも、「ラインの単位」で集めることもできます。経営の側はラインや工場の単位で突発停止の件数を見たいことが多く、保全の側は部品の単位で故障モードを見たいことが多いので、両方の見方に耐える階層が必要になります。
階層の段の数や名前は、業種や組織によって変わります。後で紹介する ISO 14224 も、設備の分類体系(規格の中では equipment taxonomy)を収集するデータの1つに挙げています。ただし、ISO 14224 の階層の具体的な段の数と名前は規格の本文で定められており、本コラムでは本文を確かめていないので、ここでは書きません。次の表は、本コラムが基本の形として使う4つの段と、各段で予知保全に関わる情報を整理したものです。
| 階層の段 | 例 | この段に付ける主な情報 | 予知保全での使い道 |
|---|---|---|---|
| 工場 | 第1工場 | 拠点の名称・所在地・稼働の形態 | 工場ごとの突発停止の件数、二重投資の有無の確認 |
| ライン | 組立ライン2 | 製品・工程・計画停止の時間枠 | 警報への対応を計画停止に合わせる判断(第9章の時間枠) |
| 設備 | ポンプ1号 | 設備番号・型式・設置日・重要度・取り付けたセンサー | 警報・作業指示・保全記録を結びつける鍵 |
| 部品 | ポンプ1号の駆動側の軸受 | 部品の種類・交換日・使用した在庫品 | 故障モードの集計、部品ごとの寿命の推定(第2章・第7章) |
設備台帳には、予知保全のために付け足しておきたい列があります。どのセンサーをどの設備のどの位置に付けたか、そのセンサーの値をどの警報のしきい値で見ているか、モデルの版はどれか、という列です。センサーの付け替えやモデルの更新が起きたときに、警報の出方が変わった理由を後から追えるようにするためです。センサーの位置や種類については第3章、モデルの監視と更新の考え方は第8章と、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。
設備台帳は一度作れば終わりではありません。設備の新設・移設・廃却・部品の型式の変更があるたびに更新が必要で、更新が止まると、警報が存在しない設備番号に出る、記録が廃却済みの設備に付く、といった食い違いが起きます。台帳の更新を誰が担うか(多くは保全部門の計画担当か、設備を管理する部門)を決め、設備の新設や改造の手続きの中に台帳の更新を入れておくことが、データの品質を保つ最初の手当てになります。データの品質を組織として管理する考え方は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。
保全業務を管理する情報システム、CMMS と EAM の役割
警報から振り返りまでの業務の工程を、紙と表計算のファイルだけで回すことも不可能ではありません。設備が少なく、保全員が数人の工場では、それで十分なこともあります。ただ、設備と警報の数が増えると、作業指示の発行・進み具合の確認・部品の引き当て・記録の集計を手作業で続けるのは難しくなります。そこで使われるのが、保全業務を管理する情報システムです。
この種のシステムは、一般に CMMS(コンピュータによる保全管理システム)と EAM(企業の設備資産の管理システム)という2つの呼び名で紹介されます。どちらも呼び名であって、規格で範囲が定められた製品の区分ではないので、本コラムでは一般論として次のように整理します。CMMS は、設備台帳・作業指示・保全記録・点検の予定・保守部品の在庫といった保全部門の日々の業務を管理することを中心にしたものです。EAM は、それに加えて、設備の取得から廃却までの一生(ライフサイクル)や、複数の拠点の設備資産をまとめて管理することまで範囲を広げたものとして説明されることが多い呼び名です。設備資産の管理(アセットマネジメント)の考え方と保全の方式との関係は、第1章で扱っています。
予知保全の観点から見ると、CMMS・EAM に求めたい働きは製品の種類を問わず次のようなものです。
- 予知保全の仕組みが出した警報を受け取り、設備番号に結びつけて、作業指示の候補として表示できる
- 作業指示に、どの警報から生まれたかを残せる
- 保全記録の項目(故障モード・原因・処置など)を、自由記述ではなく選択肢から選ぶ形で入力できる
- 設備台帳の階層に沿って、記録を部品・設備・ライン・工場の単位で集計できる
- 記録と警報の履歴を、データ担当が分析に使える形で取り出せる
本コラムでは、個別の製品の比較はしません。製品を選ぶ前に、上の働きのうちどれが必要かを、保全部門とデータ担当が一緒に書き出しておくことを勧めます。とくに最後の「分析に使える形で取り出せる」は、予知保全のモデルを作る側にとって欠かせない一方で、保全業務を回す側からは見えにくい要件です。データの取り出し方が決まっていないと、保全記録は CMMS の中に溜まっていても、モデルの学習には使えないという状態になります。
すでに CMMS を使っている場合に起きやすいのは、予知保全の仕組みを CMMS とは別に作り、警報だけが別の画面に出る形です。保全員は CMMS で作業指示を見て、別の画面で警報を見ることになり、両者を頭の中で突き合わせる手間がかかります。新しい仕組みを入れるときは、警報を既存の CMMS の作業指示の流れに入れることを先に検討し、別の画面を増やすのは最後の手段にしておくのがよいと考えています。部門や工場ごとに別の警報の画面や記録の仕組みを作っていくと、序章で整理した6つの損失の型のうち、二重投資につながります。
保全記録に残す項目、故障モード・原因・処置・停止時間・部品
保全記録は、作業のあとに「何が起きていて、何をしたか」を残すものです。予知保全の観点からは、保全記録は次の予測のための学習用のデータと評価用のデータの源でもあります。ところが、多くの職場で残されている保全記録は、作業の日付と設備名と「異音あり、軸受交換」のような短い自由記述だけ、という形になりがちです。この形では、人が読めば内容は分かっても、何百件・何千件の記録を統一した基準で集計してモデルに使うには、分類や確認の手間が大きくかかります(自由記述の記録を分類して使う方法は後の節で扱います)。
予知保全に使える保全記録にするには、項目を決め、できる限り選択肢から選ぶ形にする必要があります。本コラムでは、最低限残したい項目を次の表のように考えています。項目の名前は、後で紹介する ISO 14224 が収集するデータの区分(設備のデータ・故障のデータ・保全のデータ)を参考にしつつ、本コラムの言葉で書いています。
| 項目 | 何を書くか | 入力の形 | 予知保全での使い道 |
|---|---|---|---|
| 設備番号・部品 | 作業の対象となった設備と部品、その部品の使用を始めた日(前回の交換日) | 設備台帳から選ぶ | 警報・センサーのデータと結びつける鍵、部品ごとの使用期間の計算 |
| 作業のきっかけ | 作業を起こした理由(警報・点検の予定・点検での気付き・故障・その他) | 選択肢 | 警報から生まれた作業の割合、警報の効果の集計 |
| 実施した点検の種類 | 巡回点検・定期点検・法令で定められた点検・臨時の点検・点検なし | 選択肢 | 点検の種類ごとの気付きの集計(作業のきっかけとは別の項目にする) |
| 関連する警報 | 作業のきっかけが警報なら、その警報の番号(警報を受けて巡回点検などを行った場合も付ける) | 警報の一覧から選ぶ | 警報と作業の対応づけ、点検の所見に基づく警報の確認結果の集計。第8章の数え方では、故障・異常の発生日時と合わせて使う |
| 故障・異常の発生日時 | 故障や異常が起きた日時、あるいは見つけた日時。正確な日時が分からなければ、最後に正常を確かめた日時と異常を見つけた日時の2つ | 日時(2つまで) | 第8章の数え方での誤報・見逃し・リードタイムの計算、寿命の推定(第7章) |
| 見つかった状態 | 故障していた・兆候があった・点検した範囲では異常を見つけなかった・判定保留(未確認)。あわせて点検の方法と確かめた範囲 | 選択肢と、点検の方法・範囲の補足 | 点検の所見に基づく警報の確認結果の集計 |
| 故障モード | 故障の現れ方(軸受の外輪のはく離、ベルトの摩耗など) | 部品の種類ごとの選択肢 | 故障診断のモデルのクラス(第6章) |
| 原因 | 故障を引き起こした原因(潤滑の不良、取り付けの不良、過負荷など) | 選択肢と補足の自由記述 | 再発防止・改良保全の判断 |
| 処置 | 点検のみ・調整・予防の部品交換(故障の前の交換)・故障後の部品交換・修理 | 選択肢 | 寿命のデータで打ち切りとして扱うかの判定(第2章・第7章) |
| 停止時間 | 設備が止まっていた時間と、計画停止か計画外の停止か | 数値と選択肢 | 突発停止の件数・時間の集計 |
| 使用した部品 | 交換した部品と数量 | 保守部品の在庫から選ぶ | 部品の消費の予測と保守部品の在庫(弊社コラム『在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで』) |
| 作業時間・作業者 | 作業にかかった時間と担当者 | 数値と担当者の一覧から選ぶ | 保全員の工数の見積もり(第9章の割当の入力) |
| 補足 | 選択肢に収まらない気付き | 自由記述 | 選択肢の見直し、熟練者の判断の記録 |
この表の中で、予知保全にとってとくに大事なのは次の4つです。
- 関連する警報
- 故障・異常の発生日時
- 見つかった状態
- 処置
この4つの項目は、警報の評価の材料になります。本章では、警報の評価を2つに分けて扱います。1つは、第8章の数え方(将来の故障の発生に基づく評価)です。誤報・見逃し・リードタイムはこの数え方で数え、そのためには「故障・異常の発生日時」の記録が要ります。もう1つは、警報を受けて行った点検の所見で数える、点検の所見に基づく警報の確認結果です。こちらは「関連する警報」と「見つかった状態」から集計し、誤報・見逃しの語は使わずに、このあとに示す4つの区分で数えます。判定の根拠が違うので、両者の件数は一致するとは限りません。本章で警報の当たり外れと書くときは記録で判定したもの(点検の所見に基づく警報の確認結果)を指し、報告にはどちらの数え方かを添えます。
第8章の数え方のうち、見逃し(地図の定義では、故障の前に警報が出なかったこと)は、警報が出た設備の記録だけでは数えられません。警報が出なかった設備で起きた故障は、警報に結びついた記録には現れないからです。見逃しを数えるには、警報の有無にかかわらず、監視している設備で起きた故障や異常を発生日時つきで記録し、その設備を監視していた期間と警報の履歴に照らし合わせる必要があります。リードタイムも、警報の開始日時と、故障や異常が起きた日時の両方がそろって初めて計算できます。なお、警報は出たが作業に要る時間を確保できなかったものは、見逃しとは分けて数えます(地図の定義と第8章)。
点検の所見に基づく警報の確認結果は、警報ごとに次の4つの区分のどれかに入れて数えます。2つ目と3つ目は保全記録の「見つかった状態」の選択肢と同じ語で、1つ目はその選択肢の「故障していた」と「兆候があった」をまとめたものです。
- 故障または兆候を確かめた(見つかった状態が「故障していた」か「兆候があった」)
- 点検した範囲では異常を見つけなかった
- 判定保留(未確認)
- 未点検(その警報の番号が付いた保全記録が無いもの、あるいは記録はあっても「実施した点検の種類」が「点検なし」のもの)
「点検した範囲では異常を見つけなかった」は、対象の異常が無いと確かめたこととは限りません。点検の方法や確かめた範囲によっては見落としもあるので、この区分をそのまま誤報の件数に数えることはしません。どの方法でどこまで見たかを残し、決められないときは「判定保留(未確認)」を選べるようにしておきます。判定保留と未点検も、別の区分として件数を残します。
「処置」は、寿命のデータを作るときに必要になります。表の処置の選択肢で「予防の部品交換」と「故障後の部品交換」を分けたのはこのためです。故障する前に予防的に部品を交換した場合、その部品は「故障した」のではなく「故障する前に観察を打ち切られた」ことになります。第2章と第7章で扱った打ち切りのあるデータの扱いは、この区別が記録に残っていることが前提です。ただし、劣化の兆候を理由に交換した場合は、観察を打ち切った時点がその部品の故障しやすさと関係しています。寿命の推定の方法には、打ち切りが故障のしやすさと関係しないこと(独立な打ち切り)を前提にするものがあるので、予防交換と故障後の交換を分けるだけで、推定がそのまま妥当になるとは限りません。交換の理由と交換したときの部品の状態も残し、使う解析の方法の前提を確かめます。
故障モードの選択肢は、最初から細かくしすぎないことが大切です。選択肢が多すぎると、保全員は迷ったときに「その他」を選ぶようになり、結局は自由記述と変わらなくなります。第2章で扱った FMEA の表で挙げた故障モードを出発点にし、部品の種類ごとに5個から10個程度に絞り、振り返りの工程で「その他」が多い部品から選択肢を足していく、という進め方が現実的だと考えています。
見つかった状態の記録には、もう1つ工夫が要ります。予知保全がうまく働くほど、部品は故障する前に交換されるので、「実際に故障していた」という記録は減っていきます。そのとき、交換した部品を取り外したあとに、その部品にどの程度の劣化が見られたか(たとえば軸受の転走面にはく離があったか)を確かめて残しておくと、警報が早すぎたのか、適切だったのかを後から判断する材料になります。ただし、取り外した部品の所見だけで、交換の時期が適切だったかや、残りの寿命がどれだけあったかまで確定できるわけではありません。この確認を作業の手順に入れておかないと、交換した部品は確かめられないまま捨てられ、警報の当たり外れが分からなくなります。
ISO 14224 の考え方、信頼性と保全のデータを共通の言葉で集める
保全記録の項目を決めるときに参考になる国際規格が、ISO 14224 です。この規格は、石油・石油化学・天然ガスの産業を対象に、設備の信頼性と保全のデータを集めて交換するための規格で、ISO の技術委員会 ISO/TC 67 が担当しています。2026年10月30日に ISO の目録(ISO が公開している規格の紹介ページ)で確かめた時点で、最新の版は第3版の ISO 14224(2016年)です。2016年9月に発行され(目録には2016年10月の訂正版も示されています)、状態は発行済みです。この版は2022年2月の定期見直しで内容が確認されており、目録には新しい版の案は示されていませんでした。第1版は1999年、第2版は2006年に発行され、それぞれ次の版に置き換えられています。
目録の要旨を本コラムの言葉で短くまとめると、ISO 14224 は、信頼性と保全のデータを共通の形式と用語で集め、運転の経験を組織の間で伝え合えるようにするための規格です。故障モードも共通の一覧として定めています。一方で、データを分析して使う方法そのものは対象外とされており、データをどう分析するかではなく、分析に使えるデータをどう集めて共通の形にするかを定めた規格だといえます。集めるデータは、要旨では設備のデータ・故障のデータ・保全のデータの3つの区分で示されています。
この3つの区分を、本コラムの保全記録の項目に当てはめると、次のようになります。対応づけは本コラムが考えたもので、規格が定めたものではありません。
| ISO 14224 の要旨にあるデータの区分 | 本コラムの保全記録の項目との対応 |
|---|---|
| 設備のデータ | 設備台帳と設備の階層、設備番号・部品 |
| 故障のデータ | 故障・異常の発生日時・見つかった状態・故障モード・原因 |
| 保全のデータ | 処置・使用した部品・作業時間・停止時間 |
この規格の対象は石油・石油化学・天然ガスの産業です。それ以外の業種の工場がこの規格に従う必要はありませんし、本コラムも従うことを勧めるものではありません。それでも参考にする価値があると考えるのは、保全記録を「設備・故障・保全」の3つの区分に分け、故障モードを共通の一覧から選ぶという考え方が、要旨に書かれた範囲で見る限り、予知保全の教師データを作るという目的と重なると考えているからです。自社の保全記録の項目を決めるときに、この3つの区分に漏れが無いかを確かめる、という使い方が現実的です。たとえば、作業の記録はあっても設備台帳と結びついていなければ設備のデータが欠け、処置は書いてあっても故障モードや原因が無ければ故障のデータが欠けます。規格の本文(故障モードの一覧や設備の分類体系の詳細)は有償で頒布されており、本コラムでは本文を確かめていないので、要旨に書かれている範囲を超えては紹介しません。
保全記録が次の予測の教師データになる仕組み
ここまでの話を、予知保全のモデルの側から見直します。第5章から第8章で扱ったモデルは、それぞれ別の種類の正解を必要としていました。異常検知(第5章)は、故障の正解のラベルを使わずに正常のデータから学ぶ手法が中心でしたが、どの期間が正常だったかを決めるには、その期間に故障や異常の記録が無いことだけでなく、記録そのものに欠落が無いかも確かめる必要があります。記録が無いことだけでは、正常だったとは確かめられないからです。そのうえで、運転の条件・点検の結果・センサーの状態も合わせて見て、正常の期間を選びます。故障診断(第6章)は、どの故障モードだったかという正解のラベルが必要です。残存寿命の推定(第7章)は、いつ寿命の終わりに達したか(あるいは予防的な交換で観察を打ち切ったか)という時点が必要です。第8章の数え方(将来の故障の発生に基づく評価)は、警報の開始日時と、警報の有無にかかわらず記録した故障や異常の発生日時が必要です。点検の所見に基づく警報の確認結果(本章)は、警報が出た設備で実際に何が見つかったかが必要です。
これらの正解の多くは、センサーのデータだけからは得られず、保全記録がその重要な情報源になります。設備の運転の記録や試験の記録と照らし合わせて確かめることもあります。保全記録をセンサーのデータと組み合わせ、用途に応じて、モデルの学習に使うデータと、警報やモデルの評価に使うデータを分けて作ります。冒頭で断ったとおり、この章では、学習に使うデータと評価に使うデータの両方を指して教師データと呼びます。モデルや評価ごとに必要な正解と、それを作る元になる保全記録の項目を、次の表にまとめました。
| モデルまたは評価(章) | 必要な正解 | 保全記録のどの項目から作るか | 記録が欠けると起きること |
|---|---|---|---|
| 異常検知(第5章) | 正常だった期間 | 設備番号・停止時間・見つかった状態(異常を見つけなかった期間を、記録の欠落・運転の条件・センサーの状態と合わせて確かめる) | 故障の前兆を含んだ期間を正常として学び、検知が遅れる |
| 故障診断(第6章) | 故障モードのラベル | 故障モード・見つかった状態 | クラスを決められず、分類のモデルを作れない |
| 残存寿命の推定(第7章) | 寿命の終わりの時点、打ち切りの時点 | 処置・見つかった状態・故障や異常の発生日時・部品の使用を始めた日 | 予防交換を故障として数え、寿命を短く見積もる |
| 第8章の数え方(将来の故障の発生に基づく評価) | 警報の履歴と、故障・異常の発生日時(誤報・見逃し・リードタイムを計算する元) | 関連する警報・故障や異常の発生日時(警報の有無にかかわらず記録したもの) | 見逃しとリードタイムが数えられず、しきい値を直せない |
| 点検の所見に基づく警報の確認結果(本章) | 警報の当たり外れ(確認結果の4つの区分) | 関連する警報・見つかった状態 | どの区分に入れたかの根拠が残らず、しきい値を直す材料にならない |
表の右の列の「予防交換を故障として数え、寿命を短く見積もる」は、記録の項目が足りないときに起きる典型的な誤りの1つです。処置の選択肢が「部品交換」の1つだけで、「軸受交換」という記録だけが残っていると、それが故障してからの交換なのか、警報を受けて故障の前に交換したのかを区別できません。区別できないまますべてを故障として扱うと、寿命の分布は実際より短く推定され、交換の周期も短く決まり、過剰保全につながります。
保全記録とセンサーのデータを組み合わせるときには、時刻の扱いにも注意が要ります。保全記録の日時は、作業を始めた時刻か、終えた時刻か、記録を入力した時刻かが混ざりやすく、入力した時刻が作業の数日後になることもあります。モデルの学習では、警報の時刻と作業の時刻の前後関係が意味を持つので、記録の項目に「作業の開始」「作業の終了」を分けて持たせ、入力した時刻とは別にしておくのが安全です。また、作業の日付と、故障や異常が起きた日時は一致するとは限りません。寿命の推定に使うなら、部品の使用を始めた日(前回の交換日)、故障や異常が起きた日時(あるいは見つけた日時)、その間の累積の稼働時間を対応づけて残します。正確な故障の日時が分からない場合は、最後に正常を確かめた日時から異常を見つけた日時までの区間として残す方法もあります。故障の正確な時刻が分かるデータと、区間でしか分からないデータを区別する考え方は、米国の国立標準技術研究所(NIST)の工学統計ハンドブックの信頼性の節にも示されています。センサーのデータ側の時刻のずれについては第3章で扱っています。
この仕組みが回り始めると、予知保全は自分の記録で自分を改善できるようになります。警報が出る、保全員が判断し作業をする、記録が残る、振り返りで警報の当たり外れを集計する、その結果でしきい値とモデルを直す、という循環です。逆に、記録の工程が欠けたままでは、何年運用しても正解の付いたデータは増えにくく、導入した時点のモデルが更新されないまま使われ続けます。
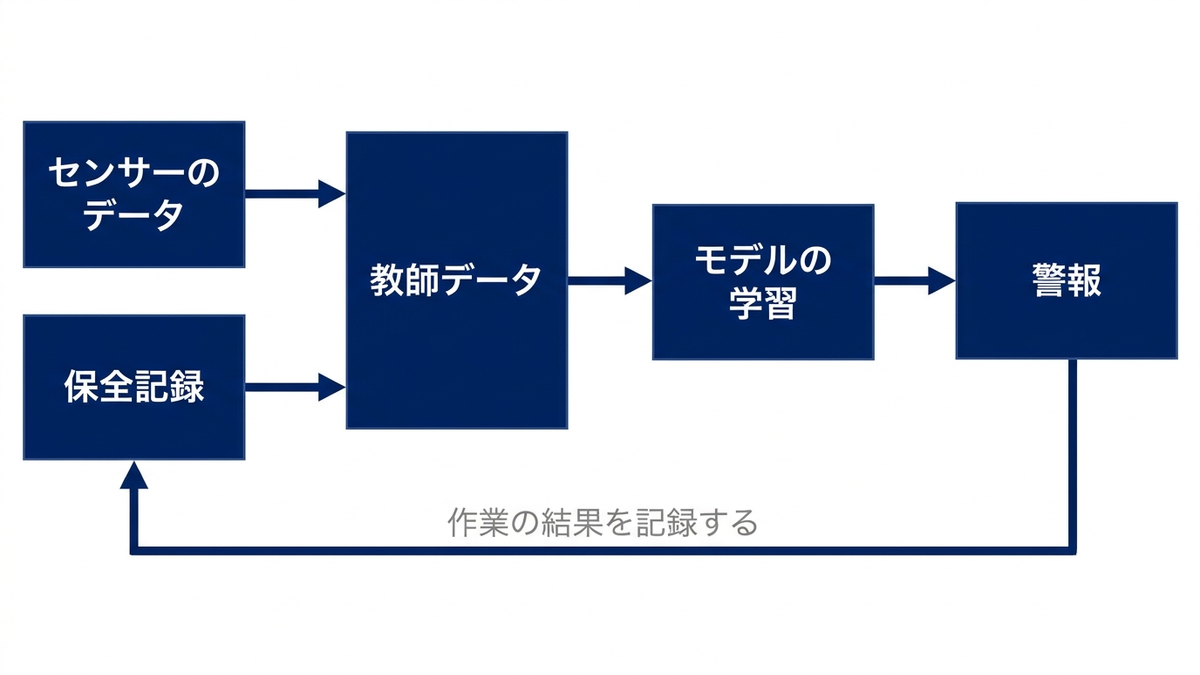
データの品質、自由記述の故障内容を分類して使える形にする
多くの職場には、すでに何年分もの保全記録が自由記述で残っています。これを捨てる必要はありません。ただ、そのままでは統一した基準で集計しにくいので、故障モード・原因・処置の分類に置き換える作業が必要になります。この作業は、新しい記録の項目を決める作業と並行して進めると効率がよいと考えています。過去の自由記述を読むと、現場で実際にどんな言葉で故障が書かれてきたかが分かり、それが新しい選択肢を決める材料になるからです。
自由記述の保全記録によく見られる問題を、次の表にまとめました。
| 問題の型 | 例 | 分類のときの手当て |
|---|---|---|
| 同じものに別の呼び方 | 「ベアリング」「軸受」「BRG」が混在する | 同じ意味の語の対応表(辞書)を作り、1つの語にそろえる |
| 症状と処置だけで原因が無い | 「異音あり、交換」 | 原因を「不明」として分類し、不明の割合を指標として追う |
| 複数の作業が1件にまとまっている | 「軸受交換、ベルト張り調整、清掃」 | 作業ごとに行を分けてから分類する |
| 設備の名前が台帳と違う | 現場の通称や、移設前の設置場所で書かれている | 通称と設備番号の対応表を作る。移設の履歴を台帳から引く |
| 予防交換と故障後の交換の区別が無い | 「部品交換」とだけある | 停止時間・作業のきっかけ・前後の記録から推定し、推定したことを印で残す |
分類の作業は、最初は人が数百件を読んで行い、その結果を正解として、残りを機械で分類する進め方が考えられます。テキストを語に分けて数える方法や、分類のモデルを使う方法、大規模言語モデル(生成AI)に分類させる方法など、テキストの扱い方は弊社コラム『ビジネスの声を数字に変える、自然言語処理とテキストマイニングの実践ガイド』で扱っています。どの方法を使う場合でも、機械が分類した結果を一部抜き出して保全員が確かめる手順を入れ、確かめた結果を正解のデータに加えていくことが必要です。保全記録の分類を誤ると、その誤りがそのまま故障診断のラベルや寿命のデータに入り込むからです。
過去の記録の分類には、限界もあります。記録が書かれなかった作業、記録が残る前に捨てられた部品の状態、記録した人にしか分からない略語は、後からどれだけ工夫しても取り戻せません。過去の記録から作った教師データは、量は多くても質にばらつきがあるものとして扱い、新しい記録の項目で集めたデータが十分に溜まった時点で、モデルの学習の重みをそちらに移していくのが現実的だと考えています。
既存の巡回点検・定期点検・法令で定められた点検との統合
予知保全を入れる工場には、たいていすでに点検の仕組みがあります。保全員が決まった経路を回って設備の音・におい・温度・漏れなどを五感で確かめる巡回点検、決まった周期で設備を止めて分解や測定を行う定期点検、そして法令で実施と記録が定められた点検です。予知保全は、これらの点検を置き換えるものとしてではなく、組み合わせるものとして業務に入れる必要があります。
法令で定められた点検の例として、労働安全衛生法第45条があります。同条は、ボイラーその他の機械等で政令で定めるものについて、事業者が厚生労働省令で定めるところにより定期に自主検査を行い、その結果を記録しておくことを定めています(定期自主検査)。こうした法令で定められた点検は、対象の設備・周期・方法・記録が法令と省令で決まっており、予知保全の警報が出ていないことを理由に省略したり、周期を延ばしたりできるものではありません。予知保全で置き換えられる、とは本コラムでは書きません。対象の設備と点検の中身は、所管の官庁の資料と条文で確かめてください。
巡回点検と定期点検については、予知保全との役割の分け方を決めておくことが大切です。次の表は、本コラムが考える分け方の例です。
| 点検の種類 | 得意なこと | 予知保全との組み合わせ方 | 保全記録への残し方 |
|---|---|---|---|
| 巡回点検 | センサーを付けていない設備や、においや漏れなどセンサーで測りにくい兆候に気付く | 警報が出た設備を巡回の経路に加え、現場で確かめる手順にする | 気付いたことを、実施した点検の種類「巡回点検」として同じ項目で残す。警報を受けて巡回の経路に加えた場合は、作業のきっかけを「警報」とし、関連する警報の番号も付ける |
| 定期点検 | 分解して内部の状態を直接確かめる | 残存寿命の予測を、定期点検での交換の要否の判断材料にする。法令で定められた点検を除く自主的な点検の周期を変えるかは、変更前のリスクの評価と、組織で決めた責任者の承認を経て決める | 分解して見た部品の状態を、見つかった状態・故障モードとして残す |
| 法令で定められた点検 | 法令が求める項目を、決められた周期と方法で確かめる | 法令の点検はそのまま行う。予知保全の警報は追加の情報として使う | 法令が求める記録はその様式で残す。同じ結果を保全記録にも設備番号つきで残す |
巡回点検で保全員が気付いたことは、予知保全にとって貴重な情報です。センサーが捉えていない兆候に人が気付き、それが後で故障につながった場合、その記録はセンサーの選び方や取り付け位置を見直す材料になります。そのためには、巡回点検の気付きも、警報から生まれた作業と同じ項目で保全記録に残しておく必要があります。点検の種類ごとに記録の様式がばらばらだと、振り返りの工程で比べられません。
定期点検の周期を予知保全の結果で延ばす、という判断は、効果が大きい一方で、誤ると突発停止や安全と環境の事故につながります。ここでいう定期点検は、法令で定められた点検を除く自主的な点検に限ります。第9章で扱った点検周期の考え方を使い、記録に基づいて少しずつ判断することが必要です。延ばす前には、故障した場合の影響を含めてリスクを評価し、組織で決めた責任者が承認することを条件にします。周期を延ばした場合は、延ばした後の故障や警報の記録を振り返りで追い、元に戻す条件も先に決めておくのが安全だと考えています。ただし、延ばした後の監視と元に戻す条件は、変更前の評価と承認を補うもので、それだけで安全を判断できるわけではありません。
経営判断、記録を残す手間を業務に組み込む
この章の内容を、経営の判断に置き換えます。予知保全を業務に組み込むときに経営が決めることは、モデルの選び方ではなく、記録を残す手間を誰が負い、それをどう業務の中に位置づけるかです。保全記録の項目を増やせば、保全員1人ひとりの作業のあとの入力の手間は増えます。この手間を「本来の作業の外にある事務」として扱うと、忙しい時期ほど記録は短くなり、選択肢は「その他」に寄りやすくなり、予知保全のモデルは学習に使えるデータを失います。
判断を誤ったときの損失は、序章で整理した6つの損失の型で整理できます。記録が残らないと警報の当たり外れが分からず、誤報が減らないまま警報の形骸化が進みます。予防交換と故障後の交換が区別されないと、寿命を短く見積もって過剰保全になります。警報が作業指示の流れに入らず別の画面に出る場合、両者の連携や担当の分担が不十分だと対応が遅れ、突発停止を防げないおそれがあります。部門や工場ごとに機能や管理が重複する画面や記録の仕組みが作られると、二重投資につながります。定期点検の周期を記録の裏付けなしに延ばすと、安全と環境の事故や品質の不良を招くおそれがあります。
これらを避けるために、経営として次のことを決めておくのがよいと考えています。
- 保全記録の入力を作業の一部と位置づけ、作業時間の見積もりと保全員の工数に、入力の時間を含める
- 設備台帳の更新の責任者を決め、設備の新設・移設・廃却の手続きに台帳の更新を入れる
- 警報を既存の作業指示の流れに入れることを、新しい画面を作ることより先に検討する
- 振り返りの会議(月に1回程度)を保全部門・データ担当・生産部門で持ち、警報の当たり外れと記録の「その他」の割合を毎回確かめる
- 法令で定められた点検は予知保全とは別に従来どおり行うことを、方針として明文化する
予算の面では、予知保全の予算をセンサーとモデルの開発だけに付けるのではなく、記録の項目の設計・過去の記録の分類・CMMS との接続・振り返りの運営にも付けることを勧めます。これらは目立たない作業ですが、ここに予算と人の時間が付いていないと、モデルの改善や運転の条件の変化への対応が進まず、性能の低下に気付かないおそれがあります。保全記録の質は、予知保全を続ける体制が機能しているかを測る指標にもなります。体制と人材の詳細は第13章で扱います。
この章のまとめ
この章では、予知保全を業務に組み込むために、警報・判断・作業指示・作業・記録・振り返りの6つの業務の工程と役割を決め、設備台帳の設備番号で警報と記録を結びつけ、保全記録の項目を選択肢から選ぶ形で設計することを扱いました。保全記録は、センサーのデータと組み合わせることで、異常検知・故障診断・残存寿命の推定の学習に使うデータと、2つの警報の評価(第8章の数え方と、点検の所見に基づく警報の確認結果)に使うデータ、つまりこの章でいう教師データの重要な情報源になります。第8章の数え方で見逃しとリードタイムを数えるには、警報の有無にかかわらず故障や異常を発生日時つきで記録することが要ります。点検の所見に基づく警報の確認結果は4つの区分で数え、「点検した範囲では異常を見つけなかった」をそのまま誤報とは数えません。また、ISO 14224 の「設備・故障・保全」の3つの区分は、記録の項目に漏れが無いかを確かめる手がかりになります。次の第11章では、記録を積み上げても故障のデータが足りない設備について、物理モデルとデジタルツインで補う方法を扱います。
この章を深めたい方への参考書籍
『一番最初に読む設備保全の本』(吉川達志、日刊工業新聞社):設備保全を構成する要素を、初心者にも分かる内容で解説した入門書です(2017年刊)。予知保全の仕組みを業務に入れる前に、既存の保全業務の全体像を確かめておくと、警報をどの業務の流れにつなぐかを整理する手がかりになります。
『現場力を高める実践的TPM入門 改訂版』(日本プラントメンテナンス協会 監修、町田勝利 著、日科技連出版社):TPM の概論から、現場が主役の自主保全活動、専門の保全部門による計画保全活動までを章を分けて解説した本です(改訂版は2017年刊)。この章で扱った巡回点検の気付きや保全記録を、自主保全と計画保全のどちらの活動として回すかを考える手がかりになります。
第11章 物理モデルとデジタルツインの併用、故障データの不足を補う
第10章では、警報から作業指示・作業・記録・振り返りまでの流れに予知保全を組み込み、保全記録が次の予測の教師データになる仕組みを扱いました。記録を積み上げる仕組みが整っても、すぐに解決しない問題が1つ残ります。予測したい故障そのものが、記録の中にほとんど現れないという問題です。この章では、故障のデータが足りない部分を、劣化の物理の知識・シミュレーション・似た設備のデータで補う考え方を扱います。
この章で扱う内容は、次の順です。
- 故障のデータが少なくなる理由
- 劣化の物理(疲労・摩耗・腐食・熱劣化)を設備の予測に使うときの考え方
- 物理の知識とデータの分析を組み合わせる「ハイブリッド」の型
- シミュレーションで故障のデータを作る考え方とその限界
- 製造業のデジタルツインの枠組みを定めた国際規格と、デジタルツインの成熟の段階
- 似た設備のデータを使う転移学習の考え方
- 補い方の選び方と経営判断
この章にはコードを載せず、表と概念図で説明します。シミュレーションの手法そのものの解説は、弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」をご参照ください。
故障のデータが少なくなる理由
予知保全の分析で最初に突き当たることが多いのは、正常に動いているときのデータは大量にあるのに、故障に至るまでのデータがほとんど無いという偏りです。この偏りは、データの集め方が悪いから起きるのではなく、保全がうまく機能している結果として起きる面があります。重要な設備ほど、時間基準保全や日常の点検で故障の前に部品を替えるので、故障まで動かした記録が残りません。第2章で扱った故障の型で言えば、摩耗故障が始まる手前で交換している設備では、寿命の分布の右側(長く使ったときにどう壊れるか)が観測されないまま終わります。
故障のデータが少なくなる理由は、少なくとも次の5つに分けられると考えています。
- 重要な設備ほど故障させない運用をしているので、故障まで至った事例が少ない
- 予防保全で部品を早めに替えると、その部品が本来どこまで使えたかが分からない(統計の言葉では「打ち切り」になる。第2章)
- 設備が新しい、あるいは更新したばかりで、運転の履歴そのものが短い
- 故障が起きていても、保全記録に故障モードや原因が残っていない(第10章)
- 同じ型の設備でも、負荷・運転条件・設置環境が違うので、別の設備の故障をそのまま当てはめにくい
このうち最初の3つは、記録の仕組みを整えても解消しません。故障が少ないことは設備の運用としては望ましい状態だからです。4つ目は第10章で扱った保全記録の整備で改善でき、5つ目は後で扱う転移学習の考え方と関係します。第5章で、故障のデータが少ない前提で正常のデータだけから学ぶ異常検知の手法を扱いましたが、異常検知が答えるのは「いつもと違うか」までです。どの故障モードか(第6章)や、あとどれくらい使えるか(第7章)を推定するには、故障の側の情報がどうしても要ります。その不足を、データ以外の知識で補うのがこの章の主題です。
| 不足の型 | 起きる理由 | 補う手段の候補 | 本コラムで扱う章 |
|---|---|---|---|
| 故障まで至った事例が少ない | 重要な設備を故障させない運用 | 劣化の物理モデル、シミュレーション | 本章 |
| 部品が本来どこまで使えたかが分からない | 予防保全による早めの交換(打ち切り) | 打ち切りを扱う寿命の推定 | 第2章・第7章 |
| 運転の履歴が短い | 新しい設備、更新したばかりの設備 | 似た設備のデータ(転移学習)、物理モデル | 本章 |
| 故障の原因が記録に無い | 保全記録の項目・書き方が決まっていない | 保全記録の項目の整備 | 第10章 |
| 他の設備の故障を当てはめにくい | 負荷・運転条件・設置環境の違い | 運転条件ごとの正常の定義、転移学習 | 第5章・本章 |
この表で「補う手段の候補」に並べたものは、どれも故障のデータの代わりになるわけではありません。物理モデルもシミュレーションも、作った人が想定した故障の進み方しか表せないという限界を持っています。この章では、それぞれの手段が何を補えて、どこで外れるかを順に書きます。
劣化の物理を予測に使う、物理モデルの考え方
本コラムでいう物理モデルは、部品が劣化する仕組み(力・温度・化学反応など)を式や手順で表し、運転の条件から劣化の進み方を計算するモデルを指します。データから当てはめるモデルが「過去にこう動いたから今後もこう動く」と考えるのに対して、物理モデルは「この条件で使えば、この仕組みでこれだけ傷む」と考えます。故障のデータが無くても、材料の性質・設計の値・運転の条件が分かれば計算を始められる点が、物理モデルの最大の利点です。
設備の部品の劣化は、仕組みで分けると次の4つが代表的です。ここでの説明は、それぞれの仕組みの考え方を一般論としてまとめたもので、個別の材料や部品の寿命を計算するには、材料の試験の結果や設計の資料が別に要ります。
| 劣化の仕組み | 起き方の考え方 | 主に効く運転の条件 | 捉えやすい兆候の例 | 物理モデルの使いどころ |
|---|---|---|---|---|
| 疲労 | 繰り返しかかる力で、材料の表面や内部に小さな亀裂が生じ、少しずつ広がる | 荷重の大きさ、繰り返しの回数(回転数・運転時間) | 振動の変化(第4章の軸受の欠陥周波数など) | 荷重と回転数から寿命の目安を計算する |
| 摩耗 | 接触して動く面が少しずつ削れる | 接触の圧力、滑りの距離、潤滑の状態、異物の混入 | すき間の増加、振動・騒音の変化、潤滑油の中の摩耗粉 | 運転の量と潤滑の状態から削れる量の傾向を見積もる |
| 腐食 | 周りの水分・薬品・ガスとの化学反応で材料が減ったり弱くなったりする | 湿度、温度、液体の性質、運転の停止と再開の繰り返し | 肉厚の減少、漏れ、外観の変化 | 環境の条件から減る速さの傾向を見積もる |
| 熱劣化 | 高い温度にさらされ続けることで、絶縁材料・樹脂・潤滑油などの性質が変わる | 温度、温度にさらされる時間、負荷の大きさ | 温度の上昇、絶縁の抵抗の低下、潤滑油の性状の変化 | 温度の履歴から劣化の進み具合を積み上げる |
疲労の代表的な例が、転がり軸受の寿命の計算です。軸受メーカーの技術資料(NSK Technical Journal No. 697(2025年))は、転がり軸受の疲労による「はく離」(表面がうろこ状に剥がれる損傷)を、最初の亀裂ができる位置によって内部起点型と表面起点型に分けています。国際規格の ISO 281(2007年)は、転がり軸受の寿命を計算する方法(規格の語では、基本動定格荷重と定格寿命の計算方法)を定めています。
ISO の目録(規格ごとの紹介ページ)によると、ISO 281 には2種類の寿命の計算があります。1つは基本定格寿命で、一般に使われる高品質の材料、良好な製造の品質、通常の運転の条件を前提にした、信頼度90%に対応する寿命です(1個の軸受の寿命ではなく、多数の軸受についての統計的な目安です。この点は次の段落で扱います)。もう1つは修正定格寿命で、日本ベアリング工業会の ISO 281 改正説明会の資料(2007年)では、基本定格寿命に係数を掛けて補正する式として示されています。目録によると、修正定格寿命の計算では次の4つを考慮に入れます。
- 信頼度(90%以外の信頼度で寿命を求める場合)
- 潤滑の状態
- 潤滑剤の汚れ
- 疲労限荷重(運転中にかかる荷重とは別に、軸受の形式や大きさ、材料の性質などから軸受ごとに計算で求める量)
同じ目録には、摩耗・腐食・電食(軸受に電流が流れて傷む現象)が寿命に与える影響はこの規格の範囲外である、と書かれています。規格の状態については、2026年10月30日に取得した目録では、この版は2021年に見直しを経て現行のまま確認されたあと、2026年5月21日に「改訂予定」となり、後継として ISO/DIS 281(改訂版の国際規格案)が作成中と表示されていました。使う前に、目録で最新の状態を確かめる必要があります。
この規格の範囲の書き方は、物理モデルの性質をよく表しています。軸受の寿命の計算は、荷重と回転数という運転の条件から疲労による寿命の目安を出せますが、摩耗・腐食・電食のように、規格の範囲の外にある劣化は扱いません。また、基本定格寿命が信頼度90%に対応する寿命と定義されていることから分かるように、この値は多数の軸受を同じ条件で使ったときの統計的な目安で、1個の軸受がいつ壊れるかを言い当てるものではありません。物理モデルは、設計の前提どおりに使われたときの劣化を表すのが得意で、前提から外れた使われ方を自分では検知できない、と整理しておくと扱いやすいと考えています。
物理モデルには、もう1つの弱点があります。モデルの中の係数(材料の性質・摩擦の係数・環境の厳しさなど)は、実際の設備では正確に分からないことが多い点です。カタログの値や設計の値は代表値であって、その設備・その部品の値ではありません。このため、物理モデルの計算は「劣化の進み方の形」は正しくても「速さ」がずれることがよくあります。このずれを、実際の設備で測ったデータで直す考え方が、次に扱うハイブリッドの型です。
物理モデルとデータの組み合わせ方、ハイブリッドの3つの型
本コラムでいう「ハイブリッド」は、物理モデル(劣化の仕組みにもとづく計算)とデータの分析(測ったデータから傾向を学ぶこと)を1つの予測の中で組み合わせるやり方を指します。物理モデルとデータの分析は、どちらか一方を選ぶものではありません。物理モデルは故障のデータが無くても使えるが係数がずれる、データの分析は実際の設備の癖を拾えるが故障のデータが無いと故障の側を学べない、という互いの弱点を補い合える関係にあります。両者を組み合わせるやり方は、本コラムでは大きく次の3つの型に分けて考えます。
| 型 | やり方 | 補えること | 外れやすいところ | 本コラムの関連する章 |
|---|---|---|---|---|
| 物理の知識を特徴量に入れる | 欠陥周波数・負荷で割った値・温度の上昇幅など、劣化の仕組みに結びついた量を計算し、異常検知や診断の入力にする | 少ないデータでも、劣化と関係の深い量だけを見られる。結果を保全員が読める | 想定していない劣化の仕組みは特徴量に現れない | 第4章・第5章・第6章 |
| 物理の知識を制約に入れる | 劣化は元に戻らない(単調に進む)・負荷が大きいほど速く進む・温度が高いほど速く進む、といった知識を、予測の形や向きの制約として与える | データが少ない区間で、物理的にありえない予測(健全性が勝手に回復するなど)を防ぐ | 部品の交換や清掃で状態が回復する場合は、制約を区切り直す必要がある | 第7章 |
| 物理モデルの係数をデータで直す | 物理モデルで劣化の進み方の形を決め、係数(速さ)を、その設備で測ったデータに合わせて更新し続ける | 設備ごとの癖を反映できる。モデルの形が合っていて、係数の推定に役立つデータが増えれば、予測の幅を狭められる場合がある | 物理モデルの形そのものが外れていると、係数をいくら直しても合わない | 第7章・本章 |
1つ目の型は、本コラムの第4章から第6章ですでに使っています。第4章で扱った軸受の欠陥周波数は、軸受の寸法と回転数から計算される物理の量で、この量に注目すると、振動の大量のデータの中から外輪や内輪の傷に対応する成分に絞って見られます。データの量が少ないときほど、物理の知識で「見るべき量」を絞り込む価値は大きくなります。
2つ目の型は、予測の形に制約を与えるやり方です。劣化は時間とともに進み、部品を替えない限り元に戻らない、という知識は、多くの部品で成り立ちます。この知識を予測のモデルに与えると、データが途切れた区間やノイズが大きい区間でも、健全性の指標が上がったり下がったりする不自然な予測を抑えられます。ただし、元に戻らないと仮定してよいのは、損傷の量を表す指標を、負荷・回転数・周囲の温度といった運転の条件の影響を補正したうえで見る場合です。振動や温度の測定値そのものは、損傷が進んでいなくても運転の条件で上下するので、測定値に「単調に増える」という制約を直接かけると、実際の変化を消してしまうおそれがあります。第7章の劣化モデルは、指数などの曲線の形を先に決めて健全性指標に当てはめる方法で、劣化の形についての知識が曲線の形として入る点で、この型の素朴な例です。
なお、物理の方程式を機械学習に組み込む研究は進んでいますが、設備の予知保全にそのまま使える道具がそろっているという意味ではありません。研究の例として、Raissi らの2019年の論文(Journal of Computational Physics 378巻)は、非線形の偏微分方程式(量が場所や時間によってどう変わるかを表す方程式の一種)を含む問題を、深層学習で解く枠組みを題にしています。Karniadakis らは2021年に、こうした物理にもとづく機械学習を題にした論文を Nature Reviews Physics 3巻に発表しています。設備に当てはめるときは、この節の3つの型のどれに当たるかを先に決め、実際の設備のデータで確かめる手順を組むことが前提になると考えています。
3つ目の型は、物理モデルとデータの分析を最も深く組み合わせるやり方です。運転を始めた直後は物理モデルの係数を設計の値で置いておき、点検や状態監視のデータが入るたびに、実測に合うように係数を直していきます。データが少ないうちは物理モデルの形が予測を支え、モデルの形が合っていれば、データが増えるにつれて、その設備の実際の速さが反映されていきます。この型は、故障のデータが少ない設備で第7章の残存寿命を推定するときに有力な選択肢になると考えています。ただし、係数を直す手順を誤ると、センサーの故障や一時的な運転の変化に係数が引きずられることがあるので、係数の変化そのものを監視する仕組みが要ります。
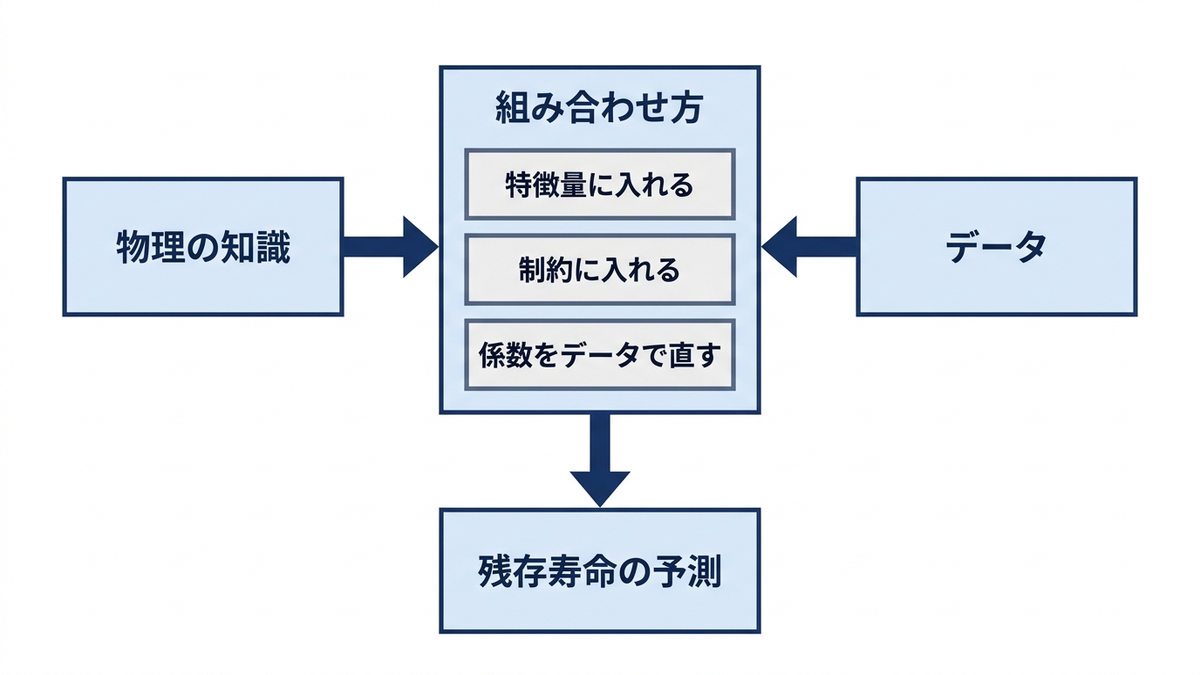
シミュレーションで故障のデータを作る考え方
物理モデルを使うと、実際には起きていない故障のデータを計算で作ることもできます。部品の劣化を少しずつ進めた状態をモデルに入れて運転を計算し、そのときにセンサーが示すはずの値を出力すれば、故障に至るまでのセンサーの時系列を、何本でも作れます。故障のデータが無いという問題に対して、最も直接的な答えに見えるやり方です。
この考え方の代表例として、米国の航空宇宙局(NASA)の研究センターと GE の研究所の研究者らが2008年に発表した、航空機のガスタービンエンジンの劣化を模擬した論文があります(Saxena らの論文。IEEE の会議録。NASA の技術報告のサーバー NTRS にも登録されています)。NTRS に載っている要旨によると、エンジンの性能を計算するシミュレーションモデルの中で、劣化が指数的に進む形に決めて計算しています。劣化の始まりの状態と進む速さは乱数で変え、健全性の指標が0に達した時点を故障として、そこまで劣化を進めています。この論文の健全性の指標は、運転の余裕(限界までのゆとり)を表す量として置かれ、劣化が進むほど小さくなって0で故障とする向きです。本コラムの第7章の健全性指標は、劣化が進むほど大きくなり、交換の水準 1.0 への到達を寿命の終わりとする設定で、この論文の指標とは向きも意味も別のものです。作られたデータは、2008年の PHM(故障の予兆検知と健全性の管理)の学会のデータ競技会の課題に使われました。予知保全の研究で使われる公開データセットの紹介は、第7章に送ります。
この例から読み取れるのは、シミュレーションで作ったデータには、作った人が決めた劣化の進み方がそのまま入っている、ということです。上の論文では、劣化の形を指数的に悪くなる形に決め、故障の基準も健全性の指標が0になる時点と決めています。このデータでモデルを評価して分かるのは、作った人が設定した指数的な劣化を含む条件のもとでの性能です。実際の設備で別の形の劣化(突然の破損、階段状に進む悪化、運転の条件で速さが変わる劣化)が起きたときの性能は、このデータでの評価では保証されません。
シミュレーションで作ったデータを予知保全に使うときの限界は、少なくとも次の4つがあると考えています。
- モデルに入れた故障モードしか現れない。想定していない故障モードのデータは作れない
- 劣化の進み方の形と速さは、作った人の設定で決まる。実際の設備で確かめるまでは仮定にすぎない
- センサーのノイズ・取り付けの違い・欠測・時刻のずれ(第3章)は、意図して入れない限り現れないので、実際のデータより「きれい」になりやすい
- シミュレーションのモデルを作る手間と、モデルが正しいことを確かめる手間がかかる。確かめるには、結局いくらかの実際のデータが要る
それでも、シミュレーションのデータには使いどころがあります。1つは、異常検知や診断のモデルを作るときに、「この故障モードが起きたら、どのセンサーにどう現れるか」を事前に確かめる用途です。どのセンサーを付けるか(第3章)を決める前に、候補の故障モードがどの測定値に現れやすいかを計算で見ておくと、センサーの選び方の根拠になります。もう1つは、警報の仕組みの試験です。故障のデータが無い設備では、警報が本当に鳴るかを確かめる手段が乏しいので、シミュレーションのデータを流して警報の動きを試すことは、第8章の評価を補う手段になります。
| シミュレーションのデータの用途 | 向いている度合い | 理由 |
|---|---|---|
| 故障モードがどのセンサーに現れるかを事前に確かめる | 向いている | モデルに入れた故障モードについて、測定値への現れ方の傾向を見る用途で、劣化の速さの正確さは問われにくい |
| 警報の仕組みが動くかを試す | 向いている | 警報の論理が設計どおりに動くかを確かめる用途で、データの正確さよりも「故障の側のデータがあること」が重要 |
| 異常検知・診断のモデルの学習を補う | 条件つきで向いている | 実際のデータと混ぜて使い、実際のデータで性能を確かめることが前提 |
| 残存寿命の予測モデルをシミュレーションのデータだけで作る | 向いていない | 劣化の速さと形が設定の仮定のままで、実際の設備での誤差が分からない |
| シミュレーションの結果だけで交換の時期を決める | 向いていない | 予測の幅(第7章)を実際のデータで確かめていない |
この表で「向いていない」とした用途は、シミュレーションを使ってはいけないという意味ではありません。シミュレーションの結果だけで判断を確定させず、実際の設備のデータで確かめる手順を挟む必要がある、という意味です。シミュレーションの手法(離散イベント・連続系のモデルの作り方など)の詳しい解説は、弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」をご参照ください。
デジタルツインとは何か、ISO 23247 の枠組み
物理モデル・シミュレーション・実際の設備のデータを、1つの仕組みとしてつなぎ続けるものがデジタルツインです。本コラムでは、実際の設備の状態をデータで写し取り、コンピュータの中に設備の「双子」を作って、状態の把握・予測・試行に使う仕組みを指します。この語の使われ方は分野や企業によって幅があり、3次元の形状を画面に表示するだけのものから、物理モデルで運転を計算し続けるものまでが同じ名前で呼ばれることがあります。
この語を題に掲げた早い時期の文献の1つに、NASA のラングレー研究センターと米国空軍科学研究局の研究者が2012年に発表した論文があります(Glaessgen と Stargel の論文。米国航空宇宙学会の会議録。要旨は NTRS で読めます)。NTRS の要旨によると、この論文は、将来の機体の認証と維持には従来のやり方では足りなくなるという問題意識から、精密なシミュレーションと、機体の状態の監視・保全の履歴のデータを統合して個々の機体の状態を写し取る構想として、デジタルツインを示しています。予知保全の文脈で言えば、物理モデルと実際のデータと保全記録を1つにつなぐ考え方が、この時点で示されていたことになります。
製造業のデジタルツインについては、国際規格 ISO 23247 の系列が枠組みを定めています。ISO の目録で2026年10月に確かめた範囲では、国際規格として次の5つの部が発行済みです。表の「観測できる製造の要素」は規格の語で、デジタルツインで写し取る対象を指します。具体的に何を含むかは規格の本文が定めており、本コラムでは本文までは確かめていません。
| 部 | 発行 | 扱う内容(目録の要旨を本コラムの言葉で要約) |
|---|---|---|
| ISO 23247-1 | 2021年10月・第1版 | 製造業のデジタルツインの枠組みの概要と一般原則。用語の定義と、枠組みへの要求事項 |
| ISO 23247-2 | 2021年10月・第1版 | 参照アーキテクチャ。領域と実体の視点からの参照モデルと、それを支える機能の構成(本コラムの言葉で言えば、デジタルツインを構成する要素の役割分担と、要素どうしの関係を整理した見取り図) |
| ISO 23247-3 | 2021年10月・第1版 | 観測できる製造の要素をデジタルで表すための基本的な情報の属性の一覧 |
| ISO 23247-4 | 2021年10月・第1版 | 参照アーキテクチャの中の実体どうしの情報交換の技術的な要求事項。利用者・デジタルツイン・機器の間の通信を、ネットワークの種類ごとに定める |
| ISO 23247-5 | 2026年6月・第1版 | デジタルスレッド(製品の一生を通じて情報をつなぐ仕組み)が、設計・計画・生産・試験にわたって製造業のデジタルツインの作成・接続・管理・維持をどう可能にするか |
いずれの部も、目録の状態は「発行済み(Published)」で、担当は ISO の自動化システムと統合の技術委員会の分科委員会(ISO/TC 184/SC 4)です。第1部から第4部は2021年10月に同時に発行され、第5部が2026年6月に加わりました。この系列には、国際規格のほかに技術報告書(ISO/TR)として、半導体のインゴットの成長の工程を題材にした適用例の ISO/TR 23247-100(2025年5月)と、ロボットによるガスシールドアーク溶接の工程を題材にした適用例の ISO/TR 23247-101(2026年5月)もあります。上の表は国際規格の5つの部だけを挙げたもので、技術報告書は含めていません。本コラムが確かめたのは目録の要旨の範囲で、規格の本文は読んでいません。また、ISO 23247 は製造業のデジタルツインの枠組み(用語・構成・情報のやり取り)を定めるもので、予知保全の手法や、劣化の物理モデルの作り方を定めるものではありません。
予知保全の立場からこの規格の系列を読むと、デジタルツインを作るときに「何を写し取るか(観測できる製造の要素の情報の属性)」「どの機能をどこに置くか(参照アーキテクチャ)」「どうつなぐか(情報交換)」を分けて考える枠組みとして使えると考えています。設備ごと・部門ごとにばらばらにデジタルツインを作ると、同じ設備の情報を別々の形で持つことになり、序章で整理した6つの損失の型のうち、二重投資につながります。規格の枠組みを共通の言葉にしておくと、設備メーカー・情報システム部門・保全部門の間で、どの部分を誰が作るかを話し合いやすくなります。
デジタルツインの成熟の段階、予知保全でどこまで作るか
デジタルツインという言葉は幅が広いので、予知保全に使う場合は、どこまで作り込むのかを先に決める必要があります。本コラムでは、これを「デジタルツインの成熟の段階」と呼び、次の4つに分けて考えることを提案します。この分け方は、本コラムが説明のために置いたもので、規格や公的資料の分類ではありません。
| 成熟の段階 | 中身 | 予知保全で答えられる問い | 必要になるもの |
|---|---|---|---|
| 1. 状態を写す | センサーと稼働ログのデータを、設備の階層(第10章)に結びつけて表示する | 今、どの設備がどういう状態か | センサー、データの収集(第3章)、設備台帳 |
| 2. 異常を知らせる | 写した状態に異常検知・診断(第5章・第6章)を組み合わせる | いつもと違う設備はどれか、原因の候補は何か | 正常の定義、診断のルールやモデル |
| 3. 先を予測する | 物理モデルやデータのモデルで、劣化の進み方と残存寿命(第7章)を計算する | あとどれくらい使えるか、その幅はどれくらいか | 劣化のモデル(物理モデルか、データから学ぶ予測のモデル)、保全記録、モデルを実際のデータで確かめて直す手順 |
| 4. 打ち手を試す | 運転の条件・保全の時期を変えたときの結果を、計算の中で試す | 負荷を下げたら交換を次の計画停止まで延ばせるか | 運転の条件を入力にできる物理モデル、保全計画(第9章)とのつながり |
予知保全の取り組みでは、成熟の段階1と2で十分な効果が得られる設備もあり、すべての設備で成熟の段階4を目指す必要はないと考えています。成熟の段階3では、表の「中身」の列のとおり、劣化の進み方を計算する物理モデルか、データから学ぶ予測のモデル(第7章)を使います。物理モデルを使う場合は、係数を実際のデータで直す手順が要ります。データから学ぶ予測のモデルを使う場合は、学習に使う保全記録と、予測を実際のデータで確かめて学習し直す手順が要ります。成熟の段階4では、運転の条件を変えたときに劣化の進み方がどう変わるかを評価できるモデルが要り、表ではこれを運転の条件を入力にできる物理モデルと書きました。どちらの成熟の段階でも、モデルを作る手間と、モデルが合っているかを確かめ続ける手間がかかります。成熟の段階を上げる対象は、故障の影響が大きく、故障のデータが少なく、劣化の仕組みが物理で説明しやすい設備に絞るのが現実的です。対象設備の選び方そのものは第12章で扱います。
成熟の段階4の「打ち手を試す」は、デジタルツインならではの使い方です。たとえば、残存寿命の予測が次の計画停止より前に尽きそうなとき、負荷を少し下げて運転を続けた場合に寿命がどれだけ延びるかを計算できれば、突発停止を避けながら計画停止まで持たせる、という判断の材料になります。ただし、この計算の結果は物理モデルの前提の範囲でしか正しくないので、計算で延ばした分は、状態監視のデータで実際に劣化の進みが遅くなっているかを確かめながら使う必要があります。安全に関わる設備では、計算の結果だけで運転の継続を決めず、保全と設備の責任者が判断する手順を残すべきだと考えています。
似た設備のデータを使う、転移学習の考え方
故障のデータが足りないときに、もう1つの補い方があります。同じ工場の別のライン、別の工場、あるいは同じ型の設備を使っている他の拠点で集めたデータを、対象の設備の予測に使うやり方です。機械学習では、こうした考え方を転移学習と呼びます。
転移学習の研究を整理した総説の1つに、Pan と Yang が2010年に発表した論文があります(IEEE の知識工学とデータ工学の論文誌 22巻10号)。要旨によると、この総説は、学習に使うデータと使う場面のデータの性質が違う場合に、データの多い別の領域から知識を移す研究を、分類・回帰・クラスタリングの問題ごとに整理したものです。ドメイン適応(学習のデータと使う場面のデータの分布の違いを埋める方法)などの関連する手法との関係も論じています。本章にとっての示唆は、学習のデータと使う場面のデータが違うこと自体が転移学習の前提であり、違いをどう扱うかが手法の中身になる、という点です。
予知保全に当てはめると、知識を移す元(データの多い領域)は故障の記録が多い設備群や、シミュレーションのデータ、移す先は故障の記録が少ない対象の設備です。前の節で扱ったシミュレーションのデータで学び、実際の設備の少ないデータで調整する、という組み合わせも、転移学習の考え方の1つの使い方と見ることができます。
ただし、どの設備のデータでも移せるわけではありません。本コラムでは、移す元と移す先の設備で、劣化の仕組みや測定する特徴量に共通性を確かめられる設備を、転移学習を優先して検討する対象と考えています。同じ型の軸受を使い、似た回転数と荷重で動いている設備どうしなら、振動の特徴量と故障モードの対応は移しやすいでしょう。一方で、型が同じでも負荷・設置の環境・保全のやり方が大きく違う設備では、移した知識がかえって予測を誤らせることがあります。データの分布が違うことは転移学習の出発点ですが、どこまで違うと移せなくなるかは、移す先の設備の実際のデータで確かめるしかありません。
| 確かめること | 確かめ方の例 | 移しにくい兆候 |
|---|---|---|
| 部品と劣化の仕組みが共通か | 部品の型番・設計の値・故障モードの一覧(第2章の FMEA)を突き合わせる | 主要な故障モードが違う、部品の型が違う |
| 運転の条件が近いか | 回転数・荷重・温度・稼働の時間の分布を比べる | 運転の条件の範囲が重ならない |
| センサーと測り方が同じか | センサーの種類・取り付け位置・サンプリング周波数(第3章)を比べる | 取り付け位置やサンプリングの条件が違い、同じ量を測っていない |
| 保全のやり方が似ているか | 交換の基準・点検の周期・記録の項目(第10章)を比べる | 交換の基準が違い、「故障」の意味が設備ごとに違う |
| 移したあとに性能が保たれているか | 移す先の設備で、誤報と見逃しの件数(第8章)を一定期間記録する | 移す先で誤報が増え続ける、見逃しが出る |
最後の行の確かめには限界があります。確かめる期間に故障が1件も起きなければ、見逃しが0件でも、検出の力が確かめられたことにはなりません。転移の効果を判断するには、誤報と見逃しの件数に加えて、転移を使わないモデルとの比較、監視した時間の長さ、その間に実際に確かめられた故障の件数も記録しておく必要があります。
また、移したあとに実際のデータで確かめるという最後の行の考え方は、転移学習に限らず、この章で扱ったすべての補い方に共通します。物理モデル・シミュレーション・似た設備のデータは、どれも対象の設備の実際のデータが足りない部分を仮定で埋めるものです。埋めた部分が正しかったかどうかは、運用を始めてから集まる実際のデータでしか確かめられません。第10章で扱った保全記録の仕組みは、この確かめのためにも欠かせない、と位置づけておくと、記録の手間を業務に組み込む理由が説明しやすくなると考えています。
補い方を選ぶ、故障のデータの量と劣化の仕組みの分かりやすさ
ここまでの補い方を、どの設備にどれを使うかという観点で整理します。選び方の軸として、本コラムでは「対象の設備の故障のデータがどれくらいあるか」と「劣化の仕組みが物理でどれくらい説明しやすいか」の2つを置きます。この整理は、本コラムが説明のために置いた目安で、個々の設備では故障の影響の大きさ(第12章の重要度評価)とあわせて判断する前提です。
| 故障のデータ | 劣化の仕組みが物理で説明しやすい設備 | 劣化の仕組みが物理で説明しにくい設備 |
|---|---|---|
| 多い | データの分析を主にし、物理の知識は特徴量と制約に使う | データの分析を主にする(第5章から第7章) |
| 少ない | 物理モデルを主にし、係数を実際のデータで直す。シミュレーションで故障モードの現れ方を事前に確かめる | 異常検知(正常だけから学ぶ)にとどめ、似た設備のデータを転移学習で使えるかを確かめる。残存寿命の予測は急がない |
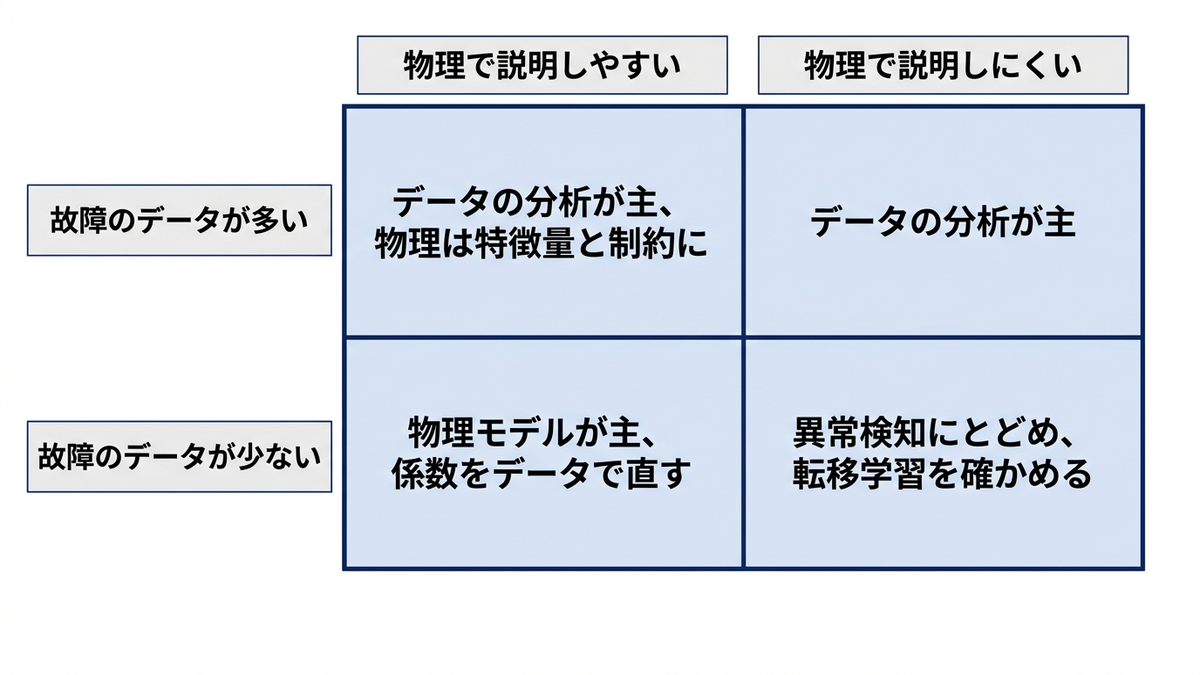
故障のデータが少なく、劣化の仕組みも物理で説明しにくい設備は、予知保全が最も難しい組み合わせです。ここで無理に残存寿命を予測しようとすると、根拠の薄い予測に保全の判断を預けることになります。この組み合わせの設備では、異常検知で「いつもと違う」ことを早く知らせ、知らせを受けた保全員が点検で状態を確かめる、という使い方にとどめ、記録が積み上がるのを待つのが現実的だと考えています。第1章で扱ったように、そもそも予知保全ではなく時間基準保全や事後保全の方が向いている設備もあります。
故障のデータは少ないが、劣化の仕組みは物理で説明しやすい設備が、この章で扱った手段が最も生きる組み合わせです。軸受の疲労のように、荷重と回転数で劣化の速さの目安が計算できる部品では、物理モデルで予測の骨格を作り、状態監視のデータで係数を直す、という進め方が取れます。
よくある誤解と、損失の型との対応
物理モデルとデジタルツインは、言葉の印象が強い分、期待と実態がずれやすい分野だと考えています。よく見られる誤解を、序章で整理した6つの損失の型と対応させて整理します。
| よくある誤解 | 実際には | 放置したときの損失の型(6つの型のうち) |
|---|---|---|
| デジタルツインを作れば故障が予測できる | 状態を写すこと(成熟の段階1)と、先を予測すること(成熟の段階3)は別の仕事で、予測には劣化のモデルと確かめの手順が要る | 二重投資、突発停止 |
| シミュレーションで作ったデータがあれば、故障のデータは要らない | シミュレーションには作った人の仮定が入っている。実際のデータで確かめるまで予測の誤差は分からない | 突発停止、過剰保全 |
| 物理モデルの寿命の計算どおりに交換すればよい | ISO 281 の範囲の外にある摩耗・腐食・電食による劣化は計算に入らない。軸受の基本定格寿命も信頼度90%に対応する統計的な目安 | 突発停止、過剰保全 |
| 同じ型の設備のモデルは、そのまま別の工場で使える | 運転の条件・設置の環境・保全のやり方が違えば、移した知識が誤報や見逃しを増やすことがある | 警報の形骸化、突発停止 |
| デジタルツインの計算で運転の継続を決めてよい | 計算はモデルの前提の範囲でしか正しくない。安全に関わる判断は責任者が行い、法令で定められた点検は別に行う | 安全と環境の事故 |
最後の行について補足します。本コラムでは、法令で定められた点検を、予知保全やデジタルツインの仕組みで置き換えられるものとしては扱いません。予知保全の仕組みは、法令の点検に加えて設備の状態を知る手段と位置づけています。法令の点検と予知保全の関係は、第1章で扱いました。
経営判断:物理の知識を持つ人を外さない
この章の経営判断は、物理の知識を持つ人を予知保全の取り組みから外さないことです。故障のデータが少ない設備で予測を成り立たせるには、劣化の仕組みを知っている人の知識が、特徴量・制約・物理モデルの形として入っている必要があります。その知識を持っているのは、多くの場合、次のような人です。
- 設備の設計者
- 設備メーカーの技術者
- 長く保全に携わってきた保全員
- 材料や潤滑の専門家
データの分析の担当者だけで取り組みを進めると、データが少ない部分を統計的な仮定で埋めることになり、その仮定が劣化の物理と合っているかを確かめる人がいなくなります。
経営として決めておくべきことは、少なくとも次の4つだと考えています。
- 物理の知識を持つ人(社内の保全員・生産技術・設備メーカー)が、モデルの設計と結果の確かめに加わる時間を、業務として確保する
- デジタルツインをどの成熟の段階(状態を写す・異常を知らせる・先を予測する・打ち手を試す)まで作るかを、設備ごとに決める。すべての設備で最上位の成熟の段階を目指さない
- シミュレーションや物理モデルの予測を、実際のデータで確かめる手順と、その結果を記録する場所を決める
- 部門や工場ごとにばらばらのデジタルツインを作らないよう、ISO 23247 のような共通の枠組みを使って、情報の持ち方とつなぎ方をそろえる
この判断を誤ったときの損失は、序章で整理した6つの型のうち、突発停止・過剰保全・二重投資の形で現れます。方向で分けると2つです。1つは、物理の知識が入っていないモデルが、データの少ない部分で外れ、突発停止を防げない、あるいは過剰保全を招く方向です。もう1つは、部門ごとにデジタルツインやシミュレーションの仕組みを作り、同じ設備の情報を別々に持つ二重投資の方向です。いずれも、モデルの精度の問題として扱われがちですが、本質は「誰の知識をモデルに入れるか」「どの仕組みを共通にするか」という体制と投資の判断です。体制と役割の決め方は第13章で扱います。
予算の面では、物理モデルやデジタルツインへの投資を、モデルを作る一度きりの費用として見ないことが大切だと考えています。物理モデルの係数を直す作業、シミュレーションの前提を実際のデータで確かめる作業、設備の更新に合わせてモデルを作り直す作業は、設備を使い続ける限り続きます。これらを保全の業務の一部として計画と予算に組み込んでおかないと、作った時点では合っていたモデルが、数年のうちに実際の設備と合わなくなっていきます。
故障のデータが少ないのは、重要な設備を故障させない運用の結果でもあり、記録の仕組みを整えるだけでは解消しません。足りない部分は、劣化の物理の知識(特徴量・制約・係数をデータで直すモデル)、シミュレーション、似た設備のデータ(転移学習)で補えますが、どれも仮定で埋めるものなので、実際の設備のデータで確かめる手順と、物理の知識を持つ人の関与が欠かせません。デジタルツインは ISO 23247 の系列が製造業の枠組みを定めており、予知保全ではどの成熟の段階まで作るかを設備ごとに決めることが出発点になります。次の第12章では、ここまでの手法をどの設備から、どういう順で導入するか、PoC の設計と効果の見立てを扱います。
この章を深めたい方への参考書籍
『AI、シミュレーションを用いた劣化・破壊評価と寿命予測』(技術情報協会 企画編集、技術情報協会):版元の紹介によると、高分子・複合材料・金属・コンクリートなどの劣化と破壊の評価、寿命の予測に、機械学習とシミュレーションを使う方法を、多数の執筆者が節ごとに扱った本です。加速試験の結果から寿命の予測式を導く手順、温度と劣化の速さの関係を使った寿命の推定、少ないデータからのモデルの作り方、疲労寿命や配管の腐食の予測の例が目次に並んでいます。この章で扱った「劣化の物理とデータを組み合わせる」考え方を、材料と部品の側から具体的な例で確かめるときの手がかりになると考えています。
『転移学習』(松井孝太、熊谷亘 著、講談社):機械学習プロフェッショナルシリーズの1冊です。版元の内容紹介によると、転移学習の基本概念から、ドメイン適応・マルチタスク学習・メタ学習・継続学習などの方法までを解説しています。目次には、「いつ転移するか」「何を転移するか」を扱う章、少ないデータで学ぶ少数ショット学習の章のほか、「ドメイン適応の理論」の章(移した先での予測の誤りの大きさを理論的に見積もる節を含む)も並んでおり、機械学習の理論を扱う専門書という位置づけです。版元のページには対象の読者の記述はありませんが、この章の「似た設備のデータを移せるかを確かめる」という問いを、理論的な裏付けから学びたいデータ分析の担当者に向く1冊として選びました。
第12章 予知保全の導入の進め方、対象設備の選定・PoC・効果の見立て
第11章では、故障のデータが少ない設備について、物理モデルやシミュレーション、似た設備のデータで不足を補う考え方を扱いました。第1章から第11章までで、保全の方式の選び方、故障の型、センサーと信号処理、異常検知・故障診断・残存寿命の推定、警報の評価、保全計画の最適化、業務への組み込みまでがそろいました。この章では、それらを自社に持ち込むときに、どの設備から始め、どう試し、何をもって「続ける」と判断するかを扱います。
この章で書くことは次の順です。
- 導入の全体の順序と、最初に決めること
- 対象設備を選ぶための重要度評価と、故障の型・監視の可否による向き不向きの見方
- PoC(本番に入る前に、小さな範囲で実現できるかと効果があるかを確かめる試行)の設計と、PoC で止まってしまう型
- 効果の見立て方
- 公的な調査に表れた製造業のデータ活用の状況
- 1設備から工場へ広げる順序と、内製と外部委託の分担
- 経営判断
この章にはコードはありません。効果は金額ではなく、件数・時間・相対コストの型で書きます。
導入の順序の全体像、最初に決めること
予知保全の導入は、技術の選定から始めると迷いやすいと考えています。センサーの種類や異常検知の手法は、どの設備のどの故障モードを捉えたいかが決まって初めて選べるからです(第3章)。そこで本コラムでは、導入を次の5つの導入の段階に分けて考えます。
- 対象設備の選定
- PoC の設計
- PoC の実施と評価
- 本番の運用への移行
- ほかの設備への展開
それぞれの導入の段階の終わりに、次へ進むかを判断する点を置きます。その判断の基準は、その導入の段階に入る前に決めておきます。
この5つのうち、最初の対象設備の選定を誤ると、後から直すときの手戻りが大きくなります。対象設備を選び直すと、センサーの取り付けやデータの収集、評価の設計をやり直すことになるからです。また、効果の出にくい設備を選ぶと、PoC で手法がうまく働いても、本番に移す理由が説明できません。逆に、故障の影響が大きく、兆候を捉えやすい設備を選ぶと、手法が簡単でも効果を示しやすくなります。手法の高度さより、対象の選び方が結果を左右することが多いように思います。
最初に決めることは、少なくとも3つあります。1つ目は、予知保全で何を減らしたいかです。序章で整理した6つの損失の型は次のとおりです。
- 突発停止
- 過剰保全
- 安全と環境の事故
- 品質の不良
- 警報の形骸化
- 二重投資
6つの型のうち、突発停止を減らしたいのか、過剰保全を減らしたいのか、品質の不良を減らしたいのかによって、選ぶ設備も評価の指標も変わります。2つ目は、誰が警報を受けて判断するかです。警報を受ける保全員が決まっていない仕組みは、PoC が終わっても使われません(第10章)。3つ目は、導入の判断を誰がいつ行うかです。PoC の結果を見て本番に進むかを決める人と時期を、PoC を始める前に決めておきます。第13章では、対象設備の選定と PoC の出口の判定は工場長が承認し、予算と対象の拡大(ラインや工場への展開)は経営が判断する、という分担にしています。同型の設備を加えるまでは工場長、1ライン以上へ広げるときは経営、という線の引き方は、後の展開の段階の表に書きました。
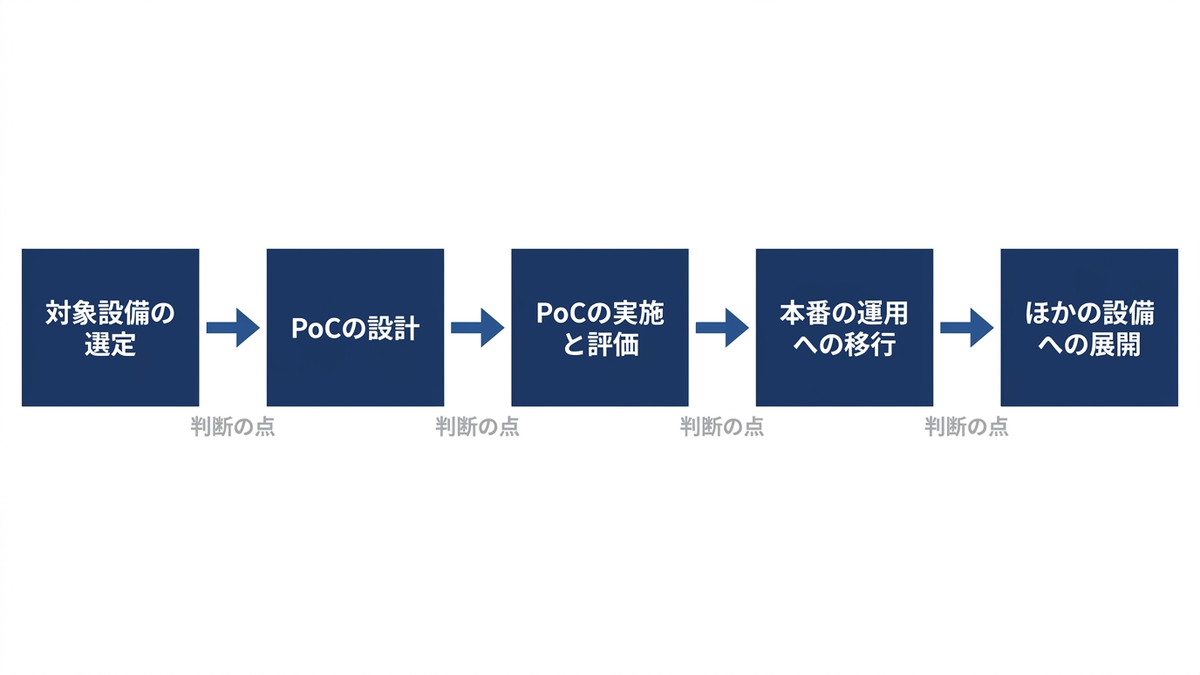
対象設備の選定、重要度評価の考え方
対象設備を選ぶときの出発点は、設備ごとの重要度評価です。重要度評価とは、設備が故障したときに事業へ与える影響の大きさと、故障の起こりやすさなどを、同じ物差しで点数や等級にして並べることを指します。設備台帳(第10章)に載っている設備をすべて同じ深さで見ることはできないので、まず重要度で並べ、上位の設備から保全の方式を見直します。重要度評価は予知保全のためだけのものではなく、保全の方式を設備ごとに選ぶ(第1章)ときの共通の土台になります。
重要度評価の項目は、大きく3つの軸に分けると整理しやすいと考えています。1つ目は故障の影響で、生産の停止、安全と環境、品質への影響を見ます。2つ目は故障の頻度で、保全記録に残っている故障の回数や、同じ種類の設備での故障の傾向を見ます。3つ目は検知できるかで、故障の前に兆候が現れるか、その兆候を測れるかを見ます。リスク(影響と起こりやすさの組み合わせ)にもとづいて保全の優先順位を決める考え方があり、リスクベースメンテナンス(RBM)と呼ばれています。第1章の参考書籍で紹介した入門書が、この考え方を基本から適用の手順まで説明しています。本章の表は、その考え方を予知保全の対象選定に合わせて簡略にしたものです。
次の表は、重要度評価表の雛形です。点数の付け方は一例で、点数の刻みの数や重みは自社の事業に合わせて決める前提です。表の点数の向きに注意してください。「故障の影響」と「故障の頻度」は点数が高いほど保全に手をかけるべき設備であることを、「検知できるか」は点数が高いほど兆候を測りやすく予知保全に向いていることを表します。点数の基準は、評価する人によって判断がぶれないよう、言葉で定義しておきます。「影響が大きい」のような曖昧な言葉ではなく、「代わりの設備が無く、ライン全体が止まる」のように、保全員と生産の担当者が同じ判断にたどり着ける書き方にします。
| 軸 | 評価項目 | 1点の例 | 3点の例 | 5点の例 |
|---|---|---|---|---|
| 故障の影響 | 生産への影響 | 止まっても代わりの設備で生産を続けられる | ラインの一部が止まり、生産が遅れる | 代わりの設備が無く、ライン全体が止まる |
| 故障の影響 | 安全と環境への影響 | 人や環境への影響は考えにくい | 周辺の設備や作業に影響が出うる | 人の安全や環境への影響につながりうる |
| 故障の影響 | 品質への影響 | 品質への影響は考えにくい | 故障の前後で不良が出うる | 不良が後工程や出荷後まで流れうる |
| 故障の影響 | 復旧にかかる時間 | 短時間で復旧できる | 部品の手配や修理に日数がかかる | 部品の調達に長い時間がかかる、修理できる人が限られる |
| 故障の頻度 | 保全記録上の故障の回数(同じ評価の期間・稼働時間でそろえる) | 記録が十分にあり、故障がほとんど無い | 一定の頻度で故障がある | 故障が繰り返し起きている |
| 検知できるか | 兆候の有無と測りやすさ | 兆候が現れないか、測れない | 兆候はあるが、測るには工夫が要る | 兆候が現れ、既存のセンサーや点検で測れる |
「故障の頻度」の点数は、保全記録の残り方に左右されます。記録を付け始めて間もない設備や、稼働の時間が短い設備では、故障が少なく見えても、それが故障の起こりにくさによるのか、記録や稼働の不足によるのかを区別できません。比べる設備のあいだで評価の期間と稼働の時間をそろえ、記録が足りずに判断できない設備は1点とせず、「評価保留」として記録の整理(後の節で扱います)を先に進めます。
評価の結果は、影響の点数と頻度の点数を組み合わせて優先順位を付け、検知できるかの点数で予知保全の向き不向きを判断する、という2つの手順で使うと扱いやすいと考えています。影響と頻度は「保全に手をかけるべき設備か」を、検知できるかは「その手のかけ方として予知保全が合うか」を表すからです。影響と頻度がどちらも高いのに検知できない設備は、予知保全ではなく、時間基準保全や、設備を変える方式(故障しにくい・保全しやすい設備に改める活動。第1章で、改良保全・保全予防と呼ばれることがあると紹介した方式)を検討する対象になります。ただし、時間基準保全が効くのは、狙う故障が使用の時間や回数とともに起こりやすくなり、決まった時期の交換や修理でその起こりやすさを下げられる場合です。この条件は次の節で扱います。
安全と環境への影響が大きい設備には、注意が要ります。こうした設備では、法令で点検が定められていることがあります。予知保全を対象に加えることはできますが、法令で定められた点検を予知保全で置き換える前提で計画や効果を見立てることはしません。予知保全は、定められた点検に加えて状態を見る手段として位置づけ、警報が出たときの判断は保全員と責任者が行います。
故障の型と監視の可否で向き不向きを見る
重要度評価で上位に来た設備でも、予知保全が合うとは限りません。第2章で扱ったように、故障には初期・偶発・摩耗の型があり、劣化が時間とともに進んで兆候が現れる故障ほど、予知保全の効果を出しやすくなります。偶然に起きる故障や、兆候が現れてから機能が失われるまでの時間(第2章の P-F 間隔)がごく短い故障では、警報が出ても保全の準備が間に合いません(第8章)。第1章で整理した方式ごとの向き不向きと、第2章の故障の型を、対象選定の判断に使える形にまとめたのが次の表です。
| 故障の型と兆候の様子 | 監視できるか | 予知保全の向き不向き | 検討する方式 |
|---|---|---|---|
| 摩耗のように劣化が徐々に進み、兆候が早めに現れる | 振動・温度・電流などで測れる | 向いている | 予知保全(状態基準保全) |
| 劣化が徐々に進むが、測る手段が無い、測ると費用や手間が大きい | 測れない、測りにくい | 向いていない | 時間基準保全(故障が使用の時間や回数とともに増え、交換や修理で減らせる場合)、点検の周期の見直し |
| 兆候が現れてから機能が失われるまでが短い | 測れても警報が間に合わない | 向いていないことが多い | 設備を変える方式、予備の設備、時間基準保全(上と同じ条件を満たす場合) |
| 偶然に起きる(外からの衝撃や誤操作など) | 劣化としては測れない | 向いていない | 故障後の対応で済むと評価できれば事後保全と予備の部品。安全や環境への影響が大きければ、防護や誤操作の防止、設計の改善。作業の手順の見直し |
| 初期の故障(据え付けや部品の不良によるもの) | まず立ち上げ時の検査で見る。軸のずれのように運転中も兆候が続くものは測れることがある | 立ち上げ時の検査が先。運転中の兆候を測れて対応の時間があるものは状態監視を併用できる | 立ち上げ時の点検の強化、状態監視の併用、設備を変える方式(次に設備を新設するときに故障の記録を設計へ反映する) |
| 故障の影響が小さく、短時間で復旧できる | 測れても測る意味が小さい | 向いていない | 事後保全 |
表の右端の列は、故障の起こり方だけで決まるものではありません。時間基準保全は、狙う故障が使用の時間や回数とともに起こりやすくなり、決まった時期の交換や修理でその起こりやすさを下げられる場合に効きます。使用の時間と故障の起こりやすさにはっきりした関係が見られない故障では、決まった時期に交換しても故障は減りにくく、交換の分だけ過剰保全になりえます。第3章で紹介した NASA の信頼性中心保全の手引き(施設と付帯設備向け、2008年9月)も、使用の時間と故障の起こりやすさの関係の型によって、使用の上限を決めて交換する方法が合うかどうかが違うと整理しています(同手引きの4.1.5節)。事後保全も同じで、故障した後の対応で済むと評価できる場合に限って選びます。同じ手引きは、保全の方法を、それが防ごうとする安全上・経済上の結果で評価すべきだとしています(4.1.4節)。安全や環境への影響が大きい故障では、事後保全ではなく、防護や誤操作の防止、設計の改善を検討します。
初期の故障の行も、一律に予知保全の対象外とはしていません。据え付けのときの軸のずれのように、立ち上げ後も運転中の振動に兆候が出つづけるものがあります。同じ手引きは、回転体の釣り合いや軸合わせの不良が軸受の早い故障の主な原因の1つであることや、状態の監視が軸受の故障を予測して交換の機会を作りうること、ただし原因の軸のずれを取り除かなければ故障が繰り返すことを説明しています(5.5節)。立ち上げ時の検査を優先し、そのうえで運転中に兆候を測れて対応の時間がある故障モードには状態監視を併用する、という順で考えます。
表の「監視できるか」は、技術的に測れるかだけでなく、測ったデータを保全員が判断に使えるかまで含めて考えます。たとえば振動のセンサーを付けられても、設備の稼働条件が頻繁に変わり、正常の範囲を定義できない場合には、異常検知の警報が誤報ばかりになるおそれがあります(第5章)。こうした設備は、条件ごとに正常を定義できるだけのデータがそろうまで、PoC の対象から外しておく方が無難です。
故障の型が分からない設備も少なくありません。保全記録に故障の内容が残っていない、記録が自由記述で分類できない、といった場合です(第10章)。この場合、対象選定の前に、過去の保全記録を故障モードの単位で整理し直す作業が要ります。整理の作業そのものは予知保全ではありませんが、ここを省くと、どの故障を捉えれば効果があるのかを説明できず、PoC の評価の指標も決められません。
重要度評価と向き不向きの判断を組み合わせると、予知保全の候補の一覧ができます。次の表は、考え方を示すための架空の例です。設備の名前も点数も架空で、特定の工場や業種を表すものではありません。影響の点数は、重要度評価表の「故障の影響」の4項目のうち最も高い点数を使う、と決めた場合の例にしてあります。合計にするか最大にするかは、自社で決める点です。「検知できるか」の列は、重要度評価表と同じく、点数が高いほど予知保全に向いていることを表します。
| 設備(架空) | 故障の影響 | 故障の頻度 | 検知できるか | 判断 |
|---|---|---|---|---|
| ポンプ1号 | 5 | 3 | 5 | PoC の第一候補。影響が大きく、軸受の劣化の兆候を振動で測れる |
| 送風機A | 3 | 5 | 5 | PoC の候補。故障が繰り返し起きており、兆候も測れる |
| 設備B | 5 | 3 | 1 | 予知保全の対象外。設備を変える方式か、故障が使用の時間とともに増えるなら時間基準保全を検討する |
| 搬送機C | 1 | 5 | 3 | 優先度は低い。故障の原因を調べ、作業の手順か設備の改良で減らせないかを先に見る |
| 設備D | 3 | 1 | 3 | 当面は現行の保全を続ける。保全記録の整理を進める |
一覧を作るときに気をつけたいのは、点数を機械的に足し上げて順位を決めないことです。点数は、保全部門・生産部門・安全の担当者が同じ表を見て話し合うための道具です。点数が同じ設備のあいだで、どちらを先に選ぶかは、PoC に協力できる現場の体制や、データがすでに取れているかといった、表に載っていない条件で決めることが多いと考えています。最初の PoC には、影響と頻度の点数が最も高い設備ではなく、それらの点数が高く、かつデータを集めやすく、現場の協力が得やすい設備を選ぶ方が、後の展開につなげやすくなります。
PoC の設計、期間・評価の指標・出口の条件を先に決める
対象設備が決まったら、PoC を設計します。予知保全の PoC は、本番の運用に入る前に、限られた設備と期間で、狙った故障モードの兆候を捉えられるか、捉えた兆候が保全の判断に役立つかを確かめる試行です。PoC で確かめたいのは手法の精度だけではありません。データが途切れずに集まるか、警報を受けた保全員が判断できるか、判断の結果を保全記録に残せるかといった、業務として回るかどうかも確かめる対象に入れます。
PoC の設計で最も大切なのは、始める前に「出口の条件」を決めておくことだと考えています。出口の条件とは、PoC の結果がどうなったら本番に進み、どうなったら対象や手法を変え、どうなったら中止するかの基準です。結果を見てから基準を決めると、少しでも良い結果が出れば「効果あり」と読み、悪い結果が出れば「データが足りなかった」と読むことになりがちです。結論の出ない PoC が続く原因の一つは、この基準の後付けにあると考えています。
次の表は、PoC の設計書に書いておく項目の例です。項目そのものは一般的なものですが、予知保全に固有の注意点を右の列に書きました。
| 項目 | 決めること | 予知保全での注意点 |
|---|---|---|
| 目的 | どの損失の型を、どの設備で減らすか | 「異常を検知する」ではなく「軸受の劣化による突発停止を減らす」のように、故障モードと損失の型まで書く |
| 対象 | 設備・故障モード・測る量 | 捉えたい故障モードと、その兆候を捉えるために測る量の対応を第3章の考え方で決めておく |
| 期間 | データを集める期間と評価の時期 | 狙う故障が期間中に起きないことがある。過去のデータ、似た設備のデータ、点検の所見で評価を補う方法を先に決める |
| 評価の指標 | 見逃し・誤報・リードタイムなど | 精度の数値ではなく、間に合う警報が何件出たか、誤報が何件あったかで評価する(第8章) |
| 正解の決め方 | 警報が正しかったかを何で判定するか | 警報のたびに点検し、所見を記録する手順を決める。点検で異常を確かめられなかった警報は、すぐに誤報とせず「判定保留」として後の所見を待つ。見逃しは警報の側からは見えないので、警報とは別に集めた定期点検の所見・故障の記録・交換した部品の所見を警報の履歴と突き合わせて数える |
| 出口の条件 | 本番に進む、条件を変えて続ける、中止する、の基準 | 指標の目安に加え、保全員が警報を使って判断できたか、データが途切れずに集まったかも条件に入れる |
| 役割 | 警報を受ける人、点検する人、評価する人、判断する人 | 保全部門の担当者を必ず入れる。データの担当だけで評価しない |
| 本番への移行の見通し | 本番の運用で誰が何を保守するか | PoC 用の一時的な仕組みのまま本番に入らない。データの保管、モデルの見直し(第8章)の担当を決めておく |
表の「期間」の行には、予知保全に特有の難しさがあります。重要度の高い設備ほど故障させないよう保全されているので、PoC の期間中に狙った故障が1回も起きないことが珍しくありません(第11章)。この場合、「故障を何件予測できたか」では評価できません。そこで、劣化の兆候が点検の所見と一致したか、正常の範囲を安定して定義できたか、誤報がどれだけ出たか、のように、故障が起きなくても評価できる指標を組み合わせておきます。故障が起きなかったときにどう評価するかを、出口の条件に含めて決めておくことが大切です。
期間の長さは、狙う故障モードの劣化の速さと、稼働条件の変化の周期に合わせて決めます。季節で温度が変わる設備や、生産品目で負荷が変わる設備では、条件がひととおり変わるまでデータを集めないと、正常の範囲を定義できません(第5章)。期間を短く切りすぎると、PoC の後で本番に入ったとたん、季節が変わって誤報が増える、ということが起きえます。
PoC で止まる型
PoC は、本番への移行・条件を変えての継続・中止のいずれかを判断できる結果につながって初めて意味があります。中止も、本番に進まない根拠が得られたという点で正当な出口です。しかし、手法としては成果が出たのに、本番に進むとも止めるとも決まらない、という結果になることがあります。この状態を、本コラムでは「PoC で止まる」と呼びます。止まる理由はいくつかの型に分けられると考えています。次の表は、その型と、PoC を設計する時点で打てる手当てをまとめたものです。
| 止まる型 | 起きること | 設計の時点での手当て |
|---|---|---|
| 出口の条件が無い | 結果の良し悪しを誰も判断できず、PoC が延長され続ける | 出口の条件と、判断する人・時期を始める前に決める |
| 使う人がいない | 警報は出るが、受け取って判断する保全員が決まっていない | 保全部門の担当者を PoC の最初から入れ、警報への対応の手順を試す |
| 故障が起きず評価できない | 期間中に狙った故障が起きず、効果を示せない | 点検の所見との一致など、故障が起きなくても評価できる指標を決めておく |
| 一時的な仕組みのまま | 手作業でデータを集めた仕組みでは本番の運用に耐えない | 本番でのデータの集め方と保守の担当を PoC の時点で見積もる |
| 効果を説明できない | 精度の数値は出たが、保全の判断や損失がどう変わるかを説明できない | 効果を損失の型と件数・時間で見立てる方法を先に決める(次の節) |
| 誤報で信頼を失う | 誤報が続き、現場が警報を見なくなる(警報の形骸化) | 誤報の許容量を現場と決め、PoC の間は、警報の段階(注意・警告・停止。第8章)のうち注意だけを出して運用することも考える。これは今回試す予知保全の仕組みの通知に限った話で、既存の安全のための警報・保護装置・停止の基準はそのまま維持する |
| 対象が広すぎる | 多くの設備に同時に手を広げ、どれも中途半端になる | 最初は1設備か少数の同型の設備、1つの故障モードに絞る |
表の型のうち、「使う人がいない」と「誤報で信頼を失う」は、手法の精度だけでは解決しない、業務の設計に関わる問題です。「誤報で信頼を失う」には、測定の条件や正常の範囲の定義、モデルやしきい値の問題(第5章・第8章)も関わるので、業務と技術の両方から手当てします。データの担当者が主導する PoC では、手法の評価に力が入る一方で、警報を受け取った保全員がどう動くかの検討が後回しになりやすいように思います。予知保全の価値は、警報によって保全の判断が変わることにあります(序章)。その判断をする人が PoC に入っていなければ、本番に進む理由を示すことは難しくなります。
効果の見立て、件数・時間・相対コストの型で考える
予知保全の効果を見立てるときには、金額に直す前に、何がどれだけ変わるかを件数と時間で書くことから始めるのがよいと考えています。金額への換算は、設備の価格や生産の条件など自社の事情に強く依存し、前提の置き方で結果が大きく変わるからです。件数と時間で書いておけば、前提が変わったときにも、どの数字を置き換えればよいかが分かります。効果の数字は、PoC の結果と過去の保全記録から見立てる「見込み」であり、確定した値ではないことを、報告するときに明記しておきます。
効果の見立ての型を、序章で整理した6つの損失の型と対応させてまとめたのが次の表です。右端の列に、対応する損失の型を書きました。左から2列目の「変わるもの」は、PoC と本番の運用で実際に数えられるものにしてあります。
| 効果の型 | 変わるもの | 数え方の例 | 見立てで外しやすい点 | 対応する損失の型 |
|---|---|---|---|---|
| 突発停止の減少 | 計画外の停止の件数と時間 | 対象設備の過去の突発停止の件数のうち、狙う故障モードによるものが何件あり、そのうち警報が間に合う見込みのものが何件か | すべての停止が予知保全で防げるわけではない。狙う故障モード以外の停止は減らない | 突発停止 |
| 保全作業の削減 | 時間基準の点検・交換の回数と作業の時間 | 状態を見て点検や交換を先送りできた回数と、その作業の時間 | 法令で定められた点検は減らす対象に入れない。警報への対応の点検は新たに増える | 過剰保全 |
| 部品の延命 | 交換の間隔、交換した部品の個数 | 状態にもとづいて交換した部品の平均の使用期間と、時間基準で交換していたときの期間の差 | 延命しすぎると突発停止の側に振れる。延命と停止の両方を並べて見る | 過剰保全 |
| 品質の不良の減少 | 劣化に起因する不良の件数 | 設備の劣化と結びついた不良の件数の変化 | 不良の原因が設備の劣化か、材料や作業か、を分けて記録していないと数えられない | 品質の不良 |
| 新たに増える手間 | 警報への対応・データの保守・モデルの見直しの時間 | 誤報への点検の回数と時間、データやセンサーの保守の時間 | 増える側を数えずに効果だけを見立てると、本番で手間が想定を超える | 誤報への点検は主に警報の形骸化に関わる(続くと警報が見られなくなるおそれがある)。データやセンサーの保守、モデルの見直しの時間は、損失の型には当てず、増える手間として差し引きに入れる |
6つの型のうち、安全と環境の事故と二重投資は、この表に入れていません。安全と環境の事故は、法令で定められた点検を含めて別に扱う対象として、本章では件数の見立てに含めませんでした。二重投資は、後の「展開の段階」の節で扱います。
表の最後の行を入れたのは、予知保全によって新たに増える手間が、効果の見立てで見落としやすい項目だからです。警報が出るたびに点検をすれば、誤報の分だけ点検が増えます。センサーの故障や通信の途切れへの対応、正常の範囲の見直し、モデルの再学習(第8章、弊社コラム「機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで」)も、続けるための手間です。減る手間と増える手間を同じ表に並べて、差し引きで見立てます。
件数と時間を比べるために、突発停止1件と予防の作業1回の重さの違いを相対コスト(単位なしの数)で置くこともできます。次の値は説明のための架空の値ですが、たとえば、突発停止1件の重さを10、計画した交換1回の重さを1、誤報への点検1回の重さを0.5と置きます。警報によって突発停止が1件減り、その代わりに計画した交換が1回、誤報への点検が3回増えたとすると、減る側が10、増える側が1+0.5×3=2.5で、損失と手間の重さの合計が、差し引き7.5だけ小さくなります。同じ件数でも、突発停止1件の重さを2と置くと、減る側の2より増える側の2.5が大きくなり、差し引きは逆になります。この件数の例では、突発停止1件の重さが2.5を下回ると逆になる、ということです。ここで置いた値は、この章の説明のためだけの架空の値で、第8章・第9章の例題の相対コストとは別に置いたものです。このように、比をどう置くかで判断が変わることがあるので、比を1つに決めずに、いくつかの値で結論が変わるかを確かめておくのが安全です。第8章と第9章で、相対コストを使ってしきい値や交換の時期を決める計算を扱っています。
効果の見立てでもう1つ注意したいのは、過去の故障の件数が少ない設備では、件数の変化が偶然の範囲に収まってしまうことです。年に1回あるかないかの故障が、導入後の1年間に起きなかったとしても、それが予知保全の効果なのか、たまたまなのかは区別できません。こうした設備では、件数の変化で効果を主張するより、事例の種類ごとに評価の仕方を分けて、仕組みが働いていることを示す方が誠実だと考えています。
- 故障が実際に起きた事例では、警報から故障までの時間(リードタイム)が保全の準備に足りていたかを評価します。
- 故障が起きなかった事例や、警報を受けて予防の交換をしたために故障に至らなかった事例では、故障の時刻が分からないので、リードタイムは実測できません。こうした事例では、警報が劣化の兆候を捉えていたか(点検の所見や交換した部品の状態との一致)と、警報から対応を終えるまでの時間で評価します。
- 故障の時刻を推定してリードタイムを示す場合は、推定した値であることと、その不確かさを併せて書きます。
公的な調査に表れた製造業のデータ活用の状況
導入の進め方を考えるうえで、製造業全体のデータ活用がどこまで進んでいるかを、公的な調査で確かめておきます。経済産業省・厚生労働省・文部科学省が2026年5月29日に公表した2026年版ものづくり白書の概要には、製造現場のデータの利活用について調べた結果が載っています。ここで扱うのは概要の資料に載っている図だけで、白書の本文の図表番号は確かめられていません。また、概要の資料の中に、予知保全や設備保全という語は見当たりませんでした。以下の数字は、保全に限らない製造のプロセス全体のデータについての調査結果です。
白書の概要の第4章の19ページの図1は、製造のプロセスにおけるデータの取得・活用・効果の有無を尋ねた結果です(回答数2,851)。データを何らかの目的で取得していると答えた割合は66.0%、取得したデータを活用している割合は51.4%、活用して効果が得られた割合は43.9%でした。概要は、データを取得している事業者が7割弱であるのに対し、活用して効果が得られた事業者は約4割にとどまる、という趣旨でこの結果をまとめています。同じページの図2では、サプライチェーンの中の企業とのデータ連携を実施している割合が、2023年の調査の19.8%から、2025年の調査の16.4%へ下がっています。概要はこの結果を「ほぼ変化がない」と表現しています。数字の上では、実施していると答えた割合が3.4ポイント下がっています。ただし、回答数は2023年の調査が2,786、2025年の調査が3,007で、回答した事業者は同じではありません。本コラムでは、これを各年の回答の割合の差として読み、製造業全体で連携が後退したとまでは読みません。
同じ概要の3ページの図2は、AI・デジタル技術を活用するうえでの課題を尋ねた結果です(回答数1,338。図の割合を足すと100%を超えるので、複数の課題を選べる設問です)。最も多かったのは「知識やノウハウの取得」で57.2%、次が「導入に必要な人材の確保」で47.9%でした。「データ連携・AI導入の効果やメリットが不明確」は28.9%、「継続的な運用・保守体制の構築が難しい」は14.5%でした。これらの図の資料は、いずれも三菱UFJリサーチ&コンサルティングの令和7年度の調査の報告書(2026年3月)と記されています。
この調査は予知保全に絞ったものではないので、保全の分野の状況をそのまま表すとは言えません。そのうえで、本章の論点とのつながりを読むなら、データを取ることと、取ったデータで効果を得ることのあいだに差がある、という点です。予知保全でも、センサーを付けてデータを集めることと、そのデータで保全の判断を変えることは別のことで、PoC の設計と効果の見立てを先に決める理由もここにあります。ただし、これは本コラムの読み方であり、白書がそう結論づけているわけではありません。
展開の段階、1設備から同型の設備・1ライン・工場へ
PoC の出口の条件を満たしたら、本番の運用に移り、ほかの設備へ広げていきます。本コラムでは、展開を5つの展開の段階に分けて進めることを考えます。1設備、同型の設備、1ライン、工場全体、複数の工場、の順です。このように分けるのは、それぞれで確かめることが違うからです。
- 1設備では、狙った故障モードの兆候を捉えられるかと、警報への対応が業務として回るかを確かめます。
- 同型の設備では、同じ手法が、据え付けや稼働条件の違う設備でも働くかを確かめます。
- 1ラインでは、複数の設備の警報が重なったときに保全員が優先順位を付けられるかと、保全計画(第9章)や生産計画との調整が回るかを確かめます。
- 工場全体では、データの集め方と保管、モデルの見直し、保全記録との連携(第10章)が、担当者を替えても続く形になっているかを確かめます。
- 複数の工場では、工場ごとの違いを残しつつ、共通の仕組みで運用できるかを確かめます。
次の表は、展開の段階ごとに確かめることと、次へ進む前に整えておくこと、その展開の段階へ進むことを承認・判断する人をまとめたものです。承認・判断する人の列は、第13章の役割の分担にそろえてあります。同じライン・同じ工場の中で同型の設備に広げるまでは工場長が承認し、1ライン以上(別のライン・工場全体・複数の工場)へ広げるときと、そのための予算は経営が判断します。
| 展開の段階 | 確かめること | 次へ進む前に整えること | 承認・判断する人 |
|---|---|---|---|
| 1設備(PoC から本番へ) | 狙った故障モードの兆候を捉えられるか、警報への対応が回るか | 警報への対応の手順、点検の所見の記録の形、データの保守の担当 | 工場長(PoC の出口の判定) |
| 同型の設備へ | 同じ手法が、据え付けや稼働条件の違う同型の設備でも働くか | 設備ごとの正常の範囲の決め方、条件の違いの扱い(第5章・第11章) | 工場長(同じライン・同じ工場の中の同型の設備に限る) |
| 1ライン | 複数の警報の優先順位、保全計画と生産計画との調整 | 警報の段階と対応の表(第8章)、保全計画への反映の手順(第9章) | 経営(予算を含む) |
| 工場全体 | 担当者を替えても続くか、保全記録との連携 | 設備台帳と保全記録の連携(第10章)、役割と教育(第13章) | 経営(予算を含む) |
| 複数の工場 | 工場ごとの違いを残しつつ、共通の仕組みで運用できるか | データの形式と評価の指標の共通化、工場ごとの判断に任せる範囲の決定 | 経営(予算を含む) |
表の最後の展開の段階で気をつけたいのは、6つの型のうちの二重投資です。工場や部門ごとにばらばらにセンサーやソフトウェアを選び、データの形式も評価の指標も違う仕組みが並ぶと、後から共通化するのに大きな手間がかかります。かといって、最初から全社共通の仕組みを決めてしまうと、1設備の PoC で分かったことを反映できません。1ラインの展開の段階が終わったあたりで、データの形式と評価の指標だけでも共通にしておく、という順序が、二重投資と、早すぎる共通化のあいだを取りやすいと考えています。
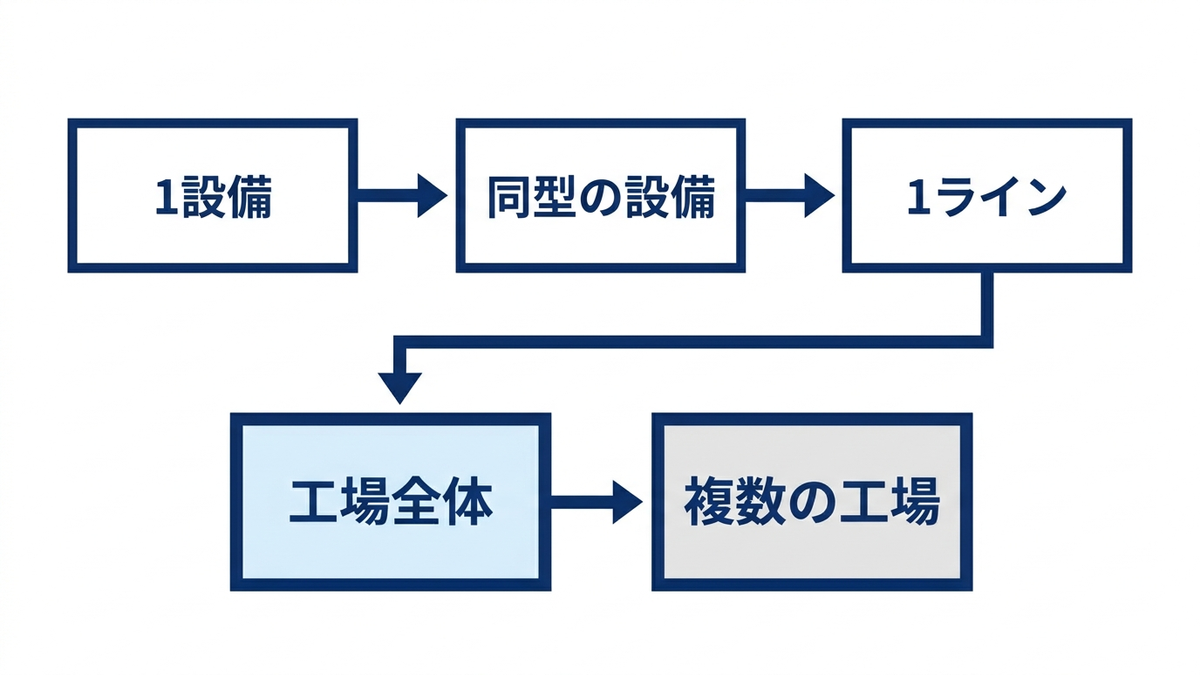
内製と外部委託の分担
予知保全の導入では、次のような多くの仕事が発生します。
- センサーの選定と取り付け
- データの収集の仕組み
- 分析と手法の開発
- 警報の運用
- 保全の作業
すべてを自社で行う必要はありませんが、すべてを外部に任せると、PoC が終わった後に誰も仕組みを直せない、という状態になりかねません。どこを自社で持ち、どこで外部の力を借りるかは、自社の人員と技能によって変わります。次の表は、その分担を一般論として整理したものです。
| 仕事 | 自社で持つことが望ましい部分 | 外部の力を借りやすい部分 |
|---|---|---|
| 対象の選定と目的の設定 | 重要度評価、狙う故障モードと損失の型の決定 | 評価の進め方の助言 |
| センサーとデータの収集 | 測る量と測定点の決定、データの所有と保管の方針 | センサーの選定と取り付け、通信の仕組みの構築 |
| 分析と手法の開発 | 正常の定義、警報の結果の確認(点検の所見との照合) | 手法の選定と実装、特徴量の設計の助言 |
| 警報の運用 | 警報を受けて判断すること、対応の手順の決定 | 警報の画面や通知の仕組みの構築 |
| 見直しと展開 | 出口の条件の判断、展開の順序の決定、保全記録の蓄積 | モデルの見直しの作業、ほかの設備への横展開の作業 |
表の「自社で持つことが望ましい部分」の列に共通しているのは、判断と、判断の材料になる知識です。どの故障を捉えるべきか、警報を受けてどう動くか、PoC の結果で本番に進むか、といった判断は、設備と現場を知っている自社の人が行うべきだと考えています。また、データの所有と保管の方針は、外部に委託する場合でも自社で決めておきます。委託先を変えたときにデータを引き継げないと、それまでに集めたデータと保全記録が次の予測に使えなくなります。外部の力を借りる場合も、PoC の時点から自社の担当者が作業に加わり、本番では自社で警報を運用できる状態にしておくことが、続けるための条件になります。体制と人材の詳細は第13章で扱います。
経営判断、PoC の出口を先に決める
この章の内容を、経営の判断に落とすと次のようになります。第一に、予知保全の導入は、技術の選定ではなく対象の選定から始めます。重要度評価で上位の設備のうち、故障の型と監視の可否から予知保全が合う設備を選びます。合わない設備に予知保全を当てはめても、警報の形骸化や二重投資という損失につながりやすく、突発停止は減りにくいと考えています。
第二に、PoC の出口の条件を、始める前に決めて文書にします。出口の条件には、見逃し・誤報・リードタイムの目安に加え、保全員が警報を使って判断できたか、データが途切れずに集まったかを入れます。判断する人と時期も決めておきます(第13章では、PoC の出口の判定は工場長が承認する分担にしています)。出口の条件が無い PoC は、結果が良くても悪くても延長されやすく、その間、保全部門とデータの担当者の時間を使い続けます。
第三に、効果は件数と時間で見立て、増える手間も同じ表に並べます。効果の見立ては見込みであり、PoC の結果が出たら見直す前提で扱います。故障の少ない設備では、件数の変化だけで効果を判断しません。第四に、展開は1設備、同型の設備、1ライン、工場の順に展開の段階を分け、1ラインの展開の段階が終わったあたりでデータの形式と評価の指標を共通にします。これは二重投資を避けるための判断で、ラインや工場へ対象を広げるかは経営が判断します。最後に、安全と環境に関わる設備では、法令で定められた点検を予知保全で置き換える前提を置かず、警報を受けた後の判断を保全員と責任者が行う体制を、導入の計画に最初から書き込みます。
この章の要点をまとめます。予知保全の導入は、重要度評価と、故障の型・監視の可否による向き不向きの判断で対象を絞るところから始まります。PoC では、期間・評価の指標・出口の条件を先に決め、故障が起きなくても評価できる指標と、警報を使う保全員を最初から組み込みます。効果は金額に直す前に件数・時間・相対コストの型で見立て、増える手間も差し引いたうえで、1設備から工場へ展開の段階を分けて広げます。次の第13章では、こうした導入を支える体制と人材、保全部門・データの担当者・現場の役割と、技能の継承を扱います。
この章を深めたい方への参考書籍
『工場・製造プロセスへのIoT・AI導入と活用の仕方』第3版(技術情報協会企画編集、技術情報協会):既存の設備を活かしながら工場に IoT・AIを導入する方法を、多くの執筆者が分担して解説した技術書です。版元の目次には、工場の IoT 化が進まない理由として費用対効果が分からず投資判断ができないことやプロジェクトを進める人材がいないことを挙げる節や、IoT・AIを使った異常検知・予知保全の節があり、本章の PoC の設計と効果の見立てを、導入の事例と課題の側から補う材料になります。
『スマートファクトリー構築ハンドブック:50のイメージセルがものづくりDXを具体化する』(毛利大、神山洋輔著、日本能率協会コンサルティング編、日本能率協会マネジメントセンター):技術ありきではなく、工場の経営から出発してスマートファクトリーの構想から実装までを進める枠組みと手順をまとめた本です。プロジェクトの進め方の章もあり、予知保全を工場全体の取り組みの一部として、展開の段階を踏んで広げるときの参考になります。
第13章 体制と人材、保全部門・データ担当・現場の役割と技能の継承
第12章では、重要度と故障の型で対象の設備を絞り、PoC の期間・評価の指標・出口の条件を先に決めてから、1設備・同型の設備・1ライン・工場の順に広げる進め方を扱いました。PoC の出口を通った後に問われるのは、その仕組みを誰が日々回すかです。異常検知のモデルも、残存寿命の予測も、保全計画の最適化も、警報を受け取って判断し、作業を指示し、結果を記録する人がいなければ、保全の判断を変えることはありません。
この章ではコードを使わず、次の内容を表と概念図で説明します。
- 予知保全の仕組みが「誰の仕事でもない」状態になりやすい理由と、仕事の境目ごとの役割と責任の分担表
- 判断の中心に保全員を置く理由
- 熟練者の判断をデータとルールに残す技能の継承の方法
- 教育の計画と、保全に関する国家検定と団体の認定資格(公式の資料で確かめた範囲)
- 最初の90日の計画表
- 担当が1人しかいない小さな工場向けの縮小版と、外部支援の使いどころ
- 経営の判断:保全を費用ではなく設備の価値を保つ仕事として扱うこと
予知保全が「誰の仕事でもない」状態になりやすい理由
予知保全の仕組みには、性質の違う仕事が少なくとも4つ含まれています。設備の状態を測るセンサーと通信を保つ仕事、データから異常や残存寿命を推定するモデルを作って見直す仕事、警報を受けて点検や交換の要否を判断する仕事、そして作業の結果を記録して次の予測に返す仕事です。前の2つは情報システムやデータ分析の技能を、後の2つは設備と故障の知識を求めます。1人や1部門ですべてを持つことは難しく、たいていは複数の部門にまたがります。
複数の部門にまたがる仕事は、立ち上げの時期には推進役の熱意で回っても、推進役が異動したり PoC の予算が終わったりすると、担当の境目から止まっていくことが多いように思います。たとえば、センサーの1つが故障して欠測が続いても、データ担当は「現場の機器の話」と考え、保全部門は「システムの話」と考えて、誰も直さないという状態です。あるいは、モデルが出す警報に誤報が続いたときに、保全員はモデルを直す権限を持たず、データ担当は現場で何が起きているかを知らないため、警報が無視されるまで放置されるという状態です。後者は、序章で整理した6つの損失の型のうち「警報の形骸化」につながります。
こうした止まり方を防ぐには、技術の選び方よりも先に、仕事の境目ごとに「誰が実行し、誰が最終的に責任を持つか」を決めておく必要があると考えています。境目の典型は次の6つです。次の節では、これらの境目を役割ごとの表に落とします。
- センサーと通信の保守
- 警報のしきい値の変更
- モデルの再学習
- 作業指示の発行
- 保全記録の入力と点検
- 予算の確保
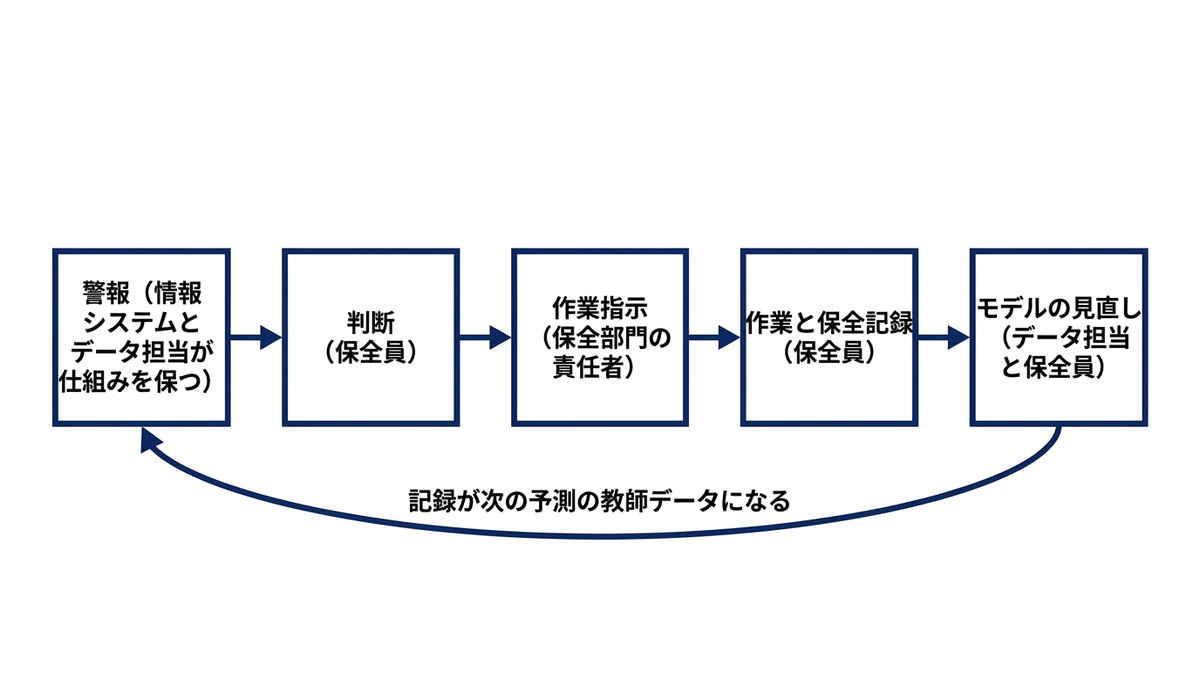
役割と責任の分担表、7つの立場が受け持つこと
予知保全に関わる立場を、本コラムでは次の7つに分けます。経営、工場長(あるいは事業所の責任者)、保全部門、生産部門(設備を日々運転する部門)、データ担当(モデルを作って見直す人。社内のデータ分析の担当でも、外部の協力先でもよい)、情報システム(ネットワーク・サーバ・クラウド・情報セキュリティを受け持つ部門)、外部の設備メーカーです。会社によっては保全部門と生産部門が一体だったり、データ担当が保全部門の中にいたりしますが、その場合でも「この仕事を誰が受け持つか」を立場ごとに書き出しておくと、境目の抜けが見つかりやすくなります。
役割を決めるときの考え方として、仕事ごとに「実行する人」「最終的な責任を持つ人」「事前に相談を受ける人」「結果の報告を受ける人」を分けて書く RACI と呼ばれる型があります。RACI の考え方そのものは弊社コラム「経営とAIの打ち手を導く戦略フレームワーク大全179選」で扱っているので、ここでは予知保全に当てはめた表を作ります。表の中の「責任」は、その仕事の結果について最終的に説明する立場(承認する立場)を指し、1つの仕事に1つだけ置きます。責任が2つの立場に分かれていると、問題が起きたときにどちらも動かない状態になりやすいからです。
表の語と RACI の対応は次のとおりです。「実行」は R(実行する人)、「責任」は A(最終的な責任を持つ人)、「相談」は C(事前に相談を受ける人)、「報告」は I(結果の報告を受ける人)に当たります。「責任・実行」は、同じ立場が責任と実行の両方を受け持つことを指します。「なし」は、その仕事に通常は関わらない立場を指します。展開の承認の線は、同じライン・同じ工場の中で同型の設備に広げるまでは工場長、別のライン・工場全体・複数の工場へ広げるときと、そのための予算は経営、と引いています。
| 仕事 | 経営 | 工場長 | 保全部門 | 生産部門 | データ担当 | 情報システム | 設備メーカー |
|---|---|---|---|---|---|---|---|
| 予算と、1ライン以上(別のライン・工場全体・複数の工場)への展開の判断 | 責任 | 実行 | 相談 | 相談 | 相談 | 報告 | なし |
| 対象設備の選定、同じライン・同じ工場の中での同型の設備への展開、PoC の出口の判定 | 報告 | 責任 | 実行 | 相談 | 実行 | 報告 | なし |
| センサーの設置と保守 | なし | 報告 | 責任・実行(内製する場合) | 相談 | 相談 | 相談 | 実行(委託する場合) |
| データの収集基盤と情報セキュリティ | なし | 報告 | 相談 | なし | 相談 | 責任・実行 | 相談 |
| モデルの構築と再学習 | なし | 報告 | 相談 | なし | 責任・実行 | 相談 | 相談 |
| 警報のしきい値と運用の決定 | なし | 責任 | 実行(変更の案を作る) | 相談 | 実行(設定を変える) | なし | なし |
| 警報を受けた判断と作業指示 | なし | 報告 | 責任・実行 | 相談 | 報告 | なし | 相談 |
| 停止の時間枠の調整 | なし | 責任 | 実行 | 実行 | なし | なし | なし |
| 作業と保全記録の入力 | なし | なし | 責任・実行 | 相談 | 報告 | なし | 実行(委託する場合) |
| 日常の点検と異常の連絡 | なし | なし | 相談 | 責任・実行 | なし | なし | なし |
| 教育と技能の継承の時間と、そのための予算の確保 | 責任 | 実行 | 実行(教育の計画の案を作る) | 相談 | 相談 | なし | なし |
| 効果の振り返りと次年度の計画 | 責任 | 実行 | 実行 | 相談 | 実行 | 報告 | なし |
この表は雛形であり、どの立場に責任を置くかは会社によって変わります。ただ、表を作るときに外さないほうがよいと考えている点が3つあります。1つ目は、警報のしきい値の変更の案を保全部門が作り、工場長が承認し、データ担当は設定を変える実行の側に回すことです。しきい値は誤報と見逃しの釣り合いを決めるもので(第8章)、その釣り合いの良し悪しを判断する材料を持っているのは、誤報に対応する手間と見逃したときの影響を知っている保全部門です。承認を工場長に置くのは、しきい値を変えると保全の作業量と生産の停止の両方が変わるためです。2つ目は、停止の時間枠の調整に工場長の責任を置くことです。予知保全で交換の時期の目安を推定できても、生産計画と停止の時間枠を調整できなければ、交換が遅れ、故障の前に対応できないおそれがあります(保全計画への反映は第9章)。保全部門と生産部門の間で決着がつかないときに決める立場を、あらかじめ決めておく必要があります。3つ目は、センサーの保守の責任を誰かに必ず置くことです。センサーの不調は、モデルから見れば「いつもと違う」入力であり、誤報の原因になります。
外部の設備メーカーの列は、保守の契約の範囲で変わります。設備メーカーが状態監視のサービスを提供している場合、センサーの設置からデータの分析までをまとめて委託することもできます。その場合も、警報を受けて自社の設備を止めるかどうかの判断は、自社の側に置いたほうがよいと考えています。保全記録の入力を外部が受け持つ場合でも、判断の根拠と保全記録を自社で続けて参照できる状態にしておく必要があります。記録を自社で参照できない形のまま委託先が変わると、設備の履歴を、次の予測の学習と評価に使う記録として使えなくなるおそれがあるからです。
判断の中心に保全員を置く理由
予知保全の仕組みを作るとき、モデルの出力をそのまま作業指示に変える自動化を目指したくなることがあります。本コラムでは、警報を受けて点検や交換を決める判断の中心には、保全員を置くことを勧めます。理由は4つあります。
- モデルが学習していない状況がある:設備の改造、部品の型式の変更、稼働条件の変化、学習データに無い故障モードなど、モデルが知らない状況は運用を続けるほど増えます(学習に無い故障の扱いは第6章)。保全員はそうした変化を知っていることが多く、警報の意味を読み替えられます
- 警報だけでは作業が決まらない:同じ「振動の上昇」という警報でも、増し締めで済むのか、軸受の交換が要るのか、設備を止めるべきかは、現場で設備を見て決めることになります
- 安全に関わる判断がある:設備を止めずに様子を見るか、止めて点検するかは、作業者の安全にも関わります。安全に関わる判断をモデルの出力だけに任せることは、本コラムでは勧めません
- 判断の結果が次の学習データになる:保全員が警報をどう判断し、点検で何が見つかったかを記録することで、誤報と的中の区別がつき、モデルの見直しに使えるデータが残ります(記録の項目は第10章)
法令で定められた点検との関係にも触れておきます。労働安全衛生法の第45条は、ボイラーその他の機械等で政令で定めるものについて、事業者に定期に自主検査を行い、その結果を記録しておくことを求めています(定期自主検査)。同条の第2項は、そのうち特定自主検査と呼ばれるものを行える者を、次の3つに限っています(e-Gov 法令検索 労働安全衛生法。2026年11月5日に条文を確かめました)。
- 厚生労働省令で定める資格を持つ事業者本人(法人の場合は、その代表者か役員)
- 事業者が使用する労働者のうち、同じ資格を持つ者
- 登録を受けて、他人の求めに応じて特定自主検査を行う検査業者
このうち事業者本人(代表者・役員)が自ら行える形は、2025年の法改正で加わり、2026年1月1日に施行されたものです(厚生労働省 特定自主検査基準の策定について(第178回安全衛生分科会資料))。本コラムでは、こうした法令で定められた点検を予知保全で置き換えられるものとしては扱いません。予知保全のデータは、法定の点検に加えて設備の状態を知るための材料として使い、法定の点検の要否や方法は所管官庁の資料と専門家の確認に従う、という線を引いておくことを勧めます。
保全員を判断の中心に置くことは、モデルを軽く扱うことではありません。保全員がモデルの警報を信頼して使えるようにするには、警報の根拠(どの特徴量がいつから変わったか)が示され(第6章)、誤報が多すぎず(第8章)、保全員の判断がモデルの見直しに反映される経路があることが必要です。逆に言えば、保全員が警報を無視し始めたら、それは保全員の問題ではなく、警報の設計か見直しの経路のどこかが詰まっている兆候として扱うのがよいと考えています。
| 判断の種類 | モデルが受け持つこと | 保全員が受け持つこと | 記録に残すこと |
|---|---|---|---|
| 異常の有無 | いつもと違う状態の検知と、警報の発出 | 現場の確認で、異常が実在するかを判断する | 警報の日時、確認の結果(異常を確認した・誤報と確認した・判定を保留した)。その場で決めきれないものは保留として残し、後の点検の結果で書き直す |
| 故障モードの特定と原因の調査 | 故障モードの候補と、その確信度(モデルがその候補をどれだけ確からしいとみているかの値。第6章)の提示 | 候補を手がかりに点検して故障モードを確かめ、それを引き起こした原因を調べる | 確かめた故障モード(確かめられなければ「未特定」)、推定した原因か確かめた原因か、判断の根拠、候補が当たったか |
| 作業の内容と時期 | 残存寿命の予測とその幅の提示 | 部品・人員・停止の時間枠を踏まえて作業を決める | 行った作業、使った部品、停止した時間 |
| 設備を止めるか | 警報の段階(注意・警告・停止。第8章)のうち停止の警報 | 設備ごとに定めた安全の手順と停止の基準に従って判断する。緊急の対応が要る場合は、上長(工場長など、手順書で定めた相談の相手)との相談を待たずに手順どおりに対応し、生産の調整はその条件の内側で行う | 止めたか、止めなかった理由 |
| モデルの見直し | 警報の履歴と、誤報と確認された警報の集計 | 故障・突発停止・点検の記録と警報の履歴を照らし合わせて見逃しを拾い、誤報の理由(設備の改造、条件の変化など)とあわせてデータ担当に伝える | 見直しの日付と理由 |
技能の継承、熟練者の判断をデータとルールに残す
設備の保全には、音・におい・手で触れたときの振動・温度の感じ方など、熟練者が経験から身に付けた判断が多く含まれています。なお、稼働中の設備や高温の部分に手で触れる確認は、設備ごとの安全の手順で認められた箇所と方法に限られるもので、本コラムはそれ以外の箇所で触れて確かめることを勧めるものではありません。本コラムでは、設備の異常に気づき、原因を見立て、適切な処置を選ぶための知識と技能をまとめて保全技能と呼びます。保全技能のうち、言葉や手順書にしにくい部分は暗黙知と呼ばれることがあり、言葉や数値や手順書に表せる部分は形式知と呼ばれます。暗黙知と形式知の区別と、その間を行き来させて組織の知識を作る考え方は、章末で紹介する野中郁次郎氏と竹内弘高氏の著書で広く知られるようになりました。
予知保全の仕組みは、熟練者の保全技能を形式知に移す道具として使えると考えています。たとえば、熟練者が「この音になったら軸受を替える」と判断していた場合、その判断の時点の振動データを残しておけば、どの周波数の成分がどれだけ増えたときに熟練者が交換を決めたかを、あとから数値で確かめられます(振動の特徴量は第4章)。熟練者が点検で何を見て、何を見なかったかを記録しておけば、診断のルールの出発点になります(第6章)。熟練者が退職した後も、こうした数値とルールは設備の履歴とともに残ります。
一方で、データとルールに移せるのは保全技能の一部だけだという点も押さえておく必要があります。工具の扱い、分解と組み立ての段取り、狭い場所での作業の安全の確保など、手を動かす技能は、記録を読むだけでは身に付きません。予知保全の仕組みを入れたことを理由に、熟練者から若手への実地の指導(OJT)の時間を削ると、警報が出ても作業できる人がいない状態になりかねません。技能の継承は、データに残す部分と、人から人へ実地で伝える部分の両方で計画するのがよいと考えています。
| 熟練者の判断の例 | データとルールに残す形 | 人から人へ伝える部分 |
|---|---|---|
| 音や振動の感じ方(安全の手順で認められた箇所での確認)で、軸受の傷みに気づく | 判断した時点の振動の特徴量を記録し、しきい値や診断ルールの候補にする | 聴診棒や振動計の当て方、測る位置の選び方 |
| 温度の上がり方で、潤滑の不足を疑う | 温度の推移と給油の記録を同じ時間軸で残す | 給油の量と方法、油の状態の見方 |
| 過去の似た故障を思い出して原因を絞る | 保全記録に故障モード・原因・処置を項目で残し、検索できるようにする | 記録に書きにくい現場の事情(周りの設備との干渉など) |
| 交換を急ぐか待つかを、生産の都合と比べて決める | 判断の理由を記録に残し、後で結果と照らし合わせる | 生産部門との調整の進め方 |
| 分解して、部品の傷み方から原因を見立てる | 傷んだ部品の写真と、見立てた原因を記録に添える | 分解と組み立ての手順、工具の扱い、作業の安全の確保 |
熟練者の判断をデータに残す作業は、熟練者本人にとって手間が増えるだけに見えることがあります。熟練者に協力してもらうには、記録の項目を絞って入力の手間を減らすこと(第10章)、熟練者の判断がモデルやルールのどこに使われたかを本人に返すこと、そして熟練者が若手に教える時間を業務として計画に入れることが要ると考えています。熟練者の判断を「AIで置き換える」と説明すると協力が得られにくいので、「熟練者の判断を設備の履歴として残し、若手が使えるようにする」と説明するほうが実態にも合っています。
教育の計画と、保全に関する国家検定・団体の認定資格
保全員の技能を育てる計画を立てるときに、外部の物差しとして使えるのが公的な技能検定と、業界団体の資格です。ここでは、公式の資料を開いて確かめた範囲で、3つを紹介します。以下の資格・検定の記述は、厚生労働省・日本プラントメンテナンス協会・日本機械学会の公式のページと資料を2026年10月30日に開いて確かめた内容です。日本機械学会の記事は、2026年11月5日にも開き直して確かめました。ISO 18436-2 の版だけは、ISO の公式の目録が開けなかったため、2026年11月5日に目録の保存版(2026年10月19日に保存されたもの)で確かめました。いずれも、受検の要件・日程・試験の内容は年度ごとに変わることがあるので、受検を計画するときは実施団体の最新の案内を確かめてください。
1つ目は、機械保全技能検定です。技能検定は、職業能力開発促進法に基づく国の検定制度で、合格すると技能士と名乗ることができます。厚生労働省の技能検定制度のページによると、2026年3月3日時点で133職種があり、都道府県が実施する職種と、指定試験機関が実施する職種に分かれています(厚生労働省 技能検定制度について)。機械保全はそのうちの1職種で、厚生労働省が公表している指定試験機関の一覧では、公益社団法人日本プラントメンテナンス協会が機械保全の指定試験機関として載っています。等級について、厚生労働省のページは、試験の難易度によって1級・2級・3級に分かれ、職種によっては管理・監督者向けの特級がある、と説明しています。
日本プラントメンテナンス協会の機械保全技能検定のサイトでは、2026年度の第2回試験で特級・1級・2級・3級を実施し、1級から3級は選択した作業ごとに試験を行うと案内しています。選べる作業は、1級と2級が機械系保全作業・電気系保全作業・設備診断作業の3つ、3級が機械系保全作業・電気系保全作業の2つです(機械保全技能検定 第2回試験の概要)。厚生労働省のサイトに掲載されている2級と3級の試験科目の資料(資料の中に作成の時期の記載は無く、本コラムでは最新版かどうかを確かめられていません)を見ると、学科試験の「機械保全法一般」に、初期故障・偶発故障・摩耗故障、予防保全、事後保全、改良保全、予知保全、保全性などの保全用語が並んでおり、2級の設備診断作業の実技試験の範囲には、振動の測定による診断が含まれています。本コラムの第1章・第2章・第4章で扱った内容の一部が、この検定の範囲と重なっていることになります。
2つ目は、自主保全士です。日本プラントメンテナンス協会が認定する資格で、協会のサイトでは製造オペレーター(設備を運転する人)を対象とし、製造部門が受け持つ保全の機能や管理技術を客観的に評価する尺度だと説明されています。協会は、自主保全に必要な能力として異常発見・処置と回復・条件設定・維持管理の4つを挙げ、資格の級は1級と2級です。1級は職場の小集団の中心として自主保全の計画と実践の指導ができること、2級は製造部門の一員として自主保全を実践できることが求められる、と説明されています(自主保全士とは)。この資格は、役割の表でいう生産部門の「日常の点検と異常の連絡」の技能を測る物差しとして位置づけられます。
3つ目は、振動による状態監視と診断に携わる人の資格です。一般社団法人日本機械学会は、国際規格 ISO 18436 シリーズの第2部に対応する機械状態監視診断技術者(振動)の資格認証を行っています。第2部の現行の版は ISO 18436-2(2014年、第2版)で、振動による状態監視と診断を行う人に求める訓練・関連する実務経験・試験の要件を定めています。ISO の目録の保存版(2026年10月19日に保存されたもの)では、この版は改訂の対象とされ、後継の原案の作成が進んでいると表示されていました。日本機械学会の認証がどの版に基づいて運用されているかは、本コラムでは確かめていません。日本機械学会誌の2023年11月号の記事によると、第1回の資格試験は2004年に行われ、カテゴリーによって必要な実務経験と訓練課程の修了の条件が異なり、資格は5年ごとに更新が必要です(日本機械学会誌 機械状態監視資格認証事業20周年)。同じ記事では、ISO 18436 シリーズの第4部に対応する油分析の分野(トライボロジー)の認証も行っていると書かれています。振動のデータを読む技能を持つ人を、保全部門とデータ担当の間に置くときの物差しとして使えます。
| 資格・検定 | 実施する団体 | 主な対象 | 役割の表でつながる立場 |
|---|---|---|---|
| 機械保全技能検定(特級・1級・2級・3級) | 公益社団法人日本プラントメンテナンス協会(厚生労働大臣の指定試験機関) | 機械系保全作業・電気系保全作業・設備診断作業に携わる人 | 保全部門 |
| 自主保全士(1級・2級) | 公益社団法人日本プラントメンテナンス協会 | 製造オペレーター | 生産部門 |
| 機械状態監視診断技術者(振動) | 一般社団法人日本機械学会 | 振動による状態監視と診断に携わる技術者 | 保全部門、データ担当 |
資格と検定は、技能の到達点を外から確かめる物差しとして役に立ちますが、取得そのものを目的にすると、試験の範囲に無い自社の設備の知識が後回しになることがあります。資格は教育の計画の中の1つの里程標として使い、自社の設備・故障の履歴・予知保全の仕組みの使い方は、社内の教育で別に補うのがよいと考えています。なお、データ分析の側の技能については、保全に固有の公的な資格は本コラムの確認の範囲では見当たらなかったため、ここでは扱っていません。
資格と検定に加えて、立場ごとに何を学ぶかの計画も要ります。予知保全の仕組みを使い続けるには、保全員がデータを読めることと、データ担当が設備と故障を知っていることの両方が要ります。どちらか一方だけを教育すると、両者の間で言葉が通じず、警報の見直しの議論がかみ合わないことが多いように思います。教育の計画は、立場ごとに「自分の専門の外側で、最低限知っておくべきこと」を中心に組むのがよいと考えています。
| 立場 | 学ぶこと | 関連する章 | 学び方の例 |
|---|---|---|---|
| 経営・工場長 | 保全の方式の違い、序章で整理した6つの損失の型、PoC の出口の条件、警報の誤報と見逃しの釣り合い | 第1章・第8章・第12章 | 月次の報告で、警報の件数と対応の結果を一緒に読む |
| 保全部門 | 特徴量の意味、異常検知と故障診断の違い、残存寿命の予測の幅の読み方、警報の段階 | 第4章〜第8章 | 自社の設備の過去の警報を、データ担当と一緒に振り返る |
| 生産部門 | 日常の点検の項目、異常に気づいたときの連絡の手順、停止の時間枠の調整の考え方 | 第1章・第9章 | 自主保全士などの資格の学習と、職場での点検の実地指導 |
| データ担当 | 故障の型、故障モード、設備の構造と測定点、保全記録の項目、法定の点検の位置づけ | 第2章・第3章・第10章 | 保全員の点検や分解に同行し、現場で設備を見る |
| 情報システム | センサーと制御システムのデータの流れ、現場の通信の制約、データの保管の期間 | 第3章 | 保全部門と一緒にデータの収集基盤の障害対応の手順を作る |
この表の中で、効果が大きいと考えているのは、データ担当が現場に出ることです。データ担当が設備を見たことがないまま特徴量を作ると、測定点の位置や稼働条件の切り替わりといった、データの外側の事情を見落としやすくなります。反対に、保全員がデータ担当と一緒に過去の警報を振り返ると、警報の意味が具体的に分かり、自分の判断がモデルの見直しにどう使われるかも見えるようになります。教育は座学で終わらせず、実際の設備と実際の警報を教材にするのがよいと考えています。
最初の90日の計画表
PoC の出口を通過し、本格的な運用に移る最初の90日を、週単位の計画にした例を示します。前提は、対象が第12章で選んだ1設備(同型の設備が数台あればその数台)であり、異常検知のモデルと警報の仕組みが PoC で一通り動いていることです。1ラインや工場への展開は、この90日の後に経営が判断する事柄として扱います。目的は、仕組みを広げることではなく、役割の分担と記録と見直しの経路を、日々の業務として回る状態にすることに置きます。警報を受ける担当・連絡先・最低限の対応の手順は、運用を始める前に決めて承認しておき、各週ではその実施の結果を基に見直す、という順にしています。
| 週 | やること | 主に受け持つ立場 | 終わったと判断する目安 |
|---|---|---|---|
| 運用の開始前(90日の前) | 次のことを決め、工場長が承認する ・役割と責任の分担表 ・警報を受ける担当と、夜間・休日を含む連絡先 ・警報の段階(注意・警告・停止。第8章)ごとの最低限の対応の手順 ・欠測に気づいたときの連絡先 ・臨時の停止を申し入れる相手 ・警報への対応の結果を暫定で残す最小の様式(警報の日時・設備・確認の結果・行った処置・対応した人) | 工場長、保全部門、データ担当 | 分担表の全行に、責任の立場が1つと、実行の立場が少なくとも1つ入っている。夜間・休日を含む連絡先と、最低限の対応の手順と、暫定の記録の様式が文書になっている |
| 第1週〜第2週 | 最初の警報への対応の結果を基に、警報の段階ごとの対応の手順を見直し、工場長が承認する | 保全部門、データ担当、工場長 | 見直した対応の手順と、夜間・休日の連絡先が、見直しの結果に合わせて手順書で更新されている |
| 第3週〜第4週 | 暫定の様式で残した記録を基に、保全記録の項目を確定し、入力の手順を保全員に説明する | 保全部門 | 暫定の様式で残した記録が確定した項目に移され、その後の警報への対応が1件以上、確定した項目で記録されている |
| 第5週 | センサーの保守の手順を決め、欠測に気づく仕組みが、開始前に決めた連絡先まで届くかを確かめる | 保全部門、情報システム | 欠測が続いたときに、決めた連絡先へ知らせが届くことを一度試してある |
| 第6週 | データ担当が保全員の点検に同行し、測定点と設備の構造を確かめる | データ担当、保全部門 | 測定点ごとの写真と説明が残っている |
| 第7週〜第8週 | 熟練者の判断の聞き取りを行い、診断のルールの候補を書き出す | 保全部門、データ担当 | ルールの候補が、根拠の記録とともに一覧になっている |
| 第9週 | 最初の振り返り:警報の件数、誤報、対応にかかった時間を集計する。あわせて、故障・突発停止・定期点検の記録と警報の履歴を照らし合わせ、警報が出なかった故障(見逃し)が無かったかを確かめる | データ担当、保全部門 | 誤報の理由が1件ずつ分類され、見逃しの有無が記録と照らして確かめられている |
| 第10週 | 振り返りの結果から、保全部門がしきい値の変更の案を作り、工場長が承認し、承認を受けてデータ担当が設定を変える。案を作るときは、誤報が減るかだけでなく、見逃しが増えないかも過去の記録で確かめる | 保全部門、工場長、データ担当 | 変更した場合に、次が記録されている ・工場長が承認した日付 ・データ担当が設定を変えた日付 ・変更の理由と、見逃しへの影響を確かめた結果 |
| 第11週 | 開始前に決めた臨時の停止の申し入れ方を、それまでの警報への対応の結果を基に見直し、生産部門と停止の時間枠の調整の手順を決める | 工場長、生産部門、保全部門 | 警報が出たときに停止を入れられる候補日が決まっている |
| 第12週 | 保全部門が教育の計画と資格の受検の予定の案を作り、工場長がまとめる。教育と技能の継承の時間と、そのための予算の確保は、経営が判断する | 保全部門、工場長、経営 | 次の半年の教育の予定と、そのための時間と予算の確保が決まっている |
| 第13週 | 90日の振り返りを経営に報告する。同じライン・同じ工場の中で同型の設備を加えるまでは工場長が承認し、別のラインや別の工場へ広げるときと、そのための予算は経営が判断する | 工場長、経営 | 次の四半期の対象と責任の立場が決まっている |
この計画で重視しているのは、第9週と第10週の振り返りです。運用を始めてからの最初の数週間は、誤報が出やすい時期であることが多いように思います。PoC のときには無かった稼働条件や季節の変化に出会うためと考えられます。この時期に誤報の理由を1件ずつ確かめず、まとめて「誤報が多い」とだけ受け止めると、警報が形骸化する入口になります。誤報の理由を分類して、しきい値の変更・正常の定義の更新・センサーの保守のどれで対処するかを決める作業を、最初の90日のうちに一度通しておくことを勧めます。警報への対応の記録だけを見ていると、警報が出なかった故障は見えないため、見逃しは故障・突発停止・定期点検の記録の側から確かめます。
担当が1人の小さな工場の縮小版と、外部支援の使いどころ
ここまでの役割の表は、保全部門・データ担当・情報システムがそれぞれ別にいる規模を想定しています。保全の担当が1人で、データ分析の専門の担当がいない工場では、同じ形の体制は組めません。その場合でも、役割の表の「仕事」の列は小さな工場にもそのまま残ります。変わるのは、1人が複数の立場を兼ねることと、仕組みの複雑さを担当1人が保てる範囲に抑えることです。
担当が1人の場合に、本コラムが勧める縮め方は次のとおりです。
- 対象の設備を、止まったときの影響が最も大きい1台から2台に絞る(重要度の評価は第12章)
- 異常検知は、固定のしきい値と管理図から始め、担当者が自分で理由を説明できる方法に留める(第5章)
- 警報の段階は、第8章の注意・警告・停止のうち「注意」と「停止」の2つに絞るかどうかを検討する。絞る場合は、それぞれの対応を1枚の手順書にまとめる
- 保全記録の項目を、日付・設備・故障モード・処置・停止時間の5つ程度に絞り、必ず埋める
・故障モードが分からないときは推測で埋めず「未特定」と書き、故障が無かったときは「該当なし」と書く
・この5つは、90日計画の第3週〜第4週で確定する保全記録の項目を絞り込んだ例で、運用の開始前に決める暫定の記録の様式とは別のもの - 担当者が不在のときに警報を受ける代わりの人を1人決め、手順書を共有しておく
- モデルの構築やセンサーの選定など、専門性が要る部分だけを外部に頼み、判断と記録は社内に残す
担当が1人の場合に最も避けたいのは、その担当者が異動や退職をしたときに、仕組みごと止まることです。止まらないようにするには、仕組みの規模を小さく保つことと、代わりの人を決めておくことに加えて、設定(しきい値・測定点・連絡先)を担当者の頭の中ではなく、文書と記録に置いておくことが欠かせません。小さな工場では、仕組みの精度を上げることより、仕組みが担当者の交代を越えて続くことを優先するのがよいと考えています。
担当が1人の場合に限らず、予知保全では、外部の支援を使う場面が多くあります。設備メーカーの状態監視のサービス、センサーや計測機器のメーカー、データ分析やシステム構築の支援会社、業界団体や公的機関の研修などです。どの外部支援が合うかは、自社に何が足りないかで決まります。ここでは、製品や会社を比べるのではなく、外部に頼みやすい仕事と、社内に残したほうがよい仕事を一般論として整理します。
| 仕事 | 外部に頼みやすいか | 理由 |
|---|---|---|
| センサーの選定と設置 | 頼みやすい | 計測の専門知識が要り、一度決まれば頻繁には変わらないため |
| モデルの最初の構築 | 頼みやすい | 手法の選定と検証に専門知識が要るため。ただし、作ったモデルの説明と引き継ぎの資料を受け取る |
| モデルの再学習と見直し | 条件つきで頼める | 見直しの判断材料(誤報の理由)は社内にしか無いため、社内の保全員が関わる形にする |
| 警報を受けた判断と作業指示 | 社内に残す | 設備を止めるかどうかは、安全と生産に関わる自社の判断であるため |
| 保全記録の蓄積 | 社内に残す | 次の予測の学習と評価に使う記録であり、委託先が変わっても残す必要があるため |
| 教育と資格の取得 | 研修は頼める | 外部の研修と資格は物差しとして使えるが、自社の設備の知識は社内で補う |
外部に頼むときに確かめておきたいのは、外部支援の利用が終わった後や頼む先を変えた後に、何を自社で使い続けられるかです。センサーのデータ、モデル、警報の設定、保全記録のそれぞれについて、外部支援の利用中も、頼む先を変えた後も、自社で続けて使える運用になっているかを、始める前に確かめておくことを勧めます。部門や工場ごとに別々の外部支援を使い、データの形式も設定もばらばらになると、後で統合するときに作り直しが必要になり、序章で整理した6つの損失の型のうち「二重投資」になります。外部支援を使う場合でも、データの形式と保全記録の項目は会社として1つに決めておくのがよいと考えています。
経営の判断、保全を費用ではなく設備の価値を保つ仕事として扱う
保全は、会計の上では費用として扱われることが多く、費用の削減の対象になりやすい仕事です。しかし、保全の仕事が生んでいるのは、設備が止まらないこと、品質が保たれること、事故が起きないことであり、成果が「何も起きなかったこと」として表れるため、目に見えにくい性質があります。本コラムでは、保全を、設備が生み出す価値を保つための仕事として扱うことを勧めます。
この扱い方の違いは、体制と人材の判断に直接表れます。保全を削るべき費用として見ると、熟練者の退職の後に人を補充しない、教育の時間を削る、予知保全の仕組みを入れたことを理由に保全員を減らす、という判断になりやすくなります。その結果として起きやすくなるのは、序章で整理した6つの損失の型のうち、突発停止(警報が出ても作業できる人がいない)、警報の形骸化(誤報の理由を確かめる人がいない)、安全と環境の事故(判断の経験が足りない人が設備を止めるかどうかを決める)です。反対に、予知保全を入れたことで保全員の手が空いたなら、その時間を熟練者の判断の記録・若手の教育・改良保全(故障しにくい設備への改善)に回すことで、仕組みの効果が積み上がると考えています。
経営が体制について決めることを、3つにまとめます。1つ目は、予算と、1ライン以上(別のライン・工場全体・複数の工場)への展開を判断することです。2つ目は、教育と技能の継承の時間と、そのための予算を確保し、保全部門の業務の計画に正式に入れることです(分担表の「教育と技能の継承の時間と、そのための予算の確保」の行と、90日計画の第12週)。3つ目は、予知保全の効果を、保全員の人数の削減ではなく、突発停止の件数・警報への対応の結果・記録の蓄積といった運用の数字で見ることです。効果の見立ての考え方は第12章で扱いました。
この3つとは別に、次の事柄は経営ではなく工場長が承認します。
- 役割と責任の分担表(90日計画の「運用の開始前」の行)
- 対象設備の選定
- 同じライン・同じ工場の中での同型の設備への展開
- 警報のしきい値と運用
- PoC の出口の判定
このうち、対象設備の選定・同型の設備への展開・PoC の出口の判定は、分担表のとおり、経営がその結果の報告を受けます。
この章のまとめ
予知保全の仕組みは、センサー・モデル・判断・記録という性質の違う仕事にまたがるため、仕事の境目ごとに実行と責任の立場を決めておかないと、担当の境目から止まりやすくなります。判断の中心には保全員を置き、法令で定められた点検は予知保全で置き換えずに続け、熟練者の判断はデータとルールに残す部分と人から人へ伝える部分の両方で継承を計画します。資格と検定は教育の物差しとして使い、最初の90日で役割・記録・見直しの経路を一度通しておくことが、運用を続ける土台になります。次の第14章では、規格の動向と公開事例、生成AIの活用を、公式の資料で確かめた範囲で扱います。
Anagraftでは、設備データの活用の構想づくりから、保全部門とデータ担当の役割の設計、対象設備の選定と試験導入、予測モデルの開発と保全業務への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『知識創造企業 新装版』(野中郁次郎・竹内弘高 著、梅本勝博 訳、東洋経済新報社):暗黙知と形式知の区別と、その間を行き来させて組織の知識を作る考え方を示した本です。熟練者の保全技能のうち、どこをデータとルールに残し、どこを人から人へ伝えるかを考えるときの土台になります。
『機械保全の徹底攻略 2026年度版 機械系・学科』(日本能率協会マネジメントセンター):機械保全技能検定の機械系保全作業の学科試験に向けた、年度ごとに改訂される対策の本です。学科試験の範囲には保全用語や故障の型が含まれているので、保全部門の教育の計画で到達点を確かめる教材として使えます。
『自主保全士公式テキスト 改訂版』(日本プラントメンテナンス協会 編、日本能率協会マネジメントセンター):自主保全士の試験に向けた公式テキストで、設備を運転する人が受け持つ日常の保全の考え方を扱っています。役割の表でいう生産部門の点検と異常の連絡を、教育の計画に落とすときに参考になります。
第14章 公開事例と最新動向、規格・業界の取り組み・生成AIの活用
第13章では、保全部門・生産部門・データ担当・情報システム・経営の役割を分け、保全員の判断を仕組みの中心に置いたうえで、熟練者の判断をデータとルールに残しながら最初の90日を進める計画を扱いました。体制が決まると、次に問われるのは「自社の取り組みを、外の動きとどう照らし合わせるか」です。この章では、次の5つを順に取り上げます。
- 予知保全をめぐる規格の改訂の状況
- 企業や公的機関が公式に公表している事例
- 故障の予兆検知と健全性の管理を扱う学会の活動
- 生成AIを保全業務に使う動き
- AIに関する規制との関係
この章で引く外部の資料は、2026年10月30日に公式のページを開いて確かめた範囲だけを使っています。このうち、EU の AIに関する規則の第2条・第3条・第6条と、東京メトロの2026年5月のニュースリリースは、2026年11月5日にも開き直して確かめました。公開事例は、そのページに書かれている名称・対象・手法・公表時期だけを書き、効果の数字を引く場合は原文の限定条件ごと書きます。事例どうしを比べて優劣を付けることはしません。公表された事例は、公表した側が選んで出したものであり、同じ手法が自社の設備で同じ結果になる保証はないからです。この章の結論は、外の事例と動向は「自社で何を確かめるべきか」の手がかりとして読み、効果の数字をそのまま自社の見込みに使わない、という点にあります。
規格の動向、ISO 13381-1 の改訂と ISO 13374 系の状況
予知保全の「予測」の部分を扱う国際規格が、ISO 13381-1です。ISO の目録では、ISO 13381-1 は機械の状態監視と診断の規格群のうち、予測(プログノスティクス。故障の進行や残存寿命を見通すこと)の一般指針を定める部として位置づけられています。担当する委員会は、第3章で扱った ISO 13374 や ISO 17359 と同じ ISO/TC 108/SC 5(機械の状態監視と診断)です。
この規格は、2025年9月に改訂されています。ISO の目録を2026年10月30日に開いたところ、第2版の ISO 13381-1(2015年)は「Withdrawn」(廃止)と表示され、改訂後の版として第3版の ISO 13381-1(2025年)が示されていました(ISO 13381-1(2015年)の目録)。第3版の発行は2025年9月(ISO 13381-1(2025年)の目録)、目録の段階(規格が作成と見直しの過程のどこにあるかを表す番号。後で説明します)は「International Standard published」(60.60)、ページ数は23です。初版は ISO 13381-1(2004年)で、目録の履歴では初版・第2版とも廃止になっています。予知保全の社内文書やベンダーの資料で ISO 13381-1 を引いている場合は、その資料が2015年版を前提にしていないかを確かめる必要があります。
第3版では題名が少し変わっています。2015年版の題名は「機械の状態監視と診断、予測、第1部:一般指針」でしたが、2025年版は対象を「機械システム」と書き、副題を「一般指針と要求事項」としています。目録の要旨も、2015年版の「予測の過程の開発と適用のための手引き」から、2025年版では「手引きと要求事項」へと書き方が変わりました。題名と要旨の変化から、手引きにとどまらず要求事項を含む文書になったことまでは読み取れます。ただし、本文の要求事項が具体的に何を定めているかは、規格の本文を確かめておらず、本コラムでは未確認です。
2025年版の要旨を本コラムの言葉で一言にまとめると、予測に関わる人の間で共通の考え方を持てるようにし、予測に必要なデータと仕組みの開発の進め方を整理するための指針です。要旨の書き方からは、本コラムの第7章(残存寿命の推定)と第8章(予測の評価)で扱った論点と重なる文書だと読めます。とくに「予測に何が要るかを先に見定める」という方向は、第3章で書いた「測る前に捉える故障モードを決める」と同じ考え方です。社内で予知保全の要求仕様を書くときに、用語と進め方の拠り所として ISO 13381-1(2025年)を参照する、という使い方が考えられます。
第3章で、状態監視のデータを処理・通信・表示する仕組みの枠組みとして ISO 13374 を扱いました。ISO 13374 の第1部から第4部について、2026年10月30日に ISO の目録(第1部・第2部・第3部・第4部)で確かめた状態は次の表のとおりです。目録の段階は、目録の「Stage」の欄にある番号です。この表に出てくる3つの番号の意味は、目録の表記にもとづくと次のとおりです。
- 60.60:国際規格として発行された状態(目録の表記は「International Standard published」)
- 90.93:見直しの結果、そのまま維持すると確認された状態(目録の表記は「International Standard confirmed」)
- 90.60:見直しの期間が終わり、結果がまだ示されていない状態(目録の表記は「Close of review」)
第3章では、第2部と第4部について、アーカイブされた目録のページにもとづいて2021年に維持が確認されたことを示しました。2026年10月30日に目録を直接開いたところ、2021年に確認したという表示はそのままで、目録の段階は 90.60 になっていました。第3章で触れていない第3部も、あわせて表に入れました。
| 規格 | 扱う範囲 | 発行 | 目録の状態(2026年10月30日) |
|---|---|---|---|
| ISO 13374-1(2003年) | 一般指針(データ処理・通信・表示のソフトウェア仕様の指針) | 2003年3月・第1版 | 発行中。2025年に見直して維持を確認(目録の段階 90.93) |
| ISO 13374-2(2007年) | データ処理(参照する情報モデルと処理モデル) | 2007年7月・第1版 | 発行中。最後の維持の確認は2021年。目録の段階 90.60(見直しの期間の終了) |
| ISO 13374-3(2012年) | 通信(データ通信の要求) | 2012年2月・第1版 | 発行中。2023年に見直して維持を確認(目録の段階 90.93) |
| ISO 13374-4(2015年) | 表示(技術的な分析と判断の支援のための情報の示し方) | 2015年12月・第1版 | 発行中。最後の維持の確認は2021年。目録の段階 90.60(見直しの期間の終了) |
| ISO 13381-1(2025年) | 予測の一般指針と要求事項 | 2025年9月・第3版 | 発行中(目録の段階 60.60)。2015年版(第2版)は廃止 |
表のとおり、ISO 13374 の第1部から第4部はいずれも第1版のまま発行中で、改訂版は目録に示されていません。第2部と第4部は目録の段階が 90.60(見直しの期間の終了)にあり、その結果(維持・改訂・廃止)は目録の上ではまだ示されていません。見直しの結果がどうなるかは未確認なので、本コラムでは「改訂される」とも「維持される」とも書きません。社内で ISO 13374 を参照している場合は、目録の状態の欄を確かめる周期と担当を社内で決めておき、その周期とは別に、要求仕様や設計を変える前にも確かめる手順にしておくのがよいと考えています。周期をどの程度にすれば十分かを示す根拠は、本コラムでは確かめていません。
規格の動向を追うのは、規格に合わせること自体が目的だからではありません。予知保全の仕組みを外部の設備メーカーやソフトウェアの会社と一緒に作るとき、規格の用語と枠組みは、発注側と受注側が同じ言葉で話すための土台になります。規格の版が食い違ったまま要求仕様を書くと、同じ「予測」「健全性」という語で別のものを指したまま開発が進み、後から作り直しになるおそれがあります。経営の側から見れば、これは部門ごとに別々の言葉で仕組みを作る二重投資の入口になりうるものです。
公開事例を読むときに確かめること
予知保全の事例は、企業のニュースリリース、設備やソフトウェアの提供者の発表、業界紙の記事、展示会の講演など、さまざまな形で公表されています。このうち本コラムが根拠に使うのは、取り組んだ企業や公的機関が自ら公式のページで公表したもの、あるいは提供者が導入先の名前を出して公式に発表したものに限りました。業界紙の記事やまとめサイトは、取材した側の言い換えが入り、効果の数字の限定条件が落ちていることがあるためです。
公式の発表であっても、そのまま読むと判断を誤るおそれがある点がいくつかあります。1つ目は、効果の数字が「見込み」なのか「実績」なのかです。発表の時点で検証が始まったばかりの取り組みでは、効果は見込みとして書かれていることが多く、実績と取り違えると自社の効果の見立てが過大になります。2つ目は、効果を何と比べているかです。「検査時間の削減」と書かれていても、何を基準にした削減なのか、どの範囲の設備の話なのかで意味が変わります。3つ目は、取り組みの段階です。試行(PoC)なのか、1か所での検証なのか、全社への展開なのかで、同じ手法の成熟の度合いがまったく違います。
4つ目は、発表した側の立場です。設備やソフトウェアの提供者が出す導入事例は、提供者の製品の紹介を兼ねているので、うまくいった点が中心に書かれます。これは発表の性質であって、内容が誤っているという意味ではありません。ただ、うまくいかなかった試みは公表されにくいので、公開事例だけを集めると「予知保全はたいてい成果が出る」という印象が強くなりすぎます。第12章で扱った PoC の出口の条件を決めるときに、公開事例の数字を基準にしないほうがよいと考えるのはこのためです。読むときに確かめる項目を、次の表にまとめました。
| 確かめる項目 | 見る場所 | 読み違えたときに起きること |
|---|---|---|
| 誰が発表したか(取り組んだ本人か、提供者か) | 発表者の欄、ページのドメイン | 製品の紹介を、利用者の評価と取り違える |
| いつ発表したか | 公表日 | 古い取り組みを最新の状況と取り違える |
| 取り組みの段階(試行・検証・展開) | 「検証」「試行」「展開予定」などの語 | 試行の結果を、全社展開の効果として見積もる |
| 対象の設備と範囲 | 設備の名称、地域・拠点の名前 | 自社の別の種類の設備にも同じ効果があると考える |
| 効果の数字が見込みか実績か | 「見込み」「最大」「平均」などの語 | 見込みを実績として予算に入れる |
| 効果を何と比べているか | 比較の基準の記述 | 基準の違う数字どうしを並べて比べる |
| うまくいかなかった点の記述があるか | 課題・今後の欄 | 導入の難しさを小さく見積もる |
公開事例、鉄道の変電所と線路・食品工場のポンプ
ここからは、公式のページで中身を確かめられた3件の事例を、前の表の項目に沿って紹介します。1件目は鉄道の変電所・電気室、2件目は鉄道の複数の会社による線路の保守、3件目は海外の食品工場のポンプの振動監視です。
1件目です。東京地下鉄株式会社(東京メトロ)は、2026年5月26日のニュースリリースで、センシングと AIの技術を使って鉄道の変電所・電気室の保守を遠隔化し、状態基準保全(CBM)へ移す取り組みを公表しました(東京メトロのニュースリリース)。対象は、電力の受電・変換・供給を担う変電所と電気室です。発表によると、従来は社員が現地で定期的に行っていた検査について、映像・温湿度・部分放電・塵埃などの状態のデータを各種のセンサーで遠隔から取り、高い頻度の測定と状態の監視を実現するとしています。発表は、現地の検査で取っていた状態のデータを遠隔で取る取り組みを説明したもので、法令に基づく点検に触れた記述はありません。この発表から、法令上必要な点検を省略できるとは判断できません。取ったデータは AIで分析し、故障の予兆をつかむことと、設備を更新する時期を適正にすることを目指すとしています。
発表に書かれた進め方は、2026年度に千代田線の代々木変電所の周辺を対象として検証を進め、2027年度以降に他の地域へ広げる予定、というものです。つまり発表の時点では、取り組みの段階としては検証にあたります。期待する効果として、故障の予兆を早くつかむこと、感電などの危険のある作業を大きく減らして労働災害を防ぐこと、検査時間の削減の3つが挙げられています。検査時間の削減については、データを遠隔で取ることで現地の作業と移動が減ることによる削減で「最大60%程度の見込み」と書かれています。この数字は最大60%程度という見込みであり、検証の結果として得た実績ではありません。何を分母にした削減率か、どの検査を算定の対象にしたかは、この発表からは確認できません。
この事例から読み取れることは、予知保全の目的が故障の予兆をつかむことだけでなく、危険な作業を減らすこと、限られた人手で保守を続けることにも置かれている点です。発表は目的として、安全性と安定性の向上に加えて、労働力の不足を踏まえた保全業務の効率化を挙げています。第13章で扱った保全の担い手の問題と、状態基準保全への移行が結びつけて説明されている例です。
2件目です。2023年6月14日、小田急電鉄・東急電鉄・東京メトロ・JR東日本の鉄道4社と、株式会社日本線路技術は、複数の鉄道会社が共通で使える保線の管理システムを開発したと共同で発表しました(東京メトロのニュースリリース)。対象は線路の設備で、線路設備モニタリング装置から得たデータを使い、効率的なメンテナンスの方法として CBM を進めるためのシステムです。発表では、このシステムを日本線路技術が国内で初めて開発したとしています。
発表が挙げている効果は、開発の費用を抑えられること、アプリを各社で相互に使えるようになることで、数字は示されていません。背景として、将来の生産年齢人口の減少を見据えて線路設備モニタリング装置を導入してきたこと、鉄道のスマートメンテナンスの確立を目指すことが書かれています。この事例で注目したいのは、予知保全の技術そのものではなく、仕組みを複数の会社で共通にしたという点です。序章で整理した6つの損失の型のうち「二重投資」を、会社の枠を越えて避けようとした取り組みとして読めます。社内の工場や部門の間でも、同じ考え方で共通化できる部分がないかを確かめる価値があると考えています。
3件目は、海外の製造業の例です。シーメンスが2025年6月4日に公式に発表した、ドイツの乳製品メーカー Sachsenmilch Leppersdorf GmbH との取り組みがあります(シーメンスのプレスリリース)。発表によると、同社の工場で新たに振動センサーと振動の計測システムを取り付け、温度・振動の大きさ・周波数を分析し、既存の制御システムのデータもあわせて取り込みました。分析には、シーメンスの予知保全のソフトウェア(Senseye Predictive Maintenance)が使われ、AIのアルゴリズムで現在と将来の問題を知らせる仕組みです。発表では、あるポンプの寿命の終わりを早い時期に捉えた例が挙げられています。この取り組みは試行(パイロット)として行われたもので、発表によると、教育を受けた後は同社のチームが自ら試行を続けて完了させました。試行の次の取り組みとして、ソフトウェアを同社の保全管理の仕組みと連携させ、保全の通知を自動で受け渡すことを予定していると書かれています。
この事例で読み取れる論点は2つあります。1つは、予知保全の仕組みを既存の保全管理の仕組み(第10章で扱った CMMS にあたるもの)とつなぐことが、試行の次の取り組みとして位置づけられている点です。警報を出すだけでは保全の作業は動かず、作業指示の流れに乗せて初めて業務になるという第10章の論点と同じ方向です。もう1つは、導入先のチームが自ら試行を続けたと書かれている点で、第13章で扱った内製と技能の継承の論点にあたります。
一方、効果については、発表には計画外の停止が減ったという記述がありますが、それを示す数字は金額の形でしか書かれていないため、本コラムでは引きません。この事例は、提供者が導入先の名前を出して発表したものです。前の節の表で挙げた「誰が発表したか」の点に注意して読む必要があります。
| 事例 | 発表者 | 公表時期 | 対象 | 手法として書かれていること | 取り組みの段階 | 効果の記述 |
|---|---|---|---|---|---|---|
| 変電所・電気室の保守の遠隔化と CBM 化 | 東京メトロ | 2026年5月26日 | 鉄道の変電所・電気室 | 映像・温湿度・部分放電・塵埃のセンサーで遠隔に状態を取り、AIで分析 | 2026年度に代々木変電所の周辺で検証。2027年度以降に展開予定 | 検査時間の削減は最大60%程度の見込み(現地作業と移動の減少による。算定の範囲は発表に書かれていない) |
| 保線の管理システムの共通化 | 鉄道4社と日本線路技術 | 2023年6月14日 | 線路の設備 | 線路設備モニタリング装置のデータを使い、CBM を進める共通のシステム | 開発を発表 | 数字は無し。開発の費用を抑えること、アプリの相互利用 |
| 食品工場のポンプなどの振動監視 | シーメンス(導入先は Sachsenmilch) | 2025年6月4日 | 乳製品工場の設備(ポンプなど) | 振動センサーと計測システム、温度・振動・周波数と制御データを AIで分析 | 試行を完了。保全管理の仕組みとの連携を予定 | 計画外の停止の減少の記述あり(数字は金額のみのため本コラムでは引かない) |
表の3件は、本コラムが公式のページを開いて中身を確かめられたものに限っています。業種も取り組みの段階も違うので、この表は事例を比べて優劣を付けるためのものではありません。自社の取り組みを考えるときに、「誰が・どの設備を・取り組みのどの段階で・何を目的に」という読み方の型として使うことを想定しています。
故障の予兆検知と健全性の管理を扱う学会、PHM Society
予知保全の研究と実務をつなぐ場として、海外にはPHM Societyがあります。PHM は、故障の予兆を検知し、設備の健全性を管理する技術の分野を指す英語の略称です。PHM Society の公式ページでは、この団体を、PHM を工学の一分野として発展させることを目的とする非営利の団体と説明しており、設立の年を2009年としています(PHM Society の公式ページ)。
公式ページによると、PHM Society は北米・欧州・アジア太平洋の3つの地域で PHM の会議を開いています。また、学術誌として、PHM の分野の国際誌である IJPHM(ISSN 2153-2648)を発行しています。過去には会議にあわせてデータを使った競技(データチャレンジ)を開いており、公式ページのお知らせには2022年の会議のデータチャレンジの開始の告知が残っています。
実務の担当者にとって、こうした学会の活動を追う意味は、手法の最新の研究を知ることよりも、評価の方法や公開されたデータの使い方の作法を知ることにあると考えています。前の段落のとおり、PHM Society は会議にあわせてデータを使った競技(データチャレンジ)を開いてきました。競技の進め方や評価の指標の中身は、本コラムでは確かめていません。それでも、第7章で扱った残存寿命の推定や第8章で扱った警報の評価について、学会の場でどの指標で何を比べているかを知っておくと、提供者の説明する精度の数字を読み解きやすくなると考えています。一方で、学会の論文や競技で示される精度は、それぞれが使ったデータと条件のもとで得られたもので、自社の設備でそのまま再現できるとは限りません。この点は公開事例の数字と同じです。
生成AIの活用、保全業務のどこに使うか
生成AI(文章や画像などを新たに作り出す AI。大規模言語モデルがその代表)を保全業務に使う動きがあり、後で引くように、予知保全のソフトウェアの提供者も生成AIの機能を発表しています。本コラムでは、センサーデータの異常検知や残存寿命の推定には第5章から第7章で扱った統計や機械学習の手法を用い、生成AIは記録の要約や検索などを補助する用途として扱います。この章で引く公式発表で生成AIの用途として書かれているのも、主に文章を扱う周辺の業務です。保全記録の要約、過去の故障事例や作業手順の検索、点検や故障の報告書の下書きの作成などが、本コラムで想定する用途の例です。
企業の公式発表で確かめられる例として、シーメンスは2024年2月5日、予知保全のソフトウェアに生成AIの機能を加えると発表しました(シーメンスのプレスリリース)。発表によると、この機能は複数の言語で書かれたものを含む保全の事例を走査して分類し、似た過去の事例とその解決策を探して、いま起きている問題の手がかりとして示します。また、利用者と AIと保全の専門家の間の対話の形で使えるようにする、と書かれています。さらに2025年3月24日には、同じソフトウェアを、生成AIで保全の作業を支援する仕組み(修理の手引きや故障の切り分けの支援)と組み合わせた提供の形を発表しました(シーメンスのプレスリリース)。この発表には、最初の試行の事例で事後保全にかかる時間が減ったという記述がありますが、試行の件数・期間・測り方は書かれていません。このため本コラムでは、その数字を引かず、一般的な効果としても扱いません。
生成AIを保全業務に使うときに、もっとも注意すべき点は誤りです。米国の国立標準技術研究所(NIST)が2024年7月26日に公表した生成AIのリスク管理の手引き(NIST AI 600-1)は、生成AIに固有の、あるいは生成AIで強まるリスクの1つとして、もっともらしく断定された誤った内容を作り出すこと(一般に「ハルシネーション」と呼ばれるもの)を挙げています。保全の文脈では、存在しない部品番号や誤った締め付けの手順、取り違えた設備の過去の記録を、自然な文章で示してしまうおそれがあるということです。
このため、生成AIの出力は、使い道ごとに、誤りの確認の方法・確認する人・記録や手順として確定する条件を決めておく必要があります。過去の保全記録の要約や検索のように、人がその後で原文を確かめることを前提にした使い方では、生成AIは調べ物の手間を減らす道具として使いやすいと考えています。一方、作業手順や安全に関わる手順のように、誤りがそのまま事故につながるものは、生成AIの出力を下書きにとどめ、保全の責任者が原典と照らし合わせて確かめてから使う、という線を引いておくのが安全です。法令に基づく点検の記録は、これとは分けて扱います。本コラムでは、法令に基づく点検の記録は生成AIに作成させない方針です。これは、法令が生成AIの利用をどう扱っているかを本コラムで確かめた結論ではなく、本コラムが置く運用の線引きです。次の表の「点検・故障の報告書の下書き」は、法令に基づかない社内の点検や故障の報告書を指します。点検の報告書でも、法令に基づく点検の記録にあたるものは、表の最後の行の扱いにします。用途ごとの考え方を、次の表にまとめました。
| 用途 | 生成AIに渡すもの | 誤りが起きたときの影響 | 誤りの確認 |
|---|---|---|---|
| 保全記録の要約 | 過去の保全記録の文章 | 要約の取り違えで、判断の手がかりがずれる | 要約から原文の記録に戻れるようにし、判断の前に原文を見る |
| 過去の故障事例の検索 | 保全記録・故障報告の集まり | 似ていない事例を似ていると示す | 示された事例の原文を保全員が読んで採否を決める |
| 作業手順の検索と提示 | 設備の取扱説明書・社内の作業標準 | 誤った手順で作業し、設備の損傷や労働災害につながる | 出典の文書と版を必ず示させ、原典で確かめてから作業する |
| 点検・故障の報告書の下書き | 点検の結果、作業の記録 | 事実と違う記述が記録として残り、次の予測の教師データを汚す | 作業した人が内容を確かめてから記録として確定する |
| 法令に基づく点検の記録 | (使う場合は記録の書式だけ) | 記録の誤りが法令上の問題になる | 生成AIに書かせず、所管の法令と社内の手順に従って人が作成する |
表の最後の行のとおり、法令に基づく点検(たとえば労働安全衛生法に基づく定期自主検査)は、予知保全の仕組みや生成AIで置き換えられるものとして扱わないことを、本コラムでは前提にしています。予知保全のデータは、こうした点検の結果を補う情報としては使えても、点検そのものの代わりにはならない、という線引きです。個別の点検の扱いは、所管の法令と所管官庁の資料で確かめる必要があります。
報告書の下書きの行で「次の予測の教師データを汚す」と書いたのは、第10章で扱ったとおり、保全記録が次の予測モデルの学習の材料になるからです。生成AIが書いた誤った記述がそのまま記録として残ると、その誤りが故障モードの分類や残存寿命の学習に入り込みます。生成AIを記録の作成に使うなら、記録を確定する前に人が確かめる工程を、作業の流れの中に組み込んでおく必要があります。
AIに関する規制との関係、設備の安全に関わる AI
予知保全の仕組みの多くは、保全員に判断の材料を示すもので、設備の安全を守る機能そのものではありません。ただし、AIが設備の停止や運転の制御に直接かかわる使い方では、AIに関する規制との関係を確かめる必要が出てきます。この節の内容が関係しうるのは、EU の市場に設備や製品を出す事業者や、そうした設備や製品に AIを組み込む事業者です。どのような事業者にこの規則がかかるかの全体は、本コラムでは確かめていません。ここでは、EU の AIに関する規則(EU AI Act)について、公式の条文で確かめた範囲だけを書きます。参照したのは、欧州委員会の AI Act Service Desk が掲載している、2026年7月27日時点の統合版です。この統合版には、デジタル・オムニバスによる改正が反映されています。デジタル・オムニバスは、EU AI Act の条文を追加・改正した EU の法令で、AI Act Service Desk は、追加・改正された箇所に印を付けて示しています。統合版は2026年10月30日に開いて確かめ、第2条・第3条・第6条は2026年11月5日にも開き直しました。附属書Iは10月30日に開いたものです。
EU AI Act の第6条第1項は、AIシステムが高リスクとされる条件の1つとして、次の2つを両方満たす場合を定めています(第6条)。
- その AIシステムが、附属書I(この規則が挙げる EU の法令の一覧。中身は後で説明します)の法令の対象となる製品の安全部品として使われることを意図している。あるいは、AIシステム自体がその製品である
- その製品が、その法令に基づいて市場に出す前などに、第三者による適合性評価を受ける必要がある
適合性評価は、定められた要求を満たしているかを確かめて示す手続きです。この規則の第3条は、適合性評価を、高リスクの AIシステムに定められた要求事項が満たされているかを示す手続きと定義し、第三者による適合性評価を行うのは、試験・認証・検査などを行う適合性評価の機関だとしています(第3条)。第6条第1項の2つ目の条件でいう適合性評価は、附属書Iの法令に基づいて製品が受けるものです。第3条第14号は「安全部品」を、製品や AIシステムの部品のうち、その製品や AIシステムの安全の機能を果たすもの、あるいはその故障や誤作動が人や財産の健康と安全を危険にさらすもの、と定義しています(この号はデジタル・オムニバスで改正されています。第3条)。第6条第2項は、これとは別に、附属書IIIに挙げた AIシステムも高リスクとしています。予知保全の AIが附属書IIIのどれかに該当するかは、本コラムでは確かめていません。
附属書Iは、EU の法令の一覧を2つに分けています。Section A は「新しい法的枠組み」にもとづく法令の一覧、Section B はそれ以外の法令の一覧です。2026年7月27日時点の統合版では、機械に関する EU の規則(規則(EU)2023/1230)は Section A ではなく Section B の21番に、デジタル・オムニバスで新しく加わった項目として載っています(附属書I)。
Section A と Section B の違いは、この規則のどの条文が適用されるかにかかわります。ただし、機械の安全部品として使う AIにこの規則の高リスクの要求事項がかかるかどうかは、本コラムで確かめた範囲では答えが出ません。確かめたことと、確かめていないことは次のとおりです。対象は、第6条第1項によって高リスクとされる AIシステムのうち、附属書Iの Section B の法令の対象となる製品に関わるものです。
- 第2条第2項(デジタル・オムニバスで改正)は、この対象に適用する条文を、第6条第1項・第60a条・第102条から第112条に限っています(第2条)。第60a条・第102条から第112条、次の箇条の第57条から第59条が何を定めているかは、本コラムでは条文を開いておらず、確かめていません
- 同じ項は続けて、第57条・第58条・第59条を条件つきで適用するとしています。条件は、この規則の高リスクの AIシステムの要求事項が、その Section B の法令に組み込まれている範囲であることです
- 1つ目と2つ目の箇条から、ここに挙げられた条文と、条件つきで適用される第57条から第59条のほかは、この規則から直接は適用されない、と読めます。ただし、このことだけから、高リスクの要求事項がかからないとは言えません。2つ目の箇条のとおり、要求事項が Section B の法令の側に組み込まれる場合を前提にした書き方があるためです
- 一方で、第102条から第112条が機械に関する規則の側にどのような要求を組み込むのか、機械に関する規則の対象の製品で AIがどのような場合に高リスクとされるのかは、本コラムでは確かめていません
このため本コラムでは、「機械の安全部品として使う AIは、この規則の高リスクの要求事項をすべて満たす必要がある」とも「満たさなくてよい」とも書きません。自社の AIが附属書Iに挙げた法令の対象となる製品の安全部品に当たるかどうか、当たる場合にどの要求がかかるかは、ここで挙げた条文と機械に関する規則の条文に沿って、法務などの専門家と確かめる必要があります。
ここからは、高リスクにあたるかどうかの入口の話です。直前に書いた「高リスクとされた場合に、どの要求事項がかかるか」とは別の問いです。第6条第1項の組み立てから言えるのは、この項の経路で予知保全の AIが高リスクにあたるかどうかは、「AIを使っているか」ではなく、次の2つの確認事項で判断する、ということです。
- 確認事項の1つ目:その AIが附属書Iの法令の対象となる製品の安全部品にあたるか(あるいは AIシステム自体がその製品か)。安全部品には、安全の機能を果たすものだけでなく、故障や誤作動が人の健康と安全や財産を危険にさらすものも含まれます。このため、意図された用途と、AIが誤ったときの影響まで含めて確かめる必要があります
- 確認事項の2つ目:その製品が第三者による適合性評価の対象か
1つ目の確認事項は、人が最終的に判断する仕組みかどうかだけでは決まらないと考えています。第3条第14号の定義は、人が最終的に判断するかどうかで区切った書き方になっていないためです。保全員が警報を見て判断する仕組みと、AIの判断で設備を自動的に止める仕組みでは、意図された用途も AIが誤ったときの影響も違うので、1つ目の確認事項への答えが変わることはありえます。それでも、人が判断する仕組みであることだけを理由に、安全部品にあたらないと決めないほうがよいと考えています。
個別の仕組みが安全部品にあたるかは、本コラムでは判断しません。デジタル・オムニバスで一部の条文が追加・改正されていることは確かめましたが、各条文がいつから適用されるかは、本コラムでは確かめていません。この節で本コラムが確かめていないと書いた事項のうち、自社で法務などの専門家と確かめる事項をまとめると、次のとおりです。
- 自社の AIが、附属書Iに挙げた法令の対象となる製品の安全部品にあたるか。あたる場合に、どの要求がかかるか
- 自社が、この規則がかかる事業者にあたるか
- 自社の AIが、附属書IIIに挙げた AIシステムのどれかに該当するか
- 自社に関わる条文が、いつから適用されるか
AIに関する規制の全体と社内ルールの作り方は、弊社コラム『AIガバナンスの実践ガイド、法規制とフレームワークから社内ルールの作り方まで』で扱っています。
予知保全の取り組みが形骸化する型
ここまで、規格・公開事例・学会・生成AI・規制と、外の動きを見てきました。外の動きに合わせて新しい技術を取り入れることは、それ自体が目的になると、仕組みが使われないまま残る原因になります。本コラムの各章で触れてきた「使われなくなる」型を、外の動きとの関係も含めて1つの表にまとめました。損失の型の列は、序章で整理した6つの損失の型のどれにつながるかを示しています。
| 形骸化の型 | 起きやすいきっかけ | つながる損失の型 | 防ぐための手当て | 扱った章 |
|---|---|---|---|---|
| 誤報が続いて警報が見られなくなる | しきい値を現場と決めずに運用を始める | 警報の形骸化・突発停止 | 誤報の許容量を現場と決め、警報ごとに結果を記録して見直す | 第8章 |
| PoC で目標を達成しても展開されない | PoC の出口の条件を先に決めていない | 二重投資 | PoC を始める前に、展開の判断の条件と担当を決める | 第12章 |
| 警報が作業指示につながらない | 予知保全の仕組みと保全管理の仕組みが別々 | 突発停止 | 警報から作業指示・記録までを1つの流れにする | 第10章 |
| 保全記録が残らず、モデルが古くなる | 記録の手間が業務に組み込まれていない | 突発停止・過剰保全 | 記録の項目を絞り、作業の完了の条件に記録を含める | 第10章 |
| 公開事例の数字をそのまま目標にする | 他社の効果を自社の見込みに使う | 二重投資・突発停止・安全と環境の事故 | 自社で測った数字を基本にし、未観測の項目は仮定・根拠・推定の幅を明示する | 第12章・本章 |
| 規格の版が古いまま要求仕様を書く | 規格の改訂を誰も追っていない | 二重投資 | 参照する規格の一覧と、目録を確かめる周期と担当を決める | 第3章・本章 |
| 生成AIの出力を確かめずに記録や手順に使う | 便利さが先に立ち、確認の工程が無い | 安全と環境の事故・品質の不良 | 用途ごとに確認の方法・確認する人・確定の条件を決め、手順と記録は人が確定する | 本章 |
| 担当者の異動で仕組みが止まる | 判断の根拠が一人の頭の中にしかない | 突発停止 | 判断のルールと根拠を文書と記録に残し、複数人で担う | 第13章 |
次の図は、この章で見た外の事例と動向を、自社の判断に取り込む順序を左から右へ並べたものです。外の情報は読み方を確かめたうえで自社の試行の材料にし、自社で測った数字で判断してから保全計画に反映する、という流れを示しています。
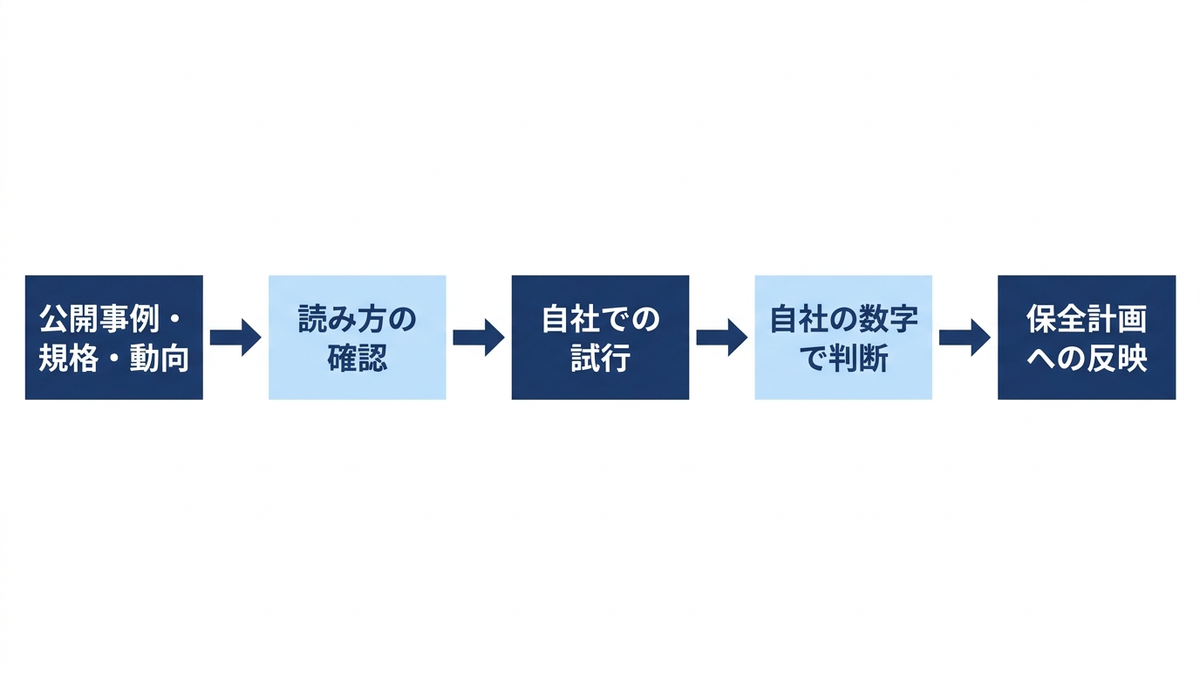
経営判断、事例の効果をそのまま自社に当てはめない
この章の経営判断は、公開事例や提供者の発表に書かれた効果を、そのまま自社の効果の見込みや予算の根拠にしないことです。公開事例の数字は、発表した側の設備・データ・体制・比較の基準のもとで得られた(あるいは見込まれた)ものです。この章で取り上げた3件を見ても、検証を始める時点で見込みとして示された数字、数字を示さず目的だけを書いたもの、効果を金額でしか示していないものがあり、自社の見立てにそのまま使える数字は1つもありませんでした。
経営の側で判断を誤ると、2つの方向の損失が起こりえます。1つは、他社の効果の数字を前提に予算と人員を決め、自社で同じ効果が出なかったときに取り組み全体が「失敗」と見なされて止まることです。この場合、それまでに集めたデータと保全記録が使われなくなり、仕組みを作り直すときに二重投資になります。もう1つは、他社の効果の数字を前提に点検や交換の周期を一気に延ばし、自社の設備では予兆が捉えられずに突発停止や安全の事故につながることです。後者は過剰保全を減らそうとして、より大きな損失を招く型です。
公開事例と動向は、次の3つの使い方にとどめるのがよいと考えています。1つ目は、自社で確かめるべき論点の一覧を作ることです。東京メトロの例からは「危険な作業を減らすことを目的に含めるか」、鉄道の複数の会社の例からは「仕組みを部門や工場の間で共通にできるか」、食品工場の例からは「保全管理の仕組みとどうつなぐか」という論点が取り出せます。2つ目は、提供者と話すときの質問を用意することです。発表に書かれた数字について、比較の基準・対象の範囲・試行の件数と期間を尋ねることで、自社に当てはまるかを見極める材料が得られます。3つ目は、規格の版と規制の動きを、要求仕様と社内ルールの見直しの周期に組み込むことです。効果の見込みそのものは、第12章で扱ったとおり、自社の試行で件数・時間・相対コストの形で測った数字を基本に立てます。短い試行では、まれにしか起きない故障の減り方のように測れない項目も残ります。その項目は、置いた仮定・その根拠・推定の幅を明示したうえで計画に入れます。
予算と体制に落とすときは、外の動きを追う役割を誰が担うかを決めておくと、続けやすくなります。規格の目録の確認、規制の改正の確認、学会や公開事例の情報の収集は、担当が決まっていないと誰も行わないまま年数がたちます。第13章で作った役割の表に、「外の動きの確認」の行を1つ足し、担当と定期の確認の周期を書き込んでおくことを勧めます。あわせて、規制の適用が始まる前と、設計や要求仕様を変える前には、定期の周期を待たずに確かめる、という決まりも書いておきます。
この章のまとめ
この章では、予測の一般指針である ISO 13381-1 が2025年9月に第3版へ改訂されたこと、状態監視のデータ処理を扱う ISO 13374 の第1部から第4部はいずれも第1版のまま発行中であることを、ISO の目録で確かめました。公開事例は、鉄道の変電所・電気室、鉄道の複数の会社による保線の管理、食品工場のポンプの振動監視の3件を、公式のページに書かれている範囲で紹介しました。学会では PHM Society の会議・学術誌・データチャレンジを紹介し、評価の方法を知る場として追う考え方を示しました。生成AIは文章を扱う周辺の業務に使い、用途ごとに誤りの確認の方法・確認する人・確定の条件を決める考え方を示しました。EU の AIに関する規則は、機械の安全部品として使う AIに高リスクの要求事項がかかるかを本コラムで確かめた範囲では判断できず、法務などの専門家と確かめる必要があることを書きました。外の事例と動向は自社で確かめるべき論点の手がかりとして読み、効果の見込みは自社で測った数字を基本にし、まだ測れていない項目は仮定と根拠と推定の幅を明示して計画に使う、というのがこの章の結論です。本コラムの本編はここまでで、終章では、予知保全を続けるために押さえておくことを振り返ります。
この章を深めたい方への参考書籍
『既存工場、製造現場への生成AI/AI導入と活用の仕方』(技術情報協会 企画編集、技術情報協会):既存の工場と製造現場に生成AIや AIを入れるときの技術の選び方、データ収集の環境づくり、異常検知への活用などを章ごとにまとめた資料集です。この章で扱った生成AIの活用を、自社の工場の業務に当てはめて考えるときの材料になります。
『MLflowで実践するLLMOps 生成AIアプリケーションの実験管理と品質保証』(弥生隆明ほか、技術評論社):大規模言語モデルを使った仕組みの実験管理と品質保証を扱う本です。この章で書いた「生成AIの出力の誤りをどう確かめるか」を、仕組みとして継続的に評価する方法を考えるときに役立ちます。
終章 予知保全を続けるために
本コラムでは、序章で示した4つの流れに沿って、保全と信頼性の基礎(第1章・第2章)、データと予測の技術(第3章から第7章)、予測から保全の計画へ(第8章から第10章)、導入と定着(第11章から第14章)を順に見てきました。全体を通した考えは、序章で述べたとおり、どの設備のどの故障を捉えるかと、警報を受け取ったあとに誰が何を判断していつ作業するかを先に決め、保全の記録を次の予測に戻しながら見直し続けることです。最後に、各章の要点を、予知保全を続けるための判断の順序としてまとめ直します。
章をまたいで見えること
第1に、予知保全はすべての設備に向く方式ではありません。保全の方式は、故障したときの影響、故障の型、状態を測れるかどうか、測る手間に見合うかどうかで、設備ごとに選ぶものです(第1章)。故障の記録から故障の型を確かめ、あわせて、劣化の兆候を測れるかどうか、兆候を見つけてから処置を終えるまでの時間を確保できるかどうかを確かめることで、時間基準の交換で足りる部品と、状態の監視が効く部品を分けていきます(第2章、第3章)。予知保全の対象を絞ることは、効果の出るところに手間を集めることだと考えています。
第2に、データと予測の技術は、捉えたい故障から逆に組み立てます。どの故障モードを捉えたいかが決まれば、測る物理量とセンサーの付け方が決まり(第3章)、故障の物理に結びついた特徴量が決まります(第4章)。故障のデータが少ないうちは、正常なときのデータから「いつもと違う」を見つける異常検知から始め(第5章)、事例と知識がたまるにつれて原因の診断(第6章)と残存寿命の推定(第7章)へ進む場合は、この順序が無理が少ないと考えています。ただし、すべての設備で残存寿命の推定まで進む必要はなく、対象の設備と故障に応じて、どの分析まで使うかを選びます(序章)。本コラムで動かしたコードはいずれも架空のデータによるもので、数値はその条件での一例にすぎません。手順の骨格は実際のデータに当てはめる際の参考にできますが、実際のデータには欠測やノイズ、設置の違いがあるため、自社のデータで確かめ直す必要があります。
第3に、予測は保全の判断と計画に変わって初めて効果を生みます。予測の評価は、精度の指標だけでなく、保全の準備に間に合う警報がどれだけ出るか、見逃しと誤報がどれだけ出るかで行います(第8章)。残存寿命の予測は、幅を持ったまま交換時期と作業の割当の計画に入れます(第9章)。警報から作業指示、作業、記録までを既存の保全業務に組み込み、保全記録が次の予測の材料として戻ってくるようにします(第10章)。ただし、記録を戻すだけで予測がよくなるとは限りません。記録の誤りや偏り、運転の条件の変化によって、予測が合わなくなることもあります。記録の品質を確かめ、モデルや計画を見直す前と後で、警報の当たり方と保全への効果を比べることで、予測のモデルも保全の計画も、自社の設備に合わせて改善していけると考えています。
第4に、導入と定着では、データが足りない部分は、物理の知識とシミュレーション、似た設備のデータで補える場合がありますが、どれも故障のデータの代わりになるわけではなく、足りない部分を仮定で埋めるものです。埋めた部分が正しかったかどうかは、運用を始めてから集まる実際の設備のデータで確かめながら使います(第11章)。そのためにも、設備の構造と劣化の物理を知る人を、データの分析から外さないことが大切です。
導入は、重要度と、故障の型と監視できるかどうかで対象の設備を絞り、試験導入の出口の条件を先に決めて進めます(第12章)。体制の中心には、警報を受けて判断する保全員を置き、熟練者の判断をデータとルールとして残していきます(第13章)。公開された事例は、対象の設備や条件ごとに読み、効果の数字をそのまま自社に当てはめないようにします(第14章)。
続けるための最小の仕組み
予知保全を続けるための仕組みは、大がかりなものである必要はありません。本コラムで扱った内容から、最小の形を挙げると次のようになります。
- 対象の設備と、捉えたい故障モードの一覧がある
- 警報を受け取る人、判断する人、作業を指示する人が決まっている
- 誤報と見逃しの件数、警報から故障までの時間を、対象の台数と期間をそろえて定期的に数えている(警報を受けて故障の前に処置した件は、下の補足のとおり別に数える)
- 保全の作業の結果(故障モード・原因・処置)が記録され、予測の見直しに使われている
- 予測のモデルと警報のしきい値を見直す時期と担当が決まっている
- 対象の設備を広げるかどうかを判断する場と時期が決まっている
3つ目の項目の補足です。警報を受けて故障の前に処置した件は、処置をしなければ故障したのかどうかが分かりません。そのため、第8章の数え方(将来の故障の発生に基づく評価)では、誤報とも正しい警報とも区別して扱う必要があります(第8章)。こうした件は、第10章で扱った点検の所見に基づく警報の確認結果として、点検で何が見つかったかで別に数えます。
この6つの条件がそろっていれば、使っている手法が単純なしきい値による状態の監視であっても、予知保全へ進むための運用の土台はできていると考えています。反対に、高度なモデルを使っていても、上の6項目が欠けていれば、警報が形骸化し、データは集まっても保全の判断が変わらないおそれがあります。手法を高度にするのは、上の6項目が回り始めてからで遅くないと考えています。まず自社で、上の6項目のうち欠けているものを確かめ、1つ目の「対象の設備と、捉えたい故障モードの一覧」から整えることをお勧めします。
経営が見るべきこと
経営の立場から予知保全の取り組みを見るときは、モデルの精度の報告よりも、次の問いに答えられるかを確かめることをお勧めします。対象の設備で、突発停止の件数と停止の時間は前と比べてどう変わったか。時間基準で交換していた部品のうち、保全の記録で裏付けて交換の周期を見直したものはあるか(法令で定められた点検は、この見直しの対象に含めません。第10章・第13章)。警報のうち、作業につながったものはどれだけあり、第8章の数え方で誤報はどれだけあったか(点検の所見に基づく警報の確認結果で数える場合は、誤報の語を使わずその区分で報告します。第10章)。保全の記録は予測の見直しに使われているか。
1つ目の突発停止の件数と停止の時間は、結果の指標です。重要度の高い設備ほど故障させないよう保全されているため、故障の件数が少ない設備では、件数の変化が偶然の範囲に収まることがあります(第12章)。増減だけで効果の有無を判断せず、運転の条件の変化も併せて見ます。後ろの3つの問いは、取り組みが保全の判断を変えているかどうかを見る手がかりになります。
予知保全は、一度仕組みを作れば終わる取り組みではなく、設備の更新、生産の条件の変化、保全員の入れ替わりに合わせて見直し続ける取り組みです。見直しを続けるための手間を、あらかじめ保全業務と予算の中に位置づけておくことが、取り組みを続けるための重要な方法だと考えています。本コラムが、自社の設備と業務に合った予知保全を組み立てるための材料になれば幸いです。
Anagraftでは、設備データの活用の構想づくりから、対象設備の選定、センサーデータの分析と異常検知・寿命予測のモデルの開発、保全計画の最適化、保全業務への組み込みと社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 保全の方式と予知保全の位置づけ、事後保全から状態基準保全まで
『実務者のための製品・設備のライフサイクルメンテナンス入門』(髙田祥三 著、森北出版):製品や設備のメンテナンス計画の考え方と手順を、ライフサイクルの視点から体系的に解説した入門書です。版元の目次では、劣化と故障、劣化・故障予測、基本メンテナンス計画、設備診断技術、TPM までを1冊で扱っており、この章で扱った方式の全体像を、計画の立て方まで含めて確かめるのに向いています。
『リスクベースメンテナンス入門-RBM-』(日本学術振興会・産学連携第180委員会「リスクベース設備管理」テキスト編集分科会 編、養賢堂):故障の起きやすさと影響の大きさ(リスク)にもとづいて保全の重点を決める考え方を、基本から適用の手順まで説明した入門書です。この章で書いた「方式は設備ごとに、故障の影響と故障の型で選ぶ」という考え方を、リスクの評価の手順として深めるのに向いています。
第2章 故障のしくみと信頼性の基礎、故障モード・寿命分布・故障率
『入門信頼性工学:確率・統計の信頼性への適用 第2版』(福井泰好 著、森北出版):版元の紹介によると、アベイラビリティや保全性設計などの用語と概念を解説し、統計学の考え方や計算方法を信頼性にどう当てはめるかを扱う入門書です。本章で扱った故障率や寿命分布、アベイラビリティの考え方を、教科書の順序で学び直したい方に向いています。
『確率・統計から始めるエンジニアのための信頼性工学:身近な故障から宇宙開発まで』(山本久志 編著、秋葉知昭・竹ケ原春貴・深津敦・古井光明 共著、コロナ社):書名のとおり、確率と統計から入って信頼性工学へ進む本で、版元の紹介では宇宙開発の分野の安全と信頼性設計の事例も紹介されています。本章のワイブル分布の当てはめの背景にある統計の考え方を確かめたい方に向く内容です。
第3章 センサーとデータ収集、振動・温度・電流・稼働ログの集め方
『機械システムの状態監視と診断技術』(日本機械学会 編、井上剛志・兵藤行志 編著、榊田均ほか 共著、コロナ社):機械の状態監視と診断を、ISO の規格の体系の概論から説き起こしている本です。この章で番号と状態だけを確かめた状態監視の規格群が、全体としてどう組み立てられているかを知る手がかりになります。
『温度計測:基礎と応用』(計測自動制御学会温度計測部会 編、コロナ社):温度とは何かという定義から、温度の測り方の基礎と応用までを扱う本です。この章で触れた、正確な温度を測るときに表面の性質や環境の影響を補正する必要がある点を、計測の側から確かめられます。
第4章 振動データの信号処理と特徴量、FFTと包絡線解析で状態を数値にする
『続 回転機械の振動』(副題「実機の振動問題と振動診断」。松下修己・田中正人・小林正生・古池治孝・神吉博 共著、コロナ社):回転機械の振動の続編として、すべり軸受・転がり軸受・磁気軸受のロータの振動と、事例を通じた診断の考え方を扱った本です。版元の目次によると、転がり軸受のロータの振動の章にエンベロープ(包絡線)処理と軸受の損傷の波形・FFT 解析の節があり、回転機械の振動の信号処理にも1章が割かれています。この章で架空のデータで確かめた欠陥周波数と包絡線解析を、実機の振動の問題の中で位置づけ直すのに向いています。
『音・振動のスペクトル解析』(金井浩 著、日本音響学会 編、コロナ社、音響テクノロジーシリーズ 5):離散的フーリエ変換・時間窓・解析信号とヒルベルト変換など、スペクトル解析の基礎を物理的な意味とあわせて体系的に解説した本です。この章では計算の手順だけを示した周波数分解能・窓関数・ヒルベルト変換を、数式の裏付けから理解したい方に向いています。1999年の刊行の本です。
第5章 異常検知の手法、しきい値・管理図・機械学習で「いつもと違う」を見つける
『入門 機械学習による異常検知 Rによる実践ガイド』(井手剛 著、コロナ社):正規分布に従うデータでのホテリングの T2 による異常検知から始め、分布がひと山にならない場合の近傍法やクラスタリング、性能評価の方法、主成分分析による異常検知とホテリングの T2 との関係までを、手順に沿って説明しています。この章で扱った「正常から学んで、異常の度合いを数値にし、しきい値を決める」という流れを、数式と実行例で確かめたい方に向いています。
『異常検知と変化検知』(井手剛・杉山将 著、講談社):ホテリングの T2 法、近傍法、サポートベクトルデータ記述法、部分空間法による変化検知、密度比推定など、異常検知と変化検知の代表的な手法を短い章に分けて解説しています。この章で紹介しきれなかった手法の位置づけや、「急な外れ」だけでなく「変わり目」を捉える考え方を広く知りたい方に向いています。
第6章 故障診断、異常の原因を分類して故障モードと結びつける
『はじめてのパターン認識』(平井有三 著、森北出版):パターン認識の入門書で、版元の目次によれば、ベイズの識別規則、k最近傍法、線形識別関数、サポートベクトルマシン、識別器の組み合わせによる性能強化などの章があります。この章で使った分類モデルの考え方や、k最近傍法のようにデータの間の距離を使う識別の基礎を学ぶのに向いています。
『Pythonではじめる機械学習』(Andreas C.Müller, Sarah Guido 著、中田秀基 訳、オライリー・ジャパン):scikit-learn を使った機械学習の入門書で、版元の目次によれば、決定木のアンサンブル法、クラス分類器の不確実性推定、交差検証、多クラス分類の評価基準などの節があります。この章で使ったランダムフォレストの学習と評価、確信度の扱いを、自社のデータで試すときの手引きになります。
第7章 残存寿命の推定、劣化モデル・回帰・生存分析
『JMPによる信頼性工学:製品の寿命予測とデータ解析』(廣野元久・遠藤幸一 著、日本規格協会):寿命データの扱い方と寿命の分布から始まり、統計ソフトの JMP の例を使って信頼性のデータ解析を説明する本です。副題のとおり製品の寿命予測を主題にしており、この章のワイブル分布の当てはめや打ち切りの扱いを、実際の解析の手順として確かめたい方に向いています。
『医薬統計のための生存時間データ解析』(David Collett 著、宮岡悦良 監訳、共立出版):医学研究の生存時間データの解析を扱う教科書の訳書で、生存時間データの特徴、生存関数とハザード関数から説明が始まります。例は医学の研究ですが、打ち切りの扱いや生存関数・ハザード関数の考え方は、設備の寿命の記録に置き換えて読むことができるので、この章の生存分析を理屈から学びたい方に向いています。
第8章 予測の評価と警報の設計、見逃し・誤報・リードタイム
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標とKPIの関係から始め、回帰・二値分類・多クラス分類の評価指標を扱う本で、二値分類の章では適合率・再現率に加えて、ビジネスへの影響の期待値の計算やコストを考慮した学習も取り上げています。この章で行った、誤報と見逃しの相対コストから期待コストを計算してしきい値を選ぶ考え方を、評価指標の側から体系立てて確かめるのに向いています。
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):データ分析のコンペティションで使われる技術をまとめた本で、モデルの評価の章では、時系列データの検証の方法やグループごとに分ける交差検証を、タスクと評価指標の章ではデータの漏れ(リーク)を扱っています。この章の「時間で分ける・設備で分ける」という評価用データの切り方と、漏れの防ぎ方を、具体的な手順で確かめるのに役立ちます。
第9章 保全計画の最適化、交換時期と点検周期と作業の割当を数理モデルで決める
『Maintenance Theory of Reliability』(Toshio Nakagawa、Springer):年齢取替・ブロック取替・点検の方策など、保全の方策を確率モデルとして体系的に扱った専門書です。この章で使ったコスト率の考え方を、修理や不完全な保全などの条件に広げたモデルまで追うことができます。英語の書籍です。
『信頼性・保全性の数理』(三根久・河合一 著、朝倉書店):信頼性と保全性を確率論の立場から扱った日本語の教科書です。寿命の分布や更新の考え方など、この章の計算の土台になる数学を確かめたいときの参照先になります。1982年の刊行です。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治 著、講談社):線形計画・整数計画の定式化と解き方を基礎から解説した教科書です。この章の作業の割当のような0か1の変数を使うモデルを、自社の条件に合わせて組み替えるときの手引きになります。
第10章 予知保全を業務に組み込む、作業指示・保全記録・設備台帳とのつなぎ方
『一番最初に読む設備保全の本』(吉川達志、日刊工業新聞社):設備保全を構成する要素を、初心者にも分かる内容で解説した入門書です(2017年刊)。予知保全の仕組みを業務に入れる前に、既存の保全業務の全体像を確かめておくと、警報をどの業務の流れにつなぐかを整理する手がかりになります。
『現場力を高める実践的TPM入門 改訂版』(日本プラントメンテナンス協会 監修、町田勝利 著、日科技連出版社):TPM の概論から、現場が主役の自主保全活動、専門の保全部門による計画保全活動までを章を分けて解説した本です(改訂版は2017年刊)。この章で扱った巡回点検の気付きや保全記録を、自主保全と計画保全のどちらの活動として回すかを考える手がかりになります。
第11章 物理モデルとデジタルツインの併用、故障データの不足を補う
『AI、シミュレーションを用いた劣化・破壊評価と寿命予測』(技術情報協会 企画編集、技術情報協会):版元の紹介によると、高分子・複合材料・金属・コンクリートなどの劣化と破壊の評価、寿命の予測に、機械学習とシミュレーションを使う方法を、多数の執筆者が節ごとに扱った本です。加速試験の結果から寿命の予測式を導く手順、温度と劣化の速さの関係を使った寿命の推定、少ないデータからのモデルの作り方、疲労寿命や配管の腐食の予測の例が目次に並んでいます。この章で扱った「劣化の物理とデータを組み合わせる」考え方を、材料と部品の側から具体的な例で確かめるときの手がかりになると考えています。
『転移学習』(松井孝太、熊谷亘 著、講談社):機械学習プロフェッショナルシリーズの1冊です。版元の内容紹介によると、転移学習の基本概念から、ドメイン適応・マルチタスク学習・メタ学習・継続学習などの方法までを解説しています。目次には、「いつ転移するか」「何を転移するか」を扱う章、少ないデータで学ぶ少数ショット学習の章のほか、「ドメイン適応の理論」の章(移した先での予測の誤りの大きさを理論的に見積もる節を含む)も並んでおり、機械学習の理論を扱う専門書という位置づけです。版元のページには対象の読者の記述はありませんが、この章の「似た設備のデータを移せるかを確かめる」という問いを、理論的な裏付けから学びたいデータ分析の担当者に向く1冊として選びました。
第12章 予知保全の導入の進め方、対象設備の選定・PoC・効果の見立て
『工場・製造プロセスへのIoT・AI導入と活用の仕方』第3版(技術情報協会企画編集、技術情報協会):既存の設備を活かしながら工場に IoT・AIを導入する方法を、多くの執筆者が分担して解説した技術書です。版元の目次には、工場の IoT 化が進まない理由として費用対効果が分からず投資判断ができないことやプロジェクトを進める人材がいないことを挙げる節や、IoT・AIを使った異常検知・予知保全の節があり、本章の PoC の設計と効果の見立てを、導入の事例と課題の側から補う材料になります。
『スマートファクトリー構築ハンドブック:50のイメージセルがものづくりDXを具体化する』(毛利大、神山洋輔著、日本能率協会コンサルティング編、日本能率協会マネジメントセンター):技術ありきではなく、工場の経営から出発してスマートファクトリーの構想から実装までを進める枠組みと手順をまとめた本です。プロジェクトの進め方の章もあり、予知保全を工場全体の取り組みの一部として、展開の段階を踏んで広げるときの参考になります。
第13章 体制と人材、保全部門・データ担当・現場の役割と技能の継承
『知識創造企業 新装版』(野中郁次郎・竹内弘高 著、梅本勝博 訳、東洋経済新報社):暗黙知と形式知の区別と、その間を行き来させて組織の知識を作る考え方を示した本です。熟練者の保全技能のうち、どこをデータとルールに残し、どこを人から人へ伝えるかを考えるときの土台になります。
『機械保全の徹底攻略 2026年度版 機械系・学科』(日本能率協会マネジメントセンター):機械保全技能検定の機械系保全作業の学科試験に向けた、年度ごとに改訂される対策の本です。学科試験の範囲には保全用語や故障の型が含まれているので、保全部門の教育の計画で到達点を確かめる教材として使えます。
『自主保全士公式テキスト 改訂版』(日本プラントメンテナンス協会 編、日本能率協会マネジメントセンター):自主保全士の試験に向けた公式テキストで、設備を運転する人が受け持つ日常の保全の考え方を扱っています。役割の表でいう生産部門の点検と異常の連絡を、教育の計画に落とすときに参考になります。
第14章 公開事例と最新動向、規格・業界の取り組み・生成AIの活用
『既存工場、製造現場への生成AI/AI導入と活用の仕方』(技術情報協会 企画編集、技術情報協会):既存の工場と製造現場に生成AIや AIを入れるときの技術の選び方、データ収集の環境づくり、異常検知への活用などを章ごとにまとめた資料集です。この章で扱った生成AIの活用を、自社の工場の業務に当てはめて考えるときの材料になります。
『MLflowで実践するLLMOps 生成AIアプリケーションの実験管理と品質保証』(弥生隆明ほか、技術評論社):大規模言語モデルを使った仕組みの実験管理と品質保証を扱う本です。この章で書いた「生成AIの出力の誤りをどう確かめるか」を、仕組みとして継続的に評価する方法を考えるときに役立ちます。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- IEC 60050-192 の予防保全(192-06-05)の定義と注記、改訂日2024年3月8日、日本語対訳「予防保全」
https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-06-05 - IEC 60050-192 の予防保全(192-06-05)の定義と注記、改訂日2024年3月8日、日本語対訳「予防保全」
https://web.archive.org/web/20250523010650/https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-06-05 - IEC 60050-192 の事後保全の対訳を持つ項目(192-06-06)の定義
https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-06-06 - IEC 60050-192 の状態基準保全に当たる項目(192-06-07)の定義と注記、対訳「状態監視保全」
https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-06-07 - IEC 60050-192 の信頼性中心保全(192-06-08)の定義と注記、対訳
https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-06-08 - IEC 60050-192 の自動保全(192-06-09)・繰延べ保全(192-06-10)・保全作業(192-06-11)・修理(192-06-14)
https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-06-10 - IEC 60050-192 の時間計画保全(192-06-12)の定義と注記、対訳「時間計画保全」
https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-06-12 - JIS Z 8115 の名称、最新改正2019年3月20日、最新確認2023年10月20日
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=Z8115 - JIS Z 8141 の名称、最新改正2022年3月22日、最新確認2026年10月20日
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=Z8141 - Nowlan と Heap の1978年の論文(IEEE 信頼性・保全性シンポジウム、1978年1月、ロサンゼルス)と抄録の内容
https://trid.trb.org/View/68167 - Nowlan と Heap の1978年の国防総省後援の報告書(DTIC 所蔵)の書誌
https://apps.dtic.mil/sti/citations/ADA066579 - TPM は JIPM が1971年に提唱、全員参加の生産保全・総合的生産保全と呼ばれる、TPM の定義、JIS Z 8141 の2001年版で TPM が定義されている
https://www.jipm.or.jp/business/tpm/ - TPM は JIPM が1971年に提唱、全員参加の生産保全・総合的生産保全と呼ばれる、TPM の定義、JIS Z 8141 の2001年版で TPM が定義されている
https://web.archive.org/web/20260928002119/https://www.jipm.or.jp/business/tpm/ - 自主保全士は「設備に強いオペレーター」を認定する制度、製造部門が受け持つ保全の一部の機能や管理技術を評価、能力の1つに設備の日常保全(自主保全活動)
https://www.jishuhozenshi.jp/about/ - ISO 55000(2024年)は第2版、2024年7月発行、状態は発行済み、用語・概要・原則を扱う
https://www.iso.org/standard/83053.html - ISO 55001(2024年)は第2版、2024年7月発行
https://www.iso.org/standard/83054.html - ISO 55002(2018年)は第2版、2018年11月発行、改訂予定、置き換わる予定の版として ISO/DIS 55002 が開発中
https://www.iso.org/standard/88958.html - ISO 55002(2018年)は第2版、2018年11月発行、改訂予定、置き換わる予定の版として ISO/DIS 55002 が開発中
https://www.iso.org/standard/70402.html - IEC のフォールトの定義と注記(故障のほか設計・製造など前の段階の不備から生じるものも含む)
https://www.electropedia.org/iev/iev.nsf/display?openform&ievref=192-04-01 - 労働安全衛生法第45条第1項と第2項の内容(定期自主検査と特定自主検査)
https://laws.e-gov.go.jp/law/347AC0000000057 - 参考書籍 実務者のための製品・設備のライフサイクルメンテナンス入門(髙田祥三 著、森北出版、2024年12月)
https://ndlsearch.ndl.go.jp/books/R100000002-I033828597 - 参考書籍 実務者のための製品・設備のライフサイクルメンテナンス入門(髙田祥三 著、森北出版、2024年12月)
https://www.morikita.co.jp/books/mid/085771 - 参考書籍 リスクベースメンテナンス入門 RBM(日本学術振興会・産学連携第180委員会 リスクベース設備管理 テキスト編集分科会 編、養賢堂、2017年3月)
https://ndlsearch.ndl.go.jp/books/R100000002-I028081582
第2章
- NIST の統計の手引きは NIST/SEMATECH e-Handbook of Statistical Methods
https://www.itl.nist.gov/div898/handbook/ - 故障率は生き残っている個体がその時点で故障する瞬間的な割合で、h は f を R で割ったもの
https://www.itl.nist.gov/div898/handbook/apr/section1/apr123.htm - バスタブ曲線の3つの期間(初期故障期・偶発故障期・摩耗故障期)と、修理可能な系では縦軸を修理の発生率として読むという注意
https://www.itl.nist.gov/div898/handbook/apr/section1/apr124.htm - ワイブル分布の信頼度・故障率・平均の式と、形状1で指数分布になること
https://www.itl.nist.gov/div898/handbook/apr/section1/apr162.htm - 打ち切りのタイプIとタイプII、打ち切りがあっても最尤推定などで当てはめられること、別の故障モードで壊れた個体を打ち切りとして扱えること
https://www.itl.nist.gov/div898/handbook/apr/section1/apr131.htm - 故障の発生率が一定の場合 MTBF は発生率の逆数
https://www.itl.nist.gov/div898/handbook/apr/section1/apr171.htm - Weibull の1951年の論文、Journal of Applied Mechanics 第18巻第3号 293から297ページ
https://doi.org/10.1115/1.4010337 - FMEA の規格 IEC 60812 は2018年の第3版で2018年8月10日発行、2006年の第2版を置き換え、FMECA も扱い、安全への適用の具体的な手引きは示さない、安定日2029年
https://webstore.iec.ch/en/publication/26359 - FTA の規格 IEC 61025 は2006年の第2版で2006年12月13日発行、手法と適用の手引きと記号を扱う、安定日2029年
https://webstore.iec.ch/en/publication/4311 - scipy の CensoredData を fit に渡すと打ち切りを考慮した推定になる
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.CensoredData.html - 入門信頼性工学 第2版の版元の紹介で、アベイラビリティや保全性設計などの用語と概念、統計学の考え方を信頼性に当てはめる方法を扱う
https://www.morikita.co.jp/books/mid/301481 - 確率・統計から始めるエンジニアのための信頼性工学の版元の紹介で、宇宙開発の分野の安全と信頼性設計の事例を紹介
https://www.coronasha.co.jp/np/isbn/9784339029208/
第3章
- 確認日:2026-10-30(JST)
https://web.archive.org/web/2026/ - ISO 17359(2018年)は第3版で、2018年1月発行、2023年に見直しのうえ確認
https://www.iso.org/standard/71194.html - ISO 13374-1(2003年)は状態監視と診断の情報のデータ処理・通信・表示に関わるソフトウェアの仕様の一般的な指針で、2025年に見直しのうえ確認
https://www.iso.org/standard/21832.html - ISO 13374-2(2007年)はデータ処理を扱い、参照用の情報モデルと処理モデルの要件を定める
https://www.iso.org/standard/36645.html - ISO 13374-3(2012年)は通信を扱い、参照用の情報と処理の仕組みのためのデータ通信の要件を定める
https://www.iso.org/standard/37611.html - ISO 13374-4(2015年)は表示を扱い、技術的な解析と意思決定の支援のための情報の表示の要件を定める
https://www.iso.org/standard/54933.html - ISO 10816-1(1995年)は廃止され、ISO 20816-1(2016年)に改訂された
https://www.iso.org/standard/18866.html - ISO 20816-1(2016年)は回転する部分と回転しない部分の測定を扱い、軸の振動の絶対値と相対値にも適用
https://www.iso.org/standard/63180.html - ISO 10816-3(2009年)は出力15 kW超・毎分120〜15,000回転の産業機械が対象で、廃止され ISO 20816-3(2022年)に改訂された
https://www.iso.org/standard/50528.html - ISO 20816-3(2022年)は出力15 kW超・毎分120〜30,000回転の連結された産業機械をその場で測る規格
https://www.iso.org/standard/78311.html - NASA の信頼性中心保全の手引き(施設と付帯設備向け、2008年9月の最終版)
https://www.nasa.gov/wp-content/uploads/2023/06/nasa-rcmguide.pdf - OPC UA は2008年に公開された、機器や基本ソフトに依存しないサービス指向の仕組み
https://opcfoundation.org/about/opc-technologies/opc-ua/ - MIMOSA の OSA-CBM は ISO 13374 の機能の仕様の実装で、6つの機能のブロックとその間のつなぎ方を記述する
https://www.mimosa.org/mimosa-osa-cbm/ - 6つのブロックの名称(Data Acquisition、Data Manipulation、State Detection、Health Assessment、Prognostic Assessment、Advisory Generation)
https://www.mimosa.org/wp-content/uploads/2006-08-28_Including_OSA-CBM_and_OSA-EAI_in_Integrated_System_Health_Management.pdf - 標本化定理により、記録できる周波数の上限はサンプリング周波数の半分まで
https://doi.org/10.1109/JRPROC.1949.232969 - 参考書籍『機械システムの状態監視と診断技術』日本機械学会 編、井上剛志・兵藤行志 編著、榊田均ほか 共著、コロナ社、2021年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I031459808 - 参考書籍『温度計測:基礎と応用』計測自動制御学会温度計測部会 編、コロナ社、2018年2月
https://ndlsearch.ndl.go.jp/books/R100000002-I028766073 - エイリアシングを防ぐフィルタは、標本化と数値化の前に置くアナログのフィルタ
https://www.ni.com/en/shop/data-acquisition/measurement-fundamentals/analog-fundamentals/anti-aliasing-filters-and-their-usage-explained.html - P-F 間隔は兆候が検出できるようになってから機能故障までの間隔で、P-F 間隔から測定の間隔を引いた残りが処置に足りる必要がある
https://assets.publishing.service.gov.uk/media/5a7dbf8640f0b65d8b4e342e/japd100c-22.pdf
第4章
- 軸受の外輪・内輪・保持器・転動体の自転の欠陥周波数の理論式
https://patents.google.com/patent/US9464671B2/en - 転動体の傷は自転の周波数の2倍とその整数倍に現れる
https://we-are-imv.com/assets/downloads/business/seminar/iso-text//category3-textbook-syusei02.pdf - IMV のカテゴリーⅢ教科書は2026年3月31日に第4版が発行された
https://we-are-imv.com/business/seminar/iso-text/ - JTEKT は型番を選ぶと転動体の通過周波数を計算するページを公開している
https://www.jtekt.co.jp/products/bearing/en/calculation/passing_frequancy/?pno=7205DT - scipy の signal.hilbert は解析信号を返し、その絶対値が包絡線
https://docs.scipy.org/doc/scipy/reference/generated/scipy.signal.hilbert.html - scipy の stats.kurtosis は既定で3を引いた値を返し fisher=False で正規分布が3
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.kurtosis.html - 窓関数は横の漏れを抑える代わりに主の山の幅を広げる
https://docs.scipy.org/doc/scipy-1.16.0/tutorial/signal.html - 片側の振幅にするとき直流と偶数長のナイキストの成分は2倍にしない
https://numpy.org/doc/2.4/reference/generated/numpy.fft.rfft.html - 深層学習にも正常のデータを中心に学ぶ異常検知の方式がある Ruff らの2018年の論文
https://proceedings.mlr.press/v80/ruff18a.html - 参考書籍 続 回転機械の振動 実機の振動問題と振動診断 松下修己 田中正人 小林正生 古池治孝 神吉博 共著 コロナ社 2012年
https://ndlsearch.ndl.go.jp/books/R100000002-I024048388 - 参考書籍 続 回転機械の振動 版元のページ
https://www.coronasha.co.jp/np/isbn/9784339046083/ - 参考書籍 音・振動のスペクトル解析 金井浩 著 日本音響学会 編 コロナ社 1999年
https://ndlsearch.ndl.go.jp/books/R100000002-I000002760887 - 参考書籍 音・振動のスペクトル解析 版元のページ
https://www.coronasha.co.jp/np/isbn/9784339011050/
第5章
- JIS Z 9020-2(管理図の第2部、シューハート管理図)の最新の改正は2025年9月22日(制定は2016年12月20日)
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=Z9020-2 - 管理限界は工程が安定している限りほとんどの点が内側に入るように選ぶ
https://www.itl.nist.gov/div898/handbook/pmc/section3/pmc31.htm - NIST の手引きでは T2 は複数の変数を監視する管理図の土台になる統計量として紹介されている
https://www.itl.nist.gov/div898/handbook/pmc/section5/pmc543.htm - カイ2乗分布は平均0・標準偏差1の正規分布に従う互いに独立な値を2乗して足したものが従う分布で、自由度は足した値の数
https://www.itl.nist.gov/div898/handbook/eda/section3/eda3666.htm - Hotelling が1931年に学術誌 The Annals of Mathematical Statistics(第2巻第3号)で t 統計量を複数の変数に広げたものを示した
https://doi.org/10.1214/aoms/1177732979 - Q 統計量は Jackson と Mudholkar が1979年に学術誌 Technometrics(第21巻第3号)で主成分分析の残差を監視する手順として示した
https://doi.org/10.1080/00401706.1979.10489779 - Isolation Forest は Liu、Ting、Zhou が2008年の IEEE のデータマイニングの国際会議(ICDM)で発表した
https://doi.org/10.1109/ICDM.2008.17 - Isolation Forest はランダムに選んだ変数を最小値と最大値の間でランダムに区切り、切り分けるまでの回数を木で平均し、短いものほど異常らしいとみなす
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.IsolationForest.html - One-Class SVM は Schölkopf らが2001年に学術誌 Neural Computation(第13巻第7号)で示した
https://doi.org/10.1162/089976601750264965 - Hinton と Salakhutdinov が2006年に科学誌 Science(第313巻第5786号)で、オートエンコーダの形のネットワークでデータの次元を減らす方法を示した
https://doi.org/10.1126/science.1127647 - 入門 機械学習による異常検知 Rによる実践ガイド(井手剛 著、コロナ社、2015年)
https://ndlsearch.ndl.go.jp/books/R100000002-I026092656 - 異常検知と変化検知(井手剛・杉山将 著、講談社、2015年)
https://ndlsearch.ndl.go.jp/books/R100000002-I026619229
第6章
- 振動の周波数ごとに疑われる故障をまとめた総説(Chu ほか、Heliyon 誌、2024年)
https://pmc.ncbi.nlm.nih.gov/articles/PMC10909639/ - ケース・ウェスタン・リザーブ大学の軸受データセンターが正常と内輪・転動体・外輪に人工的な欠陥を付けた軸受の振動データを公開
https://engineering.case.edu/bearingdatacenter - ランダムフォレストの原典は Breiman の2001年の Machine Learning 誌の論文
https://doi.org/10.1023/A:1010933404324 - class_weight の balanced は各クラスの重みを件数に反比例して自動で決める
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.RandomForestClassifier.html - 相関した特徴量の一方を並べ替えると両方の重要度が低く出ることがある
https://scikit-learn.org/stable/modules/permutation_importance.html - 不純度による重要度は、分岐による不純度の減少を、その分岐を通る学習データの割合と組み合わせて集計し、木の間で平均して合計が1になるようにそろえたもの
https://scikit-learn.org/1.9/modules/ensemble.html - 『はじめてのパターン認識』平井有三 著、森北出版
https://ndlsearch.ndl.go.jp/ - 『はじめてのパターン認識』平井有三 著、森北出版
https://www.morikita.co.jp/books/mid/084971 - 『Pythonではじめる機械学習』Andreas C.Müller, Sarah Guido 著、中田秀基 訳、オライリー・ジャパン
https://www.oreilly.co.jp/books/9784873117980/
第7章
- NASA エイムズ研究センターの PCoE が予測用データを公開しており、その1つが Turbofan Engine Degradation Simulation
https://www.nasa.gov/intelligent-systems-division/discovery-and-systems-health/pcoe/pcoe-data-set-repository/ - 各組は学習用と評価用に分かれ、学習用は故障まで、評価用は故障より前で切れ、評価用には正解の残存寿命が付く
https://data.nasa.gov/dataset/cmapss-jet-engine-simulated-data - データの作り方は Saxena・Goebel・Simon・Eklund の2008年の PHM08 の予稿
https://doi.org/10.1109/PHM.2008.4711414 - Gebraeel らの2005年の論文、IIE Transactions 第37巻第6号、劣化の信号から残存寿命の分布をベイズ的な方法で求める研究
https://doi.org/10.1080/07408170590929018 - 比例ハザードモデルは Cox が1972年に示した
https://doi.org/10.1111/j.2517-6161.1972.tb00899.x - カプラン・マイヤー推定の原論文
https://doi.org/10.1080/01621459.1958.10501452 - scikit-learn の GradientBoostingRegressor は loss に quantile を指定すると分位点の回帰ができ、予測区間の例が示されている
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.GradientBoostingRegressor.html - statsmodels の SurvfuncRight と PHReg は右側の打ち切りを扱える
https://www.statsmodels.org/stable/duration.html - 参考書籍『JMPによる信頼性工学』製品の寿命予測とデータ解析、廣野元久・遠藤幸一 著、日本規格協会
https://ndlsearch.ndl.go.jp/books/R100000002-I032331180 - 参考書籍『医薬統計のための生存時間データ解析』David Collett 著、宮岡悦良 監訳、共立出版
https://ndlsearch.ndl.go.jp/books/R100000002-I024432983 - 機能故障は要求される機能・性能を満たせなくなった状態で、劣化した状態で動いていても要求を満たしていれば機能故障ではない
https://www.nasa.gov/wp-content/uploads/2023/02/nasa_rcmguide.pdf - カプラン・マイヤー推定は独立な打ち切りを前提とし、説明変数を条件にして独立とみなせるなら、その説明変数で補正できる
https://www.statsmodels.org/v0.14.4/generated/statsmodels.duration.survfunc.SurvfuncRight.html - curve_fit の係数の共分散は、誤差の共分散を渡さない場合、ずれを日ごとに独立・等しい重みとして計算する
https://docs.scipy.org/doc/scipy-1.16.0/reference/generated/scipy.optimize.curve_fit.html - distutils は Python 3.12 で標準ライブラリから外された
https://docs.python.org/3/library/distutils.html
第8章
- IEC 62682 第2版は2022年12月8日発行、プロセス産業のアラームシステムの管理を扱う
https://webstore.iec.ch/en/publication/65543 - IEC 62682 の前の版は2014年の第1版
https://webstore.iec.ch/en/publication/80816 - ISA-18.2 は2016年版
https://www.isa.org/standards-and-publications/isa-standards/isa-18-series-of-standards - 『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社、2023年
https://gihyo.jp/book/2023/978-4-297-13314-6 - 『Kaggleで勝つデータ分析の技術』門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社、2019年
https://gihyo.jp/book/2019/978-4-297-10843-4 - NDLサーチでの書誌の確認(評価指標入門)
https://ndlsearch.ndl.go.jp/api/opensearch?title=評価指標入門 - NDLサーチでの書誌の確認(Kaggleで勝つデータ分析の技術)
https://ndlsearch.ndl.go.jp/api/opensearch?title=Kaggleで勝つデータ分析の技術
第9章
- Barlow と Hunter の論文「Optimum Preventive Maintenance Policies」は1960年、学術誌 Operations Research 第8巻第1号90〜100ページ
https://doi.org/10.1287/opre.8.1.90 - 年齢取替のコスト率の式は、予防交換の費用×信頼度と事後交換の費用×故障確率の和を、信頼度の0からTまでの積分で割る
https://jvatn.folk.ntnu.no/eLearning/PK8207/LectureNotes/PK8207PreventiveMaintenance.pdf - 年齢取替の古典的モデルの式と、有限の最適な年齢が存在する条件
https://www.maths.dur.ac.uk/stats/people/ps/jrr1.pdf - 隠れた故障の平均の不稼働率は、壊れている確率を点検の間隔で平均した値
https://ntnu.edu/documents/624876/1277046207/SIS+book+-+chapter+08+-+PFDavg+with+RBDs/e298efe8-d451-465e-9400-bb3926d04f1a - Nowlan と Heap の1978年の報告書は、運転員に見えない形で起きている故障を見つける点検を保全の作業の1つとして扱う
https://everyspec.com/DoD/DOD-General/AD-A066579_18228/ - PuLP 3.3.2 は2026年5月25日公開、4.0.0 は2026年9月25日公開
https://pypi.org/pypi/pulp/json - PuLP 4.0 で同梱の CBC と PULP_CBC_CMD が廃止された
https://raw.githubusercontent.com/coin-or/pulp/master/HISTORY - 参考書籍 Maintenance Theory of Reliability(中川覃夫、Springer、2005年)
https://ndlsearch.ndl.go.jp/books/R100000002-I000008389541 - 参考書籍 信頼性・保全性の数理(三根久・河合一 著、朝倉書店、1982年)
https://ndlsearch.ndl.go.jp/books/R100000002-I000001553956 - 参考書籍 しっかり学ぶ数理最適化 モデルからアルゴリズムまで(梅谷俊治 著、講談社、2020年)
https://ndlsearch.ndl.go.jp/books/R100000002-I030691339
第10章
- ISO 14224 は石油・石油化学・天然ガスの産業を対象に、設備の信頼性と保全のデータを集めて交換するための規格で、ISO/TC 67 が担当
https://committee.iso.org/standard/64076.html - 故障の正確な時刻が分かるデータと区間でしか分からないデータを区別する考え方は NIST の工学統計ハンドブックの信頼性の節にある
https://www.itl.nist.gov/div898/handbook/apr/section1/apr131.htm - 寿命の推定の方法には独立な打ち切りを前提にするものがある
https://www.statsmodels.org/v0.14.4/generated/statsmodels.duration.survfunc.SurvfuncRight.html - 参考書籍 一番最初に読む設備保全の本 吉川達志 著 日刊工業新聞社 2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I028442263 - 参考書籍 現場力を高める実践的TPM入門 改訂版 日本プラントメンテナンス協会 監修 町田勝利 著 日科技連出版社 2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I028281502
第11章
- ISO 281(2007年)は転がり軸受の基本動定格荷重と定格寿命の計算方法を定める
https://committee.iso.org/standard/38102.html - ISO 281 の疲労限荷重は運転中の荷重とは別に軸受ごとに計算で求める量
https://www.jbia.or.jp/cbo/pdf/iso281kaiseisetumeikai_rev5.pdf - 転がり軸受の疲労によるはく離は、最初の亀裂の位置で内部起点型と表面起点型に分けられる
https://www.nsk.com/content/dam/nsk/jp/ja/tools-resources/rd/pdf/jtj-0697.pdf - ISO 23247 の系列には技術報告書の第100部(2025年5月、半導体のインゴットの成長の工程の適用例)と第101部(2026年5月、ロボットによるガスシールドアーク溶接の工程の適用例)がある
https://committee.iso.org/standard/90387.html - ISO/TR 23247-101 は2026年5月発行の技術報告書
https://committee.iso.org/standard/93278.html - Saxena らの論文の健全性の指標は運転の余裕を表す量で、0で故障とする
https://ntrs.nasa.gov/citations/20090029214 - ISO 23247-1 は2021年10月発行の第1版で、製造業のデジタルツインの枠組みの概要と一般原則、用語の定義と要求事項を扱う
https://committee.iso.org/standard/75066.html - ISO 23247-2 は2021年10月発行の第1版で参照アーキテクチャを扱う
https://committee.iso.org/standard/78743.html - ISO 23247-3 は2021年10月発行の第1版で製造の要素をデジタルで表すための情報の属性の一覧を扱う
https://committee.iso.org/standard/78744.html - ISO 23247-4 は2021年10月発行の第1版で参照アーキテクチャの実体どうしの情報交換の要求事項を扱う
https://committee.iso.org/standard/78745.html - ISO 23247-5 は2026年6月発行の第1版でデジタルスレッドを扱う
https://committee.iso.org/standard/87425.html - Saxena らの2008年の論文、エンジンの熱力学のシミュレーションで劣化を指数的に進め、健全性の指標が0に達した時点を故障とし、データは PHM 08 のデータ競技会の課題に使われた
https://doi.org/10.1109/PHM.2008.4711414 - Glaessgen と Stargel の2012年の論文、デジタルツインを精密なシミュレーションと健全性の管理の仕組み・保全の履歴・機体群のデータの統合として位置づけた
https://ntrs.nasa.gov/citations/20120008178 - Glaessgen と Stargel の論文の DOI
https://doi.org/10.2514/6.2012-1818 - Raissi らの2019年の論文、Journal of Computational Physics 378巻、非線形の偏微分方程式を含む問題を深層学習で解く枠組みを題にしている
https://doi.org/10.1016/j.jcp.2018.10.045 - Karniadakis らは2021年に物理にもとづく機械学習を題にした論文を Nature Reviews Physics 3巻に発表した
https://doi.org/10.1038/s42254-021-00314-5 - Pan と Yang の2010年の総説、IEEE の論文誌22巻10号
https://doi.org/10.1109/TKDE.2009.191 - 参考書籍 AI、シミュレーションを用いた劣化・破壊評価と寿命予測(技術情報協会 企画編集、技術情報協会、2025年)
https://ndlsearch.ndl.go.jp/books/R100000002-I034120363 - 参考書籍 転移学習(松井孝太、熊谷亘 著、講談社、2024年、機械学習プロフェッショナルシリーズ)
https://ndlsearch.ndl.go.jp/books/R100000002-I033407627 - 参考書籍 AI、シミュレーションを用いた劣化・破壊評価と寿命予測の内容紹介と目次
https://www.gijutu.co.jp/doc/b_2294.htm - 参考書籍 転移学習の内容紹介と目次
https://www.kspub.co.jp/book/detail/5332931.html
第12章
- 2026年版ものづくり白書は令和8年5月29日に経済産業省・厚生労働省・文部科学省が公表
https://www.meti.go.jp/report/whitepaper/mono/2026/index.html - 2026年版ものづくり白書の概要 第4章 19ページ 図1 データの取得66.0%・活用51.4%・効果43.9%(n=2,851)
https://www.meti.go.jp/report/whitepaper/mono/2026/pdf/gaiyo.pdf - リスクにもとづいて保全の優先順位を決める考え方があり、リスクベースメンテナンス(RBM)と呼ばれている
https://www.yokendo.com/books/9784842505572/ - 参考書籍『工場・製造プロセスへのIoT・AI導入と活用の仕方』第3版、技術情報協会企画編集、技術情報協会、2021年
https://ci.nii.ac.jp/ncid/BC05328224 - 参考書籍『工場・製造プロセスへのIoT・AI導入と活用の仕方』第3版、技術情報協会企画編集、技術情報協会、2021年
https://gijutu.co.jp/doc/b_2055.htm - NASA の信頼性中心保全の手引きは、使用の時間と故障の起こりやすさの関係の型によって、使用の上限を決めて交換する方法が合うかどうかが違うと整理している
https://www.nasa.gov/wp-content/uploads/2023/06/nasa-rcmguide.pdf - 参考書籍『スマートファクトリー構築ハンドブック:50のイメージセルがものづくりDXを具体化する』毛利大、神山洋輔著、日本能率協会コンサルティング編、日本能率協会マネジメントセンター、2022年
https://ci.nii.ac.jp/ncid/BC18383892
第13章
- 厚生労働省 技能検定制度について
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/koyou_roudou/jinzaikaihatsu/ability_skill/ginoukentei/index.html - 技能検定の等級は1級・2級・3級で、職種により単一等級と管理・監督者向けの特級がある
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/0000198899.html - 機械保全の指定試験機関は公益社団法人日本プラントメンテナンス協会
https://www.mhlw.go.jp/content/001348737.pdf - 機械保全は技能検定の職種の1つ
https://www.mhlw.go.jp/content/001294212.pdf - 機械保全技能検定 第2回試験の概要
https://www.kikaihozenshi.jp/test_2nd/ - 機械保全技能検定は国家検定で、合格者は機械保全技能士
https://www.kikaihozenshi.jp/ - 2級と3級の学科試験の機械保全法一般に保全用語(初期故障・偶発故障・摩耗故障、予防保全、事後保全、改良保全、予知保全、保全性など)が並ぶ
https://www.mhlw.go.jp/file/06-Seisakujouhou-11800000-Shokugyounouryokukaihatsukyoku/0000190535.pdf - 自主保全士とは
https://www.jishuhozenshi.jp/about/ - 日本機械学会誌 機械状態監視資格認証事業20周年
https://www.jsme.or.jp/kaisi/1260-04/ - 機械状態監視診断技術者(振動)の資格名
https://www.jsme.or.jp/jotaiweb/uploads/sites/2/2022/08/202202jukenannai.pdf - 労働安全衛生法第45条の定期自主検査と特定自主検査
https://laws.e-gov.go.jp/law/347AC0000000057 - 事業者本人(代表者・役員)が自ら行える形は2025年の法改正で加わり2026年1月1日に施行
https://www.mhlw.go.jp/content/11201250/001567055.pdf - ISO 18436-2(2014年、第2版)は振動による状態監視と診断を行う人の訓練・実務経験・試験の要件を定め、改訂の対象とされている
https://www.iso.org/standard/50447.html - 暗黙知と形式知の考え方が野中郁次郎氏と竹内弘高氏の著書で広く知られるようになった
https://ndlsearch.ndl.go.jp/books/R100000002-I030776209 - 参考書籍 機械保全の徹底攻略 2026年度版 機械系・学科
https://ndlsearch.ndl.go.jp/books/R100000002-I034835823 - 参考書籍 自主保全士公式テキスト 改訂版
https://ndlsearch.ndl.go.jp/books/R100000002-I032465910
第14章
- ISO 13381-1(2025年)は予測の一般指針と要求事項・第3版・2025年9月発行・23ページ・TC 108/SC 5
https://www.iso.org/standard/88029.html - ISO 13381-1(2015年)は第2版・2015年9月発行で廃止
https://www.iso.org/standard/51436.html - ISO 13374-1(2003年)は第1版・2003年3月・2025年に維持を確認
https://www.iso.org/standard/21832.html - ISO 13374-2(2007年)は第1版・2007年7月・最後の維持確認2021年・段階 90.60
https://www.iso.org/standard/36645.html - ISO 13374-3(2012年)は第1版・2012年2月・2023年に維持を確認
https://www.iso.org/standard/37611.html - ISO 13374-4(2015年)は第1版・2015年12月・最後の維持確認2021年・段階 90.60
https://www.iso.org/standard/54933.html - 東京メトロは2026年5月26日に変電所・電気室の保守の遠隔化と CBM 化を公表
https://www.tokyometro.jp/news/2026/224351.html - 鉄道4社と日本線路技術が2023年6月14日に共通の保線管理システムの開発を発表
https://www.tokyometro.jp/news/2023/215646.html - シーメンスは2025年6月4日に Sachsenmilch Leppersdorf GmbH との予知保全の試行を発表
https://press.siemens.com/global/en/pressrelease/siemens-advances-predictive-maintenance-artificial-intelligence-sachsenmilch - PHM Society は PHM を工学の一分野として発展させる非営利団体で設立2009年
https://phmsociety.org/ - シーメンスは2024年2月5日に予知保全のソフトウェアへの生成AIの機能の追加を発表
https://press.siemens.com/global/en/pressrelease/generative-artificial-intelligence-takes-siemens-predictive-maintenance-solution-next - シーメンスは2025年3月24日に生成AIによる保全支援と予知保全のソフトウェアを組み合わせた提供の形を発表
https://press.siemens.com/global/en/pressrelease/siemens-expands-industrial-copilot-new-generative-ai-powered-maintenance-offering - NIST AI 600-1 は2024年7月26日公表の生成AIのリスク管理の手引きで、生成AIに固有の、あるいは強まるリスクの1つとして、もっともらしく断定された誤った内容の生成を挙げる
https://doi.org/10.6028/NIST.AI.600-1 - NIST AI 600-1 の書誌ページ
https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - EU AI Act 第6条第1項の2つの条件(附属書Iの法令の対象となる製品の安全部品、あるいは AI システム自体がその製品であること
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-6 - EU AI Act 第3条第14号の安全部品の定義
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-3 - 附属書Iは Section A 新しい法的枠組みにもとづく法令と Section B その他の法令に分かれ、機械に関する EU の規則 2023/1230 は Section B の21番にデジタル・オムニバスで新しく加わった項目として載る
https://ai-act-service-desk.ec.europa.eu/en/ai-act/annex-1 - 第2条第2項は、第6条第1項で高リスクとされ附属書I Section B の法令の対象の製品に関わる AI システムには、第6条第1項・第60a条・第102条から第112条だけを適用すると定める
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-2 - 参考書籍『既存工場、製造現場への生成AI/AI導入と活用の仕方』技術情報協会 企画編集、技術情報協会、2025年9月
https://ndlsearch.ndl.go.jp/books/R100000002-I034333650 - 参考書籍『MLflowで実践するLLMOps 生成AIアプリケーションの実験管理と品質保証』弥生隆明ほか、技術評論社、2026年5月
https://ndlsearch.ndl.go.jp/books/R100000002-I034650753 - 労働安全衛生法に基づく定期自主検査があり、結果の記録が求められる
https://laws.e-gov.go.jp/law/347AC0000000057