こんにちは、Anagraftの伊藤です。
今回は、データガバナンス、つまり自社のデータについて「誰が何を決め、何を基準に、どう確かめるか」を定める仕組みを、どう理解し、どう自社に作るかを整理しました。データ活用やAIの導入が進むほど、データそのものの定義が部門ごとに違う、同じ売上や顧客数の数字が会議のたびに食い違う、個人情報の扱いが人によってまちまちである、せっかく作った分析基盤に何が入っているか誰も説明できない、といった問題が表に出てきます。これらは、多くの場合、技術の問題というより、決める人と決め方が無いことから起きる問題です。本コラムでは、データマネジメントの知識体系として広く参照されるDMBOK(DAMA Internationalが刊行するデータマネジメント知識体系ガイド)の知識領域を見取り図にしながら、日本の公的な指針や規格と結びつけ、役割・会議体・ポリシー・データ品質の測り方・最初の90日の進め方まで、自社の体制づくりに落とす手順を説明します。
この題材を選んだ理由は、データガバナンスが、AIへの投資を含む多くのデータ活用の前提でありながら、「ルールで縛ること」「情報システム部門の仕事」「ツールを入れれば済むこと」と受け取られて、着手が遅れたり形だけになったりすることが多いように思うためです。データの定義が決まっていなければ、どれほど高度な分析も「どの数字を信じるか」という議論に戻ってしまいます。データの持ち主が決まっていなければ、品質の問題は見つかっても直す人がいません。学習データの来歴(出所と加工の履歴)や権利が確かめられていなければ、AIの出力の説明責任は果たせません。こうした状態で投資を重ねると、二重投資、判断の遅れ、法令違反、AI投資の空振りという形で損失が出ます。
本コラムでは、DMBOKの本文や図を引用することはせず、その構造と考え方を自分の言葉で解説しています。DMBOKはDAMA Internationalの著作物であり、原典に当たるには日本語版の書籍を参照していただくのがよいと考えています。その代わりに、ISOやJISの規格、デジタル庁や経済産業省、個人情報保護委員会、情報処理推進機構(IPA)が公開している指針や指標、企業や団体が公開している事例といった、読者が自分で開いて確かめられる一次情報を根拠にしました。データ品質の測定と取引先の名寄せの2つの章では、架空のサンプルデータに対して実際にPythonのコードを動かし、その結果を載せています。
想定している読者は、データガバナンスやデータマネジメントの体制づくりを任された方、あるいはそれを決める立場の方です。DX推進の担当者の方、情報システム部門の責任者の方、データ分析チームのリーダーの方、そして「データガバナンスに取り組め」と言われたが何から手を付けるかを決めなければならない経営層の方を念頭に置いています。データマネジメントの専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その領域が無いと何を誤るか」「経営はどう判断するか」を意識して書き、組織の規模や段階による違いにも触れるようにしました。
本コラムでは、各知識領域について「何を決める・守るためのものか」「それが無いと何を誤るか」「最初の一歩は何か」を軸に書いています。データガバナンスの製品やサービスは数多くありますが、どれを選ぶかより先に、自社の困りごとがどの領域の問題なのか、誰に何を任せるのか、どの順で着手するのかを決めることが大事だと考えているためです。本コラムに出てくる企業名と数値は、その企業または主催団体が公開した資料に書かれているものに限っています。製品やサービスの料金、弊社の支援の条件には触れていません。本コラムの記述は2026年10月時点で確認したものです。法令や指針、規格は改正されますので、実務で使う際は公式のページで最新の内容をご確認ください。
目的別の入口の目安を挙げておきます。データガバナンスとは何か、データマネジメントとどう違うのかを整理したい場合は、第1章が入口になります。DMBOKとは何か、知識領域がどう並んでいるのかを知りたい場合は第2章をご覧ください(本コラムで使う用語の定義は「全体の地図」の表にまとめています)。役割と会議体の設計は第3章、全社データの見取り図は第4章、データ品質の測り方は第5章、用語集とデータカタログは第6章、マスターデータと名寄せは第7章、個人情報とセキュリティは第8章、データ基盤の運用は第9章、文書の管理とデータ倫理は第10章が中心になります。
AIのためのデータ整備とAIガバナンスへの接続は第11章、自社の現状診断は第12章、体制づくりの進め方は第13章、定着と失敗の型、公開された事例は第14章で扱っています。AIガバナンスそのものの詳細(法規制とフレームワークから社内ルールの作り方まで)は、別のコラムで扱う予定です。

目次
- 序章 データガバナンスは誰の仕事か
- 全体の地図
- 第1章 データガバナンスとは何か、データマネジメントとの関係と用語の整理
- 第2章 DMBOKとは何か、知識体系の成り立ちと知識領域の見取り図
- 第3章 データガバナンスの仕組み、原則・ポリシー・役割・会議体
- 第4章 データアーキテクチャとデータモデリング、全社データの見取り図
- 第5章 データ品質、何を測りどう直すか
- 第6章 メタデータ管理とデータカタログ、データリネージ
- 第7章 参照データとマスターデータ、名寄せと正しい一件の管理
- 第8章 データセキュリティとプライバシー、個人情報保護法と社内ルール
- 第9章 データの保管・統合・提供、基盤運用とデータウェアハウス
- 第10章 ドキュメント・コンテンツ管理とデータ倫理
- 第11章 AIのためのデータ、AI Ready とAIガバナンスへの接続
- 第12章 現状診断と成熟度アセスメント
- 第13章 自社の体制づくり、最初の90日から1年の進め方
- 第14章 定着と組織変革、失敗の型と公開事例
- 終章 データガバナンスを続けるための5つの考え方
- 本コラムで紹介した書籍一覧
- 第1章 データガバナンスとは何か、データマネジメントとの関係と用語の整理
- 第2章 DMBOKとは何か、知識体系の成り立ちと知識領域の見取り図
- 第3章 データガバナンスの仕組み、原則・ポリシー・役割・会議体
- 第4章 データアーキテクチャとデータモデリング、全社データの見取り図
- 第5章 データ品質、何を測りどう直すか
- 第6章 メタデータ管理とデータカタログ、データリネージ
- 第7章 参照データとマスターデータ、名寄せと正しい一件の管理
- 第8章 データセキュリティとプライバシー、個人情報保護法と社内ルール
- 第9章 データの保管・統合・提供、基盤運用とデータウェアハウス
- 第10章 ドキュメント・コンテンツ管理とデータ倫理
- 第11章 AIのためのデータ、AI Ready とAIガバナンスへの接続
- 第12章 現状診断と成熟度アセスメント
- 第13章 自社の体制づくり、最初の90日から1年の進め方
- 第14章 定着と組織変革、失敗の型と公開事例
- 参考情報
序章 データガバナンスは誰の仕事か
データ活用の会議で「この売上の数字と、あの資料の売上の数字が合わない」という話になったことがある組織は多いと思います。片方は受注日で集計し、もう片方は請求日で集計している。片方は返品を引いていて、もう片方は引いていない。どちらも計算は正しく、どちらも「売上」と呼ばれています。この状態で分析を高度にしても、議論は「どの数字を信じるか」に戻ります。問題は分析の技術ではなく、売上という言葉の定義を誰が決め、その定義をどこに書き、変えるときに誰が承認するかが決まっていないことにあります。本コラムの主題であるデータガバナンスとは、自社のデータについて「誰が何を決め、何を基準に、どう確かめるか」を定める仕組みのことです。
データガバナンスという言葉は、ルールで縛ること、情報システム部門の仕事、ツールを導入すれば済むこと、大企業だけに必要なこと、と受け取られることが多いように思います。本コラムでは、これらはいずれも誤解だと考えています。データガバナンスの中心は意思決定の仕組みであり、決める人は、通常は業務の責任者です。ツールは決めたことを実行しやすくする道具であって、決めること自体の代わりにはなりません。そして、売上の定義が2つある問題は、小さな会社でも起こりえます。
決める層と実行する層を分ける
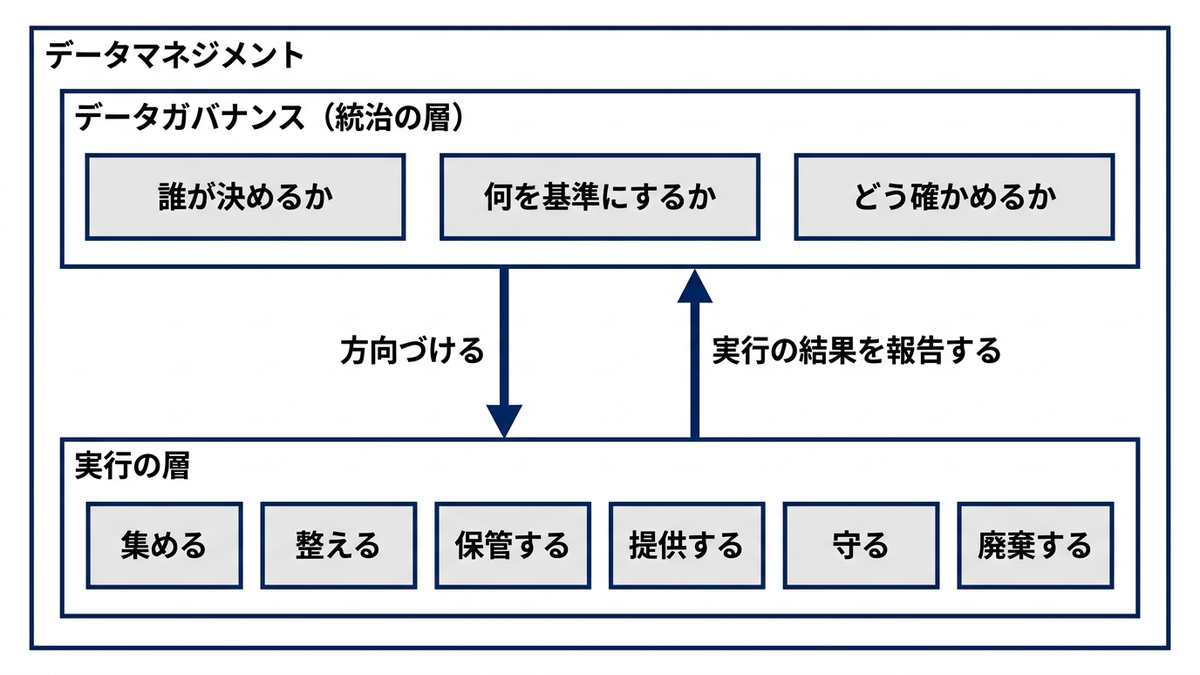
データに関する仕事の全体を、本コラムではデータマネジメントと呼び、その中を2つの層に分けて考えます。1つは、データを集め、整え、保管し、提供し、守り、廃棄する日々の活動で、本コラムではこれを実行の層と呼びます。もう1つは、その活動について「何を正とするか」「誰が責任を持つか」「どこまで許すか」を決め、守られているかを確かめる層で、これがデータガバナンスです。データガバナンスはデータマネジメントの外にあるのではなく、その一部として全体を方向づける層です。統治と管理(ここでいう管理は実行の層のことで、第1章で定義します)、と言い換えてもかまいません。この区別は、情報技術の統治に関する国際規格であるISO/IEC 38500の考え方をデータに適用したISO/IEC 38505-1(初版は2017年で、2026年8月に第2版が発行されています)でも、統治する側(取締役や経営者)の役割として、評価し、指示し、監視するという枠組みで示されています(第1章で扱います)。
この区別が無い状態では、次のようなことが起きます。情報システム部門がデータの品質を上げようとしても、どの値が正しいかは業務部門にしか分かりません。業務部門が「このデータを使いたい」と言っても、個人情報の扱いとして許されるかを判断する人が決まっていなければ、申請は止まります。分析チームが指標を定義しても、経営会議がその定義を採用すると決めなければ、資料ごとに別の数字が並び続けます。決める層が無いまま実行する層だけが頑張る状態は、努力に対して成果が出ない状態です。
データガバナンスが答える3つの問い
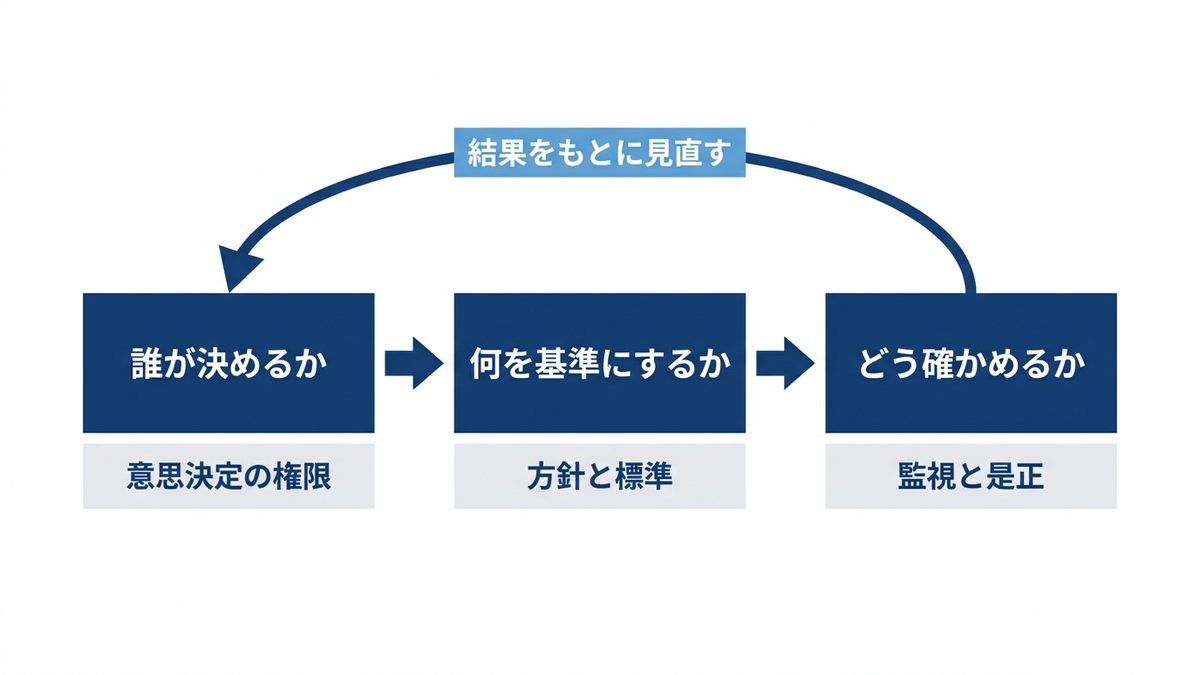
データガバナンスの仕組みは、次の3つの問いに答えられる状態を作ることだと整理できます。第1に、誰が決めるか。顧客データの定義、品質の基準、提供の可否、保存期間を、誰が決定し、誰が日々の運用を担い、誰が技術的に保護するかです。本コラムでは、決定する人をデータオーナー、日々の運用を担う人をデータスチュワード、技術的に保管し守る人をデータカストディアンと呼びます(定義は「全体の地図」の表にまとめています)。第2に、何を基準に決めるか。基本的な考え方(原則)、方針(ポリシー)、守るべき仕様(標準)、作業の手順の4層で文書化し、どこに何を書くかを決めます。第3に、どう確かめるか。品質の指標、定義済みの項目の割合、問い合わせの解決日数といった数字で、決めたことが守られているかを見ます。
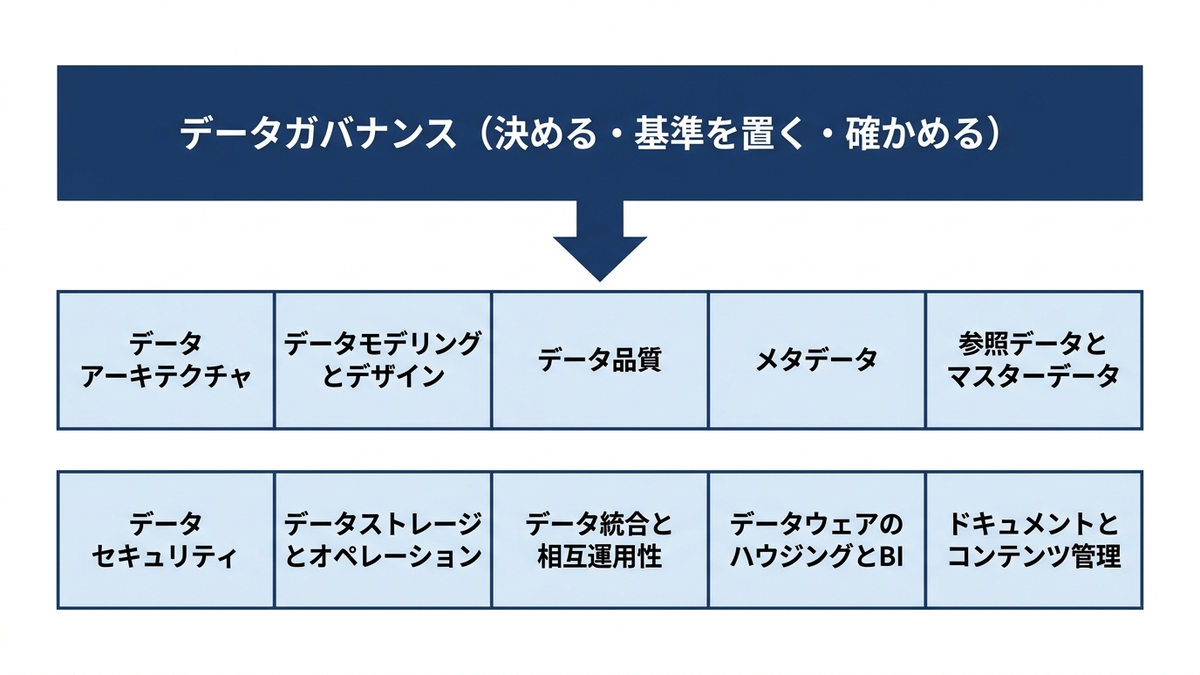
この3つの問いは、DMBOK(DAMA Internationalが刊行するデータマネジメント知識体系ガイド)が知識領域の中心に置くデータガバナンスの役割と重なります。DMBOKは、データガバナンスを中心に、データアーキテクチャ(全社のデータの配置と流れの設計)、データモデリング、データの保管と運用、セキュリティ、統合と相互運用性(システムどうしでデータをやり取りできること)、文書とコンテンツの管理、参照データとマスターデータ、データウェアハウスとBI(分析用にデータを集めて蓄積する仕組みと、集計した数字を経営や現場に見せる仕組み)、メタデータ、データ品質という10の領域を並べた、合わせて11の知識領域からなる知識体系です。本コラムは、この知識領域を見取り図として使いながら、各領域が自社の困りごとのどれに対応するのかを、自分の言葉で解説します。DMBOKそのものの成り立ちと版、知識領域の見取り図は第2章で扱います。
決めないことで出る損失の型
データガバナンスに着手しない、あるいは形だけ作って運用しないときの損失は、金額ではなく型で捉えると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。第1の型は判断の遅れです。数字の定義や品質の基準を決める人、データの提供の可否を承認する経路が決まっていないために、施策の判断が次の会議に持ち越されます。数字そのものが合っていても起こる遅れです。第2の型は二重投資です。部門ごとに似た顧客マスターや分析基盤を作り、それぞれに保守の費用がかかります。第3の型は集計の食い違いです。取引先の名寄せ(表記の揺れがある記録のうち、同じ取引先のものを確かめて1件にまとめること)ができていないために、同じ取引先の売上が複数の行に分散して重要度を見誤る、というように、集計そのものが誤った判断を導きます。第4の型は法令違反です。個人情報の利用目的や第三者提供の可否を判断する人が決まっていない組織では、現場の判断が法令と食い違っても気づきにくくなります。第5の型はAI投資の空振りです。学習データの来歴(どこから来て、どう加工されたかの履歴)、品質、権利、個人情報の扱いが確かめられていないデータでAIを作ると、精度以前に、そのAIを作るのに使ったデータの出所や扱いを社外に説明できず、利用や提供の判断が難しくなります。第6の型は現場の不信です。定義が人によって違い、数字が合わない経験が重なると、現場はデータよりも経験と勘を信じるようになり、整備したデータが使われなくなります。
これらの損失は、データマネジメントの各知識領域と、知識領域とは別に扱われるデータ倫理に、おおよそ対応しています。判断の遅れは、誰が決めるかというデータガバナンスそのものの欠落から起こり、集計の食い違いはメタデータ(用語の定義)とマスターデータの問題であることが多く、二重投資はデータアーキテクチャの問題、法令違反はセキュリティとプライバシーの問題、AI投資の空振りはデータ品質とデータ倫理と来歴の管理の問題として現れます。現場の不信は、これらが積み重なった結果として現れます。自社でどの損失が目立っているかを見れば、どの領域から着手するかの見当が付きます。全領域を一度に立ち上げる必要はなく、立ち上げるべきでもない、というのが本コラムの立場です。
体制づくりは、役割の任命から始める
本コラムを通じてお伝えしたいことが一つあります。データガバナンスの体制づくりで最初に決めるべきことは、ツールでもルールの文書でもなく、どのデータについて誰が決めるかという役割の任命であり、そのうえで対象を絞り、品質を測れる形にし、小さく運用を始めて続けることだということです。役割が決まれば、定義の食い違いは「決める人がいる」問題に変わります。対象を絞れば、最初の四半期で確かめる成果を具体的に決められます。品質を測れば、改善の効果を数字で確かめられます。運用を見直しながら続ければ、組織に定着させる足場ができます。ここでいう「最初」は、経営がデータガバナンスに取り組むと決め、対象の範囲を定めたあとの、ツールや文書より先に、という意味です。経営の意思決定と対象範囲の決め方は第13章で扱います。
本コラムは、次の5つの流れで進みます。
- 理解と用語の整理:データガバナンスとデータマネジメントの区別、DMBOKの知識領域の見取り図、役割の定義をそろえます(第1章から第3章)。
- 領域ごとの仕組み:データアーキテクチャ、データ品質、メタデータ、マスターデータ、セキュリティとプライバシー、保管と統合、文書と倫理の各領域で、何を決め、何を測るかを整えます(第4章から第10章)。
- AIへの接続:AIのためのデータ整備と、AIガバナンスとの関係を押さえます(第11章)。
- 現状診断:自社の成熟度を領域ごとに診断し、公的な指標と照らして着手する順序を決めます(第12章)。
- 体制づくりと定着:最初の90日から1年の計画を立て、失敗の型を避けながら続ける仕組みを作ります(第13章・第14章)。
経営判断に関わる方にとって、この点はデータ活用への投資の進め方に直結します。分析基盤やAIの導入に予算を付ける前に、そのデータの定義と、それを決める人(データオーナー)が決まっているか、品質が測られているか、個人情報の扱いが判断できる体制があるかを確かめる順序であれば、投資の前提を説明でき、導入後の成果も検証しやすくなります。反対に、基盤とツールを先に入れ、役割と定義を後回しにすると、基盤には何が入っているか誰も説明できないデータが溜まり、AIの出力の根拠を問われたときに、使ったデータの出所と扱いを示せません。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、データ活用の構想づくりから、データガバナンスの体制設計、データ品質やマスターデータの整備、AI活用に向けたデータ整備、意思決定への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。第1章から第3章で、データガバナンスとデータマネジメントの区別、DMBOKの成り立ちと知識領域の見取り図、役割と会議体とポリシーの設計という、体制の土台になる考え方を整理します。第4章から第10章では、知識領域(と、DMBOKが知識領域とは別に扱うデータ倫理)ごとに、何を決め、何を測り、何から着手するかを扱います。データアーキテクチャとデータモデリング、データ品質、メタデータとデータカタログ、参照データとマスターデータ、セキュリティとプライバシー、保管と統合と提供、文書とコンテンツの管理とデータ倫理の順です。第11章でAIのためのデータ整備とAIガバナンスへの接続を、第12章で自社の現状診断を、第13章で体制づくりの進め方を、第14章で定着と組織変革、失敗の型、公開された事例を扱います。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | データガバナンスとは何か、データマネジメントとの関係と用語の整理 | 統治と管理はどう違うのか。データガバナンスが無いと、どの型の損失が出るのか |
| 第2章 | DMBOKとは何か、知識体系の成り立ちと知識領域の見取り図 | DMBOKはどういう経緯で作られ、どの領域をどう並べているのか。自社の困りごとはどの領域の問題か |
| 第3章 | データガバナンスの仕組み、原則・ポリシー・役割・会議体 | 誰が何を決めるのか。方針・標準・手順をどう文書化し、会議体をどう回すのか |
| 第4章 | データアーキテクチャとデータモデリング、全社データの見取り図 | 全社のデータの配置と流れをどう描き、全社で揃える範囲と部門に任せる範囲をどう分けるか |
| 第5章 | データ品質、何を測りどう直すか | データ品質をどの特性で定義し、どう測り、どの順で改善するか |
| 第6章 | メタデータ管理とデータカタログ、データリネージ | 用語の定義をどう管理し、データがどこから来てどこへ行くかをどう追えるようにするか |
| 第7章 | 参照データとマスターデータ、名寄せと正しい一件の管理 | 顧客や取引先の「正しい一件」をどう決め、表記の揺れをどう寄せ、コード体系をどう管理するか |
| 第8章 | データセキュリティとプライバシー、個人情報保護法と社内ルール | データをどう分類し、誰にどこまで見せるか。個人情報保護法の要請を社内ルールにどう落とすか |
| 第9章 | データの保管・統合・提供、基盤運用とデータウェアハウス | データをどう保管し、どう統合し、どう提供するか。指標の定義をどう一元化するか |
| 第10章 | ドキュメント・コンテンツ管理とデータ倫理 | 文書などの非構造データをどう管理するか。法令遵守と倫理はどう違うのか |
| 第11章 | AIのためのデータ、AI Ready とAIガバナンスへの接続 | AIに使えるデータの条件は何か。データガバナンスはAIガバナンスとどうつながるのか |
| 第12章 | 現状診断と成熟度アセスメント | 自社の成熟度を領域ごとにどう診断し、公的な指標をどう使い、どこから上げるかをどう決めるか |
| 第13章 | 自社の体制づくり、最初の90日から1年の進め方 | 何をどの順で立ち上げ、誰を任命し、経営にどう報告するか。小さな組織ではどう縮小するか |
| 第14章 | 定着と組織変革、失敗の型と公開事例 | 取り組みをどう定着させ、どの失敗を避けるか。公開された事例から何が分かるか |
本コラムで使う言葉
各章で共通して使う言葉を、先に定義しておきます。詳しい説明は、初めて使う章で行います。これらは本コラムでの用語の使い方であり、組織によって呼び名や役割の切り方は異なります。
| 言葉 | 本コラムでの意味 |
|---|---|
| データガバナンス | データについて「誰が何を決め、何を基準に、どう確かめるか」を定める仕組み。意思決定の層。本コラムでは「統治」と言い換えることがあります。DMBOKでは知識領域の1つとして扱われますが、本コラムでは、データマネジメントの活動全体のうち「決める」部分を担う層として、実行の層(ほかの領域)と分けて扱います。全体の外にあるのではなく、全体の一部でありながら全体を方向づける部分です |
| データマネジメント | データを集め、整え、保管し、提供し、守り、廃棄する活動と、それについて決める活動の全体。本コラムでは、このうち「決める」部分をデータガバナンス、「実行する」部分を実行の層と呼び分けます |
| DMBOK | DAMA Internationalが刊行するデータマネジメント知識体系ガイド(DAMA-DMBOK)の略称。本コラムは、その本文や図を引用せず、構造と考え方を自分の言葉で解説しています(第2章) |
| 知識領域 | DMBOKがデータマネジメントの活動を分けて整理している単位。本コラムでは、中心のデータガバナンスと周囲の10の領域、合わせて11の知識領域という見取り図で扱います |
| データオーナー | そのデータの定義・用途・品質の水準・提供の可否について決定する責任を持つ人。通常は業務部門の責任者です。本コラムで「データの持ち主」と言うときは、この社内の意思決定の責任者を指し、法的な所有者の意味ではありません。利用や提供は、法令や社内の方針に従います |
| データスチュワード | データオーナーの決定を日々の運用に落とし、定義の維持・品質の監視・問い合わせへの対応を担う人。通常は業務側の実務者です |
| データカストディアン | データを技術的に保管し、処理し、保護する責任を持つ人。通常は情報システム部門です |
| CDO(最高データ責任者) | 全社のデータに関する方針と体制の責任者。専任の役職として置く組織もあれば、既存の役員が兼ねる組織もあります |
| 経営スポンサー | データガバナンスの取り組みに経営として責任を持ち、予算と人の裏付けを与える役員。CDOを置いている組織ではCDOが務めます(第13章) |
| データガバナンス委員会 | 部門をまたぐデータの決定(標準の承認、部門をまたぐ定義の決定、全社に影響する例外の承認)を行い、原則とポリシーの案を審議してCDOに上申する会議体。CDOが委員長を務め、主要部門のデータオーナー、情報システム部門の責任者、事務局で構成します(第3章) |
| 事務局 | データガバナンス委員会の運営、課題の管理、文書の維持を担う担当。立ち上げ期は兼務で置くことが多い役割です(第3章) |
| 原則・ポリシー・標準・手順 | 原則はデータの扱いについての基本的な考え方(たとえば「データの定義には業務部門が責任を持つ」)、ポリシーは方針(なぜ、何を)、標準は守るべき仕様(どの形式、どの値)、手順は具体的な作業(どうやって)。この4層で文書を分けます(第3章) |
| 来歴 | データがどこから来て、どう加工されてきたかの履歴。データリネージとほぼ同じ意味で、学習データや分析結果の根拠を示すときに使います |
| AI Ready | データが、AIの特定の用途に使える状態にあること。何をもって使える状態とするかは、第11章で本コラムの定義として示します |
| メタデータ | データについてのデータ。データを理解して使うための説明情報で、項目の定義、出所、形式、持ち主(データオーナー)、更新頻度などです |
| データカタログ | メタデータを集めて検索できるようにした目録 |
| データリネージ | データがどこから来て、どう加工され、どこへ行ったかの経路 |
| マスターデータ | 顧客・商品・取引先・従業員のように、複数の業務で共通に参照する「主体」のデータ |
| 参照データ | コード表・分類・区分のように、取りうる値の集合を定義するデータ |
| データ品質 | データが用途に適している度合い。完全性・正確性・一貫性・一意性・有効性・適時性などの観点で測ります(第5章) |
| データ倫理 | 法令を守ることとは別に、データの使い方が公正で、説明できるものかを判断すること。DMBOKでは知識領域ではなく独立した主題として扱われます。本コラムでは第10章で文書の管理と併せて扱います |
| 成熟度 | ある領域の取り組みがどの段階にあるかの度合い。本コラムでは「未着手・個別対応・定義済み・運用中・改善継続」の5段階の言い方を使います(第12章) |
本コラムの章の流れは、理解と用語の整理(第1章から第3章)、領域ごとの仕組み(第4章から第10章)、AIへの接続(第11章)、現状診断(第12章)、体制づくりと定着(第13章・第14章)の順に進みます。自社で着手するときの順序としては、第12章の簡易な診断で着手する領域を選び、第13章の手順でその領域のデータについて役割を任命する、という流れを想定しています。序章で述べた「役割の任命から始める」は、この選んだ領域についての任命を指します。第12章の診断の結果を、第4章から第10章のどの領域を先に読むかの判断に使う、という読み方も想定しています。
第1章 データガバナンスとは何か、データマネジメントとの関係と用語の整理
この章では、本コラム全体で使う言葉の意味を固めます。データガバナンスという言葉は、ルール集を指して使われることもあれば、データ基盤の運用やセキュリティ対策を指して使われることもあり、同じ社内でも人によって指している範囲が違うことがよくあります。範囲がずれたまま「データガバナンスを始めよう」と決めると、ある人は規程の作成を、ある人はツールの導入を、ある人は個人情報の点検を思い浮かべ、最初の打ち合わせから話がかみ合いません。そこで最初に、データについて「決める」仕事と「実行する」仕事を分け、それぞれを何と呼ぶかを定義します。そのうえで、国際規格が統治をどう位置づけているか、「データは資産」という言い方をどこまで真に受けてよいか、データガバナンスが答えるべき問いは何か、よくある誤解は何か、統治が欠けると経営上どんな損失が出るかを順に説明し、最後に、経営として最初に決めることを1つに絞って示します。
この章で扱うのは考え方と言葉の整理です。DMBOK という知識体系の成り立ちと知識領域の見取り図は第2章で、データオーナーやデータスチュワードといった役割の責任分担と会議体の詳細は第3章で扱います。
統治(決める)と管理(実行する)を分ける
本コラムでは、データを集め・整え・保管し・提供し・守り・廃棄する活動と、それについて決める活動の全体をデータマネジメントと呼びます。そのうえで、この全体を2つの層に分けて考えます。1つ目は、データについて「誰が何を決め、何を基準に、どう確かめるか」を定める層で、これをデータガバナンスと呼びます。意思決定の層で、本コラムでは「統治」と言い換えることがあります。2つ目は、決まったことに沿ってデータを集め・整え・保管し・提供し・守り・廃棄する日々の活動で、これを実行の層と呼びます。本コラムで「管理」と書くときは、この実行の層を指します。この定義は、本コラムのすべての章で同じ意味に固定して使います。
「2つの層に分ける」ことと「データガバナンスはデータマネジメントの一部である」ことは、矛盾しません。会社の経営にたとえると、取締役会の決定も現場の業務も、どちらも会社の活動の一部ですが、決める仕事と実行する仕事は分けて考えます。データについても同じで、データガバナンスはデータマネジメントの外に置かれた別の仕組みではなく、活動全体のうち「決める」部分を担う層であり、全体の一部でありながら、全体がどちらへ進むかを方向づけます。第2章で扱う DMBOK では、データガバナンスはデータマネジメントの知識領域の1つとして扱われています。本コラムはその位置づけを変えるものではなく、知識領域の1つであるデータガバナンスを、ほかの領域の活動を方向づける「決める層」として読む、という整理をしています。
2つを分ける理由は、決める仕事と実行する仕事では、求められる役割と責任が違うからです。同じ人が両方を兼ねる場合も、この区別は要ります(兼務の扱いはこの節の終わりで述べます)。たとえば「顧客」という言葉の定義を考えます。営業部門にとっての顧客は取引のある法人で、通販部門にとっての顧客は会員登録をした個人で、経理にとっての顧客は請求書の送り先かもしれません。どの定義を全社の報告に使うかは、統計の手法やデータベースの設計では決まらず、事業の判断として誰かが決める必要があります。一方で、決まった定義に沿って顧客の台帳を整え、重複を取り除き、毎月の集計に反映させるのは、情報システム部門や業務の実務者の仕事です。前者が統治で、後者が管理です。決める仕事が無いまま実行する仕事だけが進むと、現場は「どれが正しい定義か」を自分で判断するしかなくなり、部門ごとに別の定義が生まれます。逆に、決める仕事だけがあって実行する仕事が無いと、立派な規程が文書のまま置かれ、データの中身は何も変わりません。
次の表は、2つの層の違いを、仕事の性質ごとに並べたものです。
| 観点 | データガバナンス(決める層) | 実行の層 |
|---|---|---|
| 主な問い | 誰が決めるか。何を基準にするか。どう確かめるか | 決まったことを、どのような手順と仕組みで実現するか |
| 主な成果物 | 基本的な考え方(原則)、方針(ポリシー)、守るべき仕様(標準)、役割と権限の一覧、判断の記録 | 手順書、データの台帳と定義の目録、品質の測定結果、システムの設定、運用の記録 |
| 担い手の例 | 経営層、データの持ち主である業務部門の責任者、統治のための会議体 | 業務部門の実務者、情報システム部門、データ分析の担当 |
| 時間の単位 | 方針の見直しは四半期・年度などの定期。個別の定義の変更や例外の承認は、案件が生じるたびに扱う | 日次・週次・月次(取り込み、点検、問い合わせ対応) |
| 欠けたときに起きること | 部門ごとに定義が分かれ、数字が合わない。誰に聞けばよいか分からない | 決めた方針が現場で守られず、データの中身が変わらない |
表の「主な成果物」の行に挙げたもののうち、原則・ポリシー・標準・手順書の4種類の文書は、本コラムでは次の意味で使い、この4層で文書を分けます。原則はデータの扱いについての基本的な考え方で、たとえば「データの定義には業務部門が責任を持つ」のように書きます。ポリシーは方針で、なぜそれをするのか、何を守るのかを書きます。標準は守るべき仕様で、どの形式を使うか、どの値を許すかを書きます。手順は具体的な作業で、どうやってそれを行うかを書きます。統治の層が責任を持つのは原則・ポリシー・標準の決定です。手順は実行の層が作り、承認するのも実行の層(担当のデータスチュワードと情報システム部門)です。統治の層は、手順が標準に沿っているかを確かめる側に回ります。4層の文書に何を書き、誰がどの頻度で見直すかは第3章で扱います。
2つの層を分けるといっても、別々の組織を作るという意味ではありません。小さな組織では、同じ人が午前中は統治の立場で定義を決め、午後は管理の立場でその定義に沿って台帳を直す、ということが起こりえます。大事なのは、いまどちらの立場で仕事をしているかを本人と周囲が区別できることです。定義を変えるのは統治の仕事なので、管理の立場の人が作業の都合で黙って変えてはいけない、という線が引けていれば、兼務していても混乱は小さく済みます。
国際規格は統治をどう位置づけているか
統治と管理を分ける考え方は、本コラムが独自に作ったものではありません。国際標準化機構(ISO)と国際電気標準会議(IEC)が共同で作成したISO/IEC 38505-1は、組織の統治機関がデータの利用を統治するための原則・定義・モデルを示す国際規格です。統治機関とは、規格の説明では所有者・取締役・パートナー・経営幹部などから成る、組織を統治する立場の人々を指します。つまりこの規格は、データを扱う技術者向けの手順書ではなく、経営の側に向けた指針として書かれています。
この規格には版の経緯があります。ISO の目録の初版のページによると、初版は2017年4月に発行され(20ページ)、2022年の定期見直しで内容が確認されたあと、2023年に改訂することが決まりました。2026年8月に第2版が発行され、初版は2026年8月20日付で目録上の状態が「廃止」になっています。本コラムの基準時点(2026年10月)で現行なのは第2版で、目録では第2版のページが初版の改訂版として示されています。ISO のページは2026年10月22日の時点で自動の閲覧を受け付けなかったため、初版のページはウェブアーカイブ(Wayback Machine)の2026年9月17日の保存版で確かめました。第2版の中身は、規格の冒頭部分(表紙・目次・前書き・序文・適用範囲)を公開している第2版のプレビュー(チェコの規格販売サイトが置いている IEC のプレビュー。2026年10月22日に確認)で確かめた範囲だけを書きます。初版の概要は、ISO/IEC 38500 という IT の統治の規格の原則とモデルをデータの統治に当てはめること、統治機関がデータの利用と保護を判断するための指針を示すこと、データの統治にかかわる用語を定めること、を目的として挙げていました。第2版の前書きは、主な変更点を ISO/IEC 38500 の2024年版(第3版。2024年2月発行)に整合させたことだとしています。
第2版の序文と適用範囲を読むと、本コラムの2層の区別と重なる記述が3つあります。1つ目は、統治は管理とは別のもので、データを保管したり取り出したり管理したりする仕組みではなく、データの利用を評価し、指示し、監視することにかかわる、という整理です。2つ目は、データの統治を IT の統治の一部とし、IT の統治を組織の統治(会社であれば企業統治)の一部とする位置づけです。データの統治は、経営の統治から切り離された技術の話ではなく、経営の統治の中の1つの領域として扱われています。3つ目は、規格がすべての組織に適用でき、規模の大小や、どれだけデータに依存しているかを問わない、としている点です。この3つ目は、本章の後半で扱う「小さな会社でも要るか」という問いにかかわります。
第2版の目次からは、規格の骨組みも読み取れます。統治の原則を示す章、統治のモデルを示す章、データの説明責任を扱う章、データに固有の側面を扱う章があります。モデルの章には、利害関係者の関与、評価(Evaluate)、指示(Direct)、監視(Monitor)の節が並びます。各節の本文は有料の規格本体にあり、本コラムでは公開されている目次と序文の範囲で紹介しています。そのため、3つの語の中身を規格の言葉で説明することはせず、本コラムでは、評価を「現状と選択肢を基準に照らして見極めること」、指示を「方針を定めて責任を割り当てること」、監視を「指示したとおりに進んでいるかを確かめること」という意味で使います。データの説明責任の章には、収集・保管・報告・意思決定・配布・廃棄の節が並び、データの一生のそれぞれの段階で統治機関が責任を持つという組み立てになっています。データ固有の側面の章は、価値(品質・適時性・文脈・量)、リスク(管理・データの分類・セキュリティ)、制約(規制と法令・社会・組織の方針)の3つに分かれています。原則の章があることは目次で確かめられますが、原則の個々の名称は公開されている範囲では確かめられなかったため、本コラムでは「原則が示されている」とだけ書きます。
この規格の読み方として、2点を押さえておくとよいと考えています。1点目は、この規格が「何をすべきか」を細かく定める要求事項の規格ではなく、統治機関に向けた助言の性格を持つことです。第2版の序文は、自らを、細かな実装の方法ではなく大枠を示す、原則に基づく助言的な文書と説明し、統治を支えるために他の適切な規格を使うことを勧めています。データ品質の特性や情報セキュリティのような個別の領域は、それぞれ別の規格や指針で扱われます(データ品質の規格は第5章、情報セキュリティの規格は第8章で扱います)。2点目は、評価・指示・監視という3つの動詞が、本コラムでいう「誰が決めるか・何を基準にするか・どう確かめるか」と対応していることです。指示は決めることに、評価は基準を持って見極めることに、監視は確かめることに当たります。規格の言葉と本コラムの言葉は一対一に重なるわけではありませんが、統治を「方向を決めて確かめる仕事」として捉える点では同じ方向を向いています。
この節から言えるのは、少なくとも国際規格では統治と管理が区別されている、ということです。本コラムの2層の整理は、この区別に沿ったものです。
「データは資産」という言い方の意味と限界
データガバナンスの説明では、「データは企業の資産である」という言い方がよく使われます。この言い方には役に立つ面と、誤解を招く面があります。役に立つのは、データを「業務の副産物としてたまっていくもの」ではなく、「持ち主がいて、手入れをすれば価値を生み、放置すれば劣化し、失えば損害が出るもの」として扱う姿勢を表している点です。工場の設備や建物に管理の責任者がいて、点検の周期が決まっているのと同じように、データにも責任者と点検の仕組みが要る、という主張を短く伝える言葉として使えます。
一方で、この言い方をそのまま受け取ると、2つの誤解が生じます。1つ目は、会計上の資産と混同することです。本コラムでいう「資産」は、帳簿に載る金額の話ではなく、管理の責任を負う対象であり、価値の源泉である、という意味の比喩です。データの価値は、それを使う業務や意思決定があって初めて生まれ、同じデータでも使い道が無ければ価値は出ません。2つ目は、「資産だから多く持つほどよい」と考えることです。設備と違って、データは複製が容易で、保管し続けるほど漏えいや目的外利用の危険が増え、古くなった記録が新しい記録と混ざって判断を誤らせることもあります。個人情報のように、法令で取扱いの制限があるデータもあります(個人情報保護法の扱いは第8章で扱います)。持つこと自体ではなく、目的に合った形で持ち、使い終わったら手放すことまで含めて管理するのが、資産として扱うという言葉の実質だと考えています。
前節の ISO/IEC 38505-1 の第2版が、データに固有の側面を「価値」だけでなく「リスク」と「制約」に分けて示し、データの説明責任の最後の段階に廃棄を置いていることは、この見方と合っています。価値を引き出すことと、リスクを抑え制約を守ることを、同じ統治の仕組みの中で扱う、という考え方です。経営の側から見ると、「データは資産」という言葉を掲げるなら、それに続けて「では、どの資産の持ち主は誰で、どの水準で手入れをし、いつ手放すのかを決めたか」を問うことが要ります。言葉だけを掲げて持ち主を決めないと、資産と呼ばれながら誰も責任を負わないデータが増えていきます。
データガバナンスが答える3つの問い
データガバナンスの定義に含めた「誰が決めるか・何を基準にするか・どう確かめるか」の3つの問いは、どの領域のどの課題にも当てはめることができます。統治の仕組みが働いているかどうかは、この3つに具体的な答えがあるかどうかで点検できます。
1つ目の「誰が決めるか」は、意思決定の権限の問いです。ある指標の定義を変える、あるデータを社外に提供する、ある品質の不備を許容して業務を続ける、といった判断を、誰が下し、誰が承認するのかを決めます。この問いに答えが無いと、判断が必要になるたびに関係者を探して合意を取り直すことになり、判断が遅れます。本コラムの定義では、データの定義・用途・品質の水準・提供の可否を決める責任を持つ人をデータオーナー(通常は業務部門の責任者)と呼びます。本コラムで「データの持ち主」と書くときは、このデータオーナーを指します。社内で意思決定の責任を負う人という意味で、法的な所有者という意味ではなく、データの利用や提供は法令や社内の方針に従います。
2つ目の「何を基準にするか」は、判断の拠り所の問いです。決める人がいても、その人が毎回その場の感覚で判断すると、同じ種類の判断が人や時期によって変わります。方針(ポリシー)と守るべき仕様(標準)を文書にしておくと、判断のたびに議論をやり直さずに済み、例外を認めるときも「どの基準からの例外か」を記録できます。データ品質の水準や、データの機密の区分も、この問いの答えに当たります。
3つ目の「どう確かめるか」は、監視と是正の問いです。決めたことが守られているか、決めた水準にデータが達しているかを、誰がどの頻度で何を見て確かめるのかを決めます。この問いに答えが無いと、方針や標準は作った時点で止まり、守られていないことに誰も気づきません。本コラムの定義では、データオーナーの決定を日々の運用に落とし、定義の維持・品質の監視・問い合わせ対応を担う人をデータスチュワード(通常は業務側の実務者)と呼び、データを技術的に保管・処理・保護する責任を持つ人をデータカストディアン(通常は情報システム部門)と呼びます。確かめる仕事は、主にこの2つの役割と、統治の会議体の間で分担されます。
3つの問いは、順番に意味があります。誰が決めるかが決まらないうちに基準を作ると、基準を承認する人がいないので、誰の基準なのかがあいまいになります。基準が無いうちに確かめようとすると、何と比べて良し悪しを判断するのかが決まりません。統治の仕組みを作るときは、まず決める人を置き、その人が基準を承認し、基準に沿って確かめる仕組みを作る、という順に進めるのが手戻りの少ない進め方だと考えています。次の表は、3つの問いを、よくある課題に当てはめた例です。
| 課題の例 | 誰が決めるか | 何を基準にするか | どう確かめるか |
|---|---|---|---|
| 部門ごとに「売上」の数字が違う | 売上の定義の持ち主(たとえば経理の責任者)を決め、定義の変更は持ち主が承認する | 売上の定義書(計上の時点、返品と値引きの扱い、税の扱い) | 月次の報告で、各部門の数字と定義書に沿った数字の差を確かめる |
| 顧客の台帳に同じ顧客が重複している | 顧客データの持ち主(たとえば営業の責任者)を決める | 顧客を1件と数える条件と、登録時に入力する項目の標準 | 重複の件数を定期的に数え、増えたら登録の手順を見直す |
| 取引先から顧客データの提供を求められた | 提供の可否を判断する人と、承認の経路を決める | データの機密の区分と、提供してよい条件の方針 | 提供の記録を残し、条件どおりに扱われているかを定期的に点検する |
| 生成AIに社内の文書を読ませたい | どの文書を使ってよいかを決める人を決める | 文書の機密の区分、鮮度、アクセス権の扱いの方針 | 使っている文書の一覧と権限を定期的に棚卸しする |
表の最後の行のように、新しい技術を使うときにも、3つの問いの形は変わりません。生成AIのためのデータの扱いは第11章で、データの機密の区分とアクセス制御は第8章で扱います。
本コラムで使う用語の整理
ここまでに出てきた用語を含め、本コラムで意味を固定して使う用語を表にまとめます。データガバナンスの分野では、同じ言葉が書籍や製品によって少しずつ違う意味で使われることがあります。本コラムの中では、どの章でもこの表の意味で使います。役割の名前は、ここでは定義を示すだけにとどめ、誰に何を任せるか、兼務をどう扱うかは第3章で、最初の任命の進め方は第13章で扱います。
| 用語 | 本コラムでの意味 | 主に扱う章 |
|---|---|---|
| データガバナンス | データについて「誰が何を決め、何を基準に、どう確かめるか」を定める仕組み。意思決定の層。「統治」と言い換えることがある。データマネジメントの活動全体のうち「決める」部分を担う層で、全体の外ではなく、全体の一部でありながら全体を方向づける。DMBOK では知識領域の1つとして扱われる | 本章・第3章 |
| データマネジメント | データを集め・整え・保管し・提供し・守り・廃棄する活動と、それについて決める活動の全体。このうち「決める」部分をデータガバナンス、「実行する」部分を実行の層と呼び分ける | 本章・第2章 |
| データオーナー | そのデータの定義・用途・品質の水準・提供の可否について決定する責任を持つ人。通常は業務部門の責任者 | 第3章 |
| データスチュワード | データオーナーの決定を日々の運用に落とし、定義の維持・品質の監視・問い合わせ対応を担う人。通常は業務側の実務者 | 第3章 |
| データカストディアン | データを技術的に保管・処理・保護する責任を持つ人。通常は情報システム部門 | 第3章 |
| CDO(最高データ責任者) | 全社のデータに関する方針と体制の責任者。専任の役職として置く組織もあれば、既存の役員が兼ねる組織もある | 第3章 |
| 原則・ポリシー・標準・手順 | 原則はデータの扱いについての基本的な考え方(たとえば「データの定義には業務部門が責任を持つ」)、ポリシーは方針(なぜ・何を)、標準は守るべき仕様(どの形式・どの値)、手順は具体的な作業(どうやって)。この4層で文書を分ける | 第3章 |
| 来歴 | データがどこから来て、どう加工されてきたかの履歴。データリネージとほぼ同じ意味で、学習データや分析結果の根拠を示すときに使う | 第6章・第11章 |
| AI Ready | データが、AI の特定の用途に使える状態にあること。何をもって使える状態とするかは、第11章で本コラムの定義として示す | 第11章 |
| メタデータ | データについてのデータ。定義・出所・形式・持ち主・更新頻度など | 第6章 |
| データカタログ | メタデータを集めて検索できるようにした目録 | 第6章 |
| データリネージ | データがどこから来てどう加工されどこへ行ったかの経路 | 第6章 |
| マスターデータ | 顧客・商品・取引先・従業員のように、複数の業務で共通に参照する「主体」のデータ | 第7章 |
| 参照データ | コード表・分類・区分のように、取りうる値の集合を定義するデータ | 第7章 |
| データ品質 | データが用途に適している度合い。完全性・正確性・一貫性・一意性・有効性・適時性などの特性で測る。たとえば完全性は必要な項目が欠けていないか、一意性は同じものが重複して登録されていないか、適時性は用途に必要な時点で十分に新しい値になっているか、を見る | 第5章 |
| 成熟度 | ある領域の取り組みがどの段階にあるかの度合い。本コラムでは「未着手・個別対応・定義済み・運用中・改善継続」の5段階の言い方を使う | 第12章 |
この表は、本コラムの冒頭の「全体の地図」に置いた用語の表と同じ意味で書いています。表の用語のうち、役割を表す4つ(データオーナー・データスチュワード・データカストディアン・CDO)は、職位の名前ではなく責任の名前です。会社の組織図に「データスチュワード」という職位が無くても、ある業務の実務者が顧客データの定義の維持と問い合わせ対応を担っていれば、その人は本コラムの意味でのデータスチュワードの役割を果たしています。統治の仕組みを作るときに最初にすべきことは、新しい職位を作ることではなく、すでに誰かが果たしている、あるいは誰も果たしていない責任を、この表の言葉で書き出して名前を付けることだと考えています。
もう1つ、「データ品質」と「成熟度」の2つは、測る対象が違う点に注意が要ります。データ品質はデータそのものの状態(ある項目の欠損が何割あるか、重複が何件あるか)を測り、成熟度は取り組みの状態(定義を決める仕組みがあるか、それが運用されているか)を測ります。データ品質の数字が良くても、それを確かめる仕組みが無ければ、来月も良いとは限りません。逆に、成熟度の診断で「定義済み」と判定されても、データそのものが改善しているとは限りません。経営報告では両方を並べて見ることが有効だと考えています。
よくある誤解
データガバナンスを始めようとするときには、言葉の印象から生まれる誤解がいくつかあります。誤解のまま進めると、最初の設計で方向を誤り、後から作り直すことになりやすいので、代表的なものを表にまとめました。
| 誤解 | 実際にはどうか | 誤解のまま進めたときに起きやすいこと |
|---|---|---|
| データガバナンスはルールでデータの利用を縛ること | 統治の目的は、データを安心して使える状態を作ることで、禁止は手段の1つにすぎない。誰に聞けば使ってよいかが分かることも統治の成果である | 規程が増えるほど現場が申請を避け、管理されないデータの写しが個人の手元に増える |
| データガバナンスは情報システム部門の仕事 | 定義・用途・品質の水準・提供の可否を決めるのは業務の判断で、業務部門の責任者が持ち主になる。情報システム部門は技術的な保管・処理・保護を担う | 情報システム部門が業務の定義を決められずに止まる。あるいは業務の実態に合わない定義を技術の都合で決めてしまう |
| ツールを導入すれば完了する | データカタログや品質の点検の道具は、決めたことを実行し確かめるための手段で、誰が決めるかは道具では決まらない | 道具に登録された定義が空欄のまま、あるいは持ち主の欄が空のまま使われなくなる |
| 大企業だけのもの | 規模に応じて仕組みの重さは変わるが、「誰が決めるか」が要ることは規模を問わない。ISO/IEC 38505-1 も規模を問わず適用できるとしている | 小さいうちは担当者の記憶で回るが、担当者の異動や事業の拡大で一度に崩れる |
| 一度作れば終わる | 事業・システム・法令が変わるたびに、定義と基準の見直しが要る。統治は続ける活動である | 作った時点の規程が古くなり、現場の実態と合わなくなって守られなくなる |
1つ目の誤解は、ガバナンスという言葉が「統制」や「規制」を連想させることから生まれやすいと思われます。統治の仕組みが働いている組織では、たとえば新しい分析のために顧客データを使いたいと考えた人が、誰に相談すればよいか、どの条件なら使ってよいかを短い時間で知ることができます。統治が無い組織では、相談先が分からないので、担当者は使うのをあきらめるか、相談せずに使うかのどちらかになります。前者はデータの価値を取り逃がし、後者は管理の外にデータが流れ出します。統治の仕組みを設計するときは、禁止の項目を並べる前に、判断の窓口と承認の経路を決めておくことが有効だと考えています。
2つ目の誤解は、データが情報システムの中にあることから生まれます。データの置き場所を決め、権限を設定し、障害から守るのは情報システム部門の仕事ですが、「この項目は何を意味するか」「この品質で業務を続けてよいか」は、業務を知っている人にしか判断できません。情報システム部門に統治の全体を任せると、判断を求められるたびに業務部門へ確認に回ることになり、それなら最初から業務部門の責任者を持ち主にしておくほうが判断が速くなります。本コラムの役割の定義で、データオーナーを「通常は業務部門の責任者」、データカストディアンを「通常は情報システム部門」としているのはこのためです。
3つ目の誤解は、ツールの導入が予算と日程の形で示しやすいことから起きやすいと思われます。導入の計画は立てやすく、完了したかどうかも分かりやすいのに対して、誰が決めるかを決める仕事は形に表れにくいからです。ツールは、決めたことを多くの人に届け、確かめる手間を減らす点で役に立ちますが、決めるべき中身が無いところにツールを入れても、空の目録ができるだけです。データカタログについては第6章で、ツールから入ることの失敗の型は第14章で扱います。
統治が欠けたときの経営上の損失の型
データガバナンスへの投資を経営として判断するには、統治が欠けたときにどのような損失が出るかを、型として把握しておくことが役に立ちます。損失は金額では書きにくいものが多いので、ここでは型と、その型が表れる場面を示します。次の6つの型は、外部の規格や知識体系の分類ではなく、本コラム独自の整理です。本コラムのすべての章で、この6つの名前で呼びます。自社で同じ型が起きていないかを点検する材料として使えます。
| 損失の型 | 表れる場面の例 | 統治のどの問いが欠けているか |
|---|---|---|
| 判断の遅れ | 判断を下す人や承認の経路が決まっておらず、施策の判断が次回の会議に持ち越される。データの提供の可否を決める人がいないため、取引先への回答が遅れる | 誰が決めるか |
| 二重投資 | 部門ごとに似た分析の基盤や顧客の台帳を作り、同じデータを別々に整える費用がかかる | 誰が決めるか(全社で揃える範囲を決める人がいない) |
| 集計の食い違い | 部門ごとに売上・顧客数・解約率の定義が違い、同じ会議に別々の数字が並ぶ | 何を基準にするか |
| 法令違反 | 本人の同意を得ず、法令上の例外にも当たらないまま、特定した利用目的の達成に必要な範囲を超えて個人情報を取り扱ってしまう。どこに何のデータがあるかを把握する体制など、必要な安全管理の措置を講じておらず、その結果として漏えいに気づくのも遅れる | 何を基準にするか・どう確かめるか |
| AI投資の空振り | AI の導入を決めたあとで、学習や参照に使うデータの定義・品質・権利が整っていないことが分かり、準備に想定外の時間がかかる | 3つの問いのすべて |
| 現場の不信 | 報告の数字が何度も訂正され、現場が報告を信用せずに自分で集計し直すようになる | どう確かめるか |
判断の遅れと集計の食い違いは、同じ会議で同時に起きることがありますが、本コラムでは原因で分けています。判断の遅れは「決める人や承認の経路が無い」ことから起き、数字が合っていても起こります。集計の食い違いは「定義の基準が1つでない」ことから起き、決める人がいても起こります。
これらの損失の型には、表に出にくいという共通点があると考えています。判断の遅れや集計の食い違いは、毎回の会議で少しずつ時間を失う形で表れるので、1回ごとには目立ちにくくなります。二重投資は、部門ごとの予算の中に分かれて計上される場合、全社で合計して初めて見えます。法令違反とAI投資の空振りは、問題が表に出た時点ではすでに手戻りが大きくなっていることが多いように思います。統治の仕組みの価値は、こうした損失が「起きなかったこと」として表れることが多いので、投資の効果を示しにくい面があります。そのため、統治を始めるときには、まず自社で起きている損失の型を、表の「表れる場面の例」の形で具体的に書き出し、それが減ったかどうかを確かめられる形にしておくことが有効だと考えています。統治の成果をどの指標で測るかは第3章で、経営への報告の形は第13章で扱います。
個人情報の扱いにかかわる法令の具体的な義務は第8章で、AI のためのデータの整え方は第11章で扱います。ここで押さえておきたいのは、表に挙げた例では、データの定義・持ち主・確かめる仕組みという統治の基本的な部品の不足が、損失につながる要因になっているという点です。個人情報の点検や AI の準備を個別の案件として始める前に、その土台となる統治の部品がそろっているかを確かめることが、手戻りを減らす近道だと考えています。
小さな会社でも要る理由
データガバナンスは、専任の部署や委員会を置ける大きな組織のものと思われがちです。しかし、統治の中身を「誰が決めるか・何を基準にするか・どう確かめるか」の3つの問いとして捉えると、規模によって変わるのは仕組みの重さであって、問いそのものは変わりません。前に紹介したとおり、ISO/IEC 38505-1 の第2版も、規模の大小やデータへの依存の度合いを問わず適用できるとしています。
小さな会社にもデータの統治が要る理由は、3つあると考えています。1つ目は、小さな会社では特定の担当者に依存しやすいと考えられることです。担当者の数が少なければ、1つの業務を1人が受け持つ場面が増えるからです。顧客の台帳の項目の意味や、売上の集計のしかたが1人の担当者の記憶の中にしかないと、その人が休んだり辞めたりしたときに、前月の数字を再現できなくなります。定義を書き出し、持ち主を決めておくことは、この依存を減らす最も手軽な方法です。2つ目は、小さな会社でも扱うデータの種類が増えていることです。会計・販売・顧客管理・勤怠などの業務ごとに別のクラウドのサービスを使う場合には、同じ顧客や商品のデータが複数のサービスに分かれて置かれます。サービスごとに別の定義で登録されると、規模が小さくても集計の食い違いが起きます。3つ目は、データの扱いについて社外へ説明を求められる場面が、会社の規模にかかわらず起こりうることです。顧客から自分の情報がどう扱われているかを問われる、取引先からデータの管理のしかたを確認される、といった場面で、誰が答えるのか、何を根拠に答えるのかが決まっていないと、その場で答えられません。個人情報の扱いにかかわる法令上の義務は第8章で扱います。
小さな会社での統治は、委員会や専任の担当者を置くことから始める必要はありません。経営者が「どのデータを誰が決めるか」を1枚の表にし、売上や顧客数のような基本の指標の定義を短い文書に残し、月に1回、その定義どおりに数字が出ているかを確かめる、という程度から始められます。本コラムの第13章では、情報システムの担当が1人しかいない場合の縮小版の進め方を扱います。仕組みを軽くしても、3つの問いに答えがある状態を保つことが大事です。
反対に、統治の仕組みをまだ重くしなくてよい場合もあります。扱うデータの種類が少なく、使う人が数人で、定義のずれがあってもすぐに気づいて直せる段階では、規程を何本も作るより、基本の指標の定義と持ち主を決めておくだけで足りることが多いと思われます。仕組みを重くするのは、データを使う部門が増えたとき、社外へのデータの提供が始まったとき、AI のように大量のデータを前提にした取り組みを始めるとき、といった変化が起きたときです。どの段階でどの領域が要るかは、第2章の見取り図と第12章の現状診断で扱います。
経営判断、最初に「誰が決めるか」を決める
この章の内容を、経営としての最初の判断に落とすと、1つに絞れます。最初に決めるのは、規程の目次でも、導入するツールでもなく、「誰が決めるか」です。具体的には、全社のデータの統治について最終的に責任を持つ経営層の1人を決め、そのうえで、まず扱うデータ(たとえば売上と顧客)について、定義と用途と提供の可否を決める業務部門の責任者を決めます。
この判断を最初に置く理由は、3つの問いの順序にあります。決める人がいれば、その人が基準を承認でき、基準があれば確かめる仕組みを作れます。決める人がいないまま基準づくりを始めると、案を作っても承認する人がいないので、案が何度も作り直されます。ツールの導入から始めると、ツールの設定のたびに「この項目の定義は誰が決めるのか」という問いに戻ってきます。どちらの場合も、最初に避けた問いに後から答えることになり、その間の作業の一部が手戻りになります。
決める人を置くときに、経営として判断しておくべき点が2つあります。1つ目は権限です。決める人に、定義の変更を承認する権限と、部門の間で意見が分かれたときに裁定する権限を、明示的に与えます。権限を与えずに役割の名前だけを付けると、その人は調整役にとどまり、意見が分かれるたびに経営会議へ判断が戻ってきます。2つ目は時間です。業務部門の責任者が兼務でデータの持ち主を務める場合、その仕事に使う時間を、本人の業務の評価の中で認めておく必要があります。時間の裏付けが無い兼務は、繁忙期に真っ先に後回しにされます。役割ごとの責任分担と兼務の扱いは第3章で、最初の任命から90日の進め方は第13章で扱います。
反対に、この段階でやらなくてよいことも決めておくと、最初の動きが軽くなります。全社のすべてのデータについて持ち主を一度に決める必要はなく、経営の判断に直結するデータ、あるいは集計の食い違いがすでに問題になっているデータから始めれば足ります。全領域の規程をそろえる必要もありません。最初の判断の範囲を小さくしておくことで、決める人が実際に決める経験を早く積めます。対象を広げすぎることの失敗は第13章で、続けるための仕組みは第14章で扱います。
この章では、データマネジメントの活動全体を、決める層であるデータガバナンス(統治)と、実行の層(管理)に分け、本コラムで使う用語の意味を固定しました。データガバナンスは全体の外にあるのではなく、全体の一部でありながら全体を方向づける層です。ISO/IEC 38505-1 も、統治を管理と区別し、データの利用を評価・指示・監視する統治機関(取締役や経営幹部など)の仕事として位置づけています。データガバナンスは「誰が決めるか・何を基準にするか・どう確かめるか」の3つの問いに答える仕組みで、経営としての最初の判断は「誰が決めるか」を決めることです。次の第2章では、データマネジメントの知識体系である DMBOK の成り立ちと、知識領域の見取り図を扱います。
この章を深めたい方への参考書籍
『経営のためのデータマネジメント入門』(喜田昌樹 編著、日本情報システム・ユーザー協会ビジネスデータ研究会 編、中央経済社):情報システム部門ではなく経営層や業務部門の読者を想定し、データマネジメントを経営の視点から解説した入門書です。この章で扱った、データの統治を技術の話ではなく経営の判断として捉える見方を、より広い文脈で確かめたいときの材料になります。
『DXを成功に導くデータマネジメント データ資産価値向上と問題解決のための実務プロセス75』(データ総研、小川康二、伊藤洋一 著、翔泳社):データマネジメントの実務を75の項目に分けて解説した本で、目次はデータマネジメントの組織の立ち上げから始まります。この章で示した統治と管理の区別を、実際の作業の単位に落としていくときに参考になります。
第2章 DMBOKとは何か、知識体系の成り立ちと知識領域の見取り図
第1章では、データマネジメントという全体の取り組みを、データについて「誰が何を決め、何を基準に、どう確かめるか」を定めるデータガバナンス(統治)と、データを集め・整え・保管し・提供し・守り・廃棄する日々の活動である実行の層(管理)に分けて考えると、誰が何をするかが見えやすくなることを確認しました。この章では、そのデータマネジメントの全体を1つの見取り図にまとめた代表的な知識体系である、DAMA International が刊行するデータマネジメント知識体系ガイド(DAMA-DMBOK。以下 DMBOK)を扱います。DMBOK を誰がどう作ってきたのか、いまどの版が出ていて何が進行中なのか、どのような領域に分けてデータマネジメントを捉えているのか、領域どうしがどうつながっているのか、そして自社の取り組みにどう使えばよいのかを順に説明します。
最初に、この章の書き方について断っておきます。DMBOK は DAMA International の著作物です。本コラムは DMBOK の構造と考え方を自分の言葉で解説しており、原典の定義文・本文・図(中心と周囲の領域を円形に配した図や、領域ごとの入力と出力をまとめた図)を引用・転載・翻訳していません。各領域を表す名称(データ品質・メタデータ・マスターデータなど)は、データマネジメントの分野で広く使われる一般的な語として使っています。各領域について書いている「答える問い」「無いと起きること」は、公開されている情報と実務の一般論から本コラムが独自にまとめたもので、DMBOK の記述そのものではありません。DMBOK の正確な定義や記述に当たるには、この章の末尾で挙げる日本語版を参照してください。
DAMA International と DAMA日本支部
DMBOK を作っているのは、DAMA International というデータマネジメントの専門家の団体です。DAMA International の公式サイト(dama.org、2026年10月22日に確認)は、自らを独立した、ボランティアが運営する非営利の団体と説明しており、1980年に創られ、1988年に国際的な団体になったと記しています。同じページは、支部が世界の70以上の国にあると記しています。DAMA International は、DMBOK の刊行のほかに、後で触れるデータマネジメントの専門家の認定資格を運営しています。
日本には、その日本支部として一般社団法人 データマネジメント協会 日本支部(DAMA日本支部)があります(2026年10月22日に確認)。公式サイトは、国際的な非営利団体である DAMA International の日本支部であると説明しています。活動としては、年次の会議である ADMC(Asian Data Management Conference)の開催(2026年は第16回と案内されています)、テーマ別の分科会とその成果物の公開、DMBOK 第2版の内容を紹介する動画の公開、会員とスポンサー企業向けの DMBOK の図版のダウンロードの案内などが掲載されています。日本語版の DMBOK は、この DAMA日本支部が監訳に加わって日経BP から刊行されています(次の節)。
自社で取り組みを始める立場から見ると、これらの団体は「規格を定める機関」ではなく、「実務家どうしが知識を持ち寄って整理し、共有する場」と捉えるのが実態に近いと考えています。DMBOK に法的な拘束力はなく、DAMA の会員でなければ使えないものでもありません。ただ、同じ言葉で話せる人を社内外に増やすうえでは、こうした団体の会議や資料、資格の仕組みが手がかりになります。
版の経緯、第1版から改訂版と3.0の進行まで
DMBOK には複数の版があり、日本語版の刊行の時期は原書と少しずれています。社内で「DMBOK では」と話すときに、相手が第1版を読んでいるのか、第2版やその改訂版を読んでいるのかで、章の構成や用語が違うことがあるので、版の経緯を押さえておくと話がかみ合いやすくなります。ここでは、DAMA International の公式サイト、日経BP の書籍ページ、DAMA日本支部のサイト、国立国会図書館サーチ(NDL サーチ)の書誌で確かめた範囲を整理します。
原書の第2版は、NDL サーチに収録された書誌では、2017年に Technics Publications から刊行されています。同じ ISBN の改訂版の書誌には、標題紙裏の記載として「第2版の第1刷が2017年、第2版改訂版の第1刷が2024年」という趣旨の注記があります。DAMA International の DMBOK の紹介ページ(2026年10月22日に確認)は、2024年に「DMBOK 2.0 Revision」を立ち上げたと記しています。同じページは、第2版の新しい点(どの版と比べたものかは書かれていません)として、データ倫理の扱いの拡充、データガバナンスの内容の更新、データ統合と相互運用性についての新しい知見、新しい技術への言及の強化を挙げています。2024年の改訂版で何が変わったかは、DAMA International の改訂版についてのよくある質問と回答のページ(2026年10月26日に確認)が、用語と略語の統一、全章の誤字と図の誤りの修正、12の文脈図の見直し、データ品質の章の改善(付録の追加を含む)を挙げています。紹介ページには、改訂版の翻訳がイタリア語・スペイン語・ポルトガル語(ブラジル)・フランス語・トルコ語・オランダ語・アラビア語で出ていることも書かれています。
日本語版は、NDL サーチの書誌で次の3つが確かめられます。第一版は2011年12月に日経BP社から刊行され、責任表示は「DAMA International 著、データ総研 監訳」です。第二版は2018年12月の刊行で、責任表示は「DAMA International 編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳」です。そして第二版の改定新版が2024年7月に日経BP から刊行され、NDL の書誌は原タイトルを「DAMA-DMBOK 原著第2版改訂新版の翻訳」と記録しています。日経BP の書籍ページ(2026年10月22日に確認)は、書名を『データマネジメント知識体系ガイド 第二版 改定新版』、発行日を2024年7月22日、ISBN を 9784296205554、672ページ、A4判とし、改定新版では各章に軽微な修正を加え、データ品質の章の構成を変えて記述を追加したと説明しています。
日本語版の表記と日付には、資料によって小さな違いがあります。DAMA日本支部のサイトは、同じ本を「改定新版」とも「改訂新版」とも書き、発売日を2024年7月18日としています。日経BP の書籍ページの発行日は7月22日、NDL サーチの書誌は「2024.7」です。本コラムは、書名の表記は出版社の「改定新版」に、ISBN は NDL サーチと日経BP の両方で一致した 9784296205554 に揃え、刊行の時期は「2024年7月」と書きます。なお、書店のサイトによっては、この本の欄に別の ISBN が出ている例がありました(2026年10月22日に確認)。その ISBN を NDL サーチで引くと別の書籍(同じ時期に日経BP から出たデータスチュワードシップの訳書)でした。社内で購入をまとめるときは、書名と版に加えて ISBN まで照らし合わせておくと、別の本が届く取り違えを防げます。
次の版については、DAMA International が DMBOK 3.0 プロジェクトのページ(2026年10月22日に確認)を公開しています。DMBOK の紹介ページは、3.0 プロジェクトを2025年に始まった、知識体系を継続的に更新していくための取り組みと説明しています。プロジェクトのページによると、開発は「Triple Helix」と呼ぶ3つの層で運営されています。編集の中心は11名の分野別の編集者で、編集長と技術ライターが支えます。その内容を、資格の最上位である Master の保持者7名の査読の場が確かめ、さらに各国の支部の会員を中心とする実務家が草稿を読んで意見を返します。2025年6月25日にキックオフの会が開かれたこと、AI・クラウド・現代のデータ基盤といった新しい主題を取り込む予定であることも書かれています。刊行の時期は、DAMA International の 3.0 プロジェクトのサイトのよくある質問と回答のページが2027年第3四半期を目標としており、同じサイトの工程表は出版と展開の段階を2027年4月から7月に置いています(いずれも2026年10月26日に確認)。どちらも目標で、確定した発売日ではありません。本コラムの基準時点(2026年10月)では、3.0 は「進行中」と捉えるのが正確です。
| 版 | 時期 | 刊行元・責任表示 | 確かめた資料 |
|---|---|---|---|
| 日本語版 第一版 | 2011年12月 | 日経BP社。DAMA International 著、データ総研 監訳 | NDL サーチの書誌 |
| 原書 第2版 | 2017年 | Technics Publications。DAMA International | NDL サーチの書誌 |
| 日本語版 第二版 | 2018年12月 | 日経BP社。DAMA International 編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳 | NDL サーチの書誌 |
| 原書 第2版の改訂版(DMBOK 2.0 Revision) | 2024年 | Technics Publications。DAMA International | NDL サーチの書誌、DAMA International の紹介ページ |
| 日本語版 第二版 改定新版 | 2024年7月 | 日経BP。DAMA International 編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳 | NDL サーチの書誌、日経BP の書籍ページ |
| DMBOK 3.0 | 2025年に開始。刊行は2027年を目標(確定した発売日ではない) | DAMA International(Triple Helix の体制) | DAMA International の 3.0 プロジェクトのページ、3.0 プロジェクトのサイトのよくある質問と回答・工程表 |
この表で、原書の第1版の刊行年を書いていないのは、本コラムの確認の範囲で一次情報に当たれなかったためです。また、日本語版の第一版が原書のどの版の翻訳かについて、NDL の書誌には原タイトルが「DAMA-DMBOK guide」とだけ記録されています。社内の勉強会で使う本を選ぶ場合は、2024年の改定新版を基準にすると、原書の改訂版と内容がそろいます。
DMBOK は何であり、何でないか
DMBOK を初めて手に取る人が戸惑いやすいのは、それが「規格」なのか「教科書」なのか「手順書」なのかが分かりにくい点です。DAMA International の紹介ページは、この点について、DMBOK が何であり何でないかを項目に分けて説明しています。本コラムなりに要点をまとめると、DMBOK は、データマネジメントの実務家のあいだで共有されてきた知識のうち土台になる部分を選んで整理した本で、データの専門家が知るべきことをすべて並べた目録ではありません。
同じページが挙げる「DMBOK でないもの」も、自社で使う立場から短くまとめておきます。DMBOK は、使う道具や製品を指定する手引きでも、守らなければ罰せられる規制でも、研修の課程そのものでもありません。自社の課題や業種、取り組みの段階に合わせて読み替え、検討すべき事項を探すための参照の本です。採用する仕組みや優先順位は、自社で判断することになります。
この説明は、自社で DMBOK を使うときの姿勢をよく表していると考えています。DMBOK に書かれていることを全部実施すれば合格、という性質のものではありません。DMBOK は、データマネジメントにどのような領域があり、それぞれで何を考える必要があるかを示す「地図」に近いものです。地図は、目的地を決めてくれるわけではありませんが、いま自分がどこにいて、どこに抜けがあるかを確かめるのに使えます。本コラムが DMBOK を「読むもの」ではなく「使うもの」として扱うのはこのためです。
図版の扱いについても触れておきます。DAMA International は、DMBOK に含まれる一部の図版を公式サイトの図版のページ(2026年10月22日に確認)で公開しており、その図版はクリエイティブ・コモンズの「表示・改変禁止 4.0 国際」ライセンスで提供されると書かれています。同じページは、PNG の図版を変えたり著作権の表示を外したりしてはならないこと、出版物では指定の書誌を引用すること、ライセンスの対象でない内容を使いたい場合は DAMA International に問い合わせることを求めています。本コラムは、ライセンスの条件の解釈に踏み込まず、図版を一切転載していません。領域の関係は、本コラムが独自に作った表と、箱と矢印だけの図で示します。公式の図を社内資料で使いたい場合は、このページの条件を読んだうえで、自社の法務の担当と確かめるのが確実です。
知識領域の見取り図、中心のガバナンスと周囲の10領域
DMBOK は、データマネジメントをいくつかの知識領域に分けて扱っています。知識領域とは、データマネジメントの全体を、目的と担い手がまとまる単位で区切った範囲のことです。DMBOK はデータガバナンスを中心に置き、その周囲に10の領域を並べる構成を取っています。中心の1つと周囲の10を合わせて、11の知識領域です。周囲の10の領域を本コラムの表の順に挙げると、データアーキテクチャ、データモデリングとデザイン、データ品質、メタデータ、参照データとマスターデータ、データセキュリティ、データストレージとオペレーション、データ統合と相互運用性、データウェアハウジングとビジネスインテリジェンス(BI)、ドキュメントとコンテンツ管理です。この順は、本コラムで扱う章の順に合わせて並べたものです。これらの領域が日本語版でもそれぞれ章として扱われていることは、日経BP の書籍ページの目次で確認できます。
中心にデータガバナンスが置かれていることには意味があります。第1章で確認したとおり、データガバナンスは「誰が何を決め、何を基準に、どう確かめるか」を定める仕組みで、データマネジメントの活動全体のうち「決める」部分を担う層です。DMBOK ではデータガバナンスも知識領域の1つとして扱われています。つまり、データガバナンスはデータマネジメントの全体の外にあるのではなく、全体の一部でありながら全体を方向づける部分です。周囲の10の領域は、全体のうち主に実行を担う部分で、どの領域でも「誰が定義を決めるのか」「どの水準を満たせばよいのか」「守られているかを誰が確かめるのか」という問いが出てきます。その問いに答える仕組みがガバナンスなので、ガバナンスはどの領域とも接している、という位置づけになります。
次の表は、11の領域それぞれについて、本コラムが独自にまとめた「その領域が答える問い」「その領域の取り組みが無いと起きること」と、本コラムで詳しく扱う章を並べたものです。DMBOK の各章の定義や記述を写したものではなく、自社の困りごとから該当する領域を探すための索引として作りました。
| 知識領域 | その領域が答える問い(本コラムのまとめ) | 無いと起きること(本コラムのまとめ) | 本コラムの担当章 |
|---|---|---|---|
| データガバナンス | データについて誰が決め、何を基準にし、どう確かめるか | 定義や提供の可否が部門ごとに決まり、食い違いを裁く人がいない。ルールを作っても守られているかが分からない | 第1章・第3章 |
| データアーキテクチャ | 会社全体のデータがどこにあり、どう流れていて、将来どう配置するか | 同じデータを部門ごとに別のシステムで持ち、二重投資と転記が増える。新しいシステムをどこにつなぐか決められない | 第4章 |
| データモデリングとデザイン | 業務の主体と関係をどう表し、どの項目をどの形で持つか | 同じ「顧客」でも表ごとに単位や意味が違い、結合や集計のたびに解釈が要る | 第4章 |
| データ品質 | データが用途に適しているかをどう測り、どう直し、どう防ぐか | 誤りや欠損に気づかず判断や AI に使い、後から結果を疑うことになる | 第5章 |
| メタデータ | 各データの意味・出所・持ち主・更新頻度をどう記録し、探せるようにするか | データの意味を知る人が限られ、その人がいないと使えない。影響範囲を調べられない | 第6章 |
| 参照データとマスターデータ | 顧客・商品・取引先などの「正しい一件」と、コード表をどう決めて配るか | 同じ取引先が複数の ID で登録され、売上や与信の集計が合わない | 第7章 |
| データセキュリティ | どのデータを誰に見せ、どう守り、漏えいにどう備えるか | 権限が広すぎて情報が漏れる。逆に鍵をかけすぎて活用が止まる | 第8章 |
| データストレージとオペレーション | データをどこにどう保管し、バックアップ、保持期間、廃棄、処理性能をどう管理するか | 障害時に戻せない。保持期間が決まらず、不要なデータが残り続けるか、必要なデータが消える | 第9章 |
| データ統合と相互運用性 | システムの間でデータをどう受け渡し、形式と意味をどう揃えるか | 連携のたびに個別の変換を作り、取り込みの重複や漏れが起きても気づけない | 第9章 |
| データウェアハウジングとBI | 分析と報告のためのデータをどう集め、指標をどう定義して提供するか | 部門ごとに別の集計表を作り、会議に「別々の正解」が並ぶ | 第9章 |
| ドキュメントとコンテンツ管理 | 文書・画像・メールなど表になっていない情報をどう分類し、保存し、廃棄するか | 最新の文書がどれか分からない。保存すべき記録が見つからない。生成AIの素材に古い文書が混ざる | 第10章 |
表の右端の列のとおり、本コラムは11の領域を、判断の順序と担当の分け方に合わせて章に割り当てています。たとえば、データストレージとオペレーション、データ統合と相互運用性、データウェアハウジングとBI の3つは、同じ「データ基盤」の担当が受け持つ場合が多いように思いますので、第9章でまとめて扱います。データアーキテクチャとデータモデリングとデザインも、全社の見取り図を描く作業として第4章で一緒に扱います。逆に、データガバナンスは第1章で考え方を、第3章で仕組みを扱い、2回に分けています。
ここで強調しておきたいのは、11の領域は「11の部署」や「11の文書」を意味しないということです。領域は知識の整理のための区切りで、組織の区切りではありません。小さな会社であれば、1人の担当者が複数の領域を受け持つことが多く、データ品質やメタデータのように、専任の部署を置かずに業務部門と情報システム部門が分担する領域もあります。自社の体制を考えるときは、領域ごとに担当者を割り当てるのではなく、「この領域の問いに、いま社内で誰が答えているか」「答える人がいない領域はどこか」を確かめるところから始めるのが現実的だと考えています。
領域どうしの依存関係、どこから手を付けると後が楽になるか
11の領域は並列に見えますが、実務では互いに依存しています。ある領域の成果物が、別の領域の前提になっているということです。この依存関係を知らずに取り組む順序を決めると、後の領域で前の領域の作業をやり直すことになります。ここでは、DMBOK の記述ではなく、各領域が何を作り何を使うかという実務の観点から、本コラムの考えとして主な依存関係を整理します。
代表的なのは、データ品質とメタデータ・参照データの関係です。データ品質を測るには、「この項目は何を意味し、どの値が正しいのか」が決まっていなければなりません。たとえば「顧客の業種」という項目の品質を測るには、業種のコード表(参照データ)が決まっていて、その項目がどの業務で何のために使われるか(メタデータ)が記録されている必要があります。この2つが無いまま品質の点検を始めると、点検の担当者が自分で「正しい値」を仮に決めることになり、部門ごとに別の基準で点検が行われます。品質の点数が出ても、その点数が何を測っているのかを説明できません。
データセキュリティも、単独では成り立ちにくい領域です。アクセスの権限を決めるには、まずどのデータがどの程度守るべきものかという分類が要ります。分類を決めるには、どこにどのデータがあるか(データアーキテクチャとメタデータ)が分かっていなければなりません。分類が無いまま権限だけを設定すると、すべてを最も厳しい区分に入れて活用を止めるか、すべてを緩くして漏えいの危険を残すかのどちらかに寄りがちです。個人情報の扱いは第8章で、法令の条文を確かめた範囲で扱います。
データウェアハウジングとBI は、多くの領域の成果をまとめて使う側にあります。データを集める経路はデータ統合と相互運用性に、保管と運用はデータストレージとオペレーションに、指標の意味はメタデータに、顧客や商品の名寄せはマスターデータに、数字の正しさはデータ品質に依存しています。BI のダッシュボードで「数字が合わない」という問題が出たとき、その原因はダッシュボードそのものではなく、これらの上流の領域のどこかにあることが多いように思います。そうした場合には、BI の製品を入れ替えても問題は解消しません。
次の表は、主な依存関係を「使う側の領域」「前提になる領域」「前提が欠けたときに起きること」で並べたものです。本コラムの考えとしてまとめたもので、これですべての関係を網羅しているわけではありません。
| 使う側の領域 | 前提になる領域 | 前提が欠けたときに起きること |
|---|---|---|
| データ品質 | メタデータ、参照データとマスターデータ | 何を正しいとするかが決まらず、点検の基準が担当者ごとに違う |
| データセキュリティ | データアーキテクチャ、メタデータ(どこに何があるかと分類) | 権限を一律に厳しくするか一律に緩くするかに寄り、活用か保護のどちらかが崩れる |
| データウェアハウジングとBI | データ統合と相互運用性、メタデータ、マスターデータ、データ品質 | 部門ごとに数字が合わず、ダッシュボードが信用されない |
| データ統合と相互運用性 | データモデリングとデザイン、参照データ | 連携のたびに項目の意味やコードを個別に変換し、変換の誤りに気づけない |
| 参照データとマスターデータ | データガバナンス(誰が正しい一件を決めるか) | 名寄せの基準が決まらず、統合しても再び重複が増える |
| メタデータ | データガバナンス(誰が定義を決め、誰が維持するか) | 用語集を作っても更新されず、実態とのずれが広がっていく |
| ドキュメントとコンテンツ管理 | データセキュリティ、データストレージとオペレーション(保持と廃棄) | 文書の権限と保存期間が決まらず、生成AIの検索の対象に見せてはならない文書が混ざる |
この表から分かるのは、多くの領域が最終的に「誰が決めるか」に行き着くということです。メタデータの定義を誰が決めるか、マスターデータの正しい一件を誰が決めるか、セキュリティの分類を誰が決めるか。これらは技術の問いではなく、データガバナンスの問いです。DMBOK がデータガバナンスを中心に置いているのは、この構造の表れだと本コラムは理解しています。取り組みの順序を考えるときは、まず決める人と決め方を置き(第3章)、次に意味を揃える領域(メタデータと参照データ、第6章・第7章)に進み、その上で品質やセキュリティや基盤に広げると、手戻りが少なくなると考えています。これは改善を積み上げるときの基本の順序です。退職者がいまも共有フォルダを見られるといった、漏えいや不正なアクセスにつながる問題は、この順序を待たずに並行して手を打ちます。具体的な立ち上げの順序は第13章で扱います。
前の表の依存関係を、取り組みの順に4段の流れとしてまとめると次のようになります。
- 1段目 データガバナンス:誰が定義・基準・提供の可否を決めるかを置く
- 2段目 メタデータ・参照データ:項目の意味とコード表を揃える
- 3段目 データ品質・データセキュリティ:揃った意味と分類にもとづいて、点検の基準と権限を決める
- 4段目 データウェアハウジングとBI:前の3段の成果を使って、指標を1つの定義で提供する
知識領域の外側にある主題、倫理・データサイエンス・成熟度・組織
DMBOK には、11の知識領域のほかに、領域の外側からデータマネジメント全体にかかわる主題も含まれています。本コラムの言葉で挙げると、データの倫理、ビッグデータとデータサイエンス、成熟度のアセスメント、組織と役割、組織の変革の5つで、これに加えてデータマネジメントそのものの総論があります。これらの主題が日本語版でも章として扱われていることは、日経BP の書籍ページの目次で確認できます。これらの主題は、特定の領域の作業ではなく、領域を横断して効いてくるものと捉えると位置づけが分かりやすくなります。
データの倫理は、法令で禁じられていなくても、その使い方が顧客や社会から見て妥当かどうかを問う主題です。どの領域でも、データを集める・組み合わせる・提供するという判断の場面で出てきます。本コラムでは第10章で、文書の管理と合わせて扱います。ビッグデータとデータサイエンスは、大量で多様なデータを分析や機械学習に使う場面で、どの領域の成果がどう効いてくるかを問う主題です。本コラムでは、生成AIを含む AI のためのデータの整え方として第11章で扱います。
成熟度のアセスメントは、各領域の取り組みがどの段階にあるかを測り、どこから上げるかを決めるための主題です。本コラムでは第12章で、日本の公的な指標と合わせて扱います。なお、本コラムは成熟度の段階を「未着手・個別対応・定義済み・運用中・改善継続」の5段階で言い表しますが、これは本コラム独自の簡易な5段階の言い方で、DMBOK の成熟度の段階を言い換えたものではありません。組織と役割は、データオーナーやデータスチュワードといった役割を誰に任せるかの主題で、第3章で扱います。組織の変革は、仕組みを作った後に定着させ、続けるための主題で、第14章で扱います。
これらの主題が知識領域とは別に置かれていることは、データマネジメントが「技術の作業の集まり」では終わらないことを示していると考えています。領域ごとの手順を整えても、倫理の判断の場が無ければ不適切な利用を止められず、役割が決まっていなければ手順は実行されず、変革の進め方を考えなければ定着せず、元の運用に戻りやすくなります。経営の側から見ると、領域の作業に予算を付けるだけでなく、これらの横断的な主題に誰が責任を持つかを決めておくことが、投資を無駄にしないための条件になります。
CDMP、DMBOK にもとづく専門家の認定
DAMA International は、DMBOK にもとづく専門家の認定として CDMP(Certified Data Management Professional)を運営しています。CDMP の概要のページ(2026年10月22日に確認)によると、認定には3つの段階があり、Associate は経験2年未満の初学者向け、Practitioner はデータにかかわる職務の経験がおおむね2年から10年の実務者向け、Master は10年以上の経験と指導的な立場の経験を持つ人向けと説明されています。ただし、認定の段階の詳細のページ(2026年10月26日に確認)によると、Associate と Practitioner には事前の経験の条件は無く、経験年数は目安です。Master には10年以上の関連する経験が求められ、経歴書を提出して審査を受けます。経験を積んだ後に上の段階へ進むこともできると書かれています。
試験は、全員に必須の Data Management Fundamentals と、7つの専門分野の試験からなります。試験の案内のページ(2026年10月26日に確認)に挙がっている専門分野の試験は、データ品質、データガバナンス、メタデータ、データモデリングとデザイン、データウェアハウジングとBI、参照データとマスターデータの管理、データ統合と相互運用性の7つで、Practitioner と Master はこの中から2つを選んで受けます。なお、概要のページには、データアーキテクチャとデータセキュリティを含む別の組み合わせの7分野が載っており、2つのページで一覧が食い違っています。受験を考える場合は、試験の案内のページで最新の科目を確かめるのが確実です。Master は、これに加えて経歴書の提出による審査が要ります。認定の有効期間は、更新と維持の案内のページ(2026年10月26日に確認)によると最初の3年間で、その後は毎年の更新の手続きが必要とされています。試験はオンラインの選択式で、問題数・時間・段階ごとの合格の基準は試験の案内のページに示されています。
自社の取り組みの観点から見ると、CDMP は「データマネジメントの共通の言葉を持つ人を育てる手段」の1つとして位置づけるのがよいと考えています。資格を持つ人がいれば、社内の議論で用語の意味がぶれにくくなり、外部の専門家との話も通じやすくなります。一方で、資格は知識の確認であって、自社のどのデータを誰が決めるかという判断を代わりにしてくれるものではありません。資格の取得を取り組みの目標にすると、学習が業務の課題から離れやすくなります。社内の人材育成の進め方は第14章で扱います。
DMBOK を「読む」のではなく「使う」、困りごとから領域に入る
日経BP の書籍ページによると、日本語版の改定新版は672ページあり、全17章で構成されています。この分量を最初の章から順に読み進めると、自社の課題とどう結びつくのかが見えないまま時間が過ぎることがあります。本コラムは、DMBOK を通読する本としてではなく、自社の困りごとから該当する領域を引いて使う参照の本として扱う使い方を想定しています。地図にたとえれば、すべての地名を覚えてから出かけるのではなく、目的地を決めてから必要な区画を開く使い方です。
具体的には、次の3つの手順で使うのが現実的だと考えています。1つ目に、社内でいま起きているデータの困りごとを、具体的な出来事として書き出します。「会議で部門ごとに売上の数字が違う」「同じ取引先が複数登録されている」「退職者がいまも共有フォルダを見られる」といった形です。2つ目に、その困りごとがどの知識領域の問いにかかわるかを、前出の領域の表で探します。1つの困りごとが複数の領域にかかわることも多いので、最も上流にある領域から見ます。3つ目に、その領域について DMBOK の該当する章を開き、自社で決まっていないこと、担当者がいないこと、記録が無いことを洗い出します。DMBOK を、自社の抜けを見つけるための点検の観点の一覧として使う、ということです。
次の表は、よくある困りごとと、最初に見る領域、本コラムで扱う章の対応の例です。表の対応は本コラムの整理で、困りごとの原因が1つの領域に限られるという意味ではありません。
| よくある困りごと | 最初に見る知識領域 | 次に見る知識領域 | 本コラムで扱う章 |
|---|---|---|---|
| 会議で部門ごとに売上や顧客数の数字が違う | メタデータ(指標の定義) | データウェアハウジングとBI、データガバナンス | 第6章・第9章・第3章 |
| 同じ取引先や顧客が複数の ID で登録されている | 参照データとマスターデータ | データ品質、データガバナンス | 第7章・第5章・第3章 |
| 分析や AI に使ったデータに誤りや欠損が多い | データ品質 | メタデータ、データ統合と相互運用性 | 第5章・第6章・第9章・第11章 |
| 誰がどのデータを見られるのか把握できていない | データセキュリティ | メタデータ(分類)、データガバナンス | 第8章・第6章・第3章 |
| システムごとにデータを持ち、連携のたびに個別の変換を作っている | データアーキテクチャ | データ統合と相互運用性、データモデリングとデザイン | 第4章・第9章 |
| 最新版の文書がどれか分からず、生成AIの回答に古い情報が混ざる | ドキュメントとコンテンツ管理 | データセキュリティ、メタデータ | 第10章・第11章 |
| 定義やルールを決めても、誰が決めたのか、守られているのかが分からない | データガバナンス | 組織と役割(知識領域の外側の主題) | 第3章・第13章 |
この使い方の利点は、取り組みの範囲が自然に絞られることです。DMBOK のすべての領域を自社に当てはめようとすると、作るべき文書と決めるべき事項が一度に膨らみます。困りごとから入れば、まず手を付けるのはその困りごとに直結する1つか2つの領域で済みます。そのうえで、前の節の依存関係の表を見て、その領域の前提になっている領域に抜けが無いかを確かめます。たとえば「数字が部門ごとに違う」という困りごとから入った場合、指標の定義(メタデータ)を揃える作業に着手しつつ、その定義を誰が決めるのか(データガバナンス)を先に決めておく、という順序になります。
もう1つの使い方は、社内の共通の言葉として使うことです。データの話は、部門によって同じ語が別の意味で使われがちです。ある部門の「マスター」が別の部門では単なる一覧表を指していたり、「品質」が入力の誤りの少なさを指す人と、分析に使える状態かどうかを指す人がいたりします。DMBOK の領域の名称を社内の議論の見出しとして使うと、「いまの話はどの領域の話か」を確かめやすくなります。本コラムが第1章で用語の定義を固定したのも同じ理由です。
経営の判断、全領域を一度にやらない
DMBOK の見取り図を見た経営層が陥りやすい判断の誤りは、「11の領域を全部整えるのがデータガバナンスだ」と受け取り、全領域を同時に始める計画を承認することだと考えています。全領域を同時に始めると、領域ごとに担当者・文書・会議が必要になり、兼務の担当者の負担が一度に増えます。成果が出るまでに時間がかかり、その間に経営の関心が別の課題へ移ると、文書だけが残って運用されない状態になりがちです。これは、本コラムが第14章で扱う失敗の型のうち、「ルールだけ作って運用しない」「兼務の形骸化」「経営の関心の低下」に直結します。
全領域を一度に始める計画には、作り直しの手間と費用が生じやすいという問題もあります。前の節で見たとおり、領域どうしには依存関係があります。全領域を同時に始めると、前提になる領域(誰が決めるか、項目の意味、コード表)が固まる前に、後の領域の仕組み(品質の点検、権限の設定、ダッシュボード)を作ることになり、前提が決まった時点でそれらを作り直すことになりかねません。また、どの領域にも少しずつ人と予算を配ると、どの領域でも成果が出る水準に届かず、「データガバナンスに投資したが何も変わらなかった」という評価になりやすくなります。その評価が定着すると、次に本当に必要な投資の承認が難しくなります。逆に、困りごとに直結する1つか2つの領域に絞って、目に見える改善(たとえば会議に出る数字が1つに揃う)を先に出すと、次の領域へ広げる根拠が社内にできます。
そこで、経営として決めておくとよいことは3つだと考えています。1つ目は、最初に取り組む領域を1つか2つに絞り、絞った理由を困りごとと結びつけて説明できるようにすることです。2つ目は、領域にかかわらず、データについて誰が決めるかという中心の仕組み(データガバナンス)だけは、最初から置くことです。どの領域から始めても、決める人がいなければ定義も基準も定まらないからです。3つ目は、手を付けない領域を明示しておくことです。「今期はセキュリティの分類と顧客マスターに絞り、文書管理とデータカタログの導入は来期以降に検討する」のように、やらないことを書いておくと、担当者が全部に手を広げて疲弊することを防げます。
DMBOK は、この「やらないこと」を決めるときにも役立ちます。全体の見取り図があるからこそ、いま手を付けない領域がどこで、その領域を後回しにすると何が起きうるかを、あらかじめ書き出しておけます。全体を知ったうえで範囲を絞ることと、全体を知らずに目の前の問題だけに手を打つことは、同じ「一部から始める」でも結果が違います。前者であれば、後から領域を広げるときに、最初の取り組みとの整合を取りやすくなります。最初の90日から1年の進め方は第13章で具体的に扱います。
この章では、DMBOK を作る DAMA International と DAMA日本支部、原書と日本語版の版の経緯、進行中の DMBOK 3.0、11の知識領域と領域の外側の主題、領域どうしの依存関係、CDMP の認定、そして DMBOK を困りごとから引いて使う方法を整理しました。DMBOK はすべてを実施するための規範ではなく、自社の抜けを見つけ、取り組みの範囲を絞るための地図として使うものであり、どの領域から始めても中心には「誰が決めるか」というガバナンスの問いがあります。次の第3章では、その中心にあるデータガバナンスの仕組みを、原則・ポリシー・役割・会議体の順に具体的に扱います。
この章を深めたい方への参考書籍
『データマネジメント知識体系ガイド 第二版 改定新版』(DAMA International 編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳、日経BP):この章で見取り図として紹介した DMBOK の日本語版で、原書の第2版改訂版の翻訳です。データガバナンスを含む11の知識領域と、倫理・データサイエンス・成熟度・組織と役割・組織の変革の各章からなります。本コラムが自分の言葉でまとめた各領域について、原典の正確な定義と記述を確かめるときに当たる本です。自社の困りごとに対応する章を引いて、決まっていないことを洗い出す使い方に向いています。
『DAMA-DMBOK:Data Management Body of Knowledge』(DAMA International、Technics Publications):DMBOK の原書で、NDL サーチの書誌では第2版が2017年、第2版の改訂版が2024年の刷りです。CDMP の試験は DMBOK にもとづいており、資格の取得を考える人や、英語の用語で海外の資料や製品の説明と突き合わせたい人にとって、原語の表現を確かめる手がかりになります。
第3章 データガバナンスの仕組み、原則・ポリシー・役割・会議体
第2章では、DMBOK がデータガバナンスを知識領域の中心に置き、データ品質やメタデータのような他の領域を方向づける位置に据えていることを見ました。この章では、その中心にある仕組みを、自社で組み立てられる部品に分けて説明します。扱うのは、原則・ポリシー・標準・手順という文書の階層、誰が何を決めるかという意思決定権、データオーナー・データスチュワード・データカストディアンなどの役割の分担、部門をまたぐ論点を決めるデータガバナンス委員会と、データの主題ごとに案を作るワーキンググループという二層の会議体、例外承認や変更管理といった日々の運用、集中型・分散型・連邦型という体制の型、そしてガバナンスの成果の測り方です。最後に、公開された一次情報のある事例として関西電力の体制を取り上げ、経営として最初に置く役割は何かを考えます。立ち上げの具体的な手順と最初の90日の計画は第13章で扱うので、この章は「何をそろえるか」に焦点を当てます。
この章の主張は、データガバナンスの仕組みは、ルールの文書から作るより、役割と意思決定権から作る方が動き出しやすい、というものです。ルールは、それを決める人と、守られているかを確かめる人がいて初めて意味を持ちます。決める人がいないままルールだけを書くと、例外が出たときに誰も判断できず、文書は承認された時点の姿で止まります。以下の節は、文書・決定権・役割・会議体・運用・体制の型・指標の順に並べましたが、自社で取りかかる順序としては、決定権と役割を先に固める方が進めやすいと考えています。
ガバナンスの構成要素、原則からポリシー・標準・手順へ
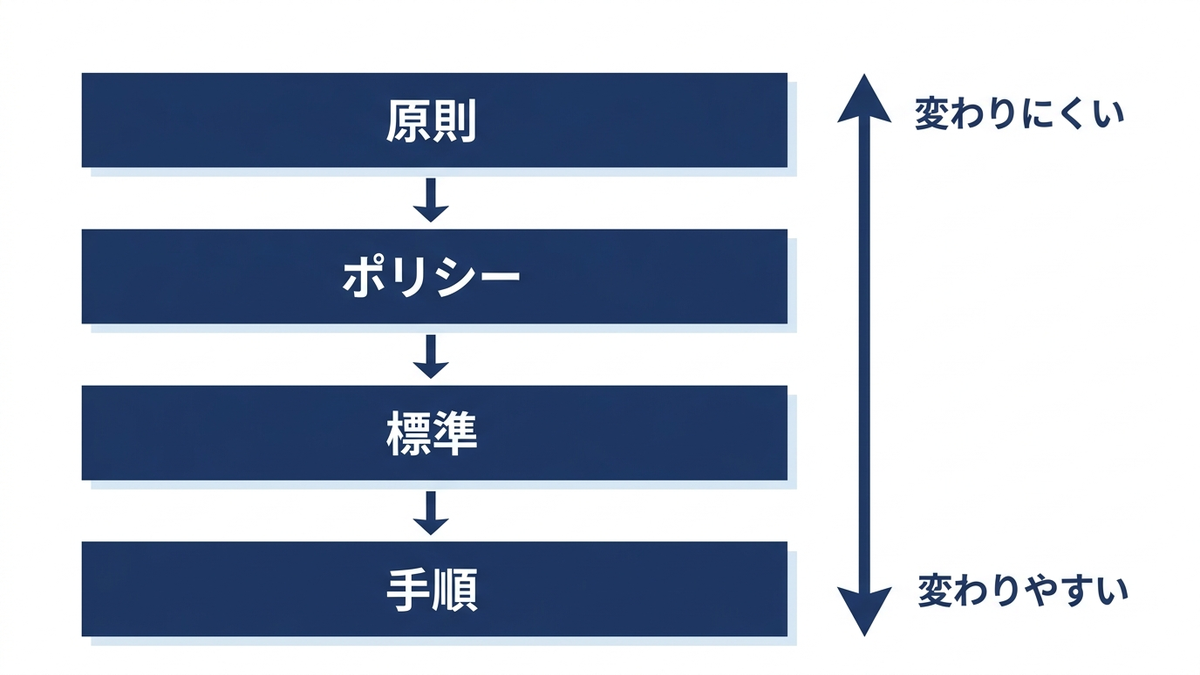
データガバナンスを「ルールを作ること」と受け取ると、最初に分厚い規程集を書こうとして止まることが多いように思います。実際に必要なのは、ルールの量ではなく、ルールがどの層に属するかの区別です。本コラムでは、データガバナンスの文書を、原則・ポリシー・標準・手順の4つの層に分けて考えます。上の層ほど変わりにくく、承認の手続きが重く、下の層ほど具体的で、頻繁に変わり、現場に近い担当者が書き換えます。
原則は、会社がデータをどう扱うかについての基本的な考え方です。たとえば「データは部門の持ち物ではなく、会社全体で使うための共有の財産として扱う」「重要なデータには、決定に責任を持つ人を必ず置く」「データの定義は、使う人が確かめられる場所に公開する」といった数行の文で、データガバナンス委員会で審議して上申し、CDO(最高データ責任者)が承認して、経営会議に報告します。原則は細かい判断の拠り所になるもので、原則そのものから日々の作業が決まるわけではありません。
ポリシーは、原則を領域ごとの方針に落としたものです。全体の地図の用語の表で定めたとおり、ポリシーは「なぜ・何を」を書きます。データ品質のポリシーなら「業務の判断に使うデータには品質の基準を定め、定期的に測って報告する」、データの提供のポリシーなら「部門の外にデータを提供するときは、データオーナーの承認を得る」のように、誰が何に責任を持つかを含めて書きます。標準は、守るべき仕様を書いたものです。日付の形式、顧客コードの桁数、機密区分の段階、全社で共通に使う品質の基準のように、値や形式まで決めます。その業務部門の中だけで使う品質基準はデータオーナーが決め、全社で共通に使う基準は標準としてデータガバナンス委員会が承認します。手順は、具体的な作業の流れです。新しいデータ項目を登録するときの申請の出し方、品質の不具合を見つけたときの報告の経路、外部へデータを渡すときの承認の取り方などを書きます。
層を分ける理由は、変更の頻度と承認の重さが違うからです。日付の形式を1つ変えるたびに経営会議の承認が要る仕組みにすると、標準が古いまま放置されます。逆に、データを部門の外へ出してよいかという方針を、現場の担当者が手順書の改訂だけで変えられる仕組みにすると、方針の一貫性が保てません。どの層の文書を誰が承認するかを最初に決めておくと、ルールの数が増えても、改訂の手間と統制の釣り合いが崩れにくくなります。次の表は、4つの層の違いを整理したものです。承認者の列は一例で、組織の規模によって変わります。
| 層 | 書くこと | 例 | 承認者の例 | 見直しの目安 |
|---|---|---|---|---|
| 原則 | データをどう扱うかの基本的な考え方 | 重要なデータには決定に責任を持つ人を必ず置く。定義は公開する | CDO(最高データ責任者)。データガバナンス委員会で審議・上申し、CDO が承認して経営会議に報告する | 中期経営計画の改定時など、数年に1回 |
| ポリシー | 領域ごとの方針(なぜ・何を)と責任の所在 | 部門外への提供はデータオーナーが承認する。判断に使うデータは品質を測って報告する | CDO。データガバナンス委員会で審議・上申し、CDO が承認して経営会議に報告する | 年1回 |
| 標準 | 守るべき仕様(形式・値・水準) | 日付の形式、顧客コードの桁数、機密区分の段階、全社で共通に使う品質の基準 | データガバナンス委員会(ワーキンググループが起案する) | 必要に応じて随時。変更は記録を残す |
| 手順 | 具体的な作業の流れ(どうやって) | 新しい項目の登録申請、不具合の報告、提供の承認の取り方 | 担当のデータスチュワードと情報システム部門 | 業務やシステムが変わるたび |
文書の目次の例、最初の版は薄くてよい
ポリシーと標準を書き始めるとき、どの項目を入れるかで迷うことが多いと思います。最初の版は、すべての領域を網羅する必要はありません。対象を絞った薄い文書を先に承認し、運用しながら章を足していく方が、使われる文書になりやすいと考えています。ここでは、全社のデータガバナンスのポリシーを1つの文書にまとめる場合の目次の例を示します。この章立ては DMBOK の構成を写したものではなく、全体の地図の用語の表と、この章で扱う部品から組み立てたものです。
| 章 | 中身 | 最初の版で書く範囲 |
|---|---|---|
| 1 目的と適用範囲 | このポリシーが何のためにあり、どのデータ・どの部門に適用されるか | 最初に対象とするデータ(たとえば顧客と商品のマスターデータ)と部門を明記する |
| 2 原則 | データガバナンス委員会の審議と上申を経て CDO が承認し、経営会議に報告した基本的な考え方 | 3〜5行の原則 |
| 3 用語の定義 | データオーナー・データスチュワード・データカストディアンなどの用語 | この文書で使う用語だけ |
| 4 役割と責任 | 誰が決め、誰が実行し、誰に相談し、誰に知らせるか | 対象データについての役割の表と、意思決定の分担表 |
| 5 会議体 | データガバナンス委員会とワーキンググループの構成・頻度・決められる範囲 | 構成員と頻度と決定権の範囲 |
| 6 データの定義と登録 | 項目の定義をどこに書き、誰が承認するか | 用語集の置き場所と承認の経路 |
| 7 データ品質 | 品質の基準を誰が決め、どう測り、どこへ報告するか | 対象データの重要な項目だけ |
| 8 データの提供と利用 | 部門の外へ提供するときの承認と、利用目的の確認 | 承認者と申請の経路 |
| 9 例外と変更 | ポリシーに沿えない場合の例外の承認と、文書の改訂の手順 | 例外を申請する窓口と承認者 |
| 10 見直しと報告 | 指標・報告の頻度・文書の見直しの時期 | 報告の頻度と見直しの時期 |
この目次で大事なのは、4章(役割と責任)と9章(例外と変更)を最初の版から入れておくことです。品質やセキュリティの細かな基準は後から足せますが、誰が決めるかと、ルールに沿えないときにどうするかが書かれていないと、文書が承認された翌日から運用が止まります。個人情報の取扱いや情報セキュリティの規程は、多くの会社で既に別の規程として存在しているので、データガバナンスのポリシーの中に同じ内容を書き直すより、既存の規程を参照する形にした方が、改訂のたびに2つの文書がずれる事態を避けられます(個人情報保護法との関係は第8章で扱います)。
標準と手順は、ポリシーの本文に入れず、別の文書として置くのが扱いやすいと考えています。ポリシーの見直しは年に1回程度を目安にできますが、標準と手順は業務やシステムが変わるたびに改訂が要るからです。ポリシーの本文には「日付の形式は全社標準に従う」とだけ書いて全社標準の文書の名前と置き場所を示し、どの版をいつから適用するかは標準の側の改訂の記録で管理しておけば、標準を改訂してもポリシーを改訂し直す必要はありません。ポリシーの本文で標準の版まで指定すると、標準を改訂するたびにポリシーの改訂も要ります。
意思決定権を先に決める、RACI で書く
データガバナンスの中身は、突き詰めると「データについての決定を、誰が、どの範囲で行うか」の取り決めです。本コラムの第1章で、データガバナンスを「誰が何を決め、何を基準に、どう確かめるか」を定める仕組みと定義しました。この「誰が何を決め」の部分を表に書き下ろすときに便利なのが RACI の表です。RACI は、ある作業や決定について、実行する人(R。決定の案を作って審議にかける作業も含めます)、最終的な責任を負い承認する人(A)、事前に相談を受ける人(C)、結果を知らされる人(I)を割り当てる書き方です。経営の戦略フレームワークとしての RACI の一般的な使い方は、弊社コラム『経営とAIの打ち手を導く戦略フレームワーク大全179選』で扱っています。ここでは、データガバナンスの決定に当てはめた例を示します。
RACI を書くときの決まりは2つです。1つ目は、1つの行に A を1人(1つの役割)だけ置くことです。A が2人いる決定は、意見が割れたときにどちらも決めません。2つ目は、C を増やしすぎないことです。相談先が多いほど決定は遅くなり、C の全員が実質的な拒否権を持つような運用になると、A を1人に絞った意味が失われます。次の表は、データガバナンスで繰り返し出てくる決定について、役割ごとの割り当ての例を示したものです。表の列のうち、データガバナンス委員会は部門をまたぐ論点を審議して決める会議体、データアーキテクトは全社のデータの配置と流れを設計する人、利用部門はそのデータを使って業務や分析を行う部門のことです。それぞれの詳しい分担は次の節で説明します。
| 決定 | CDO | データガバナンス委員会 | データオーナー | データスチュワード | データカストディアン | データアーキテクト | 利用部門 |
|---|---|---|---|---|---|---|---|
| 1つの部門の中で完結するデータ項目の定義の決定(例:営業部門だけが使う「商談の段階」の区分) | I | I | A | R | I | C | C |
| 部門をまたいで使うデータ項目の定義の決定(例:営業部門と経理部門の両方が使う「売上」) | C(合意できないときは委員長として裁定) | A | C(関係する部門のオーナー) | R | I | C | C |
| その部門の中だけで使う品質基準の決定(例:営業部門の見込み客の一覧で、電話番号の欠損を何%まで許すか) | I | I | A | R | C | I | C |
| 全社で共通に使う標準の承認(日付の形式、コード体系、全社共通の品質の基準、データモデルと連携の標準) | I | A | C | R | C | R(データモデルと連携の標準の案) | I |
| 部門の外へのデータ提供の可否 | I | I(新しい種類の提供は C) | A | R | C | I | I(申請者) |
| データを持つシステムの変更の技術的な承認(項目の追加・形式の変更。業務上の定義も変わる場合は、定義の行の承認も別に受ける) | I | I | C | C | R | A | I |
| 全社に影響するポリシーの例外の承認 | C(合意できないときは委員長として裁定) | A | C | R(申請の整理と案の作成) | C | C | I(申請者) |
この表には、いくつか判断の分かれる点があります。1つ目は、1つの部門の中で完結する定義と、その部門の中だけで使う品質基準と、提供の可否の A を、データオーナーに置いている点です。全社で共通に使う品質の基準は標準として扱い、A はデータガバナンス委員会です。データの意味と、どこまでの誤りなら業務に差し支えないかは、そのデータを使って業務を行う部門が一番よく知っているからです。情報システム部門に A を置くと、技術的には正しくても業務の実態に合わない定義が決まりやすくなります。2つ目は、システムの変更の技術的な承認の A をデータアーキテクトに置いている点です。データモデルと連携の標準そのものは、データアーキテクトが案を作り、データガバナンス委員会が承認します。項目を足す・形式を変えるといった変更は、他のシステムやデータの流れに影響するので、全社のデータの配置と流れを見ている役割が承認するのが筋だと考えています(データアーキテクチャの役割は第4章で扱います)。ただし、データアーキテクトを置いていない会社では、情報システム部門の責任者が A を担うことになります。
3つ目は、定義の決定を「1つの部門の中で完結するもの」と「部門をまたいで使うもの」の2行に分けた点です。営業部門と経理部門の両方が使う「売上」のように、複数の部門が同じ項目を使う場合、部門をまたぐ権限を与えないまま、どちらか一方の部門のデータオーナーに A を置くと、もう一方の部門の合意を得にくくなります。そこで本章では、部門をまたぐ定義はデータガバナンス委員会を A とする例を示し、関係する部門のデータオーナーを C として案の段階から意見を出してもらいます。委員会の中で合意できないときは、委員長である CDO が裁定します。CDO の裁定は委員会の決定の方法として規程に書いておくもので、A が2人になるわけではありません。
4つ目は、例外の承認を二段に分けている点です。1つの部門の中で完結する例外はデータオーナーが承認し、全社に影響する例外だけをデータガバナンス委員会の A とします。表の行は後者だけを示しています。こうしておくと、委員会の議題が部門内の小さな例外の審議で埋まることを防げます。委員会を A にする行では、委員会の決定の方法(多数決か、委員長の判断か)と、合意できないときに委員長の CDO が裁定することを規程に書いておかないと、A を1つに絞った意味が薄れます。
RACI の表は、作った時点で全員が納得していることより、迷ったときに参照される場所にあることの方が大事です。表をポリシーの4章に入れ、新しい種類の決定が出てきたら行を足す、という使い方を想定しています。行を足すたびに A を1人に絞る作業をすると、組織の中で責任があいまいになっていた所が見えてきます。
役割の分担、6つの役割と兼務の現実
RACI の列に出てきた役割を、もう少し詳しく見ます。ここで扱うのは、CDO・データガバナンス委員会・データオーナー・データスチュワード・データカストディアン・データアーキテクトの6つと、それを支える事務局です。このうちデータガバナンス委員会は人ではなく会議体ですが、決定の主体として役割の表に並べておくと、誰がどこで決めるかが1枚で見えます。事務局は、データガバナンス委員会の運営、課題の管理、文書の維持を担う担当です。立ち上げ期は兼務で置くことが多い役割です。データオーナー・データスチュワード・データカストディアンの意味は、全体の地図の用語の表で定めたものと同じです。データオーナーは決定の責任を持つ人(通常は業務部門の責任者)、データスチュワードはその決定を日々の運用に落とす人(通常は業務側の実務者)、データカストディアンはデータを技術的に保管・処理・保護する人(通常は情報システム部門)です。
CDO(最高データ責任者)は、全社のデータに関する方針と体制の責任者です。役職名としての CDO を置いていない会社でも、この役割を担う人は要ります。役員の誰か、たとえば情報システム担当の役員や経営企画担当の役員が兼ねる形が考えられます。大事なのは、部門をまたぐデータの対立(たとえば営業部門と経理部門で「売上」の定義が違う)が起きたときに、最終的に決める人が1人決まっていることです。この役割が空いていると、部門どうしの合意が取れない論点はすべて先送りになります。
| 役割 | 主な責任 | 担う人の例 | 決めること | 決めないこと | 兼務の例 |
|---|---|---|---|---|---|
| CDO(最高データ責任者) | 全社のデータの方針と体制の責任。部門間の対立の最終判断 | 専任の CDO、または情報システム担当・経営企画担当の役員 | 原則とポリシーの承認(委員会の上申を受けて)、委員会で合意できない対立の裁定、役割の任命 | 個々の項目の定義や品質の水準(委員会で合意できないときに委員長として裁定する場合を除く) | CIO(最高情報責任者)・CDO の兼任、DX 推進担当の役員 |
| データガバナンス委員会 | 部門をまたぐデータの決定、原則とポリシーの審議と CDO への上申、進み具合の確認 | CDO(委員長)、主要部門のデータオーナー、情報システム部門の責任者、事務局 | 標準の承認、部門をまたいで使う項目の定義、全社に影響する例外の承認、優先して取り組む対象 | 部門の中で完結する定義や提供 | 既存の DX 推進会議や IT 投資委員会の議題の一部 |
| データオーナー | 担当するデータの定義・用途・品質の水準・提供の可否の決定 | そのデータを使う業務部門の部長級 | 部門の中で完結する定義、その部門の中だけで使う品質基準、提供の可否、部門内の例外 | システムの実装の方法、部門をまたぐ定義の最終決定 | 部門長の通常業務の一部(決定の権限と時間を明示する) |
| データスチュワード | 定義の維持、品質の監視、問い合わせの対応、データオーナーへの起案 | 業務部門の実務者(業務とデータの両方が分かる人) | 決定の案、日々の運用の判断 | 定義や基準の最終決定 | 業務の担当者が業務時間の一部で担う |
| データカストディアン | 保管・処理・保護・アクセス権の設定・バックアップ | 情報システム部門、または委託先の運用担当 | 技術的な実装の方法、運用の手順 | データの意味や提供の可否 | システムの運用担当が兼ねる |
| データアーキテクト | 全社のデータの配置と流れの設計、システム変更の影響の確認 | 情報システム部門の設計の担当 | データモデルと連携の標準の案(承認は委員会)、システム変更の技術的な承認 | 業務上の定義 | 情報システム部門の責任者や設計担当が兼ねる |
| 事務局 | データガバナンス委員会の運営、課題の管理、文書の維持 | CDO を補佐する担当者(経営企画・情報システム部門など) | 議題の整理、担当の割り当て | 定義や基準や例外の可否 | 立ち上げ期は兼務で置くことが多い。経営企画や DX 推進の担当者が兼ねる形など |
表の「決めないこと」の列は、役割の境界をはっきりさせるために入れました。データカストディアンは、データを技術的に守る責任を持ちますが、そのデータを部門の外や社外に出してよいかは決めません。業務上の利用の可否を決めるのはデータオーナーで、データカストディアンは承認された範囲でアクセス権を設定します。社外への提供では、これとは別に、個人情報の扱いや情報セキュリティについて社内で定めた確認も受けます(第8章で扱います)。この線を引いておかないと、情報システム部門が「念のため」に提供を止めたり、逆に依頼のままに提供したりして、責任の所在が情報システム部門に寄っていきます。データガバナンスを情報システム部門の仕事と誤解する状態は、こうした線引きの欠如から生まれることが多いように思います。
多くの会社では、これら6つの役割を専任の人で埋めることはできません。中堅以下の会社なら、CDO は役員の兼務、データオーナーは部門長の兼務、データスチュワードは業務担当者の兼務になるのが普通だと思われます。兼務そのものは問題ではありません。問題になるのは、兼務の人に役割を任命しただけで、使える時間と決める権限を与えないことです。データスチュワードを任命しても、その人の評価が従来の業務の成果だけで決まるなら、スチュワードの仕事はいつまでも後回しになります。兼務にするときは、任命の文書に「業務時間のうちどの程度をこの役割に充てるか」「どの決定を起案できるか」を書き、上司である部門長がそれを承知していることを確かめておくのが有効だと考えています。
もう1つの現実は、1人が複数の役割を兼ねる場合です。情報システム担当が1人しかいない会社では、その人がデータカストディアンとデータアーキテクトを兼ね、場合によってはデータスチュワードの役も負います。このとき、役割の表で列を分けておく意味は残ります。同じ人であっても「いまはシステムの都合を言っているのか、業務の定義について起案しているのか」を本人と周囲が区別できると、技術の都合で業務上の定義が決まってしまうことを避けやすくなります。小規模な会社の縮小版の体制は、第13章で扱います。
会議体、データガバナンス委員会とワーキンググループ
役割を決めたら、その人たちが集まって決める場を決めます。データガバナンスの会議体は、二層に分けると設計しやすくなります。上の層はデータガバナンス委員会で、全体の地図の用語の表のとおり、標準の承認、部門をまたぐ定義の決定、全社に影響する例外の承認を行い、原則とポリシーの案を審議して CDO に上申する会議体です。一般に運営委員会と呼ばれる位置の会議体ですが、本コラムではデータガバナンス委員会と呼びます(立ち上げ方は第13章で扱います)。下の層は、特定のデータや論点について、定義・品質・標準の案を作る作業の場で、ここではワーキンググループと呼びます。顧客データのワーキンググループ、商品データのワーキンググループのように、データの主題ごとに置くのが典型的な形です。
データガバナンス委員会に入れる議題は、部門をまたぐもの、標準の承認、原則とポリシーの審議と CDO への上申、優先して取り組む対象の決定、進み具合と指標の確認に絞ります。部門の中で完結する定義の決定や、個々の品質の不具合の対応まで委員会に上げると、委員会が作業の場になり、出席者である部門長の時間を消費するだけの会議になります。逆に、ワーキンググループで決められない論点、つまり部門の利害が対立するものは、期限を決めて委員会に上げる、という経路を作っておきます。
| 会議体 | 頻度の目安 | 出席者 | 議題の例 | 決められること | 成果物 |
|---|---|---|---|---|---|
| データガバナンス委員会 | 四半期に1回程度(立ち上げの初年度は月1回程度) | CDO(委員長)、主要部門のデータオーナー、情報システム部門の責任者、事務局 | 原則とポリシーの審議、標準の承認、次の四半期に取り組む対象、部門をまたぐ定義、指標の報告、全社に影響する例外 | 標準の承認、部門をまたいで使う項目の定義、全社に影響する例外の承認、優先順位、原則とポリシーの CDO への上申。委員会で合意できない対立は委員長の CDO が裁定する | 議事録と決定の一覧、次回までの宿題 |
| ワーキンググループ(主題ごと) | 2週間〜1か月に1回 | その主題のデータオーナーの代理、データスチュワード、データカストディアン、必要に応じてデータアーキテクト | 定義の案、品質ルールの案、不具合の原因と対策、問い合わせの傾向 | 定義・品質基準・標準の起案、部門内の運用の決定 | 用語集の更新、品質の報告、委員会への上申事項 |
| 事務局の定例 | 週1回程度 | 事務局(CDO の補佐)、主要なデータスチュワード | 課題の一覧の更新、例外申請の受付、問い合わせの振り分け | 議題の整理、担当の割り当て | 課題の一覧、委員会の議題案 |
表の頻度はいずれも目安で、決めるべき論点の量で変わります。立ち上げの初年度は決めることが多いので、データガバナンス委員会を月1回程度にし、軌道に乗ったら四半期に1回程度へ減らす、という運び方が考えられます。会議体を新しく作らず、既にある DX 推進会議や IT 投資委員会の議題の一部としてデータガバナンス委員会の機能を持たせる形でもかまいません。その場合も、データガバナンスの議題を毎回の固定の枠として置き、決定の記録を別に残しておくと、他の議題に押されて消えることを防げます。
会議体で特に注意したいのは、事務局の存在です。委員会とワーキンググループだけを決めて事務局を置かないと、議題の準備、決定の記録、宿題の追跡を誰も担わず、会議が開かれるたびに前回の決定を確かめ直すことになります。事務局は CDO の補佐として、専任でなくてもよいので、担当者を名指しで決めておくことが有効だと考えています。
日々の運用、課題管理・例外承認・変更管理・問い合わせ窓口
文書と役割と会議体がそろっても、それを日々動かす手順が無いと、ガバナンスは会議の中だけのものになります。日々の運用で最低限必要なのは、課題管理・例外承認・変更管理・問い合わせ窓口の4つだと考えています。どれも新しい仕組みを要するものではなく、既に業務で使っている課題管理の道具や申請の様式に、データガバナンスの項目を加える形で始められます。
課題管理は、データについての問題(定義の食い違い、品質の不具合、持ち主が不明なデータ)を1つの一覧に記録し、担当と期限と状態を追うことです。一覧が無いと、同じ問題が別々の部門から別々に持ち込まれ、それぞれの場で場当たりに処理されます。一覧には、問題の内容、影響を受ける業務、担当のデータスチュワード、決定が要る場合の A(誰が決めるか)、期限、状態を書きます。委員会の議題は、この一覧から部門をまたぐものを拾って作ります。
例外承認は、ポリシーや標準に沿えない事情があるときに、期限と条件を付けて認める手順です。古いシステムが標準の日付形式に対応できない、取引先の都合で標準と違うコードを使う必要がある、といった例外はどの会社でも出てきます。例外を認める手順が無いと、現場はルールを黙って破るか、ルールに合わせるために業務を止めるかのどちらかになります。例外には必ず期限を付け、期限が来たら解消したか、延長するかを判断します。期限の無い例外は、時間がたつと事実上の別の標準になります。
変更管理は、定義・標準・データを持つシステムを変えるときに、影響を確かめてから変える手順です。たとえば「有効な顧客」の定義を変えると、それを使っている報告や指標の値が変わる可能性があります。変更の前に、どの報告や連携がその定義を使っているかを確かめ、変更前後の値を一定期間並べて示し、利用部門に知らせてから切り替えます。どこでその項目が使われているかを確かめるには、データの経路の記録が要ります(データリネージは第6章で扱います)。
問い合わせ窓口は、「このデータの意味は何か」「このデータを使ってよいか」「数字が合わないのはなぜか」といった問いを受ける入口です。窓口が無いと、問い合わせは知っていそうな人個人に集まり、その人が異動すると答えられる人がいなくなります。窓口を1つにし、受けた問いを担当のデータスチュワードに振り分け、答えを用語集やよくある質問と回答の一覧(FAQ)に残す、という流れにすると、同じ問いに何度も答える手間が減り、どの定義が分かりにくいかも見えてきます。
| 運用の仕組み | 無いと起きること | 最小の始め方 | 担当(R) | 決める人(A。決定の種類ごとに1人) |
|---|---|---|---|---|
| 課題管理 | 同じ問題が別々に持ち込まれ、場当たりに処理される | 既存の課題管理の道具に、データの課題の一覧を1つ作る | 事務局・データスチュワード | 課題ごとに RACI の表に従う |
| 例外承認 | ルールが黙って破られるか、業務が止まる | 申請の様式(理由・範囲・期限・代わりの対策)を1枚作る | 申請者・データスチュワード | 部門内はデータオーナー、全社に影響するものはデータガバナンス委員会 |
| 変更管理 | 定義やシステムの変更で、報告の値が予告なく変わる | 変更の申請に「影響を受ける報告・連携」の欄を設ける | データカストディアン・データスチュワード | 部門の中で完結する定義はデータオーナー、部門をまたぐ定義はデータガバナンス委員会、システムはデータアーキテクト |
| 問い合わせ窓口 | 問い合わせが特定の個人に集まり、異動で答えられなくなる | 窓口を1つ決め、答えを用語集や FAQ に残す | 事務局・データスチュワード | 答えに定義の決定が要る場合、部門の中で完結する定義はデータオーナー、部門をまたぐ定義はデータガバナンス委員会 |
体制の型、集中型・分散型・連邦型
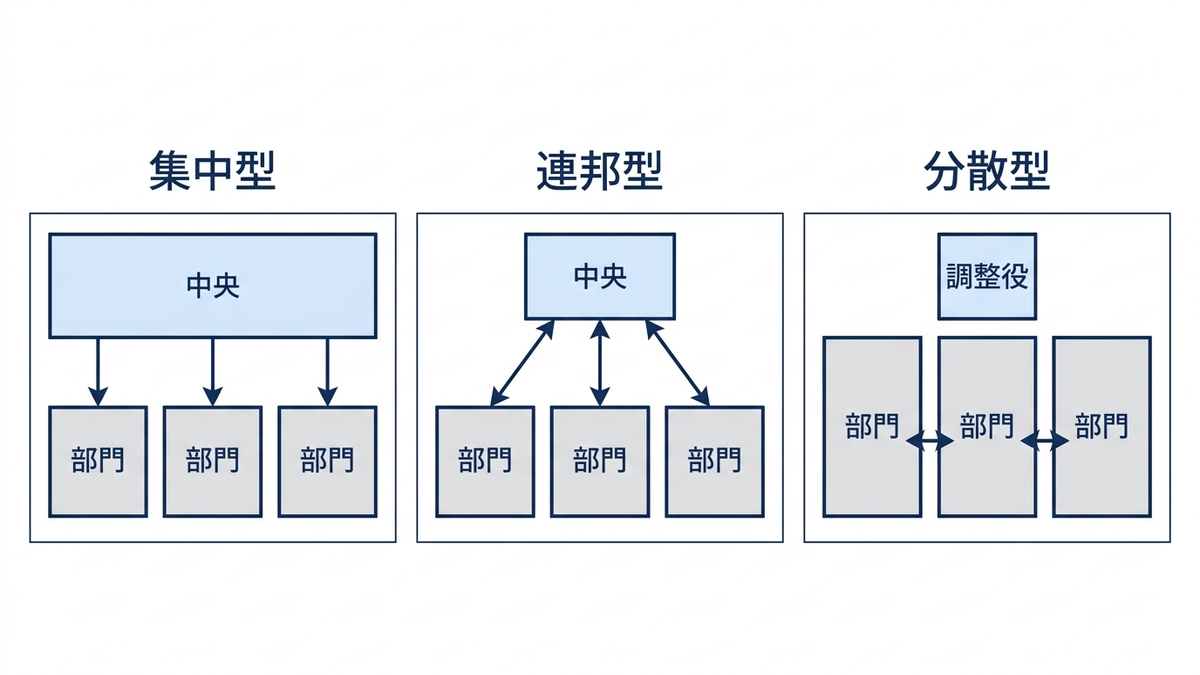
役割と会議体をどう配置するかには、いくつかの型があります。ここでは、意思決定と実務の担い手がどこにいるかで、集中型・分散型・連邦型の3つに分けて考えます。これは本コラムの整理で、どの型が正しいということはなく、会社の規模、事業の多様さ、データの使われ方によって向き不向きがあります。
集中型は、全社のデータガバナンスを1つの中央の組織(データ管理部門や CDO の直轄の組織)が担う形です。定義や標準を中央で決め、各部門はそれに従います。全社で定義をそろえやすく、決定が速い一方で、中央の組織が各事業の業務を十分に理解していないと、現場に合わない定義が決まり、各部門が独自の定義を裏で使い続ける事態を招きます。事業の種類が少なく、全社で同じデータを使う場面が多い会社に向いています。
分散型は、各事業部門がそれぞれのデータを自分で管理し、全社の中央の組織を持たないか、持っても調整役にとどめる形です。各部門の業務に合った定義と運用ができる一方で、部門をまたいでデータを使おうとすると、定義も形式も違っていて突き合わせに手間がかかります。事業ごとの独立性が高く、部門をまたいでデータを使う場面が少ない会社では、部門間の定義や形式の不一致による支障は比較的小さく済みます。ただし、個人情報の扱いのように全社で共通に守るルールと、その確認の方法は、この型でも別に要ります。
連邦型は、両者の中間です。中央の組織が原則・ポリシーと、全社で共通に使うデータ(顧客・商品・取引先のマスターデータや、経営の基本指標)の標準を決め、それ以外は各部門のデータオーナーとデータスチュワードに任せます。全社でそろえる範囲と部門に任せる範囲を明示する必要があり、その線引きの合意に時間がかかりますが、多くの事業を持つ会社では現実的な形になりやすいと考えています。どこまでを全社でそろえるかの考え方は、データアーキテクチャの観点から第4章で扱います。
| 型 | 決める場所 | 実務の担い手 | 向いている会社 | 起きやすい問題 | 問題への手当て |
|---|---|---|---|---|---|
| 集中型 | 中央の組織(CDO の直轄など) | 中央の組織のスチュワード | 事業の種類が少ない。全社で同じデータを使う場面が多い。中小規模 | 現場に合わない定義が決まり、部門が裏で独自の定義を使い続ける | 定義の起案に業務部門のスチュワードを必ず入れる |
| 分散型 | 各事業部門 | 各部門のスチュワード | 事業ごとの独立性が高い。部門をまたぐデータ利用が少ない | 部門をまたぐ集計で定義と形式が合わず、突き合わせに手間がかかる | 最低限の共通の用語と形式だけを全社で決める |
| 連邦型 | 原則と共通データは中央、それ以外は各部門 | 中央の事務局と、各部門のスチュワード | 複数の事業を持つ。共通のマスターデータと、事業ごとのデータの両方がある | どこまでを全社でそろえるかの線引きで揉める | 全社でそろえるデータの一覧を委員会で承認し、年1回見直す |
型は一度選んだら固定されるものではありません。最初は集中型で始めて定義と標準の骨格を作り、部門のスチュワードが育ってきたら連邦型へ移す、という移り方も考えられます。逆に、分散型で運用してきた会社が、全社の経営指標をそろえる必要から、共通データの定義と標準を決める権限だけを中央へ集める形で連邦型へ寄せることもあります(データの保管場所を中央へ集めることとは別の話です)。型の名前を決めることより、「どのデータを誰が決めるか」の一覧を持ち、事業の変化に合わせてその一覧を見直すことの方が大事だと考えています。
ガバナンスの成果をどう測るか
データガバナンスの仕組みを作っても、それが効いているかを測る手段が無いと、経営は投資を続けるかどうかを判断できません。会議の開催回数や承認した文書の数は、活動の量を表すだけで、データが使いやすくなったかを表しません。測りたいのは、決定権と役割が実際に働いているか、データの定義と品質が改善しているか、利用者がデータを使いやすくなったか、の3つです。
指標は、範囲を絞って少数から始めるのが有効だと考えています。最初の対象を顧客データに絞ったなら、指標も顧客データについてだけ測ります。次の表は、3つの観点ごとに指標の例を挙げたものです。目標値は会社の状況で決まるので、ここでは書きません。最初の測定値を基準として残し、そこからの変化を四半期ごとに見る使い方を想定しています。
| 観点 | 指標の例 | 測り方 | この指標で分かること | 注意点 |
|---|---|---|---|---|
| 役割と決定権が働いているか | 重要なデータのうち、データオーナーとデータスチュワードが任命されている割合 | 対象データの一覧のうち、両方の名前が埋まっている行の割合 | 決める人が空いているデータがどれだけ残っているか | 名前が埋まっていても活動していない場合がある。下の解決日数と併せて見る |
| 役割と決定権が働いているか | 課題の解決日数(中央値) | 課題の一覧の、解決済みの課題の登録日から解決日までの日数 | 決定が滞っていないか | 解決済みの課題だけで測るので、難しい課題を残したままでも見かけ上短くなる。登録件数と、未解決の件数・経過日数も併せて見る |
| 定義と品質が改善しているか | 定義済みのデータ項目の割合 | 対象データの項目のうち、用語集に承認済みの定義がある項目の割合 | 意味があいまいな項目がどれだけ残っているか | 定義の数ではなく、よく使われる項目から埋まっているかを見る |
| 定義と品質が改善しているか | 品質ルールの合格率 | 決めた品質ルール(必須項目の入力、形式、重複など)ごとに、対象の件数のうち合格した件数の割合 | 品質の水準が上がっているか | ルールの追加や対象の範囲の変更で値が動く。時期を比べるときは同じルールと同じ対象で比べ、ルールの数と併せて見る(品質ルールの作り方は第5章) |
| 利用者が使いやすくなったか | 問い合わせの解決日数と件数 | 問い合わせ窓口の記録 | 利用者が答えを得るまでの時間 | 件数の増加は、窓口が知られた結果であることもある |
| 利用者が使いやすくなったか | 経営報告での数字の食い違いの件数 | 会議で「どちらの数字が正しいか」の確認が必要になった件数を事務局が記録 | 経営判断の場で定義の確認に時間を使っていないか | 記録の基準を事務局で決めておく |
表の最後の行は、経営層に最も伝わりやすい指標だと考えています。経営会議で、営業部門と経理部門の「売上」が違い、どちらが正しいかの確認で議論が止まる、という経験を持つ経営者は多いと思われます。その件数が減っていくことは、データガバナンスの効果を、データの専門家でない人にも分かる形で示します。反対に、指標を増やしすぎると、測ること自体が目的になり、スチュワードの時間を指標の集計に奪います。最初は3〜5個に絞り、委員会で毎回同じ形で報告するのが扱いやすいと考えています。
公開事例、関西電力のデータマネジメント体制
役割と体制を全社で整えた公開事例として、関西電力株式会社を取り上げます。一般社団法人日本データマネジメント・コンソーシアム(JDMC)は、2025年3月5日付の報道発表資料で、12回目となる2025年のデータマネジメント賞の受賞企業を発表し、関西電力が大賞を受賞しました。以下は、この報道発表資料(2026年10月22日に確認)に書かれている範囲の紹介です。
報道発表資料によると、関西電力は、DMBOK に基づくデータマネジメントの通達を制定し、CDO(最高データ責任者)を筆頭に、全社と各事業部門にデータスチュワードを配置しました。そのうえで、データのニーズの管理から収集・加工・蓄積・利活用・廃棄までを一元管理する体制を作ったとされています。さらに、ガバナンスの体制、役割の定義、リスク管理までを包括的に実施することで、データの質と一貫性を担保した、と書かれています。成果として、AI などを活用した DX の実用化案件が累計478件となり、2024年度の効果額は約300億円に上る見込みであると記されています。
この章の部品に照らすと、報道発表の文面から読み取れるのは、DMBOK に基づく社内の通達という文書、全社の責任者としての CDO、全社と各事業部門の両方に置いたデータスチュワード、という3つの要素です。一方で、資料には各事業部門にどこまでの決定を任せているかは書かれていないので、この章の集中型・分散型・連邦型のどれに当たるかは、この資料からは判断できません。同様に、データオーナーに当たる役割をどう置いているか、会議体の構成や頻度、スチュワードの人数や兼務の有無も、この報道発表資料には書かれていません。効果額の約300億円は2024年度の見込みとして書かれた数字で、データマネジメントの体制だけが生んだ効果として切り出された数字ではありません。資料の文面は、データマネジメントを AI の基盤と位置づけ、その結果として実用化案件と効果額を挙げる構成になっています。
この事例から自社の体制づくりに照らせるのは、報道発表に書かれている体制の要素そのものです。文書としての社内の通達、全社の責任者としての CDO、全社と各事業部門の両方に置いたデータスチュワード、データのニーズの管理から廃棄までを扱う一元管理の体制、そしてガバナンスの体制・役割の定義・リスク管理の包括的な実施、という要素は、この章で扱った文書・役割・運用の部品と対応づけて読めます。これらをどの順に整えたか、どれだけの期間をかけたかは、報道発表資料には書かれていないので、この事例から導入の順序を読み取ることはできません。データガバナンスと AI の活用の関係は、第11章で扱います。JDMC のデータマネジメント賞の他の受賞企業と、事例から見える定着の条件は、第14章で扱います。
経営判断、最初に置く役割は何か
ここまでの部品をすべて一度にそろえる必要はありません。経営として最初に決めるのは、文書でも会議体でもなく、2つの役割だと考えています。1つは、全社のデータについて最終的に決める人、つまり CDO の役割を担う人です。もう1つは、最初に対象とするデータのデータオーナーです。この2人が決まると、部門をまたぐ対立の行き先と、対象データの定義と品質の決定の行き先が決まり、それ以外の部品(スチュワード・会議体・文書・指標)はこの2人の決定として順に整えられます。
逆に、この2つの役割を決めずに、ポリシーの文書やデータカタログの導入から始めると、誰も承認しない文書と、誰も持ち主を書き込まないカタログが残ることが多いように思います。経営上の損失の型で言えば、決める人がいないことの損失は「判断の遅れ」として表れます。部門をまたぐ定義の対立が先送りされ、その間、経営会議では部門ごとに別の数字が並び続けます。システムを部門ごとに作り直すたびに同じデータの整備が繰り返されれば「二重投資」になり、AI の活用の案件ごとにデータの準備をやり直せば、準備の費用が膨らみ実用化が遅れて投資の効果を得にくくなり、「AI 投資の空振り」に近づきます。
予算と体制に落とすときは、次の3点を経営として決めておくのが有効だと考えています。1点目は、CDO の役割を担う人を役員の中から名指しで決め、その人に部門間の対立を裁定する権限があることを社内に示すことです。2点目は、最初に対象とするデータを1つか2つに絞り、そのデータオーナーとデータスチュワードを任命し、スチュワードの業務時間の一部をこの役割に充てることを、その上司の部門長と合意することです。3点目は、四半期ごとに委員会からの報告を受ける場を経営会議の中に設け、指標の変化を見て、対象の拡大や体制の型の見直しを判断することです。どの部門から、何を、どの順で整えるかの具体的な計画は、第13章で扱います。
この章では、データガバナンスの仕組みを、原則・ポリシー・標準・手順の文書の層、RACI で書く意思決定権、CDO・データガバナンス委員会・データオーナー・データスチュワード・データカストディアン・データアーキテクトの役割と事務局、データガバナンス委員会とワーキンググループの会議体、課題管理・例外承認・変更管理・問い合わせ窓口の日々の運用、集中型・分散型・連邦型の体制の型、そして成果の指標に分けて整理しました。取りかかる順序としては、ルールの文書より先に、決める人と決める範囲を固めることが要点です。次の第4章では、こうして決めた役割が判断の対象とする、全社のデータの配置と流れの見取り図、つまりデータアーキテクチャとデータモデリングを扱います。
この章を深めたい方への参考書籍
『成果を生む攻めのデータガバナンス データを経営資産に変える仕組みづくり』(小林靖典 著、翔泳社):データを守りの管理の対象としてだけでなく、経営の成果につなげる資産として扱うための仕組みを解説した本です。出版社の紹介では、戦略・組織・実行の三層を軸に、IT 部門と業務部門をつなぐ仕組みを整理し、データガバナンスの組織・役割・統制・運営・評価を扱う章と、テーマ別の実践事例の章があります。この章で扱った役割・会議体・指標を、自社の文書のひな型に落とすときの材料になります。
『データスチュワードシップ データマネジメント&ガバナンスの実践ガイド』(David Plotkin 編著、Metafindコンサルティング株式会社 監訳、日経BP):原著第2版の翻訳で、データスチュワードの種類、役割と責任、導入の方法、業務側のスチュワードの研修、進み具合の計測を扱った本です。この章でデータオーナーとデータスチュワードの分担や兼務の扱いを考えるときに、スチュワードの側から詳しく掘り下げる材料になります。
第4章 データアーキテクチャとデータモデリング、全社データの見取り図
第3章では、原則・ポリシー・標準・手順の階層と、データオーナー・データスチュワード・データカストディアンの責任分担、会議体の置き方を整理しました。役割と意思決定の場が決まっても、決める対象である「全社のデータ」がどこにあり、どう流れ、どの言葉で呼ばれているかが見えていなければ、データオーナーは自分が何の持ち主なのかを答えられません。この章では、全社のデータの見取り図を作る2つの道具を扱います。1つは、データの配置と流れを描くデータアーキテクチャ、もう1つは、個々のデータの構造と意味を描くデータモデリングです。DMBOK もこの2つを別々の知識領域として扱っており、日本語版の目次でも「データアーキテクチャ」と「データモデリングとデザイン」は別の章になっています。本コラムでは、両者を「見取り図を作る」という1つの目的のもとで続けて説明します。この章にコードはありません。図の読み方は表と文で説明します。
データアーキテクチャが決めること
本コラムでは、データアーキテクチャを「企業全体のデータが、どのシステムに置かれ、どの経路で流れ、どこで使われるかを示した設計図」と定義して使います。建物にたとえると、部屋ごとの家具の配置ではなく、どの階に何の部屋があり、廊下と配管がどうつながっているかを示した平面図に当たります。個々のシステムの設計書は部屋の図面で、データアーキテクチャはそれらを1枚に重ねた全体図です。
この設計図が答える問いは、大きく分けて4つあります。1つ目は、会社が扱うデータにどんな種類があるか(主題の一覧)です。2つ目は、それぞれのデータが最初にどの業務システムで生まれ、どのシステムが正本を持っているか(配置)です。3つ目は、データがどのシステムからどのシステムへ、どの頻度で、どの方法で渡っているか(流れ)です。4つ目は、全社でそろえる約束事は何か(標準)です。ここでいう正本とは、同じデータが複数の場所にあるときに「食い違ったらこちらを正とする」と、データの種類や項目ごとに決めた情報源のことです。複製を持たないという意味ではありません。
設計図が無いと起きることは、経営の目から見ると次の3つの型に整理できます。1つ目は二重投資です。同じ顧客データを、営業部門は顧客管理のツールに、経理部門は請求のシステムに、マーケティング部門は配信のツールに、それぞれ別々に持ち、同じ目的の整備や連携の仕組みを、部門の間で調整しないまま別々に作るという形で起きます。2つ目は集計の食い違いです。正本が決まっていないと、同じ「今月の顧客数」が報告の出どころによって変わり、会議の時間が数字の突き合わせに使われます。3つ目は判断の遅れです。新しい施策や AI の導入を検討するたびに「そのデータはどこにあるのか」「誰に聞けばよいのか」を一から調べることになり、検討を始めるたびに、その調査に時間がかかります。
一方で、データアーキテクチャは大企業だけのものではありません。業務システムが3つしかない会社でも、顧客の情報が販売管理と会計と表計算ファイルの3か所にあれば、どれが正本かを決める必要があります。規模が小さいうちは、設計図はホワイトボードに描ける程度の1枚で足ります。逆に、業務システムが1つしかなく、外部とのデータ連携も無い段階では、配置と流れを描く必要性は低く、後で述べる命名と標準だけを先に決めておけば十分なことが多いと考えています。
主題領域の一覧を作る
見取り図の最初の1枚は、会社が扱うデータを大きな種類に分けた一覧です。本コラムでは、この大きな種類を主題領域と呼びます。顧客・商品・取引・従業員・会計のように、業務の担当者が日常的に使う名詞で、会社のデータを10〜20個程度のまとまりに分けたものです。システムの名前(販売管理システム、会計システム)で分けるのではなく、データが表している対象で分けるのが要点です。システムで分けると、同じ顧客の情報が3つのシステムに分かれて載っていることが一覧から見えなくなるからです。
主題領域の一覧には、領域の名前だけでなく、その領域に含まれる代表的なデータ、データが主に生まれる業務システム、データオーナーの候補となる部門を並べて書きます。次の表は、物を仕入れて販売する一般的な会社を想定した一例です。業種によって領域の名前と数は変わりますが、列の構成はそのまま使えます。
| 主題領域 | 代表的なデータ | データが主に生まれる業務システム | データオーナーの候補 |
|---|---|---|---|
| 顧客 | 顧客の名称・連絡先・契約の状態・担当者 | 顧客管理、販売管理、問い合わせ管理 | 営業部門の責任者 |
| 商品 | 商品コード・名称・分類・単価・仕様 | 商品管理、販売管理 | 商品企画部門の責任者 |
| 取引 | 受注・出荷・請求・入金の記録 | 販売管理、会計 | 営業管理部門の責任者 |
| 取引先 | 仕入先・委託先の名称・所在地・取引条件 | 購買管理、会計 | 購買部門の責任者 |
| 在庫 | 拠点別・商品別の在庫数・入出庫の記録 | 在庫管理、倉庫管理 | 物流部門の責任者 |
| 従業員 | 所属・役職・勤怠・資格 | 人事、勤怠管理 | 人事部門の責任者 |
| 会計 | 勘定科目・仕訳・予算・実績 | 会計、予算管理 | 経理部門の責任者 |
| 組織・拠点 | 部署・拠点の名称と階層、改組の履歴 | 人事、会計 | 経営企画部門の責任者 |
この一覧を作るときに起きやすい誤りは2つあります。1つは、領域を細かく分けすぎることです。「法人顧客」「個人顧客」「見込み客」を別の領域にすると、同じ相手が見込み客から顧客に変わったときにどちらの持ち主が管理するのかが決まりません。最初は大きく分け、領域の中の区分として扱う方が、持ち主を決めやすくなります。もう1つは、一覧をシステム部門だけで作ることです。主題領域は業務の言葉で決めるものなので、各部門の実務者に「あなたの部門が毎日扱っている名詞は何か」を聞き取り、そこから束ねていく方が、業務の側が自分の一覧として受け入れやすくなります。
表の「データオーナーの候補」の列は、第3章で決めた役割をこの一覧に結びつけるためのものです。主題領域ごとに持ち主の候補が1人ずつ決まれば、ガバナンスの会議で「顧客の定義を変えたい」という議題が出たときに、誰の承認が要るかがすぐに分かります。1つの領域に持ち主の候補が2部門以上並ぶ場合は、それ自体が最初に会議体で決めるべき論点になります。持ち主を決める考え方は第3章、顧客や商品のように複数の業務で共通に参照するデータを1件にそろえる方法は第7章で扱います。
データフロー図で流れを描く
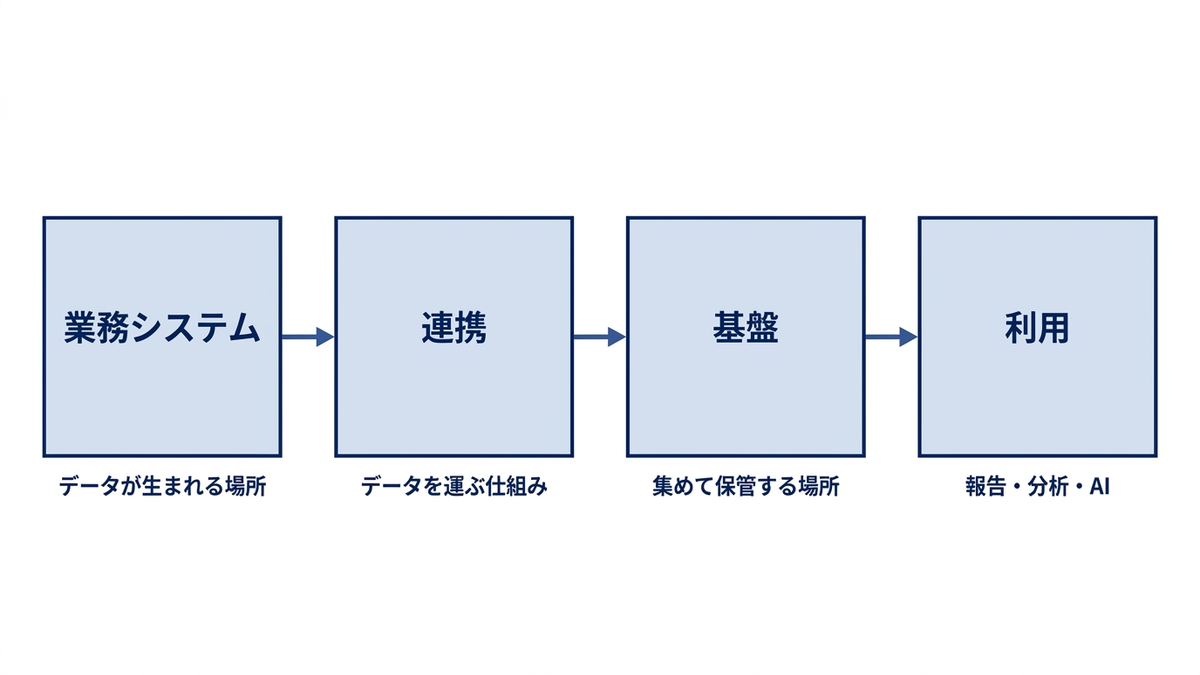
主題領域の一覧が「何があるか」を示すのに対して、データフロー図は「どこからどこへ流れるか」を示します。本コラムでは、左から右へ4つの段を並べる描き方を例に説明します。左端に業務システム(データが生まれる場所)、その右に連携(ファイルの受け渡し・API・データベースの複製など、データを運ぶ仕組み。API はシステムどうしがデータをやり取りするために決められた窓口のことで、詳しくは第9章で扱います)、その右に基盤(複数のシステムのデータを集めて保管する場所。代表的なものが、分析に使うデータを集めて整えて置いておくデータウェアハウスで、これも第9章で扱います)、右端に利用(帳票・ダッシュボード・分析・AI。ダッシュボードは主要な数字を1画面にまとめて表示するものです)を置き、それぞれの間を矢印で結びます。
矢印には、少なくとも3つのことを書き添えます。何の主題領域のデータが流れているか、どの頻度か(日次・月次・即時)、どの方法か(ファイル・API・手作業)です。特に「手作業」の矢印は、目立つように書いておく価値があります。担当者が毎朝ファイルを出力して別のシステムに取り込んでいる、表計算ファイルで加工してから基盤に入れている、といった経路は、担当者の異動や休暇で止まりやすく、加工の手順や変更の履歴を残す運用が無ければ、途中で定義が変わっても追えなくなります。設計図を描いてみると、こうした手作業の経路が想像以上に多く見つかる場合があります。
データフロー図は、全システムを一度に網羅しようとすると、完成までに時間がかかりやすくなります。最初の1枚は、経営報告に使われている数字を1つ選び、その数字が右端の帳票に出るまでに通る経路だけを左へたどって描くのが現実的だと考えています。たとえば「月次の売上」を選べば、販売管理、会計、連携のファイル、基盤の集計表、報告書という経路が描けます。この1本の経路を描くだけでも、売上の数字が2つの経路から別々に集計されていると分かる場合があります。データがどこから来てどう加工されたかを項目の単位で記録する仕組み(データリネージ)は第6章で、連携と基盤の設計そのものは第9章で扱います。
概念・論理・物理の3つのデータモデル
データアーキテクチャが全社の配置と流れを描くのに対して、データモデルは、対象とする業務の範囲について、「何を記録の単位とし、それぞれにどんな項目があり、単位どうしがどう関係しているか」を描きます。1つの主題領域の中だけでなく、顧客と取引のように複数の主題領域をまたぐ関係も扱います。データモデルは、誰に向けて何を決めるために描くかによって、概念・論理・物理の3つの段階に分けて描かれることが一般的です。段階の名前と境界の引き方は、方法論や書籍によって少しずつ違いますが、ここでは実務で使い分けるための目安として説明します。
概念データモデルは、業務の言葉で「会社が記録すべきものは何か」と「それらがどう関係するか」だけを描いたものです。たとえば「顧客は注文をする」「注文には商品が含まれる」という関係を、箱と線で示します。項目の細かい一覧や、データの形式は描きません。読み手は経営層と業務部門で、目的は、業務の範囲と言葉の意味について合意することです。主題領域の一覧が全社の目次だとすると、概念データモデルは、目次の項目の中と項目どうしの間で、何と何がつながっているかを示す図になります。
論理データモデルは、概念データモデルの各要素に、項目(属性)と、1件を見分けるための識別子と、関係の多重度(1対1・1対多・多対多など)を書き足したものです。どのデータベース製品を使うかには依存しません。読み手は業務の担当者とシステムの設計者で、目的は「顧客を見分ける番号は何か」「1件の注文に複数の商品を対応づけてよいか」といった業務の規則を、漏れなく正確に書き出すことです。業務の規則の誤りは、プログラムを書く前のこの段階で書き出しておくと見つけやすくなります。
物理データモデルは、論理データモデルを、特定のデータベースで実際に作る表の設計に落としたものです。以下では、表の形でデータを管理するリレーショナルデータベースを例に説明します。表の名前と列の名前、データ型(数値・文字・日付といった値の種類)、文字数の上限、索引(検索を速くするために作る、本の索引のような仕組み)、性能のための分割などを決めます。読み手は開発と運用の担当者です。同じ論理データモデルからでも、使う製品や性能の要件によって、表の分け方が変わることがあります。
| 段階 | 描くもの | 主な読み手 | この段階で決めること | この段階を飛ばすと起きること |
|---|---|---|---|---|
| 概念データモデル | 記録すべき対象と、対象どうしの関係 | 経営層・業務部門の責任者 | 業務の範囲と言葉の意味。主題領域の境界 | 部門ごとに「顧客」の範囲が違ったまま開発が進み、完成後に集計が合わない |
| 論理データモデル | 項目・識別子・関係の多重度 | 業務の担当者・システムの設計者 | 1件を見分ける番号、必須の項目、業務の規則 | 業務の規則がプログラムの中に埋もれ、変更のたびに調査が要る |
| 物理データモデル | 表・列・データ型・索引 | 開発・運用の担当者 | 具体的な表の設計と性能の工夫 | (設計を明示しなくても、実装上の構造はシステムの中に存在する。ただし設計の意図や制約が共有されないおそれがある) |
表の最後の列が示すとおり、物理の段階の構造は、設計書として描かれていなくても、システムを作ればどこかに存在します。リレーショナルデータベースであれば、データベースの中の表の定義がそれに当たります。問題になるのは、概念と論理の段階が作られないまま物理の段階だけがあり、業務の言葉で何を記録しているのかを誰も説明できない状態です。パッケージ製品やクラウドのサービスを使う場合は、物理データモデルを自社で設計しないことも多くなりますが、その場合でも、製品の表のどれが自社の「顧客」に当たり、どの項目が自社の「契約の状態」に当たるかを対応づけた論理の段階の整理は、自社で持つ必要があると考えています。製品を入れ替えたときに、この対応表が移行の設計図になるからです。
ガバナンスの観点から3つの段階を見ると、データオーナーが承認するのは概念と論理の段階、データカストディアンが責任を持つのは物理の段階、と分けると役割が明確になります。顧客の定義を変える、識別子の付け方を変える、といった決定は、業務の意味に関わるので、技術の側(データカストディアンやデータアーキテクト)だけで決めずに、データオーナーの承認(部門をまたいで使う定義と、全社でそろえる識別子の付け方は、データガバナンス委員会の承認)を経る対象にします。一方で、索引を足す、表を分割するといった変更は、業務の意味を変えないので、データカストディアン(設計の変更を伴う場合はデータアーキテクト)の判断で進めてよい範囲になります。項目の追加や形式の変更は、第3章のとおりデータアーキテクトが技術面を承認し、業務上の意味も変わる場合は、上の業務の側の承認(データオーナー、または部門をまたぐものはデータガバナンス委員会)も別に受けます。
ER図の読み方、顧客と注文の最小例
論理データモデルを描くときに最もよく使われる図が、ER図(実体関連図)です。ER図は、記録の単位を「実体(エンティティ)」、実体どうしのつながりを「関連(リレーションシップ)」として描きます。この考え方は、ピーター・チェン(Peter Chen)が1976年に ACM Transactions on Database Systems 誌の第1巻第1号に発表した論文で、データベース設計の道具として実体関連モデルとその図の書き方を提案したことに始まります。その後、線の端の記号の付け方にはいくつかの流儀が生まれましたが、読み方の基本は共通しています。
ここでは、最小の例として「顧客」と「注文」の2つの実体を考えます。いずれも説明のための架空の例です。顧客の実体には、顧客ID・顧客名・登録日という項目があり、注文の実体には、注文ID・注文日・顧客ID・合計の数量という項目があるとします。それぞれの項目の役割を表にすると、次のようになります。
| 実体 | 項目 | 項目の役割 | 読み方 |
|---|---|---|---|
| 顧客 | 顧客ID | 識別子(主キー) | この番号が同じなら同じ顧客、違えば別の顧客として扱う |
| 顧客 | 顧客名 | 属性 | 顧客を説明する情報。同名の別の顧客がいてもよい |
| 顧客 | 登録日 | 属性 | 顧客として登録された日 |
| 注文 | 注文ID | 識別子(主キー) | 注文1件ごとに別の番号を振る |
| 注文 | 注文日 | 属性 | 注文を受けた日 |
| 注文 | 顧客ID | 参照(外部キー) | この注文をした顧客を、顧客の実体の顧客IDで指す |
| 注文 | 合計の数量 | 属性 | 注文に含まれる商品の数量の合計 |
この2つの実体の間には、「顧客は注文をする」という関連があります。ER図では、顧客の箱と注文の箱を1本の線で結び、線の両端に「いくつ対応するか」を示す記号を付けます。この例の規則を言葉で書くと、「1人の顧客は、0件以上の注文をする」「1件の注文は、必ず1人の顧客がする」となります。これが1対多の関係です。線の顧客の側の端には「ちょうど1」、注文の側の端には「0以上の多数」を表す記号が付きます。記号の形は流儀によって違うので、社内で1つの流儀に決め、凡例を図の隅に置いておくのが無難です。
ER図を読むときは、線の両端を1つずつ言葉にしてみるのが確実です。この例なら、顧客の側から「顧客1人に対して、注文はいくつありうるか」と問い、「0件でもよいし、何件でもよい」と読みます。注文の側から「注文1件に対して、顧客は何人ありうるか」と問い、「必ず1人」と読みます。この2つの問いの答えが、業務の規則そのものです。たとえば、注文の側が「0人でもよい」になっていれば、顧客のいない注文(来店客の匿名の購入など)を記録することを認めている、ということになります。それが業務として正しいかどうかを判断するのは、システムの設計者ではなくデータオーナーです。
この小さな例からも、データモデルが業務の判断を含んでいることが分かります。「顧客IDが同じなら同じ顧客」という識別子の決め方のもとで、同じ人に別々の顧客IDを発行し、IDの件数をそのまま顧客数として集計すると、同じ人を2人として数えることになります。顧客数を経営報告に載せる会社では、この決め方が報告の数字を直接左右します。同じ相手が複数の番号で登録されている状態をどう見つけて1件にまとめるか(名寄せ)は、第7章で扱います。
命名規則と標準、コード値・日付・単位・文字コード
データモデルが決まっても、項目の名前と値の書き方がシステムごとにばらばらだと、データを突き合わせるたびに変換の作業が要ります。第3章で、ポリシーは方針、標準は守るべき仕様、手順は具体的な作業、と分けました。この節で扱うのは、そのうちの標準、とくにデータの名前と値の書き方の標準です。対象は大きく5つに分けられます。項目の名前、コード値、日付と時刻、数量と単位、文字コードです。
項目の名前の標準は、同じ意味の項目に同じ名前を付け、違う意味の項目に違う名前を付けるための約束です。たとえば、顧客を見分ける番号を、あるシステムでは「顧客番号」、別のシステムでは「得意先コード」、さらに別のシステムでは「会員ID」と呼んでいると、それらが同じものを指しているのかを毎回確かめる必要があります。命名規則として一般的なのは、項目の名前を「何についての(対象)」「何を表す(性質)」「どんな形の値か(区分)」の組み合わせで作る方法です。「顧客」「登録」「日」を組み合わせて「顧客登録日」とする、といった形です。区分を表す語(日・番号・コード・名称・数量・金額・区分・フラグなど)を一覧にして、それ以外の語を末尾に使わない、と決めておくと、名前を見ただけで値の形が分かるようになります。
コード値の標準は、「区分」や「状態」のように値の種類が決まっている項目について、使える値とその意味を一覧にしたものです。契約の状態を、あるシステムでは「1・2・3」、別のシステムでは「有効・停止・解約」で持っていると、集計のたびに対応表が要ります。コード値は、値の一覧そのものを1つの表として管理し、変更するときの承認者を決めておくのが基本です。都道府県や業種のように外部に公的なコード体系があるものは、自社で独自のコードを作らずに外部の体系を使う方が扱いやすく、取引先と同じコード体系と版を使えば、データ交換での変換を減らせます。コード表の管理と外部の標準コードは、第7章で詳しく扱います。
日付と時刻については、日本産業規格(JIS)に、情報交換のための日付及び時刻の表記を定めた JIS X 0301 があります。日本産業標準調査会(JISC)の JIS 検索で確認すると、JIS X 0301 は1970年に制定され、最新の改正は2019年5月20日、最新の確認は2024年6月20日です。社内の標準で特に決めておきたいのは、年を西暦の4桁で持つか和暦で持つか、年・月・日をどの順に並べるか、時刻を持つ場合にどのタイムゾーンの時刻か、の3つです。和暦の表示は画面や帳票の表示の段階で行い、データとしては西暦で持つ、と分けておくと、元号が変わったときにもデータの変換が要りません。時刻のタイムゾーンは、海外の拠点やクラウドのサービスとデータをやり取りする場合に、記録が日本時間か協定世界時かが項目の定義に書かれていないと、日をまたぐ集計がずれる原因になります。
数量と単位の標準は、同じ項目の値を同じ単位で持つための約束です。重さをキログラムで持つシステムとグラムで持つシステムが混在していたり、金額を税込みで持つか税抜きで持つかが項目ごとに違ったりすると、合計した値が意味を持たなくなります。単位を値と一緒に持つか、項目の定義に書いて値には持たないかを決め、項目の名前か定義のどちらかで単位が必ず分かるようにしておきます。項目ごとの単位や日付の基準は、項目の定義として第6章で扱う用語集に書き込み、定義の正本をその1か所に置きます。
文字コードは、文字をコンピュータの中でどの番号で表すかの約束です。JIS には、国際的な文字集合である UCS を定めた JIS X 0221(国際符号化文字集合)や、漢字の集合を定めた JIS X 0208・JIS X 0213 があります。JISC の JIS 検索では、JIS X 0221 は最新の改正が2020年11月20日・最新の確認が2025年10月20日、JIS X 0213 は最新の改正が2012年2月20日・最新の確認が2026年10月20日です(いずれも2026年10月22日に JISC の表示で確かめた日付です)。UCS の文字を符号化する方式の1つが UTF-8 で、インターネットの標準を定める文書の1つである RFC 3629(2003年11月)が仕様を定めています。RFC 3629 によると、UTF-8 は1文字を1〜4バイトで表し、英数字などの US-ASCII の範囲の文字は ASCII と同じ1バイトの値で表されます。古い業務システムには、日本語をシフト JIS などの別の方式で持っているものが今も残っています。方式の違うシステムの間でデータを渡すと、変換できない文字が別の文字に置き換わったり、文字化けしたりします。とくに人名や地名に使われる、集合に含まれない字(いわゆる外字)は、変換の際に失われやすい部分です。新しく作るシステムとデータの受け渡しは UTF-8 にそろえ、古いシステムとの境界で変換の規則と変換できない文字の扱いを決めておくことが有効だと考えています。
| 標準の対象 | 決めること | 参照できる公的な標準の例 | 決めていないと起きること |
|---|---|---|---|
| 項目の名前 | 同じ意味の項目に同じ名前を付ける規則。末尾に使う区分の語の一覧 | (業種ごとの公的なものは少ない。共通語彙は次節) | 同じ項目かどうかを毎回確かめる手間。別の意味の項目を同じものとして集計する誤り |
| コード値 | 使える値と意味の一覧。変更の承認者 | 都道府県・業種などの外部のコード体系(第7章) | 集計のたびに対応表が要る。古い値と新しい値が混在する |
| 日付と時刻 | 西暦か和暦か、並べる順、タイムゾーン | JIS X 0301(日付及び時刻の表記) | 日をまたぐ集計のずれ。元号の変わり目でのデータ変換 |
| 数量と単位 | 単位を値に持つか定義に持つか。税込みか税抜きか | (項目ごとに社内で決める) | 単位の違う値を合計する誤り |
| 文字コード | 使う符号化の方式。変換できない文字の扱い | JIS X 0221(UCS)、JIS X 0208・JIS X 0213、RFC 3629(UTF-8) | 文字化け、人名・地名の字の欠落、名寄せの失敗 |
標準は、作ること自体より、守られているかを確かめる仕組みの方が難しいものです。新しいシステムを導入するときやデータの連携を追加するときに、設計の段階でこの表の5つを確認する項目として入れておくと、後から直す手間が大きく減ります。すでに動いているシステムを標準に合わせて作り直すのは費用がかかるので、既存のシステムについては、後のレガシーシステムの節で述べるように、境界で変換する方法をとるのが現実的です。標準に合っているかどうかをデータの値で検査する方法は、第5章のデータ品質の章で扱います。
共通語彙とドメインモデル
命名規則が「名前の付け方」の約束だとすると、共通語彙は「どの言葉が何を意味するか」の約束です。「顧客」という同じ言葉でも、営業部門は契約を結んだ相手を、マーケティング部門はメールを配信できる相手を、問い合わせ窓口は問い合わせをしてきた相手を、それぞれ思い浮かべていることがあります。言葉が同じで意味が違う状態は、名前が違う状態よりも見つけにくく、集計の食い違いの原因として後から気づかれることが多いように思います。共通語彙は、こうした基本的な言葉について、全社で使う意味を1つに決め、文書にしたものです。
公的な分野では、この考え方を形にした取り組みがあります。共通語彙基盤(IMI)は、その公式サイトで、データに使う用語の表記・意味・構造をそろえ、分野をまたいだ検索や連携を進めることを目的に掲げています。また、デジタル庁は、データの連携と交換のためのデータの参照モデルとして、政府相互運用性フレームワーク(GIF)を公開しています。デジタル庁の説明では、GIF は、個人・法人・連絡先・住所・施設のような基本的なデータの構造を定めたコアデータモデル、日付やアドレスのように多くのモデルで共通に使う項目の値の形式を定めたコアデータパーツ、分野ごとのデータの組み合わせを定めた実装データモデル、そして共通語彙基盤の基礎となるコア語彙から構成されています。GIF の文書の公開サイトでは、2026年10月6日公開の第2.4版が最新とされ、コアデータパーツとして日付時刻・住所・所在地・郵便番号・地理情報・電話番号の文書が並んでいます。そのまま採用することも、項目を取捨選択して使うこともできるとされており、CC0 1.0 の条件で公開されています。
民間の会社が自社の共通語彙を作るときにも、こうした公的な参照モデルは出発点として使えます。住所や電話番号の項目をどう分けるか、法人をどの項目で表すか、といった多くの会社に共通する部分を一から議論せずに済むからです。そのうえで、自社に固有の言葉(契約の状態、商品の分類、自社独自の顧客区分など)だけを自社で定義します。全部を自社で作ろうとすると議論が終わらず、全部を外部のモデルに合わせようとすると業務の実態と合わない部分が出るので、共通の部分は借り、固有の部分は自社で決める、という分け方が扱いやすいと考えています。
ドメインモデルという言葉も、ここで整理しておきます。本コラムでは、ドメインモデルを「ある業務の範囲(ドメイン)について、そこで使われる言葉と、言葉どうしの関係と、業務の規則をまとめて表したもの」の意味で使います。ソフトウェアの設計の分野では、業務の範囲ごとに言葉の意味を固定し、範囲の境界をはっきりさせる設計の考え方が広く知られています。データの見取り図の観点から言えば、ドメインモデルは、主題領域の一覧と概念データモデルと共通語彙を、業務の範囲ごとに束ねたものに当たります。大事なのは、全社で1つの意味に統一する言葉と、業務の範囲ごとに意味が違ってよい言葉を区別することです。たとえば、「受注」の意味は営業と物流で同じでなければ困りますが、「在庫」の意味は、販売できる数を見る営業と、棚にある物の数を見る倉庫とで違っていてもかまいません。違っていてよい場合は、違うことを明記し、それぞれに別の名前(「販売可能数」「実在庫数」など)を付けて区別します。
本コラムでは、共通語彙とビジネス用語集を次のように区別して使います。ビジネス用語集は、業務の担当者が日常的に参照する用語と定義の一覧で、定義の正本を置く1か所です。共通語彙は、その用語集の中で、全社で意味を1つに固定すると決めた言葉の集まりを指します。つまり、共通語彙は用語集とは別の文書ではなく、用語集の中に「全社で固定」の印を付けて管理するのが扱いやすい形です。売上のように部門ごとに数え方が違い、1つの意味にまとめられない言葉は、無理に1つにせず、前の段落の在庫の例と同じく、別の名前を付けて用語集に並べて登録します。共通語彙は、作っただけでは使われません。どの項目がどの語彙に当たるかを用語集から引けるようにして初めて、集計の食い違いを防ぐ道具になります。用語集とデータカタログの作り方は第6章で扱います。
全社でそろえる範囲と、部門に任せる範囲
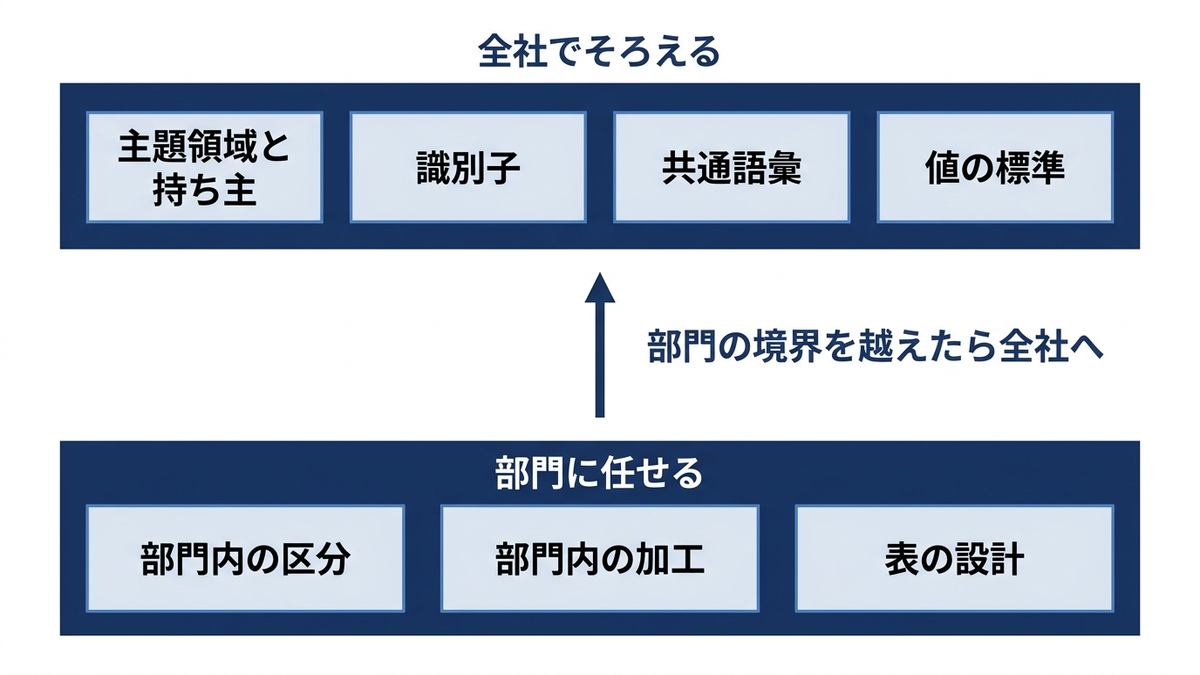
ここまで、主題領域・データフロー・データモデル・命名と値の標準・共通語彙と、全社でそろえる候補を順に見てきました。しかし、これらを全部、全社の標準として細部まで決めようとすると、決める作業そのものが何年もかかり、その間に業務とシステムが変わってしまいます。また、部門の中だけで使い、他の部門とやり取りしないデータまで全社の標準に縛ると、部門の業務改善の速度を落とします。アーキテクチャの標準を決めるときに最初に必要なのは、全社でそろえる範囲と、部門に任せる範囲の線を引くことだと考えています。
線を引く基準として使いやすいのは、「そのデータが部門の境界を越えるかどうか」です。複数の部門が参照するデータ、経営報告に使われるデータ、社外とやり取りするデータは、部門の境界を越えるので、全社でそろえる対象にします。部門の中だけで生まれて使われ、外に出ないデータは、部門に任せます。法令や契約で扱いが決まっているデータは、部門の中だけで使う場合でも、必要な共通のルール(保存の期間や取扱いの制限など)を全社で決めて適用します。ただし、部門に任せたデータでも、後で他の部門が使いたくなったときに、全社の標準に合わせて渡せるようにしておく、という約束だけは全社で決めておきます。
| 項目 | 全社でそろえる | 部門に任せる | 決める人(第3章の役割) |
|---|---|---|---|
| 主題領域の一覧と持ち主 | 領域の名前・境界・データオーナー | 領域の中の細かい区分 | データガバナンスの会議体 |
| 正本の場所 | 部門をまたいで使うデータの正本がどのシステムか | 部門の中だけのデータの置き場所 | データオーナー(データカストディアンが技術面の案を出す) |
| 識別子 | 顧客・商品・取引先・従業員を見分ける番号 | 部門の中だけの作業用の番号 | 全社でそろえる識別子の付け方は、データスチュワードが案を作り、データガバナンス委員会が承認(その主題領域のデータオーナーは案に意見を出す)。部門の中だけの作業用の番号はその部門のデータオーナー |
| 共通語彙 | 部門をまたいで使う言葉(顧客・売上・受注など、経営報告に使う言葉を含む)の意味。1つの意味にできない言葉は、別の名前を付けて並べて登録する | 部門の中だけで使う言葉 | 部門をまたいで使う言葉の意味はデータガバナンス委員会が決める(案はデータスチュワードが作り、関係する部門のデータオーナーが意見を出す)。部門の中だけで使う言葉はその部門のデータオーナー |
| 値の標準 | 日付・文字コード・部門をまたぐコード値の書き方 | 部門の中だけの区分の値 | 全社でそろえる値の標準は、データスチュワードが案を作り、データガバナンス委員会が承認。部門の中だけの区分の値はその部門のデータオーナー |
| データの受け渡し | 連携の方式と渡すときの形式。部門をまたぐ変換の規則 | 部門の中の加工の手順 | 全社でそろえる連携の方式と形式の標準は、データアーキテクトが案を作り、データガバナンス委員会が承認。個々の連携の実装はデータカストディアン。変換の規則の内容はデータオーナーが決め、データスチュワードが用語集に記録し、データカストディアンが実装して維持する |
| 物理の設計 | (全社の標準は文字コードと命名の原則だけにとどめる) | 表の分け方・索引・性能の工夫 | 各システムの開発・運用の担当者 |
この表の右から2列目、つまり部門に任せる範囲を明文化しておくことにも意味があります。任せる範囲が書かれていないと、部門は「これも全社の承認が要るのではないか」と迷い、小さな改善まで会議体にかけるようになって、会議体の議題があふれます。逆に、全社でそろえる範囲が書かれていないと、部門が独自に決めたコードや識別子が後から他の部門のデータと突き合わなくなります。両方を書いておくことで、会議体は部門の境界を越える論点だけに集中できます。
レガシーシステムと段階的な移行
見取り図を描くと、多くの会社で、長く使われてきた業務システム(レガシーシステム)が標準に合っていないことが見えてきます。識別子の付け方が古い、文字コードが別の方式である、項目の意味が設計書に残っていない、といった状態です。このとき、標準に合わせてシステム全体を一度に作り直すという判断は、費用と期間の見通しが立ちにくく、作り直している間に業務が止まる危険もあります。データアーキテクチャの観点からは、作り直す前に、古いシステムと新しい標準との境界で変換する方法と、機能ごとに順に移す方法を検討する価値があります。
境界で変換する方法は、古いシステムの中身には手を付けず、データが古いシステムから出ていくところで、識別子・コード値・日付・文字コードを全社の標準に変換してから渡す、というものです。変換の規則(古いコードと新しいコードの対応表、変換できない文字の扱いなど)は、本コラムでは次のように分担します。規則の内容はその主題領域のデータオーナーが決め、データスチュワードがそれを第6章で扱う用語集に記録し、データカストディアン(多くの場合は情報システム部門)が連携の仕組みに実装して維持します。用語集には変換の業務上の意味と責任者を書き、細かな対応表や変換の仕様は、用語集から参照できる場所に置きます。古いシステムを使い続ける期間が長いほど、この変換の規則は重要な資産になります。変換の規則が用語集に記録されず、担当者の頭の中やプログラムの中にしか無いと、古いシステムを最終的に止めるときに、どのデータをどう移せばよいかが分からなくなるからです。
機能ごとに順に移す方法については、クラウドの設計の文書が1つの型を示しています。Microsoft の Azure アーキテクチャセンターにある「ストラングラー フィグ パターン」の解説(2026年10月に確認)は、レガシーシステムの特定の機能を、新しいアプリケーションやサービスに少しずつ置き換えていく移行の方法を説明しています。利用者と古いシステム・新しいシステムの間に要求を振り分ける窓口(ファサード)を置き、最初はほとんどの要求を古いシステムへ、移行が進むにつれて新しいシステムへ振り向け、すべての機能を移したら古いシステムを止める、という手順です。同じ解説は、複数の業務の範囲のデータを1つに抱えたデータベースを、業務の範囲ごとのデータベースへ順に切り出していく例も示しており、切り出しの際には、新旧のデータベースの間で整合性を確かめてから切り替えること、古いデータベースから対象の表を消すのは新しいシステムを確かめた後の最終手順として扱うことを挙げています。一方で、小さなシステムでまとめて置き換える方が簡単な場合や、古いシステムを早く完全に止める必要がある場合には、この方法が向かないこともあるとしています。
この考え方をデータの見取り図に当てはめると、移行の順序は主題領域の単位で考えることができます。たとえば、顧客の主題領域だけを先に新しい標準に移し、取引や在庫は古いシステムに残したまま、境界で変換して使う、という形です。どの領域から移すかは、部門の境界を越えて使われる度合いが大きく、標準に合っていないことによる手間が大きい領域から選ぶのが合理的だと考えています。多くの会社では、顧客・商品・取引先のように複数の業務で共通に参照する領域がその候補になります。どのマスターデータから着手するかの判断は、第7章で扱います。
移行の判断で経営が押さえておきたいのは、段階的な移行では、多くの場合「新旧の両方を動かす期間」の費用が伴うことです。同じ解説も、移行の途中の仕組みを一時的なものとして捉え、リスクを下げる効果と一時的な基盤の費用とのつり合いを取るよう述べています。段階的な移行は、一度に作り直すより失敗の影響を小さくできる一方で、移行が長引くと二重の運用が続きます。移行の計画には、領域ごとに古いシステムを止める時期を書き、その時期を会議体で確かめる手順を入れておくことが有効だと考えています。
データ基盤の全体像との対応
データフロー図の4つの段(業務システム・連携・基盤・利用)は、データ活用の基盤の全体像と対応しています。左端の業務システムは、受注・会計・人事など日々の業務を処理する基幹系のシステムです。中央の基盤には、複数の業務システムのデータを集め、分析しやすい形に整えて保管するデータウェアハウスなどが入ります。右端の利用には、経営報告のダッシュボード、分析、機械学習や生成 AI の利用が入ります。
この対応を見取り図に書き込んでおくのは、右の段ほど左の段で決めた標準の上に乗っており、段ごとに守るべき標準と責任者が違うからです。業務システム・連携・基盤の3つの段について、重要な標準と、それを決める人・実装する人を段ごとに示します。利用の段は次の段落で扱います。
- 業務システムの段:データが生まれる時点での入力の規則と識別子の付け方が重要です。入力の規則はその主題領域のデータオーナーが決めます。全社でそろえる識別子の付け方は、データスチュワードが案を作り、データガバナンス委員会が承認します(その主題領域のデータオーナーは案に意見を出します)。
- 連携の段:変換の規則と、受け渡しの形式・頻度が重要です。変換の規則の分担は、前の「レガシーシステムと段階的な移行」の節で述べたとおりです。必要な更新の頻度は利用部門とデータオーナーが要件として示します。全社でそろえる連携の方式と受け渡しの形式の標準は、第3章のとおりデータアーキテクトが案を作り、データガバナンス委員会が承認します。その標準に沿った個々の連携の実装と、頻度を実現する方法、運用上の制約は、データカストディアンが決めます。
- 基盤の段:複数のシステムのデータを突き合わせるための共通の識別子と共通語彙が重要です。全社でそろえる識別子の付け方と、部門をまたいで使う語彙の意味は、いずれもデータスチュワードが案を作り、データガバナンス委員会が承認します。基盤への実装と保管はデータカストディアンが担います。
利用の段では、指標の定義が部門ごとに違わないことが重要です。本コラムでは、指標の定義の正本を第6章で扱う用語集の1か所に置き、その定義を集計の仕組みに実装する場所を、第9章で扱うセマンティック層とします。セマンティック層は、データの保管場所と利用者が見る画面の間に置き、指標をどの表のどの列からどう集計するかをまとめて実装しておく層で、定義の正本ではありません。セマンティック層は、この章の4つの段では「基盤」と「利用」の間に、第9章の5つの段(「業務システム」「取り込み・統合」「保管」「提供」「利用」)では「提供」の段にあたります。指標の定義の内容を決めるのはデータオーナー(部門をまたいで使う定義はデータガバナンス委員会)、用語集に記録して維持するのはデータスチュワード、集計の仕組みへの実装はデータカストディアンです。
業務システムの間で識別子や語彙が違う場合は、連携や基盤の段で対応関係を定めてそろえます。意味や対応関係が決まらないままでは、利用の段の集計の工夫だけで食い違いを解消することは困難です。なお、第9章では、連携の段を「取り込み・統合」、基盤の段を「保管」と呼び、基盤と利用の間に「提供」の段を置いて、それぞれの仕組みを説明します。
AI の利用を急ぐ場合にも、この順序は変わりません。学習や検索に使うデータが、どの業務システムで生まれ、どの経路で運ばれ、どの定義で集計されたかが見取り図に描かれていれば、AI に使うデータの出所と加工の経路を調べる手がかりになります。個々の出力を検証するには、これに加えて、使ったデータとモデルの版、入力や検索の結果などの記録も要ります。見取り図が無ければ、出力がおかしいと分かっても、原因がデータの側にあるのかを調べる手がかりが乏しくなります。見取り図が無いまま AI の導入を進めると、使えるデータを探す段階で時間を使い切ったり、出力を信頼できずに使われなくなったりして、AI 投資の空振りにつながるおそれがあります。データウェアハウス・データレイクなどの基盤の設計と運用は第9章、AI のためのデータの要件は第11章で扱います。
経営の判断、標準化の範囲を決める
この章の内容を経営の判断に落とすと、決めるべきことは「何を全社の標準にし、何を標準にしないか」です。標準化は、範囲を広げるほど効果が大きくなるように見えますが、実際には、範囲を広げるほど決める作業と守らせる作業の負担が増え、部門の業務改善の速度を落とします。全部を全社の標準にしようとすると、標準の文書が完成する前に関心が薄れ、作りかけの標準だけが残る、という結果になりやすいと考えています。
判断の基準として使いやすいのは、前の節で述べた「部門の境界を越えるかどうか」に、「経営報告に使うかどうか」と「社外とやり取りするかどうか」を加えた3つです。この3つのどれかに当てはまるデータから標準化の対象にし、当てはまらないデータは部門に任せます。法令や契約で扱いが決まっているデータには、利用の範囲にかかわらず、必要な共通のルールを適用します。最初の対象は、さらに絞って、経営報告の主要な数字(売上・顧客数・受注など)に関わる主題領域の識別子と共通語彙だけにするのが現実的です。そこから、データフロー図で見つかった手作業の経路や、変換の手間が大きい境界を順に対象に加えていきます。
予算と体制の面では、見取り図の作成そのものに大きな投資は要りません。最初の主題領域の一覧と、経営報告の数字1つ分のデータフロー図は、各部門の実務者への聞き取りと、表計算ソフトや図を描く道具で作れます。投資の判断が必要になるのは、見取り図から見つかった問題(二重に持っているデータ、標準に合わない古いシステム)を直す段階です。そのときに、見取り図があれば、どの問題がどの数字の食い違いや手作業の原因になっているかを示したうえで、直す順序を決めることができます。見取り図が無いまま個々のシステムの改修を決めると、ある部門の改修が別の部門の連携を壊す、という二重の手戻りが起きやすくなります。
役割の面では、見取り図の持ち主を決めておくことが欠かせません。主題領域の一覧とデータフロー図は、システムが入れ替わり、組織が変わるたびに古くなります。誰が、どの頻度で更新するかを決めておかないと、最初に作った1枚が更新されないまま、実態と違う図として残ります。第3章で挙げたデータアーキテクトの役割を置ける会社では、その人が持ち主になります。置けない会社では、情報システム部門の責任者が持ち主になり、新しいシステムの導入や連携の追加の承認の手順に「見取り図の更新」を組み込む形が考えられます。
この章では、全社のデータの見取り図として、データの配置と流れを描くデータアーキテクチャと、個々のデータの構造と意味を描くデータモデリングを扱いました。主題領域の一覧で何があるかを、データフロー図でどう流れるかを、概念・論理・物理のデータモデルで中身と業務の規則を示し、命名・コード値・日付・単位・文字コードの標準と共通語彙で言葉と値をそろえます。そのうえで、全社でそろえるのは部門の境界を越えるデータ(経営報告や社外とのやり取りに使うデータを含む)に絞り、法令や契約で扱いが決まっているデータには共通のルールを適用し、それ以外は部門に任せる、という線を引くことが、標準化を続けられる範囲に保つ鍵になります。最初の一歩は2つです。各部門の実務者に毎日扱っている名詞を聞き取って主題領域の一覧を作ることと、経営報告の数字を1つ選んでその経路を左へたどってデータフロー図を描くことです。次の第5章では、こうして形をそろえたデータが、実際に用途に合う状態にあるかをどう測り、どう直すかを扱います。
この章を深めたい方への参考書籍
『システム開発・刷新のためのデータモデル大全』(渡辺幸三 著、日本実業出版社):システムの設計の要となるデータモデルについて、多くの用例と実践的な書き方を紹介した本です。この章で扱った論理データモデルとER図を、実際の業務に当てはめて描くときの手本になります。書名のとおり既存システムの刷新を視野に入れているので、レガシーシステムの移行を考える際にも参考になります。
『データモデリングでドメインを駆動する 分散/疎結合な基幹系システムに向けて』(杉本啓 著、技術評論社):基幹系システムとデータモデリングを主題に、新しい事業に向けた基幹系システムの作り方や、既存のシステムを柔軟な構成へ変えていく方法を扱った本です。この章で触れたドメインモデルと、業務の範囲ごとにデータの意味を整理する考え方を、基幹系システムの設計の側から深めることができます。
『達人に学ぶDB設計徹底指南書 第2版』(ミック 著、翔泳社):データベースの設計の考え方と実践的なノウハウを、クラウドへの対応も含めて解説した本です。論理設計と物理設計を扱う章があり、この章で説明した論理データモデルと物理データモデルの違いを、データベースの設計の実務に即して確かめることができます。
第5章 データ品質、何を測りどう直すか
第4章では、全社のデータの配置と流れを見取り図にし、コード値・日付・単位のような命名と標準を、全社で揃える範囲と部門に任せる範囲に分けて決めることを確かめました。標準を決めても、実際のデータがその標準どおりに入っているとは限りません。この章では、データが標準と用途に照らしてどれだけ使える状態にあるかを測り、測った結果から直す順序を決める方法を扱います。最初にデータ品質の考え方と、国際規格と日本の行政機関の資料が示している品質の物差しを確かめます。次に、実務で使う観点に沿って品質のルールを作る方法を説明し、架空の顧客台帳を pandas で点検する最小例を実行して、品質スコアの表とグラフの作り方を示します。そのうえで、不備の原因を入力時・連携時・変換時に分ける方法、予防・検出・修正の順に直す考え方、データ品質ツールの位置づけ、品質の不良が招く経営上の損失の型、どの項目から測り始めるかという経営の判断を順に扱います。項目の定義を集めて検索できるようにする仕組みは第6章、顧客や取引先の「正しい一件」を決める名寄せは第7章で扱います。
データ品質とは何か、用途に適しているかで測る
本コラムでは、データ品質を「データが用途に適している度合い」と定めています(用語の定義は本コラムの冒頭の地図にまとめてあります)。品質を用途から定めるのは、同じデータでも使い道によって必要な水準が違うからです。たとえば顧客台帳の郵便番号は、ダイレクトメールを送る部門にとっては1件の誤りがそのまま返送の費用になりますが、都道府県別の顧客数を集計する部門にとっては、郵便番号が多少欠けていても都道府県コードが正しければ困りません。逆に、都道府県コードの誤りは集計の部門にとって致命的で、送付の部門にはあまり影響しません。「この台帳の品質は高いか」という問いには、用途を決めない限り答えられません。
この考え方は、日本の行政機関向けの資料にも書かれています。政府CIOポータルで公開された「データ品質管理ガイドブック(β版)」(2021年8月31日版。現在はデジタル庁のページから参照先が案内されています。詳しくは次の節)は、データの品質は高ければ良いというものではなく、品質を高めればそれに伴って費用も高くなることに留意が必要であり、利用目的に応じた適切な品質を考える必要がある、という趣旨を述べています。また、提供する側が自分の基準で高い品質のつもりでも、利用する側には十分でないという認識の違いが起きることにも触れています。品質の目標を決めるときに、データを作る部門だけで決めず、使う部門の要件を聞いてから決める必要があるのはこのためです。
用途から品質を定めるということは、品質の目標を決める人が、そのデータの用途に責任を持つ人でなければならないということでもあります。本コラムの用語では、それはデータオーナー(そのデータの定義・用途・品質の水準・提供の可否について決定する責任を持つ人)です。データスチュワードは、オーナーが決めた水準を日々の点検に落とし、違反を見つけて原因を追い、問い合わせに答えます。データカストディアン(情報システム部門)は、点検の仕組みを技術的に動かし、データを保管し保護します。品質の測定は技術の作業に見えますが、「何を合格とするか」を決めるのは業務の側です。この分担が無いと、情報システム部門が推測で合格の基準を置き、業務の側はその数字を自分たちのものとして受け取らない、ということが起きやすいように思います。役割の分担そのものは第3章で扱いました。
品質を測る対象は、データそのものだけではありません。データを作り、運び、加工する工程(入力の画面、システム間の連携、移行の変換)と、それを管理する組織の手順も、品質を左右します。先のガイドブックも、データそのものの評価に加えて、データを使ったサービスの評価と、データ管理のプロセスの評価の3つの視点を置いています。この章では、測りやすく、結果を工程の改善につなげやすい「データそのもの」の測定を中心に扱い、工程と組織については根本原因の節と改善の節で触れます。
品質特性の公的な物差し、ISO/IEC 25012 とデジタル庁のガイドブック
データの品質を何の観点で測るかについては、国際規格があります。ISO/IEC 25012(2008年)は、ソフトウェア製品の品質要求と評価を扱う規格群(SQuaRE と呼ばれるシリーズ)の1つで、コンピュータシステムの中に構造化された形で保持されるデータについて、一般的なデータ品質モデルを定めています。ISO のISO/IEC 25012 の目録ページによれば、この規格は品質の属性を15の特性に分類し、それを「固有(inherent)」と「システム依存(system dependent)」の2つの観点で捉えます。同じページでは、この規格は発行済みで、2025年に見直しを受けて確認されたとされています(2026年10月22日に確認)。IEC のIEC ウェブストアの同規格のページでは、版は第1版、発行日は2008年12月3日です。
2つの観点の中身と、15の特性のそれぞれがどちらの観点に属するかは、規格の本文で定められています。本コラムは規格の本文を開いていないため、特性ごとの分類は書きません(規格の解説を公開している民間のサイトには分類の一覧がありますが、一次情報ではないので使っていません)。語の意味の範囲で読むと、固有の観点はデータそのものが持つ性質として品質を見る観点、システム依存の観点はデータを扱うコンピュータシステムの中で品質が保たれているかを見る観点です。15の特性の名前は、次に紹介するガイドブックが ISO/IEC 25012 に沿って挙げている15項目の名前で示します。
日本では、この国際規格は JIS X 25012(2013年)として日本産業規格になっています。日本規格協会のJIS X 25012 の規格詳細ページでは、2013年6月20日に制定され、2018年10月22日と2023年6月20日に確認されており、対応する国際規格は ISO/IEC 25012(2008年)で、対応の程度は一致(IDT)と示されています。日本産業標準調査会(JISC)の JIS 検索でも、同じ番号と題名の規格が登録されていることを確かめました。一致規格なので、特性の数と分類は国際規格と同じです。ただし、JIS の本文で各特性にどの日本語の名称が当てられているかは、本文を開いていないので確かめていません。この章の日本語の名称は、次に紹介するデジタル庁のガイドブックのものを使います。
行政機関向けには、政府CIOポータルで公開された「データ品質管理ガイドブック」があります。この章では、その2021年のβ版を、過去に公開された参考資料として扱います。経緯は次のとおりです。この章ではデジタル庁のガイドブックと呼びますが、PDF の表紙と改定履歴には作成した組織の名前は書かれていません。現在、デジタル庁のデータ戦略のページは、データ標準と品質の資料の参照先として、国立国会図書館のインターネット資料収集保存事業(WARP)に保存された政府CIOポータルのページを案内しています。本コラムでは、WARP に2026年1月5日付で保存されたページからデータ品質管理ガイドブック(β版)の PDFを開いて確かめました。表紙は「2021年8月31日(β版)」で、改定履歴には2021年6月4日にβ版を公開し、同年8月31日にデータ品質評価ツールの公開に合わせて文言を修正したと書かれています。標準ガイドライン群の番号は「正式版公開時に指定」とされていました。その後、情報処理推進機構(IPA)のデータに関するページは、デジタル庁が政府相互運用性フレームワーク(GIF)の関連資料として公開した、デジタル社会推進実践ガイドブック DS-468-1「データ品質管理ガイドブック」を案内しています。ただし、デジタル庁のGIF の公式リポジトリは、2026年1月8日の GIF v2.2 からこの文書を管理の対象から外し、今後の更新や公式の説明の対象外とした、と告知しています(過去の版は閲覧できる状態を保つとされています。いずれも2026年10月26日に確認)。DS-468-1 の本文とβ版の違いは確かめていないため、この章ではβ版の記述を使います。
ガイドブックは、データそのものの品質を ISO/IEC 25012 に沿って15項目で評価するとしています。各項目には、最初に達成すべき「基礎」と、次に達成すべき「応用」の印が付いています(ガイドブックは、この印は重要度ではなく、目標を順に広げていくためのものだと説明しています)。次の表は、ガイドブックの15項目の名称(括弧内はガイドブックに併記された英語名)と印を並べたものです。
| 番号 | ガイドブックの名称(英語名) | ガイドブックの印 | 顧客台帳で言えば何を見るか(本コラムの例) |
|---|---|---|---|
| 1 | 正確性(Accuracy) | 基礎 | 書式や値が、実際の顧客の情報を正しく表しているか |
| 2 | 完全性(Completeness) | 基礎 | 必須の項目に空欄が無いか |
| 3 | 一貫性(Consistency) | 基礎 | 台帳の中や、支店マスタとの間で矛盾が無いか |
| 4 | 信憑性(Credibility) | 基礎 | 出所と更新日が分かり、信じてよいと言えるか |
| 5 | 最新性(Currentness) | 基礎 | 最終更新日が用途に対して古すぎないか |
| 6 | アクセシビリティ(Accessibility) | 基礎 | 使う権限のある人が、特別な道具なしに使えるか |
| 7 | 標準適合性(Compliance) | 基礎 | 郵便番号やコードが、決めた書式と選択肢に従っているか |
| 8 | 機密性(Confidentiality) | 基礎 | 許可された人だけが見られるか |
| 9 | 効率性(Efficiency) | 応用 | 重複や全角半角の混在が無く、つなぐ前の手直しが要らないか |
| 10 | 精度(Precision) | 基礎 | 日付や数値の細かさが用途に足り、揃っているか |
| 11 | 追跡可能性(Traceability) | 応用 | 誰がいつ値を変えたかが記録されているか |
| 12 | 理解性(Understandability) | 基礎 | 各項目の意味が利用者に分かるように説明されているか |
| 13 | 可用性(Availability) | 基礎 | 必要なときに台帳を取り出せるか |
| 14 | 移植性(Portability) | 基礎 | 標準的な形式で書き出して別のシステムへ移せるか |
| 15 | 回復性(Recoverability) | 基礎 | 障害のときにバックアップから戻せるか |
表の右端の列は、ガイドブックの評価項目と問題の例を参考に、この章の架空の顧客台帳に当てはめて本コラムが書いたものです。ガイドブック自体は行政機関のデータを想定しており、たとえば正確性の問題の例として「同上」のような記述や、日付の欄に「不明」と書かれていること、標準適合性の問題の例として和暦の表記や都道府県名の略称、効率性の問題の例として全角と半角の混在や、他のデータと結合するための ID が無いことを挙げています。民間企業の台帳でもそのまま起きる問題です。
15の特性を全部測る必要はありません。表の13〜15の可用性・移植性・回復性は、バックアップや障害への備えの設計としてデータカストディアンが担う部分が大きく、データの点検の表というより、システムの運用の点検で扱うのが自然です。機密性とアクセシビリティは、第8章で扱うデータの分類とアクセス制御の側で決まります。理解性と追跡可能性は、第6章で扱う項目の定義と記録の仕組みの側で整えます。この章で扱う「データの中身を測る」点検が直接受け持つのは、主に表の1〜5と7・9・10です。
実務で使う6つの観点と、品質特性との対応
データ品質の実務では、ISO/IEC 25012 の15特性とは別に、完全性・一意性・有効性・一貫性・適時性・正確性のような少数の観点で品質のルールを分類することがあります。本コラムの用語の定義でも、データ品質を「完全性・正確性・一貫性・一意性・有効性・適時性などの特性で測る」としています。規格の15特性は「データの品質とは何か」を漏れなく捉えるための枠組みで、実務の6つの観点は「台帳に対してどんな検査を書くか」を決めるための枠組みだと考えると、両者を使い分けやすくなります。
2つの枠組みは、きれいに1対1には対応しません。いちばん大きな違いは一意性です。ガイドブックが ISO/IEC 25012 に沿って挙げる15項目の名称には、一意性(同じものが2回現れないこと)に当たる語がありません。ガイドブックは、効率性の評価項目の1つとして「データの内容に重複などがないか」を挙げています。一方で、顧客台帳の点検では、同じ顧客が2行あるかどうかは真っ先に確かめたい項目です。そこで本コラムでは、一意性を独立した観点として置きます。また、有効性(決めた書式や値の範囲に従っていること)は、規格では標準適合性と、正確性のうちの構文的な正しさ(値が決められた書式の集合に近いこと)にまたがります。次の表は、本コラムの6つの観点が、規格の特性のどれに近いかを整理したものです。この対応は本コラムの整理で、規格やガイドブックが示している対応表ではありません。
| 本コラムの観点 | 何を確かめるか | 近い ISO/IEC 25012 の特性(ガイドブックの名称) | 台帳だけで機械的に測れるか |
|---|---|---|---|
| 完全性 | 必須の項目に値が入っているか | 完全性 | 測れる |
| 一意性 | 同じ実体(顧客・商品)が2回以上登録されていないか | 該当する名称は無い。重複の確認は効率性の評価項目に含まれる | コードの重複は測れる。別のコードで登録された同じ人は名寄せが要る(第7章) |
| 有効性 | 書式・型・値の範囲・選択肢に従っているか | 標準適合性、正確性(構文的な正しさ) | 測れる |
| 一貫性 | 項目どうし、表どうしで矛盾が無いか(参照整合性、つまり他の表に載っている値だけを許すことを含む) | 一貫性 | 参照先の表があれば測れる |
| 適時性 | 用途に対して十分に新しいか | 最新性 | 更新日の項目があれば、それを鮮度の代わりの目安として測れる(この章の例はこの方法。実務では連絡先を確かめた日など、用途に合う日付を使う) |
| 正確性 | 値が現実の対象と一致しているか | 正確性(意味的な正しさ)、信憑性 | 台帳だけでは測れない。本人への確認や外部の正しい情報との突き合わせが要る |
表の最後の行の正確性は、扱いに注意が要ります。メールアドレスの書式が正しくても、それが本当にその顧客のアドレスかどうかは、台帳の中をいくら調べても分かりません。郵便番号が「3桁、ハイフン、4桁」の書式に従っていても、実在する番号かどうかは、郵便番号の一覧と突き合わせない限り分かりません。有効性の検査に合格したことを「正しいデータだ」と報告すると、読み手は正確性まで保証されたと受け取りがちです。報告では、有効性(書式に従っている)と正確性(現実と一致している)を別の行として書き、正確性はどの方法でどれだけの標本(全件から確認用に抜き出した一部の行)を確かめたかを添えるのが有効だと考えています。
ISO/IEC 25012 の15特性と本コラムの6つの観点が違うように、品質の観点の数や名前、境界の引き方は、資料によって違うことがあります。どれが正しいかを議論するより、自社で使う観点を1つの表に決め、すべての品質ルールにどの観点に属するかの印を付けることの方が大切です。観点の印が揃っていれば、ルールの数が増えても観点ごとに結果を束ねて報告でき、前回の報告と比べられます。
データ品質ルールの作り方
品質を測るには、観点を具体的な検査に落とす必要があります。この章では、1件ずつのデータについて合格か違反かを機械的に判定できる形に書いた検査をデータ品質ルールと呼びます。「メールアドレスはきちんと入っていること」は願いであってルールではありません。「メール列が空欄でないこと」「メール列が、英数字と記号の並び、@、ドメイン名の順の書式に一致すること」と書いて初めて、誰が測っても同じ件数が出ます。
ルールには、判定の式のほかに、決めておくべきことがいくつかあります。1つ目は対象の範囲です。たとえば「担当支店コードが空欄でないこと」というルールは、店頭で登録された顧客には当てはまりますが、Web から申し込んだ顧客には支店がまだ割り当てられていない期間があるかもしれません。対象の範囲をルールに書いておかないと、業務上は正しい空欄が違反に数えられ、現場が点検の結果を信用しなくなります。2つ目は目標の水準です。合格率が何%以上なら「使える」とするかは、用途によって決まり、データオーナーが決めます。3つ目は、違反を見つけたときの扱いです。集計から外すのか、警告を出すだけなのか、取り込みそのものを止めるのかを決めておきます。4つ目は持ち主です。そのルールの定義を変えてよいのは誰か、違反の原因を追うのは誰かを書いておきます。
次の表は、この章の架空の顧客台帳に対して置いた11のルールを、ルールの定義書の形にまとめたものです。目標の水準と違反時の扱いは、説明のために本コラムが置いた例です。
| 観点 | ルール | 判定の式(違反とする条件) | 対象の範囲 | 目標(例) | 違反時の扱い(例) |
|---|---|---|---|---|---|
| 完全性 | メールの欠損 | メールが空欄 | 全行 | 98% | 警告。次回の接点で本人に確認 |
| 完全性 | 郵便番号の欠損 | 郵便番号が空欄 | 全行 | 98% | 警告。送付の対象から外す |
| 完全性 | 都道府県コードの欠損 | 都道府県コードが空欄 | 全行 | 98% | 集計では「不明」に分類 |
| 完全性 | 担当支店コードの欠損 | 担当支店コードが空欄 | 全行(Web の割り当て待ちをどう扱うかはオーナーが決める。決め方は根本原因の節で扱う) | 98% | 割り当ての担当へ回す |
| 一意性 | 顧客コードの重複 | 同じ顧客コードが2行以上ある | 全行 | 100% | 取り込みを止めて原因を調べる |
| 有効性 | メールの形式 | 英数字と記号、@、ドメイン名の書式に一致しない | メールが入っている行 | 99% | 警告 |
| 有効性 | 郵便番号の形式 | 半角数字3桁、半角ハイフン、半角数字4桁に一致しない | 郵便番号が入っている行 | 99% | 機械的に直せるものは直し、残りは警告 |
| 有効性 | 都道府県コードの値域 | 01〜47の2桁の文字列でない | 都道府県コードが入っている行 | 99% | 集計では「不明」に分類 |
| 一貫性 | 支店コードの参照 | 支店マスタ(B01〜B12)に無い支店コード | 担当支店コードが入っている行 | 99% | 支店の統廃合の担当へ回す |
| 一貫性 | 登録日と更新日の前後 | 最終更新日が登録日より前 | 全行 | 99% | 連携の処理を調べる |
| 適時性 | 3年以内の更新 | 最終更新日が基準日(2026年9月30日)の暦の上での3年前(2023年9月30日)より前 | 全行 | 90% | 連絡先の確認の対象にする |
表の「判定の式」の列は、そのまま点検のプログラムに書ける粒度にしてあります。第3章で扱った文書の4層(原則・ポリシー・標準・手順)で言えば、このルールの定義書は「標準」(守るべき仕様)に当たり、点検をいつ誰がどう回すかは「手順」に当たります。ルールを文書で定め、プログラムはその文書を写す、という順序にしておくと、ルールを変えたときに、どの数字がどの版のルールで測られたかを追えます。逆に、点検のプログラムの中で担当者がその場で条件を決めると、条件が文書に残らず、翌年に同じ点検を再現できなくなります。表の「一貫性」の観点のうち、支店コードの参照のように、別の表(ここでは支店マスタ)に載っている値だけを許すルールを、参照整合性の検査と呼びます。参照先の表そのものの管理は、第7章で扱う参照データとマスターデータの話題です。
ルールの数は、最初から多くしないことが有効だと考えています。ルールが100個あり、そのうち30個が未達という報告は、どこから手を付けるかを決める材料になりません。最初は、主要な用途(この例では、顧客への送付と、支店別・都道府県別の集計)が止まる項目だけに絞り、1つの台帳あたり10個前後のルールから始め、違反の原因が分かって直し方が決まったところで次のルールを足す、という進め方が扱いやすいと考えています。
架空の顧客台帳で品質を測る
ここからは、前の節の11のルールを、架空のサンプルデータに対して実際に動かします。使うのは、乱数から作った架空の顧客台帳です。実在の企業・個人・住所とは関係がありません。氏名と住所の列は持たせず、顧客は「C」と6桁の数字の顧客コードで表し、メールアドレスは例示用に予約されたドメイン(example.com などの3つ)だけを使っています。列は、顧客コード・メール・郵便番号・都道府県コード・登録日・最終更新日・担当支店コード・登録経路の8つです。登録経路は、店頭での手入力、Web の申込フォーム、旧システムからの移行の3種類としました。支店マスタには B01〜B12 の12支店があるという設定です。
この台帳には、意図的に不備を混ぜてあります。混ぜ方は、現実の台帳で起きやすいと考えられる型を、登録経路ごとに違う率で入れる形にしました。店頭の手入力では、メールの空欄、全角の@、ドメイン名の抜け、全角数字の郵便番号、存在しない支店コード(B99)が起きます。Web の申込では、支店がまだ割り当てられていない空欄と、二重送信による同じ内容の行が起きます。旧システムからの移行では、郵便番号のハイフンの欠落、都道府県コードの先頭の0の欠落(旧システムが数値として保存していたという設定)、統合で廃止された支店のコード(B13)、登録日と最終更新日の入れ違い、同じ顧客の古い版の二重取り込み、更新されないまま古くなった記録が起きます。1,970人分の台帳に、二重に取り込まれた30行を加えた2,000行です。登録経路ごとの行数は、店頭970行、Web 748行、移行282行でした(二重取り込みの行を含みます)。
次のコードが、台帳を作る部分です。乱数のシード(同じ乱数の並びを再現するための初期値)を固定しているので、同じ版の numpy と pandas で実行すれば同じ台帳ができます。本コラムでは Python 3.14、numpy 2.4.3、pandas 3.0.1、matplotlib 3.10.8 で実行し、グラフの日本語表示には japanize-matplotlib を別に入れています(pip install japanize-matplotlib)。この部品(japanize-matplotlib 1.1.3)は、Python 3.12 以降では、別の部品である setuptools が入っていないと読み込めません(本コラムの環境では setuptools 82.0.1 が入っていました)。2つのブロックを続けて1つのファイル(ch05_ledger.py)にすると、後のコードから読み込めます。
import sys, io
if sys.stdout.encoding.lower() != "utf-8":      # 他のスクリプトから読み込まれたときは包み直さない
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

BRANCHES = [f"B{i:02d}" for i in range(1, 13)]       # 支店マスタ(B01〜B12)
PREF_CODES = [f"{i:02d}" for i in range(1, 48)]      # 都道府県コード(01〜47)
BASE_DATE = pd.Timestamp("2026-09-30")               # 点検の基準日


def make_ledger(n=1970, n_dup=30, seed=20261022):
    """架空の顧客台帳。登録経路ごとに違う率で不備を混ぜる"""
    rng = np.random.default_rng(seed)
    src = rng.choice(["店頭", "Web", "移行"], size=n, p=[0.50, 0.35, 0.15])
    reg = pd.Timestamp("2015-01-01") + pd.to_timedelta(rng.integers(0, 4290, n), unit="D")
    since = np.where(src == "移行", rng.exponential(900, n), rng.exponential(350, n))
    upd = np.maximum(reg, BASE_DATE - pd.to_timedelta(since.astype(int), unit="D"))
    df = pd.DataFrame({
        "顧客コード": [f"C{x:06d}" for x in rng.choice(np.arange(100000, 1000000), n, replace=False)],
        "メール": [f"user{i:05d}@example.{d}" for i, d in enumerate(rng.choice(["com", "net", "org"], n))],
        "郵便番号": [f"{x // 10000:03d}-{x % 10000:04d}" for x in rng.integers(1000000, 10000000, n)],
        "都道府県コード": rng.choice(PREF_CODES, n),
        "登録日": reg, "最終更新日": upd,
        "担当支店コード": rng.choice(BRANCHES, n),
        "登録経路": src,
    })
続きの部分で、登録経路ごとに不備を混ぜ、二重取り込みの行を加えます。hit は、行ごとに登録経路に応じた確率で不備を入れる行を選ぶ小さな関数です。
    def hit(rates):                                  # 登録経路ごとの発生率で行を選ぶ
        return rng.random(n) < pd.Series(src).map(rates).to_numpy()

    # 入力時の不備(店頭の手入力、Webフォーム)
    df.loc[hit({"店頭": 0.06, "Web": 0.005, "移行": 0.10}), "メール"] = None
    m = hit({"店頭": 0.04, "Web": 0.005, "移行": 0.02}) & df["メール"].notna()
    df.loc[m, "メール"] = df.loc[m, "メール"].str.replace("@", "@")      # 全角の@
    m = hit({"店頭": 0.015, "Web": 0.0, "移行": 0.0}) & df["メール"].notna()
    df.loc[m, "メール"] = df.loc[m, "メール"].str.split("@").str[0] + "@"   # ドメイン抜け
    m = hit({"店頭": 0.03, "Web": 0.005, "移行": 0.0})
    df.loc[m, "郵便番号"] = df.loc[m, "郵便番号"].str.translate(str.maketrans("0123456789-", "0123456789-"))
    df.loc[hit({"店頭": 0.02, "Web": 0.005, "移行": 0.05}), "郵便番号"] = None
    df.loc[hit({"店頭": 0.005, "Web": 0.0, "移行": 0.0}), "都道府県コード"] = "48"
    df.loc[hit({"店頭": 0.01, "Web": 0.0, "移行": 0.0}), "担当支店コード"] = "B99"
    df.loc[hit({"店頭": 0.0, "Web": 0.08, "移行": 0.0}), "担当支店コード"] = None
    # 変換時の不備(旧システムからの移行)
    m = hit({"店頭": 0.0, "Web": 0.0, "移行": 0.12}) & df["郵便番号"].notna()
    df.loc[m, "郵便番号"] = df.loc[m, "郵便番号"].str.replace("-", "")       # ハイフン無し
    m = hit({"店頭": 0.0, "Web": 0.0, "移行": 0.40})
    df.loc[m, "都道府県コード"] = df.loc[m, "都道府県コード"].str.lstrip("0")  # 数値として保存
    df.loc[hit({"店頭": 0.0, "Web": 0.0, "移行": 0.03}), "都道府県コード"] = None
    df.loc[hit({"店頭": 0.0, "Web": 0.0, "移行": 0.10}), "担当支店コード"] = "B13"   # 廃止した支店
    m = hit({"店頭": 0.002, "Web": 0.002, "移行": 0.03})
    df.loc[m, ["登録日", "最終更新日"]] = df.loc[m, ["最終更新日", "登録日"]].to_numpy()
    # 連携時の不備(同じ顧客の二重取り込み)
    web = df[df["登録経路"] == "Web"].sample(20, random_state=1)          # 二重送信(同じ内容)
    mig = df[df["登録経路"] == "移行"].sample(n_dup - 20, random_state=2).copy()
    mig["最終更新日"] = mig["最終更新日"] - pd.Timedelta(days=400)        # 古い版がもう一度入った
    df = pd.concat([df, web, mig]).sample(frac=1, random_state=3).reset_index(drop=True)
    return df
次のコードが、11のルールを判定する部分です。ch05_ledger.py と同じフォルダに ch05_quality_check.py という名前で保存すると、後のグラフと修正のコードから読み込めます。ルールごとに「観点」「そのルールの対象の行」「違反の行」の3つを返し、score_table がそれを対象の件数・違反の件数・違反率・合格率の表にします。形式のルールでは、空欄の行は対象から外し、空欄は完全性のルールだけで数えるようにしました。1つの空欄を完全性と有効性の両方で違反に数えると、同じ不備が2回数えられ、観点ごとの比較がゆがむからです。書式の検査には、文字の並び方の型を記号で書く書き方(正規表現)を使っています。その中で、数字を \d ではなく [0-9] と書き、半角の数字だけを指定しました。Python の \d は全角の数字にも一致するので、全角の郵便番号を見逃すからです。なお、メールの書式の式は、この例の架空データで想定した限られた書式を調べる簡易な検査です。メールアドレスとして使える書き方を正しく判定するものではなく、たとえば + を含む正しいアドレスを違反に数え、点が2つ続くアドレスを合格に数えます。
import sys, io
if sys.stdout.encoding.lower() != "utf-8":      # 他のスクリプトから読み込まれたときは包み直さない
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import pandas as pd
from ch05_ledger import make_ledger, BRANCHES, PREF_CODES, BASE_DATE

REQUIRED = ["メール", "郵便番号", "都道府県コード", "担当支店コード"]
PATTERNS = {"メール": r"[A-Za-z0-9._-]+@[A-Za-z0-9-]+(\.[A-Za-z0-9-]+)+",
            "郵便番号": r"[0-9]{3}-[0-9]{4}"}


def check_rules(df):
    """ルール名 -> (観点, 対象の行, 違反の行)"""
    every = pd.Series(True, index=df.index)
    r = {}
    for c in REQUIRED:                                           # 完全性
        r[f"{c}の欠損"] = ("完全性", every, df[c].isna())
    r["顧客コードの重複"] = ("一意性", every, df["顧客コード"].duplicated(keep=False))
    for c, p in PATTERNS.items():                                # 有効性
        has = df[c].notna()
        r[f"{c}の形式"] = ("有効性", has, has & ~df[c].str.fullmatch(p, na=False))
    has = df["都道府県コード"].notna()
    r["都道府県コードの値域"] = ("有効性", has, has & ~df["都道府県コード"].isin(PREF_CODES))
    has = df["担当支店コード"].notna()                           # 一貫性
    r["支店コードの参照"] = ("一貫性", has, has & ~df["担当支店コード"].isin(BRANCHES))
    r["登録日と更新日の前後"] = ("一貫性", every, df["最終更新日"] < df["登録日"])
    old = df["最終更新日"] < BASE_DATE - pd.DateOffset(years=3)
    r["3年以内の更新"] = ("適時性", every, old)                  # 適時性
    return r


def score_table(df, rules):
    rows = []
    for name, (dim, target, bad) in rules.items():
        n, k = int(target.sum()), int(bad.sum())
        rows.append({"観点": dim, "ルール": name, "対象": n, "違反": k,
                     "違反率": k / n, "合格率": 1 - k / n})
    return pd.DataFrame(rows)
ch05_quality_check.py の最後に、表を出力する数行を足して実行しました(if __name__ == "__main__": の中で make_ledger() を呼び、score_table の結果を表示しています)。結果は次の表のとおりです。
| 観点 | ルール | 対象の件数 | 違反の件数 | 違反率 | 合格率 |
|---|---|---|---|---|---|
| 完全性 | メールの欠損 | 2,000 | 88 | 4.40% | 95.60% |
| 完全性 | 郵便番号の欠損 | 2,000 | 39 | 1.95% | 98.05% |
| 完全性 | 都道府県コードの欠損 | 2,000 | 1 | 0.05% | 99.95% |
| 完全性 | 担当支店コードの欠損 | 2,000 | 71 | 3.55% | 96.45% |
| 一意性 | 顧客コードの重複 | 2,000 | 60 | 3.00% | 97.00% |
| 有効性 | メールの形式 | 1,912 | 66 | 3.45% | 96.55% |
| 有効性 | 郵便番号の形式 | 1,961 | 75 | 3.82% | 96.18% |
| 有効性 | 都道府県コードの値域 | 1,999 | 30 | 1.50% | 98.50% |
| 一貫性 | 支店コードの参照 | 1,929 | 41 | 2.13% | 97.87% |
| 一貫性 | 登録日と更新日の前後 | 2,000 | 19 | 0.95% | 99.05% |
| 適時性 | 3年以内の更新 | 2,000 | 130 | 6.50% | 93.50% |
表の読み方を補います。「対象の件数」が2,000でない行は、空欄を対象から外した形式と参照のルールです。たとえばメールの形式は、メールが入っている1,912行のうち66行が書式に合いませんでした。顧客コードの重複の60行は、同じ顧客コードを持つ行をすべて数えた件数です。重複しているコードは30個で、そのうち20個は、すべての列がまったく同じ行(Web の二重送信の設定)でした。残りの10個は、同じ顧客コードで最終更新日が違う行(移行の二重取り込みで古い版が入った設定)です。この2つは、同じ「重複」でも直し方が違います。まったく同じ行は機械的に1行へまとめられますが、中身が違う行は、どちらを正とするかを決める必要があります。
点検の結果からは、どのルールがどれだけ違反しているかが分かります。この例で違反率が最も高いのは、3年以内の更新(6.50%)で、次がメールの欠損(4.40%)と郵便番号の形式(3.82%)です。ただし、違反率の大きさだけで直す順序を決めることはできません。郵便番号の形式の違反は、後の節で見るように、ほとんどが機械的に直せるものでした。一方でメールの欠損は、台帳の中の情報だけでは埋められず、本人への確認か、申込の原票のような信頼できる元の記録との照合が要ります。順序を決めるには、違反の原因と、直すのにかかる手間と、その項目の用途の重さを合わせて見る必要があります。
品質スコアの作り方と報告の形
ルールごとの合格率が出たら、それを経営や業務の側に報告できる形にまとめます。ここでは、ルールごとの合格率を目標と比べた表と棒グラフを作り、観点ごとに束ねた値を出します。この章では、ルールの合格率と、それを観点や台帳ごとに束ねた値をまとめて品質スコアと呼びます。次のコード(ch05_score_chart.py。同じフォルダに置いて実行します)は、前の節の結果に目標(例)を付け、その例の目標に対して達成か未達かを判定してグラフを描くものです。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib  # noqa: F401
from ch05_ledger import make_ledger
from ch05_quality_check import check_rules, score_table

# 観点ごとの目標(例)。目標の値はデータオーナーが用途に合わせて決める
TARGET = {"完全性": 0.98, "一意性": 1.00, "有効性": 0.99, "一貫性": 0.99, "適時性": 0.90}

df = make_ledger()
t = score_table(df, check_rules(df))
t["目標"] = t["観点"].map(TARGET)
t["判定"] = (t["合格率"] >= t["目標"]).map({True: "達成", False: "未達"})
print(t[["観点", "ルール", "合格率", "目標", "判定"]].to_string(
    index=False, float_format=lambda v: f"{v:.4f}"))
print("未達のルール数", int((t["判定"] == "未達").sum()), "/", len(t))

fig, ax = plt.subplots(figsize=(8, 5.2))
y = range(len(t))[::-1]
color = ["#002E73" if s == "達成" else "#A6A6A6" for s in t["判定"]]
ax.barh(list(y), t["合格率"], color=color, height=0.6)
ax.scatter(t["目標"], list(y), marker="|", s=300, color="black", zorder=3, label="目標(例)")
for yi, v in zip(y, t["合格率"]):
    ax.text(1.004, yi, f"{v * 100:.2f}%", va="center", fontsize=9)   # 値は右端にそろえて書く
ax.set_yticks(list(y))
ax.set_yticklabels([f"{d}:{r}" for d, r in zip(t["観点"], t["ルール"])])
ax.set_xlim(0.88, 1.025)
ax.set_xlabel("合格率(違反の無い行の割合)")
ax.set_title("架空の顧客台帳 2,000行のデータ品質ルール別の合格率")
ax.barh([0], [0], color="#002E73", label="目標を達成")
ax.barh([0], [0], color="#A6A6A6", label="目標に未達")
ax.legend(loc="upper center", bbox_to_anchor=(0.5, -0.12), ncol=3, frameon=False)
plt.savefig("../ch05_quality_score.png", dpi=120, bbox_inches="tight")
print("保存 ch05_quality_score.png")
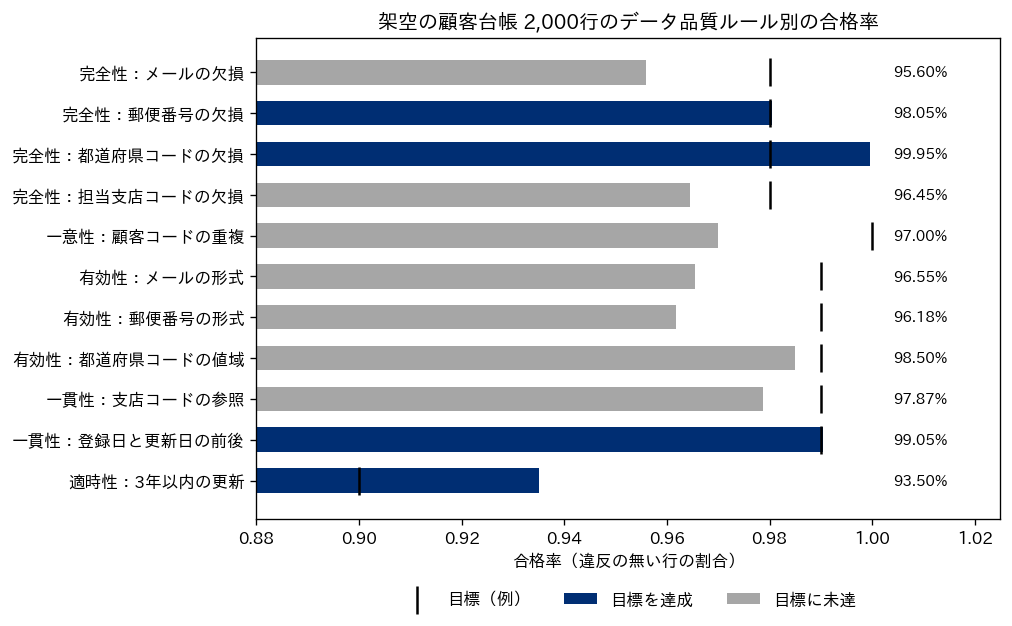
グラフの棒の色は、例として置いた目標に対して達成したルールをネイビー、未達のルールをグレーにしてあり、黒い縦線が各ルールの目標(例)です。11のルールのうち、例の目標に対して未達は7つでした。この達成と未達は、本コラムが置いた例の目標に対する判定で、目標を変えれば入れ替わります。品質の良し悪しそのものを表すものではありません。3年以内の更新は、違反率では最も高い6.50%でしたが、目標を90%に置いたので達成に入っています。逆に、顧客コードの重複は97.00%で、合格率としては低くありませんが、目標を100%に置いたので未達です。重複は1件でも集計を二重にするので、目標を100%に置くのが自然だと考えています。このように、合格率の高い低いと、目標に届いているかどうかは別のことで、報告では両方を並べる必要があります。
観点ごとに、その観点に属するルールの合格率を単純に平均すると、完全性97.51%、一意性97.00%、有効性97.07%、一貫性98.46%、適時性93.50%で、5つの観点をさらに単純に平均した総合の値は96.71%でした。一方で、11のルールのどれか1つでも違反している行を数えると、2,000行のうち515行(25.75%)ありました。総合の値が96.71%と聞くと、ほとんど問題の無い台帳に見えますが、4行に1行は何かしらの不備を抱えているということです。平均は、違反が別々の行に散っているのか、同じ行に重なっているのかを区別しません。また、この二段階の単純平均では各観点は等しく扱われますが、ルールの単位で見ると総合の値への寄与が違います(この例では完全性に4つのルールがあり、その1つの寄与は5%、適時性のルールは1つだけで、その寄与は20%です)。総合の値は、どの観点をどれだけ重く見るかという判断を隠してしまいます。
そこで、報告では総合の値を1つの数字として大きく載せるのではなく、ルールごとの合格率と目標、未達のルールの一覧、違反のある行の割合を並べるのが有効だと考えています。総合の値を経営への報告で使う場合は、重みの付け方(単純平均か、用途の重さで重み付けするか)を報告に書き、毎回同じ重みで計算して変化を見る使い方にとどめます。次の表は、品質の報告に載せる項目を、台帳ごとに1枚にまとめる形で整理したものです。
| 報告の項目 | 書くこと | この章の例での値 |
|---|---|---|
| 対象と基準日 | どの台帳の、いつ時点のデータを測ったか。ルールの定義書の版 | 架空の顧客台帳、基準日2026年9月30日、2,000行 |
| ルールごとの合格率と目標 | 今回の値、前回の値、目標、達成か未達か | 11ルール中、例の目標に未達7 |
| 違反のある行の割合 | どれか1つでも違反がある行の数と割合 | 515行(25.75%) |
| 観点ごとの値 | 観点ごとの平均と、平均に使ったルールの数 | 完全性97.51%(4ルール)など |
| 主な原因 | 違反を工程(入力時・連携時・変換時)に分けた結果 | 次の節で示す |
| 対応と担当 | 未達のルールごとの対応、担当者、期限 | (自社で決める) |
| 判断を求める事項 | 目標の見直し、ルールの追加や廃止、予算の要る対策 | (自社で決める) |
表の最後の行の「判断を求める事項」は、報告を受ける側が何を決めればよいかを示す欄です。品質の報告が「今月も96%でした」の繰り返しになると、報告を受ける側は何も決められず、やがて報告そのものが読まれなくなります。報告のたびに、目標を見直すか、どのルールの対策に人手を割くかのように、決めてほしいことを1つ以上書いておくと、報告が判断の場につながります。品質の指標を、データガバナンス全体の成果の指標としてどう使うかは第3章で、経営への報告の形は第13章で扱います。
根本原因を分ける、入力時・連携時・変換時
違反の件数が分かったら、次に、その違反がどこで生まれたかを調べます。違反を台帳の上で直しても、生まれる場所が変わらなければ、次の月には同じ違反がまた入ってきます。この章では、データの不備が生まれる場所を、大きく3つの工程に分けて考えます。入力時(人が画面や紙から値を入れるとき)、連携時(システムの間でデータを受け渡し、取り込むとき)、変換時(システムの移行やデータの加工で、形式や値を変えるとき)です。この3つは、本コラムが不備の原因を整理するために置いた分け方です。
原因を分ける最初の手がかりは、違反を、データがどこから来たかで切ってみることです。この架空の台帳では、登録経路の列がそれに当たります。次のコード(ch05_root_cause.py)は、ルールごとに、登録経路別の違反率と違反の件数を出すものです(グラフを描く部分は省いて抜き出しています)。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib  # noqa: F401
from ch05_ledger import make_ledger
from ch05_quality_check import check_rules

df = make_ledger()
rules = check_rules(df)
rows = {}
for name, (dim, target, bad) in rules.items():
    g = pd.DataFrame({"経路": df["登録経路"], "対象": target, "違反": bad})
    s = g.groupby("経路")[["対象", "違反"]].sum()
    rows[name] = s["違反"] / s["対象"]
rate = pd.DataFrame(rows).T[["店頭", "Web", "移行"]]
print("登録経路ごとの行数", df["登録経路"].value_counts().to_dict())
print(rate.to_string(float_format=lambda v: f"{v:.4f}"))
cnt = {name: df.loc[bad, "登録経路"].value_counts() for name, (_, _, bad) in rules.items()}
print(pd.DataFrame(cnt).T.fillna(0).astype(int)[["店頭", "Web", "移行"]].to_string())
結果は次の表のとおりです。違反率の分母は、そのルールの対象の行のうち、その登録経路から来た行の数です。
| ルール | 店頭 | Web | 移行 | 主な工程(この例の設定) |
|---|---|---|---|---|
| メールの欠損 | 6.08%(59件) | 0.40%(3件) | 9.22%(26件) | 入力時(移行の行は旧システムでの入力の欠け) |
| 郵便番号の欠損 | 2.06%(20件) | 0.80%(6件) | 4.61%(13件) | 入力時(移行の行は旧システムでの入力の欠け) |
| 都道府県コードの欠損 | 0.00%(0件) | 0.00%(0件) | 0.35%(1件) | 変換時 |
| 担当支店コードの欠損 | 0.00%(0件) | 9.49%(71件) | 0.00%(0件) | 入力時(業務の流れ) |
| 顧客コードの重複 | 0.00%(0件) | 5.35%(40件) | 7.09%(20件) | 連携時 |
| メールの形式 | 6.15%(56件) | 0.94%(7件) | 1.17%(3件) | 入力時 |
| 郵便番号の形式 | 3.16%(30件) | 0.81%(6件) | 14.50%(39件) | 入力時、変換時 |
| 都道府県コードの値域 | 0.82%(8件) | 0.00%(0件) | 7.83%(22件) | 入力時(店頭の存在しないコード 48)、変換時(移行の先頭の0の欠落) |
| 支店コードの参照 | 1.34%(13件) | 0.00%(0件) | 9.93%(28件) | 入力時(店頭の存在しない支店コード B99)、変換時(移行の廃止支店 B13。参照データの変更) |
| 登録日と更新日の前後 | 0.41%(4件) | 0.13%(1件) | 4.96%(14件) | 変換時 |
| 3年以内の更新 | 3.40%(33件) | 3.07%(23件) | 26.24%(74件) | 業務の運用(更新の仕組みが無い) |
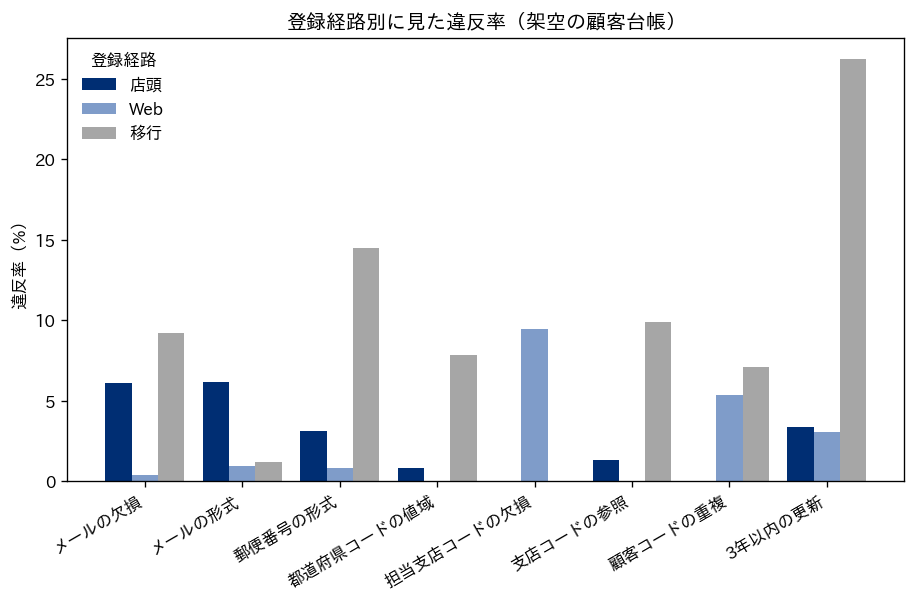
グラフには、込み合わないように11のルールのうち8つを選んで描きました。外した3つ(郵便番号の欠損、都道府県コードの欠損、登録日と更新日の前後)の値は表にあります。表とグラフで、違反の出方が登録経路によってはっきり違うことが分かります。ただし、この架空データは、登録経路ごとに違う率で不備を混ぜて作ったので、経路ごとに違いが出るのは作り方どおりの結果です。ここで示したいのは、この数字そのものではなく、違反を出所で切ると原因の見当が付く、という手順です。現実の台帳では、登録経路の列が無いことも多いので、登録した部門、取り込んだ処理の名前、取り込んだ日付のように、データの出所が分かる列を、台帳の設計の段階で持たせておくことが有効だと考えています。出所の列が無いと、違反を見つけても、どこへ直しを頼めばよいかが分かりません。
工程ごとに、この例から読める原因と、対策の向け先を整理します。入力時の不備(店頭のメールの空欄と書式の誤り、全角の郵便番号)は、入力する人の注意だけでは減りにくく、入力の画面で書式を検査する、選択肢から選ばせる、全角を自動で半角に変える、といった画面の側の対策が効きます。ガイドブックも、データの品質を高める工夫として、入力フォームの活用と、選択肢があるデータ項目をコードや選択式にすることを挙げています。連携時の不備(Web の二重送信と、移行の二重取り込み)は、取り込みの処理で、同じキーの行がすでにあるかを確かめる手順が抜けていることが原因です。取り込みの処理の設計は、第9章で扱うデータ統合の失敗の型と重なります。変換時の不備(移行の郵便番号のハイフンの欠落、都道府県コードの先頭の0の欠落、登録日と更新日の入れ違い)は、移行の変換の規則に誤りがあったことが原因で、変換の規則を直して再移行するか、移行済みのデータを規則に沿って一括で直します。
表のうち2つの行は、3つの工程のどれにもきれいには入りません。Web の担当支店コードの欠損は、入力の誤りではなく、Web の申込のあとに支店を割り当てる業務の流れがあり、その途中の状態が台帳に見えているだけかもしれません。その場合、直すべきは台帳ではなくルールの対象の範囲で、「Web の申込から何日以内は空欄を許す」のように、データオーナーがルールを書き直します。また、移行の行の26.24%が3年以内に更新されていないのは、移行した記録を更新する業務が無いことを示している可能性があり、これは工程の誤りというより運用の欠落です。支店コードの参照の違反のうち、廃止された支店 B13 の行は、支店の統廃合という参照データの変更に、台帳の側が追いついていないことを示しています。参照データの変更をどう台帳に反映させるかは、第7章で扱います。
原因を調べる作業は、データスチュワードが中心になって進め、工程の持ち主(入力の画面なら業務部門、取り込みの処理と移行ならデータカストディアン)に対策を依頼する形が扱いやすいと考えています。原因の調査を点検の担当者だけで抱えると、台帳の上で直す作業だけが繰り返され、元の工程が変わりません。
直し方の順序、予防・検出・修正
不備への手当ては、予防(不備が入らないようにする)、検出(入ってきた不備をすぐに見つける)、修正(入ってしまった不備を直す)の3つに分けられます。この章では、この3つを予防、検出、修正の順に優先することを勧めます。修正は、見つけた分しか直せず、直したそばから元の工程が新しい不備を作ります。検出は、不備が下流の集計や送付に流れる前に止められますが、止めたあとの手直しが要ります。予防は、元の工程そのものを変えるので、一度効けば毎月の手直しを減らせます。ガイドブックも、データの品質の改善作業が、データを提供する側ではなく利用する側で行われていることが社会的な非効率につながる、という趣旨を述べ、本来は提供する側で行うべき作業だとしています。社内の台帳でも、データを使う部門がそれぞれ手直しをしている状態は、同じ作業を何度も繰り返していることになります。
とはいえ、すでに台帳に入っている不備は直さなければなりません。修正のときに大切なのは、意味を変えずに機械的に直せるものと、人が判断しなければ直せないものを分けることです。全角の数字を半角にする、郵便番号のハイフンを補う、都道府県コードの先頭に0を補う、まったく同じ行を1行にまとめる、といった直し方は、この例では値の意味を変えません。ただし NFKC は全角と半角の違い以外の文字も変える(丸数字の ① を 1 にするなど)ので、ここではこの例で意図して混ぜた表記の違いに限って使っています。実務では、項目ごとに変換してよい文字を決め、元の値も残しておきます。一方で、空欄を埋める、中身の違う重複のどちらを残すかを決める、廃止された支店の顧客をどの支店に移すかを決める、といった直し方は、業務の判断を含みます。次のコード(ch05_fix.py)は、前者だけを機械的に直し、もう一度ルールを判定したものです。全角の英数字や記号を半角にそろえるところには、Unicode の正規化の1つである NFKC(全角と半角のような表記の違いを1つの書き方にそろえる処理。第7章で詳しく扱います)を使いました。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import unicodedata
import pandas as pd
from ch05_ledger import make_ledger
from ch05_quality_check import check_rules, score_table


def normalize(df):
    """意味を変えずに機械的に直せるものだけを直す"""
    d = df.copy()
    for c in ["メール", "郵便番号"]:                       # 全角を半角へ(NFKC)
        d[c] = d[c].map(lambda v: unicodedata.normalize("NFKC", v) if isinstance(v, str) else v)
    seven = d["郵便番号"].str.fullmatch(r"[0-9]{7}", na=False)  # ハイフンを補う
    d.loc[seven, "郵便番号"] = d.loc[seven, "郵便番号"].str[:3] + "-" + d.loc[seven, "郵便番号"].str[3:]
    one = d["都道府県コード"].str.fullmatch(r"[1-9]", na=False)  # 先頭の0を補う
    d.loc[one, "都道府県コード"] = d.loc[one, "都道府県コード"].str.zfill(2)
    d = d.drop_duplicates()                                     # 完全に同じ行だけを落とす
    return d


df = make_ledger()
fixed = normalize(df)
before = score_table(df, check_rules(df)).set_index("ルール")
after = score_table(fixed, check_rules(fixed)).set_index("ルール")
out = pd.DataFrame({"修正前の違反": before["違反"], "修正後の違反": after["違反"],
                    "修正後の合格率": after["合格率"]})
print("行数", len(df), "->", len(fixed))
print(out.to_string(float_format=lambda v: f"{v:.4f}"))
print("違反の合計", int(out["修正前の違反"].sum()), "->", int(out["修正後の違反"].sum()))
dup = fixed[fixed["顧客コード"].duplicated(keep=False)].sort_values("顧客コード")
print("同じ顧客コードで内容が違う行", len(dup), "(", dup["顧客コード"].nunique(), "コード)")
print(dup.head(4)[["顧客コード", "メール", "最終更新日", "登録経路"]].to_string(index=False))
結果は次の表のとおりです。同じ内容の行が2行ずつある20組を、それぞれ1行にまとめたので、行数は2,000行から1,980行になりました。
| ルール | 修正前の違反の件数 | 修正後の違反の件数 | 修正後の合格率 | 残った違反の扱い |
|---|---|---|---|---|
| メールの欠損 | 88 | 88 | 95.56% | 本人への確認が要る |
| 郵便番号の欠損 | 39 | 39 | 98.03% | 本人への確認が要る |
| 都道府県コードの欠損 | 1 | 1 | 99.95% | 本人への確認が要る |
| 担当支店コードの欠損 | 71 | 68 | 96.57% | 割り当ての業務か、ルールの見直し |
| 顧客コードの重複 | 60 | 20 | 98.99% | どちらを正とするかの判断が要る(10コード) |
| メールの形式 | 66 | 11 | 99.42% | ドメイン名の抜けは本人への確認が要る |
| 郵便番号の形式 | 75 | 0 | 100.00% | 無し |
| 都道府県コードの値域 | 30 | 8 | 99.60% | 存在しないコード(48)は本人への確認が要る |
| 支店コードの参照 | 41 | 41 | 97.86% | B99(店頭)は正しい担当支店を確かめ、B13(移行)は統廃合後の移管先を決める判断が要る |
| 登録日と更新日の前後 | 19 | 19 | 99.04% | 元の記録で日付を確かめる必要がある |
| 3年以内の更新 | 130 | 130 | 93.43% | 連絡先の確認の業務が要る |
ルール別の違反の延べ件数は、620件から425件に減りました。郵便番号の形式の違反75件は、全角の数字とハイフンの欠落だけだったので、すべて機械的に直りました。メールの形式は66件から11件に減り、残った11件はドメイン名が抜けたもので、台帳の中の情報だけでは正しい値を決められず、本人への確認か、信頼できる元の記録との照合が要ります。担当支店コードの欠損が71件から68件に減ったのは、まったく同じ重複の行の中に、支店が空欄の行が3行あったからです。重複は60行から20行になり、残ったのは中身の違う10コード分の行です。修正後の行を見ると、同じ顧客コードの2行で最終更新日が1年以上違っており、新しい方を残すのが自然に見えますが、現実の台帳では、古い方にしか無い情報が入っていることもあります。どちらを正とするかは、項目ごとに、更新日・登録経路・持ち主の確認の順で決める方法を、第7章の「似た名前を拾い、住所と電話番号で確かめる」の節の終わりで扱います。
この結果から読めるのは、機械的な修正で減る違反と、減らない違反がはっきり分かれることです。機械的に直せる違反は、毎月の取り込みのたびに自動で直す処理を入れれば済みますが、それは修正を自動化しただけで、元の工程が全角やハイフン無しの値を作り続けることは変わりません。自動の修正を入れるときは、直した件数を記録し、件数が減らなければ元の工程の対策(入力の画面の改修や、移行の変換の規則の修正)を依頼する、という形にしておくことが有効だと考えています。機械的に直せない違反は、本人への確認、業務の判断、ルールの見直しのどれかが要り、どれも人手がかかります。この人手の量が、品質の改善に必要な予算と体制を見積もる材料になります。
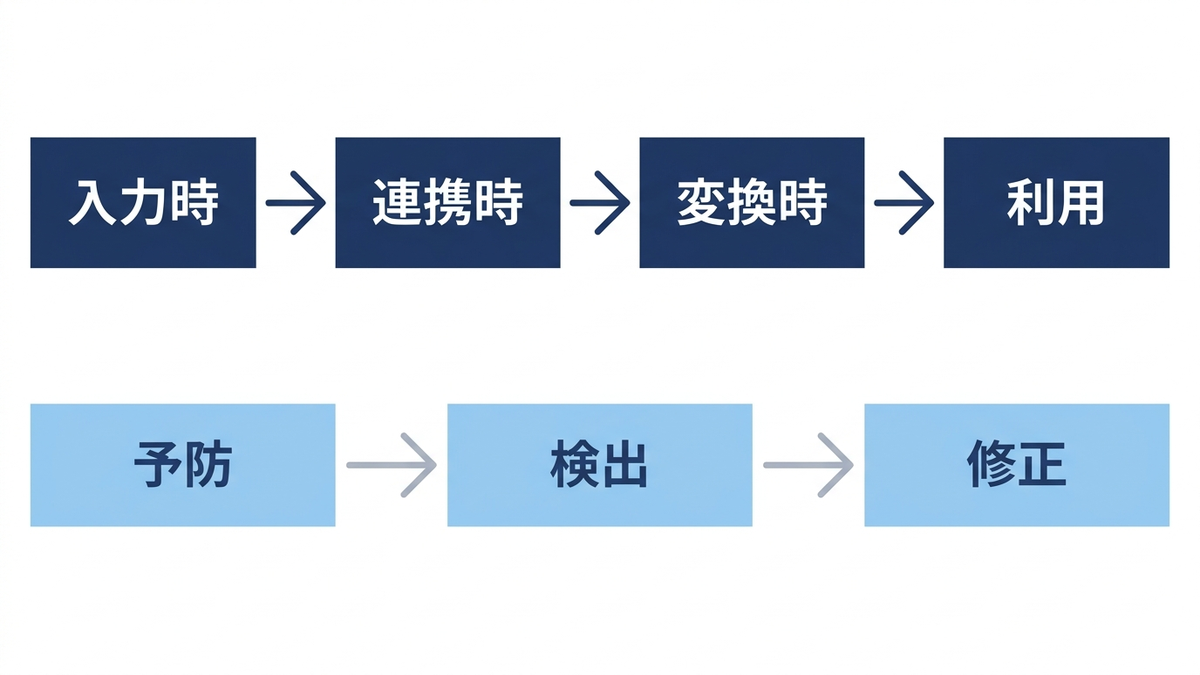
予防・検出・修正を、この章の例に当てはめて整理すると、次の表のようになります。
| 手当て | 何をするか | この例での具体策 | 主な担当 |
|---|---|---|---|
| 予防 | 不備を生む工程を変える | 店頭の入力画面で郵便番号とメールの書式を検査し、全角を自動で半角にする。移行の変換の規則を直す。取り込みの処理で既存の顧客コードを確かめる | 業務部門(画面の要件)、データカストディアン(処理の改修) |
| 検出 | 取り込みのたびに点検し、基準を下回ったら止めるか知らせる | この章の11のルールを毎月の取り込みの直後に自動で回し、目標を下回ったルールを担当に知らせる。重複のルールが違反したら取り込みを止める | データスチュワード、データカストディアン |
| 修正 | 入ってしまった不備を直す | 機械的に直せる形式の違反は一括で直し、件数を記録する。空欄と中身の違う重複は担当に確認を依頼する | データスチュワード、業務部門 |
データ品質ツールの位置づけ
この章のコードは、pandas の基本的な操作だけで品質のルールを書きました。ルールの数が少ないうちはこれで足りますが、台帳の数とルールの数が増えると、ルールの定義を1か所で管理し、判定の結果を記録し、結果を人が読める形で公開する仕組みが欲しくなります。Python の世界には、そのための公開された道具があります。ここでは、公式の文書を開いて確かめた範囲で2つを紹介します。本コラムの実行環境にはどちらも入れておらず、この章のコードでは使っていません。
1つ目は Great Expectations です。GX Core の概要のページ(2026年10月22日に確認。版の表示は 1.24.0)によれば、GX Core は Python のライブラリで、データについて検証できる主張を Expectation と呼び、Expectation をまとめたものを Expectation Suite、どのデータをどの Expectation Suite で検証するかを結び付けたものを Validation Definition と呼びます。本番の運用で検証を行う主な手段は Checkpoint で、複数の Validation Definition をまとめて実行し、結果に応じた処理を起動できます。検証の結果と Expectation Suite の定義は、人が読める文書(Data Docs)として出力されます。この章の言葉に置き換えると、Expectation がデータ品質ルール、Expectation Suite がルールの定義書、Data Docs が品質の報告に近い役割を持ちます。
2つ目は pandera です。pandera の公式文書(2026年10月22日に確認)によれば、pandera はデータフレームのような形のデータを検証するための公開の枠組みで、pandas のほか polars、dask、modin、ibis、pyspark などのデータフレームに対応しています。列ごとに期待する型と検査(値の範囲、選択肢に含まれるか、独自の条件など)を書いた表の定義(スキーマ)を作り、データがその定義に合うかを確かめます。この章のルールの表のうち、列ごとの型・書式・値域のルールは、こうしたスキーマの形で書きやすい種類のものです。
道具を入れる前に決めておくことがあります。道具が受け持つのは「ルールを書き、判定し、結果を記録する」部分で、「どのルールを置き、目標をいくつにし、違反をどう扱うか」を決めるのは、この章で見たとおり業務の側です。ルールの定義書と目標が無いまま道具を入れると、情報システム部門が思いつくルールが大量に並び、どれが業務にとって大事なのかが分からない状態になりがちです。この章の進め方で、まず10個前後のルールを表計算や pandas で回し、ルールと目標と報告の形が固まってから道具に移す、という順序が手戻りの少ない進め方だと考えています。なお、ガイドブックは、データのクレンジング(誤りや表記の揺れを直す作業)の道具として OpenRefine や IMI コンポーネントを挙げ、道具で一括処理するときは誤変換を起こさないように注意が要ると述べています。どの道具でも、一括で直す処理を入れる前に、直す前と後の件数を比べる手順を置いておくことが大切です。
品質不良が招く損失の型と、経営の判断
データ品質の不良が経営に与える損失は、金額の大きさより、どういう形で表れるかを押さえておくと、対策の優先順位を決めやすくなります。次の表は、この章の顧客台帳の例に沿って、品質の不良が招く損失の型を整理したものです。
| 損失の型 | この章の例で起きること | 関係する観点 |
|---|---|---|
| 集計の食い違い | 重複した顧客を2人と数え、支店別・都道府県別の顧客数が部門ごとに合わない。都道府県コードの先頭の0が無い行が、集計で別の都道府県か「不明」に分かれる | 一意性、有効性 |
| 判断の遅れ | 会議で数字の食い違いの原因探しに時間が使われ、施策や予算の判断が後ろにずれる。メールの空欄や古い連絡先のために案内が届かず、届かないことに気づかないまま施策の効果を低く見積もり、次の判断を誤る | 一意性、一貫性、完全性、適時性 |
| 二重投資 | 台帳を使う部門がそれぞれ全角を直し、重複を消す作業を毎月繰り返す。部門ごとに手直しの仕組みや道具を別々に用意し、同じ作業に二重に人手と費用がかかる | 有効性、一意性 |
| 法令違反 | 同じ顧客が2行あり、本人からの配信停止や利用停止の申し出が片方の行にしか反映されず、対応が漏れるおそれがある(個人情報の扱いは第8章で扱う) | 一意性、一貫性 |
| AI 投資の空振り | 重複や古い記録を含んだ台帳で予測モデルを作り、モデルの精度の問題とデータの問題を区別できない | すべて |
| 現場の不信 | 点検の結果に業務上正しい空欄(Web の支店の割り当て待ち)が違反として並び、現場が点検そのものを信用しなくなる | ルールの定義の誤り |
表の最後の行は、品質そのものではなく、品質の測り方の誤りが招く損失です。ルールの対象の範囲や目標を業務の側と決めずに測り始めると、この損失が最初に起きやすいように思います。点検を始めるときに、最初の結果を業務の側と一緒に読み、「この違反は本当に違反か」を確かめる場を設けておくことが有効だと考えています。
経営として決めるべきことは、どの台帳のどの項目から測り始めるか、そして何を測らないかです。全部の台帳の全部の項目を15の特性で測ろうとすると、点検の仕組みを作るだけで予算と関心が尽きます。測る対象は、止まると困る用途から逆にたどって選ぶのが有効だと考えています。たとえば、毎月の顧客への送付と支店別の業績の集計が主要な用途なら、それに使われる顧客台帳のメール・郵便番号・都道府県コード・担当支店コードと、顧客コードの重複が、最初に測る項目になります。ガイドブックも、初めて評価をするときはマスターデータ系を対象に選ぶことを推奨し、特にエラー処理や修正の手順が発生しているデータを対象にするよう勧めています。すでに現場で手直しが起きているデータは、品質の問題が業務の費用として表れているので、測る価値を説明しやすいデータでもあります。
測らないことを決めるのも、同じくらい大切です。分析の担当者が一度だけ使う集計用の抽出データや、用途が決まっていない蓄積用のデータに、本番の台帳と同じ点検を置く必要はありません。また、正確性(現実と一致しているか)は、台帳だけでは測れず、本人への確認や外部の情報との突き合わせに人手がかかるので、全件ではなく標本で年に1回確かめる、のように頻度と範囲を絞る判断が要ります。予算の判断としては、点検の仕組み(ルールを回す処理と報告)を作る費用と、前の節で見た「機械的に直せない違反」を人が直す費用を分けて見積もり、後者を減らすための予防(入力の画面や取り込みの処理の改修)にどれだけ投じるかを決める、という形が判断しやすいと考えています。
この章の要点は3つです。第一に、データ品質は用途に適している度合いで、品質の物差しには ISO/IEC 25012(2008年)の15特性と、それに沿ったデジタル庁のガイドブック(β版)の15項目がありますが、実務の点検では、完全性・一意性・有効性・一貫性・適時性・正確性のような少数の観点で、判定の式と対象と目標と持ち主を書いたデータ品質ルールに落とします。第二に、架空の顧客台帳の点検では、観点の平均を総合した値が96.71%でも、4行に1行(25.75%)に何かしらの違反があり、報告ではルールごとの合格率と目標、違反のある行の割合を並べる必要がありました。第三に、違反を出所で切ると原因の工程の見当が付き、機械的に直せる違反(この例では620件のうち195件)と、本人への確認や業務の判断が要る違反が分かれます。直す順序は予防、検出、修正で、測り始める対象は止まると困る用途から選びます。次の第6章では、この章で何度も出てきた「項目の意味と持ち主をどこに書くか」を扱うメタデータとデータカタログ、データの来た道をたどるデータリネージを扱います。
この章を深めたい方への参考書籍
『データ品質プロジェクト実践ガイド 質の高いデータと信頼できる情報を得るための10ステップ』(Danette McGilvray 編著、木山靖史・宮治徹・井桁貞裕 監訳、日経BP):書名のとおり、データ品質の改善を10の手順のプロジェクトとして進める方法を扱った本です。この章で扱った、品質の観点を決める、測る、原因を調べる、予防と修正を選ぶ、という流れを、自社のプロジェクトとして組み立てるときの手引きになります。
『前処理大全 SQL/pandas/Polars実践テクニック 改訂新版』(本橋智光・橋本秀太郎 著、技術評論社):分析の前のデータの加工を、SQL・pandas・Polars の3つで書き分けて示す本です。この章のコードで行った、欠損や重複の確認、文字列の書式の確認と正規化を、自社のデータベースや分析環境で書くときの参考になります。
第6章 メタデータ管理とデータカタログ、データリネージ
第5章では、データ品質を「用途に適している度合い」として捉え、品質ルールを決めて測り、原因を入力時・連携時・変換時に分けて直す進め方を扱いました。品質ルールを書くには、その項目が何を意味し、どの値が正しいのかが先に決まっている必要があります。この章では、その「意味」と「出所」を記録して共有する仕組みを扱います。データについてのデータであるメタデータの種類、業務の言葉を定義するビジネス用語集、メタデータを集めて検索できるようにしたデータカタログ、データがどこから来てどこへ行くかを示すデータリネージを順に説明し、最後に、どこから着手し、経営としてどう判断するかを述べます。この章にはコードはありません。製品や規格については、公式の文書を開いて確かめた範囲だけを書きます。
メタデータとは何か、業務・技術・運用の3つに分ける
メタデータは、本コラムの定義では「データについてのデータ」で、定義・出所・形式・持ち主・更新頻度などを指します。たとえば顧客台帳の「契約開始日」という列について、それが申込日なのか初回請求日なのか、日付の形式は何か、誰がいつ入力するのか、毎日更新されるのか月に1回なのか、といった情報がメタデータです。データそのものが正しくても、これらが分からなければ、分析する人は値を正しく読めません。逆に、メタデータが整っていれば、初めてそのデータを使う人でも、担当者に聞き回らずに使い始められます。
メタデータの分け方にはいくつかの流儀がありますが、本コラムでは、誰が書き、誰が使うかの観点から、業務・技術・運用の3つに分けます。この3区分は既存の資料でも使われている分け方で、次の表の具体例と担当の分担は本コラムで整理したものです。1つ目は、そのデータが業務の上で何を意味するかを書いた業務上の意味の情報です。2つ目は、システムの中でどう格納されているかを書いた技術的な仕様の情報です。3つ目は、そのデータがいつ作られ、どの処理を通り、どれだけ使われているかを示す運用の記録です。この3つは、書ける人も、更新される頻度も違います。業務上の意味は業務部門が内容に責任を持ち、技術的な仕様はシステムから自動で取り出せることが多く、運用の記録はデータを処理する仕組みが動くたびに増えていきます。
| 区分 | 中身の例 | 主に書く人 | 主に使う人 | 無いと起きること |
|---|---|---|---|---|
| 業務上の意味 | 用語の定義、計算式、含めるもの・除くもの、単位、データオーナー、利用してよい用途 | データオーナー・データスチュワード(業務部門) | 経営層・業務部門・分析の担当 | 同じ名前の数字が部門ごとに違う意味で使われ、会議で集計が食い違う |
| 技術的な仕様 | テーブル名・列名、データ型、桁数、必須かどうか、コード値の一覧、格納場所 | データカストディアン(情報システム部門)。多くはシステムから自動で取得 | 開発者・データエンジニア・分析の担当 | 型や桁の思い込みで連携が壊れる。どこにあるデータかを探すのに時間がかかる |
| 運用の記録 | 更新日時、更新頻度、処理の経路(リネージ)、品質ルールの結果、利用者と利用回数、アクセス権 | データを処理する仕組みが自動で記録。例外は担当者が補記 | データスチュワード・運用の担当・監査 | 古いデータが使われ続けても気づけない。障害の影響範囲を特定できない |
この表で大事なのは、「主に書く人」が情報システム部門だけではない点です。メタデータの整備は、システムの設定作業だと受け取られやすく、情報システム部門に任されることが多いように思います。しかし、技術的な仕様と運用の記録はシステムから取り出せても、業務上の意味は、業務部門が内容を確かめて承認する必要があります。既存の仕組みに説明や責任者が記録されていれば、それを自動で取り込める場合もありますが、製品を入れるだけでは、まだ決まっていない意味や責任の分担は決まりません。「有効な顧客」とは何かを決められるのは、その顧客を扱う業務の責任者です。メタデータの整備を情報システム部門だけに任せると、テーブルと列の一覧はできても、それぞれの列が業務の上で何を意味するかが空欄のまま残ります。第3章で扱ったデータオーナーとデータスチュワードの役割は、まさにこの空欄を埋めるために置くものです。
3つの区分は、どの段階から必要になるかも違います。社員が数十人で、システムが会計と販売管理の2つ程度なら、業務上の意味を表計算ソフトの1枚にまとめるだけでも、集計の食い違いの多くは防げます。システムが増え、データを基盤に集めて加工するようになると、技術的な仕様と運用の記録を人手で追い切れなくなり、自動で集める仕組みが要ります。メタデータ管理を「大きな会社が製品を入れてやること」と考えると、小さな組織は何もしない理由を得てしまいます。業務上の意味の記録は、規模にかかわらず最初から要ると考えています。
ビジネス用語集と項目定義
ビジネス用語集は、業務で使う言葉の意味を、組織として1つに決めて書き留めた一覧です。ここでの「用語」は、「受注」「出荷」「有効顧客」「解約」「粗利」のように、会議の資料や報告書に繰り返し出てくる言葉です。テーブルや列の名前ではなく、業務の言葉を単位にするのがポイントです。1つの用語が複数のシステムの複数の列に対応することもあり、逆に、同じ列名が別の業務では別の意味で使われていることもあります。用語集は、まず業務の言葉の側を固め、そのあとでシステムの列と結びつけます。
用語集の1行には、言葉の意味だけでなく、その言葉を数字にするときの決めごとまで書きます。「有効顧客数」なら、何をもって有効とするか、いつの時点で数えるか、休止中の顧客を含めるか、同じ会社の複数の部署を1件と数えるか、といった判断が要ります。これらを文章の定義だけで済ませると、読み手によって解釈が分かれます。次の表は、用語集の1項目に書く欄と、その記入例です。記入例は説明のための架空のもので、特定の業種の正解を示すものではありません。
| 欄 | 書くこと | 記入例(用語「有効顧客数」) |
|---|---|---|
| 用語名 | 組織で正式に使う呼び方。1つに決める | 有効顧客数 |
| 別名・使ってはいけない呼び方 | 部門で使われている別の呼び方と、混同しやすい別の用語 | 別名「アクティブ顧客数」。「登録顧客数」とは別の用語として扱う |
| 定義 | 業務の言葉で、1〜3文で書く | 月末時点で契約が継続しており、その月を含む直近3か月(暦の月で数える)に1回以上の請求がある顧客の数 |
| 計算式 | 分子・分母・条件を、誰が計算しても同じ結果になる形で書く | 月末時点の契約状態が「継続」で、かつ請求日が直近3か月以内にある顧客 ID の重複を除いた件数 |
| 含めるもの・除くもの | 判断が分かれやすい境界の扱い | 休止中の顧客は除く。社内の試験用の顧客 ID は除く。同じ法人の複数契約は1件と数える |
| 単位・粒度 | 件・円・人などの単位と、どの単位で数えるか | 件(顧客 ID 単位。この例では1つの法人に1つの顧客 ID を付けている)。月次 |
| 更新頻度 | 値がいつ確定するか | 毎月の締め日の翌営業日に確定 |
| データオーナー | 定義を決め、変更を承認する人(役職で書く。部門をまたいで使う定義では案に意見を出す側になり、承認はデータガバナンス委員会が行う) | 営業本部長 |
| データスチュワード | 定義を維持し、問い合わせに答える人 | 営業企画の担当者 |
| 出所となるデータ | どのシステムのどのデータから計算するか | 契約管理システムの契約テーブル、請求システムの請求テーブル |
| 状態と版 | 案・承認済み・廃止の区別と、決めた日・変えた理由 | 承認済み。第2版(休止中の扱いを変更) |
表の欄のうち、見落とされやすいのは「別名・使ってはいけない呼び方」と「状態と版」の2つです。部門の中で長く使われてきた呼び方は、用語集で正式名を決めても、すぐには消えません。別名を書いておけば、別名で検索した人も正式な定義にたどり着けます。また、定義は事業の変化に合わせて変わります。休止の扱いを変えた月から数字が変わったときに、それが業績の変化なのか定義の変更なのかを区別するには、いつ、誰が、なぜ定義を変えたかの記録が要ります。版を残さない用語集は、過去の報告と今の報告を比べられなくなります。
用語集の作り始めで迷いやすいのは、どの言葉から定義するかです。業務で使う言葉を全部集めようとすると、数百の用語が並び、どれも決まらないまま時間が過ぎます。経営会議の資料に毎月出てくる言葉、部門をまたいで数字が比べられる言葉、すでに「数字が合わない」という声が出ている言葉の3つの条件に当たるものから、数を絞って始めるのが現実的だと考えています。いくつにするかは自社で決めますが、本コラムでは、経営会議の資料1回分に出てくる指標の数を念頭に、最初の目安として10〜30語程度を想定しています。この10〜30語は、第5章で品質ルールを書く対象とも重なります。定義が決まっていない項目に品質ルールは書けないので、用語集は品質の測定の前提にもなります。
用語の定義を決める会議では、部門ごとの事情が衝突します。営業は受注した時点で数えたい、経理は請求や計上の時点で数えたい、という具合です。このとき、どちらか一方の定義に統一しようとすると議論が終わりません。多くの場合、両方とも業務上の理由がある別の数字なので、別の用語として両方を登録し、それぞれに名前と持ち主を与えるほうが早く決着します。用語集の役割は、1つの言葉に1つの意味を対応させることで、組織の数字を1つに減らすことではありません。第4章で全社にそろえる対象とした共通語彙も、この考え方で扱います。全社でそろえるのは言葉と意味の対応で、業務上の理由がある別の数字には別の名前を付けます。
用語集の欄と、第4章で扱った単位・日付・コード値などの標準との関係も整理しておきます。用語集の「単位・粒度」の欄には、その用語を数字にするときの単位を書きます。一方、システムの列ごとの単位・桁・日付の基準は、技術的な仕様のメタデータとして、後で述べるデータカタログの「格納場所と形式」の欄と、列ごとの業務上の説明(後の表の「列の業務上の説明」)に書きます。用語と列を結びつけておくと、用語の側から、その用語に対応する列の形式までたどれます。
指標の定義を1か所で管理する
用語集の中でも特に影響が大きいのは、売上・顧客数・解約率・在庫回転のような、経営の判断に直接使う基本の指標です。これらの指標は、部門ごとに少しずつ違う定義で計算されていることが多く、同じ「売上」が営業の報告と経理の報告で一致しない、という状態が起きやすいと思われます。どの部門も計算を誤っているわけではなく、それぞれの業務に自然な時点と範囲で数えているだけです。問題は、違う定義の数字が同じ名前で同じ会議に並ぶことです。
次の表は、「売上」と呼ばれうる数字が部門ごとにどう違いうるかを示した例です。これは説明のための架空の例で、会計上の収益の認識の基準を説明するものではありません。会計上の扱いは、自社の経理部門と会計の専門家の判断によります。
| 部門の呼び方の例 | 数える時点の例 | 範囲の例 | この数字が自然な用途 | 用語集での扱いの例 |
|---|---|---|---|---|
| 営業の「売上」 | 受注が確定した日 | 値引き前の金額。キャンセルは翌月に差し引く | 営業担当の活動の評価、受注の見通し | 用語「受注金額」として登録。持ち主は営業本部長 |
| 物流の「売上」 | 出荷した日 | 出荷した数量に単価を掛けた金額。返品は別に数える | 出荷量の計画、倉庫の負荷の把握 | 用語「出荷金額」として登録。持ち主は物流部門の責任者 |
| 経理の「売上」 | 経理の規程で定めた計上の時点 | 値引き・返品を反映した金額 | 決算、税務、経営会議の公式の数字 | 用語「売上高」として登録。持ち主は経理部門の責任者 |
| マーケティングの「売上」 | ウェブ上で注文が完了した日 | 自社サイト経由の注文だけ。税込み | 広告の効果の測定 | 用語「サイト注文金額」として登録。持ち主はマーケティングの責任者 |
表の右端の列のように、4つの数字に別々の名前と持ち主を与えると、同じ会議に4つが並んでも混乱しにくくなります。そのうえで、経営会議の公式の数字としてどれを使うかを決め、それ以外の数字を報告に載せるときは正式な用語名で書く、という決まりを置きます。経営会議の公式の数字は部門をまたいで使うものなので、どれを使うかは、第3章の分担に沿って、関係する部門のデータオーナーの意見を聞いたうえでデータガバナンス委員会が決めます(委員会で合意できないときは、委員長の CDO が裁定します)。これが、本コラムでいう指標の定義の一元化です。ここで一元化するのは「数字を1つにすること」ではなく、「定義を1か所に置き、どの数字がどの定義かを誰でも確かめられるようにすること」です。
定義を1か所に置くには、その置き場所が組織の中で1つに決まっている必要があります。用語集が表計算ソフトのファイルで、部門ごとに写しが作られていると、写しの間で定義がずれていきます。置き場所は1つにし、変更はデータオーナー(部門をまたいで使う定義はデータガバナンス委員会)の承認を経て、その置き場所の上でだけ行う、という手順を決めておきます。定義を変えるときは、変更の前後で両方の定義の数字を一定期間並べて出し、どれだけ変わるかを確かめてから切り替えると、過去の報告との比較が途切れにくくなります。
定義と計算式をめぐる役割の分担も、ここで決めておきます。本コラムでは、計算式や加工のルール(どの値を含め、どう計算するか)の内容はデータオーナー(部門をまたいで使う定義はデータガバナンス委員会)が決め、データスチュワードがそれを用語集に記録し、情報システム部門のデータカストディアンが集計や変換の仕組みに実装して維持する、という分担で統一します。部門をまたいで使う定義では、第3章のとおり、関係する部門のデータオーナーが案の段階から意見を出し、データガバナンス委員会の承認で確定します。データスチュワードは決める人ではなく、決まった内容を記録して維持し、問い合わせに答える人です。データカストディアンは、実装した計算が用語集の記録と一致しているかを確かめる責任も持ちます。この3者の分担が決まっていないと、仕組みの中の計算式が、誰も承認していないまま変わっていくことがあります。
決めた定義を、BI のダッシュボードや集計の仕組みにどう組み込み、全部門に同じ数字を届けるかは、第9章で扱います。この章で扱うのは、その前段の「定義をどう決め、どこに置き、どう変えるか」です。本コラムでは、指標の定義の正本(食い違ったときに正とする1か所)は、この章で述べた用語集とします。第9章で扱うセマンティック層は、用語集の定義を集計の仕組みに実装する場所であって、定義の正本ではありません。両者が食い違ったときは用語集を正とし、用語集の版を変えたときは、セマンティック層の同じ指標も同時に直します。仕組みの側で指標を一元化しても、その指標の定義が業務の側で合意されていなければ、仕組みは誰も信じない数字を正確に配ることになります。順序としては、定義の合意が先で、提供の仕組みが後です。
データカタログの機能と、載せる項目
データカタログは、本コラムの定義では、メタデータを集めて検索できるようにした目録です。図書館の蔵書目録にたとえると分かりやすく、利用者は本そのものを探し回る代わりに、目録で書名や著者から本の場所を調べます。データカタログでは、利用者が「顧客の解約」「月次の受注」のような言葉で検索し、該当するテーブルやファイル、その定義、持ち主、更新日時、使ってよい用途を調べます。データそのものを持つ仕組みではなく、データの在りかと意味を持つ仕組みです。
データカタログに求められる機能は、利用者の立場から整理すると5つにまとめられます。1つ目は検索で、業務の言葉からデータを探せることです。2つ目は定義の表示で、検索で見つけたデータに、用語集の定義と列ごとの説明が結びついていることです。3つ目は持ち主の表示で、そのデータについて誰に問い合わせればよいか、誰が利用を承認するかが分かることです。4つ目は利用状況の表示で、そのデータが最近いつ更新され、どれだけ使われているかが分かることです。5つ目はリネージの表示で、そのデータがどこから来て、どの処理を経て、どこで使われているかが分かることです。この5つのうち、検索と持ち主の表示が使えるだけでも、データを探す時間は減ると考えています。
カタログに載せる項目は、最初から多くしすぎないことが大事です。項目を増やすほど、空欄の多い目録になり、空欄の多い目録は使われなくなります。次の表は、カタログに登録するテーブルやファイルごとに載せる項目の例で、最初に必ず埋める項目と、運用が回り始めてから足す項目に分けています。
| 項目 | 中身 | 誰が埋めるか | 最初から埋めるか |
|---|---|---|---|
| 名称と説明 | 業務の言葉での名称と、何のデータかの1〜2文の説明 | データスチュワード | 最初から |
| データオーナー | 定義と提供の可否を決める人(役職) | データガバナンスの事務局(第3章)が任命を記録 | 最初から |
| 問い合わせ先 | 日々の質問に答える人(データスチュワード) | データスチュワード | 最初から |
| 結びつく用語 | ビジネス用語集のどの用語に対応するか | データスチュワード | 最初から(主要な列だけでよい) |
| 格納場所と形式 | システム名・テーブル名・列の一覧・データ型 | システムから自動で取得 | 最初から |
| 更新頻度と最終更新日時 | 日次・月次などの予定と、実際に最後に更新された日時 | 予定はデータスチュワード、実績は自動で取得 | 最初から |
| 機密区分 | 社外秘・個人情報を含む等の区分 | データオーナーが決め、データスチュワードが記録 | 最初から(区分の決め方は第8章) |
| 品質の状況 | 第5章の品質ルールの結果、既知の問題 | 品質の点検の仕組みから自動で取得。既知の問題はデータスチュワードが補記 | 運用が回ってから |
| リネージ | 出所と加工の経路、利用先 | 処理の仕組みから自動で取得。取れない部分は担当者が補記 | 運用が回ってから |
| 利用状況 | 利用者の数、参照の回数、よく使われる組み合わせ | 自動で取得 | 運用が回ってから |
| 利用の条件 | 使ってよい用途、申請の手順 | データオーナー | カタログへの掲載は運用が回ってから(それまでは問い合わせ先が用途と申請の手順を案内する。利用の条件そのものは利用を始める前に確かめる) |
「最初から」とした項目のうち、データオーナー・問い合わせ先・結びつく用語・名称と説明の4つは、人が内容を決めて確かめる必要がある項目です。既存の記録があれば自動で取り込める場合もありますが、カタログの製品を入れるだけでは、この4つの中身は決まりません。逆に、格納場所と形式、最終更新日時はシステムから取り出せるので、製品を入れる効果が出やすい部分です。カタログの整備にかかる手間の多くは、製品の設定ではなく、人が書く4つの項目をどう埋め、どう維持するかにあります。
データカタログの製品には、商用のものとオープンソース(ソースコードが公開され、ライセンスに従って利用・改変・再配布できるソフトウェア)のものがあり、クラウドの事業者もそれぞれの基盤に向けた機能を提供しています。ここでは、オープンソースの例として2つを取り上げ、公式の文書で確かめた機能だけを紹介します。いずれも2026年10月22日に公式の文書を開いて確認した内容です。製品どうしの優劣を比べるものではなく、上で述べた機能が実際の製品でどう形になっているかの例として示します。
1つ目は DataHub です。公式の文書の概要のページは、ダッシュボード・データセット・機械学習のモデル・ファイルを含むデータ全体を検索できること、所有者を定めて個人情報を含むデータを追跡できること、リネージを追跡できることを挙げています。ビジネス用語集の文書によると、用語(Term)と、用語をまとめるフォルダのような用語グループ(Term Group)を作ることができ、それぞれに説明と所有者を付けられます。用語はデータの資産と列に結びつけることができ、用語どうしの関係として、ある用語が他の用語を含む関係(Contains)と、ある用語が別の用語の下位の分類である関係(Inherits)を登録できます。文書の例では、住所が郵便番号・番地・市区町村を含み、電子メールアドレスが個人情報の下位の分類に当たる、という関係が示されています。
2つ目は OpenMetadata です。公式の文書のトップページは、データの発見・リネージ・ガバナンスのための統合された基盤と説明しています。用語集の文書は、用語集を組織の重要な概念と用語を記述するための統制された語彙と位置づけ、用語の階層(親と子の用語)や、同義語・関連する用語の登録、データの資産への用語の付与、用語の審査と承認の手順の設定、CSV ファイル(値をカンマで区切った表形式のテキストファイル)での一括の取り込みと書き出しを扱っています。
2つの製品の文書に共通しているのは、用語集を独立した機能として持ち、用語をテーブルや列に結びつける作りになっている点です。製品の文書が述べているのは機能の作りで、運用の順序ではありませんが、この作りであれば、この章で述べた「業務の言葉の側を先に固め、そのあとでシステムの列と結びつける」という順序を取りやすいと考えています。製品を選ぶときには、機能の多さよりも、自社の用語集をそのまま載せられるか、自社のシステムからメタデータを自動で取り込めるか、データスチュワードが日常の業務の中で更新できる操作になっているか、を確かめるのがよいと考えています。製品の機能や対応する接続先は版によって変わるので、検討の時点で各製品の公式の文書を確認してください。
データリネージ、どこから来てどこへ行くか
データリネージは、本コラムの定義では、データがどこから来て、どう加工され、どこへ行ったかの経路です。系譜と訳されることもあります。たとえば、経営会議のダッシュボードに出ている「月次の受注金額」が、どのシステムのどのテーブルから取り出され、どの処理で集計され、どの中間のテーブルを経てダッシュボードに届いたかを、たどれる形で記録したものがリネージです。
リネージが役に立つ場面は、大きく2つあります。1つ目は影響分析で、上流の変更が下流のどこに影響するかを、変更の前に調べることです。基幹システムの改修で、ある列の意味や形式が変わる場合、その列を使っている集計やダッシュボード、機械学習のモデルを洗い出せれば、事前に直すことができます。2つ目は原因調査で、下流で数字がおかしいと分かったときに、上流のどこで問題が起きたかをさかのぼって調べることです。第5章で品質の問題の原因を入力時・連携時・変換時に分けましたが、どの段階で起きたかを特定するには、データが通った経路が分かっている必要があります。
リネージは、テーブル単位で記録するか、列単位で記録するかで、細かさが変わります。テーブル単位のリネージは「受注テーブルから売上集計テーブルが作られる」という粒度で、全体の流れをつかむのに向いています。列単位のリネージは「売上集計テーブルの売上高の列は、受注テーブルの金額の列から値引きの列を引いて作られる」という粒度で、ある列の変更の影響を正確に調べるのに向いています。次の表は、ダッシュボードの1つの数字について、リネージを列単位で書き下した例です。ここでの「受注金額」は、前の節の表で営業の数字として登録した用語と同じく、値引き前の金額を指します。システム名と処理の名前は架空のものです。説明を簡単にするため、前の表の営業の数字にあるキャンセルの翌月の差し引きは、この例では扱いません。表の段階の分け方はリネージを説明するためのもので、第4章のデータフロー図の4段(業務システム・連携・基盤・利用)に当てはめると、発生が業務システム、取り込みが連携、整形と集計が基盤、利用が利用に当たります。
| 段階 | データの場所の例 | 処理の内容の例 | この段階の持ち主の例 | ここで起きやすい問題の例 |
|---|---|---|---|---|
| 1.発生 | 販売管理システムの受注明細(金額の列・値引きの列・受注日の列) | 営業担当が受注を入力する | 営業本部(業務)、情報システム部門(システム) | 入力漏れ、値引きの入力のずれ |
| 2.取り込み | データ基盤の取り込み用の領域(受注明細の写し) | 毎晩、前日分の差分を取り込む | データカストディアン(情報システム部門) | 取り込みの失敗、差分の取り逃し、二重の取り込み |
| 3.整形 | 整形済みの受注テーブル | テスト用の受注を除き、値引き前の金額を「受注金額」の列として残す | データカストディアンが実装して維持(除外の条件と計算式はデータオーナーが決め、データスチュワードが用語集に記録) | 除外の条件の誤り、値引き後の金額を「受注金額」の名前で作ってしまうといった、計算式と用語集の定義のずれ |
| 4.集計 | 月次の受注金額の集計テーブル | 受注日の月ごとに受注金額を合計する | データカストディアン(情報システム部門) | 月の区切りの誤り(日付の時間帯の扱い) |
| 5.利用 | 経営会議のダッシュボード「月次の受注金額」 | 集計テーブルを表示する | 経営企画(利用者) | 用語集の別の用語(売上高)と取り違えて読まれる |
表の最後の列のように、問題はどの段階でも起き、それぞれの段階で持ち主が違います。リネージが無いと、ダッシュボードの数字がおかしいという問い合わせを受けた人が、1つずつ担当者に聞いてさかのぼることになり、原因の特定に日数がかかります。リネージがあれば、どの段階のどの処理を確かめればよいかが先に分かり、その段階の持ち主に直接問い合わせられます。表の「この段階の持ち主の例」の列は、リネージとデータオーナーの記録が結びついて初めて意味を持つ情報です。
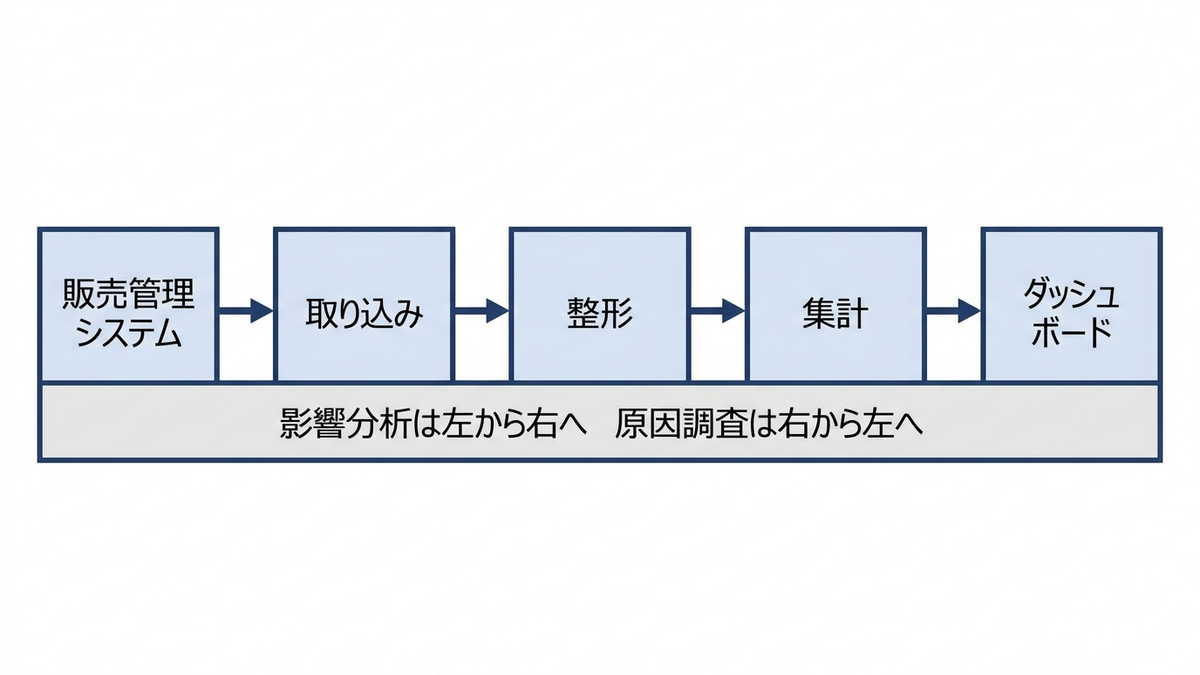
リネージの集め方には、処理の仕組みから自動で取り出す方法と、人が書き足す方法があります。DataHub のリネージの文書は、テーブル単位のリネージと列単位のリネージの両方を扱い、リネージは対応している取り込み元から自動で取り出せること、画面上で上流と下流のつながりを手で追加・削除できること、API からつながりを登録できることを挙げています。同じ文書は、手で編集したリネージと自動で取り込んだリネージが互いに上書きしうることにも注意を促し、手での編集は自動で取り込まれていない部分に使うことを勧めています。自動と手作業の境目をどこに置くかは、製品を問わず、リネージの運用で最初に決めておくことの1つです。
リネージは、すべてのデータについて完全に揃える必要はありません。経営会議に出る指標、法令や監査で説明を求められる数字、外部に提供するデータのように、間違えたときの影響が大きいものから整えるのが現実的だと考えています。表計算ソフトで手作業の加工が入る経路は自動では取れないので、その部分は担当者が経路を書き残すか、手作業の加工そのものを減らすことを検討します。
メタデータの標準、規格と共通の語彙
メタデータを組織の中で揃えるとき、書き方の枠組みを一から自分で考える必要は必ずしもありません。メタデータの記述や交換には、国際規格や公開された標準があります。ここでは、公式のページを2026年10月22日に開いて確かめた3つを紹介します。いずれも、自社の用語集やカタログの書式をそのまま規格に合わせる必要があるという意味ではなく、項目の立て方や他の仕組みとの受け渡しを考えるときの参照先として位置づけています。
1つ目は、メタデータレジストリ(メタデータを登録して管理する仕組み)についての国際規格 ISO/IEC 11179 のシリーズです。ISO のISO/IEC 11179-1 のページによると、第1部(枠組み)の現行版は2023年1月に発行された第4版で、2015年の版を置き換えています。担当は ISO と IEC の合同の技術委員会の分科委員会 ISO/IEC JTC 1/SC 32 です。同じページの概要は、第1部がシリーズの各部を理解し関連づけるための手段を示し、メタデータとメタデータレジストリを概念として理解するための土台になると説明しています。また、このシリーズのすべての部で、メタデータはデータの記述を指すと書かれています。データの意味を登録簿として管理するという考え方は、この章で述べたビジネス用語集と項目定義の考え方に通じます。規格の本文の中身は、本コラムでは扱いません。
2つ目は、ウェブで公開されるデータカタログの記述に使う語彙として W3C が定めた DCAT です。DCAT の第3版は、2024年8月22日に W3C 勧告(W3C が標準として正式に定めた仕様の段階)になっています。仕様の概要は、DCAT を、ウェブで公開されるデータカタログどうしの相互運用性を高めるための RDF の語彙と説明しています。RDF は、W3C のRDF のページがウェブ上のデータ交換のための標準のモデルと説明しているもので、DCAT はその上で、カタログの記述に使う語(項目の名前)を定めています。主な分類として、カタログ(Catalog)、データセット(Dataset)、データセットの具体的な入手の形である配布(Distribution)、データにアクセスする操作を提供するデータサービス(DataService)が定められています。社外にデータを公開する場合や、複数の組織の間でカタログの情報をやり取りする場合に、項目の立て方の参考になります。
3つ目は、リネージの情報を集めるための公開の標準である OpenLineage です。公式の文書は、OpenLineage をデータリネージの収集と分析のためのオープンな枠組みと説明し、データセット・ジョブ(処理)・ラン(処理の1回の実行)という汎用の実体のモデルを定めていること、ファセットと呼ぶ利用者の定義するメタデータ(標準の項目に加えて、利用者が必要な情報を足すための追加の項目)で各実体の情報を補えることを書いています。リネージを処理の仕組みから自動で集めるときに、仕組みごとに別々の形式で記録すると、集めた情報をつなぐのが難しくなります。共通の形式で記録するという考え方は、複数の処理の仕組みが混在する組織では検討する価値があると考えています。
自動で集めるものと、人が書くものを分ける
メタデータの整備が止まる理由の多くは、すべてを人手で埋めようとすることにあると思われます。テーブルが数百、列が数千になると、それぞれに説明を書く作業は終わりません。しかも、システムが変わるたびに書き直しが要ります。一方で、すべてを自動で集めようとすると、業務上の意味が空欄のまま残ります。整備を続けるには、自動で集められるものは自動に任せ、人は人にしか書けないものに手間を集中させる、という分担が要ります。
| メタデータの例 | 集め方 | 人が関わるところ | 更新の契機 |
|---|---|---|---|
| テーブル名・列名・データ型・桁数 | データベースやデータ基盤から自動で取得 | 取り込み先の設定と、取り込みが止まっていないかの確認 | システムの構造が変わったとき(自動で反映) |
| 最終更新日時・行数 | データ基盤から自動で取得 | 予定どおりに更新されていないときの対応 | 処理が動くたび |
| テーブル単位・列単位のリネージ | 処理の仕組み(取り込み・変換・集計)から自動で取得 | 自動で取れない経路(手作業の加工・外部からの受け取り)の補記 | 処理が変わったとき |
| 品質ルールの結果 | 品質の点検の仕組みから自動で取得 | ルールの内容の決定(第5章)、不合格のときの対応 | 点検が動くたび |
| 利用者と利用回数 | データ基盤の利用の記録から自動で取得 | 記録の扱いの決定(誰が見てよいか) | 利用のたび |
| 用語の定義・計算式・含めるもの除くもの | 人が書く | データオーナー(部門をまたいで使う定義はデータガバナンス委員会)が内容を決め、データスチュワードが用語集に記録する。集計や変換の仕組みへの実装と維持はデータカストディアン | 事業や業務の変化で定義を変えるとき |
| データオーナー・問い合わせ先 | 人が書く | データガバナンスの事務局(第3章)が任命を記録 | 組織の変更・異動のとき |
| 列の業務上の説明 | 人が書く。用語集の用語と結びつけて書く手間を減らす | データスチュワードが主要な列から書く | 列の使い方が変わったとき |
| 機密区分・利用の条件 | 人が決める。決めた区分を列やテーブルに付ける作業は一部自動にできる | データオーナーが決める(区分の決め方は第8章) | 規程や法令の変更、用途の追加のとき |
この表の上半分は、仕組みを入れれば集め続けられる部分で、下半分は、人が決めて書かなければ埋まらない部分です。下半分の手間を減らす工夫として、列ごとに説明を書く代わりに、列を用語集の用語と結びつけるやり方があります。「受注金額」という用語の定義を1回書けば、その用語に結びついた複数のシステムの列すべてに同じ定義が表示されます。1つの用語が複数のシステムの列に対応している場合には、この方法で人が書く量を減らせます。
もう1つの工夫は、メタデータの更新を日常の業務の手順に組み込むことです。新しいテーブルを作るとき、システムを改修するとき、新しい指標を報告に加えるとき、それぞれの手順の中に「用語集とカタログの更新」を1行入れておきます。メタデータの整備を独立したプロジェクトとして年に1回まとめて行うと、次の1年の間に書いた内容が古くなっていきます。変更が起きる手順の中で同時に更新するほうが、内容を新しく保ちやすいと考えています。
カタログが使われる条件、用語集から持ち主、品質の順に
データカタログは、導入しても使われないことがある仕組みです。製品を入れ、データベースからテーブルの一覧を取り込むと、見た目には目録が完成したように見えます。しかし、検索で見つかったテーブルの説明が空欄で、誰に聞けばよいかも書かれていなければ、利用者は結局これまでどおり詳しい人に直接聞きに行きます。何度か空振りすると、カタログを開く習慣は定着しません。使われるかどうかを分けるのは、取り込んだテーブルの数ではなく、利用者が知りたいことが書いてあるかどうかだと考えています。
カタログを使われる状態にするための順序として、本コラムでは、用語集、持ち主、品質の順に整えることを勧めます。ここでいう順序はカタログに載せる情報の順序で、用語の定義を承認するデータオーナーは、用語集の整備を始める時点で任命しておきます。最初に用語集を整えるのは、利用者が業務の言葉で検索し、その言葉の意味を確かめられることが、カタログの最も基本的な価値だからです。次に持ち主を整えるのは、定義だけでは答えられない質問が必ず出てくるので、その質問の行き先が要るからです。持ち主が書かれていれば、カタログは「詳しい人を探す手段」としても使えます。そのあとで品質の状況を載せると、利用者は「このデータは使ってよい状態か」を判断できるようになります。品質の結果は、定義と持ち主が無い状態で載せても、何が合格で誰が直すのかが分からないので、意味を持ちにくい情報です。
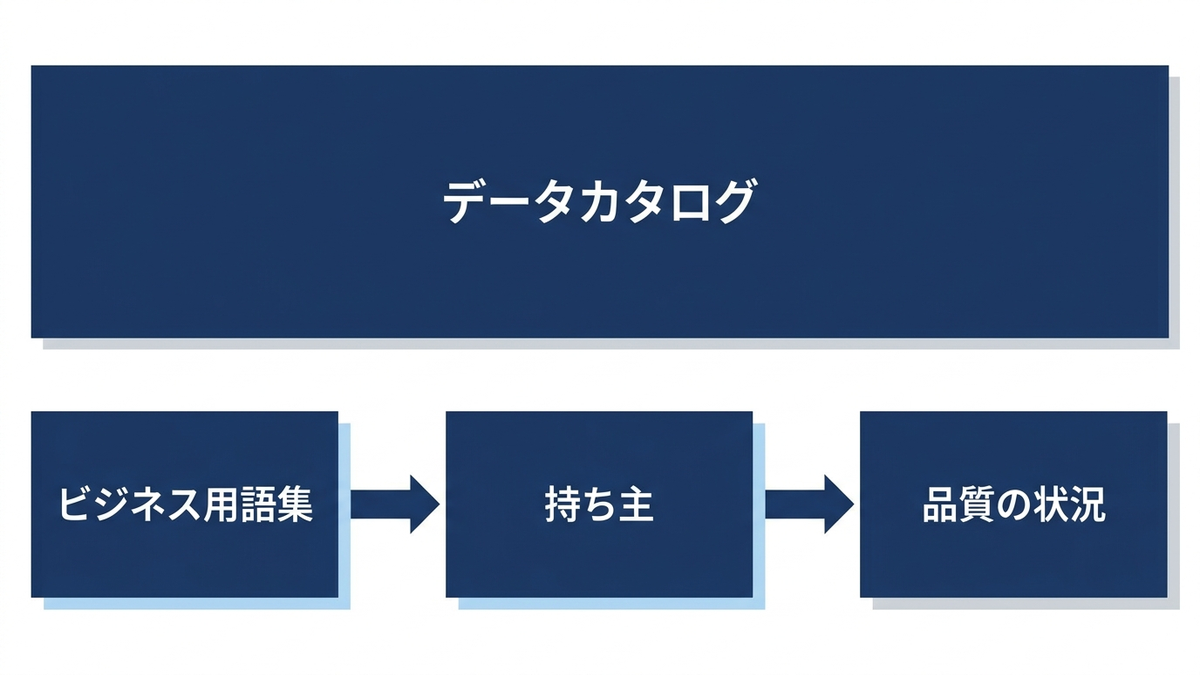
使われているかどうかは、測ることができます。カタログを検索した回数、検索した結果を開いた割合、説明と持ち主が書かれているデータの割合、カタログを経由した問い合わせの件数、といった指標を毎月見ると、整備が利用につながっているかが分かります。説明と持ち主の記入率は整備の側の指標で、検索の回数と問い合わせの件数は利用の側の指標です。整備の側の数字だけが伸び、利用の側の数字が伸びないときは、載せている情報が利用者の知りたいことと合っていない可能性があります。利用者に、何を探して見つからなかったかを聞き、その言葉を用語集の別名に加えるといった手直しが有効です。
使われる条件として、もう1つ挙げておきたいのは、カタログに書いてあることが正しいと信じられることです。古い定義が残っていたり、異動した人が持ち主のままになっていたりすると、利用者はカタログの内容を確かめ直す手間を負い、やがて使わなくなります。持ち主の欄は組織の変更や異動のたびに見直す、承認されていない定義は「案」と明示する、長く更新されていないデータには最終更新日時を目立つように出す、といった運用で、書いてあることへの信頼を保ちます。
経営判断、カタログ製品の前に用語集を整える
メタデータ管理の判断を誤ったときの経営上の損失は、本コラムで共通に使う6つの型で整理できます。1つ目は集計の食い違いです。同じ名前の指標が部門ごとに違う定義で計算されていると、経営会議に別々の数字が並びます。2つ目は判断の遅れです。会議の時間が数字の突き合わせに使われるうえ、リネージが無いまま上流のシステムを変えると、下流の集計や報告が誤った数字を出し続け、気づいて原因をたどるまでの間、判断がその数字に基づいて行われるか、止まります。3つ目は二重投資です。どこにどのデータがあるかが分からないと、すでにあるデータを別の部門がもう一度集めたり、同じ集計の仕組みを別々に作ったりします。4つ目は法令違反です。個人情報を含むデータがどこにあり、どこへ流れているかが記録されていないと、法令に沿った扱いになっているかを確かめられず、違反に気づけないおそれがあります(個人情報の扱いは第8章で扱います)。5つ目は、AI 投資の空振りです。学習や検索に使うデータの意味と出所が分からないと、モデルや生成AI の仕組みを作っても、出力の根拠や妥当性を確かめにくくなり、業務への導入や継続した利用を妨げるおそれがあります(AI のためのデータの整え方は第11章で扱います)。6つ目は、現場の不信です。カタログを入れたのに使えない、という経験が一度広がると、次にデータの整備を呼びかけたときに協力が得にくくなります。
これらの損失を避けるうえで、経営として最初に判断することは、カタログの製品を選ぶことではなく、用語集を整える体制を決めることだと考えています。具体的には、経営会議で使う基本の指標を10〜30語選び、それぞれのデータオーナーを任命し(部門をまたいで使う指標の定義は、データガバナンス委員会が承認します)、定義を承認する手順と置き場所を決めることです。この作業には製品は要らず、表計算ソフトや社内の文書の仕組みで始められます。用語集が整い、持ち主が決まり、データの量やシステムの数が人手で追い切れない規模になった段階で、カタログの製品を検討します。その段階では、どの用語をどのデータに結びつけたいか、誰が更新するかがすでに決まっているので、製品に求める機能を具体的に書けます。
逆の順序、つまり製品を先に入れてから中身を埋めようとすると、製品の導入と設定に予算と時間を使ったあとで、人が書く部分が空欄のまま残り、使われない目録ができる、という結果になりやすいと思われます。製品は、決めたことを広く届け、自動で集められるものを集め続けるための道具で、何を決めるかを代わりに決めてはくれません。予算を付けるときは、製品の費用と並べて、データスチュワードが用語集とカタログの更新に充てる時間を、本来の業務の一部として確保することを計画に入れておく必要があります。兼務のデータスチュワードに時間の手当てをしないまま更新を任せると、最初の数か月で更新が止まりがちです。
規模による違いも整理しておきます。システムが少なく、データを扱う人が限られる組織では、用語集と持ち主の一覧を1つの文書にまとめ、経営会議の資料の指標をそれに結びつけるだけで、この章で述べた効果の多くが得られます。この段階では、データカタログの製品もリネージの自動収集も要らないことが多いと考えています。データ基盤を持ち、複数の部門が同じデータを加工して使うようになると、技術的な仕様と運用の記録を自動で集める仕組みの必要性が高まります。どの段階でも、最初の一歩は同じで、経営会議に出てくる言葉を定義し、その言葉の持ち主を決めることです。
経営報告に載せる指標としては、用語集に登録され承認された基本の指標の割合、説明と持ち主が書かれたデータの割合、カタログの検索の回数と問い合わせの件数、定義の変更の件数が考えられます。最初の1年は、承認された基本の指標の割合を中心に見るのがよいと考えています。この数字が上がると、第5章の品質ルールを書ける項目が増えていきます。ただし、承認された定義が集計の仕組みに正しく実装されているとは限らないので、経営会議の数字の食い違いが減っているかは、集計への反映の状況と食い違いの件数を併せて見て確かめます。
この章では、メタデータを業務上の意味・技術的な仕様・運用の記録の3つに分け、業務上の意味は業務部門のデータオーナーとデータスチュワードが内容に責任を持つことを確認しました。ビジネス用語集には定義・計算式・含めるもの除くもの・持ち主・版を書き、部門ごとに違う指標には別々の名前と持ち主を与えて定義を1か所で管理します。データカタログとデータリネージは、自動で集めるものと人が書くものを分け、用語集(整備の開始時にデータオーナーを任命する)、持ち主と問い合わせ先、品質の順に載せていくと使われる状態に近づきます。経営としては、カタログ製品の前に用語集を整える体制を決めることが最初の判断です。
次の第7章では、用語集で意味を揃えた言葉のうち、顧客・商品・取引先のように複数の業務で共通に参照する主体のデータと、コード表のような値の集合を定義するデータを取り上げ、名寄せと正しい一件の管理を扱います。
この章を深めたい方への参考書籍
『メタデータ管理入門 メタグリッドで実現するAI時代の知識統合技術』(Ole Olesen-Bagneux 著、菊池彰 訳、オライリー・ジャパン):メタデータ管理を正面から扱った本の日本語訳で、原題は「Fundamentals of Metadata Management」です。目次では、IT・データ・情報・知識の管理それぞれのためのメタデータの置き場所を順に取り上げ、それらを連携させる考え方と、そのためのチームの作り方へと進みます。この章で述べた、メタデータを誰が書き誰が使うかで分ける考え方を、組織全体の視点から広げて考えるときの材料になります。
『最新解説 知識資源のメタデータ』(谷口祥一、緑川信之 著、勁草書房):図書館情報学の立場から、メタデータによる知識資源の組織化を体系的に解説した本です。目次では、メタデータの要求定義と概念モデル、記述のルール、ダブリンコア、分類法や統制語彙表を使った主題分析、メタデータの作成と検索の仕組みを扱っています。企業のデータを直接扱う本ではありませんが、この章で述べた用語集の作り方(言葉の意味を1つに決め、別名や上位・下位の関係を記録すること)やカタログの項目の立て方を、長い蓄積のある分野の考え方から見直すときの材料になります。
第7章 参照データとマスターデータ、名寄せと正しい一件の管理
第6章では、データの意味をそろえるためのビジネス用語集とデータカタログ、データがどこから来てどこへ行くかを追うデータリネージを扱いました。用語集で「取引先」という言葉の意味を決めても、取引先の一覧そのものに同じ会社が3行ずつ登録されていれば、取引先の数も、取引先ごとの売上も正しく数えられません。この章では、複数の業務で共通に参照する「主体」のデータであるマスターデータと、コード表や区分のように値の集合を定義する参照データを扱います。両者の違い、マスターデータ管理が目指すこと、同じ相手の重複した登録を見つけて1件にまとめる作業である名寄せ(ここでいう重複は、第5章で扱った同じコードの行の重複ではなく、別の書き方や別のコードで登録された同じ相手のことです)を架空の取引先一覧で実際に動かした結果、外部の標準コードの使い方、マスターデータ管理の実装の型、コード体系の変更管理、マスターデータの品質を交換の境界で見る国際規格の考え方、そして経営としてどのマスターから着手するかの判断を、順に説明します。
参照データとマスターデータは何が違うか
本コラムでは、マスターデータを「顧客・商品・取引先・従業員のように、複数の業務で共通に参照する主体のデータ」、参照データを「コード表・分類・区分のように、値の集合を定義するデータ」と定義しています(全体の地図の用語の定義表)。どちらも、受注や請求のような日々の取引の記録(トランザクションデータ)から参照される側のデータです。受注の1行には「どの取引先から」「どの商品を」「どの支払条件で」という項目があり、取引先と商品はマスターデータを、支払条件は参照データを指しています。取引の記録が正しくても、それが指している先が重複していたり、古くなっていたりすれば、集計の結果は誤ります。
両者の違いは、件数、変わり方、持ち主にあります。参照データは、都道府県、支払条件、取引の区分、商品の分類のように、値の数が数十から数千程度に収まることが多く、変わる頻度は低いものの、1つの変更が複数の利用先に影響し、過去のデータの読み替えが必要になる場合があります。マスターデータは、取引先や商品のように件数が数千から数百万に及ぶことがあり、新規の登録、社名や住所の変更、取引の終了が毎日のように起きます。そのため、参照データは「コード体系をどう決め、どう変更するか」の管理が中心になり、マスターデータは「同じ相手を1件として識別し、正しい値を保ち、各システムに届けるか」の管理が中心になります。
| 観点 | 参照データ | マスターデータ |
|---|---|---|
| 例 | 都道府県コード、市区町村コード、支払条件、取引区分、商品分類、勘定科目、通貨、単位 | 取引先、顧客、商品、従業員、拠点、設備 |
| 件数の目安 | 数十〜数千程度のことが多い | 数千〜数百万に及ぶことがある |
| 変わり方 | 変わる頻度は低い。1つの変更が複数の利用先に影響し、過去の集計の読み替えが要る場合がある | 毎日のように登録・変更・終了が起きる |
| 外部の標準 | 公的なコード表があるものが多い(地方公共団体コード、JIS の都道府県コード・市区町村コードなど) | 識別のための公的な番号があるものがある(法人番号など)。多くは自社で番号を振る |
| 管理の中心 | コード体系の決定、変更の承認、新旧の対応表の維持 | 同じ相手の識別(名寄せ)、正しい値の決定、各システムへの配信と同期 |
| 無いと起きること | 部門ごとに区分が違い、同じ売上が別の分類で集計される。コードの改定前後で数字がつながらない | 同じ取引先が複数行あり、取引先数・与信・売上の集計が合わない。変更が一部のシステムにしか届かない |
| 主な持ち主の例 | 経理・経営企画(勘定科目・区分) | 営業管理・購買・人事など、その主体を最もよく知る業務部門 |
表の最後の行の「持ち主」は、第3章の用語でいえばデータオーナーに当たります。取引先マスターであれば、新しい取引先を登録してよいかを決めるのは与信(取引先ごとに認める掛け売りなどの信用の上限)や契約を管理する部門で、情報システム部門は登録の仕組みを動かすデータカストディアンの立場にあります。マスターデータの不具合は画面の入力の誤りとして現れるので、情報システム部門の問題と見られやすいのですが、実際に決めなければならないのは「何をもって同じ取引先とみなすか」「どの部門の登録を正とするか」という業務上の判断です。この判断の持ち主を決めないまま重複の削除だけを進めると、削除した行を別の部門が使っていた、という事故が起きます。なお、参照データのコード表の有効期間や新旧の対応表の維持は、後の節の変更管理の表のとおり、データスチュワードが受け持ちます。
参照データとマスターデータの区別は、規模の小さい会社でも要ります。取引先が数百社しかなくても、販売管理と会計と名刺管理の3つの仕組みに別々に登録されていれば、同じ会社が3通りの書き方で存在します。一方で、取引先も商品も1つの業務システムの中だけで完結していて、他のシステムや分析に渡すことがない場合には、この章で扱う仕組みの多くは要りません。1つのシステムの中だけでも、重複登録の防止、登録の承認、変更履歴の管理は要ります。共通の識別子や同期のような仕組みの必要性が高まるのは、同じ主体のデータが2つ以上の場所に置かれ、それらを突き合わせて使う必要が出たときです。
マスターデータ管理が目指す3つのこと
マスターデータ管理(MDM。Master Data Management の略)が目指すことは、大きく3つに分けて考えると整理しやすいと考えています。1つ目は一意の識別です。現実の1つの取引先に対して、社内で1つの識別子(取引先コード)が対応している状態を作ります。2つ目は正しい値の決定です。同じ取引先について、販売管理には旧住所、会計には新住所が入っているときに、どちらを正とするかを項目ごとに決め、正しい値を集めた1件を作ります。この1件をゴールデンレコードと呼びます。3つ目は配信と同期です。ゴールデンレコードの値と識別子を、取引先を使うすべてのシステムに届け、変更があればそれも届けます。
3つは順番に依存しています。識別ができていないと、どの行どうしの値を比べてゴールデンレコードを作ればよいかが決まりません。ゴールデンレコードができていても、配信と同期の仕組みが無ければ、各システムは古い値を使い続けます。そして、配信を始めた後も新しい登録が毎日発生するので、新しい登録が既存の取引先と同じかどうかを登録の時点で確かめる仕組みが無いと、重複はすぐに元に戻ります。名寄せを1回だけ行って一覧をきれいにしても、新規の登録のたびに重複が入り込むので、時間がたつと重複は再び増えやすくなります(この章のデモでは、時間による変化は測っていません)。次の表は、3つの目指すことに、それを保つための登録時の確認を加えた4行です。
| 目指すこと | 決めること | 決める人の例 | 無いと起きること |
|---|---|---|---|
| 一意の識別 | 何をもって同じ取引先とみなすか(法人番号・名称・住所・電話番号のどれを使うか)。支店や事業所を別の取引先として扱うか | 取引先マスターのデータオーナー | 同じ会社への売上が分かれて集計され、上位の取引先の順位が変わる。与信の上限を会社単位で守れない |
| 正しい値の決定(ゴールデンレコード) | 項目ごとにどの登録元の値を正とするか(住所は法人番号の公表情報、請求先は経理の登録、など) | データオーナーとデータスチュワード | 請求書が旧住所に送られる。部門ごとに社名の表記が違い、帳票が揃わない |
| 配信と同期 | どのシステムに、どの項目を、どの頻度で届けるか。届かなかったときに誰が気づくか | データカストディアン(情報システム部門) | 変更が一部のシステムにしか反映されず、システムごとに別の値が残る |
| 登録時の確認 | 新規登録の前に既存の候補を探す手順と、似た候補が見つかったときに誰が判断するか | データスチュワード | 名寄せの後に重複が再び増える |
表の「一意の識別」の行にある「支店や事業所を別の取引先として扱うか」は、技術ではなく業務の定義の問題です。請求は本社にまとめて送るが、納品は各工場に送る、という取引先では、会社としての取引先と、納品先としての拠点を別の階層として持つ必要があります。この階層をどう持つかを決めずに名寄せを始めると、ある部門は拠点の単位で、別の部門は会社の単位で重複を判断し、結果がそろいません。名寄せを始める前に、「同じ取引先」の定義を文書にしておくことが有効だと考えています。
名寄せを手元で試す:架空の取引先一覧を作る
同じ取引先の登録がどのような形で揺れ、正規化によってどこまで見つけられるかを、Python で確かめます。ここで使うのは、乱数から作った架空のサンプルデータです。社名は「架空」「見本」「サンプル」「試験」などの語と「商事」「製作所」「工業」などの語を組み合わせた実在しない名前にし、住所は「東京都千代田区1-4-11」のように町名を含まない存在しない番地、電話番号は局番の部分を 0000 に固定した存在しない番号にしました。実在の企業や個人を表すものではありません。外部のライブラリは NumPy と pandas を使い、文字列の処理には Python の標準ライブラリの unicodedata(文字の正規化)・re(正規表現)・difflib(文字列の類似度)を使います。乱数のシードは 20261022 に固定しているので、同じ版のライブラリで実行すれば同じ結果になります。本コラムの実行環境は Python 3.14、NumPy 2.4.3、pandas 3.0.1 です。掲載したコードは、コマンドラインから通常のスクリプトとして実行する前提で、先頭の2行で標準出力の文字コードを UTF-8 に設定しています。Python の公式ドキュメントが注意しているとおり、標準出力が buffer の属性を持たないものに置き換えられている実行環境では、この2行でエラーになるので、その場合は2行を省いて実行してください。
最初に、現実の取引先にあたる「実体」を150社作ります。社名の中心部分(「架空ABシステム」のような部分)、法人格(株式会社・有限会社・合同会社)、法人格を社名の前に付けるか後に付けるか、所在地、電話番号を乱数で決め、それぞれの実体が一覧に何行登録されるかを1〜5行の間で決めます。現実の一覧で名寄せを難しくする事情を再現するため、名前の同じ別会社を4組、同じ住所に入っている別会社を6組作り、そのうち3組は、一方の社名に「販売」を足しただけのグループ会社にしました。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import itertools, re, unicodedata, difflib
import numpy as np
import pandas as pd

# ---- 1. 架空の取引先(実体)を作る ----
rng = np.random.default_rng(20261022)
PREFIX = ["架空", "見本", "サンプル", "試験", "仮想", "模擬", "想定", "例示", "雛形", "検証"]
MIDDLE = ["", "AB", "テック", "国際", "総合"]
KIND = ["商事", "商会", "製作所", "工業", "興業", "物産", "電機", "化学", "広告", "システム"]
LEGAL = ["株式会社", "株式会社", "株式会社", "有限会社", "合同会社"]
CITY = ["東京都千代田区", "大阪府大阪市北区", "愛知県名古屋市中区",
        "福岡県福岡市中央区", "北海道札幌市中央区"]
N = 150
combos = sorted({p + m + k for p in PREFIX for m in MIDDLE for k in KIND})
core = rng.choice(combos, size=N, replace=False)
same = rng.choice(N, size=8, replace=False)
core[same[4:]] = core[same[:4]]                      # 同名の別会社を4組つくる
ent = pd.DataFrame({
    "ent_id": range(N), "core": core,
    "legal": rng.choice(LEGAL, size=N),
    "front": rng.random(N) < 0.5,                    # 前株か後株か
    "city": rng.choice(CITY, size=N),
    "addr": [f"{a}-{b}-{c}" for a, b, c in zip(rng.integers(1, 10, N),
             rng.integers(1, 30, N), rng.integers(1, 20, N))],
    "tel": [f"0{d}0-0000-{t:04d}" for d, t in zip(rng.integers(1, 10, N),
            rng.choice(10000, size=N, replace=False))],
    "n_rec": rng.choice([1, 2, 3, 4, 5], size=N, p=[.35, .3, .2, .1, .05]),
})
share = rng.choice(N, size=12, replace=False)        # 同じ建物に入る別会社を6組つくる
ent.loc[share[6:], ["city", "addr"]] = ent.loc[share[:6], ["city", "addr"]].to_numpy()
for i, j in zip(share[:3], share[6:9]):              # うち3組は名前の似たグループ会社
    ent.at[j, "core"] = ent.at[i, "core"] + "販売"
次に、それぞれの実体を、部署ごとに少しずつ違う書き方で登録します。現実の取引先一覧でよく見られる揺れを、確率を決めて混ぜました。社名については、旧字(「国」を「國」、「学」を「學」など)、英数字の全角、カタカナの半角、1文字の脱落、法人格の省略、法人格の略記((株)・(株)・㈱ など)、法人格を前に付けるか後に付けるかの取り違え、法人格と社名の間の空白(半角または全角)です。住所は、ハイフンの文字の違い(半角のハイフン、全角のハイフン、長音記号、別の種類のハイフン)、「1丁目4番11号」という書き方、数字の全角、都道府県名の省略です。電話番号は、未入力、ハイフンの省略、全角、別の拠点の番号です。
# ---- 2. 同じ取引先を、部署ごとに少しずつ違う書き方で登録する ----
OLD = str.maketrans("国学広会沢", "國學廣會澤")
WIDE = str.maketrans("ABC0123456789-", "ABC0123456789-")
HALF = {"サンプル": "サンプル", "テック": "テック", "システム": "システム"}
ABBR = {"株式会社": ["(株)", "(株)", "㈱"], "有限会社": ["(有)", "(有)", "㈲"],
        "合同会社": ["(同)", "(同)"]}

def vary_name(core, legal, front):
    if rng.random() < 0.3: core = core.translate(OLD)        # 旧字
    if rng.random() < 0.3: core = core.translate(WIDE)       # 全角の英数字
    if rng.random() < 0.15:                                   # 半角カナ
        for k, v in HALF.items(): core = core.replace(k, v)
    if rng.random() < 0.08:                                   # 1文字の脱落
        i = int(rng.integers(len(core))); core = core[:i] + core[i + 1:]
    r = rng.random()
    if r < 0.15: legal = ""                                   # 法人格を省く
    elif r < 0.45: legal = str(rng.choice(ABBR[legal]))       # 略記
    if rng.random() < 0.1: front = not front                  # 前株と後株の取り違え
    sep = str(rng.choice(["", "", "", " ", " "]))            # 空白
    return legal + sep + core if front else core + sep + legal
def vary_addr(city, addr):
    a, b, c = addr.split("-")
    if rng.random() < 0.2: body = f"{a}丁目{b}番{c}号"
    else: body = str(rng.choice(["-", "-", "ー", "‐"], p=[.6, .2, .1, .1])).join([a, b, c])
    if rng.random() < 0.25: body = body.translate(WIDE)
    if rng.random() < 0.2: city = re.sub(r"^(東京都|北海道|大阪府|..県)", "", city)
    return city + body

def vary_tel(tel):
    r = rng.random()
    if r < 0.15: return None                                  # 未入力
    if r < 0.30: return tel.replace("-", "")
    if r < 0.40: return tel.translate(WIDE)
    if r < 0.50: return tel[:-4] + f"{int(rng.integers(10000)):04d}"  # 別の拠点の番号
    return tel

rows = []
for e in ent.itertuples():
    for _ in range(e.n_rec):
        rows.append({"ent_id": e.ent_id, "name": vary_name(e.core, e.legal, e.front),
                     "address": vary_addr(e.city, e.addr), "tel": vary_tel(e.tel)})
df = pd.DataFrame(rows).sample(frac=1, random_state=1).reset_index(drop=True)
df.insert(0, "rec_id", [f"T{i:04d}" for i in range(len(df))])
実行すると、150社の実体から332行の一覧ができました。このうち1行だけ登録された実体は53社、2行以上登録された実体は97社です。同じ実体の行どうしの組(重複の組)は、全部で308組あります。このデモでは、この308組を正解として候補の見つけ方を評価し、まとめた後の取引先の数(正解は150社)も別に確かめます。次の表は、5行登録された1社の実際の行です(出力をそのまま載せています)。
| 行の番号 | 社名 | 住所 | 電話番号 |
|---|---|---|---|
T0086 | 架空ABシステム有限会社 | 千代田区1ー4ー11 | 07000005096 |
T0120 | 架空ABシステム㈲ | 千代田区1ー4ー11 | 070-0000-5096 |
T0163 | 架空ABシステム有限会社 | 東京都千代田区1-4-11 | 070-0000-5096 |
T0178 | 架空ABシステム 有限会社 | 千代田区1-4-11 | 070-0000-5096 |
T0314 | 架空ABシステム 有限会社 | 東京都千代田区1-4-11 | 07000005096 |
人が見れば5行とも同じ会社だと分かりますが、文字列として完全に一致するのは T0178 と T0314 の社名の1組だけです。住所は5行とも文字列が違い、電話番号も3通りの書き方があります。このような揺れは、入力する人、入力した時期、取り込んだ元のシステムの違いから自然に生まれます。入力の画面で書き方を縛っていない限り、どの会社の一覧でも起きると考えておくのが安全です。
正規化を段階ごとに重ね、重複候補がどれだけ見つかるかを数える
同じ取引先を見つける作業は、2つの段階に分けて考えます。1つ目は、比較のための「キー」を作る段階です。社名から、同じ会社なら同じになり、違う会社なら違うものになるような文字列を作ります。2つ目は、キーが一致した行どうし、あるいはキーが似ている行どうしを「重複の候補」として拾い、本当に同じかどうかを確かめる段階です。この節では1つ目を扱い、正規化(表記をそろえる処理)を1つずつ重ねるごとに、候補がどれだけ増えるかを数えます。
正規化は次の順に重ねました。最初は Unicode の NFKC という正規化です。NFKC は、見た目や意味が同じとみなせる文字を1つの書き方にそろえる規則で、全角の英数字を半角に、半角のカタカナを全角に、㈱ を (株) に、全角の括弧を半角に、全角の空白を半角の空白に変えます。Python では unicodedata.normalize("NFKC", 文字列) の1行で使えます。次に空白を取り除き、続けて法人格(株式会社・有限会社・合同会社と、その略記)を取り除き、最後に旧字を新字に置き換えます。旧字と新字(「國」と「国」など)は Unicode では別の文字として扱われ、NFKC では変わらないので、置き換えの表を自分で持つ必要があります。住所と電話番号のキーも同じ考え方で作りました。住所は NFKC の後に「丁目・番・号」をハイフンに直し、数字にはさまれた長音記号や別の種類のハイフンを半角のハイフンにそろえ、先頭の都道府県名を取り除きます。電話番号は NFKC の後に数字以外を取り除きます。
# ---- 3. 名前の正規化を段階ごとに重ねる ----
LEGAL_RE = re.compile(r"株式会社|有限会社|合同会社|\((?:株|有|同)\)")
NEW = str.maketrans("國學廣會澤", "国学広会沢")

def name_keys(name):
    s1 = unicodedata.normalize("NFKC", name)     # 全角と半角・㈱などをそろえる
    s2 = re.sub(r"\s+", "", s1)                  # 空白を除く
    s3 = LEGAL_RE.sub("", s2)                    # 法人格を除く
    s4 = s3.translate(NEW)                       # 旧字を新字に
    return [name, s1, s2, s3, s4]

def addr_key(a):
    s = unicodedata.normalize("NFKC", a)
    s = re.sub(r"(\d+)丁目(\d+)番(\d+)号", r"\1-\2-\3", s)
    s = re.sub(r"(?<=\d)[‐ー−–](?=\d)", "-", s)
    return re.sub(r"^(東京都|北海道|大阪府|..県)", "", s)

def tel_key(t):
    if t is None: return None
    if pd.isna(t): return None
    return re.sub(r"\D", "", unicodedata.normalize("NFKC", t))

K = pd.DataFrame([name_keys(n) for n in df["name"]], columns=[f"k{i}" for i in range(5)])
df["akey"] = df["address"].map(addr_key)
df["tkey"] = df["tel"].map(tel_key)
キーが同じ行どうしを候補の組として数え、正解(同じ実体かどうか)と突き合わせます。正解が分かるのは、データを自分で作ったからです。現実の一覧では正解は分からないので、ここで測る「見逃した組」や「別の取引先の組」は、現実には人が確かめて初めて分かる数字だということに注意してください。「名寄せ後の件数」は、候補の組をすべて同じ取引先として結んだときに残る取引先の数で、組がつながっていけば(AとBが組、BとCが組なら、A・B・Cは1社)まとめて1社と数えます。
# ---- 4. 重複候補の組を数え、正解(同じ実体か)と突き合わせる ----
eid = df["ent_id"].to_numpy()
true_pairs = {(i, j) for i, j in itertools.combinations(range(len(df)), 2) if eid[i] == eid[j]}

def pairs_by_key(keys):
    out = set()
    for idx in pd.Series(range(len(keys))).groupby(list(keys)).groups.values():
        out |= set(itertools.combinations(sorted(idx), 2))
    return out

def n_groups(pairs, n):
    parent = list(range(n))
    def find(x):
        while parent[x] != x:
            parent[x] = parent[parent[x]]; x = parent[x]
        return x
    for i, j in pairs: parent[find(i)] = find(j)
    return len({find(x) for x in range(n)})

def evaluate(label, pairs):
    tp = len(pairs & true_pairs)
    return {"段階": label, "候補の組": len(pairs), "同じ取引先の組": tp,
            "別の取引先の組": len(pairs) - tp, "見逃した組": len(true_pairs) - tp,
            "名寄せ後の件数": n_groups(pairs, len(df))}

LABELS = ["原文のまま", "NFKCで正規化", "空白を除く", "法人格を除く", "旧字を新字に"]
stage_pairs = [pairs_by_key(K[f"k{i}"]) for i in range(5)]
res = [evaluate(LABELS[i], stage_pairs[i]) for i in range(5)]
類似度による候補と、住所・電話番号による確認(次の節で説明します)まで含めた7つの段階の結果を、次の表にまとめます。正解の重複の組は308組、正解の取引先の数は150社です。この章に載せたコードでは、結果を表示する部分と棒グラフを描く部分を省いています。次の節のコードまで実行した後に print(pd.DataFrame(res)) とすると、この表と同じ値が表示されます。
| 段階 | 候補の組 | 同じ取引先の組 | 別の取引先の組 | 見逃した組 | 名寄せ後の件数 |
|---|---|---|---|---|---|
| 原文のまま | 21 | 21 | 0 | 287 | 313 |
| NFKCで正規化 | 37 | 36 | 1 | 272 | 298 |
| 空白を除く | 75 | 72 | 3 | 236 | 273 |
| 法人格を除く | 236 | 213 | 23 | 95 | 191 |
| 旧字を新字に | 282 | 256 | 26 | 52 | 170 |
| 類似度0.85以上も候補 | 414 | 307 | 107 | 1 | 132 |
| 住所か電話の一致で確認 | 330 | 307 | 23 | 1 | 147 |
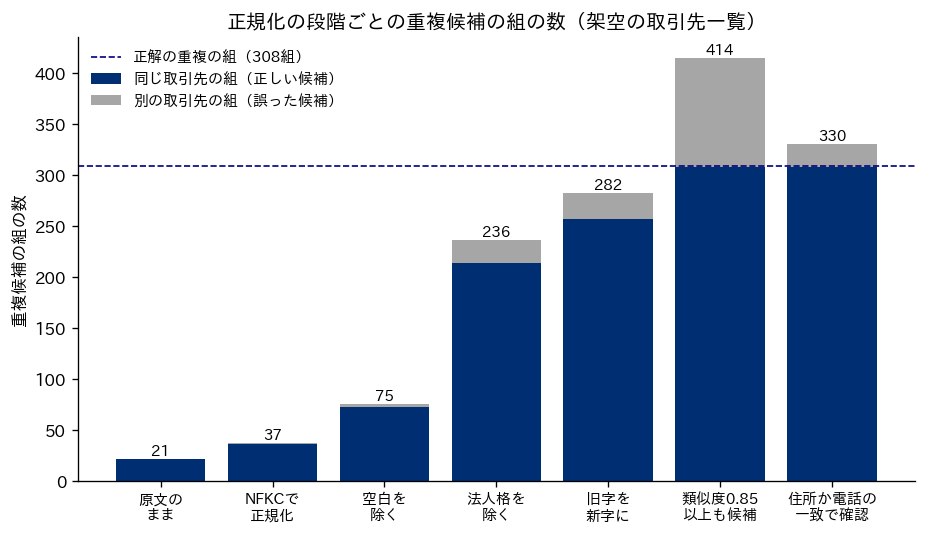
原文のままの完全一致で見つかったのは21組で、正解の308組の約7%でした。NFKC で37組、空白を除いて75組と増えますが、最も大きく増えたのは法人格を除いた段階で、75組から236組へ一気に増えています。この架空データでは、法人格の省略・略記・前後の取り違えを合わせて、およそ半数の行で法人格の書き方が揺れるように作ったので、法人格の扱いが最大の要因になりました。旧字を新字にそろえると候補は282組になり、そのうち256組が同じ取引先の組(正しい候補)で、正解の308組の約83%にあたります。残りの26組は別の取引先の組(誤った候補)です。誤った候補は、法人格を除いた段階で3組から23組に増えています。実行ログで内訳を数えると、法人格を除いた段階の23組も、旧字の段階の26組も、すべて名前の同じ別会社(4組作りました)どうしの組でした。法人格を除くと、名前の同じ別会社を区別できなくなったということです。法人格の違いは、別会社を見分ける手がかりにもなっていたということです。
この結果から、正規化の運用について2つのことが言えます。1つは、比較用のキーと元の表記を分けて持つことです。キーを作るときに法人格や空白を捨てても、元の社名の列は残しておき、候補を確かめる段階で法人格が違うかどうかを見られるようにします。もう1つは、正規化の規則そのものを文書にして持ち主を決めることです。どの文字をそろえ、どの語を取り除くかによって、拾える組も誤る組も変わります。規則を担当者がその場で書き換えると、先月と今月で名寄せの結果が違う理由を誰も説明できなくなります。NFKC は便利ですが、① が 1 に変わるなど、元に戻せない変換も含むので、元のデータを書き換えずに比較用の列にだけ使うことが有効だと考えています。
似た名前を拾い、住所と電話番号で確かめる
旧字までそろえても、52組が残りました。この架空データに混ぜた揺れのうち、ここまでの正規化で吸収できないのは社名の1文字の脱落だけなので、残った52組は、どちらかの行で社名の1文字が抜けている組です。現実の一覧でも、入力の誤りによる脱字や誤字は規則では直せません。こうした組は、キーの完全一致では拾えないので、文字列の類似度を使います。Python の標準ライブラリ difflib の SequenceMatcher は、2つの文字列の一致の度合いを0から1の値(ratio)で返します。たとえば、正規化後の「想定AB興業」と、1文字が抜けた「想AB興業」は0.909になります。ここでは、正規化後の社名の類似度が0.85以上の組も候補に加えました。332行のすべての組(約5万5千組)を比べても、この規模なら実行は数秒で終わります。件数が数十万行になると、すべての組を比べるのは現実的でないので、都道府県や電話番号の先頭の数字などで比べる範囲を絞る工夫(ブロッキングと呼ばれます)が要ります。
類似度だけで候補を拾うと、別会社まで大量に拾います。そこで、候補の組のうち、住所のキーが一致するか、電話番号のキーが一致する組だけを残しました。名前で候補を広く拾い、名前以外の項目で絞るという2段構えです。
# 類似度(difflib)で1文字の脱落なども候補にする
names = K["k4"].tolist()
ratio = {}
for i, j in itertools.combinations(range(len(names)), 2):
    sm = difflib.SequenceMatcher(None, names[i], names[j])
    if sm.quick_ratio() >= 0.75:
        r = sm.ratio()
        if r >= 0.75: ratio[(i, j)] = r
def fuzzy_pairs(th):
    return stage_pairs[4] | {p for p, r in ratio.items() if r >= th}
TH = 0.85
fuzzy = fuzzy_pairs(TH)
res.append(evaluate("類似度0.85以上も候補", fuzzy))

# 住所か電話が一致する組だけを残す
ak, tk = df["akey"].to_numpy(), df["tkey"].to_numpy()
def confirmed(i, j):
    if ak[i] == ak[j]: return True
    if pd.isna(tk[i]): return False
    return tk[i] == tk[j]
final = {p for p in fuzzy if confirmed(*p)}
res.append(evaluate("住所か電話の一致で確認", final))
前の節の表の下の2行が、その結果です。類似度0.85以上を候補に加えると、同じ取引先の組は307組になり、見逃しは1組だけになりました。その代わり、別の取引先の組が107組に増え、名寄せ後の件数は正解の150社に対して132社と、別会社どうしを結んでしまう状態になります。107組のうち26組は正規化後の社名が完全に同じ別会社の組で、残りの81組は名前が似ているだけの別会社の組でした(「サンプルABシステム」と「サンプルシステム」の類似度は0.889、「仮想AB物産」と「仮想AB物産販売」の類似度は0.857)。住所か電話番号の一致で確かめると、別の取引先の組は23組まで減り、同じ取引先の307組はすべて残りました。見逃した1組は、「例示AB商会」という実体の2つの登録で、一方は「会」が、もう一方は「示」が抜けていたため、正規化後の社名の類似度が0.85に届きませんでした。
確認の後に残った23組の誤りは、すべて同じ住所に入っているグループ会社どうしの組でした。「仮想AB物産」と「仮想AB物産販売」は名前が似ていて、住所も同じなので、今回の「類似度0.85以上で、住所か電話番号のどちらかが一致する」という規則では、別会社として外せませんでした。この規則は、住所が一致すれば電話番号の違いを判断に使っていません。電話番号の食い違いも判断に加える、類似度のしきい値を変える(次の表)といった照合の規則の見直しや、識別子の突き合わせ、人による確認が必要になります。この23組をそのまま同じ取引先として統合すると、名寄せ後の件数は147社になり、3組のグループ会社が1社に誤ってまとめられます。グループ会社どうしで与信の枠や請求先を混同すれば、請求の誤りや債権の管理の誤りにつながります。
類似度のしきい値(候補とみなす最低の類似度)を変えると、結果は次のように変わりました。
# 類似度のしきい値を変えると
th_rows = []
for th in [0.75, 0.80, 0.85, 0.90, 0.95]:
    fz = fuzzy_pairs(th)
    fc = {p for p in fz if confirmed(*p)}
    th_rows.append({"しきい値": th, "候補の組": len(fz), "同じ取引先の組": len(fz & true_pairs),
                    "確認後の組": len(fc), "確認後の同じ取引先の組": len(fc & true_pairs)})
print("類似度のしきい値ごとの結果")
print(pd.DataFrame(th_rows).to_string(index=False))
| しきい値 | 候補の組 | 同じ取引先の組 | 確認後の組 | 確認後の同じ取引先の組 |
|---|---|---|---|---|
| 0.75 | 716 | 308 | 331 | 308 |
| 0.80 | 529 | 308 | 331 | 308 |
| 0.85 | 414 | 307 | 330 | 307 |
| 0.90 | 334 | 299 | 299 | 299 |
| 0.95 | 282 | 256 | 256 | 256 |
しきい値を0.80以下にすると、正解の308組はすべて候補に入り、確認後も308組が残りますが、確認後の組は331組で、23組の誤りが残ります。しきい値を0.90に上げると、確認後の299組はすべて同じ取引先の組になり、この架空データでは誤りが0組になりましたが、9組を見逃しています。0.95では、類似度による候補は旧字の段階の結果から増えず、確認後は256組でした。しきい値を上げれば誤って統合する組が減り、下げれば見逃しが減る、という関係があり、どちらの誤りをどれだけ許すかは技術では決まりません。誤って統合したときの損失(請求の誤り、与信の混同)と、見逃したときの損失(同じ取引先が2社に見える、売上が分かれて集計される)を比べて、データオーナーが決めることだと考えています。
実務では、候補を3つに分けて扱う運用が有効だと考えています。法人番号のような確実な識別子が一致する組、あるいは名前・住所・電話番号のすべてが一致する組は自動で統合し、名前は似ているが住所だけが一致する組のように確信が持てない組は、データスチュワードが確認する一覧に回し、それ以外は候補から外します。この架空データの23組の誤りは、2つ目の一覧に入るべき組です。人の確認に回す件数を絞るための運用です。必要な工数は、確認に回る件数と1件当たりの確認時間を試行で測って見積もります(この章のデモでは、3つへの振り分けの件数も確認の時間も測っていません)。確認の結果(同じと判断した組、別と判断した組)を記録しておけば、次回の名寄せで同じ組を何度も人に見せずに済みます。
この節の数値は、乱数で作った架空のデータに、本コラムが決めた確率で揺れを混ぜた結果です。現実の取引先一覧では、揺れの種類と頻度、同名の別会社やグループ会社の割合が違うので、段階ごとの数字も違ってきます。ただし、正規化の段階を重ねるほど候補が増え、増えた候補の中に別会社が混ざり、名前以外の項目で確かめる必要がある、という構造は、多くの一覧で共通すると考えています。自社の一覧で同じ表を作るには、正解の代わりに、無作為に選んだ数百組の候補を人が確かめ、その結果から候補の中の誤りの割合を見積もる方法が使えます。ただし、この方法では、候補に入らなかった同じ取引先の組(見逃した組)は分かりません。見逃しを見積もるには、候補に入らなかった記録を対象にした別の確認が要ります。
ここまでの一連の作業が名寄せです。名寄せは、表記をそろえる正規化、候補を拾う照合、候補を確かめる確認、同じと判断した行を1件にまとめる統合の4つの工程からなる、と整理しておくと、どの工程を機械に任せ、どの工程に人を置くかを決めやすくなります。前の節と、この節のコードが受け持っているのは、正規化・照合・確認の3つで、統合(どの行のどの値をゴールデンレコードに残すか)はまだ行っていません。統合の規則は、この章の「マスターデータ管理が目指す3つのこと」の表の「正しい値の決定」の行で触れた、項目ごとに「正とする登録元」を決めることから始まります。次の段落で、その決め方を説明します。
同じ取引先と判断した2行の中身が違うとき、どちらを正とするかは、第5章で見た「同じコードなのに内容の違う行」と同じ問題で、項目ごとに決めます。本コラムでは、次の順で決める方法が有効だと考えています。1つ目は更新日です。住所や電話番号のように変わりうる項目は、最後に更新された値を正の候補にします。ただし、更新日が新しいことは、値が正しいことの保証にはなりません。2つ目は登録経路です。取引先から届いた書類や、法人番号の公表情報のように裏づけのある経路で入った値を、担当者が手で入力した値より優先します。請求先の住所なら経理の登録を、納品先の住所なら物流の登録を正とする、というように、項目ごとに「その値を最もよく知る部門の登録」を決めておきます。3つ目は持ち主の確認です。更新日と登録経路で決まらない値、あるいは両者が食い違う値は、データスチュワードがデータオーナーに確認して決め、その判断を記録します。また、残さなかった側の行にしか無い値(古い行にだけ入っている担当部署の電話番号など)は、捨てずにゴールデンレコードの別の項目として残すか、統合の記録に残しておくと、後で判断を見直せます。この章のデモでは、この統合の工程は実行していません。
外部の標準コードを使う:法人番号と地方公共団体コード
前の節の23組の誤りは、名前・住所・電話番号という「書き方が揺れる項目」だけで同じかどうかを判断しようとしたことから生まれました。取引先が法人であれば、国が指定する識別子として法人番号があります。国税庁法人番号公表サイトの「法人番号とは」のページ(2026年10月22日に確認)は、法人番号を株式会社などの法人等が持つ13桁の番号と説明し、利用範囲の制約がなく、誰でも自由に利用できるとしています。番号を指定するのは国税庁長官で、指定の対象として、国の機関、地方公共団体、設立登記法人、所定の税法上の届出書を提出することとされている法人や人格のない社団等などを挙げています。公表サイトでは、商号または名称、本店または主たる事務所の所在地、法人番号の3つ(基本3情報)が公表され(ただし、人格のない社団等は、その代表者等が公表に同意した場合だけ公表されます)、名称や所在地の変更履歴も公表の対象です。検索のほか、利用者のシステムから条件を指定して情報を取得する Web-API と、CSV 形式・XML 形式でのダウンロード(全件と差分)の機能が提供されています。
名寄せにとって重要なのは、番号が変わらないことです。公表サイトのよくある質問(名称や本店所在地を変更した場合の手続についての回答)は、一度指定された法人番号は変更されない、と説明しています。社名の変更や本店の移転があっても番号は同じなので、取引先マスターに法人番号の列を持っておけば、旧社名で登録された行と新社名で登録された行を確実に結べます。また、清算の結了等をした場合についての回答によれば、清算の結了等をした法人も、法人番号・名称・所在地は引き続き公表され、清算の結了等の事由が生じた旨と年月日も公表されます。取引先マスターと公表情報を定期的に突き合わせれば、すでに存在しない取引先に気づく手がかりにもなります。
一方で、法人番号だけで取引先マスターのすべてが片付くわけではありません。公表サイトが挙げる指定の対象は法人等なので、個人で事業を営む取引先は、この一覧には入っていません。また、法人番号は法人等に対して指定される番号なので、同じ会社の本社・工場・支店を区別したいときの拠点の識別は、自社で持つ必要があります。さらに、既存の取引先一覧に法人番号を付けていく作業そのものが、名前と所在地による名寄せになります。この章のコードで行ったような正規化をした社名と所在地で公表情報と照合し、確信の持てない組を人が確かめる、という手順は、法人番号を使う場合にも必要です。それでも、一度付けた法人番号はその後の新規登録の確認と統合の判断を大きく楽にするので、取引先マスターの整備では最初に付ける列の候補になると考えています。
住所の側にも、公的なコードがあります。総務省の全国地方公共団体コードのページ(2026年10月22日に確認)によれば、都道府県コードおよび市区町村コードは、情報処理の効率化と円滑化に資するため、コード標準化の一環として、総務省(当時は自治省)が昭和43年に設定したもので、変更が生じるたびに更新されています。確認した時点の一覧は令和6年1月1日の更新で、平成17年4月1日以降の改正一覧表(令和5年4月1日の更新)も公開されています。同じページから開ける「全国地方公共団体コード」仕様(平成19年4月1日付)は、コードを5桁の数字と1桁の検査数字の6桁とし、第1桁と第2桁が都道府県(01から47までの連番号)、第3桁から第5桁が市区町村などを表すと定めています。検査数字は、第1桁から第5桁にそれぞれ6・5・4・3・2を掛けた積の和を11で割った余りから計算する方式で、誤ったコードが入力されたことを機械で見つけるためのものです。
日本産業規格(JIS)にも、都道府県と市区町村のコードの規格があります。日本産業標準調査会(JISC)の JIS 検索で確かめると、JIS X 0401(都道府県コード)は1970年4月1日の制定、最新の改正が1973年4月1日、最新の確認が2024年10月21日で、JIS X 0402(市区町村コード)は1970年4月1日の制定、最新の改正が2020年3月23日、最新の確認が2024年6月20日です(2026年10月22日に確認)。規格の本文はこの章では開いていないので、総務省のコードと JIS の規格の細部の対応は書きません。実務では、どちらの表を自社の正とするのかを決め、その表の版(更新日)を参照データの記録に残しておくことが要ると考えています。
| 外部のコード | 何を識別するか | 管理する機関・確認先 | 名寄せでの使い方 | 注意すること |
|---|---|---|---|---|
| 法人番号 | 法人等(13桁) | 国税庁(法人番号公表サイト) | 同じ法人の行を確実に結ぶ。社名変更・本店移転の後も同じ番号で結べる | 個人事業の取引先は指定の対象の一覧に無い。拠点の区別は自社で持つ。番号を付ける作業そのものに名寄せが要る |
| 都道府県コード・市区町村コード(全国地方公共団体コード) | 都道府県・市区町村など(6桁。うち1桁は検査数字) | 総務省(全国地方公共団体コードのページ) | 住所の表記の揺れ(都道府県名の省略など)に左右されない比較の単位になる。地域別の集計の分類にも使える | 市町村の合併などでコードが新設・欠番になる。どの時点の表を使ったかを記録する |
| JIS X 0401・JIS X 0402 | 都道府県・市区町村 | 日本産業標準調査会(JIS 検索) | 自社の住所の分類を日本産業規格に合わせるときの参照先 | 規格の改正・確認の日付を確かめる。総務省の表とどちらを正とするかを決める |
総務省が公開している都道府県コード及び市区町村コードの一覧の PDF ファイル(令和6年1月1日更新)では、都道府県名と市区町村名のカナが半角カタカナで書かれています。公的なコード表を取り込むときにも、この章で行ったような文字の正規化が要るということです。外部の表を参照データとして取り込むときは、元のファイルをそのまま保存し、正規化した列を別に作る、という分け方が後で検証しやすいと考えています。
参照データの変更管理:コードが変わるときに何を決めておくか
参照データの管理で最も事故が起きやすいのは、コードの値が変わるときです。総務省の仕様は、市区町村コードの改定の規則を定めています。市町村の名称が変わっただけの場合は、コードは変わりません。町村が市になった場合や、市が町村になった場合は、新しいコードを設け、従前のコードは欠番にします。市町村の廃置分合(合併など)では、合併後の市町村が関係する市町村のいずれかの名称を引き継いだ場合はその市町村の従前のコードを使い、他の関係市町村のコードは欠番にし、どの名称も引き継がなかった場合は新しいコードを設けて関係市町村のコードをすべて欠番にします。
この規則を自社のデータに当てはめると、3つのことが分かります。1つ目に、コードが同じでも名称が変わっていることがあるので、名称を自社のマスターに複写して持っていると、古い名称が残ります。2つ目に、合併で欠番になった旧コードは、過去の取引の記録に残っていても、現に存在する市区町村には対応しなくなります(仕様の附記は、欠番にしたコードを名称の欄に「削除」と記載して表示するとしています)。過去の売上を市区町村別に集計し直すと、旧コードの行がどこにも分類されない、という事態が起きます。3つ目に、どの名称を引き継いだかでコードの扱いが変わるので、新旧の対応は一律の規則では作れず、改正一覧表を見て1件ずつ対応を作る必要があります。
こうした変更は、市区町村コードに限らず、自社で決めた参照データ(商品分類、取引区分、勘定科目、組織コード)でも起きます。組織変更で部署のコードが統合された、商品分類を見直して1つの分類を2つに分けた、といった変更は、過去のデータの集計の仕方を変えます。変更のたびに次の表の項目を決めて記録しておくことが、参照データの管理の中心だと考えています。
| 決めておくこと | 内容 | 決める人の例 | 決めていないと起きること |
|---|---|---|---|
| 変更の承認 | 誰がコードの追加・変更・廃止を承認するか。誰に事前に知らせるか | 全社で共通に使うコード体系は、第3章・第4章のとおりデータスチュワードが案を作り、データガバナンス委員会が承認。1つの部門の中だけで使うコードは、その参照データのデータオーナー | ある部署だけが新しいコードを使い始め、他の部署の集計と合わなくなる |
| 有効期間 | 各コードの有効開始日と有効終了日。廃止したコードを削除せず、終了日を入れて残す | データスチュワード | 廃止したコードを消したために、過去の取引の記録が参照先を失う |
| 新旧の対応表 | 旧コードが新コードのどれに対応するか(1対1・統合・分割) | データスチュワード | 変更の前後で数字がつながらず、前年比が出せない |
| 過去データの扱い | 過去の記録を新コードで読み替えて集計するか、当時のコードのまま集計するか | データオーナーと、その集計を使う部門 | 報告ごとに読み替えの有無が違い、同じ期間の数字が資料によって違う |
| 外部の表の版 | 外部の標準コードを使う場合、どの更新日の表を使っているか | データカストディアン | 合併の後も古い表を使い続け、新しい市区町村のコードが登録できない |
参照データは件数が少ないので、表計算のファイルで管理されていることが多いと思われます。それ自体は問題ではありませんが、ファイルが部署ごとに複写され、それぞれで書き換えられると、マスターデータの重複と同じことが参照データでも起きます。参照データの正本を1か所に置き、他の場所はそこから取得する形にすることと、変更の記録(いつ、誰が、何を、なぜ変えたか)を残すことは、件数が少ないうちに始めておくほうが手間が少なくて済みます。
マスターデータ管理の実装の型:登録型・集中型・共存型
マスターデータ管理をどう実装するかには、いくつかの型があります。この章では、各システムのデータを書き換えるかどうかと、登録・変更をどこで行うかの2つの観点で、3つの型に分けて自分の言葉で説明します。
登録型は、各システムがそれぞれの取引先データを持ち続け、中央には「どのシステムのどの行が同じ取引先か」を示す対応表と、共通の識別子だけを置く型です。各システムの画面や処理を変えずに始められ、分析や照会のときに対応表を使って行を結びます。その代わり、各システムの値は揺れたまま残るので、正しい値を1つに決める力は弱くなります。集中型は、取引先の登録と変更を中央のマスターだけで行い、各システムは中央から値を受け取る型です。値は最もそろいますが、各部門の登録の手順と、各システムの取り込みの仕組みを変える必要があります。共存型は、各システムでも登録と変更ができ、中央にもゴールデンレコードを持って、双方向に同期する型です。既存の業務の流れを残しながら値をそろえていけるので、登録型から集中型へ移る途中の形として使われることがありますが、同じ項目が2か所で同時に変更されたときにどちらを正とするかの規則が要ります。
3つの型の違いを、中央に置くもの、登録・変更をどこで行うか、各システムの値のそろい方、向いている場面、難しい点の順に並べると、次の表になります。
| 型 | 中央に置くもの | 登録・変更をどこで行うか | 各システムの値 | 向いている場面 | 難しい点 |
|---|---|---|---|---|---|
| 登録型 | どの行どうしが同じ取引先かを示す対応表と、共通の識別子 | 各システム | 書き換えない。揺れたまま残る | まず全社の取引先の数や取引の合計を正しく数えたい。各システムを改修する余裕が無い | 対応表だけを持つこの章の簡略な形では、項目ごとの値の統一までは扱わない。各システムの帳票は揺れたまま |
| 集中型 | 登録と変更の窓口を兼ねたマスター(ゴールデンレコード) | 中央のマスターだけ | 中央の値で置き換える | 新しい基幹システムへの移行などで、登録の手順を作り直す機会がある | 部門の業務の流れと各システムの取り込みを変える必要がある。中央が止まると登録が止まる |
| 共存型 | 各システムと同期するゴールデンレコード | 各システムと中央の両方 | 中央のゴールデンレコードと同期する | 既存の業務を残しながら、段階的に値をそろえたい | 同時に変更されたときの優先の規則と、同期の失敗に気づく仕組みが要る |
どの型を選ぶかは、どの判断に使うためにマスターを整えるのかで決めるのが有効だと考えています。経営会議の資料で取引先の数や上位の取引先の売上が部門ごとに違う、という問題を解くだけなら、登録型で対応表を作れば足りることが多く、各システムを書き換える必要はありません。請求書の送付先の誤りや与信の管理の誤りのように、業務の処理そのものが誤っている問題を解くには、値を書き換える集中型か共存型が要ります。また、どの型でも、新規登録の時点で既存の候補を探す仕組みと、似た候補を人が確かめる手順が無ければ、重複は再び増えます。分析用の基盤の側に取引先を集め、そこで名寄せだけを行う形もあり、これは登録型に近い考え方です。基盤の設計は第9章で扱います。
マスターデータ管理のための製品は、名寄せの規則の設定、人が候補を確かめる画面、変更の履歴、各システムへの配信の機能を持っていることが多いと思われますが、どの製品がどの型にどこまで対応しているかは、製品ごとの公式の文書で確かめる必要があり、この章では個別の製品を取り上げません。製品を入れる前に、「同じ取引先」の定義、正規化の規則、項目ごとに正とする登録元、確信の持てない候補を誰が確かめるかを決めておかないと、製品の設定の段階でそれらを決めることになり、製品の導入の作業が業務の定義の議論で止まります。
マスターデータの品質を交換の境界で見る:ISO 8000-100(2016年)の考え方
データ品質の国際規格の ISO 8000 には、マスターデータの品質を扱う一連の部があります。その概要を示すのが ISO 8000-100(2016年)です。ISO のページ(2026年10月22日に確認)によれば、題名はマスターデータの特性データの交換を扱う部の概要を示すもので、2016年10月に第1版として発行され、2009年の技術仕様書(ISO/TS 8000-100)に代わるものです。規格の見直しで2020年6月と2026年1月に確認されており、確認した時点の状態は「発行済み・確認済み」でした。
ISO のページの概要は、このマスターデータ品質の一連の部の取り組み方を2点で説明しています。1つは、データ品質を、意味を持つ最小の要素である個々の特性値から積み上げて扱うこと、もう1つは、マスターデータ管理のシステムの内部ではなく、システムの境界(インタフェース)で扱うことです。そのうえで、組織やシステムの間でマスターデータを交換するときに、計算機で確かめられる要件を含むとしています。ISO 8000-100 自体は、マスターデータの品質の基本を述べ、マスターデータの品質を可能にするために、データと組織の両方に対する要件を定める、と説明されています。マスターデータであるかどうかを問わずすべてのデータに当てはまる品質の側面は、この部の範囲外とされています。
規格の本文はこの章では開いていないので、ここから先はこの考え方を自社の運用に当てはめた本コラムの解釈です。「境界で見る」という考え方は、マスターデータの品質を、各システムの中で完璧に保とうとするよりも、データが組織やシステムの間を渡る地点で確かめる、という発想として読めます。取引先から商品の仕様を受け取るとき、取引先マスターを販売管理から会計へ配信するとき、分析の基盤へ取り込むときに、受け渡すデータが決めた形式と値の規則を満たしているかを機械で確かめる、という運用です。この章のコードで言えば、正規化のキーを作る処理を、データを受け取る境界に置くことに当たります。ただし、正規化は表記をそろえる処理で、それだけで値の正しさを確かめるものではありません。この章のコードには入れていませんが、法人番号の桁数や地方公共団体コードの検査数字の確認も、同じ境界に置ける検査の例です。「個々の特性値から積み上げる」という考え方は、取引先の「品質がよい・悪い」を1行全体で判断するのではなく、社名・所在地・法人番号・電話番号といった項目の値ごとに規則を持ち、どの値がどの規則を満たしているかを測る、という第5章のデータ品質ルールの考え方と重なります。
経営の判断:どのマスターから着手するか
マスターデータ管理は、顧客・商品・取引先・従業員のすべてを一度に整えようとすると、範囲が広すぎて最初の成果が出るまでに時間がかかります。どのマスターから着手するかは、そのマスターの重複や誤りが、どの経営判断をどれだけ止めているかで決めるのが有効だと考えています。次の表は、マスターの種類ごとに、判断の材料を並べたものです。
| マスター | 主に使われる判断 | 重複や誤りが招く損失の型 | 外部の識別子 | 先に着手する理由になりやすい状況 |
|---|---|---|---|---|
| 取引先 | 与信、購買の集約、取引先別の採算 | 同じ会社への与信が分かれて上限を超える。購買が分散して条件の交渉に使えない。請求先の誤り | 法人番号(法人の場合) | 取引先の数や上位の取引先の売上が部門ごとに違う。基幹システムの更新を控えている |
| 顧客(個人を含む) | 顧客数、継続率、顧客ごとの価値、施策の対象選び | 同じ顧客が別人として数えられ、獲得数と解約数がともに膨らむ。案内の二重送付 | 無いことが多い(自社の会員番号など) | 顧客数や解約率が部門ごとに違う。個人情報の扱いの確認が要る(第8章) |
| 商品 | 品目別の採算、在庫、価格の改定 | 同じ品目が別の品番で管理され、在庫と売上が分かれる。仕様の古い値が各システムに残る | 業界のコード(商品の種類による) | 品目の数が多く、仕入先から仕様を受け取る業務がある |
| 従業員・組織 | 人員の配置、権限の付与、組織別の集計 | 異動の後も古い権限が残る。組織変更の前後で部門別の数字がつながらない | 無い(社内の番号) | 組織変更が多い。アクセス権限の棚卸しが必要(第8章) |
判断を誤ったときの損失は、次のような型で表れます。取引先マスターが重複したまま取引先別の売上を経営会議に出すと、上位の取引先の順位が部門の資料ごとに違い、どの数字が正しいかの確認に時間が使われて判断が遅れます。同じ会社への与信が複数の取引先コードに分かれていると、会社単位の与信の上限を守れません。マスターデータ管理の製品を、「同じ取引先」の定義と正規化の規則を決めないまま導入すると、製品の設定の段階で業務の定義の議論が始まり、手戻りが生じ、導入の期間と費用が増えるおそれがあります。名寄せの誤りで別会社を1社にまとめてしまうと、それを直す作業は、重複を残したままにするより手間がかかることがあり、現場はマスターの値を信用しなくなります。この章の架空データで、類似度と、住所か電話番号の一致だけで自動統合すると、グループ会社3組が誤って1社にまとめられたのは、その小さな例です。
予算と体制に落とすときは、最初の対象を1つのマスターに絞り、その中でも範囲を区切るのが現実的だと考えています。たとえば取引先マスターなら、取引額の大きい上位の取引先から法人番号を付け、名寄せの規則とその持ち主、確信の持てない候補を確かめるデータスチュワード、新規登録の時点で候補を探す手順の4つをそろえ、効果(重複の件数、取引先別の集計の部門間の差)を測ってから範囲を広げます。データスチュワードの確認の作業量は、人の確認に回る候補の件数と1件当たりの確認時間によって変わるので、最初の名寄せでその件数を数え、確認にかかる時間を試行で測っておくと、要員の見積もりの根拠になります。製品の導入を検討するのは、この運用が手作業では回らない件数になってからでも遅くはないと考えています。
この章の要点は3つです。第一に、参照データはコード体系の決定と変更の管理が、マスターデータは一意の識別・ゴールデンレコード・配信と同期が中心で、どちらも「何をもって同じとみなすか」「どの登録を正とするか」という業務の判断の持ち主を先に決める必要があります。第二に、名寄せは正規化・照合・確認・統合の工程に分けられ、架空の取引先一覧では、原文の完全一致で正解の約7%、旧字の置き換えまで重ねて約83%、類似度を加えると見逃しは1組まで減りました。ただし、「類似度0.85以上で、住所か電話番号のどちらかが一致する」という規則で確かめた後も、同じ住所のグループ会社の23組が残りました。照合の規則の見直し、法人番号のような識別子の突き合わせ、人による確認のいずれかを加える必要がある、というのがこの架空データでの到達点です。法人番号の突き合わせと人による確認は、このデモでは行っていません。同じ取引先と判断した行のどちらの値を残すかは、更新日・登録経路・持ち主の確認の順に項目ごとに決めます。第三に、法人番号・地方公共団体コードのような外部の標準コードは名寄せと参照データの管理を楽にしますが、使う表の版と変更の規則を記録しておく必要があります。ISO 8000-100(2016年)の概要が示す、品質を組織やシステムの境界で扱うという考え方は、データが渡る地点で確かめる運用として生かせると考えています。次の第8章では、こうして整えた顧客や従業員のデータを守る側の仕組みとして、データの分類とアクセス制御、個人情報保護法の基本を扱います。
この章を深めたい方への参考書籍
『DXを成功に導くマスターデータマネジメント データ資産を管理する実践的な知識とプロセス43』(伊藤洋一 著、翔泳社):複数の業務で共通に使うマスターの設計と管理を、内製化を前提に実務の手順として解説した本です。目次は、マスターデータ管理が必要な理由、全体像、共通認識を作る仕組み、基盤の構築、組織作り、教育作りの章からなり、この章で扱った「同じ取引先」の定義や持ち主の決め方を、組織と手順の側から深めるのに向いています。
『「データ経営」を実現するIT戦略 経営管理の本質はマスターデータにある』(國本修司 著、日経BP社):副題のとおり、経営管理の土台としてマスターデータを位置づける本です。2013年の刊行なので、製品や技術の記述は当時のものとして読む必要がありますが、この章の最後の節で扱った、どのマスターの誤りがどの経営判断を止めるのかを、経営の側から考える材料になります。
第8章 データセキュリティとプライバシー、個人情報保護法と社内ルール
第7章では、参照データとマスターデータを扱い、顧客・商品・取引先のような主体について「正しい一件」を決めて配る仕組みを確かめました。マスターデータが整うと、同じ顧客の情報が社内のどこにあるかを追えるようになります。それは活用の土台であると同時に、守るべきものの所在がはっきりするということでもあります。この章では、データを守る側の仕組みを扱います。データをどの段階の機密区分に分けるか、誰にどこまで見せるか、個人情報についての法令が何を求めているか、2026年7月に公布された改正法で何が変わるのか、情報セキュリティの国際規格やクラウドの責任分担とどう組み合わせるかを、順に説明します。
法令の記述は、個人情報の保護に関する法律(平成十五年法律第五十七号。以下、個人情報保護法)について、個人情報保護委員会が公表しているガイドライン・Q&A・改正法の資料と、法令の条文を開いて確かめた範囲だけで書いています。条番号は、個人情報保護委員会のガイドライン(通則編)とガイドライン(仮名加工情報・匿名加工情報編)に掲載されている条文で確かめたうえで、法令の公式データベースである e-Gov 法令検索の条文(2026年10月1日施行の版の法と、2026年6月14日施行の版の施行規則)で2026年10月26日に照らし合わせました。条番号は、この時点の条文と同じですが、令和8年改正が施行されると変わる箇所があります。本コラムでは、個人情報の取扱いについて社内の判断を担う担当者(法務・総務・情報システムのいずれかが担うことが多い)を「個人情報の担当」と呼びます。第3章で定めたデータオーナーがデータの用途や提供の可否を業務の立場で決めるのに対して、個人情報の担当は、その用途や提供が法令上どの区分に当たり、何が必要かを確かめる役割です。専任の担当がいない組織では、誰がこの役割を担うかを最初に決めておく必要があります。個別の取扱いが法令に合うかどうかは、個人情報の担当が中心になり、必要に応じて専門家と確かめる必要があります。この章は、その確認を誰がどの順で進めるかを決めるための見取り図として書きました。
守る対象を決める、データ分類と機密区分
データセキュリティの出発点は、暗号化やファイアウォールのような技術ではなく、「どのデータを、どの程度守るのか」を決めることです。すべてのデータを同じ強さで守ろうとすると、守る費用が膨らむうえに、業務に必要なデータまで使えなくなります。逆に、守る強さを決めないままにすると、担当者ごとの感覚で扱いが分かれ、ある部署では鍵をかけている顧客の一覧が、別の部署では共有フォルダに置かれたままになります。そこで、データをいくつかの段階に分け、段階ごとに扱いのルールを決めます。本コラムでは、この段階を機密区分と呼び、段階を決める作業をデータ分類と呼びます。
機密区分の段階の数や名前は、法令で決まっているものではなく、各社が決めるものです。段階が多すぎると現場が使い分けられず、少なすぎると守る強さの差が付けられません。中小規模の組織であれば、まず4段階程度から始めるのが扱いやすいと考えています。次の表は、段階の分け方の一例です。表の「扱いのルール」の列は、第3章で扱った標準(守るべき仕様)に当たる内容で、ポリシーには「データを機密区分に分け、区分ごとの扱いに従う」という方針だけを書き、具体的な扱いは標準の文書に書く、という分け方が運用しやすいと考えています。
| 機密区分(例) | どういうデータか | 例 | 扱いのルール(例) | 区分を決める人 |
|---|---|---|---|---|
| 公開 | 社外に出してよいと決めたデータ | 公表済みの会社概要、製品カタログ、公開した統計 | 公開の手続を経たものだけを置く。改ざんの防止は要る | データオーナー(広報・事業部門) |
| 社内限り | 社内では共有してよいが、社外には出さないデータ | 社内規程、会議の資料、部門の業績の速報 | 社員のアカウントでだけ見られる場所に置く。社外への送付は承認制 | データオーナー |
| 機密 | 知る必要のある人だけに限るデータ | 顧客の一覧、取引条件、未公表の経営情報、個人データ全般 | 担当業務ごとにアクセス権を付ける。持ち出し・社外送付は記録を残し、暗号化する | データオーナー。個人データを含む場合は個人情報の担当と協議 |
| 厳秘 | 漏えいしたときの影響が特に大きいデータ | 要配慮個人情報を含む個人データ、決済に使える情報、認証情報、重要な技術情報 | 扱える人を個別に指名する。アクセスのたびにログを残し、定期的に点検する | データオーナーと経営層。個人情報の担当が必ず関与する |
この表で大事なのは、区分を決める人を「データオーナー」にしている点です。第3章で定めたとおり、データオーナーはそのデータの定義・用途・品質の水準・提供の可否について決める責任を持つ人で、通常は業務部門の責任者です。情報システム部門(データカストディアン)は、決められた区分に従ってアクセス権や暗号化を設定する側であり、区分そのものを決める側ではありません。システムの担当者がデータの中身を見て区分を推し量る運用にすると、業務の事情が反映されず、守りすぎか守らなすぎのどちらかに寄りやすくなります。
区分を付ける単位も決めておきます。ファイルや表ごとに区分を付けるのが基本ですが、顧客の台帳のように、同じ表の中に「社内限り」の列(顧客の業種など)と「厳秘」の列(病歴など)が混ざることがあります。このような場合は、表の中で最も高い区分をその表の区分にするか、高い区分の列だけを別の表に分けて保管するかを決めます。後者は手間がかかりますが、分析の担当者に高い区分の列を見せずに済むので、活用の幅が広がります。第6章で扱ったデータカタログやビジネス用語集に、項目ごとの機密区分を載せておくと、利用者が使う前に区分を確かめられます。
最初の一歩は、全社のデータを一度に分類しようとせず、個人データを含むシステムと、漏えいしたときの影響が大きいと分かっているデータから棚卸しすることです。棚卸しでは、どのシステムに、どの項目が、どれだけの件数あり、誰が持ち主で、誰が見られるかを一覧にします。個人情報保護委員会のガイドライン(通則編)も、安全管理措置のうち組織的安全管理措置の手法の例として、個人情報データベース等の種類・名称、個人データの項目、責任者・取扱部署、利用目的、アクセス権を有する者などをあらかじめ明確化しておくことを挙げています。この一覧は、後で述べる漏えい時の報告でも、影響の範囲を特定する起点になります。
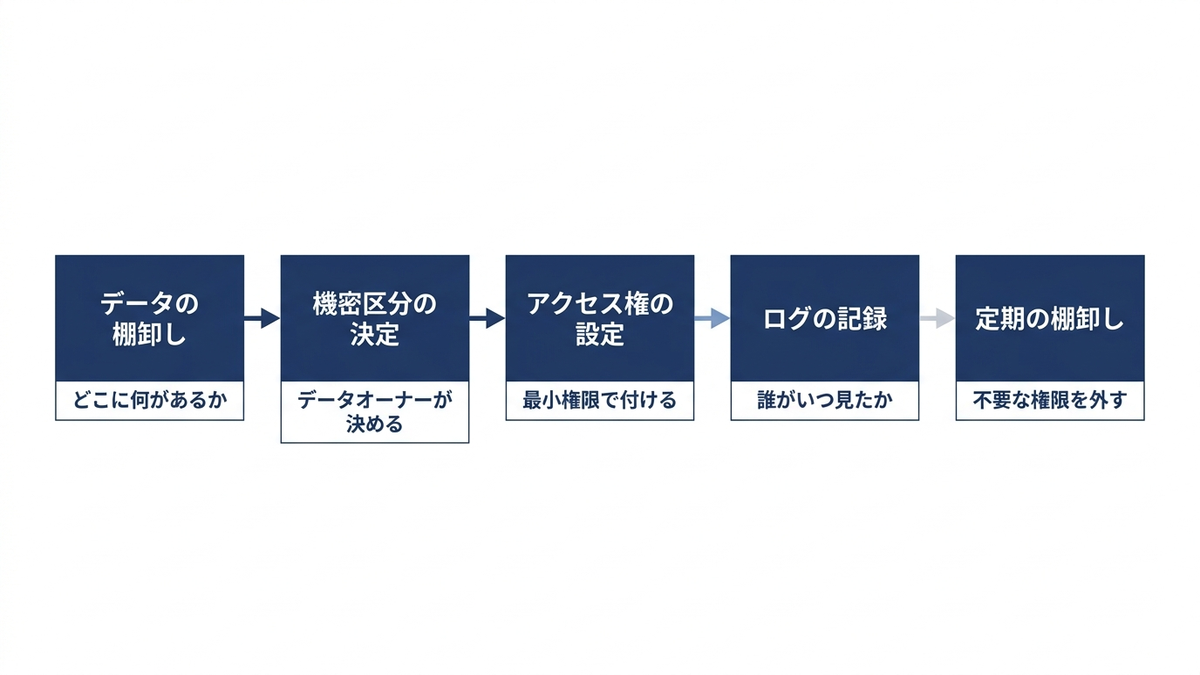
アクセス制御、最小権限・ロール・棚卸し
機密区分を決めたら、区分ごとに「誰が見てよいか」を設定します。ここでの基本の考え方は最小権限で、業務に必要な範囲のデータだけに、必要な操作(閲覧・更新・削除・持ち出し)だけを許すことを指します。最小権限を守ると、ある社員のアカウントが乗っ取られたり、誤操作が起きたりしたときに、被害の範囲が狭くなります。個人情報保護委員会のガイドライン(通則編)も、技術的安全管理措置の1つとしてアクセス制御を挙げ、担当者と取り扱う個人情報データベース等の範囲を限定するために適切なアクセス制御を行わなければならない、としています。
権限を1人ずつ付けると、人数が増えたときに管理しきれなくなります。そこで、「営業担当」「経理担当」「分析担当」のように業務の役割(ロール)を決め、ロールに権限を付け、人をロールに割り当てる方式が、多くの組織で使われています。ロールの設計で起きやすい誤りは、便利さのために広い権限を持つロールを作り、それを多くの人に割り当てることです。たとえば分析担当のロールに、顧客の氏名や連絡先まで見られる権限を付けると、分析には不要な情報まで多くの人が見られる状態になります。分析には顧客 ID と購買履歴があれば足りることが多いので、氏名や連絡先を外した表を分析用に用意し、そちらにだけ権限を付ける方が、見られる人と項目を絞れる分だけ安全です。ただし、これは社内の守り方の工夫であって、法令上の扱いが変わるわけではありません。顧客 ID で元の台帳と結び付けられる表は、氏名を外しても個人情報保護法上は個人データのままで、個人データとしての義務がそのままかかります。氏名を外しただけで、後で述べる仮名加工情報や匿名加工情報になるわけでもありません。違いは「仮名加工情報と匿名加工情報、活用のための2つの区分」の節で表にまとめます。
アクセス制御は、設定した時点では正しくても、時間とともに崩れます。異動した人の古い権限が残る、退職者のアカウントが消されていない、プロジェクトのために一時的に付けた権限が外されていない、といったことが積み重なるからです。これを防ぐために、権限の棚卸しを定期的に行います。棚卸しでは、データオーナーが自分のデータにアクセスできる人の一覧を見て、業務上必要かどうかを確かめ、不要な権限を外します。頻度は、厳秘の区分は四半期ごと、機密は半年ごとのように、区分が高いほど短くするのが一例です。人事の異動・退職の情報を、情報システム部門が確実に受け取る経路を決めておくことも欠かせません。
次の表は、アクセス制御の運用で決めておく項目と、それぞれの責任者の一例です。第3章の役割の定義に沿って、決める人(データオーナー)と設定する人(データカストディアン)を分けています。
| 決めておく項目 | 内容の例 | 決める人 | 実行・記録する人 |
|---|---|---|---|
| ロールの一覧 | 業務の役割ごとに、どの区分のどのデータに、どの操作を許すか | データオーナー(業務部門の責任者) | データカストディアン(情報システム部門) |
| 権限の申請と承認 | 新しく権限が要るときの申請の経路と承認者。一時的な権限には期限を付ける | データオーナー | データカストディアン |
| 異動・退職時の処理 | 人事の情報を受けて権限を外すまでの日数 | 人事部門と情報システム部門の合意 | データカストディアン |
| 権限の棚卸し | 区分ごとの頻度、確かめる人、不要な権限を外した記録 | データオーナー | データスチュワードが一覧を用意し、データカストディアンが外す |
| 例外の承認 | 区分のルールに合わない使い方を一時的に認めるときの承認者と期限 | データオーナー。厳秘の区分は経営層も承認 | データスチュワードが記録する |
経営の側から見ると、アクセス制御の不備が招く損失は、漏えいが起きたときの被害だけではありません。誰が何を見られるのかが分からない状態では、漏えいが疑われたときに影響の範囲を特定できず、調査に時間がかかります。また、権限の申請に時間がかかりすぎると、現場は共有フォルダへのコピーやメールでの受け渡しといった、統制の外の経路でデータを使い始めます。申請から付与までの日数を短く保つことは、守りを弱めるのではなく、統制の外に流れるデータを減らす手段だと考えています。
個人情報保護法の基本、4つの言葉を区別する
データの守りに関わる法令は1つではありませんが、本章では、顧客や従業員のデータを扱う事業者に広く関わる個人情報保護法に絞って扱います。この法律は、扱う情報の種類ごとに言葉を分け、言葉ごとに事業者の義務を変えています。個人情報保護委員会のガイドライン(通則編)も、法はこれらの語を使い分けており、事業者に課される義務はそれぞれ異なるので注意を要する、と注記しています。社内ルールを作るときに最初に揃えるべきなのは、この言葉の区別です。
個人情報は、第2条第1項で、生存する個人に関する情報であって、氏名・生年月日その他の記述等により特定の個人を識別できるもの(他の情報と容易に照合でき、それにより特定の個人を識別できることとなるものを含む)か、個人識別符号が含まれるもの、と定められています。個人識別符号は、第2条第2項で、特定の個人の身体の一部の特徴を電子計算機で使うために変換した符号などのうち、政令で定めるものとされています。要配慮個人情報は、第2条第3項で、本人の人種、信条、社会的身分、病歴、犯罪の経歴、犯罪により害を被った事実その他、本人に対する不当な差別・偏見その他の不利益が生じないように取扱いに特に配慮を要するものとして政令で定める記述等が含まれる個人情報とされています。機密区分の表で要配慮個人情報を含む個人データを「厳秘」の例に置いたのは、漏えい時の報告の対象にもなるなど、法令上も扱いが重いためです。
個人データは、第16条第3項で、個人情報データベース等を構成する個人情報とされています。個人情報データベース等は、第16条第1項で、特定の個人情報を電子計算機で検索できるように体系的に構成したもの等とされ、個人情報データベース等を事業の用に供している者が個人情報取扱事業者(第16条第2項。国の機関・地方公共団体などを除く)です。ガイドライン(通則編)は、営利・非営利の別を問わず、識別される個人の数の多寡にかかわらず該当するとしているので、規模の小さい会社も対象になります。
保有個人データは、第16条第4項で、個人情報取扱事業者が開示・内容の訂正・追加・削除・利用の停止・消去・第三者への提供の停止を行う権限を持つ個人データ(存否が明らかになると公益その他の利益が害されるものとして政令で定めるものを除く)とされています。さらに、第2条第7項は、生存する個人に関する情報であって、個人情報・仮名加工情報・匿名加工情報のいずれにも該当しないものを個人関連情報と定めています。
これらの言葉を、データマネジメントの実務の言葉に置き換えて整理すると、次の表のようになります。表の上の3行(個人情報・個人データ・保有個人データ)は、下の行ほど対象が絞られ、かかる義務が積み上がっていく関係です(ただし、安全管理措置は、個人データとして取り扱う予定の個人情報にも及びます。表の後の段落で触れます)。4行目の個人関連情報は、個人情報に当たらない情報のための別の区分で、上の3行の続きではありません。
| 法令上の言葉 | 条文 | データの実務での目安 | 主にかかる義務の例 |
|---|---|---|---|
| 個人情報 | 第2条第1項 | 特定の個人を識別できる情報そのもの。整理されていない名刺や、記入されたばかりの申込書も含む | 利用目的の特定(第17条)、利用目的による制限(第18条)、不適正な利用の禁止(第19条)、適正な取得(第20条)、利用目的の通知・公表(第21条) |
| 個人データ | 第16条第3項 | 顧客台帳・会員データベース・名刺管理の表のように、検索できる形に整理された集まりに入っている個人情報 | 上の義務に加えて、正確性・最新性の確保と不要になったときの消去の努力義務(第22条)、安全管理措置(第23条)、従業者の監督(第24条)、委託先の監督(第25条)、漏えい等の報告(第26条)、第三者提供の制限(第27条) |
| 保有個人データ | 第16条第4項 | 自社が開示や訂正、利用停止に応じる権限を持つ個人データ | 上の義務に加えて、保有個人データに関する事項の公表、開示・訂正・利用停止等の請求への対応(第32条から第39条) |
| 個人関連情報 | 第2条第7項 | 個人情報(他の情報と容易に照合して識別できるものを含む)・仮名加工情報・匿名加工情報のいずれにも当たらない情報。Cookie などの端末識別子に結び付いた閲覧履歴や位置情報など | 提供先で個人データになることが想定される場合の第三者提供の制限(第31条) |
表の右の列のとおり、データが「整理された集まりに入る」と義務が一段増え、「自社が開示などに応じる権限を持つ」とさらに増えます。データガバナンスの立場から見ると、機密区分の節で作ったデータの棚卸しの一覧に「個人データを含むか」「保有個人データか」の列を足しておくと、どのシステムにどの義務がかかるかを一覧で把握できます。
ただし、安全管理措置については、表の行の区切りどおりにはなりません。ガイドライン(通則編)は、安全管理措置(第23条)の対象には、取得した、または取得しようとしている個人情報のうち、個人データとして取り扱うことを予定しているものも含まれる、としています。記入されたばかりの申込書のように、まだ整理された集まりに入っていなくても、データベースに入力する予定の個人情報は、安全管理措置の対象として扱う必要があります。
ガイドライン(通則編)は、個人関連情報に当たる例として、Cookie 等の端末識別子を通じて収集された閲覧履歴、メールアドレスに結び付いた年齢・性別・家族構成、商品購買履歴・サービス利用履歴、位置情報、興味・関心を示す情報を挙げています。ただし、位置情報が連続的に蓄積されるなどして特定の個人を識別できる場合は個人情報に当たる、とも書いています。同じ種類のデータでも、他のデータと結び付けると区分が変わるということです。第7章の名寄せでデータを結び付けるときには、結び付けた結果がどの区分になるかを確かめる手順を入れておく必要があります。
事業者の義務を社内ルールに落とす、利用目的・安全管理措置・委託・第三者提供・漏えい
個人データを扱う事業者の義務のうち、データガバナンスの仕組みと特に関わりの深いものを、条文の順に見ていきます。
1つ目は利用目的です。第17条第1項は、個人情報を取り扱うに当たって、その利用の目的をできる限り特定しなければならない、と定めています。第21条第1項は、個人情報を取得した場合は、あらかじめ利用目的を公表している場合を除き、速やかに本人に通知するか公表しなければならない、と定めています。また第21条第2項は、契約書その他の書面(電磁的記録を含みます)に書かれた本人の個人情報を本人から直接取得する場合は、人の生命・身体・財産の保護のために緊急に必要がある場合を除き、あらかじめ本人に利用目的を明示しなければならない、と定めています。ガイドライン(通則編)は、申込書・アンケートや、自社のホームページの入力画面に本人が入力した個人情報を取得する場合を、その例に挙げています。さらに第21条第4項は、第1項から第3項までの規定を適用しない場合として、利用目的を本人に通知し又は公表することにより本人や第三者の生命・身体・財産その他の権利利益を害するおそれがある場合、事業者の権利又は正当な利益を害するおそれがある場合、国の機関や地方公共団体の法令の定める事務に協力する必要があり通知や公表がその遂行に支障を及ぼすおそれがある場合、取得の状況からみて利用目的が明らかであると認められる場合、の4つを定めています。ガイドライン(通則編)は、利用目的を抽象的・一般的に特定するのではなく、最終的にどのような事業の用に供され、どのような目的で利用されるのかが本人にとって一般的かつ合理的に想定できる程度に具体的に特定することが望ましい、としています。データを活用する側から見ると、利用目的は「そのデータで何をしてよいか」の上限を決めるものです。新しい分析や施策を始める前に、そのデータを取得したときの利用目的に収まるかを確かめる手順を、データの利用申請の中に入れておくことが有効だと考えています。
2つ目は安全管理措置です。第23条は、取り扱う個人データの漏えい・滅失・毀損の防止その他の個人データの安全管理のために必要かつ適切な措置を講じなければならない、と定めています。ガイドライン(通則編)の別添「講ずべき安全管理措置の内容」は、その内容を、基本方針の策定、個人データの取扱いに係る規律の整備、組織的・人的・物理的・技術的安全管理措置、外的環境の把握に分けて示しています。同じ別添は、従業員が100人以下の事業者を「中小規模事業者」とし(扱う個人データによって識別される個人の数が過去6月以内のいずれかの日に5,000を超える事業者と、委託を受けて個人データを扱う事業者は除く)、義務は同じだが、円滑に履行できる手法の例を別に示す、としています。次の表は、別添の区分を、データガバナンスの文書と役割に対応させたものです。
| 安全管理措置の区分 | ガイドラインが示す内容(要約) | データガバナンスでの置き場所(例) | 主な担い手(例) |
|---|---|---|---|
| 基本方針の策定 | 組織として取り組むための基本方針。名称、法令等の遵守、安全管理措置、質問・苦情の窓口などを定める例 | データのポリシーの一部、または個人情報保護方針として公表 | 経営層・CDO |
| 取扱いに係る規律の整備 | 取得・利用・保存・提供・削除・廃棄の段階ごとに、取扱方法や責任者・担当者を定める取扱規程 | データの標準と手順の文書。機密区分ごとの扱いのルール | データオーナー・データスチュワード |
| 組織的安全管理措置 | 組織体制の整備、規律に従った運用、取扱状況を確認する手段、漏えい等に対応する体制、取扱状況の把握と見直し | 役割の分担表、データの棚卸しの一覧、例外承認の記録、定期の点検 | データガバナンス委員会・データスチュワード |
| 人的安全管理措置 | 従業者への周知と教育。定期的な研修や、秘密保持を就業規則等に盛り込む例 | データの研修、利用者向けの手引 | 人事部門・データスチュワード |
| 物理的安全管理措置 | 扱う区域の管理、機器・媒体の盗難防止、持ち運び時の漏えい防止、削除・廃棄 | 保管と廃棄の手順。廃棄の記録 | 総務部門・データカストディアン |
| 技術的安全管理措置 | アクセス制御、アクセス者の識別と認証、外部からの不正アクセス等の防止、情報システムの使用に伴う漏えい等の防止 | アクセス権の設計と棚卸し、ログの記録、暗号化 | データカストディアン |
| 外的環境の把握 | 外国で個人データを扱う場合に、その国の制度等を把握したうえで措置を講じる | クラウドの保存先の国の一覧と、確認した記録 | 情報システム部門・法務 |
表の真ん中の列を見ると、ガイドラインが求める措置の多くは、データガバナンスで作る文書や役割と重なっています。安全管理措置を「個人情報の担当の仕事」として別に作り、データガバナンスの文書とは別の体系で管理すると、同じ顧客データについて2つの規程が並び、改定のたびに食い違いが生じます。安全管理措置の取扱規程と、データの標準・手順の文書は、同じ体系の中に置くのが扱いやすいと考えています。
3つ目は委託です。第25条は、個人データの取扱いの全部又は一部を委託する場合は、委託を受けた者に対する必要かつ適切な監督を行わなければならない、と定めています。ガイドライン(通則編)は、その内容として、適切な委託先の選定、委託契約の締結、委託先における個人データ取扱状況の把握を挙げ、再委託についても、委託先から事前報告を受けるか承認を行うこと等が望ましいとしています。また、第27条第5項第1号により、利用目的の達成に必要な範囲内で個人データの取扱いを委託することに伴って提供される場合、委託先は第三者に当たりません。ただし、外国にある第三者に個人データの取扱いを委託する場合について、個人情報保護委員会のガイドラインに関する Q&Aの Q12-1 は、委託の場合も、第28条第1項に基づき、外国にある第三者への提供を認める旨の本人の同意をあらかじめ得る必要がある、としています(我が国と同等の水準の制度を持つ国として規則で定める国にある場合、規則で定める基準に適合する体制を整備している場合、第27条第1項各号に当たる場合を除きます)。分析やシステム運用を外部に任せるときは、この委託の枠の中で、委託した業務の範囲を契約に書き、委託先がその範囲を超えて使わないことを確かめる必要があります。
4つ目は第三者提供です。第27条第1項は、法令に基づく場合などの例外を除き、あらかじめ本人の同意を得ないで個人データを第三者に提供してはならない、と定めています。グループ会社や取引先とデータを共有する計画は、それが委託なのか、共同利用(第27条第5項第3号。共同して利用する個人データの項目、利用する者の範囲、利用目的、管理に責任を持つ者などをあらかじめ本人に通知するか、本人が容易に知り得る状態に置いたうえで、特定の者との間で共同して利用すること)なのか、本人の同意を得た第三者提供なのかを、計画の段階で決めておく必要があります。データの提供の可否は第3章でデータオーナーが決める事項としましたが、個人データを含む場合は、データオーナーの判断の前に個人情報の担当が法的な区分を確かめる、という順序を手順に書いておくことが有効だと考えています。
5つ目は漏えい等が起きたときの対応です。第26条第1項は、個人データの漏えい・滅失・毀損その他の安全の確保に係る事態で、個人の権利利益を害するおそれが大きいものとして委員会規則で定めるものが生じたときは、委員会に報告しなければならない、と定め、第2項は、その場合に本人へ通知しなければならない(通知が困難な場合で代わりの措置をとるときを除く)、と定めています。ガイドライン(通則編)によると、報告の対象となる事態は、委員会規則第7条の4つで、要配慮個人情報が含まれる個人データの漏えい等、不正に利用されると財産的被害が生じるおそれがある個人データの漏えい等、不正の目的をもって行われたおそれがある行為による漏えい等(この事態では、取得した、または取得しようとしている個人情報のうち、個人データとして取り扱われることが予定されているものも対象に含まれます)、本人の数が1,000人を超える漏えい等です(いずれも、発生したおそれがある事態を含む。高度な暗号化などの措置を講じた個人データは除く)。報告は、事態を知った後に速やかに行う速報と、知った日から30日以内(不正の目的による事態は60日以内)に行う確報に分かれ、速報の「速やか」の日数の目安は、事態を知った時点から概ね3日から5日以内とされています。法人の場合、「知った」時点は、いずれかの部署が事態を知った時点を基準とする、とも書かれています。
最後の点は、組織の設計に直接関わります。現場の部署が漏えいに気づいてから、個人情報の担当や経営層に伝わるまでに日数がかかると、その間も報告の期限は進みます。ガイドライン(通則編)は、漏えい等事案が発覚した場合に講ずべき措置として、事業者内部における報告と被害の拡大防止、事実関係の調査と原因の究明、影響範囲の特定、再発防止策の検討と実施、委員会への報告と本人への通知を挙げています。影響範囲の特定には、どのシステムにどの項目が何件あるかの一覧が要ります。機密区分の節で作った棚卸しの一覧と、後で述べるアクセスのログが整っていれば、この特定が早く済みます。報告の連絡経路と、一覧・ログの保管場所を、平時に決めておくことが、データガバナンスが漏えい時の対応に役立つ点だと考えています。
仮名加工情報と匿名加工情報、活用のための2つの区分
個人データを分析に使うときに知っておきたいのが、加工によって扱いを変える2つの区分です。仮名加工情報は、第2条第5項で、他の情報と照合しない限り特定の個人を識別できないように個人情報を加工して得られる個人に関する情報と定められています。匿名加工情報は、第2条第6項で、特定の個人を識別できないように個人情報を加工して得られる個人に関する情報であって、当該個人情報を復元できないようにしたもの、と定められています。名前は似ていますが、義務がかなり違います。後で述べるとおり、仮名加工情報は法令に基づく場合を除いて第三者への提供が禁じられ、匿名加工情報は項目の公表と明示を条件に第三者へ提供できます。そのため本章では、仮名加工情報を社内での分析のための区分、匿名加工情報を社外への提供も視野に入れた区分として扱います。
どちらの区分も、個人情報から項目を外せば自動的になるものではありません。同じガイドラインによると、仮名加工情報を作成するときは第41条第1項に基づく委員会規則第31条の基準(特定の個人を識別できる記述等の全部又は一部の削除、個人識別符号の全部の削除、不正に利用されると財産的被害が生じるおそれがある記述等の削除。いずれも復元できる規則性を持たない方法での置き換えを含む)に従って加工する必要があり、匿名加工情報も第43条第1項に基づく委員会規則の基準に従って加工する必要があります。さらに同じガイドラインは、安全管理措置の一環として氏名等の一部を削除(又は他の記述等に置き換え)したうえで引き続き個人情報として取り扱う場合は、仮名加工情報や匿名加工情報を「作成するとき」には当たらない、と書いています。アクセス制御の節で述べた「氏名や連絡先を外した分析用の表」は、この「引き続き個人情報として取り扱う場合」に当たり、顧客 ID で元の台帳と結び付けられる限り、個人データとしての義務がそのままかかります。
次の表は、項目を外しただけの表と、2つの区分の違いを、データ活用の場面に引きつけて整理したものです。仮名加工情報には、作成した事業者のように元の個人情報や削除情報等を持っているために個人情報に当たるものと、提供を受けた事業者がそれらを持たないために個人情報に当たらないものがあるとガイドラインは説明しており、この表の仮名加工情報は前者(個人情報である仮名加工情報)に限ります。また、匿名加工情報の利用目的や漏えい時の扱いは本章では確かめていないので、表には載せていません。
個人情報保護委員会の仮名加工情報・匿名加工情報についてのガイドライン(令和8年4月一部改正の版)によると、個人情報である仮名加工情報については、特定された利用目的の達成に必要な範囲を超えて取り扱ってはならず(第41条第3項)、法令に基づく場合を除いて第三者に提供してはならず(第41条第6項)、元の本人を識別するために他の情報と照合してはならず(第41条第7項)、本人への連絡等のために含まれる連絡先その他の情報を利用してはならない(第41条第8項)とされています。一方で、第41条第9項により、利用目的の変更の制限(第17条第2項)、漏えい等の報告と本人通知(第26条)、保有個人データの開示等への対応(第32条から第39条)は適用されません。同じガイドラインは、このため変更前の利用目的と関連性を有すると合理的に認められる範囲を超える利用目的の変更も認められる、としています(変更した場合は、変更後の利用目的を公表する必要があります)。
匿名加工情報については、同じガイドラインによると、作成するときは適正な加工を行い(第43条第1項)、作成したときは含まれる情報の項目を公表し(第43条第3項)、第三者に提供するときは提供する情報の項目と提供の方法を公表するとともに、提供先に匿名加工情報である旨を明示し(第43条第4項)、自ら利用するときは元の本人を識別するために他の情報と照合してはならない(第43条第5項)とされています。
| 比べる点 | 項目を外しただけの表(ID で元の台帳と結び付けられるもの) | 仮名加工情報(個人情報であるもの) | 匿名加工情報 |
|---|---|---|---|
| 法令上の扱い | 個人情報のまま。データベース等に入っていれば個人データ。ガイドラインは、安全管理措置の一環として氏名等を削除して引き続き個人情報として扱う場合は、仮名加工情報・匿名加工情報の作成に当たらないとしている | 仮名加工情報(第2条第5項)。作成した事業者の手元では個人情報にも当たる | 匿名加工情報(第2条第6項) |
| 作り方の要件 | 法令上の加工の基準は無い。何を外すかは社内のルールで決める | 委員会規則第31条の基準に従って加工する(第41条第1項) | 委員会規則の基準に従って加工する(第43条第1項) |
| 識別できるかの程度 | ID で照合すれば識別できる | 他の情報と照合しない限り識別できない | 識別できず、元の個人情報を復元できない |
| 第三者への提供 | 個人データの第三者提供の制限(第27条)がそのままかかる | 法令に基づく場合を除き禁止(第41条第6項)。委託などで第三者に当たらない場合の扱いはガイドラインに記載がある | 項目と提供方法を公表し、匿名加工情報である旨を明示して提供(第43条第4項) |
| 識別・連絡 | 仮名加工情報・匿名加工情報の識別行為の禁止の規定の対象ではなく、個人データとして利用目的の範囲で扱う | 本人を識別するための照合の禁止(第41条第7項)、連絡先等の利用の禁止(第41条第8項) | 本人を識別するための照合の禁止(第43条第5項) |
| 漏えい等の報告・開示請求 | 個人データ・保有個人データとしての義務(第26条、第32条から第39条)がそのままかかる | 適用されない(第41条第9項) | この表では扱わない |
| データガバナンスで決めること | どの項目を外すか、誰に見せるか。法令上は個人データとして管理する | どの表を仮名加工情報として作るか、削除情報等をどこに保管し誰が見られるか、分析で作成した統計情報から得た傾向を、元の個人情報の利用目的の範囲で施策に使うときの経路(個人ごとの分析結果は元の本人に結び付けない) | 作るかどうか、加工の担当、公表の担当、提供先との取り決め |
データガバナンスの立場で特に注意したいのは、仮名加工情報で分析した結果を施策に使うときです。ここでは分析の結果を、個人ごとの分析結果と統計情報に分けて扱います。個人ごとの分析結果は、仮名加工情報の1件ごとに付けた予測値や区分のように、1人分の記録に対応する結果です。統計情報は、仮名加工情報・匿名加工情報編のガイドラインによると、複数人の情報から共通要素に係る項目を抽出して同じ分類ごとに集計して得られるデータで、集団の傾向又は性質などを数量的に把握するものです(同じガイドラインは、特定の個人との対応関係が排斥されている限り、法の「個人に関する情報」に当たらない、としています)。
個人ごとの分析結果を元の本人に当てはめて施策の対象者の一覧を作るには、仮名加工情報を元の個人情報と照合することになります。元の本人を識別するための照合は第41条第7項で禁じられており、同じガイドラインは、仮名加工情報を作成の元となった個人情報と照合することを、識別行為に当たる事例に挙げています。仮名加工情報に含まれる連絡先等を使って案内を送ることも第41条第8項で禁じられています。一方、ガイドラインに関する Q&A の Q14-20 への回答は、仮名加工情報を用いて分析を行って統計情報を作成し、その統計情報から得られた傾向等を踏まえて、元の個人情報を使って広告配信を行うことは、それが元の個人情報について特定された利用目的の範囲内であれば可能、としています。この回答が可能としているのは、統計情報から得た傾向を元の個人情報の側で使うことであり、個人ごとの分析結果を元の本人に結び付けることではありません。そのため、分析用のデータと施策用のデータを、どの区分で、どの利用目的の範囲で扱うのかを、分析を始める前に決めておく必要があります。
仮名加工情報を作成したときは、削除した記述等や加工の方法に関する情報(削除情報等)の安全管理措置も求められます(第41条第2項)。削除情報等は、元の個人と結び付ける鍵に当たる情報なので、機密区分では最も高い段階に置き、分析の担当者からは見えない場所に保管するのが自然です。なお、匿名加工情報の加工の基準は委員会規則とガイドラインに詳しく書かれており、本章では立ち入りません。
令和8年改正、何が決まり何がまだ決まっていないか
個人情報保護委員会の令和8年改正のページによると、2026年(令和8年)4月7日に第221回国会(特別会)に提出された「個人情報の保護に関する法律等の一部を改正する法律案」は、同年7月10日に可決・成立し、7月17日に「個人情報の保護に関する法律等の一部を改正する法律」が公布されました。同じページは、円滑な施行に向け、引き続き政令・規則・ガイドライン等の検討を行う、としています。
施行の日について、委員会が公開している改正法の条文(附則第1条)は、この法律は公布の日から起算して2年を超えない範囲内において政令で定める日から施行する、と定めています(一部の規定は公布の日や公布から6月を経過した日など、別の日から施行されます)。このうち附則第1条第3号は、罰則の章(現行の第176条から第185条)の改正規定などを、公布の日から起算して6月を経過した日から施行すると定めています。2026年10月27日に委員会のページを確かめた時点では、施行日を定める政令が公布されたという記載は見当たりませんでした。委員会が2026年7月31日に決定した今後の取組の資料には、政令・委員会規則・ガイドライン等の整備の工程を示したロードマップがあり、改正法の施行までに十分な期間を確保する、としていますが、同じ資料はその工程表を現時点での大まかな見込みで今後の状況によって変わり得るもの、と注記しています。そのため、本コラムでは、附則第1条第3号の規定を除き、施行の時期を特定して書きません。施行日と政令・規則の最新の状況は、委員会の令和8年改正のページで確かめる必要があります。
政令・規則の整備も進行中です。委員会のページには、2026年8月26日に「政令・規則等で定める事項の全体像」、9月9日に整備の今後の進め方、9月16日・10月1日・10月14日に政令・規則の整備に向けた基本的な考え方の①②③が、それぞれ決定されたと掲載されています。改正法の資料にも、具体的な対象範囲は委員会規則等やガイドライン等で定めることを想定する、という注記が多くの項目に付いています。社内ルールの細部は、これらが確定してから合わせることになります。
改正の中身について、委員会の資料「個人情報保護法等の一部を改正する法律について」(令和8年7月)の概要は、改正内容を、適正なデータ利活用の推進、リスクに適切に対応した規律、不適正利用等防止、規律遵守の実効性確保のための規律、の4つに分けています。次の表は、そのうちデータガバナンスとの関わりが大きい項目を、資料の表現に沿って抜き出し、社内で準備しておくことを添えたものです。準備の列は本コラムの考えで、法令や委員会の資料が求めている内容ではありません。表の「オプトアウト制度」は、本人の求めがあれば提供を停止することなどを条件に、本人の同意を得ずに個人データを第三者に提供できる現行の制度(第27条第2項)を指します。
| 改正の柱(資料の区分) | 主な内容(資料の表現の要約) | 社内で準備しておくこと(本コラムの考え) |
|---|---|---|
| 適正なデータ利活用の推進 | 個人データ等の第三者提供と、公開されている要配慮個人情報の取得について、統計情報等の作成(統計作成等であると整理できる AI 開発等を含む)にのみ利用される場合は本人同意を不要とする。一定の事項の公表や、提供元と提供先の書面による合意、目的外の利用・第三者提供の禁止などの規律を伴う | 統計の作成のためにデータを共有する計画がある場合、どのデータをどの目的で出し入れするかの記録と、目的外に使わないことを確かめる手順。対象の範囲は委員会規則等を待つ |
| 適正なデータ利活用の推進 | 取得の状況からみて本人の意思に反しないため本人の権利利益を害しないことが明らかな取扱いについて本人同意を不要とする、など同意の規律の見直し | 現在同意を取っている流れの一覧。対象の範囲は委員会規則等で定めることが想定されている |
| リスクに適切に対応した規律 | 16歳未満の者が本人である場合の法定代理人の関与の明文化。顔特徴データ等の取扱いに関する一定の事項の周知の義務化と、オプトアウト制度に基づく第三者提供の禁止 | 年齢の情報や顔特徴データ等を扱うシステムがあるかの棚卸し |
| リスクに適切に対応した規律 | データ処理等の委託を受けた事業者について、委託された個人データ等の適正な取扱いに係る義務を見直す | 委託先の一覧と、委託した業務の範囲を書いた契約の確認 |
| リスクに適切に対応した規律 | 漏えい等の発生時に、本人の権利利益の保護に欠けるおそれが少ない場合は、本人への通知義務を緩和する | 漏えい時の対応手順の見直しの予定。対象の範囲は委員会規則等を待つ |
| 不適正利用等防止 | 個人情報ではないが特定の個人に対する働きかけが可能となる情報について、不適正利用と不正取得を禁止する。オプトアウト制度による提供時に、提供先の身元と利用目的の確認を義務化する | メールアドレスや Cookie ID 等を含む個人関連情報の所在と、外部から取得したデータの出所の記録 |
| 規律遵守の実効性確保のための規律 | 命令の要件の見直し、違反行為を補助等する第三者への要請の根拠規定、罰則の見直し、重大な違反行為で個人の権利利益が侵害された場合等について課徴金の納付を命ずる制度の導入 | 経営層への報告の経路。違反が経営の損失に直結する範囲が広がることの共有 |
改正の柱のうち、統計情報等の作成に関する本人同意の見直しは、データの活用を広げる側の改正で、AI 開発等も対象になりうるとされています。一方で、課徴金制度の導入や罰則の見直しは、違反したときの損失を大きくする側の改正です。両方が同じ改正に入っていることは、データの活用を広げるには、何をどの目的で使ったのかを後から説明できる記録が前提になる、ということを示していると考えています。施行日と政令・規則の内容が確定するまでの間に企業が進められるのは、改正の対象になりうるデータがどこにあるかを把握しておくことです。対象の範囲が確定してから棚卸しを始めると、準備の期間がその分だけ短くなります。
ISO/IEC 27001 との関係、ログと監査
個人情報保護法が個人に関する情報についての法令上の義務を定めるのに対して、情報全般の守り方を組織の仕組みとして整える国際規格が ISO/IEC 27001 です。ISO の目録によると、現行版は ISO/IEC 27001(2022年)で、2022年10月に発行された第3版です。2024年には気候変動への対応に関する追補(Amendment 1)が出ています。前の版である ISO/IEC 27001(2013年)は廃止されています。ISO の紹介ページは、この規格が情報セキュリティマネジメントシステム(書籍などでは ISMS と略されます)の要求事項を定め、リスク管理の過程を適用することで情報の機密性・完全性・可用性を保ち、リスクが適切に管理されていることへの信頼を利害関係者に与える、と説明しています。日本の規格としては、日本産業標準調査会(JISC)の JIS 検索に JIS Q 27001 が掲載されており、制定年月日は2006年5月20日、最新改正年月日は2025年5月20日で、本体と追補が閲覧できるようになっています。
情報セキュリティマネジメントとデータガバナンスは重なる部分が大きいので、分担を決めておかないと、同じ文書を2つの部署が別々に作ることになります。情報セキュリティマネジメントは、情報資産を脅威から守るためにリスクを評価し、管理策を選び、運用し、見直す仕組みです。データガバナンスは、データについて誰が何を決め、何を基準に、どう確かめるかを定める仕組みで、守ることのほかに、定義・品質・活用の判断を含みます。重なるのは、データの棚卸し、機密区分、アクセス権、ログ、委託先の管理です。次の表は、分担の一例です。
| 項目 | 情報セキュリティマネジメントが主に担うこと | データガバナンスが主に担うこと | 重なりの扱い(例) |
|---|---|---|---|
| 資産の一覧 | 情報資産とその脅威・脆弱性の評価 | データの定義・持ち主・用途・品質の記録(データカタログ) | 一覧は1つにし、セキュリティの評価の列とデータの定義の列を同じ表に持つ |
| 機密区分 | 区分ごとの管理策(暗号化・持ち出しの制限など)の設計 | どのデータがどの区分に入るかの決定(データオーナー) | 区分の名前と段階の数は全社で1つに揃える |
| アクセス権 | 認証の方式、権限の技術的な設定、不正アクセスの検知 | 誰に何を見せるかの判断と、定期の棚卸し | 申請と承認の手順を1つにする |
| ログと監査 | ログの取得・保管・改ざん防止、監視の仕組み | ログを使った利用状況の確認、利用目的の範囲内かの点検 | 何のログをどれだけの期間残すかを両者で決める |
| 委託先・クラウド | 委託先のセキュリティ水準の評価 | 委託する業務の範囲とデータの範囲の決定 | 委託先の一覧を共有する |
| 品質・定義・活用 | 情報の完全性・可用性の確保(改ざんの防止、必要なときに使える状態の維持)と、提供するときの機密性・アクセス制御 | 業務上の品質の基準、定義の統一、利用価値と提供の可否の判断 | 業務上の判断はデータガバナンスが主導し、完全性・可用性や提供時の安全性は情報セキュリティの担当と連携する |
ログと監査は、守りと活用の両方に効く仕組みです。守りの側では、漏えいが疑われたときに、誰がいつどのデータにアクセスしたかをたどる手段になります。ガイドライン(通則編)も、組織的安全管理措置の手法の例として、個人情報データベース等の利用・出力状況、媒体の持ち運び等の状況、削除・廃棄の状況、情報システムの利用状況(ログイン実績・アクセスログ等)の記録の整備を挙げ、技術的安全管理措置の例として、ログ等の定期的な分析による不正アクセス等の検知を挙げています。活用の側では、どのデータがどれだけ使われているかを示す記録になり、使われていないデータの整理や、よく使われるデータの品質改善の優先順位を決める材料になります。
ログで決めておくことは、何を残すか(誰が・いつ・どのデータに・どの操作をしたか)、どれだけの期間残すか、誰が見るか、どの頻度で点検するかです。ログを残すだけで誰も見ないと、漏えいが起きた後に初めて開くことになり、平時の異常に気づけません。厳秘の区分のデータについては、ふだんと違う大量の出力や、業務時間外のアクセスを定期的に点検する、という運用が一例です。また、ログそのものにも個人に関する情報が含まれることがあるので、ログの保管場所と閲覧の権限も機密区分のルールに従わせる必要があります。法令で保存の義務が定められた書類と保持期間の決め方は、第9章で扱います。
クラウド利用時の責任分担
データをクラウドに置く場合、守る責任の一部はクラウドの事業者が負い、一部は利用者が負います。この分け方を各社は責任共有モデル(Microsoft の日本語の文書では共同責任・共有責任モデル)と呼び、公式の文書で説明しています。開いて確かめた範囲では、Amazon Web Services の責任共有モデルのページは、AWS がクラウドのサービスを実行するインフラストラクチャ(ハードウェア・ソフトウェア・ネットワーク・施設)を保護する責任を負い、利用者の責任は選んだサービスによって異なる、と説明しています。そのうえで、Amazon S3 のような抽象化されたサービスでも、データの管理(暗号化の選択を含む)、資産の分類、適切な権限の適用は利用者が責任を負う、と書いています。Microsoft Learn の「クラウドにおける共同責任」(2026年8月24日更新の版)は、責任の分担表で、顧客データ、構成と設定、ID とユーザーを、オンプレミス(自社の設備で運用する形態)・IaaS(計算機やネットワークなどの基盤を借りる形態)・PaaS(アプリケーションの実行環境を借りる形態)・SaaS(完成したアプリケーションを使う形態)のすべての形態で利用者の責任としています。Google Cloud の責任の共有と運命の共有を説明した文書(2023年8月21日に最終確認と表示された版)は、基盤となるネットワークとインフラストラクチャについてはクラウド事業者が常に責任を負い、利用者はアクセス ポリシーとデータについて常に責任を負う、としています。
3社の文書の表現は異なりますが、開いた範囲では、データそのものと、誰にアクセスさせるかは、どの形態のサービスでも利用者の責任として書かれています。つまり、機密区分の節で決めた区分と、アクセス制御の節で決めた権限は、クラウドに移しても事業者に任せられない部分です。クラウドの事業者が強固な施設を持っていても、利用者がアクセス権を広く設定すれば、データは守られません。Google Cloud の同じ文書は、責任の共有に頼るときの課題の1つとして、クラウドのセキュリティ侵害の原因に構成ミスが多いことを挙げています。設定の点検は、権限の棚卸しと同じ周期で定期に行うことに加えて、公開範囲やアクセスの設定を変えた直後にも行い、重要な設定の変更を自動で検知できる仕組みがあれば併せて使うことが有効だと考えています。
個人情報保護法との関係では、個人情報保護委員会のガイドラインに関する Q&A(令和7年7月1日の版。委託の段落で触れたものと同じ文書)の Q7-53 が、クラウドサービスの利用が第三者提供や委託に当たるかどうかは、保存している電子データに個人データが含まれているかどうかではなく、クラウドサービスを提供する事業者が個人データを取り扱うこととなっているかどうかで判断する、としています。取り扱わないこととなっている場合とは、契約条項でサーバに保存された個人データを取り扱わない旨が定められ、適切にアクセス制御を行っている場合等が考えられる、とも書いています。この場合は提供に当たらず、委託先の監督義務も課されませんが、Q7-54 は、利用する事業者は自ら果たすべき安全管理措置の一環として適切な安全管理措置を講じる必要がある、としています。また Q10-25 は、外国にある事業者のクラウドサービスを使う場合について、外的環境の把握として、事業者が所在する外国の名称と、個人データが保存されるサーバが所在する外国の名称を明らかにし、その国の制度等を把握したうえで講じた措置の内容を本人の知り得る状態に置く必要がある、としています。クラウドを契約するときは、契約条項の内容と、データの保存先の国を、データの棚卸しの一覧に記録しておく必要があります。
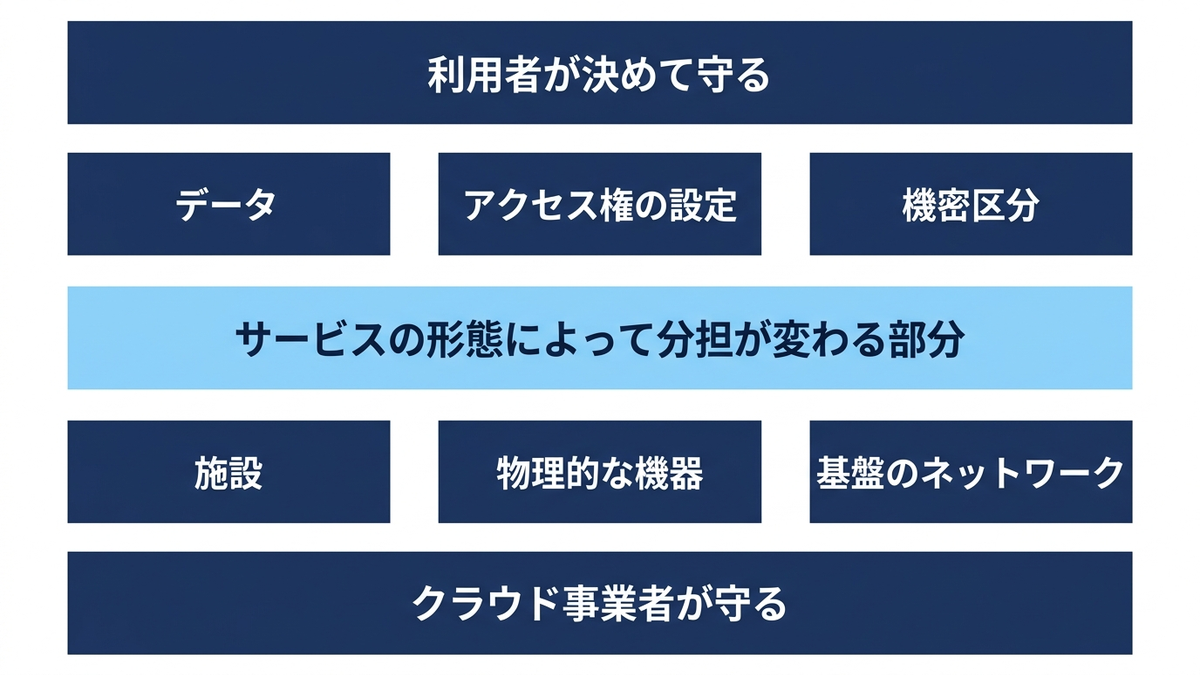
経営判断、守りと活用を両立させ、全部を鍵にかけない
データセキュリティとプライバシーで経営が判断すべきことは、どこまで守るかの水準と、その水準を誰が決めるかです。守りの判断を誤ったときの損失は、2つの方向に現れます。1つは守りが足りない方向で、本コラムの損失の型で言えば法令違反に当たります。漏えい等が起きたときの報告と本人への通知の対応、原因の調査、取引先や顧客の信頼の低下が伴い、データの所在が分からなければ影響の範囲の特定が遅れて、判断の遅れも重なります。令和8年改正で課徴金制度が導入されることになり、違反が経営の損失に結び付く経路は広がります。もう1つは守りすぎの方向で、すべてのデータを厳秘として扱った結果、分析に使える状態のデータが無くなるAI投資の空振りと、申請が通らない現場が統制の外でデータを持ち回るようになる現場の不信です。後者は事故として表に出にくいので、気づきにくい損失です。
両立のための考え方は、本章の順序そのものです。まず棚卸しでデータの所在を把握し、機密区分でデータごとの守りの強さを決め、最小権限のアクセス制御で区分を運用に落とします。そのうえで、分析には氏名や連絡先を外した表を用意して見られる人と項目を絞り(法令上は個人データとして扱います)、利用目的の変更の柔軟さなどが必要な場合は、委員会規則の基準に従って仮名加工情報を作成する、という順で活用の範囲を広げます。全部を鍵にかけるのではなく、鍵をかける場所を絞ることで、鍵の外にあるデータを安心して使えるようにする、という発想です。
予算と体制に落とすときは、次の3つを優先するのが有効だと考えています。1つ目は、個人データを含むシステムの棚卸しの一覧を作り、データオーナーを決めることです。これは漏えい時の報告にも、令和8年改正への準備にも、クラウドの保存先の把握にも使えます。2つ目は、漏えい等の報告の連絡経路を決め、速報の目安の日数の中で報告できるかを、机上で一度確かめることです。3つ目は、情報セキュリティの担当と、データガバナンスの担当と、個人情報の担当が、同じ一覧と同じ機密区分を使うと決めることです。3つの部署が別々の台帳を持つと、改正への対応のたびに3回作業することになり、二重投資と、台帳どうしの集計の食い違いの原因になります。いずれも大きなツールの導入を前提にしない作業で、規模の小さい組織でも始められます。
経営層への報告では、漏えいの件数だけでなく、機密区分が決まっているデータの割合、権限の棚卸しの実施状況、権限の申請から付与までの日数、分析用に用意したデータのうち実際に使われたものの割合、利用の申請から使い始めるまでの日数を並べると、守りと活用の両方の進み具合が見えます。守りの指標だけを報告すると、守りを強めることだけが評価され、活用の側が細っても気づけません。
この章では、データを守る仕組みを、機密区分とアクセス制御から始め、個人情報保護法の言葉の区別と事業者の義務、仮名加工情報と匿名加工情報、令和8年改正の柱と未確定の部分、ISO/IEC 27001 との分担、ログと監査、クラウドの責任共有モデルの順に整理しました。守る強さを決めるのはデータオーナーで、法的な区分の確認は個人情報の担当が、設定はデータカストディアンが担うという分け方を、どの節でも通しています。次の第9章では、守る対象であるデータを保管し、統合し、提供する基盤の運用と、データウェアハウスの考え方を扱います。
この章を深めたい方への参考書籍
『個人情報保護法の知識 第5版』(岡村久道 著、日経BP日本経済新聞出版本部):日経文庫の1冊で、個人情報保護法の仕組みを、法制のあゆみから順に解説した入門書です。2021年刊の版なので、令和8年改正は含まれていません。この章で扱った個人情報・個人データ・保有個人データの区別や事業者の義務を、条文の背景から理解したいときの土台になります。
『ISO/IEC 27001情報セキュリティマネジメントシステム〈ISMS〉構築・運用の実践 第2版』(羽田卓郎 著、日科技連出版社):JIS Q 27001 の2023年版に対応した、情報セキュリティマネジメントシステムの構築と運用の手順を扱った本です。目次には、構築におけるトップマネジメントの役割や構築手順の概要の章があります。この章で触れた、情報セキュリティマネジメントとデータガバナンスの分担を考えるときに、セキュリティの側の仕組みを知る材料になります。
『データ戦略と法律 攻めのビジネスQ&A 改訂版』(中崎隆、安藤広人、板倉陽一郎、永井徳人、吉峯耕平 編著、日経BP):データの利活用に関わる法律問題を、問いと答えの形で扱った本です。目次は総論の次に積極的なデータの利活用の章が置かれています。2021年刊の版なので、令和8年改正は含まれていません。この章の、守りと活用を両立させるという考え方を、法律の側から確かめるときに参考になります。
第9章 データの保管・統合・提供、基盤運用とデータウェアハウス
第8章では、データを機密の度合いで分類し、誰がどのデータに触れてよいかを最小権限で決めること、個人情報保護法の基本と社内ルールへの落とし方を確認しました。分類とアクセス制御は「どのデータを、誰に、どこまで見せるか」を決める仕組みでしたが、実際にデータを見せるには、データをどこかに保管し、複数の業務システムから集めてつなぎ、使う人の手元に届ける仕組みが要ります。この章では、その保管・統合・提供の3つを扱います。DMBOK はこのあたりを、データストレージとオペレーション、データ統合と相互運用性、データウェアハウジングとビジネスインテリジェンスという複数の知識領域に分けて扱っていますが、この章では、データが業務システムで生まれてから経営の報告に届くまでの一続きの流れとして説明します。この章にはコードはありません。設計の型・失敗の型・責任分担は表で示します。
保管・統合・提供は、技術の話に見えやすい領域です。サーバーの容量、連携の方式、分析用の製品の選定といった話題が先に立ち、情報システム部門の仕事として扱われることが多いと思われます。しかし、この領域の問題は、技術の選び方よりも、決めるべきことが決まっていないことから起きやすいと考えています。どのデータをいつまで残すのか、2つのシステムの数字が食い違ったらどちらを正とするのか、経営会議に出す数字はどの経路で作られたものだけにするのか、といった問いは、統治(データガバナンス)の側で答えを決め、技術の側がそれを実装する関係にあります。この章では、それぞれの仕組みについて「何を決めるためのものか」「無いと何を誤るか」「どの段階から要るか」「最初の一歩は何か」を書き、経営がどう判断するかは章の最後の節にまとめます。
流れを先に示しておきます。データは、受注・会計・顧客管理・生産管理などの業務システムで生まれます。それを分析や報告に使うために、業務システムから取り出し、形を揃え、1か所に集めます。集めたデータは、分析しやすい形に整えて保管し、ダッシュボードや報告書、分析担当者の手元、AI の学習や検索の素材として提供します。そして、保管しているデータには、残す期間と、消す時期と、壊れたときに戻す手順が要ります。この章の節は、この流れに沿って、保管と運用、法定の保存義務、統合の設計、統合の失敗の型、データウェアハウスとデータレイク、提供の仕組み、相互運用性、責任分担、経営判断の順に並べました。第4章のデータフロー図の4つの段(業務システム・連携・基盤・利用)と対応させると、この章の「取り込み・統合」が第4章の「連携」に、「保管」が「基盤」に当たります。セマンティック層は、この章の5段では「提供」の段にあたり、第4章の4段では「基盤」と「利用」の間にあたります。
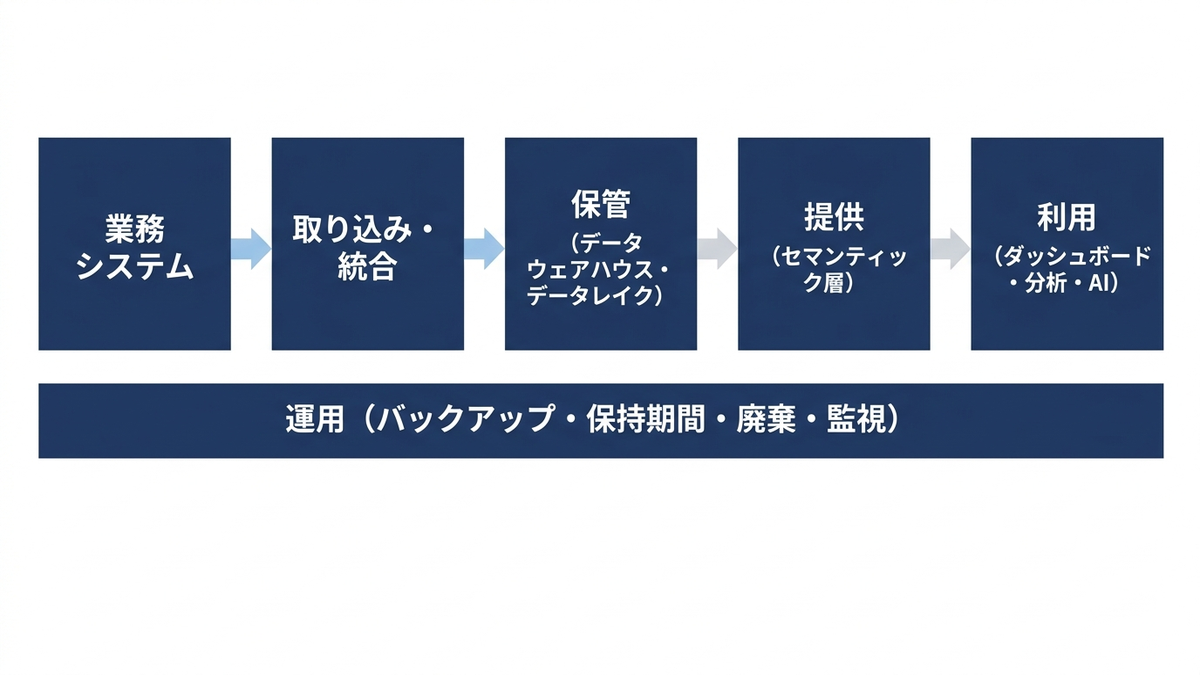
データの保管と運用、バックアップ・保持期間・廃棄・可用性・性能
データの保管と運用は、データを「置いておく」だけの仕事に見えますが、実際には5つのことを決める仕事です。1つ目はバックアップで、データが壊れたり消えたりしたときに、どの時点の状態に、どれだけの時間で戻せるかを決めます。2つ目は保持期間で、どのデータをいつまで残すかを決めます。3つ目は廃棄で、保持期間が過ぎたデータを、誰の承認で、どの方法で消し、消したことをどう記録するかを決めます。4つ目は可用性で、そのデータを使う業務が、どのくらいの時間止まっても許されるかを決めます。5つ目は性能で、利用者が待てる応答の時間と、それを保つための容量の見通しを決めます。
この5つは、どれも技術の担当だけでは決められません。たとえばバックアップで「何時間前の状態まで戻せればよいか」は、その間に失われる取引の記録を業務でどう補えるかによって決まり、それを判断できるのは業務の側です。可用性も同じで、受注のデータが半日使えないことが許されるかどうかは、受注の業務を持つ部門が答えることです。技術の担当は、その答えを実現する方式と、その方式にかかる手間の見積もりを示します。第3章で整理した役割に当てはめると、要件を決めるのはデータオーナー、要件を日々の運用に落として守られているかを確かめるのがデータスチュワード、方式を実装して運用するのがデータカストディアンという分担になります。
次の表は、保管と運用で決めることを、決める人と、決めていないときに起きることの組み合わせで整理したものです。自社の主なデータ(顧客・受注・会計・従業員など)ごとに、この表の「決めること」の列を埋めていくと、運用の穴が見えやすくなります。
| 運用の項目 | 決めること | 決める人 | 実装・運用する人 | 決めていないときに起きること |
|---|---|---|---|---|
| バックアップ | どの時点まで戻せればよいか。戻すのに何時間まで許されるか。戻す手順を年に何回試すか | データオーナー | データカストディアン | バックアップは取っていたが、戻す手順を試したことがなく、障害のときに戻せない。または戻した時点が古く、その間の取引を手作業で入れ直す |
| 保持期間 | データの種類ごとに、いつまで残すか。起算日を何にするか | データオーナー(法定の保存義務があるものは経理・法務と確かめる) | データスチュワード・データカストディアン | 法令で残すべき書類を先に消してしまう。逆に、不要になった個人データを残し続け、漏えいしたときの影響が大きくなる |
| 廃棄 | 保持期間が過ぎたデータを誰の承認で消すか。複製(分析用の写し・バックアップ)も含めて消すか。消したことをどう記録するか | データオーナー | データカストディアン | 元のシステムでは消したが、分析用の写しやバックアップに残っている。消した記録が無く、消したことを説明できない |
| 可用性 | そのデータを使う業務が、どのくらい止まっても許されるか。止まったときの代わりの手順 | データオーナー(業務の責任者) | データカストディアン | すべてのデータに同じ水準を求めて費用が膨らむ。または重要なデータの水準が低いまま放置される |
| 性能と容量 | 利用者が待てる応答の時間。データ量の増え方の見通しと、見直しの時期 | データオーナー(データスチュワードが利用者の要望をまとめる) | データカストディアン | 月末の集計の時間帯だけ処理が終わらず、報告が遅れる。容量が尽きてから慌てて増やす |
表の中で見落とされやすいのは、廃棄の行の「複製も含めて消すか」です。データを分析に使うようになると、同じデータが業務システム・分析用の保管場所・分析担当者の手元・バックアップと、複数の場所に写されていきます。業務システムで保持期間を守って消しても、写しのほうに残っていれば、そのデータは消えていません。第8章で扱った個人データの扱いとも関わるので、写しを作る経路(統合の仕組み)と、データの移動と加工の経路を示すデータリネージ(第6章で扱いました)、そして分析用の写し・担当者の手元のファイル・バックアップを含む保管先の一覧を、廃棄の手順と一緒に考えることが有効だと考えています。リネージを集める仕組みがあっても、担当者の手元の写しやバックアップまで含めて一覧になるとは限らないので、保管先の一覧は別に持っておく必要があります。
バックアップについては、取ることより戻すことのほうが確かめられていない場合が多いように思います。バックアップの処理が毎晩「成功」と記録されていても、そのバックアップから実際にデータを戻せるかどうかは、戻してみるまで分かりません。年に1回でも、重要なデータについて別の環境へ戻す訓練をして、戻すのにかかった時間と、戻した時点を記録しておくと、データオーナーが決めた要件を満たしているかどうかを事実で確かめられます。
この領域がどの段階から要るかというと、バックアップと可用性は、業務システムを持った時点で既に必要になっています。多くの会社では、情報システム部門か、システムを提供する事業者の運用の中で、何らかの形で既に行われているはずです。足りないのは、多くの場合、業務の側が要件を決めた記録です。最初の一歩は、主なデータの一覧を作り、データごとに「止まってよい時間」「戻せればよい時点」「残す期間」の3つを、データオーナーに決めてもらうことだと考えています。保持期間のうち、法令で期間が決まっているものは次の節で扱います。
法定の保存義務と、保持期間の決め方
保持期間を決めるときは、法令で保存の期間が定められている書類やデータがあることを、最初に押さえておく必要があります。ここでは、法人税の帳簿書類の保存期間を例にします。国税庁のタックスアンサー「No.5930 帳簿書類等の保存期間」(令和8年4月1日現在の法令等。2026年10月26日に確認)によれば、法人は帳簿を備え付けて取引を記録し、その帳簿と、取引等に関して作成または受領した書類を、その事業年度の確定申告書の提出期限の翌日から7年間保存しなければならない、としています。同じページは、帳簿の例として総勘定元帳・仕訳帳・現金出納帳・売掛金元帳・買掛金元帳・固定資産台帳・売上帳・仕入帳を、書類の例として棚卸表・貸借対照表・損益計算書・注文書・契約書・領収書を挙げています。
同じページには例外も書かれています。青色申告書を提出した事業年度で欠損金額(青色繰越欠損金)が生じた事業年度、または青色申告書を提出しなかった事業年度で災害損失金額が生じた事業年度については、保存期間は10年間(平成30年4月1日前に開始した事業年度は9年間)になる、とされています。また、電子計算機を使用して作成する国税関係帳簿書類の保存方法等の特例に関する法律(電子帳簿保存法)について、国税関係帳簿書類の電磁的記録等による保存、国税関係書類のスキャナ保存、電子取引を行った場合の取引情報に係る電磁的記録の保存の3つを挙げ、詳しくは国税庁の「電子帳簿保存法Q&A(一問一答)」を参照するよう案内しています。なお、令和8年4月1日現在の同じページには、青色申告法人が令和8年4月1日以後に開始する事業年度に関連者と行う取引について、取引の書類に対価の額の算定に必要な事項の記載が無い場合に、その事項を明らかにする書類を作成または取得し、7年間保存する特例も載っています。この説明は令和8年4月1日現在の法令等に基づくものなので、保持期間を決めるときは、その時点の国税庁のページで最新の内容を確かめる必要があります。
ここから、データの運用に引きつけて言えることが2つあります。1つは、保存期間の起算日が「確定申告書の提出期限の翌日」であり、データの作成日や取引日ではないことです。保持期間を「作成から7年」のように単純に設定すると、起算日のずれの分だけ早く消してしまうおそれがあります。保持期間を決めるときは、期間の長さだけでなく、何を起算日にするかを、法令の説明に合わせて決めておく必要があります。もう1つは、同じ種類の書類でも、事業年度ごとの事情(欠損金の有無など)で保存期間が変わることです。こうした条件は、技術の担当だけでは判断できないので、保持期間の表を作るときには経理の担当と一緒に確かめることが欠かせません。
法人税以外にも、会社法や労働関係の法令など、法令で保存期間が定められている書類は他にもあります。本コラムでは、公式の条文や説明を開いて確かめた範囲だけを書く方針にしているので、ここでは法人税の帳簿書類の例にとどめます。自社でどの書類にどの法令の保存義務がかかるかは、経理・法務・人事の担当と、必要に応じて税理士などの専門家と確かめる必要があります。個人データについては、法令で残す期間とは逆に、利用する必要がなくなったときの扱いも問題になります。その扱いは第8章で、文書や記録の保存と廃棄の管理は第10章で扱います。
保持期間を決める手順は、次のように進めるのが扱いやすいと考えています。まず、データの種類ごとに「法令で決まった最低限の期間があるか」を経理・法務と確かめます。次に、業務で使う期間(過去何年分の比較が要るか)をデータオーナーが決めます。個人データを除き、その長いほうを保持期間とし(個人データは、利用する必要がなくなったときの扱いを第8章に沿って別に決めます)、起算日と、期間が過ぎた後の扱い(消す・匿名にして残す・別の場所に移す)を決めます。最後に、写しを含めてその期間が守られているかを、データスチュワードが年に1回点検します。期間を決めた人と理由を記録しておくと、後で法令が変わったときに、どの期間を見直せばよいかをたどれます。
データ統合の設計、ETL・ELT、バッチとストリーム、API 連携
データ統合とは、複数の業務システムに散らばったデータを取り出し、形を揃えて、使える状態にすることです。受注のデータは販売管理のシステムに、請求と入金のデータは会計のシステムに、問い合わせの記録は顧客対応のシステムにあり、それぞれが自分の業務に都合のよい形でデータを持っています。顧客ごとの売上と問い合わせを並べて見るには、これらをどこかで突き合わせる必要があります。統合の仕組みが無い会社では、担当者が毎月それぞれのシステムから表計算ソフトにデータを書き出し、手作業でつないでいることが多いと思われます。その作業は担当者の手元にしか手順が無く、担当者が替わると同じ数字を再現できなくなります。
統合の方式には、いくつかの型があります。代表的なのがETLで、取り出す(Extract)、変換する(Transform)、読み込む(Load)の頭文字です。業務システムからデータを取り出し、保管場所に入れる前に形を揃え(コードの変換・項目の結合・不要な列の除去など)、揃えたものを保管場所に読み込みます。これに対して、取り出したデータをまず元の形のまま保管場所に読み込み、変換は保管場所の中で行う型を ELT と呼びます(取り出す・読み込む・変換するの順に頭文字を並べたもので、ETL の変換と読み込みの順を入れ替えた型です)。ELT は、保管場所の側に変換を行えるだけの計算能力があり、元の形のデータを残しておけるだけの容量がある場合に選びやすい型です。元の形のデータが残っているので、変換の規則を後から直したときに、過去の分まで作り直せるという利点があります。一方で、元の形のデータには個人データや機密のデータがそのまま含まれるので、第8章で扱ったアクセス制御を、変換前のデータにもかける必要があります。
もう1つの軸は、データを動かす間隔です。1日に1回や1時間に1回のように、まとめて動かす型をバッチと呼び、データが発生するたびに少しずつ流し続ける型をストリームと呼びます。経営の報告や月次の集計の多くは、前日までのデータが揃っていれば足りるので、バッチで十分です。在庫の引き当てや不正な取引の検知のように、数分の遅れが業務の判断を変える用途では、ストリームが候補になります。ストリームは、データの順序や重複の扱いが難しく、運用の手間も大きくなるので、「速いほうがよい」という理由だけで選ぶと、必要のない複雑さを抱えることになります。どのくらいの遅れが許されるかは、そのデータを使う業務の側が決めることです。
3つ目の型は、API による連携です。API は、あるシステムが外部に向けて「この形で問い合わせれば、この形で答えを返す」と決めた窓口のことで、システムどうしがその窓口を通じてデータをやり取りします。業務システムのデータベースに直接つないでデータを抜き出す方法と比べると、API は提供する側がデータの意味と形に責任を持つので、提供する側のシステムが内部の構造を変えても、窓口の約束が守られていれば受け取る側は影響を受けにくくなります。クラウドの業務サービスでは、データベースへ直接つなぐことができず、API が唯一の窓口になっている場合があります。その場合、統合の設計では API の使い方(一度に取り出せる件数・呼び出しの回数の上限・差分の取り出し方)を最初に確かめることになります。
次の表は、これらの型を、向いている用途と、決めておくことの組み合わせで整理したものです。どれか1つを選ぶものではなく、データごとに組み合わせて使うのが普通です。
| 統合の型 | 何をするか | 向いている用途 | 注意すること | 決めておくこと |
|---|---|---|---|---|
| ETL | 取り出したデータを、保管場所に入れる前に変換する | 変換の規則が安定している定型の集計。保管場所に入れる前に個人データを除きたい場合 | 取り出した元のデータを別に残していない場合、変換の規則を変えたときに過去の分を作り直すには、元のシステムから取り出し直す必要がある | 変換の規則の持ち主と、変更の承認の手順 |
| ELT | 取り出したデータを元の形のまま入れ、保管場所の中で変換する | 変換の規則が変わりやすい分析。過去の分を作り直す可能性がある場合 | 元の形のデータに個人データや機密のデータが残るので、変換前のデータにもアクセス制御が要る | 元の形のデータを誰が見てよいか。元の形のデータを残す期間 |
| バッチ | 決まった間隔でまとめて動かす | 日次・月次の報告、経営の集計 | 処理が失敗したときに、次の回までデータが古いままになる | 許される遅れ。失敗したときに誰に知らせ、誰が再実行するか |
| ストリーム | データが発生するたびに流し続ける | 数分の遅れが判断を変える業務(在庫・不正の検知など) | 順序の入れ替わり・重複・一時的な停止への備えが要り、運用の手間が大きい | 本当に数分の遅れが問題になるのか。止まったときの代わりの手順 |
| API 連携 | システムが用意した窓口を通じてデータをやり取りする | クラウドの業務サービスとの連携。提供する側が形と意味に責任を持つ場合 | 取り出せる件数や呼び出しの回数に上限があることが多い。窓口の版が変わることがある | 窓口の版の変更を誰が受け取り、いつまでに対応するか |
統合の設計で、技術の選択より先に決めておくべきことが1つあります。それは、同じものを表すデータが2つのシステムで食い違ったときに、どちらを正とするかです。たとえば、顧客の住所が販売管理のシステムと顧客対応のシステムで違っている場合、統合の処理はどちらかを採らなければなりません。この判断を統合の担当者がその場で決めると、判断の根拠が処理の中に埋もれ、誰も説明できなくなります。どのデータについてどのシステムを正とするか(第4章でいう正本の場所)は、データオーナーが決め、データスチュワードが用語集に記録し、統合の処理はその記録に従う、という順序にしておくことが有効だと考えています。顧客や商品のように複数の業務で共通に使うデータの「正しい一件」の決め方は第7章で扱いました。
統合の仕組みがどの段階から要るかというと、2つ以上の業務システムのデータを突き合わせた数字を、毎月決まって作るようになった時点だと考えています。年に数回の分析のために手作業でつなぐ程度なら、仕組みを作る費用のほうが大きくなることがあります。最初の一歩は、いま手作業でつないでいる集計を1つ選び、その作業の手順(どのシステムから何を書き出し、どの項目でつなぎ、どの値をどう読み替えているか)を書き出すことです。書き出した読み替えが変換の規則の最初の版になり、その規則をデータオーナーに確かめてもらってから、統合の処理として実装します。
統合の失敗の型、二重取り込み・順序の崩れ・差分の取り逃し
統合の仕組みは、作った直後は正しく動いていても、運用を続けるうちに、集計した数字が少しずつずれていくことがあります。処理そのものは「成功」と記録されているのに、集計した数字が業務の実感と合わない、という形で気づかれることが多いと思われます。原因の多くは、いくつかの決まった型に分けられます。型を知っておくと、設計の段階で防ぐ手当てを入れられ、数字が合わないときに原因を探す順序も決められます。
1つ目は二重取り込みです。処理が途中で失敗したので再実行したところ、失敗する前に読み込まれていた分がもう一度読み込まれ、同じ取引が2件になる、という型です。売上の合計が実際より大きくなり、しかも件数が少しずつ増えるだけなので、気づきにくいのが特徴です。防ぐには、同じデータを何回読み込んでも結果が変わらないように処理を作ることです。取引ごとに一意の番号を持たせ、既に読み込んだ番号は上書きする、または読み込む前にその回の分を消してから入れ直す、といった作り方をします。
2つ目は順序の崩れです。ある顧客の住所が月曜に変わり、水曜にもう一度変わったのに、水曜の変更が先に届き、月曜の変更が後から届いて上書きされると、古い住所が最新として残ります。ストリームや API 連携で、複数の経路からデータが届く場合に起きやすい型です。届いた順ではなく、業務で変更が起きた順序で新旧を判断する、という規則を決めておくことで防げます。そのためには、業務システムの側で変更の順序を表す情報が記録されていることが前提になります。変更ごとに増えていく番号(版の番号や連番)が記録されていれば、それを順序の手がかりにできます。変更の時刻を使う場合は、システムの間で時刻の基準と精度を揃え、同じ時刻に記録された変更をどう区別するかも決めておく必要があります。
3つ目は差分の取り逃しです。毎回すべてのデータを取り出すと時間がかかるので、前回から変わった分だけを取り出す方法がよく使われます。このとき、「更新日時が前回の処理の後のもの」を取り出す規則にしていると、更新日時を書き換えずにデータを直す操作(業務システムの保守担当による一括の修正など)や、処理の実行中に書き込まれたデータを取り逃します。取り逃した分は、元のシステムにはあるのに保管場所には無い状態のまま残ります。
取り出す範囲に少し重なりを持たせる(前回の処理の少し前から取り出し、重複は1つ目の型の手当てで吸収する)と、処理の実行中や境目の付近の取り逃しは減らせます。ただし、更新日時を書き換えない修正が、重ねた範囲より古いデータに対して行われると、この方法では拾えません。そうした修正まで拾うには、業務システムの側で追加・更新・削除を記録する変更の記録の仕組み(業務システムが備えているかは、システムごとに確かめます)を使って取り出すか、定期的に全件を取り出し直して項目ごとに比べ、違いを入れ直す方法を組み合わせます。件数や合計を元のシステムと突き合わせる点検は取り逃しに気づく手がかりになりますが、住所だけの修正のように件数も合計も変わらない取り逃しは、この点検では見つかりません。
これらの他にも、業務システムで削除されたデータが保管場所には残り続ける型、業務システムの項目の意味が変わったのに統合の処理が古い意味のまま変換し続ける型、日付や時刻の基準(日本時間か協定世界時か)が混在して日付の境目の取引が前後の日にずれる型があります。次の表に、型ごとに起きること・防ぐ設計・気づくための点検をまとめました。
| 失敗の型 | 起きること | 防ぐ設計 | 気づくための点検 |
|---|---|---|---|
| 二重取り込み | 再実行で同じ取引が2件になり、売上や件数が実際より大きくなる | 取引ごとの一意の番号で上書きする。その回の分を消してから入れ直す | 一意であるべき番号の重複の件数を毎回数える |
| 順序の崩れ | 後から届いた古い変更が新しい変更を上書きし、古い値が最新として残る | 届いた順ではなく、業務で変更が起きた順序(変更ごとに増える番号、または基準を揃えた変更の時刻)で新旧を決める | 元のシステムと保管場所で、最新の値を抜き取りで突き合わせる |
| 差分の取り逃し | 更新日時を変えない修正や、処理中の書き込みが保管場所に届かない | 取り出す範囲に重なりを持たせる。変更の記録の仕組みを使う、または定期的に全件を取り出し直す | 元のシステムと保管場所の件数・合計を日次で突き合わせる。件数・合計が変わらない修正は、定期的な全件の取り出しで項目ごとに比べる |
| 削除の未反映 | 業務システムで取り消した取引や退会した顧客が、保管場所に残り続ける | 削除を「削除した」という記録として受け取る仕組みにする | 最新の状態を写す対象について、元のシステムに無い番号が有効なデータとして残っていないかを数える(履歴として残すデータは別に扱う) |
| 意味の変更の見落とし | 業務システムの改修で項目の意味や区分が変わり、ある月から数字が急に動く | 業務システムの変更の予定を、統合の担当が受け取る経路を決める | 項目ごとの値の分布の変化を月次で見る |
| 時刻の基準の混在 | 日本時間と協定世界時が混ざり、日付の境目の取引が前後の日にずれる | 保管場所での時刻の基準を1つに決め、変換の規則を記録する | 日別の件数を元のシステムの日別の件数と突き合わせる |
表の「気づくための点検」の列は、どれも処理の成功・失敗の記録ではなく、出てきたデータそのものを見る点検になっています。統合の処理が「成功」と記録されていることは、データが正しいことを意味しません。元のシステムとの件数・合計の突き合わせのように、結果を外から確かめる点検を、統合の仕組みと一緒に作っておくことが有効だと考えています。点検の項目と合格の基準は、第5章で扱ったデータ品質のルールとして書いておくと、品質の監視と同じ仕組みで回せます。
経営の側から見ると、統合の失敗の損失は「集計の食い違い」として表れます。経営会議に出た売上と、経理が確定させた売上が合わないと、議論はまず「どちらが正しいか」の確認に費やされ、本来の判断が後回しになります。食い違いは、こうして判断の遅れにつながります。さらに、食い違いが何度か続くと、報告の数字そのものが信用されなくなる現場の不信が生まれ、各部門が自分で数字を作り直すようになります。そうなると、統合の仕組みに投資した意味が失われ、手作業の集計が並行して残る二重投資の状態になります。統合の点検を地味な作業として後回しにせず、統合の仕組みの一部として最初から予算と工数に入れておくことが、この損失を防ぐ近道だと考えています。
データウェアハウス・データレイク・レイクハウスの考え方
統合したデータを保管する場所には、いくつかの考え方があります。製品の名前が先に語られやすい分野ですが、ここでは製品から離れて、それぞれが何を目的にした保管の仕方なのかを説明します。
データウェアハウスは、分析と報告のために、複数の業務システムのデータを集め、意味と形を揃えて、時系列で蓄積しておく保管場所です。業務システムは「いま」の状態を正しく保つことを目的に作られているので、過去の状態を残さないことや、集計の処理が業務の処理を遅くすることがあります。データウェアハウスは、業務システムとは別に分析専用の場所を用意し、そこに「いつ時点で、どういう状態だったか」を残すことで、過去と比べる集計や、部門をまたいだ集計を可能にします。報告や分析に提供する段階までに形と意味を揃えておく(顧客の番号を統一する・コードを全社の参照データに合わせる・売上の計上の基準を揃える)ことが前提になります。揃える作業は、データウェアハウスに入れる前に行う場合(ETL)もあれば、元の形のまま一時的な表に読み込んでからデータウェアハウスの中で行う場合(ELT)もあります。どちらの場合も、揃えたデータは使いやすい反面、新しい種類のデータを報告や分析に使うには、揃え方を先に決める手間がかかります。
データレイクは、形を揃える前のデータを、元の形のまま大量に置いておく保管場所です。表の形をしたデータだけでなく、文書・画像・音声・機器の記録のように、表になっていないデータも置けます。使い道が細かく決まる前でもデータを元の形のまま残しておけることが特徴で(使い道が決まった分析にも使われます)、新しい種類のデータを入れる手間は小さくなります。その代わり、入っているデータの意味・持ち主・鮮度が記録されていないと、どこに何があるのか、どれを信じてよいのかが分からなくなります。そのため、第6章で扱ったメタデータとデータカタログの整備が伴わない場合には、データレイクは置いたデータが探せず使えない状態になりやすいと考えています。なお、使い道が細かく決まっていなくても、集める目的・置いてよいデータの範囲・保持期間は決めておきます。
レイクハウスは、この2つを組み合わせようとする考え方です。データレイクのように元の形のデータを安く大量に置ける場所を使いながら、その上にデータウェアハウスのような表の管理(どの表にどの列があるか、いつの時点の状態か、更新の途中の状態を読ませない仕組み)を載せます。これを支える技術として、表のデータを列ごとにまとめて保存するファイルの形式や、ファイルの集まりを1つの表として扱うための形式が公開されています。たとえば、Apache Parquetの公式サイトは、Parquet を、効率的なデータの保存と取得のために設計された、オープンソースの列指向のデータファイル形式と説明しています(列指向とは、表のデータを行ごとではなく列ごとにまとめて保存する方式のことで、特定の列だけを集計する分析では読み込む量が少なくて済みます)。Apache Icebergの公式サイトは、Iceberg を、大きな分析用の表のための形式と説明し、複数の処理エンジン(保管されたデータに問い合わせや集計を行うソフトウェア)が同じ表を同時に安全に扱えること、表全体を書き直さずに列の追加や名前の変更ができること、同じ時点の状態を指定して問い合わせを再現できることを挙げています(いずれも2026年10月22日に確認)。
この3つは、どれが優れているかを比べるものではなく、どのデータを、どの段階で、どの程度揃えて置くかの違いです。実際の基盤では、元の形のデータを置く層、形を揃えた層、報告や分析にそのまま使える層、のように、揃え方の段階ごとに場所を分けて、1つの基盤の中で組み合わせることが多いと思われます。次の表は、3つの考え方を、ガバナンスの観点から比べたものです。
| 考え方 | 何を目的にした保管か | 置くデータ | ガバナンスで先に決めること | 決めずに進めたときに起きること |
|---|---|---|---|---|
| データウェアハウス | 分析と報告のために、意味と形を揃えて時系列で蓄積する | 主に表の形をした、揃え方が決まったデータ | 顧客や商品の番号の統一、コードの体系、売上などの計上の基準。どの業務システムを正とするか | 揃え方の議論が終わらず、データを入れられない。または部門ごとに揃え方が違う表が並ぶ |
| データレイク | 使い道が細かく決まる前のデータも含めて、元の形のまま残す | 表・文書・画像・音声・機器の記録など、形を問わない | 置いたデータの持ち主・意味・鮮度・機密の区分を記録する規則。置いてよいデータの範囲と保持期間 | 何がどこにあるか分からず使われない。個人データが区分されないまま広く見える状態で置かれる |
| レイクハウス | 元の形のデータを置く場所の上に、表の管理を載せる | 元の形のデータと、揃えた表の両方 | 揃え方の段階ごとの層の分け方と、層ごとの持ち主・アクセス権・品質の基準 | 層の境目があいまいになり、揃える前のデータが報告に使われる |
表の「ガバナンスで先に決めること」の列を見ると、どの考え方を選んでも、決めることの中身は製品の機能ではなく、データの意味・持ち主・アクセス権・保持期間であることが分かります。製品を選ぶ前にこれらを決めておけば、製品を比べるときの共通の要件にでき、製品ごとに、その機能で実装できる範囲と、別の仕組みを足す必要がある範囲を比べられます。逆に、これらを決めずに製品を導入すると、製品が何でも置ける場所を用意してくれる分だけ、整理されないデータが早く増えます。どの考え方から始めるべきかは、次のように考えるのが扱いやすいと思います。経営の報告や部門をまたいだ集計が主な目的で、扱うデータの多くが業務システムの表であれば、データウェアハウスの考え方から始めます。文書や機器の記録のように表になっていないデータを、使い道を探りながら残しておく必要があるなら、データレイクの考え方が加わります。最初の一歩は、製品を選ぶ前に、最初に入れるデータについて表の「ガバナンスで先に決めること」の列を埋めることです。業務システムが1つで、経営の報告もその業務システムの集計機能で足りている段階では、別の保管場所を用意する必要性はまだ低いと考えています。
クラウドの各社は、これらの考え方を実装するサービスをそれぞれ提供しています。サービスの見取り図と選び方は、弊社コラム『AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方』で扱っています。この章では、どのサービスを使う場合にも共通する、決めておくべきことに焦点を当てます。
BI での提供、セマンティック層とダッシュボードの統制
保管したデータは、使う人に届いて初めて価値が出ます。届け方の代表が BI(ビジネスインテリジェンス)の道具で、集計した数字をダッシュボードや定型の報告書として見せます。BI の道具は、利用者が自分で集計の条件を変えたり、新しい画面を作ったりできるように作られていることが多く、それが便利な反面、同じ「売上」が画面ごとに別の条件で集計され、会議で別々の数字が並ぶ原因にもなります。売上や顧客数のような基本的な指標の定義を決めて管理すること自体は、第6章で扱いました。この節では、決めた定義を、すべての画面と報告に同じ形で届けるための提供の仕組みを扱います。
そのための仕組みの1つがセマンティック層です。セマンティック層は、保管場所の表と、利用者が見る画面の間に置く「意味の層」で、「売上」「粗利」「有効な顧客数」といった指標を、どの表のどの列を、どの条件で、どう集計して出すかを、集計の仕組みとしてまとめて実装しておき、画面や報告はそれを呼び出して数字を出します。ここで注意したいのは、指標の定義の正本は第6章で扱った用語集の1か所であり、セマンティック層は定義の正本ではないことです。セマンティック層は、用語集で決めた定義を集計の仕組みに実装する場所です。用語集の定義を変えたら、同じ版の変更をセマンティック層にも反映し、両者に同じ版の番号を付けておくと、2つが食い違ったときに用語集のほうを正として直せます。利用者は表の構造や集計の式を知らなくても、「売上」という名前を選べば、全社で決めた定義どおりの数字を得られます。定義を変えるときも、用語集の変更をセマンティック層に反映すれば、それを使っているすべての画面の数字が同じように変わります。画面ごとに集計の式を書いている状態では、定義を変えるたびにすべての画面を探して直す必要があり、直し漏れが新しい食い違いを生みます。
セマンティック層は、BI の道具に組み込まれた機能として提供される場合もあれば、保管場所と BI の道具の間に置く独立した仕組みとして作られる場合もあります。どちらの形でも、ガバナンスの観点から決めておくことは同じです。1つは、セマンティック層に載せる指標の定義の持ち主で、これは用語集の定義の持ち主(データオーナー)と同じ人にし、セマンティック層の側に別の持ち主を置きません。もう1つは、定義を変更するときの手順で、データオーナーが用語集の変更を承認し、データスチュワードが用語集に記録し、データカストディアンがセマンティック層に反映して、変更の前後でどの画面の数字がどれだけ変わるかを示す、という順にします。セマンティック層の側だけを先に直すと、用語集と集計の仕組みの定義が食い違うので、変更はいつも用語集から始めます。
セマンティック層があっても、画面そのものが無秩序に増えると、どの画面を見ればよいかが分からなくなります。そこで、ダッシュボードを区分して統制することが有効だと考えています。全社の公式の数字として経営会議や対外的な報告に使う画面、部門の業務で使う画面、個人が試しに作る画面、の3つに分け、区分ごとに、作ってよい人・使ってよいデータ・確かめる手順・表示する印を決めます。次の表はその一例です。
| ダッシュボードの区分 | 使う場面 | 作ってよい人 | 使ってよいデータ | 公開前の確かめ | 画面に表示すること |
|---|---|---|---|---|---|
| 全社の公式 | 経営会議、取締役会、対外的な報告 | データカストディアン(データ基盤を担当する部門。データオーナーの承認つき) | セマンティック層の指標だけ | データオーナーが数字を確かめ、承認の記録を残す | 「公式」の印、定義の版、データの期間、最終更新の日時、問い合わせ先 |
| 部門 | 部門の会議、日々の業務 | 部門のデータスチュワード、部門の担当者 | セマンティック層の指標と、部門が持つデータ | 部門のデータスチュワードが確かめる | 部門の画面であること、独自の指標を使っている場合はその定義 |
| 個人・試作 | 分析の試行、新しい指標の検討 | 利用者の誰でも(アクセス権の範囲内) | アクセス権の範囲のデータ | 確かめを求めない | 試作であること。会議の資料に使わない約束 |
この区分の例では、経営会議に出す数字を「全社の公式」の画面の数字に限ることにしています。目的は、会議の数字を承認済みの定義とデータに基づくものにし、対象の期間・更新の時点・絞り込みの条件を確かめられるようにすることで、公式の画面に限るのはそのための方法の1つです。公式の画面どうしでも絞り込みの条件が違えば数字は変わるので、表のとおり画面に定義の版・データの期間・最終更新の日時を表示します。部門や個人の画面の数字が会議に持ち込まれると、定義の違う数字が並ぶ状態に戻りやすくなります。部門や個人の画面で見つかった有用な指標は、定義を用語集に登録してからセマンティック層に載せ、公式の画面に格上げする、という経路を用意しておくと、利用者が自由に試す余地を残しながら、公式の数字を1つに保てます。また、使われなくなった画面を定期的に棚卸しして片付けることも、画面の数を管理できる範囲に保つために必要です。画面ごとの閲覧の記録を取れる道具であれば、一定の期間開かれていない画面を作った人に確かめ、要らなければ片付ける、という手順を半年に1回程度回すことが考えられます。
BI での提供では、指標の定義と変更の記録は、画面を作る人が1人の段階から要ります。1人の担当者がすべての画面を作っていても、作った時期や用途によって集計の条件が変わることがあるためです。そのうえで、どの画面にも共通の定義を参照させる仕組みとしての統制は、画面を作る人が複数になった時点から要ると考えています。作る人が増え、部門ごとに画面を作り始めると、定義のずれが生まれやすくなり、共通の定義を参照する仕組みの必要性が高まるためです。最初の一歩は、いま経営会議に出している数字がどの画面から来ているかを一覧にし、その画面を「全社の公式」として印を付け、その画面の指標の定義を書き出すことです。セマンティック層の仕組みを入れるのは、その後で構いません。
相互運用性、標準フォーマット・API・データ交換の標準
相互運用性とは、異なるシステムや組織の間で、データを意味を保ったままやり取りでき、受け取った側がそのまま使える度合いのことです。統合が社内のシステムどうしをつなぐ話だったのに対して、相互運用性は、つなぎ方を標準に合わせておくことで、新しいシステムや取引先とつなぐときの手間を小さくする、という考え方です。社内に閉じた独自の形式でデータを持っていると、システムを入れ替えるたび、取引先が増えるたびに、変換の処理を一から作ることになります。
相互運用性には、いくつかの層があります。1つ目はファイルの形式の層で、データをどの形式で保存し、受け渡すかです。前の節で紹介した Apache Parquet は、分析用の表のデータを保存する形式として公開されているもので、特定の製品に縛られない形式でデータを持っておくと、保管場所や処理の道具を替えるときにデータを変換し直す手間が減ります。2つ目は窓口の層で、API の仕様をどう記述するかです。OpenAPI Specificationは、HTTP の API(ウェブの通信の仕組みを使ってデータをやり取りする窓口)について、プログラミング言語に依存しない標準的なインターフェースの記述を定めるもの、と説明されています(2026年10月22日に確認)。API の仕様をこうした標準の形式で書いておくと、受け取る側は仕様書を読んで窓口の使い方を確かめられ、仕様の変更も版として管理できます。
3つ目は意味の層で、ここがデータガバナンスと最も深く関わります。ファイルの形式と窓口が揃っていても、「住所」の項目に都道府県から書くのか市区町村から書くのか、「日付」を和暦で書くのか西暦で書くのかが揃っていなければ、受け取った側はそのまま使えません。この層の標準として、日本の行政分野では、デジタル庁が政府相互運用性フレームワーク(GIF)を公開しています。デジタル庁のページは、GIF を、データの相互運用性を確保し、効率的な情報共有と情報連携を実現することを目指すデータモデルのひな形(参照モデル)として説明しています(2026年10月22日に確認)。GIF の構成と使い方は第4章で紹介しました。
民間の企業が GIF をそのまま採用する必要はありませんが、住所や法人や日付のような、どの業務にも出てくる項目について、公開された標準の形式を参照して社内の標準を決めておくと、行政のデータや取引先のデータと突き合わせるときの変換が少なくなります。社内の項目の命名や値の形式の標準の決め方は第4章で、法人番号や都道府県コードのような外部の標準コードの使い方は第7章で扱いました。この章の範囲で言えば、統合の処理の中で変換している規則を、どの標準に合わせた変換なのかと一緒に記録しておくことが、相互運用性を保つ最初の一歩になります。
運用の責任分担、業務部門と情報システム部門
保管・統合・提供の仕組みを運用するには、業務部門と、情報システム部門(データカストディアン)が関わります。本コラムでは、統合の処理・保管場所・セマンティック層・BI の道具を技術的に作って動かす、データ基盤を担当する部門(DX 推進や経営企画の中に置かれることもある)を含めて「情報システム部門(データカストディアン)」と呼びます。業務部門と技術の側の境目があいまいなままだと、統合の処理は動いているのに数字がおかしいとき、処理の側と入力の側がそれぞれ自分の担当の範囲には問題が無いと説明し、原因の調査が進まないことがあります。
この分担を考えるときの基本は、第3章で整理した3つの役割です。データの意味・用途・品質の水準・提供の可否を決めるのはデータオーナー(業務部門の責任者)、その決定を日々の運用に落とすのがデータスチュワード(業務側の実務者)、データを技術的に保管・処理・保護するのがデータカストディアン(情報システム部門、データ基盤を担当する部門を含む)でした。統合の処理の中の変換の規則も、この3つの役割で分けます。変換の規則の内容(コードをどう読み替えるか、どのシステムを正とするか)はデータオーナーが決め、データスチュワードが第6章で扱った用語集に記録し、データカストディアンがその記録どおりに処理を実装して維持します。次の表は、この章で扱った作業ごとに、主に誰が何を持つかを整理した一例です。
| 作業 | データオーナー(業務部門の責任者) | データスチュワード(業務側の実務者) | データカストディアン(情報システム部門、データ基盤を担当する部門を含む) |
|---|---|---|---|
| バックアップと復旧 | 戻せればよい時点と、戻すのに許される時間を決める | 要件を記録し、戻す訓練の結果が要件を満たしているかを確かめる | 方式を実装し、戻す訓練を行い、結果を記録する |
| 保持期間と廃棄 | データごとの保持期間と起算日を決める(法定の保存義務は経理・法務と確かめる) | 分析用の写しを含めて期間が守られているかを年に1回点検する | 期間が過ぎたデータを、写しやバックアップを含めて消し、記録を残す |
| 統合の処理と変換の規則 | 変換の規則の内容と、どのシステムを正とするかを決める | 決まった規則を用語集に記録する。業務システムの変更の予定を技術の側へ知らせる | 用語集の記録どおりに処理を実装して維持し、件数・合計の突き合わせを回し、失敗を検知して知らせる |
| 保管場所の構成 | 置いてよいデータの範囲と機密の区分を決める | 層ごとの品質の基準を品質ルールとして記録し、結果を監視する | 層の分け方を設計し、アクセス権の設定、容量と性能の管理を行う |
| セマンティック層 | 用語集の指標の定義を決め、変更を承認する | 用語集の定義の変更を記録し、技術の側へ伝える | 用語集の定義を集計の仕組みに実装し、実装が用語集の定義と一致しているかを確かめ、変更の前後で数字がどう変わるかを示す |
| 公式のダッシュボード | 公開前に数字を確かめて承認する | 利用者の問い合わせを受け、使われない画面の棚卸しを取りまとめる | 画面を作って保守し、閲覧の記録を保管する |
| 数字が合わないときの調査 | 業務の実態と照らし、どちらが正しいかを判断する | 調査の窓口になり、調査の結果を記録する | 処理の記録、変換の規則の実装、元のシステムの変更の履歴を調べ、原因の候補を絞る |
表の最後の行のように、数字が合わないときの調査を3つの役割の共同の作業として最初から書いておくと、担当の範囲の外だという説明が続くことを避けやすくなります。調査の窓口をどこに置くか(この表ではデータスチュワード)と、調査の結果をどこに記録するかも決めておくと、同じ原因の食い違いが繰り返されたときに、前回の調査を参照できます。
小さな会社や、情報システムの担当が1人しかいない会社では、この3つの列を別々の人に分けることはできません。その場合も、1人の担当者が「いまはデータカストディアンの立場で処理を直している」「いまはデータスチュワードの立場で用語集を書き直している」と区別できるように、役割そのものは表に書いておくことが有効だと考えています。特に、変換の規則やセマンティック層の定義を変えるときは、変更する人と承認する人を分け、承認は業務部門の責任者に置くことで、1人の判断で数字が変わる状態を避けられます。クラウドのサービスを使う場合は、サービスを提供する事業者が受け持つ範囲と、自社が受け持つ範囲があります。その分担は各事業者が公開している説明で確かめる必要があり、第8章で扱った範囲と合わせて確かめておくと、バックアップや可用性の要件を誰が満たすのかがはっきりします。
経営判断、基盤投資の順序と、利用の無い基盤を作らないこと
この章で扱った仕組みは、どれも費用と工数のかかる投資です。データ基盤の投資で起きやすい損失の型は、利用の見込みが立たないうちに大きな基盤を作り、使われないまま維持の費用だけがかかり続けることだと考えています。基盤を作る側は、後から足りなくなることを避けようとして、あらゆるデータを入れられる大きな仕組みを先に用意しがちです。しかし、使う人と使い道が決まっていない段階では、どのデータをどの形に揃えればよいかが決まらず、置かれたデータの意味も持ち主も記録されないまま増えていきます。その結果、基盤はできたが報告は相変わらず手作業の表計算で作られている、という二重投資の状態になります。
この損失を避けるには、基盤の投資を、使い道の順に積み上げることが有効だと考えています。最初に、いま経営会議や部門の会議で使っている数字のうち、作るのに手間がかかっているもの、部門によって数字が食い違っているものを選びます。次に、その数字を作るのに必要なデータだけを統合し、件数・合計の突き合わせの点検と一緒に、データウェアハウスの考え方で保管します。その数字をセマンティック層の定義として載せ、公式のダッシュボードとして提供し、実際に会議で使われることを確かめます。そこで初めて、次の使い道に必要なデータを足していきます。この順序であれば、投資の1段ごとに「どの会議の、どの数字が、手作業から置き換わったか」という形で成果を確かめられます。
経営が判断に使える問いとして、次の4つを挙げておきます。1つ目は、この基盤のデータを最初にどの会議で使い、どの数字を作るのか、です。答えが無いなら、基盤の規模を決める根拠がまだありません。2つ目は、経営会議に出す数字が、承認された定義とデータに基づき、対象の期間・更新の時点・絞り込みの条件を確かめられるものになっているか、です。公式の画面に限るのは、そのための方法の1つです。なっていなければ、基盤に投資しても、会議のたびに数字の食い違いを確かめる手間が残りやすくなります。3つ目は、主なデータについて、残す期間と、戻せればよい時点を、業務の責任者が決めた記録があるか、です。無いなら、障害や法令の確認のときに判断の根拠を示せません。4つ目は、数字が合わないときの調査の窓口と記録の場所が決まっているか、です。決まっていなければ、食い違いのたびに同じ調査が繰り返されます。
この4つの問いは、どれも製品や技術の選択を問うものではありません。基盤の技術や製品は将来入れ替えることがありえますが、どのデータを誰の判断で残し、どの数字を公式とし、食い違いを誰が調べるかという決めごとは、基盤を入れ替えても引き継げる資産になります。基盤の予算を承認するときには、技術の構成の説明と並べて、これらの決めごとがどこまでできているかを確かめることが、投資を空振りさせないための判断になると考えています。また、AI の活用を目的に基盤を整える場合も、学習や検索の素材になるデータの来歴と保持期間とアクセス権がこの章の仕組みで管理されていることが前提になります。AI のためのデータの要件は第11章で扱います。
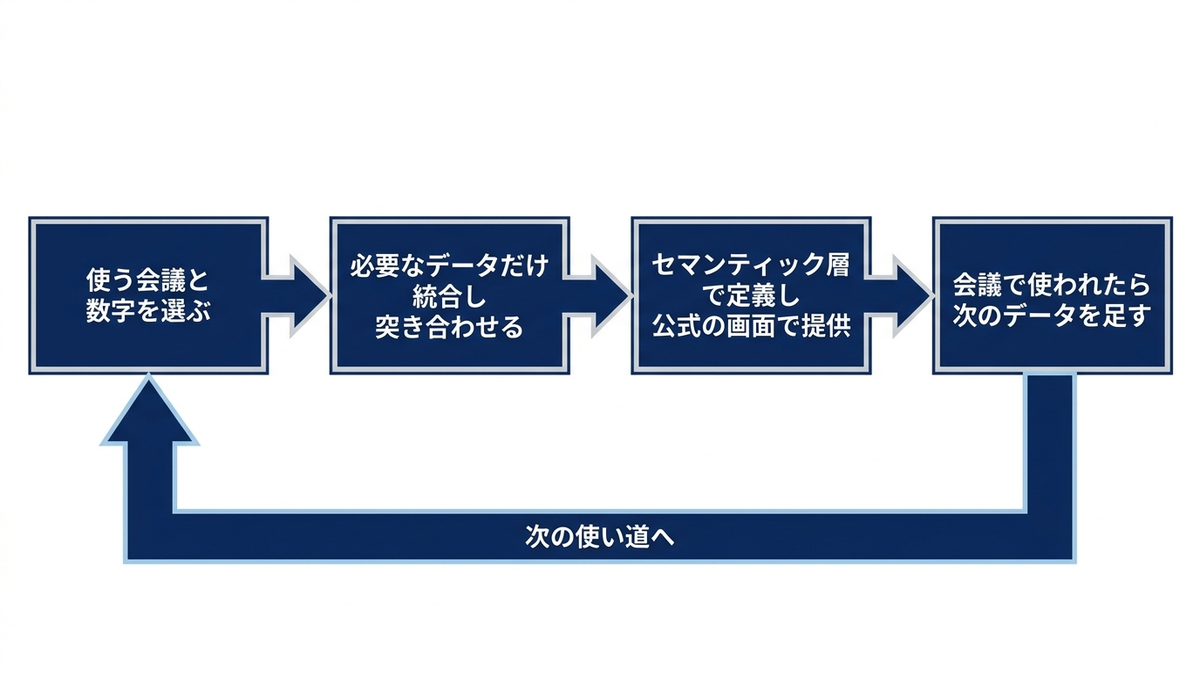
この章では、データの保管・統合・提供を、業務システムから経営の報告までの一続きの流れとして整理しました。保管と運用では、バックアップ・保持期間・廃棄・可用性・性能の要件を業務の責任者が決め、技術の担当が実装する分担にし、法定の保存義務は公式の説明で起算日まで確かめます。統合では、どのシステムを正とするかを先に決め、二重取り込み・順序の崩れ・差分の取り逃しといった失敗の型を、出てきたデータを外から突き合わせる点検で捕まえます。提供では、第6章の用語集で決めた指標の定義をセマンティック層に実装してすべての画面へ同じ形で届け、経営会議の数字は、定義・期間・更新の時点・絞り込みの条件を確かめられる公式の画面の数字に揃えます。基盤の投資は、使う会議と数字から順に積み上げます。
次の第10章では、ここまで主に扱ってきた表の形のデータから離れ、文書・メール・画像・音声のような非構造データの管理と、法令の外側で判断が要るデータ倫理を扱います。
この章を深めたい方への参考書籍
『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社):データ活用のためのデータ整備、データ基盤システムのつくり方、データ分析の組織の3つの章で、データ基盤が思うように機能しない原因と対処を整理した本です。この章で扱った、統合の仕組みと点検、基盤を使い道から作ることを、データ・システム・組織の3つの側面から具体的に考えるときの材料になります。
『データエンジニアリングの基礎 データプロジェクトで失敗しないために』(Joe Reis、Matt Housley 著、中田秀基 訳、オライリー・ジャパン):データの生成・保存・取り込み・変換・提供を「データエンジニアリングライフサイクル」として整理し、組織のデータ成熟度に応じた基盤の作り方の指針を示した本です。目次には、ストレージへの保存、データ取り込み、アナリティクスや機械学習へのデータの提供を扱う章があり、この章の保管・統合・提供の流れを技術の側から深めるときに参考になります。
第10章 ドキュメント・コンテンツ管理とデータ倫理
第9章では、データの保管・統合・提供を扱い、データウェアハウスや BI で指標の定義を一元化しないと、部門ごとに別々の正解が出ることを確認しました。そこで扱ったのは、主に表の形に整った構造化データでした。この章では、表に収まらない文書・メール・画像・音声・チャットのようなデータの管理と、データを「使ってよいか」を法令とは別の物差しで判断するデータ倫理の2つを扱います。2つは一見すると別の話題ですが、どちらも「持っているデータを、誰が、どの目的で、いつまで使ってよいかを決める」という点で、データガバナンスの同じ問いにつながっています。DMBOK も、文書とコンテンツの管理を知識領域の1つとして、データの取扱いの倫理を独立した主題として扱っています。この章はその位置づけを踏まえつつ、中身は公開されている一次情報と実務の一般論から書きます。
表に収まらないデータを管理する理由
業務の判断の根拠は、基幹システムの表だけでなく、文書にも残ります。契約書、仕様書、議事録、稟議書、社内規程、顧客とのメールのやり取り、問い合わせの通話の録音、現場で撮った写真、チャットでの合意などです。こうしたデータは、行と列の決まった形を持たないので、データベースの品質の点検やデータカタログの仕組みからこぼれやすく、置き場所も共有フォルダ・メールボックス・チャットのツール・個人の端末に散らばります。この章では、これらをまとめて非構造データと呼びます。
非構造データの管理が弱いと、困りごとは3つの形で表れます。1つ目は、必要な文書が見つからないことです。どれが最新の契約書か、どの版の仕様書で合意したのかが分からないと、判断が遅れ、同じ確認を何度も繰り返します。2つ目は、消すべき文書が残り続けることです。保管の期限を決めていない文書は、誰も消す判断をしないので増え続け、検索の妨げになるだけでなく、漏えいしたときの被害の範囲を広げます。3つ目は、見せてはいけない人に見えてしまうことです。共有フォルダの権限を一度広く設定すると、誰がどの文書を見られるかを把握する人がいなくなりやすい、という問題があります。
この3つは、生成AI を業務に入れるときに、さらに表に出やすくなります。社内文書を検索して回答の材料にする仕組みでは、古い版の文書や、重複して置かれた文書や、本来は一部の人にしか見せない文書が、そのまま回答の根拠になるおそれがあるからです。この章では論点の提示にとどめ、生成AI のための文書の整え方の詳細は第11章で扱います。
どの規模から非構造データの管理に手を付けるかは、文書の量よりも、置き場所の数と文書の性質で判断するのが扱いやすいと考えています。従業員が十数人で、文書の置き場所が1つのクラウドストレージにまとまっている段階なら、まず後で述べる保持期間の表と、フォルダの権限の棚卸しから始め、必要が見えてから範囲を広げる、という順序が考えられます。一方で、部門ごとに別のツールを使っている、取引先との契約や個人情報を含む文書を大量に扱っている、文書を生成AI の材料にする計画がある、のいずれかに当てはまる場合は、文書の分類と持ち主の決め方まで含めて、仕組みとして整える段階に入っていると考えられます。
記録管理の考え方、ただのファイルと「記録」の違い
文書の管理を考えるときに、まず区別しておきたいのが、作業中のファイルと記録管理の対象になる「記録」の違いです。本コラムでは、記録を「業務の証拠として、後から内容と成立の経緯を確かめられる状態で残す文書やデータ」と定義します。下書きのファイルや個人のメモは作業の途中経過で、内容が変わることが前提です(ただし、修正の理由や判断の経緯を示すものは、下書きやメモという名前だけで外さず、証拠として残す必要があるかを中身で判断します)。一方で、締結した契約書、承認された稟議書、確定した議事録は、その時点で何が決まったかを示す証拠です。そのため、内容を後から書き換えられないことと、誰がいつ作り承認したかが分かることが求められます。あわせて、決めた期間は残し、期間が満了したときには決めた基準に沿って廃棄・保存の延長・長期保存への移行のいずれかを判断し、廃棄と決めたものは基準どおりに消すことが求められます。そのうえで本コラムでは、記録管理を「どの文書を記録として扱うかを決め、作成から廃棄までの間、ここに挙げた状態と、必要なときに見つけられる状態を保つための一連の管理」と定義します。
記録管理には国際規格があります。ISO 15489-1(2016年)は、記録の作成・取り込み・管理の考え方の基礎となる概念と原則を定めた規格で、ISO の規格のページは、記録・記録のためのメタデータ・記録システム、記録管理を支える方針・責任の割当て・監視・教育、業務の状況の分析と記録に求められる要件の特定、記録の管理のための統制、記録を作成し取り込み管理する手順を扱うと説明しています(同じページによると、2021年に見直しを経て確認された現行の版です)。国内では、記録管理の第1部として概念と原則を扱う JIS X 0902-1 があります(日本産業標準調査会(JISC)のデータベースによると、最新の改正は2019年、最新の確認は2024年です)。本コラムでは規格の本文には立ち入らず、規格の公式のページと書誌情報で確かめた範囲で紹介します。ここで読み取っておきたいのは、記録管理が、文書の保存の技術ではなく、方針と責任の割当てと監視を含む管理の仕組みとして扱われている、という点です。これは、データガバナンスが「誰が決め、何を基準に、どう確かめるか」を定める仕組みであることと、同じ構造をしています。
実務では、すべての文書を記録として扱う必要はありません。記録として扱う文書の種類を先に決め、それ以外は作業用のファイルとして、置き場所と消し方の大まかな決まりだけを置く、という二段構えが扱いやすいと考えています。全部を厳格に管理しようとすると、現場が手続きの重さを嫌って、記録を管理の外の場所に置くようになるからです。
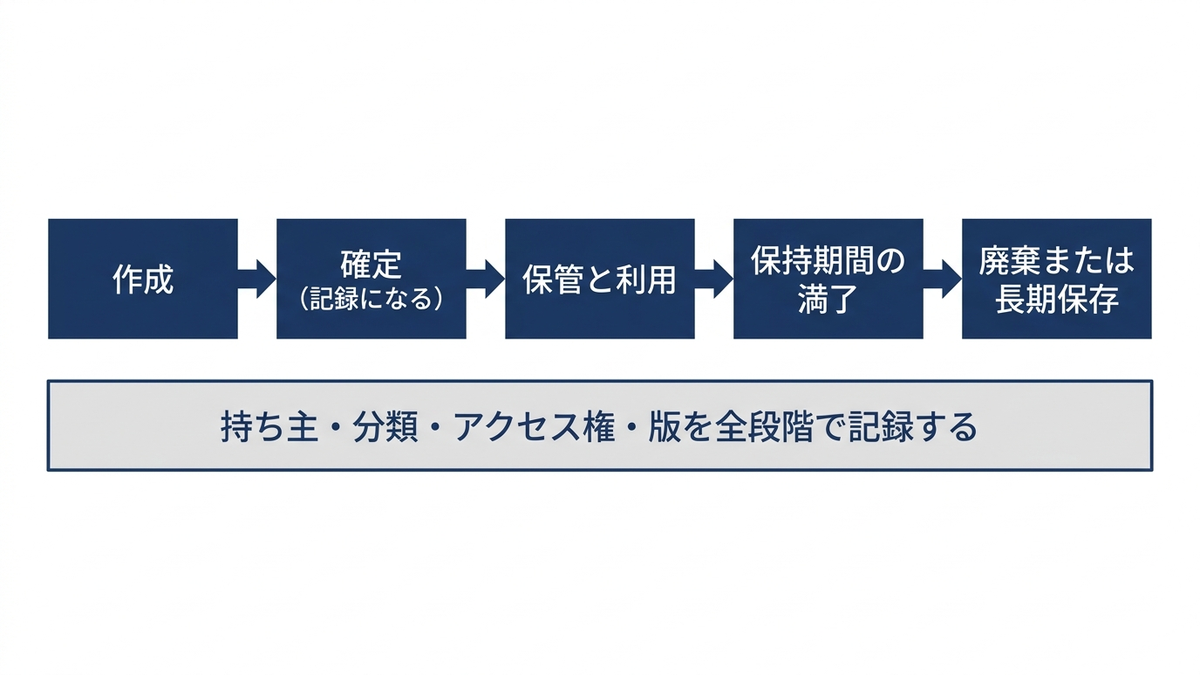
文書の分類と保持期間を決める
記録として扱う文書を決めたら、次に種類ごとの持ち主・保持期間・保管場所・廃棄の手順を1つの表にまとめます。この表を本コラムでは保持期間表と呼びます。保持期間表は、文書の管理を個人の判断から組織の判断に移すための道具で、ここに書かれていない文書は、責任者と、適用する保存のルールを確かめる対象にします。
保持期間を決める根拠は、大きく3つあります。1つ目は法令です。会計・税務・労務・契約に関わる書類のうち、法令で保存の期間が定められているものがあります。法令の保存期間の具体的な年数は、国税庁の公式の説明に基づいて第9章で扱っており、この章では年数を書きません。2つ目は業務上の必要です。製品の保証期間中は設計の記録を残す、継続中の取引は契約が終わるまで契約書を残す、といった判断です。3つ目は、残すことの危険です。個人情報を含む文書は、必要がなくなった後も持ち続けるほど、漏えいしたときの被害が大きくなります。個人情報を含む文書については、保持期間は「長いほど安全」ではなく、法令と業務の必要を満たす最短の期間を選ぶ、という考え方が有効だと考えています。一方で、契約書や議事録のように会社の意思決定の証拠になる記録は、法令の定めと業務上の必要から、結果として長く残すことになる場合があります。最短を選ぶ原則は、個人情報を含む文書と、業務上の必要が終わった文書に強く効かせるもの、と整理しておくと、次の表の扱いと矛盾しません。
次の表は、保持期間表の列の例です。期間の欄には、具体的な年数ではなく、決め方を書きました。自社の表では、この欄に自社で確かめた期間と、その根拠を書きます。
| 文書の種類(例) | 持ち主 | 保持期間の決め方 | 保管場所 | 期間が過ぎたときの扱い |
|---|---|---|---|---|
| 契約書・覚書 | 契約を所管する業務部門の責任者 | 法令の定めと、契約の終了からの業務上の必要の両方を満たす期限。起算日が違う場合は、それぞれの起算日から期限を出して遅い方に合わせ、起算日と根拠を記録する | 契約管理の仕組み、または権限を絞った専用の保管場所 | 持ち主の承認を得て廃棄。廃棄した日と承認者を記録する |
| 稟議書・決裁の記録 | 決裁の規程を所管する部門 | 社内規程と、監査で求められる期間 | 申請と承認を電子で回すワークフローの仕組み | 規程に沿って廃棄、または長期保存に移す |
| 議事録(経営会議・委員会) | 会議の事務局 | 会社の意思決定の証拠になるので、法令の定めと社内規程を確かめたうえで、作業用の文書より長く残す候補にする | 会議ごとの決まった保管場所 | 長期保存に移す候補にする |
| 顧客とのメール・問い合わせの記録 | 顧客対応の部門の責任者 | 対応の継続に必要な期間。個人情報を含むので最短を選ぶ | 問い合わせ管理の仕組み | 期間が過ぎたら自動で削除する設定にする(廃棄を止めている文書は対象から外す) |
| 通話の録音・画像 | 収集を決めた業務部門の責任者 | 収集の目的を果たすのに必要な期間 | アクセスの記録が残る保管場所 | 自動で削除し、削除の記録を残す(廃棄を止めている文書は対象から外す) |
| 作業用のファイル・下書き | 作成した人の部門 | 記録に確定したら下書きは残さない、など大まかな決まりだけ置く。修正の理由や判断の経緯を示す下書きは、記録として残すかを中身で判断する | 部門の共有フォルダ | 定期的な整理の対象にする |
表の中で最も運用が難しいのは、最後の列です。保持期間を決めても、期間が過ぎた文書を誰も消さなければ、表は飾りになります。廃棄は誤りが許されにくい作業で、間違えて消すと取り戻せず、消し忘れると残す危険が続きます。そのため、持ち主が承認して廃棄する、廃棄した日と承認者を記録する、自動で消せるものは仕組みの設定で消す、という3つを組み合わせるのが有効だと考えています。訴訟や調査の対象になった文書は、保持期間が過ぎても消してはいけない場合があるので、そうした文書の廃棄を止める手順も、法務の担当と一緒に決めておく必要があります。
版・重複・アクセス権、文書を「使える」状態に保つ
保持期間が「いつまで残すか」を決めるのに対して、版管理・重複の整理・アクセス権の管理は「残している間、正しく使えるか」を決めます。構造化データでいえば、第5章のデータ品質と第8章のアクセス制御に当たる論点が、文書にもそのまま当てはまります。
版管理で決めることは、どれが正の版かを誰が見ても分かるようにすることです。ファイル名の末尾に「最新」「修正版2」「確定」といった語を付けて区別する運用は、文書が増えると、どれが本当に最新なのかを作った本人にしか分からなくなりやすい、という弱点があります。版の履歴を自動で残す保管の仕組みを使い、正の版は1つの場所にだけ置き、他の場所にはその場所への参照を置く、という形が有効だと考えています。契約書や規程のように確定後に内容を変えてはいけない文書は、確定した版を書き換えられない形で保存し、改訂は新しい版として別に残します。
重複の整理は、同じ文書の写しがメールの添付・共有フォルダ・個人の端末に散らばっている状態を減らすことです。写しが多いと、正の版を直しても古い写しが使われ続け、保持期間が過ぎて正の版を消しても写しが残ります。完全に写しを無くすことは難しいので、まず「記録として扱う文書は写しを配らず、保管場所への参照を共有する」という決まりを置き、メールの添付で正の版を回す習慣を減らしていくのが現実的な一歩だと考えています。
アクセス権の管理は、文書ごとに見てよい人を決め、その決定が実際の設定に反映されているかを定期的に確かめることです。共有フォルダの権限は、異動や退職、プロジェクトの終了のたびに見直しが要りますが、見直しの担当が決まっていないと、権限は広がる一方になりやすいと思われます。文書の分類(社外秘・部門内限り・公開してよい、など)を文書の持ち主が付け、その分類に応じて情報システムの担当が権限を設定し、四半期や半期ごとに持ち主が棚卸しする、という分担にすると、第3章で扱ったデータオーナーとデータカストディアンの役割分担と同じ形になります。機密の区分そのものの決め方は第8章で扱います。
これらの論点を、社内文書を検索して見つけた内容を生成AI の回答の材料にする仕組み(RAG と呼ばれます)を入れる場合に照らすと、次の表のようになります。いずれも、仕組みを入れる前から文書の側で整えておかないと、回答の質と安全の両方に影響が出る論点です。
| 論点 | 整えていないと起きること | 文書の側で決めておくこと | 主に決める人 |
|---|---|---|---|
| 鮮度(どれが正の版か) | 改訂前の規程や古い価格表が回答の根拠になる | 正の版の置き場所、改訂時に旧版を検索の対象から外す手順 | 文書の持ち主 |
| 重複(同じ文書の写し) | 同じ内容が何度も回答の材料に入り、版の違う写しが混ざる | 記録は写しを配らず参照を共有する決まり、写しの整理の担当 | 文書の持ち主と情報システムの担当 |
| アクセス権(誰が見てよいか) | 本来は一部の人にしか見せない文書の内容が、権限の無い人への回答に出る | 文書の分類と閲覧権限を検索の仕組みに引き継ぎ、質問した人が閲覧できる文書だけを回答の材料にする方法 | 文書の持ち主が分類し、情報システムの担当が設定する |
| 保持期間(いつまで残すか) | 保持期間が過ぎて消すべき文書や、目的を終えた個人情報を含む文書が回答に使われる | 保持期間表と、廃棄した文書を検索の対象からも外す手順。保存している間も、利用目的と閲覧権限に応じて回答の材料に使える範囲を絞る | 文書の持ち主と法務の担当 |
表の4行は、どれも生成AI のために新しく生まれた論点ではなく、文書の管理として元からあった論点です。生成AI を入れると、それまで人が目で見て気づいていた古さや重複が、仕組みの中で見えにくくなる点が違います。生成AI と RAG に向けた文書の整え方の詳細は第11章で扱います。また、問い合わせの記録や議事録のような文書の中身を数えて分析する方法は、弊社コラム『ビジネスの声を数字に変える、自然言語処理とテキストマイニングの実践ガイド』で扱っています。
経営の側から見ると、文書の管理を後回しにしたときの損失は、序章で挙げた型のうち、判断の遅れと AI投資の空振りの2つで表れます。前者は、必要な契約書や過去の決定の記録が見つからず、同じ調査や確認を繰り返す時間として表れます。後者は、社内文書を使う生成AI の仕組みを入れたものの、古い文書や重複した文書が回答に混ざり、現場が回答を信用しなくなって使われなくなる、という形です。文書の持ち主と保持期間表と権限の棚卸しは、生成AI の導入の有無にかかわらず要るものなので、AI への投資を判断する前に、少なくとも対象にする文書の範囲についてはこの3つが整っているかを確かめることが有効だと考えています。
データ倫理とは何か、4つの観点
ここから、章の後半の主題であるデータ倫理に移ります。本コラムでは、データ倫理を「データを集め、組み合わせ、使い、提供するときに、法令で許されているかどうかとは別に、その使い方が本人や社会から見て正当と言えるかを判断する考え方と、その判断の仕組み」と定義します。データガバナンスが「誰が決め、何を基準に、どう確かめるか」を定める仕組みだとすると、データ倫理は、そのうち「何を基準に」の部分に、法令の外側の基準を加えるものです。
倫理と聞くと、抽象的な議論に見えるかもしれませんが、実務で使うには、判断の観点をいくつかに絞っておくのが扱いやすいと考えています。本コラムでは、次の4つの観点で整理します。1つ目は目的の正当性で、そのデータを使う目的が、本人がデータを渡したときに想定していた範囲に収まっているか、収まらないならその目的は本人に説明して受け入れられるものか、を問います。2つ目は公正で、データの使い方が、特定の人や集団を合理的な理由なく不利に扱う結果になっていないか、を問います。3つ目は透明で、どんなデータを何のために使っているかを、本人や社会が知ることができるか、を問います。4つ目は説明責任で、判断の結果に問題が起きたときに、誰が、どういう根拠でその判断をしたのかを示し、是正できるか、を問います。
この4つは本コラムの整理ですが、公的な一次情報にも対応する考え方があります。OECD(経済協力開発機構)の理事会勧告として示されているプライバシー保護と個人データの国際流通についてのガイドライン(勧告の文書の中では OECD Privacy Guidelines と呼ばれています。以下、OECD プライバシーガイドライン)は、1980年9月23日に採択され、2013年7月11日に改訂されました。OECD が公開している勧告の文書(OECD/LEGAL/0188)によると、このガイドラインは国内適用の基本原則として8つの原則を示しています。本コラムの訳で書くと、収集の制限、データの内容の質、目的の明確化、利用の制限、安全保護、公開、本人の参加、責任です。たとえば目的の明確化の原則は、個人データを集める目的を、遅くとも集める時点までに明らかにすることを求めています。そのうえで、その後の利用は、その目的の達成か、当初の目的と矛盾しない別の目的の達成に限り、別の目的に使う場合は、目的を変えるたびにその目的を明らかにすることを求めています。公開の原則は、個人データに関する取組や方針を公開し、データの存在・性質・主な利用目的などを知る手段を用意することを、責任の原則は、データの管理者が原則を実現する措置に責任を負うことを求めています。本コラムの4つの観点のうち3つは、8つの原則のうち目的の明確化と利用の制限を「目的の正当性」に、公開を「透明」に、責任を「説明責任」に対応させて、個人データに限らないデータの使い方の判断にも使えるように言い換えたものです。残る「公正」(特定の人や集団を合理的な理由なく不利に扱わないこと)に直接対応する原則は、8つの原則の中にはありません。分析や AI の利用が広がり、データの使い方が人の扱いの差に結びつきやすくなったことを踏まえて、本コラムが加えた観点です。なお、収集の制限の原則には、データを適法かつ公正な手段で得ることが含まれていますが、これは取得の手段についての言葉で、本コラムの「公正」とは意味が違います。
OECD のガイドラインには、データガバナンスの体制づくりに直接つながる記述もあります。2013年の改訂で加わった第3部は、責任の原則を実施するための事項として、データの管理者がプライバシーの管理のための取組の仕組みを持つことを挙げ、その仕組みが事業の構造や規模やデータの量と機微さに合わせたものであること、プライバシーのリスクの評価に基づく保護措置を設けること、組織のガバナンスの構造に組み込まれ内部の監督の仕組みを持つこと、継続的な監視と定期的な評価に基づいて更新されること、を求めています。また、ガイドラインの第6項は、ガイドラインを最低限の基準と位置づけ、プライバシーと個人の自由を守るための追加の措置で補えるとしています。最低限の基準の上に、組織ごとの判断を積み上げるという構造は、次の節で扱う「法令遵守と倫理の違い」と同じ考え方です。
なお、OECD のガイドラインが対象にしているのは個人データとプライバシーです。データ倫理は、個人を特定できない統計データや、取引先から預かった業務データの使い方にも関わります。たとえば、取引先から品質の改善のために受け取ったデータを、その取引先の競合の営業に使うことは、個人データの問題ではありませんが、目的の正当性の観点で問題になりえます。この章では個人データの例を多く使いますが、4つの観点は、データの種類を問わず使えるように整理しています。
法令遵守と倫理は別物、合法でも不適切な使い方がある
データの使い方の判断で最も誤りやすいのは、「法令に違反していなければ問題ない」と考えることです。個人情報の保護に関する法律の条文と、その解釈は第8章で扱うので、この節では、法令遵守と倫理がなぜ別のものとして扱われているかに絞り、公的機関の資料が示している考え方を紹介します。
個人情報保護委員会が2021年6月30日に公表した「PIA の取組の促進について」(PIA はプライバシー影響評価のことです。後述します)は、冒頭で、個人情報保護法に定める義務は、あらゆる分野を対象とする法律の性格上、必要最小限度の規律であると述べ、事業者には法律の遵守の範囲にとどまらず、取り扱う情報の性質や利用の方法や実態に即した自主的な取組が期待されているとしています。同じ資料は、形式的な法令遵守を超えて、取扱いの性質に着目した実質的な個人の権利利益の保護が求められているとも書いています。法令を所管する機関自身が、法令は最低限の線だと明示している点は、社内で倫理の判断の仕組みを置く根拠として使いやすいと考えています。
総務省と経済産業省が2023年4月に公表した「DX 時代における企業のプライバシーガバナンスガイドブック ver1.3」は、この問題をさらに具体的に書いています。ガイドブックは、国内ではプライバシーの問題への対応が個人情報保護法の遵守を中心に考えられてきた一方で、法律の遵守の範囲にとどまらない形で、社会に受け入れられるかという観点から企業に疑問が投げかけられ、批判を受ける事例が見られるようになったと述べています。そのうえで、法令の遵守が受動的な対応になり、問題の発生をどう防ぐかという本来の目的の意識が薄れると、批判が起きたときに「法令は守っていたのに」という事態に陥り、企業が保守的になってデータの利活用をためらう悪循環が生まれかねない、と指摘しています。ガイドブックは、法令の遵守を当然の前提としながら、自ら行動の規範を定めて守り、それを社会に説明して信頼を得る形への転換を求めています。本コラムの時点で、総務省のページで確認できた版は ver1.3 です。
この2つの資料が共通して示しているのは、法令遵守は倫理の判断の出発点であって、終点ではない、という考え方です。法令の手続きを満たしていても不適切になりうる使い方を、4つの観点ごとに例で示します。次の表は、本コラムが4つの観点に沿って作った一般的な例で、特定の事案を指すものではありません。また、表は「合法であることが確定した例」の一覧ではありません。目的の正当性・公正・透明の行のように個人データを扱う例は、利用目的の特定や通知・公表、不適正な利用の禁止との関係で、具体的な事実関係によっては法令上の問題にもなりえます(法令の中身は第8章で扱います)。ここで示したいのは、法令の手続きを形の上で満たしていることだけでは、使い方の適否の判断が終わらない、という点です。個別の判断は法務の担当や専門家と確かめる必要があります。説明責任の行は、法令の議論と混ざらないように、個人データではない業務データの例にしました。
| 観点 | 法令の手続きを満たしていても不適切になりうる使い方(例) | 何が問題になりうるか | 判断のために確かめること |
|---|---|---|---|
| 目的の正当性 | 特定した利用目的の範囲に入ることを根拠に、本人が想定していなかった組み合わせの分析を行い、その結果を本人への働きかけに使う | 形式上は目的の範囲内でも、本人の予想を大きく超える使い方になっている | 本人がデータを渡した場面で、その使い方を予想できたか。説明したら受け入れられるか |
| 公正 | 過去の実績のデータで作った点数を使い、特定の地域や属性の人への対応の質を下げる | 過去の偏りがそのまま再生産され、合理的な理由のない不利な扱いになる | 点数に効いている項目は何か。不利な扱いを受ける集団に偏りはないか |
| 透明 | データの使い方を、本人が読まない場所に、読んでも分からない表現でだけ書いておく | 形式上は公表していても、本人が知る手段が実質的に無い | 本人がその使い方を知る手段は何か。一般の人が読んで分かる表現か |
| 説明責任 | 取引先から預かった業務データや外部から入手した統計データを加工して社内の判断に使っているが、加工の手順と、使うと決めた人と理由を誰も記録していない | 判断の結果に問題が起きたときや取引先から問われたときに、誰がどの根拠で判断したかを示せない | データの出所と、使うと決めた人と理由が記録されているか |
表の例のうち、目的の正当性と透明の行は、法令の手続きを満たしているかどうかと、本人から見て納得できるかどうかが分かれやすい典型です。個人情報保護法の利用目的の特定について、個人情報保護委員会のQ&A(Q2-1)は、本人が、自らの個人情報がどのような事業に使われ、どのような目的で利用されるかを一般的かつ合理的に予測・想定できる程度に特定することを求め、抽象的・一般的な内容ではできる限り具体的に特定したことにならないとしています(2026年10月27日に確認。法令の中身は第8章で扱います)。そのうえで、特定した目的の範囲に収まる使い方であっても、本人の受け止めや社会から見た妥当性は別に検討する必要がある、と本コラムでは考えています。
バイアスと差別的な取扱いを避ける
4つの観点のうち、データ分析と AI の利用が広がるほど重みを増すのが公正です。ここでいうバイアスは、データやその使い方に含まれる偏りのうち、特定の人や集団に合理的な理由のない不利な結果をもたらすものを指します。バイアスは、悪意が無くても入り込みます。過去の判断の記録には、その時点の判断の偏りが含まれていることがあり、それを正解として点数や規則を作ると、偏りが仕組みとして固定されるからです。
バイアスが入り込む経路は、大きく3つに分けて考えると点検しやすいと考えています。1つ目は、データの集め方の偏りです。特定の経路から来た顧客や、特定の時期のデータだけが多く含まれていると、少ない集団について誤った傾向が出やすくなります。2つ目は、項目の選び方の偏りです。性別や年齢のような属性そのものを使っていなくても、住所の地域や利用している端末の種類のように、属性と強く結びついた項目を通じて、実質的に属性で区別する結果になることがあります。3つ目は、結果の使い方の偏りです。同じ点数でも、それを「優先して支援する対象を選ぶ」ために使うのか、「条件を厳しくする対象を選ぶ」ために使うのかで、本人への影響はまったく違います。
3つ目の経路は、データガバナンスの仕組みで最も直接に統制できる部分です。分析の結果を本人に不利益な扱いの判断に使う場合は、使う前に倫理の観点の審査を通し、使い始めた後も結果を点検する、という決まりを置くことで、偏りが本人への不利益に変わるのを抑えやすくなります。結果の使い道を「何かを提供する優先順位」にする場合でも、対象から外れる人や提供が後回しになる人が、支援やサービスや機会を得られなくなることがあるので、その人たちへの影響も審査と点検の対象にします。点数の使い道を決めて文書にしておくことは、バイアスの点検そのものより先に着手できる、費用の小さな一歩だと考えています。
点検の方法としては、結果を集団ごとに分けて並べる、という素朴な方法が有効です。全体の精度がよくても、ある集団でだけ誤りが多い、ある集団にだけ不利な判断が集中している、ということがあります。どの集団で分けて見るかは、事業の性質と、本人への影響の大きさで決めます。属性のデータを持っていない場合は点検そのものが難しくなるので、点検のために属性のデータを持つかどうか自体が、個人情報の扱いと合わせて判断の対象になります。この判断は法令の解釈を伴うので、第8章の扱いと法務の担当の確認を前提にしてください。AI の公平性に関する公的な枠組みや、AI ガバナンスの全体像は第11章で扱います。
倫理の審査の仕組み、誰がいつ判断するか
倫理の判断を、担当者一人ひとりの良識に任せると、判断の基準が人によって変わり、判断した記録も残りません。データ倫理をデータガバナンスの一部として扱うには、審査をいつ行うか、誰が判断するか、何を記録するかを決めておく必要があります。
この仕組みを作るときの参考になるのが、プライバシー影響評価(PIA)の考え方です。前出の個人情報保護委員会の資料は、PIA を、個人情報等の収集を伴う事業の開始や変更の際に、プライバシーなどの個人の権利利益の侵害のリスクを低減・回避するために、事前に影響を評価するリスク管理の手法と説明しています。同じ資料は、PIA の一般的な流れを、実施の要否の検討と体制の整備を含む準備、リスクの特定と評価、リスクの低減の3つに大別し、実施の手順は事業者の規模や性質によって変わり、画一的なものではないとしています。また、PIA を担当部署に任せきりにせず、経営層も関与する形で行うことが重要だとしています。同じ資料は、PIA の国際規格を翻訳した日本産業規格として JIS X 9251 を挙げており、JISC のデータベースでは、プライバシー影響評価のためのガイドラインを扱うこの規格が2021年1月20日に制定され、2025年10月20日に最新の確認が行われています。同じ資料は、公表した2021年6月の時点で、民間部門の PIA については法令による規定が無いとし、自主的な取組を促す立場を示しています。
PIA は個人情報等を対象にした手法ですが、その骨組みである「事業を始める前・変える前に、影響を評価し、対策を決め、記録する」という形は、データ倫理の審査一般に応用できます。本コラムでは、PIA の考え方を下敷きにして、データの使い方についての倫理の審査を、次のような仕組みとして置くことを考えます。表は一例で、審査の対象と判断する人は、組織の規模とデータの性質に合わせて決めます。
| 審査の契機 | 主な確認事項(4つの観点) | 判断する人 | 記録するもの |
|---|---|---|---|
| 新しいデータの収集を始めるとき | 目的の正当性(何のために集めるか)、透明(本人にどう伝えるか) | データオーナーが判断し、法務・個人情報の担当が確認する | 収集の目的、本人への説明の方法、保持期間 |
| 既に持っているデータを、集めたときと違う目的で使うとき | 目的の正当性(本人が予想できたか)、透明 | データオーナーと、目的を変える業務部門の責任者。個人データの場合は、法務・個人情報の担当が、目的を変えられる範囲や本人への通知・公表、同意の要否を確認する | 新しい目的、元の目的との関係、判断の理由 |
| 分析の結果を、本人への不利益な扱いの判断に使うとき | 公正(集団ごとの偏り)、説明責任(判断の根拠を示せるか) | データガバナンスの会議体。必要に応じて社外の助言を求める | 使う項目、集団ごとの点検の結果、本人からの問い合わせへの対応の方法 |
| 外部からデータを買う・外部にデータを提供するとき | 説明責任(出所と取得の経緯)、目的の正当性 | データオーナーと法務の担当 | 相手先、データの出所、利用の条件 |
| 使い方について、社外から懸念や問い合わせが寄せられたとき | 4つの観点すべて | データガバナンスの会議体 | 寄せられた懸念、判断、是正の内容 |
表で、判断する人の欄に会議体が出てくるのは、本人への影響が大きい判断を、一つの部門の都合だけで決めないためです。データを使いたい部門は、使うことの利益を大きく見積もりやすい立場にあるので、使う部門とは別の目が入る形にしておくことが有効だと考えています。前出のプライバシーガバナンスガイドブックも、体制の構築の項で、事業部門と、プライバシー保護の組織と、内部監査部門やアドバイザリーボード(社外の有識者などが助言する場)のような第三者的な組織の役割をそれぞれ挙げています。社外の有識者を招く余裕が無い組織でも、データを使う部門とは別の部門の責任者を審査に加えることで、使う部門の都合だけで決まる状態は避けやすくなると考えています。会議体の作り方は第3章で、立ち上げの順序は第13章で扱います。
審査の仕組みでもう1つ大事なのは、審査を重くしすぎないことです。すべてのデータの使い方を会議体で審査すると、審査待ちが積み上がり、現場は審査を通さずに済む方法を探すようになります。表の5つの契機のうち、毎回会議体を通すのは本人への影響が大きいものに限り、それ以外はデータオーナーの判断と記録で済ませる(新しいデータの収集、目的の変更、外部とのデータのやり取りの行のように、法務・個人情報の担当の確認が要るものは、表のとおり確認を経る)、という段階を付けるのが現実的だと考えています。どの使い方を「影響が大きい」と見なすかの目安として、PIA の資料が、最初の段階に置いた実施の要否の検討の中で、要配慮個人情報(第8章参照)や、顔や指紋のような体の特徴を使って本人を確かめる生体認証のデータのような機微な情報を扱う場合、本人の行動や関心を分析するいわゆるプロファイリングの結果を使う場合、委託や共同利用で他の事業者と一緒に個人情報等を扱う場合などを、PIA の実施が有効な例として挙げていることが参考になります。
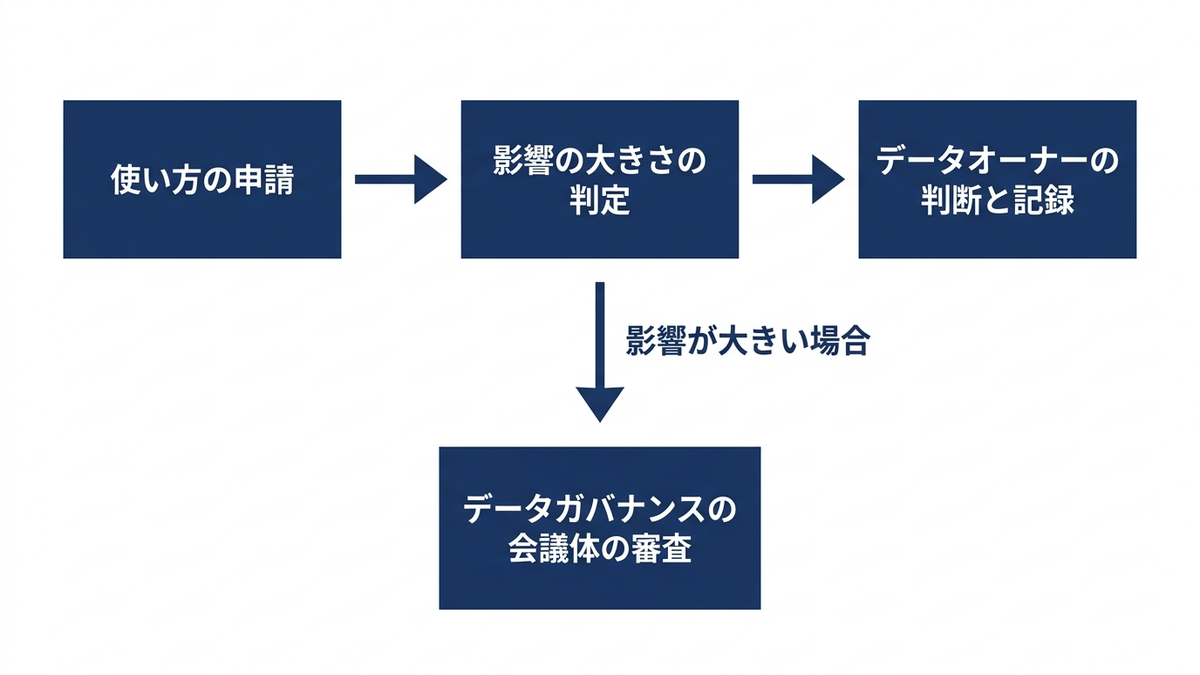
経営判断、倫理を法令の外側に置く理由
経営の側から見ると、データ倫理の仕組みを持つかどうかは、守りの費用の問題ではなく、データを使い続けられるかどうかの問題です。法令の範囲だけで判断していると、法令に違反していないのに批判を受けたとき、その使い方を止めるか続けるかを判断する基準を社内に持っていません。前出のガイドブックは、こうした事態が企業を保守的にし、データの利活用をためらわせる悪循環を生みかねないと指摘しています。倫理の基準を先に持っておくことは、批判を避けるためだけでなく、「この使い方は自社の基準で審査を通している」と言える状態を作り、データの活用を前に進めるための条件になると考えています。
序章で挙げた損失の型に当てはめると、倫理の仕組みが無いときの損失は、主に次の3つの型で表れます。1つ目は現場の不信です。社内の従業員が、自社のデータの使い方に疑問を持っても、それを上げる窓口と判断する人がいなければ、疑問は放置され、データを扱う部門への信頼が下がります。2つ目は AI投資の空振りです。序章は AI投資の空振りを、データ品質と来歴の管理に加えてデータ倫理の問題としても挙げました。データの収集や分析、AI の仕組みに投資した後で、使い方が批判を受けて止めざるを得なくなると、投資が回収できません。この型は AI に限らず、データの収集や分析の仕組みへの投資全般に起きます。PIA の資料も、事業の企画・設計の段階で影響を評価すれば、多額のシステム投資をする前に軌道修正できる、と効果を説明しています。3つ目は法令違反です。個人情報保護法には令和8年の改正があったように(内容は第8章で扱います)、法令の線は動きます。法令の範囲だけを基準にしていると、線が動くたびに使い方を一から点検し直すことになり、点検が追いつかなければ、改正後の基準に合わない使い方を続けてしまうおそれがあります。倫理の4つの観点で審査し、その理由を記録しておけば、改正の内容と照らして見直すべき使い方を絞り込みやすくなると考えています。
この判断を予算と体制に落とすと、最初に必要なのは大きな組織ではありません。倫理の4つの観点を自社の言葉で文書にし、表の5つの契機のうちどれを会議体で審査するかを決め、審査の記録を残す場所を決める、という3つから始めるのが有効だと考えています。文書の管理についても同じで、保持期間表と文書の持ち主と権限の棚卸しの3つが最初の一歩になります。どちらも、データガバナンスの会議体の議題として定期的に扱い、審査や棚卸しの件数と結果を報告に載せることで、仕組みが動いているかを確かめられます。
この章では、表に収まらない文書やメールなどのデータを、記録として扱う範囲・保持期間表・版と重複とアクセス権の管理の3つで整えることと、データの使い方を法令とは別の物差しで判断するデータ倫理を、目的の正当性・公正・透明・説明責任の4つの観点と、PIA を下敷きにした審査の仕組みで運用することを扱いました。公的機関の資料も、法令の遵守は最低限の線であり、その上に組織ごとの判断を積み上げることを求めています。次の第11章では、ここで提示した文書の鮮度・重複・アクセス権の論点を含め、分析と AI のためのデータの整え方と、AI ガバナンスへの接続を扱います。
この章を深めたい方への参考書籍
『AI・データ倫理の教科書』(福岡真之介 著、弘文堂):AI とデータの利用が社会に受け入れられるための考え方を扱った本で、倫理の判断の枠組み、各国の AI 倫理の原則、倫理が問題になった事例を章立てにしています。この章で扱った「法令に違反していなくても不適切になりうる使い方」を、具体的な事例に沿って考えるときの材料になります。
『プライバシーガバナンスの教科書』(小林慎太郎、夛屋早百合、芦田萌子、中居捷俊 著、中央経済社):データの利活用と個人情報の保護を両立させるための考え方を整理した本です。この章で紹介した総務省と経済産業省のガイドブックが示す「法令遵守を前提に、自ら規範を定めて説明する」という考え方を、企業の体制づくりの側から考えるときに参考になります。
『アーカイブズと文書管理 米国型記録管理システムの形成と日本』(坂口貴弘 著、勉誠出版):大量の記録をどう管理するかについて、米国で形成された記録管理の仕組みと、日本での取組を扱った本です。この章で扱った、文書を「記録」として扱い、保持と廃棄を組織として決めるという考え方が、どういう経緯で形づくられてきたかを知るときに役立ちます。
第11章 AIのためのデータ、AI Ready とAIガバナンスへの接続
第10章では、文書・メール・画像のような非構造データを記録として管理する方法と、法令の外側に置くデータ倫理の考え方を確認しました。この章では、ここまでの章で扱ってきたデータガバナンスの仕組みが、分析や AI(人工知能)の活用でどう効いてくるかを扱います。機械学習のモデルを作るための学習データにどんな要件があるか、生成AIに社内の文書を参照させるときに何を整えておく必要があるか、データサイエンスの運用とガバナンスがどこで接するか、そして AI そのものの使い方を統治する AI ガバナンスの枠組みとデータガバナンスがどうつながるかを順に説明します。この章にはコードはありません。AI に関する法令・指針・規格は、公式のページや文書を開いて確かめた範囲だけを、名前・制定主体・位置づけ・主要な日付と、データに関わる条文があるかどうかに絞って書き、個々の義務の内容には立ち入りません。
AI の成否はデータの整い方で決まりやすい
AI の導入を検討するとき、議論はどのモデルや製品を選ぶかに集まりやすい傾向があります。しかし、機械学習のモデルは学習に使ったデータの傾向を写し取るもので、データに欠損や誤り、偏りがあれば、モデルはそれをそのまま学びます。生成AIに社内の規程や手順書を参照させて回答させる場合も、参照先の文書が古い版のままだったり、同じ内容の文書が複数の版で残っていたりすると、生成AIはもっともらしい文章で古い内容や食い違った内容を答えます。このような場合には、モデルの性能をいくら比べても、入力するデータの状態が成果の上限を決めてしまうことが多いと考えています。
モデルの改良と同じ重さでデータの整備を扱うこの立場は、データ中心の AI(Data-centric AI)と呼ばれることがあり、章末で紹介する書籍の1冊もこの名前を題に掲げています。本コラムの文脈に引きつけると、第5章のデータ品質、第6章のメタデータとデータリネージ、第7章のマスターデータ、第8章のアクセス制御と個人情報の扱い、第10章の文書管理は、どれも AI の前提条件そのものです。AI のためのデータ整備とは、これまでの章で扱った仕組みを、AI という用途に合わせて点検し直すことだと言い換えられます。
経営の側から見ると、データの整備を後回しにして AI の導入を先行させたときの損失は、主に AI 投資の空振りという形で表れることがあります。試験導入では一部の整ったデータだけを使うので良い結果が出ても、本番で全社のデータにつなぐと精度が落ちる、部門ごとに定義の違うデータが混ざって出力が信用されない、権限の設定が無いまま文書を読み込ませたために見せてはいけない情報が回答に出る、といった事態が起きると、投資を止めるか、データを整えるところからやり直すことになります。AI の予算を決める段階で、どのデータをどの状態まで整える費用と期間を見込んでいるかを確かめることが、空振りを防ぐ最初の一歩だと考えています。
分析・AI 向けのデータに求められる要件
分析や機械学習に使うデータには、日々の業務で使うデータと共通の要件に加えて、AI で特に重く問われる要件があります。業務のデータでも、必要な品質は使い道によって変わります。学習データではそれに加えて、「学習した時点で何を使ったか」「それは本番で予測する対象を代表しているか」「使う権利があるか」まで問われます。モデルは一度学習すると、学習データの性質を長く引きずるからです。次の表は、学習データについて確かめておきたい観点を、本コラムの各章の仕組みと対応させて整理したものです。
| 観点 | 確かめる問い | 整っていないと起きること | 関わる仕組み(本コラムの章) |
|---|---|---|---|
| 品質 | 欠損・誤り・重複・形式の違いがどれだけあるか。予測したい項目(正解のラベル)は正しく付いているか | 誤ったデータの傾向をモデルが学ぶ。正解のラベルの誤りは評価の数字そのものを狂わせる | データ品質の測定と品質ルール(第5章) |
| 来歴 | どのシステムから、いつ、どの加工を経て作られたデータか | 精度が落ちたときに原因をたどれない。同じ学習データを作り直せない | メタデータとデータリネージ(第6章) |
| 定義の一貫性 | 顧客・商品・取引の数え方や区分が、学習時と本番で同じか | 学習時と本番で意味の違う値が入り、予測がずれる | ビジネス用語集(第6章)、マスターデータと参照データ(第7章) |
| 権利 | そのデータを学習や生成AIの参照に使ってよいか。契約・利用規約・著作権・個人情報の制約はないか | 後から使えないことが分かり、モデルを作り直す。法令違反や取引先との紛争になる | データの分類と利用目的の管理(第8章)、本章の後半 |
| 偏り | 特定の期間・地域・顧客層に偏っていないか。予測の対象を代表しているか | 一部の層で精度が大きく落ちる。特定の層に不利な判断を繰り返す | データ倫理と審査の仕組み(第10章) |
| 時点 | どの時点の値か。予測する時点では知り得ない情報が混ざっていないか | 学習時の評価だけが良く、本番では使えないモデルになる | データの保持と履歴の管理(第9章) |
表のうち、AI に固有の色合いが強いのは「権利」「偏り」「時点」の3つです。「時点」について補足すると、学習データの中に、予測を行う時点ではまだ分かっていないはずの情報が紛れ込むことがあります。たとえば、解約を予測するモデルの説明変数(予測の手がかりとしてモデルに入力する項目)に、解約の手続きの後に記録される項目が入っていると、学習時の評価は非常に良く見えますが、本番では解約の前にその項目が存在しないので役に立ちません。これは手法の問題に見えますが、原因の1つは、その項目が予測する時点で使える情報かどうかを確かめる手がかり、つまり「その項目がいつ記録されるか」というメタデータが無いことにあります。項目ごとに記録の時点が定義されていれば、学習データを作る担当者がこの混入に気づきやすくなります。ただし、時点が記録されていても、抽出や結合の条件を誤れば混入は起きるので、実際の抽出・結合の条件もあわせて点検します。
「偏り」も、データの側で確かめられることが多い観点です。過去の判断の記録を学習データにすると、過去の判断に含まれていた偏りをモデルがそのまま受け継ぎます。どの層のデータがどれだけ含まれているかを、学習データを作るたびに集計して記録しておくことが、偏りに気づく最低限の手段になります。偏りを見つけたときにどう判断するかは、第10章で扱った倫理の審査の仕組みにつなぎます。
「権利」は、データの持ち主と利用目的が決まっていないと判断できません。顧客から集めたデータを AI の学習に使ってよいかは、そのデータを集めたときに示した利用目的と、個人情報の扱いの規律によって決まります(第8章)。取引先から受け取ったデータや、外部から購入・取得したデータは、契約や利用規約で使い道が限られていることがあります。誰がそれを確かめて許可するかは、第3章で扱ったデータオーナーの決定事項にあたります。学習データの権利、とくに著作物の扱いについては、本章の後半で公的な文書を開いた範囲で触れます。
「AI Ready なデータ」をどう定義するか
AI に使える状態に整ったデータを、AI Ready(AI レディ)なデータと呼ぶことがあります。この言葉は製品の紹介や業界の記事で広く使われていますが、意味は書き手によって違い、国際規格のような共通の定義は、本コラムの執筆時点で確かめた範囲では見つけられませんでした。公的な資料では、英国政府が2026年1月19日に、政府のデータセットを AI に使える状態にするための指針とベストプラクティスを公表しています(公的部門の実務者と政策の責任者向け。2026年10月22日に確認)。この指針は、AI に使える状態のデータセットは技術的な形式だけでは決まらず、文脈・統治・相互運用性・特定の AI の用途への適合によって決まる、という立場をとり、技術的な最適化、データとメタデータの品質、組織と基盤の文脈、法令・セキュリティ・倫理の遵守、の4つの柱で整理しています。
この指針は英国の公的部門を対象にしたもので、日本の企業がそのまま従う性質のものではありません。ただ、「形式が整っていること」だけでなく「統治されていること」と「用途に合っていること」を条件に入れている点は、本コラムの考え方と重なります。そこで本コラムでは、次のように定義して使います。これは本コラムの定義で、公的な定義ではありません。全体の地図の用語表で「第11章で本コラムの定義として示す」とした AI Ready の中身は、この定義です。
本コラムでいう AI Ready なデータとは、「特定の AI の用途について、その用途に足りる品質であることが測られ、偏りと、どの時点の値かが確かめられており、意味と来歴が記録され、使う権利と範囲が確かめられ、持ち主が決まっていて、同じ状態を再び作り出せるデータ」のことです。ポイントは「特定の用途について」という限定です。ある需要予測のモデルには十分な品質のデータが、別の用途の生成AIの参照先としては古すぎる、ということは普通に起きます。AI Ready は、データそのものの性質ではなく、データと用途の組み合わせについての判定だと考えています。なお、この章でいう「持ち主」は、データについては第3章のデータオーナーを指し、文書やモデルについては、それぞれの内容に責任を持つ担当者(文書の作成部門の責任者や、モデルを作ったデータサイエンスの担当)を指します。
この定義を、点検に使える形に分けると次の表になります。各条件は、本コラムのどの章の仕組みで満たすかと対応させてあります。
| 本コラムの定義の条件 | 点検の問い | 満たしていると言える状態の例 | 関わる章 |
|---|---|---|---|
| 用途が決まっている | そのデータを、どの AI の、どの判断や業務に使うのかが書かれているか | 「月次の需要予測の学習データ」「社内規程の問い合わせに答える生成AIの参照先」のように、用途ごとに対象のデータが一覧になっている | 第3章(意思決定権) |
| 用途に必要な品質を満たしている | その用途に必要な品質の基準が決まっていて、いまの測定結果がその基準を満たしているか | 欠損率・重複・鮮度などの品質ルールの測定結果が用途ごとの基準を満たし、その判定の結果が記録されている | 第5章 |
| 偏りと時点が確かめられている | どの期間・地域・顧客層のデータがどれだけ含まれるか。各項目がいつ時点の値で、予測する時点では知り得ない情報が混ざっていないか | 学習データの層ごとの構成が集計・記録され、項目ごとに記録の時点が定義されている | 第6章・第10章、本章の前の節 |
| 意味と来歴が記録されている | 項目の定義・単位・記録の時点・出所・加工の経路を、利用者が自分で調べられるか | データカタログに定義と持ち主が載り、どのシステムから来たかをたどれる | 第6章 |
| 権利と範囲が確かめられている | 学習や参照に使ってよいことと、使ってよい範囲を、誰がいつ確かめたか | 利用目的・契約・アクセス権の確認の記録があり、確認した人が分かる | 第8章、本章の後半 |
| 持ち主が決まっている | 問題が見つかったとき、誰が直すかを決める人が決まっているか | データオーナーとデータスチュワードが任命され、問い合わせの窓口が決まっている | 第3章 |
| 再現できる | 同じ学習データ、同じ参照先を、後から作り直せるか | 抽出の条件・時点・加工の手順と、使ったデータの版が記録されている | 第6章・第9章 |
表を見ると分かるように、AI Ready の条件のほとんどは、AI のために新しく作る仕組みではなく、これまでの章で扱ったデータガバナンスとデータマネジメントの仕組みそのものです。用途に照らして品質を判定する考え方は、AI に限らず、一般的なデータ品質の管理にも共通します。AI の場合は、学習・評価・本番での利用の関係を踏まえて、偏り・時点・使う権利・再現できるかを用途ごとに具体的に確かめるところに重みがあります。ただし、条件の多くが既存の仕組みと重なるのは、本コラムが既存の仕組みに沿って定義を組み立てたためでもあります。そのうえで、データガバナンスが一定の水準で運用されている組織では、AI Ready の判定は、既存の管理の記録と役割を活かしながら、用途ごとに足りない確認を足していく形で進められると考えています。
国際規格の側では、分析と機械学習のためのデータ品質を扱う ISO/IEC 5259 シリーズが発行されています。ISO の目録で確かめた範囲では、ISO/IEC 5259-1(概要・用語・例。2024年7月、第1版)はこのシリーズの基礎となる部で、データのライフサイクルの各段階でデータ品質を評価し高めるための枠組みを示すと説明されています。同じく2024年7月に、データ品質マネジメントの要求事項と指針を扱うISO/IEC 5259-3と、データ品質のプロセスの枠組みを扱うISO/IEC 5259-4が発行されています。規格の本文は有償で、本コラムでは中身に立ち入りません。AI 向けのデータ品質を社内の基準として定めるときに、第5章で扱った ISO/IEC 25012 の品質モデルとあわせて、参照先の候補になる規格です。
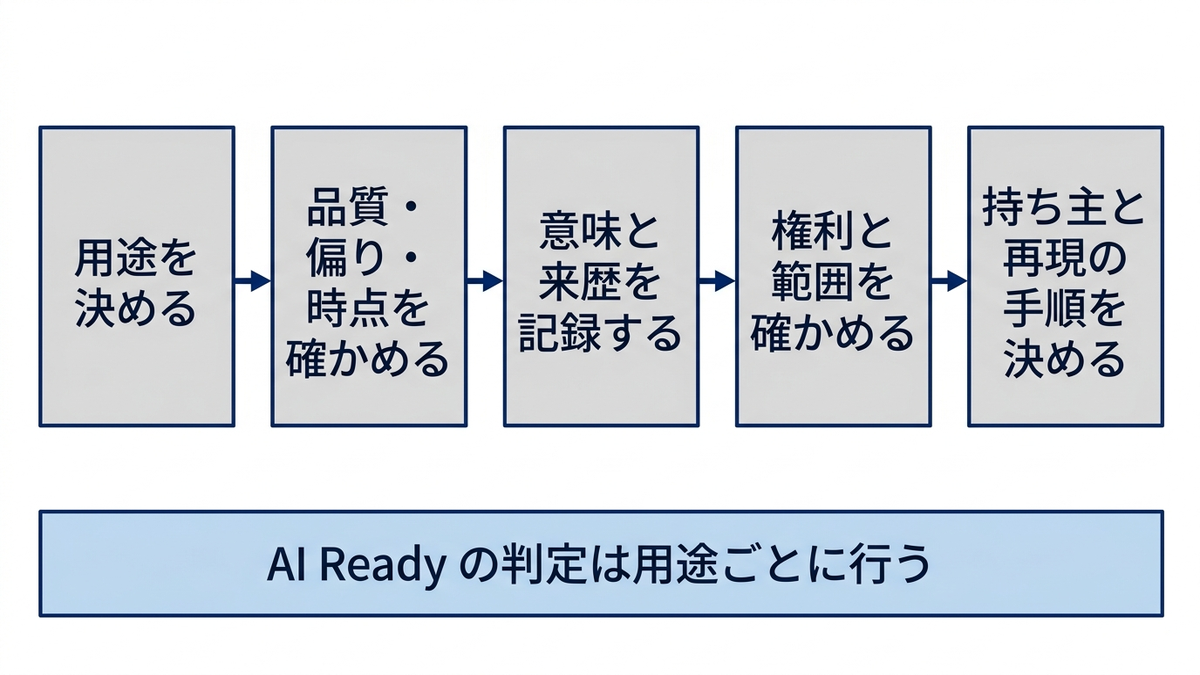
生成AIと RAG に必要なデータ整備
生成AIを社内の業務に使うとき、よく使われる方法の1つが、質問に関係する社内の文書を検索して取り出し、その内容を生成AIに渡して回答を作らせる方法です。この方法は検索拡張生成、英語の頭文字からRAG(Retrieval-Augmented Generation)と呼ばれます。生成AIのモデルを作り直さずに社内の知識を回答に反映できるので、規程・手順書・製品の資料・過去の問い合わせ記録などへの質問応答に使われることがあります。
RAG では、回答の正しさが、検索で取り出される文書の正しさに強く依存します。生成AIのモデルがどれだけ優れていても、取り出された文書が改定前の古い規程であれば、回答は古い規程に沿ったものになります。つまり RAG を導入すると、それまで人が読んでいたときには目立たなかった文書管理の不備が、AI の回答の誤りとして表に出てきます。第10章で扱った文書の分類・保持・版管理は、RAG の導入ではそのまま回答の品質の問題になります。RAG の参照先として文書を整えるときに確かめておきたい点を、次の表にまとめました。
| 整える点 | 確かめる問い | 整っていないと起きること | 最初の一歩 |
|---|---|---|---|
| 鮮度 | 参照先の文書は最新の版か。廃止・改定された文書が混ざっていないか | 改定前の規程や終了した制度に沿った回答が出る | 参照先に入れる文書の一覧に、版・改定日・有効期限の欄を設ける |
| 重複の排除 | 同じ内容の文書が複数の版・複数の場所に残っていないか | 版の違う文書が両方取り出され、食い違った回答になる。どちらが正しいか利用者が判断できない | 正本の置き場を1つに決め、写しは参照先から外す |
| アクセス権の継承 | 元の文書に設定されていた閲覧の権限が、参照先でも守られるか | 見る権限の無い人の質問に対して、人事・経営・顧客の情報を含む文書の内容が回答に出る | 元の文書の権限を検索の段階で反映する設計かを確かめる。確かめられない文書は参照先に入れない |
| メタデータ | 文書の種類・持ち主・対象部門・作成日・機密区分が付いているか | 検索で関係の薄い文書が取り出される。誤りが見つかっても誰に直してもらうか分からない | 参照先に入れる文書に、最低限の属性(持ち主・作成日・機密区分)を付ける |
| 出所の表示 | 回答がどの文書のどの部分に基づくかを利用者が確かめられるか | 誤った回答を利用者が見分けられず、そのまま業務に使われる | 回答とともに参照した文書の名前と版を表示する |
| 権利 | 参照先に入れる文書を、生成AIの回答に使ってよいか | 外部から取得した資料や他社の著作物を、許された範囲を超えて回答に使う | 外部の資料を参照先に入れる前に、契約・利用規約・著作権の確認を通す |
表のうち、見落とされやすく、影響が大きいのはアクセス権の継承です。社内の文書は、部門や役職によって閲覧の範囲が分けられていることが多く、その権限は文書の保管場所の設定として管理されています。RAG のために文書を1か所に集めて検索の索引(どの文書に何が書かれているかをすばやく探すための目録)を作ると、元の保管場所の権限の設定が索引の側に引き継がれない作り方もありえます。その場合、ふだんは見られない文書の内容が、質問の答えとして誰にでも返ってしまいます。製品やクラウドのサービスによって、権限をどう引き継ぐかの仕組みは異なるので、導入前に公式の文書で確かめ、確かめられない範囲の文書は参照先に入れないことが安全だと考えています。アクセス制御の考え方そのものは第8章で扱いました。
鮮度と重複の管理には、文書を改定・廃止する運用と、その変更や削除を検索の索引に反映する仕組みの両方が要ります。文書を改定したときに古い版を参照先から外す手順が無ければ、参照先は時間とともに古い版で埋まっていきます。また、検索の製品によっては、元の保管場所で文書を消しても、その削除を検知する設定をしておかないと索引から消えない作りもあります。規程や手順書の改定の手続きの中に「参照先の差し替え」を1行加え、文書の持ち主がそれを行い、差し替えや削除が索引に反映されたことまで確かめる、という形にしておくと、手順が抜けにくくなります。これは第10章で扱った文書の保持と廃棄の規則を、RAG の参照先にも当てはめることにあたります。
経営の側から見ると、RAG の品質を決めるのは導入のときの作業より、導入した後の文書の運用です。導入の予算には、最初の文書の整理だけでなく、文書の持ち主が改定のたびに参照先を差し替える手間と、誤った回答が見つかったときに、原因が文書・検索・回答の生成のどこにあるかを切り分けて直す手順を含めておく必要があります。これを見込まずに導入すると、時間とともに参照先が古い版で埋まって回答の誤りが増え、利用者が離れて投資が空振りに終わるおそれがあると考えています。
データサイエンスの運用とガバナンスの接点
機械学習のモデルを業務で使い続けるには、モデルを作って終わりではなく、学習に使ったデータの管理、予測に使う特徴量(モデルに入力する変数)の管理、モデルの精度の監視、必要に応じた再学習が要ります。こうした運用の仕組みは、一般に MLOps と呼ばれます。MLOps の具体的な進め方は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。ここでは、MLOps のうちデータガバナンスと重なる部分に絞って整理します。
1つ目の接点は、学習データの版の管理です。モデルの予測に問題が見つかったとき、そのモデルがどのデータで学習されたかが分からなければ、原因を調べることも、同じモデルを作り直すこともできません。学習データについて、抽出の条件、対象の期間、加工の手順、使ったデータの版を記録しておくことは、第6章で扱ったメタデータとデータリネージを、学習データという成果物に当てはめることにあたります。
2つ目の接点は、特徴量の定義です。たとえば「直近3か月の購入回数」という特徴量は、「購入」に返品やキャンセルを含めるか、「3か月」を暦の月で数えるか日数で数えるかによって値が変わります。学習の担当者と本番の予測の担当者が別々に計算すると、同じ名前で違う値が入り、予測がずれます。特徴量の定義をビジネス用語集と同じように登録し、持ち主を決めておくと、このずれを防げます。
3つ目の接点は、上流のデータの変更の通知です。モデルの入力になっている業務システムの項目の意味が変わった、コード値が追加された、入力の手順が変わった、といった変更は、モデルの側から見ると予告なしに入力の性質が変わることを意味します。第3章で扱った変更管理の手続きで、変更の影響を受ける利用者の一覧にモデルの持ち主を入れておくことが、精度の急な低下を防ぐ現実的な手段だと考えています。
4つ目の接点は、説明の求めへの対応です。モデルの予測が業務の判断に使われると、なぜその予測になったのかを顧客や社内から問われることがあります。予測の理由を示す手法は、弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』で扱っています。どの手法を使う場合でも、説明の土台になるのは、モデルに入力したデータが何で、どこから来て、どう加工されたかの記録です。データの記録が無いと、手法で出した説明そのものを確かめられません。
これらの接点を、誰が何を担うかの形で整理すると、データオーナーは学習や予測にそのデータを使ってよいかを決め、データスチュワードは特徴量と学習データの定義を維持し、データカストディアンは学習データの版を保管し、モデルの持ち主(データサイエンスの担当)はどのデータの版でどのモデルを作ったかを記録する、という分担になります。これは自社でモデルを作る場合の例です。外部の生成AIのサービスを使う場合は、自社の側で利用の責任者を決め、提供者から確かめられた情報と、確かめられない範囲を記録しておきます。役割の名前は第3章のものをそのまま使えます。AI のために新しい役割を増やすより、既存の役割の責任の欄に、学習データと特徴量を書き足す方が、兼務の多い組織では運用しやすいと考えています。
AIガバナンスの枠組みの見取り図
データガバナンスが「データについて誰が何を決め、何を基準に、どう確かめるか」を定める仕組みであるのに対して、AIガバナンスは、AI の開発・提供・利用について同じ問いに答える仕組みです。どの用途に AI を使ってよいか、どんなリスクをどう評価するか、問題が起きたときに誰が説明し責任を負うか、を決めます。AI ガバナンスには、国や地域の法令、政府の指針、任意で使う枠組み、国際規格が関わっており、国内外で整備が進んでいます。
次の表は、企業が AI ガバナンスを考えるときに参照されることの多い枠組みを、名前・制定主体・位置づけ・主要な日付に絞って並べたものです。いずれも公式のページや文書を2026年10月22日に開いて確かめた範囲で書いています。データに関わる条文については、その条文があることと題名までにとどめ、個々の義務の内容や、自社が対象になるかどうかの判断には立ち入りません。AI ガバナンスの詳細(法規制とフレームワークから社内ルールの作り方まで)は、別のコラムで扱う予定です。本コラムでは、名前と位置づけ、そしてデータガバナンスとの接続だけを扱います。
| 枠組み | 制定主体 | 位置づけ | 主要な日付(確認した範囲) |
|---|---|---|---|
| EU の AI 規則(AI Act。EU 規則 2024/1689) | 欧州連合 | AI システムを対象にした EU の規則(法令)。AI システムを、許容できないリスク・高リスク・透明性のリスク・最小限またはリスクなしの4つの水準に分けて扱う。高リスクは、健康・安全・基本的な権利に深刻なリスクをもたらしうる用途を指す。高リスクの AI について、データに関する要件を定めた条文(第10条。題名は「データとデータガバナンス」)がある | 2024年8月1日発効。2026年8月2日から一般的に適用。一部の規定は2025年2月2日・2025年8月2日から先に適用。高リスクの AI の規定の適用日は、2026年7月27日に発効した簡素化のための改正規則(デジタル・オムニバスと呼ばれる)で改められ、規則の附属書IIIで定める分野で使うものは2027年12月2日、附属書Iに挙げる EU の製品規制の対象製品に組み込まれるものは2028年8月2日から適用 |
| 人工知能関連技術の研究開発及び活用の推進に関する法律(AI推進法。令和7年法律第53号) | 日本(法律) | AI の研究開発と活用の推進を目的とする日本の法律。人工知能戦略本部の設置と人工知能基本計画の策定を定める | 2025年6月4日公布・一部施行。2025年9月1日に全面施行 |
| 人工知能基本計画 | 日本政府(閣議決定) | AI推進法第18条第1項に基づく計画。施策を、AI 利活用の加速的推進・AI 開発力の戦略的強化・AI ガバナンスの主導・AI 社会に向けた継続的変革の4つに分けて示す | 最初の計画は2025年12月23日閣議決定。現行は第Ⅱ期の計画で2026年7月14日閣議決定 |
| 人工知能関連技術の研究開発及び活用の適正性確保に関する指針 | 人工知能戦略本部 | AI推進法第13条に基づく指針。事業者・国民などすべての主体に、AI の研究開発・活用を適正に行う自主的な取り組みを促す | 2025年12月19日 人工知能戦略本部決定 |
| AI事業者ガイドライン | 総務省・経済産業省 | AI の開発・提供・利用を担うすべての者に、必要な取り組みについての基本的な考え方を示すガイドライン | 第1.0版 2024年4月19日公表。現行は第1.2版で2026年3月31日公表 |
| NIST AI RMF(AI リスクマネジメントフレームワーク) | 米国国立標準技術研究所(NIST) | 任意で使うことを想定した、AI のリスクを管理するための枠組み | 1.0 を2023年1月26日に公表。生成AI向けのプロファイル(枠組みを生成AIという用途に当てはめた補足の文書。NIST AI 600-1)を2024年7月26日に公表。2026年10月22日時点の公式ページには、1.0 を改訂中との記載がある |
| ISO/IEC 42001(AI マネジメントシステム) | ISO と IEC(両者が合同で設けた AI の規格づくりの委員会。JTC 1/SC 42) | 組織の中で AI マネジメントシステムを確立・実施・維持・継続的に改善するための要求事項と指針を定める国際規格 | 2023年12月、第1版 |
表の各行の確認先は次のとおりです。EU の AI 規則の適用日は、欧州委員会の AI Act Service Desk の第113条(2026年7月27日時点の統合版)と、欧州委員会の AI 規則の解説ページで確かめました。4つの水準と高リスクの意味は同じ解説ページ、第10条の題名は 同じ Service Desk の第10条によります。AI推進法は内閣府の AI 法のページ、人工知能基本計画は内閣府の人工知能基本計画のページと第Ⅱ期の計画の本文、適正性確保に関する指針は指針の本文、AI事業者ガイドラインは総務省の掲載ページと内閣府の府省庁ガイドラインの一覧、NIST AI RMF は NIST の公式ページ、ISO/IEC 42001 は ISO の目録で確かめています。AI に関する規制の成り立ちと経緯は、弊社コラム『AIの歴史ノート、ダートマス会議から生成AIまでの70年』の制度と社会の章でも扱っています。
この表から読み取れることを2つ挙げます。1つ目は、法令・政府の指針・任意で使う枠組み・国際規格が、それぞれ違う性格を持つことです。EU の AI 規則は EU の法令で、どの事業者が対象になるかは規則の条文で定められています。日本の企業が対象になるかどうかは、事業の内容と AI の使い方によるので、法務や専門家の確認が要ります。日本の AI推進法は、名前のとおり AI の研究開発と活用の推進に関する法律で、事業者の取り組みについての考え方は、AI事業者ガイドラインや適正性確保に関する指針に示されています。NIST AI RMF は任意で使うことを想定した枠組みで、ISO/IEC 42001 は組織の AI マネジメントシステムについての要求事項を定める国際規格です。どれに従う必要があるか、どれを参考にするかは、事業を行う地域と AI の使い方によって変わり、個別の判断には法務や専門家の確認が要ります。
2つ目は、AI の規制の中に、データそのものを扱う条文が置かれていることです。EU の AI 規則には、高リスクの AI についてデータに関する要件を定めた条文があり、その題名は「データとデータガバナンス」です。条文の中身は別のコラムで扱いますが、AI の規制がデータガバナンスという言葉を条文の題名に使っている、という事実は、AI ガバナンスを考えるときにデータの記録と責任の分担が問われることを示しており、データガバナンスの担当者が押さえておくべき位置づけだと考えています。
AI ガバナンスで問われることと、それに答えるデータガバナンスの記録との対応は、次の節の表で1行ずつ示します。
データガバナンスが AI ガバナンスの土台になる理由
AI ガバナンスで問われることの多くは、突き詰めるとデータについての問いに行き着きます。AI の判断について説明を求められたとき、組織が答えるべきことは「このモデルは何のデータで学習したか」「そのデータはどこから来て、どう加工されたか」「そのデータを使う権利はあったか」「個人情報は適切に扱われたか」「データに偏りは無かったか」です。これらの問いに答えるための記録と責任の分担は、AI を使う場面ごとに作るより、データを扱う日々の運用の中で残していく方が漏れにくいので、データガバナンスの側に置くのが適していると考えています。AI ガバナンスの方針を先に定めても、データの記録が無い場合には、方針どおりに運用されているかを確かめる手段が乏しくなります。
次の表は、AI ガバナンスで問われる主な問いと、それに答えるためにデータガバナンスの側で用意しておくものを対応させたものです。左の列は AI の用途を判断する会議や、リスクの評価で出てくる問いの例で、右の列は本コラムのこれまでの章で扱った仕組みです。
| AI ガバナンスで問われること | データガバナンスの側で用意しておくもの | 用意が無いと起きること | 本コラムの章 |
|---|---|---|---|
| このモデルは何のデータで学習したか | 学習データの抽出条件・期間・版の記録 | 説明を求められても答えられず、同じモデルを作り直せない | 第6章・本章 |
| そのデータはどこから来て、どう加工されたか | データリネージとメタデータ | 精度の低下や誤りの原因をたどれない | 第6章 |
| そのデータは用途に足りる品質か | 品質ルールと測定の結果、用途ごとの基準 | 品質の根拠を示せず、AI の出力が信用されない | 第5章 |
| そのデータを使う権利はあったか | 利用目的・契約・利用規約の確認の記録と、許可したデータオーナー | 後から使えないことが分かり、モデルや参照先を作り直す。紛争になる | 第3章・第8章 |
| 個人情報は適切に扱われたか | データの分類、アクセス制御、利用目的の管理 | 法令違反のおそれ。本人からの求めに対応できない | 第8章 |
| データに偏りは無かったか | 学習データの構成の集計と、倫理の審査の記録 | 特定の層に不利な判断を繰り返し、気づくのが遅れる | 第10章 |
| 問題が起きたら誰が直すのか | データオーナー・データスチュワード・モデルの持ち主の分担 | 部門の間で責任が押し付け合いになり、対応が遅れる | 第3章・第13章 |
この表の2列目(データガバナンスの側で用意しておくもの)の多くは、AI を導入する前から必要だったものです。AI に固有なのは、学習データの抽出条件・期間・版の記録(1行目)と、学習データの構成の集計(6行目)の2つで、これも既存のメタデータの記録と倫理の審査の延長として作れます。言い換えると、AI ガバナンスのために新しく作るものは、AI の用途の判断とリスクの評価の手続き、AI 固有のリスク(誤った出力・不適切な生成物・悪用など)への対応が中心で、その手続きが参照する証拠の多くはデータガバナンスの側に置かれます。AI ガバナンスとデータガバナンスを別々の部門が別々に立ち上げると、同じデータの持ち主や権利の確認を二重に行うことになり、記録が食い違うおそれもあります。データガバナンスの委員会や役割の中に、AI の用途の判断を議題として加える形から始めることが、重複を避ける現実的な方法だと考えています。
一方で、データガバナンスだけでは AI ガバナンスにはなりません。生成AIの出力が事実と異なる、差別的な表現を生む、他者の権利を侵害する生成物を作る、といったリスクは、データを整えるだけでは防げず、AI の使い方そのものの規則と、出力を人が確かめる手順が要ります。データガバナンスは AI ガバナンスの土台であって、その全体ではない、という位置づけを経営と共有しておくと、どちらか一方に投資して安心してしまうことを防げます。
学習データと参照先の権利、著作物の扱い
学習データや RAG の参照先に、他者が作った文章・画像・資料を使う場合は、著作権の扱いを確かめる必要があります。日本の著作権法の第30条の4は(e-Gov 法令検索の条文で2026年10月26日に確認)、著作物に表現された思想や感情を自ら享受したり他人に享受させたりすることを目的としない場合には、その必要と認められる限度において著作物を利用できると定めています。ただし、この規定にはただし書があり、著作物の種類・用途・利用の態様に照らして著作権者の利益を不当に害することとなる場合は適用されないとされています。どんな利用でも許されるわけではありません。
文化庁の文化審議会著作権分科会法制度小委員会は、2024年3月15日付で「AIと著作権に関する考え方について」を取りまとめています(2026年10月22日に確認)。この文書は、公表時点での小委員会としての一定の考え方を示すもので、それ自体が法的な拘束力を持つものではなく、特定の生成AIや技術について確定的な法的評価を行うものではない、と冒頭で断っています。そのうえで、この文書は、たとえば次のように整理しています。AI の学習のための利用であっても、学習データに含まれる著作物の創作的表現の全部または一部を出力させることを目的とするなど、享受の目的が併存すると評価される場合には、第30条の4は適用されないとしています。RAG のように、著作物を含むデータを検索して回答を生成する手法のためにデータベースを作る行為についても、その複製などが、回答の生成の際に著作物の創作的表現の全部または一部を出力することを目的とする場合には、第30条の4は適用されないと考えられる、としています。そして、第30条の4が適用されない場合でも、回答の生成の際に既存の著作物を利用することには第47条の5第1項の適用がありうるが、その利用は軽微なもの(軽微利用)に限られることに留意が要る、としています。第47条の5第1項は、検索や情報解析などをコンピューターで行ってその結果を提供する行為に付随して、公表された著作物などを利用することを認める規定で、その利用を、利用される部分の割合や量、表示の精度などに照らして軽微なものに限っています。個々の利用が軽微にあたるかどうかも、次の段落の末尾に書く法務や専門家の確認の対象です。また、RAG のためにデータベースを作るなどの行為に伴う複製などは、同条第2項に定める準備行為(第1項の行為の準備のために、軽微利用の準備に必要な限度で複製などを行うこと)として、権利制限規定の適用を受けることが考えられる、としています。
データガバナンスの立場から押さえておきたいのは、権利の判断が、データの種類だけでは決まらず、利用の目的や具体的な使い方によっても変わるという点です。同じ外部の資料でも、傾向を学ぶための学習に使う場合と、回答の中でその表現をそのまま示す参照先に使う場合とでは、検討すべき規定が変わりえます。そのため、外部から取得したデータには、どの用途に使ってよいと確かめたかを、データカタログのメタデータとして記録しておくことが有効だと考えています。用途を変えるときは、改めて確認を通します。条文の解釈と個別の利用が適法かどうかの判断は、本コラムでは行いません。法務や専門家の確認が要ります。
著作権のほかにも、取引先から受け取ったデータの契約上の使い道、ウェブサイトやデータ提供サービスの利用規約、個人情報の利用目的の範囲が、学習や参照に使えるかどうかを左右します。個人情報を学習データに使う場合の扱いは、第8章で扱った個人情報保護法の規律に従います。いずれの場合も、権利の確認は AI の担当者が個別に行うのではなく、データオーナーが許可する手続きとして組み込み、誰がいつ確かめたかを残すことが、後から説明を求められたときの備えになります。
経営判断、AI 投資の前に整えるデータは何か
AI の投資を決めるとき、経営が確かめるべきことは「どのモデルや製品を使うか」より先に、「その用途に使うデータが、本コラムの定義での AI Ready の条件をどこまで満たしているか」です。条件を満たしていないデータを使う計画であれば、AI の費用とは別に、データを整える費用と期間を見込む必要があります。逆に、すべてのデータを先に整えてから AI に取りかかる計画は、整備の範囲が広がりすぎて成果が出るまでの時間が長くなります。用途を1つ決め、その用途に必要なデータだけを先に整える、という順序が手戻りの少ない進め方だと考えています。
次の表は、AI の用途の型ごとに、投資の前に整えておきたいデータと、整っていないときの損失の型を並べたものです。損失の型は、本コラムで共通に使う6つ(判断の遅れ・二重投資・集計の食い違い・法令違反・AI 投資の空振り・現場の不信)の名前で書いています。用途の型は一例で、自社の計画に当てはめて、どの行に近いかを見る使い方を想定しています。
| AI の用途の型 | 投資の前に整えるデータ | 整っていないときの損失の型 | 経営が確かめること |
|---|---|---|---|
| 需要予測・解約予測のような数値の予測 | 予測する対象の定義(何を売上・解約と数えるか)、過去の実績の品質、説明変数の記録の時点 | AI 投資の空振り(試験では良く本番で外れる)。集計の食い違い(部門ごとに定義が違う)。現場の不信(予測が信用されず使われない) | 予測する数字の定義の持ち主が決まっているか。過去の実績の品質が測られているか |
| 社内文書への質問応答(RAG) | 参照先の文書の正本・版・有効期限、閲覧の権限、持ち主 | 現場の不信(古い規程に沿った回答が続き利用者が離れる)。法令違反のおそれ(権限の無い人に個人情報などが回答として出る)。AI 投資の空振り | 文書の改定のたびに参照先を差し替える担当が決まっているか。権限の引き継ぎを確かめたか |
| 顧客の対応や審査を支援する分類・判定 | 過去の判断の記録、正解のラベルの付け方、層ごとのデータの構成 | 法令違反のおそれ(過去の偏りを再生産した判断が、適用される差別の禁止などの規定に触れる場合。説明を求められても答えられない)。判断の遅れ(問題が見つかっても原因をたどれない) | 学習データの偏りを確かめる手順と、判断を人が確かめる手順があるか |
| 外部のデータを使う分析や生成 | 取得元・契約・利用規約・著作権の確認の記録、使ってよい用途 | 二重投資(後から使えないことが分かり、作り直す)。法令違反のおそれ(著作権の侵害にあたる利用)。契約・利用規約に反する利用は、法令違反とは別に、取引先や提供元との紛争の原因になる | 権利を確かめた人と用途が記録されているか |
表のどの行でも、経営が確かめることの中心は「持ち主が決まっているか」「記録が残っているか」の2点です。これは、本コラムの第3章で扱った役割と意思決定権、第6章で扱ったメタデータの仕組みが、AI の投資判断にそのまま効いてくることを意味します。AI の予算を承認するときに、対象のデータのデータオーナーが誰で、データの品質と権利がどの程度確かめられているかを、計画書の必須項目にしておくと、AI 投資の空振りを入口で減らせると考えています。
もう1つの判断は、AI ガバナンスの体制をどう立ち上げるかです。前の節で述べたとおり、AI ガバナンスの証拠の多くはデータガバナンスの側に置かれるので、データガバナンスの体制がまだ無い組織が AI ガバナンスだけを先に作ると、方針はあっても確かめる手段が無い状態になりやすいと考えています。データガバナンスの立ち上げ(第13章)の中で、AI の用途の判断を最初の議題の1つに含め、AI の利用が広がるにつれて AI ガバナンスの手続きを足していく、という順序が、限られた人員で両方を進めるときの現実的な選択肢になります。現状がどの段階にあるかを確かめる方法は、次の第12章で扱います。
この章では、AI の成否がデータの整い方で決まりやすいことを出発点に、学習データの要件(品質・来歴・定義の一貫性・権利・偏り・時点)、本コラムの定義での AI Ready なデータの条件、RAG の参照先として文書を整えるときの点検の観点、MLOps とデータガバナンスの接点を整理しました。あわせて、EU の AI 規則・日本の AI推進法と人工知能基本計画・AI事業者ガイドライン・NIST AI RMF・ISO/IEC 42001 の位置づけを確かめ、AI ガバナンスで問われることの多くが、データの来歴・品質・権利・個人情報の扱いについての問いに行き着くことを見ました。データガバナンスは AI ガバナンスの土台であり、AI 投資の前に整えるべきものは、用途を1つ決めたうえでのその用途のデータです。次の第12章では、自社のデータマネジメントの現状がどの段階にあるかを診断し、どの領域から上げるかを決める方法を扱います。
この章を深めたい方への参考書籍
『Data-centric AI入門』(片岡裕雄 監修、宮澤一之 ほか 執筆、技術評論社):書名のとおり、データの側から機械学習の成果を高める Data-centric AI を扱った入門書で、技術評論社の ML Systems のシリーズの1冊です。この章で扱った学習データの品質や正解のラベルの点検を、データサイエンスの担当者の側から掘り下げるときの材料になります。
『AIガバナンス入門 リスクマネジメントから社会設計まで』(羽深宏樹 著、早川書房):副題のとおり、AI のリスクマネジメントから社会の仕組みの設計までを扱ったハヤカワ新書の1冊です。この章では名前と位置づけだけに絞った AI ガバナンスを、データガバナンスの次に何を整えるかという視点で見渡すときの入口になります。
第12章 現状診断と成熟度アセスメント
第11章では、AI に投資する前に整えるべきデータとして、学習データの品質・来歴・権利・個人情報を確かめる仕組みを扱い、データガバナンスが AI ガバナンスの土台になることを確認しました。ここまでの章で、役割と会議体、データアーキテクチャ、データ品質、メタデータ、マスターデータ、セキュリティとプライバシー、保管と統合、文書と倫理、AI のためのデータという領域を順に見てきました。この章では視点を変えて、自社がそれぞれの領域で今どこにいるのかを確かめる方法を扱います。成熟度という考え方、領域ごとの自己診断の質問と証拠の集め方、経済産業省と情報処理推進機構(以下、IPA)が公開している DX推進指標とデジタルガバナンス・コード3.0 の使い方、診断結果の読み方、そしてギャップから優先順位とロードマップを作るまでを順に説明します。公的な制度と数値は、2026年10月に経済産業省と IPA の公開資料を開いて確かめた範囲だけを書きます。
成熟度を測る目的は、次の一段を決めること
本コラムでいう成熟度とは、ある領域の取り組みがどの段階にあるかの度合いです。成熟度を測る作業、つまり領域ごとに現状を確かめて段階を判定し、目指す段階との差を明らかにする作業を、本コラムでは成熟度アセスメントと呼びます。DMBOK も成熟度アセスメントを独立した主題として扱っていますが、本コラムは DMBOK の段階の名前や評価の枠組みを使わず、本コラムの冒頭の用語の定義で定めた5段階の言い方(未着手・個別対応・定義済み・運用中・改善継続)で説明します。
成熟度アセスメントの目的は、点数を付けることそのものではありません。データガバナンスを始めよと言われた立場の人が最初に困るのは、「どの領域から手を付けるか」「どこまでやれば十分か」を決める根拠が無いことです。全領域を同時に整えようとすると予算も人も足りず、どれも中途半端に終わります。逆に、声の大きい部門の困りごとから順に手を付けると、土台になる領域(たとえば用語の定義や持ち主の決定)が後回しになり、上に積んだ取り組みが崩れます。成熟度アセスメントは、領域ごとの現在地を同じ物差しで並べ、次にどの領域を一段上げるかを決めるための材料を作る作業だと考えています。
もう1つの目的は、関係者の認識を揃えることです。データの問題は、経営層・業務部門・情報システム部門で見えている景色が違います。経営層は「データは揃っているはずだ」と考え、業務部門は「欲しいデータがどこにあるか分からない」と感じ、情報システム部門は「定義を決めてもらえないので作れない」と困っている、という食い違いは珍しくないように思います。同じ質問に3つの立場が答え、答えの違いを議論することで、どこに本当のボトルネックがあるかが見えてきます。後で紹介する DX推進指標のガイダンスも、関係者が集まって議論しながら回答することを勧めています。
経営の側から見ると、現状診断を省いたときの損失は、二重投資と判断の遅れとして表れます。品質の測り方を決める計画が無いままデータ品質ツールを入れる、用語の定義や管理の責任を整える計画が無いままデータカタログだけを入れる、といった進め方は、製品を入れた後に「使われない」という形で表に出ることがあり、部門ごとに別の製品を入れ直せば二重投資になります。また、どの領域が弱いのかが分からないまま「データガバナンスを強化する」という方針だけを掲げると、毎期の予算の議論で何に投資するかが決まらず、取り組みそのものが先送りになりがちです。診断は、この2つを防ぐための最初の投資だと位置づけています。
本コラムの5段階と、段階を判定する手がかり
成熟度の段階は、細かくしすぎると判定が人によってぶれ、粗くしすぎると改善の手応えが見えません。本コラムでは、第3章から第11章で扱った領域(多くはデータマネジメントの知識領域にあたり、これにデータ倫理と AI のためのデータを加えています)ごとに、次の5段階で現状を表します。段階の名前は本コラムの用語として定めたもので、特定の規格や知識体系の段階名を写したものではありません。
| 段階 | 状態 | 判定の手がかりになる証拠 | 次の段階へ進むために必要なもの |
|---|---|---|---|
| 未着手 | その領域について、誰も責任を持っておらず、決まりも無い。問題が起きたときにその場で対処している | 担当者の名前が挙がらない。関連する文書が見つからない | 困りごとの棚卸しと、その領域の取りまとめ役を1人決めること |
| 個別対応 | 一部の部門や担当者が、自分の業務の範囲で工夫している。やり方は人によって違う | 部門ごとの手順書や表計算のファイルはあるが、部門をまたぐと形式が違う。担当者が異動すると止まる | 全社で揃える範囲を決め、決める人(データオーナー)を任命すること |
| 定義済み | 全社の原則・ポリシー・標準・手順が文書になり、責任者が決まっている。ただし運用は始まったばかり | 承認されたポリシーや標準の文書、任命の記録がある。文書の版と承認日が分かる | 文書どおりに回っているかを確かめる指標と、定期的に確かめる場を作ること |
| 運用中 | 文書どおりの運用が日常業務に組み込まれ、指標で状態を確かめている | 指標の推移、会議の議事録、例外承認の記録、問い合わせの対応記録がある | 指標と事故・問い合わせの記録から原因を分析し、ポリシーや標準を見直す手順を持つこと |
| 改善継続 | 運用の結果をもとに、原則・ポリシー・標準・手順を定期的に見直している。改善の効果も測っている | 見直しの履歴(いつ何をなぜ変えたか)と、変えた後の指標の変化が残っている | 事業に必要な品質やリスク管理の水準を保つために、見直しを続ける。対象の範囲を広げるかどうかを経営が判断する |
表の3列目を「判定の手がかりになる証拠」としたのは、段階の判定を印象ではなく、実際にある文書や記録で行うためです。「定義は決まっていると思う」という回答と、「承認日と版番号のついた定義書がここにある」という回答では、同じ「定義済み」でも重みが違います。必要な証拠が揃わない場合は、下の段階の要件も確かめたうえで、証拠で確かめられる最も高い段階と判定する、という約束を最初に置いておくと、自己評価が甘くなることを防げます。
段階は、全社で1つの値にするのではなく、領域ごとに付けます。顧客のマスターデータは運用中なのに、メタデータは個別対応、文書管理は未着手、というように領域ごとに段階がばらつくのが普通です。さらに同じ領域でも、部門によって段階が違うことがあります。その場合は、全社の段階を最も進んだ部門で判定せず、全社で揃っている範囲で判定し、進んだ部門の取り組みは他部門へ広げる材料として別に記録しておくのが有効だと考えています。
すべての領域を改善継続まで上げる必要はありません。どの段階を目指すかは、その領域が事業にとってどれだけ重要か、事故が起きたときの損失がどれだけ大きいかで決まります。たとえば個人情報を大量に扱う事業ではデータセキュリティを運用中以上に保つ必要がありますが、社内の文書の版管理は定義済みで十分な場合もあります。目標の段階を領域ごとに決めること自体が、経営の判断です。
領域ごとの自己診断の質問例
自己診断の質問は、領域ごとに「決める人がいるか」「決まりが文書になっているか」「決まりどおりに回っているかを確かめているか」「見直しているか」の4点を確かめる形にすると、5段階の判定と対応させやすくなります。次の表は、本コラムで扱った領域ごとに、本コラムが独自に作った質問の例です。公的な指標の設問を写したものではありません。2列目の質問に「はい」と答えるには、3列目に挙げた証拠を示せることを条件にします。
| 領域 | 自己診断の質問の例 | 「はい」と言うために示す証拠 | 未着手・個別対応にとどまるときの兆候 | 詳しく扱った章 |
|---|---|---|---|---|
| 統治の仕組み | データについて誰が何を決めるかが文書で決まり、決める人が任命されているか。決めたことを確かめる会議が定期的に開かれているか | 役割と意思決定権の表、任命の記録、会議の議事録 | データの問題が起きるたびに「どこの部門の担当か」で議論が止まる | 第3章 |
| データアーキテクチャ | 主要な主題領域(顧客・商品・取引など)の一覧と、どのシステムがどのデータを持つかの見取り図があり、最新か | 主題領域の一覧、データフロー図と更新日 | 同じデータが複数のシステムにあり、どれが元なのか誰も答えられない | 第4章 |
| データ品質 | 重要なデータ項目について品質のルールが決まり、定期的に測って結果を報告しているか | 品質ルールの一覧(ルールごとの目標の水準とデータオーナーを含む)、測定結果の推移、報告先 | 品質の問題が利用者からの苦情で初めて見つかる | 第5章 |
| メタデータ | 基本的な指標(売上・顧客数など)の定義・計算式・持ち主が1か所にまとまり、誰でも参照できるか | ビジネス用語集、項目定義書、参照の手段 | 会議で部門ごとに違う「売上」や「顧客数」が並ぶ | 第6章 |
| マスターデータ・参照データ | 顧客・商品・取引先の「正しい一件」を決める手順と、コード表を変えるときの承認手順があるか | 名寄せの手順書、コード表の変更履歴と承認者 | 同じ取引先が別々のコードで登録され、取引の合計が合わない | 第7章 |
| セキュリティとプライバシー | データの機密区分が決まり、区分ごとのアクセス権を定期的に棚卸ししているか。個人データの取扱いの責任者が決まっているか | 分類の基準、権限の棚卸しの記録、責任者の任命 | 退職者や異動者の権限が残っている。どこに個人データがあるか一覧が無い | 第8章 |
| 保管・統合・提供 | 保持期間と廃棄の手順が決まり、連携処理の失敗を検知して対応する担当が決まっているか | 保持期間の表、連携処理の監視と障害対応の記録 | 連携の失敗に月末の集計で初めて気づく | 第9章 |
| 文書とコンテンツ・倫理 | 文書の分類と保存・廃棄の決まりがあるか。データの利用が適切かを判断する場と手順があるか | 文書管理の規程、倫理の審査の記録 | 同じ文書の古い版が共有フォルダに残り、どれが最新か分からない | 第10章 |
| AI のためのデータ | AI に使うデータの来歴・権利・品質を確かめる手順があり、使ったデータの版を記録しているか | 学習や検索に使ったデータの一覧と版、利用の承認の記録 | どのデータで作ったモデルや仕組みかを後から説明できない | 第11章 |
表の質問は、どれも「仕組みがあるか」を問う形にしました。「データの品質は良いか」のような印象を問う質問にすると、答える人の立場によって答えが大きく変わり、比較ができないからです。「品質のルールが決まり、定期的に測って結果を報告しているか」と問えば、答えは証拠の有無で決まります。表の5列目の章に、それぞれの領域で何を決めるのかを書いているので、質問に「いいえ」と答えた領域は、その章が最初の一歩の手がかりになります。
回答から段階を決めるときは、冒頭に挙げた4点を順に当てはめます。4点のどれにも証拠つきで「はい」と言えなければ未着手、一部の部門や担当者の範囲でしか言えなければ個別対応とします。全社について「決める人がいる」と「決まりが文書になっている」の2点に証拠があれば定義済み、それに加えて「決まりどおりに回っているかを確かめている」に証拠があれば運用中、4点すべてに証拠があれば改善継続です。前の段階の点に証拠が無いのに後の点だけ「はい」と答えた場合(文書は無いが確認はしている、など)は、証拠の揃っている段階までで判定します。
質問の数は、最初は1領域あたり2〜3問に絞るのが扱いやすいと考えています。詳細な質問票を最初から作ると、回答に時間がかかり、回答者の負担から形式的な答えが増えます。最初の診断で弱いと分かった領域についてだけ、次の回で質問を細かくする、という進め方の方が、診断そのものを続けやすくなります。
この表は、自社の事業に合わせて書き換えて使うことを想定しています。たとえば製造業で設備や品目のデータが中心になる場合は、マスターデータの行の例を「品目と部品表の正しい一件」に置き換えるなど、質問の中の具体例を自社の主要なデータに差し替えると、回答者が答えやすくなります。ただし、領域を減らすときは、減らした理由を記録しておきます。「今回は診断しない」と決めた領域と、「診断を忘れた」領域を区別するためです。
証拠の集め方と、診断の進め方
診断の質を決めるのは、質問票の出来よりも、誰が答え、どの証拠で確かめるかです。進め方の一例を、準備・回答・確認・合意の4つの段階で説明します。
準備の段階では、診断の対象範囲と回答者を決めます。全社を一度に診断するのが難しい場合は、売上や顧客に直結する事業を1つ選び、その事業に関わるデータに範囲を絞ります。その場合は、前の節の判定の「全社」を、合意した対象の範囲に読み替え、診断の結果には対象の事業と部門を書き添えて、全社の段階として扱わないようにします。回答者は、領域ごとに業務部門・情報システム部門・管理部門(法務や経理など)から最低1人ずつ選びます。同じ質問に立場の違う人が答えることで、認識の違いそのものが診断の結果になります。
回答の段階では、各回答者が質問票に段階と根拠を書きます。根拠の欄には、証拠の文書名や記録の場所を書いてもらいます。この段階で「この文書はあるはずだが見たことがない」という回答が出ることがありますが、それも大事な情報です。文書が存在しても関係者が知らないのであれば、その領域は運用中とは言えません。
確認の段階では、取りまとめ役が証拠を実際に開いて確かめます。確かめ方は3つあります。1つ目は文書の確認で、原則・ポリシー・標準・手順の文書に承認日・版・責任者が書かれているかを見ます。2つ目は記録の確認で、会議の議事録・品質の測定結果・権限の棚卸しの記録などが、決められた頻度で残っているかを見ます。3つ目はデータそのものの確認で、たとえば品質のルールが決まっているという回答に対して、実際のデータで欠損や重複を少しだけ数えてみます。データの点検の方法は第5章で扱いました。3つ目の確認は手間がかかりますが、文書と現実のずれを見つける最も確かな方法です。
合意の段階では、回答者を集めて結果を見せ、段階の判定を確定します。回答が分かれた領域は、どちらの判定が正しいかを決めることより、なぜ分かれたのかを話し合うことに時間を使います。業務部門が「定義済み」、情報システム部門が「個別対応」と答えた場合、定義の文書はあるがシステムに反映されていない、という具体的な問題が見つかることがあります。最終的な判定と、判定の理由、確かめた証拠を1枚の記録に残し、次回の診断と比べられるようにします。
診断を外部の支援者に頼む場合も、この4つの段階は変わりません。外部の目には、社内の思い込みを指摘できる利点がありますが、証拠を集めて現場の回答を取りまとめるのは社内の人の仕事です。外部の診断の結果だけを受け取って社内で誰も根拠を説明できない状態になると、次の回に同じ物差しで比べることができなくなります。
公的な物差し、デジタルガバナンス・コード3.0 とDX推進指標
自社で作る質問票に加えて、公的な物差しを使うと、他社との比較や、経営層への説明がしやすくなります。日本でデータとデジタルの取り組みを経営の視点から診断する公的な仕組みとして、経済産業省の「デジタルガバナンス・コード」と、それに基づくDX推進指標、そして DX認定制度があります。いずれもデータガバナンスだけを対象にしたものではなく、DX(デジタルトランスフォーメーション)全体を対象にしたものですが、データの扱いに関わる項目を含んでいます。
デジタルガバナンス・コードは、経済産業省が2020年11月に取りまとめた、経営者に求められる対応をまとめた文書です。2022年9月に「デジタルガバナンス・コード2.0」に改訂され、2024年9月19日にデジタルガバナンス・コード3.0が策定されました。経済産業省の報道発表によると、3.0 では副題に「DX経営による企業価値向上」を掲げ、全体像を「DX経営に求められる3つの視点・5つの柱」として整理し直したほか、データが企業の成長に欠かせない要素になっていることを踏まえて、経営におけるデータ活用やデータ連携の重要性を強調しています。
コード3.0 の本文によると、3つの視点は「経営ビジョンとDX戦略の連動」、現在の姿(As is)と目指すべき姿(To be)のギャップを課題ごとに KPI(重要な成果指標。成果や目標への進み具合を測る指標)で定量的に把握して見直すこと、「企業文化への定着」の3つです。2つ目の視点は、本章で扱うギャップ分析の考え方そのものです。5つの柱は「経営ビジョン・ビジネスモデルの策定」「DX戦略の策定」「DX戦略の推進」「成果指標の設定・DX戦略の見直し」「ステークホルダーとの対話」(ステークホルダーは、顧客・投資家・社員・取引先など企業に関わる人や組織のことです)で、3つ目の「DX戦略の推進」は「組織づくり」「デジタル人材の育成・確保」「ITシステム・サイバーセキュリティ」の3つに分かれています。
データガバナンスとの関わりで目を引くのは、2つ目の柱「DX戦略の策定」の「望ましい方向性」です。要旨を本コラムの言葉でまとめると、経営陣がデータを部門を越えて価値を生む資産と捉えていること、社内に眠るデータを見つけて整理し管理する力を持つこと、取引先とデータをやり取りする際に関係する法令やガイドラインを守ること、の3点がデータに関わる方向性として示されています。コード3.0 の本文では、そのうち2点目が「企業は、社会の状況変化や課題を迅速に把握・予測し、柔軟に対応するために、自社の保有データを発掘・整理・管理する能力を高めている。」と書かれています(デジタルガバナンス・コード3.0、2つ目の柱の望ましい方向性)。また、3つ目の柱の「組織づくり」の望ましい方向性には、DX を推進する部署の責任者の例として、データに関する責任者(Chief Data Officer)を役割とともに定めて任命すること(他の役割との兼任でもよい)が挙がっています。第3章で扱った CDO の任命は、公的な文書の上でも経営の取り組みとして位置づけられていることになります。
DX推進指標は、経済産業省が2019年7月に取りまとめた自己診断の指標で、経営者や社内の関係者が DX の推進に向けた現状や課題の認識を共有し、行動につなげる気付きの機会を提供することを目的としています。経済産業省のDX推進指標のページと2026年2月13日の報道発表によると、経済産業省と IPA は2025年1月に検討会を立ち上げ、デジタルガバナンス・コード3.0 に基づいて設問と成熟度レベルを見直し、2026年2月13日に DX推進指標を改訂しました。改訂前は「経営のあり方、仕組み」と「ITシステムの構築」の2つの観点で構成されていました(後で紹介する分析レポートは、この2つを「経営視点」「IT視点」と呼んでいます)。指標には、成熟度レベルで答える定性指標と、数値で答える定量指標があります。改訂後の定性指標は、コード3.0 の各柱の「認定基準」と「望ましい方向性」に基づく構成になり、定量指標もコード3.0 の5つの柱に基づいて設問の分類が見直されました。改訂版の自己診断フォーマットは、2026年4月3日から提出を受け付けると案内されていました。
提出の方法も変わりました。IPA の2026年8月3日のプレス発表は、自己診断フォーマットを Excel 形式から Web フォームにすること、提出後5分から10分程度でベンチマークレポート(自社の診断結果を、全国や業界の提出企業の結果と比べられる帳票)を確認できるようにすること(それまでは年2回の発行)、あわせて「DX推進指標」のガイダンス資料を公開したことを伝えています。その後、IPA のDX推進指標のご案内のページは、2026年9月18日から提出方法が Web フォームに変わり、Excel ファイルによる提出の受付を終えたと告知しています(2026年10月に確認)。同じページによると、IPA に自己診断の結果を提出するとベンチマークレポートを受け取ることができ、個々の企業の診断結果を外部に公表するものではありません。また IPA は、10月と11月を DX推進指標の集中実施期間として案内しています。
改訂後の成熟度レベルは、レベル0からレベル5までの6段階です。2026年8月のDX推進指標のガイダンスは、各レベルの基本的な考え方の見出しとして、次の語句を示しています(ガイダンス17ページの表記のまま引きます)。レベル0「未着手」、レベル1「一部の部門での散発的実施」、レベル2「全社戦略に基づく一部の部門での戦略的実施」、レベル3「全社戦略に基づく各部門での実施」、レベル4「全社戦略に基づく不断の見直し・部門横断的な実施」、レベル5「個社の取組を超え、社会価値を創出している」です。本コラムの成熟度は未着手から改善継続までの5段階で、DX推進指標はレベル0からレベル5までの6段階なので、段階の数も数え始めも違います(本コラムの「未着手」とレベル0の「未着手」は同じ語ですが、別の物差しの別の段階です)。報道発表は、レベル0からレベル4を個社内の取組が行われている水準、レベル5を個社の取組を超えて社会価値を創出している水準と説明しています。回答では、現在のレベルと3年後に目標とするレベルを選び、判断根拠と、達成に向けた今後のアクションを書く欄があります。
データに関わる設問も、ガイダンスで確かめられます。「DX戦略の策定」の柱には、前の段落で要旨を紹介した3つの方向性に対応する設問があり、それぞれについて、全社としての方針があるか、それが一部の部門にとどまらず各部門に広がっているかで成熟度レベルを分けています。ガイダンスは回答の要点として、データの管理と活用について全社の方針や戦略を定めているか、取引先とのデータ連携について全社の方針を定めているかを最初に確かめるよう説明しています。設問の文言そのものは、IPA が公開しているガイダンスで確かめることができます。参考資料として、IPA の「データガバナンス読本」やデジタル庁の「データガバナンス・ガイドライン」などが挙げられています。
DX認定制度は、デジタルガバナンス・コードに対応し、DX 推進の準備が整っていると認められた事業者を国が認定する制度です。IPA のDX認定制度のご案内によると、情報処理の促進に関する法律の第28条に基づく制度で、対象は法人と個人事業主を含む全ての事業者、申請は1年を通していつでも可能で、審査の標準処理期間は60営業日、認定の有効期間は2年です。認定基準はデジタルガバナンス・コードの各柱の「認定基準」に対応しており、コード3.0 の4つ目の柱「成果指標の設定・DX戦略の見直し」の認定基準は、DX推進指標などで自己診断を実施していることの説明文書などの提出によって確認するとされています。つまり、DX推進指標による自己診断は、DX認定を目指す事業者にとって認定の手続きの一部にもなります。
3つの仕組みの関係を、自社の診断での使いどころと合わせて整理すると、次の表のようになります。
| 仕組み | 運営 | 性格 | データガバナンスとの関わり | 自社の診断での使いどころ |
|---|---|---|---|---|
| デジタルガバナンス・コード3.0(2024年9月19日) | 経済産業省 | 経営者が実践すべき事柄をまとめた文書。3つの視点・5つの柱で構成 | データを部門を越えた資産と捉えること、社内のデータを見つけて整理し管理する力、取引先とのデータ連携での法令やガイドラインの順守、データに関する責任者の任命 | 経営層に「なぜデータガバナンスが経営の課題か」を説明するときの共通言語 |
| DX推進指標(2026年2月13日改訂) | 経済産業省・IPA | コード3.0 に基づく自己診断。成熟度はレベル0〜5、現在と3年後の目標を回答 | データマネジメントとデータガバナンスに関する全社方針の有無と、各部門への広がりを問う設問がある | DX 全体の中でデータに関わる設問の位置を確かめる。ベンチマークで他社と比べる |
| DX認定制度 | 経済産業省(事務局は IPA) | コードの認定基準に適合した事業者を国が認定。有効期間2年 | 認定基準にデータ活用の要素が明示的に含まれる。自己診断の実施が基準の確認の一部になる | 診断の結果を、認定の申請で求められる文書の整備につなげる |
表の最後の列のとおり、公的な指標と本コラムの質問票は役割が違います。DX推進指標は DX 経営の全体を診断するもので、データマネジメントの各知識領域(品質・メタデータ・マスターデータなど)を個別に診断するものではありません。そのため、DX推進指標でデータに関わる設問の段階が低いと分かったら、本コラムの質問票で領域ごとに掘り下げる、という二段構えで使うのが扱いやすいと考えています。逆に、本コラムの質問票で領域ごとの段階を確かめておくと、DX推進指標のデータに関わる設問に答えるときの判断根拠を書きやすくなります。
2つの物差しの段階の付け方にも違いがあります。DX推進指標の成熟度レベルは、全社戦略の有無と、取り組みがどこまでの部門に広がっているかを軸にしています。本コラムの5段階は、決める人・文書・運用の確認・見直しの有無を軸にしています。2つの物差しを機械的に対応させることはできませんが、どちらも「一部の人の工夫」から「全社の仕組み」へ、さらに「見直しが回る状態」へ進むという方向は共通しています。
なお、DX推進指標のガイダンスは、成熟度レベルの把握や特定のレベルへの到達そのものが目的化しないよう留意する必要があると書いています。中堅・中小企業向けの問いへの回答としても、高いレベルの達成そのものを目的とせず、重要な課題についてレベルを段階的に引き上げることを勧めています。これは本章の考え方とも一致します。
自己診断の結果を集計した公的な数値
IPA は、DX推進指標で各企業が提出した自己診断の結果を集め、毎年分析レポートにまとめています。自社の診断の結果を読むときの参考として、IPA が公開している分析レポート(2024年版)(2025年5月7日)と分析レポート(2025年版)(2026年5月15日公開。IPA の分析レポートのページによると、集計方法の不備を修正して2026年6月10日に差し替え)の数値を紹介します。数値はいずれも、2026年10月に IPA のページから取得した PDF で確かめたものです。
読む前に3つの限定条件があります。1つ目は、2つのレポートが集計しているのは、それぞれ2024年1月から12月、2025年1月から12月に提出された自己診断で、2026年2月の改訂より前の指標によるものだということです。改訂前の指標は「経営視点」と「IT視点」の2つの観点で構成され、レベル5の定義も改訂後とは違います。したがって、改訂後の指標で自社が出した値を、この表の値とそのまま比べることはできません。2つ目は、対象が自己診断を提出した企業に限られ、日本企業全体を無作為に選んだものではないことです。3つ目は、成熟度レベルは本来は順序を表す尺度ですが、レポートはレベルの間を等間隔とみなして平均を計算していると断っていることです。
| 項目 | 2024年版(2024年に提出された分) | 2025年版(2025年に提出された分) |
|---|---|---|
| 受け付けた件数と分析対象 | 1,456件を受領し、重複や未入力などを除いた1,349件 | 1,241件を受領し、同じ条件で除いた1,164件 |
| 全指標の現在値の平均と目標値の平均 | 現在値 1.67、目標値 3.34(差 1.67) | 現在値 1.98、目標値 3.51(差 1.53) |
| 現在値の平均が4以上の企業 | 18社(全体の約1%) | 38社(全体の3%) |
| 大企業と中小企業の現在値の平均 | 大企業 2.30(408社)、中小企業 1.40(941社) | 大企業 2.42(495社)、中小企業 1.69(669社) |
| IT視点で現在値が最も高い指標 | 「プライバシー、データセキュリティ」2.03 | 「プライバシー、データセキュリティ」2.43 |
| データに関わる他の指標の例 | 「データ活用の人材連携」現在値 1.94、目標値 3.55(IT視点で目標値が最も高い) | 「データ活用」現在値 2.05、目標値 3.63(IT視点で現在値と目標値の差が大きい指標の1つ) |
表の「全指標」は、レポートの用語の定義で、成熟度で答える定性指標の全体を指し、数値で答える定量指標は含みません。表の大企業と中小企業も、レポートの定義によるもので、従業員数100人未満の卸売業・サービス業・小売業の企業と、それ以外の業種で従業員数300人未満の企業を中小企業、それ以外を大企業としています。両年とも、レポートは現在値の分布が低い方に偏り、4以上の企業が非常に少ないことから、多くの企業の DX 推進は「一部での散発的実施」にとどまっていると述べています。また両年とも、経営視点で現在値と目標値の差が大きい指標の上位に「評価」と「投資意思決定、予算配分」が入っており、KPI に沿って評価する仕組みを整えて行動につなげることに課題を抱える企業が多いことがうかがえる、という趣旨の示唆を書いています。
この数値を読むときに押さえておきたいのは、DX推進指標はデータ活用を含む DX 全体の自己診断であり、データガバナンスの領域ごとの成熟度を直接示すものではない、ということです。そのうえで言えることは2つです。1つ目は、DX 全体の指標で見ても、自己診断を提出した企業のうち現在値の平均が4以上の企業は少数にとどまる、ということです。これは本コラムの5段階とは別の物差しによる結果なので、自社のデータガバナンスの段階が低いことの言い訳にも、高いことの裏付けにもなりません。2つ目は、データの活用に関わる指標についてです。両年とも、IT視点の中で「プライバシー、データセキュリティ」の現在値が最も高く、データの活用に関わる指標の現在値はそれより低い一方で、その目標値は全指標の目標値の平均を上回っています。ただし、表での挙がり方は年によって違い、2024年版では「データ活用の人材連携」の目標値が IT視点で最も高く、2025年版では「データ活用」が現在値と目標値の差の大きい指標の1つに入っています。レポートの数値から言えるのはここまでで、データの定義や品質、カタログといった個別の領域の整備状況は、この数値では測られていません。自社でどの領域が遅れているかは、自社の診断で確かめる必要があります。
公的な数値を社内の説明に使うときは、出典の版と対象を必ず添えます。「日本企業の平均は1.98」のように限定条件を外して書くと、提出企業に限った自己評価の平均であることや、改訂前の指標の値であることが伝わらず、誤った比較の根拠になります。経営会議の資料に載せるなら「IPA の分析レポート(2025年版)で、2025年に自己診断を提出した1,164社の全指標の現在値の平均は1.98」と、対象と時点まで書くのが安全です。
診断結果の読み方、点数より変化とボトルネックを見る
診断が終わると、領域ごとの段階が並んだ一覧ができます。この一覧を読むときに避けたいのは、段階を数値に置き換えて全領域の平均を出し、その平均の上下で取り組みの良し悪しを判断することです。平均は、弱い領域を強い領域が隠してしまいます。たとえばセキュリティが運用中、品質とメタデータが個別対応という会社と、すべての領域が定義済みという会社は、平均が近くなることがありますが、次に打つべき手はまったく違います。
読むときに見るのは、3つの点だと考えています。1つ目はボトルネックです。第2章で見たとおり、データガバナンスの領域には依存関係があります。定義があいまいな項目は、品質のルールを作る前にまず定義を決める必要があり(第5章で見たように、主要な用途に関わる少数の項目なら、全社の用語集が無くてもルールを作って測り始めることはできます)、アクセス権の設計はデータの分類が無いと決まらず、AI のためのデータ整備は来歴と品質の記録が無いと進みません。ある領域の段階が低いことが、他の複数の領域の足を引っ張っている場合、その領域がボトルネックです。段階の数字そのものより、「この領域が上がらないと他が上がらない」という関係を見つけることが、診断の最も大事な成果になります。
2つ目は変化です。1回の診断の結果は、その時点の自己評価にすぎません。半年後や1年後に同じ質問票と同じ証拠の基準で診断し直すと、どの領域が上がり、どの領域が止まっているかが見えます。DX推進指標のガイダンスも、1年後など経年で自己診断を行って進捗を把握することを活用方法として挙げています。変化を見るためには、質問票と判定の基準を毎回変えないことが前提です。質問を改善したい場合は、旧い質問と新しい質問の両方で一度診断し、どれだけ判定が変わるかを確かめてから切り替えます。
3つ目は回答のばらつきです。同じ領域について、業務部門と情報システム部門の判定が2段階以上離れている場合は、その領域に認識の断絶があります。たとえば業務部門は「定義は決めて渡した」と考え、情報システム部門は「渡された定義は解釈が分かれるので実装できない」と考えている状態です。ばらつきの大きい領域は、段階を上げる前に、役割の分担と受け渡しの手順を見直す必要があります。役割と意思決定権の決め方は第3章で扱いました。
診断の結果を、部門や担当者の評価に直接結びつけることにも注意が要ります。段階が低いと判定された部門が責められる仕組みにすると、次回から回答が甘くなり、診断そのものが役に立たなくなります。診断はあくまで現状を知るための道具で、低い段階が見つかったことは、改善の対象が見つかったという成果として扱う方が、診断を続けやすくなると考えています。DX推進指標のガイダンスが、レベルの到達そのものを目的化しないよう求めているのも、同じ理由によるものと読めます。
ギャップ分析とロードマップへの落とし方
診断で現在の段階が分かったら、次は領域ごとに目標の段階を決め、現在との差を埋める手順を考えます。この作業を本コラムではギャップ分析と呼びます。前に紹介したデジタルガバナンス・コード3.0 の2つ目の視点は、現在と目標の差を数値で確かめて戦略を見直すことを経営者に求めており、ギャップ分析はその作業をデータガバナンスの領域ごとに行うものと位置づけられます。ギャップ分析は、次の表のような1枚のシートにまとめると、経営会議で議論しやすくなります。表の行は記入の例で、架空の会社を想定したものです。
| 領域 | 現在の段階 | 目標の段階と時期 | ギャップの中身 | 依存する領域 | 最初の一手 | 確かめる指標 |
|---|---|---|---|---|---|---|
| メタデータ(指標の定義) | 個別対応 | 定義済み(6か月後) | 売上・顧客数の定義が部門ごとに違い、持ち主が決まっていない | 統治の仕組み(持ち主の任命) | 経営会議で使う指標10個について、持ち主と定義を決める | 定義と持ち主が決まった指標の数 |
| データ品質 | 未着手 | 定義済み(12か月後) | 品質の問題が苦情で見つかる。ルールも測定も無い | メタデータ(項目の定義) | 定義が決まった指標の元データについて、欠損と重複を月1回数える | 品質ルールの数と合格率 |
| マスターデータ(顧客) | 個別対応 | 定義済み(12か月後) | 販売と請求で顧客コードが別。名寄せの手順が担当者の手元にしかない | データ品質、統治の仕組み | 顧客マスターのデータオーナーを決め、名寄せの手順を文書にする | 重複候補の件数の推移 |
| セキュリティとプライバシー | 既存の環境は運用中。分析用の環境は未評価 | 分析用の環境を含めて運用中(6か月後) | 権限の棚卸しは年1回行っているが、分析用の環境が対象外 | データアーキテクチャ(データの置き場所の一覧) | 分析用の環境を棚卸しの対象に加える | 棚卸しの対象に入っている環境の割合 |
シートの「依存する領域」の列は、ロードマップの順序を決めるために置きました。依存先の領域が目標の段階に達していないのに、依存する側の領域だけを先に上げようとすると、手戻りが起きます。例の表では、品質の行がメタデータに依存しているので、品質の測定は指標の定義が決まった範囲から始める、という順序になります。品質の行は現在が未着手なので、12か月の間に個別対応を経て定義済みまで2段階上げる計画で、途中の6か月の時点で個別対応に達しているかを確かめます。「最初の一手」の列は、3か月以内に終わる大きさの作業にします。大きすぎる一手は、最初の報告までに時間がかかり、関心が薄れる原因になります。「確かめる指標」は進み具合を見るためのもので、それだけでは段階が上がったことの証拠になりません。次回の診断での段階の判定には、5段階の表に挙げた証拠(任命の記録、承認された手順書、品質ルールと合否の基準など)を別に確かめます。
ギャップ分析のシートができたら、ロードマップに落とします。ロードマップは、領域ごとの最初の一手と次の一手を、依存関係の順に四半期の単位で並べたものです。並べるときは、同じ四半期に段階を上げる領域を2〜3個までに絞ることが有効だと考えています。データガバナンスの作業の多くは、業務部門のデータオーナーとデータスチュワードの時間を使います。多くの領域を同時に動かすと、同じ人に依頼が集中し、どれも進まなくなります。ロードマップの立て方と、最初の90日から1年の体制づくりの進め方は第13章で扱います。
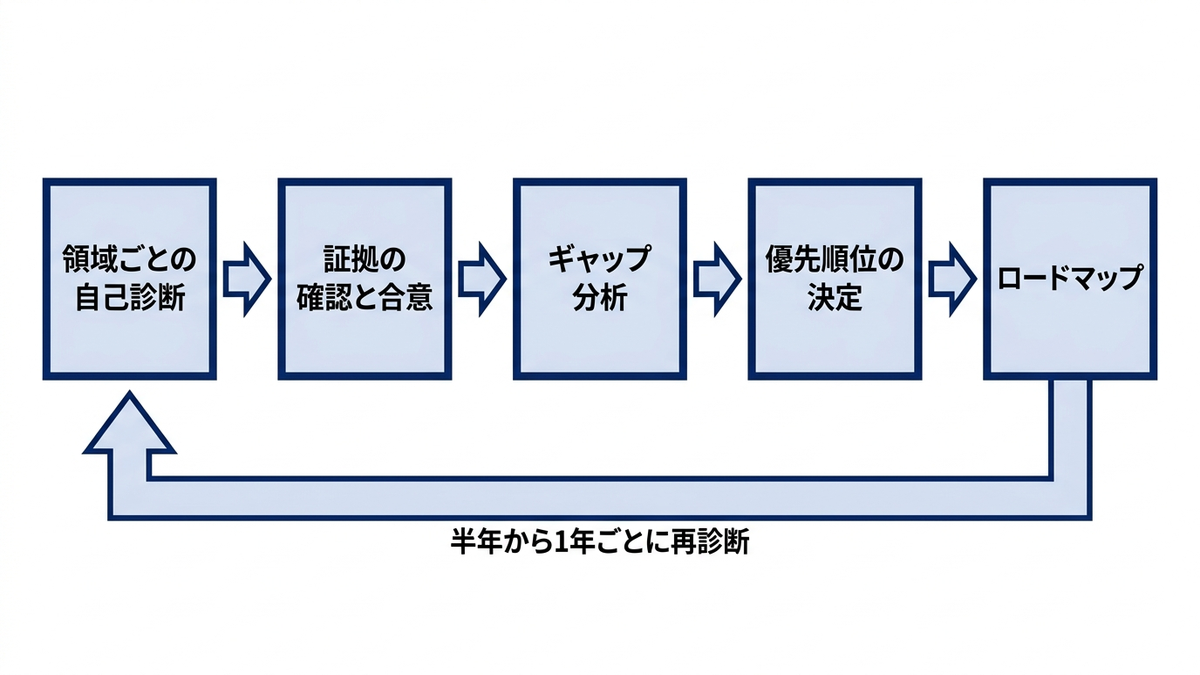
経営判断、どの領域から上げるか
ギャップ分析で差のある領域が複数見つかったとき、どれから上げるかを決めるのは経営の仕事です。判断の材料として、3つの問いを当てはめることが有効だと考えています。1つ目は、その領域が他の領域のボトルネックになっているかです。用語と持ち主の定義、データの分類のように、多くの領域が依存する土台の領域は、それ自体の困りごとが目立たなくても先に上げる価値があります。2つ目は、その領域の不備が、近い将来の経営判断や投資の失敗につながるかです。たとえば来期に AI や新しい分析基盤への投資を予定しているなら、その投資が使うデータの品質と来歴の領域を先に上げないと、投資が空振りするおそれがあります。3つ目は、その領域の不備が法令違反につながるか、取引先や顧客の信頼に関わるかです。個人データの取扱いや取引先とのデータ連携に関わる領域は、事故が起きたときの損失が大きいので、段階を下げないことが優先になります。
3つ目の問いだけは向きが違います。1つ目と2つ目は「どの領域を上げるか」を選ぶ問いで、3つ目は「どの領域を下げてはいけないか」を確かめる問いです。そこで、使う順序は3つ目を先にするのが扱いやすいと考えています。まず法令や信頼に関わる領域が目標の段階を保てているかを確かめ、保てていなければその回復を最優先にします。保てていれば、残りの人と時間で、1つ目の問い(土台の領域)、2つ目の問い(近い投資を左右する領域)の順に上げる領域を選びます。1つの領域が複数の問いに当てはまる場合は、当てはまる問いが多い領域を先にします。
次の表は、3つの問いと、判断を誤ったときの損失の型を並べたものです。損失は金額ではなく型で示しています。
| 判断の問い | 当てはまる領域の例 | 判断を誤ったときの損失の型 | 経営が決めること |
|---|---|---|---|
| 他の領域のボトルネックになっているか | 統治の仕組み(持ち主の任命)、メタデータ(用語と指標の定義)、データの分類 | 二重投資(部門ごとに同じ目的の品質ツールやカタログを重複して入れる)、集計の食い違いが続く | 土台の領域に、目に見える成果が出る前から人の時間を割り当てること |
| 近い将来の投資の成否を左右するか | データ品質、AI のためのデータ、データアーキテクチャ | AI 投資の空振り、判断の遅れ(基盤ができてもデータが使えない) | 投資の計画の前提として、対象データの診断を求めること |
| 法令や信頼に関わるか | セキュリティとプライバシー、取引先とのデータ連携、文書の保存と廃棄 | 法令違反、現場の不信 | 段階を下げないための最小限の運用(棚卸し・監査)を予算として確保すること |
3つの問いのどれにも強く当てはまらない領域は、今回のロードマップには入れず、次回の診断まで現状を維持する、と明示的に決めます。「やらない」と決めた領域を記録しておくことは、「忘れていた」領域と区別するために必要です。全部の領域を同時に上げようとしないことが、限られた人と予算でデータガバナンスを前に進めるための最も大事な判断だと考えています。
経営への報告の形も決めておきます。診断の結果を報告するときは、全領域の段階の一覧に加えて、前回からの変化、ボトルネックと判断した領域とその理由、今期に段階を上げる2〜3領域と最初の一手、上げないと決めた領域、の4点を1枚にまとめると、経営会議で判断しやすくなります。段階の一覧だけを報告すると、「点数が低い」という感想で議論が終わりやすく、何を決めるべきかが見えなくなります。報告の頻度は、診断そのものは半年から1年に1回、ロードマップの進み具合は四半期に1回とするのが、データガバナンスの作業の速さに合っていると考えています。
中堅・中小企業で情報システムの担当が少ない場合も、考え方は同じです。質問票の領域を、統治の仕組み・メタデータ・品質・セキュリティの4つ程度に絞り、回答者も経営者と業務の責任者と情報システムの担当の3人で始めてかまいません。DX推進指標のガイダンスも、該当する部門が無い組織では「部門」を役割やチームなどに読み替えてよいとしています。小さく始めて、毎年同じ物差しで測り続けることの方が、最初から網羅的な診断を1回だけ行うことより役に立つと考えています。
この章では、成熟度アセスメントを、点数を付ける作業ではなく、領域ごとの現在地を同じ物差しで並べて次の一段を決める作業として扱いました。本コラムの5段階(未着手・個別対応・定義済み・運用中・改善継続)で領域ごとに判定し、判定は文書・記録・データの証拠で確かめます。公的な物差しとしては、デジタルガバナンス・コード3.0 と、それに基づいて2026年2月に改訂された DX推進指標があり、データマネジメントとデータガバナンスの全社方針を問う設問を含んでいます。診断の結果は平均ではなく、ボトルネック・変化・回答のばらつきで読み、ギャップ分析のシートで依存関係の順に優先順位を付けます。次の第13章では、ここで選んだ領域を実際に上げていくための体制づくりを、最初の90日から1年の進め方として扱います。
この章を深めたい方への参考書籍
『DX白書2023』(情報処理推進機構 企画・著作・制作、情報処理推進機構):IPA が日米の企業へのアンケート調査の経年変化と国内の DX 事例の分析をもとに、DX の取組状況と課題をまとめた白書です。副題は『進み始めた「デジタル」、進まない「トランスフォーメーション」』で、戦略・人材・ITシステムの各面から現状を整理しています。自社の診断結果を、他社の取り組みの全体像と照らし合わせて読むときの材料になります。
『図解はじめての「開発のためのCMMI」とプロセス改善』(橋本隆成 著、日刊工業新聞社):書名のとおり、ソフトウェア開発の組織のプロセス改善に使われる CMMI(開発のための CMMI)を図解で解説した入門書で、2013年刊行の第2版です。CMMI は成熟度レベルで組織の取り組みを捉えるモデルとして知られています。扱っているのは刊行当時の版のモデルなので、現行の版の詳細は CMMI の公式の情報で確かめる必要がありますが、組織の取り組みを段階で捉えて一段ずつ改善するという考え方を、データ以外の分野の例で知る材料になります。
第13章 自社の体制づくり、最初の90日から1年の進め方
第12章では、領域ごとの自己診断で現状の成熟度を確かめ、どの領域から上げるかを決めて、ギャップを計画に落とす方法を扱いました。診断の結果は、それだけでは何も変えません。誰が、いつ、どの順で、何を決めて動かすかという段取りに置き換えて、初めて体制の変化になります。この章では、診断を終えた会社が、データガバナンスの体制を実際に立ち上げる順序を扱います。第12章の診断をまだ行っていない場合は、対象にしたい領域について第12章の該当する質問に先に答え、困りごとを2〜3個書き出してから、この章の第1週に入る形を想定しています。着手の前に経営が決めること、最初の90日を週単位でどう使うか、データオーナーとデータスチュワードを誰に頼むか、ポリシーを何枚の文書から始めるか、最初の会議で何を議題にするか、経営への報告をどういう形にするか、1年目の後半に何を広げるか、を順に書きます。最後に、情報システムの担当が1人しかいない会社のための縮小版と、最初につまずきやすい判断の型をまとめます。
役割・会議体・意思決定権の考え方そのもの(何をどの文書に書くか、RACI の表の作り方、体制の集中型・分散型・連邦型の違い)は第3章で扱いました。この章ではそれらを説明し直さず、「どの順で置いていくか」と「立ち上げの時期に何をするか」の実務に絞ります。表は、読者が自社の名前と日付を書き込めば、そのまま計画の叩き台として使える粒度にしました。金額や工数の目安は、会社の規模と対象範囲で大きく変わり、一般的な値を示す根拠を持たないので書いていません。
立ち上げの順序と、順序を守る理由
データガバナンスの立ち上げには、前のステップの成果物が次のステップの入力になるという順序の関係があります。順序を飛ばすと、後のステップで前に戻って作り直すことになります。たとえば、対象範囲を決めないまま役割を任命すると、任命された人は自分がどのデータに責任を持つのか分からず、最初の会議が範囲の議論で終わります。用語の定義が無いままでも、空欄の割合や値の分布を調べる事前の調査はできますが、何を「正しい値」とするかの基準が無いので、業務上の合否は判定できず、結果を受け取って直す人も決まりません。データカタログの製品を先に入れると、表名や列名のような技術的な情報は自動で集められる製品もありますが、業務上の意味や持ち主はまだ決まっていないので、それらの欄が空のまま残り、活用が進みにくくなるおそれがあります。
本コラムでは、立ち上げの順序を次の8つのステップで整理しています。経営の意思決定、対象範囲の決定、役割の任命、ポリシーの骨子、用語集、品質の測定、カタログ、拡大の順です。最初の3つのステップは「誰が、何について決めるか」を固める部分で、ここが固まらないうちは、文書や道具を整えても使われにくいと考えています。次の3つは、決める人が実際に決めた中身(方針・定義・基準)を形にする部分です。最後の2つは、形にしたものを検索できるようにし、対象を広げる部分です。序章で、体制づくりで最初に決めるのは役割の任命だと述べたのは、経営が取り組むと決め、対象の範囲を定めたあとの、ツールや文書より先に、という意味です。つまり、ステップ1・2(経営の決定と対象範囲)はその前提に当たり、ステップ3の役割の任命がツールと文書より先に来る点は、序章と変わりません。
| ステップ | まとまり | このステップで決めること | 成果物 | 前提になるステップ | 飛ばしたときに起きること |
|---|---|---|---|---|---|
| 1 経営の意思決定 | 誰が何を決めるか | 取り組むこと、経営スポンサー、取り組む理由、最初の1年で目指す状態、参加する人の時間の扱い | 立ち上げの決定の記録(経営会議の議事録など) | なし(第12章の診断の結果を材料にする) | 部門間で優先順位が衝突したときに裁く人がいない。兼務の人が本業を優先し、活動が止まる |
| 2 対象範囲の決定 | 誰が何を決めるか | 最初に扱う主題領域(顧客・商品・取引先のように、データを業務の主題ごとにまとめた単位。第4章)、対象の業務とシステム、対象外とするもの(やらないこと) | 対象範囲の一覧(やらないことを含む) | 1 | 任命された人が自分の範囲を知らない。最初の会議が範囲の議論で終わる |
| 3 役割の任命 | 誰が何を決めるか | 対象範囲のデータオーナー・データスチュワード・データカストディアン、事務局 | 役割の一覧(氏名・所属・担当範囲・兼務の割合の目安) | 1・2 | 定義や品質の判断を誰に持っていけばよいか分からない。問い合わせが情報システム部門に集中する |
| 4 ポリシーの骨子 | 決めた中身を形にする | 目的、適用範囲、役割と責任、決定と例外の手続き | データガバナンスの基本方針(数ページ)。骨子は第6週、初版は第9週、CDO の承認は第12週 | 3 | 決定の手続きが無いので、定義をめぐる意見の違いが決着しない |
| 5 用語集 | 決めた中身を形にする | 対象範囲の主要な用語と指標の定義、計算方法、持ち主 | ビジネス用語集の初版 | 3・4 | 部門ごとに違う「顧客数」「売上」が会議に並び続ける |
| 6 品質の測定 | 決めた中身を形にする | 重要な項目の品質ルール、測る頻度、許容する水準 | 品質の測定結果の初回報告 | 5 | 業務上の合否の基準が無く、測った数字を受け取って直す人がいない |
| 7 カタログ | 探せるようにし広げる | データセット名・所在・対応する業務用語・持ち主・品質の結果をどこで検索できるようにするか | データカタログ(表計算の一覧でもよい) | 5・6 | 技術的な情報は集まっても、業務上の意味と持ち主の欄が空のまま残る。製品の機能に合わせて運用が決まってしまう |
| 8 拡大 | 探せるようにし広げる | 次に加える主題領域と部門、続ける指標 | 2年目の計画 | 1〜7の運用の結果 | 最初の範囲で効果が出ないうちに広げ、どの範囲でも定着しない |
この順序は、すべてのステップを前のステップが完全に終わってから始めるという意味ではありません。用語集の作業を進めると、対象範囲に入れるべきだった用語が見つかって範囲を直すことがあり、品質を測ると定義のあいまいさが見つかって用語集に戻ることもあります。戻ること自体は問題ではありません。避けたいのは、前のステップの成果物がまだ1枚も無いうちに後のステップへ進むことです。本コラムでは、各ステップの最初の版を「暫定で決めて先に進み、運用しながら直す」ことを前提にしています。
また、ステップ6とステップ7の順番には、会社によって入れ替えの余地があります。既にデータ基盤の中に多くの表があり、どの表に何が入っているかを探すこと自体が最初の困りごとになっている会社では、品質の測定より先に、表の一覧と持ち主を簡単な目録にまとめる方が効果が出やすい場合があります。その場合も、目録に載せる項目のうち業務上の定義と持ち主はステップ3とステップ5の成果物から来るので、ステップ1〜5より前に目録の製品を選ぶ理由にはなりません。カタログの機能と製品の考え方は第6章で扱っています。
8つのステップがどの順に並び、どの3つのまとまり(誰が何を決めるか/決めた中身を形にする/探せるようにし広げる)に分かれるかは、上の表の「まとまり」の列と「前提になるステップ」の列で確かめられます。
着手の前に経営が決める4つのこと
立ち上げの最初のステップは、担当者の作業ではなく経営の判断です。データガバナンスは、部門をまたいで「この定義に揃える」「このデータはこの部門が責任を持つ」と決める仕組みなので、部門の長どうしの意見が分かれたときに裁く人がいなければ、最初の衝突で止まります。本コラムでは、データガバナンスの取り組みに経営として責任を持ち、予算と人の裏付けを与え、部門の間の衝突を裁く役員を経営スポンサーと呼びます。CDO を置いている組織では CDO が経営スポンサーを務め、置いていなければ、担当の役員が CDO の役割を担って経営スポンサーを務めます。以下では、データガバナンス委員会の委員長と基本方針の承認者も、この人を指します。経営スポンサーが立ち上げの時期に決めることは、次の4つだと考えています。このうち3つは第2週の経営会議で決め、やらないことだけは、対象範囲が決まる第4週に対象範囲とあわせて決めます。
1つ目は、取り組む理由です。「データガバナンスが必要だから」では、兼務で参加する人が本業より優先する理由になりません。第12章の診断で見つかった具体的な困りごと(経営会議に部門ごとに違う売上の数字が出る、顧客の件数が台帳によって違う、AI の検討で使えるデータが見つからない、個人データの所在が把握できていない、など)を1つか2つ挙げ、「これを1年で解消する」という形で書きます。理由が具体的であるほど、対象範囲の決定と、後で成果を測る指標の選び方が楽になります。
2つ目は、最初の1年で目指す状態です。成熟度の5段階(未着手・個別対応・定義済み・運用中・改善継続)で言えば、対象範囲の領域を「個別対応」から「定義済み」へ、一部を「運用中」へ上げる、といった書き方が目安になります。全領域を「改善継続」にする、という目標は1年目には置かないことを勧めます。目指す状態が高すぎると、半年後の報告で進捗が小さく見え、経営の関心が下がる原因になります。
3つ目は、やらないことです。最初の1年で対象にしない主題領域、入れない道具、作らない文書を明記します。対象にしない主題領域は、対象範囲の候補が出そろう第3週より前には決められないので、やらないことは第4週に対象範囲と一緒に確定し、経営会議に報告します。たとえば「1年目は顧客と商品のマスターに限り、会計と人事のデータは対象外とする」「データカタログの製品の選定は2年目に行う」「全社規程の改定は1年目には行わず、基本方針の承認にとどめる」といった書き方です。やらないことを書いておくと、立ち上げの途中で「ついでにこれも」という要望が来たときに、範囲を守る根拠になります。この点は章の最後でもう一度扱います。
4つ目は、参加する人の時間の扱いです。データオーナーやデータスチュワードは、多くの会社で兼務で始めることになります。兼務の場合、本業の評価だけで働きぶりが測られると、ガバナンスの作業は後回しになります。どの程度の時間を割いてよいか、その活動を評価でどう扱うかを、本人の上長と経営スポンサーの間で事前に合意しておくことが有効だと考えています。時間の割合を数字で決めるかどうかは会社の慣行によりますが、少なくとも「この活動は業務として認められている」ことを、上長が本人に伝える形にしておきます。
理由・目指す状態・時間の扱いの3つは第2週の経営会議の1つの議題として決め、やらないことは第4週に対象範囲とあわせて経営会議に報告し、どちらも議事録に残すのが扱いやすい形です。後のステップで範囲や優先順位をめぐる議論が起きたとき、議事録が判断の拠り所になります。経営の側から見ると、このステップを省いて担当者に「データガバナンスを進めておいて」と任せることの損失は、担当者が部門の長を説得する権限を持たないまま時間を使い、半年後に「何も決まっていない」という報告を受けることです。その間に作られた文書は、承認されていないので使われず、作り直しになります。
最初の90日の計画表
最初の90日は、およそ13週です。本コラムでは、この期間を「準備(第1〜2週)」「範囲の確定と候補者の調整(第3〜4週)」「任命と骨子・定義づくり(第5〜9週)」「最初の測定と報告(第10〜13週)」の4つに分けています。90日の終わりに目指すのは、対象範囲について、誰が決めるかが決まっていて、基本方針の初版が承認され、主要な用語の定義の初版があり、重要な項目の品質を1回測った結果を経営に報告できている状態です。カタログの製品の導入や、対象範囲の拡大はこの期間に入れていません。
次の表は、週ごとの作業と成果物の一例です。「主に動く人」の列は、第3章で扱った役割の名前で書いています。事務局は、委員会の運営、課題の管理、文書の維持(会議の準備・記録・文書の版の管理・進捗の取りまとめ)を担う担当で、本コラムの想定では、情報システム部門・DX 推進部門・経営企画部門のいずれかに置きます。部門をまたぐ決定はデータガバナンス委員会で行います。委員会は、CDO(経営スポンサー)が委員長を務め、主要部門のデータオーナー、情報システム部門の責任者、事務局で構成します。立ち上げの90日は、主要部門のデータオーナーを対象範囲の関係部門に絞ります。対象範囲の外の部門の長まで集めると、その回に決めることの無い出席者が増え、会議が報告会になりやすいからです。ただし、情報システム部門の責任者は、データカストディアンの手配とシステム変更の判断にかかわるので、最初から入れます。委員会の位置づけは第3章で扱ったので、ここでは90日の中で3回開く前提で、その時期と議題だけを表に入れています。文書の承認者は第3章の4層に合わせ、原則と基本方針は委員会で審議して CDO が承認し経営会議へ報告する、標準は委員会が承認する、手順は担当のデータスチュワードと情報システム部門が承認する、としています。
| 週 | 主な作業 | 主に動く人 | その週の成果物 | 次の週へ進む条件 |
|---|---|---|---|---|
| 第1週 | 第12章の診断結果の読み直し。取り組む理由の候補を2〜3個に絞る。経営スポンサーの候補の選定と本人への打診 | 経営スポンサーの候補・事務局 | 取り組む理由の案 | 経営スポンサーの候補が打診を受け、了承している |
| 第2週 | 経営会議で、取り組むことを決め、経営スポンサーを正式に置き、理由・目指す状態・時間の扱いを決める。対象範囲の候補を出すよう事務局に指示する。事務局の担当者を決める | 経営スポンサー・経営会議 | 立ち上げの決定の議事録 | 議事録が残っている |
| 第3週 | 対象範囲の候補の洗い出し(主題領域・業務・システム)。各候補の困りごとの大きさと関係部門を一覧にする | 事務局・情報システム部門 | 対象範囲の候補の一覧 | 候補ごとの関係部門が分かっている |
| 第4週 | 対象範囲とやらないことの決定(経営スポンサーが決め、経営会議に報告する)。データオーナー・データスチュワード・データカストディアンの候補者と、その上長への説明 | 経営スポンサー・事務局・各部門の長 | 対象範囲の一覧(確定版。やらないことを含む)。役割の一覧(案) | 候補者の上長の了承がある |
| 第5週 | 役割の任命。第1回のデータガバナンス委員会(立ち上げの会)。用語集に載せる用語の候補の洗い出しを始める | 経営スポンサー・データオーナー・情報システム部門の責任者・事務局 | 役割の一覧(確定版)。第1回の議事録 | 任命が通知されている |
| 第6週 | 基本方針の骨子の起草。用語の候補の洗い出し(各部門の帳票・報告書・システムの項目名から) | 事務局・データスチュワード | 基本方針の骨子(目次と各節の要点)。用語の候補の一覧 | 骨子の目次がそろっている |
| 第7週 | 用語の定義の下書き。部門ごとに定義が違う用語の洗い出し | データスチュワード | 用語集の下書き。定義が食い違う用語の一覧 | 食い違いの一覧ができている |
| 第8週 | 第2回のデータガバナンス委員会。食い違う用語の定義を決める。基本方針の骨子の確認 | データオーナー・経営スポンサー・情報システム部門の責任者 | 決めた定義の記録。第2回の議事録 | 主要な食い違いに結論が出ている(保留を含む) |
| 第9週 | 基本方針の初版の仕上げ。用語集の初版の公開。品質を測る項目の選定 | 事務局・データスチュワード・データカストディアン | 基本方針の初版。用語集の初版。測る項目の一覧 | 測る項目と、その品質ルールの案がある |
| 第10週 | 品質ルールの確定(データオーナーが承認する)と、最初の測定(抽出と集計は手作業を含んでよい) | データオーナー・データスチュワード・データカストディアン | 品質の測定結果(初回) | 測定結果が数字で出ている |
| 第11週 | 測定結果の読み解き。不良の原因の当たりを付け、直す順の案を作る | データスチュワード・データオーナー | 品質の課題一覧(原因の当たり・直す順の案) | 課題ごとに担当の候補がいる |
| 第12週 | 第3回のデータガバナンス委員会。基本方針の初版を審議し、CDO(経営スポンサー)が承認する。課題一覧の優先順位の決定。経営への報告の準備 | データオーナー・経営スポンサー・情報システム部門の責任者・事務局 | CDO が承認した基本方針。課題の優先順位。第3回の議事録 | 基本方針が CDO に承認されている |
| 第13週 | 経営会議への最初の報告(承認した基本方針の報告を含む)。次の90日の計画の承認 | 経営スポンサー・事務局 | 経営への報告書(初回)。次の90日の計画 | 次の90日の計画が承認されている |
この表で「次の週へ進む条件」の列を置いたのは、日付どおりに進まなかったときの判断を事前に決めておくためです。条件を満たさないまま次の週の作業に入ると、たとえば上長の了承が無いまま任命した人が、第1回の会議に出られないということが起きます。条件が満たせないときは、計画を1週ずらすか、条件を満たせなかった範囲を外して先に進むかを、事務局が経営スポンサーに相談して決めます。13週の計画は、会社の事情でずれることを前提にし、ずれたときにこの判断をする場を、毎週の事務局の打ち合わせなどに決めておきます。
第7週と第8週の「定義が食い違う用語」の扱いが、90日の中で最も時間のかかる作業になりやすいと思われます。「顧客」を契約単位で数えるか取引先の法人単位で数えるか、受注額・出荷額・請求額のどれを「売上」と呼んでいるか、といった違いは、各部門の業務の都合から生まれていることが多く、業務の指標としてはどちらかが誤っているとは限りません。ただし、会計上の売上高をいつ計上するかは部門の都合で選べるものではなく、適用する会計基準(国内では企業会計基準第29号「収益認識に関する会計基準」など)と自社の会計方針に従います。受注額や出荷額のような業務の指標は、会計上の売上高とは別の名前と集計条件を付けて用語集に載せます。この時点では、全社の正式な定義を1つ決めることにこだわらず、「経営報告に使う定義はこれ。部門の業務で使う別の数え方には別の名前を付ける」という形で決めると、合意が早くなることが多いと考えています。用語集と指標の定義の作り方そのものは第6章で扱っています。
第10週の最初の測定は、手作業を含んでかまいません。表計算で抽出した一覧に対して、空欄の割合、重複の件数、決めた形式に合わない値の件数を数えるだけでも、最初の報告の材料になります。品質ルールの作り方と測り方は第5章で扱いました。ここで大事なのは、測定を自動化することより、測った数字を誰が受け取り、誰が直すかが決まっていることです。測定の自動化は、ルールと報告の形が固まった後、1年目の後半に回します。
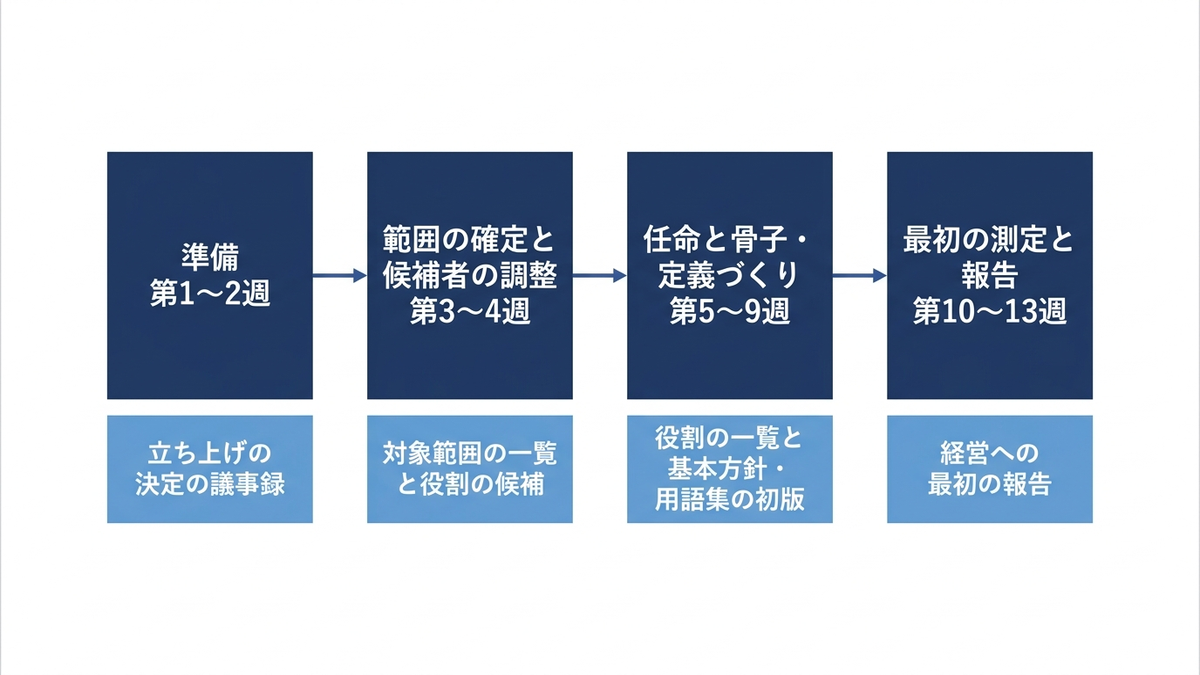
データオーナーとデータスチュワードの選び方、兼務の扱い
役割の責任の範囲は第3章で定義しました。立ち上げの実務で迷うのは、その役割を「誰に頼むか」です。データオーナーは、そのデータの定義・用途・品質の水準・提供の可否を決める人なので、決めた結果に業務上の責任を負える立場であることが条件になります。多くの場合、そのデータを生み出す業務、またはそのデータを最も使う業務を所管する部門の長が候補になります。顧客のマスターなら営業か顧客対応の部門の長、商品のマスターなら商品企画か調達の部門の長、といった形です。ただし、部門の長が多忙で会議にほとんど出られない場合は、決定の権限を委ねられた次の階層の管理職を充てる方が、実際に決定が進むことがあります。その場合も、委任の範囲を部門の長が文書で示しておくと、後から決定が覆されにくくなります。
データスチュワードは、データオーナーの決定を日々の運用に落とす人なので、業務とデータの両方を知っていることが条件になります。帳票やシステムの画面のどの欄に何が入るか、どういう例外の処理があるかを知っている実務者が向いています。情報システム部門の担当者は、システムの項目の意味には詳しくても、業務の上でその値がどう決まるかを知らないことがあるので、データスチュワードには業務側の人を置き、情報システム部門はデータカストディアンとして支える形が、本コラムの定義に沿った分担です。
次の表は、役割ごとに候補者を選ぶときの観点をまとめたものです。各役割を担う人の例と兼務の例は第3章の役割の表にあるので、ここでは選ぶときに確かめる質問と、避けたい選び方だけを並べました。質問の列は、候補者本人か、その上長に聞くことを想定しています。
| 役割 | 選ぶときに確かめる質問 | 避けたい選び方 |
|---|---|---|
| 経営スポンサー(CDO。置いていなければ CDO の役割を担う担当役員) | 部門の長どうしの意見が分かれたときに裁けるか。基本方針を承認する立場にあるか。四半期に1回、経営会議で報告を受ける時間を取れるか | 権限の無い部長級を「スポンサー」と呼ぶ。複数の役員の共同担当にして責任を分散させる |
| データオーナー | このデータの定義を変えると、自分の部門の業務と数字にどう影響するかを説明できるか。決めた結果に責任を負えるか。委員会に出席できるか | データに詳しいという理由だけで、決定の権限の無い担当者を充てる |
| データスチュワード | このデータがどの業務のどの時点で入力されるかを説明できるか。部門の外からの問い合わせに答える時間を取れるか。本業の繁忙期はいつか | 情報システム部門の担当者だけで固める。新人や異動直後の人に任せる |
| データカストディアン | 対象のデータがどのシステムのどの表にあり、誰が権限を持っているかを示せるか。委託先がある場合、その窓口を示せるか | 委託先に任せたまま、社内の窓口を置かない |
| 事務局 | 部門をまたいで会議を設定し、議事録と文書の版を管理できるか。立ち上げの90日に本業の業務量を調整できるか | 事務局に決定の権限まで持たせる。事務局がすべての文書を書く。兼務のまま主担当を決めない |
表の「避けたい選び方」の列のうち、立ち上げで最も起きやすいのは、データオーナーに決定の権限の無い人を充てることだと思われます。データに詳しい担当者は会議で発言できますが、部門の業務を変える決定はできないので、決めたことを部門に持ち帰ると覆されます。データに詳しいことと、決められることは別の条件です。前者はデータスチュワードの条件、後者はデータオーナーの条件として分けて選びます。
兼務の任命の文書に、役割に充てる時間と起案できる決定を書いておくことは、第3章で述べました。立ち上げの実務で加えておきたいのは、計画表の日程を、兼務の人の本業の繁忙期から外すことです。決算期の経理、繁忙期の営業や物流の担当者に、その時期に定義の確認を頼んでも、作業は後回しになります。それ自体は自然なことで、責める理由にはなりません。90日の計画を組む第3〜4週の時点で、候補者の上長に各部門の繁忙期を聞き、第7〜10週の定義と測定の作業がそこに重ならないよう、計画の開始時期そのものをずらすことも考えます。データスチュワードを専任で置くかどうかは、1年目の運用の結果を見て、2年目の計画で判断します。
役割の一覧には、氏名・所属・担当する主題領域・兼務か専任か・任命した日・任命した人を書きます。異動のある会社では、異動の時期に一覧を見直す手順を事務局の作業に入れておかないと、異動の後も一覧が更新されず、載っている担当者が実態と合わなくなることがあります。役割は人ではなく職位に付ける(「営業企画部長がデータオーナー」と書く)方法もあり、異動に強い反面、新しく就いた人が役割を知らないまま時間が過ぎることがあるので、異動の際の引き継ぎの項目に役割を入れておきます。
ポリシーの最小構成、基本方針の目次の雛形と書き出し
ポリシー・標準・手順の層の違いと、全社のポリシーを1つの文書にまとめる場合の目次の例は第3章で示しました。この節では、その目次を立ち上げの90日の中でどう埋めるかを扱います。立ち上げの時期に作る文書は、最小限にとどめることが有効だと考えています。最初から全領域の標準と手順をそろえようとすると、文書の作成と承認に時間を取られ、90日の中で何も運用が始まりません。本コラムでは、最初の90日に整える基本の文書を、基本方針(ポリシー)1本と、用語集の初版、役割の一覧、対象範囲の一覧の4つに絞っています。品質ルールの一覧は第9週から第10週にかけて加え、議事録や測定結果のような運用の記録は、これとは別に残します。データ分類やアクセスの標準のように、既に情報セキュリティの規程で定めている会社では、新しく作らずに基本方針から既存の規程を参照する形にします。
基本方針は、委員会で審議して CDO(経営スポンサー)が承認し、経営会議へ報告します。そのうえで、全社の規程として正式に制定するか、CDO が承認した方針のまま運用を始めるかを、自社の決裁規程に定められた手続きで決めます。全社規程にすると拘束力が強い反面、改定のたびに規程の改定の手続きが必要になり、立ち上げの時期の試行錯誤には向きません。最初の1年は CDO が承認した方針として運用し、内容が固まった時点で全社規程に格上げする順序も考えられます。
次の表は、基本方針の目次の雛形を、90日の計画表のどの週に、誰が、何を材料にして書くかと合わせて示したものです。「最初の版の書き出しの例」の列は、白紙から書き始めずに済むよう、各節の1文目の例を置きました。かぎ括弧の中を自社の名前と範囲に置き換えて使うことを想定しています。
| 節 | 最初の版の書き出しの例 | 材料 | 起草する人 | 書く週 |
|---|---|---|---|---|
| 1 目的と適用範囲 | この方針は、「経営会議に出る顧客数や商品別の数字の前提になる、顧客と商品の識別と分類を部門の間で揃える」ために、「顧客と商品のマスター」とそれを使う「営業・経理・物流の業務」に適用する | 立ち上げの決定の議事録(取り組む理由)、対象範囲の一覧 | 事務局 | 第6週 |
| 2 原則 | 対象のデータには、定義と品質の水準を決める責任者を必ず置く。定義は用語集の1か所で管理し、誰でも参照できる場所に置く | 第2週の経営会議で決めたことと、第4週に経営スポンサーが決めたこと | 事務局が起草し、経営スポンサーが確認 | 第6週 |
| 3 用語の定義 | この方針でデータオーナーとは、担当するデータの定義・用途・品質の水準・提供の可否を決める者をいう | 本コラムの用語の定義(第1章・第3章) | 事務局 | 第6週 |
| 4 役割と責任 | データオーナーは「部門の長」が務め、氏名は別に定める役割の一覧に記す。データオーナーは、データスチュワードを指名する | 役割の一覧(確定版) | 事務局 | 第7週 |
| 5 会議体 | データガバナンス委員会は「CDO」を委員長とし、主要部門のデータオーナー、情報システム部門の責任者、事務局で構成し、「月1回」開く。合意に至らない事項は委員長が決める | 第1回の委員会で決めた運営の決まり | 事務局 | 第7週 |
| 6 データの定義と登録 | 対象のデータの定義は、データスチュワードが起案し、データオーナーが承認して用語集に登録する | 用語集の下書き | データスチュワード | 第8週 |
| 7 データ品質 | 対象のデータの重要な項目について、データオーナーが品質ルールと許容する水準を承認し、データスチュワードとデータカストディアンが「四半期」ごとに測定して委員会に報告する | 測る項目の一覧の案 | データスチュワード・データカストディアン | 第9週 |
| 8 データの提供と利用 | 対象のデータを部門の外へ提供するときは、データオーナーの承認を得る。個人データの扱いは「個人情報の取扱いの規程」による | 既存の情報セキュリティ・個人情報の規程 | 事務局・データカストディアン | 第8週 |
| 9 例外と変更 | この方針と定義に沿えない場合は、理由と期限と代わりの対策を添えて事務局に申請する。期限の無い例外は認めない | 例外の申請の様式の案 | 事務局 | 第8週 |
| 10 見直しと報告 | この方針は委員会が「年1回」見直し、改定は CDO が承認する。委員会は「四半期」ごとに経営会議へ進み具合を報告する | 報告書の形(後の節) | 事務局 | 第9週 |
表の起草者が事務局に偏っているのは、立ち上げの時期は、各節が数行で済み、内容の大半が経営会議と委員会で既に決めたことの書き写しだからです。事務局が新しく考えるのではなく、決めたことを文に直す作業だと位置づけておくと、起草の時間が短くなり、内容が現場と合わないまま承認されることも避けられます。逆に、第6節と第7節は業務の実態に依存するので、データスチュワードが起草します。事務局がこの2節まで書くと、定義の登録の流れや品質の測り方が、実際の帳票やシステムと合わないものになりやすいと思われます。
第9節の例外は、立ち上げの時期に軽視されやすい節です。第2回の委員会で定義を決めると、すぐに「この業務ではこの定義に従えない」という声が出ます。例外を申請する道が第8週の時点で用意されていないと、従えない部門は黙って従わなくなるおそれがあります。基本方針の承認は第12週なので、それまでの間の申請先と承認者(たとえば、申請先は事務局、承認者は対象のデータのデータオーナー、部門をまたぐものは経営スポンサー)と、暫定の扱いを始める時期を、第1回の委員会で運営の決まりの一部として決めておき、期限の来た例外は委員会で再審査します。例外を認めることは方針の後退ではなく、方針の外にあるものを見える場所に置くことだと考えています。
対象範囲に入らない領域(たとえば、顧客と商品から始める会社にとっての会計や人事のデータ)の方針は、最初の版には書かず、第1節に「対象外」と明記するだけにします。全領域の方針を最初にそろえようとすると、各領域のデータオーナーがまだ決まっていないので、事務局がすべてを書くことになるからです。文書の分量は、基本方針で数ページに収まるのが目安です。標準や手順の細部は、運用が始まってから、実際に問い合わせや例外が多かった箇所から書き足していく方が、使われる文書になります。
会議体の立ち上げと、最初の3回の議題
会議体の種類と頻度の考え方は第3章で扱いました。ここでは、データガバナンス委員会を立ち上げる最初の3回に何を議題にするかを具体的に書きます。立ち上げの時期の会議で避けたいのは、毎回が報告会になり、決めることが無いまま終わることです。各回に「この回で決めること」を1〜3個置き、事前に資料を配って、会議の時間は決定に使う形にします。
| 回 | 時期の目安 | この回で決めること | 事前に配る資料 | 会議の後に残すもの |
|---|---|---|---|---|
| 第1回(立ち上げの会) | 第5週 | 委員会の運営の決まり(頻度・定足数(会議が成立する最低の出席者数)・決め方・決まらないときに誰が裁くか)。運営の決まりには、基本方針の承認(第12週)までの例外の申請先と承認者、暫定の扱いを始める時期を含める。対象範囲と役割の一覧の確認。90日の計画の確認 | 経営会議の議事録、対象範囲の一覧、役割の一覧、90日の計画表 | 議事録。運営の決まり。各データオーナーの宿題(用語の候補を出す担当者の指名など) |
| 第2回 | 第8週 | 部門ごとに定義が食い違う用語の結論(経営報告に使う定義と、別の名前を付ける部門の定義)。基本方針の骨子への意見 | 用語集の下書き、定義が食い違う用語の一覧(各部門の定義・使っている帳票・違いが生じる理由)、基本方針の骨子 | 決めた定義の記録(決めた人・日付・理由)。保留にした用語と、次に決める期限 |
| 第3回 | 第12週 | 基本方針の初版の審議と、CDO による承認。品質の課題の優先順位。経営への報告の内容。次の90日の計画の案 | 基本方針の初版、品質の測定結果と課題一覧、経営への報告書の案 | 承認の記録。課題ごとの担当と期限。経営会議への報告の日程 |
第1回で運営の決まりを先に決めるのは、第2回の定義の議論で意見が分かれたときに、決め方が決まっていないと結論が出ないからです。全員の合意を条件にするか、データオーナーの多数で決めるか、最後は委員長の CDO(経営スポンサー)が裁くか、を最初に決めておきます。本コラムでは、対象のデータのデータオーナーが案を出し、関係するデータオーナーの意見を聞いたうえで、合意できないものは CDO が裁く、という決め方を基本にしています。
第2回の資料で「違いが生じる理由」の欄を設けたのは、定義の議論を「どちらが正しいか」から「どの業務の都合で違うのか」に移すためです。理由が並ぶと、どちらかを捨てるのではなく名前を分ければよい、という結論になりやすくなります。保留にした用語は、保留の理由と次に決める期限を記録に残します。保留が記録されないと、同じ議論が次の回にも、その次の回にも繰り返されます。
90日を過ぎた後の開催頻度は、立ち上げの時期より下げてかまいません。第3章の目安(初年度は月1回、軌道に乗ったら四半期に1回)を基準に、扱う課題の量に合わせて決めます。頻度を下げる代わりに、データスチュワードどうしの実務の打ち合わせを別に置き、定義の細部や品質の課題の進捗はそちらで扱うと、委員会を決定の場として保てます。
指標と経営への報告、報告書の形
経営への報告は、データガバナンスを続けるかどうかを経営が判断する材料です。報告が作業の一覧(何回会議を開いたか、何本の文書を作ったか)だけだと、経営は「それで何が良くなったのか」を判断できず、関心が下がります。報告では、活動の量ではなく、取り組む理由に挙げた困りごとがどれだけ解消に近づいたかを中心に置くことが有効だと考えています。成果を測る指標の考え方(定義済みのデータ項目の割合、品質ルールの合格率、問い合わせの解決日数など)は第3章で扱ったので、ここでは立ち上げの1年目に報告する指標の選び方と、報告書の形を扱います。
第3章では、指標を「役割と決定権が働いているか」「定義と品質が改善しているか」「利用者が使いやすくなったか」の3つの観点に分けました。この章では、それぞれを体制・中身・困りごとの指標と呼びます。立ち上げの1年目に報告するときに意識したいのは、この3つの観点の指標が動き始める時期がずれることです。役割の任命の割合は最初の90日でほぼ決まり、定義済みの項目の割合と品質ルールの合格率は第2四半期から動き、経営会議に出る数字の食い違いの件数や問い合わせの解決日数は、運用が回り始める第3四半期以降に動く、というのが本コラムの想定です。実際の時期は、対象範囲と会社の事情で大きく変わります。最初の報告で3つ目の観点の指標が動いていなくても、それは異常ではありません。どの指標がいつ動き始める見込みかを最初の報告書に書いておくと、経営の期待とのずれを防げます。また、最初の90日の終わりに測った値は、以後の比較の基準になるので、測った日と測り方を報告書に残しておきます。
次の表は、経営会議に出す報告書の形の一例です。1回の報告を数ページに収め、毎回同じ順で並べることを前提にしています。毎回同じ形にしておくと、経営は前回の報告と並べて、何が動いたかを自分で確かめられます。
| 報告書の欄 | 書く内容 | 書き方の注意 |
|---|---|---|
| 1 要点 | この期間に決まったこと、解消に近づいた困りごと、経営に判断してほしいこと | 3〜5行。判断してほしいことがある場合は最初に書く |
| 2 取り組む理由に対する進み具合 | 経営会議で決めた「取り組む理由」ごとに、現在の状態と次の目標 | 理由ごとに1行。進んでいないものも、理由とともに書く |
| 3 指標 | 体制・中身・困りごとの3種類の指標の、今回の値と前回の値 | 定義を変えた指標は、変えたことと理由を注記し、できれば前回の値も新しい定義で集計し直す。できない場合は単純に比べられないことを明記する。値の横に測った日を書く |
| 4 決めたことの一覧 | 委員会で決めた定義・例外・優先順位 | 件名と決めた日だけを並べ、詳細は議事録を参照する形にする |
| 5 課題と対応 | 品質の課題、決まっていない定義、人員や時間の不足 | 課題ごとに担当と期限を書く。期限を過ぎたものはその理由を書く |
| 6 経営に判断してほしいこと | 範囲の変更、人員の配置、他の施策との優先順位、予算の要否 | 選択肢と、事務局の推奨と、その根拠を並べる |
| 7 次の期間の計画 | 次の90日または次の四半期の主な作業と成果物 | 前回の計画と比べ、変えた点を明記する |
報告書の第6欄に「選択肢と推奨と根拠」を並べるのは、経営が判断に使う時間を短くするためです。「人員が足りない」とだけ書くと、経営は何を判断すればよいか分かりません。「対象範囲を予定どおり商品に広げるには、データスチュワードがもう1名必要。選択肢は、増員する、拡大を半年遅らせる、顧客の範囲の品質改善を一部止める、の3つ。推奨は2つ目で、理由は顧客の範囲の品質ルールの合格率がまだ目標に届いていないため」のように書くと、経営はその場で選べます。
経営の側から見ると、報告の形が固まらないことの損失は、判断の材料が毎回違うために、続けるか止めるか、広げるかを決められないまま時間が過ぎることです。また、報告に良い数字だけが並ぶと、問題が表に出るのが遅れます。課題の欄を必ず置き、期限を過ぎたものを隠さずに書くことが、報告を信頼される材料にする条件だと考えています。報告の頻度は、立ち上げの90日の終わりに1回、その後は四半期に1回が目安です。
90日の後、1年目の残りの進め方
最初の90日で、対象範囲について「誰が決めるか」と「最初の定義」と「最初の測定」がそろいます。1年目の残りの約9か月は、それを運用として回し続け、運用の結果を見て2年目の範囲を決める期間です。本コラムでは、1年の進め方を四半期単位のロードマップとして示します。ロードマップは、各四半期に何を整え、何を後回しにし、四半期の終わりにどの状態になっているかを並べた計画です。第12章のギャップ分析で決めた優先順位を、ここで時期に置き換えます。
| 時期 | 整えるもの | 後回しにするもの | 四半期の終わりの状態 |
|---|---|---|---|
| 第1四半期(最初の90日) | 経営の決定、対象範囲、役割の任命、基本方針の初版、用語集の初版、最初の品質の測定と報告 | カタログの製品の選定、測定の自動化、対象範囲の拡大、全社規程化 | 対象範囲について誰が決めるかが決まり、最初の定義と測定結果がある |
| 第2四半期 | 品質の課題の改善(入力の手順やシステムの入力チェックなど、原因の側を直す)。用語集の追加と見直し。例外の申請の運用。問い合わせ窓口の運用 | カタログの製品の導入、対象範囲の拡大 | 品質ルールの合格率の変化が2回以上の測定で見える。問い合わせの記録が残っている |
| 第3四半期 | 品質の測定の定期化と、測定の自動化の要否の判断。データセット名・所在・対応する用語と定義・持ち主・品質の結果を検索できる目録(表計算の一覧でもよい)。カタログの製品が要るかどうかの検討 | 全社への展開 | 目録が使われている(問い合わせの一部が目録で解決している)。製品の要否の判断材料がそろっている |
| 第4四半期 | 1年目の振り返り。第12章の診断のやり直し。基本方針の改定。2年目に加える主題領域と部門の決定。専任の担当を置くかどうかの判断 | 2年目の範囲に入れないもの(経営の決定として明記する) | 2年目の計画が経営会議で承認されている |
第2四半期に「原因の側を直す」と書いたのは、品質の不良を見つけるたびにデータを手で直す運用を続けると、直す作業が終わらないからです。たとえば、取引先の名称の表記ゆれが多いなら、登録の画面に入力の規則を設ける、登録の申請を一か所に集める、といった直し方の方が、件数を減らす効果が続きます。品質の改善の考え方は第5章で、マスターデータの名寄せの方法は第7章で扱っています。
第3四半期にカタログの製品の「要否の検討」を置いたのは、その時点で初めて、何を載せるか(用語・定義・持ち主・品質の結果)と、誰が使うか(問い合わせの記録から分かる)がそろうからです。表計算の一覧で目録を運用して、検索の不便さや更新の手間がはっきりしてから製品を選ぶと、製品に求める機能を具体的に書けます。表計算の一覧で困らない規模であれば、製品を入れないという判断もあり得ます。
第4四半期の振り返りでは、第12章と同じ質問で診断をやり直し、1年前と並べます。成熟度の段階が上がった領域と、上がらなかった領域の理由を報告書に書き、2年目の範囲の判断材料にします。2年目に範囲を広げる場合は、1年目の範囲で役割と運用が回っていることを条件にするのが安全だと考えています。1年目の範囲で運用が回っていないのに範囲を広げると、新しい範囲の立ち上げに事務局の時間が取られ、1年目の範囲の運用も止まります。
予算と人員の考え方、外部支援の使いどころ
データガバナンスの予算と人員を、一般的な目安の金額や工数で示すことはこの章ではしません。必要な人と時間は、対象範囲の広さ、既にある規程や体制、データの散らばり具合、外部に委託している業務の量で大きく変わり、規模だけから決まる値を示す根拠を持たないからです。代わりに、予算と人員を考えるときの順序を書きます。
1つ目は、人の時間が先で、道具の費用は後だということです。立ち上げの1年目に必要なのは、データオーナーが決定に使う時間、データスチュワードが定義と品質に使う時間、事務局が会議と文書に使う時間です。データオーナーとデータスチュワードは兼務で始めることが多く、その場合は新しい予算ではなく、本業の時間の一部をガバナンスに振り向けることになります。経営が明示的に認めるべきなのは、この時間の振り向けです。道具の費用は、第3四半期に製品の要否を検討した結果として、2年目の予算で判断するのが、本コラムの順序です。
2つ目は、事務局の時間を確保することです。立ち上げの時期は、会議の準備、文書の起草、部門間の調整が集中するので、事務局の担当者が本業の片手間で回すと、計画の遅れが最も起きやすい箇所になります。事務局を専任にするかどうかは会社によりますが、少なくとも立ち上げの90日は、事務局の主担当の業務量を調整しておくことが有効だと考えています。
3つ目は、品質の改善に伴う費用を、ガバナンスの予算と分けて見ることです。品質の課題の中には、システムの入力チェックの追加や、登録の仕組みの変更のように、システムの改修が必要なものがあります。その費用はガバナンスの活動そのものではなく、課題を解消するための投資なので、課題ごとに効果と合わせて経営に判断を求める形にします。報告書の第6欄はこの判断に使います。
外部の支援(コンサルティング会社、製品の導入支援、研修の提供者など)を使う場面は、一般論として、社内に経験者がいない段階で進め方の型を持ち込む、部門間の議論で中立の立場の進行役を置く、第12章の診断を外部の目で行う、製品の選定と導入の技術的な作業を任せる、といったものが考えられます。一方で、外部に任せられないものもあります。データオーナーとして決定すること、取り組む理由を決めること、やらないことを決めること、兼務の人の時間と評価を扱うことは、社内の人にしかできません。外部の支援者が作った文書が、社内で誰の決定も経ないまま採用されると、承認はされても運用されない文書になりやすいと思われます。外部の支援を使う場合も、決める人は社内に置き、外部には「決めるための材料と進め方」を求める形にしておくことが有効だと考えています。
経営の側から見ると、予算と人員の判断を誤ったときの損失は、二重投資と判断の遅れとして表れます。役割と定義が決まる前に製品を入れると、運用が製品の機能に合わせて決まり、後で定義が固まったときに製品の設定や選定をやり直すことになります。逆に、人の時間を認めないまま始めると、活動が止まり、1年後に「何も変わっていない」という報告を受けて、取り組みそのものを止める判断に傾きます。どちらも、取り組みを始める前の順序の判断で避けられる損失です。
中小企業と、情報システムの担当が1人の会社の縮小版
ここまでの計画は、部門が複数あり、経営スポンサー・データオーナー・データスチュワード・データカストディアン・事務局を別の人に割り当てられる会社を想定していました。従業員が少なく、情報システムの担当が1人しかいない会社では、同じ形をそのまま当てはめると、会議と文書の負担が活動の中身を上回ります。小さな会社でもデータガバナンスが要る理由は第1章で述べました。ここでは、同じ8つのステップの順序を保ったまま、各ステップを小さくする方法を書きます。
縮小版の考え方は3つです。1つ目は、役割は兼ねてよいが、役割の名前は分けて書くことです。社長が経営スポンサーとデータオーナーを兼ね、情報システムの担当がデータカストディアンと事務局を兼ねる、といった形になります。第3章でも触れたとおり、同じ人が複数の役割を持つ場合でも、「いまはどの立場で決めているか」を区別できるように、役割の一覧には役割ごとの行を作っておきます。特に、情報システムの担当が業務上の定義まで決めてしまう状態は避け、定義の決定は業務を所管する人(小さな会社では社長や営業の責任者)に残します。
2つ目は、会議を新しく作らず、既にある会議の一部を使うことです。定例の経営会議や部門長の打ち合わせに、月に1回、データについての議題を短い固定の枠として入れれば、データガバナンス委員会の役目を果たせます。3つ目は、文書と道具を最小にすることです。基本方針は1〜2ページ、用語集と役割の一覧と品質の測定結果は、1つの表計算のファイルのシートとして持てば足ります。次の表は、標準の計画と縮小版を並べたものです。
| 項目 | 標準の計画 | 縮小版(情報システムの担当が1人の会社) |
|---|---|---|
| 経営スポンサー | CDO か担当の役員 | 社長、または管理部門を所管する役員 |
| データオーナー | 対象のデータの業務を所管する部門の長 | 社長か、営業・経理など対象の業務の責任者が兼ねる |
| データスチュワード | 業務の実務者(主題領域ごと) | 対象の業務の実務者。主題領域を1つに絞るので、本コラムの想定では1名から始める |
| データカストディアン | 情報システム部門の担当者 | 情報システムの担当者。外部に委託している部分は委託先の窓口を一覧に書く |
| 事務局 | 情報システム・DX 推進・経営企画の担当 | 情報システムの担当者が兼ねる。会議の記録は議事録の一部で足りる |
| 会議体 | データガバナンス委員会を立ち上げの90日に3回 | 経営会議の中の固定の枠を月1回 |
| 対象範囲 | 1〜2の主題領域 | 1つの主題領域(困りごとの最も大きいもの。顧客か商品か取引先のどれか) |
| 基本方針 | 数ページ | 1〜2ページ。目的・範囲・役割・決め方・例外の5点だけ |
| 用語集と品質の測定 | 用語集の初版と、重要な項目の品質の測定 | 表計算のファイルの1シートに、主要な用語と定義を並べる。品質は空欄と重複の件数を数えるところから |
| カタログ | 第3四半期に要否を検討 | 表計算のファイルにデータセット名・所在・対応する用語・持ち主の列を設け、社内の共有の場所に置くことで代える |
| 経営への報告 | 四半期に1回、数ページの報告書 | 月1回の経営会議の枠で、報告書の第1・3・6欄(要点・指標・判断してほしいこと)だけを口頭と1枚の資料で |
| 期間 | 最初の90日で骨格、1年で運用と振り返り | 同じ順序を、範囲を小さくして回す。週割の例は次の表。期間は会社の事情で決める |
次の表は、縮小版の最初の90日の週割の例です。標準の計画表のうち、データガバナンス委員会の回を経営会議の固定の枠に読み替え、ステップ6までを同じ順で小さく回す形にしました。週の区切りは本コラムの想定で、会社の事情に合わせて伸ばしてかまいません。
| 週 | 主な作業 | 主に動く人 | 成果物 |
|---|---|---|---|
| 第1〜2週 | 社長が取り組むと決め、困りごとを2〜3個挙げる。経営会議に月1回のデータの枠を設ける | 社長(経営スポンサー)・情報システムの担当(事務局) | 取り組む理由を書いた経営会議の議事録 |
| 第3〜4週 | 対象の主題領域を1つ決め、やらないことを決める。役割の一覧を役割ごとの行で作る | 社長・情報システムの担当・対象の業務の責任者 | 対象範囲とやらないことのメモ。役割の一覧 |
| 第5週 | 基本方針の骨子(目的・範囲・役割・決め方・例外の扱い)を書き、社長と暫定で確認する | 情報システムの担当(事務局)・社長 | 基本方針の骨子 |
| 第6〜7週 | 主要な用語と定義を1シートに書き出す。部門ごとに違う数え方を洗い出す | 対象の業務の実務者(データスチュワード) | 用語と定義のシート(下書き) |
| 第8週 | 経営会議の枠で、食い違う定義を決める。1〜2ページの基本方針を確認し、CDO の役割を担う社長が承認する | 社長・対象の業務の責任者(データオーナー) | 決めた定義の記録。基本方針の初版 |
| 第9〜11週 | 対象の台帳で、空欄と重複の件数を数える。直す順の案を作る | データスチュワード・情報システムの担当 | 品質の測定結果(初回)と課題の一覧 |
| 第12〜13週 | 経営会議の枠で、報告書の第1・3・6欄を報告し、次の90日を決める | 社長・情報システムの担当 | 1枚の報告資料。次の90日の計画 |
縮小版で最も注意したいのは、情報システムの担当1人に、すべてを任せきりにすることです。その担当者が事務局とデータカストディアンを兼ねるのは自然ですが、定義の決定や、例外を認めるかどうかの判断まで担うと、第3章で見た「データガバナンスは情報システム部門の仕事」という誤解がそのまま体制になります。また、1人に依存した体制は、その人の異動や退職で止まります。縮小版でも、定義を決める人(業務の責任者)と、記録を持つ場所(共有のファイル)を、担当者個人から切り離しておくことが有効だと考えています。
外部に基幹システムやクラウドの運用を委託している会社では、データカストディアンの役目の一部を委託先が担っています。その場合、委託先にどのデータの保管と処理を任せているか、障害や変更の連絡をどの窓口で受けるかを役割の一覧に書いておきます。委託先との契約の内容や個人データの委託に関する法令上の義務は、この章の範囲を超えるので、個人情報の扱いは第8章を参照し、契約の確認は自社の法務の担当と行ってください。
失敗しやすい最初の判断
立ち上げの時期の判断の誤りは、1年後になってから表に出ることが多く、気づいたときには作り直しの範囲が広がっています。ここでは、立ち上げの最初の数週間に下しやすい判断のうち、後で手戻りが大きくなるものを型として整理します。定着の段階で起きる失敗の型と組織変革の進め方は第14章で扱うので、ここでは最初の判断に限ります。
| 最初の判断の型 | そう判断しやすい理由 | 後で起きること | 経営上の損失の型 | 代わりの判断 |
|---|---|---|---|---|
| 対象範囲を広げすぎる | 全社の課題として始めたいという意欲。どの部門も外されたくない | 事務局と兼務の人の時間が足りず、どの範囲でも定義が決まらない。90日の終わりに報告できる成果が無い | 判断の遅れ | 困りごとの最も大きい1〜2の主題領域に絞り、残りは「2年目以降」と明記する |
| ツールから入る | 製品は目に見える成果になり、予算も取りやすい。製品の説明会で機能の多さに説得される | 技術的な情報は集まっても、業務上の定義と持ち主の欄が空のまま残る。運用が製品の機能に合わせて決まる | 二重投資。現場の不信 | ステップ1〜5の成果物(役割・方針・用語集)を先に作り、製品の要否は第3四半期に判断する |
| 兼務に任せきりにする | 新しい人員を置かずに始められる。任命すれば動くと考える | 本業の繁忙期に作業が止まる。誰も止まっていることを報告しない | 判断の遅れ | 時間の扱いを上長と合意し、事務局の主担当を明示する。止まった作業を報告書の課題の欄に必ず書く |
| 規程の制定から入る | 規程があれば各部門が従うと考える。文書は承認を取りやすい | 決める人が決まる前に文書だけができ、例外の申請が来ても誰も判断できない | 判断の遅れ。現場の不信 | 役割の任命を先にし、基本方針は CDO が承認した方針として運用を始め、固まってから規程にする |
| 定義を全社で1つに統一しようとする | 1つの正しい定義があるはずだと考える | 部門の業務の都合で違う定義をめぐって議論が終わらない | 集計の食い違い。判断の遅れ | 経営報告に使う定義を1つ決め、部門の業務の定義には別の名前を付ける |
| 最初の成果を事業の数字(売上や費用)の改善で測る | 投資の効果を事業の数字で示したい | 1年目のような短い期間では事業の数字に効果が表れない場合があり、取り組みが効果なしと判断されるおそれがある | 判断の遅れ(続けるか止めるかの判断を誤る)。二重投資(打ち切った後に作り直す) | 1年目は体制と中身の指標を中心に置き、困りごとの指標がいつ動き始める見込みかを最初に示す |
| AI の案件と切り離して始める、または AI の案件の中だけで始める | ガバナンスと AI 活用を別の予算・別の部署で扱う | AI の案件ごとにデータの準備をやり直す。または案件の終了とともに整備も止まる | AI 投資の空振り。二重投資 | AI で使う予定のデータを対象範囲の候補に入れ、ガバナンスの成果物を案件で再利用する(第11章) |
この表の型は、どれも「早く目に見える成果を出したい」という、それ自体は妥当な動機から生まれます。製品の導入や規程の制定は、取り組みが進んでいるように見えやすく、報告もしやすい作業です。しかし、それらは決める人と決めた中身があって初めて働くもので、順序を逆にすると、目に見える成果が出た後に中身を作り直すことになります。最初の90日で目に見える成果として示すべきなのは、製品や規程ではなく、「この数字の食い違いは、この定義に揃えることで解消する」と決めた記録だと考えています。
最後の行の AI の案件との関係は、立ち上げの時期に判断を迫られやすい点です。生成AI や機械学習の案件の予算でデータの整備を進める場合、整備はその案件の作業の一部として扱われることがあります。案件の中で作った定義や品質ルールを、案件の終了後も誰かが維持する体制にしておかないと、次の案件で同じ整備をやり直すことになります。AI に使うデータの要件とデータガバナンスとの接続は第11章で扱っています。
経営判断、やらないことを決める
この章で扱った計画の多くは、何をやるかの順序でした。しかし、立ち上げの成否を分けるのは、やらないことを決めて守れるかどうかだと考えています。データガバナンスの対象になりうるものは、主題領域・業務・システム・文書・道具のどれをとっても多く、どれも「やった方がよい」理由があります。そのすべてを1年目に入れようとすると、限られた人の時間が薄く広く使われ、どの範囲でも運用が回る状態に届きません。
やらないことは、立ち上げの第4週に対象範囲とあわせて決めて経営会議に報告し、基本方針の第1節に「対象外」として書き、四半期の報告書で毎回確認する、という3か所に置くことを勧めます。決めるだけでは、途中で「ついでにこれも」という要望が来たときに守れません。報告書で毎回確認すると、範囲を広げたいという要望を、経営が判断する議題として正式に扱えます。広げる場合は、何を後回しにするかを同時に決めます。
やらないことの例を挙げると、次のようなものがあります。1年目は対象範囲以外の主題領域の定義を作らない。カタログの製品を選ばない。全社の規程は改定しない。品質の測定を自動化しない(第3四半期に、定期化とあわせて要否を判断するまで)。全部門に研修を行わない(対象範囲の関係者に限る)。他社の成熟度と比べる目標を置かない。これらは「永久にやらない」ではなく、見送る期間を項目ごとに決めておくという意味です。測定の自動化は第3四半期に要否を判断し、その他の項目は2年目の計画で改めて判断します。期限を付けておくと、関係部門にとっても、外されたのではなく順番が後になったと受け取りやすくなります。
経営の側から見ると、やらないことを決めないことの損失は、最初の1年の終わりに「どれも途中」という報告を受けることです。その報告を受けた経営は、取り組みを続けるか止めるかを判断する材料を持たず、多くの場合、関心を失います。逆に、範囲を絞って「この範囲では、決める人が決まり、定義が揃い、数字の食い違いが減った」と報告できれば、2年目に範囲を広げる判断は根拠を持って下せます。データガバナンスの体制づくりは、範囲を絞って運用を回し、その結果を根拠に範囲を広げる、という繰り返しで進めるものだと考えています。
この章では、データガバナンスの体制を立ち上げる順序を、経営の意思決定・対象範囲・役割の任命・ポリシーの骨子・用語集・品質の測定・カタログ・拡大の8つのステップで整理し、最初の90日を週単位の計画に、1年目の残りを四半期単位のロードマップに落としました。役割は「決められる人」と「業務とデータを知っている人」を分けて選び、基本方針は数ページから始め、委員会の最初の3回にはそれぞれ決めることを置きます。経営への報告は、活動の量ではなく困りごとの解消に近づいたかを毎回同じ形で示し、判断してほしいことには選択肢と推奨を添えます。小さな会社では同じ順序を保ったまま範囲と文書を小さくし、どの規模でも、やらないことを決めて守ることが1年目を回す条件になります。
次の第14章では、こうして立ち上げた体制を、2年目以降も続けるための組織変革の考え方と、定着の段階で起きやすい失敗の型、公開された一次情報のある事例を扱います。
Anagraftでは、データ活用の構想づくりから、データガバナンスの体制設計、役割と会議体の立ち上げ、データ品質やマスターデータの整備、意思決定への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『データマネジメント 仕組みづくりの教科書』(小川康二・仲程隆顕 著、日経BP):生成AI の活用を視野に入れて、データマネジメントを全社の仕組みとして整える方法を解説した本です。出版社の紹介では、経営者・データ管理の担当・現場の業務担当のそれぞれの立場から全員参加の必要を説く部と、実装の要点と着手点を整理したうえで、データ活用のプロセス・データアーキテクチャ・マスターデータ・データセキュリティ・データ品質・メタデータ・データガバナンスの7つの管理を、原則・体制・プロセス・ガイドラインの目次の例とともに扱う部があります。この章の立ち上げの順序とポリシーの雛形を、領域ごとに具体化するときの材料になります。
『実践データマネジメント AI/BIの活用レベルを上げる新しい基盤・組織・運用』(川上明久 著、日経BP):データ活用のための人と組織、環境の整備、データマネジメントの方法、活用を進めるうえでの課題の4つの章で構成された本です。出版社の紹介する目次には、DX を支えるデータマネジメント組織の作り方、事業部門との目標の共有、データ活用のトップダウンとボトムアップの進め方を扱う節があります。この章の経営スポンサーの置き方や、事務局と業務部門の分担を考えるときに、組織の側から補う材料になります。
第14章 定着と組織変革、失敗の型と公開事例
第13章では、データガバナンスの体制を立ち上げる順序と、最初の90日から1年目の後半までの進め方を扱いました。立ち上げが終わると、役割の一覧・基本方針・用語集の初版・品質の初回報告がそろい、会議体も動き始めます。この章で扱うのは、その後です。担当者が替わっても、経営の関心が別の課題へ移っても、2年目・3年目に同じ仕組みが回り続けるようにするには、何を組織の側に組み込む必要があるのか。組織変革としての見方、データ文化とデータリテラシーの育て方、続かなくなる失敗の型、公開された一次情報で確かめられる事例、分散と統制を両立させる考え方としてのデータメッシュ、続ける仕組み、の順に書きます。
事例は、一般社団法人日本データマネジメント・コンソーシアム(JDMC)がデータマネジメント賞の報道発表として公開している資料と、JDMC が公開している講演の報告、デジタル庁が公開している「データガバナンス・ガイドライン」を開いて確かめた範囲だけを使います。この章で引く外部の資料は、いずれも2026年10月22日に開いて確認しました。成果の数値は、その資料に書かれているものだけを引き、資料に無い効果や経緯は補いません。組織変革の一般論についても、「データガバナンスの取り組みの◯%が失敗する」といった割合は、調査主体の一次情報を確かめられたものが無かったので書いていません。
立ち上げと定着は別の仕事
立ち上げの時期には、経営の意思決定という後ろ盾があり、任命された人にも「新しい取り組みを始める」という意識があります。会議の議題も、範囲を決める・役割を決める・方針を書く、と次々に出てきます。定着の時期に入ると、この条件が一つずつ外れていきます。議題は「先月と同じ指標の確認」になり、任命された人の本業は忙しくなり、経営会議では別の新しい課題が取り上げられます。データガバナンスの価値は、判断の遅れや集計の食い違いが「起きなかったこと」として表れることが多いので、うまく回っているほど成果が見えにくくなる、という性質もあります。
このため、定着の時期には、立ち上げの時期とは別の問いに答える必要があります。立ち上げの問いが「誰が何を決めるか」だったのに対して、定着の問いは「決める仕組みを、特定の個人の献身に頼らずに回し続けるには何が要るか」です。答えの多くは、データの技術の側ではなく組織の側にあります。会議を年間の予定に固定すること、役割を人事の評価に入れること、成果を測って経営に報告し続けること、続けている人を認めること、の4つが中心になると考えています。この章の後半で、それぞれを具体的な仕組みとして書きます。
DMBOK も、知識領域とは別に、組織と役割、組織の変革を主題として扱っており、日本語版にもそれらを扱う章があります。DMBOK の位置づけは第2章で扱いました。この章は DMBOK の該当部分を要約するものではなく、公開された事例と公的な資料をもとに、定着の段階で何が起きやすいかを整理するものです。
組織変革として見る、抵抗の理由と推進者
データガバナンスは、多くの場合、それまでの仕事の進め方を変えることを人に求めます。定義を勝手に変えないこと、新しい項目を作るときに届け出ること、品質の結果を毎月報告すること、他部門からの問い合わせに答えること、などです。仕事の進め方が変わる取り組みには、データに限らず抵抗が生じます。抵抗を「理解が足りない人の反発」として扱うと、説得の回数を増やすことしか打ち手が残りません。抵抗には理由があり、理由ごとに打ち手が違う、と考える方が実務では扱いやすいと考えています。
次の表は、データガバナンスの定着の段階で生じやすい抵抗を、理由の型ごとに整理したものです。表の打ち手は一般論で、どれが効くかは会社の状況によって変わります。
| 抵抗の理由の型 | 現場から出やすい言葉の例 | 背景にあること | 打ち手の例 |
|---|---|---|---|
| 手間が増えるだけに見える | 「届け出の手続きが増えただけ」 | 手間は自部門が負い、効果は他部門や経営に出る | 手間を負う部門に効果を返す。問い合わせの減少や、集計のやり直しの減少を、その部門の数字として報告する |
| 権限を取られるように感じる | 「自分たちのデータの定義を他人が決めるのか」 | 定義や提供の判断が、部門から全社の会議体へ移る | 決める権限はデータオーナーとして業務部門に残す設計にする(第3章)。全社共通の方針と標準は会議体で決め、その範囲内の定義や品質の水準はデータオーナーが決める。会議体の日常の役目は部門間の調整と例外の承認に絞る |
| 評価されない | 「品質を直しても誰も見ていない」 | 役割が人事の評価に入っていない。兼務の時間が本業の評価だけで測られる | 役割と活動を目標設定と評価の項目に入れる。続けている人を表彰する |
| 過去の誤りを責められるのが怖い | 「品質を測ったら、うちの部門の数字が悪く出る」 | 測ることが、責任の追及と結びついて受け止められる | 最初の測定は改善の出発点として扱い、部門の順位付けに使わないと事前に決めて伝える |
| 必要性が腹に落ちていない | 「今まで困っていない」 | 困りごとが他部門や経営の側で起きていて、当事者に見えていない | 集計の食い違いや問い合わせの往復など、実際に起きた困りごとを具体的に共有する |
表の打ち手に共通しているのは、仕組みの側を変えることで抵抗の理由そのものを減らす、という考え方です。説得や研修だけで抵抗が消えることは少なく、手間と効果の配分、権限の置き場所、評価の項目といった組織の設計を変える方が持続しやすいと考えています。とくに「権限を取られるように感じる」という抵抗は、データガバナンスを全社の部署が部門のデータを管理する仕組みだと受け止められたときに強く出ます。第3章で扱ったとおり、定義や品質の水準を決める権限を業務部門のデータオーナーに置き、全社の会議体は全社共通の方針と標準を決めたうえで部門間の調整と例外の承認を担う、という分担にしておくと、この抵抗は小さくなります。
抵抗への対応と並んで、定着の段階で欠かせないのが推進者です。ここでいう推進者は、データガバナンスの事務局や担当役員のように任命された人だけを指しません。各部門の中で、定義を守る意味を自分の言葉で説明でき、困ったときに相談される人のことです。データスチュワードがこの役を担うことが多いと思われますが、任命しただけでは推進者にはなりません。事務局が推進者の候補と定期的に話す場を持ち、推進者が部門で受けた質問を全社の改善につなげる経路を作ることが、推進者を育てる近道だと考えています。
後で紹介する JDMC の受賞企業の報道発表には、推進の進め方について「トップダウン」と「現場主導」の両方の記述が出てきます。三菱電機については、トップダウンによるデータガバナンス推進体制を整備したと書かれ、大規模製造業における全社ガバナンス体制の設計と運用の両面での先進性は高く評価できる、と JDMC の評価が記されています。古野電気については、推進担当者が現場を訪れながら草の根的に展開し、トップダウンではなく現場の課題に即した形で技術を適用した、と記載されています。ロート製薬については、トップダウンに依存せず現場の知見を反映させたアプローチを、データマネジメント推進の有効なモデルといえる、と評価しています。本コラムでは、この2つを対立するものとしては読みません。経営が会議体と権限を決めることと、現場の困りごとに即して一つずつ広げることは、対象と段階が違えばどちらも要る、と考えています。
データ文化とデータリテラシー、研修と評価への組み込み
「データ文化」という言葉は、人によって指すものが違います。本コラムでは、判断の場面で、勘や声の大きさではなく、定義の決まったデータを根拠として示すことが当たり前になっている状態、という意味で使います。データ文化を支えるのがデータリテラシーです。本コラムでは、データリテラシーを、データの意味と限界を理解し、データを根拠に判断し、データの扱いに伴うリスクを知っている度合い、と定義します。分析の手法を使いこなす専門的な技能とは分けて考えます。
デジタル庁の「データガバナンス・ガイドライン」(2025年6月20日)は、データ文化について、データの価値とリスクを現場を含めて全社的に理解する必要があること、企業文化は所与のものではなく、データガバナンスを検討する段階から目指す企業文化を見据えて経営方針として周知することが重要であることを述べています。同じガイドラインは、結びの部分で全社的なデータリテラシーの向上を挙げ、データ関連の技術教育にとどまらず、企業価値の向上のためのデータの重要性とリスクについての教育が重要だとしています。つまり、ここで求められているリテラシーは、道具の操作の研修ではなく、データの価値とリスクの理解です。
この考え方を研修に落とすと、対象者ごとに中身を分けるのが扱いやすいと考えています。全社員向けには、用語集の場所と引き方、自部門のデータオーナーとデータスチュワードが誰か、定義が分からないときの問い合わせ先、個人情報や機密の区分の基本、を短い時間で伝えます。データオーナーとデータスチュワード向けには、定義の決め方と変え方の手続き、品質の結果の読み方と報告の仕方、例外の承認の流れ、を扱います。経営層向けには、データガバナンスの指標の読み方と、判断を誤ったときの損失の型(判断の遅れ・二重投資・集計の食い違い・法令違反・AI 投資の空振り・現場の不信)を扱います。個人情報の取扱いの中身は第8章で扱いました。
研修で学んだことを実務で使い、その実践を評価する仕組みがあると、定着を支えると考えています。同じガイドラインは、データマチュリティ(組織がデータを使いこなす総合的な能力を指す、ガイドラインの用語)の向上には全社的なデータリテラシーの向上だけでなく、高いデータスキルを持つ人材を各組織の責任者などに置くことが不可欠であるとし、CDO などが経営や人事部門と連携して人材の育成と採用の計画を作り、そうした人材が評価・処遇される人事制度を構築している状態を、望ましい方向性として挙げています。データスチュワードの活動が目標設定と評価の項目に入っていない会社では、役割が本業の余り時間で担われ、繁忙期に活動が後回しになるおそれがあります。データの人材の育て方やキャリアの考え方は、弊社コラム『データサイエンティストの学習とキャリアのノート』で扱っています。DAMA International が運営する認定資格 CDMP のような外部の資格の位置づけは第2章で扱いました。
なお、ガイドラインのデータマチュリティは組織の総合的な能力を指す言葉で、本コラムが第12章で使っている成熟度の5段階(未着手・個別対応・定義済み・運用中・改善継続)とは別の物差しです。本コラムでは両者を同じものとしては扱いません。
続かなくなる失敗の型
データガバナンスが立ち上げの後に続かなくなる経緯には、いくつかの型があります。立ち上げの最初の数週間に下しやすい判断の型(対象範囲を広げすぎる、ツールから入る、兼務に任せきりにする、規程の制定から入る、など)は第13章で扱いました。ここでは、立ち上げは終わり、役割も文書も道具もいったんそろったのに、1年目の後半から2年目にかけて仕組みが形だけになっていく型に限ります。立ち上げの時点の判断が原因であれば第13章の型にあたり、この表は、立ち上げを正しく終えた後でも起きる側を扱います。どれも、データの技術の誤りよりも、権限・担当の時間・評価の仕組みのような、運用を支える組織の側の不足から起きるものとして整理しています。
| 失敗の型 | 起きること | 経営上の損失 | 早く気づくための兆候 | 防ぐ手順 |
|---|---|---|---|---|
| 導入した道具が更新されない | 立ち上げの時点では用語集やデータカタログに定義と持ち主が入っていたが、定義の変更や新しい項目が反映されず、中身が古くなる | 二重投資。古い定義を信じた集計で集計の食い違いが再発し、使われないまま次の製品の検討が始まる | 定期確認の期限を過ぎた項目が増える。目録(データの所在・定義・持ち主を検索できる一覧。第13章)の検索回数が減る | 定義の変更の手続きに「目録の更新」を必ず含める。更新の担当と定期確認の期限を項目ごとに決める(立ち上げ時の製品の選び方は第13章) |
| ルールだけ作って運用しない | 基本方針と標準の文書はそろったが、例外の承認や定義の変更の手続きが一度も使われない | 文書と実態がずれ、監査や事故の際に「規程はあったが守られていなかった」状態になる | 業務の変更や従えない事情が生じているのに、例外の申請が0件のまま。業務が変わっても文書の改訂日が初版から動かない | 手続きを使った件数を毎月報告する。0件が続いたら、例外が必要な事情が本当に無いのか、手続きが知られていないのか、迂回されているのかを確かめる |
| 任命後に時間が割かれなくなる | 任命の時点では時間の扱いを上長と合意していたが、上長や担当者の異動、本業の繁忙で合意が引き継がれず、問い合わせと品質の確認が止まる | 問い合わせが情報システム部門に戻り、判断の遅れが再発する | 問い合わせの解決日数が延びる。会議の欠席や代理出席が増える | 異動のたびに役割と時間の合意を引き継ぐ手順を置く。役割を評価の項目に入れる(任命時の兼務の扱いは第13章) |
| 経営の関心の低下 | 担当役員が替わる、または別の経営課題が優先され、経営会議への報告の枠が消える | 部門間の対立を裁く人がいなくなり、定義の食い違いが放置される。AI 投資の前提となるデータの整備が止まる | 経営会議の議題から外れる。報告が書面だけになる | 報告の枠を経営会議の年間予定に固定する。担当役員の交代時に引き継ぎの議題を置く |
| 品質改善が報われない | 品質を直した部門の手間は増えるが、効果は他部門の集計や分析に出るため、直した部門の評価にならない | 現場の不信。品質の測定結果が悪く出ることを避けて、測ること自体が嫌がられる | 品質ルールの合格率が横ばいのまま。改善の提案が出てこない | 改善の効果を、直した部門の成果として報告する。表彰の対象にする |
| 部門間の縄張り | 部門ごとに別の「顧客」「売上」の定義を持ち続け、全社の用語集が承認されない | 集計の食い違い。経営会議の議論が定義の確認に費やされる | 用語集の未承認の項目が積み上がる。同じ指標の別名が増える | 決める権限を持つデータオーナーを項目ごとに1人に決める。決まらないものは会議体が期限を切って裁く |
6つの型は、互いに独立しているわけではありません。経営の関心が下がると、兼務の人は本業を優先しやすくなり、任命された人の時間が割かれなくなると品質改善の手が止まり、改善が止まると用語集も更新されず、文書だけが残ります。逆に言えば、1つの型の兆候に気づいたときは、隣の型の兆候も確かめる価値があります。表の「早く気づくための兆候」の列の一部は、第3章で扱った成果の指標(定義済みのデータ項目の割合・品質ルールの合格率・問い合わせの解決日数)と、手続きが使われた件数で拾えます。それ以外の兆候は、目録の利用と更新の状況、会議の開催と出席の状況、経営会議の議題と報告の形、未承認の項目の滞留をあわせて確かめることで拾います。
JDMC が公開している講演の報告(2025年11月20日掲載。JDMC の部会の会員が講演を報告した記事で、登壇者の発言そのものではありません)にも、同じ種類の壁についての言及があります。報告によると、東京ガスの登壇者が、データ活用を推進してきた同社でも、PoC(概念実証)で止まってしまう、システム化したが思うように使われない、業務に組み込めたが担当者が異動すると元通りになる、といった壁があることに触れた、と報告されています。最後の「異動すると元通りになる」は、この章で扱っている定着の問題そのものです。同じ報告によると、登壇者は今後の展望として、組織としての文化・KPI・マネジメントシステムへの働きかけが重要だと述べています。
経営の側から見ると、失敗の型の損失は、いずれも「一度払った立ち上げの費用が回収されない」という形で表れます。立ち上げに使った経営の時間、任命した人の時間、作った文書と用語集は、運用が止まれば更新されずに古くなっていき、いずれ同じ取り組みをもう一度立ち上げることにもなりえます。続けるために要るのは、主に会議と更新の時間と報告の枠で、新しい製品や組織を必要としないものが中心です。このため、立ち上げの予算を承認するときに、2年目以降の運用の時間と報告の枠も同時に確保しておくことが有効だと考えています。
公開事例、JDMC データマネジメント賞の受賞企業
国内で、企業のデータマネジメントの取り組みが公開資料として継続的にまとまっているものの一つに、JDMC のデータマネジメント賞があります。JDMC の報道発表によると、この賞は、データマネジメントにおいて他の模範となる活動を実践している企業・機関などの中から優秀なものに授与する表彰制度で、JDMC の運営委員会内に組織した審査委員会が評価して決めています。2025年の賞は2025年3月5日に発表され、12回目で6社が受賞しました。2026年の賞は2026年3月5日に発表され、13回目で、報道発表では8社が受賞したとされています。過去の受賞結果は JDMC の表彰制度のページから辿れます。
次の表は、2025年と2026年の報道発表(2025年の報道発表、2026年の報道発表)に書かれた受賞理由のうち、組織と定着に関わる記述を抜き出して整理したものです。数値は報道発表に書かれたものだけで、各社の決算資料などで別に確かめたものではありません。表の「定着の観点で読める点」の列は、報道発表に書かれている要素のうち、この章の主題に関わるものを挙げたもので、報道発表がその点を受賞の理由として評価しているという意味ではありません。表の語のうち、プロセスマイニングは業務システムの操作の記録から業務の流れを再現して可視化する手法、UML はソフトウェアや業務の構造を図で表す標準的な記法、ノーコード・ローコードはプログラムをほとんど書かずに仕組みを作る開発の方法、CRM は顧客との関係を管理する仕組み、KPI は目標の達成度を測る重要な指標、サイロ化は部門ごとにデータが分断されている状態を指します。関西電力の取り組み(DMBOK に基づく社内の通達・CDO・データスチュワードの配置)は第3章で詳しく扱ったので、ここでは1行にとどめます。
| 年・賞 | 受賞企業・機関 | 報道発表に書かれた取り組み | 報道発表に書かれた成果・進捗 | 定着の観点で読める点 |
|---|---|---|---|---|
| 2025年・大賞 | 関西電力 | DMBOK に基づくデータマネジメント通達の制定、CDO を筆頭に全社と各事業部門へデータスチュワードを配置(第3章) | AI 等を活用した DX 実用化案件が累計478件、2024年度の効果額は約300億円の見込み | 通達と役割を全社に置く体制が書かれている(第3章) |
| 2025年・データ統合賞 | アダストリア | 3社の統合・合併で生まれた会社で、マスターデータ管理の仕組みを商品系から段階的に導入し、次に取引先系、続いて店舗・人事系へ展開中。ワークフローの導入でガバナンスを強化 | ノーコード・ローコード化により運用コストを年間4,000万円削減。運用担当だった社員を本来業務へ移した | 商品系から順に対象を広げる段階的な導入が書かれている |
| 2025年・データ活用賞 | アフラック生命保険 | プロセスマイニングで業務を可視化。保険金の業務プロセスから小さく始めて他の業務へ順に展開。IT 部門と事務部門が共同で分析し、事務部門のメンバーに日常的な活用を促すトレーニングを実施 | 1.2億円の価値創出 | 小さく始めて順に展開したこと、IT 部門と事務部門の共同の分析、事務部門向けのトレーニングが書かれている |
| 2025年・データドリブン経営賞 | APR グループ | 表計算による店舗の売上・利益管理から経営データの管理システムへ移行し、飲食店経営の5大コストを日次で可視化。スマートフォンで経営陣と現場が数字を共有 | 従業員にとって伸ばすべき指標が明確になり、表彰制度の導入やモチベーション向上につながっている、と記載 | 経営と現場の数字の共有と、表彰制度の導入が書かれている |
| 2025年・先端技術活用賞 | 古野電気 | 社内の技術文書・サービス履歴・FAQ を一元管理し、RAG(社内文書を検索して生成AI の回答に使う仕組み)で若手が自ら検索できる環境を整備。推進担当者が現場を訪れながら草の根的に展開 | 技術支援の窓口(テクニカルセンター)の負担が軽減された、と記載 | 現場への訪問による草の根的な展開と、「トップダウンではなく、現場の課題に即した形」で技術を適用したことが書かれている |
| 2025年・モデリング賞 | 星野リゾート | ホテル現場のスタッフに UML を教育し、データモデリングを内製化。約60名の社員と35〜36名の外部パートナーで開発から運用まで担当。経営陣も新たな取り組みを支援し、全社的な推進を後押し | 2024年12月に最初の施設への導入が完了し、フィードバックを基に再設計を進めている、と記載 | 現場のスタッフへの教育と、モデリングの内製化が書かれている |
| 2026年・大賞 | 東京ガス・東京ガスiネット | 中央集権型の基盤から、各事業部門が自律的に管理し、ハブドメイン(部門をまたいでデータを共有するための中央の管理基盤)を介して横断共有するデータメッシュ型のアーキテクチャへ移行。データアーキテクチャ・メタデータ・データ保護・データ品質の4領域を軸とした連邦型のガバナンス体制(後の節で説明)。社長が経営会議で各部門長に AI・データ活用の進捗を報告させている | AI・データ活用の相談件数や現場主導のアプリ開発が増加し、コーポレート部門にも活用が広がっている、と記載 | 経営会議での部門長からの報告と、各部門がデータ品質に責任を持つ形の両方が書かれている |
| 2026年・大賞 | CRISP | 注文・CRM・勤怠のシステムを自社で開発し、データを単一の基盤に集約。データの収集を既存の業務に組み込み、6つの経営領域に KPI を設定・可視化 | 売上の約50%をアプリ経由で獲得。年間約20万件の顧客フィードバックをスタッフの評価と金銭的な報酬に直結させ、約600名のスタッフのサービスを定量化 | 顧客フィードバックとスタッフの評価・金銭的な報酬の直結が書かれている |
| 2026年・データ基盤賞 | 花王 | 商品画像や動画などのクリエイティブ資産を一元管理する基盤を整備し、商品マスターのコードを起点にメタデータを入口で標準化。外部制作会社には指定場所への納品を支払い条件とするルールを整備 | 社内外の業務フローの標準化に、全国説明会を重ねながら約2年を要した、と記載 | 納品のルールと支払い条件の結びつきと、全国説明会を重ねたことが書かれている |
| 2026年・データ基盤賞 | CCCMK ホールディングス | 法務・コンプライアンス・セキュリティの各部門と合意形成を重ねてクラウドへ移行し、データを3層で管理する構成を導入。10年間業務を止めずに基盤を刷新 | 月間340時間を要していたデータ処理を34時間に短縮。クラウドコストを5分の1に削減 | 法務・コンプライアンス・セキュリティの各部門との合意形成が書かれている |
| 2026年・データガバナンス賞 | 三菱電機 | 2025年5月に「データ活用宣言」を社内外に発信。「データ/AI ガバナンス ステアリング会議」(取り組みの方向を決める会議)を設置し、その下に遂行責任者と、AI ガバナンスとデータガバナンスの主管部門を配置。ポリシーとガイドラインの策定、全社データ基盤の構築、教育とモニタリングを一連のプロセスとして担う | 熱関連事業でデータ活用による事業価値の創出を実証しつつある、と記載 | トップダウンの推進体制として、宣言・会議体・主管部門・教育とモニタリングが書かれている |
| 2026年・データ活用賞 | ロート製薬 | 各部門でサイロ化していたマスターデータに対し、現場主導でマスターデータ管理を構築。多くのメンバーによるデータクレンジングと現場へのヒアリング。生成AI のツールを全国に展開し、草の根的な普及活動を実施 | ロス・廃棄の大幅削減とサプライチェーン全体の効率化を実現、と記載 | 現場主導の構築、現場へのヒアリング、草の根的な普及活動が書かれている |
| 2026年・特別賞 | 文部科学省 マテリアル先端リサーチインフラ(ARIM)運営機構 | 全国26の大学・研究機関の設備から出る実験データを共通の形式で構造化し、メタデータをそろえて蓄積・提供。知的財産の保護とデータの共用を両立させる共用ルールを策定 | データの可視化にかかる時間が「1日がかり」から「数分以内」へ短縮。2026年1月時点で約190万ファイル、1.7万件超のデータセットが蓄積 | 機関をまたぐ共用のルールの策定が書かれている |
2026年の受賞企業には、表に載せた企業のほかに、熟練者の技能をデータとして取り込む取り組みで先端技術活用賞を受けた荏原製作所があります。この章の主題である組織の定着とは観点が異なるので、表には入れていません。また、各社の取り組みの詳細や、報道発表に書かれていない成果は、この表には含めていません。表に挙げた金額や時間は、受賞企業の取り組みについて主催団体が公表した値で、他社が同じ取り組みをしたときに同じ効果が出ることを示すものではありません。
この表を読むときには、資料の性質による限界があります。13件は、賞を受けた企業・機関の、受賞の時点の取り組みを主催団体がまとめたものです。その後の2年目・3年目に取り組みが続いているかどうか、つまりこの章の主題である定着の実績を示す資料ではありません。また、途中でやめた例や、うまくいかなかった例は含まれていません。以下に挙げる共通の要素は、選ばれた例に書かれている要素の傾向であって、「これをすれば定着する」ことを示すものではありません。
そのうえで、複数の報道発表に実際に書かれている要素を拾うと、次の3つがあります。1つ目は、段階的な導入です。アダストリアについては商品系から取引先系、店舗・人事系へと順に展開していること、アフラック生命保険については保険金の業務プロセスから小さく始めて他の業務へ順に展開したこと、が書かれています。第13章で扱った「範囲を絞って始め、結果を根拠に広げる」という順序と、同じ向きの記述です。なお、東京ガスとロート製薬の報道発表にも「段階的」という語がありますが、データ基盤の拡張や確立の経緯を述べたもので、取り組みの対象を順に広げる進め方の記述ではないため、ここでは根拠に含めていません。
2つ目は、業務の現場の参加です。アフラック生命保険では IT 部門と事務部門が共同で分析に参画したこと、星野リゾートでは現場のスタッフに UML を教育してデータモデリングを内製化したこと、ロート製薬では現場主導でマスターデータの管理を構築したこと、古野電気では推進担当者が現場を訪れながら展開したこと、が書かれています。第1章で扱った「データガバナンスは IT 部門の仕事」という誤解とは違う向きの記述です。
3つ目は、経営の関与です。東京ガスについては社長自らが経営会議で各部門長に進捗を報告させていること、三菱電機についてはトップダウンによる推進体制としてステアリング会議を設置したこと、星野リゾートについては経営陣が新たな取り組みを支援して全社的な推進を後押ししていること、が書かれています。報道発表には、こうした関与がどのくらいの頻度で、何年続いているかは書かれていません。
この3つとは別に、複数社に共通するとは言えないものの、個別の会社の報道発表に見られた仕組みもあります。CRISP については、年間約20万件の顧客フィードバックをスタッフの評価と金銭的な報酬に直結させていることが書かれています。APR グループについては、経営陣と現場の数字の共有が表彰制度の導入につながっていることが書かれています。花王については、外部の制作会社への指定場所への納品を支払い条件とするルールを整備し、社内外の業務フローの標準化に全国説明会を重ねながら約2年を要したことが書かれています。教育については、アフラック生命保険が事務部門のメンバーにトレーニングを実施したこと、星野リゾートが現場のスタッフに UML を教育したこと、三菱電機の主管部門が教育とモニタリングを担うことが、それぞれ書かれています。評価・表彰・支払い条件は1社ずつ別々の仕組みで、教育も対象と中身が会社ごとに違うため、ここでは共通の要素としてではなく、個別の例として挙げます。
共通の3つの要素と個別の例は、どれも大きな技術投資ではなく、範囲の決め方・担い手の選び方・経営の関与の仕方・評価や教育の仕組みという、経営が決められることに属しています。受賞企業の成果の数値に目が向きがちですが、自社に持ち帰って検討できるのは数値ではなく、こうした組織の側の決め方だと考えています。それが自社でも続くかどうかは、この章の後半で扱う続ける仕組みと、自社での測定によって確かめる必要があります。
デジタル庁「データガバナンス・ガイドライン」が経営者に求めていること
デジタル庁は、2025年6月20日付で「データガバナンス・ガイドライン」を公開しています。冒頭の「はじめに」によると、このガイドラインは主として企業の経営者を対象にしたもので、上場・非上場にかかわらず広く企業経営者を想定読者としています。企業が保有するデータを最大限に活用して持続的な企業価値の向上につなげるための、データガバナンスの必要性とあり方、実践の要点をまとめたもの、と位置づけられています。行政機関の内部の手引きではなく、企業の経営者に向けた資料である点に注意が要ります。
ガイドラインは、データガバナンスの4つの柱として、越境データの現実に即した業務プロセス、データセキュリティ、データマチュリティ、AI などの先端技術の利活用に関する行動指針、を挙げています。そのうえで、経営者に求められる視点として、経営ビジョンと DX 戦略との連動、経営者による説明責任、データを最大限利活用できる体制の構築、企業文化への定着と人材の育成、の4つを示しています。この章の主題である定着に直接関わるのは、最後の「企業文化への定着と人材の育成」と、柱の一つであるデータマチュリティです。
体制について、ガイドラインは CDO の設置などの体制整備を経営者の重要な責務としつつ、注記で、CDO や専任部門の設置自体が目的なのではなく、それ以外の手段も含めて個別企業の実情に応じた体制を構築することが望ましいとしています。第13章で扱った、情報システムの担当が1人の会社の縮小版のように、役職を新設せずに役割を割り当てる進め方も、この考え方と矛盾しません。
続け方について、ガイドラインはデータマチュリティの望ましい方向性として、方針を策定・展開し、結果を評価して更なる改善を施すループを回し続けること、その評価は CDO などのリーダーシップのもとで事業の現場から独立した監査組織や外部有識者によって行われていること、を挙げています。自社の水準を決めて現在のレベルを自己評価し、その結果を組織内に周知して次に目指すレベルと施策を展開すること、も挙げています。評価を推進する側だけで完結させず、独立した立場から確かめることは、失敗の型の「ルールだけ作って運用しない」状態に早く気づくための仕組みとして読むことができます。成熟度の診断の方法は第12章で扱いました。
もう一つ、定着の観点で目を留めておきたいのは、ガイドラインがデータセキュリティの望ましい方向性の中で、データの重要性とリスクに応じた区分を行ったうえで、価値の創出が本来の目的であることを踏まえ、過度に「守りの固い」運用とならないようにしている、と書いている点です。データガバナンスがルールで縛る仕組みとして受け止められると、現場の抵抗が強まり、定着しにくくなります。データの重要性とリスクに応じて保護の手段を設け、過度な制限で活用を妨げないことが、公的な資料でも望ましい方向性として示されています。
データメッシュとデータプロダクト、分散と統制の両立
定着の段階で、組織の規模が大きい会社が直面しやすいのが、全社のデータを1つの部署と1つの基盤で集中して管理する形の限界です。部門の数とデータの種類が増えると、中央の部署が定義の確認や新しいデータの取り込みの窓口として渋滞し、部門は待ちきれずに独自の仕組みを作り始めます。この問題への考え方の一つとして注目されているのがデータメッシュです。提唱者の記事が主に扱っているのは分析や AI 活用に提供するデータで、この節もその管理を中心に説明します。
データメッシュは、当時 Thoughtworks に所属していた Zhamak Dehghani が提唱した考え方で、2020年12月3日に公開された原則と論理的な構成を解説した記事で4つの原則が示されています。本コラムの言葉で言い換えると、1つ目は、データの所有と構成を業務の領域(ドメイン)ごとに分散させること。2つ目は、各領域が提供するデータを、利用者に価値を届ける製品として扱うこと。3つ目は、各領域が自分でデータを提供できるように、共通の基盤をセルフサービスで使えるものとして用意すること。4つ目は、各領域の自律を保ちながら、領域をまたいで使うための共通のルールを全体で決め、できるだけ基盤の側で自動的に守られるようにする、連邦型のガバナンスです。
2つ目の原則に出てくるのがデータプロダクトです。本コラムでは、データプロダクトを、ある業務の領域が、他の部門が使える形に整え、定義・品質・持ち主(そのデータについて決める責任を持つデータオーナー)を明示して提供するデータの単位、という意味で使います。同じ記事は、データを製品として扱うための性質として、見つけやすさ、セキュリティ、探索しやすさ、理解しやすさ、信頼できること、などを挙げています。これらは、第5章のデータ品質、第6章のメタデータとデータカタログ、第8章のセキュリティで扱った内容を、提供する側の責任としてまとめ直したものと読むことができます。
データメッシュは、データガバナンスを不要にする考え方ではありません。むしろ、4つ目の原則が示すとおり、分散させるほど、全体で守る共通のルールをはっきりさせる必要が出てきます。2026年の JDMC データマネジメント賞で大賞を受けた東京ガス・東京ガスiネットの報道発表では、各事業部門がデータ品質に責任を持つデータプロダクトの概念を導入し、データアーキテクチャ・メタデータ・データ保護・データ品質の4領域を軸とした連邦型のガバナンス体制を整備した、と書かれています。分散させたのは日々の管理の責任で、領域をまたぐルールの軸は全体で持っている、という形です。第3章で扱った体制の型でいえば、連邦型に近い形だと考えています。
データメッシュが向いているかどうかは、会社の規模と部門ごとのデータの担い手の有無に加えて、共通の基盤と全体の統制を維持できるかどうかで判断することになると考えています。部門の中にデータを整えて提供できる人がいない会社で所有だけを分散させると、データプロダクトの持ち主が名目だけになり、失敗の型の「任命後に時間が割かれなくなる」が部門の数だけ起きるおそれがあります。データの担い手が中央の部署にしかいない段階では、まず中央で用語集と品質の測定を回し、部門の中に担い手が育ってから、提供の責任を部門へ移していく順序の方が無理が少ないと考えています。データウェアハウスやデータレイクなど、データ基盤の構成の考え方は第9章で扱いました。DMBOK の改訂の動向(DMBOK 3.0)は第2章で扱っています。
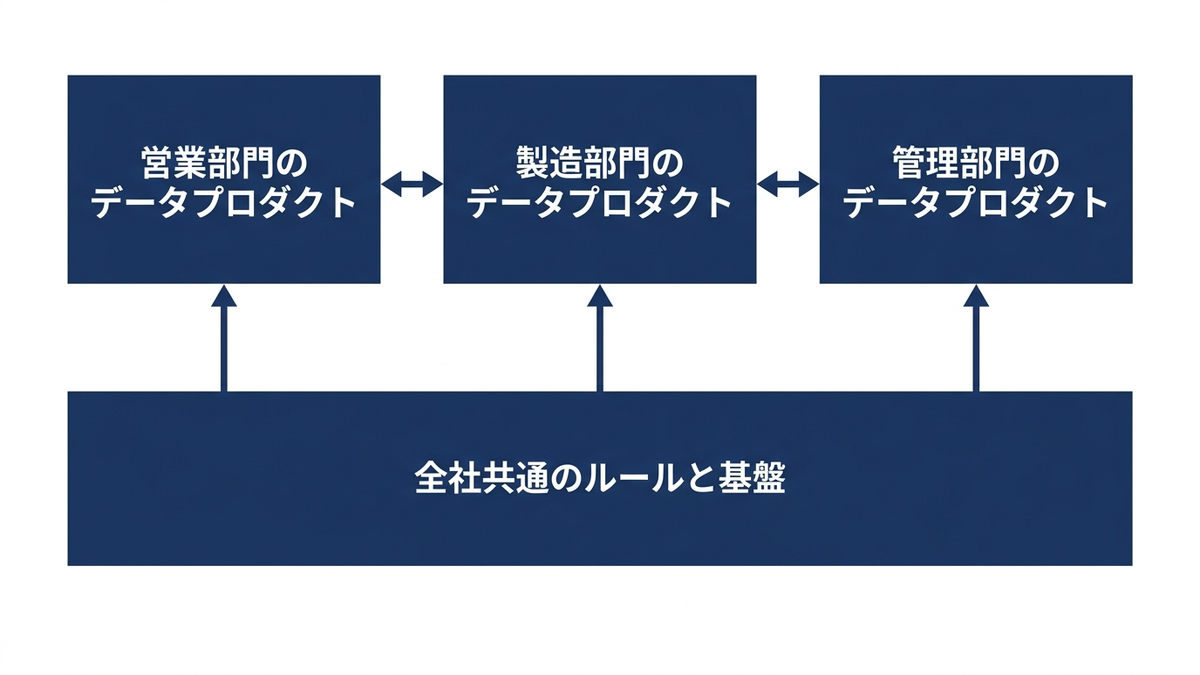
続ける仕組み、定例・指標・表彰
ここまでの内容を、続ける仕組みとしてまとめます。中心になるのは、定例の会議、継続して測る指標、続けている人を認める表彰の3つと、それを支える人事の評価です。どれも新しい製品を必要としない場合が多く、年間の予定と評価の項目を決めることが出発点になります。ただし、担当する人の時間を確保するために、既存の業務の削減や再配分が要ることがあります。次の表は、その一例です。間隔や中身は、会社の規模と会議の周期に合わせて変えてください、という意味の例で、この形でなければならないという意味ではありません。
| 仕組み | 間隔の例 | 中身 | 担い手 | 止まったときの兆候 |
|---|---|---|---|---|
| データスチュワードの定例 | 月次 | 問い合わせと品質の結果の共有、定義の変更の提案、困りごとの持ち寄り | 事務局とデータスチュワード | 欠席と代理出席が増える。議題が報告の読み上げだけになる |
| 会議体の定例 | 四半期 | 指標の推移、未承認の定義の裁定、例外の承認の振り返り、次の四半期の対象 | データガバナンス委員会(第3章) | 未承認の項目が積み上がる。開催が延期される |
| 経営会議への報告 | 四半期 | 指標の推移、失敗の型の兆候、次の四半期に経営に決めてほしいこと | 担当役員 | 議題から外れる。書面だけの報告になる |
| 継続して測る指標 | 毎月集計し、四半期ごとに委員会と経営会議へ報告 | 定義済みのデータ項目の割合、品質ルールの合格率、問い合わせの解決日数、手続きが使われた件数。あわせて目録の利用と更新の状況、会議の開催と出席の状況、未承認の項目の件数を確かめる | 事務局 | 集計が遅れる。指標の定義が途中で変わる |
| 研修 | 入社時・任命時・年次 | 全社員、データオーナーとデータスチュワード、経営層の3種類(前出) | 事務局と人事部門 | 受講者が減る。内容が初版のまま更新されない |
| 表彰 | 年次 | 品質の改善、定義の整備、問い合わせへの対応など、続けた活動を対象にする | 経営と事務局 | 対象の候補が出てこない |
| 人事の評価 | 評価の周期ごと | データオーナー・データスチュワードの役割を目標と評価の項目に入れる | 人事部門と各部門の上長 | 任命された人の上長が役割を知らない |
| 独立した確認 | 年次 | 運用の実態が方針と合っているかを、推進する側以外の立場から確かめる | 内部監査、または外部の有識者 | 確認の結果が次の年の計画に反映されない |
表の最後の行は、前節で紹介したデジタル庁のガイドラインが、データマチュリティの評価を事業の現場から独立した監査組織や外部有識者によって行うことを望ましい方向性として挙げていることに対応させました。推進する側だけで成果を評価すると、続いていることを示す数字を選びやすくなります。年に一度でも、別の立場から運用の実態を確かめる場を置くと、文書と実態のずれに早く気づけます。
表彰の行は、公開事例のうち、APR グループの記述で数字の共有が表彰制度の導入につながっていたことや、CRISP の記述で顧客フィードバックが評価と報酬に結びついていたことを踏まえて置きました。データガバナンスの活動は、事故や食い違いが起きなかったことが成果になるため、本人も周囲も成果を実感しにくい性質があります。続けた活動そのものを対象にした表彰は、成果が見えにくい仕事を見える形にする手段の一つです。表彰の対象を「大きな成果」に限ると、地道な品質の確認や問い合わせへの対応が対象から外れやすいので、続けたこと自体を評価する枠を設けておくことが有効だと考えています。
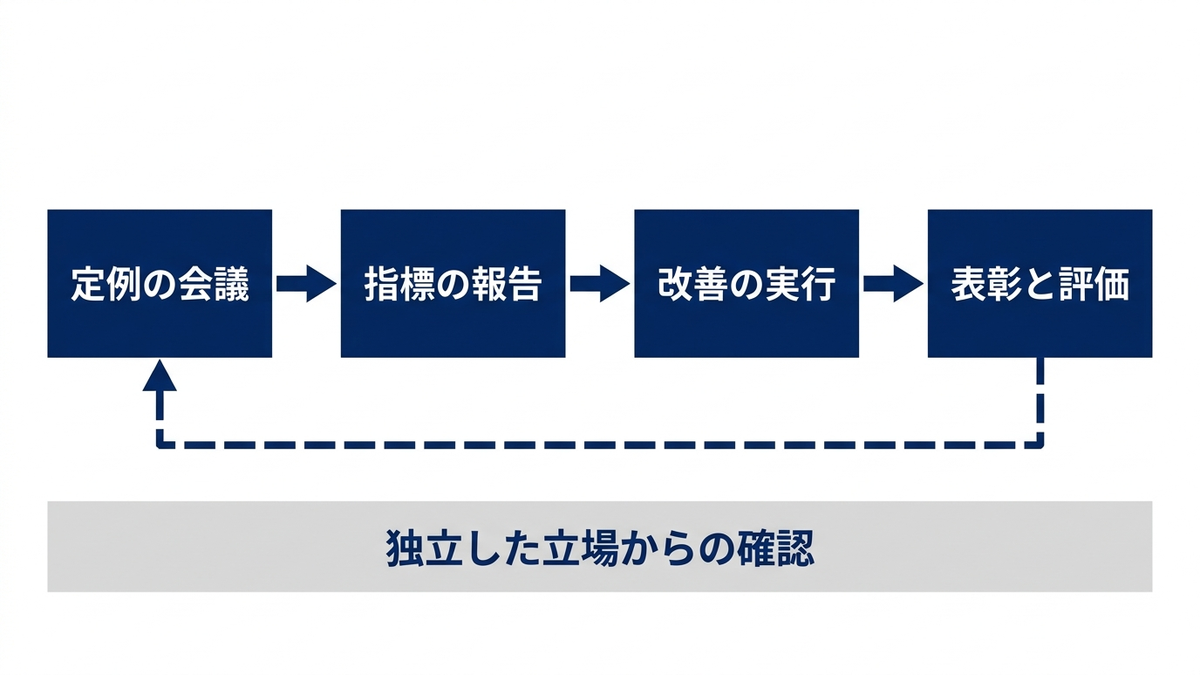
経営判断、続けるための最小の投資
この章の最後に、経営が続けるために何を最小限確保すればよいかをまとめます。立ち上げの時期には、範囲・役割・方針という大きな決定が要りましたが、定着の時期に経営が決めることは、それと比べると小さく、しかし省けないものです。
1つ目は、時間の確保です。データスチュワードの兼務の割合の目安を任命時に決め、上長と合意しておくこと。月次の定例と四半期の会議体の開催を年間の予定に入れておくこと。経営会議に四半期に一度の報告の枠を固定すること。これらは新しい製品の予算が無くても始められる場合がありますが、担当する人の工数と既存の業務の調整は必要です。予定に入っていないものは、忙しい時期に削られやすくなります。
2つ目は、評価の項目です。データオーナーとデータスチュワードの役割を、目標設定と人事の評価の項目に入れること。これは人事部門との調整が要るので、経営の側から指示しないと進みにくい項目です。公開事例でも、CRISP の評価と報酬への結びつけや、デジタル庁のガイドラインが挙げる「人材が評価・処遇される人事制度」のように、評価の仕組みとの接続が出てきます。
3つ目は、測ることと報告することの継続です。第3章で扱った成果の指標と、手続きが使われた件数を、毎月同じ定義で集計し、四半期ごとに委員会と経営会議へ報告する。指標の数は少なくてかまいません。同じ数字を同じ形で並べ続けることが、失敗の型の兆候に早く気づく一番の手段になります。
4つ目は、やめる判断の基準を持つことです。続けることが大事だといっても、使われていない会議や、誰も見ていない指標を続ける必要はありません。たとえば「半年間、議題が報告の読み上げだけだった会議は、統合するか、議題を見直す」「1年間、一度も参照されなかった文書は、必要性・保存の要件・緊急時の用途を確かめたうえで、維持・改訂・廃止のどれにするかを決める」のように、見直しの基準を先に決めておくと、仕組みが形だけになったときに、それを放置せずに直すきっかけになります。
続けるための投資は、立ち上げの投資を回収するための保険のようなものだと考えています。この投資を省いたときの損失は、いずれ同じ取り組みを立ち上げ直す費用、その間に起きる判断の遅れと集計の食い違い、そして「前にもやったが続かなかった」という現場の不信として表れます。最後の不信は、次に立ち上げるときの抵抗を強くするので、金額以上に重い損失だと考えています。
この章では、データガバナンスを立ち上げた後に定着させるための考え方を整理しました。抵抗には理由の型があり、説得よりも手間と効果の配分・権限の置き場所・評価の項目という組織の設計を変える方が持続しやすいこと。続かなくなる失敗の型は6つあり、互いに連鎖するので、兆候を指標で早く拾うこと。JDMC の受賞企業の報道発表には、段階的な導入・業務の現場の参加・経営の関与が複数社に共通して書かれており、評価・表彰・支払い条件・教育の仕組みは個別の会社の例として見られること。ただしそれは受賞時点の取り組みで、定着の実績を示すものではないこと。デジタル庁のガイドラインも、企業文化への定着と人材の育成、独立した立場からの評価を経営者に求めていること。分散と統制を両立させる考え方としてデータメッシュがあり、分散させるほど全体の共通ルールが要ること。そして、続けるための最小の投資は、時間・評価の項目・測定と報告の継続・やめる判断の基準であることです。終章では、本コラム全体を振り返り、データガバナンスを続けるために経営と現場が持っておくべき視点をまとめます。
この章を深めたい方への参考書籍
『企業変革力』(ジョン・P.コッター 著、梅津祐良 訳、日経BP社):原題は Leading Change で、企業の変革をどう率いるかを扱った経営書です。データガバナンスの定着は、データの技術よりも仕事の進め方を変える組織変革の問題であることが多く、この章で扱った推進者・抵抗・経営の関与を、データに限らない変革の一般論として考えるときの材料になります。
『スイッチ! 「変われない」を変える方法』(チップ・ハース、ダン・ハース 著、千葉敏生 訳、早川書房):人や組織がなぜ変われないのか、どうすれば変われるのかを扱った本で、ハヤカワ文庫 NF にも収められています。この章で、抵抗を「理解が足りない人の反発」としてではなく理由の型として扱い、仕組みの側を変えて抵抗の理由を減らす、と書いた考え方を、行動の変化という側面から考えるときに参考になります。
『解読データアーキテクチャ モダンデータウェアハウス、データファブリック、データレイクハウス、データメッシュの選び方』(James Serra 著、村上列 訳、オライリー・ジャパン):データ基盤の主な構成の考え方を比べて解説した本で、目次にはデータメッシュの基礎と、データメッシュを採用すべきかを扱う章、人とプロセスを扱う章があります。この章で触れたデータメッシュを、自社の規模と担い手の状況に照らして採るかどうかを考えるときの材料になります。
終章 データガバナンスを続けるための5つの考え方
本コラムでは、データガバナンスを「誰が何を決め、何を基準に、どう確かめるか」を定める仕組みとして捉え、DMBOKの知識領域を見取り図にしながら、役割と会議体とポリシーの設計、データアーキテクチャ、データ品質、メタデータ、マスターデータ、セキュリティとプライバシー、保管と統合と提供、文書とデータ倫理、AIのためのデータ整備、現状診断、体制づくり、定着までを見てきました。この章では、各章の内容から、データガバナンスを自社で始め、続けるための考え方を5つにまとめます。序章で示した5つの流れ(理解、領域ごとの仕組み、AIへの接続、診断、体制づくり)が章の並びであるのに対し、ここでの5つは章をまたいで繰り返し現れた判断の軸です。いずれも、公開されている規格や指針、事例と、各章で確かめた内容から導いたもので、組織の規模や事業の型に合わせて調整する前提で使えるものだと考えています。
1. 決める層と実行する層を分け、役割の任命から始める
第1章と第3章で見たとおり、データに関する問題には、技術の不足だけでなく、責任者や判断の基準があいまいなことから起きるものがあります。売上の定義が複数あるのに使い分けが共有されていない、部門ごとの顧客マスターを突き合わせる責任者がいない、個人情報の利用可否を判断する経路が無い、といった状態がその例です。データオーナーが決定し、データスチュワードが日々の運用を担い、データカストディアンが技術的に守るという分担を、対象を絞った範囲で先に決めることが、ツールや文書の整備より先に来る一歩になります。ルールの文書やツールは、この分担が決まってから、決めたことを実行しやすくするために整えるものです。
役割を任命するときは、兼務の現実を前提にすることが大事だと考えています。専任のCDOやデータスチュワードを置ける組織は限られており、多くの場合は業務部門の責任者や実務者が兼ねることになります。兼務でも機能させるための条件として、本コラムでは、対象のデータが絞られていること、決めることと日々の作業の範囲が文書で明示されていること、役割に充てる時間を本人の上長と合意していること、権限の範囲内では担当者が判断でき、部門の間で解決できない事項を経営に上げる経路があること、を挙げてきました。第13章で示した90日の計画は、この条件を最初の四半期で満たすことを狙ったものです。
2. 全領域を一度にやらず、自社の損失の型から着手する領域を決める
第2章で見たとおり、DMBOKの知識領域は、データガバナンスを中心に10の領域が並ぶ、合わせて11の領域の見取り図です。この見取り図は網羅的であるがゆえに、限られた人員ですべてを同時に立ち上げようとすると、取り組みが分散し、どの領域も中途半端になるおそれがあります。序章で挙げた6つの損失の型、すなわち判断の遅れ、二重投資、集計の食い違い、法令違反、AI投資の空振り、現場の不信のうち、自社でどれが目立っているかを見れば、着手する領域の見当が付きます。数字の食い違いが目立つなら用語の定義などのメタデータとマスターデータから、個人情報の扱いが不安ならセキュリティとプライバシーから、AIの導入を控えているならデータ品質と来歴(どこから来てどう加工されたかの記録。第11章)とデータ倫理から、という順序です。
第12章の現状診断は、この判断を属人的な印象ではなく、領域ごとの成熟度の段階として言葉にするためのものです。未着手・個別対応・定義済み・運用中・改善継続という5段階で領域ごとに現在地を置いたうえで、第12章では、その領域が他の領域の足かせになっているか、近い将来の投資の失敗につながるか、法令違反や信頼の喪失につながるか、という3つの問いで着手の優先順位を付けます。経済産業省と情報処理推進機構のDX推進指標のような公的な指標は、自社の位置を外の物差しで見るために使えますが(DX推進指標はレベル0から5の6段階の自己診断で、本コラムの5段階とは評価の対象と基準が異なるため、点数を直接換算することはできません)、点数そのものが目的ではありません。
3. 品質は測れる形にして初めて改善でき、定義は管理して初めて揃う
第5章では、データ品質を完全性・正確性・一貫性・一意性・有効性・適時性といった観点に分け、架空の顧客台帳に対して品質ルールを当てて測る例を示しました。品質を「悪い気がする」という印象のままにしておくと、改善の優先順位も、改善の成果も示せません。ルールごとの合格率として測れば、どこから直すか、直した結果どう変わったかを数字で報告でき、改善への貢献を評価する材料にもなります。測る項目は最初から全部である必要はなく、業務への影響が大きい数項目から始めて増やしていくほうが続きます。
第6章と第7章で扱ったメタデータとマスターデータは、品質を測る前提になる領域です。項目の定義があいまいなままでは、何をもって「正しい」とするかの合意が難しく、品質ルールを決めにくくなります。顧客や取引先の「正しい一件」を決める仕組みが無ければ、同じ顧客や取引先を識別できず、重複や集計の食い違いが生じやすくなります。データカタログの製品を入れる前に用語集を整える、マスターデータ管理の製品を入れる前にどのマスターの何を正とするかを決める、という順序が、道具を活かす順序だと考えています。
4. 守りと活用は対立させず、分類とアクセス制御と倫理の審査を土台にする
第8章で見たとおり、個人情報保護法は2026年7月に改正法が成立し、公布されました。施行日は政令(法律に基づいて内閣が定める命令)で定められる予定で、一部の規定は別の日に施行されます。2026年10月27日に個人情報保護委員会の令和8年改正法の案内ページを確認した範囲では、施行日を定める政令が公布されたという記載は見当たらず、政令・規則・ガイドラインの整備が続いています(施行の状況の詳細は第8章で扱っています)。法令の要請を社内ルールに落とす作業は、法務や情報システム部門だけの仕事ではなく、どのデータに個人情報が含まれ、何の目的で使い、誰に提供するかを知っている業務部門が判断に関わって初めて成り立ちます。データの分類(機密区分)とアクセス制御を土台にしておけば、「全部を鍵にかける」か「全部を開ける」かの二択ではなく、分類に応じて使える範囲を決められます。
第10章で扱ったデータ倫理では、法令を守ることを前提に、法令だけでは判断しきれない使い方の適切さを検討します。合法であっても、顧客や従業員の信頼を損なう使い方はあります。第10章で示したように、どういう契機で、誰が判断し、何を記録するかという審査の仕組みを決めておくと、現場が迷ったときに持ち込む先がはっきりします。第11章で見たとおり、AIの学習データの来歴、品質、権利、個人情報の扱いは、AIの出力を社外に説明するための前提であり、データガバナンスがAIガバナンスの土台になる理由はここにあります。
5. 小さく始めて運用を続け、成果を経営に報告する
第14章で見たとおり、立ち上げを正しく終えたあとでもデータガバナンスの取り組みが止まる経緯を、本コラムでは、導入した道具が更新されないこと、ルールだけ作って運用しないこと、任命後に時間が割かれなくなること、経営の関心の低下、品質改善が報われないこと、部門間の縄張りの6つの型に整理しました。立ち上げの最初の判断で起きやすい誤り(ツールから入る、対象範囲を広げすぎる、兼務に任せきりにする)は第13章で扱いました。定着期の6つの型は、データの技術の誤りよりも、権限・担当の時間・評価の仕組みのような、運用を支える組織の側の不足から起きるものとして整理しています。対象を絞り、品質を測り、定例の会議体で指標を見て、経営に四半期ごとに報告する、という小さな循環を先に作れば、成果が見えるまでの期間が短くなり、次の領域に広げる根拠ができます。
公開されている事例の読み方にも、この見方が関わります。第3章と第14章で紹介した、日本データマネジメント・コンソーシアム(JDMC)がデータマネジメント賞の受賞企業について公表した報道発表を見ると、取り組みの対象も形も各社で異なります。関西電力の例では、CDOを筆頭に全社と各事業部門にデータスチュワードを置き、データのニーズの管理から収集・加工・蓄積・利活用・廃棄までを一元的に管理する体制が報道発表に記されています(第3章)。この報道発表に書かれた体制の説明だけからは、長期的な定着や、データガバナンス単独の効果までは判断できません。続ける仕組みをどう設計するかは、事例ではなく、第14章の6つの型を自社に当てはめて考えることになります。
データガバナンスを、経営の判断の手順に組み込む
データガバナンスは、一度文書を作って終わる取り組みではなく、役割の任命、対象の選定、品質の測定、定例の会議体、経営への報告という循環を、経営の意思決定の手順に固定の項目として組み込んで初めて、判断を変える力を持つと考えています。データ活用やAIへの投資を決めるとき、そのデータの持ち主と定義が決まっているか、品質が測られているか、個人情報の扱いを判断する経路があるかを確かめる項目が、投資の審査に含まれていれば、投資判断の前提を説明しやすくなります。投資の成果を検証するには、これに加えて、業務上の目標と導入前の状態を記録しておく必要があると考えています。
最初の一歩は、次の順で進めるのがよいと考えています。第1に、経営がデータガバナンスに取り組むと決め、経営スポンサーを置きます。第2に、対象範囲を決めます。簡易には、序章の6つの損失の型のうち自社で目立っているものを1つ選び、その損失が起きているデータ(たとえば顧客データや売上データ)を対象にします。正式には、第12章の診断で領域を選んでから対象を決めます。第3に、その対象データのデータオーナーとデータスチュワードを任命します。第4に、対象データの項目の定義を用語集として書き出します。第5に、品質を数項目で測り、経営に最初の報告をします。第13章の90日の計画でいえば、この5つの手順は着手前の経営の決定から第13週の最初の報告までの骨格にあたり、計画にはこのほかに基本方針の初版と承認、委員会の3回の開催が含まれます。そのうえで、第12章の診断を改めて行って次の領域を選び、同じ循環を広げていく順序であれば、大きな投資をする前に、自社で何が決められ、何が測れるかを確かめながら進められます。
Anagraftでは、データ活用の構想づくりから、データガバナンスの体制設計、データ品質やマスターデータの整備、AI活用に向けたデータ整備、意思決定への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 データガバナンスとは何か、データマネジメントとの関係と用語の整理
『経営のためのデータマネジメント入門』(喜田昌樹 編著、日本情報システム・ユーザー協会ビジネスデータ研究会 編、中央経済社):情報システム部門ではなく経営層や業務部門の読者を想定し、データマネジメントを経営の視点から解説した入門書です。この章で扱った、データの統治を技術の話ではなく経営の判断として捉える見方を、より広い文脈で確かめたいときの材料になります。
『DXを成功に導くデータマネジメント データ資産価値向上と問題解決のための実務プロセス75』(データ総研、小川康二、伊藤洋一 著、翔泳社):データマネジメントの実務を75の項目に分けて解説した本で、目次はデータマネジメントの組織の立ち上げから始まります。この章で示した統治と管理の区別を、実際の作業の単位に落としていくときに参考になります。
第2章 DMBOKとは何か、知識体系の成り立ちと知識領域の見取り図
『データマネジメント知識体系ガイド 第二版 改定新版』(DAMA International 編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳、日経BP):この章で見取り図として紹介した DMBOK の日本語版で、原書の第2版改訂版の翻訳です。データガバナンスを含む11の知識領域と、倫理・データサイエンス・成熟度・組織と役割・組織の変革の各章からなります。本コラムが自分の言葉でまとめた各領域について、原典の正確な定義と記述を確かめるときに当たる本です。自社の困りごとに対応する章を引いて、決まっていないことを洗い出す使い方に向いています。
『DAMA-DMBOK:Data Management Body of Knowledge』(DAMA International、Technics Publications):DMBOK の原書で、NDL サーチの書誌では第2版が2017年、第2版の改訂版が2024年の刷りです。CDMP の試験は DMBOK にもとづいており、資格の取得を考える人や、英語の用語で海外の資料や製品の説明と突き合わせたい人にとって、原語の表現を確かめる手がかりになります。
第3章 データガバナンスの仕組み、原則・ポリシー・役割・会議体
『成果を生む攻めのデータガバナンス データを経営資産に変える仕組みづくり』(小林靖典 著、翔泳社):データを守りの管理の対象としてだけでなく、経営の成果につなげる資産として扱うための仕組みを解説した本です。出版社の紹介では、戦略・組織・実行の三層を軸に、IT 部門と業務部門をつなぐ仕組みを整理し、データガバナンスの組織・役割・統制・運営・評価を扱う章と、テーマ別の実践事例の章があります。この章で扱った役割・会議体・指標を、自社の文書のひな型に落とすときの材料になります。
『データスチュワードシップ データマネジメント&ガバナンスの実践ガイド』(David Plotkin 編著、Metafindコンサルティング株式会社 監訳、日経BP):原著第2版の翻訳で、データスチュワードの種類、役割と責任、導入の方法、業務側のスチュワードの研修、進み具合の計測を扱った本です。この章でデータオーナーとデータスチュワードの分担や兼務の扱いを考えるときに、スチュワードの側から詳しく掘り下げる材料になります。
第4章 データアーキテクチャとデータモデリング、全社データの見取り図
『システム開発・刷新のためのデータモデル大全』(渡辺幸三 著、日本実業出版社):システムの設計の要となるデータモデルについて、多くの用例と実践的な書き方を紹介した本です。この章で扱った論理データモデルとER図を、実際の業務に当てはめて描くときの手本になります。書名のとおり既存システムの刷新を視野に入れているので、レガシーシステムの移行を考える際にも参考になります。
『データモデリングでドメインを駆動する 分散/疎結合な基幹系システムに向けて』(杉本啓 著、技術評論社):基幹系システムとデータモデリングを主題に、新しい事業に向けた基幹系システムの作り方や、既存のシステムを柔軟な構成へ変えていく方法を扱った本です。この章で触れたドメインモデルと、業務の範囲ごとにデータの意味を整理する考え方を、基幹系システムの設計の側から深めることができます。
『達人に学ぶDB設計徹底指南書 第2版』(ミック 著、翔泳社):データベースの設計の考え方と実践的なノウハウを、クラウドへの対応も含めて解説した本です。論理設計と物理設計を扱う章があり、この章で説明した論理データモデルと物理データモデルの違いを、データベースの設計の実務に即して確かめることができます。
第5章 データ品質、何を測りどう直すか
『データ品質プロジェクト実践ガイド 質の高いデータと信頼できる情報を得るための10ステップ』(Danette McGilvray 編著、木山靖史・宮治徹・井桁貞裕 監訳、日経BP):書名のとおり、データ品質の改善を10の手順のプロジェクトとして進める方法を扱った本です。この章で扱った、品質の観点を決める、測る、原因を調べる、予防と修正を選ぶ、という流れを、自社のプロジェクトとして組み立てるときの手引きになります。
『前処理大全 SQL/pandas/Polars実践テクニック 改訂新版』(本橋智光・橋本秀太郎 著、技術評論社):分析の前のデータの加工を、SQL・pandas・Polars の3つで書き分けて示す本です。この章のコードで行った、欠損や重複の確認、文字列の書式の確認と正規化を、自社のデータベースや分析環境で書くときの参考になります。
第6章 メタデータ管理とデータカタログ、データリネージ
『メタデータ管理入門 メタグリッドで実現するAI時代の知識統合技術』(Ole Olesen-Bagneux 著、菊池彰 訳、オライリー・ジャパン):メタデータ管理を正面から扱った本の日本語訳で、原題は「Fundamentals of Metadata Management」です。目次では、IT・データ・情報・知識の管理それぞれのためのメタデータの置き場所を順に取り上げ、それらを連携させる考え方と、そのためのチームの作り方へと進みます。この章で述べた、メタデータを誰が書き誰が使うかで分ける考え方を、組織全体の視点から広げて考えるときの材料になります。
『最新解説 知識資源のメタデータ』(谷口祥一、緑川信之 著、勁草書房):図書館情報学の立場から、メタデータによる知識資源の組織化を体系的に解説した本です。目次では、メタデータの要求定義と概念モデル、記述のルール、ダブリンコア、分類法や統制語彙表を使った主題分析、メタデータの作成と検索の仕組みを扱っています。企業のデータを直接扱う本ではありませんが、この章で述べた用語集の作り方(言葉の意味を1つに決め、別名や上位・下位の関係を記録すること)やカタログの項目の立て方を、長い蓄積のある分野の考え方から見直すときの材料になります。
第7章 参照データとマスターデータ、名寄せと正しい一件の管理
『DXを成功に導くマスターデータマネジメント データ資産を管理する実践的な知識とプロセス43』(伊藤洋一 著、翔泳社):複数の業務で共通に使うマスターの設計と管理を、内製化を前提に実務の手順として解説した本です。目次は、マスターデータ管理が必要な理由、全体像、共通認識を作る仕組み、基盤の構築、組織作り、教育作りの章からなり、この章で扱った「同じ取引先」の定義や持ち主の決め方を、組織と手順の側から深めるのに向いています。
『「データ経営」を実現するIT戦略 経営管理の本質はマスターデータにある』(國本修司 著、日経BP社):副題のとおり、経営管理の土台としてマスターデータを位置づける本です。2013年の刊行なので、製品や技術の記述は当時のものとして読む必要がありますが、この章の最後の節で扱った、どのマスターの誤りがどの経営判断を止めるのかを、経営の側から考える材料になります。
第8章 データセキュリティとプライバシー、個人情報保護法と社内ルール
『個人情報保護法の知識 第5版』(岡村久道 著、日経BP日本経済新聞出版本部):日経文庫の1冊で、個人情報保護法の仕組みを、法制のあゆみから順に解説した入門書です。2021年刊の版なので、令和8年改正は含まれていません。この章で扱った個人情報・個人データ・保有個人データの区別や事業者の義務を、条文の背景から理解したいときの土台になります。
『ISO/IEC 27001情報セキュリティマネジメントシステム〈ISMS〉構築・運用の実践 第2版』(羽田卓郎 著、日科技連出版社):JIS Q 27001 の2023年版に対応した、情報セキュリティマネジメントシステムの構築と運用の手順を扱った本です。目次には、構築におけるトップマネジメントの役割や構築手順の概要の章があります。この章で触れた、情報セキュリティマネジメントとデータガバナンスの分担を考えるときに、セキュリティの側の仕組みを知る材料になります。
『データ戦略と法律 攻めのビジネスQ&A 改訂版』(中崎隆、安藤広人、板倉陽一郎、永井徳人、吉峯耕平 編著、日経BP):データの利活用に関わる法律問題を、問いと答えの形で扱った本です。目次は総論の次に積極的なデータの利活用の章が置かれています。2021年刊の版なので、令和8年改正は含まれていません。この章の、守りと活用を両立させるという考え方を、法律の側から確かめるときに参考になります。
第9章 データの保管・統合・提供、基盤運用とデータウェアハウス
『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社):データ活用のためのデータ整備、データ基盤システムのつくり方、データ分析の組織の3つの章で、データ基盤が思うように機能しない原因と対処を整理した本です。この章で扱った、統合の仕組みと点検、基盤を使い道から作ることを、データ・システム・組織の3つの側面から具体的に考えるときの材料になります。
『データエンジニアリングの基礎 データプロジェクトで失敗しないために』(Joe Reis、Matt Housley 著、中田秀基 訳、オライリー・ジャパン):データの生成・保存・取り込み・変換・提供を「データエンジニアリングライフサイクル」として整理し、組織のデータ成熟度に応じた基盤の作り方の指針を示した本です。目次には、ストレージへの保存、データ取り込み、アナリティクスや機械学習へのデータの提供を扱う章があり、この章の保管・統合・提供の流れを技術の側から深めるときに参考になります。
第10章 ドキュメント・コンテンツ管理とデータ倫理
『AI・データ倫理の教科書』(福岡真之介 著、弘文堂):AI とデータの利用が社会に受け入れられるための考え方を扱った本で、倫理の判断の枠組み、各国の AI 倫理の原則、倫理が問題になった事例を章立てにしています。この章で扱った「法令に違反していなくても不適切になりうる使い方」を、具体的な事例に沿って考えるときの材料になります。
『プライバシーガバナンスの教科書』(小林慎太郎、夛屋早百合、芦田萌子、中居捷俊 著、中央経済社):データの利活用と個人情報の保護を両立させるための考え方を整理した本です。この章で紹介した総務省と経済産業省のガイドブックが示す「法令遵守を前提に、自ら規範を定めて説明する」という考え方を、企業の体制づくりの側から考えるときに参考になります。
『アーカイブズと文書管理 米国型記録管理システムの形成と日本』(坂口貴弘 著、勉誠出版):大量の記録をどう管理するかについて、米国で形成された記録管理の仕組みと、日本での取組を扱った本です。この章で扱った、文書を「記録」として扱い、保持と廃棄を組織として決めるという考え方が、どういう経緯で形づくられてきたかを知るときに役立ちます。
第11章 AIのためのデータ、AI Ready とAIガバナンスへの接続
『Data-centric AI入門』(片岡裕雄 監修、宮澤一之 ほか 執筆、技術評論社):書名のとおり、データの側から機械学習の成果を高める Data-centric AI を扱った入門書で、技術評論社の ML Systems のシリーズの1冊です。この章で扱った学習データの品質や正解のラベルの点検を、データサイエンスの担当者の側から掘り下げるときの材料になります。
『AIガバナンス入門 リスクマネジメントから社会設計まで』(羽深宏樹 著、早川書房):副題のとおり、AI のリスクマネジメントから社会の仕組みの設計までを扱ったハヤカワ新書の1冊です。この章では名前と位置づけだけに絞った AI ガバナンスを、データガバナンスの次に何を整えるかという視点で見渡すときの入口になります。
第12章 現状診断と成熟度アセスメント
『DX白書2023』(情報処理推進機構 企画・著作・制作、情報処理推進機構):IPA が日米の企業へのアンケート調査の経年変化と国内の DX 事例の分析をもとに、DX の取組状況と課題をまとめた白書です。副題は『進み始めた「デジタル」、進まない「トランスフォーメーション」』で、戦略・人材・ITシステムの各面から現状を整理しています。自社の診断結果を、他社の取り組みの全体像と照らし合わせて読むときの材料になります。
『図解はじめての「開発のためのCMMI」とプロセス改善』(橋本隆成 著、日刊工業新聞社):書名のとおり、ソフトウェア開発の組織のプロセス改善に使われる CMMI(開発のための CMMI)を図解で解説した入門書で、2013年刊行の第2版です。CMMI は成熟度レベルで組織の取り組みを捉えるモデルとして知られています。扱っているのは刊行当時の版のモデルなので、現行の版の詳細は CMMI の公式の情報で確かめる必要がありますが、組織の取り組みを段階で捉えて一段ずつ改善するという考え方を、データ以外の分野の例で知る材料になります。
第13章 自社の体制づくり、最初の90日から1年の進め方
『データマネジメント 仕組みづくりの教科書』(小川康二・仲程隆顕 著、日経BP):生成AI の活用を視野に入れて、データマネジメントを全社の仕組みとして整える方法を解説した本です。出版社の紹介では、経営者・データ管理の担当・現場の業務担当のそれぞれの立場から全員参加の必要を説く部と、実装の要点と着手点を整理したうえで、データ活用のプロセス・データアーキテクチャ・マスターデータ・データセキュリティ・データ品質・メタデータ・データガバナンスの7つの管理を、原則・体制・プロセス・ガイドラインの目次の例とともに扱う部があります。この章の立ち上げの順序とポリシーの雛形を、領域ごとに具体化するときの材料になります。
『実践データマネジメント AI/BIの活用レベルを上げる新しい基盤・組織・運用』(川上明久 著、日経BP):データ活用のための人と組織、環境の整備、データマネジメントの方法、活用を進めるうえでの課題の4つの章で構成された本です。出版社の紹介する目次には、DX を支えるデータマネジメント組織の作り方、事業部門との目標の共有、データ活用のトップダウンとボトムアップの進め方を扱う節があります。この章の経営スポンサーの置き方や、事務局と業務部門の分担を考えるときに、組織の側から補う材料になります。
第14章 定着と組織変革、失敗の型と公開事例
『企業変革力』(ジョン・P.コッター 著、梅津祐良 訳、日経BP社):原題は Leading Change で、企業の変革をどう率いるかを扱った経営書です。データガバナンスの定着は、データの技術よりも仕事の進め方を変える組織変革の問題であることが多く、この章で扱った推進者・抵抗・経営の関与を、データに限らない変革の一般論として考えるときの材料になります。
『スイッチ! 「変われない」を変える方法』(チップ・ハース、ダン・ハース 著、千葉敏生 訳、早川書房):人や組織がなぜ変われないのか、どうすれば変われるのかを扱った本で、ハヤカワ文庫 NF にも収められています。この章で、抵抗を「理解が足りない人の反発」としてではなく理由の型として扱い、仕組みの側を変えて抵抗の理由を減らす、と書いた考え方を、行動の変化という側面から考えるときに参考になります。
『解読データアーキテクチャ モダンデータウェアハウス、データファブリック、データレイクハウス、データメッシュの選び方』(James Serra 著、村上列 訳、オライリー・ジャパン):データ基盤の主な構成の考え方を比べて解説した本で、目次にはデータメッシュの基礎と、データメッシュを採用すべきかを扱う章、人とプロセスを扱う章があります。この章で触れたデータメッシュを、自社の規模と担い手の状況に照らして採るかどうかを考えるときの材料になります。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- ISO/IEC 38505-1 の初版は2017年4月発行・20ページ
https://www.iso.org/standard/56639.html - 第2版は2026年8月発行で初版を置き換え、主な変更点は ISO/IEC 38500 の2024年版との整合
https://www.technickenormy.cz/publicdoc/iec_previews/4311698.pdf - ISO/IEC 38500 の2024年版は第3版で2024年2月発行
https://www.iso.org/standard/81684.html - 目録では第2版のページが初版の改訂版として示されている
https://www.iso.org/standard/87195.html - ISO のページは2026年10月22日の時点で自動の閲覧を受け付けず、Wayback の保存版で確かめた
https://web.archive.org/web/20260917213429/https://www.iso.org/standard/56639.html - DMBOK ではデータガバナンスはデータマネジメントの知識領域の1つとして扱われている
https://bookplus.nikkei.com/atcl/catalog/24/07/02/01453/ - 参考書籍『経営のためのデータマネジメント入門』喜田昌樹 編著、日本情報システム・ユーザー協会ビジネスデータ研究会 編、中央経済社
https://ndlsearch.ndl.go.jp/books/R100000002-I029176340 - 参考書籍『DXを成功に導くデータマネジメント データ資産価値向上と問題解決のための実務プロセス75』データ総研、小川康二、伊藤洋一 著、翔泳社
https://ndlsearch.ndl.go.jp/books/R100000002-I031853886 - 個人情報保護法では、本人の同意なく、法令上の例外にも当たらずに、特定した利用目的の達成に必要な範囲を超えて個人情報を取り扱うことと、必要な安全管理措置を講じないことが義務に反する
https://www.ppc.go.jp/personalinfo/legal/guidelines_tsusoku/
第2章
- DAMA International は独立した、ボランティアが運営する非営利の団体で、1980年に創られ1988年に国際化した
https://www.dama.org/ - DAMA日本支部の正式名称と、DAMA International の日本支部であること
https://www.dama-japan.org/ - DMBOK の紹介ページは2024年に DMBOK 2.0 Revision を立ち上げたと記す
https://www.dama.org/cpages/body-of-knowledge - DMBOK はデータガバナンスを中心に置き、周囲に10の領域を並べる構成を取る
https://www.dama.org/dmbok2r-infographics/ - DMBOK 3.0 の Triple Helix の体制(11名の分野別編集者・編集長・技術ライター、Master 保持者7名の査読、各国の実務家)、2025年6月25日のキックオフ、AI・クラウド・現代のデータ基盤を取り込む予定
https://dama.org/dama-dmbok-3-0-project/ - 原書の第2版は2017年に Technics Publications から刊行
https://ndlsearch.ndl.go.jp/books/R100000136-I1971993809728088463 - 原書の第2版の改訂版は2024年の刷り
https://ndlsearch.ndl.go.jp/books/R100000136-I1970586434879172022 - 日本語版 第一版は2011年12月、日経BP社、DAMA International 著、データ総研 監訳
https://ndlsearch.ndl.go.jp/books/R100000002-I023161996 - 日本語版 第二版は2018年12月、日経BP社、DAMA International 編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳
https://ndlsearch.ndl.go.jp/books/R100000002-I029344141 - 日本語版 第二版 改定新版は2024年7月、日経BP、責任表示は DAMA International 編著、DAMA日本支部、Metafindコンサルティング株式会社 監訳
https://ndlsearch.ndl.go.jp/books/R100000002-I033578813 - 日経BP の書籍ページの書名・発行日2024年7月22日・ISBN・672ページ・A4判・全17章、改定新版の変更点(各章の軽微な修正、データ品質の章の構成変更と追記)
https://bookplus.nikkei.com/atcl/catalog/24/07/02/01453/ - 日本語版の第一版は2011年、第二版は2018年(日経BP の紹介記事)、第二版は全章を書き直し6章を追加
https://bookplus.nikkei.com/atcl/column/032900009/071000641/ - 書店のサイトによってはこの本の欄に別の ISBN が出ていた例があり、その ISBN を NDL サーチで引くと別の書籍(データスチュワードシップの訳書)だった
https://ndlsearch.ndl.go.jp/books/R100000002-I033578812 - CDMP の3つの段階(Associate・Practitioner・Master)と対象の経験年数、必須試験 Data Management Fundamentals、7つの専門分野から2つ、Master は経歴書の審査、オンラインの監督付き試験
https://dama.org/certification/about-cdmp-certification/ - CDMP の試験はオンラインの選択式で、問題数・時間・段階ごとの合格の基準は試験の案内のページに示されている
https://dama.org/certification/exam-information-and-pricing/ - 2024年の改訂版の変更点は、用語と略語の統一、全章の誤字と図の誤りの修正、12の文脈図の見直し、データ品質の章の改善(付録の追加を含む)
https://dama.org/dama-dmbok2-revised-edition-faqs/ - DMBOK 3.0 の刊行は、プロジェクトのサイトのよくある質問と回答で2027年第3四半期が目標、工程表では出版と展開の段階が2027年4月から7月
https://www.damadmbok.org/faq - DMBOK 3.0 の刊行は、プロジェクトのサイトのよくある質問と回答で2027年第3四半期が目標、工程表では出版と展開の段階が2027年4月から7月
https://www.damadmbok.org/project - Associate と Practitioner には事前の経験の条件が無く(Practitioner の2〜10年は目安)、Master は最低10年の関連経験と経歴書の審査
https://dama.org/certification/cdmp-certification-levels/ - 認定は最初の3年間有効で、その後は毎年の更新の手続きが要る
https://dama.org/certification/cdmp-renewal-and-maintenance/
第3章
- JDMC の2025年データマネジメント賞で関西電力が大賞を受賞した(2025年3月5日の報道発表資料、12回目)
https://japan-dmc.org/?p=23564 - 『成果を生む攻めのデータガバナンス データを経営資産に変える仕組みづくり』小林靖典 著、翔泳社
https://ndlsearch.ndl.go.jp/books/R100000002-I034637103 - 『成果を生む攻めのデータガバナンス データを経営資産に変える仕組みづくり』小林靖典 著、翔泳社
https://www.books.or.jp/book-details/9784798191003 - 『データスチュワードシップ データマネジメント&ガバナンスの実践ガイド』David Plotkin 編著、Metafindコンサルティング株式会社 監訳、日経BP
https://ndlsearch.ndl.go.jp/books/R100000002-I033578812 - 『データスチュワードシップ データマネジメント&ガバナンスの実践ガイド』David Plotkin 編著、Metafindコンサルティング株式会社 監訳、日経BP
https://www.books.or.jp/book-details/9784296205530
第4章
- DMBOK の日本語版はデータアーキテクチャとデータモデリングとデザインを別々の章として扱う
https://bookplus.nikkei.com/atcl/catalog/24/07/02/01453/ - 実体関連モデルはピーター・チェンが1976年に ACM Transactions on Database Systems 誌に発表した論文で提案された
https://doi.org/10.1145/320434.320440 - JIS X 0301 は情報交換のための日付及び時刻の表記を定めた JIS
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X0301 - JIS X 0221 は国際符号化文字集合(UCS)
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X0221 - JIS X 0213 は漢字の集合を定めた JIS
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X0213 - JIS X 0208 は漢字の集合を定めた JIS
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X0208 - UTF-8 は RFC 3629(2003年11月)が定め、1文字を1〜4バイトで表し、US-ASCII の範囲は ASCII と同じ1バイトの値
https://www.rfc-editor.org/rfc/rfc3629 - デジタル庁の政府相互運用性フレームワーク(GIF)はデータ連携のための参照モデルで、コアデータモデル・コアデータパーツ・実装データモデル・コア語彙から成る
https://www.digital.go.jp/policies/data_strategy_government_interoperability_framework - GIF の最新は2026年10月6日公開の第2.4版、CC0 1.0 で公開、そのまま採用も取捨選択も可
https://gif.digital.go.jp/ - GIF のコアデータパーツには日付時刻・住所・所在地・郵便番号・地理情報・電話番号の文書がある
https://gif.digital.go.jp/2.4/440_コアデータパーツ/docx/index.html - 共通語彙基盤(IMI)はデータに使う用語の表記・意味・構造をそろえ、分野をまたいだ検索や連携を進めることを目的に掲げる
https://imi.go.jp/ - ストラングラー フィグ パターンは、レガシーシステムの機能を新しいサービスへ少しずつ置き換える移行の方法
https://learn.microsoft.com/ja-jp/azure/architecture/patterns/strangler-fig - 参考書籍『システム開発・刷新のためのデータモデル大全』
https://ndlsearch.ndl.go.jp/books/R100000002-I030353293 - 参考書籍『データモデリングでドメインを駆動する』
https://ndlsearch.ndl.go.jp/books/R100000002-I033318431 - 参考書籍『達人に学ぶDB設計徹底指南書 第2版』
https://ndlsearch.ndl.go.jp/books/R100000002-I033644126
第5章
- ISO/IEC 25012(2008年)は構造化されたデータの一般的なデータ品質モデルを定め、品質の属性を15特性に分け、固有とシステム依存の2観点で捉える
https://www.iso.org/standard/35736.html - IEC ウェブストアでの ISO/IEC 25012 の版は第1版、発行日は2008年12月3日
https://webstore.iec.ch/publication/11246 - JIS X 25012(2013年)は2013年6月20日制定、2018年10月22日と2023年6月20日に確認、ISO/IEC 25012(2008年)と一致(IDT)
https://webdesk.jsa.or.jp/books/W11M0090/index/?bunsyo_id=JIS%20X%2025012:2013 - JISC の JIS 検索にも同じ番号と題名の規格が登録されている
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X25012 - IPA のデータに関するページは、デジタル庁が GIF の関連資料として公開したデジタル社会推進実践ガイドブック DS-468-1「データ品質管理ガイドブック」を案内している
https://www.ipa.go.jp/digital/ai/data.html - デジタル庁の GIF の公式リポジトリは、2026年1月8日の GIF v2.2 からデータ品質管理ガイドブックを管理の対象から外し、今後の更新や公式の説明の対象外とした(過去の版は閲覧できる状態を保つ)
https://github.com/digital-go-jp/GIF - 15の特性の名前と英語名は、ガイドブックが ISO/IEC 25012 に沿って挙げる15項目のもの
https://warp.ndl.go.jp/20260107/20260105150000/https://cio.go.jp/sites/default/files/uploads/documents/data_hinshitu_guide_beta_20210831.pdf - デジタル庁のデータ戦略のページは、データ標準と品質の資料の参照先として WARP に保存された政府CIOポータルのページを案内している
https://www.digital.go.jp/policies/data_strategy - 架空データのメールアドレスに使った example.com、example.net、example.org は例示用に予約されたドメイン
https://www.rfc-editor.org/rfc/rfc2606 - Great Expectations の GX Core は Python のライブラリで、Expectation は検証できる主張、Expectation Suite はその集まり、Validation Definition はデータと Suite の結び付け
https://docs.greatexpectations.io/docs/core/introduction/gx_overview - pandera はデータフレーム状のデータを検証する公開の枠組みで、pandas、polars、dask、modin、ibis、pyspark などに対応する
https://pandera.readthedocs.io/en/stable/ - 参考書籍『データ品質プロジェクト実践ガイド 質の高いデータと信頼できる情報を得るための10ステップ』
https://ndlsearch.ndl.go.jp/books/R100000002-I033844769 - 参考書籍『前処理大全 SQL/pandas/Polars実践テクニック 改訂新版』
https://ndlsearch.ndl.go.jp/books/R100000002-I033469943
第6章
- メタデータを業務・技術・運用の3つに分ける区分は既存の資料でも使われている
https://dama-ny.com/images/meeting/011508/dama_nyc___bus_md_final.pdf - DataHub は dbt からの取り込みで、説明・所有者・用語集の用語の結びつけを取り込める
https://docs.datahub.com/docs/generated/ingestion/sources/dbt/ - ISO/IEC 11179-1 の現行版は2023年1月発行の第4版で、2015年の版を置き換えた
https://web.archive.org/web/20261013002339/https://www.iso.org/standard/78914.html - ISO/IEC 11179-1 の現行版は2023年1月発行の第4版で、2015年の版を置き換えた
https://www.iso.org/standard/78914.html - DCAT 第3版は2024年8月22日に W3C 勧告
https://www.w3.org/TR/vocab-dcat-3/ - OpenLineage はデータリネージの収集と分析のためのオープンな枠組み
https://openlineage.io/docs/ - RDF はウェブ上のデータ交換のための標準のモデル
https://www.w3.org/RDF/ - DataHub はデータ全体の検索、所有者の定義と個人情報を含むデータの追跡、リネージの追跡を挙げる
https://docs.datahub.com/docs/features - DataHub のビジネス用語集は用語と用語グループ、説明と所有者、資産と列への付与、Contains と Inherits の関係、住所と電子メールの例
https://docs.datahub.com/docs/glossary/business-glossary - DataHub のリネージはテーブル単位と列単位、取り込み元から自動取得、画面での手動追加削除、API での登録、手動と自動の上書きの注意
https://docs.datahub.com/docs/features/feature-guides/lineage - OpenMetadata はデータの発見・リネージ・ガバナンスのための統合された基盤
https://docs.open-metadata.org/latest - OpenMetadata の用語集は統制された語彙、親子の階層、同義語と関連用語、資産への付与、審査と承認の手順、CSV の一括取り込みと書き出し
https://docs.open-metadata.org/latest/how-to-guides/data-governance/glossary - 参考書籍『メタデータ管理入門 メタグリッドで実現するAI時代の知識統合技術』Ole Olesen-Bagneux 著、菊池彰 訳、オライリー・ジャパン
https://www.oreilly.co.jp/books/9784814401765/ - 参考書籍『メタデータ管理入門 メタグリッドで実現するAI時代の知識統合技術』Ole Olesen-Bagneux 著、菊池彰 訳、オライリー・ジャパン
https://ndlsearch.ndl.go.jp/books/R100000002-I034877074 - 参考書籍『最新解説 知識資源のメタデータ』谷口祥一、緑川信之 著、勁草書房
https://www.books.or.jp/book-details/9784326000647 - 参考書籍『最新解説 知識資源のメタデータ』谷口祥一、緑川信之 著、勁草書房
https://ndlsearch.ndl.go.jp/books/R100000002-I034855706
第7章
- 法人番号は株式会社などの法人等が持つ13桁の番号で、利用範囲の制約がなく誰でも自由に利用できる
https://www.houjin-bangou.nta.go.jp/setsumei/ - 公表サイトは検索・Web-API・CSV形式とXML形式のダウンロード(全件と差分)を提供
https://www.houjin-bangou.nta.go.jp/ - 一度指定された法人番号は変更されない
https://www.houjin-bangou.nta.go.jp/shitsumon/shosai.html?selQaId=00045 - 清算の結了等をした法人も法人番号・名称・所在地は引き続き公表され、事由が生じた旨と年月日も公表される
https://www.houjin-bangou.nta.go.jp/shitsumon/shosai.html?selQaId=00147 - 都道府県コードと市区町村コードは総務省(当時は自治省)が昭和43年に設定し、変更のたびに更新している
https://www.soumu.go.jp/denshijiti/code.html - 全国地方公共団体コードは5桁の数字と1桁の検査数字の6桁
https://www.soumu.go.jp/main_content/000137948.pdf - 総務省の一覧の PDF では都道府県名と市区町村名のカナが半角カタカナ
https://www.soumu.go.jp/main_content/000925834.pdf - JIS X 0401 都道府県コードは1970年4月1日制定、最新改正1973年4月1日、最新確認2024年10月21日
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X0401 - JIS X 0402 市区町村コードは1970年4月1日制定、最新改正2020年3月23日、最新確認2024年6月20日
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X0402 - ISO 8000-100 の2016年版はマスターデータの特性データの交換を扱う部の概要で、2016年10月に第1版として発行、2009年の技術仕様書に代わる
https://www.iso.org/standard/62392.html - 参考書籍『DXを成功に導くマスターデータマネジメント データ資産を管理する実践的な知識とプロセス43』伊藤洋一 著、翔泳社
https://ndlsearch.ndl.go.jp/books/R100000002-I033263364 - 参考書籍『DXを成功に導くマスターデータマネジメント データ資産を管理する実践的な知識とプロセス43』伊藤洋一 著、翔泳社
https://www.books.or.jp/book-details/9784798178882 - 参考書籍『「データ経営」を実現するIT戦略 経営管理の本質はマスターデータにある』國本修司 著、日経BP社
https://ndlsearch.ndl.go.jp/books/R100000002-I024992244 - 参考書籍『「データ経営」を実現するIT戦略 経営管理の本質はマスターデータにある』國本修司 著、日経BP社
https://www.books.or.jp/book-details/9784822262808 - (2026-10-27 追加)標準出力が buffer 属性を持たないものに置き換えられている環境では、冒頭2行の文字コード設定がエラーになる
https://docs.python.org/3.14/library/sys.html - (2026-10-27 再確認)書籍の著者表記
https://ndlsearch.ndl.go.jp/api/opensearch?isbn=9784798178882
第8章
- 確認日はすべて 2026-10-22(JST)
https://www.ppc.go.jp/personalinfo/legal/ - 個人情報の保護に関する法律(平成十五年法律第五十七号)
https://www.ppc.go.jp/files/pdf/261001_houritsu_shinkyu.pdf - 個人情報保護法の条文の掲載元
https://laws.e-gov.go.jp/law/415AC0000000057 - 個人情報保護法の条文の掲載元
https://laws.e-gov.go.jp/law/428M60020000003 - ガイドライン通則編の版
https://www.ppc.go.jp/personalinfo/legal/guidelines_tsusoku/ - 仮名加工情報・匿名加工情報についてのガイドラインの版
https://www.ppc.go.jp/personalinfo/legal/guidelines_anonymous/ - 令和8年改正の提出・成立・公布 4月7日 第221回国会(特別会)、7月10日成立、7月17日公布
https://www.ppc.go.jp/personalinfo/legal/r8kaiseihogohou/ - 施行期日 公布の日から起算して2年を超えない範囲内において政令で定める日、一部は公布の日や6月を経過した日
https://www.ppc.go.jp/files/pdf/260717_houritsu.pdf - 今後の取組とロードマップ、施行までに十分な期間を確保、大まかな見込みで変わり得るという注記
https://www.ppc.go.jp/files/pdf/260731_kongonotorikumi.pdf - 改正の4つの柱と各項目の内容、規則等で定めることを想定するという注記
https://www.ppc.go.jp/files/pdf/260717_kaiseihounitsuite.pdf - 政令・規則等で定める事項の全体像の資料の存在
https://www.ppc.go.jp/files/pdf/260826_zentaizou.pdf - ISO/IEC 27001(2022年)が現行版、第3版、2022年10月、追補1(2024年、気候変動への対応)、2013年版は廃止
https://www.iso.org/standard/82875.html - JIS Q 27001 の制定年月日 2006年5月20日、最新改正年月日 2025年5月20日、本体と追補
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=Q27001 - AWS の責任共有モデル インフラストラクチャの保護は AWS、抽象化されたサービスでもデータの管理・資産の分類・権限の適用は利用者
https://aws.amazon.com/jp/compliance/shared-responsibility-model/ - Microsoft のクラウドにおける共同責任 顧客データ・構成と設定・ID とユーザーは全形態で利用者
https://learn.microsoft.com/ja-jp/azure/security/fundamentals/shared-responsibility - Google Cloud の責任の共有と運命の共有 基盤はクラウド事業者、アクセス ポリシーとデータは利用者、構成ミスが侵害の原因に多いという課題
https://docs.cloud.google.com/architecture/framework/security/shared-responsibility-shared-fate?hl=ja - ガイドラインに関する Q&A の版と Q7-53・Q7-54・Q10-25
https://www.ppc.go.jp/personalinfo/faq/APPI_QA/ - 個人情報保護法の知識 第5版(岡村久道 著、日経BP日本経済新聞出版本部)
https://ndlsearch.ndl.go.jp/books/R100000002-I031548179 - ISO/IEC 27001情報セキュリティマネジメントシステム〈ISMS〉構築・運用の実践 第2版(羽田卓郎 著、日科技連出版社)
https://ndlsearch.ndl.go.jp/books/R100000002-I033256255 - データ戦略と法律 攻めのビジネスQ&A 改訂版(中崎隆、安藤広人、板倉陽一郎、永井徳人、吉峯耕平 編著、日経BP)
https://ndlsearch.ndl.go.jp/books/R100000002-I031573758 - (2026-10-27 追加)外国にある第三者への委託も第28条第1項の本人同意が必要(除外3つ)
https://www.ppc.go.jp/files/pdf/250701_APPI_QA.pdf
第9章
- 国税庁タックスアンサー No.5930 帳簿書類等の保存期間
https://www.nta.go.jp/taxes/shiraberu/taxanswer/hojin/5930.htm - Apache Parquet は効率的なデータの保存と取得のために設計された、オープンソースの列指向のデータファイル形式
https://parquet.apache.org/ - Apache Iceberg は大きな分析用の表のための形式で、複数の処理エンジンが同じ表を同時に安全に扱え、表全体を書き直さずに列の追加や名前の変更ができ、同じ時点の状態を指定して問い合わせを再現できる
https://iceberg.apache.org/ - OpenAPI Specification は HTTP の API について、プログラミング言語に依存しない標準的なインターフェースの記述を定める
https://spec.openapis.org/oas/latest.html - デジタル庁の政府相互運用性フレームワーク(GIF)の目的と構成、公開と更新の日付
https://www.digital.go.jp/policies/data_strategy_government_interoperability_framework - 参考書籍『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社)
https://ndlsearch.ndl.go.jp/books/R100000002-I031840097 - 参考書籍『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社)
https://gihyo.jp/book/2021/978-4-297-12445-8 - 参考書籍『データエンジニアリングの基礎 データプロジェクトで失敗しないために』(Joe Reis、Matt Housley 著、中田秀基 訳、オライリー・ジャパン)
https://ndlsearch.ndl.go.jp/books/R100000002-I033378936 - 参考書籍『データエンジニアリングの基礎 データプロジェクトで失敗しないために』(Joe Reis、Matt Housley 著、中田秀基 訳、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784814400652/ - 差分の取り出しの方式(更新日時や増えていく番号を目印にする方式と、追加・更新・削除を記録する変更の記録の仕組みは別の方式)
https://learn.microsoft.com/en-us/azure/data-factory/tutorial-incremental-copy-overview - ELT ではデータウェアハウスの一時的な表(staging table)に読み込んでから中で変換できる
https://learn.microsoft.com/en-us/azure/synapse-analytics/sql-data-warehouse/design-elt-data-loading
第10章
- DMBOK は文書とコンテンツの管理と、データの取扱いの倫理をそれぞれ独立した章として扱っている
https://bookplus.nikkei.com/atcl/catalog/24/07/02/01453/ - ISO 15489-1(2016年)は記録の作成・取り込み・管理の概念と原則を定める規格で、2021年に見直しを経て確認された
https://www.iso.org/standard/62542.html - JIS X 0902-1 は記録管理の第1部として概念と原則を扱い、2005年7月20日制定、2019年11月20日最新改正、2024年6月20日最新確認
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X0902-1 - OECD プライバシーガイドラインは1980年9月23日に採択、2013年7月11日に改訂
https://legalinstruments.oecd.org/api/print?ids=114 - 個人情報保護委員会「PIA の取組の促進について」は2021年6月30日公表
https://www.ppc.go.jp/files/pdf/pia_promotion.pdf - 個人情報保護委員会「PIA の取組の促進について」は2021年6月30日公表
https://www.ppc.go.jp/personalinfo/independent_effort/ - JIS X 9251 はプライバシー影響評価のためのガイドラインで、2021年1月20日制定、2025年10月20日最新確認
https://www.jisc.go.jp/app/jis/general/GnrJISNumberNameSearchList?show&jisStdNo=X9251 - 総務省と経済産業省は2023年4月に「DX 時代における企業のプライバシーガバナンスガイドブック ver1.3」を公表した
https://www.soumu.go.jp/menu_kyotsuu/important/kinkyu02_000513.html - 総務省と経済産業省は2023年4月に「DX 時代における企業のプライバシーガバナンスガイドブック ver1.3」を公表した
https://www.soumu.go.jp/main_content/000877678.pdf - 個人情報保護法の令和8年の改正
https://www.ppc.go.jp/personalinfo/legal/r8kaiseihogohou/ - 個人情報保護委員会の Q&A(Q2-1)は、利用目的を、本人が自らの個人情報がどのような事業の用に供され、どのような目的で利用されるかを一般的かつ合理的に予測・想定できる程度に特定することを求め、抽象的・一般的な内容ではできる限り具体的に特定したことにならないとする
https://www.ppc.go.jp/all_faq_index/faq1-q2-1/ - 参考書籍『AI・データ倫理の教科書』福岡真之介 著、弘文堂、2022年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I032178500 - 参考書籍『プライバシーガバナンスの教科書』小林慎太郎、夛屋早百合、芦田萌子、中居捷俊 著、中央経済社、2022年12月
https://ndlsearch.ndl.go.jp/books/R100000002-I032531137 - 参考書籍『アーカイブズと文書管理 米国型記録管理システムの形成と日本』坂口貴弘 著、勉誠出版、2016年4月
https://ndlsearch.ndl.go.jp/books/R100000002-I027260860 - JIS の閲覧が無償かどうか
https://www.jisc.go.jp/ - JIS の閲覧が無償かどうか
https://www.jisc.go.jp/jis-act/reading.html
第11章
- 英国政府は2026年1月19日に、政府のデータセットを AI に使える状態にするための指針を公表した
https://www.gov.uk/government/publications/making-government-datasets-ready-for-ai/guidelines-and-best-practices-for-making-government-datasets-ready-for-ai - ISO/IEC 5259-1 は分析と機械学習のためのデータ品質のシリーズの基礎の部で、2024年7月、第1版
https://www.iso.org/standard/81088.html - ISO/IEC 5259-3 はデータ品質マネジメントの要求事項と指針、2024年7月
https://www.iso.org/standard/81092.html - ISO/IEC 5259-4 はデータ品質のプロセスの枠組み、2024年7月
https://www.iso.org/standard/81093.html - RAG は検索拡張生成(Retrieval-Augmented Generation)
https://www.bunka.go.jp/seisaku/bunkashingikai/chosakuken/pdf/94037901_01.pdf - EU の AI 規則は EU 規則 2024/1689、2024年8月1日発効、2026年8月2日から一般的に適用
https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai - 一部の規定は2025年2月2日・2025年8月2日から先に適用
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - AI 規則には高リスクの AI についてデータに関する要件を定めた条文(第10条)があり、題名はデータとデータガバナンス
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-10 - AI推進法の正式名称は人工知能関連技術の研究開発及び活用の推進に関する法律
https://www8.cao.go.jp/cstp/ai/ai_act/ai_act.html - AI推進法は令和7年法律第53号
https://www8.cao.go.jp/cstp/ai/ai_guideline/ai_gl_2025.pdf - AI推進法は人工知能戦略本部の設置と人工知能基本計画の策定を定める
https://www8.cao.go.jp/cstp/ai/ai_plan/aiplan_20260714.pdf - 人工知能基本計画は最初の計画が2025年12月23日閣議決定、現行は第Ⅱ期で2026年7月14日閣議決定
https://www8.cao.go.jp/cstp/ai/ai_plan/ai_plan.html - AI事業者ガイドラインは総務省・経済産業省、AI の開発・提供・利用を担うすべての者が対象
https://www8.cao.go.jp/cstp/ai/ai_guideline/ai_guideline.html - AI事業者ガイドラインは第1.0版 2024年4月19日公表、現行は第1.2版 2026年3月31日公表
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - NIST AI RMF 1.0 は2023年1月26日公表、任意で使うことを想定、生成AIプロファイル(NIST AI 600-1)は2024年7月26日、1.0 を改訂中
https://www.nist.gov/itl/ai-risk-management-framework - ISO/IEC 42001 は AI マネジメントシステムの要求事項と指針を定める国際規格、2023年12月、第1版、JTC 1/SC 42
https://www.iso.org/standard/42001 - 第30条の4は非享受目的の場合に必要と認められる限度で利用できると定め、ただし書で著作権者の利益を不当に害する場合を除く
https://laws.e-gov.go.jp/law/345AC0000000048 - 参考書籍『Data-centric AI入門』(片岡裕雄 監修、宮澤一之 ほか 執筆、技術評論社、2025年1月、ML Systems シリーズ)
https://ndlsearch.ndl.go.jp/books/R100000002-I033857663 - 参考書籍『AIガバナンス入門 リスクマネジメントから社会設計まで』(羽深宏樹 著、早川書房、2023年12月、ハヤカワ新書 017)
https://ndlsearch.ndl.go.jp/books/R100000002-I033209767 - データ品質は用途への適合(fitness for purpose)として捉えられ、必要な品質の水準は用途によって変わる(一般的なデータ品質の管理にも共通する、の根拠
https://www.gov.uk/government/publications/the-government-data-quality-framework/the-government-data-quality-framework - 検索の製品によっては、元の保管場所で文書を消しても削除を検知する設定をしないと索引から消えない(2026-10-27 Codex part12 #5 で追記)
https://learn.microsoft.com/en-us/azure/search/search-how-to-index-azure-blob-changed-deleted
第12章
- DMBOK も成熟度アセスメントを独立した主題として扱っている
https://bookplus.nikkei.com/atcl/catalog/24/07/02/01453/ - デジタルガバナンス・コードは2020年11月に取りまとめ、2022年9月に2.0へ改訂、2024年9月19日に3.0を策定
https://www.meti.go.jp/press/2024/09/20240919001/20240919001.html - 3つの視点の名称(経営ビジョンとDX戦略の連動/As is と To be のギャップの定量把握・見直し/企業文化への定着)
https://www.meti.go.jp/policy/it_policy/investment/dgc/dgc3.0.pdf - 5つの柱の名称と、3つ目の柱が組織づくり・デジタル人材の育成・確保・ITシステム・サイバーセキュリティに分かれること
https://www.ipa.go.jp/digital/dx-suishin/rcu1hd000001a4xh-att/dx-suishin-guidance.pdf - DX推進指標は2019年7月に取りまとめた自己診断の指標で、認識の共有と行動につなげる気付きの機会を提供することが目的
https://www.meti.go.jp/policy/it_policy/investment/dx-shihyo.html - 2025年1月に検討会を立ち上げ、コード3.0 に基づき設問と成熟度レベルを見直して2026年2月13日に改訂
https://www.meti.go.jp/press/2025/02/20260213001/20260213001.html - 改訂版フォーマットは2026年4月3日から受付と案内されていた
https://www.ipa.go.jp/digital/dx-suishin/about.html - 2026年8月3日の IPA のプレス発表で、Web フォーム化、提出後5分から10分程度でベンチマークレポート(従来は年2回)、ガイダンス資料の公開
https://www.ipa.go.jp/pressrelease/2026/press20260803.html - 10月と11月は DX推進指標の集中実施期間
https://www.ipa.go.jp/digital/dx-suishin/syucyu.html - DX認定制度はデジタルガバナンス・コードに対応し、DX推進の準備が整った事業者を国が認定
https://www.ipa.go.jp/digital/dx-nintei/about.html - 分析レポート2024年版は2025年5月7日、2024年1月から12月の提出分
https://www.ipa.go.jp/digital/dx-suishin/tbl5kb0000007nt4-att/dx-suishin-report2024.pdf - 分析レポート2025年版は2026年5月15日公開、2026年6月10日に集計方法の不備を修正して差し替え
https://www.ipa.go.jp/digital/dx-suishin/tbl5kb0000007nt4-att/dx-suishin-report2025.pdf - 分析レポート2025年版は2026年5月15日公開、2026年6月10日に集計方法の不備を修正して差し替え
https://www.ipa.go.jp/digital/dx-suishin/bunseki-report.html - 参考書籍 DX白書2023
https://ndlsearch.ndl.go.jp/books/R100000002-I032726169 - 参考書籍 DX白書2023
https://www.ipa.go.jp/publish/wp-dx/dx-2023.html - 参考書籍 図解はじめての「開発のためのCMMI」とプロセス改善
https://ndlsearch.ndl.go.jp/books/R100000002-I024726890 - CMMI は成熟度レベルで組織の取り組みを捉えるモデルとして知られている
https://cmmiinstitute.com/cmmi
第13章
- 『データマネジメント 仕組みづくりの教科書』(小川康二・仲程隆顕 著、日経BP)
https://bookplus.nikkei.com/atcl/catalog/25/09/11/02192/ - 『データマネジメント 仕組みづくりの教科書』(小川康二・仲程隆顕 著、日経BP)
https://ndlsearch.ndl.go.jp/books/R100000002-I034293469 - 『実践データマネジメント AI/BIの活用レベルを上げる新しい基盤・組織・運用』(川上明久 著、日経BP)
https://bookplus.nikkei.com/atcl/catalog/24/02/06/01259/ - 『実践データマネジメント AI/BIの活用レベルを上げる新しい基盤・組織・運用』(川上明久 著、日経BP)
https://ndlsearch.ndl.go.jp/books/R100000002-I033303199 - 会計上の売上高の計上時点は会計基準と会計方針に従う(企業会計基準第29号)
https://www.asb-j.jp/jp/accounting_standards_system/details.html?topics_id=13 - カタログ製品には表名・列名などの技術的な情報を自動で集めるものがある
https://learn.microsoft.com/en-us/purview/data-map-scanning-best-practices
第14章
- JDMC データマネジメント賞の表彰制度と過去の受賞結果
https://japan-dmc.org/?page_id=15253 - JDMC 2025年データマネジメント賞の報道発表
https://japan-dmc.org/?p=23564 - JDMC 2026年データマネジメント賞の報道発表
https://japan-dmc.org/?p=24332 - 東京ガスの登壇者が講演で触れた定着の壁
https://japan-dmc.org/?p=24129 - デジタル庁のデータガバナンス・ガイドラインは2025年6月20日付で主として企業の経営者が対象
https://www.digital.go.jp/assets/contents/node/information/field_ref_resources/71bf19c2-f804-488e-ab32-e7a044dcac58/b1757d6f/20250620_news_data-governance-guideline_01.pdf - データメッシュの4つの原則とデータプロダクトの性質
https://martinfowler.com/articles/data-mesh-principles.html - DMBOK の日本語版には組織と役割、組織の変革を扱う章がある
https://bookplus.nikkei.com/atcl/catalog/24/07/02/01453/ - 参考書籍 企業変革力
https://ndlsearch.ndl.go.jp/books/R100000002-I000003630006 - 参考書籍 スイッチ 変われないを変える方法
https://ndlsearch.ndl.go.jp/books/R100000002-I027620430 - 参考書籍 解読データアーキテクチャ
https://www.oreilly.co.jp/books/9784814401505/ - 同書の NDL の書誌
https://ndlsearch.ndl.go.jp/books/R100000002-I034536630 - Zhamak Dehghani は記事の公開当時 Thoughtworks に所属(現在は退職)
https://www.thoughtworks.com/en-us/profiles/z/zhamak-dehghani - (終章)令和8年改正個人情報保護法の施行日を定める政令の公布の記載が無い
https://www.ppc.go.jp/personalinfo/legal/r8kaiseihogohou/ - (終章)DX推進指標はレベル0から5の6段階の自己診断
https://dx.ipa.go.jp/tools/dxpi