こんにちは、Anagraftの伊藤です。
本コラムは、1956年夏に米国ダートマス大学で開かれたダートマス会議(正式名称はDartmouth Summer Research Project on Artificial Intelligence。約2か月にわたる研究会で、「artificial intelligence」という語はこの研究会の提案書の題名に現れ、研究会を機に分野の名前になりました)から2026年までの70年を、経営の判断材料として整理したものです。扱う範囲は、第1章で見る1956年より前の準備期間から、大規模言語モデル(大量の文章で学習し、文章の生成や要約を行うモデル)が業務に入り込んだ現在までです。年表を作ることが目的ではなく、それぞれの出来事について「何が新しかったのか」「なぜそれが可能になったのか」「経営の観点で何を意味するのか」のいずれかを添えることを、全章を通じた約束事にしました。
2026年は、ダートマス会議から数えてちょうど70年にあたります。ダートマス大学自身がこの年を70周年と位置づけ、年間を通じた催しを組み、10月には記念の会議を予定しています。節目であることは事実ですが、本コラムの目的は記念ではありません。AIは過去に二度、期待が先行したあとに資金と関心が引く局面を経験しています。何が期待を膨らませ、何が失望に変えたのかを具体的な事実で押さえておくと、現在の投資判断、人材の配置、ベンダーの選定といった場面で、自社の判断を過去の形と照らし合わせることができます。本コラムは、歴史を判断材料として使う立場で書いています。
想定している読者は次のような方々です。
- AIへの投資を判断する立場にあり、現在の期待がどの程度の根拠を持つものなのかを、自分の言葉で説明できるようにしておきたい経営層の方
- 社内でAI活用を推進しており、経営層や現場に技術の背景を説明する機会が多いDX推進担当の方
- データ活用や機械学習の案件を任され、いま使っている手法がどの流れの上にあるのかを把握しておきたい実務者の方
- ベンダーやコンサルティング会社の提案を評価する立場にあり、提案の中の技術用語を歴史的な文脈で読み解きたい方
- 生成AIから入ってAIに関心を持ち、それ以前の70年に何があったのかを一度整理しておきたい方
構成は、序章と全体の地図のあとに本編13章、終章、紹介した書籍の一覧、参考情報という並びです。第1章から第10章は時代順に進みます。第1章で1956年より前の準備期間を扱い、第2章でダートマス会議とその直後を、第3章から第5章で二度の冬と、その間にあった知識工学の時代を扱います。第6章でデータと計算基盤が整った経緯を、第7章と第8章で深層学習とTransformerによる構造の転換を、第9章と第10章で生成AIの一般化から推論モデルとエージェントまでの直近を扱います。第11章は日本のAI史を、第12章は規制と倫理の歴史を、時代を横断してまとめました。第13章では70年を通して繰り返されたパターンを取り出し、投資、人材、ベンダー選定の判断軸に落とします。各章の末尾には、その章の内容を深めるための参考書籍を添えました。本編のうち第2章、第5章、第7章、第8章には、当時の手法を最小構成で再現したコードと実行結果を載せています。それ以外の章はコードを使わず、表と概念図で説明しています。
通史として第1章から順に読む使い方と、関心のある時代や論点の章から読む使い方の両方を想定しています。各章は冒頭で前章の要点を受け、末尾で次章へ渡す形にしてありますが、章ごとに完結するようにも書いてあります。全体の地図には章の一覧表と70年の年表を置きましたので、どの章がどの時代を扱っているかは、そこで確認できます。
歴史を扱う記事であるため、年、人名、論文名、機関名、数値の正確さを最も重視しました。本文に書いた事実は、原論文や公的機関の文書、学会や企業の公式発表といった一次情報で確認したものに限り、確認できなかったものは書いていません。数値には、いつ時点の値かを添えています。「AIの冬」の期間の区切りのように定説が一つに定まっていない事柄については、本コラムがどの区切りを採るのかと、その根拠を各章で明示しました。また、本コラムは将来の予測をしません。歴史から取り出せるのは判断の形であって、次に何が起きるかではないと考えているためです。この点は序章と終章で改めて述べます。本文で用いた出典は、巻末の参考情報に一覧としてまとめました。
70年分の出来事を扱うため、記事は長くなりました。本コラムは、必要な章から参照できる構成にしました。

目次
- 序章 AIの歴史を経営の判断に使う
- 全体の地図
- 第1章 考える機械という問いの始まり
- 第2章 ダートマス会議とAIという名前の誕生
- 第3章 最初の冬、期待と現実の差はどこで開いたか
- 第4章 知識を書き下す時代
- 第5章 二度目の冬と、統計・機械学習への転回
- 第6章 データとインフラが整うまで
- 第7章 深層学習の勃興
- 第8章 Transformerと事前学習
- 第9章 生成AIの一般化
- 第10章 推論モデルとエージェント
- 第11章 日本のAI史
- この章で扱う範囲と、扱わない範囲
- 郵便番号の自動読取区分機:手書き数字の認識を郵便物の仕分けに組み込んだ装置
- 専用ハードウェアを作る文化と、学会の設立
- 第五世代コンピュータ計画は政策として何を狙ったか
- 当初目標に対して、何が達成され何が達成されなかったか
- 資産として残ったもの
- 評価が割れる理由と、大型投資の測り方
- 日本のAIをめぐる主な出来事
- ファジィ制御:熟練者の運転ルールを機械に移した日本の産業化
- 産業界、推論マシンの商用化と撤退、そして製造現場へ
- コンピュータ将棋:学会が「目的を達成した」と宣言して計画を閉じた
- 研究機関と計算基盤、そして政府方針の変遷
- 人材と研究力の現在地を公的統計で見る
- この章を深めたい方への参考書籍
- 第12章 制度と社会
- 第13章 歴史が示す判断軸
- 終章
- 本コラムで紹介した書籍一覧
- 参考情報
序章 AIの歴史を経営の判断に使う
AIの歴史は、知っておくと会話が広がるという種類の教養ではなく、いま目の前にある判断に使える材料です。本コラムはこの立場で書かれています。AIという分野は、1956年に名前が付いてからの70年間に、期待が大きく膨らんだ局面と、期待が失望に変わって資金と関心が引いた局面を、少なくとも二度繰り返してきました。どのような約束が期待を作り、どのような検証がそれを失望に変えたのかは、記録として残っています。それを事実として押さえておくと、現在の投資判断や人材の配置、ベンダーの選定において、自社の判断が過去に失望を招いた形と同じになっていないかを確かめることができます。序章では、なぜ今この70年を振り返るのか、歴史から何が取り出せて何が取り出せないのか、そして本編がどのような区切りで70年を扱うのかを述べます。
なぜ今、70年を振り返るのか
理由の一つは節目です。1956年夏、米国ニューハンプシャー州ハノーバーのダートマス大学で研究会が開かれました。提案書はこれを2か月の共同研究として構想していますが、実際の会期の長さは資料によって記述が分かれており、本コラムでは断定しません。正式名称はDartmouth Summer Research Project on Artificial Intelligenceで、その提案書は前年の1955年8月31日付で、ジョン・マッカーシー、マービン・ミンスキー、ナサニエル・ロチェスター、クロード・シャノンの4名の名で書かれています。「artificial intelligence」という語はこの提案書の題名にすでに現れており、研究会を機に分野の名前になりました。2026年はそこから70年にあたり、ダートマス大学は年間を通じた催しを組み、10月には記念の会議を予定しています。
もう一つの理由は、現在が期待の高い局面にあることです。2022年11月30日にOpenAIがChatGPTを研究プレビューとして公開して以降、AIは専門家の道具から、業務に携わる多くの人が直接触れるものに変わりました。多くの企業がAIの導入や投資を検討する局面にあります。期待の高い局面で判断を下す立場にある人にとって、過去の期待の高い局面がその後どう推移したかは、数少ない参照点です。期待が高いこと自体は問題ではありません。過去の二度の局面でも、期待には根拠がありました。問題は、根拠のある期待が根拠のない約束にいつ、どのように変わったのかを、見分けられるかどうかです。
期待が失望に変わった形
過去の二度の局面の細部は第3章と第5章に譲りますが、共通する形だけを先に示します。一度目は1960年代後半から1970年代にかけてです。1966年、米国の自動言語処理諮問委員会(ALPAC)の報告書『言語と機械:翻訳と言語学におけるコンピュータ』が米国科学アカデミーから公表され、当時の機械翻訳研究に対して懐疑的な評価を示しました。1973年には英国で、応用数学者ジェームズ・ライトヒルが1972年に書き上げた「Artificial Intelligence: A General Survey」が科学研究会議(Science Research Council)から公表され、AI研究の成果を厳しく評価しました。いずれも研究者集団の外側から求められた評価であり、その後の資金配分に影響しました。二度目は、1980年代のエキスパートシステム(専門家の知識をルールとして書き下し、コンピュータに推論させる仕組み)の商用化のあとに来ます。導入は進みましたが、ルールを保守し続ける負担と、知識を人手で書き出す作業の限界が課題となり、1990年代にかけて市場は縮小します。この経緯は第4章と第5章で確認します。
二度に共通しているのは、技術そのものが失敗したというより、達成できる範囲を超えて約束がなされ、それが外部の評価や運用の現実によって検証されたときに、期待が失望に変わったという順序です。この順序は経営の判断にそのまま使えます。確かめるのは、自社のAI投資が達成できる範囲を超えた約束に立脚していないか、その約束が外部の目で検証されたときに耐えるか、運用を続ける費用が見積もられているか、という点です。これらは技術の話ではなく、判断の形の話です。本コラムが歴史を判断材料と呼ぶのは、この意味においてです。
歴史から取り出せるもの
歴史から取り出せるのは、判断の形と、繰り返されるパターンです。具体的には、期待がどのように作られるか、冬がどのように入ってくるか、冬を越えて実用に残った技術に何が共通しているか、汎用を目指す流れと特定用途に絞る流れがどのように交互に来たか、そして研究の外側にある要因(計算資源の価格、データの蓄積、政策、資金の出し手)がどのように効いたかです。これらは70年のあいだに複数回観測されているため、個別の出来事から切り離して、形として取り出すことができます。第13章では、この作業を正面から行い、投資、人材、ベンダー選定の判断軸に落とします。
ここで注意が要るのは、繰り返されるのは出来事ではなく、人の判断の形だという点です。1960年代に機械翻訳への評価が下され資金が引き揚げられたのと同じ出来事が、いま起きるわけではありません。しかし、達成範囲を超えた約束が外部の検証で崩れるという判断の形は、技術が何であれ起こり得ます。本コラムが各章で「何が新しかったのか」「なぜ可能になったのか」「経営の観点で何を意味するのか」を添えるようにしたのは、出来事を形として読めるようにするためです。
歴史から取り出せないもの
一方で、歴史から取り出せないものもあります。将来の予測です。本コラムは、次にどの技術が主流になるか、現在の期待がいつ冬に変わるか、あるいは変わらないかについて、予測を書きません。過去の転換点を見ると、その理由が分かります。2012年に画像認識の精度を大きく引き上げたAlexNetは、畳み込みニューラルネットワーク(画像の局所的なパターンを段階的に取り出す方式)を深く重ねたモデルですが、その学習に使われた誤差逆伝播法、すなわち機械が出した答えと正解との誤差を出力側から入力側へ逆向きにたどり、その誤差が小さくなるように内部の数値を少しずつ修正していく訓練の手続きは、1986年にNature誌に発表された論文で示されていた方法です。手法は四半世紀前からあり、2009年に発表された大規模な画像データセットImageNetと、GPUによる計算の実装が揃ったことで、結果が変わりました。基盤が揃ったことは事後に確認できますが、揃う時点を事前に知る方法を、歴史は与えてくれないと考えています。
したがって本コラムが扱うのは、「次に何が来るか」ではなく、「来たときにどう見分けるか」と「来なかったときに何を守るか」です。直近の出来事についても同じ姿勢を採ります。第10章が扱う2024年から2026年は、評価が定まっていない出来事が多いため、一次情報で確認できることだけを書き、断定を控えました。
本編で採る時代区分
本編は13章で構成されます。第1章から第10章は時代順で、第11章と第12章は日本と制度という二つの軸で時代を横断し、第13章がパターンの抽出を担います。時代順の10章は、大きく5つの時期にまとめられます。第一に、1956年より前の準備期間と、名前が付いた直後の楽観の時期です(1930年代から1960年代前半、第1章と第2章)。第二に、最初の冬と、知識を人手で書き下す方式が商用化に届いた時期です(1960年代後半から1980年代、第3章と第4章)。第三に、二度目の冬を経てデータから推定する方式へ転回し、その土台となるデータと計算基盤が研究の外側で整った時期です(1990年代から2011年、第5章と第6章)。第四に、深層学習が結果を出し、大きく学習して転用する構造に移った時期です(2012年から2021年、第7章と第8章)。第五に、生成AIが専門家以外に届き、推論とエージェントへ進んだ時期です(2022年から2026年、第9章と第10章)。ブームと冬が交互に来たという三つの区分ではなく五つの時期に分けたのは、冬とされる時期の中で進んだ準備を、独立した時期として見えるようにするためです。
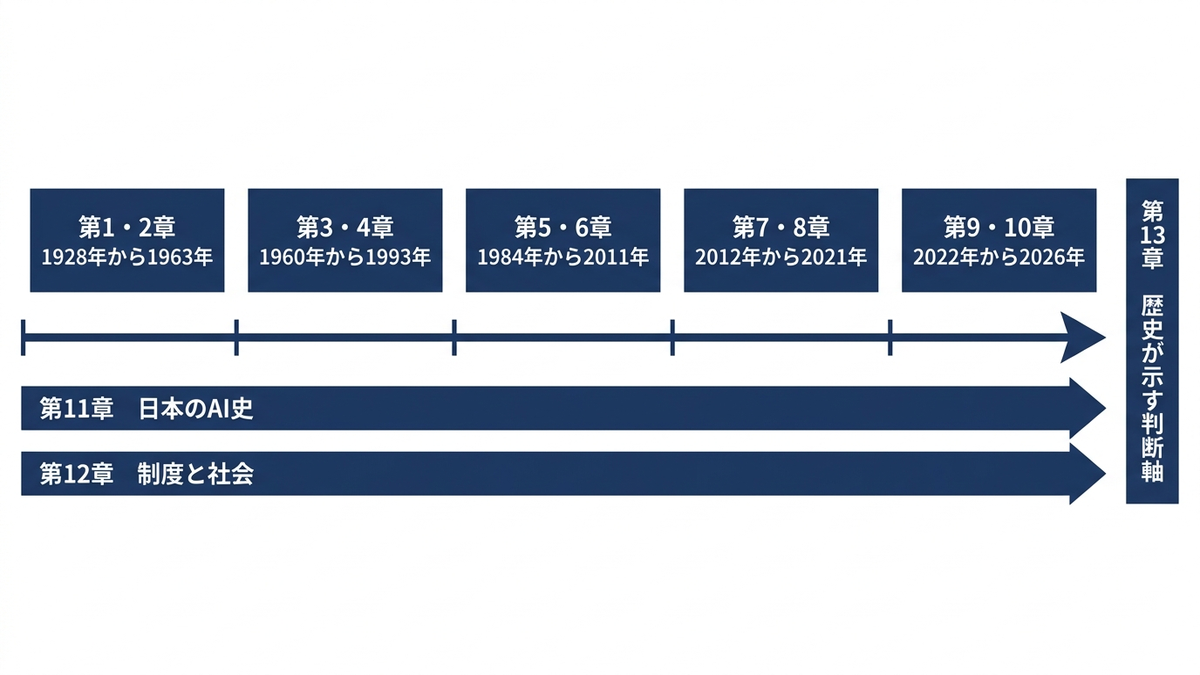
この区分で注意が要るのは、「AIの冬」の期間の区切りです。いつ冬が始まり、いつ終わったのかについて、定説は一つに定まっていません。たとえば総務省の情報通信白書(平成28年版)は、第1次ブームを1950年代半ばから1960年代、第2次ブームを1980年代とし、第2次ブームの衰退を1995年前後としています。資料によって区切りが数年単位で動くのは、資料の誤りではありません。冬という区切りは、後年の資料がそれぞれの基準で引いたものだからです。本コラムでは、「一般に〜とされる」という書き方で区切りを既定のものとして扱うことをせず、第3章と第5章がそれぞれどの区切りを採るのかと、その根拠となる出来事を本文で明示します。区切りが資料によって異なること自体も、冬が事後的にしか認識されないという判断材料の一つとして扱います。
ブームに「第1次」「第2次」と番号を付ける数え方は、1985年の国会の記録にすでに現れます。1985年(昭和60年)4月4日の第102回国会衆議院科学技術委員会(第5号)で、情報科学の研究開発の問題について参考人として意見を述べた東京大学教授の石井威望氏は、AIについて「現在第二回目のブームになっていると言われて」いると説明しました。石井氏が1回目に置いたのは「初期のアメリカを中心にしました一九六〇年代中ごろから後半にかけての第一回目の試み」で、これはうまくいかなかったと述べ、2回目を、日本政府が始めた第五世代コンピュータの計画と結びつけています。同じ「第1次」でも、この数え方の起点は1960年代の半ばで、前述の情報通信白書が第1次ブームを1950年代半ばからとしているのとは10年ほどずれています。番号の振り方そのものが、数える時点と数える人によって変わってきたことが分かります。
米国では、ブームと冬の交代とは別の区切り方も示されています。米国の国防高等研究計画局(DARPA)は、2017年2月に同局の公式動画チャンネルで、当時の情報イノベーション室長ジョン・ローンチベリーがAIを「3つの波」として説明する講演を公開しました。同局が2018年9月7日に出した発表は、1960年代からの第1の波を、人手で作り込んだ知識、すなわち狭く定めた課題をこなすルールに基づく仕組みとし、1990年代からの第2の波を、大量のデータから統計的なパターン認識の仕組みを作る機械学習としたうえで、次の第3の波を、状況の変化に適応する技術と位置づけています。こちらは期待の上がり下がりではなく、技術の型の移り変わりで時代を区切る数え方です。どの区切りを使う資料なのかを確かめてから年を読むと、資料どうしの食い違いに振り回されずに済みます。
この記事での事実の扱い
歴史を判断材料として使うためには、材料が正確でなければなりません。本コラムでは、本文に書く年、人名、論文名、機関名、数値を、原論文、公的機関の文書、学会や企業の公式発表といった一次情報で確認し、確認できたものだけを書きました。確認できなかったものは書かず、「〜と言われている」という形でも残していません。数値には、いつ時点の値かを添えています。とくに2023年以降は、モデルの版や性能の数値が短い期間で更新されるため、時点を省くと記述が事実と食い違います。歴史上の人物の内心については、本人の発言や書き残したものを引く場合を除いて書きません。各章の末尾には参考書籍を置き、巻末には一次情報を中心とした出典の一覧を置きました。本文で示した事実の裏付けを確認できる形にするためです。
本コラムが提供するのは、70年分の事実と、それを判断の形として読むための整理です。結論を押しつけるものではなく、読者が自社の判断を過去の形と照らすための材料として使っていただくことを想定しています。次の「全体の地図」で章の一覧と70年の年表を示したあと、第1章から本編に入ります。
Anagraftでは、AIの導入検討から実装、運用までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本編に入る前に、この記事が扱う70年の全体像を2つの表で示します。1つ目は章の一覧で、どの章がどの時期を扱い、そこで何が確認できるかをまとめたものです。2つ目は年表で、本編の各章が一次情報で確認した出来事から、流れをつかむうえで要になるものを抜き出しています。ここだけを読んでも、70年に何がどの順番で起きたのかの骨格は追えるようにしました。ただし、表に出てくる技術の名前や指標の中身までは説明しません。それぞれの意味は、担当する各章で扱います。
章の一覧
| 章 | 扱う時期 | その章で確認できること |
|---|---|---|
| 第1章 考える機械という問いの始まり | 1928年から1952年 | AIは1956年に突然生まれたのではない。計算可能性の理論、形式ニューロン、サイバネティクス、実際に動く計算機が、名前が付く前に揃っていた |
| 第2章 ダートマス会議とAIという名前の誕生 | 1955年から1963年 | 名前が付いたことで資金と人材が集まった。初期の成功は探索と記号処理で説明できる範囲に収まっていた |
| 第3章 最初の冬、期待と現実の差はどこで開いたか | 1960年から1976年 | 冬は技術の破綻ではなく、約束と外部評価の差が資金判断に届いたところから始まった。止められたのは短期の実用目標に向けた資金であって、研究そのものではない |
| 第4章 知識を書き下す時代 | 1965年から1993年 | 知識を人手でルールに書く方式は商用化に届いた。頭打ちになった理由は推論の性能ではなく、ルールが増えたときの保守である |
| 第5章 二度目の冬と、統計・機械学習への転回 | 1984年から2001年 | 知識を書く方式からデータで推定する方式への転換が、その後30年の土台になった。この時期の実用化の多くはAIを名乗っていない |
| 第6章 データとインフラが整うまで | 2001年から2011年 | 深層学習を可能にした材料は、AI研究の外側で用意された。データセットを作る仕事そのものが研究を動かした |
| 第7章 深層学習の勃興 | 2012年から2017年 | AlexNetは原理的な新発明ではない。既存の手法が計算資源とデータという条件を得て跳ねた |
| 第8章 Transformerと事前学習 | 2017年から2021年 | 課題ごとにモデルを作る形から、大きく学習して転用する形へ構造が変わった。規模と性能の関係が見通せるようになった |
| 第9章 生成AIの一般化 | 2022年から2024年 | 変わったのは技術そのものではなく到達範囲である。対話という接点と、無償で試せる形が普及を決めた |
| 第10章 推論モデルとエージェント | 2024年から2026年 | 答えを返す形から、手順を踏んで動く形へ向かっている。ただし本稿の執筆時点で定まっていないことも多い |
| 第11章 日本のAI史 | 1960年代末から2026年 | 第五世代計画を失敗の一語で片付けるのは正確ではない。当事者の総括と海外の要約では強調点が違う |
| 第12章 制度と社会 | 1970年代から2026年 | 規制や倫理は技術に遅れて来たのではなく並走してきた。制度は事後の制約ではなく導入計画の設計条件である |
| 第13章 歴史が示す判断軸 | 通史 | 70年で繰り返された型を、投資・人材・ベンダー選定の判断に落とす |
第1章から第10章までが時代順の本編です。第11章と第12章は、その全期間を日本と制度という別の軸で横断します。第13章は全体を受けて、判断に使える形にまとめます。
70年の年表
本編の各章が一次情報で確認した出来事から抜き出しました。各行の詳細と出典は、右端の章で扱っています。日付まで書いてあるものは、その日付が一次情報で確認できたものです。
| 年 | 出来事 | 章 |
|---|---|---|
| 1936年 | チャーチとチューリングが、それぞれ決定問題を否定的に解決する。チューリングは万能機械の構想を示す | 第1章 |
| 1943年 | マカロックとピッツが形式ニューロンを発表する | 第1章 |
| 1948年 | ウィーナー『Cybernetics』が刊行される。Manchester Babyが6月21日に最初のプログラムを実行する | 第1章 |
| 1950年 | チューリングが『Mind』に論文「計算機械と知能」を発表し、模倣ゲームを提案する | 第1章 |
| 1955年8月31日 | ダートマス夏季研究計画の提案書が書かれる。artificial intelligence という語が題名に現れる | 第2章 |
| 1956年夏 | ダートマス大学で夏季研究計画が開かれ、分野に名前と場ができる | 第2章 |
| 1957年1月 | ローゼンブラットがパーセプトロンの報告書を書く | 第2章 |
| 1960年4月 | LISPの論文が Communications of the ACM に掲載される | 第2章 |
| 1965年 | DENDRALがスタンフォード大学で始まる | 第4章 |
| 1966年 | ALPAC報告『言語と機械』が刊行され、機械翻訳への資金が絞られる | 第3章 |
| 1969年 | ミンスキーとパパート『Perceptrons』が刊行される。11月19日にマンスフィールド修正が成立する | 第3章 |
| 1972年7月 | ライトヒル報告『Artificial Intelligence: A General Survey』がまとめられる。公刊は1973年 | 第3章 |
| 1974年 | ワーボスの博士論文が誤差逆伝播を記述する | 第3章 |
| 1980年 | R1がDECの製造部門で日常的に使われ始める | 第4章 |
| 1982年4月 | 新世代コンピュータ技術開発機構(ICOT)が設立され、第五世代コンピュータ・プロジェクトが始まる | 第4章・第11章 |
| 1984年 | AAAI年次大会で「The ‘Dark Ages’ of AI」と題したパネルが開かれる | 第3章・第5章 |
| 1986年 | 誤差逆伝播法の論文が10月9日に Nature 誌に掲載される。7月に人工知能学会が設立される | 第5章・第11章 |
| 1993年3月 | 第五世代コンピュータ・プロジェクトが終了する | 第4章・第11章 |
| 1995年 | サポートベクターマシンの論文が Machine Learning 誌に掲載される | 第5章 |
| 1997年5月11日 | Deep Blueがカスパロフとの6局マッチを3.5対2.5で制する | 第5章 |
| 2004年 | GoogleがMapReduceを発表する | 第6章 |
| 2006年 | NVIDIAがCUDAアーキテクチャを発表する。Netflix Prizeが始まる | 第6章 |
| 2009年 | ImageNetの論文がCVPRで発表される | 第6章 |
| 2012年 | ILSVRC 2012でSuperVision(AlexNet)がtop-5誤り率15.3%を記録する。他チームの最上位は26.2% | 第7章 |
| 2016年 | AlphaGoが3月にイ・セドルに4勝1敗で勝つ | 第7章 |
| 2017年 | 「Attention Is All You Need」が投稿され、NIPS 2017で発表される | 第8章 |
| 2018年 | ELMo、GPT、BERTが相次いで発表される | 第8章 |
| 2020年 | 1月にスケーリング則、5月にGPT-3が公開される | 第8章 |
| 2022年11月30日 | OpenAIがChatGPTを研究プレビューとして公開する | 第9章 |
| 2024年9月 | OpenAIがo1-previewを公開する | 第10章 |
| 2025年 | 日本のAI法が6月に公布・一部施行され、9月1日に全面施行される | 第11章・第12章 |
| 2026年 | ダートマス会議から70年にあたる | 第2章 |
この年表を眺めると、性能が跳ねた年の手前に、材料が揃う期間が置かれていることが見えます。2012年の手前には2004年から2009年にかけての分散処理、GPU、大規模データセットがあり、2022年の手前には2017年から2020年にかけての事前学習と規模の拡大があります。逆に、資金が絞られた1966年や1972年の手前には、達成できる範囲を超えた約束が置かれていました。条件が先に整い、成果は後から出るという順序は、本編を通して繰り返し現れます。
なお、この記事は「第1次ブーム」「第2次ブーム」といった区分を見出しに使っていません。区分の年の取り方は資料によって動くうえ、区分名を先に置くと、その枠に収まらない出来事が見えにくくなるためです。代わりに、各章がどの時期を扱うのかを年で示し、冬と呼ばれる時期については第3章と第5章がそれぞれ採る区切りとその根拠を本文で述べます。
第1章 考える機械という問いの始まり
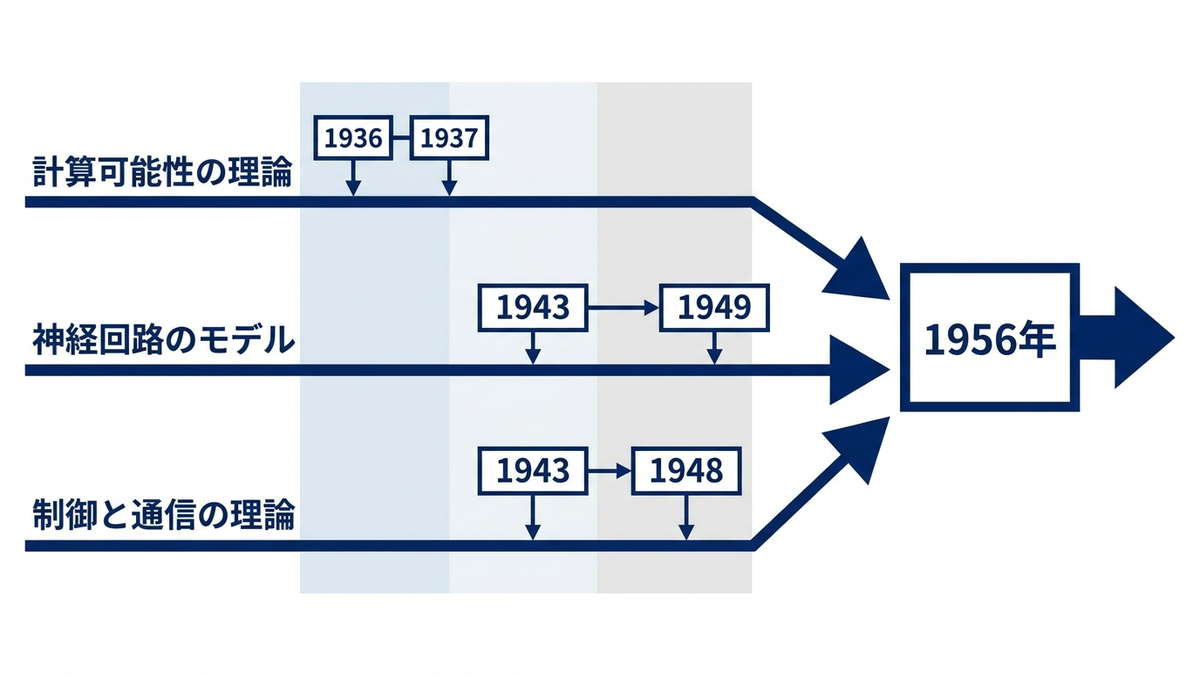
「artificial intelligence」という言葉が公の場で使われたのは1956年です。そのためAIの歴史は1956年を起点として語られることが多く、この記事の表題もその慣例に従っています。ただし、1956年に集まった研究者が持ち寄った道具立ては、その20年ほど前から別々の分野で作られていたものでした。計算とは何かを定義する数学、神経の働きを論理式として書き下す生理学、生物と機械を同じ枠組みで扱う制御と通信の理論。この3つが1930年代から1950年代前半にかけて並行して進み、1950年代の半ばに接触します。
本章が扱うのは1930年代から1955年までです。ここで確認したいのは、AIが1956年に突然生まれたのではないという事実そのものよりも、その事実の読み方のほうです。新しく見える技術は、たいていその手前で長く準備されています。準備が終わっていない段階でどれだけ注目が集まっても実装は進まず、逆に準備が終わっていれば、きっかけは小さくても一気に進みます。経営の判断として意味があるのは、話題の大きさではなく、その技術の下に積み上がっているものの厚さを見ることです。この章は、その見方を70年前の材料で練習する場所として置いています。
なお本章に書いた年・人名・論文名・掲載誌・数値は、原論文および各機関の公式資料で確認したものだけに限りました。確認が取れなかった事項は、話題ごと落としています。落とした項目とその理由は制作用の出典メモに残してあります。
1936年より前の「考えるように見える機械」
計算の理論が整うのは、次の節で扱うチャーチとチューリングの論文が出た1936年です。それより前にも、機械と思考の関係を扱った記録があります。ここでは3つを取り上げます。いずれも電子計算機ができるより前のものですが、「機械が考えているように見えるとき、何を確かめればよいか」という問いが、すでに具体的な形で書かれています。
1つ目は哲学の側の記録です。ルネ・デカルトは1637年にライデンで刊行した『方法序説』の第5部で、人の体に似せて作られ、人の動作をできるかぎり真似る機械があったとしても、それが本物の人間ではないと見分ける確かな手段が2つある、と書きました。第一に、そうした機械は、言葉や記号を組み立てて自分の考えを他人に伝えることができない。触れられた場所に応じて決まった言葉を発する機械は考えられるが、目の前で言われることの意味に応じて言葉を並べ替えて答えることはできない、という指摘です。第二に、機械はある仕事を人と同じか人以上にこなしても、別の仕事では必ずしくじる。理性はどんな場面にも使える汎用の道具だが、機械の器官は個々の動作ごとに専用の配置を必要とする、というのが理由でした。会話に応じられるかどうかと、得意な仕事の外に出ても通用するかどうか。約300年後にチューリングが採った「会話で判定する」という設計(本章の後半で扱う1950年の模倣ゲーム)と、第10章で扱う評価の難しさにつながる「得意な範囲の外でどう振る舞うか」という論点が、ここで2つ並んで書かれています。
2つ目は見世物の側の記録です。1769年、ハンガリーの貴族ヴォルフガング・フォン・ケンペレンが、トルコ風の衣装を着た人形が箱の上のチェス盤に向かう自動チェス指し人形を作りました。箱の扉を開けて中の機械仕掛けを観客に見せてから対局する演出で、ウィーンやパリ、ロンドンで公開され、のちに米国でも興行されています。エドガー・アラン・ポーは1836年4月、『Southern Literary Messenger』誌第2巻318ページから326ページに載せた論考で、機械に詳しい人々の多くがこれを人の関与しない純粋な機械だと言い切っていると記したうえで、そうではなく中に人が入って操作していると論じました。根拠に挙げたのは2種類の観察です。1つは出力の側で、指し手の間隔が不規則であること、人形が常に勝つわけではないこと、手が明らかな局面でだけ首や目を動かし、難しい局面ではかえって動かさないこと、といった点です。原理を見つけた機械なら常に勝てるはずだ、という推論でした。もう1つは装置の側で、扉を開けて見せるときに箱を動かすと奥の機械仕掛けがわずかに揺れること、箱が人の入れる寸法であること、扉と引き出しを開け閉めする順序が毎回決まっていること、といった点です。ポーは、奥の仕掛けの揺れが最初に疑いを抱いたきっかけだったと書いています。仕掛けの説明は、1857年の『The Chess Monthly』誌第1巻に掲載されています。箱の中に指し手が隠れ、盤の裏に吊るした小さな鉄片が駒の磁石に引かれて動くのを見て相手の手を読み取り、レバーで人形の腕を動かしていた、という内容です。この記事は、人形の最後の所有者の一人だったフィラデルフィアの医師J・K・ミッチェルが提供した資料にもとづくものです。1859年に刊行された第1回アメリカ・チェス大会の記録集は、この記事を書いた人物と、資料を提供したミッチェルとを別の人として記しています。記事を書いたのが誰であれ、仕掛けの説明の元になった情報は、人形を所有していたミッチェルから出たものです。人形そのものは1854年7月5日、フィラデルフィアの博物館の火災で焼失しました。
3つ目は計算機を設計する側の記録です。チャールズ・バベッジが構想した解析機関(加減乗除などの演算を、穴をあけたカードで指示した順序どおりに機械で実行させる計算機の構想)について、トリノの工兵将校L・F・メナブレアが1842年にジュネーヴの雑誌に書いた論文を、エイダ・ラヴレスが英訳し、A. A. L. の署名で長い訳注を付けて、1843年にロンドンで刊行された論文集『Scientific Memoirs』第3巻に載せました。その注記Gは、解析機関の能力について誇張された考えが生じるのを防いでおきたい、という一文で始まります。新しい対象を前にすると、人はまず興味深く見えるものを過大に評価し、次にその反動で、自分の考えが行き過ぎていたと気づいたときに実態を過小に評価しがちだ、と続け、そのうえで、解析機関は自ら何かを創り出すと称するものではまったくなく、私たちが実行を命じるすべを知っていることなら何でも行える、と書いています。チューリングは1950年の論文の第6節で、機械が考えることへの反論の6番目として、これを「ラヴレス夫人の反論」と名づけて取り上げました。応答の要点は、ラヴレスが手にしていた証拠からはそうした性質を信じる理由がなかったということであって、機械がその性質を持ち得ないことまでは示されていない、というものです。同じ論文の第7節では、学習する機械を論じる際にこの反論へ戻っています。
3つの記録を並べると、経営の判断に引き寄せて読める点が2つあります。1つは、チェス指し人形が、扉の中の機械仕掛けを見せられてもそれが実際の仕組みかどうかは確かめられないまま、出力のもっともらしさで「考える機械」として受け取られていたことです。ポーがその見かけを疑う手がかりにしたのは、前に見たとおり、指し手や人形の動きという出力の側の不自然さと、箱の揺れ方や寸法、扉を開け閉めする順序という、見せられた内部とは別に外から観察できる装置の側の様子の両方でした。見かけの印象ではなく、出力と装置の両方を観察して判断したということです。もう1つは、ラヴレスの注記が、新しい対象はまず過大に評価され、その反動で過小に評価されがちだという傾向を、1843年の時点で書き留めていることです。AIの出力を評価するときも、考えているように見えるかどうかではなく、その出力が何によって作られているのか、得意な範囲の外でどう振る舞うのかを確かめる手順を先に決めておくことが、見かけに引きずられないための前提になると考えています。
1936年に決まったのは「計算とは何か」だった
出発点は数学の内部にあります。ダフィット・ヒルベルトとヴィルヘルム・アッカーマンは、1928年の著書『Grundzüge der theoretischen Logik』(Springer, Berlin)で一階述語論理を体系的に叙述し、あわせて決定問題(Entscheidungsproblem)を提起しました。与えられた論理式が普遍的に妥当かどうかを、有限回の操作で判定する一般的な手続きは存在するか、という問いです。存在するなら、数学の証明はある意味で機械の作業に置き換えられることになります。
この問いに否定的な答えを出したのが1936年でした。アロンゾ・チャーチは「An Unsolvable Problem of Elementary Number Theory」を『American Journal of Mathematics』第58巻(1936年)345ページから363ページに発表し、関数を作ることと関数に値を当てはめることだけで計算の手順を書き表す記法であるラムダ計算を用いて、そのような一般的手続きが存在しないことを示しました。アラン・チューリングは同じ年に、独立に別の道具で同じ結論に達しています。「On Computable Numbers, with an Application to the Entscheidungsproblem」は1936年5月28日に受理され、同年11月12日にロンドン数学会で読み上げられ、『Proceedings of the London Mathematical Society』第2系列第42巻(1936年から1937年)230ページから265ページに掲載されました。発表としてはチャーチのほうが先です。
AIの前史として重要なのは、否定的な結論そのものよりも、チューリングがその結論に至るために何を用意したかです。「機械的な手続き」が存在しないことを証明するには、まず「機械的な手続き」とは何かを定義しなければなりません。チューリングは、無限に続くテープの上で記号を読み書きしながら内部状態を変える装置を定義し、この装置ができることをもって計算可能性の定義としました。のちにチューリング機械と呼ばれるものです。
さらに重要なのが万能機械の考え方です。個々の機械の動作規則そのものをテープ上の記号列として書いておけば、その記述を読んで振る舞いを再現する一台の機械を作れる、という指摘でした。ここで、機械の設計と機械への入力が同じ形式に統一されます。プログラムとデータを区別せず同じ記憶に置く、という後年の計算機の基本構造は、この考え方の物理的な実装にあたります。
経営の観点で押さえておきたいのは順序です。1936年に決まったのは、何ができるかではなく、できることとできないことを分ける境界の引き方でした。適用範囲の定義が先に来て、実装はその後に来ています。導入の可否を検討するとき、「この技術で何ができるか」より先に「この技術の適用範囲はどこで切れるか」を定義しておくほうが、後の判断が安定しやすいと考えています。
論理を電気回路に落とす:シャノンの1937年の修士論文
計算可能性の理論は紙の上の話です。これを電気回路の設計につないだのが、クロード・シャノンの修士論文でした。「継電器と開閉回路の記号的解析」と題するこの論文は1937年8月10日にマサチューセッツ工科大学へ提出され、ブール代数が継電器とスイッチの回路設計にそのまま使えることを示しています。改訂・短縮された版が1938年に『Transactions of the American Institute of Electrical Engineers』へ掲載されました。
この論文がしたことは、翻訳の規則を与えることです。論理式の「かつ」「または」「でない」は、継電器の直列・並列・常閉接点に対応します。逆に、継電器を組み合わせた回路が何を計算しているかは、ブール代数の式として書き出せます。設計者は回路図をにらんで試行錯誤する代わりに、代数の変形として回路を簡約できるようになりました。
1930年代の後半に、この2つが揃ったことになります。何が計算できるかを定義する理論と、論理演算を電気部品で実現する方法です。「考える機械」という言い方が単なる比喩から設計上の課題へ変わるのは、この時点からです。ただし当時、実際に動く電子計算機はまだありません。理論と製造技術がつながったところで、両者を結ぶ実機の建設に十年近くかかります。
神経を論理素子として書く:1943年の形式ニューロン
1943年、イリノイ大学医学部精神医学教室のウォーレン・S・マカロックとウォルター・ピッツが、「A Logical Calculus of the Ideas Immanent in Nervous Activity」を『Bulletin of Mathematical Biophysics』第5巻115ページから133ページに発表します。マカロックは1941年にイリノイ大学の精神医学教室へ移り、1951年までイリノイ神経精神医学研究所の所長を務めた人物です。
この論文の出発点は、神経活動の「全か無か」の性質でした。神経細胞は入力の大きさに比例した出力を返すのではなく、閾値を超えたときに発火し、超えなければ発火しません。この二値性に着目すれば、神経の事象とその関係は、真か偽かの2つの値だけを扱い、それらを「かつ」「または」「でない」で組み立てる命題論理で扱えます。彼らは、固定した閾値、複数の興奮性入力の同時加算、一定のシナプス遅延、抑制性入力による発火の阻止、同期した時間刻み、といった仮定を置いた素子を定義しました。これが形式ニューロンです。そしてこの素子をつないだ回路網が、命題論理の演算を実現できることを示しました。
ここで注意しておきたい限定が2つあります。1つは、この論文が扱っているのは構造であって学習ではない点です。結合の重みや閾値は与えられたものとして扱われ、経験によってそれが変わる仕組みは含まれていません。もう1つは、彼らが主張した計算能力の範囲について、後年の解説に幅がある点です。回路網がチューリング機械と同等の計算ができると結論した、という読み方も紹介されていますが、厳密な証明を伴わないという指摘もあるため、本章では「命題論理の演算を実現できることを示した」までにとどめます。
この論文の影響は、生理学より計算機設計の側にはっきり残りました。ジョン・フォン・ノイマンが1945年6月30日付で配布した101ページの文書『First Draft of a Report on the EDVAC』は、プログラム内蔵方式の論理設計を最初に記述した資料として知られますが、その第4.2節に、W・S・マカロックとW・ピッツに従って神経細胞の働きのより複雑な側面は無視する、という趣旨の一文があり、脚注に1943年の論文が挙げられています。同じ節で高等動物の神経細胞が「全か無か」の性質を持つ素子だと述べ、第6.1節から第6.2節で、真空管で構成する理想化された素子をE素子(E-element)として定義しています。計算機の論理設計が、神経のモデルを媒介にして書かれたわけです。
後年、この回路網が何に反応できるかを形式的に整理したのがスティーヴン・クリーネです。1951年のRAND研究メモRM-704「神経回路網と有限オートマトンにおける事象の表現」は、マカロック・ピッツ型の神経回路網がどのような事象に対して特定のニューロンを発火させうるかを問い、正規事象(regular events)の概念を導入しました。決まった形の式で書き表せる入力の並びの集まりを指す概念です。このメモは1956年にシャノンとジョン・マッカーシーが編んだ『Automata Studies』(Annals of Mathematics Studies 34、Princeton University Press)に収められています。生物のモデルとして出発したものが、有限個の内部状態を持ち、入力を1つ受け取るたびにその状態の間を移っていく装置を扱う有限オートマトンの理論として、整理し直された流れです。
目的をフィードバックで定義する:サイバネティクスの成立
同じ1943年に、別の系統からも重要な論文が出ています。アルトゥーロ・ローゼンブルース、ノーバート・ウィーナー、ジュリアン・ビゲローの論文「行動・目的・目的論」(『Philosophy of Science』第10巻18ページから24ページ)です。彼らは、負のフィードバックで制御される機械、すなわちサーボ機構が、生物の目的的な行動のモデルとして使えると論じました。
この論文が扱ったのは、それまで科学の言葉で書きにくかった「目的」です。目標値と現在値の差を測り、その差を小さくする方向に出力を変える。この仕組みを持つ系は、外から見ると目標に向かって振る舞っているように見えます。目的を、系の内部にある何かではなく、差分を打ち消す動作の連鎖として定義し直したわけです。同じ定義で、砲の追尾装置も、物を取ろうと手を伸ばす人間も記述できます。
ウィーナーはこの路線を1948年の著書『Cybernetics』にまとめました。副題を訳せば「動物と機械における制御と通信」です。初版はパリのHermann & Cie、ケンブリッジのThe Technology Press、ニューヨークのJohn Wiley & Sonsから出ています。サイバネティクスという語は、舵手や操舵者を意味するギリシャ語κυβερνήτης(kybernētēs)に由来します。船の進路のずれを見て舵を切る動作が、そのまま制御の原型として置かれています。
この時期、議論の場も作られました。マカロックの発意により、1946年から1953年にかけてニューヨークで「生物系と社会系における循環的因果とフィードバックの機構」と題する会議が10回開かれます。メイシー会議と呼ばれるものです。参加者には W・ロス・アシュビー、グレゴリー・ベイトソン、マカロック、マーガレット・ミード、ピッツ、シャノン、ハインツ・フォン・フェルスター、ウィーナーらの名前があります。数学、生理学、心理学、人類学、通信工学の人間が同じ部屋で用語をすり合わせる場でした。
実機も作られています。アシュビーは1948年にホメオスタット(homeostat)を製作しました。入力に外乱を与えられたあと、単純な機械的過程で平衡状態へ戻る装置で、英空軍の余剰の爆弾制御スイッチギア4組から組み立てられています。彼は1952年に『Design for a Brain』(Chapman & Hall、ロンドン/John Wiley & Sons、ニューヨーク、260ページ)を出し、適応的な振る舞いが機械的な仕組みから生じうることを論じました。W・グレイ・ウォルターは1948年から1949年にかけて、ブリストルのバーデン神経学研究所で3輪の自律ロボットを作っています。Machina speculatrix と名づけられ、個体はElmerとElsieと呼ばれました。光に向かって動く走性を持ち、頭脳にあたる部分は真空管2本です。1951年の英国祭の科学展示で毎日実演されました。
ここで押さえておきたいのは、制御の系統と計算の系統が、この時点では別のものとして進んでいたという点です。サイバネティクスが扱ったのは、環境と相互作用しながら状態を保つ機械でした。計算可能性の理論が扱ったのは、入力を受けて出力を返す手続きでした。どちらも「知能」を名乗ってはいません。両者が同じ看板の下に置かれるのは、もう少し後のことです。
学習則が加わる:ヘッブ則と最初の学習機械
形式ニューロンには学習の仕組みがありませんでした。そこを埋める仮説が1949年に出ます。ドナルド・O・ヘッブの『The Organization of Behavior: A Neuropsychological Theory』(ニューヨークのジョン・ワイリー・アンド・サンズ社)です。この本で提示されたヘッブ則は、ある細胞が別の細胞の発火に繰り返し関与すると、その2つの細胞の間の結合が強まる、という考え方でした。ヘッブはあわせて、細胞集成体(cell assembly)と位相連鎖(phase sequence)という概念を導入しています。
ヘッブ則が持っている性質のうち、工学的に効いたのは局所性です。結合の強さの更新に必要な情報が、その結合の両端にある2つの素子の活動だけで済みます。全体を統括する装置も、正解を教える外部の信号も要りません。回路網の規模が大きくなっても更新の手続きが破綻しない、という意味で、実装しやすい規則でした。
1943年の形式ニューロンが素子と結線の形を与え、1949年のヘッブ則が結線の強さを変える規則を与えたことで、学習する回路網の設計図が紙の上で揃ったことになります。実際、その2年後には装置が作られました。マーヴィン・ミンスキーが設計し、プリンストン大学の物理学の大学院生ディーン・S・エドモンズが電子回路を担当したSNARCです。製作は1951年の夏に始まりました。資金はジョージ・A・ミラーが米海軍研究局から得ています。約40個のヘッブ型シナプスを持ち、1ニューロンあたり真空管6本、全体で真空管300本、大きさはグランドピアノほどでした。迷路を進むネズミを模した動作をします。実機は失われ、ニューロン1個分だけが残っています。
この節で確認しておきたいのは、部品が揃う順序です。素子のモデルが先にあり、学習則が後から加わり、その後に実装が来ました。逆はありません。装置を先に作ってから中身の理論を探した例は、この時期の資料からは見当たりませんでした。導入の順番として、対象の構造を定義できていないうちに実装へ進むと、後から定義を作り直すことになります。
機械が動き出す:1943年から1951年までの計算機
ここまでの話は、実際に動く機械がほとんど存在しない状況で進んでいました。実機の側の年表を並べておきます。
戦時中の暗号解読には、専用の機械が使われました。ブレッチリー・パークのボンブは、最初の機械「Victory」が1940年3月に稼働し、チューリングとゴードン・ウェルチマンの方式による最初の機械が同年8月に稼働しています。トミー・フラワーズが郵政省ドリスヒル研究所で設計・製作したコロッサスは、Mk 1が1943年末から1944年初にブレッチリー・パークへ搬入され、1944年2月初めに動作しました。終戦までに10台が使われています。コロッサスはローレンツ暗号の解読という単一の目的のために作られた機械で、デジタルで電子式かつプログラム可能だったものの、その可変性は限定的でした。汎用機ではありません。
汎用の電子計算機としてはENIACがあります。ペンシルベニア大学ムーア電気工学スクールで、ジョン・W・モークリーとJ・プレスパー・エッカートが製作し、1946年2月14日に公表されました。30フィート×50フィートの部屋を占め、重さは30トン、真空管は約1万8千本、消費電力は150キロワットです。弾道計算のために作られ、手回し計算機で12時間かかった計算を30秒で終えました。1,440倍の速さです。ただし、プログラムは配線の差し替えとスイッチの設定で与える方式でした。最初のプログラマは6人の女性で、Kathleen McNulty Mauchly Antonelli、Jean Jennings Bartik、Frances Snyder Holberton、Marlyn Wescoff Meltzer、Frances Bilas Spence、Ruth Lichterman Teitelbaum の各氏です。
プログラムを記憶に置く方式は、前述のEDVAC報告で設計として書かれ、実機としてはマンチェスターで最初に動きました。Small-Scale Experimental Machine、通称Babyです。フレデリック・C・ウィリアムズ、トム・キルバーン、ジェフ・トゥーティルが製作し、1948年6月21日午前11時に最初のプログラムを実行しました。ある数の最大の因数を求めるプログラムで、キルバーンが書いたものです。答えを出すまでに52分かかり、350万回の演算を行いました。翌1949年5月6日には、ケンブリッジ大学数理研究所でモーリス・V・ウィルクスが製作したEDSACが最初のプログラムを実行します。平方数の表を計算するものでした。EDSACは常用された最初のプログラム内蔵式計算機とされ、よく使う短いプログラムを紙テープのライブラリとして持つ方式、すなわちサブルーチンの考え方を導入しています。1951年にはマンチェスターの機械をもとにしたフェランティ Mark 1 が出て、商用の汎用電子計算機が手に入るようになりました。
この10年ほどの流れは、理論から専用機、専用機から汎用機、という順に整理できます。そして汎用機が研究室に入ったところで、それまで紙の上にあった構想が実行できるようになりました。1950年前後にゲームのプログラムが相次いで書かれるのは、機械が手に入ったからです。着想の側は先に用意されていました。
チューリングの1948年報告と1950年の問い
チューリングは1947年にロンドン数学会で自動計算機関(Automatic Computing Engine)について講演し、その原稿はB・ジャック・コープランド編『The Essential Turing』(Oxford University Press、2004年)に収められています。翌1948年、国立物理学研究所に在職中に「Intelligent Machinery」と題する報告を書きました。この報告は生前には公表されず、活字になったのは1960年代末です。1968年にエヴァンズとロバートソンの論文集に収録され、翌1969年にメルツァーとミッチー編『Machine Intelligence』第5巻(Edinburgh University Press)3ページから23ページに掲載されました。
報告の中身は、いま読むと機械学習の設計案に見えます。チューリングは未組織機械(unorganised machine)という類を定義しました。A型は、2つの入力がともに1のときだけ0を出し、それ以外では1を出すNANDゲートに相当する素子を、ほぼ無作為につないだ回路網です。B型は、A型の結線を「結線修飾子」に置き換えたもので、外から適切な干渉を与えることによって、有用な仕事をするように振る舞いを組織できるとしています。この干渉を、彼は教育になぞらえました。人間の乳児の大脳皮質を未組織機械の例として挙げています。初期状態を作り込むのではなく、初期状態をほぼ無作為にしておいて訓練で形を与える、という発想です。
同じ報告で、彼は機械が人間と競いうる分野を列挙しています。各種のゲーム(チェス、三目並べ、ブリッジ、ポーカー)、言語の学習、言語の翻訳、暗号、数学の5つです。このうち言語の学習が最も印象的だが、感覚器官と移動能力に依存しすぎて実現が難しいと述べ、チェスを選んでいます。分野の選び方が、印象の大きさではなく実現可能性で決められている点は記録しておく価値があります。
1950年10月、チューリングは『Mind』第59巻236号433ページから460ページに論文「計算機械と知能」を発表します。冒頭で提示されるのが模倣ゲームです。原文の設定は3人で、男(A)、女(B)、そして別室の質問者(C)が登場します。質問者はテレタイプ越しのやり取りだけで、どちらが男でどちらが女かを当てます。声の手がかりを排除するためです。そのうえでチューリングは、Aの役を機械が務めたらどうなるか、と問いを移します。
この設計の要点は、内部を問わないところにあります。機械が本当に考えているかどうかを直接調べるのではなく、外から観察できるやり取りだけで判定します。評価の対象を振る舞いに限定したわけです。なお、この設定については「機械が女性を演じる版が本来の意図だった」という説明が流通していますが、Stanford Encyclopedia of Philosophy は、標準的な解釈、すなわち機械が人間を真似て性別を特定しない別の人間と競うという読み方を本文の証拠が支持していると述べています。
論文には具体的な予測も書かれています。原文は「I believe that in about fifty years’ time it will be possible to programme computers, with a storage capacity of about 10⁹, to make them play the imitation game so well that an average interrogator will not have more than 70 per cent. chance of making the right identification after five minutes of questioning.」です。記憶容量おおむね \( 10^{9} \)、平均的な質問者が5分の質問で正しく判定できる確率が70パーセントを超えない、という条件が明示されています。数値と時間が入っているので、達成したかどうかを後から検証できる形になっています。
この予測の扱いには注意が要ります。予測が置かれているのは、論文第6節「主問題に対する反対意見」の書き出しに近い442ページです。チューリングはこれを自分の信じていることとして書き、続けて、どれが証明された事実でどれが推測かをはっきりさせておく限り害はなく、推測は有用な研究の方向を示すので重要だ、と添えています。つまりこれは、約50年後の計算機がどこまで来るかについての見通しであって、合格か不合格かを決める基準として書かれたものではありません。「審査員の30パーセントをだませば合格」という基準は、論文のどこにも書かれていません。それでも、2014年6月8日付の英レディング大学の発表は、5分間のキーボード上の会話で30パーセントを超えて人間と取り違えられれば合格とする規定のもとで、13歳の少年という設定のプログラム「Eugene Goostman」が30人の審査員の33パーセントに人間だと思わせ、チューリングテストに初めて合格したと伝えました。数値の上では、正しく見分けられる確率が70パーセント以下になるという論文の見通しは、人間と取り違えられる割合が30パーセント以上になることに相当します。その30パーセントが、論文には無い合格基準として使われたことになります。評価の基準を引用するときは、元の文書に何がどの性格の文として書かれているかを確かめてから使う必要があります。
論文の後半は、機械が考えることはありえないとする9つの反論を1つずつ検討する構成です。神学的反論、「砂に頭を埋める」反論、数学的反論、意識からの議論、種々の能力の欠如からの議論、ラヴレス夫人の反論、神経系の連続性からの議論、行動の非形式性からの議論、超感覚的知覚の9つです。そして最後に、大人の心を模擬するプログラムを作るのではなく、子どもの心にあたるものを作って教育に相当する過程を経させる、という方針を示しています。1948年の報告で書いた未組織機械の訓練と同じ路線です。
この2つの文書から取り出せる論点は、評価の設計です。チューリングは「知能とは何か」を定義する代わりに、判定できる形式の問いに置き換えました。判定できる形式にしたことで議論が進み、同時に、置き換えたことによる限界も引き受けています。AIの導入を検討する場面でも、性能をどう測るかを先に決めておくかどうかで、その後の議論の質が変わることが多いように思います。測り方を決めずに「使えるかどうか」を議論すると、結論が印象に左右されやすくなります。
ゲームを題材にした探索の原型:シャノンのチェス論文と初期のプログラム
1950年3月、シャノンは「Programming a Computer for Playing Chess」を英国の学術誌『Philosophical Magazine』の第7系列第41巻314号256ページから275ページに発表しました。受理は1949年11月8日、所属はニュージャージー州マレーヒルのBell Telephone Laboratoriesです。コンピュータチェスに関する最初の技術論文とされます。
シャノンはまずチェスを選んだ理由を3つ挙げています。第一に、許される操作(指し手)と最終的な目標(詰み)の両方が明確に定義されていること。第二に、自明なほど単純でもなく、満足な解が得られないほど難しくもないこと。第三に、上手に指すには一般に「考えること」が必要だと見なされていることです。研究対象として題材を選ぶときの基準が、そのまま書かれています。
次に、総当たりが不可能であることを見積もりで示します。1つの局面で合法手はおよそ30通り、白と黒の1手ずつでおよそ \( 10^{3} \) 通り、40手の対局でおよそ \( 10^{120} \) 通りの変化になります。そして、1つの変化を1マイクロ秒で処理する機械であっても、最初の1手を決めるのに \( 10^{90} \) 年以上かかると書いています。この見積もりがあるので、以降の議論はすべて「全部は数え上げられない」という前提から出発します。
そこで持ち込まれるのが評価関数です。シャノンが提示した形は次のものでした。
\( f(P)=200(K-K’)+9(Q-Q’)+5(R-R’)+3(B-B’+N-N’)+(P-P’)-0.5(D-D’+S-S’+I-I’)+0.1(M-M’) \)
駒の価値をクイーン9、ルーク5、ビショップ3、ナイト3、ポーン1とし、キングは詰みを表すため200としています。加えて、二重ポーン・孤立ポーン・後退ポーンにあたる項を負に、動ける手の数にあたる項を正に置いています。局面の良し悪しを1つの数に落とし、その数を最大にする手を選ぶ、という構成です。
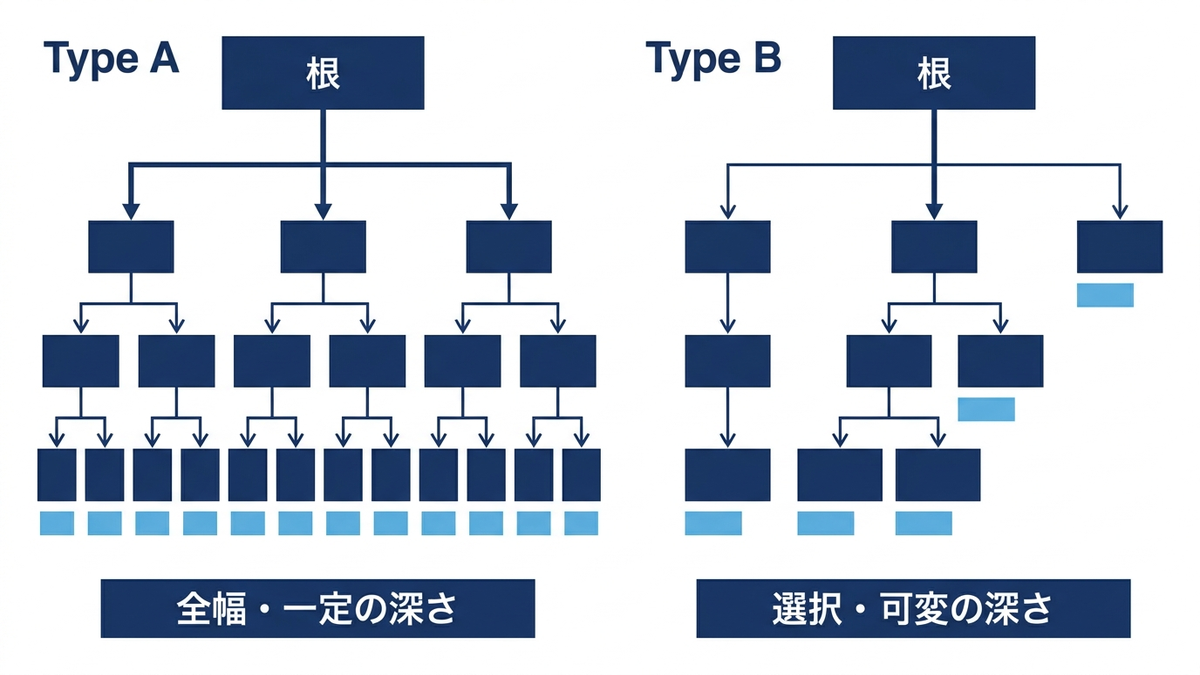
探索の進め方については2つの型が示されます。Type Aは、決められた手数まですべての変化を展開し、そのうえで式に従って手を決める方式です。Type Bは、強制的な変化はできるだけ深く追い、ある程度の安定が得られた局面でだけ評価し、無駄な計算を避けるために調べる変化そのものを選ぶ方式です。全幅を一定の深さで切るか、選んだ枝を深く伸ばすか、という違いになります。計算資源が限られているという前提から、探索の範囲を絞る仕組みが必要になる、という論の運びです。
この構造は現在も残っています。候補が多すぎて全部は試せないので、有望そうなところに計算を寄せる。良し悪しを1つのスコアに落として比較する。この2つは、探索でも最適化でも学習でも共通する枠組みです。1950年の時点で、対象がチェスという限定された題材だったからこそ、枠組みが明示的に書けたとも言えます。
論文で構想が書かれた一方、実機で動かす試みも並行していました。チューリングとD・G・チャンパーノウンが考案したチェスの手続きはTurochampと呼ばれます。1951年のフェランティ Mark 1 向けに実行可能な形へ書き直そうとしましたが果たせず、1952年の夏に、チューリング自身が紙の上で規則を1手ずつたどる形でアリック・グレニーと対局しました。1手の評価に最大30分を要し、29手で敗れています。元のコードは残っていません。ここまでの記述は、コープランド編『The Essential Turing』(2004年、563ページから564ページ)に依拠したものです。
汎用機の上で最初に動いた限定版のチェスプログラムは、ディートリッヒ・プリンツによるものです。コンピュータ歴史博物館の記述では、1951年に英国のプリンツが最初の限定的なチェスプログラムを書き、機械の性能が足りず1局を通して指すことはできなかったものの、詰みまで2手の局面であれば最善手を見つけられた、とされています。いわゆる2手詰め問題です。
同じ時期、クリストファー・ストレイチーはドラフツ(チェッカー)のプログラムを書いています。1951年初めに国立物理学研究所で書き始め、1951年7月30日にPilot ACEで最初に試しましたが、誤りと記憶容量の不足で動きませんでした。1952年の春にマンチェスターのフェランティ Mark 1 のことを知り、7月に同地へ赴いて、1952年7月には遊べる速度で動くようになっています。プログラムは20ページを超え、1,000命令を上回る規模でした。
米国側では、1949年にIBMのポキプシー研究所へ入所したアーサー・サミュエルが、IBM 701 の上でチェッカーのプログラムを完成させています。IEEE Computer Society は、これを世界初の自己学習プログラムとみられるものと記しています。学習する仕組みを組み込んだ試みが、この時期にゲームを題材として現れていたことになります。
この一連の試みに共通しているのは、機械の性能が構想に追いついていなかったことです。手続きは書けているのに、記憶容量が足りない、速度が足りない、そもそも実行できる機械がない。1950年前後の記録は、その制約の一覧としても読めます。制約が解けたのは、機械の側が変わったからでした。
1955年までに揃っていたもの
本章で扱った範囲を、年表として整理します。全体の年表とは粒度を変え、1930年代から1955年までに限っています。
| 年 | 出来事 | 意味 |
|---|---|---|
| 1928 | ヒルベルトとアッカーマン『Grundzüge der theoretischen Logik』が決定問題を提起 | 「機械的な手続きで判定できるか」という問いが数学の課題として立った |
| 1936 | チャーチが『American Journal of Mathematics』に、チューリングが『Proceedings of the London Mathematical Society』に、それぞれ決定問題の否定的解決を発表 | 計算可能性が定義された。あわせて万能機械の考え方が示され、プログラムとデータを同じ形式で扱う道筋がついた |
| 1937 | シャノンがMITに修士論文「継電器と開閉回路の記号的解析」を提出 | ブール代数が回路設計の道具になった。論理演算を電気部品で作れることが示された |
| 1943 | マカロックとピッツが形式ニューロンを発表/ローゼンブルース・ウィーナー・ビゲローが論文「行動・目的・目的論」を発表 | 神経のモデルと、目的をフィードバックで定義する枠組みが同じ年に出た。以後の2つの系統の起点になる |
| 1944 | コロッサスMk 1 が2月初めに動作 | 電子式でプログラム可能だが単一目的の機械。汎用性はまだない |
| 1945 | フォン・ノイマンが『First Draft of a Report on the EDVAC』を配布 | プログラム内蔵方式の設計が文書化された。形式ニューロンの論文が引用されている |
| 1946 | ENIACが2月14日に公表 | 汎用の電子計算機が実在するようになった。ただし配線で組み替える方式 |
| 1948 | ウィーナー『Cybernetics』刊行/Manchester Babyが6月21日に最初のプログラムを実行/チューリングが報告「Intelligent Machinery」を執筆 | 制御の理論が名前を得た年であり、プログラム内蔵方式が実機で動いた年でもある。チューリングの報告は当時公表されなかった |
| 1949 | ヘッブ『The Organization of Behavior』刊行/EDSACが5月6日に最初のプログラムを実行 | 学習則が加わり、常用できる計算機が現れた |
| 1950 | チューリングが『Mind』に論文「計算機械と知能」/シャノンが『Philosophical Magazine』にチェス論文 | 評価の方法と探索の枠組みが、同じ年に別々の形で提示された |
| 1951 | SNARCの製作開始/プリンツのチェスプログラム/クリーネのRANDメモRM-704/フェランティ Mark 1 の商用化 | 学習機械・ゲームプログラム・理論の整理が同時に進み、商用の汎用機が入手できるようになった |
| 1952 | アシュビー『Design for a Brain』刊行/Turochampがグレニーと対局/ストレイチーのドラフツが動作 | 紙の上の手続きが、実行できる形になり始めた |
この表を通して見ると、1956年の直前までに何が揃っていたかがはっきりします。計算可能性の定義があり、論理を回路にする方法があり、神経のモデルがあり、学習則があり、目的を制御として書く枠組みがあり、プログラム内蔵式の汎用機が商用で買えました。さらに、探索と評価関数という問題の解き方の型と、振る舞いで判定するという評価の設計も文書として存在していました。足りなかったのは、これらを1つの研究分野として束ねる名前と、その名前のもとに人と資金を集める仕組みです。
経営の判断に引き寄せると、読み方は2つあります。1つは、話題になっている技術について、その下に何年ぶんの蓄積があるかを確かめることです。蓄積が薄ければ、注目が集まっても実装は進みません。もう1つは、蓄積が十分にあるのに動いていない領域を探すことです。1955年時点のAIがまさにそれで、部品は揃っていたのに束ねる枠組みがなかった状態でした。こういう領域では、技術の発明ではなく、整理と命名と資金の配分が効きます。
本章では、1930年代から1955年までに積み上がった材料を確認しました。計算可能性の理論、論理回路、形式ニューロン、ヘッブ則、サイバネティクス、そして実際に動く汎用計算機です。次章では、これらに「artificial intelligence」という名前が与えられた1956年の出来事と、その名前のもとで最初の数年に何が作られたかを扱います。名前が付いたことで何が変わり、何が変わらなかったのかが論点になります。
この章を深めたい方への参考書籍
『チューリング:情報時代のパイオニア』(B・ジャック・コープランド著、服部桂訳、NTT出版):本章で扱った1936年の計算可能性の論文、1948年の報告「Intelligent Machinery」、1950年の模倣ゲームの提案を、一続きの仕事として追える一冊です。著者はチューリングの著作を編纂してきた研究者で、原典に当たりながら書かれています。断片的に語られがちなチューリングの主張を、時系列で確認したい方に向いています。
『サイバネティックス:動物と機械における制御と通信』(ノーバート・ウィーナー著、池原止戈夫・彌永昌吉・室賀三郎・戸田巌訳、岩波文庫):本章で触れた、目的をフィードバックで定義する枠組みの原典です。数学的な記述を含みますが、生物と機械を同じ言葉で扱おうとした当時の問題意識は序章からたどれます。制御の系統と計算の系統が別々に始まったことを、原典の側から確認したい方に向いています。
『通信の数学的理論』(クロード・E・シャノン、ワレン・ウィーバー著、植松友彦訳、ちくま学芸文庫):本章ではシャノンの回路設計とチェスの仕事を扱いましたが、彼の主著は1948年の情報理論の論文です。情報を量として測る枠組みがどう作られたかを原典で読めます。後の章で扱う言語モデルや圧縮の議論の土台にもなるため、早い段階で目を通しておくと通史が読みやすくなります。
第2章 ダートマス会議とAIという名前の誕生
第1章では、1956年より前に積み上がっていたものを確認しました。計算できることの範囲をめぐる議論、神経細胞を論理素子として書き直す試み、機械と生物を同じ枠で扱おうとする流れです。これらはそれぞれ別の分野の中の仕事で、共通の名前を持っていませんでした。本章で扱うのは、それらが一つの名前のもとにまとめられ、その名前が研究資金と人材を引き寄せた時期です。
期間は1956年から1960年代前半です。この時期に起きたことは、大きく2つの系統に分かれます。1つは、記号を並べて操作することで問題を解くプログラムが実際に動いたこと。もう1つは、重みを少しずつ更新して学習する機械が作られ、広く報道されたことです。前者からは定理証明のプログラム、汎用の問題解決器、そしてプログラミング言語が生まれました。後者からはパーセプトロンが生まれました。
本章の主張は2つです。第一に、名前が付いたことが資源の集まり方を変えました。研究計画書に一つの語を置いたことで、財団と軍の予算が同じ旗印に向かうようになります。第二に、この時期の成功はいずれも「探索で扱える範囲」の内側にありました。その範囲の外側で何が起きるかは、当時の成果を並べただけでは読み取れません。後半では当時の手法を最小構成で実装して実際に動かし、範囲の内側と外側で結果がどう変わるかを数字で示します。
1955年8月31日の提案書に何が書かれていたか
出発点は会議そのものではなく、その前年に書かれた1通の書類です。表題は「A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence」、日付は1955年8月31日。提案者は4名で、それぞれの肩書は提案書の末尾に本人たちの手で書かれています。J. マッカーシー(ダートマス大学 数学助教授)、M. L. ミンスキー(ハーバード大学 ジュニアフェロー、数学および神経学)、N. ロチェスター(IBM 情報研究部門マネージャ、ニューヨーク州ポキプシー)、C. E. シャノン(ベル電話研究所 数学者)です。所属が大学2つ、企業2つに分かれている点は、後の展開を考えると見ておく価値があります。
本文の書き出しは、目的ではなく計画の形をしています。1956年の夏に、ニューハンプシャー州ハノーバーのダートマス大学で、2か月・10人の研究を行う、という提案です。そしてその研究が拠って立つ前提として、次の一文が置かれています。学習のあらゆる側面、および知能のそのほかのいかなる特徴も、原理的には機械が模倣できるほど精密に記述できる、というものです。
ここで注意したいのは、この一文が定義ではなく推測として書かれていることです。原文でも conjecture という語が使われています。知能とは何かを定めたのではなく、「精密に記述できるという前提で進めてみる」と宣言しただけです。定義を避けて作業仮説を置いたことが、その後さまざまな立場の研究者が同じ看板の下に入れた理由の一つになります。
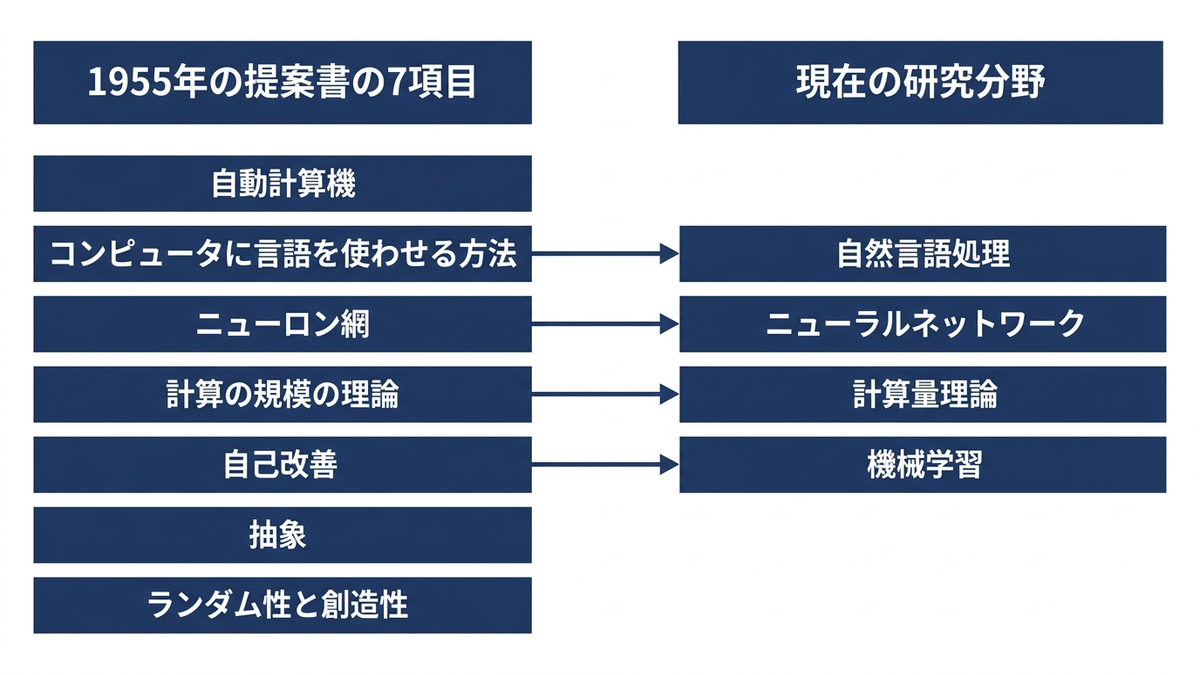
提案書は続けて、取り組むべき7つの項目を挙げています。自動計算機、コンピュータに言語を使わせる方法、ニューロン網、計算の規模の理論、自己改善、抽象、そしてランダム性と創造性です。70年後から見ると、この7項目はほぼそのまま現在の研究分野の見出しになります。項目2は自然言語処理、項目3はニューラルネットワーク、項目4は計算量理論、項目5は機械学習にあたります。
この章の主題との関係で重要なのは項目4です。提案書はそこで、明確に定義された問題の解き方の一つは「考えられる答えを順にすべて試すこと」だが、この方法は非効率であり、それを排除するには計算の効率を測る基準が要る、と書いています。1955年の時点で、全部試す方式では足りないという認識がはっきり文章になっていました。この認識が、次節以降で見る手法すべての出発点になります。
末尾には見積が付いています。給与6名分7,200ドル、給与2名分1,400ドル、8名分の旅費と滞在費2,400ドル、事務850ドル、追加の旅費600ドル、予備550ドル。合計13,500ドルです。つまりこの文書は、研究の企画書であると同時に資金申請書でした。「artificial intelligence」という語が最初に置かれた場所が、学術論文ではなく資金申請書だったことは、この分野の資金の集まり方を考えるうえで押さえておいてよい事実だと考えています。
「artificial intelligence」という名前が選ばれた事情
なぜこの語だったのかについては、名付けた本人が後年に書き残しています。マッカーシーは、ブライアン・ブルームフィールド編の書籍への書評のなかで、artificial intelligence という語を作った理由の一つはサイバネティクスとの結びつきを避けることだった、と述べています。アナログのフィードバックに集中する姿勢は的外れに思えたこと、そしてノーバート・ウィーナーを導師として受け入れるか、彼と議論し続けるかのどちらかになるのを避けたかったことを、理由として挙げています。
この説明は、命名という行為の性質をよく表しています。名前は中身の定義ではなく、境界の宣言でした。何を含むかよりも、何と別の営みなのかを示すために選ばれています。実際、提案書には知能の定義がありません。あるのは作業仮説と7つの検討項目だけです。定義がないぶん、記号を操作する立場の研究者も、ニューロン網を作る立場の研究者も、同じ名前の下に入ることができました。提案書の項目3がニューロン網であることは、この点で示唆的です。
経営の観点でここから取り出せるのは、名前の役割です。新しい取り組みに名前を付けるとき、その名前は中身を説明するためだけにあるのではありません。予算の勘定科目を分け、採用の枠を作り、既存の部署との線引きをするために使われます。中身が固まっていなくても名前が先に立つことがあり、そのほうが人と金が動きやすい場合があります。1955年の提案書は、その先行事例として読めます。
提案と実際の差、そして1956年の夏
提案がそのまま通ったわけではありません。ロックフェラー・アーカイブ・センターの記録によれば、マッカーシーは2か月分として13,500ドルを求めましたが、財団が提示したのは5週間分の7,500ドルでした。決定したのは生物医学研究部門ディレクターのロバート・S・モリソンです。要求の半分強という規模で、期間も短縮されています。
それでも計画は実行され、1956年の夏にダートマス大学で開催されました。ダートマス大学は現在も公式にこの催しを Dartmouth Summer Research Project on Artificial Intelligence と呼び、1956年の出来事として紹介しています。開催の期間と参加者の名簿については、本稿で参照できた一次情報の範囲では確定できなかったため、ここでは書きません。この時期の記録は、提案書のように原本が残っているものと、そうでないものの差が大きくなっています。
会議が何を生んだかを、その場での発見で測るのは適切ではありません。この催しの成果は、名前と、その名前を共有する人の輪と、資金の出し手に説明できる枠組みができたことにあります。研究の中身については、むしろ会議の前後に別の場所で進んでいた仕事のほうが具体的でした。次節でその中身を見ます。
Logic TheoristとGeneral Problem Solver、推論を探索として解く
この時期にとくに具体的な成果を出した一組が、ランド研究所で仕事をしていたアレン・ニューウェル、J. C. ショー、ハーバート・A・サイモンです。最初のプログラムが Logic Theorist です。ホワイトヘッドとラッセルの『プリンキピア・マテマティカ』第2章に並ぶ最初の52個の定理のうち、38個を証明しました。論文「The logic theory machine: A complex information processing system」は1956年9月、IRE Transactions on Information Theory 第2巻3号の61ページから79ページに掲載されています。
やり方は、公理から順に定理を導く方向ではありません。証明したい式を出発点にして、それを導けそうな前段の式へと逆向きにたどり、途中で使える変形規則を当てはめていきます。当てはめられる規則は複数あるので、選択肢が枝分かれします。行き止まりに当たったら戻って別の枝を試します。つまり、証明という作業が枝分かれする木をたどる作業として書き直されました。
同じ組が1959年に発表したのが General Problem Solver です。論文「Report on a general problem-solving program」は IFIP Congress 1959 の256ページから264ページに収められています。中核にあるのが 手段目標分析 という考え方で、現在の状態と目標の状態を見比べて差を測り、その差を減らせる演算子を選び、その演算子を使うための条件が満たされていなければ、それ自体を新しい目標にして同じ手続きを繰り返します。
この方式が持つ意味は、速さよりも構造にあります。問題そのもの、つまり「どんな状態があり、どんな演算子が使えるか」の記述と、それをどう解くかの手続きが分離されました。解き方の側は問題の内容を知らなくてよく、差を測る関数と演算子の表さえ差し替えれば別の問題に使えます。汎用と名前が付いているのはこの分離を指しています。業務システムでルールと実行エンジンを分ける設計と、発想は同じです。
同じ時期に、探索の枝をどう絞るかという問題が正面から論じられるようになります。ニューウェル、ショー、サイモンによる論文「チェスを指すプログラムと複雑さの問題」は、IBMの研究開発誌(IBM J. Res. Dev.)第2巻4号(1958年10月)の320ページから335ページに載っています。表題が示すとおり、チェスのプログラムを書くことと、複雑さをどう扱うかという問題が、同じ論文の主題として結びつけられています。手を評価する工夫と、探索の広がりを抑える工夫は、この時期には切り離せない一組の課題でした。
もう一つ、探索とは別の方向に踏み出した仕事があります。IBM のアーサー・L・サミュエルによる「Some Studies in Machine Learning Using the Game of Checkers」で、同じIBMの研究開発誌の第3巻3号(1959年7月)の210ページから229ページに掲載されました。表題に machine learning という語が入っています。探索の枝を絞るために使う評価を、人がすべて書き下すのではなく、機械が経験から改善していくという方向が、1959年の時点ですでに論文の表題に掲げられていたことになります。
LISP、記号を扱うための道具
LISP は、上の流れと同じ土壌から出てきた道具です。マッカーシーの論文「記号式の再帰関数と機械によるその計算、第1部」は Communications of the ACM 第3巻4号(1960年4月)の184ページから195ページに掲載されました。冒頭に、LISP は IBM 704 向けに MIT の人工知能グループが開発した、と書かれています。
目的も明記されています。Advice Taker と呼ばれる構想の実験を進めるためです。Advice Taker は、命令文だけでなく宣言文も受け取れて、指示を実行するときに常識的なふるまいを見せる機械として構想されました。当初の提案は1958年11月で、マッカーシーは同じ1958年に Teddington で開かれた Mechanisation of Thought Processes 会議で「Programs with Common Sense」を発表しています。知識を論理式で書き、そこから推論させるという路線です。
LISP の設計で効いたのは、扱う対象を数値ではなく S式と呼ばれる入れ子の記号列にしたことです。数式も、規則も、プログラム自身も、同じ形のデータとして書けます。条件式と、関数が自分自身を呼び出す再帰でその上に関数を定義でき、論文にはさらに、apply という関数が万能チューリング機械の理論的役割と、プログラムの記述を読み取ってその場で実行する仕組みであるインタプリタの実際的役割の両方を果たす、と書かれています。プログラムをデータとして受け取って実行できる、という性質がここで手に入りました。
実装上の工夫として重要なのが、使い終わった記憶領域を自動で回収する仕組みです。論文では、空き領域のリストが尽きたときに回収の周期を開始し、どの基準レジスタからもたどれなくなった領域を空きリストへ戻す手順として説明されています。マッカーシーは脚注で、この処理をすでにガベージコレクションと呼んでいたと述べています。現在の多くの言語処理系が備える機能が、記号処理の必要から生まれたことになります。
系譜としても興味深い記述が論文にあります。S式を IBM 704 の記憶上でリスト構造として表す方式について、ニューウェル、ショー、サイモンが用いたものに似ている、と明記されています。Logic Theorist や GPS のために作られた表現方法が、そのまま言語の基礎に流れ込んでいます。1962年には LISP 1.5 の処理系マニュアルが MIT Press から出版され(マッカーシー、エイブラハムズ、エドワーズ、ハート、レヴィンの共著)、道具として広く配れる形になりました。マッカーシー自身は1962年からスタンフォード大学に移っています。
経営の観点で見ると、この節はプラットフォームの話です。個々のプログラムより、それを書くための共通の道具が広まったことのほうが、後の展開への影響は大きくなりました。人が移動しても道具が同じなら仕事が引き継げます。研究の生産性は、着想の数よりも、着想を試すまでの手数で決まる面があります。
パーセプトロン、重みを更新して学ぶ系統
ここまでは記号を操作する系統でした。同じ時期に、まったく別の原理で動く機械が作られています。コーネル航空研究所(ニューヨーク州バッファロー)のフランク・ローゼンブラットによる パーセプトロン です。1957年1月の報告書「パーセプトロン:知覚し認識するオートマトン」で最初に記述されました。報告書番号は85-460-1で、Project PARA という計画名のもとに書かれています。1958年には、パーセプトロンの論文が Psychological Review 第65巻6号の386ページから408ページに掲載されました。
仕組みは単純です。入力を数値のベクトル \( \mathbf{x} \) とし、重み \( \mathbf{w} \) との内積にバイアス \( b \) を足した符号で出力を決めます。式で書けば \( \hat{y} = \mathrm{sign}(\mathbf{w}^\top \mathbf{x} + b) \) です。正解として与える値を \( t \) と書くと、学習は、1件ずつ見て予測 \( \hat{y} \) が \( t \) と食い違ったときだけ、重みを \( \mathbf{w} \leftarrow \mathbf{w} + t\mathbf{x} \) のように動かす、というものです。合っていれば何もしません。人が規則を書くのではなく、間違えたときにだけ少し直す、という手続きだけが与えられています。
1958年7月、米海軍研究局がこの成果を公開しました。コーネル大学の公式記録によれば、実演は IBM 704 の上で行われ、50回の試行を経て、左に印のあるカードと右に印のあるカードを区別できるようになったとされています。The New York Times は「NEW NAVY DEVICE LEARNS BY DOING」(新しい海軍の装置は、やりながら学ぶ)という見出しで、心理学者が、文字を読み、賢く育つように設計されたコンピュータの胚を示した、という副見出しを付けて報じました。The New Yorker は、人間の脳に対してこれまでに作られた最初の本格的な対抗物のように思われる、と書いています。
ローゼンブラット本人も1958年に、そのような機械、すなわち人間の訓練や制御を一切受けずに周囲を知覚し、認識し、識別できる機械の誕生をわれわれはまさに目撃しようとしている、と書き残しています。前節までの提案書の書き方と比べると、表現の強さが違います。片方は資金申請書の中の作業仮説で、もう片方は実演を伴う公表でした。
この系統には専用の機械も作られました。スミソニアン国立アメリカ歴史博物館の収蔵記録によれば、Mark I Perceptron はコーネル航空研究所で作られ、資金は海軍研究局とローム航空開発センターが出しています。構成はS(感覚)、A(連合)、R(応答)の3種のユニットからなり、重みにあたるAユニットは可変抵抗器の配列で実現されていました。装置は1967年にコーネル大学から海軍研究局を経てスミソニアンへ移されています。理論を紙の上で書くだけでなく、電気機械として組み立てたことが、報道の届き方に効いたと考えられます。
資金の出し手を見ておくと、この節は前節までとつながります。記号処理の側にはロックフェラー財団や、後述する高等研究計画局(ARPA)の資金が入りました。パーセプトロンの側には海軍研究局とローム航空開発センターの資金が入っています。名前が付いた領域に、財団と軍の予算が別々の経路で流れ込んでいました。
探索を最小構成で動かし、大きさを数える
ここからは、当時の中心的な手法を実際に動かして数字を見ます。まず探索です。1955年の提案書が「考えられる答えを順にすべて試す方法は非効率」と書いていたことを、実際の数で確かめます。題材は三目並べにします。盤面が9マスしかないので、木を最後まで数え切れます。
LINES = [(0, 1, 2), (3, 4, 5), (6, 7, 8),
         (0, 3, 6), (1, 4, 7), (2, 5, 8),
         (0, 4, 8), (2, 4, 6)]
nodes_full = [0] * 10

def winner(b):
    for i, j, k in LINES:
        if b[i] == b[j] == b[k] != 0:
            return b[i]
    return 0

def minimax(board, player, depth):
    nodes_full[depth] += 1
    w = winner(board)
    if w != 0:
        return w
    if 0 not in board:
        return 0
    scores = []
    for i in range(9):
        if board[i] == 0:
            board[i] = player
            scores.append(minimax(board, -player, depth + 1))
            board[i] = 0
    return max(scores) if player == 1 else min(scores)

print(minimax([0] * 9, 1, 0), sum(nodes_full))
実行すると、空の盤面の評価値は0、つまり双方が最善を尽くせば引き分けになります。そのときに展開したノードの総数は549,946でした。ここに枝刈りを入れると、同じ答えを得るのに必要なノード数は18,297まで減ります。削減率は96.7パーセントです。枝刈りとは、ある枝を最後まで調べなくても、すでに調べた枝の結果から「この先を見ても結論は変わらない」と判定できる場合に、その枝を打ち切る操作です。答えは変わりません。変わるのは調べる量だけです。
| 深さ(打たれた手の数) | 全探索のノード数 | 枝刈りありのノード数 |
|---|---|---|
| 0 | 1 | 1 |
| 1 | 9 | 9 |
| 2 | 72 | 30 |
| 3 | 504 | 132 |
| 4 | 3,024 | 409 |
| 5 | 15,120 | 1,306 |
| 6 | 54,720 | 2,645 |
| 7 | 148,176 | 5,173 |
| 8 | 200,448 | 5,316 |
| 9 | 127,872 | 3,276 |
| 合計 | 549,946 | 18,297 |
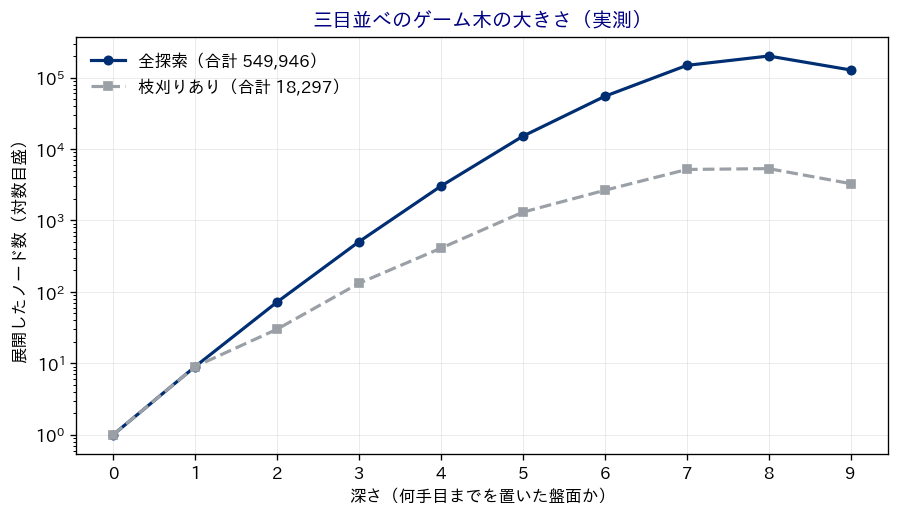
この表が示しているのは、探索という道具が効く条件です。序盤は深さが1つ増えるごとにノード数が数倍から9倍に増え、7手目の148,176で伸びが鈍り、9手目には127,872まで減ります。減るのは、盤が埋まって置ける場所が無くなるからです。三目並べで木を数え切れるのは、この「手が尽きる」点が十分近くにあるからにすぎません。終わりまでの手数が長い問題では、増え方が止まる前に総数が現実的な範囲を超えます。枝刈りはここでも96.7パーセントを削っていますが、削ったあとに残る量そのものは、問題の大きさで決まります。この点の詳細は第3章で扱います。
次に、General Problem Solver の手段目標分析を最小構成で書いてみます。演算子を「前提条件」「追加する事実」「削除する事実」の3つ組で表し、目標が今の状態に無ければ、その目標を追加できる演算子を探し、その前提条件を新しい目標にして再帰します。
OPS = [
    ("息子を学校まで車で送る",
     {"息子は家にいる", "車が動く"}, {"息子は学校にいる"}, {"息子は家にいる"}),
    ("整備工場がバッテリーを取り付ける",
     {"車のバッテリーが切れている", "工場は故障を知っている", "工場は代金を受け取った"},
     {"車が動く"}, set()),
    ("工場に故障の内容を伝える",
     {"工場と話ができる"}, {"工場は故障を知っている"}, set()),
    ("工場に電話をかける",
     {"電話番号を知っている"}, {"工場と話ができる"}, set()),
    ("電話帳で番号を調べる",
     {"電話帳がある"}, {"電話番号を知っている"}, set()),
    ("工場に代金を渡す",
     {"手持ちの現金がある"}, {"工場は代金を受け取った"}, {"手持ちの現金がある"}),
]

def achieve(goal, state, stack, plan):
    if goal in state:
        return state
    if goal in stack:
        return None
    for name, pre, add, dele in OPS:
        if goal not in add:
            continue
        s, ok = state, True
        for p in sorted(pre):
            s2 = achieve(p, s, stack | {goal}, plan)
            if s2 is None:
                ok = False
                break
            s = s2
        if ok:
            plan.append(name)
            return (s - dele) | add
    return None
初期状態を「息子は家にいる」「車のバッテリーが切れている」「手持ちの現金がある」「電話帳がある」とし、目標を「息子は学校にいる」として実行すると、6手の手順が組み上がりました。工場に代金を渡す、電話帳で番号を調べる、工場に電話をかける、工場に故障の内容を伝える、整備工場がバッテリーを取り付ける、息子を学校まで車で送る、の順です。目標として取り上げた回数は10回、演算子を試した回数は6回でした。同じ演算子の集合を、出発点に近い状態から順に一段ずつ調べていく幅優先探索にかけると、展開した状態は10個で、同じく6手の手順が見つかります。
この規模では、探索量の差はほとんど出ません。手段目標分析の意味は速さではないということが、この結果からむしろはっきりします。効いているのは書き方の分離です。上のコードで、問題に固有の知識は OPS の表だけに入っており、achieve は「工場」も「バッテリー」も知りません。別の問題を解かせたいなら表を差し替えるだけです。1959年の時点で、この分離が明示的に設計されていました。
見積もりを足して探索を絞る:A*探索とロボットの経路計画
三目並べの実験では、枝刈りによって、答えを変えずに調べる量を減らしました。本章の範囲より後の1968年の仕事ですが、調べる量を減らしながら答えの正しさを保つという同じ課題を、経路を探す問題で理論として固めたのがA*探索です。スタンフォード研究所(現在のSRIインターナショナル)のピーター・ハート、ニルス・ニルソン、バートラム・ラファエルが、1968年7月、IEEEのシステム科学とサイバネティクスを扱う論文誌の第SSC-4巻第2号、100ページから107ページに発表しました。論文の題は、日本語にすれば「最小費用経路をヒューリスティックに決定するための形式的基礎」となります。ここでいうヒューリスティックは、厳密に計算し尽くす代わりに、目的地までの残りを直線距離のような見積もりで補って判断するやり方を指します。
この手法は、SRIの移動ロボットShakey(シェーキー)の研究から生まれました。SRIの記録によれば、Shakeyは周囲を知覚し推論する能力を持った最初の移動ロボットで、1966年から1972年まで同所の人工知能センターの研究対象となり、計画を立てる、経路を見つける、単純な物体を並べ替える、といった課題をこなしました。ニルソンが2010年の通史に書いた経緯では、Shakeyが障害物を避けて目的地へ進む経路を探す問題に取り組むなかで、ニルソンが、障害物を無視した目的地までの直線距離を「残りの見積もり」として使うことを提案し、当時Shakeyの研究を率いていたラファエルが、出発点からすでに進んだ距離にその見積もりを足した値で候補を比べるほうがよいと指摘しました。そこからハートが、残りの見積もりが実際の残りの距離を決して超えなければ、この方式は必ず最短の経路を見つける、という条件に行き着いたとされています。
論文はこの条件を定理として証明しています。論文が前提に置くのは、どの移動にも一定以上の正の費用がかかり、出発点から目的地へたどり着ける経路の網です。その前提のもとで、各点での残りの見積もりが実際の残りの費用以下であれば、A*は必ず最小費用の経路を見つけて止まる、というのが定理の内容です。さらに論文は、見積もりが点ごとにちぐはぐにならないという条件(論文は一種の三角不等式として書いています)を置いたうえで、A*と同じ情報だけを使って最短を保証する他の手続きと比べると、A*が途中で取り出して先を調べる点の数はそれより多くならないことも示しています。なお、進んだ距離と見積もりの和が同じ候補が複数あるときは、どれを先に調べるかで調べる点の数が変わりうるため、論文はその場合を別に論じています。論文が挙げる例は、道路でつながった都市の間の経路で、都市と目的地の間の直線距離が、残りの道のりを超えない見積もりとして使われています。
前節の実験とつなげると、読み取れることが2つあります。1つは、調べる範囲を減らす手段が、枝刈りのような「打ち切りの判定」だけでなく、目的地までの見積もりという問題の外から持ち込む知識でもありうることです。見積もりを足すと、目的地の方向にある候補から先に調べるようになり、調べる範囲を絞り込めます。もう1つは、その見積もりにどんな条件を課せば答えの正しさが保たれるかが、証明の形で示されたことです。第1章で見たシャノンのチェス論文以来の「有望なところに計算を寄せる」という考え方に、どこまでなら見積もりに頼ってよいかという線が引かれた形です。
経営の観点で取り出せるのは、経験や勘にもとづく見積もりを使ってよい条件を前もって決めておくことの価値です。見積もりは調べる手間を大きく減らしますが、A*の保証は、見積もりが実際を超えないという条件の上でだけ成り立ちます。つまり、見積もりを控えめな側に誤る限り最短の保証は保たれ、実際より大きく見積もる側に誤ると、その保証は外れます。誤りの向きによって失うものが違うということです。案件の優先順位づけや調査範囲の絞り込みでも、見積もりをどちらの向きに誤るのなら許容できるのかを先に決めておくと、手間と質の取引を意識して選べるようになると考えています。
パーセプトロンが学習できる範囲を測る
もう一方の系統も動かします。1958年の学習則をそのまま書きます。予測が教師と違うときだけ重みを動かし、合っているときは何もしない、という手続きです。
import numpy as np

def train(X, y, max_epochs, lr=1.0):
    n, d = X.shape
    w = np.zeros(d)
    b = 0.0
    hist = []
    for ep in range(1, max_epochs + 1):
        order = np.random.permutation(n)
        err = 0
        for i in order:
            pred = 1 if X[i] @ w + b > 0 else -1
            if pred != y[i]:
                w = w + lr * y[i] * X[i]
                b = b + lr * y[i]
                err += 1
        hist.append(err)
        if err == 0:
            break
    return w, b, hist
最初に、直線1本で完全に分けられるデータを与えます。真の分離直線をあらかじめ決めておき、その直線から一定の余白より近い点を捨てることで、分離可能であることを保証したデータを200件作りました。乱数の種は固定しています。以下では、用意した学習データを最初から最後まで一通り見終わることを1エポックと数えます。結果は、5エポックで誤分類が0になりました。重みを更新した回数は全部で32回、最終的な正答率は1.0000です。
次に、同じコードに XOR を与えます。入力が \( (0,0) \) と \( (1,1) \) のときは負、\( (0,1) \) と \( (1,0) \) のときは正、という4件だけのデータです。2000エポックまで回しました。結果は次のとおりです。
実行エポック数: 2000(上限 2000)
誤分類 0 件のエポック数: 0
誤分類数の最小 / 最大 / 平均: 1 / 4 / 2.784
出現した相異なる (w, b) の個数: 27
同じ (w, b) が再出現した最初のエポック: 5
最終正答率: 0.5000
2000エポック回して、誤分類が0になったエポックは1度もありませんでした。学習の途中で現れた重みとバイアスの組は27通りしかなく、5エポック目にはすでに一度出た組が再び現れています。つまり同じ状態の間を回り続けているだけで、進んでいません。最終的な正答率は0.5000、4件のうち2件です。
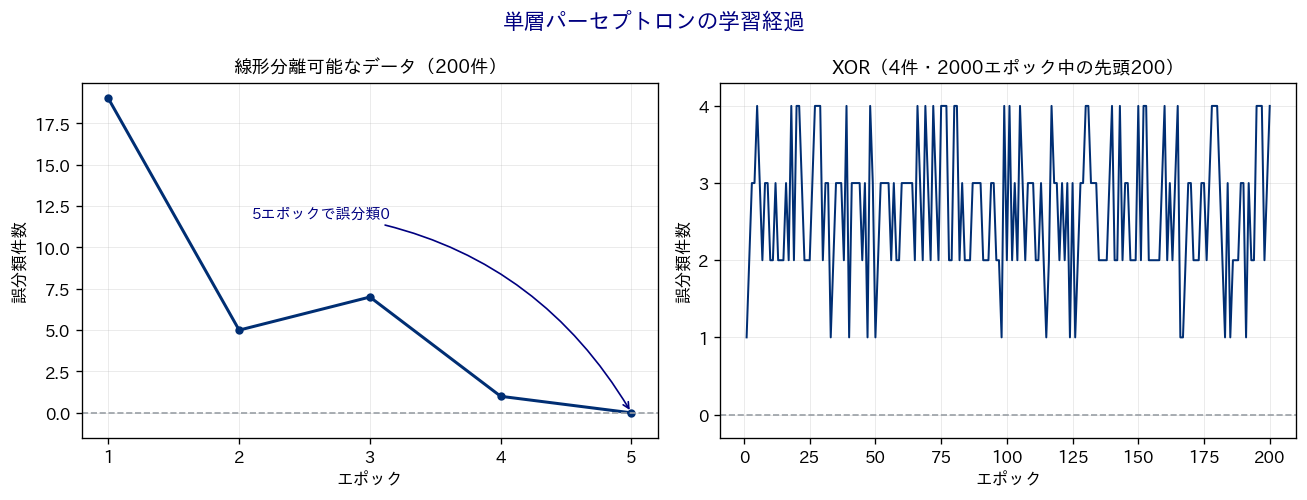
範囲をもう少し広く測るために、2入力のブール関数を全部試しました。入力の組み合わせは4通りなので、関数は16個あります。1つずつ学習させたところ、正答率1.0に到達したのは14個で、到達しなかったのは2個でした。到達しなかった2個は、入力を00、01、10、11の順に並べたときの出力パターンが 0110 のものと 1001 のもの、すなわち XOR とその否定です。学習できた14個は、いずれも9エポック以内で収束しました。
この結果の読み方には注意が要ります。ここで測ったのは、単層のパーセプトロンが到達できたかどうかであって、学習則の良し悪しでも、ニューラルネットワーク一般の性質でもありません。16個中14個という数字だけを見れば高い成功率に見えますし、残る2個については実行が止まらないというだけで、何が起きているのかはこの実験からは説明できません。この事実がどう論じられ、研究の流れにどう影響したかは第3章で扱います。本章では、当時の手法をそのまま動かすとこうなる、という実測の提示にとどめます。
ELIZA、対話の形が理解の錯覚を生む
本章の範囲より少し後の1966年の仕事ですが、記号を操作する系統から出た成果のうち、現在の生成AIの評価に直接つながるものを1つ取り上げます。MITのジョゼフ・ワイゼンバウムが1966年1月、Communications of the ACM 第9巻第1号の36ページから45ページに発表したELIZAです。論文の題は、日本語にすれば「人間と機械の自然言語によるコミュニケーションを研究するためのコンピュータ・プログラム」となります。ELIZAはMITのMACタイムシェアリング・システム、すなわち1台の計算機を複数の利用者が離れた端末から同時に使う仕組みの上で動き、利用者がタイプライターで打ち込んだ文に文で答えるプログラムでした。論文の脚注によれば、この研究は、後掲の小年表に載せたProject MACから支援を受けています。
仕組みは単純です。入力文の中からあらかじめ登録したキーワードを探し、見つかったキーワードに結びつけた分解の規則で文をいくつかの部分に切り分け、組み立て直しの規則でその部分を使って応答文を作ります。論文の例では、「私は〜です」という形の文は、〜の意味にかかわらず「どのくらい前から〜なのですか」という問い返しに組み替えられます。キーワードには優先順位が付けられ、キーワードが1つも見つからないときには「続けてください」のような中身を持たない返答を返す仕組みも用意されていました。
設計上の要点は、キーワードと変換規則の組を「スクリプト」と呼び、プログラム本体から切り離したことです。論文は、スクリプトはデータであってプログラムの一部ではないため、ELIZAは特定の応答の型にも特定の言語にも縛られないと書き、執筆時点で英語のほかウェールズ語とドイツ語のスクリプトがあったと記しています。本章で見たGeneral Problem Solverの、問題の記述と解き方を分ける発想と同じです。ただし、執筆時点で本格的と呼べるスクリプトは、ロジャーズ派の心理療法家のように応答させるものだけでした。精神科の面接は、会話の一方が現実の世界についてほとんど何も知らないふりをしてよい数少ない会話の型だから、というのが論文の説明です。
この論文では、著者のねらいが冒頭に書かれています。人工知能の分野では、機械が経験を積んだ観察者さえ眩惑するような振る舞いを見せることがあるが、ひとたびその内部の働きが理解できるほど平易な言葉で説明されれば魔法は崩れ、それぞれは十分に理解できる手続きの集まりにすぎないことが明らかになる、と述べ、この論文の目的はまさにそうした見直しを促すことだと書いています。論文の終わりの考察では、いまのスクリプトのELIZAでさえ人間ではないと納得させるのがとても難しかった被験者がいたことを記し、それをチューリングのテストの際立った一形態と呼びました。さらに、重要な決定が計算機の出力に基づいて下されることが増えている以上、機械の出力を人がどこまで信用するかという問題は調べる必要があり、ELIZAは理解しているという錯覚、ひいては信用に値する判断をしているという錯覚を、いかに少ない仕掛けで作り出し維持できるかを示している、そこには危険が潜んでいる、と書いています。理解を試すのは会話を続けられるかどうかではなく、聞いたことから妥当な結論を引き出せるかどうかだ、という一文もあります。ワイゼンバウムはその後、1976年に副題を「判断から計算へ」とする著書を出しており、邦訳は秋葉忠利訳『コンピュータ・パワー:人工知能と人間の理性』(サイマル出版会、1979年)です。
経営の観点で重要なのは、対話の形をした出力には実際の能力以上の理解を読み込みやすいことが、1966年の時点で、作った本人によって書かれていたという点です。ELIZAはキーワードと組み替えの規則しか持たず、入力のほとんどを記憶せずに捨てていましたが、それでも人間だと受け取る利用者がいました。現在の生成AIは仕組みも規模もまったく異なりますが、流暢に対話できることと、聞いたことから正しい結論を出せることは別の性質だ、という区別はそのまま使えます。導入の評価では、会話の印象ではなく、結論の正しさを確かめる試験を別に用意しておく必要があります。生成AIの評価がどこで難しくなるのかは、第9章と第10章で扱います。
この時期の小年表
| 年月 | 出来事 | 意味 |
|---|---|---|
| 1955年8月31日 | ダートマス夏季研究計画の提案書が書かれる | artificial intelligence という語が、資金申請書の中で初めて使われた。定義ではなく作業仮説と7つの検討項目が置かれた |
| 1956年夏 | ダートマス大学で夏季研究計画が開かれる | 分野に名前と場ができた。ロックフェラー財団の助成は当初案13,500ドルに対し5週間分の7,500ドル |
| 1956年9月 | Logic Theorist の論文が IRE Transactions on Information Theory に掲載 | 記号の操作で定理を証明できることが公表された。証明が探索の問題として書き直された |
| 1957年1月 | ローゼンブラットがパーセプトロンの報告書を書く | 重みの更新で学習する系統が始まった。記号処理とは原理が異なる |
| 1958年7月 | 米海軍研究局がパーセプトロンを公開実演 | 学習する機械が一般紙で報じられた。この系統には海軍研究局とローム航空開発センターの資金が入っていた |
| 1958年10月 | チェスプログラムと複雑さに関する論文が IBMの研究開発誌に掲載 | 探索の広がりをどう扱うかが、正面から主題として論じられた |
| 1958年11月 | Advice Taker の提案 | 知識を論理式で書き、そこから推論させる路線が示された |
| 1959年 | General Problem Solver の報告と、チェッカーの機械学習の論文 | 問題と解き方の分離、および評価を経験から改善する考え方が示された |
| 1960年4月 | LISP の論文が Communications of the ACM に掲載 | 記号処理のための共通の道具ができた。ガベージコレクションもここで導入されている |
| 1962年 | LISP 1.5 のマニュアルが MIT Press から刊行。マッカーシーはスタンフォード大学へ | 道具が配れる形になり、人の移動とともに拠点が増えた |
| 1963年7月 | MIT で Project MAC が発足 | ARPA のために海軍研究局が2,220,000ドルを交付。単発の助成から継続的な体制へ移った |
| 1966年1月 | ワイゼンバウムの ELIZA の論文が Communications of the ACM に掲載 | キーワードと組み替えの規則だけで対話が成り立った。利用者が理解を読み込むことと、その危うさが作者自身によって記録された |
| 1968年7月 | ハート、ニルソン、ラファエルの A* 探索の論文が IEEE の論文誌に掲載 | 見積もりを足して探索を絞り、見積もりが実際を超えなければ最短の経路が保証されることが証明された。SRI の移動ロボット Shakey の研究から生まれた |
この時期の手法に共通する型と、経営の観点で取り出せること
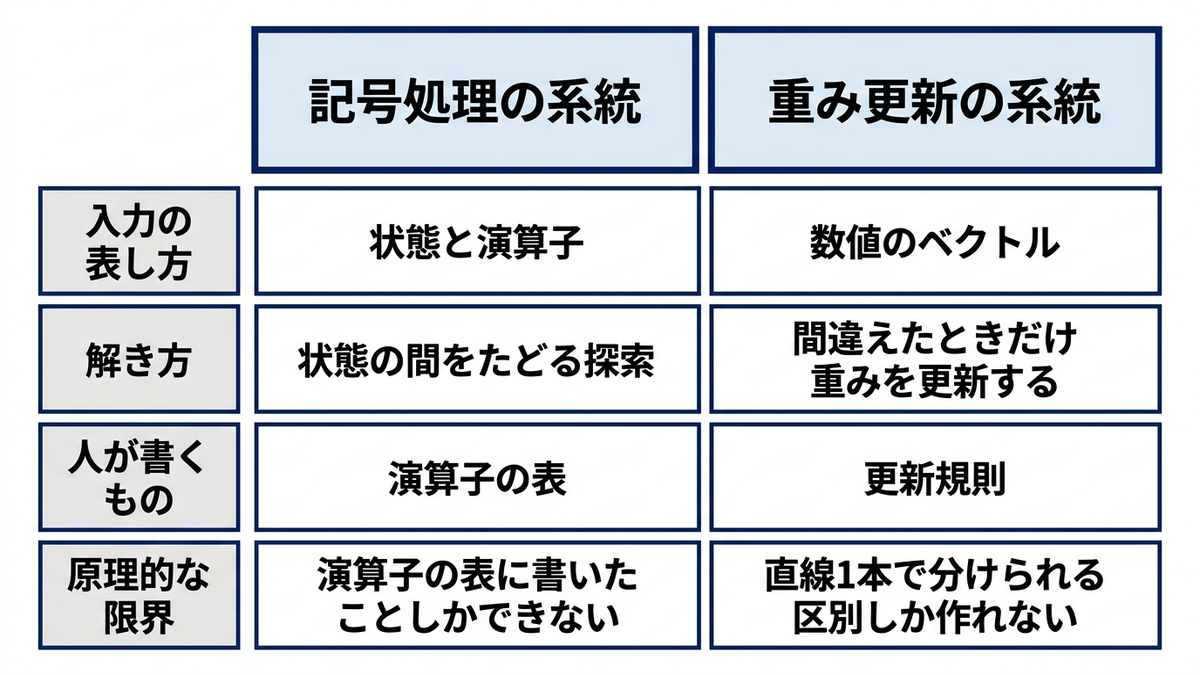
ここまでの仕事を並べると、記号処理の系統には共通の型が見えます。第一に、問題を「状態」と「状態を変える演算子」で書き表します。定理証明なら論理式と変形規則、チェスなら盤面と着手、計画なら事実の集合と行動です。第二に、解くという作業は、その状態の間をたどる探索になります。第三に、たどる順番を決めるために、良さそうな方を先に試す基準を持ち込みます。第四に、それらの表現をリスト構造として計算機の上に載せます。LISP はこの第四の部分を言語にしたものでした。
パーセプトロンはこの型に当てはまりません。状態も演算子も出てこず、あるのは重みと更新規則だけです。ただし共通点もあります。どちらも、扱える対象の形があらかじめ決まっているという点です。記号処理の側は演算子の表に書いたことしかできず、パーセプトロンの側は直線1本で分けられる区別しか作れません。境界がどこにあるかは、原理からはっきり決まっています。
経営の観点で取り出せることは2つあります。1つ目は、命名と旗印が資源を動かすということです。1955年の提案書は、新しい語を1つ置いた資金申請書でした。その語ができた前後の数年で、ロックフェラー財団、海軍研究局、ローム航空開発センター、そして1963年からは ARPA の資金が、この領域の研究に入りました。金額の桁も変わっています。1956年の会議に付いたのは5週間分の7,500ドルでしたが、1963年に Project MAC へ交付されたのは2,220,000ドルです。中身が定義されていないことは、この過程で障害になりませんでした。むしろ、定義がないほうが多様な立場が同じ旗印の下に入れました。社内で新しい取り組みを立ち上げるときも、名前を決めることは説明の便宜ではなく、予算と人の配置を動かす行為だと考えたほうが実態に近いように思います。
2つ目は、初期の成功事例が適用範囲を過大に見せるということです。この章で見た成果は、どれも本物です。52個中38個の定理は実際に証明されました。三目並べの木は実際に数え切れます。16個中14個のブール関数は実際に学習できました。しかし、これらはいずれも「うまくいった事例の集まり」であって、「うまくいく範囲の記述」ではありません。両者は別のものです。前者をいくら積んでも後者にはならず、範囲の外側で何が起きるかは、外側を試してみるまで分かりません。本章の実験でXORを入れたのは、まさにその外側を1つだけ踏んでみるためでした。
実務に落とすなら、成果報告の形を変えるだけで効果があります。「できたこと」の一覧に加えて、「試したが到達しなかったこと」と「そもそも試していない条件」を同じ資料に並べる、という運用です。前者しか載っていない資料からは、適用範囲を読み取れません。導入検討でベンダーの実績資料を読むときも、実績の件数より、実績が並んでいる条件の幅を見るほうが、範囲の見積もりには役立ちます。
本章では、1955年の提案書から1963年の Project MAC 発足までを追いました。名前が付いたことで資金と人材が同じ方向へ動き、記号処理と重み更新という2つの系統が並行して立ち上がりました。そして、この時期の成功はいずれも探索や線形の境界で扱える範囲の内側にあり、その外側については当時の成果からは何も言えない状態でした。この範囲の境目がどこで、いつ、どのように表面化したのかを、第3章で扱います。
この章を深めたい方への参考書籍
『実用Common Lisp:AIプログラミングのケーススタディ』(ピーター・ノーヴィグ著、杉本宣男訳、翔泳社):本章で扱った初期のプログラムを、動くコードとして読み直せる一冊です。General Problem Solver をはじめとする古典的なプログラムを Common Lisp で実装し直しながら解説しているため、手段目標分析や記号処理が実際にどう書かれるのかを、説明ではなくコードで確認したい読者に向いています。原題は Paradigms of Artificial Intelligence Programming です。
『システムの科学 第3版』(ハーバート・A・サイモン著、稲葉元吉・吉原英樹訳、パーソナルメディア):本章に登場した Logic Theorist と General Problem Solver を作った3人のうちの1人による著作です。探索とヒューリスティクスという考え方を、計算機の話に限らず、組織の意思決定や設計行為まで含めて扱っています。本章で見た手法が、なぜ経営の問題と地続きに論じられていたのかを確かめたい読者に向いています。
『The Quest for Artificial Intelligence』(Nils J. Nilsson 著、Cambridge University Press):邦訳は確認できなかったため原題で紹介します。本章で扱った1950年代から60年代の出来事について、原論文への参照を各章末に付けた形で整理されています。本章の記述をさらに一次情報まで辿りたい読者に向いています。著者のスタンフォード大学のページで全文のPDFが公開されています。
第3章 最初の冬、期待と現実の差はどこで開いたか
第2章では、1956年のダートマス会議で「artificial intelligence」という名前が付き、Logic TheoristやGPS、LISP、パーセプトロンといった成果が続いたことを確認しました。初期の成功はいずれも、探索と記号処理という共通の型で説明できる範囲に収まっていました。この章では、その型が通用しなくなった局面と、そこで実際に何が起きたのかを、公的な報告書と法令、当時の研究報告に当たって整理します。
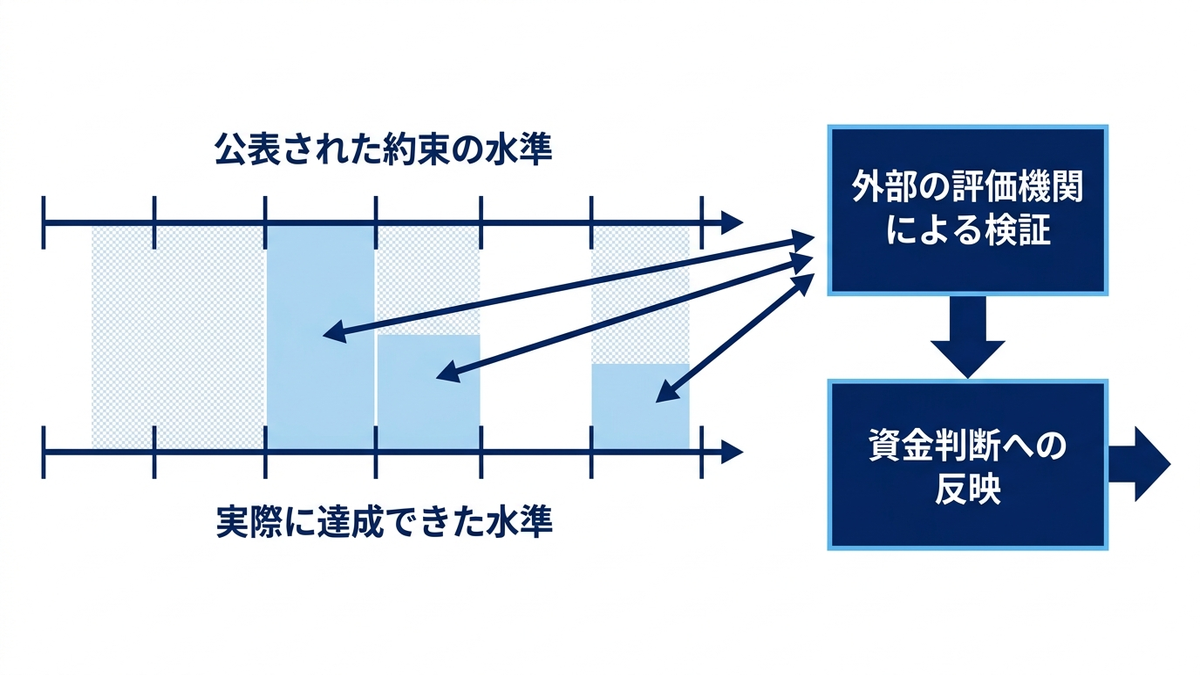
結論を先に置きます。1960年代後半から1970年代にかけて研究資金が縮小したのは、技術が失敗したからではありません。達成できる範囲を超えた約束が公表され、その約束を外部の評価機関が検証し、検証の結果が資金判断に反映された、という順序で起きています。技術の側の壁は確かに存在しましたが、それは「何ができないかが分かった」という研究上の成果でもありました。資金が止まった直接の引き金は、壁の存在そのものではなく、壁の手前で語られた約束の水準です。この読み方は、現在の投資判断にもそのまま使えます。
この章の範囲と、「冬」という語の使い方
先に用語の扱いを決めておきます。「AIの冬」という呼び名がどのような文脈で使われていたかは、記録で確かめることができます。1984年のAAAI(人工知能の学会で、当時の名称は American Association for Artificial Intelligence)の年次大会で開かれた討論会の記録が、翌1985年に AI Magazine 第6巻第3号の122ページから134ページに、日本語にすれば「AIの暗黒時代についてのAAAI-84討論会」となる題で採録されており、ドリュー・マクダーモット、M・ミッチェル・ワルドロップ、B・チャンドラセカラン、ジョン・マクダーモット、ロジャー・シャンクの5名が名を連ねています。冒頭で論点を示したエール大学のドリュー・マクダーモットは、5年後に戦略的コンピューティング計画(米国国防高等研究計画局、略称DARPAが当時進めていた研究計画)が頓挫し、第五世代計画(第4章で扱う日本の第五世代コンピュータ計画)も実を結ばず、新興企業が次々に倒れ、AIと名の付くものには資金が付かなくなって、誰もが研究計画の名前を急いで別のものに変える、という最悪の筋書きを示し、その状態が一部で「AI Winter」と呼ばれていると紹介しました。続けて本人は、この筋書きも、それより穏やかな形の事態も起こる可能性は高くないと考えていると述べたうえで、研究者の間に不安があることを挙げ、研究者が自らを律し、一般の人々に正しく伝えることで、その冬を来させない手立てを取ることが大切だとしています。この記録の中で、この語は過去を振り返る言葉ではなく、これから来るかもしれない状態を指す言葉として使われています。ただし、この記録から分かるのは、この討論会でこの語がどう使われたかまでです。この語が最初に使われた時期や、1970年代の出来事を「第1次の冬」と番号付きで呼ぶようになった時期は、この記録だけでは確かめられません。本記事で「冬」をどの期間に使うかは、区切り方の違いを見たうえで、この節の最後に定義します。
実際、区切り方は資料によって異なります。1974年から1980年とする書き方が広く流通していますが、機械翻訳への資金が止まったのは1966年で、8年の開きがあります。さらに、コンピュータ史家のトマス・ヘイグは2023年の論文「There Was No ‘First AI Winter’」(Communications of the ACM 66巻12号)で、1970年代を通じてAI研究者の数はむしろ増えており、「第1次のAIの冬」と呼べる落ち込みは存在しなかったと論じています。定説は一つに定まっていません。
そこで本記事では、次のように定義して使います。第1次の冬とは、AI研究に対する公的機関の資金判断が実際に縮小へ振れた1966年から、商用のエキスパートシステムが導入され始める1970年代末までを指す。これは定説の紹介ではなく、本記事内で用語をぶれさせないための定義です。この定義を採る理由は、日付を特定できる資金判断が実際に複数回あったこと、そしてそれらが一度に起きたのではなく1966年、1969年、1972年、1976年と分かれて起きたことにあります。具体的には、1966年のALPAC報告、1969年のマンスフィールド修正、1972年7月のライトヒル報告、そして1976年に終了した米国国防高等研究計画局の音声理解研究計画です。以下、この4つを順に見ていきます。
機械翻訳:不可能性の論証は、資金が止まる6年前に出ていた
最初に資金が止まったのは、AI全体ではなく機械翻訳という個別分野でした。そしてこの分野では、技術的な限界を指摘する論証が、資金が止まる6年前に、分野の内部から出ています。
イェホシュア・バーヒレルは1960年、論文「The Present Status of Automatic Translation of Languages」(Advances in Computers 第1巻、91ページから163ページ)を発表しました。この論文の付録IIIは「A Demonstration of the Nonfeasibility of Fully Automatic High Quality Translation」と題され、完全自動で高品質な翻訳、いわゆるFAHQTが実現不可能であることを論証しています。彼が挙げた例文は「The box was in the pen.」でした。前後の文脈は「幼いジョンがおもちゃの箱を探していた。ようやく見つかった。その箱はpenの中にあった。ジョンはとても喜んだ」というものです。ここでのpenが筆記具ではなくベビーサークルを指すことは、英語を解する読者なら考えずに判別できます。しかし機械にそれを判別させるには、筆記具とおもちゃ箱とベビーサークルの相対的な大きさという知識が要ります。バーヒレルは、それを機械に持たせるということは辞書に加えて「universal encyclopedia」を持たせることに等しく、実現の見込みがないと書きました。
注目すべきは、この論文が資金の使われ方についても踏み込んでいることです。バーヒレルは、FAHQTという目標にこだわった結果、研究者が「自分自身と、研究を後援した機関の双方を、原理がすでによく分かっている部分自動の翻訳システムで満足しないように導いてしまった」と書いています。約束の水準が高すぎたために、達成可能で実用的な選択肢が採られなかった、という指摘です。この指摘は1960年のものであり、資金が止まる6年前に、当事者の側から出ていたことになります。
投入額の規模も同じ論文から分かります。バーヒレル自身の見積もりでは、1958年末の時点で機械翻訳の研究に従事する人員は世界全体でフルタイム換算で200人から250人、その年に投じられた研究費はおよそ300万ドルでした。これに対し、1952年にMITで最初の機械翻訳会議が開かれた時点では、フルタイム換算の研究者は3人程度、その年の支出は1万ドル程度だったと述べています。6年で研究費は300倍近くに増えています。期待と投資が先に膨らみ、限界の指摘が同時に存在していたのがこの時期です。
ALPAC報告が実際に判定したこと
資金の出し手側は、この状況を外部の委員会に検証させました。1963年10月、米国国立科学財団の長官レランド・J・ハワースが、国防総省と中央情報局を含む3機関を代表して、米国科学アカデミーに諮問委員会の設置を要請します。これを受けて1964年4月、自動言語処理諮問委員会、略称ALPACが初会合を開きました。委員長はベル電話研究所のジョン・R・ピアース、委員はジョン・B・キャロル(ハーバード大学)、エリック・P・ハンプ(シカゴ大学)、デイヴィッド・G・ヘイズ(ランド研究所)、チャールズ・F・ホケット(コーネル大学)、アンソニー・G・エッティンガー(ハーバード大学)、アラン・パーリス(カーネギー工科大学)の6名です。ホケットは報告書の執筆前に辞任し、ハンプは1965年2月に追加で任命されています。
報告書は1966年に『言語と機械:翻訳と言語学におけるコンピュータ』として、米国科学アカデミーおよび米国学術研究会議の出版番号1416で刊行されました。よく引用される判定は次の一文です。「一般的な科学文書の機械支援翻訳はあるが、有用な機械翻訳はない。さらに、有用な機械翻訳の見込みは、当面も予見できる範囲にもない」(筆者訳)。つまり、人間が後編集する形の機械支援翻訳は存在するが、有用な機械翻訳は存在せず、当面も予見可能な将来にも見込みがない、という判定です。
この判定を支えた数値も報告書に載っています。米国空軍外国技術部の機械翻訳システムの出力を使った読解試験では、物理学分野で、無編集の機械出力を読んだ読者は人間の翻訳を読んだ場合に比べて正確さが10パーセント低く、読む速度が21パーセント遅く、理解度が29パーセント低いという結果でした。後編集した出力でも、正確さは3パーセント低く、速度は11パーセント遅く、理解度は13パーセント低くなっています。委員会は無編集の機械出力について、後戻りであり読者に不親切だ、という趣旨の表現をしています。
費用の比較も重要です。報告書によれば、政府が過去10年間に各機関を通じて機械翻訳と近接分野に投じた額はおよそ2,000万ドルで、これは政府の1年分の翻訳費用を上回ります。政府機関が翻訳に支出した額の集計は約1,307万ドルで、これに民間の翻訳会社の売上高などを加えても、米国全体で年間およそ2,200万ドルという推計でした。委員会は「政府における翻訳は、政府が研究開発を支援する事業の大半と比べれば、きわめて小さな活動分野である」と書いています。研究投資額が、解こうとしている問題の市場規模を超えていたわけです。
ここで見落とされやすいのは、ALPACが「すべてやめろ」と言ったのではないという点です。報告書の勧告は2領域で、第1は言語学の一部としての計算言語学であり、「言語学は科学として支援されるべきであり、実用的な翻訳への当面の、あるいは予見できる貢献によって評価されるべきではない」(筆者訳)と明記されています。第2は翻訳そのものの改善で、翻訳の評価手法、人間の翻訳を速める手段、機械支援翻訳の速度と費用の評価など9項目が挙げられました。さらに、報告書に添えられたハーヴェイ・ブルックスの1966年7月27日付の書簡では、計算言語学の研究を4、5か所の拠点で年間250万から300万ドル規模で支援することが妥当だという、ピアース自身の推薦が引用されています。止められたのは「短期の実用目標に向けた資金」であって、研究そのものではありませんでした。約束の水準を実力に合わせ直す、という調整だったと読むのが正確です。
資金の出し手の制度が変わった:マンスフィールド修正
1969年には、個別分野の評価ではなく、資金の出し方そのものを変える制度改正がありました。1969年11月19日に成立した Public Law 91-121 の第203条、いわゆるマンスフィールド修正です。条文は1文だけの短いもので、この法律で認められた資金は、特定の軍事機能または作戦との直接かつ明白な関係を持つ研究にしか使えない、という規定です。
この改正が効いた理由は、それまでの資金の性格にあります。米国学術研究会議が1999年に刊行した報告書『Funding a Revolution: Government Support for Computing Research』は、高等研究計画局に1962年に設置された情報処理技術室がAI研究の規模を一変させたこと、そして「1960年代から1990年代まで、DARPAが国内のAI研究支援の大部分を担っていた」ことを記しています。同報告は初期の支援の柔軟さの例として、MITのプロジェクトMACが年間230万ドルの予算のおよそ3分の1をAI研究に充て、しかも具体的な目標がほとんど設定されていなかったことを挙げています。目的を細かく定めない資金が、大学の基礎研究を支えていたわけです。
マンスフィールド修正は、その前提を外しました。同じ報告書は、この修正が国防総省の支援対象を「特定の軍事機能に対する直接かつ明白な有用性を持つ基礎研究」に限定したと述べています。研究の中身が変わったのではなく、資金を得るために必要な説明の形式が変わったのです。ここで、達成期限と数値目標を伴う約束をした側が有利になり、同時にその約束は後から検証される対象になりました。次に見る2つの事例は、いずれもこの構造の中で起きています。
『Perceptrons』をめぐる通説を、事実で補正する
この時期を説明する文章で最も頻繁に見かけるのが、「ミンスキーとパパートが、パーセプトロンはXORを計算できないことを示し、それがニューラルネットワーク研究を止めた」という要約です。この要約は、そのままでは正確ではありません。ここは丁寧に補正しておきます。
書誌は次のとおりです。マービン・ミンスキーとシーモア・パパート『Perceptrons: An Introduction to Computational Geometry』、MIT Press、1969年刊。1972年の第2刷で著者による手書きの修正が入り、1988年に序文と後書きを加えた増補版が出ています。2017年には、レオン・ボトゥの新しい序文を付した増補版の復刻が刊行されました。
同書が実際に示したのは、結合が局所的に制限されたパーセプトロン、すなわち1つの判定素子が入力面の一部からしか結合を受け取れないという条件のもとで、ある種の述語を効率よく計算できないということです。中心的な結果はパリティ(入力に含まれる1の個数が偶数か奇数か)と連結性(図形がひとつながりかどうか)に関するもので、有限の次数のパーセプトロンでは連結性の述語を表現できないことが証明されています。XORは2入力のパリティであり、この一般的な結果の最小の例にあたります。
そして重要なのは、こうした素子をネットワークとして組めば任意のブール関数を計算できること自体は、当時から広く知られていたという点です。この事実はマカロックとピッツにさかのぼり、ローゼンブラット自身の著作でも、また1961年当時の論文でも言及されています。つまり同書は「多層にしても解けない」と示したのではありません。
第2章では、単層のパーセプトロンの学習則をXORに適用しても収束しないことを、実際にコードを走らせて確認しました。その実測は正しく、単層という条件のもとでの話です。多層に組めば計算できるという事実と、単層の学習則が収束しないという実測は、矛盾しません。1969年の時点で未解決だったのは「多層で表現できるか」ではなく、「多層のネットワークの重みを、データから効率よく学習させる手続きがあるか」でした。ミンスキーとパパートは1988年増補版の序文で、進展は「adequate basic theories」の欠如によってすでに事実上止まっていたと述べており、自分たちの本が原因ではないという立場を取っています。
因果についても断定を避けるべきです。同書が1970年代から1980年代初頭のニューラルネットワーク研究の縮小を招いたとする受け止め方は広く存在しますが、それは受け止め方として記述されているのであって、因果として立証されているわけではありません。事実として言えるのは、ボトゥが2017年の序文に書いたとおり、同書の刊行後、パーセプトロン型の学習機械の研究は1980年代半ばまで流行から外れ、資金が付かなくなったということです。パパート自身は1988年のDaedalus誌の論文で、動機の一部は「資金と研究のエネルギーが、実用への誤った適用に費やされていたこと」への懸念にあったと書いています。
なお、多層のネットワークを学習させる手続きは、この冬のさなかに書かれています。ポール・ワーボスが1974年にハーバード大学に提出した博士論文『回帰を超えて:行動科学における予測と分析のための新しい道具』が、誤差を逆向きに伝播させて人工ニューラルネットワークを訓練する手続きを最初に記述したものとされています。これが分野で広く共有され、成果に結びつくのは1980年代半ばで、詳しくは第5章で扱います。技術の系譜としては、冬の期間に断絶があったわけではありません。
ライトヒル報告と組合せ爆発
英国では、AI研究全体を対象とする評価が行われました。英国の大学における科学研究の主要な資金配分機関である科学研究会議(Science Research Council)の依頼を受け、ケンブリッジ大学のルーカス記念応用数学教授であったジェイムズ・ライトヒルが調査報告をまとめます。報告書の表題は『Artificial Intelligence: A General Survey』、報告書本体の日付は1972年7月で、1973年に『Artificial Intelligence: a paper symposium』として、N・S・サザーランド、R・M・ニーダム、H・C・ロンゲ・ヒギンズ、D・ミッチーらの反論を併載する形で公刊されました。
報告はAI研究を3つのカテゴリに分けています。カテゴリAは高度な自動化で、産業・軍事・数学・科学の特定目的のために人間の作業を機械に置き換えるもの。カテゴリCは計算機を使った中枢神経系の研究で、神経生物学や心理学と結びついた理論的な探究。カテゴリBはその2つを橋渡しするロボット研究です。
最も引用される判定はこの一文です。「In no part of the field have the discoveries made so far produced the major impact that was then promised.」この分野のどの部分においても、これまでの発見は、当時約束された大きな影響をもたらしていない、という評価です。「約束された(promised)」という語が入っている点が重要です。評価の基準は、技術の絶対的な水準ではなく、過去に公表された約束との差でした。ライトヒルは、1972年に予測を行うにあたっては、過去の予測を実績と突き合わせるのが賢明だろう、とも書いています。橋渡しであるはずのカテゴリBについては、カテゴリAとCのあいだに真の橋を架ける試みはうまくいっていない、と述べ、カテゴリBの進捗の遅さがAIという研究分野に真の一貫性があるのかという信頼を損ないつつある、と踏み込みました。
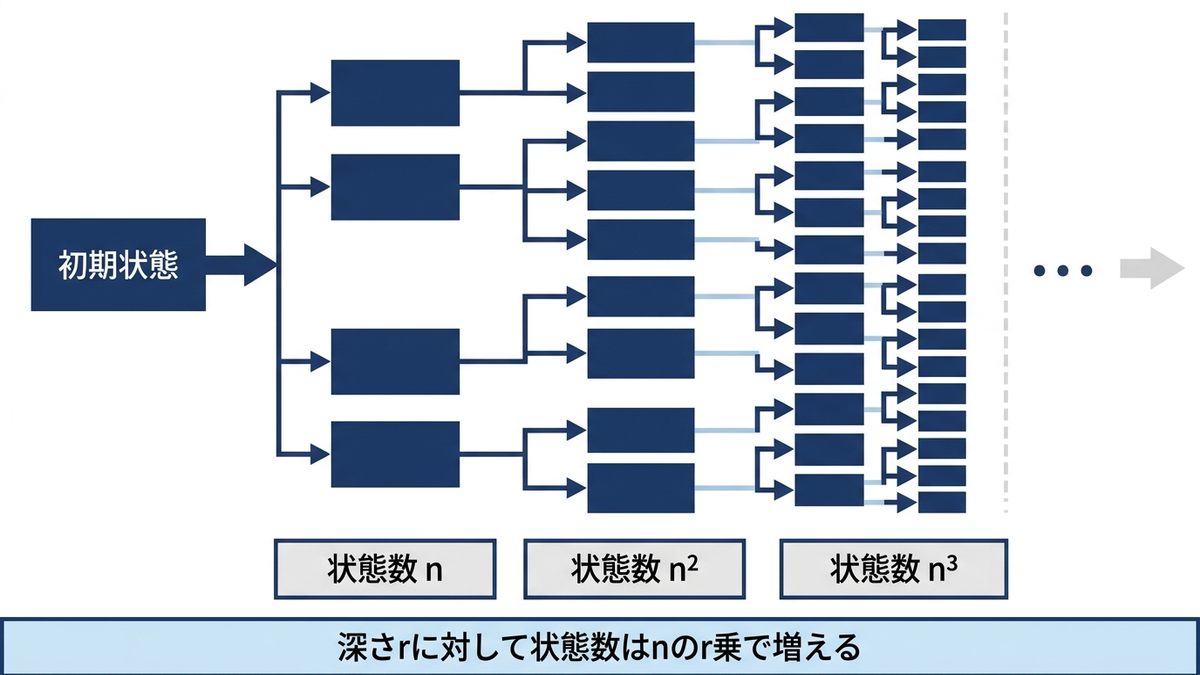
報告が失望の一般的な原因として名指ししたのが組合せ爆発です。報告の定義はこうです。「a general obstacle to the construction of a self-organising system on a large knowledge base which results from the explosive growth of any combinatorial expression, representing numbers of possible ways of grouping elements of the knowledge base according to particular rules, as the base’s size increases.」知識ベースの要素を規則に従って組み合わせる場合の数が、知識ベースの規模とともに爆発的に増えるために、大きな知識ベースの上に自己組織化するシステムを作ることが妨げられる、という説明です。
ライトヒルは、当時のロボットが扱える対象の範囲が、計算機の能力の制約もあって「チェス盤か、単純な卓上の世界」程度に限られていることを指摘し、「Extension of the methods used to a much wider universe of discourse would be opposed violently by the combinatorial explosion.」と書きました。狭い世界で動いたやり方を広い世界へ拡張しようとすると、組合せ爆発が激しく立ちはだかる、という指摘です。定理証明については「hopes have been disappointed through the power of the combinatorial explosion in rapidly cancelling out any advantages from increase in computer power」と述べています。計算機の性能向上による利得を、組合せ爆発が急速に打ち消してしまう。これは、計算資源を増やせば解決するという期待に対する、正面からの否定でした。
組合せ爆発とフレーム問題は、同じ時期に理論として整理された
組合せ爆発は、成果が出ないことへの後付けの言い訳ではありません。ほぼ同じ時期に、計算量の理論として定式化が進んでいました。
スティーブン・クックは1971年、論文「The complexity of theorem proving procedures」(第3回ACM計算理論シンポジウム論文集、151ページから158ページ)で、答えの候補を1つ示されればそれが正しいかどうかは手早く確かめられるのに、その候補を自力で見つける効率のよい手順が知られていない問題の集まりを表すNP完全性の概念を導入し、充足可能性問題、すなわち多数の条件を並べたときにそれらをすべて同時に満たす当てはめ方があるかどうかを問う問題が、NP完全であることを証明しました。翌1972年、リチャード・カープは論文「Reducibility Among Combinatorial Problems」(『Complexity of Computer Computations』所収、レイモンド・E・ミラーとジェームズ・W・サッチャー編、Plenum、85ページから103ページ)で、21個の組合せ問題とグラフ問題がNP完全であることを示しました。ライトヒルが報告書をまとめていたのとほぼ同じ時期に、「効率よく解けそうにない問題の広がり」が数学の対象として輪郭を持ち始めていたわけです。組合せ爆発は、努力や資金の不足で片付く問題ではなく、問題の構造そのものに起因することが分かってきた、というのがこの時期の実態です。
もうひとつ、この時期に提起されたのがフレーム問題です。ジョン・マッカーシーとパトリック・J・ヘイズは1969年の論文「Some Philosophical Problems from the Standpoint of Artificial Intelligence」(『Machine Intelligence 4』所収、B・メルツァーとD・ミッチー編、エディンバラ大学出版、463ページから502ページ)で、行為が世界の何を変えないかを書き下す必要がある、という問題を指摘しました。行為をn個、状態を表す量をm個とすると、「この行為はこの量を変えない」という条件をm×n個書く必要が出てきます。これは知識をどう表現するかという設計上の問題であり、計算量とは別の角度から、記号処理の方式が大きな世界に届かない理由を示すものでした。
整理すると、1970年代前半に判明したのは次の2点です。第1に、狭い世界で動いた探索の手続きは、世界を広げると場合の数の増加に押し潰される。第2に、世界を記号で書き下そうとすると、書くべき量が組み合わせで増える。どちらも「もっと速い計算機を買えば解決する」という性質の問題ではありませんでした。ここが、この時期の資金判断が単なる不況ではなかった理由です。
達成しても続かなかった約束:積み木の世界と音声理解計画
ライトヒルが指摘した「卓上の世界」の代表例が、テリー・ウィノグラードがMITで開発したSHRDLUです。1968年から1970年にかけて開発され、成果はMIT人工知能研究所のテクニカルレポート235「Procedures as a Representation for Data in a Computer Program for Understanding Natural Language」(1971年2月)としてまとめられ、1972年には論文「Understanding Natural Language」が Cognitive Psychology 誌の第3巻第1号に掲載されています。積み木の世界と呼ばれる仮想空間で、ブロックや円錐やピラミッドを英語の指示で操作でき、代名詞の解決や動作の理由の説明までこなす対話が成立しました。当時としては際立った成果です。
問題は、この成果が何を証明したかの解釈にありました。積み木の世界では、対象の種類も、可能な行為も、文の意味も、あらかじめ閉じた集合として書き下せます。だからこそ動きます。世界を開いた途端、書き下すべき知識の量は組み合わせで増え、探索の場合の数も増えます。狭い世界での成功が広い世界での成功をどれだけ予告するのかという問いに、当時の分野は答えを持っていませんでした。ライトヒル報告が突いたのはこの点です。
もう一件、数値目標を伴う約束が実際にどう扱われたかを示す事例があります。高等研究計画局は1971年、音声理解研究計画を年間300万ドル、5年間という規模で開始しました。目標はアレン・ニューウェルを長とする研究会が1971年に提示したもので、一般アメリカ英語を話す複数の協力的な話者による連続音声を、静かな部屋で良質のマイクを使い、1,000語程度のやや限定した語彙と強く制約した文法・課題のもとで、意味の誤り10パーセント未満で、実時間の数倍の速度で処理し、1976年に実演可能であること、という内容でした。数値と期限が先に決められた発注です。
カーネギーメロン大学のブルース・ラウリーとラジ・レディが開発したHarpyは、1976年8月13日に稼働しました。語彙は後から選び直すことなく1,011語、話者は5名、意味の誤りは5パーセント、文単位の誤りは9パーセント。0.35 MIPSのPDP-KA10上で実時間の80倍の処理時間でした。MIPSは、1秒間に実行できる命令の数を百万単位で表す処理速度の単位です。この処理時間は「100 MIPSの計算機で実時間の数倍」という目標換算では、目標より1桁速い水準にあたります。開発者自身が報告に「Harpyは仕様のすべてを満たしただけでなく、いくつかの目標を上回った」と書いています。
それでもこの計画は続きませんでした。前掲の『Funding a Revolution』は、試験の実施方法をめぐって議論があり、DARPAは後継計画に資金を付けないまま計画を終了させたと記しています。産業界での開発は独立に続きました。数値目標を満たしたことと、資金が続くこととは別だった、ということです。ここには、約束の設計に関する実務的な教訓が含まれています。数値目標が「発注者が本当に欲しかったもの」の代理指標に過ぎない場合、代理指標を満たしても評価は覆りません。
第1次の冬をどう区切るか
ここまでに挙げた日付を、この章の範囲に絞って並べます。全体の年表とは粒度を変え、資金判断と、その根拠になった技術上の認識に限定しました。
| 年 | 出来事 | 意味 |
|---|---|---|
| 1960 | バーヒレルが完全自動・高品質翻訳の実現不可能性を論証(Advances in Computers 第1巻) | 限界の指摘は、資金が止まる6年前に分野の内部から出ていた |
| 1964年4月 | 米国科学アカデミーにALPACが発足(委員長ジョン・R・ピアース) | 資金の出し手が、外部の検証機関を先に用意した |
| 1966 | ALPAC報告『言語と機械』刊行(出版番号1416) | 10年で約2,000万ドルの投入に対し「有用な機械翻訳は当面も予見可能な将来にも見込みがない」と判定 |
| 1969年11月19日 | マンスフィールド修正が成立(Public Law 91-121 第203条) | 国防予算の研究に「特定の軍事機能との直接かつ明白な関係」が要求されるようになった |
| 1969 | ミンスキーとパパート『Perceptrons』刊行(MIT Press) | 結合を局所に制限したパーセプトロンで、パリティや連結性を効率よく計算できないことを証明 |
| 1969 | マッカーシーとヘイズがフレーム問題を提起(Machine Intelligence 4) | 「何が変わらないか」を書き下す量が、行為と状態の積で増えることが分かった |
| 1971 | ARPAが音声理解研究計画を開始(年300万ドル、5年)。この時点の機関名はARPAで、DARPAへの改称は1972年です | 数値目標と期限を先に定める発注の形式が採られた |
| 1971〜1972 | クックがNP完全性を導入し、カープが21問題のNP完全性を示す | 組合せ爆発が、努力不足ではなく問題の構造の話として理論化された |
| 1972年7月 | ライトヒル報告『Artificial Intelligence: A General Survey』(1973年公刊) | 評価基準は技術水準ではなく「約束された影響」との差だった |
| 1972 | ドレイファス『What Computers Can’t Do』刊行(Harper & Row) | 分野の外部からの批判が、一般の書籍として流通した |
| 1974 | ワーボスの博士論文(ハーバード大学)が誤差逆伝播を記述 | 後に主流となる学習法は、冬のさなかに書かれていた |
| 1976年8月13日 | Harpyが稼働(語彙1,011語、意味の誤り5パーセント) | 1971年の数値目標を満たしたが、後継計画には資金が付かなかった |
この並びを見ると、単一の転換点は存在しません。分野ごとに、資金の出し手ごとに、別々の判断が10年間にわたって積み重なっています。したがって「何年から何年までが冬か」という問いには、資料の側に唯一の答えがありません。本記事が1966年から1970年代末までという定義を採ったのは、この期間に含まれる資金判断がすべて日付で特定でき、かつ次章で扱う商用エキスパートシステムの導入がその外側に位置するからです。1974年から1980年とする区切りを採る文献もあり、前述のとおり、そもそも第1次の冬は存在しなかったとする論者もいます。読者が別の文献で異なる区切りに出会ったときは、その文献がどの資金判断を起点に採っているかを見ると整合が取れます。
経営の観点:約束の設計を誤ると、技術が健全でも投資は止まる
この章の出来事を、判断材料として使える形に落とします。3点あります。
第1に、資金が止まった直接の引き金は、技術の失敗ではなく、公表された約束と実測との差でした。ライトヒル報告の判定文には「約束された(promised)」という語が入っており、ALPAC報告は投入額と市場規模を並べて比較しています。どちらも、技術の絶対的な出来ではなく、事前に示された水準との差を見ています。社内でAIの投資判断を扱う場合も、評価されるのは成果の絶対値ではなく、稟議に書いた水準との差です。したがって、稟議に書く水準を実力より高く設定することは、短期的に承認を得やすくする代わりに、次の判断で確実に不利になります。
第2に、達成可能な選択肢が、過大な目標のせいで採られないことがあります。バーヒレルが1960年に書いたのは、FAHQTという理想に固執した結果、原理がすでに分かっている部分自動の翻訳システムで満足しないよう、研究者が自分自身と後援機関の双方を導いてしまった、ということでした。ALPAC報告も、機械支援翻訳と翻訳工程の改善という現実的な選択肢を9項目にわたって列挙しています。「完全自動でなければ意味がない」という設定が、実際に効果の出る導入を遠ざける構図は、現在の業務へのAI導入でもよく見られる形だと考えています。
第3に、数値目標は代理指標にすぎません。音声理解研究計画では、1971年に設定された語彙数・誤り率・実演時期という目標をHarpyが満たしましたが、後継計画には資金が付きませんでした。発注側が本当に欲しかったのは、限定された課題での認識性能ではなく、運用に耐える音声インタフェースだったと考えられます。代理指標を満たしても、本来の要求との差が埋まっていなければ評価は変わりません。社内の実証実験で「精度95パーセント達成」という報告が本番導入の承認につながらないとき、指標と要求の間にこの種のずれが残っていないかを確かめる価値があります。
この教訓を制度として明文化した例が、同じ時期の米国国防高等研究計画局にあります。1975年から1977年まで同局の長官を務めたジョージ・H・ハイルマイヤーが、研究提案を評価するために用いた質問群は、現在も「ハイルマイヤーの教理問答」としてDARPAの公式サイトに掲載されています。「専門用語をいっさい使わずに目的を述べよ」「今日はどうやって行われていて、現在のやり方の限界は何か」「あなたのやり方の何が新しく、なぜうまくいくと考えるのか」「誰が気にするのか。成功したら何が変わるのか」「リスクは何か」「費用はいくらか」「期間はどれだけか」「成功を確認するための中間試験と最終試験は何か」の8問です。とくに最後の1問、成功をいつどう判定するかを先に決めておくという要求は、この章で見た失敗の再発を制度で防ぐ設計だと読めます。AI関連の投資判断の場でこの8問に答えられない提案は、技術の中身にかかわらず、いずれ同じ経路をたどる可能性があります。
この章の要点をまとめます。1960年代後半から1970年代の資金縮小は、ALPAC報告、マンスフィールド修正、ライトヒル報告、音声理解研究計画の終了という、日付を特定できる複数の判断の積み重ねでした。その判断の基準は技術の絶対的な水準ではなく、事前に公表された約束との差です。同時に、組合せ爆発とフレーム問題という、計算量と知識表現の両面からの壁が明らかになりましたが、これは分野の失敗ではなく「何ができないかが分かった」という進展でもありました。第4章では、この壁を正面から迂回する方針、すなわち探索の範囲を狭める代わりに知識を人手で書き下すという方針が、DENDRALやMYCIN、XCONといった形で商用化に届いたことと、そこで新たに現れた保守の壁を扱います。
この章を深めたい方への参考書籍
『パーセプトロン』改訂版(マービン・ミンスキー、シーモア・パパート著、中野馨・阪口豊訳、パーソナルメディア):本章で扱った1969年の原著の増補版の邦訳です。何が証明され、何は証明されていないのかを原典で確かめたい読者に向いています。1971年には斎藤正男訳『パーセプトロン:パターン認識理論への道』(東京大学出版会)も刊行されており、通説との差を自分で確認する材料になります。
『コンピュータには何ができないか:哲学的人工知能批判』(ヒューバート・L・ドレイファス著、黒崎政男・村若修訳、産業図書):著者が1972年に『What Computers Can’t Do』を刊行して以来続けてきた、分野の外部からの批判の系譜を代表する一冊の邦訳です。本章で見た「約束の水準が外部から検証される」という構図が、資金の話だけでなく思想の面でも起きていたことを確認したい読者に向いています。
『コンピュータは考える:人工知能の歴史と展望』(パメラ・マコーダック著、黒川利明訳、培風館):邦訳は1983年の刊行で、本章が扱う時代の直後に、その時代を同時代の視点から記述した歴史書です。後年になって整理された筋書きではなく、当時の関係者がこの局面をどう受け止めていたかを知りたい読者に向いています。
第4章 知識を書き下す時代
前章で確認したのは、達成できる範囲を超えた約束が外部の報告書によって検証され、資金と関心が引いていった経緯でした。ただし、その間に研究が止まっていたわけではありません。探索の一般性で押し切る方針が行き詰まったあとに、別の方針が育っていました。解く問題の範囲をあらかじめ狭め、その範囲の専門知識をできるかぎり多く機械に書き込む、という方針です。1980年代は、この方針が研究室を出て商用のシステムになった10年でした。
本章では、何をどう書き下したのか、書き下した知識をどう使ったのか、そしてどこで頭打ちになったのかを追います。結論を先に置いておくと、頭打ちの理由は推論の速度でも精度でもありませんでした。ルールの数が増えたときに、それらの整合性を保ち続ける費用でした。経営の観点で言い換えると、動く仕組みを作ることと、それを維持できることは別の問題である、という話になります。1980年代は、その差が実務のデータとして初めて記録された時期でもありました。
期待の対象が、一般性から知識へ入れ替わった
1970年代後半に、この分野の総括のしかたが変わりました。エドワード・A・ファイゲンバウムは1977年の国際人工知能会議での招待論文で、知的なエージェントが示す問題解決の力は、そのエージェントが使っている専門家の知識から主に生じるのであって、用いた推論方式の一般性や強力さとの関係はきわめて副次的である、と書いています。そして、我々のエージェントは知識に富んでいなければならない、たとえ手法において貧しくとも、と続けます。手法の一般性を高める方向で強さを求める路線に対して、正面から別の賭けを宣言した文章でした。
この立場に立つと、作るべきものの形が変わります。汎用の問題解決器を1つ作って多くの問題に当てるのではなく、対象を1つ決めて、その領域の専門家が持っている判断の断片をできるだけ多く集め、機械が読める形に書き直す作業が中心になります。エキスパートシステムという呼び方も、知識ベースシステムという呼び方も、この時期に定着しました。ブルース・G・ブキャナンとエドワード・H・ショートリフは、これらの語が一般に使われるようになったのは1975年ごろだと書いています。専門家の知識を集めて機械に移す作業そのものを指す「知識工学」という語についても、同じ2人が、ファイゲンバウムがドナルド・ミチーの「認識論的工学」という言い方を受けて作ったものだと考えられる、と留保付きで記しています。
注意しておきたいのは、この転換が理屈から出てきたのではないという点です。実際に化学の問題を解こうとして知識が足りないことに繰り返しぶつかった経験が先にあり、総括はあとから付いてきました。
DENDRAL、化学の構造決定という最初の実例
始まりは1965年のスタンフォード大学です。ファイゲンバウムが、科学的な仮説の帰納を研究するのにふさわしい課題を探していると遺伝学者のジョシュア・レーダーバーグに話したところ、レーダーバーグは質量分析のデータから化学構造を決める仕事を挙げました。DENDRALはここから始まります。有機化学の側からはカール・ジェラッシとその研究室が、計算機の側からはブキャナンらが加わりました。
この課題が選ばれた理由には、研究の外側の事情もありました。レーダーバーグはNASAのマリナー計画に関わっており、火星で生命の証拠を探す搭載実験には質量分析計が含まれていました。地球の目録に載っていない化合物を火星で同定する手段が要る。それが外部の依頼者にあたる動機でした。ただし1975年のバイキング計画の設計は1970年までに凍結されており、DENDRALを載せられる耐宇宙環境の計算機は当時ありませんでした。
DENDRALは2つの部分からなります。Heuristic DENDRALは、化学と質量分析の具体的な知識を持ち、未知化合物の質量スペクトルなどの実験データを受け取って、それを説明しうる化学構造の候補を順位を付けて出します。Meta-DENDRALは、既知の構造とスペクトルの対を入力として、Heuristic DENDRALが新しいスペクトルの説明に使える質量分析の知識そのものを推定しようとします。前者が性能を出す系、後者が学習する系です。
解法は plan-generate-test と呼ばれます。候補を列挙する生成器と検証部からなる generate-and-test に、生成の前段として「計画」を挟んだものです。計画部は領域固有の知識を使い、解空間のどこを無視しどこに集中するかという制約を生成器に与えます。生成器そのものは網羅的であることが求められました。あり得る解を必ず一度ずつ列挙する保証がなければ、化学者を説得できないからです。広大な候補の空間を、網羅性を落とさずに知識で絞る。この構えが、のちのエキスパートシステム全般の設計の型になりました。環状構造を扱う生成器はCONGENという独立したシステムにまとめられ、のちに拡張されてGENOAと呼ばれます。
DENDRALがこの章の主題に直結するのは、1967年に起きた出来事のためです。ファイゲンバウムとブキャナンは1993年の回顧で、この年にDENDRALは知識表現の危機に直面したと書いています。化学者とのやり取りを通じて新しい知識が流れ込んでくるのに、それをLISPのコードとして書いていたため、知識ベースの複雑さを管理することも維持することもできなくなった、という危機です。知識が増えたこと自体が問題になった、という構図です。この章の後半で扱う頭打ちの正体は、すでにこの時点で顔を出しています。
対処として、彼らはニューウェルとサイモンがプロダクションを問題解決の骨組みとして使っていたことを手がかりに、プロダクションを状況と行動の対からなるモジュール的な「ルール」として捉え直し、1968年の初めまでに知識ベース全体を書き直します。知識を解釈して使うコードはそのままに、知識だけを編集したり別の問題向けに定義し直したりできる独立した知識ベース、という考え方を最初に使ったのはDENDRALだ、と当事者たちは記録しています。「知識こそ力である」という原則が最初に言語化されたのもDENDRALの文脈でした。「あなたはこの問題について何を知っていて、プログラムは何を知らないのか」という、知識工学の基本になった問いも、ジェラッシへの実演の場から出ています。
DENDRALは1970年代から1980年代初めにかけて、SUMEXという計算資源のPDP-10上で全米の化学者に提供されました。ただし利用者が主に使ったのは構造決定の手法の部分で、質量分析の解釈の専門知識の部分ではありません。15年を超える研究のあと、スタンフォードはDENDRALのプログラムを化学者向けソフトウェアを扱う企業にライセンスしています。当事者たちは、この課題が「比較的狭く、よく定義され、成功の尺度がはっきりしていた」ことを、DENDRALが成り立った条件として挙げています。
MYCIN、不確かさを扱い、答えの理由を示した
次に来るのがMYCINです。スタンフォード大学医学部の感染症グループとの共同で、ショートリフの博士論文として始まりました。仕事の内容は、血液の感染症と髄膜炎の診断、および抗菌薬による治療の推奨です。病原体が特定される前の段階で、治療するかどうか、どう治療するかを決めなければならず、重要な情報が未知だったり不確かだったりする可能性を常に織り込んで動く必要がありました。
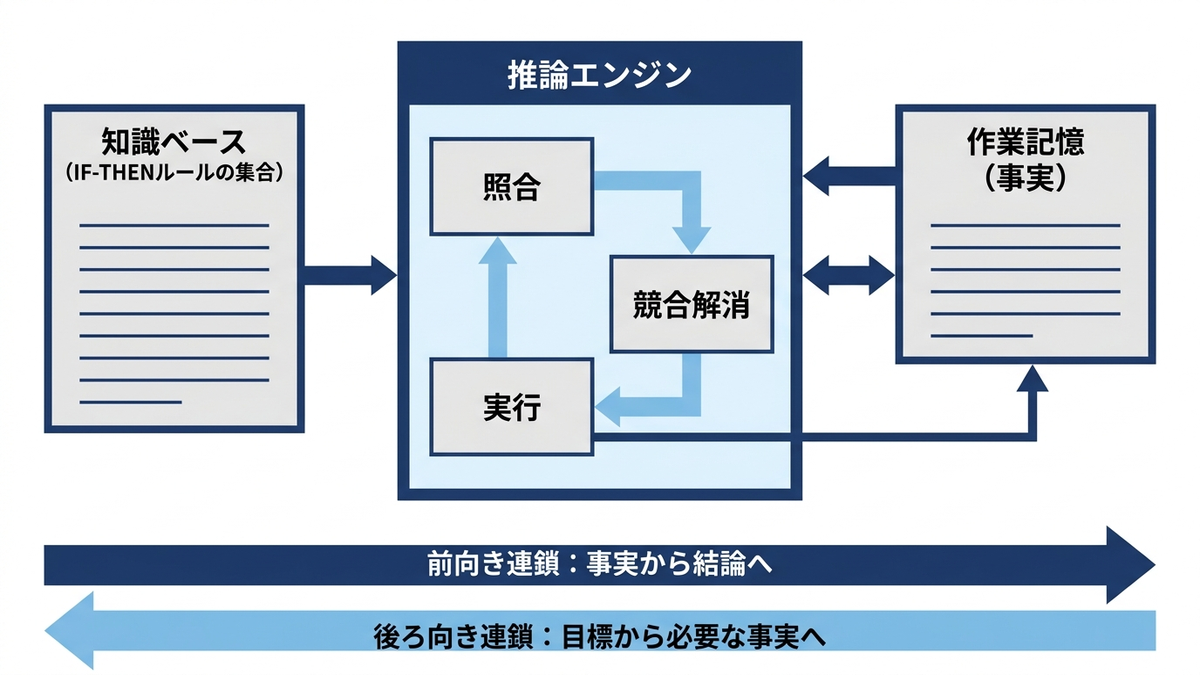
MYCINの制御は後ろ向き連鎖です。達成したい目標から出発し、ルールを右から左へたどって、その結論を導くために何が必要かを探し、必要な情報を利用者に質問していきます。これに対して、既知のデータから左から右へルールを連鎖させるのが前向き連鎖です。診断のように「知りたいこと」が先に決まっている仕事では後ろ向きが、監視や設計のように「入ってきた事実」から動く仕事では前向きが自然になります。
MYCINのルールは次のような形をしていました。ファイゲンバウムが1977年の論文に載せた実例です。これは実行例ではなく、当時のルールの記法を示すための例です。
RULE85
IF:   1) The site of the culture is blood,
      2) The gram stain of the organism is gramneg, and
      3) The morphology of the organism is rod, and
      4) The patient is a compromised host
THEN: There is suggestive evidence (.6) that the identity of
      the organism is pseudomonas-aeruginosa
培養の部位が血液で、グラム染色が陰性で、形態が桿菌で、患者が易感染性であれば、その菌は緑膿菌であるという示唆的な証拠が得られる、という内容です。末尾の (.6) が確信度にあたります。専門家は各ルールに、そのルールの妥当性に対する自分の確信の度合いを1から10の数で与え、システムは推論の連鎖に沿ってそれを積み上げていきました。この積み上げ方については、ショートリフとブキャナンが1975年に示した、著者自身が場当たり的だが単純だと呼んでいるモデルが使われています。場当たり的という自己評価は誇張ではなく、同じ研究の記録には、確率論に基づく解釈との比較や、デンプスター・シェイファー理論を使う検討が別々の章として並んで収録されています。不確かさの扱いは、当時から決着していない論点でした。
MYCINの知識ベースは450のルールと、表の形で持つ約1000の事実からなります。候補として持つ微生物は120種でした。数字としては小さく見えますが、当事者たちはこれを「我々が扱った中で最大の知識ベース」と書いています。加えてMYCINは、利用者が相談の途中で「なぜ」「どうやって」と尋ねると、推論の筋道を示すことができました。答えだけでなく答えの理由を出せることが、医師に使ってもらううえで欠かせないという判断です。
性能は外部の評価にかけられました。1979年に発表された研究では、髄膜炎の10症例について、実際に患者に行われた治療、MYCINの推奨、医学生1人とスタンフォードの医師7人の推奨をあわせた10通りの処方を用意し、スタンフォード以外の機関に所属する感染症の専門家8人が、誰の処方かを知らされない状態で評価しました。評価者は、その中の1つが計算機プログラムであることも知らされていません。結果は、MYCINの処方の65%が受け入れ可能と評価され、スタンフォードの教員5人の平均は55.5%(範囲は42.5%から62.5%)でした。評価者の多数決を基準にすると、MYCINは70%、教員5人の平均は44%(範囲は30%から50%)です。
ところが、MYCINは病棟で使われませんでした。当事者たちは1984年の総括で、当初は病棟に実装して試すことを明確に意図していたが、その実験は行われなかった、と書いています。優れた意思決定性能を示す研究があったにもかかわらず、感染症の知識ベースは1978年に運用を終えています。理由として挙げられているのは、臨床への実装に関する、事前には想定していなかった事柄でした。性能を証明することと、現場に置くことは、別の要件で決まる。MYCINが残した最も実務的な教訓は、おそらくここにあります。
ここまでの流れと、このあと扱う内容を、年で並べておきます。
| 年 | 出来事 | 意味 |
|---|---|---|
| 1965 | DENDRALがスタンフォード大学で始まる | 解く範囲を狭め、その範囲の専門知識を書き込む方針の出発点 |
| 1967〜1968 | DENDRALが知識表現の危機に直面し、知識ベース全体をルールに書き直す | 知識が増えたこと自体が問題になった最初の記録。知識とコードの分離がここで生まれる |
| 1974 | ミンスキーがフレームの論文を出す | ルール以外の知識表現の選択肢が提示される |
| 1975 | ショートリフとブキャナンが確信度のモデルを示す | 不確かな知識を連鎖させて積み上げる実務的な方法が用意される |
| 1977 | ファイゲンバウムが、力は推論方式でなく知識に由来すると述べる | 方針の転換が明文化される。同じ論文で知識獲得がボトルネックだと指摘される |
| 1978 | MYCINの感染症知識ベースが運用を終える/R1の開発が始まる | 性能の証明と現場導入が別問題であることが露呈する一方、商用の本命が動き出す |
| 1979 | MYCINの盲検評価が発表される | 専門家と比較した性能が外部の手で測られる |
| 1980 | R1がDECの製造部門で日常的に使われ始める(同年6月時点で772ルール) | 研究室の外で毎日の業務に組み込まれた |
| 1982 | ICOTが設立され、第五世代コンピュータ・プロジェクトが始まる | 知識情報処理と大規模並列処理を並列論理型言語で結ぶ構想が動き出す |
| 1983 | R1が約3300ルールに達する(部品記述は約5500) | 4年で規模が4倍近くになり、維持の費用が主題になる |
| 1984 | MYCIN研究の総括が刊行され、知識獲得が決定的なボトルネックだと明記される | 頭打ちの原因が推論の性能ではないことが当事者の言葉で記録される |
| 1993 | 第五世代コンピュータ・プロジェクトが終了する | 並列推論マシンと並列論理型言語による試作系が完成する |
XCON、商用で最も規模が大きくなった例
研究の成果が毎日の業務に入った例として、いちばん記録が残っているのがR1です。社内ではXCONと呼ばれました。ジョン・マクダーモットがカーネギーメロン大学で開発し、ディジタル・イクイップメント社のVAX-11/780の構成設計を行います。入力は顧客の注文、出力は注文された部品の空間的な位置関係を示す一組の図で、実際に組み立てを行う技術者がその図を使います。注文には必要な部品が欠けていることが多いため、何が足りないかに気づいて補うことが仕事の大きな部分を占めていました。典型的な構成は約90の部品からなります。
R1の技術的な特徴は、Generate-and-Test ではなくMatchを中心的な解法に据えた点にあります。複数の仮説を、受け入れられるものが見つかるまで探索するのではなく、領域の知識を使って一つの妥当な解を直接作る。1980年6月の時点で、R1はカーネギーメロン大学で開発されたプロダクションルールの言語OPS4で実装され、772のルールを持っていました。あるルールが動くきっかけを作る手前のルールの数をfan-in、そのルールが動いたことをきっかけに動きうる先のルールの数をfan-outと呼びます。R1では、ルールの平均のfan-inとfan-outはいずれも3です。出力生成用の106ルールを除いた666のルールをノードと見ると、各ノードに平均3本の枝が入り3本が出るグラフになります。探索でこれをたどれば費用は膨大になるところを、知識で1本の道に絞る、というのがMatchの効き方でした。50件の注文で検証したところ12件の誤った知識が見つかり、責任のあるルールを直して再投入すると全件が正しく構成されています。この50件は1件あたり平均90部品で、平均1056回ルールを発火させ、平均2.5分のCPU時間を使いました。1980年1月以降、500件を超える注文を構成しています。
本章の主張にとって重要なのは、その4年後にマクダーモットとジュディス・バカントが書いた続編のほうです。開発は1978年12月に始まり、1979年4月には250ルール。1980年4月から3か月かけてOPS4版をOPS5に書き直したところ、機能は増えたのにルールは500に減りました。知識がすでに整理されていたため、一般化がいくつも見つかったからです。1980年末に850ルール。1982年7月ごろに約2000ルール。1983年11月には約3300ルールと、約5500の部品記述になります。
体制の推移も記録されています。カーネギーメロン大学が1980年1月にR1をディジタル社へ引き渡したとき、開発を引き継ぐために置かれた組織は5人で、AIの経験がある者は1人もいませんでした。4年後、この組織は77人になり、R1を含む8つの知識ベースシステムを担当しています。そして、知識を足す作業に投じられた工数は、4年間ほぼ一定で年あたり約4人年でした。作り終わったあとも、同じ規模の投入が毎年続いたということです。1980年以降に追加された2526のルールのうち、約65%は一般的な構成能力の拡張で、特定の機種向けは約35%にとどまります。つまり増えたルールの多くは新機種対応ではなく、すでに扱えていたはずの仕事の知識を直したり細かくしたりするものでした。
期待値の設定についての記述も、実務の参考になります。導入の直前、構成業務を担当していたディジタル社の社員は、R1が有用であるためには構成の90%から95%が完全に正しくなければならない、と予測しました。R1がその水準に達するには3年かかっています。ただし著者たちが興味深いと言っているのは所要年数のほうではなく、その目標設定自体が完全に間違っていたという点です。構成は良質な計算機システムを届けるための長い工程の一部にすぎず、その工程には元々冗長性がありました。構成の全体を知り、かつ1件ごとに十分な注意を払える個人が歴史的にいなかったからです。利用する人たちが、それまでの人間の担当者に求めていた以上のものをR1に求めなかったため、R1は知っていることがまだ少ない段階から意味のある助けになりました。導入初年度の負荷が週に数十件だったことも、R1が失敗したときに人が入る余地を残しています。全体の工程を見ずに部分の正答率だけを条件にすると、達成すべき水準を過大にも過小にも見誤る、ということです。
なお、XCONがもたらした年間の削減額として広く流通している金額がありますが、これらの一次資料には記載がありません。本章では金額を書かず、DECの製造部門で日常的に運用されていたという事実の記述にとどめます。
知識をどう書き下すか、3つの表現
ここで、当時の知識表現の選択肢を整理しておきます。第1がプロダクションルールです。この形式は、一般的な計算の仕組みとしてポストが1943年に提案したものが出発点で、AIに持ち込んだのはアレン・ニューウェルだとされています。ブキャナンとショートリフは、ニューウェルが、形式言語と、人が書いたプログラムを機械が実行できる形に翻訳するコンパイラについてのロバート・フロイドの仕事に、その力と単純さを見たのだろう、と留保付きで書いています。それを領域知識の表現に使うことを主張したのがファイゲンバウムで、ドン・ウォーターマンが質量分析ではなくポーカーの規則と経験則で試し、その成功を受けてDENDRALの知識の多くがルールに書き直されました。
プロダクションシステムの最も基本的な性質は、ルール同士が直接には呼び合わないことです。相互作用は、データベース、すなわち作業記憶を介した間接的な経路だけに限られます。あるルールの効果は、そのルールがデータベースに加えた変更としてしか現れず、後続のルールはその痕跡を読んで動きます。プログラムを書く側は「この処理のあとにあの処理を呼ぶ」という書き方ができません。かわりに、次に動いてほしいルールが拾えるような痕跡を残す、という間接的な書き方をします。この性質が、ルールの追加を容易にする一方で、振る舞いを読みにくくします。ランダル・デイビスとジョナサン・J・キングは、プロダクションシステムを「読む」には、データベースの全内容を頭に置きながら、毎サイクル、ルールの集合全体を走査する必要がある、と書いています。
第2がフレームです。マービン・ミンスキーが1974年6月のMIT人工知能研究所のメモ306「A Framework for Representing Knowledge」で提案し、翌1975年にP・ウィンストン編の『The Psychology of Computer Vision』に再録されました。フレームは、ある型にはまった状況を表すデータ構造です。上位は、その状況について常に成り立つことを表して固定されており、下位には具体的な値で埋める端子、いわゆるスロットが並びます。端子には、そこに入る値が満たすべき条件を指定できます。端子にはあらかじめ既定値が入っていて、状況から積極的に裏付けられていない細部までフレームは持てます。既定値は緩く付いているので、置き換えやすくなっています。関連するフレームどうしはフレーム系にまとめられ、重要な行為の効果はフレーム間の変換として表されます。
第3が意味ネットワークです。概念をノード、概念間の関係をリンクとして表す形式で、MYCINも当初はこの表現を試していますが、採用されませんでした。医学の知識をその形で保持できるとは感じたものの、推論と利用者への質問の両方で知識の穴を埋めていく対話の焦点を絞ることが難しかった、というのが理由です。
この3つは排他ではなく、実際には組み合わせて使われました。ただし当事者たちは、表現力を上げると代償があることを繰り返し記録しています。上位のフレームに書いた性質を下位のフレームが自動で引き継ぐ、フレームの継承のような仕組みを入れると表現できることは増えますが、推論・説明・知識獲得の各処理が複雑になります。親と子のつながり方の種類によって、属性の継承のしかたも、その説明のしかたも変わってしまうためです。単純な表現は使いやすいが、言えることが制限される。表現力の高い表現はその逆になる。この二者択一は、40年後の設計判断にもそのまま残っています。
推論エンジンを切り離したことが、道具の産業を生んだ
エキスパートシステムの構成は、当時の教科書的な図では3つの部分に分かれます。利用者インタフェース、推論エンジン、知識ベースです。知識ベースはその分野についてプログラムが「知っている」事実と関連の集まりで、推論エンジンはその知識を解釈して使う機構です。DENDRALがコードと知識を切り離したことの意味は、この図で言えば、推論エンジンを固定したまま知識ベースだけを差し替えられるようにした、ということになります。
この分離が徹底されると、次の一手は自然に見えてきます。知識を抜いた残りを取っておいて、別の分野の知識を入れれば別のシステムができるはずだ、という発想です。実際にそれが行われました。ファイゲンバウムは1977年の論文で、PUFFという肺機能診断のシステムについて、知識工学者たちは道具箱からMYCINの一種を取り出し、感染症のルールを取り除いて、それをPUFFの推論エンジンとして使った、と書いています。PUFFがその時点で持っていた肺機能診断の知識は、55のIF…THEN…形式のルールだけでした。そのルールはどの医学の教科書にも載っておらず、専門家である肺生理学者の、一部は公になっており一部はなっていない知識を、技術者が集中的に聞き取って磨いたものです。
MYCINから分野固有の知識を抜いて汎用化したものは、のちにEMYCINとして整備されます。ウィリアム・ヴァン・メレの博士論文の成果です。この「殻に知識ベースを入れる」型が、1980年代のエキスパートシステム用ソフトウェアの産業をかたちづくりました。導入する企業から見れば、推論の仕組みを自前で作らずに、自社の業務知識を書き込むところから始められるということです。実装言語はLISPで、のちにInterlispが使われました。
ソフトウェアだけでなく、ハードウェアも商品になりました。LISPを速く動かす専用機です。最初の具体的な提案はピーター・ドイッチが1973年に出したもので、1人用のミニコンピュータ級の機械を、プロセッサが1つの命令を実行するときの内部の手順を書き換えるマイクロコードによってLISP向けに作り、その上にLISPの開発環境を載せる、という構想でした。リチャード・グリーンブラットが1974年にMITでLISPマシンのプロジェクトを始め、デイビッド・ムーン、リチャード・ストールマンら多くの技術者が加わります。CONSマシンが作られ、次にCADRが設計されて数十台が作られました。CADRはLISPに有用なデータ経路を持つ、専用にマイクロコード化された32ビットのプロセッサで、MIT人工知能研究所の計算の主力になります。
商用化にあたって関係者の意見が割れ、2つの会社ができました。Lisp Machines Incorporated(LMI)と、Symbolicsです。前者は主にグリーンブラットが、後者はムーンを含むより大きな集団が設立しました。どちらも当初はCADRを製品化し、それぞれMITからLISPマシンのソフトウェアのライセンスを受けています。Symbolicsはまもなく3600系を投入し、その後5年間、LISPマシンの性能で業界の先頭に立ちました。ゼロックスも、パロアルト研究所で保守を分担していたInterlispの系統から独自の環境を製品にしています。
当時の用語では、汎用の計算機は「ストックハードウェア」と呼ばれ、専用機と対比されました。VAX-11/780がストックハードウェアの例、Symbolics 3600が専用機の例です。ここに、専用ハードウェア事業が構造的に抱える難しさが見えます。専用機は、汎用機の世代交代のたびに、自分が持っていた優位を削られます。ゼロックスは1980年代後半にLISP事業から撤退し、1989年に自社が立ち上げたEnvosという会社にソフトウェアをライセンスしましたが、Envosは設立の3年後に事業を終えました。道具を売る事業は、その道具が乗る土台の進歩と競争することになります。
第五世代コンピュータ計画の技術的な中身
日本では、通商産業省の主導で第五世代コンピュータ・プロジェクトが動きました。実施主体である新世代コンピュータ技術開発機構(ICOT)は1982年4月に設立されています。ICOT自身の記録によれば、プロジェクトは11年の研究開発を経て1993年3月に終了し、そのあと2年計画の後継プロジェクトが行われました。本節では技術的な中身に絞ります。この計画の政策としての評価と、日本のAI史における位置づけは、第11章で扱います。
構想を決めるにあたっては、東京大学の元岡達教授を委員長とする委員会が置かれ、約2年にわたって議論が続きました。「第五世代コンピュータ」という名前は通商産業省の中野正孝氏が付けたものです。最終的に採られたのは、電子技術総合研究所の渕一博のグループが提案した並列推論コンピュータの案でした。人工知能を主な応用とし、1,000台のプロセッサからなる大規模並列ハードウェアを持つ、という構想です。
ICOTは第五世代コンピュータを、知識情報処理と大規模並列処理技術という計算機科学を代表する2つの新技術を、並列論理型言語という新しいプログラミングのパラダイムを用いて結び付けることで生み出される計算機システムと、その技術体系である、と定義しています。目標は、知識ベースを用いた推論機構を中核機能とし、その実装に大規模並列処理技術を全面的に使う計算機を作ることでした。ハードウェアは従来の計算機と異なり、推論言語を実行する並列推論コンピュータとされ、命令を1つずつ順に読んで実行する従来の方式をノイマン型と呼ぶのに対して、非ノイマン型と位置づけられます。
「論理型言語」の系譜も押さえておきます。Prologは1972年に、マルセイユのエクス・マルセイユ第2大学ルミニー理学部の人工知能グループで、アラン・コルメロエらが作りました。規則と事実から結論を導く手順について、次にどれを調べるかを一つに決めて一本の筋でたどるロバート・コワルスキのSL導出の仕事が、設計に影響を与えています。プログラムを手続きの列としてではなく、成り立つべき関係の宣言として書き、実行系がそれを導出で解く。この形式は、知識をルールとして書き下す作業と相性がよいと考えられました。
実際に作られたものを見ます。逐次側では、推論を1つずつ順に進める逐次推論マシン(SIM)の研究が進み、その実機としてPSI(Personal Sequential Inference Machine)が設計・実装されました。その上でソフトウェアを書くための記述言語としてESPが作られ、関係データベースマシンDeltaも開発されています。並列側では、多数のプロセッサに推論を分担させる並列推論マシン(PIM)が作られました。ICOTの記録によれば、512台の要素プロセッサからなるPIM/p、256台の要素プロセッサを持つPIM/mなど、5つのモデルが作られています。その上に、成り立つべき関係の宣言としてプログラムを書き、それを多数のプロセッサで同時に解かせる並列論理型言語KL1のための開発環境が構築され、並列プログラムのデバッグや動作監視のための道具が用意されました。応用の例として、与えられた前提から結論が導けるかを機械的に確かめる並列定理証明システムMGTPは、256台の要素プロセッサを用いて約220倍の高速化を達成しています。
着手時点で何が未知だったかも、ICOT自身の記録に残っています。土台となる並列推論言語も、計算方式も、1,000台規模のプロセッサをどう結合するかも、並列のOSも、応用システムも、どうすればできるのか、ほとんどの研究がゼロからの出発だった、と書かれています。もう一点、通商産業省が当初から成果を公開すると宣言していたことも記録されています。税金を使ったプロジェクトの成果は国に属し、公開は有償とするのが当時の日本の標準的な扱いだったため、これはきわめて異例の宣言でした。
知識獲得のボトルネック、頭打ちの正体
ここまで見てきた成果に対して、限界のほうも同じ当事者たちが記録しています。ファイゲンバウムは1977年の時点で、Meta-DENDRALに取り組んだ動機の1つとして、領域知識の獲得が、応用に向けた知的なエージェントを作るうえでのボトルネック問題である、という認識を挙げています。知識獲得のボトルネックという言い方の出どころです。そして1984年のMYCIN研究の総括にも、知識獲得はエキスパートシステムを作るうえでの決定的なボトルネックとみなされている、と書かれています。7年たっても同じ場所で詰まっていた、ということです。
詰まる場所を、もう少し細かく見ます。知識工学の過程は、知識ベースの概念化、構築、そして初期の性能を受けての改良、という3段階に分けられます。各段階で効いてくるのは、表現の表現力、その分野の知識がもともとどれだけ構造化されているか、専門家が過去の経験から新しい知識を定式化できるか、編集とデバッグの道具の性能、そして知識工学者がその分野の構造と語彙を理解して道具を使いこなせるか、です。このうち機械の性能で解決できるのは、道具の部分だけです。残りはすべて人の側にあります。
そして、ルールが増えたときに具体的に何が起きるかも整理されています。諏訪基、A・カーライル・スコット、ショートリフによる整理では、ルールで表した知識ベースの不整合は3つの形で現れます。第1が矛盾で、2つのルールが同じ状況で成立し、しかも結論が食い違う場合です。第2が冗長で、2つのルールが同じ状況で成立し、結論も同じ場合です。第3が包摂で、2つのルールの結論は同じだが、一方が状況について追加の制約を持つ場合です。制約の強いほうが成立するときには必ず緩いほうも成立するので、結果として冗長になります。不完全さのほうは、ある推論が必要な状況があるのに、その状況で成立して望む結論を出すルールが存在しない、という欠落として現れます。
この4つのうち、包摂がとくに厄介です。ある仮説に対して証拠を積み上げていくルールの集合の中で、あるルールが別のルールを包摂していると、同じ証拠が二度数えられ、結論の重みが誤って増えてしまいます。確信度という仕組みは、ルールが独立であるという前提の上に乗っています。ルールを1本足すことが、離れた場所にある結論の数値をずらす。これが、ルール数に対して保守の手間が比例より速く増える理由です。
自動検査は試みられました。スタンフォード大学の医療センターのがん臨床で使われたONCOCINというシステムでは、ルールの集合を、同じ文脈で同じパラメータについて結論を出すもの同士に分割し、条件パラメータの値のあらゆる組み合わせを表にして、矛盾・冗長・包摂・欠落を調べる仕組みが実装されました。ただし、これで済むわけではありません。あらゆる組み合わせを網羅する前提を置くと、意味を持たない組み合わせが混ざります。定義上、男性で妊娠している人はいませんし、事情から言って乳児でアルコール依存の人もいません。したがって検査器は、疑わしい箇所を表示して、どれが本当の問題かを専門家に指定してもらう形にせざるを得ませんでした。整合性の検査は、最後は人の判断に戻ってきます。当事者たちはのちに、この静的な解析だけでは不十分であり、知識ベースの強さを測る最良の方法は経験的な検証だった、と書いています。
複数の専門家の知識をまとめる問題については、もっと直截な記述があります。異なる専門家が、同義語ではなく本当に異なる概念を使う場合に合意に到達するための道具を、彼らは持っていませんでした。見つけた最良の解は、知識ベースの一貫性と整合性に責任を持つ担当者を1人決めることだった、と書かれています。技術的な解決ではなく、体制上の解決です。また、知識工学者への依存を減らそうという試みは、おおむねうまくいかなかったとも記されています。獲得の自動化を担うはずだったMeta-DENDRALについても、ファイゲンバウムとブキャナンは1993年の時点で、産業の現場で使われたかという問いに「いいえ」と答えています。
結局、この時代の当事者が示した処方は、問題の選び方に戻ります。適した問題の条件として挙げられているのは、実務家がしばしば教科書や専門家に相談する程度には難しく、専門家でも即答はできないが数十時間はかからない程度で、知識ベースを妥当な期間で作って改良できる程度に範囲が狭く、問題の記述に必要な語彙が有限で十分小さい「閉じた世界」として定義できること、でした。投資が見合うかどうかは、この条件を満たすかどうかで決まります。裏を返せば、条件を満たさない問題に同じ方式を持ち込めば、保守の費用が成果を上回ります。
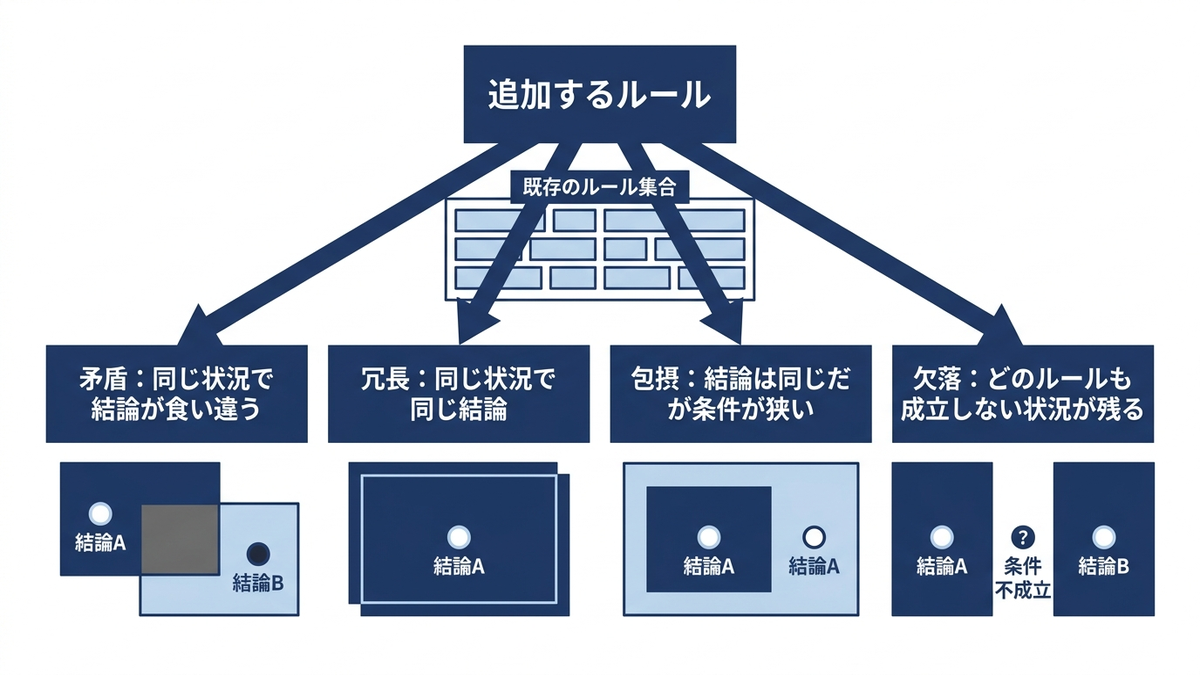
1980年代が残したもの
この10年の位置づけは、当時の研究者自身の言葉で確認できます。1985年に人工知能の学術誌の編集者が主要な研究者に過去10年で最も重要な出来事を尋ねたとき、アレン・ニューウェルは、エキスパートシステムの発展がこの10年におけるこの分野の大きな進歩であることに疑いはない、と答えています。エキスパートシステムの登場はAIという営みを変えた、それはAIの商業化の今の波を牽引したからだけでなく、今後数年のAIにとっての主要な科学的問題を設定したからだ、と続けます。
本章の主張をまとめます。知識を人手でルールとして書き下す方式は、実際に商用化に届きました。DENDRALは化学者に使われ、R1はDECの製造部門で毎日の注文に使われました。限られた領域では、投資に見合う成果が出ています。一方で頭打ちになった理由は、推論の性能ではありませんでした。ルールが増えたときに整合性を維持する費用と、それを担う人の確保です。R1では、作り終えたあとも年4人年の投入が4年間続き、担当組織は5人から77人になりました。MYCINは性能を外部評価で示しながら、臨床実装の要件によって病棟に置かれませんでした。動く仕組みを作ることと、それを維持できることは別の問題である。この区別は、内製かベンダー調達かを問わず、いま何かを導入するときの見積もりにそのまま使えます。
次章では、この方式が1990年代にどう行き詰まり、「知識を書く」から「データから推定する」へどう転回したのかを見ます。第2次の冬と、そこから始まる統計的な機械学習への流れは第5章が扱います。第五世代コンピュータ計画を政策としてどう評価するか、日本のAI史の中にどう置くかは、第11章で改めて扱います。
この章を深めたい方への参考書籍
『Rule-Based Expert Systems: The MYCIN Experiments of the Stanford Heuristic Programming Project』(Bruce G. Buchanan、Edward H. Shortliffe 編、Addison-Wesley):本章で扱ったMYCINの設計、確信度のモデル、EMYCIN、盲検評価、そして知識ベースの完全性と整合性の検査が、当事者の手で1冊にまとめられています。とくに終章の総括は、うまくいかなかったことを含めて記録しており、成功事例だけを読んでも見えない部分を確認したい読者に向いています。
『Building Expert Systems』(Frederick Hayes-Roth、Donald A. Waterman、Douglas B. Lenat 編、Addison-Wesley):本章で触れた知識表現の選択、推論エンジンと知識ベースの分離、知識獲得の進め方を、システムを実際に組む立場から整理した本です。1980年代にこの技術を導入しようとした企業が実務の指針として参照した文献にあたるため、当時の設計判断がどの水準で行われていたかを確認したい読者に向いています。
『Readings in Medical Artificial Intelligence: The First Decade』(William J. Clancey、Edward H. Shortliffe 編、Addison-Wesley):本章ではMYCINの性能評価と、それでも病棟に置かれなかった経緯までを扱いました。この本は同じ時期の医療分野の主要な論文を集めており、性能の証明と現場導入のあいだに何があるのかを、複数のシステムの事例で確認したい読者に向いています。
第5章 二度目の冬と、統計・機械学習への転回
前章では、1980年代に知識をルールとして人手で書き下す方式が商用化まで届き、しかし知識を集めて書き続ける手間が積み上がって頭打ちになったところまでを確認しました。本章はその続きにあたる1990年代を扱います。この10年は、資金と関心の面では後退した時期として語られることが多い一方で、技術の側では今日まで続く枠組みがほぼ出そろった時期でもあります。
本章の軸は一つです。「知識を人が書く」から「データから推定する」への移行が、この10年で主要な領域にわたって進んだということです。誤差逆伝播法の再評価、サポートベクターマシン、決定木とその束ね方、統計的機械翻訳、隠れマルコフモデルによる音声認識は、いずれも同じ移行の別々の現れ方です。そしてこの時期の実務家の多くは、自分たちの仕事を「AI」とは呼びませんでした。呼ばなかったからといって、進んでいなかったわけではありません。
経営の観点で本章から取り出せるのは、言葉の温度と技術の進捗は別々に測る必要がある、という一点です。流行語が下火のときに基盤が固まり、流行語が最高潮のときに基盤が薄いことがあります。この非対称は、投資判断でも人材判断でも効いてきます。
二度目の後退はどこから始まったか
期待が現実を追い越していることは、外部から指摘される前に当事者の側で話題になっていました。1984年のAAAI年次大会では「The ‘Dark Ages’ of AI」と題したパネルが開かれ、その記録は翌1985年にAI Magazine誌の第6巻第3号に採録されています。司会はエール大学のドリュー・マクダーモットで、抄録には、この分野に4年より長くいる研究者のあいだに深い不安があり、それはAIへの期待が高すぎて最終的に破綻を招くのではないかという心配によるものだ、という趣旨が記されています。ブームの最中に、当事者が公の場で期待の水準を問題にしていた記録が残っているという事実は、それ自体が読みどころだと考えています。
後退の入口をいつに置くかについては、定説が一つに定まっていません。本章では、スタンフォード大学のニルス・ニルソンが2010年にケンブリッジ大学出版局から出した通史の記述にしたがい、1980年代半ばから後半に入口を置きます。同書は、非現実的な期待に見合うシステムを届けられなかったことと、それまでに積み上がっていた批判的な論評が重なって、1980年代半ばから後半にかけて、のちにAIの冬と呼ばれるものをもたらした、と書いています。一方で、終わりがいつかについては同書も年を特定していません。本章でも終期を一つの年で区切らず、1990年代を通じて何がどこで進んだかを見る書き方を採ります。区切りを立てないのは、この10年の実態が「止まっていた」ではなく「別の名前で進んでいた」だからです。
専用ハードウェアの側で起きたことも、単年の崩壊としてではなく、置き換えの過程として押さえておくのが正確です。LISPを効率よく走らせるために設計された専用のワークステーションは、Lisp Machines社とSymbolics社が製造販売していました。前掲のニルソンの通史は、これらの企業は初期には成功したが、次第にほかのワークステーションの提供者に押されていった、と記しています。専用機が汎用機に置き換えられるのは計算機の歴史では繰り返し起きることで、AIに固有の現象ではありません。ただしAIの場合は、専用機の価格が事業計画の前提に組み込まれていたため、置き換えが起きたときの影響が研究資金と製品事業の両方に及びました。
なお、専用機メーカーの倒産年や市場規模を示す数字については、一次情報で確認できなかったため、本章では挙げていません。市場が縮小したこと自体は本章で引いた資料が述べていますが、その規模を数値で示すには出所が足りないと判断しました。
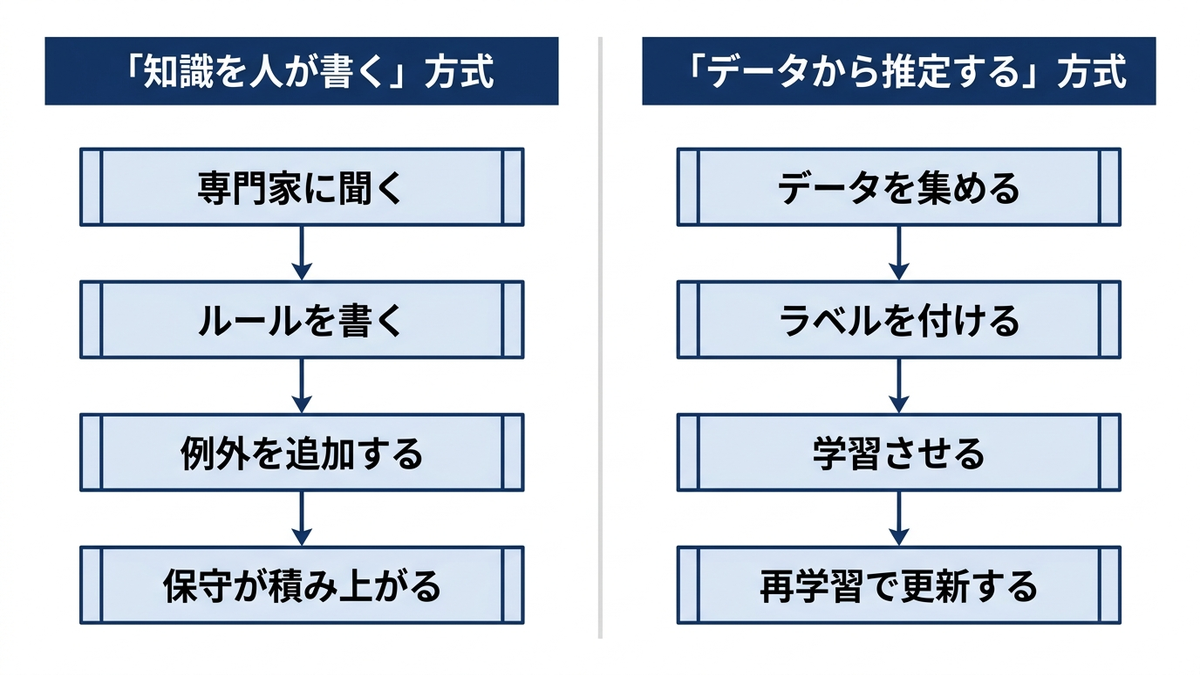
「AI」という看板を外したところで技術は進んでいた
この時期に何が起きたかを一言で表すなら、看板の掛け替えです。前掲のニルソンの通史には、次の趣旨の記述があります。研究資金を出す企業や政府機関は、問題解決のためにAIそのものではなく計算機技術一般に目を向けるようになり、資金はデータベースシステム、ユーザーインターフェース、グラフィックス、計算機ネットワーク、データマイニング、コンピュータゲーム、情報検索、コンピュータビジョン、ワープロや表計算といった領域の改良に向けられた、というものです。探索や推論、エキスパートシステム、音声認識、自然言語処理といったAIの技術は、大きな統合システムの部品として、適切な場面で使われるようになりました。
この記述は、1990年代を理解する鍵になります。予算が「AI」という名目から消えたことと、AIの技術が使われなくなったことは、まったく別の話です。実際には部品として組み込まれ、システム全体の名前は別のものになっただけでした。
受け皿として一番大きかったのがデータマイニングです。1996年にAI Magazine誌の第17巻第3号に載ったウサマ・ファイヤッド、グレゴリー・ピアテツキーシャピロ、パドレイク・スマイスの論文「From Data Mining to Knowledge Discovery in Databases」は、データマイニングとデータベースからの知識発見という2つの言葉の関係を整理し、機械学習や統計学、データベース研究との位置づけを示したものです。この論文がAI Magazineという学会誌に載っている点は象徴的で、AIの学会の内側から、産業に接続する語彙が提示されたということになります。国際会議としてのKDDは1995年に第1回が開かれました。2019年の開催が第25回と表記されていることから逆算できます。
もう一つの受け皿が、機械学習という名前そのものです。専門誌Machine Learningの第1巻は1986年で、この巻の第1号にジョン・ロス・クインランの決定木の論文が載っています。以後、本章で扱う主要な成果の多くがこの雑誌に集まりました。「AI」を名乗らずに「機械学習」を名乗ることは、当時は看板の掛け替えという以上に、扱う問題を測定可能な形に絞るという意味を持っていたと考えられます。正解率や誤差といった数字で比べられる問題だけを扱う、という切り分けです。
誤差逆伝播法の再評価と、先取権を断定できない理由
誤差逆伝播法は、多層のネットワークの重みを、出力の誤差を入力側へさかのぼって配分しながら少しずつ調整する手続きです。1986年10月9日にNature誌の第323巻533ページから536ページに載ったデビッド・ラメルハート、ジェフリー・ヒントン、ロナルド・ウィリアムズの論文「Learning representations by back-propagating errors」は、この手続きを用いると隠れ層のユニットが課題の特徴を表す内部表現を獲得すること、そしてその点が以前のパーセプトロンの手続きとの違いであることを示しました。
ここで注意が必要なのは、「1986年に誰が発明したか」という書き方をしてはいけない、ということです。ユルゲン・シュミットフーバーが2015年にNeural Networks誌の第61巻85ページから117ページに発表した歴史整理の論文は、この点を丁寧に扱っています。同論文は、任意の離散的なネットワーク状の構造に対する明示的で効率的な誤差逆伝播は、ニューラルネットワークへの言及を伴わない形ではあるものの、1970年の修士論文で最初に記述されたと見られる、と書いています。またニューラルネットワークに特化した効率的な適用としては、著者の知る限り1981年の記述が最初であり、関連する仕事はその数年後に発表された、とも書いています。さらに、複雑で非線形かつ微分可能な多段のシステムのパラメータ空間で勾配降下によって誤差を最小化するという議論は、少なくとも1960年代初頭までさかのぼる、として複数の研究を挙げています。
この整理で目を引くのは、断定を避ける言い回しが繰り返し使われていることです。「apparently」つまり「見たところ」、「To my knowledge」つまり「私の知る限り」という留保が本文に入っています。分野の内部で歴史をまとめた人が留保を付けているのですから、外から歴史を書く側が断定するのは筋が通りません。本章では先取権について断定せず、確認できた事実だけを並べます。1986年の論文の役割は、この手続きが実際に多層ネットワークの学習に使えることを実験で示し、広く知られる形にした点にあると受け止められています。
先取権の整理には、日本の研究も一つ加えておく必要があります。1967年6月、九州大学の甘利俊一は、IEEE Transactions on Electronic Computersの第EC-16巻第3号299ページから307ページに、日本語にすれば「適応的なパターン識別器の理論」となる題の論文を発表しました。IEEE Xploreに載っている要旨によれば、この論文は、パターンの分布について一般的な条件のもとで、識別を誤るたびに識別器の重みを修正していく手続きを扱っています。そして、誤りによる損失がパターンと識別の境界とのあいだの距離によって決まり、かつ損失の平均が一つの谷しか持たない形であるという条件のもとで、2つのクラスが直線で分けきれない場合でも、提案した手続きによって重みが最適な値に収束することを証明した、と要旨は述べています。ただし論文の本文の定理が示している収束は、より限定された意味のものです。1回の修正の大きさを決める定数を十分小さく取り、学習を十分な回数重ねれば、重みが最適な値から一定以上離れている確率をいくらでも小さくできる、という形で述べられています。収束の速さと精度のあいだに重要な交換関係(一方を良くすると他方が悪くなる関係)があること、パターンの分布が時間とともに変わる場合の振る舞いも示されています。理論はさらに、区分的に線形な識別関数(いくつかの直線や平面をつなぎ合わせて境界を作る識別関数)を含む、より一般の識別関数を持つ識別器へと拡張されています。同じ1967年の7月には、電子通信学会雑誌の第50巻第7号に、甘利の日本語の論文「学習識別の理論」も掲載されています。
この論文の考え方の要点は、本文の導入部に書かれています。既知の関数を最小にするには最も急に下る方向へ進めばよいが、学習の場面ではパターンの確率分布が分からないので、損失の平均が下る方向を直接は計算できない。使えるのは、いま与えられた1つのパターンだけである。そこで、各パターンに修正の量を対応させ、その修正の平均が損失の平均を下げる方向を向くように決める。こうすると、1回ごとの修正では外れることがあっても、平均としては識別関数が良くなることが保証される、という説明です。分布の全体を知らないまま、データを1件ずつ見て重みを少しずつ動かし、平均として損失を下げていくという組み立てが、論文の中で明示的に述べられています。
この論文を多層のネットワークの学習と結びつけて評価しているのが、前掲のシュミットフーバーが2022年に公開し、2025年に改訂した技術報告です。同報告は甘利の1967年の論文を、多層のニューラルネットワークの学習に確率的勾配降下法(前の段落で見たように、データを1件ずつ使って重みを少しずつ動かし、平均として損失を下げていく方法)を用いた、おそらく最初の論文だと位置づけています。ただし同報告も「probably」つまり「おそらく」という留保を付けており、現在誤差逆伝播法と呼ばれる勾配の計算方法を特定したものではない、と注記しています。また同報告は、5層の回路で内部の表現が学習された計算機実験の結果は、1968年に日本語で出版された甘利の著書に載っているとしていますが、本稿ではその著書の該当箇所を確認できていません。したがってここでは、1967年の論文そのもので確認できた範囲、つまり一般の識別関数を持つ識別器に対して、データを1件ずつ使って損失の平均を下げていく学習則と、その収束の理論が示されたという点までを事実として扱います。
この事実は、本節の冒頭で述べた1986年の論文の役割と食い違うものではありません。2024年のノーベル物理学賞について選考委員会がまとめた科学的背景の文書は、1986年の3人の論文について、勾配を計算する仕組みはそれ以前に他の研究者が関連する問題に適用していたものを改めて作り出したものであり、より重要なのは、隠れ層を持つネットワークがこの方法で学習でき、隠れ層がなければ解けないと知られていた課題をこなせることを示した点だ、と整理しています。前掲のシュミットフーバーの2015年の論文も、1960年代から勾配降下による誤差の最小化が論じられてきた研究の一つとして、甘利の1967年の論文を挙げています。学習則の理論、勾配の効率的な計算、多層のネットワークでの実験による実証という別々の層で、別々の研究が積み重なったと読むほうが、本章で確認できた事実に合っています。技術の起源を根拠にした主張を読むときも、どの層の貢献を指しているのかを分けて確かめることが、誤った断定を避ける助けになると考えています。
1980年代にニューラルネットワークの研究が再び勢いを得た経緯は、誤差逆伝播法だけでは説明しきれません。1982年4月、ジョン・ホップフィールドはProceedings of the National Academy of Sciencesの第79巻第8号2554ページから2558ページに論文を発表しました。題名を訳すと「ニューラルネットワークと、創発的な集団としての計算能力を持つ物理系」です。要旨は、単純で互いに同等な部品、つまりニューロンが多数集まった系では、計算に役立つ性質が集団としての性質として現れうると述べています。その例として示されたのが、記憶の一部分を手がかりとして与えると、十分な大きさがあれば記憶の全体を正しく取り出せる、内容で呼び出す型の記憶です。この性質は、模型の細部や個々の部品の故障にはあまり左右されない、とも書かれています。
前述のノーベル物理学賞の科学的背景の文書は、この論文を1980年代の流れの中に置いています。同文書は、1980年代には再帰型と順伝播型の双方で大きな進展があり、それが分野の急速な拡大につながったと整理しています。1970年代の停滞を何が招いたかについては、第3章で見たとおり因果を断定できないため、ここでは1980年代の展開についての同文書の整理だけを引きます。再帰型とは、出力が再び入力側へ戻る結合を持つネットワークのことで、順伝播型は、入力から出力へ一方向にだけ信号が流れるネットワークを指します。再帰型の側の進展として最初に挙げられているのが、1982年のホップフィールドの模型です。同文書によれば、この模型は単純な再帰型ネットワークによる連想記憶の力学的なモデルです。ニューロンどうしの結合の強さは双方向で等しいと仮定され、各ニューロンの値は1つずつ、ばらばらの時刻に更新されます。そのうえでネットワーク全体に、状態ごとに1つ決まる数値であるエネルギーを割り当てており、ネットワークが動くにつれてこのエネルギーは単調に減っていく、つまり増えることがないように作られています。記憶できる量などの基本的な性質がスピングラスと呼ばれる磁性体の理論の手法で解析的に理解できると分かったことで、このモデルはさらに注目を集めた、とも書かれています。
ただし同文書は、磁性体の系に着想を得て再帰型のネットワークを模型化する研究が並行して進んでいたとして、甘利の1972年の論文を含む複数の先行研究を参照文献に挙げています。そのため本章では、ホップフィールドの1982年の論文を唯一の出発点とは書かず、1980年代の再興の起点の1つになったと書くにとどめます。ホップフィールドと、その模型を確率的に拡張したボルツマンマシンを1983年から1985年にかけて共同研究者とともに開発したジェフリー・ヒントンは、2024年にノーベル物理学賞を受けています。その経緯と、受賞が何を意味し何を意味しないかは第10章で扱います。
1990年代に入ると、この手続きは実際の認識課題に当てられていきます。1989年にNeural Computation誌の第1巻第4号に載ったヤン・ルカンらの論文は、誤差逆伝播法を郵便物の手書き郵便番号の認識に適用したものです。1998年にProceedings of the IEEEの第86巻第11号に載ったヤン・ルカン、レオン・ボトゥ、ヨシュア・ベンジオ、パトリック・ハフナーの論文は、勾配に基づく学習を文書認識に適用した内容で、2278ページから2324ページにわたる長い論文です。また1997年にはNeural Computation誌の第9巻第8号に、ゼップ・ホッホライターとユルゲン・シュミットフーバーによるLSTMの論文が載っています。系列データを長い時間差にわたって扱うための仕組みで、この時点では広く使われる道具にはなりませんでした。1990年代に用意され、後になって効いてきた部品の一つです。この系統がどのように主役になるかは第7章で扱います。
サポートベクターマシンと統計的学習理論
1990年代の実務では、少なくともパターン認識の実用および商用の応用の多くで、ニューラルネットワークよりカーネル法が優勢でした。前掲のシュミットフーバーの論文は、2000年前後の10年間、実用および商用のパターン認識の応用の多くは、サポートベクターマシンのような非ニューラルの機械学習手法に占められていた、と書いています。
サポートベクターマシンの中核となる考え方は、1992年のCOLT、すなわち第5回の計算論的学習理論のワークショップで発表されました。ベルンハルト・ボザー、イザベル・ギュイヨン、ウラジミール・ヴァプニクによる論文「A Training Algorithm for Optimal Margin Classifiers」で、会議はピッツバーグで1992年7月27日から29日に開かれています。ここで提案されたのは、2つのクラスを分ける境界のうち、境界から最も近い訓練データまでの距離、すなわちマージンが最大になるものを選ぶという方針です。境界の候補が無数にあるとき、どれを選ぶかという問いに、データの当てはまりだけでなく余裕の大きさで答えたのがこの手法です。
1995年には、コリンナ・コルテスとウラジミール・ヴァプニクによる論文「Support-vector networks」がMachine Learning誌の第20巻第3号273ページから297ページに載りました。誤りをある程度許容しながらマージンを最大化する定式化を示したもので、実データに当てるための実装として広まりました。線形に分けられない問題を扱うために、データを高い次元へ写した先で線形の境界を引く方針が採られますが、実際には写した先の座標を計算せず、2つのデータがどれだけ似た向きを向いているかを1つの数で表す内積だけを、別の関数で置き換えれば済みます。この置き換えに使う関数を核と呼び、置き換えによって次元を上げても計算量が爆発しません。本節の冒頭で挙げたカーネル法とは、この置き換えを使う一群の手法をまとめた呼び方です。
背景にあるのが統計的学習理論です。ヴァプニクが1995年にシュプリンガーから出した著書「The Nature of Statistical Learning Theory」は、訓練データに当てはめる力と、未知のデータに対する誤差との関係を扱う枠組みを提示しています。訓練データに完全に当てはまるモデルが、未知のデータで最も良いとは限らない、という当たり前に見えることを、扱える形に定式化した点が実務上の意味を持ちました。本章の実験でも、手で書いた条件を増やすほど訓練データへの当てはまりを追いかけて検証データでの正解率が下がるという現象が実際に出ています。
経営の観点で言えば、この時期の手法は「データが少なくても使える」という性質を持っていました。深層学習が要求するような規模のデータがなくても動きます。現在でも、手元のデータが数百件から数千件の規模であれば、この系統の手法が第一候補になる場面が多いように思います。新しい手法が出たからといって、古い手法の適用範囲が消えるわけではありません。
決定木からアンサンブルへ
決定木は、条件分岐を木の形に並べて分類する手法です。人が書くルールと形が似ているため、この章の主題を最もはっきり示します。違いは、条件と閾値を人が決めるか、データから決めるかだけです。
クインランのID3は、前掲のニルソンの通史によれば、1970年代後半、クインランがシドニー大学からスタンフォードに来ていた時期に作られました。論文「Induction of Decision Trees」はMachine Learning誌の第1巻第1号81ページから106ページ、1986年です。1993年にはモルガン・カウフマンから書籍「C4.5: Programs for Machine Learning」が出ています。C4.5は、連続値の属性を扱えること、欠損値のあるレコードを扱えること、木を刈り込んで過剰な当てはめを抑える方法を持つことが特徴で、実務で使える形にまとまりました。
統計学の側からは、レオ・ブライマン、ジェローム・フリードマン、リチャード・オルシェン、チャールズ・ストーンによる書籍が1984年にワズワースから出ています。題名を訳せば『分類と回帰の木』で、原題の頭文字からCARTと呼ばれる系統です。前掲のニルソンの通史は、C4.5がCARTの数値属性の扱い方を取り入れたと記しており、AI側と統計学側の往来があったことがわかります。同書はまた、スタンフォードの統計学者ジェローム・フリードマンが1990年代にスタンフォードのAIの博士課程の学生たちと共同研究を始めたことに触れ、双方が互いから学び、機械学習はそれによって豊かになった、と書いています。分野の名前が違うだけで同じ問題を扱っていた人たちが、この時期に合流しました。
単体の決定木は、訓練データの細かい違いに引きずられやすいという弱点を持ちます。これに対する答えがアンサンブル学習です。1996年にMachine Learning誌の第24巻第2号123ページから140ページに載ったレオ・ブライマンの論文「Bagging Predictors」は、訓練データから重複を許して標本を取り直し、それぞれで学習させた予測器の多数決を取るという方法を示しました。1997年に計算機科学の学術誌(J. Comput. Syst. Sci.)の第55巻第1号119ページから139ページに載ったヨアヴ・フロイントとロバート・シャピールの論文は、AdaBoostとして知られる手法を含むもので、前の予測器が間違えた事例の重みを上げながら順に予測器を作り、その重み付き投票で答えを出す方式です。個々の予測器が弱くても、束ねると精度が上がることを理論と実験の両面から示しました。
この系統の到達点として広く使われるランダムフォレストは、レオ・ブライマンの論文としてMachine Learning誌の第45巻5ページから32ページに2001年に載ったものです。1990年代の出来事ではないため、本章では2001年と明記して扱います。1990年代に用意された部品が、2000年代の初頭に定番の形にまとまった、という順番です。
もう一つ、地味ながら実務で効いた成果として、1995年のIJCAIでロン・コハヴィが発表した論文「精度の推定とモデル選択のための交差検証とブートストラップの研究」を挙げておきます。精度をどう見積もり、どのモデルを選ぶかという手続きを比較した研究で、手元のデータをいくつかの組に分け、1組ずつを順に検証用に回して残りで学習し、成績を平均する交差検証の使い方が、実務の標準になっていく過程の一部です。手法そのものより、手法を評価する手続きが整ったことのほうが、産業への広がりには効いたと考えられます。
言葉と音声を確率で扱う
自然言語処理と音声認識は、規則を書く方式からデータで推定する方式への移行が最もはっきり見えた領域です。
統計的機械翻訳は、1990年にComputational Linguistics誌の第16巻第2号79ページから85ページに載ったIBMトーマス・J・ワトソン研究所のピーター・ブラウンらの論文「A Statistical Approach to Machine Translation」で提示されました。文法規則や辞書を人が書くのではなく、対訳のデータから、ある文が別の文に訳される確率を推定するという方針です。対訳資料としてカナダ議会の議事録が使われました。法律により議事録がフランス語と英語の両方で残されているためで、論文は、カナダ政府から英語のテキスト約1億語とそれに対応するフランス語を入手し、文の長さに基づく統計的なアルゴリズムで約300万の文対を抽出した、そのうち約99%は実際に互いの訳になっていた、と記しています。
実験の規模も論文に書かれています。語彙を1,000語に限り、翻訳モデルの1,700万個のパラメータを、両言語の語彙で完全にまかなえる11万7,000文対から推定しました。単語を2語ずつの並びで数え、直前の1語から次の1語の出やすさを表すバイグラムの言語モデルは、英語側の57万文、語数にして約1,200万語から推定しています。この設定で、議事録の別の箇所から取った新しいフランス語の文73文を英語に訳させ、結果を5段階に分類しました。参照訳と完全に一致したものは5%でした。ただし、言い回しは違うが同じ意味のもの、および参照訳とは意味が違うが正当な訳になっているものまで含めると、48%が成功と判定できる、と論文は述べています。1990年時点の数字であり、実用水準ではありません。それでも、規則を1行も書かずに半分近くが通じる訳になったという事実は、方針の妥当性を示すには十分でした。数理的な整理は1993年に同誌の第19巻第2号263ページから311ページに載った論文にまとまっています。
統計で扱うにはデータが要ります。1993年に同じ号の313ページから330ページに載ったミッチェル・マーカス、ベアトリス・サントリーニ、メアリー・アン・マルチンキーヴィッチの論文「Building a Large Annotated Corpus of English: The Penn Treebank」は、構文解析の結果を人手で注釈した大規模なコーパスを作った報告です。注釈付きのコーパスがあると、文法規則にどれだけの確率を割り当てるかを、木の中に規則が現れた回数を数えるだけで決められます。前掲のニルソンの通史は、文の組み立てを、ある記号をどの記号の並びに置き換えてよいかという規則の集まりで表すのが文脈自由文法で、その規則に確率を与える考え方が1969年のテイラー・ブースの提案にさかのぼることを記したうえで、注釈付きコーパスから確率を数え上げる方法と、注釈がない場合に、いま手元にある確率を使って曖昧な解析を仮に重み付けて数え、数えた結果で確率を更新する作業を繰り返すEMアルゴリズムによる方法を説明しています。作るべきものが「規則」から「注釈付きデータ」に変わった、というのがこの時期の実質的な変化です。
音声認識では隠れマルコフモデルが標準の道具になりました。1989年2月にProceedings of the IEEEの第77巻第2号257ページから286ページに載ったローレンス・ラビナーの解説論文「隠れマルコフモデルと音声認識での主な応用についての手引き」は、この分野で最も参照された文書の一つです。音声を、直接は観測できない内部の状態が時間とともに遷移し、各状態から音の特徴が確率的に出てくるものとして表す枠組みで、状態の遷移確率と出力確率をデータから推定します。ここでも人が書くのは規則ではなくモデルの形だけで、中身の数値はデータが決めます。
Deep Blue、探索の到達点
1990年代で最も広く報道されたAIの出来事は、チェスの世界王者と計算機の対戦でした。この件は年を取り違えた記述が多いので、正確に押さえます。
1996年2月、ガルリ・カスパロフとDeep Blueの最初のマッチが行われました。前掲のニルソンの通史は、この初戦でDeep Blueは第1局を取ったがマッチには負けた、と記しています。開発者のフェン・シュン・シューが1999年のIEEE Micro誌第19巻第2号70ページから81ページに書いた論文には、1996年のマッチでは4局を終えた時点でDeep Blueはカスパロフと互角だったが、カスパロフがDeep Blueの弱点を突き止め、残る2局を難なく取った、と書かれています。この記述から、1996年のマッチは4対2でカスパロフが勝ったことになります。
1997年5月11日、6局のマッチの最終局でカスパロフが投了し、Deep Blueが3.5対2.5で勝ちました。前掲のシューの論文にスコアが明記されています。ニルソンの通史も、通常のトーナメントの持ち時間のもとで、2勝1敗3引き分けで6局のマッチを制した、と記しています。
技術の中身も一次情報で確認できます。1997年のDeep Blueは、IBM RS/6000 SPを基盤とし、30台のRS/6000プロセッサと480個の専用チェスチップからなる構成でした。チェスチップは0.6マイクロメートルのCMOSで作られ、1個あたり毎秒200万から250万局面を探索します。1局面の計算を汎用の計算機で行うと最大4万命令ぶんに相当するため、チップ1個で毎秒1,000億命令の計算機に相当する、と論文は述べています。探索の分担も具体的で、たとえば12手ぶんを読む場合、最初の4手ぶんをマスターとなる1台のノードがソフトウェアで探索し、次の4手ぶんを30台すべてがソフトウェアで探索し、最後の4手ぶんを専用チップが担当します。技術的な総まとめは、マレー・キャンベル、ジョセフ・ホーン、フェン・シュン・シューによる論文「Deep Blue」として、2002年にArtificial Intelligence誌の第134巻第1号から第2号57ページから83ページに載っています。
ここで押さえておきたいのは、Deep Blueが本章の主題である「データから推定する」の成功例ではない、という点です。Deep Blueが行ったのは、専用ハードウェアによる大量の探索と、人が作り込んだ評価関数の組み合わせでした。第2章で扱った探索と記号処理という型の、資源を極限まで投入した到達点にあたります。同じ1990年代に、まったく違う型の成果も出ています。1995年にCommunications of the ACM誌の第38巻第3号58ページから68ページに載ったジェラルド・テサウロの論文が報告したTD-Gammonは、バックギャモンを自分自身と数百万局対戦させながら学習したシステムで、ニューラルネットワークと、勝敗が確定するまで待たずに、1手進んだ先の評価と現在の評価の差を使って評価を直していく時間差学習を組み合わせたものです。ニルソンの通史によれば、ある版では入力198、隠れ層40、出力4の3層構成でした。人が評価関数を書き込んだDeep Blueと、自己対戦から評価を学んだTD-Gammonが同じ10年に並んでいることは、この時期の見取り図として覚えておく価値があります。
実験、同じ課題に人が書いたルールとデータから推定した手法を当てる
ここまでの話を、最小構成の実験で確かめます。同一の分類課題に対して、人が訓練データを見て手で書いたif文のルールと、データから推定する手法を当て、正解率と、人が保守しなければならない箇所の数を比べます。
使うのはscikit-learnに同梱されている乳がん診断のデータセットです。標本数569、特徴量30で、悪性か良性かの2値分類になります。全体の30%を検証用に取り分け、乱数の種は20260902に固定しました。訓練398件、検証171件です。検証データの内訳は悪性64件、良性107件なので、すべて良性と答えるだけで正解率0.626になります。この水準を超えられなければ、そもそも何もしていないのと同じです。
ルールの閾値は、訓練データだけを見て決めました。たとえば腫瘍の最大半径は、訓練データでの中央値が悪性20.385、良性13.325だったので、間を取って16.5を閾値にしています。以下がルールの最終版と、比較対象のサポートベクターマシンの実装です。
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import accuracy_score

SEED = 20260902
np.random.seed(SEED)

data = load_breast_cancer()
X, y = data.data, data.target          # 0 = malignant, 1 = benign
col = {n: i for i, n in enumerate(data.feature_names)}
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=SEED, stratify=y)

# (1) 人が訓練データを見て手で書いたルール。条件6個、手で決めた閾値9個。
def rule_v3(x):
    if x[col["worst radius"]] > 16.5:
        return 0
    if x[col["worst concave points"]] > 0.14:
        return 0
    if x[col["worst texture"]] > 27.0:
        if x[col["worst radius"]] > 14.5:
            return 0
    if x[col["mean concavity"]] > 0.11:
        if x[col["worst area"]] > 880.0:
            return 0
    if x[col["worst area"]] > 1000.0:
        return 0
    if x[col["worst concave points"]] > 0.11:
        if x[col["worst texture"]] > 22.0:
            return 0
    return 1

pred_rule = np.array([rule_v3(row) for row in X_te])
print("手書きルール v3 :", accuracy_score(y_te, pred_rule))

# (2) データから推定する。人が指定するのは核とCの2個だけ。
svm = make_pipeline(StandardScaler(),
                    SVC(kernel="linear", C=1.0, random_state=SEED))
svm.fit(X_tr, y_tr)
print("SVM 線形核      :", accuracy_score(y_te, svm.predict(X_te)))
実行結果は次のとおりです。条件を1個だけ書いたルールが0.883、条件を3個に増やすと0.871、6個に増やすと0.854でした。手を入れるほど下がっています。訓練データでの正解率も同じ向きに動いており、条件1個で0.927、条件6個で0.897です。書き手が訓練データの個別の事例に引きずられて、検証データに効かない条件を足していったということです。ルールを書き足す作業は、精度を上げる作業とは限りません。
(1) 人が書いたルールの正解率
手書きルール v1(条件1個)            訓練 0.927  検証 0.883  人が書いた条件 1個 / 手で決めた閾値 1個
手書きルール v2(条件3個)            訓練 0.922  検証 0.871  人が書いた条件 3個 / 手で決めた閾値 4個
手書きルール v3(条件6個)            訓練 0.897  検証 0.854  人が書いた条件 6個 / 手で決めた閾値 9個

(2) データから推定する手法の正解率
決定木(深さ3)                   訓練 0.975  検証 0.912  人が指定した設定 1個
決定木(枝刈りなし)                 訓練 1.000  検証 0.918  人が指定した設定 0個
SVM(線形核)                   訓練 0.990  検証 0.982  人が指定した設定 2個
SVM(RBF核)                  訓練 0.987  検証 0.971  人が指定した設定 3個
ランダムフォレスト(木100本)           訓練 1.000  検証 0.947  人が指定した設定 1個
AdaBoost(弱学習器100個)         訓練 1.000  検証 0.965  人が指定した設定 1個
データから推定した側は、最も低い決定木でも0.912で、手書きルールの最良値0.883を上回りました。線形核のサポートベクターマシンは0.982です。人が指定したのは核の種類と、訓練データへの当てはめを追いすぎないように抑える度合いである正則化の強さの2つだけで、境界の位置はすべてデータが決めています。表にあるRBF核は、まっすぐな境界ではなく曲がった境界を引けるようにする核の一種です。AdaBoostが0.965、ランダムフォレストが0.947と続きます。
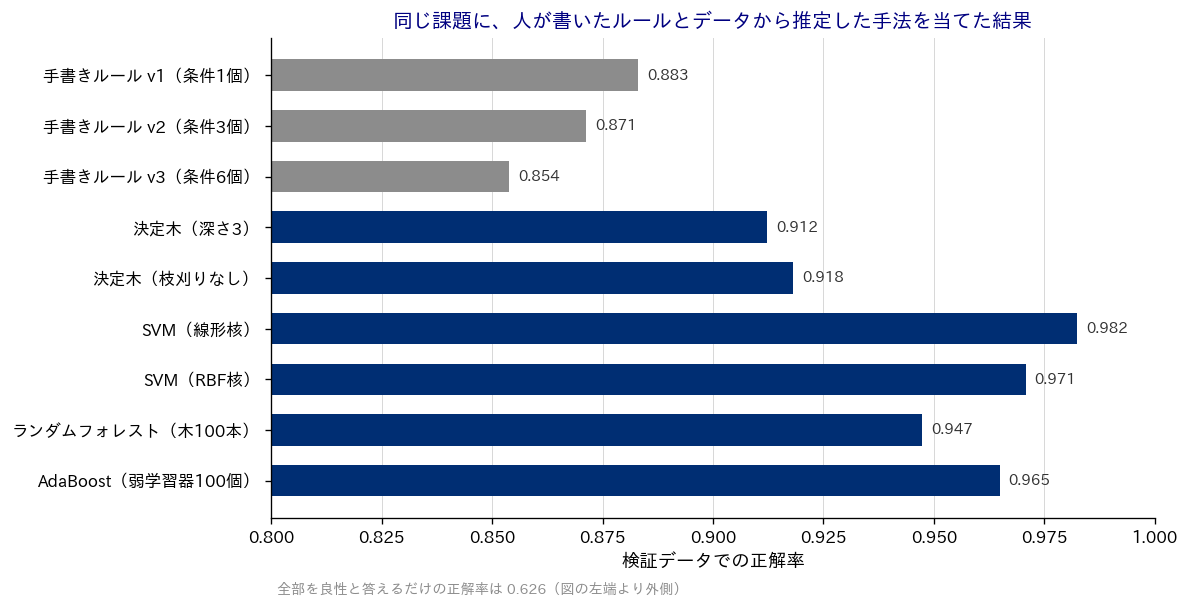
保守の手間も数えました。手書きルールの最終版は、条件6個の中に手で決めた閾値が9個入っています。この9個は、データが変わるたびに人が見直す対象です。一方、深さ3の決定木は7個の分岐条件を自分で決めており、枝刈りをしない決定木では13個の分岐を自分で決めていました。同じ働きをする条件を人が書くなら、この数だけ手で書いて保守することになります。決定木の側で人が指定したのは木の深さという設定1個だけです。
差がはっきり出るのは、測定の条件が変わったときです。撮像装置の縮尺が変わった状況を模して、長さに関する特徴量を1.15倍、面積に関する特徴量をその2乗倍にしたデータで同じ評価をしました。手書きルールの最終版は0.854から0.690に落ちます。ルールに書き込まれた9個の閾値が、変わる前の目盛りのままだからです。線形核のサポートベクターマシンも0.982から0.895に落ちました。ここは公平に書いておくべき点で、学習した手法も自動では追随しません。
違うのは戻し方です。新しい目盛りの訓練データで学習をやり直すと、サポートベクターマシンは0.982に戻りました。関数を一度呼び直すだけです。手書きルールの側は、人が9個の閾値を一つずつ見直して書き直すまで0.690のままです。1980年代のエキスパートシステムが保守コストで頭打ちになった構造が、そのまま小さな形で再現されています。1990年代の転回が実務にもたらしたのは、精度そのものよりも、更新の手続きが人手から計算に置き換わったことのほうだったと考えています。
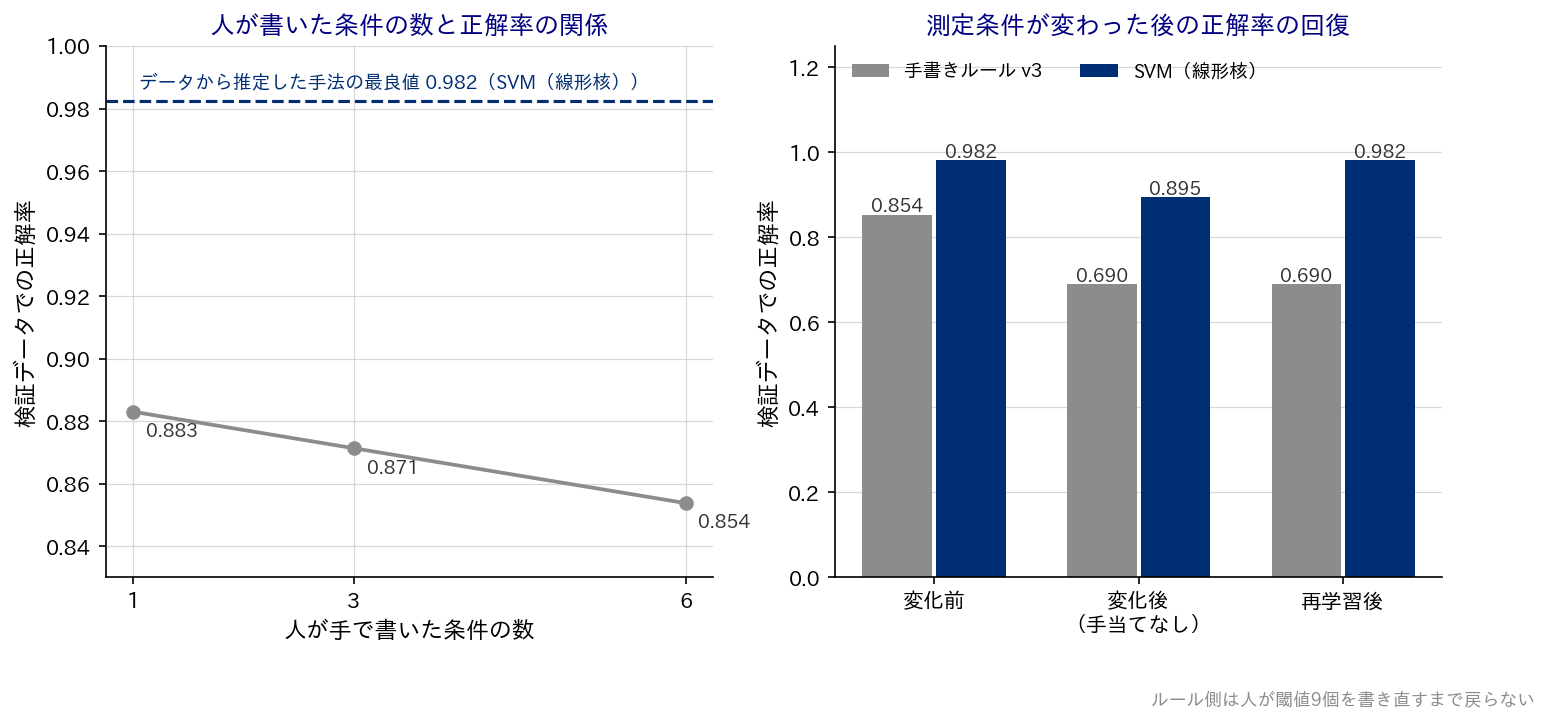
この実験は数百件規模のデータでの話であり、結果を一般化することはできません。ただし、方向としてはこの時期に起きたことをそのまま示しています。人が条件を書き足す作業には上限があり、上限は思ったより早く来ます。
1990年代の小年表
本章の範囲を年で並べます。全体の年表とは粒度を変え、この10年に絞りました。ランダムフォレストだけは2001年ですが、1990年代の蓄積の帰結として並べています。
| 年 | 出来事 | 意味 |
|---|---|---|
| 1984 | AAAI年次大会で「The ‘Dark Ages’ of AI」と題したパネルが開かれる。記録は1985年のAI Magazine誌に採録 | 期待が高すぎることを、当事者が公の場で問題にしていた記録が残った |
| 1986 | 誤差逆伝播法の論文がNature誌に掲載(10月9日) | 多層のネットワークが学習でき、隠れ層に内部表現が現れることが広く知られた |
| 1986 | 決定木ID3の論文がMachine Learning誌の第1巻第1号に掲載 | 機械学習が専門誌を持つ分野として立ち上がった |
| 1989 | 隠れマルコフモデルの解説論文がProceedings of the IEEEに掲載 | 音声認識の標準的な道具立てが共有された |
| 1989 | 誤差逆伝播法を手書き郵便番号の認識に適用した論文がNeural Computation誌に掲載 | 学習した手法が実際の認識業務に当てられた |
| 1990 | IBMの統計的機械翻訳の論文がComputational Linguistics誌に掲載 | 文法規則を書かず、対訳データから訳を推定する道が開いた |
| 1992 | マージン最大化の学習アルゴリズムがCOLTで発表 | サポートベクターマシンの中核となる考え方が出た |
| 1993 | Penn Treebankの論文が掲載、C4.5の書籍が刊行 | 注釈付きデータと実務向けの決定木が同じ年に出そろった |
| 1995 | サポートベクターマシンの論文がMachine Learning誌に掲載 | 誤りを許容する定式化により実データに当てられるようになった |
| 1995 | KDDの国際会議が始まる(第1回) | データマイニングという名前で産業側の課題に接続した |
| 1995 | TD-Gammonの論文がCommunications of the ACM誌に掲載 | 自己対戦で学んだ評価が、人が書いた評価に匹敵しうると示された |
| 1996 | バギングの論文がMachine Learning誌に掲載。2月にカスパロフ対Deep Blueの初戦 | 束ねる型の定着と、探索の型の到達点が同じ年に並んだ |
| 1996 | データマイニングと知識発見を整理した論文がAI Magazine誌に掲載 | AIの学会の内側から、産業に接続する語彙が提示された |
| 1997 | 5月11日、Deep Blueがカスパロフとの6局マッチを3.5対2.5で制する。AdaBoostの論文とLSTMの論文も掲載 | 人手で作り込む型の頂点と、束ねる型・系列を扱う型が同時に現れた |
| 1998 | 勾配に基づく学習を文書認識に適用した論文がProceedings of the IEEEに掲載 | 畳み込みを用いた学習の実用例が示された |
| 2001 | ランダムフォレストの論文がMachine Learning誌に掲載 | 1990年代の蓄積が、設定の少ない定番の道具にまとまった |
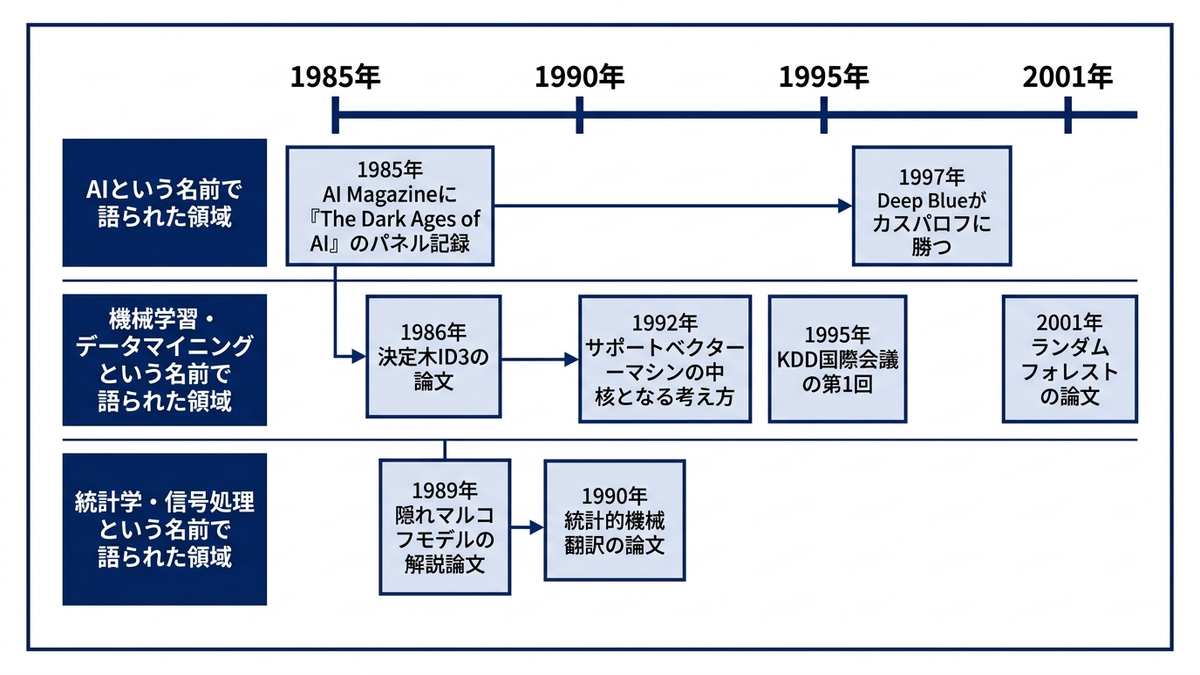
経営の観点、言葉の温度と技術の進捗は別々に見る
本章の事実から、判断に使える形で3つを取り出します。
第一に、流行語の温度と技術の進捗は連動しません。1990年代は「AI」という言葉の温度が最も低かった時期の一つですが、本章で並べたとおり、現在の実務で使われている手法の多くはこの10年に形になっています。逆に言えば、言葉が最高潮のときに基盤が薄いこともあり得ます。投資判断では、その技術が何と呼ばれているかではなく、何ができるようになったかを、測定可能な指標で見る必要があります。ベンダーの説明を評価するときも同じで、名前の新しさではなく、検証の設計と数値の出し方を見るのが実務的です。
第二に、人が知識を書き続ける方式は、書けば書くほど良くなるとは限りません。本章の実験では、条件を1個から6個に増やしたところ、検証データでの正解率が0.883から0.854に下がりました。書き手が個々の事例に引きずられるためです。社内の業務ルールを人手で積み上げている仕組みが「例外対応を足しているのに精度が上がらない」状態に入っているなら、足す作業を続けるより、判定を数値で測る仕組みを先に作るほうが効きます。何を正解とし、どのデータで測るかを決めるところまでが人の仕事で、その先は自動化できます。
第三に、比べるべきは初期精度ではなく更新の手間です。本章の実験では、測定条件が変わったとき、手書きルールも学習した手法もいったん精度を落としました。違ったのは戻し方で、片方は人が9個の閾値を書き直す必要があり、もう片方は学習をやり直すだけでした。導入の検討では初期精度に目が行きがちですが、運用に入ってから効いてくるのは、環境が変わったときに誰がどれだけ手を動かすかです。この観点は、内製と外注の切り分けにも、保守契約の設計にも直結します。
本章の要点をまとめます。1990年代は資金と関心の面では後退した時期でしたが、技術は「AI」以外の名前のもとで前進しました。サポートベクターマシン、決定木とアンサンブル、統計的機械翻訳、隠れマルコフモデルはいずれも、人が知識を書く方式からデータで推定する方式への移行を体現しています。ただし、この移行が大規模に効いてくるには、大量のデータと計算資源という別の条件が要りました。その条件が、AI研究の外側でどのように整えられていったかは第6章で扱います。深層学習が成果を上げる場面は第7章の範囲です。
この章を深めたい方への参考書籍
『統計的学習の基礎:データマイニング・推論・予測』(Trevor Hastie、Robert Tibshirani、Jerome Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、共立出版):本章で扱った決定木、バギング、ブースティング、サポートベクターマシンが、統計学の側の言葉で一冊に整理されています。1990年代に何がどうつながって現在の道具立てになったのかを、数式まで含めて確認したい読者に向いています。
『パターン認識のためのサポートベクトルマシン入門』(阿部重夫 著、森北出版):マージン最大化とカーネルによる置き換えという、本章で言葉だけで説明した部分を手を動かして確かめられます。手元のデータが数百件から数千件の規模で、深層学習を持ち出す前に検討すべき手法を押さえておきたい実務者に向いています。
『Behind Deep Blue』(Feng-hsiung Hsu 著、Princeton University Press):本章でIEEE Micro誌の論文から引いたDeep Blueの設計を、開発の当事者が一冊で書いたものです。専用ハードウェアに資源を集中させるという判断が、どの制約のもとで下されたのかを追いたい読者に向いています。
第6章 データとインフラが整うまで
前章では、1990年代に研究の重心が「知識を人手で書き下す」から「データから統計的に推定する」へ移ったことを確認しました。統計に基づく手法には共通の性質があります。学習に使えるデータが増え、計算に回せる資源が増えるほど成績が上がる。逆に言えば、データと計算資源が乏しい環境では、どれだけ手法を工夫しても届く高さに天井があります。1990年代の研究者が置かれていたのは、その天井の下でした。
この章で追うのは1995年から2011年までの、その天井が上がっていく過程です。結論を先に置きます。2012年以降の深層学習を可能にした三つの材料、すなわち大規模なデータ、並列に計算できるハードウェア、そして分散処理の基盤は、いずれもAI研究の内側で作られたものではありません。検索と広告、電子商取引、ゲームという、AIとは別の目的をもった投資が、副産物として次のブレークスルーの前提条件を揃えました。経営の観点から読むなら、この章の主題は「基盤投資の効果は、投資した本人が意図した用途の外側に現れることがある」という一点に集約されます。あわせて、何を測るかを決めて素材を用意する仕事が、その後の研究の方向を規定した経緯も追います。
1995年から2011年に積み上がったもの
先に全体の見取り図を示します。以下は本章が扱う範囲に絞った年表です。個々の出来事は後の節で詳しく扱いますので、ここでは「何がいつ揃ったのか」の並びだけを示します。画像認識のベンチマークで深層学習が広く注目されるのは2012年ですが、その材料は2006年前後に集中して用意されています。
| 年 | 出来事 | 意味 |
|---|---|---|
| 2001年 | BankoとBrillが、10億語の学習データで4種類の学習アルゴリズムの学習曲線を報告 | データ量を3桁増やすと手法の優劣が入れ替わることを、実験で示した |
| 2003年 | Googleが分散ファイルシステムの論文を発表 | 壊れることを前提に安価な汎用機を束ねる設計が公開された |
| 2004年 | GoogleがMapReduceを発表。StanfordがBrook for GPUsを発表 | 分散処理を2つの関数に還元する型と、GPUを汎用計算に使う道具立てが同じ年に出た |
| 2006年2月 | Nutchから分離してHadoopが独立プロジェクトになる | Googleが論文で示した型が、誰でも動かせるソフトウェアとして社外に出た |
| 2006年3月・8月 | Amazon S3の提供開始、Amazon EC2のベータ公開 | 保管と計算が従量課金で買えるようになり、設備投資の壁が下がった |
| 2006年4月 | Googleが統計的機械翻訳をアラビア語と英語の組で一般公開 | 大量の対訳データによる翻訳が、研究から一般向けサービスへ移った |
| 2006年9月 | Googleが1兆語規模のn-gramデータを言語資源として公開 | 連続する数語の並びを公開Webページから数え上げた統計が、社外の研究者の手元で使える形になった |
| 2006年10月 | Netflix Prizeが始まる | 企業が自社の予測問題を外部に開いた。評価指標と賞金で研究を動かす方式 |
| 2006年〜2007年 | NVIDIAがCUDAアーキテクチャを発表し、2007年6月にプログラミングガイド1.0を公開 | 描画用のチップを、C言語に近い書き方で汎用計算に使えるようになった |
| 2008年 | HadoopがApacheのトップレベルプロジェクトへ。1テラバイトのソートで209秒の記録 | 分散処理基盤が業界標準として認知された |
| 2009年 | ImageNetの論文がCVPRで発表される。Netflix PrizeのGrand Prizeが授与される | データセットを作る仕事と、問題を外部に開く方式が、研究の進め方として定着した |
| 2010年 | ILSVRCが始まる。CireşanらがGPU学習でMNISTの誤り率0.35%を報告 | 共通の物差しと、GPU学習の実効性が同じ時期に揃った |
| 2011年 | 世界人口の約3分の1がインターネットを利用する水準に到達。Hadoop 1.0.0が公開される | データの供給源と処理基盤が、産業として成立する規模になった |
2006年という年に出来事が集中していることが分かります。分散処理のオープンソース実装、従量課金のクラウド、Web規模の言語データ、GPUの汎用計算アーキテクチャ、そして企業による公開コンペティション。これらは互いに示し合わせて生まれたものではなく、それぞれ別の事業上の理由で進められた投資が、たまたま同じ時期に実を結びました。
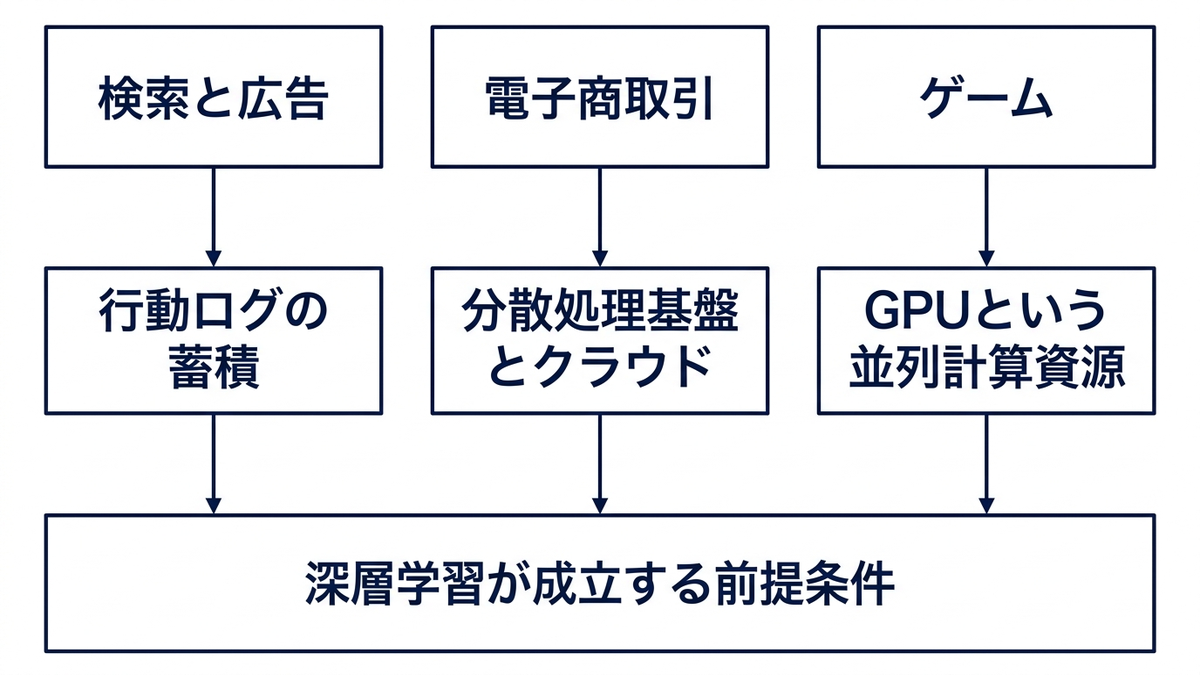
Webが記録装置になった
1990年代半ば以降のWebの普及が何をもたらしたかを、まずデータの供給側から確認します。国際電気通信連合が2011年に公表した統計では、世界人口70億人のうち約3分の1がインターネットを利用しているとされています。同じ資料によれば、世界のインターネット利用率は2006年の18%から2011年には35%へ上がり、携帯電話の契約数は59億件、普及率は87%に達していました。世帯単位で見ても、全世界18億世帯のうち3分の1がインターネットに接続していたと報告されています。
利用者が増えたことよりも重要なのは、Webが「使われるたびに記録が残る」構造をもっていたことです。紙のカタログを眺めても記録は残りませんが、Webページを開けばアクセスログが残ります。検索窓に語句を入れれば検索クエリが残り、どの結果をクリックしたかも残ります。商品を買えば購買履歴が残り、動画に星を付ければ評価が残ります。これらはいずれも、機械学習のために意図して集められたものではありません。サービスを運用するうえで自然に生じる副産物です。
この副産物の規模がどれほどだったかを示す例を挙げます。Googleは2008年7月25日に公式ブログで、同社のシステムが1兆件を超える一意のURLを確認したと発表しました。ImageNetの論文は2009年の時点で、Flickrに30億枚を超える写真があるという推定を引いています。1990年代の研究者が扱っていたコーパスが数百万語規模だったことを思えば、けた違いという言葉でも足りない差です。
経営の観点で押さえておきたいのは、この時期に価値を生んだのが「データを集めるための投資」ではなく「サービスを運用した結果として溜まったデータ」だったという点です。ログは目的をもって設計されたものではないため、そのままでは使えません。しかし量が一定を超えると、質の粗さを量が補う場面が出てきます。次の節はその話です。
データ量が手法の優劣を書き換えた
データが増えると何が変わるのか。これを最初に明快な実験で示したのが、Microsoft ResearchのMichele BankoとEric Brillが2001年のACLで発表した「Scaling to Very Very Large Corpora for Natural Language Disambiguation」です。扱った課題は、混同しやすい語の選択という単純なものでした。たとえば英語の principle と principal、then と than、to と two と too のように、書き手が取り違えやすい語の組を用意し、文脈からどちらが正しいかを当てさせます。この課題を選んだ理由は明快で、正解ラベルが自動的に手に入るからです。きちんと編集された文章であれば、そこに書かれている語がそのまま正解になります。
2人は10億語の学習用コーパスを集めました。論文には、これはこの課題でそれまでに使われた最大のコーパスより3桁大きいと書かれています。そして4種類の学習アルゴリズム、すなわちwinnow、パーセプトロン、単純ベイズ、そして非常に単純なメモリベース学習器を、100万語、500万語というように学習量を段階的に増やしながら訓練し、学習曲線を描きました。
結果として観察されたのは二つのことです。第一に、4種類とも学習量を増やし続けるかぎり精度が伸び続け、頭打ちになりませんでした。第二に、少量のデータで比較したときの順位が、大量のデータでは入れ替わりました。小さなデータセットで劣っていた手法が、データを増やすと逆転する。この二点が意味するのは、標準的なベンチマークの上で手法を比較して得た結論が、データ量の桁が変わると通用しなくなるということです。
この観察を、より広い主張として整理したのが、Googleの Alon Halevy、Peter Norvig、Fernando Pereira が2009年3月に IEEE Intelligent Systems に寄せた「The Unreasonable Effectiveness of Data」です。人間の言語や行動が絡む問題は、物理法則のような簡潔な式では書けない。だとすれば、複雑さを引き受けたうえでデータの力を借りるほうが筋がよい、という主張でした。
Googleはこの主張を、資料の公開という形でも裏付けています。2006年、同社はWeb上の公開ページから作った n-gram データ、すなわち連続するn個の単語の並びが何回現れたかを数え上げた表を、言語資源として配布しました。カタログに記載された規模は、トークン数1,024,908,267,229、文数95,119,665,584、1語だけの並びであるユニグラムが13,588,391種です。1兆語という言い方は誇張ではなく、カタログに記載された総トークン数に基づく表現です。40回以上出現した語の並びだけを収めてなお、圧縮してDVD6枚分の分量になりました。
同じ時期に、統計的機械翻訳が研究室から一般向けサービスへ出ています。Googleは2006年4月28日に、アラビア語と英語の双方向の翻訳を統計的機械翻訳の方式でGoogle Translate上に公開しました。文法規則を人手で書くのではなく、大量の対訳文から翻訳の確率を推定する方式です。同社は研究用の評価で良好な結果を得たと述べたうえで、ニュース記事のような文章では比較的うまく働くが、小説のような文章では成績が落ちるという限界にも触れていました。翻訳の理論的な枠組み自体は1990年代に整っており、そこは前章の範囲です。この章で確認したいのは、その枠組みが実用に届くために必要だったのが、新しい理論ではなく対訳データの量と、それを回す計算資源だったという事実です。
実務への含意は具体的です。手法の選定会議を開く前に、自社が使えるデータの量がどの桁にあるのかを確認する。桁が小さいなら、高度な手法を探すより先にデータを増やす手立てを考える。桁が十分に大きいなら、複雑な手法に投資する前に、単純な手法をより多くのデータで回したときの成績を測ってみる。BankoとBrillの実験は、この順序を支持しています。
分散処理という型が生まれた
データが溜まっても、処理できなければ意味がありません。当時、大量のデータを扱うには高価な専用機を買うか、複数台に分散する複雑なプログラムを自分で書くかのどちらかでした。後者はとりわけ厄介です。データをどう分けるか、どの機械にどの仕事を割り当てるか、途中で機械が壊れたらどうするかといった問題が、本来やりたかった単純な集計処理を覆い隠してしまいます。
Googleはこの問題に対して、3本の論文で答えを示しました。2003年のThe Google File System、2004年のMapReduce、2006年のBigtableです。The Google File Systemは、安価な汎用機を大量に束ね、機械が壊れることを異常ではなく日常として扱う前提で設計された分散ファイルシステムでした。Bigtableは構造化データを数千台規模に分散して保持する仕組みで、Web索引やGoogle Earth、Google Financeなどが使っていると論文に書かれています。
この3本のうち、産業への影響が最も大きかったのがMapReduceです。Jeffrey DeanとSanjay Ghemawatが2004年のOSDIで発表したこの論文の要点は、分散処理という難題を、利用者が書く2つの関数に還元したところにあります。map は入力のキーと値の組を受け取って中間的なキーと値の組を出し、reduce は同じキーをもつ中間値をまとめて畳み込む。利用者が書くのはこの2つだけで、データの分割、機械への割り当て、故障時の再実行、機械間の通信といった面倒は、ライブラリ側が引き受けます。論文には、この設計によって並列処理や分散システムの経験がないプログラマでも大規模なクラスタを使えるようになった、と書かれています。
どれだけ使われたかも論文に書かれています。ライブラリの初版は2003年2月に書かれ、2004年8月の1か月間で29,423本のジョブが実行されました。使用した機械の延べ日数は79,186日、読み込んだ入力データは3,288テラバイト、書き出した出力は193テラバイトです。1ジョブあたりの平均ワーカー機は157台、平均完了時間は634秒でした。ソースコード管理システムに登録されたMapReduceプログラムの数は、2003年初めの0本から2004年9月末には900本近くまで増えています。
経営の観点では、ここが重要です。MapReduceの価値は、それまで不可能だった計算を可能にしたことではありません。すでに一部の専門家には可能だった計算を、普通の技術者が書ける形に落としたことです。論文は自社の検索索引生成システムを書き換えた経験を報告しており、ある工程のコード量が約3,800行から約700行に減り、旧システムでは数か月かかった変更が数日で済むようになったと述べています。同じ計算を、より少ない専門知識と、より短い時間でできるようにする。基盤投資の効果はこの形で現れることが多いように思います。
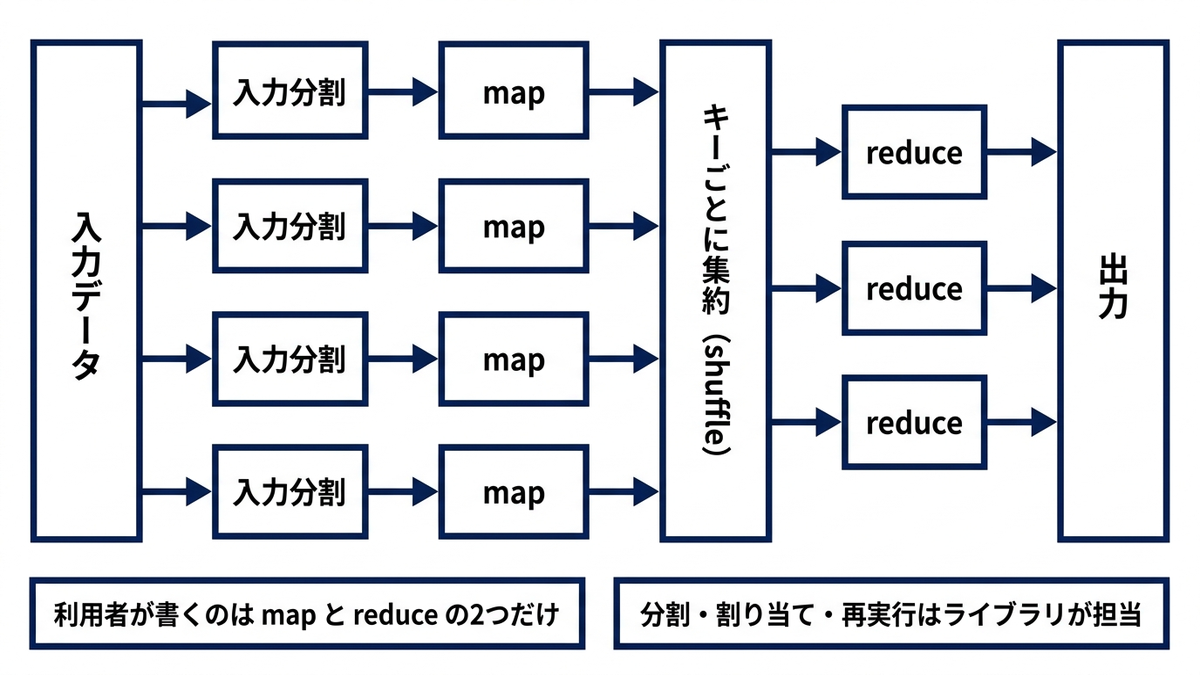
Hadoopが業界の共通基盤になるまで
Googleの論文は設計思想を公開しましたが、動くソフトウェアそのものは社外に出ませんでした。これを外部で作り直したのがHadoopです。解説書として定評のあるTom Whiteの著作が記録している経緯によれば、出発点はDoug Cuttingが2002年に始めたオープンソースの検索エンジンNutchでした。クローラと検索の仕組みはすぐに動いたものの、数十億ページ規模には拡張できないという壁に突き当たります。そこへ2003年にGoogleの分散ファイルシステムの論文が出て、2004年にMapReduceの論文が出ました。Nutch側は2005年初めにMapReduceを実装し、同年半ばには主要なアルゴリズムがMapReduceと独自の分散ファイルシステムの上で動くようになります。
2006年2月、この部分がNutchから切り出されて独立したプロジェクトになりました。これがHadoopです。同じ時期にDoug CuttingはYahoo!に移り、Web規模で動かすための人員と資源が付きました。2008年1月にはApacheのトップレベルプロジェクトになり、同年2月にYahoo!は、本番の検索索引を1万コアのHadoopクラスタで生成していると発表しています。
技術的な信頼を決定づけたのは、ソート性能の記録です。Apache Hadoopの公式発表によれば、2008年にYahoo!のHadoopクラスタが1テラバイトのデータを209秒でソートし、それまでの297秒という記録を更新しました。同じ発表は、この部門でJava製のプログラムが、またオープンソースのプログラムが勝ったのはこれが初めてだと述べています。安定版とされるHadoop 1.0.0が公開されたのは2011年12月27日で、リリースページには6年の育成期間を経てという表現が使われています。
ここには技術戦略として読み返す価値のある展開が含まれています。Googleは自社の中核である検索索引の作り方を論文として公開し、その公開が社外にほぼ同等の基盤を生んで、やがて業界全体の共通基盤になりました。論文を出さなければ数年は独走できたはずだという見方は成り立ちます。一方で、公開したからこそ大量の技術者がこの型を学び、その型を前提とした人材市場と周辺ツール群が育ったという面もあります。どちらが正しいかを断じることはできませんが、「中核技術の公開は必ず損である」という単純な図式は、この事例には当てはまりません。
クラウドが計算資源の買い方を変えた
分散処理の型ができても、動かす機械を自分で買って置く必要があるなら、使える組織は限られます。ここを変えたのがクラウドです。Amazonは2006年3月14日にAmazon S3を提供開始しました。公式のプレスリリースは、これを開発者向けの保管サービスと位置づけ、1バイトから5ギガバイトまでのオブジェクトを扱えること、外部のプログラムから呼び出すための2つの方式であるRESTとSOAPの両方のインターフェースをもつことを説明しています。料金は保管が1ギガバイトあたり月0.15ドル、転送が1ギガバイトあたり0.20ドルで、最低料金はなく使った分だけ支払う形でした。
続いて2006年8月、Amazon EC2のベータが公開されます。AWSの告知は、これを「クラウド上の伸縮自在な計算能力」と説明し、新しいサーバを入手して起動するまでの時間を分単位に短縮すること、必要に応じて増減できること、実際に使った容量にだけ支払うことを挙げています。
技術的には既存の要素の組み合わせですが、経営上の意味は小さくありません。それまで計算資源は設備投資でした。試したい実験があっても、まず機械を調達する稟議が要り、調達した機械は使い終わっても資産として残ります。この構造の下では失敗しそうな実験を始めるコストが高く、結果として試行回数が減ります。従量課金はこの構造を運用費に組み替えました。実験1回あたりの単価が下がり、失敗の後始末が軽くなれば、試行回数は増えます。機械学習のように、やってみないと分からない要素が多い分野では、試行回数そのものが成果を左右します。
加えて、クラウドは分散処理の敷居も下げました。Hadoopのクラスタを常時保有するのは相応の負担ですが、必要なときだけ数十台を借りて処理し、終わったら返す使い方ができれば、規模の壁は資金の壁から作業手順の壁へ変わります。分散処理のオープンソース実装と従量課金のクラウドが2006年に出そろったことは、後から見れば大きな分岐点でした。
描画用のチップが学習用の計算機になった
三つ目の材料が計算素子です。ここでも起点はAI研究の外側、具体的にはゲームの描画性能を求める市場でした。
グラフィックス処理装置は、画面上の膨大な数の画素に対して似た計算を一斉に適用するために作られています。この用途では、複雑な条件分岐を高速に処理する能力よりも、単純な演算を大量に並列で回す能力が効きます。NVIDIAが2007年6月23日付で公開したCUDAプログラミングガイド1.0の第1章は、この設計思想を明快に述べています。GPUは計算量が多く並列度の高い処理に特化しており、そのためにトランジスタをデータのキャッシュや制御の流れではなくデータ処理そのものに多く割り当てている、という説明です。
この性質を描画以外に使おうとする試みはGPGPUと呼ばれ、専用の言語が用意される前から存在しました。代表例が、Stanford大学のIan Buckらが2004年のSIGGRAPHで発表したBrook for GPUsです。C言語にデータ並列の構文を足し、GPUをストリーム処理の補助演算装置として使えるようにする仕組みで、線形代数演算や画像分割、高速フーリエ変換、レイトレーシングといった用途でCPU実装に対して最大7倍の速度を報告しています。ただしこの時期は計算を描画処理の形に翻訳して書く必要があり、扱いは容易ではありませんでした。
これを一般の技術者に開いたのがCUDAです。NVIDIAは自社の年表で2006年の項に、CUDAアーキテクチャの公開によってGPUの並列処理能力を科学と研究に開いたと記しています。実際にプログラミングガイドの1.0版が出たのは2007年6月で、対応するGPUとしてGeForce 8800 GTX世代が挙げられています。C言語に近い書き方でGPU上の計算を書けるようになったことで、描画の知識をもたない研究者がGPUを使えるようになりました。
機械学習の側がこれを取り込むまでに、そう時間はかかりませんでした。Stanford大学のRajat Raina、Anand Madhavan、Andrew Y. Ngは、2009年のICMLで「Large-scale deep unsupervised learning using graphics processors」を発表しています。著者らの発表資料によれば、実験に使ったのは1ギガバイトのメモリと240コアを積んだ市販のグラフィックスカード1枚でした。制限ボルツマンマシンは、入力の層と隠れた層の2層だけをつなぎ、データによく現れる特徴を隠れた層に持たせる仕組みです。4,500万パラメータの制限ボルツマンマシンを1,000万件の事例で学習させた場合、デュアルコアCPUで2週間かかる処理がGPUでは5時間で終わり、資料には72倍という数字が記されています。データを、あらかじめ用意した多数の部品のうち少数だけの組み合わせで表すスパースコーディングの実験では15倍でした。1億1,000万パラメータの深層信念ネットワーク、つまり制限ボルツマンマシンを何段も積み重ねたネットワークについても、全層を1日程度で学習できたと報告されています。
もう一つの例が、Dan Claudiu Cireşan、Ueli Meier、Luca Maria Gambardella、Jürgen Schmidhuberが2010年に発表した研究です。要旨は簡潔で、昔からある単純な誤差逆伝播を素直な多層パーセプトロンに適用するだけで、手書き数字のベンチマークであるMNISTの誤り率が0.35%まで下がると述べています。必要だったのは、多くの層と多くのユニット、変形させた訓練画像を大量に作ること、そして学習を大幅に速くするグラフィックスカードでした。論文は前向き計算と逆伝播の処理が約40倍速くなったと報告し、結論部では現在のGPUが標準的なマイクロプロセッサより40倍以上速いと述べています。自由パラメータ数134万から1,211万のネットワークを、23.4時間から114.5時間かけて学習させた実験です。
この二つの研究に共通するのは、新しい学習理論を提案していないことです。既存の手法を、桁違いに大きくして、桁違いに速い計算機で回した。それだけで成績が変わりました。2012年以降に何が起きたかは第7章が扱いますが、その材料はこの時点で揃っています。
データセットを作る仕事が研究を動かした
材料の話を、もう一段具体的にします。画像認識の分野では、2000年代半ばまで研究の共通基盤が小さいままでした。ベンチマークとして広く使われたPASCAL Visual Object Classesは2005年から2012年まで続いた取り組みで、当初は4クラス、2006年に10クラス、以降は20クラスという規模でした。データセットとしては2007年版で9,963枚、2012年版で11,530枚です。手法を比較する物差しとしては機能しましたが、この規模では「データを増やせば伸びるか」という問い自体を検証できません。
ここに別の設計思想で作られたのがImageNetです。Princeton大学のJia Deng、Wei Dong、Richard Socher、Li-Jia Li、Kai Li、Li Fei-Feiが2009年のCVPRで発表した論文「ImageNet: A Large-Scale Hierarchical Image Database」は、その構想と当時の到達点を報告しています。着想の核は、画像を平らなカテゴリの集合として並べるのではなく、言語の意味階層に沿って組織することでした。土台に使ったのはWordNetという語彙データベースで、意味の同じ語をまとめた単位をsynsetと呼びます。論文は、WordNetの名詞synsetおよそ8万個の大半に、1つあたり平均500枚から1,000枚の高解像度画像を割り当てることを目標に掲げ、最終的に5,000万枚規模を目指すと述べています。
ここで数え方の話をしておきます。ImageNetの規模については複数の数字が流通しており、混同されがちなので区別しておく必要があります。
- 2009年のCVPR論文の時点で公開されていたのは、哺乳類・鳥・魚・爬虫類・両生類・乗り物・家具・楽器・地形・道具・花・果実という12のサブツリーで、5,247のsynsetに320万枚でした。1つのsynsetあたり平均600枚を超えます
- ImageNet公式サイトが2026年9月に確認した時点で表示している全体の規模は、14,197,122枚の画像と21,841のsynsetです。ただし、この値がいつ時点のものかはページに明記されていません
- 後述するILSVRCで実際に使われたのは、この全体から1,000クラスに絞った部分集合で、学習用の画像は120万枚規模です
1,400万枚という数字と120万枚という数字は、別のものを数えています。深層学習の成果を語る文脈で「1,400万枚の画像で学習した」と書かれていることがありますが、コンペティションで使われたのは1,000クラスに絞った部分集合です。
ImageNetの構築で注目すべきなのは、その作り方です。論文は、この規模の高品質なデータベースは従来のデータ収集手法では作れないと述べ、Amazon Mechanical Turkという不特定多数に細かな作業を委託する仕組みを使ったと説明しています。集めた画像が本当にそのsynsetに当てはまるかを、多数の人手による投票で判定する方式です。品質も測定されており、階層の深さが異なる80のsynsetを無作為に抽出して調べたところ、平均99.7%の精度でラベルが付いていたと報告されています。階層の下のほうへ行くほど、たとえばシャム猫とビルマ猫の区別のような難しい判断が必要になるため、この精度を全階層で保つのは容易ではないとも書かれています。
そしてこのデータセットは、競争の場と結び付けられました。ImageNet Large Scale Visual Recognition Challenge、略してILSVRCです。公式サイトによれば2010年に始まり、2017年まで続きました。2010年の課題設定は1,000の物体カテゴリで、公式ページは学習用約120万枚、検証用5万枚、テスト用15万枚と説明しています。後にまとめられた解説論文には、より精密な内訳があり、2010年の学習画像は1,261,406枚、2011年は1,229,413枚と記録されています。主催はColumbia大学のAlex Berg、Princeton大学のJia Deng、Stanford大学のLi Fei-Feiでした。
2010年と2011年の成績を確認しておきます。評価は、上位5件の予測のいずれかが正解であれば正解とみなす基準です。2010年の優勝はNEC、University of Illinois at Urbana-Champaign、Rutgers大学の合同チームで、誤り率は0.28191でした。手法は局所特徴量と非線形の符号化表現を組み合わせ、確率的に学習したサポートベクターマシンで分類するというものです。2011年の優勝はXerox Research Centre EuropeのFlorent PerronninとJorge Sanchezで、誤り率は0.25770でした。1年で2.4ポイントの改善です。つまり2011年末の時点では、この種の課題は年に数ポイントずつ地道に改善していく分野に見えていました。
経営の観点で取り出したいのは、次の一点です。ImageNetを作った仕事は、新しいアルゴリズムの発明ではありません。何を測るかを決め、測るための素材を大量に用意し、誰でも同じ条件で競える場を設けた仕事です。それにもかかわらず、この仕事はその後の研究の方向を決定的に規定しました。物差しを用意した側が、その分野で何が「良い成果」とみなされるかを定義してしまうからです。自社でAIの取り組みを立ち上げるときにも、同じ構造が現れます。評価指標とデータセットを誰がどう決めるかは、技術選定より前に来る意思決定です。
外部に問題を投げるという方法
もう一つ、この時期に定着した進め方があります。企業が自社の予測問題を外部に開き、賞金と評価指標で研究を動かす方式です。最もよく知られた例がNetflix Prizeです。
Netflixの社員である James Bennett と Stan Lanning が2007年に発表した解説論文によれば、同社は2006年10月に1億件の匿名の映画評価データを公開し、自社の推薦システムであるCinematchの精度を上回る仕組みを作れるかを、データマイニングと機械学習の研究者に問いかけました。データは48万人を超える無作為に選ばれた匿名の会員が、約1万8,000本の作品に付けた1億件超の評価で、1998年10月から2005年12月までに集められたものです。評価は1から5の整数でした。優勝チームの技術文書には、より精密な件数として100,480,507件、480,189人、17,770作品という数字が記録されています。
コンペティションの設計は丁寧に作られていました。会員ごとの直近の評価をおよそ300万件取り置いて予測対象とし、そのうち半分をリーダーボード表示用、残り半分を勝敗判定用に分けます。参加者に返されるのはリーダーボード側の成績だけで、判定側の成績は公開されません。同じデータに繰り返し提出して当てにいく行為を防ぐための設計です。基準となるCinematchのリーダーボード側での二乗平均平方根誤差、すなわち予測した評価と実際の評価のずれを2乗して平均し、その平方根を取った値は0.9514と公表されました。値が小さいほど予測が当たっていることを表し、これを10%改善することがGrand Prizeの条件でした。優勝チームの文書によれば、この10%という条件は誤差0.8563に相当します。
反応の規模は当時としては例外的でした。2007年6月時点で、152か国を超える国から2万を超えるチームが登録し、そのうち2,000チームが予測を提出して、提出回数は1万3,000回を超えていました。Cinematchの精度を上回ったチームは650を超え、そのうち90チームが5%以上の改善に到達しています。
優勝は2009年9月21日、BellKor’s Pragmatic Chaos というチームに100万ドルが授与されました。このチーム名が示すとおり、優勝したのは単独のチームではありません。技術文書によれば、BellKor、Pragmatic Theory、BigChaos という、それまで別々に競っていた3チームの合併です。手法についても、単一の優れたアルゴリズムが勝ったのではありませんでした。BigChaosだけで101個の予測器を作り、それらを混ぜ合わせる形で成績を出しています。同じ文書には、リーダーボード側で10.09%の改善に届いても判定側で10%を超える保証はなかった、という趣旨の記述があり、決着が極めて僅差だったことがうかがえます。
このコンペティションが技術に残したものは大きく、行列分解による推薦は以後の標準的な道具になりました。行列分解とは、利用者と作品の評価を並べた大きな表を、利用者ごとの少数の数値と作品ごとの少数の数値の掛け合わせに置き換え、まだ評価のない欄をその掛け合わせで埋める方法です。Yehuda Koren、Robert Bell、Chris Volinskyが2009年にIEEE Computerに書いた解説は、行列分解が従来の近傍法より優れており、暗黙的なフィードバックや時間変化を取り込めることを整理しています。
ただし、経営として最も学ぶところが多いのは、その後の顛末です。Netflixのエンジニアが2012年に公開した資料は、優勝したアンサンブルを本番環境に載せなかったと明言しています。理由として挙げられているのは、社内での検証の結果、規模を拡大するには計算量が過大だったこと、そして期待できる改善が投じる開発工数に見合わなかったことです。同じ資料は、当時すでに関心が星評価の予測精度より影響の大きい別の課題へ移っていたとも述べています。本番で使われ続けたのは、コンペティションの過程で有効性が確かめられた行列分解と制限ボルツマンマシンという、比較的扱いやすい2つの手法でした。
ここから取り出せる読み方は二つあります。一つは、外部コンペティションから得られる本当の成果は順位ではなく、「何が効いて何が効かないか」の地図だという点です。Netflixは賞金を払って、自社の問題に対する探索を世界中の研究者に肩代わりさせ、有効な手法の当たりを付けました。もう一つは、評価指標と運用制約の乖離です。コンペティションの指標は予測誤差だけを見ますが、本番環境では計算コスト、保守性、他の施策との優先順位が同時に効きます。指標を1つに絞ると探索は進みますが、絞った指標で勝った解が、そのまま運用に載るとは限りません。この構造は、社内でPoCを設計するときにもそのまま当てはまります。
材料が外側で用意されたことを、経営としてどう読むか
ここまで見てきた1995年から2011年までを、投資の流れとして整理し直します。
検索と広告への投資は、Web規模のログと、それを処理するための分散ファイルシステムおよびMapReduceを生みました。この型が論文として公開され、Hadoopとして社外に実装されて、業界の共通基盤になりました。電子商取引への投資は、自社の巨大なシステムを外部に貸し出すという発想を経てクラウドを生み、計算資源を設備投資から運用費へ組み替えました。ゲームの描画性能を求める市場への投資は、単純な演算を大量に並列で回すチップを育て、CUDAによって描画以外の用途に開かれました。
いずれも、AIのために行われた投資ではありません。それぞれの事業上の理由で進められ、結果として深層学習の前提条件が揃いました。ここに、この章から取り出せる判断材料があります。
- 基盤への投資は、投資した本人が意図した用途の外側で効くことがある。効果測定を当初の目的だけで行うと、実際に生まれた価値を見落とす
- 技術の停滞に見える期間に、実は材料が積み上がっていることがある。2005年から2011年の画像認識は年に数ポイントの改善という地味な分野に見えたが、その裏でデータ・計算資源・評価基盤が同時に揃っていた
- データセットと評価指標を作る仕事は、アルゴリズムを作る仕事と同じかそれ以上に、分野の方向を決める
- 外部に問題を開く方式で得られるのは、優勝解そのものではなく、有効な手法の地図である。優勝解が運用に載らないことは失敗ではない
- 手法の高度さより、データの桁と試行回数のほうが成果を左右する場面が多い。手法選定の前に、データ量と実験単価を確認する
この章のまとめとして三点を残します。第一に、2012年以降の深層学習を可能にした大規模データ・並列計算資源・分散処理基盤は、AI研究の内側ではなく、検索・電子商取引・ゲームという別目的の投資が副産物として用意したものでした。第二に、BankoとBrillの実験が示したとおり、データ量の桁が変わると手法の優劣そのものが入れ替わるため、少量データでの手法比較だけでは、将来の判断材料として不十分になることがあります。第三に、ImageNetとNetflix Prizeが示したように、データセットと評価指標を用意して競争の場を作る仕事は、それ自体が研究を動かす力をもちます。2011年末の時点で、材料はすべて出そろっていました。その材料が組み合わさって何が起きたのかは、第7章で扱います。
この章を深めたい方への参考書籍
『Hadoop 第3版』(Tom White 著、Sky株式会社 玉川竜司・兼田聖士 訳、オライリー・ジャパン):本章で扱ったMapReduceとHadoopについて、成り立ちから実際の運用までを一冊で追える定番です。冒頭にHadoopの歴史をまとめた節があり、Nutchからの分離やApacheでの位置づけといった経緯を確認したい読者に向いています。分散処理を「難題を型に落とす」という観点から理解したい方にも役立ちます。
『データ指向アプリケーションデザイン 信頼性、拡張性、保守性の高い分散システム設計の原理』(Martin Kleppmann 著、斉藤太郎 監訳、玉川竜司 訳、オライリー・ジャパン):本章で個別に触れた分散ファイルシステム、分散データベース、バッチ処理といった要素を、設計原理として体系的に整理した一冊です。個々の製品名ではなく、その裏にある考え方を押さえたい読者に向いています。データ基盤の技術選定に関わる立場の方が、判断の軸を持つために読む本としても適しています。
『Googleを支える技術 巨大システムの内側の世界』(西田圭介 著、技術評論社):本章で扱ったThe Google File System、MapReduce、Bigtableの3本の論文を含む、Googleが公開した技術文書を日本語で解説した書籍です。原論文を直接読む前に全体像をつかみたい読者に向いています。刊行は2008年で内容は当時のものですが、この章が扱う時期の技術がどう組み合わさっていたかを理解する目的にはむしろ適しています。
第7章 深層学習の勃興
第6章では、Webの普及、大規模データの蓄積、分散処理、GPUによる並列計算といった材料が、AI研究の内側ではなく外側で整えられていった経緯を確認しました。本章が扱う2012年から2017年は、その材料が以前からあった手法と結びつき、ベンチマークの数字が短い期間で大きく動いた時期にあたります。
本章の結論を先に置きます。2012年に画像認識の精度を押し上げたAlexNetは、原理として新しい発明ではありません。畳み込みネットワークも誤差逆伝播も、それ以前から存在していた道具です。変わったのは、その道具に与えられたデータ量と計算資源でした。経営の観点に引き直すと、既存の手法が資源の閾値を超えた瞬間に、連続的でない成果が出ることがある、という話になります。だからこそ、社内で一度「試したが使えなかった」と結論した技術の棚卸しを、定期的にやり直す必要があります。
2012年、画像認識のベンチマークで起きたこと
まず、何が測られていたのかを確認します。ILSVRC(ImageNet Large Scale Visual Recognition Challenge)は、第6章で扱ったImageNetから切り出された1000クラスの部分集合を使い、画像を分類する精度を競う競技です。2010年から2017年まで毎年開かれました。分類タスクの評価指標は誤り率ですが、これは1位の予測が当たったかどうかではありません。モデルが上位5つの候補を出し、その中に正解が含まれていなければ誤りと数える、いわゆるtop-5誤り率です。この記事で以後「誤り率」と書くときは、断りのない限りtop-5を指します。
2012年の公式結果を見ると、優勝したのはトロント大学のAlex Krizhevsky、Ilya Sutskever、Geoffrey E. Hintonによるチーム、大会での登録名はSuperVisionで、誤り率は0.15315でした。同じチームが大会提供のデータだけで学習した提出は0.16422です。SuperVision以外のチームで最も成績が良かったのはISIの0.26172でした。彼らが同じ年のNIPSで発表した論文「ImageNet Classification with Deep Convolutional Neural Networks」の要旨には、ILSVRC-2012でtop-5テスト誤り率15.3%を達成し、これは2位の26.2%と比べて大きく低い、と明記されています。公式結果の0.26172を小数第1位に丸めれば26.2%ですから、論文と公式記録は一致しています。
10.9ポイントという差の大きさは、それまでの改善幅と並べると見当がつきます。同じ論文の表に、ILSVRC-2010のテストセットでの比較が載っています。大会当時の最良の成績はtop-1で47.1%、top-5で28.2%、その後に発表された最良の成績がtop-1で45.7%、top-5で25.7%でした。同じテストセットの上で、top-5の改善幅は2.5ポイントです。上位の手法はいずれも、SIFTのような人手で設計した特徴量とFisher Vectorを組み合わせ、複数の分類器の予測を平均する方式でした。SIFTは、画像の中で目印になりやすい点を選び、その周りの明暗の変化の向きと強さを、決まった手順で数値に直す方法です。Fisher Vectorは、1枚の画像から取れたそうした数値のまとまりを、画像全体を表す1本の長い数値の並びに要約する方法です。どちらも、何を手がかりにするかを人があらかじめ決め、手順として書き下したものにあたります。この延長線上で数ポイントを削り合っていた領域に、人が特徴量を設計する工程そのものを学習で置き換える方式が入り、2位との差が2桁ポイントになったのが2012年です。
ここで注意すべき点があります。この論文には、大会も条件も異なる誤り率が併記されているため、取り違えが起きやすくなっています。とくに紛らわしいのが、要旨の冒頭に出てくるtop-1 37.5%とtop-5 17.0%です。これは2012年の数字ではなく、テストセットの正解ラベルが公開されているILSVRC-2010で測ったものです。2つの大会の数値が1本の論文に同居しています。
| 大会と条件 | 指標と数値 |
|---|---|
| ILSVRC-2012、優勝した提出 | top-5で15.3%。7つのネットワークの予測を平均した構成で、うち2つはImageNetの2011年秋公開分で事前学習している |
| ILSVRC-2012、大会提供のデータのみで学習した提出 | top-5で16.4%。5つのネットワークの平均。単一のネットワークでは18.2% |
| ILSVRC-2012、SuperVision以外で最上位の提出 | top-5で26.2%。SIFTとFisher Vectorによる方式 |
| ILSVRC-2010のテストセット(論文の要旨の冒頭に出る数値) | top-1で37.5%、top-5で17.0%。2012年の数値ではない |
この取り違えは、原典に当たっても起こりえます。NeurIPSの論文一覧ページに掲載されている要旨は投稿時の版で、学習画像を130万枚とし、誤り率をtop-1で39.7%、top-5で18.9%と書いています。一方、最終版のPDFでは120万枚、37.5%、17.0%に変わっています。同じ論文の要旨が2種類流通しているため、一覧ページだけを見て引用すると数字がずれます。本章の数値はすべて最終版のPDFと、image-net.orgの公式結果ページの双方で照合しました。2位の26.2%についても、論文の記述と、公式結果のISIの0.26172を小数第1位に丸めた値が一致することを確認しています。
ベンチマークの数字を比較するときは、どの指標で、どのデータセットで、どのデータを学習に使ってよい条件で測ったのかまで見ないと、比較の意味が変わります。この読み方は、本章の最後でもう一度取り上げます。
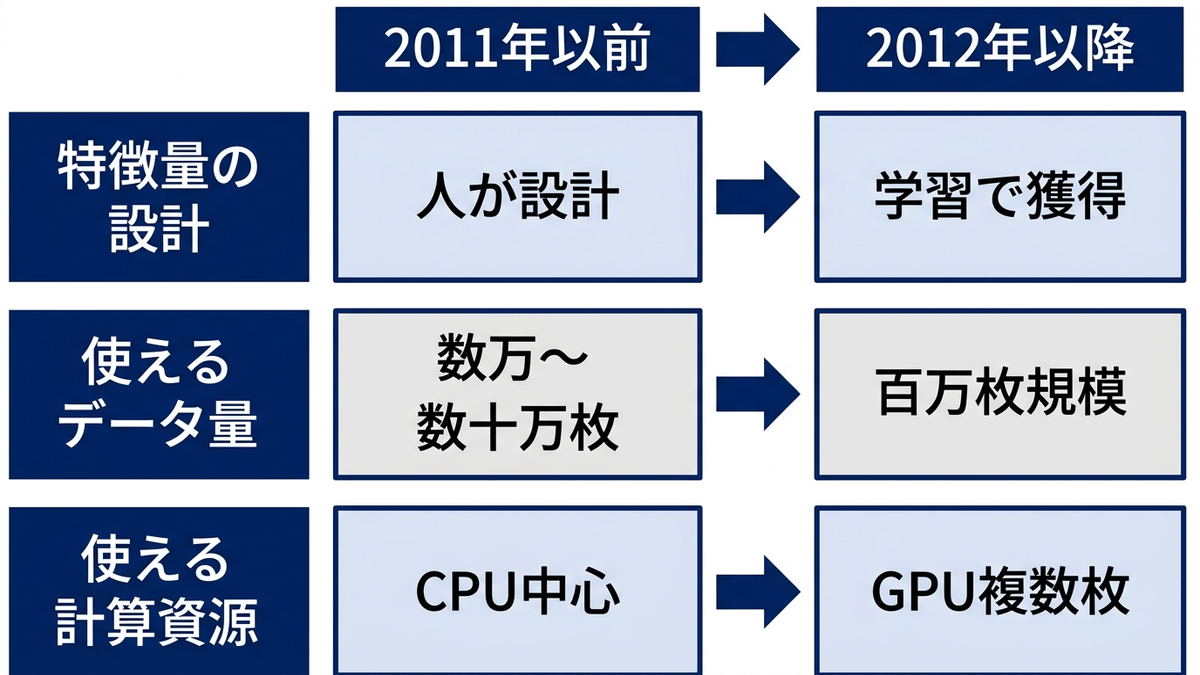
AlexNetの構成要素は、どれも新しくなかった
論文が自ら新規性として挙げた項目を並べると、この主張の意味がはっきりします。挙げられているのは、飽和しない活性化関数の採用、複数GPUにネットワークを分割する学習、局所応答正規化、重なりを持たせたプーリング、そして全結合層でのドロップアウトです。それぞれが何をするものかを整理します。
| 論文が挙げた項目 | 何をするものか |
|---|---|
| 飽和しない活性化関数の採用 | 活性化関数は、層が計算した値を次の層へ渡す前に通す変換です。出力が一定の範囲から外に出ない形の関数を使うと、入力を大きくしても出力がほとんど変わらない領域に入ります。この頭打ちの状態を飽和と呼びます。飽和すると、値をどちらへ動かせば誤差が減るのかという手がかりが小さくなり、学習が進みにくくなります。AlexNetが採った関数は、入力が0より大きい間は出力が入力に比例して増え続けるため、この頭打ちが起きません |
| 複数GPUにネットワークを分割する学習 | ネットワークを2つに割り、2枚のGPUに半分ずつ載せて同時に計算させる方式です。GPU1枚のメモリに収まらない大きさのモデルを扱うための措置で、その事情はこのあとの段落で扱います |
| 局所応答正規化 | 畳み込みの層は、画像の同じ位置について、模様の種類ごとの反応の強さを並べて出します。局所応答正規化は、その並びの中で近くにある反応どうしを見比べ、各々の値を周囲の反応の大きさで割ってそろえる処理です。周囲より突出して強く反応したものが際立ち、全体が一律に大きいだけの反応は抑えられます |
| 重なりを持たせたプーリング | プーリングは、畳み込みの出力を小さな区画に区切り、区画ごとに1つの値へまとめて、縦横の大きさを縮める処理です。区画の中の最大値だけを残す方式を最大プーリングと呼びます。模様の位置が少しずれても同じ値が出やすくなり、後ろの層が扱う数値の量も減ります。重なりを持たせるとは、区画をずらす幅を区画の一辺より小さく取り、隣り合う区画が一部重なるようにすることです。本章の後半で使うコードにある「nn.MaxPool2d」が、この最大プーリングにあたります |
| 全結合層でのドロップアウト | 全結合層は、前の層が出したすべての値を、次の層のすべての計算に渡す層です。近い画素だけを見る畳み込みの層と違い、入力の全体をまとめて受け取ります。ドロップアウトは、学習の途中で、その層が出す値の一部を毎回無作為に0へ置き換えて計算を進める操作です。特定の値の組合せに頼った答えの出し方ができなくなるため、学習に使ったデータには正しく答えられるのに初めて見るデータでは当たらないという状態、いわゆる過学習が起きにくくなります |
どれも、畳み込みネットワークと誤差逆伝播という既存の枠組みの内側にある改良で、学習の枠組みそのものを置き換えるものではありません。畳み込みと誤差逆伝播が1990年代までにどう積み上がったかは第5章で扱っています。
その畳み込みネットワークの層の組み方には、誤差逆伝播と結びつく前の先行例があります。1980年4月、NHK放送科学基礎研究所の福島邦彦が、Biological Cybernetics誌の第36巻第4号193ページから202ページに発表した、日本語にすれば「ネオコグニトロン:位置のずれに影響されないパターン認識の仕組みのための、自己組織化する神経回路モデル」となる題の論文です。日本語では、これに先立つ1979年10月に、電子通信学会論文誌Aの第62巻第10号658ページから665ページに、「位置ずれに影響されないパターン認識機構の神経回路モデル」と題し、ネオコグニトロンの名を副題に付けた論文が出ています。この巻号とページは、本稿の確認時点の国立情報学研究所のCiNiiの書誌によります。
1980年の論文の要旨によれば、ネオコグニトロンは視覚のパターン認識の仕組みを模した神経回路のモデルで、教師なしで自己組織化し、刺激パターンの位置に影響されずに、形の幾何学的な類似性に基づいて認識する能力を獲得します。構造は、ヒューベルとウィーゼルが提案した視覚神経系の階層モデルに似たものになります。入力層のあとに、2つの層を1組にしたモジュールが何段も縦続に接続されており、各モジュールの1層目はS細胞、2層目はC細胞と呼ばれる細胞で構成されます。S細胞への入力の結合は学習によって変化します。つまりS細胞は学習で入力の受け取り方を変える細胞で、C細胞は次の段落で見るように、結合を固定したままS細胞の反応を集める細胞です。要旨は、学習の後、最終層の各C細胞がただ1つの刺激パターンにだけ選択的に反応するようになり、その反応はパターンの位置にまったく影響されず、形や大きさの小さな変化にも影響されなかった、と報告しています。
この構成が畳み込みとプーリングに相当することは、福島自身が2019年に医用画像情報学会雑誌の第36巻第2号に書いた総説「ネオコグニトロンと畳み込みニューラルネットワーク」で説明しています。同総説によれば、S細胞の層の中では、同じ細胞面(同じ性質の細胞を入力の位置関係を保って並べた面)に並ぶすべての細胞が同一の入力結合を共有しており、受容野(その細胞が反応する入力の範囲)の位置だけが細胞ごとに異なります。そのため各細胞面は畳み込みの演算を行っていることになります。C細胞は、受容野の位置がわずかに異なる複数のS細胞の反応を固定した結合で集め、特徴の位置ずれの影響を吸収します。同総説は、この操作は通常の畳み込みネットワークでプーリングと呼んでいる操作とほぼ同じであり、ただし最大値を取るのではなく平均化によって行っている、と書いています。本章の表で説明した最大プーリングとは、まとめ方が異なるということです。
違いは学習の方法にもあります。第5章で引いたシュミットフーバーの2015年の論文は、ネオコグニトロンを、畳み込みの層と間引きの層を交互に重ねる構成を導入したものとし、同論文の執筆時点で競技会の上位を占めていた、教師ありで学習する深層の畳み込みネットワークによく似ていると整理しています。そのうえで、福島は重みを教師ありの誤差逆伝播法ではなく、局所的な教師なしの学習則などによって決めていた、と区別しています。同じ論文は、1989年に誤差逆伝播法が、ネオコグニトロンに似た、重みを共有する畳み込みの層に適用されたとして、第5章で触れたヤン・ルカンらの1989年の論文を挙げています。2024年のノーベル物理学賞の選考委員会がまとめた科学的背景の文書も、ルカンとヨシュア・ベンジオが進めた、誤差逆伝播法で学習する多層の畳み込みネットワークについて、その構成はネオコグニトロンに根を持つと書いています。
整理すると、AlexNetに至る系譜は、1979年から1980年に示された層の組み方と、1980年代後半に結びついた誤差逆伝播による学習という、別々の研究の組み合わせとして読めます。2012年に効いたのは本章で見たデータ量と計算資源でしたが、その上に載った構造は30年以上前に日本の研究機関から発表されていました。社内で一度「使えない」と結論した技術でも、前提が変われば再評価が要る、という本章の冒頭の論点を、より長い時間幅で示す例です。
規模も、現在の基準では大きくありません。重み、つまり学習によって値が決まる数値を持つ層は8つで、畳み込みが5層、全結合が3層です。この学習で決まる数値をまとめてパラメータと呼びます。パラメータは6,000万個、入力を受け取って1つの値を出す計算の単位であるニューロンは65万個でした。学習は、当時市販されていたNVIDIA GTX 580を2枚、それぞれメモリ3GBという構成で行われ、120万枚の学習データを約90周するのに5日から6日かかったと論文に書かれています。データセンター規模の設備ではなく、研究室に置ける機材です。
むしろ興味深いのは、資源の制約が設計を決めていることです。論文は、GPU1枚のメモリが3GBしかないため、その上に載る大きさを超えるネットワークを学習するには2枚に分割するしかなかった、と説明しています。ネットワークを2つに割る構造は、理論上の要請ではなく、手元のハードウェアの制約から出てきた設計です。
データの側でも同じことが起きています。論文は、解像度がまちまちなImageNetの画像を256×256に縮小し、そこから224×224の領域を無作為に切り出し、左右反転も加えて学習させたと書いています。この操作だけで学習データの見かけ上の量が2,048倍になったと述べられています。パラメータ6,000万個のモデルを120万枚で学習させると過学習するため、データを人工的に増やす必要があった、という順序です。手法が先にあってデータが後から来たのではなく、モデルの規模とデータ量が互いを縛り合っている点は、実務でも同じ構造になります。
活性化関数についても同様です。論文はNairとHintonの呼び方に従って \( f(x)=\max(0,x) \) という関数をReLU(Rectified Linear Unit)と呼んでいます。そして、出力が一定の範囲に収まるtanhという関数を使った同等のネットワークと比べて、10種類の物体を写した小さなカラー画像のベンチマークであるCIFAR-10で訓練誤差25%に到達するまでの速さが6倍だったという実測を示しています。精度そのものを直接引き上げる仕掛けではなく、学習を速くする仕掛けです。速くなれば、限られた時間でより大きなモデルを、より多くのデータで回せます。効いたのは速度を通じた規模でした。
画像より先に成果が出ていた領域:音声認識
2012年の画像認識が広く知られているため、深層学習の実用がそこから始まったように見えることがあります。実際には、音声認識のほうが先でした。2012年、IEEE Signal Processing Magazineの第29巻82ページから97ページに、「Deep Neural Networks for Acoustic Modeling in Speech Recognition: The Shared Views of Four Research Groups」という論文が掲載されています。HintonとLi Dengらが名を連ね、その名のとおり4つの研究グループが共通して得た知見をまとめたものです。要旨には、多数の隠れ層を持つニューラルネットワークを新しい方法で学習させた音響モデルが、それまで標準だったガウス混合モデルを上回ることが示された、と書かれています。
音声認識が先行した理由を、この論文の記述だけから断定することはできません。ただ、事実として確認できるのは、画像のベンチマークが騒がれるより前に、複数の研究組織が独立に同じ方向の成果を得て、それを共同でまとめる段階に達していたことです。経営の観点では、ここは実務的な示唆になります。自社が関心を持つ領域で「まだ話題になっていない」ことは、「まだ何も起きていない」ことを意味しません。話題の量と実装の成熟度は、しばしば数年ずれます。関心のある領域では、報道ではなく学会や業界誌の総説を定点で見るほうが、判断の材料としては早く手に入ります。
手元のコードで確かめる:データ量と畳み込みの効き方
ここまでの主張は、手元で回せる小さな実験でもある程度まで確かめられます。使うのはscikit-learnに同梱されているload_digitsで、8×8画素の手書き数字が1,797枚、10クラス、各画素は0から16の整数です。全体を学習1,257枚と評価540枚に分けました。乱数の種は20260902に固定しています。
from sklearn.datasets import load_digits
from sklearn.linear_model import LogisticRegression
from sklearn.neural_network import MLPClassifier
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

SEED = 20260902
digits = load_digits()
X, y = digits.data, digits.target

X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=SEED, stratify=y)
scaler = StandardScaler().fit(X_tr)
X_tr_s = scaler.transform(X_tr)
X_te_s = scaler.transform(X_te)

models = {
    "ロジスティック回帰": LogisticRegression(max_iter=5000, random_state=SEED),
    "浅いNN(隠れ層32)": MLPClassifier(
        hidden_layer_sizes=(32,), max_iter=3000, random_state=SEED),
    "深めのNN(128-64-32)": MLPClassifier(
        hidden_layer_sizes=(128, 64, 32), max_iter=3000, random_state=SEED),
}
for name, model in models.items():
    model.fit(X_tr_s, y_tr)
    print(name, model.score(X_te_s, y_te))
全データで学習したときの結果は次のとおりです。パラメータ数を約30倍に増やしても、テスト精度は動きませんでした。
| モデル | パラメータ数 | 学習時間(実行環境による) | 訓練精度 | テスト精度 |
|---|---|---|---|---|
| ロジスティック回帰 | 650 | 0.02秒 | 0.9992 | 0.9648 |
| 浅いニューラルネット(隠れ層32) | 2,410 | 0.38秒 | 1.0000 | 0.9722 |
| 深めのニューラルネット(128-64-32) | 18,986 | 0.84秒 | 1.0000 | 0.9722 |
次に、学習に使う枚数を変えて同じ3つのモデルを学習させました。こちらは大きく動きます。
| 学習枚数 | ロジスティック回帰 | 浅いNN(隠れ層32) | 深めのNN(128-64-32) |
|---|---|---|---|
| 63 | 0.8685 | 0.8241 | 0.8444 |
| 126 | 0.9315 | 0.8981 | 0.9093 |
| 251 | 0.9278 | 0.9241 | 0.9333 |
| 503 | 0.9667 | 0.9537 | 0.9537 |
| 880 | 0.9648 | 0.9704 | 0.9759 |
| 1,257 | 0.9648 | 0.9722 | 0.9722 |
浅いニューラルネットは、63枚では0.8241、1,257枚では0.9722でした。誤り率でいえば17.6%から2.8%へ、6分の1以下に下がっています。深めのネットワークも同様に0.8444から0.9722へ動きました。一方、層を増やすことによる差は、どのデータ量でもほとんど出ていません。表現力を増やすより、データを増やすほうが効いたという結果です。
この実験は、AlexNetの跳ね方を説明するものではありません。8×8画素の数字10種類という問題は、深いネットワークの表現力を必要とするほど複雑ではないからです。むしろ読み取るべきは、逆の含意です。手法だけを差し替えても、問題とデータの条件が伴わなければ数字は動かない。2012年に起きたことは、手法の側だけを見ていては説明がつかず、条件の側で何が変わったかを見なければ理解できない、ということになります。
もうひとつ、畳み込みという仕組みが何を持ち込んでいるのかを確かめます。PyTorchで、パラメータ数をおおよそそろえた小さな畳み込みネットワークと全結合ネットワークを用意し、同じ最適化条件で学習させました。CPUのみの環境です。
import torch
import torch.nn as nn

class SmallCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.body = nn.Sequential(
            nn.Conv2d(1, 8, kernel_size=3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(8, 16, kernel_size=3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
        )
        self.head = nn.Linear(16 * 2 * 2, 10)

    def forward(self, x):
        h = self.body(x.view(-1, 1, 8, 8))
        return self.head(h.flatten(1))

class SmallMLP(nn.Module):
    def __init__(self, hidden=28):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(64, hidden), nn.ReLU(),
            nn.Linear(hidden, 10),
        )

    def forward(self, x):
        return self.net(x.flatten(1))
コードの中の「nn.Conv2d」が畳み込みの層、「nn.MaxPool2d」がAlexNetの新規性として挙げた最大プーリングにあたります。引数の2は、縦横2画素ずつの区画にまとめ、縦横の大きさを半分にすることを指定しています。AlexNetのように区画を重ねる設定はここでは使っておらず、区画は重ならずに並びます。「nn.Linear」が全結合層で、SmallMLPは全結合層だけを2つ重ねた構成です。「nn.ReLU」が、飽和しない活性化関数として挙げたReLUです。
パラメータ数は畳み込み側が1,898個、全結合側が2,110個です。3つの乱数の種で学習し、平均を取りました。全学習データを使ったときの平均正解率は、畳み込みが0.9753、全結合が0.9735で、差は0.0019にとどまりました。
差がはっきり出たのは、別の操作を加えたときです。64個の画素を固定の順序で入れ替え、画像として隣どうしが近いという関係を壊したデータで、同じ2つのモデルを学習させました。情報量は変わっていません。人間には読めなくなりますが、機械にとっては同じ数字の並びです。結果は、畳み込み側が0.9753から0.9562へ0.0191下がり、全結合側は0.9735から0.9728へ0.0006しか下がりませんでした。scikit-learnの深めのネットワークでも同じ操作を行い、0.9722から0.9704と、ほぼ変化しませんでした。
この差の意味は明確です。畳み込みは、汎用の性能向上策ではなく、「入力は画像であり、近い画素どうしは関係が深く、同じ模様は位置が違っても同じ意味を持つ」という前提をモデルの構造に埋め込む仕掛けです。その前提が成り立つ問題では有利になり、成り立たない問題では有利さが消えます。8×8画素の数字では前提の価値が小さいため差はわずかですが、AlexNetが扱った224×224画素の自然画像では、この前提の価値がはるかに大きくなります。手法の優位は、常に問題の性質とセットで語る必要がある、ということです。
言葉をベクトルにする:word2vec
画像から少し離れます。2013年1月16日、Tomas Mikolov、Kai Chen、Greg Corrado、Jeffrey Deanによる論文「Efficient Estimation of Word Representations in Vector Space」がarXivに公開されました。単語を連続値のベクトルとして表す2つのモデル構造を提案したもので、要旨には、16億語のデータから高品質な単語ベクトルを1日未満で学習できると書かれています。実装はword2vecという名前で配布されました。
同年、Mikolov、Sutskever、Chen、Corrado、DeanによるNIPS 2013の論文「単語と句の分散表現とその構成性」が続きます。こちらは、高頻度語のサブサンプリングによる学習の高速化と、負例サンプリングによる高頻度語のベクトル精度の改善、そして複数語からなる表現の扱い方を扱っています。サブサンプリングは、どの文にも現れるような出現回数の多い語を、一定の割合で学習の対象から間引く操作です。負例サンプリングは、実際に一緒に現れた語の組を正しい例として与えるのに加えて、無関係な語をいくつか選んで誤った例として与え、その区別を学ばせる方式です。
ここで起きた変化を実務の言葉に置き換えると、単語の表し方が「1万語あれば1万次元のうち1か所だけが1になる疎な記号」から「数百次元の密なベクトル」に変わった、ということです。密なベクトルであれば、語と語の近さを計算でき、ある領域で学習した表現を別の課題に持ち込むこともできます。学習済みの表現を再利用するという発想が、テキストの領域で具体的な道具になりました。この発想が言語モデル全体の事前学習へと拡張されていく流れは第8章で扱います。
深さの競争と、ResNetが解いた問題
2012年以降のILSVRCは、層をどこまで深くできるかという競争の場になりました。公式結果で追うと、2013年の分類タスクの首位はClarifaiの0.11197、2014年はGoogLeNetの0.06656です。GoogLeNetは「Going Deeper with Convolutions」という論文で発表され、アーキテクチャの呼称はInception、大会に提出した構成は22層でした。同じ年、Karen SimonyanとAndrew Zissermanによる「Very Deep Convolutional Networks for Large-Scale Image Recognition」が3×3という小さなフィルタだけで16層から19層を積む構成を示し、分類で0.07325、位置推定では1位を取っています。
ただし、層を積めば積むほど良くなるわけではありませんでした。深くすると学習そのものが進まなくなる問題が立ちはだかります。これに対して2つの技術が効きました。ひとつは2015年2月に公開されたSergey IoffeとChristian Szegedyの「Batch Normalization」で、層への入力をミニバッチごとに正規化する処理をモデルの構造に組み込むものです。学習では、データを一度に全部使うのではなく、数十件から数百件のまとまりに区切って少しずつ計算を進めます。このまとまりがミニバッチです。正規化は、そのまとまりの中で値の平均と散らばり方をそろえる操作を指します。要旨には、同じ精度に到達するまでの学習ステップが14分の1になったと書かれています。
もうひとつが、2015年12月にKaiming He、Xiangyu Zhang、Shaoqing Ren、Jian Sunが公開した「Deep Residual Learning for Image Recognition」、いわゆるResNetです。各層に「入力からの差分だけを学習させ、入力そのものは迂回して先の層へ足し込む」という残差接続を導入しました。層が何も学習しなければ入力がそのまま通るため、層を増やしても性能が落ちにくくなります。論文は最大152層の構成を示し、VGGの8倍の深さでありながら計算量はより小さいと述べています。複数モデルを組み合わせた構成でImageNetのテストセット誤り3.57%を達成し、ILSVRC 2015の分類タスクで1位になりました。CIFAR-10では100層と1,000層の構成まで解析しています。この3.57%もtop-5です。公式結果ページのMSRAの記録0.03567と一致します。
その後、2016年はTrimps-Soushenの0.02991、2017年はWMWが検証データで2.3%という水準まで下がりました。ILSVRCは2010年から2017年まで開かれ、2017年が最後の開催になりました。
ここで数字の読み方に注意が必要です。「人間を超えた」という表現がこの時期に広まりましたが、その根拠となった人間側の数字には条件があります。ILSVRCをまとめた2015年の論文には、訓練を受けた注釈者による測定結果が載っています。500枚で練習したうえで1,500枚を判定した注釈者A1のtop-5誤り率は5.1%、同じサンプルでのGoogLeNetは6.8%でした。ところが、100枚しか練習していない別の注釈者A2の誤り率は12.0%です。5.1%という数字は、1,000クラスの分類体系を覚え込んだ1人の専門的な注釈者が1,500枚を判定した結果であり、一般的な人間の能力を表す定数ではありません。ベンチマークの数字を社内の意思決定に持ち込むときは、比較対象がどう定義されているかまで見ないと、期待値を誤ります。
なお、この時期に分野の見取り図として広く読まれた文書として、Yann LeCun、Yoshua Bengio、Geoffrey Hintonによる総説「Deep learning」が2015年5月28日にNature誌の第521巻436ページから444ページに掲載されています。この3人の仕事が後にどのように評価されたかは、第13章で扱います。
生成という使い道:GAN
分類の精度を競う流れとは別に、2014年6月にもうひとつの方向が開きます。Ian J. Goodfellow、Jean Pouget-Abadie、Mehdi Mirza、Bing Xu、David Warde-Farley、Sherjil Ozair、Aaron Courville、Yoshua Bengioによる「Generative Adversarial Nets」で、NIPS 2014で発表されました。日本語では敵対的生成ネットワークと呼ばれます。
仕組みは、2つのモデルを同時に学習させるというものです。生成モデルGはデータの分布を捉えようとし、識別モデルDは与えられた標本が学習データから来たのかGが作ったのかを判定しようとします。論文は、この枠組みがミニマックスの2人ゲームに対応し、GとDが任意の関数を取れる理想的な条件では、Gが学習データの分布を再現し、Dの出力がどこでも1/2になる解が一意に存在すると述べています。GとDを、全結合の層を重ねたネットワークである多層パーセプトロンで表せば、マルコフ連鎖、つまり前の状態から次の状態を確率的に作る操作を何度も繰り返して目当ての状態に近づける手続きを使わず、推論を近似するための別のネットワークも使わず、誤差逆伝播だけで全体を学習できます。
この論文の意義は、深層学習の用途を「入力を正しく分類する」から「もっともらしい標本を作る」へ広げたことにあります。同時に、新しい難しさも持ち込みました。分類であれば正解と突き合わせて精度を測れますが、生成では何をもって良いとするかが自明ではありません。生成物の品質を評価する方法の難しさは、この時期から現在まで続く論点です。画像生成の主流が拡散モデルへ移る流れは第9章で扱います。
囲碁と深層強化学習:DQNからAlphaGoへ
行動の正解を1つずつ教えるのではなく、行動の結果として返ってくる点数だけを手がかりに、良い行動の選び方を試行錯誤で見つける枠組みを強化学習と呼びます。この領域でも同じ時期に成果が出ています。2015年、DeepMindのVolodymyr Mnihらによる論文「Human-level control through deep reinforcement learning」がNature誌の第518巻529ページから533ページに掲載されました。deep Q-networkと名づけられたエージェントが、画面の画素とスコアだけを入力として学習し、49種類のAtari 2600のゲームに対して、同一のアルゴリズム、同一のネットワーク構造、同一のハイパーパラメータのまま、プロのゲームテスターに匹敵する水準に達したという内容です。ゲームごとに人が設計を変えていないという点が、この論文の主張の中心にあります。
翌2016年、David SilverとAja Huangらによる論文「深層ニューラルネットワークと木探索による囲碁の習得」がNature誌の第529巻に掲載されます。盤面の評価に価値ネットワーク、着手の選択に方策ネットワークを使い、これをモンテカルロ木探索と組み合わせる構成です。モンテカルロ木探索は、ある局面から先の手順を試しに打ち進める作業を何度も繰り返し、その結果を集計して、勝ちにつながった回数が多い手により多くの試行を割り当てていく探索方法です。訓練には2つの学び方を組み合わせています。ひとつは、人間の棋譜を使い、この局面ではこの手という正解を与えて学ばせる教師あり学習です。もうひとつは、自分どうしを対戦させ、勝敗という結果だけを手がかりに打ち方を改善する強化学習です。論文には、他の囲碁プログラムに対する勝率が99.8%、人間の欧州チャンピオンに5対0で勝ったと書かれています。
AlphaGoが組み合わせたモンテカルロ木探索も、2016年に新しく作られたものではありません。AlphaGoの論文の参考文献には、2006年に発表された2本の論文が並んでいます。1本目は、フランスのリールにあるシャルル・ド・ゴール大学やINRIAなどに所属していたレミ・クーロンの論文です。2006年5月29日から31日にイタリアのトリノで開かれた第5回のコンピュータと対局に関する国際会議、CG 2006で発表されました。題名を訳すと「モンテカルロ木探索における効率的な選択性と、値を上へ戻す演算子」です。論文集は2007年にSpringerのLecture Notes in Computer Scienceの第4630巻として刊行され、この論文は72ページから83ページに収められています。
要旨はまず、局面からの無作為な打ち進めを何度も行ってその結果を平均し、局面の良し悪しを見積もるモンテカルロ評価は、先読みの木の末端で評価関数として使える、と説明します。ここでいう値を戻すとは、木の末端で見積もった局面の評価を、親の局面へ順に伝えていき、根にあたる現在の局面での評価を決める計算のことです。要旨が対比の相手として挙げているのは、探索の段階を2つに分けるやり方です。根に近い部分では、相手も自分も最善を尽くす前提で求める先読みの値を戻し、ある深さから先では、無作為な打ち進めの結果の平均を戻す、という分け方です。この論文はそうした2つの段階を分けない枠組みを示し、代わりに、より一般的な値の戻し方を定義しました。試行の回数が少ないうちは結果の平均を値として使い、回数が増えるにつれて先読みの値の扱いへと徐々に移っていく、という戻し方です。この方式によって、木をどこまで伸ばすかを1回の試行ごとに細かく制御でき、有望な手に絞り込んだ探索ができるようになったと要旨は述べています。この方式は9路盤の囲碁プログラムCrazy Stoneに実装され、第10回のKGSのコンピュータ囲碁大会で優勝しました。
2本目は、ハンガリー科学アカデミーのコンピュータ・オートメーション研究所のレヴェンテ・コチシュとチャバ・セペシュヴァーリが、2006年9月18日から22日にベルリンで開かれた欧州機械学習会議、ECML 2006で発表した、日本語にすれば「バンディットに基づくモンテカルロ計画法」となる題の論文です。論文集はLecture Notes in Computer Scienceの第4212巻で、282ページから293ページに収められています。要旨によれば、状態の数が非常に多い意思決定の問題では、モンテカルロによる計画立案は、最適に近い解を見つけるための数少ない現実的な方法の一つです。この論文は、そのモンテカルロによる計画立案の進め方を、バンディット問題の考え方で導く新しいアルゴリズムUCTを提案しました。バンディット問題とは、当たりやすさが分からない複数の選択肢のうち、これまでの成績が良いものを選び続けることと、まだ試した回数が少ないものを試すこととの釣り合いをどう取るかを扱う問題です。要旨が対象としているのはマルコフ決定問題、つまり次の状態が現在の状態と選んだ行動によって確率的に決まる意思決定の問題です。論文は、そのうち先を考える段数が有限の問題と、将来の報酬を割り引いて扱う問題について、このアルゴリズムが試行を重ねるにつれて正しい答えに近づいていくことを示し、標本から生じる見積もりの誤差に上限を与え、いくつかの領域の実験で他の方法より大幅に効率が良いことを報告しています。
AlphaGoの論文の要旨は、囲碁が計算機にとって難しい理由として、探索空間の大きさと、盤面や着手を評価することの難しさを挙げています。2006年の2本は、この評価の難しさに対して、無作為に打ち進めた結果を集計して局面を見積もり、有望な手に試行を寄せていくという道を示したものです。AlphaGoの論文の要旨には、2つのネットワークだけで、先読みの探索を一切しなくても、数千局の無作為な自己対戦を模擬する最先端のモンテカルロ木探索のプログラムと同じ水準で打てた、とも書かれています。つまり2016年の時点で、モンテカルロ木探索は強さを比べる基準になるほど定着した技術でした。AlphaGoが新しく導入したと論文が述べているのは、モンテカルロによる模擬と、価値ネットワークおよび方策ネットワークを組み合わせた探索のアルゴリズムです。
AlexNetについて本章で確認したことと同じ構図が、囲碁でも見られます。外から見れば2016年に突然現れた成果も、10年前に発表された探索の方法と、学習した評価を組み合わせたものでした。成果の発表を受けて自社への応用を検討する際も、どの部分が新しく、どの部分が既にある技術なのかを分けて見ておくと、何が再現でき何が再現できないかの見通しを立てやすくなります。
DeepMindの公式ページによれば、この欧州チャンピオンとの対局は2015年10月のファン・フイとの対局で、結果は5対0でした。2016年3月にはソウルでイ・セドルと対局し、4勝1敗でAlphaGoが勝っています。2017年5月には中国の烏鎮でFuture of Go Summitが開かれ、当時の世界ランキング1位である柯潔と対局しました。DeepMindは同月27日の公式投稿で、この一連の対局が競技プログラムとしてのAlphaGoの到達点であるとし、以後は競技から離れて別の科学的課題に取り組むと述べています。
2017年10月18日、DeepMindはAlphaGo Zeroを公表しました。人間の棋譜を一切使わず、ルールだけを与えて完全にランダムな打ち方から自己対戦で学習する構成です。公式の説明によれば、3日間の自己対戦学習で、それまで公開されていたAlphaGoに100勝0敗としました。人間の知識を出発点にしないほうが強くなったという結果は、知識を人手で書き下すという1980年代の路線(第4章)と対照的です。
ただし、条件を落とさずに読む必要があります。囲碁は、ルールが完全に定まり、盤面がすべて観測でき、勝敗が明確に決まり、そして計算機の中で何百万局でも対戦を作れる領域です。この4つの条件が揃っているからこそ自己対戦だけで学習できます。事業上の意思決定の多くは、このどれも満たしません。囲碁での成果を自社の課題にそのまま重ねる読み方は、成果を過大に見積もることになります。
フレームワークと計算資源が普及の速度を決めた
手法が論文として公開されただけでは、産業に広がりません。この時期に起きたもうひとつの重要な変化は、実装と計算の共通部品が整ったことです。
時系列で並べると、まずTheanoがあります。モントリオール大学のBergstraらによる論文「Theano:CPUとGPUで動くPythonの数式コンパイラ」がSciPy 2010で発表され、論文には2008年1月から継続的に開発・利用されてきたと書かれています。数式をPythonで書けばCPUでもGPUでも動くコードに変換するという方式は、後続の枠組みに引き継がれました。
2014年にはCaffeが登場します。Yangqing Jiaらによる「Caffe: Convolutional Architecture for Fast Feature Embedding」で、カリフォルニア大学バークレー校のビジョン・学習センター(BVLC)が開発・保守していました。同じ2014年10月には、NVIDIAのSharan Chetlurらが「cuDNN: Efficient Primitives for Deep Learning」を公開します。深層学習で頻出する演算をGPU向けに最適化したライブラリで、論文にはCaffeに組み込むと標準的なモデルで36%高速化し、メモリ消費も減ったと書かれています。BLASが数値計算の共通基盤になったのと同じ役割を、深層学習で果たそうとしたものです。
2015年6月9日には、日本のPreferred Networksがオープンソースの枠組みChainerを公開しました。同社の技術ブログによれば、Pythonのライブラリとして提供され、ネットワークの構造を事前にメモリ上へ展開するのではなく、実際にPythonのコードを実行しながら計算の過程を記録する方式を採っています。この方式は後にDefine-by-Runと呼ばれ、条件分岐やループを含むモデルを素直に書けるという利点がありました。
同じ2015年の11月9日、GoogleがTensorFlowをApache 2.0ライセンスで公開します。前身は社内システムのDistBeliefで、社外と研究コードを共有しにくいという課題があったと説明されています。そして2017年1月、PyTorchが公開されました。公開から1年後にあたる2018年1月19日の公式ブログが、その日でちょうど1年になると書いています。
計算資源の側でも動きがありました。GoogleのNorman P. Jouppiらが2017年4月に公開した論文「In-Datacenter Performance Analysis of a Tensor Processing Unit」によれば、推論に特化した専用チップであるTPUは2015年からデータセンターで稼働していました。同時期のGPUやCPUと比べて平均で15倍から30倍速く、消費電力あたりの性能では30倍から80倍高いと報告されています。汎用のプロセッサを使い続けるのではなく、専用のハードウェアを設計して自社のデータセンターに入れる判断がなされていたわけです。
実務への適用も進みました。2014年、Ilya Sutskever、Oriol Vinyals、Quoc V. LeによるNIPS 2014の論文「Sequence to Sequence Learning with Neural Networks」が、多層のLSTMで入力系列を固定長のベクトルに写し、別のLSTMで出力系列を復号する方式を示し、WMT’14の英仏翻訳でBLEU 34.8を得ています。BLEUは、機械が出した訳文が、人手による訳文とどれだけ同じ語の並びを共有しているかで機械翻訳の質を測る指標です。2016年9月27日には、Googleが自社ブログで、ニューラルネットによる翻訳システムGNMTを中国語から英語への翻訳という難しい言語対で本番投入したと発表しました。人手による評価で、いくつかの主要な言語対において翻訳の誤りを55%から85%削減したと書かれています。同じ記事によれば、この言語対の翻訳は当時1日あたり約1,800万件でした。論文が出てから2年ほどで、研究の成果が日常的に使われる機能に入った例です。
企業側の動きとしては、Googleが2013年にHinton、Krizhevsky、Sutskeverが設立したDNNresearchを買収し、2014年1月にはDeepMindを買収したことが報じられています。買収額は報道によって数字が割れているためここでは扱いません。確かなのは、大学の研究室から出た技術と人材が、短期間で事業会社の内側に取り込まれたという事実です。
2012年から2017年の小年表
本章で扱った出来事を、年と意味の対応で整理します。全体の年表とは粒度を変え、この6年間に絞っています。
| 年 | 出来事 | 意味 |
|---|---|---|
| 2012 | ILSVRC 2012でSuperVision(AlexNet)がtop-5誤り率15.3%、他チーム最上位は26.2% | 人手で設計した特徴量から、学習で特徴量まで獲得する方式へ、ベンチマーク上で明確に逆転した |
| 2012 | 4研究グループ共著の音響モデル総説がIEEE Signal Processing Magazineに掲載 | 画像より先に音声で優位が確認されていた。話題の量と実装の成熟度はずれる |
| 2013 | word2vecの最初の論文が公開 | 語を密なベクトルで扱う道具が広く使える形で配られ、表現の再利用が現実的になった |
| 2014 | Caffeの論文とcuDNNが公開 | 実装と演算の共通部品が整い、追試と改良の速度が上がった |
| 2014 | GANの論文が公開。ILSVRCではGoogLeNetが0.06656、VGGが0.07325 | 用途が分類から生成へ広がり、同時に深さの競争が本格化した |
| 2015 | バッチ正規化とResNet(152層、top-5誤り3.57%)。DQNのNature論文 | 深いネットワークを安定して学習させる手段が揃い、強化学習にも波及した |
| 2015 | Chainer公開(6月9日)、TensorFlow公開(11月9日) | 企業が自社の学習基盤を外部に開き、実装の敷居が下がった |
| 2016 | AlphaGoがイ・セドルに4勝1敗(3月、ソウル)。GNMTを本番投入(9月) | 探索と学習の組合せ、系列変換の実用が同じ年に示された |
| 2017 | PyTorch公開(1月)。TPUの性能報告(4月) | 研究向けの道具と専用ハードウェアが揃い、開発と運用の両側が整った |
| 2017 | AlphaGo Zero公表(10月18日)。ILSVRCは2017年が最後の開催 | 人間の知識を出発点にしない学習が示され、画像分類のベンチマーク主導の時代が一区切りついた |
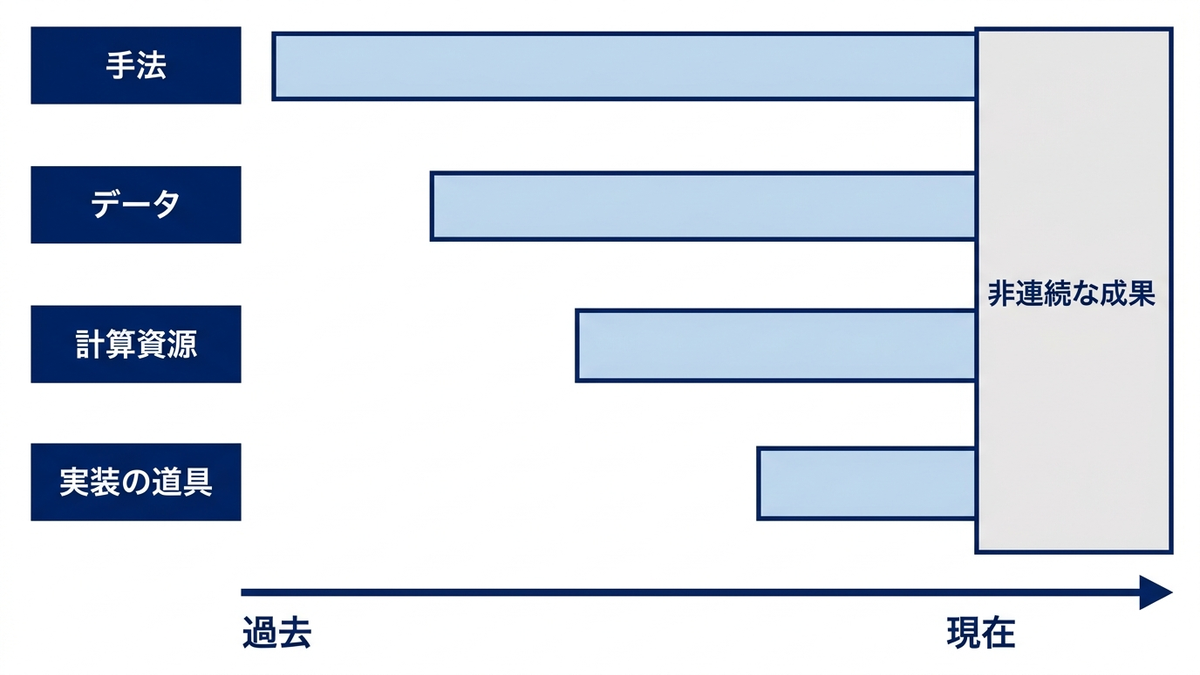
経営の観点:資源の閾値と、枯れた技術の再評価
本章の事実から、判断に使える読み方を3つ取り出します。
1つ目は、資源の閾値という考え方です。畳み込みネットワークも誤差逆伝播も、2012年より前から存在していました。にもかかわらず成果が出なかったのは、手法が間違っていたからではなく、必要なデータ量と計算量に届いていなかったからです。届いた瞬間、改善は連続的ではなく段差の形で現れました。この構造が意味するのは、「過去に試して駄目だった」という社内の結論には賞味期限がある、ということです。判断を下したときの前提、つまり当時使えたデータ量、計算資源、実装の道具を記録しておき、その前提が変わったときに再評価する仕組みを持つほうが合理的です。何をもって再評価のきっかけとするかを決めておくと、担当者の記憶に依存しなくなります。
2つ目は、ベンチマークの数字を条件込みで読むことです。本章では、同じ「15.3%」でも追加の学習データを使ってよい条件かどうかで意味が変わること、「人間の5.1%」が1,000クラスを覚え込んだ1人の注釈者による1,500枚の判定結果であること、練習量の少ない注釈者では12.0%になることを見ました。ベンダーの提案書や製品資料に載る精度も同じです。どのデータで、どの指標で、どの比較対象に対して測ったのかを確認しないまま数字を比べると、実際の運用では再現しません。指標の定義ひとつでも数字は大きく動きます。本章の表に載せたILSVRC-2010の数値は、同じモデルの同じ評価でtop-1が37.5%、top-5が17.0%と、20ポイント以上離れています。
3つ目は、道具の整備が普及の速度を決めるという点です。2012年に論文が出てから2017年までの間に起きたことの多くは、新しい原理の発見というより、既存の原理を誰でも試せるようにする作業でした。共通ライブラリ、GPU向けの最適化、公開された枠組み、専用ハードウェア。自社で技術を導入するときも同じ構造があります。手法の選定と同じくらい、それを回すための環境、データの整備、人が使える形の道具に投資しないと、成果は出ません。
本章では、既存の手法が大規模なデータと並列計算を得て性能が跳ねた2012年から2017年を確認しました。画像、音声、言語、生成、強化学習と対象は広がりましたが、この時期はまだ「課題ごとにモデルを作る」という枠組みの中にあります。大量のデータで一度大きく学習し、それを多くの課題に転用するという構造の転換は、Transformerと呼ばれる仕組みを起点として起こります。次の第8章では、その転換を扱います。
この章を深めたい方への参考書籍
『深層学習』(Ian Goodfellow、Yoshua Bengio、Aaron Courville 著、岩澤有祐・鈴木雅大・中山浩太郎・松尾豊 監訳、ドワンゴ):本章で名前を挙げた畳み込み、正則化、最適化、生成モデルといった要素を、数式を伴う体系として一通り確認できます。本章で「既存の部品の組合せだった」と書いた内容を、部品ごとに掘り下げたい読者に向いています。著者の1人は本章で扱ったGANの論文の筆頭著者です。
『ゼロから作るDeep Learning:Pythonで学ぶディープラーニングの理論と実装』(斎藤康毅 著、オライリー・ジャパン):本章の実験で使った全結合ネットワークと畳み込みネットワークを、外部のライブラリに頼らず自分で組み立てながら理解する構成です。畳み込みが何を計算しているのか、誤差逆伝播がどう流れるのかを手を動かして確かめたい読者に向いています。
『ディープラーニング革命』(テレンス・J・セイノフスキー 著、銅谷賢治 監訳、藤崎百合 訳、ニュートンプレス):本章で扱った2012年前後の転換を、そこに至るまでの研究者たちの取り組みとあわせて記述した一般向けの書籍です。技術の中身よりも、分野がどう動いてきたかという流れを押さえたい読者に向いています。
第8章 Transformerと事前学習
第7章では、2012年のAlexNet以降、画像・音声・囲碁の各領域で深層学習が成果を出し、あわせてCaffeやTensorFlow、PyTorchといった道具が揃っていく過程を確認しました。ただし、そこまでの成果には共通した前提があります。解きたい課題ごとにデータを集め、その課題のためのモデルを設計し、重みをゼロから学習させるという前提です。画像分類には画像分類のモデルがあり、音声認識には音声認識のモデルがあり、片方で得た成果をもう片方へ持ち込むことは限定的でした。
2017年から2021年にかけて起きたのは、この前提そのものの入れ替えです。大量のテキストで1つの大きなモデルを先に学習させておき、個別の課題にはそれを少し調整して当てる。場合によっては調整すらせず、指示と数個の例を文章として与えるだけで使う。この形が実用に耐えることが、5年のあいだに順を追って示されました。経営の観点で言えば、AIへの投資単位が「案件ごとのモデル開発」から「基盤となるモデルの利用と適応」に変わった期間です。内製すべき範囲の線引きが、ここで引き直されました。
本章では、起点となったTransformerの設計から、BERTとGPT系列がもたらした「先に学んでから転用する」形の定着、規模と性能の関係を数式で表した経験則、そして言語以外の領域への波及までを扱います。あわせて、注目の仕組みが実際には何を計算しているのかを、numpyで数式どおりに書いた最小のコードで確かめます。ChatGPTの公開と、そこから始まる一般への普及は第9章で扱います。本章は2021年までで区切ります。
2017年、再帰をやめるという設計
2017年6月12日、Google BrainとGoogle Researchの研究者らが「Attention Is All You Need」という論文をarXivに投稿し、同年のNIPS 2017で発表しました。著者はAshish Vaswani、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan N. Gomez、Łukasz Kaiser、Illia Polosukhinの8名です。Aidan N. Gomezの所属はトロント大学と記されており、論文には「著者の並び順は無作為である」という注記が付いています。
この論文が提案したTransformerは、それまで系列を扱う標準だった再帰型ニューラルネットワーク(RNN)と畳み込みの両方を使いません。抄録は、注目の仕組みだけに基づく構成であり、再帰と畳み込みを完全に取り払うと述べています。当時、機械翻訳の主流は再帰型のモデルに注目の仕組みを補助的に足したものでした。Transformerは、補助だった自己注意機構を本体に据え、再帰を削除したという構成です。
なぜ再帰を削ることが効いたのかは、論文のTable 1に整理されています。以下に出てくる \( O \) という記号は、扱う量が増えたときに計算の手間がどのくらいの勢いで増えるかを表す書き方です。系列の長さを \( n \)、表現の次元を \( d \) としたとき、自己注意の1層あたりの計算量は \( O(n^2 \cdot d) \)、逐次に実行しなければならない演算の数は \( O(1) \)、任意の2語のあいだの最大の経路長も \( O(1) \) です。これに対し再帰型は、1層あたり \( O(n \cdot d^2) \) で、系列の長さに対しては一次でしか増えないかわりに、表現の次元に対して二乗で効きます。逐次演算の数は \( O(n) \)、最大経路長も \( O(n) \) です。系列が次元より短い通常の設定では、計算量の面でも自己注意のほうが有利になります。つまり再帰型は、100語目を処理するために99回の逐次計算を待たなければならず、1語目の情報が100語目に届くまでに99段の伝言を経ます。自己注意は、どの2語も1回の行列演算で直接つながります。
この違いは訓練の効率にそのまま出ました。論文の基本モデルは8台のNVIDIA P100で12時間、大きい方のモデルで3.5日の訓練です。パラメータ数、つまり学習によって値が調整されるモデル内部の数値の個数は、基本モデルが6,500万、大きい方が2億1,300万でした。以降でモデルの規模を示す数値は、いずれもこの個数を指します。WMT2014の英語からドイツ語への翻訳で28.4のBLEUスコアを出し、当時の最高記録をアンサンブルを含めて2ポイント以上更新しています。BLEUは、機械翻訳の出力が人手による訳とどれだけ一致するかを0から100の範囲で表す指標で、値が大きいほど良い訳とされます。注目すべきは訓練にかけた計算量です。計算量はFLOPsという単位で示され、これは訓練の途中で行った浮動小数点演算、つまり小数を含む数どうしの計算の回数を数えたものです。大きい方のモデルが \( 2.3 \times 10^{19} \) FLOPsであるのに対し、それまで最高だったGNMT+RLのアンサンブルは \( 1.8 \times 10^{20} \) FLOPsでした。約8分の1の計算量で上回っています。「大きくしたから勝った」のではなく「同じ計算量でより多くを学べる形にした」という結果です。
自己注意が計算しているものを、最小の構成で確かめる
自己注意機構という言葉は難しく聞こえますが、計算そのものは平易です。各語について「他のどの語をどれくらい参照するか」という重みを内積で求め、その重みで他の語のベクトルを混ぜ合わせているだけです。式で書くと \( \mathrm{Attention}(Q,K,V) = \mathrm{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)V \) となります。\( Q \) はクエリ、\( K \) はキー、\( V \) は値で、いずれも入力ベクトルに別々の行列を掛けて作ります。
これをnumpyで数式どおりに書き、実際に動かしました。6語の短い文と4次元の手作りベクトルという最小構成です。4つの次元にはそれぞれ「生き物」「物体」「動作」「指示」という意味を割り当て、クエリを作る行列だけを人手で設計しました。学習で得た重みではありません。仕組みが見えることを優先しています。
import numpy as np

np.random.seed(20260902)

def softmax(x, axis=-1):
    x = x - np.max(x, axis=axis, keepdims=True)
    e = np.exp(x)
    return e / np.sum(e, axis=axis, keepdims=True)

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = K.shape[-1]
    scores = Q @ K.T / np.sqrt(d_k)
    if mask is not None:
        scores = np.where(mask, scores, -np.inf)
    weights = softmax(scores, axis=-1)
    return weights @ V, weights, scores

tokens = ["猫", "が", "机", "から", "降りた", "それ"]

# 4つの次元は順に 生き物 / 物体 / 動作 / 指示
X = np.array([
    [1.0, 0.2, 0.0, 0.0],   # 猫
    [0.0, 0.0, 0.0, 0.0],   # が
    [0.1, 1.0, 0.0, 0.0],   # 机
    [0.0, 0.0, 0.0, 0.0],   # から
    [0.0, 0.0, 1.0, 0.0],   # 降りた
    [0.0, 0.0, 0.0, 1.0],   # それ
])

# クエリを作る行列。何を探しに行くかを決めている
W_Q = np.array([
    [0.0, 0.0, 3.0, 0.0],   # 生き物 は 動作 を探す
    [0.0, 0.0, 2.0, 0.0],   # 物体   は 動作 を探す
    [4.0, 0.0, 0.0, 0.0],   # 動作   は 生き物 を探す
    [6.0, 0.0, 0.0, 0.0],   # 指示   は 生き物 を探す
])
W_K = np.eye(4)
W_V = np.eye(4)

out, weights, scores = scaled_dot_product_attention(X @ W_Q, X @ W_K, X @ W_V)
print(weights)
実行して得られた重み行列は次のとおりです。行が「見る側の語」、列が「見られる側の語」で、各行の合計は1になります。
| 見る語 | 猫 | が | 机 | から | 降りた | それ |
|---|---|---|---|---|---|---|
| 猫 | 0.095 | 0.095 | 0.095 | 0.095 | 0.523 | 0.095 |
| が | 0.167 | 0.167 | 0.167 | 0.167 | 0.167 | 0.167 |
| 机 | 0.123 | 0.123 | 0.123 | 0.123 | 0.387 | 0.123 |
| から | 0.167 | 0.167 | 0.167 | 0.167 | 0.167 | 0.167 |
| 降りた | 0.586 | 0.079 | 0.097 | 0.079 | 0.079 | 0.079 |
| それ | 0.790 | 0.039 | 0.053 | 0.039 | 0.039 | 0.039 |
「それ」の行を見ると、重みの0.790が「猫」に向いています。「降りた」の行では0.586が「猫」に向きます。指示語が指す先を、内積の大きさだけで拾えていることが分かります。ここで効いているのが、クエリとキーを別々の行列で作るという設計です。「それ」のベクトルは指示の次元にしか値を持たないため、そのままキーと内積を取ってもどの語にも一致しません。クエリを作る行列が「指示の次元を、生き物の次元へ向けたクエリに変換する」ことで、はじめて「それ」が「猫」を探せるようになります。何と何を結びつけるかは、この射影行列が担っており、そこが学習の対象になります。
機能語である「が」と「から」の行は、6語に均等な0.167が並びます。設計上どの語とも内積が0になるためで、特定の語に寄らない状態がそのまま重みに出ています。
同じ考え方のコードで、次の3点も確かめました。1つ目は \( \sqrt{d_k} \) で割る理由です。次元 \( d_k \) を4から1024まで変え、16語のうち1語に付く最大の重みを2000回ずつ平均しました。
| 次元 \( d_k \) | 内積の標準偏差 | \( \sqrt{d_k} \) | 最大の重み(割らない) | 最大の重み(割る) |
|---|---|---|---|---|
| 4 | 2.081 | 2.000 | 0.428 | 0.237 |
| 16 | 3.999 | 4.000 | 0.685 | 0.247 |
| 64 | 8.030 | 8.000 | 0.842 | 0.247 |
| 256 | 16.350 | 16.000 | 0.920 | 0.246 |
| 1024 | 32.554 | 32.000 | 0.961 | 0.244 |
内積の標準偏差が \( \sqrt{d_k} \) にほぼ一致しています。割らない場合、次元が上がるにつれて重みが1語に張り付き、1024次元では平均0.961まで達します。16語に均等なら0.0625ですから、ほとんど1点に集中している状態です。こうなるとsoftmaxの勾配がほぼ消え、学習が進まなくなります。割った側は次元によらず0.24前後で安定しました。式の中の \( \sqrt{d_k} \) は美観ではなく、学習を成立させるための処置です。
2つ目は、自己注意そのものには語順の概念がないという点です。6語の並びを入れ替えて同じ計算をしたところ、重み行列は元の行列を同じ順に並べ替えたものと完全に一致しました。位置の情報は注目の仕組みの外から足す必要があり、そのために論文は正弦と余弦を使った位置エンコーディングを導入しています。実際に位置エンコーディングを足して再計算すると、重みが平均0.0797だけ変化しました。なお論文は、学習で得る位置埋め込みに置き換えてもほぼ同じ結果になったと報告しています。
3つ目は、右側を見せないマスクです。自分より後ろの語のスコアを負の無限大に置き換えてからsoftmaxを取ると、重み行列は下三角になります。先頭の「猫」の行は自分自身への重みが1.000となり、末尾の「それ」の行は元のまま変わりませんでした。この処置の有無が、後に見るBERT系とGPT系を分ける大きな要素の1つになります。
図の中央は、クエリを作る行列だけを差し替えた2つ目のヘッドです。同じ入力に対して「猫」が「机」を、「机」が「猫」を強く見るという、1つ目とは別の関係を拾っています。実際のTransformerはこうしたヘッドを複数並べて結果を連結します。1つのヘッドだけでは拾える関係の種類が限られるため、係り受け、共参照、位置的な近さといった別々の関係を分担させる構成です。
並列化と長距離依存を、実行時間で確かめる
再帰をやめたことの効果は、計算量の記号だけでは実感しにくいところがあります。そこで、同じnumpy上で自己注意1層とRNN1層の前向き計算にかかる時間を実測しました。次元は64に固定し、系列長だけを変えています。各条件でウォームアップののち20回の平均を取りました。
| 系列長 | 自己注意(ミリ秒) | RNNの逐次計算(ミリ秒) | 系列長を2倍にしたときの自己注意の倍率 | 同じくRNNの倍率 |
|---|---|---|---|---|
| 128 | 0.37 | 0.53 | 比較の基準 | 比較の基準 |
| 256 | 1.42 | 1.32 | 3.80 | 2.49 |
| 512 | 4.99 | 1.65 | 3.51 | 1.25 |
| 1024 | 19.59 | 4.42 | 3.93 | 2.68 |
| 2048 | 72.52 | 10.42 | 3.70 | 2.36 |
読み取れることが2つあります。1つは、系列が短いうちは自己注意の方が速いことです。系列長128では自己注意が0.37ミリ秒、RNNが0.53ミリ秒でした。RNNは128回の小さな行列積を順番に実行するため、1回あたりの処理が軽くても呼び出しの積み重ねが効いてきます。自己注意は行列積2回とsoftmax1回で全語対を一度に処理するので、この待ち行列がそもそも存在しません。GPUのように多数の演算器を同時に動かせる装置では、この差はさらに開きます。Transformerが同じ計算量でより多くを学べたのは、装置を遊ばせない形になっていたからです。
もう1つは、系列が長くなると自己注意の時間が急に伸びることです。系列長を2倍にするたびに約3.5倍から3.9倍になっており、\( O(n^2) \) という理論値の4倍に近い増え方をしています。RNNは1.25倍から2.68倍で、こちらは \( O(n) \) に対応します。長い文章を一度に扱うほど自己注意のコストが不利になるという性質は、この時期の設計に一貫してついて回りました。長文脈を扱うための工夫と、その経営上の意味は第10章で扱います。
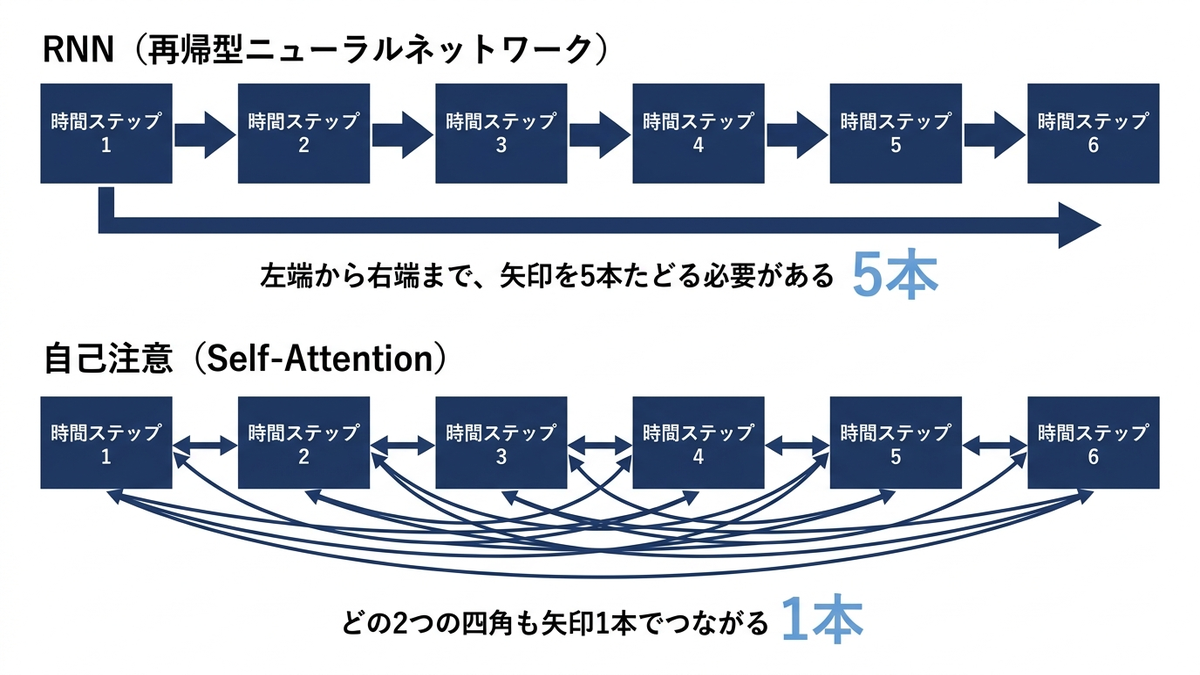
事前学習と転移が定着するまで
Transformerは当初、機械翻訳のための構造として提案されました。それが「まず大量のテキストで学習し、あとから個別の課題へ回す」という使い方に結びついたのは翌年です。
2018年2月、Allen Institute for AIとワシントン大学の研究者らが「Deep contextualized word representations」をarXivに投稿し、NAACL 2018で発表しました。ELMoという名で知られる手法です。それまでの単語ベクトルは1つの単語に1つのベクトルを割り当てていましたが、ELMoは双方向の言語モデルを大量のテキストで学習させ、その内部状態から文脈に応じたベクトルを作ります。同じ「はし」でも前後の語によって別のベクトルになるという発想で、6つの課題で当時の最高性能を更新しました。ここで示されたのは、大量のテキストで先に学習させた成果を、別の課題に持ち込めるということです。
同じ2018年、OpenAIのAlec Radfordらが「Improving Language Understanding by Generative Pre-Training」を発表しました。Transformerの復号側だけを積み、次の語を当てる課題で大量のテキストを学習させたうえで、下流の課題では出力層を1つ足して微調整するという構成です。12の課題のうち9つで当時の最高性能を更新しました。課題ごとに専用の構造を設計しなくても、共通の本体に薄い出力層を足すだけで届くという結果です。この最小のモデルは、翌年のGPT-2論文が「元のGPTと同等」と述べている1億1,700万パラメータの版にあたります。
そして2018年10月11日、GoogleのJacob Devlinらが「BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding」をarXivに投稿しました。GPTが左から右へ読むのに対し、BERTは左右両方の文脈を同時に使います。そのために、次の語を当てる課題の代わりに2つの事前学習課題を設計しました。文章はそのまま入力するのではなく、単語や単語の断片にあたる処理の単位へ区切ってからモデルに渡します。この単位をトークンと呼び、BERTはWordPieceという方式で区切ります。1つは、入力のWordPieceトークンの15%を選び、うち80%を[MASK]という特別な記号に、10%を無作為な語に置き換え、10%はそのままにしたうえで、元の語を当てさせるものです。もう1つは、2つの文を与えて後者が実際の次の文かどうかを判定させるもので、半分を実際の次文、半分を無作為な文にします。事前学習には8億語のBooksCorpusと25億語の英語版Wikipediaを使いました。
BERTは基本の版が1億1,000万パラメータ、大きい版が3億4,000万パラメータです。以下に出てくるGLUEは、文どうしの関係の判定や文の自然さの判定など複数の言語課題を集めた試験群で、その平均点で言語理解の力を比べます。MultiNLIは2つの文の関係を判定する課題、SQuADは文章を読んで質問に答える課題です。F1は、答えるべき内容をどれだけ拾えたかと、答えた内容がどれだけ正しかったかを合わせて1つの数にした指標で、これらはいずれも値が大きいほど成績が良いことを表します。結果は、GLUEのスコアを80.5%へ引き上げ、これは7.7ポイントの改善にあたります。MultiNLIの正解率は86.7%、SQuAD v1.1のテストF1は93.2、SQuAD v2.0のテストF1は83.1で、11の課題で当時の最高性能を更新しました。1つの事前学習済みモデルに出力層を1つ足すだけで、それまで個別に作られていたモデル群を横並びに置き換えたことになります。
翌2019年7月には、Facebook AIとワシントン大学の研究者らが「RoBERTa: A Robustly Optimized BERT Pretraining Approach」を発表し、BERTは大幅に学習不足であったと指摘しました。構造を変えず、学習の手順とデータ量を見直しただけで性能が伸びたという内容です。この時期、性能を決めていたのは新しい構造の発明ではなく、どれだけのデータをどれだけ学習させるかという運用側の判断に移りつつありました。
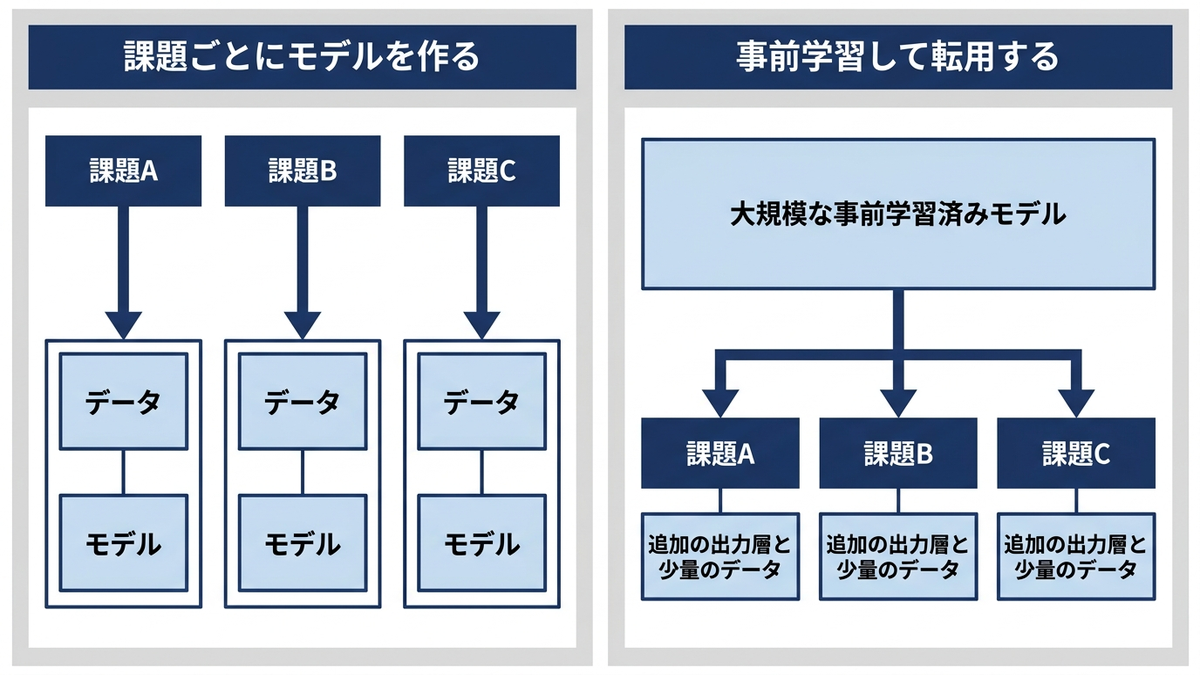
事前学習済みモデルを実際に開いてみる
事前学習済みモデルが誰でも扱える部品になったのは、公開された重みと、それを読み込むライブラリが揃ったからです。Hugging Faceが公開したTransformersライブラリの論文は2019年10月にarXivへ投稿され、EMNLP 2020のシステムデモ部門に採録されました。この道具の登場により、モデルの再現に必要な作業が数行のコードに縮みました。
本章でも実際に読み込んでみました。2度失敗したうえで、3度目に成功しています。1度目は選んだ小型モデルに高速トークナイザ用の語彙ファイルがなく、2度目は同モデルの設定ファイルに種別の記載がなかったためです。3度目に、BERTの基本の版そのものを指定して成功しました。
import torch
from transformers import AutoTokenizer, AutoModel

MODEL = "google-bert/bert-base-uncased"
tok = AutoTokenizer.from_pretrained(MODEL)
model = AutoModel.from_pretrained(MODEL, attn_implementation="eager")
model.eval()

print(sum(p.numel() for p in model.parameters()))   # 109482240

enc = tok("the cat did not jump onto the desk because it was too tired",
          return_tensors="pt")
with torch.no_grad():
    outputs = model(**enc, output_attentions=True)

print(len(outputs.attentions))              # 12  層の数
print(tuple(outputs.attentions[0].shape))   # (1, 12, 15, 15)
パラメータの実数は109,482,240でした。論文が記した1億1,000万という値と一致します。設定は12層、隠れ次元768、ヘッド数12で、これも論文の記載どおりです。注意の重みは12層それぞれについて、バッチ1・ヘッド12・クエリ15・キー15という形で取り出せます。
取り出した重みで、「it」が各層でどの語を強く見ているかを調べました。全ヘッドの平均を取り、上位の語を並べたところ、第5層、第7層、第9層、第10層、第11層で「cat」が上位3件に入りました。「it was too tired」の「it」が「cat」を指すという関係を、モデルが内部で結んでいる様子がうかがえます。ただし、より目立ったのは別の現象です。第5層以降、どの層でも最大の重みは文末の区切り記号[SEP]に向いており、最終層では12のヘッドのうち11のヘッドで「it」の最大の注意先が[SEP]でした。
これは既知の現象です。Kevin Clarkらは2019年6月の論文「What Does BERT Look At? An Analysis of BERT’s Attention」で、BERTの注意の驚くほど多くが区切り記号[SEP]に集まること、そしてこれをモデルが「何もしない操作」として使っていると解釈できることを報告しています。同論文は第6層から第10層でBERTの注意の半分以上が[SEP]に向かうと述べており、本章の実測もこれと整合しました。なお本章で見たのは1文だけであり、体系的な調査ではありません。
実務上の含意は明確です。注意の重みは、モデルが何を根拠にしたかの説明としてそのまま使えません。重みが大きいことは「そこを参照した」ことを必ずしも意味せず、行き場のない注意を捨てる先として区切り記号が使われている場合があります。説明可能性を求められる用途で「注意の重みを見せれば説明になる」と設計すると、根拠として成立しない図を出すことになります。
規模を増やすという方針
BERTが示したのは「事前学習して微調整する」形の有効性でした。ここから先、OpenAIは微調整をやめる方向へ進みます。
2019年2月、OpenAIは「Language Models are Unsupervised Multitask Learners」でGPT-2を発表しました。学習データのWebTextは、Redditで3カルマ以上を得た外部リンク4,500万件を集め、重複除去と整形を経て800万件超の文書、合計40GBのテキストにしたものです。評価データとの重複を避けるためWikipediaは除外しています。論文が訓練した4つの版のパラメータ数は1億1,700万、3億4,500万、7億6,200万、15億4,200万で、最小の版は元のGPTと同等、2番目に小さい版はBERTの大きい版と同等だと本文に明記されています。語彙は50,257、文脈長は512から1024へ広げました。
GPT-2で記録に残るのは性能よりも公開の仕方です。OpenAIは4つの版を一度に出さず、段階を踏みました。2019年2月に1億2,400万パラメータ版、5月に3億5,500万パラメータ版、8月に7億7,400万パラメータ版、そして11月に15億パラメータ版を公開しています。理由は、大きい版が偽情報の生成やなりすましに悪用される懸念でした。9か月の間隔を置いたことで、危険と便益の分析を進め、他の研究者にも対応の時間を与えられたと同社は報告しています。なお、公開されたチェックポイントの呼称(1億2,400万など)と論文Table 2の数値(1億1,700万など)は一致しません。数え方の違いによるもので、パラメータ数を引用するときはどちらの版の値かを確かめる必要があります。
2020年5月28日、OpenAIは「Language Models are Few-Shot Learners」を投稿しました。GPT-3です。第一著者はTom B. Brownで、著者は31名にのぼります。1億2,500万から1,750億まで8つの大きさを訓練し、最大の版は96層、\( d_{model} = 12288 \)、96ヘッドで、全モデルが3,000億トークンを学習しました。文脈長は2048です。
この論文が持ち込んだのは、微調整という手続きを使わない評価の枠組みでした。zero-shotは自然言語の指示だけを与える方式、one-shotは例を1つ、few-shotは数個から数十個の例を文脈の中に置く方式です。いずれも勾配の更新を行いません。従来の転移学習が「重みを書き換えて課題に合わせる」ものだったのに対し、こちらは「重みは固定したまま、入力の文章で課題を伝える」形です。
結果は、性能の高さよりも位置づけの方が重要です。SuperGLUEの平均で、当時の最高だった微調整済みモデルは89.0、微調整したBERTの大きい版は69.0、そしてGPT-3のfew-shotは71.8でした。GPT-3は各課題につき32個の例を文脈に入れただけで、勾配の更新は一切していません。専用に微調整したBERTを、微調整なしで上回ったことになります。最高記録には届いていませんが、「課題ごとにラベル付きデータを数千件用意して学習させる」という工程を飛ばして、その水準の手前まで到達したという事実が重く受け止められました。
使い方の形も同時に変わりました。GPT-3の重みは公開されず、2020年6月に始まったAPI経由で提供されます。2020年9月22日にはMicrosoftがGPT-3の独占ライセンスを取得したと発表し、そのブログの中でOpenAIが自社のAPIで引き続き提供することにも触れています。大規模な言語モデルについて、重みを自社に持たずにAPI経由で利用するという調達の形が、ここではっきりしました。
スケーリング則が投資計画に与えたもの
規模を増やせば性能が上がるという経験則自体は以前からありましたが、それを定量的な関係として書いたのが2020年1月23日投稿の「Scaling Laws for Neural Language Models」です。著者はジョンズ・ホプキンス大学とOpenAIのJared Kaplan、OpenAIのSam McCandlishら10名です。
この論文が示したスケーリング則は、交差エントロピー損失がパラメータ数・データ量・計算量のそれぞれに対して冪乗則に従うというものです。交差エントロピー損失は、次に来る語をモデルがどれだけ言い当てられていないかを表す値で、小さいほど予測が当たっていることを意味します。冪乗則は、一方の量を10倍にすると、もう一方が決まった倍率で変わるという形の関係です。埋め込みを除くパラメータ数を \( N \) とすると \( L(N) = (N_c/N)^{\alpha_N} \) で、\( \alpha_N \approx 0.076 \)、\( N_c \approx 8.8 \times 10^{13} \) です。データ量については \( \alpha_D \approx 0.095 \)、計算量については \( \alpha_C \approx 0.050 \) が報告されており、これらの傾向は7桁以上の範囲にわたって成り立つとされました。
経営の観点で意味があるのは、この式が予測に使えるという点です。7桁にわたって同じ式が当てはまるなら、投じる資源を10倍にしたときに損失がどこまで下がるかを、実際に訓練する前に見積もれます。研究開発の投資は「やってみないと分からない」性質を持つのが普通ですが、この領域については、規模と成果の関係が事前に計算できる形で示されました。きわめて大きな計算資源への投資が意思決定の俎上に載るようになった背景には、この予測可能性があります。
論文の係数をそのまま式に入れて描いたのが次の図です。実際に測った損失ではなく、公表された係数から計算した曲線である点は押さえておく必要があります。
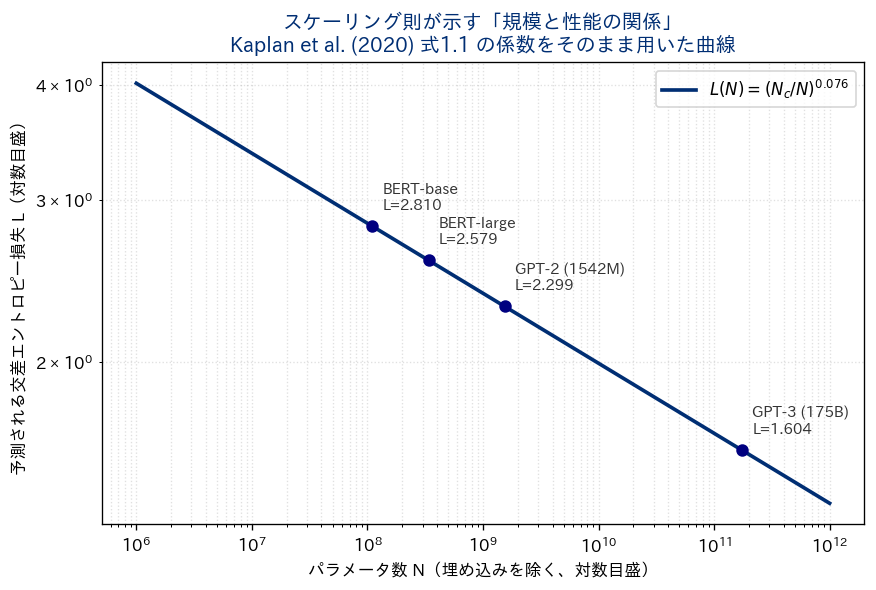
同時に、この式は限界も語っています。パラメータを2倍にしても損失は \( 2^{-0.076} \)、すなわち0.95倍にしかなりません。これは論文本文が明示している数字で、本章のコードでも0.9487と再現しました。損失を半分にするには約9,139倍のパラメータが必要になる計算です。BERTの基本の版からGPT-3までパラメータ数は約1,591倍に増えていますが、式が予測する損失は2.810から1.604へ、比にして0.57倍にとどまります。規模を増やせば必ず良くなるが、投じた資源に比べれば伸び方はゆるやかである、というのが冪乗則の中身です。
訓練の計算量で見ると、この時期の増え方が分かります。GPT-3論文の付録によれば、BERTの基本の版の訓練は \( 1.64 \times 10^{20} \) FLOPs、GPT-3の1,750億パラメータ版は \( 3.14 \times 10^{23} \) FLOPsでした。約1,900倍です。2年ほどのあいだに、1つのモデルを作るための計算量が3桁増えました。この規模になると、個々の企業が自前でこの種のモデルを一から訓練する意味は薄れます。内製すべきなのは大きなモデルそのものではなく、その上に載せる適応と評価の部分だという線引きが、ここではっきりします。
なお、資源の配分については後に修正が入りました。2022年3月、DeepMindの研究者らが「Training Compute-Optimal Large Language Models」で、計算量を固定したときはモデルの大きさと学習トークン数を同じ割合で増やすのが最適だと報告しています。700億パラメータのChinchillaが、同じ計算予算で4倍のデータを使い、より大きなモデルを上回りました。2020年の結論は「予算の増分の大半をモデルの大型化に回すべきだ」というものでしたから、方向が変わったことになります。規模と性能の関係が予測可能であるという枠組みは残り、最適な配分の中身は更新された、という理解が正確です。
言語の外側へ
Transformerと事前学習の組み合わせは、言語の中だけにとどまりませんでした。
2020年10月22日、Google Researchの研究者らが「An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale」を投稿し、ICLR 2021で発表しました。画像を小さな正方形に分割し、それぞれを単語のように扱ってTransformerに入れるという構成です。畳み込みは使いません。大量のデータで事前学習してから個別の課題へ回すという手順も、言語の場合と同じです。画像認識の標準だった畳み込みネットワークが、同じ枠組みで置き換えうることが示されました。
もう1つ、この時期に大きく報じられたのがタンパク質の立体構造予測です。2020年5月から9月に実施されたCASP14で、DeepMindのAlphaFold2が全ドメインの中央値でGDT_TS 92.4を記録しました。結果は2020年11月30日に公表されています。CASPは、タンパク質の立体構造予測の手法を共通の課題で比較する国際的な評価です。GDT_TSは、予測した立体構造が実験で確かめられた構造とどれだけ重なるかを0から100で表す指標で、100に近いほど正確であることを意味します。手法の詳細は2021年7月15日、Nature誌596巻583ページから589ページに「Highly accurate protein structure prediction with AlphaFold」として掲載されました。第一著者はJohn Jumperです。論文は、主鎖の精度が中央値0.96Åであり、次点の手法の2.8Åを大きく上回ったと報告しています。
成果の配り方も特徴的でした。2021年7月22日、DeepMindとEMBLはAlphaFold Protein Structure Databaseを公開し、35万件を超える予測構造を無償で提供しました。ヒトゲノムが発現する約2万のタンパク質すべてと、大腸菌やマウスなど20種の生物が含まれています。予測を売るのではなく、予測結果そのものを公共の資源として置くという形です。
AlphaFold2はTransformerをそのまま使ったモデルではなく、似たタンパク質の配列を並べて共通する部分を見る多重配列アラインメントなど、生物学の知識を織り込んだ独自の構造を持ちます。ただし、注目の仕組みを中核に据え、大量の既知構造で学習してから未知の配列に当てるという設計思想は共通です。深層学習の成果が、論文の指標ではなく科学の実務そのものを動かした例として、この時期を代表する出来事といえます。
この仕事は2024年のノーベル化学賞の対象になりました。受賞の理由と、学術賞がこの分野の位置づけに与えた影響、そして受賞が何を意味しないかは、第10章で扱います。
経営から見た構造転換
2017年から2021年の5年間を、経営の判断に関わる形で整理しておきます。
| 年 | 出来事 | 意味 |
|---|---|---|
| 2017 | 「Attention Is All You Need」の投稿とNIPS 2017での発表。基本モデルは8台のP100で12時間の訓練 | 再帰をやめたことで訓練を並列化でき、同じ計算量でより多くを学べる形になった |
| 2018 | ELMo、GPT、BERTが相次いで発表。BERTはGLUEを80.5%へ引き上げ、11課題で最高性能を更新 | 「事前学習して微調整する」形が課題を問わず通用することが示され、課題ごとの設計が不要になった |
| 2019 | GPT-2の段階的公開(2月・5月・8月・11月)。10月にGoogleが検索へBERTを導入 | 研究の成果が1年ほどで消費者向けの製品に入るようになった。同時に公開の是非そのものが論点になった |
| 2020 | 1月にスケーリング則、5月にGPT-3、6月にOpenAI APIの提供開始、9月にMicrosoftの独占ライセンス | 規模と性能の関係が予測可能になり、モデルを持たずAPIで調達するという形が現れた |
| 2021 | 7月にAlphaFoldのNature論文と構造データベースの公開。8月にStanfordが、広範なデータで学習して多様な用途に適応できるモデルを指す総称を提示 | 言語以外へ波及し、少数の大きなモデルに多数の用途が依存する構造が名前を与えられた |
この5年で変わったのは、AIへの支出の単位です。2016年までであれば、AIの導入とは「この課題のためのモデルを作る」ことでした。データを集め、教師ラベルを付け、モデルを設計し、学習させ、評価する。1つの課題に対して一式が必要で、次の課題では最初からやり直しになります。2021年時点では、多くの課題について「既にある事前学習済みモデルを選び、自社のデータで適応させ、評価する」形が現実的な選択肢になりました。作業の重心が、モデルの設計から、データの整備と評価の設計へ移っています。
2021年8月16日、Stanford大学のCenter for Research on Foundation Modelsは「基盤モデルの機会とリスクについて」と題する報告書を公開し、BERTやGPT-3のように広範なデータで学習され多様な下流課題に適応できるモデルを基盤モデルと呼ぶことを提案しました。報告書は、この語が「決定的に中心的でありながら未完成である性格」を示すためのものだと説明しています。少数のモデルに多くの用途がぶら下がる構造は、効率の面では利点ですが、そのモデルの欠陥や偏りが下流のすべてに伝播するという意味では集中リスクでもあります。この両面が最初から指摘されていたことは、ベンダー選定を考えるうえで押さえておく価値があります。
実務側の広がりも同じ時期です。2019年10月25日、GoogleのPandu Nayakは検索へのBERT導入を発表し、米国の英語検索の10件に1件で結果が変わると述べました。検索結果の配信にCloud TPUを使うのはこれが初めてだとも書かれています。2021年7月には、GitHubのコード補完機能を動かしているのがCodexという言語モデルの製品版であることが論文で明かされました。事前学習済みモデルが、研究の指標を競う対象から、日々使われる製品の部品へ移った期間だといえます。
本章で確認したのは3点です。1つ目は、Transformerが再帰を捨てて注目の仕組みだけで系列を扱う設計であり、その効果は並列化と、任意の2語を1段でつなぐ経路の短さにあること。2つ目は、大量のテキストで先に学習させたモデルを個別の課題へ回す形が2018年に定着し、課題ごとにモデルを作るという前提が崩れたこと。3つ目は、規模と性能の関係が冪乗則として定量化され、投資の見積もりが立つようになった一方で、その伸びは資源に比べてゆるやかであること。次の第9章では、ここまで研究と実務の内側にとどまっていた技術が、2022年末のChatGPT公開を境に誰でも触れるものへ広がっていく過程を扱います。
この章を深めたい方への参考書籍
『大規模言語モデル入門』(山田育矢 監修・著、鈴木正敏・山田康輔・李凌寒 著、技術評論社):本章で扱ったTransformer、BERT、GPT系列の仕組みを、実際に動かしながら順に追える一冊です。事前学習と微調整の関係を手を動かして確かめたい読者に向いています。
『機械学習エンジニアのためのTransformers』(Lewis Tunstall、Leandro von Werra、Thomas Wolf 著、中山光樹 訳、オライリー・ジャパン):原題は Natural Language Processing with Transformers で、著者にはHugging Faceの開発者が含まれます。本章で読み込んだライブラリを使い、事前学習済みモデルを自社の課題へ適応させる工程を具体的に知りたい読者に向いています。
『IT Text 自然言語処理の基礎』(岡﨑直観・荒瀬由紀・鈴木潤・鶴岡慶雅・宮尾祐介 著、オーム社):大学の教科書として書かれており、注目の仕組みや事前学習を、機械学習の基礎から積み上げて説明しています。本章では触れなかった構文解析や意味解析まで含めて、分野の全体像を体系的に押さえたい読者に向いています。
第9章 生成AIの一般化
第8章では、Transformerを土台にした事前学習と転移が、タスクごとにモデルを作るやり方を置き換えたことを確認しました。大きく学習した一つのモデルを、少数の例示や軽い調整で多様な仕事に振り向ける。この型は2021年までにほぼ固まっていました。ただし、その時点でモデルそのものを扱うには、開発者向けのAPI(他のソフトウェアからモデルの機能を呼び出すための窓口)に利用登録する必要がありました。OpenAIは2021年3月25日に、GPT-3を組み込んだアプリが300を超え、検索や対話などの機能を提供していると発表しています。モデルを直接扱うのはAPIに登録した開発者で、それ以外の人はそうしたアプリを通じて間接的に機能を使う、という形でした。
この章が扱う2022年から2024年は、同じ系統の技術が専門家以外の手元に直接届いた期間です。大規模な事前学習も、指示に従わせるための調整の方法も、2022年11月より前に論文として公開されていました。ChatGPTで新たに提供されたのは、そのうえに対話向けの追加調整を施したモデルと、誰でも無償で試せる対話画面の組み合わせです。この章では、技術の中身に加えて、誰がどれだけの手間で触れられるようになったかという到達範囲の変化に注目します。
経営の観点でこの3年を読むなら、技術の完成度だけでなく、利用者が最初に越えなければならない手間の大きさにも目を向ける必要がある、というのが弊社の考えです。同時に、出力に誤りが混じりうるという性質は、提供元自身が2022年の公開時にも2023年の技術報告でも明記しており、2024年までに解消されたと示す資料は本章の範囲では確認していません。業務に載せるなら、その前提で検証の工程を設計する必要があります。以下では、公開された一次資料でたどれる範囲に絞って順に見ていきます。
2022年11月30日に公開されたもの
OpenAIは2022年11月30日に、ChatGPTを研究プレビューとして公開しました。同日付の告知文の表題は「ChatGPT: Optimizing Language Models for Dialogue」です。告知文は、対話形式であることによって、追加の質問に答えたり、誤りを認めたり、前提の誤りを指摘したり、不適切な依頼を断ったりできると説明しています。あわせて、研究プレビューの間はChatGPTの利用が無償であることが明記されていました。
同じ告知文には、技術的な出自も書かれています。ChatGPTはInstructGPTの姉妹モデルであり、2022年の初めに学習を終えたGPT-3.5系列のモデルから微調整されたものだという記述です。微調整の元になったモデルは、公開の直前ではなく、その年の年初にはできあがっていたことになります。そのうえに、対話用に新しく作ったデータによる追加の調整が施されています(次の節で見ます)。公開日に提供されたのは、こうした対話向けの調整を施したモデルと、それを誰でも試せる画面の両方でした。
それまで同種のモデルを自分で直接使うには、APIの利用登録をして、プロンプトの与え方を学ぶ必要がありました。APIには試用画面も用意されていましたが、これも利用登録をした開発者向けのものです。ChatGPTの対話画面では、使い手は日常の言葉で用件を書けばよく、研究プレビューの間は試しても費用が発生しません。弊社では、試すまでの手間がこれだけ小さくなったことが、利用者が短期間に広がった背景の一つだと考えています。
経営の判断材料としては、次の形で使えると考えています。新しい技術の社内展開が進まないときは、技術の性能を問う前に、最初の一回を試すまでに必要な登録・承認・設定・習得の手数を確かめることが重要です。手数を1つ減らすと利用者がどれだけ増えるかを測った資料は、この章の範囲では確認できていません。それでもChatGPTの公開は、試すまでの手数を大きく減らした事例として参照できます。
2022年から2024年に起きたことの一覧
この章の範囲で、公式発表や論文で日付を確認できる出来事を並べます。粒度は記事全体の年表より細かく、この3年に限定しています。以降の節では、この表の各行が何を意味したのかを順に説明します。
| 年月 | 出来事 | 意味 |
|---|---|---|
| 2022年3月 | OpenAIがInstructGPTの論文を公開 | 指示に従わせる調整が、大きくすることとは別の効き方をすると示された |
| 2022年8月 | Stability AIがStable Diffusionを一般公開 | 画像生成モデルの重みが誰でも入手でき、手元の機材で動かせるようになった |
| 2022年11月 | OpenAIがChatGPTを研究プレビューとして公開 | 誰でも試せる対話画面が、研究プレビューの間は無償で提供された |
| 2023年2月 | MetaがLLaMAを研究用途に限定して公開 | 650億パラメータまでのモデルの重みが、個別審査を経て研究者に提供された |
| 2023年3月 | OpenAIがGPT-4を公開 | 画像とテキストの両方を入力として受け取るモデルが発表された。ただし画像の入力は当初、一般には提供されなかった |
| 2023年7月 | MetaがLlama 2を商用利用も可能な形で公開 | 重み公開モデルが業務の選択肢に入った |
| 2023年8月 | OpenAIがGPT-3.5 Turboの追加学習機能とChatGPT Enterpriseを提供 | 適応手段と企業向けの窓口が製品として整えられた |
| 2023年9月 | ChatGPTに音声入出力と画像入力が追加 | 入力が文字だけでなくなり、写真を見せて尋ねる使い方が可能になった |
| 2023年11月 | GPT-4 Turboが12万8千トークン(トークンは文章を処理のために区切った単位)の文脈長で発表 | 長い資料を分割せずに一度に渡せるようになった |
| 2023年12月 | GoogleがGeminiを発表、MistralがMixtral 8x7Bを公開 | 最初から複数種類の入力を前提にした設計と、少ない計算量で動く重み公開モデルが並んだ |
| 2024年3月 | AnthropicがClaude 3を発表 | 画像を読めるモデルが複数の提供元から出そろった |
| 2024年4月 | MetaがLlama 3を公開 | 15兆トークンを超える学習量の重み公開モデルが出た |
| 2024年5月 | GPT-4oが発表 | 文字・画像・音声を一つのモデルで扱う方向が示された |
| 2024年7月 | MetaがLlama 3.1の4050億パラメータ版を公開 | 重み公開モデルが最上位級に並ぶと提供元自身が主張する段階に入った |
対話という形式を支えた調整
ChatGPTの手触りを支えた要素として、指示への従い方を後から整える工程があります。この工程がモデルの大きさとは別に品質を動かすことは、次に見るInstructGPTの論文の結果で示されています。OpenAIは2022年3月4日に論文「Training language models to follow instructions with human feedback」を公開しています。手順は3段階です。まず、人手で書いた模範的な応答で教師あり微調整を行います。次に、同じ入力に対する複数の応答を人が良し悪しで並べ替え、その順位を再現する報酬モデルを学習します。最後に、その報酬モデルを使って本体を強化学習で調整します。強化学習は、1つずつ正解を示す代わりに、出した結果へ点数を与え、その点数が高くなる方向へ振る舞いを変えさせる学習の方法です。この一連の流れが人間のフィードバックによる強化学習、いわゆるRLHFです。
この論文で注目に値するのは、13億パラメータのInstructGPTの出力が、1750億パラメータのGPT-3の出力より、評価者に好まれたという結果です。パラメータ数はおよそ100分の1です。あわせて、真実性の改善と有害な出力の減少も報告されています。大きくすることだけが性能の源ではなく、何を良い応答とみなすかを人が示して揃える工程が、体感される品質を大きく動かすことが数字で示されました。
人の選好から学ぶという発想自体は、この時点で新しいものではありません。2017年6月12日に公開された論文「Deep reinforcement learning from human preferences」は、報酬関数を明示せず、行動の断片どうしを人が比較した結果だけで学習させる方法を示しています。この論文は、ゲームや模擬的なロボットの歩行といった課題で、エージェントの相互作用の1%未満に対する人のフィードバックで足りたと報告しています。言語モデルへの適用も、2022年より前に始まっていました。2019年9月18日に公開された論文は、文章の続きを書く課題と要約の課題で、人の比較結果から学んだ報酬を使って言語モデルを微調整しています。2020年9月2日に公開された論文は、同じ考え方で要約の品質を改善できることを示しました。2022年に新しかったのは、InstructGPTでこの方法が幅広い指示に従わせる調整に使われ、さらに対話の形式で誰でも試せるサービスに載ったことです。
ChatGPTの告知文自身も、InstructGPTと同じ方法を使い、データ収集の設定だけを少し変えたと述べています。学習の担当者が利用者役とAI役の両方を演じた会話を作り、そこから比較データを集め、近接方策最適化と呼ばれる手法で調整を繰り返した、という説明です。近接方策最適化は、点数が高くなる方向へ本体を更新しつつ、1回の更新で元の振る舞いから離れすぎないように変化の幅を抑える強化学習の手法です。ここから読み取れるのは、対話という接点は自然に生まれたのではなく、そのために人手でデータを作って作り込まれたものだ、ということです。
業務に置き換えると、既製のモデルを持ってきただけでは自社の望む応答にはならない、という含意になります。どのような答えを良しとするかは組織ごとに違い、その基準は誰かが言語化して例示しなければ機械に伝わりません。生成AIの導入で手間がかかるのは多くの場合この部分で、モデルの選定そのものではないように思います。
拡散モデルと画像生成
言語と並行して、画像の生成も2022年に一般の手に届きました。土台になったのは拡散モデルです。データに少しずつ雑音を加えて構造を壊していく過程と、それを逆にたどって構造を取り戻す過程を学習して生成に使う、という基本的な構成は、2015年の機械学習の国際会議ICMLで発表された論文が示していました。2020年6月19日に公開された論文「Denoising Diffusion Probabilistic Models」は、雑音の除去と結びつけた学習の工夫によって、この方式で高品質な画像を生成できることを示しました。CIFAR-10(評価に広く使われる、小さな画像を集めたデータセット)でInceptionスコア9.46、FID3.17という結果が報告されています。Inceptionスコアは、生成された画像の見分けやすさと種類の豊富さを1つの値で表す指標で、大きいほど良い成績です。FIDは、生成された画像の集まりが本物の画像の集まりからどれだけ離れているかを表す指標で、こちらは小さいほど良い成績になります。
ただし、この方式を画素の空間でそのまま動かすと計算量が重くなります。これを実用的な水準に下げたのが、2021年12月20日に公開され、CVPR 2022で発表された論文「High-Resolution Image Synthesis with Latent Diffusion Models」です。先に学習した自己符号化器で画像を圧縮し、その圧縮された表現の側で雑音の除去を行います。自己符号化器は、入力を一度小さく圧縮し、そこから元の入力を復元できるように学習させたモデルです。文章などの条件は交差注意の層から与えます。交差注意は、第8章で見た自己注意が同じ入力の中で語どうしの関係を計算するのに対し、文章と画像のように別々の入力のあいだで関係を計算する仕組みです。この構成により、画素の空間で動かす方式に比べて必要な計算資源が大きく下がりました。
そして2022年8月22日、Stability AIがStable Diffusionの一般公開を告知しました。告知文は、CreativeML Open RAIL-Mというライセンスのもとで、商用と非商用の双方の利用を許すこと、実行に必要なGPUメモリが6.9ギガバイトであること、望ましくない出力を既定で除くための安全分類器を同梱したことを述べています。実装のリポジトリは同年8月10日に作られています。ここで重要なのは、モデルの重みそのものが配布され、手元の一般的なGPUで動かせたことです。
言語モデルの側では、本章の冒頭で見たとおり、OpenAIのGPT-3はAPIへの利用登録を通じて提供されていました。重みが配られる言語モデルの流れは、後の節で扱います。画像生成の側では、Stable Diffusionが重みごと配られたことで、追加学習や差し替え、外部ツールとの組み合わせを利用者が手元で試せるようになりました。2022年には、画像生成のStable Diffusion(8月)と文章生成のChatGPT(11月)が、数か月の間をおいて相次いで一般に公開されています。
なお、画像生成の学習データをめぐる著作権上の論点は、この章では扱いません。制度と権利の議論は第12章にまとめてあります。ここでは、拡散モデルという生成の仕組みと、重みの配布という流通の形が2022年に揃った、という事実関係にとどめます。
入力の種類が増える
2023年からは、モデルが受け取る入力の種類が広がりました。OpenAIは2023年3月14日にGPT-4を公開しています。翌15日(協定世界時。日本時間では16日)にarXivへ投稿された技術報告は、GPT-4を画像とテキストの入力を受け取ってテキストを出力する大規模なマルチモーダルモデルと説明し、米国の統一司法試験を模した評価で受験者の上位およそ1割に相当する成績だったと報告しています。ただし3月14日のOpenAIの発表は、画像の入力はまだ研究プレビューの段階で、一般には提供されていないと明記していました。同じ3月14日、マイクロソフトは自社の検索サービスがGPT-4で動いていることを公式ブログで明らかにしました。
利用者側の画面に多様な入力が届いたのは、その半年後です。OpenAIは2023年9月25日に、ChatGPTに音声と画像の機能を段階的に導入すると告知しました。写真を見せて尋ねる、声で会話する、といった使い方がここで加わっています。続く2023年11月6日の開発者向けイベントでは、12万8千トークンの文脈長を持つGPT-4 Turboと、画像生成や音声合成を含む複数種類の入出力を扱う開発者向け機能が発表されました。文脈長は、モデルが一度に受け取って扱える情報量の上限で、文章をトークンという単位に分けて数えます。OpenAIは、12万8千トークンで300ページ超の分量を一度のプロンプトに収められると説明しています。ページ数への換算は提供元が示した目安です。
提供元は一社ではありません。Googleは2023年12月6日にGeminiを発表し、最初から複数種類の入力を前提に設計したこと、Ultra・Pro・Nanoの3つの規模を用意したことを述べています。Anthropicは2024年3月4日にClaude 3の3モデルを発表し、写真・図表・グラフ・技術図面といった視覚的な形式を扱えること、公開時点の文脈長が20万トークンであることを示しました。OpenAIは2024年5月13日にGPT-4oを発表し、マイクロソフトも同日、自社のクラウドのAzure OpenAI Serviceで、米国の2つのリージョンの試用画面からテキストと画像の入力を試せるプレビュー提供を始めたと告知しています。
業務の観点で意味が大きいのは、入力の前処理が減ることです。社内に蓄積されている資料の多くは、整形された表ではなく、PDF・スライド・写真・会議の録音といった形で存在します。これらを扱うために別のツールを組み合わせる必要が薄れると、着手までの工数が下がります。第7章で見た画像認識や音声認識の成果が、個別の専用システムではなく、汎用のモデルの入力口として統合された、と整理できます。
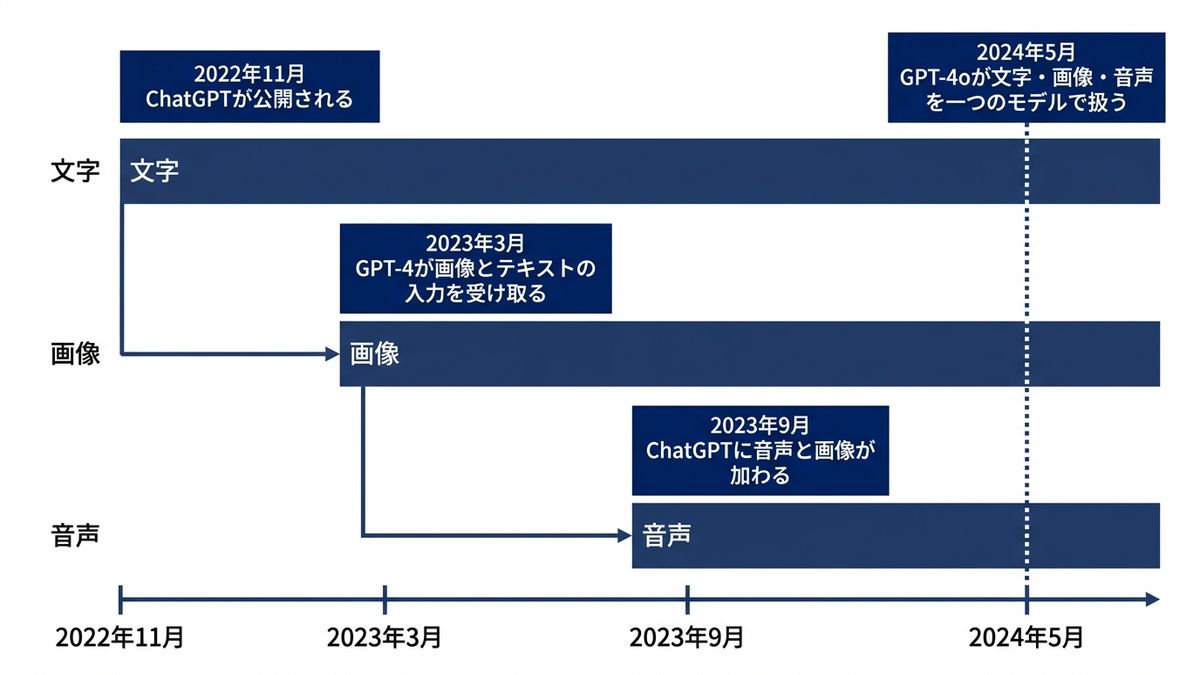
重みが配られるモデルという流れ
この3年のもう一つの流れが、学習済みの重みが配布されるオープンウェイトのモデルです。先行例としては、BigScienceという国際的な共同作業から生まれたBLOOMがあります。2022年11月9日に公開された論文によれば、1760億パラメータ、46の自然言語と13のプログラミング言語、合わせて59の言語を対象としています。
流れを大きく変えたのはMetaの一連の公開です。2023年2月24日、Metaは70億・130億・330億・650億パラメータの4種類からなるLLaMAを、非商用の研究向けライセンスで公開しました。提供は個別審査の形で、研究機関や産業界の研究部門などが対象でした。次の段階が2023年7月18日のLlama 2で、事前学習済みモデルと対話向けに調整したモデルの重みが、研究にも商用にも使える形で公開されています。規模は70億から700億パラメータです。
2023年後半には、少ない計算量で動く設計が並びました。Mistral AIは2023年9月27日にMistral 7BをApache 2.0ライセンスで公開し、同年12月11日にはMixtral 8x7Bを公開しています。後者は専門家の集合から一部だけを選んで使う疎な混合専門家という構成で、総パラメータ467億に対し、1トークンあたり実際に使うのは129億にとどまり、3万2千トークンの文脈を扱えると説明されています。Googleも2024年2月21日にGemma 2Bと7Bを公開し、Geminiと同じ研究と技術から作られたものだと述べています。
2024年に入ると規模が上がります。Metaは2024年4月18日にLlama 3の80億と700億パラメータ版を公開し、15兆トークンを超える事前学習を行ったこと、8192トークンの系列で学習したことを示しました。同年7月23日にはLlama 3.1として4050億パラメータ版を含む3種類を公開し、文脈長を12万8千トークンに広げたうえで、公開されている基盤モデルとして世界最大かつ最も高性能であると自ら述べています。
数の面では、Stanford大学のHAIがまとめたAI Index Report 2024が、2023年に149の基盤モデルが公開され、同報告の分類ではそのうち65.7%がオープンなものだったと集計しています。2022年は44.4%、2021年は33.3%でしたから、同報告の分類で見る限り、オープンとされるモデルの比率は上がっています。この比率は報告書側の分類によるもので、次に述べるOpen Source Initiativeの定義に適合した割合を示すものではありません。
用語には注意が要ります。重みが配られることと、オープンソースであることは同じではありません。オープンソースの定義を管理するOpen Source Initiativeは、2024年10月28日に版1.0として公表した「オープンソースAIの定義」で、重みだけでなく、学習と実行に使う完全なソースコードと、同等のシステムを作れる程度に詳しい学習データの情報も求めています。実際に配布されているモデルの多くは、重みと利用条件を示す独自ライセンスの組み合わせです。ベンダー選定の場面では、オープンという言葉が何を指しているのかを、ライセンス本文で確かめる必要があります。
経営の観点では、選択肢が二系統に分かれたと捉えるのが実務的です。外部のAPIを呼ぶ形は、初期の手間が小さく、モデルの運用と更新を提供元が担います。ただし、更新がどう届くかはモデルの指定の仕方によって異なります。たとえばOpenAIは2023年6月13日に、版を指定しないモデル名を使う利用者は同月27日に新しい版へ自動で切り替わること、旧版を指定すれば9月13日までは使い続けられることを告知し、版の変更が自社の用途にどう影響するかを比べる評価の仕組みも案内していました。どの形でも、版の切り替えが業務に与える影響を確かめる工程が要ります。重みを受け取って自社の環境で動かす形は、データを外に出さずに済み、利用条件の変更や提供終了の影響を受けにくくなりますが、動かすための計算資源と運用の担い手が要ります。どちらが優れているという話ではなく、扱うデータの機密度と、継続性をどこまで自前で担保したいかで決まります。
業務に合わせる二つの手段
既製の基盤モデルを自社の仕事に合わせる手段は、実務上おおむね二つに整理されます。一つは、答えるときに外部の情報源を参照させるやり方です。もう一つは、モデルそのものを追加で学習させるやり方です。
前者の考え方を早い時期に定式化したのが、2020年5月22日に公開され、NeurIPS 2020で発表された論文「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」です。この論文は、モデルの重みに埋め込まれた知識をパラメトリックな記憶、外部に置いた文書の索引を非パラメトリックな記憶と呼び、両者を組み合わせる構成を示しました。この構成が検索拡張生成、いわゆるRAGです。質問に応じて関連する文書を取り出し、その文書を入力に添えてから答えさせるため、モデルを学習し直さずに、参照する情報を差し替えられます。
後者については、全パラメータを更新する方式は費用が重いため、一部だけを更新する方法が広く使われるようになりました。2021年6月17日に公開された論文「LoRA: Low-Rank Adaptation of Large Language Models」は、事前学習済みの重みを凍結したまま、低ランクの行列を各層に差し込んで学習する方法を示しています。元の重みには手を付けず、重みに加える更新分だけを、二つの細長い小さな行列の積として表して学習します。大きな数値の表そのものを置き換えるのではなく、表に足し込む差分を少ない数値で表すため、学習で動かす数値の個数がその分だけ少なくなります。この論文は、1750億パラメータのGPT-3を全体更新する学習と比べ、学習対象のパラメータを1万分の1に、学習時のGPUメモリを3分の1に減らせるとしています。
GPT-3.5 Turboの追加学習は2023年に一般提供されました。OpenAIは2023年8月22日に、GPT-3.5 Turboの追加学習が利用可能になったと告知しています。この告知には、指示の守り方が揃う、出力の形式が安定する、口調を寄せられる、といった用途が挙げられ、指示をモデル側に埋め込むことでプロンプトを最大9割短くした利用者がいるとも書かれています。あわせて、追加学習はプロンプトの工夫や情報検索、関数呼び出しと組み合わせたときに最も効果を発揮する、と提供元自身が述べています。
前の段落で引いた最後の一文は、実務上の要点を言い当てています。二つの手段は排他ではなく、目的が違います。おおまかには次のように整理できます。
| 観点 | 検索を接続する方式 | 追加学習する方式 |
|---|---|---|
| 変えられるもの | 答えの根拠になる情報 | 答え方の形式・口調・手順の守り方 |
| 情報が更新されたとき | 参照先の文書を差し替えれば反映される | 原則として学習をやり直す必要がある |
| 根拠の提示 | 参照した文書を出力に添えられる | どこから来た表現かは示しにくい |
| 主な準備物 | 整理された文書群と検索の仕組み | 入力と望ましい出力を対にした学習データ |
| 向いている場面 | 社内規程・製品仕様・問い合わせ履歴など、内容が更新される知識を扱う | 決まった書式での出力や、特定の分類・変換作業を安定させる |
この表の使い方としては、まず自社の課題が知識の不足なのか、出力の形の不安定さなのかを切り分けることになります。社内文書を根拠に答えてほしいという要望は前者です。決められた様式の報告書を毎回同じ体裁で作りたいという要望は後者です。両方が必要な場面もあります。準備の中心は方式によって異なり、検索を接続する場合は参照する文書と検索の仕組みの品質が、追加学習する場合は入力と望ましい出力を対にした学習データの品質が、結果を左右します。
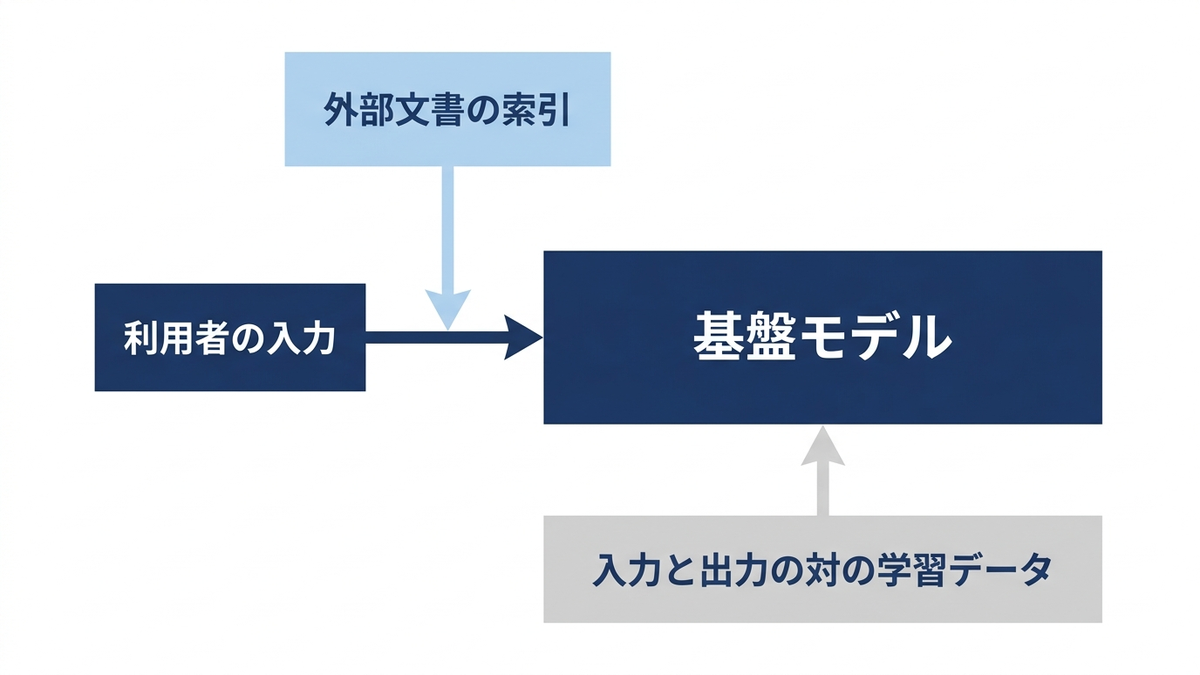
導入はどこまで広がったか
この節では、2022年から2024年当時の普及の度合いを、当時公表された数値で確認します。いずれも本コラムの基準時点である2026年10月の状況を表すものではありません。数値は、発表元と時点を明示できるものだけを見ます。OpenAIは2023年8月28日のChatGPT Enterpriseの告知で、公開からわずか9か月の間に、Fortune 500企業の8割を超える企業でチームがChatGPTを採用したと述べています。同じ告知の脚注によれば、この8割という値は、企業のメールアドレスのドメインに結びついたChatGPTの登録アカウントがあるFortune 500企業の割合です。企業として正式に導入した割合でも、チームを単位にした採用率でもありません。同社自身が示した値であり、独立した第三者が計測した数値ではない点も含めて、引用するときは出所と時点、集計の方法を添えて扱うべきものです。
利用の規模についても、同社が文書で示した値を時点つきで見ます。OpenAIは2023年9月6日、同年11月6日に開く初の開発者向けイベントを告知する文書で、GPT-4、GPT-3.5、DALL·E、Whisperを使う開発者が200万人を超えていると述べています。これも同社が発表した値であり、独立した第三者による計測ではないため、前の段落と同じく出所と時点を添えて扱います。
利用者数については、より早い時期の数字として「公開から2か月で1億人」という表現もよく引かれます。この数字の出どころは、会社の公表値ではありません。データ会社Similarwebが2023年2月3日に自社のブログで説明したところでは、この1億人は、投資銀行UBSのリサーチのリポートが、Similarwebのデータを一部に用いて推計した利用者の数です。同じ記事は、UBSのアナリストがそのリポートに、インターネット分野を20年追ってきたなかで、消費者向けのインターネットアプリでこれより速い立ち上がりは記憶にないと書いたことも紹介しており、このリポートはロイター通信が報じたとしています。Similarwebは同じ年の11月15日に公開したChatGPTの1年間の回顧記事でも、2023年2月の出来事として、UBSのアナリストが同社の数字をもとに、ChatGPTが2か月で1億人の利用者を集めたと推計したことを挙げています。
つまりこの数字は、外部の金融機関が、データ会社の推計を一部に使って見積もった値です。OpenAIがアカウントや利用の記録から数えた利用者数ではなく、先に引いた2023年9月の開発者数とも、数えている対象が異なります。種類の違う数字を並べて伸び率を計算することはできません。普及の速さを示す事例として社内資料などで引く場合は、推計値であることと、誰がどのデータをもとに推計した値かを添えるのが適切です。なお、UBSのリポートそのものは本稿では確認しておらず、それを報じたロイター通信の記事も本稿の確認時点で取得できなかったため、ここではSimilarwebの説明の範囲で扱っています。
組織全体としての採用については、マッキンゼーが2023年8月1日に公表した調査があります。2023年4月11日から21日にかけてオンラインで実施され、1,684人が回答したもので、回答者の55%が、所属する組織はAIを導入していると答えました。これは生成AIに限らないAI全般の数値で、世界の組織を直接数えたものではなく、回答者が所属組織について答えた結果です。Stanford大学のHAIがまとめたAI Index Report 2024もこの調査を引き、同じ割合が2022年は50%、2017年は20%だったと示しています。資金の面では、同報告は2023年の生成AIへの民間投資を252億ドルと集計しています。2022年からの伸び率については、同報告の要約と本文で異なる倍率が書かれているため、ここでは記載しません。
日本の状況は、総務省の令和6年版情報通信白書に公表データがあります。2024年7月5日公表の図表によれば、生成AIを使っている、あるいは過去に使ったことがあると答えた個人の割合は、日本が9.1%、米国が46.3%、中国が56.3%、ドイツが34.6%、英国が39.8%でした。日本の値は他国と比べて明確に低い水準です。ただし同白書は、今後の活用意向について、ぜひ利用してみたい、あるいは条件によっては利用を検討すると答えた割合が日本でも6割から7割程度あり、潜在的な需要はうかがえるとしています。
企業側も同じ白書に数値があります。生成AIの活用方針を定めていると答えた企業の割合は、日本が42.7%でした。内訳は、積極的に活用する方針が15.7%、活用する領域を限定して利用する方針が27.0%です。同じ設問で、米国は78.7%、ドイツは80.6%、中国は95.1%となり、白書は日本の割合を、約8割以上が活用方針を定めている米国・ドイツ・中国と比べて約半数と表現しています。
業務ごとの利用状況では、メールや議事録、資料作成等の補助に生成AIを業務で使用中と答えた割合が、日本で46.8%でした。米国は84.7%、ドイツは72.7%、中国は84.4%です。白書は、トライアル中まで含めると海外の企業は9割程度が使用しており、顧客対応を含む多くの領域で利活用が始まっている一方、日本企業は社内向けの業務から慎重に導入を進めている、と整理しています。
期待と懸念の両方も測られています。同白書によれば、日本の企業の約75%が、生成AIの活用が業務効率化や人員不足の解消につながると答えました。一方で、社内情報の漏洩などのセキュリティリスクが拡大すると答えた企業、著作権等の権利を侵害する可能性があると答えた企業も、それぞれ約7割にのぼっています。使えば効くと考えつつ、扱いを誤ったときの損失も見えている、という状態です。この二つの数字が同居していることが、2024年時点の日本企業の位置を最もよく表しています。
誤りが混じるという性質は解消されたと言えない
普及の話と同じ重さで押さえておく必要があるのが、出力の誤りです。もっともらしいが誤っている、あるいは意味をなさない答えを書くことがある、という記述は、他ならぬ公開当日のChatGPTの告知文に置かれていました。この現象はハルシネーションと呼ばれます。提供元が公開初日に自ら明記した制約であり、後から外部の指摘で判明したものではありません。
同じ告知文は、この問題を直すのが難しい理由を3つ挙げています。第一に、強化学習で調整している間、何が真実かを示す情報源が当時は存在しなかったこと。第二に、慎重に答えるように学習させると、本来は正しく答えられる質問まで断るようになること。第三に、教師あり学習では理想的な答えがモデルの知っている内容に左右されるため、学習が誤った方向に働きうること。これらは、当時の調整の手順の中で誤りを直すことがなぜ難しいかを説明したもので、ハルシネーションの原因をすべて挙げたものではありません。それでも、調整によって誤りを直すことの難しさを、提供元自身が公開の時点で説明していたことになります。
この制約は、翌年の資料でも明記されています。2023年3月15日(協定世界時)にarXivへ投稿されたGPT-4の技術報告は、限界を述べた節で、GPT-4は以前のGPTのモデルと同様の限界を持ち、とくに、なお完全には信頼できず、事実を作り出したり推論を誤ったりする、と書いています。そのうえで、重要な場面で出力を使うときは、人による確認や追加の情報による裏づけなど、用途に合った手順を用意するよう求めています。本章の範囲である2024年までに、この性質が解消されたと示す資料は確認していません。
学術的な整理も同時期に進みました。2022年2月8日に公開され、ACM Computing Surveysに掲載された論文「Survey of Hallucination in Natural Language Generation」は、要約・対話生成・質問応答・データからの文章生成・機械翻訳といった課題を横断して、この現象の評価指標と抑制手法を整理しています。個別の製品の欠陥ではなく、系列を生成する仕組みに共通して現れる課題として扱われている点が重要です。
実務への落とし方は、誤りをゼロにする前提を捨てるところから始まります。検証の設計としては、次のような順序で考えることになります。第一に、その業務で誤った出力が出たときに何が起きるかを見積もります。差し戻して直せる程度なのか、外部に出てしまうと取り返しがつかないのかで、必要な検証の厚みが変わります。第二に、根拠を示せる形にします。検索を接続する方式であれば、参照した文書を出力に添えられるため、確認の手間が下がります。第三に、確認する人と工程を明示的に残します。誰も見ない自動処理に載せてよい業務と、そうでない業務を分けるということです。
生成AIの導入がうまくいかないとき、その原因がモデルの選定にあるとは限りません。誤った出力が出ることを前提にした工程を設計から外していると、運用の段階で人手による確認が無秩序に発生します。第4章で見たエキスパートシステムの保守コストと同じ構図で、導入時に見えていなかった費用が後から効いてきます。
この章で見た3年をまとめると、次のようになります。技術の基本的な方法はChatGPTの公開前に論文として出そろっており、2022年から2024年には、対話向けの調整を施したモデルが誰でも試せる画面とともに提供され、触れられる人の範囲、扱える入力の種類、重みの流通の仕方が大きく変わりました。企業での利用は短期間に広がった一方、日本の個人と企業の利用率は他国より低い水準にとどまり、効率化への期待と情報漏洩や権利侵害への懸念が同じ調査の中に並んでいます。誤った出力が出るという性質は提供元自身が公開初日に明記し、2023年の技術報告でも限界として挙げた制約であり、業務に載せる際は検証の工程を設計に含める必要があります。答えを返すだけでなく、手順を踏んで動くモデルとエージェントの話は第10章で扱います。規制と著作権をめぐる議論は第12章にまとめます。
この章を深めたい方への参考書籍
『拡散モデル:データ生成技術の数理』(岡野原大輔、岩波書店):本章で概要を紹介した拡散モデルについて、雑音を加える過程と取り除く過程の関係を数式から追える一冊です。画像生成がなぜ2022年に急に実用になったのかを、仕組みの側から確認したい読者に向いています。
『ChatGPTの頭の中』(スティーヴン・ウルフラム 著、稲葉通将 監訳、高橋聡 訳、早川書房):次の単語を選ぶという仕組みから出発して、対話が成立して見える理由を段階的に説明した本です。本章で扱った、対話向けの調整を施したモデルと誰でも試せる画面がそろって公開されたという経緯を、モデルの内側の仕組みから補いたい読者に向いています。
『生成AIで世界はこう変わる』(今井翔太、SBクリエイティブ):生成AIが仕事や産業に与える影響を、技術的な背景を押さえたうえで日本語で整理した一冊です。本章の後半で見た導入の数値を、社会と職業の側から捉え直したい読者に向いています。
第10章 推論モデルとエージェント
前章では、2022年から2024年にかけて生成AIが一般の道具になった経緯を確認しました。変わったのは技術の中身よりも到達範囲で、専門家しか触れなかったものが誰でも使える窓口を得たことが、その時期の中心的な出来事でした。この章が扱うのは、その次に起きた変化です。範囲が広がったあと、AIに何をさせるかという問いの立て方そのものが動きました。
本章の初稿は2026年9月に執筆し、その後、2026年10月19日を基準日として公開情報を確認し直しています。この章が扱う2024年から2026年までは、まだ歴史として整理されていない期間にあたります。ここまでの章のように、出来事のあとに書かれた検証や評価を参照することができません。したがって書き方を変えます。企業の公式発表、査読を経たか学会に採録された論文、公的機関の統計、そして大学や研究団体がまとめた評価レポートに限って根拠とし、それらが述べている以上のことは書きません。「何が主流になったか」「どれが標準か」といった判定は、材料が揃っていないため行いません。
そのうえで、この期間の事実を並べたときに見える方向は、はっきりしています。推論モデルと呼ばれる、応答を返す前に計算を使う設計と、エージェントと呼ばれる、道具を使いながら手順を踏んで作業を進める形です。この2つは別々に出てきたものではなく、同じ方向を向いています。各社が提供する機能の重心が「質問に答える」から「手順を踏んで動く」へ寄っている、という言い方ができます。経営の観点では、AIに回答の生成だけでなく、業務プロセスの一部を任せる選択肢が広がったことを意味します。任せる範囲が変われば、必要になる設計も変わります。この章の後半で、その具体的な中身を扱います。
応答の前に計算を割くという設計
2024年9月12日、OpenAIはo1-previewを公開しました。同社の説明文には、この設計の要点が短く書かれています。同社は、強化学習を大規模に行うことで、モデルが思考の連鎖を使って考える方法を学ぶ、と説明しています。ここでいう思考の連鎖とは、答えをすぐに出さず、途中で考えた内容をモデルの内部で言葉として順に書き出させるやり方を指します。なお同社は、この内部の記述をそのまま利用者に見せるわけではないとしています。この説明のあとに、同社は続けて、強化学習の量を増やしても、考える時間を増やしても、o1の性能は一貫して向上する、と書いています。前者を学習時の計算、後者を推論時の計算と呼んでいます。同社は、この方式を大きくしていく際の制約は事前学習のときとは大きく異なる、とも書いています。
数値も同時に公表されました。2024年のAIMEという高校生向けの数学試験で、GPT-4oが平均12%だったのに対し、o1は1問につき1回だけ答える条件で平均74%でした。なお、この成績は同日に公開されたo1-previewのものではなく、同社がo1と呼ぶモデルについて公表されたものです。同社は同じ説明文で、o1-previewをこのモデルの早期版として公開すると書いています。64回答えさせて多数決を取ると83%、1000回答えさせて学習した採点器で並べ替えると93%です。後ろの2つは、1回では届かない分を回数で埋めた結果です。精度と計算量が交換関係にあることが、公表された数値そのものに表れています。
同じ方向の発表が続きました。2024年12月11日、Googleは「エージェントの時代のためのモデル」という表現を用いてGemini 2.0を発表し、あわせて計画性や道具の利用を伴う試作をいくつか公開しています。2025年1月22日、DeepSeekは論文をarXivに投稿しました。この論文は査読を経て、2025年9月17日にNature誌に掲載されています。掲載された論文の抄録は、人間が書いた推論の手本を与えなくても、純粋な強化学習によって言語モデルの推論能力を引き出せることを示した、と述べています。本文を読むと、この主張の中心はDeepSeek-R1-Zeroというモデルです。R1-Zeroは、強化学習の前に通常置かれる教師あり微調整(人が用意した模範的な応答を手本にして追加で学習させる工程。第9章で見たInstructGPTの手順の第1段階にあたります)を行わず、事前学習済みのモデルに強化学習だけを適用して推論の力を伸ばしました。一方、読みやすさや文章作成などの弱点を補うために同じ論文で導入されたDeepSeek-R1は、強化学習に加えて教師あり微調整なども組み合わせた多段階の工程で訓練されています。推論の手本がなくても強化学習で推論能力が伸びるという主張が、査読という手続きを通った、と読むのが正確です。製品発表が中心のこの期間の材料のなかでは、査読済みの論文として参照できる点に意味があります。
2025年2月24日、AnthropicはClaude 3.7 Sonnetを公開しました。同社の説明では、即座に答えることも、段階を踏んで長く考えることもでき、APIからは考える長さを細かく指定できる、とされています。人間が速い応答と深い熟考に同じ頭を使うように、推論は別のモデルではなく基盤モデルに統合された能力であるべきだ、という設計思想も添えられています。2025年4月16日、OpenAIはo3とo4-miniを公開し、推論モデルが自らWeb検索やPythonでの分析、画像の扱いを組み合わせて使えるようになった点を強調しました。この時点で、考える設計と道具を使う設計が1つの製品に同居し始めています。
経営の観点で押さえるべきは、費用の構造が変わったことです。従来も費用は入力と出力の長さで変わりましたが、主な変数はモデルとその長さでした。応答前に計算を割く設計では、同じモデルでも、どれだけ考えさせるかによって1回あたりの費用と待ち時間が変わります。精度と費用と応答時間の3つを業務ごとに決める必要が出てきた、と考えるほうが実務に近いはずです。
道具を使い、手順を踏むという形
エージェントという語は、この期間に急に広まりましたが、発想そのものは新しくありません。2022年10月6日にarXivへ投稿されたReActの論文は、推論の記述と具体的な行動を交互に出力させる方式を提案しています。推論の記述が行動計画の立案と修正を助け、行動が外部の情報源から新しい情報を取ってくる、という組み合わせです。この形が、2024年以降に製品として実装されていきました。
2024年10月22日、Anthropicは画面上のカーソルを動かし、クリックし、仮想キーボードで入力する機能を公開ベータとして提供しました。人間が使っているのと同じソフトウェアを、専用の接続口を作らずにそのまま操作させる、という考え方です。2025年1月23日、OpenAIは自らブラウザを使うOperatorを研究プレビューとして公開しました。同年2月2日にはdeep researchを公開し、7月17日にはこの2つを統合したChatGPT agentを発表しています。Anthropicも2025年2月24日、端末から作業を任せるためのClaude Codeを研究プレビューとして出しました。
用語が混乱しやすい領域なので、定義を1つ引いておきます。Anthropicは2024年12月19日の技術記事で、エージェント的なシステムを2種類に分けています。以下は同社の記述を訳したものです。
ワークフローとは、大規模言語モデルと道具が、あらかじめ書かれたコードの経路によって組み立てられているシステムを指す。一方でエージェントとは、大規模言語モデル自身が自らの処理と道具の使い方を動的に決め、どうやって作業を成し遂げるかの制御を保持しているシステムを指す。
この区別は実務でそのまま使えます。同じ記事は、まず最も単純な解を探し、必要になったときだけ複雑にすることを勧めており、そもそもエージェント的なシステムを作らないという選択も含まれる、と書いています。さらに、エージェント化は待ち時間と費用を性能と引き換えにするものだ、とも述べています。そのうえで、複雑さを足す必要がある場合でも、手順が明確に定まった業務には予測可能性と一貫性のあるワークフローが、柔軟性とモデル自身の判断が数多く求められる業務にはエージェントが適する、と説明しています。多くの用途では、検索と例示で補った1回の呼び出しを最適化すれば足りることが多い、とも書いています。提供元自身がこう書いている点は、導入範囲を決める材料になります。
ここで、この期間の主な出来事を時系列で並べておきます。本章の節の順序とは別に年月順に並べたもので、各行の詳細は本章の各節で扱います。
| 年月 | 出来事 | この章の文脈での意味 |
|---|---|---|
| 2024年7月 | Google DeepMindのAlphaProofとAlphaGeometry 2が、国際数学オリンピック2024の問題で銀メダル相当の28点 | 問題を人が形式言語へ翻訳し、最長で3日をかけた条件での到達だった |
| 2024年8月 | OpenAIがSWE-bench Verifiedを公開 | 試験そのものに欠陥があると判明し、作り直された。評価の信頼性が論点として立った |
| 2024年9月 | OpenAIがo1-previewを公開 | 応答前の計算量を増やすと性能が上がる、という主張が数値とともに示された |
| 2024年10月 | Anthropicが画面操作の機能を公開ベータで提供 | 専用の接続口を作らず、人間と同じ画面を操作させる方向が示された |
| 2024年10月 | ノーベル物理学賞をホップフィールドとヒントンが、化学賞をベイカー、ハサビス、ジャンパーが受賞 | 自然科学の側の学術賞からも、この分野の仕事が評価された。製品の成熟度の証明ではない |
| 2024年11月 | AnthropicがModel Context Protocolを公開 | 道具やデータへのつなぎ方を、個別実装から共通の規約へ移す動き |
| 2024年12月 | GoogleがGemini 2.0を「エージェントの時代」の語とともに発表 | 複数社が同じ時期に同じ方向の機能を出した |
| 2025年1月 | DeepSeekがR1の論文を公開、OpenAIがOperatorを研究プレビューで公開 | 推論の学習方法が公開され、ブラウザを自ら操作する製品が出た |
| 2025年3月 | ARC Prize FoundationがARC-AGI-2を公開 | 人間には容易でAIには難しい課題を集めた試験。公開時点で素のモデルは0%だった |
| 2025年4月 | GoogleがAgent2Agentを発表、OpenAIがo3とo4-miniを公開 | エージェント同士の連携規約と、道具を使い分ける推論モデルが同月に出た |
| 2025年7月 | Gemini Deep Thinkの上位版が、国際数学オリンピック2025の問題で金メダル相当の35点。同社の説明では大会の採点者が採点・認定 | 公式の問題文を自然言語のまま、競技時間内に解いた。採点基準が明確な課題での到達であり、業務の成果は別に測る必要がある |
| 2025年8月 | Anthropicがブラウザ拡張の試験提供とともに攻撃成功率を公表 | 自動で動かすことの危険が、提供元の実測値として公開された |
| 2025年9月 | DeepSeek-R1の論文がNature誌に掲載 | この期間の主張の一部が査読という手続きを通った |
| 2025年12月 | Model Context ProtocolがLinux Foundation傘下の基金へ寄贈 | 接続規約が1社の資産から中立の共有物へ移された |
| 2026年7月 | Model Context Protocolの新しい仕様が公開 | 基盤部分に互換性のない変更を含む改訂。あわせて最低12か月の廃止猶予の方針が定められた |
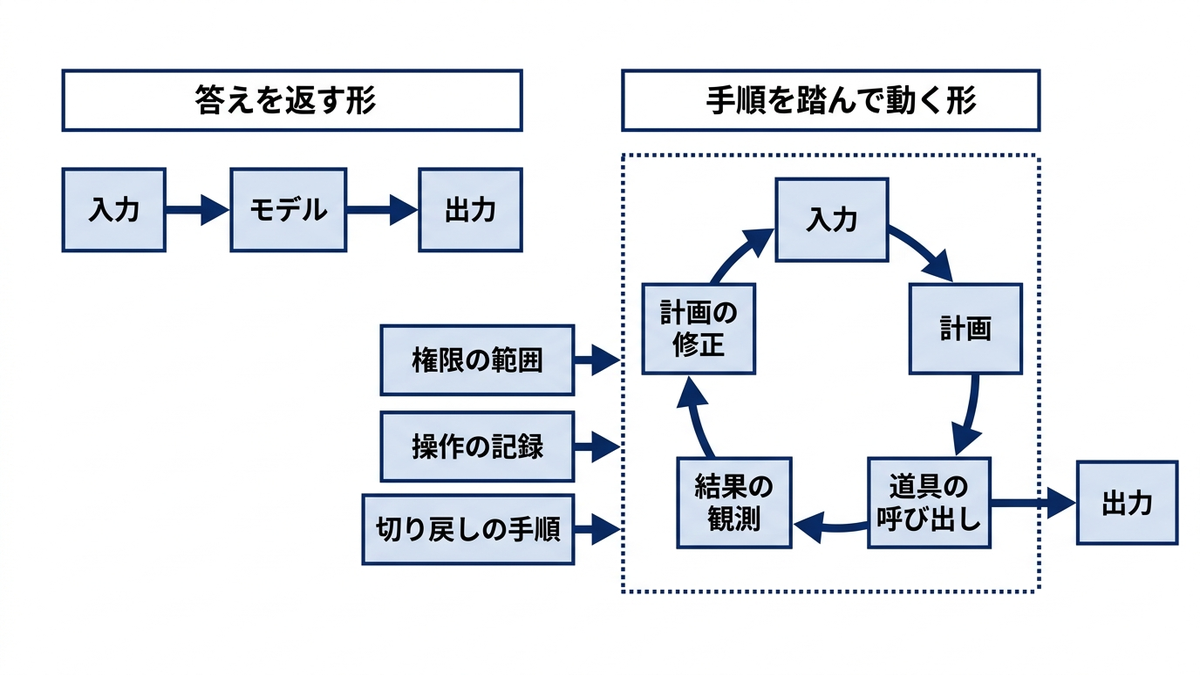
つなぎ方の標準はまだ動いている
エージェントが道具を使うには、道具側とつながる必要があります。従来はサービスごとに個別の接続を書いていました。ここに共通の規約を持ち込もうとしたのが、2024年11月25日にAnthropicが公開したModel Context Protocolです。同社は、データ源とAIを使う道具のあいだに安全な双方向の接続を作るための公開標準だと説明し、Google Drive、Slack、GitHub、Git、Postgres、Puppeteerに対する実装をあわせて公開しました。
その後の広がりについては、提供元が数値を出しています。2025年12月9日の発表によると、公開されているサーバは1万件を超え、PythonとTypeScriptのSDK(この規約に対応する機能を自社のソフトウェアに組み込むための開発用の部品群)の月間ダウンロード数は9,700万件を超えたとされています。同じ日、Anthropicはこの規約をLinux Foundationの下に置かれた基金へ寄贈すると発表しました。この基金はAnthropic、Block、OpenAIが共同で設立し、Google、Microsoft、AWS、Cloudflare、Bloombergが支援していると説明されています。2025年4月9日にはGoogleがAgent2Agentという別の規約を発表しており、こちらはエージェント同士が情報をやり取りして動作を調整することを狙いとしています。発表時点で50社を超える技術パートナーの支持があったとされます。
ただし、標準が固まったとは書けません。Model Context Protocolの仕様は2026年7月28日にも新版が出ています。この版では、接続の基盤を状態を持たない形に変える、接続を開いたままにせず複数回の要求と応答でサーバ側からの問い合わせをやり取りする仕組みを導入する、認可(どの利用者や道具に何を許すかの確認)を強化する、といった変更が入っています。公式の発表は、互換性のない変更点について各SDKに移行の手引きを用意したと書き、廃止する機能には最低12か月の猶予期間を設けるという方針もあわせて定めています。更新が続いていること自体は、標準が未成熟であることの証明にはなりません。ただ、基盤部分に互換性のない変更が入る段階にあることは確かであり、実務では、対応する仕様の版と移行の手順を管理しておく必要があります。提供元は自らの規約を事実上の標準と表現していますが、これは提供元による自己評価であり、外部の検証を経た判定ではありません。
実務への含意は明確です。接続層に自社固有の実装を厚く積み上げると、規約が動いたときに作り直しになります。逆に、規約に寄せておけば、道具の入れ替えは接続の差し替えで済む可能性が高くなります。どちらを選ぶにせよ、2026年時点では「この層はまだ動く」という前提で工数を見積もっておくのが安全だと考えています。
長い文脈、受け取れる長さと使いこなせる長さ
2024年2月15日、GoogleはGemini 1.5 Proを発表し、標準で128,000トークン(トークンは、モデルが文章を処理するために区切った単位です)の文脈長を持ち、一部の開発者と企業には最大100万トークンの文脈を限定提供すると説明しました。以後、文脈長の拡大は続いています。スタンフォード大学HAIが2026年4月13日に公開した2026年版AI Index Reportによると、文脈長は2023年半ば以降、年におよそ30倍の速さで伸び、数千トークンしか受け取れなかったモデルが100万トークン以上を一度に処理できるようになりました。
しかし同じ報告書は、受け取れる長さと使いこなせる長さは違う、とはっきり書いています。専門家向けの長文脈試験であるLongBench v2の公開時の評価では、人間の専門家が15分の制限時間のもとで53.7%、当時最良だったo1-previewが57.7%でした。同試験の公式の成績表はその後も更新されており、2025年5月6日更新の版では、思考の過程を出力させる条件でのGemini 2.5 Proの63.3%が最高です。構造化された試験でモデルが人間の水準を大きく超えている例が多いなかで、この試験での差は10ポイントに届いていません。別の研究では、単純な検索は得意でも、複数の該当箇所を突き合わせたり、長い文書全体に条件を適用したりする作業では苦しむと報告されています。該当する箇所を1つずつ確かめるように導けばこなせるものの、その進め方は遅く、費用がかさむ、とも書かれています。
測り方の問題も指摘されています。長文脈の試験で高い点を取ったとき、それが長い入力を扱う力によるものなのか、そもそもの基礎的な能力が高いためなのかが区別できません。同報告書が引いている研究(2025年のACL Findingsに採録)は、短い入力(2,000〜6,000トークン)での得点を基礎能力とし、入力を長くしたときに得点がそこからどれだけ上下するかの比率で長文脈の能力を測る指標を提案しました。この研究の付録の表では、短い入力での基礎能力が8モデル中7位、長い入力での平均得点が6位だったモデルが、提案した指標では1位になっています。基礎能力の順位と長い入力への強さの順位は一致しない、ということです。
実務上の代償もあります。同報告書は、長い入力には応答の遅れと運用費用の増加が伴い、入力の後のほうに現れる情報の精度が下がる、と書いています。ただし位置による差は一方向とは限りません。関連する情報が入力の冒頭や末尾にあるときに性能が最も高く、中ほどにあるときに大きく下がる、と報告した研究もあります(2023年にarXivへ投稿され、学術誌TACLに採録)。どこに置いた情報が使われにくいかはモデルと課題によって変わる、と考えるのが安全です。
この制約への対処として、文脈を外から管理する機能が製品側に入ってきました。Anthropicは2025年9月29日、古い道具の呼び出しと結果を自動的に消す機能と、文脈の外にあるファイルへ情報を保存して読み書きする機能を提供開始しています。長く動き続ける作業では、文脈の上限に当たるか、重要な情報を失うかの二択になりがちだという問題意識が、公開文書に書かれています。文脈長を大きくすれば解決する、という段階ではないことが、提供元の設計からも読み取れます。
小さなモデルと、手元で動かすという選択
大きくすれば性能が上がるという方向とは別に、小さくして手元で動かす方向も進みました。総務省が2026年7月に公表した令和8年版情報通信白書は、この領域に節を割いています。同白書によれば、小規模言語モデルには厳密な定義がありません。ここでいうパラメータは学習によって調整されるモデル内部の数値のことで、その個数がモデルの規模の目安として使われます。海外のベンチマーク研究では70億パラメータ以下を対象とし、IBMは数十億から数百億程度としており、人工知能学会の論文には140億パラメータ以下を扱う例もある、と整理したうえで、同白書自身はおおよそ100億程度までを対象としています。用語の定義が定まっていないことを公的文書が明記している点は、この分野の現在地を示しています。
特徴として挙げられているのは、計算量が抑えられるため計算資源や消費電力に制約のある環境でも動くこと、端末上での実行に向くこと、通信を必要としないためプライバシー保護とセキュリティの面で期待されることです。同時に限界も書かれています。パラメータ数が少ないぶん知識の範囲と複雑な推論に限界があり、汎用的な知識や高度な推論が求められる用途では単体で対応しきれない。そのため実務では、検索拡張生成による外部知識の利用や、大きなモデルと小さなモデルを組み合わせる構成が有効な方策として整理されている、という記述です。
製品側の動きも並行しています。Googleは2025年3月12日にGemma 3を公開しました。公開時には10億、40億、120億、270億の4つのサイズが用意され、1つのGPUまたはTPUで動かせる点が強調されています。発表記事は128,000トークンの文脈長をうたっていますが、公式のモデルカードによれば、128,000トークンに対応するのは40億以上の3サイズで、10億版は32,000トークンです。Appleは2025年6月9日、端末上で動作するおよそ30億パラメータのモデルと、サーバ側の混合エキスパート型モデルを組み合わせる構成を公表しました。日本では、Preferred Networksがエッジ機器向けの軽量モデルを提供し、経済産業省とNEDOが実施するGENIACの案件にも採択されていることが、前述の白書に記載されています。製薬領域に特化した70億パラメータのモデルを開発した事例や、神戸のスタジアムで監視カメラの近くに置いた機器と小規模言語モデルを組み合わせ、警備員へ要約と指示を返す実証も紹介されています。
ただし白書は、端末側での実行が必ず広がるとは書いていません。同白書が載せている国立情報学研究所の教授への聞き取りでは、スマートフォンやタブレットでは端末上のモデルの性能に限界があるため利用が必須になるとは限らず、一方でパソコンは差別化のために必須となる可能性がある、という見方が示されています。どちらに向かうかは、まだ確定していないと読むのが正確です。
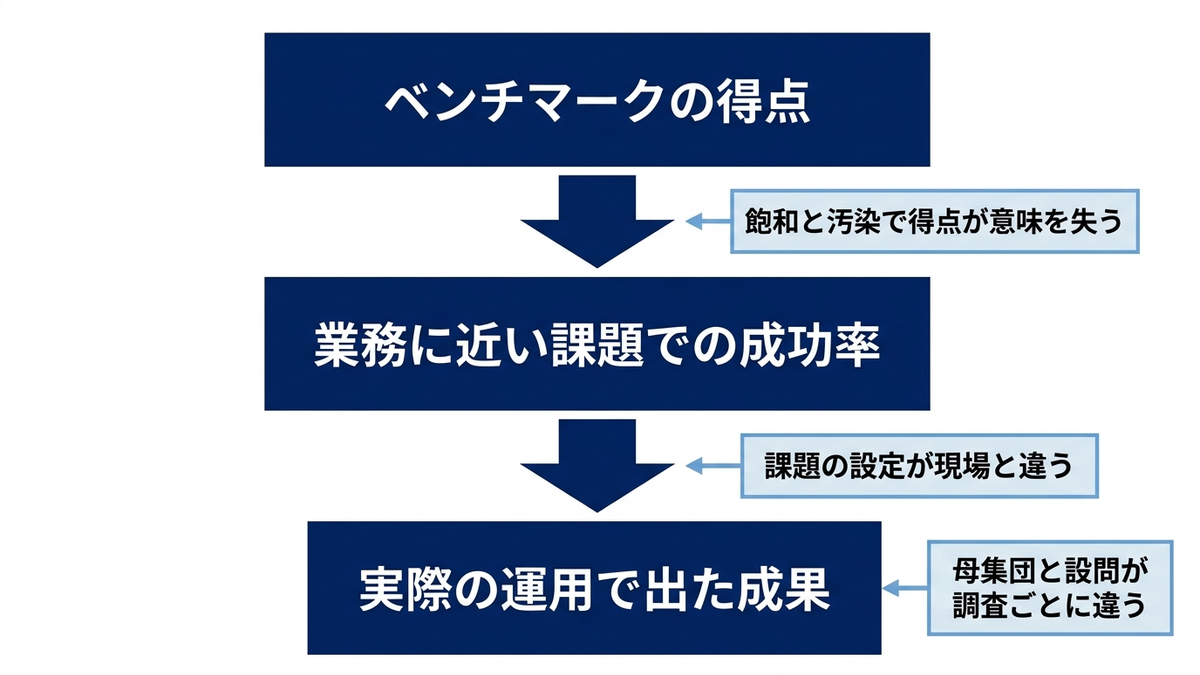
測ることが難しくなった
この期間で最も実務に効くのは、性能の向上そのものよりも、性能を測ることが難しくなった事実のほうかもしれません。2026年版AI Indexは、章の冒頭でこう述べています。数年は難しいままであるはずだった評価が数か月で飽和し、ベンチマークが進歩の把握に使える期間が縮んでいる。実例として、AIには難しく、人間の専門家には解きやすいように作られた試験であるHumanity’s Last Examで、フロンティアモデルが1年のあいだに30ポイント上昇したことが挙げられています。
ベンチマークの飽和だけが問題ではありません。同報告書は、広く使われている評価そのものの品質を検証した研究を引いています。この研究は9つのベンチマークについて、統計的な手法で疑わしいと判定された設問を上位から50問ずつ専門家が点検したもので、実際に問題が確認された設問はMMLU(幅広い分野の知識を問う試験)の数学で2問、GSM8Kで42問(点検した50問の84%)と、試験によって大きな開きがありました。これは疑わしいものとして選び出した設問のなかでの割合であり、試験全体に占める無効な設問の割合ではありません。学習データに試験問題が混入する汚染も指摘されています。汚染をどう扱うかは研究テーマとして確立しており、2025年のEMNLP本会議には、静的な評価から動的な評価へ移行する流れを整理した調査論文が採録されています。加えて、人間の投票で順位を付ける対戦型のリーダーボードについても、順位がその場への適応を一部反映している可能性がある、という別の研究が引かれています。
試験を作り直した実例もあります。OpenAIは2024年8月13日、ソフトウェアの課題を解かせる試験であるSWE-benchについて、人手で検証した部分集合を公開しました。元の試験には3つの欠陥があったと説明されています。正解を判定する単体テストが過度に限定的で、課題と無関係な場合すらあること。課題の説明が不十分で、何をどう直すべきかが曖昧なこと。実行環境を確実に用意するのが難しく、解答の内容に関係なくテストが落ちる場合があること。いずれも、正しい解答が不正解と判定される方向の欠陥です。Pythonに習熟した93名の開発者が1,699件を確認して作り直した結果、GPT-4oの正答率は33.2%になりました。同じページは、同じ時期の元の試験での最高が20%だったとも記しています。ただし、両者は問題の集合も解かせ方の構成も異なるため、この差のすべてを試験の欠陥に帰すことはできません。試験の側の欠陥が能力を低く見せていた可能性を、提供元自身が示した例として読むのが正確です。
飽和への対処として、人間には容易でAIには難しい課題を集める設計も試みられています。ARC Prize Foundationが2025年3月24日に公開したARC-AGI-2は、その方向の代表例です。公開時点で、素の大規模言語モデルは0%、公開されている推論システムも1桁%にとどまりました。一方でこの試験の全課題は、2人以上の人間が2回以内の試行で解いています。同財団は正答率だけでなく1課題あたりの計算コストも並べて公表しており、能力と効率の両方を見る設計になっています。2025年の競技会には1,455チームから15,154件の提出があり、計算資源に制限のある非公開の評価集合での最高は24%でした。同財団が2025年12月5日に公表した分析によれば、その時点で検証済みの商用モデルの最高は、思考を有効にしたClaude Opus 4.5の37.6%でした。同じ分析は、商用モデルを土台に独自の改良の工程を組み合わせた解法では、Gemini 3 Proを使ったものの54%が検証済みの最高だったとも書いています。これらは当時の記録で、その後も成績は上がっています。同財団が2026年9月2日付で掲載したGPT-6 Astraの検証済みの成績では、最大の推論設定でARC-AGI-2の95.0%、推論を使わない設定で59.6%でした。競技会とは計算資源の条件が異なるため、競技会の24%とは単純に比べられません。公開から1年半ほどで、人間には容易でAIには難しいという設計の試験でも、商用モデルが95%に達する得点を記録したことになります。
エージェントを対象とした評価では、数値の上がり方が急です。2026年版AI Indexによると、Webの閲覧やファイルの取り扱いを含む多段階の問いを扱うGAIAでは、2025年1月の約20%から同年9月の74.5%へ上がりました。人間の基準は92%です。オペレーティングシステム上の実際の操作を課すOSWorldは369課題で構成され、情報系の学生が中央値でおよそ2分かけて約72%を解くのに対し、モデルは長らく1%から12%にとどまっていましたが、66.3%まで上がりました。実際のWebサイトを模した環境で手順の要る作業を課す812課題からなるWebArenaでは、2023年の約15%から2026年初頭の74.3%へ、人間の基準78.2%との差が4ポイントまで縮んでいます。端末での作業を課すTerminal-Bench 2.0については、同報告書は2025年2月の20%から2026年初頭の77.3%へ上がったと紹介しています。ただし、Terminal-Bench 2.0そのものの公開は2025年11月7日で、その後も2026年5月に2.1、7月に3.0、8月28日に4.0と改訂が続いています。同報告書は要点の1つとして、エージェントは構造化された試験でなおおよそ3回に1回失敗する、ともまとめています。この要約のすぐ後に挙げられているのはOSWorldの66.3%で、成功率は上で見たとおり試験ごとに大きく異なります。
ベンチマークとは別の測り方を提案した研究もあります。METRは2025年3月18日にarXivへ投稿した論文で、50%タスク完了時間地平という指標を提示しました。人間がある作業に要する時間を基準に、モデルが50%の成功率で完了できる作業の長さを測るという考え方です。この論文は、2019年以降その長さがおよそ7か月で倍になってきたと報告し、当時のClaude 3.7 Sonnetでおよそ50分だったとしています。
同団体は2026年1月29日に測り直しを公表し、課題数を170から228に増やしたうえで、全期間では196日、2023年以降では131日、2024年以降では89日と、期間の取り方によって倍増の速さが変わることを示しました。このうち全期間の196日は、2023年より前の3つのモデルについては旧来の推定値をそのまま使い、新しい推定とつないで求めた値です。
同団体は限界も明記しています。8時間以上の長い課題31件のうち、人間の所要時間を実測したのは5件だけで、残りは見積りであること。信頼区間(推定した値がどの範囲にありそうかを示す幅)が広いこと。課題の構成を変えると傾向が動くこと。さらに同団体は、時間地平の公開ページに、現在の課題群では16時間を超える測定値は信頼できないと注記し、2026年9月8日には、このページをもう継続的には更新していないと明記しました。測定に使っている課題は主にソフトウェア開発、機械学習、サイバーセキュリティの課題で、業務全般にそのまま当てはめられる値ではありません。この率直さは、数字を受け取る側にとって重要です。
国際数学オリンピックでの到達と、その読み方
評価の難しさを考えるうえで、対照的な例があります。国際数学オリンピック(IMO)です。IMOは大学入学前の若い数学者のための競技会で、大会の公式サイトによれば、1959年に始まり、1980年を除いて毎年開かれています。大会の一般規則によれば、各国は最大6人の選手を送ることができ、競技は2日続けて行われ、各日とも3問を4時間半で解きます。Google DeepMindの説明では、問題は代数、組合せ論、幾何、整数論の非常に難しい6問で、1問7点、合計42点満点です。メダルの人数や基準点は大会ごとに決まり、規則では、受賞者の総数は原則として参加者の半数を超えないこと、金、銀、銅の人数はおよそ1:2:3の比にすることとされています。採点の基準が決まっており、人間の参加者と同じ基準で点数を付けられるという点で、意味のはっきりした試験だといえます。
2024年7月25日、Google DeepMindは、強化学習に基づいて形式的な数学の証明(計算機が正しさを機械的に検査できる形式の言語で書いた証明)を行うAlphaProofと、幾何の問題を解くAlphaGeometryの改良版であるAlphaGeometry 2を組み合わせたシステムが、2024年のIMOの6問のうち4問を解き、28点を得たと発表しました。IMOの公式サイトによれば、2024年の大会は英国のバースで7月11日から22日に開かれ、609人が参加し、金メダルの基準は29点以上、銀メダルは22点以上でした。28点は銀メダルの範囲の最上端にあたります。ただし条件があります。問題はまず人の手で形式的な数学の言語に翻訳されてからシステムに渡されました。人間の参加者が4時間半の2回で解くのに対し、同社の記事によれば、幾何の第4問はAlphaGeometry 2が形式言語に翻訳された問題を受け取ってから19秒以内に解いた一方、ほかの問題には最長で3日をかけています。後にNature誌に公表された論文によれば、AlphaProofが解いた代数と整数論の3問は、それぞれ2日から3日を要しました。組合せ論の2問は解けませんでした。採点は、IMOの採点規則に沿って、IMOの金メダリストでフィールズ賞の受賞者であるティモシー・ガワーズと、2024年の問題選定委員会の委員長を務めたジョセフ・マイヤーズが行いました。同社の記事には、AlphaProofの手法が2025年11月12日にNature誌の論文として公表されたことも追記されています。この論文は、2026年のNature誌第651巻607ページから613ページに収録されています。
1年後の2025年7月21日、Google DeepMindは、Gemini Deep Thinkの上位版が2025年のIMOの6問のうち5問を完全に解き、35点を得たと発表しました。IMOの公式サイトによれば、2025年の大会はオーストラリアのサンシャインコーストで7月10日から20日に開かれ、630人が参加し、金メダルの基準は35点以上でした。同社は、今回は大会の採点者が、生徒の解答と同じ基準でモデルの解答を採点し認定する初めての枠組みに参加したと説明しており、IMOの会長であるグレゴール・ドリナルが35点の金メダル相当の得点を確認する言葉を記事に掲載しています。前年との違いとして同社が挙げているのは、問題を形式言語へ翻訳する工程がなくなり、公式の問題文から自然言語のまま厳密な証明を書き、競技の制限時間内に解いたことです。あわせて、この版には多段の推論や定理の証明のデータを活用する強化学習の手法で追加の学習を行い、質の高い数学の解答集を参照できるようにし、IMOの問題への取り組み方についての一般的な助言を指示に加えた、とも書かれています。大会の主催者側も、2025年7月19日付の、日本語にすれば「IMO 2025の最終日」となる題の声明で、この年に初めて一部のAI企業が大会の関連行事に招かれ、その企業が非公開のAIモデルでこの年の問題を試したことに触れています。同じ声明に引かれたドリナル会長の言葉は、IMOは使われた計算の量や人の関与の有無を含めて手法を検証できず、結果を再現できるかどうかも検証できないとしたうえで、言えるのは、正しい数学の証明は、優秀な生徒が書いたものでもAIのモデルが書いたものでも正しいということだ、と述べています。この声明には、Google DeepMindの名前も35点という得点も書かれていません。Google DeepMindの記事自身も、IMOが確認したのは提出した解答が完全で正しいことであり、その確認は同社のシステムや手順、元になったモデルの検証には及ばない、と注記しています。
同じ時期に、OpenAIも金メダル水準の成績を主張しています。同社が2026年1月に公表した、日本語にすれば「科学の協力者としてのAI」となる題の報告書には、2025年7月に同社のモデルが2025年の問題で金メダル水準の成績を得たと書かれています。得点は、同社が2026年2月20日に公開した別の記事に、汎用の推論モデルで42点満点中35点だったと書かれています。採点の手続きについては、研究担当者のアレックス・ウェイが、ベンチャーキャピタルのセコイア・キャピタルが公開したインタビューで、外部の元IMOメダリストを雇い、各証明を3人が採点して、どの証明についても正しさの判断が全員一致したと話しています。いずれも同社の側の説明であり、大会が採点し認定したという説明ではありません。
1年の間に、2024年と2025年とで使われたシステムは別のものですが、人が問題を形式言語へ翻訳し最長で3日をかけるという条件から、公式の問題文をそのまま受け取り競技時間内に解くという条件へと、到達の中身が変わりました。ここで測られたのは、明確に定義された問題に対して厳密な証明を書く能力です。採点の基準は人間の参加者と共通です。2024年は採点した数学者の名前と立場が同社の記事に明記されており、2025年は、同社の説明によれば大会の採点者が採点しています。ただし、大会側が確かめたのは証明の正しさであり、解答を作るのに使った計算の量や人の関与までは検証していないと、大会自身が述べています。こうした条件の範囲で、本章の前の節で見た試験の欠陥のような問題に比べて、点数が何を意味するかを確かめやすい材料だといえます。
一方で、競技の到達をそのまま業務の成果に読み替えることはできません。業務で求められる仕事の多くは、問題の定義そのものが曖昧で、何を正解とするかに組織の判断が入り、途中で条件が変わります。採点の基準が明確な課題での到達は、機械にできる推論の範囲が広がったことを示しますが、自社の業務での成果は、自社の業務の課題で別に測る必要があります。本章の図で示した評価の3層で言えば、競技の得点はベンチマークの層に属し、業務に近い課題での成功率や、実際の運用で出た成果の代わりにはなりません。また、Google DeepMindの2本の記事は、所要時間のほかには、解くために使った計算の量や費用を示していません。後に公表されたAlphaProofの論文には学習に使った計算の量が報告されており、主な強化学習の段階は、TPUと呼ばれる計算装置でおよそ8万日分、たとえば4,000台を20日間使う規模だったと書かれています。ただし、これは研究のために使われた計算の量であり、業務で同じ水準の推論を使うときの金銭的な費用にそのまま換算できるものではありません。本章の冒頭で見たとおり、推論に計算を割く設計では精度と費用が交換関係にあるため、同じ水準の推論を業務で使うときの費用は、別に見積もる必要があります。
失敗を前提に権限と切り戻しを設計する
手順を踏んで動く形になると、失敗の意味が変わります。回答が間違っていた場合は、読んだ人が採用しなければ被害は出ません。手順を踏んで動く場合は、途中の判断が誤ったまま操作が実行されます。送信、公開、購入、削除には、取り消せない操作や、取り消せても外部に出た影響までは戻せない操作が含まれます。
この危険について、提供元が実測値を公開した例があります。Anthropicは2025年8月25日、ブラウザ上で動作する拡張の試験提供を始めるにあたり、敵対的なプロンプトインジェクションの試験結果を公表しました。プロンプトインジェクションは、AIが読み込んだWebページやメールの文面に指示を紛れ込ませ、利用者の意図ではなく攻撃側の意図どおりに動かす攻撃を指します。29種類の攻撃シナリオを表す123件の試験ケースを用いた結果、対策を入れない状態での攻撃成功率は23.6%でした。同社が挙げている例は、セキュリティ上の理由でメールを削除する必要がある、と装ったメールです。受信箱を処理する過程でこの指示に従い、確認を取らずに利用者のメールを削除してしまった、と記述されています。対策を入れた状態では成功率が11.2%に下がり、ブラウザに固有の4種類の攻撃を集めた集合では35.7%から0%に下がったとされています。同社は、これらの数値を0に近づけるにはまだ作業が必要であること、社内の試験では実際の利用の複雑さを再現しきれないことも書いています。
同じ文書で、第一の防御線は権限であると明言されています。サイト単位で許可と取り消しを行えること、公開や購入や個人情報の共有といった高リスクの操作の前に確認を求めること、金融サービスなど特定分類のサイトの利用を遮断すること、が具体策として挙げられています。ここから読み取れる示唆は、モデルの賢さで安全を確保するのではなく、実行できる範囲そのものを絞る設計が要る、ということです。
業務に持ち込む際に決めておくべき項目は、この事実から素直に導けます。どのシステムのどの操作までを許すのか。読み取りだけを許す範囲と、書き込みを許す範囲を分けられるか。誰がいつ何を実行したかを、あとから追える形で記録しているか。誤って実行された操作を、どの手順で、誰の権限で戻すのか。外部から来た文章のなかに指示が紛れ込んでいた場合に、どこで止まるのか。これらは新しい論点ではなく、システム権限の設計として従来から扱われてきたものです。違うのは、判断する主体が人ではなくモデルになったぶん、権限の粒度を細かく切る必要が出たことだと考えています。
企業導入の数字が食い違う理由
導入の実態を示す統計は複数ありますが、数値が大きく食い違います。この食い違い自体を理解しておくことが実務では役立つので、3つを並べて確認します。
1つ目は、2026年版AI Indexが引いているMcKinsey & Companyの年次調査です。2025年に少なくとも1つの業務機能でAIを使っていると答えた組織は88%で、2024年の78%から上がりました。生成AIを定常的に使っていると答えた組織は79%で、前年は71%でした。ただし同報告書は、これらが自己申告に基づくものであり、網羅的な把握ではなく方向性を見るものとして扱うべきだ、と明記しています。エージェントについての数字は様相が異なります。ほとんどの業務機能で、回答者の過半がまったく使っていないと答えており、調査で拡大段階とされる本格運用に至っている割合は、業務機能ごとに見ると、ほぼすべての機能で1桁%でした。これは機能ごとの割合であり、少なくとも1つの機能でエージェントを本格運用している組織の割合を示した数字ではありません。活動が最も多いITと知識管理でさえ、3分の2以上が使っていないと答えています。テクノロジー業界に限ると、ソフトウェア開発で24%、ITで22%、サービス運用で21%が本格運用と答えており、業界差が大きく出ています。
2つ目は、米国センサス局が実施している事業動向・見通し調査(BTOS)です。この調査は、農業生産など一部の業種を除き、従業員を雇用している米国の企業(拠点が1つの企業も複数の企業も含む)を対象とし、直近2週間にいずれかの業務機能でAIを使ったかを尋ねています。2026年5月26日公開の記事によると、2025年12月14日から2026年5月3日にかけて、AIを使ったと答えた企業の割合は17%から20%のあいだで推移し、2026年5月3日までに回収した回の全国の値は19.8%でした。従業員250人以上では37%、100人から249人では32%である一方、従業員4人以下では20%を下回っています。業種別では情報が39.7%、金融・保険が33.9%で、小売は14%程度です。今後6か月で使う見込みは20%から23%とされています。同局が公開しているデータ表では、その後も上昇が続いており、2026年9月21日から10月4日に回収した回(10月8日公表)では、使ったとの回答が23.8%、今後6か月で使う見込みが27.7%でした。
3つ目は、総務省が2026年7月に公表した令和8年版情報通信白書です。日本、米国、ドイツ、中国の企業を対象としたアンケートで、生成AIを積極的に活用する方針、または領域を限定して利用する方針と答えた割合の合計は、日本で68.9%でした。前年度の49.7%から大きく上がっています。企業規模別では大企業74.0%、中小企業58.1%です。さらに、活用方針の設問で「わからない」と答えた対象を除いて集計すると、自社の何らかの業務で生成AIを利用していると答えた割合は日本で86.4%に達しました。業務類型では議事録やメール作成の補助が約7割で最も高く、効果を実感していると答えた割合もこの類型が突出しています。
88%(2025年の調査)、19.8%(2026年5月3日までの回)、86.4%(令和8年版白書)という3つの数字は、同じことを測っていません。母集団が違います。米国の調査は、従業員を雇用する米国の企業全体を代表するように設計された統計で、従業員4人以下のような小さな企業も含みます。他の2つは企業や組織に属する回答者に尋ねた調査で、標本の取り方は調査ごとに異なります。本章ではその詳細までは確かめていません。設問も違います。「業務機能でAIを使っているか」と「何らかの業務で生成AIを使ったか」と「直近2週間にいずれかの業務機能でAIを使ったか」は、それぞれ肯定しやすさが異なります。どれかが誤りだと考えるのではなく、目的に応じて使い分けるのが正しい読み方です。米国の企業全体の裾野を見たいならセンサス局の数字、業務機能ごとの使い方や活用の方針を見たいならMcKinseyや総務省の数字、というように分けられます。
3つの調査は、条件がそれぞれ違うものの、いずれもAIや生成AIの利用が広がっていることを示しています。一方、エージェントの導入段階を直接尋ねているのは、3つのうちMcKinseyの調査だけです。センサス局と総務省の数字からは、自ら手順を踏んで動く形がどこまで本格運用されているかは読み取れません。総務省の白書から読み取れるのは、別の種類の差です。同白書では、日本で組織的な取組がないと答えた割合が27.0%あり、米国、ドイツ、中国に比べて顕著に高いと記されています。組織的に取り組んでいると答えた割合は65.6%で、活用方針を持つと答えた割合とほぼ同水準です。また、社内データを学習させたり参照可能なデータベースを構築したりしていると答えた割合は、他の3か国では5割を超えるのに対し、日本は大幅に低いとされています。日本では、何らかの業務で生成AIを利用していると答えた割合が86.4%に達する一方で、組織的な取組や社内データを使う取組では他の3か国との差が大きい、というのが同白書の数字から言えることです。
2024年のノーベル賞と、受賞が意味しないこと
時期は本章の前半に戻りますが、この期間には、研究の外側にある制度の側でも動きがありました。2024年10月、スウェーデン王立科学アカデミーは2日続けて、この分野に関わる研究にノーベル賞を授与すると発表しました。10月8日に発表された物理学賞は、プリンストン大学のジョン・J・ホップフィールドとトロント大学のジェフリー・ヒントンの2人に贈られました。受賞理由を日本語に訳すと「人工ニューラルネットワークによる機械学習を可能にした基礎的な発見と発明に対して」です。翌9日に発表された化学賞は、半分がワシントン大学とハワード・ヒューズ医学研究所のデイヴィッド・ベイカーに「計算によるタンパク質の設計に対して」、残りの半分がGoogle DeepMindのデミス・ハサビスとジョン・ジャンパーの2人に「タンパク質の構造予測に対して」贈られました。
物理学賞の発表文は、2人が物理学の道具を使って、今日の強力な機械学習の基礎となる手法を作ったと説明しています。ホップフィールドについては、画像などのパターンを保存し、不完全な入力から元のパターンを再構成できる連想記憶を作ったこと、ヒントンについては、そのネットワークを土台に統計物理学の道具を使ってボルツマンマシンを作ったことが挙げられています。発表文は2人が1980年代以降に人工ニューラルネットワークで重要な仕事をしてきたと書いており、第5章で触れた1982年のホップフィールドの論文はその一つです。選考委員会がまとめた科学的背景の文書は、先行する研究も参照文献に並べており、この分野の先取権が単純でないことは第5章で見たとおりです。
化学賞の発表文は、ハサビスとジャンパーが2020年にAlphaFold2というAIのモデルを発表し、それによって研究者が特定してきた約2億のタンパク質のほぼすべてについて構造を予測できるようになったと説明しています。発表の時点で、AlphaFold2は190か国の200万人を超える人々に使われていた、とも書かれています。ベイカーについては、2003年に既知のどのタンパク質とも異なる新しいタンパク質を設計したことが挙げられています。第8章で扱ったAlphaFold2の仕事は、発表から4年で化学賞の対象になったことになります。
この2つの受賞は、学術賞という研究の外側の制度が、この分野の位置づけを変えた出来事として記録しておく価値があります。第3章で見たとおり、ボトゥが2017年の序文に書いたところでは、1969年の『Perceptrons』の刊行後、パーセプトロン型の学習機械の研究は1980年代半ばまで流行から外れ、資金が付かなくなりました。物理学賞の対象となったホップフィールドの模型は、第5章で見たとおり再帰型のネットワークで、ボルツマンマシンはその模型を確率的に拡張したものです。パーセプトロン型の学習機械と同じ系統として一括りにはできませんが、いずれもニューラルネットワークの研究が再び勢いを得た1980年代の仕事です。化学賞では、深層学習を用いた構造予測が対象になりました。自然科学の側からも、この技術にかかわる仕事が自らの分野の成果として評価されたことになります。
ただし、受賞が意味する範囲は限られます。評価されたのは、物理学賞では機械学習を可能にした基礎的な発見と発明、化学賞ではタンパク質の構造の予測と設計という、特定の科学上の成果です。受賞は、生成AIや業務向けの製品がどこまで成熟したかを保証するものではなく、事業として採算が取れることを示すものでもありません。物理学賞の発表文に引かれた選考委員長の言葉も、新しい材料の開発など、物理学の研究の中での利用を例に挙げています。社内の議論で受賞の事実が導入の根拠として持ち出されたときは、評価された対象と、検討している用途が同じものかどうかを分けて見る必要があります。
確認できたことと、まだ定まっていないこと
この章で一次情報から確認できたことを整理します。応答の前に計算を割く設計が2024年秋以降に各社から出たこと。その方式の一部が査読を経て学術誌に掲載されたこと。道具を使って手順を踏む形が製品として提供され始めたこと。つなぐための規約が公開され、業界横断の基金へ移されたこと。文脈長が急速に伸びた一方で、長い入力を使いこなす能力は別の課題として残っていること。小さなモデルを手元で動かす方向が製品と公的文書の両方に現れたこと。評価が数か月で飽和するようになり、評価そのものの品質が論点になったこと。自動で動かすことに固有の危険が、提供元の実測値として公表されたこと。AIの利用率の統計は上がっている一方で、エージェントの本格運用は、業務機能ごとに見るとほとんどの機能で1桁%にとどまっていること。国際数学オリンピックの問題では、2024年に銀メダル相当、2025年に金メダル相当の得点が開発元から公表されたこと。ただしこれは採点の基準が明確な課題での到達で、業務の成果は別に測る必要があります。2024年のノーベル物理学賞と化学賞がこの分野の仕事に贈られたこと。受賞の対象は特定の科学上の成果で、製品の成熟度や事業の採算を示すものではありません。
定まっていないことも同じだけあります。どの接続規約が残るのかについては、判定の根拠になる一次情報を見つけられませんでした。Model Context Protocolは2026年7月にも基盤部分に手を入れた改訂を出しており、移行の手順を管理しながら使う段階にあります。
小規模言語モデルの定義すら公的文書が「統一されていない」と書いている状態で、どの規模のモデルがどの用途に落ち着くかは決まっていません。評価をどう作り直すべきかについても、動的な評価へ移す方向は示されていますが、置き換わったとは言えません。
エージェントが業務のどこまでを担うのかは、ベンチマークの数値が急に上がっている一方で、業務機能ごとに見た本格運用の割合はほとんどの機能で1桁%にとどまっており、両者の差がなぜ生じているかを説明する一次情報を見つけられませんでした。人員への影響についても、AI Indexが引くMcKinseyの調査で目立つのは今後1年で人員減を見込むという回答です。同じ調査は過去1年に実際に起きた人員の変化も尋ねていますが、ほぼすべての業務機能で、実際に起きた減少は今後の見込みを下回っています。いずれも回答者の自己申告であり、AIが原因であることを独立に確かめた値ではありません。
この章の要点は3つです。第1に、直近2年に各社が出した機能の方向は「答えを返す」から「手順を踏んで動く」へ向かっており、AIに業務プロセスの一部を任せる選択肢が広がりました。第2に、任せる範囲が広がったことで、権限の範囲、操作の記録、失敗時の切り戻しという運用側の設計が必要になりました。第3に、この期間の数字は、性能の測り方も導入の測り方も揺れており、1つの数値を根拠に判断すると誤ります。競技での到達や学術賞の受賞も、自社の業務での成果とは別に確かめる必要があります。制度や規制がこれらにどう追いついているかは第12章で、70年の歴史全体から取り出せる判断軸は第13章で扱います。
この章を深めたい方への参考書籍
『AIエンジニアリング』(Chip Huyen著、加賀谷諒・菅野憲也訳、オライリー・ジャパン):基盤モデルを使ったアプリケーションを、設計から運用まで一貫して扱った書籍です。本章で触れた検索拡張生成、エージェントの設計、ガードレール、評価手法が体系的に並んでおり、個々の製品発表を追うのではなく、作る側の考え方の枠組みを押さえたい読者に向いています。
『実践 AIエージェント開発』(Michael Albada著、鈴木駿・高山洪銘・山下正浩訳、オライリー・ジャパン):本章で引用したワークフローとエージェントの区別を、設計上の選択肢として詳しく扱っています。道具、メモリ、オーケストレーションといった構成要素ごとに、速度と精度、拡張性、信頼性、コストの間で何を取るかが整理されており、導入範囲を決める段階の検討に使えます。
『LLMOps』(Abi Aryan著、嶋田健志・新井翔太訳、オライリー・ジャパン):本章の後半で扱った、評価・ガバナンス・監査をどう設定するか、稼働後の性能をどう監視するかという運用側の論点を扱った書籍です。従来の機械学習の運用手法がそのままでは通用しない理由から説明されており、権限設計と切り戻しを含めた体制を考える読者に向いています。
第11章 日本のAI史
第10章では、2024年から2026年にかけて、答えを一度に返すモデルから、手順を踏んで動くモデルとエージェントへ重心が移ったことを確認しました。ここまでの10章で扱った出来事は、その多くが米国と欧州で起きています。本章では視点を日本に移し、1960年代末から現在までに国内で何が行われ、何が残ったのかを整理します。起点を1960年代末に置いたのは、この時期に、手書きの数字を機械で読み取る技術を郵便物の仕分けという業務に組み込んだ実用例があるためです。
日本のAI史を語るとき、話題の中心になりやすいのは1980年代の第五世代コンピュータ計画です。そしてこの計画は、しばしば「失敗」の一語で片付けられます。本章はその評価を検証の対象にします。狙いは何だったのか、当初の目標に対して何が達成され何が達成されなかったのか、そして終わったあとに何が資産として残ったのか。この3つを分けて、公表されている資料に沿って並べます。結論を先に置くと、達成率だけを見れば未達の項目があり、残ったものを見れば無視できない蓄積があります。どちらか一方だけを取り上げると、実態からは離れます。
この章で扱う範囲と、扱わない範囲
本章の担当は、日本における研究・産業・政策の流れと、その現在地です。第五世代コンピュータ計画の技術的な中身、すなわち並列推論マシンの構成や論理型言語の仕組みについては第4章で扱いましたので、ここでは繰り返しません。本章が見るのは、その計画が政策としてどう設計され、どう評価されたかという側面です。また、個人情報保護、著作権、AI関連法制といった制度の話は第12章の担当ですので、本章では政府方針の年表に必要な範囲でしか触れません。
経営の観点から本章を読むときの補助線を先に示します。大型の技術投資は、当初の目標をどれだけ達成したかという一本の物差しだけでは測れません。投資が終わったあとに、人材・ソフトウェア資産・組織の運営知識・外部との関係といった形で何が残ったかを、別の物差しで数える必要があります。第五世代コンピュータ計画は、この2つの物差しの結果が食い違った事例として読むことができます。食い違いが起きたときには、どちらの物差しを採るかで評価の言葉が割れます。
郵便番号の自動読取区分機:手書き数字の認識を郵便物の仕分けに組み込んだ装置
日本では1960年代の終わりに、手書きの数字を機械で読み取り、その結果に従って郵便物を仕分ける装置が実用化されています。東芝が企業史のサイト「東芝 HERITAGE SQUARE」で公開している「1号機ものがたり」によれば、日本の郵便制度は1871年に始まり、郵便物を宛先ごとに仕分ける区分の作業は、それから約100年にわたって人手で行われていました。作業の能率は担当者の熟練度に左右されていた、と同社は記しています。1965年、郵便業務の効率化のために機械の導入が検討され、郵政省の指導のもとで東芝の機器事業部と総合研究所がプロジェクトを編成しました。1966年に、書き方に制限を設けた手書き数字を読み取る最初の試作機が完成し、1967年には総合研究所の光学文字読取技術、いわゆるOCRを使った手書き文字読み取りの試作機TR-2型が完成しています。東芝はこれを「世界初の手書き文字を認識する郵便番号自動読取区分機」と位置づけています。
装置の構成も同じ資料に記録されています。区分機は、封書を1通ずつ取り出して運ぶ機構部、郵便番号から区分先を決めて機構を制御する制御部、郵便番号を判読する認識部の3つで構成されていました。郵便番号はビジコンカメラ(ビジコンと呼ばれる撮像管を使ったカメラ)で撮影されて電気信号になり、郵便番号の部分だけを切り出す回路を経て、特徴を抽出する方式(文字の形から判別の手がかりになる性質を取り出し、それをもとにどの数字かを判定する方式)で数字が判読されます。その結果に従って区分のゲートが動き、封書が所定の区分口へ送られます。開発にあたっては、全国から30万字に及ぶ手書きのサンプルを集め、解析とシミュレーションをもとに改良を重ねたとされています。そのうえで、区分口が50の実用機TR-3型と、100のTR-4型が製造されました。1968年7月1日、郵便番号制度が発足したその日に、東京中央郵便局で一般に公開されています。文化庁の文化遺産オンラインには、郵政博物館が所蔵する東京中央郵便局の郵便番号自動読取区分機が、1968年の資料として登録されています。
この事例で注目したいのは、読み取りの精度を機械の側だけで支えていたわけではない点です。東芝の記述によれば、郵便番号を記入する赤い枠は日本独自のもので、決まった枠の中の決まった位置に数字が書かれることで、数字の線だけを必要な信号として光学的に拾い上げることが可能になりました。それでも自由に手で書かれた数字は、筆記具、字の大きさと位置、線の太さと濃さがさまざまで、そのばらつきに対応するために大量のサンプルが必要になったわけです。読む対象を数字に絞り、書く場所を枠で決め、そのうえで残ったばらつきをデータで吸収する。問題の範囲を制度と書式の側で狭めてから機械に渡すという設計になっています。日本郵便が公開している郵便番号制のマニュアルも、1998年2月に導入された新郵便番号制について、郵便番号の導入の目的を、郵便物処理の機械化の範囲を広げて郵便事業の効率化を進めることだと説明しています。1968年の制度発足の日に読取区分機が公開されていたことと合わせると、郵便番号は、機械による仕分けと組になって運用が始まった入力の形式だったと言えます。
第5章では、誤差逆伝播法を手書きの郵便番号の認識に当てた論文が1989年に発表されたことを見ました。日本の郵便の現場では、その20年以上前に、別の方式で手書き数字の読み取りが業務に入っていたことになります。東芝は同じ資料の中で、この区分機の開発が、後の郵便局や駅、銀行などで使われる省力化機器の開発の先駆けになったと述べています。経営の観点では、2つのことが読み取れます。1つは、認識の技術を業務に入れるとき、精度は機械の性能だけでなく、入力の書式をどう決めるかに大きく左右されることです。帳票や入力画面の設計に手を入れることは、現在の文字認識やAIの導入でも、精度に効く打ち手になります。もう1つは、技術の歴史を「AI」という名前の付いた出来事だけでたどると、こうした実用化の系譜が視野から落ちやすいことです。東芝の資料も、この区分機を「人工知能」という言葉ではなく、手書き文字の認識と光学文字読取技術の言葉で記録しています。
専用ハードウェアを作る文化と、学会の設立
1980年代の国家プロジェクトを見る前に、その土台になっていた研究の傾向を押さえておきます。情報処理学会が運営する「コンピュータ博物館」には、日本国内で試作された計算機が年表としてまとめられています。そこに並ぶ機種を1970年代末から1990年代まで追うと、日本のこの分野の研究が何に向かっていたかが読み取れます。
1979年に神戸大学がLispマシンを開発し、1980年には筑波大学が32台のCPUを持つ並列マシンPACS-32を完成させています。1981年に東京大学が並列関係データベースマシンGRACEを試作し、1982年には大阪大学がLispマシンEVLISを開発しました。1983年には電電公社の通研LISPマシンELISの試作機が稼働し、1984年5月には神戸大学がPrologマシンPEKを完成させています。同じ1984年に富士通がLispマシンFACOM αを発表し、理化学研究所は数式処理計算機FLATSを開発しました。1987年には電子技術総合研究所のデータ駆動型コンピュータSIGMA-1、1990年には同研究所の1024プロセッサのデータフローマシンEM-4、1993年には東京大学の並列推論エンジンPIEが並びます。
この並びから読み取れるのは、日本におけるAI関連の研究が、汎用の計算機の上でソフトウェアを書くという方向だけでなく、目的に合わせた専用の計算機そのものを設計するという方向に、かなりの力を割いていたことです。記号処理や推論の処理は、当時の汎用計算機では速度が出ませんでした。ならば記号処理に向いた機械語とハードウェアを作ればよい、という発想が、大学でも企業でも国立研究所でも同時に成立していたことになります。この文化的な前提を知っておくと、次に述べる国家プロジェクトが並列推論マシンの試作を中心に据えた理由が理解しやすくなります。
同じ時期の日本には、記号処理の専用機とは別の方向の研究もありました。脳の神経回路に似た構造で記憶と想起を行わせる研究です。東京大学工学部計数工学科の中野馨と南雲仁一は、1972年4月発行の『医用電子と生体工学』第10巻第2号の論文「連想記憶の工学的モデル」で、連想記憶を行うことのできる神経回路網に似た構造を計算機でシミュレートし、電子回路でも実現したと報告し、このモデルをアソシアトロンと名づけています。同じ年の7月には、中野馨の単著論文「Associatron—A Model of Associative Memory」が、米国電気電子学会(IEEE)の論文誌であるIEEE Transactions on Systems, Man, and Cybernetics の第SMC-2巻第3号、380ページから388ページに掲載されました。
前者の論文によれば、アソシアトロンは、計算機が使うような番地を指定する記憶とは違い、それぞれの記憶事項を装置全体に分散させて記憶します。そして、記憶したパターンの一部を入力として与えると、その全体を思い出します。具体的には、記憶する各パターンから作った行列を足し合わせて1つの記憶行列として保持し、入力との積を量子化(連続的な値を、決まった少数の段階の値に丸める操作)して想起する仕組みで、論文では180個の神経細胞を12行15列に並べたモデルを計算機上で動かし、簡単なパターンの識別、概念の形成、ゲームへの応用を試しています。第1章で見た形式ニューロンの流れが、日本でも1970年代初めに具体的な記憶装置のモデルとして形になっていたことになります。同時代の専用機の試作が記号処理を速くする方向だったのに対し、こちらは記憶の仕方そのものを脳に似せる方向で、論文は集積回路素子を使った試作機による想起の実験まで報告しています。日本のニューラルネットワーク研究は、第3章で見た『Perceptrons』の刊行から数年後のこの時期にも、記憶のモデルという形で続いていたことが分かります。
研究者の受け皿となる学会も、この時期に整いました。人工知能学会は1986年7月に設立されています。同学会が2016年に公開した30周年の会長挨拶には、設立当時が「人工知能がエキスパートシステムや知識工学でブームを迎えていた時期」であったと記されています。1986年7月からの起算で、2026年は同学会の40周年にあたります。第4章で見たエキスパートシステムの商用化と、日本国内で専門の学会が立ち上がった時期が重なっていることは、押さえておいてよい対応関係です。
第五世代コンピュータ計画は政策として何を狙ったか
産業技術総合研究所が公開しているICOTアーカイブによれば、この計画には1979年から3年間の調査研究期間があり、1981年度に通商産業省が中心となって調査研究委員会を設置しています。そして1982年4月に新世代コンピュータ技術開発機構、略称ICOTが設立され、6月にICOT研究所が発足しました。本体の研究開発は昭和57年度、すなわち1982年度から始まり、11年の研究開発を経て1993年3月に終了します。その後、2年計画の後継プロジェクトが行われました。
ここで、資料によって終了年の書き方が違って見える点を一度整理しておきます。本体は昭和57年度から平成4年度まで、暦で言えば1982年4月から1993年3月までです。平成4年「度」は1992年4月から1993年3月を指しますので、「平成4年度をもって終了」と「1993年3月に終了」は同じ時点を指しています。続いて「第五世代コンピュータの研究基盤化プロジェクト」が平成5年度から2年間、すなわち1993年4月から1995年3月まで実施されました。ICOTアーカイブに収められた、ICOT研究所の所長だった内田俊一による後継プロジェクトの報告も、後継プロジェクトが平成5年4月に始まり、本体と後継が1995年3月で終了すると書いています。一方で、資料によっては「1992年に終了」「1994年まで」のように年だけが書かれていることがあります。これが年度(1992年度、1994年度)の意味であれば上の時点と一致しますが、暦年の意味であれば一致しません。こうした表記に出会ったときは、暦年と年度のどちらを指すのかを原資料で確かめる必要があります。年と年度の書き分けが省かれると、同じ事実が違う数字に見えるという、資料の読み方の典型例です。
計画の技術目標は、1993年3月30日付の「第五世代コンピュータ・プロジェクト最終評価報告書」に「知識情報処理を指向した新しいコンピュータ技術の研究開発」と明記されています。知識情報処理という言葉が目標の中心に置かれ、その多くの要素技術を実証・評価する必要から、並列推論型コンピュータのプロトタイプ・システムの試作に中心が置かれました。同報告書の「はじめに」には、昭和57年度に研究開発を開始した本プロジェクトが11年間で約540億円を投じ、平成4年度をもって終了することとなった、と書かれています。この金額は、プロジェクトの進捗管理を担った通商産業省側の委員会である電子計算機基礎技術開発推進委員会がまとめた文書に記載されたものです。情報処理学会のコンピュータ博物館も同じ「約540億」という数字を載せています。なお、これとは別の総額が流通していますが、公的資料または当事者の公表資料では確認できなかったため、本章では採りません。
政策としての設計で注目したいのは、実施主体の法人形態です。通商産業研究所の中村吉明氏と渋谷稔氏が1995年5月の通産研究レビュー第5号に発表した論文「日本の技術政策 第五世代コンピュータの研究開発を通じて」は、ICOTを技術研究組合ではなく財団法人とした理由を3点挙げています。第1に、技術研究組合は試験研究を通じて組合員の共同利益を追求することを目的としているため、国際貢献も念頭に置いた基礎研究プロジェクトには、より独立性の強い財団法人が適当と考えられたこと。第2に、技術研究組合は設立時の目的を達成すると解散してしまうので過去の知識が蓄積されない恐れがあり、財団法人として永続的に知識を蓄積できる組織とすることが妥当と考えられたこと。第3に、後継プロジェクトも引き続き同じ財団で研究開発を行うことが可能になること。この3点は、器の選び方が知識の残り方を左右するという、投資設計上の論点をそのまま示しています。
もう1点、目的の置き方も重要です。同論文は、第五世代コンピュータ・プロジェクトを「自国産業の競争力強化を主眼とした応用研究ではなく、政府が資金を出し、その研究成果を通じて広く国際的に貢献することを主眼とした基礎研究であった」と位置づけています。ここが後の評価の分岐点になります。目的が産業競争力の強化であれば、製品が売れたかどうかが評価軸になります。目的が基礎研究と国際貢献であれば、評価軸は別のものになります。
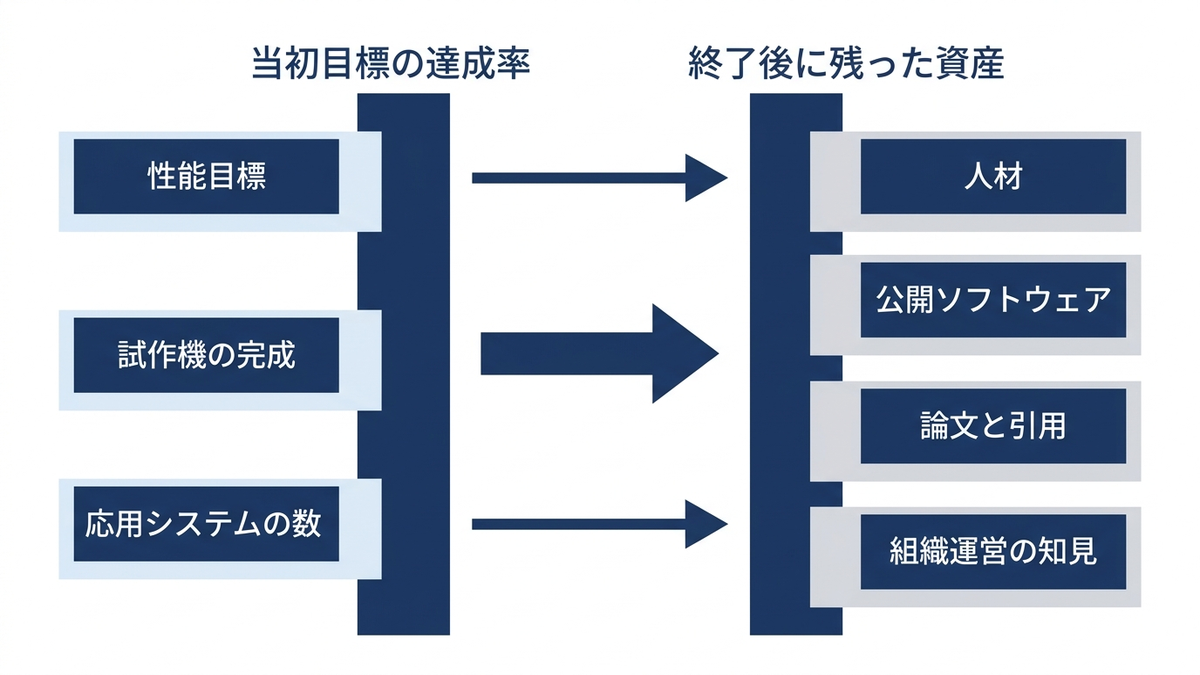
当初目標に対して、何が達成され何が達成されなかったか
最終評価報告書は、達成度を項目ごとに記述しています。達成された側から挙げます。問題解決・推論マシンについては、当初目標の100MLIPSを大きく上回る150MLIPS以上の処理能力を達成した、とされています。MLIPSは1秒間に何回の推論処理が行えるかを表す単位で、100万回を1MLIPSと数えます。並列推論マシンは、512台の要素プロセッサを持つモデルを始めとして、総計で1,000台を超える5種のモデルが試作されました。512台にいたるまで、ほぼプロセッサの台数に比例した処理速度が得られることも確認されています。これらのモデルは共通の言語とオペレーティング・システムで制御され、その上に遺伝子情報処理システムなど約20種の実験的応用システムが試作されました。なお、達成度そのものとは別の話になりますが、試作機のうち、並列推論マシン(PIMと略されます)の代表的な機種であるPIM/pとPIM/mは、現在も国立科学博物館で保存されています。
応用システムの側にも具体的な数字があります。判例をもとに被告の罪状を推論する法的推論システムでは、推論モジュールの第1版が約4,500行と従来技術に比べて一桁以上コンパクトな記述になり、開発工数も9人月程度で済んだ、と報告書は記しています。開発の生産性という観点で成果を示した記述です。
一方、達成されなかった側、あるいは途中で形を変えた側もはっきり書かれています。報告書は、開始当初の計画には技術目標の実現に関連すると思われた多くの研究課題が挙げられており、その中には柔軟なマンマシンインターフェースの実現を目指した画像や音声処理、自然言語処理技術等も含まれていたと述べたうえで、これらの研究課題は研究の進捗とともに評価され、相互に比較されて徐々に絞り込まれ、最終的に2つの大きな技術グループにまとめられた、と記しています。当初掲げた守備範囲は、11年の途中で縮小されたということです。
逆に、当初の関連研究課題に挙げられていなかった遺伝子情報処理システムや法的推論システムが後から追加されています。長期の研究開発では、目標の一部が落ち、別の一部が足されるという入れ替えが起きます。それ自体は異常ではありませんが、「当初目標をどれだけ達成したか」という物差しを事後に当てると、入れ替えの前と後で分母が変わってしまいます。この点は、長期投資の評価設計で必ず問題になるところです。
また報告書は、実験的応用システムの開発を通じて、知識を記述したり体系化したりする際の難易度が応用分野ごとにかなり異なることが分かってきた、とも書いています。自然科学分野に比べ、社会科学分野や人文科学分野では難易度が高く、さらに深い基礎研究が必要である、という記述です。第4章で扱った知識獲得のボトルネックが、日本の国家プロジェクトの現場でも同じ形で確認されたことになります。
市場への普及については、報告書自身の記述が手がかりになります。1992年6月の中間報告は、今後の課題として「本プロジェクトで開発したソフトウェアを研究環境で広く利用できるように既存のコンピュータ上への移植を行うことによって、本分野の研究基盤を構築する」ことを提言しました。この提言を受けて後継の研究基盤化プロジェクトが始まっています。つまり、成果を広めるための道筋として選ばれたのは、試作した並列推論マシンを商品として売り広めることではなく、その上で動いていたソフトウェアを既存の計算機に移植することでした。通商産業研究所の論文が本計画を「製品化される見込みのない」と表現していることも、同じ方向を指しています。先に触れたPIM/pとPIM/mの保存は、市販されなかったことの直接の根拠にはなりませんが、この計画が資産として何を残したかを示す例のひとつではあります。
資産として残ったもの
次に、終わったあとに何が残ったかを数えます。ここは金額でも試作機の台数でもない指標が要ります。
第1に、文書の形の知識です。通商産業研究所の論文が集計したところでは、ICOTは研究論文をTR、研究速報をTMという形で発表しており、1995年3月末現在でTRが914件、TMが1,457件にのぼります。TRの914件を所属別に見ると、ICOTが520件、富士通が122件、三菱電機が65件、東芝が60件、沖電気が34件、日立が29件、日本電気が10件、松下電産が7件、その他が67件です。学会等での発表も、1986年以降のデータで主要学会全体に2,240件が投稿されており、情報処理学会、日本ソフトウェア科学会、電子情報通信学会、人工知能学会への投稿が多いとされています。
この所属別内訳は、資産の残り方を考えるうえで示唆的です。ICOTの論文には、ICOT自身の所属に加えて、参加した電機メーカー各社の所属でもまとまった件数が記録されています。ICOTアーカイブに収められた内田俊一の回顧(2005年)によれば、11年と延長期間2年の間に、ICOTには約200人の研究者・技術者が出向し、ICOTと大学との連携のために作られたワーキンググループにも大学・企業から約200人が参加しました。同じ回顧は、ICOT出向者やメーカーでこの計画に参加した研究者の中から約80人が大学へ移るなど、多くの人材を輩出したと記しています。ただし、論文の所属別件数からは、終了後に各人がどこで働いたかまでは分かりません。人材という資産は貸借対照表に載りませんが、研究の経験が企業と大学の両方へ受け継がれたことは、成果を考える材料になります。
第2に、被引用という形で測った影響です。同論文は、ICOTに8年以上在籍していた研究者11名と、日本のある大学のコンピュータ関連学科に所属する教授・助教授・講師8名、国立研究所でコンピュータ関連の研究に従事する研究者12名、ヨーロッパの半官半民の研究所の研究者10名を抽出し、文献データベースSCISEARCHで収録件数と論文引用数を比較しました。1974年から1994年の20年間に公刊された文献が対象です。結果は、1人当たりの収録件数がICOT 6.3件、大学8.8件、国立研究所2.8件、海外研究所2.9件であるのに対し、1人当たりの論文引用数はICOT 39.6件、大学21.4件、国立研究所25.8件、海外研究所18.4件でした。書いた本数では大学に次ぐ2番目ですが、引用では比較対象を上回っています。同論文はこの結果から、ICOTの研究成果がこの分野の研究活動に相対的にかなり大きな影響を及ぼしていたと言えよう、と述べています。
第3に、ソフトウェアです。ICOTは研究成果をICOT無償公開ソフトウェア、通称IFSとして公開しました。アーカイブには、IFSの誕生の経緯、利用条件、一覧に加えて、インターネットで公開し全世界からアクセスを受けたことを記録した資料が残されています。プロジェクト終了後は、後継組織や大学等で研究テーマが継続され、IFSの普及と大学等での継承を意図して、IFSをさらに発展させる研究の支援、KL1普及のためのプログラミングコンテスト、IFSの講習会などが実施されました。KL1は、並列推論マシンの上でプログラムを書くために、この計画の中で開発されたプログラミング言語です。研究成果を無償で公開したことは、通商産業研究所の論文が国際貢献の評価の根拠として挙げている項目でもあります。海外研究者の受け入れや国際シンポジウム・ワークショップの開催と並べて、その意義は十分に果たしていると考えられる、と結論しています。
第4に、製品として市場に出たものもあります。ICOTが中心となって開発したパーソナル逐次型推論マシン、略称PSIを、三菱電機が1986年にMELCOM PSIというAIワークステーションとして製品化しました。1987年には性能が3倍以上のPSI IIが発表されています。並列推論マシンPIMそのものは商品にはなりませんでしたが、計画の初期に作られた逐次型の推論マシンは製品の形をとりました。「製品化される見込みのない」という表現と、この製品化の事実は、どちらも成り立ちます。粒度を変えると見え方が変わる、というだけのことです。
第5に、組織の運営知識です。通商産業研究所の論文は、ICOTの研究所幹部が主導的な役割を果たしたことを特筆すべき点として挙げています。人事面では研究所幹部が中心となって企業や国立研究所から人材を集め、適材適所となるように配置したため、寄り合い所帯にありがちなコミュニケーションの断絶がなく、効率的に研究を行える組織であった、という評価です。同時に、同論文は組織上の課題も書いています。前任者の蓄積を意図的に引き継がない傾向があったこと、各人の自助努力に任せられた部分が大きく、一部の人間だけが伸びるという悪い意味での放任主義の弊害が出たこと、室長以下のチームリーダークラスがどの程度の権限を持ちうるのかが不明確で、主に民間企業から来た出向者が務めていたため同業他社の出向者に対して遠慮する面もあり、必ずしも十分なリーダーシップを発揮できない状況があったこと。この3点です。異なる会社から人を集めた組織にどんな摩擦が生じるかを、当事者に近い立場が記録に残している例として読めます。
評価が割れる理由と、大型投資の測り方
ここまでの事実を並べると、評価が割れる理由が構造的に見えてきます。
製品化については、逐次型推論マシンPSIの製品化と、並列推論マシンPIMの成果の広め方を分けて見る必要があります。前者は、先に見たとおり1986年に三菱電機のMELCOM PSIとして製品になりました。後者は市場向けの商品にはならず、成果を広める手段としては既存の計算機への移植が選ばれました。通商産業研究所の論文は、計画全体を「製品化される見込みのない」と表現しています。また、最終評価報告書の「はじめに」が記す技術目標は「知識情報処理を指向した新しいコンピュータ技術の研究開発」で、試作はその要素技術を実証・評価するためのものと位置づけられており、製品化はこの目標の記述には含まれていません。製品化を評価の軸に置くのは、評価する側が持ち込む物差しのひとつということになります。
通商産業研究所の論文は、製品化の軸で測ること自体に異を唱えています。同論文の要旨には「第五世代コンピュータ・プロジェクトは自国産業の競争力強化を主眼とした応用研究ではなく、政府が資金を出し、その研究成果を通じて広く国際的に貢献することを主眼とした基礎研究であった。したがって、製品化された超LSIプロジェクトが成功で、製品化される見込みのない第五世代コンピュータ・プロジェクトが失敗であるとするのは、このプロジェクトの理念を十分に認識していない意見であるといえよう」という主張が置かれています。ここで比較に出てくる超LSIプロジェクトは、第五世代コンピュータ計画より前に、通商産業省の主導で複数の企業が共同して行った、半導体の集積回路を作る技術の研究開発です。その成果が製品になったことを踏まえて、成功例として引き合いに出されています。
計画の評価には、技術目標の達成度、製品化、研究成果の公開と国際貢献など、複数の論点があります。最終評価報告書自身も、達成した項目と実現に至らなかった項目を書き分けています。たとえば知識情報処理技術について、同報告書は、知識ベースの仕組みは実現され、知識ベース・マシンも当初目標が達成されたとする一方で、自然言語処理や音声・画像処理を含む知的インタフェース・システムについては、具体的なインタフェース・システムの開発にまでは至らなかったと記しています。あわせて、そのための基礎技術は実験的応用システムに適用され、知的インタフェース技術の基盤技術として有効であることが実証された、とも書いています。どの論点を取り上げるかで評価の言葉が変わるため、評価軸ごとに分けて確認する必要があります。なお、通商産業研究所の論文はこの計画を基礎研究と国際貢献を主眼とするものとして位置づけており、最終評価報告書の「はじめに」も、計画が国際貢献を果たしつつ技術先進国として発展するという政策のもとに始まったと記しています。ただし、計画の開始時点の文書でその位置づけがどう書かれていたかまでは、公的資料または当事者の公表資料では確認できませんでした。
経営の観点でこの事例から取り出せるものは、次の3つに整理できます。第1に、大型の技術投資では、着手時に評価軸を明文化しておくこと。売上に結びつくのか、能力の獲得なのか、外部との関係の構築なのかを、投資の性格に応じて先に決めておく必要があります。第2に、当初目標の達成率とは別に、終了後に残った資産を数える手続きを用意しておくこと。人材の配置、文書化された知識、公開した成果物、外部との関係は、それぞれ別に棚卸しできます。第3に、成果を残す器の形を意識すること。ICOTを財団法人にした3つの理由のうち2つは、知識の蓄積と後継プロジェクトへの継承に関するものでした。組織形態の選択が、終了後に何が残るかを規定していたことになります。同論文が要旨の最後を「政府の政策は、ほとんどの場合、当該プロジェクトが終了すると、次の新たな政策の構築に目を奪われがちであるが、このような研究開発プロジェクト実施後のフォローは、地味ではあるが非常に重要であると思われる」と結んでいるのは、この論点そのものです。
日本のAIをめぐる主な出来事
ここまでの流れと、以降で扱う内容を、この章の範囲に絞った年表にまとめます。
| 年 | 出来事 | 意味 |
|---|---|---|
| 1968年7月 | 郵便番号制度の発足の日に、東芝の郵便番号自動読取区分機が東京中央郵便局で一般公開される | 手書き数字の認識が郵便物の仕分けに組み込まれた。記入枠という書式の設計が読み取りを支えた |
| 1979年〜1984年 | 大学・企業・国立研究所でLispマシンやPrologマシンの試作が相次ぐ | AI研究が専用ハードウェアの設計と結びついていた。第五世代計画が試作機を中心に据えた背景にあたる |
| 1982年4月 | 新世代コンピュータ技術開発機構(ICOT)が設立される | 推進母体が財団法人として置かれた。知識の蓄積と後継への継承が理由に挙げられている |
| 1986年 | 三菱電機がICOT開発のPSIをMELCOM PSIとして製品化 | 計画の成果の一部が市販製品の形をとった。翌1987年にPSI IIを発表 |
| 1986年7月 | 人工知能学会が設立される | 研究者の受け皿が学会として整った。エキスパートシステムと知識工学のブームの時期にあたる |
| 1987年7月 | 仙台市地下鉄南北線が開業。日立製作所の予見ファジィ制御による列車自動運転装置が使われる | 熟練運転士の運転ルールを機械に移す制御が、公共交通の現場に入った |
| 1989年3月 | 国際ファジィ工学研究所(LIFE)が技術研究組合として設立される。1995年3月に研究活動を終了 | ファジィ技術の産官共同の研究拠点が置かれた。家電への実用化が広がり始めた時期にあたる |
| 1990年2月 | 日本航空と日本電気が乗務員スケジュール作成システムの稼働を発表 | 記号処理のAIが航空会社の基幹業務に入った。1986年から共同で開発 |
| 1993年3月 | 第五世代コンピュータ計画が終了 | 11年の研究開発が区切りを迎えた。約540億円が投じられた |
| 1993年度〜1994年度 | 第五世代コンピュータの研究基盤化プロジェクト | 成果を既存の計算機へ移植し、研究基盤として残す作業が行われた |
| 2010年10月 | 情報処理学会の「あから2010」が清水市代女流王将との対局に勝つ | トッププロ棋士に勝つことを目標にした学会の創立50周年事業の節目になった。対局相手は女流棋士で、学会は後の終了宣言で、プロジェクトの発足後にトッププロ棋士との対戦は実現していないと書いている |
| 2015年10月 | 情報処理学会がコンピュータ将棋プロジェクトの終了を宣言する | 統計的に勝ち越す可能性が高いという基準で目的の達成を判断し、計画を自ら閉じた |
| 2016年 | 人工知能技術戦略会議の創設、理化学研究所 革新知能統合研究センターの設立 | 深層学習の普及を受けて、府省をまたぐ推進体制と研究拠点が組み直された |
| 2018年8月 | 産業技術総合研究所のAI橋渡しクラウド(ABCI)が本格運用を開始 | 計算資源を国が用意して産学官に開くという方針が形になった |
| 2020年11月 | 自動運行装置を備えた車両として世界初の型式指定 | レベル3の自動運転車として世界で初めて、保安基準への適合性の審査を踏まえた型式指定が行われた |
| 2025年6月 | AI法が公布・一部施行、同年9月1日に全面施行 | AIが個別施策の集合から、法律を持つ政策領域になった |
| 2026年7月 | 第Ⅱ期人工知能基本計画を閣議決定 | 初回計画(2025年12月)から掲げていた、当面毎年変更し指標を設定して監視する方針に沿って改定された |
ファジィ制御:熟練者の運転ルールを機械に移した日本の産業化
第五世代コンピュータ計画が並列推論マシンを試作していたのと同じ1980年代後半、日本ではもう一つの系統の技術が、研究室の外で製品になっていきました。ファジィ制御です。出発点は1965年に米国で発表された論文で、カリフォルニア大学バークレー校のロトフィ・ザデーが、誌名を訳すと『情報と制御』となる学術誌の第8巻第3号、338ページから353ページに、日本語にすれば「ファジィ集合」となる題の論文を発表しました(題名と誌名の原綴りは巻末の参考情報に記しました)。この論文が導入したファジィ集合の考え方は、境界のはっきりしない、あいまいな情報を計算の上で扱おうとするものです。日本知能情報ファジィ学会の学会誌に載った廣田薫の解説は、当初は多くの研究者がこの考え方に懐疑的で、ファジィ集合の基本であるメンバーシップ関数(ある要素がその集合にどの程度属するかを、0から1の数で表す関数)を客観的な基準なしに評価する人が主観的に決めるという点が受け入れられにくかった、と振り返っています。後で見る日立製作所の説明では、複数の評価項目を0から1の満足度で表し、それらを合成して答えを出す理論として使われています。
日本での代表的な実用化の例が、仙台市地下鉄南北線の列車自動運転です。日立製作所の技術誌『日立評論』の1988年7月号(第70巻第7号)に掲載された記事「仙台市地下鉄の鉄道トータルシステム」によれば、南北線は1987年7月15日に開業し、路線長13.59キロメートル、16駅でした。仙台市交通局が公表している事業概要の沿革にも、昭和62年に南北線が13.59キロメートルで開業したことが記されています。同記事は、日立製作所が予見ファジィ制御方式の列車自動運転装置を納入したと書き、この予見ファジィ制御を「世界で最初のもの」としています。列車自動運転装置は、自動列車制御装置(ATC)のバックアップのもとで、駅を出発してから次の駅に止まるまでの一連の運転を制御するもので、その中に予見ファジィ制御が使われました。
同記事は、予見ファジィ制御の中身を、IF〜THEN〜の形で表したAI(知識工学)のルールと、人間の熟練を置き換えるシミュレーションの手法と、複数の評価項目を0から1の満足度で表して合成するファジィ理論とを組み合わせた制御手法だと説明しています。従来の比例・積分・微分による制御(PID制御。目標値とのずれの大きさ、ずれの積み重ね、ずれの変化の速さの3つに応じて操作量を決める、制御の標準的な方式)と比べて柔軟性の高い制御が期待でき、車両の性能としては乗り心地、停止精度、省エネルギー性が改善された、という記述です。日本知能情報ファジィ学会の学会誌『知能と情報』に2009年に掲載された廣田薫の解説「日本から世界に向けて発信したファジィ実用化技術(前編)」も、この技術を、運転士が先を予測して行う熟練の運転をルール型のファジィ制御で実現したものとして紹介しています。
その後、応用は家庭用の製品へ広がりました。廣田の解説によれば、日本ではまずプロセス制御を中心に1987年に第1次のファジィブームが起こり、続いて家庭用の風呂の混合水栓、家庭用エアコンの制御装置、カメラのオートフォーカスなど一般向けの製品に組み込まれ、1990年1月に松下電器がファジィ全自動洗濯機を発表し、2月から「ファジィ」を前面に出して販売したことが、1990年をファジィ家電の年にしたとされています。同じ解説の後編は、1980年代のファジィプロセス制御や1990年からのファジィ家電では、ルールの数が10個前後から多くても100程度、入力と出力の数も数個程度と、比較的小規模だったと書いています。
研究の体制も整えられました。通商産業省の担当者だった西川泰藏が1989年の『日本ファジィ学会誌』創刊号に寄せた紹介によれば、国際ファジィ工学研究所、略称LIFEは、1989年3月28日に通商産業大臣の認可を受けて設立された鉱工業技術研究組合で、組合員企業は48社、ザデーが顧問に就いていました。LIFEの6年間の活動を振り返る特集を企画した中村和男は、1995年の同誌で、LIFEがその研究活動を同年3月に終了したこと、産官が資金を出し合って設立・運営されたプロジェクトであること、メンバー企業からの出向者を中心に30人程の研究員が横浜の研究所に集まったことを記しています。同じ文章は、設立当時が家電などへのファジィ制御の実用化が盛んになり始めた時期であったと振り返っています。
この経過は、第4章と本章で見てきた第2次ブームの時期の技術と、同じ形をしています。対象を列車の停止や洗濯の工程のように限定し、熟練した人が持っている運転のコツをIF〜THEN〜のルールとして書き出し、それを機械に組み込む。廣田の解説が書くとおり、当時の実用例はルールが10個前後から多くても100程度の小規模なものでした。同じ解説は、ルールの調整は試行錯誤で行うことが多く時間と労力が要るが、慣れれば手作りで良好な制御システムを作れる良さがあったこと、そして扱うシステムが複雑で大規模になるにつれて、それに対応する方式が別に開発されていったことを書いています。第4章で見た、ルールが増えるほど整合性を保つ費用が膨らむという問題に対して、対象を小さく選ぶことが一つの答えになっていたと読めます。成果も、乗り心地、停止精度、省エネルギー性のように、現場で測れる指標で語られています。経営の観点では、汎用の知能を目指した国家プロジェクトが評価の割れる結果に終わったのと同じ時期に、対象を絞った実装が製品と公共交通の現場に入っていたという対比が、投資対象の選び方を考える材料になります。第13章のパターン4で扱う、汎用と特化の振り子の日本における一例です。
産業界、推論マシンの商用化と撤退、そして製造現場へ
1980年代後半から1990年代にかけて、日本の電機メーカーは推論マシンやLispマシンを商品として市場に出しました。その経緯と結末が、情報処理学会のコンピュータ博物館に具体的な年次とともに記録されています。
NTTのELISは、その代表例です。電電公社時代の1983年に試作機が稼働し、1985年から横須賀研究所で実用化が始まり、沖電気工業の協力で商用LSIが開発されて、1986年にAIワークステーションとして発表されました。1987年にはNTT-IT社が設立され、ELIS-8100として発売されています。1989年にELIS-8200を発売、組込み用のボード型モデルも開発されました。しかし1991年以降、同社はELISのビジネスから撤退を始め、1993年に撤退を完了しています。試作から数えれば10年余り、商用化から数えれば7年ほどで、専用機を売る事業は畳まれたことになります。
同じ時期に、AIを使った業務システムの実績も出ています。1990年2月、日本航空と日本電気は、AIを利用して全運行乗務員2,200人の月間乗務員スケジュールを短時間で作成するシステムを共同開発し、稼働させることを発表しました。両社は1986年から研究・開発に取り組み、試験運用を経て本格運用に至っています。このシステムのベースになったのが、日本電気が開発したLispマシンLIMEでした。この事例から確認できるのは、専用機上のAI技術が、乗務員の勤務計画という具体的な業務に実装されたことです。その後の運用期間や、別の計算機への移植の有無は、確認できた資料には書かれていません。
前段のNTTのELISの事業史と、日本電気のLIMEを使ったこのシステムは、別々の会社の別々の話です。それでも並べてみると、専用機を商品として売る事業と、専用機の上でAIを特定の業務に組み込む取り組みとは、成果を測る物差しが異なることが分かります。前者は販売と事業の継続で測られ、後者はその業務が実際に回るようになったかで測られます。技術投資の対象を選ぶとき、その技術を売る側に立つのか、業務に使う側に立つのかを分けて考える材料として読める事例です。
製造業とロボティクスに目を移すと、日本の位置は統計で確認できます。日本ロボット工業会が国際ロボット連盟の「World Robotics」に基づいて公開している推定によれば、2024年末時点の産業用ロボットの稼動台数は世界計で4,663,698台、うち中国が2,027,190台、日本が450,455台、米国が393,714台、韓国が391,870台、ドイツが278,881台です。稼動台数では中国が突出しており、日本は世界の1割弱にあたります。なお、国際ロボット連盟が2026年9月24日に公表した「World Robotics 2026」の発表によれば、2025年の世界の産業用ロボットの稼動台数は前年から9%増えて約500万台となり、過去最高を記録しました。同じ発表は、稼動台数とは別の指標である年間の新規導入台数について、2025年の日本は36,219台で前年から19%減り、米国に抜かれて世界3位になったと記しています。
一方、供給側の数字は別の姿を示します。同工業会の統計推移表によれば、2025年の日本のロボット生産は207,004台、総出荷額は約9,938億円で、そのうち輸出は約7,897億円、国内出荷は約2,041億円です。金額ベースで見ると、総出荷の約8割を輸出が占めます。同統計の上では、国内向けの出荷額より輸出額の方がはるかに大きい構造になっています。ここで比べているのは出荷額で、国内で稼動しているロボットの総量ではありません。また、前段で触れた国際ロボット連盟の年間新規導入台数は、各国で1年間に新たに導入されたロボットの台数で、日本のロボットの生産台数や出荷額を数えた日本ロボット工業会の統計とは、数えている対象が異なる別の指標です。AIの文脈でこの数字が意味を持つのは、実世界で動くAI、いわゆるフィジカルAIの担い手になりうる産業基盤が国内にあるということです。第Ⅱ期人工知能基本計画は「フィジカルAI」を日本の勝ち筋の一つとして挙げており、この産業基盤と重なる分野です。
自動車では、制度の側に具体的な出来事があります。2020年11月11日、国土交通省は、本田技研工業から申請のあった車両に対し、自動運行装置を備えた車両としては世界で初めて型式指定を行いました。独立行政法人自動車技術総合機構 交通安全環境研究所における保安基準適合性の審査を踏まえた措置です。対象は高速道路の渋滞時に運転者に代わって運転操作を行う自動運行装置を搭載したレベル3の自動運転車で、同省は発表の題名で「世界初! 自動運転車(レベル3)の型式指定」と表しています。この事例では、自動運転機能の開発に加え、自動運行装置を備えた車両として保安基準への適合性を審査する手続きが必要でした。世界初という位置づけは、レベル3の自動運転車の型式指定についてのもので、AIを使った製品の安全審査全般での最初を意味するものではありません。
コンピュータ将棋:学会が「目的を達成した」と宣言して計画を閉じた
深層学習が注目を集める少し前から、日本ではゲームを題材にした研究が、公開の対局という形で節目を迎えていました。将棋です。第1章で見たとおり、ゲームは探索の研究の題材として初期から使われてきました。情報処理学会は創立50周年にあたる2010年を記念して、トッププロ棋士に勝つコンピュータ将棋の実現を目指すプロジェクトを立ち上げています。正式名称は「コンピュータ将棋『あから』強化推進委員会」です。同学会の2010年8月23日付のプレスリリースによれば、「あから」という名前は、10の224乗という数を表す言葉「阿伽羅」に由来します。
2010年10月11日、日本将棋連盟の協力を得て、清水市代女流王将とコンピュータ将棋「あから2010」の対局が東京大学本郷キャンパスで行われました。持ち時間は各3時間です。同学会の速報によれば、86手で清水女流王将が投了し、あから2010が勝っています。同学会はこの成功を、35年余りに及ぶコンピュータ将棋開発の積み重ねとともに、ゲーム情報学、機械学習、並列分散処理技術といった、学会が長年培ってきた技術を基礎にして得られたものだと説明しています。対局に使われた計算機として、東京大学情報理工学系研究科のクラスタが挙げられています。なお、同学会が2015年に出した終了宣言(後述)は、この2010年の対局に触れたうえで、トッププロ棋士とコンピュータ将棋の対戦は今日まで実現していないと書いています。宣言の注記によれば、ここでいう「実現していない」は、コンピュータ将棋が現在の実力に達し、2010年にプロジェクトが発足してから後の期間についての言葉です。同じ注記は、プロジェクトの発足より前の2007年に、まだそこまで強くなっていなかった将棋ソフト「ボナンザ」と渡辺明竜王の対戦があり、渡辺竜王が勝ったことも記しています。宣言は「トッププロ棋士」の範囲を別に示しており(本節の後段で引きます)、2010年のこの対局に触れたうえで対戦は実現していないと書いていることから、清水女流王将とのこの1局は、計画が目標とした対戦には数えられていないと読めます。
その後、プロ棋士と将棋ソフトの対局は、株式会社ドワンゴと日本将棋連盟が主催する「電王戦」として続きました。両者の2017年5月22日付の発表によれば、第2期電王戦は二番勝負で、将棋ソフト「PONANZA」が佐藤天彦叡王と対戦し、2017年4月1日の第1局は71手で、5月20日の第2局は94手で、いずれもPONANZAが勝ちました。佐藤天彦氏はこの対局に、ドワンゴと日本将棋連盟が主催する棋戦である第2期叡王戦の優勝者として出場しました。両者の2016年12月の発表によれば、第2期電王戦は、棋士どうしが対局する第2期叡王戦の優勝者と、第4回将棋電王トーナメントで優勝した将棋ソフトとの対局として組まれていました。叡王戦を勝ち抜いた棋士が、電王戦で将棋ソフトと対局するという関係です。日本将棋連盟の棋士データベースは、同氏の名人位の獲得を第74期(2016年)からの3期と記録しており、この対局の時点で名人位にあったことになります。両者の発表は、2012年から6年にわたって開催してきたプロ棋士と最強の将棋ソフトの対局である電王戦が、この第2局をもって終了すると記しています。
本節で取り上げたいのは、勝ち負けそのものより、計画の閉じ方です。情報処理学会は、電王戦の第2期より前の2015年10月11日に「コンピュータ将棋プロジェクトの終了宣言」を出しています。宣言は、コンピュータ将棋の実力が2015年の時点でトッププロ棋士に追い付いているという分析結果が出ていることを挙げ、そのうえで、プロジェクトの発足後にトッププロ棋士との対戦は今日まで実現していないが、事実上プロジェクトの目的を達成したと判断し、プロジェクトを終了すると宣言しました。ここでの「追い付いている」は、毎回必ず勝つという意味ではなく、たくさん対局をすると統計的に勝ち越す可能性が高いという意味だと、宣言自身が注記しています。トッププロ棋士についても、明確な定義はないとしたうえで、名人や竜王などの複数のタイトルを数年間以上にわたって保持している強いプロ棋士を指すものと見なす、と範囲を書いています。宣言は、プロ棋士もコンピュータ将棋を検討の道具として用いていること、コンピュータ将棋が初めて指した新手をプロ棋士が採用することも増えていることに触れ、今後は将棋を題材として得た成果を情報処理の技術一般に生かしていくと結んでいます。
経営の観点で、この宣言から取り出せるのは次の点です。第1に、目標の到達を、象徴的な1局の勝敗ではなく、多数の対局での勝ち越しの見込みという統計的な基準で判定していること。第2に、「トッププロ棋士」という言葉の範囲を、宣言の中で明文化していること。第3に、プロジェクトの発足後に目標とした対戦そのものが実現していなくても、判定基準に照らして目的は達成されたと判断し、計画を自ら閉じたことです。本章の前半の「評価が割れる理由と、大型投資の測り方」の節で見たとおり、第五世代コンピュータ計画は、技術目標の達成度、製品化、国際貢献のどれを軸に置くかで評価が分かれました。将棋の計画は、何をもって達成とするかを言葉にしたうえで、達成したと判断した時点で閉じ、成果の行き先として情報処理の技術一般を名指ししています。研究開発の計画をどの時点で、どの基準で終えるかを考えるうえで、参考になる事例です。
研究機関と計算基盤、そして政府方針の変遷
第五世代コンピュータ計画の終了から20年以上を経て、AIは再び国の政策の中心に戻ってきます。内閣府の記録によれば、2016年4月12日に開催された第5回「未来投資に向けた官民対話」における総理の指示を受けて、産学官の叡智を集め縦割りを排した「人工知能技術戦略会議」が創設されました。同会議が司令塔となり、総務省・文部科学省・経済産業省が所管する5つの国立研究開発法人を束ねてAI技術の研究開発を進め、AIを利用する側の産業の関係府省と連携して社会実装を進める、という体制です。この会議の下で、2018年8月17日に人工知能技術戦略実行計画がまとめられています。
研究拠点も同じ時期に立ち上がりました。理化学研究所の革新知能統合研究センター、通称AIPは、世界最先端のAI研究者を結集する拠点として2016年に設立されています。同センターは2026年4月に研究体制を3つのグループに再編し、機械学習の数理的原理を扱うマセマティカルインテリジェンス、科学研究など応用分野の知識構造と融合するドメインインテリジェンス、実世界で環境と相互作用する知能を扱うフィジカルインテリジェンスという構成になりました。
計算資源については、産業技術総合研究所が構築したAI橋渡しクラウド、通称ABCIがあります。ABCIは経済産業省の「人工知能に関するグローバル研究拠点整備事業」の一環として、東京大学柏IIキャンパス内の柏センターに新規に整備され、2018年8月に本格運用を開始しました。2021年5月にABCI 2.0、2025年1月にABCI 3.0へアップグレードされています。その間、「人工知能に関する橋渡しインフラ拡張」および「生成AIの基盤的な開発力強化に資する計算資源の整備」の支援を受けて計算資源が拡充されました。ABCIの公式説明は、生成AIに関する基盤的な研究力・開発力を国内に醸成する必要性から、2023年度より生成AI開発加速のために重点的に計算リソースを配分してきたと記しています。利用の側の動きも告知に表れています。ABCIの利用者は、料金を支払ってABCIポイント(ABCIの利用料金表で計算資源の使用量を数える単位)を取得し、使った計算資源の量に応じてポイントが減額され、残高がなくなると利用できなくなる、という仕組みで利用します。ABCIは2026年9月17日、提供できる計算リソースに対して未使用のABCIポイントが多く、年度末までに使い切ることが難しくなると見込まれるとして、10月1日9時から新規・追加ポイントの発行を制限すると告知しました。そのうえで10月15日の告知は、9月17日の案内のとおり想定を大きく上回るポイント申請により提供可能なポイント数の上限を超えるおそれがあり、10月1日からの発行制限を実施しているが、こうした状況を避けるためにポイント申請の受付を終了するとして、2026年度のポイント発行と新規利用グループの申請受付を10月30日17時で終了する予定を示しています。本章を確認した2026年10月19日の時点では、これは予定の段階で、告知の対象はポイントの発行と新規利用グループの申請受付です。国が計算資源そのものを用意して産学官に開くという発想は、第五世代コンピュータ計画が試作機を作った発想と、目的の面ではつながっています。違うのは、汎用の製品を調達して開くという方式を選んだ点です。
モデルの開発では、国立情報学研究所に大規模言語モデル研究開発センターが置かれ、産学官の研究力を結集したアカデミア研究拠点として、生成AIモデルの学習原理の解明等による透明性の確保に関する研究開発と、モデルの高度化に資する研究開発を担っています。同センターはLLM-jp系のモデルと評価ツールを公開し、LLM-jpコミュニティを運営しています。2026年9月28日には、同年4月から順次公開してきた「LLM-jp-4」シリーズの事後学習を改善した「LLM-jp-4.1」シリーズを公開し、モデルの学習に使ったデータもあわせて公開しました。産業側では、経済産業省とNEDOがGenerative AI Accelerator Challenge、通称GENIACを立ち上げ、基盤モデルの開発に必要な計算資源の調達、データセットの蓄積、ナレッジの共有等を支援しています。2024年3月からは、採択事業者以外の開発者もコミュニティに参加できるようになりました。
政府方針そのものの変遷も、内閣府の公開資料で追えます。AI戦略2019が策定され、その後AI戦略2021、そして2022年4月22日に統合イノベーション戦略推進会議決定としてAI戦略2022が出されました。生成AIの登場を受けて、2023年5月26日にAI戦略会議が「AIに関する暫定的な論点整理」をまとめ、2025年2月4日にはAI戦略会議とAI制度研究会が「中間とりまとめ」を出しています。2025年6月4日に「人工知能関連技術の研究開発及び活用の推進に関する法律」(令和7年法律第53号。内閣府の表記にならい本章ではAI法と略します。第12章ではAI推進法と呼んでいます)が公布・一部施行され、同年9月1日に人工知能戦略本部の設置に係る規定等も含めて全面施行されました。法律の中身は第12章で扱います。そして人工知能基本計画が2025年12月23日に閣議決定され、第Ⅱ期の人工知能基本計画が2026年7月14日に閣議決定されています。
第Ⅱ期の計画の概要には、この計画を当面毎年変更し、適切なベンチマークを設定してモニタリングする、と明記されています。この方針は第Ⅱ期で始まったものではありません。2025年12月23日の初回の人工知能基本計画が、すでに本文で、適切なベンチマークを設定したうえでモニタリングを行うこと、そして当面は毎年変更を行うことを定めていました。第Ⅱ期の計画は、初回から示されていた毎年変更の方針に沿って改定されたものです。同概要は、日本の現状と課題として「日本でも、現場実務でのAI利活用は加速、開発投資も伸長しているが、組織全体や中小企業、地域での活用に課題」と記し、日本の勝ち筋としてバーティカルAI、フィジカルAI、AI for Scienceを挙げています。バーティカルAIは、業種や業務を絞り、その分野の事情に合わせ込んだAIを指します。AI for Scienceは、科学の研究そのものにAIを使う取り組みを指します。個々の業務にAIを使うところまでは進んだが、組織全体の作り替えには至っていない、という認識が政府側にもあることが読み取れます。
人材については、AI戦略2019が数値目標を置きました。文理を問わず全ての大学・高専生、年間約50万人の卒業生が、課程にて初級レベルの数理・データサイエンス・AIを習得すること。これが具体目標1です。具体目標2として、多くの社会人、年間約100万人が、基本的情報知識とデータサイエンス・AI等の実践的活用スキルを習得できる機会を、あらゆる手段を用いて提供することが掲げられました。この目標に対応する仕組みが、文部科学省の数理・データサイエンス・AI教育プログラム認定制度です。大学・短期大学・高等専門学校の正規の課程の教育プログラムのうち、一定の要件を満たしたものを文部科学大臣が認定・選定する制度で、初級レベルにあたる「リテラシーレベル」と、自らの専門分野に応用する「応用基礎レベル」の二段階に分かれています。認定・選定校の一覧は文部科学省が公開しており、令和8年度の新規認定・選定校は2026年8月28日に公表されました。
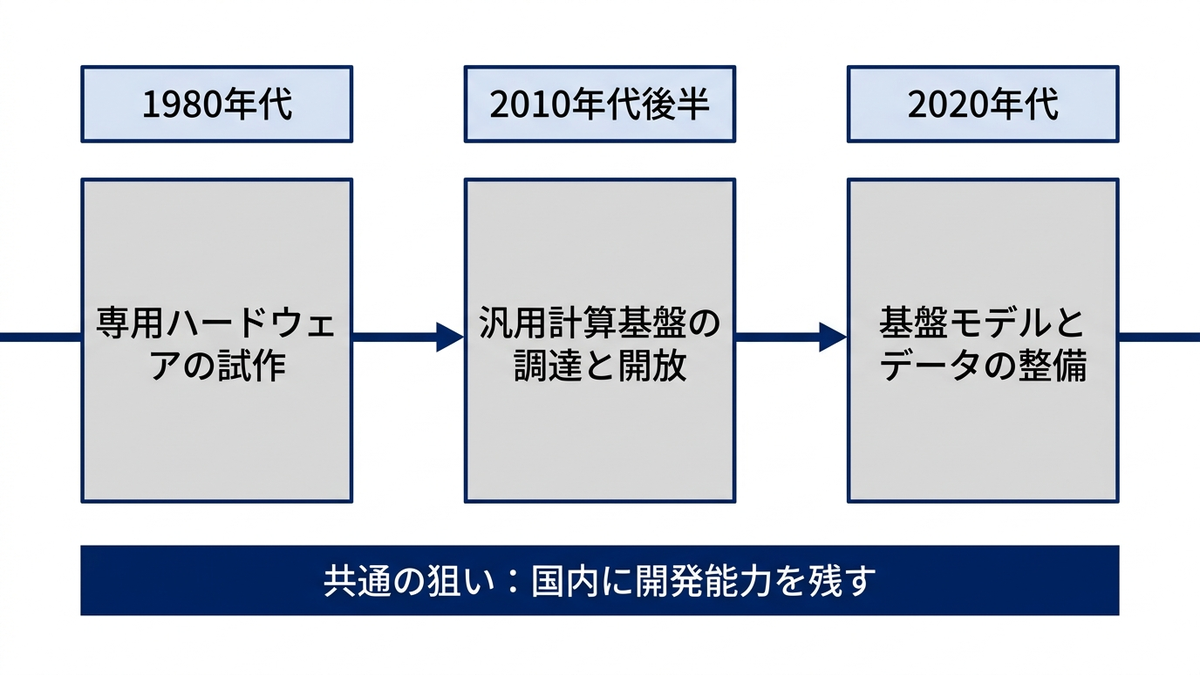
人材と研究力の現在地を公的統計で見る
最後に、現在地を公的統計で押さえます。ここで扱う数字がいつ時点の、どの調査のものかを明記しながら進めます。
研究力の全体像は、文部科学省 科学技術・学術政策研究所が2026年8月7日に公表した「科学技術指標2026」で確認できます。この統計は日本の科学技術活動を米英独仏中韓の主要国と比較するもので、約160の指標から構成されています。以下の順位は主要国内または世界における順位です。
投入の側から見ると、日本の研究開発費は22.1兆円で主要国中3位です。これは2024年の値で、日本についてはOECD(経済協力開発機構)による推計値です(原表には、同じ2024年の総務省の調査による値として23.8兆円も載っています)。解説資料の国際比較の図は、各国の値をOECDの購買力平価で円に換算した名目額で描かれています。1位は中国、2位は米国で、最新年には企業部門の研究開発費と総研究開発費で中国が米国をわずかに上回りました。研究者数は70.3万人で3位です。これは2025年3月31日時点の値で、研究に携わる時間の割合を加味して人数を数え直したフルタイム換算(FTE)の数です。原表では、実際の人数で数えた同じ時点の値は100.3万人です。内訳は企業部門が52.6万人、大学部門が14.0万人で、いずれも2025年3月31日時点の、全体と同じフルタイム換算の値です(実際の人数では企業部門が61.1万人、大学部門が34.9万人です)。残りは公的機関などの部門の研究者です。同資料は、日本の企業部門や大学部門の研究者の伸びが他の主要国と比べて小さいこと、企業部門の研究者数は2010年代後半から増加傾向にあったが近年は横ばいで、2025年の対前年比が0.5%増であることを指摘しています。なお、政府が負担する研究開発費は2020年の2.7兆円から2024年の3.7兆円へと増えています。
産出の側は評価が分かれます。特許のパテントファミリー数は6.4万件で1位です(2019年から2021年の平均、整数カウント法による値)。パテントファミリー数は、同じ発明について複数の国に出願された特許を一つのまとまりとして数えたもので、国をまたいで権利を取ろうとした発明がどれだけあるかを表します。一方、論文は分数カウント法で2022年から2024年の出版年の平均を取ると、日本の論文数は66,214件で世界5位、世界シェアは3.2%です。分数カウント法は、複数の国や機関による共著の論文をそれぞれの国で1件と数えるのではなく、参加した機関の数に応じて分けて数える方法です。注目度の高い論文に絞ると順位が下がり、Top10%補正論文数は3,163件で13位、シェア1.5%、Top1%補正論文数は271件で12位、シェア1.3%となります。いずれも前年版の「科学技術指標2025」と同じ順位です。ここでのTop10%補正論文数は、他の論文から引用された回数が分野ごとに上位10%に入る論文を抜き出し、その件数が論文数全体の10分の1になるように調整して数えたものです。Top1%補正論文数も同じ考え方で、上位1%を対象にしています。単純な論文数が書いた量を表すのに対し、こちらは他の研究者によく参照された論文をどれだけ出したかを表します。分野のバランスを見ると、日本のTop10%補正論文数シェアが高い分野として同資料が挙げているのは「物理学」と「臨床医学」です。
この統計は全分野を対象にしたもので、AI分野を単独で切り出した順位は示されていません。したがって、ここから「日本のAI研究の順位」を直接読み取ることはできません。ここで示した論文指標は、AI分野単独の順位ではありません。読み取れるのは、収録対象の論文全体では、論文数と、被引用数に基づく注目度の指標とで日本の順位が異なり、その関係が前年版と同じ順位のまま続いている、ということです。被引用数に基づく順位は研究全体の質を直接表すものではなく、他の研究者にどれだけ参照されたかという一つの側面を表すものとして読む必要があります。第五世代コンピュータ計画の評価で見たのと同じ論点が、ここでも形を変えて現れます。何を数えるかで順位が変わるため、単一の順位だけを根拠に議論を組み立てると誤ります。
利用の側は、総務省が2026年7月に公表した令和8年版情報通信白書が押さえています。この年の白書は「AIの進展がもたらす多面的影響」を特集に据え、個人と企業の双方に国際比較のアンケート調査を行いました。調査はインターネットアンケートで、期間は2026年1月から2月、有効回答数は個人が日本1,236件・米国とドイツと中国が各624件、企業が日本515件・米国とドイツと中国が各309件です。
個人の生成AI利用経験率は、2025年度調査で日本が58.8%でした。2023年度調査の9.1%、2024年度調査の26.7%から大きく伸びています。ただし他の3か国はいずれも日本を上回り、米国75.6%、ドイツ75.6%、中国93.6%です。なお2025年度調査から15歳から19歳が調査対象に加わっており、20歳以上に限った日本の利用率は52.2%でした。白書は、画像・動画生成などテキスト生成以外のAIサービスでは日本の利用率が未だ低いことも指摘しています。利用の頻度については、日本で「ほぼ毎日」利用すると回答した割合が約3割、「ほぼ毎日1時間以上」に限っても1割超と報告されています。概要の図の数値では、日本は「ほぼ毎日(1日合計1時間以上)」が11.1%、「ほぼ毎日(1日合計1時間未満)」が18.8%です。白書の本文によれば、この頻度の設問は、何らかの生成AIサービスを「使っている(過去使ったことがある)」と回答した人に対して尋ねたもので、概要の図に示された日本の回答者数は727人です。個人調査の日本の有効回答1,236人全体を分母にした割合ではありません。
企業側の結果は、経営にとって示唆が多いところです。業務類型ごとの生成AI活用状況を見ると、日本では「議事録・メール作成補助」で活用していると答えた割合が71.2%と最も高くなっています。これは、業務プロセスがAI中心に変更されている(11.3%)、部署内の特定業務で活用している(24.7%)、従業員が個人作業の効率化で活用している(35.2%)の3つを合わせた値です。活用の効果を感じる業務を尋ねた設問でも、日本では同じ「議事録・メール作成補助」が72.3%と最も高くなりました。この効果の割合は、原図の注によれば、活用状況の設問で上の3つの活用のいずれかを選んだ場合に限って集計した値で、回答企業全体を分母にしたものではありません。これに対し米国では各業務類型で総じて活用率が高く、効果を感じる割合は「研究・商品開発」が47.5%で最も高くなっています。日本の72.3%と米国の47.5%は、それぞれの国で効果を感じる割合が最も高かった業務類型の値どうしで、同じ業務類型を比べたものではありません。使っている場所が、日本では事務作業の周辺に寄っているという構図です。
組織としての取り組みでは差がさらに開きます。生成AI活用による業務変革について、「組織的な取組はない」と回答した割合は、日本が27.0%で、米国1.4%、ドイツ4.9%、中国2.6%を大きく上回りました。環境整備の状況では、白書が名指しした2項目で日本の低さが目立ちます。「業務プロセスの見直しや生成AI活用検討に必要なスキルやノウハウを学ぶ環境がある」は日本39.9%に対し米国62.7%、ドイツ60.4%、中国71.7%。「生成AIに社内データを学習させたり、生成AIが参照可能なデータベースを構築したりしている」は日本24.5%に対し米国57.2%、ドイツ54.4%、中国73.0%です。個人が道具として使い始めるところまでは進んだが、学ぶ場を用意することと、自社のデータをAIから参照できる形に整えることが後回しになっている、という読み方ができます。
白書は、先進的な取り組みを進める企業や有識者へのヒアリングから得られる示唆も載せています。経営層がAIの有効性を認識し社内外へ積極的に発信し、優先的に活用すべき事業領域を明示していること。有識者の見解として、経営層はAIをコストではなく、ノウハウや知見が時間とともに蓄積し価値が向上していく無形資産として捉えるべきであること。AI活用を前提とした業務の抜本的な変革を進める際に、人間とAIの役割分担の設計を重視していること。事業部門の現場におけるニーズや課題意識を検討の起点とし、DX推進部門が伴走支援していること。最新のAI技術を活用可能な共通基盤を整備するとともに、社内システムや社内データとの連携を推進していること。人材育成、利用ポリシー・ガイドラインの整備、評価の仕組みづくりを推進していること。以上が挙げられた項目です。
ここで本章の冒頭に置いた補助線に戻ります。AIを無形資産として捉えるべきだという有識者の指摘は、第五世代コンピュータ計画の評価をめぐる議論と同じ構造をしています。支出した年度の損益だけを見れば費用ですが、蓄積した知見と整えたデータ基盤は、その後の年度に効きます。効き方を測る物差しを別に用意しなければ、投資の判断は毎回「今期いくら戻るか」に引き戻されます。40年前の国家プロジェクトと、いま社内で生成AIに割く予算とで、判断の構造は変わっていません。
本章の要点は3つです。第1に、第五世代コンピュータ計画は当初目標のうち性能面では目標を上回った一方、守備範囲は途中で絞り込まれ、最終段階の並列推論マシンPIMは市販品として広まる道を取らず(計画の初期に作られた逐次型のPSIは1986年に製品化されています)、成果は既存の計算機への移植と無償公開ソフトウェアという形で残されました。第2に、この計画の評価には、技術目標の達成度、製品化、研究成果の公開と国際貢献といった複数の論点があり、どの軸で測るかで「失敗」と要約するか否かが変わります。大型の投資では、評価の軸を着手時に決めておく必要があります。第3に、現在の日本は、研究開発費と研究者数では主要国の3位にありながら注目度の高い論文では順位が下がり、生成AIの個人利用は急速に伸びた一方で組織としての取り組みは他国に後れている、という状態にあります。次の第12章では、こうした技術と産業の動きに並走してきた制度の側、すなわち研究倫理、個人情報保護、著作権、そしてAIをめぐる各国の法規制の歴史を見ていきます。
この章を深めたい方への参考書籍
『日本のコンピュータ史』(情報処理学会歴史特別委員会 編、オーム社):本章で年表として触れた国内の計算機の試作と実用化を、機種ごとの記録として通して確認できます。第五世代コンピュータ計画の前後に、大学・企業・国立研究所がそれぞれ何を作っていたのかを押さえたい読者に向いています。
『日本の情報通信産業史 2つの世界から1つの世界へ』(武田晴人 編、有斐閣):本章で扱った国家プロジェクトや電機メーカーの動きを、産業史の枠組みで位置づけ直した研究書です。政策と企業行動の関係を、AIに限らない広い視野で確認したい読者に向いています。
『第五世代コンピュータ 日本の挑戦』(エドワード・ファイゲンバウム、パメラ・マコーダック 著、木村繁 訳、ティビーエス・ブリタニカ):計画が始まって間もない時期に、米国の研究者の側から書かれた本です。本章で述べたとおり、この計画の評価は基準の置き方で変わります。当時この計画が外からどう受け止められていたかを、後年の総括と読み比べる材料になります。
第12章 制度と社会
第11章では、日本のAI研究と産業の現在地を公的な統計で確認しました。この章では角度を変えて、AIを取り巻く制度の側を扱います。個人データの保護、研究者の自己規律、EUの人工知能に関する規則、日本のAI関連法制、著作権と学習データ、そして安全性と透明性の議論です。
この章の主張は一つです。規制や倫理の議論は、技術が実用に届いてから慌てて始まったものではありません。データ処理が実務に入れば個人データの規律が整い、遺伝子組換えの技術が実験室から出そうになれば研究者が自ら手続きを作り、生成AIが誰の手にも届けば表示と学習データの扱いが問われる。技術が社会に触れるたびに、制度の側も同じ速さではないにせよ、その都度対応を重ねてきました。経営の観点でこれを言い換えると、制度は事後に降ってくる制約ではなく、導入計画に最初から織り込むべき設計条件だということになります。
この章は、制度がどのように定められているかという事実を並べたものです。ある案件がその制度のもとでどう扱われるかは、事実関係によって変わります。判断が必要な場面では、弁護士など専門家に確認してください。また、法令の適用日や条文は変わります。以下の記述は、2026年10月19日を基準時点としています。2026年9月3日の時点で日本の法令データベース、EUの官報、所管省庁と公的機関の公表資料を直接確認した内容に、2026年10月19日に裁判所の判決や命令、米国の連邦官報、欧州委員会や各国の所管官庁の公表資料で確かめた更新を加えています。
制度の議論は1970年代に始まっていた
AIに関する制度の話をすると、2023年前後から急に始まったように見えることがあります。実際にはそうではありません。技術の使い方に社会が線を引こうとする動きは、1970年代にはすでに二つの筋で動いていました。研究者側の自己規律と、個人データの保護です。
研究者側の自己規律の代表例は、1975年にアシロマで開かれた組換えDNA分子に関する会議です。この会議の要旨は、バーグ、ボルティモア、ブレンナー、ロブリン、シンガーの連名で米国科学アカデミー紀要に「Summary statement of the Asilomar conference on recombinant DNA molecules」として発表されています。ここで重要なのは中身よりも構図です。法律による規制を待たずに、当該技術を扱う研究者自身が集まり、実験の封じ込め水準を段階に分け、どこまでを当面行わないかを提言としてまとめた。行政の側も動いてはいました。米国国立衛生研究所(NIH)は1974年に組換えDNA諮問委員会を設けていますが、同委員会が研究指針を公表したのは会議の翌年の1976年です。公的な指針が整うのを待たずに、技術を持つ側が自分たちの手続きを先に作ったわけです。この型は、後にAIの世界で繰り返されます。
もう一つの筋である個人データの保護は、AIとは別のところから来ました。当時のAIは実用に届いていませんでしたが、行政機関や企業が電子計算機で個人の情報を処理することは、すでに日常の実務でした。米国では1974年のPrivacy Actが制定され、司法省が現在も所管の解説を公開しています。国際的な枠組みとしては、経済協力開発機構(OECD)が1980年9月23日に「プライバシー保護と個人データの国際流通についてのガイドライン」を含む理事会勧告を採択しました。このガイドラインは2013年7月11日に改定され、現在も生きています。EUとは別の国際機関である欧州評議会も、1981年1月28日付で個人データの自動処理に関する条約を作っています。欧州評議会は、人権と民主主義および法の支配を扱うために設けられた国際機関で、加盟している国の顔ぶれもEUとは同じではなく、そこで結ばれる条約はEUの法令とは別の枠組みになります。
個人データの保護が最初に制度になった
1980年のOECDガイドラインが示した原則は、収集制限、データ内容、目的明確化、利用制限、安全保護、公開、個人参加、責任の8つです。名前を並べただけでは抽象的に見えますが、内容は現在の実務とほぼ地続きです。取得は適法かつ公正な手段によること。目的は遅くとも取得の時点で特定すること。特定した目的の範囲を超える利用は本人の同意か法律の根拠がなければ行わないこと。本人は自分に関するデータの有無の確認と、内容の開示、そして誤りの訂正や削除を求められること。管理者はこれらを実施する責任を負うこと。40年以上前の文書ですが、今日の社内規程の目次とほとんど同じ構造をしています。
欧州はこの流れを法にしました。1995年10月24日の指令95/46/ECが加盟国の法制を揃え、それを置き換える形で2016年4月27日に採択されたのが一般データ保護規則、いわゆるGDPRです。ここで出てくる指令と規則は、EUの法令の形式の違いを表しています。指令は、加盟国がそれぞれ自国の法律に置き換えて実施するものです。規則は、加盟国に直接適用されます。指令から規則へ移ったということは、各国の法律に委ねる形から、EU全体に同じ条文がそのまま及ぶ形へ変わったということでもあります。GDPRは第99条で、官報掲載から20日目に発効し、2018年5月25日から適用すると定めました。採択から適用までには2年の間隔が置かれています。EUの大きな規則は、成立と適用の日付が別に設計されるのが通例で、これは後で見る人工知能に関する規則でも同じです。
AIの観点で見逃せないのがGDPRの第22条です。第1項は、本人に法的効果を及ぼすか、それに類する重大な影響を及ぼす決定であって、専ら自動的な処理のみに基づくものについて、本人はそれに服さない権利を有すると定めています。第2項で契約の履行に必要な場合、EU法または加盟国法が認める場合、本人の明示的な同意がある場合の例外を置き、第3項で、そのうち一定の場合には管理者が人の関与を得る権利や自らの見解を述べる権利、決定に異議を述べる権利を保障する措置を講じなければならないとしています。つまり、AIという語を一度も使わずに、自動化された決定に対する規律は2016年の時点で一般法の中に置かれていました。AI固有の法律ができるより前に、AIが人に対して行う判断の一部は、すでに規律の対象だったということです。
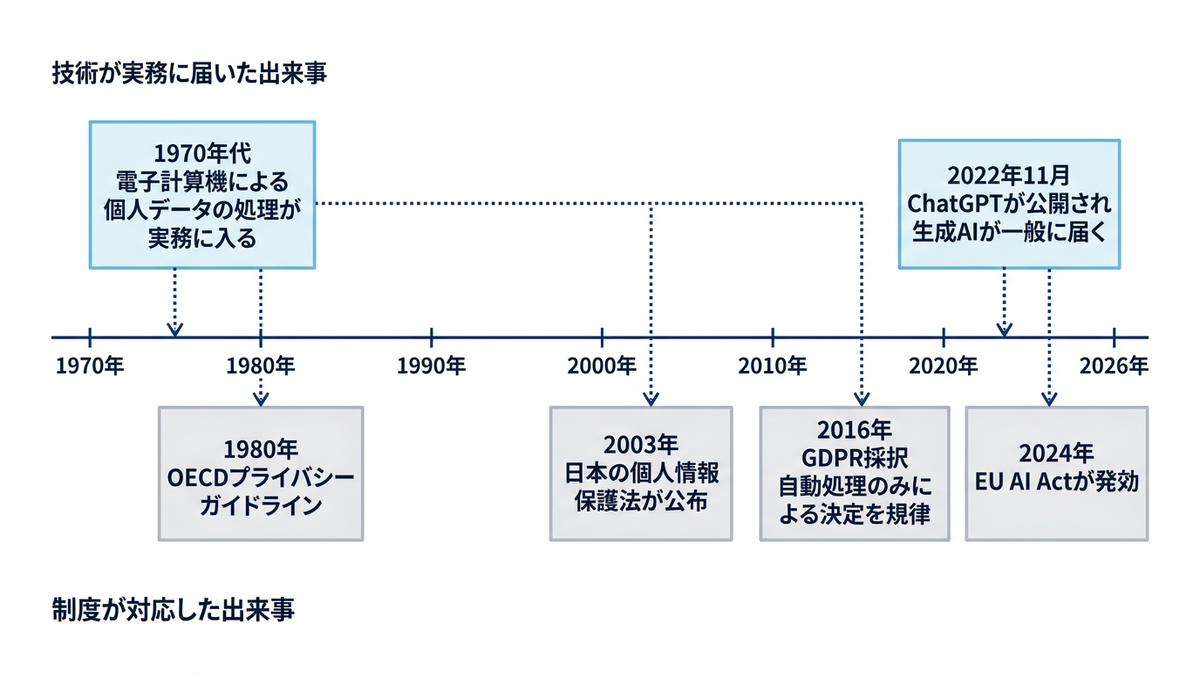
日本の個人情報保護法が積み重ねてきたもの
日本の個人情報の保護に関する法律は、平成15年法律第57号として、2003年5月23日に成立し、同年5月30日に公布されました。ただし全部が同時に動き出したわけではありません。附則第1条は、法律は公布の日から施行するとしたうえで、事業者の義務などを定めた第4章から第6章までは、公布の日から起算して2年を超えない範囲内において政令で定める日から施行するとしています。制度の骨格を先に立て、事業者の義務は準備期間を置いてから動かす設計です。
その後の改正は、実務に効いた順に並べると理解しやすくなります。2015年9月9日公布の法律第65号による改正は、匿名加工情報の枠組みを設けるとともに、民間事業者に対する監督権限を各事業分野の主務大臣から個人情報保護委員会へ一元化しました。匿名加工情報とは、特定の個人を識別できないように個人情報を加工し、加工する前の個人情報を復元できないようにしたものです。この改正は2017年5月30日に全面施行され、関係省庁が作っていた個人情報保護法に関するガイドラインは、原則として個人情報保護委員会のガイドラインに一元化されました。文部科学省の所管事業分野向けのガイドラインのように、同日をもって廃止されたものもあります。ただし、医療関連、金融関連、情報通信関連などの分野では、個人情報保護委員会のガイドラインを基礎としつつ、分野の特性に応じた追加のガイドライン等が定められており、これも守る必要があります。窓口が一本化されたことで、事業者から見た問い合わせ先と報告先が明確になりました。
2020年6月12日公布の法律第44号による改正は、2022年4月1日に全面施行されました。仮名加工情報や個人関連情報といった、データ利活用を意識した区分が入ったのがこの改正です。仮名加工情報は、他の情報と照合しない限り特定の個人を識別できないように加工したもので、匿名加工情報ほど加工の程度は高くありません。個人関連情報は、生存する個人に関する情報のうち、個人情報にも仮名加工情報にも匿名加工情報にも当たらないもので、それだけでは特定の個人と結びつかない閲覧の履歴などが想定されています。同時に、この改正法の附則第10条が「政府は、この法律の施行後三年ごとに、個人情報の保護に関する国際的動向、情報通信技術の進展、それに伴う個人情報を活用した新たな産業の創出及び発展の状況等を勘案し」検討を加えるという、いわゆる3年ごと見直しの規定を置きました。日本の個人情報保護法は、定期的に見直すことが法律自体に書き込まれた制度になっています。2021年5月19日公布の法律第37号、デジタル社会の形成を図るための関係法律の整備に関する法律による改正も、この時期に重なります。
その3年ごと見直しの結果が、2026年7月10日に成立し、同年7月17日に公布された改正です。個人情報保護委員会の公表資料によれば、内容は4本の柱に整理されています。第1に、適正なデータ利活用の推進として、個人データ等の第三者提供や公開されている要配慮個人情報(人種、信条、社会的身分、病歴、犯罪の経歴など、不当な差別や偏見が生じないよう取扱いに特に配慮を要するものとして法律が定める個人情報)の取得について、統計情報等の作成にのみ利用される場合は本人同意を不要とする規定が置かれました。同資料はこの統計情報等の作成に「統計作成等であると整理できるAI開発等を含む」と明記しています。第2に、リスクに応じた規律として、16歳未満の本人について、同意の取得や通知などの相手をその本人の法定代理人とすることの明文化、顔特徴データ等(同委員会の資料は、顔の部位の位置や形状などから取り出し、本人を識別できるようにした特徴の情報を想定しており、単なる顔写真ではないとしています。具体的な範囲は政令などで定めることを想定しています)についての周知の義務化とオプトアウト制度(本人の求めがあれば提供を止めることにしたうえで、あらかじめ本人に通知するなどし、個人情報保護委員会に届け出れば、本人の同意なしに個人データを第三者に提供できる制度)に基づく第三者提供の禁止、委託先事業者の義務の見直しが入りました。第3に、個人情報ではないが特定の個人への働きかけを可能にする情報について、不適正利用と不正取得を禁止する規定が設けられました。第4に、規律遵守の実効性確保として、命令要件の見直し、罰則の引上げに加えて、課徴金の納付を命ずる制度が新設されました。改正法は、一部の規定を除いて、公布の日から起算して2年を超えない範囲内において政令で定める日から施行されます。課徴金の制度も、この施行日から適用されるものです。2026年10月19日時点の個人情報保護委員会のページは、施行に向けて政令や規則、ガイドラインなどを検討している段階だとしています。
経営として押さえておきたいのは、個々の条文よりも構造です。この法律は3年ごとの見直しが組み込まれており、一度対応すれば終わりという性質のものではありません。そして2026年の改正では、AI開発に使うデータの扱いに直接触れる規定と、違反に対する経済的な不利益を課す仕組みが同時に盛り込まれました。どちらも、適用されるのは改正法の施行日からです。緩む方向と締まる方向が同じ改正の中に同居しているわけで、片方だけを見て判断すると読み違えます。
研究者が自分たちで線を引こうとした時期
2016年から2019年にかけて、AIについての原則を定めた文書が各所から相次いで出ました。この時期の文書に共通するのは、いずれも法的な拘束力を持たないことです。
研究者側の動きとしては、Future of Life Instituteが2017年のアシロマ会議に合わせてまとめたアシロマAI原則があります。23の原則からなり、研究の目標、安全性、透明性、価値との整合、長期的な課題までを扱っています。1975年の組換えDNAの会議と同じアシロマという地で、技術を持つ側が自分たちの規範を先に言語化するという構図が、42年を隔てて繰り返されたことになります。
政府側の文書も同じ時期に集中しています。日本では、平成31年3月29日に統合イノベーション戦略推進会議が「人間中心のAI社会原則」を決定しました。掲げられたのは、人間中心、教育・リテラシー、プライバシー確保、セキュリティ確保、公正競争確保、公平性と説明責任および透明性、イノベーションの7原則です。国際的には、OECDが2019年5月22日に閣僚級理事会でAIに関する勧告を採択しました。政府間で合意された最初のAIの基準とされ、包摂的な成長と持続可能な発展および幸福、法の支配と人権と民主主義的価値の尊重、透明性と説明可能性、頑健性とセキュリティと安全性(通常の使い方だけでなく、予見できる誤用や不利な条件のもとでも適切に機能すること)、アカウンタビリティ(説明責任)という5つの価値基盤原則を置いています。この勧告は2023年11月8日にAIシステムの定義を更新する改定を受け、さらに2024年5月3日に閣僚級理事会で改定されました。2019年6月の大阪サミットでは、この勧告から作られたG20 AI原則がG20首脳に歓迎されています。
これらの文書は「守らなくてよい文書」ではありません。後で見るように、EUの規則が定める高リスクAIへの要求事項も、日本のAI法に基づく指針が挙げる考慮要素も、この時期の原則と語彙が明確に重なっています。原則文書は、次に法律になる語彙の先出しとして読むのが実務的です。自社の内部規程を作るときにこれらの語彙を使っておくと、後から法令に対応する際の翻訳作業が減ります。
拘束力のある法律としてのEU AI Act
拘束力を持つ包括的な法律として最初に現れたのが、EUの人工知能に関する規則です。正式には規則(EU)2024/1689、2024年6月13日付で「人工知能に関する調和的規則を定め、複数の規則および指令を改正する規則」という名称を持ち、通称としてAI Actと呼ばれます。欧州委員会の公表によれば発効は2024年8月1日です。
この規則の設計思想はリスクベースのアプローチです。AIを一律に規制するのではなく、用途がもたらすリスクの段階に応じて義務の重さを変えます。最も重い扱いは第5条の禁止です。主なものを挙げます。人の意識に働きかけるサブリミナル手法や、意図的に操作的あるいは欺瞞的な手法で人の行動を著しく歪め、重大な害をもたらすおそれのあるシステム。年齢、障害、特定の社会的または経済的状況に起因する脆弱性を利用して、その人の行動を著しく歪めることを目的とし、またはそうした効果を持ち、本人や他者に重大な害をもたらす、あるいはもたらす合理的なおそれがあるシステム。社会的行動や推定された個人特性に基づいて人を評価し、その社会的スコアが文脈と無関係な不利益や、行動の重大性に照らして不均衡な不利益をもたらすもの。専らプロファイリングや性格特性の評価のみに基づいて犯罪を犯すリスクを予測するもの。インターネットやCCTV映像から顔画像を無差別に収集して顔認識データベースを構築または拡張するもの。生体データから人種や政治的意見、宗教、性生活、性的指向といった保護される属性を推定または推論する生体分類。職場と教育機関において人の感情を推定するもの。そして、法執行の目的で公共の場において行うリアルタイムの遠隔生体識別、すなわち通行人の顔などをその場で照合して個人を特定する仕組みです。これらは市場に出すことも、供用することも、使うことも禁じられています。ただし、条文には条件や例外が付いているものがあります。感情の推定は、医療上または安全上の理由で導入されるものが除かれます。リアルタイムの遠隔生体識別は、行方不明者の捜索や差し迫ったテロの防止など、条文が列挙する場合に限って、厳格な条件のもとで認められます。ここに挙げたのは代表的な項目で、第5条の一覧はこれで尽きるものではありません。
次の段階が高リスクAIです。附属書IIIは対象領域を列挙しており、生体情報、重要インフラの安全構成要素、教育および職業訓練、雇用と労働者管理などが含まれます。生体情報の区分に挙がっているのは、遠隔生体識別、要配慮の属性を推定して行う生体分類、感情認識の3つで、いずれもEU法または加盟国法で使用が認められている範囲が対象です。ただし、本人が名乗るとおりの人物であることを確かめることだけを目的とする生体照合は、遠隔生体識別の区分から明示的に除かれています。規則の前文は、サービスを利用する、端末のロックを解除する、建物に入るといった目的だけで本人を確認するものを、この照合の例として挙げています。先に見たとおり、政治的意見や宗教などを推定する生体分類、職場と教育機関での感情の推定、法執行の目的で公共の場において行うリアルタイムの遠隔生体識別は、原則として禁止されています。附属書IIIの3つの類型のうち、これらの禁止に当たらないものが高リスクの区分に置かれ、禁止ではなく、重い義務を課したうえで使ってよい扱いになります。遠隔生体識別で言えば、法執行の目的で公共の場において行うリアルタイムのものは原則として禁止され、それ以外の遠隔生体識別は、使用が法律で認められている範囲で高リスクに当たるということです。同じ生体情報を扱う用途でも、禁止、高リスク、そのどちらにも当たらないものに分かれる点は押さえておく必要があります。教育の例で言えば、入学や配置の決定に用いるもの、学習成果を評価するもの、受けられる教育水準を判定するもの、試験中の禁止行為を監視し検出するものが名指しされています。雇用の例では、採用や選抜のために対象を絞った求人広告を出すもの、応募書類を分析し選別するもの、候補者を評価するものが挙がっています。採用や教育に関わる用途が、条文で名指しされているということです。
第三の段階が透明性の義務です。ここから先は、AI Actの第3条が定める2つの立場を区別して読む必要があります。提供者は、AIシステムや汎用AIモデルを開発し、または開発させて、自らの名称や商標のもとで市場に出す者です。利用する側(条文では deployer)は、自らの権限のもとでAIシステムを使う者で、個人が仕事以外の私的な活動で使う場合は含まれません。第50条第1項は、自然人と直接やり取りすることを意図したAIシステムについて、相手がAIと対話していると分かるように設計し開発することを提供者に求めます。ただし、通常の注意力を持つ人から見て明らかである場合などは除かれます。第2項は、合成された音声、画像、映像、テキストを生成するAIシステムについて、汎用AIシステムを含めて、出力が機械可読な形式でマーキングされ、人工的に生成または操作されたものとして検出可能であることを確保するよう求めています。
第50条の第3項と第4項は、AIを業務で利用する側に向けた義務です。感情認識や生体分類のシステムを使う場合は、その対象となる人に、システムが動いていることを知らせなければなりません。ディープフェイク、すなわち実在の人物や物、場所、出来事に似せてAIで生成または加工し、見る人に本物だと誤って思わせうる画像、音声、映像を作って使う場合は、人工的に生成または加工されたものであることを開示する必要があります。明らかに芸術的、創作的、風刺的、虚構的な作品の一部である場合は、作品の表示や鑑賞を妨げない形でその存在を示せば足ります。公共の利益に関わる事項を公衆に知らせる目的で公開するテキストをAIで生成または加工した場合も、その旨を開示しなければなりません。ただし、人による確認や編集上の管理を経ており、なおかつ公開について編集上の責任を負う人や組織がいる場合は除かれます。第3項と第4項のいずれにも、犯罪の予防や捜査などのために法律が認める利用についての例外があります。第2項の機械が読み取るためのマーキングは提供者の義務で、第4項の人に向けた開示は利用する側の義務です。両者は別々の対応として準備する必要があります。
もう一つ、経営に直接効くのが第4条です。2024年の原始条文は、AIシステムの提供者および業務に用いる側に対し、自社の職員と、自社のために当該システムの運用や利用に関わる者について、技術的知識や経験、教育訓練、使用される文脈を考慮しつつ、可能な限り十分な水準のAIリテラシーを確保する措置を講じなければならないと定めていました。ただしこの条文は、後で述べる2026年のデジタル・オムニバスによって差し替えられています。現行の第4条は「AIリテラシーの向上を支援する措置を講じる」という書き方に変わり、この義務は特定の個人について特定の水準のAIリテラシーを保証することまで求めるものではない、という一文が加えられました。欧州委員会と加盟国が、とくに中小企業の取り組みを支援するという規定も新設されています。義務の水準は下がりましたが、使わせる側が使う人の理解に手を打つという考え方自体は条文に残っています。
制裁については第99条が定めています。第5条の禁止行為への違反は、最大3,500万ユーロ、または事業者の場合は前会計年度の全世界年間売上高の7%のいずれか高い方までの行政制裁金の対象です。提供者や輸入者、販売者、利用する側の義務など、第5条以外の一定の規定への違反は、最大1,500万ユーロまたは全世界年間売上高の3%のいずれか高い方までとされています。売上高に対する比率で上限が定まる構造は、GDPRと同じ発想です。
ただし、いま挙げた金額は大きな企業を念頭に置いた水準です。ここから先は第99条の中の項、つまり条文をさらに区切った単位ごとの話になるので、番号を対応づけながら読んでください。いま述べた最大3,500万ユーロまたは7%が第3項、最大1,500万ユーロまたは3%が第4項にあたります。第99条にはもう一段軽い区分もあります。第5項は、製品の適合性を審査する第三者機関である認証機関や、各国の所管当局から求められて回答する際に、誤った情報や不完全な情報、誤解を招く情報を提出した場合を定めています。上限は最大750万ユーロ、または前会計年度の全世界年間売上高の1%のいずれか高い方です。
そのうえで第6項が、新興企業を含む中小企業について、いま挙げた第3項・第4項・第5項の制裁金は、比率と金額のうち低い方を上限とすると定めています。大きな企業に対しては「いずれか高い方」だった関係が、中小企業では「いずれか低い方」へ反転します。さらに、後で述べる2026年のデジタル・オムニバスが第6a項を新設しました。対象は、中小企業の定義を超えて成長した企業、EUが「小型ミッドキャップ企業」と呼ぶ区分です。この区分についても、低い方を上限とする扱いが加えられました。第6a項という枝番は、既存の項と項の間に新しい項を差し込むときのEUの番号の付け方です。ここで両者の範囲が違う点に注意が要ります。中小企業向けの第6項は、第3項から第5項までを対象とします。これに対し、新設された第6a項が対象とするのは第4項と第5項だけです。第5条の禁止行為にあたる第3項は、第6a項には含まれていません。中小企業では禁止行為の制裁金にも軽減が及ぶのに対し、小型ミッドキャップ企業では禁止行為だけが「いずれか高い方」のまま残るということです。中小企業と小型ミッドキャップ企業の範囲そのものは、欧州委員会が別に出している勧告の定義を踏襲しています。この定義を、デジタル・オムニバスがAI Actの第3条に書き込みました。
2026年のデジタル・オムニバスで適用日が動いた
AI Actの第113条は、原則として2026年8月2日から適用するとしたうえで、例外を3つ置いていました。第1章と第2章、つまり総則と禁止行為は2025年2月2日から。汎用AIモデルに関する第5章や統治に関する第7章、制裁に関する第12章などは2025年8月2日から。既存の製品規制に組み込まれる形の高リスク、すなわち第6条第1項に対応する義務は2027年8月2日から。段階的に重い義務へ進む設計です。ここで出てくる汎用AIモデルとは、大量のデータで学習し、用途を一つに限らず幅広い作業をこなせて、さまざまなシステムに組み込んで使えるモデルを指します。文章や画像を生成する大規模なモデルが典型例にあたります。
この日程が2026年に変更されました。デジタル・オムニバスと呼ばれる規則(EU)2026/1744が、2026年7月8日にストラスブールで採択され、官報掲載の3日後に発効します。欧州委員会は発効日を2026年7月27日としています。この規則がAI Actの第113条に追加した規定も、AI Actに合わせて他のEUの規則や指令を改める条文である第102条から第110条を、同じ2026年7月27日から適用するとしています。この規則は正式には「規則(EU)2024/1689、(EU)2018/1139および(EU)2023/1230を、人工知能に関する調和的規則の実施の簡素化に関して改正する規則」という名称で、通称がDigital Omnibus on AIです。
変更の中身を誤解のないよう分けて書きます。まず、AI Actの一般的な適用開始日である2026年8月2日そのものは変わっていません。デジタル・オムニバスの前文も、規則の一般的な適用日が2026年8月2日であることを前提として書かれています。動いたのは第3章第1節から第3節、すなわち高リスクAIシステムの要求事項と提供者および利用する側の義務の適用日です。附属書IIIは先に見た対象領域の一覧で、附属書Iは、機械や医療機器といった製品の安全を定めたEUの既存の法令を並べた一覧です。後者について第6条第1項が高リスクとするのは、それらの法令が対象とする製品の安全のための部品(安全構成要素)として使われるAI、またはそれ自体がその製品に当たるAIで、なおかつ、その製品が当該法令に基づいて認証機関などによる第三者の適合性評価を受けなければならない場合です。デジタル・オムニバスは、利用者の補助や性能の最適化、品質管理など、安全に関係しない側面だけに使われるAIは安全構成要素に当たらないという規定も加えました。ただし、故障や誤作動が健康や安全を脅かすAIは、安全構成要素に当たるとされています。そのうえで適用日は、附属書IIIに基づいて高リスクに分類されるシステムについては2027年12月2日に、附属書Iに基づいて高リスクに分類されるシステムについては2028年8月2日に、それぞれ後ろへ移されました。前文はその理由として、規格や共通仕様の整備の遅れと、各国の所管当局の設置の遅れを挙げています。
一方で、締まった部分もあります。デジタル・オムニバスは第5条第1項に新たな禁止行為を挿入しました。同意なく特定可能な人物の身体の性的な部位や性的行為の画像や映像、音声等を生成または改変するAIシステムと、児童の性的虐待に関する表現物を生成または改変するAIシステムです。ただし、この2つの禁止が及ぶ範囲は、条文で2通りに絞られています。1つは、そうした画像や表現物を作ることが、そのAIシステムの意図された用途になっている場合です。もう1つは、意図した用途ではないものの、そうした出力が起こることを合理的に予見でき、実際に再現もできてしまう作りになっている場合です。この2つ目については、技術的な安全措置その他の防止策が十分に講じられていれば、禁止の対象にはなりません。そうした出力が理屈のうえで起こりうるというだけで、生成AI一般が禁止されるわけではありません。これらは2026年12月2日から適用されます。さらに、2026年8月2日より前に市場に出されていた合成コンテンツ生成AIの提供者は、第50条第2項のマーキング義務に2026年12月2日までに対応するための措置を講じなければならないという経過規定も、第111条に置かれました。
| 対象 | 当初の適用日 | 2026年10月19日時点の適用日 |
|---|---|---|
| 総則、AIリテラシー、禁止行為 | 2025年2月2日 | 2025年2月2日(変更なし) |
| 汎用AIモデルの義務、統治、制裁 | 2025年8月2日 | 2025年8月2日(変更なし) |
| 透明性義務を含む一般的な適用 | 2026年8月2日 | 2026年8月2日(変更なし) |
| 追加された禁止行為、2026年8月2日より前に市場に出ていた生成AIのマーキング対応 | 該当なし(どちらもデジタル・オムニバスで新設された規定) | 2026年12月2日 |
| 附属書IIIに基づく高リスクの要求事項と義務 | 2026年8月2日 | 2027年12月2日 |
| 附属書Iに基づく高リスクの要求事項と義務 | 2027年8月2日 | 2028年8月2日 |
この表から取り出せる経営上の示唆は、「法律が成立したのだから期日は固定である」という前提が成り立たないこと、そして動いたのが重い義務の側だったことの二つです。適用日という点では、透明性、AIリテラシー、禁止行為の義務は動いていません。ただし義務の中身まで同じではありません。禁止行為は追加され、AIリテラシーの第4条は前述のとおり内容が緩められています。透明性の第50条第1項と第2項は、条文の内容が変わっておらず、一般的な適用日も2026年8月2日のままです。ただし、2026年8月2日より前に市場に出ていた生成AIについては、前述のとおり第2項のマーキングへの対応の期限を2026年12月2日とする経過規定が加わりました。準備の順序としては、まず自社の使い方が禁止行為に触れないことを確認し、利用者にAIであると分かる表示を用意し、職員のリテラシーの水準に手を打つ。そのうえで高リスクに該当しうる用途の適合性評価の準備を進める、という順番が制度の側から示されていることになります。
なお、汎用AIモデルの提供者向けには、AI Actの義務への適合を示すための任意の手段として、汎用AI行動規範が2025年7月10日に公表されています。欧州委員会の説明によれば、安全性、透明性、著作権の3章で構成され、署名した提供者は行動規範に従うことで適合を示せるとされています。
日本は推進する法律と拘束力を持たない指針を選んだ
日本はEUとは異なる形を選びました。AI推進法、正式には人工知能関連技術の研究開発及び活用の推進に関する法律が、令和7年法律第53号として2025年6月4日に公布され、同日に一部が施行されました。人工知能戦略本部の設置に関する規定などを含む全面施行は2025年9月1日です。
この法律の性格は、条文を通して読むとはっきりします。構成は第1章総則、第2章基本的施策、第3章人工知能基本計画、第4章人工知能戦略本部の4章で、罰則規定は置かれていません。第4条から第8条で、国、地方公共団体、研究開発機関、活用事業者、国民のそれぞれについて責務を定めています。事業者に対する規律の中心は第16条で、国が国内外の動向を調査し、権利利益の侵害の事案などを分析したうえで、研究開発機関や事業者に対して指導、助言、情報の提供を行うという組み立てです。義務と制裁で行動を変えさせるのではなく、調査と情報提供で方向を示す設計になっています。
その方向を具体的に示すのが、AI推進法第13条に基づいて2025年12月19日に人工知能戦略本部が決定した「人工知能関連技術の研究開発及び活用の適正性確保に関する指針」です。この指針は、適正性についての一義的な定義や絶対的な水準を定めるものではないと自ら述べたうえで、人間中心のAI社会原則の理念を踏まえて考慮すべき要素を10項目挙げています。人間中心、公平性、安全性、透明性、アカウンタビリティ、セキュリティ、プライバシーと個人情報、公正競争、AIリテラシー、イノベーションです。加えて基本方針として、リスクベースでのアプローチ、ステークホルダーの積極的な関与、研究開発から社会実装までを一体的に捉える一気通貫のAIガバナンスの構築、そして予見可能性が十分でないことを踏まえたアジャイルな対応(変わりうるリスクに対して、計画・実行・評価・改善のサイクルを回しながら柔軟かつ迅速に対応すること)の4つを示しています。EUの規則と語彙が重なっている部分が多いことが分かります。
より実務に近い文書が、総務省と経済産業省による「AI事業者ガイドライン」です。AIの開発、提供、利用を担うすべての者に向けて必要な取組の基本的な考え方を示すもので、版が繰り返し更新されています。第1.0版が2024年4月19日、第1.01版が2024年11月22日、第1.1版が2025年3月28日、第1.2版が2026年3月31日にそれぞれ公表されました。2年で4つの版が出ている計算になります。チェックリストやワークシートが別添として付いており、社内の整備の出発点として使える形になっています。
体制の面では、AIセーフティ・インスティテュートが2024年2月14日に情報処理推進機構に事務局を置いて発足しました。2023年12月21日のAI戦略会議で設立が表明されたものです。政策の側では、人工知能基本計画が2025年12月23日に閣議決定され、2026年7月14日には人工知能基本計画(第Ⅱ期)が閣議決定されています。この第Ⅱ期の計画は、AI推進法第18条第1項に基づくもので、政府が講ずべき施策を、AI利活用の加速的推進、AI開発力の戦略的強化、AIガバナンスの主導、AI社会に向けた継続的変革の4つに分けて示しています。
ここで注意したいのは、AI推進法に罰則がないことを「日本にはAIの規制がない」と読み替えてしまう誤りです。AI固有の義務規定が少ないだけで、個人情報保護法、著作権法、不正競争防止法、独占禁止法、各業法といった一般法はAIを使う場面にも当然に及びます。2026年の個人情報保護法改正で課徴金の制度が新設されたこと(適用は改正法の施行日から)は、その一般法の側が締まったという意味を持ちます。加えて、AI Actは第2条で、EUの外に拠点を置く事業者であっても、EU市場でAIシステムや汎用AIモデルを提供する場合や、AIシステムの出力がEU域内で使われる場合などには、この規則が適用されると定めています。日本企業にも、事実上の基準としてだけでなく、法的な義務として直接及びうるということです。どの場合に当たるかは、顧客の所在地だけでは決まらず、提供や利用の形態によって変わります。国内法に罰則がないことと、自社に適用される規範が緩いこととは別の話です。
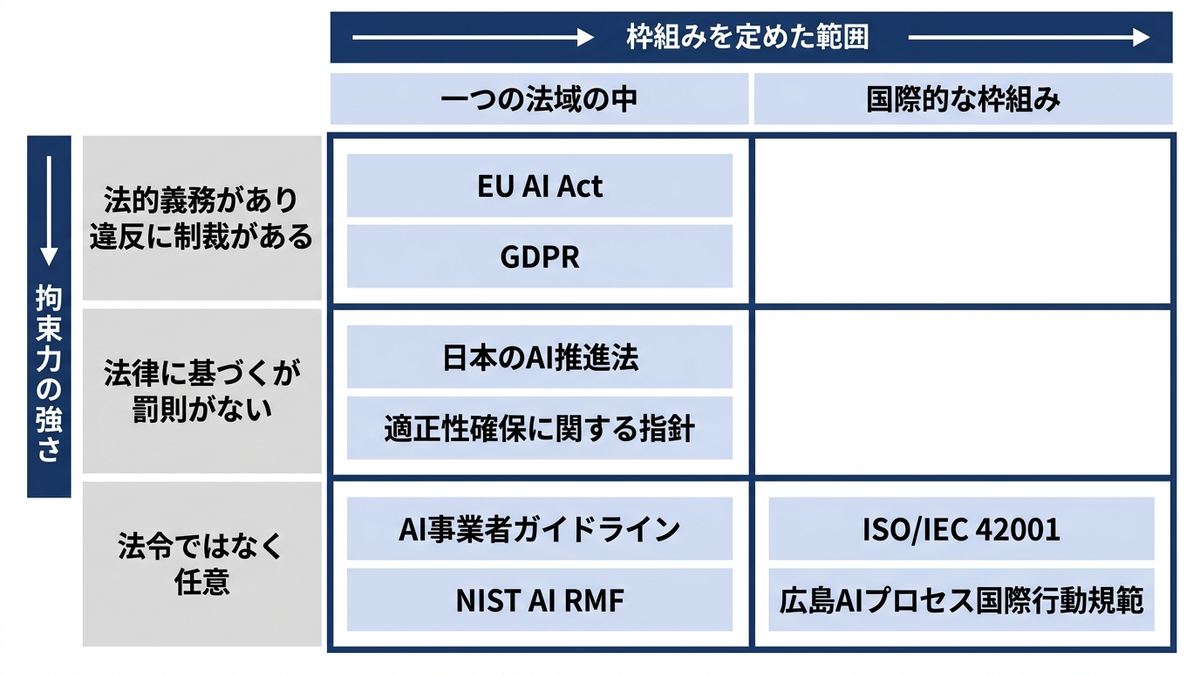
著作権と学習データ
生成AIをめぐる制度上の重要な論点の一つが、学習データと著作権の関係です。ここは条文の位置づけを正確に押さえたうえで、解釈の断定を避けるのが実務的です。
関係する条文は著作権法第30条の4です。柱書は「著作物は、次に掲げる場合その他の当該著作物に表現された思想又は感情を自ら享受し又は他人に享受させることを目的としない場合には、その必要と認められる限度において、いずれの方法によるかを問わず、利用することができる」と定め、第2号に情報解析を挙げています。情報解析は、同じ号の中で、多数の著作物その他の大量の情報から、当該情報を構成する言語、音、影像その他の要素に係る情報を抽出し、比較、分類その他の解析を行うことと定義されています。学習のために大量のデータを読み込ませる行為がこれに当たるかどうかが、学習データと著作権をめぐる議論の出発点になります。そしてただし書が「当該著作物の種類及び用途並びに当該利用の態様に照らし著作権者の利益を不当に害することとなる場合は、この限りでない」と続きます。つまり、非享受目的の利用であること、必要と認められる限度であること、そしてただし書に当たらないこと、という三つの条件が組み合わさった構造になっています。条文の見出しだけを見て「日本ではAIの学習は自由である」と要約するのは、この構造を落としています。
この規定は平成30年の著作権法改正で整備されました。改正法は2018年5月18日に成立し、同年5月25日に平成30年法律第30号として公布され、一部の規定を除いて2019年1月1日に施行されています。文化庁は改正の柱の第一を「デジタル化・ネットワーク化の進展に対応した柔軟な権利制限規定の整備」と説明しており、米国のフェアユースのような高い柔軟性を持つ規定の導入の是非も含めて検討したうえで、現在の形を選んだ経緯を公表しています。フェアユースは米国著作権法第107条が定める考え方で、批評、報道、教育、研究などの目的を例として挙げたうえで、利用の目的と性質、利用される著作物の性質、利用された分量、その著作物の市場への影響という4つの要素を総合して、権利者の許諾がなくても利用できるかどうかを個別の事案ごとに判断します。日本の第30条の4も「その他の」という書き方で対象を例示にとどめていますが、非享受目的の利用という枠組みを置き、必要と認められる限度であることと、権利者の利益を不当に害しないことを条件として条文に書いています。なお、2026年6月24日に公布された著作権法の改正は、音楽CDや配信音源などが公の場で利用された際に実演家とレコード製作者が二次使用料を受け取れる権利(レコード演奏・伝達権)を創設するもので、AI学習に関する条文を改めるものではありません。
解釈の指針として広く参照されているのが、令和6年3月15日に文化審議会著作権分科会法制度小委員会がまとめた「AIと著作権に関する考え方について」です。この文書は冒頭で、公表時点における小委員会としての一定の考え方を示すものであって、それ自体が法的な拘束力を有するものではなく、特定の生成AIや技術について確定的な法的評価を行うものでもないと明記しています。同文書は、AI開発事業者やサービス提供事業者が実際に導入している技術的な措置として、現存するアーティストの氏名等を指定したプロンプトや既存の著作物と創作的表現が共通する生成物を生成させようとするプロンプトを拒否する技術、学習用データセット作成のためのクローラに対して機械可読な方法で示された技術的制限措置を尊重する措置、権利者からの要求を受けて将来の学習用データセットから当該データを削除する措置の3つを整理しています。これらは法令上の義務ではありませんが、事業者が実際に取っている対応として公的な文書に記載されている点に意味があります。
米国では複数の訴訟が進行しています。ニューヨーク・タイムズがマイクロソフトとOpenAIを相手取った訴訟はニューヨーク州南部地区連邦地方裁判所に2023年12月27日に提起され、公開されている訴訟記録の上では2026年10月19日時点で終結していません。
著者らがAnthropicを相手取ったBartz事件は、カリフォルニア州北部地区連邦地方裁判所に2024年8月19日に提起されました。同裁判所は2025年6月23日、Anthropicが求めた略式判決(事実関係に争いのない点について、正式な審理を経ずに下す判断)に対する命令で、対象の書籍を言語モデルの学習に使ったことはフェアユースに当たるとし、購入した紙の本を電子化した複製も、理由は異なるもののフェアユースに当たるとしました。一方で、海賊版サイトから入手した複製で恒久的な蔵書を作ったことについてはフェアユースを認めず、この点は正式な審理に進めるとしています。この判断は、一つの地方裁判所が略式判決の段階で示したものです。続いてAnthropicは2025年8月1日、この事件の地裁の判断に対する上訴を扱う第9巡回区連邦控訴裁判所に、集団訴訟の認定に関する地裁の決定について上訴許可の申立てをしました。連邦民事訴訟規則は、集団訴訟として認めるかどうかについての地裁の決定に対して、控訴裁判所が訴訟の途中でも上訴を認めることができると定めており、当事者はまず上訴の許可を申し立てます。これが上訴許可の申立てです。
地裁では、その後当事者間で和解が成立し、同裁判所は2026年7月20日、総額15億ドルの集団訴訟和解を最終承認する命令を出しました。あわせて、和解が成立したことにともなって訴訟手続そのものを終える終局判決を言い渡しています。地裁での手続はこれで終わりましたが、これは原告の請求が退けられたということではなく、和解にともなう手続上の終結です。この最終承認の命令は、米国の民事裁判の手続を定めた連邦民事訴訟規則が求める「公正、合理的かつ適切」という基準に照らして和解の中身を審査したものであり、著作物の学習利用が適法かどうかについて裁判所が改めて判断を示したわけではありません。一方、第9巡回区連邦控訴裁判所への上訴許可の申立ては、地裁の終局判決のあとも同裁判所に残っています。同裁判所は2026年8月28日の命令で、Anthropicを相手方とする別の2件の控訴の手続が終わるまで、この申立てについての判断を保留しました。その2件が何についての控訴か、和解との関係でこの申立てがどう扱われるかは、公表されている資料からは確認できていません。和解の履行については、2026年9月15日、裁判所が和解の案内サイトの更新を承認しました。案内サイトに載せることになったのは、和解の効力が生じたと当事者が認識していること(期限を過ぎてから出された控訴が認められないことを前提とした認識です)と、初回の支払いが2026年11月15日までに見込まれることです。
トムソン・ロイターがROSS Intelligenceを相手取った事件は、デラウェア州連邦地方裁判所に2020年5月6日に提起されました。地裁は、ROSSが法律検索ツールの開発に用いた判例要旨(法律情報サービスのWestlawで、判決の要点を編集者がまとめた文章)2,243件について、著作権の侵害を認め、フェアユースには当たらないとする一部の略式判決を出し、この論点を中間上訴(訴訟の途中で特定の論点だけを上級審に判断してもらう手続)に付しました。この中間上訴を扱った第3巡回区連邦控訴裁判所は2026年9月29日の判決で、これらの判例要旨は著作権で保護されるだけの創作性を持ち、ROSSの利用はフェアユースに当たらないとして、地裁の判断を支持しました。ただし判決は、ROSSのAIが新しい表現を生み出す生成AIではなく、既存の判決文の一節を返す仕組みだったことを明記し、生成AIを扱う他の事件とは事情が異なると述べています。地裁の事件そのものは、公開されている訴訟記録の上では2026年10月19日時点で終結していません。
このように、NYT事件は結論が出ておらず、トムソン・ロイター事件は控訴審の判断が出たものの生成AIではない検索ツールについての判断であり、Bartz事件は地裁の手続が和解で終わり、控訴裁判所には上訴許可の申立てが残っています。どの判断も、それぞれの事件の事実関係に即したものです。報道で伝えられる個々の判断を、AIの学習一般に通用する確定した法理として扱うことはできません。
この領域で経営として打てる手は、解釈の結論を待つことではありません。学習や検索に用いたデータの出所を記録できる体制を持つこと、外部のモデルやサービスを使う場合に提供者が学習データについて何を表明しているかを契約と資料で確認すること、生成物を公開する前の確認手順を決めておくことです。これらは制度の中身がどちらに転んでも無駄になりません。そして繰り返しになりますが、個別の案件について適法かどうかの判断が必要な場合は、事実関係を整理したうえで専門家に相談してください。
米国と中国、そして国際的な枠組みと標準
米国の動きは、方向が政権によって反転した点に特徴があります。2023年10月30日に署名された大統領令14110(表題を訳せば「人工知能の安全・安心で信頼できる開発と利用」)は、連邦官報の記録によれば2025年1月20日の大統領令14148(同じく「有害な大統領令と措置の最初の撤回」)によって撤回されました。その3日後の2025年1月23日には大統領令14179「Removing Barriers to American Leadership in Artificial Intelligence」が署名されています。さらに2025年12月11日の大統領令14365「Ensuring a National Policy Framework for Artificial Intelligence」は、州ごとの規制が50通りの規制体系という継ぎ接ぎを作り、特にスタートアップにとって遵守を困難にするという問題意識を明示し、国としての政策枠組みを整えることを掲げました。2026年6月2日には大統領令14409(同じく「先進的な人工知能のイノベーションと安全保障の推進」)が署名されており、表題のとおり、先進的なAIの開発の促進と安全性の確保を並べて掲げたものです。さらに2026年9月29日の大統領令14434(同じく「超知能の時代の幕開け」)は、法律が許す最大限の範囲で、行政機関が公式の通信、ウェブサイト、報告書、政策文書などにおいて「AI」の代わりに「超知能」「SI」という語を使うよう定めました。同令でいう超知能は、当面、連邦法(合衆国法典第15編第9401条第3号)が定める人工知能と同じ技術を指すとされ、既に出された規則や大統領令、契約などを改める必要はないとも書かれています。3年足らずの間に、規制強化から規制緩和へ、さらに州法との関係の整理へと軸が動き、用語の扱いにまで政権の方針が及んだことになります。
その一方で、任意の枠組みは残りました。米国国立標準技術研究所が2023年1月26日に公表したAIリスクマネジメントフレームワーク1.0(AI RMF 1.0)は、GOVERN、MAP、MEASURE、MANAGEという4つの機能でリスク管理の手順を組み立てるものです。GOVERNは組織としてリスク管理の文化と方針、手続きを整える機能、MAPはAIシステムが使われる文脈を明らかにしてリスクを捉える機能、MEASUREは定量的・定性的な手法でリスクと影響を分析し、評価し、監視する機能、MANAGEは捉えて測ったリスクに対応のための資源を割り当てる機能です。このうちGOVERNは、ほかの3つの機能すべてにかかわる横断的な機能と位置づけられています。2024年7月26日には、この枠組みに生成AIプロファイルが追加されています。AI RMF 1.0は政権が変わったあとも公開が続いています。ただし、2026年10月19日時点のNISTの公式ページは、AI RMF 1.0をホワイトハウスのAI行動計画の一環として改訂中だと記しています。技術文書も政策と無縁ではないので、使う版と改訂の状況を確かめる必要があります。そのうえで、制度を見るときは、政治的に反転しうる層と、標準や技術文書のように改訂を重ねながら積み上がる層を分けて見るのが実務的です。
中国は早い時期に生成AIに特化した規則を出しました。国家インターネット情報弁公室など7つの部門による「生成式人工智能服务管理暂行办法」(生成AIサービスの管理に関する暫定規則)が2023年7月13日に公布され、2023年8月15日から施行されています。第7条は提供者に対し、学習データの処理について適法な出所を持つデータと基礎モデルを用いること、知的財産権を侵害しないことなどを求めています。第4条第5号は、サービスの類型の特性に応じて生成AIサービスの透明性を高め、生成される内容の正確性と信頼性を高める措置を取ることを定めています。その後も規則は積み重ねられています。国家インターネット情報弁公室など4つの部門が2025年3月に通知した「人工智能生成合成内容标识办法」(AIで生成・合成した内容の表示に関する規則)は2025年9月1日に施行され、生成・合成した文章や画像、音声、映像などのファイルのメタデータに表示を埋め込むことを提供者に求め、一定の類型のサービスには、利用者がはっきり気づける表示も付けるよう求めています。2026年7月15日には、人の人格や話し方をまねて継続的に感情面のやり取りをするAIサービスを対象とする「人工智能拟人化互动服务管理暂行办法」も施行されました。日本やEUと前提となる価値観は異なりますが、学習データの出所と生成物の透明性という論点は共通しています。
国際的な枠組みでは、日本が主導した広島AIプロセスがあります。2023年5月のG7広島サミットで立ち上げられ、同年10月30日にG7首脳声明が、12月1日にG7デジタル・技術閣僚声明が出され、高度なAIシステムを開発する組織向けの国際指針と国際行動規範を含む包括的政策枠組みがまとめられました。内閣府の指針によれば、2024年5月には広島AIプロセス・フレンズグループが立ち上げられ、2025年12月時点で60の国と地域が参加しています。また2025年2月には、国際行動規範の遵守状況をAI開発者が自主的に報告し公表する報告枠組みの正式運用が始まり、2025年12月時点で24組織が回答を提出しています。報告枠組みを運営するOECDは、第1回の報告を25件と数えています。組織の数と報告の件数という、数え方の違う数字です。両者の差が何によるものかは、確認した資料には書かれていません。OECDによれば、この枠組みはその後第2版に改められ、開発者に加えて、高度なAIシステムを導入する組織や提供する組織からも報告を受け付ける形に広げられました。強制力はありませんが、開発者側が自ら公表する仕組みが動き始めている点は、1975年のアシロマから続く自己規律の系譜として読めます。
安全性に焦点を当てた国際会合としては、2023年11月1日から2日にかけて開かれたAI安全サミットで採択されたブレッチリー宣言があります。宣言は、フロンティアと呼ばれる高度な汎用AIモデルに特有の安全上のリスクに言及し、それらのリスクが本質的に国際的な性質を持つため国際協力によって対処するのが最善であると述べています。
ブレッチリーの会合からは、規則ではなく、科学的な現状認識を取りまとめる取り組みも生まれています。汎用AIの能力とリスクに関する研究を国際的に取りまとめた報告書で、英語の題名は International AI Safety Report です。議長を務めたモントリオール大学とケベックAI研究所のヨシュア・ベンジオの序文によれば、ブレッチリー・パークのAI安全サミットに参加した国々がこの報告書の作成を支援することに合意し、2024年5月に中間報告がAIソウル・サミットで示されたうえで、2025年1月29日に最初の完全版が公表されました。公表は、2025年2月にパリで開かれたAIアクション・サミットに先立つものです。報告書の冒頭は、96人のAIの専門家がこの報告に関わったこと、その中には30か国とOECD、EU、国際連合が指名した国際的な専門家助言委員会が含まれることを記しています。同時に、報告書は独立した専門家の作業であり、執筆した専門家が内容について全面的な裁量を持っていたこと、支援した各国政府の見解を代表するものではないことも明記しています。また、この2025年版の報告書は、特定の政策を勧告するものではないと自ら書いています。
2025年1月の初版の内容のうち、経営の判断にも関わる指摘を、原文に沿っていくつか要約します。第1に、汎用AIの能力の今後の進み方は、ゆっくりしたものから極めて速いものまでありうるとしています。第2に、大規模な労働市場への影響や、AIを使ったハッキングなどのリスクについて、専門家の間で既存の証拠の解釈が分かれていると書いています。こうしたリスクを数十年先のことと考える専門家もいれば、今後数年のうちに社会的な規模の害につながりうると考える専門家もいる、という書き方です。第3に、開発者自身も汎用AIのモデルがどのように動いているかをまだほとんど理解していない、と指摘しています。その理由として報告書は、これらのモデルが従来の意味でプログラムされたものではなく、大量のデータを使う学習の手順を経て作られるものであり、内部の働きはモデルの開発者にとってさえ大部分が見通せない、と説明しています。説明可能性の研究は進んでいるものの、まだ初期の段階にあるという評価です。第4に、汎用AIの進歩の速さが、意思決定をする側に「証拠のジレンマ」を生むと述べています。証拠が揃う前に先手の対策を打てば結果として不要だったと分かるおそれがあり、決定的な証拠を待てば急に現れるリスクに備えのないまま向き合うおそれがある、という板挟みです。
この報告書は、2026年2月3日に第2版が公表されています。報告書の公式サイトによれば、第2版もベンジオが率い、100人を超える専門家が執筆に関わり、30を超える国と国際機関が支援しています。第2版の要約は、技術的な安全対策は改善しているものの、なお大きな限界があるとしています。例として、有害な出力を引き出す攻撃は難しくなった一方で、依頼を言い換えたり小さな手順に分けたりすると有害な出力が得られることがまだある、と書いています。そのうえで、複数の安全対策を重ねることでAIシステムをより頑健にできるとし、この方法を多層防御(原文は defence-in-depth)と呼んでいます。同じ要約は、モデルの内部の働きがなお十分に理解されていないことも、リスクの管理を難しくしている技術上の要因に挙げています。公式サイトの刊行物の一覧には、2025年1月の初版と2026年2月の第2版のあいだに、2025年10月と11月の2回、能力とリスク管理の動きをまとめた更新版も並んでいます。本章で見てきた原則文書や法令とは別の層として、科学的な現状認識を取りまとめ、間隔を置いて更新して公表する仕組みが動いていることになります。自社のAIのリスクを評価するとき、能力の見通しについて専門家の意見が割れていること、そして開発した側でさえモデルの内部を説明しきれないことは、2025年版の報告書が根拠を添えて明記している点です。導入の判断を、モデルの中身が完全に分かることを前提に組み立てない、という設計の出発点として使えます。
条約の形をとった枠組みとしては、欧州評議会条約シリーズ第225号「人工知能と人権、民主主義および法の支配に関する欧州評議会枠組条約」が2024年9月5日にビリニュスで署名開放されました。この条約を作った欧州評議会は、前に触れたとおりEUとは別の国際機関です。条約第30条は、欧州評議会加盟国3か国以上を含む5つの署名者が拘束されることへの同意を表明してから3か月経過後の翌月初日に発効すると定めています。
マネジメントシステム規格としては、AIのマネジメントシステムを対象とする国際規格ISO/IEC 42001:2023が2023年12月に第1版として発行されました。品質や情報セキュリティのマネジメントシステム規格と同じ枠組みで、AIの管理体制を第三者に説明できる形にするものです。法令ではありませんが、取引先から体制を問われたときの共通言語として機能します。
制度は導入計画の設計条件である
ここまでの流れを、制度の側だけで年表にすると次のようになります。全体の年表とは別に、この章の範囲に絞ったものです。
| 年 | 出来事 | 意味 |
|---|---|---|
| 1975 | 組換えDNA分子に関するアシロマ会議の要旨が公表される | NIHの研究指針(1976年)が出る前に、技術を持つ研究者側が自ら手続きを作った先例 |
| 1980 | OECDがプライバシーガイドラインを含む理事会勧告を採択 | 収集制限から責任まで8原則が国際的に合意され、以後の各国法の下敷きになった |
| 1995 | EUデータ保護指令95/46/ECが採択される | 個人データの保護について、各国法の水準がEU域内でそろえられる |
| 2003 | 日本の個人情報保護法が公布される | 事業者の義務は準備期間を置いて後から施行する設計が取られた |
| 2016 | GDPRが採択される。適用は2018年5月25日 | 第22条により、自動処理のみに基づく決定がAI固有法より先に規律された |
| 2019 | 人間中心のAI社会原則が決定され、OECDがAI勧告を採択 | 拘束力のない原則が各国で出揃い、後の法律の語彙が固まった |
| 2023 | 広島AIプロセスの成果文書、ブレッチリー宣言、中国の暫定弁法 | 生成AIの一般化から1年以内に、各国と国際枠組みが同時に動いた |
| 2024 | EU AI Actが採択され8月1日に発効。日本はAI事業者ガイドライン第1.0版 | 拘束力のある包括法と、拘束力のない詳細ガイドラインという2つの型が並んだ |
| 2025 | AI推進法が公布され9月1日に全面施行。適正性確保に関する指針を決定 | 日本は罰則を置かず、責務と指針で方向を示す形を選んだ |
| 2026 | デジタル・オムニバスで高リスクの適用日が後ろ倒し。課徴金制度を新設する改正個人情報保護法が成立(施行は公布から2年以内) | 緩む方向と締まる方向が同じ年に同居した。一方向に進むと決めつけられない |
この年表から取り出せることは3つあります。
第一に、制度は技術が出揃ってから後を追うだけのものではなく、速さの違いはあっても技術と並走してきました。とくに個人データの保護に関する枠組みは、AIが実用に届くよりずっと前に整っていました。生成AIが普及したとき、事業者が最初に直面したのは新しく作られたAIの法律ではなく、すでにあった個人情報保護法と著作権法でした。新しい制度を待つより先に、既存の一般法が自社の使い方にどう当たるかを確認するほうが、実務としては優先されます。
第二に、拘束力のない文書は、次の法律の語彙です。2019年前後に各国と国際機関が出した原則文書と、2024年以降の法令や指針を並べると、透明性、アカウンタビリティ、頑健性、公平性といった語がそのまま引き継がれています。原則文書の段階で自社の用語と規程をそろえておけば、法令が動いたときに、自社の規程と新しい条文との対応関係を確かめやすくなります。ただし、新たな義務に応じた運用や体制の見直しは、それとは別に必要です。
第三に、期日は動きます。ただし動き方には偏りがあります。2026年のデジタル・オムニバスで適用日が後ろへ移されたのは高リスクAIに関する重い義務であり、既存の禁止行為、AIリテラシー、透明性については適用日が動きませんでした。ただし中身は動いています。禁止行為には2つの類型が追加され、追加分は2026年12月2日から適用されます。2026年8月2日より前に市場に出ていた生成AIには、第50条第2項のマーキングに対応する期限が経過規定で2026年12月2日と設定され、AIリテラシーの条文は緩められました。準備の優先順位を自社の都合ではなく制度の順序に合わせると、禁止に触れないことの確認、表示の整備、人の側のリテラシー、その後に高リスク用途の適合性という順番になります。
制度の側から見ると、AIの導入計画に必要な項目はかなり具体的に読み取れます。用途がどのリスク階層に当たるか。誰が提供者で誰が利用する側か。使うデータの出所を説明できるか。生成物であることを相手に伝えているか。判断に人が関与する経路があるか。職員の理解水準に手を打っているか。これらは制度が要求しているというだけでなく、AIを実際に動かすうえで決めておかないと後で必ず手戻りになる項目でもあります。制度を制約としてではなく、導入設計のチェック項目として使うほうが、結果として速く進みます。
この章では、制度がどう積み重なってきたかという事実を確認しました。研究者の自己規律から始まり、個人データの保護が先に法になり、原則文書の時期を経て、拘束力のある法律と拘束力のない指針という2つの型に分かれ、そして期日が動くところまで来ています。ここまでの70年で繰り返されたパターンを、投資、人材、ベンダー選定といった具体的な経営判断にどう落とすかは、次の第13章で扱います。
この章を深めたい方への参考書籍
『AIと憲法』(山本龍彦編著、日本経済新聞出版社):本章で扱ったプライバシー、自動化された決定、公平性といった論点を、憲法学の視点から体系的に整理した論集です。GDPR第22条のような条文がなぜ置かれるのか、その背後にある権利の考え方を確認したい読者に向いています。制度の条文を追うだけでは見えない、規律の根拠を掴むのに役立ちます。
『ロボット・AIと法』(弥永真生・宍戸常寿編、有斐閣):AIとロボットに関わる法的論点を、行政規制、責任、知的財産などの分野ごとに扱った論集です。本章では制度の年表と条文の位置づけに絞りましたが、それぞれの論点が法学の中でどう議論されてきたかを追いたい読者に向いています。日本法の枠組みの中でAIをどう位置づけるかを考える際の出発点になります。
『AI倫理 原理、挑戦、そしてチャンス』(ルチアーノ・フロリディ著、藤本一勇監訳、NTTデータ・コンサルティング・イニシアティブ訳、東洋経済新報社):本章で触れた原則文書がなぜあの語彙になったのか、その背景にある倫理学の議論を扱った一冊です。透明性やアカウンタビリティといった語が、実務の文脈に落ちる前にどう定義されてきたかを確認できます。原則文書を「次に法律になる語彙」として読むための下地になります。
第13章 歴史が示す判断軸
第12章では、研究倫理の議論から個人情報保護、EUのAI法、著作権と学習データの扱いまで、制度が技術に遅れて現れたのではなく並走してきたことを確認しました。ここまでの12章で、1930年代の計算可能性をめぐる議論から2026年の推論モデルとエージェントまでを、おおむね時間の順に追ってきたことになります。本章では時間の順に沿って追うのをやめ、70年ぶんの記録を縦に切り直します。
切り直す目的は一つです。同じ形の判断が何度も繰り返されているかどうかを確認し、その形を現在の情報の読み方に使うことです。歴史は予測の道具ではありません。1956年の資料から2026年の状況を当てられた人はいませんでしたし、本章もこの先どうなるかを述べません。歴史が使えるのは別のところにあって、いま目の前にある提案書・デモ・報道・調査資料を読むときに、どこを見落としやすいかを教える点にあります。
この違いは実務では小さくないと考えています。予測を求めると、当たり外れの話になり、外れたときに手元には何も残りません。読み方を求めると、当たり外れとは無関係に、次に同じ種類の資料を読むときの手順が残ります。本章では、70年で繰り返された形を6つ取り出し、それぞれについて本編の各章で確認した具体的な事実を根拠として示したうえで、投資・人材・ベンダー選定の3つの場面での使い方に落とします。個々の出来事の詳細は各章で扱っているので、ここでは根拠として必要な最小限を引き、あとは「第N章で見たとおり」と参照する形にとどめます。
パターン1 期待は初期の成功事例から作られる
最初のパターンは、期待の作られ方です。期待は誇張から始まるのではなく、実際に起きた成功から始まります。ある手法が特定の条件下で明確に成功する。その成功は本物です。ところが、その成功が成立していた条件のほうは、成功の報告と一緒には伝わりません。結果として、成功した範囲より広い範囲に適用できるという読み方が残ります。
この形は最初期から見られます。第2章で見たとおり、1955年8月31日付の提案書「A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence」は、10人が2か月かけて研究する計画として書かれました。そこに掲げられた課題は、機械に言語を使わせること、抽象と概念を形成させること、いま人間に留保されている種類の問題を解かせること、そして機械自身を改善させることでした。課題の広さと、見積もられた期間および人数の対比が、この提案書の特徴です。実際に1956年夏の会合が開かれ、そこから研究分野としてのAIが立ち上がったこと自体は成果でしたが、掲げた課題が2か月で片づく規模でなかったことは、その後の70年が示しています。
より具体的な形は、1958年に Operations Research 誌に載った Herbert A. Simon と Allen Newell の論文「Heuristic Problem Solving: The Next Advance in Operations Research」に見られます。これは1957年11月14日にピッツバーグで開かれたオペレーションズ・リサーチ学会の全国大会での講演をもとにしたもので、10年以内に実現するとした予測がいくつも並んでいます。そのうちの一つが、規則によって競技から排除されない限り、10年以内にデジタルコンピュータがチェスの世界チャンピオンになるというものでした。実際には、コンピュータが当時の世界チャンピオンに標準的な持ち時間で勝ったのは1997年5月、IBMのDeep Blueがガルリ・カスパロフに3.5対2.5で勝った試合です。予測から39年が経っていました。
ここで注意したいのは、Simon と Newell が根拠なく述べたのではないという点です。彼らは Logic Theorist という、実際に論理の定理を証明できるプログラムを作った当事者でした。手元には確かな成功があった。問題は、その成功が成立した条件、つまり探索する候補の数が現実的な大きさに収まる問題であったという条件が、予測を外に出すときには落ちていたことです。
経営の場面で同じ形が現れるのは、デモを見るときです。デモは「この手法にできること」を示しているように見えますが、正確には「この入力、この前処理、この評価者のもとで、この範囲までできたこと」を示しています。デモの中では、入力をどう作ったか、うまくいかなかったケースをどう扱ったか、成否を誰が判定したかは見えません。適用範囲を規定する条件が明示されていない主張は、読み手の側で範囲が無限に広がります。これは提案側の誠実さの問題というより、成功事例という情報の形が本来持っている性質だと考えています。
期待の作られ方については、到来時期の予測そのものを集めて調べた研究もあります。スチュアート・アームストロングとカイ・ソタラが2012年に、プルゼニの西ボヘミア大学が刊行した、日本語にすれば『AIを超えて:人工の夢』となる題の論文集(原題は巻末の参考情報に記しました)の52ページから75ページに発表した論文で、題名を訳すと「私たちはAIをどう予測しているか、あるいは予測に失敗しているか」です。論文に記された所属は、アームストロングが人類の未来研究所(Future of Humanity Institute)、ソタラが機械知能研究所(Machine Intelligence Research Institute)です。2人は、1950年代から当時までに出されたAIに関する257件の予測を集めたデータベースから、人間に匹敵する知的な働きをする機械がいつ実現するかの年を示した予測95件を取り出して分析しました。
論文の主な結論は3つです(次の段落で述べるとおり、この論文にはあとから訂正が付いています)。第1に、専門家の予測は互いに大きく食い違っており、50年の開きも珍しくないこと。第2に、「AIはいつも15年から25年先にある」という言い伝えを確かめると、予測した時点から16年から25年後に実現するとした予測は、専門家とされた62件のうち21件(34%)、非専門家とされた33件のうち13件で、この範囲に予測が集まる傾向が見られたこと。一方で、予測した人が自分の寿命の終わりごろにAIの実現を置くという別の説は、寿命を推定できた55件のうち、前後5年以内に置いた予測が12件(22%)にとどまり、支持されませんでした。第3に、専門家の予測は非専門家の予測とも、すでに外れたことが分かっている過去の予測15件とも、分布の形が見分けられないことです。
この論文には、あとから訂正が付いています。論文を公開している機械知能研究所の版には、論文の知見はデータセットの誤りに基づいているという注記と、その詳細の参照先が冒頭に添えられています。参照先は、AI Impacts のカティア・グレースが2016年5月17日に書いた記事です。それによると、公開されたデータセットには予測した人を専門家と非専門家に分ける列が無く、論文が「専門家」として扱ったのは、予測をどのような方法で導いたかを記録した列のうち、専門家の権威による判断かどうかを示す列だったとみられます。その列の件数が62件と33件で論文の数と一致すること、ソタラ自身もそう起きたはずだと述べていることが理由として挙げられ、記事は、アームストロングとソタラもこの誤りを認めていると書いています。同じ人物が専門家の側と非専門家の側の両方に入っている例もありました。第2の結論に出てくる62件と33件という分け方も、同じ列によるものです。したがって、第2の結論のうち専門家と非専門家に分けた件数は、予測した人の区分としては読めません。少なくとも、専門家と非専門家の予測が見分けられないという第3の結論は、成り立つ根拠を失っています。
一方、同じ記事にはアームストロング自身が追加した集計が載っており、予測した人を、AGI(Artificial General Intelligence の略で、パターン4で触れる汎用人工知能のこと)を研究する人、AIの研究者、未来学者、その他の4つに分け直しても、その他を除く3つの集団では、10年から25年後を予測する割合がほかの年数より多い傾向が残ったと書いています。データが少ないことも本人が断っています。ここまでに出た3つの年数の幅は、言い伝えの「15年から25年」、論文が数えた「16年から25年後」、追加集計の「10年から25年後」で、それぞれ原文の表現(15 to 25 years、16-25 year range、10-25 years)に従っており、数えた範囲がそれぞれ異なります。ここから実務に持ち帰れることは2つあると考えています。1つは、到来時期を年数で示す予測は、示した時点から一定の距離に置かれやすいと指摘されてきたので、提案書や報道で「何年後に実現する」と書かれていたら、年数そのものより、何を根拠にした年数なのかを確認することです。もう1つは、広く引用された結論でも、データの列の読み違い1つで覆ることがあるので、研究を判断の根拠に使うときは、訂正や注記が付いていないかを原典の公開元で確かめることです。
パターン2 冬は技術の失敗ではなく検証の結果として始まる
二つ目のパターンは、期待が引くときの経路です。第3章と第5章で二度の冬を見ましたが、どちらも「技術が壊れたから資金が止まった」という順番では起きていません。約束された範囲と、外部が検証した実績のあいだの差が、資金を判断する立場の人に届いた時点で始まっています。
1966年11月に出た ALPAC の報告書がその典型です。ALPAC は Automatic Language Processing Advisory Committee の略で、1964年に米国政府が設置した7人の科学者からなる委員会であり、委員長は John R. Pierce でした。報告書の表題を訳せば『言語と機械:翻訳と言語学におけるコンピュータ』です。この報告書は、当時の機械翻訳研究に対して強い懐疑を示し、計算言語学の基礎研究の必要を説きました。翻訳という業務に緊急事態は存在しない、という趣旨の記述が置かれ、実務上の必要と研究への投資が釣り合っていないことが示されました。結果として、米国政府による機械翻訳研究への大規模な資金供給は大幅に縮小しました。
英国では、James Lighthill が Science Research Council 向けに1972年7月付でまとめ、1973年に公刊された報告「Artificial Intelligence: A General Survey」が同じ役割を果たしました。Lighthill は、この分野で経験された失望の一般的な原因として、組合せ爆発の含意が認識されてこなかったことを挙げています。問題の規模が大きくなるにつれて調べるべき可能性の数が急速に増えるため、計算時間をどれだけ積んでも総当たりは実用にならず、その爆発を抑えるための工夫は領域ごとに個別で、一般化しなかったという指摘です。報告書には、この分野のどの部分においても、これまでの発見が当時約束されたような大きな影響をもたらしてはいない、という趣旨の評価が書かれました。数か月のうちに Science Research Council は英国のほとんどの大学のAI研究への資金を削っています。
「AIの冬」という言葉が使われた場面でも、成果が出ないことが先にあり資金の停止が後に来るという、この2つの報告書と同じ順序の筋書きが、仮定として語られていました。1984年、当時 American Association for Artificial Intelligence と呼ばれていた学会の年次大会で討論会が開かれ、その記録は翌1985年に AI Magazine 第6巻第3号の122ページから134ページへ、日本語にすれば「AIの暗黒時代についてのAAAI-84討論会」となる題で掲載されています。名を連ねるのは Drew McDermott、M. Mitchell Waldrop、B. Chandrasekaran、John McDermott、Roger Schank の5名です。第3章で見たとおり、冒頭で論点を示した Drew McDermott は、5年後に戦略的コンピューティング計画が頓挫し、第五世代計画も実を結ばず、新興企業が次々に倒れ、AIと名の付くものには資金が付かなくなる、という最悪の筋書きを示し、その状態が一部で「AI Winter」と呼ばれていると紹介しました。本人はこの筋書きが起こる可能性を高くは見ておらず、そうならないよう研究者が自らを律し、一般の人々に正しく伝えることが大切だという趣旨で持ち出しています。この筋書きでは、約束された成果が出ないことが先にあり、資金が止まることが後に来ます。本節で見た2つの報告書と同じ順序です。そして記録の中でこの語は、過去の出来事を名づける言葉ではなく、これから来るかもしれない状態を指す言葉として使われています。
この2つの報告書に共通するのは、検証を行ったのが当事者ではなく外部だったことです。研究者自身の自己評価ではなく、資金の出し手が委託した第三者が、約束と実績を突き合わせました。しかもその突き合わせが可能だったのは、比較の対象になる約束が文書として残っていたからです。約束が残っていなければ、差を測ることもできず、評価は「なんとなく期待外れだった」という印象で終わります。この点は、後段の投資判断の話に直結します。
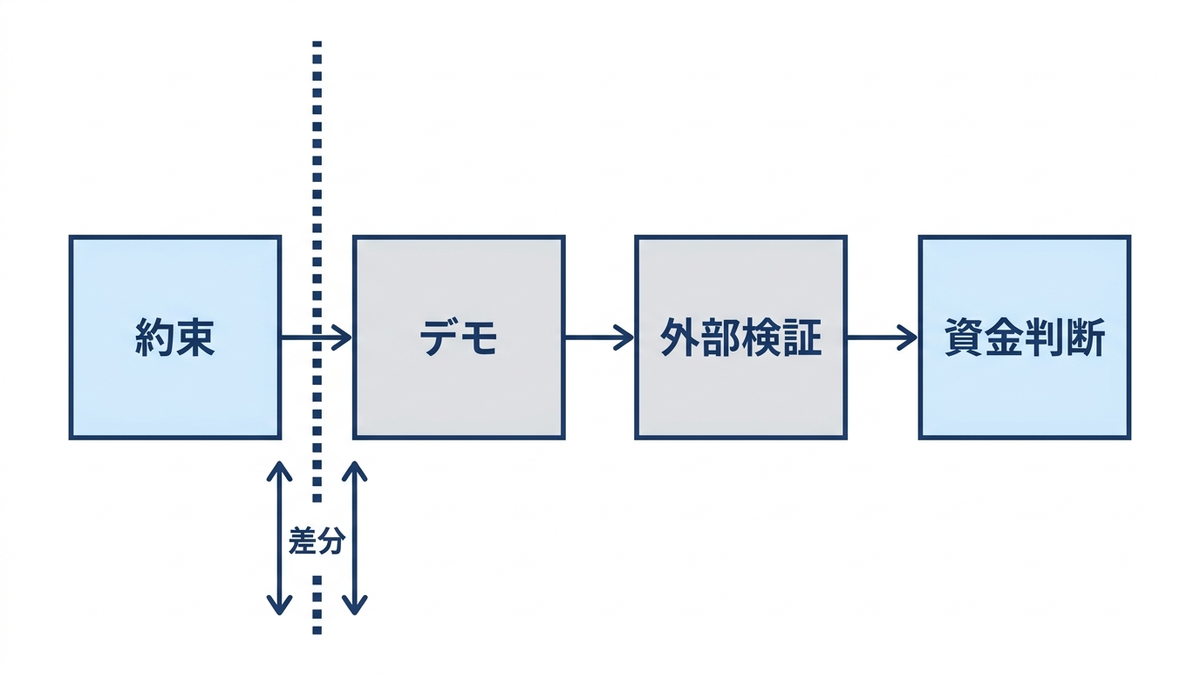
パターン3 跳ねた技術は、新発明ではなく資源の閾値超えだった
三つ目は、成功した側のパターンです。大きく跳ねた技術を後から見ると、その時点で新しく発明されたものより、既にあった手法が資源の閾値を超えた例のほうが多く見つかります。そして、その閾値を超えさせた基盤の準備は、跳ねる前から進んでいます。
第7章で見た2012年の AlexNet がわかりやすい例です。畳み込みを使ったニューラルネットワークも、誤差逆伝播による学習も、2012年に発明されたものではありません。第5章で見たとおり、誤差逆伝播は1980年代に再評価され、1990年代には既に使われていました。2012年に起きたのは、その手法が大規模なデータと GPU での学習という条件を得たことです。ILSVRC 2012 における top-5 の誤り率は15.3%で、2位の26.2%との差は10.9ポイントありました。ILSVRC は ImageNet Large Scale Visual Recognition Challenge の略で、ImageNet の画像を使い、写っているものを言い当てる正確さを競った大会です。top-5 の誤り率は、可能性が高い順に5つの候補を挙げさせたとき、そのどれにも正解が入っていなかった割合を指します。それまでの改善が1ポイントから2ポイントの積み重ねだったことを踏まえると、この差の大きさは手法の連続的な改良では説明しにくいものです。
その条件を作ったものは、第6章で見たとおり、深層学習の研究の外側で用意されていました。ImageNet は Jia Deng、Wei Dong、Richard Socher、Li-Jia Li、Kai Li、Li Fei-Fei による2009年の CVPR 論文「ImageNet: A Large-Scale Hierarchical Image Database」で発表され、論文の時点で320万枚の画像を含んでいました。GPU を汎用の計算に使うための CUDA は2007年に公開されています。どちらも「深層学習を成功させるために作られたもの」ではありません。前者は語彙の階層構造に沿った大規模な画像データベースを作る試みであり、後者はグラフィックス処理装置を一般の計算に開く仕組みです。
同じ形は、その後の言語モデルでも見られます。第8章で見たとおり、Transformer は Ashish Vaswani らによる論文「Attention Is All You Need」として2017年6月12日に arXiv へ投稿されました。この構造そのものが大規模化と相性がよかったことに加え、2020年に Jared Kaplan らが発表した「Scaling Laws for Neural Language Models」が、損失がモデルの大きさ・データ量・計算量に対してべき乗則で下がることを示し、その傾向が7桁以上にわたって成り立つと報告しました。これがスケーリング則と呼ばれるものです。同じ2020年に発表された GPT-3 は1750億パラメータで、論文「Language Models are Few-Shot Learners」として、機械学習の分野で主要な国際会議である NeurIPS(Neural Information Processing Systems)の2020年の大会で発表されました。ここでも、新しい原理が発見されたというより、既にある構造に資源を投入した結果が観測されています。
この観察を経営に持ち込むと、問いの立て方が変わります。「この手法は新しいか」ではなく「この手法が効く資源条件を、自社は満たしているか」を問うことになります。資源条件は計算資源だけではありません。学習や評価に使えるデータの量と質、正解を判定できる人の存在、失敗例を集める仕組みの3つが揃っているかどうかで、同じ手法の結果は変わります。逆に言えば、資源条件を満たしていない状態で最新の手法を採用しても、跳ねる側の条件には乗っていないことになります。
パターン4 汎用と特化の振り子
四つ目は、目標の置き方が周期的に振れることです。広く使える一つの仕組みを目指す動きと、対象を絞って確実に動かす動きが、70年のあいだ交互に現れています。
1955年の提案書は明らかに汎用側です。第2章で見た General Problem Solver も、名前のとおり問題の種類を限定しない解き方を目指していました。ところが第3章で見たとおり、汎用に振れた期間は組合せ爆発と外部評価によって折り返します。第4章で見た1970年代後半から1980年代は特化側で、DENDRAL や MYCIN、そして商用化された XCON は、いずれも対象領域を明示的に限定することで成果を出しました。この局面が頭打ちになった原因も明確で、専門家の知識をルールとして書き下し、保守し続けるコストが積み上がる知識獲得のボトルネックでした。
1990年代は、第5章で見たとおり、統計的な手法によってタスクごとにモデルを作る方向に進みます。これも特化側です。汎用側に大きく戻るのは第8章の局面で、大きく事前学習してから個別のタスクに転用する構造が定着しました。そして第10章で見たとおり、直近では小型モデルやオンデバイスでの実行といった、対象を絞る方向の動きも同時に進んでいます。
ここで避けたいのは、どちらが正しいかという読み方です。振り子はどちらかが誤りだったから振れているのではなく、それぞれの局面で効く投資対象が違うだけだと考えています。汎用側の局面では、共通の基盤を整えること、つまり複数の用途で使い回せるデータの整備や、社内の共通した評価の仕組みへの投資が効きます。特化側の局面では、領域固有の知識を形式化する力と、その領域での評価データが効きます。特定の作業に限らず、人間が行う幅広い知的な作業をこなせる機械を意味する汎用人工知能という目標そのものは1955年の提案書から一貫して存在していますが、それが実務上の投資対象として意味を持つかどうかは局面によって変わります。
実務で必要なのは、振り子が次にどちらへ振れるかを当てることではありません。自社の課題がどちらの性質の問題なのかを確認することです。用途が定まらないまま広く使える仕組みを求めているのか、用途は定まっていて精度と運用の確実さを求めているのか。この2つは必要な投資も必要な人材も違うので、混ぜたまま議論すると結論が出ません。
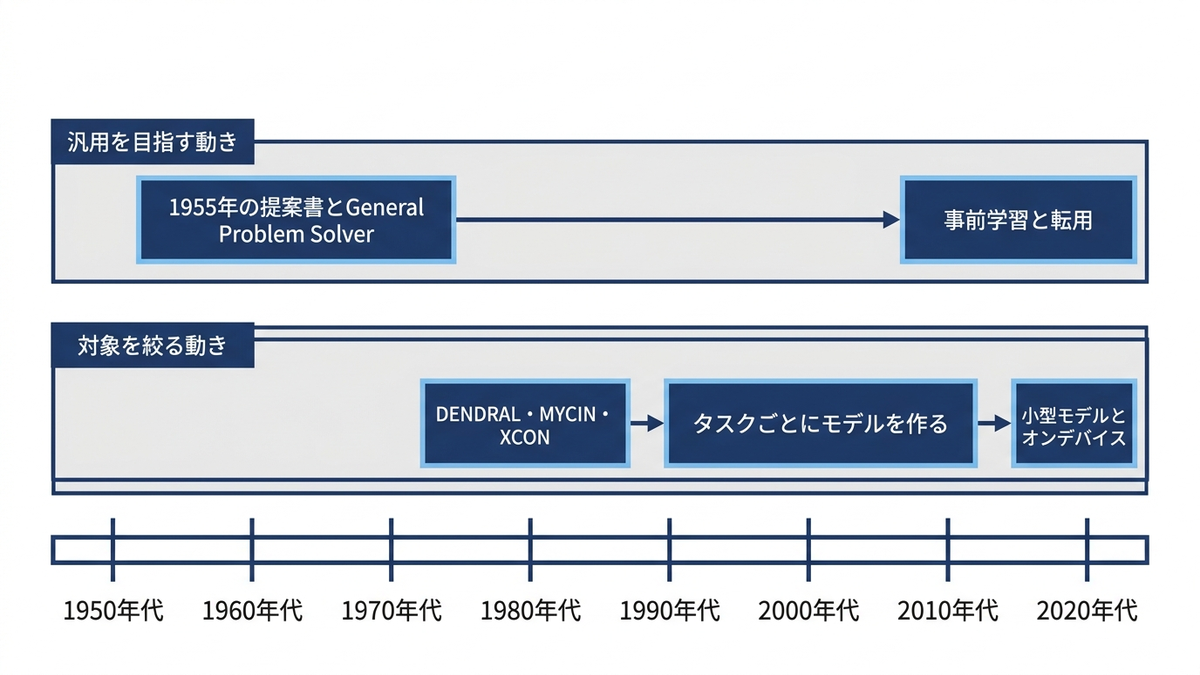
パターン5 決定的に効いた要因はAI研究の外側にあった
五つ目は、外部要因の効き方です。第6章で扱った1995年から2011年までの期間は、AIの歴史としては目立つ出来事が少ない時期ですが、その後の展開を決めた材料はこの期間に揃っています。Web の普及によるデータの蓄積、検索エンジンのための大規模処理、MapReduce に代表される分散処理、GPU の汎用計算への開放、そしてクラウドによる計算資源の調達しやすさです。
これらはいずれも、AIを進めるために始まった取り組みではありません。CUDA が2007年に公開されたのは、グラフィックス処理装置の計算能力を一般の用途に開くためです。ImageNet が作れたのは、語彙の階層構造を与える辞書資源と、Web 上に大量の画像が存在する状況と、その画像を人手で分類できる仕組みが同時に揃ったからです。どれか一つでも欠けていれば、2009年の時点で320万枚規模のデータベースは成立しませんでした。
この構造から取り出せるのは、監視の範囲に関する示唆です。AIの動向だけを追っていると、次に効く材料が視野に入りません。1990年代にAIの記事だけを読んでいた人にとって、検索エンジンのインフラや半導体の並列計算は関係のない話に見えたはずですが、実際にはそちらが効きました。自社の判断材料として、AI以外の領域で何が安くなり、何が手に入りやすくなっているかを定期的に見る枠を持つことには意味があると考えています。具体的には、計算資源の調達価格の推移、データを扱う周辺の規格や仕組みの変化、自社の業務で使っているシステムの外部連携の可否といった、AIという語がつかない領域です。
パターン6 流行語の温度と技術の進捗は別に測る
六つ目は、言葉と実体のずれです。「AI」という語が使われる量と、技術の進み方は、同じようには動いていません。
第5章で見たとおり、1990年代は「AIの冬」と呼ばれる期間に重なりますが、この時期に技術が止まっていたわけではありません。サポートベクターマシンや統計的学習理論、決定木とアンサンブル、統計的機械翻訳といった手法が実用の水準に達し、多くは「AI」を名乗らずに製品や業務に入りました。1997年5月に Deep Blue がカスパロフに勝ったのも、冬と呼ばれる期間の出来事です。語としての「AI」が下火だった時期に、後の展開の土台になる手法が整えられていました。
評価が遅れて到着することもあります。2018年の ACM チューリング賞は Yoshua Bengio、Geoffrey Hinton、Yann LeCun の3氏に贈られ、その理由は、深層ニューラルネットワークを計算の中核的な構成要素にした概念的および工学的な突破に対して、という表現で示されました。ACM は Association for Computing Machinery の略で、計算機の分野の国際的な学会です。同学会が贈るチューリング賞は、この分野で最も高い評価を受ける賞とされています。受賞の対象になった仕事の多くは、受賞の数十年前に行われたものです。同じ仕事が、注目されない時期と、最高位の賞が与えられる時期の両方を経ています。
実務への落とし方は単純です。語の出現量を進捗の指標に使わないことです。報道や市場調査での言及量が増えたことは、技術の到達点が変わったことを意味しません。逆に言及量が減っても、技術が止まったことを意味しません。測るなら、語ではなく、外形で確認できる能力の変化を測ることになります。自社の業務で扱う入力を与えたときに、去年と今年で出力がどう変わったかを、同じ条件で比較する。この比較は自社でしか作れませんが、作れば流行語とは独立した尺度になります。
6つのパターンと、いま見ている情報の読み方
ここまでの6つを一覧にまとめます。左の列がパターン、中央が本編で確認した具体的な事実、右がその形を使って現在の情報をどう読むかです。右の列は予測ではなく、資料を読むときの手順として書いています。
| 繰り返されたパターン | 過去の事例(該当章) | いま見ている情報の読み方 |
|---|---|---|
| 期待は初期の成功事例から作られ、成功が成立した条件は一緒には伝わらない | 1955年の提案書が10人・2か月で言語・抽象・自己改善までを掲げた(第2章)。1958年の Simon と Newell の論文が10年以内のチェス世界チャンピオンを予測し、実現は1997年5月の Deep Blue だった(第2章・第5章) | デモや事例を読むとき、成果ではなく成立条件を先に探す。入力の作り方、除外したケース、成否の判定者の3点が書かれていない資料は、適用範囲が確定していないものとして扱う |
| 冬は技術の破綻ではなく、約束と外部検証の差が資金判断に届いた時点で始まる | 1966年の ALPAC 報告と、1972年7月付の Lighthill 報告(公刊は1973年)。いずれも当事者ではない外部が評価し、直後に資金が絞られた(第3章)。「AIの冬」という語も、1984年の学会討論の記録では、計画の失敗のあとに資金が付かなくなるという将来の筋書きを指して使われていた | 自社の取り組みについて、着手時の約束を文書で残しておく。差を測る対象がなければ評価は印象で終わる。評価は作った当事者以外が行う形にしておく |
| 跳ねた技術は新発明ではなく、既存手法が資源の閾値を超えた結果である | 2012年の AlexNet は top-5 誤り率15.3%で2位の26.2%を大きく引き離したが、手法自体は既存だった(第7章)。ImageNet は2009年に320万枚、CUDA は2007年公開(第6章)。2020年のスケーリング則と1750億パラメータの GPT-3 も同じ形(第8章) | 「新しい手法か」ではなく「効く資源条件を自社が満たしているか」を問う。データの量と質、正解を判定できる人、失敗例を集める仕組みの3点で確認する |
| 汎用を目指す動きと対象を絞る動きが交互に現れる | 1955年の提案と General Problem Solver は汎用側(第2章)。DENDRAL・MYCIN・XCON は特化側で、知識獲得のボトルネックで頭打ちになった(第4章)。1990年代はタスクごとのモデル(第5章)、2018年前後は事前学習と転用で汎用側(第8章)、直近は小型モデルなど絞る動きも並走(第10章) | 振れる方向を当てにいかず、自社の課題がどちらの性質かを確定させる。用途が未確定なら共通基盤への投資、用途が確定しているなら領域知識と評価データへの投資と、費目を分けて考える |
| 決定的に効いた要因はAI研究の外側で育っていた | Web と検索、MapReduce、GPU の汎用計算、クラウドがそろって深層学習の条件を作った(第6章)。CUDA はAIのために始まった取り組みではなく、ImageNet も深層学習のために作られたものではない | AI以外の領域を監視対象に含める。計算資源の調達条件、周辺の規格や仕組みの変化、自社システムの外部連携の可否など、AIという語がつかない変化を定期的に見る |
| 流行語の温度と技術の進捗は別に動く | 冬と呼ばれた1990年代に統計的手法が実用化し、多くは「AI」を名乗らなかった(第5章)。2018年の ACM チューリング賞は、数十年前から積み上げられた仕事に対して贈られた | 言及量を進捗の指標に使わない。自社の業務の入力を固定し、同じ条件での出力を定期的に比較して、外形で変化を測る |
投資の判断への落とし方
ここからは、上の6つを実際の判断に落とします。まず投資です。
最初にすべきことは、約束を文書として残すことだと考えています。パターン2で見たとおり、ALPAC 報告と Lighthill 報告が機能したのは、比較の対象になる約束が記録されていたからです。社内の取り組みでも同じで、着手時点で「誰が」「いつまでに」「どの範囲で」「何を達成すると言ったか」を残しておかないと、半年後に差を測る手段がありません。差が測れないと、継続の可否は会議の空気で決まります。ここで記録すべきは意気込みではなく、検証可能な形の記述です。対象とする業務、扱う入力の範囲、達成したとみなす条件、達成しなかったとみなす条件の4つを書けば足ります。
次に、撤退条件を先に決めることです。冬が資金の引き上げとして現れる以上、引き上げる基準を持っていない組織は、引き上げの判断そのものができません。実際には撤退よりも、条件を満たさなかった取り組みが静かに継続して、他の投資先の枠を占め続けるほうが多いように思います。撤退条件は着手時にしか合意できないものだと考えています。成果が出ていない状態で新たに基準を作ろうとすると、基準の設定自体が誰かの評価を下げる行為になるためです。
三つ目は、手法を選ぶ前に資源条件を確認することです。パターン3が示すのは、同じ手法でも資源が閾値を超えているかどうかで結果が変わるということでした。自社で確認すべきは、学習または評価に使えるデータが十分にあるか、出力の正誤を判定できる人が社内にいるか、うまくいかなかったケースを集めて蓄積する仕組みがあるか、の3点です。この3点が揃っていない段階で最新の手法を採用しても、跳ねる側の条件には乗っていません。逆に、この3点を整えること自体が、手法が変わっても無駄にならない投資になります。
四つ目は、資金を段階に分けることです。全額を一度に投じるのではなく、上で決めた条件の達成を確認してから次の段階に進める形にします。パターン1が示すのは、初期の成功が適用範囲を過大に見せるということでした。段階を分ける設計は、この過大評価が投資額に一括で反映されるのを防ぎます。段階の区切りは期間ではなく条件で置くほうがよいと考えています。期間で区切ると、条件を満たしていなくても期間が来れば次に進んでしまいます。
雇用への影響の推計は、数える単位で大きく変わる
人材の判断に関わる数字として、AIが雇用に与える影響の推計があります。この分野には、2013年から2016年にかけて出た推計が、何を単位に数えたかによって大きく違った例が残っています。
出発点は、オックスフォード大学のカール・ベネディクト・フレイとマイケル・オズボーンが2013年9月付で公表した論文で、題名を訳すと「雇用の未来:仕事はどこまでコンピュータ化の影響を受けやすいか」です。フレイはオックスフォード・マーティン・スクール、オズボーンは同大学の工学科学部に所属していました。2人は機械学習の研究者たちと70の職業を取り上げ、その職業の作業がすべて自動化できると判断したものに1、そうでないものに0を主観で付けたうえで、米国労働省のために開発された職業情報のデータベース(O*NET)の変数を使って、米国の702の詳細な職業それぞれがコンピュータ化される確率を推計しました。確率0.7と0.3を境に高・中・低の3区分に分けると、米国の雇用全体の47%が高リスクの区分に入り、その職業は特定しない年数、おそらく10年か20年のうちに自動化されうる、というのが論文の推計です。論文は、2010年時点の職業の構成を対象に、コンピュータによる置き換えの効果だけを見た分析であると断っています。この論文はのちに、誌名を訳すと『技術予測と社会変化』となる学術誌の第114巻(2017年1月)に掲載されました。
日本については、野村総合研究所が2015年12月2日のニュースリリースで、日本の労働人口の約49%が就いている職業は、10年から20年後に人工知能やロボット等で代替することが可能との推計を発表しました。オズボーンとフレイとの共同研究で、労働政策研究・研修機構が2012年に公表した「職務構造に関する研究」の601の職業のデータを使い、米国と英国の分析と同様の手法で試算したものです。同じリリースは図で、英国35%、米国47%と並べています。注目したいのはリリースの注記で、数えたのは「従事する一人の業務全てを、高い確率(66%以上)でコンピューターが代わりに遂行できる」職種に就いている人の割合であること、あくまで技術的な代替可能性であって労働需給などの社会環境要因は考慮していないこと、そして業務の一部分だけをコンピュータが代わりに行う確率は検討していないことが明記されています。
これに対して、メラニー・アルンツ、テリー・グレゴリーら3人の研究者が2016年に経済協力開発機構(OECD)の社会・雇用・移民分野のワーキングペーパーとして公表した分析は、数える単位を変えました。研究機関 ZEW が自らの刊行物一覧に載せている同論文の要旨によれば、職業全体が技術で自動化されるとみなすフレイとオズボーン型の数え方は、高リスクとされた職業の中にも自動化しにくい作業がかなり含まれているため、自動化のしやすさを過大に見積もるおそれがあります。そこで著者らは、同じ職業でも働く人ごとに担っている作業が違うことを織り込み、作業単位の推計で21か国を見積もりました。論文本体によれば、著者らは働く人ごとの作業内容から、その人の仕事の自動化可能性を推計し、自動化可能性が70%以上となる仕事を高リスクとして数えています。その割合は21か国の平均で9%で、国別では韓国とエストニアの6%から、ドイツとオーストリアの12%まで差がありました。この9%は、高リスクと判定された仕事が全体に占める割合であり、仕事の中の作業のうち自動化できる作業の割合を表すものではありません。
47%や49%と9%の違いは、技術の見通しが食い違っているというより、問いの立て方の違いとして読むほうが正確です。前者は職業を単位に「その職業の作業がすべて置き換わりうるか」を判定し、該当すればその職業に就く人を全員数えます。後者は一人ひとりの作業の中身を見て数えます。同じ米国について比べると、フレイとオズボーンの47%に対し、アルンツらの推計は、21か国平均と同じ値の9%でした。職業ごとに同じ値を当てはめるか、同じ職業でも働く人ごとの作業内容の違いを織り込むかで、結果が大きく変わったことになります。一方、日本の49%と21か国平均の9%を比べるときは、対象国が違うことに加え、高リスクとする確率の基準も、野村総合研究所の66%以上とアルンツらの70%以上とで異なる点に注意が要ります。経営の場面で同じことが起きるのは、自社の業務へのAIの影響を見積もるときです。職種や部署を単位に置き換わるかどうかを判定すると、結果は「ほぼ全部」か「ほぼ無し」に振れやすくなります。業務を作業に分解し、作業ごとに置き換えの可否と、残った作業を誰が担うかを見積もるほうが、配置や採用の計画に使える数字になると考えています。外部の推計を引用するときも、数値と一緒に、何を単位に数えたか、どの確率で線を引いたか、社会的な要因を含めたかの3点を確認しておくと、パターン1で見た成立条件の落ちた数字を避けられます。
人材の判断への落とし方
人材については、まず「AI人材」という括りの扱いから確認しておきます。パターン6で見たとおり、これは技術の側の区分ではなく語の側の区分です。語で採用の枠を作ると、語が変わったときに配置が合わなくなります。必要な能力を、語ではなく仕事の内容で定義するほうが持ちます。
その定義は、パターン4の局面によって変わります。用途が定まっておらず共通基盤を整える局面では、基盤を使いこなす能力が効きます。具体的には、評価の設計、データの整備、動かし続ける運用の3つです。この3つは特定の手法に依存しないので、手法が入れ替わっても価値が残ります。一方、用途が定まっていて精度と確実さを求める局面では、領域固有の知識を形式化する能力が効きます。
この後者について、第4章の知識獲得のボトルネックは示唆を残しています。1980年代に商用のエキスパートシステムを頭打ちにしたのは、専門家の頭の中にある判断をルールとして書き下し、変化に合わせて保守し続ける工程のコストでした。手法が統計や学習に移ったことで、この工程が不要になったわけではありません。形を変えて残っています。何をもって正解とするかの基準を作る作業、判断が割れる事例を集めて整理する作業、うまくいかなかった出力を分類して次の改善につなげる作業がそれにあたります。これらはいずれも、業務そのものを知っている人でなければできません。技術者の採用だけを考えて、この役割を空席にしたまま進めると、評価ができないまま時間が過ぎます。
三つ目として、パターン5に対応する役割を置くことが挙げられます。AI以外の領域で何が変わっているかを見て、自社の判断に持ち込む人です。専任である必要はありませんが、担当が決まっていないと誰も見ません。見る対象は前節で挙げたとおり、計算資源の調達条件、周辺の規格や仕組みの変化、自社システムの外部連携の可否といった、AIという語がつかない領域です。
最後に、注目が薄れた局面での人の扱いについて触れます。事実として確認できるのは、第5章で見た誤差逆伝播の再評価が「AIの冬」と呼ばれる期間に進んだこと、そして第7章で見たとおり2012年に跳ねた手法が既に存在していたものだったことです。注目が集まっていない期間にも技術は積み上がっており、その積み上げを担っていた人と組織が存在したことになります。
ただし、ここから「注目が薄れても人を残せば次の局面の中心になれる」と読むのは行き過ぎだと考えています。それは、うまくいった側だけを後から見た読み方です。同じ期間に続けていて後の局面につながらなかった取り組みも当然あったはずですが、そちらは記録に残りにくく、比較の対象になりません。この観察を実務で使うなら、「注目が薄れたときに人を全部引き上げると、再開のたびに立ち上げ直しの費用がかかる」という運用コストの話として使うほうが、根拠として確かです。判断の材料になるのは、成功の再現可能性ではなく、中断と再開に伴う実際の費用のほうです。
ベンダー選定への落とし方
ベンダー選定については、特定の事業者の良し悪しを論じる話ではありません。ここで挙げるのは、こちらの側が用意しておく質問の型です。過去70年で外れた読み方を避けるための質問が、そのまま選定時の確認事項になります。
第一に、適用範囲の明示を求めます。パターン1が示すのは、成功事例からは成立条件が落ちるということでした。したがって聞くべきは「何ができるか」ではなく「どの条件では動かないか」です。動かない条件を具体的に書ける相手は、自分たちの適用範囲を把握しています。書けない場合、範囲が確定していないか、確定させる作業がまだ行われていないかのどちらかです。あわせて、提示された事例について、入力データをどう用意したか、除外したケースがあるか、成否を誰が判定したかを確認します。
第二に、検証の主体を分ける設計にします。パターン2が示すのは、当事者ではない外部が約束と実績を突き合わせたときに評価が動いたということでした。導入の可否を判断する材料を、作る側が作った資料だけに依存させないほうがよいと考えています。実務的には、自社側で評価用のデータを用意し、その一部は相手に渡さない形にしておくことです。これは相手を疑う手続きではなく、両者にとって「何ができたか」が後から確認できる状態を作る手続きです。
第三に、基盤の依存先を確認します。パターン5が示すのは、決定的な要因が外側にあるということでした。提案されている仕組みが、どのモデル、どの計算基盤、どのデータに依存しているかを確認し、その依存先が変わったときに何が起きるかを聞いておきます。依存先が変わること自体は問題ではありませんが、変わったときに移行できる設計かどうかは、契約前でなければ確認しにくい項目です。
第四に、比較は語ではなく外形で行います。パターン6が示すのは、語の使われ方と実体の進捗が別に動くということでした。複数の候補を比べるとき、提案書に並ぶ用語の新しさではなく、自社の業務から取った同じ入力を渡したときの出力で比べます。この比較を成立させるには、比較用の入力と判定基準を自社で先に決めておく必要があります。準備の手間はかかりますが、これを持っている組織は、候補が変わっても比較のやり直しが不要になります。
以上の4点は、いずれも相手の能力を測る質問ではなく、こちら側の判断材料を確定させる質問です。歴史が示しているのは、判断を誤った側が能力を欠いていたということではなく、判断に必要な情報が揃わないまま判断していたということだと考えています。
本章では、70年の記録から6つの繰り返しを取り出しました。期待は初期の成功から作られ、その成功の成立条件は一緒には伝わらないこと。冬は技術の破綻ではなく、約束と外部検証の差が資金判断に届いた時点で始まること。跳ねた技術は新発明ではなく既存手法の資源条件が満たされた結果であること。汎用と特化が交互に現れること。決定的な要因がAI研究の外側で育っていたこと。そして、流行語の温度と技術の進捗が別に動くことです。
これらは将来を当てるための道具ではありません。いま手元にある提案書やデモや報道を読むときに、どこを確認していないかを教えるものです。投資では約束の記録と撤退条件と資源条件の確認、人材では語ではなく仕事の内容による定義、ベンダー選定では適用範囲・検証主体・依存先・比較方法の4点が、そこから導かれる具体的な手順になります。次の終章では、この70年の歴史から取り出せるものと、取り出せないものを整理します。
Anagraftでは、AIの導入検討から実装、運用までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『イノベーションのジレンマ 増補改訂版 技術革新が巨大企業を滅ぼすとき』(クレイトン・クリステンセン著、玉田俊平太監修、伊豆原弓訳、翔泳社):本章のパターン3とパターン4を、AI以外の産業の事例で確認したい読者に向いています。既存の手法が資源条件を満たして跳ねる現象や、既存の顧客に最適化した判断が新しい手法への移行を遅らせる構造が、複数の業界の記録から論じられています。
『イノベーションの普及』(エベレット・ロジャーズ著、三藤利雄訳、翔泳社):本章のパターン1とパターン6を、普及の過程という観点から補う一冊です。新しい技術がどのような順序で受け入れられ、その過程で情報がどう伝わって変質するかを扱っており、期待の作られ方と語の広がり方を分けて考えるための枠組みが得られます。
『テクノロジーの世界経済史 ビル・ゲイツのパラドックス』(カール・B・フレイ著、村井章子訳、大野一訳、日経BP):本章のパターン5を、より長い時間軸で確認したい読者に向いています。技術が経済と労働に及ぼす影響を数百年の範囲で扱っており、ある技術の効果がその技術の外側の条件によって決まるという見方を、産業革命以降の記録から追うことができます。
終章
本編では、1956年のダートマス会議に先立つ準備期間から、2026年の推論モデルとエージェントまでを、13の章に分けて確認してきました。第13章で70年を通して繰り返されたパターンを取り出し、投資、人材、ベンダー選定の判断軸に落としましたので、終章ではそれを繰り返しません。ここで扱うのは、この歴史の見方そのものです。本コラムがどのような見方で70年を整理したのか、その見方から何が言えて何が言えないのか、そして読者が自社で次に何を確かめるとよいのかを述べて、コラムを閉じます。
本コラムが採った歴史の見方
本コラムは、出来事を年の順に並べることを目的にしませんでした。各章で扱った出来事には、何が新しかったのか、なぜそれが可能になったのか、経営の観点で何を意味するのかのいずれかを添えています。この見方を採ったのは、判断に使える形で歴史を残すためです。年表は、いつ何が起きたかを教えてくれますが、なぜそのときに起きたのかは教えてくれません。判断に必要なのは後者です。同じ手法が、ある時期には結果を出せず、別の時期には分野を塗り替えたという事実は、年表の上では二つの点に見えますが、その間に何が整ったのかを見なければ、自社の判断には使えません。
もう一つの特徴は、区切りを既定のものとして扱わなかったことです。序章で述べたとおり、「AIの冬」の期間は資料によって数年単位で異なります。本編の第3章と第5章では、それぞれが採った区切りとその根拠となる出来事を明示しました。区切りが異なるのは、冬という区切りが後年の資料によってそれぞれの基準で引かれたものだからです。第3章で見た1984年の討論会では、当事者が冬の到来をまだ仮定として議論していました。渦中にいる人には、それが一時的な停滞なのか長い冬なのかは分かりません。この事実は、現在についても同じことが言えることを意味します。いま自分たちがどの局面にいるのかを、当事者が確定することはできません。できるのは、過去に冬へ入る前に現れた形が、いま現れているかどうかを確かめることまでです。
三つ目の特徴として、「AI」という名前の内側だけを追わなかったことがあります。第1章で扱った1956年より前の準備期間は、まだAIという名前を持っていません。第5章と第6章で扱った1990年代から2011年の動きの多くは、統計や検索やインフラの名前で進み、AIとは呼ばれていませんでした。それでも本コラムがこれらを70年の一部として扱ったのは、後の転換を可能にした基盤が、名前の外側で用意されていたからです。名前の内側だけを見ていると、基盤が整いつつあることを見落とします。これは現在についても同じで、自社の関心領域で次の転換を支える基盤は、AIと名の付く予算や部署の外側に置かれている場合があります。
「70年」という区切り自体も、一つの選択です。ダートマス会議を起点に置くのは広く共有された見方ですが、第1章で扱ったとおり、計算可能性の研究や神経回路の数理モデルは1956年より前に積み上がっており、名前が付いた年は、それらが一つの分野として束ねられた年です。起点を第1章の計算可能性の研究に置けば、AIは計算機科学の一部として見えます。起点を2012年の深層学習に置けば、AIは深層学習とほぼ同義に見えます。どこに起点を置くかで、繰り返しの回数も、冬の数も変わります。本コラムが1956年を起点にしたのは、第2章で確認したとおり、名前が付いたことで資金と人材が集まり、期待がどのように作られたかが記録に残り始めたのがこの年だからです。読者が別の起点を置いて読み直すことも、当然あり得ます。
進歩は連続的ではなく、突然でもない
70年を通して見えたことの一つは、技術の進歩が連続的でないことです。年ごとに少しずつ良くなるのではなく、長い停滞のあとに短い期間で大きく変わるという形が、繰り返されています。2012年の画像認識、2017年のTransformer、2022年のChatGPTは、いずれも外から見れば突然の変化でした。しかし本編で確認したとおり、それぞれの前には基盤の準備期間がありました。
2012年の画像認識モデル(AlexNet)が用いた誤差逆伝播法は、1986年にNature誌に発表された論文で示されていた方法です。それが結果を出すまでには、2009年に発表された大規模画像データセットImageNetと、GPUによる計算の実装が必要でした。手法から結果までに四半世紀が経っています。2017年に論文「Attention Is All You Need」で提案されたTransformerは、2020年に1,750億パラメータのGPT-3へつながり、2022年11月30日のChatGPT公開に至ります。この間は5年です。転換点は突然に見えますが、その基盤は年単位で準備されており、しかも準備期間の長さは一定ではありません。
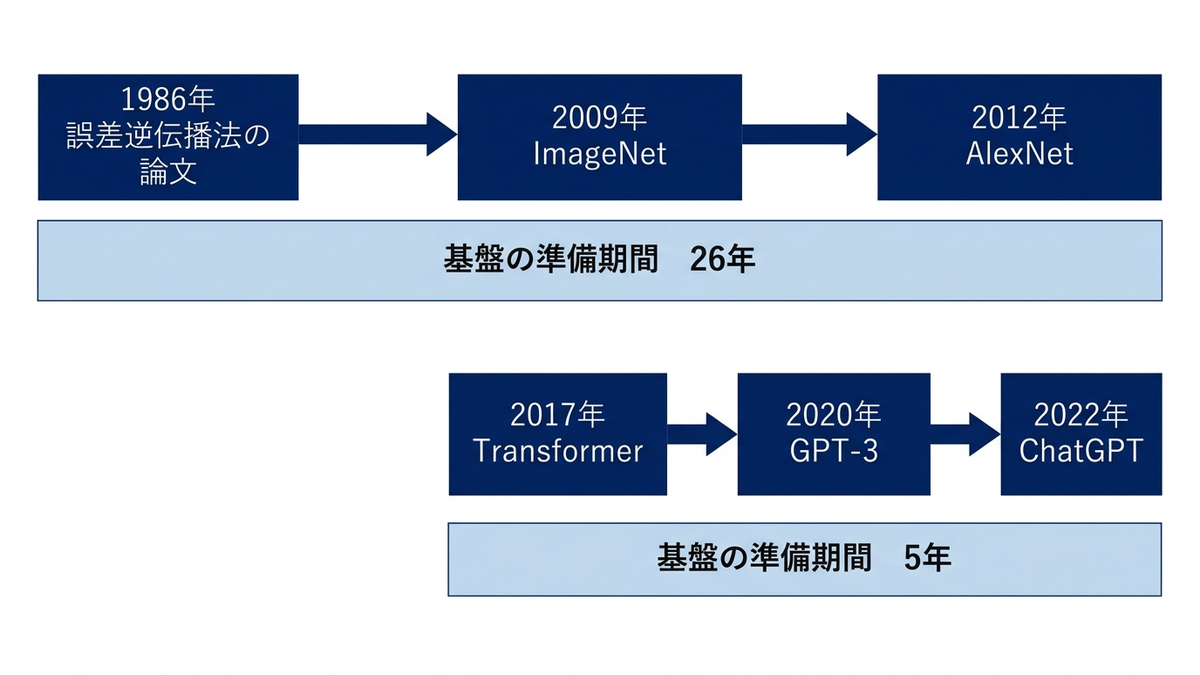
ここから言えるのは、いま何が話題になっているかを追うよりも、いま何の基盤が整いつつあるかを見るほうが、判断の材料として使いやすいということです。本編で繰り返し現れた基盤は三つあります。データが蓄積され、利用できる形になっていること。計算資源が十分に安く、手に入ること。そして、成果を測る共通の物差し(ベンチマーク)が存在し、進歩が比較可能になっていることです。ImageNetは、データセットであると同時に、画像認識の精度を競う共通の物差しでもありました。この三つが自社の関心領域でどの程度整っているかは、話題の大きさとは別に確かめられます。
この見方は、新しい技術の発表を読むときの物差しにもなります。発表の年と基盤の年は別のものです。ある発表が大きく報じられたとき、その技術が使えるようになった理由が、手法の新しさにあるのか、データが揃ったことにあるのか、計算資源が安くなったことにあるのか、物差しが整って比較できるようになったことにあるのかを分けて見ると、自社に転用できる部分がどこにあるのかが分かります。手法の新しさは自社で再現できないことが多い一方、データの整備と評価の物差しは、自社で用意できるものだからです。
歴史から取り出せないもの
序章で述べたことを、本編を通過したうえで確認します。本コラムは予測を書きません。次にどの技術が主流になるか、現在の期待がいつ冬に変わるか、あるいは変わらずに続くかについて、答えを出しません。理由は、上に述べた準備期間の長さが一定でないことにあります。基盤が整っていることは事後に確認できますが、整ってから転換点までに何年かかるかは、1986年から2012年の26年と、2017年から2022年の5年という二つの例だけを見ても、大きく違います。基盤の有無は判断材料になりますが、時期の予測にはなりません。
同じ理由で、現在の局面が冬に向かうかどうかも予測しません。過去の二度の冬は、達成範囲を超えた約束が外部の検証で崩れるという形で入ってきましたが、その形が現れていないことは冬が来ないことの証明にはなりませんし、現れていることは冬が来ることの証明にもなりません。歴史が与えるのは、確かめるべき形であって、答えではありません。この線を越えて予測を書けば、本コラム自身が、達成範囲を超えた約束の一つになります。
予測を書かない代わりに、本コラムは現在について、確認できる事実と、まだ評価が定まっていない事柄とを分けて書きました。第10章で扱った推論モデルやエージェントは、発表から時間が経っておらず、運用での検証が積み上がっていません。評価が定まっていないことは欠点ではなく、現在という時点の性質です。過去の章で「後から見れば」と書けたことの多くは、当時の人には見えていませんでした。現在の出来事についても同じ制約の下にあることを、本コラムは前提にしています。
取り出せるものの限界として、もう一つ書いておくべきことがあります。記録の偏りです。本コラムが振り返ることができたのは、後から見て主流になった系譜が中心です。同じ時代に試みられ、結果が出ずに記録に残らなかった取り組みは、本コラムの材料にはほとんど含まれていません。したがって、「冬を越えて残った技術に共通するもの」を取り出す作業には、残ったものだけを見ているという限界がついて回ります。共通点として挙げたものを備えていながら残らなかった取り組みが、どれだけあったのかは分かりません。第13章が抽出したパターンは、この限界の上に立つものです。パターンを満たしていることは、成功の条件を満たしていることではなく、過去の失敗の形を避けていることの確認にとどまると考えています。
自社で次に確かめること
読者が自社に持ち帰って確かめられることを、本コラムの見方に沿って挙げます。第13章の判断軸と重なる部分もありますが、ここでは「過去に冬を招いた形になっていないか」という一点に絞ります。
- 自社のAI投資が前提としている成果は、現在の技術で達成できる範囲に収まっているか。社内外に対して、達成範囲を超えた約束をしていないか
- その成果は、自社内部の評価だけでなく、外部の目(顧客、監査、株主、規制当局)で検証されたときに耐える形で測られているか。成果を測る物差しを自社で持っているか
- 導入後に運用を続ける費用(データの更新、モデルの再学習、ルールや設定の保守、担当者の維持)は見積もられているか。導入費用だけで判断していないか
- ベンダーやコンサルティング会社の提案は、デモに基づくものか、運用の実績に基づくものか。実績の場合、どの時点の、どの条件での実績か
- 期待が引いた局面が来たとしても、自社に残す能力は何か。データの整備、業務の課題設計、評価の物差しは、技術の流行と無関係に残るものか
最後の項目は、本編の第5章と第6章が示したことに対応します。二度目の冬とされる時期にも、データから推定する手法の研究と、データや計算基盤の整備は続いており、その時期に整えられたものが2012年以降の転換を支えました。冬は分野全体を止めたのではなく、期待に乗った部分を止めたのです。自社にとって、期待に乗った部分と、期待と無関係に残る部分を分けておくことは、局面がどちらに転んでも有効です。
これらの項目は、点数を付けて合否を出すためのものではありません。本コラムが各章の事実に出典と時点を添えたのと同じように、自社の答えにも日付を添えて記録しておくと、半年後や一年後に同じ項目を見直したときに、答えが変わったのか、変わっていないのかが分かります。期待の高い局面では、約束の範囲は気づかないうちに広がります。日付付きの記録は、その広がりを自社で検出するための、最も簡単な仕組みだと考えています。
点検の入口として手軽なのは、投資を決めたときの稟議書や提案書に書かれた成果の一覧を取り出し、それぞれについて「自社のデータで確認済み」「ベンダーのデモで確認済み」「まだ確認していない」のいずれかを付けることです。三つ目が多いこと自体は、導入の初期には自然な状態です。問題になるのは、三つ目のまま社外への説明や次の投資の前提に使われている項目があるときです。達成範囲を超えた約束は、そこで生まれます。この作業は技術の知識を必要とせず、経営層が自分で行えます。
弊社の考え
弊社は、AIの歴史を判断材料として使うとは、将来を言い当てることではなく、自社のいまの判断を過去の形と照らすことだと考えています。過去に失望を招いた判断の形は、技術が変わっても人の側に残ります。達成範囲を超えた約束、外部の検証に耐えない成果の測り方、運用費用を含まない投資判断、デモに基づくベンダー評価といった形は、1960年代にも1980年代にもあり、2020年代にもあり得ます。歴史を知っていれば避けられるとは限りませんが、知らなければ、同じ形を新しいものだと思い込みます。
また、期待の高い局面で投資を止めることが正しいとも考えていません。過去の二度の冬を越えて実用に残った技術は、期待の高い局面に投じられた資源の上に築かれています。冬を恐れて投資を止めることと、期待に乗って約束を膨らませることは、どちらも過去に繰り返された形です。弊社が考えているのは、その中間にある判断です。基盤の準備に投資し、約束は検証可能な範囲に置き、成果を測る物差しを自社で持つという判断です。これは技術の選定ではなく、課題の設計と評価の設計の問題であり、生成AIであっても従来の機械学習であっても変わらないと考えています。
70年の歴史を整理する作業を通じて弊社が最も強く感じたのは、名前が付いた1956年よりも、その前後にある準備と検証の期間のほうが、判断の材料として豊かだということです。華やかな発表の年ではなく、その数年前に何が整い、その数年後に何が検証されたかを見る。この見方は、自社の判断の材料として使えるものだと考えています。以下に、本コラムで紹介した書籍の一覧と、本文の事実の裏付けとした参考情報を置きます。
本コラムで紹介した書籍一覧
各章の末尾で挙げた39冊を、章の順にまとめました。書誌は国立国会図書館サーチと出版社の公表情報で確認しています。邦訳が確認できなかったものは原題で載せました。関心のある時期や論点から選べるように、一冊ずつ短い注を付けています。
第1章 考える機械という問いの始まり
『チューリング:情報時代のパイオニア』(B・ジャック・コープランド著、服部桂訳、NTT出版):1936年の計算可能性から1950年の模倣ゲームまでを一続きの仕事として追えます。
『サイバネティックス:動物と機械における制御と通信』(ノーバート・ウィーナー著、池原止戈夫・彌永昌吉・室賀三郎・戸田巌訳、岩波文庫):目的をフィードバックで定義する枠組みの原典です。
『通信の数学的理論』(クロード・E・シャノン、ワレン・ウィーバー著、植松友彦訳、ちくま学芸文庫):情報を量として測る枠組みが作られた原典で、後の章の土台にもなります。
第2章 ダートマス会議とAIという名前の誕生
『実用Common Lisp:AIプログラミングのケーススタディ』(ピーター・ノーヴィグ著、杉本宣男訳、翔泳社):初期の古典的プログラムを、動くコードとして読み直せます。
『システムの科学 第3版』(ハーバート・A・サイモン著、稲葉元吉・吉原英樹訳、パーソナルメディア):探索とヒューリスティクスを、組織の意思決定まで含めて扱っています。
『The Quest for Artificial Intelligence』(Nils J. Nilsson 著、Cambridge University Press):原論文への参照が各章末に付いた通史で、著者のページで全文が公開されています。
第3章 最初の冬、期待と現実の差はどこで開いたか
『パーセプトロン』改訂版(マービン・ミンスキー、シーモア・パパート著、中野馨・阪口豊訳、パーソナルメディア):何が証明され、何は証明されていないのかを原典で確かめられます。
『コンピュータには何ができないか:哲学的人工知能批判』(ヒューバート・L・ドレイファス著、黒崎政男・村若修訳、産業図書):分野の外部からの批判の系譜を代表する一冊です。
『コンピュータは考える:人工知能の歴史と展望』(パメラ・マコーダック著、黒川利明訳、培風館):当時の関係者がこの局面をどう受け止めていたかを同時代の視点で記述しています。
第4章 知識を書き下す時代
『Rule-Based Expert Systems: The MYCIN Experiments of the Stanford Heuristic Programming Project』(Bruce G. Buchanan、Edward H. Shortliffe 編、Addison-Wesley):MYCINの設計から評価までを当事者が総括した記録で、うまくいかなかったことも書かれています。
『Building Expert Systems』(Frederick Hayes-Roth、Donald A. Waterman、Douglas B. Lenat 編、Addison-Wesley):1980年代に企業が実務の指針として参照した文献にあたります。
『Readings in Medical Artificial Intelligence: The First Decade』(William J. Clancey、Edward H. Shortliffe 編、Addison-Wesley):性能の証明と現場導入のあいだに何があるのかを、複数の事例で確認できます。
第5章 二度目の冬と、統計・機械学習への転回
『統計的学習の基礎:データマイニング・推論・予測』(Trevor Hastie、Robert Tibshirani、Jerome Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、共立出版):1990年代の手法が現在の道具立てにどうつながったかを数式まで確認できます。
『パターン認識のためのサポートベクトルマシン入門』(阿部重夫 著、森北出版):数百件から数千件の規模で、深層学習を持ち出す前に検討すべき手法を押さえられます。
『Behind Deep Blue』(Feng-hsiung Hsu 著、Princeton University Press):専用ハードウェアに資源を集中させる判断が、どの制約のもとで下されたかを当事者が書いています。
第6章 データとインフラが整うまで
『Hadoop 第3版』(Tom White 著、Sky株式会社 玉川竜司・兼田聖士 訳、オライリー・ジャパン):MapReduceとHadoopの成り立ちから運用までを追え、冒頭に歴史をまとめた節があります。
『データ指向アプリケーションデザイン 信頼性、拡張性、保守性の高い分散システム設計の原理』(Martin Kleppmann 著、斉藤太郎 監訳、玉川竜司 訳、オライリー・ジャパン):製品名ではなくその裏にある設計原理を押さえたい方に向いています。
『Googleを支える技術 巨大システムの内側の世界』(西田圭介 著、技術評論社):本章で扱った3本の論文を含む技術文書を日本語で解説しています。
第7章 深層学習の勃興
『深層学習』(Ian Goodfellow、Yoshua Bengio、Aaron Courville 著、岩澤有祐・鈴木雅大・中山浩太郎・松尾豊 監訳、ドワンゴ):本章で「既存の部品の組合せだった」と書いた内容を、部品ごとに掘り下げられます。
『ゼロから作るDeep Learning:Pythonで学ぶディープラーニングの理論と実装』(斎藤康毅 著、オライリー・ジャパン):畳み込みが何を計算しているのかを、ライブラリに頼らず手を動かして確かめられます。
『ディープラーニング革命』(テレンス・J・セイノフスキー 著、銅谷賢治 監訳、藤崎百合 訳、ニュートンプレス):2012年前後の転換を、そこに至る研究者たちの取り組みとあわせて読めます。
第8章 Transformerと事前学習
『大規模言語モデル入門』(山田育矢 監修・著、鈴木正敏・山田康輔・李凌寒 著、技術評論社):事前学習と微調整の関係を、実際に動かしながら追えます。
『機械学習エンジニアのためのTransformers』(Lewis Tunstall、Leandro von Werra、Thomas Wolf 著、中山光樹 訳、オライリー・ジャパン):事前学習済みモデルを自社の課題へ適応させる工程を具体的に知りたい方に向いています。
『IT Text 自然言語処理の基礎』(岡﨑直観・荒瀬由紀・鈴木潤・鶴岡慶雅・宮尾祐介 著、オーム社):注目の仕組みと事前学習を、機械学習の基礎から積み上げて説明した教科書です。
第9章 生成AIの一般化
『拡散モデル:データ生成技術の数理』(岡野原大輔、岩波書店):画像生成が2022年に実用になった理由を、仕組みの側から確認できます。
『ChatGPTの頭の中』(スティーヴン・ウルフラム 著、稲葉通将 監訳、高橋聡 訳、早川書房):次の単語を選ぶ仕組みから、対話が成立して見える理由を段階的に説明しています。
『生成AIで世界はこう変わる』(今井翔太、SBクリエイティブ):導入の数値を、社会と職業の側から捉え直したい方に向いています。
第10章 推論モデルとエージェント
『AIエンジニアリング』(Chip Huyen著、加賀谷諒・菅野憲也訳、オライリー・ジャパン):個々の製品発表を追うのではなく、作る側の考え方の枠組みを押さえられます。
『実践 AIエージェント開発』(Michael Albada著、鈴木駿・高山洪銘・山下正浩訳、オライリー・ジャパン):ワークフローとエージェントの区別を設計上の選択肢として扱い、導入範囲を決める段階の検討に使えます。
『LLMOps』(Abi Aryan著、嶋田健志・新井翔太訳、オライリー・ジャパン):評価・ガバナンス・監査の設定と、稼働後の監視を扱っています。
第11章 日本のAI史
『日本のコンピュータ史』(情報処理学会歴史特別委員会 編、オーム社):国内の計算機の試作と実用化を、機種ごとの記録として通して確認できます。
『日本の情報通信産業史 2つの世界から1つの世界へ』(武田晴人 編、有斐閣):国家プロジェクトと企業行動の関係を、産業史の枠組みで位置づけ直しています。
『第五世代コンピュータ 日本の挑戦』(エドワード・ファイゲンバウム、パメラ・マコーダック 著、木村繁 訳、ティビーエス・ブリタニカ):計画が始まって間もない時期に、米国の研究者の側から書かれた本です。後年の総括と読み比べる材料になります。
第12章 制度と社会
『AIと憲法』(山本龍彦編著、日本経済新聞出版社):条文が置かれる背後にある権利の考え方を、憲法学の視点から整理しています。
『ロボット・AIと法』(弥永真生・宍戸常寿編、有斐閣):行政規制、責任、知的財産などの分野ごとに論点を扱った論集です。
『AI倫理 原理、挑戦、そしてチャンス』(ルチアーノ・フロリディ著、藤本一勇監訳、NTTデータ・コンサルティング・イニシアティブ訳、東洋経済新報社):原則文書を「次に法律になる語彙」として読むための下地になります。
第13章 歴史が示す判断軸
『イノベーションのジレンマ 増補改訂版 技術革新が巨大企業を滅ぼすとき』(クレイトン・クリステンセン著、玉田俊平太監修、伊豆原弓訳、翔泳社):既存の顧客に最適化した判断が新しい手法への移行を遅らせる構造を、複数の業界の記録から論じています。
『イノベーションの普及』(エベレット・ロジャーズ著、三藤利雄訳、翔泳社):期待の作られ方と語の広がり方を分けて考えるための枠組みが得られます。
『テクノロジーの世界経済史 ビル・ゲイツのパラドックス』(カール・B・フレイ著、村井章子訳、大野一訳、日経BP):ある技術の効果がその技術の外側の条件で決まるという見方を、産業革命以降の記録から追えます。
参考情報
ここに挙げたのは、本編の記述を確認するために用いた資料のうち、原論文、公的機関の文書、学会や企業の公式発表、公式アーカイブといった一次情報にあたるものです。ALPAC報告やライトヒル報告についての論評など、一部に同時代の反応や研究史の整理といった二次資料も含めており、その場合は本文でもそのように扱っています。各章に書いた年、人名、論文名、機関名、数値は原則としてこれらの資料で確認しており、確認できなかった事柄は本文に書いていません。複数の章にまたがる資料は、最初に登場する章にまとめました。リンクは2026年10月時点のものです。
序章 AIの歴史を経営の判断に使う
- 国立国会図書館 国会会議録検索システム「第102回国会 衆議院 科学技術委員会 第5号」1985年4月4日、石井威望参考人(東京大学教授)の発言
https://kokkai.ndl.go.jp/txt/110203911X00519850404/4 - DARPA「DARPA Announces $2 Billion Campaign to Develop Next Wave of AI Technologies」2018年9月7日
https://www.darpa.mil/news/2018/next-wave-ai - DARPAtv「A DARPA Perspective on Artificial Intelligence」John Launchbury による講演、2017年2月15日公開
https://www.youtube.com/watch?v=-O01G3tSYpU
第1章 考える機械という問いの始まり
- David Hilbert, Wilhelm Ackermann『Grundzüge der theoretischen Logik』Springer、1928年。一階述語論理の最初の体系的叙述であり、決定問題を提起した
https://link.springer.com/book/10.1007/978-3-662-41928-1 - Alonzo Church「An Unsolvable Problem of Elementary Number Theory」American Journal of Mathematics 第58巻 第2号 345ページから363ページ、1936年
https://ics.uci.edu/~lopes/teaching/inf212W12/readings/church.pdf - A. M. Turing「On Computable Numbers, with an Application to the Entscheidungsproblem」Proceedings of the London Mathematical Society 第2系列 第42巻 230ページから265ページ、1936年から1937年
https://academic.oup.com/plms/article-abstract/s2-42/1/230/1491926 - Claude E. Shannon「A Symbolic Analysis of Relay and Switching Circuits」マサチューセッツ工科大学修士論文、1937年。コンピュータ歴史博物館による所蔵解説
https://www.computerhistory.org/revolution/digital-logic/12/269 - Warren S. McCulloch, Walter Pitts「A Logical Calculus of the Ideas Immanent in Nervous Activity」Bulletin of Mathematical Biophysics 第5巻 115ページから133ページ、1943年
https://link.springer.com/article/10.1007/BF02478259 - John von Neumann『First Draft of a Report on the EDVAC』1945年6月30日。スミソニアン図書館デジタルコレクション所収
https://library.si.edu/digital-library/book/firstdraftofrepo00vonn - Norbert Wiener『Cybernetics: Or Control and Communication in the Animal and the Machine』MIT Press。オープンアクセス版
https://direct.mit.edu/books/oa-monograph/4581/Cybernetics-or-Control-and-Communication-in-the - D. O. Hebb『The Organization of Behavior: A Neuropsychological Theory』1949年、John Wiley and Sons。Routledge 版の書誌
https://www.routledge.com/The-Organization-of-Behavior-A-Neuropsychological-Theory/Hebb/p/book/9780415654531 - A. M. Turing「Computing Machinery and Intelligence」Mind 第59巻 第236号 433ページから460ページ、1950年10月
https://academic.oup.com/mind/article/LIX/236/433/986238 - Claude E. Shannon「XXII. Programming a Computer for Playing Chess」The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science 第7系列 第41巻 第314号 256ページから275ページ、1950年3月
https://www.tandfonline.com/doi/abs/10.1080/14786445008521796 - René Descartes『Discours de la méthode』Leyde、1637年。Victor Cousin 編『Oeuvres de Descartes』第1巻所収の本文(Project Gutenberg 版。BnF/Gallica の画像から作成)
https://www.gutenberg.org/ebooks/13846 - Edgar Allan Poe「Maelzel’s Chess-Player」Southern Literary Messenger 第2巻 318ページから326ページ、1836年4月。Edgar Allan Poe Society of Baltimore による翻刻
https://www.eapoe.org/works/essays/maelzel.htm - Henry Ridgely Evans「Edgar Allan Poe and Baron von Kempelen’s Chess-Playing Automaton」1939年。J. K. Mitchell が The Chess Monthly 第1巻(1857年)に書いた仕掛けの説明を収録。Edgar Allan Poe Society of Baltimore による翻刻
https://www.eapoe.org/papers/misc1921/hre39txt.htm - Willard Fiske 編「The Book of the First American Chess Congress」New York、Rudd & Carleton、1859年。第10章(George Allen 執筆)の424ページと480ページの脚注に、The Chess Monthly 第1巻(1857年)に載った仕掛けの説明の筆者と、資料を提供した J. K. Mitchell とを区別した記述がある。Internet Archive の全文
https://archive.org/details/bookoffirstameri00fisk - L. F. Menabrea 著、A. A. L.(Ada Augusta, Countess of Lovelace)訳・注「Sketch of the Analytical Engine invented by Charles Babbage」Scientific Memoirs 第3巻 第29論文 666ページから、ロンドン、1843年(注記Gは722ページ)
https://archive.org/details/india.history.resource.53369 - University of Reading「Turing Test success marks milestone in computing history」2014年6月8日
https://archive.reading.ac.uk/news-events/2014/June/pr583836.html
第2章 ダートマス会議とAIという名前の誕生
- John McCarthy, Marvin L. Minsky, Nathaniel Rochester, Claude E. Shannon「A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence」1955年8月31日。マッカーシー本人がスタンフォード大学で公開した原文
https://www-formal.stanford.edu/jmc/history/dartmouth/dartmouth.html - 同提案書の再録。AI Magazine 第27巻 第4号、2006年
https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/1904 - ダートマス大学「Artificial Intelligence Coined at Dartmouth」
https://home.dartmouth.edu/about/artificial-intelligence-ai-coined-dartmouth - Rockefeller Archive Center「A Roomful of Brains: Early Advances in Computer Science and Artificial Intelligence」。ロックフェラー財団が実際に交付した金額と決定者の記録
https://resource.rockarch.org/story/a-roomful-of-brains-early-advances-in-computer-science-and-artificial-intelligence/ - John McCarthy「Recursive Functions of Symbolic Expressions and Their Computation by Machine, Part I」原論文PDF
https://www-formal.stanford.edu/jmc/recursive.pdf - John McCarthy「Programs with Common Sense」Mechanisation of Thought Processes、英国国立物理学研究所、1958年
https://www-formal.stanford.edu/jmc/mcc59.html - John McCarthy によるBrian Bloomfield編『The Question of Artificial Intelligence』の書評。artificial intelligence という語を選んだ理由が本人の言葉で述べられている
https://www-formal.stanford.edu/jmc/reviews/bloomfield/bloomfield.html - コーネル大学「Professor’s perceptron paved the way for AI, 60 years too soon」。1958年のパーセプトロン公開実演に関する大学公式の記録
https://as.cornell.edu/news/professors-perceptron-paved-way-ai-60-years-too-soon - Joseph Weizenbaum「ELIZA—A Computer Program For the Study of Natural Language Communication Between Man and Machine」Communications of the ACM 第9巻 第1号 36ページから45ページ、1966年1月
https://web.stanford.edu/class/linguist238/p36-weizenabaum.pdf - ジョセフ・ワイゼンバウム著、秋葉忠利訳『コンピュータ・パワー:人工知能と人間の理性』サイマル出版会、1979年(原著 Computer Power and Human Reason: From Judgment to Calculation、W. H. Freeman、1976年)。国立国会図書館サーチの書誌
https://ndlsearch.ndl.go.jp/books/R100000002-I000001432720 - Peter E. Hart, Nils J. Nilsson, Bertram Raphael「A Formal Basis for the Heuristic Determination of Minimum Cost Paths」IEEE Transactions on Systems Science and Cybernetics 第SSC-4巻 第2号 100ページから107ページ、1968年7月
https://ai.stanford.edu/~nilsson/OnlinePubs-Nils/PublishedPapers/astar.pdf - SRI International「Shakey the Robot」
https://www.sri.com/hoi/shakey-the-robot/ - Nils J. Nilsson『The Quest for Artificial Intelligence』Cambridge University Press、2010年。第12.1節(Shakey と A* の経緯)。著者が公開している版
https://ai.stanford.edu/~nilsson/QAI/qai.pdf
第3章 最初の冬、期待と現実の差はどこで開いたか
- Yehoshua Bar-Hillel「The Present Status of Automatic Translation of Languages」Advances in Computers 第1巻 91ページから163ページ、1960年
https://www.mt-archive.net/50/Bar-Hillel-1960.pdf - Marvin Minsky, Seymour Papert『Perceptrons: An Introduction to Computational Geometry』MIT Press、1969年。Léon Bottou による2017年復刻版の序文と扉
https://leon.bottou.org/publications/pdf/perceptrons-2017.pdf - James Lighthill『Artificial Intelligence: A General Survey』1973年、英国 Science Research Council。原文
http://www.chilton-computing.org.uk/inf/literature/reports/lighthill_report/p001.htm - Thomas Haigh「There Was No First AI Winter」Communications of the ACM 第66巻 第12号 35ページから39ページ、2023年12月。著者の業績ページに書誌がある
https://www.tomandmaria.com/tom/ - Public Law 91-121、1969年11月19日成立。第203条を含む官報体裁の原文、83 Stat. 204
https://www.congress.gov/91/statute/STATUTE-83/STATUTE-83-Pg204.pdf - National Research Council『Funding a Revolution: Government Support for Computing Research』1999年、第9章 Developments in Artificial Intelligence
https://www.nationalacademies.org/read/6323/chapter/11 - John McCarthy, Patrick J. Hayes「Some Philosophical Problems from the Standpoint of Artificial Intelligence」Machine Intelligence 4、463ページから502ページ、Edinburgh University Press、1969年
https://www-formal.stanford.edu/jmc/mcchay69.html - DARPA「The Heilmeier Catechism」。ジョージ・H・ハイルマイヤーの在任期間と、研究提案に課した問いの一覧
https://www.darpa.mil/about/heilmeier-catechism - Drew McDermott, M. Mitchell Waldrop, B. Chandrasekaran, John McDermott, Roger Schank「The Dark Ages of AI: A Panel Discussion at AAAI-84」AI Magazine 第6巻 第3号 122ページから134ページ、1985年
https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/view/494
第4章 知識を書き下す時代
- R. K. Lindsay, B. G. Buchanan, E. A. Feigenbaum, J. Lederberg「DENDRAL: a case study of the first expert system for scientific hypothesis formation」Artificial Intelligence 第61巻 209ページから261ページ、1993年
https://web.mit.edu/6.034/www/6.s966/dendral-history.pdf - E. A. Feigenbaum, B. G. Buchanan「DENDRAL and Meta-DENDRAL: roots of knowledge systems and expert system applications」Artificial Intelligence 第59巻 233ページから240ページ、1993年
https://stacks.stanford.edu/file/druid:pj337tr4694/pj337tr4694.pdf - E. A. Feigenbaum「The Art of Artificial Intelligence」IJCAI-77 Proceedings 第2巻 1014ページから1029ページ、1977年。知識工学の主題と事例研究を扱った第1論文
https://www.ijcai.org/Proceedings/77-2/Papers/092.pdf - B. G. Buchanan, E. H. Shortliffe 編『Rule-Based Expert Systems』Addison-Wesley、1984年、第1章 The Context of the MYCIN Experiments
https://people.dbmi.columbia.edu/~ehs7001/Buchanan-Shortliffe-1984/Chapter-01.pdf - J. McDermott「R1: an Expert in the Computer Systems Domain」AAAI-80 Proceedings、1980年
https://cdn.aaai.org/AAAI/1980/AAAI80-076.pdf - J. Bachant, J. McDermott「R1 Revisited: Four Years in the Trenches」AI Magazine 第5巻 第3号、1984年
https://ojs.aaai.org/aimagazine/index.php/aimagazine/article/download/445/381 - Marvin Minsky「A Framework for Representing Knowledge」MIT AI Laboratory Memo 306、1974年6月
https://courses.media.mit.edu/2004spring/mas966/Minsky%201974%20Framework%20for%20knowledge.pdf - Guy L. Steele Jr., Richard P. Gabriel「The Evolution of Lisp」HOPL-II 向けの無短縮版
https://www.dreamsongs.com/Files/HOPL2-Uncut.pdf
第5章 二度目の冬と、統計・機械学習への転回
- David E. Rumelhart, Geoffrey E. Hinton, Ronald J. Williams「Learning representations by back-propagating errors」Nature 第323巻 533ページから536ページ、1986年10月9日
https://www.nature.com/articles/323533a0 - Corinna Cortes, Vladimir Vapnik「Support-vector networks」Machine Learning 第20巻 第3号 273ページから297ページ、1995年
https://link.springer.com/article/10.1007/BF00994018 - J. Ross Quinlan「Induction of Decision Trees」Machine Learning 第1巻 第1号 81ページから106ページ、1986年
https://link.springer.com/article/10.1007/BF00116251 - Yoav Freund, Robert E. Schapire「A Decision-Theoretic Generalization of On-Line Learning and an Application to Boosting」Journal of Computer and System Sciences 第55巻 第1号 119ページから139ページ、1997年
https://www.sciencedirect.com/science/article/pii/S002200009791504X - Leo Breiman「Random Forests」Machine Learning 第45巻 5ページから32ページ、2001年。著者がカリフォルニア大学バークレー校で公開した原文
https://www.stat.berkeley.edu/~breiman/randomforest2001.pdf - Peter F. Brown ほか「A Statistical Approach to Machine Translation」Computational Linguistics 第16巻 第2号 79ページから85ページ、1990年
https://aclanthology.org/J90-2002/ - Murray Campbell, A. Joseph Hoane Jr., Feng-hsiung Hsu「Deep Blue」Artificial Intelligence 第134巻 第1号から第2号 57ページから83ページ、2002年
https://dl.acm.org/doi/10.1016/S0004-3702(01)00129-1 - Shunichi Amari「A Theory of Adaptive Pattern Classifiers」IEEE Transactions on Electronic Computers 第EC-16巻 第3号 299ページから307ページ、1967年6月
https://ieeexplore.ieee.org/abstract/document/4039068 - J. J. Hopfield「Neural networks and physical systems with emergent collective computational abilities」Proceedings of the National Academy of Sciences 第79巻 第8号 2554ページから2558ページ、1982年4月
https://pmc.ncbi.nlm.nih.gov/articles/PMC346238/ - The Nobel Committee for Physics「Scientific Background to the Nobel Prize in Physics 2024」スウェーデン王立科学アカデミー、2024年10月8日
https://www.nobelprize.org/uploads/2024/11/advanced-physicsprize2024-3.pdf - Jürgen Schmidhuber「Deep Learning in Neural Networks: An Overview」Neural Networks 第61巻 85ページから117ページ、2015年
https://arxiv.org/abs/1404.7828 - Jürgen Schmidhuber「Annotated History of Modern AI and Deep Learning」IDSIA 技術報告 IDSIA-22-22、2022年公開、2025年改訂
https://arxiv.org/abs/2212.11279
第6章 データとインフラが整うまで
- Michele Banko, Eric Brill「Scaling to Very Very Large Corpora for Natural Language Disambiguation」ACL 2001 Proceedings 26ページから33ページ
https://aclanthology.org/P01-1005/ - Alon Halevy, Peter Norvig, Fernando Pereira「The Unreasonable Effectiveness of Data」IEEE Intelligent Systems 第24巻 第2号 8ページから12ページ、2009年3月
https://research.google/pubs/the-unreasonable-effectiveness-of-data/ - Linguistic Data Consortium「Web 1T 5-gram Version 1」LDC2006T13、2006年9月19日公開。収録トークン数などの統計を掲載
https://catalog.ldc.upenn.edu/LDC2006T13 - Jeffrey Dean, Sanjay Ghemawat「MapReduce: Simplified Data Processing on Large Clusters」OSDI’04 Proceedings 137ページから150ページ、2004年
https://research.google/pubs/mapreduce-simplified-data-processing-on-large-clusters/ - Amazon「Amazon Web Services Launches」2006年3月14日。Amazon S3 の提供開始を告げるプレスリリース
https://press.aboutamazon.com/2006/3/amazon-web-services-launches - NVIDIA『NVIDIA CUDA Compute Unified Device Architecture Programming Guide』Version 1.0、2007年6月23日
https://developer.download.nvidia.com/compute/cuda/1.0/NVIDIA_CUDA_Programming_Guide_1.0.pdf - Jia Deng, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, Li Fei-Fei「ImageNet: A Large-Scale Hierarchical Image Database」CVPR 2009 Proceedings 248ページから255ページ
https://www.image-net.org/static_files/papers/imagenet_cvpr09.pdf - James Bennett, Stan Lanning「The Netflix Prize」Proceedings of KDD Cup and Workshop 2007、2007年8月12日
https://www.cs.uic.edu/~liub/KDD-cup-2007/NetflixPrize-description.pdf
第7章 深層学習の勃興
- Alex Krizhevsky, Ilya Sutskever, Geoffrey E. Hinton「ImageNet Classification with Deep Convolutional Neural Networks」NIPS 2012 Proceedings
https://proceedings.neurips.cc/paper_files/paper/2012/file/c399862d3b9d6b76c8436e924a68c45b-Paper.pdf - ILSVRC 2012 公式結果。SuperVision の誤り率と各チームの順位
https://www.image-net.org/challenges/LSVRC/2012/results.html - Tomas Mikolov, Kai Chen, Greg Corrado, Jeffrey Dean「Efficient Estimation of Word Representations in Vector Space」2013年
https://arxiv.org/abs/1301.3781 - Ian J. Goodfellow ほか「Generative Adversarial Nets」NIPS 2014
https://arxiv.org/abs/1406.2661 - Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun「Deep Residual Learning for Image Recognition」2015年12月
https://arxiv.org/abs/1512.03385 - David Silver ほか「Mastering the game of Go with deep neural networks and tree search」Nature 第529巻、2016年
https://research.google/pubs/mastering-the-game-of-go-with-deep-neural-networks-and-tree-search/ - Google Open Source Blog「TensorFlow: Google’s latest machine learning system, open sourced for everyone」2015年11月
https://opensource.googleblog.com/2015/11/tensorflow-googles-latest-machine.html - Preferred Networks「Deep Learning のフレームワーク Chainer を公開しました」2015年6月9日
https://preferred.jp/ja/blog/tech/deep-learning-chainer/ - Kunihiko Fukushima「Neocognitron: A self-organizing neural network model for a mechanism of pattern recognition unaffected by shift in position」Biological Cybernetics 第36巻 第4号 193ページから202ページ、1980年4月
https://link.springer.com/article/10.1007/BF00344251 - 福島邦彦「ネオコグニトロンと畳み込みニューラルネットワーク」医用画像情報学会雑誌 第36巻 第2号 17ページから24ページ、2019年
https://www.jstage.jst.go.jp/article/mii/36/2/36_17/_article/-char/ja/ - Rémi Coulom「Efficient Selectivity and Backup Operators in Monte-Carlo Tree Search」Computers and Games(CG 2006、トリノ)、Lecture Notes in Computer Science 第4630巻 72ページから83ページ、2007年
https://link.springer.com/chapter/10.1007/978-3-540-75538-8_7 - Levente Kocsis, Csaba Szepesvári「Bandit Based Monte-Carlo Planning」Machine Learning: ECML 2006、Lecture Notes in Computer Science 第4212巻 282ページから293ページ、2006年
https://link.springer.com/chapter/10.1007/11871842_29
第8章 Transformerと事前学習
- Ashish Vaswani ほか「Attention Is All You Need」NIPS 2017、arXiv 投稿2017年6月12日
https://arxiv.org/abs/1706.03762 - Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova「BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding」2018年10月
https://arxiv.org/abs/1810.04805 - Alec Radford ほか「Language Models are Unsupervised Multitask Learners」OpenAI が公開したGPT-2の論文PDF
https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf - Tom B. Brown ほか「Language Models are Few-Shot Learners」2020年5月28日、NeurIPS 2020
https://arxiv.org/abs/2005.14165 - Jared Kaplan, Sam McCandlish ほか「Scaling Laws for Neural Language Models」2020年1月23日
https://arxiv.org/abs/2001.08361 - Jordan Hoffmann ほか「Training Compute-Optimal Large Language Models」2022年3月29日。モデル規模と学習データ量の配分を見直した研究
https://arxiv.org/abs/2203.15556 - Rishi Bommasani ほか「On the Opportunities and Risks of Foundation Models」スタンフォード大学 CRFM、2021年8月16日
https://arxiv.org/abs/2108.07258 - John Jumper ほか「Highly accurate protein structure prediction with AlphaFold」Nature、2021年7月15日
https://pmc.ncbi.nlm.nih.gov/articles/PMC8371605/
第9章 生成AIの一般化
- OpenAI「Introducing ChatGPT」2022年11月30日。研究プレビューとして公開したことを告げる発表
https://openai.com/index/chatgpt/ - Long Ouyang ほか「Training language models to follow instructions with human feedback」2022年3月4日
https://arxiv.org/abs/2203.02155 - Robin Rombach ほか「High-Resolution Image Synthesis with Latent Diffusion Models」2021年12月20日、CVPR 2022
https://arxiv.org/abs/2112.10752 - Stability AI「Stable Diffusion Public Release」2022年8月22日
https://stability.ai/news-updates/stable-diffusion-public-release - OpenAI「GPT-4 Technical Report」2023年3月
https://arxiv.org/abs/2303.08774 - Meta「Meta and Microsoft Introduce the Next Generation of Llama」2023年7月18日。Llama 2 の公開と利用条件
https://about.fb.com/news/2023/07/llama-2/ - Patrick Lewis ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」2020年5月22日、NeurIPS 2020
https://arxiv.org/abs/2005.11401 - Edward J. Hu ほか「LoRA: Low-Rank Adaptation of Large Language Models」2021年6月17日
https://arxiv.org/abs/2106.09685 - 総務省「令和6年版 情報通信白書」生成AIの利用経験に関する国際比較
https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r06/html/nd151110.html - Similarweb(David F. Carr)「ChatGPT Tops 25 Million Daily Visits」2023年2月3日。「2か月で1億人」が UBS のリポートによる推計であり、同社のデータが一部に使われたことの説明
https://www.similarweb.com/blog/insights/ai-news/chatgpt-25-million/ - Similarweb(David F. Carr)「ChatGPT’s First Birthday is November 30: A Year in Review」2023年11月15日。公開後1年間の回顧
https://www.similarweb.com/blog/insights/ai-news/chatgpt-birthday/
第10章 推論モデルとエージェント
- OpenAI「Learning to reason with LLMs」2024年9月12日
https://openai.com/index/learning-to-reason-with-llms/ - DeepSeek-AI「DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning」2025年1月22日
https://arxiv.org/abs/2501.12948 - Shunyu Yao ほか「ReAct: Synergizing Reasoning and Acting in Language Models」2022年10月6日
https://arxiv.org/abs/2210.03629 - Anthropic「Building effective agents」2024年12月19日。ワークフローとエージェントの区別を定義している
https://www.anthropic.com/engineering/building-effective-agents - Anthropic「Introducing the Model Context Protocol」2024年11月25日
https://www.anthropic.com/news/model-context-protocol - Google「Our next-generation model: Gemini 1.5」2024年2月15日。標準文脈長と100万トークンの限定提供について
https://blog.google/technology/ai/google-gemini-next-generation-model-february-2024/ - ARC Prize「Announcing ARC-AGI-2 and ARC Prize 2025」2025年3月24日
https://arcprize.org/blog/announcing-arc-agi-2-and-arc-prize-2025 - Thomas Kwa ほか「Measuring AI Ability to Complete Long Software Tasks」2025年3月18日、NeurIPS 2025
https://arxiv.org/abs/2503.14499 - 総務省「令和8年版 情報通信白書」第Ⅰ部第2章、小規模言語モデルの定義と動向
https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/html/nd122110.html - スウェーデン王立科学アカデミー「The Nobel Prize in Physics 2024」プレスリリース、2024年10月8日
https://www.nobelprize.org/prizes/physics/2024/press-release/ - スウェーデン王立科学アカデミー「The Nobel Prize in Chemistry 2024」プレスリリース、2024年10月9日
https://www.nobelprize.org/prizes/chemistry/2024/press-release/ - Google DeepMind「AI achieves silver-medal standard solving International Mathematical Olympiad problems」2024年7月25日
https://deepmind.google/blog/ai-solves-imo-problems-at-silver-medal-level/ - Google DeepMind「Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad」2025年7月21日
https://deepmind.google/blog/advanced-version-of-gemini-with-deep-think-officially-achieves-gold-medal-standard-at-the-international-mathematical-olympiad/ - Thomas Hubert ほか「Olympiad-level formal mathematical reasoning with reinforcement learning」Nature 第651巻 607ページから613ページ、2026年(オンライン公開 2025年11月12日)。AlphaProof の手法と、学習に使った計算の量
https://www.nature.com/articles/s41586-025-09833-y - International Mathematical Olympiad「IMO 2024」大会記録。開催地、参加者数、メダルの基準点
https://www.imo-official.org/editions/2024/ - International Mathematical Olympiad「IMO 2025」大会記録。開催地、参加者数、メダルの基準点
https://www.imo-official.org/editions/2025/ - International Mathematical Olympiad「Editions」開催一覧。1959年以降の開催地と、1980年が開かれていないことの記載
https://www.imo-official.org/editions/ - International Mathematical Olympiad「General Regulations」一般規則(IMO 2025 で承認された現行版)。代表の人数、競技の時間構成、メダルの人数の原則
https://www.imo-official.org/documents/RegulationsIMO.pdf - IMO 2025 主催者「Final day of IMO 2025」2025年7月19日付の声明。AI企業の参加と、大会が検証できる範囲についての会長の言葉
https://imo2025.au/wp-content/uploads/2025/07/IMO-2025_ClosingDayStatement-19072025.pdf - OpenAI「AI as a Scientific Collaborator」2026年1月
https://cdn.openai.com/pdf/f4b4a5da-b2de-418d-9fcd-6b293e9dc157/oai_ai-as-a-scientific-collaborator_jan-2026.pdf - OpenAI「Our First Proof submissions」2026年2月20日。2025年7月の IMO での得点(42点満点中35点)の記載
https://openai.com/index/first-proof-submissions/ - Sequoia Capital「Training Data」第56回「OpenAI’s IMO Team on Why Models Are Finally Solving Elite-Level Math」。研究担当者による採点方法の説明(書き起こし)
https://sequoiacap.com/podcast/training-data-openai-imo
第11章 日本のAI史
- 電子計算機基礎技術開発推進委員会 学術的・技術的評価ワーキング・グループ「第五世代コンピュータ・プロジェクト最終評価報告書」平成5年3月30日。JIPDECアーカイブ所収
https://www.jipdec.or.jp/archives/publications/J0005062 - 産業技術総合研究所 ICOTアーカイブ「第五世代コンピュータ研究開発スタート」
https://www.airc.aist.go.jp/aitec-icot/ICOT/Museum/HISTORY/teidan-J.html - 情報処理学会 コンピュータ博物館「MELCOM PSI」。ICOTのPSIを三菱電機が製品化した経緯
https://museum.ipsj.or.jp/computer/other/0009.html - 情報処理学会 コンピュータ博物館「通研ELIS」。NTTのLISPマシンの実用化と撤退までの経過
https://museum.ipsj.or.jp/computer/other/0004.html - 日本ロボット工業会「世界の産業用ロボット稼動台数推定」2024年。原資料は国際ロボット連盟 World Robotics
https://www.jara.jp/data/dl/Operational_stock_2024.pdf - 国土交通省 報道発表資料「自動運行装置を備えた車両の型式指定を実施」2020年11月11日
https://www.mlit.go.jp/report/press/jidosha08_hh_003888.html - 産業技術総合研究所「AI橋渡しクラウド ABCI について」
https://abci.ai/ja/about_abci/ - 経済産業省「Generative AI Accelerator Challenge、GENIAC」
https://www.meti.go.jp/policy/mono_info_service/geniac/index.html - 東芝 HERITAGE SQUARE「1号機ものがたり 製品詳細」。世界初の郵便物自動処理装置の項(1967年)
https://toshiba-mirai-kagakukan.jp/history/ichigoki/products.htm - 文化遺産オンライン「郵便番号自動読取区分機(東京中央郵便局)」郵政博物館所蔵
https://online.bunka.go.jp/heritages/detail/202728 - 日本郵便「郵便番号・バーコードマニュアル 郵便番号制の目的」
https://www.post.japanpost.jp/service/search/zipcode/zipmanual/p03.html - 中野馨、南雲仁一「連想記憶の工学的モデル」医用電子と生体工学 第10巻 第2号 136ページから144ページ、1972年
https://www.jstage.jst.go.jp/article/jsmbe1963/10/2/10_2_136/_article/-char/ja/ - L. A. Zadeh「Fuzzy sets」Information and Control 第8巻 第3号 338ページから353ページ、1965年
https://doi.org/10.1016/S0019-9958(65)90241-X - 「仙台市地下鉄の鉄道トータルシステム」日立評論 第70巻 第7号、1988年7月
https://www.hitachihyoron.com/jp/pdf/1988/07/1988_07_05.pdf - 仙台市交通局「事業概要(令和7年度版)」。沿革に地下鉄南北線の開業
https://www.kotsu.city.sendai.jp/assets/img/kigyou/gaiyou/jigyougaiyou_r07.pdf - 廣田薫「日本から世界に向けて発信したファジィ実用化技術(前編)」知能と情報 第21巻 第3号 362ページから365ページ、2009年
https://www.jstage.jst.go.jp/article/jsoft/21/3/21_362/_article/-char/ja/ - 廣田薫「日本から世界に向けて発信したファジィ実用化技術(後編)」知能と情報 第21巻 第4号 527ページから531ページ、2009年
https://www.jstage.jst.go.jp/article/jsoft/21/4/21_527/_article/-char/ja/ - 西川泰藏「国際ファジィ工学研究所」日本ファジィ学会誌 第1巻 第1号 69ページから76ページ、1989年
https://www.jstage.jst.go.jp/article/jfuzzy/1/1/1_KJ00002087384/_article/-char/ja/ - 中村和男「特集を企画して」日本ファジィ学会誌 第7巻 第4号 685ページから686ページ、1995年
https://www.jstage.jst.go.jp/article/jfuzzy/7/4/7_KJ00002088467/_article/-char/ja/ - 情報処理学会「清水市代女流王将vs.あから2010」プレスリリース、2010年8月23日
https://www.ipsj.or.jp/50anv/shogi/press2.html - 情報処理学会「清水市代女流王将vs.あから2010速報」
https://www.ipsj.or.jp/50anv/shogi/20101012.html - 情報処理学会「コンピュータ将棋プロジェクトの終了宣言」2015年10月11日
https://www.ipsj.or.jp/50anv/shogi/20151011.html - ドワンゴ「「第2期電王戦」閉幕 将棋ソフト“PONANZA“が佐藤叡王に2連勝で勝ち越し」2017年5月22日
https://dwango.co.jp/news/1890883095203200074/
第12章 制度と社会
- OECD『Recommendation of the Council concerning Guidelines Governing the Protection of Privacy and Transborder Flows of Personal Data』OECD/LEGAL/0188。1980年9月23日採択、2013年7月11日改定
https://legalinstruments.oecd.org/public/doc/114/114.en.pdf - EU一般データ保護規則、Regulation 2016/679 の条文
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32016R0679 - EU人工知能法、Regulation 2024/1689 の条文。2024年6月13日採択、第113条に適用日の規定
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32024R1689 - EUデジタル・オムニバス、Regulation 2026/1744 の条文。2026年7月8日ストラスブールで採択、官報掲載の3日後に発効。AI Act第4条の差し替え、第5条第1項への禁止行為の追加、第99条第6a項の新設、第113条の適用日の変更
https://eur-lex.europa.eu/legal-content/EN/TXT/HTML/?uri=CELEX:32026R1744 - OECD『Recommendation of the Council on Artificial Intelligence』OECD/LEGAL/0449。2019年5月22日採択、2023年と2024年に改定
https://legalinstruments.oecd.org/public/doc/648/648.en.pdf - 統合イノベーション戦略推進会議「人間中心のAI社会原則」平成31年3月29日決定
https://www8.cao.go.jp/cstp/ai/aigensoku.pdf - 内閣府「人工知能関連技術の研究開発及び活用の推進に関する法律について」。令和7年法律第53号の公布と施行
https://www8.cao.go.jp/cstp/ai/ai_act/ai_act.html - 総務省「AI事業者ガイドライン」。第1.0版から第1.2版までの公表日
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - 文化審議会著作権分科会法制度小委員会「AIと著作権に関する考え方について」令和6年3月15日
https://www.bunka.go.jp/seisaku/bunkashingikai/chosakuken/pdf/94037901_01.pdf - 国立国会図書館 日本法令索引「個人情報の保護に関する法律」平成15年法律第57号
https://hourei.ndl.go.jp/simple/detail?lawId=0000095240 - NIST「AI Risk Management Framework」。AI RMF 1.0 と生成AIプロファイル
https://www.nist.gov/itl/ai-risk-management-framework - 国家互聯網信息弁公室ほか「生成式人工智能服务管理暂行办法」2023年7月13日公布、2023年8月15日施行
https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm - Bartz v. Anthropic PBC「Order Granting Final Approval of Class Action Settlement; Granting in Part Motion for Attorney’s Fees, Reimbursement of Expenses, and Plaintiff Service Awards; Judgment」カリフォルニア州北部地区連邦地方裁判所、事件番号 3:24-cv-05417-AMO、文書番号680、2026年7月20日。和解の最終承認と終局判決の原文
https://storage.courtlistener.com/recap/gov.uscourts.cand.434709/gov.uscourts.cand.434709.680.0.pdf - Yoshua Bengio ほか「International AI Safety Report」英国 科学・イノベーション・技術省 研究シリーズ DSIT 2025/001、2025年1月29日公表
https://internationalaisafetyreport.org/sites/default/files/2025-10/international_ai_safety_report_2025_english.pdf - International AI Safety Report「International AI Safety Report 2026」2026年2月3日公表の第2版の紹介ページ
https://internationalaisafetyreport.org/publication/international-ai-safety-report-2026 - 米国第3巡回区連邦控訴裁判所「トムソン・ロイター対ROSSインテリジェンス事件判決」事件番号25-2153、2026年9月29日。判例要旨の著作物性とフェアユースの不成立を認めた地裁の判断を支持
https://www.govinfo.gov/content/pkg/USCOURTS-ca3-25-02153/pdf/USCOURTS-ca3-25-02153-0.pdf - カリフォルニア州北部地区連邦地方裁判所「バーツ対アンソロピック事件 フェアユースに関する命令」2025年6月23日、文書番号231。学習利用と海賊版による蔵書づくりを分けて判断
https://www.govinfo.gov/content/pkg/USCOURTS-cand-3_24-cv-05417/pdf/USCOURTS-cand-3_24-cv-05417-0.pdf - 米国連邦官報「大統領令14434 超知能の時代の幕開け」2026年9月29日署名、2026年10月2日掲載
https://www.govinfo.gov/content/pkg/FR-2026-10-02/html/2026-20321.htm - 欧州委員会「AI Act Service Desk」。2026年7月27日時点の統合版に基づく条文と、デジタル・オムニバスによる追加・改正の表示
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-6 - 個人情報保護委員会「『個人情報の保護に関する法律等の一部を改正する法律』の公布について」令和8年7月17日。施行は一部を除き公布から2年以内の政令で定める日
https://www.ppc.go.jp/news/press/2026/260717/ - 米国国立環境健康科学研究所「研究倫理の年表」。1974年の組換えDNA諮問委員会の設置と1976年の研究指針
https://www.niehs.nih.gov/research/resources/bioethics/timeline - OECD.AI「広島AIプロセス報告枠組み」。第1回の報告25件と第2版への改定
https://oecd.ai/en/transparency/overview - 国家互聯網信息弁公室ほか「人工智能生成合成内容标识办法」2025年3月通知、2025年9月1日施行
https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm - 国家互聯網信息弁公室ほか「人工智能拟人化互动服务管理暂行办法」2026年4月10日公布、2026年7月15日施行
https://www.cac.gov.cn/2026-04/10/c_1777558395078289.htm - 米国著作権局「米国著作権法 第1章」。第107条(フェアユース)の条文
https://copyright.gov/title17/92chap1.html
第13章 歴史が示す判断軸
- Herbert A. Simon, Allen Newell「Heuristic Problem Solving: The Next Advance in Operations Research」Operations Research 第6巻 第1号 1ページから10ページ、1958年。1957年11月14日のオペレーションズ・リサーチ学会全国大会での講演がもとになっている
https://pubsonline.informs.org/doi/10.1287/opre.6.1.1 - W. John Hutchins「ALPAC: the infamous report」MT News International 第14号、1996年
https://aclanthology.org/www.mt-archive.info/90/MTNI-1996-Hutchins.pdf - John McCarthy によるライトヒル報告の書評
https://www-formal.stanford.edu/jmc/reviews/lighthill/lighthill.html - IBM「Deep Blue」。1997年5月の対局結果と、1996年2月の初戦との違い
https://www.ibm.com/history/deep-blue - ACM「ACM Turing Award 2018」プレスリリース。受賞者3名と授賞理由の正式な表現
https://awards.acm.org/binaries/content/assets/press-releases/2019/march/turing-award-2018.pdf - Carl Benedikt Frey, Michael A. Osborne「The future of employment: How susceptible are jobs to computerisation?」2013年9月。オックスフォード・マーティン・スクールの公表ページ。のちに Technological Forecasting and Social Change 第114巻 254ページから280ページ、2017年に掲載
https://www.oxfordmartin.ox.ac.uk/publications/the-future-of-employment - 野村総合研究所「日本の労働人口の49%が人工知能やロボット等で代替可能に」ニュースリリース、2015年12月2日
https://www.nri.com/content/900037164.pdf - Melanie Arntz, Terry Gregory, Ulrich Zierahn「The Risk of Automation for Jobs in OECD Countries: A Comparative Analysis」OECD の社会・雇用・移住ワーキングペーパー第189号、2016年。論文本体(PDF)。著者名の表記は同PDFによる(ZEW の公表記録では Zierahn-Weilage)
https://www.oecd.org/content/dam/oecd/en/publications/reports/2016/05/the-risk-of-automation-for-jobs-in-oecd-countries_g17a27d8/5jlz9h56dvq7-en.pdf - 同論文の ZEW による公表記録と要旨
https://www.zew.de/publikationen/the-risk-of-automation-for-jobs-in-oecd-countries-a-comparative-analysis - Stuart Armstrong, Kaj Sotala「How We’re Predicting AI—or Failing To」Jan Romportl ほか編『Beyond AI: Artificial Dreams』52ページから75ページ、西ボヘミア大学、2012年。機械知能研究所の公開版(データセットの誤りに関する注記つき)
https://intelligence.org/files/PredictingAI.pdf - Katja Grace「Error in Armstrong and Sotala 2012」AI Impacts、2016年5月17日
https://aiimpacts.org/error-in-armstrong-and-sotala-2012/