こんにちは、Anagraftの伊藤です。
今回は、広告の効果を売上のデータから測り、その結果を広告予算の配分に使うための手法である、マーケティング・ミックス・モデリングを整理しました。テレビCM、検索広告、SNS広告、ディスプレイ広告など、企業が使う広告の手段は増え、それぞれの媒体が自分の管理画面で成果の数字を出してくれるようになりました。一方で、媒体ごとの数字を足し合わせると実際の売上の増え方より大きくなる、テレビCMのように管理画面で成果を追えない媒体の効果が分からない、個人の閲覧の追跡が難しくなって数字そのものが取れなくなってきた、といった悩みもよく聞かれます。本コラムでは、週ごとの売上と広告費の記録から、売上を「広告が無くても出る部分」と「媒体ごとに広告が上乗せした部分」に分け、その結果を予算の配分にどうつなげるかを、一つの架空のデータを通して実際にコードを動かしながら説明します。
この題材を選んだ理由は、広告費の配分が、多くの企業で毎期くり返される大きな予算判断でありながら、その根拠が媒体ごとの管理画面の数字や前年の実績に頼っていることが多いように思うためです。売上には、季節の波、値引きの販促、休日、景気、そして複数の媒体の効果が同時に混ざっています。広告を出した週に売上が上がっても、それが広告の効果なのか、もともと売れる季節だったのかは、売上の数字を眺めるだけでは分かりません。広告の効果は翌週以降にも持ち越されますし、広告費を倍にしても売上が倍になるわけではありません。こうした性質を踏まえずに配分を決めると、効いている媒体を削り、効いていない媒体に予算を積むことが起こります。
各章では、架空の日用品メーカーの週次データを共通の題材にして、実際にコードを動かした結果を載せています。3年分(156週)の週ごとの売上と、テレビCM・検索広告・SNS広告・ディスプレイ広告の4つの媒体の広告費、値引きの販促と休日の印をそろえたものです。データは乱数で生成したもので、実在の企業やブランドの記録ではありません。その代わり、データを作った側は「本当の広告効果」を知っているので、推定した結果がどれだけ当たっているか、その推定に従って予算を配分し直すと売上がどれだけ変わるかを、答え合わせできます。
想定している読者は、広告費の配分を決める、あるいは決める材料を作る立場の方です。マーケティング部門の責任者の方、事業部門の企画担当の方、DX推進やデータ分析チームのリーダーの方、そして広告への投資の妥当性を判断する経営層の方を念頭に置いています。統計の専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にしています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各手法について「何を測るためのものか」「それが無いと何を誤るか」「どの規模や段階から要るか」「結果をどう読み、予算の判断にどう翻訳するか」を書くようにしました。効果測定のための製品やサービスは数多くありますが、どれを選ぶかより先に、自社のデータの量と粒度、媒体の数、判断を誤ったときの影響の大きさから、どの手法をどの順で組み合わせるかを決めることが大事だと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムに出てくる売上や広告費の金額は、すべて架空の設定による例題の値です。製品・サービス・広告媒体の料金には触れていません。本コラムの記述は2026年10月時点で確認したものです。製品の機能や各社の方針は更新がありますので、実務で使う際は公式のページで最新の内容をご確認ください。ライブラリの関数名や引数も版によって変わります。計算時間は本コラムの実行環境で測った値であり、計算機が変われば変わります。
目的別の入口の目安を挙げておきます。広告の効果測定を経営の問題としてどう見るかを整理したい場合は、第1章と第13章が入口になります。マーケティング・ミックス・モデリングと、アトリビューション分析や実験との違いを知りたい場合は第2章をご覧ください。データの集め方は第3章、売上を分解する回帰の考え方は第4章、広告の効果の持ち越しと飽和は第5章と第6章、季節や販促との切り分けは第7章、推定と検証の手順は第8章が中心になります。
推定の不確かさをどう示すかは第9章、実験の結果で推定を答え合わせする方法は第10章、ROIと限界ROIの読み方は第11章、予算の配分の最適化は第12章、組織での使い続け方は第13章、公開された道具と事例を含む最新の動向は第14章で扱っています。

目次
- 序章 広告の効果は売上の数字に直接は書かれていない
- 全体の地図
- 第1章 広告の効果測定はなぜ経営の問題なのか
- 第2章 効果測定の手法の全体像、MMM・アトリビューション・実験
- 第3章 MMMに使うデータを集めて整える
- 第4章 回帰分析で売上を分解する
- 第5章 アドストック、広告の効果は翌週以降に持ち越される
- 第6章 飽和と逓減、広告費を増やしても売上は比例しない
- 第7章 季節性・販促・外部要因を切り分ける
- 第8章 モデルを推定し、検証する
- 第9章 不確実性を示す、ベイズMMMとブートストラップ
- 第10章 実験で答え合わせする、リフトテストと地域実験
- 第11章 ROIと限界ROIで投資判断をする
- 第12章 広告予算の配分を最適化する
- 第13章 MMMを組織で使い続ける
- 第14章 事例と最新動向
- 終章 広告の効果を測り続けるための5つの考え方
- 本コラムで紹介した書籍一覧
- 第1章 広告の効果測定はなぜ経営の問題なのか
- 第2章 効果測定の手法の全体像、MMM・アトリビューション・実験
- 第3章 MMMに使うデータを集めて整える
- 第4章 回帰分析で売上を分解する
- 第5章 アドストック、広告の効果は翌週以降に持ち越される
- 第6章 飽和と逓減、広告費を増やしても売上は比例しない
- 第7章 季節性・販促・外部要因を切り分ける
- 第8章 モデルを推定し、検証する
- 第9章 不確実性を示す、ベイズMMMとブートストラップ
- 第10章 実験で答え合わせする、リフトテストと地域実験
- 第11章 ROIと限界ROIで投資判断をする
- 第12章 広告予算の配分を最適化する
- 第13章 MMMを組織で使い続ける
- 第14章 事例と最新動向
- 参考情報
序章 広告の効果は売上の数字に直接は書かれていない
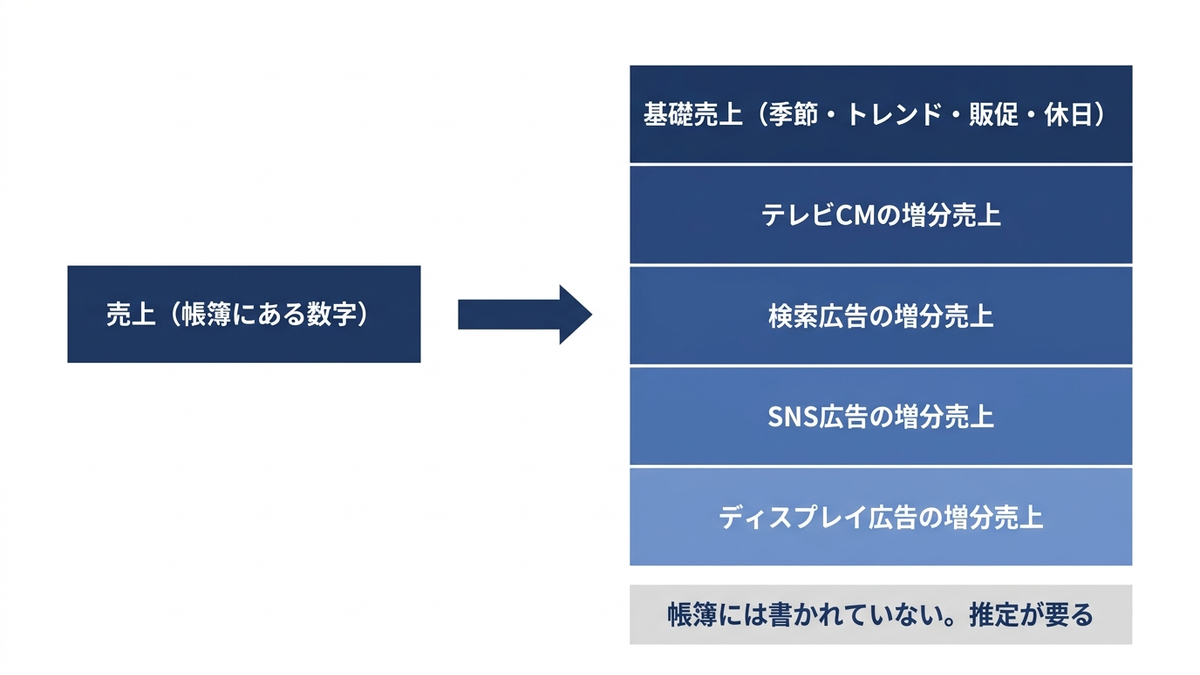
ある週に売上が伸びたとき、その伸びのうちどれだけが広告によるものかは、売上の数字そのものには書かれていません。売上には、季節の波、値引きの販促、年末や大型連休といった休日、長い目で見た成長の傾向、そして複数の広告媒体の効果が、同時に混ざって記録されます。広告を多く出した週に売上が高くても、もともと売れる季節だったから広告も多く出していた、という場合もあります。週ごとの売上と広告費、販促や休日の記録を統計のモデルで分析し、売上を「広告が無くても出る部分」と「媒体ごとに広告が上乗せした部分」に分けて、媒体ごとの効果と投資の効率を推定する手法が、マーケティング・ミックス・モデリング(英語の頭文字からMMMと呼ばれます)です。本コラムの主題はこの手法と、その結果を広告予算の配分に使う方法です。
MMMは新しい手法ではなく、売上をさまざまなマーケティングの手段と外部の要因で説明する回帰分析として、長く使われてきました。近年あらためて注目されている背景には、個人の閲覧や購買の追跡が、プライバシー保護の流れの中で難しくなってきたことがあります。広告をクリックした人がその後に購入したかを一人ずつ追う測り方は、追跡ができる範囲でしか使えません。MMMは個人を追跡せず、週ごと・地域ごとといった集計したデータだけで分析できるため、テレビCMのように個人を追えない媒体も同じ物差しで扱えます。手法の位置づけと、ほかの測り方との違いは第1章と第2章で整理します。
媒体ごとの数字を足しても、広告全体の効果にはならない
検索広告やSNS広告の管理画面には、広告経由の購入件数や売上が表示されます。これは便利な数字ですが、その媒体が自分の側から見た成果であって、その広告が無かったら失われていた売上と同じとは限りません。広告を見る前から買うつもりだった人が、たまたま最後に検索広告をクリックして購入した場合も、管理画面では検索広告の成果として数えられます。複数の媒体がそれぞれ同じ購入を自分の成果として数えれば、媒体ごとの数字の合計は、実際に広告が増やした売上より大きくなります。
経営の判断に要るのは、「その広告が無かった場合と比べて、売上がどれだけ増えたか」という増分です。増分は直接は観測できません。同じ週に広告を出した場合と出さなかった場合の両方を見ることはできないからです。そこで、広告費が多い週と少ない週、媒体の組み合わせが違う週を数多く比べ、季節や販促の影響を差し引いたうえで、広告費の違いが売上の違いにどう結びついているかを推定します。これがMMMの基本的な考え方です。増分の考え方は第1章で、推定の手順は第4章から第8章で扱います。
答えの分かっている架空のデータで、推定と配分を比べる
共通の題材は、架空の日用品メーカーの週次データです。3年分(第1〜156週)の週ごとの売上と、テレビCM・検索広告・SNS広告・ディスプレイ広告の4つの媒体の広告費、値引きの販促を行った週と年末・大型連休の週の印をそろえました。金額の単位はすべて万円で、週の売上の平均は約5,063万円です。テレビCMは年に数回、数週間の放映期間にまとめて出し、検索広告は需要の高い週に増え、ディスプレイ広告はテレビCMの放映期間に合わせて増やす、という出し方にしてあります。データは乱数で生成したもので、実在の企業やブランドの記録ではありません。
データを作った側は、本当の広告効果を知っています。媒体ごとに、効果が翌週へどれだけ持ち越されるか、広告費を増やしたときにどこで頭打ちになるかを決めてからデータを作ったためです。現実の企業には見えませんが、本コラムではこれを「真の値」と呼び、推定がどれだけ当たっているかを確かめる物差しとして使います。3年間の売上のうち、真の値で約65%は広告が無くても出る部分で、残りが4つの媒体の効果です。
参考までに、第2章で説明する基準の計算の結果を先に示します。売上を、季節・販促・休日と各媒体の広告費で説明するモデルを、2つの方法で推定しました。1つは広告費をそのまま説明に使う素朴な回帰、もう1つは広告の効果の持ち越しと頭打ちを組み込んだMMMです。MMMは、学習に使わなかった最後の26週の売上を平均2.64%の誤差で言い当てました。素朴な回帰の誤差は13.53%です。予測の当てはまりでは、MMMのほうがはるかに良い結果でした。
ところが、媒体ごとの投資の効率を見ると、話は変わります。直近52週(第105〜156週)に生じた媒体の効果(増分売上)を、同じ期間の広告費で割った値(本コラムでは売上ROIと呼びます。売上ROI=増分売上÷広告費)は、真の値で検索広告が2.35、SNS広告が1.76でした。MMMの推定は検索広告が1.18、SNS広告が0.90で、どちらも真の値の約半分です。予測がよく当たっていても、媒体ごとの効果まで正しく分けられているとは限らない、ということをこの結果は示しています。推定したパラメータの一部は、推定の際に設けた範囲の上限に張り付いており、156週のデータでは効果の形を一通りに決めきれていないことが分かります。基礎売上の水準も真の値より大きめに推定されていましたが、第7章で基礎売上の真の値を与えて推定し直しても、検索広告とSNS広告の過小評価は残りました。売上全体はよく説明できても、その内訳を媒体どうしにどう振り分けるかがデータだけでは決まりきらない、というのがこの例で確かめられたことです。この点は第7章と第8章で詳しく扱います。
この差は、予算の配分に直結します。直近52週の週あたりの広告費の総額を変えずに、4つの媒体の配分を推定に従って組み替え、真の値で売上の増え方を確かめました。ここでの比較は、組み替えた配分を毎週同じ額で出し続けたと仮定した計算(本コラムでは定常状態と呼びます)で週の売上の増分を求め、52倍して年に換算したものです。切り替えの途中の期間や季節の波は含みません。素朴な回帰に従って組み替えると、売上は現状より年に約1億741万円減りました。MMMに従うと年に約3,816万円増え、真の値を知っていれば年に約1億6,622万円増やせました。素朴な測り方に頼ると配分を組み替えることでかえって損をし、MMMを使っても推定がずれていれば、取れるはずの増分の一部しか取れない、ということです。第9章では推定の不確かさの示し方を、第10章では実験の結果でモデルを答え合わせする方法を、第12章では較正したモデルで配分し直した結果を扱います。なお、ここで示した数字は、この架空のデータの、この設定での結果です。媒体の数や効果の大きさ、データの期間が違えば、推定のずれ方も配分の差も変わります。
当てはまりより、答え合わせの仕組みを
本コラムを通じてお伝えしたいことが一つあります。広告の効果測定で大事なのは、当てはまりの良い1本のモデルではなく、推定の不確かさを示し、実験で答え合わせをし、その結果で配分を少しずつ動かして確かめる循環を、毎期の予算の判断に組み込んでおくことだということです。上の例のように、売上をよく言い当てるモデルでも、媒体ごとの効果を大きく取り違えることがあります。モデルの推定を1つの数字として受け取り、それに従って予算を一度に大きく動かすと、推定のずれがそのまま損失になります。
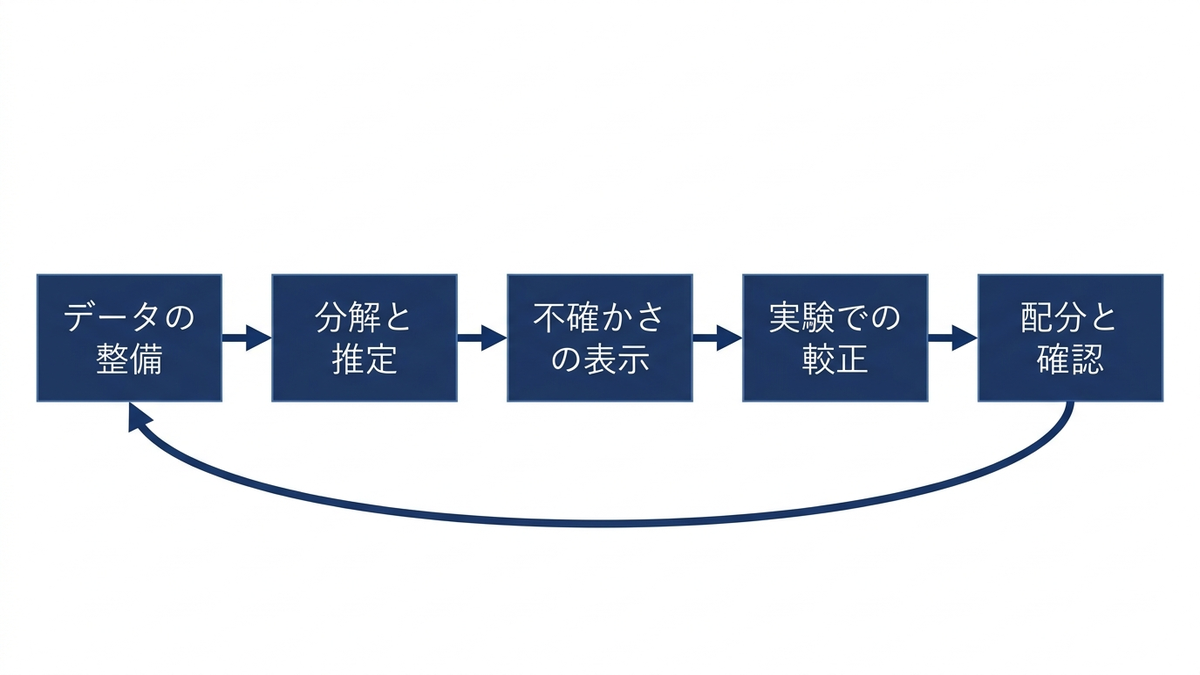
この循環は、次の5つの段階で成り立ちます。
- データの整備:売上・広告費・販促・季節の記録を、同じ粒度と期間でそろえます(第3章)。
- 分解と推定:持ち越しと頭打ちを組み込んで売上を分解し、媒体ごとの効果を推定します(第4章から第8章)。
- 不確かさの表示:推定の幅を示し、1つの数字で判断しないようにします(第9章)。
- 実験での較正:地域を分けて広告を止めるなどの実験で、推定を答え合わせし、モデルに取り込みます(第10章)。
- 配分と確認:限界ROIを見て配分を少しずつ動かし、次の期のデータで確かめます(第11章・第12章)。
経営判断に関わる方にとって、この点は広告への投資の進め方に直結します。MMMを一度外部に依頼して媒体ごとのROIの表を受け取り、それをもとに翌年の予算を大きく組み替える、という使い方は、推定のずれが大きいときに損失を生みます。反対に、分析の結果を使わずに前年の配分を踏襲し続ければ、効いていない媒体があっても気づかないまま、予算を積み続けるおそれがあります。推定の幅を確かめ、幅の大きい媒体から実験で答え合わせをし、配分を段階的に動かす順序であれば、効果を確かめながら予算を組み替えられます。組織での使い方は第13章で扱います。
Anagraftでは、データ活用の構想づくりから、マーケティングデータの整備、効果測定のモデルの設計と実装、予算配分の意思決定への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。第1章と第2章で、広告の効果測定がなぜ経営の問題になるのか、効果を測る手法にはどんな種類があり、MMMはその中でどこに位置づくのかを整理し、共通の題材である架空の週次データと基準の結果を紹介します。第3章から第8章では、データの集め方、回帰による売上の分解、広告の効果の持ち越し(アドストック)、頭打ち(飽和)、季節や販促との切り分け、推定と検証の順に、MMMを組み立てる手順を扱います。第9章と第10章は、推定の不確かさの示し方と、実験による答え合わせです。第11章と第12章で、推定の結果を投資判断と予算の配分に使う方法を、第13章で組織での使い続け方を、第14章で公開された道具と事例、最新の動向を扱います。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | 広告の効果測定はなぜ経営の問題なのか | 広告の効果はなぜ売上の数字から直接分からないのか。測り方を誤ると、どういう損失がどれだけ出るのか |
| 第2章 | 効果測定の手法の全体像、MMM・アトリビューション・実験 | 効果を測る手法にはどんな種類があり、それぞれ何に答えられて何に答えられないのか |
| 第3章 | MMMに使うデータを集めて整える | どのデータを、どの粒度と期間でそろえればよいか。データが足りないと何が起きるか |
| 第4章 | 回帰分析で売上を分解する | 売上を「広告が無くても出る部分」と媒体ごとの効果にどう分けるか。素朴な回帰はどこで誤るか |
| 第5章 | アドストック、広告の効果は翌週以降に持ち越される | 広告の効果がどれだけ後の週まで続くかを、どう表し、どう推定するか |
| 第6章 | 飽和と逓減、広告費を増やしても売上は比例しない | 広告費を増やしたときの売上の増え方の頭打ちを、どう表し、どう読むか |
| 第7章 | 季節性・販促・外部要因を切り分ける | 「広告が効いた」と「季節が良かった」を、どう取り違えずに分けるか |
| 第8章 | モデルを推定し、検証する | 推定した結果をどう検証し、当てはまりが良くても効果を取り違える問題にどう備えるか |
| 第9章 | 不確実性を示す、ベイズMMMとブートストラップ | 推定の不確かさをどう示し、幅のある結果で何を決められるか |
| 第10章 | 実験で答え合わせする、リフトテストと地域実験 | 実験の結果で推定を確かめ、モデルに取り込むにはどうするか |
| 第11章 | ROIと限界ROIで投資判断をする | 平均のROIと、次の1万円の効果である限界ROIを、投資判断でどう使い分けるか |
| 第12章 | 広告予算の配分を最適化する | 総額が決まっているとき、媒体ごとの配分をどう決め、どこまで動かすか |
| 第13章 | MMMを組織で使い続ける | 誰が何を担い、どの頻度で更新し、予算の会議にどう組み込むか |
| 第14章 | 事例と最新動向 | 公開されている道具と事例から何が分かり、効果測定はどこへ向かっているか |
本コラムで使う指標と言葉
各章で共通して使う指標と言葉を、先に定義しておきます。詳しい説明は、初めて使う章で行います。金額の単位は、特に断らない限り万円です。
| 言葉 | 本コラムでの意味 |
|---|---|
| 増分売上 | その媒体の広告が無かった場合と比べて増えた売上。翌週以降に持ち越された効果も含めます |
| 売上ROI | 増分売上を、同じ期間の広告費で割った値。1を超えれば、広告費より多くの売上を生んでいます。期間を区切るときは、その期間に生じた効果を数えます(期間より前に出した広告の持ち越しを含み、期間の後に持ち越される分は含みません)。特に断らない限り、本コラムで「ROI」と書くときはこれを指します |
| 粗利ROI | 増分売上に粗利率(架空の設定で0.50)を掛け、広告費で割った値。1を超えれば、広告費を粗利で回収できています |
| 限界ROI | 週の広告費をあと1万円増やして毎週出し続けたとき(定常状態)に、週の増分売上がいくら増えるか。広告費と増分売上の関係を表す曲線の傾きです。詳しくは第11章で扱います |
| 寄与の割合 | 売上の合計に占める、その媒体の増分売上の割合 |
| 基礎売上 | 広告が無くても出る売上。季節の波、成長の傾向、販促、休日の影響を含みます |
| MAPE | 予測の誤差を実際の売上に対する割合で表し、平均したもの。小さいほど予測がよく当たっています |
| 真の値 | データを作った側だけが知っている本当の効果。現実の企業には見えませんが、本コラムでは推定の答え合わせに使います |
| 素朴な回帰 | 広告費をそのまま説明に使い、季節・販促・休日と一緒に売上を説明する回帰。持ち越しや頭打ちを考えません |
| MMM(基準) | 各媒体に持ち越しと頭打ちを組み込み、季節・販促・休日と一緒に推定したモデル。第2章で設定を示し、第8章で推定の手順を詳しく扱います |
共通のデータと基準の計算の詳しい設定は第2章で示します。第3章以降は、第2章で用意したデータを使って、各手法を実際に動かした結果を載せています。各章の数字は、特に断らない限り、この架空のデータの、その章の設定での結果です。
第1章 広告の効果測定はなぜ経営の問題なのか
広告費が売上をいくら生んだかは、会計の帳簿にも、売上の集計表にも直接は書かれていません。売上の数字には、季節の波、値引き販促、市場のトレンド、休日、そして複数の広告媒体の効果が混ざって入っています。どの媒体にいくら配分するかという判断は、この混ざった数字から各媒体の効果を取り出すことができて、はじめて根拠を持ちます。この章では、広告の効果が売上の数字から直接は読めない理由、最後に触れた広告に手柄を付ける測り方の偏り、増分売上という考え方、日本の広告費の規模、個人単位の追跡が難しくなった流れを確認したうえで、誤った効果の見積もりで予算を配分したときにどれだけの損失が出るかを、第2章で詳しく紹介する架空のサンプルデータで計算して示します。手法の比較は第2章で扱います。
広告の効果は売上の数字に直接は書かれていない
ある週の売上が前の週より300万円増えたとき、その増加のどれだけがテレビCMのおかげで、どれだけが季節や販促のおかげかは、売上の数字だけでは分かりません。売上を「広告が無くても出たはずの売上」と「各媒体の広告が上乗せした売上」に分けて考える必要があります。この記事では前者を基礎売上と呼びます。基礎売上には、季節性・トレンド・販促・休日の効果を含めます。後者は媒体ごとの増分売上で、この章の後半で定義します。
この分け方を、この記事の共通データで具体的に見てみます。共通データは、架空の日用品メーカー(通販と店頭で販売)の第1〜156週(3年)の週次の売上と広告費で、乱数の種を固定して作った架空のデータです。実在の企業の記録ではありません。データの設定は第2章で表にして示します。データを作った側は、売上のうちどれだけが基礎売上で、どれだけが各媒体の効果かという答え(この記事では「真の値」と呼びます)を知っています。現実の企業には真の値は見えませんが、この記事では推定の答え合わせに使えます。3年合計の売上を真の値で分けると、次の表のようになりました。金額の単位は万円です。
| 売上の中身(3年合計、真の値) | 金額(万円) | 売上に占める割合 | 同じ期間の広告費(万円) |
|---|---|---|---|
| 基礎売上 | 513,092 | 0.650 | なし |
| テレビCMの増分売上 | 113,374 | 0.144 | 70,765 |
| 検索広告の増分売上 | 82,833 | 0.105 | 35,100 |
| SNS広告の増分売上 | 62,983 | 0.080 | 36,467 |
| ディスプレイ広告の増分売上 | 18,041 | 0.023 | 47,694 |
| 売上の合計 | 789,749 | 1.000 | 190,026 |
売上の合計のうち約65%は基礎売上で、広告が無くても出たはずの売上です。媒体の増分売上の合計は残りの約35%です(表の4媒体の増分売上と基礎売上を足した額と売上の合計の差、-574万円は、データに入れた観測の誤差の3年分の合計です)。この表は真の値なので書けますが、現実の企業が手にしているのは一番下の行の「売上の合計」と、一番右の列の「広告費」だけです。基礎売上の行も、各媒体の増分売上の行も、帳簿には存在しません。広告の効果測定とは、手元にある売上と広告費の記録から、この表の真ん中の列を推定する作業だと言えます。
表の一番右の列と、増分売上の列を見比べると、媒体ごとの差の大きさが分かります。ディスプレイ広告には3年で47,694万円を使い、テレビCMに次いで2番目に大きな広告費ですが、増分売上は18,041万円で、使った広告費を下回っています。一方、検索広告は35,100万円の広告費で82,833万円の増分売上を生んでいます。ただし、これは答えを知っている架空データだから言えることで、現実の企業がこの差を知るには推定が要ります。そして後で示すとおり、推定の方法を誤ると、この差を逆向きに見積もることがあります。
素朴な比べ方は、ほかの要因を広告の手柄にする
帳簿に無い数字を推定する最も素朴な方法は、広告を出した週と出さなかった週の売上を比べることです。共通データのテレビCMは、年に数回の放映期間(フライト)に集中して出しており、3年156週のうち放映した週は44週、放映しなかった週は112週でした。売上の平均は、放映週が6,128.3万円、非放映週が4,643.8万円で、差は1,484.6万円です。放映週のテレビの広告費の平均は1,608.3万円なので、素朴に「広告費1万円あたり売上が0.92万円増えた」と読みたくなります。
この差の中身を、真の値で分けてみました。放映週と非放映週の平均の差1,484.6万円のうち、テレビCMの真の増分売上の差は1,293.2万円で、残りは基礎売上の差123.5万円、検索広告の効果の差62.1万円、ディスプレイ広告の効果の差35.1万円、SNS広告の効果の差-28.1万円、観測の誤差でした。つまり、放映週はもともと基礎売上(季節・トレンド・販促・休日による売上)が高い週と重なっていたり、テレビの放映に合わせてディスプレイ広告を増やしていたりするので、素朴な差にはテレビ以外の要因が入り込みます。
逆向きの誤りも同時に起きています。テレビCMの真の増分売上の平均は、放映週が1,655.2万円でしたが、非放映週も362.0万円ありました。テレビCMの効果は、放映が終わった翌週以降にも持ち越されて残るからです(持ち越しの仕組みは第5章で扱います)。非放映週を「広告が無かった状態」の基準にすると、その基準自体にテレビの効果が混ざっているので、差はテレビの効果を小さく見せます。この例では、ほかの要因が差を大きく見せる向きと、持ち越しが差を小さく見せる向きが一部打ち消し合って、たまたま0.92という数字になっています。2つの誤りが打ち消し合った数字は、どちらの誤りの大きさも教えてくれません。データの期間や放映の時期が変われば、同じ比べ方で全く違う数字が出ます。
売上と広告費の単純な相関も同じ問題を抱えています。共通データでは、売上との相関係数はテレビCM 0.69、検索広告 0.67、ディスプレイ広告 0.65、SNS広告 0.11でした。相関だけを見ると、ディスプレイ広告は検索広告とほぼ同じくらい売上と連動して見えます。しかし表の真の値では、ディスプレイ広告の増分売上は広告費を下回っています。ディスプレイ広告はテレビの放映期間に合わせて増やす運用になっており、テレビCMの広告費との相関が0.91あるので、テレビの効果の「影」として売上と連動して見えているにすぎません(この連動は、第4章で扱う問題を示すために、共通データを作るときに意図して入れた設定です)。反対に、SNS広告は売上との相関が0.11と低いのに、真の値では広告費を上回る増分売上を生んでいます。相関の高い媒体が効いている媒体だとは限りません。
最後に触れた広告に手柄を付ける測り方の偏り
デジタル広告では、売上の数字とは別に、広告を経由した購入(コンバージョン)を記録する仕組みがあります。購入した人が購入までにどの広告に触れたかを記録し、購入の手柄を広告に割り振る考え方をアトリビューション(貢献度の割り当て)と呼びます。その中で最も単純な割り振り方がラストクリックです。Google 広告のヘルプページ「アトリビューション モデルについて」は、ラストクリックモデルを、コンバージョン経路で最後にクリックされた広告とそれに対応するキーワードだけに貢献度を割り当てるもの、と説明しています。同じページによると、Google 広告では「ファースト クリック」「線形」「減衰」「接点ベース」のアトリビューション モデルのサポートが終了し、それらを使っていたコンバージョン アクションはデータドリブン アトリビューション(アカウントの過去のデータから各広告の貢献度を計算するモデル)に切り替えられました。現在使えるモデルとして挙げられているのは、ラストクリックとデータドリブンの2つです。
ラストクリックは定義のうえで、次の3つの偏りを持ちます。1つ目は、クリックされない広告に手柄が付かないことです。テレビCMを見て商品を知った人が、後日その商品名で検索し、検索広告をクリックして購入した場合、ラストクリックは購入の手柄をすべて検索広告に付けます。テレビCMの記録はコンバージョン経路に残らないので、テレビCMの貢献度は0になります。2つ目は、購入の直前の経路に置かれた媒体ほど有利になることです。たとえば、ほかの広告で買う気になった人が商品名で検索し、検索広告をクリックしてから購入する経路では、その手前で需要を作った広告の働きまで検索広告の手柄として数えられます。3つ目は、広告が無くても買っていた人の購入も手柄に数えることです。普段からそのブランドを買っている人が、たまたま検索広告を経由して購入した場合も、検索広告の貢献として記録されます。この3つ目の偏りは、ラストクリックに限らず、広告に触れた人の購入を数える測り方すべてに共通します。
この最後の点は、効果測定で最も大事な区別につながります。広告に触れた人が購入したことと、広告があったから購入が増えたことは、別のことです。前者は記録から数えられますが、後者は「広告が無かったら何が起きていたか」と比べなければ分かりません。共通データの検索広告は、需要が高い週(季節の山や休日)に入札が増えて広告費が増える設定にしてあります。この設定では、検索広告の広告費が多い週は、もともと売上が多い週でもあります。広告に触れた購入を数えるだけの測り方は、需要が高かったから増えた売上まで広告の手柄に数えてしまいます(広告と売上の両方を同時に動かす要因があるために生じる見かけの関係を交絡と呼び、第7章で扱います)。
経営の判断に引き直すと、ラストクリックの数字をそのまま配分の根拠にすると、購入の直前に位置する媒体に予算が寄り、需要を作る側の媒体(テレビCMなど、クリックの記録に残りにくい媒体)が削られる方向に判断が傾きます。テレビCMの効果は持ち越されて残るので、削った直後には売上はすぐには減らず、減少は数週かけて表れます(共通データのテレビCMでは、放映が終わった後も4週以上にわたって効果が残りました。この章の後半で示します)。そのころには、ほかの要因でも売上が上下しているので、何が原因で売上が下がったのかを特定しにくくなります。ラストクリックは、日々の運用(どのキーワードの入札を上げるか)を見るには手軽な指標ですが、媒体をまたいだ予算配分の根拠には向かないと考えています。
増分売上という考え方
素朴な比べ方とラストクリックの問題を避けるために、この記事では媒体の効果を増分売上で測ります。増分売上は、その媒体の広告が無かった場合と比べて増えた売上です。この記事では、持ち越して翌週以降に出た分も含めます。ただし、直近52週のように期間を区切って数えるときは、その期間に生じた効果を数えます。期間より前に出した広告から持ち越して期間内に出た分は含め、期間の後に持ち越される分は含めません。共通データの真の値は、ある媒体の広告費だけを0にしたときの売上と、実際の売上の差として計算しています。
増分売上から、この記事で使う指標を次のように定めます。売上ROIは、増分売上を同じ期間の広告費で割った値で、1を超えれば広告費以上の売上を生んでいることを意味します。特に断らない限り、この記事で「ROI」と書けば売上ROIを指します(ROAS と呼ぶ流儀もあることは第11章で説明します)。粗利ROIは、増分売上に粗利率を掛けてから広告費で割った値で、1を超えれば広告費を粗利で回収していることを意味します。共通データでは架空の粗利率を0.50に置いています。この粗利率では、売上ROIが2を超えないと粗利ROIは1を超えません。
共通データの直近52週(第105〜156週)について、真の売上ROIと粗利ROIを並べると次の表になりました。
| 媒体 | 直近52週の広告費(万円) | 真の増分売上(万円) | 真の売上ROI | 真の粗利ROI(粗利率0.50) |
|---|---|---|---|---|
| テレビCM | 20,951 | 31,547 | 1.51 | 0.75 |
| 検索広告 | 11,661 | 27,440 | 2.35 | 1.18 |
| SNS広告 | 11,884 | 20,947 | 1.76 | 0.88 |
| ディスプレイ広告 | 15,643 | 5,962 | 0.38 | 0.19 |
この架空データでは、売上ROIが1を超える媒体は3つありますが、粗利ROIが1を超えるのは検索広告だけです。売上ROIだけを見て「どの媒体も広告費以上の売上を生んでいるので問題ない」と報告すると、粗利では回収できていない媒体を見逃します。どちらの指標で判断するかで結論が変わるので、経営への報告では粗利ROIを併記するのが安全だと考えています。また、この表の値は直近52週の平均の ROI で、広告費をあと1万円増やして毎週出し続けたとき(定常状態)に増える売上(限界ROI)とは別のものです。平均の ROI が1を下回る媒体でも、出し方や額を変えれば回収できる場合があり、その判断には限界ROIが要ります。限界ROIは第11章で扱います。
増分売上の考え方の要点は、比べる相手が「広告が無かった場合」だという点にあります。この相手は観測できません。ある週に広告を出したら、同じ週に広告を出さなかった世界は観測できないからです。そのため、増分売上は必ず何らかの方法で推定することになります。過去の売上と広告費の記録から統計モデルで推定するのが、この記事の主題のマーケティング・ミックス・モデリング(MMM)です。一部の地域や一部の人に広告を出さない実験を組んで推定する方法もあります。それぞれの得意・不得意は第2章で比べ、実験については第10章で扱います。
日本の広告費の規模
広告の効果測定が経営の問題になる理由の1つは、その金額の大きさです。電通が推定している「2025年 日本の広告費」(2026年3月5日公表)によると、2025年の日本の総広告費は8兆623億円(前年比105.1%)で、4年連続で過去最高を更新しました。媒体別では、インターネット広告費が4兆459億円(前年比110.8%)で初めて4兆円を超え、総広告費に占める構成比は50.2%と初めて半数を超えました。マスコミ四媒体(新聞・雑誌・ラジオ・テレビメディア)の広告費は2兆2,980億円(前年比98.4%)でほぼ横ばい、そのうちテレビメディアは1兆7,556億円(前年比99.7%)でした。プロモーションメディア広告費は1兆7,184億円(前年比102.0%)です。公表日は、電通の発表を配信した共同通信PRワイヤのリリースで確認しました。基準時点の2026年10月に開けた最新版はこの2025年版です。
この数字を読むときの注意が2つあります。1つ目は、推定の範囲が年によって変わっていることです。同じページによると、2019年から「物販系ECプラットフォーム広告費」をインターネット広告費に、「イベント」領域を展示・映像ほかに追加して推定しています。2018年以前の数字と単純には比べられません。2つ目は、これが媒体ごとの広告費の推定であって、広告の効果の推定ではないことです。インターネット広告費が総広告費の半分を超えたことは、企業がインターネット広告に多くを配分していることを示しますが、その配分が売上や粗利の面で妥当かどうかは、この統計からは分かりません。
個々の企業にとっての意味も考えておきます。共通データの架空のメーカーの広告費は、直近52週で合計60,139万円(週平均1,156.5万円)です。この規模の広告費の配分を1割見誤るだけで、6,000万円を効果の薄い媒体に置くことになります。後で示すとおり、配分の誤りは「6,000万円が無駄になる」だけでは済まず、効果の高い媒体から予算を奪うことで、売上の機会も同時に失います。インターネット広告の比重が高まり、媒体の種類と配信の選択肢が増えるほど、配分の判断の数は増え、測り方の誤りが経営に効いてくる場面も増えます。
個人単位の追跡が難しくなった流れ
ラストクリックやマルチタッチ・アトリビューション(購入までに触れた複数の広告に手柄を分ける方法。第2章で扱います)は、同じ人がどの広告に触れ、その後に購入したかを、個人や端末の単位でたどれることを前提にしています。この前提は、ここ数年のプライバシー保護の流れで大きく揺らいでいます。主な公式の発表を、開いて確認した範囲で次の表にまとめました。
| 発表の時期 | 発表した主体 | 内容(公式の発表で確認した範囲) |
|---|---|---|
| 2020年1月14日 | Google(Chromium ブログ) | Chrome でサードパーティ Cookie のサポートを段階的に廃止する計画と、2年以内に行う意向を表明 |
| 2020年3月24日 | Apple(WebKit ブログ) | Safari 13.1(macOS)と iOS・iPadOS 13.4 で、クロスサイトのリソースの Cookie を既定でブロック |
| iOS 14.5 以降 | Apple(開発者向けページ) | アプリがユーザーを追跡する、または広告識別子を使うには、App Tracking Transparency でユーザーの許可を得ることが必要。許可が無ければ広告識別子の値はすべて0 |
| 2022年6月14日 | Mozilla(公式ブログ) | Firefox のデスクトップ版の全ユーザーで、サイトごとに Cookie の保存場所を分ける Total Cookie Protection を既定で有効に |
| 2024年7月22日 | Google(Privacy Sandbox ブログ) | サードパーティ Cookie を廃止する代わりに、ユーザーが選ぶ新しい仕組みを Chrome に導入する方針を発表 |
| 2025年4月22日 | Google(Privacy Sandbox ブログ) | サードパーティ Cookie の選択を利用者に委ねる現在の方式を維持し、新しい単独の確認画面は出さないと発表 |
| 2025年10月17日 | Google(Privacy Sandbox ブログ) | 利用が少なかったとして、Attribution Reporting API・Topics・Protected Audience などの Privacy Sandbox の技術を廃止すると発表 |
Apple の開発者向けページユーザーのプライバシーとデータの使用に関するページは、iOS 14.5、iPadOS 14.5、tvOS 14.5 以降では、ユーザーを追跡したり端末の広告識別子にアクセスしたりするには、App Tracking Transparency(ATT)の枠組みでユーザーの許可を得る必要がある、としています。ここでの追跡は、アプリで集めたユーザーや端末のデータを、他社のアプリやウェブサイトなどで集めたデータと結び付けて、ターゲティング広告や広告の効果測定に使うことと定義されています。許可を得られなければ、端末の広告識別子の値はすべて0になります。つまり、アプリの広告を見た人がその後に購入したかを、他社のデータと突き合わせて確かめる方法は、許可した人の分しか使えません。
ブラウザでは、Apple の Safari が先行しました。WebKit の公式ブログの2020年3月24日の記事は、Intelligent Tracking Prevention の強化として、クロスサイトのリソースの Cookie を既定ですべてブロックするようにしたと説明しています。Mozilla は2022年6月14日の公式ブログで、ウェブサイトごとに Cookie の保存場所を分ける Total Cookie Protection を、Firefox のデスクトップ版の全ユーザーで既定の機能にしたと発表しています。サイトをまたいで同じ人の行動をつなげる手段が、ブラウザの側で順に閉じられてきたことになります。
Google Chrome の方針は二転三転しました。Chromium の公式ブログの2020年1月14日の記事は、Chrome でサードパーティ Cookie のサポートを段階的に廃止する計画を示し、それを2年以内に行う意向を述べていました。その後、Privacy Sandbox の公式ブログの2024年7月22日の記事は、サードパーティ Cookie を廃止する代わりに、ユーザーが自分で選ぶ新しい仕組みを Chrome に導入する方針に変えました。さらに2025年4月22日の記事で、サードパーティ Cookie の選択を利用者に委ねる現在の方式(Chrome の設定画面で選ぶ方式)を維持し、新しい単独の確認画面は出さないと発表しました。シークレットモードではサードパーティ Cookie が既定でブロックされている、とも書かれています。そのうえで2025年10月17日の記事は、利用が少なかったことを理由に、広告の効果測定のための Attribution Reporting API を含む Privacy Sandbox の多くの技術を廃止すると発表し、計測については W3C の作業部会で検討される相互運用可能な仕組みに言及しています。本記事の基準時点(2026年10月)に確認できた公式の発表の範囲では、これが最新です。
この流れを経営の判断に引き直すと、次のように言えます。Chrome ではサードパーティ Cookie を一律には廃止せず、利用者が設定画面で選ぶ現在の方式を維持することになった一方で、Safari と Firefox では既定でブロックされ、iOS のアプリでは許可を得た人の分しか追跡できません。購入までの経路を個人の単位でたどる測り方は、端末やブラウザの種類によって見える範囲が違い、その範囲は各社の方針で今後も変わりえます。経路の記録に頼った測定は、見えている人の範囲が変わるたびに数字の意味が変わります。これに対して MMM は、週ごとの売上と広告費のような集計されたデータだけを使うので、個人の追跡ができるかどうかに左右されません。個人の追跡が難しくなるほど、集計データで推定できる MMM の役割は大きくなると考えています。ただし MMM にも固有の弱点があり、それはこの章の後半と第2章以降で順に見ていきます。
誤った ROI で配分したときの損失
効果の見積もりを誤ると、経営上どれだけの損失になるのかを、共通データで計算しました。使ったのは、第2章で紹介する2つの推定方法です。1つは素朴な回帰で、広告費をそのまま説明変数(売上を説明するために式に入れる数字)に入れた最小二乗回帰(式で計算した売上と実際の売上の差の2乗の合計が最も小さくなるように係数を決める方法)です。季節・トレンド・販促・休日の統制変数(広告以外で売上を動かす要因を、広告の効果と取り違えないために式に入れる変数)は入れています。もう1つは MMM(基準)で、各媒体の広告費に持ち越しと飽和(広告費を増やしても効果が頭打ちになること)の形を掛けてから推定したものです。どちらも第1〜130週のデータで推定しています。直近52週の ROI の推定は、素朴な回帰がテレビCM 0.54・検索広告 2.23・SNS広告 1.34・ディスプレイ広告 0.97、MMM(基準)がそれぞれ 1.44・1.18・0.90・0.17でした(真の値は前の表のとおり 1.51・2.35・1.76・0.38)。素朴な回帰は、テレビCMを小さく、テレビと連動して動くディスプレイ広告を大きく見積もりました。MMM(基準)は、テレビCMはほぼ当てましたが、検索広告と SNS広告を真の値の約半分に見積もりました。MMM(基準)の予測の当てはまりは良く、推定に使わなかった第131〜156週の売上を平均2.64%の誤差で当てています。それでも ROI は大きく外れました。外れ方の中身は第2章で示し、売上全体は説明できても媒体どうしへの振り分けがデータだけでは決まりきらないという点を、第7章と第8章で扱います。
次に、それぞれの推定に従って予算を配分し直した場合を計算しました。条件は、直近52週の週平均の広告費の総額(1,156.5万円/週)を変えず、各媒体を現状の0.5〜2倍の範囲で動かす、というものです。応答は「毎週同じ額を出し続けたときの週次の増分売上」(定常状態)で計算しています。素朴な回帰に従う配分は、推定した ROI が高い媒体から順に上限まで寄せたものです。真の最適は、真の応答を知っていれば選べた配分です。配分した後の増分売上は、すべて真の応答で評価しました。現実の企業は真の応答を知らないので、これは答えを知っているこの架空データでだけできる答え合わせです。
| 媒体 | 現状(万円/週) | MMM(基準)で最適化 | 真の最適 | 素朴な回帰に従う |
|---|---|---|---|---|
| テレビCM | 402.9 | 443.3 | 633.3 | 201.5 |
| 検索広告 | 224.3 | 448.5 | 193.2 | 448.5 |
| SNS広告 | 228.5 | 114.3 | 179.6 | 356.1 |
| ディスプレイ広告 | 300.8 | 150.4 | 150.4 | 150.4 |
| 真の応答で測った週次の増分売上(万円/週) | 1,861.9 | 1,935.3 | 2,181.6 | 1,655.3 |
| 現状との差の年換算(万円/年) | 0 | +3,816 | +16,622 | -10,741 |
| 粗利換算(粗利率0.50、万円/年) | 0 | +1,908 | +8,311 | -5,371 |
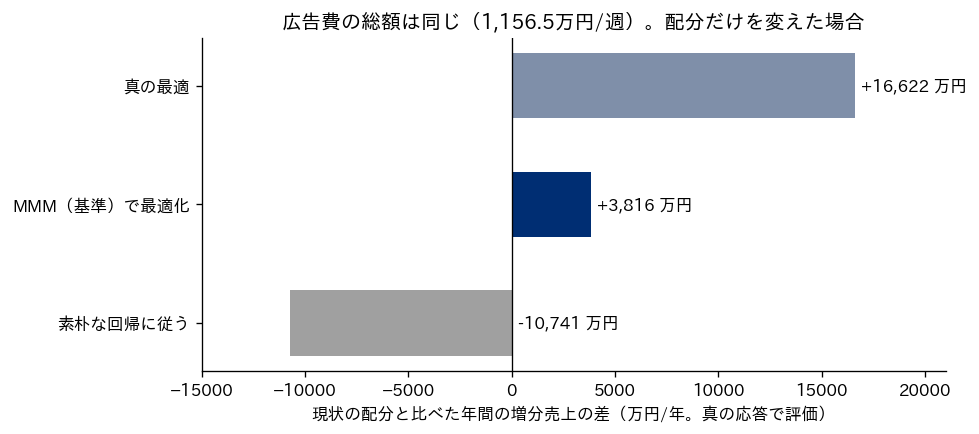
表と図の読み方を整理します。広告費の総額は4つの配分ですべて同じで、年に60,139万円です。それでも、配分だけで年間の増分売上に大きな差が出ました。素朴な回帰に従うと、現状より年10,741万円の増分売上を失います。これは年間の広告費の総額の約18%にあたる額です。粗利に換算すると年5,371万円の減少です。素朴な回帰はテレビCMの効果を小さく見積もったのでテレビの予算を下限の半分まで削り、推定値の高い検索広告と SNS広告に予算を寄せました(ディスプレイ広告も効果を大きく見積もりましたが、検索広告と SNS広告の推定値の方が高かったので下限まで減らしています)。テレビCMを削った損が大きく、全体では減少になりました。
MMM(基準)で最適化すると、現状より年3,816万円増えました(粗利で年1,908万円)。この例では、MMM(基準)は配分の方向の一部を正しく示しています。効果の低いディスプレイ広告を下限まで減らし、テレビCMを少し増やす方向は、真の最適と同じです。一方で、検索広告と SNS広告の ROI を約半分に見積もったので、真の最適では減らすべき検索広告を2倍に増やし、真の最適よりも SNS広告を大きく減らしました。その結果、真の最適の年16,622万円に対して、取れたのはその約4分の1でした。真の最適との差は年12,807万円(粗利で年6,403万円)です。そして、真の最適と素朴な回帰に従う配分の差は、年27,364万円(粗利で年13,682万円)に達します。
この計算の限定条件も書いておきます。これは架空データの、この設定での結果です。配分の計算は毎週同じ額を出し続ける定常状態を前提にしていますが、共通データのテレビCMは実際には放映期間に集中して出しています。同じ年間の額でも出し方で効果は変わるので、定常状態の数字はそのまま現実の放映計画の効果にはなりません(第5・6・12章で扱います)。表の現状の1,861.9万円/週も定常状態の値で、直近52週に実際に生じた4媒体の真の増分売上(前の表の合計85,896万円、週平均で約1,652万円)より約13%高くなっています。差の大部分はテレビCMの分で、直近52週と同じ年間額を毎週均等に出したと仮定した場合のテレビの真の ROI は1.95、放映期間にまとめて出した実際の出し方では1.51でした(出し方による違いは第6章で扱います)。年換算の数字は、定常状態の週の増分を52倍したもので、翌年の売上の予測ではありません。配分を切り替える途中の期間や季節の波も含みません。また、各媒体を現状の0.5〜2倍という範囲に制限しているので、範囲を変えれば数字も変わります。この計算が示しているのは個々の金額の正確さではなく、損失の大きさの桁です。同じ予算でも、測り方の違いだけで、現状と比べて年間の広告費の総額の18%にあたる増分売上を失う配分(素朴な回帰に従う)から、28%にあたる増分売上を増やせる配分(真の最適)までの開きが生まれ、両者の差は年27,364万円でした。
判断を誤ったときの損失の型
配分の誤りは、いくつかの型に分けられます。ここでは、効いている媒体を削る、効いていない媒体に積む、持ち越しを見ずに止める、の3つの型を、共通データの真の応答で計算しました。計算に使ったコードを次に示します。第2章で紹介する補助モジュール(mmm_data.py)と同じフォルダに置いて実行する形です。前半は、直近52週のテレビCMの真の増分売上のうち、放映していない週に出た分を数えます。後半は、広告費の総額を変えずに、ある媒体の予算の一部を別の媒体へ移したときの、年間の増分売上と粗利の差を、定常状態の真の応答で計算します。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import mmm_data as md

df = md.make_data()
recent = df[df["week"].between(105, 156)]          # 直近52週
cur = {c: recent[c].mean() for c in md.CHANNELS}    # 現状の週平均の広告費(万円/週)

# テレビCMの真の増分売上のうち、放映していない週に出た分(持ち越し)
eff = recent["eff_tv"].sum()
off = recent.loc[recent["tv"] == 0, "eff_tv"].sum()
print(f"テレビ 増分 {eff:.0f} うち非放映週 {off:.0f}({off / eff:.1%})")
print(f"テレビ 真のROI {eff / recent['tv'].sum():.2f}"
      f" 放映週だけで数えたROI {(eff - off) / recent['tv'].sum():.2f}")

# 総額を変えずに、媒体 a の広告費の一部を媒体 b へ移したときの年間の差(定常状態)
def move(a, b, amount):
    new = dict(cur)
    new[a] -= amount
    new[b] += amount
    before = sum(md.true_response(c, cur[c]) for c in md.CHANNELS)
    after = sum(md.true_response(c, new[c]) for c in md.CHANNELS)
    d_sales = 52 * (after - before)
    return d_sales, md.GROSS_MARGIN * d_sales

for a, b, share in [("search", "display", 0.5), ("social", "display", 0.5),
                    ("display", "search", 0.5), ("tv", "search", 0.5),
                    ("tv", "social", 0.5)]:
    amount = cur[a] * share
    d_sales, d_gp = move(a, b, amount)
    print(f"{md.CHANNEL_JA[a]}の{share:.0%}({amount:.1f}万円/週)を{md.CHANNEL_JA[b]}へ"
          f" 売上 {d_sales:+,.0f} 粗利 {d_gp:+,.0f} 万円/年")
# 出力:
# テレビ 増分 31547 うち非放映週 12218(38.7%)
# テレビ 真のROI 1.51 放映週だけで数えたROI 0.92
# 検索広告の50%(112.1万円/週)をディスプレイ広告へ 売上 -10,102 粗利 -5,051 万円/年
# SNS広告の50%(114.3万円/週)をディスプレイ広告へ 売上 -9,198 粗利 -4,599 万円/年
# ディスプレイ広告の50%(150.4万円/週)を検索広告へ 売上 +6,307 粗利 +3,154 万円/年
# テレビCMの50%(201.5万円/週)を検索広告へ 売上 -16,440 粗利 -8,220 万円/年
# テレビCMの50%(201.5万円/週)をSNS広告へ 売上 -17,031 粗利 -8,515 万円/年
実行した結果を、損失の型ごとに次の表にまとめました。どの行も広告費の総額は変えていないので、増分売上の差はそのまま配分の良し悪しの差です。
| 損失の型 | 動かした予算(定常状態) | 増分売上の差(万円/年) | 粗利の差(万円/年) |
|---|---|---|---|
| 効いている媒体を削り、効いていない媒体に積む | 検索広告の50%(112.1万円/週)をディスプレイ広告へ | -10,102 | -5,051 |
| 効いている媒体を削り、効いていない媒体に積む | SNS広告の50%(114.3万円/週)をディスプレイ広告へ | -9,198 | -4,599 |
| 持ち越しを見ずに止める | テレビCMの50%(201.5万円/週)を検索広告へ | -16,440 | -8,220 |
| 持ち越しを見ずに止める | テレビCMの50%(201.5万円/週)を SNS広告へ | -17,031 | -8,515 |
| (参考)正しい向きに動かす | ディスプレイ広告の50%(150.4万円/週)を検索広告へ | +6,307 | +3,154 |
1つ目の型は、効いている媒体を削ることです。この例では、検索広告の予算の半分をディスプレイ広告に移すと、年10,102万円の増分売上を失いました。SNS広告の半分を移した場合も年9,198万円の減少です。前の節で見たとおり、ディスプレイ広告はテレビの放映期間に合わせて増やしているので、売上との相関が高く見え、テレビの効果の一部を自分の効果のように見せます。この見かけに従って予算を移すと、表のような損失になります。2つ目の型は、効いていない媒体に積むことで、1つ目の型の裏返しです。表の参考の行のとおり、逆向きにディスプレイ広告の半分を検索広告へ移せば、年6,307万円増えます。同じ割合(その媒体の予算の50%)を動かしても、向きを誤るか正しく選ぶかで、年に1億6千万円あまりの差になります。
総額を固定しない場合も計算しました(定常状態の真の応答。年換算)。ディスプレイ広告の予算を2倍にすると、広告費は年15,643万円増えますが、増分売上は年2,498万円しか増えず、粗利から追加の広告費を差し引くと年14,394万円のマイナスでした。一方、検索広告の予算を半分にすると、広告費は年5,831万円減り、増分売上は年11,244万円減りますが、粗利から広告費の減少分を差し引いた額はほぼ変わりませんでした(年209万円のプラス)。売上の面では大きな損失でも、粗利の面では広告費の節約とほぼ相殺される、という結果です。これは、現状の額での検索広告の限界ROIが、粗利で回収できる水準(売上ROIで2)を下回っていることによります。総額をいくらにするかの判断は、配分の判断とは別の問いで、第11章と第12章で扱います。
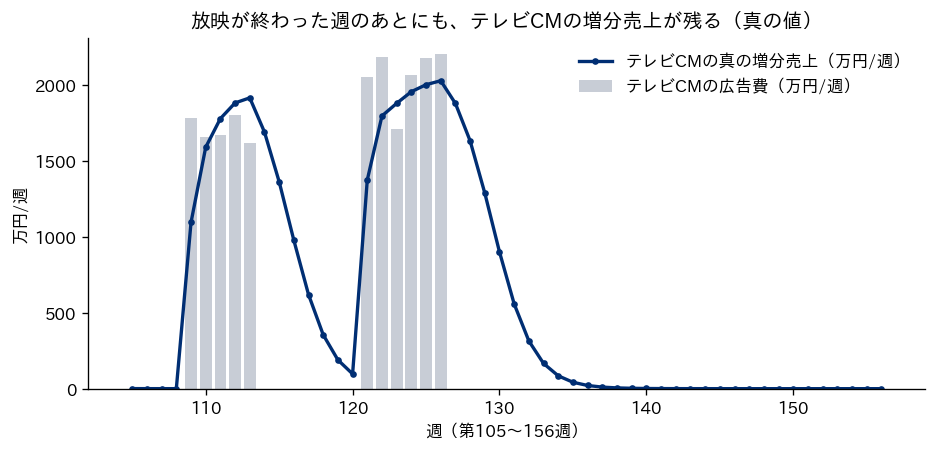
3つ目の型は、持ち越しを見ずに止めることです。図は、直近52週のテレビCMの広告費(灰色の棒)と、真の増分売上(ネイビーの線)です。放映期間が終わった後も、増分売上はすぐには0にならず、数週かけて減っていきます。第121〜126週の放映期間では、最後の放映週の増分売上が2,031万円で、翌週から1,881万円、1,635万円、1,290万円、902万円と続きました。直近52週のテレビCMの真の増分売上31,547万円のうち、38.7%にあたる12,218万円は放映していない週に出ていました。放映した週に出た分だけで効果を数えると、ROI は真の1.51ではなく0.92に見えます(この節の冒頭で見た、放映週と非放映週の売上の平均の差から出した3年の0.92とは別の計算で、値が同じになったのはたまたまです)。0.92と読むと、テレビCMは検索広告(真の2.35)や SNS広告(真の1.76)より効率が悪いように見え、テレビの予算を削ってそちらへ回す判断に傾きます。仮にそう判断してテレビCMの半分を移した場合を計算すると、表のとおり、検索広告へ移せば年16,440万円、SNS広告へ移せば年17,031万円の増分売上を失いました。この2行の計算も、テレビCMを毎週同じ額で出す定常状態を前提にしています。放映期間に集中して出す現実の出し方では効果の大きさが変わるので、金額はこの前提での計算です。
3つの型に共通するのは、損失がすぐには見えないことです。予算を移した翌週に売上が大きく落ちるわけではなく、持ち越しがある媒体ほど、効果の減少は遅れて表れます。その間にも、季節や販促で売上は上下するので、予算を移したことによる減少は、ほかの変動に紛れて見分けにくくなります。損失が見えないまま次の期の予算も同じ測り方で決めれば、同じ向きの誤りが積み重なります。広告の効果測定を経営の問題として扱う必要があるのは、この損失が金額として大きいうえに、会計上の数字には表れず、気づいたときには何期分も積み重なっているからだと考えています。
効果測定を経営の判断につなげるために
ここまでの内容を、予算を決める立場から整理します。第一に、広告の効果は帳簿に書かれていないので、必ず推定が要ります。推定の方法によって、媒体の評価は逆転しえます。この章の例では、素朴な回帰はディスプレイ広告の ROI を真の値の2.5倍余り(0.97対0.38)に、テレビCMを約3分の1(0.54対1.51)に見積もり、その配分に従うと年10,741万円の増分売上を失いました。第二に、MMM のように持ち越しと飽和を入れたモデルでも、予測の当てはまりの良さは ROI の正しさを保証しません。この例の MMM(基準)は推定に使わなかった期間の売上を誤差2.64%で当てながら、検索広告と SNS広告の ROI を約半分に見積もりました。第三に、個人単位の追跡に頼る測り方は、ブラウザやアプリの方針によって見える範囲が変わり続けています。
これらを踏まえると、効果測定の仕組みには、次の3つを求めるのがよいと考えています。1つ目は、比べる相手が「広告が無かった場合」であること、つまり増分売上で測ることです。広告に触れた人の購入を数えるだけの指標は、運用の指標としては使えても、配分の根拠にはしません。2つ目は、推定の不確かさを数字の幅として示すことです。ROI を1つの数字で報告すると、上の例のように半分も外れた数字が確かなものとして扱われます(第9章で扱います)。3つ目は、推定を実験で答え合わせすることです。一部の地域で広告を止める実験などで、推定した ROI が実際の増分と合っているかを確かめます(第10章で扱います)。
判断の単位も決めておく必要があります。この章の計算は、売上ではなく粗利で見ると結論が変わる場面があること(売上ROIが1を超えても粗利ROIは1を下回る媒体がある)、配分の判断と総額の判断は別の問いであること、を示しました。経営への報告では、媒体ごとの増分売上・売上ROI・粗利ROIを並べ、どの指標でどの判断をするのかを事前に決めておくと、測定の結果が予算の議論に直接つながります。誰がどの数字の持ち主になり、どの会議でモデルの結果を使うかといった組織の側の論点は、第13章で扱います。
この章の要点は3つです。第一に、広告の効果は売上の数字に直接は書かれておらず、素朴な比べ方や最後に触れた広告に手柄を付ける測り方は、季節・ほかの媒体・持ち越しの影響を取り違えます。第二に、効果は「広告が無かった場合」と比べた増分売上で測る必要があり、個人単位の追跡が難しくなった現在、集計データで推定する MMM の役割は大きくなると考えています。第三に、共通データでは、同じ広告費の総額でも測り方の違いだけで年に1億円を超える増分売上の差が出ました(真の最適と素朴な回帰に従う配分の差は年27,364万円)。次の第2章では、効果測定の3つの手法(MMM、マルチタッチ・アトリビューション、実験)を比べたうえで、この章で使った共通データと基準の結果を詳しく紹介します。
この章を深めたい方への参考書籍
『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』(マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社):マーケティングの判断をデータに基づいて行うための指標を、経営者やマーケティング幹部に向けて解説した本です。ブランド認知などの非財務指標から、マーケティング投資の収益の評価、ネット広告の指標までを扱っています。この章で述べた「売上ではなく、経営の数字で広告の効果を評価する」という考え方を、指標の側から整理するのに向いています。
『マーケティングROI:投資効果を測定する客観的経営手法』(ジェームズ・D.レンズコールド 著、ベリングポイント戦略グループ 訳、ダイヤモンド社):マーケティングへの支出を投資として扱い、その効果を ROI で測って判断する考え方を解説した本です。ゴールは利益で尺度は ROI だという原則から始まり、投資と収益の測り方、企業や顧客の単位での収益性の管理までを扱っています。この章で売上ROIと粗利ROIを分けて示した理由、つまり広告の効果を売上ではなく利益の側から評価するという考え方を、経営の手法として確かめるのに向いています。
第2章 効果測定の手法の全体像、MMM・アトリビューション・実験
第1章では、広告の効果は売上の数字に直接は書かれておらず、広告が無かった場合と比べて増えた売上(増分売上)を推定して初めて分かること、誤った ROI で予算を配分すると経営上の損失になることを確認しました。この章では、その増分売上を推定する代表的な手法を3つ並べ、それぞれが何を測り、何を苦手とするかを整理します。3つとは、マーケティング・ミックス・モデリング(以下 MMM)、個人の広告接触の履歴から成果を割り振るアトリビューション、広告を出す群と出さない群を作って比べる実験です。後半では、この記事の第3章以降で繰り返し使う共通のサンプルデータ(架空の日用品メーカーの週次データ)と、その上で動かした基準の分析の結果を紹介します。
広告の効果測定で知りたいことは、突き詰めると1つです。「この広告にかけたお金で、広告が無かった場合より売上がいくら増えたか」。第1章で定義した増分売上と、それを広告費で割った売上ROI(増分売上÷広告費)がその答えにあたります。難しいのは、広告が無かった場合の売上は、実際には起きなかった世界の数字なので、誰も直接は観測できないことです。3つの手法は、この観測できない「広告が無かった場合」を、それぞれ別の材料から推し量ります。
MMM は、売上と広告費の週ごとの推移を統計モデルで説明し、モデルの中で広告費を0にしたときの売上を計算して「広告が無かった場合」を作ります。アトリビューションは、個人が購入に至るまでに触れた広告の履歴を集め、購入という成果をその履歴の上の広告に配分します。実験は、広告を見せない人や地域を意図して作り、その人や地域の成果を「広告が無かった場合」の実物として使います。材料が違うので、得意な問い、苦手な問い、結果が出るまでの速さ、個人データの扱いへの依存の度合いが大きく違います。
手法を選ぶときに最初に決めるべきなのは、手法の名前ではなく問いの方です。Meta のマーケティング・サイエンスの担当者が公開している、オープンソースの MMM である Robyn の解説文書An Analyst’s Guide to MMMは、MMM に取り組む前に測定で答えたい経営上の問いを集めることを勧め、問いによっては MMM ではなく、増分を測る調査(コンバージョンリフトやブランドリフト)やアトリビューションのほうが適していることがある、と書いています。同じ文書は MMM が答えるのに向いた問いとして、各媒体がどれだけの売上をもたらしたか、各媒体の ROI はいくらか、KPI を最大にするには予算を媒体にどう配分すべきか、といった問いを挙げています。この記事の主題は最後の問い、つまり媒体をまたいだ予算の配分です。
MMM:集計データで売上を分解する
MMM は、売上を、広告が無くても出る売上(基礎売上)と、媒体ごとの広告による増分とに分解する統計モデルです。先の Robyn の解説文書は、MMM を、マーケティング施策とそれ以外の要因が売上などの KPI に与える増分の影響を定量化する計量経済学のモデルだと説明し、マーケティングの予算を媒体・製品・地域にどう配分するかを理解するための全体的なモデルだと位置づけています。言葉にすると、この記事の MMM は次の形をしています。
\( \text{売上}_t = \text{基礎売上}_t + \sum_{m} \text{媒体}m\text{の効果}_t + \text{誤差}_t \)
添え字の \( t \) は週、\( m \) は媒体です。基礎売上には季節性・トレンド・販促・休日などが入り、媒体の効果には「広告の効果は翌週以降にも持ち越される」「広告費を増やしても効果は比例して増えず、やがて頭打ちになる」という性質を入れます。持ち越しは第5章、頭打ちは第6章、基礎売上の側に入れる要因は第7章で扱います。
MMM は新しい手法ではありません。Google の David Chan と Michael Perry が2017年に公開したメディア・ミックス・モデリングの課題と改善の機会を論じた論文は、MMM を、広告主が広告費の効果を測るために使う統計モデルだと定義し、1960年代からさまざまな形で使われてきたと書いて、Borden の1964年の論文「マーケティング・ミックスの概念」(Journal of Advertising Research 掲載)と McCarthy の1978年の教科書を挙げています。同じ論文は、MMM が集計された過去の時系列データを使い、広告の変数・その他のマーケティングの変数・天候や季節性や競合などの統制変数の関数として売上をモデル化すること、そこから広告費あたりの売上(ROAS)や最適な予算配分といった指標を導くことを説明しています。
MMM が近年あらためて注目されている理由は、個人単位のデータを使わないことです。Robyn の解説文書は、MMM の強みとして、個人単位のデータを必要とせず、キャンペーン単位などの集計データで動くので、オンラインの信号に強く依存するマルチタッチ・アトリビューション(次の節で説明します)と違い、信号の欠落に強いことを挙げています。国内では、博報堂DYメディアパートナーズが2023年9月22日に、Google Japan と協働してまとめたマーケティング・ミックス・モデリングのガイドブックを公開したと発表しています。その発表文は、MMM を、広告出稿や売上などのマーケティングに関連するデータを時系列で蓄積し、統計学を用いて分析する手法だと説明し、クッキーレスの動きの中でコンバージョン計測やアトリビューション分析の精度の低下が懸念されるなか、クッキーを用いずに ROI を測定できる手法として MMM が再注目されている、と書いています(発表文の注記では、ここでのクッキーはサードパーティ Cookie を指します)。個人の追跡が難しくなった経緯は第1章で扱いました。
一方で、MMM には構造的な弱点があります。先の Chan と Perry の論文は、課題を大きく3つに分けています。1つ目はデータの限界です。全国の週次データ3年分は156点しかなく、そこから20以上の媒体を推定するよう求められることがあり、媒体ごとに持ち越しと頭打ちを表すのに3〜4個のパラメータが要るとすると、パラメータの数がデータの数を上回りうる、と書いています。媒体どうしの広告費が連動して動くと、当てはまりは同じくらい良いのに傾きが違う解がいくつも見つかること、過去に出したことのない水準の広告費の効果は外挿になり不確かになることも挙げています。2つ目は選択バイアス(広告を出す相手や時期の選び方が、もともとの需要と結び付いていることによる偏り)で、論文はこれを MMM が妥当な推定を出すうえで最大の障害かもしれないと書いています。検索広告は、すでにその商品に関心を持って検索した人に表示されるので、観測できない需要と広告費が一緒に動き、モデルは売上の増加を広告と需要のどちらに帰すべきかを区別できません。季節の需要に合わせて広告を増やす運用や、テレビ CM が検索を増やし、それが検索広告の量を増やすという媒体間の連鎖も、同じ種類の偏りを生むと説明しています。3つ目はモデルの選び方の不確かさで、論文は実在の広告主のデータで5つのもっともらしいモデルを当てはめ、どれも決定係数 R2 が0.98か0.99で、うち4つは直近12週を使った交差検証の MAPE が6〜8%だったのに、予算を変えたときの売上の予測が最大50%違い、媒体ごとの最適な配分についても一致しなかった例を示しています。この章の後半で共通データに対して示す基準の結果は、この3つ目の指摘を、答えの分かっている架空データで再現したものになっています。
マルチタッチ・アトリビューション:個人の接触履歴で手柄を配分する
アトリビューションは、購入や問い合わせなどの成果(コンバージョン)を、その人が成果に至るまでに触れた広告に配分する測り方です。Google 広告のヘルプ「アトリビューション モデルについて」は、コンバージョン達成までに発生した各広告インタラクションに対して貢献度に応じた評価を行う枠組みをアトリビューション モデルと呼ぶ、と説明しています。第1章で取り上げたラストクリックは、最後にクリックされた広告にだけ手柄を付けるモデルです。これに対して、経路上の複数の接点に手柄を分けるものをマルチタッチ・アトリビューション(以下 MTA)と呼びます。
同じヘルプによると、2026年10月の時点で Google 広告が提供しているモデルはラストクリックとデータドリブンの2つです。データドリブンは、そのコンバージョンアクションの過去のデータに基づいて貢献度を割り当てるモデルで、ほとんどのコンバージョンアクションの既定のモデルになっています。かつて選べたファーストクリック・線形・減衰・接点ベースのモデルはサポートが終了し、それらを使っていたコンバージョンアクションはデータドリブンに移行された、と書かれています。手柄の分け方を人が決めるルールから、データで決める方式へ寄せてきた流れと読めます。
MTA の強みは速さと細かさです。Google が2024年に公開したModern Measurement Playbook(2024年版。以下、Google の測定の手引き)は、データドリブン アトリビューションを、コンバージョンに至る経路上の接点に手柄を割り当てる処理だと定義し、速く拡張しやすく、キャンペーン・媒体の単位で日々の入札や最適化に使える即時の情報を出せることを利点に挙げています。同じ表は、弱点として、デジタルの媒体に限られること、短期の効果の測定に向いていること、モデルによる補完に頼ること、正確に較正する(実験で実測した増分に合わせて、モデルの数字を補正する)には大規模な実験が要ることを挙げています。
MTA の最も大きな限界は、手柄を配分する仕組みであって、増分を測る仕組みではないことです。Google の測定の手引きは、データドリブン アトリビューションはコンバージョンに結び付けられる接点に手柄を与えるが、マーケティングの働きかけが無くてもその売上が起きたかどうかは考慮しない、と明記し、広告をクリックしたあと友人の勧めで購入した人の例を挙げています。この場合、アトリビューションは購入の前にあった広告に手柄を付けますが、購入を決めたのは友人の勧めだったかもしれません。テレビ CM や店頭の売上のように、個人の接触の記録に残らない経路も配分の対象になりません。さらに、個人の閲覧の記録をつなぐ前提が、ブラウザや OS のプライバシー保護の強化で崩れつつあります。手引き自体も、タグですべてのコンバージョンを観測して利用者の経路をつなぐことや、利用者単位の MTA に全面的に頼ることは、もう期待できないと書いています。
実験:広告を出さない群を作って比べる
3つ目の手法は実験です。広告を出す群(テスト群)と出さない群(対照群)を無作為に分け、両者の成果の差を広告の増分とみなします。無作為に分ければ、広告以外の条件は統計的に両群で同じになるので、差は広告によるものと考えられます。Chan と Perry の論文は、無作為化した実験を因果の問いに答えるための一般に認められた最も確かな方法(ゴールドスタンダード)と位置づけ、実験は利用者・店舗・地域などの単位で行えると書いています。Google の測定の手引きも、増分を測る実験を、因果を測るゴールドスタンダードで、マーケティング投資の増分の価値を最も厳密に示すものだと説明しています。
広告媒体の側にも実験の機能があります。Google 広告のヘルプ「コンバージョン リフト測定について」は、コンバージョン リフト測定を、広告を見たユーザーが直接行った購入やサイトアクセスなどのコンバージョンの数を測定できるインクリメンタリティ(増分)のツールだと説明し、広告を見たユーザーのグループと見なかったユーザーのグループのコンバージョン数の差をリフト(増分)とする、と書いています。同じヘルプは、ユーザーに基づく方式と、地域に基づく方式があり、地域に基づく方式はオフラインのデータにも対応している、と説明しています。Robyn の解説文書も、人単位の実験として Meta のコンバージョンリフトを、地域単位の実験として Meta の GeoLift を挙げています。地域を無作為に分ける実験(地域実験)の方法は、Google の Jon Vaver と Jim Koehler の2011年の論文Measuring Ad Effectiveness Using Geo Experimentsが、重ならない地域を対照と処置に無作為に割り当てる設計として説明しています。実験の設計と、その結果を MMM に取り込む方法は第10章で扱います。
実験にも弱点があります。Google の測定の手引きは、実験の結果を、特定の時点の特定の施策のスナップショットであり、規模を広げるのが難しいと書いています。Chan と Perry の論文は、MMM が答える問いの全体(媒体ごとに、いくつもの広告費の水準での効果を知り、予算を最適化すること)に実験だけで答えようとすると、多くの条件で多くの実験を繰り返す必要があり、ほとんどの広告主には現実的でない、と述べています。論文は実験の妨げとして、実装の技術的な障壁、対照群を作ることで失う機会、テスト群の費用、広告の効果が弱いと非常に大きな標本が要ることも挙げています。経営の言葉に直すと、実験は「広告を止めた地域の売上を一時的に犠牲にして、答えを買う」手段です。何でも実験で確かめるのではなく、判断を誤ったときの損失が大きい媒体や、MMM の推定が不確かな媒体に絞って使うものだと考えています。
3つの手法を並べる
ここまでの内容を1つの表にまとめます。「更新の頻度」の列は Google の測定の手引きの比較表の記載で、データドリブン アトリビューションは継続的・即時、増分を測る実験は四半期ごと、MMM は年2回(一部の進んだ広告主は四半期ごと)とされています。各社の実情によって変わる目安です。
| 観点 | MMM | マルチタッチ・アトリビューション(MTA) | 実験(リフト調査・地域実験) |
|---|---|---|---|
| 使うデータ | 週次などの集計データ(売上・媒体別の広告費・季節・販促など) | 個人単位の広告接触とコンバージョンの記録 | 無作為に分けたテスト群と対照群の成果 |
| 答えられる問い | 媒体をまたいだ増分売上・ROI・予算配分、広告費を変えたときの売上の見通し | デジタル広告のどのキャンペーン・接点が成果に結び付いたか(日々の運用の比較) | その期間・その施策の増分(広告が無かった場合との差) |
| 主な弱点 | データの点数が少ない、媒体どうしの連動、需要と一緒に動く広告(検索広告など)の選択バイアス、モデルの選び方で答えが変わる | 増分ではなく手柄の配分、記録に残らない経路(テレビ・店頭)を扱えない、個人の追跡の前提が崩れつつある | 特定の時点のスナップショット、規模を広げにくい、対照群の売上を犠牲にする費用 |
| 更新の頻度(Google の手引きの目安) | 年2回(一部は四半期ごと) | 継続的・即時 | 四半期ごと |
| プライバシー保護の影響 | 小さい(個人単位のデータを使わない) | 大きい(個人の閲覧の記録をつなぐ前提に依存) | 方式による(利用者単位の方式は計測の記録に依存、地域単位の方式は集計の売上で測れる) |
| 主な利用場面 | 媒体をまたいだ予算の配分(この記事の主題) | 日々の入札・キャンペーンの調整 | MMM や MTA の答え合わせと較正 |
表の「答えられる問い」の列を見ると、3つの手法は競合するものではなく、答える問いの粒度と時間の長さが違うことが分かります。MTA はキャンペーンの単位で毎日答えを出しますが、その答えは手柄の配分で、増分ではありません。実験は増分を最も確かに測りますが、一度に答えられるのは1つの媒体・1つの期間・1つの水準だけです。MMM はすべての媒体を同じ物差しで並べ、予算を動かしたときの見通しまで出しますが、その答えはモデルの前提に依存し、検証しないと誤りに気づけません。
経営の判断に置き換えると、どの手法を使うかは「どの判断の根拠を作りたいか」で決まります。来年度の広告予算をテレビとデジタルにどう分けるかを決めるのは MMM の仕事で、MTA の数字をそのまま使うと、記録に残りやすいデジタルの接点、特に購入の直前に触れる検索広告に手柄が偏ります。逆に、検索広告のキーワードの入札を日々調整するのに MMM を待つのは遅すぎます。どの規模から何が要るかも問いで決まります。媒体がデジタルの1つか2つで、日々の運用の最適化が主な関心なら、MTA と媒体の実験機能で足りることが多いと考えています。テレビなどのオフラインの媒体を含めて複数の媒体に大きな予算を配分していて、その配分の根拠を経営会議で説明する必要があるなら、MMM が要ります。
組み合わせる考え方、三角測量
3つの手法の弱点は互いに補い合える位置にあります。複数の手法の結果を突き合わせ、1つの手法では確かめられない答えを、別の手法で挟み込んで確かめる考え方を、この記事では三角測量と呼びます。Google の測定の手引きは、MMM・アトリビューション・増分を測る実験の3つを使うことを Google では「モダン・メジャメント」と呼んでいると書き、それぞれの強みを生かし弱みを補い合うように組み合わせることが重要だとしています。また、もはや1つの道具がすべての答えを持つことはなく、それぞれの強みを使って隙間を埋める組み合わせが必要だ、とも書いています。
同じ手引きは、3つの手法の結果が食い違うのは当然だとしたうえで、その食い違いの読み方を示しています。デジタルのクリック型の媒体では、自社のアトリビューションはその施策の貢献を気前よく見積もった値(上限)、増分を測る実験は最も保守的な値(下限)を表すことが多く、MMM の評価はその間に収まるはずだ、という考え方です。食い違いが極端に大きいときは、コンバージョンの計測の設定やモデルの前提といった、道具の土台を見直すよう勧めています。経営の会議で3つの数字が並んだときに、どれか1つを正解として選ぶのではなく、範囲として読むための目安になります。
組み合わせ方の具体例も示されています。実験の結果で MMM を検証・較正すること(ベイズ型の MMM でもそうでない MMM でも)、MMM の推定で区間が広い媒体を実験の対象に選ぶこと、検索広告は常時出していて需要と一緒に動くため MMM で測るのが難しいので、定期的に実験して MMM を検証すること、などです。予算を動かすときの目安として、MMM の予測で予算を移すときは1つの媒体の支出を一度に最大20%までの調整にとどめ、10%を超える変更をするなら、可能であれば実験で検証することを勧めています。MMM の側の道具も実験との統合を前提にしています。Robyn の解説文書は、正解とみなせる実験の結果で MMM を較正することを強く勧め、Google が公開している MMM である Meridian の公式ドキュメントは、実験の結果を含む利用できる知識のすべてを事前分布(推定の前に置く、パラメータについての見込み)の設定に使える、と書いています。各ツールの具体的な取り込み方は第10章と第14章で扱います。
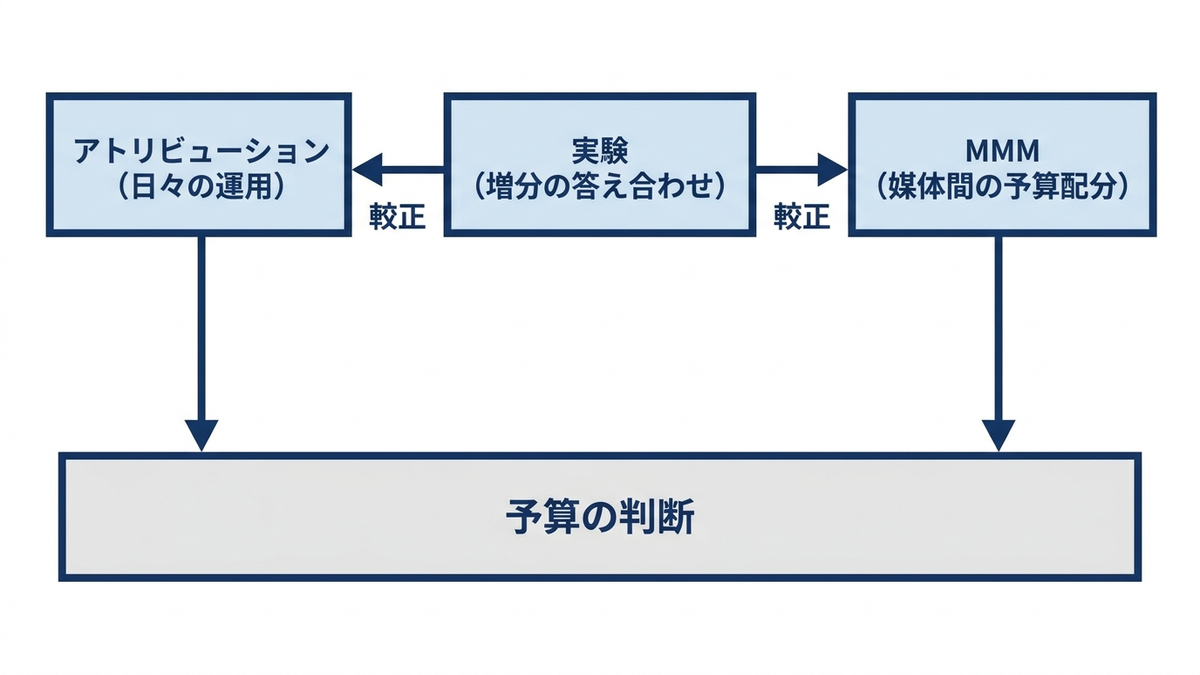
三角測量で大事なのは、手法ごとに「どの判断に使うか」を決めておくことです。Google の測定の手引きは、MMM を媒体をまたいだ全体の予算配分に使い、その予算をキャンペーンや手法に配分するのにアトリビューションを使う、という役割分担の例を挙げ、MMM は通常年に1〜4回というゆっくりした頻度で回り、媒体の担当者が日々の仕事で必要とするより集計された粒度で結果を出す、と書いています。判断の単位と頻度に合わせて道具を割り当てることで、同じ媒体について3つの数字が出ても、どの会議でどの数字を使うかが決まります。この記事の第3章から第12章では、この役割分担のうち MMM の部分を、データの整備から予算の配分まで順に掘り下げます。
この記事のサンプルデータ:架空の日用品メーカーの156週
ここからは、この記事全体で使う共通のサンプルデータを紹介します。このデータは実在の企業の記録ではありません。通販と店頭で販売する架空の日用品メーカーを想定し、乱数の種を固定して Python で生成した架空のサンプルです。期間は第1〜156週の3年間、金額の単位はすべて「万円/週」です。媒体はテレビCM・検索広告・SNS広告・ディスプレイ広告の4つで、ほかに値引き販促の週と休日の週の印があります。
架空のデータを使う理由は、答え合わせができることです。データを作った側は、どの媒体がどれだけ売上を増やしたかという本当の値(この記事では「真の値」と呼びます)を知っています。現実の企業の広告データでは、真の値は誰にも分かりません。モデルの推定がどれだけ当たっているかは、当てはまりの良さから推し量るしかありません。架空のデータなら、推定した ROI を真の ROI と並べて、どれだけずれたか、そのずれで予算の判断がどれだけ変わったかを直接測れます。先に紹介した博報堂DYメディアパートナーズの発表文も、仮定した真のモデル構造から正解となるダミーデータを生成し、MMM による推定値と比べることで、モデル構造がメディア効果の推定に与える影響を検討した、と書いています。この記事も同じ考え方を取ります。ただし、ここで得られる結果はすべて「この架空データの、この設定での結果」であり、現実の媒体の効果について一般的に何かを言うものではありません。
データの作り方(架空の設定)は次の表のとおりです。
| 項目 | 架空の設定 |
|---|---|
| 期間・粒度 | 第1〜156週(3年)の全国の週次データ。金額の単位は万円/週 |
| 基礎売上(広告が無くても出る売上) | 3,000万円+週ごとに2万円のトレンド(年104万円)+季節性(夏と年末に山がある52週周期の波)+販促の週350万円+休日の週500万円 |
| 値引き販促 | 年8回、各2週。3年で延べ46週(回どうしが重なった分だけ48週より少ない) |
| 休日 | 各年の第51・52週(年末)と第18週(大型連休)。3年で9週 |
| テレビCM の出し方 | 4〜6週の放映期間(フライト)にまとめて出し、期間外は0。3年で8回の放映期間、延べ44週。出した週の広告費は1,168.8〜2,206.0万円 |
| 検索広告の出し方 | 需要(季節性・休日)に連動して増える。売上と同じ向きに動く |
| SNS広告の出し方 | 週ごとにゆっくり変動し、第71週以降は150万円を上乗せする設定。第121〜128週は第10章で使う地域実験のため全国の支出が半分 |
| ディスプレイ広告の出し方 | ほぼ一定に、テレビの放映期間に合わせて増やす運用。テレビとの広告費の相関0.91(第4章の多重共線性の例として、意図して連動させた設定) |
| 観測の誤差 | 標準偏差120万円 |
| 架空の粗利率 | 0.50 |
SNS広告の「第71週以降は150万円を上乗せ」は生成の設定で、ゆっくりした変動と重なるため、実際の週平均は第1〜70週が237.0万円、第71〜156週が231.1万円で、データの上では増額は目に見えません。地域実験の8週間(第121〜128週)の週平均は132.9万円で、直前の10週(第111〜120週)の273.1万円の約半分です。第10章で使う地域実験の観測値は、この全国の時系列とは別に、半分の地域を独立の市場とみなして計算した架空の値です。
媒体の効果は、第5章で説明する幾何アドストック(今週の効果の元=今週の広告費+持ち越す割合×先週の値)を掛けたあと、第6章で説明する Hill 関数(広告費を増やすと効果が上限に向かって頭打ちになる S 字の関数)を通して作りました。媒体ごとの真のパラメータは次の表のとおりです。これは現実には分からない値で、この記事では答え合わせにだけ使い、モデルの入力には使いません。
| 媒体 | decay(翌週へ持ち越す割合) | half(効果が上限の半分になる、アドストック後の週次広告費。万円) | shape(1より大きいと S 字) | beta(その媒体で上げられる週次売上の上限。万円) |
|---|---|---|---|---|
| テレビCM | 0.70 | 1,800 | 2.0 | 2,200 |
| 検索広告 | 0.10 | 250 | 1.2 | 1,100 |
| SNS広告 | 0.40 | 400 | 1.5 | 850 |
| ディスプレイ広告 | 0.30 | 600 | 1.0 | 280 |
この設定から、3年間で売上に占める真の寄与の割合は、テレビCM 0.144、検索広告 0.105、SNS広告 0.080、ディスプレイ広告 0.023、基礎売上 0.65 になりました。真の売上ROI(増分売上÷広告費)は、3年全体でテレビCM 1.60、検索広告 2.36、SNS広告 1.73、ディスプレイ広告 0.38、直近52週(第105〜156週)ではそれぞれ 1.51、2.35、1.76、0.38 です。ディスプレイ広告は売上ROI が1を下回り、広告費ほどの売上を生んでいない設定にしてあります。
データの読み込みは次の1行です。データを作る関数は補助モジュール mmm_data.py にまとめてあり、掲載するコードは、この補助モジュールと同じフォルダに置いて実行する形です。補助モジュールは配布していないので、データの設定は上の2つの表に示しました。
import mmm_data as md

df = md.make_data()                     # 156週。乱数の種は0で固定
cols = ["week"] + md.CHANNELS + ["promo", "holiday", "sales"]
print(df[cols].head(3).to_string(index=False))
print("3年合計の広告費(万円)")
print(df[md.CHANNELS].sum().round().to_string())
print("売上の平均(万円/週)", round(df["sales"].mean(), 1))
print("広告費どうし・売上との相関")
print(df[md.CHANNELS + ["sales"]].corr().round(2).to_string())

# 出力:
#  week  tv  search  social  display  promo  holiday  sales
#     1 0.0   180.7   293.1    192.5      0        0 3885.6
#     2 0.0   228.9   339.1    334.8      0        0 4016.6
#     3 0.0   179.3   333.2    196.3      1        0 4271.8
# 3年合計の広告費(万円)
# tv         70765.0
# search     35100.0
# social     36467.0
# display    47694.0
# 売上の平均(万円/週) 5062.5
# 広告費どうし・売上との相関
#            tv  search  social  display  sales
# tv       1.00    0.27   -0.10     0.91   0.69
# search   0.27    1.00    0.19     0.24   0.67
# social  -0.10    0.19    1.00    -0.08   0.11
# display  0.91    0.24   -0.08     1.00   0.65
# sales    0.69    0.67    0.11     0.65   1.00
列名の tv・search・social・display がテレビCM・検索広告・SNS広告・ディスプレイ広告の週の広告費、promo と holiday が販促と休日の週の印(該当する週が1)、sales が週の売上です。売上の平均は週5,062.5万円、3年合計の広告費は4媒体で190,026万円、売上の3年合計789,749万円に対して約24%です。
相関の表には、この記事の後の章で扱う難しさがすでに表れています。売上との相関(sales の列)は、テレビCM 0.69、検索広告 0.67、ディスプレイ広告 0.65 とほぼ同じ高さですが、真の ROI はテレビCM 1.51、検索広告 2.35、ディスプレイ広告 0.38 と大きく違います。ディスプレイ広告の相関が高いのは、テレビの放映期間に合わせて増やしているから(テレビとの相関0.91)で、ディスプレイ広告自体の効果が大きいからではありません。検索広告は需要の高い週に増えるので、売上との相関の一部は需要によるものです。SNS広告は真の ROI が1.76あるのに、売上との相関は0.11しかありません。相関の高さで媒体を評価すると、効いていない媒体を高く、効いている媒体を低く見誤る例です。
週ごとの推移を図にしました。上段は売上(ネイビーの実線)と、答え合わせ専用の真の基礎売上(グレーの破線)、下段は媒体別の週の広告費です。
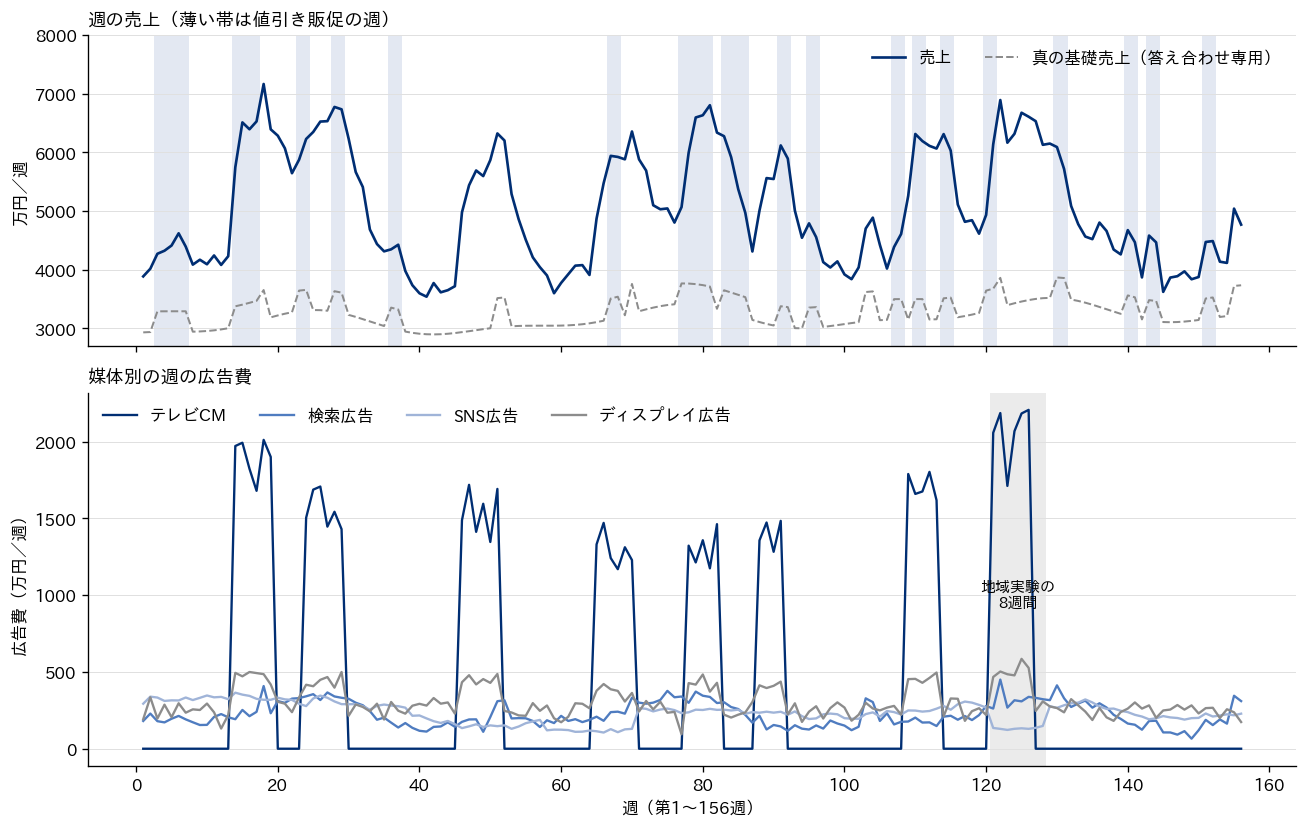
上段の売上の大きな山は、テレビの放映期間と、夏と年末の季節の山が重なったところに出ています。真の基礎売上と売上の差が広告による増分ですが、現実の企業にはこの破線は見えません。MMM は、見えない破線を、統制変数(定数・トレンド・季節の波・販促・休日)から推定することになります。下段を見ると、テレビCM は放映期間の外では0で、ディスプレイ広告は放映期間に合わせて上下しています。この2つの媒体の効果を分けて推定する材料は、ディスプレイ広告が放映期間と無関係に動いた部分の、わずかなばらつきしかありません。
基準の分析:素朴な回帰と MMM(基準)
第3章以降の各章は、同じデータに2つの基準の分析を当てた結果から出発します。補助モジュール baseline.py にまとめてあり、この記事では次の名前で呼びます。
- 素朴な回帰:広告費をそのまま説明変数に入れた最小二乗回帰です。統制変数は MMM と同じ(定数・トレンド・季節の波を表すフーリエ項2組・販促・休日)です。広告費の係数は「広告費1万円あたりの売上」になり、そのまま ROI の推定として読みます。持ち越しも頭打ちも考えません。
- MMM(基準):媒体ごとに幾何アドストックと Hill 関数を掛け、統制変数と一緒に、非線形最小二乗法(scipy の
least_squares)で推定します。媒体1つあたり4つ(decay・half・shape・beta)、4媒体で16個のパラメータと、統制変数の係数8個を同時に推定します。初期値を変えて12回推定し、学習期間の誤差が最も小さいものを採ります。
どちらも、第1〜130週で学習し、第131〜156週を検証用に残しました。学習に使わなかった26週で予測がどれだけ当たるかを見るためです。ROI は直近52週(第105〜156週)で測り、真の値と比べます。素朴な回帰と MMM(基準)を推定し、媒体ごとの ROI を並べるコードは次のとおりです(作図と、記録用の行は省きました)。
import os, time
import numpy as np
import mmm_data as md
import baseline as bl

df = md.make_data()
t0 = time.time()
ols = bl.naive_ols(df)            # 素朴な回帰(学習 第1〜130週)
theta = bl.fit_mmm(df)            # MMM(基準)。初期値を変えて12回推定
sec = time.time() - t0
os.makedirs("../_out/ch02_theta", exist_ok=True)
np.save("../_out/ch02_theta/theta.npy", theta)

W = (105, 156)                    # ROI を測る直近52週
print("%-8s %8s %8s %8s %8s" % ("媒体", "広告費", "真のROI", "MMM", "素朴な回帰"))
for c in md.CHANNELS:
    sp = df[c].iloc[W[0] - 1: W[1]].sum()
    r = (md.true_roi(df, c, W), bl.est_roi(theta, df, c, W), ols[c])
    print("%-8s %8.0f %8.2f %8.2f %8.2f" % (c, sp, *r))
print("推定にかかった時間 %.1f 秒" % sec)

# 出力:
# 媒体            広告費    真のROI      MMM    素朴な回帰
# tv          20951     1.51     1.44     0.54
# search      11661     2.35     1.18     2.23
# social      11884     1.76     0.90     1.34
# display     15643     0.38     0.17     0.97
# 推定にかかった時間 60.7 秒
md.true_roi は答え合わせ専用の真の ROI、bl.est_roi は MMM(基準)の推定から計算した ROI、ols[c] は素朴な回帰の係数です。推定にかかった時間は、この記事の実行環境(一般的なノートPC)での実測で60.7秒でした。ほかの計算と並行して動かしたので、環境によって変わります。
MMM(基準)の推定の中心部分は次のとおりです。baseline.py の fit_mmm から要所を抜き出したもので、最良の解を残す判定の書き方だけ改めてあります。
def fit_mmm(df, weeks=TRAIN, n_starts=12, seed=0):
    a, b = weeks
    y = df["sales"].to_numpy(dtype=float)
    rng = np.random.default_rng(seed)
    # パラメータの範囲(媒体ごとに decay・half・shape・beta、統制変数は制限なし)
    lo, hi = [], []
    for c in md.CHANNELS:
        mx = df[c].max()
        lo += [0.0, 0.05 * mx, 0.5, 0.0]
        hi += [0.9, 5.0 * mx, 3.0, 5000.0]
    lo += [-np.inf] * len(CONTROL_NAMES)
    hi += [np.inf] * len(CONTROL_NAMES)

    def resid(theta):             # 学習期間だけの予測誤差
        return (predict(theta, df) - y)[a - 1: b]

    best = None
    for s in range(n_starts):     # 初期値を変えて12回推定する
        x0 = []
        for c in md.CHANNELS:
            mx = df[c].max()
            x0 += [rng.uniform(0.1, 0.8), rng.uniform(0.3, 2.0) * mx,
                   rng.uniform(0.8, 2.5), rng.uniform(100, 2000)]
        x0 += [float(np.mean(y)), 0, 0, 0, 0, 0, 0, 0]
        r = least_squares(resid, np.array(x0), bounds=(lo, hi), max_nfev=4000)
        if best is None:
            best = r
        elif r.cost < best.cost:
            best = r
    return best.x
やっていることは、予測と実績の差(残差)の二乗和を最小にするパラメータを探すことです。持ち越しと頭打ちを入れるとパラメータに対して式が曲がるので、答えは一度の計算では求まらず、出発点(初期値)から少しずつ誤差の小さい方向へ動かして探します。出発点によって行き着く先が変わるので、出発点を12通り試して、最も誤差の小さい答えを採っています。パラメータには範囲を設けました。持ち越す割合 decay は0〜0.9、形 shape は0.5〜3.0、上限 beta は0〜5,000万円です。この範囲の置き方が結果に影響することは、次の節で見ます。推定と検証の詳しい手順は第8章で扱います。
基準の結果:当てはまりは良いのに、ROI は外れる
まず予測の当てはまりです。MMM(基準)は学習期間の R2(売上の変動のうちモデルで説明できた割合)が0.989、MAPE(予測の誤差の大きさを実績に対する割合で平均したもの)が学習期間で1.72%、検証期間で2.64%でした。素朴な回帰の MAPE は学習期間で7.02%、検証期間で13.53%です。予測の当てはまりだけを見れば、MMM(基準)は素朴な回帰よりはるかに良く、検証期間の誤差が3%を切るのは良いモデルに見えます。
次に、直近52週(第105〜156週)の媒体ごとの売上ROI と増分売上を真の値と並べます。
| 媒体 | 直近52週の広告費(万円) | 真のROI | MMM(基準)の推定 | 素朴な回帰の推定 | 真の増分売上(万円) | MMM の増分売上(万円) |
|---|---|---|---|---|---|---|
| テレビCM | 20,951 | 1.51 | 1.44 | 0.54 | 31,547 | 30,235 |
| 検索広告 | 11,661 | 2.35 | 1.18 | 2.23 | 27,440 | 13,789 |
| SNS広告 | 11,884 | 1.76 | 0.90 | 1.34 | 20,947 | 10,662 |
| ディスプレイ広告 | 15,643 | 0.38 | 0.17 | 0.97 | 5,962 | 2,658 |
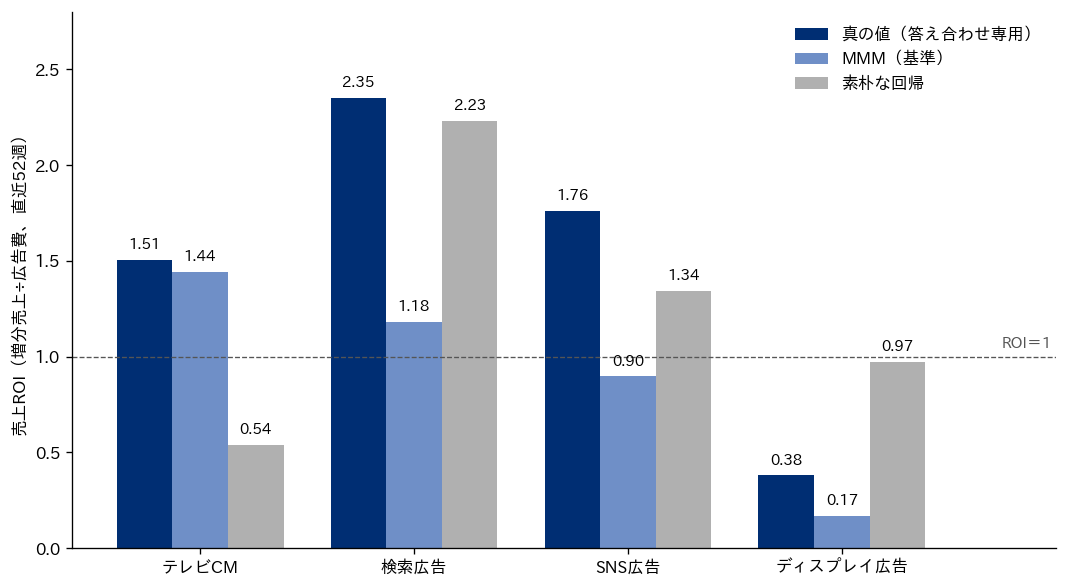
表の「MMM(基準)の推定」の列を「真のROI」の列と比べると、テレビCM は1.44対1.51でほぼ当たっています。ところが、検索広告は1.18対2.35、SNS広告は0.90対1.76で、どちらも真の値の約半分に見積もりました。ディスプレイ広告も0.17対0.38で半分以下です。増分売上の列で見ると、検索広告の真の増分27,440万円に対して MMM の推定は13,789万円で、13,651万円を見落としています。3年間の売上に占める寄与の割合(真/MMM)でも、テレビCM 0.144/0.139、検索広告 0.105/0.052、SNS広告 0.080/0.043、ディスプレイ広告 0.023/0.010 と、テレビCM 以外は半分前後になりました。
見落とした分はどこへ行ったのか。推定した統制変数を見ると、定数が3,511(真の基礎売上の水準3,000)、トレンドが年124.7(真は年104.0)と、どちらも大きめに出ています。第1〜156週の基礎売上の週平均でも、推定3,834.5万円に対して真の値は3,289.1万円でした(第7章の計算)。ただし、基礎売上が大きめに出たことだけでは、検索広告と SNS広告の過小評価は説明できません。第7章で真の基礎売上を既知として与えて推定し直しても、ROI は検索広告0.98・SNS広告0.85と過小のままでした。このとき4媒体の増分売上を足し合わせると真の値とほぼ同じで、ディスプレイ広告の ROI が2.09(真の0.38)に膨らんでいました。外れていたのは媒体の効果の合計ではなく、媒体どうしへの振り分けです。第3章で推定に使う期間を2年・3年にした場合も、定数は真の値に近づいたのに、SNS広告の ROI は真の値の約半分のままでした。この例で確かめられたのは、売上全体はよく説明できても、それを媒体どうしにどう振り分けるかがデータだけでは決まりきらない、ということです(この架空データでの結果です。第7章と第8章で扱います)。媒体ごとのパラメータでも、テレビCM は decay 0.67(真 0.70)、half 1,514(真 1,800)、shape 1.81(真 2.00)、beta 2,081(真 2,200)とほぼ当たっているのに、検索広告は beta が範囲の上限の5,000に張り付き(真は1,100)、SNS広告とディスプレイ広告は shape が範囲の上限の3.00に張り付いています(真は1.50と1.00)。この推定でパラメータが範囲の端に張り付いているのは、データからその値を決めきれていない兆候で、前の節で設けた範囲の置き方が答えを左右していることを意味します(データから値が一通りに決まるかどうかの問題として、第8章で扱います)。これは Chan と Perry の論文が指摘した「当てはまりは同じくらい良いのに、答えが違う解がいくつもある」状態を、答えの分かるデータで再現したものです。
「素朴な回帰の推定」の列は、別の形で外れています。テレビCM を0.54と、真の1.51の3分の1程度に小さく見積もり、ディスプレイ広告を0.97と、真の0.38の2倍以上に大きく見積もりました。素朴な回帰は持ち越しを考えないので、放映期間が終わったあとも続くテレビの効果を、テレビの広告費とは結び付けられません。一方で、ディスプレイ広告は放映期間に合わせて増えるので、放映期間中の売上の上昇の一部がディスプレイ広告の手柄になりました。検索広告の2.23が真の2.35に近いのは、この例での結果で、素朴な回帰が検索広告を正しく測れるという意味ではありません。
この結果から言えることは、予測の当てはまりの良さは、ROI の正しさを保証しないということです。検証期間の MAPE 2.64% は、売上の予測には使えることを示していますが、その売上を基礎売上と媒体にどう分けたかが正しいことは示していません。売上の大部分(この設定では約65%)は基礎売上なので、基礎売上をうまく予測できれば当てはまりは良くなり、媒体の間の配分が多少ずれても誤差にはほとんど表れないからです。この限界は、この記事の後半の章で、不確実性を区間で示すこと(第9章)と、実験の結果で較正すること(第10章)によって補います。
経営の判断に翻訳する
この基準の結果を予算の判断に使うとどうなるかも、計算してあります。直近52週の週平均の総額1,156.5万円/週を固定し、各媒体を現状の0.5〜2倍の範囲で動かして、推定した応答(毎週同じ額を出し続けた状態での増分売上)が最大になる配分を求め、真の応答で答え合わせしました。
| 媒体 | 現状(万円/週) | MMM(基準)で最適化 | 真の最適 | 素朴な回帰に従う |
|---|---|---|---|---|
| テレビCM | 402.9 | 443.3 | 633.3 | 201.5 |
| 検索広告 | 224.3 | 448.5 | 193.2 | 448.5 |
| SNS広告 | 228.5 | 114.3 | 179.6 | 356.1 |
| ディスプレイ広告 | 300.8 | 150.4 | 150.4 | 150.4 |
真の応答で測った週の増分売上は、現状が1,861.9万円、MMM(基準)で最適化した配分が1,935.3万円、真の最適が2,181.6万円、素朴な回帰に従った配分が1,655.3万円でした。年に直す(52倍する)と、MMM(基準)に従えば現状より年3,816万円の増分売上(架空の粗利率0.50で粗利年1,908万円)が得られますが、真の最適なら年16,622万円で、取り逃がしている分のほうがはるかに大きくなります。素朴な回帰に従うと、現状より年10,741万円の増分売上を失います。素朴な回帰はテレビCM の効果を小さく見積もったので、テレビCM を半分に削っています。この配分の数字は「毎週同じ額を出し続ける」という前提の計算で、放映期間に集中して出す現実のテレビCM とは条件が違います。年換算は定常状態の週の増分を52倍したもので、翌年の売上の予測ではありません。この前提と、配分の求め方の詳細は第12章で扱います。
経営の判断に置き換えると、この結果は3つのことを示しています。1つ目は、使う手法を誤ると、予算を動かしたことでかえって損をする(この例では素朴な回帰に従うと年10,741万円の減少)ということです。2つ目は、手法の形が正しくても、推定が外れていれば取り分は小さくなる(MMM(基準)に従っても、真の最適で得られる増分の約23%しか得られない)ということです。3つ目は、どちらの誤りも、予測の当てはまりを見ているだけでは気づけないということです。現実の企業では真の値が見えないので、MMM の推定を「検証期間の誤差が小さいから正しい」と報告すると、SNS広告とディスプレイ広告を半分に削り、検索広告を倍に増やす配分が、根拠のある判断として通ってしまいます。この例では、ディスプレイ広告を削る判断は真の最適と一致していますが、検索広告を倍にする判断は真の最適(現状より減らす)と逆向きです。
判断の誤りを小さくする方法は、この章で整理した3つの手法の組み合わせにあります。MMM の結果をそのまま配分に使うのではなく、推定の幅を示し(第9章)、推定が疑わしい媒体を実験で確かめ(第10章)、その結果を取り込んだモデルで配分を決め直し、予算は一度に大きく動かさない(第12章)という順序です。Google の測定の手引きが勧める「一度に動かすのは1媒体の支出の20%まで、10%を超えるなら可能であれば実験で検証」という目安も、この順序の中に位置づけられます。
広告の増分を測る手法には、集計データで売上を分解する MMM、個人の接触履歴で手柄を配分する MTA、広告を出さない群を作って比べる実験があり、答えられる問い、速さ、プライバシー保護の影響が違います。媒体をまたいだ予算の配分に答えるのは MMM ですが、MMM の推定は前提に依存し、この記事の架空データでも、検証期間の MAPE 2.64% という良い当てはまりのまま、検索広告と SNS広告の ROI を真の値の約半分に見積もりました。次の第3章では、MMM の出発点になるデータ、つまり目的変数・広告費や露出量・統制変数をどう集めて整えるかを扱います。
この章を深めたい方への参考書籍
『データ分析の力 因果関係に迫る思考法』(伊藤公一朗 著、光文社):「広告が売り上げに影響したのか」のような因果関係の分析に焦点を当てた、数式を使わない入門書(光文社新書)です。第1章で、データから因果関係を導くのがなぜ難しいのかを扱い、第2章でランダム化比較試験を取り上げています。この章で整理した「観察データから推定する MMM」と「実験で増分を測る」方法の違いを、広告以外の例も含めて確かめるのに向いています。
『マーケティング・サイエンス入門 新版』(古川一郎・守口剛・阿部誠 著、有斐閣):データと論理に基づいて市場を把握するマーケティング・サイエンスの考え方と手法を、マーケティング計画の流れに沿って解説した教科書(有斐閣アルマ)です。第7章「コミュニケーションと広告」と第10章「テストとコントロール」が、この章で扱った広告の効果のモデル化と実験による検証の基礎にあたります。
第3章 MMMに使うデータを集めて整える
第2章では、効果測定の3つの手法を比べ、第3章以降で使う共通のサンプルデータ(架空の日用品メーカーの第1〜156週の週次データ)と、その上で動かした基準の分析の結果を紹介しました。基準の MMM は、検証期間の予測の誤差(MAPE)が2.64%と小さいのに、検索広告と SNS 広告の ROI を真の値の約半分に見積もっていました。この章では、モデルの式に入る前の段階、つまり MMM に入れるデータを何にし、どの細かさで、どれだけの期間集め、どう整えるかを扱います。MMM の結果は入力したデータ以上のことは言えないので、データの選び方を誤ると、どれほど丁寧にモデルを組んでも ROI は正しく出ません。この章では、公式ドキュメントが示している目安を開いて確かめた範囲で紹介し、そのうえで共通データの期間を短くしたり、記録に不備を入れたりして、推定がどう崩れるかを実際に計算して示します。回帰の仕組みそのものは第4章で扱います。
MMMに入れるデータの全体像
MMM は、週ごとの売上を「広告が無くても出る売上(基礎売上)」と「媒体ごとの広告が上乗せした売上」に分ける分析です。そのため、入力に要るデータは大きく3つの群に分かれます。1つ目は分解される側の数字、つまり目的変数(モデルが説明しようとする数字)で、多くは売上です。2つ目は媒体ごとの広告の量で、広告費と、広告がどれだけ見られたかを表す露出量です。3つ目は、広告以外で売上を動かす要因で、価格・販促・流通(店頭での取り扱い)・季節・休日・天候・競合の動き・景気などです。3つ目の群は、モデルの中では基礎売上の側に入り、広告の効果と取り違えないための「統制変数」として働きます。
Google が2017年に公開した、MMM の課題と改善の機会を整理した論文(David Chan と Michael Perry の共著)は、MMM の典型的なデータを次のように整理しています。応答のデータ(多くは売上だが、来店数などほかの指標もありうる)、媒体ごとの指標(インプレッション、クリック、GRP など。定義はこの章の後半で説明します。最も多いのは広告費)、マーケティングの指標(価格、販促、商品の配荷)、統制要因(季節性、天候、市場の競合)の4つです。同じ論文は、これらのデータは週次か月次で全国に集計した過去の時系列であることが多く、地域別や店舗別のデータを使うこともある、と書いています。
Meta がオープンソースで公開している MMM のパッケージ Robyn の公式ドキュメントにある分析者向けの手引き(An Analyst’s Guide to MMM)も、ほぼ同じ分け方をしています。目的変数には売上が最もよく使われるが、業種によって別の指標を使うこと(通信会社の契約の申込数、銀行の住宅ローンの申込数の例が挙がっています)、説明する側の変数には媒体、媒体以外のマーケティング(販促・値引き)、季節性(天候・休日)、マクロ経済の要因(経済成長)が最もよく使われる、と書いています。この記事の共通データに当てはめると、次の表のようになります。
| データの群 | 中身の例 | 共通データでの扱い | 主な持ち主(社内の例) |
|---|---|---|---|
| 目的変数 | 売上、販売数量、新規顧客数、申込数 | 週の売上(万円) | 経理・営業管理・EC の運営 |
| 広告の量 | 媒体ごとの広告費、インプレッション、GRP、クリック | 4媒体の週の広告費(万円) | 宣伝部・媒体の担当・広告代理店 |
| マーケティングの施策 | 価格、値引き販促、配荷、新商品の発売 | 値引き販促の週(1か0) | 商品企画・営業・販促の担当 |
| 季節・暦 | 季節性、祝日、大型連休、年末 | 季節のフーリエ項(季節の波を表す部品)2組、休日の週(1か0) | 暦から作れる(社内の持ち主は不要) |
| 外部要因 | 天候、競合の広告・価格、景気の指標 | 入れていない(データを作るときに使っていない) | 外部のデータ提供者・公的統計 |
表の右から2列目は、第2章のサンプルデータにどの形で入っているかを示しています。共通データは乱数で作った架空のデータで、売上を作るときに外部要因を使っていないので、外部要因の列が無くても推定が偏ることはありません。現実の企業ではそうはいかず、データに無い要因が広告の動きと重なると、その要因の影響が広告の効果として数えられてしまいます。この点は第7章で詳しく扱います。表の一番右の列は、それぞれの数字を社内で誰が持っていることが多いかの例です。MMM のデータ集めで時間がかかるのは、計算よりも、この持ち主の違う数字を同じ週の単位にそろえる作業であることが多いように思います。体制の話はこの章の後半で扱います。
目的変数を売上・販売数量・新規顧客数のどれにするか
最初に決めるのは、モデルで何を説明するかです。売上(金額)は経営の数字に直結し、ROI を「広告費1万円あたりの増分売上」として出せるので、最もよく使われます。一方で、売上には価格の変動が入ります。値上げをした年は、同じ数量でも売上が増えるので、値上げの時期と広告の増額が重なると、値上げの効果を広告の効果と取り違えるおそれがあります。販売数量を目的変数にすれば価格の変動の影響は外れますが、ROI を金額で出すには、数量1単位あたりの売上(平均単価)を掛けて金額に戻す必要があります。
Google がオープンソースで公開している MMM のライブラリ Meridian の公式ドキュメント(データの収集と整理のページ)は、目的変数(KPI)は売上金額でも、アプリのインストール数のような売上以外の指標でもよいとしたうえで、地域と時間の方向に足し合わせられる指標であることを求めています。足し合わせられる指標の例として販売数量・売上・コンバージョン(成果)の総数を挙げ、クリック率のような足し合わせられない率の指標は、そのままでは使わず、足し合わせられるクリック数などの形でモデルにすることを勧めています。率や平均を週ごと・地域ごとに足すと意味の無い数字になるので、これは Meridian に限らず MMM の入力全般に当てはまる注意だと考えています。同じページは、売上以外の KPI を使うときは、KPI 1単位あたりの平均の売上(revenue per KPI)を任意の入力として渡せること、正確な値が無いときも妥当な近似値を入れることを強く勧めることも書いています。
新規顧客数や申込数を目的変数にするのは、売上がすぐには立たない事業、たとえば定期購入や金融商品のように、獲得した顧客が長く売上を生む事業です。この場合、MMM が出すのは「広告費1万円あたり何人の新規顧客が増えたか」であり、それを金額に直すには顧客1人あたりの生涯の粗利の見積もりが要ります。見積もりを誤ると ROI の水準そのものがずれるので、目的変数を売上以外にするときは、金額への換算の根拠も一緒に決めておく必要があります。
経営の観点で付け加えると、目的変数は「予算を決める会議で使う数字」と一致させるのがよいと考えています。財務が粗利で予算を判断しているのに、モデルが売上で ROI を出していると、会議の場で換算をめぐる議論が始まり、判断が1回分遅れます。第2章の定義のとおり、この記事は売上ROIを主に使い、粗利率(架空の0.50)を掛けた粗利ROIを併記します。どちらを主にするかは、モデルを作る前に財務と合意しておくべき事項です。
広告の量を何で測るか、広告費・インプレッション・GRP
広告の量の測り方には、払った金額(広告費)と、広告がどれだけ見られたか(露出量)の2通りがあります。露出量の代表がインプレッションと GRP です。ビデオリサーチの用語集が引いている日本インタラクティブ広告協会(JIAA)のインターネット広告基礎用語集(2022年度版)は、インプレッションを「広告の配信回数」と定義し、インターネット広告では、Web サイトの媒体力の指標としてのページビューと区別する、と説明しています。JIAA が一般に公開している同じ用語集のウェブ版でも、2026年10月に確認した時点で、この定義は変わっていませんでした。GRP(Gross Rating Point)については、ビデオリサーチの用語集が、ある期間中に放送したテレビCMの各回の世帯視聴率の合計で、「延べ視聴率」ともいう、と定義しています。たとえば世帯視聴率10%の枠に CM を5回流せば、その期間の GRP は50です。同じ用語集の TARP(Target Audience Rating Point)の項は、個人を対象にした延べ視聴率を TARP(TRP とも呼ぶ)、世帯を対象にしたものを GRP とし、主に TARP はマーケティングデータとして、GRP は広告取引に使われる、と書いています(この項の出典は上記の JIAA の用語集です)。
MMM の公式ドキュメントは、どちらも露出量を入力にすることを優先しています。Robyn の分析者向けの手引きは、媒体のデータはどれだけの「目」に触れたか(インプレッションや GRP)を反映するのが理想で、ROI を計算するために広告費も集めるべきだが、モデルへの直接の入力には露出量を使うのがよい慣行だ、と書いています。理由として、テレビの1ドルと Facebook の1ドルでは届く人数が違うことを挙げています。デジタル広告ではインプレッションが、テレビとラジオでは GRP か TARP が最もよく使われ、クリックは避けるべきだとしています。クリックは、広告を見ただけで後から購入する人(ビュースルーのコンバージョン)を数えないからです。同じ手引きの変数の説明でも、有料の媒体には広告費よりも露出をよく反映するインプレッション・クリック・GRP などを使い、それが無ければ最後の手段として広告費を使う、と書かれています。つまり同じ手引きの中で、データを集める節はクリックを避けるよう勧め、変数の説明はクリックを露出の指標の例に含めています。2つを合わせて、インプレッションや GRP が取れる媒体ではそちらを優先し、クリックしか手に入らない媒体でクリックを使うときは、広告を見ただけで購入した人を数えていないという限界を結果に書き添えるのがよいと考えています。
Meridian のデータの収集と整理のページも、有料の媒体ごとにインプレッション・クリック・広告費のいずれか1つの露出の指標を求めたうえで、実際のインプレッションやクリックのデータがまったく得られない場合に限り、広告費を露出の代わりに使えるとしています。その場合の注意として、広告費が実際の露出を表すとモデルが仮定すると、広告の単価が高い時期を、広告の量が多い時期と読み違えるおそれがある、と書いています。競合の多い時期に広告費を増やしても、単価が跳ね上がって実際のインプレッションは横ばい、ということがあり、効果の推定が不正確になりうる、という例です。
この読み違いが MMM の ROI をどう動かすかを、共通データに架空の設定を足して確かめました。設定は次の表のとおりです。テレビの1GRPあたりの単価が、1年目を1.00として毎年15%ずつ上がり、さらに各年の第45週以降(年末の8週)は平常より20%高い、という世界です。売上は、払った広告費ではなく露出量で決まるように、共通データのテレビの真の効果だけを差し替えました。露出量は、1年目の平常の単価で換算した「万円相当」の単位で表しています。ほかの3媒体・基礎売上・誤差は共通データのままです。
| 架空の設定 | 値 |
|---|---|
| テレビの単価の指数(平常の週) | 1年目 1.00・2年目 1.15・3年目 1.30 |
| テレビの単価の指数(各年の第45〜52週) | 平常の1.20倍(1年目 1.20・2年目 1.38・3年目 1.56) |
| 露出量 | 広告費÷単価の指数(1年目の平常の単価で換算した万円相当) |
| 売上の作り方 | テレビの真の効果を、露出量に第2章の真のパラメータ(decay 0.70・half 1,800・shape 2.0・beta 2,200)を掛けたものに差し替える |
| 直近52週のテレビ | 広告費 20,951万円、露出量 16,116万円相当 |
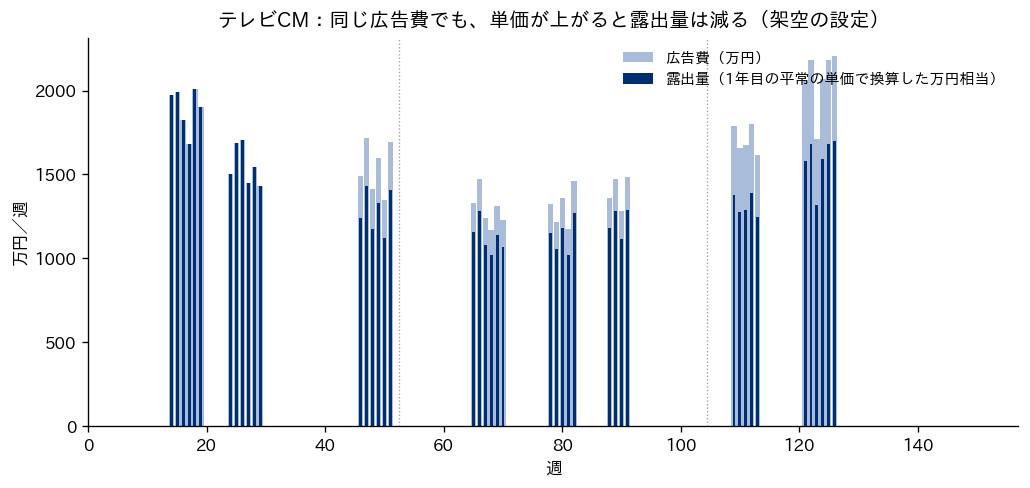
上の図の薄い棒が週の広告費、濃い棒が露出量です。1年目の平常の週は両者が重なり、年末の週や2年目・3年目になるほど、同じ広告費で買える露出量が少なくなっています。直近52週では、広告費20,951万円に対して露出量は16,116万円相当でした。
この世界で、基準と同じ MMM(学習 第1〜130週、初期値12回、乱数の種0)を2回推定しました。1回目はテレビの入力に広告費を使い、2回目は露出量を使いました。ほかの入力は同じです。データの作り替えの要所は次のとおりで、実行したスクリプトから抜き出したものです(実際には、2回の推定を別々に実行しました)。
import numpy as np
import mmm_data as md
import baseline as bl

df = md.make_data()
week = df["week"].to_numpy()
year = (week - 1) // 52                  # 0, 1, 2
woy = (week - 1) % 52 + 1                # 年の中の週
price = (1.0 + 0.15 * year) * np.where(woy >= 45, 1.20, 1.00)
spend_tv = df["tv"].to_numpy(dtype=float)
exposure = spend_tv / price              # 1年目の平常の単価で換算した露出量

# 売上は露出量で決まる世界に作り替える(テレビの真の効果だけ差し替え)
eff_new = md.media_effect(exposure, md.TRUE["tv"])
df["sales"] = df["sales"] - df["eff_tv"] + eff_new

theta_spend = bl.fit_mmm(df, n_starts=12, seed=0)   # 入力=広告費
df_exp = df.copy()
df_exp["tv"] = exposure
theta_exp = bl.fit_mmm(df_exp, n_starts=12, seed=0) # 入力=露出量
# ROI は、どちらも実際に払った広告費で割る(第105〜156週)
結果は次の表のとおりです。ROI は、どちらの推定でも、モデルが出した直近52週(第105〜156週)の増分売上を、実際に払った広告費で割っています。露出量で推定したモデルでも、経営が知りたいのは「払った1万円あたり」の増分売上だからです。真の ROI も同じ割り方で、この世界のテレビの真の ROI は1.28です(単価が上がったぶん、第2章の共通データの1.51より低くなります)。
| 媒体 | 真のROI | テレビの入力=広告費 | テレビの入力=露出量 |
|---|---|---|---|
| テレビCM | 1.28 | 1.34 | 1.22 |
| 検索広告 | 2.35 | 1.57 | 1.13 |
| SNS広告 | 1.76 | 1.05 | 0.93 |
| ディスプレイ広告 | 0.38 | 3.43 | 0.19 |
| (参考)MAPE 学習/検証 | なし | 1.75%/2.83% | 1.73%/2.75% |
この例で目立ったのは、テレビ自身の ROI ではなく、ディスプレイ広告の ROI でした。テレビの入力を広告費にしたモデルは、テレビの ROI を1.34と真の1.28に近く出した一方で、ディスプレイ広告の ROI を真の0.38に対して3.43と、約9倍に見積もりました。露出量を入れたモデルでは0.19で、基準の MMM(0.17)と同じ程度の過小評価に戻っています。広告費を入れたモデルの推定値を見ると、ディスプレイ広告の half(効果が上限の半分になる水準)が41万円と、ディスプレイの週の広告費の最小値(94.0万円)より小さく推定されていました。この推定では、ディスプレイ広告の効果はどの週でもほぼ上限に張り付き、毎週ほぼ一定の額を足す項になります。同じモデルの定数(基礎売上の水準)は2,483と、露出量で推定したモデルの3,530より約1,000小さく出ていました。数字の上では、基礎売上の水準が小さく、ディスプレイ広告の効果が大きく推定された組み合わせです。原因を切り分けたわけではありません。
予測の当てはまりは、2つのモデルでほとんど変わりませんでした(検証期間の MAPE 2.83% と 2.75%)。つまり、当てはまりを見るだけでは、どちらの入力が正しいかは分かりません。この例の数字は、テレビとディスプレイの広告費が強く連動している(共通データで相関0.91)という第2章の設定の上で出たもので、単価の変動があれば必ずディスプレイが過大になる、という一般則ではありません。言えるのは、テレビの単価が年ごとに上がる世界で広告費を露出量の代わりに使うと、テレビの単価の変動というモデルに無い動きを、ほかの変数が吸収した可能性があり(この章では切り分けていません)、別の媒体の ROI が大きくずれることがある、ということです。検索広告と SNS 広告は、どちらの入力でも真の値を下回っており、この過小評価は入力の選び方では直りませんでした(第7章・第8章・第10章で扱います)。
実務では、テレビは GRP、デジタル広告はインプレッションを露出量としてモデルに入れ、広告費は ROI の分母と、最適な配分を金額で出すために別に持つ、という形が公式ドキュメントの勧めに沿っています。予算は金額で決めるので、最後は「露出量1単位あたりの単価」で金額に戻す必要があり、単価の見通しも配分の計算の前提になります。単価が今後も上がる見込みなら、過去と同じ広告費で同じ露出は買えず、過去の ROI をそのまま来年の予算に当てはめると、増分売上を高く見積もることになります。
広告以外で売上を動かす要因のデータ
広告以外の要因のデータは、モデルの中で基礎売上の側に入り、広告の効果と取り違えないための統制変数として働きます。Meridian のデータの収集と整理のページは、統制変数の目的を交絡(広告と売上の両方に影響する要因による見かけの関係)の統制だとし、その選び方は MMM で因果の効果を推定するうえで重要だとしています。集めるべきなのは、目的変数(KPI)と媒体の指標・媒体の出し方の両方に因果の影響を持つ変数で、売上に影響する変数を網羅するのは難しいので、媒体の予算や計画の決定に影響した変数に絞るほうが実際的だ、とも書いています。そのために、マーケティングの計画担当者に、意識的にせよ無意識にせよ、何が判断に影響したかを聞くところから始められる、という勧めです。統制変数の例としては、市場の競合と Google の検索量(クエリボリューム)が挙がっています。Robyn の分析者向けの手引きは、マクロ経済の要因について、事業への影響の仕方によるとしたうえで、よく使われる指標として GDP の成長率・失業率・インフレ率を挙げています。説明する側の変数には、影響しうる要因を理想的には全部入れたいが、それはその要因の時系列データが手に入るかどうかによる、とも書いています。
集めにくいのは競合のデータです。Chan と Perry の論文は、売上・価格・販促のデータは多くの業種で第三者の提供者がおり、自社の内部のデータに加えて競合のデータを買うこともあるが、競合の価格・販促・配荷の変数を手に入れるのは難しいことが多く、こうした変数は MMM から抜け落ちることが多い、と書いています。抜け落ちた変数が広告の動きと重なっていれば、その影響は広告の効果として数えられます。たとえば、競合が値下げした時期に自社がテレビCMを止めていたら、その時期の売上の落ち込みは「テレビCMを止めた効果」に見えます。
この節で挙げた要因を、どの形でデータにするかを表にまとめます。表の右端の列は、この記事が考える集め方の注意です。季節性・トレンド・販促を統制変数としてどう表すか、統制変数を入れすぎると何が起きるかは、第7章で扱います。
| 要因 | データの形の例 | 集め方の注意 |
|---|---|---|
| 価格 | 週の平均売価、通常売価からの値引き率 | 目的変数が売上なら、価格の変動が売上に直接入る。値上げの時期を記録しておく |
| 販促 | 値引き販促の週(1か0)、値引き率 | 実施した週の一覧を、計画ではなく実績で作る |
| 流通・配荷 | 取り扱い店舗数、配荷率 | 新しい販路に入った時期は、広告の増額と重なりやすい |
| 季節・暦 | 季節のフーリエ項、祝日・大型連休・年末の週 | 暦から作れる。週の区切りと祝日の割り当てをそろえる |
| 天候 | 週の平均気温、降水の日数 | 商品によって効き方が違う。地域別のモデルでは地域ごとに要る |
| 競合 | 競合の広告量、競合の価格 | 入手が難しいことが多い。入らないなら、その旨を結果の注記に残す |
| 景気 | GDP の成長率、失業率、物価 | 月次・四半期の統計を週に割り振る方法を決めておく |
粒度を決める、週次か日次か、全国か地域別か
次に決めるのは、データの細かさ(粒度)です。時間の方向では日次・週次・月次、場所の方向では全国・地域別・店舗別、媒体の方向では媒体単位かキャンペーン単位か、という選択があります。粒度を細かくするとデータの点は増えますが、1点ごとのばらつき(雑音)も増えます。粗くすると雑音は減りますが、点の数が減り、広告の動きも均されて見えにくくなります。
時間の粒度について、Meridian のデータの収集と整理のページは、週次を推奨(Best Practice)としています。週次のデータは、日次や月次と比べて、変動の大きさと雑音の大きさの釣り合いが良い、という理由です。週次が無いときは日次や月次を試してもよいが、日次では計算時間が長くなり、月次では推定が収束しない(計算が答えに落ち着かない)ことや、ROI などの推定の幅(信用区間。詳しくは第9章)が広くなることがある、と書いています。Robyn の分析者向けの手引きも、期間の目安を週次のデータで示しています(次の節で紹介します)。共通データが週次なのは、この2つの公式ドキュメントの推奨と同じ単位にそろえたためです。
場所の粒度について、Meridian の同じページは、地域別(geo)のデータを集めることを推奨としています。地域ごとの違いを考慮でき、Meridian の階層ベイズの枠組み(地域どうしで情報を共有しながら推定する仕組み)を使って、ROI などの推定の幅を狭くできる、という理由です。ただし、観測の少ない地域はモデルに入れる前に外すことが望ましいとも書いています。Chan と Perry の論文は、MMM のデータは結局、いちばん粗い媒体の粒度にそろうことが多い、と指摘しています。たとえばテレビの露出量が全国単位でしか手に入らなければ、ほかの媒体が地域別に取れても、モデル全体が全国単位になる、ということです。
媒体の粒度について、Meridian の必要なデータ量のページは、Meridian は媒体(チャネル)単位のモデルであり、MMM は媒体単位でうまく働くマクロの道具なので、キャンペーン単位で動かすことは一般には勧めない、と書いています。開始と終了がはっきりしたキャンペーンを別々の変数にすると、アドストック(広告の効果が翌週以降に持ち越される性質。第5章)の記憶が失われるおそれがある、という理由も添えられています。逆に、広告費の少ない媒体は、ほかの媒体とまとめることが ROI の推定の問題を避けるうえで望ましい、とデータの収集と整理のページは書いています。媒体を細かく分けるほど推定するパラメータが増え、次の節で見る「データ点の数とパラメータの数の比」が悪くなるためです。
| 粒度の方向 | 選択肢 | 公式ドキュメントの記載(Meridian) | 決めるときの目安 |
|---|---|---|---|
| 時間 | 日次・週次・月次 | 週次を推奨。日次は計算時間が長くなる。月次は収束しないことや推定の幅が広がることがある | 広告費の記録が週単位でそろうか |
| 場所 | 全国・地域別・店舗別 | 地域別を推奨。観測の少ない地域は外すことが望ましい | いちばん粗い媒体の粒度が全体を決める |
| 媒体 | 媒体単位・キャンペーン単位 | 媒体単位。キャンペーン単位は一般には勧めない。広告費の少ない媒体はまとめることが望ましい | 推定するパラメータの数が増えすぎないか |
この表の右端の列は、公式ドキュメントの記載を受けて、この記事が付け加えた判断の目安です。どの粒度にするかは、分析の都合よりも、予算を動かす単位で決めるのがよいと考えています。地域ごとに予算を配分できない会社が地域別のモデルを作っても、結果を使う場面が限られます。一方で、地域別のデータがあれば、第10章で扱う地域実験の結果とモデルを突き合わせやすくなります。
期間の長さ、何年分あれば推定できるか
「MMM には何年分のデータが要るか」は、導入の最初によく出る問いです。公式ドキュメントの記載を開いて確かめると、目安は次のとおりでした。Meridian のデータの収集と整理のページは、経験則として、地域別のモデルでは最低2年分の週次データ、全国のモデルでは3年分のデータを目安とし、月次しか無い場合は最低3年分を勧めています。同時に、必要な量は最終的にはデータの中身によって決まる、とも書いています。Robyn の分析者向けの手引きは、頑健な結果を得るには最低2年分の週次の過去データが要り、月次しか無い場合は2年より多く(例として4〜5年)集めることを強く勧めています。理想を言えばデータは多いほどよく、季節性の影響をより頑健に捉えられる、という説明です。
年数の目安の背後にあるのは、推定するパラメータ(モデルの中の未知の数)の数と、データ点の数の比です。Meridian の必要なデータ量のページは、全国のモデルでは「パラメータ1つあたりのデータ点の数」が確信の度合いを点検する鍵になると書き、媒体12・統制変数6・時間の効果の節点8でパラメータ26個(アドストックと飽和のパラメータは簡単のため数えない)の例を挙げています。2年分の週次データ(104点)では1パラメータあたり4点しかなく、これでは信頼できる推定には少なすぎる、という結論です。対策として、媒体をまとめる・統制変数を絞るなどしてモデルの範囲を狭める、2年ではなく3年分の週次データを使うなどしてデータを大きく増やす、地域別のデータにして地域別のモデルを使う、の3つを挙げ、データを足すと推定のばらつきは減るが、推定が今の状況に対して当てはまりにくくなる(関連が薄くなる)かもしれない、と注意しています。
Chan と Perry の論文も同じ問題を「限られたデータ量」として最初に挙げています。全国の週次データ3年分という典型的な MMM のデータは156点しかなく、そこから20以上の媒体のモデルを作ることを求められることが多い。持ち越しと逓減を表すには媒体ごとに3〜4個のパラメータが要るので、パラメータの数がデータ点の数を超えることもある。安定した線形回帰に要るデータ点の数の経験則は、因果の効果を正しく推定できるかは別にして、1パラメータあたり7〜10点で、典型的な MMM はそれに届かない、と書いています。
共通データの基準の MMM で数えると、推定するパラメータは媒体ごとに4つ(持ち越し率 decay・効果が半分になる水準 half・形 shape・上限 beta)の4媒体分で16個、統制変数(定数・トレンド・季節のフーリエ項2組の4本・販促・休日)が8個で、合わせて24個です。1パラメータあたりのデータ点は、52週で2.2点、104週で4.3点、基準の学習期間の130週で5.4点、156週で6.5点になります。全部の期間を使っても、Chan と Perry の論文が挙げる7〜10点には届きません。媒体が4つしかない小さなモデルでも、3年分の週次データでぎりぎりの量だということです。
では、期間を短くすると推定は実際にどう崩れるのでしょうか。共通データで、推定に使う期間を第1〜52週(1年分)、第1〜104週(2年分)、第1〜156週(3年分すべて)の3通りにして、基準と同じ MMM(baseline.fit_mmm。初期値を変えた推定12回のうち誤差が最小のものを採る。乱数の種0)を推定し直しました。ROI は、それぞれの期間の最後の52週(1年分のときは第1〜52週、2年分のときは第53〜104週、3年分のときは第105〜156週)で測り、同じ52週の真の ROI と比べています。分析した時点の「直近1年」の ROI を出す、という使い方を想定した比べ方です。掲載するコードは、補助モジュール(mmm_data.py と baseline.py)と同じフォルダに置いて実行する形です。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import mmm_data as md
import baseline as bl

df = md.make_data()                      # 第2章の共通データ(156週)
for end in (52, 104, 156):
    theta = bl.fit_mmm(df, weeks=(1, end), n_starts=12, seed=0)
    win = (end - 51, end)                # 期間の最後の52週で ROI を測る
    y = df["sales"].to_numpy(dtype=float)
    fit = bl.mape(y[:end], bl.predict(theta, df)[:end])
    print("第1〜%d週で推定  推定期間の MAPE %.4f" % (end, fit))
    for c in md.CHANNELS:
        print("  %-8s 真のROI %.2f  推定ROI %.2f" % (
            c, md.true_roi(df, c, win), bl.est_roi(theta, df, c, win)))
# 出力(抜粋):
# 第1〜52週で推定  推定期間の MAPE 0.0129
#   display  真のROI 0.37  推定ROI 8.41
# 第1〜156週で推定  推定期間の MAPE 0.0182
#   display  真のROI 0.38  推定ROI 0.41
このコードは、実際に実行したスクリプトから、期間ごとに1回ずつ推定して ROI を出す部分を抜き出したものです。実際には、1回の実行時間を抑えるため、期間ごとに別々に実行しました。この記事の実行環境(一般的なノートPC。ほかの計算と並行して動かしていた)での実測で、1回の推定に第1〜52週で57.5秒、第1〜104週で51.9秒、第1〜156週で126.5秒かかりました。結果を、基準の MMM(第1〜130週で推定。ROI は第105〜156週)と並べると次の表になります。
| 推定に使った期間 | 1パラメータあたりのデータ点 | 推定期間の MAPE | ROI を測った52週 | テレビCM 真/推定 | 検索広告 真/推定 | SNS広告 真/推定 | ディスプレイ広告 真/推定 |
|---|---|---|---|---|---|---|---|
| 第1〜52週(1年) | 2.2 | 1.29% | 第1〜52週 | 1.45/1.59 | 2.35/1.80 | 1.65/2.63 | 0.37/8.41 |
| 第1〜104週(2年) | 4.3 | 1.61% | 第53〜104週 | 1.94/1.97 | 2.37/1.55 | 1.79/0.87 | 0.39/0.35 |
| 第1〜130週(基準) | 5.4 | 1.72% | 第105〜156週 | 1.51/1.44 | 2.35/1.18 | 1.76/0.90 | 0.38/0.17 |
| 第1〜156週(3年) | 6.5 | 1.82% | 第105〜156週 | 1.51/1.50 | 2.35/1.97 | 1.76/0.95 | 0.38/0.41 |
表の「真/推定」の列は、左が真の ROI、右が MMM の推定した ROI です。「推定期間の MAPE」は、推定に使った期間の中での予測の誤差(平均絶対誤差率)で、基準の行は学習期間の MAPE です。真の ROI が行ごとに少し違うのは、ROI を測った52週が違うためです(たとえばテレビは、第53〜104週の放映の出し方では1.94、第105〜156週では1.51です)。
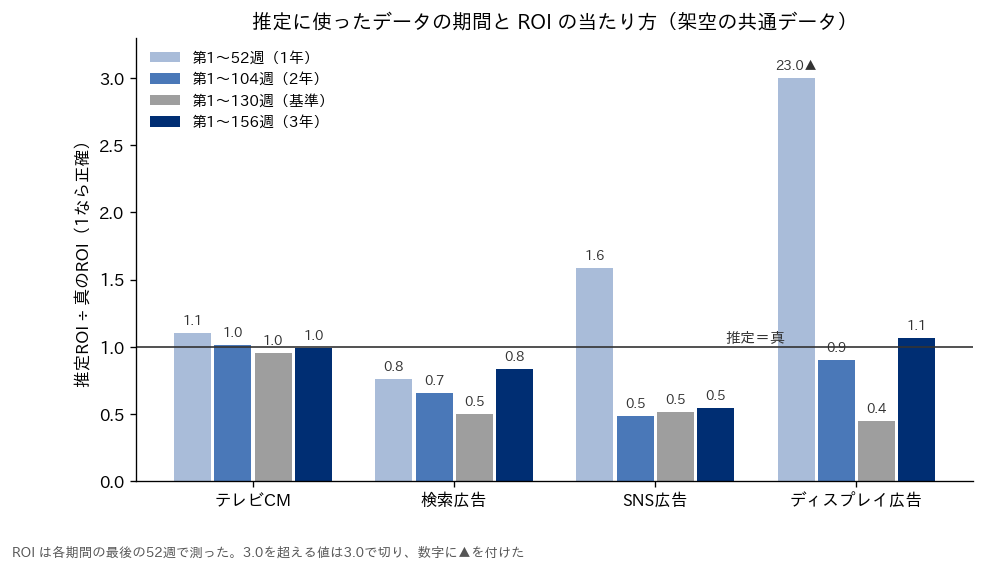
上の図は、同じ結果を「推定した ROI÷真の ROI」で描き直したものです。1に近いほど正確で、1より下は過小評価、上は過大評価です。1年分のディスプレイ広告(23.0倍)は縦軸に収まらないので、3.0で切って数字に印を付けました。
この表から読み取れることは3つあります。1つ目は、1年分のデータでは推定が大きく崩れたことです。ディスプレイ広告の ROI を真の0.37に対して8.41と、約23倍に見積もりました。SNS 広告も真の1.65に対して2.63と過大です。推定された統制変数を見ると、定数(基礎売上の水準)は334、トレンドは年 -226 で、真の値(定数3,000・トレンド年104)とかけ離れていました。この実験だけで原因を切り分けたわけではありませんが、数字の上では、基礎売上の水準が真の値の1割ほどに小さく推定され、媒体の効果が大きく推定された、という組み合わせになっていました。なお、1年分のデータには夏と年末の山が1回ずつしか無く、季節性・トレンド・広告の効果を見分ける手がかりはそれだけ少なくなります。
2つ目は、予測の当てはまりは1年分のときが最も良かったことです。推定期間の MAPE は1年分で1.29%、2年分で1.61%、3年分で1.82%と、期間が短いほど小さくなりました。点の数に比べてパラメータが多いと、モデルはデータの細かな揺れにまで合わせられるので、当てはまりは良くなります。第2章で見た「当てはまりの良さは ROI の正しさを保証しない」が、ここでも極端な形で出ています。データが少ないときに当てはまりの良さを根拠に結果を受け入れると、最も危うい結果を最も自信をもって報告することになります。
3つ目は、期間を3年に延ばしても、すべてが直るわけではないことです。3年分では、テレビ(真1.51/推定1.50)とディスプレイ(0.38/0.41)はほぼ当たり、検索広告も1.97と、基準の1.18より真の2.35に近づきました。それでも SNS 広告は0.95と、真の1.76の約半分のままです。次の節で数えるとおり、SNS 広告の広告費は年ごとの変動係数(標準偏差÷平均)が0.23〜0.28と、4媒体の中で最も動きが小さい媒体です。この過小評価の原因がその動きの小ささなのかは、この記事の計算では確かめていません。一方で、3年分の推定の定数は3,245、トレンドは年114.1で、真の値(3,000と年104)に近く出ています。基礎売上の水準が大きく外れていないのに SNS 広告が半分のままだったことになり、基礎売上の見積もりの誤りだけでは、この過小評価は説明できません。第7章で真の基礎売上を既知として与えた推定でも、SNS 広告の ROI は0.85と過小のままで、媒体の効果の合計は合うのに媒体どうしへの振り分けが外れていました(第7章と第8章で扱います。実験の結果で補う方法は第10章です)。なお、3年分の行は、推定に全期間を使ったので、モデルが見ていない期間で答え合わせをする検証(ホールドアウト検証。第8章)をしていません。
この実験は、架空のデータで、初期値12回・乱数の種0という1つの設定で行った結果です。別の乱数でデータを作れば数字は変わりますし、「1年分では必ずディスプレイが約23倍になる」と一般化できるものではありません。言えるのは、この例では、Meridian の記載(全国のモデルで3年分)や Chan と Perry の論文の経験則(1パラメータあたり7〜10点)を大きく下回るデータ量で推定すると、当てはまりが良いまま ROI が桁違いにずれることが起きた、ということです。
データの量より先に、広告費の「動き」を点検する
期間の実験で、3年分のデータでも SNS 広告の ROI が真の値の約半分のままだったのは、量だけでは足りないことを示しています。MMM が広告の効果を推定できるのは、広告費が動いた週と動かなかった週の売上の差からです。広告費がほとんど一定なら、その媒体の効果は基礎売上の水準と見分けがつきません。ほかの媒体と同じ向きに動いていれば、どちらの効果かを見分けられません。季節と同じ向きに動いていれば、季節性の効果と見分けられません。Meridian の必要なデータ量のページは、全国のモデルの例の中で、媒体の広告費の変動が不十分だと全国のモデルに悪い影響が出る、と括弧書きで添えています。
Chan と Perry の論文は、この問題を2つの課題として整理しています。1つ目は「相関した入力変数」です。広告主は媒体の広告費を連動させて配分しがちで、ある媒体が高い水準で観測されるのは別の施策が高い水準のときか、特定の季節だけ、ということが起きる。入力どうしの相関が強いと係数の推定のばらつきが大きくなり、売上を誤った媒体に割り振ることにつながる。予測の精度が良い面(モデル)がいくつもあっても、広告主が過去の出し方から外れたときに予測が外れる、と書いています。2つ目は「限られたデータの範囲」です。広告主は事業の都合に合う広告費の範囲に落ち着いていることが多く、その範囲のデータで作ったモデルに「来年広告費を倍にしたらどうなるか」を問うと、観測した範囲の外への外挿になり、大きな不確実性を抱える、と書いています(飽和の位置の推定の難しさは第6章で扱います)。
共通データで、媒体ごとの広告費の動きを年ごとに数えると、次の表のとおりでした(推定はしておらず、データの集計だけです)。
| 媒体 | 週平均(3年目、万円) | 変動係数(1年目/2年目/3年目) | 3年目の最小〜最大(万円) | 動き方の特徴 |
|---|---|---|---|---|
| テレビCM | 402.9 | 1.40/1.59/1.97 | 0〜2,206.0 | 放映期間は3年で8回(年3・3・2回)。放映の無い週は年34・37・41週 |
| 検索広告 | 224.3 | 0.34/0.34/0.38 | 65.4〜450.4 | 季節・休日に連動して動く(第7章) |
| SNS広告 | 228.5 | 0.26/0.28/0.23 | 122.4〜321.0 | 4媒体で最も動きが小さい |
| ディスプレイ広告 | 300.8 | 0.31/0.29/0.35 | 173.8〜585.0 | テレビとの相関が年ごとに0.91/0.85/0.93 |
変動係数は、週の広告費の標準偏差を平均で割ったもので、平均に比べてどれだけ動いたかを表します。テレビは放映期間に集中して出すので、出す週と出さない週の差がはっきりしており、変動係数は1.40〜1.97と大きくなります。基準の MMM でも、期間を2年・3年にした推定でも、テレビの ROI は真の値に近く出ました。逆に、変動係数が0.23〜0.28と最も小さい SNS 広告は、期間を延ばしても推定が真の値に近づきませんでした。動きの大きい媒体ほど当たった、という対応はこの例で見えていますが、動きの大きさが当たり外れの原因であることを、この記事の計算で確かめたわけではありません。ディスプレイ広告は、テレビの放映期間に合わせて増やす運用なので、どの年もテレビとの相関が0.85以上あります。
なお、共通データを作る手順(補助モジュール mmm_data.py)は、テレビの放映期間の開始週を毎年5つ引いて置く設定ですが、前の放映期間と重なりそうな開始週は飛ばすので、実際にデータに残った放映期間を数えると、上の表のとおり3年で8回でした。データを作った側の意図と、出来上がったデータの中身が違うことは、架空のデータでも起きます。現実のデータではなおさらで、「年5回放映した」という計画の記録ではなく、データそのものを数えて確かめることが、整備の最初の作業になります。
この点検は、モデルを作る前に、表計算ソフトでもできる集計です。それでいて、Chan と Perry の論文が挙げた「相関した入力」と「限られた範囲」に当たる媒体がどれかを、推定の前に洗い出す材料になります。この例では、動きの最も小さい SNS 広告と、テレビと連動して動くディスプレイ広告が、期間や入力を変えた推定のどこかで真の値から大きく外れました。その場合は、第10章で扱う地域実験のように、その媒体の広告費を意図して動かし、データに「動き」を作るほうが、データを溜め続けるより早く答えに近づけると考えています。
データの欠け、媒体の分類のぶれ、部門ごとに別の台帳
MMM のデータは、社内外のいくつもの台帳を寄せ集めて作ります。Chan と Perry の論文は、広告の露出データは広告代理店などいくつもの仲介者を通じて計画・実行されることが多く、広告主は自社が費用を出したキャンペーンのデータを得るのに多くの別々の組織を回らなければならないことがあり、その過程の複雑さが重要なデータの欠落や読み違いにつながりやすい、と書いています。また、広告費は手に入っても露出のデータは集めにくく、媒体やデータの提供者によって推計の仕方が違う、とも書いています。Robyn の分析者向けの手引きは、計画のデータではなく、実際に起きたことのデータを優先して集めることを勧めています。メディアプランに書かれた予定のインプレッションや広告費ではなく、実際に配信されたものを集める、ということです。ただし、屋外広告のように実績を測りにくい媒体では、計画の到達や広告費を使ってもよい場合がある、としています。
欠けたデータの埋め方について、Meridian のデータの収集と整理のページは、Meridian は欠けた値の無い完全なデータを必要とし、モデルを動かす前に補完か0埋めで処理しなければならない、と書いています。媒体の変数は、その媒体がその期間・その地域で動いていなかったために欠けている場合は0で埋める。目的変数と統制変数は、0で埋めるとモデルの推定が歪むので0で埋めず、前の値や後ろの値で埋める・直線で補間する・その地域や期間の過去の平均を使う、といった標準的な補完の手法を使う、としています。ここで大事なのは、媒体を0で埋めてよいのは「本当に出していなかった」場合に限られる、という点です。出していたのに記録が無いだけの週を0で埋めると、その週は「広告を出さなかったのに売上は普段どおりだった週」としてモデルに入ります。
この2種類の不備が ROI をどう動かすかを、共通データで確かめました。どちらも架空の設定で、学習期間・初期値の数・乱数の種は基準の MMM と同じにし、入力するデータだけを変えています。
| 架空の設定 | 何が起きたか | モデルに入る数字 |
|---|---|---|
| 分類のぶれ | 第79週から、ディスプレイ広告として買っていた枠の一部(広告費の40%)を、SNS 広告の台帳に記帳するようになった | 第79週以降、ディスプレイは本当の額の60%、SNS は本当の額+ディスプレイの40% |
| 記録の欠け | 第1〜26週の SNS 広告の台帳が見つからず、0で埋めた(実際には毎週出していた) | 第1〜26週の SNS 広告費が0、それ以外は本当の額 |
真の ROI は、本当に払った広告費と真の増分売上から計算しています。推定の ROI は、会社が手元で見る数字に合わせて、モデルが出した増分売上を台帳の広告費で割っています。分類のぶれでは台帳の額と本当に払った額が食い違うので、同じ推定を払った額で割った列も並べました(記録の欠けは第1〜26週だけの不備なので、ROI を測る第105〜156週では台帳の額と払った額が同じです)。結果は次の表のとおりです(ROI はいずれも第105〜156週)。
| 媒体 | 真のROI | MMM(基準) | 分類のぶれ(台帳の額で割る) | 分類のぶれ(払った額で割る) | 記録の欠け |
|---|---|---|---|---|---|
| テレビCM | 1.51 | 1.44 | 1.42 | 1.42 | 1.43 |
| 検索広告 | 2.35 | 1.18 | 0.96 | 0.96 | 0.75 |
| SNS広告 | 1.76 | 0.90 | 0.94 | 1.44 | 0.55 |
| ディスプレイ広告 | 0.38 | 0.17 | 0.15 | 0.09 | 0.19 |
| (参考)MAPE 学習/検証 | なし | 1.72%/2.64% | 1.78%/2.46% | 1.78%/2.46% | 2.16%/3.28% |
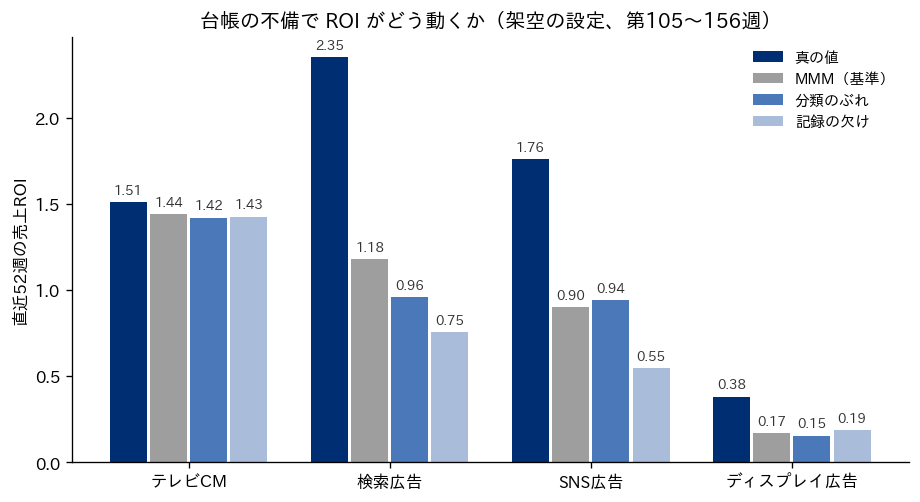
記録の欠けでは、SNS 広告の ROI が基準の0.90から0.55に下がり、真の1.76の3分の1以下になりました。0で埋めた26週は、モデルから見ると「SNS 広告を止めても売上が落ちなかった期間」です。MMM は広告費が動いた週と売上の対応から効果を推定するので、この26週は SNS 広告の効果を小さく見せる方向に働くデータになります。触っていない検索広告の ROI も1.18から0.75に下がりました。学習期間の MAPE は1.72%から2.16%に、検証期間は2.64%から3.28%に悪化しており、この不備は当てはまりの悪化として少しは表に出ています。
分類のぶれでは、台帳で見た SNS 広告の ROI は0.94、ディスプレイ広告は0.15で、基準(0.90と0.17)からあまり動かないように見えます。ところが、払った額で割ると SNS 広告は1.44、ディスプレイ広告は0.09でした。第105〜156週の SNS 広告の台帳の額は18,141万円で、本当に払った11,884万円より膨らんでいるので、モデルが SNS 広告に割り振った増分売上は基準より大きくなっているのに、台帳で割った ROI は低く見えます。ディスプレイ広告は逆に、台帳の額(9,386万円)が払った額(15,643万円)より小さくなっています。台帳の不備は、増分売上の推定と、ROI の分母の両方を動かすということです。さらに、台帳を一切変えていない検索広告の ROI が、1.18から0.96に下がりました。1つの媒体の台帳の誤りが、別の媒体の推定を動かすということです。しかも、検証期間の MAPE は2.64%から2.46%へと、むしろ良くなりました。当てはまりの指標では、この不備は見つけられません。分類のぶれは、誰かが記帳のルールを変えた時点を知っていれば直せますが、データだけからは気づきにくい種類の誤りです。
この2つの結果も、この架空のデータの、この設定での結果です。不備の入れ方を変えれば、動く媒体も動く向きも変わります。一般に言えるのは、台帳の不備はその媒体だけの問題にとどまらず、ほかの媒体の ROI まで動かしうること、そしてその一部は当てはまりの指標には現れないことです。だからこそ、データの点検は、モデルの当てはまりとは別の工程として持つ必要があります。
実務では、次のような点検の項目を、モデルの推定の前に1つずつ確かめることを勧めます。
- 媒体ごとに、広告費の合計が経理の支払いの記録(請求書の合計)と一致するか。一致しない週はどこか
- 媒体の分類(どの買い付けをどの媒体に入れるか)のルールが、期間の途中で変わっていないか。変わった時点はいつか
- 広告費が0の週は、本当に出していなかった週か、記録が無いだけの週か
- 露出量(インプレッション・GRP)は、計画の値ではなく実績の値か
- 売上の集計の定義(税込か税抜か、返品を引いているか、通販と店頭を足しているか)が全期間で同じか
- 週の区切り(月曜始まりか日曜始まりか)が、すべての台帳でそろっているか
- 新商品の発売・値上げ・流通の変更・大きな欠品など、売上を動かした出来事の一覧があるか
データ整備の体制、誰がどの数字の持ち主か
MMM のデータは、1つの部署では揃いません。この章の最初の表で見たとおり、売上は経理や営業管理、広告費は宣伝部や広告代理店、露出量は媒体社や調査会社、販促は商品企画や営業、と持ち主が分かれています。持ち主が違えば、集計の単位も定義も違います。経理の広告費は請求の月で計上され、宣伝部の広告費は放映や配信の週で管理され、代理店の報告は手数料を含むか含まないかが会社ごとに違う、ということが起こりえます。MMM の担当者がこれを後から突き合わせると、合わない理由を調べるだけで多くの時間を使います。
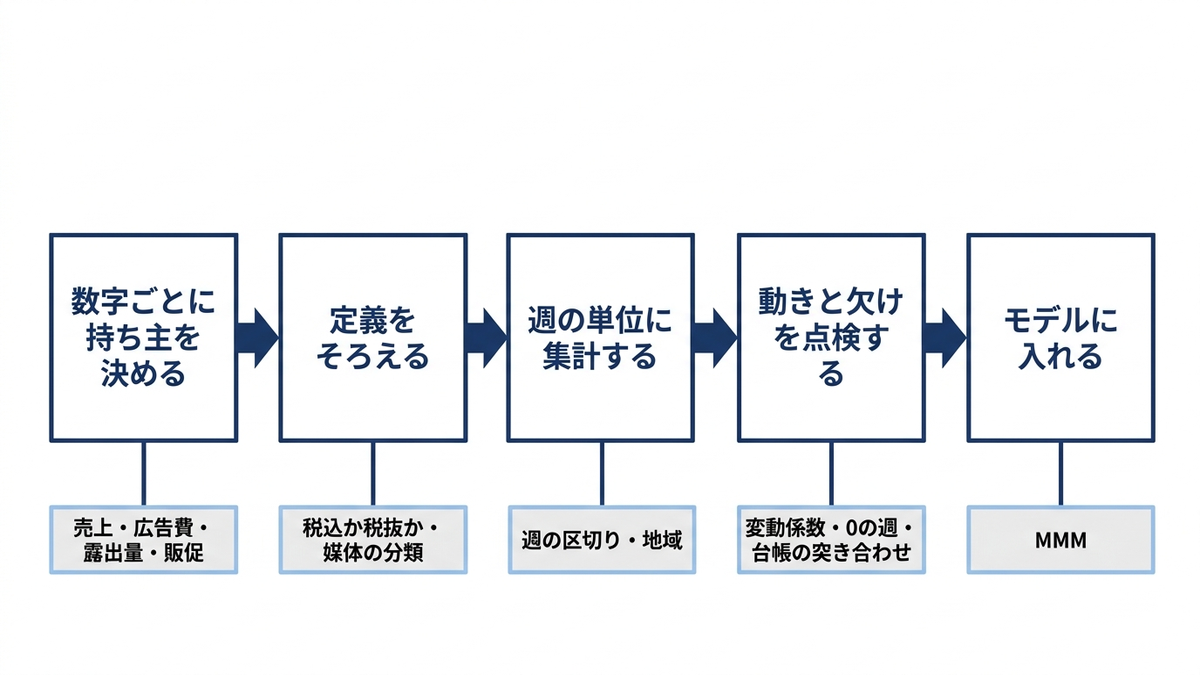
そこで、データ整備は「数字ごとに持ち主を決める」ところから始めるのがよいと考えています。持ち主とは、その数字の定義を決め、毎週(または毎月)の値に責任を持ち、定義を変えるときは MMM の担当者に知らせる人です。下の表は、その分担の一例です。
| 数字 | 持ち主の例 | 持ち主が決めること | MMM の担当者が確かめること |
|---|---|---|---|
| 週の売上 | 経理・営業管理 | 税込か税抜か、返品の扱い、販路の範囲 | 定義が全期間で同じか |
| 媒体ごとの広告費 | 宣伝部(代理店の報告を取りまとめる) | 媒体の分類のルール、手数料を含むか、計上する週 | 経理の支払いの合計と合うか、分類のルールが途中で変わっていないか |
| 露出量(GRP・インプレッション) | 宣伝部・媒体の担当 | 実績の値の取り方、指標の定義(世帯か個人か) | 計画の値が混ざっていないか、広告費が0の週に露出が残っていないか |
| 販促・価格 | 商品企画・営業 | 販促の週の一覧、通常売価の定義 | 売上の大きな山と販促の週が対応しているか |
| 出来事の一覧 | 経営企画 | 新商品・値上げ・欠品・流通の変更の日付 | モデルの残差(説明できなかった売上)の大きな週と対応しているか |
表の右端の「MMM の担当者が確かめること」は、前の節の点検の項目を、持ち主ごとに割り振り直したものです。持ち主が決まっていれば、点検で食い違いが見つかったときに、誰に聞けばよいかが最初から分かります。データ整備の考え方として、データの品質は、それが生まれる元(データソース)で担保するのが基本だ、という整理があります(章末の参考書籍を参照)。MMM で言えば、代理店の報告や社内の台帳の段階で定義をそろえておけば、分析の段階での手直しが減る、ということです。
経営判断、データ整備にどれだけの期間をかけるか
データ整備にかかる時間について、Robyn の分析者向けの手引きは、初めて MMM の分析を行うときの典型的な所要期間の目安を工程ごとに示しています。事業上の問いと範囲を決める工程が1〜2週間、データ収集が4〜6週間、データの点検が1〜2週間です。データ収集については、MMM の分析で最も重要だが最も時間のかかる工程の1つで、複数の異なる情報源から同じ形式でデータを集めるのが難しいため、少なくとも4週間を割り当てるように、と書いています。これらは初回の目安で、モデルの更新や、社内で行うか外部の協力者と行うかによって短くできる、とも書かれています。
この目安を経営の判断に置き換えると、MMM の最初の結果が予算の会議に出るまでには、モデルを作る前の段階(問いと範囲を決める・データを集める・点検する)だけで、この目安を足し合わせて6〜10週間かかりうる、ということです。年度の予算を決める時期から逆算して、データ整備をいつ始めるかを決めておかないと、結果が会議に間に合わず、その年度はこれまでどおりの配分で決めることになります。第2章で紹介した基準の結果では、真の増分売上が、MMM(基準)で最適化した配分で現状より年3,816万円、真の最適の配分で年16,622万円増えました(どちらも架空のデータでの、毎週同じ額を出し続ける定常状態の計算です)。判断が1年遅れることは、この例で言えば、MMM(基準)で最適化した配分で得られたはずの、真の応答で測ると年3,816万円の増分売上を1年分見送ることに当たります(年16,622万円は、真の値が分かるこの架空データでだけ計算できる上限です)。
一方で、この章の実験が示したのは、急いで不十分なデータで作ったモデルは、当てはまりが良いまま ROI を大きく誤りうる、ということでした。1年分のデータで推定したモデルは、ディスプレイ広告の ROI を真の値の約23倍に見積もりました。このモデルの ROI で配分を決めた場合の損失は、この章では計算していません。ただ、ROI を誤ったモデルに従って配分した結果として、第2章の素朴な回帰の例では、真の増分売上が現状より年10,741万円減りました。データが揃っていない段階で結果を出すなら、その結果は配分を動かす根拠ではなく、データの何が足りないかを洗い出すための試算として扱うのがよいと考えています。
この2つを合わせると、経営としての決め方は次のようになります。まず、全国の週次データが何年分あり、媒体ごとの広告費がどれだけ動いているかを、この章の点検の表の形で確かめます。3年分に届かない、あるいは動きの小さい媒体が多いなら、モデルの結果だけで配分を大きく動かさず、第10章で扱う実験と組み合わせることを前提にします。同時に、数字ごとの持ち主を決め、来年のモデルに入るデータが今年から正しく記録されるようにします。データ整備は MMM を1回作るための準備ではなく、毎期の予算判断の材料を作り続けるための仕組みだからです。モデルを使い続ける体制は第13章で扱います。
MMM に入れるデータは、目的変数・広告の量・広告以外の要因の3つの群からなり、公式ドキュメント(Meridian・Robyn)は、週次のデータで、全国のモデルなら3年分(Meridian)、少なくとも2年分(Robyn)を目安とし、広告の量は広告費より露出量(GRP・インプレッション)を入力にすることを勧めていました。共通データで実際に試すと、この例では、1年分のデータで推定したモデルは当てはまりが最も良いのにディスプレイ広告の ROI を約23倍に見積もり、広告費を露出量の代わりにした場合や台帳に不備がある場合には、別の媒体の ROI まで動きました。データの量だけでなく、広告費の動き・定義の一貫性・記録の正しさを、モデルの前に点検することが必要です。次の第4章では、こうして整えたデータを回帰分析にかけ、売上を基礎売上と媒体ごとの効果に分ける仕組みを扱います。
この章を深めたい方への参考書籍
『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』(本橋智光、橋本秀太郎 著、技術評論社):データの抽出・集約・結合・日時の扱いなど、分析の前の加工を SQL・pandas・Polars で整理した本です。日次の記録を週に集計する、複数の台帳を週の単位で結合する、欠けた週を見つけるといった、この章で扱った整備の作業を手を動かして進めるときの手引きになります。
『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社):データ整備・システム・組織のあり方を扱った本で、第1章ではデータの品質を生成元のデータソースで担保するという考え方を説明しています。この章の後半で扱った「数字ごとに持ち主を決める」「台帳の段階で定義をそろえる」といった体制づくりを考えるときの参考になります。
第4章 回帰分析で売上を分解する
第3章では、MMM に使うデータの集め方と整え方を見ました。データがそろったら、次は週ごとの売上を「広告が無くても出た売上」と「媒体ごとに上乗せされた売上」に分ける作業に入ります。この分解の土台になるのが回帰分析です。この章では、第2章で用意したサンプルデータ(架空の日用品メーカーの第1〜156週の週次データ)を使い、広告費をそのまま説明変数に入れた最も単純な回帰(この記事で「素朴な回帰」と呼んでいるもの)を statsmodels で推定して、係数・標準誤差・信頼区間を読みます。そのうえで、係数をそのまま売上ROI と読めるのはどういう前提のときか、テレビCMとディスプレイ広告のように一緒に動く媒体を回帰がなぜ分けられないのか、分けられないときに何が起きるのかを、実行結果で確かめます。広告の効果が翌週以降に持ち越される性質は第5章、広告費を増やしても売上が比例して増えない性質は第6章、需要の高い週に広告が増える問題は第7章で扱います。
売上を基礎売上と媒体ごとの増分に分けるという考え方
週ごとの売上には、いろいろな理由で出た売上が混ざっています。広告を1円も出さなくても、既存のお客さまの買い替えや店頭での目に留まり方によって、一定の売上は出ます。夏と年末には売上が増え、値引き販促の週や大型連休の週にも増えます。事業が伸びていれば、年を追って売上の水準そのものが上がります。この記事では、こうした広告以外の理由で出る売上をまとめて基礎売上と呼んでいます(季節性・トレンド・販促・休日を含みます)。そのうえに、テレビCM・検索広告・SNS広告・ディスプレイ広告のそれぞれが上乗せした売上(増分売上)が積み上がって、観測される売上になる、と考えます。
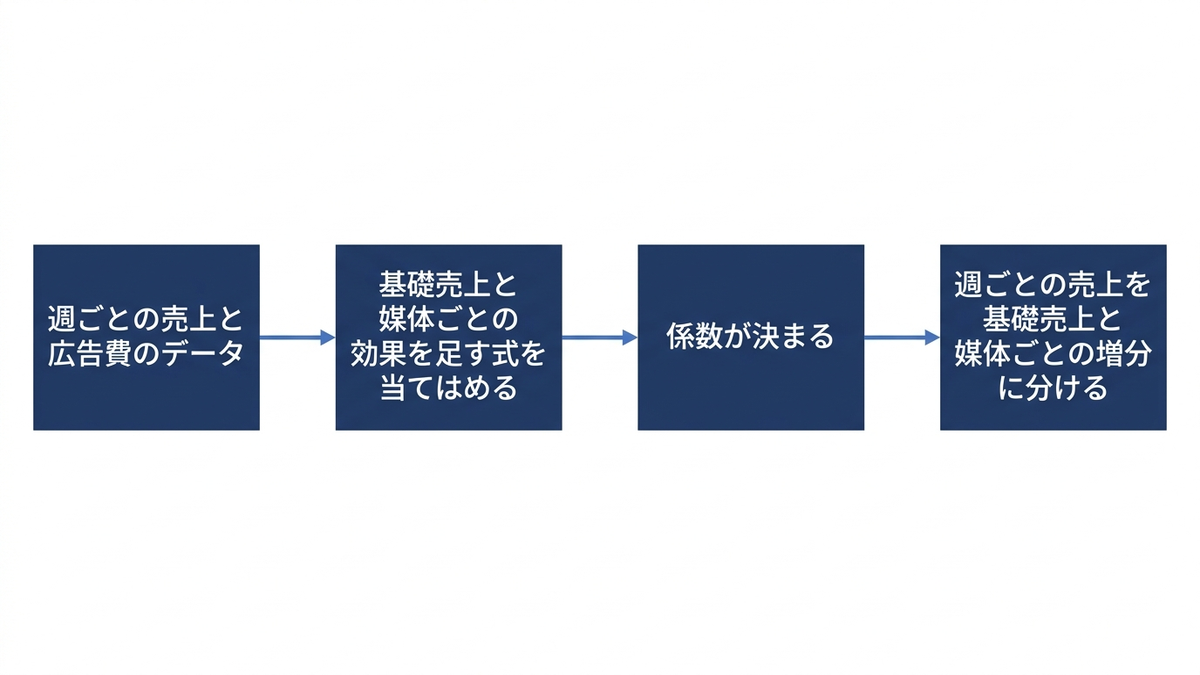
回帰分析は、この積み上げを「売上=基礎売上の部品+媒体ごとの効果+誤差」という式で表し、過去の週の売上と説明変数の動きから、それぞれの部品の大きさを推定する方法です。基礎売上の部品には、定数(売上の基本の水準)・トレンド(週を追って伸びる分)・季節を表す波(フーリエ項。第7章で詳しく扱います)・販促の週の印・休日の週の印を入れます。これらを統制変数と呼びます。媒体ごとの効果の部品には、各媒体の週の広告費を入れます。最小二乗法は、式で計算した売上と実際の売上の差を2乗して足した値が最も小さくなるように、各部品の係数を決めます。
こうして係数が決まると、週ごとの売上を部品ごとに分けて積み上げることができます。たとえばテレビCMの係数が0.54なら、その週のテレビの広告費に0.54を掛けた額が「テレビが上乗せした売上」で、統制変数の部分を足したものが「基礎売上」です。この分解が正しければ、媒体ごとの増分売上を広告費で割って売上ROI が出せ、予算をどの媒体に寄せるべきかの材料になります。問題は、この分解が正しいかどうかを、現実の観測データだけでは確かめにくいことです(実験で一部を確かめる方法は第10章で扱います)。この記事の共通データは乱数で作った架空のデータなので、データを作った側は本当の分解(真の値)を知っています。この章では、その真の値と照らし合わせながら、回帰の分解がどこで合い、どこでずれるかを見ていきます。
素朴な回帰を statsmodels で推定する
第2章で紹介した基準の結果では、素朴な回帰は baseline.naive_ols という関数で、numpy の最小二乗の計算だけを使っていました。係数は出ますが、係数がどれくらい確かなのか(標準誤差や信頼区間)は出していません。そこで、同じ回帰を statsmodels の OLS(通常の最小二乗法)で推定し直しました。学習期間は基準の結果と同じ第1〜130週で、統制変数も同じです。次のコードは、補助モジュール(mmm_data.py と baseline.py)と同じフォルダに置いて実行する形で、出力の文字コードを指定する冒頭の2行を省いて載せています。
import numpy as np
import pandas as pd
import statsmodels.api as sm
import mmm_data as md
import baseline as bl

df = md.make_data()
d = df.iloc[0:130]                       # 学習期間 第1〜130週
X = pd.DataFrame(bl.controls(d), columns=bl.CONTROL_NAMES)
for c in md.CHANNELS:                    # 広告費(万円)をそのまま説明変数に入れる
    X[c] = d[c].to_numpy()
y = d["sales"].to_numpy()
res = sm.OLS(y, X).fit()

ci = res.conf_int()
for c in md.CHANNELS:
    print("%-8s 係数 %5.2f  標準誤差 %4.2f  95%%区間 [%5.2f, %5.2f]  真のROI %.2f" % (
        c, res.params[c], res.bse[c], ci.loc[c, 0], ci.loc[c, 1],
        md.true_roi(df, c, (105, 156))))
print("R2 %.3f" % res.rsquared)
# 出力:
# tv       係数  0.54  標準誤差 0.13  95%区間 [ 0.28,  0.80]  真のROI 1.51
# search   係数  2.23  標準誤差 1.77  95%区間 [-1.28,  5.75]  真のROI 2.35
# social   係数  1.34  標準誤差 0.72  95%区間 [-0.09,  2.77]  真のROI 1.76
# display  係数  0.97  標準誤差 0.99  95%区間 [-0.99,  2.94]  真のROI 0.38
# R2 0.793
bl.controls は、定数・トレンド・季節のフーリエ項2組・販促・休日の8列を作る補助モジュールの関数で、bl.CONTROL_NAMES はその列名です。statsmodels で推定した係数は、基準の結果の baseline.naive_ols の係数と、差の最大が1.36×10のマイナス12乗という計算の丸めの範囲で一致しました。真のROI の列は、直近52週(第105〜156週)の真の売上ROI で、第2章の比較表と同じものです。媒体と統制変数の係数をまとめると、次の表になります。
| 変数 | 係数 | 標準誤差 | 95%信頼区間 | 真の値 |
|---|---|---|---|---|
| 定数(万円/週) | 3,340.90 | 498.47 | 2,353.80〜4,328.01 | 3,000 |
| トレンド(万円/年) | 212.99 | 65.17 | 83.93〜342.04 | 104.0 |
| 販促の週(万円) | 374.17 | 99.05 | 178.03〜570.31 | 350 |
| 休日の週(万円) | 510.49 | 302.12 | -87.78〜1,108.77 | 500 |
| テレビCM(広告費1万円あたり) | 0.54 | 0.13 | 0.28〜0.80 | 1.51 |
| 検索広告(同) | 2.23 | 1.77 | -1.28〜5.75 | 2.35 |
| SNS広告(同) | 1.34 | 0.72 | -0.09〜2.77 | 1.76 |
| ディスプレイ広告(同) | 0.97 | 0.99 | -0.99〜2.94 | 0.38 |
表の「真の値」の列は、統制変数の行では共通データを作ったときの設定(基礎売上3,000万円・トレンド週2万円=年104万円・販促350万円・休日500万円)、媒体の行では直近52週の真の売上ROI です。媒体の係数の単位は「広告費1万円あたりの売上(万円)」で、真の売上ROI と同じ単位になっています。標準誤差は、同じ仕組みからデータを取り直したら係数がどれくらいばらつくかの目安で、95%信頼区間はおおよそ係数の前後に標準誤差の2倍弱をとった幅です。ただし、ここでの標準誤差と信頼区間は、残差が週ごとに独立でばらつきが一定である、といった通常の最小二乗法の仮定に基づく参考値です。この章の後半で見るとおり、この回帰の残差には前後の週のつながり(自己相関)があるので、厳密な不確かさの評価には第9章で扱う方法が要ります。学習期間の決定係数(R2。売上の動きのうち式で説明できた割合)は0.793でした。基準の結果によると、素朴な回帰の予測の誤差(MAPE)は学習期間で7.02%、検証期間(第131〜156週)で13.53%で、アドストックと飽和を入れた MMM(基準)の検証期間 2.64% と比べて大きく外れています。
表から読めることを3つ挙げます。1つ目は、テレビCMの係数0.54が真の1.51の約3分の1しかなく、しかも95%信頼区間(0.28〜0.80)が真の値を含んでいないことです。信頼区間は「このモデルの形が正しければ」という前提で計算された幅なので、形が間違っていると、狭い区間が自信を持って誤った値を示すことがあります。2つ目は、ディスプレイ広告の係数0.97が真の0.38の2倍以上で、検索広告(2.23)やSNS広告(1.34)と大差のない媒体に見えてしまうことです。3つ目は、検索広告・SNS広告・ディスプレイ広告の3つとも、信頼区間が0をまたいでいることです。統計の言葉では「有意ではない」状態ですが、これは「効果が無い」ことを意味しません。真の値で見ると、検索広告は4媒体の中で最も売上ROI の高い媒体です。このデータからは効果の大きさを絞り込めなかった、という意味に読むのが正確です。
係数を売上ROIと読めるのはどういう前提のときか
素朴な回帰の媒体の係数は「他の説明変数を固定したまま、その週の広告費を1万円増やしたときに、その週の売上が何万円増えるか」を表しています。この係数をそのまま売上ROI(増分売上÷広告費)として予算の判断に使うには、少なくとも次の前提が成り立っている必要があります。
- 広告の効果がその週のうちに出て、翌週以降に持ち越されない(持ち越しがあると、広告を出していない週の売上の一部も広告のおかげになる)
- 広告費と効果が比例する(広告費を2倍にすれば効果も2倍になる。飽和があると、広告費の水準によって1万円あたりの効果が変わる)
- 広告費の増減が、売上を動かす他の理由と結びついていない(需要が高い週に広告費を増やす運用をしていると、需要の高さが広告の手柄に見える)
- 媒体どうしの広告費が、互いに独立に動いた週が十分にある(いつも一緒に動いていると、どちらの手柄かを分けられない)
- 基礎売上を表す統制変数が、売上を動かす広告以外の理由を取りこぼしていない
1つ目と2つ目が成り立てば、増分売上は「係数×広告費」になり、平均の ROI(増分売上÷広告費)と、あと1万円増やしたときの ROI(限界ROI。第11章で詳しく扱います)がどちらも係数に一致します。直線の式を当てはめるということは、この2つの ROI が同じだと仮定していることでもあります。共通データの真の仕組みは、1つ目と2つ目を両方とも満たしていません。テレビCMは翌週へ70%の効果を持ち越し、どの媒体にも上限のある S字や逓減の曲線が掛かっています。3つ目については、検索広告の広告費を需要(季節性・休日)に連動させて作ってあります。4つ目については、ディスプレイ広告をテレビの放映期間に合わせて増やす運用にしてあり、テレビとの相関は0.91です。素朴な回帰の係数がずれたのは、こうした前提の崩れの結果です。
回帰という道具そのものに問題があるのか、それとも式の形が合っていないのかを分けるために、データを作った側だけが知っている真の変換を説明変数に使って、同じ最小二乗の回帰をやり直しました。現実には真の持ち越し率や飽和の形は分からないので、これは考え方を確かめるためだけの計算です。1つ目は広告費をそのまま入れた素朴な回帰、2つ目は真の持ち越し率でアドストック(持ち越しを足し込んだ広告費。第5章で扱います)に変換した広告費を直線のまま入れたもの、3つ目は真のアドストックに真の Hill 関数(飽和の曲線。第6章で扱います)を掛けたものです。学習期間はいずれも第1〜130週で、ROI は直近52週で計算しました。
| 説明変数の形 | 学習期間のR2 | 検証期間のMAPE | テレビCMのROI | 検索広告のROI | SNS広告のROI | ディスプレイ広告のROI |
|---|---|---|---|---|---|---|
| 広告費そのまま(素朴な回帰) | 0.793 | 13.53% | 0.54 | 2.23 | 1.34 | 0.97 |
| 真の持ち越し率でアドストック(直線) | 0.953 | 3.14% | 1.48 | 2.90 | 1.37 | -0.11 |
| 真のアドストック+真のHill関数 | 0.988 | 2.16% | 1.48 | 2.21 | 1.88 | 0.43 |
| 真の値(直近52週) | なし | なし | 1.51 | 2.35 | 1.76 | 0.38 |
表の3行目(真のアドストック+真のHill関数)では、4媒体の ROI が真の値に近くなりました。このとき回帰が推定した係数は、テレビCM 2,169・検索広告 1,035・SNS広告 909・ディスプレイ広告 313 で、真の上限(beta)の 2,200・1,100・850・280 に近い値です。統制変数の定数は 2,979(真 3,000)、トレンドは年 114.9(真 104.0)でした。式の形さえ合っていれば、最小二乗の回帰はこのデータから媒体の効果をかなりの精度で分けられる、ということです。2行目の持ち越しだけを入れた形では、テレビCMの ROI は1.48と真の値に近づきましたが、ディスプレイ広告が -0.11 と負になり、検索広告は2.90と真の値を上回りました。持ち越しを入れても飽和を入れなければ、残ったずれを別の媒体が吸い取ってしまうことがある、という例です。
ただし、この表は「真の形を知っていれば」という仮定の上の結果です。現実には持ち越し率や飽和の形もデータから推定しなければならず、第2章で見たとおり、それを推定する MMM(基準)は、予測の当てはまりが良い(検証期間の MAPE 2.64%)のに、検索広告とSNS広告の ROI を真の値の約半分に見積もりました。式の形を推定する難しさは第8章で、推定の不確かさをどう示すかは第9章で扱います。この章で押さえておきたいのは、回帰の係数を ROI と読むときに疑うべきは「計算の精度」より先に「式の形と前提」だ、ということです。
推定した分解を真の値と比べる
素朴な回帰の係数で週ごとの売上を分解し、真の分解と比べました。真の分解はデータを作った側だけが知る分解、素朴な回帰の分解は第1〜130週で推定した係数で全156週を分けたもので、第131〜156週は推定に使っていない検証期間です。どちらも、週ごとの売上を基礎売上と、テレビCM・検索広告・SNS広告・ディスプレイ広告の増分売上に分けています。2つの分解の違いが最もはっきり出るのはテレビCMなので、テレビCMの増分売上を、テレビを放映した週と放映していない週に分けて3年間(第1〜156週)で合計しました。
| テレビCMの増分売上(3年) | 真の分解 | 素朴な回帰の分解 |
|---|---|---|
| テレビを放映した週(44週)の合計 | 72,830万円 | 38,191万円 |
| テレビを放映していない週(112週)の合計 | 40,544万円 | 0万円 |
| 3年間の合計 | 113,374万円 | 38,191万円 |
| 放映していない週に出た割合 | 35.8% | 0% |
真の分解では、テレビCMの増分売上が放映期間の後にも裾を引いて、数週間かけて減っていきます。素朴な回帰の分解では、テレビCMの増分売上は放映期間の週だけに現れ、放映が終わった週には0になります。素朴な回帰は広告費をその週の売上にしか結びつけないので、持ち越しを表しようがないからです。そのため、放映が終わった直後の週には、観測された売上が素朴な回帰の分解の合計(基礎売上と4媒体の増分売上の和)を上回り、説明できない売上として残っています。表の数字で見ると、共通データでテレビを放映した週は156週のうち44週で、真のテレビCMの増分売上113,374万円のうち40,544万円(35.8%)は、放映していない112週に出ていました。素朴な回帰では、放映していない週のテレビの増分は0で、放映した週の増分も38,191万円と、真の値(72,830万円)の約半分でした。
3年間の売上の合計に占める割合(寄与の割合)で比べると、次のようになります。
| 項目 | 真の寄与の割合(3年) | 素朴な回帰の寄与の割合(3年) |
|---|---|---|
| 基礎売上 | 0.650 | 0.751 |
| テレビCM | 0.144 | 0.048 |
| 検索広告 | 0.105 | 0.099 |
| SNS広告 | 0.080 | 0.062 |
| ディスプレイ広告 | 0.023 | 0.059 |
素朴な回帰は、テレビCMの寄与の割合を真の0.144に対して0.048と約3分の1に見積もり、ディスプレイ広告を真の0.023に対して0.059と2倍以上に見積もりました。基礎売上は真の0.650に対して0.751で、媒体の効果の一部が基礎売上の側に入っています(残差の合計は売上の合計の -0.020 で、4媒体と基礎売上の割合を足すと1を少し上回ります)。基礎売上の係数を見ると、定数は3,341万円(真 3,000)、トレンドは年213.0万円(真 104.0)で、どちらも大きめに推定されました。素朴な回帰は放映していない週のテレビの増分を表せないので、その週の売上は基礎売上の部品と他の媒体で説明するしかありません。MMM(基準)でも定数とトレンドは大きめに推定されましたが、第2章で見たとおり、MMM(基準)が検索広告と SNS広告を約半分に見積もったことは、基礎売上の大きさだけでは説明できません。真の基礎売上を与えて推定し直しても過小評価は残り、媒体の効果の合計は合うのに媒体どうしへの振り分けが外れていました(第7章と第8章で扱います)。基礎売上と媒体の効果の境目は、回帰の分解で最もずれやすい場所の1つです。
残差(実際の売上と式の売上の差)にも、持ち越しの痕跡が出ています。素朴な回帰の学習期間の残差について、ある週の残差と翌週の残差の相関(1次の自己相関)は0.69、ダービン・ワトソン統計量(残差に前後の週のつながりが無ければ2の近くになる指標)は0.62でした。残差が前の週の残差に引きずられて同じ向きに続いているということで、式に入っていない「週をまたいで続く何か」がある印です。残差の確かめ方は第8章で扱います。
多重共線性:テレビCMとディスプレイ広告を分けられない
素朴な回帰がディスプレイ広告を大きく、テレビCMを小さく見積もった理由は、持ち越しの無視だけではありません。共通データでは、ディスプレイ広告をテレビの放映期間に合わせて増やす運用をしているので、2つの媒体の週ごとの広告費の相関は0.91(学習期間の第1〜130週でも0.91)でした。説明変数どうしがこのように強く連動している状態を多重共線性と呼びます。2つの広告費がいつも一緒に増え、一緒に減っていると、売上が増えた週にどちらの手柄だったのかを、データの中で区別する手がかりがほとんど残りません。回帰は、2つの広告費が少しだけ違う動きをした週の売上の差を頼りに割り振るしかなく、その少しの違いに乗っている誤差の影響を強く受けます。
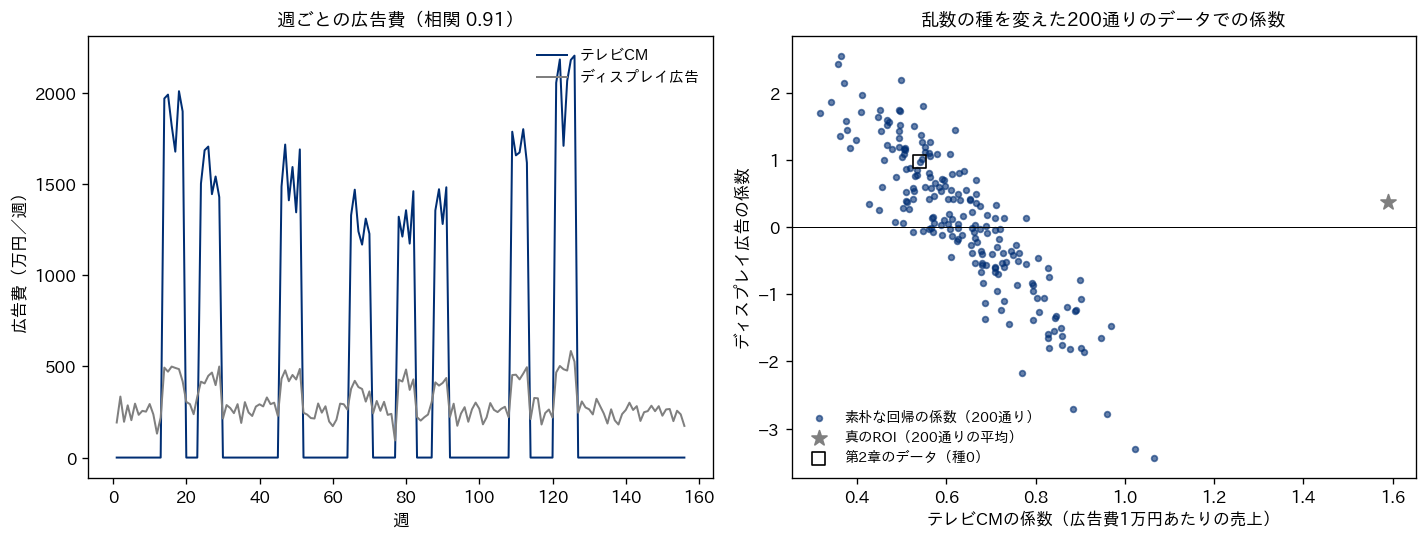
どれくらい連動しているかを測る指標に、分散拡大係数(VIF)があります。ある説明変数を、残りのすべての説明変数で回帰したときの決定係数を R2 として、次の式で計算します。
\( \mathrm{VIF} = \dfrac{1}{1 – R^2} \)
言葉で言うと、「その変数の動きが、他の変数の組み合わせでどれだけ言い当てられてしまうか」を測っています。他の変数で全く説明できなければ R2 が0で VIF は1、9割説明できてしまえば VIF は10です。VIF は、他の変数と全く連動していない場合と比べて、その係数のばらつき(分散)が何倍に膨らむかを表しています。statsmodels の variance_inflation_factor の説明文には、VIF が5を超えると、その説明変数は他の説明変数と強い共線性を持ち、係数の推定値の標準誤差が大きくなる、という目安が1つの推奨として書かれています(statsmodels の公式ドキュメント。この記事の実行環境の 0.14.6 の説明文でも同じ記述を確認しました)。前のコードの続きとして、VIF を計算し、テレビCMとディスプレイ広告の片方を外した回帰と、2つを足し合わせた回帰を推定しました。
from statsmodels.stats.outliers_influence import variance_inflation_factor

Xv = X.to_numpy(dtype=float)
for c in md.CHANNELS:
    print("%-8s VIF %5.2f" % (c, variance_inflation_factor(Xv, list(X.columns).index(c))))

variants = {
    "ディスプレイを外す": X.drop(columns=["display"]),
    "テレビを外す": X.drop(columns=["tv"]),
    "合算する": X.drop(columns=["tv", "display"]).assign(tvd=X["tv"] + X["display"]),
}
for name, Xa in variants.items():
    r = sm.OLS(y, Xa).fit()
    keys = [k for k in ["tv", "display", "tvd"] if k in Xa.columns]
    print(name, {k: round(float(r.params[k]), 2) for k in keys}, "R2 %.3f" % r.rsquared)
# 出力:
# tv       VIF  6.22
# search   VIF 10.80
# social   VIF  1.53
# display  VIF  5.96
# ディスプレイを外す {'tv': 0.66} R2 0.791
# テレビを外す {'display': 4.58} R2 0.764
# 合算する {'tvd': 0.59} R2 0.792
VIF は、テレビCMが6.22、ディスプレイ広告が5.96で、どちらも目安の5を超えました。補助の回帰(テレビの広告費を他のすべての説明変数で回帰したもの)の決定係数は、テレビで0.839、ディスプレイで0.832で、それぞれの広告費の動きの8割以上が、もう一方の広告費と統制変数で言い当てられてしまう、ということです。statsmodels で求めた係数の推定値どうしの相関(係数のばらつきの共分散から計算したもの)は、テレビCMとディスプレイ広告の間で -0.90 でした。一方の係数が大きめに出るデータでは、もう一方が小さめに出るという、シーソーのような関係です。
見落としやすいのは、VIF が最も大きかったのがテレビでもディスプレイでもなく、検索広告(10.80)だったことです。検索広告の広告費を他の説明変数で回帰すると、決定係数は0.907で、効いていたのは季節の波(cos1 の t値 -23.01、cos2 の t値 15.64)と休日の週の印(t値 12.94)でした。t値は、係数が標準誤差の何倍あるかを表す値で、絶対値が大きいほど、その変数とのつながりがはっきりしていることを示します。テレビ・SNS・ディスプレイの広告費の係数はほぼ0です。共通データでは検索広告の広告費を需要(季節性・休日)に連動して増える設定にしているので、検索広告は他の媒体ではなく、基礎売上の側の統制変数と連動しています。検索広告の係数と休日の係数の推定値どうしの相関は -0.76 で、「休日の週に売上が増えたのは、休日のせいか、休日に増やした検索広告のせいか」を分けにくい状態です。検索広告の係数の標準誤差が1.77と大きく、信頼区間が -1.28 から 5.75 まで広がっているのはこのためです。媒体どうしの相関だけを見ていると、この種の多重共線性を見逃します。需要と連動して広告を出す運用が推定をどう歪めるかは、交絡の問題として第7章で詳しく扱います。
片方を外す・足し合わせると何が起きるか
多重共線性に気づいたとき、すぐに思いつく対処は「片方の媒体を説明変数から外す」ことと「2つを足し合わせて1つの説明変数にする」ことです。前のコードの結果に、検証期間の予測の誤差と標準誤差・信頼区間を加えて整理したのが次の表です。学習期間はいずれも第1〜130週です。
| 回帰の形 | テレビCMの係数 | ディスプレイ広告の係数 | テレビ+ディスプレイ合算の係数 | 学習期間のR2 | 検証期間のMAPE |
|---|---|---|---|---|---|
| A 4媒体すべて(素朴な回帰) | 0.54(0.28〜0.80) | 0.97(-0.99〜2.94) | なし | 0.793 | 13.53% |
| B ディスプレイを外す | 0.66(0.54〜0.77) | なし | なし | 0.791 | 13.78% |
| C テレビを外す | なし | 4.58(3.66〜5.50) | なし | 0.764 | 13.35% |
| D 2つを合算する | なし | なし | 0.59(0.48〜0.69) | 0.792 | 13.62% |
括弧の中は95%信頼区間です。学習期間のR2 は4つの形で0.764から0.793、検証期間のMAPE は13.35%から13.78%で、予測の当てはまりはほとんど変わりません。ところが係数は大きく動きます。C のテレビを外した回帰では、ディスプレイ広告の係数が4.58になり、信頼区間も3.66〜5.50と狭くなりました。真のディスプレイ広告の売上ROI は0.38なので、10倍以上の過大評価です。テレビの放映期間に出ていた売上の増加を、同じ時期に増えていたディスプレイ広告が引き受けた形になっています。しかも、この誤った係数は狭い信頼区間を伴っていて、統計的には「はっきり効いている」ように見えます。説明変数を外すと、外した変数の効果は、それと連動している残りの変数に乗り移ります。外した変数が売上に効いているなら、乗り移った先の係数は偏ったものになります(回帰分析の用語で、欠落変数による偏りと呼ばれるものです)。
B のディスプレイを外した回帰では、テレビCMの係数が0.66に上がり、信頼区間が0.54〜0.77と狭くなりました。真のテレビの売上ROI 1.51には遠いままで、これは持ち越しを無視していることによるずれが残っているためです。この例では、ディスプレイ広告を外したことでテレビの係数は0.12上がっただけでした(ディスプレイ広告の真の売上ROI は0.38です)。ただし、それは真の値を知っているから言えることで、現実のデータで「ディスプレイの効果は小さいから外してよい」と判断する根拠は、外す前の回帰の結果からは得られません。A の回帰はディスプレイの係数を0.97と推定していて、それを信じるなら外してはいけない媒体に見えるからです。
D の2つを合算した回帰では、係数は0.59、信頼区間は0.48〜0.69と、A のテレビとディスプレイの個別の係数よりずっと狭くなりました。2つの媒体を分けることをあきらめれば、「2つを合わせた広告費1万円あたりの売上」は安定して推定できる、ということです。真の値で見ると、直近52週のテレビとディスプレイを合わせた売上ROI は1.03(増分売上37,509万円÷広告費36,594万円)、3年間では1.11でした。合算の係数0.59は、持ち越しを無視しているぶん、この真の値からも低くずれています。合算は予測の安定には効きますが、「テレビとディスプレイのどちらに予算を寄せるべきか」という問いには答えられなくなります。配分の判断が要る媒体どうしを合算すると、肝心の判断の材料を手放すことになります。
データを作り直して200回推定すると、係数はどこまで揺れるか
多重共線性の害は、1回の推定結果を見ているだけでは分かりにくいものです。第2章のデータ(乱数の種0)での推定値は、テレビ0.54・ディスプレイ0.97という1組の数字にすぎません。同じ仕組み(真のパラメータ・広告費の出し方・誤差の大きさ)から、乱数の種だけを変えて共通データを200通り作り直し、それぞれで素朴な回帰を推定しました。テレビの放映の時期や長さ、販促の週、SNS広告の動き、観測の誤差は種ごとに変わります。前のコードの続きです。
rows = []
for s in range(200):                     # 乱数の種だけを変えてデータを作り直す
    ds = md.make_data(seed=s).iloc[0:130]
    Xs = pd.DataFrame(bl.controls(ds), columns=bl.CONTROL_NAMES)
    for c in md.CHANNELS:
        Xs[c] = ds[c].to_numpy()
    p = sm.OLS(ds["sales"].to_numpy(), Xs).fit().params
    rows.append({"tv": p["tv"], "display": p["display"]})
r = pd.DataFrame(rows)
for k in ["tv", "display"]:
    print("%-8s 平均 %.2f  標準偏差 %.2f  負になった割合 %.1f%%" % (
        k, r[k].mean(), r[k].std(), 100 * (r[k] < 0).mean()))
print("2つの係数の相関 %.2f" % r["tv"].corr(r["display"]))
# 出力:
# tv       平均 0.63  標準偏差 0.14  負になった割合 0.0%
# display  平均 0.10  標準偏差 1.08  負になった割合 44.5%
# 2つの係数の相関 -0.89
掲載したコードは、テレビCMとディスプレイ広告の係数を集計する部分に絞って抜き出したものです。検索広告・SNS広告の係数と、テレビとディスプレイを合算した回帰の係数も同じ200通りで集計し、真の売上ROI(直近52週)の200通りの平均と並べたのが次の表です。200通りのデータで、テレビとディスプレイの広告費の相関は平均0.92(最小0.85・最大0.95)でした。
| 係数 | 200通りの平均 | 標準偏差 | 5%点 | 95%点 | 負になった割合 | 真の売上ROIの平均 |
|---|---|---|---|---|---|---|
| テレビCM | 0.63 | 0.14 | 0.41 | 0.89 | 0.0% | 1.59 |
| ディスプレイ広告 | 0.10 | 1.08 | -1.66 | 1.71 | 44.5% | 0.38 |
| 検索広告 | 1.48 | 1.85 | -1.60 | 4.30 | 21.5% | 2.36 |
| SNS広告 | 0.82 | 1.39 | -1.42 | 2.90 | 28.0% | 1.39 |
| テレビ+ディスプレイ合算 | 0.58 | 0.06 | 0.47 | 0.67 | 0.0% | なし |
ディスプレイ広告の係数は、200通りの平均が0.10、標準偏差が1.08で、5%点の -1.66 から95%点の 1.71 まで散らばり、44.5%のデータで負になりました。負の係数は「ディスプレイ広告を出すほど売上が減る」という意味になり、現実の予算会議にそのまま出せば「ディスプレイは止めるか、大きく削るべきだ」という結論に傾きます。逆に、1を超える係数も200通りのうち22.5%で出ました。また、ディスプレイ広告の係数がテレビCMの係数を上回り、テレビより効いている媒体に見える結果は200通りのうち35.0%ありました。同じ仕組みから出てきたデータなのに、どのデータを手にしたかで、ディスプレイ広告は「止めるべき媒体」にも「テレビより効く媒体」にもなる、ということです。テレビの係数とディスプレイの係数の200通りでの相関は -0.89 で、前の図の右側のとおり、点が左上から右下への帯の上に並びます。2つの係数は、片方が増えればもう片方が減る形で、合計をほぼ保ったまま揺れています。合算した回帰の係数の標準偏差が0.06と小さいのは、この合計が安定していることの表れです。
テレビCMの係数は、標準偏差0.14と揺れは小さいものの、200通りの最大でも1.07で、200通りのすべてで同じデータの真の売上ROI(種ごとに1.38〜1.80)を下回りました。これは多重共線性ではなく、持ち越しを無視していることによる系統的な偏りです。持ち越しを無視した同じ式のままでは、データを増やしても、偏りは平均の位置をずらしたまま残ります。この表は、素朴な回帰の誤差に2つの種類があることを示しています。ディスプレイ広告のように「平均の周りで大きく揺れる」誤差と、テレビCMのように「揺れは小さいが平均そのものがずれている」誤差です。前者は不確かさとして区間で示せば判断の材料になりますが、後者は区間を示しても気づけません。区間の示し方は第9章、実験で偏りを確かめる方法は第10章で扱います。
なお、検索広告とSNS広告の係数も、負になった割合がそれぞれ21.5%と28.0%ありました。SNS広告の真の売上ROI は種によって0.85から1.85まで変わり、200通りの平均は1.39で、第2章のデータ(1.76)とは同じではありません。真の値もデータごとに違うので、この表の「真の売上ROIの平均」の列は、係数の平均と大まかに比べるための目安です。
多重共線性にどう対処するか
多重共線性はデータの性質なので、計算の工夫だけで消すことはできません。2つの媒体の広告費がいつも一緒に動いていれば、データの中には2つを分ける情報がそもそも少ししか無いからです。対処の選択肢は、大きく分けて「データに分ける情報を足す」ものと「モデルの側で分けることをあきらめる、または外の情報を入れる」ものの2つです。
データに情報を足す方法として、最も直接的なのは、連動している媒体の出し方を意図的にずらすことです。たとえば、テレビの放映期間のうち一部の期間だけディスプレイ広告を増やさない、地域によってディスプレイ広告の出し方を変える、といった運用です。2つの広告費が別々に動いた週が増えれば、回帰が割り振りに使える手がかりが増えます。共通データのディスプレイ広告は、テレビとの相関が0.91になるように作ってあり、この「連動させる運用」こそが分けられない原因でした。媒体の運用の決め方そのものが、後で効果を測れるかどうかを左右する、ということです。広告の出し方を計画的に変えて効果を測る実験(地域実験など)は第10章で扱います。
モデルの側の方法としては、ここまでに見た合算のほかに、係数が極端な値に振れないよう罰則を掛ける正則化(リッジ回帰。第8章で扱います)や、過去の実験や業界の知見から「この媒体の効果はこのくらいの範囲にあるはずだ」という情報を事前分布として入れるベイズ推定(第9章で扱います)があります。どちらも、データだけでは決めきれない割り振りを、データの外の考え方や情報で補うものです。補った情報が正しければ推定は安定しますが、補った情報が誤っていれば、その誤りがそのまま結果に入ります。補った前提を必ず報告に書き添えることが、この種の方法を使うときの条件だと考えています。
してはいけないのは、VIF が大きいからといって、効果を確かめないまま媒体を説明変数から外すことです。前の節の C の回帰のように、外した媒体の効果が残りの媒体に乗り移り、狭い信頼区間を伴った誤った係数が出てきます。外すかどうかは統計の指標ではなく、「その媒体の効果を個別に知る必要があるか」という判断の問題です。予算の判断に要らない区別(たとえば、同じテレビの中の時間帯の違い)なら合算してかまいませんが、予算を付け替える候補どうしなら、データに情報を足す方向で対処するのが筋だと考えています。回帰分析そのもの(係数の読み方・多重共線性・変数の選び方)をより詳しく知りたい場合は、弊社コラム『ビジネスの要因分析に効く回帰分析と統計モデリングについて』で扱っています。
経営の判断に翻訳する
この章の結果を、予算の判断の言葉に置き換えます。第2章で紹介した基準の結果では、素朴な回帰の係数をそのまま ROI と信じて配分を決めると(直近52週の週平均の総額1,156.5万円/週を固定し、各媒体を現状の0.5〜2倍の範囲で動かした場合)、テレビCMを週402.9万円から201.5万円へ、ディスプレイ広告を300.8万円から150.4万円へ、それぞれ半分に削り、検索広告を224.3万円から448.5万円へ、SNS広告を228.5万円から356.1万円へ増やす配分になりました。真の応答で測ると、この配分は現状より増分売上が年10,741万円少なくなります。架空の粗利率0.50で粗利に直すと、年約5,371万円の減少です(いずれも「毎週同じ額を出し続ける」定常状態での計算)。素朴な回帰の誤りが、効いている媒体(テレビ)を削り、その分を素朴な回帰が ROI を高く見積もった媒体に積む判断になって表れた例です。
この章の分析は、その誤りがどこから来たかを2つに分けて示しています。1つは持ち越しの無視で、3年合計でテレビの効果の35.8%(直近52週では38.7%。第1章)が放映していない週に出ていたのに、素朴な回帰はそれを基礎売上の側や他の媒体の手柄にしてしまいました。もう1つは多重共線性で、テレビと連動するディスプレイ広告の係数が、同じ仕組みのデータでも負から1を超える値まで揺れました。前者は「テレビを止めても売上はすぐには落ちない」という観察を「テレビは効いていない」と取り違える誤りにつながり、後者は「たまたま手にしたデータ」によって媒体の評価が入れ替わる誤りにつながります。どちらも、回帰の当てはまり(R2 や MAPE)を見ているだけでは気づけません。前の節の A〜D の4つの回帰は、検証期間の MAPE がほぼ同じなのに、ディスプレイ広告の係数は0.97から4.58まで違っていました。
経営の側で確かめるべきことを3つに整理します。1つ目は、媒体別の ROI の報告に、係数の信頼区間と、その媒体と連動している他の変数(他の媒体・季節・休日)が併記されているかです。信頼区間が0をまたぐ媒体や、VIF が大きい媒体の数字は、単独で予算の付け替えの根拠にしないほうが安全です。2つ目は、媒体の出し方の決め方です。テレビとディスプレイを一緒に増やす、需要が高い週に検索広告を増やすといった運用は、それぞれに理由がありますが、そのままでは効果を分けて測れません。年に数回でも、連動を外した期間や地域を作ることは、測定のための投資として検討する価値があると考えています。3つ目は、「有意ではない」を「効果が無い」と読み替えないことです。この例の検索広告は信頼区間が0をまたいでいましたが、真の値では4媒体の中で最も売上ROI の高い媒体でした。
この章の要点は3つです。第一に、回帰分析は売上を基礎売上と媒体ごとの増分に分ける土台ですが、係数を売上ROI と読めるのは、持ち越しが無い・効果が広告費に比例する・広告費が他の売上の理由と連動していない・媒体どうしが独立に動いた週がある、といった前提が成り立つときだけです。共通データで真の変換を使った回帰が ROI をほぼ当てたことから、問題は回帰という道具より式の形と前提にあることが分かります。第二に、テレビCMとディスプレイ広告のように連動して動く媒体は、多重共線性のために個別の効果が大きく揺れ、片方を外すと効果が残りの媒体に乗り移ります。予測の当てはまりは、この揺れを教えてくれません。第三に、素朴な回帰がテレビCMを大きく過小評価したのは、多重共線性より持ち越しの無視によるところが大きく、この偏りは同じ式のままデータを増やしても消えません。次の第5章では、その持ち越しを表すアドストックを取り上げ、持ち越し率をデータから推定する方法を扱います。
この章を深めたい方への参考書籍
『計量経済学』(西山慶彦・新谷元嗣・川口大司・奥井亮、有斐閣):New Liberal Arts Selection の1冊で、第5章で重回帰モデルの推定と検定を扱い、第Ⅲ部で系列相関と時系列モデル、トレンドと構造変化を扱う教科書です。この章で使った最小二乗法・標準誤差・信頼区間の考え方を体系的に確かめるのに加え、週次の売上のように時間の順に並んだデータを回帰するときの注意点(残差の系列相関など)へ進むのに向いています。
『Rによる実証分析 第2版 回帰分析から因果分析へ』(星野匡郎・田中久稔・北川梨津、オーム社):回帰分析の基礎から、相関関係と因果関係、外生変数と内生変数を経て、ランダム化実験・操作変数法・パネルデータ分析までを、Rで手を動かしながら進める本です。この章で見た「広告費が他の売上の理由と連動していると係数が偏る」問題を、因果関係の推定という観点から整理し直すのに向いています。
第5章 アドストック、広告の効果は翌週以降に持ち越される
第4章では、売上を基礎売上と媒体ごとの効果に分ける回帰を組み、広告費をそのまま説明変数に入れた素朴な回帰が、第2章で用意したサンプルデータのテレビCMの売上ROIを0.54と、真の値1.51の約3分の1に見積もったことを確かめました。その理由の1つが、この章の主題である広告の効果の持ち越しです。テレビCMを見た人がその週に買うとは限らず、翌週や翌々週に買うこともあります。素朴な回帰は「広告費を出した週の売上」だけを広告の手柄として数えるので、翌週以降に出た売上は、基礎売上か、たまたま同じ週に動いていた別の媒体の手柄になります。この章では、持ち越しを表すアドストックという考え方とその由来、最もよく使われる幾何減衰の形と、効果の山が後ろにずれる「遅れのあるアドストック」、持ち越し率を半減期に言い換える方法、テレビCMの放映期間と持ち越しの関係、持ち越し率をデータから推定する方法を、共通データで実行して確かめます。広告費を増やしても売上が比例して増えない飽和の問題は第6章で扱います。
アドストックという考え方とその由来
アドストックは、広告の効果を「その週の広告費」ではなく、「過去の広告費が少しずつ目減りしながら積み上がった量」として表す考え方です。今週の売上に効いているのは今週のテレビCMだけではなく、先週・先々週に見たCMの記憶も残っている、という見方を、1つの数式で扱えるようにしたものです。広告の効果を、在庫のように積み上がっては目減りしていくものとして捉えている、と言い換えることもできます。
この考え方の由来として広く引用されているのは、Simon Broadbent が、英国の市場調査協会の学会誌(Journal of the Market Research Society)に1979年に発表した、テレビ広告の効き方を論じた論文です。たとえば、広告のアドストック変換の考え方を整理した Joy Joseph の2006年の論文は、テレビ広告には最初に見た時点から数期間にわたって効果が続き、これが一般に広告の持ち越し、つまりアドストックと呼ばれていると書き、その出典として Broadbent の1979年の論文を挙げています。同じ論文は、Broadbent のモデルとして「今期のアドストック=今期の広告の量+減衰の係数×前期のアドストック」という式を示しています。本記事では、この1979年の原論文そのものは開いて確かめることができませんでした。参考として、Broadbent が Tim Fry と共著で同じ学会誌に1995年に発表した、長期の効果を視野に入れたアドストックのモデル化を題にした論文があることは、学術論文の書誌データベース(Crossref)の記録で確かめました。
なぜ広告の効果は持ち越されるのか。MMM(マーケティング・ミックス・モデリング)にベイズ推定を使った Google の研究者らの2017年の論文(Jin ら。広告の持ち越し効果と飽和をベイズ推定で扱ったもの)は、広告には露出した週より後の期間に現れる効果、つまり持ち越し効果があると広く考えられているとし、その理由として、消費者の反応が遅れること、家庭に在庫があるために購入が遅れること、広告を最初に見た人から話を聞いた人が買うことを挙げています。日用品であれば、CMを見た時点では家にまだ在庫があり、在庫が切れたときに思い出して買う、という流れは想像しやすいと思います。
持ち越しを数式に入れる意味は、広告の効果の総量を、広告費を出した週とその後の週に正しく割り振ることにあります。割り振りを誤ると、媒体の売上ROIを小さく見積もるだけでなく、「広告を止めても売上は落ちない」「放映の翌週に売上が落ちたのは別の理由だ」といった誤った読み方につながります。その具体的な大きさは、この章の後半で共通データを使って測ります。
幾何減衰:今週の効果の元=今週の広告費+持ち越し率×先週の値
アドストックの最も基本的な形が幾何減衰です。第2章で用意した補助モジュール(mmm_data.py)の md.geometric_adstock は、この形をそのまま実装しています。今週のアドストックを \( A_t \)、今週の広告費を \( x_t \)、持ち越し率を \( d \)(0以上1未満。この記事では decay と書きます)とすると、次の式になります。
\( A_t = x_t + d \times A_{t-1} \)
言葉で言い換えると、「今週の効果の元は、今週の広告費に、先週の効果の元の d 倍を足したもの」です。この式を過去にさかのぼって展開すると、今週の広告費は1倍、先週の広告費は d 倍、2週前は d の2乗倍、3週前は d の3乗倍、という重みで足し合わせたものになります。重みが毎週同じ割合で縮んでいくので、幾何減衰(等比数列の形で減っていくこと)と呼ばれます。Jin らの論文も、よく使われる重みの関数として、経過週数を \( l \) として重みを \( \alpha^{l} \) とする幾何減衰を挙げ、\( \alpha \) を広告の効果が1期から次の期へ残る割合(retention rate)と呼んでいます。この記事の decay と同じものです。
形を数字で見るために、第1週だけ100万円を出し、その後は1円も出さなかった場合のアドストックの値を、decay を変えて計算しました。次のコードは、補助モジュール(mmm_data.py)と同じフォルダに置いて実行する形です。
import numpy as np
import mmm_data as md

pulse = np.zeros(8)
pulse[0] = 100.0                      # 第1週だけ100万円、あとは0
for d in [0.1, 0.4, 0.7]:
    a = md.geometric_adstock(pulse, d)
    half = np.log(0.5) / np.log(d)    # 半減期(週)
    print("decay %.1f 半減期 %.2f週 累計 %.0f 値 %s" % (
        d, half, a.sum(), np.round(a[:6], 1)))

df = md.make_data()                   # 第2章の共通データ
tv = df["tv"].to_numpy()
stock = md.geometric_adstock(tv, md.TRUE["tv"]["decay"])
off = tv == 0
print("放映していない週 %d週、そのうちアドストックが100万円以上の週 %d週" % (
    off.sum(), (off & (stock >= 100)).sum()))
# 出力:
# decay 0.1 半減期 0.30週 累計 111 値 [100.   10.    1.    0.1   0.    0. ]
# decay 0.4 半減期 0.76週 累計 167 値 [100.   40.   16.    6.4   2.6   1. ]
# decay 0.7 半減期 1.94週 累計 314 値 [100.   70.   49.   34.3  24.   16.8]
# 放映していない週 112週、そのうちアドストックが100万円以上の週 64週
decay 0.1(共通データの検索広告の真の値)では、100万円の効果の元は翌週に10、2週後に1と、ほぼ1週で消えます。decay 0.4(SNS広告の真の値)では翌週40・2週後16・3週後6.4と、2〜3週で消えます。decay 0.7(テレビCMの真の値)では翌週70・2週後49・3週後34.3・4週後24・5週後16.8と、5週たってもまだ出した週の6分の1が残っています。コードの「累計」は、8週で打ち切った合計です。打ち切らずに足し続けた場合の合計は \( 1 / (1 – d) \) 倍になり、decay 0.7 では出した額の3.33倍です。この「3.33倍」はアドストックの単位での話で、売上がその倍だけ増えるという意味ではありません。アドストックは、第6章で扱う飽和の変換を通してから売上の効果になるからです。
コードの最後の2行は、共通データのテレビCMについて、放映していない週のアドストックを数えたものです。3年156週のうち112週はテレビCMの広告費が0ですが、そのうち64週は、アドストックがまだ100万円以上残っていました。素朴な回帰は、この64週を「テレビCMの効果が0の週」として扱っていたことになります。
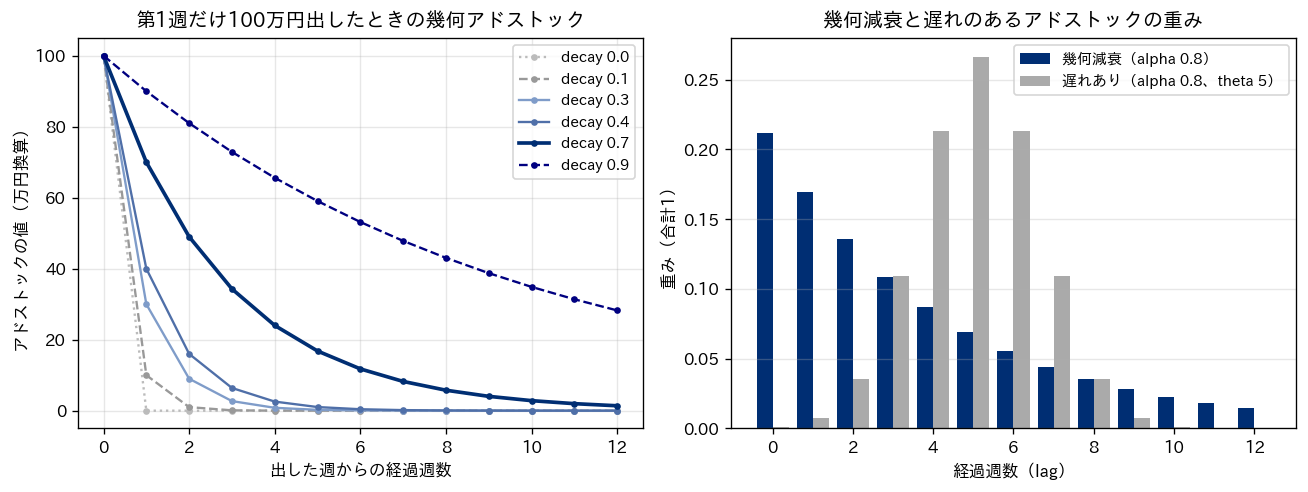
次の表は、decay の値ごとに、その意味を言葉に直しやすい形で整理したものです。「出した週より後の割合」は、打ち切らずに足し続けた累計のうち、広告費を出した週より後に現れる割合で、ちょうど decay に等しくなります。「4週後に残る割合」は、出した週の値に対する4週後の値の割合です。「累計の90%に届く週」は、出した週を週0と数えて、累計の90%以上が現れ終わる週です。
| decay | 半減期(週) | 累計の倍率 | 出した週より後の割合 | 4週後に残る割合 | 累計の90%に届く週 |
|---|---|---|---|---|---|
| 0.10 | 0.30 | 1.11 | 10.0% | 0.0% | 週0 |
| 0.30 | 0.58 | 1.43 | 30.0% | 0.8% | 週1 |
| 0.40 | 0.76 | 1.67 | 40.0% | 2.6% | 週2 |
| 0.50 | 1.00 | 2.00 | 50.0% | 6.2% | 週3 |
| 0.67 | 1.73 | 3.03 | 67.0% | 20.2% | 週5 |
| 0.70 | 1.94 | 3.33 | 70.0% | 24.0% | 週6 |
| 0.80 | 3.11 | 5.00 | 80.0% | 41.0% | 週10 |
| 0.90 | 6.58 | 10.00 | 90.0% | 65.6% | 週21 |
表の「出した週より後の割合」の列が示すとおり、decay 0.7 の媒体では、アドストックの単位で見た効果の元の70%が、広告費を出した週より後に現れます。decay が0.7から0.9へ0.2だけ上がると、「累計の90%に届く週」は週6から週21へ3倍以上に延びます。decay の値は0から1の間に収まる小さな数ですが、1に近い側では、わずかな違いが効果の続く期間を大きく変えます。後で見るとおり、decay を推定するときに1に近い値の判別が難しいのは、この性質のためです。表の decay 0.67 の行は、記事全体の基準の MMM(第2章で紹介した、アドストックと Hill 関数を掛けて最小二乗で推定したもの)がテレビCMについて推定した値で、真の0.70とほぼ同じ形になっています。
幾何減衰のアドストックから売上への効果が出るまでの計算は、毎週、次の順に進みます。
- 先週の効果の元(アドストック)に持ち越し率(decay)を掛けて、今週へ持ち越す分を出す
- 今週の広告費に、1で出した持ち越す分を足して、今週の効果の元(アドストック)にする
- 今週の効果の元を飽和の変換(第6章で扱います)に通して、売上への効果にする
- 翌週は、今週の効果の元を「先週の効果の元」として、1から同じ計算を繰り返す
持ち越し率を半減期に言い換える
decay 0.7 と言われても、経営の会議ではぴんと来ないことが多いと思います。そこで使われるのが半減期への言い換えです。半減期は、広告を止めたあと、アドストックが半分になるまでの週数です。decay を \( d \) とすると、次の式で計算できます。
\( \text{半減期} = \dfrac{\log 0.5}{\log d} \)
言葉で言い換えると、「毎週 d 倍ずつ縮むものが、0.5倍になるまでに何週かかるか」を計算しています。前述の Joseph の論文も、アドストックの減衰は通常、広告の半減期で表されるとし、放射性物質の半減期と同じ方法で計算するとして、同じ形の式を示しています。この式で、テレビCMの真の decay 0.70 は半減期1.94週、基準の MMM が推定した0.67は1.73週、SNS広告の0.40は0.76週、検索広告の0.10は0.30週になります。「テレビCMの効果は約2週で半分になり、6週でほぼ出尽くす」と言えば、放映計画を立てる人にも伝わりやすくなります。
半減期で話すときに気を付けたい点が2つあります。1つ目は、半減期はアドストックの単位での話だということです。売上の効果は、アドストックを飽和の変換に通した後のものなので、アドストックが半分になっても、売上の効果が半分になるとは限りません。共通データのテレビCMでは、後で見るとおり、放映を止めた翌週の真の増分売上は、放映の最終週の93%もありました。アドストックの単位では、放映の最終週(第126週)の6,250から翌週の4,375へ70%に落ちています。ところが、テレビCMの真の半飽和点(効果が上限の半分になるアドストックの値)は1,800なので、どちらの週も飽和の曲線(S字)の上の方にあり、効果の上限に対する割合は0.923から0.855へしか下がりませんでした。売上の効果がほとんど落ちなかったのはこのためです。2つ目は、半減期は週次データでの decay から計算したもので、データの粒度を変えると decay の値そのものが変わることです。日次データの decay と週次データの decay は同じ数字にはなりません。他社の事例や公開資料の decay の値を参考にするときは、何の粒度のデータでの値かを必ず確かめる必要があります。
媒体ごとの decay の目安として公開されているものに、Meta のオープンソースの MMM である Robyn の公式ドキュメントがあります。Robyn のドキュメントは、幾何アドストックの持ち越し率 theta について、theta=0.75 なら1期目の広告の75%が2期目に持ち越されるという意味だと説明したうえで、週次のモデルでの経験として、テレビは0.3〜0.8、屋外広告・印刷・ラジオは0.1〜0.4、デジタル広告は0.0〜0.3の範囲になる傾向があったと書いています。同時に、これは経験に基づく助言にすぎないので、自分のモデルを作るときは自分の判断で使うように、とも断っています。共通データの真の値は架空の設定で、テレビ0.70はテレビの目安の範囲に、検索0.10とディスプレイ0.30はデジタル広告の目安(0.0〜0.3)の範囲に入りますが、SNS 0.40 はデジタル広告の目安を上回ります。この目安は、推定した decay が常識外れの値になっていないかを確かめる物差しとしては使えますが、自社の decay の答えとして使うことはできません。
もう1つ、ツールによって式の「規格」が違う点にも注意が要ります。共通データの md.geometric_adstock は、重みを足し合わせただけの形(今週の広告費+d×先週の値)です。一方、Jin らの論文の式は、過去 L 週の広告費の重み付き和を、重みの合計で割った「重み付き平均」の形になっています。Google のオープンソースの MMM である Meridian の公式ドキュメントも、幾何減衰の重みは合計が1になるように正規化されると書いています。重みの合計で割るかどうかで、アドストックの値の大きさ(単位)が変わり、それに合わせて飽和の曲線の位置や効果の上限の推定値も変わります。曲線の形そのものは同じなので、どちらが正しいということではありませんが、ツールの出力の数字を別のツールや社内の計算と見比べるときに、同じ「半飽和点」でも単位が違うことがあります。
遅れのあるアドストック:効果の山が後ろにずれる場合
幾何減衰には、効果が最も大きいのは広告費を出した週で、あとは減る一方だという前提があります。Jin らの論文も、幾何減衰のアドストックは広告の効果が露出と同じ期間に山を迎えると仮定していると指摘し、媒体によっては効果が積み上がるのに時間がかかり、山がすぐには来ないことがあるとして、遅れのあるアドストック(delayed adstock)を提案しています。重みの式は、経過週数を \( l \)、山が来るまでの遅れを \( \theta \) として次の形です。
\( w(l) = \alpha^{(l – \theta)^{2}} \)
言葉で言い換えると、「経過週数が \( \theta \) のときに重みが最大になり、そこから前後に離れるほど、離れた週数の2乗に応じて重みが小さくなる」形です。論文は、この式が平均 \( \theta \) の正規分布の密度に比例すると説明しています。\( \theta \) が0なら山は出した週に来ますが、それでも幾何減衰(経過週数に比例して指数が増える形)とは違い、経過週数の2乗で減っていく形になります。論文は、持ち越しが続く最長の週数 L をすべての媒体で13週とし、重みの合計で割って重み付き平均の形にしています。論文の図1と同じ設定(\( \alpha \)=0.8、\( \theta \)=5、L=13)で重みを計算すると、幾何減衰の重みは経過0週の0.212が最大で、そこから0.169・0.135と減っていくのに対し、遅れのあるアドストックの重みは経過5週の0.267が最大で、経過4週と6週が0.213、経過3週と7週が0.109と、5週目を中心に左右対称に広がりました。前の図の右側がこの比較です。
遅れのある形が意味を持つのは、検討から購入までに時間がかかる商品です。Robyn の公式ドキュメントは、幾何アドストックに加えて、ワイブル分布(形を2つの値で柔軟に変えられる確率分布)を使った2種類のアドストックを用意しています。1つは減衰の速さが時間とともに変わる形(ワイブル分布の累積分布関数を使うもの)、もう1つは遅れた効果を表せる形(確率密度関数を使うもの)で、後者は購入までの期間(コンバージョンの窓)が長い商品に強く勧める、と書いています。Meridian の公式ドキュメントは、幾何減衰と二項分布型の減衰の2つを用意し、効果が持ち越しの期間の後半まで大きく残ると考えられる媒体には二項分布型、そうでなければ幾何減衰を勧めています。持ち越しを数える最長の期間(max_lag)の推奨の範囲は、幾何減衰で2〜10期、二項分布型で4〜20期とされ、max_lag を大きくするとデータが足りなくなってモデルのばらつきが大きくなりやすいこと、max_lag を大きくしても ROI の推定値が増えるとは限らないことも書かれています。
形の選択肢が増えると、どれを使うかの判断が要ります。共通データのテレビCMは幾何減衰で作られているので、遅れのある形を当てはめたときに、データが「遅れ無し」を選ぶかを確かめました。テレビCMだけを遅れのあるアドストック(Jin らの式。L=13、重みの合計で割る形)に変え、\( \alpha \) を0.05〜0.95の0.05刻み、\( \theta \) を0〜6週で振り、他の3媒体は持ち越し無しとして、統制変数(定数・トレンド・季節のフーリエ項2組・販促・休日。基準の MMM と同じ)と一緒に学習期間(第1〜130週)で回帰しました。誤差の二乗和が最も小さかったのは \( \theta \)=0(\( \alpha \)=0.95)で、\( \theta \) ごとの最良の誤差の二乗和は、\( \theta \)=0で約635万、1で約702万、2で約794万、3で約1,049万、5で約2,015万と、遅れを大きくするほど当てはまりが悪くなりました。データは「山は出した週に来る」ことを正しく選んでいます。ただし、最良の \( \alpha \) は探した範囲の上端の0.95に張り付いていて、遅れのある形で幾何減衰の長い裾をまねようとした結果だと読めます。形の取り違えは、パラメータが範囲の端に張り付くことで表に出ることがあります。
実務での判断の目安としては、まず幾何減衰で始め、遅れのある形を試すのは、商品の性質(高額で検討期間が長い、予約から利用までに間がある、など)から遅れが疑われ、なおかつデータの当てはまりや検証期間の誤差が明らかに改善するときに限るのがよいと考えています。形を柔軟にするほど推定するパラメータが増え、週次3年分程度のデータでは、当てはまりの差が誤差の範囲に埋もれやすくなるからです。Jin らの論文が、ベイズ情報量規準(当てはまりの良さとパラメータの数の釣り合いを測る指標)を使って形を選ぶ手順を示しているのも、この問題への対処です。形の選び方と検証は第8章で扱います。
テレビCMの放映期間(フライト)と持ち越し
持ち越しが最も大きな影響を持つのは、テレビCMのように、決まった期間に集中して出し、期間外は0にする媒体です。この記事では、この集中して出す期間を放映期間、またはフライトと呼びます。共通データのテレビCMは、3年間に8回のフライト(4〜6週)を持ち、156週のうち放映したのは44週だけです。次の図は、第2年(第53〜104週)のテレビCMの広告費と、真のテレビCMの効果(データを作った側だけが知る増分売上)を重ねたものです。
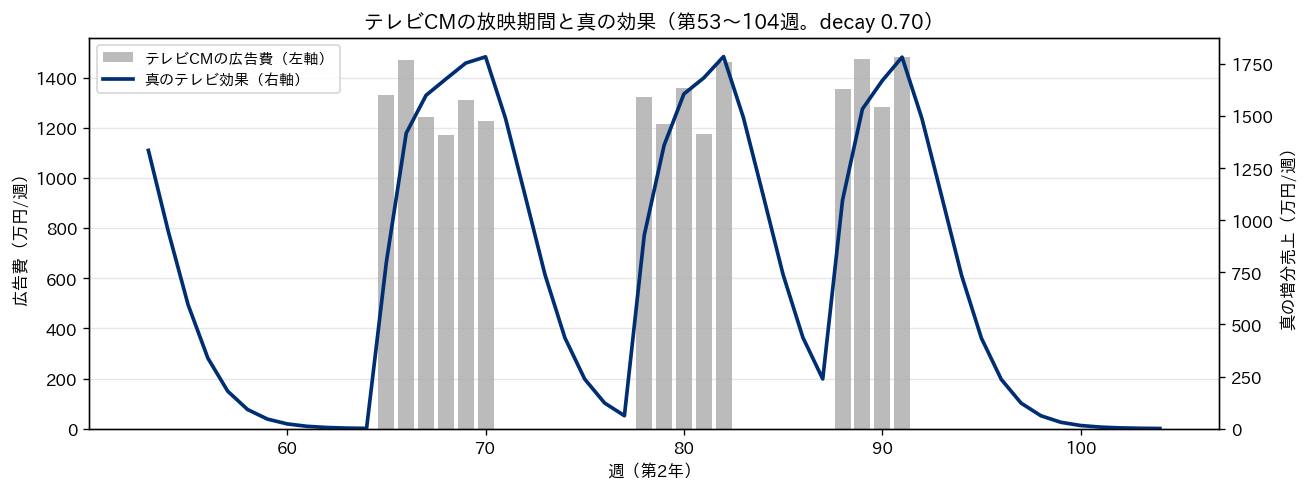
図の線は、放映が始まると数週かけて立ち上がり、放映が終わったあとも4〜6週かけてなだらかに下がっています。第53週(第2年の最初の週)は広告費が0ですが、前年の第46〜51週のフライトの効果が残っていて、真の効果は1,335万円の高さから下がり始めています。この「放映していない週に出ている効果」が全体のどれだけかを測ると、3年間の真のテレビCMの効果113,374万円のうち40,544万円(35.8%)、直近52週(第105〜156週)の31,547万円のうち12,218万円(38.7%)が、広告費0の週に出ていました。テレビCMの効果の3分の1以上は、放映していない週の売上の中にあるということです。
フライトごとに見るとどうなるかを、1つのフライトだけを0にした場合との差(そのフライトによる真の増分売上)で測りました。他のフライトはそのまま残しています。
| フライト | 週数 | 広告費(万円) | 放映中の増分(万円) | 放映後の増分(万円) | 放映後の割合 | フライトの売上ROI |
|---|---|---|---|---|---|---|
| 第14〜19週 | 6 | 11,375 | 10,635 | 6,335 | 37.3% | 1.49 |
| 第24〜29週 | 6 | 9,315 | 9,692 | 5,306 | 35.4% | 1.61 |
| 第46〜51週 | 6 | 9,250 | 9,722 | 5,295 | 35.3% | 1.62 |
| 第65〜70週 | 6 | 7,750 | 9,031 | 4,557 | 33.5% | 1.75 |
| 第78〜82週 | 5 | 6,528 | 7,301 | 4,707 | 39.2% | 1.84 |
| 第88〜91週 | 4 | 5,594 | 5,850 | 4,246 | 42.1% | 1.80 |
| 第109〜113週 | 5 | 8,542 | 8,274 | 5,538 | 40.1% | 1.62 |
| 第121〜126週 | 6 | 12,409 | 10,960 | 6,916 | 38.7% | 1.44 |
表の「放映後の割合」の列は、8回のフライトすべてで33.5%から42.1%の範囲にあり、どのフライトも増分売上の3分の1以上を放映が終わった後に生んでいます。放映後の増分のうち80.4%から88.5%は、放映終了から4週以内に出ていました。「フライトの売上ROI」の列は、放映中と放映後を合わせた増分を、そのフライトの広告費で割った値です。最も高いのは週数の短い第78〜82週(1.84)・第88〜91週(1.80)で、最も低いのは週平均の広告費が大きい第121〜126週(1.44、週平均2,068万円)・第14〜19週(1.49、週平均1,896万円)でした。週あたりの額を大きくするほど飽和に近づいて効率が下がる、という第6章の主題が、ここにも表れています。なお、この表はフライトを1つずつ消して測ったもので、飽和の曲線が直線ではないため、8回分を足しても3年間の真の増分と一致しません。また、「フライトの売上ROI」は、そのフライトが生んだ増分(後の週に持ち越す分を含む)をそのフライトの広告費で割った値です。この記事でテレビCMの真の売上ROIとして使っている1.51は、直近52週の窓の中で生じた増分を窓の中の広告費で割った値で、窓の前の放映からの持ち越しが入り、窓の後へ持ち越す分は入りません。数え方が違うので、この表の値と1.51は直接は比べられません。
持ち越しは、予算の年度の区切りもまたぎます。第1年(第1〜52週)に出したテレビCMの広告費29,941万円の真の増分売上46,920万円のうち、3,625万円(7.7%)は第2年に入ってから出ていました。第1年の最後のフライトが第46〜51週と年度末の直前にあったためです。第2年は最後のフライトが第88〜91週で年度末から離れていたので、翌年度に出た分はほぼ0でした。年度ごとに「その年度の広告費」と「その年度の売上」で効果を測ると、年度末の近くに放映した年ほど、その年度の広告の効果を小さく、翌年度の効果を大きく見ることになります。
持ち越しを無視すると何を誤るか:素朴な回帰のテレビ0.54の理由
第4章の素朴な回帰は、テレビCMの係数を0.540と推定しました。他の説明変数を同じとしたとき、広告費1万円あたり、その週の売上が0.54万円高い、という意味です。この数字がなぜ小さいのかを、直近52週の2つ目のフライト(第121〜126週、広告費12,409万円)で週ごとに分解しました。次の図と表は、このフライトだけによる増分売上を、真の値、素朴な回帰、テレビCMだけに decay 0.70 の幾何アドストックを掛けた線形の回帰(この後の節で格子探索によって選ばれるもの。飽和は入れていない)の3つで並べたものです。
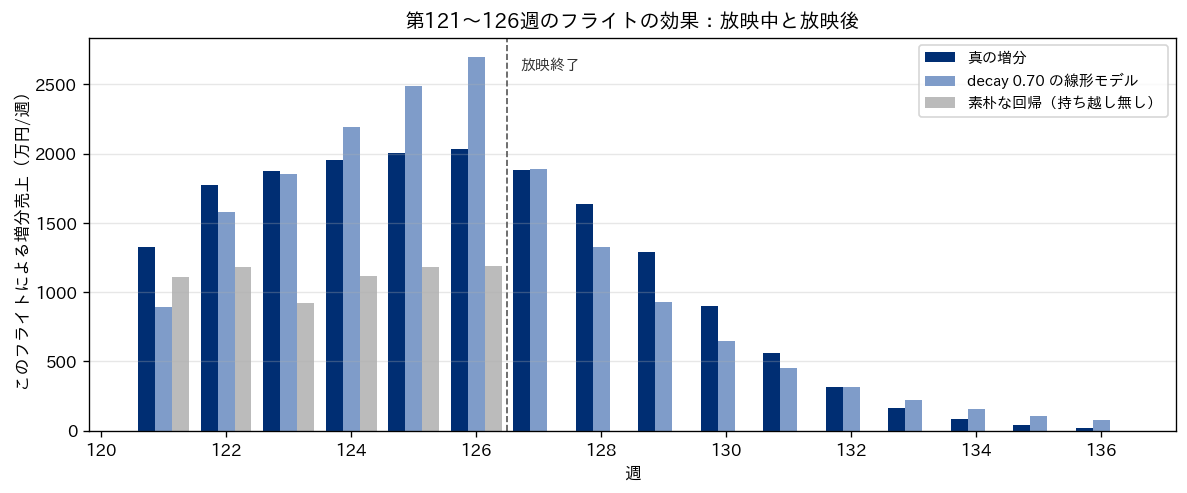
| 週 | テレビCMの広告費(万円) | 真の増分(万円) | 素朴な回帰(万円) | decay 0.70 の線形の回帰(万円) |
|---|---|---|---|---|
| 第121週 | 2,057 | 1,328 | 1,110 | 895 |
| 第123週 | 1,711 | 1,870 | 923 | 1,849 |
| 第126週(放映最終週) | 2,206 | 2,030 | 1,191 | 2,700 |
| 第127週(放映終了の翌週) | 0 | 1,881 | 0 | 1,890 |
| 第128週 | 0 | 1,635 | 0 | 1,323 |
| 第129週 | 0 | 1,290 | 0 | 926 |
| 第130週 | 0 | 902 | 0 | 648 |
| 第132週 | 0 | 315 | 0 | 318 |
表の「真の増分」の列では、放映を止めた翌週(第127週)にも1,881万円の増分が出ていて、放映最終週の2,030万円の93%に当たります。第127〜130週の4週間の合計は5,708万円で、これは放映後の増分6,916万円の大部分です。一方、「素朴な回帰」の列は、広告費が0になった週から増分も0になります。素朴な回帰が見ている世界では、放映を止めた翌週に売上が約1,200万円下がるはずですが、実際の売上はそれほど下がりません。回帰の計算は、放映中の売上の高さと放映後の売上の高さの両方を説明しようとして、「放映中の売上の上がり方は小さく、放映後の売上の高さは基礎売上や他の媒体のおかげ」という折り合いを付けます。これがテレビCMの係数が0.54と小さく出た主な理由の1つです。第4章で見たとおり、テレビCMの放映期間に合わせて増やす運用をしているディスプレイ広告(テレビCMとの相関0.91)が、素朴な回帰で0.97と大きく見積もられたのも、テレビCMの効果の一部がディスプレイ広告に付け替えられたためと読めます。ただし、この読みはこの章の計算では確かめていません。
「decay 0.70 の線形の回帰」の列は、放映後の減り方を真の値に近い形でとらえていますが、放映中の形は違います。真の増分は飽和のために第124週以降ほぼ頭打ち(1,953〜2,030万円)なのに、線形の回帰は第126週の2,700万円まで伸び続けます。持ち越しを入れただけでは、週ごとの効果の形はまだ正しくなく、飽和を入れる第6章の変換が要ります。ただし、フライト全体の増分の合計で見ると、線形の回帰も真の値にかなり近づきます。
この違いは、フライトの効果をどの期間で測るか(評価の窓)の問題として、経営の判断に直接響きます。同じ第121〜126週のフライトの売上ROIを、窓を変えて計算しました。
| 評価の窓 | 真の増分(万円) | 真の売上ROI | 素朴な回帰の売上ROI | decay 0.70 の線形の回帰の売上ROI |
|---|---|---|---|---|
| 放映中の6週だけ | 10,960 | 0.88 | 0.54 | 0.94 |
| 放映中+放映後1週 | 12,840 | 1.03 | 0.54 | 1.10 |
| 放映中+放映後2週 | 14,475 | 1.17 | 0.54 | 1.20 |
| 放映中+放映後4週 | 16,667 | 1.34 | 0.54 | 1.33 |
| 放映中+放映後8週 | 17,792 | 1.43 | 0.54 | 1.42 |
| 放映中+放映後13週 | 17,873 | 1.44 | 0.54 | 1.45 |
表の「真の売上ROI」の列は、放映中の6週だけで測ると0.88で、広告費を下回ります。放映後1週を含めると1.03、4週を含めると1.34、8週で1.43となり、13週でほぼ出尽くして1.44になります。放映の直後に「売上の増分が広告費に届かなかった」と判断すると、実際には広告費の1.44倍の売上を生んでいるフライトを、売上の増分が広告費に届かない施策として低く評価することになります(粗利で見た評価は、この章の最後で扱います)。8回のフライトすべてで同じ計算をすると、放映中だけで測った真の売上ROIは0.88から1.17(8回合計で1.01)、放映後まで含めた真の売上ROIは1.44から1.84(8回合計で1.62)でした。窓の取り方1つで、テレビCMの評価は「売上の増分が広告費とほぼ同じ」から「広告費の1.6倍の売上」まで変わります。
「素朴な回帰の売上ROI」の列が窓によらず0.54で一定なのは、素朴な回帰が放映後の増分をそもそも0と見ているからです。素朴な回帰に従う限り、評価の窓を延ばしても見え方は改善しません。これに対して、decay 0.70 の線形の回帰は、窓を4週以上にすると真の売上ROIとほぼ同じ値になりました。持ち越しをモデルに入れておけば、放映が終わってから効果が出尽くすまで待たなくても、放映後の増分を含めた売上ROIを、モデルから見積もることができます。
decay を推定する:候補を格子で振って当てはまりを比べる
ここまでは、データを作った側だけが知る真の decay(テレビCM 0.70)を使ってきました。現実には decay は分からないので、データから推定する必要があります。最も素朴で分かりやすい方法は、decay の候補をいくつも用意し、それぞれでアドストックを計算して回帰を行い、当てはまりが最も良い候補を選ぶ方法です。候補を等間隔の格子の点として並べるので、格子探索と呼ばれます。次のコードは、テレビCMの decay だけを0から0.95まで0.05刻みで振り、他の3媒体は持ち越し無しのまま、統制変数と一緒に学習期間(第1〜130週)で最小二乗の回帰を行い、学習期間の誤差の二乗和と、直近52週のテレビCMの売上ROIを出すものです。補助モジュール(mmm_data.py と baseline.py)と同じフォルダに置いて実行する形で、出力は0.1刻みの点だけを表示しています。
import numpy as np
import mmm_data as md
import baseline as bl

df = md.make_data()
y = df["sales"].to_numpy()
Z = bl.controls(df)                   # 定数・トレンド・季節・販促・休日
others = [df[c].to_numpy() for c in ["search", "social", "display"]]
tv = df["tv"].to_numpy()

for d in np.arange(0.0, 0.951, 0.05):
    X = np.column_stack([Z, md.geometric_adstock(tv, d)] + others)
    coef, *_ = np.linalg.lstsq(X[:130], y[:130], rcond=None)   # 学習 第1〜130週
    sse = np.sum((y[:130] - X[:130] @ coef) ** 2)
    k = Z.shape[1]
    stock = md.geometric_adstock(tv, d)
    roi = coef[k] * stock[104:].sum() / tv[104:].sum()          # 直近52週の売上ROI
    if round(d * 100) % 10 == 0:
        print("decay %.2f  誤差の二乗和 %10.0f  テレビの売上ROI %.2f" % (d, sse, roi))
# 出力:
# decay 0.00  誤差の二乗和   26542372  テレビの売上ROI 0.54
# decay 0.10  誤差の二乗和   24058886  テレビの売上ROI 0.72
# decay 0.20  誤差の二乗和   20907657  テレビの売上ROI 0.89
# decay 0.30  誤差の二乗和   17272335  テレビの売上ROI 1.04
# decay 0.40  誤差の二乗和   13474528  テレビの売上ROI 1.17
# decay 0.50  誤差の二乗和    9949047  テレビの売上ROI 1.27
# decay 0.60  誤差の二乗和    7218969  テレビの売上ROI 1.35
# decay 0.70  誤差の二乗和    5935494  テレビの売上ROI 1.45
# decay 0.80  誤差の二乗和    7115590  テレビの売上ROI 1.66
# decay 0.90  誤差の二乗和   12393959  テレビの売上ROI 2.33
decay 0(持ち越し無し)の行は、第4章の素朴な回帰そのもので、テレビCMの売上ROIは0.54です。decay を上げるにつれて誤差の二乗和は小さくなり、0.05刻みの全20点の中で最小になったのは0.70(約594万)で、真の値と一致しました。0.65(約635万)と0.75(約613万)がそれに続き、0.8を超えると誤差の二乗和は再び大きくなります。検証期間(第131〜156週)の予測の誤差(MAPE)は、decay 0の13.53%から、0.70で3.35%、0.75で2.23%まで下がりました。持ち越しを入れるだけで、検証期間の予測が大きく改善したことになります。
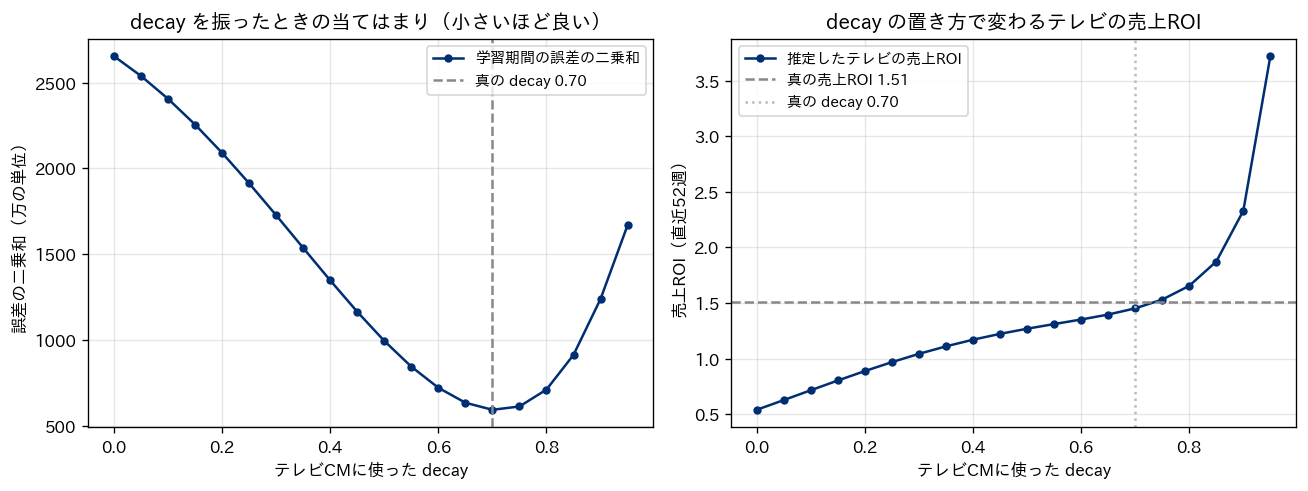
図の右側は、decay の置き方で推定されるテレビCMの売上ROIがどう変わるかを示しています。decay 0では0.54、0.5で1.27、0.70で1.45、0.80で1.66、0.90で2.33、0.95で3.72と、decay を大きく置くほど売上ROIは大きくなり、1に近い側では急に大きくなります。decay を大きくすると、放映後の売上の高さまでテレビCMの手柄として数えるようになるからです。誤差の二乗和が最小の0.70での1.45は、真の1.51に近い値でした。ただし、この回帰には飽和が入っておらず、他の3媒体も持ち越し無しとして扱っているので、真の値と一致することまでは期待できません。逆に言えば、decay を当てはまりで選ばずに、「テレビの効果は長く続くはずだ」という思い込みで大きめに置くと、売上ROIを過大に見積もることになります。decay は売上ROIを直接動かすつまみなので、誰がどんな根拠で決めた値かを、報告に必ず添える必要があります。
1回の結果が偶然でないかを確かめるため、共通データと同じ設定で乱数の種だけを0〜29に変えた30通りのデータを作り、同じ格子探索でテレビCMの decay を選びました。選ばれた decay は、0.70が12回、0.75が17回、0.65が1回で、30通りすべてが0.65〜0.75の範囲に入りました(平均0.727)。中央値は0.75で、真の0.70よりやや大きめの値を選ぶ回数のほうが多くなりました。テレビCMについては、この方法で真の値の近くを安定して選べています。
では、4媒体すべての decay を同時に推定するとどうなるか。4媒体の decay をそれぞれ0〜0.9の0.1刻みで振り、1万通りの組み合わせすべてで同じ回帰を行いました。
| 順位(学習期間の誤差の二乗和が小さい順) | テレビCM | 検索広告 | SNS広告 | ディスプレイ広告 | 検証期間のMAPE | 売上ROI テレビCM | 売上ROI 検索広告 | 売上ROI SNS広告 | 売上ROI ディスプレイ広告 |
|---|---|---|---|---|---|---|---|---|---|
| 1位 | 0.7 | 0.2 | 0.0 | 0.9 | 2.86% | 1.44 | 3.22 | 1.54 | 0.50 |
| 2位 | 0.7 | 0.2 | 0.0 | 0.8 | 3.01% | 1.41 | 3.20 | 1.45 | 0.52 |
| 3位 | 0.7 | 0.1 | 0.0 | 0.9 | 2.80% | 1.44 | 2.89 | 1.54 | 0.59 |
| 真の decay の組(221位) | 0.7 | 0.1 | 0.4 | 0.3 | 計算していない | 1.48 | 2.90 | 1.37 | -0.11 |
| 真の値 | 0.70 | 0.10 | 0.40 | 0.30 | (該当なし) | 1.51 | 2.35 | 1.76 | 0.38 |
表の上位3つは、どれもテレビCMの decay を0.7と正しく選んでいます。一方、SNS広告は真の0.40に対して0.0、ディスプレイ広告は真の0.30に対して0.9または0.8と、大きく外れました。真の decay の組は1万通りのうち221位で、1位との誤差の二乗和の差は約3%(約582万に対して約600万)しかありません。真の組でのディスプレイ広告の売上ROIは -0.11 と負になり、線形の回帰ではディスプレイ広告の効果をうまく取り出せていないことも分かります(真の組の検証期間の MAPE は計算していません)。上位3組の検索広告の売上ROIも3.22・3.20・2.89と、真の値2.35から大きく外れています。decay が決まらない媒体では、売上ROIも外れるということです。テレビCMの decay が安定して当たるのに、他の媒体が当たらないのは、広告費の動き方の違いによると考えられますが、この章の計算で原因を切り分けたわけではありません。テレビCMは、ある週に急に出て急に0になる動き方をするので、「止めた後に売上がどう下がるか」がデータにはっきり刻まれています。SNS広告はゆっくりとしか動かず、ディスプレイ広告はほぼ一定で、テレビCMの放映期間に合わせて増えるだけなので、持ち越しがあってもなくても売上の動きがほとんど変わりません。データに区別の手がかりが無いパラメータは、このデータだけからは、推定方法を変えても安定して決めることができません。事前分布や実験の結果のように、データの外の情報を足す方法は第9章と第10章で扱います。
記事全体の基準の MMM(アドストックと Hill 関数を掛け、初期値を変えて12回推定したもの)も、同じ傾向を示していました。第2章で紹介した基準の結果では、テレビCMの decay は0.67(真0.70)とほぼ当たり、検索広告は0.39(真0.10)、SNS広告は0.09(真0.40)、ディスプレイ広告は0.68(真0.30)と外れています。基準の MMM は検証期間の MAPE 2.64% という良い当てはまりを示しながら、検索広告と SNS 広告の売上ROIを真の値の約半分に見積もりました。その同じモデルの中で、この2媒体の decay も真の値から外れていたことになります。良い当てはまりは、媒体ごとの decay が正しいことを保証しません。当てはまりが同じくらい良いのにパラメータの組が違うという問題(識別性)は第8章で、推定の不確かさをどう示すかは第9章で、実験の結果で decay を含むモデルを確かめる方法は第10章で扱います。
格子探索は、仕組みが分かりやすく、decay ごとの当てはまりと売上ROIを並べて見せられる点で、経営への説明に向いています。基準の MMM のように decay を他のパラメータと一緒に非線形の最小二乗で推定する方法や、Jin らの論文や Meridian のようにベイズ推定で事前分布(推定の前に置く、decay がどのあたりにありそうかという見込み)を入れる方法に進む前に、主要な媒体について格子探索の図を1枚作っておくと、推定値がどの程度データに支えられているかの見当が付きます。誤差の二乗和の谷が深くはっきりしている媒体(この例のテレビCM)は、データが decay を決めています。谷が浅く平らな媒体(この例のSNS広告やディスプレイ広告)は、データではなく、事前分布や推定の初期値が decay を決めていることになります。
経営の判断に翻訳する:放映の止め時・評価の窓・年度の区切り
この章の結果を、広告費の判断に使える形に整理します。1つ目は、放映を止めるかどうかの判断です。共通データのテレビCMでは、効果の3分の1以上が放映していない週に出ていて、放映を止めた翌週の真の増分は最終週の93%ありました。放映を止めた直後に売上が大きく下がらないことは、「テレビCMは効いていなかった」証拠にはなりません。逆に、止めて数週たってから売上が下がり始めたとき、その原因を同じ時期の別の出来事(価格改定や競合の動き)に求めてしまう誤りも起きます。持ち越しのある媒体を止める判断は、止めた直後の売上ではなく、持ち越しを入れたモデルで「止めた場合に今後何週でどれだけ売上が減るか」を見積もって行う必要があります。
2つ目は、効果を測る評価の窓を、社内のルールとして決めておくことです。第121〜126週のフライトの真の売上ROIは、放映中だけで測ると0.88、放映後4週まで含めると1.34、8週まで含めると1.43でした。キャンペーンが終わった直後の振り返りの会議で効果を判定する運用だと、持ち越しのある媒体は系統的に低く評価され、効果の出方が速い媒体(この例の検索広告のように decay の小さい媒体)が相対的に高く評価されます。媒体ごとの半減期を推定し、「放映後、半減期の数倍の週数まで含めて評価する」と決めておくか、モデルから放映後の増分を見積もって評価に含めることが有効だと考えています。
3つ目は、予算の年度の区切りです。共通データでは、年度末の直前に放映した第1年のテレビCMの効果の7.7%が翌年度に出ていました。年度ごとに媒体の効果を締めて翌年度の配分を決める運用では、年度末に放映した媒体の効果が、翌年度の基礎売上や翌年度の広告の手柄として数えられます。年度の配分を議論するときは、その年度に出した広告費が生んだ増分(翌年度に出る分を含む)と、その年度の売上に含まれる前年度の広告の持ち越し分を、分けて示す必要があります。
4つ目は、decay の値が売上ROIと予算配分を直接動かすことです。格子探索の結果では、テレビCMの decay を0.5と置くと売上ROIは1.27、0.7で1.45、0.9で2.33でした。予算配分の計算にも decay は入ります。記事全体の基準の配分の計算(第12章で扱います)は、毎週同じ額を出し続けた定常状態の応答を使っていて、そこでは週の広告費を \( 1 – d \) で割った値、つまり decay 0.7 なら週の広告費の3.33倍が、飽和の変換に入るアドストックの水準になります。decay を誤れば、媒体の応答曲線(第6章)の位置がずれ、配分の答えも変わります。decay は分析の担当者が技術的に決める細部ではなく、配分の結論を左右する前提なので、どの値をどの根拠(格子探索の谷の深さ、検証期間の誤差、実験の結果、公開されている目安との比較)で決めたかを、経営への報告に添えることが有効だと考えています。
最後に、売上で見るか粗利で見るかの区別も添えておきます。第121〜126週のフライトの真の売上ROIは、放映後まで含めて1.44でした。共通データの架空の粗利率0.50を掛けると、粗利ROIは0.72で、このフライトは粗利では広告費を回収できていません。放映中だけの0.88という数字で「売上の増分が広告費を下回ったから止める」と判断するのは評価の窓の誤りですが、正しい窓で測っても、粗利で見れば回収できていないことはあります。結論は、評価の窓と、売上と粗利のどちらで測るかの両方で変わります。粗利で見た投資判断と、平均の売上ROIと限界ROIの違いは第11章で扱います。
この章の要点は3つです。第一に、広告の効果は翌週以降に持ち越され、その持ち越しは幾何減衰のアドストック(今週の効果の元=今週の広告費+decay×先週の値)で表せます。decay は半減期に言い換えると説明しやすく、共通データのテレビCMの decay 0.70 は半減期約2週に当たります。第二に、持ち越しを無視した素朴な回帰は、テレビCMの効果の3分の1以上が出る放映後の週を見落とし、売上ROIを0.54と小さく見積もりました。放映中だけで効果を測っても同じ誤りが起き、この例のフライトでは真の1.44が0.88に見えます。第三に、decay は格子探索で当てはまりを比べて推定でき、テレビCMのように急に出て急に止める媒体では真の値の近くを安定して選べますが、ゆっくりとしか動かない媒体や一定の額を出し続ける媒体では、データだけでは決まりません。次の第6章では、この章で何度か顔を出した飽和、つまり広告費を増やしても売上が比例して増えない性質を、Hill 関数と応答曲線で扱います。
この章を深めたい方への参考書籍
『経済・ファイナンスデータの計量時系列分析』(沖本竜義、朝倉書店):自己回帰(AR)過程を含む ARMA 過程、予測、VAR モデルとインパルス応答関数などを扱う時系列分析の教科書です。幾何減衰のアドストックは「今週の値=今週の入力+係数×先週の値」という自己回帰と同じ形の式で、この章の「1週だけ広告を出したときの値の推移」は、インパルス応答(ある時点に1回だけ加えた衝撃が、その後どう伝わるか)の考え方そのものです。持ち越しを時系列のモデルとして理解し直すのに向いています。
『入門 計量経済学 第2版 Excelによる実証分析へのガイド』(山本拓・竹内明香、新世社):回帰分析の基礎から始めて、多重回帰分析の拡張の章で遅れのある変数(ラグ変数)を扱い、後半の章で1次の自己回帰モデルと予測、インパルス応答関数を扱う入門書です。この章の「過去の広告費を重みを付けて足し合わせる」アドストックを、回帰に遅れのある変数を入れるという、より一般的な考え方の中で位置づけ直すのに向いています。副題のとおり、Excel を使った実証分析の手引きとして書かれています。
第6章 飽和と逓減、広告費を増やしても売上は比例しない
第5章では、広告の効果が翌週以降に持ち越されることを、幾何アドストックという足し合わせの式で表しました。持ち越しを入れると、テレビCMの効果を素朴な回帰より正しく捉えられるようになります。ただ、持ち越しだけでは、広告費を2倍にすれば増分売上も2倍になる、という比例の関係が残ります。現実の広告では、同じ人に何度も広告が届くようになり、届く相手も興味のある人から順に埋まっていくので、広告費を積み増すほど1万円あたりの効果は小さくなっていくと考えるのが自然です。この章では、この「増やすほど効きが鈍る」性質を、マーケティング・ミックス・モデリング(MMM)がどう式にしているかを説明します。中心になるのは、S字の形も上に凸の形も1つの式で表せる関数と、それを使って描く「週の広告費と増分売上の関係」の曲線です。第2章で用意したサンプルデータ(架空の日用品メーカーの週次データ)で、真の曲線と MMM(基準)が推定した曲線を並べ、どこが合っていてどこが外れているのか、外れていると予算の判断の何を誤るのかを実測します。
広告費を2倍にしても増分売上は2倍にならない
広告費を増やしたときに、増える売上の伸びがだんだん小さくなる性質を収穫逓減と呼びます。「逓減」は、次第に減っていくという意味です。広告費を週100万円から200万円に増やしたときの売上の増え方より、900万円から1,000万円に増やしたときの増え方のほうが小さい、という関係です。さらに広告費を増やし続けると、売上の増え方がほぼ0になり、それ以上お金を積んでも売上が増えない水準に近づきます。この状態を飽和と呼びます。収穫逓減は「伸びが鈍る」こと、飽和は「伸びが止まる上限がある」ことを指していて、多くの MMM はこの2つを1本の曲線でまとめて表します。
広告で収穫逓減が起きる理由として、一般に次のような説明がされます。1つ目は、同じ人に同じ広告が何度も届くことです。最初の1回で商品を知った人に、5回目、10回目の広告を見せても、購入の確率はそれほど上がりません。2つ目は、届く相手の質が変わることです。検索広告であれば、少ない予算はまず購入の意図が強い検索語に使われ、予算を増やすほど、購入につながりにくい検索語にまで広告を出すことになります。3つ目は、そもそもの需要に上限があることです。日用品の市場が一定の大きさであれば、広告だけで売上を無限に増やすことはできません。どの理由がどの程度効いているかは媒体や商品によって違い、MMM はその内訳までは区別しません。MMM が推定するのは、結果として「週の広告費がいくらのとき、増分売上がいくらになるか」という関係だけです。
Google の研究者らが2017年に公開した、広告の持ち越し効果と効き方の形をベイズ推定で扱った論文(Jin・Wang・Sun・Chan・Koehler)は、広告費と売上の関係を直線で置く従来の回帰では、高い支出水準での飽和や収穫逓減を表せないことを、モデルを提案する動機として挙げています。論文はこの性質を「形の効果(shape effect)」と呼び、持ち越しの効果と並ぶ要素として扱っています。第4章の素朴な回帰は、広告費をそのまま説明変数に入れるので、広告費1万円あたりの売上の増え方が、支出がいくらであっても同じだと仮定していることになります。この仮定のもとで予算を最適化すると、「ROI の高い媒体から順に、許された上限まで予算を寄せる」という答えになります。第2章で示した基準の結果で、素朴な回帰に従った配分が、4媒体のうち3媒体で現状の0.5倍の下限か2倍の上限に張り付いていた(テレビCM 201.5・検索広告 448.5・ディスプレイ広告 150.4万円/週。残りの SNS広告が総額の帳尻を合わせる356.1万円/週)のはこのためです。
経営の言葉に直すと、収穫逓減を無視したモデルは「今うまくいっている媒体は、予算を倍にしても同じ効率で売上を生む」と答えます。この答えに従って予算を積み増すと、実際には1万円あたりの増分売上が下がっていくので、計画した売上に届かず、広告費だけが計画どおり出ていきます。逆に、効きが鈍っている媒体を見分けられれば、その媒体から外した予算を、まだ伸びしろのある媒体に回すことができます。予算の配分を変えるという判断は、各媒体が曲線のどのあたりにいるかを知って、はじめて根拠を持てます。
Hill 関数で、S字と上に凸の形を1つの式で表す
収穫逓減と飽和を表す式として、MMM で広く使われているのがHill 関数です。先に挙げた Google の2017年の論文は、形の効果を表す候補としてこの関数を採り上げ、その由来を薬理学に置いています。論文が引いているのは、生理学者の A. V. ヒルが1910年に Journal of Physiology 第40巻の補遺(英国生理学会の会報)に載せた、ヘモグロビンの分子の集まり方が酸素の解離曲線に与える影響についての報告と、この式の歴史をまとめた2012年の論文(Gesztelyi ほか、Archive for History of Exact Sciences 第66巻第4号)です。薬の濃度を上げるほど効き目が強まり、やがて頭打ちになる関係を表すために使われてきた式を、広告費と売上の関係に転用したものです。
共通データの真のモデルと MMM(基準)は、どちらも次の形を使っています。ある週の、アドストック(第5章の持ち越しを足し合わせた値)を \( x \) としたとき、その媒体の週の増分売上は次のとおりです。
\( \text{増分売上} = \beta \times \dfrac{x^{s}}{x^{s} + K^{s}} \)
言葉で言うと、「その媒体で上げられる売上の上限 \( \beta \) に、0から1までの割合を掛けたもの」です。割合のほうが Hill 関数で、\( x \) が0のときは0、\( x \) が大きくなるほど1に近づきます。\( K \) は、割合がちょうど0.5、つまり上限の半分の効果が出るアドストックの水準で、この記事では half と呼んでいます。\( s \) は曲線の形を決める値で、この記事では shape と呼んでいます。同じ論文は \( K \) を半飽和点、\( s \) を形のパラメータ(傾きとも呼ぶ)と説明しています。
shape の値によって、曲線の形は大きく変わります。shape が1のときは、広告費0の点から上に凸の曲線になり、最初の1万円が最も効き、その後は一貫して効きが鈍っていきます。shape が1より大きいと、広告費が小さいうちは下に凸、つまり出すほど効きが良くなる区間があり、half を過ぎたあたりから上に凸に変わって頭打ちになります。全体として S字の形です。Google の論文も、shape が1より大きい曲線は0の近くで下に凸になって S字の形になり、1より小さい曲線は0の近くでより強く上に凸になって早く平らになる、と説明しています。S字の下の方は、広告がある程度の量に達するまで効果がほとんど出ない「閾値」のような区間を表していて、認知が広がるまでに一定の露出が要る媒体を表すのに使われます。
第2章で示した共通データの真のパラメータを、この章の目線で並べ直したのが次の表です。「定常状態で half に届く週の広告費」は、毎週同じ額を出し続けたときに、アドストックがちょうど half に達する週の広告費です。幾何アドストックでは、毎週 \( x \) 万円を出し続けるとアドストックは \( x \div (1 – \text{decay}) \) に落ち着くので、\( \text{half} \times (1 – \text{decay}) \) で計算できます。
| 媒体 | decay(翌週へ持ち越す割合) | half(万円) | shape | beta(週の増分売上の上限、万円) | 定常状態で half に届く週の広告費(万円) | 直近52週の週平均の広告費(万円) | 曲線の形 |
|---|---|---|---|---|---|---|---|
| テレビCM | 0.70 | 1,800 | 2.0 | 2,200 | 540.0 | 402.9 | S字 |
| 検索広告 | 0.10 | 250 | 1.2 | 1,100 | 225.0 | 224.3 | ゆるい S字 |
| SNS広告 | 0.40 | 400 | 1.5 | 850 | 240.0 | 228.5 | S字 |
| ディスプレイ広告 | 0.30 | 600 | 1.0 | 280 | 420.0 | 300.8 | 上に凸 |
この架空の設定では、検索広告と SNS 広告は、現状の週平均の広告費がほぼ half に届く水準にあり、曲線の折り返しのあたりで運用されています。テレビCMは、毎週均等に出したと考えると現状の402.9万円が half に届く540.0万円より下にあり、まだ S字の下の方にいます。ディスプレイ広告は shape が1なので最初から上に凸で、しかも上限の beta が280万円と小さく、現状でも上限の半分に届いていません。これらは「この架空データの設定」であって、テレビは S字、検索はゆるい S字、ディスプレイは上に凸、と一般に決まっているわけではありません。どの媒体がどの形になるかは、商品・市場・クリエイティブ・出稿の仕方によって変わり、データから推定するしかありません。
Google の論文は、持ち越しと形の効果を組み合わせるときの順序にも触れています。先にアドストックを計算してから Hill 関数を掛ける方法と、その逆の方法があり、各期の支出が複数期の累計に比べて小さいときは前者が、支出が特定の期に集中して出したり止めたりを繰り返すときは後者が向いているかもしれない、と述べたうえで、論文自身は前者を選んでいます。Google が公開している MMM のライブラリ Meridian の公式ドキュメント(モデルの仕様の説明)でも、既定ではアドストックを先に計算してから Hill 関数を掛け、設定でこの順序を逆にもできると説明されています。共通データの真のモデルと MMM(基準)は、どちらも前者の「アドストックが先」です。この順序の違いは、次の節以降で扱うテレビの放映期間の話と関係します。
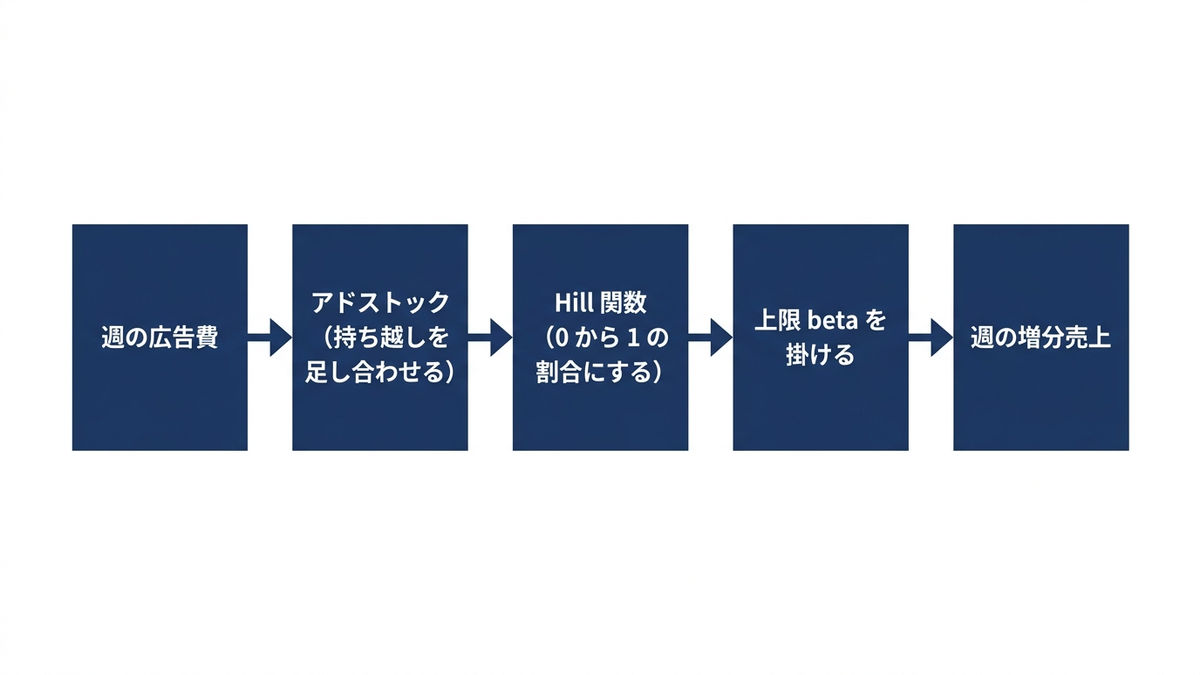
対数・べき関数と比べると、違いは観測した範囲の外で出る
収穫逓減を表す式は Hill 関数だけではありません。広告費の対数を取る形(広告費が2倍になるごとに売上が一定額ずつ増える)や、広告費のべき乗の形(広告費を0.6乗するなど、1より小さい指数を掛ける)でも、増やすほど伸びが鈍る曲線を作れます。この章ではこの2つを比較の相手に選びました。Google の論文も、Hill 関数のほかに、ロジスティック関数(S字の曲線の代表的な式)や正規分布などの確率分布を積分した形、単調な回帰スプライン(右上がりという条件だけを付けて、なめらかな曲線を自由に当てはめる方法)を候補に挙げ、どの形がよいかの比較は今後の課題だとしています。
形による違いを確かめるため、次の実験をしました。共通データのテレビCMと検索広告について、真の応答(毎週同じ額を出し続けたときの週の増分売上)を、ある範囲の週の広告費で計算し、その点に4つの式を最小二乗で当てはめます。当てはめに使う点には誤差を入れていません。現実のデータよりはるかに恵まれた条件で、式の形の違いだけを見るための実験です。当てはめた範囲は、テレビCMが週200〜600万円、検索広告が週100〜350万円で、どちらも現状の週平均の広告費を含みます。4つの式は、shape を自由にした Hill 関数、shape を1に固定した Hill 関数、対数(\( a \times \log(1 + x / k) \))、べき(\( a \times x^{e} \))です。結果の数値は、この記事の実行結果です。表の「範囲内の誤差 RMSE」は、当てはめた範囲の中で、式の値と真の応答の差を2乗して平均し、その平方根を取った値(二乗平均平方根誤差)で、万円単位のずれの目安です(第8章でも使います)。
| 媒体と当てはめた範囲 | 式の形 | 範囲内の誤差 RMSE(万円) | 週50万円(範囲の外・下) | 週400万円(範囲の中) | 週1,000万円(範囲の外・上) | 週1,500万円(範囲の外・上) |
|---|---|---|---|---|---|---|
| テレビCM 週200〜600万円 | 真の応答 | – | 18.7 | 779.5 | 1,703.3 | 1,947.6 |
| テレビCM | Hill(S字を許す) | 0.00 | 18.7 | 779.5 | 1,703.3 | 1,947.6 |
| テレビCM | Hill(shape=1に固定) | 64.41 | 99.2 | 782.4 | 1,911.2 | 2,813.0 |
| テレビCM | 対数 | 61.83 | 97.8 | 781.1 | 1,946.8 | 2,913.0 |
| テレビCM | べき | 24.98 | 53.6 | 753.1 | 2,413.3 | 4,040.3 |
| 媒体と当てはめた範囲 | 式の形 | 範囲内の誤差 RMSE(万円) | 週25万円(範囲の外・下) | 週225万円(範囲の中) | 週600万円(範囲の外・上) | 週900万円(範囲の外・上) |
|---|---|---|---|---|---|---|
| 検索広告 週100〜350万円 | 真の応答 | – | 73.5 | 550.0 | 840.8 | 924.8 |
| 検索広告 | Hill(S字を許す) | 0.00 | 73.5 | 550.0 | 840.8 | 924.8 |
| 検索広告 | Hill(shape=1に固定) | 3.59 | 93.0 | 546.2 | 881.7 | 1,005.1 |
| 検索広告 | 対数 | 5.46 | 98.4 | 544.0 | 918.4 | 1,095.1 |
| 検索広告 | べき | 10.37 | 136.7 | 538.7 | 993.7 | 1,279.9 |
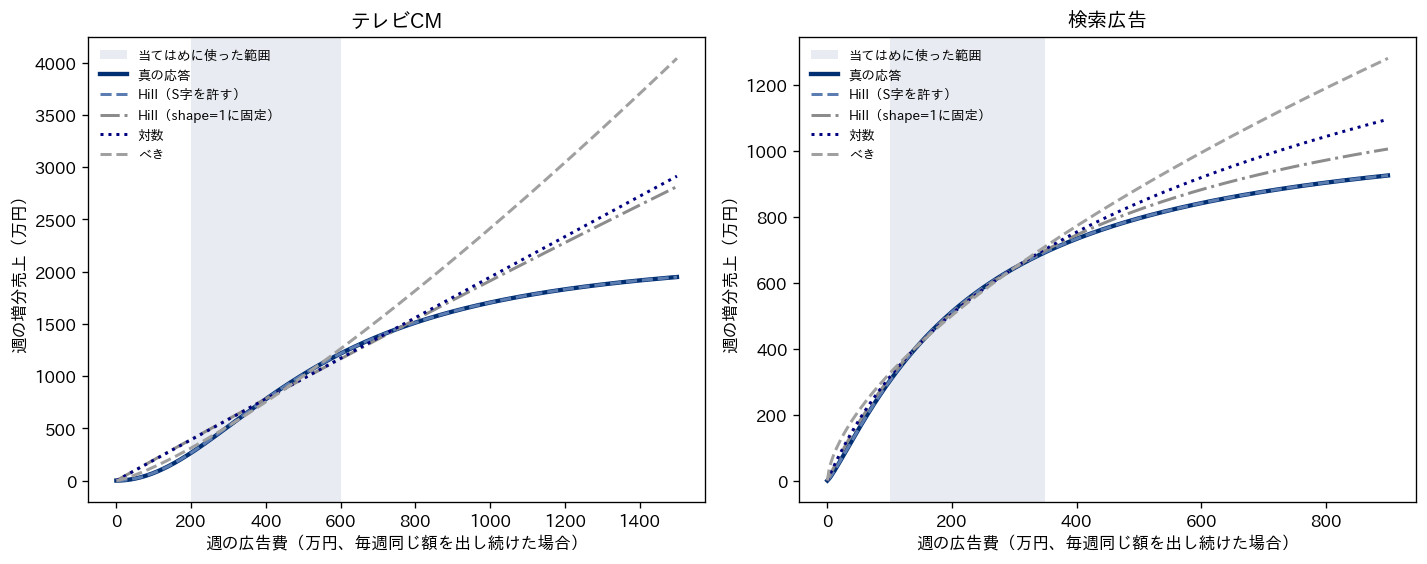
真のモデルが Hill 関数なので、shape を自由にした Hill 関数が誤差0で真の曲線を再現するのは当然です。見るべきは他の3つの式です。表の「週400万円(範囲の中)」「週225万円(範囲の中)」の列では、4つの式の値はテレビCMで753.1〜782.4万円、検索広告で538.7〜550.0万円に収まり、範囲の中ではどの式もそれなりに当たっています。ところが、範囲の外に出ると答えが大きく分かれます。テレビCMの週1,500万円の列では、真の値1,947.6万円に対して、べきの式は4,040.3万円と2倍を超える値を返しました。検索広告の週900万円の列でも、真の924.8万円に対して、べきの式は1,279.9万円です。対数とべきの式には上限が無いので、広告費を増やせば増分売上はどこまでも増えていきます。飽和を表せないということです。
テレビCMでは、もう1つの問題がはっきり出ました。週200〜600万円は、真の曲線の S字の下の方から折り返しの近くまでにあたり、出すほど効きが良くなる区間を含みます。上に凸の形しか取れない式(shape=1の Hill 関数と対数)は、この区間をうまく表せず、誤差の小さい解を探した結果、ほぼ直線に近い形になりました(係数が当てはめの探索範囲の端に張り付いています)。べきの式は指数が1.271と1を超え、下に凸の形で当てはまりました。範囲の下側(週50万円)では、上に凸の2つの式が真の約5倍の値を返しています。S字の曲線を上に凸の式で表すと、小さな予算での効果を大きく見積もり、「少しだけ出しても効く」という誤った判断につながります。
この実験の条件では、関数の形の選び方による差は、観測した広告費の範囲の中では小さく、範囲の外で大きく出ました。予算の判断は、多くの場合「今より増やすか減らすか」なので、まさに範囲の端か外を問うています。どの形を使うかは、データの当てはまりだけでは決めにくく、Google の論文がベイズ情報量規準(当てはまりの良さとパラメータの数の釣り合いを測る指標)で形を選ぶ例を示しているように、候補を比べる手続きと、媒体についての業務の知識の両方が要ります。
応答曲線を真の値と MMM(基準)で描く
週の広告費を横軸に、その広告費を出したときの週の増分売上を縦軸に取った曲線を応答曲線と呼びます。この記事の応答曲線は、「毎週同じ額を出し続けて、持ち越しが落ち着いた状態(定常状態)」での週の増分売上です。第2章の基準の結果で予算配分に使ったのも、この定常状態の応答です。共通データでは、真の応答曲線は md.true_response、MMM(基準)の応答曲線は baseline.est_response で計算できます。どちらも、週の広告費を \( 1 – \text{decay} \) で割って定常状態のアドストックに直し、Hill 関数と beta を掛けるだけの計算です。
次のコードは、MMM(基準)の推定値(baseline.fit_mmm の結果)をいったんファイルに保存しておき、それを読み込んで、各媒体の現状の週平均の広告費での応答・平均ROI・限界ROIを、真の値と並べて計算するものです。この章で実行したスクリプトから要所を抜き出したもので、補助モジュール(mmm_data.py・baseline.py)と同じフォルダに置いて実行する形です(保存したファイルの場所の指定は簡略化して載せています)。推定値は第2章の基準の結果と同じもので、直近52週の ROI は テレビCM 1.44・検索広告 1.18・SNS広告 0.90・ディスプレイ広告 0.17 と、基準の結果と一致しました。
import numpy as np
import mmm_data as md
import baseline as bl

df = md.make_data()
theta = np.load("../_out/ch06/theta.npy")    # bl.fit_mmm(df) の結果を保存したもの
cur = {c: df[c].iloc[104:].mean() for c in md.CHANNELS}   # 直近52週の週平均の広告費

for c in md.CHANNELS:
    x = cur[c]
    rt, re_ = md.true_response(c, x), bl.est_response(theta, c, x)
    mt = md.true_response(c, x + 1) - rt             # あと1万円増やしたときの増分
    me = bl.est_response(theta, c, x + 1) - re_
    print("%-8s %7.1f  %7.1f / %7.1f  %5.2f / %5.2f  %5.2f / %5.2f"
          % (c, x, rt, re_, rt / x, re_ / x, mt, me))
# 出力(媒体・週の広告費・応答 真/MMM・平均ROI 真/MMM・限界ROI 真/MMM):
# tv         402.9    786.7 /   848.8   1.95 /  2.11   2.51 /  2.26
# search     224.3    548.9 /   236.6   2.45 /  1.06   1.47 /  2.26
# social     228.5    409.4 /   200.2   1.79 /  0.88   1.39 /  1.88
# display    300.8    116.9 /    44.0   0.39 /  0.15   0.23 /  0.43
同じ推定値で、テレビCM・検索広告・SNS広告・ディスプレイ広告の4媒体について、真の応答曲線と MMM(基準)が推定した応答曲線を、現状の週平均の広告費の0.5倍から3倍までの倍率で比べます。先に、それぞれの倍率の週の広告費が、第1〜156週に実際に観測した週の広告費の範囲(最小から最大)に入っているかを確かめたのが次の表です。
| 媒体 | 現状の週平均の広告費(万円) | 観測した週の広告費の最小(万円) | 観測した週の広告費の最大(万円) | 観測した範囲に入る倍率(0.5倍・1倍・2倍・3倍のうち) |
|---|---|---|---|---|
| テレビCM | 402.9 | 0.0 | 2,206.0 | 0.5倍・1倍・2倍・3倍 |
| 検索広告 | 224.3 | 65.4 | 450.4 | 0.5倍・1倍・2倍 |
| SNS広告 | 228.5 | 105.3 | 364.8 | 0.5倍・1倍 |
| ディスプレイ広告 | 300.8 | 94.0 | 585.0 | 0.5倍・1倍 |
検索広告の3倍、SNS広告とディスプレイ広告の2倍・3倍は、観測した週の広告費の最大を超える水準です。この水準での応答は、データの範囲の外へ曲線を延ばした値になります。
倍率ごとの応答を数字で並べたのが次の表です。単位は万円/週で、「真」は真の応答、「MMM」は MMM(基準)の推定です。
| 媒体 | 0.5倍 真 | 0.5倍 MMM | 1倍(現状)真 | 1倍(現状)MMM | 2倍 真 | 2倍 MMM | 3倍 真 | 3倍 MMM |
|---|---|---|---|---|---|---|---|---|
| テレビCM | 268.8 | 341.4 | 786.7 | 848.8 | 1,518.2 | 1,472.0 | 1,834.0 | 1,736.2 |
| 検索広告 | 332.7 | 51.9 | 548.9 | 236.6 | 765.5 | 952.3 | 867.1 | 1,844.2 |
| SNS広告 | 210.2 | 33.3 | 409.4 | 200.2 | 615.7 | 535.8 | 704.2 | 644.4 |
| ディスプレイ広告 | 73.8 | 5.7 | 116.9 | 44.0 | 164.9 | 289.4 | 191.1 | 659.1 |
テレビCMは、真の曲線と MMM の曲線がほぼ重なりました。現状(1倍)の応答は真の786.7万円に対して MMM が848.8万円、2倍では1,518.2万円に対して1,472.0万円で、差は1割以内です。第2章で見たとおり、テレビCMは4つのパラメータがほぼ当たっていて、曲線の形もよく再現されています。テレビCMは放映期間に週1,200〜2,200万円を出し、期間外は0という出し方なので、観測した週の広告費が0から2,206.0万円まで広く散らばっていて、曲線の下の方も上の方もデータで裏付けられています。
検索広告は、まったく違う形になりました。真の曲線は現状の224.3万円のあたりですでに傾きが緩み始めているのに、MMM の曲線は現状のあたりでまだ下に凸で、2倍・3倍と増やすほど伸びが大きくなっています。3倍の列では、真の867.1万円に対して MMM は1,844.2万円と2倍を超える値を返しました。ディスプレイ広告も同じ傾向で、3倍の列では真の191.1万円に対して MMM は659.1万円です。逆に、現状より下の0.5倍の列では、検索広告で真の332.7万円に対して MMM は51.9万円、SNS広告で210.2万円に対して33.3万円と、MMM は0.5倍での応答そのものを大幅に小さく見積もっています。ただし、現状(1倍)から0.5倍へ減らしたときに失う増分売上で比べると、検索広告は真の216.2万円に対して MMM は184.7万円、SNS広告は真の199.2万円に対して MMM は166.9万円で、MMM の見積もりは約15〜16%小さい程度です。3倍での過大と0.5倍での過小は、同じ向きの読み方を生みます。MMM(基準)の曲線を信じると、「検索広告は今の水準では効きが悪いが、増やせば効きが良くなる」と読めてしまうのです。
第2章の予算配分の表で、MMM(基準)で最適化した配分が検索広告を現状の224.3万円から448.5万円(上限の2倍)まで増やしていたのは、この曲線の形の誤りによるものです。真の最適では、検索広告はむしろ193.2万円に減らすのが良い配分でした。応答曲線の推定の誤りは、ROI の数字の誤り以上に、予算を動かす向きそのものを誤らせます。
平均ROIと限界ROIは、曲線の上で別の場所を見ている
応答曲線が曲がっていると、ROI には2種類の読み方が生まれます。1つは、増分売上の合計を広告費の合計で割った平均の ROI です。この記事で特に断らずに「売上ROI」と書いているのはこちらで、応答曲線の上では、原点と現状の点を結んだ直線の傾きにあたります。もう1つは、あと1万円増やしたときに増える売上です。これは現状の点での曲線の接線の傾きにあたり、この記事では限界ROIと呼びます(定義と使い方は第11章で詳しく扱います)。素朴な回帰のように応答が直線なら2つは同じ値ですが、曲線では一般に一致しません。
前の節のコードの出力を、平均ROIと限界ROIの列に整理したのが次の表です。いずれも定常状態の応答曲線から計算した値で、第2章の表の「直近52週の売上ROI」(実際の出し方で計算したもの)とは計算の前提が違います。
| 媒体 | 現状の週の広告費(万円) | 平均ROI 真(定常状態) | 平均ROI MMM(定常状態) | 限界ROI 真 | 限界ROI MMM | 真の曲線での現状の位置 |
|---|---|---|---|---|---|---|
| テレビCM | 402.9 | 1.95 | 2.11 | 2.51 | 2.26 | S字の下の方(限界が平均より大きい) |
| 検索広告 | 224.3 | 2.45 | 1.06 | 1.47 | 2.26 | 逓減の区間(限界が平均より小さい) |
| SNS広告 | 228.5 | 1.79 | 0.88 | 1.39 | 1.88 | 逓減の区間(限界が平均より小さい) |
| ディスプレイ広告 | 300.8 | 0.39 | 0.15 | 0.23 | 0.43 | 逓減の区間(限界が平均より小さい) |
真の値で見ると、テレビCMだけが「限界ROI 2.51 が平均ROI 1.95 より大きい」媒体です。S字の下の方にいるので、あと1万円増やしたときのほうが、これまでの平均より効率が良いということです。検索広告は定常状態の平均ROIが2.45と4媒体で最も高い一方、限界ROIは1.47に下がっています。この2.45は毎週同じ額を出し続けたと仮定した値で、他の章で検索広告の真の売上ROIとして使う2.35(直近52週の実際の出し方で計算した値)とは別の量です。平均で見れば一番の稼ぎ頭でも、次の1万円を足す先としてはテレビCMのほうが良い、という読み方になります。平均ROIの順位と限界ROIの順位が入れ替わるのは、応答曲線が曲がっているからです。
MMM(基準)の列では、検索広告・SNS広告・ディスプレイ広告の3つで、限界ROIが平均ROIを上回っています。真の値とは大小が逆です。前の節で見たとおり、MMM はこの3媒体の現状を S字の下の方だと推定しているためで、検索広告の限界ROIを2.26と、真の1.47より大きく見積もっています。予算配分の最適化は、各媒体の限界ROIを比べて、高い媒体へ予算を移していく計算なので、この誤りがそのまま配分の誤りになります。平均ROIと限界ROIの使い分け、粗利で見たときの読み方、経営報告での見せ方は第11章で詳しく扱います。この章で押さえておきたいのは、「予算を増やすか減らすかの判断に効くのは、平均ではなく曲線の傾きのほうで、その傾きは曲線の形の推定に強く依存する」という点です。
S字の下の方では、出し方を集中させる意味がある
応答曲線が S字のとき、同じ年間の広告費でも、毎週均等に出すか、特定の週に集中させるかで、得られる増分売上が変わります。広告費が少なく、毎週均等に出すと S字の下の平らな区間にとどまってしまう場合は、出す週を絞って1週あたりの額を大きくし、曲線の傾きが大きい区間まで押し上げたほうが、年間の増分売上は大きくなります。逆に、広告費が十分に大きい場合は、集中させると曲線の上の平らな区間(飽和)に入ってしまい、均等に出したほうが得になります。テレビCMの放映期間(フライト)をどう組むかを考えるとき、応答曲線の形から見ると、この「下の方なら集中、上の方なら分散」という関係が1つの判断材料になります。
共通データのテレビCMの真のパラメータ(decay 0.70・half 1,800・shape 2.0・beta 2,200)を使って、これを実測しました。年間の広告費を決め、それを4通りの出し方で1年52週に割り振ります。毎週均等(52週)、5回×5週(25週)、4回×3週(12週)、4回×2週(8週)で、放映期間の開始週は、52週を回数で割った週数ごとに置き(5回×5週では10週ごとで、年をまたぐ間隔だけ12週になります)、放映する週には年間の額を週数で割った同じ額を出します。同じ出し方を3年続け、3年目の増分売上の合計(前年からの持ち越しを含む)を年間の広告費で割って売上ROIとしました。この節の計算は実行したスクリプトからの抜き出しで、補助モジュール mmm_data.py と同じフォルダに置いて実行する形です。
import numpy as np
import mmm_data as md

P = md.TRUE["tv"]  # decay 0.70・half 1,800・shape 2.0・beta 2,200(架空)

def pattern(n_flights, length):
    """1年52週のうち、n_flights 回の放映期間(各 length 週)を等間隔に置いた 0/1 の並び"""
    on = np.zeros(52)
    gap = 52 // n_flights
    for k in range(n_flights):
        on[k * gap: k * gap + length] = 1
    return on

def annual_effect(budget, on):
    """年間 budget 万円を on の週に均等に割り振り、3年続けたときの3年目の増分売上(持ち越し込み)"""
    week = budget / on.sum() * on
    eff = md.media_effect(np.tile(week, 3), P)
    return eff[104:].sum()

PATTERNS = {"毎週均等(52週)": pattern(1, 52), "5回×5週(25週)": pattern(5, 5),
            "4回×3週(12週)": pattern(4, 3), "4回×2週(8週)": pattern(4, 2)}
for b in [2000, 5000, 10000, 20951, 40000]:   # 年間の広告費(万円)
    print(b, [round(float(annual_effect(b, on) / b), 2) for on in PATTERNS.values()])
# 出力(売上ROI。左から 毎週均等・5回×5週・4回×3週・4回×2週):
# 2000 [0.29, 0.36, 0.5, 0.56]
# 5000 [0.7, 0.85, 1.11, 1.2]
# 10000 [1.29, 1.45, 1.63, 1.66]
# 20951 [1.95, 1.87, 1.71, 1.64]
# 40000 [1.92, 1.67, 1.36, 1.28]
年間の増分売上と売上ROIを表にまとめます。単位は万円で、カッコ内が売上ROIです。年間20,951万円は、共通データのテレビCMの直近52週(第105〜156週)の実際の広告費の合計です。
| 年間の広告費(万円) | 毎週均等(52週) | 5回×5週(25週) | 4回×3週(12週) | 4回×2週(8週) |
|---|---|---|---|---|
| 2,000 | 577(0.29) | 719(0.36) | 1,005(0.50) | 1,119(0.56) |
| 5,000 | 3,516(0.70) | 4,261(0.85) | 5,571(1.11) | 5,991(1.20) |
| 10,000 | 12,876(1.29) | 14,467(1.45) | 16,327(1.63) | 16,568(1.66) |
| 20,951 | 40,911(1.95) | 39,225(1.87) | 35,864(1.71) | 34,317(1.64) |
| 40,000 | 76,634(1.92) | 66,838(1.67) | 54,527(1.36) | 51,062(1.28) |
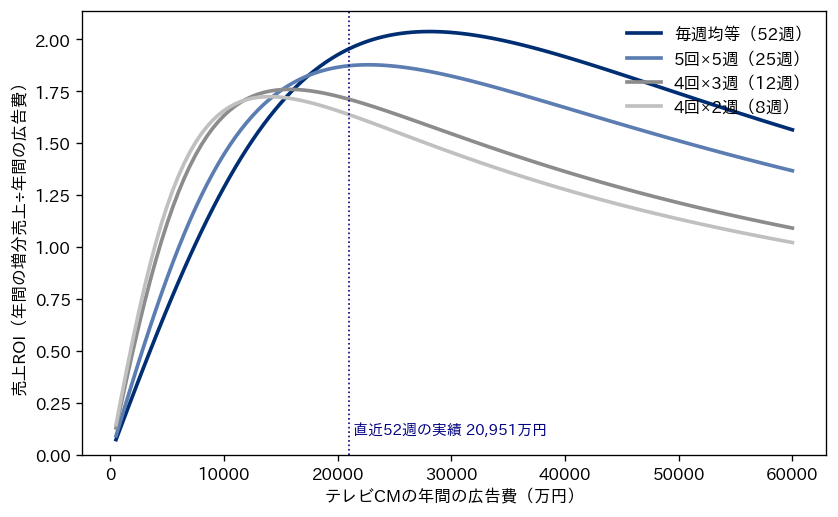
年間2,000万円や5,000万円のように少ない額では、出す週を絞るほど売上ROIが高くなりました。5,000万円の行では、毎週均等の0.70に対して、4回×2週は1.20です。毎週均等だと週あたり約96万円で、テレビCMの S字のほとんど平らな区間にとどまるのに対し、8週に絞ると週625万円になり、曲線の傾きが大きい区間に入るためです。年間10,000万円でも、まだ集中させたほうが高い結果でした。ところが、20,951万円になると順位が逆転し、毎週均等の1.95が最も高く、4回×2週は1.64まで下がります。40,000万円では、毎週均等の1.92に対して4回×2週は1.28で、集中させると放映期間の週に飽和してしまい、積み増した広告費の多くが売上に結びつかなくなります。図の曲線で見ると、出し方ごとに売上ROIが最大になる年間の広告費があり、毎週均等では年28,000万円(売上ROI 2.04)、5回×5週では22,500万円(1.88)、4回×2週では14,000万円(1.72)でした(年500万円刻みで探した結果です)。
この結果は、テレビCMの真のパラメータという1つの架空の設定での計算です。どの額から均等に出したほうが良くなるかの境目は、half と shape、持ち越しの decay によって変わります。また、この実験は「アドストックを計算してから Hill 関数を掛ける」順序のモデルでの結果です。順序を逆にしたモデルや、decay・half・shape の違う媒体には、この表の数字はそのまま当てはまりません。自社の媒体で同じ判断をするには、その媒体について推定した応答曲線(と、その推定の確からしさ)で同じ計算をし直す必要があります。
テレビの放映期間の集中は、飽和を招くことがある
共通データのテレビCMの実際の出し方を、前の節の結果と照らし合わせます。直近52週(第105〜156週)にテレビCMを放映した週は11週で、放映した週の平均の広告費は約1,905万円でした。年間20,951万円を11週に集中させた出し方です。この出し方での真の増分売上は31,547万円、真の売上ROIは1.51です。同じ年間の額を毎週均等に出したと仮定すると、売上ROIは1.95で、年間の増分売上は40,911万円になります。第2章の注意書きで触れた「直近52週の真の ROI 1.51 と、毎週均等に出した定常状態の約1.95の差」は、この比較のことです。
ただし、この2つの数字の差を、すべて出し方の違いだけによるものとは言えません。1.51 は、直近52週の窓の中で生じた増分売上を、窓の中の広告費で割ったもので、窓の前の放映からの持ち越しが入り、窓の後に持ち越す分は入りません。前の節の計算は、同じ出し方を3年続けたときの3年目で、持ち越しの出入りが釣り合った状態です。放映の時期・回数・週ごとの額のばらつきも違います。2つは数え方が同じ計算ではないことを断ったうえで、「この架空データの設定では、年間約2億円の規模では、11週に集中させるより均等に近い出し方のほうが、真の応答では売上ROIが高い」という方向は、前の節の表の20,951万円の行(集中させるほど1.95→1.64と下がる)とも一致しています。
ここで注意したいのは、MMM の予算配分が、通常この差を扱っていないことです。第2章の基準の結果で使った optimize_budget は、週の広告費を「毎週同じ額を出し続けた定常状態」の応答曲線で評価しています。テレビCMを週402.9万円から633.3万円に増やすのが真の最適だという答えも、毎週均等に出す前提での答えです。実際に放映期間に集中させて出すと、同じ年間の額でも増分売上は定常状態の計算より小さくなることがあり、この記事の例では約2割(1.51÷1.95)の違いでした(前の節で断ったとおり、この差には数え方の違いも含まれます)。予算の総額と媒体ごとの配分は応答曲線で決め、媒体ごとの出し方(放映期間をいくつに分けるか、1回あたり何週か)は、同じ応答曲線を使って週ごとの計画を評価し直す、という2段階で考えるのが妥当だと考えています。配分の最適化と定常状態の前提は第12章でも扱います。
飽和の位置は、データにその広告費の水準が無いと推定できない
MMM(基準)は、テレビCMの応答曲線をほぼ正しく推定した一方で、検索広告とディスプレイ広告の曲線を大きく外しました。その違いがどこから来るかを見るため、各媒体について、観測したアドストックの最大値が half に対してどこまで届いていたかを数えました。half は上限の半分の効果が出る水準なので、データの中に half を超える週がどれだけあるかは、曲線の折り返しから上の部分がデータで裏付けられているかどうかの目安になります。
| 媒体 | 観測した週の広告費(万円) | 真の half | 真の decay で計算したアドストックの最大値 | 真の half を超えた週の数 | MMM(基準)の half | MMM の decay で計算したアドストックの最大値 | MMM の half を超えた週の数 |
|---|---|---|---|---|---|---|---|
| テレビCM | 0.0〜2,206.0 | 1,800 | 6,249.6 | 57 | 1,514 | 5,892.0 | 59 |
| 検索広告 | 65.4〜450.4 | 250 | 479.6 | 63 | 1,401 | 617.0 | 0 |
| SNS広告 | 105.3〜364.8 | 400 | 585.6 | 72 | 342 | 396.8 | 25 |
| ディスプレイ広告 | 94.0〜585.0 | 600 | 790.1 | 24 | 2,925 | 1,533.7 | 0 |
テレビCMは、真の half 1,800 に対してアドストックの最大値が6,249.6と3倍を超え、156週のうち57週で half を超えていました。曲線の上の方まで、実際のデータが届いています。一方、MMM(基準)は検索広告の half を1,401、ディスプレイ広告の half を2,925と推定しましたが、MMM 自身の decay で計算したアドストックの最大値は、それぞれ617.0と1,533.7で、推定した half を超えた週は1週もありません。MMM は、データのどこにも無い水準に曲線の折り返しを置いた、ということです。3倍の列で MMM が真の2倍を超える値を返したのは、データの範囲の外に曲線を延ばした結果です。データにある範囲から、無い範囲の値を推し量ることを外挿と呼びます。
この現象は、Google の2017年の論文がすでに指摘しています。論文は、Hill 関数の3つのパラメータ(上限・半飽和点・形)が状況によっては事実上識別できないと述べ、その例の1つとして、半飽和点が観測した広告費の範囲の外にある場合を挙げています。範囲の中ではほとんど同じ曲線が、まったく違うパラメータの組から作れてしまい、範囲の外で初めて分かれる、という説明です。そのうえで論文は、この場合は観測した範囲の外に応答曲線を延ばすことはできないが、半飽和点の事前分布を観測した範囲に収めておけば、範囲の中の曲線はうまく推定できる、とシミュレーションの結果を示しています。事前分布の考え方は第9章で、パラメータの組が1つに決まらない問題(識別性)の全体は第8章で扱います。
では、他の部分がすべて分かっている理想的な条件なら、飽和の位置は推定できるのでしょうか。これを確かめるため、架空の設定で次の実験をしました。共通データの売上から、真の基礎売上と、検索広告以外の3媒体の真の効果を差し引き、「検索広告の効果+観測の誤差(標準偏差120万円)」だけを残します。現実には基礎売上も他の媒体の効果も分からないので、MMM が実際に置かれる状況よりはるかに恵まれた条件です。この残りに、half をいくつかの値に固定して、decay・shape・beta を最小二乗で当てはめ直し、当てはまりと、応答曲線の各点を比べました。次のコードは、実行したスクリプトからの抜き出しで、補助モジュール mmm_data.py と同じフォルダに置いて実行する形です。
import numpy as np
from scipy.optimize import least_squares
import mmm_data as md

df = md.make_data()
x = df["search"].to_numpy(dtype=float)
others = sum(df["eff_" + c] for c in md.CHANNELS if c != "search")
y = (df["sales"] - df["base_true"] - others).to_numpy()   # 検索広告の効果+観測の誤差
cur = x[104:].mean()                                       # 直近52週の週平均 224.3万円

def fit_with_half(half):
    """half を固定し、decay・shape・beta を最小二乗で推定する"""
    f = lambda q: md.media_effect(x, {"decay": q[0], "half": half, "shape": q[1], "beta": q[2]}) - y
    best = None
    for d0 in (0.1, 0.4):
        for s0 in (0.8, 1.5):
            r = least_squares(f, [d0, s0, 1000], bounds=([0, 0.5, 0], [0.9, 3, 1e6]))
            if best is None:
                best = r
            elif r.cost < best.cost:
                best = r
    return best.x
結果は次の表のとおりです。「RMSE」は残りの系列への当てはめの誤差(万円)、「応答」の列は、当てはめたパラメータでの定常状態の週の増分売上(万円/週)で、1倍が現状の週平均224.3万円です。「直近52週の売上ROI」は、当てはめたパラメータで第105〜156週の増分売上を計算し、同じ期間の広告費で割った値です。
| half(固定した値) | RMSE(万円) | decay | shape | beta(万円) | 応答 1倍 | 応答 2倍 | 応答 3倍 | 限界ROI | 直近52週の売上ROI |
|---|---|---|---|---|---|---|---|---|---|
| 真の値(250) | – | 0.10 | 1.20 | 1,100 | 548.9 | 765.5 | 867.1 | 1.47 | 2.35 |
| 150 | 114.6 | 0.00 | 1.79 | 829 | 557.3 | 726.3 | 775.8 | 1.45 | 2.33 |
| 250 | 113.7 | 0.00 | 1.20 | 1,166 | 545.1 | 779.0 | 893.0 | 1.55 | 2.34 |
| 400 | 113.7 | 0.00 | 1.00 | 1,507 | 541.1 | 796.5 | 945.1 | 1.55 | 2.34 |
| 700 | 113.7 | 0.00 | 0.88 | 2,002 | 538.6 | 807.8 | 983.5 | 1.54 | 2.34 |
| 1,000 | 113.8 | 0.00 | 0.83 | 2,390 | 537.6 | 812.6 | 1,000.8 | 1.54 | 2.34 |
| 1,500 | 113.8 | 0.00 | 0.79 | 2,922 | 536.8 | 816.6 | 1,016.3 | 1.53 | 2.34 |
| 3,000 | 113.8 | 0.00 | 0.74 | 4,140 | 535.8 | 821.5 | 1,035.6 | 1.53 | 2.34 |
half を250から3,000まで12倍に動かしても、当てはめの誤差 RMSE は113.7〜113.8万円とほとんど変わりませんでした。データだけでは、half が250なのか3,000なのかを見分けられないということです。それでも、この理想的な条件では、現状(1倍)の応答は535.8〜545.1万円、直近52週の売上ROI は2.34と、どの half でも真の値(548.9万円・2.35)に近い値になりました。データにある範囲の中の曲線は、half が分からなくても推定できています。分かれるのは範囲の外で、3倍の応答は half 250 の893.0万円から half 3,000 の1,035.6万円まで広がり、half を大きく置くほど、上限の beta も大きくなって、増やしたときの伸びを大きく見積もります(真の値は867.1万円)。なお、どの組でも decay は0.00と推定され、真の0.10とは違いました。
この実験と MMM(基準)の結果を並べると、外挿の問題が2段構えになっていることが分かります。第1に、他の部分が完全に分かっていても、データの範囲の外の曲線は形の仮定次第で変わります。この実験では3倍の応答に約16%(893.0万円と1,035.6万円)の幅が出ました。第2に、現実の MMM では基礎売上や他の媒体も同時に推定するので、範囲の中の曲線すら外れることがあります。MMM(基準)の検索広告は、現状の応答を真の548.9万円に対して236.6万円と、範囲の中でも半分以下に見積もっていました。この誤りの原因は、1つに確かめられてはいません。この記事で確かめた事実は3つです。MMM(基準)の定数とトレンドが真の値より大きめに推定されていたこと(第2章)、真の基礎売上を与えて推定し直しても検索広告の売上ROIは0.98、SNS広告は0.85と真の値の約半分のままで、媒体どうしの効果の振り分けが誤っていたこと(第7章)、推定値の一部が探索の範囲の上限に張り付いていたこと(第8章)です。この2つ目の誤りは、飽和の式を工夫するだけでは直りません。
経営判断への翻訳:上限に近い媒体に積み増さず、範囲の外は試して確かめる
この章の結果を、予算の判断に使える形にまとめます。1つ目は、上限に近い媒体に積み増さないことです。応答曲線の上の方で運用している媒体は、平均ROIが高くても、追加の1万円が生む売上は小さくなっています。共通データの真の値では、検索広告の平均ROI(定常状態)は2.45と4媒体で最も高いのに、限界ROIは1.47でした。粗利率0.50の架空の設定では、限界ROI 1.47 の追加の1万円は粗利で約0.74万円しか回収できず、追加分だけを見ると赤字です。平均ROIの順位で予算を積み増す判断は、曲線が曲がっている限り、この種の損失を生みます。媒体ごとの報告には、平均ROIと並べて、現状の支出での限界ROIを必ず添えるべきだと考えています。
2つ目は、データの範囲の外への積み増しを、モデルの答えだけで決めないことです。MMM が「この媒体は増やすほど効きが良くなる」と答えたとき、それが曲線の下の方にいるという正しい推定なのか、範囲の外に折り返しを置いた外挿なのかは、当てはまりの良さからは区別できません。この章の実験では、half を12倍に動かしても当てはまりの誤差は0.1万円しか変わりませんでした。見分ける手がかりは、推定した half を、実際に観測した支出(アドストック)の最大値と比べることです。ただし、この比較で見分けられるのは外挿かどうかだけで、範囲の中の誤りは見分けられません。MMM(基準)の SNS広告は、half 342 が観測したアドストックの最大値396.8の内側にあったのに、売上ROIは0.90と真の1.76の約半分でした。half が観測した範囲の外にあるなら、その媒体の「増やしたときの効果」は、データではなく式の仮定が決めています。その場合は、予算を一度に大きく動かさず、上限を区切って少しずつ増やし、その増分を地域実験などで測ってから次の判断に進むのが、損失を抑える進め方です。実験の設計と、実験の結果を MMM に取り込む方法は第10章で扱います。
3つ目は、出し方の計画を、配分の計画と分けて評価することです。テレビCMのように S字の媒体では、同じ年間の額でも、集中させるか均等に出すかで増分売上が変わります。この章の架空の設定では、年間5,000万円なら8週に集中させたほうが売上ROIが0.70から1.20に上がり、年間40,000万円なら逆に均等に出したほうが1.28に対して1.92と高くなりました。年間の額を決める会議と、放映期間を組む会議が別々に動いていると、総額は応答曲線の定常状態の前提で決まり、出し方は別の理由で決まって、計画した増分売上に届かないことが起きえます。配分の計算に使った応答曲線で、実際の週ごとの出稿計画をもう一度評価する手順を、予算策定の流れに入れておくことを勧めます。
この3つは、いずれも「応答曲線が曲がっている」という1つの事実から出てきます。逆に言えば、応答曲線を描かずに媒体別の ROI だけを並べた報告では、どれも判断できません。広告費の配分を決める立場の方が MMM の結果を受け取るときには、媒体ごとの応答曲線の図と、その上に現状の支出と観測した支出の範囲が描かれているかを確かめるのがよいと考えています。
まとめます。広告費と増分売上の関係は直線ではなく、増やすほど伸びが鈍り、やがて頭打ちになります。MMM はこれを Hill 関数で表し、S字の形も上に凸の形も1つの式で扱います。共通データでは、データが曲線の上の方まで届いていたテレビCMの応答曲線は MMM(基準)でもほぼ正しく推定できた一方、推定した折り返しの位置が観測した範囲の外にあった検索広告とディスプレイ広告では、現状の3倍の広告費での応答を真の値の2倍以上に見積もり、予算を動かす向きまで誤らせました。曲線の形は平均ROIと限界ROIの違い、放映期間を集中させるか均等に出すかの判断にも直結します。次の第7章では、範囲の中の誤りに関わるもう1つの側、つまり季節性・販促・外部要因を基礎売上の側にどう切り分けるかを扱い、基礎売上を正しく置いても残る誤りがあることも確かめます。
この章を深めたい方への参考書籍
『マーケティング・モデル 第2版』(里村卓也、共立出版):「Rで学ぶデータサイエンス」シリーズの1冊で、統計ソフト R の入門から始めて、マーケティングの数理モデルを章ごとに扱う教科書です。目次には「市場反応の分析と普及の予測」という章があり、マーケティングの施策に市場がどう反応するかをモデルで表すという、この章の応答曲線と同じ問題意識を、マーケティング・サイエンスの側から学ぶ入口になります。
『データ分析のための数理モデル入門 本質をとらえた分析のために』(江崎貴裕、ソシム):目次によれば、数理モデルの適用限界、線形モデルと実験式・カーブフィッティング、モデルの数理構造とパラメータの選び方、パラメータの推定、情報量規準や交差検証によるモデルの評価までを1冊で扱う入門書です。どの関数の形を選ぶか、その形がどこまで通用するかという、この章の「範囲の外では形の仮定が答えを決める」という問題を、広告に限らない一般的な視点から考える助けになります。
第7章 季節性・販促・外部要因を切り分ける
第5章と第6章では、広告の効果が翌週以降に持ち越されること(アドストック)と、広告費を増やしても売上が比例して増えないこと(飽和)を、媒体の側の形として扱いました。MMM の残りの半分は、広告が無くても動く売上、つまり基礎売上の側です。売上は季節で上下し、年ごとに少しずつ伸び、値引き販促や休日の週に跳ね上がります。この動きを基礎売上の側で説明しきれないと、広告がたまたま同じ時期に出ていただけの売上の山が、広告の手柄として数えられます。逆に基礎売上の側に説明させすぎると、広告が本当に生んだ売上まで基礎売上に吸われます。この章では、基礎売上の側に置く変数(統制変数)の選び方と表し方を説明し、第2章で用意したサンプルデータ(架空の日用品メーカーの週次データ)で、統制変数の組を変えると媒体の ROI の推定がどれだけ動くかを実測します。
統制変数は基礎売上の側に置くもの
MMM の式は、売上を「基礎売上」と「媒体ごとの増分売上」の足し算で表します。このうち基礎売上を表すために入れる変数を、この記事では統制変数と呼びます。Google のオープンソースの MMM である Meridian の公式ドキュメント(Control variables のページ)では control variables と書かれ、「処置(効果を測りたい媒体)ではない、モデルの中の変数」で、基礎となる成果の水準を推定するために使うものと説明されています。共通データで使っている統制変数は、定数(売上の水準)、トレンド(年ごとの伸び)、季節を表す4本の項(後で説明するフーリエ項を2組)、値引き販促の週の印、休日の週の印の合計8本です。第2章で紹介した基準の MMM(以下、MMM(基準))も、素朴な回帰も、この8本を共通に使っています。
統制変数を入れる目的は、売上の予測を良くすることそのものではありません。媒体の効果を、他の理由で動いた売上と取り違えないようにすることです。たとえば年末に売上が増える会社で、年末にだけテレビCMを出していれば、年末の売上の山は「年末だから」と「テレビCMを出したから」の両方で説明できてしまいます。季節を表す変数をモデルに入れておけば、年末の山のうち季節で説明できる部分は季節に割り振られ、テレビCMには、季節では説明できない残りの部分だけが割り振られます。統制変数は、媒体の効果を測るための「比べる相手」を作る道具だと言い換えられます。
反対に、統制変数を入れると、媒体の効果を推定するための材料は減ります。季節を統制変数に入れると、季節と同じ向きに動いている広告費の動きは、季節と区別できなくなるからです。媒体の効果を推定できるのは、統制変数では説明できない広告費の動き、つまり季節や休日とは無関係に広告費が増えたり減ったりした週の情報だけになります。この章の実測で繰り返し出てくるのは、この「比べる相手を作ること」と「推定の材料が減ること」の釣り合いです。
Meridian の同じページは、統制変数を3種類に分けています。媒体と成果(売上などの指標)の両方に影響する変数は入れる(入れると媒体の効果の偏りが取れる)。成果だけに強く影響する変数は、媒体の効果の推定のばらつきを小さくできるので入れる。媒体が成果に効く途中の経路にある変数(媒介変数)は入れない。そのうえで、予測の当てはまりを良くすることだけを目的に変数を増やしすぎないこと、増やすとモデルの定式化の誤りによる偏りの危険が増えることを挙げています。この章の実測は、この推奨のそれぞれが共通データでどういう数字の違いになって現れるかを見るものでもあります。
| 統制変数の種類 | 表す動き | 共通データでの入れ方 | 入れないと起きうること |
|---|---|---|---|
| 定数・トレンド | 売上の水準と、年ごとの伸び | 定数1本と、週番号を52で割った値1本 | 伸びている時期に増額した媒体に、伸びの分が割り振られる |
| 季節性 | 1年周期の上下(夏と年末の山) | フーリエ項2組(正弦と余弦を合わせて4本) | 需要の高い時期に増える媒体に、季節の山が割り振られる |
| 休日 | 年末と大型連休の週の上乗せ | 各年の第51・52週と第18週に1を立てる印 | 休日に増える媒体に、休日の上乗せが割り振られる |
| 販促・価格 | 値引き販促の週の上乗せ | 販促の週に1を立てる印 | 販促と同じ週に出した媒体に、販促の効果が割り振られる |
| 外部要因 | 天候・競合の動き・景気など | 共通データには無い(この章で架空の要因を足して試す) | 外部要因に反応して動く媒体に、外部要因の効果が割り振られる |
季節性の表し方、フーリエ項・ダミー変数・休日の印
週次の売上の季節性を回帰の式に入れる方法は、大きく2つあります。1つは、1年の中の位置ごとに印(ダミー変数)を立てる方法です。「1年の第何週か」の印を立てれば、1年52週のそれぞれに別の水準を持たせられます。月ごとに印を立てれば、月ごとの水準になります。もう1つは、1年を1周期とする正弦波と余弦波の組を足し合わせる方法で、この組をフーリエ項と呼びます。1組目は1年に山と谷が1つずつある波、2組目は1年に山と谷が2つずつある波で、それぞれの組の係数を推定すると、波の高さと山の位置が決まります。2組を足し合わせると「夏と年末に山がある」といった形を表せます。
Hyndman と Athanasopoulos による予測の教科書(オンラインで公開されている第3版の時系列回帰の章)は、回帰で使う説明変数の節でフーリエ項を取り上げ、次のように説明しています。周期を m としたとき、使える組の数の上限は m の半分で、上限まで使うと季節ごとのダミー変数を使った場合と同じ結果になる。周期が長いときは、ダミー変数よりも少ない本数で済むことが多く、週次のデータ(周期がおよそ52)のような場合に役立つ。逆に四半期のように周期が短いデータでは、ダミー変数に対する利点はほとんど無い。同じ節は、ダミー変数を使うときは区分の数より1つ少ない本数にすること(定数と合わせて全部の区分に印を立てると、推定する係数が1つ多すぎて求まらなくなること)も注意しています。
MMM の道具も、季節性や基礎売上の時間による動きを表す部品を用意していますが、その方式は道具によって違います。PyMC-Marketing のMMM クラスの公式 API ドキュメントは、引数 yearly_seasonality を「年周期の季節性に使うフーリエの成分の数」と説明しており、統制変数は control_columns に列名を渡して入れる形です。Meta が公開している Robyn の公式ドキュメントは、トレンド・季節・休日・曜日の分解を、時系列予測のライブラリ Prophet を使って最初から用意していると説明しています(曜日は日次データのときだけ)。Meridian は、時間とともに動く基礎売上の水準を「ノット」と呼ぶ区切り点で表す方式を公式ドキュメントで説明しており、休日のような特定の時期の効果には、その時期に1を立てる印を使う方法とノットを密に置く方法の違いを解説しています。同じページは、フーリエ級数のような周期的な関数を統制変数として足す方法にも触れています。どの道具を使う場合も、季節をどの方式で、何本の変数で表すかは分析する側が決める設定です。
共通データの真の季節性は、52週周期の正弦波2組で作ってあります(第2章の設定)。したがって、MMM(基準)が使っているフーリエ項2組は、真の季節性を正確に表せる形です。現実の売上の季節性はこのようにきれいな波ではないので、何組使えば足りるかは分からず、組を増やすか、ダミー変数を使うかを選ぶことになります。そこで、媒体の持ち越しと飽和の形(decay・half・shape)を真の値に固定し、統制変数の組だけを変えて最小二乗で回帰しました。形を固定すると、各媒体の係数はその媒体の上限 beta の推定になり、ROI は推定した beta と真の beta の比で動きます。媒体の形の推定の難しさ(第8章で扱う)を取り除き、統制変数の影響だけを見るための設定です。次のコードは、補助モジュール mmm_data.py と同じフォルダに置いて実行する形です。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import statsmodels.api as sm
import mmm_data as md

df = md.make_data()
w = df["week"].to_numpy(dtype=float)
# 持ち越し・飽和の形は真の値に固定し、媒体ごとに 0〜1 の特徴量を作る(係数が上限 beta になる)
F = [md.hill(md.geometric_adstock(df[c].to_numpy(dtype=float), md.TRUE[c]["decay"]),
             md.TRUE[c]["half"], md.TRUE[c]["shape"]) for c in md.CHANNELS]

def controls(k_fourier, holiday=True):
    cols = [np.ones(len(w)), w / 52.0]                      # 定数・トレンド
    for k in range(1, k_fourier + 1):                       # フーリエ項(52週周期)
        cols += [np.sin(2 * np.pi * k * w / 52.0), np.cos(2 * np.pi * k * w / 52.0)]
    cols.append(df["promo"].to_numpy(dtype=float))          # 販促の週
    if holiday:
        cols.append(df["holiday"].to_numpy(dtype=float))    # 休日の週
    return np.column_stack(cols)

y = df["sales"].to_numpy(dtype=float)
for name, C in [("フーリエ2組", controls(2)), ("季節なし", controls(0)),
                ("季節・休日なし", controls(0, holiday=False)), ("フーリエ6組", controls(6))]:
    X = np.column_stack([C] + F)
    res = sm.OLS(y[:130], X[:130]).fit()                    # 学習は第1〜130週
    b, se = res.params[-3], res.bse[-3]                     # 検索広告の beta
    roi = b * F[1][104:].sum() / df["search"].iloc[104:].sum()
    print("%-8s 検索広告 beta %5.0f(標準誤差 %4.0f) ROI %.2f" % (name, b, se, roi))
# 出力:
# フーリエ2組   検索広告 beta  1035(標準誤差  329) ROI 2.21
# 季節なし     検索広告 beta  2615(標準誤差  145) ROI 5.59
# 季節・休日なし  検索広告 beta  2851(標準誤差  149) ROI 6.10
# フーリエ6組   検索広告 beta   868(標準誤差  354) ROI 1.86
ROI は MMM(基準)と同じく直近52週(第105〜156週)の売上ROI で、学習期間も第1〜130週にそろえています。この表は持ち越しと飽和の形を真の値に固定した回帰の結果で、後の節で形も推定する MMM の表を別に示します。2つの表の「A 基準」は同じ統制変数の組ですが、推定の方法が違うので、検索広告の ROI も2.21と1.18で違います。同じ計算を、統制変数の組を9通りに変えて行い、4つの媒体すべての ROI を並べたのが次の表です。「統制変数の本数」は定数を含めた本数です。「検索広告の beta の標準誤差」は、検索広告の上限 beta の推定値がどれだけ不確かかを表す値で、大きいほど推定が不安定です。月ダミーは、1年52週を4週ずつ13の区切りに分け、最初の区切りを除く12本の印を立てたものです。「第何週かのダミー」は、休日の週(第18・51・52週)も含めて1年の各週に印を立てるので、休日の印と重なるため休日の印は外しています。
| 統制変数の組(形を真の値に固定した回帰) | 統制変数の本数 | テレビCM | 検索広告 | 検索広告の beta の標準誤差 | SNS広告 | ディスプレイ広告 | 学習期間 R2 |
|---|---|---|---|---|---|---|---|
| 真の値 | なし | 1.51 | 2.35 | なし | 1.76 | 0.38 | なし |
| A 基準(定数・トレンド・フーリエ2組・販促・休日) | 8 | 1.48 | 2.21 | 329 | 1.88 | 0.43 | 0.988 |
| B 季節(フーリエ項)を外す | 4 | 1.50 | 5.59 | 145 | 1.89 | 0.48 | 0.984 |
| C 季節と休日を外す | 3 | 1.48 | 6.10 | 149 | 1.74 | 0.72 | 0.981 |
| D トレンドを外す | 7 | 1.51 | 2.15 | 397 | 1.31 | 0.28 | 0.982 |
| E 販促を外す | 7 | 1.52 | 3.14 | 560 | 2.76 | 0.61 | 0.964 |
| F 定数だけ | 1 | 1.55 | 6.14 | 237 | 2.06 | 0.55 | 0.952 |
| G フーリエ6組に増やす | 16 | 1.50 | 1.86 | 354 | 1.86 | 0.39 | 0.989 |
| H 4週区切りの月ダミー(12本)に替える | 16 | 1.48 | 2.81 | 306 | 1.84 | 0.39 | 0.989 |
| I 第何週かのダミー(51本)に替える | 54 | 1.46 | 2.65 | 477 | 1.85 | 0.69 | 0.993 |
表の「検索広告」の列を見ると、季節を表す項を入れた組(A・G・H・I)では1.86から2.81の範囲に収まり、真の値2.35の近くにあります。季節を外した組(B)では5.59、季節と休日を外した組(C)では6.10、定数だけの組(F)では6.14と、真の値の2倍を大きく超えました。持ち越しと飽和の形を真の値に固定していても、季節を統制しないだけで、検索広告の ROI がこれだけ過大になるということです。一方で、季節を表した組どうしの差も小さくありません。フーリエ6組(G)の1.86と月ダミー(H)の2.81では、0.95の開きがあります。季節を入れていても、その方式や本数によって検索広告の推定が動きます。真の季節性を正確に表せる形どうし(フーリエ6組の G と、第何週かのダミーの I)でも、1.86と2.65の開きがありました。
「学習期間 R2」の列は、売上の動きのうち何割をモデルが説明できたかを表します。季節を外した B(0.984)も、基準の A(0.988)とほとんど変わりません。当てはまりの数字だけを見ていると、季節の項を外したことによる検索広告の過大評価には気づけないということです。逆に、第何週かのダミーを51本入れた I は R2 が0.993と最も高くなりましたが、検索広告の beta の標準誤差は477と、基準の329より大きくなりました。統制変数を増やして当てはまりが良くなっても、媒体の推定が安定するとは限らないことを示しています。これは、Meridian のドキュメントが「予測の当てはまりを良くすることだけを目的に変数を増やしすぎない」と勧めていることと同じ向きの結果です。
この例での実務上の判断としては、週次データで季節性を表すなら、まずフーリエ項を少ない組数(この設定では1〜3組程度。真の季節性を2組で作ってあるための目安です)から入れ、組数やダミー変数への置き換えで媒体の ROI がどれだけ動くかを確かめることが有効だと考えています。動きが大きい媒体は、季節と区別しにくい媒体だということであり、その媒体の ROI は1つの数字として報告しないほうが安全です。区間の付け方は第9章で扱います。
なお、共通データの季節性は毎年同じ形で繰り返すように作ってあります。現実には、季節の山の位置や高さが年によって変わること(たとえば気温の推移で夏物の売れ始めが前後すること)があります。毎年同じ形を仮定するフーリエ項やダミー変数は、この年ごとの違いを表せません。前に紹介した Meridian のノットは、基礎売上の水準が時間とともに動くことを表す方式です。共通データではこの点は試していません。
トレンドと販促、価格の扱い
トレンドは、売上の長期的な伸びや縮みです。共通データの真の基礎売上は、週に2万円ずつ(年に104万円)伸びるように作ってあります。トレンドを統制変数に入れないと、伸びている時期に増額した媒体に、伸びの分が割り振られるおそれがあります。共通データでは、SNS広告を第71週から増額しているので、トレンドと SNS 広告の増額が同じ時期に重なっています。前の表の D(トレンドを外す)を見ると、SNS広告の ROI は1.31になり、真の値1.76より小さくなりました。この例では過大ではなく過小の向きに動いています。SNS広告の支出と週番号の相関を測ると -0.32 でした。この例の SNS広告の支出は、増額の前に第1〜10週の平均323.4万円から第61〜70週の平均117.0万円まで下がっており、第71週の増額だけでは期間全体として右肩上がりになっていません。トレンドを外したときに媒体の推定がどちらへ動くかは、その媒体の支出が期間中にどう動いたかで決まり、あらかじめ向きを決めつけることはできません。
販促も同じ理屈です。値引き販促の週は売上が跳ね上がるので、販促と同じ週に広告を出していれば、販促の効果が広告に割り振られます。共通データの販促の週は乱数で決めてあり、広告費の出し方とは独立に作ってあります。それでも、前の表の E(販促を外す)では、検索広告の ROI が3.14、SNS広告が2.76と、真の値から大きく離れました。この組では、販促で説明されるはずの売上の跳ね上がりが説明されずに残るため、残差(モデルで説明できなかった売上の動き)の標準偏差が基準の115.8万円から197.8万円に増え、検索広告の beta の標準誤差も560に広がっています。販促が広告と同じ時期に重ならなくても、売上を大きく動かす要因を入れ忘れると、推定のばらつきが大きくなり、媒体の数字が偶然の重なりに引きずられやすくなるということです。これは Meridian のドキュメントが「成果だけに強く影響する変数も、媒体の効果のばらつきを小さくできるので入れる」と勧めている理由に当たります。
価格の扱いは、販促よりも注意が要ります。値下げは販売数量を増やし、同時に1点あたりの売上を減らすので、売上を目的変数にした MMM では、価格の効果の向きと大きさが品目の構成によって変わります。また、販促のときに広告も一緒に打つ運用(チラシと SNS 広告を同じ週に出すなど)では、販促と広告が同時に動くので、両者を分けて推定するための材料が少なくなります。価格と販促の効果を推定する方法そのものは、弊社コラム『価格を決める数理モデル、需要曲線の推定からダイナミックプライシングまで』で扱っています。MMM の側では、少なくとも「販促を実施した週」「値引きの深さ」「通常価格の改定」を週次の統制変数として記録しておくことが、媒体の効果の推定を守るために有効だと考えています。
交絡、検索広告は需要が高い週に増える
統制変数の選び方でいちばん重要なのが、交絡への対処です。交絡とは、ある要因が広告費と売上の両方を動かしているために、広告費と売上の間に、広告の効果とは別の結びつきが生まれることです。典型が検索広告です。検索広告は、利用者が検索した語に連動して表示されるので、需要が高い週には検索の回数が増え、広告の表示と支出も増えます。このとき売上が増えたのは、広告が売上を上げたからなのか、売上が上がる週に広告が増えたからなのかを、売上と広告費の数字だけでは区別できません。
Google の研究者による2018年の論文「MMM における検索広告の偏りの補正」は、この問題を正面から扱っています。論文は、MMM で検索広告の効果を測るときの大きな障害として、広告のターゲティングに由来する選択の偏りを挙げ、対象となる人々の関心や需要が広告費と売上の両方を動かすときにそれが生じると説明しています。さらに、広告主は需要が強いときに広告費を多く使うことが多く、その結果、広告費の変化に対する売上の変化を測る素朴な回帰は ROAS(広告費あたりの売上。この記事の売上ROI に当たる)を過大に推定すると述べています。論文が示した補正の方法は、検索の回数(関連する検索クエリの量)を統制変数としてモデルに入れるものです。Meridian の統制変数のドキュメントも、検索クエリの量は、関連する検索がしばしば検索広告の前提条件になるので検索広告にとっては交絡要因であり、モデルに入れるほうが正しい判断になることが多いと書いています。
共通データの検索広告は、この構造をまねて作ってあります。第2章で説明したとおり、検索広告の支出は季節性と休日に連動して増える設定です。下の図の上段は売上(観測値)と真の基礎売上、下段は検索広告の支出で、休日の週に印を付けました。検索広告の支出は、売上の山と同じ時期に山を作っています。測ってみると、検索広告の支出と真の季節成分の相関は0.86、真の基礎売上との相関は0.68でした。休日の週の検索広告の支出は平均344.8万円で、それ以外の週の平均217.7万円より大きくなっています。
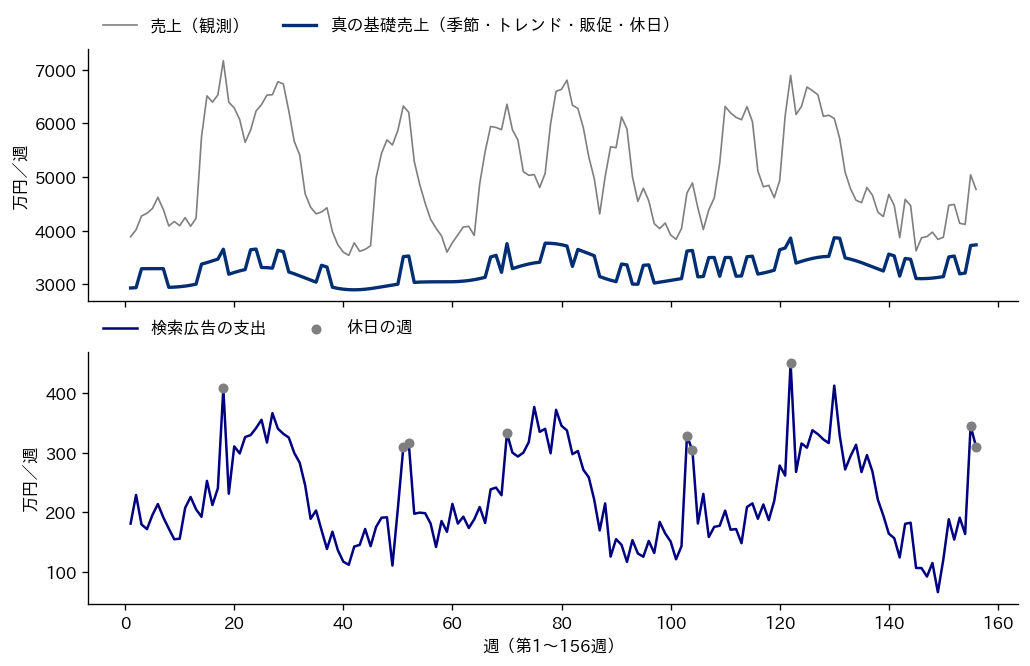
この構造のもとで季節と休日を統制変数から外すと何が起きるかは、前の表の B と C が示しています。検索広告の ROI は5.59と6.10になり、真の値2.35の2倍を超えました。季節の山と休日の上乗せが、それと同じ向きに動く検索広告の効果として数えられたためです。このデータでは、売上を動かした本当の理由(季節と休日)を、データを作った側が知っているので、過大評価だと判定できます。現実の企業には真の値が見えないので、季節を統制しないモデルが出した「検索広告の ROI 5.59」は、もっともらしい数字として報告されうるということです。
交絡を統制変数で取り除くと、推定の材料が減ることも確かめました。検索広告の支出を、基準の統制変数8本で回帰すると、R2 は0.903でした。検索広告の支出の動きの約9割は、季節・休日・トレンド・販促で説明できるということです。残りの動き(標準偏差25.0万円)だけが、検索広告の効果を季節と区別して推定する材料になります。前の表で、基準の A の検索広告の beta の標準誤差が329と、推定値1,035の約3分の1もあるのはこのためです。季節を外した B の標準誤差が145と小さいのは、推定が正確になったからではありません。季節と区別できない動きまで材料に使った結果、見かけ上は確かそうに見えるだけで、その推定値は真の値から大きく外れています。標準誤差が小さいことは、推定に偏りが無いことを保証しないということです。
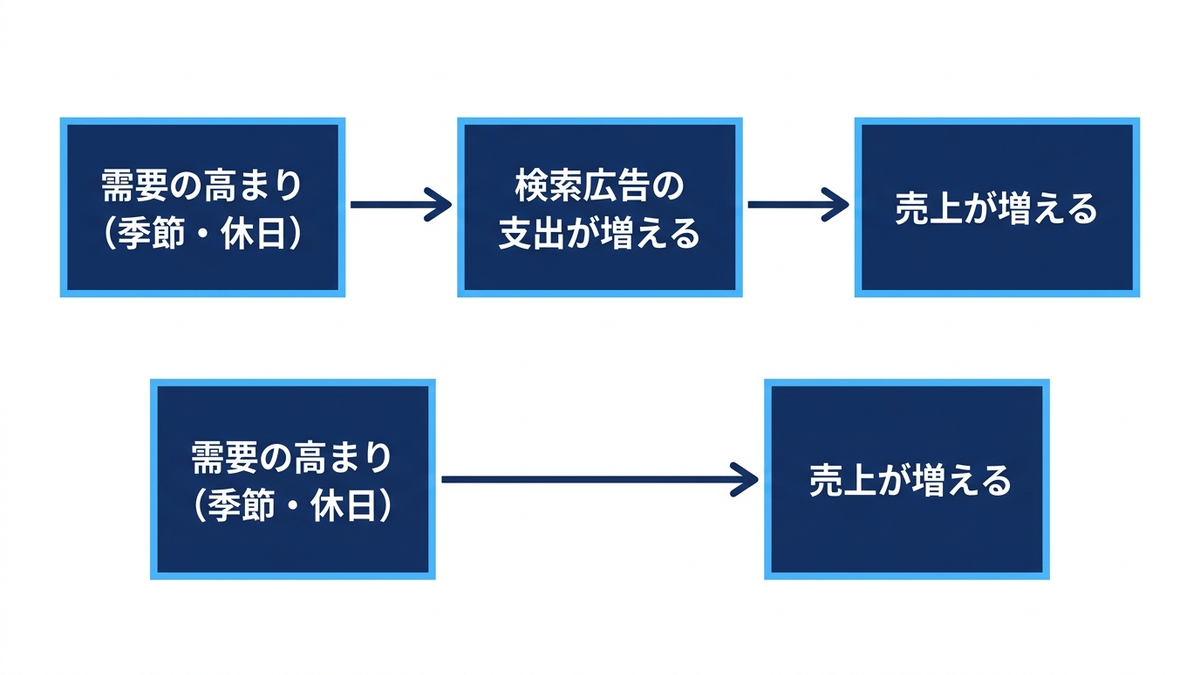
交絡が起きるのは検索広告だけではありません。共通データでは、ディスプレイ広告をテレビCMの放映期間に合わせて増やす運用にしてあり、両者の支出の相関は0.91です。これは媒体どうしの重なり(第4章の多重共線性)で、統制変数の側の問題とは別ですが、「同じ時期に動くものは区別できない」という点では同じ構造です。現実には、需要が高い時期にテレビCMの放映を集中させる、売上が伸びた年に広告予算を増やす、といった運用も、広告費が需要に連動して動く例になりえます。広告費を決めるときに何を見て決めたか(季節の需要の見込み、前年の売上、検索の回数など)を記録しておけば、それが交絡の候補になり、統制変数として入れるべきものの一覧になります。
統制変数の組を変えて MMM を推定し直す
ここまでは、持ち越しと飽和の形を真の値に固定した回帰で、統制変数の影響だけを取り出して見てきました。現実の MMM は、形も推定します。そこで、MMM(基準)と同じ手順で、統制変数の組だけを変えて推定し直しました。MMM(基準)は、各媒体に幾何アドストックと Hill 関数を掛け、統制変数と一緒に scipy.optimize.least_squares で推定し、初期値を変えて12回推定した中から学習期間の誤差が最小のものを採る方法です。次のコードは、補助モジュール baseline.py の推定関数 fit_mmm と同じ境界・初期値の振り方・推定回数を保ったまま、統制変数の行列 C を外から渡せるようにした関数で、この章のスクリプトから抜き出したものです。offset は既知の部分を売上から差し引くための引数で、後で「真の基礎売上を知っていた場合」を試すときに使います。
def fit_custom(df, C, offset, weeks=bl.TRAIN, n_starts=12, seed=0):
    """baseline.fit_mmm と同じ手順。統制変数の行列 C と、既知の部分 offset を受け取る"""
    a, b = weeks
    y = df["sales"].to_numpy(dtype=float) - offset
    nC = C.shape[1]
    X = {c: df[c].to_numpy(dtype=float) for c in md.CHANNELS}
    rng = np.random.default_rng(seed)
    lo, hi = [], []
    for c in md.CHANNELS:
        mx = df[c].max()
        lo += [0.0, 0.05 * mx, 0.5, 0.0]
        hi += [0.9, 5.0 * mx, 3.0, 5000.0]
    lo += [-np.inf] * nC
    hi += [np.inf] * nC

    def pred(theta):
        yhat = C @ theta[16:] if nC > 0 else np.zeros(len(y))
        for i, c in enumerate(md.CHANNELS):
            d, h, s, be = theta[4 * i: 4 * i + 4]
            yhat = yhat + md.media_effect(X[c], {"decay": d, "half": h, "shape": s, "beta": be})
        return yhat

    def resid(theta):
        return (pred(theta) - y)[a - 1: b]

    best = None
    for s in range(n_starts):
        x0 = []
        for c in md.CHANNELS:
            mx = df[c].max()
            x0 += [rng.uniform(0.1, 0.8), rng.uniform(0.3, 2.0) * mx,
                   rng.uniform(0.8, 2.5), rng.uniform(100, 2000)]
        if nC > 0:
            x0 += [float(np.mean(y))] + [0.0] * (nC - 1)
        r = least_squares(resid, np.array(x0), bounds=(lo, hi), max_nfev=4000)
        if best is None:
            best = r
        elif r.cost < best.cost:
            best = r
    return best.x, pred(best.x) + offset
基準の組(A)でこの関数を実行すると、推定したパラメータと ROI は MMM(基準)と小数点以下まで一致しました(検索広告 1.18、SNS広告 0.90 など)。同じ手順が再現できていることを確かめたうえで、季節を外す(B)、季節と休日を外す(C)、トレンドを外す(D)、フーリエ6組に増やす(G)の4通りと、真の基礎売上を既知として売上から差し引き、媒体の効果だけを推定する(O)の1通りを加えて、6通りを推定しました。O は、基礎売上の側を完全に正しく置けた場合の答え合わせで、現実には実行できません。推定の回数は MMM(基準)と同じ12回で、1通りの推定にかかった時間は13.0秒から135.8秒でした(この記事の実行環境である一般的なノートPCでの実測。2通りずつ並列に実行)。
| 統制変数の組(形も推定する MMM) | MAPE 学習 | MAPE 検証 | テレビCM | 検索広告 | SNS広告 | ディスプレイ広告 | 推定した基礎売上の平均(第105〜156週) |
|---|---|---|---|---|---|---|---|
| 真の値 | なし | なし | 1.51 | 2.35 | 1.76 | 0.38 | 3,397.5 |
| A 基準(MMM(基準)そのもの) | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,963.9 |
| B 季節を外す | 1.82% | 2.74% | 1.49 | 1.90 | 0.73 | 0.30 | 3,805.7 |
| C 季節と休日を外す | 1.97% | 2.73% | 1.48 | 2.04 | 0.69 | 0.42 | 3,745.6 |
| D トレンドを外す | 1.99% | 4.12% | 1.51 | 1.79 | 1.84 | 7.85 | 1,139.0 |
| G フーリエ6組に増やす | 1.63% | 2.67% | 1.51 | 1.19 | 0.95 | 0.49 | 3,818.2 |
| O 真の基礎売上を既知とする | 1.77% | 2.41% | 1.49 | 0.98 | 0.85 | 2.09 | 3,397.5(既知として与えた値) |
表の4つの媒体の列は直近52週の売上ROI、「MAPE 検証」は第131〜156週の予測の誤差率、「推定した基礎売上の平均」は、モデルの予測から推定した媒体の効果を引いた値の第105〜156週の平均(万円/週)です。テレビCMの ROI は、どの組でも1.44から1.51の範囲に収まりました。この例のテレビCMの支出は放映期間の外では0で、季節やトレンドとは別の形で大きく動いています。統制変数の組によって大きく動いたのは、検索広告・SNS広告・ディスプレイ広告の3つです。
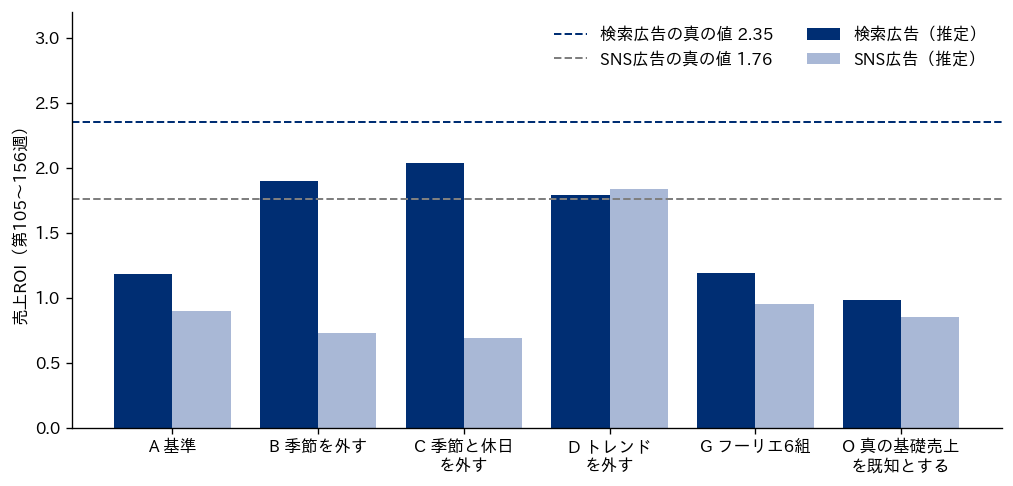
上の図は、検索広告と SNS広告の ROI を組ごとに並べ、破線で真の値を示したものです。まず目を引くのは、季節を外した B(1.90)と、季節と休日を外した C(2.04)で、検索広告の ROI が基準の1.18より真の値2.35に近づいたことです。しかし、これを「季節を外したほうが良いモデルだ」という根拠にはできません。形を真の値に固定した回帰では、同じ操作で検索広告の ROI は5.59と6.10になり、真の値の2倍を超えていました。季節を外すと検索広告の推定が大きく出る方向に動くことは、形を固定した回帰で確かめたとおりです。MMM(基準)の検索広告は、もともと真の値の約半分に出ていました。B と C の検索広告が真の値に近い数字になったことを、検索広告の効果を季節と正しく分けられた証拠として扱うことはできません。実際、同じ B と C で SNS広告の ROI は0.73と0.69に下がり、真の値1.76からさらに離れています。1つの媒体の数字が真の値に近づいたかどうかで、統制変数の組の良し悪しを判断してはいけないということです。
フーリエ6組に増やした G は、検索広告1.19・SNS広告0.95と基準の A とほとんど同じで、学習期間の MAPE が1.63%と少し良くなった以外の違いはありませんでした。この例では、季節の項を増やしても、検索広告と SNS広告の過小評価は直りませんでした。共通データの真の季節性はフーリエ項2組で正確に表せる形なので、2組から6組に増やしても季節の表し方は良くならず、過小評価も残ったということです。
統制変数と媒体は同じ売上を取り合う
MMM(基準)が検索広告と SNS広告を約半分に見積もったことと、統制変数の側との関係を見ます。第2章で、MMM(基準)の定数が3,511(真の値3,000)、トレンドが年124.7(真の値104.0)と大きめに推定されたことを紹介しました。上の表の「推定した基礎売上の平均」で比べると、基準の A は第105〜156週の平均が3,963.9万円/週で、真の3,397.5万円/週より566.4万円大きくなっています。売上の合計は観測された値で決まっているので、基礎売上が大きく推定された分だけ、媒体の効果は小さく推定されます。4媒体の推定効果の合計の週平均は、真の1,777万円に対して A では1,232万円でした。ただし、これは媒体の効果の合計が小さく出たことの説明です。検索広告と SNS広告が個別に約半分になった原因がこれだと確かめたわけではありません。後で見る O のとおり、基礎売上を真の値どおりに置いても、この2媒体は約半分のままでした。
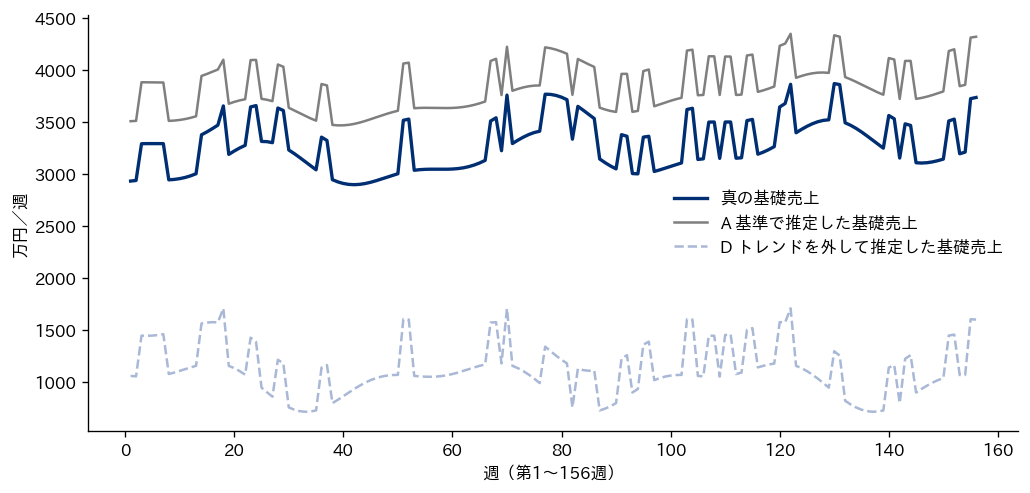
上の図は、真の基礎売上(濃いネイビー)と、A で推定した基礎売上(グレー)、D で推定した基礎売上(薄いネイビーの破線)の週次推移です。A の基礎売上は、真の基礎売上とほぼ同じ形のまま、全期間で上にずれています(第1〜156週の平均で545.4万円)。季節の形は正しく捉えられているのに、水準だけが高く推定されているということです。季節の項を6組に増やした G でも、推定した基礎売上の平均は3,818.2万円/週で、真の値より約421万円大きいままでした。定数と、ほぼ一定の水準で出し続けている媒体の効果は、同じ売上を取り合う関係になりえます。ただし、A のずれがこの取り合いによるものかどうかは確かめていません。
この取り合いがはっきり現れたのが、トレンドを外した D です。D では、推定した基礎売上の平均が1,139.0万円/週と真の値の約3分の1まで下がり、代わりにディスプレイ広告の ROI が7.85と、真の値0.38の20倍を超えました。推定したディスプレイ広告の週次の効果を測ると、最小2,264万円・平均2,361万円・最大2,369万円で、ほとんど動いていません(真のディスプレイ広告の効果は最小68万円・平均116万円・最大159万円)。ディスプレイ広告は毎週ほぼ一定の額を出し続けている媒体なので、飽和の形を急にすれば、その効果を「毎週ほぼ同じ額」にできます。毎週ほぼ同じ額の効果は、定数と区別できません。D では、トレンドを外して基礎売上の伸びを表す手段が無くなり、定数の役割の一部をディスプレイ広告が担う解が選ばれたということです。D の検証期間の MAPE は4.12%と、他の組(2.4〜2.7%)より悪くなっていたので、この例では予測の当てはまりの悪化が異常を知らせる手がかりになっていました。
最も示唆的なのは、真の基礎売上を既知とした O です。基礎売上の側を完全に正しく置いたにもかかわらず、検索広告の ROI は0.98、SNS広告は0.85と、真の値の約半分のままで、ディスプレイ広告は2.09と大きく出ました。推定した4媒体の効果の合計の週平均は1,776万円で、真の1,777万円とほぼ一致しています。媒体の効果の合計は正しく出たのに、媒体どうしの配分が誤っているということです。O のディスプレイ広告の推定効果は、週の最小579万円・平均629万円・最大635万円とほとんど動いていません。第1〜156週の週平均で比べると、ディスプレイ広告の推定効果は真の値より513万円大きく(推定629万円・真116万円)、検索広告は312万円小さく(推定219万円・真531万円)、SNS広告は202万円小さく(推定202万円・真404万円)なっていました。検索広告と SNS広告の不足分の合計514万円と、ディスプレイ広告の超過分513万円がほぼ見合っています。
この結果から言えるのは、基礎売上の側を正しく置くことは必要条件であって、十分条件ではないということです。季節や休日の統制変数は、季節と同じ向きに動く媒体(この例の検索広告)の過大評価を防ぎます。しかし、媒体の効果のうち、期間を通じてほぼ一定の部分は、定数とも、他の媒体の一定の部分とも区別できません。媒体の効果を区別できるのは、その媒体の広告費が他と違う動きをした週の情報だけです。どの媒体の効果をどれだけ区別できるか(識別性)と、それをホールドアウト検証でどう確かめるかは第8章で、区別しきれない部分を事前の知識や実験の結果で補う方法は第9章と第10章で扱います。
データに無い外部要因は推定できない
天候、競合の新商品や値下げ、景気、感染症の流行、報道など、売上を動かす外部要因は数多くあります。Robyn の公式ドキュメントは、競合や天候のような外部の変数を、トレンド・季節・休日などと同じく基礎売上の側(ベースライン)に属するものとして扱い、モデルに入れるときは文脈変数(context_vars)として指定すると説明しています。統制変数に入れられるのは、週次の数字として記録されているものだけです。記録の無い外部要因が売上を動かし、同時に広告費も動かしていると、その分は広告の効果として数えられます。
この影響の大きさを、共通データに架空の外部要因を足して確かめました。設定は次の表のとおりです。第1〜156週から乱数で12週を選び、その週は外部要因(たとえば競合の欠品や天候による需要の増加を想定)で需要が上がって売上が300万円増え、検索広告もその需要に合わせて入札が増えて支出が60万円増える、というものです。12週のうち9週は学習期間(第1〜130週)に入ります。推定は、持ち越しと飽和の形を真の値に固定した回帰(統制変数は基準の8本)で、外部要因の週の印を分析する側が持っていない場合と持っている場合を比べました。
| 項目 | 架空の設定・結果 |
|---|---|
| 外部要因の週 | 第9・35・45・47・87・92・101・117・126・133・137・138週(乱数の種7で選んだ12週) |
| 外部要因の週の売上の上乗せ | 300万円 |
| 外部要因の週の検索広告の支出の上乗せ | 60万円 |
| 検索広告の支出と外部要因の印の相関 | 0.12 |
| 検索広告の真の ROI(外部要因を足したデータ、直近52週) | 2.32 |
| 外部要因の印が無い場合の検索広告の ROI | 4.72(beta の標準誤差 352、学習期間 R2 0.982) |
| 外部要因の印を統制変数に入れた場合の検索広告の ROI | 2.37(beta の標準誤差 340、学習期間 R2 0.988) |
| 外部要因の印を入れた場合の外部要因の係数 | 322.7万円(真の値300万円) |
外部要因の印が無いと、検索広告の ROI は4.72と、真の値2.32の約2倍になりました。印を統制変数に入れると2.37になり、真の値にほぼ戻りました。他の媒体の ROI は、印の有無でほとんど変わっていません(テレビCMはどちらも1.48、SNS広告は1.92と1.88)。注目したいのは、検索広告の支出と外部要因の印の相関が0.12と小さいことです。相関が小さいので、一見すると無視してよさそうに見えます。しかし前の節で見たとおり、季節と休日を統制した後に検索広告の推定に使える材料は、標準偏差25.0万円ほどの小さな動きだけです。その小さな動きの中で、外部要因の週の60万円の上乗せは目立つ大きさになり、推定を大きく引きずりました。統制変数で交絡を取り除いた後に残る材料が少ない媒体ほど、記録されていない外部要因の影響を受けやすいということです。
この架空の設定では、外部要因の印を統制変数に入れるだけで、検索広告の推定を大きく補正できました。ただし、要因が起きた週が正確に分かり、売上の上乗せも毎回同じ大きさという単純な設定での結果です。外部要因の係数は322.7万円と、真の300万円に近く推定されました。競合の大きな動き、記録的な天候、報道による需要の急増、物流の障害による欠品など、売上が普段と違う動きをした週について、何が起きたかを週次で記録しておくことには、こうした要因を統制変数として後から入れられるという実務上の意味があります。記録が無ければ、その週の売上の動きは、その週に多く出ていた広告の手柄になります。
反対に、統制変数に入れてはいけないものもあります。Meridian のドキュメントが入れないよう勧めている媒介変数、つまり広告が売上に効く途中の経路にある変数です。たとえば、テレビCMを見た人が商品名で検索し、その検索を経由して購入する場合、検索の回数はテレビCMの効果の通り道です。テレビCMの効果を測るモデルで検索の回数を統制変数に入れると、テレビCMが検索を増やした分の効果が検索の回数の側に割り振られ、テレビCMの効果を小さく見積もる方向に働きます。同じドキュメントも、検索クエリの量は検索広告にとっては交絡要因である一方、検索行動を生み出す他の媒体にとっては媒介変数になると注意しています。何を統制変数に入れるかは、データの相関から機械的に決めるものではなく、「この変数は広告費の決め方に影響したか」「広告の結果として動いたものではないか」を業務の知識で1つずつ確かめて決めるものです。
「広告が効いた」と「季節が良かった」を取り違えたときに起きうる損失
先に整理しておくと、この節で見る検索広告の過大評価は、持ち越しと飽和の形を真の値に固定した回帰で確かめたものです。形も推定する MMM では、季節を外した B・C の検索広告は1.90・2.04で過大にはならず、過小評価が残る形で現れました。配分も A・B・C・G で同じになり、この例では季節の取り違えによる配分上の損失は出ていません。そのうえで、経営の目線で見ると、この章で扱った誤りは「広告が効いた」と「季節が良かった」の取り違えです。季節の良い時期にだけ広告を増やす会社は少なくありません。その時期の売上の伸びを広告の効果として数えると、広告の ROI は高く見えます。前の表の B と C で、形を固定した回帰の検索広告の ROI が5.59・6.10になったのがその例です。この数字を信じて検索広告の予算を積み増すと、推定の上では1万円あたり5.59万円の売上を見込んだ判断になりますが、真の値で見た売上ROI は2.35です。見込んだ売上と実際の売上の差は、季節の山を広告の効果として数えた分です。共通データの粗利率は架空の0.50なので、売上ROI が2を下回る支出は粗利で回収できません。真の値で見ると検索広告の売上ROI は2.35で回収できていますが、限界的な追加分も同じ水準で回収できるとは限りません(限界ROI は第11章で扱います)。
逆向きの取り違えもあります。統制変数が媒体の効果を吸うと、効いている媒体が効いていないように見えます。MMM(基準)は検索広告と SNS広告を真の値の約半分に見積もりました(この例では、基礎売上を真の値どおりに置いても約半分のままだったので、原因は統制変数の側だけではありません)。SNS広告の推定 ROI 0.90 は、売上ROI でも1を下回っているので、「広告費以上の売上を生んでいない」と読まれます。真の値は1.76です。この推定を信じて SNS広告を削ると、真の値で見て広告費の1.76倍の売上を生んでいた支出を止めることになります。
統制変数の組を変えた6通りの MMM で、第2章と同じ方法(総額を固定し、各媒体を現状の0.5〜2倍の範囲で動かす。応答は毎週同じ額を出し続けた定常状態)で予算配分を最適化し、真の応答で答え合わせもしました。A・B・C・G の4通りは、どれも検索広告を上限の2倍(448.5万円/週)、SNS広告とディスプレイ広告を下限の0.5倍(114.3万円/週と150.4万円/週)にし、テレビCMに残り(443.3万円/週)を回す同じ配分になり、真の増分売上は現状より年3,816万円(粗利換算で1,908万円)増えました。ROI の推定値は組によって大きく違うのに配分が同じになったのは、この例では配分が媒体ごとの上下限に張り付いたためです。D は、テレビCM 392.2万円/週・SNS広告165.4万円/週に変わり、年2,417万円の増加にとどまりました。O は、テレビCM 457.0万円/週・検索広告434.9万円/週で、年5,042万円の増加でした。D でディスプレイ広告の ROI が7.85と推定されていたにもかかわらず、配分の最適化はディスプレイ広告を下限まで減らしています。推定した効果がほぼ一定なので、広告費を増やしても増分がほとんど増えないと計算されたためです。ROI の一覧表を見て予算を決める人と、応答曲線で配分を計算する人とで、逆の結論が出うるということです。
この例から、経営への報告について2つのことが言えると考えています。1つ目は、媒体の ROI を報告するときに、統制変数の組を変えたときの幅を一緒に示すことです。この章の表のように、季節の表し方やトレンドの有無を変えても動かない媒体(この例のテレビCM)と、大きく動く媒体(この例の検索広告とディスプレイ広告)を分けて示せば、どの数字に基づいて予算を動かしてよいかが判断しやすくなります。2つ目は、大きく動く媒体については、MMM の数字だけで予算を大きく動かさず、第10章で扱う実験で答え合わせをしてから動かすことです。この例で、基礎売上を真の値どおりに置いても検索広告の推定が真の値の約半分にとどまったように、媒体どうしの効果には、観測データだけでは区別しきれない部分が残りうるからです。
| 確認すること | この章の例での結果 | 予算判断への使い方 |
|---|---|---|
| 季節・休日を外すと媒体の ROI が大きく変わるか | 形を固定した回帰で検索広告が2.21から5.59・6.10に上がった | 大きく変わる媒体は需要に連動している。その媒体の ROI は単独の数字で扱わない |
| 季節の表し方を変えると ROI が動くか | 季節を表した組どうしで検索広告が1.86〜2.81の幅で動いた | 幅を報告する。幅の中で判断が変わるなら実験で確かめる |
| 基礎売上の水準が媒体の効果を吸っていないか | MMM(基準)の基礎売上は真の値より、第1〜156週の平均で545.4万円(第105〜156週の平均で566.4万円)高かった | 媒体の効果の合計が業務の感覚や実験と合うかを確かめる |
| ほぼ一定の効果を持つ媒体が定数の役割を担っていないか | トレンドを外した D でディスプレイ広告の ROI が7.85、週次の効果がほぼ一定 | 週次の効果の動きを確かめる。ROI と配分の結論が食い違ったら推定を疑う |
| 記録の無い外部要因が無いか | 架空の外部要因12週で検索広告の ROI が2.32から4.72になった | 売上が普段と違う動きをした週の理由を週次で記録し、統制変数に入れる |
この章の要点は3つです。第一に、統制変数は媒体の効果を測るための比べる相手であり、季節や休日のように広告費と同じ向きに動く要因を入れないと、その媒体の ROI は過大になります。共通データでは、季節と休日を外すと、形を固定した回帰で検索広告の ROI が真の値の2倍を超えました。第二に、統制変数を入れると推定の材料は減り、季節の表し方の違いだけでも ROI は動きます。統制変数を増やして当てはまりが良くなっても、媒体の推定が安定するとは限りません。第三に、基礎売上の側を真の値どおりに置いても、媒体の効果のうちほぼ一定の部分は区別できず、MMM(基準)の検索広告と SNS広告の過小評価は直りませんでした。次の第8章では、こうした「当てはまりが同じでも答えが違う」問題を、推定と検証の側から扱います。
この章を深めたい方への参考書籍
『「原因と結果」の経済学 データから真実を見抜く思考法』(中室牧子・津川友介、ダイヤモンド社):相関と因果の違いと、反事実(もしその要因が無かったらどうなったか)の考え方から始め、ランダム化比較試験、差の差分析、操作変数、回帰不連続デザイン、マッチングを順に紹介し、最後の章で重回帰分析が交絡因子の影響を取り除く仕組みを説明しています。この章で扱った交絡と統制変数の考え方を、数式を使わずに確かめるのに向いています。
『Pythonではじめる時系列分析入門』(馬場真哉、講談社):時系列データの構造、季節調整とトレンド除去、見せかけの回帰、SARIMAX モデル、状態空間モデルとその中の基本構造時系列モデルまでを、Python の実装とともに扱う入門書です。この章で扱った季節性とトレンドの表し方を、時系列分析の側から体系的に学ぶのに向いています。
第8章 モデルを推定し、検証する
第5章から第7章までで、MMM の部品がそろいました。広告の効果が翌週以降に持ち越されることをアドストックで、広告費を増やしても売上が比例しないことを Hill 関数で表し、季節性・販促・休日・トレンドを統制変数として基礎売上の側に置きました。この章では、それらの部品を1つの式にまとめたモデルの中身の数字(パラメータ)を、データからどう決めるか(推定)と、決めた数字をどこまで信じてよいか(検証)を扱います。第2章で用意したサンプルデータ(架空の日用品メーカーの第1〜156週の週次データ)と、記事全体の基準である MMM(基準)を使い、推定を12回やり直したときのばらつき、学習に使っていない週での予測の当てはまり、学習期間をずらしたときの ROI の動き、当てはまりがほとんど変わらないのに ROI が大きく違う解が並ぶ現象、正則化、残差の確認を、すべて実行した結果で示します。
先に、この章の結論の向きを書いておきます。共通データの MMM(基準)は、学習に使っていない第131〜156週の売上を平均2.64%の誤差で当てました。それでも、検索広告と SNS 広告の ROI は真の値の約半分でした。この章の計算では、検索広告の ROI を真の値と同じ2.35に固定して推定し直しても、学習期間の誤差は約1.4%しか増えず、検証期間の誤差はかえって小さくなりました。予測の当てはまりは、ROI の正しさを確かめる道具としては力が弱い、ということです。この章は、その弱さを数字で確かめ、それでも検証で何が分かり、何が分からないかを整理します。不確実性の幅をどう示すかは第9章、実験の結果で答え合わせする方法は第10章で扱います。
非線形最小二乗法でパラメータを決める
MMM(基準)の式は、媒体ごとに「今週の広告費に、先週までの効果の持ち越しを足し(アドストック)、それを S 字の曲線に通して(Hill 関数)、上限を掛けたもの」を作り、4媒体の分と統制変数の分を足し合わせて週の売上を表します。媒体ごとのパラメータは4つで、翌週へ持ち越す割合(decay)、効果が上限の半分になる、アドストック後の広告費の水準(half)、曲線の形(shape)、その媒体で上げられる週次売上の上限(beta)です。4媒体で16個、統制変数(定数・トレンド・季節のフーリエ項2組・販促・休日)の係数が8個で、全部で24個の数字を決めることになります。
決め方は、第4章の回帰と同じく「予測と実績の差(残差)の2乗の合計を最も小さくする数字の組を選ぶ」という最小二乗の考え方です。違うのは、decay・half・shape が式の中で掛け算や累乗の形で入っているので、回帰のように1回の行列計算では答えが出ないことです。こうした式を最小二乗で当てはめる方法を非線形最小二乗法と呼び、数字の組を少しずつ動かしては残差の2乗和が減る方向を探す、という繰り返しの計算で答えに近づきます。MMM(基準)は、Python の科学計算ライブラリ SciPy の scipy.optimize.least_squares を使っています。SciPy の公式ドキュメントによれば、この関数の既定の計算方法は trf(Trust Region Reflective、信頼領域法の一種)で、パラメータの上限と下限(境界)を扱えます。同じドキュメントは、この関数が見つけるのはコスト関数の「局所的な」最小である、と書いています。出発点(初期値)の近くにある谷の底には降りられても、それが一番深い谷であるとは限らない、ということです。
境界は、推定値が現実にありえない値へ飛ばないようにするための枠です。MMM(基準)では、decay を0から0.9、half をその媒体の週の広告費の最大値の0.05倍から5倍、shape を0.5から3.0、beta を0から5,000万円の範囲に置きました。統制変数の係数には枠を置いていません。次のコードは、補助モジュール(共通データを作る mmm_data.py と、記事全体の基準の計算をまとめた baseline.py)と同じフォルダに置いて実行する形です。baseline.fit_mmm は12回の推定のうち最良の1回だけを返すので、12回それぞれの結果を残すために、同じ手順(同じ乱数の種・同じ初期値の引き方・同じ境界)を書き写しました。最良の回を選ぶ部分だけ、書き方を変えています。
import numpy as np
from scipy.optimize import least_squares
import mmm_data as md
import baseline as bl          # predict(予測)と統制変数の定義を使う

df = md.make_data()
y = df["sales"].to_numpy(dtype=float)
a, b = 1, 130                  # 学習期間(第1〜130週)
rng = np.random.default_rng(0)
lo, hi = [], []
for c in md.CHANNELS:          # 媒体ごとに decay・half・shape・beta の範囲
    mx = df[c].max()
    lo += [0.0, 0.05 * mx, 0.5, 0.0]
    hi += [0.9, 5.0 * mx, 3.0, 5000.0]
lo += [-np.inf] * 8            # 統制変数8個は範囲なし
hi += [np.inf] * 8

def resid(theta):              # 学習期間の残差(予測 - 実績)
    return (bl.predict(theta, df) - y)[a - 1: b]

results = []
for s in range(12):            # 初期値を変えて12回
    x0 = []
    for c in md.CHANNELS:
        mx = df[c].max()
        x0 += [rng.uniform(0.1, 0.8), rng.uniform(0.3, 2.0) * mx,
               rng.uniform(0.8, 2.5), rng.uniform(100, 2000)]
    x0 += [float(np.mean(y)), 0, 0, 0, 0, 0, 0, 0]
    r = least_squares(resid, np.array(x0), bounds=(lo, hi), max_nfev=4000)
    results.append(r)
best = min(results, key=lambda r: r.cost)   # 学習期間の誤差が最小の回を採る
theta = best.x
print([round(r.cost) for r in results])
print({c: round(float(bl.est_roi(theta, df, c)), 2) for c in md.CHANNELS})
# 出力:
# [695023, 695024, 695023, 695024, 695023, 695023, 695023, 695021, 695023, 697773, 695021, 717215]
# {'tv': 1.44, 'search': 1.18, 'social': 0.9, 'display': 0.17}
コードの要所は3つです。1つ目は、アドストックを第1週から計算し、残差は学習期間(第1〜130週)の分だけを返していることです。持ち越しは過去の広告費から積み上がるので、学習期間の最初の週から計算を始めると、その前の放映の持ち越しが見えません。共通データは第1週より前に広告を出していない設定なので問題になりませんが、現実のデータでは、学習期間の前に数週から数か月の「助走」の期間を置いて、持ち越しを積み上げておく必要があります。2つ目は、初期値を乱数で12通り引いていることです。前に述べたとおり、この関数は出発点の近くの谷の底を探すので、出発点を変えて何度か解き、残差の2乗和が最も小さい回を採ります。3つ目は、出力の cost です。SciPy の公式ドキュメントは最小化する関数を残差の2乗和の半分として定義しているので、cost の2倍が学習期間130週の残差の2乗和になります。
この推定でいう「誤差が最小」は、あくまで学習期間の売上の当てはまりが最も良い、という意味です。ROI が真の値に最も近い回を選んでいるわけではありません。現実の企業には真の ROI が見えないので、選びようがないからです。この区別が、この章全体の論点になります。
初期値を変えた12回の推定は、ほぼ同じ答えに集まった
12回の推定それぞれについて、学習期間の誤差、検証期間の誤差、直近52週(第105〜156週)の売上ROI を記録したのが次の表です。「学習の誤差(RMSE)」は残差の2乗平均の平方根で、週あたり何万円ずれているかの目安です。「学習 MAPE」「検証 MAPE」は、学習期間(第1〜130週)と検証期間(第131〜156週)の平均絶対誤差率です。真の売上ROI は、テレビCM 1.51・検索広告 2.35・SNS広告 1.76・ディスプレイ広告 0.38 です。
| 回 | cost(残差の2乗和の半分) | 学習の誤差(RMSE、万円) | 学習 MAPE | 検証 MAPE | テレビCM の ROI | 検索広告の ROI | SNS広告の ROI | ディスプレイ広告の ROI | 定数(万円/週) |
|---|---|---|---|---|---|---|---|---|---|
| 第1回 | 695,023 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,512 |
| 第2回 | 695,024 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,512 |
| 第3回 | 695,023 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,512 |
| 第4回 | 695,024 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,512 |
| 第5回 | 695,023 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,511 |
| 第6回 | 695,023 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,512 |
| 第7回 | 695,023 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,512 |
| 第8回 | 695,021 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,511 |
| 第9回 | 695,023 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,512 |
| 第10回 | 697,773 | 103.6 | 1.72% | 2.66% | 1.50 | 1.15 | 0.89 | 0.32 | 3,456 |
| 第11回(採用) | 695,021 | 103.4 | 1.72% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 | 3,511 |
| 第12回 | 717,215 | 105.0 | 1.76% | 2.48% | 1.48 | 1.27 | 4.38 | 0.65 | 2,561 |
12回のうち10回(第1〜9回と第11回)は、cost が695,021から695,024の範囲に集まり、4媒体の ROI も小数第2位まで同じでした。出発点が乱数でばらばらでも、ほぼ同じ谷の底に降りたということです。採用されたのは cost が最小の第11回で、この結果は記事全体の基準の結果(テレビCM 1.44・検索広告 1.18・SNS広告 0.90・ディスプレイ広告 0.17)と一致しています。第8回も cost は同じ695,021でしたが、表示の桁より細かい差で第11回が選ばれました。
残りの2回は別の谷に降りています。第10回は cost が697,773で、最良の回より0.4%大きいだけですが、ディスプレイ広告の decay が上限の0.90に張り付き、ROI は0.32と、最良の回の0.17の約2倍になりました。第12回は cost が717,215で3.2%大きく、学習の誤差(RMSE)は105.0万円と最良の回の103.4万円より1.6万円悪いのに、検証 MAPE は2.48%と、12回の中で最も小さくなっています。そしてこの回の SNS広告の ROI は4.38で、最良の回の0.90の約5倍、真の値1.76の2.5倍です。第12回では SNS広告の shape が下限の0.5に、half が1,031万円になっていて、定数(広告が無くても出る売上の水準)が2,561万円と、ほかの回の約3,500万円より約1,000万円小さくなっていました。定数が小さく、SNS広告の ROI が大きい解でした。2つが同時に起きていたことは確かですが、一方が他方の原因かは確かめていません。
「12回ともほぼ同じ答え」という結果は安心材料に見えます。しかし、ここで確かめられたのは「この出発点の範囲から降りると、ほとんどが同じ谷に着く」ということだけで、その谷の底の ROI が正しいかどうかは何も言っていません。実際、10回が集まった解は、検索広告と SNS広告の ROI を真の値の約半分に見積もっていました。推定が安定していることと、推定が正しいことは別の性質です。
パラメータそのものを見ると、もう1つ気になる点があります。採用した第11回では、検索広告の beta が上限の5,000万円に、SNS広告とディスプレイ広告の shape が上限の3.00に張り付いていました。検索広告の half は1,401万円で、真の値250万円の5.6倍です。検索広告の週の広告費は65〜450万円の範囲にしかないので、half がその3倍以上の位置にあるということは、データのある範囲では S 字の曲線の立ち上がりの部分だけを使っていることになります。Hill 関数の式から、広告費が half よりずっと小さい範囲では、効果は上限 beta を half の shape 乗で割った値に比例するので、beta と half を同時に大きくしても、データのある範囲での曲線の形はほとんど変わりません。境界に張り付いたパラメータは「データがその値を決められていない」ことの合図で、推定の結果を読むときに最初に確かめたい点です。この記事の実行環境(一般的なノートPC)での実測で、12回の推定は1回あたり2.5〜7.9秒、全体で61.3秒かかりました。
ホールドアウト検証で、学習に使っていない週を予測する
学習期間の当てはまりは、モデルの良し悪しの物差しとしては甘すぎます。パラメータを24個も持つモデルは、学習に使った週の売上の細かい上下まで合わせにいけるので、学習期間の誤差は小さく出やすいからです。そこで、データの一部を推定に使わずに取っておき(ホールドアウト)、推定したモデルでその期間の売上を予測して、実績とどれだけずれるかを測ります。これをホールドアウト検証と呼びます。MMM(基準)は、第1〜130週で推定し、最後の26週(第131〜156週)を検証期間として取っておきました。
取っておく週を、乱数で選ばずに最後の連続した期間にしているのには理由があります。週次の売上は前後の週とつながっていて、アドストックはまさにそのつながりを表す部品です。検証に使う週を乱数で飛び飛びに抜くと、抜いた週の前後の週が学習に入り、持ち越しの計算を通じて検証の週の情報が学習側に漏れます。さらに、実務でモデルを使う場面は常に「過去のデータで推定し、これからの期間を予測する」形なので、検証もその形にそろえるほうが、使う場面での誤差に近い数字が出ます。Google の研究者による2017年の MMM の課題を論じた論文(Chan と Perry)も、MMM で意味のある交差検証ができる範囲は、データが小さいことと、時系列のデータは単純な無作為抽出で検証用のデータを作れないことから、通常は限られる、と注記しています。
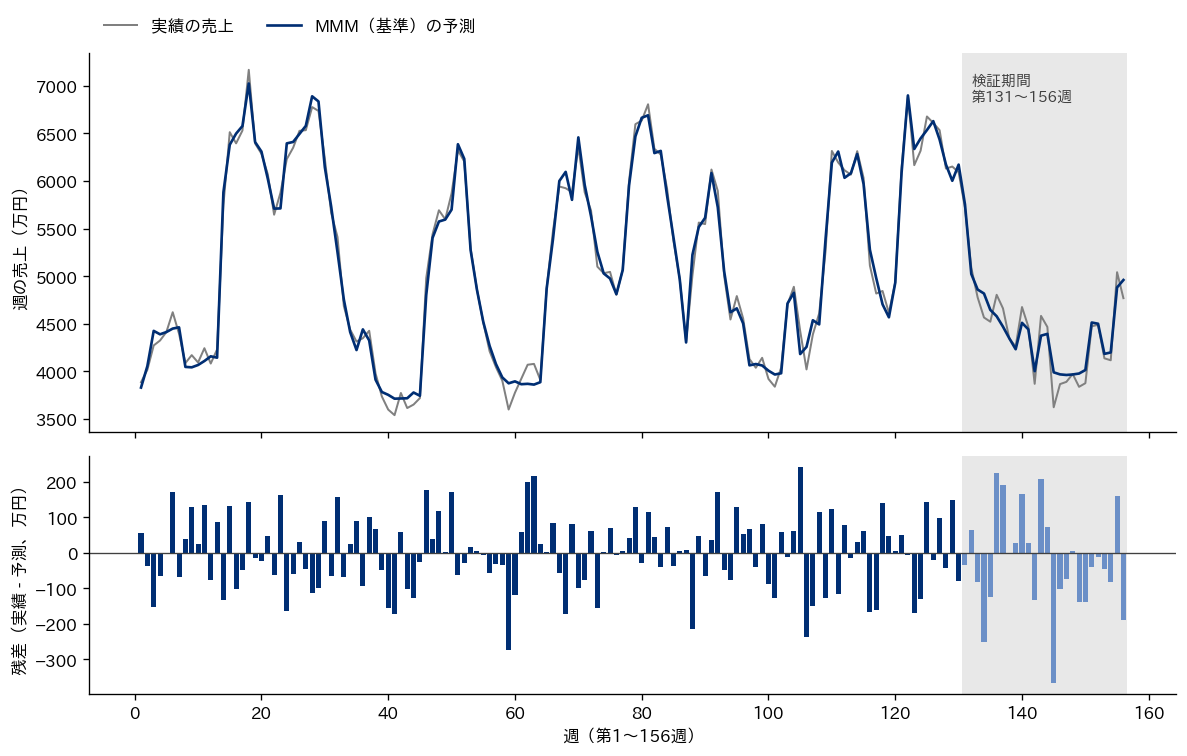
図の上の段は、実績の売上(グレー)と MMM(基準)の予測(ネイビー)を156週分重ねたものです。右端の塗った部分が検証期間で、ここではモデルは売上の実績を一度も見ていません。それでも2本の線はほぼ重なっていて、検証期間の MAPE は2.64%でした。同じ検証期間で、ほかのモデルの誤差と比べたのが次の表です。「統制変数だけ」は、媒体の広告費を一切入れず、定数・トレンド・季節のフーリエ項2組・販促・休日だけで最小二乗の回帰をしたモデルです。「真の媒体パラメータで統制変数だけ推定」は、媒体の4つのパラメータに真の値(データを作った側だけが知る値)を入れて固定し、統制変数の係数だけを学習期間で推定したモデルで、現実には作れない答え合わせ用のものです。
| モデル | 学習の誤差(RMSE、万円) | 学習 MAPE | 検証 MAPE | 検索広告の ROI | SNS広告の ROI |
|---|---|---|---|---|---|
| 統制変数だけ(広告を入れない) | なし | なし | 18.66% | なし | なし |
| 素朴な回帰 | 451.9 | 7.02% | 13.53% | 2.23 | 1.34 |
| MMM(基準) | 103.4 | 1.72% | 2.64% | 1.18 | 0.90 |
| 真の媒体パラメータで統制変数だけ推定(答え合わせ用) | 110.8 | 1.83% | 2.11% | 2.35 | 1.76 |
表の「検証 MAPE」の列を見ると、広告を入れない「統制変数だけ」のモデルは18.66%、広告費をそのまま入れた素朴な回帰は13.53%、MMM(基準)は2.64%でした。アドストックと Hill 関数を入れたことで、学習に使っていない期間の予測は大きく良くなっています。広告が売上を動かしていること、それを持ち越しと飽和の形で表すことが予測に効いていることは、ホールドアウト検証からはっきり読めます。ここまでは、検証が役に立った部分です。
一方で、表の最後の行は、検証の限界を示しています。真の媒体パラメータを入れたモデルは、学習の誤差(RMSE)が110.8万円で、MMM(基準)の103.4万円より大きく、学習期間の当てはまりでは負けています。検証 MAPE は2.11%で MMM(基準)の2.64%より良いのですが、その差は0.53ポイントです。検索広告の ROI は2.35対1.18、SNS広告は1.76対0.90と倍ほど違う2つのモデルが、検証期間の誤差では0.5ポイントほどしか違わないということです。現実には真のモデルは手元に無く、比べられるのは自分たちが推定した何通りかのモデルどうしです。検証 MAPE が2.6%と2.1%の2つのモデルが並んだとき、その差を「ROI が倍違う」ことの証拠として読むのは難しいと考えています。
参考までに、共通データに乗っている観測の誤差そのもの(真の基礎売上と真の媒体効果の合計と、実績の売上との差)は、学習期間で RMSE 113.7万円でした(データを作るときの誤差の標準偏差の設定は120万円)。MMM(基準)の学習の誤差103.4万円はこれより小さく、モデルが偶然の上下まで一部を「説明」してしまっていることになります。24個のパラメータを130週のデータに当てはめると、こうした当てはめ過ぎは避けにくく、学習期間の誤差の小ささを根拠にモデルを選ぶと、当てはめ過ぎたモデルを選びやすくなります。
検証期間の残差の平均は -25.7万円でした。予測が実績より平均で25.7万円高めに出ていた、ということで、検証期間の週の売上の平均4,418.9万円に対して約0.6%の偏りです。検証期間の最大の外れは第145週の -367.1万円で、絶対値が200万円を超えた週は26週のうち4週(第134・136・143・145週)でした。ホールドアウト検証で見るべきは MAPE の1つの数字だけでなく、こうした偏りの向きと、外れが特定の週に集まっていないかです。
時系列の交差検証で、学習期間をずらして確かめる
ホールドアウト検証は、検証期間を1か所しか持たないので、その期間がたまたま予測しやすかったのか、しにくかったのかが分かりません。そこで、学習期間の終わりを何か所かにずらして、そのつど「それまでのデータで推定し、直後の期間を予測する」ことを繰り返します。これを時系列の交差検証と呼びます。予測の教科書として広く使われている Hyndman と Athanasopoulos のオンライン教科書(予測の原理と実践を題にしたもの。第3版)は、これを予測の起点を少しずつ進めていく評価(rolling forecasting origin)として説明しています。Python の機械学習ライブラリ scikit-learn の TimeSeriesSplit の公式ドキュメントも、ほかの交差検証の方法は将来のデータで学習して過去のデータで評価することになるので時系列データには向かないと述べ、学習用のデータが折りごとに前の折りを含んで大きくなっていく方式を提供しています。
共通データで、学習期間の終わりを第78週・第104週・第130週の3か所に置き、それぞれ直後の26週を検証期間にして、MMM(基準)と同じ推定(初期値12通り)をやり直しました。ROI は、それぞれの学習期間の最後の52週で計算し、同じ52週の真の値と並べています。
| 折り | 学習期間 | 検証期間 | MMM の学習 MAPE | MMM の検証 MAPE | 素朴な回帰の検証 MAPE | 統制変数だけの検証 MAPE | テレビCM の ROI(推定/真) | 検索広告の ROI(推定/真) | SNS広告の ROI(推定/真) | ディスプレイ広告の ROI(推定/真) |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 第1〜78週 | 第79〜104週 | 1.63% | 2.10% | 14.28% | 15.36% | 1.61/1.76 | 2.37/2.37 | 0.79/1.79 | 0.38/0.38 |
| 2 | 第1〜104週 | 第105〜130週 | 1.61% | 2.16% | 8.44% | 12.38% | 1.97/1.94 | 1.55/2.37 | 0.87/1.79 | 0.35/0.39 |
| 3 | 第1〜130週 | 第131〜156週 | 1.72% | 2.64% | 13.53% | 18.66% | 1.56/1.61 | 1.19/2.34 | 0.88/1.77 | 0.19/0.37 |
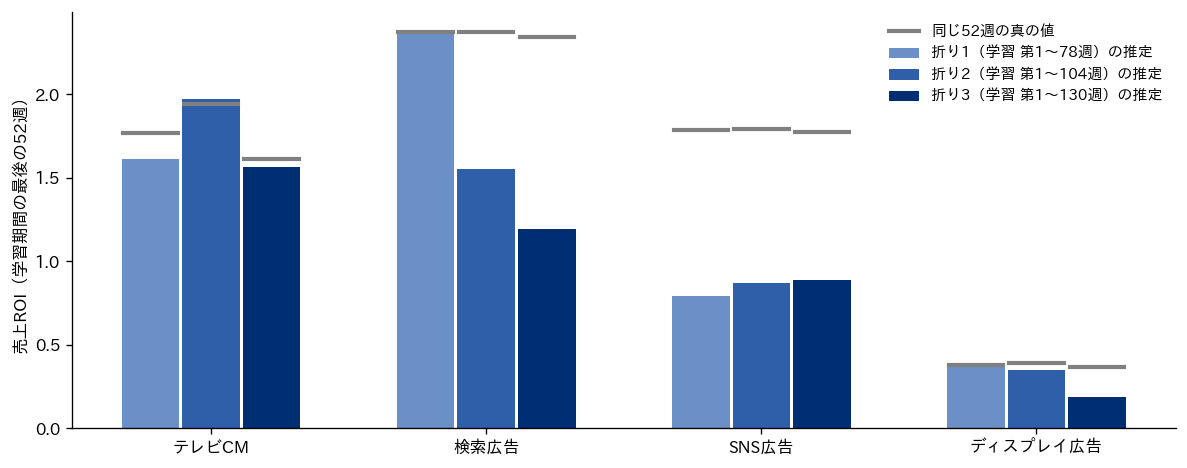
表の「MMM の検証 MAPE」の列は、3つの折りで2.10%・2.16%・2.64%と、どれも2%台にそろいました。3折りの平均は2.30%で、素朴な回帰の平均12.08%、統制変数だけの平均15.47%を大きく下回っています。予測の当てはまりという点では、MMM は学習期間の長さによらず安定していました。
ところが、ROI の列は安定していません。検索広告は、第78週までのデータで推定すると2.37で、同じ52週の真の値2.37とほぼ一致しました。第104週まで伸ばすと1.55、第130週まで伸ばすと1.19に下がり、真の値(2.37・2.34)から離れていきました。データが増えたのに推定が真の値から遠ざかったことになります。SNS広告は3つの折りとも0.79〜0.88で、真の値(1.79前後)の半分以下にとどまりました。テレビCM は1.56〜1.97の範囲で、各折りの真の値(1.61〜1.94)とおおむね同じ向きに動いています。ディスプレイ広告は第1・2の折りでは真の値に近く、第3の折りで0.19と約半分になりました。
この表からは、検証の進め方について2つのことが読めます。1つ目は、時系列の交差検証で見るべきは予測の誤差だけでなく、折りごとの ROI の動きだということです。予測の誤差がそろっていても、ROI が折りによって倍近く動く媒体は、データがその媒体の効果をはっきり決められていないと読むべきです。真の値が見えない現実の企業でも、「折りによって ROI がどれだけ動くか」は測れます。2つ目は、ROI が安定している媒体が正しいとは限らないことです。SNS広告は3つの折りとも0.8前後で安定していましたが、3つとも真の値の半分以下でした。折りの間で同じ偏りが続いていれば、交差検証はそれを見つけられません。
実装上の注意も1つ書いておきます。MMM(基準)は、half の境界を「その媒体の週の広告費の最大値」の倍数で決めていて、その最大値を全156週から取っています。厳密な時系列の交差検証では、検証期間の情報を学習に一切使わないように、境界も学習期間の値から決めるべきです。共通データでこの影響は測っていないので、この節の結論の向きが変わるかどうかは未確認です。この記事の実行環境での実測で、3つの折りの推定はそれぞれ43.1秒・82.7秒・69.4秒かかりました。折りを増やすほど推定の回数が増えるので、実務では折りの数と1回の推定の重さの釣り合いを考える必要があります。Meta が公開している MMM のパッケージ Robyn の公式ドキュメントは、時系列の検証を有効にすると、データを学習・検証・テストの3つに時系列で分け、たとえば学習の割合を0.7にすると検証とテストがそれぞれ0.15になる、と説明しています。
識別性、当てはまりが同じでも答えが1つに決まらない
ここまでの結果をまとめると、MMM(基準)は予測の当てはまりが良く、推定も安定しているのに、検索広告と SNS広告の ROI は真の値の約半分でした。この現象の正体を確かめるために、検索広告の ROI を指定した値に寄せる罰則を足して推定をやり直し、ROI を0.8から3.5まで動かしたときに、学習期間と検証期間の当てはまりがどれだけ悪くなるかを測りました。罰則は、推定した直近52週の ROI と指定した値の差に5,000を掛けたものを残差に1つ追加する形で、ROI がほぼ指定どおりになるまで強く効かせています。初期値は、採用した推定の値と、真の媒体パラメータの値の2通りから始め、cost の小さい方を採りました。
| 検索広告の ROI を寄せた値 | 学習の誤差(RMSE、万円) | 採用した推定との差 | 学習 MAPE | 検証 MAPE | テレビCM の ROI | SNS広告の ROI | ディスプレイ広告の ROI | 定数(万円/週) |
|---|---|---|---|---|---|---|---|---|
| 0.80 | 103.7 | +0.3% | 1.72% | 2.77% | 1.44 | 0.87 | 0.18 | 3,594 |
| 1.18(罰則なし。採用した推定) | 103.4 | 0.0% | 1.72% | 2.64% | 1.44 | 0.90 | 0.17 | 3,511 |
| 1.60 | 103.7 | +0.3% | 1.72% | 2.56% | 1.49 | 0.91 | 0.32 | 3,354 |
| 2.00 | 104.3 | +0.9% | 1.74% | 2.42% | 1.44 | 0.92 | 0.17 | 3,331 |
| 2.35(真の値) | 104.8 | +1.4% | 1.75% | 2.36% | 1.43 | 0.92 | 0.18 | 3,248 |
| 2.80 | 105.3 | +1.8% | 1.76% | 2.33% | 1.43 | 0.92 | 0.18 | 3,144 |
| 3.50 | 105.8 | +2.3% | 1.76% | 2.38% | 1.43 | 0.90 | 0.19 | 2,981 |
表の「学習の誤差(RMSE)」の列は、検索広告の ROI を0.80から3.50まで4倍以上動かしても、103.4万円から105.8万円の範囲にしか動きませんでした。採用した推定との差は最大でも2.3%です。「学習 MAPE」の列は1.72%から1.76%で、0.04ポイントしか違いません。データから見て、検索広告の ROI が0.8でも3.5でも、売上の当てはまりはほとんど同じだということです。ROI が上がるにつれて「定数」の列は3,594万円から2,981万円まで下がっていて、検索広告の効果を大きく見た分だけ、基礎売上を小さく見て帳尻を合わせていることが分かります。検索広告の広告費は季節性や休日に連動して動く設定で(第7章)、この表のとおり、検索広告の効果と基礎売上の水準の取り合いは、データだけでは決着がつきません。
パラメータの組が違っても予測がほとんど同じになり、データから1つの組に決めきれない状態を、統計学では識別性が弱い(あるいは識別できない)と言います。識別性は「データがそのパラメータを決める力を持っているか」という性質で、推定の計算方法を工夫しても、データに無い情報は出てきません。この章の最初の表で12回の推定がほぼ同じ答えに集まったことは、同じ出発点の範囲から同じ計算をすると同じ谷に降りやすいことを示しているだけです。谷の底が平らに広がっていて(前の表と次の図)、どこが本当の底かをデータが決められていないことは、この表のように動かしてみて初めて見えます。
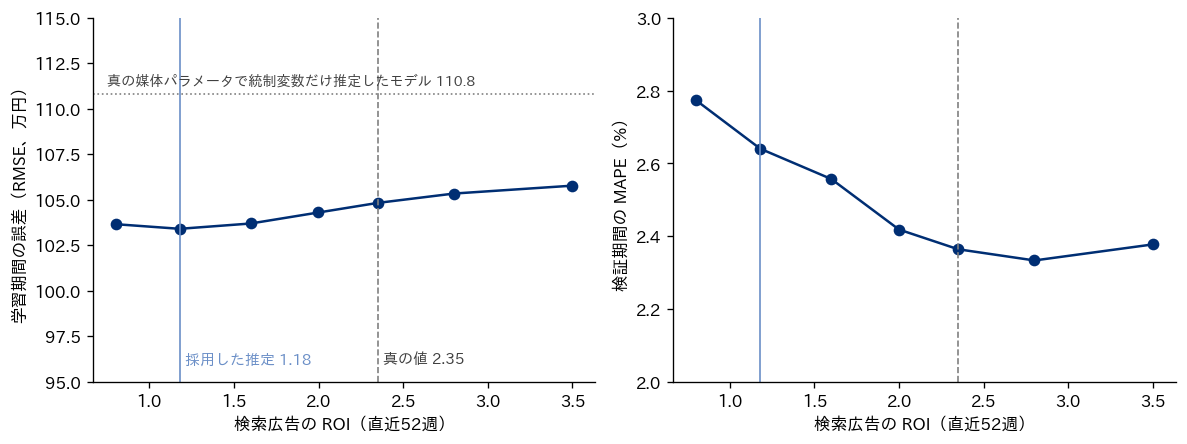
図の左は、表の「学習の誤差(RMSE)」を折れ線にしたものです。採用した推定(薄い青の縦線、1.18)のところで最も低くなっていますが、真の値(グレーの破線、2.35)との差は約1.4万円で、平らな谷の底のわずかなくぼみにすぎません。グレーの点線で示した真の媒体パラメータのモデルの学習の誤差110.8万円は、この折れ線のどこよりも上にあります。学習期間の誤差だけを物差しにする限り、真のモデルは「当てはまりの悪いモデル」として退けられる、ということです。
図の右は検証期間の MAPE で、こちらは ROI が大きくなるほど下がり、2.80の点(2.33%)で最も小さくなりました。この例では、検証期間の誤差で選べば、学習期間の誤差で選ぶより真の値に近い ROI を選べたことになります。ただし、その差は2.64%と2.33%の0.31ポイントで、検証期間はわずか26週です。第12回の推定(SNS広告の ROI 4.38)の検証 MAPE も2.48%と採用した推定より良かったことを思い出すと、検証期間の誤差で選ぶ方針は、SNS広告の ROI を真の値の2.5倍に見積もる解を選ぶ危険も持っています。検証期間の誤差は、ROI を選ぶ物差しとしても十分な力を持っていません。
SNS広告についても同じ計算をしました。SNS広告の ROI を0.50に寄せると学習の誤差は106.5万円、1.30で103.8万円、真の値の1.76で104.0万円、2.20で104.2万円でした。真の値に寄せても学習の誤差の増え方は0.6%にとどまります。検索広告と SNS広告の ROI を両方とも真の値(2.35と1.76)に寄せると、学習の誤差は105.3万円(採用した推定より1.8%大きい)、検証 MAPE は2.29%で、テレビCM は1.43、ディスプレイ広告は0.18でした。両方を真の値にしても、データとの当てはまりはほとんど損なわれません。
この計算は、次のコードで再現できます。コード1の続きとして実行する形で、出発点は採用した推定の1通りだけにしています(表は出発点2通りのうち cost の小さい方なので、数字がわずかに違う行があります)。
# コード1の続き。検索広告の ROI(直近52週)を target に寄せる罰則を足して推定し直す
W = 5000.0
def resid_pen(th, target):
    r = (bl.predict(th, df) - y)[a - 1: b]
    pen = W * (bl.est_roi(th, df, "search") - target)
    return np.append(r, pen)

for target in [0.8, 1.6, 2.35, 3.5]:
    r = least_squares(resid_pen, theta, args=(target,), bounds=(lo, hi), max_nfev=1500)
    yhat = bl.predict(r.x, df)
    rmse = np.sqrt(np.mean((y - yhat)[a - 1: b] ** 2))
    print(target, round(bl.est_roi(r.x, df, "search"), 2), round(rmse, 1),
          round(bl.mape(y[130:], yhat[130:]), 4))
# 出力(寄せた値・推定の ROI・学習の誤差・検証 MAPE):
# 0.8 0.8 103.7 0.0277
# 1.6 1.6 103.7 0.0253
# 2.35 2.35 104.8 0.0236
# 3.5 3.5 105.8 0.0238
この「1つのパラメータ(ここでは ROI)を固定して、ほかを推定し直し、当てはまりがどれだけ悪くなるかを見る」方法は、識別性を確かめる手堅いやり方です。当てはまりが急に悪くなるなら、データはその値を強く決めています。この例のようにほとんど悪くならないなら、データはその値をほとんど決めていません。Chan と Perry の論文も、広告費どうしが強く相関していると、どちらもデータによく当てはまるのに傾きの違う複数の応答の面が得られることを図で示し、そうしたモデルは学習に使っていない期間の売上もよく予測できるが、広告主が過去と違う出し方をしたときの予測は外れる、と述べています。同じ論文は、同じ程度にもっともらしい5つのモデルが、どれも R2 0.98〜0.99 で、そのうち4つは直近12週の検証で MAPE 6〜8% に収まったのに、予算を変えたときの売上の予測が最大50%違い、媒体への配分の推奨も一致しなかった実データの例を紹介しています。共通データで起きたことは、その小さな再現になっています。
識別性が弱くなる原因は、共通データの設定にいくつも入っています。テレビCM とディスプレイ広告の広告費の相関は0.91で(第4章)、検索広告は需要の高い週に増え(第7章)、SNS広告は第71週の増額と地域実験の8週を除くとゆっくりとしか動きません。広告費が独立に大きく動いた記録が少ないほど、データは媒体ごとの効果を見分けられません。この弱さはモデルの計算の工夫では直らず、広告費の動きそのものに情報を足す(実験で一部の地域や期間だけ広告を止める)か、データの外の情報(過去の実験の結果や業務の知識)を事前の情報として持ち込むしかありません。前者は第10章、後者は第9章で扱います。
正則化、リッジ回帰で係数を縮めると ROI はどう動くか
パラメータがデータで決めきれないときによく使われる手当てが、正則化です。推定の目的に「係数を大きくしすぎない」という罰則を足して、データが決めきれない方向に推定が振れるのを抑えます。その代表がリッジ回帰で、scikit-learn の Ridge の公式ドキュメントによれば、残差の2乗和に、係数の2乗和に alpha を掛けたものを足した値を最小にします。alpha は罰則の強さで、大きいほど係数は0に向かって縮みます。同じドキュメントは、正則化は問題の扱いやすさ(条件)を改善し、推定値のばらつきを小さくする、と説明しています。
MMM でリッジ回帰を採っている代表例が Robyn です。Robyn の公式ドキュメントは、複数の媒体を同時に動かす運用(たとえば年末商戦にすべての媒体を増やす)が一般的なので MMM は多重共線性の問題を抱えやすく、係数の推定が不安定になり、当てはめ過ぎにつながると述べたうえで、L2 型の正則化、つまりリッジ回帰を使うと説明しています。ラッソ(L1 型)ではなくリッジを選んだ理由として、ラッソは変数を0に落としがちだが、リッジは大きさを縮める方向に働くこと、MMM で多くの媒体の効果が0になるのは現実的でないことを挙げています。同じドキュメントは、リッジ回帰は正規分布の事前分布を置いたベイズ回帰と同じ形になる、とも書いています。事前分布の考え方は第9章で扱います。
リッジ回帰は線形の回帰なので、アドストックと Hill 関数の形を決める decay・half・shape は、あらかじめ何らかの値に決めておく必要があります(Robyn は、これらを外側の探索で何通りも試します)。ここでは、変換のパラメータを MMM(基準)の推定値に固定して、4媒体の「Hill 関数を通した後の値(0〜1)」を説明変数に作り、統制変数7列(定数は切片として別に扱う)と一緒にリッジ回帰を当てはめました。媒体の係数は、その媒体の上限 beta に当たります。比べるために、変換のパラメータに真の値を入れた場合(答え合わせ用)も計算しました。説明変数は学習期間の平均と標準偏差で標準化してから罰則を掛けています。
# コード1の続き。変換(アドストックと Hill)を固定し、上限 beta をリッジ回帰で推定する
from sklearn.linear_model import Ridge
p, _ = bl._unpack(theta)                 # 変換のパラメータはコード1の推定値を流用
Xc = bl.controls(df)[:, 1:]              # 定数を除く統制変数7列
M = np.column_stack([md.hill(md.geometric_adstock(df[c].to_numpy(dtype=float), p[c]["decay"]),
                             p[c]["half"], p[c]["shape"]) for c in md.CHANNELS])
X = np.column_stack([Xc, M])
tr = slice(0, 130)
mu, sd = X[tr].mean(axis=0), X[tr].std(axis=0)
Z = (X - mu) / sd                        # 列ごとに標準化してから罰則を掛ける
for alpha in [0.1, 1.0, 10.0, 100.0]:
    m = Ridge(alpha=alpha).fit(Z[tr], y[tr])
    beta = (m.coef_ / sd)[7:]            # 媒体の係数=上限 beta(万円/週)
    roi = [beta[i] * M[104:156, i].sum() / df[c].iloc[104:156].sum()
           for i, c in enumerate(md.CHANNELS)]
    print(alpha, np.round(roi, 2), round(bl.mape(y[130:], m.predict(Z)[130:]), 4))
# 出力(alpha・4媒体の ROI・検証 MAPE):
# 0.1 [1.44 1.18 0.9  0.18] 0.0264
# 1.0 [1.39 1.12 0.88 0.27] 0.0267
# 10.0 [1.12 1.03 0.76 0.77] 0.0312
# 100.0 [0.63 1.01 0.4  1.07] 0.064
罰則の強さ alpha をもう少し細かく振り、学習期間の中で時系列の交差検証(scikit-learn の TimeSeriesSplit で4分割。学習は78・91・104・117週、検証はその直後の13週ずつ)を行って、検証の誤差が最も小さい alpha を探した結果が次の表です。「時系列分割の MAPE」がその4分割の検証 MAPE の平均です。
| 変換のパラメータ | alpha | 時系列分割の MAPE | 検証 MAPE(第131〜156週) | テレビCM の ROI | 検索広告の ROI | SNS広告の ROI | ディスプレイ広告の ROI |
|---|---|---|---|---|---|---|---|
| MMM(基準)の推定値 | 0.0001 | 1.88% | 2.64% | 1.44 | 1.18 | 0.90 | 0.17 |
| MMM(基準)の推定値 | 1 | 2.03% | 2.67% | 1.39 | 1.12 | 0.88 | 0.27 |
| MMM(基準)の推定値 | 10 | 3.14% | 3.12% | 1.12 | 1.03 | 0.76 | 0.77 |
| MMM(基準)の推定値 | 100 | 6.09% | 6.40% | 0.63 | 1.01 | 0.40 | 1.07 |
| 真の値(答え合わせ用) | 0.0001 | 2.01% | 2.16% | 1.48 | 2.21 | 1.88 | 0.43 |
| 真の値(答え合わせ用) | 1 | 2.19% | 2.17% | 1.45 | 2.38 | 1.85 | 0.70 |
| 真の値(答え合わせ用) | 10 | 3.39% | 2.54% | 1.21 | 3.08 | 1.59 | 2.28 |
| 真の値(答え合わせ用) | 100 | 6.71% | 6.42% | 0.66 | 3.49 | 0.83 | 3.90 |
表から読めることは3つあります。1つ目は、変換のパラメータを MMM(基準)の推定値に固定したままでは、罰則をどう掛けても検索広告と SNS広告の ROI は真の値に近づかないことです。alpha を大きくすると、テレビCM と SNS広告の ROI は下がり、ディスプレイ広告の ROI は0.17から1.07まで上がりました。これは真の値(ディスプレイ広告 0.38)から遠ざかる方向です。リッジ回帰は「標準化した係数を0に近づける」罰則で、どの係数がどれだけ縮むかは説明変数の散らばり方と相関で決まり、真の ROI の方向へ導く仕組みではありません。罰則の対象を媒体の係数だけにした計算も行いましたが、その場合は alpha を大きくするほど、テレビCM・検索広告・SNS広告の ROI が小さくなる向きが強まり(alpha 100 でテレビCM 0.55・検索広告 0.09・SNS広告 0.25)、ディスプレイ広告の ROI は0.17から alpha 30 で1.05まで上がりました(alpha 100 では0.97)。
2つ目は、時系列分割で選ぶと、2通りの変換のどちらでも、試した中で最も小さい alpha(0.0001、ほぼ罰則なし)が選ばれたことです。予測の誤差を物差しにする限り、この例では罰則を掛けない方が良いと判定されました。これは識別性の節の結果と同じ構図で、予測の誤差は ROI の良し悪しをほとんど見分けられないので、罰則が ROI を良くしても悪くしても、予測の誤差の物差しにはその違いが映りません。罰則の強さを予測の誤差だけで選ぶ方式には、この限界があります。Robyn の公式ドキュメントが、予測の誤差(NRMSE)と並べて、媒体の効果の割合と広告費の割合のずれ(DECOMP.RSSD)を2つ目の目的として最適化し、両者の釣り合いの良いモデルの候補を並べる、と説明しているのは、予測の誤差だけでは MMM を選べないという同じ問題意識によるものです。同じドキュメントは、この指標には議論があることも認めています。
3つ目は、変換のパラメータが真の値なら、罰則がほとんど無くても検索広告 2.21・SNS広告 1.88・テレビCM 1.48・ディスプレイ広告 0.43 と、真の値(2.35・1.76・1.51・0.38)にかなり近い ROI が出たことです。共通データでは、上限 beta や統制変数の係数(線形の部分)の推定はうまくいっていて、問題は decay・half・shape(変換の形を決める非線形の部分)がデータから決めきれないことにある、と読めます。ここで使ったリッジ回帰は線形の部分のばらつきを抑える道具で、変換の形の取り違えを直す道具ではありません。変換の形について外から情報を持ち込む(事前分布や実験)ことが要る、という結論は前の節と同じです。
残差を確かめる、自己相関と偏り
推定したモデルが見落としている構造が無いかは、残差(実績から予測を引いた値)を見て確かめます。残差が週ごとにでたらめに上下しているだけなら、モデルはデータの規則的な動きをおおむね取り込んでいます。逆に、プラスの週が何週も続く、テレビの放映期間にだけ偏る、といった規則性があれば、モデルが何かを取りこぼしている合図です。特に時系列では、ある週の残差が翌週の残差と似ている度合い(残差の自己相関)を必ず見ます。持ち越しを入れ忘れたモデルは、広告を出した週の後に効果の残りを説明できず、残差がプラスの週が続くからです。
確かめ方は3つ使いました。1つ目は、残差の自己相関をラグ(何週ずらすか)1〜8週で計算することです。Hyndman と Athanasopoulos の前述の教科書は、ホワイトノイズ(規則性の無いでたらめな系列)なら自己相関の95%がプラスマイナス1.96÷√(系列の長さ)の範囲に入ると説明していて、130週ならプラスマイナス0.172です。2つ目はダービン・ワトソン比で、統計ライブラリ statsmodels の公式ドキュメントによれば、この値は常に0から4の間にあり、自己相関が無ければ2になり、0に近いほど正の自己相関、4に近いほど負の自己相関の証拠が強いことを表します。3つ目はリュン・ボックス検定で、複数のラグの自己相関をまとめた統計量を計算します。同じ教科書は、この統計量が大きいことは自己相関がホワイトノイズから来たものではないことを示すと説明し、p値が比較的大きい例について、残差はホワイトノイズと見分けがつかないと結論しています。どれも statsmodels で計算できます。
| 確認の項目(学習期間 第1〜130週) | MMM(基準) | 素朴な回帰 |
|---|---|---|
| 残差の標準偏差(万円) | 103.4 | 451.9 |
| 残差の自己相関(ラグ1週) | -0.10 | 0.69 |
| 残差の自己相関(ラグ2週) | -0.02 | 0.48 |
| 残差の自己相関(ラグ3週) | 0.03 | 0.23 |
| ダービン・ワトソン比 | 2.20 | 0.62 |
| リュン・ボックス検定の p値(ラグ4週まで) | 0.368 | 0.001未満 |
| リュン・ボックス検定の p値(ラグ8週まで) | 0.413 | 0.001未満 |
| 残差の平均(テレビの放映週44週) | -6.1 | 17.6 |
| 残差の平均(放映週以外) | 3.1 | -9.0 |
| 検証期間(第131〜156週)の残差の平均 | -25.7 | -593.0 |
素朴な回帰の残差は、ラグ1週の自己相関が0.69、ダービン・ワトソン比が0.62で、リュン・ボックス検定の p値は0.001未満でした。ある週に予測より売上が多いと、翌週も多い状態が続いているということで、広告の持ち越しを入れていないことの典型的な症状です。検証期間の残差の平均は -593.0万円で、予測が実績を平均で約600万円上回っていました。素朴な回帰については、残差の確認だけで「何かを取りこぼしている」と判断できます。
MMM(基準)の残差は、ラグ1〜8週の自己相関がすべて -0.16 から0.03の範囲に収まり、目安のプラスマイナス0.172を超えたものはありませんでした。ダービン・ワトソン比は2.20と2に近く、リュン・ボックス検定の p値もラグ4週まで0.368、ラグ8週まで0.413で、自己相関があるとは言えない結果です。テレビの放映週の残差の平均は -6.1万円、放映週以外は3.1万円で、放映の有無による偏りもほとんどありません。この節の最初の図の下の段を見ても、残差に目立った規則性は見当たりません。
ここで強調したいのは、残差の確認に合格したこのモデルが、検索広告と SNS広告の ROI を真の値の約半分に見積もっていることです。残差の確認は「モデルが説明しきれていない動きが残っていないか」を見るもので、「説明に使った内訳が正しいか」は見ません。検索広告の効果の半分をほかの部分(基礎売上やほかの媒体)で説明していても、合計の予測が合っていれば残差はきれいになります。残差の確認は、不合格なら必ず手を打つべきものですが、合格しても ROI の正しさの保証にはなりません。
受け入れ基準、予測の当てはまりの次に何を確かめるか
ここまでの検証の結果を、モデルを予算の判断に使ってよいかを決める「受け入れ基準」として整理します。予測の当てはまりは最初の関門として必要ですが、それだけで合格とはしません。共通データの MMM(基準)について、各項目の結果を並べたのが次の表です。「この例での結果」は、この架空データの、この設定での結果です。
| 確かめる項目 | 何を防ぐためか | 確かめ方 | この例での結果(MMM(基準)) |
|---|---|---|---|
| 予測の当てはまり | 広告の効果を表す形そのものの誤り | ホールドアウト検証の MAPE と偏り。素朴な回帰・統制変数だけのモデルと比べる | 検証 MAPE 2.64%(統制変数だけ 18.66%、素朴な回帰 13.53%)。合格 |
| 残差の規則性 | 持ち越し・季節性・販促などの取りこぼし | 残差の自己相関・ダービン・ワトソン比・放映週などの条件ごとの平均 | 自己相関はすべて目安の範囲内、ダービン・ワトソン比 2.20。合格 |
| 推定の安定(初期値) | 計算が局所的な谷に落ちること | 初期値を変えた複数回の推定の cost と ROI を並べる | 12回中10回が同じ解。ただし cost が0.4%大きいだけの解でディスプレイ広告の ROI が約2倍。条件付きで合格 |
| 推定の安定(学習期間) | 特定の期間への当てはめ過ぎ | 時系列の交差検証で折りごとの ROI を並べる | 検索広告の ROI が2.37・1.55・1.19と折りで2倍動く。不合格 |
| 境界への張り付き | データが決めていないパラメータを決まったものとして読むこと | 推定値が境界の上限・下限に当たっていないか | 検索広告の beta が上限5,000、SNS広告・ディスプレイ広告の shape が上限3.00。不合格 |
| 識別性 | 当てはまりが同じで ROI の違う解の取り違え | ROI を固定して推定し直し、当てはまりの悪化を見る | 検索広告の ROI を0.8〜3.5に動かしても学習の誤差の増加は2.3%以内。不合格 |
| 外部の証拠との整合 | 観察データだけでは見分けられない偏り | 実験(地域実験・リフト調査)の結果、業務の知識と ROI を比べる | 第10章の地域実験(一部の地域だけ広告を止めて売上の差を測る実験)では、SNS広告の観測 iROAS(実験で測った広告費あたりの増分売上。第10章で定義)が1.73。MMM の0.90と食い違う。不合格 |
表の「合格」「条件付きで合格」「不合格」は、この例を説明するために置いた判定で、決まった閾値があるわけではありません。自社で同じ判定をするなら、たとえば「交差検証の折りの間で ROI の最大が最小の1.5倍を超えたら要注意」のような目安を、分析を始める前に社内で決めておくのがよいと考えています(この1.5倍は例として置いた数字で、根拠のある基準ではありません)。この表のとおり、MMM(基準)は予測と残差の関門は通るのに、推定の安定・識別性・外部の証拠との整合の関門で落ちます。現実の企業では、このうち「外部の証拠との整合」以外の項目は、真の値を知らなくても自分たちで確かめられます。学習期間をずらすと ROI が倍動く、ROI を固定しても当てはまりが変わらない、という結果が出た時点で、少なくともその媒体の ROI を1つの数字として予算の判断に使うことは控えるべきだと考えています。
逆に、この例でも判断に使える候補は残っています。テレビCM の ROI は、12回の推定のすべてで1.44〜1.50、識別性の計算のどの行でも1.43〜1.49で、時系列の交差検証でも各折りの真の値とおおむね同じ動きでした。ディスプレイ広告の ROI は、この章の3つの計算(12回の推定・識別性の計算・交差検証)では0.17〜0.65の範囲にあり、この3つの計算の中では1を下回るという結論は変わりませんでした。ただし、別の設定では1を超えています。同じ章のリッジ回帰では alpha 100 で1.07、第7章ではトレンドを外した組で7.85、真の基礎売上を既知とした組で2.09、第9章では事前分布の置き方によって1.01〜2.02でした。ディスプレイ広告は「減らす向き」の候補としては使えても、ROI の数字そのものは固くありません。受け入れ基準は、モデル全体を合格か不合格かで裁くだけでなく、「どの媒体のどの結論なら使えるか」を仕分けるためにも使えます。この仕分けの結果を幅として示す方法が第9章、使えないと判定された媒体に実験で情報を足す方法が第10章の主題です。
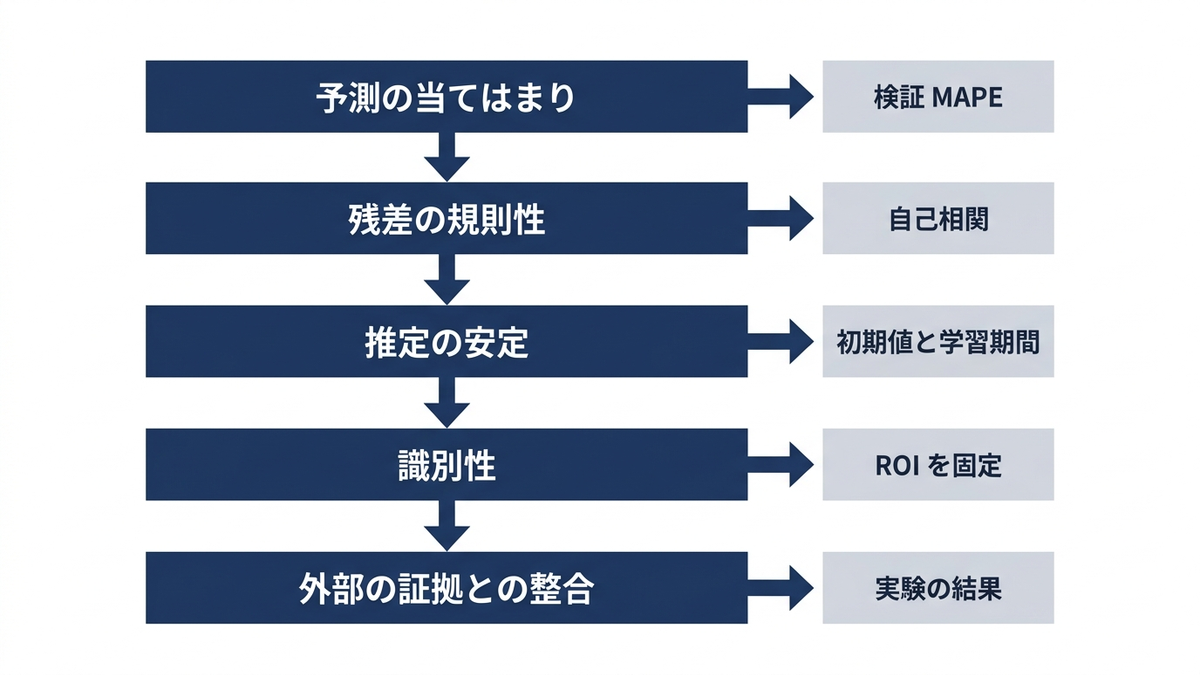
経営の判断に翻訳する
この章の結果を経営の言葉に直すと、最も大事なのは「当てはまりが良い」を「ROI が正しい」と報告しないことです。共通データの MMM(基準)は検証期間の誤差2.64%という、数字だけ見れば申し分のない精度でしたが、記事全体の基準の結果では、このモデルで最適化した配分は、真の応答で測った増分売上を現状より年3,816万円増やすにとどまり、真の最適の年16,622万円との差は年12,806万円でした(いずれも定常状態の前提での年換算。粗利率0.50の架空の設定では、差は粗利で年6,403万円)。配分の中身を比べると、MMM(基準)で最適化した配分は検索広告を現状の224.3万円/週から上限の448.5万円/週へ2倍にし、SNS広告を228.5万円/週から下限の114.3万円/週へ半分にしていました。真の最適は逆に、検索広告を193.2万円/週、SNS広告を179.6万円/週とし、テレビCM を402.9万円/週から633.3万円/週へ増やしています。「予測が当たっているモデルの言うとおりに配分した」結果、取れたはずの増分の4分の3以上を取りこぼした、というのがこの例の数字です。
報告の形としては、ROI の数字と一緒に、この章で行った検証の結果を1枚にまとめて添えることが有効だと考えています。具体的には、媒体ごとに、採用した推定の ROI、初期値を変えたときの ROI の範囲、学習期間をずらしたときの ROI の範囲、ROI を固定したときの当てはまりの悪化の大きさを並べ、「この媒体の ROI はデータで決まっている」「この媒体の ROI はデータで決まっていない」を明記します。この例なら、テレビCM は前者、検索広告と SNS広告は後者です。ディスプレイ広告は、この章の計算の中では向きが安定していましたが、他の章の設定で1を超えたので、向きだけを使う候補にとどめ、数字は後者と同じく実験で確かめる扱いにします。前者の媒体については ROI にもとづいて配分を動かし、後者の媒体については、配分を大きく動かす前に実験で ROI を確かめる、という判断の分け方ができます。
判断の遅れという面でも、検証は経営の問題です。ROI が決まっていない媒体の配分を、モデルの数字だけで大きく動かすと、外れたときの損は1年分の予算の配分で効いてきます。この例で、検索広告の配分を現状の224.3万円/週から448.5万円/週へ2倍にし、SNS広告を228.5万円/週から114.3万円/週へ半分にした配分は、記事全体の基準の計算では、真の応答で見ると現状より良くはなるものの、真の最適からは大きく離れていました。モデルを作り直すのに数週間、実験に数か月かかるとしても、ROI が決まっていない媒体の配分を一度に大きく動かさず、検証と実験の結果を待って動かすほうが、外れたときの損を小さく抑えられると考えています。
もう1つ、検証の作業そのものを予算の判断の前提として組み込むことが有効だと考えています。この章で行った計算は、12回の推定に約1分、時系列の交差検証の3つの折りに合わせて約3分、識別性の計算に約1分で、この記事の実行環境(一般的なノートPC)で数分のうちに終わります。現実のデータで媒体の数や統制変数が増えれば時間はかかりますが、それでもモデルを使った予算の判断が動かす金額に比べれば小さな手間です。予算会議に出す ROI の表は、この検証の結果が添えられて初めて「判断に使える表」になると考えています。
この章の要点は3つです。第一に、MMM のパラメータは非線形最小二乗法で推定でき、初期値を変えて何度か解くことで計算の局所的な落とし穴にはまる危険を下げられます(避けられる保証はありません)が、推定が安定していることは推定が正しいことを意味しません。第二に、ホールドアウト検証と時系列の交差検証は、広告の効果の形の誤りや残差の取りこぼしを見つける力は強い一方で、ROI の正しさを見分ける力は弱く、この例では検索広告の ROI を0.8から3.5まで動かしても当てはまりはほとんど変わりませんでした。これが識別性の問題で、この章で試したリッジ回帰(変換の形を固定したうえでの正則化)では直らず、変換の形については、データの外から情報を足す必要があります。第三に、受け入れ基準は予測の当てはまりに加えて、学習期間をずらしたときの ROI の安定、境界への張り付き、ROI を固定したときの当てはまりの変化、実験との整合を確かめ、どの媒体の結論なら使えるかを仕分けるために使います。次の第9章では、ROI を1つの数字ではなく幅で示す方法として、ブートストラップとベイズの考え方を扱います。
この章を深めたい方への参考書籍
『スパース推定法による統計モデリング』(川野秀一・松井秀俊・廣瀬慧、共立出版):統計学One Point シリーズの1冊で、第1章で最小二乗法と正則化法、リッジ回帰、lasso を順に説明し、正則化パラメータの選び方として交差検証法の節を置いています。この章で使ったリッジ回帰と、罰則の強さを検証用のデータで決める手順を、lasso やエラスティックネットなどほかの正則化と並べて、数式と数値例で確かめるのに向いています。数値例を実行する R のコードも載っています。
『Rによる統計的学習入門』(G. James、D. Witten、T. Hastie、R. Tibshirani 著、落海浩・首藤信通 訳、朝倉書店):統計的学習の入門書の訳書で、リサンプリング法の章と、線形モデル選択と正則化の章を含みます。この章のホールドアウト検証・交差検証・リッジ回帰の考え方を、予測モデルの評価と選択という広い文脈で確かめるのに向いています。Robyn の公式ドキュメントも、リッジ回帰とベイズ回帰の関係の説明でこの本の原書を参照しています。
第9章 不確実性を示す、ベイズMMMとブートストラップ
第8章では、MMM を推定し、検証する方法を扱いました。第2章の基準の結果では、MMM(基準)は検証期間の予測の当てはまりが良い(MAPE 2.64%)にもかかわらず、検索広告の ROI を真の値の約半分に見積もっていました。当てはまりの良さだけでは、推定が正しいかどうかを決められないということです。この章では、推定した ROI を1つの数字で出すのをやめ、「どのくらいの幅で分かっていないか」を数字で示す方法を扱います。データを何度も作り直して推定をやり直すブートストラップと、推定の前に持っている知識を確率分布の形で入れるベイズ MMM の2つを、第2章で用意したサンプルデータ(架空の日用品メーカーの週次データ)で実行し、出てきた区間が予算の判断に何を言え、何を言えないかを確かめます。
ROI を1つの数字で出すと何を見落とすか
第2章の基準の結果では、MMM(基準)は直近52週(第105〜156週)の検索広告の売上ROI を1.18、SNS 広告を0.90と推定しました。この記事の共通データは乱数で作った架空のデータなので、真の値(検索広告2.35、SNS 広告1.76)を答え合わせに使えますが、現実の企業には真の値は見えません。現実の分析の場で手元にあるのは「検索広告の ROI は1.18」という1つの数字だけです。この数字だけを見た人は、検索広告は広告費とほぼ同じ額の売上しか生んでおらず、粗利率0.50の下では広告費を回収できていない(粗利ROI 0.59)と読めるので、この数字は検索広告を削る判断につながりかねません。
ところが、同じデータに同じ形のモデルを当てはめても、推定に使う週の誤差が少し違っただけで、検索広告の ROI は大きく動きえます。初期値を変えた推定のばらつきは第8章で扱いました。1つの数字には、その数字がどのくらい確かなのかという情報が入っていません。ROI が1.18と出たとき、それが「1.1〜1.3のどこか」なのか「0.6〜2.6のどこか」なのかで、取るべき行動はまったく違います。前者なら検索広告の粗利ROI は1を下回るとほぼ言えますが、後者なら、広告費を回収しているかどうかすら分からない、というのが正直な答えです。
経営の側から見ると、1つの数字で報告された ROI には2種類の損失の危険があります。1つは、幅が広いのに狭いと思い込んで、効いている媒体を削ったり、効いていない媒体に積んだりする損失です。第2章の基準の結果で、MMM(基準)に従って配分を変えた場合、現状からの真の増分売上は年換算で +3,816万円にとどまり、真の最適に配分した場合の +16,622万円との差は12,806万円ありました(いずれも架空データでの、定常状態の前提の値)。もう1つは、幅を示さないまま報告して、後で別の分析や実験と食い違ったときに、モデル全体の信用を失う損失です。区間を添えて報告していれば、食い違いが区間の中に収まるかどうかで説明できますが、1つの数字で断言していると、その数字が外れたときにモデル全体の信用を損ねやすくなります。
この章で扱う方法は、どちらも「推定の幅」を数字にするためのものです。ただし、2つの方法が測っている幅は同じではありません。ブートストラップは「同じ仕組みからデータがもう一度出てきたら、推定値がどのくらい揺れるか」を測ります。ベイズ MMM の区間は「事前に置いた知識と、手元のデータを合わせたとき、パラメータについてどのくらい確信が持てるか」を表します。どちらも、モデルの形そのものが間違っている場合や、統制変数が媒体の効果を吸っている場合の偏りは、それだけでは測れません。この限界は、後の節で共通データの結果として具体的に示します。
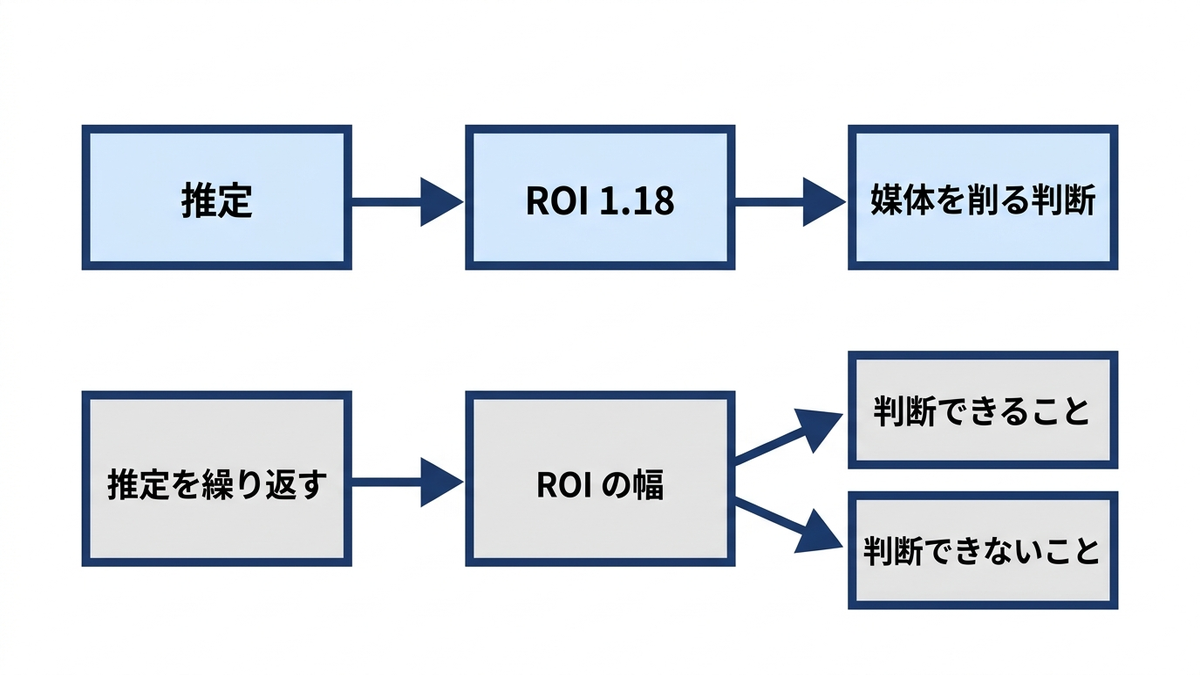
ブートストラップは、データを作り直して推定をやり直す
ブートストラップは、手元のデータから「ありえた別のデータ」を何通りも作り、それぞれで推定をやり直して、推定値のばらつきを直接数える方法です。統計学者の Bradley Efron が1979年に Annals of Statistics 誌(第7巻第1号)に発表した論文『Bootstrap Methods: Another Look at the Jackknife』は、要旨で、未知の分布から得た標本だけを使って、関心のある統計量がどう分布するかを推定する問題を立て、そのための一般的な方法を「ブートストラップ」と名付けて導入した、と述べています。同じ要旨は、標本の中央値の分散や回帰のパラメータの推定などの例で、この方法がうまく働くことを示したとしています。標準誤差の公式を導けない複雑な推定でも、計算を繰り返すだけで推定の幅を出せるのが、この方法の実務上の利点です。MMM の推定は、アドストックと Hill 関数を含む非線形の最小二乗で、ROI はさらにそのパラメータから計算する値なので、公式で幅を出すのは難しく、ブートストラップが向いています。
ただし、MMM の週次データにそのまま使える形には注意が要ります。最も基本的なブートストラップは、データの行を「重複を許して無作為に選び直す」ことで別のデータを作りますが、週次の売上は時間の順に並んでおり、広告の効果は翌週以降に持ち越されます。行をばらばらに選び直すと、この時間の並びが壊れてしまいます。そこで、この章では次の手順を取りました。まず元のデータで MMM を推定し、各週の予測値と残差(実際の売上と予測の差)を出します。次に、残差を連続した4週ずつの塊として無作為に選んで並べ直し、予測値に足して「ありえた別の売上」を作ります。広告費の列は元のまま使うので、アドストックの計算に必要な広告費の時間の並びは保たれます。
残差を1週ずつではなく塊で選ぶのは、残差どうしに時間の相関があったとき、その相関を残すためです。この章ではこの形をブロック・ブートストラップと呼びます。時間の並びがあるデータへのブートストラップの広げ方については、H. Künsch が1989年に同じ Annals of Statistics 誌(第17巻第3号)に、一般の定常な観測値に対するジャックナイフとブートストラップを題にした論文を出しています(書誌は参考情報に載せています。本文は開けなかったので、中身はこの章では引用しません)。基準の MMM の学習期間(第1〜130週)の残差を実測すると、標準偏差は103.8万円、1週ずれの自己相関は -0.102、4週ずれは -0.146 で、強い相関はありませんでした。共通データは誤差を週ごとに独立に作っているので、これは作り方どおりの結果です。現実のデータでは、統制変数で拾いきれない動き(天候や競合の動きなど)が残差に残り、週どうしの相関が出ることがあります。そうしたデータにもそのまま使える形を示すため、塊で選ぶ形にしました。塊の長さ4週は、この章で置いた設定です。
ブートストラップが答えるのは「データの誤差の出方が違っていたら、推定値がどのくらい動いたか」という問いです。答えられないのは「モデルの形や統制変数の選び方が間違っていたら、推定値がどのくらいずれているか」という問いです。ブートストラップのデータは、元の MMM の予測値を「本当の売上の動き」とみなして作るので、元の MMM が検索広告の効果を小さく見積もっていれば、作り直したデータでも同じことが起きます。このことは次の節の結果で確かめます。
ブロック・ブートストラップを共通データで実行する
手順を共通データで実行しました。MMM(基準)の推定は、初期値を変えて12回推定する設定で、この記事の実行環境での実測では1回あたり62.9秒(約1分)かかりました。この設定のまま100回繰り返すと1時間を超えるので、ブートストラップの各回では、元のデータで推定した値(基準の推定値)を初期値にして1回だけ推定し直し、関数評価(予測を計算する回数)は最大400回で打ち切りました。1回の推定の時間は、中央値1.9秒、最も長い回で21.6秒でした(この記事の実行環境での実測)。100回を10回ずつ10回の実行に分け、結果をファイルに保存してから集計しています。次のコードは、実行したスクリプトから1回分の作り直しと推定の部分を抜き出したものです。補助モジュール(mmm_data.py・baseline.py)と同じフォルダに置き、基準の推定値 theta0 と推定の範囲 lo・hi(fit_mmm と同じ範囲)を先に用意して実行する形です。
import numpy as np
from scipy.optimize import least_squares
import mmm_data as md
import baseline as bl

BLOCK = 4                                   # 塊の長さ(週)
df = md.make_data()
y = df["sales"].to_numpy(dtype=float)
yhat0 = bl.predict(theta0, df)              # 基準の推定値での予測
res0 = (y - yhat0)[:130]                    # 学習期間(第1〜130週)の残差

def block_resample(res, rng):
    """連続した BLOCK 週の残差の塊を、ランダムな位置から取って並べる"""
    out = []
    while len(out) < len(res):
        s = rng.integers(0, len(res) - BLOCK + 1)
        out.extend(res[s: s + BLOCK])
    return np.array(out[:len(res)])

rois = []
for b in range(100):                        # 実際は10回ずつ10回の実行に分けた
    rng = np.random.default_rng(1000 + b)
    d = df.copy()
    ystar = y.copy()
    ystar[:130] = yhat0[:130] + block_resample(res0, rng)   # ありえた別の売上
    d["sales"] = ystar
    r = least_squares(lambda th: (bl.predict(th, d) - ystar)[:130],
                      np.clip(theta0, lo + 1e-6, hi - 1e-6),
                      bounds=(lo, hi), max_nfev=400)
    rois.append([bl.est_roi(r.x, df, c) for c in md.CHANNELS])  # 直近52週の ROI
print(np.percentile(rois, [5, 50, 95], axis=0).round(2))
100回のうち5回は、関数評価400回の上限で打ち切られました(推定が収まりきらないまま止まった回です)。打ち切られた回も含めて集計した結果が次の表です。ROI は直近52週の売上ROI、「5%点」から「95%点」までが90%の区間です。「真の値を含むか」は、その90%区間に真の値が入ったかどうかです。
| 媒体 | 真の値 | MMM(基準)の推定 | 5%点 | 中央値 | 95%点 | 標準偏差 | 真の値を含むか |
|---|---|---|---|---|---|---|---|
| テレビCM | 1.51 | 1.44 | 1.32 | 1.45 | 1.51 | 0.06 | 含む |
| 検索広告 | 2.35 | 1.18 | 0.60 | 1.13 | 1.87 | 0.40 | 含まない |
| SNS広告 | 1.76 | 0.90 | 0.73 | 0.98 | 13.74 | 3.99 | 含む |
| ディスプレイ広告 | 0.38 | 0.17 | 0.00 | 0.30 | 1.23 | 0.71 | 含む |
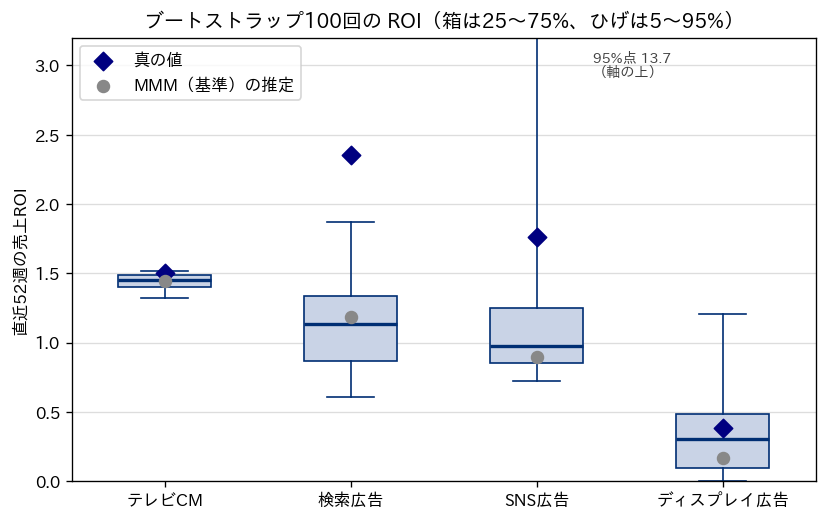
図は、同じ100回の ROI の分布を箱ひげ図で示したものです(箱は25〜75%点、ひげは5〜95%点、凡例は右上)。縦軸は0〜3.2で切っており、SNS 広告のひげの上端(95%点13.74)は図の外に出ています。100回のうち、いずれかの媒体の ROI が3.2を超えた回は10回でした。
結果は媒体によってはっきり分かれました。テレビCM は90%区間が1.32〜1.51と狭く、標準偏差も0.06で、データの誤差が違っていても推定はほとんど揺れません。真の値1.51は区間の上端(95%点1.51)と小数第2位まで同じ値で、区間の境界の上にあります。丸め方しだいで「含む」「含まない」が入れ替わる位置です。検索広告は区間が0.60〜1.87と広く、標準偏差は0.40でした。それでも区間は真の値2.35を含まず、100回のうち真の値以上の ROI が出たのは2回だけでした。SNS 広告は中央値0.98に対して95%点が13.74と、上側に極端に長い裾を持っています。表で SNS 広告の区間が真の値を「含む」のは、この極端に広い区間のためで、推定が当たったことを意味しません。SNS 広告の ROI が3を超えた9回の推定パラメータを調べると、効果が上限の半分になる広告費(half)の中央値が22万円(推定の範囲の下限は18.2万円)、効果の上限(beta)の中央値が3,664万円でした。それ以外の回の中央値(half 401万円・beta 951万円)と比べると、ごく少ない広告費で効果が上限に達し、その上限がとても大きい解です。SNS 広告の広告費は第1〜156週を通して0にならないので、この解では SNS 広告の効果が毎週ほぼ一定の大きな額になり、基礎売上の定数とほとんど区別が付きません。ROI が極端に大きくなった回は、こうした解でした。そのとき基礎売上の定数がどう動いたかは確かめていません。こうした回を含むので、平均(2.18)は中央値(0.98)よりかなり大きくなっていました。
この推定の仕方には、もう1つ確かめておくことがあります。各回を基準の推定値から推定し直しているので、基準の推定値の近くの解に戻りやすく、区間が狭めに出ている可能性があります。そこで、同じ作り直しのデータ(乱数の種も同じ)に対して、fit_mmm と同じ範囲の乱数の初期値2つから推定し直す形でも40回実行しました(関数評価は各最大400回。4回ずつ10回の実行に分けました)。なお、fit_mmm を初期値2つの設定でそのまま呼ぶ形も試しましたが、1回の推定に160秒を超える回が出たため中止しています。乱数の初期値から推定し直した40回では、検索広告の90%区間は0.66〜1.66(中央値1.05)、SNS 広告は0.73〜14.27(中央値1.04)、ディスプレイ広告は0.00〜4.44(中央値0.36)、テレビCM は1.33〜1.53(中央値1.47)でした。ディスプレイ広告の上側の裾が伸びたほかは、基準の推定値から推定し直した結果と大きな違いはなく、検索広告の区間はこちらでも真の値2.35を含みませんでした(40回のうち真の値以上は1回)。
ブートストラップの区間が真の値を含まない理由
検索広告の区間が真の値を含まなかったのは、ブートストラップが測れないものがこの例に含まれていたからです。ブートストラップで作ったデータは、基準の MMM の予測値に残差を足したものです。基準の MMM は、検索広告の効果を真の値の約半分に見積もっていました。その原因は1つに確かめられてはいません。確かめた事実は、定数とトレンドを大きめに推定していたこと(定数3,511万円、真は3,000万円)、真の基礎売上を与えて推定し直しても検索広告の ROI は0.98のままだったこと(第7章)、推定値の一部が範囲の上限に張り付いていたこと(第8章)です。いずれにしても、作り直したデータは「検索広告の効果が小さい世界」から出てきたデータであり、そこで推定をやり直せば、検索広告の ROI は小さい値の周りに散らばります。区間は「基準の推定値の周りでのデータの揺れ」を正しく表していますが、「基準の推定値そのものがずれている分」は表していません。
また、第2章の設定では、検索広告の広告費が需要(季節性・休日)に連動して増えます。広告費が季節と同じ向きに動くので、売上の山が広告のおかげなのか季節のおかげなのかを、データだけでは分けにくくなります。この取り違え(交絡)の詳しい扱いは第7章で扱っています。ブートストラップは、この取り違えを解く方法ではありません。取り違えがある状態のまま、その推定がどのくらい揺れるかを示すだけです。
経営の側から見ると、この結果は2つのことを意味します。1つは、ブートストラップの区間が狭いことは、推定が正しいことの証明にならないということです。テレビCM の区間が狭く真の値を含んだのは、テレビCM の広告費が放映期間と期間外で大きく動き、データに効果を決める情報が多く含まれていたからで、区間の狭さはその結果にすぎません。もう1つは、区間の広さそのものが、どの媒体の判断に注意すべきかを教えてくれるということです。この例では、検索広告・SNS 広告・ディスプレイ広告の区間が広く、テレビCM だけが狭く出ました。区間が広い媒体の ROI は、配分を大きく動かす根拠には使わず、実験などの別の情報で確かめてから使うのが安全です。
ベイズ MMM は、推定の前に持っている知識を分布として入れる
ベイズ MMM は、パラメータ(持ち越し率・飽和の形・効果の上限など)を「1つの正しい値があって、それを当てる」ものではなく、「どの値がどのくらいありそうか」を表す確率分布として扱います。データを見る前の見込みを事前分布、データを見たあとの見込みを事後分布と呼びます。事後分布は、事前分布と「そのパラメータの値なら手元のデータがどのくらい出やすいか」(尤度)を掛け合わせ、全体の確率の合計が1になるように割り戻して作ります。事後分布から「ROI が90%の確率で入る範囲」を切り出したものが信用区間です。名前の似た「信頼区間」(頻度主義の統計で使う区間。頻度主義は、パラメータを決まった1つの値とみなし、データを取り直したときの推定の手続きの性質で考える、従来の統計学の立場です)とは別のもので、読み方が違います。ブートストラップの区間が「データを作り直したときの推定値の揺れ」であるのに対し、信用区間は「事前の知識と手元のデータを合わせたときの、値そのものについての確信の幅」という読み方をします。
この考え方を MMM に用いた文献の1つが、Google の Yuxue Jin らが2017年に公開した、広告の持ち越し効果と効き方の形をベイズ推定で扱った論文です(Google Research の論文ページ)。論文は、持ち越し(アドストック)と飽和(Hill 関数)を含む MMM を、マルコフ連鎖モンテカルロ法(MCMC。事後分布から乱数で標本を取り出す計算方法の総称)で推定しています。要旨は、シミュレーションでは大きなデータならモデルをよく推定できる一方、標本が小さいと事前分布が事後分布に大きく影響し、偏った推定につながりうると述べています。さらに、モデルにもとづく最適な広告の配分は、パラメータの推定のばらつきのために大きなばらつきを持つ、とも述べています。本文では、事後分布の平均・中央値に加えて、分位点にもとづく信用区間がより多くの情報を持つ要約になると説明し、データにパラメータを決めるだけの情報が無いと、事後分布が事前分布とほとんど同じになる場合があるとも書いています。
同じ論文が事前分布を置く理由として挙げているのは、1つの MMM のデータが持つ情報の量が、推定するパラメータの数に比べて少ないという点です。論文は、事前の知識は業界の経験や、同じ広告主・似た広告主の過去の MMM から得られるとしています。持ち越し率には0以上1未満に限られるベータ分布か一様分布を、Hill 関数の形のパラメータにはガンマ分布を、効果の大きさの係数には負にならない半正規分布を置くのが典型だとしています。論文のシミュレーション(2年分の週次データ)で使った事前分布の表では、持ち越し率に beta(3, 3)、形のパラメータに gamma(3, 1)、係数に half normal(0, 1) が並んでいます。
Google がオープンソースで公開している MMM の Meridian も、ベイズの考え方にもとづくツールです(Meridian の詳細は第14章で扱います)。Meridian の公式リポジトリの説明は、Meridian をベイズの因果推論にもとづくモデルの枠組みとし、推定には NUTS(No U Turn Sampler)と呼ばれる MCMC の方法を使うとしています。Meridian の公式ドキュメントの概要ページは、Meridian をベイズのモデルとして説明し、事前分布は手元の情報にもとづいてモデルに出発点を与え、業務の知識を反映させるためのものだとしています。同じページは、モデルの主な出力をパラメータの事後分布とし、行動につなげる出力として ROI の推定値と信用区間を挙げています。既定の事前分布を説明する公式ドキュメントによれば、Meridian は有料の媒体について、既定で事前分布を ROI に置きます。ROI の事前分布の既定は LogNormal(0.2, 0.9)(ROI の対数が平均0.2・標準偏差0.9の正規分布に従う形)です。同じページは、この事前分布は各媒体の ROI の平均を1.83、半分の媒体の ROI が1.22を超えるとみなすものだと説明しています。ただし同じページは、成果の指標(KPI)が売上ではなく、KPI 1単位あたりの売上のデータも無い場合には、有料の媒体全体で KPI の何割を生むか(平均40%・標準偏差20%)を見込みとして置き、そこから全媒体に共通の ROI の事前分布を決める、という別の置き方を説明しています。この章の例は、売上を KPI にした場合に当たります。Python のライブラリである PyMC-Marketing も、公式ドキュメントの MMM の入門ページで、事前分布を自由に設定して業務の知識をモデルに入れられること、標本外の予測を信用区間つきで出せることを挙げています。
この記事の実行環境には PyMC・PyMC-Marketing・Meridian・Stan が入っていないので、これらのツールでの計算は行っていません。この章では、同じ考え方を numpy・scipy で最小限に実装して2段階で示します。1段階目は、事前分布を「罰則」として最小二乗に足し、事後分布の山の頂上(MAP 推定。最も確率の高い1点)を求める方法です。2段階目は、numpy で書いた単純なメトロポリス法(MCMC の最も基本的な方法)で事後分布から標本を取り、信用区間を出す方法です。どちらも、専用のツールが行っている計算をそのまま再現したものではなく、考え方を確かめるための最小限の実装です。
事前分布の置き方で ROI はどれだけ動くか
1段階目として、Meridian と同じく事前分布を ROI に置きました。具体的には、学習期間(第1〜130週)の各媒体の ROI の対数が、中心の値の対数を平均とし、決めた幅を標準偏差とする正規分布に従うとみなし、そこから外れる分を罰則として最小二乗の誤差に足しています。誤差の標準偏差は、基準の MMM の学習期間の残差の標準偏差103.8万円に固定しました。罰則は「ROI の対数が中心からどれだけ離れたか÷幅」の二乗の半分で、データの誤差は「残差÷103.8」の二乗の半分なので、両者の和を最小にする点を求めます。ここでは事前分布をモデルのパラメータそのものではなく、パラメータから計算した ROI に置いているので、この点は厳密なベイズモデルの MAP 推定ではなく、MAP 推定に相当する罰則付きの推定です。中心の値と幅を変えた7つの設定で、全媒体に同じ事前分布を置いて推定し直しました。各設定で、基準の推定値を初期値にした1回と、乱数の初期値2回の計3回推定し、目的の値が最小のものを採っています(関数評価は1回あたり最大400回)。次のコードは、実行したスクリプトから要所を抜き出したものです。補助モジュール(mmm_data.py・baseline.py)と同じフォルダに置いて実行する形です。
import numpy as np
from scipy.optimize import least_squares
import mmm_data as md
import baseline as bl

df = md.make_data()
y = df["sales"].to_numpy(dtype=float)
X = {c: df[c].to_numpy(dtype=float) for c in md.CHANNELS}
SIGMA = 103.8                      # 誤差の標準偏差(基準の MMM の残差から。固定)

def resid_vec(theta, prior):
    """データの残差÷σ と、ROI の事前分布の罰則を並べる。二乗和の半分が負の対数事後確率"""
    p, gamma = bl._unpack(theta)
    eff = {c: md.media_effect(X[c], p[c]) for c in md.CHANNELS}
    yhat = bl.controls(df) @ gamma + sum(eff.values())
    r = ((yhat - y) / SIGMA)[:130]                       # 学習 第1〜130週
    if prior is None:
        return r
    m, s = prior                                          # ROI の中心と幅(対数で)
    roi = np.array([eff[c][:130].sum() / X[c][:130].sum() for c in md.CHANNELS])
    return np.concatenate([r, (np.log(np.maximum(roi, 1e-6)) - np.log(m)) / s])

# lo, hi は fit_mmm と同じ範囲。theta0 は基準の推定値
r = least_squares(resid_vec, theta0, args=((np.exp(0.2), 0.9),),
                  bounds=(lo, hi), max_nfev=400)
# 出力(直近52週の ROI):
# tv 1.49 search 1.20 social 0.93 display 1.25
7つの設定の結果が次の表です。ROI はいずれも直近52週(第105〜156週)の売上ROI で、第2章の基準の結果と同じ期間です。「残差の標準偏差」は学習期間の当てはまり、「検証 MAPE」は第131〜156週の予測の誤差です。「定数」は統制変数の定数項(基礎売上の水準。真の値は3,000万円/週)です。
| 事前分布の設定(全媒体の ROI に置く) | テレビCM | 検索広告 | SNS広告 | ディスプレイ広告 | 残差の標準偏差(万円) | 検証 MAPE | 定数(万円/週) |
|---|---|---|---|---|---|---|---|
| 真の値 | 1.51 | 2.35 | 1.76 | 0.38 | (誤差の真の標準偏差 120) | なし | 3,000 |
| 事前分布なし(MMM(基準)と同じ) | 1.44 | 1.18 | 0.90 | 0.17 | 103.8 | 2.64% | 3,511 |
| 中心1.22・幅0.9(Meridian の既定と同じ中心と幅) | 1.49 | 1.20 | 0.93 | 1.25 | 103.9 | 2.80% | 3,157 |
| 中心0.5・幅0.9 | 1.42 | 0.92 | 0.86 | 0.34 | 104.1 | 2.75% | 3,533 |
| 中心2.0・幅0.9 | 1.49 | 1.27 | 0.92 | 1.74 | 104.3 | 2.63% | 2,999 |
| 中心0.5・幅0.3 | 1.38 | 0.61 | 0.74 | 0.47 | 105.1 | 2.84% | 3,598 |
| 中心1.0・幅0.3 | 1.46 | 1.03 | 0.90 | 1.01 | 104.3 | 2.72% | 3,288 |
| 中心2.0・幅0.3 | 1.48 | 1.61 | 1.87 | 2.02 | 105.3 | 2.43% | 2,635 |
表の「残差の標準偏差」の列は103.8〜105.3万円、「検証 MAPE」の列は2.43%〜2.84%の範囲に収まっており、どの設定も当てはまりはほとんど同じです。それにもかかわらず、検索広告の ROI は0.61〜1.61、ディスプレイ広告の ROI は0.17〜2.02まで動きました。データが「どの値がよいか」をほとんど決められず、事前分布が決めている、ということです。これは、Jin らの論文が述べている「データにパラメータを決めるだけの情報が無いと、事後分布が事前分布に近くなる」という状況が、この架空データでも起きていることを示しています。一方、テレビCM の ROI は1.38〜1.49の狭い範囲にとどまりました。テレビCM は放映期間と期間外で広告費が大きく動くので、データにテレビの効果を決める情報が多く含まれている、と読めます。
この表には、もう1つ読み取れることがあります。ROI を高めに置く設定ほど、「定数」の列が小さくなっています(中心2.0・幅0.3で2,635万円、中心0.5・幅0.3で3,598万円)。媒体の効果を大きく見るほど、基礎売上が小さく推定されるという、媒体と基礎売上の間の取り合いです。第2章の基準の結果でも、基礎売上の定数とトレンドは大きめに推定されていました。ただし、検索広告と SNS 広告の ROI が真の値の約半分になった原因がそれだけだとは言えません。第7章で真の基礎売上を与えて推定し直しても、この2媒体は約半分のままでした。この取り合いはデータだけでは決着がつかず、どこで決着するかを事前分布が左右しています。
結果の向きにも注意が要ります。Meridian の既定と同じ中心と幅(中心1.22・幅0.9)を置くと、検索広告(1.18→1.20)と SNS 広告(0.90→0.93)はほとんど動かず、真の値が0.38のディスプレイ広告だけが0.17から1.25へ大きく引き上げられました。この例では、全媒体に同じ事前分布を置くと、データに情報の少ない媒体ほど事前分布の中心に引き寄せられ、それが「効いていない媒体を効いているように見せる」向きに働きました。中心2.0・幅0.3の設定は検証 MAPE が7つの中で最も小さく(2.43%)、検索広告と SNS 広告は真の値に近づきましたが(1.61・1.87)、ディスプレイ広告は2.02と真の値の5倍以上に推定されています。当てはまりで設定を選ぶと、この設定が選ばれてしまいます。事前分布は「データの代わりに答えを決めてしまう」力を持っており、その力は良い方向にも悪い方向にも働く、というのがこの表の結論です。
ここでの事前分布は、全媒体に同じものを置く単純な設定です。現実の分析では、媒体ごとに別の事前分布を置くことができます。その場合も、根拠(過去の MMM・業界の経験・実験の結果)を媒体ごとに記録しておくのがよいと考えています。とくに実験の結果を事前分布や罰則として入れる方法は、第10章で SNS 広告の地域実験を使って扱います。
メトロポリス法で事後分布から標本を取り、信用区間を出す
MAP 推定は事後分布の頂上の1点しか教えてくれません。区間を出すには、事後分布の広がりを知る必要があります。2段階目として、numpy で単純なメトロポリス法を書き、事後分布から標本を取りました。メトロポリス法は、今いるパラメータの値から少しずらした候補を乱数で作り、候補の事後確率が今より高ければ移り、低ければ「事後確率の比」の確率で移る、という手順を繰り返す方法です。これを十分な回数繰り返すと、たどった値の集まりが事後分布に従う標本になります。標本ごとに ROI を計算すれば、ROI の事後分布が手に入り、その5%点から95%点までが90%信用区間になります。
設定は次のとおりです。対象は前の表の「事前分布なし」と「中心1.22・幅0.9」の2つで、出発点はそれぞれの MAP 推定値です。パラメータの範囲は fit_mmm と同じにし、範囲の外に出た候補は捨てました(範囲の中では一様な事前分布を置いたことになります)。誤差の標準偏差は MAP 推定と同じく103.8万円に固定しています。候補をずらす幅は、反復の最初の40%の期間に、それまでたどった値のばらつきに合わせて調整し、残り60%では幅を固定して標本を集めました。各設定で乱数の種を変えた2本の鎖(連鎖)を、それぞれ150,000回反復し、調整後の90,000回から10回に1回を残して、鎖1本あたり9,000個、2本で18,000個の標本にしています。次のコードは、その繰り返しの部分を抜き出したものです。
# theta:出発点(MAP 推定値)、log_post(theta, prior):対数事後確率(範囲外は -inf)
# L:候補をずらす幅(調整期間にたどった値の共分散から作る)、mult:幅の倍率
rng = np.random.default_rng(seed)
lp = log_post(theta, prior)
for it in range(n_iter):
    prop = theta + mult * (L @ rng.standard_normal(len(theta)))   # 少しずらした候補
    lp_new = log_post(prop, prior)
    if np.log(rng.uniform()) < lp_new - lp:                     # 事後確率の比の確率で移る
        theta, lp = prop, lp_new
    if (it >= n_adapt) & (it % 10 == 0):                        # 調整後、10回に1回残す
        keep.append(roi_report(theta))                           # 直近52週の ROI を記録
# 90%信用区間:np.percentile(keep, [5, 95], axis=0)
調整後の期間の採択率(候補に移った割合)は、4本の鎖で0.141〜0.195でした。1本あたりの計算時間は60.0〜92.4秒で、この記事の実行環境(一般的なノートPC)での実測です(他の計算と並行して動かしたので揺れがあります)。同じ設定の2本の鎖の中央値を比べると、テレビCM は2本とも1.47(事前分布なし)、検索広告は1.10と1.02、SNS 広告は1.22と1.06でした。鎖どうしで中央値が0.1以上ずれる媒体があるということは、この反復回数では事後分布をまだ十分に探り切れていない可能性がある、ということです。鎖が事後分布を探り切れたかどうかの確かめ方(収束診断)は、弊社コラム『ベイズ統計の考え方と使い方、MCMCから階層ベイズまで』で扱っています。ここでは、2本の鎖を合わせた結果を、収束を確かめていない暫定の目安として示します。次の表の中央値・区間・確率も同じ扱いです。
| 媒体 | 真の値 | 事前分布なし:中央値 | 事前分布なし:90%信用区間 | 事前分布なし:ROI 1以上の確率 | 中心1.22・幅0.9:中央値 | 中心1.22・幅0.9:90%信用区間 | 中心1.22・幅0.9:ROI 1以上の確率 |
|---|---|---|---|---|---|---|---|
| テレビCM | 1.51 | 1.47 | 1.40〜1.54 | 1.00 | 1.46 | 1.39〜1.52 | 1.00 |
| 検索広告 | 2.35 | 1.06 | 0.51〜1.76 | 0.56 | 1.22 | 0.67〜1.98 | 0.71 |
| SNS広告 | 1.76 | 1.13 | 0.74〜1.94 | 0.67 | 1.01 | 0.67〜1.78 | 0.51 |
| ディスプレイ広告 | 0.38 | 0.11 | 0.01〜0.44 | 0.00 | 0.61 | 0.18〜1.68 | 0.22 |
ROI はいずれも直近52週の売上ROI です。「ROI 1以上の確率」は、標本のうち売上ROI が1以上(広告費以上の売上を生んでいる)だったものの割合です。テレビCM は、どちらの設定でも90%信用区間が1.4〜1.5前後の狭い範囲に収まり、真の値1.51を含んでいます。検索広告は、区間が0.51〜1.76(事前分布なし)、0.67〜1.98(中心1.22・幅0.9)と広く、どちらも真の値2.35を含んでいません。SNS 広告は、どちらの区間も真の値1.76を含んでいますが、中心1.22・幅0.9の区間(上端1.78)では上端ぎりぎりです。ディスプレイ広告は、事前分布なしでは0.01〜0.44、中心1.22・幅0.9では0.18〜1.68と、事前分布の有無で区間の位置が大きく変わりました。
粗利で回収しているかどうか(粗利率0.50の下では売上ROI 2以上)で見ると、標本のうち売上ROI が2以上だった割合は、事前分布なしで検索広告0.01・SNS 広告0.04、中心1.22・幅0.9で検索広告0.05・SNS 広告0.03でした。この結果だけを見れば「検索広告と SNS 広告は粗利で回収できていない可能性が高い」という報告になります。真の値は検索広告2.35・SNS 広告1.76なので、検索広告は実際には粗利で回収しており(真の粗利ROI 1.18)、検索広告についてのこの報告は誤りです(SNS 広告は真の粗利ROI が0.88なので、回収できていないという報告は当たっています)。信用区間は、モデルの形と事前分布を正しいとみなしたうえでの確信の幅であり、この例のようなモデルの側の偏り(媒体の効果の大きさや、媒体どうしの効果の振り分けの誤り)は、区間をいくら精密に計算しても直りません。
テレビCMは逆の向きの例です。90%信用区間の上端は事前分布なしで1.54、中心1.22・幅0.9で1.52と、どちらも売上ROI 2を下回っているので、モデルの前提の下では「テレビCMは粗利では広告費を回収できていない」と言えます。真の売上ROI 1.51も2を下回っているので、この報告は当たっています(第5章でも、第121〜126週のフライトは放映後まで含めて粗利ROI 0.72でした)。区間は、売上で見て回収している媒体が、粗利で見ても回収しているとは限らないことも示します。
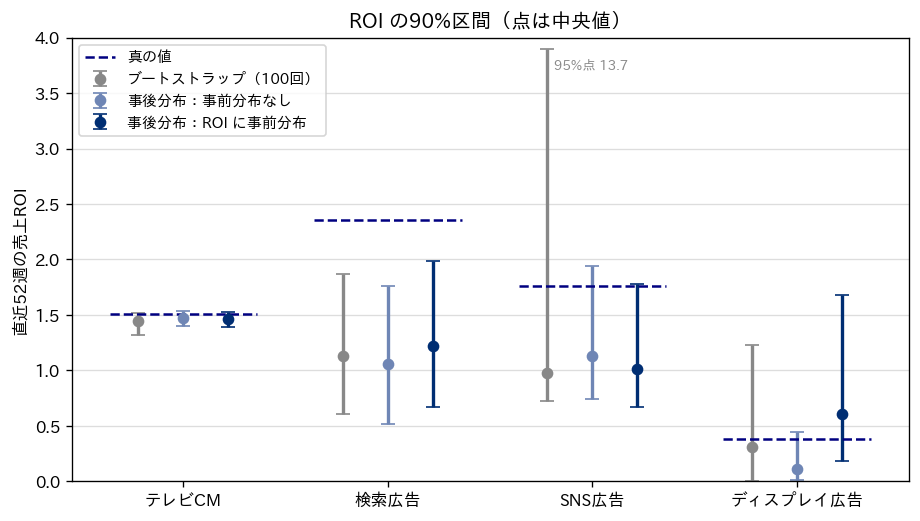
上の図は、媒体ごとに、ブートストラップ(基準の推定値から推定し直した100回の結果)、事前分布なしの事後分布、中心1.22・幅0.9の事前分布を置いた事後分布の3つの90%区間を並べ、真の値を破線で示したものです(凡例は左上)。SNS 広告のブートストラップの区間は上端が13.7まで伸びており、縦軸の範囲(0〜4)を超える部分は切って数値を添えています。3つの方法は区間の幅も位置も違いますが、検索広告では3つとも真の値の破線の下にあります。「区間を出した」ことと「区間が真の値を含む」ことは別の話だということが、この図から読めます。
ROI の幅は、予算配分の幅になる
ROI の区間が広いことは、予算配分の答えも揺れることを意味します。Jin らの論文も、要旨で、モデルにもとづく最適な配分はパラメータの推定のばらつきのために大きなばらつきを持つと述べ、本文では、事後分布の標本1つずつで最適な配分を解けば、その配分のばらつきから、最適化の結果をどこまで信用してよいかが分かると説明しています。同じことを、ブートストラップの100回の推定で確かめました。各回の推定パラメータから応答曲線を作り、第2章の基準の結果と同じ条件(直近52週の週平均の総額1,156.5万円/週を固定し、各媒体を現状の0.5〜2倍の範囲で動かす。毎週同じ額を出し続ける定常状態の前提)で配分を最適化しました。100回の最適化にかかった時間は1.9秒です。
| 媒体 | 現状(万円/週) | 最適化した配分の5%点 | 中央値 | 95%点 | 下限(0.5倍)に張り付いた割合 | 上限(2倍)に張り付いた割合 |
|---|---|---|---|---|---|---|
| テレビCM | 402.9 | 388.8 | 443.3 | 574.2 | 0.00 | 0.00 |
| 検索広告 | 224.3 | 112.1 | 448.5 | 448.5 | 0.16 | 0.73 |
| SNS広告 | 228.5 | 114.3 | 114.3 | 449.1 | 0.72 | 0.05 |
| ディスプレイ広告 | 300.8 | 150.4 | 150.4 | 150.4 | 0.98 | 0.00 |
「中央値」の列は、第2章の基準の結果で MMM(基準)から求めた配分(テレビCM 443.3・検索広告 448.5・SNS 広告 114.3・ディスプレイ広告 150.4万円/週)と同じ値です。しかし、5%点と95%点を見ると、検索広告は100回のうち73回で上限の2倍に、16回で下限の0.5倍に張り付きました。SNS 広告は72回で下限に、5回で上限に張り付いています。つまり、データの誤差の出方が少し違うだけで、「検索広告を倍にする」という答えと「検索広告を半分にする」という答えの両方が出てくるということです。ディスプレイ広告だけは98回で下限に張り付いており、ブートストラップの範囲では「減らす」という答えはほぼ揺れませんでした(真の最適でもディスプレイ広告は下限の150.4万円/週です)。
100回それぞれの配分を真の応答で評価すると、現状からの増分売上は年換算で、5%点が1,598万円、中央値が3,816万円、95%点が11,809万円で、現状より減ったのは100回のうち1回でした(真の最適に配分した場合は +16,622万円)。この架空データでは、MMM に従って配分を変えても大きく損をする回はほとんどありませんでしたが、得られる増分は約1,600万円から約1.2億円まで7倍以上の幅があります。粗利率0.50で換算すると、約800万円から約5,900万円の幅です。区間を見ずに1つの配分案だけを出すと、この幅の中のどこに当たるかを知らないまま、配分の変更を決めることになります。
経営の判断に引き直すと、配分案の安定性は「どの変更を今すぐ実行し、どの変更を実験で確かめてから実行するか」を分ける材料になります。この例なら、ブートストラップの100回のほぼすべてで同じ答えが出たディスプレイ広告の減額は、最初に段階的に動かす候補です。ただし、ブートストラップは基準の推定値の周りでの揺れしか測らず、答えが安定していることは正しさの証明になりません。この章の事前分布の表では、ディスプレイ広告の ROI は事前分布の置き方で0.17から2.02まで動きました。事前分布を変えても減額という方向が変わらないかを確かめ、実験で裏づけながら動かすのがよいと考えています。答えが倍と半分に割れた検索広告と SNS 広告の増減は、一度に上限まで動かさず、実験で確かめてから動かす候補です。不確実性を踏まえた配分の決め方(区間の下側で判断する、少しずつ動かす)は第12章で扱います。
区間をどう経営に報告するか
区間を報告するときに大切なのは、区間の幅そのものより、区間が「判断の分かれ目」をまたいでいるかどうかです。広告費の判断の分かれ目は、少なくとも2つあります。1つは売上ROI 1(広告費と同じ額の売上を生む点)、もう1つは粗利ROI 1(この記事の架空の粗利率0.50なら売上ROI 2。広告費を粗利で回収できる点)です。区間がこの分かれ目の片側に収まっていれば、その媒体について「回収できている」「回収できていない」と言えます。区間が分かれ目をまたいでいれば、どちらとも言えない、というのが報告すべき答えです。
例として「検索広告の売上ROI の90%区間は0.51〜1.76」(事前分布なしの事後分布)という結果を経営会議に出す場合を考えます。この区間は売上ROI 1をまたいでいるので、「検索広告が広告費以上の売上を生んでいるかどうかは、このモデルでは決められない」が正直な報告です。一方、区間の上端1.76は粗利の損益分岐の2を下回っているので、モデルの形が正しいという前提の下では「粗利で回収できている見込みは小さい」とは言えます。ただし、この章の結果が示したとおり、この架空データでは真の値は2.35で、その前提が崩れていました。区間を報告するときは、「何を前提にした区間か」(モデルの形・統制変数・事前分布)を必ず添え、前提が崩れていないかを別の方法(実験)で確かめる計画を一緒に出すのがよいと考えています。
区間の形と、そこから決められること・決められないことを整理すると、次の表のようになります。数字はこの章の架空データでの結果で、どの媒体にも一般に当てはまるものではありません。
| 区間の形 | この章の例 | 決められること | 決められないこと | 次の行動 |
|---|---|---|---|---|
| 区間全体が売上ROI 1より上で、幅も狭い | テレビCM(事後分布の90%区間 1.40〜1.54) | 広告費以上の売上を生んでいる。区間の上端も売上ROI 2を下回るので、粗利では回収できていない(どちらもモデルの前提の下で) | 増額すべきか(限界ROI を見る必要がある) | 限界ROI と配分の計算に進む(第11・12章) |
| 区間全体が売上ROI 1より下 | ディスプレイ広告(事前分布なしの90%区間 0.01〜0.44) | 広告費以上の売上を生んでいない(モデルの前提の下で) | 事前分布を変えると区間が0.18〜1.68に動くので、前提の置き方に結論が左右される | 段階的に減額し、売上の変化を確かめる |
| 区間が判断の分かれ目をまたぐ | 検索広告(0.51〜1.76)、SNS 広告(0.74〜1.94) | どちらとも言えない、ということ | 増やすべきか減らすべきか | 実験で答え合わせする(第10章) |
| 方法や事前分布で区間の位置が大きく変わる | ディスプレイ広告、SNS 広告 | データだけではこの媒体の効果を決められない、ということ | どの区間を信じるか | 事前分布の根拠を記録し、実験で確かめる |
この表の「次の行動」の列が示すとおり、区間が広い・判断の分かれ目をまたぐという結果は、失敗ではなく「どこに追加の情報(実験)を投じるべきか」を教えてくれる結果です。経営の側から見ると、区間を出すことの価値は、すべての媒体を同じ精度で測ろうとするのではなく、判断が分かれる媒体にだけ実験の費用をかける、という優先順位を付けられる点にあります。逆に、区間を出さずに1つの数字で判断すると、検索広告の ROI 1.18 を「回収できていない」と読んで削り、実際には粗利で回収していた媒体を失う、という判断を確信を持って下してしまいます。
報告の形としては、媒体ごとに「中央値」「90%区間」「売上ROI 1以上の確率」「粗利ROI 1以上(売上ROI 2以上)の確率」を1行にまとめ、表の下に「この区間が前提にしていること」を書く形が扱いやすいと考えています。確率で表すと、「検索広告が広告費以上の売上を生んでいる確率は56%」(事前分布なし。この章では鎖の収束を確かめていない暫定の値)のように、経営の言葉に近い表現になります。ただし、この確率もモデルと事前分布を前提にした値であることは、区間と同じです。報告の書式全体(ROI・限界ROI・区間を1枚にまとめる形)は第11章で扱います。
ブートストラップとベイズ MMM をどう使い分けるか
2つの方法は、測っているものも、手間も違います。ブートストラップは、すでに作った MMM の推定の手順をそのまま繰り返すだけなので、新しい道具を入れずに始められます。オープンソースの MMM でも使われており、Meta の Robyn の公式ドキュメントの機能紹介のページは、似たハイパーパラメータ(推定の前に決める設定値)を持つ候補のモデルをまとめた群(クラスタ)の中で、ROAS(または CPA)をブートストラップし、その分布と95%区間を出すと説明しています(Robyn の詳細は第14章で扱います)。この章では、1回の推定を中央値1.9秒・最長21.6秒に抑える工夫(基準の推定値から推定し直す、関数評価の回数に上限を置く)をしたうえで、100回を10回ずつに分けて実行しました。一方で、データが少し変わるだけで推定が別の解に移る場合は、その移り方が区間に混ざり、SNS 広告の95%点13.7のような極端な値が出ます。事前の知識を入れる仕組みも無いので、データが媒体の効果を決められない状況では、区間が広がるか、不安定になるかのどちらかです。
ベイズ MMM は、事前分布という形で「データの外にある知識」を入れられます。過去の MMM・業界の経験・実験の結果があるなら、それを推定に反映できるのが最大の利点です。その代わり、事前分布の置き方が結果を左右するので、その根拠を説明できなければなりません。この章の表で見たとおり、全媒体に同じ事前分布を置くだけでも、ディスプレイ広告の ROI は0.17から1.25に動きました。事前分布は、置いた人の判断が結果に入り込む入口でもあります。誰が、どの根拠で、どの値を置いたかを記録し、事前分布だけを変えたときに結論が変わるかどうか(感度)を報告に添えるのがよいと考えています。
| 観点 | ブートストラップ | ベイズ MMM(事後分布・信用区間) |
|---|---|---|
| 区間が表すもの | データの誤差の出方が違ったら、推定値がどのくらい揺れたか | 事前の知識と手元のデータを合わせたときの、値についての確信の幅 |
| データの外の知識 | 入れられない | 事前分布として入れられる(根拠の説明が要る) |
| この章の検索広告の90%区間 | 0.60〜1.87(基準の推定値から推定し直した100回)、0.66〜1.66(乱数の初期値から推定し直した40回) | 0.51〜1.76(事前分布なし)、0.67〜1.98(中心1.22・幅0.9) |
| 測れないもの | モデルの形・統制変数の選び方による偏り | 同じく、モデルの形・統制変数の選び方による偏り |
| 始めやすさ | 既存の推定を繰り返すだけ。計算時間は推定1回の時間×回数 | 専用のツール(Meridian・PyMC-Marketing など)を入れるか、確率モデルを書く必要がある |
どの規模・段階から要るかについては、次のように考えています。媒体が2〜3つで、それぞれの広告費が大きく動いた履歴がある段階では、ブートストラップで区間を添えるだけでも、1つの数字で報告するより判断の誤りを減らせます。媒体が増え、互いに連動して動く(この記事のテレビCM とディスプレイ広告のように)、あるいは広告費がほぼ一定で動きが少ない媒体を含む段階では、データだけでは効果を決められない媒体が出てくるので、事前分布で知識を入れるベイズ MMM が意味を持ちます。逆に、どちらの方法も要らないのは、広告費の配分を変える余地が無い場合(契約で総額も配分も固定されている場合など)です。区間は判断のための情報なので、判断の余地が無ければ作る意味が薄れます。
どちらの方法を使う場合も、区間は「モデルが正しいとしたときの幅」です。モデルが正しいかどうかは、区間をいくら精密にしても分かりません。この章の結果で、検索広告の区間がどの方法でも真の値を含まなかったのは、そのためです。モデルの外から答え合わせをする方法が、次の第10章で扱う実験です。
MMM の ROI は1つの数字ではなく区間で示すべきもので、その方法としてブートストラップとベイズ MMM があります。第2章で用意したサンプルデータでは、テレビCM の ROI はどの方法でも狭い区間に収まり真の値を含みましたが、検索広告は区間が広く、しかもどの方法の区間も真の値2.35を含みませんでした。事前分布の置き方を変えると、当てはまりがほとんど同じまま、ディスプレイ広告の ROI が0.17から2.02まで動きました。区間は「どの媒体なら判断できて、どの媒体は追加の情報が要るか」を教えてくれますが、モデルの側の偏りは教えてくれません。次の第10章では、モデルの外から答え合わせをする実験(リフトテストと地域実験)と、その結果を MMM に取り込む方法を扱います。
この章を深めたい方への参考書籍
『ブートストラップ入門』(汪金芳・桜井裕仁 著、共立出版):シリーズ「Rで学ぶデータサイエンス」の1冊で、英文の副題のとおり、統計ソフトの R を使ってブートストラップの方法を学ぶ入門書です。この章で使った「データを作り直して推定をやり直す」手順を、手を動かしながら確かめたいときに役立ちます。
『標準ベイズ統計学』(ピーター・D・ホフ 著、入江薫・菅澤翔之助・橋本真太郎 訳、朝倉書店):二項モデル・正規モデルから、ギブスサンプラー、階層モデル、線形回帰、非共役な事前分布とメトロポリス・ヘイスティングス法までを章立てで扱うベイズ統計の教科書です。この章で書いたメトロポリス法の背景を学べます。原書(A First Course in Bayesian Statistical Methods)は、この章で取り上げた Jin らの論文が、信用区間の説明の参考文献として挙げている本の1つです。
第10章 実験で答え合わせする、リフトテストと地域実験
第9章では、MMM の ROI を1つの数字ではなく幅で示す方法を扱いました。幅を示すと、推定がどれだけ不確かかは伝わります。ただし、幅の中心そのものがずれている場合、幅を示しても誤りは直りません。第2章で用意したサンプルデータ(架空の日用品メーカーの週次データ)では、MMM(基準)が検証期間の MAPE 2.64% という良い当てはまりを示しながら、SNS広告の直近52週の ROI を 0.90(真の値 1.76)、検索広告を 1.18(真の値 2.35)と、真の値の約半分に見積もっていました。この章では、MMM の外側にある証拠、つまり広告を意図的に止めたり増やしたりする実験の結果でモデルを答え合わせし、ずれていれば直す方法を扱います。実験の種類、共通データに入れてある地域実験の読み方、実験の結果を MMM に取り込む方法(scipy で実装して実行しました)、それで ROI と予算配分がどう変わり、何が変わらないのか、実験の費用と設計の注意、専用ツールの取り込み方の順に進めます。
観察データだけでは答えが1つに決まらない
MMM は、過去の週次の売上と広告費の動きから、媒体ごとの効果を逆算する方法です。逆算に使えるのは、過去にたまたま起きた広告費の変動だけです。第2章の共通データでは、検索広告は需要が高い週に増える運用で、売上と同じ向きに動きます。テレビCMとディスプレイ広告は同じ時期に増える運用で、広告費の相関が0.91あります。このような運用では、「売上が増えたのは広告のおかげか、季節のおかげか、同じ週に出ていた別の媒体のおかげか」をデータだけで切り分けることが難しくなります。第7章と第8章で見たとおり、基準の MMM は定数とトレンドを真の値より大きめに推定し(定数 3,511 に対して真の基礎の水準 3,000)、検索広告と SNS 広告の ROI を真の約半分に見積もりました。当てはまりは良いままです。ただし、「定数とトレンドを大きめに推定したこと」と「ROI を約半分に見積もったこと」のうち、一方が他方の原因なのかは、この記事では確かめていません。第7章で真の基礎売上をモデルに与えて推定し直しても、検索広告の ROI は0.98、SNS 広告は0.85と約半分のままだったので、媒体どうしの効果の振り分けにも誤りがあります。推定したパラメータのいくつかが、推定の範囲の端に張り付いていたことも分かっています。
この状態は、モデルを作り直したり推定を何度もやり直したりしても解消しにくいものです。データの中に「SNS 広告だけを、他の条件を変えずに動かした」記録が十分にないと、モデルはどの説明が正しいかを決める手がかりを持ちません。そこで、広告費をこちらから意図的に動かし、動かさなかった比較対象と売上の差を測るのが実験です。実験は、広告費の変動を「たまたま起きたもの」から「こちらが決めたもの」に変えるので、季節や他の媒体と広告費が一緒に動く問題を設計の段階で大きく抑えられます。Google の研究者 Jon Vaver と Jim Koehler が2011年にまとめた地域実験による広告効果の測定の論文は、観察データによる方法は対照群(広告を見せない比較の集団)が無いため統計モデルで「広告が無かった場合」を推し量るしかなく、結果に懐疑的な目が向けられやすいこと、最も厳密な方法は無作為化した実験であることを述べています。
ただし、実験にも弱点があります。実験は、ある期間・ある地域・ある支出の水準で、1つの媒体の効果を測るものです。媒体ごと・時期ごと・支出の水準ごとに何度も実験を重ねることは、費用と時間の面で現実的ではありません。MMM は全期間・全媒体を一度に扱えますが、答えが1つに決まらないことがあります。実験は、観察データだけに頼るより因果の効果を確かめやすい一方で、測れる範囲が狭く、精度にも限りがあります。実験の結果にも誤差があり、設計を誤れば結果もずれます(この章の後半で扱います)。この章で扱うキャリブレーション(較正)は、この2つを組み合わせ、「実験で確かめた点ではモデルが実験と合うように」推定をやり直すことを指します。第2章で触れた三角測量の考え方を、モデルの推定の中に組み込む方法と言えます。
実験の種類:リフト調査・ホールドアウト・地域実験
広告の効果を測る実験は、何を単位に「広告を出す側」と「出さない側」に分けるかで大きく3つに分かれます。1つ目は、広告媒体が提供するリフト調査です。媒体の利用者を無作為に2つに分け、片方には広告を配信し、もう片方には配信しないで、購入や来訪などの差を測ります。Meta の地域実験ツール GeoLift の公式ドキュメントの冒頭は、人を単位にした実験(Conversion Lift など)が実施できる場合はそちらを推奨し、その理由を地域を単位にした実験より統計的な検出力が高いからとしています。リフト調査の弱点は、その媒体の中で測れる行動しか測れないことです。店頭での購入のように、媒体の外で起きる売上は対象にしにくくなります。
2つ目は、広くホールドアウトと呼ばれるやり方で、広告を出さない集団(利用者・顧客・店舗など)をあらかじめ取り分けておき、出した集団と比べるものです。Vaver と Koehler の論文は、Google での例として、検索ごとに対照と処置を割り当てるトラフィック実験と、Cookie ごとに割り当てる Cookie 実験を挙げています。同じ論文は、トラフィック実験は検索の後に続く購入までの行動を追えないこと、Cookie 実験は Cookie の入れ替わりや複数の端末の利用によって同じ人に一貫して広告を出し分けられないことを、それぞれの弱点として挙げています。第1章で扱ったとおり、個人単位の追跡は年々難しくなっており、利用者単位で出し分ける実験はこの影響を受けます。
3つ目が、この章の中心になる地域実験(ジオリフト)です。国をいくつかの重ならない地域に分け、地域ごとに広告を出す側と出さない(あるいは増やす)側に割り当て、地域ごとの売上を比べます。Vaver と Koehler の論文は、地域実験の2つの前提として、地域単位で広告の出し分けがある程度の精度でできること、地域単位で広告費と売上(論文の言葉では反応の指標)を追えることを挙げ、米国の例として Nielsen の210の DMA(テレビの視聴の市場区分)を挙げています。地域実験は個人の追跡を必要とせず、店頭の売上も含めて測れるので、MMM と同じ「売上」という単位で答えが返ってきます。この点が、MMM の答え合わせに地域実験がよく使われる理由です。
| 実験の種類 | 分ける単位 | 測れるもの | 弱点 | MMM の答え合わせへの使いやすさ |
|---|---|---|---|---|
| 媒体のリフト調査 | 媒体の利用者(無作為に2群) | その媒体で追える購入・来訪など | 媒体の外で起きる売上を測りにくい。媒体ごとに別の仕組み | 媒体の中の成果に限れば使える。売上全体との対応づけが要る |
| ホールドアウト(利用者・Cookie 単位など) | 利用者・Cookie・検索など | 出し分けた単位で追える行動 | 個人の追跡が難しくなると成立しにくい。購入までの行動を追えないことがある | 追える範囲の成果に限られる |
| 地域実験(ジオリフト) | 重ならない地域 | 地域ごとの売上(店頭を含む) | 人を単位にした実験より検出力が低い。地域をまたぐ移動や配信の精度の問題 | MMM と同じ「売上」で答えが出るので使いやすい |
表の「弱点」の列にあるとおり、どの実験にも測れないものがあります。この章では、共通データに入れてある地域実験を例にとり、地域実験の結果を MMM に取り込む手順を示します。媒体のリフト調査の結果を取り込む場合も、「実験で測った増分売上と、モデルが同じ状況で予測する増分売上を合わせる」という考え方は同じです。
地域実験を設計する:期間・地域の選び方・持ち越し
地域実験の結果が使えるかどうかは、ほとんどが設計の段階で決まります。Vaver と Koehler の論文は、地域を無作為に対照と処置に割り当てることを重視し、無作為化は地域どうしの未知の違いを両群に統計的に均等に散らす役割を持つと説明しています。そのうえで、割り当ての前に地域を規模でまとめておくと、ROAS(広告費あたりの増分売上)の信頼区間の幅を10%以上縮められたことがある、と述べています。同じ論文は、実験を「事前期間」と「実験期間」の2つに分けて説明しています。事前期間にはすべての地域で同じ運用をし、実験期間に処置の地域だけ運用を変えます。そして、広告費の変化が売上に表れるまでに遅れがあるので、実験期間は広告費の変更を終えた後もその遅れの分だけ延ばして、増分の売上を取りこぼさないようにする、としています。
Meta の GeoLift のベストプラクティスのページは、より具体的な目安を書いています。実験期間は、日次のデータなら最低15日、週次のデータなら最低4〜6週で、商品の購買周期を少なくとも1回含むこと。実験前の過去データは実験期間の4〜5倍程度で、最低25期間、季節性を捉えるためにできれば直近52週分を使うこと。過去データは20以上の地域単位を含むこと。データは週次より日次を強く推奨すること。地域の粒度は、広告を出し分けられる最も細かい単位にすること。これらはいずれも GeoLift というツールの推奨で、どの実験にもそのまま当てはまる規則ではありませんが、「短すぎる実験・少なすぎる地域・粗すぎるデータでは差が測れない」という方向は共通しています。
GeoLift の手法の説明のページによると、GeoLift は合成コントロール法の2つの派生(Augmented Synthetic Control Method と Generalized Synthetic Control)を組み合わせています。広告を止めた地域(処置の地域)について、実験前のデータを使って、止めていない地域の重み付きの平均で「処置の地域にできるだけ似た架空の地域」を作り、実験開始後にその架空の地域と処置の地域の売上に差が開けば、その差を広告の効果とみなす、という考え方です。同じページは、実験前に使う検出力の計算として、決まった地域での実験期間と投資額の計算、地域の数の計算、過去データから地域・期間・設定を推奨する地域の選定の3つを用意しているとしています。地域が少ない場合の方法としては、Google の Jouni Kerman・Peng Wang・Jon Vaver による2017年の時間軸の回帰による地域実験の分析の論文があり、要旨は、地域を多数使う回帰の方法が小さな国や1対1の地域比較では使いにくいこと、その場合に実験期間の「広告を変えなかった場合の売上」の時系列を予測して累積の効果を推定する方法を提案することを述べています。
共通データの地域実験(架空)は、次の設計にしました。データの作り方は第2章で説明した補助モジュールに入っていて、ここではその設定を表に示します。
| 項目 | 架空の設定 |
|---|---|
| 対象の媒体 | SNS広告 |
| 実験期間 | 第121〜128週の8週間 |
| 処置 | 全国の半分の地域(売上の50%を占める地域)で SNS 広告を止める |
| 減少を測る期間 | 実験期間の8週+止めた後の持ち越しの4週(第121〜132週) |
| 観測の誤差 | 地域のばらつきに由来する誤差。標準偏差80万円の正規乱数を、真の減少に足した |
| 全国の週次データへの表れ方 | 第121〜128週の全国の SNS 広告費が半分になる |
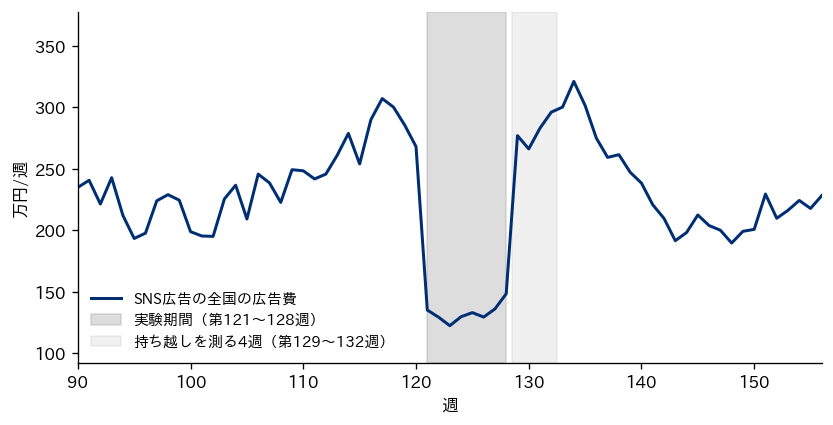
図は、第90週以降の SNS 広告の全国の広告費です。濃い帯が実験期間、薄い帯が持ち越しを測る4週です。全国の半分の地域で止めたので、全国の広告費は実験期間だけ半分に下がっています。この設計の要点は、減少を測る期間を、止めた8週で打ち切らずに4週延ばしていることです。第5章で扱ったとおり、広告の効果は翌週以降に持ち越されます。SNS 広告の真の持ち越し率(decay)は0.40なので、止めた直後の週にも前の週までの広告の効果が残り、逆に、止めた影響は再開した後の数週にも残ります。どれだけ延ばせば足りるかを、真のパラメータで計算しました(実験の観測の誤差は足していない、真の減少です)。
| 減少を測る期間 | 真の売上減少(万円) | 真の iROAS |
|---|---|---|
| 止めた8週だけ | 1,681.9 | 1.58 |
| 8週+持ち越し1週 | 1,763.6 | 1.66 |
| 8週+持ち越し2週 | 1,792.7 | 1.69 |
| 8週+持ち越し4週 | 1,807.4 | 1.70 |
| 8週+持ち越し8週 | 1,809.9 | 1.70 |
表の「真の iROAS」は、真の売上減少を、止めた地域で浮いた広告費 1,063.2万円で割ったものです。iROAS は incremental ROAS の略で、実験で動かした広告費あたりの増分売上を表します(ROAS・iROAS と売上ROI の呼び方の違いは第11章で扱います)。止めた8週だけで測ると、真の iROAS は1.58で、持ち越しを4週含めた1.70より約7%小さくなります。持ち越しを8週まで延ばしても1.70のままなので、この設定では4週延ばせば十分でした。持ち越し率がもっと大きい媒体、たとえば真の持ち越し率0.70のテレビCMで同じ実験をすれば、延ばす期間はもっと長く要ります。延ばす期間は、第5章の半減期の考え方で、媒体ごとに決めておくことになります。
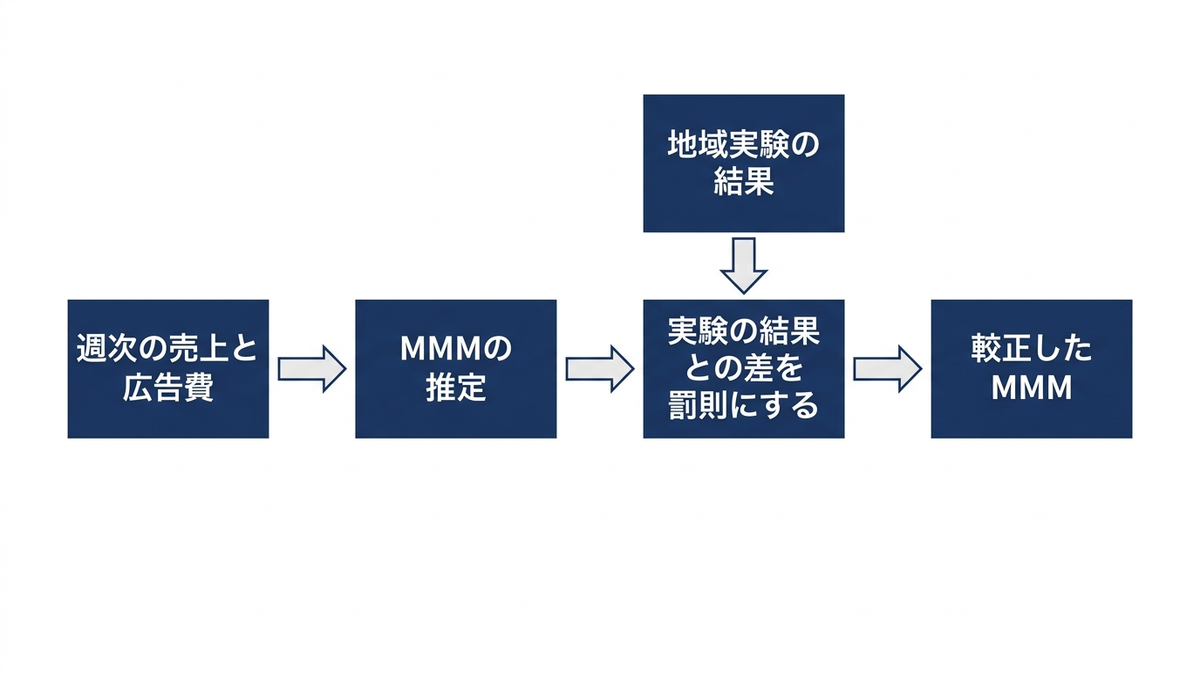
共通データの地域実験を読み、MMM と突き合わせる
共通データの地域実験の観測結果は次のとおりです。止めた地域で浮いた広告費は1,063.2万円、観測された売上の減少は1,835.1万円で、観測の iROAS は1.73でした。データを作った側だけが知る真の減少は1,807.4万円、真の iROAS は1.70です。観測が真の値より27.6万円大きいのは、地域のばらつきに由来する誤差を足しているためです。
実験の結果は、誤差の大きさと一緒に読む必要があります。この架空の設定では観測の誤差の標準偏差を80万円としたので、iROAS の標準誤差は 80÷1,063.2=0.075 で、観測値の上下に標準誤差の1.96倍をとった95%の区間は1.58〜1.87になります。現実の実験では、誤差の大きさは分析の手法(GeoLift などのツールが出す信頼区間や p 値)から得ます。区間の幅は、止める地域の規模・期間・地域の売上のばらつきで決まり、設計の段階の検出力の計算で見積もっておくものです。
この実験の結果を、第2章の MMM(基準)と突き合わせました。突き合わせの方法は、「推定した MMM のパラメータを使って、実験と同じ状況(第121〜128週に全国の半分の地域で SNS 広告を止め、持ち越しの4週まで含めて減少を合計する)を計算し、モデルが予測する減少を出す」というものです。真のパラメータの代わりに推定したパラメータを使うだけで、計算の手順は共通データが実験の結果を作る手順と同じにしました。
| 比べるもの | 実験の売上減少(万円) | iROAS |
|---|---|---|
| 実験の観測 | 1,835.1 | 1.73(95%の区間 1.58〜1.87) |
| MMM(基準)が予測する値 | 1,107.4 | 1.04 |
| 真の値(現実には分からない) | 1,807.4 | 1.70 |
MMM(基準)は、同じ状況での減少を1,107.4万円、iROAS にして1.04と予測しました。実験の95%の区間 1.58〜1.87 の外にあり、実験の観測より約4割小さい値です。この突き合わせで大事なのは、表の3行目の真の値を使わなくても、1行目と2行目だけで「モデルの SNS 広告の効果は実験と矛盾している」と判断できることです。現実の企業は真の値を知りませんが、実験をすれば、モデルのどの媒体の、どの状況での予測が外れているかを確かめられます。第8章で見たとおり、MMM の当てはまり(検証期間の MAPE)が良くても ROI が正しいとは限りません。実験との突き合わせは、当てはまりとは別の物差しで ROI を検査する手段になります。
実験の iROAS とモデルの ROI は、同じものを測っているとは限らない点にも注意が要ります。実験の iROAS は「その時期に、その地域で、広告を全部止めたときの効果」です。この記事で使う売上ROI は「直近52週に、全国で、広告費を0にしたときの効果」です。この例では、実験の観測 iROAS 1.73 と真の直近52週の売上ROI 1.76 が近い値になりましたが、いつもそうなるとは限りません。後で見る検索広告の架空の実験では、真の iROAS 2.03 に対して真の直近52週の売上ROI は2.35で、両者は離れます。そのため、実験の iROAS をモデルの ROI と直接比べるのではなく、上のように「モデルに実験と同じ状況を計算させて比べる」形にしました。
実験の費用と、得られる情報の釣り合い
地域実験には費用がかかります。広告を止める実験では、止めた地域で売上が減ることが実験の費用です。この架空の実験で減った売上は1,835.1万円(観測)で、止めた地域の第121〜132週の売上(全国の売上の半分として計算した37,263万円)の4.92%にあたります。一方、止めた期間は広告費1,063.2万円を使っていません。粗利率0.50(架空)で粗利に直すと、失った粗利は 1,835.1×0.50=917.5万円です。浮いた広告費1,063.2万円から失った粗利を引くと、この12週の粗利の収支は+145.7万円でした(真の減少で計算すると+159.5万円)。
この例では、実験をしたことで短期の粗利はむしろ増えています。理由は、SNS 広告の iROAS が1.73で、粗利率0.50の下で広告費を粗利で回収できる iROAS の2を下回っていたからです(粗利ROI と売上ROI の関係は第11章で扱います)。これは「SNS 広告は止めた方がよい」という意味ではありません。この計算は12週の短期の収支で、広告を止めたことによる長期の影響(ブランドの想起や新規顧客の獲得が後の売上に与える影響)は含んでいません。また、粗利ROI が1を下回るという判断は平均の話で、配分を決めるのは限界ROI です(第11・12章)。ここで言いたいのは、実験の費用は「止めた地域の売上の減少」だけでなく「浮いた広告費」と差し引きで見るべきで、効果の小さい媒体ほど実験の費用は小さく、効果の大きい媒体ほど大きくなる、ということです。
得られる情報の価値は、第1章で示した配分の誤りの大きさと比べて考えます。共通データでは、現状の配分から真の最適に動かせば真の増分売上が年に16,622万円増える余地があるのに対し、素朴な回帰に従って配分すると逆に年に10,741万円減りました。年に数千万円から億円単位の配分を動かす判断の前に、そのうちの1媒体について数百万円から千万円程度の売上の減少を受け入れて答え合わせをすることは、釣り合う場合が多いと考えています。逆に、広告費の総額が小さく、配分を変えても増分の差が実験の費用を下回る規模の企業では、地域実験の費用は見合わないことがあります。その場合は、媒体のリフト調査のように費用の小さい実験から始めるか、配分の変更を小刻みにして結果を見ながら進める方法が考えられます。
キャリブレーション:実験の結果を MMM に取り込む
MMM が実験と矛盾していると分かったら、次は実験と矛盾しないように推定をやり直します。この章では、第2章の MMM(基準)と同じ最小二乗の推定に、実験1件につき1つの「罰則」を足す方法で実装しました。罰則は、モデルが予測する実験の売上減少と、実験で観測した減少の差を、実験の標準誤差で割ったものです。モデルが実験と合わないほど、推定の誤差が大きく数えられるので、推定は「週次の売上にもよく当てはまり、実験とも合う」パラメータを探すことになります。
罰則の重みは、次のように決めました。週次の売上の当てはめの誤差は、MMM(基準)の学習期間の残差の標準偏差(実行した結果 103.4万円)を物差しにします。実験の誤差は、その標準誤差(80万円)を物差しにします。それぞれを自分の物差しで割って足し合わせると、実験1件は「週次の売上1週分の観測」と同じ重みで扱われます。統計の言葉で言えば、誤差が正規分布に従うと仮定した尤度(データの出やすさ)に、実験の観測1件を加えたことに相当します。実験をどれだけ強く信じるかを変えられるように、罰則に倍率(強さ)を掛けられるようにし、既定値は1にしました。次のコードは、実装から要所を抜き出して短くしたものです。共通データの補助モジュール(mmm_data.py)と基準の推定の補助モジュール(baseline.py)と同じフォルダに置いて実行する形です。
import numpy as np
import mmm_data as md
import baseline as bl

def model_geo_loss(theta, df, channel="social", post_weeks=4):
    """推定したパラメータで、地域実験の売上減少(万円)を計算する"""
    p, _ = bl._unpack(theta)
    q = p[channel]
    g0, g1 = md.GEO_TEST_WEEKS            # 第121〜128週
    share = md.GEO_TEST_SHARE             # 全国の半分の地域
    x = df[channel].to_numpy(dtype=float)
    x_cf = x.copy()
    x_cf[g0 - 1: g1] = x[g0 - 1: g1] / (1 - share)   # 実験が無かった場合の全国の支出
    region_cf = x_cf * share                         # 止めた地域の支出(実験が無かった場合)
    region = region_cf.copy()
    region[g0 - 1: g1] = 0.0                         # 実験期間は0
    eff_cf = md.media_effect(region_cf / share, q) * share
    eff = md.media_effect(region / share, q) * share
    span = slice(g0 - 1, g1 + post_weeks)            # 8週+持ち越し4週
    return float((eff_cf - eff)[span].sum())

SIGMA = 103.4   # 基準の MMM の学習期間の残差の標準偏差(実行した結果)
SE = 80.0       # 架空の地域実験の標準誤差(万円)

def resid(theta, df, y, observed_loss, strength=1.0):
    """least_squares に渡す残差:学習期間の週次の誤差+実験の罰則1つ"""
    r = (bl.predict(theta, df) - y)[0:130]
    pen = strength * SIGMA * (model_geo_loss(theta, df) - observed_loss) / SE
    return np.append(r, pen)
推定のやり方(媒体ごとのパラメータの範囲、初期値を変えて12回推定し誤差が最小のものを採ること、学習 第1〜130週)は、第2章・第8章の MMM(基準)とまったく同じにしました。違いは、残差の最後に実験の罰則が1つ付くことだけです。1回の推定にかかった時間は約49秒でした(この記事の実行環境、一般的なノートPCでの実測)。結果は次の表のとおりです。
| 媒体 | 真のROI | MMM(基準)の推定 | 実験で較正した MMM の推定 | 真の増分売上(万円) | MMM(基準)の増分売上(万円) | 較正した MMM の増分売上(万円) |
|---|---|---|---|---|---|---|
| テレビCM | 1.51 | 1.44 | 1.44 | 31,547 | 30,235 | 30,209 |
| 検索広告 | 2.35 | 1.18 | 1.21 | 27,440 | 13,789 | 14,084 |
| SNS広告 | 1.76 | 0.90 | 1.74 | 20,947 | 10,662 | 20,631 |
| ディスプレイ広告 | 0.38 | 0.17 | 0.18 | 5,962 | 2,658 | 2,760 |
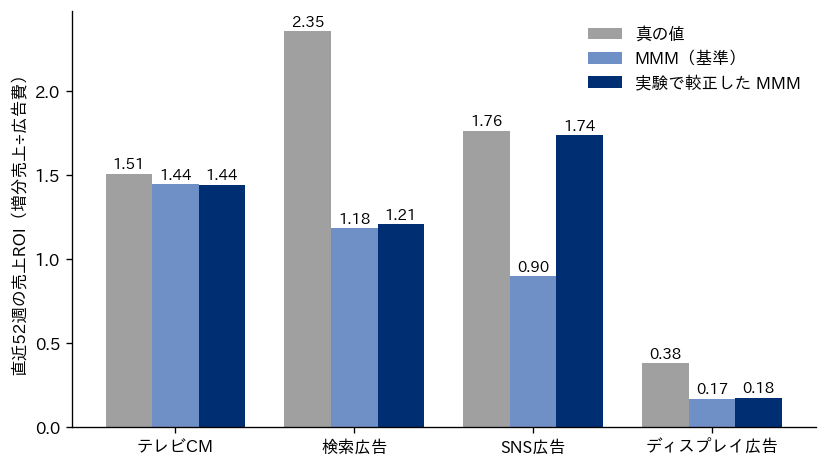
表と図の ROI は、いずれも直近52週(第105〜156週)の売上ROI です。SNS 広告の「実験で較正した MMM の推定」の列は1.74になり、MMM(基準)の0.90から真の値1.76に近づきました。増分売上も10,662万円から20,631万円になり、真の20,947万円との差は約1.5%です。3年間の売上に占める SNS 広告の寄与の割合も、基準の0.043から0.080になり、真の値0.080と小数第3位まで一致しました。較正したモデルが予測する実験の売上減少は1,831.2万円(iROAS 1.72)で、観測の1,835.1万円とほぼ合っています。
較正で動いたのは SNS 広告だけではありません。基礎売上の側の定数は3,511.4から3,324.7に下がり、真の基礎の水準3,000に近づきました。基準の MMM では定数が真の値より大きく、SNS 広告の ROI は小さく出ていました。実験で較正すると、SNS 広告の ROI が上がり、定数が下がりました。2つが同時に動いたことは確かですが、どちらが原因なのかは、この章の計算では確かめていません。第7章で真の基礎売上を与えて推定し直しても SNS 広告の ROI は0.85のままだったので、定数の大きさだけで説明できる誤りでもありません。当てはまりはほとんど変わらず、学習期間の決定係数(R2)はどちらも0.989、MAPE は学習期間で1.72%から1.74%、検証期間で2.64%から2.55%でした。週次の売上への当てはまりを犠牲にせずに、実験と合う解に移ったということです。これは、第8章で扱った「当てはまりが同じでもパラメータの組が違う解が複数ある」状態の中から、実験が1つを選んだと読めます。
一方で、検索広告の ROI は1.18から1.21、ディスプレイ広告は0.17から0.18と、ほとんど変わりませんでした。テレビCMは1.44のままです。実験で確かめたのは SNS 広告だけなので、他の媒体のずれは直りません。検索広告は、真の値2.35に対して約半分のままです。実験1件で直るのは、実験した媒体だけだということが、この表から読めます。
較正しても予算配分が変わらなかった理由
SNS 広告の ROI が真の値に近づいたので、予算配分も良くなることを期待して、第2章と同じ条件(直近52週の週平均の総額 1,156.5万円/週を固定し、各媒体を現状の0.5〜2倍の範囲で動かす。応答は毎週同じ額を出し続けた定常状態)で配分を計算し直しました。結果は、MMM(基準)で最適化した配分とまったく同じでした。テレビCM 443.3・検索広告 448.5・SNS広告 114.3・ディスプレイ広告 150.4(万円/週)で、真の応答で測った増分売上の改善も、現状との差で年+3,816万円のまま、真の最適(+16,622万円)には近づきませんでした。
理由は、配分を決めるのが平均の ROI ではなく限界ROI(もう1万円増やしたときに増える売上)の大小の順番だからです。各媒体の、現状の支出での限界ROI を比べました。
| 媒体 | 真の限界ROI | MMM(基準) | SNS広告の実験1件で較正 | 2件で較正(検索広告は架空の追加実験) |
|---|---|---|---|---|
| テレビCM | 2.51 | 2.26 | 2.26 | 2.30 |
| 検索広告 | 1.47 | 2.26 | 2.24 | 2.63 |
| SNS広告 | 1.39 | 1.88 | 1.63 | 1.66 |
| ディスプレイ広告 | 0.23 | 0.43 | 0.44 | 0.08 |
表の値は、直近52週の週平均の支出から毎週1万円増やしたときの、定常状態での週の増分売上の増え方です。真の限界ROI の列では、テレビCM(2.51)が最も高く、SNS 広告(1.39)は検索広告(1.47)より低い側にあります。真の最適の配分が SNS 広告を228.5から179.6万円/週に減らしているのはこのためです。較正したモデルでも、SNS 広告の限界ROI(1.63)はテレビCM(2.26)・検索広告(2.24)より低いので、SNS 広告は削る側に入り、下限の0.5倍(114.3万円/週)まで削られます。つまり、較正で SNS 広告の平均の ROI は大きく変わりましたが、「媒体の限界ROI の順番」は変わらなかったので、配分の答えも変わりませんでした。
配分の誤りの大きな部分は、検索広告にあります。第12章で、検索広告を増やしたときの効果を測る実験を足すと、真の応答で測った改善が年3,816万円から年12,789万円に増えることを確かめます。テレビCMを真の最適(633.3万円/週)ほど積み増していない(443.3万円/週)という不足も、別にあります。MMM(基準)は検索広告の平均の ROI を真の約半分(1.18)に見積もる一方で、限界ROI は真の1.47に対して2.26と高く見積もっています。推定した検索広告の応答曲線は、真の曲線よりずっと急な S 字の形をしていて、「今は効果が小さいが、増やせば急に効く」という形になっていました(基準の推定の shape は2.24、真の値は1.20)。このため、どのモデルも検索広告を上限の2倍(448.5万円/週)まで積み増し、真の最適(193.2万円/週)と逆の方向に動かしています。
では、検索広告にも実験をすれば直るのかを確かめました。共通データには検索広告の実験は入っていないので、架空の追加設定として、SNS 広告と同じ設計(第121〜128週・全国の半分の地域で停止・持ち越し4週)の地域実験の結果を作りました。観測の減少は、真の減少に標準偏差80万円の誤差(乱数の種2)を足したものです。共通データの全国の検索広告費は変えず、実験の結果だけを与えています。止めた地域の広告費は1,297.0万円、観測の減少は2,647.1万円(iROAS 2.04。真の減少は2,632.0万円、真の iROAS 2.03)で、MMM(基準)の予測は2,246.9万円(iROAS 1.73)でした。この実験と SNS 広告の実験の2件で較正し直すと、モデルは2件の実験にほぼ合いました(予測は SNS 広告 1,831.1万円、検索広告 2,645.9万円)。ところが、検索広告の直近52週の ROI は1.29で、真の2.35には届きませんでした。テレビCM は1.49、SNS 広告は1.73、ディスプレイ広告は0.38(真の値 0.38)になりましたが、配分の答えはやはり変わらず、真の増分売上の改善も年+3,816万円のままでした。
検索広告の実験に合わせても直らなかった理由は、実験が測ったのが「ある時期の、ある支出の水準での効果」だから、というのが1つの読み方です。曲線の形や持ち越し率の取り違えなど、ほかの理由を除いて確かめたわけではありません。実験期間の第121〜128週は休日の週を含む需要の高い時期で、検索広告費の週平均は324.2万円と、直近52週の平均224.3万円より約45%高い水準でした。2件で較正したモデルは、この高い水準の時期の効果には合わせましたが、支出の低い時期の効果を小さく見積もったままでした。期間別の検索広告の ROI を見ると、第105〜120週は真の2.56に対して0.96、第133〜156週は真の2.47に対して1.10です。実験は応答曲線の上の1か所を押さえますが、曲線の形までは決めません。PyMC-Marketing のリフトテストによる較正の解説が、各リフトテストを媒体の飽和曲線の上の2点として扱うと説明しているのも、同じ見方です。曲線の形を押さえるには、支出の水準を変えた実験(たとえば半分に減らす地域と全部止める地域を分ける)や、時期を変えた実験を重ねる必要があります。
この節の結果は、この架空データ・この設定での結果です。そのうえで、ここから読み取れる一般的な注意は2つあります。1つ目は、較正で ROI が真の値に近づいても、配分が良くなるとは限らないことです。配分は限界ROI の順番で決まり、順番を決めているのは実験していない媒体の曲線の形であることがあります。2つ目は、実験は「どの媒体を、どの時期・どの支出の水準で」測るかを、配分で動かしたい範囲に合わせて選ぶべきだということです。この例で配分の誤りの大きな部分は検索広告の積み増しにあったので、優先して確かめるべきだったのは「検索広告を増やしたときに本当に効くか」で、検索広告を全部止めたときの効果ではありませんでした。
同じことは SNS 広告の応答曲線でも見られます。次の表は、毎週同じ額を出し続けた定常状態の、SNS 広告の週の増分売上を、週の広告費の水準ごとに、真の値、MMM(基準)、実験で較正した MMM の3つで並べたものです。
| 週の広告費の水準 | SNS広告の週の広告費(万円/週) | 真の値の週の増分売上(万円/週) | MMM(基準)の推定(万円/週) | 実験で較正した MMM の推定(万円/週) |
|---|---|---|---|---|
| 直近52週の平均の0.5倍 | 114.3 | 210.2 | 33.3 | 203.6 |
| 直近52週の平均 | 228.5 | 409.4 | 200.2 | 398.4 |
| 直近52週の平均の1.5倍 | 342.8 | 536.0 | 403.4 | 576.6 |
| 直近52週の平均の2倍 | 457.1 | 615.7 | 535.8 | 738.7 |
直近52週の平均 228.5万円/週では、真の値が409.4万円/週、MMM(基準)が200.2万円/週、較正した MMM が398.4万円/週で、較正で真の値に近づきました。ところが、支出を2倍の457.1万円/週にした点では、真の値615.7万円/週に対して、較正した MMM は738.7万円/週と、逆に大きく見積もっています。較正したモデルの SNS 広告の曲線は、真の曲線より直線に近い形(推定の shape 1.055、真の値 1.50)になっていて、実験した付近の水準では合っていても、そこから離れるほど外れます。較正したモデルで「SNS 広告を2倍に増やす」判断をすると、増分を約2割多く見込むことになります。第6章で扱った外挿の問題は、較正の後も残るということです。
実験の設計を誤ると、較正も誤る
較正は、実験の結果を「正しいもの」としてモデルを引き寄せます。実験の設計を誤れば、モデルは誤った方向に引き寄せられます。その例として、持ち越しの期間を数えずに、止めた8週だけで減少を測った場合を計算しました。8週だけの真の減少1,681.9万円に、同じ誤差を足した観測の減少は1,709.6万円(iROAS 1.61)です。この値を「持ち越しを含めた効果」としてモデルに取り込みました。また、実験の結果をどれだけ強く信じるかの影響を見るために、罰則の強さを0.2倍にした場合も計算しました。強さ0.2倍は、実験の標準誤差を5倍の400万円と見なすことに相当します。
| 較正の条件 | 取り込んだ観測の減少(万円) | モデルが予測する実験の減少(万円) | SNS広告の直近52週の ROI(真 1.76) | SNS広告の増分売上(万円。真 20,947) |
|---|---|---|---|---|
| 較正しない(MMM(基準)) | なし | 1,107.4 | 0.90 | 10,662 |
| 正しく設計した実験で較正(強さ1) | 1,835.1 | 1,831.2 | 1.74 | 20,631 |
| 持ち越しを数えない実験で較正(強さ1) | 1,709.6 | 1,705.7 | 1.59 | 18,883 |
| 正しく設計した実験で弱く較正(強さ0.2) | 1,835.1 | 1,737.0 | 1.63 | 19,320 |
持ち越しを数えない実験で較正すると、SNS 広告の ROI は1.59になり、正しく設計した実験で較正した1.74より小さく出ました。実験で過小に測った分が、そのままモデルに持ち込まれたということです。どの条件でも較正しないよりは真の値に近づいていますが、それはこの例で基準の MMM のずれ(0.90)が実験の設計の誤り(1.61 対 1.70)より大きかったからです。実験を MMM の「正解」として扱う以上、実験の設計の誤りは、そのままモデルの誤りになります。実験の結果を取り込む前に、測った期間が持ち越しを含んでいるか、比べた地域が似ているか、実験期間に他の施策(販促や他の媒体の大きな変更)が重なっていないかを確かめる必要があります。
強さ0.2倍で較正すると、モデルは実験の観測(1,835.1万円)まで寄り切らず、1,737.0万円の予測にとどまりました。SNS 広告の ROI は1.63です。罰則の強さは、実験の標準誤差だけでなく、「実験の状況とモデルが扱う状況がどれだけ同じか」という判断も含めて決めるものです。Google の Meridian の較正の公式ドキュメントは、実験の結果を事前分布に翻訳する単一の公式は無いとし、実験と MMM で ROI の定義が違いうる理由として、実験の時期、実験の期間(短い実験は長期の効果を取りこぼすこと)、対象の集団、キャンペーン単位か媒体単位かという粒度、「広告費0との比較」か「減らした分との比較」かという測るものの違いを挙げています。そのうえで、翻訳には実験の標準誤差に加えてもう一段の不確かさが伴う、と述べています。実験の結果を強く信じるほどモデルは実験に寄りますが、実験と MMM の状況が違うほど、強く信じることの危険も大きくなります。
Meridian・Robyn・PyMC-Marketing は実験の結果をどう取り込むか
この章では最小二乗に罰則を足す形で較正を実装しましたが、MMM の専用ツールは、それぞれ実験の結果を取り込む仕組みを持っています。この記事の実行環境にはこれらのツールが入っていないので、ここでは公式ドキュメントを開いて確かめた範囲だけを書きます(ツールそのものの紹介は第14章で扱います)。
Google の Meridian は、ベイズ推定の MMM で、実験の結果を媒体ごとの ROI の事前分布(推定の前に置く、ROI がこのあたりだろうという分布)として取り込みます。上で引いた公式ドキュメントによると、較正した事前分布は、広告費の小さい媒体が不自然に大きな売上を生んでいるように見えることを防ぐ「ガードレール」の役割を持ちます。事前分布の標準偏差を小さくすると実験を強く信じ、大きくすると実験がモデルにどれだけ当てはまるかに懐疑的であることを表します。事前分布は出発点にすぎず、データが強く逆を示せばモデルはそこから離れうる、とも書かれています。同じページは、実験を ROI の事前分布に変換する CalibrationBuilder という仕組みが、実験の新しさ・期間・支出の規模・媒体の粒度を調整すると説明しています。事前分布と事後分布を並べて、モデルがデータから学んでいるかを確かめることも推奨しています。
Meta の Robyn の機能の説明のページによると、Robyn は実験の結果をデータフレームで受け取り(入力を設定する関数 robyn_inputs() に渡します)、較正を多目的最適化の目的関数の1つとして実装しています。実験の効果とモデルの予測する媒体の寄与のずれを平均絶対誤差率で測ったものを較正の誤差(MAPE.LIFT)と呼び、予測の誤差(NRMSE。売上の予測の外れの大きさ)、同じページがビジネス上の誤差と呼ぶ DECOMP.RSSD(有料の媒体について、広告費の割合と効果の割合の差の大きさ)に続く3つ目の目的関数として、ハイパーパラメータの探索に使います。同じページは、扱う実験として、Meta や Google の Conversion Lift のような売上の実験と、処置の地域と対照の地域を比べる地域実験を挙げています。
PyMC-Marketing は、前の節で引いた解説のとおり、リフトテストの結果を媒体名・実験前の支出・支出の変化量・それによる売上の変化・その標準偏差の5つの列で受け取り(メソッドの名前は add_lift_test_measurements)、モデルの尤度に項を足して、飽和曲線がその変化に合うように推定します。同じ解説は、広告費が完全に相関した2つの媒体ではモデルだけでは飽和のパラメータを分けられず、リフトテストを足すと推定が真の値に近づき、信用区間が狭くなり、テストを増やすとさらに良くなった、という事例を示しています。この章の実装は、尤度に実験の項を足すという点では PyMC-Marketing のやり方に近く、事前分布として取り込む Meridian とは形が違いますが、いずれも「実験で確かめた点でモデルが実験と合うように推定を引き寄せる」という目的は同じです。
| ツール | 実験の結果の取り込み方 | 実験の信頼度の表し方 | この章の実装との関係 |
|---|---|---|---|
| Meridian(Google) | 媒体ごとの ROI の事前分布として取り込む。実験を事前分布に変換する仕組みがある | 事前分布の標準偏差 | 罰則の強さが事前分布の幅にあたる |
| Robyn(Meta) | 実験の結果をデータフレームで受け取り、較正の誤差を多目的最適化の目的関数の1つにする | 較正の誤差を他の目的と並べて候補のモデルを選ぶ | 罰則を足す点は近いが、1つの目的関数にまとめない |
| PyMC-Marketing | リフトテストの結果を尤度の項として足し、飽和曲線を合わせる | 実験ごとに与える売上の変化の標準偏差 | 尤度に実験の項を足すという点で近い |
どのツールを使っても、この章で見た2つの限界は残ります。実験していない媒体のずれが直る保証はないこと、実験した支出の水準から離れた点の効果は曲線の形の仮定に頼ることです。ツールが較正の仕組みを持っていることと、較正した結果が配分の判断に十分であることは別の問題です。
経営の判断:実験を予算の判断にどう組み込むか
MMM を実験で答え合わせしないまま配分を変えると、モデルのずれがそのまま予算に移ります。共通データでは、MMM(基準)は SNS 広告の効果を半分に見積もっていて、実験との突き合わせをしなければ、そのずれに気づく手段がありませんでした。経営の側から見ると、実験は「モデルの数字を信じてよいか」を確かめるための費用で、配分を動かす額が大きいほど、その費用は相対的に小さくなります。この例の SNS 広告の実験は、12週の粗利の収支では費用がかからず、むしろプラスでした。効果の大きい媒体の実験ほど費用は大きくなりますが、その分、その媒体の効果を誤ったときの損失も大きくなります。
実験を予算の判断に組み込むときは、次の順に考えることが有効だと考えています。まず、MMM の結果のうち、配分を最も大きく動かしている媒体(この例では、上限まで積み増された検索広告と、下限まで削られた SNS 広告・ディスプレイ広告)を特定します。次に、その媒体について「動かしたい方向に、動かしたい幅で」実験を設計します。積み増す判断を確かめたいなら増やす実験、削る判断を確かめたいなら減らす実験です。そして、実験の結果をモデルに取り込み、配分を計算し直し、配分がどれだけ変わるかを見ます。この例のように配分が変わらなければ、その実験は配分の判断にとっては情報が足りなかったということで、次に確かめるべき媒体と支出の水準を選び直します。
実験の計画は、年間の予算の計画と一緒に立てるのが現実的です。地域実験は、GeoLift のベストプラクティスに沿えば週次のデータで少なくとも4〜6週、持ち越しを測る期間を足すとさらに長くかかり、1つの媒体について結果が出るまでに四半期の大半を使います。年に何回、どの媒体を確かめるかを先に決めておかないと、実験は配分を決める会議に間に合いません。会議体への組み込み方は第13章で扱います。実験の結果は1回で捨てず、モデルを更新するたびに較正の候補として持ち続けます。ただし、古い実験ほど今の状況に当てはまるとは限らないので、実験の新しさや条件の違いに応じて、どれだけ強く信じるか(この章の実装では罰則の強さ)や、使うかどうかを見直します。Meridian の較正の公式ドキュメントも、実験を事前分布に変換する仕組みが、古い実験ほど不確かさを足す調整をすると説明しています。Robyn の機能の説明のページは、2022年の Robyn のハッカソンの優勝者によるシミュレーションとして、媒体あたり10件までの実験で真の ROAS の予測が大きく改善した、という結果を紹介しています。
実験の設計と分析の手法(無作為化、差の差、合成コントロール法)の詳しい内容は、弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』で扱っています。
この章のまとめ
MMM は当てはまりが良くても ROI がずれることがあり、データだけではずれに気づけません。地域実験は、MMM と同じ売上という単位で、ある媒体のある時期の効果を確かめる手段で、モデルに実験と同じ状況を計算させて突き合わせると、モデルの矛盾を真の値を知らずに検出できます。共通データでは、SNS 広告の地域実験1件で較正すると、SNS 広告の ROI は0.90から1.74(真の値1.76)に近づきましたが、限界ROI の順番が変わらなかったため予算配分は変わらず、配分の誤りの大きな部分を生んでいた検索広告の曲線の形は、検索広告の実験を足しても直りませんでした。次の第11章では、ここで何度も出てきた平均の ROI と限界ROI の違いを、投資判断の指標として整理します。
この章を深めたい方への参考書籍
『効果検証入門 正しい比較のための因果推論/計量経済学の基礎』(安井翔太 著、株式会社ホクソエム 監修、技術評論社):無作為化した実験(RCT)が効果の測定の基準になる理由から始め、回帰分析・傾向スコア・差の差・CausalImpact・回帰不連続デザインと、実験ができないときに比較を正しくする方法を順に扱っています。この章の地域実験の考え方(比べる相手を正しく作る)と、実験の結果を観察データのモデルと突き合わせる考え方の土台になります。
『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』(Ron Kohavi・Diane Tang・Ya Xu 著、大杉直也 訳、ドワンゴ):オンラインの対照実験の進め方、陥りやすい落とし穴、実験を組織で広げるために要ることを扱った本です。この章で触れた「実験の設計を誤ると、その誤りがそのまま判断に入る」という問題を、実験を運用する側から考える材料になります。
第11章 ROIと限界ROIで投資判断をする
第10章では、SNS広告の地域実験(架空)の結果を MMM に取り込み、実験で確かめた数字に推定を近づける方法を見ました。推定が実験と合うようになっても、その数字を投資の判断にどう使うかは別の問題として残ります。広告の効果を表す数字には、ROI・ROAS・iROAS・CPA など似た名前の指標がいくつもあり、同じ「ROI」でも、これまでに使った広告費全体の平均を見ているのか、次に足す1万円の効果を見ているのかで、答えられる問いが違います。この章では、まず指標の定義の違いを公式ドキュメントで確かめたうえで整理し、次に第2章で用意したサンプルデータ(架空の日用品メーカーの週次データ)で、各媒体の平均の ROI と、あと1万円増やしたときの効果を表す限界ROI(この記事では、週の広告費を毎週1万円増やし続けた状態で、週の増分売上が何万円増えるか)を、真の値と MMM(基準)の両方で実測します。そのうえで、粗利で見たときの損益分岐、短期と長期の効果の扱い、経営に報告するときの表の形を示します。予算の配分そのものを最適化する計算は第12章で扱います。
「ROI」と呼ばれる指標は何種類もある
広告の効果を表す指標は、名前が似ていても、分子と分母に何を置くかが違います。この記事では第2章で定義を固定し、特に断らない限り「ROI」は売上ROI、つまり増分売上(その媒体の広告が無かった場合と比べて増えた売上)を同じ期間の広告費で割ったものを指してきました。1を超えれば、広告費以上の売上を生んでいるという意味です。粗利ROIは、増分売上に粗利率を掛けてから広告費で割ったもので、1を超えれば広告費を粗利で回収しているという意味になります。共通データでは架空の粗利率を0.50と置いています。
広告の運用の現場では、ROI よりも ROAS(Return On Ad Spend の略。Google 広告の日本語のヘルプでは「広告費用対効果」)という語がよく使われます。Google 広告のヘルプの目標広告費用対効果(Target ROAS)に基づく入札の説明は、目標 ROAS を「広告に使った1単位の費用あたりに得たいコンバージョン値(たとえば売上)の平均」と説明し、売上5を広告費1で割って100%を掛けた500%を目標 ROAS の例として示しています。ここでのコンバージョン値は、広告主がコンバージョン測定(広告を見た人やクリックした人の購入などを記録する仕組み)で報告した値です。つまり、媒体の管理画面に出る ROAS は「その広告に紐づけて記録された売上÷広告費」であり、定義の中に「広告が無かった場合との差」は入っていません。第1章で扱ったラストクリックのように、広告が無くても買っていた人の購入も紐づけて数えうるので、管理画面の ROAS は、この記事の売上ROI(増分で定義したもの)とは別物として扱う必要があります。また、管理画面の ROAS は百分率で表示されることがあり、500%はこの記事の書き方では5.00に当たります。
増分であることを名前に入れた指標が iROAS(incremental ROAS、増分の広告費用対効果)です。Google が公開している地域実験の分析ライブラリ(Trimmed Match)が出典として挙げている論文(Chen と Au による、対にした地域の無作為化実験で iROAS を頑健に推定する方法を提案したもの。arXiv で公開され、Annals of Applied Statistics 誌の2022年の号に掲載)は、要旨の冒頭で iROAS を「施策が関心のある指標(売上など)に与えた因果効果と、広告費に与えた因果効果の比」と定義しています。言い換えると、「広告を出したことで増えた売上÷広告を出したことで増えた広告費」です。第10章の地域実験の観測 iROAS 1.73 は、止めた地域で減った売上(観測で1,835.1万円)を、止めた広告費(1,063.2万円)で割ったもので、この定義に沿っています。Trimmed Match の説明も、推定結果を iROAS として報告する例を載せています。
CPA(Cost Per Action。Google 広告の日本語のヘルプでは「アクション単価」)は向きが逆の指標で、1件のコンバージョン(購入・申し込みなど)を得るのにかかった広告費です。Google 広告のヘルプの目標アクション単価(Target CPA)の説明は、目標 CPA を、コンバージョン1件あたりの平均費用の目標として設定するものと説明しています。CPA は売上の金額を使わないので、1件あたりの売上や粗利が商品によって違うときは、CPA だけでは採算を判断できません。また、ROAS と同じく、分子の件数がコンバージョン測定で紐づけた件数であれば、増分の件数ではありません。
| 指標 | 計算 | 増分(広告が無かった場合との差)か | 平均か限界か | 主に使う場面 |
|---|---|---|---|---|
| 売上ROI(この記事の「ROI」) | 増分売上÷広告費 | 増分 | 期間の平均 | 媒体の過去の成果の評価 |
| 粗利ROI | 増分売上×粗利率÷広告費 | 増分 | 期間の平均 | 広告費を粗利で回収できたかの判断 |
| ROAS(媒体の管理画面) | 紐づけて記録したコンバージョン値÷広告費 | 定義上は増分ではない | 期間の平均 | 入札・運用の目標 |
| iROAS | 広告で増えた売上÷広告で増えた広告費 | 増分 | 実験で動かした範囲の平均 | 実験の結果の報告・MMM の答え合わせ |
| CPA | 広告費÷コンバージョン件数 | 件数の数え方による | 期間の平均 | 獲得の効率の管理 |
| 限界ROI | あと1万円増やしたときに増える売上÷1万円 | 増分 | 限界 | 増額・減額の判断、配分の最適化 |
表の「平均か限界か」の列が、この章の主題です。表の上の5つは、どれも「ある期間に使った広告費の全体」に対する平均の効率を表しています。最後の限界ROIだけが、「今の支出の水準から少し動かしたら、どれだけ変わるか」を表しています。経営が広告費について下す判断は、ほとんどが「来期はこの媒体をいくら増やすか、減らすか」という形をしているので、答えに直接つながるのは限界のほうです。一方で、平均の ROI は「この媒体にこれまで出してきたお金は報われていたか」という過去の評価には向いています。2つを取り違えると、次の節以降で見るように、増やすべきでない媒体に積み増す判断が起きます。
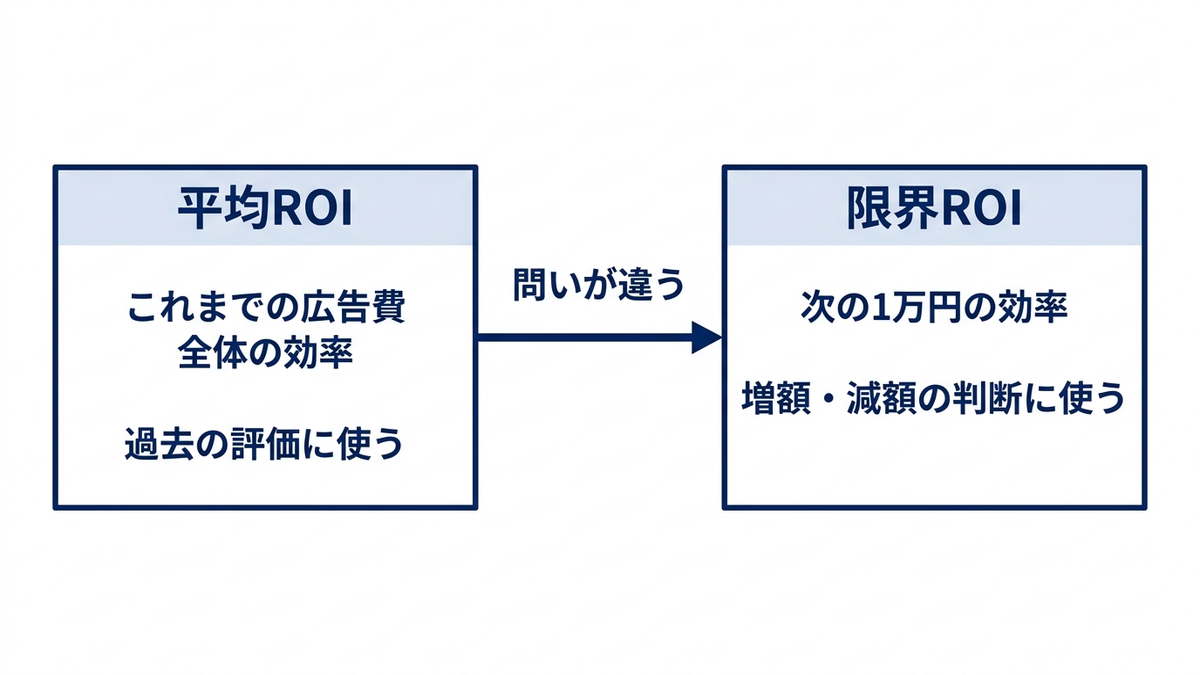
平均ROIと限界ROIは、応答曲線の上の別の量である
第6章で描いた応答曲線(横に週の広告費、縦にその媒体による週の増分売上をとった曲線)の上で考えると、2つの違いがはっきりします。平均の ROI は、原点(広告費0)と現在の支出の点を結んだ直線の傾きです。限界ROIは、現在の支出の点で曲線に引いた接線の傾きです。広告費を増やすほど1万円あたりの効果が小さくなる(逓減する)曲線では、接線の傾きは原点から引いた直線の傾きより小さくなるので、限界ROIは平均の ROI を下回ります。反対に、第6章で見たS字の曲線の下のほう(効果が立ち上がる前の水準)では、接線のほうが急になり、限界ROIが平均の ROI を上回ることがあります。
Google の MMM である Meridian(第14章で扱います)の公式ドキュメントの増分の成果・ROI・mROI・応答曲線の説明は、ROI を「過去の支出の水準での増分の成果を、その支出で割ったもの」、mROI(marginal ROI、限界ROI)を「過去の予算の水準を超えて次の1ドルを使ったときの増分の成果」と定義しています。計算式としては、媒体の支出を \( (1+\delta) \) 倍にしたときの増分の成果を、増やした支出 \( \delta \times \text{Cost} \) で割るもので、\( \delta \) には0.01のような小さな値を使うと書かれています。言葉で言い換えると、「支出を1%だけ増やしたら、増やした額の何倍の売上が増えるか」です。同じページは、mROI が ROI よりずっと低いときは、その媒体が過去の支出の水準で飽和し始めていると読めること、また過去の支出を超える範囲の計算はモデルの仮定に基づく外挿(データの無い範囲への延長)になるので注意が要ることを述べています。さらに、応答曲線と mROI の定義は、媒体の1単位あたりの費用(たとえば表示1回あたりの単価)が過去の平均のまま一定であることを暗に仮定している、とも書かれています。
この章では、冒頭と地図の表で示したとおり、限界ROIを「週の広告費をあと1万円増やし、その額を毎週出し続けたときに、週の増分売上が何万円増えるか」として計算します。Meridian の定義は「過去の期間の支出を一律に1%増やす」もので、この章の定義は「毎週同じ額を出し続けた状態(定常状態)で1万円増やす」ものです。どちらも応答曲線の傾きを測っている点は同じですが、数字は一致しないことがあります。報告書で限界ROIを示すときは、どちらの意味で計算したかを添える必要があります。
共通データで平均ROIと限界ROIを測る
第2章で用意したサンプルデータ(架空の日用品メーカーの第1〜156週)について、4つの媒体の平均の ROI と限界ROIを、真の値と MMM(基準)で計算しました。共通データは乱数で作った架空のデータなので、データを作った側は本当の応答曲線を知っています。現実の企業には見えない「真の値」を、ここでは答え合わせに使います。次のコードは、計算の要所を抜き出したものです。補助モジュール(mmm_data.py と baseline.py)と同じフォルダに置いて実行する形です。この記事の実行環境(一般的なノートPC)での実測では、MMM(基準)の推定を含めて全体で約1分かかりました。
import mmm_data as md
import baseline as bl

df = md.make_data()                     # 第2章の共通データ(架空)
theta = bl.fit_mmm(df)                  # MMM(基準)の推定。全体で約1分(実測)
cur = {c: float(df[c].iloc[104:156].mean()) for c in md.CHANNELS}  # 直近52週の週平均

def marginal(resp, c, s):
    # 週の広告費をあと1万円増やしたときの週の増分売上(定常状態)
    return resp(c, s + 1.0) - resp(c, s)

true_r = lambda c, s: md.true_response(c, s)          # 真の応答曲線
mmm_r = lambda c, s: bl.est_response(theta, c, s)     # MMM(基準)の応答曲線

for c in md.CHANNELS:
    s = cur[c]
    print(c, round(s, 1),
          "平均ROI 真 %.2f MMM %.2f" % (md.true_roi(df, c, (105, 156)), bl.est_roi(theta, df, c)),
          "限界ROI 真 %.2f MMM %.2f" % (marginal(true_r, c, s), marginal(mmm_r, c, s)))
# 出力:
# tv 402.9 平均ROI 真 1.51 MMM 1.44 限界ROI 真 2.51 MMM 2.26
# search 224.3 平均ROI 真 2.35 MMM 1.18 限界ROI 真 1.47 MMM 2.26
# social 228.5 平均ROI 真 1.76 MMM 0.90 限界ROI 真 1.39 MMM 1.88
# display 300.8 平均ROI 真 0.38 MMM 0.17 限界ROI 真 0.23 MMM 0.43
結果を、定常状態での平均の ROI(現在の週平均の支出を毎週出し続けた場合の、週の増分売上÷週の広告費)も加えて表にしました。「現状の週の広告費」は直近52週(第105〜156週)の週平均です。「平均ROI(直近52週)」の列は、実際の出し方で直近52週に生まれた増分売上を、同じ52週の広告費で割ったもので、記事全体の基準の結果と同じ数字です。
| 媒体 | 現状の週の広告費(万円) | 平均ROI(直近52週)真の値 | 平均ROI(直近52週)MMM | 平均ROI(定常状態)真の値 | 平均ROI(定常状態)MMM | 限界ROI 真の値 | 限界ROI MMM |
|---|---|---|---|---|---|---|---|
| テレビCM | 402.9 | 1.51 | 1.44 | 1.95 | 2.11 | 2.51 | 2.26 |
| 検索広告 | 224.3 | 2.35 | 1.18 | 2.45 | 1.06 | 1.47 | 2.26 |
| SNS広告 | 228.5 | 1.76 | 0.90 | 1.79 | 0.88 | 1.39 | 1.88 |
| ディスプレイ広告 | 300.8 | 0.38 | 0.17 | 0.39 | 0.15 | 0.23 | 0.43 |
真の値の列を見ると、4つの媒体の順位は平均と限界で入れ替わっています。「平均ROI(直近52週)真の値」の列で最も高いのは検索広告の2.35で、テレビCMは1.51です。ところが「限界ROI 真の値」の列では、テレビCMが2.51で最も高く、検索広告は1.47に下がります。検索広告は、この架空データの設定では週の広告費が比較的少ない水準から効果が立ち上がる媒体で(第2章の表で、効果が上限の半分になる水準 half は250万円。真の限界ROIが最大になるのは週30万円付近)、現在の224.3万円ではすでに逓減の領域に入っています。そのため、これまでの広告費全体の平均では効率が良く見えても、次の1万円が生む売上は1.47万円にとどまります。テレビCMは逆で、限界ROIが平均を上回る位置にいるため(定常状態の平均1.95に対して限界2.51)、次の1万円が平均より大きな効果を生みます。真のテレビCMの限界ROIが最大になるのは週311.5万円付近で、現状の402.9万円はそこを少し過ぎたところです。SNS広告も検索広告と同じく限界が平均を下回り(1.76に対して1.39)、ディスプレイ広告は平均でも限界でも1を下回っています(0.38と0.23)。
上の表の「平均ROI(定常状態)真の値」と「限界ROI 真の値」の列を比べると、現状の支出で限界ROIが平均の ROI を上回っているのはテレビCMだけです(2.51と1.95)。検索広告(1.47と2.45)・SNS 広告(1.39と1.79)・ディスプレイ広告(0.23と0.39)は、限界ROIが平均の ROI を下回っています。真の応答曲線が S字のテレビCM・検索広告・SNS 広告では、週の広告費を0から増やしていくと、はじめは限界ROIが平均の ROI より大きく、ある支出の水準で限界ROIが平均の ROI を上から下へ横切ります。ディスプレイ広告は、真の曲線が S字ではない設定(shape 1.0)なので、支出を増やしても限界ROIが平均の ROI を下回ったままです。限界ROIが平均の ROI より大きい範囲では、支出を増やすほど平均の ROI も上がり、限界ROIが平均の ROI を横切る点で平均の ROI が最大になり、そこから先は増やすほど平均も下がります。テレビCMの現状は横切る点の手前にあり、検索広告と SNS 広告の現状は横切る点を過ぎています。
平均ROIが高い媒体に積み増しても、限界ROIは低いことがある
平均の ROI の順位で予算を動かすと何が起きるかを、現状の週の広告費を5割増やした場合で確かめました。次の表の「追加分のROI」は、増やした分の広告費に対して、増分売上がいくら増えたかの比です。限界ROIが1万円という小さな動きの傾きであるのに対し、こちらは5割という大きな動きでの平均の傾きで、実際の増額の判断に近い量です。
| 媒体 | 追加する週の広告費(万円) | 真の値で増える週の増分売上(万円) | 追加分のROI 真の値 | MMM で増える週の増分売上(万円) | 追加分のROI MMM |
|---|---|---|---|---|---|
| テレビCM | 201.5 | 436.6 | 2.17 | 377.8 | 1.88 |
| 検索広告 | 112.1 | 131.3 | 1.17 | 312.5 | 2.79 |
| SNS広告 | 114.3 | 126.6 | 1.11 | 203.2 | 1.78 |
| ディスプレイ広告 | 150.4 | 28.2 | 0.19 | 94.3 | 0.63 |
「追加分のROI 真の値」の列のとおり、平均の ROI が最も高い検索広告(直近52週で2.35)を5割増やしても、追加した112.1万円が生む売上は131.3万円で、追加分のROIは1.17です。同じ5割の増額でも、テレビCMなら追加分のROIは2.17でした。「平均が高い媒体を伸ばす」という判断は、検索広告については、追加の広告費に対してほぼ同額の売上しか返ってこない投資になります。粗利率0.50で見れば、追加の広告費の約6割しか粗利で回収できない投資です(1.17×0.50=0.585)。
支出の倍率ごとの限界ROIも並べておきます。表の値は「真の値/MMM」の順です。
| 媒体 | 現状の0.5倍 | 現状の1.0倍 | 現状の1.5倍 | 現状の2.0倍 |
|---|---|---|---|---|
| テレビCM | 2.35/2.57 | 2.51/2.26 | 1.80/1.51 | 1.17/0.97 |
| 検索広告 | 2.48/1.03 | 1.47/2.26 | 0.92/3.26 | 0.62/3.86 |
| SNS広告 | 2.07/0.84 | 1.39/1.88 | 0.86/1.51 | 0.56/0.84 |
| ディスプレイ広告 | 0.36/0.11 | 0.23/0.43 | 0.15/0.83 | 0.11/1.15 |
真の値では、検索広告・SNS 広告・ディスプレイ広告は、この表の範囲で支出を増やすほど限界ROIが下がり、検索広告は現状の1.5倍で1を下回ります(0.92)。テレビCMは、現状の0.5倍から1.0倍の間では限界ROIがわずかに上がり(2.35から2.51)、そのあと1.5倍で1.80、2.0倍で1.17まで下がります。限界ROIは「その媒体の固定の性質」ではなく、「今どの水準で出しているか」によって決まる量だということが、この表から読めます。同じ媒体でも、支出の水準が違う会社どうしでは限界ROIが違い、同じ会社でも予算を動かせば変わります。他社の事例や業界の平均の ROI を、支出の水準の違いを確かめずに自社の判断に持ち込むと誤ることがあるのは、このためです。
MMMの誤りは、平均と限界で向きが変わることがある
同じ表の MMM の値を見ると、もう1つ大事なことが分かります。記事全体の基準の結果で、MMM は検索広告の平均の ROI を真の値の約半分(直近52週で1.18、真の値は2.35)に見積もっていました。ところが限界ROIでは、MMM は検索広告を2.26と見積もり、真の1.47より高く出しています。平均では過小、限界では過大と、誤りの向きが逆になっているのです。支出の倍率ごとの表でも、真の値では支出を増やすほど検索広告の限界ROIは下がるのに、MMM では現状の1.5倍で3.26、2.0倍で3.86と、増やすほど上がっていきます。
この食い違いは、MMM(基準)が推定した検索広告の曲線の形から来ています。基準の結果では、検索広告の Hill 関数の形を決める shape が2.24(真の値は1.20)、効果が上限の半分になる水準 half が1,401万円(真の値は250万円)、上限の beta は推定の範囲の上限5,000万円に張り付いていました(真の値は1,100万円)。つまり MMM は、検索広告を「まだS字の立ち上がりの途中にあり、増やすほど効率が上がる媒体」として描いています。この架空データでは、検索広告の週の広告費は3年間で65.4〜450.4万円の範囲を動いていますが、需要の高い週に増える出し方(第7章で扱った交絡)なので、支出の高い週は季節や休日の山と重なっていて、曲線の形を季節の効果と切り分けにくい状態だった可能性があります。ただし、MMM がなぜこの形を選んだのかは、この章では確かめていません。確かめられているのは、推定した shape・half・beta の値と、beta が推定の範囲の上限に張り付いたことです。また、週448.5万円を毎週出し続けた状態は、データの中に一度もありません。記事全体の基準の配分で、MMM に従った最適化が検索広告を上限の2倍(448.5万円)まで増やしたのは、この右上がりの限界ROIを信じた結果です。真の応答で測ると、この増額の部分は追加分のROIが1を下回る投資になっています。真の定常状態の週の増分売上は、現状の週224.3万円で548.9万円、2倍で765.5万円なので、増えた216.6万円は追加した広告費224.3万円を下回り、追加分のROIは約0.97です。
Google の研究者による MMM の課題をまとめた2017年の技術報告(Chan と Perry によるメディア・ミックス・モデリングの課題と改善の機会を論じた報告)は、広告主が支出の限られた範囲でしか広告を出していないとき、データの範囲では同じくらいよく当てはまる応答曲線が何通りも描け、範囲の外では大きく違う売上を予測することを図で示しています。そのうえで、平均の ROAS を知るには支出0までの外挿が要るので、現在の支出の近くにあるデータから限界の ROAS はそれなりに推定できても、平均の ROAS の推定は悪くなりうる、と述べています。この例では、平均の ROI だけでなく限界ROIも外れました。平均(支出0までの外挿)と限界(現在の点での傾き)は曲線の別の部分に依存するので、片方が当たっていても、もう片方が当たっているとは限りません。MMM の結果を報告するときは、平均と限界の両方を示し、それぞれがどの範囲のデータに支えられているかを添える必要があります。
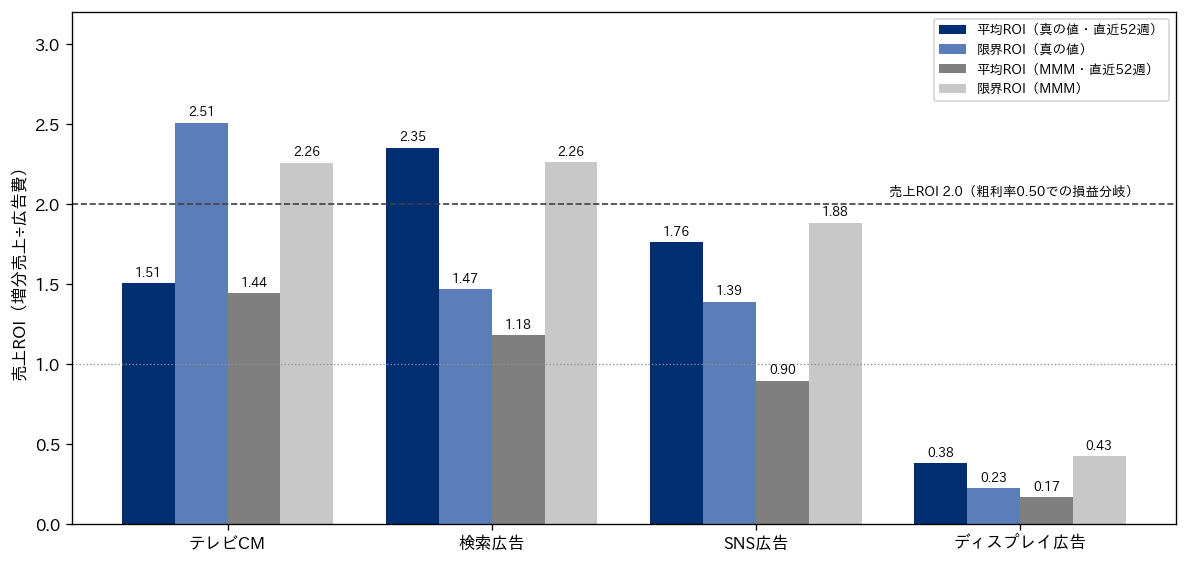
上の図は、現状の支出での4つの数字を媒体ごとに並べた棒グラフです(凡例は右上)。テレビCMは4本がおおむねそろっていますが、検索広告と SNS 広告は、真の値では平均(濃いネイビー)より限界(薄いネイビー)が低いのに、MMM では平均(濃いグレー)より限界(薄いグレー)が高くなっています。破線は、次の節で説明する粗利で見た損益分岐の売上ROI 2.0 です。
粗利で見ると、売上ROIが1を超えても赤字になる
売上ROIが1を超えていれば「広告費以上の売上を生んでいる」とは言えますが、それは「広告が儲かっている」という意味ではありません。売上のうち、会社の手元に残るのは粗利の部分だけだからです。粗利率が0.50なら、増分売上の半分しか広告費の回収に使えないので、広告費を粗利で回収するには売上ROIが2.0(1÷0.50)を超える必要があります。粗利率が0.30なら損益分岐は約3.3、0.70なら約1.4です。粗利率が低い商品ほど、広告に求める売上ROIの水準は高くなります。
共通データの媒体ごとに、粗利ROI(売上ROI×0.50)を計算しました。
| 媒体 | 粗利ROI 平均(直近52週)真の値 | 粗利ROI 平均(直近52週)MMM | 粗利ROI 限界 真の値 | 粗利ROI 限界 MMM |
|---|---|---|---|---|
| テレビCM | 0.75 | 0.72 | 1.25 | 1.13 |
| 検索広告 | 1.18 | 0.59 | 0.73 | 1.13 |
| SNS広告 | 0.88 | 0.45 | 0.70 | 0.94 |
| ディスプレイ広告 | 0.19 | 0.08 | 0.11 | 0.21 |
「粗利ROI 平均(直近52週)真の値」の列で1を超えているのは検索広告(1.18)だけです。テレビCM(0.75)と SNS 広告(0.88)は、売上ROIでは1を超えていても(1.51と1.76)、直近52週の実際の出し方では広告費を粗利で回収できていません。ディスプレイ広告は売上ROIでも1を下回っており(0.38)、粗利では広告費の2割も回収していません(0.19)。ただし、この表の粗利は「売上×粗利率」で計算した粗利で、広告の制作費や代理店の手数料、物流費のように売上に比例して増える費用の扱いは、架空の設定に含めていません。実務で損益分岐を引くときは、増分売上1万円あたり実際に手元に残る額(変動費を差し引いた利益)で計算する必要があります。
この表で最も大事なのは、平均と限界で判断が分かれる媒体です。検索広告は、平均の粗利ROIでは1.18で「これまでの広告費は粗利で回収できていた」と言えます。ところが限界の粗利ROIは0.73で、「次の1万円は7,300円の粗利しか生まない」という状態です。言い換えると、検索広告の予算は、全体としては黒字でも、最後のほうに足した部分は赤字になっています。反対にテレビCMは、平均の粗利ROIが0.75で全体としては回収できていないのに、限界の粗利ROIは1.25で、次の1万円は粗利で回収できる状態です。平均の粗利ROIだけを見て「テレビCMは赤字だから減らす」「検索広告は黒字だから増やす」と判断すると、この架空データでは、どちらも粗利を減らす方向の判断になります。
限界ROIが粗利の損益分岐(売上ROI 2.0)や売上の損益分岐(1.0)を下回るのは、週の広告費がどの水準を超えたときかも計算しました(定常状態。週の広告費を0.5万円刻みで現状の4倍まで動かし、限界ROIが最大になる点より右で初めて下回る点を探しました。S字の曲線では、支出の少ないところで限界ROIがいったん上がるためです)。真の値では、テレビCMの限界ROIが2.0を下回るのは週549.5万円、1.0を下回るのは週877.0万円でした。検索広告は週157.5万円で2.0を、週316.5万円で1.0を下回り、現状の224.3万円は、粗利で見た損益分岐をすでに越えた水準です。SNS 広告も週129.5万円で2.0を下回り、現状の228.5万円はそれを越えています。ディスプレイ広告は、真の値では支出0の近くでも限界ROIが0.66(週1万円のとき)で、どの水準でも2.0に届きません。同じ計算を MMM の曲線で行うと、検索広告は限界ROIが週557.0万円で最大(4.03)になり、そこから現状の4倍まで2.0を下回りませんでした。ディスプレイ広告は、MMM の限界ROIが現状の支出では0.43と1.0を下回っていますが、支出を増やすといったん1.0を超え、週753.0万円で最大(1.26)になったあと、週1,046.5万円で再び1.0を下回ります。どちらも、データに無い高い支出の水準(共通データの週の広告費の最大は、検索広告で450.4万円、ディスプレイ広告で585.0万円)で効率が上がると読める、推定の仮定から出た数字です。
平均ROIの測り方で、数字は変わる
同じ「平均の ROI」でも、どの出し方を前提に測ったかで数字が変わります。最初の表で、テレビCMの真の平均の ROI は、直近52週の実際の出し方では1.51、同じ週平均402.9万円を毎週均等に出した定常状態では1.95でした。実行した結果では、直近52週のテレビCMは11週の放映期間に集中して出されており、放映した週の広告費は平均1,904.6万円でした。持ち越しを含めたアドストック後の値(第5章で説明した、今週の広告費に過去の週からの持ち越しを足したもの)は、放映した週の平均で4,110万円で、効果が上限の半分になる水準(half 1,800万円)を大きく超えています。集中して出した週は飽和の領域に入るため、同じ年間の額でも、均等に出した場合より生む売上が少なくなります。直近52週の真の増分売上は、実際の出し方で31,547万円、均等に出した場合の定常状態の計算では40,910万円(週786.7万円×52週)でした。
この差は、平均の ROI を引用するときに「どの出し方での数字か」を必ず添える必要があることを示しています。過去の実績を評価するなら実際の出し方での数字(1.51)が正しく、来期に同じ額を均等に出す計画を評価するなら定常状態の数字(1.95)が参考になります。第12章の配分の最適化は定常状態の応答曲線を使っているので、その結果をテレビCMの放映計画(どの週に集中して出すか)に落とすときには、この差を考えに入れる必要があります。放映期間の組み方そのものは第5・6章で扱いました。
短期の効果と長期の効果
この章で測った ROI は、すべて「週次のデータに現れる、持ち越しを含めた効果」です。広告には、ブランドの認知や好意を積み上げ、何か月も何年も先の売上に効く長期の効果があると考えられていますが、週次の MMM がそれをどこまで捉えられるかには限界があります。Meridian の公式ドキュメントの持ち越しの最大の遅れ(max_lag)の設定についての説明は、広告の効果は max_lag を超えて長く続く可能性があるが、Meridian は遅れの効果が単調に0へ減っていき、いずれ小さくなると仮定し、実用上の理由で max_lag の値で効果を打ち切る、と述べています。同じページは、長期の効果を見込むモデルでは max_lag を大きくすることが役立ちうる一方、max_lag が大きいとデータが遅れの効果を精度よく推定するには足りないことが多く、推定のばらつきが増えるとも書いています。幾何減衰(第5章の幾何アドストック)では、2〜10の範囲に設定すると釣り合いが良いとしています。モデルの設定の説明では、max_lag の既定値は8です。
共通データの真の持ち越し率で、8週で打ち切ると持ち越しの重みがどれだけ落ちるかを計算しました。幾何アドストックでは、ある週に出した広告費の重みは、その週を1として翌週に持ち越し率(decay)倍、翌々週にその2乗倍と減っていきます。テレビCM(decay 0.70)では、重みが半分になるまで約1.94週で、8週目より先に残る重みは全体の4.04%でした。SNS 広告(decay 0.40)では0.03%、検索広告とディスプレイ広告では0.00%(小数第4位まで0)です。この架空データでは、真の持ち越しが短いので、8週で打ち切ってもほとんど落ちません。ただし、これは共通データを「持ち越しは幾何減衰で、それ以外の長期の効果は無い」と設定して作ったからです。現実の広告に、数か月から数年かけて現れる効果があるかどうか、その大きさがどれくらいかは、週次の売上データからは識別が難しく、この記事のデータでは確かめられません。
経営の判断としては、2つのことを分けて扱うのが有効だと考えています。1つ目は、MMM の ROI は「データの期間と持ち越しの打ち切りの範囲で測った効果」であり、それより長い効果は含まれていない可能性がある、と報告書に明記することです。ブランド広告のように長期の効果を期待して出している媒体は、MMM の短期の ROI だけで削ると、長期の効果があった場合にそれを失います。2つ目は、長期の効果を主張するなら、その根拠を MMM とは別に用意することです。たとえば、第10章の地域実験を長めに続けて、止めた地域の売上が止めた後に何週にわたって戻らないかを見る、ブランドの認知や検索数のような中間の指標を MMM の外で追う、といった方法があります。どちらの場合も、「長期の効果があるはずだ」という期待を、数字の無いまま ROI に上乗せしないことが大切です。
経営に報告する1枚の表
ここまでの内容を、経営に報告する1枚の表にまとめます。媒体ごとに、現状の支出、平均の ROI、限界ROI、それぞれの区間(推定の不確かさの幅)、実験の結果を並べます。区間は第9章で詳しく扱うブートストラップで出しました。ここでは時間の制約から簡易な方法にしています。MMM(基準)で当てはめた売上と実際の売上の差(残差)を4週ずつのかたまりで引き直して架空の売上の系列を作り、基準の推定結果を初期値にして推定し直すことを40回繰り返し、5%点から95%点を区間としました。推定し直すたびの計算の回数には上限を設けたので、40回のうち16回は上限で止まっています。初期値を基準の推定結果に固定しているので、初期値を変えたときに別の解に移る不確かさは含んでいません。区間は実際より狭く出ている可能性が高く、目安として扱う必要があります。計算はこの記事の実行環境(一般的なノートPC)での実測で53.0秒でした。
| 媒体 | 現状の週の広告費(万円) | 平均ROI MMM(直近52週) | 平均ROIの区間 | 限界ROI MMM | 限界ROIの区間 | 実験の結果 | 平均ROI 真の値 | 限界ROI 真の値 |
|---|---|---|---|---|---|---|---|---|
| テレビCM | 402.9 | 1.44 | 1.34〜1.51 | 2.26 | 2.03〜2.51 | なし | 1.51 | 2.51 |
| 検索広告 | 224.3 | 1.18 | 0.50〜2.13 | 2.26 | 1.11〜3.38 | なし | 2.35 | 1.47 |
| SNS広告 | 228.5 | 0.90 | 0.66〜1.83 | 1.88 | 1.42〜2.05 | 地域実験の iROAS 1.73(第121〜128週) | 1.76 | 1.39 |
| ディスプレイ広告 | 300.8 | 0.17 | 0.00〜1.32 | 0.43 | 0.00〜1.17 | なし | 0.38 | 0.23 |
現実の報告では、右の2列(真の値)は存在しません。ここでは答え合わせのために載せています。真の値が区間に入ったかを見ると、平均の ROI はテレビCM・SNS 広告・ディスプレイ広告で入り、検索広告(真の2.35に対して区間0.50〜2.13)では入りませんでした。限界ROIは検索広告とディスプレイ広告で入り、SNS 広告(真の1.39に対して区間1.42〜2.05)では入りませんでした。テレビCMの限界ROIは、真の2.51が区間の上端2.51と小数第2位で並び、丸める前の値では区間の外側でした。前の段落で述べたとおり、この区間は狭く出やすい作り方なので、真の値が区間の外に出た媒体があることは、その限界を示しています。
それでも、この表の形には、1つの数字で報告するより多くの判断材料があります。1つ目に、区間の幅が媒体によって大きく違うことが分かります。テレビCMの平均の ROI は1.34〜1.51と狭く、ディスプレイ広告は0.00〜1.32と広い。幅の広い媒体は「データからは効果の大きさがよく分からない」媒体で、予算を大きく動かす前に実験で確かめる候補になります。2つ目に、実験の結果と MMM の推定を並べると食い違いが見えます。SNS 広告では、iROAS と売上ROI は測っている状況が違うので、MMM の平均の ROI 0.90 と地域実験の iROAS 1.73 は直接は比べません(第10章)。MMM(基準)に実験と同じ状況を計算させると、売上の減少の予測は1,107.4万円で、観測の1,835.1万円と食い違います。実験と MMM が食い違ったときにどちらを信じ、どう取り込むかは第10章で扱いました。3つ目に、平均と限界を並べることで、「全体としては報われているが、増やす余地は小さい」媒体と「全体としてはまだ回収できていないが、増やす余地がある」媒体を区別できます。
報告書の表には、この章で見た条件も書き添えるのが有効だと考えています。ROI が売上か粗利か、平均の期間はいつか、限界ROIはどの増やし方(1万円か1%か、定常状態か実際の出し方か)で計算したか、持ち越しの打ち切りは何週か、区間はどの方法で出したか、という条件です。条件が書かれていない ROI は、別の会議で別の条件の数字と並べられ、比べられないものが比べられてしまいます。
経営の判断に翻訳する
この章の結果を、予算の判断に使える形に整理します。1つ目は、増額・減額の判断には限界ROIを使い、平均の ROI は過去の評価に使う、という使い分けです。共通データの真の値では、平均の ROI で最も高い検索広告(2.35)が、限界ROIでは1.47にとどまり、5割増やした分の追加分のROIは1.17でした。この架空データでは、平均の ROI の順位で予算を積み増すと、効率の良い媒体を選んだつもりで、粗利で見て回収できない追加の投資をすることになります。
2つ目は、損益分岐を売上ROI 1.0 ではなく、粗利率で割り戻した水準で引くことです。粗利率0.50なら損益分岐は売上ROI 2.0 で、この架空データの真の値では、現状の支出で限界ROIが2.0を超えていたのはテレビCM(2.51)だけでした。売上ROI 1.0 を基準にした「広告費以上の売上を生んでいるから続ける」という判断は、粗利で見ると赤字の投資を続ける判断になりえます。
3つ目は、限界ROIの推定には、平均の ROI とは別の誤り方があることを前提にすることです。この例の MMM は、検索広告の平均の ROI を約半分に見積もる一方で、限界ROIは真の1.47に対して2.26と高く見積もり、支出を増やすほど効率が上がると描きました。この限界ROIを信じて配分を最適化すると、記事全体の基準の結果のように検索広告を上限の2倍まで増やすことになります。限界ROIが高く出た媒体ほど、その数字がデータのある範囲で支えられているのか、範囲の外への延長から出ているのかを確かめ、外側に頼っている場合は、少しずつ動かして結果を測る進め方が有効です。
判断を誤ったときの損失の型も整理しておきます。平均の ROI が高いことを理由に飽和した媒体へ積み増すと、追加した広告費のうち粗利で回収できない部分がそのまま損になります。平均の ROI が低いことを理由に、限界ROIの高い媒体を削ると、削った額以上の粗利を失います。この架空データのテレビCMは、平均の粗利ROIが0.75で「赤字の媒体」に見えますが、限界の粗利ROIは1.25で、削れば1万円あたり1.25万円の粗利を失う計算です。売上ROI 1.0 を基準にすると、粗利では赤字の広告を続けます。長期の効果を MMM の外で確かめないまま、期待だけを上乗せすると、どの媒体も削れなくなります。どの型も、「どの ROI で判断したか」を報告書に明記していれば、後から検証できる誤りです。
この章の要点は3つです。第一に、売上ROI・粗利ROI・ROAS・iROAS・CPA は分子と分母の定義が違い、媒体の管理画面の ROAS は定義上は増分ではありません。第二に、平均の ROI と限界ROIは応答曲線の上の別の量で、共通データでは平均で最も高い検索広告の限界ROIが1.47にとどまり、平均と限界で媒体の順位が入れ替わりました。MMM の誤りも、検索広告では平均で過小・限界で過大と、向きが変わりました。第三に、粗利率0.50の下では売上ROI 2.0 が損益分岐で、平均では黒字の媒体でも、最後に足した部分は赤字になっていることがあります。報告では、平均・限界・区間・実験の結果を1枚に並べ、計算の条件を添えます。次の第12章では、この限界ROIの考え方を使って、総額を固定したうえで媒体の間の配分を最適化します。
この章を深めたい方への参考書籍
『マーケティング・メトリクス マーケティング成果の測定方法』(ポール・W.ファリス、ネイル・T.ベンドル、フィリップ・E.ファイファー、ディビッド・J.レイブシュタイン 著、小野晃典、久保知一 監訳、ピアソン桐原):原書第2版(Marketing Metrics)の訳書です。原書は、利益とマージン、販売促進、広告媒体とウェブの指標、マーケティングと財務を章として立てており、この章で整理した ROI・ROAS・CPA のような指標を、マーケティングの成果の測り方の体系の中で確かめるのに向いています。
『ミクロ経済学の力』(神取道宏、日本評論社):消費者行動・企業行動・市場均衡・市場の失敗・独占を扱う価格理論の部と、ゲーム理論と情報の経済学の部からなるミクロ経済学の教科書で、第2章が企業行動の理論です。この章の「平均ではなく、次の1単位で判断する」という限界の考え方を、企業の利潤の最大化の理論から基礎づけて読むのに向いています。
第12章 広告予算の配分を最適化する
第11章では、平均のROI(これまでに出した広告費1万円あたりの増分売上)と限界ROI(あと1万円増やしたときに増える売上)が別の数字であること、予算を動かす判断に使うのは限界ROIのほうであることを確かめました。この章では、その限界ROIを使って、媒体ごとの広告費の配分を決める計算を扱います。配分の計算は、総額や媒体ごとの上下限という条件を守りながら、推定した応答曲線(週の広告費と増分売上の関係)の上で増分売上が最も大きくなる点を探す問題として書けます。この章では、第2章で用意したサンプルデータ(架空の日用品メーカーの週次データ)と基準の結果を使い、配分の表の読み方、第10章で地域実験の結果を取り込んだモデルで配分し直すと何が変わるか、上下限の幅の決め方、不確実性があるときの動かし方、総額そのものの決め方、テレビCMの放映期間と計算の前提のずれを、順に実行して確かめます。
この章の数字は、すべて「この架空データの、この設定での結果」です。共通データは乱数で作った架空のデータなので、データを作った側は本当の応答曲線(真の値)を知っています。現実の企業には真の値は見えません。この章では、真の値を「現実には分からないが、この記事では答え合わせに使えるもの」として使い、推定したモデルで決めた配分を真の応答で評価することで、モデルの誤りが配分の判断にどれだけの差を生むかを測ります。
予算配分を制約付き最適化の問題として書く
広告予算の配分は、数理最適化の言葉では制約付き最適化の問題になります。制約付き最適化とは、守らなければならない条件(制約)の範囲の中で、ある量(目的関数)を最も大きく、または最も小さくする答えを探す問題のことです。広告予算の配分に当てはめると、「動かせるもの」は媒体ごとの週の広告費、「大きくしたいもの」は媒体ごとの増分売上の合計、「守る条件」は広告費の総額と、媒体ごとに動かしてよい範囲です。式で書くと、媒体 \( i \) の週の広告費を \( x_i \)、その広告費で生まれる週の増分売上を \( f_i(x_i) \) として、次のようになります。
\( \max \sum_i f_i(x_i) \quad \text{subject to} \quad \sum_i x_i = B, \quad L_i \le x_i \le U_i \)
言葉で言い換えると、「媒体ごとの増分売上の合計を最大にする。ただし広告費の合計は予算 \( B \) に等しく、各媒体の広告費は下限 \( L_i \) と上限 \( U_i \) の間に収める」という意味です。\( f_i \) が第6章で扱った応答曲線で、MMM が推定するのはこの曲線の形です。つまり、配分の計算そのものは MMM の推定が終わった後の、比較的機械的な工程です。配分の答えの良し悪しは、ほとんどが \( f_i \) の推定の良し悪しで決まります。この章の後半で、推定の誤りが配分の誤りにどう伝わるかを繰り返し測るのはそのためです。
共通データの基準の計算(第2章で紹介した補助モジュール baseline.py の optimize_budget)は、この問題を次の設定で解いています。総額 \( B \) は直近52週(第105〜156週)の週平均の広告費の合計で、1,156.5万円/週に固定しています。上下限は、各媒体について現状の週平均の0.5倍から2倍です。\( f_i \) には、毎週同じ額を出し続けたときに落ち着く週次の増分売上(定常状態の応答)を使っています。定常状態とは、アドストック(広告の効果が翌週以降に持ち越される仕組み。第5章)の持ち越しが積み上がりきって、週ごとの効果が一定になった状態のことです。この前提が現実の出し方と合わない場合の影響は、この章の後半で測ります。
応答曲線が飽和する形(第6章の Hill 関数)をしているので、目的関数は直線ではなく曲線になります。曲線の目的関数を、等式の制約(総額)と上下限の制約のもとで解くために、基準の計算では SciPy の minimize 関数の SLSQP 法を使っています。SciPy の公式ドキュメント(minimize(method=’SLSQP’))は、SLSQP を「逐次最小二乗計画法」による、多変数の関数の最小化の手法として説明し、変数の上下限(bounds)と、等式・不等式の制約(constraints)を指定できるとしています。最小化の関数なので、増分売上の合計に負号を付けて渡します。
次のコードは、基準の計算の optimize_budget と同じ処理を、書き方を少し変えて抜き出したものです。補助モジュール mmm_data.py と同じフォルダに置いて実行する形です(補助モジュールは配布していないので、使っている設定は第2章の表に示しました)。ここでは応答に真の値(md.true_response)を渡して、真の最適の配分を求めています。
import numpy as np
from scipy.optimize import minimize
import mmm_data as md


def optimize_budget(resp, current, lo_mult=0.5, hi_mult=2.0):
    """resp(媒体, 週の広告費) の合計を最大にする。総額は現状の合計で固定"""
    cur = np.array([current[c] for c in md.CHANNELS])
    total = cur.sum()

    def neg(x):  # 最小化の関数に渡すので、増分売上の合計に負号を付ける
        return -sum(resp(c, x[i]) for i, c in enumerate(md.CHANNELS))

    cons = [{"type": "eq", "fun": lambda x: x.sum() - total}]   # 総額は変えない
    bounds = [(lo_mult * v, hi_mult * v) for v in cur]           # 媒体ごとの上下限
    starts = [cur, np.full(len(cur), total / len(cur))]          # 現状と均等の2通りから解く
    results = [minimize(neg, s, method="SLSQP", bounds=bounds, constraints=cons,
                        options={"maxiter": 500, "ftol": 1e-9}) for s in starts]
    best = min(results, key=lambda r: r.fun)
    return dict(zip(md.CHANNELS, best.x))


df = md.make_data()
w0, w1 = 105, 156
current = {c: float(df[c].iloc[w0 - 1: w1].mean()) for c in md.CHANNELS}
alloc = optimize_budget(md.true_response, current)
print({c: round(float(v), 1) for c, v in alloc.items()})
# 出力: {'tv': 633.3, 'search': 193.2, 'social': 179.6, 'display': 150.4}
出力は、基準の結果の「真の最適」の列と同じです。本記事の計算では、このコードの結果と baseline.optimize_budget の結果の差は、4媒体とも0.0001万円未満でした。初期値を「現状」と「4媒体均等」の2通りにしているのは、S字の応答曲線では、出発点によって別の答え(局所解。その近くでは最良だが全体では最良でない答え)に落ち着くことがあるからです。念のため、初期値を32通り(現状比・均等・乱数30通り)に増やして解き直しましたが、総額固定・0.5〜2倍の条件では、MMM(基準)の配分でも真の最適の配分でも答えは変わりませんでした(最大の差0.00万円/週)。上下限や総額を変えると局所解の現れ方も変わりうるので、この章のそれ以降の計算は、念のため32通りの初期値で解いています。
最適な配分で限界ROIが揃う理由
総額が決まっているとき、配分が最適になっている点では、上下限に当たっていない媒体どうしの限界ROIが等しくなります。理由は単純です。ある媒体Aの限界ROIが2.0、媒体Bの限界ROIが1.5だったとします。Bから1万円を外してAに回すと、Bで1.5万円の売上を失い、Aで2.0万円の売上を得るので、総額を変えずに増分売上が0.5万円増えます。この付け替えは、AとBの限界ROIが等しくなるまで続けられます。応答曲線が飽和で頭打ちになっていく範囲では、広告費を増やすほど限界ROIが下がり、減らすほど上がるので、付け替えを続けるとAの限界ROIは下がり、Bの限界ROIは上がって、どこかで等しくなります。そこで付け替えの得が無くなります。つまり、上下限に当たっていない媒体の限界ROIが揃うことは、最適な配分が満たす条件です。ただし、揃うだけで最適とは限りません。S字の応答曲線(第6章)では、広告費の小さい範囲で限界ROIがかえって上がるので、限界ROIが揃う配分が複数ありえ、その中には最適でないもの(局所解など)も含まれます。上下限に当たった媒体は、それ以上動かせないので、限界ROIが他と揃っていなくても止まります。
この直観を共通データで確かめました。次の表は、総額固定・0.5〜2倍の条件で求めた配分と、それぞれの配分での限界ROI(その支出から1万円増やしたときの週次の増分売上。真の値)です。
| 媒体 | 現状(万円/週) | 真の最適(万円/週) | 限界ROI(真)現状の支出で | 限界ROI(真)真の最適の支出で |
|---|---|---|---|---|
| テレビCM | 402.9 | 633.3 | 2.51 | 1.69 |
| 検索広告 | 224.3 | 193.2 | 1.47 | 1.69 |
| SNS広告 | 228.5 | 179.6 | 1.39 | 1.69 |
| ディスプレイ広告 | 300.8 | 150.4(下限) | 0.23 | 0.36 |
「限界ROI(真)現状の支出で」の列を見ると、現状の配分では、テレビCMの限界ROIが2.51と高く、ディスプレイ広告は0.23と低くなっています。現状は、限界ROIの低い媒体に広告費が多く、高い媒体に少ない状態です。「真の最適の支出で」の列では、テレビCM・検索広告・SNS広告の3媒体の限界ROIが1.69で揃い、ディスプレイ広告だけが0.36で取り残されています。ディスプレイ広告は下限(現状の0.5倍=150.4万円/週)に当たっていて、それ以上減らせないからです。下限が無ければ、ディスプレイ広告はさらに減らされます(後の上下限の節で確かめます)。
この性質は、配分の結果を報告するときの点検にも使えます。最適化の計算が出した配分について、媒体ごとの限界ROIを並べ、上下限に当たっていない媒体の限界ROIが揃っていなければ、計算が途中で止まっています。反対に、限界ROIが揃っているのに配分が直感と大きく違うときは、初期値を変えて解き直しても同じ答えになることを確かめたうえで、応答曲線の推定を疑うことになります。限界ROIが揃う点という考え方は、最適化の計算を使わない場合でも、「今いちばん限界ROIが高い媒体に次の1万円を回す」という予算の付け替えの原則として使えます。経営の言葉にすると、予算の付け替えで得られる利益は、媒体ごとの限界ROIの差から生まれ、差が無くなれば付け替えの余地も無くなる、ということです。
基準の配分の表を読む
第2章で紹介した基準の結果には、4通りの配分を並べた表があります。現状、MMM(基準)の応答曲線で最適化した配分、真の応答曲線で最適化した配分(真の最適)、素朴な回帰の係数に従って寄せた配分です。条件はいずれも総額 1,156.5万円/週の固定と、各媒体0.5〜2倍の上下限です。下の表の右の列の「真の応答で測った週次の増分売上」は、それぞれの配分を真の応答曲線(定常状態)に入れて計算した値です。
| 媒体 | 現状(万円/週) | MMM(基準)で最適化 | 真の最適 | 素朴な回帰に従う |
|---|---|---|---|---|
| テレビCM | 402.9 | 443.3 | 633.3 | 201.5 |
| 検索広告 | 224.3 | 448.5 | 193.2 | 448.5 |
| SNS広告 | 228.5 | 114.3 | 179.6 | 356.1 |
| ディスプレイ広告 | 300.8 | 150.4 | 150.4 | 150.4 |
| 真の応答で測った週次の増分売上(万円/週) | 1,861.9 | 1,935.3 | 2,181.6 | 1,655.3 |
| 現状との差の年換算(万円/年) | 0 | +3,816 | +16,622 | -10,741 |
この表は3つの段階で読みます。1つ目は、配分の向きです。ディスプレイ広告は、3つの配分のどれでも下限の150.4万円/週まで減らされています。MMM(基準)と真の値では、ディスプレイ広告の限界ROIが4媒体の中で最も低くなっています。素朴な回帰は直線のモデルなので、ROIと限界ROIが同じ値になります。素朴な回帰では、ディスプレイ広告(0.97)は検索広告(2.23)・SNS 広告(1.34)より低いものの、テレビCM(0.54)よりは高く、テレビCMも下限の201.5万円/週まで減らされています。ディスプレイ広告を減らすという判断は、どのモデルを信じても変わらない、比較的頑健な判断と言えます。2つ目は、モデルによって向きが割れる媒体です。検索広告は、MMM(基準)と素朴な回帰が上限の2倍(448.5万円/週)まで増やしているのに、真の最適では現状より少し減らしています(193.2万円/週)。SNS広告は、MMM(基準)が下限まで減らし、素朴な回帰が1.6倍近くまで増やし、真の最適は少し減らしています。向きが割れる媒体は、モデルの誤りが配分の誤りに直結する媒体です。
3つ目は、増分売上の差です。MMM(基準)で最適化した配分は、真の応答で測ると現状より週73.4万円(年3,816万円)増えます。真の最適は年16,622万円増えるので、MMM(基準)は取れるはずの改善の約23%しか取れていません。素朴な回帰に従うと、年10,741万円減ります。この3つの数字の違いは、配分の計算方法の違いではなく、使った応答曲線の違いだけから生まれています。計算は同じ optimize_budget です。
もう1つ大事なのは、MMM(基準)が自分で見込んでいる改善の大きさです。MMM(基準)の応答曲線で測ると、現状の週次増分 1,329.6万円が最適化後に 1,928.3万円になり、週598.7万円(年31,133万円)の改善を見込んでいます。真の応答で測った改善は年3,816万円なので、モデルは自分の配分の効果を約8倍に見積もっていることになります。理由は限界ROIの読み違いです。MMM(基準)は、検索広告の限界ROIを現状の支出で2.26(真は1.47)、2倍に増やした448.5万円/週では3.86(真は0.62)と見ています。基準の MMM の検索広告の応答曲線は S字が強い形(shape 2.24)に推定されていて、学習データにほとんど無い支出の水準で、限界ROIが上がっていく形になっています。検索広告を2倍にした水準での真の限界ROIは0.62なので、実際にはそこでは広告費1万円あたり0.62万円の売上しか増えません。経営の判断としては、「モデルが大きな改善を見込む配分ほど、モデルの外挿(学習データに無い範囲へのあてはめ。第6章)に依存している」と読むのが安全です。
実験で較正したモデルで配分し直す
第10章では、SNS広告の地域実験(第121〜128週の8週間、全国の半分の地域で SNS 広告を止めた架空の実験。観測 iROAS 1.73)の結果を MMM に取り込みました。取り込み方は、基準の MMM と同じ最小二乗の誤差に、「モデルが予測する実験の売上減少と、実験で観測した減少の差」を罰則として1つ足して推定し直す、というものです。この章では、第10章が作った較正の関数(fit_calibrated)と、その推定結果をそのまま読み込んで使いました。較正の仕組みの詳細は第10章で扱っています。
読み込んだ較正後のモデルは、実験の売上減少を1,831.2万円と予測し、観測の1,835.1万円にほぼ一致しました(基準の MMM の予測は1,107.4万円でした)。直近52週の SNS 広告の ROI は、基準の 0.90 から 1.74 に上がり、真の値 1.76 に近づいています。テレビCM(1.44)・検索広告(1.21)・ディスプレイ広告(0.18)の ROI は、基準の MMM とほとんど変わりませんでした。ここで、このモデルで予算配分をやり直すと何が変わるかを確かめました。次のコードは、第10章の較正の関数で推定し直し、基準の optimize_budget で配分を求め、真の応答で答え合わせをするものです。補助モジュール(mmm_data.py・baseline.py)と、第10章の較正のモジュール(ch10_calibrate.py)を同じフォルダに置いて実行する形です。
import numpy as np
import mmm_data as md
import baseline as bl
import ch10_calibrate as cal

df = md.make_data()
theta_cal = cal.fit_calibrated(df)          # 地域実験の結果を罰則として足した推定
w0, w1 = bl.ROI_WEEKS                       # 直近52週(第105〜156週)
current = {c: float(df[c].iloc[w0 - 1: w1].mean()) for c in md.CHANNELS}


def resp(c, s):
    return bl.est_response(theta_cal, c, s)


alloc = bl.optimize_budget(resp, current, 0.5, 2.0)
true_now = sum(md.true_response(c, current[c]) for c in md.CHANNELS)
true_new = sum(md.true_response(c, alloc[c]) for c in md.CHANNELS)
print({c: round(float(v), 1) for c, v in alloc.items()})
print("真の応答で測った年の差", round(52 * (true_new - true_now)))
# 出力: {'tv': 443.3, 'search': 448.5, 'social': 114.3, 'display': 150.4}
# 出力: 真の応答で測った年の差 3816
この記事の実行環境(一般的なノートPC)での実測で、このコードの実行には約54秒かかりました(大半は推定の時間です)。推定し直した結果は、第10章が保存した推定結果と、推定したパラメータの値で小数第6位まで一致しました。
結果は意外なものでした。較正後のモデルで最適化した配分は、テレビCM 443.3・検索広告 448.5・SNS広告 114.3・ディスプレイ広告 150.4(万円/週)で、基準の MMM の配分と小数第1位まで同じです。真の応答で測った改善も、同じ年3,816万円でした。SNS 広告の平均の ROI は真の値に近づいたのに、配分は小数第1位で見ても変わらず、SNS 広告は相変わらず下限の0.5倍まで減らされています。
理由は、配分を決めるのが平均の ROI ではなく限界ROIだからです。次の表は、現状の支出での限界ROI(1万円増やしたときの週次の増分売上)を、3つの応答曲線で比べたものです。
| 媒体 | 限界ROI(MMM(基準)) | 限界ROI(較正後) | 限界ROI(真) | 直近52週のROI(較正後) | 直近52週のROI(真) |
|---|---|---|---|---|---|
| テレビCM | 2.26 | 2.26 | 2.51 | 1.44 | 1.51 |
| 検索広告 | 2.26 | 2.24 | 1.47 | 1.21 | 2.35 |
| SNS広告 | 1.88 | 1.63 | 1.39 | 1.74 | 1.76 |
| ディスプレイ広告 | 0.43 | 0.44 | 0.23 | 0.18 | 0.38 |
較正後のモデルでは、SNS 広告の平均の ROI は1.74に上がりましたが、現状の支出での限界ROIは基準の1.88から1.63に下がっています。較正後のモデルの SNS 広告の応答曲線は、上限の半分に届く広告費(half)が1,824万円/週という、現状の支出よりはるかに大きな位置にあり、形もほぼ直線(shape 1.055)です。実験の結果に合わせるために、モデルは「SNS 広告はどの支出でもほぼ同じ効率で効く」という形を選びました。平均の ROI と限界ROI がほぼ同じになる形なので、限界ROIは平均の ROI と同じ1.6〜1.7程度にとどまります。一方で、検索広告の限界ROIは、較正後も2.24と真の値1.47より大きく見積もられたままです。配分の計算から見ると、検索広告が「最も効率よく増やせる媒体」に見える状態は変わらないので、SNS 広告から検索広告へ予算を移すという結論も変わりません。
ここから読み取れることは、2つあります。1つは、実験で較正しても、較正したのが「その媒体を止めたときの平均の効果」である限り、配分を決める限界ROIまでは直らないことがあるという点です。もう1つは、配分の誤りの大きな部分が、実験した媒体(SNS 広告)ではなく別の媒体(検索広告)にあったという点です。この例では、配分の誤りの大きな部分は、検索広告の応答曲線の形の推定にありました。実験の予算には限りがあるので、どの媒体の、どの水準の効果を測るかを選ぶ必要があります。次の節では、この選び方を架空の追加実験で確かめます。
増額の実験で応答曲線の傾きを測る
検索広告の誤りを実験で直せるかを確かめるため、この章では架空の追加実験を2通り設定しました。どちらも共通データには含まれていない、この章だけの架空の設定です。売上のデータそのものは変えず、実験の観測結果だけを真のパラメータから計算して作りました(観測の誤差は、第10章の SNS 広告の実験と同じ標準偏差80万円の乱数です)。実際に地域の半分で検索広告を止めれば全国の広告費も変わりますが、ここでは簡単のため扱っていません。
| 架空の設定 | 停止の実験 | 増額の実験 |
|---|---|---|
| 対象の媒体と期間 | 検索広告、第121〜128週の8週間 | 検索広告、第121〜128週の8週間 |
| 対象の地域 | 全国の半分の地域(売上の50%) | 全国の半分の地域(売上の50%) |
| 実験の中身 | その地域の検索広告を止める | その地域の検索広告を5割増やす |
| 動かした広告費(万円) | 1,297.0(止めた額) | 648.5(増やした額) |
| 売上の差(真、8週+持ち越し4週、万円) | 2,632.0(減少) | 479.1(増加) |
| 売上の差(観測、万円) | 2,647.1 | 494.2 |
| 観測 iROAS(真) | 2.04(2.03) | 0.76(0.74) |
iROAS は、動かした広告費1万円あたりの売上の差です(第11章)。停止の実験は「今出している広告をすべて止めたら、どれだけ売上が減るか」を測るので、平均の ROI に近いものを測ります。増額の実験は「今より増やしたら、増やした分でどれだけ売上が増えるか」を測るので、現状より上の範囲での応答曲線の傾き、つまり限界ROIに近いものを測ります。この例では、停止の実験の iROAS は2.04、増額の実験は0.76と、同じ媒体・同じ期間でも3倍近く違いました。どちらも正しい数字で、測っている問いが違うということです。
それぞれの実験の結果を、第10章の SNS 広告の実験の結果と一緒に罰則として足し、MMM を推定し直しました(罰則の作り方は第10章と同じで、実験が2件になっただけです)。推定し直したモデルは、どちらも検証期間の MAPE が2.62%で、当てはまりは基準の MMM(2.64%)とほとんど変わりません。そのうえで、各モデルで最適化した配分を真の応答で答え合わせしました。
| モデル | 検索広告のROI(直近52週) | 検索広告の限界ROI(現状の支出で) | 0.5〜2倍で最適化した配分の改善(真の応答、万円/年) | 0.8〜1.2倍で最適化した配分の改善(真の応答、万円/年) |
|---|---|---|---|---|
| MMM(基準) | 1.18 | 2.26 | +3,816 | +6,377 |
| SNS の実験で較正 | 1.21 | 2.24 | +3,816 | +6,377 |
| SNS の実験+検索の停止の実験 | 1.29 | 2.63 | +3,816 | +6,377 |
| SNS の実験+検索の増額の実験 | 0.71 | 1.46 | +12,789 | +7,096 |
| 真の値 | 2.35 | 1.47 | +16,622(真の最適) | +7,680(真の最適) |
検索広告の停止の実験を足したモデルは、実験の売上減少を2,645.9万円と予測し、観測の2,647.1万円にほぼ一致しました。それでも配分は基準の MMM と同じで、真の応答で測った改善も変わりませんでした。検索広告の限界ROIは2.63と、かえって真の値(1.47)から離れています。停止の実験で合わせられるのは「その期間に、ゼロとの間で生じる効果の合計」です。その合計が同じでも、今の支出の近くでの傾きが違う曲線はありえます。この例でも、推定し直した曲線は実験の売上減少をほぼ再現しながら、現状の支出での限界ROIは真の曲線の1.47ではなく2.63でした。
増額の実験を足したモデルでは、検索広告の限界ROIが1.46になり、真の値1.47とほぼ一致しました。0.5〜2倍で最適化した配分は、テレビCM 595.7・検索広告 112.1・SNS広告 298.3・ディスプレイ広告 150.4(万円/週)に変わり、真の応答で測った改善は年3,816万円から年12,789万円に増えました。真の最適(年16,622万円)の約77%です。0.8〜1.2倍の範囲でも、年6,377万円から年7,096万円に増えています。興味深いのは、このモデルの検索広告の平均の ROI が0.71と、真の値2.35から基準の MMM よりさらに離れたことです。検索広告の平均の ROI は大きく外れたまま、配分の判断に使う検索広告の限界ROIだけが真の値に合った状態で、配分は真の最適に大きく近づきました。ほかの媒体の限界ROIは、SNS 広告が1.65(真は1.39)のように、まだずれています。
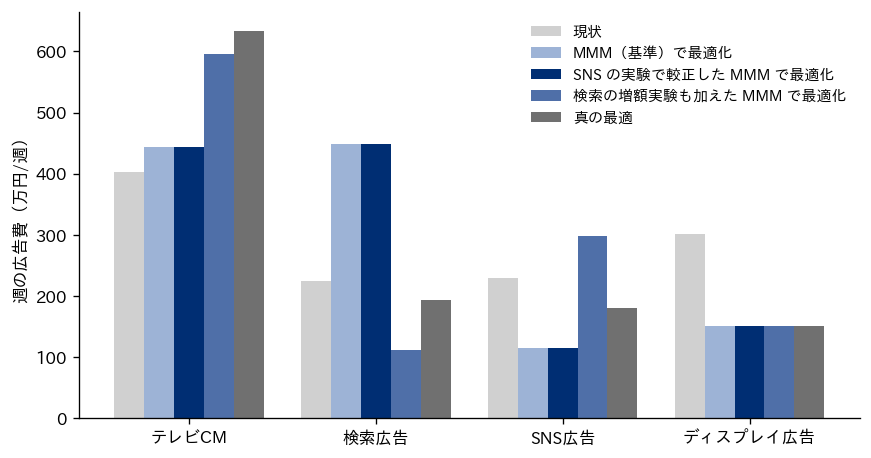
図は、0.5〜2倍の条件での5通りの配分を媒体別に並べたものです。MMM(基準)と SNS の実験で較正したモデルの棒は、4媒体とも同じ高さです。検索の増額実験も加えたモデルは、検索広告を減らしてテレビCMを増やすという、真の最適と同じ向きに動いています。SNS 広告は、真の最適(179.6万円/週)より多い298.3万円/週に振っていて、この点はまだ真の値とずれています。
この結果は、実験の設計についての示唆を含んでいます。配分の判断が知りたいのは「今の支出から少し動かしたら、どれだけ変わるか」なので、実験もその問いに合わせて、現状の支出から上げ下げする形で設計するほうが、配分に直接効く情報が取れることがあります。止める実験はその媒体が効いているかどうか(平均の効果)を確かめるのに向き、増やす・減らす実験は予算を動かす判断(限界の効果)に向いています。どの媒体の実験を次に行うかは、最適化の計算が「大きく動かせ」と言っている媒体のうち、その根拠が外挿に頼っている媒体から選ぶのが合理的だと考えています。この例では、MMM(基準)が上限の2倍まで増やそうとした検索広告がそれに当たりました。実験の設計そのもの(期間・地域の選び方・持ち越しの扱い)は第10章で扱っています。
上下限の幅を決める
媒体ごとの上下限は、計算の都合で置く条件ではなく、モデルをどこまで信じるかを表す経営の判断です。上下限が狭ければ、配分は現状の近くにとどまり、モデルの応答曲線のうち、学習データに支出の実績がある範囲だけを使うことになります。上下限が広ければ、モデルは学習データに無い支出の水準まで外挿して答えを出します。外挿の範囲でモデルが誤っていれば、配分も大きく誤ります。基準の計算の0.5〜2倍という幅も、1つの選択にすぎません。
そこで、総額を1,156.5万円/週に固定したまま、上下限の幅を4通りに変えて、MMM(基準)で最適化した配分と真の最適の配分を求め、どちらも真の応答で評価しました。次の表の「MMM(基準)の見込み」は、MMM(基準)が自分の応答曲線で見込んだ改善、「真の応答で測った改善」は、その配分を真の応答曲線に入れて測った改善です。単位はいずれも、現状と比べた年の増分売上の差(万円/年、定常状態の週次の値×52)です。「真の最適に対する達成率」は、MMM(基準)の配分を真の応答で測った改善を、真の最適の改善で割った値です。マイナスは、現状より悪くなったことを表します。
| 上下限の幅 | MMM(基準)の見込み | MMM(基準)の配分を真の応答で測った改善 | 真の最適の改善 | 真の最適に対する達成率 |
|---|---|---|---|---|
| 現状の0.9〜1.1倍 | +3,463 | +3,440 | +4,010 | 0.86 |
| 現状の0.8〜1.2倍 | +7,265 | +6,377 | +7,680 | 0.83 |
| 現状の0.5〜2.0倍 | +31,133 | +3,816 | +16,622 | 0.23 |
| 現状の0〜4倍 | +93,533 | -27,299 | +25,033 | -1.09 |
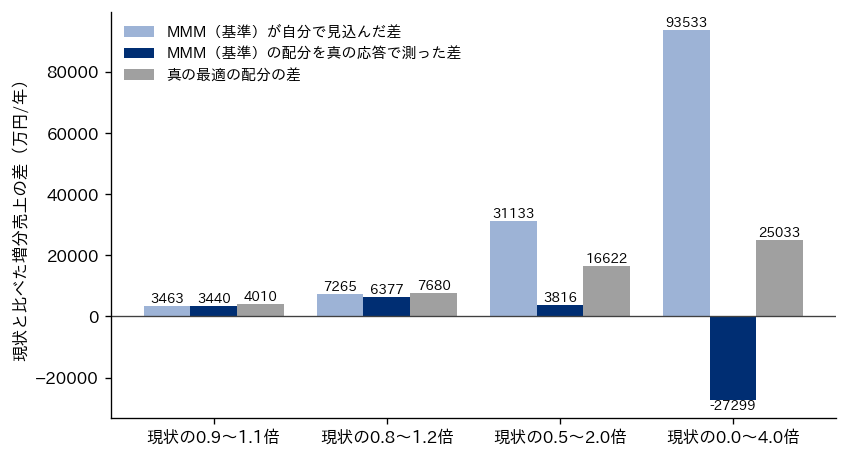
表と図から、3つのことが読み取れます。第一に、狭い幅(0.9〜1.1倍・0.8〜1.2倍)では、MMM(基準)の配分でも真の最適の8割以上の改善が取れています。0.8〜1.2倍では年6,377万円で、基準の0.5〜2倍で得た年3,816万円より大きい改善です。ただし、狭めるほど改善が大きくなるわけではありません。0.9〜1.1倍では動かせる幅が小さく、改善は年3,440万円と、0.5〜2倍の年3,816万円より小さくなりました。この4通りの中では、0.8〜1.2倍の改善が最も大きくなっています。第二に、狭い幅では、MMM(基準)の見込みと真の応答で測った改善がよく合っています(0.9〜1.1倍で見込み3,463万円・実際3,440万円、0.8〜1.2倍で見込み7,265万円・実際6,377万円)。現状の近くでは、応答曲線の推定が真の値と大きくは離れていないからです。第三に、幅を広げるほど、見込みと実際の差が開きます。0.5〜2倍では見込み年31,133万円に対して実際は年3,816万円、0〜4倍では見込み年93,533万円に対して実際は年27,299万円の減少でした。0〜4倍のとき、MMM(基準)は検索広告に897.0万円/週(現状の4倍)を積み、SNS 広告とディスプレイ広告をゼロにしました。真の最適は、テレビCM 708.3・検索広告 228.5・SNS広告 219.8・ディスプレイ広告 0(万円/週)で、検索広告はほぼ現状のままです。
この結果から、上下限の幅は、モデルが信頼できる範囲に合わせて決めるのがよいと考えています。目安になるのは、学習データの中にその支出の水準の実績があるかどうかです。過去に一度も出したことのない水準の広告費について、モデルの応答曲線は推定ではなく外挿です。0.8〜1.2倍のような慎重な幅で動かし、動かした結果を次の推定のデータに加えて、少しずつ範囲を広げていく進め方には、この例のように見込みと実際がずれにくいという利点があります。経営の言葉にすると、1回で大きく動かして年3,816万円を取るより、小さく動かして年6,377万円を取り、翌期にさらに動かすほうが、この例では得でした。
もう1つの見方として、幅を広げたときに最適化の答えが上限・下限に張り付く媒体は、モデルの外挿が配分を決めている媒体だと読めます。0.5〜2倍の MMM(基準)の配分では、検索広告が上限、SNS 広告とディスプレイ広告が下限に張り付いていました。張り付いた媒体は、限界ROIが他の媒体と揃わないまま止まっているので、「もし上限が無ければもっと動かしたい」というモデルの主張がそのまま残っています。報告では、張り付いた媒体を明示し、その媒体については「モデルの外挿に基づく」と注記することが、判断の誤りを防ぐ助けになります。
不確実性があるときの決め方
現実の企業には真の応答曲線が見えないので、上の表の「真の最適」は計算できません。手元にあるのは、推定した応答曲線と、その不確実性(第9章で扱った区間)だけです。この状況で配分を決める考え方を、ここまでの結果をもとに3つ挙げます。
1つ目は、区間の下側で判断することです。ある媒体を増やす判断は、その媒体の限界ROIの区間の下側でも、他の媒体の限界ROIの区間の上側を上回るときに限る、という決め方です。区間が重なっている媒体どうしでは、どちらに付け替えても得をするとは言い切れないので、付け替えを見送ります。この決め方は、得られる改善が小さくなる代わりに、損をする配分を選ぶ可能性を下げます。区間は、どの方法(ブートストラップ・ベイズ推定など)と、どの前提で作ったかによって変わりうるので、区間の作り方を報告に添えることも必要です。区間の作り方は第9章で扱っています。
2つ目は、複数のモデルの見込みのうち、最も悪い場合をできるだけ良くする配分を選ぶことです。この章では、MMM(基準)と SNS の実験で較正したモデルの2つについて、「2つのモデルの見込みのうち悪い方を最大にする配分」も計算しました。結果は、2つのモデルそれぞれで最適化した配分と同じでした(0.8〜1.2倍・0.5〜2倍とも)。2つのモデルが検索広告について同じ誤りを共有していたので、2つの悪い方を取っても答えが変わらなかったのです。この方法が役に立つのは、モデルどうしの見立てが本当に異なるときであり、似た前提のモデルを並べても安全にはならないことを、この結果は示しています。
3つ目は、少しずつ動かして、動かした結果で確かめることです。上下限の節で見たとおり、0.8〜1.2倍の幅では、見込みと実際のずれが小さく、真の最適の8割以上の改善が取れました。さらに、前の節で見たとおり、増額の実験は限界ROIを直接測り、配分を大きく改善しました。予算の変更を、一部の地域や期間で先に試す実験として設計すれば、予算の変更そのものが次の推定の材料になります。配分を一度に決めきろうとせず、「動かす→測る→推定し直す」の循環として運用する考え方です。この循環を組織の中でどう回すかは、第13章で扱います。
3つの考え方に共通するのは、配分の答えを1つの数字の組として扱わず、「どこまでなら自信をもって動かせるか」という幅として扱うことです。経営会議に出す配分の案は、最適化の答えだけでなく、上下限の幅、張り付いた媒体、モデルの見込みと、その見込みが外挿に頼っている度合いを添えて出すのがよいと考えています。
総額そのものを決める
ここまでは総額を固定して、配分だけを動かしてきました。実際の予算の議論では、総額そのものを増やすか減らすかも問われます。総額を決めるときの目安は、売上ではなく粗利で考えることです。広告費を1万円増やしたときに増える売上(限界ROI)に粗利率を掛けたもの、つまり限界の粗利ROIが1を上回っている限り、その1万円は粗利で回収できるので、総額を増やす意味があります。限界の粗利ROIが1を下回ったら、その1万円は粗利で回収できないので、総額を増やすべきではありません。共通データの粗利率は架空の0.50なので、限界の粗利ROIが1になるのは、限界ROI(売上)が2になる点です。総額を最適に配分した後は、上下限に当たっていない媒体の限界ROIが揃っているので、総額の判断は「上下限に当たっていない媒体の、揃った限界ROIが2を超えているか」で決まります。
総額を現状の0.55倍から1.95倍まで0.05倍刻みで変え、それぞれの総額で最適な配分を求めました(各媒体は現状の0.5〜2倍の範囲)。評価には「粗利の増分から広告費を引いた額」を使いました。広告を一切出さない場合と比べて、広告によって増えた粗利から広告費を差し引いた額です。次の表は、その一部を、真の最適の配分と MMM(基準)の見込みについて示したものです(単位は万円/週)。
| 総額(現状比) | 総額(万円/週) | 真の最適の配分での、粗利の増分から広告費を引いた額(真) | そのときの限界ROI(真、上下限に当たっていない媒体) | MMM(基準)が見込む、粗利の増分から広告費を引いた額 |
|---|---|---|---|---|
| 0.6倍 | 693.9 | -103.5 | テレビCM 2.65(他の3媒体は下限) | -327.4 |
| 0.8倍 | 925.2 | -54.5 | テレビCM 2.13・検索広告 2.12 | -245.3 |
| 0.85倍 | 983.0 | -52.7 | テレビCM 2.01・検索広告 2.00・SNS広告 2.01 | -227.3 |
| 0.9倍 | 1,040.9 | -54.0 | 3媒体とも 1.90 | -210.8 |
| 1.0倍(現状の総額) | 1,156.5 | -65.7 | 3媒体とも 1.69 | -192.4 |
| 1.2倍 | 1,387.8 | -123.3 | 3媒体とも 1.32 | -226.9 |
| 1.6倍 | 1,850.4 | -367.1 | SNS広告 0.58(テレビCM・検索広告は上限) | -372.5 |
表の数字は、まずこの例の前提として、どの総額でも負の値になっていることに注意が要ります。現状の配分・総額では、真の応答で測った粗利の増分から広告費を引いた額は週-225.6万円でした。この架空データでは、広告全体としては、定常状態の短期の売上効果だけでは粗利で広告費を回収できていないということです。この例で直近52週の真の売上ROIが2を超えているのは、検索広告(2.35)だけです。ブランドへの長期の効果のように、週次の売上データで測れない効果は、この計算には入っていません(第11章)。そのうえで、総額を変えたときの差を見ると、真の最適の配分での値は総額0.85倍(983.0万円/週)で最も大きく(週-52.7万円)、そこではテレビCM・検索広告・SNS広告の限界ROIが2.00〜2.01で揃っています。限界ROIがちょうど2、つまり限界の粗利ROIがちょうど1になる点で、総額が最適になっています。ただしこの最適は、各媒体を現状の0.5倍未満にはできないという条件の中でのものです。ディスプレイ広告は、表のどの総額でも限界ROI 0.36(限界の粗利ROI 0.18)のまま下限に当たっていて、この条件を外せば、さらに減らす余地が残っています。現状の総額では揃った限界ROIは1.69で2を下回っているので、真の値に照らすと、この例では総額を減らすのが正しい方向です。
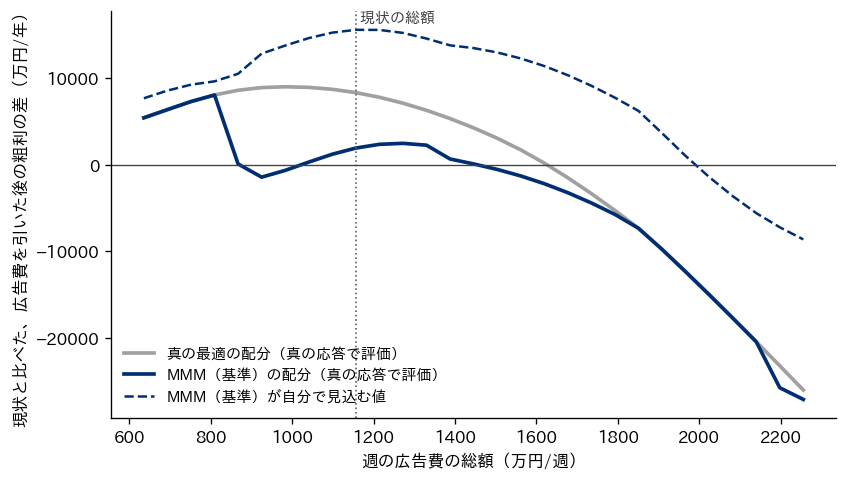
図は、同じ計算を、現状の配分・総額と比べた粗利の差(広告費を引いた後、万円/年)で描いたものです。灰色の線(真の最適の配分を真の応答で評価)は総額0.85倍付近で山になり、現状と比べて年8,987万円の改善です。総額を据え置いたまま真の最適に配分し直した場合の改善が年8,311万円(年16,622万円の増分売上に粗利率0.50を掛けた額)なので、総額の見直しで上乗せできるのは年676万円で、この例では配分の見直しのほうがはるかに大きな改善を生みます。
一方、MMM(基準)が自分の応答曲線で見込む値(破線)は、総額1.0倍のときに最も大きくなりました。MMM(基準)は、総額1.0倍の最適な配分で、検索広告(上限に当たっている)の限界ROIを3.86、テレビCMを2.10と見ていて、どちらも2を上回っているので、MMM(基準)から見ると総額を減らす理由がありません。MMM(基準)の判断に従うと、総額は据え置きで、真の応答で測った改善は年1,908万円(配分の見直しの年3,816万円に粗利率0.50を掛けた額)にとどまります。SNS の実験で較正したモデルでも、粗利の増分が最大になる総額は1.0倍で、真の応答で測った改善は同じ年1,908万円でした。図の濃い実線(MMM(基準)の配分を真の応答で評価)が総額0.7倍から0.75倍の間で大きく落ち込むのは、その間で MMM(基準)の最適な配分が切り替わるためです。総額0.7倍ではテレビCM 432.8万円/週(真の最適の428.5万円/週に近い)だったのが、0.75倍ではテレビCMを下限の201.5万円/週まで減らし、検索広告を401.3万円/週に増やす配分になりました。応答曲線の推定の誤りは、配分だけでなく総額の判断も誤らせます。
経営の判断としては、総額の議論を「前年比で何%」から始めず、「最適に配分した後の限界の粗利ROIが1を超えているか」から始めるのがよいと考えています。限界の粗利ROIが1を超えていれば、追加の予算は粗利で回収できる見込みがあり、1を下回っていれば、総額を減らすと、広告費を引いた後の粗利はかえって増える見込みです。ただしその判断は、限界ROIの推定の確かさにそのまま依存します。この例のように限界ROIを大きく見積もるモデルは、総額を増やす方向に判断を誤らせます。総額を大きく動かす前に、限界ROIを増額・減額の実験で確かめておくことが、総額の判断の誤りを防ぐ手段になります。なお、粗利率は商品・チャネルによって違うので、ここでの「限界ROIが2」という基準は、粗利率0.50という架空の設定での値です。実際には、自社の増分売上に対応する粗利率(値引きや送料を差し引いた後のもの)を使います。
定常状態の前提とテレビCMの放映期間
ここまでの配分の計算は、すべて「毎週同じ額を出し続けたときの定常状態の応答」を使っていました。現実のテレビCMは、放映期間(フライト)に集中して出し、期間外はゼロにする出し方が普通です。共通データでも、直近52週のうちテレビCMを放映した週は11週でした。同じ年間の広告費でも、集中して出すか均等に出すかで、効果は違います。飽和のある応答曲線では、集中して出した週ほど飽和に近づき、1万円あたりの効果が下がるからです。この差が配分の答えにどう効くかを、真のモデルで測りました。次の表の「毎週均等」は、第105〜156週の各週に、その期間の週平均と同じ額を出した場合を、真のモデルで1週ずつ計算したものです(第104週までの出し方はそのままなので、期間の初めは持ち越しが積み上がりきっていません)。「定常状態の式」は、配分の計算が使っている式で、持ち越しが積み上がりきった週の値を52倍したものです。どちらも実際には出していない出し方での計算で、実際の額と出し方での値は表の1行目だけです。
| テレビCMの出し方(直近52週) | 52週の広告費(万円) | 真の増分売上(万円) | 売上ROI |
|---|---|---|---|
| 現状の額・実際の出し方(放映期間に集中) | 20,951 | 31,547 | 1.51 |
| 現状の額・毎週均等 | 20,951 | 38,589 | 1.84 |
| 現状の額・定常状態の式(週の値×52) | 20,951 | 40,910 | 1.95 |
| 真の最適の額(現状の1.57倍)・実際の出し方を拡大 | 32,931 | 38,935 | 1.18 |
| 真の最適の額・毎週均等 | 32,931 | 63,176 | 1.92 |
| 真の最適の額・定常状態の式(週の値×52) | 32,931 | 66,239 | 2.01 |
現状の額でも、実際の出し方の売上ROI 1.51に対して、均等なら1.84、定常状態の式では1.95になります。真の最適の額(現状の1.57倍)では差がさらに開き、実際の出し方をそのまま1.57倍に拡大すると、売上ROIは1.18まで下がります。放映期間の週の広告費が大きくなり、Hill 関数の飽和にさらに近づくからです。
この差を配分全体で確かめるため、4媒体それぞれについて、直近52週の実際の週ごとの出し方の形をそのまま残し、倍率だけを配分に合わせて変えた場合の真の増分売上(52週の合計)を計算しました。定常状態の式で年16,622万円の改善になるはずだった真の最適の配分は、実際の出し方で実行すると、現状より927万円の減少になりました。MMM(基準)の配分も、定常状態の式の年3,816万円に対して、実際の出し方では448万円の改善にとどまりました。最適化の答えは「その額を毎週均等に出す」ことを前提にしており、テレビCMの増額を放映期間の週の額を上げる形で実行すると、改善が消えるどころか損になることがあるということです。
実務での対応は2つ考えられます。1つは、最適化の答えを実行するときに、出し方も合わせて変えることです。テレビCMを増やすなら、放映期間の週の額を上げるのではなく、放映する週の数を増やす(期間を延ばす・フライトの数を増やす)形にすれば、定常状態の計算に近い効果が期待できます。もう1つは、最適化の計算そのものに、週ごとの出し方(放映の計画)を変数として入れることです。週ごとの広告費を変数にし、アドストックの持ち越しと飽和を週ごとに計算して増分売上の合計を最大にする問題として書けば、放映期間の組み方まで含めた配分を求められます。変数が媒体数から「媒体数×週数」に増えるので計算は重くなりますが、考え方はこの章の制約付き最適化と同じです。放映期間の集中と飽和の関係は第5章・第6章で扱いました。経営の判断としては、予算の配分を決める会議と、媒体の出稿計画を決める会議が別々に開かれている場合、配分の前提(均等に出す)が出稿計画の段階で崩れていないかを確認する手順を置くことが、この損を防ぐ手段になります。
配分の結果を予算の判断に落とす
この章で確かめたことを、予算の判断の手順としてまとめます。まず、最適化の計算は MMM の応答曲線の上で行われるので、答えの良し悪しはほとんど応答曲線の推定で決まります。この例では、同じ計算方法で、使う応答曲線を変えるだけで、改善は年-27,299万円から年+25,033万円まで開きました。配分の計算を外部に依頼するときも、社内で行うときも、確かめるべきは計算の方法より、応答曲線のどの部分が実績に基づき、どの部分が外挿なのかです。
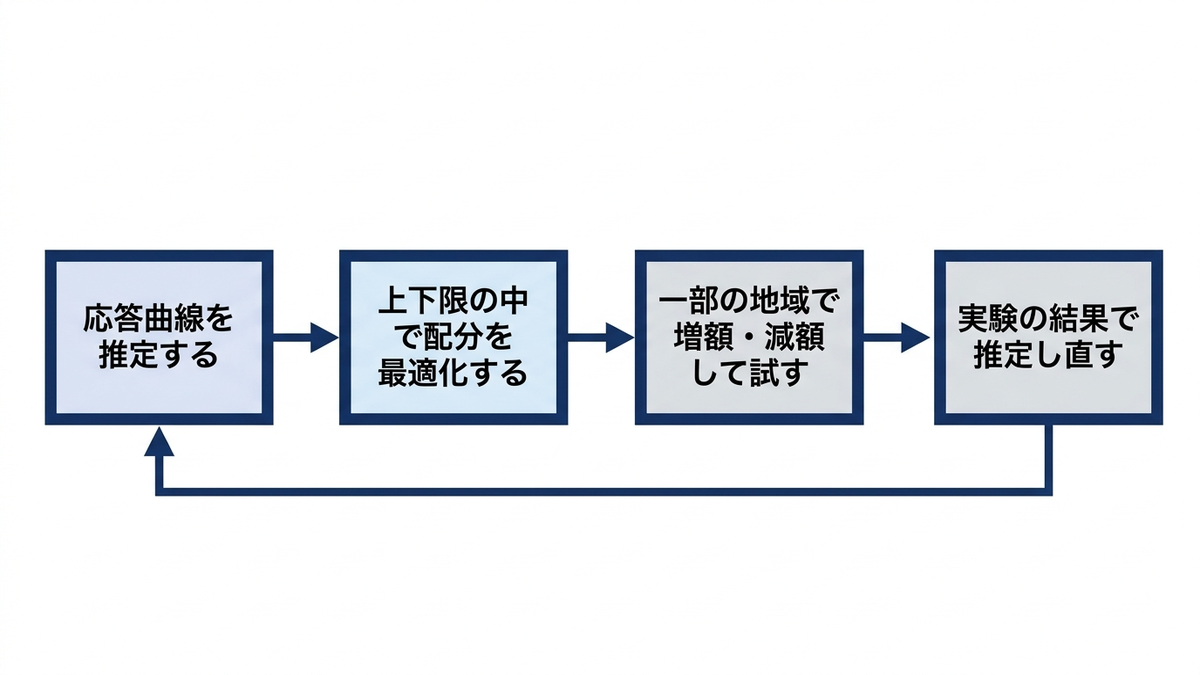
次に、判断の順序です。この例の結果に沿うと、次の順序が考えられます。1つ目に、どのモデルでも同じ向きになる判断(この例ではディスプレイ広告を減らす)から実行します。2つ目に、モデルによって向きが割れる媒体(この例では検索広告と SNS 広告)は、上下限を狭くして小さく動かすか、増額・減額の実験で限界ROIを確かめてから動かします。3つ目に、総額は、最適に配分した後の限界の粗利ROIが1を超えているかで判断し、その限界ROIが外挿に頼っている場合は、総額を大きく動かす前に実験で確かめます。4つ目に、配分を実行するときは、出し方(放映期間の組み方)が計算の前提と合っているかを確かめます。
| 判断 | この例での結果 | 誤ったときの損失の型 | 防ぐ手段 |
|---|---|---|---|
| どの媒体を減らすか | ディスプレイ広告はどのモデルでも下限まで減らす | 効いていない媒体に積み続ける | 複数のモデルで向きが揃う判断から実行する |
| どの媒体を増やすか | MMM(基準)は検索広告を2倍にしたが、真の最適は少し減らす | 外挿の範囲で限界ROIを大きく見積もった媒体に積む | 上下限を狭くする。増額の実験で限界ROIを測る |
| 上下限の幅 | 0.8〜1.2倍で年6,377万円、0.5〜2倍で年3,816万円、0〜4倍で年27,299万円の減少 | モデルの外挿を信じて大きく動かす | 実績のある範囲から始め、結果を見て広げる |
| 総額 | 真の値では0.85倍が最適。MMM(基準)は1.0倍を最適と見た | 限界ROIを大きく見積もり、総額を減らす機会を逃す | 限界の粗利ROIが1を超えるかで判断し、実験で確かめる |
| 出し方 | 真の最適の配分を実際の出し方で実行すると927万円の減少 | 定常状態の前提で決めた額を集中して出す | 出稿計画が配分の前提と合っているかを確認する |
表の「この例での結果」の列は、いずれもこの架空データ・この設定での結果で、一般に同じ結果になるとは限りません。ただ、「誤ったときの損失の型」と「防ぐ手段」の列は、応答曲線を推定して配分を決めるという作業の構造から来るもので、多くの場合に当てはまると考えています。予算の配分を数理最適化として書く考え方は、弊社コラム『投資配分を決める数理モデル、ポートフォリオ最適化から事業投資の予算配分まで』で、制約の書き方の型は弊社コラム『数理最適化の定式化パターン集』で、より一般的な形で扱っています。
この章の要点は3つです。第一に、予算の配分は、総額と上下限を制約とし、応答曲線の上で増分売上の合計を最大にする制約付き最適化として書け、最適の点では上下限に当たっていない媒体の限界ROIが揃います。総額は、上下限に当たっていない媒体の揃った限界ROIに粗利率を掛けた値が1になる点で決まります。第二に、配分の答えは応答曲線の推定、特に限界ROIの推定でほぼ決まります。この例では、SNS 広告の停止の実験で平均の ROI を較正しても配分は変わらず、検索広告の増額の実験で限界ROIを合わせると、真の応答で測った改善が年3,816万円から年12,789万円に増えました。第三に、上下限を広げるほどモデルの外挿に頼り、見込みと実際の差が開きます。狭い幅で動かし、動かした結果を次の推定に加える進め方と、計算の前提(毎週均等に出す)と実際の出し方を合わせることが、配分の判断の誤りを小さくします。次の第13章では、この「推定する・配分する・確かめる」の循環を、組織の中で使い続けるための体制と手順を扱います。
Anagraftでは、マーケティングデータの整備から、効果測定のモデルの設計と実装、実験の設計、広告予算の配分の意思決定への組み込みまで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『これなら分かる最適化数学 基礎原理から計算手法まで』(金谷健一、共立出版):関数の極値とラグランジュの未定乗数法から始まり、勾配法・ニュートン法、非線形最小二乗法、線形計画法、非線形計画法、動的計画法までを1冊で扱う教科書です。この章の「最適な配分では、上下限に当たっていない媒体の限界ROIが揃う」という条件は、ラグランジュ乗数の考え方を広告予算に当てはめたものなので、その背景を数式でたどるのに向いています。MMM の推定に使った非線形最小二乗法の章もあり、推定と配分の両方の計算を同じ本で確かめられます。
『非線形最適化の基礎』(福島雅夫、朝倉書店):最適化問題の定式化、凸解析、最適性条件(カルーシュ・キューン・タッカー条件)、双対性理論を扱う専門書です。この章で使った、総額の等式と上下限の不等式を持つ配分の問題で、最適の点がどんな条件を満たすか(上下限に当たった媒体の限界ROIが揃わないのはなぜか)を厳密に理解したい方に向いています。
第13章 MMMを組織で使い続ける
第12章では、推定した応答曲線から広告予算の配分を計算し、総額を固定して媒体ごとの上下限の中で動かしたときに、どの配分で増分売上が最も大きくなるかを確かめました。第2章で用意したサンプルデータ(架空の日用品メーカーの週次データ)では、MMM(基準)に従って配分を変えると、真の応答で測った増分売上は年換算で現状より3,816万円増え、素朴な回帰に従うと10,741万円減りました。ここまでの章は、1回の分析としての MMM を扱ってきました。この章では、その分析を毎期の予算判断に組み込み、使い続けるための仕組みを扱います。誰がどの数字に責任を持つか、モデルをどのくらいの間隔で更新するか、更新の結果をどの会議で予算に反映するか、内製と外部委託をどう考えるか、最初の四半期で何を整えるか、どういう失敗の型があるかを順に説明します。この章にはコードはありません。数値は、第2章で示した基準の結果と、公式ドキュメント・論文を開いて確かめた範囲だけを使います。
1回の分析と、使い続ける仕組みの違い
MMM の結果は、作った時点のデータと仮定から出た1つの推定です。広告の出し方は毎期変わり、商品の構成も競合の動きも変わるので、半年前の推定をそのまま翌年の予算に使い続けると、推定と現実の差が広がっていきます。逆に、毎期の予算会議の直前に推定をやり直し、その結果を使って配分を少しずつ動かし、動かした結果を次の推定の材料にする、という循環ができると、MMM は「一度出した報告書」ではなく「予算を決める手順の一部」になります。この章で扱うのは後者を作るための段取りです。
使い続ける仕組みが要る理由は、ここまでの章の結果にも表れています。第2章で紹介し、第8章で詳しく見たとおり、MMM(基準)は検証期間の MAPE が2.64%と予測の当てはまりは良いのに、検索広告の売上ROI を1.18(真の値は2.35)、SNS 広告を0.90(真の値は1.76)と、真の値の約半分に見積もりました。第10章では、SNS 広告を一部の地域で止めた地域実験(架空)を行い、MMM(基準)に同じ状況を計算させると、売上の減少の予測は1,107.4万円で、観測の1,835.1万円を大きく下回りました。MMM と実験の数字がこれだけ食い違ったとき、どちらを採るか、モデルをどう直すかを決めるのは、分析の手法ではなく組織の手順です。手順が決まっていないと、食い違いが出るたびに議論がやり直しになり、予算の判断が遅れるか、声の大きい部門の数字が通ります。
この「当てはまりが良くても、効果の推定が定まらない」という問題は、この記事の架空データに限った話ではありません。Google の研究者 David Chan と Michael Perry が2017年に公開したMMM の課題と改善の方向を整理した論文は、実際の MMM のデータ(米国の週次データ、数年分)に、季節性の代理変数を変える・直近2年だけを使う・指名検索の広告を外す・時間のトレンドを入れる、といった違いのある5つのモデルを当てはめた例を示しています。5つとも R2 は0.98か0.99で、うち4つは直近12週を使った交差検証の MAPE が6〜8%でした。それにもかかわらず、総額を変えたときの売上の予測は最大で50%違い、媒体ごとの推奨配分も一致しなかったと報告しています。同じ論文は、予測の当てはまりに注目するだけでは、ROAS(広告費あたりの売上)の推定を誤るモデルを除けないとも書いています。どのモデルを採るかは、データだけでは決まらず、誰かが判断して記録する必要があるということです。この判断を担う役割と手順を、組織の中に置いておくことがこの章の主題です。
経営の側から見ると、仕組みが無いことの損失は「判断の遅れ」として表れます。第2章の基準の結果では、MMM(基準)で最適化した配分は、現状の配分より真の増分売上が年3,816万円多くなりました(粗利率0.50で換算すると年1,908万円)。この差は、配分を変えた週から積み上がるものなので、配分の見直しが1四半期(13週)遅れれば、単純に4で割って約954万円分の増分売上を見送る計算になります(この架空データの、定常状態の前提での割り算です)。真の最適の配分との差は年16,622万円あり、モデルが真の最適に近い配分を示すほど、遅れの損失も大きくなります(第12章で検索広告の増額の実験を取り込んだモデルでは、改善が年12,789万円でした)。分析の精度を上げることと、分析を予算に反映するまでの時間を短くすることは、同じ重さで扱う必要があると考えています。
役割と責任分担
MMM を使い続けるには、少なくとも5つの立場が関わります。マーケティングの責任者、財務(経理・経営企画)、データ分析の担当、媒体ごとの運用の担当、そして外部の広告代理店や分析の委託先です。それぞれが持っている情報と、決める権限が違います。MMM の結果は、媒体ごとの予算を増やすか減らすかに直結するので、責任の所在があいまいなままだと、結果を受け取った側が「自分の媒体の数字が低いのはモデルが悪いからだ」と反論し、議論が止まります。最初に、誰がどの数字の持ち主で、誰が何を決めるのかを表にしておくことが有効だと考えられます。
次の表は、役割ごとの責任分担の一例です。組織の規模によっては1人が複数の役割を兼ねますが、役割そのものは分けて書いておくと、兼務している人が「いまどの立場で発言しているか」を自覚しやすくなります。
| 役割 | 持っている情報 | MMM で責任を持つもの | 決める権限 |
|---|---|---|---|
| マーケティングの責任者 | 商品・ブランドの方針、施策の予定、媒体ごとの狙い | MMM の結果を予算案に翻訳すること。どのモデルを採るかの最終判断 | 媒体ごとの予算案。実験をどの媒体で行うか |
| 財務(経理・経営企画) | 確定した広告費の実績、売上・粗利の実績、粗利率 | 売上と広告費の数字が会計の数字と一致していること。粗利ROI の計算に使う粗利率 | 広告費の総額。総額を決める基準(限界の粗利ROI で見るかどうか) |
| データ分析の担当 | モデルの仕様、推定の結果、検証の結果、不確実性の幅 | モデルの更新・検証・記録。結果の幅と限界を正直に報告すること | モデルの技術的な変更(統制変数・期間・事前分布)の提案 |
| 媒体ごとの運用の担当 | 入札・出稿・クリエイティブの変更履歴、媒体の管理画面の数値 | 広告費・露出量の週次データの正しさ。出し方を変えた時期の記録 | 決まった予算の中での運用の細部 |
| 広告代理店・分析の委託先 | 媒体の購入の実績、媒体側の計測、他社の運用の知見 | 委託された範囲の分析・データの提供。方法の開示 | 委託契約で決めた範囲だけ |
この表で大事なのは、「どのモデルを採るか」の最終判断を、モデルを作るデータ分析の担当ではなく、予算に責任を持つマーケティングの責任者に置いている点です。前の節で見たとおり、当てはまりが同程度のモデルが複数あるとき、その中からどれを採るかは統計だけでは決まりません。データ分析の担当は、候補ごとの当てはまり・ROI・実験との整合を並べて提示し、採る理由を記録する役目を負います。判断した人と理由が残っていれば、次の更新で結果が動いたときに、どの判断が変わったのかをたどれます。
財務の関与も欠かせません。MMM の売上・広告費が、会計で確定した数字とずれていると、経営会議で「MMM の言う増分売上は、決算の売上とどう対応しているのか」と問われたときに答えられません。広告費は、発注した時点・放映した時点・請求を受けた時点で計上の時期がずれることがあるので、MMM の週次データでどの時点の広告費を使うかを財務と合わせておく必要があります(データの整え方は第3章で扱いました)。粗利ROI を出すための粗利率も、財務が持つ数字です。この記事の共通データでは粗利率を架空の0.50に固定しましたが、実際には商品ごと・時期ごとに違うので、どの粗利率を使ったかを報告書に書いておきます。
媒体ごとの運用の担当は、MMM にとっては入力データの持ち主です。入札の方針を変えた週、クリエイティブを差し替えた週、計測タグを入れ替えた週の記録は、モデルの結果が動いたときの説明に使えます。運用の担当が、MMM を「自分の成果を評価する道具」とだけ受け取ると、記録を出すことに消極的になりやすいと思われます。MMM の目的は担当者の評価ではなく次の配分を決めることだ、と最初に共有しておくことが有効だと考えられます。
広告代理店・媒体の計測と、内製・外部委託
広告の効果の数字は、社内の MMM だけでなく、外からも届きます。各媒体の管理画面には、その媒体の広告に接触した後の購入(コンバージョン)の数が出ますし、広告代理店は出稿の報告に効果の推定を添えることがあります。第1章・第2章で扱ったとおり、こうした数字は広告に接した後の行動を数えたもので、広告が無かった場合との差(増分売上)とは定義が違います。また、媒体ごとに別々に数えているなら、1件の購入の前に複数の媒体の広告に接した人がいれば、その購入はそれぞれの媒体の画面で数えられることがあります。足し合わせた数字は、売上の増分の合計とは別物です。数字の定義が違うので、MMM の数字と媒体の数字が食い違うこと自体は異常ではありません。
ここで整理しておきたいのは、数字の出どころと、その数字を出す側の立場の関係です。媒体の計測は、その媒体の広告を売る側が用意したものです。広告代理店の報告は、出稿を取り扱った側が作ったものです。これは、計測に悪意があるという意味ではありません。どの計測も、その立場から見える範囲のデータで作られていて、見えていない部分(他の媒体の影響、広告が無くても買った人)は扱えない、という構造上の制約があるという意味です。予算を決める側は、どの数字が誰の立場から、どの定義で作られたかを並べて見る必要があります。
運用のうえでは、次の3つを決めておくことが有効だと考えられます。1つ目は、予算の配分を決める会議で使う「正の数字」を1つに決めることです。たとえば「媒体の間の配分は MMM の増分売上で決め、媒体の中の細かい運用(入札・クリエイティブ)は媒体の管理画面の数字で決める」と、使う場面ごとに数字を割り当てます。2つ目は、外部から届いた効果の推定について、方法(何を比較対象にした差か、期間、持ち越しの扱い)の開示を求めることです。方法が分からない数字は、MMM と並べて比べられません。3つ目は、外部の数字と MMM の数字が大きく食い違ったときに、実験(第10章)で確かめる媒体の候補にすることです。食い違いは、どちらかの数字を捨てる理由ではなく、次に何を確かめるかを決める材料として扱います。
経営の側から見ると、この整理を怠ったときの損失は、同じ広告費の効果を複数の部署が別々の数字で主張し、合計すると広告費の効果が過大に見えることです。媒体ごとの管理画面の数字を足し合わせた「広告経由の売上」を増分売上のように扱い、それが実際の増分より大きければ、広告費の総額を増やす判断が甘くなります。総額の判断(第12章の「限界の粗利ROI が1になる点」)は、MMM のように全媒体を同じ物差しで測った数字で行うのが筋だと考えています。
MMM を誰が作るかには、社内で作る(内製)、分析会社や広告代理店に委託する、の2つの形と、その組み合わせがあります。前出の Chan と Perry の論文は、MMM は通常、第三者が広告主との契約で作るが、社内で作る広告主もいる、と書いています(論文の公開は2017年で、その時点の記述です)。その後、MMM のソフトウェアがオープンソースで公開され、広告主が自分でモデルを作る道具は増えました。Google の Meridian の公式リポジトリは、Meridian を「広告主が社内のモデルを組んで運用できるようにする」MMM の枠組みと説明しており、ライセンスは Apache-2.0 です。Meta の Robyn の公式リポジトリは、Robyn を Meta の Marketing Science チームによる実験的なオープンソースの MMM パッケージと説明し、モデリングの知識を広く開くことを目的に掲げています(ライセンスは MIT)。一方で、Meridian の公式サイトには、Meridian の MMM と地域実験の導入を手伝う認定パートナーの一覧があり、2026年10月14日に開いた時点で51社が載っていました。道具が公開されていることと、それを運用する人手を社内に持つことは別の問題です。各ツールの機能の詳細は第14章で扱います。
内製と委託のどちらが良いかは、一律には決まりません。判断の材料を、次の表に整理しました。
| 観点 | 内製 | 外部委託 |
|---|---|---|
| モデルの仕様の透明さ | 仕様・コード・データを社内で直接確かめられる | 契約で開示の範囲を決める必要がある。開示されないと更新のたびの差を説明できない |
| 更新の速さ | 社内のデータが揃えばすぐ回せる。担当者の手が空いているかに左右される | 契約の単位(年1回・四半期ごとなど)に縛られやすい |
| 必要な人材 | 統計・データ整備・業務の3つが分かる人が要る。1人に依存すると異動・退職で止まる | 委託先の専門家を使える。社内には結果を読んで問い返せる人が要る |
| 業務の知識の反映 | 施策の予定・運用の変更を日常的にモデルへ反映できる | 社内からの情報提供の量と質に依存する |
| 立場の中立 | 社内の部門間の利害が入り込む余地がある | 委託先が媒体の購入も扱う場合、測る側と売る側が同じ組織になる |
表の最後の行は、どちらの形にも利害の入り込む余地がある、という意味で並べました。社内で作る場合も、MMM を作る部署が特定の媒体の予算を持っていれば、結果の読み方に立場が混ざります。委託する場合は、委託先が媒体の購入も扱っているかどうかを確かめ、扱っているなら、分析の方法とデータの開示、モデル選択の理由の記録を契約で求めるのが有効だと考えられます。どちらの形でも、「結果を読んで問い返せる人」が社内にいることが前提になります。委託先から届いた ROI の表を、統制変数に何を入れたか、どの期間で推定したか、当てはまりが同程度の別の候補はあったか、と問い返せないと、委託先が変わったときに数字の連続性も失われます。
段階で分けて考える方法もあります。最初の1〜2回は外部の専門家と一緒に作って手順とデータの流れを固め、その後の定期の更新は社内で回し、仕様を大きく変えるときだけ外部の目を入れる、という分け方です。この記事の第8章・第9章で扱った検証や不確実性の評価は、同じ人がモデルを作って同じ人が検証すると見落としが残りやすい作業なので、作る人と確かめる人を分けることには意味があります。社内に2人以上の担当を置けない規模なら、検証の部分だけを外部に依頼する形も考えられます。
モデルの更新頻度は予算を決める周期に合わせる
モデルの更新頻度とは、新しい週のデータを加えて MMM を推定し直す間隔のことです。間隔が長すぎると、推定が古くなり、媒体の出し方や市場の変化を反映できません。短すぎると、加えたデータが少ないので推定が大きく揺れ、そのたびに予算を動かすと、かえって判断が不安定になります。公式ドキュメントが示している目安を、開いて確かめた範囲で整理します。
Google の Meridian の公式ドキュメントには、モデルの更新(refresh)を扱ったページがあります(2026年6月30日更新の版を2026年10月14日に確認)。このページは、更新は望むだけ頻繁に行ってよいとしたうえで、四半期ごと、年ごと、あるいはマーケティングの予算を決める手順に合った頻度で更新することを提案しています。新しいデータの扱いについては、新しいデータを古いデータに足して推定し直すことを勧め、新しい期間のデータだけで推定することは、技術的には(1四半期ほどの少量のデータでも)できるものの、古いデータと切り離すと広告の遅れて出る効果(持ち越し)を正しく扱えないとして、一般には勧めないとしています。足すときに古いデータを落とすかどうかは、MMM でよく使われる2〜3年のデータの窓に収めるために必要になることがあり、偏り(バイアス)とばらつき(分散)の釣り合いの判断だと説明しています。期間を長くすれば推定のばらつきは減りますが、媒体の効き方や戦略がその間に変わっていれば、古いデータが偏りを持ち込みます。同じページは、Meridian は媒体の効き方が時間とともに変わることをモデルに入れていない、とも明記しています。
同じページには、更新の結果を読むときの注意も書かれています。MMM の推定はばらつきが大きいことが多く、少しのデータを足しただけで結果が目に見えて変わりうること、少量の新しいデータでは結論を出すのに十分な情報にならないことが多いことです。新しいモデルの結果を古いモデルに近づけたい場合は、古いモデルの事後分布(推定の結果の分布)に合わせて新しいモデルの事前分布(推定の前に置く仮定。第9章で扱いました)を置く方法があるが、それは古いデータを実質的に2回数えることになる、と注意しています。また、元のモデルと更新したモデルでハイパーパラメータ(推定の前に人が決める設定)を揃えることも勧めています。
Meta の Robyn の公式ドキュメントの機能の説明は、モデルの更新の節で、従来の MMM の更新の周期は半年ごと(原文は bi-annual)か、それより長いとし、その時間の遅れが MMM の示唆を行動に移しにくくしている、と課題を書いています。そのうえで、Robyn の更新の機能(robyn_refresh())は、選んだ最初のモデルを土台にし、新しいデータが全体に占める割合に応じて、ハイパーパラメータを探す範囲を狭めて推定し直す、と説明しています。新しい期間が短い場合には、基礎売上が最初のモデルと比べて安定していること、新しい期間の広告費の変化が結果に反映されることを期待する、とも書いています。ただし、同じドキュメントは、この機能はまだ十分に検証されていないと断っています。
PyMC-Marketing のMMM の入門ガイドも、新しいデータでモデルを継続的に更新して、媒体の効き方の変化を追うことを勧めています。同じガイドは、MLflow(機械学習の実験の記録を管理するオープンソースの道具)と組み合わせて、モデルの版を比べ、実験の経過を記録できることにも触れています。
3つの公式ドキュメントに共通しているのは、「頻繁に更新できる仕組みを用意したうえで、予算を決める周期に結果を合わせる」という考え方です。更新の間隔そのものに正解があるわけではなく、予算を動かせる周期より細かく更新しても、使い道がありません。この記事の共通データのように週次で集計している場合、四半期は13週、半期は26週にあたります。四半期ごとに再推定すると、そのたびに足されるのは13週分で、全体の156週から見ると1割に満たない量です。Meridian のページが注意しているとおり、少量の新しいデータで結論が大きく変わったときは、変わった理由を確かめずに予算を動かさないことが大切です。
更新の作業を、間隔ごとに分けて整理すると、たとえば次の表のようになります。これは一例で、どの作業をどの間隔で行うかは、予算を決める周期と、データが揃うまでの時間(広告費の請求が確定するまでの日数など)で決めます。
| 間隔 | 主な作業 | 見るもの | 決めること |
|---|---|---|---|
| 週次 | 広告費・露出量・売上のデータの取り込みと点検 | 欠け・急な変化・媒体の分類のぶれ | データの修正(モデルは動かさない) |
| 月次 | 既存のモデルで予測した売上と、実際の売上の比較 | 予測の誤差(MAPE)の推移、誤差が大きい週の理由 | 次の再推定で調べる論点の記録 |
| 四半期 | 新しいデータを足した再推定と検証。前回との比較 | 媒体別の ROI・限界ROI・区間の前回からの変化 | 次の四半期の媒体間の配分(上下限の中で) |
| 年次 | モデルの仕様の見直し。実験の結果の取り込み。外部の目による検証 | 統制変数・期間・事前分布の妥当性。実験と MMM の食い違い | 翌年度の広告費の総額。翌年度に行う実験の計画 |
表の「決めること」の列は、更新の間隔が長いほど大きな判断になるように並べました。週次の点検でモデルを動かさないのは、1週分のデータで推定を変えても、ばらつきが増えるだけだからです。四半期の再推定では、第12章で扱った上下限(たとえば現状の0.8〜1.2倍)の中で配分を動かし、年次の見直しで総額と仕様に踏み込みます。この順にしておくと、モデルの推定が揺れても、1回の更新で予算が大きく振れることを防げます。
更新で数字が動いたときの扱いと、モデルの記録
モデルを更新すると、媒体の ROI は必ず動きます。動いた理由は大きく3つに分けられます。1つ目は、実際に媒体の効き方が変わった場合です(クリエイティブの刷新、出稿先の変更、競合の動きなど)。2つ目は、データが足されたことで推定のばらつきの範囲内で数字が揺れた場合です。3つ目は、モデルの仕様(統制変数・期間・事前分布・アドストックや飽和の形)を変えたことで数字が変わった場合です。そのまま予算の判断に使いやすいのは1つ目です。2つ目は区間(第9章)の中の揺れとして扱い、3つ目は仕様の変更として別に記録して、新旧の仕様で同じデータを推定した結果を並べて説明する必要があります。
この3つを見分けるには、毎回の更新で次のものを記録しておくことが有効だと考えています。使ったデータの期間と、前回からデータを修正した箇所。モデルの仕様(統制変数の一覧、アドストックと飽和の形、事前分布、推定の初期値と回数、学習と検証の期間)。推定の結果(媒体別の ROI と区間、当てはまり、検証の MAPE)。採らなかった候補のモデルと、採らなかった理由。そして、その結果を見て何を決めたか、です。この記事の MMM(基準)であれば、「学習 第1〜130週、検証 第131〜156週、初期値を変えた12回の推定から学習期間の誤差が最小のものを採用、統制変数は定数・トレンド・季節のフーリエ項2組・販促・休日」が仕様の記録にあたります。MMM(基準)が初期値を変えて12回推定しているのは、非線形の推定では初期値によって行き着く解が変わりうるためです(第8章で扱います)。推定の回数と選び方まで書いておかないと、同じデータで同じ結果を再現できません。
前回の結果との比較は、媒体ごとに「前回の推定」「今回の推定」「区間が重なっているか」を並べた形にすると読みやすくなります。区間が重なっている範囲の変化は、ばらつきの中の揺れとして扱い、予算を動かす根拠にしません。区間が重ならないほど動いた媒体があれば、その媒体のデータ(広告費の計上の時期、媒体の分類の変更)を先に点検し、データに問題が無ければ、効き方が変わった可能性を実験(第10章)で確かめる候補にします。Meridian のドキュメントが注意しているように、新しい結果を古い結果に近づけるために事前分布を古い推定に合わせると、古いデータを2回数えることになるので、結果を安定させたいという理由だけでこの方法を使うと、変化を見落とします。
記録の置き場所は、誰でも後から開ける場所にします。担当者の手元のファイルだけに残すと、担当者が替わったときに、なぜその仕様にしたのかが分からなくなります。モデルの版の管理、データの点検の自動化、予測の誤差の監視といった運用の仕組みは、機械学習のモデル全般に共通する話題で、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で詳しく扱っています。MMM はモデルの数が少なく、更新の間隔も長いので、最初から大きな仕組みを入れる必要はありませんが、版の番号・使ったデータ・仕様・結果・決めたことを1か所にまとめる記録は、1回目の推定から始めておくのが有効だと考えられます。
意思決定の会議体に組み込む
MMM の結果が予算に反映されるかどうかは、結果がどの会議に、どの時期に、どの形で出るかで決まります。分析の担当者が報告書を配っただけでは、予算を決める場に届かないことが多いと思われます。ここでは、MMM の結果を受け取り、配分の変更を決める場を意思決定の会議体と呼びます。新しい会議を作る必要は必ずしもなく、既にある四半期の予算会議や、マーケティング施策の計画会議の議題に、MMM の報告を固定の枠として入れる形でもかまいません。
会議体を設計するときに決めておくことは、次の5つだと考えています。1つ目は時期です。再推定の結果が会議の数週間前に出ていないと、データの点検や、動いた数字の理由の確認が間に合いません。予算の締め日から逆算して、データの締め日・再推定・点検・報告の日程を決めます。2つ目は出席者です。前出の役割の表のうち、マーケティングの責任者・財務・データ分析の担当の3者は毎回出席し、媒体の運用の担当と外部の委託先は議題に応じて加わる形が考えられます。3つ目は、その場で決められることの範囲です。たとえば「四半期の会議では、媒体ごとに現状の0.8〜1.2倍の範囲で配分を変えられる。それを超える変更と総額の変更は年度の予算会議で決める」と、あらかじめ権限を決めておきます。4つ目は、MMM の結果と媒体の担当の意見が食い違ったときの手順です。「食い違いが一定の幅を超えたら、その媒体を次の実験の候補にする」のように、議論で決着させずに確かめる手順へ回すと、会議が感想の応酬になることを防げます。5つ目は、決めたことの記録です。前の節のモデルの記録と同じ場所に、決めた配分と、その根拠になった数字を残します。
会議体を置く理由を、共通データの数字で確かめておきます。第2章の基準の結果では、MMM(基準)に従った配分は、検索広告を現状の224.3万円/週から448.5万円/週(上限の2倍)に増やし、SNS 広告を228.5万円/週から114.3万円/週(下限の0.5倍)に減らしました。真の最適の配分では、検索広告は193.2万円/週、SNS 広告は179.6万円/週です。この例では、MMM(基準)の配分に従うと、検索広告を増やす向きに動かしますが、真の最適は現状より減らす向きで、変更の向きが逆になっていました。モデルの出力をそのまま予算に流す仕組みだと、この逆向きの変更がそのまま実行されます。会議体で「上下限の端に張り付いた媒体は、配分を変える前に区間と実験の結果を確かめる」という手順を決めておけば、変更の幅を抑えたうえで、確かめるべき媒体を特定できます。上下限の幅の計算は第12章で扱いました。上下限を狭くとるほど、モデルが誤っていたときの損失も、正しかったときの改善も小さくなるので、幅の決め方そのものが会議体で決める事項になります。
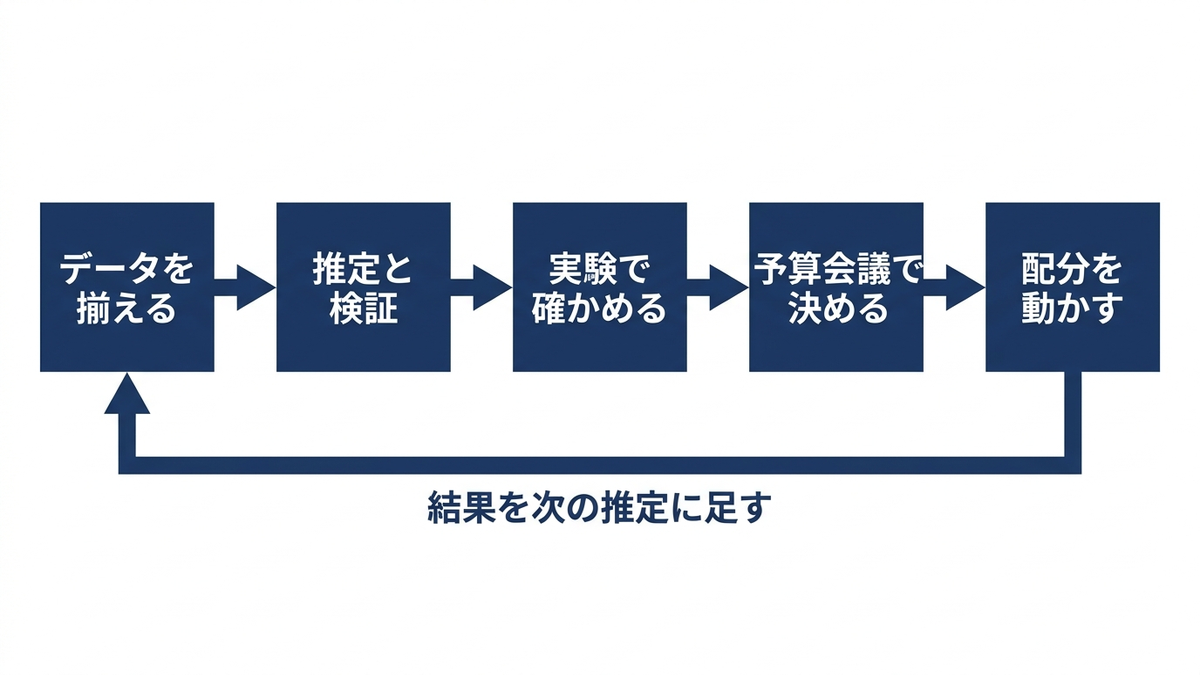
経営報告の指標と1枚の表
経営会議に出す MMM の報告は、技術的な指標(R2・MAPE・パラメータの推定値)ではなく、予算の判断に使う指標で組み立てます。この記事で定義を固定した指標のうち、経営報告に載せるのは、媒体ごとの広告費、増分売上、売上ROI、粗利ROI、限界ROI、寄与の割合、それぞれの区間、そして実験の結果がある媒体ではその数字です。予測の当てはまり(MAPE)は、モデルが使える状態かどうかの確認として脚注に置き、主役にしません。第2章の基準の結果が示すとおり、検証の MAPE が2.64%と小さくても、検索広告と SNS 広告の ROI は真の値の約半分でした。当てはまりの良さを報告の冒頭に置くと、ROI の数字まで正しいと受け取られやすくなります。
共通データの MMM(基準)の結果を、経営報告の形に並べると次の表になります。売上ROI と増分売上は第2章の基準の結果(直近52週=第105〜156週)、粗利ROI は売上ROI に架空の粗利率0.50を掛けた値、寄与の割合は3年間の MMM(基準)の推定です。限界ROI は、第11章で求めた、現状の週平均の支出からあと1万円増やしたときの週次の増分売上(MMM(基準)の推定)です。地域実験の列は、第10章で扱った SNS 広告の地域実験(架空。第121〜128週)の観測 iROAS です。現実の報告では、真の値の列は存在しないので載せていません。区間の列は、第9章のブロック・ブートストラップ(100回)で求めた売上ROI の90%区間です。
| 媒体 | 直近52週の広告費(万円) | MMM の増分売上(万円) | MMM の売上ROI | 粗利ROI(粗利率0.50) | MMM の限界ROI(現状の支出で) | 寄与の割合(3年) | 地域実験の iROAS | 売上ROI の90%区間(第9章) |
|---|---|---|---|---|---|---|---|---|
| テレビCM | 20,951 | 30,235 | 1.44 | 0.72 | 2.26 | 0.139 | なし | 1.32〜1.51 |
| 検索広告 | 11,661 | 13,789 | 1.18 | 0.59 | 2.26 | 0.052 | なし | 0.60〜1.87 |
| SNS広告 | 11,884 | 10,662 | 0.90 | 0.45 | 1.88 | 0.043 | 1.73 | 0.73〜13.74 |
| ディスプレイ広告 | 15,643 | 2,658 | 0.17 | 0.085 | 0.43 | 0.010 | なし | 0.00〜1.23 |
区間の列の数字は、第11章の表の区間(たとえば SNS 広告は0.66〜1.83)とは一致しません。第11章の区間は、推定し直すたびの計算の回数に上限を設けた40回の簡易な方法で求めたもので、作り方が違うからです。SNS 広告の上端13.74が極端に大きいのは、100回のうち少数の回で、ごく少ない広告費で効果が上限に達する極端な解に推定が行き着き、ROI がとても大きくなったためです(第9章)。区間がこれだけ広い媒体は、データからは効果の大きさが事実上決まっていない媒体として報告します。地域実験の iROAS 1.73 がこの区間に入っていることも、MMM と実験が合っていることを意味しません。
この表から読み取れることと、読み取ってはいけないことを分けておきます。読み取れることは、MMM(基準)の推定では、どの媒体も粗利ROI が1を下回っている(広告費を粗利で回収できていない)ことと、SNS 広告については MMM と地域実験が食い違っていることです。iROAS と売上ROI は測っている状況が違うので、0.90 と 1.73 を直接は比べません(第10章)。MMM(基準)に実験と同じ状況を計算させると、売上の減少の予測は1,107.4万円で、観測の1,835.1万円を大きく下回り、iROAS にして1.04と、実験の95%区間(1.58〜1.87)の外でした。経営報告では、この食い違いを隠さずに1行目の論点として出すのが有効だと考えています。食い違いがある媒体の予算を MMM だけに従って半分に減らすと(基準の配分では SNS 広告を0.5倍の114.3万円/週にしています)、実験が正しかった場合の損失を負います。読み取ってはいけないことは、「粗利ROI が1未満だから全媒体を削るべきだ」という結論です。売上ROI・粗利ROI の列は平均の ROI で、今の支出からあと1万円増やしたり減らしたりしたときの効き方(限界ROI の列)とは別物です(第11章で扱いました)。総額の判断は、限界の粗利ROI で行います。
もう1つ、真の値と並べられるのはこの記事の架空データだからこそですが、真の売上ROI(テレビ1.51・検索2.35・SNS 1.76・ディスプレイ0.38)に粗利率0.50を掛けると、検索広告だけが1を超え(1.175)、他は1を下回ります。架空の設定とはいえ、粗利で見ると判断が変わることは、売上ROI だけの報告では見えません。経営報告には売上ROI と粗利ROI を必ず並べ、どの粗利率を使ったかを明記しておくことを勧めます。
報告の形を毎回同じにしておくことにも意味があります。列と定義が固定されていれば、前回の報告と並べて、どの媒体の数字がどれだけ動いたかを経営層が自分で確かめられます。毎回、分析の担当者が見せたい図を選ぶ形にすると、変化が都合よく切り取られていないかを確かめる手段が無くなります。
導入の順序、最初の四半期で整えるもの
MMM を初めて導入するときは、全部を一度に整えようとすると、最初の結果が出るまでに時間がかかり、その間に関心が薄れます。逆に、データの持ち主や仕様の記録を後回しにしてモデルだけを先に作ると、2回目の更新で前回の結果を再現できず、数字の連続性が失われます。整える順番を決めておくことが有効だと考えられます。次の表は、四半期を単位にした導入の順序の一例です。
| 時期 | 整えるもの | 後回しにするもの | この時期の成果物 |
|---|---|---|---|
| 最初の四半期 | MMM で答える問いの決定(媒体間の配分か、総額か)。売上・広告費の週次データの持ち主の決定。過去2〜3年分のデータの収集と点検。最初のモデルの推定と検証。仕様の記録の書式 | 媒体の細かい分類。日次・地域別の粒度。更新の自動化。ツールの本格導入 | 最初の推定結果と、その限界の説明。データの持ち主の一覧 |
| 2四半期目 | 1回目の更新(新しいデータを足した再推定)と前回との比較。会議体への初回の報告。MMM と食い違う媒体の特定 | 予算の大きな変更 | 経営報告の1枚の表。実験の候補の一覧 |
| 3四半期目 | 最も食い違いの大きい媒体で実験を1つ実施。上下限を狭くした配分の変更 | 総額の変更 | 実験の結果と、それを踏まえたモデルの見直し |
| 4四半期目 | 年次の仕様の見直し。実験の結果の取り込み(第10章の較正)。翌年度の総額の検討 | なし | 翌年度の予算の根拠の資料。翌年度の実験計画 |
最初の四半期で「MMM で答える問い」を決めることを先頭に置いたのは、問いによって必要なデータと精度が変わるからです。媒体の間の配分を決めたいのか、広告費の総額を決めたいのか、特定の媒体(たとえばテレビCM)を続けるかどうかを決めたいのかで、どの媒体を分けて推定するか、どの期間のデータが要るかが変わります。データの期間は、Meridian のドキュメントが MMM でよく使われる窓として挙げている2〜3年を一つの目安にできます。データの期間を短くしたときに推定がどう崩れるかは、第3章で扱いました。
後回しにするものに「ツールの本格導入」を入れたのは、道具を選ぶ前に、問い・データ・会議体が決まっている必要があるからです。Meridian・Robyn・PyMC-Marketing は、いずれも公式に公開された道具ですが(第14章)、どの道具を使っても、データの持ち主と仕様の記録と、結果を受け取る会議が無ければ、結果は予算に届きません。この記事の第4〜8章のように、numpy・scipy の範囲で小さなモデルを作り、手順全体を1周回してから、必要に応じて専用の道具に移る順序も考えられます。
経営の側から見ると、導入の初年度に期待してよいのは「予算が大きく改善すること」ではなく、「予算の根拠を説明できる状態になること」と「確かめるべき媒体が特定されること」だと考えています。この記事の共通データでも、MMM(基準)で最適化した配分の改善は年3,816万円で、真の最適の年16,622万円の約23%(3,816÷16,622)にとどまりました。残りの差を埋めるのは、実験による較正と、更新を重ねて推定を確かめる手順です。初年度の成果を改善額だけで評価すると、2年目以降の仕組みに投資する判断を誤ります。
使われなくなる失敗の型
MMM が組織の中で使われなくなる経緯には、いくつかの型があります。どれも手法の誤りではなく、手順と役割の欠けから起きるものです。型ごとに、起きること・経営上の損失・防ぐ手順を次の表にまとめました。
| 失敗の型 | 起きること | 経営上の損失 | 防ぐ手順 |
|---|---|---|---|
| 結果が直感に合わないので使われない | 担当者の実感と違う ROI が出ると、モデルが悪いと判断されて報告が棚上げになる | 分析の費用を払ったのに、配分は従来どおりで改善が得られない | 結果を見る前に「どういう結果なら何をするか」を会議体で決めておく。食い違いは実験の候補に回す |
| 媒体の担当ごとに別の数字 | 各担当が媒体の管理画面や委託先の数字で自分の媒体の効果を主張し、MMM と並立する | 同じ増分売上を複数の数字が主張し、総額の判断が甘くなる | 媒体の間の配分に使う数字を1つに決める。外部の数字には方法の開示を求める |
| 一度作って更新しない | 最初の報告のあと、データの取り込みと再推定の担当が決まらず、古い推定が使われ続ける | 媒体の効き方が変わっても配分が追いつかず、改善の機会を毎期見送る | 更新の日程を予算会議の日程から逆算して固定する。データの持ち主を決める |
| 当てはまりの良さだけで報告する | R2 や MAPE の良さが ROI の正しさの根拠として示される | この記事の例では、MMM(基準)は検証 MAPE 2.64% でも検索・SNS の ROI を約半分に見積もった。それに従うと向きを誤った配分を実行しうる | 報告に区間と実験の結果を並べる。当てはまりは使える状態かの確認に留める |
| 1人に依存する | モデルの仕様とデータの処理が担当者の手元にしかない | 担当者の異動・退職で更新が止まり、前回の結果を再現できなくなる | 仕様・データ・結果・決定を1か所に記録する。作る人と確かめる人を分ける |
1つ目の型については、MMM の結果が直感と合わないこと自体は、悪い知らせとは限りません。直感と同じ結果しか出ないなら、MMM を作る意味は小さくなります。問題は、合わなかったときにどうするかが決まっていないことです。結果を見る前に、たとえば「検索広告の売上ROI の推定が1を下回り、その区間の上側も1を下回るなら、翌四半期に検索広告の地域実験を行う」のように、結果と行動の対応を決めておくと、結果が出た後で都合よく解釈を変える余地が減ります。これは、実験の分析で事前に判断基準を決めておくのと同じ考え方です(弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』)。
3つ目の型は、前出の Robyn のドキュメントが課題として挙げていた「更新の周期が長く、示唆を行動に移しにくい」状態が、組織の側の理由で起きるものです。道具が更新の機能を持っていても、データを取り込む担当と日程が決まっていなければ更新は行われません。更新が止まった MMM は、使われ続けていても、古い推定に基づく判断を続けることになり、使われないより悪い結果を招くことがあります。報告書に「データの期間」と「推定した日」を必ず書いておくと、古い推定が使われていることに気づけます。
4つ目の型は、この記事の共通データで具体的に示せます。MMM(基準)は学習期間の R2 が0.989、検証の MAPE が2.64%で、当てはまりだけを見れば十分に使えるモデルに見えます。しかし、その配分に従った場合の改善は年3,816万円で、真の最適の年16,622万円との間には年12,806万円(16,622から3,816を引いた差)の開きがありました。当てはまりの良さを根拠に「この配分が最適です」と報告すれば、この差は誰にも見えないまま残ります。
この章では、MMM を1回の分析で終わらせず、予算を決める手順の一部として使い続けるための段取りを整理しました。役割と責任を分け、どのモデルを採るかの判断を予算に責任を持つ人に置き、データの持ち主を決めます。モデルの更新頻度は予算を決める周期に合わせ、Meridian の公式ドキュメントが示すように四半期ごと・年ごと、あるいは予算の決め方に合った頻度で、新しいデータを古いデータに足して推定し直します。更新で数字が動いたときは、効き方の変化・推定のばらつき・仕様の変更を見分けられるよう、仕様と結果と決定を記録します。結果は意思決定の会議体に固定の枠で出し、その場で決められる配分の幅をあらかじめ決めておきます。経営報告は売上ROI と粗利ROI、区間、実験の結果を並べた1枚の表にし、当てはまりの良さを ROI の正しさの根拠にしません。
手法の精度を上げても、結果が予算に届くまでの手順が無ければ、改善は実現しません。最後の第14章では、この記事で numpy・scipy を使って最小限に実装してきた考え方を、公開された道具(Meridian・Robyn・PyMC-Marketing)がどう扱っているか、公開された一次情報で確かめられる事例と研究の動向とあわせて紹介します。
この章を深めたい方への参考書籍
『最強のデータ分析組織 なぜ大阪ガスは成功したのか』(河本薫 著、日経BP社):刊行時に大阪ガスでデータ分析の組織(ビジネスアナリシスセンター)を率いていた著者が、その組織の構成と役割、会社への貢献のしかたを書いた本です。目次には「意思決定プロセスを改革するのが仕事」という項目があります。この章で扱った役割の分担や、分析の結果を意思決定の場に届ける手順を、MMM に限らない組織づくりの観点から考える材料になります。
『データドリブン・カンパニーへの道 データ・AIで変革を進める企業人に学ぶ』(河本薫 著、講談社):企業でデータと AI の活用を進めてきた人たちへの取材をもとに、日本企業がデータに基づいて判断する会社へ進むための手がかりをまとめた本です。MMM を予算の判断に組み込むときにぶつかる、部門間の調整や経営層の関与の問題を考えるときに参考になります。
第14章 事例と最新動向
第13章では、MMM を一度作って終わりにせず、四半期や半期の予算の会議に組み込んで使い続けるための役割分担と更新の仕方を整理しました。この章では視点を社外に移し、MMM を実際に作るときに候補になるオープンソースの道具と、公開された一次情報で確認できる企業の事例、研究の動きを整理します。取り上げるのは、Google が公開している Meridian、Meta が公開している Robyn、PyMC Labs が中心になって開発している PyMC-Marketing、そして公式リポジトリで Meridian への移行が勧められている LightweightMMM です。いずれも2026年10月に公式ドキュメント・公式リポジトリ・パッケージの配布元を開いて確かめた範囲だけを書きます。この記事の実行環境にはこれらの道具が入っていないので、どれも実行はしていません。第2章から第12章までの計算は、同じ考え方を numpy と scipy で最小限に書いたものです。
企業の事例については、公式のケーススタディ・公式の技術ブログ・企業のプレスリリースを開いて、そこに書かれている数字だけを引きます。事例の数字は、多くが「モデルで見積もった改善の余地」であり、「実際に予算を動かして得た成果」とは限りません。この章では、その区別を資料の文言に沿って書き分けます。ツールや支援サービスの料金は書きません。製品どうしの優劣も断定しません。どれを選ぶかは、自社のデータの形と、分析を担う人の言語や体制で決まる部分が大きいからです。
オープンソースの MMM が相次いで公開された背景
MMM そのものは新しい手法ではありません。第2章で見たとおり、売上を広告と広告以外の要因に分解する回帰の考え方は、計量経済学のマーケティング・ミックスの分析として長い歴史があります。変わったのは、その手法を実装した道具が、広告媒体を運営する大手企業からオープンソースとして公開され、誰でも中身を読めるようになったことです。Google の研究者は2017年に、広告の持ち越し効果と飽和をベイズ推定で扱う論文(Jin らの論文。第5章・第9章でも取り上げたもの)と、地域別のデータを階層ベイズで扱う論文、MMM が抱える課題を整理した論文を公開しています。Google の GitHub の組織のもとではベイズ推定の MMM のライブラリ LightweightMMM が公開され、2025年1月には Google の公式の MMM として Meridian が一般に公開されました。Meta は Robyn を、PyMC Labs は PyMC-Marketing を、それぞれオープンソースで公開しています。
道具の公式資料が MMM の利点として挙げていることの1つが、個人を追跡しない計測であることです。Meridian の公式リポジトリの説明は、MMM は集計されたデータを使うのでプライバシーに配慮した手法であり、Cookie や利用者単位の情報を使わない、と書いています。第1章で扱ったとおり、ブラウザや OS の側で個人単位の追跡を制限する動きがあり、第2章で扱ったマルチタッチ・アトリビューションのように個人の接触履歴をつなぐ手法は、その影響を直接受けます。週や地域ごとに集計した広告費・売上と、販促や季節などの情報から推定する MMM は、こうした制限の影響を受けにくい手法です。ただし、受けにくいのは「データが取れなくなる」影響であり、第8章で見た識別性の問題(当てはまりが良くても効果の配分を誤る問題)は、道具が新しくなっても残ります。
経営の側から見ると、道具が無料で手に入るようになったことは、MMM の費用の中心が「ソフトウェアを買う費用」から「データを整え、モデルを検証し、結果を予算の判断につなぐ人の時間」に移ったことを意味すると考えられます。道具の選定に時間をかけるより、第3章で扱ったデータの整備と、第10章で扱った実験による答え合わせの計画に時間を割く方が、判断の質に効くと考えています。この章の後半で見る事例でも、成果として書かれているのは道具の名前ではなく、実験や外部データと組み合わせて媒体の配分を見直した過程です。
Meridian(Google)の機能
Meridian は、Google が公開しているオープンソースの MMM です。Google の公式ブログは2025年1月29日付の記事で、Meridian をすべてのマーケティング担当者とデータサイエンティストが使えるようにしたと発表しました。同じ記事は、一般公開の前に世界の数百のブランドで試したこと、Meridian の扱いについて訓練と認定を受けた20社を超える計測パートナーのプログラムを始めたことを書いています。日本語版の公式ブログも2025年1月30日付で同じ内容を発表し、日本の認定パートナーとして電通デジタルと博報堂DYグループの担当者のコメントを載せています。Python のパッケージ配布元(PyPI)で確かめた最新版は、2026年9月25日(UTC)に登録された 2.1.0 です。公式リポジトリの説明では、動かすには Python 3.11〜3.13 が要り、GPU を少なくとも1枚使うことを推奨しています。
公式リポジトリと公式ドキュメントに書かれている主な機能は次のとおりです。第1に、ベイズ推定で、事前分布(推定の前に置く「おそらくこのあたり」という見込み)とデータを組み合わせて媒体の効果を推定します。推定には MCMC(乱数を使って事後分布からの標本を得る計算法)の一種である NUTS を使い、計算が重いので GPU で速くできるようにしています。第2に、地域別のデータを扱えます。公式ドキュメントは、地域別のデータは統計的な情報を多く含み、媒体の効果の推定を改善すると説明し、使えるなら地域別のデータを使うことを勧めています。全国1本のデータでも動かせます。第3に、実験の結果や事前の知識を事前分布として取り込む、いわゆる較正(第10章のキャリブレーション)を支えます。第4に、テレビや動画広告について、表示回数だけでなく、何人に届いたか(リーチ)と1人あたり何回見たか(フリークエンシー)のデータを使い、最適な接触回数を探せます。第5に、推定したモデルから媒体別の ROI・応答曲線・予算配分の提案を出します。
検索広告の扱いには、この記事の内容と直接つながる記述があります。公式ドキュメントの検索広告の章は、検索広告は利用者の検索語が広告主の指定したキーワードに合ったときにだけ表示されるので、もともと需要が高い週には、自然な検索の量と検索広告の費用がそろって増える、と説明しています。そのうえで、Google 検索のクエリボリューム(検索された量を集計した指標)を統制変数として入れないと、需要が生んだ売上を検索広告の手柄と数えて、検索広告の効果を過大に見積もるおそれがある、と書いています。第7章で扱った交絡の問題を、検索の量という外部データで抑える設計です。なお、この記事の共通データでは、第2章の基準の MMM は検索広告の ROI を真の値 2.35 に対して 1.18 と、逆に小さく見積もりました。交絡の向きと大きさは、データの作られ方と統制変数の入れ方で変わります。公式ドキュメントの記述は「統制しないと過大評価のおそれがある」という一般的な注意であり、この架空データの結果と矛盾するものではありません。
実験結果の取り込み方について、公式ドキュメントの「ROI の事前分布と較正」の章は、媒体ごとの ROI に事前分布を置く形を基本にしています。実験の結果と業務の知識を1つの分布にまとめ、推定の「ガードレール」として使うという説明です。そのうえで注意点として、MMM が比べる反実仮想は「その媒体の広告費が0だった場合」なのに、実験が測るのは「広告費を少し増やした・減らした場合」の差であることが多く、両者の測るものがずれること、実験の時期がモデルの期間と違えばそのまま当てはまるとは限らないこと、短い実験は長く続く効果を取りこぼしうること、実験の結果を事前分布に直す段階で実験そのものの標準誤差を超える不確かさが加わること、を挙げています。事前分布と事後分布を並べて、データが結果を動かしているのか、事前分布が結果を決めてしまっているのかを確かめることも求めています。第10章で地域実験の結果を罰則として足した計算と、考え方は同じです。
必要なデータの量について、公式ドキュメントのデータの収集と整理のページは、経験則として、地域別のモデルでは最低2年分の週次データ、全国のモデルでは3年分、月次しか無い場合は最低3年分という目安を示しています(第3章)。これとは別に、「必要なデータの量」の章は、全国1本のモデルでは「モデルのパラメータ1つあたりのデータ点の数」を確かめることを挙げ、パラメータが26個(媒体12・統制変数6・ノット8。ノットは基礎売上の時間変化を表す節点。持ち越しと飽和のパラメータは簡単のため数えない)で2年分の週次データ(104点)なら1パラメータあたり約4点で、信頼できる推定には少なすぎる、という例を示しています。対策として、媒体の数や統制変数を減らす、期間を3年に延ばす、を挙げつつ、古いデータを足すと今の判断との関連が薄れるという注意も添えています。この記事の共通データに同じ物差しを当てると、基準の MMM のパラメータは媒体ごとに4つ(持ち越し率・効果が上限の半分になるアドストック後の広告費・形・上限)で4媒体16個、統制変数が8個(定数・トレンド・季節の項4つ・販促・休日)で計24個、学習期間は130週なので、1パラメータあたり約5.4点です。ただし、この24個は持ち越しと飽和のパラメータも数えているので、Meridian の例とは数え方がそろっていません。第8章で見た識別性の問題(当てはまりは良いのに検索と SNS の ROI が半分に出た)が、この点数の少なさと無関係とは言い切れませんが、この記事では確かめていません。
モデルの更新について、公式ドキュメントの「モデルの更新」の章は、四半期ごと・年ごと、あるいは予算を決める周期に合わせて更新することを考えてよい、と書いています。推奨する方法は、新しいデータを古いデータに足して推定し直すことで、典型的な2〜3年の期間に収めるために最も古いデータを落とすこともある、としています。前回の結果に近い事前分布を置く方法については、過去のデータを二重に数えることになると注意しています。新しいデータだけで推定し、前回の事後分布を事前分布に使う方法は、一般には勧めないと書いています。第13章で扱った更新の頻度を決めるときの、具体的な手がかりになります。
Meridian の周辺には、推定したモデルを使う人のための道具も加わっています。公式ドキュメントには「Meridian シナリオプランナー」の章があり、題に「オープンベータ」と添えたうえで、推定済みのモデルから、媒体の効果を分析したレポートを数回のクリックで作り、予算の場面を変えて結果を見比べられる、と説明しています(2026年9月10日更新の版で確認)。2026年6月の Google の公式記事(Think with Google)は、この道具について、総額を固定した場合・目標の ROI を置いた場合・媒体ごとの支出の上下限を置いた場合の場面を、コードを書かずに試せると紹介しています。また、Google Cloud 上で Meridian のモデルを作って管理する企業向けの基盤として「Meridian Studio」の公式ページがあり、数百のモデルを同時に回せると説明しています。この記事の第12章で示した制約付きの配分の計算を、分析担当者以外が触れる形にする試みです。
Robyn(Meta)の機能
Robyn は、Meta のマーケティング・サイエンスの部門が公開している MMM のパッケージです。公式リポジトリは自らを、実験的な、AI と機械学習を使ったオープンソースの MMM のパッケージと説明しています。本体は R 言語のパッケージで、R の公式の配布元(CRAN)で確かめた最新版は2025年7月2日に公開された 3.12.1 です。Python 版(robynpy)も公開されていますが、公式リポジトリはベータ版と位置づけ、R 版を大規模言語モデルの助けを借りて翻訳したもので不具合を含みうる、と書いています。PyPI で確かめた robynpy の最新版は、2025年4月3日(UTC)に登録された 0.3.6 です。
Robyn の設計は、Meridian や PyMC-Marketing のベイズ推定とは異なります。公式の分析者向けガイドによれば、媒体の係数はリッジ回帰(係数が大きくなりすぎないよう罰則を足す回帰。第8章で扱ったもの)で推定し、多重共線性と過学習を抑えます。持ち越しの形と飽和の形を決めるパラメータ(第5章・第6章で扱ったもの)は、Meta の進化計算による最適化の基盤 Nevergrad で探します。持ち越しの形は3種類から選べ、幾何減衰はパラメータが1つで速い代わりに減衰の速さが一定で、デジタル広告には合わないことが多いとガイドは書いています。ワイブル分布を使う2つの形は減衰の速さが変わり、そのうち1つは効果の山が遅れて来る形も表せます。飽和は Hill 関数で表し、形を決めるパラメータと曲がり目の位置を決めるパラメータの2つを持ちます。季節性・トレンド・休日は、時系列の分解の道具 Prophet で取り出します。
Robyn に特徴的なのは、1つの「最良のモデル」を出さず、複数の目的を同時に見て、互いに優劣のつかないモデルの組(パレート最適な組)を出し、最後の1つを分析者が選ぶ設計です。ガイドによれば、目的の1つめは予測の誤差(正規化した二乗平均平方根誤差)を小さくすること、2つめは「事業として妥当か」を測る指標で、媒体ごとの効果の割合が広告費の割合からかけ離れていないかを距離で測ります。この距離が大きいと、広告費の小さい媒体に最大の効果が割り当てられるといった非現実的な結果になりうる、とガイドは説明しています。一方で、公式の機能説明のページは、この指標には媒体どうしの ROAS を近づける方向に働くという理由で議論があることを認めています。広告費の割合と効果の割合が近いこと自体は、効果の推定が正しいことを保証しません。実験の結果がある場合は、モデルの結果と実験の結果のずれを3つめの目的として加えます。第8章で「当てはまりが良い=正しい」とは限らないことを見ましたが、Robyn はその問題に、当てはまり以外の物差しを最適化の目的そのものに入れることで対処しようとしています。
実験の取り込み方について、ガイドは、実験や因果推論で得た結果を正解と見なして MMM を較正することを勧め、Meta の利用者単位の効果測定(コンバージョンリフト)と地域単位の効果測定(GeoLift)を例に挙げています。Robyn が受け取るのは実験の点推定(実験の開始日と終了日、その期間の増分の大きさ)だけで、実験の不確かさの幅は入力しません。予算配分については、ガイドは配分の結果を実行の前に検証するよう注意しています。配分の関数が扱う場面を CRAN の 3.12.1 のリファレンスで確かめると、指定した期間の総額(過去と同じ額か、任意に指定した額)のもとで反応の伸びを最大にする max_response と、目標の ROAS か顧客獲得単価(CPA)を置き、それに沿って反応の伸びと支出の水準を求める target_efficiency の2つです。データの量については、週次で少なくとも2年分の履歴を求め、月次しかない場合はより長い期間(4〜5年など)を集めるよう勧め、説明変数1つに対して観測10点という比率を目安に挙げています。この記事の共通データでは、学習期間130週に対して説明変数が媒体4つと統制変数8つの計12個なので、約10.8点です。目安はぎりぎり満たしますが、第8章で見たとおり、それでも検索と SNS の ROI は真の値の約半分に出ました。目安を満たすことは、推定が正しいことの保証にはなりません。また、先に数えた1パラメータあたりの約5.4点(持ち越しと飽和のパラメータを含む24個が分母)と、この説明変数1つあたりの約10.8点(説明変数12個が分母)は、分母の数え方が違う参考値です。この計算だけでは、データが十分か不足かは判定できません。
PyMC-Marketing と LightweightMMM
PyMC-Marketing は、Python のベイズ推定のライブラリ PyMC の上に作られたマーケティング分析の道具箱です。公式リポジトリは、PyMC の中心的な開発者とマーケティングの専門家が開発していること、Apache 2.0 のライセンスで商用にも無償で使えることを書いています。PyPI で確かめた最新版は、2026年9月29日(UTC)に登録された 1.2.0 で、公式リポジトリの説明では Python 3.12 以上を求めています。2026年8月には、ソフトウェアの論文誌 Journal of Open Source Software(第11巻第124号)に、開発者たちによる論文が掲載されました。MMM のほか、顧客生涯価値のモデルや、新商品の発売が既存商品に与える影響を測るモデルなども含んでいます。
MMM について公式リポジトリが挙げている機能は、持ち越しと飽和の関数を選べる(自作の関数も使える)こと、基礎売上の時間変化と媒体の効き目の時間変化をガウス過程の近似(時間とともになめらかに変わる量を、決まった式の形を置かずに表す統計の手法を、計算しやすくしたもの)で表せること、実験の結果での較正、ROAS や顧客獲得単価の見込みを使った較正、予算配分の最適化などです。実験の取り込み方は、Meridian が ROI の事前分布を置くのとは別の形をとっています。公式ドキュメントの実験の取り込みの解説によれば、ある媒体の広告費を x から x+Δx に動かしたときに売上が Δy 動いたという実験の結果を、その媒体の飽和の曲線の上の2点の差として扱い、モデルの尤度(データの当てはまりを測る部分)に観測として加えます。このとき実験の結果の不確かさ(売上の変化 Δy の標準偏差)も合わせて指定するので、実験の結果を誤差の無い正解として固定するわけではありません。解説は、2つの媒体の広告費が完全に連動していると、通常の MMM では両者の効果を区別できないという架空の例を示し、実験の結果を加えると飽和のパラメータの推定が真の値に近づき、幅も狭まったことを示しています。この記事の共通データでテレビとディスプレイの広告費の相関が 0.91 あり、第4章でディスプレイの効果を分けにくかったのと同じ種類の問題に、実験で別の情報を足して対処する設計です。
地域や商品のように、データを別の切り口で分けたモデルも扱えます。公式ドキュメントの多次元の MMM の例は、2つの市場を1つのモデルで推定し、媒体の飽和の上限のパラメータについては、市場ごとの値が共通の分布から出ていると見なして情報を共有させています(部分的な共有)。一方で、持ち越しの率は市場ごとに独立に推定しています。どのパラメータを地域間で共有させるかを、分析者が選べる設計です。公式ドキュメントは、この新しい MMM のクラスを実験的な段階にあるが機能はそろっている、と説明しています。
LightweightMMM は、Google の GitHub の組織のもとで公開されていたベイズ推定の MMM のライブラリで、NumPyro と JAX の上に作られ、全国のモデルと地域別の階層モデルを扱います。公式リポジトリは、Google の公式の製品ではないので支援は限られる、と断っていました。同じリポジトリの説明には、2025年1月29日に Google が新しい公式のベイズ MMM として Meridian を公開したこと、LightweightMMM はもうサポートされていないので Meridian に移ることを強く勧めることが書かれています。リポジトリは2026年1月19日に所有者によってアーカイブされ、読み取り専用になっています。PyPI で確かめた最後の版は、2023年5月23日(UTC)に登録された 0.1.9 です。Meridian の公式リポジトリには、LightweightMMM から移る人向けの移行ガイドへの案内があります。過去に LightweightMMM でモデルを作った場合は、支援の終わった道具の上で予算の判断を続けることになるので、移行の計画が要ります。移行のときは、同じデータで新旧のモデルの ROI を並べ、差が出た媒体について、その差がモデルの仕様の違いから来るのかを確かめてから切り替えることが有効だと考えています。
4つの道具を並べて見る
ここまでの内容を、公式の資料で確かめた範囲で1つの表にまとめます。版と日付は2026年10月14日に各パッケージの配布元で確かめたものです。表は優劣の比較ではなく、「自社の体制ならどれが動かしやすいか」を考える材料として並べています。表の「実験の取り込み方」の列は、第10章で扱ったキャリブレーションを、それぞれの道具がどの形で受け取るかを示します。公式リポジトリは、Meridian、Robyn、PyMC-Marketing、LightweightMMM です。
| 項目 | Meridian | Robyn | PyMC-Marketing | LightweightMMM |
|---|---|---|---|---|
| 公開元 | Meta のマーケティング・サイエンスの部門 | PyMC Labs を中心とする開発者 | Google の GitHub の組織(公式製品ではないと明記) | |
| 言語 | Python(3.11〜3.13) | R が本体。Python 版はベータ | Python(3.12 以上) | Python |
| 推定の方法 | ベイズ推定(MCMC の NUTS。GPU を推奨) | リッジ回帰+進化計算でパラメータを探索し、複数の目的でモデルの組を出す | ベイズ推定(PyMC) | ベイズ推定(NumPyro) |
| 実験の取り込み方 | 媒体ごとの ROI の事前分布として置く | 実験の点推定とのずれを最適化の目的の1つに加える | 飽和の曲線の上の2点の差を観測として尤度に加える(実験の不確かさも指定する)。ROAS などの見込みでの較正もある | 公式リポジトリの説明では確認していない |
| 地域別のデータ | 扱える。使えるなら推奨 | 公式ガイドの範囲では確認していない | 多次元のモデルで扱える(実験的な段階と明記) | 地域別の階層モデルを扱える |
| 予算配分 | 配分の提案。シナリオプランナー(オープンベータ)もある | 総額を指定して反応を最大にする場面(max_response)と、目標の ROAS か CPA に沿って支出の水準を求める場面(target_efficiency) | 予算配分の最適化 | (支援終了) |
| 確認した最新版 | 2.1.0(2026年9月25日 UTC) | R 版 3.12.1(2025年7月2日)、Python 版 0.3.6(2025年4月3日 UTC) | 1.2.0(2026年9月29日 UTC) | 0.1.9(2023年5月23日 UTC)。2026年1月19日にアーカイブ |
| ライセンス | Apache 2.0 | MIT | Apache 2.0 | Apache 2.0 |
表から読み取れるいちばん大きな違いは、実験の結果をどこに入れるかです。Meridian は ROI そのものに事前分布を置くので、「この媒体の ROI は実験で1.7前後だった」という情報をそのまま入れやすい形です。PyMC-Marketing は、実験で広告費を動かした幅とそのときの売上の変化を、応答曲線の形の情報として入れます。Robyn は、実験の結果に合うモデルを、たくさんの候補の中から選びやすくします。この記事の第10章では、SNS 広告の ROI が実験の値に近づくよう罰則を足して推定し直しました。第10章で整理したとおり、これはモデルの尤度(データの当てはまりを測る部分)に実験の観測を1件加えたことに相当し、尤度に実験の項を足す PyMC-Marketing の形に近いものです。どの形が良いかは、手元にある実験が「ROI の水準」を測ったものか、「広告費を動かしたときの変化の幅」を測ったものかで変わります。実験を設計する段階で、どの道具にどの形で入れるかまで決めておくと、実験の費用を無駄にしにくくなります。
もう1つの違いは、計算の重さと、使う人に求める技能です。Meridian と PyMC-Marketing は MCMC で事後分布を求めるので、1回の推定に時間がかかり、Meridian は GPU を推奨しています。その代わり、結果は ROI の幅(信用区間)として出てきます。第9章で、この記事の共通データの ROI を1つの数字で報告する危険を見ましたが、ベイズ推定の道具は、その幅を最初から出す設計です。Robyn は、パラメータの探索に多数の反復(ガイドは幾何減衰の場合に2,000回の反復を5回行う例を挙げています)を回し、その結果から分析者が1つを選びます。選ぶ人の判断が結果に入るので、どの基準で選んだかを記録して、次の更新でも同じ基準を使うことが大事になります。
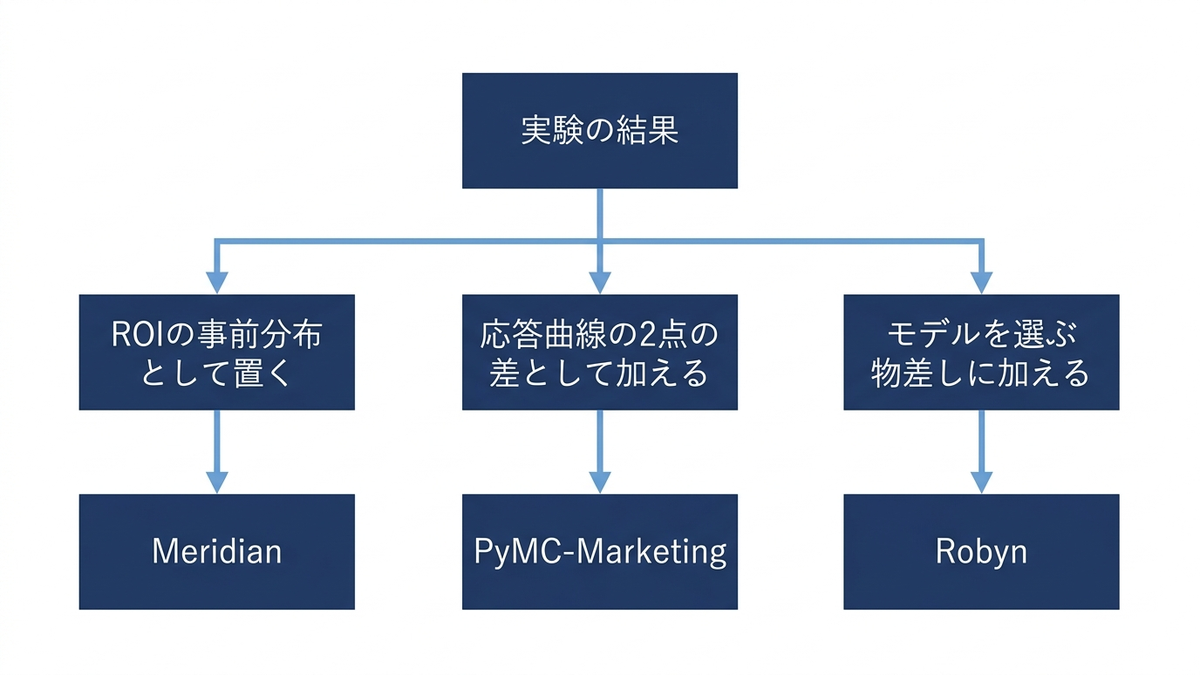
公開された一次情報で確認できた事例
MMM の導入事例は、媒体を運営する企業や分析を支援する企業の発信が多く、成果の数字の多くは「モデルで見積もった改善の余地」です。この節では、公式の資料を開いて確かめた事例だけを、資料に書かれた文言の区別(見積もりか、実績か、数字が無いか)とともに並べます。企業の広告費の金額は、どの資料にも書かれていなかったので書きません。
| 企業・組織(概要) | 出典の種類 | 何をしたか | 資料に書かれた数字 | 数字の性質 |
|---|---|---|---|---|
| Akulaku(金融サービス) | Google の公式記事(Think with Google、2025年9月) | Meridian で媒体の効果を分析し、配分を見直す場面を試算 | 有料メディアが流通取引総額の75%を生んだ。総額を変えずに配分を見直すと流通取引総額が16%増える可能性。分析は3か月未満で完了 | 75%は分析の結果として記載。16%は「可能性」としての見積もり |
| NoBroker(物件の所有者と借り手・買い手をつなぐサービス) | 同上 | YouTube と複数の動画配信サービスでのリーチとフリークエンシーの釣り合いを分析 | YouTube の見込み客1件あたりの費用が動画配信サービスより69%低く、媒体全体より31%低い。検索は媒体全体より14%低い。Google の広告への投資を20%を超えて増やすと売上が40%を超えて伸びうる | 費用の比較は分析の結果として記載。40%は「伸びうる」としての見積もり |
| 博報堂DYグループの顧客の飲料メーカー(社名の記載なし) | Google の公式記事(Think with Google、2026年6月) | 最適な接触回数の分析と ROI の試算 | YouTube TV のキャンペーンで約10%の ROI の改善を見いだした | 見積もりか実績かは記載なし |
| Google がアジア太平洋で依頼した Meridian の案件(25件) | 同上 | Meridian の結果に基づく予算配分の見直し | 媒体由来の売上またはコンバージョンが14%増えうる(認定パートナー12社が行った案件の集計。内訳は日本4件のほか、米国5件・トルコ1件なども含む。2025年5月〜2026年2月) | 見積もりの集計 |
| HelloFresh | PyMC Labs の公式ブログ | ベイズ MMM の精度と速度を改善(持ち越しの計算の高速化、外れ値に強い分布への変更など) | 予測のばらつきを60%減らした。推定の時間が20分から2分になった | モデルの性能の実績(広告の成果ではない) |
| Finder(オーストラリアの金融関連の企業) | Google の公式ブログ(2025年1月) | 自前で一から作っていた線形回帰のモデルから Meridian に移行 | 数字の記載なし | 担当者のコメントのみ |
| マクロミル(日本) | 同社のプレスリリース(2024年11月12日) | 自社の MMM のサービスに Robyn を組み込み、Meta の広告データの受け渡しを連携 | 数字の記載なし | 「迅速」「工数削減」という定性的な記述 |
| 博報堂DYメディアパートナーズ・Hakuhodo DY ONE(日本) | 同社のプレスリリース(2025年1月31日) | Meridian を自社の分析サービスに組み込み、日本とアジア太平洋で認定パートナーに | Meridian では最低2年分のデータから分析できる、と記載(同社の説明。Meridian の公式ドキュメントは、地域別のモデルで最低2年分の週次データ、全国のモデルで3年分を目安としている) | 提供体制の発表 |
表の事例を読むときに大事なのは、「数字の性質」の列です。Akulaku の16%、NoBroker の40%、アジア太平洋の25件の14%は、いずれも資料の文言が「増える可能性がある」「伸びうる」で、モデルが示した改善の余地です。実際に予算を動かしてその分だけ売上が増えたことを示した数字ではありません。この記事の共通データで言えば、第12章で見た MMM(基準)自身の見込みに当たります。MMM(基準)は自分の応答曲線で測って、配分を見直せば週の増分売上が 1,329.6万円から 1,928.3万円に増える(年 +31,133万円の改善)と見込みました。ところが、同じ配分を真の応答で測ると、改善は年 +3,816万円(定常状態の週の差を52倍した年換算)でした。モデルは自分の配分の効果を約8倍に見積もっていたことになります。真の最適(年 +16,622万円)と比べても、かなり小さい改善です。モデルが「増えうる」と言った額と、真の応答で測った額は一致するとは限りません。第12章で見たとおり、実際の週ごとの出し方で計算し直すと、この改善はさらに小さくなりました。事例の数字は、自社で同じ額が得られることの根拠ではなく、「この種の分析で配分の見直しの余地が見つかることがある」という程度に受け取るのが妥当だと考えています。
もう1つ注意したいのは、事例の出どころです。表の事例のうち多くは、媒体を運営する企業(Google)の記事に載ったもので、その媒体の効果が高く出た例が含まれています。NoBroker の例は YouTube の費用対効果が他より良かったという結果で、提案は Google の広告への投資を増やす場面でした。資料が誤っていると言っているのではありません。媒体の運営者が自社の媒体に有利な事例を選んで紹介するのは自然なことで、読む側は、選ばれた事例であることを前提に読む必要があります。自社で MMM を使うときに、ある媒体の担当や代理店の出した結果を、その媒体の実験や別の手法で確かめる(第2章の三角測量)のは、同じ理由によります。
国内の動きとしては、大手の広告会社が Meridian や Robyn を自社の分析サービスに組み込む発表が続いています。博報堂DYメディアパートナーズと Hakuhodo DY ONE は2025年1月31日のプレスリリースで、Meridian を自社のサービスに組み込んで提供を始めたこと、Google から日本とアジア太平洋の両地域で認定パートナーに選ばれたことを発表しました。同じリリースは、認定パートナーには Google の広告の詳しい出稿データ(YouTube のリーチとフリークエンシーのデータや検索量のデータなど)が提供されること、同グループが10年以上 MMM を提供してきたこと、2023年9月に Google Japan と共同で MMM の活用の手引きを公開したことも書いています。Google の Meridian のパートナーの一覧のページには、アジア太平洋の MMM のパートナーとして電通デジタルと Hakuhodo DY ONE が載っています。マクロミルは2024年11月12日のプレスリリースで、自社のブランディングの効果を測る MMM のサービスに Robyn を組み込んだことを発表しました。これらはいずれも提供体制の発表で、特定の広告主の成果の数字は書かれていません。この章で調べた範囲では、日本の広告主が自社の名前と成果の数字を出した MMM の公開事例は見つかりませんでした。
経営の判断として、事例から引き出せることは2つあると考えています。1つは、MMM の結果を予算に反映するまでの期間です。Akulaku の例では、分析が3か月未満で終わったことが、他の MMM で通常かかる期間の半分だとして紹介されています。この比較は Google の記事の記述で、何と比べて半分なのかは記事からは分かりません。ただ、数か月単位の時間がかかる前提で予算の周期に組み込む必要がある、という点は第13章の更新の周期の話と合っています。もう1つは、事例が示す「改善の余地」の大きさは、自社の現状の配分がどれだけ偏っているかに左右されることです。この記事の共通データでも、見直しの余地の1つはディスプレイ広告にありました(MMM(基準)の配分でも真の最適の配分でも、下限の0.5倍まで減らされました)。見直しの余地が大きいと出たときほど、その根拠になった媒体の ROI が実験で確かめられているかを先に問うのが、損失を避ける順序です。
研究の動き、地域別の階層モデルと実験との統合
道具の設計の背後にある研究も、公開された論文で確かめられます。次の表は、Google の研究者が公開した MMM の論文のうち、Google Research の公式ページで書誌と要旨を確かめたものです。題名は日本語で言い換えています。
| 年 | 論文の主題(著者) | 要旨で述べられていること | この記事との関係 |
|---|---|---|---|
| 2017 | MMM の課題と改善の機会(Chan、Perry) | MMM が媒体の効果について妥当な答えを出すうえでの障害を整理し、推論を改善する方向を示す | 第8章の識別性、第13章の運用 |
| 2017 | 持ち越しと形の効果をベイズ推定で扱う MMM(Jin ら) | 柔軟な関数の形で持ち越しと逓減を表す。標本が小さいと事前分布の影響が強く、推定が偏りうる。最適な配分は推定の不確かさのために大きくばらつく | 第5章・第6章・第9章 |
| 2017 | 地域別のデータを使う階層ベイズの MMM(Sun ら) | 全国のデータだけのモデルより信用区間が狭くなることが多い。一部の媒体に地域別のデータが無く全国の値で補うと、推定は一般に悪くなる | 第3章のデータの粒度、第9章の区間 |
| 2018 | 検索広告の偏りの補正(Chen ら) | 広告の配信先の選び方から生じる偏りを、因果の図と裏口基準で補正する。無作為化実験と比べて検証し、よくある場面ではおおむね偏りの無い推定が得られうる | 第7章の交絡 |
| 2024 | ベイズの事前分布による MMM の較正(Zhang ら) | ROI をモデルのパラメータとして書き直し、その事前分布を実験の結果や知識に合わせる。シミュレーションで、ROI の推定の偏りと不確かさを大きく減らせることを示す | 第10章のキャリブレーション |
表の論文には、持ち越しと飽和の形をどう表すかの工夫に加えて、観察データだけでは決まらない部分を地域の差と実験の結果で補う研究の流れが見られます。2017年の Jin らの論文の要旨はすでに、標本が小さいと事前分布が結果を強く左右し、最適な配分が大きくばらつくと書いています。この記事の共通データでも、当てはまりは良いのに検索広告と SNS 広告の ROI が真の値の約半分に出ました(第8章)。配分の見直しで得られた改善も、真の最適よりかなり小さくなりました(第12章)。Jin らの指摘する小標本での不安定さが、これらの原因かどうかは確かめていません。ただ、当てはまりが良くても配分の判断が大きく外れうるという点では、同じ方向の注意として読めます。
地域別のデータを使う方向は、2017年の Sun らの論文から Meridian の設計(地域別のデータを推奨)まで一貫しています。地域ごとに広告費の動きが違えば、全国の合計では1本の線にしか見えなかった広告費と売上の関係に、より多くの手がかりが加わるからです。同じ論文の要旨が、一部の媒体だけ地域別のデータが無い場合は推定が悪くなると書いている点は、データの整備の優先順位に関わります。テレビの地域別の出稿量は取れるのに、デジタル広告は全国の合計しか無い、という状態では、地域別のモデルの利点が十分に出ません。第3章で扱ったデータ整備の段階で、媒体ごとにどの粒度で取れるかをそろえておく意味がここにあります。
実験との統合も、2018年の検索広告の論文(実験で補正の妥当性を確かめた)から、2024年の較正の論文(ROI を直接の対象にして実験の結果を事前分布に入れる)へと進んでいます。Meridian の公式ドキュメントは、媒体の係数の代わりに ROI をモデルのパラメータにする書き直しを説明する章で、この較正の方法の詳細としてこの論文を案内しています(論文の年は、Google Research の公式ページでは2024年、Meridian の参考文献の一覧では2023年と表記されています)。公式ドキュメントが挙げている注意(実験が測るものと MMM が測るもののずれ、時期のずれ、短い実験の取りこぼし)は、研究の段階でもまだ解決しきれていない論点です。PyMC-Marketing の公式リポジトリは、媒体の効き目の時間変化を表す機能や、長期のブランドへの効果を表すベイズのベクトル自己回帰のモデル(複数の時系列が、互いの過去の値から影響し合う関係を表すモデル)を機能として挙げています。この記事の第11章で、週次のデータで測れる効果には限界があることを見ましたが、その限界をモデルの側から広げようとする試みです。ただし、時間とともに変わる効果や長期の効果をモデルに加えるほど推定するパラメータが増え、第8章で見た識別性の問題は厳しくなると考えられます。新しい機能を使うほど、実験での答え合わせの重みが増すと考えています。
生成AIとの関係
生成AIとの関係では、道具の公式資料に2つの動きが見られます。1つは、AI のエージェント(指示を受けて、コードを書いたり実行したりを自分で進めるプログラム)に、MMM の作業の手順を教える部品です。Meridian の公式ドキュメントにはエージェントスキルの章があり(2026年9月3日更新の版で確認)、公開された共通の規格に沿った5つのスキルを提供していると説明しています。公式ドキュメントに答える相談役、データの読み込みから事前分布の設定・推定・保存までを案内するモデル構築、収束の確認と経営向けの要約レポートを作る結果の可視化、総額を固定した場合や目標の ROI を置いた場合の予算の最適化、シナリオプランナー用のデータの準備、の5つです。公式ドキュメントは、列の対応づけの確定、事前分布の設定(ROI の事前分布や、ノットの間隔など)、時間のかかる MCMC の実行、スクリプトの実行の前に、エージェントが止まって人の確認を待つ仕組み(チェックポイント)を組み込んでいる、と書いています。PyMC-Marketing の公式リポジトリも、PyMC-Marketing を使ったマーケティング分析の質問に答える AI の相談役(MMM-GPT)を案内しています。
もう1つは、道具そのものの開発に生成AIが使われていることです。Robyn の公式リポジトリは、Python 版を R 版から大規模言語モデルの助けを借りて翻訳したもので、不具合を含みうると明記しています。開発の速度が上がる一方で、利用者の側に「動くが正しいとは限らない」ことを確かめる責任が残る例です。
この2つの動きから言えるのは、生成AIが縮めるのは主に「コードを書いて動かすまでの時間」だということです。この記事で見てきた MMM の難しさの中心は、コードを書くことではなく、当てはまりの良いモデルが ROI を誤ることがある(第8章)、事前分布の置き方で ROI が動く(第9章)、当てはまりだけでは効果の誤りを見抜けないことがあり、実験はその誤りを確かめる有力な手段になる(第10章)、という点にありました。Meridian のエージェントスキルが、事前分布の設定や推定の前に人の確認を待つ設計になっているのは、まさにこの判断の部分を人に残すためだと読めます。AI に MMM を組ませると、もっともらしい ROI の表が短い時間で出てきます。その表を予算の判断に使う前に、どの事前分布を置いたか、実験の結果と合っているか、当てはまりだけで選んでいないかを、人が確かめる手順を決めておくことが有効だと考えています。
道具を選ぶ前に経営として決めておくこと
ここまでの内容を、経営の判断の形にまとめます。オープンソースの MMM は無料で手に入りますが、どれを使っても、データの整備・検証・実験・会議への組み込みにかかる人の時間は同じように要ります。そのため、道具を選ぶ前に決めておくべきことは、道具の機能の比較ではなく、次の4つだと考えています。
- 誰が作り、誰が検証するか。社内で作るなら、R と Python のどちらを使える人がいるか、GPU を含む計算の環境を用意できるか。外部に頼むなら、結果の検証を誰が行うか(第13章)
- どの粒度のデータを、どの媒体についてそろえられるか。地域別のデータを全媒体でそろえられるなら、地域別のモデルを使える道具の利点が大きい(第3章)
- どの実験を、どの形で行えるか。ROI の水準を測る実験か、広告費を動かしたときの変化の幅を測る実験かで、取り込みやすい道具が違う(第10章)
- 結果を何に使うか。年1回の予算配分に使うのか、四半期ごとに配分を少しずつ動かすのか。更新の頻度で、計算の重さの許容範囲が変わる(第12章・第13章)
判断を誤ったときの損失は、道具の選択そのものより、道具の出した数字をそのまま予算に反映することから生まれうるものです。この記事の共通データでは、当てはまりの良い MMM(検証期間の MAPE 2.64%)に従って配分を変えると、真の応答で測った年換算(定常状態の週の差の52倍)で +3,816万円の増分売上でしたが、真の最適なら年 +16,622万円でした。差は約1億2,800万円で、このうち少なくとも約9,000万円は、モデルの応答曲線の形の誤り、とくに検索広告の限界ROIを大きく見積もったこと(現状の支出で2.26、真の値は1.47)で取り逃した分と読めます。第12章では、SNS 広告の実験で平均の ROI を真の値に近づけても(第10章)配分は変わらず、改善は年 +3,816万円のままで、この差は縮みませんでした。検索広告の支出を増やす実験を足して限界ROIの推定が真の値に近づくと、改善は年 +3,816万円から年 +12,789万円に増えました(真の最適の約77%)。差の残りは、この実験では縮みませんでした。逆に、素朴な回帰に従うと年 -10,741万円で、現状より悪くなりました。どの道具を使っても、この種の誤りは起こりえます。道具を入れることを MMM の導入の完了と見なさず、実験での答え合わせと、配分を少しずつ動かして結果を確かめる手順までを1つの計画として予算に組み込むことが、損失を抑える現実的な方法だと考えています。
この章のまとめ
Meridian・Robyn・PyMC-Marketing は、いずれも持ち越しと飽和を表す MMM をオープンソースで提供していますが、推定の方法と実験の取り込み方がそれぞれ違います。公開された事例の数字の多くは「配分を見直せば増えうる」という見積もりで、媒体を運営する企業の記事に載ったものが中心です。研究の動きは、地域別のデータと実験の結果で観察データの弱さを補う方向に進んでおり、生成AIは作業の時間を縮めても、ROI が正しいかを確かめる判断までは代わりません。この記事の終章では、ここまでの14章を、広告の効果を測り続けるための考え方としてまとめます。
この章を深めたい方への参考書籍
『Pythonによるベイズ統計モデリング PyMCでのデータ分析実践ガイド』(Osvaldo Martin 著、金子武久 訳、共立出版):この章で紹介した PyMC-Marketing の土台になっている、Python のベイズ推定のライブラリ PyMC を使ってデータを分析する手順を扱う訳書です。第1章で確率と不確実性、単一のパラメータの推論から入ります。PyMC-Marketing や Meridian が出す事後分布や信用区間を、道具の画面の数字としてではなく、どういう計算から出てきたものかを理解して読むための準備に向いています。
『2030年の広告ビジネス デジタル化の次に来るビジネスモデルの大転換』(横山隆治・榮枝洋文、翔泳社):広告とマーケティングの業界の変化を扱う本で、データ利活用の常識の逆転、コネクテッドTVの時代のメディア、業界地図の変化、広告代理店のビジネスモデルの変化、次世代の広告人に求められる機能とスキルなどを章として立てています。版元の内容紹介はターゲティング広告への規制強化にも触れています。この章の冒頭で見た、個人単位の追跡を制限する動きと、集計データで推定する MMM の道具の公開を、広告業界全体の変化の中に置いて捉え直すのに向いています。
終章 広告の効果を測り続けるための5つの考え方
本コラムでは、架空の日用品メーカーの週次データを使い、売上を基礎売上と媒体ごとの増分に分ける手順から、持ち越しと飽和の組み込み、季節や販促との切り分け、推定と検証、不確かさの表し方、実験による較正、ROIと限界ROIの読み方、予算の配分の最適化、組織での使い続け方までを、実際にコードを動かしながら見てきました。この章では、各章の結果から、広告の効果を測り、予算の判断に使い続けるための考え方を5つにまとめます。いずれも、この架空のデータとその設定での結果から導いたものです。媒体の数や効果の大きさ、データの期間が違えば数字は変わりますが、判断の手順としては一般に通用する部分が大きいと考えています。
1. 当てはまりの良さを、効果の正しさの根拠にしない
第2章の基準の結果では、MMM(基準)は学習に使わなかった最後の26週の売上を、MAPE(平均絶対誤差率)2.64%の誤差で言い当てました。それでも、直近52週の売上ROIは、検索広告で真の値2.35に対して1.18、SNS広告で1.76に対して0.90と、どちらも約半分でした。第8章では、検索広告のROIを0.8から3.5まで固定して推定し直しても、学習期間の誤差(二乗平均平方根誤差 RMSE)は、採用した推定と比べて最大でも2.3%(相対的な増加)しか増えないことを確かめました。売上全体の動きを説明できるパラメータの組は1つではなく、その中で媒体どうしへの効果の振り分けが大きく違いうる、ということです。第7章では、広告が無くても出る基礎売上の真の値を与えても、検索広告とSNS広告の振り分けは直らないことも確かめました。
したがって、MMMの結果を報告するときは、予測の当てはまりを効果の正しさの証拠として示さないことが大事です。当てはまりは「モデルが使える状態にあるか」の確認であり、媒体ごとの効果が正しいかは、別の材料(推定の幅、実験の結果、業務の知識との整合)で確かめる必要があります。この点を報告の受け手と共有しておかないと、当てはまりの良いモデルの数字が、そのまま予算の組み替えに使われます。
2. 配分は平均のROIではなく、限界ROIで決める
第11章で見たとおり、平均のROIが高い媒体ほど、次の1万円の効果(限界ROI)が高いとは限りません。この例では、検索広告の売上ROIは直近52週で2.35と4媒体の中で最も高い一方、現状の支出での限界ROIは真の値で1.47でした。広告費を増やすほど効果が頭打ちになるためです。第12章では、真の値で最適な配分を求めると、配分を動かした3つの媒体(テレビCM・検索広告・SNS広告)の限界ROIが1.69でそろうことを確かめました。平均のROIの順位で予算を寄せると、すでに頭打ちに近い媒体へ積み増すことになります。
限界ROIは、推定の誤りの影響も大きく受けます。MMM(基準)は検索広告の平均のROIを小さく見積もった一方で、現状の支出での限界ROIは2.26と、真の値1.47より大きく見積もっていました。2倍の支出でも3.86(真の値は0.62)と見ていました。この限界ROIの大きな見積もりが、MMM(基準)の配分で検索広告を上限の2倍まで増やした理由です。配分の判断に使う数字は、平均ではなく限界の側で、しかもその推定がどれだけ確かかを確かめてから使う必要があります。また、粗利で見ると、この例の架空の粗利率0.50の下では、週次の売上に現れる短期の効果だけで見て、限界ROIが2.0未満では次の1万円の広告費を粗利で回収できず、2.0でちょうど回収でき、2.0を超えると広告費を差し引いても粗利が残ります(第11章・第12章)。長期の効果は含みません(第11章)。
3. 推定には幅を付け、幅の大きい媒体から確かめる
第9章では、残差を4週ずつのまとまりごとに、重複を許して選び直すブートストラップで推定を100回やり直し、売上ROIの90%区間を求めました(第11章の報告の表に載せた、回数を40回に減らした簡易の区間とは別の計算です)。この第9章の100回の区間では、テレビCMは1.32〜1.51と狭い一方、SNS広告は0.73〜13.74、ディスプレイ広告は0.00〜1.23と、判断に使えないほど広い区間になりました。検索広告の区間は0.60〜1.87で、真の値2.35を含みませんでした。区間は推定の不確かさをすべて表すわけではなく、モデルの形そのものの誤りは区間の外に残ります。それでも、媒体ごとの確かさの違いを示すことはでき、どの媒体を先に確かめるかの候補を選ぶ材料になります。
経営報告には、1つの数字ではなく区間を並べることが有効だと考えています。その際、増分売上が生じているか(売上ROIが0より大きいか)と、粗利で広告費を回収できるか(この例の架空の粗利率0.50では売上ROIが2以上か)は分けて判断します。売上ROIの区間が2をまたぐ媒体について、広告費を回収できるかを断定せず、確かめる手段(実験)と時期を決めておけば、結果が出るまでの間に予算を大きく動かすことを避けられます。
4. 実験は、配分を左右する媒体と支出の水準で行う
第10章では、SNS広告を全国の半分の地域で8週間止めた地域実験(架空)の結果をMMMに取り込み、SNS広告の売上ROIを0.90から1.74(真の値1.76)に直しました。ところが、第12章で配分を計算し直すと、配分は較正の前とまったく同じで、真の値で測った増分の改善は年に約3,816万円のままでした。配分を大きく左右していたのは、限界ROIを大きく見積もっていた検索広告でした。第12章では、架空の設定として検索広告の支出を5割増やす実験を足すと、検索広告の限界ROIの推定が1.46(真の値1.47)に近づき、真の応答で測った現状比の改善は年に約1億2,789万円まで増えました。真の最適の配分での現状比の改善(年に約1億6,622万円)の約77%です。
この結果は、実験をどの媒体で、どの支出の水準で行うかが、実験の価値を決めることを示しています。推定がもっとも配分を動かしている媒体から実験するのが合理的です。上下限の端に張り付いた媒体や区間の広い媒体はその候補ですが、区間の幅と配分への影響の大きさは別です(SNS広告は区間が広くても、較正で配分は変わりませんでした)。推定値を妥当な範囲で変えたときに配分と期待利益がどれだけ変わるかを調べ、影響の大きい媒体を優先します。また、配分の判断に要るのは「今より増やしたらどうなるか」なので、支出を止める実験だけでなく、増やす実験も選択肢に入ります。実験の負担(止めた地域で失う粗利から節約できた広告費を差し引いた分に、実験の実施の費用を加えたもの)と、得られる情報で配分を直すことで見込める粗利の改善を、同じ粗利の尺度で比べて、実験の対象と順番を決めます。
5. 配分は小さく動かし、次の期のデータで確かめる
第12章では、各媒体を動かせる範囲を変えて、MMM(基準)で最適化した配分の結果を真の値で確かめました。現状比の改善は、0.9〜1.1倍の範囲で年に約3,440万円、0.8〜1.2倍で約6,377万円と、0.8〜1.2倍が最も大きくなりました。そこから0.5〜2倍に広げると約3,816万円に下がり、0〜4倍まで広げると約2億7,299万円の悪化になりました。MMM(基準)自身の見込みは範囲を広げるほど大きくなりましたが、真の応答で測った改善は、0.8〜1.2倍より広げると小さくなりました。推定に誤りがあると、動かす幅を広げるほど、その誤りが損失として表に出やすくなると考えられます。
また、本コラムの配分の計算は、毎週同じ額を出し続ける定常状態を前提にしています。第12章では、定常状態の前提で真の応答から求めた配分(真の最適の配分)を、4媒体それぞれの実際の週ごとの出し方の形を残して倍率だけを変える形で実行したと見なし、真の応答で測ると、現状を年に927万円下回ることを確かめました。最適化したときの前提(毎週均等に出す)と、評価したときの条件(実際の週ごとの出し方)が違うためです。配分の数字を実行の計画に移すときは、媒体ごとの出し方(放映期間の組み方、入札の運用)まで含めて確かめる必要があります。動かす幅を決め、動かした結果を次の四半期のデータで確かめ、必要ならモデルと配分を直す、という循環を回すことが、推定の誤りを小さな損失のうちに見つける方法だと考えています。
広告の効果測定を、予算の判断の手順に組み込む
MMMは、媒体ごとの効果を一度で正確に言い当てる道具ではなく、推定と実験と配分の見直しをくり返す中で、効果の見積もりを少しずつ確かにしていくための道具だと考えています。データの整備(第3章)、持ち越しと飽和を組み込んだ推定(第4章から第8章)、不確かさの表示(第9章)、実験での較正(第10章)、限界ROIによる配分(第11章・第12章)を、四半期や半期の予算の会議に固定の手順として組み込み(第13章)、公開されている道具(第14章)を使って更新の手間を抑えることが、広告の効果を測り続けるための現実的な進め方です。
最初の一歩としては、売上・広告費・販促・休日の週次の記録を同じ粒度でそろえ、媒体ごとの広告費の台帳の持ち主を決めることから始めるのがよいと考えています。期間の目安は、第3章で見たとおり、Meridian の公式ドキュメントでは地域別のモデルで最低2年分の週次データ、全国のモデルで3年分です。ただし、期間がそろっても、媒体ごとの効果を見分けられるとは限りません。そのうえで、素朴な回帰とMMMの結果を並べ、両者の差が大きい媒体や区間の広い媒体を、最初の実験の候補にします。こうした順序であれば、大きな投資をする前に、自社のデータでどこまで効果を見分けられるかを確かめながら進められます。
Anagraftでは、データ活用の構想づくりから、マーケティングデータの整備、効果測定のモデルの設計と実装、実験の設計、予算配分の意思決定への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 広告の効果測定はなぜ経営の問題なのか
『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』(マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社):マーケティングの判断をデータに基づいて行うための指標を、経営者やマーケティング幹部に向けて解説した本です。ブランド認知などの非財務指標から、マーケティング投資の収益の評価、ネット広告の指標までを扱っています。この章で述べた「売上ではなく、経営の数字で広告の効果を評価する」という考え方を、指標の側から整理するのに向いています。
『マーケティングROI:投資効果を測定する客観的経営手法』(ジェームズ・D.レンズコールド 著、ベリングポイント戦略グループ 訳、ダイヤモンド社):マーケティングへの支出を投資として扱い、その効果を ROI で測って判断する考え方を解説した本です。ゴールは利益で尺度は ROI だという原則から始まり、投資と収益の測り方、企業や顧客の単位での収益性の管理までを扱っています。この章で売上ROIと粗利ROIを分けて示した理由、つまり広告の効果を売上ではなく利益の側から評価するという考え方を、経営の手法として確かめるのに向いています。
第2章 効果測定の手法の全体像、MMM・アトリビューション・実験
『データ分析の力 因果関係に迫る思考法』(伊藤公一朗 著、光文社):「広告が売り上げに影響したのか」のような因果関係の分析に焦点を当てた、数式を使わない入門書(光文社新書)です。第1章で、データから因果関係を導くのがなぜ難しいのかを扱い、第2章でランダム化比較試験を取り上げています。この章で整理した「観察データから推定する MMM」と「実験で増分を測る」方法の違いを、広告以外の例も含めて確かめるのに向いています。
『マーケティング・サイエンス入門 新版』(古川一郎・守口剛・阿部誠 著、有斐閣):データと論理に基づいて市場を把握するマーケティング・サイエンスの考え方と手法を、マーケティング計画の流れに沿って解説した教科書(有斐閣アルマ)です。第7章「コミュニケーションと広告」と第10章「テストとコントロール」が、この章で扱った広告の効果のモデル化と実験による検証の基礎にあたります。
第3章 MMMに使うデータを集めて整える
『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』(本橋智光、橋本秀太郎 著、技術評論社):データの抽出・集約・結合・日時の扱いなど、分析の前の加工を SQL・pandas・Polars で整理した本です。日次の記録を週に集計する、複数の台帳を週の単位で結合する、欠けた週を見つけるといった、この章で扱った整備の作業を手を動かして進めるときの手引きになります。
『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社):データ整備・システム・組織のあり方を扱った本で、第1章ではデータの品質を生成元のデータソースで担保するという考え方を説明しています。この章の後半で扱った「数字ごとに持ち主を決める」「台帳の段階で定義をそろえる」といった体制づくりを考えるときの参考になります。
第4章 回帰分析で売上を分解する
『計量経済学』(西山慶彦・新谷元嗣・川口大司・奥井亮、有斐閣):New Liberal Arts Selection の1冊で、第5章で重回帰モデルの推定と検定を扱い、第Ⅲ部で系列相関と時系列モデル、トレンドと構造変化を扱う教科書です。この章で使った最小二乗法・標準誤差・信頼区間の考え方を体系的に確かめるのに加え、週次の売上のように時間の順に並んだデータを回帰するときの注意点(残差の系列相関など)へ進むのに向いています。
『Rによる実証分析 第2版 回帰分析から因果分析へ』(星野匡郎・田中久稔・北川梨津、オーム社):回帰分析の基礎から、相関関係と因果関係、外生変数と内生変数を経て、ランダム化実験・操作変数法・パネルデータ分析までを、Rで手を動かしながら進める本です。この章で見た「広告費が他の売上の理由と連動していると係数が偏る」問題を、因果関係の推定という観点から整理し直すのに向いています。
第5章 アドストック、広告の効果は翌週以降に持ち越される
『経済・ファイナンスデータの計量時系列分析』(沖本竜義、朝倉書店):自己回帰(AR)過程を含む ARMA 過程、予測、VAR モデルとインパルス応答関数などを扱う時系列分析の教科書です。幾何減衰のアドストックは「今週の値=今週の入力+係数×先週の値」という自己回帰と同じ形の式で、この章の「1週だけ広告を出したときの値の推移」は、インパルス応答(ある時点に1回だけ加えた衝撃が、その後どう伝わるか)の考え方そのものです。持ち越しを時系列のモデルとして理解し直すのに向いています。
『入門 計量経済学 第2版 Excelによる実証分析へのガイド』(山本拓・竹内明香、新世社):回帰分析の基礎から始めて、多重回帰分析の拡張の章で遅れのある変数(ラグ変数)を扱い、後半の章で1次の自己回帰モデルと予測、インパルス応答関数を扱う入門書です。この章の「過去の広告費を重みを付けて足し合わせる」アドストックを、回帰に遅れのある変数を入れるという、より一般的な考え方の中で位置づけ直すのに向いています。副題のとおり、Excel を使った実証分析の手引きとして書かれています。
第6章 飽和と逓減、広告費を増やしても売上は比例しない
『マーケティング・モデル 第2版』(里村卓也、共立出版):「Rで学ぶデータサイエンス」シリーズの1冊で、統計ソフト R の入門から始めて、マーケティングの数理モデルを章ごとに扱う教科書です。目次には「市場反応の分析と普及の予測」という章があり、マーケティングの施策に市場がどう反応するかをモデルで表すという、この章の応答曲線と同じ問題意識を、マーケティング・サイエンスの側から学ぶ入口になります。
『データ分析のための数理モデル入門 本質をとらえた分析のために』(江崎貴裕、ソシム):目次によれば、数理モデルの適用限界、線形モデルと実験式・カーブフィッティング、モデルの数理構造とパラメータの選び方、パラメータの推定、情報量規準や交差検証によるモデルの評価までを1冊で扱う入門書です。どの関数の形を選ぶか、その形がどこまで通用するかという、この章の「範囲の外では形の仮定が答えを決める」という問題を、広告に限らない一般的な視点から考える助けになります。
第7章 季節性・販促・外部要因を切り分ける
『「原因と結果」の経済学 データから真実を見抜く思考法』(中室牧子・津川友介、ダイヤモンド社):相関と因果の違いと、反事実(もしその要因が無かったらどうなったか)の考え方から始め、ランダム化比較試験、差の差分析、操作変数、回帰不連続デザイン、マッチングを順に紹介し、最後の章で重回帰分析が交絡因子の影響を取り除く仕組みを説明しています。この章で扱った交絡と統制変数の考え方を、数式を使わずに確かめるのに向いています。
『Pythonではじめる時系列分析入門』(馬場真哉、講談社):時系列データの構造、季節調整とトレンド除去、見せかけの回帰、SARIMAX モデル、状態空間モデルとその中の基本構造時系列モデルまでを、Python の実装とともに扱う入門書です。この章で扱った季節性とトレンドの表し方を、時系列分析の側から体系的に学ぶのに向いています。
第8章 モデルを推定し、検証する
『スパース推定法による統計モデリング』(川野秀一・松井秀俊・廣瀬慧、共立出版):統計学One Point シリーズの1冊で、第1章で最小二乗法と正則化法、リッジ回帰、lasso を順に説明し、正則化パラメータの選び方として交差検証法の節を置いています。この章で使ったリッジ回帰と、罰則の強さを検証用のデータで決める手順を、lasso やエラスティックネットなどほかの正則化と並べて、数式と数値例で確かめるのに向いています。数値例を実行する R のコードも載っています。
『Rによる統計的学習入門』(G. James、D. Witten、T. Hastie、R. Tibshirani 著、落海浩・首藤信通 訳、朝倉書店):統計的学習の入門書の訳書で、リサンプリング法の章と、線形モデル選択と正則化の章を含みます。この章のホールドアウト検証・交差検証・リッジ回帰の考え方を、予測モデルの評価と選択という広い文脈で確かめるのに向いています。Robyn の公式ドキュメントも、リッジ回帰とベイズ回帰の関係の説明でこの本の原書を参照しています。
第9章 不確実性を示す、ベイズMMMとブートストラップ
『ブートストラップ入門』(汪金芳・桜井裕仁 著、共立出版):シリーズ「Rで学ぶデータサイエンス」の1冊で、英文の副題のとおり、統計ソフトの R を使ってブートストラップの方法を学ぶ入門書です。この章で使った「データを作り直して推定をやり直す」手順を、手を動かしながら確かめたいときに役立ちます。
『標準ベイズ統計学』(ピーター・D・ホフ 著、入江薫・菅澤翔之助・橋本真太郎 訳、朝倉書店):二項モデル・正規モデルから、ギブスサンプラー、階層モデル、線形回帰、非共役な事前分布とメトロポリス・ヘイスティングス法までを章立てで扱うベイズ統計の教科書です。この章で書いたメトロポリス法の背景を学べます。原書(A First Course in Bayesian Statistical Methods)は、この章で取り上げた Jin らの論文が、信用区間の説明の参考文献として挙げている本の1つです。
第10章 実験で答え合わせする、リフトテストと地域実験
『効果検証入門 正しい比較のための因果推論/計量経済学の基礎』(安井翔太 著、株式会社ホクソエム 監修、技術評論社):無作為化した実験(RCT)が効果の測定の基準になる理由から始め、回帰分析・傾向スコア・差の差・CausalImpact・回帰不連続デザインと、実験ができないときに比較を正しくする方法を順に扱っています。この章の地域実験の考え方(比べる相手を正しく作る)と、実験の結果を観察データのモデルと突き合わせる考え方の土台になります。
『A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは』(Ron Kohavi・Diane Tang・Ya Xu 著、大杉直也 訳、ドワンゴ):オンラインの対照実験の進め方、陥りやすい落とし穴、実験を組織で広げるために要ることを扱った本です。この章で触れた「実験の設計を誤ると、その誤りがそのまま判断に入る」という問題を、実験を運用する側から考える材料になります。
第11章 ROIと限界ROIで投資判断をする
『マーケティング・メトリクス マーケティング成果の測定方法』(ポール・W.ファリス、ネイル・T.ベンドル、フィリップ・E.ファイファー、ディビッド・J.レイブシュタイン 著、小野晃典、久保知一 監訳、ピアソン桐原):原書第2版(Marketing Metrics)の訳書です。原書は、利益とマージン、販売促進、広告媒体とウェブの指標、マーケティングと財務を章として立てており、この章で整理した ROI・ROAS・CPA のような指標を、マーケティングの成果の測り方の体系の中で確かめるのに向いています。
『ミクロ経済学の力』(神取道宏、日本評論社):消費者行動・企業行動・市場均衡・市場の失敗・独占を扱う価格理論の部と、ゲーム理論と情報の経済学の部からなるミクロ経済学の教科書で、第2章が企業行動の理論です。この章の「平均ではなく、次の1単位で判断する」という限界の考え方を、企業の利潤の最大化の理論から基礎づけて読むのに向いています。
第12章 広告予算の配分を最適化する
『これなら分かる最適化数学 基礎原理から計算手法まで』(金谷健一、共立出版):関数の極値とラグランジュの未定乗数法から始まり、勾配法・ニュートン法、非線形最小二乗法、線形計画法、非線形計画法、動的計画法までを1冊で扱う教科書です。この章の「最適な配分では、上下限に当たっていない媒体の限界ROIが揃う」という条件は、ラグランジュ乗数の考え方を広告予算に当てはめたものなので、その背景を数式でたどるのに向いています。MMM の推定に使った非線形最小二乗法の章もあり、推定と配分の両方の計算を同じ本で確かめられます。
『非線形最適化の基礎』(福島雅夫、朝倉書店):最適化問題の定式化、凸解析、最適性条件(カルーシュ・キューン・タッカー条件)、双対性理論を扱う専門書です。この章で使った、総額の等式と上下限の不等式を持つ配分の問題で、最適の点がどんな条件を満たすか(上下限に当たった媒体の限界ROIが揃わないのはなぜか)を厳密に理解したい方に向いています。
第13章 MMMを組織で使い続ける
『最強のデータ分析組織 なぜ大阪ガスは成功したのか』(河本薫 著、日経BP社):刊行時に大阪ガスでデータ分析の組織(ビジネスアナリシスセンター)を率いていた著者が、その組織の構成と役割、会社への貢献のしかたを書いた本です。目次には「意思決定プロセスを改革するのが仕事」という項目があります。この章で扱った役割の分担や、分析の結果を意思決定の場に届ける手順を、MMM に限らない組織づくりの観点から考える材料になります。
『データドリブン・カンパニーへの道 データ・AIで変革を進める企業人に学ぶ』(河本薫 著、講談社):企業でデータと AI の活用を進めてきた人たちへの取材をもとに、日本企業がデータに基づいて判断する会社へ進むための手がかりをまとめた本です。MMM を予算の判断に組み込むときにぶつかる、部門間の調整や経営層の関与の問題を考えるときに参考になります。
第14章 事例と最新動向
『Pythonによるベイズ統計モデリング PyMCでのデータ分析実践ガイド』(Osvaldo Martin 著、金子武久 訳、共立出版):この章で紹介した PyMC-Marketing の土台になっている、Python のベイズ推定のライブラリ PyMC を使ってデータを分析する手順を扱う訳書です。第1章で確率と不確実性、単一のパラメータの推論から入ります。PyMC-Marketing や Meridian が出す事後分布や信用区間を、道具の画面の数字としてではなく、どういう計算から出てきたものかを理解して読むための準備に向いています。
『2030年の広告ビジネス デジタル化の次に来るビジネスモデルの大転換』(横山隆治・榮枝洋文、翔泳社):広告とマーケティングの業界の変化を扱う本で、データ利活用の常識の逆転、コネクテッドTVの時代のメディア、業界地図の変化、広告代理店のビジネスモデルの変化、次世代の広告人に求められる機能とスキルなどを章として立てています。版元の内容紹介はターゲティング広告への規制強化にも触れています。この章の冒頭で見た、個人単位の追跡を制限する動きと、集計データで推定する MMM の道具の公開を、広告業界全体の変化の中に置いて捉え直すのに向いています。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 電通「2025年 日本の広告費」 総広告費8兆623億円で前年比105.1%、4年連続で過去最高
https://www.dentsu.co.jp/knowledge/ad_cost/2025/ - 電通「2025年 日本の広告費」の公表日 2026年3月5日
https://kyodonewsprwire.jp/release/202603045005 - Google 広告のラストクリックモデルの定義、ファーストクリック・線形・減衰・接点ベースのサポート終了、データドリブンへの切り替え、現在使えるモデルはラストクリックとデータドリブン
https://support.google.com/google-ads/answer/6259715?hl=ja - Apple の App Tracking Transparency
https://developer.apple.com/app-store/user-privacy-and-data-use/ - WebKit 公式ブログ 2020年3月24日
https://webkit.org/blog/10218/full-third-party-cookie-blocking-and-more/ - Mozilla 公式ブログ 2022年6月14日
https://blog.mozilla.org/en/products/firefox/firefox-rolls-out-total-cookie-protection-by-default-to-all-users-worldwide/ - Chromium 公式ブログ 2020年1月14日
https://blog.chromium.org/2020/01/building-more-private-web-path-towards.html - Privacy Sandbox 公式ブログ 2024年7月22日
https://privacysandbox.google.com/blog/privacy-sandbox-update - Privacy Sandbox 公式ブログ 2025年4月22日
https://privacysandbox.google.com/blog/privacy-sandbox-next-steps - Privacy Sandbox 公式ブログ 2025年10月17日
https://privacysandbox.google.com/blog/update-on-plans-for-privacy-sandbox-technologies - 『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社、2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I028101232 - 『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社、2017年
https://www.diamond.co.jp/book/9784478039632.html - 『マーケティングROI:投資効果を測定する客観的経営手法』ジェームズ・D.レンズコールド 著、ベリングポイント戦略グループ 訳、ダイヤモンド社、2004年
https://ndlsearch.ndl.go.jp/books/R100000002-I000007393951 - 『マーケティングROI:投資効果を測定する客観的経営手法』ジェームズ・D.レンズコールド 著、ベリングポイント戦略グループ 訳、ダイヤモンド社、2004年
https://www.kinokuniya.co.jp/f/dsg-01-9784478502334
第2章
- Meta の Robyn の解説文書が、MMM の前に経営上の問いを集めることを勧め、問いによっては増分を測る調査やアトリビューションが適すると書き、MMM 向きの問いとして媒体別の売上・ROI・予算配分を挙げている
https://facebookexperimental.github.io/Robyn/docs/analysts-guide-to-MMM/ - Google の Chan と Perry の2017年の論文
https://research.google/pubs/challenges-and-opportunities-in-media-mix-modeling/ - 博報堂DYメディアパートナーズが2023年9月22日に Google Japan と協働した MMM のガイドブックを公開したこと、MMM の説明、クッキーレスの流れで MMM が再注目されていること、クッキーはサードパーティ Cookie を指すという注記
https://www.hakuhodody-media.co.jp/wordpress/wp-content/uploads/2023/09/202309221100-02.pdf - Google 広告のヘルプのアトリビューション モデルの定義、現在のモデルはラストクリックとデータドリブン、データドリブンが既定、ファーストクリック・線形・減衰・接点ベースはサポート終了でデータドリブンへ移行
https://support.google.com/google-ads/answer/6259715?hl=ja - Google の Modern Measurement Playbook 2024年版
https://storage.googleapis.com/twg-content/documents/For_pub_on_TwG___External_Playbook_Modern_Measurement.pdf - 同手引きが3つを使うことを Google ではモダン・メジャメントと呼び、強みを生かし弱みを補う組み合わせが重要としていること、1つの道具がすべての答えを持つことはないと書いていること
https://business.google.com/us/think/measurement/drive-business-goals-modern-measurement/ - Google 広告のコンバージョン リフト測定の説明(広告を見たグループと見なかったグループの差、ユーザーに基づく方式と地域に基づく方式、地域に基づく方式はオフラインのデータに対応)
https://support.google.com/google-ads/answer/12003020?hl=ja - Google の Vaver と Koehler の2011年の地域実験の論文
https://research.google/pubs/measuring-ad-effectiveness-using-geo-experiments/ - Meridian の公式ドキュメントが、実験の結果を含む利用できる知識のすべてを事前分布の設定に使えると書いている
https://developers.google.com/meridian/docs/causal-inference/rationale-for-causal-inference-and-bayesian-modeling - 参考書籍『データ分析の力 因果関係に迫る思考法』伊藤公一朗 著、光文社(光文社新書 878)、2017年、ISBN 978-4-334-03986-8
https://ndlsearch.ndl.go.jp/books/R100000002-I028081131 - 参考書籍『データ分析の力 因果関係に迫る思考法』伊藤公一朗 著、光文社(光文社新書 878)、2017年、ISBN 978-4-334-03986-8
https://www.kobunsha.com/shelf/book/isbn/9784334039868 - 参考書籍『マーケティング・サイエンス入門 新版』古川一郎・守口剛・阿部誠 著、有斐閣(有斐閣アルマ)、2011年4月、ISBN 978-4-641-12438-7
https://www.yuhikaku.co.jp/books/detail/9784641124387 - 参考書籍『マーケティング・サイエンス入門 新版』古川一郎・守口剛・阿部誠 著、有斐閣(有斐閣アルマ)、2011年4月、ISBN 978-4-641-12438-7
https://ndlsearch.ndl.go.jp/books/R100000002-I000011179711
第3章
- MMM の課題と改善の機会を整理した2017年の Google の論文(David Chan、Michael Perry)
https://research.google/pubs/challenges-and-opportunities-in-media-mix-modeling/ - MMM の課題と改善の機会を整理した2017年の Google の論文(David Chan、Michael Perry)
https://storage.googleapis.com/gweb-research2023-media/pubtools/3803.pdf - Robyn の分析者向けの手引き 目的変数は売上が最も多く通信会社の契約申込や銀行の住宅ローン申込の例、説明変数は媒体・販促値引き・季節性の天候休日・マクロ経済の要因
https://facebookexperimental.github.io/Robyn/docs/analysts-guide-to-MMM/ - Meridian のデータの収集と整理のページ KPI は売上でも売上以外でもよく地域と時間で足し合わせられる指標であること、クリック率のような率は足し合わせられる形にする、revenue per KPI は任意で正確な値が無いときも妥当な近似値を強く勧める
https://developers.google.com/meridian/docs/pre-modeling/collect-data - Meridian の必要なデータ量のページ 全国のモデルでは1パラメータあたりのデータ点が鍵、媒体12・統制変数6・節点8で26個、2年分104点で4点は少なすぎる、対策3つ、データを足すと関連が薄くなるかもしれない、広告費の変動不足の悪影響
https://developers.google.com/meridian/docs/pre-modeling/amount-data-needed - GRP は、ある期間中に放送したテレビCMの各回世帯視聴率の合計で延べ視聴率ともいう
https://www.videor.co.jp/words/ghi.html - TARP は個人を対象にした延べ視聴率で TRP とも呼び、世帯対象は GRP、主に TARP はマーケティングデータに GRP は広告取引に使われる
https://www.videor.co.jp/words/st.html - インプレッションは広告の配信回数で、ページビューと区別する
https://www.videor.co.jp/words/index.html - JIAA が一般公開している用語集のウェブ版でも、インプレッションの定義は広告の配信回数でページビューと区別する、で変わっていない
https://www.jiaa.org/katudo/yogo/yogoshu_html/ - JIAA が一般公開している用語集のウェブ版でも、インプレッションの定義は広告の配信回数でページビューと区別する、で変わっていない
https://www.jiaa.org/katudo/kankobutu/jitumu2025/ - 参考書籍『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』本橋智光・橋本秀太郎 著、技術評論社、2024年6月、ISBN 978-4-297-14138-7
https://ndlsearch.ndl.go.jp/books/R100000002-I033469943 - 参考書籍『改訂新版 前処理大全 SQL/pandas/Polars実践テクニック』本橋智光・橋本秀太郎 著、技術評論社、2024年6月、ISBN 978-4-297-14138-7
https://gihyo.jp/book/2024/978-4-297-14138-7 - 参考書籍『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』ゆずたそ・渡部徹太郎・伊藤徹郎 著、技術評論社、2021年12月、ISBN 978-4-297-12445-8
https://ndlsearch.ndl.go.jp/books/R100000002-I031840097 - 参考書籍『実践的データ基盤への処方箋 ビジネス価値創出のためのデータ・システム・ヒトのノウハウ』ゆずたそ・渡部徹太郎・伊藤徹郎 著、技術評論社、2021年12月、ISBN 978-4-297-12445-8
https://gihyo.jp/book/2021/978-4-297-12445-8
第4章
- statsmodels の分散拡大係数の関数の説明で、VIF が5を超えるとその説明変数は他の説明変数と強い共線性を持ち、係数の標準誤差が大きくなるという目安が1つの推奨として書かれている
https://www.statsmodels.org/stable/generated/statsmodels.stats.outliers_influence.variance_inflation_factor.html - 参考書籍『計量経済学』西山慶彦・新谷元嗣・川口大司・奥井亮、有斐閣、2019年7月、ISBN 978-4-641-05385-4
https://ndlsearch.ndl.go.jp/books/R100000002-I029799302 - 参考書籍『計量経済学』西山慶彦・新谷元嗣・川口大司・奥井亮、有斐閣、2019年7月、ISBN 978-4-641-05385-4
https://www.yuhikaku.co.jp/books/detail/9784641053854 - 参考書籍『Rによる実証分析 第2版 回帰分析から因果分析へ』星野匡郎・田中久稔・北川梨津、オーム社、2023年1月、ISBN 978-4-274-23002-8
https://ndlsearch.ndl.go.jp/books/R100000002-I032595895 - 参考書籍『Rによる実証分析 第2版 回帰分析から因果分析へ』星野匡郎・田中久稔・北川梨津、オーム社、2023年1月、ISBN 978-4-274-23002-8
https://www.ohmsha.co.jp/book/9784274230028/
第5章
- 広告の持ち越し効果と飽和をベイズ推定で扱った2017年の Google の論文(Jin ら)
https://research.google/pubs/bayesian-methods-for-media-mix-modeling-with-carryover-and-shape-effects/ - 広告の持ち越し効果と飽和をベイズ推定で扱った2017年の Google の論文(Jin ら)
https://storage.googleapis.com/gweb-research2023-media/pubtools/3806.pdf - Joseph の2006年の論文が、テレビ広告の持ち越しを一般にアドストックと呼ぶとして Broadbent の1979年の論文を出典に挙げ、Broadbent のモデルとして今期のアドストック=今期の広告の量+減衰の係数×前期のアドストックの式を示していること
https://mpra.ub.uni-muenchen.de/7683/ - Joseph の2006年の論文が、テレビ広告の持ち越しを一般にアドストックと呼ぶとして Broadbent の1979年の論文を出典に挙げ、Broadbent のモデルとして今期のアドストック=今期の広告の量+減衰の係数×前期のアドストックの式を示していること
https://mpra.ub.uni-muenchen.de/7683/4/MPRA_paper_7683.pdf - Broadbent が Tim Fry と共著で同じ学会誌に1995年に発表した、長期の効果を視野に入れたアドストックのモデル化を題にした論文
https://doi.org/10.1177/147078539503700404 - Robyn の公式ドキュメントの幾何アドストックの説明(theta 0.75 なら1期目の75%が2期目に持ち越す)、週次のモデルでの経験としてテレビ0.3〜0.8・屋外広告と印刷とラジオ0.1〜0.4・デジタル0.0〜0.3、経験に基づく助言にすぎないという断り
https://facebookexperimental.github.io/Robyn/docs/features/ - Meridian の公式ドキュメントの幾何減衰と二項分布型の減衰、効果が持ち越しの期間の後半まで大きく残るなら二項分布型、そうでなければ幾何減衰を勧めること、重みが合計1に正規化されること、alpha の既定の事前分布が0から1の一様分布
https://developers.google.com/meridian/docs/advanced-modeling/set-adstock-decay-spec-parameter - Meridian の max_lag の推奨範囲(幾何減衰2〜10期、二項分布型4〜20期)、大きくするとデータが足りずばらつきが増えやすいこと、大きくしても ROI の推定値が増えるとは限らないこと
https://developers.google.com/meridian/docs/advanced-modeling/set-max-lag-parameter - 参考書籍『経済・ファイナンスデータの計量時系列分析』沖本竜義 著、朝倉書店、2010年2月、ISBN 978-4-254-12792-8、統計ライブラリー
https://ndlsearch.ndl.go.jp/books/R100000002-I000010689145 - 参考書籍『経済・ファイナンスデータの計量時系列分析』沖本竜義 著、朝倉書店、2010年2月、ISBN 978-4-254-12792-8、統計ライブラリー
https://www.asakura.co.jp/detail.php?book_code=12792 - 参考書籍『入門 計量経済学 第2版 Excelによる実証分析へのガイド』山本拓・竹内明香、新世社、2024年2月、ISBN 978-4-88384-377-0、経済学叢書 Introductory
https://ndlsearch.ndl.go.jp/books/R100000002-I033278144 - 参考書籍『入門 計量経済学 第2版 Excelによる実証分析へのガイド』山本拓・竹内明香、新世社、2024年2月、ISBN 978-4-88384-377-0、経済学叢書 Introductory
https://www.saiensu.co.jp/search/?isbn=978-4-88384-377-0&y=2024
第6章
- 広告の持ち越し効果と効き方の形をベイズ推定で扱った2017年の Google の論文(Jin・Wang・Sun・Chan・Koehler)
https://research.google/pubs/bayesian-methods-for-media-mix-modeling-with-carryover-and-shape-effects/ - 広告の持ち越し効果と効き方の形をベイズ推定で扱った2017年の Google の論文(Jin・Wang・Sun・Chan・Koehler)
https://storage.googleapis.com/gweb-research2023-media/pubtools/3806.pdf - A. V. ヒルの1910年の報告は Journal of Physiology 第40巻の補遺
https://doi.org/10.1113/jphysiol.1910.sp001386 - Hill の式の歴史をまとめた2012年の論文 Gesztelyi ほか Archive for History of Exact Sciences 第66巻第4号
https://doi.org/10.1007/s00407-012-0098-5 - Meridian 公式ドキュメント(モデルの仕様の説明)では既定でアドストックを先に計算してから Hill を掛け、設定で順序を逆にできる
https://developers.google.com/meridian/docs/basics/model-spec - 『マーケティング・モデル 第2版』(里村卓也、共立出版)
https://ci.nii.ac.jp/ncid/BB18363785 - 『データ分析のための数理モデル入門 本質をとらえた分析のために』(江崎貴裕、ソシム)
https://ci.nii.ac.jp/ncid/BB30526175 - 『データ分析のための数理モデル入門 本質をとらえた分析のために』(江崎貴裕、ソシム)
https://www.maruzenjunkudo.co.jp/products/9784802612494
第7章
- Meridian の公式ドキュメントでの統制変数の定義と3分類、交絡要因は入れる、成果だけに強く効く変数はばらつきを小さくできるので入れる、媒介変数は入れない、予測の当てはまりだけを目的に変数を増やしすぎない
https://developers.google.com/meridian/docs/advanced-modeling/control-variables - Meridian は時間とともに動く基礎売上の水準をノットで表し、特定の時期の効果に印を使う方法とノットを密に置く方法の違いを解説している
https://developers.google.com/meridian/docs/advanced-modeling/setting-knots - Hyndman と Athanasopoulos による予測の教科書(オンライン版の第3版)のフーリエ項の説明
https://otexts.com/fpp3/regression.html - PyMC-Marketing の MMM クラスの引数 yearly_seasonality は年周期の季節性に使うフーリエの成分の数、統制変数は control_columns
https://www.pymc-marketing.io/en/stable/api/generated/pymc_marketing.mmm.mmm.MMM.html - Robyn はトレンド・季節・休日・曜日の分解を Prophet で用意(曜日は日次データのみ)、競合や天候などの外部変数は基礎売上の側、context_vars で指定
https://facebookexperimental.github.io/Robyn/docs/features/ - Google の研究者による2018年の論文 MMM における検索広告の偏りの補正
https://research.google/pubs/bias-correction-for-paid-search-in-media-mix-modeling/ - Google の研究者による2018年の論文 MMM における検索広告の偏りの補正
https://storage.googleapis.com/gweb-research2023-media/pubtools/4388.pdf - 参考書籍『「原因と結果」の経済学 データから真実を見抜く思考法』中室牧子・津川友介、ダイヤモンド社、2017年2月、ISBN 978-4-478-03947-2
https://ndlsearch.ndl.go.jp/books/R100000002-I027967794 - 参考書籍『「原因と結果」の経済学 データから真実を見抜く思考法』中室牧子・津川友介、ダイヤモンド社、2017年2月、ISBN 978-4-478-03947-2
https://www.diamond.co.jp/book/9784478039472.html - 参考書籍『Pythonではじめる時系列分析入門』馬場真哉、講談社(実践Data Scienceシリーズ)、2024年9月20日、ISBN 978-4-06-536982-1
https://ndlsearch.ndl.go.jp/books/R100000002-I033688530 - 参考書籍『Pythonではじめる時系列分析入門』馬場真哉、講談社(実践Data Scienceシリーズ)、2024年9月20日、ISBN 978-4-06-536982-1
https://www.kodansha.co.jp/book/products/0000398240
第8章
- SciPy の least_squares の既定の計算方法と境界の扱い
https://docs.scipy.org/doc/scipy/reference/generated/scipy.optimize.least_squares.html - Google の研究者による2017年の MMM の課題を論じた論文
https://research.google/pubs/challenges-and-opportunities-in-media-mix-modeling/ - Google の研究者による2017年の MMM の課題を論じた論文
https://storage.googleapis.com/gweb-research2023-media/pubtools/3803.pdf - Hyndman と Athanasopoulos のオンライン教科書 第3版の時系列の交差検証
https://otexts.com/fpp3/tscv.html - 同教科書の、ホワイトノイズの自己相関の95%の範囲
https://otexts.com/fpp3/wn.html - 同教科書の、リュン・ボックス検定の読み方
https://otexts.com/fpp3/diagnostics.html - scikit-learn の TimeSeriesSplit
https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.TimeSeriesSplit.html - scikit-learn の Ridge の目的関数と alpha
https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.Ridge.html - statsmodels のダービン・ワトソン比
https://www.statsmodels.org/stable/generated/statsmodels.stats.stattools.durbin_watson.html - statsmodels のリュン・ボックス検定の関数
https://www.statsmodels.org/stable/generated/statsmodels.stats.diagnostic.acorr_ljungbox.html - Robyn がリッジ回帰を使う理由
https://facebookexperimental.github.io/Robyn/docs/features/ - 『スパース推定法による統計モデリング』 川野秀一・松井秀俊・廣瀬慧 共立出版
https://ndlsearch.ndl.go.jp/books/R100000002-I028842622 - 『スパース推定法による統計モデリング』 川野秀一・松井秀俊・廣瀬慧 共立出版
https://www.kinokuniya.co.jp/f/dsg-01-9784320112575 - 『Rによる統計的学習入門』 G. James ほか著 落海浩・首藤信通 訳 朝倉書店
https://www.asakura.co.jp/detail.php?book_code=12224
第9章
- ブートストラップを名付けて導入した Efron の1979年の論文
https://doi.org/10.1214/aos/1176344552 - 一般の定常な観測値に対するジャックナイフとブートストラップを題にした Künsch の1989年の論文
https://doi.org/10.1214/aos/1176347265 - 広告の持ち越し効果と効き方の形をベイズ推定で扱った Jin らの2017年の Google の論文
https://research.google/pubs/bayesian-methods-for-media-mix-modeling-with-carryover-and-shape-effects/ - 広告の持ち越し効果と効き方の形をベイズ推定で扱った Jin らの2017年の Google の論文
https://storage.googleapis.com/gweb-research2023-media/pubtools/3806.pdf - Meridian の公式リポジトリの説明
https://github.com/google/meridian - Meridian の公式ドキュメントの概要ページ
https://developers.google.com/meridian/docs/basics/about-the-project - Meridian の既定の事前分布を説明する公式ドキュメント
https://developers.google.com/meridian/docs/advanced-modeling/default-prior-distributions - PyMC-Marketing の公式ドキュメントの MMM の入門ページ
https://www.pymc-marketing.io/en/stable/guide/mmm/mmm_intro.html - Robyn の公式ドキュメントの機能紹介のページ
https://facebookexperimental.github.io/Robyn/docs/features/ - 参考書籍『ブートストラップ入門』汪金芳・桜井裕仁 著、共立出版
https://ndlsearch.ndl.go.jp/books/R100000002-I023229764 - 参考書籍『標準ベイズ統計学』ピーター・D・ホフ 著、入江薫・菅澤翔之助・橋本真太郎 訳、朝倉書店
https://ndlsearch.ndl.go.jp/books/R100000002-I032167945 - 参考書籍『標準ベイズ統計学』ピーター・D・ホフ 著、入江薫・菅澤翔之助・橋本真太郎 訳、朝倉書店
https://www.asakura.co.jp/detail.php?book_code=12267
第10章
- Google の Jon Vaver と Jim Koehler による2011年の地域実験の論文
https://research.google/pubs/measuring-ad-effectiveness-using-geo-experiments/ - Google の Jon Vaver と Jim Koehler による2011年の地域実験の論文
https://static.googleusercontent.com/media/research.google.com/en//pubs/archive/38355.pdf - Meta の GeoLift の公式ドキュメントの冒頭
https://facebookincubator.github.io/GeoLift/docs/intro - GeoLift のベストプラクティス
https://facebookincubator.github.io/GeoLift/docs/Best%20Practices/BestPractices - GeoLift の手法の説明
https://facebookincubator.github.io/GeoLift/docs/Methodology/ - Google の Kerman・Wang・Vaver による2017年の時間軸の回帰による地域実験の分析の論文
https://research.google/pubs/estimating-ad-effectiveness-using-geo-experiments-in-a-time-based-regression-framework/ - Meridian の較正の公式ドキュメント
https://developers.google.com/meridian/docs/advanced-modeling/roi-priors-and-calibration - Robyn の機能の説明のページ
https://facebookexperimental.github.io/Robyn/docs/features/ - PyMC-Marketing のリフトテストによる較正の解説
https://www.pymc-marketing.io/en/stable/notebooks/mmm/mmm_lift_test.html - 参考書籍 効果検証入門 正しい比較のための因果推論/計量経済学の基礎
https://gihyo.jp/book/2020/978-4-297-11117-5 - 参考書籍 A/Bテスト実践ガイド 真のデータドリブンへ至る信用できる実験とは
https://www.kadokawa.co.jp/product/302101000901/
第11章
- Google 広告の目標広告費用対効果に基づく入札の説明
https://support.google.com/google-ads/answer/6268637?hl=en - Google 広告の目標アクション単価の説明
https://support.google.com/google-ads/answer/6268632?hl=en - iROAS の定義を示した地域実験の論文
https://arxiv.org/abs/1908.02922 - Google の地域実験の分析ライブラリ Trimmed Match
https://github.com/google/trimmed_match - Meridian の ROI と mROI の定義
https://developers.google.com/meridian/docs/post-modeling/roi-mroi-response-curves - Meridian の持ち越しの最大の遅れの設定の説明
https://developers.google.com/meridian/docs/advanced-modeling/set-max-lag-parameter - Meridian のモデルの設定の説明
https://developers.google.com/meridian/docs/user-guide/configure-model - メディア・ミックス・モデリングの課題と改善の機会を論じた2017年の Google の技術報告
https://research.google/pubs/challenges-and-opportunities-in-media-mix-modeling/ - 参考書籍『マーケティング・メトリクス マーケティング成果の測定方法』
https://ndlsearch.ndl.go.jp/books/R100000002-I000011262869 - 同書の原書第2版の章立て
https://www.informit.com/store/marketing-metrics-the-definitive-guide-to-measuring-9780137058297 - 参考書籍『ミクロ経済学の力』
https://ndlsearch.ndl.go.jp/books/R100000002-I025772446 - 同書の目次
https://www.kinokuniya.co.jp/f/dsg-01-9784535557567
第12章
- SciPy の minimize 関数の SLSQP 法
https://docs.scipy.org/doc/scipy/reference/optimize.minimize-slsqp.html - 『これなら分かる最適化数学 基礎原理から計算手法まで』金谷健一、共立出版
https://ndlsearch.ndl.go.jp/books/R100000002-I000007936600 - 『これなら分かる最適化数学 基礎原理から計算手法まで』金谷健一、共立出版
https://www.kinokuniya.co.jp/f/dsg-01-9784320017863 - 『非線形最適化の基礎』福島雅夫、朝倉書店
https://ndlsearch.ndl.go.jp/books/R100000002-I000002980371 - 『非線形最適化の基礎』福島雅夫、朝倉書店
https://www.asakura.co.jp/detail.php?book_code=28001
第13章
- Google の研究者 David Chan と Michael Perry による MMM の課題と改善の方向を整理した2017年の論文
https://research.google/pubs/challenges-and-opportunities-in-media-mix-modeling/ - Meridian の公式ドキュメントのモデル更新のページ
https://developers.google.com/meridian/docs/post-modeling/refreshing-model - Robyn の公式ドキュメントの機能の説明
https://facebookexperimental.github.io/Robyn/docs/features/ - PyMC-Marketing の MMM の入門ガイド
https://www.pymc-marketing.io/en/stable/guide/mmm/mmm_intro.html - Meridian の公式リポジトリの説明とライセンス
https://github.com/google/meridian - Meridian の認定パートナーの一覧
https://developers.google.com/meridian/partners - Robyn の公式リポジトリの説明とライセンス
https://github.com/facebookexperimental/Robyn - 最強のデータ分析組織 なぜ大阪ガスは成功したのか
https://ndlsearch.ndl.go.jp/books/R100000002-I028637140 - 最強のデータ分析組織の版元ページ
https://bookplus.nikkei.com/atcl/catalog/17/264490/ - データドリブン・カンパニーへの道 データ・AIで変革を進める企業人に学ぶ
https://ndlsearch.ndl.go.jp/books/R100000002-I033371348
第14章
- Meridian の公式リポジトリ、集計データを使いCookieや利用者単位の情報を用いない設計、地域別データの推奨、実験と事前情報による較正、リーチとフリークエンシー、NUTS、GPU推奨、Python 3.11〜3.13、Apache 2.0
https://github.com/google/meridian - Meridian の最新版 2.1.0、2026年9月25日UTC登録
https://pypi.org/pypi/google-meridian/json - Meridian の一般公開を発表したGoogle公式ブログ、2025年1月29日、数百のブランドで試験、20社を超える計測パートナーのプログラム、Finderの担当者のコメント
https://blog.google/products/ads-commerce/meridian-marketing-mix-model-open-to-everyone/ - Meridian の提供開始を伝えたGoogle日本語版公式ブログ、2025年1月30日、日本の認定パートナーとして電通デジタルと博報堂DYグループのコメント
https://blog.google/intl/ja-jp/company-news/technology/meridian-japan-launch/ - Meridian の公式ドキュメントの概要、地域別データは統計的な情報を多く含み推定を改善する、検索のクエリボリュームの統制
https://developers.google.com/meridian/docs/basics/about-the-project - Meridian 公式ドキュメントの検索広告の章、クエリボリュームを統制しないと検索広告の効果を過大評価するおそれ
https://developers.google.com/meridian/docs/advanced-modeling/paid-search-modeling - Meridian 公式ドキュメントのROIの事前分布と較正の章、ガードレール、実験と MMM の測るもののずれ、時期・期間、変換で加わる不確かさ、事前分布と事後分布の比較
https://developers.google.com/meridian/docs/advanced-modeling/roi-priors-and-calibration - Meridian 公式ドキュメントのROIをパラメータにする書き直しの章が、較正の方法の詳細として Zhang らの論文を案内
https://developers.google.com/meridian/docs/advanced-modeling/roi-mroi-contribution-parameterizations - Meridian 公式ドキュメントの参考文献一覧で Zhang らの論文は2023年と表記、Jin ら・Sun ら・Chen らも掲載
https://developers.google.com/meridian/docs/causal-inference/reference-list - Meridian 公式ドキュメントの必要なデータ量の章、パラメータ26個で104点なら約4点で少なすぎる、対策と注意(期間の目安はこの章ではなくデータの収集と整理のページにある)
https://developers.google.com/meridian/docs/pre-modeling/amount-data-needed - Meridian 公式ドキュメントのモデルの更新の章、四半期・年ごと、新旧データを合わせて推定し直す、2〜3年の期間、過去データの二重計上の注意
https://developers.google.com/meridian/docs/post-modeling/refreshing-model - Meridian シナリオプランナー、オープンベータ、数回のクリックでレポート、2026年9月10日更新
https://developers.google.com/meridian/docs/scenario-planning/meridian-scenario-planner - Meridian Studio、Google Cloud 上の企業向け基盤、数百のモデルを同時に実行
https://developers.google.com/meridian/studio - Meridian のエージェントスキル、5つのスキル、チェックポイントで人の確認を待つ、2026年9月3日更新
https://developers.google.com/meridian/docs/user-guide/agent-skills - Meridian の結果の因果推論とベイズ推定を採る理由
https://developers.google.com/meridian/docs/causal-inference/rationale-for-causal-inference-and-bayesian-modeling - Meridian のパートナー一覧にアジア太平洋の MMM パートナーとして電通デジタルと Hakuhodo DY ONE が掲載
https://developers.google.com/meridian/partners?hl=ja - Robyn の公式リポジトリ、Meta のマーケティング・サイエンス部門による実験的な AI と機械学習を使ったオープンソースの MMM、Python 版はベータで大規模言語モデルの助けで翻訳、MIT ライセンス
https://github.com/facebookexperimental/Robyn - Robyn の R 版の最新版 3.12.1、2025年7月2日公開
https://cran.r-project.org/web/packages/Robyn/index.html - Robyn の Python 版の最新版 0.3.6、2025年4月3日UTC登録
https://pypi.org/pypi/robynpy/json - Robyn 公式の分析者向けガイド、リッジ回帰、Nevergrad、持ち越しの3つの形、Hill 関数、Prophet、複数の目的、実験の点推定、予算配分の2つの場面、週次で最低2年、変数1つに観測10点、2,000回の反復を5回
https://facebookexperimental.github.io/Robyn/docs/analysts-guide-to-MMM/ - PyMC-Marketing の公式リポジトリ、Apache 2.0 で商用にも無償、時間変化、実験での較正、ROAS や顧客獲得単価での較正、予算配分、長期のブランド効果のベイズのベクトル自己回帰、MMM-GPT の案内
https://github.com/pymc-labs/pymc-marketing - PyMC-Marketing の最新版 1.2.0、2026年9月29日UTC登録
https://pypi.org/pypi/pymc-marketing/json - PyMC-Marketing の論文、Journal of Open Source Software 第11巻第124号、2026年8月27日掲載
https://joss.theoj.org/papers/10.21105/joss.10805 - PyMC-Marketing の実験の取り込みの解説、飽和曲線の2点の差を観測として加える、完全に連動した2媒体の架空の例
https://www.pymc-marketing.io/en/stable/notebooks/mmm/mmm_lift_test.html - PyMC-Marketing の多次元の MMM の例、2市場、上限のパラメータを部分的に共有、持ち越しは市場ごと、実験的な段階
https://www.pymc-marketing.io/en/stable/notebooks/mmm/mmm_multidimensional_example.html - LightweightMMM の公式リポジトリ、NumPyro と JAX、全国と地域別の階層モデル、Google の公式製品ではない、2025年1月29日に Meridian 公開、サポート終了で移行を強く推奨、2026年1月19日にアーカイブ、Apache 2.0
https://github.com/google/lightweight_mmm - LightweightMMM の最後の版 0.1.9、2023年5月23日UTC登録
https://pypi.org/pypi/lightweight-mmm/json - Google の公式記事で紹介された Akulaku と NoBroker の事例、2025年9月
https://business.google.com/us/think/measurement/google-meridian-maximise-roi/ - Google の公式記事で紹介されたアジア太平洋の事例、2026年6月、博報堂DYグループの顧客の飲料メーカーが YouTube TV のキャンペーンで約10%の ROI 改善を見いだした、25件の集計で14%増えうる、シナリオプランナーの紹介
https://business.google.com/en-all/think/measurement/google-meridian-marketing-mix-modelling/ - PyMC Labs の公式ブログの HelloFresh の事例、予測のばらつきを60%削減、推定時間が20分から2分
https://www.pymc-labs.com/blog-posts/reducing-customer-acquisition-costs-how-we-helped-optimizing-hellofreshs-marketing-budget/ - マクロミルのプレスリリース、2024年11月12日、Brand Dynamics Modeling に Robyn を導入、成果の数値の記載なし
https://digitalpr.jp/r/98616 - 博報堂DYメディアパートナーズと Hakuhodo DY ONE のプレスリリース、2025年1月31日、Meridian を自社サービスに組み込み、日本とアジア太平洋で認定パートナー、詳細な出稿データの提供、10年以上の MMM の提供
https://hakuhodody-media.co.jp/wordpress/wp-content/uploads/2025/01/HDYMP202501301100-1.pdf - 広告の持ち越しと形の効果をベイズ推定で扱った2017年の Google の論文、Jin ら
https://research.google/pubs/bayesian-methods-for-media-mix-modeling-with-carryover-and-shape-effects/ - 地域別のデータを使う階層ベイズの MMM の2017年の Google の論文、Sun ら
https://research.google/pubs/geo-level-bayesian-hierarchical-media-mix-modeling/ - 検索広告の偏りの補正を扱った2018年の Google の論文、Chen ら
https://research.google/pubs/bias-correction-for-paid-search-in-media-mix-modeling/ - MMM の課題と改善の機会を整理した2017年の Google の論文、Chan と Perry
https://research.google/pubs/challenges-and-opportunities-in-media-mix-modeling/ - ベイズの事前分布による MMM の較正を扱った Google の論文、Zhang ら
https://research.google/pubs/media-mix-model-calibration-with-bayesian-priors/ - 参考書籍『Pythonによるベイズ統計モデリング PyMCでのデータ分析実践ガイド』Osvaldo Martin 著、金子武久 訳、共立出版、2018年6月、ISBN 978-4-320-11337-4
https://ndlsearch.ndl.go.jp/books/R100000002-I029031259 - 参考書籍『2030年の広告ビジネス デジタル化の次に来るビジネスモデルの大転換』横山隆治・榮枝洋文 著、翔泳社、2023年4月、ISBN 978-4-7981-7872-1、MarkeZine BOOKS
https://ndlsearch.ndl.go.jp/books/R100000002-I032753743 - 参考書籍『2030年の広告ビジネス デジタル化の次に来るビジネスモデルの大転換』横山隆治・榮枝洋文 著、翔泳社、2023年4月、ISBN 978-4-7981-7872-1、MarkeZine BOOKS
https://www.kinokuniya.co.jp/f/dsg-01-9784798178721 - Meridian 公式ドキュメントのデータの収集と整理のページ、経験則として地域別のモデルは最低2年分の週次データ、全国のモデルは3年分、月次しか無い場合は最低3年分
https://developers.google.com/meridian/docs/pre-modeling/collect-data - Meridian のノット、時間とともに変わる切片で基礎売上の時間変化を表す節点、区分線形、季節の境界を指定する機能ではない
https://developers.google.com/meridian/docs/advanced-modeling/setting-knots - Robyn の配分の関数の場面、総額(過去と同じ額か任意の額)で反応の伸びを最大にする max_response、目標の ROAS か CPA を置いて反応の伸びと支出の水準を求める target_efficiency
https://cran.r-project.org/web/packages/Robyn/refman/Robyn.html - Robyn の機能説明のページ、DECOMP.RSSD は広告費の割合と効果の割合の差、媒体の ROAS を近づけるため議論があると明記
https://facebookexperimental.github.io/Robyn/docs/features/