こんにちは、Anagraftの伊藤です。
今回は、機械学習のモデルを作ったあと、本番の業務で使い続けるために何が要るのかを整理しました。需要予測、解約予測、与信、異常検知など、機械学習のモデルを業務に組み込む企業は増えています。一方で、モデルを作るまでの手順に比べると、作ったモデルを何か月、何年と使い続けるための仕組み、すなわちデータの品質を守る、実験を記録する、モデルの版を管理する、本番に届ける、性能を監視する、必要に応じて学習し直す、といった運用の仕組みは、まとまった形で語られることが少ないように思います。本コラムでは、こうした運用の仕組みの全体を、一つの架空のデータを通して実際にコードを動かしながら説明します。
この題材を選んだ理由は、機械学習の投資の成否が、モデルを作った時点ではなく、使い続ける段階で決まることが多いためです。モデルは学習に使ったデータの時点の世の中を前提にしています。料金の改定、新しい販売経路、競合の施策、データを集める仕組みの不具合など、世の中や社内の仕組みが変われば、モデルの予測は少しずつ実態とずれていきます。ずれに気づく仕組みがなければ、誤った予測にもとづく判断が続き、損失は表に出ないまま積み上がります。どこまでを仕組みとして自動化し、どこから先を人が確かめるべきかを見極める材料として、運用の考え方と手法を紹介します。
各章では、架空の定額制サービス(月額課金の会員サービス)の解約予測を共通の題材にして、実際にコードを動かした結果を載せています。各月5,000人の会員について、契約月数・プラン・月額・利用日数・問い合わせ件数・獲得経路などと、翌月末までに解約したかどうかを36か月分そろえたものです(各月の会員は月ごとに別々に作っており、同じ会員を36か月追ったものではありません)。途中には、料金の改定、新しい獲得経路の開始、データ連携の不具合による欠損、競合の乗り換え施策という4つの変化を起こしてあります。データは乱数で生成したもので、実在の企業や顧客の記録ではありません。その代わり、データを作った側は会員一人ひとりの本当の解約確率を知っているので、運用の仕方の違いがどれだけの損益の差になるかを答え合わせできます。
想定している読者は、機械学習のモデルを業務に入れた、あるいは入れようとしている事業部門の企画担当の方、DX推進や情報システム部門で運用の仕組みを整える立場の方、データ分析チームのリーダーの方、そして運用のための投資をどこまで認めるかを判断する経営層の方です。機械学習の専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にしています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各仕組みについて「何を防ぐ仕組みか」「それが無いと何が起きるか」「どの規模や段階から要るか」「結果を経営指標にどう翻訳するか」を書くようにしました。運用のための製品やクラウドのサービスは数多くありますが、どの製品を選ぶかより先に、自社のモデルの本数・更新の頻度・判断を誤ったときの影響の大きさから、どの仕組みをどの順で整えるかを決めることが大事だと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムに出てくる損益の金額(引き止め施策の費用や、引き止めによって守れる粗利など)は、すべて架空の設定による例題の値です。製品やサービスの料金には触れていません。本コラムの記述は2026年10月時点で確認したものです。製品の機能、ガイドラインや法令は更新がありますので、実務で使う際は公式のページで最新の内容をご確認ください。ライブラリの関数名や引数も版によって変わります。計算時間や応答時間は本コラムの実行環境で測った値であり、計算機が変われば変わります。
目的別の入口の目安を挙げておきます。運用の仕組みへの投資を経営の問題としてどう見るかを整理したい場合は、第1章と第13章が入口になります。自社の運用がどの段階にあるかを見極めたい場合は、第2章の成熟度の整理をご覧ください。データの不具合や学習と本番の食い違いを防ぎたい場合は第3章と第4章、実験の記録と再現性は第5章、本番に出す前の評価と承認の手順は第6章と第7章、モデルを業務のシステムに届ける方式は第8章、テストと自動化は第9章が中心になります。
本番に出したモデルの性能が落ちていないかを見張る方法は第10章、学習し直す頻度ときっかけの決め方は第11章、説明責任と法令・ガイドラインへの対応は第12章、体制と費用対効果は第13章、公開された事例と大規模言語モデルの運用を含む最新の動向は第14章で扱っています。

目次
- 序章 モデルは作った日から古くなり始める
- 全体の地図
- 第1章 MLOpsはなぜ経営の問題なのか
- 第2章 機械学習システムの全体像と成熟度
- 第3章 データの品質を守る
- 第4章 特徴量と学習データを正しく作る
- 第5章 実験を記録し、再現できるようにする
- 第6章 本番に出す前にモデルを評価する
- 第7章 モデルを登録し、承認して版を管理する
- 第8章 モデルを届ける、バッチ推論とオンライン推論
- 第9章 機械学習のテストとパイプラインの自動化
- 第10章 モデルを監視する
- 第11章 再学習を設計する
- 第12章 説明責任とガバナンス
- 第13章 体制・役割・費用対効果
- 第14章 事例と最新動向
- 終章 モデルを運用し続けるための5つの考え方
- 本コラムで紹介した書籍一覧
- 参考情報
序章 モデルは作った日から古くなり始める
機械学習のモデルは、過去のデータから「入力と結果の関係」を学び、その関係が将来も続くことを前提に予測を出します。解約予測のモデルであれば、利用日数が減った会員や問い合わせが増えた会員ほど解約しやすいという関係を、学習に使った期間の記録から読み取ります。ところが、その関係も、入力の分布も、モデルを作ったあとに変わります。料金を改定すれば会員の構成が変わり、新しい販売経路を始めれば学習のときに見たことのない種類の会員が入ってきます。競合が乗り換えの施策を打てば、これまで解約しにくかった会員まで抜けるようになります。社内でも、データを集める仕組みの改修や不具合で、ある日から一部の項目が欠けることがあります。機械学習のモデルを本番の業務で使い続けるために、こうした変化に備える仕組みと体制を整える取り組み、すなわちMLOpsが、本コラムの主題です。
MLOpsという言葉は、ソフトウェアの開発と運用を一体で回す考え方であるDevOpsを、機械学習に広げたものとして使われることが多い言葉です。ソフトウェアとの違いは、変わるものが3つあることです。通常の業務ソフトウェアでは、判断の規則は主にコードや設定として人が明示的に書きます。機械学習のシステムでは、コードに加えて、学習に使うデータと、データから作られたモデルが判断の規則を決めます。そして、コードを1行も変えなくても、入ってくるデータが変われば予測の当たり方が変わります。この「何もしなくても性能が変わりうる」という性質が、機械学習の運用に固有の仕組みを必要とする理由です。定義と全体像は第1章と第2章で整理します。
作るまでと、使い続けるあいだとでは、要る仕組みが違う
モデルを作るまでの作業は、データを集め、前処理し、いくつかの手法を試し、検証用のデータで最も良いものを選ぶ、という流れで進みます。この段階で問われるのは、主に予測の精度です。一方、作ったモデルを本番で使い続けるあいだに問われるのは、精度に加えて次のようなことです。毎月届くデータが、学習のときと同じ形式と意味で届いているか。予測の当たり方が落ちていないか、落ちていたらいつ気づけるか。学習し直したモデルを本番に出してよいと、誰がどの根拠で判断したか。半年前の予測がなぜその値になったのかを、あとから説明できるか。担当者が異動しても、同じ手順でモデルを作り直せるか。
これらは、モデルを作る段階の精度の高さだけでは答えられません。データの検証、実験の記録、モデルの版の管理、本番への届け方、監視、再学習、そしてそれらを誰が担うかという体制が、それぞれ別の仕組みとして要ります。本コラムでは、第3章から第9章でモデルを本番に出すまでの仕組みを、第10章と第11章で本番に出したあとの監視と再学習を、第12章と第13章で説明責任と体制を扱います。
答えの分かっている架空のデータで、運用の違いを損益で比べる
共通の題材は、架空の定額制サービス(月額課金の会員サービス)の解約予測です。各月5,000人の会員について、契約月数・プラン・月額・前月の利用日数・問い合わせ件数・獲得経路などと、翌月末までに解約したかどうかを、36か月分そろえました。各月の会員は月ごとに別々に作っており、同じ会員を月をまたいで追ってはいません。このサービスでは、解約しそうな会員に引き止めの施策(特典の案内など)を打ちます。施策には1件あたりの費用がかかり、解約しそうにない会員に打てば費用だけが出ていきます。そこで、モデルが予測した解約確率が一定の値を超えた会員にだけ施策を打つ、という使い方を想定しました。費用や引き止めの効果の値は、すべて架空の設定です。
途中には4つの変化を起こしてあります。第19か月に料金の改定、第22か月に新しい獲得経路の開始、第25〜26か月にデータ連携の不具合による利用日数の欠損、第28か月以降に競合の乗り換え施策です。データは乱数で生成したもので、実在の企業や顧客の記録ではありません。データを作った側は、会員一人ひとりの本当の解約確率(本コラムでは「真の確率」と呼びます)を知っています。現実の企業には見えませんが、本コラムでは運用の仕方の違いを答え合わせする物差しとして使います。
参考までに、第2章で説明する基準の計算の結果を先に示します。第1〜12か月の記録で学習したモデルを、その後の24か月(第13〜36か月)にわたって、学習し直さずに使い続けた場合(以下「放置」)と、毎月、直近12か月の記録で学習し直した場合(以下「毎月再学習」)を比べました。24か月の引き止め施策の損益の合計は、放置が1,964.0万円、毎月再学習が2,384.2万円で、差は420.2万円でした。真の確率を知っていれば得られた損益は2,691.1万円です。差の多くは、競合の施策が始まった第28か月以降に生じています。この期間の実際の解約率は月平均で14.3%に上がっていましたが、放置したモデルの予測の平均は8.6%のままでした。モデルが解約の起きやすさを低く見積もり続けたため、施策を打つべき会員の多くに打てていなかったのです。
この結果から、毎月学習し直せばよいという結論にはなりません。この結果を期間別に見ると、料金の改定のあとは、月額という入力の分布が学習のときと大きく違う状態が続いたのに、予測の並べ替えの正しさ(第2章で説明するAUC)は、真の確率で並べた場合と同じ程度にしか下がっていませんでした。料金の改定は会員の構成を変えましたが、利用日数や月額と解約の関係そのものは変えていなかったためです。反対に、競合の施策による変化は、この計算で分布の変化を測った3つの項目(利用日数・月額・予測)にはほとんど現れず、解約の結果が届いてから当たり方を測って初めて分かる種類のものでした。何を測り、どの変化に反応して、いつ学習し直すかを決めないまま再学習だけを自動化すると、データの不具合が起きた月の記録で学習し直してしまうこともあります。第10章と第11章では、こうした監視と再学習の設計を実測で比べます。なお、ここで示した数字は、この架空のデータの、この設定での結果です。変化の種類や大きさが違えば、運用の仕方の差も変わります。
モデルの一生を、記録と点検でつなぐ
本コラムを通じてお伝えしたいことが一つあります。機械学習の運用で大事なのは、一度作った精度の高いモデルではなく、データ・実験・モデル・予測・結果を記録し、変化に気づき、根拠をもって作り直して入れ替える循環を、人が替わっても回り続ける形にしておくことだということです。上の例のように、学習した時点の前提は時間とともに崩れます。崩れたことに気づく仕組みと、作り直したモデルを安全に入れ替える仕組みがなければ、モデルの価値は導入したあと目減りしやすくなります。
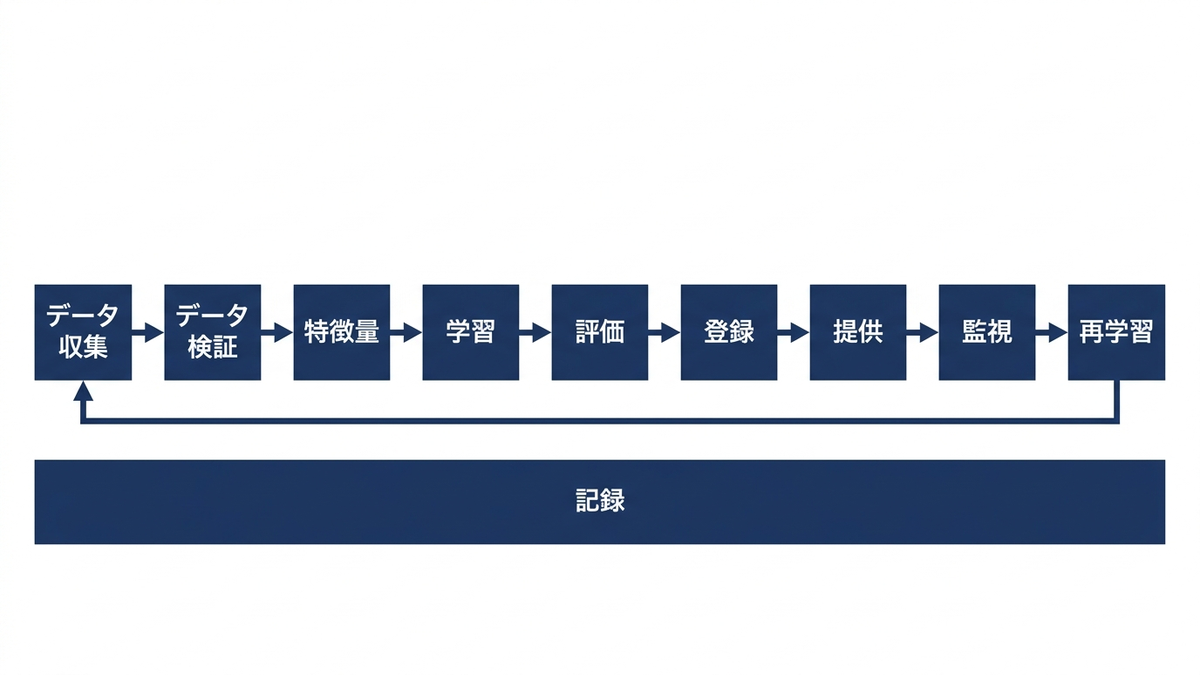
この循環は、次の6つの段階で成り立ちます。
- データの検証:届いたデータが、決めた形式・範囲・意味を守っているかを確かめます(第3章・第4章)。
- 学習と記録:どのデータ・コード・設定でモデルを作ったかを残し、作り直せるようにします(第5章)。
- 評価と承認:本番に出してよいかを、決めた基準と承認者で判断し、版を登録します(第6章・第7章)。
- 提供:モデルを業務のシステムに届け、予測を記録します(第8章・第9章)。
- 監視:入力・予測・結果を測り、変化に気づきます(第10章)。
- 再学習:根拠をもって作り直し、現行のモデルと比べて入れ替えます(第11章)。
第1章では同じ流れを「開発・評価・登録・提供・監視・再学習」の6つに、第2章では10個の部品に分けて整理します。どこで区切るかが違うだけで、対象としている流れは同じです。
経営判断に関わる方にとって、この点は運用への投資の置き方に直結します。精度の高いモデルを作ることに予算を集中し、運用の仕組みを後回しにすると、導入の直後は成果が出ても、変化に気づかないまま成果が目減りし、やがて現場で使われなくなることが多いように思います。反対に、最初から大がかりな基盤を整えようとすると、モデルが1本しかない段階で過大な投資になります。まず、予測と結果を記録して当たり方を毎月測ることと、モデルを作り直せる手順を残すことから始め、モデルの本数と影響の大きさに応じて仕組みを足していく順序であれば、投資の効果を確かめながら進められます。導入の順序は第13章で扱います。
Anagraftでは、データ活用の構想づくりから、機械学習モデルの設計と実装、本番での運用の仕組みづくり、監視と再学習の設計、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。第1章と第2章で、機械学習の運用がなぜ経営の問題になるのか、運用の仕組みの全体像と成熟度をどう捉えるかを整理し、共通の題材である架空の解約予測のデータと基準の結果を紹介します。第3章から第9章では、モデルを本番に出すまでの仕組みを、データの品質、特徴量と学習データの作り方、実験の記録、評価、登録と承認、本番への届け方、テストと自動化の順に扱います。第10章と第11章は、本番に出したあとの監視と再学習です。第12章と第13章で説明責任と体制・費用対効果を、第14章で公開された事例と最新の動向を扱います。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | MLOpsはなぜ経営の問題なのか | モデルを作ったあとに何が要るのか。運用を怠ると、どういう損失がどれだけ出るのか |
| 第2章 | 機械学習システムの全体像と成熟度 | 運用の仕組みはどんな部品でできていて、自社はどの段階にあり、次に何を整えるべきか |
| 第3章 | データの品質を守る | 届いたデータの欠けや食い違いに、予測を出す前に気づくにはどうするか |
| 第4章 | 特徴量と学習データを正しく作る | 予測の時点で使えない情報が学習に混ざる事故を、どう防ぐか |
| 第5章 | 実験を記録し、再現できるようにする | どのデータと設定でモデルを作ったかを残し、あとから作り直せるようにするには何を記録するか |
| 第6章 | 本番に出す前にモデルを評価する | 本番での当たり方を楽観せずに見積もり、業務の判断に合った指標で評価するにはどうするか |
| 第7章 | モデルを登録し、承認して版を管理する | 本番に出すモデルを、誰がどの根拠で承認し、どの版がいつ使われていたかをどう残すか |
| 第8章 | モデルを届ける、バッチ推論とオンライン推論 | 予測を業務のシステムにどう届け、新しいモデルを安全に入れ替えるにはどうするか |
| 第9章 | 機械学習のテストとパイプラインの自動化 | データとモデルの不具合を、本番に出る前に自動で止めるには何をテストするか |
| 第10章 | モデルを監視する | 本番のモデルの劣化に、何を測ればいつ気づけるか。鳴っても対処の要らない警報をどう減らすか |
| 第11章 | 再学習を設計する | どのきっかけで、どの期間のデータで学習し直し、いつ入れ替えるか |
| 第12章 | 説明責任とガバナンス | ガイドラインや法令が運用に求める記録と監視に、どう応えるか |
| 第13章 | 体制・役割・費用対効果 | 誰が何を担い、運用への投資をどの順で、どこまで行うか |
| 第14章 | 事例と最新動向 | 公開された事例から何が分かり、大規模言語モデルの運用で何が変わるか |
本コラムで使う指標と言葉
各章で共通して使う指標と言葉を、先に定義しておきます。詳しい説明は、初めて使う章で行います。
| 指標・言葉 | 本コラムでの意味 |
|---|---|
| 正解(ラベル) | 会員一人ひとりについて、実際に翌月末までに解約したかどうか。翌月が終わるまで確定しないので、学習に使えるのは1か月遅れになる |
| 解約率 | その月の会員のうち、翌月末までに実際に解約した人の割合 |
| 予測平均 | その月の会員に対してモデルが出した解約確率の平均。解約率とのずれが、確率の水準のずれを表す |
| AUC | 予測の高い順に会員を並べたとき、解約した人を上位に並べられている度合い(0.5はランダムに並べた場合と同じ、1は完全)。確率の水準のずれは測れない |
| 損益 | 予測した解約確率が一定の値を超えた会員に引き止めの施策を打ったときの、守れた粗利から施策の費用を引いた額(円。架空の設定) |
| 施策件数 | 引き止めの施策を打った会員の数 |
| PSI | 学習に使った期間と、その月とで、ある項目の分布がどれだけ違うかを表す指標(第10章で詳しく扱う) |
| 放置 | 第1〜12か月の記録で一度だけ学習し、その後は学習し直さずに使うモデル |
| 毎月再学習 | 毎月、結果が確定している直近12か月の記録で学習し直すモデル(最初の第13か月だけは、使える記録が11か月分) |
| 四半期ごと再学習 | 3か月に1回、同じ方法で学習し直すモデル |
| 真の確率 | データを作った側だけが知る、会員一人ひとりの本当の解約確率。現実には見えないが、本コラムでは答え合わせに使う |
コードはPythonで書き、scikit-learnなどの公開されたライブラリを使いました。運用のための専用の製品(実験管理や監視の製品)は、本コラムの実行環境には導入していません。それらの製品については公式のドキュメントで機能を確かめた範囲を紹介し、同じ考え方をPythonの標準ライブラリやscikit-learnで小さく実装して、実行結果を示すようにしました。
第1章 MLOpsはなぜ経営の問題なのか
機械学習のモデルは、作って精度を確かめた時点では、まだ事業の役に立っていません。本番の業務に組み込まれ、毎日・毎月の判断に使われ続けて、はじめて損益に効きます。そして、使い続けるあいだにも、顧客・商品・料金・競合・データの連携の仕組みは変わっていきます。この章では、モデルを本番で使い続けるために要る仕組みがどれだけの量になるのか、それを整えずにモデルを放置すると経営上どれだけの損失になるのかを、一次情報と、この記事で共通に使うサンプルデータの計算結果で確かめます。そのうえで、MLOps という言葉の定義と、判断を誤ったときに起きる損失の型、この記事で使う経営指標を整理します。個々の仕組みの作り方は第2章以降で扱います。
モデルは作って終わりではない、機械学習システムの隠れた負債
機械学習を本番で使い続けることの難しさを、早い時期に体系立てて論じた文献として、2015年の国際会議 NeurIPS(当時の略称は NIPS)の論文集に収められた、Sculley らによる機械学習システムの技術的負債の論文があります。著者は10名で、論文の所属欄はいずれも Google, Inc. です。技術的負債とは、ソフトウェア工学の比喩で、目先の速さを優先して先送りした手当てが、あとで利子のついた費用として返ってくることを指します。この論文は要旨で、機械学習は役に立つ予測の仕組みを素早く作れる強力な道具だが、その素早い成果を「ただで手に入るもの」と考えるのは危険であり、現実の機械学習システムでは大きな保守の費用が継続的に発生しがちだ、と述べています。
論文は、こうした負債が見えにくい理由も書いています。本文の序論は、隠れた負債は気づかれないまま複利で膨らむので危険だ、と述べ、機械学習の負債はコードの水準ではなくシステムの水準に存在するので検出しにくい、と続けます。この記事ではこれを隠れた技術的負債と呼びます。通常のソフトウェアなら、コードを読めば何をしているかが分かります。機械学習のシステムでは、振る舞いの多くがデータで決まるため、コードが1行も変わっていなくても、入ってくるデータが変われば結果が変わります。コードの品質を上げる従来の手当てだけでは、この種の負債は返せない、というのが論文の主張です。
論文が挙げる負債の源は、要旨の列挙では、抽象化の境界の侵食、もつれ(入力どうしの絡み合い)、隠れたフィードバックの経路、宣言されていない利用者、データへの依存、設定の問題、外の世界の変化、システムの水準のアンチパターン(避けるべき作り方)です。もつれについて、論文はCACE原則という言葉を使っています。何か1つを変えると全部が変わる(Changing Anything Changes Everything)という意味で、入力の1つを足したり外したりするだけでなく、ハイパーパラメータ(学習を始める前に人が決めておく設定値。学習の繰り返しの回数や学習の速さなど)・学習の設定・標本の取り方・データの選び方など、ほぼあらゆる調整がモデル全体の振る舞いを変えうる、という指摘です。
論文の図1は、現実の機械学習システムのうち機械学習のコードはごく一部で、その周りに必要な基盤は広大で複雑だ、と説明しています。本文では、汎用の機械学習の部品を使うと、データを部品に出し入れするための大量の支えのコード、つまりグルーコードが生まれやすく、成熟したシステムは「多くて」5%が機械学習のコードで「少なくとも」95%がグルーコードになりうる、と書いています。この5%と95%は、論文が測定した統計ではなく、成熟したシステムの姿を示すための書き方です。この記事ではこの数字を「本番で使い続けるための仕組みは、モデルを作るコードよりはるかに大きい」という方向の主張として読み、数字そのものを一般の企業の目安としては使いません。
この論文が経営の読者にとって重要なのは、結論の節の指摘です。論文は、チームがまだ速く動けているということ自体は負債が小さい証拠にならず、負債の全体の費用は時間がたって初めて見えてくる、と書いています。また、外の世界の変化を扱う節では、外の世界はめったに安定しておらず、その変化が継続的な保守の費用を生むこと、変化する世界では部品の単体テストやつなぎのテストだけでは、システムが意図どおり動いている証拠として足りず、本番の振る舞いを常に監視し、自動で対応する仕組みが長期の信頼性に欠かせないことを述べています。監視の出発点として論文が挙げているのは、予測の分布と実際の結果の分布がそろっているかを見ること、現実の世界に働きかける行動の量に上限を設けて超えたら人が介入すること、上流のデータの作り手を監視することの3つです。この記事の第3章(データの品質)と第10章(監視)は、この3つを共通データで具体的に確かめる章になっています。
放置したモデルの損失を共通データで測る
この記事では、第2章で詳しく紹介する共通のサンプルデータを、全章で使います。乱数の種を固定して作った架空の定額制サービスの解約予測のデータで、実在の企業・顧客の記録ではありません。各月5,000件・36か月の顧客について、契約月数・プラン・月額・利用日数・問い合わせ件数・決済失敗回数・獲得経路などと、翌月末までに解約したかどうかが入っています。途中で4つの変化が起きるように作ってあり、第19か月に料金改定(standard プランの月額を1,980円から2,380円へ。月額などの条件が同じ会員の解約のしやすさは変わらないが、月額が上がった会員がいるので、実際の解約率は第13〜18か月の平均0.082から第19〜21か月の平均0.091へ上がる)、第22か月に新しい獲得経路 partner の開始、第25〜26か月にデータ連携の不具合(店舗経路の顧客の利用日数の一部が欠損)、第28か月以降に競合の乗り換え施策(解約の起きやすさそのものと、利用日数と解約の関係が変わる)が起きます。
モデルの使い道も、架空の業務の設定として決めてあります。予測した解約確率がしきい値(約0.106)を超える顧客に引き止めの施策を打ち、施策1件に800円かかり、解約するはずだった顧客の35%を引き止めて、引き止めた顧客が平均12か月、月1,800円の粗利を生む、という設定です。解約する顧客に施策が当たれば7,560円の粗利を守れるので、予測確率が800÷7,560=約0.106を超える顧客に打てば、期待値として得になります。この施策の損益(守れた粗利から施策の費用を引いた額)を、この記事では「損益」と呼び、モデルの良し悪しを最終的にはこの金額で測ります。いずれも架空の設定で、実在のサービスの価格・費用ではありません。
比べるのは、第1〜12か月のデータで一度だけ学習してそのまま使い続ける「放置」と、毎月、正解が確定している直近12か月のデータで学習し直す「毎月再学習」です。解約は翌月末に確定するので、第 m か月の予測に使えるのは第 m-2 か月までの正解です。この1か月の遅れも設定に入れてあります。ただし、放置のモデルだけは、第12か月の解約が確定したあとに作って第13か月から使い始める初期のモデルという設定(例外)にしてあり、第13か月の時点で第1〜11か月のデータで学習する毎月再学習より、第13か月に限って1か月分新しいデータを使っています。この例外の詳しい説明は第2章で行います。このほか、記事全体の基準として、四半期ごとに学習し直す方式と、データを作った側だけが知っている「真の確率」(現実には分からないが、この記事では答え合わせの上限の目安に使えるもの)でも計算しています。第13〜36か月の24か月で、それぞれの方式の損益を合計した結果が次の表です。
| 方式 | 学習し直す回数(第13〜36か月) | 24か月の損益合計 | 放置との差 |
|---|---|---|---|
| 放置 | 0回 | 1,964.0万円 | 0 |
| 四半期ごと再学習 | 7回 | 2,357.7万円 | +393.7万円 |
| 毎月再学習 | 24回 | 2,384.2万円 | +420.2万円 |
| 真の確率(上限の目安) | なし | 2,691.1万円 | +727.1万円 |
表の「24か月の損益合計」の列のとおり、この架空データのこの設定では、放置は1,964.0万円、毎月再学習は2,384.2万円で、差は420.2万円でした。放置の損益に対して約21.4%の差です。四半期ごと再学習は2,357.7万円で、学習し直す回数は毎月の24回に対して7回(第16・19・22・25・28・31・34か月)ですが、毎月再学習との損益の差は26.5万円にとどまりました。真の確率で施策を打った場合の2,691.1万円との比較では、毎月再学習でもなお306.9万円の開きがあります。この差は学習し直すだけでは埋まらなかった部分で、1か月遅れの正解で学ぶ限界や、使っている入力の種類・モデルの形の限界を含みますが、それぞれがどれだけを占めるかは、この記事では測っていません。再学習の頻度とその費用の釣り合いは第11章で詳しく扱います。
この420.2万円が、どの月に、どういう理由で生まれたのかを分解するため、放置と毎月再学習を月ごとに計算し直しました。記事全体の基準の計算をしている補助モジュール baseline.py の関数(学習する fit と、1か月分を評価する evaluate)を使っています。次のコードは、その計算の要所を抜き出したもので、共通データを作る補助モジュール mlops_data.py と baseline.py を同じフォルダに置いて実行する形です。
import pandas as pd
import mlops_data as md
import baseline as bl

frozen = bl.fit(1, 12)                       # 放置:第1〜12か月で一度だけ学習
rows = []
for m in range(13, 37):
    d = md.month_data(m)
    monthly = bl.fit(max(1, m - 13), m - 2)  # 毎月再学習:正解が確定した直近12か月
    ef = bl.evaluate(frozen, d)
    em = bl.evaluate(monthly, d)
    rows.append({"month": m,
                 "value_frozen": ef["value"], "value_monthly": em["value"],
                 "contact_frozen": ef["n_contact"], "contact_monthly": em["n_contact"],
                 "hits_frozen": ef["hits"], "hits_monthly": em["hits"]})
t = pd.DataFrame(rows).set_index("month")
t["gap"] = t.value_monthly - t.value_frozen  # 毎月再学習から放置を引いた損益の差(円)

print("差の合計 %.1f 万円" % (t.gap.sum() / 1e4))
for name, a, b in [("変化前", 13, 18), ("料金改定", 19, 21), ("partner開始", 22, 24),
                   ("欠損事故と翌月", 25, 27), ("競合施策", 28, 36)]:
    s = t.loc[a:b]
    print(name, "差 %.1f 万円(月平均 %.1f)" % (s.gap.sum() / 1e4, s.gap.mean() / 1e4))
# 出力:
# 差の合計 420.2 万円
# 変化前 差 -1.5 万円(月平均 -0.2)
# 料金改定 差 10.0 万円(月平均 3.3)
# partner開始 差 18.9 万円(月平均 6.3)
# 欠損事故と翌月 差 28.0 万円(月平均 9.3)
# 競合施策 差 364.8 万円(月平均 40.5)
計算し直した放置と毎月再学習の月ごとの損益は、記事全体の基準の結果と一致しました(照合した第13・28・36か月で、差は1円未満の浮動小数の丸めだけです)。放置と毎月再学習だけの計算は、この記事の実行環境(一般的なノートPC)での実測で18.7秒でした。月ごとの推移を図にしたのが次の図です。
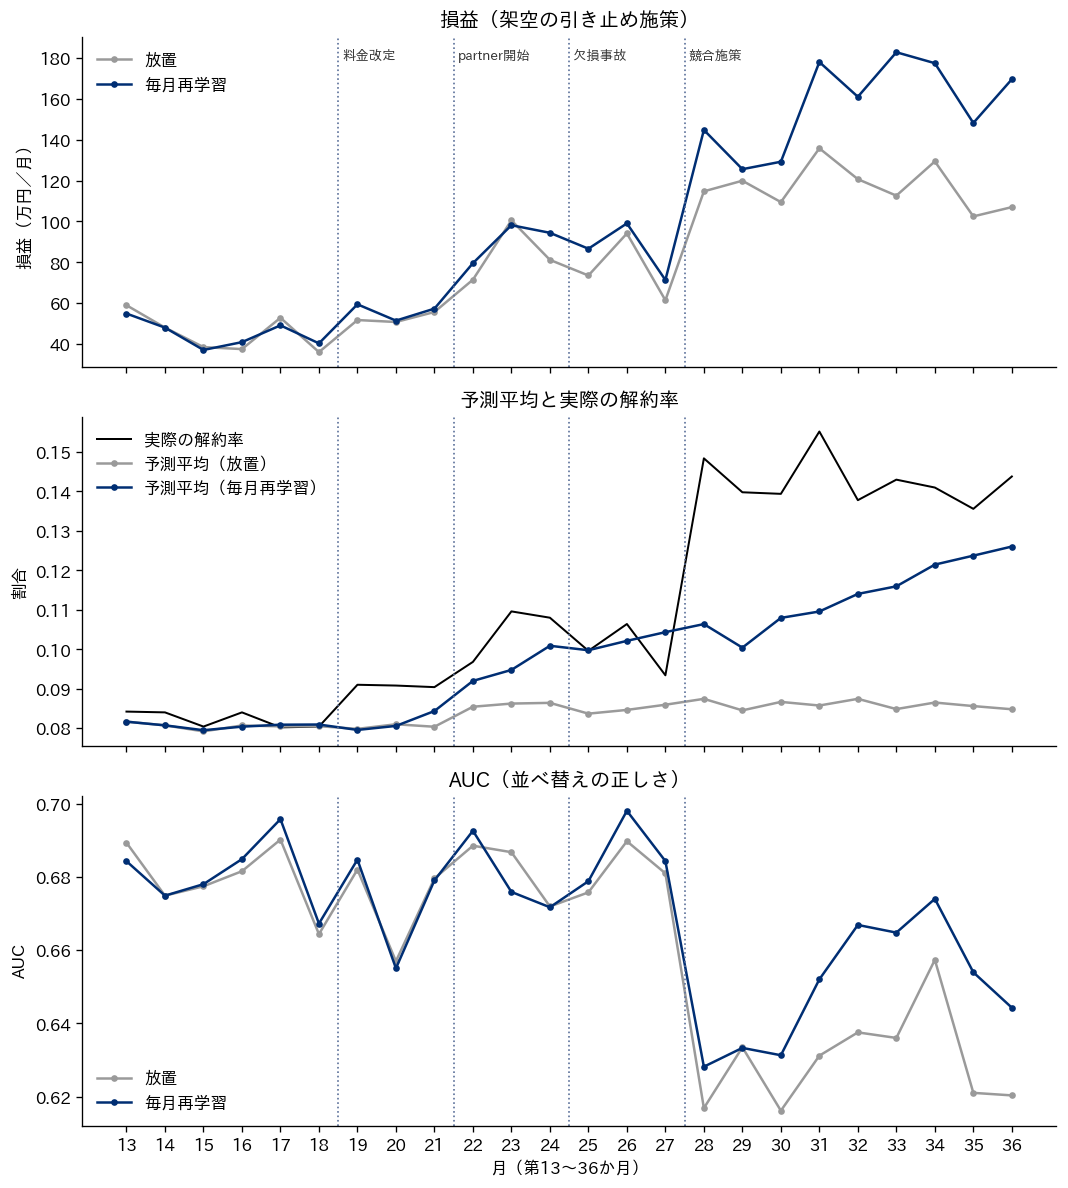
毎月再学習の損益から放置の損益を引いた差を月ごとに並べ、その累積を添えたのが次の表です。差が負の月は、放置のほうが損益の大きかった月です。括弧内は4つの変化が始まった月です。
| 月 | 損益の差(その月、万円) | 損益の差の累積(万円) |
|---|---|---|
| 第13か月 | -4.1 | -4.1 |
| 第14か月 | 0.0 | -4.1 |
| 第15か月 | -1.4 | -5.5 |
| 第16か月 | 3.4 | -2.1 |
| 第17か月 | -3.7 | -5.8 |
| 第18か月 | 4.3 | -1.5 |
| 第19か月(料金改定) | 7.7 | 6.2 |
| 第20か月 | 0.7 | 6.9 |
| 第21か月 | 1.6 | 8.5 |
| 第22か月(partner開始) | 8.1 | 16.6 |
| 第23か月 | -2.4 | 14.2 |
| 第24か月 | 13.3 | 27.5 |
| 第25か月(欠損事故) | 13.1 | 40.6 |
| 第26か月 | 4.9 | 45.5 |
| 第27か月 | 9.9 | 55.4 |
| 第28か月(競合施策) | 30.1 | 85.5 |
| 第29か月 | 5.7 | 91.1 |
| 第30か月 | 19.8 | 110.9 |
| 第31か月 | 42.3 | 153.2 |
| 第32か月 | 40.3 | 193.5 |
| 第33か月 | 70.2 | 263.7 |
| 第34か月 | 48.1 | 311.8 |
| 第35か月 | 45.8 | 357.6 |
| 第36か月 | 62.6 | 420.2 |
第13〜27か月の差は月に -4.1万円から13.3万円の範囲で、累積は第27か月に55.4万円でした。第28か月以降は月に5.7万円から70.2万円の差が出て、累積は第36か月に420.2万円に達します。これを期間ごとにまとめたのが次の表です。月ごとの表は値を小数1桁に丸めているので、その値を足し合わせると、期間ごとの表の合計と0.1万円ずれる期間があります(たとえば第22〜24か月は、月ごとの値の和が19.0万円、期間の表では18.9万円です)。期間ごとの表は、丸める前の値で合計しています。
| 期間 | 月数 | 損益の差の合計 | 損益の差の月平均 | 差の合計に占める割合 |
|---|---|---|---|---|
| 第13〜18か月 変化前 | 6 | -1.5万円 | -0.25万円 | -0.4% |
| 第19〜21か月 料金改定 | 3 | 10.0万円 | 3.3万円 | 2.4% |
| 第22〜24か月 partner開始 | 3 | 18.9万円 | 6.3万円 | 4.5% |
| 第25〜27か月 欠損事故と翌月 | 3 | 28.0万円 | 9.3万円 | 6.7% |
| 第28〜36か月 競合施策 | 9 | 364.8万円 | 40.5万円 | 86.8% |
| 合計 | 24 | 420.2万円 | 17.5万円 | 100% |
表の「損益の差」は、毎月再学習の損益から放置の損益を引いた額です。変化が起きる前の6か月(第13〜18か月)は、差の合計が -1.5万円で、放置のほうがわずかに上回っていました。月ごとに見ても、放置のほうが損益の大きい月が第13・15・17・23か月の4か月あります(第13か月は、前に述べた例外の設定で放置のモデルが1か月分新しいデータを使っている月で、差 -4.1万円のうちどれだけがその影響かは、この計算では分けていません)。世の中が変わっていないあいだは、学習し直しても得はなく、この期間に限れば、再学習にかける手間はそのまま費用になります。差が開くのは変化が起きてからで、料金改定・partner開始・欠損事故の各期間は月に3〜9万円程度、競合施策が始まった第28か月以降は月平均40.5万円に広がります。24か月の差420.2万円のうち86.8%に当たる364.8万円が、最後の9か月で生まれていました。
損失の中身を読む、件数の取りこぼしと確率の水準のずれ
競合施策の期間に何が起きていたかを、施策の件数で見たのが次の表です。「施策件数」はしきい値を超えて施策を打った顧客の数、「当たり件数」はそのうち実際に解約した顧客の数、「解約者数」はその月に実際に解約した顧客の数で、いずれも第28〜36か月の月平均です。
| 第28〜36か月の月平均 | 放置 | 毎月再学習 | 差 |
|---|---|---|---|
| 実際の解約率 | 0.1427 | 0.1427 | なし |
| 予測平均 | 0.0859 | 0.1139 | +0.0280 |
| AUC | 0.630 | 0.650 | +0.020 |
| 施策件数 | 1,347.6件 | 2,233.2件 | +885.7件 |
| 当たり件数 | 297.2件 | 444.6件 | +147.3件 |
| 解約者数 | 713.3件 | 713.3件 | なし |
| 解約者のうち施策が届いた割合 | 0.417 | 0.623 | +0.206 |
| 施策の的中率(当たり件数÷施策件数) | 0.221 | 0.199 | -0.022 |
| 損益 | 116.9万円 | 157.4万円 | +40.5万円 |
表の「予測平均」の行が、この期間の損失の中心です。実際の解約率は0.1427に上がっているのに、放置したモデルの予測平均は0.0859のままでした。放置したモデルは第1〜12か月の世の中(解約率は0.08前後)を覚えているので、解約が起きやすくなったことを知りません。その結果、しきい値を超える顧客の数、つまり施策件数が月に1,347.6件にとどまり、実際に解約した713.3件のうち施策が届いたのは41.7%でした。毎月再学習のモデルは、1か月遅れで新しい正解を学ぶので予測平均が0.1139まで上がり、施策件数は2,233.2件、施策が届いた解約者の割合は62.3%になりました。施策の的中率は、件数を広げた分だけ0.221から0.199へ少し下がっていますが、それでも施策1件の費用800円に対して、当たりの期待値(0.199×7,560円=約1,504円)が上回っているので、件数を広げたほうが損益は大きくなります。
もう1つの指標である AUC(予測で顧客を並べたときの並べ替えの正しさ。0.5はランダムに並べた場合と同じ、1は完全)は、放置0.630・毎月再学習0.650で、差は0.020でした。技術の指標で見ると小さな差に見えますが、損益では月40.5万円の差になっています。この食い違いは、AUC が「並べ方」だけを測り、確率の水準のずれを測らない指標であることから来ています。記事全体の基準の結果によれば、予測の上位10%に施策を打つ方式(確率の水準に依らず、件数を固定する使い方)では、この期間の損益は放置62.8万円・毎月再学習66.9万円で、差は小さくなります。確率の水準のずれが損益に効くのは、この例のように確率をしきい値と比べて施策の件数を決める使い方のときです。このことから、この期間の差の大部分は確率の水準のずれによるものと見ています(この章では、ずれだけを補正して比べる計算はしていません。較正だけをやり直す計算は第6章で扱います)。モデルの劣化を技術の指標だけで判断すると、損益への影響を小さく見積もることがある、ということです。確率の水準の較正は第6章、予測平均と実際の解約率の差を監視に使う方法は第10章で扱います。
この結果を経営の言葉に直すと、競合施策に気づかずにモデルを放置した1か月ごとに、この架空の設定では、毎月再学習(これも1か月遅れの正解で学ぶ方式です)と比べて約40.5万円の損益を取りこぼしていた、ということになります。判断の遅れを月数で数えれば、そのまま金額になります。ただし、この数字はこの架空データの、この設定での結果です。施策の費用や引き止め率、変化の大きさが違えば差も変わり、変化が起きなければ再学習の得はありません(変化前の6か月では差は -1.5万円でした)。再学習すれば必ず損益が増える、という一般論ではありません。この記事が全章を通じて示したいのは、損失がどこで、どういう仕組みで生まれるかを測れる形にしておくことの価値です。
もう1つ注意したいのは、この損失が、システムの外から見える形では何の異常も出さずに生まれていることです。放置したモデルは、競合施策の期間も毎月予測を出し、施策件数も月1,295〜1,410件の範囲で、直前の第22〜27か月(1,264〜1,380件)とほぼ同じ水準でした。エラーも警告も出ません。記事全体の基準の結果では、この期間、モデルの予測の分布の変化を測る指標(スコアの PSI)は約0.01〜0.025と小さく、ほかに測った入力の PSI も、利用日数は第27か月0.059・第28か月0.057とほぼ変わらず、月額は料金改定のあとから0.58〜0.81の高い値が続いていて、第28か月に新しい動きはありませんでした。この記事で測ったこの3つの分布を見ているだけでは、気づけなかったということです。気づくには、1か月遅れで届く正解と予測を突き合わせる必要があります。Sculley らの論文が監視の出発点に、予測の分布と実際の結果の分布の比較を挙げていたのは、この状況に当たります。
AIの導入の現状と、運用の課題
モデルを使い続ける仕組みの話は、AI を業務に入れている企業にとって経営の課題になります。その企業がどれだけあるかを、国内の公的な調査で、2026年10月時点で開けた最新版の数字を2つ確かめました。どちらも、ここで扱う解約予測のような予測モデルだけでなく、生成AIを含めた「AI」全体についての調査である点に注意が必要です。
1つ目は、情報処理推進機構(IPA)の「DX動向2026」(2026年7月30日公開)です。国内企業の経営層または ICT 関連の部門を対象に、2026年4月17日から6月12日に行ったアンケートで、1,799社から有効回答を得ています。ただし、設問ごとに回答の対象が絞られているものがあり、以下の割合は、設問ごとに報告書の図表に示された回答社数に対するものです。AI の導入状況(回答1,794社)は「導入している」が42.3%、「現在、試験利用をしている」が15.7%で、合わせて58.0%の企業が何らかの形で AI を導入・試験利用していました。一方で、AI の導入・運用上の課題(回答1,770社)としては、「専門人材が不足している」が50.1%で最も高く、「生成AIの効果やリスクに関する理解が不足している」が45.8%、「適切な利用を管理するためのルールや基準の作成が難しい」が39.7%と続き、報告書はこれを人材不足・リテラシー不足・ガバナンス整備の遅れの三大課題とまとめています。AI に使う学習データの整備状況(回答1,192社)は、「整備しておりAIに活用している」が7.0%にとどまり、「整備しているが十分ではない」が28.4%、「必要性は認識しているができていない」が27.6%でした。AI のリスクマネジメントの設問は、AI を導入している・試験利用している・利用に向けて検討を進めていると答えた企業(1,190社)だけが対象で、そのうち AI や生成AI に独自のリスクマネジメントを実施している企業は14.2%です。
2つ目は、総務省の「令和8年版 情報通信白書」の概要です。日本・米国・ドイツ・中国の企業の管理職以上を対象に2026年1月から2月にインターネットで行ったアンケート(日本の有効回答は調査全体で515件)で、日本で自社の何らかの業務で生成AIを利用していると答えた割合は86.4%でした。所属する企業の生成AIの活用方針として「積極的に活用する方針」「活用する領域を限定して利用する方針」と答えた割合の合計は、2024年度調査の49.7%から2025年度調査の68.9%へ上がっています。こちらは生成AIに限った数字で、調査の対象も方法も IPA の調査とは違うので、2つの調査の数字を直接比べることはできません。
この2つの調査から読めるのは、AI を導入・試験利用している企業が合わせて58.0%いて(IPA)、生成AIを活用する方針の企業の割合も2024年度調査から2025年度調査にかけて上がっている(総務省)一方で、それを担う人材・ルール・データの整備が追いついていない、という状況です。この記事の共通データで見たように、モデルは入れた日から、世の中の変化とのずれを抱え始めます。導入の件数が増えるほど、そのずれを見つけて直す仕組みの有無が、損益の差として積み上がっていきます。IPA の調査で、学習データの整備状況に答えた企業のうち「整備しておりAIに活用している」が7.0%にとどまり、「整備しているが十分ではない」と「必要性は認識しているができていない」を合わせると56.0%になることは、第3章・第4章で扱うデータの品質と学習データの作り方について、整備が十分とはいえない企業が多いことを示しています。人材の確保と体制は第13章、ルールとガバナンスは第12章で扱います。
MLOpsとは何か、DevOpsとの違い
MLOps という言葉には、決まった1つの定義があるわけではありません。この記事では、Google Cloud のアーキテクチャの文書「MLOps:機械学習における継続的デリバリーと自動化のパイプライン」(2024年8月28日更新)の定義を出発点にします。この文書は MLOps を、機械学習システムの開発(Dev)と機械学習システムの運用(Ops)を統合することを目指す、機械学習のエンジニアリングの文化と実践だと説明しています。そして、機械学習のコードを作ること自体よりも、統合された機械学習のシステムを作り、本番で継続的に運用することが本当の難しさだと述べ、現実の機械学習システムのうち機械学習のコードはごく一部だという図を、前に紹介した Sculley らの論文から引いています。
同じ文書は、DevOps を大規模なソフトウェアのシステムを開発・運用するときに広く使われている実践だと説明し、その利点として、開発の周期を短くすること、配備の速さを上げること、信頼できるリリースを挙げています。そのうえで、機械学習のシステムもソフトウェアのシステムなので、ソース管理や単体テストなど同様の実践が当てはまり、DevOps の原則を機械学習のシステムに適用できる(それが MLOps だ)としたうえで、機械学習のシステムが通常のソフトウェアと違う点を挙げています。その要点を表にまとめました。
| 観点 | 通常のソフトウェア(DevOps) | 機械学習のシステム(MLOps)で加わること |
|---|---|---|
| チーム | ソフトウェアの技術者が中心 | データサイエンティストなど、本番のサービスを作る経験が少ない人が加わる |
| 開発 | 仕様に沿って作る | 本質的に実験的で、何が効いたかの記録と再現が要る |
| テスト | コードの単体テストとつなぎのテスト | データの検証、学習したモデルの品質の評価、モデルの検証が加わる |
| 配備 | 1つのソフトウェアやサービスを届ける | 学習済みのモデルを置くだけでは済まず、学習し直す仕組み(パイプライン)ごと届ける |
| 本番 | 判断の規則は主にコードや設定として人が明示的に書く | データの変化によって、通常のソフトウェアより多くの経路で性能が落ちる |
| 継続的に行うこと | 継続的インテグレーション(CI)と継続的デリバリー(CD) | CI はコードと部品だけでなく、データ・データの形式(スキーマ)・モデルのテストと検証を含み、CD はシステム全体を届けるものになり、さらに継続的な訓練(CT、モデルを自動で学習し直して届けること)が加わる |
表の右の列のうち、経営の目線で最も重いのは「本番」の行です。通常の業務ソフトウェアでは、判断の規則は主にコードや設定として人が明示的に書きます。機械学習のモデルは、コードを誰も変えていなくても、世の中が変われば成果が落ちます。共通データの放置したモデルがまさにその例で、第28か月以降、コードもモデルも何も変えていないのに、毎月再学習との損益の差が月に5.7万円から70.2万円、平均で月40.5万円開きました。同じ文書は、すべての段階が手作業で、モデルの更新が年に数回しかない段階(この文書の「レベル0」)の課題として、本番に出したモデルが環境の変化やデータの変化に適応できずに壊れることが多いと書き、本番でのモデルの品質を能動的に監視すること、本番のモデルを頻繁に学習し直すこと、新しい作り方を継続的に試すことの3つを求めています。成熟度の段階の詳しい定義は第2章で扱います。
この記事では、MLOps を「モデルを本番で使い続け、その成果を保ち続けるための、データ・モデル・コードの扱い方と体制の全体」という意味で使います。特定の製品の名前ではなく、製品を入れれば済むものでもありません。どの仕組みをどの順で整えるかは、モデルの本数・更新の頻度・判断の影響の大きさで決まります。どの段階から何が要るかの目安は第2章で整理します。
判断を誤ったときの損失の型
モデルの運用で判断を誤ったときに起きる損失は、いくつかの型に分けられます。型ごとに、何が起きるか、どの経営指標に表れるか、どの仕組みで防ぐかが違います。共通データで実際に起きる変化と、この記事で扱う章を対応させたのが次の表です。
| 損失の型 | 何が起きるか | 共通データでの例 | 表れる経営指標 | 防ぐ仕組み(扱う章) |
|---|---|---|---|---|
| 気づかない劣化 | 世の中の変化でモデルの成果が落ちるが、エラーは出ない | 第28か月以降の競合施策。放置との差は9か月で364.8万円 | 損益、施策件数、判断の遅れの月数 | 性能の監視(第10章)、再学習(第11章) |
| データ事故 | 連携の不具合で入力が欠けたり、意味が変わったりしたまま予測が出続ける | 第25〜26か月に店舗経路の利用日数の40%が欠損(月全体で約12%) | 障害時間、誤った判断に使われた施策件数 | データの品質の検査(第3章)、学習データの作り方(第4章) |
| 再現できない | 本番のモデルがどのデータ・コード・設定で作られたか分からず、作り直せない | 共通データでは第5章で、記録が無い場合と有る場合を比べる | 不具合の調査や作り直しにかかる人手の工数 | 実験の記録(第5章)、モデルの版の管理(第7章) |
| 承認されないまま本番 | 評価や確認が不十分なモデルが、誰の判断か分からないまま本番に出る | 共通データでは第6章で、評価の仕方による見え方の違いを測る | 誤った施策の件数と費用、説明に要する工数 | 本番前の評価(第6章)、登録と承認(第7章)、ガバナンス(第12章) |
| 担当者の離任で止まる | 手作業の更新が特定の人に依存し、その人が抜けると更新が止まる | 更新が止まれば、結果は「放置」と同じになる | 停止した月数、引き継ぎの工数 | テストとパイプラインの自動化(第9章)、体制(第13章) |
表の「共通データでの例」の列のうち、金額で示せたのは気づかない劣化だけですが、他の型も最後は同じところに行き着きます。担当者の離任で更新が止まれば、モデルはその日から「放置」になり、共通データでは変化が起きた期間に月数万円から数十万円の差になりました。データ事故の期間も、放置したモデル・毎月再学習のモデルのどちらも、欠損の入ったデータに対してエラーを出さずに予測を返しています(記事全体の基準の計算は、第25〜26か月も止まらずに最後まで進みました)。欠損が予測と損益にどう効いたかは第3章で詳しく測ります。
Sculley らの論文も、この表の「再現できない」「担当者の離任で止まる」の型に近い負債を挙げています。実験をやり直して同じような結果を得られることを難しくする要因を「再現性の負債」、多数のモデルを同時に動かすときの設定の更新や資源の割り振りの問題を「プロセス管理の負債」と呼び、手作業の多い共通の手順を、避けるべきシステムの兆候としています。また、機械学習の研究と工学のあいだに硬い線を引くことは長期のシステムの健全さに逆効果になりうるとして、精度の改善と同じように、特徴量の削除・複雑さの削減・再現性・安定性・監視の改善を評価するチームの文化を作ることが重要だと述べています(論文はこれを「文化の負債」と呼んでいます)。運用の仕組みを整える仕事は、精度を上げる仕事に比べて成果が見えにくく、評価されにくいものです。だからこそ、その成果を経営の指標で示すことが要ります。
経営指標で語る、損益・施策件数・障害時間・人手の工数
モデルの良し悪しを AUC のような技術の指標だけで語ると、経営の判断にはつながりにくくなります。前の節で見たとおり、競合施策の期間の AUC の差は0.020でしたが、損益の差は月40.5万円でした。この記事では、各章の結果をできるだけ次の経営指標に翻訳して示します。
| 経営指標 | この記事での定義 | 共通データでの例 | 判断に使う場面 |
|---|---|---|---|
| 損益 | 予測確率がしきい値を超えた顧客に引き止め施策を打ったときの、守れた粗利から施策の費用を引いた額(架空の設定) | 24か月の合計で、放置1,964.0万円、毎月再学習2,384.2万円 | 仕組みへの投資の効果を金額で比べる |
| 施策件数 | しきい値を超えて施策を打った顧客の数 | 競合施策の期間の月平均で、放置1,347.6件、毎月再学習2,233.2件 | 現場の作業量・予算の見通し、確率の水準のずれの発見 |
| 障害時間 | データ事故やモデルの不具合が起きてから、検知して直すまでの時間(その間の予測は誤ったまま業務に使われる) | 欠損事故は第25〜26か月の2か月続いた設定 | データの検査や監視の仕組みの効果を測る |
| 人手の工数 | 再学習・確認・監視・調査にかかる人の作業時間 | 学習し直す回数は、毎月再学習24回、四半期ごと7回(第13〜36か月) | 自動化の範囲と、体制の規模を決める |
| 判断の遅れの月数 | 変化が起きてから、対応(再学習や入れ替え)を済ませるまでの月数 | 競合施策の期間、放置との差は月平均40.5万円 | 監視の頻度とアラートの設計を決める |
このうち損益と施策件数は、共通データで計算できる指標です。障害時間と人手の工数は、データだけでは決まらず、組織の仕組みと体制で決まる指標です。たとえば、四半期ごと再学習は、毎月再学習より学習し直す回数が17回少なく、損益の差は26.5万円でした。学習し直すたびに人が結果を確認する運用なら、この17回分の確認の工数と26.5万円を比べることになります。どちらを選ぶべきかは、確認1回にかかる工数と、その人の時間の費用で決まり、この記事では一般の相場を示しません。再学習の方式と費用の釣り合いは第11章、体制と工数の見積りの考え方は第13章で扱います。
経営指標で語ることには、もう1つの利点があります。運用の仕組みへの投資は、何も起きない期間には費用だけが見え、効果が見えません。共通データでも、変化が起きる前の6か月は、毎月学習し直しても損益の差は -1.5万円で、得はありませんでした。効果が出るのは変化が起きてからで、それがいつ来るかは事前には分かりません。仕組みへの投資は、保険に近い性質を持つと考えています。その判断には、「変化が起きたときに、気づくまでの1か月でいくら失うか」という見積りが役に立ちます。この架空の設定では、競合施策のような変化に気づかずにいると月約40.5万円でした。自社のモデルについて同じ見積りを持っておくことが、仕組みにどこまで投資するかを決める出発点になります。
モデルの一生と、この記事の構成
モデルを本番で使い続けるあいだに必要になる段階を、1本の流れとして並べると、開発(データを集めて特徴量を作り、学習する)、評価(本番に出してよいかを確かめる)、登録(版と承認の記録を残す)、提供(予測を業務に届ける)、監視(データと成果の変化を見張る)、再学習(新しいデータで作り直し、評価に戻る)になります。Google Cloud の文書も、データの取り出し・分析・準備、モデルの学習・評価・検証、提供、監視を機械学習の段階として挙げ、監視の結果が次の繰り返しを起こしうる、としています。この記事では、この流れを「モデルの一生」と呼び、段階ごとに章を割り当てています。
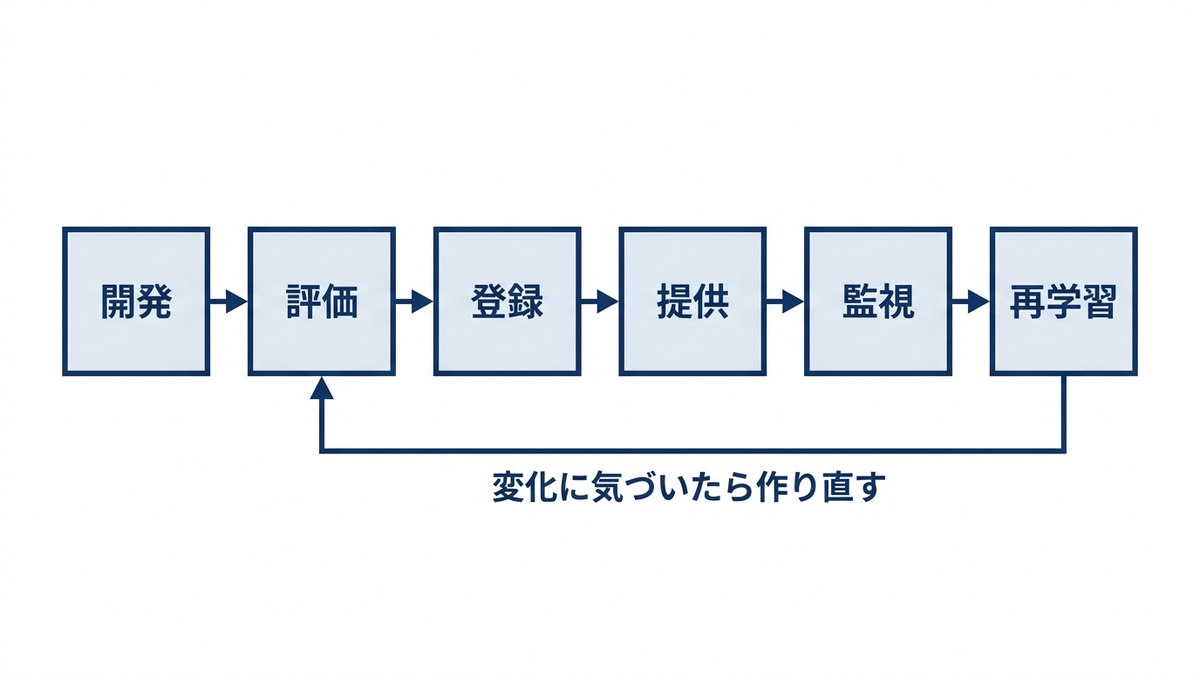
段階と章の対応は次のとおりです。開発の段階のうち、データの品質を守る仕組みは第3章、特徴量と学習データの作り方は第4章、実験の記録と再現は第5章で扱います。評価は第6章、登録と承認は第7章、提供は第8章、これらをつなぐテストとパイプラインの自動化は第9章です。監視は第10章、再学習は第11章で、この章で測った420.2万円の差がどのような監視と再学習で取り戻せるのかを、共通データで具体的に確かめます。流れ全体にかかわる説明責任とガバナンスは第12章、体制と費用対効果は第13章、公開された事例と最新の動向は第14章です。全体の構成要素と成熟度の段階は、次の第2章で一覧にします。
流れの中で見落とされやすいのは、提供のあとの監視と再学習です。モデルを作って評価し、本番に出すところまでは、プロジェクトとして予算と期限が付きやすい段階です。監視と再学習は、本番に出したあとに始まり、終わりのない仕事になります。この章の計算で、差の86.8%が最後の9か月に生まれていたことは、モデルの価値を守る仕事の多くが、本番に出したあとに来ることを示しています。
この章の要点は3つです。第一に、機械学習のモデルは作って終わりではなく、本番で使い続けるための仕組みのほうがはるかに大きく、その負債は見えにくいまま膨らむことが、2015年の Sculley らの論文で指摘されています。第二に、共通データ(架空の定額制サービスの解約予測)で、一度学習したモデルを放置すると、毎月学習し直す場合に比べて24か月で420.2万円の損益を取りこぼし、その86.8%は競合施策で解約と利用の関係そのものが変わった最後の9か月に生まれていました。その主な原因は、予測の確率の水準が実際の解約率に追いつかず、施策を打つべき顧客に打てていなかったことだと見ています(この章では、ずれだけを補正した計算はしていません)。AUC の差は0.020にすぎませんでした。第三に、MLOps は、データ・モデル・コードが変わり続けるシステムを本番で運用し続けるための考え方と実践の全体で、その効果は損益・施策件数・障害時間・人手の工数・判断の遅れの月数といった経営指標で示す必要があります。次の第2章では、機械学習システムの構成要素と成熟度の段階を整理し、この記事の共通データと基準の結果を詳しく紹介します。
この章を深めたい方への参考書籍
『仕事ではじめる機械学習 第2版』(有賀康顕・中山心太・西林孝、オライリー・ジャパン):機械学習のプロジェクトを「仕事で使う」観点から整理した本で、第2版では機械学習システムの開発と運用の統合を扱う章や、継続的トレーニングのための基盤、施策の効果検証の章が加わっています。この章で見た「モデルを作ることと、業務で成果を出し続けることは別の問題だ」という論点を、プロジェクトの進め方の側から読むのに向いています。
『事例でわかるMLOps 機械学習の成果をスケールさせる処方箋』(杉山阿聖・太田満久・久井裕貴 編著、講談社):第1部で MLOps の背景と全体像、それを実現する技術・プロセス・文化を整理し、第2部で国内の企業や技術者による実践の事例を集めた本です。この章で整理した損失の型と、それを防ぐ仕組みが、実際の組織でどう作られているかを確かめるのに向いています。
第2章 機械学習システムの全体像と成熟度
第1章では、モデルを作って本番に出したあと、手を入れずに使い続けると、気づかないうちに損益を取りこぼすこと、そしてそれが技術の問題にとどまらず経営の問題であることを確認しました。この章では、本番で使い続ける機械学習の仕組みが、どんな部品からできているかを一覧にし、組織がどこまで整えているかを測る物差し(成熟度の段階)を、Google Cloud と Microsoft の公式ドキュメントで確かめます。そのうえで、モデルの本数・更新の頻度・判断を誤ったときの影響の大きさから、どの段階で何を整えればよいかを表にまとめます。後半では、第3章以降のすべての章で使うサンプルデータ(架空の定額制サービスの解約予測)の設定と、途中で起きる4つの変化を紹介し、学習したまま放置したモデルと、定期的に学習し直すモデルを比べた基準の結果を示します。個々の仕組みの作り方は、第3章から第11章で1つずつ扱います。
機械学習システムを構成する部品の一覧
機械学習のモデルは、学習のコードを書いて精度を確かめれば完成するように見えます。ところが、本番で使い続けるには、モデルの周りに多くの仕組みが要ります。Google Cloud の MLOps の解説文書(最終更新 2024年8月28日)は、実際の機械学習システムのうち機械学習のコードが占めるのはごく一部で、その周りに要る要素は大きく複雑だと述べ、第1章で扱う2015年の技術的負債の論文の図を基にした図で、周りの要素として、設定、自動化、データ収集、データ検証、テストとデバッグ、計算資源の管理、モデルの分析、処理とメタデータ(実行の記録)の管理、提供の基盤、監視の10個を挙げています。同じ文書は、機械学習のモデルを本番に届ける手順を、データの抽出、データの分析、データの準備、学習、評価、検証(本番に出してよいかの確認)、提供、監視の8段に分けています。
この記事では、この2つの整理を、読者が自社の状況と照らし合わせやすいように、次の10個の部品に組み直しました。表の「無いと起きること」は、その部品が欠けたときに起きる典型的な事故です。部品の名前は製品の名前ではなく、役割の名前です。1つの製品が複数の部品を兼ねることもあれば、表計算ソフトと手順書で代用できる部品もあります。
| 部品 | 何をするか | 無いと起きること | 扱う章 |
|---|---|---|---|
| データ収集 | 学習と予測に使うデータを、決まった時刻に決まった形で集める | 担当者が手で集め直すたびに中身が変わり、同じモデルを作り直せない | 第3章 |
| データ検証 | 型・範囲・カテゴリの許容値・欠損率を、学習と予測の前に確かめる | 連携の不具合で値が欠けても、予測はエラーにならずに出続ける | 第3章 |
| 特徴量 | 生のデータからモデルの入力を作る定義を1か所で持つ | 学習と予測で計算の仕方が食い違う。予測の時点で使えない情報が学習に混ざる | 第4章 |
| 学習 | 決まった手順でモデルを作る | 作るたびに手順が違い、良くなった理由も悪くなった理由も分からない | 第5章 |
| 評価 | 本番に出す前に、業務の判断に合った指標で現行モデルと比べる | 過去のデータでは良く見えたモデルが、本番では損益を下げる | 第6章 |
| 登録 | モデルの版・作り方・承認者を台帳に残す | 本番で動いているモデルがどれか、誰が承認したかを答えられない | 第7章 |
| 提供 | 予測をまとめて計算する、または問い合わせに即座に答える | 新しいモデルへの切り替えで障害が起き、元に戻せない | 第8章 |
| 監視 | 入力の分布・予測・実際の結果・業務の数字を見続ける | 性能が落ちても数か月気づかない | 第10章 |
| 再学習 | 決まった時期か、条件を満たしたときに学習し直して入れ替える | 環境の変化に追いつけず、損益の取りこぼしが続く | 第11章 |
| 記録 | データの版・コードの版・設定・指標・成果物を、実行ごとに残す | 担当者が離任すると誰も作り直せない。監査や不具合の調査に答えられない | 第5章・第7章・第12章 |
表の部品は、互いに依存しています。たとえば「再学習」は、「データ収集」と「データ検証」が自動で動き、「評価」の基準が決まっていて、「登録」で入れ替えの前後を記録でき、「監視」で入れ替えの効果を確かめられるときに、はじめて安全に回せます。逆に言えば、監視も評価の基準も無いまま再学習だけを自動化すると、壊れたデータで学習したモデルが確認されないまま本番に入る危険があります(第11章で、欠損事故の月のデータで学習し直すと何が起きるかを実測します)。部品を1つずつ整える順序が大事なのはこのためで、順序の考え方はこの章の後半と第13章で扱います。
変わるものは3つある、データ・モデル・コード
通常の業務ソフトウェアでは、判断の規則は主にコードや設定として人が明示的に書きます。機械学習のシステムは、ここが違います。2019年9月に Martin Fowler 氏のサイトに掲載された、機械学習の継続的デリバリーを解説した記事(記事の中での略称はCD4ML)(Danilo Sato 氏ほか)は、機械学習のアプリケーションは、コードそのもの、モデル、データの3つの軸で変わると述べています。コードを1行も変えなくても、学習に使うデータが変われば別のモデルができ、モデルが同じでも、予測に入ってくるデータの性質が変われば結果の良し悪しが変わります。
3つの変化は、それぞれ別の仕組みで受け止める必要があります。コードの変化は、普通のソフトウェア開発と同じく、版の管理とテストで受け止めます。モデルの変化は、どのデータとどのコードから作ったモデルかを記録し、本番に出す前に現行モデルと比べる仕組みで受け止めます。データの変化は、入ってくるデータを検証し、分布の変化と性能を監視する仕組みで受け止めます。Google Cloud の同じ文書も、機械学習のシステムでは継続的インテグレーション(コードを変えるたびに自動で組み立てて試すこと)がコードと部品の試験だけでなくデータ・データの形式(スキーマ)・モデルの試験も含むこと、さらに、モデルを自動で学習し直して提供し直す継続的学習(CT)という、機械学習のシステムに固有の性質が加わることを挙げています。
経営の目線で言い換えると、「システムを触っていないから、本番の結果は変わっていないはずだ」という前提が、機械学習のシステムでは成り立たないということです。この記事のサンプルデータでも、コードとモデルを一度も変えていない「放置」のモデルの損益は、データの側の変化だけで大きく変わります(この章の後半で示します)。予算を組むときも、開発の費用だけでなく、データとモデルの変化を受け止め続ける費用を、運用の費用として見込む必要があります。
Google Cloud の MLOps レベル0〜2
組織が機械学習の運用をどこまで整えているかを測る物差しを、成熟度モデルと呼びます。成熟度モデルは、段階ごとに「何ができていれば、その段階にいると言えるか」を定めたもので、自社の現在地を確かめ、次に何を整えるかを決めるために使います。機械学習の運用の成熟度モデルとして広く参照されているものに、Google Cloud の段階(レベル0〜2)と、Microsoft の段階(レベル0〜4)があります。どちらも公式ドキュメントで公開されているので、この節と次の節で、それぞれの定義を原文で確かめた範囲で紹介します。
Google Cloud の MLOps の解説文書(2026年10月に開いた時点の最終更新は2024年8月28日。旧来の cloud.google.com のアドレスは、このアドレスへ転送されます)は、前の節で挙げた8段の手順(データの抽出から監視まで)がどこまで自動化されているかで成熟度が決まるとし、自動化が無い段階から、学習の流れと CI/CD の両方を自動化した段階までの3段階を示しています。同じ文書は、段階を一度に上げる必要はなく、少しずつ取り入れればよいとも書いています。
| 段階 | 文書での名前 | 何が自動化されているか | 文書が挙げる特徴 | 文書が挙げる限界 |
|---|---|---|---|---|
| レベル0 | 手作業のプロセス | 自動化されていない。各段を人が手で実行し、手で次の段へ渡す | Notebook で対話的に書いたコードで作る/モデルを作る人と本番に載せる人が分かれ、学習済みモデルを成果物として受け渡す/新しい版の投入は年に数回程度/CI も CD も無い/本番に出すのは予測サービスだけ/予測とその結果を記録しないので、性能の低下に気づく手段が無い | 機械学習を使い始めた多くの企業に見られ、モデルをめったに変えないなら足りることもある。ただし環境やデータの変化に適応できず、本番で壊れることが多い |
| レベル1 | 機械学習パイプラインの自動化 | 学習の流れ(パイプライン)全体。新しいデータで自動的に学習し直し、検証を通ったモデルを提供する(継続的学習) | 開発と本番で同じパイプラインを使う/部品をモジュールに分ける/モデルではなくパイプラインごと本番に出す/データの検証とモデルの検証を自動で行う/実行ごとの記録(メタデータ)を残す/学習し直すきっかけ(トリガー)を持つ | パイプラインの数が少なく、作り替えがまれな前提。多くのパイプラインを抱え、新しい手法をすばやく入れたいなら CI/CD が要る |
| レベル2 | CI/CD パイプラインの自動化 | パイプライン自体の組み立て・試験・配置(CI/CD)と、学習し直し | 版の管理、試験と組み立ての仕組み、配置の仕組み、モデルレジストリ、特徴量ストア、メタデータの保管庫、パイプラインの実行管理を備える/開発から監視までの6つの段(開発と実験、パイプラインの CI、パイプラインの CD、自動のトリガー、モデルの継続的デリバリー、監視)で回す | データの分析とモデルの分析は、この段階でも人の手作業として残る、と文書は書いている |
表の「文書が挙げる特徴」のうち、レベル0の「予測とその結果を記録しない」は、見落とされやすい点です。予測を出しっぱなしにして、後から届く実際の結果(この記事のサンプルデータなら、翌月末に確定する解約の有無)と突き合わせなければ、モデルの性能が落ちたかどうかを確かめる材料そのものがありません。第10章で実測するとおり、入力の分布だけを見ていても気づけない変化があり、それに気づくには、予測と実際の結果を突き合わせる記録が要ります。
レベル1の文書は、学習し直すきっかけとして5つを挙げています。人が必要なときに手で動かす、決まった周期(日次・週次・月次)で動かす、新しい学習データが届いたときに動かす、性能の低下が目に見えたときに動かす、入力の分布が大きく変わったときに動かす、の5つです。周期については、データの傾向がどのくらいの頻度で変わるかと、学習し直す費用がどれくらいかによって決まる、と書かれています。この記事の基準の結果で比べる「毎月再学習」と「四半期ごと再学習」は、2つめの「決まった周期」の例にあたり、第11章では、性能の低下や分布の変化をきっかけにする方式を実装して比べます。
レベル1の追加の部品として、文書は、データの検証(学習の前に、データの形式の食い違いを見つけたらパイプラインを止める。値の統計的な性質の大きな変化を見つけたら学習し直しのきっかけにする)と、モデルの検証(新しいモデルを現行のモデルと比べ、上回ることを確かめてから本番に出す。全体の精度が上がっても顧客の地域ごとに精度がばらつくことがあるので、データの区分ごとにも確かめる)を挙げています。地域ごとのばらつきの例として、顧客の解約予測のモデルが挙げられているのは、この記事のサンプルデータと同じ題材です。区分ごとの評価は第6章で、獲得経路別に実測します。
Microsoft の MLOps 成熟度モデル(レベル0〜4)
Microsoft は、Azure のアーキテクチャセンターでMLOps の成熟度モデルを公開しています(2026年10月に開いた時点で、記事の日付は2026年6月3日)。このモデルは5つの段階を定め、各段階を「人」「モデルの作成」「モデルのリリース」「アプリケーションへの組み込み」の4つの観点で記述しています。文書は使い道として、新しい取り組みの作業範囲の見積もり、現実的な成功の基準の設定、取り組みの最後に引き渡す成果物の特定、の3つを挙げています。また、実際の組織は複数の段階の特徴を同時に持つことが多く、段階は互いに切り離されたものではなく、重なりながら少しずつ進む連続したものとして扱うよう書いています。
| 段階 | 文書での名前 | 文書が挙げる要点(抜粋) |
|---|---|---|
| レベル0 | MLOps が無い | モデルの一生の全体を管理しにくい/チームがばらばらでリリースが難しい/本番に出した後の手応え(性能の情報)がほとんど無い/組み立て・配置・試験・学習が手作業/データを手で集め、実験を一貫して記録していない |
| レベル1 | DevOps はあるが MLOps は無い | アプリケーションの組み立てとコードの試験は自動化され、コードは版の管理下にある/ただし新しいモデルのたびにデータのチームに頼る/本番の性能の手応えは依然として少ない/結果を追跡・再現しにくい |
| レベル2 | 学習の自動化 | 学習の環境が管理され追跡できる/モデルを再現しやすい/実験の結果を記録し、学習のコードとモデルの両方を版の管理下に置く/定期のジョブや出来事をきっかけにしたジョブで学習し直す/リリースは手作業だが実施は容易 |
| レベル3 | モデルの配置の自動化 | リリースが自動で容易/配置したモデルから元のデータまで完全にたどれる/モデルの性能の A/B テスト(利用者を無作為に分けて、新旧のモデルの成果を比べる方法)を配置に組み込む/CI/CD のパイプラインがリリースを管理する |
| レベル4 | MLOps の運用まで完全に自動化 | システム全体が自動化され、監視しやすい/本番の指標をきっかけに自動で学習し直す(ドリフトや性能の後退の兆候で再学習が始まる。ドリフトは、入力のデータの分布や、入力と結果の関係が時間とともに変わることで、第10章で扱う)/モデルの昇格(本番への格上げ)が方針に基づいて自動で行われる/停止時間がほぼ無い状態に近づく |
Microsoft のモデルには、Azure Machine Learning の機能名(ワークスペース、レジストリ、Event Grid など)が技術の欄に書かれていますが、表には製品に依らない内容だけを抜き出しました。Google Cloud の3段階と比べると、Microsoft の5段階は、自動化の範囲に加えて「人」の観点、つまりデータサイエンティスト・データエンジニア・ソフトウェアエンジニアが孤立して働いているか、協力して実験のコードを繰り返し動かせる形に直しているか、を段階の定義に含めている点が特徴です。たとえばレベル0と1では、3つの職種がそれぞれ孤立して働き、モデルは他のメンバーから受け取る、と書かれています。レベル1は、普通のソフトウェア開発の自動化(DevOps)だけが進み、モデルの側は手作業のまま、という状態を別の段階として切り出しています。アプリケーションの開発の自動化が先に進んでいる企業では、モデルの側が手作業のまま残る、この「レベル1」に当たる状態が起こりうると考えています。
2つのモデルの段階は、公式に対応づけられたものではありません。この記事では、読み替えの目安として、Google Cloud のレベル0が Microsoft のレベル0〜1に、Google Cloud のレベル1(学習の流れの自動化)が Microsoft のレベル2(学習の自動化)に、Google Cloud のレベル2が Microsoft のレベル3〜4に、おおむね近いと見ています。これは2つの文書の記述を並べた上での弊社の読み替えで、どちらの文書にも書かれていません。どちらの物差しを使う場合も、大事なのは段階の番号ではなく、自社のモデルにとって、次の段階に上がる費用に見合う効果があるかどうかです。
どの段階から何が要るか、モデルの本数・更新の頻度・影響の大きさで決める
成熟度モデルは「上の段階ほど良い」と読まれがちですが、Google Cloud の文書自身が、モデルをめったに変えないならレベル0の手作業でも足りることがあると書いています。上の段階に上がるには、仕組みを作る費用と、それを維持する人手が要ります。モデルが1本しかなく、年に1回見直せば足りる用途に、レベル2の仕組みを一式そろえるのは過剰な投資です。逆に、何十本ものモデルが毎日の業務の判断に使われているのに、手作業で学習し直している状態は、障害と判断の遅れの危険を抱え続けることになります。
どこまで整えるかは、次の3つで決めるのがよいと考えています。1つめは、運用するモデルの本数です。本数が増えるほど、手作業の手順は人によってばらつき、記録と自動化の価値が上がります。2つめは、モデルを更新する頻度と、データの傾向が変わる速さです。月に1回以上の更新が要るなら、手作業の学習し直しは人手の負担と確認漏れの元になります。3つめは、判断を誤ったときの影響の大きさです。予測が顧客への連絡や与信・価格のような判断に直接使われ、誤りが損益や顧客に届くなら、監視・承認・記録は本数が少なくても要ります。次の表は、この3つの組み合わせごとに、最低限整える部品と後回しにしてよい部品を、弊社の考えとして整理したものです。公的な基準ではありません。
| 状況 | 本数・更新・影響の例 | 最低限整える部品 | 後回しにしてよい部品 | 目安の段階 |
|---|---|---|---|---|
| 試行・分析の補助 | 1本/年に数回以下/人が結果を見てから判断する | 記録(データの版・コード・設定・指標)、評価の基準 | 自動の再学習、特徴量の共通基盤、自動の配置 | Google Cloud のレベル0。ただし記録だけは最初から残す |
| 1本を業務の判断に使う | 1〜数本/月次で判断に使う/施策の件数や費用に直接効く | 上に加えて、データ検証、予測と実際の結果の突き合わせ(監視)、登録と承認、決まった周期の再学習の手順書 | パイプラインの CI/CD、特徴量の共通基盤 | Google Cloud のレベル0から1への移行期。この記事のサンプルデータの想定はここ |
| 複数本を日常の業務に組み込む | 数本〜数十本/週次〜月次で更新/顧客対応や価格などに自動で反映 | 上に加えて、学習の流れの自動化(継続的学習)、再学習のきっかけの設計、新旧モデルの比較による入れ替え、ロールバック | パイプライン自体の CI/CD は、モデルの作り替えが少なければ後回しにできる | Google Cloud のレベル1 |
| 多数のモデルを継続的に改良する | 数十本以上/新しい手法を頻繁に試して入れ替える/障害が顧客や取引先に直接届く | 上に加えて、パイプライン自体の CI/CD、特徴量の共通基盤、体制と役割の明確化 | なし | Google Cloud のレベル2 |
表で強調したいのは2点です。1点めは、どの行でも「記録」が最低限の部品に入っていることです。記録は後から作り直せません。担当者が離任したあとに「このモデルはどのデータで、どの設定で作ったのか」を問われても、記録が無ければ誰も答えられず、同じモデルを作り直すこともできません。記録の仕組みは小さく始められ(第5章で、Python の標準ライブラリの sqlite3 を使って実験の記録の仕組みを作ります)、費用に比べて効果が大きいので、最初の1本から整えるのが有効だと考えています。2点めは、2行めの「1本を業務の判断に使う」段階で、監視と決まった周期の再学習が最低限に入っていることです。この段階では、自動化は後回しにできても、「性能が落ちたことに気づく手段」と「学習し直す手順」が無いことは許されない、と考えています。モデルが1本でも、その予測で毎月数千件の施策を打っているなら、劣化に気づかない月が続くほど損失が積み上がるからです。
経営の判断に直すと、段階を上げる投資の上限の目安は「その段階に上がることで防げる損失」です。この記事のサンプルデータでは、1本のモデルを24か月放置したときと毎月学習し直したときの損益の差が、架空の設定で420.2万円になります(この章の後半で内訳を示します)。月に直せば約17.5万円です。毎月の学習し直しと確認にかかる人手と仕組みの費用が、この額を大きく超えるなら、四半期ごとの学習し直しや、性能が落ちたときだけ学習し直す方式のほうが釣り合います。この比較の詳しい考え方は第11章(再学習の方式)と第13章(体制と費用対効果)で扱います。ここで押さえておきたいのは、成熟度の段階は目的ではなく、防げる損失と整える費用の釣り合いで決めるもの、ということです。
この記事で使うサンプルデータ、架空の定額制サービスの解約予測
第3章から第12章では、同じ1つのサンプルデータを使って、各章の仕組みが何を防ぐかを実行して確かめます(第13章と第14章では、その結果の数字を使います)。このデータは、実在の企業・顧客の記録ではありません。乱数の種(シード)を固定して、この記事のために生成した架空のデータです。題材は、月額課金の会員サービス(定額制サービス)で、毎月その月に契約中の顧客の中から、翌月末までに解約しそうな顧客を予測し、引き止めの施策(特典の案内や連絡など)を打つかどうかを決める、という業務を想定しています。1か月あたり5,000件、36か月分のデータがあり、各月の顧客は独立に作っています(同じ顧客を月をまたいで追跡はしません)。
データの生成とモデルの入力の作成は、補助モジュール mlops_data.py にまとめ、基準の結果の計算は補助モジュール baseline.py にまとめました。この記事に載せるコードは、この2つの補助モジュールと同じフォルダに置いて実行する形です。補助モジュール自体は配布していないので、コードが使う設定の値は、この節と次の節の表に示します。データの列は次のとおりです。
| 列名 | 中身 | 備考 |
|---|---|---|
month | 第何か月か(1〜36) | モデルの入力には使わない |
tenure_m | 契約月数 | 数値 |
plan | プラン(basic/standard/premium) | 月額は basic 980円、standard 1,980円(第19か月から2,380円)、premium 3,480円 |
monthly_fee | 月額(円) | 数値 |
usage_days | 前月の利用日数 | 第25〜26か月に一部が欠損する |
usage_change | 利用日数の前月差 | 数値 |
support_tickets | 問い合わせ件数 | 数値 |
payment_failures | 決済失敗の回数 | 数値 |
channel | 獲得経路(web/store/partner) | partner は第22か月から現れる |
discount | 割引の有無(1=有り) | 数値 |
churn | 翌月末までに解約したら1 | 予測の対象(目的変数)。翌月末にならないと確定しない |
true_p | 真の解約確率 | 答え合わせ専用。モデルの入力には使わない |
表の最後の true_p(この記事では「真の確率」と呼びます)は、現実のデータには無い列です。このデータは乱数で作っているので、データを作った側は、顧客1人ひとりの本当の解約確率を知っています。現実の企業には、本当の解約確率は見えません。見えるのは、解約したかどうかという結果だけです。この記事では、真の確率を「現実には分からないが、この記事では答え合わせに使えるもの」として扱い、モデルの予測がどこまで上限に近づけるかの目安にします。モデルの予測と真の確率は、必ず書き分けます。
モデルに入れるのは、month・churn・true_p を除く9つの列です。プランと経路は文字の列なので、補助モジュールの encode 関数で、区分ごとに0か1を立てる列(one-hot)に直し、数値の7列と合わせて13列の入力にします。このとき、学習のデータに無い経路 partner の列も最初から用意して、列の並びを固定しました。学習のときに無かった区分が本番で現れても、入力の列の数が変わらずに予測が出る作りです。これが第22か月の変化で何を引き起こすかは、第3章で確かめます。
業務の側の設定も、すべて架空です。引き止めの施策は1件800円かかり、翌月末までに解約する顧客に施策を打つと、その35%を引き止められ、引き止めた顧客は平均してさらに12か月継続し、継続1か月あたりの粗利は1,800円、と置きました。この設定では、解約する顧客に施策を1件打つと、0.35×12×1,800=7,560円の粗利を守れる見込みになります。施策を打つかどうかは、モデルが出した解約の確率と比べて決めます。確率 \( p \) の顧客に施策を打つと、守れる粗利の見込みは \( 7{,}560 \times p \) 円、費用は800円なので、\( p \) が 800÷7,560=0.1058 を超える顧客に打てば得になります。言葉で言い換えると、「解約の確率が約10.6%を超える顧客にだけ施策を打つ」というルールです。
| 設定 | 補助モジュールでの名前 | 値(架空) |
|---|---|---|
| 施策1件の費用 | CONTACT_COST | 800円 |
| 解約する顧客を引き止められる割合 | RETAIN_RATE | 0.35 |
| 引き止めた顧客の追加の継続月数 | RETAIN_MONTHS | 12か月 |
| 継続1か月あたりの粗利 | MARGIN | 1,800円 |
| 解約する顧客に施策を打ったときに守れる粗利 | HIT_VALUE | 7,560円 |
| 施策を打つかどうかのしきい値 | THRESHOLD | 0.1058(800÷7,560) |
この記事でいう「損益」は、モデルの予測確率がしきい値0.1058を超えた顧客全員に施策を打ったときの、守れた粗利の合計から施策の費用の合計を引いたものです。実際に解約した顧客に打った件数(当たり)×7,560円から、打った件数(施策件数)×800円を引いて計算します。予測の確率の水準がずれると、しきい値を超える顧客の数そのものが変わり、打つべき顧客に打てなくなるか、打たなくてよい顧客に打ってしまいます。この点が、後で示す基準の結果を読む鍵になります。次のコードは、補助モジュールを読み込んで、設定の値と第1か月のデータの先頭、いくつかの月の要約を出すものです。
import mlops_data as md

print("施策の費用", md.CONTACT_COST, "円 / 守れる粗利", round(md.HIT_VALUE), "円 / しきい値", round(md.THRESHOLD, 4))
d = md.month_data(1)                     # 第1か月の5,000件
print(d.shape)
print(d.drop(columns=["true_p"]).head(3).to_string())
X = md.encode(d)                         # モデルの入力(数値7列と one-hot 6列)
print(X.shape)
print("月 解約率 月額平均 partner比率 usage欠損率")
for m in (1, 18, 19, 22, 25, 28, 36):
    d = md.month_data(m)
    print(m, round(d.churn.mean(), 4), round(d.monthly_fee.mean(), 1),
          round((d.channel == "partner").mean(), 4), round(d.usage_days.isna().mean(), 4))
# 出力:
# 施策の費用 800 円 / 守れる粗利 7560 円 / しきい値 0.1058
# (5000, 12)
#    month  tenure_m      plan  monthly_fee  usage_days  usage_change  support_tickets  payment_failures channel  discount  churn
# 0      1      18.0     basic        980.0         7.0          -6.0                0                 0     web         0      0
# 1      1      20.0   premium       3480.0        21.0           3.0                1                 0   store         0      0
# 2      1      21.0  standard       1980.0        15.0          -0.0                0                 0     web         0      0
# (5000, 13)
# 月 解約率 月額平均 partner比率 usage欠損率
# 1 0.0822 1891.0 0.0 0.0
# 18 0.0804 1880.4 0.0 0.0
# 19 0.091 1999.4 0.0 0.0
# 22 0.0968 1886.0 0.1768 0.0
# 25 0.0996 1867.4 0.1806 0.1238
# 28 0.1484 1864.4 0.184 0.0
# 36 0.1438 1871.6 0.182 0.0
第1か月の5,000件は12列で、encode で直した入力は13列になりました。第1か月の構成は、プランが standard 47.5%・basic 35.1%・premium 17.4%、経路が web 62.4%・store 37.6% です。学習に使う第1〜12か月の60,000件の解約率は0.0798(約8.0%)で、月ごとには0.0724から0.0846の間で揺れています。月ごとの揺れは、各月5,000件を乱数で作っていることによる偶然の揺れで、この期間の真の確率の平均は0.080から0.082の間でほぼ一定です。
途中で起きる4つの変化
このサンプルデータでは、第13か月以降に、本番の運用で実際に起こりうる種類の変化を4つ、順に起こしています。4つは、変化の性質がそれぞれ違うように選びました。入力の分布は変わるが解約との関係は変わらないもの、学習のときに無かった区分が現れるもの、データの連携の不具合で値が欠けるもの、解約との関係そのものが変わるもの、の4種類です。どの変化がどの仕組みで見つかり、どの仕組みでは見つからないかが、第3章から第11章の主題になります。
| 月 | 変化(架空) | データで何が変わるか(実測) | 解約との関係 | 主に扱う章 |
|---|---|---|---|---|
| 第19か月 | 料金改定 | standard の月額が1,980円から2,380円へ。standard の一部が basic へ移る。月額平均は第13〜18か月の1,865.8円から第19〜21か月の1,993.5円へ | 関係の式は変わらない(条件が同じ会員なら解約のしやすさは同じ)。ただし月額が上がった会員がいるので、全体の解約率は第13〜18か月の0.0822から第19〜21か月の0.0907へ上がる | 第10章 |
| 第22か月 | 新しい獲得経路 partner の開始 | 学習のときに無かった区分 partner が約18%混ざる(第22〜24か月の平均0.1759)。partner の顧客は basic が約72%、割引ありが約6割(他の経路は約15%)。利用日数の平均は6.6日(他の経路は約12日)、契約月数の平均は4.6か月(他の経路は約18か月) | partner の顧客は、他の条件が同じでも解約しやすい作りにした。第22〜24か月の partner の解約率は0.1789(web 0.0887、store 0.0895) | 第3章・第6章 |
| 第25〜26か月 | データ連携の不具合 | store 経路の顧客の利用日数の約4割が欠損(store の中で0.4072・0.3863)。月全体の欠損率は0.1238・0.1152 | 本当の利用日数と解約の関係は変わらない。モデルに届く値だけが欠ける | 第3章・第11章 |
| 第28か月以降 | 競合の乗り換え施策 | 解約率が第28〜36か月の平均で0.1427に上がる | 関係そのものが変わる。解約の基礎率が上がり、利用日数が多い顧客も抜けるようになる | 第10章・第11章 |
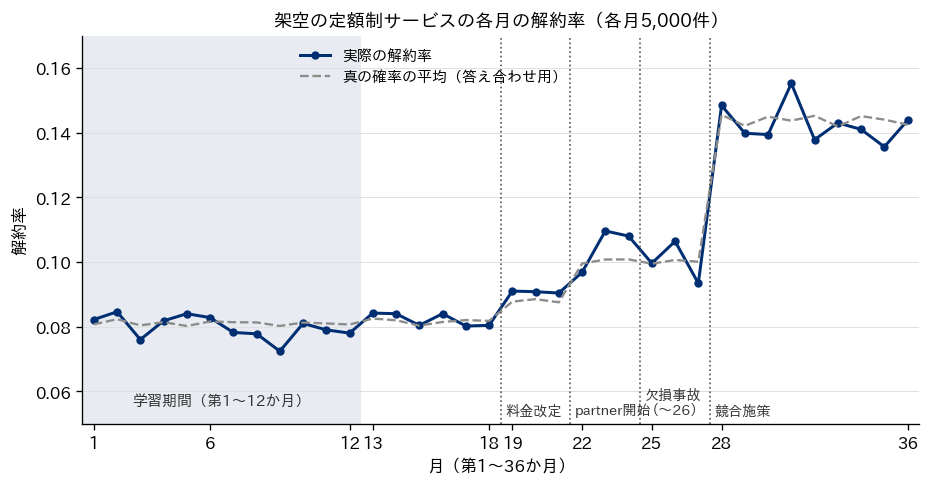
図は、各月の実際の解約率(実線)と、真の確率の平均(破線)を、第1か月から第36か月まで並べたものです。網かけは学習に使う第1〜12か月です。解約率は、変化前の第13〜18か月は平均0.0822で学習期間とほぼ同じ水準にあり、料金改定のあとの第19〜21か月は平均0.0907、partner が加わった第22〜24か月は平均0.1048、欠損事故の第25〜26か月は平均0.1030、第27か月は0.0934と動き、競合の施策が始まった第28か月に0.1484へ跳ね上がって、第28〜36か月は0.1356から0.1552の間(平均0.1427)にとどまります。学習期間の平均0.0798と比べると、最後の9か月の解約率は約1.8倍です。
欠損事故の2か月は、解約率の線には何も表れていません。欠損は、モデルに届くデータの側で起きた事故で、顧客の行動は変わっていないからです。解約率だけを見ていると、この事故には気づけません。逆に、料金改定と partner の開始では解約率が上がっていますが、どちらも真の確率の平均が同じように上がっていて、顧客の構成と料金が変わった結果として説明がつく変化です。料金改定でいえば、条件が同じ会員の解約のしやすさは改定の前後で変わりませんが、月額が上がった会員がいるため、全体の解約率は上がります。「関係が変わらない」ことと「解約率が変わらない」ことは別の話です。
第28か月以降の変化は、ほかの3つと性質が違います。同じ利用日数の顧客でも、解約のしやすさが変わります。利用日数で顧客を区分して解約率を比べると、第1か月は、利用日数0〜5日の顧客の解約率が0.1273、21〜30日の顧客が0.0479で、よく使う顧客ほど解約しにくい関係がはっきりしていました。第30か月では、0〜5日が0.1656、21〜30日が0.1481で、よく使う顧客も同じくらい抜けるようになっています(ここで比べたのは第1か月と第30か月の2つの月だけで、1か月5,000件の結果には偶然の揺れも含まれます)。学習期間のデータで覚えた「利用が多い顧客は安全」という関係が、本番の途中で成り立たなくなったということです。第10章で扱うとおり、この記事で測った範囲では、入力や予測の分布を見張るだけでは、この種類の変化はつかめませんでした。
基準の結果を作る仕組み
第3章以降の各章は、4つの変化に対して、それぞれの仕組みが何を防ぐかを確かめます。そのときの比較の土台として、「何もしない場合」と「決まった周期で学習し直す場合」の結果を、あらかじめ計算しておきました。これをこの記事では基準の結果と呼びます。比べる方式は次の4つで、いずれも第13〜36か月の24か月について、月ごとに予測して評価します。
- 放置:第1〜12か月(60,000件)で一度だけ学習し、以後そのまま使うモデル
- 毎月再学習:第 m か月の予測の前に、解約の有無が確定している直近12か月(第 m-13〜m-2 か月)で学習し直すモデル。解約は翌月末に確定するので、直前の第 m-1 か月の結果はまだ使えず、1か月の遅れを置いています
- 四半期ごと再学習:第16・19・22・25・28・31・34か月の7回だけ、毎月再学習と同じ方法で学習し直すモデル。第13〜15か月は放置と同じモデルです
- 真の確率:データを作った側だけが知る本当の解約確率を、モデルの予測の代わりに使った場合。現実には実現できない、上限の目安です
モデルは、scikit-learn の勾配ブースティングの分類器 HistGradientBoostingClassifier を、木の数200・学習率0.08・葉の数の上限31・乱数の種0の設定で使いました。この記事の目的はモデルの精度を競うことではなく、同じモデルを運用の仕方だけ変えて比べることなので、設定は全章で固定しています。次のコードは、補助モジュール baseline.py から、学習・評価・比較の要所を抜き出し、説明のコメントと損益の合計を出す数行を足して、単体で流れが追える形に書き直したものです(実際の関数は、これに加えて指標を表にまとめる処理と PSI の計算を含みます)。補助モジュール mlops_data.py と同じフォルダに置いて実行し、損益の合計が基準の結果と一致することを確かめました。
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score
import mlops_data as md

MODEL_PARAMS = dict(max_iter=200, learning_rate=0.08, max_leaf_nodes=31, random_state=0)

def make_model():
    return HistGradientBoostingClassifier(**MODEL_PARAMS)

def fit(start, end, seed=0):                      # 第 start〜end か月で学習する
    d = md.months(start, end, seed)
    m = make_model()
    m.fit(md.encode(d), d.churn)
    return m

def evaluate(model, d):                           # その月の AUC・予測平均・損益・施策件数
    s = model.predict_proba(md.encode(d))[:, 1]
    val, hits, k = md.campaign_value_threshold(d.churn, s)
    return dict(auc=roc_auc_score(d.churn, s), pred_mean=s.mean(), value=val, n_contact=k)

train = md.months(1, 12)
frozen = make_model().fit(md.encode(train), train.churn)   # 放置:一度だけ学習
q_model = frozen
total = [0.0, 0.0, 0.0, 0.0]                      # 放置・毎月・四半期・真の確率の損益合計
for m in range(13, 37):
    d = md.month_data(m)
    if (m > 13) & ((m - 13) % 3 == 0):            # 四半期ごと:第16・19・22…か月
        q_model = fit(max(1, m - 13), m - 2)
    r_model = fit(max(1, m - 13), m - 2)          # 毎月:第 m-13〜m-2 か月で学習し直す
    ef, er, eq = evaluate(frozen, d), evaluate(r_model, d), evaluate(q_model, d)
    tv, _, tk = md.campaign_value_threshold(d.churn, d.true_p)  # 真の確率で同じ判断をした場合
    for i, v in enumerate((ef["value"], er["value"], eq["value"], tv)):
        total[i] += v
print("24か月の損益合計(万円) 放置 %.1f / 毎月 %.1f / 四半期 %.1f / 真の確率 %.1f" % tuple(x / 1e4 for x in total))
# 出力:
# 24か月の損益合計(万円) 放置 1964.0 / 毎月 2384.2 / 四半期 2357.7 / 真の確率 2691.1
学習の期間を決める max(1, m - 13) は、第13か月だけ学習の開始が第1か月より前になってしまうのを防ぐためのものです。このため、第13か月の毎月再学習のモデルは第1〜11か月の11か月分で学習し、第14か月以降は直近12か月分で学習します(たとえば第36か月の予測には第23〜34か月を使います)。第13か月の毎月再学習の AUC が放置と少し違うのは、この学習期間の違いによるものです。
ここで、放置のモデルの扱いには1つ例外があることを断っておきます。毎月再学習の決まりに従えば、第13か月の予測に使えるのは第11か月までの結果です。ところが放置のモデルは第1〜12か月で学習しています。これは、放置のモデルを「第12か月の解約が確定したあとに作り、第13か月から使い始める初期モデル」と位置づけたためです。この設定のため、第13か月に限っては、放置のモデルが1か月分多いデータで学習していて、わずかに有利です(第13か月の損益は放置が58.95万円、毎月再学習が54.88万円)。第14か月以降は、放置が第12か月までのデータのまま、毎月再学習が新しいデータを取り込むので、この有利さは消えます。この例外があっても結論の向きは変わらず、後で示す24か月の損益の差420.2万円のうち364.8万円は第28〜36か月で生じています。四半期ごと再学習は、第13〜15か月は放置と同じ初期モデルを使い、第16か月から学習し直します。24か月分の比較の計算には、この記事の実行環境(一般的なノートPC)での実測で35.6秒かかりました。同じPCで他の計算が並行して動いていた別の実行では109.0秒かかっており、実行のたびに揺れます。
評価の指標は、全章で次の定義に固定します。AUC は、予測の確率で顧客を並べたときの並べ替えの正しさを表す指標で、0.5はランダムに並べた場合と同じ、1は完全です。AUC は並び順だけを見るので、確率の水準が全体にずれていても値は変わりません。予測平均は、その月のモデルの予測確率の平均です。これをその月の実際の解約率と比べると、確率の水準のずれ(較正のずれ)が分かります。損益と施策件数は、前の節で定義したとおりです。PSI(母集団安定性指標)は、学習期間と比べて分布がどれだけ変わったかを表す指標で、基準の結果では利用日数・月額・モデルの予測(スコア)の3つについて計算しました。PSI の詳しい定義と読み方は第10章で扱います。
基準の結果、放置・四半期ごと・毎月・真の確率を比べる
基準の結果を、4つの変化で区切った期間ごとに平均したのが次の表です。AUC・実際の解約率・予測平均は各月の値の平均、損益はその期間の1か月あたりの平均(万円)です。「真」は真の確率を予測の代わりに使った場合で、上限の目安です。
| 期間 | AUC 放置 | AUC 毎月 | AUC 真 | 実際の解約率 | 予測平均 放置 | 予測平均 毎月 | 損益 放置 | 損益 四半期 | 損益 毎月 | 損益 真 |
|---|---|---|---|---|---|---|---|---|---|---|
| 第13〜18か月 変化前 | 0.680 | 0.681 | 0.692 | 0.082 | 0.081 | 0.081 | 45.3 | 45.6 | 45.0 | 47.4 |
| 第19〜21か月 料金改定 | 0.673 | 0.673 | 0.683 | 0.091 | 0.080 | 0.081 | 52.7 | 55.5 | 56.0 | 66.0 |
| 第22〜24か月 partner | 0.682 | 0.680 | 0.697 | 0.105 | 0.086 | 0.096 | 84.4 | 89.2 | 90.7 | 96.2 |
| 第25〜26か月 欠損事故 | 0.683 | 0.688 | 0.700 | 0.103 | 0.084 | 0.101 | 83.8 | 93.8 | 92.8 | 101.0 |
| 第27か月 | 0.681 | 0.684 | 0.696 | 0.093 | 0.086 | 0.104 | 61.4 | 68.0 | 71.3 | 71.1 |
| 第28〜36か月 競合施策 | 0.630 | 0.650 | 0.670 | 0.143 | 0.086 | 0.114 | 116.9 | 155.0 | 157.4 | 183.0 |
| 第13〜36か月 全体 | 0.661 | 0.669 | 0.684 | 0.111 | 0.084 | 0.098 | 81.8 | 98.2 | 99.3 | 112.1 |
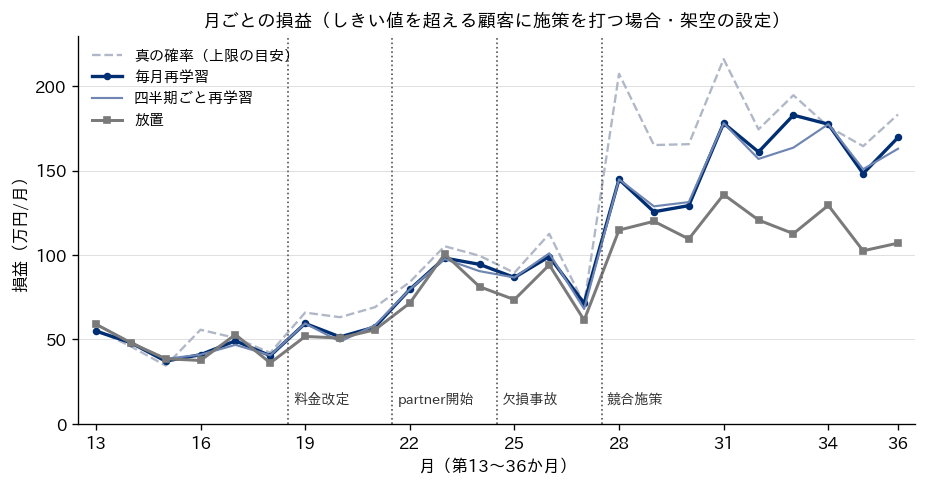
表と図から読めることを、期間の順に整理します。変化前の第13〜18か月は、4つの方式の差がほとんどありません。損益の列は放置45.3万円・四半期45.6万円・毎月45.0万円で、AUC もほぼ同じです。環境が変わらないうちは、学習し直しても得るものが無いということで、この期間に毎月学習し直す手間は、この設定では報われていません。
料金改定から欠損事故までの第19〜27か月は、差が少しずつ開きます。この期間、AUC の列は放置と毎月でほとんど同じ(0.673〜0.688)なのに、損益の列は毎月再学習のほうが1か月あたり3〜10万円ほど大きくなっています。差が出ているのは予測平均の列です。実際の解約率が期間平均で0.091から0.105へ上がっていくのに、放置のモデルの予測平均は0.080〜0.086にとどまり、確率を低めに見積もっています。毎月再学習のモデルは、直近のデータで学び直すので、期間平均の予測平均が0.081から0.104へと、実際の解約率に近づいていきます。並べ替えの正しさ(AUC)が同じでも、確率の水準がずれると、しきい値0.1058を超える顧客の数が変わり、損益が変わります。
差が大きく開くのは、競合の施策が始まった第28〜36か月です。この期間の AUC は、放置0.630・毎月0.650・真0.670と、どの方式も変化前より下がりました。関係そのものが変わったので、真の確率でさえ並べ替えの正しさが落ちています。損益の列は、放置116.9万円・四半期155.0万円・毎月157.4万円・真183.0万円で、放置と毎月の差は1か月あたり40.5万円です。次の段落で見るとおり、確率の水準に依らない使い方では差が小さくなるので、この差の大部分は確率の水準のずれによるものと見ています(この章では、ずれだけを補正して比べる計算はしていません。較正だけをやり直す計算は第6章で扱います)。実際の解約率0.143に対して、放置のモデルの予測平均は0.086のままで、施策件数(月平均)は放置1,347.6件・毎月2,233.2件・真3,154.6件でした。放置のモデルは、解約の確率を実際より低く見積もるので、施策を打つべき顧客の多くがしきい値を下回り、打てていません。
確率の水準のずれが効くのは、確率をしきい値と比べて施策の件数を決める使い方のときです。参考に、確率の水準に依らず、予測の上位10%(毎月500件)に施策を打つ使い方でも計算しました。この使い方では、競合の施策の期間の損益は放置62.8万円・毎月66.9万円で、差は小さくなります。同じモデルでも、予測をどう業務の判断に使うかで、放置したときの損失の大きさが変わるということです。どちらの使い方が適切かは、施策の予算が決まっているか(上位何件と決める)、1件ごとの損得で決めるか(しきい値で決める)によります。しきい値の決め方と確率の較正は第6章で扱います。
表には、短い期間の偶然の揺れも表れています。第25〜26か月は四半期ごと再学習(93.8万円)が毎月再学習(92.8万円)をわずかに上回り、第27か月は毎月再学習(71.3万円)が真の確率(71.1万円)をわずかに上回りました。真の確率は「平均すれば最も得になる判断」を与えるものですが、1か月5,000件の結果は乱数で決まるので、1〜2か月の短い期間では順位が入れ替わることがあります。方式の良し悪しは、1か月の結果ではなく、まとまった期間の合計で比べる必要があります。
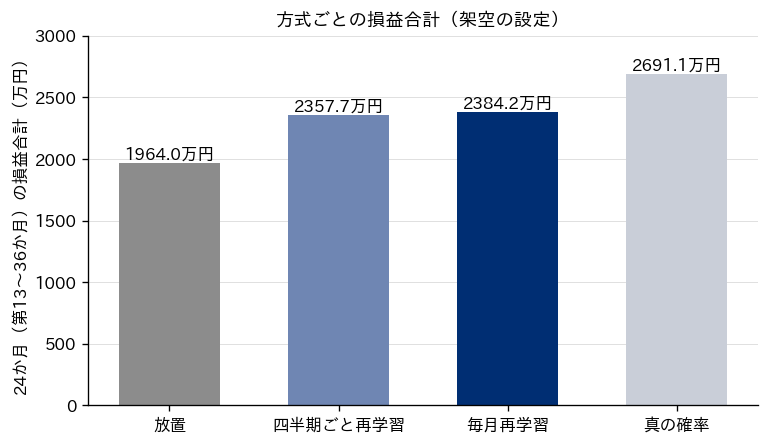
24か月(第13〜36か月)の損益合計は、放置1,964.0万円・四半期ごと再学習2,357.7万円・毎月再学習2,384.2万円・真の確率2,691.1万円でした。放置と毎月再学習の差は420.2万円で、そのうち364.8万円(86.8%)が第28〜36か月の9か月で生じています。四半期ごと再学習は、学習し直す回数が7回(毎月再学習は24回)でありながら、放置との差の393.7万円を取り戻し、毎月再学習との差は26.5万円にとどまりました。一方、毎月再学習と真の確率の間には306.9万円の差が残っています。この差は、学習し直すだけでは埋まらなかった部分で、関係そのものが変わったあとに、1か月遅れの正解(解約したかどうか)で学ぶ限界や、モデルと入力の作り方の限界を含みます。ただし、それぞれがどれだけを占めるかは、この記事では測っていません。
PSI(学習期間と比べた分布の変化)の期間平均も、基準の結果に含めました。月額の PSI は第19か月の料金改定以降ずっと0.58〜0.81の大きな値が続きますが、関係の式は変わっていないので、AUC は目立って落ちていません(放置のモデルで変化前0.680、料金改定の期間0.673)。月額は値が数種類しかなく、10区分に分けて比べる計算がそのままは成り立たないので、この PSI は「大きな変化があった」ことの検知としてだけ読めるものです。利用日数の PSI は、欠損事故の第25・26か月だけ0.89〜0.96に跳ね上がります。モデルの予測(スコア)の PSI は、競合の施策の期間も月ごとに0.011〜0.025と小さいままでした。損益に最も大きく効いた第28か月以降の変化は、入力や予測の分布を見張るだけでは気づきにくく、1か月遅れで届く実際の解約の有無と予測を突き合わせて、はじめて見えるということです。この読み方は第10章で詳しく扱います。
| 期間 | PSI 利用日数 | PSI 月額 | PSI スコア |
|---|---|---|---|
| 第13〜18か月 変化前 | 0.002 | 0.000 | 0.002 |
| 第19〜21か月 料金改定 | 0.004 | 0.805 | 0.004 |
| 第22〜24か月 partner | 0.048 | 0.616 | 0.015 |
| 第25〜26か月 欠損事故 | 0.923 | 0.590 | 0.012 |
| 第27か月 | 0.059 | 0.579 | 0.015 |
| 第28〜36か月 競合施策 | 0.053 | 0.595 | 0.017 |
基準の結果を経営の数字に直す
基準の結果は、この架空のデータの、この設定での結果です。再学習すれば必ず損益が増える、という一般論ではありません。そのうえで、運用の判断に使える形に直すと、次の3つが読み取れます。
1つめは、放置の損失は「ある月に突然」大きくなるということです。第13〜27か月の15か月間、放置と毎月再学習の損益の差は合計55.4万円で、月に直せば4万円に届きません。この期間だけを見て「再学習しなくても大差ない」と判断すると、第28か月以降の9か月で364.8万円を取りこぼします。差が小さい期間が続いていることは、今後も小さいことを保証しません。運用の仕組みの価値は、平時ではなく、環境が変わった月に表れます。
2つめは、損失の中身が「打つべき施策を打っていないこと」だという点です。競合の施策の期間、放置のモデルは毎月約886件(毎月再学習との施策件数の差、2,233.2件と1,347.6件の差)少なく施策を打ち、守れたはずの粗利を守れていません。障害のように画面が止まるわけではなく、施策の担当者から見ると、モデルが出したリストに従って普段どおり施策を打っているだけです。この種類の損失は、予測の確率の平均と実際の解約率を毎月並べて見ていれば、1か月遅れで気づけます。監視の仕組みの費用を考えるときは、この「気づくまでの月数×月あたりの取りこぼし」と比べるのが分かりやすいと考えています。この設定では、競合の施策の期間に気づくのが1か月遅れるごとに、放置と毎月再学習の差にあたる約40万円を取りこぼす計算になります。
3つめは、学習し直す頻度と費用の釣り合いです。この設定では、四半期ごと(7回)でも毎月(24回)の損益の大部分を取り戻し、差は24か月で26.5万円でした。毎月にすると増える17回の学習し直しで26.5万円、1回あたり約1.6万円の上乗せです。学習し直しのたびに人が評価の結果を確かめて入れ替えを承認する運用なら、その人手の費用が1回あたりこの額を上回るかどうかが、毎月にするか四半期にするかの分かれ目になります。ただし、これはこの架空のデータの変化の起き方での結果で、別のデータや別の変化でも同じ釣り合いになるとは限りません。性能が落ちたときに学習し直す方式との比較は第11章で、人手の見積もりの考え方は第13章で扱います。
この章の要点をまとめます。本番で使い続ける機械学習のシステムは、データ収集・データ検証・特徴量・学習・評価・登録・提供・監視・再学習・記録の10の部品からなり、コードだけでなくデータとモデルが変わるので、それぞれを受け止める仕組みが要ります。どこまで整えるかは、Google Cloud(レベル0〜2)や Microsoft(レベル0〜4)の成熟度モデルを物差しにしつつ、モデルの本数・更新の頻度・判断を誤ったときの影響の大きさで決め、どの段階でも記録だけは最初から残すのが有効だと考えています。共通のサンプルデータ(架空の定額制サービス、4つの変化)での基準の結果では、放置と毎月再学習の24か月の損益の差が420.2万円で、その大部分は関係そのものが変わった第28か月以降に、確率の低い見積もりによる施策の打ち漏れとして生じたと見ています(この章では、確率の水準のずれだけを補正した計算はしていません)。
次の第3章では、部品の最初の段であるデータの品質を扱い、このサンプルデータの第22か月の新しい区分 partner と、第25〜26か月の欠損事故を、データの検証で見つけられるかを確かめます。
この章を深めたい方への参考書籍
『MLOps実装ガイド 本番運用を見据えた開発戦略』(Yaron Haviv・Noah Gift 著、井伊篤彦ほか 訳、オライリー・ジャパン):MLOps が何で、なぜ必要かから始めて、データと特徴量ストア、本番向けのモデルの開発、配置、監視と再学習までを、段階ごとにたどる本です。投資対効果や企業としての進め方を扱う節もあるので、この章で扱った「どの段階で何を整えるか」を、組織全体に広げて考えるときの手がかりになります。
『実践MLOps 作って理解する機械学習システムの構築と運用』(長江五月 著、オーム社):機械学習のパイプライン、実験の基盤、版の管理、CI・CD、推論のサービス、継続的学習、監視を、手を動かしながら1章ずつ組み立てていく構成の本です。この章の部品の一覧が、実際にはどんな仕組みとして実装されるのかを、全体を通して確かめたいときに向いています。
第3章 データの品質を守る
第2章では、機械学習システムを構成する要素と成熟度の段階を整理し、そこで用意したサンプルデータ(架空の定額制サービスの解約予測、各月5,000件・36か月)と、学習したまま放置したモデル・定期的に再学習するモデルの基準の結果を示しました。この章では、その構成要素のうち最も上流にある「データ」の品質を扱います。モデルはデータから作られ、本番ではデータを入力にして予測を出します。データが壊れていれば、モデルがどれほど丁寧に作られていても予測は壊れます。しかも、欠損や想定外の値を受け付ける種類のモデルは、壊れたデータを受け取ってもエラーを出さずに予測を返し続けるので、障害として表に出にくくなります(共通データのモデルはこの種類で、欠損を受け付けないモデルは止まることを、この章の後半で確かめます)。この章では、データの品質の観点、作る側と使う側の取り決めであるデータ契約、その取り決めを機械的に確かめるスキーマ検証を共通データに当てて、どの変化が検出でき、どの変化が検出できないかを実行して確かめます。あわせて、欠損をそのままモデルに流したときの影響、学習と推論で前処理が食い違う事故の影響、データのバージョン管理、データの持ち主と責任の所在という経営判断を扱います。特徴量の作り方と学習データの時点の合わせ方は第4章で扱います。
データの品質を5つの観点で見る
データの品質という言葉は広く使われますが、何を確かめれば品質が保たれていると言えるのかは、観点を分けないと議論が噛み合いません。データ品質の国際規格である ISO/IEC 25012(データ品質モデル)は、データの品質を15の特性で定義しています。規格の解説サイト(iso25000.com)によれば、15の特性は、データそのものに備わる品質、データを扱うシステムに依存する品質、その両方にまたがる品質の3つに分けられています。データそのものに備わる品質に分類されているのは、正確性(Accuracy)・完全性(Completeness)・一貫性(Consistency)・信憑性(Credibility)・最新性(Currentness)の5つです(日本語の名前はこの記事での訳です)。アクセシビリティ(Accessibility)など7つは両方にまたがる品質、可用性(Availability)など3つはシステムに依存する品質とされています。この記事では、機械学習のモデルを運用するときに日々の検査へ落とし込みやすいものとして、次の5つの観点で整理します。完全性・一貫性・鮮度(最新性)は規格の特性名に対応させ、妥当性と一意性は検査の実装に合わせてこの記事で加えた観点です。
| 観点 | 何を確かめるか | 共通データでの例 | 崩れたときに起きること |
|---|---|---|---|
| 完全性 | あるべき行と列と値がそろっているか(件数・欠損率) | 第25〜26か月に store 経路の利用日数の40%が欠損 | 欠損した顧客の予測が別の値で埋められ、施策の対象から漏れる |
| 妥当性 | 値が型・範囲・許された値の一覧に収まっているか | 第19か月の新しい月額2,380円、第22か月の新しい経路 partner | モデルが学習で見たことのない値を受け取り、扱いが決まっていない |
| 一貫性 | 同じ意味の値が、システムや時期をまたいで同じ定義・単位で記録されているか | この章で架空に起こす単位の取り違え・符号の反転 | 学習時と推論時で同じ列が別の意味になり、予測が系統的にずれる |
| 鮮度 | 予測に使う時点で、データが十分に新しいか | 解約のラベルは翌月末に確定する(1か月の遅れ) | 古い状態で予測し、手遅れの顧客に施策を打つ |
| 一意性 | 同じ対象が重複して記録されていないか | 共通データは顧客IDを持たないので、この章では検査しない | 同じ顧客に二重に施策を打つ、件数や率の集計が狂う |
表の「共通データでの例」の列のとおり、第2章で用意したサンプルデータに起こした4つの変化のうち、3つはこの表の観点のどれかに当たります。第19か月の料金改定と第22か月の新しい獲得経路は妥当性、第25〜26か月のデータ連携の不具合は完全性の問題として現れます。残る第28か月以降の競合の乗り換え施策は、データの値そのものは正常で、解約との関係が変わる変化なので、この表のどの観点でも捉えられません。この点は、後の節で検査を実際に当てて確かめます。一意性については、共通データに顧客を識別する列が無いため、この章では検査を実装していません。現実のデータでは、取り込みの再実行で同じ月のデータが二重に入る事故が起こりうるので、顧客IDと月の組が重複していないかを検査の項目に入れておくのが基本です。
5つの観点は、どれも「モデルの性能」ではなく「データの状態」を確かめるものです。モデルの性能は正解のラベルが届くまで測れませんが(共通データでは1か月遅れ)、データの状態はデータが届いた時点で確かめられます。予測を出す前に止められるのはデータの検査だけ、という点が、この章の検査をモデルの監視(第10章)と分けて置く理由です。
データ契約、作る側と使う側の取り決め
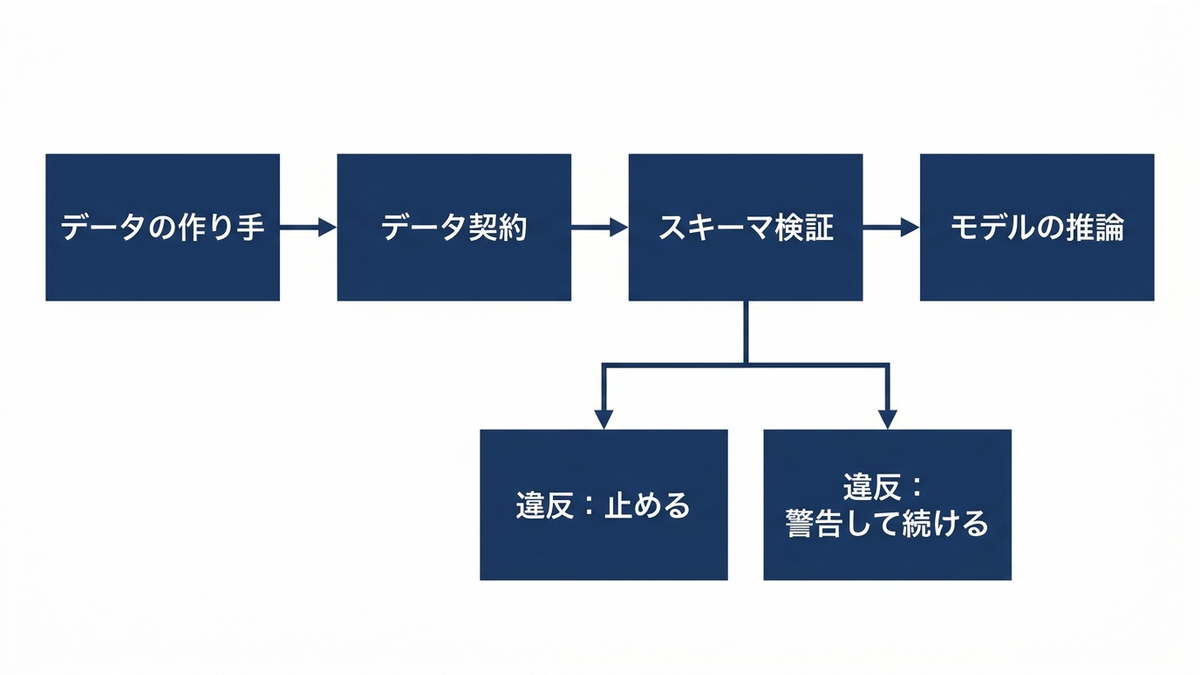
機械学習のモデルが使うデータの多くは、モデルを作るチームとは別の部署やシステムが作っています。共通データの例でいえば、契約月数やプランは契約管理のシステム、利用日数はサービスのログ、獲得経路は営業や販売の管理、決済の失敗は決済のシステムから来ます。それぞれのシステムの担当者は、自分のシステムの都合で列の名前を変えたり、単位を変えたり、新しい区分を足したりします。その変更は、そのシステムの中では正しい変更でも、下流で同じデータを使っているモデルにとっては、予告なく入力の意味が変わる事故になります。データ契約は、この「作る側」と「使う側」の間で、データの形と中身と届け方を文書で取り決め、変えるときの手続きを決めておく考え方です。
データ契約の書き方には、標準化の動きがあります。Linux Foundation AI & Data のプロジェクトである Bitol(2026年10月に開いた同財団のプロジェクトのページでは、卒業(Graduate)の段階に位置づけられています)は、データ契約の公開標準として Open Data Contract Standard(ODCS)を定めています。ODCS の文書は、データ契約を YAML 形式のファイルで書くときの項目と値を定めたもので、契約は特定の製品に依存しない形で書くべきだとしています。文書の構成は、基本事項・スキーマ・文脈・参照・データ品質・問い合わせの窓口・料金・チーム・役割・サービスレベルの合意・基盤とサーバー・独自の項目・権威ある定義・タグ・変数の各節に分かれています。つまり、列の型だけでなく、品質の基準、誰が持ち主で誰に問い合わせるか、いつまでに届けるかといった運用の約束まで、同じ文書に書く設計になっています。
この記事では、ODCS の書式そのものではなく、その考え方を共通データに当てはめた架空の契約を作りました。第1〜12か月の学習データを作った時点で、作る側と使う側が合意していた内容を、次の表の「契約 v1」として置いています。
| 区分 | 項目 | 契約 v1 の取り決め(架空) | 主に守る観点 |
|---|---|---|---|
| 列の形 | 列の一覧 | 月・契約月数・プラン・月額・利用日数・利用日数の前月差・問い合わせ件数・決済失敗回数・獲得経路・割引の有無の10列。取り決めに無い列は受け取らない | 妥当性 |
| 列の形 | 型と範囲 | 契約月数は1〜120の整数、利用日数は0〜30の整数、前月差は -30〜30、問い合わせ件数は0〜20、決済失敗回数は0〜2 | 妥当性 |
| 列の形 | 許された値 | プランは basic・standard・premium、月額は料金表の980円・1,980円・3,480円、経路は web・store、割引は0か1 | 妥当性 |
| 月のまとまり | 件数 | 1か月4,000〜6,000件 | 完全性 |
| 月のまとまり | 欠損率 | どの列も欠損は1%以下 | 完全性 |
| 運用の約束 | 変更の手続き | 列・単位・許された値を変えるときは、使う側に事前に通知し、契約の版を上げる | 一貫性 |
| 運用の約束 | 届ける時期 | 月初の決まった日までに前月分を届ける | 鮮度 |
表の「区分」の列のうち、「列の形」と「月のまとまり」はプログラムで機械的に確かめられる取り決めで、次の節でスキーマ検証として実装します。「運用の約束」は、人と組織の間の取り決めで、プログラムだけでは守れません。後の節で見るとおり、共通データの料金改定は「列の形」の検査で検出できますが、検出したときにはすでに本番のデータが変わっています。事前に知らせてもらう約束があれば、料金改定の前にモデルの側で準備ができます。データ契約の価値の半分は、検査よりもこの事前の通知にあると考えています。
スキーマ検証を実装する
契約のうち機械的に確かめられる部分を、プログラムで検査するのがスキーマ検証です。スキーマとは、データの列の名前・型・範囲・許された値の一覧といった「形の定義」のことです。ここでは、Python の型の検証に広く使われている pydantic(この記事の実行環境では 2.12.5)で1行ずつの取り決めを書き、月のまとまりとしての取り決め(欠損率・件数)は pandas で書きました。次のコードは、本記事で使った検査の要所を抜き出したもので、第2章で説明した補助モジュール mlops_data.py と同じフォルダに置いて実行する形です。
from typing import Literal, Optional
from pydantic import BaseModel, ConfigDict, Field, ValidationError
import mlops_data as md


class Customer(BaseModel):
    """データ契約 v1 の1行分の取り決め(架空)"""
    model_config = ConfigDict(extra="forbid")      # 取り決めに無い列は受け取らない
    month: int = Field(ge=1, le=36)
    tenure_m: int = Field(ge=1, le=120)
    plan: Literal["basic", "standard", "premium"]
    monthly_fee: Literal[980, 1980, 3480]          # 料金表にある月額だけ
    usage_days: Optional[int] = Field(default=None, ge=0, le=30)  # 欠損は月の率で見る
    usage_change: int = Field(ge=-30, le=30)
    support_tickets: int = Field(ge=0, le=20)
    payment_failures: int = Field(ge=0, le=2)
    channel: Literal["web", "store"]
    discount: Literal[0, 1]


def check_rows(df, model=Customer):
    """1行ずつ契約に通し、違反した行の数を返す"""
    cols = list(model.model_fields)
    recs = df[cols].astype(object).where(df[cols].notna(), None).to_dict("records")
    bad = 0
    for r in recs:
        try:
            model(**r)
        except ValidationError:
            bad += 1
    return bad


def check_batch(df, max_missing=0.01):
    """月のまとまりとしての取り決め(欠損率の上限・件数)"""
    miss = df.drop(columns=["churn", "true_p"]).isna().mean()
    fails = [f"{c} の欠損率 {r:.3f}" for c, r in miss.items() if r > max_missing]
    if not (4000 <= len(df) <= 6000):
        fails.append("件数")
    return fails


for m in (18, 19, 22, 25, 28):
    d = md.month_data(m)
    print(m, check_rows(d), check_batch(d))
# 出力:
# 18 0 []
# 19 2048 []
# 22 2599 []
# 25 2601 ['usage_days の欠損率 0.124']
# 28 2608 []
コードの読み方を補足します。Field(ge=1, le=120) は「1以上120以下」、Literal[980, 1980, 3480] は「この3つの値のどれか」という取り決めです。extra="forbid" は、1行分のデータに取り決めに無い項目が入っていたら違反にする設定です。ただし、この抜き出しの check_rows は、取り決めにある列だけを元のデータから取り出してから検査に渡しているので、元のデータに取り決めに無い列が増えていても、この関数では見つかりません。契約の表の「取り決めに無い列は受け取らない」を確かめるには、届いたデータの列名の一覧を取り決めの列名と比べる検査を別に置く必要があります(この章のコードには入れていません)。利用日数だけは、1行ずつの検査では欠損を許し(Optional)、欠損の多さは月の欠損率で見るように分けました。欠損は個々の顧客では起こりうることで、問題になるのは「ふだんより多いこと」だからです。共通データの月額や契約月数は小数の型(例えば 18.0)で入っていますが、pydantic は既定の動作では小数部が0の小数を整数として受け付けたので、型の違いでは違反になっていません。この挙動は実行して確かめたものです。
出力の各行は、月、1行ずつの検査で違反した行の数、月のまとまりの検査で引っかかった項目の順です。変化の前の第18か月は違反が0件、料金改定の第19か月は2,048行が違反、partner が始まった第22か月は2,599行が違反、欠損事故の第25か月は2,601行が違反したうえに利用日数の欠損率0.124が上限1%を超えました。そして、競合の乗り換え施策が始まった第28か月は、違反の数が第22か月以降と同じ水準(2,608行)で、新しい種類の違反は出ていません。
検査にかかる時間も測りました。この記事の実行環境(一般的なノートPC)での実測で、1か月5,000行を pydantic で1行ずつ検査すると0.040秒、pandas で月のまとまりの検査をすると0.0017秒でした(36か月の中央値)。1行ずつの検査は、まとまりの検査より桁違いに遅いものの、月に一度の一括の予測であれば問題になる時間ではありません。行数が数百万件になる場合や、1件ずつ即時に予測を返す場合は、この差が効いてくるので、まとまりで判定できる取り決めはまとまりで書くほうが向いています。
共通データの36か月に契約を当てる
同じ検査を第1〜36か月のすべてに当てた結果が次の図です。横軸が月、縦軸がその月の行に占める割合で、実線が「月額が料金表に無い行」、破線が「経路が取り決めに無い行」、点線が利用日数の欠損率です。縦の点線は、第2章で示した4つの変化の月を示しています。
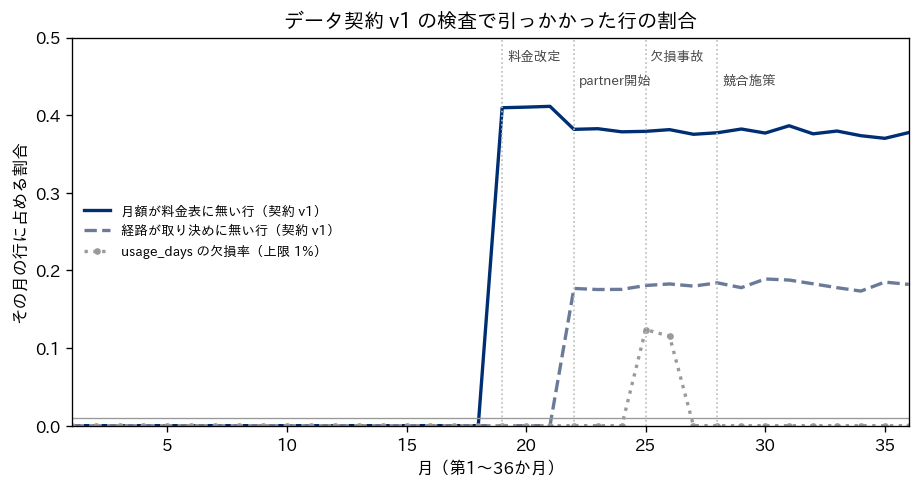
月ごとの数字を、変化の区切りごとに抜き出したのが次の表です。「月額の違反」と「経路の違反」は、1行ずつの検査で違反した行の数を項目別に数えたもので、1つの行が両方に違反することがあるため、2つを足しても「違反した行」とは一致しません。
| 月 | その月に起きたこと | 違反した行(契約 v1) | 月額の違反 | 経路の違反 | 月のまとまりの検査 | 違反した行(契約 v1.2) |
|---|---|---|---|---|---|---|
| 第1〜18か月 | 変化なし | 0 | 0 | 0 | 問題なし | 0 |
| 第19か月 | 料金改定 | 2,048 | 2,048 | 0 | 問題なし | 0 |
| 第22か月 | partner 開始 | 2,599 | 1,909 | 884 | 問題なし | 0 |
| 第25か月 | 欠損事故 | 2,601 | 1,896 | 903 | 利用日数の欠損率 0.124 | 0 |
| 第26か月 | 欠損事故 | 2,623 | 1,907 | 913 | 利用日数の欠損率 0.115 | 0 |
| 第28か月 | 競合施策の開始 | 2,608 | 1,887 | 920 | 問題なし | 0 |
「違反した行(契約 v1)」の列が示すとおり、契約 v1 は第19か月の料金改定、第22か月の partner、第25〜26か月の欠損事故を、それぞれ起きた月に検出しました。いずれも、第2章で示した基準の結果では「放置のモデルの並べ替えの正しさ(AUC)が目立って落ちなかった」変化です(損益には差が出ていたことは第2章で見たとおりです)。基準の結果の AUC(並べ替えの正しさ)は、料金改定の期間で0.673、partner の期間で0.682、欠損事故の期間で0.683と、変化前の0.680からほとんど動いていません。データの検査は、性能の数字に表れない変化も、データが届いた時点で知らせてくれます。
一方で、表の最後の行の第28か月、競合の乗り換え施策が始まった月には、新しい違反は1件も出ていません。違反した行の数(2,608行)は、料金改定と partner による違反がそのまま続いているだけです。競合施策は、顧客の利用日数や月額の値を変えず、「利用日数と解約の関係」を変える変化なので、データの形をいくら厳しく検査しても見えません。基準の結果では、この期間に放置のモデルの AUC が0.630まで落ち、24か月の損益の差(放置と毎月再学習の差 420.2万円、いずれも架空の設定での計算)の多くがこの期間に生じています。データの検査は必要ですが、それだけでは足りず、正解のラベルが届いてから性能を測る監視(第10章)と組み合わせる必要がある、というのがこの表から読めることです。
表の右端の「違反した行(契約 v1.2)」は、料金改定に合わせて月額の許された値に2,380円を加え、partner の開始に合わせて経路に partner を加えた版の契約で検査し直した結果で、36か月を通して違反は0件でした。ここに大事な点があります。v1.2 では、第25〜26か月の欠損事故は月のまとまりの検査で引き続き検出されますが、料金改定と partner は「正常」として扱われます。契約を更新するのは、作る側と使う側が変化を確かめ、モデルの側でも扱いを決めた後であるべきで、違反が多くてうるさいからという理由で許された値を広げると、検査は何も守らなくなります。
違反を見つけたら止めるのか、警告して続けるのか
検査で違反が見つかったときにどう動くかは、検査の書き方と同じくらい重要な設計です。選択肢は大きく2つあり、予測を止めて人の判断を待つか、警告を出して予測は続けるかです。共通データの料金改定を例に、この判断の重さを測ってみます。契約 v1 は第19か月に全体の約4割(2,048行)を違反として検出しました。もしこの違反で予測を全部止めていたら、その月の引き止め施策は打てません。基準の結果では、第19か月の放置のモデルの損益は51.7万円(架空の設定での計算)で、AUC は0.682でした。モデルは料金改定の後も変化前とほぼ同じ並べ替えの正しさを保っていたので、止めればその月の51.7万円をまるごと失っていたことになります。
一方、欠損事故のように、データそのものが壊れている場合は話が違います。次の節で測るとおり、欠損を含むデータでもモデルは予測を出し続けますが、欠損した顧客の予測は系統的に低く出ます。どちらの場合も「検査で違反を見つけた」ことは同じですが、取るべき動きは違います。違反の種類ごとに止めるか続けるかを前もって決め、契約に書いておくことが有効だと考えています。目安としては、型が合わない・必須の列が無い・件数が極端に少ないといった「予測そのものが信用できない」違反は止め、新しいカテゴリ・新しい値・分布の変化といった「予測はできるが前提が変わった」違反は、警告を出して予測を続けつつ、担当者が数日以内に影響を確かめる、という分け方です。この判断の基準と通知の宛先は、監視のアラートの設計(第10章)と同じ考え方で作ります。
| 違反の種類 | 共通データでの例 | 推奨する動き | 理由 |
|---|---|---|---|
| 必須の列が無い・型が合わない | (この章では起こしていない) | 止める | 予測が計算できないか、意味のない値になる |
| 件数が取り決めの範囲外 | (この章では起こしていない) | 止める | 取り込みの失敗や二重取り込みの疑いがある |
| 欠損率が上限を超える | 第25〜26か月の利用日数 | 欠損した行を分けて扱い、警告 | 欠損した行の予測が系統的にずれる(次の節) |
| 許された値に無い値 | 第19か月の月額2,380円、第22か月の partner | 警告して続け、影響を確かめて契約を更新 | モデルは予測できるが、学習時の前提が変わっている |
欠損をそのまま推論に流すとどうなるか
共通データのモデル(scikit-learn の HistGradientBoostingClassifier)は、入力に欠損があっても受け付けます。scikit-learn の公式ドキュメントによれば、このモデルは学習のときに、木の分岐ごとに欠損した値を左右のどちらに送るかを学びます。そして、学習のときにある列で欠損が一度も無かった場合は、予測のときにその列が欠損していると、件数の多い側の枝に送ると説明されています。第1〜12か月の学習データには利用日数の欠損が1件も無いので、放置のモデルは、第25〜26か月に欠損した利用日数を、各分岐で「多数派の側」に寄せて扱うことになります。まず、欠損を含むデータを渡したときに何が起きるかを確かめました。
import numpy as np
from sklearn.linear_model import LogisticRegression
import mlops_data as md
import baseline as bl

train = md.months(1, 12)
X_tr = md.encode(train)
frozen = bl.make_model().fit(X_tr, train.churn)     # 放置のモデル

d25 = md.month_data(25)                              # 欠損事故の月
X25 = md.encode(d25)
p = frozen.predict_proba(X25)[:, 1]
miss = X25.usage_days.isna().to_numpy()
print("欠損", miss.sum(), "行 / 予測の欠損", np.isnan(p).sum(), "件")
print("欠損した行:予測平均 %.4f / 実際の解約率 %.4f / 真の確率の平均 %.4f"
      % (p[miss].mean(), d25.churn[miss].mean(), d25.true_p[miss].mean()))
try:
    LogisticRegression(max_iter=1000).fit(X_tr, train.churn).predict_proba(X25)
except ValueError as e:
    print("LogisticRegression:", str(e).splitlines()[0])
# 出力:
# 欠損 619 行 / 予測の欠損 0 件
# 欠損した行:予測平均 0.0694 / 実際の解約率 0.0727 / 真の確率の平均 0.0890
# LogisticRegression: Input X contains NaN.
このコードは、第2章で説明した補助モジュール(mlops_data.py と baseline.py)と同じフォルダに置いて実行する形で、本記事で使ったものから欠損の部分を抜き出したものです(後半の食い違いの検査は後の節で示します)。第25か月の5,000行のうち619行で利用日数が欠損していましたが、放置のモデルは5,000行すべてに予測を返し、予測が欠損した行は0件でした。エラーも警告も出ていません。比較のために、欠損を受け付けないモデルの例として scikit-learn のロジスティック回帰に同じデータを渡すと、「入力に NaN(欠損)が含まれている」という ValueError で止まりました。止まるモデルなら、少なくとも事故は表に出ます。止まらないモデルでは、データの検査を置いていなければ、事故は損益の数字が悪くなるまで気づかれません。
では、欠損した顧客の予測は正しいのでしょうか。欠損した行と、同じ store 経路で欠損しなかった行を比べたのが次の表です。「真の確率の平均」は、データを作った側だけが知る本当の解約確率で、現実の企業には見えませんが、この記事では答え合わせに使えます。「施策件数」は予測確率がしきい値(約0.106)を超えた顧客の数、「真の確率でしきい値を超える顧客」は、本当の解約確率がしきい値を超えている顧客の数です。
| 月 | 区分 | 件数 | 予測平均 | 実際の解約率 | 真の確率の平均 | 施策件数 | 真の確率でしきい値を超える顧客 |
|---|---|---|---|---|---|---|---|
| 第25か月 | 利用日数が欠損した行 | 619 | 0.0694 | 0.0727 | 0.0890 | 89 | 186 |
| 第25か月 | store で欠損しなかった行 | 901 | 0.0777 | 0.0788 | 0.0870 | 188 | 258 |
| 第26か月 | 利用日数が欠損した行 | 576 | 0.0673 | 0.0885 | 0.0897 | 72 | 168 |
| 第26か月 | store で欠損しなかった行 | 915 | 0.0766 | 0.0918 | 0.0853 | 191 | 236 |
欠損した行の「予測平均」は第25か月0.0694、第26か月0.0673で、「真の確率の平均」(0.0890と0.0897)より約2ポイント低く出ています。同じ store 経路の欠損しなかった行の予測平均(0.0777と0.0766)と比べても低く、欠損した行の予測は、平均すると「解約しにくい」側に寄っていました。欠損した利用日数は各分岐で件数の多い側の枝に送られるので、利用日数が少なく解約しやすい顧客も、多数派の顧客と同じ扱いになります。その結果として予測が低めに出た、と考えています(モデルの内部でどの分岐を通ったかまでは確かめていません)。本記事の計算では、欠損した行の予測のばらつき(標準偏差。値が平均のまわりにどれだけ散らばっているかを表す数で、小さいほど値がそろっている)も、第25か月で0.0373と、欠損しなかった行の0.0504より小さくなっていました。欠損した行のうちしきい値を超えて施策の対象になったのは、第25か月で89件、第26か月で72件でした。本当の解約確率でしきい値を超えている顧客の数(186件と168件)に対する比で見ると、欠損した行では約48%と約43%でした。同じ store 経路の欠損しなかった行では、同じ比が約73%(188件対258件)と約81%(191件対236件)です。この比は件数どうしを比べたもので、予測で選んだ顧客と真の確率で選んだ顧客が同じ人かどうかは見ていませんが、欠損した行では、本当の解約確率でしきい値を超えている顧客の数に対して施策の対象になった件数の割合が、欠損しなかった行より低く出ていたことは読み取れます。
第25〜26か月の実際の欠損事故では、欠損の扱い方を変えても損益の差は小さく出ました。2か月の損益の合計は、欠損のまま流した場合167.6万円、学習時の中央値(12日)で埋めた場合166.1万円、欠損した行には施策を打たない場合163.9万円で、真の確率を使った場合(上限の目安)は201.9万円でした(いずれも放置のモデル、架空の設定での計算)。中央値で埋めた場合も、欠損した行の予測平均は0.0713で、欠損のまま流した場合の0.0684と大きくは変わりませんでした。埋めた値も1つの値なので、利用日数が少ない顧客と多い顧客の区別が失われる点は同じだから、と考えていますが、その理由までは確かめていません。欠損が全体の約12%に留まったこの事故では、扱い方の選び方よりも、事故そのものを早く見つけて直すことのほうが効く、ということです。
事故の規模が大きければ影響も大きくなります。事故の無い月(第22〜24か月と第27か月)の利用日数に、欠損を人工的に起こした結果が次の表です。数字は4か月の平均で、モデルは放置のモデルです。表の行は欠損率の小さい順に並べてあり、下の行ほど欠損が広がります。
| 起こした欠損 | 欠損率 | AUC | 予測平均 | 実際の解約率 | 施策件数 | 損益(万円/月) |
|---|---|---|---|---|---|---|
| 欠損なし | 0.000 | 0.6820 | 0.0860 | 0.102 | 1,341.8 | 78.6 |
| store の40%(実際の事故と同じ起こし方) | 0.120 | 0.6733 | 0.0847 | 0.102 | 1,302.8 | 73.6 |
| store の100% | 0.307 | 0.6658 | 0.0827 | 0.102 | 1,221.2 | 68.8 |
| 全経路の50% | 0.503 | 0.6325 | 0.0761 | 0.102 | 973.5 | 49.5 |
| 全経路の100% | 1.000 | 0.5935 | 0.0666 | 0.102 | 623.0 | 21.2 |
表の「損益」の列は、欠損なしの78.6万円/月から、実際の事故と同じ起こし方で73.6万円/月(5.0万円減)、store の全件が欠損すると68.8万円/月、全経路の半分で49.5万円/月、全件が欠損すると21.2万円/月まで下がりました。全件が欠損した場合、利用日数という最も効いている入力が丸ごと失われ、AUC は0.6820から0.5935へ、予測平均は0.0860から0.0666へ下がり、施策件数は1,341.8件から623.0件に半減しています。それでも、モデルは最後まで1件のエラーも出さずに予測を返し続けました。予測平均(0.0666)が実際の解約率(0.102)から大きく離れる点は、ラベルが届いた1か月後には監視で分かりますが、その間の1か月分の損は取り戻せません。この例では、全件が欠損した状態で1か月気づかなければ、57.4万円(78.6万円と21.2万円の差、架空の設定)を失う計算です。月のまとまりの欠損率の検査なら、データが届いた日に気づけます。
学習と推論で前処理が食い違う事故
データの品質の問題には、データそのものは正しいのに、学習のときと推論のときで処理が食い違うために起きるものがあります。Google が公開している機械学習の実務の指針「Rules of Machine Learning」は、学習のときの性能と本番で提供しているときの性能の差を training-serving skew(学習と提供の食い違い)と呼び、その原因として、学習と提供の処理の仕方の違い、学習してから提供するまでの間のデータの変化、モデルとアルゴリズムの間のフィードバックの3つを挙げています。そのうえで、提供のときに使った特徴量を記録して学習に使うこと、学習と提供の処理のコードをできるだけ共通にすることを勧めています。Google の研究者らが2019年の学会 MLSys で発表した、機械学習のためのデータ検証を論じた論文も、Google の機械学習基盤 TFX の一部として運用しているデータ検証の仕組みについて、学習と提供の食い違いを課題の1つとして扱っています。この論文の要旨によれば、この仕組みは Google の数百の製品チームが使い、1日に数ペタバイトの本番のデータを監視しているとされています。
この食い違いを、共通データに架空に起こして影響を測りました。学習のときの処理は第2章のままとし、推論のときだけ処理が変わってしまった、という4つの事故を置いています。どれも、システムの改修や担当者の交代で起こりうる種類のものとして選びました。1つ目は、月額を円ではなく千円単位で送ってしまう事故(1,980円が1.98になる)です。2つ目は、利用日数の前月差を「当月から前月を引く」ではなく「前月から当月を引く」で計算してしまい、符号が逆になる事故です。3つ目は、獲得経路の表記が先頭大文字(Web・Store)になる事故です。4つ目は、利用日数を「直近30日の利用日数」ではなく「直近7日の利用日数」で数えてしまう事故です(共通データの利用日数に7÷30を掛けて丸めたもので代用しました)。モデルは放置のモデルで、変化の前の第13〜18か月の6か月平均で比べています。
| 食い違い(推論側だけ) | AUC | 予測平均 | 施策件数 | 損益(万円/月) | 契約 v1 の違反行(1か月あたり) | その列の PSI |
|---|---|---|---|---|---|---|
| 食い違いなし | 0.6796 | 0.0805 | 1,144.5 | 45.3 | 0 | (該当なし) |
| 月額を千円単位で送る | 0.6404 | 0.0608 | 635.8 | 27.6 | 5,000 | 1.295 |
| 利用日数の前月差の符号が逆 | 0.6575 | 0.0804 | 1,131.8 | 36.8 | 0 | 0.002 |
| 経路の表記が先頭大文字 | 0.6793 | 0.0800 | 1,119.8 | 45.5 | 5,000 | (該当なし) |
| 利用日数を直近7日で数える | 0.6491 | 0.1597 | 3,990.5 | -35.7 | 0 | 7.36 |
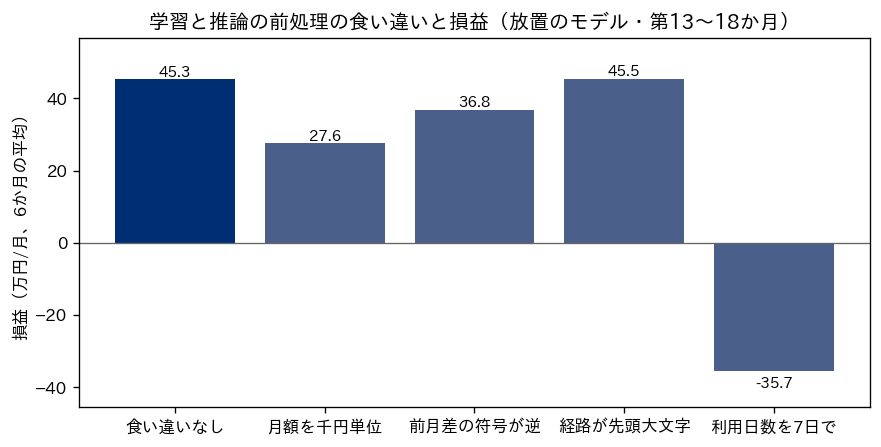
表の「損益」の列を見ると、影響の大きさは事故によってまったく違います。最も大きいのは「利用日数を直近7日で数える」で、損益は45.3万円/月から -35.7万円/月へ、81.0万円の悪化でした。利用日数が実際より少なく届くので、モデルは多くの顧客を「利用が少なく解約しやすい」側に扱ったと考えられます(内部の判断までは確かめていません)。予測平均は0.1597(実際の解約率0.0822の約2倍)、施策件数は3,990.5件と、1か月5,000件のほぼ8割に施策を打つことになります。施策の費用が守れる粗利を上回り、施策を打つほど損が出る状態です。次が「月額を千円単位で送る」で、17.7万円の悪化でした。月額が1.98のような小さな値で届くと、学習のときに見た最も安い月額より小さい値ばかりになるので、モデルはすべての顧客を最も安い側の月額と同じように扱ったと考えられます。予測平均は0.0608に下がり、施策件数が635.8件に減りました。「前月差の符号が逆」は8.5万円の悪化、「経路の表記が先頭大文字」は0.2万円の増加で、この期間の損益にはほとんど影響しませんでした(変化の前の期間は、経路による解約のしやすさの差が小さいためで、どんな場合でも影響が小さいという意味ではありません)。4つの事故のどの数字も、放置のモデルを第13〜18か月に当てた平均で、ほかの期間やほかのモデルで同じ大きさになるとは限りません。
見逃せないのは、表の右の2列です。契約 v1 のスキーマ検証は、「月額を千円単位で送る」(月額が料金表に無い)と「経路の表記が先頭大文字」(経路が許された値に無い)を、1か月5,000行すべての違反として検出しました。ところが、損の大きい「利用日数を直近7日で数える」と「前月差の符号が逆」は、値が取り決めの範囲(0〜30日、-30〜30)に収まっているので、違反は0件でした。前者は、その列の PSI(母集団安定性指標、学習時の分布と比べた分布のずれの大きさ。第10章で詳しく扱います)が7.36と非常に大きく、分布の監視をしていれば気づけます。基準の結果で料金の PSI が料金改定の後に0.58〜0.81だったことと比べても、桁が1つ大きい値です。しかし「前月差の符号が逆」は、PSI が0.002で、変化の前の期間のふつうの揺れと区別がつきません。利用日数の前月差は0を中心にほぼ左右対称に分布しているので、符号を逆にしても分布の形が変わらないからです。値の範囲を見る検査でも、分布を見る検査でも捉えられず、損益だけが月8.5万円ずつ悪くなる、という事故です。
分布でも範囲でも見えない食い違いを見つける方法は、同じ顧客の同じ時点のデータを、学習側の処理と推論側の処理の両方に通して、出てきた入力の値を1行ずつ突き合わせることです。この記事では、これを特徴量の一致検査と呼びます。先の「Rules of Machine Learning」が勧めている「提供のときに使った特徴量を記録しておく」は、この突き合わせを後からでもできるようにする手段でもあります。次のコードは、本記事で使ったものから符号の反転の部分を抜き出したもので、前のコードの続きとして実行する形です。
def serve_sign(d):                                   # 推論側だけ前月差の向きが逆(架空の事故)
    d = d.copy()
    d["usage_change"] = -d["usage_change"]
    return d


d13 = md.month_data(13)
a = md.encode(d13)                                   # 学習側の処理
b = md.encode(serve_sign(d13))                       # 推論側の処理
diff = (a.fillna(-999) != b.fillna(-999)).mean()
print("一致しない行の割合:", diff[diff > 0].round(3).to_dict())
print("PSI(学習時と推論側の usage_change):%.3f" % bl.psi(train.usage_change, serve_sign(d13).usage_change))
# 出力:
# 一致しない行の割合: {'usage_change': 0.868}
# PSI(学習時と推論側の usage_change):0.001
第13か月の1か月分で比べると、PSI は0.001でほとんど動かないのに、行ごとに突き合わせると利用日数の前月差の86.8%の行が一致しませんでした(残りの13.2%は前月差が0の行で、符号を変えても値が変わりません)。同じ突き合わせを4つの事故すべてに当てると、月額は100%、経路は web の列で61.9%・store の列で38.1%、利用日数(7日で数える)は98.1%の行が一致せず、4つとも検出できました。突き合わせは、値の範囲や分布が正常に見える事故も拾えます。ただし、見つけられるのは学習側と推論側の処理の違いだけで、両方の処理が同じ誤りを持っている場合や、元のデータそのものが誤っている場合は、値が一致してしまうので見つかりません。
その代わり、突き合わせには「学習側の処理」と「推論側の処理」が別々に動いていて、両方に同じ元データを通せる、という前提が要ります。推論のシステムを新しく作ったとき、前処理のコードを改修したとき、データの取り込み元を切り替えたときには、本番に出す前にこの突き合わせを一度通しておくことが有効だと考えています。日々の運用では、推論のときに使った入力の値を記録しておき、ラベルが確定した後に学習用のデータを作るときに、同じ顧客・同じ月の値と突き合わせれば、ずれが入り込んだ時期を特定できます。より根本的な対策は、学習と推論で同じ前処理のコードを使うことで、特徴量の定義を1か所にまとめる考え方は第4章で扱います。テストとして自動化する方法は第9章で扱います。
この節の4つの事故を、どの検査が捉えたかで整理しておきます。
| 事故 | スキーマ検証(範囲・許された値) | 分布の監視(PSI) | 特徴量の一致検査 | 損益への影響(万円/月) |
|---|---|---|---|---|
| 月額を千円単位で送る | 検出(全行が違反) | 検出(1.295) | 検出(100%) | -17.7 |
| 利用日数の前月差の符号が逆 | 検出できない | 検出できない(0.002) | 検出(86.8%) | -8.5 |
| 経路の表記が先頭大文字 | 検出(全行が違反) | (カテゴリの列なので計算していない) | 検出(web 61.9%・store 38.1%) | +0.2 |
| 利用日数を直近7日で数える | 検出できない | 検出(7.36) | 検出(98.1%) | -81.0 |
表の「損益への影響」の列は、食い違いなしの45.3万円/月との差です。検査の種類ごとに見える事故が違い、1種類の検査ですべてを捉えることはできませんでした。損の大きさと検査の見え方も一致していません。最も損の大きい事故(-81.0万円/月)はスキーマ検証をすり抜け、損のほとんど無い事故(+0.2万円/月)はスキーマ検証で全行が違反になりました。スキーマ検証、分布の監視、特徴量の一致検査は、互いの穴を埋める関係にあるので、重ねて置くことが有効です。
検査の道具とデータのバージョン管理
この章では、検査を pydantic と pandas で最小限に書きましたが、データの検査には専用のライブラリや製品もあります。この記事の実行環境には入っていないので実行はしておらず、以下は公式ドキュメントを開いて確かめた範囲での紹介です。Great Expectations の公式ドキュメントは、検査の単位である Expectation を「データについての検証可能な主張」と定義しており、列の値が欠損していないこと、列の値が一意であること、表の行数が範囲に収まることなどを、名前の付いた検査として用意しています。pandera の公式ドキュメントは、データフレームのような形のデータを検証するための API を提供するものだと説明しており、pandas・polars・dask・modin・ibis・pyspark のデータフレームを対象にしています。TensorFlow Data Validation(TFDV)の公式ドキュメントは、データの統計量からスキーマの初期版を推定する機能、統計量をスキーマと照らして異常を見つける機能、学習のデータと提供のデータの統計量を比べて食い違いを見つける機能を説明しています。同じドキュメントは、推定したスキーマを人が見直し、業務の知識に合わせて直すことを強く勧めています。この章の契約 v1 で、月額の許された値を料金表から決めたのは、まさにこの「業務の知識」に当たる部分です。
もう1つ、データの品質を守るうえで欠かせないのが、データのバージョン管理です。モデルの予測がおかしくなったとき、「どの版のデータで学習したモデルか」が分からなければ、原因を調べることも、前の状態に戻すこともできません。DVC(Data Version Control)の公式ドキュメントは、DVC を Git を拡張してデータのバージョン管理を行う道具として紹介しています。データセットや機械学習の成果物について、何を追跡するかを書いた小さなメタファイルを作り、大きなファイルの代わりにこのメタファイルを Git に入れ、データ本体は手元や外部のストレージに置く、という仕組みです。データのファイルやフォルダの版はそれぞれ重複を避けて保存され、版を切り替えることができると説明されています。共通データの場合、第1〜12か月の学習データ、欠損事故の起きた第25〜26か月のデータ、それを直した後のデータを別の版として残しておけば、事故の前後でモデルがどう変わったかを後から再現できます。実験とモデルの記録の側からデータの版をどう結びつけるかは、第5章(実験の記録)と第7章(モデルの登録)で扱います。
どの段階からこうした道具が要るかについては、次のように考えています。モデルが1本で、月に一度、決まった担当者が手作業で学習データを作っている段階では、この章のように数十行の検査を書き、学習に使ったデータのファイルを日付つきで保管しておくだけでも、気づける事故は多くあります。この章で起こした事故でいえば、欠損・単位の取り違え・表記の変化・新しい値は、データが届いた時点でこの程度の検査で見つかりました。一方で、前月差の符号の反転と利用日数の数え方の変化は、範囲と許された値の検査だけでは見つかりませんでした。モデルが複数になり、データを作る部署や取り込み元が増え、担当者が入れ替わるようになると、検査の取り決めを人が覚えておくことはできなくなるので、契約を文書として管理し、検査とデータの版を道具で管理する意味が出てきます。道具を選ぶ前に、まず「何を検査するか」を契約の形で書き出すことが先です。道具は、書き出した取り決めを毎日漏れなく実行するためのものです。
経営の判断、データの持ち主と責任の所在
この章の結果を、経営の判断に使える形に整理します。1つ目は、データの品質の事故は、モデルの側からは見えにくいという点です。欠損事故でも、前処理の食い違いでも、モデルは最後までエラーを出さずに予測を返し続けました。損益の数字が悪くなって初めて気づく運用では、気づくまでの月数がそのまま損になります。共通データの例では、4つの食い違いのうち最も損の大きかった「利用日数を7日で数える」が1か月続くと、引き止め施策の損益が81.0万円悪化する計算でした(架空の設定での計算)。ほかの3つは17.7万円・8.5万円の悪化と0.2万円の増加で、事故によって損の大きさは大きく違います。参考に並べると、記事全体の基準である放置と毎月再学習の損益の差は、差が最も大きかった競合施策の期間(第28〜36か月)で月40.5万円でした。ただし、食い違いの数字は変化の前の第13〜18か月に「食い違いなし」との差として測ったもので、運用の2つの方式の差を第28〜36か月で測った40.5万円とは、期間も比べている相手も違います。この2つの数字から、データの検査を置かないことと再学習を怠ることのどちらの損が大きいかを決めることはできません。この例題で言えるのは、データの事故は1件でも、再学習の方式の差と同じ程度の月の損を生むことがある、ということです。
2つ目は、データの持ち主を決めることです。データ契約は、作る側と使う側の取り決めですが、取り決めを結ぶには、それぞれの側に責任を持つ人が要ります。利用日数のログを作るのはサービスの開発部門、月額を決めるのは事業部門、獲得経路を増やすのは営業部門、モデルを使って施策を打つのはマーケティングの部門、というように、共通データの1つの表でも関わる部署は多岐にわたります。ODCS がチーム・役割・問い合わせの窓口・サービスレベルの合意を契約の項目に含めているのは、この「誰が」を契約の一部として書くためです。次の表は、データの品質に関する責任を分ける1つの案です。
| 役割 | 責任を持つこと | 共通データでの例 |
|---|---|---|
| データの持ち主(作る側の責任者) | データの定義・単位・届ける時期を守る。変えるときは事前に知らせ、契約の版を上げる | 料金改定の前に、月額の新しい値を使う側へ通知する |
| データの利用者(使う側の責任者) | 使うデータの取り決めを書き、検査を置き、違反のときの動き(止める・警告)を決める | 欠損率の上限1%と、超えたときの扱いを決める |
| データの管理の担当 | 契約の文書と版を管理し、部署をまたぐ変更の調整をする | partner 開始の際に、営業部門と解約予測の担当の間で契約 v1.2 を結ぶ |
| 事業の責任者 | 違反で予測を止めたときの業務の代わりの手段と、止める判断の権限を持つ | 欠損事故の月に、施策の対象をどう選ぶかを決める |
表の「データの持ち主」の行が最も大事で、かつ最も決まっていないことが多い役割だと考えています。データを作る部署にとって、下流のモデルのためにデータの定義を守ることは、自分の業務の成果に直接つながりません。だからこそ、経営の側から「このデータを使って月に数十万円の施策を動かしている」という事実を示し、データの持ち主に責任と権限を割り当てる必要があります。料金改定や新しい販売経路は、事業として正しい判断であり、止めるべきものではありません。必要なのは、その判断がデータの定義を変えることを、使う側へ前もって知らせる仕組みです。
3つ目は、検査の結果をどの経営指標で報告するかです。検査の違反の件数をそのまま報告しても、経営の判断には使えません。この章で見たとおり、全行が違反になっても損益にほとんど影響しない事故(経路の表記)もあれば、違反が0件でも損益が大きく悪化する事故(利用日数の数え方)もあるからです。報告には、違反の件数に加えて、「その違反で予測を止めた時間・止めた間に打てなかった施策の件数」「違反を見つけてから直すまでの日数」「事故の期間の損益と、事故が無かった場合の損益の見込み」を添えると、データの品質への投資の判断に使える形になります。共通データの欠損事故でいえば、検出したのは事故の起きた月(第25か月)で、事故は2か月続きました。この「何か月続いたか」が、データの品質の仕組みが働いているかを測る最も分かりやすい指標です。
判断を誤ったときの損失の型も整理しておきます。検査が無い、または緩すぎる場合は、事故が損益の悪化として表に出るまで続き、その間の損がそのまま失われます。検査が厳しすぎ、違反のたびに予測を止める場合は、料金改定のような正当な変化のたびに施策が止まり、止めた月の損益(共通データの第19か月なら51.7万円)を失います。検査を置いても違反の通知が誰にも届かない、または届いても対応する人が決まっていない場合は、検査が無いのと同じです。どの型を避けるかは、検査の書き方ではなく、契約の中の「違反のときの動き」と「持ち主」の取り決めで決まります。
この章の要点は3つです。第一に、データの品質は完全性・妥当性・一貫性・鮮度・一意性の観点に分けて取り決め、データ契約として作る側と使う側で合意し、機械的に確かめられる部分はスキーマ検証として実装します。共通データでは、料金改定・新しい獲得経路・欠損事故をそれぞれ起きた月に検出できましたが、関係そのものが変わる競合施策は、データの検査では検出できませんでした。第二に、欠損や前処理の食い違いを含むデータでも、モデルはエラーを出さずに予測を返し続け、損益だけが悪化します。スキーマ検証・分布の監視・特徴量の一致検査はそれぞれ見える事故が違うので、重ねて置く必要があります。第三に、検査の価値は、違反のときの動きとデータの持ち主を決めて初めて生まれます。次の第4章では、品質を確かめたデータから、予測の時点で使える情報だけを使って特徴量と学習データを正しく作る方法を扱います。
この章を深めたい方への参考書籍
『実践的データ基盤への処方箋』(ゆずたそ・渡部徹太郎・伊藤徹郎、技術評論社):データ基盤を作り運用するためのノウハウを、データ・システム・人の3つの面から扱う本です。目次には、データの品質を生成元のデータソースで担保すること、マスタ・共通ID・履歴の整備、サービスレベルの設定と計測、データ品質を支えるデータスチュワードの役割といった節があり、この章の「データの持ち主」と「運用の約束」を組織の側から具体化するのに向いています。
『データエンジニアリングの基礎』(Joe Reis・Matt Housley 著、中田秀基 訳、オライリー・ジャパン):データの生成から保存・取り込み・変換・提供までを「データエンジニアリングライフサイクル」として整理した本の日本語版です。ソースシステムにおけるデータ生成、データ取り込み、機械学習へのデータの提供といった章があり、この章で扱った「データを作る側」と「使う側」の間で何が起きるかを、データの流れ全体の中で理解するのに向いています。
第4章 特徴量と学習データを正しく作る
第3章では、入ってくるデータそのものの品質を守る仕組みとして、データの型・範囲・欠損率を検査する方法を見ました。品質の検査を通ったデータでも、それを学習データに組み立てる段階で誤ると、モデルは本番で役に立ちません。この章では、モデルの入力にする項目(特徴量)と、学習に使う表(学習データ)の作り方を扱います。中心になるのは、予測の時点では手に入らない情報が学習に混ざってしまう事故です。第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)に、この事故を架空に起こし、オフラインの評価では高い成績が出るのに本番では成績が出ないことを実行して確かめます。そのうえで、予測の時点までに確定していた値だけを結合する方法、解約の確定が1か月遅れることの影響、特徴量の定義を1か所にまとめる仕組み(特徴量ストア)、学習データの作り方の記録を順に扱います。
予測の時点では使えない情報が混ざる事故
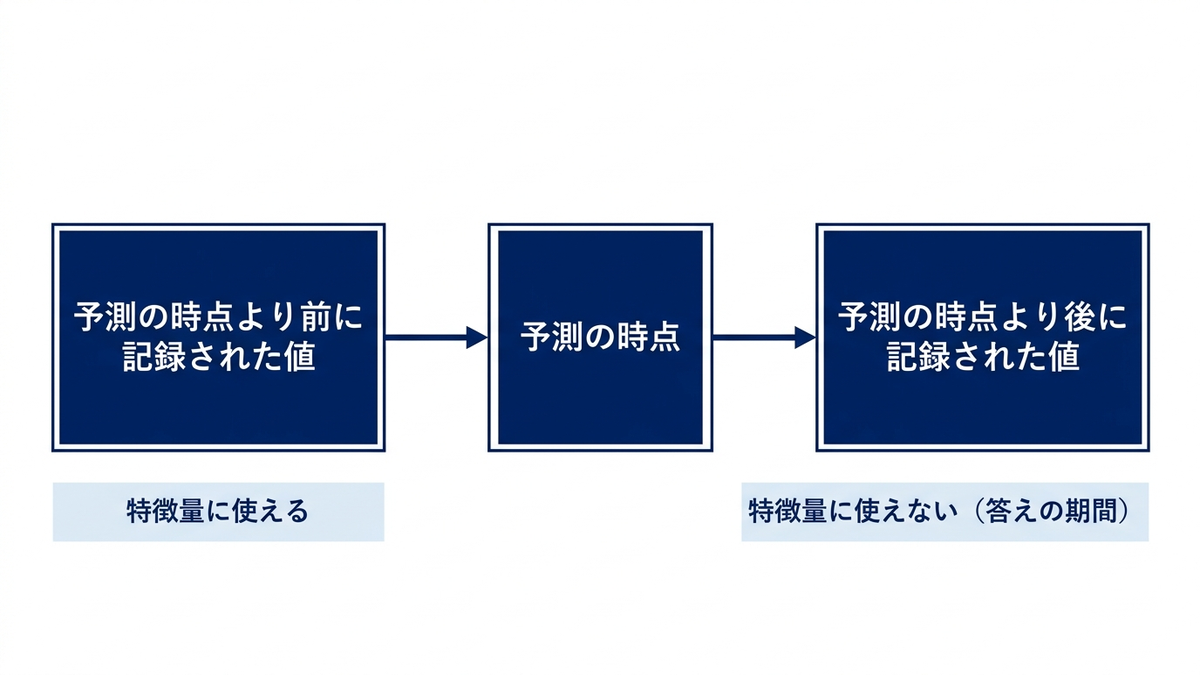
機械学習のモデルは、過去のデータで「入力と答えの関係」を学び、その関係を将来のデータに当てはめて予測します。このとき、学習に使った入力が、本番で予測するときにも同じ意味・同じ値で手に入ることが前提になります。予測の時点では手に入らないはずの情報が学習データに混ざってしまうことをデータリーク(情報の漏れ)と呼びます。漏れた情報の多くは答え(解約したかどうか)と強く結びついているので、モデルはその情報に頼って答えを当てるようになり、学習データの上や、同じ作り方をした評価用データの上では、非常に高い成績が出ます。ところが本番では、その情報はまだ存在しないので、成績は出ません。
データリークが厄介なのは、評価の数字がよく見えることです。評価用データも同じデータ倉庫から同じ手順で作るので、漏れた情報は評価用データにも入っています。そのため、モデルを作った担当者も、評価の報告を受けた経営層も、「精度の高いモデルができた」と判断してしまいます。誤りに気づくのは本番に出してからで、しかも解約のように答えが確定するまでに時間がかかる問題では、気づくまでにさらに1か月以上かかります。
漏れの典型は3つあります。1つ目は、答えが決まった後に記録される項目です。解約の予測であれば、解約手続きのページを見た回数、解約理由のアンケート、退会の受付記録などがこれに当たります。2つ目は、予測の時点より後の期間の値です。たとえば「翌月の利用日数」は、解約する顧客ほど小さくなるので答えとよく結びつきますが、予測の時点ではまだ起きていません。3つ目は、データ倉庫の表が上書きで更新されていて、過去の時点の値が残っていない場合です。今日の時点の値(現在の契約プラン、現在までの問い合わせの累計など)を、過去の予測の時点の値として結合してしまうと、2つ目と同じ漏れになります。3つ目は後の節で扱う「時点整合」の問題で、ここでは1つ目と2つ目を実際に起こして影響を測ります。
漏れのある項目を混ぜると、評価は上がり本番では下がる
第2章のサンプルデータに、予測の時点では手に入らない項目を2つ、架空に足しました。どちらも、データ倉庫には後から記録されている、という想定です。この2つの項目は第2章のデータには無く、この章のために作った架空の設定です。
| 架空に足した項目 | 作り方(架空の設定) | データ倉庫に入る時期 | 予測の時点で手に入る値 |
|---|---|---|---|
| 解約手続きの閲覧回数 | 翌月に解約した顧客は平均1.2回、解約しなかった顧客は平均0.08回(ポアソン分布の乱数) | 翌月中に記録される | 0(手続きはまだ起きていない) |
| 翌月の利用日数 | 解約した顧客は当月の利用日数の0.4倍に乱数を加えた値、解約しなかった顧客は当月の利用日数に乱数を加えた値(0〜30日に収める) | 翌月末に集計される | 未来の値なので無い。本番では当月の利用日数で代用してしまう |
学習は第1〜12か月の6万件で行い、変化の起きる前の第13〜18か月で評価しました。モデルは第2章の基準と同じ HistGradientBoostingClassifier です。「オフライン評価」は、データ倉庫に後から記録された値で評価した成績で、モデルを作った時点で担当者が見る数字です。「本番」は、予測の時点で手に入る値(解約手続きの閲覧回数は0、翌月の利用日数は当月の値で代用)で予測した成績で、実際に運用したときに出る数字です。損益は第2章で定義したとおり、予測確率がしきい値(約0.106)を超えた顧客に引き止め施策を打ったときの架空の損益です。
import numpy as np
import pandas as pd
import mlops_data as md
import baseline as bl

def add_leaky(d):
    """データ倉庫に後から記録される2項目を足す(架空の設定)。"""
    d = d.copy()
    rng = np.random.default_rng(100 + int(d.month.iloc[0]))
    n, y = len(d), d.churn.to_numpy()
    d["cancel_view"] = np.where(y == 1, rng.poisson(1.2, n), rng.poisson(0.08, n))
    u = d.usage_days.fillna(d.usage_days.mean()).to_numpy()
    nxt = np.where(y == 1, u * 0.4 + rng.normal(0, 2, n), u + rng.normal(0, 2, n))
    d["usage_next"] = np.clip(nxt, 0, 30).round()
    return d

def serve_view(d):
    """予測の時点で実際に手に入る値に置き換える(本番)。"""
    d = d.copy()
    d["cancel_view"] = 0               # 解約手続きはまだ起きていない
    d["usage_next"] = d["usage_days"]  # 翌月は未来なので当月の値で代用してしまう
    return d

def X(d, extra):
    x = md.encode(d)
    for c in extra:
        x[c] = d[c].to_numpy()
    return x

train = pd.concat([add_leaky(md.month_data(m)) for m in range(1, 13)])
test = [add_leaky(md.month_data(m)) for m in range(13, 19)]
extra = ["cancel_view"]                # 漏れのある項目を1つ混ぜる
model = bl.make_model().fit(X(train, extra), train.churn)
for d in test[:1]:
    off = model.predict_proba(X(d, extra))[:, 1]              # オフライン評価
    on = model.predict_proba(X(serve_view(d), extra))[:, 1]   # 本番
    print(md.campaign_value_threshold(d.churn, off), md.campaign_value_threshold(d.churn, on))
# 出力(損益の円, 当たり件数, 施策件数):
# (1694839.9999999995, 299, 707) (139319.99999999997, 27, 81)
このコードは、補助モジュール(mlops_data.py と baseline.py。第2章で説明したもの)と同じフォルダに置いて実行する形です。実行したスクリプトから要所を抜き出したもので、ここでは第13か月の1か月分だけを出力しています。解約手続きの閲覧回数を混ぜたモデルは、第13か月について、オフライン評価では707件に施策を打って約169.5万円の損益になるのに、本番では81件しか打たず、損益は約13.9万円でした。第13〜18か月の6か月分の平均を出す集計と図の作図は省いています。6か月の平均は次の表のとおりでした。この期間の実際の解約率は0.0822です。
| 条件 | 評価 | AUC | 予測平均 | 施策件数(月平均) | 損益(万円/月) |
|---|---|---|---|---|---|
| 漏れなし(基準) | オフライン評価 | 0.680 | 0.081 | 1,144.5 | 45.3 |
| 漏れなし(基準) | 本番 | 0.680 | 0.081 | 1,144.5 | 45.3 |
| 解約手続きの閲覧回数を混入 | オフライン評価 | 0.879 | 0.081 | 660.3 | 167.4 |
| 解約手続きの閲覧回数を混入 | 本番 | 0.673 | 0.029 | 76.7 | 10.0 |
| 翌月の利用日数を混入 | オフライン評価 | 0.978 | 0.083 | 774.5 | 221.9 |
| 翌月の利用日数を混入 | 本番 | 0.605 | 0.017 | 259.8 | 12.2 |
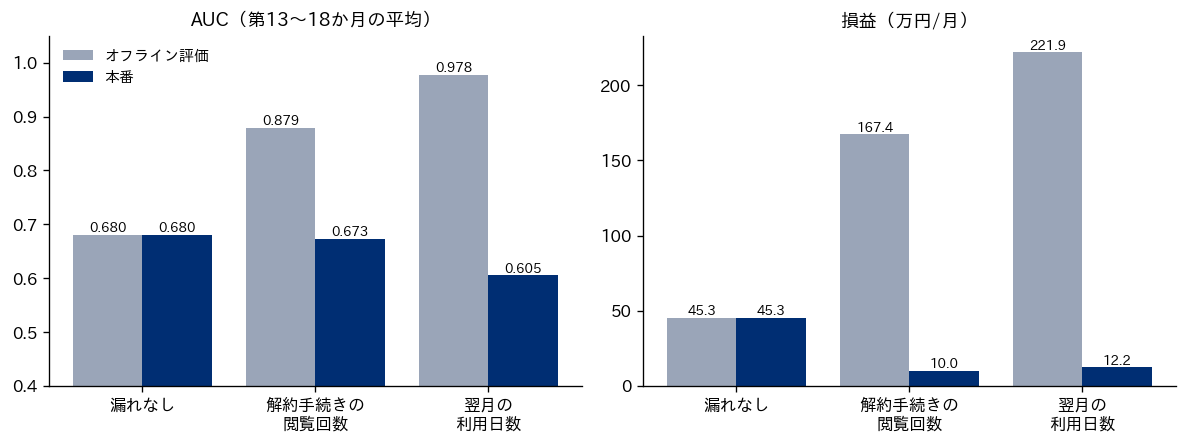
漏れの無い基準のモデルは、オフライン評価と本番で同じ成績になります(入力が同じなので当然です)。AUC は0.680、損益は月45.3万円で、第2章の基準の結果の「13〜18 変化前」の放置の行と一致します。解約手続きの閲覧回数を混ぜたモデルは、オフライン評価の AUC が0.879に上がり、損益の見込みは月167.4万円と、基準の3.7倍になりました。翌月の利用日数を混ぜたモデルは、オフライン評価の AUC が0.978で、ほぼ完全に解約を言い当てているように見え、損益の見込みは月221.9万円です。どちらも、モデルの報告を受けた側が「導入すべきだ」と判断する数字です。
本番では結果が逆転します。解約手続きの閲覧回数を混ぜたモデルは、本番ではその項目が全員0になるので、全員を「手続きをしていない顧客」として扱い、予測平均は0.029まで下がりました。実際の解約率0.082の3分の1ほどです。確率を低く見積もるので、しきい値を超える顧客が月76.7件しか出ず、損益は月10.0万円でした。翌月の利用日数を混ぜたモデルも同じで、本番の予測平均は0.017、損益は月12.2万円です。基準のモデルの月45.3万円と比べると、それぞれ月35.3万円・月33.1万円少なく、6か月では211.7万円・198.3万円の差になります。オフラインの見込みとの差で言えば、月150万円以上の見込み違いです。
AUC の動きにも注意が要ります。解約手続きの閲覧回数を混ぜたモデルの本番の AUC は0.673で、基準の0.680とほとんど変わりません。並べ替えの正しさだけを見ると、漏れの被害は小さく見えます。一方、翌月の利用日数を混ぜたモデルの本番の AUC は0.605で、基準より0.075低く、こちらは AUC にも被害が表れました。漏れの種類によって、AUC に表れる場合も表れない場合もあるということです。解約手続きの閲覧回数の例で損益を大きく減らしたのは、予測確率の水準がずれ、施策を打つ件数が月1,144.5件から76.7件に減ったことでした。第2章で説明したとおり、確率をしきい値と比べて施策の件数を決める使い方では、確率の水準のずれがそのまま損益に効きます。本番で AUC だけを監視していると、この例のような被害を見落とします。
漏れを見つける手がかり
漏れのある項目は、学習の前に見つけられることが多くあります。最も手軽な方法は、特徴量を1つずつ取り出し、その1つだけで解約をどれだけ言い当てられるか(その特徴量だけで並べたときの AUC)を測ることです。上の実演の学習データ(第1〜12か月の6万件)で測ると、もとからある7つの数値の項目は0.518(割引の有無)から0.609(利用日数)の範囲に収まりました。これに対して、解約手続きの閲覧回数は0.826、翌月の利用日数は0.891でした。どの項目も1つだけでは0.6前後しか言い当てられない問題で、1つだけで0.8を超える項目が現れたら、まず「その値はいつ記録されたか」を確かめる価値があります。
この確認は機械的にできますが、判定には業務の知識が要ります。1つだけで高い AUC を示す項目が、正当に強い手がかりである場合もあるからです。たとえば決済の失敗回数は、解約と強く結びついていても、予測の時点で確定している過去の事実なので漏れではありません。確かめるべきことは、項目の強さではなく、記録された時刻と予測の時刻の前後関係です。データ倉庫の各項目について「その値は、いつの出来事を表し、いつ記録されたか」を表にしておくと、この確認が速くなります。この表は、後の節で扱う特徴量の定義の一元化と、学習データの作り方の記録の土台になります。
機械学習のライブラリ scikit-learn の公式ドキュメントは、注意すべき落とし穴の1つとしてデータリークを取り上げ、予測の時点では手に入らない情報をモデルの構築に使ってしまうことであり、交差検証などで性能を楽観的に見積もる結果になり、本番のような本当に新しいデータでは性能が落ちる、と説明しています。同じページは、典型的な原因として、学習用と評価用のデータを分ける前に前処理(平均で割る正規化など)の値を全データから計算してしまうことを挙げ、前処理とモデルをひとまとめにするパイプラインの機能を使うことを勧めています。この種の漏れ(評価用データの情報が前処理を通じて学習に入る漏れ)は、評価の作法の問題として第6章で扱います。データマイニングの分野では、2012年に Kaufman・Rosset・Perlich・Stitelman が学術誌 ACM Transactions on Knowledge Discovery from Data に、漏れを正面から論じた論文(題は「Leakage in Data Mining」、副題は「定式化、検出、回避」)を発表しています。要旨は、漏れを「予測の対象について、正当には使えないはずの情報が持ち込まれること」と定義し、データの管理と「学習と予測の分離」によって漏れを避けられること、データの集め方を制御できない場合にも漏れを検出する方法があることを述べています。
予測の時点までに確定していた値だけを結合する(時点整合)
学習データは、多くの場合、顧客の一覧(予測の対象)に、複数の表から特徴量を結合して作ります。このとき、各顧客の各予測の時点について、その時点までに確定していた値だけを結合する必要があります。これを時点整合(英語では point-in-time correctness。ある時点の状態をその時点の値で再現すること)と呼びます。データ倉庫の表には、顧客ごとに最新の値だけを持ち、毎日上書きされる表がよくあります。この表を過去の予測の時点の顧客一覧にそのまま結合すると、各顧客について「学習データを作った日の値」が入り、予測の時点より後の出来事が混ざります。前の節の3つ目の典型で、項目そのものに問題が無くても、結合のしかたで漏れが起きます。
第2章のサンプルデータは月ごとの横断面で、同じ顧客を月をまたいで追跡しないので、この問題を再現できません。そこで、この節だけの架空の設定を作りました。顧客ごとに問い合わせの記録が日時つきで残り、解約する顧客は解約日の前に「解約に関する問い合わせ」が増える、という設定です。特徴量は「予測の時点までの直近30日の問い合わせ件数」と「利用日数」の2つです。
| 項目 | この節の架空の設定 |
|---|---|
| 顧客の集団 | 学習用4,000人(予測の時点 2026年4月1日)、本番用4,000人(予測の時点 2026年6月1日)。乱数で作った架空の顧客 |
| 解約のしやすさ | 顧客ごとの値 z(標準正規分布の乱数)。解約の確率は z が大きいほど高い(ロジスティック関数で -2.4+0.8×z を確率に直した値) |
| 答え(ラベル) | 予測の時点から30日以内に解約したら1。解約日はその30日のどこか |
| 問い合わせの記録 | 予測の時点の90日前から日時つきで記録。1日あたりの件数の平均は 0.01×exp(0.4×z)。解約する顧客は、解約日の前10日以内に平均1.5件の問い合わせが加わる(予測の時点より後) |
| 利用日数 | 予測の時点で分かる値。12から3×z を引いた値に乱数を加え、0〜30日に収める |
| 学習データを作る日(抽出日) | 2026年5月1日(4月の解約が確定した翌日) |
| 損益の設定 | 第2章と同じ(施策1件800円、解約する顧客に打てば7,560円を守れる。しきい値は約0.106) |
時点整合の結合には、pandas の merge_asof を使いました。pandas の公式ドキュメント(3.0.6版)は、この関数を「キーの距離による結合」と説明しています。既定の direction="backward" では、左の表の各行について、右の表のうちキーが左のキー以下である最後の行を選びます。by に顧客の番号を指定すると、同じ顧客の記録の中で探します。両方の表は結合のキー(ここでは日時)で昇順に並べておく必要があり、by の列で並べる必要はありません。allow_exact_matches の既定は True で、キーがちょうど等しい記録も結合します(予測の時点ちょうどに記録された値を使ってよいかは、業務の決めごととして別に決める必要があります)。次のコードは、問い合わせの記録に「その記録までの累計件数」を付け、予測の時点と、その30日前の時点の累計を merge_asof で引き、その差を直近30日の件数にしています。
import pandas as pd

def pit_features(cust, events, at_col="t0"):
    """予測の時点までに起きた問い合わせだけを数える(merge_asof で直前の累計を引く)。"""
    ev = events.sort_values("ts").copy()
    ev["cum"] = ev.groupby("customer_id").cumcount() + 1          # その記録までの累計件数
    left = cust.sort_values(at_col).copy()
    left["t_30"] = left[at_col] - pd.Timedelta(days=30)
    a = pd.merge_asof(left, ev[["customer_id", "ts", "cum"]], left_on=at_col, right_on="ts",
                      by="customer_id", direction="backward")
    a = a.rename(columns={"cum": "cum_now"}).drop(columns="ts").sort_values("t_30")
    b = pd.merge_asof(a, ev[["customer_id", "ts", "cum"]], left_on="t_30", right_on="ts",
                      by="customer_id", direction="backward")
    b["tickets_30d"] = b["cum_now"].fillna(0) - b["cum"].fillna(0)
    return b.drop(columns=["ts", "cum", "cum_now", "t_30"]).sort_values("customer_id").reset_index(drop=True)
このコードは、この節の実験に使ったスクリプトから、時点整合の結合の関数だけを抜き出したものです。cust は顧客の一覧(顧客の番号・予測の時点・利用日数・答え)、events は問い合わせの記録(顧客の番号・日時)で、どちらも上の架空の設定で作りました。比較のために、抽出日(2026年5月1日)の時点の「直近30日の問い合わせ件数」をそのまま結合した学習データも作りました。上書きされる集計表を、過去の予測の時点の顧客一覧に結合したときに起きることを再現したものです。この結合では、直近30日が4月の1か月にあたり、解約に関する問い合わせがそのまま入ります。2つの結合で値が食い違った顧客は、全体の0.430(43.0%)でした。
次の表は、直近30日の問い合わせ件数の平均を、時点整合で結合した学習データ、抽出日の値で結合した学習データ、本番の予測の時点の値の3つについて、解約した顧客と解約しなかった顧客に分けて比べたものです。
| データ | 解約した顧客 | 解約しなかった顧客 |
|---|---|---|
| 学習データ(時点整合で結合) | 0.700件 | 0.303件 |
| 学習データ(抽出日の値で結合) | 1.378件 | 0.317件 |
| 本番(予測の時点の値) | 0.742件 | 0.325件 |
時点整合で結合した学習データでは、解約した顧客が0.700件、しなかった顧客が0.303件で、本番の予測の時点の値(0.742件と0.325件)とほぼ同じ水準でした。抽出日の値で結合した学習データでは、解約した顧客が1.378件と、本番の2倍近くになっています。モデルは、この「解約した顧客は問い合わせが多い」という、学習データの上でだけ強く見える関係を学びます。
2つの学習データで、ロジスティック回帰(利用日数と直近30日の問い合わせ件数を入力にする単純なモデル)を学習しました。オフライン評価は、学習用の4,000人を7対3に分け、3割の1,200人で評価した成績です。本番は、本番用の4,000人について、2026年6月1日の時点で存在する記録だけから特徴量を作って予測した成績です。損益は1,000人あたりの円に直しています。
| 学習データの作り方 | 評価 | AUC | 予測平均 | 実際の解約率 | 施策件数(1,000人あたり) | 損益(1,000人あたり、円) | 問い合わせの係数 |
|---|---|---|---|---|---|---|---|
| 時点整合で結合 | オフライン評価 | 0.651 | 0.110 | 0.108 | 340.0 | 131,200 | 0.744 |
| 時点整合で結合 | 本番 | 0.668 | 0.111 | 0.103 | 351.5 | 159,170 | 0.744 |
| 抽出日の値で結合 | オフライン評価 | 0.792 | 0.116 | 0.108 | 319.2 | 324,267 | 1.284 |
| 抽出日の値で結合 | 本番 | 0.663 | 0.098 | 0.103 | 283.3 | 136,280 | 1.284 |
抽出日の値で結合したモデルは、オフライン評価の AUC が0.792で、時点整合のモデルの0.651より大きく上回りました。損益の見込みも1,000人あたり324,267円と、時点整合のモデルの見込み(131,200円)の2.5倍です。この比較だけを見ると、抽出日の値で作ったモデルを採用する判断になります。ところが本番では、AUC は0.663で時点整合のモデル(0.668)とほぼ同じ、損益は1,000人あたり136,280円で、時点整合のモデル(159,170円)を22,890円下回りました。オフラインの見込みとの比較では、見込みの約4割しか実現していません。
差を生んだのは、問い合わせの係数です。抽出日の値で学習したモデルは、問い合わせ1件あたりの重みを1.284と、時点整合のモデル(0.744)の1.7倍に見積もりました。本番では、予測の時点の問い合わせ件数は学習時ほど解約と結びついていないので、このモデルは問い合わせの多い顧客の解約確率を高く見すぎ、少ない顧客を低く見すぎます。予測平均は0.098と実際の解約率0.103を下回り、施策を打つ件数は1,000人あたり283.3件と、時点整合のモデルの351.5件より少なくなりました。打つべき顧客に打てていない分が、損益の差になっています。なお、評価に使った人数が少なく(オフライン評価は1,200人)、乱数の種も1つだけで計算した結果なので、この表の数字は乱数の種を変えると動きます。種を変えて確かめてはいないので、この表から読めるのは、この1回の計算でのオフライン評価と本番の差の向きと大きさまでです。
この実験の漏れは、前の節の実演より穏やかです。学習データの値が「本番より強め」にずれただけで、本番で全員0になるような極端な変化はありません。そのぶん、本番の AUC にはほとんど差が出ず、損益と施策件数で見てはじめて分かる損になりました。時点のずれた結合は、データ倉庫の表の作りに由来するので、モデルを作り直しても同じ誤りが繰り返されます。表の作りを直す(上書きせずに日時つきの履歴を残す)か、結合を時点整合にするかのどちらかが要ります。
答えの確定が遅れると、学習に使える期間が後ろにずれる
学習データには、特徴量のほかに答え(ラベル)が要ります。解約の予測では、第2章で定義したとおり、答えは「翌月末までに解約したか」で、翌月が終わるまで確定しません。第 m か月の予測を作る時点では、第 m-1 か月の顧客の答えはまだ確定していないので、学習に使えるのは第 m-2 か月までです。第2章の「毎月再学習」は、この1か月の遅れを置いて、第 m-13〜m-2 か月の12か月分で学習し直しています。答えの確定の遅れは、業務によって大きく違います。広告のクリックなら数秒で確定しますが、貸し倒れの予測では返済の期限まで、設備の故障の予測では故障が起きるまで分かりません。
この遅れには、2つの扱い方の誤りがあります。1つは、遅れを無視して、確定していない月を学習に混ぜてしまうことです。第 m-1 か月の顧客のうち、すでに解約した人は記録に現れていますが、月末までに解約する人の一部はまだ記録に現れていません。この月をそのまま混ぜると、「まだ解約していない」顧客が「解約しなかった」顧客として学習され、解約の確率を低く学びます。もう1つは、遅れを必要以上に大きく取ることです。答えの集計の仕組みが月次の締めに依存していて、確定してから学習データに入るまでさらに1か月かかる、といった場合です。新しい月のデータを使えないぶん、変化への追随が遅れます。
この2つの影響を、第2章のサンプルデータで測りました。毎月再学習の学習期間の取り方を4通りに変え、第13〜36か月の24か月で比べています。C の「前月の解約は半分しか記録されていない」は、この節のための架空の設定です。モデルと損益の計算は第2章の基準と同じです。
| 方式 | 第 m か月の予測の前に学習に使う期間 | 位置づけ |
|---|---|---|
| A 確定済みだけ | 第 m-13〜m-2 か月 | 第2章の「毎月再学習」と同じ(基準) |
| B 遅れが無いと仮定 | 第 m-12〜m-1 か月(第 m-1 か月の答えも確定していると仮定) | 現実には不可能。遅れの費用を測るための参考 |
| C 未確定の前月を0のまま混ぜる | 第 m-12〜m-1 か月。第 m-1 か月は解約のうち半分だけが記録済みで、残りを「解約しなかった」として扱う | 遅れを無視する誤り |
| D 確定が2か月遅れる | 第 m-14〜m-3 か月 | 遅れを大きく取る場合 |
| 方式 | AUC(24か月平均) | 予測平均 | 施策件数(月平均) | 損益(万円/月) | 24か月の損益合計(万円) | A との差(万円) |
|---|---|---|---|---|---|---|
| A 確定済みだけ | 0.669 | 0.098 | 1,706.3 | 99.3 | 2,384.2 | 0 |
| B 遅れが無いと仮定 | 0.671 | 0.100 | 1,756.6 | 101.8 | 2,443.9 | 59.8 |
| C 未確定の前月を0のまま混ぜる | 0.668 | 0.092 | 1,555.8 | 99.3 | 2,382.7 | -1.4 |
| D 確定が2か月遅れる | 0.668 | 0.096 | 1,649.7 | 98.1 | 2,355.2 | -29.0 |
この期間の実際の解約率の平均は0.111です。A の24か月の損益合計2,384.2万円は、第2章の基準の結果の「毎月」と一致しています。答えの確定の遅れが無いと仮定した B は2,443.9万円で、A より59.8万円多くなりました。この架空データの、この設定では、1か月の遅れの費用は24か月で約60万円、月にならすと約2.5万円です。確定が2か月遅れる D は、A より29.0万円少なくなりました。第1章・第2章で見た放置と毎月再学習の差(24か月で420.2万円)と比べると、遅れの1か月の差は小さく、この設定では、まず再学習をすること自体が大きく効き、遅れを縮める効果はその次に来る、という順序になりました。なお、この差は同じデータ・同じ乱数の種で1回ずつ計算した方式の差で、乱数を変えたときの揺れは測っていないので、「約60万円」という金額の精度は評価できていません。とくに A と C の1.4万円の差は、揺れの範囲に収まるかどうかも判断できません。
未確定の前月を混ぜた C は、24か月の損益合計では A とほぼ同じ(1.4万円少ない)でした。ただし中身は同じではありません。予測平均は0.092で、A の0.098より低く、実際の解約率0.111からさらに離れています。施策件数は月1,555.8件で、A より約150件少なくなりました。答えの欠けた月を混ぜたことで、解約の確率を低く学んだためです。料金改定から欠損事故までの第19〜27か月に限ると、C の損益は月73.0万円で、A の月77.5万円を4.5万円下回りました。一方、競合施策の第28〜36か月では、C は月160.6万円で A の月157.4万円を上回っています。最新の月のデータが入ることで、関係そのものが変わった後の顧客の傾向を早く学べた効果が、確率を低く見積もる損を打ち消したと読めます。つまり、合計がほぼ同じになったのはこの架空データでの2つの効果の釣り合いの結果で、未確定の月を混ぜることが安全だという意味ではありません。記録済みの割合(ここでは半分)が月によって変われば、予測平均もそれにつれて動き、監視の指標(予測平均と実際の解約率の差)そのものが読みにくくなります。
次の表は、学習期間の取り方を4通りに変えた毎月再学習の、月ごとの損益(万円/月)です。括弧内は4つの変化が始まった月です。
| 月 | A 確定済みだけ | B 遅れが無いと仮定 | C 未確定の前月を0のまま混ぜる | D 確定が2か月遅れる |
|---|---|---|---|---|
| 第13か月 | 54.9 | 59.0 | 56.2 | 52.9 |
| 第14か月 | 48.0 | 46.2 | 47.4 | 42.8 |
| 第15か月 | 37.1 | 36.9 | 39.1 | 38.4 |
| 第16か月 | 40.9 | 46.3 | 45.2 | 43.2 |
| 第17か月 | 49.1 | 46.4 | 47.6 | 46.7 |
| 第18か月 | 40.3 | 46.4 | 44.5 | 41.2 |
| 第19か月(料金改定) | 59.4 | 62.9 | 59.1 | 59.4 |
| 第20か月 | 51.4 | 55.8 | 46.2 | 48.7 |
| 第21か月 | 57.3 | 60.5 | 51.2 | 51.2 |
| 第22か月(partner) | 79.5 | 73.9 | 72.3 | 84.1 |
| 第23か月 | 98.1 | 105.8 | 88.3 | 97.6 |
| 第24か月 | 94.4 | 88.6 | 90.0 | 80.3 |
| 第25か月(欠損事故) | 86.6 | 81.9 | 79.4 | 80.5 |
| 第26か月 | 99.0 | 102.4 | 97.4 | 100.9 |
| 第27か月 | 71.3 | 73.2 | 73.0 | 69.8 |
| 第28か月(競合施策) | 144.8 | 141.1 | 135.3 | 143.9 |
| 第29か月 | 125.6 | 144.2 | 134.6 | 128.8 |
| 第30か月 | 129.2 | 134.5 | 133.1 | 128.1 |
| 第31か月 | 178.1 | 185.8 | 185.1 | 176.4 |
| 第32か月 | 161.0 | 162.3 | 162.3 | 156.9 |
| 第33か月 | 182.8 | 191.0 | 191.1 | 181.9 |
| 第34か月 | 177.5 | 182.6 | 179.9 | 183.4 |
| 第35か月 | 148.2 | 148.1 | 154.9 | 150.8 |
| 第36か月 | 169.6 | 168.4 | 169.5 | 167.3 |
4つの方式の損益は多くの月で近い値になっていて、どの月も方式の差は変化の大きさ(第27か月から第28か月の競合施策にかけての段差)に比べて小さくなっています。学習期間の取り方を誤っても、毎月学習し直している限り、損益が大きく崩れることはこの設定では起きませんでした。ここから引き出せる実務の指針は2つです。1つは、答えの確定の遅れを学習データの作り方に明示的に書き込み、「どの月の答えが、いつ確定するか」を決めておくことです。もう1つは、遅れを縮める投資(集計の締めを早める、答えを別の早い手がかりで置き換えるなど)の効果は、答えの確定が1〜2か月遅れるこの架空データでは、変化への追随が少し早まる分に限られた、ということです。この結果は遅れが1〜2か月の場合だけを測ったもので、貸し倒れや故障の予測のように答えの確定が何か月も、あるいは何年も遅れる業務では、遅れを縮める効果がずっと大きくなることもありえます。自社の業務の遅れの長さで同じ比較をして、費用と見合うかを測ってから判断するのがよいと考えています。答えの遅れと監視の関係は第10章、学習期間の長さの比較は第11章で扱います。
特徴量の定義を1か所にまとめ、学習データの作り方を記録する
ここまでの実演のうち、後から記録される項目の混入と時点のずれた結合の2つには共通点があります。どちらも、学習データを作るコードと、本番で予測の入力を作るコードが別々に書かれ、それぞれの担当者が「その値がいつの出来事で、予測の時点で手に入るか」を個別に判断していることから起きます(未確定の答えの混入は、答えの側の取り扱いの問題で、前の節で見たとおり答えの確定の時期を決めておくことで防ぎます)。学習のコードはデータ分析の担当者が Notebook で書き、本番の入力のコードはシステムの担当者が別の言語で書き直す、という分担は珍しくないように思います。この分担のままでは、同じ名前の特徴量でも定義がずれていきます。第3章で扱った、学習と推論で前処理が食い違う事故(単位の取り違えなど)も同じ根から生じます。
対策の基本は、特徴量の定義を1か所にまとめ、学習と本番の両方がそこから入力を作ることです。定義には、計算の方法だけでなく、意味、どの時点の出来事を表すか、予測の時点で使えるか、版の番号を書きます。そのうえで、学習データを作るたびに「どの期間のデータを、どの定義の版で、どの答えの定義で作ったか」を記録として残します。次のコードは、この考え方を最小限に実装したものです。実行したスクリプトから要所を抜き出しており、台帳は7つの数値の特徴量のうち3つだけを載せています。
import hashlib, inspect
import pandas as pd
import mlops_data as md

FEATURES = {   # 特徴量の定義の台帳(抜き出し)
    "usage_days":   dict(desc="前月の利用日数", event="前月", usable=True, version=1, fn=lambda d: d["usage_days"]),
    "usage_change": dict(desc="利用日数の前月差", event="前月", usable=True, version=1, fn=lambda d: d["usage_change"]),
    "discount":     dict(desc="割引の有無", event="予測の時点", usable=True, version=1, fn=lambda d: d["discount"]),
}
LABEL = dict(name="churn", desc="翌月末までに解約したら1", confirm_lag_months=1)

def make_X(d, features):
    """学習でも本番でも、この関数だけで入力を作る(プランと経路の列は省略)。"""
    return pd.DataFrame({k: v["fn"](d) for k, v in features.items()})

def build_training_set(pred_month, features, window=12):
    bad = [k for k, v in features.items() if not v["usable"]]
    if bad:
        raise ValueError("予測の時点で使えない特徴量が台帳にある: %s" % bad)
    last = pred_month - 1 - LABEL["confirm_lag_months"]   # 答えが確定している最後の月
    first = max(1, last - window + 1)
    d = md.months(first, last)
    X, y = make_X(d, features), d[LABEL["name"]]
    h = pd.util.hash_pandas_object(pd.concat([X, y], axis=1), index=False)
    manifest = dict(pred_month=pred_month, months=[first, last], rows=len(d),
                    label=LABEL, data_sha256=hashlib.sha256(h.values.tobytes()).hexdigest(),
                    features={k: dict(version=v["version"], event=v["event"],
                                      code=hashlib.sha256(inspect.getsource(v["fn"]).encode()).hexdigest()[:12])
                              for k, v in features.items()})
    return X, y, manifest
実行したスクリプトでは、台帳に7つの数値の特徴量をすべて載せ、make_X でプランと経路の one-hot の6列も作っています。この形で第20か月の予測に使う学習データを作ると、答えの確定の遅れ(1か月)が台帳から自動的に反映され、学習期間は第7〜18か月、6万件、解約率0.0800、列は13列になりました。make_X で作った入力は、第2章の補助モジュールの md.encode と列の並びも値も一致しました。作り方の記録(JSON)には、学習期間・件数・答えの定義・各特徴量の版と計算のコードの指紋・データの指紋(SHA-256。データの中身が1か所でも変われば別の値になる要約の文字列)を書いています。この記録を使って確かめたことを表にまとめます。
| 確かめたこと | 結果 | 何の役に立つか |
|---|---|---|
| 同じ記録の条件で学習データを作り直す | データの指紋が一致した | 後から「このモデルはどのデータで学習したか」を再現できる |
| 利用日数の前月差の定義を変える(±5日で打ち切る版2) | データの指紋が変わり、記録の差分から変わった特徴量(usage_change、版1から版2)が分かった。値が変わった行は全体の0.0675(6.75%) | 定義の変更が、いつ・どの特徴量で起きたかを追える |
| 予測の時点で使えない項目(解約手続きの閲覧回数)を台帳に入れる | 学習データを作る段階で止まった | 漏れのある項目を、モデルを作る前に機械的に排除できる |
| 本番で届いた1件の入力と、一括で作った入力を比べる | 13列すべて一致した | 学習と本番で入力の作り方がずれていないことを確かめられる |
この仕組みで防げるのは、台帳に正しく書かれた情報に基づく事故だけです。「予測の時点で使えるか」の欄を誤って書けば、漏れはそのまま通ります。台帳の価値は、その判断を項目ごとに1回、記録の残る形で行わせることにあります。新しい特徴量を足すときに「どの時点の出来事か」「いつ記録されるか」を書く欄が空いていれば、そこで手が止まり、確認が起きます。なお、学習データの記録をモデルの学習の記録(パラメータ・指標・成果物)と結びつけて管理する方法は、実験管理として第5章で扱います。
特徴量ストアは何を引き受けるか
前の節の台帳と結合の仕組みを、組織で共有する製品として提供するのが特徴量ストア(フィーチャーストア)です。ここでは、オープンソースの Feast と、AWS・Google Cloud・Azure の公式ドキュメントを開いて、何を引き受ける製品として説明されているかを確かめました。この記事の実行環境にはどれも導入していないので、実行はしていません。製品の見取り図と選び方は、弊社コラム『AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方』で扱っています。
Feast の公式ドキュメントは、Feast を本番の機械学習システムを運用するためのオープンソースの特徴量ストアと説明し、モデルの学習のために過去の特徴量を取り出すオフラインストアと、本番のシステムに低い遅延で特徴量を返すオンラインストアを持つとしています。目的の1つとして、時点整合のとれた特徴量の組を作ることでデータリークを避け、将来の特徴量の値が学習に漏れないようにすることを挙げています。時点整合の結合を説明するページでは、予測の対象の一覧(エンティティの表)に書かれた各時刻を「その時点の状態を再現したい時刻」とし、そこから過去へさかのぼって、指定した有効期間(TTL)の範囲で値を探すと説明しています。この節の前半で merge_asof で行ったことを、製品が引き受ける形です。同じドキュメントは、Feast が汎用のデータパイプラインの仕組みでも、データ倉庫の代わりでも、データベースでもないことも明記しています。特徴量を計算する元のデータの整備は、別に必要だということです。
AWS の Amazon SageMaker Feature Store の公式ドキュメントは、特徴量を「特徴量グループ」という表にまとめ、オンラインストアには最新の記録だけを持ってミリ秒単位の読み出しに使い、オフラインストアにはすべての記録を履歴として持って探索・学習・バッチ推論に使う、と説明しています。オフラインストアは追記のみの保存で、すべての特徴量の値の履歴を残し、異なる時点のデータを取り出せるとしています。また、特徴量の処理を一貫した方法で取り込むことで、学習時と本番時の性能の差を生む「学習と推論の食い違い」(training-serving skew)を減らせると書いています。
Google Cloud の Feature Store の公式ドキュメント(2026年10月7日更新。ページの題では Gemini Enterprise Agent Platform の機能として説明されています)は、特徴量のデータを BigQuery の表やビューに置いたまま管理し、それらがまとめてオフラインストアになるので、別のオフラインストアを用意しない、と説明しています。過去のある時点のデータは BigQuery で問い合わせられ、オンラインでの提供には Bigtable を使う方式があります。特徴量のデータの元を記録しておく「特徴量レジストリ」もあり、登録は任意とされています。ただし特徴量グループの作り方を説明する別のページは、同じ ID に過去の値が何行も並ぶ時系列のデータで学習する場合、複数の BigQuery の表から列を集める場合、継続的なデータの同期を使う場合、特徴量の監視を設定する場合には登録が必要だとしています。Azure Machine Learning の管理された特徴量ストアの公式ドキュメント(2025年10月30日付)は、特徴量ストアが解決する問題として、特徴量の検索と再利用、変換の仕組み、特徴量を作るパイプラインの運用、学習データの作成と推論で同じパイプラインを使うことによるオンラインとオフラインの一貫性を挙げています。特徴量の集合には版があり、作った後は変更できないこと、取り出しの際にデータリークを避けるための時点整合の結合(タイムトラベル)に対応していることも書かれています。
4つの説明を並べると、特徴量ストアが引き受けるものは、共通して次の3つにまとめられます。特徴量の定義と版を1か所で管理し、検索・再利用できるようにすること。過去の任意の時点の値を時点整合で取り出し、学習データを作れるようにすること。学習と本番で同じ定義の値を返し、食い違いを防ぐこと。逆に、元のデータの品質(第3章)、特徴量として何を作るべきかの判断、「予測の時点で使えるか」の業務上の判断は、製品を入れても人が担います。
| 状況 | 特徴量ストアの要否(弊社の考え) | 代わりに整えるもの |
|---|---|---|
| モデルが1〜2本で、予測は月次のバッチ | 多くの場合は不要 | この章の台帳と merge_asof の結合、学習データの記録。データ倉庫の表を上書きせず、日時つきの履歴で残す |
| 同じ特徴量(利用日数の推移など)を複数のモデル・複数のチームが使う | 検討の価値が高い | 定義が二重に書かれ始めた時点で、台帳を共有の場所に移す |
| 本番で1件ずつ即時に予測し、直近の行動(数分前の操作など)を特徴量に使う | 要ることが多い | オンラインとオフラインで同じ値を返す仕組みが要る。自前で作ると二重実装の食い違いが起きやすい |
| 監査・説明の要求が強く、過去の予測の入力を再現する必要がある | 履歴を残す仕組みとして有効 | 製品を使わない場合も、時点ごとの値を再現できる履歴の保存が要る(第12章) |
この表は、公式ドキュメントの説明と、この章の実演から整理した弊社の考えで、製品の導入を判断する基準を定めた公的な資料があるわけではありません。判断の軸は、特徴量の定義が二重に書かれているか、本番で即時の予測があるか、の2つだと考えています。モデルが1本で月次のバッチ予測なら、この章の台帳と時点整合の結合で必要なことはほぼ満たせます。逆に、特徴量ストアを入れても、データ倉庫に履歴が残っていなければ、過去の時点の値は作れません。導入の前に、まず元のデータが日時つきの履歴で残っているかを確かめることが先です。
経営の判断に翻訳する
この章の結果を、経営の判断に使える形に整理します。1つ目は、オフライン評価の数字の扱いです。漏れのある項目を混ぜたモデルは、オフライン評価で AUC 0.879〜0.978、損益の見込み月167.4万〜221.9万円という、基準のモデル(AUC 0.680、月45.3万円)を大きく上回る数字を示しました。本番の損益は月10.0万〜12.2万円で、基準より月33万〜35万円少なく、6か月で約200万円の差です。この架空データの設定では、オフラインの見込みとの差は月150万円を超えました。評価の数字が前のモデルより急に良くなったときは、喜ぶ前に「その特徴量は予測の時点で手に入るか」を確かめる手順を、承認の条件に入れておくべきだと考えています。モデルの承認の流れは第7章で扱います。
2つ目は、損失の見え方です。この章の実演では、本番の AUC が漏れの無いモデルとほとんど変わらないのに損益が大きく減った例が2つありました。解約手続きの閲覧回数を混ぜた例(本番の AUC 0.673、基準0.680)と、時点のずれた結合の例(0.663、時点整合の0.668)です。どちらも、損益を減らしたのは確率の水準がずれて施策の件数が変わったことでした。一方、翌月の利用日数を混ぜた例では、本番の AUC が0.605と基準の0.680より下がっており、AUC にも被害が表れています。つまり、AUC に表れる損失もあれば表れない損失もあり、経営への報告で AUC だけを示していると、後者は報告に現れません。報告には、予測平均と実際の解約率、施策件数、損益を並べることが有効だと考えています。第1章で整理した経営指標の考え方とも一致します。
3つ目は、投資の順序です。この章の答えの確定の遅れの比較では、1か月の遅れの費用は24か月で約60万円(この架空データの、遅れが1〜2か月の設定での値)で、放置と毎月再学習の差(420.2万円)の7分の1ほどでした。答えの確定の遅れが大きい業務では、この比は違ってきうるので、この数字をそのまま他の業務に当てはめることはできません。学習データを正しく作る仕組みへの投資は、目立つ成果(精度の向上)を生みませんが、漏れのあるモデルを本番に出して施策費を無駄にする事故を防ぎます。投資の順序としては、まず学習データの作り方の記録と、予測の時点で使える項目の台帳を整え、次にデータ倉庫の表を日時つきの履歴で残すようにし、特徴量ストアの導入は、定義の二重化や即時の予測が実際に問題になってから検討する、という順が有効だと考えています。これは弊社の考えで、根拠にしているのは、この章の実測で漏れと時点のずれが損益に大きく効いた一方、遅れ1〜2か月の差は小さかったことです。
判断を誤ったときの損失の型も整理しておきます。漏れのある項目を使ったモデルは、本番に出してから答えが確定するまで(解約の予測なら1か月以上)誤りに気づけず、その間の施策は誤った確率に基づいて打たれます。この章の解約手続きの閲覧回数の実演では、施策の件数が基準の7%(月1,144.5件に対して76.7件)まで減り、打つべき顧客に打てない損が出ました。逆に、漏れの向きによっては確率を高く見積もり、不要な施策を打ちすぎる損になることもあります。どちらの場合も、気づいた後にはモデルを作り直すだけでなく、データ倉庫の表や結合の作りを直す必要があり、モデルだけを直すより手戻りが大きくなります。モデルの精度を議論する前に、学習データの作り方を議論する時間を取ることが、結果として最も安くつくと考えています。
この章の要点は3つです。第一に、予測の時点では手に入らない情報が学習データに混ざると、オフライン評価では非常に高い成績が出ても、本番では成績が出ません。共通データの実演では、オフラインの損益の見込みが月167万円を超えたモデルが、本番では月10万円台にとどまりました。第二に、漏れは項目そのものだけでなく、上書きされる表を過去の時点に結合するといった、結合のしかたからも起きます。予測の時点までに確定していた値だけを結合する時点整合の結合(merge_asof や特徴量ストアの機能)で防げます。第三に、答えの確定の遅れは学習に使える期間を後ろにずらし、未確定の月を混ぜると確率を低く学びます。これらを防ぐには、特徴量の定義を1か所にまとめ、「予測の時点で使えるか」を項目ごとに記録し、学習データの作り方を記録として残すことが基本になります。次の第5章では、こうして作った学習データでモデルを学習する実験を記録し、同じ結果を再現できるようにする方法を扱います。
この章を深めたい方への参考書籍
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司、技術評論社):データ分析のコンペティションで使われる手法を、評価指標・特徴量の作成・モデルの検証の順に整理した本です。目次には、予測に有用な情報が想定外に漏れている意味でのリーク、検証の枠組みの誤りという意味でのリーク、時系列データで予測する時点より過去の情報のみを使うこと、予測に使えるデータの期間といった節があり、この章で扱ったデータリークと時点整合を、特徴量の作り方の側から具体的に学ぶのに向いています。
『機械学習のための特徴量エンジニアリング:その原理とPythonによる実践』(Alice Zheng・Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン):数値データ・テキストデータ・カテゴリ変数の扱い、特徴量のスケーリング、次元削減など、データから特徴量を作る方法を原理から説明した本です。この章で「1か所にまとめる」とした特徴量の定義の中身を、どう設計するかを学ぶのに役立ちます。
第5章 実験を記録し、再現できるようにする
第4章では、予測の時点で使えない情報を学習に混ぜないこと、特徴量と学習データの作り方を1か所に定めて記録することを確かめました。学習データを正しく作れても、そこから先でどのパラメータを試し、どのモデルを選び、なぜそれを選んだのかが残っていなければ、半年後に同じモデルを作り直すことも、選んだ理由を説明することもできません。この章では、モデルを作る過程の試行(実験)を記録する仕組みと、記録から同じモデルを作り直せるかどうか(再現性)を扱います。記録すべき項目を整理し、専用ツールの例として MLflow の記録の考え方を公式ドキュメントで確認したうえで、同じ項目を Python 標準の sqlite3 で記録する小さな仕組みを実装し、第2章で用意したサンプルデータで実際に記録・検索・作り直しを行います。評価の作法(どの期間で、どの指標で測るか)は第6章で扱います。
実験管理で記録すべき項目
モデルを作る作業は、一度の学習で終わることはほとんどなく、パラメータや学習期間や特徴量を変えた試行を何度も繰り返します。この試行の1回1回を「実験」と呼び、実験ごとに何を入れて何が出たかを残して後から検索・比較できるようにすることを、実験管理と呼びます。実験管理が防ぐのは、「良かったはずのモデルを、どの条件で作ったのか誰も言えない」状態です。この状態になると、本番のモデルに不具合が見つかったときに原因の切り分けができず、担当者が替わると同じ精度のモデルを作り直すところからやり直すことになります。
記録すべき項目は、モデルの結果を左右する入力と、結果そのものに分けて考えると整理できます。入力の側は、どのデータで学習したか(データの版)、どのコードで学習したか(コードの版)、どの設定で学習したか(パラメータと乱数の種)、どの環境で学習したか(ライブラリの版)です。結果の側は、評価の指標と、学習したモデルのファイルなどの成果物です。次の表に、この章で実装した記録の項目と、それが無いときに起きることをまとめました。
| 項目 | 記録する中身 | 無いと起きること | この章の実装での例 |
|---|---|---|---|
| データの版 | 学習・検証に使ったデータの期間と、中身から計算した指紋(ハッシュ値) | 同じ期間を指定したつもりで別の中身を使っても気づけない | 期間(学習=第1〜10か月、検証=第11〜12か月)と12桁の指紋 |
| コードの版 | 学習に使ったソースファイルの版(Git のコミット、またはファイルの指紋) | 前処理を直した前後のどちらで作ったモデルか分からない | 学習のスクリプト・記録の部品・データ生成の3ファイルの指紋 |
| パラメータ | モデルの設定値すべて(既定値に任せたものも含めて) | 「同じ設定」で作り直したつもりで結果が合わない | 学習率・葉の数・反復回数の上限・乱数の種を JSON で保存 |
| 乱数の種 | 学習やデータの分割に使った乱数の初期値 | 同じデータと設定でも結果がぶれ、合わない理由を説明できない | パラメータとは別の列にも保存して検索しやすくした |
| ライブラリの版 | Python・numpy・pandas・scikit-learn などの版と OS | 環境を作り直したときに結果がずれても原因を絞れない | 実行時に版を取得して JSON で保存 |
| 指標 | AUC・損益・予測平均など、判断に使う値 | どの実験が良かったかを後から並べられない | 1つの実験に8つの指標 |
| 成果物 | 学習済みモデルのファイルと、その指紋 | 本番のモデルがどの実験から来たか確かめられない | joblib で保存したファイルの場所と指紋 |
表の中で見落とされやすいのは、データの版と乱数の種です。データの版は「第1〜10か月」という期間の指定だけでは足りません。元のデータベースが後から修正されたり、抽出の条件が変わったりすると、同じ期間を指定しても中身が変わるからです。この章の実装では、データの中身からハッシュ値(データの内容から計算する短い文字列で、1つの値が変わっても別の文字列になるもの)を計算し、それを指紋として記録しました。乱数の種は、学習の途中で乱数を使うモデルでは結果を左右します。どれだけ左右するかは、後の節で共通データを使って実測します。
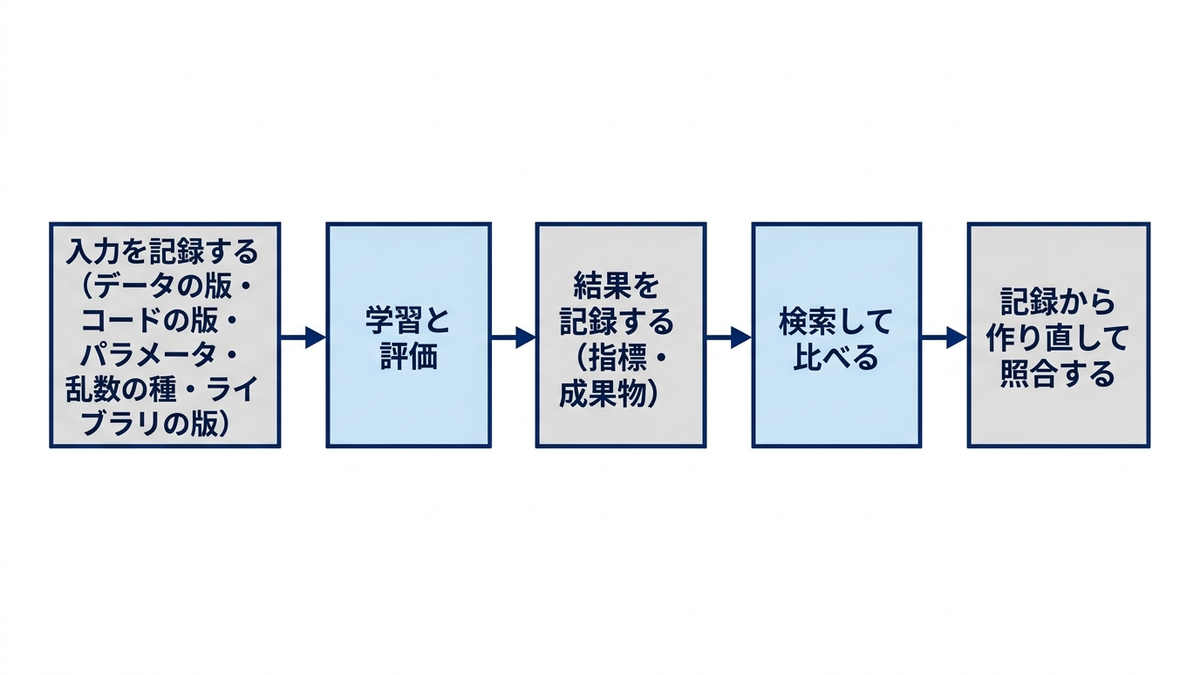
MLflow Tracking の記録の考え方
実験管理の専用ツールとして広く使われているものの1つに、オープンソースの MLflow があります。この記事の実行環境には MLflow を導入していないので、ここでは公式ドキュメントを開いて確認できた範囲だけを紹介し、実行はしていません。MLflow Tracking の公式ドキュメントは、MLflow Tracking をパラメータ・コードの版・指標・出力ファイルを記録するための API と画面の組み合わせと説明しています。記録の単位は「実行(run)」で、実行ごとに指標・パラメータ・開始と終了の時刻などのメタデータと、モデルの重みや画像などの出力ファイル(artifact)を残します。実行は、特定の課題ごとに「実験(experiment)」という単位でまとめられます。
保存の仕組みは2つに分かれています。同じページによると、実行ID・開始と終了の時刻・パラメータ・指標などのメタデータは「バックエンドストア」に保存され、ファイルシステムのほか PostgreSQL などのデータベースを使えます。モデルのファイルのような大きな成果物は「アーティファクトストア」に保存され、既定ではローカルの mlruns フォルダ、ほかに Amazon S3 や Azure Blob Storage などを使えます。複数人で共有するときは、REST API と画面を提供する追跡サーバーを別に立てる構成も選べます。記録した実行は、MlflowClient.search_runs() に並べ替えの条件(ドキュメントの例では検証の損失の小さい順)を渡して検索できます。
記録用 API のドキュメントには、パラメータを記録する mlflow.log_param()、指標を記録する mlflow.log_metric()、データセットの情報を記録する mlflow.log_input()、任意のタグを付ける mlflow.set_tag() が並んでいます。同じページの「システムタグ」の表によると、MLflow は実行元のファイルやノートブックの名前(mlflow.source.name)、実行したユーザー(mlflow.user)を自動で記録し、Git のリポジトリから実行したときはコミットのハッシュ値(mlflow.source.git.commit)も記録します。また、自動記録(autolog)のドキュメントには、学習の前に mlflow.autolog() を呼んでおくと、記録の命令を書かなくても指標・パラメータ・モデルが記録されること、対象のライブラリに scikit-learn や XGBoost、PyTorch などが含まれることが書かれています。
ここから分かるのは、専用ツールの中心にあるのが「実行ごとに入力と結果を1行にまとめ、検索できるようにする」という単純な考え方だということです。ツールを入れる前でも、この考え方は小さく実装できます。逆に、ツールを入れても、データの版を記録しない運用(期間の指定だけを残す運用)にしていれば、データが入れ替わったことには気づけません。次の節では、同じ考え方を Python 標準の sqlite3 で実装します。製品ごとの機能の見取り図は、弊社コラム「AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方」で扱っています。
sqlite3 で同じ項目を記録する小さな仕組み
SQLite は、1つのファイルで動くデータベースで、Python には標準で sqlite3 モジュールが入っています。追加のソフトもサーバーも要らないので、実験管理の考え方を試すには十分です。次のコードは、記録の部品(ch05_tracker.py)から要所を抜き出したものです。実験の行を入れる表(runs)、指標を入れる表(metrics)、成果物を入れる表(artifacts)の3つを作り、データの版はデータの中身から、コードの版はソースファイルの中身から、それぞれ SHA-256 のハッシュ値の先頭12桁を計算して記録します。この記事のフォルダは Git で管理していないので、コミットのハッシュ値の代わりにファイルの指紋を使いました。
import hashlib, json, sqlite3, platform, datetime, uuid
from pathlib import Path
import numpy as np, pandas as pd, sklearn, joblib

SCHEMA = """
CREATE TABLE IF NOT EXISTS runs (
  run_id TEXT PRIMARY KEY, experiment TEXT, started_at TEXT, finished_at TEXT, status TEXT,
  data_desc TEXT, data_version TEXT, code_version TEXT, params TEXT, seed INTEGER, env TEXT, note TEXT);
CREATE TABLE IF NOT EXISTS metrics (run_id TEXT, key TEXT, value REAL);
CREATE TABLE IF NOT EXISTS artifacts (run_id TEXT, path TEXT, sha256 TEXT);
"""

def data_version(df):
    """データの中身から作る指紋(1つの値が変わっても変わる)"""
    h = pd.util.hash_pandas_object(df, index=False).to_numpy()
    return hashlib.sha256(h.tobytes()).hexdigest()[:12]

def code_version(paths):
    """学習に使ったソースファイルの指紋(Git が無い環境の代わり)"""
    s = hashlib.sha256()
    for p in sorted(paths):
        s.update(Path(p).read_bytes())
    return s.hexdigest()[:12]

def environment():
    return {"python": platform.python_version(), "numpy": np.__version__,
            "pandas": pd.__version__, "scikit-learn": sklearn.__version__,
            "joblib": joblib.__version__, "os": platform.platform()}

class Tracker:
    def __init__(self, db_path):
        self.con = sqlite3.connect(db_path)
        self.con.executescript(SCHEMA)

    def search(self, metric, ascending=False, limit=5):
        order = "ASC" if ascending else "DESC"
        q = f"""SELECT r.run_id, r.params, m.value
                FROM (SELECT * FROM runs WHERE status = 'FINISHED') r
                JOIN (SELECT * FROM metrics WHERE key = ?) m USING (run_id)
                ORDER BY m.value {order} LIMIT ?"""
        return self.con.execute(q, (metric, limit)).fetchall()
# start(行の追加)・log_metrics・log_artifact・finish(終了時刻と状態の更新)は省略
表を3つに分けたのは、指標の数が実験によって変わっても表の形を変えずに済むようにするためです。MLflow のバックエンドストアが実行のメタデータと指標を持ち、アーティファクトストアがファイルを持つ分け方と、考え方は同じです。runs の表に状態(RUNNING/FINISHED)の列を置き、学習の途中で落ちた実験を検索の対象から外せるようにしました。検索の関数は、終了した実験の中から指定した指標で並べ替えて上位を返します。
この仕組みで足りないものもはっきりさせておきます。複数人が同時に書き込む使い方、記録の画面、モデルの読み込みの規約(どの形式で保存し、どう読み込むか)は持っていません。1人か少人数で、1つのモデルの改良を進める段階なら、この程度の仕組みでも「何をどう作ったかが後から分かる」という目的は果たせます。モデルの本数や関わる人数が増え、記録を共有して比べる場面が増えてきたら、専用ツールや各クラウドの実験管理の機能に移すのが順当だと考えています。どの段階で何を整えるかの目安は、第2章の成熟度の表と合わせて判断するのが有効です。
共通データでパラメータを9通り試して記録する
記録の仕組みを使って、第2章で用意したサンプルデータで実際に実験を記録しました。基準のモデルと同じ HistGradientBoostingClassifier を使い、学習率(1回の学習の反復でどれだけ大きく修正するか)を 0.03・0.08・0.2 の3通り、葉の数(1本の決定木が最大で何個の枝先に分かれるか)を 15・31・63 の3通り、合わせて9通り試しました。学習は第1〜10か月の50,000件、検証は時間の後ろ側にあたる第11〜12か月の10,000件で行いました。第11〜12か月は4つの変化が起きる前の期間で、この節の結果は変化の前の設定で比べたものです。次のコードは、実験の繰り返しの部分を抜き出したもので、補助モジュール mlops_data.py と記録の部品と同じフォルダに置いて実行する形です。
import itertools, json
import numpy as np, pandas as pd, joblib
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score, log_loss
import mlops_data as md
from ch05_tracker import Tracker, data_version, code_version

SEED = 0
train, valid = md.months(1, 10, seed=SEED), md.months(11, 12, seed=SEED)
Xtr, Xva = md.encode(train), md.encode(valid)
data_desc = json.dumps({"train": [1, 10], "valid": [11, 12], "data_seed": SEED})
data_ver = data_version(pd.concat([train, valid]))
code_ver = code_version(["ch05_experiments.py", "ch05_tracker.py", "mlops_data.py"])

tr = Tracker("../_out/ch05_runs/runs.db")
for lr, leaves in itertools.product([0.03, 0.08, 0.2], [15, 31, 63]):
    params = dict(max_iter=200, learning_rate=lr, max_leaf_nodes=leaves, random_state=SEED)
    run_id = tr.start("churn_hgb", data_desc, data_ver, code_ver, params, SEED)
    model = HistGradientBoostingClassifier(**params).fit(Xtr, train.churn)
    p = model.predict_proba(Xva)[:, 1]
    val, hits, k = md.campaign_value_threshold(valid.churn, p)
    tr.log_metrics(run_id, {"auc": roc_auc_score(valid.churn, p),
                            "logloss": log_loss(valid.churn, np.clip(p, 1e-6, 1 - 1e-6)),
                            "pred_mean": p.mean(), "actual": valid.churn.mean(),
                            "value_man_per_month": val / 2 / 1e4,
                            "contacts_per_month": k / 2, "n_iter": model.n_iter_})
    path = f"../_out/ch05_runs/models/{run_id}.joblib"
    joblib.dump(model, path)
    tr.log_artifact(run_id, path)
    tr.finish(run_id)

print(tr.search("value_man_per_month", limit=3))   # 損益の上位3件
9通りの学習と記録にかかった時間は32.4秒でした(この記事の実行環境、一般的なノートPCでの実測で、ほかの処理と並行して動かしたので揺れます)。記録は runs の表に9行、metrics の表に72行(実際のスクリプトでは学習時間も加えて1実験8指標)入り、データベースのファイルは20,480バイトでした。保存したモデル9個は合計2,336,064バイト(約2.3MB)です。記録そのものはごく小さく、記録の費用は保存したモデルのファイルが大半を占めます。次の表が記録の一覧です。損益と施策件数は、第2章で定義した損益(予測確率がしきい値の約0.106を超える顧客に引き止め施策を打ったときの、架空の設定での損益)を、検証の2か月の平均として月あたりに直したものです。
| 学習率 | 葉の数 | 実際の反復回数 | AUC | 予測平均 | 施策件数(件/月) | 損益(万円/月) |
|---|---|---|---|---|---|---|
| 0.03 | 15 | 146 | 0.6828 | 0.0796 | 1,127.0 | 43.27 |
| 0.03 | 31 | 115 | 0.6790 | 0.0795 | 1,118.5 | 40.93 |
| 0.03 | 63 | 94 | 0.6730 | 0.0794 | 1,093.0 | 35.79 |
| 0.08 | 15 | 67 | 0.6828 | 0.0795 | 1,151.0 | 42.87 |
| 0.08 | 31 | 71 | 0.6752 | 0.0795 | 1,149.0 | 39.25 |
| 0.08 | 63 | 37 | 0.6718 | 0.0796 | 1,097.0 | 34.33 |
| 0.2 | 15 | 29 | 0.6805 | 0.0795 | 1,129.0 | 43.11 |
| 0.2 | 31 | 25 | 0.6743 | 0.0798 | 1,111.5 | 37.71 |
| 0.2 | 63 | 19 | 0.6655 | 0.0798 | 1,133.5 | 31.41 |
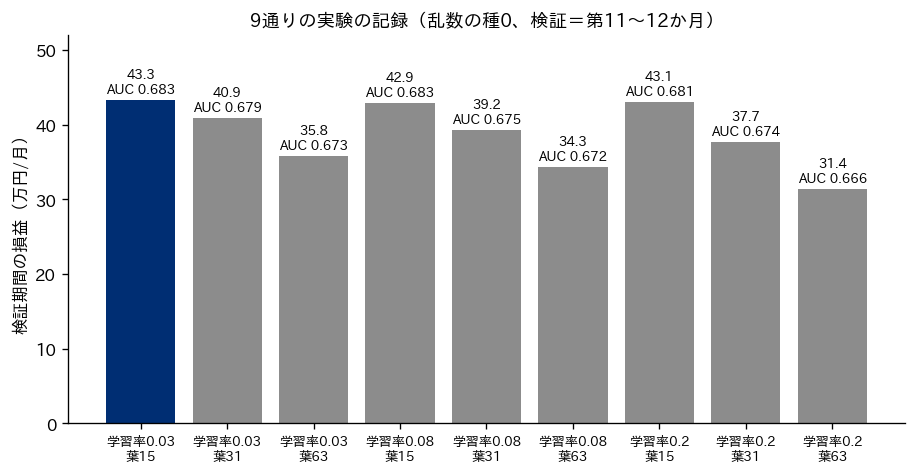
検証の2か月の実際の解約率は0.0785で、表の予測平均の列は9通りとも0.0794〜0.0798に収まり、確率の水準はどの設定でもほぼ合っていました。差が出たのは並べ替えの正しさ(AUC)と損益です。損益の列は、学習率0.03・葉15の43.27万円/月が最大で、学習率0.2・葉63の31.41万円/月が最小でした。記録を検索すると、AUC の上位3件は学習率0.03・葉15と学習率0.08・葉15(どちらも0.6828)、学習率0.2・葉15(0.6805)、損益の上位3件は学習率0.03・葉15(43.27)、学習率0.2・葉15(43.11)、学習率0.08・葉15(42.87)で、どちらの指標でも葉15の3つが上位を占めました。一方、確率の当てはまりを測る対数損失(小さいほど良い)の最小は学習率0.08・葉15(0.2592)で、指標によって1位が入れ替わります。どの指標で選んだかを記録に残しておかないと、後から「なぜこのモデルなのか」に答えられなくなる理由がここにあります。
表の「実際の反復回数」の列にも注目してください。反復回数の上限は200に設定しましたが、実際の回数は19〜146回で止まっています。これは、scikit-learn の早期終了(学習データの一部を検証用に取り分け、そこでの成績が改善しなくなったら反復を打ち切る仕組み)が働いたためです。scikit-learn の HistGradientBoostingClassifier のドキュメントによると、早期終了の既定値は「auto」で、標本の数が10,000を超えると有効になります。学習データは50,000件なので、パラメータに書いていなくても早期終了が働いていました。既定値に任せた設定も結果を左右するので、実験の記録には指定したパラメータだけでなく、実際に学習したモデルの状態(ここでは反復回数)も残すのが有効です。
記録から作り直して予測が一致するかを確かめる
記録の価値は、記録から同じモデルを作り直せるかどうかで決まります。この性質を再現性と呼びます。ここでは、損益が最大だった実験(学習率0.03・葉15)の記録を読み、記録と今の状態を照合してから作り直し、保存しておいたモデルと検証の10,000件の予測が一致するかを確かめました。次のコードは、照合と作り直しの部分を抜き出したものです。
run_id, params_json, best = tr.search("value_man_per_month", limit=1)[0]
data_desc, data_ver, code_ver, env = tr.con.execute(
    "SELECT data_desc, data_version, code_version, env FROM runs WHERE run_id=?", (run_id,)).fetchone()
desc, params = json.loads(data_desc), json.loads(params_json)

# 記録と今の状態を照合する
train = md.months(*desc["train"], seed=desc["data_seed"])
valid = md.months(*desc["valid"], seed=desc["data_seed"])
print("データの版", data_ver, data_version(pd.concat([train, valid])))
print("コードの版", code_ver, code_version(["ch05_experiments.py", "ch05_tracker.py", "mlops_data.py"]))
print("環境の差分", {k: v for k, v in environment().items() if json.loads(env).get(k) != v})

# 記録どおりに作り直し、保存したモデルと予測を比べる
path, sha = tr.con.execute("SELECT path, sha256 FROM artifacts WHERE run_id=?", (run_id,)).fetchone()
saved = joblib.load(path)
Xva = md.encode(valid)
p_saved = saved.predict_proba(Xva)[:, 1]
p_new = HistGradientBoostingClassifier(**params).fit(md.encode(train), train.churn).predict_proba(Xva)[:, 1]
print("予測の最大差", np.abs(p_new - p_saved).max())
print("施策の判定が変わる顧客", ((p_new > md.THRESHOLD) != (p_saved > md.THRESHOLD)).sum())
# 出力(要旨):
# データの版 a4add355b192 a4add355b192
# コードの版 ed0590825b6c ed0590825b6c
# 環境の差分 {}
# 予測の最大差 0.0
# 施策の判定が変わる顧客 0
データの版・コードの版・ライブラリの版はすべて記録と一致し、成果物のファイルの指紋も記録と同じでした。記録どおりに作り直したモデルの予測は、保存したモデルの予測と10,000件すべてで完全に一致し(最大差0)、施策を打つかどうかの判定が変わる顧客は0件でした。反復回数も同じ146回、損益も同じ43.27万円/月です。つまり、この環境では、記録した項目のうち作り直しに使う5つ(データの版・コードの版・パラメータ・乱数の種・ライブラリの版)がそろえば同じモデルを作り直せ、残る2つ(指標と成果物)と照らし合わせて、作り直したものが同じであることを確かめられました。
この確認には、もう1つの意味があります。作り直しの前に、データ・コード・環境の指紋を照合していることです。照合で不一致が出れば、作り直す前に「何が変わったか」が分かります。作り直してから結果が合わないと気づくのでは、原因がデータにあるのか、コードにあるのか、環境にあるのかを1つずつ調べることになります。指紋の照合は数秒で終わるので、本番のモデルを作り直す手順の最初に置いておくのが有効だと考えています。
乱数の種・データ・実行環境を変えるとどれだけずれるか
記録のどれか1つが欠けたときにどれだけ結果がずれるかを、条件を1つずつ変えて実測しました。基準は先の作り直し(学習率0.03・葉15・乱数の種0)で、変えたのは、乱数の種(1〜9、および指定しない場合)、学習データの行の順番、学習期間(第10か月が抜けた場合)、早期終了の有無、計算に使うスレッドの数です。「判定が変わる顧客」は、記録したモデルと比べて、施策を打つかどうかの判定(予測確率がしきい値を超えるかどうか)が入れ替わった顧客の数で、検証の10,000件のうちの件数です。
| 条件 | 実際の反復回数 | AUC | 損益(万円/月) | 予測の最大差 | 判定が変わる顧客(件) |
|---|---|---|---|---|---|
| 記録どおりに作り直し | 146 | 0.6828 | 43.27 | 0 | 0 |
| 保存したモデルを読み戻し | 146 | 0.6828 | 43.27 | 0 | 0 |
| スレッド数1の別プロセスで作り直し | 146 | 0.6828 | 43.27 | 0 | 0 |
| 乱数の種を1にする | 118 | 0.6819 | 42.78 | 0.1124 | 365 |
| 乱数の種を指定しない | 200 | 0.6802 | 42.65 | 0.1135 | 316 |
| 学習データの行の順番を並べ替える | 155 | 0.6812 | 42.83 | 0.0934 | 342 |
| 学習期間から第10か月が抜ける | 163 | 0.6828 | 39.77 | 0.1424 | 431 |
| 早期終了を切る(種0) | 200 | 0.6811 | 44.03 | 0.1222 | 263 |
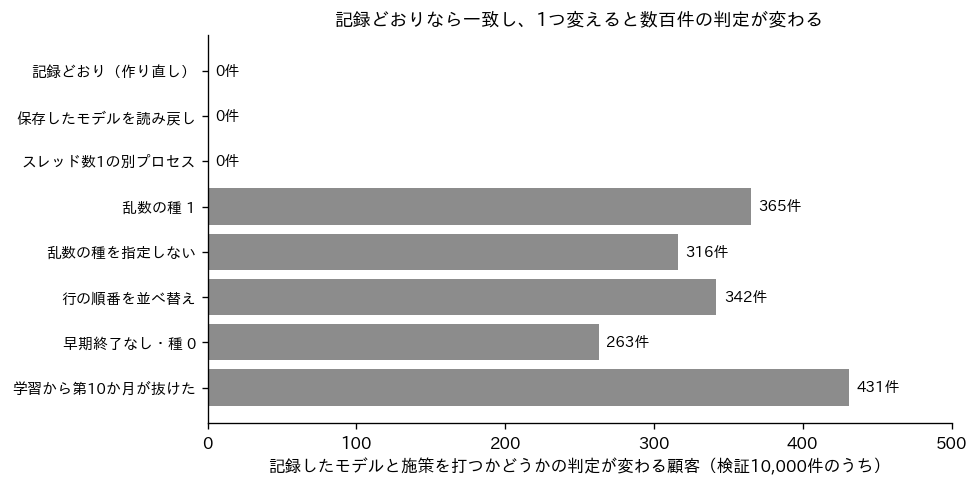
表の上の3行は、記録どおりの条件なら、作り直しても、保存したファイルを読み戻しても、計算のスレッド数を変えても、予測が完全に一致したことを示しています。スレッド数は、環境変数 OMP_NUM_THREADS を1にした別のプロセスで学習し直して確かめました。そのプロセスの中で並列計算のスレッド数を調べると1になっており、指定しないときの8とは違う条件で計算したうえで、予測は同じでした。この結果は、この環境のこのモデルでのものです。モデルの種類やライブラリによっては、並列計算の順番の違いで結果がわずかに変わる場合もあるので、作り直しの確認は自分のモデルで一度は行う必要があります。
残りの行は、条件を1つ変えるだけで、予測の最大差が0.09〜0.14になり、施策の判定が263〜431件入れ替わったことを示しています。乱数の種を変えると結果が変わるのは、前の節で見た早期終了のためです。scikit-learn のドキュメントによると、このモデルの乱数の種は、特徴量を区切るときの標本の抜き出しと、早期終了が有効なときの学習用と検証用の分割を決めます。実際、早期終了を切ったうえで種を0と1にして学習し直すと、予測の最大差は0でした。行の順番を並べ替えたときも、早期終了を切ると予測の最大差は0でした。つまり、この例でのずれは、早期終了のために取り分ける検証用の行が変わったことから来ています。乱数の種を指定しない場合は実行のたびに種が変わるので、同じコードを2回動かしても同じモデルになりません。
学習期間から第10か月が抜けた場合は、データの版の指紋が記録の a4add355b192 から 458f1459a68a に変わりました。指紋を照合していれば、作り直す前に気づけます。照合していなければ、AUC は記録と同じ0.6828なのに損益は39.77万円/月と3.50万円下がり、判定が431件入れ替わるという、原因の見えないずれだけが残ります。AUC が同じでも判定が変わるのは、AUC が並べ替えの正しさしか測らず、しきい値の近くにいる顧客の確率が少し動いただけで判定が入れ替わるからです。
ライブラリの版を変えた比較は、この記事の実行環境に scikit-learn が1つの版(1.9.0)しか入っていないため、行っていません。版が変わったときに結果がずれるかどうかは、この章では確かめていないので、ここでは「ずれる」とも「ずれない」とも書きません。分かっているのは、版を記録しておけば、ずれが出たときに版の違いを原因の候補として最初に確かめられる、ということです。保存したモデルを別の版で読み込むときの注意は、モデルの保存と版の管理を扱う第7章で取り上げます。
乱数の種によるぶれと、設定の差を見分ける
乱数の種で結果が変わるなら、9通りの実験の差のうち、どこまでが設定の差で、どこからが種によるぶれなのかが問題になります。そこで、損益の表で1位(学習率0.03・葉15)と3位(学習率0.08・葉15)だった設定、最下位(学習率0.2・葉63)だった設定について、乱数の種を0〜9の10通りに変えて学習し直しました。
| 設定 | 種0の損益(記録した値) | 種0〜9の平均 | 標準偏差 | 最小〜最大 | AUC の範囲 |
|---|---|---|---|---|---|
| 学習率0.03・葉15 | 43.27 | 42.18 | 1.22 | 40.33〜44.08 | 0.6794〜0.6828 |
| 学習率0.08・葉15 | 42.87 | 41.80 | 2.02 | 38.68〜44.05 | 0.6786〜0.6828 |
| 学習率0.2・葉63 | 31.41 | 33.52 | 3.55 | 28.01〜39.28 | 0.6608〜0.6715 |
表の損益の単位はいずれも万円/月で、検証の第11〜12か月の平均です。
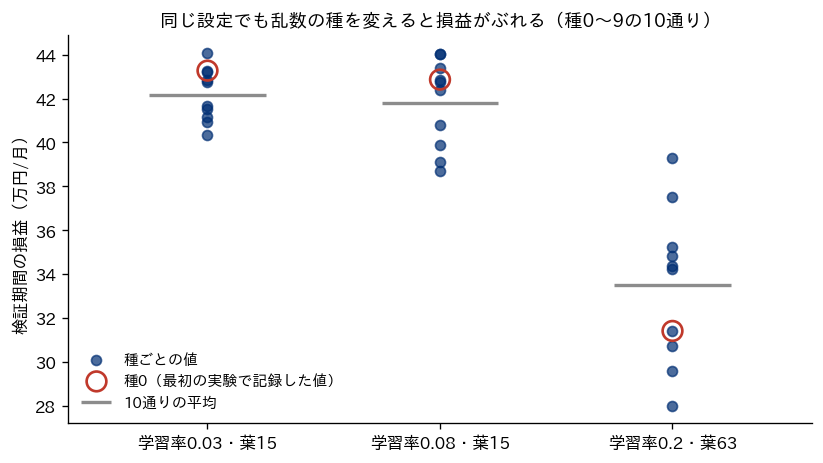
学習率0.03・葉15の種0の値43.27万円/月は、10通りの中では上から2番目で、平均は42.18万円/月でした。種によるぶれの幅は、最小40.33から最大44.08までの約3.76万円/月(丸める前の値44.082と40.326の差。上の表に示した小数第2位の値どうしで引くと3.75)あり、種0の記録で1位と3位を分けた差(表に示した43.27と42.87の差の0.40万円/月。丸める前の値では0.408万円/月)の9倍以上です。学習率0.08・葉15の平均41.80万円/月と比べても、平均の差は0.38万円/月で、標準偏差(1.22と2.02)より小さく、この2つの設定のどちらが良いかは、この検証のデータでは決められないということになります。一方、学習率0.2・葉63は、10通りの平均が33.52万円/月で、最も良かった種の値(39.28万円/月)でも学習率0.03・葉15の最小値40.33万円/月を下回りました。こちらは種のぶれを超えて劣っていると言えます。
この結果から、実験の記録について2つのことが言えます。1つは、乱数の種を記録しておかないと、1回の実験で出た数字が「設定の実力」なのか「その種の運」なのかを区別できないということです。もう1つは、設定どうしの差が小さいときは、種を変えて数回学習し、平均とばらつきを記録してから比べる必要があるということです。種を固定するのは作り直しのため、種を変えて試すのはぶれの大きさを知るためで、目的が違います。どちらの場合も、使った種が記録に残っていれば、後から同じ比較をやり直せます。
記録が無いと何が起きるか、経営の損失として見る
ここまでの結果を、経営の判断に置き換えて整理します。数字はすべて第2章で用意した架空のサンプルデータと、架空の施策の設定(施策1件800円、引き止められる割合0.35など)でのものです。
1つ目は、選び間違いの損失です。学習率0.2・葉63と学習率0.03・葉15では、種0〜9の平均で損益に8.66万円/月(42.18と33.52の差)の開きがありました。検証の期間(第11〜12か月。変化の前の月)の水準が12か月続くとすれば約104万円です。変化の後の月では損益の水準そのものが変わるので、この換算はその前提の下での目安です。種ごとの結果を記録しておけば、後から並べて比べ、この規模の差が種のぶれを超えた設定の差であることを確かめられます。逆に、学習率0.03と0.08の葉15の差(平均で0.38万円/月)は種のぶれより小さく、ここに時間をかけて最適な1つを探しても、得られる損益の差は小さいという判断ができます。記録があれば、どの比較に人手を使い、どの比較を打ち切るかを数字で決められます。
2つ目は、作り直せないことの損失です。乱数の種を記録していない場合、同じコードを動かしても、施策の判定が検証の10,000件のうち300件以上(この章の実測では、種を1〜9にした場合と指定しない場合で300〜379件)入れ替わります。本番のモデルが壊れて作り直したとき、「前と同じモデルに戻した」と言えず、施策の対象者が変わった理由を説明できません。学習期間の1か月が抜けた例では、損益が3.50万円/月下がっても AUC は変わらず、データの版を照合していなければ原因の調査に入ることすら難しくなります。
3つ目は、人の入れ替わりと説明責任です。担当者が離任したとき、記録が無ければ、後任は前任者のモデルと同じ精度のモデルを作るところからやり直すことになります。社内の監査や顧客への説明で「このモデルはどのデータで作り、なぜこの設定を選んだのか」を問われたときも、答えられるのは記録だけです。説明責任とガバナンスの考え方は第12章で扱います。この章の仕組みでは、9つの実験の記録はデータベースのファイル20,480バイトに収まり、記録のために追加したコードは数十行でした。記録の費用は、作り直せないときの調査ややり直しの費用と比べると小さく、モデルを1本でも本番で使うなら、最初から記録を付けておくのが有効だと考えています。
ノートブック中心の開発で注意すること
モデルの開発では、コードと結果と説明を1つの画面に並べられる Jupyter Notebook がよく使われます。試行錯誤には便利ですが、再現性の面では注意が要ります。2019年の国際会議 MSR(ソフトウェアリポジトリのマイニングに関する会議)で発表された、Jupyter Notebook の品質と再現性を大規模に調べたPimentel らの論文は、GitHub 上の約140万個のノートブックを分析しました。実行順序が定まっている Python のノートブックを実際に実行し直したところ、試みた863,878件のうち、エラーなく実行できたのは24.11%、元と同じ結果を出したのは4.03%だったと報告しています。
同じ論文は、再現できない原因として、セルを書かれた順番と違う順番で実行していること、セルを実行し直したり書き換えたり消したりしたあとに残る「隠れた状態」(画面のコードからは分からない変数の状態)、使ったライブラリの版を宣言していないことを挙げています。実行し直した試みの29.23%は、必要なライブラリが見つからないエラー(ImportError と ModuleNotFoundError)で失敗していました。論文が提案している良い習慣には、コードを関数やモジュールに切り出してテストする、依存するライブラリを要件のファイルに書いて版を固定する、まっさらな環境で依存関係を確かめる、データには相対パスでアクセスする、保存する前にノートブックを上から順に実行し直す、といった項目が含まれています。
この論文は GitHub に公開されたノートブックを対象にした調査で、企業の中で使われているノートブックの状況をそのまま表すものではありません。それでも、指摘されている原因は、この章の実測と同じ方向を向いています。ノートブックで試行錯誤すること自体に問題はありませんが、本番に出すモデルを作る段階では、学習の処理をスクリプトや関数に切り出し、上から順に1回で実行できる形にしたうえで、この章のような記録を付けて学習させるのが有効だと考えています。学習の処理をパイプラインとして自動化する方法は、第9章で扱います。
どの段階で何を記録するか
記録の項目は、最初から全部をそろえる必要はありません。次の表は、モデルの段階ごとに、最低限記録しておきたい項目の目安を、この章の実測にもとづいてまとめたものです。
| 段階 | 最低限の記録 | この章の実測から見た理由 |
|---|---|---|
| 試作(本番に出すか検討中) | パラメータ・乱数の種・指標 | 設定の差が種のぶれより小さいかどうかを判断するのに要る(1位と3位の差0.40万円/月に対し、種のぶれの幅約3.76万円/月) |
| 本番の1本目 | 上に加えて、データの版・コードの版・ライブラリの版・成果物の指紋 | 記録どおりなら予測が完全に一致し、1つ欠けると判定が数百件入れ替わる |
| 複数のモデル・複数の担当者 | 上に加えて、記録の共有の仕組み(専用ツール・クラウドの機能)と、選んだ理由の記述 | 指標によって1位が入れ替わるため、どの指標で選んだかを共有しないと判断を引き継げない |
ここでの段階の分け方は、この章の結果から導いた目安です。第2章で扱った成熟度の考え方と合わせて、自社のモデルの本数・更新の頻度・判断を誤ったときの影響の大きさで調整するのが有効だと考えています。
この章の要点は3つです。第一に、実験の記録には、データの版・コードの版・パラメータ・乱数の種・ライブラリの版・指標・成果物の7つを残し、データの版は期間の指定だけでなく中身の指紋で残す必要があります。第二に、架空のサンプルデータでの実測では、作り直しに使う5つ(データの版・コードの版・パラメータ・乱数の種・ライブラリの版)がそろえば保存したモデルと作り直したモデルの予測は完全に一致し、乱数の種・行の順番・学習期間・早期終了の有無のどれか1つが変わるだけで、施策の判定が検証の10,000件のうち263〜431件入れ替わりました。第三に、乱数の種によるぶれは設定どうしの差より大きいことがあり、記録が無いと運と実力を見分けられません。次の第6章では、記録した実験を本番に出してよいかを判断するための、評価の作法を扱います。
この章を深めたい方への参考書籍
『再現可能性のすゝめ』(高橋康介、共立出版):「Wonderful R」シリーズの第3巻で、R と RStudio を使った再現可能なデータ解析とレポート作成を扱っています。その場限りのデータ解析の問題点から、スクリプト化、R マークダウンによるレポート作成へと進む構成で、この章で扱った「後から同じ結果を出せるように作業を残す」考え方を、言語は違っても具体的な手順で確かめられます。
『Kaggle Grandmasterに学ぶ機械学習実践アプローチ』(Abhishek Thakur 著、石原祥太郎 訳、マイナビ出版):機械学習のコンテストで実績のある著者が、交差検証・評価指標・ハイパーパラメータの最適化などを実装とともに解説した本で、機械学習のプロジェクトの構築の章と、コードの再現性やモデルのデプロイを扱う章があります。この章の実験の繰り返しとパラメータの比較を、プロジェクトのコードの組み立て方から学ぶのに向いています。
第6章 本番に出す前にモデルを評価する
第5章では、実験の条件と結果を記録し、同じ記録から同じモデルを作り直せるようにする仕組みを扱いました。記録が残っていれば、どの候補がどの数字を出したかを後から比べられます。ただし、記録された数字そのものが正しい測り方で出ていなければ、比べても意味がありません。この章では、本番に出す前にモデルを評価する作法を、第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)で実行して確かめます。扱うのは、評価用のデータの分け方(ランダムに分けるか、時間の順に分けるか)、評価の指標を業務の判断に合わせること(AUC と損益の関係、施策を打つしきい値の意味)、予測の確率が実際の解約率と合っているか(確率の較正)、顧客の区分ごとの評価、本番に出すかどうかを決める受け入れ基準、オフラインの評価で分からないことの扱いです。評価に通ったモデルを登録し、承認して版を管理する仕組みは第7章で扱います。
オフライン評価は「本番で起きること」を手元で再現する作業
本番に出す前の評価は、過去のデータだけを使って手元で行うので、オフライン評価と呼ばれます。これに対して、本番で実際の顧客に使ってみて効果を測ることをオンライン評価と呼びます。オフライン評価の目的は、本番に出したときにモデルがどれだけの成績を出すかを、出す前に見積もることです。見積もりが本番の成績より甘ければ、期待した効果が出ないモデルを本番に出してしまいます。逆に厳しすぎれば、使えるモデルを見送ることになります。どちらも経営上の損失です。
オフライン評価で決めることは、大きく3つあります。1つ目は、どのデータで学習し、どのデータで測るかという分け方です。2つ目は、何を測るかという指標です。3つ目は、どの区分で測るかという単位です。この3つは、本番でモデルがどう使われるかに合わせて決めます。共通データの解約予測では、モデルは毎月、その月に契約中の顧客5,000件の解約確率を出し、確率がしきい値(約0.106)を超えた顧客に引き止め施策を打ちます(架空の設定。第2章で表にしたとおり、施策1件800円、解約する顧客に打てば7,560円の粗利を守れる)。モデルが使われるのは、学習に使った月より後の月です。本番の成績を左右するのは、並べ替えの正しさだけではなく、確率の水準が合っているかどうかでもあります。この章の各節は、この使われ方を手元でどこまで再現できるかを順に見ていきます。
この章の数値は、すべて第2章で用意した架空のサンプルデータを、この章の設定で計算した結果です。モデルは第2章の基準と同じ HistGradientBoostingClassifier(scikit-learn の勾配ブースティング。設定は max_iter=200、learning_rate=0.08、max_leaf_nodes=31、random_state=0)を使いました。現実のデータで同じ大きさの差が出るとは限りません。この章で示すのは、数字の大きさそのものより、どの測り方でどの向きのずれが出るかです。
ランダム分割と時系列分割で評価はどう変わるか
評価用のデータの分け方には、大きく2通りあります。1つは、手元のデータを行ごとにランダムに混ぜて、たとえば5つに分け、4つで学習して残り1つで測ることを5回繰り返す方法です(交差検証、ランダム分割)。もう1つは、時間の順番を守り、ある時点までのデータで学習して、その後の期間で測る方法です。この記事ではこれを時系列分割と呼びます。本番のモデルは、学習に使った期間より後の顧客に使われるので、時系列分割の方が本番の使われ方に近い測り方です。Rob J Hyndman と George Athanasopoulos による時系列予測の教科書(第3版、OTexts のオンライン版)も、時系列の交差検証として、検証に使う期間より前の観測だけで学習する手順を、学習の期間を1つずつ延ばしながら繰り返す形で説明しています(同書 5.10節)。
scikit-learn には時系列分割のための TimeSeriesSplit があります。注意が要るのは、この関数が並んでいる行の順番で切るだけで、月の境目を知らないことです。12行に TimeSeriesSplit(n_splits=3) を当てると、学習が先頭3行で検証が次の3行、学習が先頭6行で検証が次の3行、学習が先頭9行で検証が最後の3行、という分け方になりました。1か月に5,000件ある共通データの行にそのまま当てると、分割の数によっては月の途中で切れます。たとえば第1〜12か月の60,000行を n_splits=7 で分けると、既定の検証の大きさは60,000÷8=7,500行で、1.5か月分になります。そこで、この章では TimeSeriesSplit を行ではなく「月の一覧」に当て、月単位で学習期間と検証期間を分けました。次のコードは、補助モジュール(mlops_data.py と baseline.py)と同じフォルダに置いて実行する形で、実際に使ったスクリプトから要所を抜き出したものです。
import numpy as np
from sklearn.model_selection import KFold, TimeSeriesSplit
from sklearn.metrics import roc_auc_score
import mlops_data as md
import baseline as bl

def auc_of(train_df, test_df):
    m = bl.make_model().fit(md.encode(train_df), train_df.churn)
    s = m.predict_proba(md.encode(test_df))[:, 1]
    return roc_auc_score(test_df.churn, s)

def random_cv(df, k=5):
    # 行をランダムに混ぜて5つに分ける
    sp = KFold(n_splits=k, shuffle=True, random_state=0).split(df)
    return np.mean([auc_of(df.iloc[tr], df.iloc[te]) for tr, te in sp])

def month_cv(df, months, n_splits=3):
    # 月の一覧に TimeSeriesSplit を当て、月単位で前後に分ける
    aucs = []
    for tr, te in TimeSeriesSplit(n_splits=n_splits, test_size=1).split(months):
        tr_m = [months[i] for i in tr]
        te_m = [months[i] for i in te]
        aucs.append(auc_of(df[df.month.isin(tr_m)], df[df.month.isin(te_m)]))
    return aucs

dB = md.months(17, 28)   # 第30か月の予測の直前に使える直近12か月
print(random_cv(dB))
print(month_cv(dB, list(range(17, 29))))
# 出力(要約):
# ランダム5分割 0.6778
# 時系列分割 第26か月 0.6972/第27か月 0.6831/第28か月 0.6232
2つの場面で比べました。場面Aは、第1〜12か月のデータでモデルを作る場面です。この期間には第2章で説明した4つの変化がまだ起きていません。場面Bは、第30か月の予測を出す直前に、ラベル(解約したかどうか)が確定している直近12か月、つまり第17〜28か月のデータでモデルを作る場面です(解約は翌月末に確定するので、第30か月の予測の時点では第29か月のラベルはまだありません)。場面Bの学習期間には、料金改定・新しい獲得経路 partner・データ連携の不具合・競合の乗り換え施策の始まり(第28か月)が含まれています。それぞれの場面で、ランダム5分割の AUC、月単位の時系列分割(学習期間を1か月ずつ延ばし、直後の1か月で測ることを3回)の AUC、そして本番で実際に出た AUC を並べたのが次の表です。ここでの「本番で実際に出た AUC」は、それぞれの場面で作ったモデル(場面Aは第1〜12か月、場面Bは第17〜28か月で学習したもの)を学び直さずに後の月に当てた値です。場面Bの値は、第2章の毎月再学習のように毎月作り直したモデルの値ではありません。
| 場面 | ランダム5分割の AUC | 時系列分割の AUC(3回の平均) | 時系列分割の最後の回の AUC | 本番で実際に出た AUC(作ったモデルを後の月に当てた値) |
|---|---|---|---|---|
| A:第1〜12か月で作る | 0.678 | 0.678 | 0.683(第12か月) | 0.680(第13〜18か月)、0.630(第28〜36か月) |
| B:第17〜28か月で作る | 0.678 | 0.668 | 0.623(第28か月) | 0.647(第30〜36か月) |
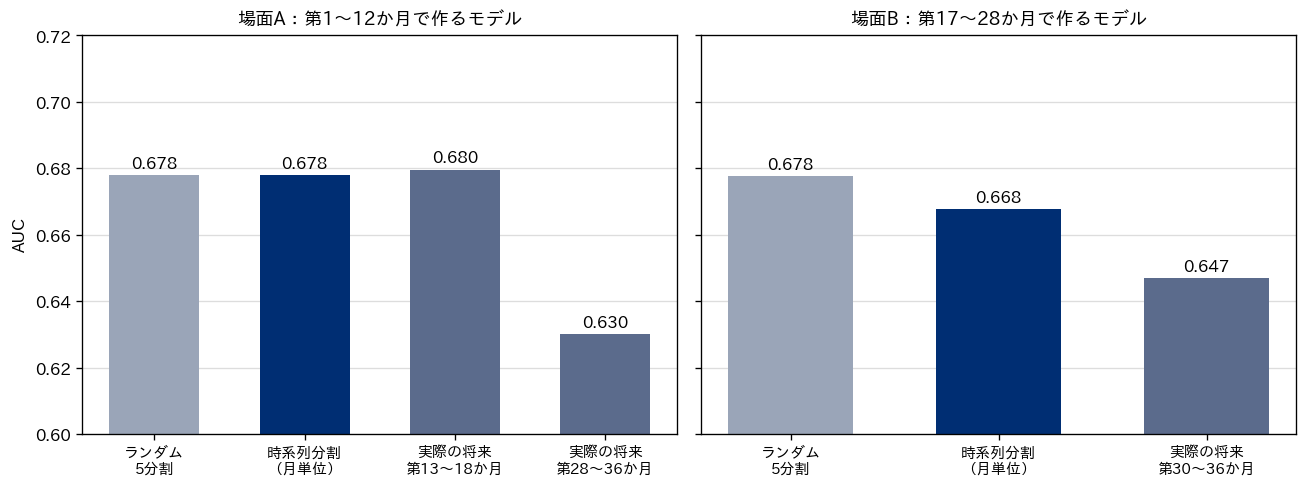
場面Aでは、ランダム5分割も時系列分割も AUC は 0.678 で、ほとんど差がありませんでした。本番の第13〜18か月に実際に出た AUC も 0.680 で、どちらの見積もりも当たっています。この架空データでは、各月の顧客を独立に作っていて、同じ顧客が複数の月に出てこないので、変化の無い期間ではランダムに分けても楽観的にはなりませんでした。ランダム分割がいつでも楽観的に出るわけではない、ということです。ただし、場面Aのどちらの測り方も、第28か月以降の AUC 0.630 は見積もれていません。学習に使ったデータに含まれていない将来の変化は、どんな分け方をしても手元の評価には出てきません。この限界は第10章の監視で補います。
場面Bでは差が出ました。ランダム5分割の AUC は 0.678 で場面Aと同じ水準ですが、時系列分割では3回の平均が 0.668、最後の回(第17〜27か月で学習し、第28か月で測った回)は 0.623 でした。本番で実際に出た第30〜36か月の AUC は平均 0.647(月ごとには 0.631〜0.665)です。ランダム5分割は、競合の乗り換え施策が始まった第28か月の顧客を学習にも検証にも混ぜてしまうので、第28か月だけで起きている成績の低下が、変化の前の11か月分に薄められて見えなくなります。時系列分割の最後の回は、まさに「変化の後の月を、変化の前のデータで学習したモデルで測る」形になっているので、低下がそのまま出ました。
ずれは AUC よりも、確率の水準の方に大きく出ました。場面Bのランダム5分割では、検証データでの予測平均が 0.0996、実際の解約率も 0.0996 で、完全に合っているように見えます。ところが、第17〜27か月で学習して第28か月で測ると、予測平均 0.1045 に対して実際の解約率は 0.1484 でした。本番の第30〜36か月でも、予測平均 0.1065 に対して実際は 0.1423 です。ランダムに分けた評価では「確率の水準が合っている」と判定されたモデルが、第28か月では実際より約30%、本番の第30〜36か月では約25%、解約を少なく見積もっていたことになります。後の節で見るとおり、確率をしきい値と比べて施策の件数を決める使い方では、この水準のずれが損益に直結します。
この結果から言えることは、時系列分割は「ランダム分割より常に低い数字が出る測り方」ではなく、「本番と同じ向きの時間の流れで測るので、直近に起きた変化が評価に出る測り方」だということです。モデルを本番に出す前の評価は、時系列分割で行い、検証期間には手元で使える最も新しい月を入れるのが有効だと考えています。とくに、学習の期間の中に料金改定や新しい販路の開始のような業務上の変化が入っているときは、ランダム分割の数字を本番の見込みとして報告しないことです。
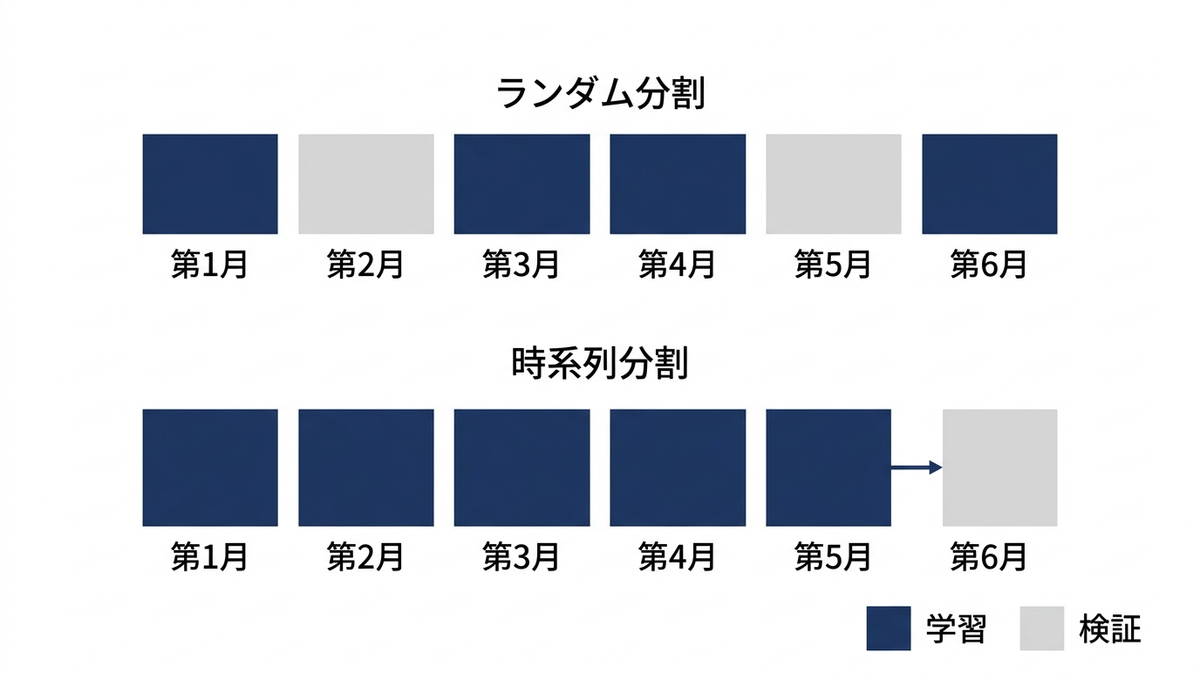
もう1つ、評価の数字そのものに揺れがあることも知っておく必要があります。放置のモデル(第1〜12か月で一度だけ学習したもの)を第13か月の5,000件で測ると AUC は 0.689 でしたが、同じ5,000件から重複を許して5,000件を選び直す計算(ブートストラップ)を1,000回行うと、AUC の標準偏差は 0.014、95%の範囲は 0.662〜0.718 でした。1か月分のデータで2つのモデルの AUC を比べて 0.005 の差が出ても、それは測り方の揺れの範囲に収まっています。小さな差で「新しいモデルの方が良い」と判断しないための考え方は、受け入れ基準の節で扱います。
なお、scikit-learn の公式ドキュメント(TimeSeriesSplit の説明)は、この関数を、他の交差検証の方法では将来のデータで学習して過去のデータで評価することになってしまう、時間の順に並んだデータのためのものと説明しています。学習期間の終わりと検証期間の始まりのあいだを指定した数だけ空ける gap という引数もあります。共通データのように正解が1か月遅れて確定する業務では、学習期間の最後の月と検証の月のあいだに1か月を空けると、本番でラベルが届くまでの遅れまで含めて再現できます。この章の時系列分割では、比べやすさを優先して空けずに測りました。
評価の指標を業務の判断に合わせる
AUC は、モデルの予測で顧客を並べたとき、実際に解約する顧客をどれだけ上位に置けているかを測る指標です(0.5 がランダムに並べた場合と同じ、1 が完全)。並べ替えの正しさだけを見るので、予測した確率の水準が全体に2倍ずれていても、並び順が同じなら AUC は変わりません。一方、共通データの業務では、モデルの確率をしきい値と比べて、施策を打つ顧客を決めます。確率の水準がずれれば打つ件数が変わり、損益が変わります。AUC だけでモデルを選ぶと、業務の判断に効く性質の片方しか見ていないことになります。
しきい値の約0.106は、次の考え方で決まっています。解約確率が \( p \) の顧客に施策を1件打つと、費用が800円かかり、その顧客が実際に解約する人であれば7,560円の粗利を守れます(架空の設定。引き止められる割合0.35×追加で続く12か月×月の粗利1,800円)。施策を打ったときの損益の見込みは \( 7560 \times p – 800 \) 円です。これが0より大きいのは \( p > 800 \div 7560 = 0.1058 \) のときです。言葉で言えば、「施策の費用を、当たったときに守れる粗利で割った値」より解約確率が高い顧客にだけ打てば、1件ごとの見込みが黒字になります。この計算が成り立つ前提は、モデルの出す確率が実際の解約の起きやすさと一致していることです。確率が実際より低く出るモデルでは、本当は打つべき顧客がしきい値を下回り、施策の件数が減ります。
ここで1つ、実装上の落とし穴があります。scikit-learn の分類モデルの predict は、2値の分類では確率が0.5を超えたかどうかでラベルを返します。scikit-learn の公式ドキュメントも、この固定のしきい値はほとんどの用途で最適ではないと書き、費用の違いを反映した指標でしきい値を調整する TunedThresholdClassifierCV と、しきい値を手で固定する FixedThresholdClassifier を用意しています。共通データの解約率は8〜15%なので、0.5を超える確率が出る顧客はほとんどいません。放置のモデルで実際に計算すると、しきい値0.5で施策を打つ件数は第13〜18か月の平均で月0.2件、損益はほぼ0円でした。predict の結果をそのまま「施策の対象」として業務に渡すと、モデルの性能に関係なく施策が1件も打たれない、ということが起こります。業務のしきい値は、モデルの既定値ではなく、費用と効果から決めて明示的に設定する必要があります。
AUC と損益の関係を、第1〜12か月で学習した4つの候補モデルを第13〜18か月(変化の前)で測って確かめました。基準の勾配ブースティングに加えて、木の数と大きさを絞った浅い勾配ブースティング、ロジスティック回帰(各入力の重み付きの和から確率を出す、古くからある統計モデル)、学習を強くしすぎた勾配ブースティングを作りました。Brier スコアは、予測した確率と実際の結果(解約なら1、継続なら0)の差の2乗の平均で、小さいほど良い指標です(scikit-learn の brier_score_loss)。
| モデル(第1〜12か月で学習) | AUC | Brier スコア | 予測平均 | 損益(万円/月) | 施策件数(月平均) | 上位10%に打つ損益(万円/月) |
|---|---|---|---|---|---|---|
| 勾配ブースティング(基準) | 0.680 | 0.0728 | 0.0805 | 45.3 | 1,144.5 | 33.0 |
| 勾配ブースティング(浅い。木30本・葉4枚) | 0.672 | 0.0735 | 0.0804 | 38.9 | 835.5 | 32.1 |
| ロジスティック回帰 | 0.690 | 0.0722 | 0.0804 | 48.2 | 1,173.8 | 40.6 |
| 勾配ブースティング(学習を強くしすぎ。木600本・学習率0.3・葉63枚) | 0.668 | 0.0738 | 0.0810 | 40.3 | 1,188.2 | 29.4 |
| (参考)真の確率 | 0.692 | 0.0722 | 0.0822(実際の解約率) | 47.4 | 1,212.2 | なし |
この期間の実際の解約率は 0.0822 で、4つのモデルの予測平均はいずれも 0.080〜0.081 でした。確率の水準はどれもほぼ合っているので、差は主に並べ替えの正しさと、確率の散らばり方から来ています。AUC の順位と損益の順位は、おおむね一致しました。AUC が最も高いロジスティック回帰(0.690)は、損益も最も高く(月48.2万円)、真の確率の損益(月47.4万円)をわずかに上回りました。6か月分の実際の結果には偶然の揺れが入るので、有限のデータでは真の確率を上回ることもあります。ロジスティック回帰が有利になった理由として考えられるのは、共通データの作り方です。共通データの真の解約確率は、利用日数・利用日数の前月差・契約月数(60か月で頭打ち)・月額・問い合わせ件数・決済失敗の回数・割引の有無・獲得経路(partner かどうか)にそれぞれ重みを掛けて足し合わせた値を、ロジスティック関数(値を0〜1の確率に直すS字の曲線)に通して作っています。第28か月以降は、解約の基礎率を上げ、利用日数の効きを弱める項がこの足し算に加わります。ロジスティック回帰も「入力に重みを掛けて足し、ロジスティック関数で確率に直す」形のモデルなので、データの作り方とモデルの形が近くなっています。現実のデータの解約の起きやすさがこのような形をしているとは限らず、同じ順位になるとは限りません。
ただし、順位が逆転した組もあります。浅い勾配ブースティングは AUC が 0.672 で、学習を強くしすぎたモデル(0.668)より高いのに、損益は月38.9万円で、後者(月40.3万円)より低くなりました。浅いモデルは確率の散らばりが小さく(第13〜18か月の予測確率の標準偏差が、基準の 0.052 に対して 0.029)、しきい値0.106を超える顧客が月835.5件と少なかったためです。AUC の差(0.004)は前の節で見た揺れの範囲ですが、損益の差は施策件数の差として表に出ています。モデルを選ぶ指標には、AUC のような汎用の指標に加えて、そのモデルを業務で使う方法そのもの(ここではしきい値を超えた顧客に打つ)で計算した損益を並べるのが有効だと考えています。
しきい値を動かしたときの損益も計算しました。次の図は、放置のモデルの予測確率に対して、しきい値を0.03から0.30まで0.005刻みで動かしたときの月あたりの損益です。実線が変化前の第13〜18か月、破線が競合の乗り換え施策が始まった後の第28〜36か月で、点はそれぞれの期間で損益が最も大きかったしきい値です。
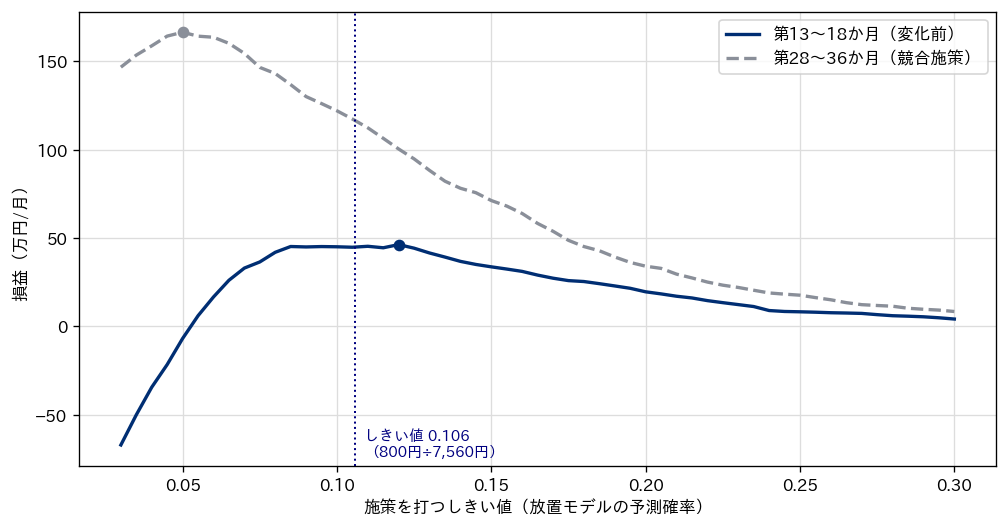
変化前の第13〜18か月では、しきい値0.106で月45.3万円、損益が最も大きかったのはしきい値0.120で月46.4万円でした。しきい値0.085〜0.125のあいだは損益が月44.3万〜46.4万円でほぼ平らで、費用と効果から計算したしきい値が、後から答えを見て選んだ最良のしきい値とほとんど同じ損益を出しています。確率の水準が合っているモデルでは、しきい値は費用と効果の計算で決めてよい、ということです。0.05まで下げると施策が月3,451件に増えて損益は月-6.8万円の赤字に、0.30まで上げると施策が月29件に減って損益は月4.2万円になりました。しきい値の設定を誤ると、同じモデルでも損益が大きく変わります。
競合の乗り換え施策の後の第28〜36か月では、様子が違いました。しきい値0.106での損益は月116.9万円でしたが、損益が最も大きかったのはしきい値0.050で月166.5万円でした。放置のモデルが解約確率を低く見積もっているので、費用と効果から計算したしきい値では打つ件数が足りず、しきい値を下げた方が損益が出たのです。ただし、0.050という値は、この期間の答えを後から見て選んだものです。本番の時点では分かりません。この状況への正しい対処は、しきい値を勘で下げることではなく、確率の水準のずれそのものを測って直すことだと考えています。それが次の節の確率の較正です。
確率の較正を確かめる
モデルの出す確率が、実際の起きやすさと一致していることを、確率が較正されている、と言います。一致しているかを確かめ、ずれていれば合わせ直す作業を、この記事では確率の較正と呼びます。scikit-learn の公式ドキュメントの確率の較正の章は、よく較正された2値の分類モデルとは、たとえば確率0.8前後を出した顧客のうち、およそ8割が実際に陽性(ここでは解約)になるようなモデルだと説明しています。較正を確かめる図が較正曲線(信頼性図とも呼ばれる)です。予測確率で顧客をいくつかの区分に分け、横軸に各区分の予測確率の平均、縦軸にその区分の実際の解約率をとります。点が対角線の上に並べば較正されていて、対角線より上にあれば、モデルが確率を実際より低く見積もっていることになります。scikit-learn では calibration_curve でこの点を計算できます。
放置のモデルの較正曲線を、変化前の第13〜18か月と、競合施策の後の第28〜36か月で描きました。予測確率の低い順に顧客を10等分し(各区分の件数が同じになる分け方)、区分ごとに予測確率の平均と実際の解約率を比べています。
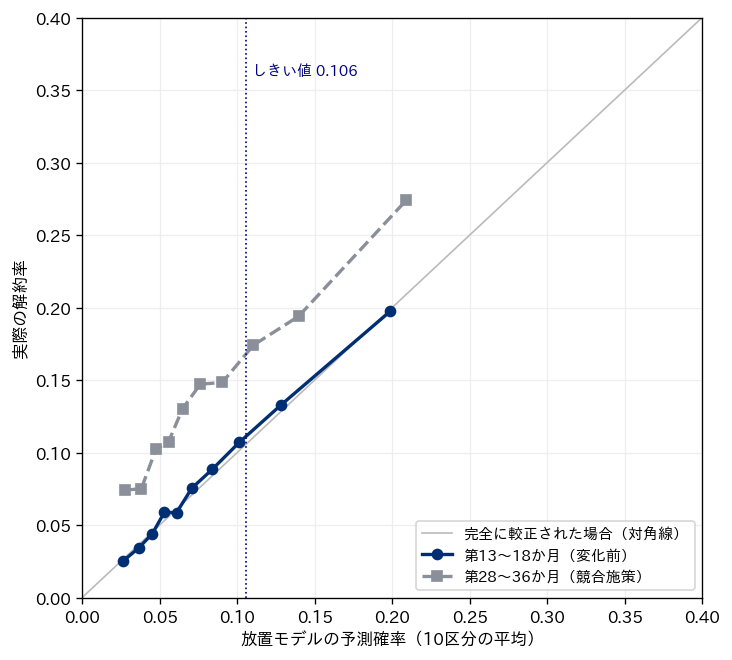
変化前の第13〜18か月では、10の区分のすべてで点が対角線のすぐ近くにありました。予測確率の平均が 0.101 の区分の実際の解約率は 0.107、0.199 の区分は 0.197 です。Brier スコアは 0.0728 で、真の確率の 0.0722 とほぼ同じでした。第28〜36か月では、10の区分のすべてで点が対角線より上に出ました。予測確率の平均が 0.027 の最も低い区分でも実際の解約率は 0.074、予測 0.090 の区分は実際 0.148、予測 0.209 の最も高い区分は実際 0.274 です。期間全体の予測平均 0.0859 に対して、実際の解約率は 0.1427 でした。Brier スコアは 0.1220 で、真の確率の 0.1161 より悪くなっています(この期間は解約率そのものが上がっているので、Brier スコアの値を変化前の期間と直接比べることはできません。比べられるのは同じ期間の真の確率との差です)。
この較正のずれは、そのまま施策件数の不足になります。第2章で示した基準の結果では、第28〜36か月の施策件数は月平均で、放置のモデルが1,347.6件、毎月再学習するモデルが2,233.2件、真の確率でしきい値を当てた場合が3,154.6件でした。放置のモデルは、本当は確率がしきい値を超えている顧客の多くに、施策を打てていないことになります。同じ期間の AUC は放置が 0.630、真の確率が 0.670 で、並べ替えの正しさも落ちています。損益の差(放置が月116.9万円、真の確率が月183.0万円で、差は月66.1万円)のうち、どれだけが件数の不足によるものかは、この節の後半で較正だけを直したモデルを作って確かめます。
scikit-learn には、モデルの出力を較正し直す CalibratedClassifierCV があります。公式ドキュメントによれば、モデルの出力を確率に写す小さな回帰(較正器)を当てはめるもので、この章で使う方法は、ロジスティック関数(S字の曲線)を当てはめる sigmoid(Platt の方法)と、単調に増える階段状の関数を当てはめる isotonic です。この記事で使った scikit-learn 1.9 では、ほかに温度スケーリングの temperature も指定できます(1.8 で加わった方法です。この章では使いません)。同じドキュメントは、isotonic は約1,000件より少ないデータでは過学習しやすいこと、isotonic は予測に同じ値(同順位)を作るので AUC が変わりうること、並び順を厳密に保ちたいときは sigmoid を使うことを書いています。すでに学習済みのモデルを、学習に使っていない別のデータで較正するには、モデルを FrozenEstimator で包んで渡します。
まず、学習の時点で較正を被せる効果を測りました。第1〜12か月で CalibratedClassifierCV(5分割、sigmoid と isotonic)を学習し、第13〜18か月で測ると、Brier スコアは較正なしの 0.0728 に対してどちらも 0.0727、損益は較正なしの月45.3万円に対して sigmoid が月46.0万円、isotonic が月45.0万円でした。基準の勾配ブースティングは、学習した期間と同じ傾向の月では、もともと較正がほぼ合っていたので、被せても差はわずかでした。そして、学習の時点でどれだけ較正しておいても、第28か月以降のように解約の起きやすさそのものが後から変わると、較正はまたずれます。較正は、本番に出す前に一度確かめれば済むものではなく、ラベルが届くたびに測り直すものです。
そこで、放置のモデルの本体はそのままにして、較正だけを直近のデータでやり直すとどうなるかを測りました。第 m か月の予測の前に、ラベルが確定している直近2か月(第 m-3 か月と第 m-2 か月、計10,000件)で sigmoid の較正器を当てはめ直します。次のコードは、実際に使ったスクリプトから要所を抜き出したものです(補助モジュールと同じフォルダに置いて実行する形)。
from sklearn.calibration import CalibratedClassifierCV
from sklearn.frozen import FrozenEstimator
import mlops_data as md
import baseline as bl

train = md.months(1, 12)
frozen = bl.make_model().fit(md.encode(train), train.churn)   # 放置のモデル

for m in range(13, 37):
    d = md.month_data(m)
    cal_d = md.months(m - 3, m - 2)          # ラベルが確定している直近2か月
    rc = CalibratedClassifierCV(FrozenEstimator(frozen), method="sigmoid")
    rc.fit(md.encode(cal_d), cal_d.churn)    # モデル本体は動かさず、較正器だけを当てはめる
    s = rc.predict_proba(md.encode(d))[:, 1]
    value, hits, n_contact = md.campaign_value_threshold(d.churn, s)
# 出力(第28〜36か月の平均):
# 予測平均 0.0859 → 0.1317(実際 0.1427)
# 施策件数 1,347.6 → 2,997.0 件/月、損益 116.9 → 154.2 万円/月、AUC 0.630 → 0.630
| 期間(月平均) | 実際の解約率 | 予測平均(放置) | 予測平均(較正だけやり直し) | 施策件数(放置) | 施策件数(較正だけやり直し) | 損益 放置(万円/月) | 損益 較正だけやり直し(万円/月) |
|---|---|---|---|---|---|---|---|
| 第13〜18か月(変化前) | 0.0822 | 0.0805 | 0.0818 | 1,144.5 | 1,199.3 | 45.3 | 45.9 |
| 第19〜27か月(料金改定〜欠損事故) | 0.0984 | 0.0837 | 0.0945 | 1,260.1 | 1,569.2 | 71.1 | 74.8 |
| 第28〜36か月(競合施策) | 0.1427 | 0.0859 | 0.1317 | 1,347.6 | 2,997.0 | 116.9 | 154.2 |
競合施策の期間では、較正だけをやり直したモデルの予測平均が 0.1317 まで上がり、施策件数は月1,347.6件から2,997.0件に、損益は月116.9万円から154.2万円になりました。sigmoid の較正は並び順を変えないので、AUC は 0.630 のままです。損益の改善は、すべて確率の水準を直して施策件数を適正にした効果です。放置と真の確率の差 月66.1万円のうち、月37.3万円(約56%)が較正だけで埋まった計算になります。第13〜36か月の24か月の損益合計は、放置の1,964.0万円に対して、較正だけのやり直しで2,336.6万円でした。基準の結果の毎月再学習(2,384.2万円)、四半期ごと再学習(2,357.7万円)に近い水準です。ただし、較正に使う2か月は予測の月より2〜3か月前なので、変化が始まった直後の第28・29か月の予測平均は 0.107 と 0.099 にとどまり、ずれが残りました。また、第13〜15か月の予測の前に較正に使った月には第10〜12か月が含まれ、放置のモデルの学習期間(第1〜12か月)と重なっています。公式ドキュメントは、学習済みのモデルを FrozenEstimator で包んで較正するときは、モデルの学習に使うデータと較正に使うデータを分けるのは利用者の責任だとしています。この3か月は厳密には学習に使っていないデータでの較正になっていません。この3か月で較正のやり直しが放置を上回った損益は合計2.2万円です。この2.2万円は上の24か月の合計2,336.6万円にも含まれていますが、除いても放置との差は370.4万円で、較正のやり直しが放置を大きく上回るという結論は変わりません。競合施策の期間(第28〜36か月)の較正に使ったのは第25〜34か月なので、学習期間との重なりはありません。また、較正だけでは並べ替えの正しさ(AUC)は戻りません。モデル本体を学習し直すか、較正だけを直すかの使い分けと、その費用の比較は、第11章の再学習の設計で扱います。この節で確かめておきたいのは、確率をしきい値と比べて件数を決める使い方では、較正のずれが損益に大きく効くこと(この架空データの競合施策の期間では、真の確率との損益の差の半分強が較正だけで埋まった)、そして較正は本番に出す前の評価と本番での監視の両方で測るべき項目だということです。
顧客の区分ごとに評価する
全体の数字が良くても、一部の顧客の区分でモデルが大きく外れていることがあります。共通データでは、第22か月に新しい獲得経路 partner が始まりました。第1〜12か月の学習データには partner の顧客が1件もありません(実行して確かめた件数は0件)。放置のモデルは、partner という区分を一度も見ないまま、partner の顧客の解約確率を出していることになります。そこで、第22〜27か月(partner の開始から競合施策の前まで)を、獲得経路ごとに分けて評価しました。毎月再学習のモデルは、第2章の基準と同じく、第 m か月の予測の前に第 m-13〜m-2 か月で学習し直したものです。
| 獲得経路(第22〜27か月) | 件数(月平均) | 実際の解約率 | 予測平均 放置 | 予測平均 毎月 | AUC 放置 | 施策件数 放置 | 施策件数 真 | 損益 放置(万円/月) | 損益 毎月(万円/月) | 損益 真(万円/月) |
|---|---|---|---|---|---|---|---|---|---|---|
| partner | 892.3 | 0.1696 | 0.1141 | 0.1508 | 0.646 | 421.7 | 616.5 | 38.5 | 46.3 | 48.8 |
| store | 1,523.8 | 0.0871 | 0.0791 | 0.0894 | 0.674 | 330.5 | 440.7 | 15.4 | 15.0 | 16.2 |
| web | 2,583.8 | 0.0880 | 0.0792 | 0.0867 | 0.671 | 571.2 | 697.7 | 26.5 | 26.9 | 28.6 |
| 全体 | 5,000.0 | 0.1023 | 0.0854 | 0.0990 | 0.682 | 1,323.3 | 1,754.8 | 80.4 | 88.2 | 93.6 |
partner の顧客の実際の解約率は 0.1696 でしたが、放置のモデルの予測平均は 0.1141 で、約3分の1少なく見積もっていました。web と store では、予測平均 0.079 に対して実際は 0.087〜0.088 で、ずれは小さめです。損益で見ると、放置と真の確率の差は全体で月13.2万円(80.4万円と93.6万円)で、そのうち月10.4万円が partner の区分で生じていました。全体の顧客の約18%の区分に、損失の約8割が集まっていたことになります。全体の予測平均(0.0854)と実際の解約率(0.1023)を見るだけでは、ずれが全体に薄く広がっているのか、特定の区分に集中しているのかは分かりません。区分に分けて見ることで、どこを直せばよいかが分かります。毎月再学習のモデルは、学習データに partner の顧客が入るので、partner の予測平均が 0.1508 まで上がり、損益は月46.3万円になりました。
放置のモデルが partner の顧客にどう確率を出しているかも確かめました。partner の顧客の入力のうち、獲得経路の列を web に書き換えても、store に書き換えても、予測平均は 0.1163、0.1149 で、書き換える前(0.1141)とほとんど同じでした。学習データに partner の行が無かったので、モデルは「partner である」という情報を使う手がかりを持っておらず、partner の顧客の確率は、利用日数や契約月数などの他の入力だけで決まっていたことになります。共通データの真の解約確率では、partner であること自体が解約を高める要因として入っているので(第2章)、その分が丸ごと抜け落ちていました。学習データに無いカテゴリが本番で現れることは、第3章のデータの検証で検出する対象でもあります。評価の側では、学習データに無い区分の成績は、オフライン評価では一切測れていないことを、評価の報告に明記することが大切です。
区分ごとの評価には、もう1つ読み方の注意があります。表の AUC を見ると、全体の AUC(放置で 0.682)は、partner(0.646)、store(0.674)、web(0.671)のどの区分の AUC よりも高くなっています。全体の AUC には、解約率の高い partner の顧客を、解約率の低い web や store の顧客より上に並べる、という比較的易しい並べ替えが含まれているためと考えられます(この章では、この理由を分けて確かめてはいません)。区分の中での並べ替え、たとえば partner の顧客の中で誰が解約しやすいかを当てる力は、全体の AUC が示すより弱いことがあります。施策を区分ごとに予算を分けて打つ場合には、区分の中の AUC を見る必要があります。
区分を細かくするほど、1つの区分の件数は減り、評価の数字の揺れは大きくなります。partner の第22か月の1か月分は884件(うち解約151件)で、AUC は 0.661 でしたが、ブートストラップ1,000回で見た標準偏差は 0.024、95%の範囲は 0.615〜0.706 でした。全体の5,000件での標準偏差 0.014 より大きく、区分ごとの小さな差を読みすぎないように、件数と揺れの幅を一緒に示すのが有効だと考えています。
プラン別にも分けて見ました。競合施策の期間(第28〜36か月)では、premium の顧客の実際の解約率が 0.1994 だったのに対して、放置のモデルの予測平均は 0.0942 で、半分以下でした。basic(実際 0.1077、予測 0.0860)や standard(実際 0.1649、予測 0.0827)より、ずれが大きい区分です。共通データの競合施策は、利用日数が多い顧客も解約するように関係を変えたので(第2章)、利用が多い premium の顧客で、学習時の「よく使う顧客は解約しにくい」という関係が最も大きく外れたと考えられます(この理由も、この章では確かめていません)。損益では、premium の区分の放置と真の確率の差が月18.2万円(33.7万円と51.9万円)でした。どの区分を見ればよいかは、事業の変化(新しい販路、料金改定、競合の施策の対象)から決めるのが実務的です。変化が起きた区分を評価の表に必ず入れておくと、全体の数字に埋もれた外れに気づけます。
本番に出すかどうかを決める受け入れ基準
新しいモデル(候補)を本番に出すかどうかは、いま本番で使っているモデル(現行)と同じデータで比べて決めます。比べるデータは、どちらの学習にも使っていない、ラベルが確定している最も新しい期間(ホールドアウト)です。共通データでは、第 m か月の予測を出す前に使えるホールドアウトは第 m-2 か月です。そこで、候補を第 m-14〜m-3 か月の12か月で学習し、第 m-2 か月で現行(第1〜12か月で学習した放置のモデル)と比べました。差の揺れを見るために、ホールドアウトの5,000件から重複を許して選び直し、同じ顧客の組で両方のモデルを測ることを1,000回繰り返しました(対にしたブートストラップ)。そのうえで、判断の後の実際の成績(候補を入れた場合と、現行のまま使った場合)も計算しました。
import numpy as np
from sklearn.metrics import roc_auc_score
import mlops_data as md
import baseline as bl

train = md.months(1, 12)
champion = bl.make_model().fit(md.encode(train), train.churn)   # 現行

m = 30                                  # 第30か月の予測の前の判断
cand = bl.fit(m - 14, m - 3)            # 候補:第16〜27か月で学習
h = md.month_data(m - 2)                # ホールドアウト:第28か月
y = h.churn.to_numpy()
sc = champion.predict_proba(md.encode(h))[:, 1]
sn = cand.predict_proba(md.encode(h))[:, 1]

rng = np.random.default_rng(0)
d_auc, d_val = [], []
for _ in range(1000):                   # 同じ顧客の組で両方を測る
    i = rng.integers(0, len(y), len(y))
    d_auc.append(roc_auc_score(y[i], sn[i]) - roc_auc_score(y[i], sc[i]))
    v_new = md.campaign_value_threshold(y[i], sn[i])[0]
    v_old = md.campaign_value_threshold(y[i], sc[i])[0]
    d_val.append((v_new - v_old) / 1e4)
print(np.quantile(d_auc, [0.025, 0.975]), np.quantile(d_val, [0.025, 0.975]))
# 出力: AUC の差 -0.0019〜+0.0202、損益の差 +12.08〜+43.11(万円)
| 判断の時点(ホールドアウト) | AUC 現行/候補 | AUC の差(95%の範囲) | 損益 現行/候補(万円) | 損益の差(95%の範囲、万円) | 予測平均 現行/候補(実際の解約率) | その後6か月の実際の損益の差(候補から現行を引いた値、万円/月) |
|---|---|---|---|---|---|---|
| 第18か月の前(第16か月) | 0.682/0.686 | +0.005(-0.004〜+0.013) | 37.5/46.3 | +8.8(+0.7〜+16.5) | 0.0807/0.0809(0.0840) | +4.05(第18〜23か月) |
| 第24か月の前(第22か月) | 0.689/0.695 | +0.006(-0.004〜+0.017) | 71.5/73.9 | +2.4(-9.6〜+14.6) | 0.0854/0.0938(0.0968) | +7.24(第24〜29か月) |
| 第30か月の前(第28か月) | 0.617/0.626 | +0.009(-0.002〜+0.020) | 114.7/141.1 | +26.4(+12.1〜+43.1) | 0.0874/0.1046(0.1484) | +26.63(第30〜35か月) |
3つの判断の時点のどれでも、AUC の差は 0.005〜0.009 で、95%の範囲は0をまたいでいました。AUC だけを基準に「候補が明らかに上回ったら入れ替える」と決めていたら、3回とも入れ替えなかったことになります。損益の差は、第18か月の前と第30か月の前では95%の範囲が0を上回り、第24か月の前では0をまたいでいました(-9.6万円〜+14.6万円)。ところが、その後6か月の実際の損益では、3回とも候補の方が上回りました(月4.05万円、7.24万円、26.63万円)。第24か月の前の判断で「損益が明らかに上回ったときだけ入れ替える」という基準を使うと、その後6か月で月7.24万円の上積みを逃すことになります。
この結果は、受け入れ基準の作り方について2つのことを示しています。1つ目は、1か月分のホールドアウトでは、モデルどうしの小さな差を見分けるには件数が足りないことです。差を見分けたいなら、ホールドアウトを複数月にする必要がありますが、そうすると候補の学習に使えるデータが古くなります。2つ目は、「候補が明らかに上回ること」を求める基準は、入れ替えに慎重すぎることがある、ということです。現行のモデルが古くなっていく状況では、入れ替えないこと自体が損失を生みます。そこで、受け入れ基準は「候補が現行より明らかに悪くないこと」(業務上許せる下げ幅を決めておき、差の範囲の下限がそれを下回らないこと)を中心にし、そのうえで確率の水準と区分ごとの成績、運用上の条件を確かめる形にするのが有効だと考えています。
共通データの例で、受け入れ基準を表にしました。数値の幅は、この架空の設定に合わせて置いた例です。実際の値は、事業の損益の大きさと、入れ替えにかかる手間から決めます。
| 確かめる項目 | 測り方 | 基準の例(この架空の設定の場合) | 満たさないときの扱い |
|---|---|---|---|
| 業務の損益 | ホールドアウトで、現行と候補をしきい値0.106の使い方で比べ、対にしたブートストラップで差の範囲を出す | 差の95%の範囲の下限が、許せる下げ幅(たとえば月-10万円)を下回らない | 入れ替えない。学習データや設定を見直す |
| 並べ替えの正しさ | 同じホールドアウトでの AUC の差 | 差の95%の範囲の下限が -0.02 を下回らない | 入れ替えない |
| 確率の水準 | 予測平均と実際の解約率の差、較正曲線 | 予測平均が実際の解約率の±10%以内。較正曲線が全区分で一方向に外れていない | 較正をやり直し、確率の水準を測り直してから本番に出す(この項目だけを理由に入れ替えを止めない。現行も同じ基準で測る) |
| 区分ごとの成績 | 獲得経路・プランごとの予測平均・AUC・損益。件数を併記する | 変化が起きた区分(新しい経路など)で現行より明らかに悪くない | 区分の扱いを見直す。必要ならその区分だけ別の方法で打つ |
| 評価の作法 | 時系列分割で測ったか。ホールドアウトを学習に使っていないか | 評価の記録(第5章)に分け方と期間が残っている | 評価をやり直す |
| 運用上の条件 | 推論にかかる時間、入力の検証、再現できること | 第8章・第9章の条件を満たす | 本番に出さない |
この基準の例を、前の表の3つの判断の時点に当てはめました。この章で計算した3つの項目(業務の損益・並べ替えの正しさ・確率の水準)だけで判定しています。区分ごとの成績と運用上の条件は、この計算では測っていません。確率の水準の列は、候補の予測平均が実際の解約率よりどれだけ低かったかを、実際の解約率に対する割合で示しています。
| 判断の時点 | 損益の差の下限(基準:-10万円を下回らない) | AUC の差の下限(基準:-0.02を下回らない) | 確率の水準 候補(基準:±10%以内) | 確率の水準 現行(参考) | 基準の例による扱い |
|---|---|---|---|---|---|
| 第18か月の前 | +0.71万円(満たす) | -0.0038(満たす) | 約4%低い(満たす) | 約4%低い | 入れ替える |
| 第24か月の前 | -9.58万円(満たす) | -0.0043(満たす) | 約3%低い(満たす) | 約12%低い | 入れ替える |
| 第30か月の前 | +12.08万円(満たす) | -0.0019(満たす) | 約30%低い(満たさない) | 約41%低い | 較正をやり直し、確率の水準を測り直してから入れ替える |
第30か月の前の候補は、損益と並べ替えの正しさでは現行より明らかに悪くない一方、予測平均が0.1046で、実際の解約率0.1484より約30%低く、確率の水準の基準を満たしません。ここで確率の水準を「入れ替えない」理由にすると、比べる相手の現行は予測平均0.0874で約41%低く、候補よりさらに大きく外れているので、より外れたモデルを使い続けることになります。そこでこの例では、確率の水準を、入れ替えるかどうかを決める項目ではなく、入れ替えるときに較正のやり直しが要るかどうかを決める項目として置きました。前の節で見たとおり、sigmoid による較正のやり直しは、並び順を変えずに確率の水準だけを直す作業です。なお、前の表のその後6か月の上積み(月26.63万円)は、候補を較正し直さずにそのまま入れた場合の値です。較正をやり直してから入れた場合の損益は、この章では計算していません。較正のやり直しに時間がかかって入れ替えが遅れれば、その間は現行のモデルの損益にとどまります。承認の遅れが損益に与える影響は、第7章で計算します。
基準を満たした候補をどう登録し、誰が承認し、どの版として記録するかは、第7章で扱います。受け入れ基準そのものも、評価の結果と一緒に記録しておく必要があります。基準を後から緩めて候補を通すことが起きないよう、評価の前に基準を決めて記録しておくのが有効だと考えています。
オフライン評価で分からないことと、オンラインでの効果検証
ここまでの評価は、過去のデータで「解約しそうな顧客を当てられるか」を測ったものです。損益の計算には、施策を打った解約予定の顧客の35%を引き止められる、という架空の設定を使っています。この35%という値は、オフライン評価では確かめられません。施策を打たなかった顧客が実際にどうなったかしか、過去のデータには残っていないからです。現実の業務では、引き止めの効果そのものを、施策を打つ顧客と打たない顧客をランダムに分けて比べる実験(A/B テスト)で測る必要があります。効果の測り方は、弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』で扱っています。
モデルを本番で使い始めると、評価にもう1つの注意が加わります。施策で引き止めた顧客は解約しないので、本番の期間のラベルには、モデルの予測に基づいて打った施策の効果が混ざります。モデルが解約しやすいと判断して施策を打ち、実際に引き止めに成功した顧客は、ラベルの上では「解約しなかった顧客」になります。このラベルでそのままモデルを評価したり学習し直したりすると、モデルの当たり方を正しく測れません。施策を打たない比較用の顧客を一定の割合で残しておくと、その顧客たちのラベルは施策の影響を受けないので、モデルの評価と効果の測定の両方に使えます。比較用の顧客を残すことは、その分の施策を打たないことなので費用がかかりますが、評価の土台を守るための費用として、予算の段階で見込んでおくのが有効だと考えています。
新しいモデルを本番に出す方法にも、評価の役割があります。新しいモデルの予測を本番と同じ入力で計算するが業務には使わない運用(シャドー運用)や、一部の顧客にだけ新しいモデルを使う段階的な出し方は、オフライン評価で測れなかったこと(本番の入力での予測の分布、処理の時間、業務の流れの中での扱われ方)を、損失を抑えながら確かめる手段です。これらの出し方は第8章で扱います。
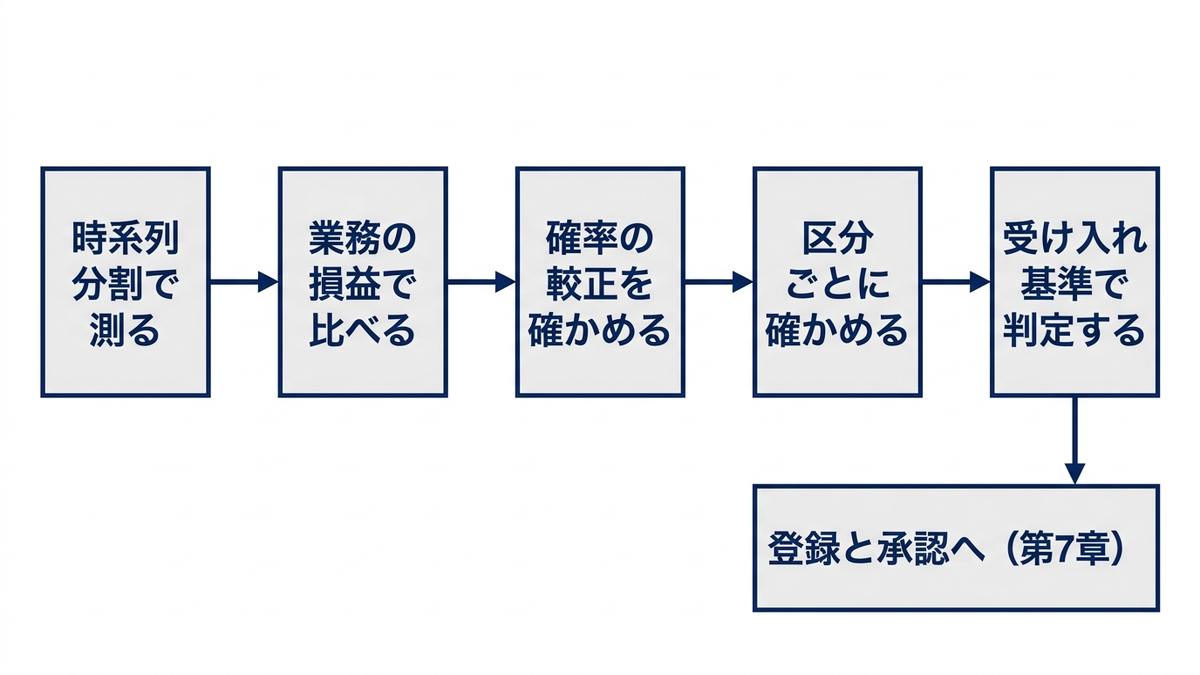
評価の誤りが経営にもたらす損失
この章で測った評価の誤りを、経営の指標に直して並べます。いずれも第2章で用意した架空のサンプルデータの、この章の設定での結果です。
| 評価の誤り | この章の計算で起きたこと | 経営の指標への翻訳 |
|---|---|---|
| ランダム分割の数字を本番の見込みにする | 場面Bで、ランダム5分割では予測平均と実際の解約率がともに 0.0996 で合って見えたが、時系列分割の最後の回では予測 0.1045 に対して実際 0.1484 | 確率の水準のずれを見逃したまま本番に出し、施策件数が足りない状態が続く |
predict(しきい値0.5)の結果を施策の対象にする | 第13〜18か月で施策は月0.2件、損益はほぼ0円 | 施策費用を見込んだ予算が使われず、守れたはずの粗利(同じ期間でしきい値0.106なら月45.3万円)を失う |
| 較正を本番に出す前に一度しか確かめない | 競合施策の期間に施策件数が月1,347.6件(真の確率なら3,154.6件)。較正だけをやり直すと月2,997.0件・損益は月37.3万円の改善 | 24か月で、較正だけのやり直しと放置の差は372.6万円(2,336.6万円と1,964.0万円) |
| 全体の数字だけを見る | 第22〜27か月の放置の損失(真の確率との差)月13.2万円のうち月10.4万円が partner の区分 | 新しい販路への投資の判断に、外れた予測が使われる |
| 「明らかに上回る」ときだけ入れ替える | 第24か月の前の判断で候補を見送ると、その後6か月の損益で月7.24万円の上積みを逃す | 入れ替えを見送るたびに、古いモデルの損失が積み上がる |
これらの誤りに共通しているのは、評価の数字そのものは計算されていて、報告の上では「評価済み」に見えることです。ランダム分割の AUC も、較正なしの予測平均も、全体の AUC も、それ自体は正しく計算された数字です。誤っているのは、本番の使われ方と測り方が合っていないことです。経営の側からモデルの評価の報告を受けるときには、数字の大きさより先に、「学習に使った期間より後の期間で測っているか」「施策の判断に使う方法で損益を計算しているか」「確率の水準は合っているか」「新しい区分や変化のあった区分はどうか」「差の揺れの幅はどれくらいか」の5つを確かめることが、判断の誤りを減らす近道だと考えています。
評価にかかる手間も、経営判断の材料になります。この章の計算は、一般的なノートPCで実行して、時系列分割とランダム分割の比較が約22秒、4つの候補モデルとしきい値の計算が約5秒、較正の計算が約36秒、区分ごとの評価が約44秒、受け入れ基準の計算が約37秒でした(この記事の実行環境での実測。14章分の計算を同じPCで並行して動かしたので揺れがある)。共通データの規模であれば、評価を自動で毎月回すことは計算の上では負担になりません。費用の大部分は、計算ではなく、基準を決めて結果を読み、入れ替えを判断する人の時間です。その時間を減らすために、この章の評価を決まった手順として組み込む方法(テストとパイプライン)は、第9章で扱います。
この章のまとめ
本番に出す前の評価では、学習より後の期間で測る時系列分割を使い、AUC だけでなく業務の使い方そのもので計算した損益と、確率の較正、変化のあった区分の成績を確かめます。この架空データでは、ランダム分割でも変化の無い期間は楽観的になりませんでしたが、変化を含む期間では確率の水準のずれを隠し、較正のずれは施策件数の不足として損益に大きく効きました。受け入れ基準は、1か月分のデータの揺れを踏まえて「現行より明らかに悪くないこと」を中心に置き、評価の前に決めて記録しておきます。次の第7章では、評価に通ったモデルを登録し、承認して版を管理する仕組みを扱います。
この章を深めたい方への参考書籍
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標と KPI と目的関数の関係から始め、二値分類の章で ROC-AUC・PR-AUC などの指標に加えて、ビジネスインパクトの期待値計算とコスト考慮型学習を扱っています。この章で行った、しきい値を施策の費用と守れる粗利から決め、損益でモデルを比べる考え方を、指標の側から体系的に整理できる1冊です。
『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』(齋藤優太・安井翔太 著、ホクソエム 監修、技術評論社):機械学習の実践に潜む落とし穴から始め、予測の正確さと意思決定の性能を分けて考える枠組みを示しています。オフライン評価で測った予測の良さと、施策として打ったときの効果が一致しないという、この章のオフライン評価で分からないことの節で触れた問題を考える土台になります。
第7章 モデルを登録し、承認して版を管理する
第6章では、本番に出す前のモデルを、時系列に沿った分け方と業務の判断に合わせた指標で評価し、何を満たせば本番に出してよいかという受け入れ基準を考えました。評価に合格したモデルは、そのまま担当者のパソコンから本番の仕組みへ置けばよいわけではありません。どの版が、どのデータとコードから作られ、誰の承認を経て、いつから本番で使われているのかを記録しておかないと、成績が落ちたときに原因を調べることも、1つ前の版に戻すこともできなくなります。この章では、その記録を一か所に集める仕組みであるモデルレジストリの役割と、主要な製品が備える機能(公式ドキュメントで確かめた範囲)、モデルの性質と限界を書き残すモデルカードを扱います。さらに、Python の標準ライブラリの sqlite3 と joblib で小さなレジストリを作り、第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)で、登録・審査・承認・本番化・ロールバックを一通り実行します。承認が遅れたときや誤った版を通してしまったときの損失も、同じデータで金額に直します。モデルを本番の業務へ届ける方式(バッチ推論とオンライン推論、段階的なリリース)は第8章で扱います。
モデルレジストリは何を防ぐ仕組みか
この記事でモデルレジストリと呼ぶのは、学習済みのモデルの保存物を版ごとに登録し、それぞれの版について「どのデータとコードから作ったか」「評価の結果はどうだったか」「いまどの状態にあるか(審査中・本番・保管・却下)」「誰がいつ承認したか」を記録して、検索・参照できるようにした台帳です。第5章で扱った実験管理が「試したもの全部」の記録であるのに対し、レジストリは「本番に出す候補になったもの」と「実際に本番で使ったもの」の記録です。実験の記録が研究ノートだとすると、レジストリは出荷の台帳にあたります。
レジストリが無いと、次のようなことが起きます。1つ目は、本番で動いているモデルがどれなのか分からなくなることです。共有フォルダに model_final.pkl・model_final2.pkl・model_0815.pkl が並び、本番の設定ファイルがどれを指しているかを担当者しか知らない、という状態です。2つ目は、成績が落ちたときに原因を切り分けられないことです。モデルを作り直したのか、データが変わったのか、ライブラリの版が上がったのかが記録に無ければ、調べる手がかりがありません。3つ目は、1つ前の版に戻せないことです。前の版の保存物が上書きされていれば、作り直すしかなく、作り直すための学習期間やパラメータの記録も無ければ、同じものは二度と作れません。4つ目は、承認を経ないまま本番に入ることです。担当者が手元で作り直したモデルを、誰の確認も経ずに差し替えられる仕組みでは、誤りを含んだ版がそのまま顧客への施策に使われます。
これらは、どれも担当者が1人でモデルが1本のうちは表に出にくい問題です。担当者が覚えていれば答えられるからです。表に出るのは、担当者が離任したとき、モデルが数本を超えたとき、監査や顧客から「この判断はどのモデルで出したのか」と問われたとき、そして成績が落ちて急いで前の版に戻したいときです。第1章で整理した損失の型のうち、「再現できない」「承認されないまま本番」「担当者の離任で止まる」の3つは、レジストリが直接防ぐものです。
どの段階から要るかは、更新の頻度と影響の大きさで決まると考えています。年に1回作り直す程度のモデルが1本だけで、使い道が社内の参考資料に限られるなら、表計算ソフトの台帳と、日付入りのフォルダに保存物を残す運用でも足ります。四半期に1回以上作り直す、モデルが複数ある、予測が顧客への施策や与信のように外に向かう判断に使われる、のいずれかに当てはまるなら、台帳と保存物を結び付け、承認を経ないと本番の版を切り替えられない仕組みを用意する価値があります。逆に、試作の段階や、一度きりの分析に使うモデルにまでレジストリの手続きを課すと、作業が重くなるだけで得るものは小さいと考えています。
レジストリに記録する項目
レジストリに何を記録するかは、「あとから何を問われたら答えられる必要があるか」から逆算して決めます。この章で作った小さなレジストリでは、版ごとに次の項目を1行に記録しました。製品のレジストリでも、名前や置き場所は違っても、同じ種類の情報を持たせるのが一般的です。
| 記録する項目 | この章の実装での中身 | 無いと困る場面 |
|---|---|---|
| 名前と版の番号 | モデルの名前ごとに1から振る連番 | 本番で動いているのがどれか答えられない |
| 保存物の場所と指紋 | joblib で保存したファイルの場所と、その SHA-256(ファイルの中身から計算する64桁の値。1バイトでも変われば別の値になる) | 保存物がすり替わった・壊れたことに気づけない |
| 学習データの範囲と指紋 | 学習に使った月(第何か月から第何か月まで)、件数、解約率、入力行列とラベルから計算した SHA-256 | 同じデータで作り直せない。データ側の変更が原因かを切り分けられない |
| コードの指紋 | データの生成・学習に使ったスクリプトのファイルから計算した SHA-256 | 手元で直したコードで作った版を区別できない |
| パラメータと乱数の種 | 学習の設定一式(random_state=0 を含む) | 同じ設定で作り直せない |
| ライブラリの版 | Python・NumPy・pandas・scikit-learn・joblib の版 | 版を上げたあとで読み戻せない、結果がずれる原因を調べられない |
| 評価の結果 | 学習に使っていない評価月の AUC・予測平均・実際の解約率・損益 | 承認の根拠を示せない。あとの版と比べられない |
| 状態と出来事の記録 | 状態(本番・保管・却下)と、登録・審査・承認・却下・本番化・ロールバックの出来事を、誰が・第何か月に・何を根拠に行ったかとともに追記 | 誰がいつ承認したのか、なぜその版を本番に入れたのかを説明できない |
| 別名(どの版が本番か) | champion(本番の版)・previous(直前の本番の版。戻し先) | 本番の版の切り替えと戻しのたびに、利用側の設定を書き換える必要がある |
このうち、学習データそのものはレジストリに入れていません。データは別の場所(データ基盤)に置き、レジストリには「どの範囲を使ったか」と「その中身の指紋」だけを残しました。指紋が一致すれば、あとから同じ範囲を取り出したときに、登録時と同じデータであることを確かめられます。データの版の管理は第3章、学習データを時点をそろえて作る方法は第4章で扱っています。
この表の項目の選び方には、scikit-learn の公式ドキュメントのモデルの保存に関するページが裏付けを与えています。このページは、将来の版の scikit-learn で似たモデルを作り直せるように、保存したモデルと一緒に残すべき情報として、学習データ(たとえば変更されない複製への参照)、モデルを作った Python のソースコード、scikit-learn とそれが依存するライブラリの版、学習データで得た交差検証のスコアの4つを挙げています。スコアを残す理由として、作り直したモデルのスコアが以前と同じ範囲に入っているかを確かめられるから、と説明しています。表の「学習データの範囲と指紋」「コードの指紋」「ライブラリの版」「評価の結果」は、この4つに対応します。なお、この記事では評価の結果を交差検証ではなく、第6章の考え方に合わせて「学習に使っていない後の月」で測っています。
製品のレジストリが備える機能
レジストリの機能は、主要な機械学習の基盤製品にも組み込まれています。ここでは、2026年10月に各社の公式ドキュメントを開いて確かめた範囲だけを書きます。製品どうしの優劣は比べません。料金も書きません。クラウドの製品の全体の見取り図は、弊社コラム「AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方」で整理しています。
オープンソースの MLflow のModel Registry の概要のページは、登録した各版が、それを作った MLflow の実行(run)や記録したモデル、ノートブックと結び付けられ、再現できるようにしている、と説明しています。同じ名前で登録し直すと版の番号が増え、版にはタグ(キーと値の組)を付けられます。本番で使う版を指すには、別名(alias)を使います。別名は登録済みのモデルの特定の版を指す、付け替えのできる名前で、公式の例では champion という別名を作っています。かつて使われていた「Staging」「Production」「Archived」といった段階(stage)の仕組みについて、同じく公式の運用手順のページは、MLflow 2.9.0 で非推奨になり、将来の大きな版で取り除かれると書き、段階から別名とタグへの移行の手順を載せています。同じページは、開発用の登録名にある候補の版を、本番用の登録名へ新しい版として複製する copy_model_version という関数の例も示しています。古い解説記事で段階の仕組みを前提にした手順を見かけたら、この変更を踏まえて読む必要があります。
Amazon SageMaker のModel Registry のモデルと版に関するページは、版を束ねる単位をモデルグループと呼び、各版の番号は1から始まり、グループに新しい版が加わるたびに1ずつ増える、と説明しています。承認の状態を更新する手順のページでは、版に承認の状態(承認待ちを表す PendingManualApproval、承認済みの Approved、却下の Rejected)を持たせ、状態を承認済みにすると継続的デリバリー(CI/CD)による配備を始められる、と書いています。ただし、状態の変化と配備の動きの対応表は、SageMaker が用意したプロジェクトのひな形を使う場合の説明として載っています。承認と配備を結び付けるかどうかは、使い方の設計で決まるということです。
Google Cloud のモデルの登録の仕組み(Model Registry)は、以前は Vertex AI の公式ドキュメントとして案内されていました。2026年10月に Vertex AI のドキュメントの URL を開くと、Gemini Enterprise Agent Platform という名前の下のページへ転送されました。転送先の版の管理のページは、モデルの版の一覧と、それぞれの版の ID を表示できると説明し、版の別名のページは、モデルを新しく作ると最初の版に自動で default という別名が付き、版を指定せずに使ったときはこの別名の版が使われること、どれか1つの版が常にこの別名を持っている必要があること、独自の別名も付けられ、別の版へ付け替えられることを説明しています。別名は数字だけにはできず、版の ID と区別する決まりになっています。
Microsoft の Azure Machine Learning のモデル管理の概念のページは、登録したモデルを名前と版で識別し、既存のモデルと同じ名前で登録するたびに版の番号が増えること、登録時にタグを付けて検索に使えること、誰がモデルを公開したか・なぜ変更したかといった系譜(リネージ)の情報を、ガバナンスのために記録できることを説明しています。
4つの製品の説明を並べると、名前と版の番号、作った実行やデータとの結び付き、タグ、本番の版を指す仕組み(別名や承認の状態)が共通しています。言い換えると、レジストリの中心は「保存物に、それがどこから来て、いまどういう扱いなのかを結び付けた台帳」であり、製品を入れなくても考え方は小さく再現できます。次の節では、それを標準ライブラリで作ります。
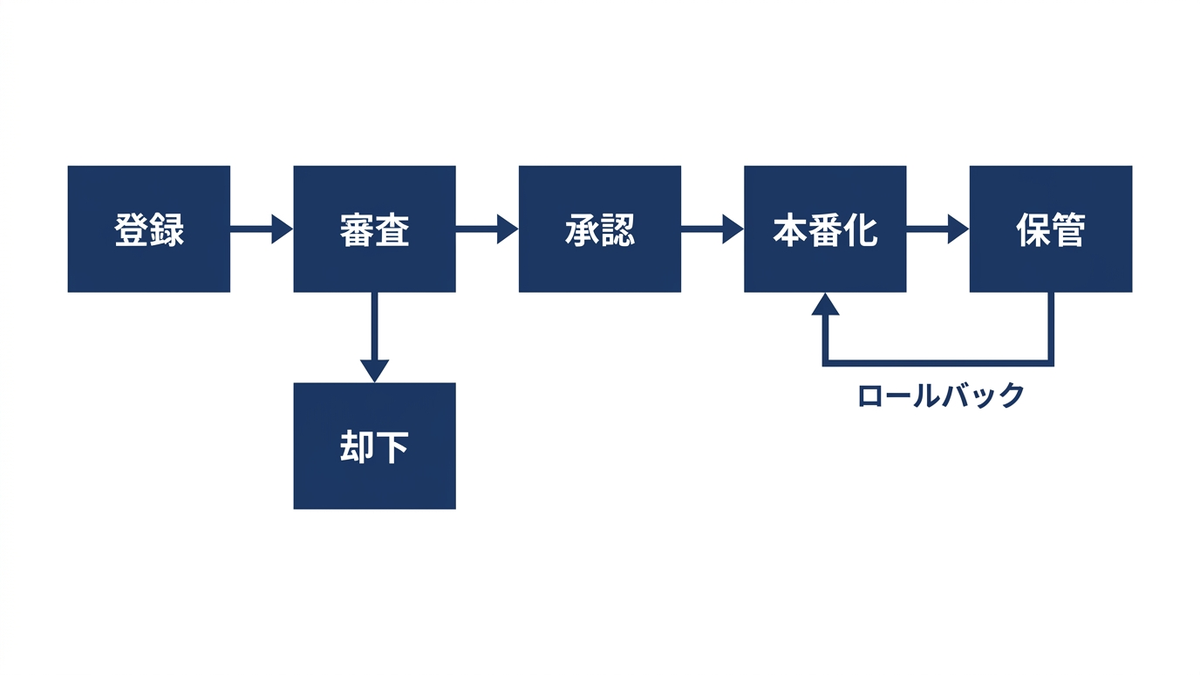
sqlite3 と joblib で小さなレジストリを作る
この記事の実行環境には MLflow が入っていないので、同じ考え方を Python の標準ライブラリの sqlite3(ファイル1つで動くデータベース)と、scikit-learn のモデルの保存によく使われる joblib で実装しました。表は3つです。版ごとの記録を1行にまとめる model_versions、出来事を追記していく events、本番の版などを指す別名の aliases です。次のコードは、実行したスクリプトから、版を登録する関数・保存物を読み戻す関数・別名を付け替える関数を抜き出したものです。補助モジュール(mlops_data.py と baseline.py)と同じフォルダに置いて実行する形で、表の作成や指紋の計算の関数(sha256_frame・sha256_file)は省いています。register の引数 label_shift は、後で述べる結合のずれを再現するためのもので、定義には残し、中身(この引数を指定したときに各行の正解ラベルを1行ずらす処理)は省略しています。
import os, json, sqlite3, joblib
import mlops_data as md
from baseline import make_model, MODEL_PARAMS

def register(month, a, b, val_month, label_shift=False):
    """第 a〜b か月で学習し、第 val_month か月で評価して、新しい版として登録する。"""
    d = md.months(a, b)
    X, y = md.encode(d), d.churn
    model = make_model().fit(X, y)
    ver = (con.execute("SELECT COALESCE(MAX(version),0) FROM model_versions WHERE name=?", (NAME,)).fetchone()[0]) + 1
    path = os.path.join(ROOT, "artifacts", f"{NAME}_v{ver}.joblib")
    joblib.dump(model, path)
    ev = evaluate(model, md.month_data(val_month))
    con.execute("INSERT INTO model_versions VALUES(?,?,?,?,?,?,?,?,?,?,?,?,?,?,?,?,?,?,?,?)",
                (NAME, ver, month, a, b, len(d), float(y.mean()), sha256_frame(X, y), CODE_SHA,
                 json.dumps(MODEL_PARAMS), json.dumps(LIBS), os.path.relpath(path, ROOT), sha256_file(path),
                 os.path.getsize(path), val_month, ev["auc"], ev["pred_mean"], ev["actual"], ev["value"], "登録済み"))
    log(ver, month, "登録", "作成者(データサイエンティスト)", f"学習 第{a}〜{b}か月 {len(d)}件")
    return ver, model, ev

def load(ver):
    """記録された指紋と照合してから読み戻す。指紋が違えば読み込まない。"""
    path, digest = con.execute("SELECT artifact, artifact_sha256 FROM model_versions WHERE name=? AND version=?",
                               (NAME, ver)).fetchone()
    full = os.path.join(ROOT, path)
    if sha256_file(full) != digest:
        raise ValueError(f"v{ver} の保存物の指紋が登録時と一致しない")
    return joblib.load(full)

def set_alias(alias, ver):
    con.execute("REPLACE INTO aliases VALUES(?,?,?)", (NAME, alias, ver))
運用の筋書きは次のとおりです。初版の v1 は第1〜11か月の55,000件で学習し、学習に使っていない第12か月で評価して登録し、承認を経て第13か月から本番で使います。以後、四半期ごと(第16・19・22・25・28・31・34か月)に、その時点でラベルが確定している直近の月を使って候補を作ります。候補は第 m-14〜m-3 か月の12か月分で学習し、第 m-2 か月を評価月として、現行の本番の版と同じ月で比べます。第2章の基準の結果の「四半期ごと再学習」は第 m-13〜m-2 か月で学習していますが、ここでは評価に使う月を学習から外すために1か月手前で切りました。第31か月には、正しい候補の前に、データの結合がずれて各行の正解ラベルが隣の行の顧客のものになった候補(架空の事故)が1つ出てくる設定にしました。実行すると、9つの版が登録されました。この章の v1〜v9 は、このレジストリが登録した順に振った番号です。第8章でも v1・v2 という呼び名を使いますが、そちらは第8章の実演のために用意した別の2つのモデルを指します。
| 版 | 登録した月 | 学習に使った月 | 件数 | 学習データの解約率 | 学習データの指紋(先頭12桁) | 保存物の大きさ(バイト) | 最終の状態 |
|---|---|---|---|---|---|---|---|
| v1 | 第12か月 | 第1〜11か月 | 55,000 | 0.0800 | 99d2bc00dd22 | 172,088 | 保管 |
| v2 | 第16か月 | 第2〜13か月 | 60,000 | 0.0800 | 514d991a2a30 | 168,512 | 保管 |
| v3 | 第19か月 | 第5〜16か月 | 60,000 | 0.0805 | 5186b944863f | 237,208 | 保管 |
| v4 | 第22か月 | 第8〜19か月 | 60,000 | 0.0810 | 3e4d9236de47 | 222,792 | 保管 |
| v5 | 第25か月 | 第11〜22か月 | 60,000 | 0.0849 | 4dcd8a03b195 | 204,704 | 保管 |
| v6 | 第28か月 | 第14〜25か月 | 60,000 | 0.0913 | 230b367dc7e6 | 204,672 | 保管 |
| v7 | 第31か月 | 第17〜28か月 | 60,000 | 0.0996 | e476f2151830 | 78,088 | 却下 |
| v8 | 第31か月 | 第17〜28か月 | 60,000 | 0.0996 | f68123d62c8d | 161,264 | 保管 |
| v9 | 第34か月 | 第20〜31か月 | 60,000 | 0.1148 | d14b4bf65153 | 175,728 | 本番 |
v7 と v8 は、学習に使った月も件数も学習データの解約率も同じです。違うのは「学習データの指紋」の列だけで、v7 は e476f2151830、v8 は f68123d62c8d です。ラベルを1行ずらしても、解約した顧客の数は変わらないので解約率は同じになりますが、入力とラベルの組み合わせが変わるので指紋は変わります。件数や解約率のような要約の数字だけを記録していると、この2つを区別できません。指紋を残す意味はここにあります。また、v7 の保存物は78,088バイトで、ほかの版(161,264〜237,208バイト)の半分以下でした。大きさが違う理由はこの章では調べていないので、保存物の大きさを異常の検知に使えるかどうかは、この1例からは言えません。
承認の流れと承認者、受け入れ基準で候補を止める
候補を本番に入れるまでの流れは、「登録」「審査」「承認」「本番化」の4段に分けました。登録は候補を作った人(作成者)が行い、審査は決められた検査を機械的に回し、承認は業務の結果に責任を持つ人が審査の記録を見て判断し、本番化は運用の担当が別名を付け替えて行います。作る人と承認する人を分けるのは、作った本人は自分の候補の欠点に気づきにくく、また、作った本人だけで本番を差し替えられる仕組みでは、誤りを止める機会が一度も無くなるからです。役割は2つに分けるのが筋が通っていると考えています。モデルの中身の確認(審査の記録の数字が妥当か、学習データやコードに問題が無いか)はデータ分析の側が受け持ち、本番に入れてよいかの最後の判断は、その予測を使って施策を打つ側の責任者が受け持つ、という分担です。最後の判断を施策の側に置くのは、予測の誤りで損をするのが施策の側だからです。技術の確認を省いてよいという意味ではなく、技術の確認を経た記録を見て、施策の責任者が承認するという順序です。
審査の受け入れ基準は、第6章の考え方に沿って、この章では次のように架空に置きました。評価月(第 m-2 か月)で、候補の AUC が現行の本番の版の AUC より0.01を超えて下回らないこと、かつ、候補の損益(予測確率がしきい値を超えた顧客に施策を打ったときの損益)が現行以上であること、の2つです。AUC に少しの幅を持たせたのは、評価月が1か月分(5,000件)しかなく、AUC が月ごとに揺れるためです。これは第6章の受け入れ基準の表を簡略にしたもので、差の95%の範囲は使わず評価月1か月の値どうしで比べ、確率の水準・区分ごとの成績の項目は入れていません。レジストリの仕組みを動かすことを優先したためです。第6章の表の例(予測平均が実際の解約率の±10%以内)に当てはめると、後で示す v8(評価月の予測平均0.1044、実際の解約率0.1398)と v9(0.1181、0.1378)はこの幅の外にあり、較正をやり直す対象になります(第6章の表では、この項目を満たさないときは入れ替えを止めず、較正をやり直してから本番に出す扱いにしています)。次のコードは、実行したスクリプトから審査の部分を抜き出したものです。
AUC_TOL = 0.01      # 候補の AUC が現行より 0.01 以上低くない
for m, bad in plan:
    a, b, vm = m - 14, m - 3, m - 2
    ver, cand, ec = register(m, a, b, vm, label_shift=bad)
    champ_ver = get_alias("champion")
    champ = load(champ_ver)
    eo = evaluate(champ, md.month_data(vm))
    ok_auc = ec["auc"] >= eo["auc"] - AUC_TOL
    ok_val = ec["value"] >= eo["value"]
    passed = bool(ok_auc & ok_val)
    note = "AUC 候補%.4f/現行%.4f、損益 候補%.0f円/現行%.0f円" % (ec["auc"], eo["auc"], ec["value"], eo["value"])
    log(ver, m, "審査", "審査(自動の検査)", ("合格 " if passed else "不合格 ") + note)
    if passed:
        log(ver, m, "承認", "承認者(事業責任者)", "審査記録を確認して承認")
        set_alias("previous", champ_ver)
        set_alias("champion", ver)
        log(ver, m, "本番化", "運用担当", f"champion を v{champ_ver} から v{ver} へ")
    else:
        log(ver, m, "却下", "承認者(事業責任者)", "基準を満たさないため現行を継続")
このコードも抜き出したもので、状態の列を更新する行と、結果を表にまとめる行は省いています。実行した結果の審査の記録は次の表のとおりです。損益は評価月1か月分の値で、単位は万円です。
| 審査した月 | 候補 | 評価月 | AUC 候補 | AUC 現行 | 現行の版 | 損益 候補(万円) | 損益 現行(万円) | 判定 |
|---|---|---|---|---|---|---|---|---|
| 第16か月 | v2 | 第14か月 | 0.6774 | 0.6777 | v1 | 46.2 | 42.8 | 合格 |
| 第19か月 | v3 | 第17か月 | 0.6921 | 0.6896 | v2 | 46.4 | 45.0 | 合格 |
| 第22か月 | v4 | 第20か月 | 0.6550 | 0.6492 | v3 | 55.8 | 46.9 | 合格 |
| 第25か月 | v5 | 第23か月 | 0.6877 | 0.6811 | v4 | 105.8 | 94.4 | 合格 |
| 第28か月 | v6 | 第26か月 | 0.6945 | 0.6928 | v5 | 102.4 | 101.7 | 合格 |
| 第31か月 | v7(結合のずれ) | 第29か月 | 0.5295 | 0.6352 | v6 | 28.1 | 131.0 | 不合格 |
| 第31か月 | v8 | 第29か月 | 0.6433 | 0.6352 | v6 | 144.2 | 131.0 | 合格 |
| 第34か月 | v9 | 第32か月 | 0.6704 | 0.6594 | v8 | 162.3 | 154.2 | 合格 |
正しく作った候補7つは、すべて基準を満たして合格しました。第16か月の v2 は AUC 候補が0.6774で、現行の0.6777をわずかに下回りましたが、0.01の幅の内側なので AUC の条件は満たし、損益 候補の46.2万円が現行の42.8万円を上回ったので合格しています。結合のずれた v7 は、AUC 候補が0.5295(0.5はランダムに並べた場合と同じ)、損益 候補が28.1万円で、どちらの条件でも現行の v6 を大きく下回り、却下されました。レジストリの出来事の記録には、v7 について「登録」「審査(不合格と、AUC と損益の値)」「却下」の3行が残り、本番の版は v6 のまま変わりませんでした。この記録は全部で35行になりました(本番に入った8つの版が「登録」「審査」「承認」「本番化」の4行ずつで32行、却下した v7 が3行)。どの版を、誰が、第何か月に、どの数字を根拠に本番に入れたのか、あるいは入れなかったのかを、あとから1行ずつたどれます。
v7 の誤りは、学習データの件数・解約率・学習期間といった登録時の要約には一切表れていません。気づけたのは、学習に使っていない月で現行の版と同じ物差しで比べたからです。審査を省いて作り直したモデルをそのまま入れる運用だった場合に何が起きるかは、この章の後半で金額に直します。
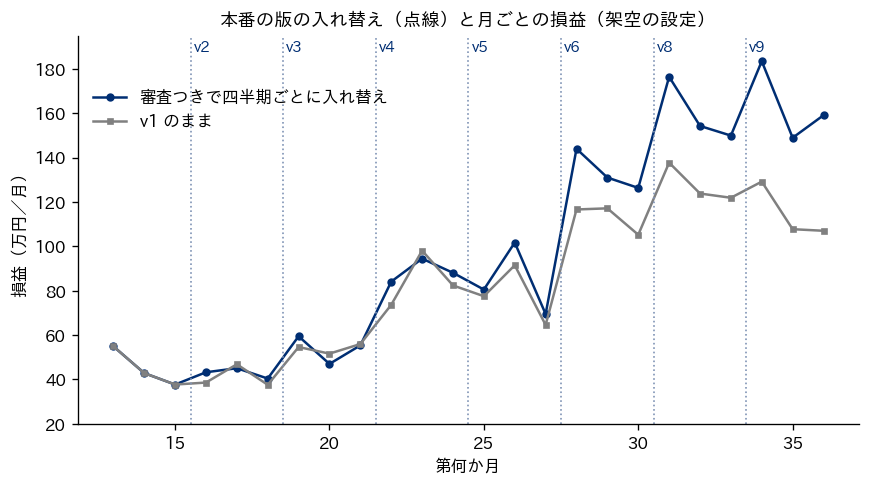
上の図は、この運用で本番の版が入れ替わった月(縦の点線と版の名前)と、月ごとの損益を、v1 を入れ替えずに使い続けた場合と比べたものです。第13〜36か月の24か月の損益の合計は、審査つきで四半期ごとに入れ替えた場合が2,316.9万円、v1 のままの場合が1,973.7万円で、差は343.2万円でした。差の大半は、競合の乗り換え施策が始まった第28か月以降に生じています。第2章の基準の結果(放置1,964.0万円、四半期ごと再学習2,357.7万円)と数字が少し違うのは、この章では v1 の学習を第1〜11か月にし、候補の学習期間も評価月を外すために1か月手前で切ったためです。四半期ごと再学習(2,357.7万円)より40.8万円少ない分には、この2つの影響が両方含まれており、学習に使っていない月で候補を確かめるための費用と見ることができます。
版の番号の付け方と別名
版の番号は、この章の実装でも、公式ドキュメントで確かめた MLflow・SageMaker・Azure Machine Learning でも、同じ名前のモデルを登録するたびに1つずつ増える連番です。連番の利点は、番号から「どちらが新しいか」が一目で分かり、番号の付け方で人が迷わないことです。ソフトウェアでよく使われる「1.2.3」のような意味のある番号(互換性を壊す変更・機能の追加・修正を桁で表す付け方)をモデルに使うこともできますが、モデルの場合は「入力の列が変わったら上の桁を上げる」「再学習だけなら下の桁を上げる」のような規則を自分たちで決めて守る必要があります。この章では、番号は連番のまま、意味は記録の列(学習期間・コードの指紋・入力の列の定義)に持たせる方が単純だと考えています。
連番だけでは「いま本番で使っているのはどれか」は分かりません。そこで、番号とは別に、付け替えのできる名前を版に付けます。MLflow や Google Cloud の Model Registry はこれをエイリアス(別名)と呼んでいます。この章の実装では、本番の版を指す champion と、直前の本番の版を指す previous の2つを使いました。推論の仕組みは「champion が指す版を読み込む」とだけ書いておけば、版を入れ替えるたびに推論の設定を書き換える必要がありません。入れ替えも戻しも、レジストリの中で別名を付け替える1行の操作になります。別名の付け替え自体が本番を変える操作なので、誰でもできるようにはせず、承認の記録がある版にだけ付け替えられるようにしておくべきだと考えています。この章の実装では、承認の出来事を記録した直後にだけ set_alias を呼ぶ順序にしてあります。
保存と読み戻し、ロールバックとライブラリの版
レジストリに置いた保存物は、読み戻したときに保存前と同じ予測を出さなければ意味がありません。v1 の保存物を、登録時に記録した指紋と照合してから読み戻し、第36か月の5,000件を予測して、学習した直後のメモリ上のモデルの予測と比べました。予測の最大の差は0で、5,000件すべてが完全に一致しました。読み戻しにかかった時間は0.005秒でした(この記事の実行環境、一般的なノートPCでの実測です)。次に、保存物の末尾の1バイトだけを書き換えて読み込もうとすると、指紋が登録時と一致しないので、読み込みの前に止まりました。保存物の取り違えや、転送・複製の途中での破損に気づくための最小限の仕組みです。
ロールバック(本番の版を1つ前の版に戻すこと)も試しました。最後に本番に入った v9 から、previous が指す v8 へ別名を付け替え、指紋を照合して読み戻すまでにかかった時間は0.009秒で、戻した後の予測は v8 の予測と完全に一致しました。戻した操作も「ロールバック」の出来事として記録に残ります。戻せるのは、前の版の保存物が上書きされずに残り、どれが前の版かが記録されているからです。
保存物が失われていた場合も試しました。v8 の記録にある学習期間(第17〜28か月)・パラメータ・乱数の種で作り直すと、2.34秒かかり、学習データの指紋は登録時と一致し、予測も v8 と完全に一致しました。同じ期間でも元データが違う場合(データの乱数の種を変えて作った別のデータ)は、指紋が一致しないことも確かめました。ここで作り直しが完全に一致したのは、この記事のデータが乱数の種を固定して作った架空のものであり、同じ環境・同じライブラリの版で、同じ乱数の種を指定して学習したからです。現実のデータ基盤では、過去のデータが後から訂正・削除されていることがあり、学習に使った時点のデータを取り出せる仕組み(第3章で扱ったデータの版の管理)が無いと、作り直しは一致しません。保存物を消さずに残すことと、作り直せるだけの記録を残すことは、どちらか一方ではなく両方が要ると考えています。
| 戻し方 | この章の実測 | 前提になる記録 |
|---|---|---|
| 別名の付け替え | 0.009秒、予測は完全一致 | 前の版の保存物・その指紋・どれが前の版かの記録 |
| 記録からの作り直し | 2.34秒、学習データの指紋と予測が完全一致 | 学習期間・データの指紋・パラメータ・乱数の種・ライブラリの版、そして同じデータを取り出せること |
| 記録が無い | 同じものを作れたかを確かめる手段が無い | なし |
この表の時間の差は、この章の小さなモデル(6万件・木200本)では2秒あまりにすぎません。学習に数時間から数日かかるモデルや、学習のたびに人の確認が要る業務では、別名の付け替えで戻せるかどうかが、障害の時間をそのまま左右します。
保存物を読み戻すときのもう1つの危険は、ライブラリの版の食い違いです。先に挙げた scikit-learn の公式ドキュメントは、ある版の scikit-learn で保存したモデルが別の版で読み込めることはあるが、それはまったくサポートされておらず、勧められない、と書いています。読み込めたとしても、予期しない異なる結果を出したり、Python の処理そのものが異常終了したりすることがある、とも書いています。保存物と一緒にライブラリの版を記録しておく理由はここにあります。
この記事の実行環境には scikit-learn 1.9.0 しか無いので、別の版で保存したファイルを実際に作って読むことはできません。そこで、保存物の中に記録されている版の情報を確かめ、その記録だけを書き換えて読み込み、scikit-learn がどう反応するかを確かめました。次のコードはその要所を抜き出したものです。
import copy, warnings
from sklearn.exceptions import InconsistentVersionWarning

state = model.__getstate__()
print(state.get("_sklearn_version"))          # 保存物に入っている版
fake = copy.copy(state)
fake["_sklearn_version"] = "1.5.0"             # 別の版で保存したことにする
obj = type(model).__new__(type(model))
with warnings.catch_warnings(record=True) as w:
    warnings.simplefilter("always")
    obj.__setstate__(copy.copy(fake))
print(w[0].category.__name__)

obj2 = type(model).__new__(type(model))
with warnings.catch_warnings():
    warnings.simplefilter("error", InconsistentVersionWarning)   # 警告を例外にして止める
    try:
        obj2.__setstate__(copy.copy(fake))
    except InconsistentVersionWarning as e:
        print(e.original_sklearn_version, e.current_sklearn_version)
# 出力:
# 1.9.0
# InconsistentVersionWarning
# 1.5.0 1.9.0
保存物の中には、保存したときの scikit-learn の版(1.9.0)が記録されていました。記録を1.5.0に書き換えて読み込むと、InconsistentVersionWarning という警告が1件出ました。警告の文面は、1.5.0で保存された推定器を1.9.0で読み込もうとしており、コードが壊れたり結果が無効になったりするおそれがある、という趣旨です。ただし、これは警告で、読み込みそのものは止まりません。この演習では中身が同じ版で作ったものなので予測は完全に一致しましたが、実際に別の版で保存したファイルを読んだときに予測が一致するかどうかは、この環境では確かめられていません。警告を例外として扱う設定にすると、読み込みはそこで止まり、記録された版(1.5.0)といまの版(1.9.0)を取り出せました。
この結果から、運用の決まりとして2つを勧めます。1つは、本番の推論の仕組みでは、版の食い違いの警告を例外として扱い、黙って読み込ませないことです。もう1つは、読み込む前に、レジストリに記録したライブラリの版といまの環境の版を照合することです。この章の実装では、記録(Python 3.14.3・NumPy 2.4.3・pandas 3.0.1・scikit-learn 1.9.0・joblib 1.5.3)といまの環境の差は「なし」で、記録が scikit-learn 1.8.0 だった場合を想定して照合すると、差として scikit-learn の1.8.0と1.9.0の組が取り出されました。ライブラリの版を上げるときは、保存物を読み戻すのではなく、新しい版の環境で記録から作り直し、評価をやり直して新しい版として登録する、という手順にしておくと、食い違いの問題を避けられます。
保存物には安全上の注意もあります。scikit-learn の同じページは、pickle 形式の保存物を信頼できない出所から読み込んではならず、それは信頼できない出所のコードを実行してはならないのと同じだ、と書いています。joblib の保存と読み込みに関する公式ドキュメントも、joblib.load() は Python の pickle の仕組みの上に作られており、読み込みの途中で任意の Python のコードを実行しうること、自分で作っていないファイルや信頼しきれない出所のファイルには使ってはならないことを明記しています。レジストリで保存物の指紋を照合し、置き場所への書き込みを限られた人に絞ることは、取り違えの防止だけでなく、この危険への備えにもなります。scikit-learn のページは、読み込みで任意のコードが自動的に実行されない保存形式として skops を、最も安全な選択肢として ONNX 形式を挙げています。ただし同じページは、ONNX 形式でも任意の計算を表せるので、計算資源やメモリを悪用されないよう、ONNX のモデルはサンドボックス(外部から隔離した実行環境)で提供することを勧めています(どちらもこの記事の実行環境には入っていないので、試していません。ONNX については第8章で触れます)。
モデルカードを書く
レジストリが「どの版がいつどう扱われたか」の台帳だとすると、モデルカードは「その版がどういう性質のモデルで、どこまで信用してよいか」を、モデルを使う人に向けて短くまとめた文書です。この考え方は、2019年の公平性・説明責任・透明性に関する国際会議(FAT* 2019)で発表された Mitchell らの論文「Model Cards for Model Reporting」で提案されました(arXiv の論文ページ)。要旨は、モデルカードを学習済みのモデルに添える短い文書とし、文化・人口統計・外見の特徴の集団など、さまざまな条件の下での評価の結果を示すとともに、モデルの使われることが想定されている文脈も開示するもの、と説明しています。論文の図1は、モデルカードの節と、各節で答えるべき問いをまとめています。節は次の9つです。
| 論文の節 | 書く内容(この章での言い換え) | この章の v1 での中身 |
|---|---|---|
| Model Details | 作成者・作成日・種類・版・パラメータなど | 作成者、第12か月に登録、HistGradientBoostingClassifier とそのパラメータ、ライブラリの版、保存物とコードの指紋 |
| Intended Use | 想定する用途・利用者、想定外の用途 | 確率がしきい値0.1058を超える顧客に引き止め施策を打つ。学習に無い獲得経路の顧客への適用は想定外 |
| Factors | 性能が変わりうる区分 | 獲得経路(web/store)、プラン(basic/standard/premium) |
| Metrics | 使う指標とその理由 | AUC、予測平均と実際の解約率の差、損益 |
| Evaluation Data | 評価に使ったデータ | 学習に使っていない第12か月の5,000件 |
| Training Data | 学習に使ったデータ | 第1〜11か月の55,000件、解約率0.0800、経路は web/store のみ、データの指紋 |
| Quantitative Analyses | 区分ごとの評価の結果 | 下の表 |
| Ethical Considerations | 倫理上の考慮 | 区分ごとの施策の当たり方を毎月確かめる(第12章) |
| Caveats/Recommendations | 注意と推奨 | partner の顧客が混ざり始めたら、使う前に区分別の評価をやり直す |
論文は、学習データの節について、実務では詳しく書けない場合があることも認めています。この章では、レジストリの記録から数値の欄を機械的に埋めるスクリプトを書き、v1 のモデルカードを実際に作りました。人が書くのは「想定する用途」「想定外の用途」「注意と推奨」のような判断の欄だけで、指紋・件数・評価の数字は記録から写すので、カードとレジストリの中身が食い違うことがありません。定量的な分析の節に入れた、評価月(第12か月)の区分別の結果は次のとおりです。
| 区分 | 件数 | AUC | 予測平均 | 実際の解約率 |
|---|---|---|---|---|
| 全体 | 5,000 | 0.6834 | 0.0797 | 0.0780 |
| 経路 store | 1,946 | 0.6874 | 0.0783 | 0.0817 |
| 経路 web | 3,054 | 0.6809 | 0.0806 | 0.0756 |
| プラン basic | 1,775 | 0.7027 | 0.0759 | 0.0794 |
| プラン premium | 856 | 0.7041 | 0.0923 | 0.0853 |
| プラン standard | 2,369 | 0.6586 | 0.0780 | 0.0743 |
登録の時点では、経路の間で AUC にも確率の水準にも大きな差はなく、プラン standard の AUC(0.6586)がほかの2つ(0.70前後)より低いことが読み取れます。このカードの「注意と推奨」には、学習データに partner 経路が無いことを書きました。第2章で紹介したとおり、共通データでは第22か月から partner 経路の顧客が約18%混ざり始めます。そこで、v1 をそのまま第22〜24か月に使ったときの経路別の結果を、事後の確認として測りました。partner の顧客(2,639件)では、AUC が0.6396、予測平均が0.1229に対して実際の解約率が0.1789でした。store(AUC 0.6699、予測平均0.0828、実際0.0895)や web(AUC 0.6661、予測平均0.0780、実際0.0887)と比べて、partner では並べ方の正しさが低く、確率を実際より約0.056低く見積もっています。カードに「学習に無い経路の顧客への適用は想定外」と書いてあれば、partner の開始が決まった時点で、使う側が評価のやり直しを求めるきっかけになります。モデルカードは、作った人が去った後にも残る「取扱説明書」であり、どこまでが検証済みでどこからが未検証なのかの境目を書いておく場所だと考えています。
モデルカードをどこまで詳しく書くかは、影響の大きさで決めてよいと考えています。顧客への施策・与信・採用のように、予測が人に向かう判断に使われるモデルでは、論文の9つの節をすべて埋め、区分ごとの評価も載せるべきです。社内の在庫の参考値のように、誤っても影響が小さく、使う人が作った人の近くにいるモデルなら、用途・学習データ・評価の結果・注意の4つ程度から始めても十分に役に立ちます。説明責任の制度との関係は第12章で扱います。
承認の遅れと誤った版を経営指標に翻訳する
承認の手続きを入れると、新しい版が本番に入るまでに時間がかかります。手続きを重くしすぎると、その遅れ自体が損失になります。そこで、第2章の基準の結果と同じ定義の四半期ごと再学習(第16・19・…・34か月に、第 m-13〜m-2 か月で学習)について、候補ができてから本番に入るまでに承認待ちで0〜3か月遅れた場合の、第13〜36か月の損益の合計を計算しました。遅れの間は、それまでの本番の版を使い続けます。
| 承認の遅れ | 損益合計(万円) | 遅れ0か月との差(万円) |
|---|---|---|
| 0か月 | 2,357.7 | 0.0 |
| 1か月 | 2,335.7 | -22.0 |
| 2か月 | 2,333.7 | -24.0 |
| 3か月 | 2,281.1 | -76.6 |
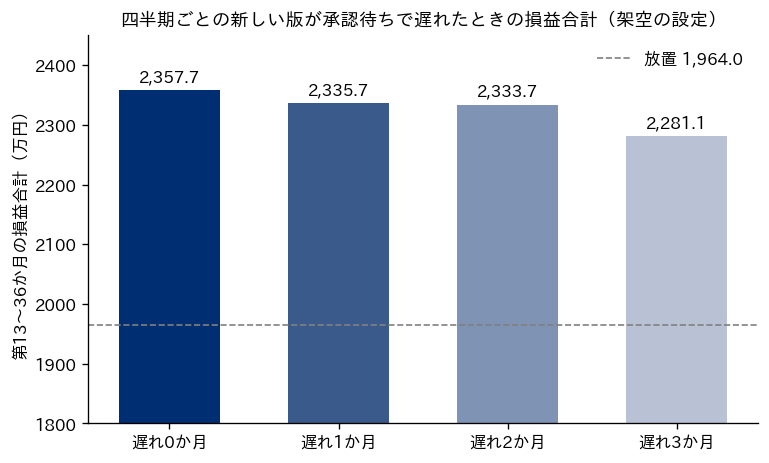
遅れ0か月の2,357.7万円は、第2章の基準の結果の四半期ごと再学習の損益合計と一致しており、計算の土台が同じであることを確かめています。遅れが3か月になると、次の版ができるまで前の版を使い続けることになり、損益の合計は76.6万円減りました。図の縦軸は1,800万円から始めているので、棒の高さの違いは見た目より小さい点に注意が要ります。遅れ3か月でも、放置(1,964.0万円)よりは317.1万円多く、承認の手続きが遅いことよりも、新しい版を入れないことの方が損失は大きい、というのがこの架空の設定での結果です。
一方、審査を省いて、作り直した候補をそのまま入れる運用だった場合を考えます。第31か月に結合のずれた v7 がそのまま本番に入り、次の入れ替え(第34か月)まで使われたとすると、第31〜33か月の損益は月に20.0〜22.1万円にとどまり、正しい v8 を使った場合(月に149.9〜176.4万円)との差は3か月で416.5万円になりました。施策件数も、v7 では月に537〜558件、v8 では月に1,944〜2,022件で、打つべき顧客に施策が届かなくなります。v7 の AUC はこの3か月で0.5312〜0.5447で、ランダムに並べた場合に近い並べ方でした。
2つの数字を並べると、承認の手続きの価値が見えます。この架空の設定では、承認が1か月遅れると、第13〜36か月の24か月の合計で損益が22.0万円減りました。一方、誤った版を審査なしで入れていた場合は、第31〜33か月の3か月だけで416.5万円の損失になりました。期間の違う数字なので割り算はしませんが、3か月だけの損失が、24か月にわたる遅れの損失を大きく上回っており、この設定では誤った版を通す損失のほうが大きいと言えます。もちろん、誤った版がどのくらいの頻度で出てくるか、出てきたときにどれだけの期間気づかれないかは、組織ごとに違い、この計算からは決まりません。経営の判断としては、「承認を省けば速くなる」ではなく、「審査は機械に自動で回させ、人の承認は記録を見て判断するだけの軽い作業にして、遅れを短くする」方向で設計するのが筋だと考えています。審査の自動化は、第9章で扱う学習のパイプラインの中に組み込むのが一般的です。
レジストリと承認の仕組みに投資する判断の材料としては、次の3つを経営指標に直して並べるとよいと考えています。1つ目は、承認の遅れによる損益の差(この章の設定では、24か月の間の7回の入れ替えがどれも同じ月数だけ遅れたとして、第13〜36か月の24か月の合計で、遅れ1か月なら22.0万円、遅れ3か月なら76.6万円の減少)。2つ目は、誤った版を本番に入れたまま気づかなかった場合の損失(この章の設定では、1回の誤った版が第31〜33か月の3か月使われたとして、その3か月の合計で416.5万円)。この2つは、期間も、数えた入れ替えの回数も違うので、1か月あたりに割って比べることはせず、期間と回数を添えたまま並べます。3つ目は、障害のときに前の版へ戻すまでの時間(別名の付け替えなら1秒未満、記録から作り直すならモデルの学習時間と確認の時間)です。これらを、レジストリを整えるのにかかる人手の工数と比べます。
この章では、モデルの版を登録し、承認し、本番の版を管理する仕組みを扱いました。レジストリの中心は、保存物に、学習データとコードの指紋・ライブラリの版・評価の結果・承認の出来事を結び付けた台帳で、主要な製品も連番の版・タグ・別名や承認の状態という共通の考え方で作られていることを、公式ドキュメントで確かめました。第2章で用意したサンプルデータでは、審査と承認を経た四半期ごとの入れ替えで、結合のずれた候補を止めつつ、24か月の損益を初版のままより343.2万円多くでき、誤った候補を通していれば3か月で416.5万円を失っていたことを実測しました。モデルカードには、学習に無い経路への適用は想定外だと書き、実際にその経路で確率を低く見積もることを確かめました。次の第8章では、こうして本番の版として承認したモデルを、バッチ推論とオンライン推論で業務に届ける方法と、段階的に切り替えるリリースの方式を扱います。
この章を深めたい方への参考書籍
『機械学習デザインパターン:データ準備、モデル構築、MLOpsの実践上の問題と解決』(Valliappa Lakshmanan、Sara Robinson、Michael Munn 著、鷲崎弘宜、竹内広宜、名取直毅、吉岡信和 訳、オライリー・ジャパン):機械学習の設計で繰り返し現れる問題と解決を30のパターンにまとめた本です。再現性のパターンの章に、モデルのバージョニングのパターンがあり、新しいモデルと新しい版をどう区別するか、管理サービスで版を扱う方法を説明しています。この章の版の番号と別名の考え方を、設計の型として確かめるのに向いています。
『機械学習工学』(石川冬樹、丸山宏 編著、柿沼太一、竹内広宜、土橋昌、中川裕志、原聡、堀内新吾、鷲崎弘宜 著、講談社):機械学習を使ったシステムを工学として作り、運用するための考え方をまとめた本で、機械学習システムの運用、品質のとらえ方と管理、品質に関するガイドラインの章があります。この章で扱った受け入れ基準や承認の記録を、品質を管理する仕組みの中に位置づけて考えるのに役立ちます。
第8章 モデルを届ける、バッチ推論とオンライン推論
第7章では、学習したモデルをモデルレジストリに登録し、誰がいつ承認したか、どのデータとコードから作られたかを版ごとに残す仕組みを確かめました。承認されたモデルは、それだけでは業務の判断に使われません。予測を必要とする業務システムや担当者の手元に、決まった時刻に、決まった形で予測を届けて、はじめて施策が動きます。この章では、予測の届け方の2つの型であるバッチ推論とオンライン推論の選び方を整理し、第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)のモデルを、推論の API とバッチ推論の両方の形で動かして、応答時間と処理時間を実測します。そのうえで、新しい版のモデルを本番に出すときのリリースの方式と、問題が起きたときに前の版へ戻すロールバック、後の監視と再学習の材料になる推論の記録を扱います。学習と評価を自動でつなぐパイプラインは第9章で扱います。
予測を届ける2つの型、バッチ推論とオンライン推論
学習したモデルに新しいデータを入れて予測を出すことを、推論と呼びます。推論の届け方には大きく2つの型があります。1つは、決まった時刻に対象の全件をまとめて予測し、結果をファイルやデータベースの表に書き出しておくバッチ推論です。業務システムや担当者は、書き出された結果を読んで使います。もう1つは、業務システムから1件または少数の顧客についての問い合わせが来るたびに、その場で予測して返すオンライン推論です。オンライン推論は、ネットワーク越しに呼び出せる窓口(API。プログラムどうしが決まった形式でやり取りするための入口)としてモデルを常に動かしておく形をとるのが一般的です。
クラウドの機械学習基盤も、この2つを別の仕組みとして用意しています。Microsoft の Azure Machine Learning の公式ドキュメント「Endpoints for inference」は、リアルタイムの推論のための仕組みとしてオンラインのエンドポイント(モデルを呼び出すための固定の URL)と standard deployments と呼ぶ配置の形を、長時間かかるバッチ推論のための仕組みとしてバッチのエンドポイントを挙げ、バッチのエンドポイントを呼ぶと実際の処理を行うバッチのジョブが作られる、と書いています。Amazon SageMaker AI の公式ドキュメント「Batch transform for inference with Amazon SageMaker AI」は、大きなデータセットの推論を得たいときや、常時動いているエンドポイントを必要としないときにバッチ変換(同社のバッチ推論の機能)を使う、と案内しています。製品ごとの機能の見取り図は、弊社コラム「AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方」で扱っています。この章では製品に依らない考え方と、手元で動かした結果を示します。
2つの型の違いを表にまとめます。表の右端の列は、この章の共通データ(各月5,000件の顧客)に当てはめたときの例です。
| 観点 | バッチ推論 | オンライン推論 | 共通データでの例 |
|---|---|---|---|
| 予測するとき | 決まった時刻にまとめて(毎日・毎月など) | 問い合わせが来たそのとき | 毎月の初めに5,000件をまとめて予測するならバッチ推論 |
| 待てる時間 | 数分から数時間でも業務に間に合えばよい | 画面の表示や手続きの途中なので、数十ミリ秒から数秒 | 解約手続きの画面で引き止めの提案を出すならオンライン推論 |
| 入力のデータ | 締めた後の確定したデータを使える | その時点で取れるデータだけを使う | 前月の利用日数は月初には確定している |
| 動かしておくもの | 処理のあいだだけ計算機を使う | 窓口を常に動かし、止まらないように見張る | 月1回の処理なら、常に動かしておく窓口は要らない |
| 失敗したとき | やり直して書き出し直せば済むことが多い | その場で予測を返せず、業務の画面や手続きが止まる | 月初の処理が失敗しても、施策の開始前にやり直せばよい |
| 結果の確かめ方 | 書き出した全件を、使う前に集計して確かめられる | 返した予測を後から記録で確かめる | 施策件数や予測平均を、施策を打つ前に前月と比べられる |
この表の最後の行は、運用の安全性の点で大きな違いです。バッチ推論では、予測を業務に使う前に、全件の予測平均や施策件数を前月と並べて確かめる時間があります。オンライン推論では、返した予測はその場で業務に使われるので、異常に気づくのは記録を後から見たときになります。
どちらを選ぶか、判断の頻度・待てる時間・費用で決める
バッチ推論とオンライン推論のどちらを選ぶかは、モデルの種類ではなく、予測を使う業務の判断の形で決まります。考える順序は3つです。1つめは判断の頻度で、施策の対象を月に1回決めるのか、顧客の行動のたびに決めるのか。2つめは待てる時間で、予測が出るまで業務が何秒待てるのか。3つめは費用で、窓口を常に動かして見張る費用と、その費用に見合う効果があるか、です。
共通データの解約予測は、毎月、引き止め施策の対象を決めるために使う設定でした。入力の利用日数は前月の値で、月初には確定しています。施策は月単位で打つので、予測が数分遅れても損益は変わりません。この使い方なら、バッチ推論で十分です。一方、同じモデルを、顧客が解約の手続きを始めたその画面で引き止めの提案を出すために使うなら、予測は数百ミリ秒のうちに返らなければなりません。このときはオンライン推論が要ります。同じモデルでも、業務の使い方が変われば届け方が変わる、ということです。
オンライン推論は、バッチ推論より多くのものを抱えます。窓口が止まると業務の画面が止まるので、障害の監視と夜間・休日の対応の体制が要ります。応答時間の目標を決め、それを守れているかを測り続ける必要があります。入力は業務システムから1件ずつ届くので、入力の誤りもその場で処理しなければなりません。こうした仕組みと体制には、継続して人手と計算機の費用がかかります。月に1回の判断のためにオンライン推論を作ると、この費用を払いながら、バッチ推論と同じ損益しか得られません。逆に、手続きの画面での判断のようにその場でしか打てない施策をバッチ推論で代用しようとすると、前日の予測を使うことになり、その日に新しく利用を始めた顧客や、その日の行動の変化を反映できません。
経営の判断として言い換えると、オンライン推論を選ぶ理由は「速いから」ではなく、「その場で予測しないと打てない施策があり、その施策の効果が常時の運用の費用を上回るから」であるべきです。判断の頻度が月1回・週1回の業務から始めるなら、まずバッチ推論で業務に組み込み、効果を確かめてから、その場で打つ施策を追加する順序が無理の少ない進め方だと考えています。
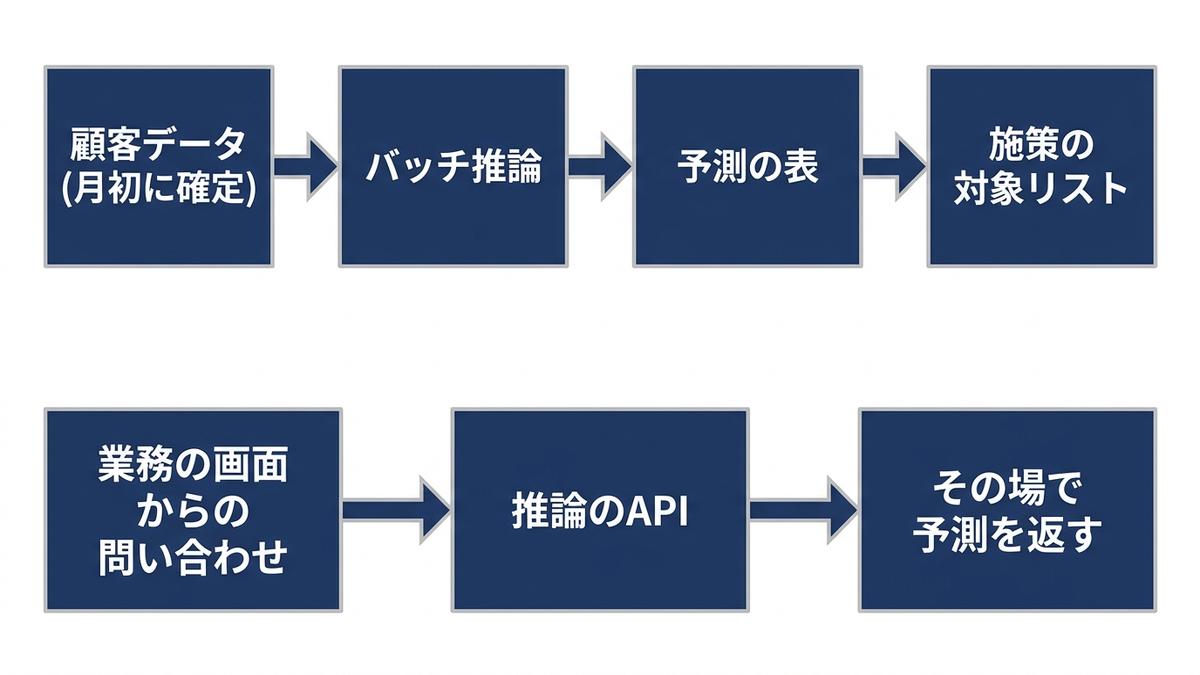
推論の API を FastAPI で作り、応答時間を測る
オンライン推論の窓口を、Python の Web API の枠組みである FastAPI で作ります。モデルは第2章の基準の結果と同じ設定の HistGradientBoostingClassifier で、第1〜12か月で学習した版(以下 v1。第2章の「放置」のモデルと同じもの)と、第15〜26か月で学習した版(以下 v2。第28か月の時点でラベルが確定している直近12か月で学習したもので、第2章の「毎月再学習」の第28か月のモデルと同じ期間)の2つを用意しました。この v1・v2 は、この章の中だけの呼び名です。第7章のレジストリにも v1・v2 という版が出てきますが、学習した期間が違う別のモデルです(第7章の v1 は第1〜11か月、v2 は第2〜13か月で学習)。次のコードは、実際に動かしたコードから要所を抜き出し、推論の記録を書き込む部分と、後で述べる複数件をまとめて受け付ける窓口の定義を省いたものです。補助モジュール(mlops_data.py・baseline.py)と同じフォルダに置いて実行する形です。
from typing import Literal
import pandas as pd
from fastapi import FastAPI
from pydantic import BaseModel, Field
import mlops_data as md
import baseline as bl

class Customer(BaseModel):          # 1件の顧客の入力の形と、許す値の範囲
    tenure_m: float = Field(ge=1, le=120)
    plan: Literal["basic", "standard", "premium"]
    monthly_fee: float = Field(gt=0, le=10000)
    usage_days: float | None = Field(default=None, ge=0, le=31)   # 欠損は None で受ける
    usage_change: float = Field(ge=-31, le=31)
    support_tickets: int = Field(ge=0, le=50)
    payment_failures: int = Field(ge=0, le=10)
    channel: Literal["web", "store", "partner"]
    discount: int = Field(ge=0, le=1)

models = {"v1": bl.fit(1, 12), "v2": bl.fit(15, 26)}
app = FastAPI()
app.state.active = "v1"             # 今使う版の名前

@app.post("/predict")
def predict(c: Customer):
    df = pd.DataFrame([c.model_dump()])
    df["usage_days"] = df["usage_days"].astype(float)   # None を欠損値に
    ver = app.state.active
    p = models[ver].predict_proba(md.encode(df))[0, 1]
    # 実際のコードでは、ここで要求番号・版・入力・予測を SQLite に記録する
    return {"model_version": ver, "churn_prob": round(float(p), 6),
            "contact": bool(p > md.THRESHOLD)}
入力の形は pydantic の BaseModel で定義しました。プランと獲得経路は許す値を列挙し、数値は上限と下限を決めています。この定義に合わない入力は、モデルに届く前に FastAPI が断ります(次の節で実測します)。返す値は、解約の予測確率、第2章で決めたしきい値(約0.106)を超えて施策の対象になるかどうか、そして予測に使ったモデルの版の名前です。版の名前を毎回返して記録に残しておくと、後で「この予測はどの版が出したか」を必ず辿れます。複数の顧客をまとめて受け付ける /predict_batch(1回に1件から1,000件まで)も同じ形で作り、この章の測定では100件ずつ送りました。/predict_batch の定義は掲載を省いています。
この窓口を、FastAPI の TestClient で呼び出して応答時間を測りました。FastAPI の公式ドキュメント「Testing」は、TestClient が HTTPX という HTTP の通信のライブラリを基にしたテスト用の呼び出し口であることを説明しています。TestClient を使うと、サーバーを起動したりポートを開いたりせずに、同じプログラムの中から API を呼べます。そのため、ここで測った時間には、実際のネットワークを通る時間は含まれていません。次のコードも要所だけの抜粋で、上の窓口に続けて実行する想定です。省いた /predict_batch の定義と、データを API に送る形に変える関数 records の定義は載せていないので、このままでは動きません。実際に動かしたコードでは、この2つを推論の API の本体と同じファイルに書いています。
import time
import numpy as np
from fastapi.testclient import TestClient

client = TestClient(app)             # サーバーを起動せず、同じプロセスの中から呼ぶ
d = md.month_data(28)                # 第28か月の5,000件
recs = records(d)                    # API に送る形(辞書のリスト。欠損は None)に変えたもの

def median_ms(fn, n):
    ts = []
    for _ in range(n):
        s = time.perf_counter(); fn(); ts.append((time.perf_counter() - s) * 1000)
    return np.median(ts), np.percentile(ts, 95)

i = iter(range(10**6))
print(median_ms(lambda: client.post("/predict", json=recs[next(i) % 5000]), 300))
j = iter(range(10**6))
print(median_ms(lambda: client.post("/predict_batch",
      json={"customers": recs[(next(j) * 100) % 5000:][:100]}), 50))
# 出力(この記事の実行環境での実測。実行ごとに揺れる)
# 1件:中央値 24.16 ms / 95%点 29.49 ms
# 100件まとめ:中央値 24.15 ms / 95%点 28.47 ms
結果を表にまとめます。時間は、この記事の実行環境(一般的なノートPC)での実測です。同じPCで他の処理も動いていたので、実行のたびに揺れます。「95%点」は、測った回数のうち95%がその時間以内に収まった値で、たまに遅くなる応答の目安です。
| 呼び方 | 測った回数 | 中央値 | 95%点 | 1件あたり(中央値÷件数) |
|---|---|---|---|---|
| API に1件を送る | 300回 | 24.16ミリ秒 | 29.49ミリ秒 | 24.16ミリ秒 |
| API に100件をまとめて送る | 50回 | 24.15ミリ秒 | 28.47ミリ秒 | 0.242ミリ秒 |
| モデルを直接呼ぶ(1件) | 300回 | 5.99ミリ秒 | 測っていない | 5.99ミリ秒 |
| モデルを直接呼ぶ(100件) | 50回 | 6.16ミリ秒 | 測っていない | 0.062ミリ秒 |
この表から読み取れることは2つあります。1つめは、1件を送っても100件をまとめて送っても、1回の呼び出しにかかる時間がほとんど変わらないことです(中央値で 24.16ミリ秒と 24.15ミリ秒)。モデルを直接呼んだ場合も、1件で 5.99ミリ秒、100件で 6.16ミリ秒と差がわずかでした。1回の呼び出しには件数に依らない決まった手間がかかり、件数を増やしたときに増える分は小さい、ということです。2つめは、API を通すと、モデルを直接呼ぶ場合より1件で約18ミリ秒長くかかったことです。この差には、JSON(データをやり取りするための文字の形式)の読み書き、入力の検証、推論の記録の書き込み、TestClient の呼び出しの仕組みが含まれています。内訳は測っていません。
同じ5,000件を、3つのやり方で予測し終えるまでの時間も測りました。API に1件ずつ送るやり方は、1,000回送るのに 32,059.6ミリ秒(約32.1秒)かかったので、5,000件ではその5倍の約160秒という見込みです。API に100件ずつ50回送ると 1,293.4ミリ秒(約1.29秒)、次の節で作るバッチ推論で一括して処理すると、データの読み込みと CSV への書き出しを含めて中央値 39.2ミリ秒(約0.04秒)でした。3つのやり方を並べると次のとおりです。
| やり方 | 時間の出し方 | 同じ5,000件を予測し終えるまでの時間 |
|---|---|---|
| API に1件ずつ5,000回送る | 1,000回送った実測(32,059.6ミリ秒)の5倍の見込み | 約160秒(160,298ミリ秒) |
| API に100件ずつ50回送る | 実測 | 約1.29秒(1,293.4ミリ秒) |
| バッチ推論で一括して処理する(データの読み込みと CSV への書き出しを含む) | 実測(10回の中央値) | 約0.04秒(39.2ミリ秒) |
1件ずつ送るやり方とバッチ推論の一括処理では、同じ5,000件に4,000倍ほどの差がありました。ただし、1件ずつ送るやり方には、API の入力の検証や推論の記録の書き込みといった、バッチ推論の一括処理には無い処理も含まれています。この倍率は、送り方の違いだけでなく、処理の中身の違いも含んだものです。毎月5,000件をまとめて予測する業務で、業務システムの側が API に1件ずつ問い合わせる作りにすると、それだけで処理に数分かかり、そのあいだ窓口を占有します。オンライン推論の窓口を作った後に、月次の一括処理もその窓口経由で流そうとする設計は起こりやすいので、一括で予測する用途には一括の経路を別に用意するのが素直だと考えています。
なお、上のコードは測り方の要所だけを示したもので、実際に測ったコードでは、測り始める前に1件の呼び出しを20回、100件の呼び出しを5回行って、初回の呼び出しに特有の準備の時間が結果に入らないようにしています。
入力検証の失敗をどう扱うか
オンライン推論の窓口には、業務システムから想定外の入力が届くことがあります。項目の欠落、知らないカテゴリの値、文字列が入った数値の項目などです。こうした入力をモデルにそのまま渡すと、エラーで止まるか、もっと悪い場合は、もっともらしい予測が黙って返ります。そこで、入力の形を定義しておき、合わない入力はモデルに届く前に断るようにします。FastAPI の公式ドキュメント「Handling Errors」は、要求に不正なデータが含まれるとき、FastAPI が内部で RequestValidationError という例外を起こし、それを処理する既定の仕組みを持っていると説明しています。実際に、さまざまな入力を送って結果を確かめました。
| 送った入力 | 応答の状態コード | 返った内容 |
|---|---|---|
| プランに未知の値 gold | 422 | plan の項目が、許された3つの値のどれでもないという誤り(種類 literal_error) |
| 利用日数に -3 | 422 | usage_days の項目が0以上でないという誤り(種類 greater_than_equal) |
| 獲得経路の項目が無い | 422 | channel の項目が必須なのに無いという誤り(種類 missing) |
| 月額に文字列「1,980円」 | 422 | monthly_fee の項目が数として読めないという誤り(種類 float_parsing) |
| 100件のうち38件目だけプランが gold | 422 | 38件目の plan の誤りが1件だけ示され、残り99件の予測も返らない |
| 利用日数を欠損(None)にした | 200 | 予測 0.0354(同じ顧客の利用日数が3日のときは 0.0819) |
| standard の顧客の月額 2,380 を千円単位の 2.38 で送った | 200 | 予測 0.0339(正しい単位のときは 0.0457) |
状態コード422は、HTTP の仕様であるRFC 9110で「Unprocessable Content」と名付けられ、要求の内容の形式は読めるが、その中身を処理できないことを示すコードと定められています。表の上の5行は、定義した形に合わない入力が、モデルに届く前に断られたことを示しています。応答には、どの項目がどういう理由で誤っているかが入っているので、送った側のシステムが直すべき箇所を特定できます。
一方、表の下の2行は、検証を通ってしまった入力です。利用日数の欠損は、第3章で扱ったとおり、このモデル(HistGradientBoostingClassifier)が欠損を受け付けるので、エラーにならずに予測が出ます。この顧客では、利用日数が3日のときの予測 0.0819 が、欠損にすると 0.0354 になりました。欠損を許すかどうかは業務の判断で、この章の入力の定義では欠損を許しています。月額を千円単位で送った例は、値が0より大きく1万以下という範囲には入っているので、検証を通りました。予測は 0.0457 から 0.0339 に下がっています。第28か月の5,000件すべてで月額をこの単位で送ってしまった場合を計算すると、予測平均は 0.0874 から 0.0704 に下がり、施策件数は 1,382件から 937件に減り、損益は約114.7万円から約80.0万円に下がりました(いずれも第2章の架空の設定での値)。単位の取り違えのように、値としてはありうる範囲に収まる誤りは、項目ごとの範囲の検証では止まりません。プランと月額の組み合わせが料金表と合っているかといった、項目をまたぐ確かめ方が要ります。データの検証の作り方は第3章で扱いました。
もう1つの設計の判断は、100件をまとめて送ったときに1件だけ不正だった場合の扱いです。この章の作りでは、FastAPI の既定の動きのまま、要求全体を断っています。こうすると、正しい99件の予測も返りません。送る側が直して送り直せる業務ならこれで足ります。一方、毎晩の処理で1件の誤りのために全体が止まると困る業務なら、正しい件の予測は返し、誤った件だけを理由つきで返す作りにする必要があります。どちらにするかは、止まったときの業務の損と、誤った入力で予測を出してしまう損のどちらが大きいかで決めることになります。
バッチ推論を実装する
バッチ推論は、仕組みとしてはオンライン推論より単純です。対象の全件を読み込み、モデルで予測し、結果を書き出すだけです。次のコードは、第28か月の5,000件を放置のモデル(v1)でまとめて予測し、CSV ファイルに書き出すものです。補助モジュールと同じフォルダに置いて実行する形です。
import os, time
import numpy as np
import pandas as pd
import mlops_data as md
import baseline as bl

model = bl.fit(1, 12)                    # 放置のモデル(第1〜12か月で学習)
os.makedirs("ch08_runs", exist_ok=True)

s = time.perf_counter()
d = md.month_data(28)                    # 第28か月の5,000件
p = model.predict_proba(md.encode(d))[:, 1]
out = pd.DataFrame({"row": np.arange(len(d)), "model_version": "v1",
                    "churn_prob": p, "contact": p > md.THRESHOLD})
out.to_csv("ch08_runs/batch_m28_v1.csv", index=False)
print("%.1f ms" % ((time.perf_counter() - s) * 1000))
print(md.campaign_value_threshold(d.churn, p))   # (損益, 当たり件数, 施策件数)
# 出力(時間は10回の中央値。この記事の実行環境での実測)
# 39.2 ms
# (1147279.9999999995, 298, 1382)
5,000件の読み込み・予測・書き出しは、10回の中央値で 39.2ミリ秒(95%点 51.4ミリ秒)でした。このうち予測だけにかかったのは中央値 19.6ミリ秒です。第28か月の損益は約114.7万円、施策件数は 1,382件で、第2章の基準の結果の第28か月の放置のモデルの値(損益 1,147,280円、施策件数 1,382件)と一致しています。
同じ5,000件を API に100件ずつ送って得た予測と、バッチ推論の予測を突き合わせると、差の最大は 0.0000005(10のマイナス7乗の5倍)でした。API は予測を小数6桁に丸めて返すように作ったので、この差は丸めの分です。施策の対象になる顧客は2つの経路で完全に一致し、損益も同じ値になりました。オンラインとバッチの2つの経路を持つときは、このように「同じ入力に同じ予測を返すか」を確かめておく必要があります。2つの経路で前処理を別々に書くと、第3章で扱った学習と推論の食い違いと同じ種類の事故が、経路のあいだで起きるからです。前処理を共通の関数(この章では md.encode)にまとめて、両方の経路から呼ぶのが防ぎ方です。
バッチ推論の運用で気をつける点は、計算の速さよりも、処理の前後にあります。予測の結果には、どの版のモデルで、どの月のデータを予測したかを必ず書き込みます。上のコードではファイル名と model_version の列にそれを残しました。同じ月を2回処理したときに、前の結果を上書きするのか、別の版として残すのかを決めておきます。そして、書き出した結果を業務に渡す前に、施策件数と予測平均を前月の値と並べて確かめる工程を入れます。第2章の基準の結果では、放置のモデルの施策件数は第13〜36か月を通じて月に1,100件から1,410件の範囲でした。これが急に半分や2倍になったら、データかモデルのどこかがおかしいと考えて、施策を打つ前に止めるべきです。この確かめ方を自動のテストにする方法は第9章で扱います。
経営の目線でいうと、バッチ推論の利点は、予測が業務に使われる前に人や仕組みが確かめる時間を取れることです。月初の処理で異常に気づいて止めれば、損失は施策を数日遅らせる分で済みます。気づかずに施策を打てば、誤った対象に打った施策の費用と、打つべき顧客に打てなかった分の粗利を、1か月分まとめて失います。
推論を速く・軽くする選択肢と ONNX Runtime
推論の速さや、推論を動かす環境の制約が問題になるときに検討されるのが、学習に使ったライブラリから切り離した形式にモデルを変換して動かすやり方です。代表的なものに、機械学習のモデルを表すための共通の形式である ONNX と、その形式のモデルを動かす ONNX Runtime があります。ONNX Runtime の公式ドキュメント「ONNX Runtime」は、ONNX Runtime を、ハードウェアごとのライブラリと組み合わせられるクロスプラットフォームの機械学習モデルの高速化の仕組みと説明し、PyTorch・TensorFlow/Keras・TFLite・scikit-learn などで作ったモデルに使えるとしています。scikit-learn のモデルを ONNX の形式に変換する道具 sklearn-onnx(skl2onnx)の公式ドキュメント(1.20.0 版)の「Supported scikit-learn Models」には、変換できるモデルの一覧があり、この章のモデルと同じ HistGradientBoostingClassifier も変換できるものとして載っています。同じページは、一覧の変換が ONNX Runtime で試験されていると書いています。
この記事の実行環境には ONNX Runtime は入っていますが、変換に要る onnx と skl2onnx が入っていないので、共通データのモデルを変換して動かすことはしていません。したがって、変換によってこの章のモデルの推論がどれだけ速くなるかは確かめていません。この章の実測から言えるのは、API の1回の呼び出し(中央値 24.16ミリ秒)のうち、モデルの予測そのもの(直接呼んで 5.99ミリ秒)は4分の1ほどで、残りは API の仕組みの側にかかっていた、ということだけです。この条件では、モデルの予測をいくら速くしても、応答時間の大半は縮みません。変換を検討するのは、推論を Python 以外の環境(業務システムの言語や端末の中など)で動かしたいとき、または、モデルの予測そのものが時間の大半を占めることを実測で確かめたときが妥当だと考えています。変換した場合は、変換の前後で同じ入力に同じ予測が返るかを、上のバッチと API の突き合わせと同じ方法で確かめてから本番に出す必要があります。
新しい版を出す方式、一斉切り替え・ブルーグリーン・カナリア・シャドー
第7章で承認された新しい版のモデルを、本番の予測に使い始める段階に進みます。ここで決めるのは、新しい版を「いつ、誰に対して」使い始めるかです。ソフトウェアのリリースで使われてきた方式が、モデルにもそのまま使えます。代表的なものを、開いて確かめた一次情報の定義とともに整理します。
一斉切り替えは、ある時点で全員の予測を新しい版に替える方式です。最も単純ですが、新しい版に問題があれば、全員が同時にその影響を受けます。
ブルーグリーンデプロイメントは、Martin Fowler 氏の2010年の解説「BlueGreenDeployment」によれば、できるだけ同じに作った本番の環境を2つ用意し、片方(例えば青)が本番として動いているあいだに、もう片方(緑)で新しい版の最後の試験を行い、問題が無ければ要求の振り分け先をすべて緑に切り替える方式です。同じ解説は、何か問題があれば振り分け先を青に戻せば素早く元に戻せることを利点に挙げています。切り替える瞬間には全員が新しい版に移るので、影響の範囲は一斉切り替えと同じですが、戻すのが速いことが違いです。
カナリアリリースは、同じサイトの Danilo Sato 氏の2014年の解説「CanaryRelease」によれば、新しい版を全体に広げる前に、まず利用者のごく一部に少しずつ出していくことで、本番に新しい版を入れるリスクを減らす方式です。名前は、炭鉱で有毒なガスを早く知るためにカナリアを連れて入った習わしに由来すると説明されています。Google が SRE(サイト信頼性エンジニアリング。サービスを安定して動かし続けるための技術と運用の考え方)のサイトで公開している実践の解説の第16章「Canarying Releases」は、カナリアを「サービスへの変更を、一部に、期間を限って展開し、それを評価すること」と定義し、変更を受け取る部分をカナリア、残りを対照群(コントロール)と呼んでいます。同じ章は、カナリアは実質的に A/B テスト(利用者を2つの組に分けて比べる試験)の手続きであるとも書いています。
シャドー運用は、新しい版にも本番と同じ入力を流して予測させるが、その予測は業務に使わず記録だけする方式です。Amazon SageMaker AI の公式ドキュメント「Shadow tests」は、本番の推論の要求の写しを、新しい版に実時間で送り、呼び出し元には本番の版の応答だけを返し、新しい版の応答は記録して後で比べられる、と説明しています。同じページには、サーバーレスの推論や非同期の推論など、一部の機能を使うエンドポイントではこの試験が使えないという注意も書かれています。Azure Machine Learning の公式ドキュメント「Safe rollout for online endpoints」も、本番の要求の一定の割合を写して新しい版に送る機能(トラフィックのミラーリング。シャドーイングとも呼ぶ)を説明し、呼び出し元に返る結果は変わらないこと、写せる割合の上限が50%であることを書いています。
用語には注意が要ります。同じ Azure Machine Learning のドキュメントは、新しい版をまず一部の利用者や要求に出してから全体に広げるやり方を、「ブルーグリーンデプロイメントの戦略(安全なロールアウトの戦略とも呼ぶ)」と呼んでいます。上の Fowler 氏の解説でいうブルーグリーンは振り分け先を一度に切り替える方式なので、同じ言葉が資料によって違うやり方を指していることになります。社内で方式を決めるときは、名前ではなく「新しい版の予測を業務に使う顧客の割合を、いつ、どう変えるか」で書いておくのが確実です。
| 方式 | 新しい版の予測を業務に使う範囲 | 新しい版が壊れていたときの影響 | 新しい版の良し悪しの測り方 |
|---|---|---|---|
| 一斉切り替え | 切り替えた時点から全員 | 全員に及ぶ | 切り替えの前後の比較(時期の違いと混ざる) |
| ブルーグリーン | 切り替えた時点から全員(戻すのは速い) | 気づいて戻すまで全員に及ぶ | 一斉切り替えと同じ |
| カナリアリリース | はじめは一部の顧客だけ、問題が無ければ広げる | カナリアの組の顧客に限られる | 同じ時期のカナリアの組と対照群の比較 |
| シャドー運用 | 使わない(予測を記録するだけ) | 業務には及ばない | 同じ顧客について、2つの版の予測を比べる |
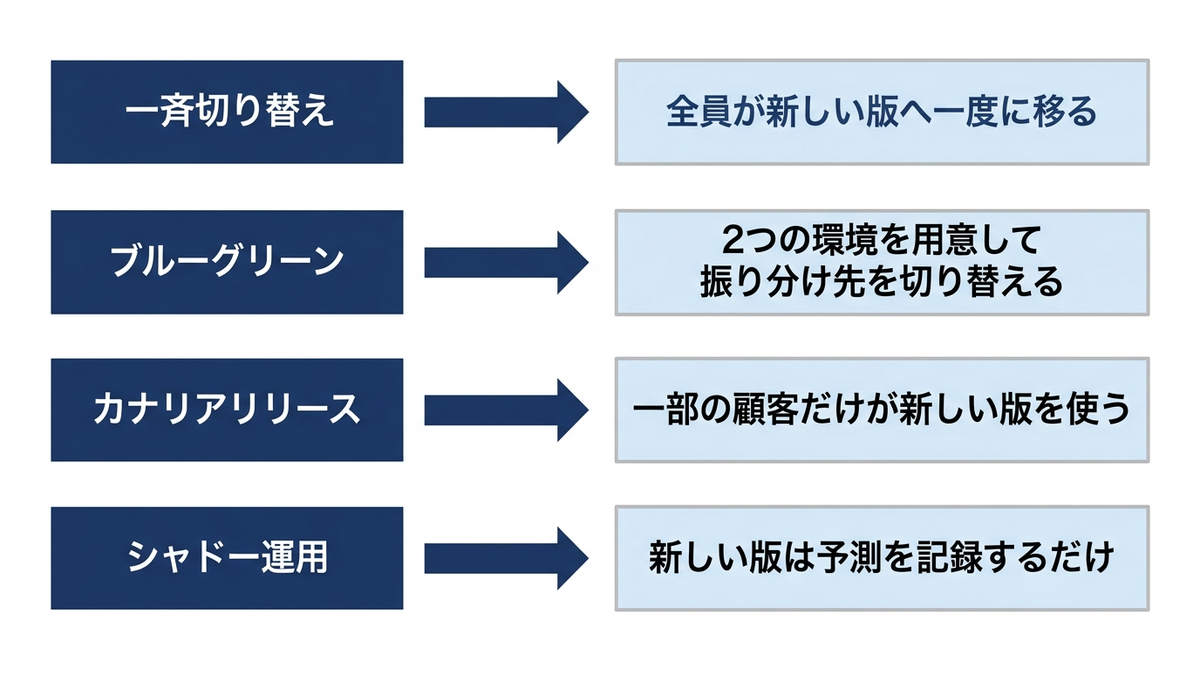
共通データで、リリースの方式ごとの損益を比べる
リリースの方式の違いが損益にどう効くかを、共通データで架空に実演しました。設定は次のとおりです。現行の版は v1(第1〜12か月で学習)で、第28か月の初めに新しい版 v2(第15〜26か月で学習)を出します。v2 には2つの場合を用意しました。1つは良い新しい版で、そのまま使います。もう1つは壊れた新しい版で、モデルは同じ v2 ですが、推論の前処理に、月額を千円単位に取り違える不具合が入っている場合です。上の入力検証の節で見たとおり、この取り違えは範囲の検証を通ります。比べる期間は、第2章で関係そのものが変わったと説明した競合施策の期間(第28〜36か月)です。解約のラベルは翌月末に確定するので、第28か月の結果を見て判断できるのは第30か月の初めです。
| 架空の設定の項目 | 値 |
|---|---|
| 現行の版 | v1(第1〜12か月で学習) |
| 新しい版 | v2(第15〜26か月で学習)。良い版と、月額を千円単位に取り違える壊れた版の2通り |
| 新しい版を出す月 | 第28か月 |
| カナリアの組 | 各月の顧客から乱数(種0)で約10%を選ぶ(第28か月は527人) |
| 判断の時期と方法 | 第30か月の初めに、第28か月の顧客1人あたりの損益で新旧を比べ、新しい版が上回れば以後全員を新しい版に、下回れば現行の版に戻す |
| 損益の計算 | 第2章と同じ(しきい値を超えた顧客に施策を打つ。施策1件800円、解約する顧客に打てば7,560円を守れる) |
カナリアとシャドーの判断の部分を抜き出すと、次のようになります。
import numpy as np
import mlops_data as md
import baseline as bl

v1 = bl.fit(1, 12)                       # 現行の版
v2 = bl.fit(15, 26)                      # 新しい版

def score(model, d, broken=False):
    X = md.encode(d)
    if broken:                           # 壊れた版:月額を千円単位に取り違える
        X = X.copy(); X["monthly_fee"] = X["monthly_fee"] / 1000
    return model.predict_proba(X)[:, 1]

rng = np.random.default_rng(0)
d = md.month_data(28)
y = d.churn.to_numpy()
p_old, p_new = score(v1, d), score(v2, d)
canary = rng.random(len(d)) < 0.10      # 約1割をカナリアの組にする
value = lambda yy, pp: md.campaign_value_threshold(yy, pp)[0]
# カナリア:組ごとに、実際に使った版の損益を1人あたりで比べる
print(value(y[canary], p_new[canary]) / canary.sum(), value(y[~canary], p_old[~canary]) / (~canary).sum())
# シャドー:施策は現行の版で決め、新しい版の予測は記録だけ。全員で両方の損益を計算する
print(value(y, p_new) / len(y), value(y, p_old) / len(y))
# 出力(円/人)
# 250.5 235.0
# 289.6 229.5
良い新しい版の場合、カナリアでは新しい版の組が1人あたり 250.5円、対照群が 235.0円、シャドー運用では同じ5,000人について新しい版が 289.6円、現行の版が 229.5円となり、どちらも第30か月から新しい版に切り替える判断になりました。壊れた新しい版の場合は、カナリアで新しい版の組が 45.8円、対照群が 235.0円、シャドー運用で新しい版が 170.6円、現行の版が 229.5円となり、どちらも現行の版に戻す判断になりました。この判断に従って第28〜36か月の損益を計算した結果が次の表です。
| 方式 | 良い新しい版:第28〜29か月 | 良い新しい版:第28〜36か月の合計 | 壊れた新しい版:第28〜29か月 | 壊れた新しい版:第28〜36か月の合計 |
|---|---|---|---|---|
| 現行のまま(v1 を使い続ける) | 234.7万円 | 1,052.1万円 | 234.7万円 | 1,052.1万円 |
| 一斉切り替え(第28か月から全員) | 273.6万円 | 1,316.5万円 | 146.6万円 | 685.1万円 |
| カナリアリリース(約10%から) | 236.4万円 | 1,279.4万円 | 219.7万円 | 1,037.1万円 |
| シャドー運用 | 234.7万円 | 1,277.6万円 | 234.7万円 | 1,052.1万円 |
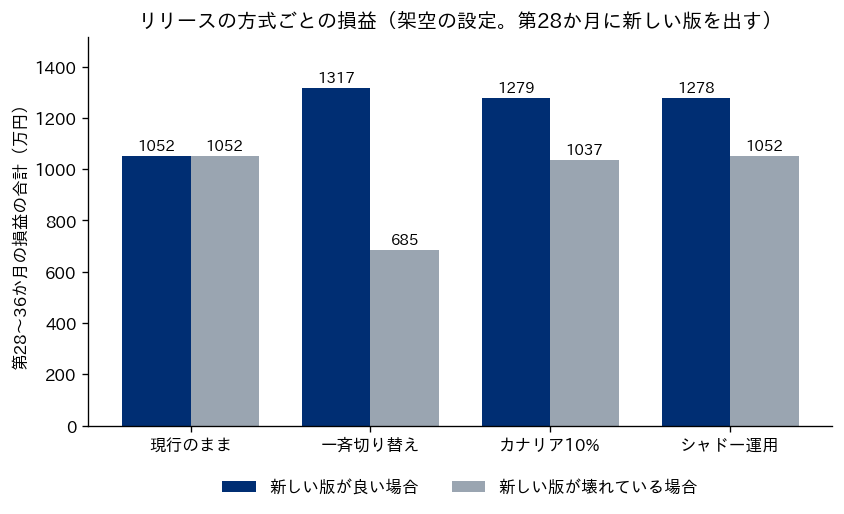
現行のままの第28か月の損益は約114.7万円で、第2章の基準の結果の放置のモデルの値と一致しています。良い新しい版を一斉に出した第28か月の損益(約144.8万円)も、基準の結果の毎月再学習の第28か月の値と一致しています。どちらも同じ期間で学習した同じ設定のモデルだからです。
表の読み方を、良い場合と壊れた場合に分けて述べます。新しい版が良い場合、最も損益が大きいのは一斉切り替え(1,316.5万円)で、カナリアリリース(1,279.4万円)とシャドー運用(1,277.6万円)はそれより37.1万円と38.9万円少なくなりました。慎重な方式では、判断を待つ2か月のあいだ、全員には良い版を使えないからです。新しい版が壊れていた場合は、一斉切り替えの損益が 685.1万円まで下がり、現行のままより367.0万円少なくなりました。カナリアリリースでは、壊れた版を使ったのが2か月・約1割の顧客だけなので、現行のままより15.0万円少ない 1,037.1万円にとどまりました。シャドー運用では、壊れた版の予測を業務に使っていないので、損失はありません。
経営の判断に翻訳すると、慎重なリリースの方式は保険にあたります。この架空の設定では、保険料にあたるのが、新しい版が良かったときに取り逃す約37万〜39万円で、保険金にあたるのが、新しい版が壊れていたときに防げる約352万〜367万円です。どちらが得かは、新しい版が壊れている確率をどう見積もるかで決まります。第7章までの評価と承認を通った版でも、推論の経路の不具合は評価の段階では見つからないことがあります(この例の取り違えは、学習と評価には入っておらず、推論の前処理にだけある不具合として作りました)。モデルの更新が損益に直結する業務では、少なくとも最初の数回の更新はカナリアリリースかシャドー運用で出すことが妥当だと考えています。
ただし、上の実演のカナリアの判断は、たまたま正しかった可能性があります。カナリアが小さな改善を見分けられるかを確かめるため、同じ設定で乱数の種だけを変えた第28か月のデータを200通り作り(第2章の生成の仕組みで、種1〜200。v1 と v2 は種0のデータで学習したものをそのまま使う)、良い新しい版を「良い」と正しく判断できた割合を数えました。200通りの平均で、良い新しい版の改善は顧客1人あたり月 54.9円です。
| 比べ方 | 新しい版で予測する顧客の数 | 正しく「良い」と判断できた割合(200通り中) |
|---|---|---|
| カナリア 5% | 約250人 | 129通り(64%) |
| カナリア 10% | 約500人 | 138通り(69%) |
| カナリア 20% | 約1,000人 | 165通り(82%) |
| カナリア 50% | 約2,500人 | 165通り(82%) |
| シャドー運用 | 5,000人全員(2つの版を同じ顧客で比べる) | 200通り(100%) |
カナリア10%の1か月分では、良い新しい版を「良い」と判断できたのは69%で、残りの31%は「現行より悪い」と判断して、良い版を捨てることになりました。カナリアでは、新しい版の組と対照群が別々の顧客なので、組の顧客の顔ぶれの偶然の違いが、版の違いと混ざります。1人あたり月50円台の改善は、その偶然の揺れに埋もれやすいということです。なお、カナリア20%と50%は、どちらも200通り中165通り(82%)で同じ割合になりました。新しい版の組を増やしても割合が上がらなかった理由は、この章では調べていません。シャドー運用では、同じ顧客に対して2つの版の予測を比べるので、顔ぶれの違いが無く、この設定では200通りすべてで正しく判断できました。
この結果は、先の Danilo Sato 氏の解説の注意と合っています。同じ解説は、カナリアリリースは問題や性能の後退を見つけるのに向いた方式で、仮説を確かめる A/B テストとは目的が違うので混同しないほうがよいこと、A/B テストで統計的に意味のある差を示すには数日分のデータが要ることがある一方で、カナリアの展開は数分から数時間で終えたいものであることを書いています。この章の実演に当てはめると、カナリアは「壊れた版」のような大きな悪化を少ない顧客で止めるのには役に立ちましたが、「少し良い版」を見分ける道具としては、1か月・1割では心もとない、ということです。小さな改善を確かめたいときは、シャドー運用で同じ顧客について比べるか、期間と人数を十分に取った効果検証の設計が要ります。効果検証の考え方は、弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」で扱っています。
シャドー運用の結果には、この実演では表に出ない前提があります。共通データの損益は、解約のラベルを「施策を打たなかったら解約したか」として計算しています。現実には、現行の版が施策を打った顧客は施策の影響を受けているので、その顧客について「新しい版なら打たなかった場合」の結果は観察できません。シャドー運用で新しい版の損益を計算するときは、現行の版が施策を打った顧客の扱いを決めておく必要があります。施策を打たない比較用の組を小さく残しておくなどの設計が、この問題への対処になります。上の表のカナリアリリースとシャドー運用の損益には、こうした比較用の組を残す費用(その組に施策を打たないことで生じる損益の差)は入っていません。
もう1つ、ラベルを待たずに分かることもあります。第28か月のカナリアの組と対照群の予測を比べると、良い新しい版の組では予測平均 0.1090・施策の対象の割合 0.404、壊れた新しい版の組では予測平均 0.0813・施策の対象の割合 0.230で、対照群は予測平均 0.0872・施策の対象の割合 0.275でした。良い版も壊れた版も、対照群とは違う値を示しています。予測の分布の違いは、新しい版を出したその日に分かりますが、それだけでは良い変化か悪い変化かを区別できません。リリースの前に、過去のデータで新しい版を評価したときの予測平均や施策の対象の割合を記録しておき、本番のカナリアの組の値がそこから外れたら止める、という使い方にすれば、ラベルの確定を待たずに不具合を疑えると考えています。予測の分布の監視は第10章で扱います。
ロールバックと推論の記録
新しい版に問題が見つかったら、前の版に戻します。これがロールバックです。ロールバックを速く確実にするには、前の版のモデルをすぐに使える状態で残しておくことと、今どの版を使っているかを1か所で切り替えられることが要ります。この章の API では、版の名前とモデルの対応を持っておき、使う版の名前を切り替える窓口を作りました。実際に v1 から v2 に切り替えて同じ顧客を予測し、v1 に戻してもう一度予測しました。予測は v1 で 0.097975、v2 で 0.138321、戻した後の v1 で 0.097975 となり、戻した後の予測は切り替える前と一致しました。切り替えにかかった時間は数ミリ秒でしたが、これは同じプログラムの中で使う版の名前を替えただけの時間です。実際の本番では、前の版のモデルを読み込み直す時間や、振り分けの設定を変える時間がかかるので、ロールバックの手順は本番と同じ環境で前もって試しておく必要があります。第7章で扱ったモデルレジストリに前の版と、それを作ったデータとコードの記録が残っていることが、ロールバックの前提になります。
ロールバックと並んで重要なのが、推論の記録です。この章の API では、要求ごとに、要求番号・時刻・モデルの版・入力・予測を SQLite(ファイル1つで動く小さなデータベース)に書き込みました。応答時間の測定と入力検証の確認で送った要求のうち、記録されたのは 1,429件、予測した顧客は延べ 11,824件で、記録のファイルは約2.1MBでした。入力検証で断られた要求は、モデルに届く前に断られるので、この記録には入っていません。断られた要求の件数と理由は、送った側のシステムの不具合を見つける手がかりになるので、別に数えておくのが望ましいと考えています。記録しておく項目と、その使い道を表にまとめます。
| 記録する項目 | 何に使うか | 使う章 |
|---|---|---|
| 要求番号・時刻 | 問い合わせの追跡、障害の調査 | この章 |
| モデルの版 | どの版の予測かを後から分ける。ロールバックの前後、カナリアの組と対照群を分けて集計する | 第7章・この章 |
| 入力 | 入力の分布の変化(PSI など。分布がどれだけ変わったかを1つの数で表す指標)を学習時と比べる。後の再学習の学習データにする | 第10章・第11章 |
| 予測の確率 | 予測平均の推移を見る。ラベルが届いたら実際の解約率と突き合わせる | 第10章 |
| 施策の対象になったか | 施策件数を数える。施策を打った顧客と打たなかった顧客を分けて評価する | 第10章・第11章 |
推論の記録は、後から作ることができません。第10章で扱う監視は「学習時と今の入力や予測の分布がどれだけ違うか」を測るので、今の入力と予測が記録されていなければ測れません。第11章で扱う再学習も、本番で予測した顧客のデータとラベルを突き合わせて学習データを作ります。記録が無いまま運用を始めると、性能が落ちたことに気づいても、いつから・どの版で・どの顧客で落ちたのかを調べられず、原因の調査と再学習の準備に、本来なら不要な時間がかかります。表の最後の行にある「施策の対象になったか」は、シャドー運用の節で述べた、施策がラベルを変えてしまう問題を後から扱うためにも必要です。一方で、入力には顧客の情報が含まれるので、記録の保存期間と、記録を見られる人の範囲を決めておく必要があります。記録の保持の考え方は第12章で扱います。
この章の要点をまとめます。予測の届け方は、モデルの種類ではなく業務の判断の頻度と待てる時間で選びます。月に1回の施策の判断ならバッチ推論で足り、その場で打つ施策があるときにオンライン推論を加えます。この章の実測では、同じ5,000件を API に1件ずつ送ると約160秒の見込み、バッチ推論で一括すると約0.04秒で、一括の用途には一括の経路を用意するのが素直です。入力の検証は形の誤りを確実に止めますが、単位の取り違えのように範囲に収まる誤りは通り、第28か月の架空の設定では損益を約114.7万円から約80.0万円に下げました。新しい版を出すときは、壊れていた場合の損失(この架空の設定では一斉切り替えで9か月に367.0万円)と、慎重な方式で良い版の効果を取り逃す分(約37万〜39万円)を比べて方式を選びます。カナリアは大きな悪化を止めるのに向き、小さな改善の確認には、同じ顧客で比べるシャドー運用のほうがこの設定では確かでした。そして、版の名前を含めた推論の記録が、ロールバックと、その後の監視と再学習の土台になります。
ここまでの章で、データの検証、学習、評価、登録、推論とリリースのそれぞれの段を見てきました。これらを人の手で毎回つなぐと、手順の抜けや取り違えが起きます。次の第9章では、各段のテストを書き、学習から登録までを自動でつなぐパイプラインを扱います。
Anagraftでは、データ活用の構想づくりから、機械学習モデルの設計と実装、本番での運用の仕組みづくり、監視と再学習の設計、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『AIエンジニアのための機械学習システムデザインパターン』(澁井雄介、翔泳社):機械学習のモデルを本番で動かす仕組みを、繰り返し使える設計の型(パターン)として整理した本です。この本のサンプルコード集として公開されているリポジトリの一覧には、バッチ推論や同期・非同期の推論の型、推論の記録、シャドー運用での比較の型が並んでおり、この章で扱った届け方とリリースの選択肢を、具体的な構成と結びつけて確かめられます。
『Web API: The Good Parts』(水野貴明、オライリー・ジャパン):Web API の設計と運用の考え方をまとめた本です。目次には、応答のデータの設計、エラーの表現と状態コードの使い分け、API をバージョンで管理する方法が並んでおり、推論の API を業務システムから呼んでもらう窓口として設計するときの論点を、機械学習に限らない一般の API 設計の視点から確かめられます。
『動かして学ぶ!Python FastAPI開発入門』(中村翔、翔泳社):この章で推論の窓口を作るのに使った FastAPI の入門書です。ToDo アプリを題材に、要求と応答の形(スキーマ)の定義、テスト用のクライアントを使ったユニットテスト、クラウドへのデプロイまでを順に組み立てる構成で、この章のコードの背景にある使い方を手を動かして確かめられます。
第9章 機械学習のテストとパイプラインの自動化
第8章では、登録したモデルをバッチ推論とオンライン推論で届ける方法と、新しいモデルを一部にだけ適用して確かめるリリースの方式を見ました。届ける仕組みが整っても、モデルを作り直すたびに人が手で確認していては、確認の抜けと遅れが避けられません。この章では、機械学習のシステムに対する「テスト」とは何を確かめることなのかを、Google の研究者が2017年に発表した評価表で整理し、第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)とモデルに対するテストを実際に書いて実行します。そのうえで、テストを毎回自動で回す仕組み(継続的インテグレーション・継続的デリバリー・継続的学習)と、データの取得から登録までをつないだ学習のパイプラインを関数で組み、途中の検証で失敗したら止まることを実演します。最後に、止まる仕組みを入れたときに何が得られ、何を失うかを、共通データの損益で比べます。
機械学習のテストは何を確かめるのか
普通のソフトウェアのテストは、「この入力にはこの出力を返す」という仕様をコードが満たしているかを確かめます。機械学習のモデルは、ふるまいがコードに直接書かれておらず、データから学んで決まります。このため、コードだけをテストしても、モデルが正しく動くかどうかは分かりません。Google の研究者 Breck らが2017年の IEEE Big Data の会議で発表した論文(Google Research の論文ページ)は、学習をコンパイル(プログラムを実行できる形に変換すること)にたとえ、その原料はコードと学習データの両方なので、学習データもコードと同じようにテストが要り、学習したモデルには実行ファイルと同じように、不具合の調べやすさ・切り戻し・監視といった本番の作法が要る、と述べています。
この論文は、本番で動く機械学習のシステムに要るテストと監視を28項目にまとめ、システムがどれだけ本番に耐えるかを点数で測る評価表を示しました。論文の題名から、この評価表はML Test Scoreと呼ばれています。28項目は、データと特徴量のテスト7項目、モデルの開発のテスト7項目、機械学習の基盤(インフラ)のテスト7項目、監視のテスト7項目の4つの区分に分かれています。論文は、この評価表が機械学習に固有の項目に絞ったもので、単体テストの網羅率やリリースの手順といった一般的なソフトウェア開発の作法は含めていないが、それらも引き続き必要だと断っています。
点数の付け方も具体的です。論文によれば、各項目について、手作業で実施して結果を文書にして共有していれば0.5点、繰り返し自動で実施する仕組みがあれば1点を与え、4つの区分ごとに合計し、4つの合計のうち最も低いものを最終の点数にします。最も低い区分で決めるのは、4つの区分がどれも重要で、どれかを放っておくと点数が上がらないようにするためだと説明されています。論文は、Google 社内の数十のチームへの調査で、どの項目も8割を超えるチームでは実施されていなかった一方、ほとんどの項目は少なくとも半数のチームで0点ではなかった、と述べています。また、評価表に沿って36チームに聞き取りを行った結果も報告しています。テストの作法が「言われれば当たり前」でも、実際には抜けやすいことを示す材料です。
評価表の4つの区分と、この章で実装したもの
28項目のうち、この章の主題に関わるものを区分ごとに整理したのが次の表です。項目の訳は、論文の各表に載っている短い見出しを日本語にしたものです。「この章での実装」の列は、共通データとモデルに対してこの章で実際に書いて実行したテストを示します。監視の区分の大部分は第10章、モデルの段階的な投入(カナリア)は第8章、再現性の記録は第5章で扱っています。
| 区分 | 論文の項目(抜粋) | 何を防ぐか | この章での実装 |
|---|---|---|---|
| データと特徴量 | 特徴量への期待をスキーマ(列・型・値の範囲の定義)に書く/特徴量を作るコードをすべてテストする | 入力の異常や、特徴量の作り方の誤りが学習と推論に入り込むこと | 列と型・カテゴリの許容値・値の範囲・欠損率の4つのテスト |
| モデルの開発 | 単純なモデルのほうが良いということがない/重要なデータの切り口(セグメント)で品質が十分/古くなったモデルの影響が分かっている | 複雑なモデルを入れる意味が無いこと、全体の平均に隠れた一部の劣化 | 性能の下限・予測の向きのテスト・単純なモデルとの比較 |
| 機械学習の基盤 | 学習が再現できる/モデルの仕様のコードを単体テストする/パイプライン全体を結合テストする/本番に出す前に品質を確かめる/切り戻せる | 作り直したら別物になること、段どうしのつなぎ目の不具合、品質の悪いモデルの自動投入 | 再現性・推論時間のテスト、学習パイプラインの評価の関門 |
| 監視 | 入力のデータが学習時と推論時で不変の性質を満たす/学習と推論で特徴量が同じ値になる/モデルが古すぎない/本番の予測の品質が落ちていない | 本番で起きる変化や事故を見逃すこと | 予測平均と実際の解約率の差(詳細は第10章) |
論文の説明の中で、この章の実装に直接つながる記述を3つ挙げておきます。1つ目は、スキーマの作り方で、学習データから統計量を計算し、業務の知識で手直しして作る方法と、先に期待を書き出してからデータと突き合わせる方法を挙げ、後者は計算した値に引きずられる偏りを避けるのに役立つとしています。2つ目は、本番に出す前の品質の確認で、学習のあと実際の利用者に影響する前に、自動の仕組みがモデルを調べて合格か不合格かを決め、不合格なら本番への投入を止めるべきだとしています。ゆっくりした劣化と、新しい版での急な低下の両方を調べる必要がある、とも書いています。3つ目は、パイプライン全体の結合テストで、聞き取りの中で他の項目より実施率がずっと低かったこと、実施していても推論の側だけで学習の側が含まれないことが多く、その理由の一部は学習が場当たり的なスクリプトと手作業の集まりとして作られがちなためだと述べています。
共通データとモデルにテストを書いて当てる
評価表の考え方を、第2章で用意したサンプルデータとモデルで実際に試しました。テストの対象は、第1〜12か月で一度だけ学習して以後そのまま使う「放置」のモデル(記事全体の基準と同じ勾配ブースティングのモデル)です。テストは、データのテスト4つ(列と型・カテゴリの許容値・値の範囲・欠損率)、モデルのテスト5つ(予測の範囲・予測の向き2つ(決済失敗の回数と利用日数)・性能の下限・予測平均と実際の解約率の差)、基盤のテスト2つ(再現性・推論時間)を書きました。テストの「期待」は、すべて学習期間(第1〜12か月)のデータを見て決めています。つまり、カテゴリの許容値は学習時に現れた経路(web・store)とプラン、月額の許容値は学習時に現れた3つの金額(980円・1,980円・3,480円)、欠損率の上限は列ごとに1%です。これはデータの作り手と使い手の取り決め(第3章で扱ったデータ契約)の第1版に当たります。
性能の下限は、テストを当てる前に学習期間の中で決めました。第1〜11か月だけで学習したモデルを第12か月で測ると AUC(予測で顧客を並べたときの並べ替えの正しさ。0.5がランダムに並べた場合と同じ、1が完全)は0.6834で、ここから0.03を引いた0.653を下限としました。差し引く幅をどう選ぶかに決まった答えはなく、この章では「月ごとの揺れで鳴らない程度の余裕」として置いた値です。予測平均と実際の解約率の差の許容幅は0.02としました。次のコードは、テストの関数の一部を抜き出し、短く書き直したものです。補助モジュール(mlops_data.py と baseline.py)と同じフォルダに置いて実行する形です。
import numpy as np
from sklearn.metrics import roc_auc_score
import mlops_data as md
import baseline as bl

ALLOWED_CHANNELS = {"web", "store"}           # 学習時に現れた経路
ALLOWED_FEES = {980.0, 1980.0, 3480.0}        # 学習時に現れた月額
MAX_MISSING = 0.01                            # 列ごとの欠損率の上限
FLOOR = 0.653                                 # 性能の下限(第12か月の AUC 0.6834 - 0.03)

def check_missing(df):
    rate = float(df[md.FEATURES].isna().mean().max())
    return rate <= MAX_MISSING, rate

def check_direction(model, df, col, delta, expect):
    """col を delta だけ動かしたとき、予測が expect(+1 上がる/-1 下がる)の向きに動くか"""
    base = model.predict_proba(md.encode(df))[:, 1]
    d2 = df.copy()
    d2[col] = (d2[col] + delta).clip(0, 30) if col == "usage_days" else d2[col] + delta
    moved = model.predict_proba(md.encode(d2))[:, 1] - base
    return np.sign(moved.mean()) == expect, float(moved.mean())

def check_auc_floor(model, df):
    auc = roc_auc_score(df.churn, model.predict_proba(md.encode(df))[:, 1])
    return auc >= FLOOR, float(auc)

frozen = bl.fit(1, 12)                        # 放置のモデル
for m in range(13, 37):
    d = md.month_data(m)
    print(m, check_missing(d), check_direction(frozen, d, "payment_failures", 1, +1),
          check_direction(frozen, d, "usage_days", 5, -1), check_auc_floor(frozen, d))
予測の向きのテストは、ある入力を動かしたときに予測がどちらに動くべきかが業務の知識から分かっている場合に、その向きに動くかを確かめるものです。ここでは、決済失敗の回数を1回増やしたら解約の予測は上がるはず、前月の利用日数を5日増やしたら下がるはず、という2つを確かめました。答え(正解ラベル)が無くても実行できるので、モデルを作り直すたびに回せます。結果を月ごとに並べたのが次の図です。濃い色で×の付いたマスが不合格です。性能の下限と予測平均の差は正解ラベルが要るので、解約が確定する1か月後にしか判定できません。
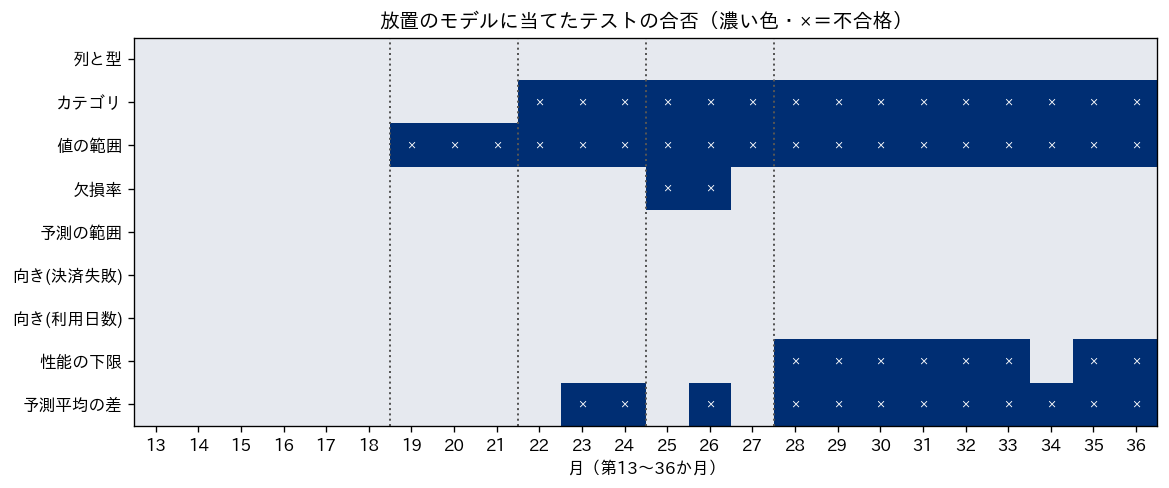
| テスト | 区分 | 最初に不合格になった月 | 不合格の月数(24か月中) | 不合格のときに測った値 |
|---|---|---|---|---|
| 列と型 | データ | なし | 0 | なし |
| カテゴリの許容値 | データ | 第22か月 | 15 | 学習時に無い経路 partner |
| 値の範囲 | データ | 第19か月 | 18 | 学習時に無い月額 2,380円 |
| 欠損率 | データ | 第25か月 | 2 | 第25か月 0.1238、第26か月 0.1152 |
| 予測の範囲 | モデル | なし | 0 | なし |
| 向き(決済失敗) | モデル | なし | 0 | 予測の平均の変化 +0.0810〜+0.0835 |
| 向き(利用日数) | モデル | なし | 0 | 予測の平均の変化 -0.0317〜-0.0269 |
| 性能の下限(0.653) | モデル | 第28か月 | 8 | 第28か月 0.6169 など(第34か月は0.6574で合格) |
| 予測平均の差(±0.02) | モデル | 第23か月 | 12 | 第23か月 -0.0234、第31か月 -0.0695 など |
表の「最初に不合格になった月」の列は、共通データに仕込んだ4つの変化の月とよく対応しています。第19か月の料金改定は値の範囲のテストが、第22か月の新しい獲得経路 partner はカテゴリのテストが、第25〜26か月のデータ連携の不具合は欠損率のテストが、それぞれ変化の当月に捉えました。いずれも正解ラベルを待たずに、データが届いた時点で分かります。一方、第28か月以降の競合の乗り換え施策(解約との関係そのものの変化)は、4つのデータのテストのどれにも新しい不合格を出していません。入力の列・カテゴリ・値・欠損に変わったところが無いからです。この変化を捉えたのは性能の下限のテスト(第28か月)と予測平均の差のテストで、どちらも正解ラベルが届く1か月後にしか判定できません。この結果は、第10章で扱う「入力の分布を見ているだけでは関係の変化に気づけない」という論点と同じものを、テストの側から見たものです。
基盤のテストは2つとも合格しました。同じデータ・同じ乱数の種で2回学習したモデルの予測は、第13か月の5,000件で差の最大が0で、完全に一致しました。推論時間は、5,000件の予測を5回測った中央値が0.0325秒で(この記事の実行環境、一般的なノートPCでの実測)、上限として置いた1秒を大きく下回りました。推論時間のテストは、モデルが大きくなったり特徴量が増えたりしたときに、気づかないうちに遅くなることを止めるためのもので、上限は業務の要求(第8章の応答時間の考え方)から決めます。
テストが不合格になったら何をするか
テストが不合格を出したとき、それがいつも「直すべき不具合」とは限りません。上の結果の第19か月と第22か月の不合格は、事業側が決めた料金改定と新しい獲得経路の開始によるもので、データとしては正しい値です。このときにすべきことは、モデルやデータを直すことではなく、事業側に変更の内容を確かめたうえで、テストの期待(データ契約)を改版することです。改版しないまま放っておくと、第19か月以降は値の範囲のテストが毎月鳴り続け、やがて誰も見なくなります。図の値の範囲とカテゴリの行が最後まで濃い色のままなのは、まさにその状態です。テストの期待を誰がいつ改版してよいかを決めておくことは、テストを書くことと同じくらい重要だと考えています。
第25〜26か月の欠損率の不合格は、性質が違います。こちらはデータ連携の事故で、データとして誤っています。この場合は、事故の月のデータで学習や推論を進めてよいかを判断し、必要なら止める必要があります。この判断を自動で行うのが、後で組む学習のパイプラインの検証の段です。なお、利用日数の向きのテストの「予測が下がった顧客の割合」は、通常の月は0.97前後でしたが、第25か月は0.8534、第26か月は0.8590に下がりました。欠損した顧客は値を動かしても欠損のままなので予測が変わらず、その分だけ割合が下がったものです。テストの合否は平均の向きで決めたので合格でしたが、測った値を記録しておくと、合否だけでは見えない変化にも気づけます。
もう1つ、評価表の「単純なモデルのほうが良いということがない」に当たるテストも試しました。第1〜11か月で学習したロジスティック回帰(入力の重み付きの和から確率を出す、最も基本的な分類のモデル)と勾配ブースティングを第12か月で比べると、AUC はロジスティック回帰が0.6948、勾配ブースティングが0.6834で、単純なモデルのほうが高く出ました。1か月の結果では偶然の可能性があるので、第1〜12か月で学習した2つのモデルを第13〜18か月(変化の前)の6か月で比べたところ、6か月すべてでロジスティック回帰が上回り、AUC の平均は0.6902対0.6796、損益(予測確率がしきい値を超える顧客に引き止め施策を打ったときの損益。架空の設定)の平均は月48.2万円対45.3万円でした。このテストは、この架空データでは不合格です。理由として考えられるのは、データの作り方です。第6章で説明したとおり、共通データの真の解約確率は、利用日数や決済失敗の回数などの入力にそれぞれ重みを掛けて足し合わせた値を、ロジスティック関数(値を0〜1の確率に直すS字の曲線)に通して作っています。入力をそのまま足すのではなく形を変えて使っているのは、契約月数を60か月で頭打ちにしているところだけです。ロジスティック回帰も入力に重みを掛けて足す形のモデルなので、データの作り方とモデルの形が近く、よく当てはまったと考えられます。記事全体では、各章の比較をそろえるために基準のモデルを変えていませんが、現実の案件では、このテストが不合格なら、より単純なモデルを採るか、複雑なモデルを使い続ける理由を記録に残すべきです。論文も、単純な基準のモデルとの定期的な比較は、パイプライン全体が機能していることの確認にも、より高度な手法の費用対効果の判断にも役立つと述べています。
コードを変えるたびに自動で回す
テストは、書いただけでは効果がありません。コードやデータが変わるたびに、人が思い出さなくても回る必要があります。ソフトウェア開発では、コードの変更を共有の置き場に取り込むたびに、組み立てとテストを自動で実行する仕組みを継続的インテグレーション(CI)と呼びます。機械学習のテストもこの仕組みに載せることができます。ここでは、Python のテストの道具 pytest(この記事の実行環境の版は9.0.2)で、前の節のテストの一部を書き直し、推論の側の前処理のコードを「書き換えた」場合に、テストがどう反応するかを確かめました。
書き換えの内容は、推論のときにモデルへ渡す入力の行列を作る部分で、列を名前の順に並べ替え、列の名前を持たない配列で渡す、という変更です。見た目はささいな整理ですが、学習のときと列の並びが変わるので、モデルは「決済失敗の回数」の位置に別の列の値を読むことになります。次のコードは、テストのファイルから一部を抜き出したものです。環境変数で、正しい前処理と書き換えた版を切り替えています。
import os
import numpy as np
import pytest
from sklearn.metrics import roc_auc_score
import mlops_data as md
import baseline as bl

FLOOR = 0.653

def encode_serving(df):
    if os.environ.get("CH09_BUGGY") == "1":
        X = md.encode(df)
        return X[sorted(X.columns)].to_numpy()   # 書き換えた版:列を名前順に並べ替え、配列で渡す
    return md.encode(df)

@pytest.fixture(scope="module")
def model():
    return bl.fit(1, 11)                         # 学習は第1〜11か月

@pytest.fixture(scope="module")
def holdout():
    return md.month_data(12)                     # 評価は第12か月

def predict(model, df):
    return model.predict_proba(encode_serving(df))[:, 1]

def test_prediction_range(model, holdout):
    p = predict(model, holdout)
    assert not np.isnan(p).any()
    assert (p.min() >= 0) & (p.max() <= 1)

def test_direction_payment_failures(model, holdout):
    d2 = holdout.copy()
    d2["payment_failures"] += 1
    assert (predict(model, d2) - predict(model, holdout)).mean() > 0

def test_auc_floor(model, holdout):
    assert roc_auc_score(holdout.churn, predict(model, holdout)) >= FLOOR
テストのファイルには、このほかに特徴量の列が13列に固定されていること、利用日数の向き、再現性、推論時間のテストを入れ、全部で7つにしました。正しい前処理では7つすべて合格し、実行時間は11.72秒でした(この記事の実行環境での実測。学習を含む)。書き換えた版では、7つのうち3つが不合格になりました。
| テスト | 正しい前処理 | 書き換えた版 | 書き換えた版で測った値 |
|---|---|---|---|
| 特徴量の列が13列に固定 | 合格 | 合格 | 学習側の前処理は変えていないため |
| 予測の範囲(0以上1以下・欠損なし) | 合格 | 合格 | 予測は0.2334〜0.4110で範囲内 |
| 向き(決済失敗) | 合格 | 不合格 | 予測の平均の変化 -0.0023(上がるはずが下がった) |
| 向き(利用日数) | 合格 | 不合格 | 予測の平均の変化 0.0(まったく動かない) |
| 性能の下限(0.653) | 合格 | 不合格 | AUC 0.4723 |
| 再現性 | 合格 | 合格 | 学習側は変えていないため |
| 推論時間(1秒以内) | 合格 | 合格 | 速さは変わらない |
注目したいのは、書き換えた版でもプログラムは止まらず、予測を返し続けたことです。別に測ったところ、scikit-learn は「列の名前が無い入力が渡された」という警告(UserWarning)を1件出しただけで、例外にはなりませんでした。予測の範囲のテストも合格しているので、「エラーが出ていない」「確率が0〜1に収まっている」という見張り方では、この誤りは見つかりません。一方、列の名前を付けたまま並びだけ変えた場合は、scikit-learn が学習時と列の名前の順が違うという例外(ValueError)を出して止まりました。列の名前を落とすという1行の違いで、大きな音を立てて止まる誤りが、黙って間違い続ける誤りに変わります。
この誤りがそのまま本番に出たときの影響を、第12か月の5,000件で測りました。正しい前処理では、予測平均は0.0797(実際の解約率0.0780)、しきい値(約0.106)を超えて施策を打つ顧客は1,147件、損益は39.0万円でした。書き換えた版では、予測平均が0.2903に跳ね上がり、5,000件すべての予測がしきい値を超えたので全員に施策を打つことになり、損益は -105.2万円でした。差は1か月で144.2万円です。架空の設定での数字ですが、前処理の1行の変更が、テストが無ければ「全顧客への施策の一斉配信」という形で、1か月分の利益をまるごと失わせうることを示しています。予測の向きと性能の下限のテストがあれば、この変更は本番に届く前に止まります。なお、予測平均が実際の解約率の4倍近くに跳ねたことは、正解ラベルを待たなくても分かるので、「予測平均が学習時の水準から大きく動いていないか」を推論の側で毎回確かめることも、安い見張りとして有効です。
継続的インテグレーション・継続的デリバリー・継続的学習
Google Cloud の Architecture Center にある MLOps の文書(MLOps の継続的デリバリーと自動化のパイプラインを扱った文書、2024年8月28日更新)は、機械学習のシステムもソフトウェアのシステムなので、継続的インテグレーション(CI)と継続的デリバリー(CD)の作法が当てはまるとしたうえで、機械学習では次の違いがあると整理しています。CI はコードと部品のテストだけでなく、データ・データのスキーマ・モデルのテストと検証も含むようになる。CD は1つのソフトウェアやサービスを届けるのではなく、別のサービス(モデルの予測サービス)を自動で届けるシステム(学習のパイプライン)を届けるものになる。そして、継続的学習(CT、Continuous Training)は機械学習のシステムに固有の新しい性質で、モデルを自動で学習し直して提供することに関わる、という整理です。
| 略号 | 文書の整理 | きっかけ | この章の例 |
|---|---|---|---|
| CI(継続的インテグレーション) | コードの組み立てとテストに加え、データ・スキーマ・モデルのテストと検証を行う | コードの変更を置き場に取り込んだとき | 前処理の書き換えを7つのテストで止める |
| CD(継続的デリバリー) | 学習のパイプライン(予測サービスを自動で届ける仕組み)そのものを届ける | CI を通った部品ができたとき | テストを通ったパイプラインを本番の環境に置く |
| CT(継続的学習) | 本番でモデルを自動で学習し直して提供する | 予定の日時、新しいデータ、性能の低下、データの分布の大きな変化など | 毎月の学習パイプライン(次の節) |
同じ文書は、CI で行えるテストとして、特徴量を作る処理の単体テスト、モデルに実装した各処理の単体テスト(例として、カテゴリの列を one-hot の特徴量に変える関数)、学習が収束すること(損失が下がり、少数のデータには過学習できること)、学習の途中で0による割り算などから非数(NaN)が出ないこと、パイプラインの各部品が期待どおりの成果物を作ること、部品どうしの結合を挙げています。CD では、モデルが届け先の環境の部品や資源と合うことの確認、予測サービスを期待する入力で呼んで期待する応答が返ることの確認、負荷をかけて応答時間などを測ること、再学習やバッチ推論に使うデータの検証、本番に出す前にモデルが予測性能の目標を満たすことの確認などを挙げています。この章の前の節で書いたテストは、この一覧の一部を小さく実装したものです。
文書は、自動化の度合いで MLOps を3段階に分けています。レベル0は手作業の過程、レベル1は学習のパイプラインを自動化して継続的学習を行う段階、レベル2はパイプラインそのものを CI/CD で自動で組み立て・テスト・配置する段階です(成熟度の段階の詳しい定義は第2章で扱いました)。レベル1については、本番の新しいデータでモデルを作り直すには、データとモデルの検証の段、パイプラインの起動条件、記録(メタデータ)の管理が要るとしています。起動条件としては、必要なときに手で起動する、予定に沿って起動する、新しい学習データが届いたときに起動する、モデルの性能が落ちたときに起動する、データの分布に大きな変化があったときに起動する、の5つが挙げられています。また、パイプラインの新しい実装を頻繁には配置せず、管理するパイプラインが少ないうちは、パイプラインとその部品は手でテストし、手で配置するのが普通だとも書いています。レベル2の CI/CD が要るのは、新しいアイデアを素早く試して配置したい場合や、本番で多くのパイプラインを管理する場合です。文書は最後に、すべての過程を一度に次の段階へ移す必要はなく、少しずつ取り入れてよいと述べています。
学習のパイプラインを関数でつなぎ、失敗したら止める
Google Cloud の文書は、レベル1で本番のパイプラインに入れる検証として、学習の前のデータの検証と、学習の後のモデルの検証を挙げています。データの検証は、モデルを学習し直すか、パイプラインの実行を止めるかを決める段で、期待するスキーマに合わないデータ(予期しない特徴量、期待した特徴量が無い、予期しない値)を受け取ったら、パイプラインを止めてデータサイエンスのチームが調べるべきだとしています。モデルの検証は、新しいモデルをテスト用のデータで評価し、現行のモデルなどと比べ、データの切り口ごとに性能が安定しているかを確かめ、本番に昇格させる前に行う段です。
この考え方に沿って、取得→検証→学習→評価→登録の5つの段を関数でつないだ毎月のパイプラインを組みました。第 m か月の予測の前に、解約が確定している第 m-13〜m-2 か月のデータを取得し、最後の1か月(第 m-2 か月)を評価用に取り分け、残りの11か月で学習します(記事全体の基準の「毎月再学習」は12か月で学習して評価用を取り分けないので、数字は基準と一致しません)。検証の段は、前の節のデータのテスト4つを月ごとに当てます。ただし、料金改定と partner の開始は事業側から告知があったものとして、データ契約を第19か月と第22か月に改版し、2,380円と partner を許容値に加えました。評価の段は、予測の範囲・決済失敗の向き・性能の下限(AUC 0.653)の3つを関門にしました。どの段でも失敗したら、その回は登録せず、登録済みの現行の版を使い続けます。次のコードは、パイプラインを動かす関数を抜き出し、後で述べる「止める」運用(検証に落ちたら止める)の形に短く書き直したものです。
class StageFailed(Exception):
    pass

def run_pipeline(m, registry, models, log):
    stage = "取得"
    try:
        data = extract(m)                        # 第 m-13〜m-2 か月を {月: DataFrame} で返す
        stage = "検証"
        bad = validate(data)                     # データのテスト4つ。落ちた月と理由を返す
        if len(bad) > 0:
            raise StageFailed("検証: " + str(bad))
        months = list(data)
        val_month, train_months = months[-1], months[:-1]
        stage = "学習"
        model = train(train_months)              # 勾配ブースティングを学習
        stage = "評価"
        auc = evaluate(model, data[val_month])   # 範囲・向き・性能の下限。落ちたら StageFailed
        stage = "登録"
        ver = register(registry, m, model, train_months, val_month, auc)
        models[ver] = model
        log.append((m, "登録", ver, auc))
        return ver
    except StageFailed as e:
        log.append((m, "停止(" + stage + ")", None, str(e)))
        return None                              # 現行の版を使い続ける
実行した記録から、第24〜29か月の回を抜き出したのが次の表です(後で述べる「止める」運用の記録)。第24〜26か月の回は、すべての段を通って新しい版(第13〜15版)が登録されました。版の番号は、このパイプラインが登録した順の通し番号(第1〜12か月で学習した初版を第1版とする)で、第7章の v1〜v9 や第8章の v1・v2 とは別の数え方です。第27か月の回は、取得した第14〜25か月のうち第25か月の欠損率が0.1238で上限1%を超えたため、検証の段で止まり、第15版が使われ続けました。第28か月以降は、取得する期間に第25か月と第26か月(欠損率0.1152)の両方が入るので、同じ理由で止まり続けました。
| 回(予測する月) | 結果 | 使った版 | 記録された内容 |
|---|---|---|---|
| 第24か月 | 登録 | 第13版 | 学習 第11〜21か月(11か月)・評価 第22か月 AUC 0.6961 |
| 第25か月 | 登録 | 第14版 | 学習 第12〜22か月・評価 第23か月 AUC 0.6795 |
| 第26か月 | 登録 | 第15版 | 学習 第13〜23か月・評価 第24か月 AUC 0.6695 |
| 第27か月 | 検証で停止 | 第15版のまま | 第25か月 欠損率 0.1238 |
| 第28か月 | 検証で停止 | 第15版のまま | 第25か月 欠損率 0.1238、第26か月 欠損率 0.1152 |
| 第29か月 | 検証で停止 | 第15版のまま | 同上 |
上流の仕組みの変更で列の名前が変わる、という別の失敗も注入してみました。第24か月の回で、取得した第22か月のデータの利用日数の列の名前を usage_days から usage_day に変えると、検証の段は「第22か月の列と型の検査で usage_days が無い」と記録して、その回を止めました。どの月のどの検査に落ちたかが記録に残るので、調べる人は原因の場所からすぐに始められます。Google Cloud の文書が、記録(メタデータ)の管理の説明で、パイプラインの各段が作った成果物の場所を記録しておけば、失敗した段で止まったときに最新の段から再開でき、不具合の調査にも役立つとしているのと同じ考え方です。
止める仕組みには、止まった後の手順が要る
検証で止める仕組みは、事故のデータでモデルを作り直すことを防ぎます。しかし、止まったままにしておくと、今度は古いモデルを使い続ける損が出ます。そこで、同じパイプラインを3つの運用で第13〜36か月に回し、使われたモデルの損益を比べました。1つ目の「含める」運用は、検証の段を置かずに、事故の月も含めたまま学習へ進むものです。2つ目の「止める」運用は、検証に落ちた月が1つでもあれば止めて、現行の版を使い続けるものです。止まった後に人が判断して再開する手順は入れていません。3つ目の「外す」運用は、検証に落ちた月を学習と評価から外して続けるもので、止まった後に人が「事故の月を外して作り直す」と判断した場合を、自動で先取りしたものに当たります。評価の段の関門は3つの運用で共通です。第11章でも事故の月の扱いを A・B・C の記号で比べていますが、この章の3つの運用とは中身が別なので、この章では記号を使わず「含める」「止める」「外す」の名前で書きます。
第13〜26か月は、3つの運用が毎月同じ版のモデルを使い、損益も同じでした。違いが出始めた第27か月以降の、月ごとの損益(万円/月、架空の設定)と、その月に使ったモデルの版は次のとおりです。
| 月 | 含める | 止める | 外す |
|---|---|---|---|
| 第27か月 | 71.0(第16版) | 73.5(第15版) | 70.1(第16版) |
| 第28か月(競合施策) | 142.8(第17版) | 136.9(第15版) | 139.1(第17版) |
| 第29か月 | 127.1(第18版) | 128.8(第15版) | 131.7(第18版) |
| 第30か月 | 125.1(第18版) | 115.4(第15版) | 129.3(第18版) |
| 第31か月 | 172.6(第18版) | 166.4(第15版) | 173.5(第18版) |
| 第32か月 | 148.3(第18版) | 139.7(第15版) | 144.5(第18版) |
| 第33か月 | 180.8(第19版) | 135.3(第15版) | 172.0(第19版) |
| 第34か月 | 179.1(第20版) | 144.1(第15版) | 176.0(第20版) |
| 第35か月 | 147.9(第21版) | 118.3(第15版) | 149.6(第21版) |
| 第36か月 | 169.5(第22版) | 140.7(第15版) | 169.4(第22版) |
「止める」運用は第27か月以降、毎月第15版を使い続けています。差が大きく開くのは第33か月以降で、第33か月の損益は「止める」運用が135.3万円、「含める」運用が180.8万円、「外す」運用が172.0万円でした。期間ごとにまとめると次の表のとおりです。
| 運用 | 停止した回 | 新しく登録した版の数 | 損益 第28〜36か月(万円/月) | AUC 第28〜36か月 | 施策件数 第28〜36か月(月平均) | 損益 24か月合計(万円) |
|---|---|---|---|---|---|---|
| 含める(検証の段なし) | 3回(第30〜32か月。評価で停止) | 21 | 154.8 | 0.6461 | 2,122.1 | 2,322.9 |
| 止める(検証で止め、再開しない) | 10回(第27〜36か月。検証で停止) | 14 | 136.2 | 0.6352 | 1,777.6 | 2,157.7 |
| 外す(落ちた月を外して続ける) | 3回(第30〜32か月。評価で停止) | 21 | 153.9 | 0.6433 | 2,179.7 | 2,313.8 |
表の「損益 24か月合計」の列のとおり、検証で止めたまま再開しない「止める」運用は2,157.7万円で、検証の段を置かない「含める」運用(2,322.9万円)より165.2万円、同じ検証の段を置いたうえで事故の月を外して続ける「外す」運用(2,313.8万円)より156.1万円少なくなりました。第13〜24か月の損益は3つの運用で同じ(月平均56.4万円)で、差は止まった後の期間に生じています。「止める」運用は第27か月から最後の第36か月まで10回続けて止まり、その間ずっと第26か月の回に作った第15版を使っていたので、第28か月以降の競合施策による解約の増加に追いつけず、施策件数の月平均が1,777.6件にとどまりました。記事全体の基準と比べると、「止める」運用の合計は「放置」の1,964.0万円よりは多いものの、事故の月を境に、作り直しの効果の多くを失っています。
この165.2万円は、「検証の段を置かない方が得だ」という意味ではありません。損が出たのは、検証で止めたこと自体からではなく、止まった後に人が状況を確かめて再開する手順が無く、止まったままになったことからです。同じ検証の段で事故の月を見つけたあと、その月を外して作り直しを続けた「外す」運用(止まった後の人の判断を自動で先取りしたもの)は、「含める」運用との差が9.1万円にとどまりました。止める仕組みだけを入れて、止まった後に誰が何をするかを決めていないと、パイプラインは「安全に止まったまま」になります。
「外す」運用は、事故の月を外して学習を続け、合計2,313.8万円でした。一方で、この架空データでは、検証を置かずに事故の月を含めたまま学習した「含める」運用が2,322.9万円で、「外す」運用を9.1万円上回りました。ただし、この差は24か月の合計に比べて小さく、この比較だけで「含める」と「外す」のどちらが良いかは決められません。第11章でも、事故の月をそのまま使うか外すかを比べていますが、そちらは評価用の月を取り分けずに直近12か月で学習する設定で、第27〜36か月の損益の合計は外した方が34.7万円多く、向きが逆の結果になりました(第11章は、その差も事故を外した効果とは読めないとしています)。2つの比較は、設定がいくつも違います。この章のパイプラインは最後の1か月を評価用に取り分けて11か月で学習し(事故の月を外すと9〜10か月)、評価の関門で「含める」「外す」とも第30〜32か月の3回、作り直しが止まりました。第11章は評価用の月を取り分けずに直近12か月で学習し(事故の月を外すと10〜11か月)、関門を置いていないので止まる回はありません。外す月を決める欠損率の基準も、この章は1%、第11章は5%です(どちらの基準でも、外れたのは第25・26か月の2か月でした)。このうちどの違いが向きを分けたのかは切り分けていません。言えるのは、どちらの比較でも差は小さいということです。どちらの章でも差が小さかった理由として考えられるのは、基準のモデル(scikit-learn の HistGradientBoostingClassifier)が欠損を含むデータをそのまま学習できることと、事故の規模が小さいことです。欠損したのは store 経路の利用日数の約4割で、月全体の欠損率は第25か月0.1238、第26か月0.1152、事故の2か月が両方入る回の11か月の学習データ全体に対しては約2%でした。つまり、この例では、検証の段の価値は損益の差としては現れていません。ここでいう検証の段は、学習の前にデータを検査する段のことで、学習の後の評価の関門は含みません(評価の関門は3つの運用で共通です)。これは「検証は要らない」という意味ではなく、この事故の性質(欠損の割合と、モデルが欠損を扱えること)の下での結果です。欠損が別の値(例えば0)に置き換わって届く事故や、単位の取り違えのように値そのものが誤る事故では、モデルは誤ったデータから何の警告もなく学習します(その影響は第3章で扱いました)。検証の段は、どの事故が害になるかを事前に知らなくても、学習に進む前に人の判断を挟めるようにするための仕組みで、その判断の結果として「この程度なら含めて学習してよい」と決めることもありうる、と考えるのが実際的です。事故の月のデータで再学習したときの影響は、第11章でさらに詳しく扱います。
もう1つ、表の「停止した回」の列で、「含める」運用と「外す」運用は第30〜32か月の3回、評価の段で止まっています。評価に使った第28〜30か月は競合施策が始まった後の月で、新しいモデルの AUC は0.6232・0.6416・0.6349と、学習期間の中で決めた下限0.653を下回りました。ところが、この時期は世の中のほうが変わったので、どのモデルでも AUC が下がっています。止めたことで、より新しいデータで作ったモデルの代わりに、それより古い版が使われ続けました。絶対的な下限だけを関門にすると、変化が起きて作り直しが最も必要なときに、作り直しを止めてしまうことがあるということです。新しいモデルを現行のモデルと同じデータで比べて、上回ったときだけ入れ替える方式(チャンピオン・チャレンジャー)は第11章で扱います。
ワークフローの製品は何を肩代わりするか
この章のパイプラインは、1つのプログラムの中で関数を順に呼ぶだけの最小の形です。本番では、決まった日時に起動する、段ごとに別の計算資源で動かす、失敗した段から再開する、実行の記録を画面で見る、といった機能が要り、それを担うのがワークフローの製品です。この記事の実行環境にはどの製品も入っていないので、ここでは公式ドキュメントで確かめた範囲で位置づけだけを紹介します。製品の比較で優劣は付けません。クラウドの製品の見取り図は、弊社コラム「AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方」で扱っています。
Apache Airflow の公式ドキュメント(Airflow のドキュメントの概要のページ、2026年10月時点の版は3.3.2)は、Airflow をワークフローを開発し、予定に沿って実行し、監視するためのオープンソースの基盤と説明し、対象として、時間で起動するバッチ処理のデータのパイプライン、機械学習、モデルの学習などを挙げています。ワークフローはすべて Python のコードで定義し、その単位を Dag(処理の順序を表す、巡回の無い有向グラフ)と呼び、Dag には実行の予定・タスク(作業の単位)・タスクの依存関係などを持たせる、と説明しています。Kubeflow Pipelines の公式ドキュメント(Kubeflow Pipelines の概要のページ)は、Kubernetes を土台にした環境で、コンテナを使って持ち運びやすく規模を広げやすい機械学習のワークフローを作り配置する基盤と説明しています。部品とパイプラインを Python で書き、中間表現の YAML に変換して、オープンソースの実行基盤や Google Cloud の Vertex AI Pipelines で実行できること、パイプラインは部品を組み合わせた巡回の無い有向グラフで、実行時には部品の1回の実行がコンテナの1回の実行に対応することが書かれています。
Google Cloud の Vertex AI Pipelines の公式ドキュメントのアドレス(/vertex-ai/docs/pipelines/introduction)を2026年10月9日に開くと、「Gemini Enterprise Agent Platform Pipelines」という名前の紹介ページ(Agent Platform Pipelines の紹介ページ、2026年10月7日更新)へ転送されました。このページは、機械学習のパイプラインを使ってワークフローを組み立て、サーバーの管理なしに機械学習のシステムを自動化・監視・統制できると説明し、Kubeflow Pipelines か TensorFlow Extended(TFX)で定義したパイプラインを実行できること、パイプラインはコンテナにしたタスクを入出力の依存関係でつないだ巡回の無い有向グラフであることを述べています。製品の名前が変わることがあるので、導入を検討するときは、その時点の公式ドキュメントで名前と機能を確かめる必要があります。
3つに共通しているのは、パイプラインを「段(タスク・部品)と、段どうしの依存関係」として定義する考え方です。この章の5つの関数と、関数を呼ぶ順序は、そのままこの形に置き換えられます。逆に言えば、製品を入れても、各段で何を検査し、失敗したら誰が何をするかは、自分たちで決めて書く必要があります。製品が肩代わりするのは、起動・実行・再開・記録の仕組みで、検査の中身ではありません。
どの段階から何を整えるか
テストとパイプラインの自動化は、最初から全部をそろえる必要はありません。Google Cloud の文書も、管理するパイプラインが少ないうちは手でテストし手で配置するのが普通だとしています。この章の結果から、整える順序の考え方を表にまとめました。
| 段階 | まず整えるもの | 理由(この章の結果) | 後回しにしてよいもの |
|---|---|---|---|
| 最初の1本を本番に出す前 | データのテスト(列と型・カテゴリ・値の範囲・欠損率)、予測の範囲と向きのテスト、単純なモデルとの比較 | データのテストは料金改定・新経路・欠損事故を当月に捉えた。単純なモデルとの比較は、この架空データでは複雑なモデルが勝てないことを示した | ワークフローの製品、パイプラインの CI/CD |
| コードを複数の人が直し始めたとき | テストを変更のたびに自動で回す仕組み(CI) | 前処理の1行の書き換えが、エラーを出さずに損益を1か月で144.2万円悪化させた | 段ごとの別の計算資源 |
| 定期的に作り直すとき | 検証と評価の関門を持つ学習のパイプライン、止まったときの連絡先と再開の手順 | 検証で止めたまま再開しない運用は、24か月の合計で、検証を置かない運用より165.2万円、事故の月を外して続けた運用より156.1万円少なかった。損の原因は止めたことではなく、止めた後に人が判断して再開する手順が無かったこと | 多数のパイプラインの一元管理 |
| モデルの本数が増えたとき | ワークフローの製品、パイプライン自体の CI/CD | 起動・記録・再開を本数ぶん手で回す工数が増える | なし |
経営の目線で読むと、テストの価値は「事故を起こさないこと」そのものより、「事故の影響が出る前に止め、どこで止まったかが分かること」にあります。この章の例では、前処理の書き換えという小さなコードの変更が、予測を返し続けたまま、全顧客への施策の配信という大きな損失につながりえました。テストを書く工数は、モデルを作る工数に比べれば小さく、効く範囲は広いと考えています。一方、止める仕組みは、止まった後の手順と組みで初めて利益を守ります。検証で止まったパイプラインの再開が1か月遅れるごとに、古いモデルを使い続ける損が積み上がります。この章の架空の設定では、止めたまま再開しない「止める」運用と、事故の月を外して続ける「外す」運用の差は、第28〜36か月の損益で月17.7万円(153.9万円と136.2万円の差)でした。止まったことを誰に知らせ、何日以内に誰が再開の判断をするかを、パイプラインを作るときに決めておくことを勧めます。また、テストの期待(データ契約)を改版しないまま警報を鳴らし続けると、本当の事故の警報が埋もれます。期待の改版の責任者を事業側とデータ側のどちらに置くかは、テストの設計と同時に決める必要があります。
この章の要点は3つです。第一に、機械学習のテストは、コードだけでなくデータとモデルと基盤を対象にし、共通データでは、データのテストが料金改定・新経路・欠損事故をその月のうちに捉えた一方、関係そのものの変化は正解ラベルを使う性能のテストでしか捉えられませんでした。第二に、テストは変更のたびに自動で回すことで効き、前処理の書き換えのように黙って誤り続ける変更は、予測の向きや性能の下限のテストで本番の前に止まります。第三に、学習のパイプラインの検証と評価の関門は、止めるだけでは損を生むことがあり(この架空の設定では、検証で止めたまま再開しない運用は、検証を置かない運用より24か月で165.2万円少なかった。損の出どころは止めたことではなく、止まった後に人が判断して再開する手順が無かったこと)、止まった後の手順と、変化のときに作り直しを止めすぎない関門の設計が要ります。次の第10章では、本番に出たモデルを監視する仕組みを、データの分布の変化と関係の変化の違いから扱います。
この章を深めたい方への参考書籍
『継続的デリバリー 信頼できるソフトウェアリリースのためのビルド・テスト・デプロイメントの自動化』(Jez Humble、David Farley 著、和智右桂、髙木正弘 訳、ドワンゴ):ソフトウェアを変更のたびに組み立て・テストし、いつでも安全にリリースできる状態に保つための考え方を体系的に扱った本で、目次には構成管理・継続的インテグレーション・テスト戦略の実装の章があります。この章で機械学習に当てはめた CI/CD の土台になっている、ソフトウェア側の作法を確かめるのに向いています。
『テスト駆動Python 第2版』(Brian Okken 著、安井力 監修、クイープ 監訳、翔泳社):この章でテストを書くのに使った pytest の入門書で、目次はテスト関数の書き方、フィクスチャ(テストの前準備を共有する仕組み)などから始まります。データやモデルのテストを、手元の確認用の関数から、変更のたびに自動で回るテストへ育てるときの実装の手引きになります。
第10章 モデルを監視する
第9章では、データ・モデル・推論の仕組みに対するテストを書き、学習の段をパイプラインとしてつないで、失敗したら止まるようにしました。テストとパイプラインは、本番に出す前と、学習し直すたびに品質を確かめる仕組みです。しかし、本番に出したあとの世界は、テストを書いた時点の想定どおりには動きません。料金が改定され、新しい獲得経路が始まり、データの連携が壊れ、競合が施策を打ちます。この章では、本番で動いているモデルに何が起きているかを見張る仕組み、つまり監視を扱います。監視の対象を5つの層に分け、入力の分布の変化と、入力と解約の関係そのものの変化を区別し、第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)で、どの指標がどの変化に気づけて、どの変化に気づけないのかを月ごとに実測します。そのうえで、鳴りすぎず見逃さないアラートの設計と、監視の遅れを経営指標に翻訳する方法を述べます。監視で気づいたあとに学習し直す方法は第11章で扱います。
監視の対象を5つの層に分ける
機械学習のモデルを監視するというと、精度の数字をグラフにすることを思い浮かべがちですが、精度は監視の対象のうち最後に分かるものの1つにすぎません。この記事では、監視の対象を、システム・データ・予測・性能・業務指標の5つの層に分けて考えます。層によって、何が分かるか、いつ分かるかが違うからです。
1つ目のシステムの層は、推論の仕組みがそもそも動いているかを見ます。Google の SRE(サイト信頼性エンジニアリング)の書籍の公開版にある分散システムの監視の章は、利用者に面したシステムで4つだけ測れるならこれを測れとして、遅延(応答にかかる時間)・トラフィック(要求の量)・エラー(失敗した要求の割合)・飽和(最も逼迫している資源の使用率)の4つを挙げています。同じ章は、エラーには HTTP の500のような明示的なものだけでなく、正常の応答コードで誤った中身を返すものもあると書いています。機械学習の推論では、この「正常に見える誤り」が起きやすいのが特徴です。この記事のモデル(勾配ブースティングの HistGradientBoostingClassifier)は欠損を受け付けるので、この章の計算でも、利用日数の欠損が混ざった第25〜26か月に、エラーを出さずに予測を返しました(欠損の影響は第3章で扱います)。システムの層の監視が緑でも、予測が正しいとは限りません。
2つ目のデータの層は、モデルに入ってくる入力を見ます。欠損率、カテゴリの種類、値の範囲、分布の形です。3つ目の予測の層は、モデルが出す予測確率の分布と、その平均(予測平均)を見ます。この2つの層は、予測を出したその時点で計算できるのが利点です。4つ目の性能の層は、予測と正解を突き合わせた AUC や、予測平均と実際の解約率のずれを見ます。正解が届くまで計算できません。5つ目の業務指標の層は、施策件数や損益など、モデルを使った結果としての事業の数字を見ます。
| 層 | 何を見るか | いつ分かるか(この記事のデータの場合) | この層だけでは分からないこと |
|---|---|---|---|
| システム | 遅延・要求の量・エラーの割合・資源の使用率 | その場で | 正常に応答しているのに予測の中身が誤っていること |
| データ | 欠損率・カテゴリの種類・入力の分布(PSI・KS 検定) | 予測を出したその月のうちに | 分布の変化が予測の正しさに効いているかどうか |
| 予測 | 予測確率の分布(スコアの PSI)・予測平均 | 予測を出したその月のうちに | 入力と解約の関係が変わったこと |
| 性能 | AUC・予測平均と実際の解約率の差 | 第 m か月の顧客の分は第 m+1 か月末に(解約の確定を待つ) | 原因(どの入力・どの区分が変わったか) |
| 業務指標 | 施策件数・損益 | 性能と同じか、それより後 | 本来得られたはずの損益との差 |
表の右端の列が、この章の主題です。どの層も単独では足りず、下の層ほど確かなことが分かる代わりに、分かるのが遅くなります。監視の設計とは、速いが当てにならない上の層と、遅いが確かな下の層を、どう組み合わせるかを決めることです。以下では、データ・予測・性能の層を共通データで実際に計算し、業務指標の層に翻訳します。システムの層は一般的なシステム監視と同じ作り方になるので、ここでは上の4つの信号を挙げるにとどめます。
データドリフトとコンセプトドリフトを区別する
本番のデータが学習時から変わることを、まとめてドリフトと呼びます。ドリフトには性質の違う2種類があり、監視の設計はこの区別から始まります。2018年に IEEE の知識工学・データ工学の論文誌(TKDE)に載った、変化するデータの下での学習を130本以上の文献から整理したレビュー論文(Lu ほか)は、入力 \( X \) と正解 \( y \) の同時分布が時点によって変わることを広い意味の変化と定義し、それを入力の分布 \( P(X) \) と、入力が与えられたときの正解の分布 \( P(y \mid X) \) の積に分けて、変化の出どころを3つに分類しています。入力の分布だけが変わり入力と正解の関係は変わらないもの、関係が変わるもの、その両方です。同じ論文は、前者は判定の境界に影響しないので仮想的な変化(virtual drift)とも呼ばれ、後者は判定の境界を変えて精度を下げると書いています。
この記事では、前者をデータドリフト、後者をコンセプトドリフトと呼びます。言葉で言い換えると、データドリフトは「来るお客さまの顔ぶれが変わった」ことで、コンセプトドリフトは「同じ顔ぶれのお客さまでも、解約するかどうかの決まり方が変わった」ことです。なお、用語の使い方は文献によって揺れがあり、上の論文は両方を含めて広い意味で concept drift と呼んでいます。社内で監視の報告をするときは、どちらの意味で使っているかを最初に決めておくと、議論がかみ合います。
第2章で用意したサンプルデータの4つの変化は、この区別に沿って作られています。第19か月の料金改定(standard プランが月額1,980円から2,380円へ)は、入力の分布(月額)が変わるデータドリフトで、データを作った式では月額と解約の関係は変わっていません。第22か月の新しい獲得経路 partner も、学習時に無かった顔ぶれの顧客が約18%混ざるデータドリフトです。第25〜26か月のデータ連携の不具合は、顧客は変わっていないのに観測された入力が壊れる、データ品質の事故です。第28か月以降の競合の乗り換え施策は、解約の基礎率が上がり、利用日数と解約の関係が弱まる、コンセプトドリフトです。この4つに対して、監視の各指標がどう反応するかを順に見ていきます。
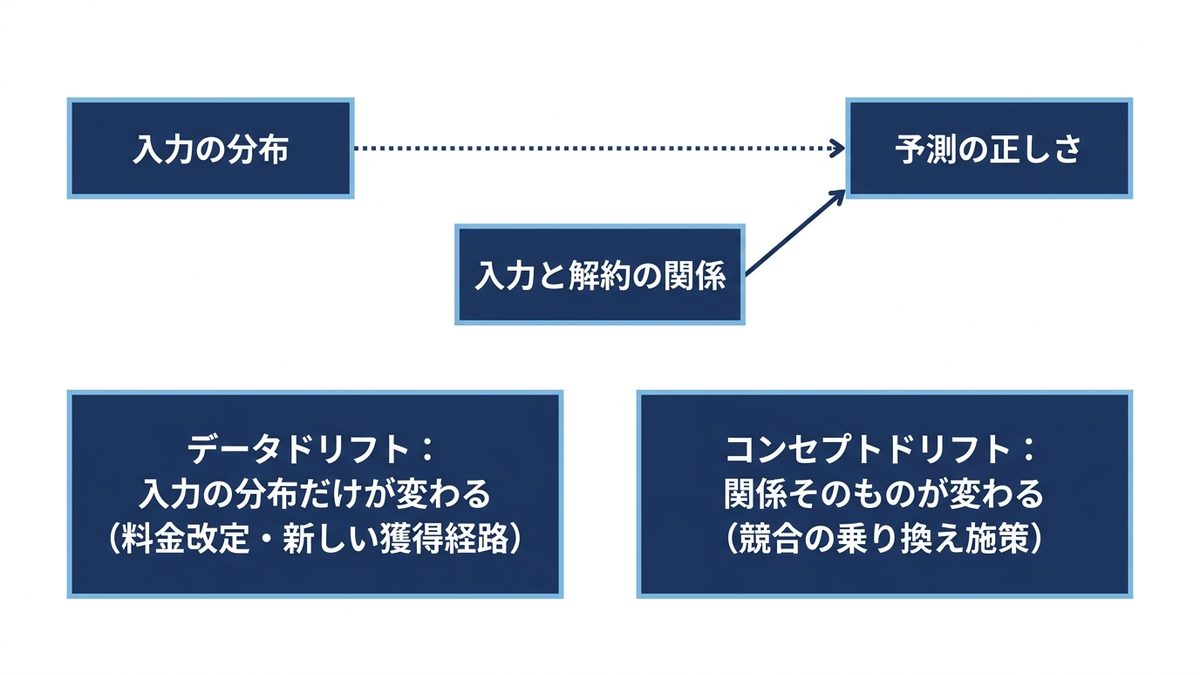
PSIで入力と予測の分布の変化を測る
入力の分布が学習時からどれだけ変わったかを1つの数字にする指標として、銀行がモデルの開発時のデータと現在のデータのずれを測るのによく使っている(後で紹介する論文の要旨による)のがPSI(母集団安定性指標、Population Stability Index)です。考え方は単純で、学習時のデータを値の大きさで10個の区分に分け(各区分に1割ずつ入るように区切ります)、本番の月のデータがそれぞれの区分に何割入ったかを数えて、学習時の割合とのずれを足し合わせます。式で書くと、区分 \( i \) の学習時の割合を \( e_i \)、その月の割合を \( a_i \) として、次のとおりです。
\( \mathrm{PSI} = \sum_{i} (a_i – e_i) \ln \dfrac{a_i}{e_i} \)
言葉で言うと、「各区分で、割合の差に、割合の比の対数を掛けたものを足す」です。割合が増えた区分でも減った区分でも各項は正になるので、PSI は0以上の値をとり、分布がまったく同じなら0、ずれるほど大きくなります。この記事の計算では、第2章の補助モジュール baseline.py の psi 関数を使います。学習時(第1〜12か月)の分位点で10区分に分け、欠損は独立の11番目の区分として数えます。割合が0の区分があると対数が計算できないので、割合の下限を0.0001に置いています。月額のように値の種類が少ない入力では、分位点が重なって区分が10個より少なくなります。カテゴリ(獲得経路)については、各カテゴリを1つの区分にして同じ式で計算する小さな関数を足しました。
PSI の値の読み方には、実務で使われている目安があります。2020年に Journal of Risk Model Validation 誌に載った、PSI の統計的な性質を調べた論文(Yurdakul・Naranjo)は、その要旨で、実務では「0.10未満は小さな変化、0.10から0.25は中程度の変化、0.25を超えると大きな変化で対処が必要」という経験則が使われていると紹介しています。同じ論文は、この目安が統計的な第1種・第2種の誤り(変化が無いのに鳴る誤りと、変化があるのに鳴らない誤り)の大きさと結び付けられないまま使われていること、0.10と0.25を信号機のように使う使い方には学術的な裏付けが無いことを指摘し、PSI の期待値とばらつきは区分の数と、学習時と本番の両方の件数に依存するので、件数と区分の数を考慮して使うべきだと述べています。この章では0.1と0.25を図の補助線として描きますが、それは「実務の慣行の目安」としてであり、根拠のあるしきい値としてではありません。
月ごとの監視の計算は次のとおりです。章の実行に使ったスクリプトから要所を抜き出して短くしたもので、第2章の補助モジュール mlops_data.py・baseline.py と同じフォルダに置いて実行する形です。放置したモデル(第1〜12か月で一度だけ学習したモデル)を、第13〜36か月の各月のデータに当てて、入力と予測の分布の指標と、ラベルが届いてから分かる指標を記録します。
import pandas as pd
from scipy.stats import ks_2samp
from sklearn.metrics import roc_auc_score
import mlops_data as md
import baseline as bl

train = md.months(1, 12)                 # 学習時のデータ(60,000件)
model = bl.fit(1, 12)                    # 放置するモデル
s_train = model.predict_proba(md.encode(train))[:, 1]

rows = []
for m in range(13, 37):
    d = md.month_data(m)
    s = model.predict_proba(md.encode(d))[:, 1]
    k = ks_2samp(s_train, s)             # 統計量と p 値の両方が返る
    rows.append({
        "month": m,
        # 予測を出したその月のうちに計算できる指標
        "psi_fee": bl.psi(train.monthly_fee, d.monthly_fee),
        "psi_usage": bl.psi(train.usage_days, d.usage_days),
        "psi_score": bl.psi(s_train, s),
        "ks_usage": ks_2samp(train.usage_days.dropna(), d.usage_days.dropna()).statistic,
        "ks_score": k.statistic,
        "ks_p_score": k.pvalue,
        "miss_usage": d.usage_days.isna().mean(),
        "pred_mean": s.mean(),
        # 正解ラベル(翌月末に確定)が届いてから計算できる指標
        "actual": d.churn.mean(),
        "gap": d.churn.mean() - s.mean(),
        "auc": roc_auc_score(d.churn, s),
    })
t = pd.DataFrame(rows).set_index("month")
print(t.round(4))
このコードは、毎月の監視に要る計算がこれだけの量で書けることを示しています。監視の仕組みで手間がかかるのは計算そのものより、学習時のデータの分布(基準)を保存しておくこと、毎月の入力と予測を記録しておくこと(第8章の推論の記録)、ラベルが届いたときに予測と突き合わせられるように顧客と月の鍵を揃えておくことです。基準を保存していないと、PSI はそもそも計算できません。
実行した結果を、第2章の4つの変化に合わせた期間ごとの平均にまとめたのが次の表です。PSI の値は第2章の基準の結果と一致しています(同じモデル・同じ関数で計算しているためです)。KS の列は次の節で説明する KS 検定の統計量(2つの分布の累積の割合の差の最大値)です。コードでは、利用日数は欠損を除いてから比べ、スコアは統計量と p 値の両方を記録しています。
| 期間 | PSI 料金 | PSI 利用日数 | PSI 獲得経路 | PSI スコア | KS 統計量 利用日数 | KS 統計量 スコア |
|---|---|---|---|---|---|---|
| 第13〜18か月 変化前 | 0.0002 | 0.0023 | 0.0005 | 0.0022 | 0.0147 | 0.0145 |
| 第19〜21か月 料金改定 | 0.8047 | 0.0039 | 0.0002 | 0.0038 | 0.0230 | 0.0154 |
| 第22〜24か月 partner 開始 | 0.6156 | 0.0482 | 1.3484 | 0.0153 | 0.0888 | 0.0558 |
| 第25〜26か月 欠損事故 | 0.5902 | 0.9231 | 1.3990 | 0.0125 | 0.1038 | 0.0392 |
| 第27か月 | 0.5791 | 0.0590 | 1.3824 | 0.0148 | 0.1019 | 0.0541 |
| 第28〜36か月 競合施策 | 0.5952 | 0.0530 | 1.4043 | 0.0170 | 0.0946 | 0.0550 |
表の読み方を変化ごとに確かめます。料金改定では「PSI 料金」の列が第19〜21か月に平均0.8047へ跳ね、第22か月以降も0.58〜0.62で鳴り続けます(月ごとの値は第19か月以降ずっと0.5791〜0.8120の範囲です)。partner の開始では「PSI 獲得経路」の列が1.3484と、表の中で最も大きな値になります。学習時に1件も無かったカテゴリが約18%現れたためで、PSI の式では割合0の区分を0.0001に置き換えているので、新しいカテゴリが現れると値が大きく出ます。欠損事故では「PSI 利用日数」の列が第25〜26か月だけ0.9231に跳ね、事故が終わった第27か月には0.0590に戻ります。欠損を独立の区分として数えているので、欠損率の上昇(第25か月0.1238、第26か月0.1152)がそのまま PSI に表れています。ここまでの3つの変化は、入力の PSI で、変化が起きたその月のうちに捉えられました。
一方、第28か月からの競合施策の期間を見ると、入力の PSI はどの列も第27か月とほとんど同じで、変化の兆しがありません。「PSI スコア」の列も0.0170で、24か月を通じた最大値は第32か月の0.0247でした。実務の目安の0.1にも届きません。競合施策は入力の顔ぶれを変えず、入力と解約の関係を変える変化なので、入力と予測の分布だけを見ている限り、監視の画面には何も起きていないように見えます。この点は後の節で、ラベルが届いてから分かる指標と並べて確かめます。
KS検定は件数が多いと小さな差でも鳴る
分布の変化を測るもう1つの道具が、2標本の Kolmogorov-Smirnov 検定(KS 検定)です。SciPy の公式ドキュメント(scipy.stats.ks_2samp)によると、既定の両側検定は「2つの標本が同じ分布から来ている」を帰無仮説とし、統計量は2つの標本の経験分布関数(値ごとの累積の割合)の差の絶対値の最大値です。戻り値には統計量と p 値が入っています。p 値が小さいほど「同じ分布とは考えにくい」ことを意味し、0.05未満を「変化あり」とする使い方がよく見られます。
PSI と違って p 値という確率の言葉で結果が出るので扱いやすく見えますが、監視に使うときには注意が要ります。この記事の計算では、学習時の60,000件とその月の5,000件を比べています。件数がこれだけ多いと、業務上は意味の無い小さな差でも p 値が小さくなります。実際、変化を何も起こしていない第13〜18か月の6か月のうち、利用日数では第17か月(p 値0.0388)、スコアでは第13か月(p 値0.048)で、p 値が0.05を下回りました。どちらも統計量は0.02程度で、分布の差としてはごく小さなものです。毎月たくさんの入力に検定をかけると、変化が無くても、そのうちいくつかは偶然0.05を下回ります。
逆の面も確かめました。スコアの KS 検定は、第22か月以降すべての月で p 値が0.05を下回り、競合施策の期間(第28〜36か月)も9か月すべてで「変化あり」になります。これだけを見ると、KS 検定は競合施策に気づけているように見えます。しかし、表の「KS 統計量 スコア」の列を見ると、競合施策の期間の平均は0.0550で、partner 開始の期間の0.0558とほぼ同じです。スコアの分布は partner の顧客が混ざった第22か月にずれ、その後は変わっていません。競合施策の期間に鳴っているのは、第22か月から続いている partner の影響であり、競合施策そのものには反応していません。p 値の「変化あり」は、何が変わったかまでは教えてくれません。
このため、KS 検定を監視に使うなら、p 値だけでなく統計量(差の大きさ)を並べて見ること、件数が多い場合は p 値のしきい値より統計量のしきい値で判定することが有効だと考えています。後の節で紹介する監視の道具の Evidently も、公式ドキュメントによると、数値の列に KS 検定を既定で使うのは件数が1,000件以下のときで、それより多いときは既定の方法が別の距離(正規化した Wasserstein 距離)に切り替わります。件数が多いと検定が鳴りやすいという同じ問題への、1つの対処です。
鳴っても対処が要らない警報と、対処が要る警報
分布の監視で最初に困るのは、鳴り続ける警報です。この記事のデータでは、料金の PSI が第19か月から第36か月までの18か月、一度も途切れずに0.25を超えています。料金改定は会社が自分で決めた変化で、起きたことは監視の画面を見るまでもなく分かっています。そのうえ、データを作った式では月額と解約の関係は変わっていないので、並べ替えの正しさ(AUC)は目立って落ちていません。第2章の基準の結果で、料金改定の期間(第19〜21か月)の AUC は、放置したモデルで0.673、変化前(第13〜18か月)は0.680で、月ごとのばらつき(後の節で示すとおり、1か月の AUC の標準偏差は約0.014)の範囲に収まっています。
ただし、「料金の PSI は無視してよい」と言い切るのは誤りです。同じ期間の予測平均と実際の解約率を見ると、放置したモデルの予測平均は0.080のまま、実際の解約率は0.091に上がっています。月額と解約の関係式は変わっていなくても、月額そのものが上がったので、その式に従って解約する人が増えたのです(データを作った側だけが知る真の確率の平均も、第18か月の0.0818から第19か月の0.0877に上がっています)。放置したモデルは、学習時に一度も現れなかった2,380円という月額を受け取っても予測平均がほとんど動かず、解約率の上昇を予測に反映できていません。基準の結果では、この期間の損益は放置で52.7万円/月、毎月再学習で56.0万円/月でした。並べ替えは崩れていなくても、確率の水準は少しずれ、それが施策件数と損益に効いています。
ここから分かるのは、入力の PSI は「何かが変わった」ことは教えても、「対処が要るか」までは教えないということです。料金の PSI が鳴ったときに要る対応は、慌てて再学習することではなく、ラベルが届くのを待って、予測平均と実際の解約率のずれ、AUC に影響が出ているかを確かめることです。そして、計画された変化(料金改定や新しい獲得経路の開始)は、監視の警報より前に、事業側からモデルの担当者へ予定として伝わっているべきものです。警報で知るのでは遅く、手間もかかります。
一方、欠損事故の警報は性質が違います。利用日数の PSI が0.9231に跳ねた第25〜26か月は、顧客が変わったのではなく、データの連携が壊れて観測値が欠けた月です。この警報には、すぐ対処が要ります。対処はモデルの再学習ではなく、データの連携を直すことと、壊れた月のデータを学習に混ぜないことです(再学習で悪化する危険は第11章で扱います)。PSI だけを見ていると、データドリフトと品質の事故はどちらも「PSI が大きい」としか見えません。欠損率そのものを別の指標として監視しておくと、両者を一目で見分けられます。この記事のデータでは、利用日数の欠損率は変化前の各月が0で、第25か月に0.1238、第26か月に0.1152でした。
関係そのものの変化は、ラベルが届くまで見えない
競合施策の期間に何が起きていたかを、4つの指標の月ごとの推移で確かめます。次の図は、上から順に、入力と予測の PSI、予測平均と実際の解約率、AUC、利用日数と解約の関係です。縦の点線は4つの変化の始まりです。
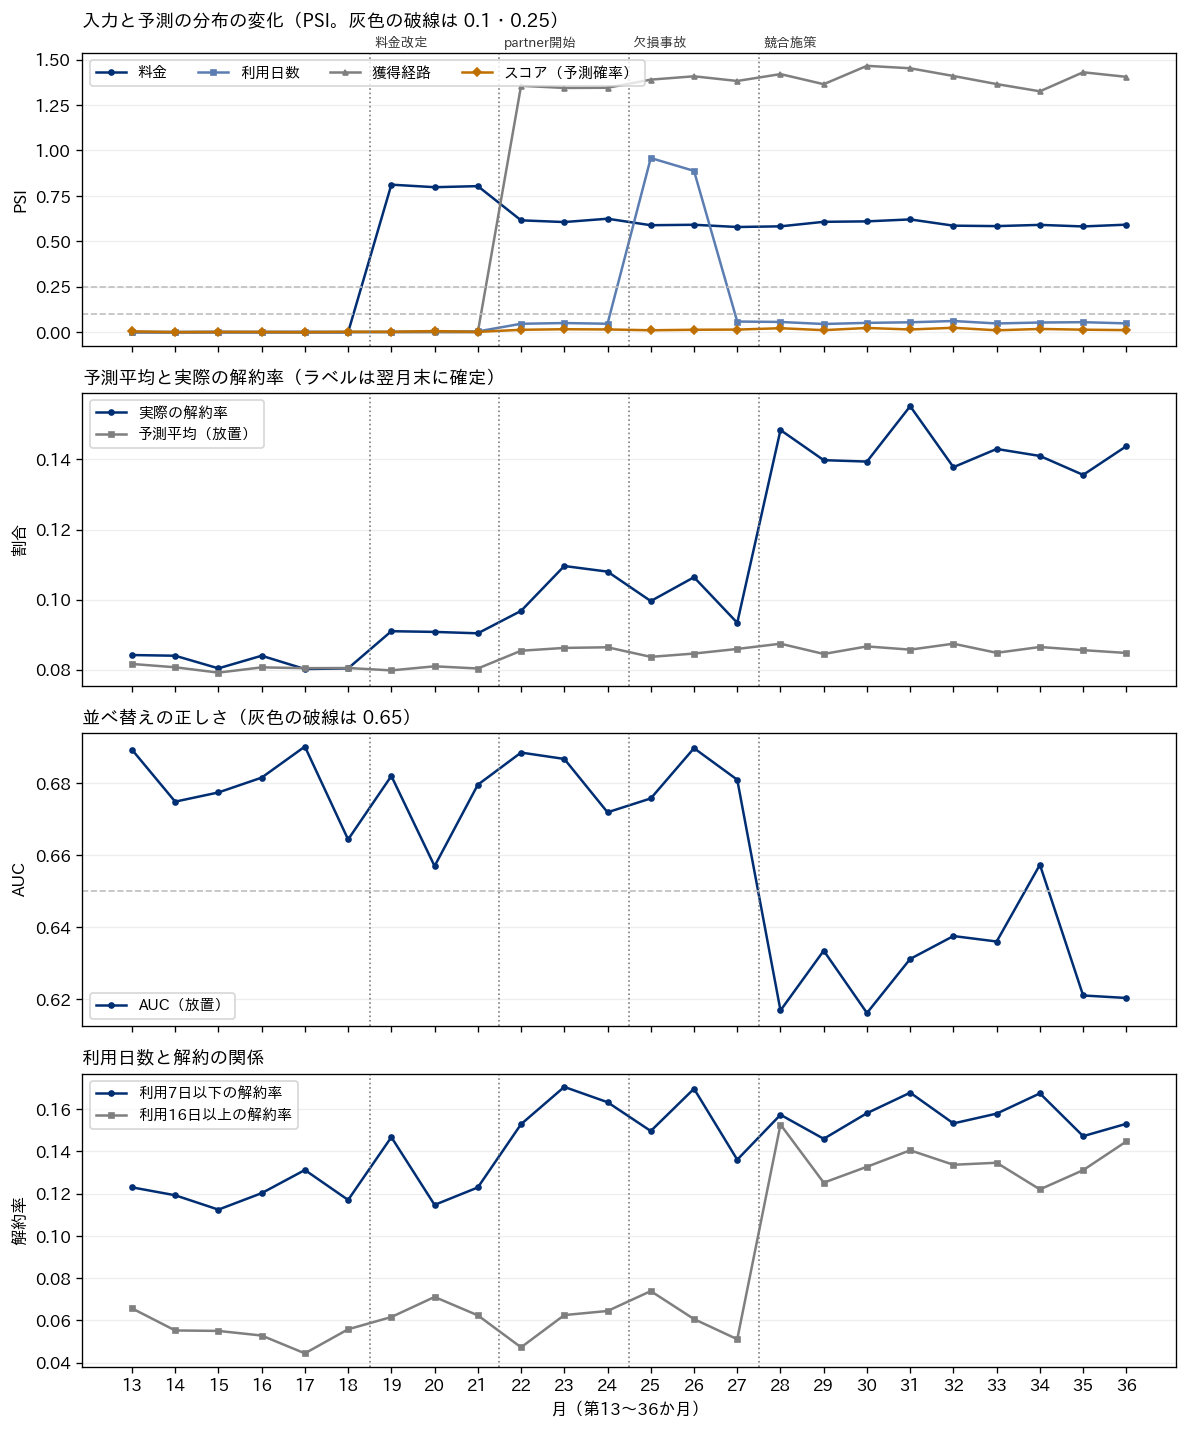
一番上の段(縦軸は PSI の値、灰色の破線は0.1と0.25)では、料金・獲得経路・利用日数の PSI が、それぞれ料金改定・partner の開始・欠損事故の月に跳ねていますが、第28か月の点線の前後では何も変わりません。スコアの PSI(橙色の線)は24か月を通じて底に張り付いています。ところが2段目(縦軸は割合。ネイビーの線が実際の解約率、灰色の線が放置したモデルの予測平均)では、第28か月に実際の解約率が0.0934から0.1484へ跳ね、以後0.14前後が続くのに、放置したモデルの予測平均は0.085前後のままです。競合施策の期間の平均で、予測平均0.0859に対して実際の解約率は0.1427でした。3段目の AUC(灰色の破線は0.65)は、第13〜27か月には0.6570〜0.6902の範囲にあったのが、第28〜36か月には0.6162〜0.6574に下がり、期間の平均は0.6300です。
一番下の段は、コンセプトドリフトの中身を直接見るために足した指標です。利用日数が7日以下の顧客と16日以上の顧客に分けて、それぞれの実際の解約率を月ごとに計算しました。第13〜27か月には、利用の多い顧客の解約率は0.0444〜0.0739で、どの月も利用の少ない顧客より低く、15か月のうち12か月は半分以下でした(利用の少ない顧客の解約率を多い顧客の解約率で割った比は1.61〜3.24で、2を下回ったのは第13・20・21か月です)。第28か月以降、利用の多い顧客の解約率は0.1220〜0.1527に跳ね上がり、比は1.03〜1.37に縮まります。「よく使っている顧客は解約しにくい」という、モデルが学習時に覚えた関係が弱まったことが、ここにそのまま表れています。入力の分布(利用日数の分布そのもの)は変わっていないので、PSI はこれに反応できません。
この3つの段の指標(予測平均と実際の解約率の差、AUC、利用日数別の解約率)は、どれも正解ラベル、つまり実際に解約したかどうかを使って計算しています。共通データの解約のラベルは「翌月末までに解約したか」なので、第28か月の顧客について解約が確定するのは第29か月末です。つまり、コンセプトドリフトが第28か月に始まっても、ラベルを使う指標でそれが分かるのは早くても第29か月末で、その時点ですでに第28か月と第29か月の2か月分の判断が、古い関係のまま下されています。分布の監視が無力だった変化に対して、ラベルを使う性能の監視は確実に反応しましたが、その代わりに必ず遅れます。第2章の基準の結果が、毎月再学習するモデルでもラベルが確定している第 m-2 か月までしか学習に使えないとしているのも、同じ理由です。
この遅れはデータの性質で決まり、監視の仕組みを工夫しても縮められません。縮められるのは、ラベルが確定してから集計し、判断し、対処を決めるまでの時間です。ラベルが確定したのに、集計が四半期に一度の報告会まで回ってこない、という運用では、遅れはさらに数か月延びます。性能の監視は、ラベルの確定に合わせて自動で集計し、決まった人に届くところまでを作っておく必要があります。
ラベルを待つあいだに見られる代わりの指標
ラベルが届くまでの空白を埋める代わりの指標として、予測平均がよく挙げられます。予測平均はラベルを待たずに毎月計算でき、実際の解約率と比べれば確率の水準のずれが分かります。ただ、この記事のデータで確かめると、予測平均だけでは競合施策に気づけません。放置したモデルの予測平均は、変化前の第13〜18か月に平均0.0805、競合施策の期間に0.0859で、ほとんど動いていないからです。モデルは入力しか見ていないので、入力が変わらなければ予測も変わりません。予測平均が意味を持つのは、1か月遅れで届く実際の解約率と並べたときです(2段目の図)。
業務指標も、それだけでは同じ罠にはまります。放置したモデルで実際に得られた損益は、変化前の第13〜18か月に45.3万円/月、競合施策の期間に116.9万円/月でした。損益だけを見ると、モデルの成績は2倍以上に上がったように見えます。これは、解約する顧客そのものが増えたので、施策を打った相手のうち実際に解約しそうだった顧客の数(当たり)が増えたためです。第2章の基準の結果では、同じ期間に真の確率で打っていれば183.0万円/月、毎月再学習したモデルでも157.4万円/月が得られていました。放置したモデルは、損益が伸びて見える陰で、施策件数が月平均1,347.6件にとどまり(真の確率なら3,154.6件)、打つべき顧客に打てていませんでした。業務指標は「いくら得たか」は示しても、「いくら得られたはずか」は示しません。
もう1つ、予測から見込んだ損益と実際の損益を並べる方法があります。モデルの予測確率がしきい値を超えた顧客について、予測確率に1件あたり守れる粗利(第2章の架空の設定で7,560円)を掛けて足し、施策の費用を引けば、モデル自身が「これだけ得られるはず」と見込んでいる損益が、ラベルを待たずに計算できます。実行した結果、変化前の期間は見込みが44.0万円/月、実際が45.3万円/月とほぼ一致していましたが、競合施策の期間には見込み54.0万円/月に対して実際は116.9万円/月で、2倍以上ずれました。見込みと実際が一致しなくなったことは、モデルの確率がもう現実を表していない信号です。この比較もラベル(実際の損益)を使うので1か月遅れますが、技術指標を経営指標の言葉で示せるので、事業側への報告に向いていると考えています。
ラベルの遅れを本当に縮めたいなら、ラベルそのものより早く届く業務上の信号を探すことになります。解約の例でいえば、解約の手続きページの閲覧や、解約の申し出の件数のように、解約の確定より前に観測できる行動です。どの信号が使えるかは事業ごとに違い、共通データにはこうした項目が無いので、この記事では計算していません。代わりの信号を選ぶときは、それが過去に解約とどれだけ連動していたかを、過去のデータで確かめてから使うことが大切です。
アラートを設計する、しきい値・連続月数・届け先
監視の指標が揃ったら、どの値で誰に知らせるかを決めます。これがアラートの設計です。先に挙げた SRE の書籍の公開版の監視の章は、人を呼び出す通知について、どの通知も対処できるもの(actionable)であるべきこと、人が緊急の対応をできるのは1日に数回までで、それ以上は疲れて通知を読み流すようになること、何かが少し変に見えるというだけで鳴らすべきではないこと、原因より症状に対して鳴らすべきことを述べています。機械学習の監視にも、この考え方がそのまま当てはまります。鳴りすぎる警報は無視され、無視された警報の列の中に、本当に対処が要る警報が埋もれます。
共通データで、9つの規則を作って24か月に当ててみました。入力の分布の規則(R1〜R4)、予測の分布の規則(R5・R6)、ラベルを使う規則(R7〜R9)です。しきい値の0.25・0.1は前の節の実務の目安を使いました。3ポイント・0.65・1.5は、第13〜27か月の値の範囲(実際の解約率と予測平均の差は最大0.0234、AUC は最小0.6570、解約率の比は最小1.61)にかからないように置いた、この記事の例示のための値です。現実には変化が起きた後のデータは手元に無いので、変化前の期間のばらつきだけからしきい値を決めることになり、この例ほどきれいには分かれないと考えておく必要があります。本文に載せた2つ目のコードは、そのうち6つの規則を計算する部分を抜き出したもので、1つ目のコードの続きとして実行する形です。
def relation(d):
    """利用7日以下の解約率を、利用16日以上の解約率で割る(ラベルが要る)。"""
    low = d.churn[d.usage_days <= 7].mean()
    high = d.churn[d.usage_days >= 16].mean()
    return low / high

t["ratio"] = [relation(md.month_data(m)) for m in t.index]

rules = {
    "料金のPSIが0.25超": t.psi_fee > 0.25,
    "利用日数の欠損率が1%超": t.miss_usage > 0.01,
    "スコアのPSIが0.1超": t.psi_score > 0.1,
    "解約率が予測平均を3ポイント超上回る": t.gap > 0.03,
    "AUCが0.65未満": t.auc < 0.65,
    "低利用と高利用の解約率の比が1.5未満": t.ratio < 1.5,
}
for name, fired in rules.items():
    twice = fired & fired.shift(1, fill_value=False)   # 2か月連続で鳴った月
    print(name, int(fired.sum()), list(t.index[fired]), "連続", list(t.index[twice]))
# 出力(抜粋):
# AUCが0.65未満 8 [28, 29, 30, 31, 32, 33, 35, 36] 連続 [29, 30, 31, 32, 33, 36]
9つの規則の結果をまとめたのが次の表と図です。「鳴った月」は、その規則の条件を満たした月です。R7〜R9 はラベルを使うので、第 m か月の結果が分かるのは第 m+1 か月末です。
| 規則 | 鳴った月数(24か月中) | 鳴った月 | 競合施策(第28か月〜)に気づけたか |
|---|---|---|---|
| R1 料金の PSI が0.25超 | 18 | 第19〜36か月 | 第19か月から鳴りっぱなしで、新しい情報にならない |
| R2 利用日数の PSI が0.25超 | 2 | 第25・26か月 | 鳴らない |
| R3 獲得経路の PSI が0.25超 | 15 | 第22〜36か月 | 第22か月から鳴りっぱなしで、新しい情報にならない |
| R4 利用日数の欠損率が1%超 | 2 | 第25・26か月 | 鳴らない |
| R5 スコアの PSI が0.1超 | 0 | なし | 鳴らない |
| R6 スコアの KS 検定の p 値が0.05未満 | 16 | 第13か月、第22〜36か月 | 第22か月から鳴りっぱなしで、新しい情報にならない |
| R7 実際の解約率が予測平均を3ポイント超上回る | 9 | 第28〜36か月 | 第29か月末に気づける |
| R8 AUC が0.65未満 | 8 | 第28〜33・35・36か月 | 第29か月末に気づける |
| R9 低利用と高利用の解約率の比が1.5未満 | 9 | 第28〜36か月 | 第29か月末に気づける |
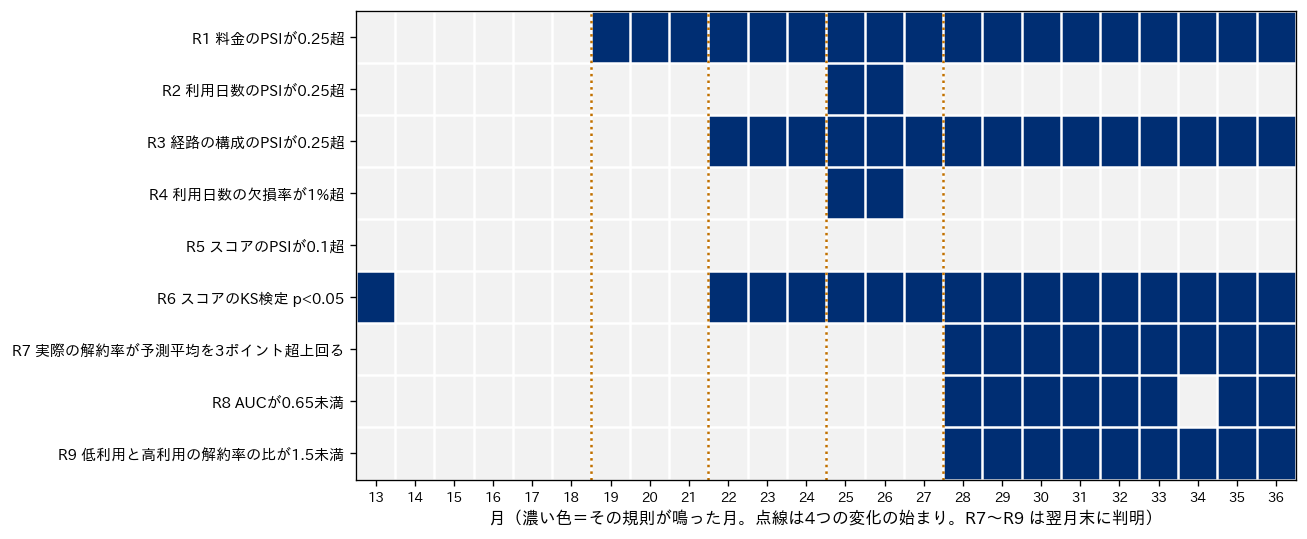
表から読み取れることは3つあります。1つ目に、第13〜27か月に一度も鳴らず、第28〜36か月に鳴った規則は、ラベルを使う R7・R8・R9 の3つだけでした。分布の規則のうち R1・R3・R6 も第28か月以降に鳴ってはいますが、それより前から鳴り続けていたので、担当者から見れば「いつもの警報」で、新しい変化の知らせにはなりません。2つ目に、R6 は変化の無い第13か月にも鳴っています。前の節で見た、件数が多いと KS 検定が鳴りやすい性質の表れです。3つ目に、R8 は第34か月だけ鳴っていません。第34か月の AUC は0.6574で、しきい値0.65をわずかに上回りました。
この3つ目の点が、しきい値と連続月数の設計につながります。1か月の AUC は、それ自体が5,000件の標本から計算した値なので、変化が無くても月ごとにぶれます。第13か月のデータで、顧客を復元抽出で選び直して AUC を計算し直すこと(ブートストラップ)を200回繰り返したところ、AUC の標準偏差は0.0137で、95%の範囲は0.6628〜0.7110でした。1か月の AUC で0.02や0.03の上下は、それだけでは変化の証拠になりません。しきい値を厳しくすれば偶然の揺れで鳴り、緩くすれば本当の変化を見逃します。「2か月連続で条件を満たしたら知らせる」とすれば偶然の揺れには強くなりますが、その分さらに1か月遅れます。共通データでは、2か月連続の規則にすると R7・R8・R9 が最初に知らせるのは第29か月の分で、それが分かるのは第30か月末になります。どちらを選ぶかは、鳴ったときの対処にかかる手間と、見逃したまま1か月過ごしたときの損失の釣り合いで決まります。
届け先も設計の一部です。料金改定や新しい獲得経路のような計画された変化は、事業側からモデルの担当者へ事前に伝わる経路を作り、警報は記録とダッシュボードにとどめて人を呼び出さない、という扱いが考えられます。欠損事故のようなデータ品質の警報は、データの連携の担当者へその月のうちに届ける必要があります。ラベルを使う性能の警報は、モデルの担当者と、モデルの予測を使って施策を決めている事業側の責任者の両方に届けるべきです。性能が落ちたときに施策の件数や対象を見直すのは事業側だからです。1つの警報に1人の担当者を決め、鳴ったときに何をするか(確認だけか、再学習の判断か、施策の停止か)を事前に書いておくと、警報が鳴ったまま誰も動かない事態を防げます。
規則の数は、増やすほど安心に見えますが、増やすほど鳴る回数も増えます。この記事の9つの規則を毎月そのまま担当者に送ると、24か月で延べ79回(9規則の鳴った月数の合計)の通知が届き、そのうち競合施策の新しい知らせになったのは、ラベルを使う3つの規則の第28か月の分だけです。どの規則を人に届け、どの規則を記録だけにするかを、導入時に決めておくことが大切です。
監視の道具に任せられること、任せられないこと
ここまでの計算は、pandas・SciPy・scikit-learn だけで書きました。監視の専用の道具を使うと、こうした計算と報告の画面を少ない手間で揃えられます。この記事の実行環境には導入していないので実行はしていませんが、公式ドキュメントで確かめた範囲で2つを紹介します。製品の見取り図は弊社コラム『AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方』に送ります。
オープンソースの Evidently は、公式ドキュメントのデータドリフトの設定のページによると、列の種類と件数に応じて既定の判定方法を切り替えます。数値の列は、件数が1,000件以下なら KS 検定(p 値0.05未満でドリフト)、それより多ければ正規化した Wasserstein 距離(0.1以上でドリフト)を使い、カテゴリの列は、件数が1,000件以下ならカイ二乗検定か Z 検定、それより多ければ Jensen-Shannon 距離(0.1以上でドリフト)を使います。ここに出てくる Wasserstein 距離と Jensen-Shannon 距離は、PSI と同じく2つの時期の分布の違いを1つの数で表す指標で、カイ二乗検定と Z 検定は、KS 検定と同じく「差が偶然で説明できるか」を確かめる検定です。それぞれの計算の中身は、この記事では扱いません。データ全体としてのドリフトは、ドリフトした列の割合が設定値(既定は0.5)を超えたときに判定されます。PSI も方法の1つとして選べ、既定のしきい値は0.1です。既定の方法を件数で切り替えているのは、前の節で見た「件数が多いと検定が鳴りやすい」問題への備えだと読めます。
クラウドの製品では、Amazon SageMaker の Model Monitor が、公式ドキュメントで、データの品質、モデルの品質(正解率などの性能の指標)、偏りの変化、特徴量の寄与の変化の4種類の監視を挙げています。モデルの品質の監視については、推論の入力と出力を記録し、利用者が保存した正解ラベルと突き合わせてから性能を計算する、と書かれています。ラベルを使う性能の監視には、道具を使っても、ラベルを集めて予測と突き合わせる段取りが要るということです。なお、同じドキュメントには、Model Monitor は新規の利用者の受け付けを終了しており、既存の利用者は引き続き使えるが新しい機能を加える予定は無い、という注記があります(2026年10月に確認)。製品の提供状況は変わるので、採用するときは最新の公式ドキュメントを確かめる必要があります。
道具に任せられるのは、指標の計算、画面、通知の配送です。任せられないのは、どの指標を誰に届けるか、しきい値をどこに置くか、鳴ったときに何をするかの決定と、ラベルを集めて予測と突き合わせる業務の段取りです。この記事の例でいえば、どの道具を入れても、料金の PSI が18か月鳴り続けることも、競合施策が分布の指標に出ないことも変わりません。道具を選ぶ前に、この章で見た「どの変化にどの指標が反応するか」を、自社のデータで一度確かめておくことが有効だと考えています。
監視の遅れを経営指標に翻訳する
監視の仕組みにどれだけ手間をかけるべきかは、気づくのが遅れたときの損失で決まります。第2章の基準の結果を使って、競合施策の期間について、放置したモデルと毎月再学習したモデルの損益の差を月ごとに並べました。差は第28か月30.1万円、第29か月5.7万円、第30か月19.8万円、第31か月42.3万円と続き、第28〜36か月の9か月で合計364.8万円、月平均40.5万円でした(いずれも架空の設定での金額です)。監視が無く、競合施策に最後まで気づかなければ、この差がそのまま積み上がります。
ラベルを使う監視で競合施策に最も早く気づけるのは第29か月末なので、気づいてから手を打つ限り、第28か月と第29か月の差(合計35.7万円。月ごとの差は小数1桁に丸めて示しているため、30.1万円と5.7万円を足した値とは0.1万円ずれます)は、その対処では取り戻せません。なお、この2か月に毎月再学習が放置を上回っているのは、毎月再学習が競合施策より前の月(料金改定や partner の開始の後の月)で学習し直していたためで、競合施策に気づいていたからではありません。毎月再学習の定義では、第29か月の予測に使うモデルの学習期間は第16〜27か月で、競合施策の月を含まないからです。そのうえで、気づいた翌月(第30か月)から毎月再学習と同じ水準の損益に戻せたと仮定すると、取り戻せる額の目安は第30〜36か月の差の合計329.1万円です。この329.1万円は上限ではありません。気づく前から別の理由で学習し直していれば第28・29か月の差の一部も縮まるので、再学習の方式によってはこの目安を上回ります(第11章のトリガー型の結果がその例です)。逆に、気づいても毎月再学習と同じ水準まで戻せなければ、目安を下回ります。2か月連続の規則にして気づきが第30か月末になると、第30か月の差19.8万円がさらに取り戻せなくなります。偶然の揺れで鳴る誤報を減らすための1か月が、この架空の設定では約20万円にあたるということです。この19.8万円は「気づきを第29か月末から第30か月末へ1か月遅らせたときに増える損失」で、第30か月の差が期間の月平均(40.5万円)より小さい月だったため、月平均より小さくなっています。月平均の40.5万円は、競合施策に最後まで気づかずに放置した場合に、1か月あたり平均して失う額の目安です。どの月の気づきが遅れるかで、1か月の遅れの損失は変わります。また、毎月再学習との差は、本来得られたはずの損益(真の確率で打った場合)との差よりも小さく、真の確率との差は同じ期間で月平均66.1万円(183.0万円と116.9万円の差)でした。
この翻訳を使うと、監視への投資の判断が具体的になります。監視の仕組みを作って運用する工数と、気づきが1か月遅れるごとの損失(この例では、2か月連続の規則で気づきが第30か月末にずれたときに増える損失が19.8万円、競合施策に気づかずに放置し続けたときの1か月あたりの平均が40.5万円)を比べればよいのです。モデルが1本で、予測を使った施策の規模が小さく、1か月の遅れの損失が監視の工数より小さいなら、月に一度、担当者が予測平均と実際の解約率、AUC を表で確かめるだけで十分です。モデルが何本にも増え、1本あたりの損失が大きくなるほど、計算と通知を自動にし、届け先と対処を決めた監視の仕組みが割に合うようになります。どちらの場合も、最初に整えるべきなのは、ラベルが確定したときに予測と突き合わせて性能を計算する段取りです。この章の実測では、競合施策のようなコンセプトドリフトに確実に反応したのは、ラベルを使う指標だけでした。
経営の側から見たもう1つの論点は、損益が伸びているときほど監視が要るということです。前の節で見たとおり、放置したモデルの実際の損益は、変化前の45.3万円/月から、競合施策の期間には116.9万円/月へ伸びました。事業の数字が好調に見える時期に、モデルの劣化を示す報告が上がってきても、受け止められにくいものです。モデルの報告では、得た損益だけでなく、予測から見込んだ損益と実際の損益のずれ、施策件数が本来の水準からどれだけ離れているかを並べて示すことが、判断を誤らないために有効だと考えています。
この章の要点をまとめます。監視の対象は、システム・データ・予測・性能・業務指標の5つの層に分かれ、上の層ほど早く分かり、下の層ほど確かなことが分かります。共通データ(架空のデータ)のこの設定では、入力の分布の変化(料金改定・新しい獲得経路)とデータ品質の事故(欠損)は PSI でその月のうちに捉えられましたが、料金の PSI のように、鳴り続けても並べ替えの正しさには影響しない警報もありました。入力と解約の関係そのものが変わる競合施策は、入力とスコアの分布のどの指標にも新しい変化として表れず、ラベルが届いてからの性能の監視でだけ、第29か月末に気づけました。アラートは、しきい値・連続月数・届け先・鳴ったときの対処を事前に決めておかないと、鳴りすぎて読まれなくなります。次の第11章では、監視で気づいたあとにどう学習し直すか、再学習の方式とその損益を比べます。
この章を深めたい方への参考書籍
『異常検知と変化検知』(井手剛・杉山将 著、講談社):機械学習プロフェッショナルシリーズの1冊で、異常検知と変化検知の基本的な考え方から、部分空間法による変化検知、密度比推定による変化検知までを扱っています。この章で使った PSI や KS 検定の背後にある「2つの時期のデータの分布の違いを測る」という発想を、より一般的な手法として学べます。
『入門 監視:モダンなモニタリングのためのデザインパターン』(Mike Julian 著、松浦隼人 訳、オライリー・ジャパン):監視のアンチパターンとデザインパターン、アラート・オンコール・インシデント管理、ビジネスの監視までを扱った本です。誤報の減らし方や手順書の書き方など、この章のアラートの設計(鳴りすぎる警報を減らし、対処できる通知だけを人に届ける)を、機械学習に限らない監視の一般論として補えます。
第11章 再学習を設計する
第10章では、モデルを監視する仕組みを扱い、入力の分布の変化(データドリフト)は PSI で捉えられる一方、解約との関係そのものが変わる変化は、正解が届いてから性能を測らないと気づけないことを確かめました。監視で異常に気づいたあとに取る手当ての中心が、モデルの再学習です。この章では、再学習をいつ・どのデータで・誰の確認を経て行うかを設計する考え方を、第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)で実行して確かめます。扱うのは、再学習の方式(定期・条件で起動する方式・常時の学習)、学習に使う期間の長さ、再学習の費用と効果の釣り合い、新しいモデルが現行を上回ったときだけ入れ替える仕組み、事故の月のデータで学習し直したときに起きること、自動化してよい範囲と人が確認すべき範囲の6つです。
この章の数値は、すべて「この架空データの、この設定での結果」です。乱数で作ったデータなので、データを作った側は本当の解約確率(真の確率)を知っています。現実の企業には見えない値ですが、この記事では答え合わせ(上限の目安)に使います。損益は、第2章で定めた架空の引き止め施策の設定(施策1件800円、解約する顧客に打てば7,560円の粗利を守れる)で、予測確率がしきい値の約0.106を超える顧客に施策を打ったときの値です。「放置」「毎月再学習」「四半期ごと再学習」も第2章の定義と同じで、毎月再学習は、第 m か月の予測の前に、正解が確定している直近12か月(第 m-13〜m-2 か月)で学習し直す方式です。解約は翌月末に確定するので、予測の時点で手元にある最新の正解は2か月前の月の分です。
再学習の方式は「いつ学習し直すか」の決め方で分ける
再学習の方式は、学習し直す時期の決め方で分けると整理しやすくなります。Google Cloud の Cloud Architecture Center にある、機械学習の継続的デリバリーと自動化のパイプラインを解説した文書(Google Cloud の MLOps の解説文書、2024年8月28日更新)は、本番の学習の流れ(パイプライン)を起動するきっかけとして、必要なときに手で起動する、決まった周期で起動する、新しい学習データが届いたときに起動する、モデルの性能の低下が目立ったときに起動する、データの分布が大きく変わったときに起動する、の5つを挙げています。同じ文書は、周期で再学習するときの頻度は、データの傾向がどれだけ速く変わるかと、再学習にどれだけ費用がかかるかの両方で決まる、とも書いています。この章では、この5つを次の4つの方式にまとめて扱います。
| 方式 | 学習し直す時期 | 向いている状況 | 弱点 |
|---|---|---|---|
| 手動 | 担当者が必要と判断したとき | モデルの本数が少なく、変化がまれで、判断の影響が小さい段階 | 担当者の気づきと時間に依存する。担当者が替わると止まる |
| 定期(毎月・四半期など) | 決まった周期 | 正解が一定の周期で届き、運用の段取りを固定したいとき | 変化が無い時期にも費用がかかる。周期の途中で起きた変化には次の周期まで追いつけない |
| 条件で起動する(トリガー型) | 監視の値が基準を超えたとき(性能の低下・確率の水準のずれ・分布の変化) | 監視の仕組みがあり、変化の時期が読めないとき | 基準の決め方しだいで、鳴りすぎ(費用の無駄)と鳴らなすぎ(見逃し)の両方が起きる |
| 常時(オンライン学習) | 新しいデータが届くたびに少しずつ | 正解がすぐに届き、変化が速い用途 | 使えるモデルの種類が限られる。異常なデータもすぐに取り込んでしまう |
このうち、条件で起動する方式を、この章ではトリガー型の再学習と呼びます。トリガー型は「必要なときだけ学習し直す」ので、費用を抑えながら変化に追いつける可能性がありますが、その成否は、何を監視し、どの値を超えたら起動するかの設計で決まります。以下では、まず定期とトリガー型を共通データで比べ、常時の学習は後半で位置づけだけを確かめます。
どの方式を選ぶにしても、決めておくべきことは同じです。1つ目は、学習し直したモデルを本番に入れる条件(新しいモデルが現行を上回ることの確かめ方)です。2つ目は、学習に使うデータの範囲(直近何か月分か、事故のあった月を含めるか)です。3つ目は、誰がどこで結果を確認するか(自動で入れ替えるのか、人が承認するのか)です。この3つが決まっていない再学習は、仕組みとして回っていても、結果に責任を持てる人がいない状態になります。モデルの承認の流れそのものは第7章で、学習の流れの自動化は第9章で扱いました。この章は、その流れを「いつ回すか」「何を入れるか」の設計に絞ります。
トリガー型の再学習を共通データで実装する
共通データで、トリガー型の再学習を実装し、放置・四半期ごと再学習・毎月再学習と比べました。監視に使えるのは、予測の時点で正解が確定している最新の月、つまり第 m か月の予測の前なら第 m-2 か月の分だけです。そこで、毎月の予測の前に、いま使っているモデル(現行のモデル)を第 m-2 か月の正解で採点し、次の2つの基準のどちらかを外れたら、その場で直近12か月(第 m-13〜m-2 か月)で学習し直すことにしました。
- 確率の水準のずれ:第 m-2 か月の予測平均と実際の解約率の差が、実際の解約率の10%を超えたら再学習する(例えば実際の解約率が0.10の月に、予測平均が0.09を下回るか0.11を上回る)
- 並べ替えの正しさの低下:第 m-2 か月の AUC が0.66を下回ったら再学習する
基準の値(10%と0.66)は、この章で置いた架空の設定です。第2章の基準の結果では、変化の前(第13〜18か月)の放置の AUC が0.680、予測平均と実際の解約率の差がほぼ0だったので、その水準から目に見えて外れたら動く、という程度の意味で置きました。現実の運用では、変化の無い時期の月ごとの揺れの大きさを測ってから決めます。比較のために、確率の水準のずれだけで起動するもの、AUC の下限だけで起動するもの、どちらかで起動するものの3通りを用意しました。あわせて、後の節で説明するチャンピオン・チャレンジャー(新しく作ったモデルが、いま本番で使っているモデルを上回ったときだけ入れ替える方式)も同じ表に入れて比べます。
実装では、同じ学習期間で作ったモデルは同じものになることを利用しました。第 k か月に作るモデル(第 k-13〜k-2 か月で学習)を第13〜36か月の24本、放置のモデルを1本、先にまとめて学習しておき、方式ごとに「どの月にどのモデルを使うか」だけを変えて採点しています。次のコードは、その要所を抜き出したものです。補助モジュール(mlops_data.py・baseline.py)と同じフォルダに置いて実行する形で、models にはモデルの一覧、check にはモデルをある月の正解で採点する関数(AUC・予測平均・実際の解約率・対数損失・損益を返す)が入っている前提です。
import mlops_data as md
import baseline as bl

# "F" は第1〜12か月で一度だけ学習した放置のモデル。数字は第 k か月に作ったモデル
models = {"F": bl.fit(1, 12)}
for k in range(13, 37):
    models[k] = bl.fit(max(1, k - 13), k - 2)

CAL_LIMIT = 0.10   # 予測平均と実際の解約率のずれの許容幅(実際の解約率に対する割合)
AUC_FLOOR = 0.66   # AUC の下限

def trig_both(m, cur):
    c = check(cur, m - 2)          # 現行のモデルを、正解が確定している最新の月で採点
    bad_cal = abs(c["pred"] - c["actual"]) / c["actual"] > CAL_LIMIT
    bad_auc = c["auc"] < AUC_FLOOR
    return m if (bad_cal | bad_auc) else None   # 再学習するなら第 m か月のモデルに替える

def simulate(decide):
    cur, rows = "F", []
    for m in range(13, 37):
        new = decide(m, cur)
        if new is not None:
            cur = new
        r = check(cur, m)          # 第 m か月を、そのとき使っているモデルで予測して採点
        r.update(month=m, retrain=int(new is not None))
        rows.append(r)
    return rows
このやり方で、放置・四半期ごと・毎月の3方式の24か月の損益合計を再計算すると、1,964.0万円・2,357.7万円・2,384.2万円となり、第2章の基準の結果と一致しました。実行時間は、モデル25本の学習と全方式の採点を合わせて96.0秒でした(この記事の実行環境、一般的なノートPCでの実測。他の処理と並行して動かしたので揺れます)。結果を次の表にまとめます。「競合期」は第28〜36か月、競合の乗り換え施策で解約との関係そのものが変わった期間で、この期間の実際の解約率は平均0.1427です。
| 方式 | 再学習の回数 | 24か月の損益合計(万円) | AUC(24か月平均) | 競合期の損益(万円/月) | 競合期の予測平均 | 競合期の施策件数(件/月) |
|---|---|---|---|---|---|---|
| 放置 | 0 | 1,964.0 | 0.6608 | 116.9 | 0.0859 | 1,347.6 |
| 四半期ごと再学習 | 7 | 2,357.7 | 0.6684 | 155.0 | 0.1115 | 2,133.8 |
| 毎月再学習 | 24 | 2,384.2 | 0.6689 | 157.4 | 0.1139 | 2,233.2 |
| トリガー型(確率の水準のずれ) | 10 | 2,366.1 | 0.6693 | 157.0 | 0.1137 | 2,232.8 |
| トリガー型(AUC の下限) | 5 | 2,340.8 | 0.6681 | 154.8 | 0.1093 | 2,091.2 |
| トリガー型(どちらか) | 11 | 2,367.1 | 0.6687 | 157.0 | 0.1137 | 2,232.8 |
| チャンピオン・チャレンジャー(後述) | 16(入れ替えの回数) | 2,366.7 | 0.6684 | 157.6 | 0.1109 | 2,142.1 |
| 真の確率(上限の目安) | 対象外 | 2,691.1 | 対象外 | 対象外 | 対象外 | 対象外 |
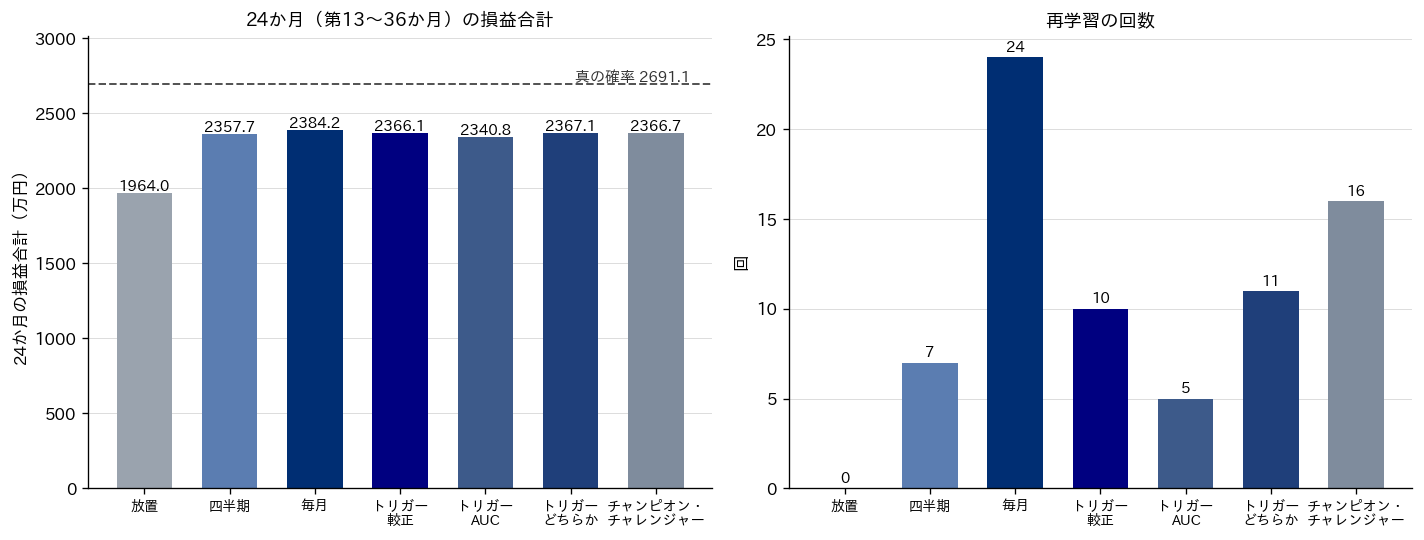
「24か月の損益合計」の列を見ると、トリガー型(どちらか)は再学習11回で2,367.1万円となり、24回学習し直す毎月再学習(2,384.2万円)との差は17.1万円、7回の四半期ごと再学習(2,357.7万円)より9.4万円多い結果でした。確率の水準のずれだけで起動するものも10回で2,366.1万円と、ほぼ同じです。一方、AUC の下限だけで起動するものは5回で2,340.8万円と、四半期ごと再学習を16.9万円下回りました。放置との差で見ると、どの方式も放置の1,964.0万円を377〜420万円上回っており、この架空データでは「再学習するかしないか」の差が、「どの方式で再学習するか」の差よりずっと大きいことが分かります。
AUC の下限だけで起動する方式が劣った理由は、この共通データの変化の性質にあります。第2章で見たとおり、第19か月の料金改定と第22か月の partner の開始では、AUC はほとんど落ちず、予測平均が実際の解約率を下回る「確率の水準のずれ」が先に出ました。損益はしきい値と確率を比べて施策の件数を決める使い方なので、水準のずれは施策を打つべき顧客に打てない形で損益に響きます。AUC だけを見る基準はこのずれに反応しないため、競合期の予測平均が0.1093と、確率の水準のずれで起動する方式(0.1137)より低いままでした。何を監視して再学習を起動するかは、モデルの予測をどう使うかに合わせる必要があります。確率をしきい値と比べる使い方なら確率の水準を、上位から順に施策を打つ使い方なら並べ替えの正しさを、起動の基準に入れます。
トリガー型が動いた月を読む
トリガー型(どちらか)が、どの月に、何を見て再学習を起動したかを次の表にまとめました。「判定に使った月」は、その月の予測の前に正解が確定していた最新の月(第 m-2 か月)です。「ずれ」は、予測平均と実際の解約率の差を実際の解約率で割った値です。
| 再学習した月 | 判定に使った月 | 判定に使った月の AUC | 予測平均 | 実際の解約率 | ずれ | 起動した基準 | 背景にある変化 |
|---|---|---|---|---|---|---|---|
| 第21か月 | 第19か月 | 0.6820 | 0.0798 | 0.0910 | 0.123 | 確率の水準のずれ | 第19か月の料金改定 |
| 第22か月 | 第20か月 | 0.6550 | 0.0855 | 0.0908 | 0.059 | AUC の下限 | 月ごとの揺れ(真の確率でも AUC 0.6638 の月) |
| 第25か月 | 第23か月 | 0.6744 | 0.0935 | 0.1096 | 0.147 | 確率の水準のずれ | 第22か月の partner の開始 |
| 第29か月 | 第27か月 | 0.6915 | 0.1030 | 0.0934 | 0.103 | 確率の水準のずれ(予測が高すぎる側) | 第27か月の解約率が偶然低かった |
| 第30か月 | 第28か月 | 0.6256 | 0.1046 | 0.1484 | 0.295 | 両方 | 第28か月の競合の乗り換え施策 |
| 第31〜36か月(毎月) | 第29〜34か月 | 0.6314〜0.6729 | 0.1044〜0.1252 | 0.1378〜0.1552 | 0.112〜0.274 | 確率の水準のずれ(第31・32・33か月は AUC の下限も) | 学習し直しても新しい傾向の月が学習期間の一部にしか入らない |
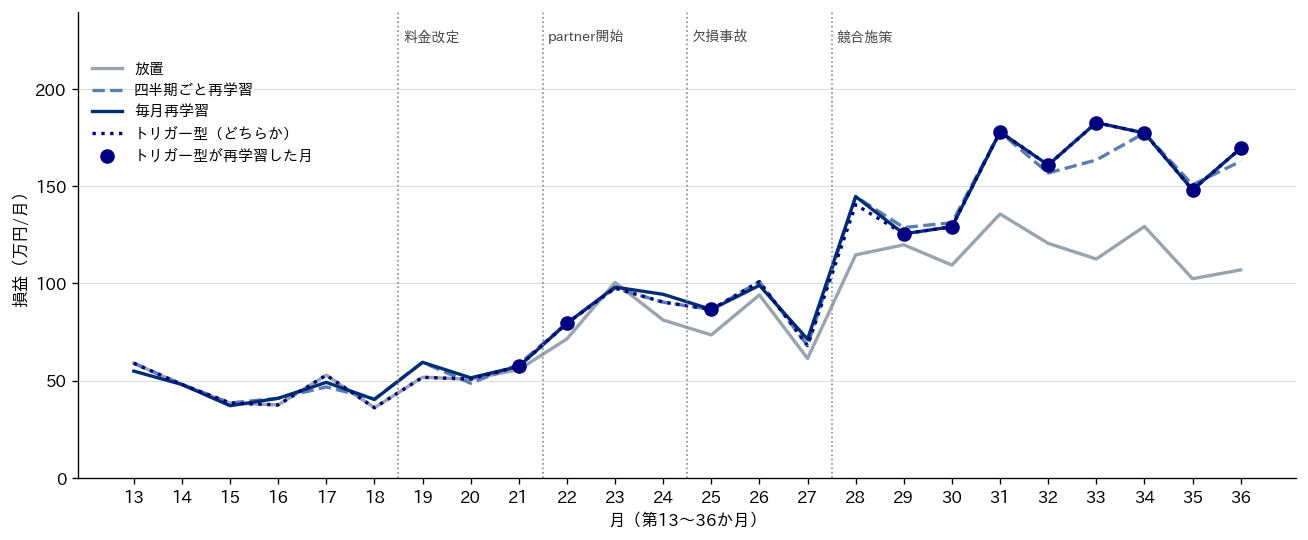
この表から読み取れることが4つあります。1つ目は、変化に気づくまでに少なくとも2か月かかることです。第19か月の料金改定には第21か月、第28か月の競合施策には第30か月の判定で反応しています。第30か月の判定は、第28か月の正解が確定した第29か月末の時点で行うもので、第10章で「ラベルを使う監視で気づけるのは第29か月末」と書いたのと同じ時点です。正解が届くのが翌月末なので、正解で性能を測る限り、この遅れは避けられません。第10章で見たように、競合施策の変化は入力やスコアの分布にはほとんど出ないので、この共通データの設定では、この2か月を縮めるには、正解をもっと早く確定させる業務側の工夫(例えば解約の申し出の時点で記録する)が要ります。
2つ目は、変化ではなく月ごとの偶然の揺れで起動した月があることです。第22か月の起動は、第20か月の AUC が0.6550と下限を下回ったためですが、この月は真の確率で並べても AUC が0.6638しかなく、モデルが劣化したのではなく、その月の顧客の構成でたまたま並べ替えが難しかった月でした。第29か月の起動も、第27か月の実際の解約率(0.0934)が真の確率の平均(0.1001)より偶然低かったために、予測が高すぎると判定されたものです。1か月5,000件のデータでは、AUC も解約率もこの程度は揺れます。再学習のたびに人の確認が入る運用なら、偶然の揺れで起動した再学習の分の工数は、変化への対応には使われていないことになります。揺れで鳴らないようにするには、基準を「2か月続けて外れたら」のように連続月数で決めるか、許容幅を揺れの大きさから決める方法があります。第10章のアラートの設計と同じ考え方です。
この第29か月の起動は、損益の面では結果として効いています。トリガー型(どちらか)は、第28か月には第25か月に作ったモデル(partner の開始への対応で学習し直したもの)を、第29か月には偶然の揺れで作り直したモデルを使い、第30か月以降は毎月再学習と同じ月に作ったモデルを使いました。そのため競合期の損益は月157.0万円と毎月再学習(157.4万円)にほぼ並び、放置(116.9万円)との差は月40.1万円、9か月で約361万円(表の月平均の値から計算した概算)になりました。第10章では、競合施策に気づいた翌月の第30か月から毎月再学習の水準に戻せたと仮定して、取り戻せる額の目安を329.1万円としましたが、トリガー型がこれを上回ったのは、競合施策に気づく前の第28・29か月にも、別の理由で作り直したモデルを使っていて、その2か月の差の一部を縮めていたためです。第29か月の分は偶然の揺れによる起動の結果で、競合施策を見越したものではありません。
3つ目は、競合施策の後は、再学習しても基準を外れ続け、第30か月から第36か月まで毎月起動したことです。直近12か月で学習し直しても、第30か月の時点で新しい傾向の月は学習期間の12か月のうち1か月(第28か月)しか入っていません。そのため、学習し直したモデルの予測平均は実際の解約率に届かず、翌月も基準を外れます。トリガー型は「起動したら直る」ことを前提にしていますが、関係そのものが変わったときは、再学習を繰り返すだけでは追いつくのに時間がかかります。この点は、次の節で学習に使う期間の長さとして確かめます。
4つ目は、トリガー型は「再学習するかどうか」を決めるだけで、再学習したモデルが良くなったかどうかは確かめていないことです。この実装では、起動したら無条件に新しいモデルに入れ替えています。新しいモデルが現行より悪い場合に入れ替えを止める仕組みは、後の節のチャンピオン・チャレンジャーで扱います。
学習に使う期間の長さを決める
再学習では、いつ学習し直すかと並んで、どれだけ前までのデータで学習するかを決める必要があります。学習期間が長いほどデータの件数が増え、月ごとの偶然の揺れに左右されにくくなりますが、古い傾向も多く混ざります。短いほど新しい傾向に早く追いつきますが、件数が減って予測が不安定になります。第2章の定義の毎月再学習・四半期ごと再学習は直近12か月で学習していますが、この長さに決まった正解はありません。共通データで、直近6か月・12か月・24か月を比べました。第 k か月に作るモデルは、第 k-1-L〜k-2 か月(L か月分。第1か月より前のデータは無いので、そこで切り詰める)で学習します。
実行時間を120秒以内に収めるため、比較は2つに分けました。1つ目は四半期ごと再学習(第16・19・22・25・28・31・34か月)で24か月全体を比べたもの(実行時間62.6秒)、2つ目は毎月再学習で、競合期(第28〜36か月)だけを、直近3か月・6か月・24か月で比べたもの(37.2秒)です。毎月再学習・12か月の値は第2章の基準の結果を使います。
| 学習期間 | 四半期ごと:24か月の損益合計(万円) | 四半期ごと:第19〜27か月の損益(万円/月) | 四半期ごと:競合期の損益(万円/月) | 四半期ごと:競合期の予測平均 | 四半期ごと:競合期の施策件数(件/月) |
|---|---|---|---|---|---|
| 直近6か月 | 2,392.3 | 74.0 | 160.4 | 0.1190 | 2,399.2 |
| 直近12か月 | 2,357.7 | 76.6 | 155.0 | 0.1115 | 2,133.8 |
| 直近24か月 | 2,352.3 | 79.2 | 151.5 | 0.1079 | 2,023.6 |
四半期ごと再学習では、24か月の損益合計は直近6か月が2,392.3万円と最も多く、12か月(2,357.7万円)と24か月(2,352.3万円)がほぼ並びました。ただし期間を分けると、向きが逆になります。料金改定から欠損事故までの第19〜27か月(解約との関係式は変わらず、入力の分布と、それに伴う全体の解約率が変わった期間)では、24か月(79.2万円/月)が最も良く、6か月(74.0万円/月)が最も悪い結果でした。同じ期間の AUC の平均も、24か月が0.6836、6か月が0.6749です。関係が変わっていないときは、件数が多い方が有利だということです。反対に、関係そのものが変わった競合期では、6か月(160.4万円/月)が最も良く、24か月(151.5万円/月)が最も悪くなりました。競合期の実際の解約率は平均0.1427で、予測平均は6か月が0.1190、24か月が0.1079と、古いデータが多いほど新しい解約の水準に追いつけていません。
| 学習期間 | 毎月再学習:競合期の損益(万円/月) | AUC | 予測平均 | 施策件数(件/月) |
|---|---|---|---|---|
| 直近3か月 | 161.1 | 0.6470 | 0.1298 | 2,722.0 |
| 直近6か月 | 164.0 | 0.6502 | 0.1236 | 2,527.4 |
| 直近12か月(第2章の基準の結果) | 157.4 | 0.6499 | 0.1139 | 2,233.2 |
| 直近24か月 | 154.9 | 0.6495 | 0.1096 | 2,076.3 |
毎月再学習で競合期だけを比べても、損益は6か月(164.0万円/月)が最も良く、24か月(154.9万円/月)が最も低い結果でした。直近3か月は予測平均が0.1298と実際の解約率に最も近づきましたが、件数が月5,000件の3か月分しかないため AUC が0.6470と最も低く、損益は6か月を下回りました。関係が変わった直後は「新しい傾向に追いつく速さ」と「件数による安定」の釣り合いで最適な長さが決まり、この架空データではそれが6か月前後だったということです。この結果から「学習期間は6か月がよい」とは言えません。変化の無い時期には長い方が有利だったように、最適な長さは、その時期にどんな変化が起きているかで変わります。
実務では、学習期間を1つに固定せず、候補を2〜3通り用意して、次の節のチャンピオン・チャレンジャーの比較に一緒にかけるやり方が考えられます。関係そのものの変化が疑われるとき(予測平均と実際の解約率のずれが、再学習のあとも続くとき)は短い期間の候補を、変化の無い時期は長い期間の候補を選ぶ、という使い分けが、比較の結果から自然に出てきます。古い月を捨てるのではなく、新しい月ほど重く扱う(学習の重みを付ける)方法もありますが、この章では実行していません。
再学習の費用と効果の釣り合い
再学習には費用がかかります。計算機の費用だけでなく、学習したモデルの評価結果を人が確認し、承認し、本番に入れ替える作業の工数がかかります。第7章で扱った承認の流れを毎回通すなら、再学習の回数はそのまま人手の工数の回数になります。そこで、方式どうしの損益の差を再学習の回数の差で割り、「追加の再学習1回あたり、損益がいくら増えたか」を出しました。これが、1回の再学習にかけてよい費用の上限の目安になります。
| 比べた組み合わせ | 24か月の損益の差(万円) | 再学習の回数の差 | 追加の再学習1回あたりの損益の増分(万円) |
|---|---|---|---|
| 放置 → 四半期ごと再学習 | 393.7 | 7 | 56.2 |
| 四半期ごと再学習 → トリガー型(どちらか) | 9.4 | 4 | 2.35 |
| 四半期ごと再学習 → トリガー型(確率の水準のずれ) | 8.4 | 3 | 2.80 |
| 四半期ごと再学習 → 毎月再学習 | 26.5 | 17 | 1.56 |
「追加の再学習1回あたりの損益の増分」の列を見ると、放置から四半期ごと再学習に移るときは、再学習1回あたり56.2万円の損益が増えました。四半期ごとから毎月に増やすと、増える再学習17回で損益は26.5万円しか増えず、1回あたり1.56万円です。つまり、この架空データの設定では、再学習1回にかかる費用(人の確認の工数を金額に直したものを含む)が1.56万円を超えるなら、毎月再学習は四半期ごと再学習より損になります。トリガー型は、四半期ごとより4回多い11回の再学習で9.4万円多く、1回あたり2.35万円でした。回数を増やすほど1回あたりの効果は小さくなる、という当たり前の形が数字で確かめられます。
経営の判断に直すと、論点は2つです。1つ目は、最初の一歩(放置をやめて、何らかの周期で再学習する)の価値が圧倒的に大きいことです。この架空データでは、24か月で393.7万円、競合期の損益は月116.9万円から155.0万円に上がりました。最初の再学習の仕組みを整える費用は、ここと比べて判断します。2つ目は、そこから先の頻度の上げ下げは、1回あたりの費用との比べ合いになることです。再学習の工程が自動化されていて、人の確認が軽ければ、毎月でも採算が合います。確認が重いなら、四半期ごとか、トリガー型で必要なときだけ学習し直す方が合理的です。どちらを選ぶかは、第9章で扱った学習の流れの自動化がどこまで進んでいるかで決まります。損益の差(ここでは数十万円の単位)と、再学習1回の工数(担当者の何時間か)を同じ単位に直して並べることが、この判断の出発点です。体制と費用の見積りの考え方は第13章で扱います。
チャンピオン・チャレンジャーで入れ替えを判定する
チャンピオン・チャレンジャーは、いま本番で使っているモデルを「チャンピオン(現行)」、新しく作ったモデルを「チャレンジャー(挑戦者)」と呼び、同じデータで両者を比べて、挑戦者が上回ったときだけ入れ替える方式です。Google Cloud の MLOps の解説文書も、自動で再学習する仕組みのモデルの検証の段で、新しく学習したモデルの評価指標を現行のモデルと比べ、新しいモデルの方が良い性能を出すことを確かめてから本番に昇格させる、と書いています。同じ文書は、データの区分(地域など)ごとに性能がそろっていることの確認や、本番の推論の仕組みとの互換性の確認も、この段の確認項目に挙げています。
この比較で大事なのは、両者がどちらも学習に使っていない月で比べることです。挑戦者を、手元にある最新の正解の月(第 m-2 か月)まで含めて学習すると、その月で採点したときに挑戦者だけが有利になります。そこでこの実装では、挑戦者を「1か月前に作ったモデル」(第 m-14〜m-3 か月で学習)とし、両者を第 m-2 か月の正解で比べました。比べる指標には、予測確率の当たり具合を測るlog_loss(対数損失。確率の水準のずれと並べ替えの両方を反映し、小さいほど良い)を使いました。1か月の損益で比べると、施策の当たり外れの偶然で大きく揺れるためです。
def champion_challenger(m, cur):
    # 挑戦者:1か月前に作ったモデル(第 m-14〜m-3 か月で学習)
    ch = m - 1 if m - 1 >= 13 else "F"
    if ch == cur:
        return None
    c_old = check(cur, m - 2)      # 第 m-2 か月は、どちらのモデルも学習に使っていない
    c_new = check(ch, m - 2)
    return ch if c_new["ll"] < c_old["ll"] else None   # 対数損失が小さければ入れ替える

rows = simulate(champion_challenger)
上のコードは、前に示した simulate に渡す判定の関数を抜き出したものです。結果は前の表のとおりで、24か月の損益合計は2,366.7万円、トリガー型(どちらか)の2,367.1万円とほぼ同じでした。競合期の損益は157.6万円/月で、表の中では毎月再学習(157.4万円/月)をわずかに上回りました。挑戦者は毎月作るので、学習の手間は毎月再学習と変わりません。第13か月は挑戦者がまだ無く、第14〜36か月の23回の比較のうち、入れ替えたのが16回、現行を据え置いたのが7回(第14・15・19・22・27・28・29か月)でした。
据え置いた月の比較を見ると、対数損失の差はごく小さいものでした。例えば第28か月は、現行(第25か月に作ったモデル)が0.31389、挑戦者(第27か月に作ったモデル)が0.31482です。この程度の差で入れ替えるかどうかを決めると、どちらを選んでも結果はほとんど変わりません。一方、競合施策の後の第30か月以降は、挑戦者が毎月勝ち、7か月続けて入れ替わりました。新しい傾向の月を多く含む挑戦者ほど良い、という状況が続いたためです。
この方式には、比べるための月を残す代わりに、本番に入るモデルが1か月古くなるという代償があります。毎月再学習は第 m-2 か月まで学習したモデルを使いますが、この実装のチャンピオン・チャレンジャーでは、入れ替わるモデルは第 m-3 か月までしか学習していません。この実装では、入れ替えを止めたことによる得と、1か月古くなることによる損を分けて測っていないので、損益がほぼ並んだ理由をどちらかに帰することはできません。比べる月を検証専用に取っておき、勝った挑戦者を同じ設定で最新の月まで含めて学習し直してから入れ替える、という組み方も考えられます。その場合は、学習し直したモデルそのものは検証していないことになるので、予測の範囲や件数の簡単な確認(第9章のテスト)を挟みます。
チャンピオン・チャレンジャーの価値は、損益の数字よりも、入れ替えの判断に記録が残ることにあります。「なぜこの月にこのモデルに替えたのか」「なぜ替えなかったのか」が、比べた月と指標の値で説明できます。第7章のモデルレジストリにこの比較の結果を一緒に残しておけば、後から入れ替えの判断を監査することも、問題が起きたときに前のモデルに戻すこともできます。比べる指標が業務の判断とずれていないか(損益で使うなら確率の水準を反映する指標か)、区分ごとに悪化していないか(例えば partner 経路だけ悪化していないか)も、この段で確かめる項目です。区分ごとの評価は第6章で扱いました。
事故の月のデータで学習し直すと何が起きるか
再学習は、新しいデータを取り込んでモデルを良くするための仕組みですが、取り込むデータに問題があれば、その問題もモデルに取り込みます。共通データの第25〜26か月には、store 経路の利用日数の40%が欠損する、データ連携の不具合を仕込んであります(月全体の欠損率は第25か月0.1238、第26か月0.1152)。毎月再学習(直近12か月)では、第27か月から第39か月まで、学習期間にこの2か月のどちらかが入ります。この架空データは第36か月までなので、そのうちデータのある第27〜36か月について、次の3通りを比べました。
- A そのまま:欠損は欠損のまま学習する(第2章の毎月再学習と同じ)
- B 除外:利用日数の欠損率が5%を超える月を、学習から外す(学習は残りの10〜11か月分)
- C 0埋め:架空の設定。連携の不具合で、欠けた利用日数が欠損ではなく「0日」として記録されてしまった場合
予測する月(第27〜36か月)のデータには欠損はありません。比べたのは学習の側の扱いだけです。第3章で見たとおり、基準のモデル(HistGradientBoostingClassifier)は欠損をそのまま受け付けるので、A でもエラーにはならず学習が終わります。
| 学習期間 | 扱い | 第27〜36か月の損益合計(万円) | AUC | 利用日数0〜3日の顧客への予測平均 | 同じ顧客の真の確率の平均 |
|---|---|---|---|---|---|
| 直近12か月 | A そのまま | 1,488.1 | 0.6533 | 0.1742 | 0.1733 |
| 直近12か月 | B 除外 | 1,522.8 | 0.6544 | 0.1726 | 0.1733 |
| 直近12か月 | C 0埋め | 1,505.7 | 0.6538 | 0.1683 | 0.1733 |
直近12か月で学習する場合、3通りの差は小さいものでした。事故の影響を受けた行は、12か月6万件の学習データのうち2か月分の約12%で、全体の2%程度にとどまるためです。損益は B 除外が最も多く(1,522.8万円)、A そのまま(1,488.1万円)より34.7万円多い結果でしたが、この差を「事故の月を外した効果」とは読めません。B は学習期間が10〜11か月に縮み、前の節で見たように、競合期には学習期間が短いほど有利だったからです。C 0埋めでは、利用日数が少ない顧客(予測する月に0〜3日)への予測平均が0.1683と、真の確率の平均0.1733を下回りました。欠損が「0日」として記録されると、「利用0日なのに解約しなかった」顧客が学習データに増え、モデルが低利用の顧客の解約しやすさを低めに学ぶ方向に動きます。
学習期間が短いと、話が変わります。直近3か月で毎月再学習する場合(第 m か月のモデルを第 m-4〜m-2 か月で学習)について、同じ3通りを第27〜29か月で比べました(実行時間26.2秒)。
| 予測した月 | 扱い | 学習に使った月 | 損益(万円) | AUC | 利用日数0〜3日の顧客への予測平均 | 同じ顧客の真の確率の平均 |
|---|---|---|---|---|---|---|
| 第27か月 | A そのまま | 第23・24・25か月 | 58.0 | 0.6642 | 0.1842 | 0.1900 |
| 第27か月 | B 除外 | 第23・24か月 | 43.2 | 0.6384 | 0.1929 | 0.1900 |
| 第27か月 | C 0埋め | 第23・24・25か月 | 63.1 | 0.6734 | 0.1711 | 0.1900 |
| 第28か月 | A そのまま | 第24・25・26か月 | 133.9 | 0.6165 | 0.1826 | 0.1729 |
| 第28か月 | B 除外 | 第24か月 | 113.0 | 0.5923 | 0.1769 | 0.1729 |
| 第28か月 | C 0埋め | 第24・25・26か月 | 144.0 | 0.6213 | 0.1658 | 0.1729 |
| 第29か月 | A そのまま | 第25・26・27か月 | 125.3 | 0.6232 | 0.1720 | 0.1655 |
| 第29か月 | B 除外 | 第27か月 | 79.6 | 0.5841 | 0.1498 | 0.1655 |
| 第29か月 | C 0埋め | 第25・26・27か月 | 121.4 | 0.6190 | 0.1606 | 0.1655 |
この表で目立つのは、B 除外の悪さです。第29か月は学習に使える月が第27か月の1か月分(5,000件)しか残らず、AUC は0.5841、損益は79.6万円と、A そのまま(125.3万円)を45.7万円下回りました。「欠損の多い月は自動で外す」という規則は一見安全ですが、学習期間が短いと、学習データそのものを痩せさせて、事故よりも大きな害を生みます。C 0埋めでは、学習データのうち利用日数が0日の行の割合が8.2〜12.3%に増えました(事故の無い第23・24・27か月の各月では4.0〜4.8%)。低利用の顧客への予測平均は、3つの月のどれでも A より低く、3つの月すべてで真の確率の平均も下回りました(A が真の確率の平均を下回ったのは第27か月だけです)。損益は第27・28か月では C の方が多く出ましたが、1か月の損益は偶然で大きく揺れるので、この差から0埋めが有利とは読めません。
この2つの実験から言えるのは、次のことです。事故のデータを取り込んだ再学習の害は、この架空データの欠損の設定(第25・26か月に store 経路の利用日数の40%が欠損)では、事故の規模(全体の2%程度)に見合って小さいものでした。害が大きくなりうるのは、学習期間が短く事故の月の比重が大きいときと、欠損が欠損として見えず、もっともらしい値(0日)に化けて記録されるときです。後者は、欠損率の検査では見つかりません。この例でいえば「利用日数が0日の行の割合が、普段の4〜5%から8〜12%に増えた」ことに気づく、値の分布の検査が要ります。第3章で扱ったデータ契約とスキーマ検証を、推論の前だけでなく、再学習の学習データを作る段にもかけるのはこのためです。そして、検査に引っかかった月を機械的に外すのではなく、学習の流れを止めて、人が「外すか、直してから使うか、そのまま使うか」を判断するのが安全です。Google Cloud の MLOps の解説文書も、学習の前のデータ検証の段について、想定外の特徴量や値が見つかったらパイプラインを止めてデータサイエンスのチームが調べるべきだ、と書いています。
常時の学習(オンライン学習)の位置づけ
オンライン学習は、データをまとめて学習し直すのではなく、新しいデータが届くたびに、今のモデルに少しずつ追加で学習させる方式です。scikit-learn の公式ドキュメントの、大きなデータを扱うための方策を説明したページ(scikit-learn の Strategies to scale computationally のページ、1.9.1 の版で確認)は、全部のデータを一度に見ずに少しずつ学習できるモデルは partial_fit という関数を持っていると説明し、分類に使えるものとして MultinomialNB・BernoulliNB・Perceptron・SGDClassifier・MLPClassifier を挙げています。同じページは、この方式で分類を学習するときは、最初の partial_fit の呼び出しで、起こりうる全部の分類先を classes 引数で渡す必要があるとも書いています。
この記事の実行環境(scikit-learn 1.9.0)で確かめたところ、基準のモデルの HistGradientBoostingClassifier は partial_fit を持っておらず、SGDClassifier は持っていました。つまり、基準のモデルのままではオンライン学習はできず、モデルの種類を替える必要があります。さらに、SGDClassifier に第1か月のデータで partial_fit をかけたあと、欠損を含む第25か月のデータを渡すと、ValueError(入力に欠損が含まれるという内容)で止まりました。欠損事故の月のデータは、オンライン学習ではそのまま取り込めず、取り込む前に欠損を埋める処理が要ります。そこで前の節の C 0埋めのような値が入れば、それは確認の機会なしに、すぐにモデルに反映されます。
この共通データのような解約予測では、オンライン学習の利点は小さいと考えています。正解(解約したかどうか)が届くのは翌月末で、データが届くたびに学習するといっても、結局は月に1回、前々月の分を取り込むことになるからです。オンライン学習が向いているのは、正解が予測の直後に届き(広告がクリックされたかどうかのように、結果がすぐ分かるもの)、傾向の変化が速い用途です。そうした用途でも、異常なデータがすぐにモデルに入るので、入力の検査と、モデルの出力の監視を、まとめて学習し直す方式より厳しくする必要があります。オンライン学習の理論と実装は、章末の参考書籍で詳しく扱われています。
自動化してよい範囲と人が確認すべき範囲
ここまでの結果を踏まえて、再学習の工程を「自動で進めてよいところ」と「人が確認すべきところ」に分けます。次の表は、この章の実験の結果から導いた整理で、共通データの設定に合わせた例です。モデルの用途と、判断の誤りが及ぼす影響の大きさに合わせて調整する前提です。
| 工程 | 自動で進めてよい条件 | 人が確認すべき条件 | この章の根拠 |
|---|---|---|---|
| 再学習の起動 | 定期の周期が来た、またはトリガーの基準を外れた | 基準を外れた状態が再学習のあとも続く(関係そのものの変化が疑われる) | 競合施策の後、トリガー型が7か月続けて起動した |
| 学習データの検証 | 欠損率・値の分布・件数が普段の範囲に収まっている | 欠損率や特定の値(0日など)の割合が普段を外れた。学習件数が普段より大きく減った | 0埋めでは欠損率の検査を通り抜けた。機械的な除外で学習が1か月分に減り、損益が45.7万円下がった |
| 挑戦者の学習 | 学習期間の候補(例えば6か月と12か月)を決めた設定どおりに作る | 学習期間の候補そのものを見直すとき | 最適な学習期間は時期によって逆転した |
| 現行との比較 | 両者が学習に使っていない月で、決めた指標で比べる | 差がごく小さい。区分(経路・プラン)によって勝ち負けが分かれる | 据え置いた月は対数損失の差がごく小さかった |
| 入れ替え | 影響の小さい用途で、比較に勝ち、テストを通った | 施策の件数が大きく変わる(例えば月に数百件以上)。初めての種類の変化への対応 | 競合期には、方式によって施策件数が月2,091〜2,233件と変わった |
| 業務の設定の見直し | 自動化しない | 関係そのものの変化が起きたとき、しきい値や施策の前提を見直す | 再学習しても真の確率の損益(上限の目安)との差は残った |
この表の最後の行は、再学習の外側にある判断です。競合の乗り換え施策のように顧客の行動そのものが変わったとき、再学習でモデルは新しい解約の水準に近づきますが、引き止め施策の費用や引き止められる割合といった業務の前提は、モデルの外にあります。共通データでは、これらの前提は変化の前後で同じに置いていますが、現実には、競合が施策を打った時期に、自社の引き止め施策の効き方が同じとは限りません。モデルの再学習は自動化できても、施策の前提を見直す判断は、事業の責任者が持つべきものと考えています。
経営の目線で言い換えると、自動化の目的は「人の確認をなくすこと」ではなく、「人の確認を、判断が必要な場面に集めること」です。毎月の再学習の結果を全部人が確認していると、1回あたりの確認の費用が、前の節で求めた損益分岐(毎月と四半期の比較では1回1.56万円)を超えやすくなります。検証と比較を自動化し、基準を外れたときだけ人が見る形にすれば、確認の回数を減らしながら、事故のデータや関係の変化のような、自動では判断できない場面を見落とさずに済みます。
再学習の工程を、監視から入れ替えまでの順に並べると次のようになります。このうち学習データの検証と入れ替えの2つの段には、上の表の「人が確認すべき条件」に当たったときに止めて人が確認する場所を置いておきます。
- 監視(正解が届いた月で採点する)
- 再学習の判定
- 学習データの検証(条件に当たれば止めて人が確認する)
- 挑戦者の学習
- 現行との比較
- 入れ替え(条件に当たれば止めて人が確認する)
この章では、再学習を「いつ」「どのデータで」「誰の確認を経て」行うかを、第2章で用意した架空の共通データで確かめました。この架空データの設定では、放置をやめて再学習の仕組みを入れるだけで、比べた6つの方式(トリガー型の3種類を別々に数えた)のどれでも24か月の損益が約377〜420万円増え、そこから先の方式の違い(四半期・毎月・トリガー型・チャンピオン・チャレンジャー)の差は数十万円の範囲でした。トリガー型は、確率の水準のずれを基準に入れると、毎月再学習の半分以下の回数(11回)で近い損益(2,367.1万円)を出しましたが、変化に気づくまで2か月の遅れは避けられず、偶然の揺れでも起動しました。学習に使う期間の長さは、関係が変わらない時期は長い方が、関係が変わった直後は短い方が有利で、正解は時期によって変わりました。事故の月のデータは、そのまま入れても害は小さく、むしろ機械的に除外して学習データを痩せさせる方が害が大きい場面がありました。
再学習の仕組みは、監視・データの検証・比較・承認の各段がそろって初めて安全に回ります。次の第12章では、これらの判断の記録を、説明責任とガバナンスの観点から、社外の規範に照らしてどう残すかを扱います。
この章を深めたい方への参考書籍
『オンライン機械学習』(海野裕也・岡野原大輔・得居誠也・徳永拓之、講談社):データが届くたびにモデルを少しずつ更新するオンライン学習の考え方と、その性能の解析、実装を扱った専門書です。この章で位置づけだけを確かめた常時の学習を、どんな用途で、どんな前提のもとで使えるかを理解するのに役立ちます。
『実践 時系列解析 統計と機械学習による予測』(Aileen Nielsen 著、山崎邦子・山崎康宏 訳、オライリー・ジャパン):時系列データを統計モデルと機械学習の両方で扱い、誤差の測り方やバックテスト(過去のある時点に立って予測し、その後の実績で採点する検証)、モデルの当てはめと提供の性能に関する考慮事項までを扱った本です。後半の章には、手持ちの全データを使うことが必ずしもよいとは限らない、という観点の節があり、この章で比べた学習期間の長さの判断を、時系列の検証の作法から考え直すのに役立ちます。
第12章 説明責任とガバナンス
第11章では、再学習を定期・トリガー・チャンピオン・チャレンジャーの方式で設計し、再学習の回数と損益の釣り合い、自動化してよい範囲と人が確認すべき範囲を整理しました。ここまでの章で扱ってきたのは、モデルの性能と損益を守るための仕組みでした。この章では、同じ仕組みを「説明できる状態を保つ」という観点から見直します。モデルの判断について、社内の経営会議、監査、顧客からの問い合わせ、取引先や規制当局から「なぜその判断になったのか」「誰がいつ承認したのか」「問題に気づいていたのか」と問われたときに、記録に基づいて答えられるかどうか、という観点です。
この章では、まず説明責任の場面で何を問われるかを整理し、日本の総務省・経済産業省のAI事業者ガイドライン(第1.2版)、EU の AI 規則(規則2024/1689)、AI マネジメントシステムの国際規格 ISO/IEC 42001、米国 NIST の AI リスクマネジメントフレームワークが、運用・監視・記録について何を書いているかを原文で確かめます。そのうえで、第2章で用意したサンプルデータ(架空の定額制サービスの解約予測)のモデルについて、説明の出し方(SHAP)、変化の前後で説明がどう変わるか、顧客の区分ごとの施策の当たり方の差、判断の記録の残し方と再現の確認を、実行して確かめます。説明可能性の手法そのものの詳しい解説は、弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』に譲り、この章では運用の仕組みとしての使い方に絞ります。
説明責任の場面で問われること
モデルを本番で使っていると、その判断について説明を求められる場面がいくつかあります。1つ目は個別の判断への問い合わせで、「なぜこの顧客に引き止めの連絡をしたのか(しなかったのか)」という問いです。2つ目は集計の判断への問いで、「なぜ今月は施策の件数が先月の倍になったのか」「なぜ予算を超えたのか」という経営会議の問いです。3つ目は過程への問いで、「このモデルはいつ、誰の承認で入れ替わったのか」「どのデータで学習したのか」という監査の問いです。4つ目は気づきへの問いで、「性能が落ちていたことに、いつ気づけたはずか」「気づいてから何をしたか」という、事故のあとの原因究明の問いです。
これらの問いに答えるには、その場で考えた説明では足りず、判断の時点の記録が要ります。第5章の実験の記録、第7章のモデルレジストリとモデルカード、第8章の推論の記録、第10章の監視の記録は、性能を守るための仕組みであると同時に、説明責任を果たすための証拠でもあります。逆に言えば、記録が無い仕組みは、どれだけ性能が良くても、問われたときに「たぶんこうだったと思います」としか答えられません。次の表は、問われる場面ごとに、答えるために要る記録と、その記録を扱っている章を整理したものです。
| 問われる場面 | 典型的な問い | 答えるために要る記録 | 扱っている章 |
|---|---|---|---|
| 個別の判断への問い合わせ | なぜこの顧客に施策を打ったのか | その時点の入力・モデルの版・予測確率・しきい値・主な理由 | 第8章(推論の記録)、この章 |
| 集計の判断への問い | なぜ今月は施策の件数が増えたのか | 月ごとの予測平均・施策件数・入力の分布・モデルの版の履歴 | 第10章(監視)、第11章(再学習) |
| 過程への問い(監査) | いつ誰の承認でモデルが入れ替わったのか | 学習データとコードの版、評価の結果、承認者と日時 | 第5章(実験管理)、第7章(レジストリ) |
| 気づきへの問い(事故のあと) | 劣化にいつ気づけたはずか、何をしたか | 監視の指標とアラートの履歴、対応の記録 | 第10章(監視)、第9章(パイプライン) |
| 偏りへの問い | 特定の顧客層だけ扱いが違っていないか | 区分ごとの予測平均・施策率・的中率・捕捉率の推移 | この章 |
この表で「この章」としたのは、個別の判断の理由を記録する仕組みと、区分ごとの扱いの差を監視する仕組みです。どちらも、性能の監視だけでは見えない種類の問いに答えるためのものです。
AI事業者ガイドライン(第1.2版)が運用に求めていること
日本で AI を事業に使う企業の指針として、総務省と経済産業省が「AI事業者ガイドライン」を公表しています。2024年4月19日の第1.0版、2024年11月22日の第1.01版、2025年3月28日の第1.1版を経て、2026年3月31日に第1.2版が公表されました。総務省の掲載ページと経済産業省の掲載ページを2026年10月9日に開き、第1.2版が最新版であることを確かめました。経済産業省の検討会のページによれば、第4回以降の検討会は経済産業省と IPA の AI セーフティ・インスティテュート(AISI)の共同事務局で運営されており、IPA の検討会のページ(2026年8月27日更新)にも、第1.2版より新しい版の公表は載っていませんでした。第1.2版の更新内容の資料は、AI エージェントやフィジカル AI に関する事項の追記と、主体区分の整理を主な論点に挙げています。
本編は、取組について「各主体の資源制約を考慮しながら自主的に進めることが重要」としています。対象となる事業者を、AI システムを開発する「AI 開発者」、AI システムをサービスに組み込んで提供する「AI 提供者」、事業活動で AI を利用する「AI 利用者」の3つに分け、1つの事業者が複数を兼ねる場合もあるとしています。自社で解約予測のモデルを作り、自社の引き止め施策に使う企業は、3つの立場を1社で兼ねていることになります。開発者としての事項(学習データの扱い・検証可能性の確保)と、利用者としての事項(適正な利用・関係者への説明)の両方が、自社の中で完結する、ということです。
ガイドラインの本編は、すべての主体に共通する「共通の指針」として、人間中心・安全性・公平性・プライバシー保護・セキュリティ確保・透明性・アカウンタビリティ・教育リテラシー・公正競争確保・イノベーションの10項目を挙げています。このうち、モデルの運用・監視・記録に直接関わる記述を本編から抜き出したのが次の表です(記述は第1.2版本編の文言を要約したもので、括弧内は本編の項目番号です。たとえば「項目2の①」は、本編の「2)安全性」の①を指します)。
| 共通の指針の項目 | 本編の記述の要点 | この記事の仕組みとの対応 |
|---|---|---|
| 安全性(項目2の①) | 様々な状況下でパフォーマンスレベルを維持する(堅牢性)。AI の性質・用途に照らし、必要に応じて定期的かつ客観的なモニタリング及び対処も含めて、人間がコントロールできる制御可能性を確保する | 第10章の監視、第11章の再学習と人の確認、第8章のロールバック |
| 公平性(項目3の②) | AI に単独で判断させるだけでなく、適切なタイミングで人間の判断を介在させる利用を検討する。その際、人間の判断が自動化バイアスに左右されない対策を講じる | この章の区分ごとの監視、第11章の人が確認すべき範囲 |
| 透明性(項目6の①) | 検証可能性を確保するため、合理的な範囲で、開発過程、利用時の入出力、学習プロセス、推論過程、判断根拠等のログを記録・保存する。記録方法・頻度・保存期間は、事故等の原因究明や再発防止策の検討等を踏まえて検討する | 第5章の実験の記録、第8章の推論の記録、この章の決定ログ |
| 透明性(項目6の④) | 関係者の納得感と安心感の獲得のため、どのような説明が求められるかを分析・把握し、必要な対応を講じる | この章の SHAP による説明 |
| アカウンタビリティ(項目7の①③⑥) | データの出所や開発・提供・利用中の意思決定を、技術的に可能かつ合理的な範囲で追跡・遡求できる状態を確保する(トレーサビリティ)。責任者を設定する。情報を文書化して一定期間保管し、必要なときに参照できる状態にする | 第7章のモデルレジストリとモデルカード、第13章の責任分担 |
| アカウンタビリティ(項目7の⑤) | AI の出力の誤り等について、関係者からの指摘を受け付ける機会を設けるとともに、定期的かつ客観的なモニタリングを実施する | 第10章の監視、問い合わせ窓口の設計 |
表から読めるのは、ガイドラインが求めているのは特定の手法や製品ではなく、「状況が変わっても性能を保つ仕組み」「人が介在して止められる仕組み」「後から追跡できる記録」「責任者」の4つだという点です。いずれも「合理的な範囲で」「必要に応じて」という限定が付いており、どこまでやるかは、AI の用途とリスクの大きさに応じて各社が決めることになっています。本編は、アカウンタビリティについて「各主体の役割及び開発・提供・利用するAIシステム・サービスのもたらすリスクの程度を踏まえ、合理的な範囲で」果たすとしています。解約予測で引き止めの連絡先を選ぶモデルと、融資の可否を決めるモデルでは、求められる記録の細かさも保存期間も違ってよい、ということです。
また、本編の AI 提供者の事項には、提供時点でデータの公平性を担保するだけでなく、「AIモデルの入出力及び判断根拠を定期的に評価し、バイアスの発生をモニタリングする」とあります。公平性を、モデルを作った時点の確認だけでなく、運用中の監視項目として扱うことを求めている記述です。この章の後半で、区分ごとの施策の当たり方を月ごとに監視する仕組みを実装するのは、この記述に対応させるためです。
EU の AI 規則が高リスクAIに課す記録・人による監視・市販後の監視
EU の AI 規則(規則(EU)2024/1689)は、AI システムをリスクの大きさで分け、高リスクAIに分類されるものに、記録・人による監視・市販後の監視などの義務を課しています。2026年10月9日には EUR-Lex(EU の法令データベース)の本文のページが表示されず、条文を EUR-Lex 上で確かめることはできませんでした。そこで、欧州委員会が運営する AI Act Service Desk の条文表示で条文を確かめました。このページは、表示している本文が「2026年7月27日時点の EUR-Lex の統合版」に基づくこと、AI に関するデジタル・オムニバス(規則の改正)による追加と改正の箇所に印を付けていることを明記しています。以下の条文の訳は、この記事による仮訳です。
まず適用の範囲です。第2条第1項は、EU 域内で AI システムを市場に出す、または使用を開始する提供者を、その提供者が EU 域内にいるか第三国にいるかを問わず対象とし(a号)、さらに第三国にいる提供者と導入者(deployer、AI システムを自らの権限で使う者)も、AI システムが生み出した出力が EU 域内で使われる場合は対象とする(c号)と定めています。日本企業でも、EU 域内で AI システムを提供する場合や、AI の出力を EU 域内で使う場合には、適用の対象になりうるということです。
次に、どの AI が高リスクかです。第6条第2項が参照する附属書IIIは、高リスクとなる用途を分野ごとに列挙しています。たとえば、雇用の分野の採用・選考や昇進・解雇に関わる判断(4)、個人の信用力の評価や信用スコア(5(b)、ただし金融不正の検知は除く)、生命保険と健康保険における個人のリスク評価と価格設定(5(c))などです。この記事の例題である「定額制サービスの解約予測で、引き止め施策の連絡先を選ぶ」用途は、附属書IIIの列挙の中には見当たりませんでした。なお、第6条第3項は、附属書IIIに挙がる AI システムでも、人の健康・安全・基本的権利に重大な害を及ぼすリスクが無い場合(限られた手続き的な作業だけを行う場合など)は高リスクとみなさないという例外を置いています。ただし同じ項は、附属書IIIに挙がる AI システムが自然人のプロファイリング(個人に関するデータを自動で処理して、その人の行動や好み、経済状況などを評価・予測すること)を行う場合は、この例外によらず常に高リスクとみなす、と定めています。ある AI システムが高リスクに当たるかどうかの最終的な判断は、用途の詳細と規則の条文全体に照らして行うもので、この記事はその判断をするものではありません。同じ解約予測のモデルでも、出力を与信や保険料の設定に使えば、附属書IIIの別の項目に近づきます。
高リスクAIに課される義務のうち、この記事の運用の仕組みに直接関わる条文を抜き出したのが次の表です。
| 条文 | 主な名宛人 | 内容の要点(仮訳・要約) | この記事の仕組みとの対応 |
|---|---|---|---|
| 第12条 記録の保持 | 高リスクAIシステム(の設計) | システムの存続期間を通じて、事象の記録(ログ)を自動で取れるように技術的に備える。記録は、リスクのある状況や実質的な変更の特定、市販後の監視、導入者による運用の監視に役立つものとする | 第8章の推論の記録、この章の決定ログ |
| 第14条 人による監視 | 高リスクAIシステム(の設計) | 使用中に人が効果的に監視できるよう設計する。監視を担う人が、能力と限界を理解し、異常や予期しない性能を検知できること、自動化バイアスを自覚できること、出力を正しく解釈できること、出力を使わない・覆す判断ができること、停止できることを可能にする | 第10章の監視、第11章の人の確認、第8章のロールバック |
| 第19条 自動生成ログ | 提供者 | 自らの管理下にある自動生成のログを、用途に見合った期間、少なくとも6か月保存する(EU 法・加盟国法、特に個人データの保護の法に別段の定めがある場合を除く) | この章の記録の保持 |
| 第26条 導入者の義務 | 導入者 | 使用説明書に沿って使う。必要な能力と権限のある人に人による監視を割り当てる。使用説明書に基づいて運用を監視する(第5項)。管理下にあるログを少なくとも6か月保存する(第6項) | 第10章の監視、第13章の役割 |
| 第72条 市販後の監視 | 提供者 | リスクに見合った市販後モニタリングの仕組みを作って文書化し、存続期間を通じて性能に関するデータを能動的かつ体系的に集めて分析する。仕組みは市販後モニタリング計画に基づき、計画は技術文書の一部とする | 第10章の監視、第11章の再学習の判断 |
第72条の市販後モニタリングは、「市場に出したあとも性能を追い続け、その記録を残す」ことを、提供者に仕組みとして求めるものです。この記事の第10章で扱った監視の仕組みを、規則の言葉で言い直したものに近いと言えます。また、第14条が監視を担う人に求める能力の中に、「自動化バイアス(AI の出力に自動的に頼りすぎる傾向)を自覚できること」が入っている点は、前節の AI事業者ガイドラインの公平性の記述と共通しています。人が介在していても、出力をそのまま追認するだけなら、人による監視にはならない、という考え方です。
適用の時期も確かめておきます。第113条は、規則が2026年8月2日から適用されるとしたうえで、例外を定めています。デジタル・オムニバスによる改正後の第113条(c)では、高リスクAIの分類・要件・義務を定めた第III章の第1節から第3節は、附属書IIIに基づいて高リスクに分類される AI システムについては2027年12月2日から、附属書Iの EU の製品安全の法令に基づくものについては2028年8月2日から適用されるとされています。この日付は改正で変わったものなので、検討の時点で必ず最新の統合版を確かめる必要があります。この記事の基準時点(2026年10月)では、附属書IIIの高リスクAIの義務はまだ適用前です。
経営の目線で見ると、EU の規則が直接適用されるかどうかにかかわらず、第12条・第14条・第19条・第72条の要求は、この記事が第5章から第11章で積み上げてきた運用の仕組みとほぼ重なります。記録を取る、監視する、人が止められるようにする、記録を一定期間残す、の4つです。この仕組みを最初から整えておけば、将来、ある用途が規制の対象になったときに、新たに作るものは少なくて済みます。逆に、記録の無いモデルが規制の対象になった場合、過去の判断を遡って説明することはできず、作り直しになります。
ISO/IEC 42001 と NIST AI RMF は、組織の仕組みとしての枠組み
AI事業者ガイドラインと EU の規則が「何をすべきか」を書いているのに対し、組織の中でそれを回し続ける仕組みの枠組みとして、2つの文書がよく参照されます。1つは国際標準化機構(ISO)と国際電気標準会議(IEC)の規格 ISO/IEC 42001、もう1つは米国国立標準技術研究所(NIST)の AI リスクマネジメントフレームワーク(AI RMF)です。
ISO の ISO/IEC 42001 のページによれば、この規格は2023年12月に発行された第1版(51ページ)で、組織の中で AI マネジメントシステム(AIMS)を確立し、実施し、維持し、継続的に改善するための要求事項を定めています。AI を使った製品やサービスを提供する組織にも利用する組織にも向けたもので、業種や規模を問いません。同じページは、この規格がマネジメントシステム規格であり、個々の AI の応用の細部を見るのではなく、計画・実行・評価・改善(Plan-Do-Check-Act)の進め方で、組織全体の AI のリスクと機会を管理するための方針と手順を整えるものだと説明しています。規格の本文は有料のため、この記事では本文の要求事項の中身には立ち入りません。
NIST の AI RMF のページによれば、AI RMF 1.0 は2023年1月26日に公開された、任意で使う枠組みです。同じページには、2024年7月26日に生成 AI 向けのプロファイル(NIST AI 600-1)が公開されたこと、AI RMF 1.0 が米国の AI 行動計画の一環として改訂中であることも書かれています。本文(NIST AI 100-1)は、リスク管理の活動を GOVERN(統治)・MAP(把握)・MEASURE(測定)・MANAGE(対処)の4つの機能に分け、それぞれをカテゴリとサブカテゴリに細分しています。本文は、これらの行動はチェックリストではなく、必ずしも順番に行う手順でもないと断っています。日本語訳も同じページから公開されています。
AI RMF のサブカテゴリには、この記事の運用の仕組みにそのまま対応するものがあります。本文から該当する項目を抜き出し、要点を訳したのが次の表です。
| サブカテゴリ | 内容の要点(仮訳・要約) | この記事の仕組みとの対応 |
|---|---|---|
| GOVERN 1.5 | リスク管理の過程とその結果の継続的な監視と定期的な見直しを計画し、組織の役割と責任を定める。定期的な見直しの頻度を決めることを含む | 第13章の役割と責任分担 |
| GOVERN 1.6 | AI システムの一覧(台帳)を作る仕組みがあり、組織のリスクの優先度に応じて資源が割り当てられている | 第7章のモデルレジストリ |
| MEASURE 2.4 | 本番での AI システムとその構成要素の機能と振る舞いを監視する | 第10章の監視 |
| MEASURE 2.9 | モデルを説明し、検証し、文書化する。出力をその文脈の中で解釈し、責任ある利用とガバナンスに役立てる | この章の SHAP による説明、第7章のモデルカード |
| MEASURE 2.11 | 公平性とバイアスを評価し、結果を文書化する | この章の区分ごとの監視 |
| MANAGE 4.1 | 運用開始後の監視計画を実施する。利用者などからの意見の取り込み、異議申し立てと上書き、廃止、事故対応、復旧、変更管理の仕組みを含む | 第8章のロールバック、第11章の再学習の判断 |
2つの文書の使い分けは、目的で考えると分かりやすくなります。ISO/IEC 42001 はマネジメントシステム規格なので、組織の仕組みとして外部に示す(たとえば取引先に体制を説明する)場面で参照されることが多い文書です。NIST AI RMF は任意の枠組みで、自社の取組に抜けが無いかを点検する目録として使いやすい文書です。どちらも「モデル1本の精度」ではなく、「組織が AI のリスクを継続的に把握し、測り、対処し、その責任者がいる」状態を求めています。モデルが1〜2本の段階でこれらの枠組みに沿った体制を一度に整える必要はありませんが、モデルの本数が増え、事業への影響が大きくなるほど、個々のチームの工夫では一覧も責任者も保てなくなります。第2章で見た成熟度の段階を上がるときに、どの枠組みのどの項目を自社の仕組みで満たしているかを対応表にしておくと、後から体制を説明する手間が小さくなると考えています。
説明可能性:SHAP で個々の予測の理由を出す
ここから、共通データのモデルで実際に手を動かします。まず、個々の予測の理由を出す方法として SHAP を使います。SHAP は、Lundberg と Lee が2017年の Neural Information Processing Systems(機械学習の国際会議。当時の略称は NIPS、現在の略称は NeurIPS)で発表したモデルの予測を解釈する統一的な方法の論文で提案されたもので、要旨によれば、1つの予測について、特徴量(モデルの入力の項目)ごとに重要度の値を割り当てる枠組みです。名前(SHapley Additive exPlanations)が示すとおり、協力ゲーム理論のシャープレイ値に基づく、足し算の形の説明で、「基準値(平均的な予測)から、この顧客の予測まで、どの項目がどれだけ押し上げたか・押し下げたか」を項目ごとの値に分けます。項目ごとの値をすべて足すと、基準値からその顧客の予測までの差にちょうど一致する、という性質があります。
この記事の基準のモデルは、決定木を多数組み合わせた HistGradientBoostingClassifier です。SHAP には決定木のモデル向けの計算方法(TreeExplainer)があり、SHAP の公式ドキュメントは、決定木のモデルとその組み合わせについて SHAP の値を速く正確に求める方法だと説明しています。次のコードは、実行したスクリプトから要所を抜き出したもので、補助モジュール(mlops_data.py と baseline.py)と同じフォルダに置いて実行する形です。baseline.fit(a, b) は第a〜bか月のデータで基準のモデルを学習する関数です。プランと獲得経路は one-hot(区分ごとに0か1の列)で入力しているので、区分の列の値を合計して1つの項目にまとめています。
import numpy as np
import pandas as pd
import shap
import mlops_data as md
from baseline import fit

GROUPS = {"契約月数": ["tenure_m"], "月額": ["monthly_fee"], "利用日数": ["usage_days"],
          "利用日数の前月差": ["usage_change"], "問い合わせ件数": ["support_tickets"],
          "決済失敗回数": ["payment_failures"], "割引": ["discount"],
          "プラン": ["plan_basic", "plan_standard", "plan_premium"],
          "獲得経路": ["channel_web", "channel_store", "channel_partner"]}

def explain(model, d):
    X = md.encode(d)
    sv = shap.TreeExplainer(model)(X)              # 値の単位は対数オッズ
    vals = pd.DataFrame(sv.values, columns=X.columns)
    g = pd.DataFrame({k: vals[v].sum(axis=1) for k, v in GROUPS.items()})
    return g, sv, X

frozen = fit(1, 12)        # 放置モデル(第1〜12か月で学習)
retrained = fit(17, 28)    # 第30か月の予測の前に学習し直したモデル
for name, model, m in [("放置・第16か月", frozen, 16), ("放置・第30か月", frozen, 30),
                       ("再学習・第30か月", retrained, 30)]:
    g, sv, X = explain(model, md.month_data(m))
    p = model.predict_proba(X)[:, 1]
    gap = np.abs(sv.values.sum(axis=1) + sv.base_values - np.log(p / (1 - p))).max()
    print(name, "検算の最大誤差 %.1e" % gap)
    print(g.abs().mean().sort_values(ascending=False).round(4))
# 出力(抜粋):
# 放置・第16か月 検算の最大誤差 4.4e-15
# 放置・第30か月 検算の最大誤差 6.2e-15
# 再学習・第30か月 検算の最大誤差 4.0e-15
実行した環境は shap 0.52.0、scikit-learn 1.9.0 です。SHAP の値は確率ではなく対数オッズ(確率 \( p \) を \( \log \frac{p}{1-p} \) に直した値)の単位で出ます。検算として、項目ごとの値の合計に基準値を足したものが、モデルの出力した確率を対数オッズに直した値と一致するかを、各月5,000件すべてで確かめました。最大の誤差は 4.0e-15〜6.2e-15 で、計算機の丸め誤差の範囲で一致しています。この性質があるので、SHAP の値は、対数オッズの単位では「この顧客の予測が平均より高いのは、利用日数がこれだけ、問い合わせ件数がこれだけ押し上げたから」と、足し算で説明できます(確率そのものを項目ごとに足し合わせているわけではありません)。
1人分の説明の例を見ます。第30か月に放置モデルで施策の対象になった1,410人のうち、予測確率が中央値の顧客は、契約25か月・basic プラン(月額980円)・store 経路・前月の利用4日・利用日数の前月差 -5日・問い合わせ1件・決済失敗0回・割引なしの顧客でした(いずれも架空のデータです)。予測確率は0.1460で、しきい値0.1058を超えたので施策の対象になりました。基準値の対数オッズ -2.6126 から、この顧客の対数オッズ -1.7663 までの差を、SHAP は利用日数 +0.6731、利用日数の前月差 +0.3750、問い合わせ件数 +0.1469 が押し上げ、月額 -0.2057、契約月数 -0.0945 が押し下げた、と分けました。窓口の担当者に伝えるなら、「利用が少なく、先月より減っていて、問い合わせもあったため、解約しやすいと判断された。月額が低いことと契約が長いことは、解約しにくい方向に効いている」という説明になります。
この説明を出せることには、運用上の意味が2つあります。1つは、問い合わせや社内の確認に、記録に基づいて答えられることです。もう1つは、担当者が出力を鵜呑みにせず、理由を見て「この理由なら連絡の文面を変えよう」「この理由はおかしい」と判断する材料になることです。AI事業者ガイドラインと EU の規則がそろって挙げていた自動化バイアスへの対策は、まずこうした理由の提示から始まります。ただし、SHAP が示すのは「モデルが何に基づいてその確率を出したか」であって、「顧客が実際にその理由で解約するか」という因果ではありません。利用日数を増やす働きかけをすれば解約が減るかどうかは、モデルの説明からは分からず、施策の効果検証(弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』)で確かめる必要があります。
説明は「モデルの説明」であって「世界の説明」ではない
SHAP をモデル全体の重要度として使うときは、顧客ごとの値の絶対値を平均します。この平均を、変化の前後で比べました。比べたのは、放置モデル(第1〜12か月で学習)を変化前の第16か月・欠損事故の第25か月・競合施策の第30か月に当てた場合と、第30か月の予測の前に学習し直したモデル(毎月再学習と同じく、ラベルが確定している第17〜28か月で学習)を第30か月に当てた場合です。放置モデルは、第2章で説明した基準の結果と同じく、第12か月の解約が確定したあとに作り、第13か月から使う初期モデルです。値はいずれも各月5,000件の平均で、単位は対数オッズです。
| 項目 | 放置モデル・第16か月(変化前) | 放置モデル・第25か月(欠損事故) | 放置モデル・第30か月(競合施策) | 再学習モデル・第30か月(競合施策) |
|---|---|---|---|---|
| 利用日数 | 0.3778(1位) | 0.3760(1位) | 0.4205(1位) | 0.3625(1位) |
| 月額 | 0.2132(2位) | 0.2256(2位) | 0.2264(2位) | 0.2865(2位) |
| 問い合わせ件数 | 0.1439(3位) | 0.1462(3位) | 0.1468(3位) | 0.1626(4位) |
| 利用日数の前月差 | 0.1197(4位) | 0.1173(5位) | 0.1186(5位) | 0.1242(5位) |
| 契約月数 | 0.1170(5位) | 0.1264(4位) | 0.1295(4位) | 0.1656(3位) |
| 決済失敗回数 | 0.0853(6位) | 0.0819(6位) | 0.0816(6位) | 0.0661(7位) |
| 割引 | 0.0566(7位) | 0.0715(7位) | 0.0733(7位) | 0.0582(8位) |
| プラン | 0.0187(8位) | 0.0199(8位) | 0.0190(8位) | 0.0222(9位) |
| 獲得経路 | 0.0062(9位) | 0.0067(9位) | 0.0066(9位) | 0.0736(6位) |
表の放置モデルの3列(第16か月・第25か月・第30か月)は、上位3つ(利用日数・月額・問い合わせ件数)の順位が同じでした。値は項目によって動いており、第16か月から第30か月にかけて利用日数は0.3778から0.4205へ、割引は0.0566から0.0733へ上がっています。第28か月以降、競合の乗り換え施策で解約の基礎率が上がり、利用日数と解約の関係が弱まっている(第2章の設定では、利用日数1日あたりの効きが、対数オッズで -0.11 から -0.05 に弱まる)にもかかわらず、放置モデルの説明では、利用日数はむしろ第16か月の0.3778から第30か月の0.4205へ大きく出ています。放置モデルの式も説明の計算の基準も学習した時点のまま固定なので、この違いは、モデルに入ってくる第30か月の顧客の入力の値が変わったことから生じています。どの項目の値の変化がどれだけ効いたかは、この計算では切り分けていません。放置モデルの SHAP は、学習した時点の世界でのモデルの理屈を説明し続けます。現実の顧客の行動が変わったことは、放置モデルの説明には現れません。
一方、学習し直したモデルを第30か月に当てた右端の列では、利用日数の重要度が0.3625に下がり、月額(0.2865)と契約月数(0.1656)が上がり、獲得経路が9位の0.0066から6位の0.0736に上がりました。獲得経路が上がったのは、学習データに第22か月から始まった partner 経路の顧客が含まれるようになったからです。放置モデルは partner 経路の顧客を学習で一度も見ていないので、その列はいつも0で、獲得経路の効きを学べません。利用日数の効き方も、利用5日以下の顧客の SHAP の平均と利用20日以上の顧客の平均の差で見ると、放置モデルの第30か月では1.6557、再学習モデルの第30か月では1.3165で、学習し直したモデルのほうが利用日数の差を小さく評価していました。真の関係が弱まった向きと同じです。
欠損事故の第25か月も見ておきます。この月は store 経路の顧客の利用日数の一部が欠損しており、5,000件のうち619件が欠損でした。欠損した顧客の利用日数の SHAP の平均は -0.0761 で、欠損していない store の顧客の平均 -0.0093 より解約しにくい側に出ていました。予測平均も、欠損した顧客が0.0694、欠損していない store の顧客が0.0777です。HistGradientBoostingClassifier は欠損を受け付けて予測を出し続けるので(第3章)、SHAP はその予測を忠実に分解し、「利用日数(が欠損であること)が予測を下げた」という説明を返します。説明だけを見ていても、それがデータの事故によるものだとは分かりません。
この節の結果から言えるのは、モデルの説明は「そのモデルが何を根拠にしているか」の説明であり、「今の顧客が何を理由に解約しているか」の説明ではない、ということです。説明可能性を説明責任の道具として使うなら、2つのことが要ります。1つは、説明と一緒に、そのモデルがいつのデータで学習したか(版と学習期間)を必ず添えることです。もう1つは、モデルを入れ替えたときに、新旧のモデルの重要度の表を並べて、順位の大きな変化(この例では獲得経路の9位から6位への上昇)を承認の場で確認することです。重要度の変化は、学習データの中身の変化(新しい経路の顧客が入った)を映していることがあり、それを説明できないまま入れ替えると、承認したことの意味が薄れます。
公平性を運用の監視項目にする:区分ごとの施策の当たり方
公平性という語は、法令上の差別の禁止から統計的な偏りまで幅広い意味で使われます。この節では法令上の判断には踏み込まず、運用の監視項目として「顧客の区分によって、モデルに基づく扱いの当たり方が大きく違っていないか」を測ります。区分は、共通データにある獲得経路(web/store/partner)とプラン(basic/standard/premium)を使いました。区分ごとに、次の4つを出しています。予測平均とその区分の実際の解約率の比較(確率の水準が区分ごとに合っているか)、施策率(その区分の顧客のうち施策を打った割合)、的中率(施策を打った顧客のうち実際に解約した割合)、捕捉率(実際に解約した顧客のうち施策を打てていた割合)です。施策を打つかどうかは、予測確率がしきい値0.1058を超えたかどうかで決めています。
捕捉率は、「解約しそうな顧客に引き止めの機会を届けられたか」を表します。引き止めの連絡に割引や特典の案内を含める場合、捕捉率が区分によって大きく違えば、同じように解約しかけている顧客の間で、機会の届き方に差がついていることになります。比べたのは、放置・毎月再学習と、答え合わせ用の真の確率(現実には分からないが、この記事では上限の目安に使えるもの)の3つで、期間は変化前(第13〜18か月)と競合施策(第28〜36か月)です。毎月再学習は、第2章の定義どおり第mか月の予測の前に第m-13〜m-2か月で学習し直しています。
| 期間 | 獲得経路 | 件数(月平均) | 実際の解約率 | 予測平均 放置 | 予測平均 毎月 | 捕捉率 放置 | 捕捉率 毎月 | 捕捉率 真 | 的中率 放置 | 的中率 毎月 |
|---|---|---|---|---|---|---|---|---|---|---|
| 変化前 | web | 3,072.0 | 0.0814 | 0.0805 | 0.0806 | 0.4493 | 0.4500 | 0.4673 | 0.1601 | 0.1583 |
| 変化前 | store | 1,928.0 | 0.0835 | 0.0806 | 0.0807 | 0.4265 | 0.4306 | 0.4607 | 0.1550 | 0.1559 |
| 競合施策 | web | 2,589.7 | 0.1297 | 0.0795 | 0.0997 | 0.3602 | 0.5448 | 0.7625 | 0.2102 | 0.1981 |
| 競合施策 | store | 1,499.6 | 0.1397 | 0.0803 | 0.1047 | 0.3584 | 0.5440 | 0.7768 | 0.2202 | 0.1941 |
| 競合施策 | partner | 910.8 | 0.1843 | 0.1136 | 0.1697 | 0.6023 | 0.8789 | 0.9351 | 0.2348 | 0.2044 |
変化前は、web と store の捕捉率の差は放置で0.0228(0.4493と0.4265)と小さく、予測平均も実際の解約率とよく合っていました。競合施策の期間に入ると、放置モデルの予測平均は web で0.0795、store で0.0803、partner で0.1136にとどまり、実際の解約率(0.1297・0.1397・0.1843)を大きく下回りました。捕捉率は web と store で0.36前後まで下がり、partner だけが0.6023と高くなっています。経路の間の捕捉率の差(最大と最小の差)は、放置で0.2438、毎月再学習で0.3349、真の確率でも0.1727でした。
この結果の読み方には注意が要ります。真の確率で選んでも経路の間に0.1727の差が出るのは、partner 経路の顧客は実際に解約しやすく(解約率0.1843)、その多くの真の確率がしきい値を超えるからです。捕捉率の差そのものは、区分ごとのリスクの違いを映しているだけのことがあり、差がゼロであることを目標にすべきものではありません。監視で見るべきは、差の大きさよりも、「予測平均と実際の解約率のずれが、区分によって大きく違っていないか」です。競合施策の期間の放置モデルでは、予測平均を実際の解約率で割った比が web で0.61、store で0.57、partner で0.62と、どの経路も同じくらい低く見積もっていました。毎月再学習では web で0.77、store で0.75、partner で0.92と、partner だけが実際に近づき、web と store は低く見積もったまま残りました。区分ごとに確率の水準のずれ方が違うと、施策の機会の届き方がモデルの都合で偏ります。
プランの区分では、プランごとに違う形のずれが出ました。次の表で競合施策の期間を見ると、実際の解約率は変化前と比べて、premium が0.1115から0.1994へ(差は3つのプランで最も大きい0.0879)、standard が0.0822から0.1649へ(倍率は最も大きい約2.0倍)、basic が0.0687から0.1077へ上がっていました。放置モデルの予測平均は、premium で0.0942と実際の半分以下、standard で0.0827とほぼ半分にとどまりました。一方、放置モデルの捕捉率は standard が0.3578で最も低く、basic 0.4469、premium 0.4893の順でした。真の確率で選んだ場合の捕捉率(standard 0.8837、premium 0.9618、basic 0.6268)との開きも、standard が約0.53で最も大きく、premium が約0.47、basic が約0.18です。つまり、確率の水準を最も低く見積もっていたのは premium、施策を届けられなかった割合が最も大きかったのは standard で、どちらも全体の数字(競合施策の期間の捕捉率 放置0.4167、毎月0.6232)だけを見ていると見えません。なぜプランによってずれ方が違うのかは、この計算では切り分けていません(この記事の損益の設定では、粗利はプランによらず月1,800円と置いているので、どのプランの取りこぼしも損益には同じ単価で数えています)。
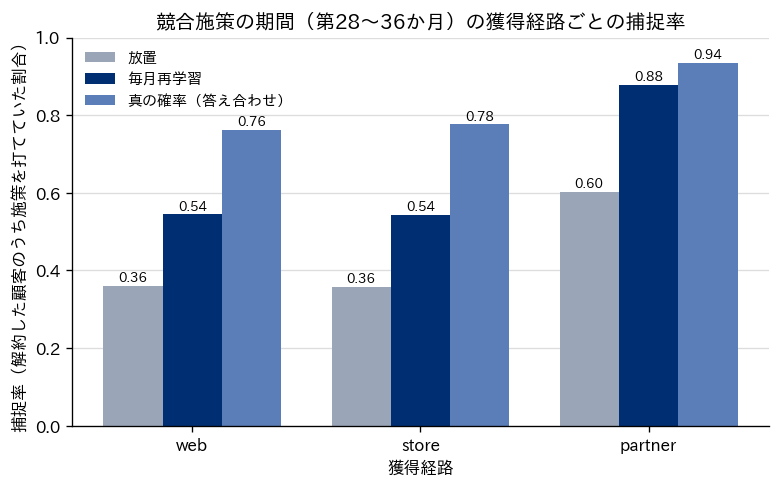
| 期間 | プラン | 実際の解約率 | 予測平均 放置 | 予測平均 毎月 | 施策率 放置 | 施策率 毎月 | 施策率 真 | 捕捉率 放置 | 捕捉率 毎月 | 捕捉率 真 |
|---|---|---|---|---|---|---|---|---|---|---|
| 変化前 | basic | 0.0687 | 0.0767 | 0.0754 | 0.2119 | 0.2080 | 0.1952 | 0.4040 | 0.4000 | 0.3947 |
| 変化前 | standard | 0.0822 | 0.0791 | 0.0793 | 0.2048 | 0.2112 | 0.2362 | 0.4064 | 0.4091 | 0.4465 |
| 変化前 | premium | 0.1115 | 0.0928 | 0.0960 | 0.3327 | 0.3366 | 0.3626 | 0.5587 | 0.5676 | 0.5961 |
| 競合施策 | basic | 0.1077 | 0.0860 | 0.1017 | 0.2802 | 0.3594 | 0.4327 | 0.4469 | 0.5384 | 0.6268 |
| 競合施策 | standard | 0.1649 | 0.0827 | 0.1234 | 0.2266 | 0.5053 | 0.7675 | 0.3578 | 0.6632 | 0.8837 |
| 競合施策 | premium | 0.1994 | 0.0942 | 0.1296 | 0.3455 | 0.5794 | 0.9241 | 0.4893 | 0.6870 | 0.9618 |
運用の監視項目にするなら、区分ごとの「予測平均÷実際の解約率」と「捕捉率」を、全体の指標と並べて月ごとに記録し、区分の間でずれ方が開いたら確認する、という形が考えられます。解約のラベルは1か月遅れで確定するので(第4章)、この監視も1か月遅れになります。どの区分を見るかは、事業として扱いの差を説明する必要がある区分(契約の種類、獲得経路、地域、年齢層など)から選びます。年齢や性別のような属性をモデルの入力に使っていなくても、他の項目を通じて区分ごとの扱いに差がつくことはあり、AI事業者ガイドラインの本編も、センシティブな属性を取り除いたデータでも関連する情報から類推されてしまう場合を潜在的なバイアスの例に挙げています。入力に使っていない属性でも、区分の集計には使えるように保持しておくかどうかは、個人情報の扱いと合わせて決める必要があります。
プランの区分の「予測平均÷実際の解約率」は、競合施策の期間の放置モデルで basic 0.80、standard 0.50、premium 0.47、毎月再学習で basic 0.94、standard 0.75、premium 0.65でした。毎月再学習にしても premium のずれは残っており、再学習が全体の水準を戻しても、区分ごとのずれまで均等に戻すとは限らないことが分かります。再学習の判断(第11章)に区分ごとの指標を加えておくと、こうした取り残しに気づけます。
判断の記録を残し、後から再現できるかを確かめる
最後に、個別の判断を記録する仕組み(決定ログ)を作り、後から同じ判断を再現できるかを確かめました。第30か月の5,000件について、顧客ごとに「月・顧客の行・モデルの版・入力の値・予測確率・しきい値・施策の有無・主な理由(SHAP の絶対値が大きい上位3項目)」を、標準ライブラリの sqlite3 で1つのファイルに記録しました。モデルの版は、別の表に「版の名前・モデルのファイルの指紋(SHA-256 のハッシュ値)・学習した月・ハイパーパラメータ・scikit-learn の版・しきい値・承認者・承認日」として記録しています。次のコードは、実行したスクリプトから記録と再現の要所を抜き出したものです(補助モジュールと同じフォルダに置いて実行する形です)。
# 記録:顧客ごとに入力・版・確率・しきい値・施策の有無・主な理由を残す(抜き出したもの)
top = np.argsort(-np.abs(sv[i]))[:3]
reasons = [[cols[j], round(float(sv[i, j]), 4)] for j in top]
inputs = {c: (None if pd.isna(v) else v) for c, v in d.iloc[i][md.FEATURES].items()}
rows.append((m, i, "churn-v1", json.dumps(inputs, ensure_ascii=False, default=float),
             float(prob[i]), md.THRESHOLD, int(prob[i] > md.THRESHOLD),
             json.dumps(reasons, ensure_ascii=False)))
con.executemany("INSERT INTO decision VALUES (?,?,?,?,?,?,?,?)", rows)

# 再現:記録だけを読み、モデルのファイルを読み戻して同じ確率が出るかを照合する
ver = con.execute("SELECT model_sha256 FROM model_version WHERE model_version='churn-v1'").fetchone()[0]
sha2 = hashlib.sha256(open(mpath, "rb").read()).hexdigest()
print("モデルの指紋の一致:", ver == sha2)
re_model = joblib.load(mpath)
recs = con.execute("SELECT customer_row, inputs, prob, contacted FROM decision WHERE month=30").fetchall()
df = pd.DataFrame([json.loads(r[1]) for r in recs]).astype({"usage_days": float})
p2 = re_model.predict_proba(md.encode(df))[:, 1]
p1 = np.array([r[2] for r in recs])
print("再計算した確率と記録の差の最大 %.1e、施策の有無の不一致 %d 件" % (
    np.abs(p1 - p2).max(), int(((p2 > md.THRESHOLD).astype(int) != np.array([r[3] for r in recs])).sum())))
# 出力:
# モデルの指紋の一致: True
# 再計算した確率と記録の差の最大 0.0e+00、施策の有無の不一致 0 件
結果は次のとおりです。第30か月に施策の対象になったのは1,410件で、基準の結果の放置モデルの第30か月の施策件数と一致しました。記録したファイルの大きさは1か月分で1.59MB で、6か月分に単純に掛けると9.6MB です。EU の規則の第19条・第26条は高リスクAIのログを少なくとも6か月保存するよう求めていますが、この例と同じ粒度の記録を6か月分残す場合の記憶容量は、約9.6MB で足ります(実際の量は顧客数・記録する項目・保存の形式で変わります)。これは記憶容量の目安にすぎず、規則の保存の義務に対応するには、記録する項目、用途に見合った保存期間、個人データの保護の法令との関係、記録を閲覧できる人の範囲を、別に決める必要があります。後から再現する確認では、記録したモデルの指紋と保存してあるモデルのファイルの指紋が一致し、記録した入力から再計算した予測確率と記録した確率の差は最大で0、施策の有無の不一致も0件でした。問い合わせへの回答の例として、第30か月の顧客行5の記録を引くと、モデル churn-v1、確率0.1321(しきい値0.1058)、施策あり、主な理由は利用日数(+1.151)、契約月数(+0.2519)、月額(-0.2075)と返ります。
この確認で一致したのは、同じ環境(同じ scikit-learn の版)で同じファイルを読み戻したからです。第7章で扱ったとおり、ライブラリの版が変わると、保存したモデルを読み戻せない、あるいは結果がずれる危険があります。記録を一定期間残すと決めるなら、記録そのものに加えて、モデルのファイルと、それを動かせる実行環境(ライブラリの版の一覧)も同じ期間残す必要があります。ガイドラインの本編が、ログの保存期間を「事故等の原因究明、再発防止策の検討、損害賠償責任要件の立証上の重要性等を踏まえて」検討するとしているのは、記録が使われる場面から逆算して期間と中身を決めよ、ということだと読めます。問い合わせへの回答に使うなら、契約の終了後に問い合わせを受け付ける期間、監査に使うなら監査の周期、事故の原因究明に使うなら、劣化に気づくまでにかかりうる期間(この記事の例では、ラベルが確定するまで1か月)を下回らない期間が目安になります。
記録には個人に関する情報が含まれることにも注意が要ります。この例では入力の値をそのまま残しましたが、実際には顧客 ID と入力の値の組は個人情報に当たりうるので、保存期間・閲覧できる人・削除の手順を、個人情報の扱いの規程と合わせて決める必要があります。EU の規則の第19条・第26条も、ログの保存期間について、個人データの保護に関する EU 法などに別段の定めがある場合を除く、としています。記録を残すことと、残しすぎないことの両方を、同じ規程で決めておくのが現実的だと考えています。
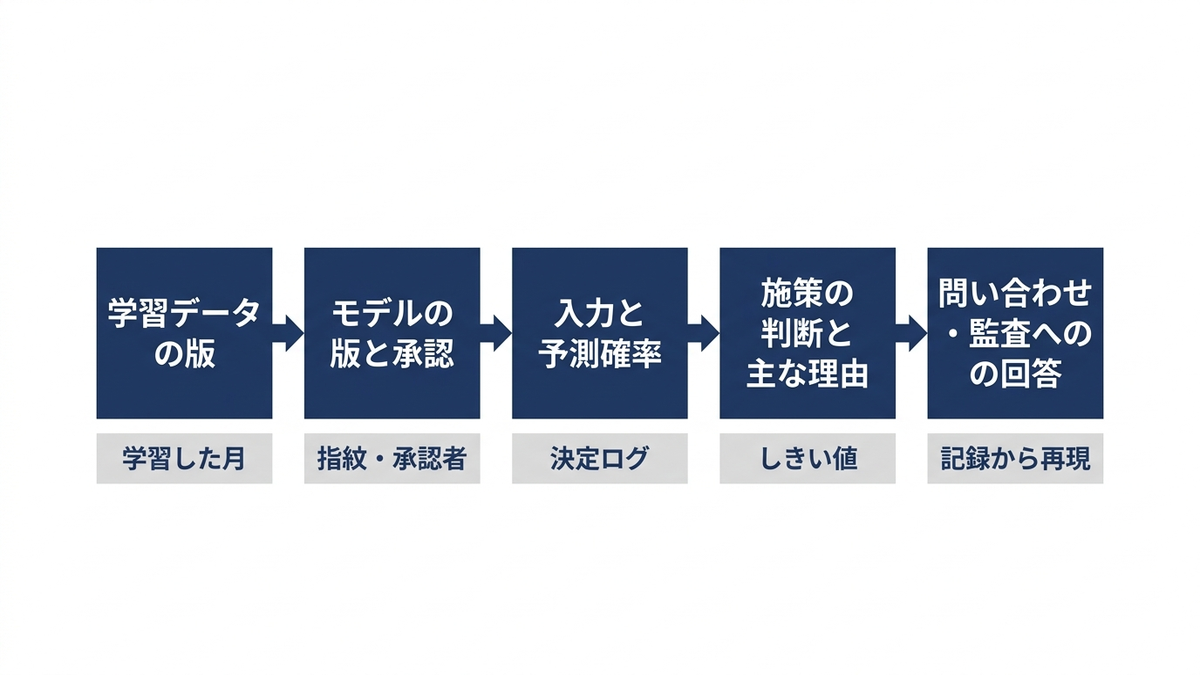
経営の判断に翻訳する
この章の結果を、経営の判断に使える形に整理します。1つ目は、ガバナンスの要求の多くが、すでに運用の仕組みとして作るものと重なっていることです。AI事業者ガイドラインの第1.2版、EU の AI 規則の高リスクAIの条文、NIST AI RMF のサブカテゴリは、いずれも「状況が変わっても性能を保つ監視」「人が介在して止められる仕組み」「後から追跡できる記録」「責任者」を求めていました。第5章から第11章の仕組みを、記録を残す前提で作っておけば、ガバナンスのために別の仕組みを作る部分は小さくなります。逆に、記録を残さない作り方をしてしまうと、後から求められたときに、過去の判断は説明できず、仕組みを作り直すことになります。作り直しの手間は、最初から記録を残す手間より大きくなりがちです。
2つ目は、説明の出し方です。SHAP のような方法で個々の判断の理由を出すことは、問い合わせへの回答と、担当者が出力を鵜呑みにしないための材料の両方に使えます。この章の例では、4つの条件で各5,000件の説明を出して重要度を比べる一連の計算が、2つのモデルの学習と図の作成を含めて11.8秒で終わりました(この記事の実行環境(一般的なノートPC)での実測)。一方で、放置モデルの説明は、顧客の行動が変わっても重要度の上位の順位が変わらず、現実には効きが弱まった利用日数が、むしろ大きく出ていました。説明を出していることを理由に「モデルの中身は把握できている」と判断するのは誤りで、説明には必ずモデルの版と学習期間を添え、モデルを入れ替えるたびに新旧の説明を並べて確認する運用が要ります。
3つ目は、区分ごとの監視です。競合施策の期間、全体の捕捉率は放置で0.4167でしたが、プランで見ると standard 0.3578、premium 0.4893、basic 0.4469と開き、予測平均÷実際の解約率は premium で0.47まで下がっていました。全体の指標が許容範囲に見えても、特定の顧客層で取りこぼしや過剰な施策が起きていることがあります。どの区分を監視するかは、事業として扱いの差を説明する必要がある区分から選び、全体の指標と同じ報告書に並べるのが有効だと考えています。
判断を誤ったときの損失の型も整理しておきます。記録が無い場合の損失は、問い合わせや監査のたびに担当者が過去の状況を推測で再構成する工数と、説明できないことによる信用の毀損です。説明を鵜呑みにした場合の損失は、劣化やデータの事故を説明が覆い隠し、気づくのが遅れることです。第25か月の欠損事故の例では、SHAP は「利用日数(の欠損)が予測を下げた」と忠実に説明し、事故であることは示しませんでした。区分の監視が無い場合の損失は、特定の顧客層での取りこぼしが、全体の数字に埋もれて放置されることです。いずれも、技術の問題というより、記録と確認の手順を決めていないことから生じます。
この章の要点は3つです。第一に、AI事業者ガイドライン(第1.2版)、EU の AI 規則、ISO/IEC 42001、NIST AI RMF は、それぞれ性格は違いますが、運用については監視・人の介在・追跡できる記録・責任者という共通の要求を持っており、この記事の運用の仕組みを記録を残す前提で作ることが、その要求に応える近道になります。第二に、SHAP による説明は問い合わせへの回答と人の判断の材料になりますが、説明するのはモデルの理屈であって現実の変化ではないので、版と学習期間を添え、入れ替えのたびに新旧を比べる必要があります。第三に、公平性は区分ごとの予測平均と実際の解約率のずれ、捕捉率を月ごとに監視する形で運用に組み込めます。次の第13章では、これらの仕組みを誰が担い、どれだけの工数をかけるかという体制と費用対効果を扱います。
この章を深めたい方への参考書籍
『AIガバナンス入門 リスクマネジメントから社会設計まで』(羽深宏樹 著、早川書房):ハヤカワ新書の1冊(2023年12月刊)で、副題のとおり、AI のガバナンスを企業のリスクマネジメントから社会の制度設計までの広がりで論じています。この章で見たガイドラインや規則の条文を、個々の要求として読む前に、それらがどういう考え方で組み立てられているかをつかむのに向いています。
『EU AI法概説』(古川直裕・吉永京子・有坂陽子・羽深宏樹・早川政哉 編著、商事法務):別冊NBL の1冊(2025年7月刊、360ページ)で、EU の AI 規則を日本語で解説した本です。この章で抜き出した高リスクAIの記録・人による監視・市販後の監視の条文を、規則全体の構造の中で読むのに向いています。刊行は2026年のデジタル・オムニバスによる改正より前なので、適用日など改正された箇所は、最新の統合版の条文で確かめながら読む必要があります。
第13章 体制・役割・費用対効果
第12章では、AI事業者ガイドラインや海外の規則・規格が、運用中のモデルに記録・監視・人による確認を求めていることを確かめ、説明責任を果たすには「誰が、いつ、何を確認したか」が残る仕組みが要ることを見ました。仕組みは、動かす人と、その人の時間があってはじめて回ります。この章では、モデルを本番で使い続けるための役割と責任の分け方、内製と外部委託の分け方、運用にかかる工数の見積もり方と費用対効果の考え方、最初の1本で何を整え何を後回しにするかという導入の順序、よくある失敗の型、経営への報告に使う指標を整理します。費用対効果は、第2章で用意したサンプルデータの例で、監視と再学習にかかる工数を架空に置いて、損益の差と比べる形で示します。人件費やツールの費用の相場は、この章では扱いません。工数は時間のまま示し、金額への換算は読者の社内の単価で行う形にしました。
モデルの運用に関わる役割
モデルを本番で使い続ける仕事は、1人の専門家の仕事ではなく、いくつかの役割の共同作業です。MLOps を論じた研究の中で役割を整理したものとして、文献調査・ツール調査・専門家への聞き取りをもとに MLOps の原則・構成要素・役割・アーキテクチャをまとめた Kreuzberger らの論文があります(2022年に arXiv で公開され、2023年に IEEE Access 誌の第11巻に掲載)。この論文は、MLOps を「分野をまたぐ集団の作業」と位置づけ、7つの役割を挙げています。事業の目標を決めて投資対効果を説明する事業側の責任者(論文の呼び名はビジネスステークホルダー。プロダクトオーナーやプロジェクトマネージャーが近い役割)、システム全体の構成と使う技術を決めるソリューションアーキテクト、事業の課題を機械学習の問題に置き換えてモデルを作るデータサイエンティスト、データと特徴量を作る仕組みを作って管理するデータエンジニア、設計の型や規約に沿って製品として仕上げるソフトウェアエンジニア、開発と運用の橋渡しとして自動化・本番への配置・監視を担う DevOps エンジニア、そしてこれらの役割の技能をまたいで持つ機械学習エンジニア、つまり MLOpsエンジニアです。
論文は、MLOpsエンジニアを「いくつもの役割の側面をあわせ持ち、分野をまたぐ知識を持つ役割」と説明し、その仕事を、機械学習の基盤を作って運用すること、自動化した学習の流れ(パイプライン)と本番への配置を管理すること、モデルと基盤の両方を監視すること、としています。データサイエンティストがモデルの中身に責任を持つのに対し、MLOpsエンジニアはモデルが本番で動き続ける仕組みに責任を持つ、と読み替えると分かりやすいと考えています。第5章の実験の記録、第7章の登録と承認、第9章のテストとパイプライン、第10章の監視、第11章の再学習の多くは、この役割の仕事です。
クラウド事業者の文書にも、同じ考え方の役割の一覧があります。Microsoft の Azure Architecture Center の 機械学習の運用(MLOps v2)のガイドは、アクセス権限の設計の前提として、データサイエンティストと機械学習エンジニア、データアナリスト、モデルのテスト担当、事業側の関係者、プロジェクトの責任者(データサイエンスのリード)、プロダクトの責任者、基盤の技術サポートなどの役割を挙げています。この文書で目を引くのは、責任の境界の書き方です。基盤の技術サポートは基盤や設備の障害対応を受け持つ一方で、モデル・パッケージ・データの障害対応は受け持たず、それらはデータサイエンティストや機械学習エンジニアの役割に残り、プロジェクトの責任者の責任である、と明記しています。また、モデルのテスト担当は、継続的インテグレーションの流れから機能を分けておく役割として置かれています。作る人と確かめる人を分ける、という考え方です。
この記事で扱ってきた仕組みに引き寄せて、役割を次の表のように整理しました。役割の名前は組織によって違い、1人が複数の役割を兼ねることも普通です。大事なのは肩書きをそろえることではなく、表の右の列の「この役割が欠けると何が起きるか」を、自社のどの人が防いでいるかを言えることです。
| 役割 | 主な仕事 | この記事で関わる章 | この役割が欠けると何が起きるか |
|---|---|---|---|
| 事業側の責任者 | モデルを使う目的と、損益など成果を測る指標を決める。本番に出すか、止めるかを最終的に決める | 第1章・第6章・第11章 | 精度は良いのに業務で使われない。止める判断が誰にもできない |
| データサイエンティスト | 課題を予測の問題に置き換え、モデルを作り、評価する | 第4章〜第6章 | モデルの中身を説明できる人がいなくなる |
| MLOpsエンジニア | 記録・登録・パイプライン・監視・再学習の仕組みを作って動かす | 第5章・第7章〜第11章 | 作ったモデルが本番に載らない。載っても劣化に気づけない |
| データエンジニア | データを集め、検証し、特徴量にして渡す仕組みを作る | 第3章・第4章 | データの事故が予測の誤りとして黙って流れる |
| 情報システム部門 | 推論を動かす基盤・権限・障害対応の窓口を受け持つ | 第8章 | 障害のとき、モデルの問題か基盤の問題かを切り分けられない |
| リスク管理・監査 | 記録・説明・公平性の観点で、承認の前後を確認する | 第7章・第12章 | 問い合わせや監査に、誰がいつ承認したかを示せない |
表の「情報システム部門」と「リスク管理・監査」は、Kreuzberger らの7つの役割には名前としては出てきません。Microsoft の文書の基盤の技術サポートやデータガバナンスの役割、第12章で見たガイドラインの求めに当たるものを、日本の企業の部門の名前に置き換えて加えました。
人材が足りないことを前提に役割を割り当てる
表の6つの役割を、それぞれ専任の担当者でそろえられる企業は多くないと考えています。独立行政法人情報処理推進機構(IPA)の 『DX動向2026』(2026年7月30日公開)は、日本企業の経営層または ICT 関連部門を対象に、2026年4月中旬から6月中旬に行ったアンケート(1,799社の有効回答。報告書は「2025年度調査」と呼んでいます)の結果をまとめています。DX に取り組んでいる企業のうち、DX を推進する人材の「量」が「やや不足している」「大幅に不足している」と答えた企業は合わせて85.5%でした。「大幅に不足している」だけを見ると50.1%で、2023年度の62.1%、2024年度の58.5%から下がっていますが、報告書は依然として高い水準にあるとしています。人材の「質」も、2つの回答の合計は2024年度の86.1%から2025年度の88.8%に上がり、「大幅に不足している」は58.9%から52.9%に下がりました。
第1章で見たとおり、同じ報告書では、AI の導入・運用上の課題として専門人材の不足が最も多く挙げられています。第1章で引いたその割合も50.1%ですが、これは AI の導入・運用上の課題を尋ねた設問(報告書の図表3-16)の値で、前の段落の「大幅に不足している」の50.1%(DX を推進する人材の「量」を尋ねた設問、図表4-1)とは別の設問の数字です。AI に関わる人材の種別ごとの充足状況では、多くの種別で「不足している」が過半数を占め、「データマネジメントの知見があり、社内で企画、推進できる人材」などは不足しているとの回答率が高いままだと述べています。この記事の文脈に置き直すと、第3章のデータの品質や第4章の学習データの作り方を受け持つ人が、最も見つけにくい人材の1つだということです。
人が足りないときに起きやすいのは、モデルを作ったデータサイエンティストが、そのまま監視も再学習も障害対応も1人で抱える形です。最初の1本ではそれで回りますが、2本目・3本目のモデルが増えると、新しいモデルを作る時間が運用に食われていきます。担当者が異動や退職で離れると、記録が無ければモデルは誰にも直せなくなります。第1章で「担当者の離任で止まる」として挙げた損失の型です。人材が足りないことを前提にするなら、役割を減らすのではなく、1人が兼ねる役割の組み合わせを意図して決め、兼ねた結果として抜けやすい仕事を仕組みで補うのが現実的だと考えています。たとえば、作る人と確かめる人を同じ人が兼ねるなら、第9章のテストを自動で回して確認の抜けを防ぐ、監視を1人で見るなら、第10章のアラートの宛先を2人以上にしておく、といった補い方です。
IPA の報告書は、評価基準を設定している企業やスキルを把握している企業ほど不足感が低い傾向があり、特に「質」の確保で差が大きいことも示しています。人材像を設定して社内に周知している企業、評価基準を整備している企業は、いずれも2割に満たないとしています。この記事の言葉に置き換えると、「MLOpsエンジニアに何を期待するか」を表の形で言葉にしておくこと自体が、採用や育成の前提になるということです。
責任分担表で「最後に決める人」を1人に絞る
役割を並べただけでは、誰が何を決めるのかは決まりません。そこで使われるのが、仕事ごとに各役割の関わり方を4種類の記号で埋めた表、RACI(責任分担表)です。Microsoft のクラウド導入の手引き(Cloud Adoption Framework)のチーム間の責任をそろえる方法を説明したページは、RACI を、責任を負う(Responsible)、説明責任を負う(Accountable)、相談を受ける(Consulted)、知らされる(Informed)の4つの関わり方で整理するものとし、例の表では、ある機能について説明責任を負うチームを1つ、成果に責任を負うチーム、計画の段階で相談を受けるべきチーム、作業が終わったときに知らされるべきチーム、という形で書き分けています。この章では、R を「手を動かす人」、A を「最後に決めて結果に責任を持つ人」、C を「決める前に意見を聞く人」、I を「決まったら知らせる人」と言い換えて使います。
モデルの運用で責任分担表を作るときに最も大事なのは、A を仕事ごとに1人(1つの役割)に絞ることだと考えています。A が2人いる仕事は、実際には誰も決めない仕事になりやすいからです。第10章で見たとおり、共通データでは第19か月の料金改定のあと、料金の PSI が0.58〜0.81で鳴り続けますが、関係式は変わっていないので、放置のモデルの AUC(期間の平均)は変化前の0.680から料金改定の期間の0.673への小さな低下にとどまり、真の確率で並べた場合の低下(0.692から0.683)と同じ程度でした。このような「鳴っているが対処が要らない警報」を、誰が「対処しない」と決めて記録するのかが決まっていないと、警報は無視されるか、毎月同じ議論が繰り返されます。逆に第28か月からの競合の施策は、入力やスコアの分布にはほとんど出ず、1か月遅れで届く正解ラベルで性能を測ってはじめて分かる変化でした。この変化に気づいたあと、再学習するのか、施策のしきい値を変えるのか、モデルを止めるのかを決めるのは、技術の担当者ではなく事業側の責任者であるべきだと考えています。損益に責任を持つ人が決めないと、技術的に正しいが事業として誤った判断になりうるからです。
この記事の仕組みに合わせて、責任分担表の一例を作りました。どの役割を A に置くかは、組織の規模やモデルの影響の大きさで変わります。ここに示すのは考え方の例で、正解の配置ではありません。
| 仕事 | 事業側の責任者 | データサイエンティスト | MLOpsエンジニア | データエンジニア | 情報システム部門 | リスク管理・監査 |
|---|---|---|---|---|---|---|
| 目的と成果の指標(損益・施策件数)を決める | A | R | C | I | I | C |
| データの品質の基準を決めて守る(第3章) | I | C | C | A/R | C | I |
| モデルを作って評価する(第4章〜第6章) | C | A/R | C | C | I | I |
| 本番に出すことを承認する(第7章) | A | R | R | I | C | C |
| 推論の基盤を動かし障害に対応する(第8章) | I | C | R | I | A | I |
| 監視の結果を読み、警報に対応する(第10章) | I | C | A/R | C | C | I |
| 再学習・入れ替え・停止を決める(第11章) | A | R | R | C | I | C |
| 記録を保管し、監査に応じる(第12章) | I | C | R | C | C | A |
表の読み方を2つ補います。1つは、「監視の結果を読み、警報に対応する」の A を MLOpsエンジニアに置き、「再学習・入れ替え・停止を決める」の A を事業側の責任者に置いたことです。警報を受けて調べ、何が起きているかを整理するまでは技術の担当者が責任を持ち、その結果を受けて事業として何をするかは事業側が決める、という分け方です。もう1つは、「データの品質の基準を決めて守る」の A をデータエンジニアに置いたことです。第3章で扱ったデータ契約は、データを作る側と使う側の取り決めでした。データを作る側が社内の別の部門なら、A はその部門の責任者になります。責任分担表を作ると、こうした「部門の境目にある仕事」が浮かび上がります。
責任分担表は、作って終わりにせず、最初の障害や最初の再学習のあとに見直すのがよいと考えています。実際に起きた出来事を表に当てはめてみると、A が空いている仕事や、R が誰にも割り当てられていない仕事が見つかるからです。経営の目から見ると、責任分担表の価値は、判断の遅れを減らすことにあります。共通データの例では、競合の施策が始まった第28か月から第36か月まで、放置のモデルと毎月再学習のモデルの損益の差は1か月あたり平均40.5万円でした(本章の計算で、基準の結果の月ごとの損益から求めた値)。この架空の設定では、「誰が再学習を決めるのか」が決まらずに判断が遅れると、その期間は1か月あたり平均でこの程度の損益の差を失い続けることになります。ただし40.5万円は9か月の平均で、どの月の判断が遅れるかで額は変わります。第10章で見たとおり、気づきを第29か月末から第30か月末へ1か月遅らせたときに増える損失は、第30か月の差の19.8万円でした。
内製するもの、外部に委ねてよいもの
人材が足りないとき、運用の一部を外部の事業者に委ねることは自然な選択です。ただし、すべての工程が同じように委ねやすいわけではありません。委ねやすいのは、成果物の形がはっきりしていて、終わったかどうかを外から確かめられる工程です。委ねにくいのは、事業の判断そのものや、自社の業務の知識がなければ正しく決められない工程です。この区別を工程ごとに整理したのが次の表です。
| 工程 | 内製に残したい度合い | 理由 | 委ねるときに受け取るべきもの |
|---|---|---|---|
| 目的と成果の指標の決定 | 高い | 損益に責任を持つのは自社であり、指標の選び方が投資の判断そのものになる | (委ねない。助言を受ける場合も決定は自社) |
| 本番に出す・止めるの承認 | 高い | 承認者の記録が説明責任の中心になる(第7章・第12章) | (委ねない) |
| データの持ち主としての品質の責任 | 高い | データの意味と発生の仕組みを知っているのは自社の業務部門 | データの検証の規則と、違反の記録 |
| 監視の結果の解釈 | 中くらい | 警報の多くは業務の出来事(料金改定・新しい販路)と照らして読む必要がある | 監視の画面・警報の基準・月ごとの報告の型 |
| 最初のモデルの開発 | 中くらい | 手法の知識は外部にもあるが、引き継げないと2回目以降が外部頼みになる | 学習の記録(第5章)・コード・モデルカード(第7章) |
| 学習・推論の基盤の構築 | 低い | 成果物の形がはっきりしていて、出来上がりを確かめやすい | 構成の記録・手順書・テスト(第9章) |
| 定型の再学習の実行 | 低い | パイプラインが整っていれば手順が決まっている | 実行の記録と、受け入れ基準を満たしたかの結果 |
表の右の列が、この節で最も伝えたいことです。外部に委ねた工程が自社にとって資産になるかどうかは、何を受け取るかで決まります。モデルのファイルだけを受け取ると、第5章で見た「同じ記録から作り直せるか」が確かめられず、データが変わったときに自社で作り直せません。学習に使ったデータの範囲と版、コードの版、パラメータ、乱数の種、ライブラリの版、評価の結果をそろえて受け取っておけば、委託先が変わっても、自社の担当者が変わっても、作り直すことができます。受け取るべきものを委託の最初の段階で成果物として決めておくことが、外部委託の費用を一度きりの支出で終わらせないために大事だと考えています。契約の条件そのものは個別の事情によるので、この記事では扱いません。
もう1つの観点は、運用の段階を誰が受け持つかです。開発だけを外部に委ね、運用は自社で受け持つ形はよく見られますが、開発の時点で運用の仕組み(記録・登録・監視)を作っておかないと、受け取った側は監視も再学習もできません。逆に、運用まで外部に委ねる場合でも、第10章の監視の結果と第11章の再学習の判断の報告を、月ごとに自社の事業側の責任者が受け取る形にしておけば、責任分担表の A を自社に残すことができます。
運用にかかる工数を見積もる
モデルの運用の費用は、計算機やツールの費用と、人の工数に分かれます。計算機やツールの費用は製品や契約によって大きく違うので、この記事では扱いません。ここでは人の工数の見積もり方を整理します。工数は、一度だけかかるものと、繰り返しかかるものに分けて考えると見積もりやすくなります。一度だけかかるのは、監視と再学習の仕組みを作る初期構築です。繰り返しかかるのは、毎月の監視の結果を確かめて報告する作業と、再学習1回ごとの作業、そして頻度の読めない障害への対応です。
工数を大きく動かす要因は3つあります。1つ目はモデルの本数です。監視の報告や承認の作業は、モデルが1本増えるごとにほぼ同じだけ増えます。2つ目は再学習の頻度です。毎月再学習すれば年12回、四半期ごとなら年4回の作業が発生します。3つ目は自動化の度合いです。第9章のパイプラインが整っていれば、再学習1回の人の作業は、結果を見て承認するだけになります。整っていなければ、データの抽出・前処理・学習・評価・記録をそのつど手で行うことになり、1回の工数は何倍にもなります。
再学習の頻度をどう決めるかについては、Google の開発者向けの資料 『Rules of Machine Learning』(Martin Zinkevich)の8番目の規則が参考になります。この規則は、システムに求められる鮮度を知っておくことを求め、1日前のモデル、1週間前のモデルを使ったら性能がどれだけ落ちるかを問いかけています。言い換えると、再学習の頻度は好みで決めるものではなく、「古いモデルを使い続けたときに失う額」と「学習し直す作業の量」を比べて決めるものだということです。この比べ方を、次の節で共通データを使って具体的に行います。
見積もりの段階で見落としやすいのは、障害への対応です。第3章で見たデータ連携の不具合のように、データの事故はいつ起きるかを前もって知ることができません。共通データの第25〜26か月の欠損の事故では、HistGradientBoosting が欠損を受け付けるため、エラーにならずに予測が出続けました。こうした事故の調査にかかる時間は、どの月のどのデータでどのモデルが予測したかの記録が残っているかどうかで大きく変わります。見積もりには障害対応の枠を別に取っておき、実際にかかった時間を記録して次の見積もりに使うのがよいと考えています。
共通データで費用対効果を試算する
ここからは、第2章で用意したサンプルデータの基準の結果を使って、監視と再学習にかかる工数と、それで守れる損益を比べます。基準の結果では、第13〜36か月の24か月の損益の合計は、放置が1,964.0万円、四半期ごと再学習が2,357.7万円、毎月再学習が2,384.2万円、真の確率を使った場合が2,691.1万円でした。放置と毎月再学習の差は420.2万円です。損益はいずれも、引き止め施策の費用(1件800円)を差し引いた後の架空の値です。これに対して、監視と再学習にかかる工数を、次の表のように架空に置きました。
| 架空の工数の設定 | 時間 | 内容 |
|---|---|---|
| 初期構築 | 160 | 監視と再学習の仕組みを作る。1回だけ |
| 月次の監視 | 8(毎月) | 指標の確認と事業側への報告 |
| 再学習1回(自動化あり) | 6 | パイプラインが学習と評価を行い、人は結果の確認と承認だけを行う |
| 再学習1回(自動化なし) | 40 | データの抽出から学習・評価・記録までを手作業で行う |
これらの時間は、この試算のために置いた架空の値で、相場や標準を示すものではありません。読者の組織で実際に計る場合は、最初の数回の作業時間を記録して置き換えてください。再学習の回数は基準の結果の定義どおりで、毎月再学習は24か月で24回、四半期ごと再学習は第16・19・22・25・28・31・34か月の7回です。放置は監視も再学習もしないので、工数は0時間としました。この前提で24か月の工数と、放置と比べた損益の差を計算した結果が次の表です。
| 方式 | 再学習の回数 | 工数の合計(時間) | 損益の差(放置との差、万円) |
|---|---|---|---|
| 四半期ごと・自動化あり | 7 | 394 | 393.7 |
| 四半期ごと・自動化なし | 7 | 632 | 393.7 |
| 毎月・自動化あり | 24 | 496 | 420.2 |
| 毎月・自動化なし | 24 | 1,312 | 420.2 |
この表は、工数を時間のまま、損益の差を万円のまま並べています。工数を金額に直すには、監視と再学習に関わる人の1時間あたりの社内の費用(社内の工数の単価)が要ります。この単価は組織ごとに違うので、この記事では置きません。読者の組織の単価を表の工数の合計に掛け、それが損益の差を下回るかどうかを比べれば、この例で工数をかけた方が得になるかどうかを判断できます。なお、この試算は計算機やツールの費用を含めていないので、それらを加えると、工数をかけた側に求められる損益の差はその分だけ大きくなります。
表から読み取れることを3つ挙げます。1つ目は、24か月の損益の差で見ると、毎月再学習(420.2万円)と四半期ごと再学習(393.7万円)の差は26.5万円と小さく、放置との差の大部分は四半期ごとの再学習でも得られていることです。2つ目は、毎月にすると、四半期ごとより再学習が17回増え、工数は自動化ありなら102時間、自動化なしなら680時間増える一方、損益の増え方はどちらも26.5万円だということです。増える工数が7倍近く違っても、得られる損益は同じです。同じ「毎月再学習」でも、自動化の有無で費用対効果の評価が大きく変わります。3つ目は、自動化なしの毎月再学習は、損益の差は自動化ありの毎月再学習と並んで4つの方式で最も大きい一方、工数の合計も1,312時間と最も大きく、自動化ありの四半期ごと再学習(394時間)の3倍を超えることです。頻度を上げる判断は、自動化とセットで行うべきだと読めます。
24か月の合計だけを見ると、再学習はいつでも得をするように見えます。期間ごとに分けると、そうではないことが分かります。次の図と表は、放置と比べた損益の差を、第2章で紹介した4つの変化の期間ごとに、1か月あたりで示したものです。
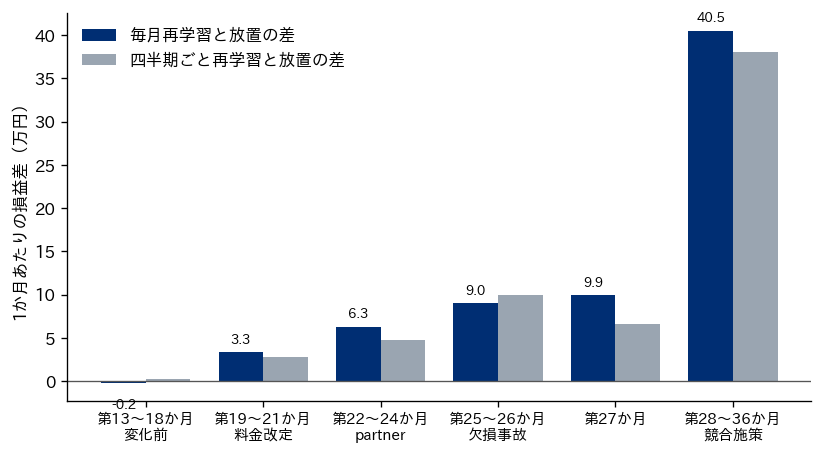
| 期間 | 月数 | 毎月再学習と放置の差(万円/月) | 四半期ごと再学習と放置の差(万円/月) | 毎月再学習と放置の差の期間合計(万円) |
|---|---|---|---|---|
| 第13〜18か月 変化前 | 6 | -0.25 | 0.31 | -1.5 |
| 第19〜21か月 料金改定 | 3 | 3.34 | 2.76 | 10.0 |
| 第22〜24か月 partner | 3 | 6.31 | 4.79 | 18.9 |
| 第25〜26か月 欠損事故 | 2 | 9.02 | 9.98 | 18.0 |
| 第27か月 | 1 | 9.92 | 6.60 | 9.9 |
| 第28〜36か月 競合施策 | 9 | 40.53 | 38.07 | 364.8 |
変化の無い第13〜18か月では、毎月再学習と放置の差は1か月あたり -0.25万円で、6か月の合計では -1.5万円でした。この期間だけを見て投資を判断すると、初期構築の160時間と毎月の監視・再学習の工数をかけても損益は増えない、という結論になります。差が出始めるのは料金改定の第19か月からで、差の大部分は競合の施策が始まった第28か月以降に集中しています。毎月再学習と放置の差の24か月の合計420.2万円のうち、第28〜36か月の9か月で364.8万円、つまり約87%を占めます。毎月再学習の累積の差は、第18か月の時点では -1.5万円、第27か月の時点で55.4万円、第36か月の時点で420.2万円でした。
この結果から、経営の判断について2つのことが言えると考えています。1つは、この例では、監視と再学習への投資は変化の無い第13〜18か月には回収できず、環境が大きく変わった期間にまとめて回収された、という保険に近い形になったことです。導入して半年たっても効果が見えないことを理由に仕組みをやめると、この例のように後から変化が来たとき、守れたはずの損益を失います。変化の無い期間にも再学習の効果が出る事業があるかどうかは、この試算からは分かりません。もう1つは、投資の判断は「自社のモデルを取り巻く環境が、どれくらいの頻度で、どれくらい大きく変わるか」の見立てに強く依存することです。料金の改定、販路の追加、データ連携の変更、競合の動きは、事業側の責任者の方がよく知っています。監視と再学習の頻度を決める会議に事業側の責任者が入るべき理由は、ここにもあります。
この試算の限定条件を明記しておきます。結果は、この架空のデータの、この工数の設定での結果です。4つの変化を24か月の間に意図して入れたデータなので、現実の事業がこれほど変化するとは限りません。逆に、もっと速く変化する事業もあります。また、損益の差は「監視して再学習した」ことで得たもので、監視だけで損益が増えるわけではありません。監視は、変化に気づいて再学習などの手を打つための前提です。
導入の順序:最初の1本で何を整え、何を後回しにするか
第2章で見た成熟度モデルは、到達すべき段階を示していますが、すべてを最初の1本で整える必要はありません。整える順序を誤ると、使われない仕組みに工数を使い、肝心の記録や監視が後回しになります。順序を考える手がかりとして、前の節でも引いた『Rules of Machine Learning』の最初の規則が参考になります。1番目の規則は、機械学習を使わずに製品を出すことを恐れないように、と述べ、2番目の規則は、まず指標を設計して実装するように、と述べています。4番目の規則は、最初のモデルは単純にして基盤を正しく作るように、とし、最初のモデルが製品に最も大きな改善をもたらすので凝ったものである必要はないが、想像以上に多くの基盤の問題にぶつかる、と説明しています。
これらの規則と、この記事の各章の内容を合わせて、最初の1本から複数本の運用までの順序を次の表のように整理しました。
| 段階 | 整えるもの | 後回しにしてよいもの | 次の段階へ進む目安 |
|---|---|---|---|
| 1.成果の測り方を決める | 損益・施策件数など経営の指標と、モデルを使わない場合の基準(第1章・第6章) | モデルの手法の工夫 | モデルを入れる前の基準の値が、毎月同じ方法で出せる |
| 2.最初の1本を記録つきで出す | 学習の記録(第5章)、登録と承認者の記録(第7章)、推論の記録(第8章) | 特徴量ストア、オンライン推論、自動の再学習 | 同じ記録からモデルを作り直せる。誰が承認したかを示せる |
| 3.監視を始める | データの検証(第3章)、正解ラベルが届いてからの性能の監視(第10章)、警報の宛先と責任分担表 | 多数の指標を並べた監視画面 | 警報が鳴ったとき、誰が何を決めるかが決まっている |
| 4.再学習を定期で回す | 四半期ごとなど低い頻度の定期の再学習と、受け入れ基準(第6章・第11章) | トリガー型の再学習、毎月の再学習 | 再学習1回の作業時間と、その効果が記録されている |
| 5.自動化して頻度を上げる | パイプラインとテスト(第9章)、新旧のモデルを比べて入れ替える仕組み(第11章) | (2本目以降のモデルで共通の仕組みにする) | 2本目のモデルが、同じ仕組みに載せて出せる |
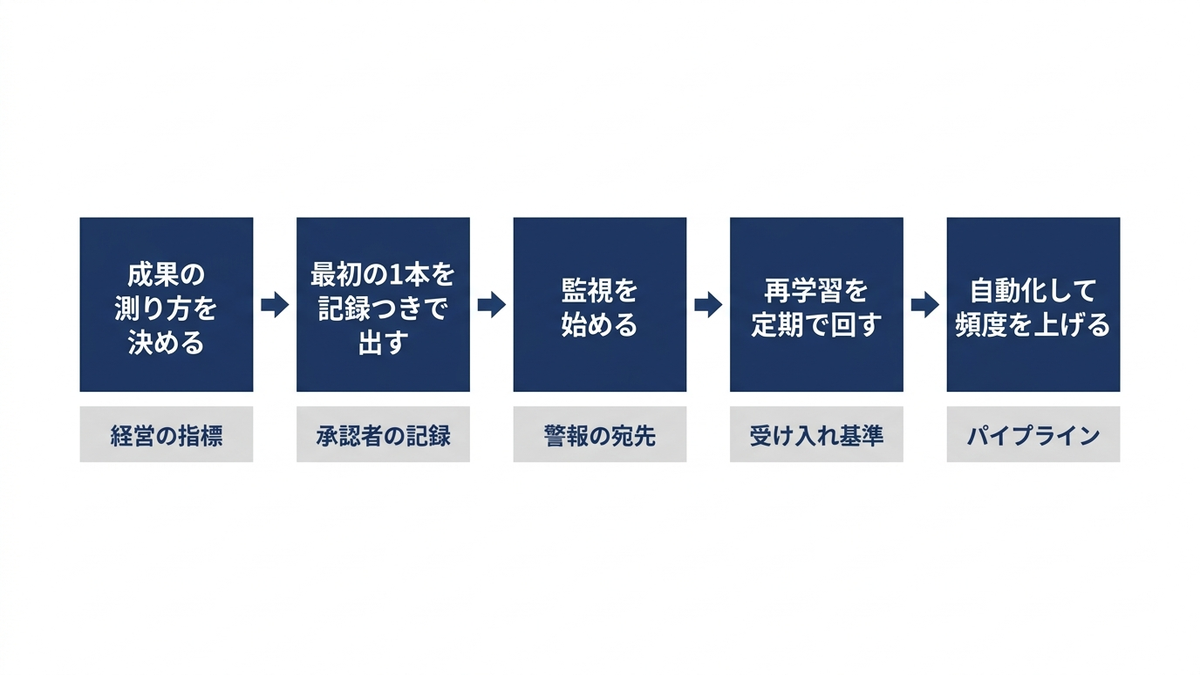
表で段階2の「後回しにしてよいもの」に特徴量ストアやオンライン推論を置いたのは、これらが複数のモデルで特徴量を共有するときや、即時の応答が要るときに効く仕組みだからです(第4章・第8章)。共通データの解約予測のように、月に1回の判断に使うモデルなら、バッチ推論で十分なことが多いと考えています。逆に、段階2の記録を後回しにすると、後から取り戻すことができません。学習に使ったデータの範囲や承認の記録は、その時点で残さなければ失われるからです。
段階4で、最初の再学習を四半期ごとにしたのは、前の節の試算の結果に合わせたものです。共通データでは、四半期ごと再学習で放置との差の大部分(420.2万円のうち393.7万円)が得られ、毎月にした場合の増分は26.5万円でした。自動化の無い段階で毎月に上げると、その26.5万円のために工数が680時間増えます。まず低い頻度で回して作業時間と効果を記録し、その記録をもとに自動化と頻度の引き上げを判断する、という順序です。ただしこれもこの架空の例での結果であり、変化の速い事業では最初から高い頻度が要ることがあります。
2本目以降のモデルを考える段階で、仕組みを共通にするかどうかの判断が出てきます。1本目のために作った記録・登録・監視の仕組みを、2本目でも使える形にしておけば、2本目の初期構築の工数は小さくなります。前の節の試算でいえば、初期構築の160時間を2本目以降で分け合える分だけ、1本あたりの工数は小さくなります。MLOps の投資の効果は、モデルの本数が増えるほど大きくなるということです。
よくある失敗の型
第1章では、判断を誤ったときの損失の型として、気づかない劣化、データの事故、再現できない、承認されないまま本番、担当者の離任で止まる、の5つを挙げました。体制と費用の観点から見ると、これらの損失は、次のような組織の側の失敗から生まれることが多いように思います。
| 失敗の型 | 起きること | 防ぐ仕組み | 関係する章 |
|---|---|---|---|
| 作って終わりの予算 | 開発の予算だけが付き、監視と再学習の工数が誰の予定にも入っていない。劣化に気づかないまま使われ続ける | 運用の工数を、初期構築・月次・再学習1回の単位で見積もり、開発と同時に予算に入れる | 本章・第10章 |
| 1人に集中した運用 | モデルを作った1人が運用も抱え、離任とともに止まる | 実験の記録、モデルカード、責任分担表の R を2人以上にする | 第5章・第7章・本章 |
| 決める人がいない警報 | 警報が鳴っても誰も判断せず、やがて無視される。料金の PSI のように対処が要らない警報が続くと起きやすい | 警報ごとに A を決め、「対処しない」という判断も記録する | 第10章・本章 |
| 技術の指標だけの報告 | AUC の小さな上下だけが報告され、経営は投資の効果を判断できない | 損益・施策件数に翻訳した報告 | 第1章・本章 |
| 受け取るもののない外部委託 | モデルのファイルだけが残り、データが変わると自社で作り直せない | 記録・コード・手順書を成果物として決める | 第5章・第7章・本章 |
| 早すぎる全面の自動化 | 1本目のモデルで大きな基盤を作り、使われないまま維持の工数がかかる | 段階を踏み、2本目のモデルが載るときに共通化する | 第2章・第9章・本章 |
表の中で、経営の側が最も防ぎやすいのは1行目の「作って終わりの予算」だと考えています。運用の工数を開発の予算と同時に確保するかどうかは、経営の判断そのものだからです。前の節の試算でいえば、開発の予算で最初のモデルを作ったあと、監視と再学習の工数を確保しなかった状態が「放置」です。この架空の例では、それが24か月で420.2万円の差になりました。逆に6行目の「早すぎる全面の自動化」は、MLOps に熱心な組織ほど起きやすい失敗です。モデルが1本しかない段階で、何本ものモデルを前提にした基盤を作ると、その維持の工数に見合う効果が出るまでに時間がかかります。
経営への報告に使う指標
運用の状況を経営に報告するとき、技術の指標をそのまま並べても、経営の判断には使いにくいものです。この記事の第1章で定めた経営の指標(損益・施策件数・障害時間・人手の工数・判断の遅れの月数)を中心に、月ごとの報告の項目を次の表のように整理しました。
| 報告の項目 | 中身 | 読み方 |
|---|---|---|
| 損益 | モデルを使った施策の損益(この記事の例では引き止め施策の損益)と、前月・前年同月との比較 | モデルの価値そのもの。下がったら原因の説明を求める |
| 施策件数 | モデルの判断で施策を打った件数 | 急に減った・増えたときは、確率の水準のずれを疑う(第6章)。共通データの競合施策の期間では、放置のモデルの施策件数は月平均1,347.6件で、毎月再学習の2,233.2件を大きく下回った |
| 予測平均と実際の解約率の差 | 1か月遅れで分かる、確率の水準のずれ | 差が広がり続けたら、再学習かしきい値の見直しを判断する |
| 警報の件数と、判断までの日数 | 鳴った警報の数、対処した数、対処しないと決めた数、判断にかかった日数 | 判断までの日数が長いと、その間の損益の差を失う |
| 再学習の回数と工数 | 実施した再学習の回数、1回あたりの作業時間 | 前の節のように、工数と損益の差を並べて比べるのに使う |
| 障害時間 | データの事故や推論の停止の時間と、影響した件数 | 同じ原因の障害が続いたら、仕組みへの投資を判断する |
この中で、技術の指標である AUC を直接の報告項目にしていないのは、AUC が並べ替えの正しさだけを測り、確率の水準のずれを測れないからです(第2章の定義)。共通データの競合施策の期間では、放置のモデルの AUC は0.630、毎月再学習は0.650と差は0.02ですが、損益の差は1か月あたり平均40.5万円でした。AUC の0.02の差は経営の判断には結びつきにくい一方、月40.5万円の差は判断に使えます。AUC は技術の担当者が監視に使う指標とし、経営への報告では損益と施策件数に翻訳して示すのがよいと考えています。
報告の頻度は、モデルを使う判断の頻度に合わせるのが自然です。共通データのように月に1回の判断に使うモデルなら、月ごとの報告で足ります。報告の中で特に大事なのは、「対処しないと決めた警報」を含めることです。何かをしたことだけでなく、確認したうえで何もしないと決めたことも、後から判断の経緯を説明するための記録になると考えているからです。
モデルを本番で使い続けるには、事業側の責任者・データサイエンティスト・MLOpsエンジニア・データエンジニア・情報システム部門・リスク管理の役割が要り、責任分担表で仕事ごとに最後に決める人を1人に絞ることが、判断の遅れによる損失を防ぎます。共通データの架空の工数の試算では、監視と再学習の効果は環境が変わった期間に集中し、頻度を上げる判断は自動化とセットで行うべきだという結果になりました。第14章では、こうした仕組みを実際に整えた企業の公開された事例と、大規模言語モデルの運用など最新の動向を見ていきます。
この章を深めたい方への参考書籍
『信頼性の高い機械学習 SRE原則を活用したMLOps』(Cathy Chen ほか著、井伊篤彦・張凡・樋口千洋訳、オライリー・ジャパン):サービスの信頼性を守るエンジニアリング(SRE)の考え方を機械学習の運用に当てはめた本です。監視・継続的な学習・障害対応の章に加えて、機械学習を組織に組み込む方法と、実際の組織の事例を扱う章があり、この章の役割分担や体制の議論を深めるのに向いています。
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen著、江川崇・平山順一訳、オライリー・ジャパン):データの扱いからデプロイ・監視・継続学習までを通して説明した本で、MLOps のインフラとツールの章に続いて、最終章で機械学習の人的側面を扱っています。その章のチーム構成の節では、機能をまたいだチームの協働や、データサイエンティストがどこまでを受け持つかを論じており、この章の役割分担を考える材料になります。
第14章 事例と最新動向
第13章では、モデルを運用し続けるための役割の分担、内製と外部委託の分け方、工数の見積りの考え方、導入の順序を整理しました。ここまでの章は、第2章で用意した架空の定額制サービスのサンプルデータを使い、仕組みの一つひとつを手元で実行して確かめてきました。この章では視点を外に向け、実在の企業が公開した一次情報(公式の技術ブログ・論文・発表資料)から、各社がどの順番で何を整えたかを読みます。続いて、大規模言語モデル(LLM)を業務に組み込むときの運用、いわゆるLLMOpsで何が新しく必要になり、何がこれまでの MLOps と変わらないかを、公式ドキュメントと論文で確かめます。最後に、ドリフト(データや関係の変化)と継続的な学習に関する研究の動向を、サーベイ論文(ある分野の研究を広く整理した論文)の要旨から紹介します。
この章で取り上げる事例は、公開された資料を実際に開いて中身を確かめたものだけです。成果の数値は、その資料に書かれているものだけを、書かれている条件とともに引用しました。資料に数値が書かれていない事例は「数値は示されていない」と書いています。クラウド各社の製品の機能の見取り図は、弊社コラム『AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方』で扱っているので、この章では製品の比較には立ち入りません。
企業の技術ブログや学会発表は、自社の判断の材料として価値がありますが、読み方を誤ると判断を誤らせます。第1の注意は、公開される事例が成功した取り組みに偏りやすいことです。うまくいかなかった基盤づくりが公開されることは少なく、読み手は「どの会社もこの順で整えて成功している」という印象を持ちやすくなります。この章では、その偏りを補うために、共通の機械学習基盤を作るチームを立ち上げ、最終的にチームを閉じた国内の事例も取り上げます。
第2の注意は、規模の違いです。後で紹介する Uber の基盤は、2024年の公式ブログの時点で本番のモデルが5,000本を超えると書かれています。モデルが数本の企業が同じ基盤を目指すと、作る費用に見合う効果が出ません。事例からは「何を整えたか」よりも「どの困りごとに対して、何を先に整えたか」を読み取る方が、自社に当てはめやすくなります。第3の注意は、数値の条件です。技術ブログの数値は、その会社のその時点の条件で測ったもので、測り方が詳しく書かれていないことも多くあります。この章では、数値を自社の目標値として使える形では示していません。自社の目標は、第1章で定義した経営指標(損益・施策件数・障害の時間・人手の工数・判断の遅れの月数)で、自社のデータから立てる必要があります。
Uber の Michelangelo、モデルの一生を1つの基盤にまとめた例
機械学習の運用基盤の事例として最もよく参照されるものの1つが、Uber の社内基盤 Michelangelo です。2017年9月5日に Uber の公式ブログに掲載されたMichelangelo の紹介記事(Mike Del Balso 氏と Jeremy Hermann 氏による)は、これを社内向けの「サービスとしての機械学習」の基盤と位置づけ、基盤が受け持つ流れを6つの段階に分けています。データの管理、モデルの学習、モデルの評価、モデルの配備、予測、予測の監視の6つです。記事は、Michelangelo 以前の状態として、データサイエンティストがさまざまな道具でモデルを作っていたこと、信頼でき再現できる処理の流れを作る仕組みが無かったこと、モデルを本番に出す決まった道筋が無く、案件ごとに技術チームが専用の提供の仕組みを作る必要があったことを挙げています。この記事の第3章から第10章で扱った仕組みが、ほぼこの6段階に対応しています。
記事によると、当時の Michelangelo はおよそ1年本番で使われ、数十のチームが利用していました。特徴量(モデルの入力に使う加工済みの項目)を共有する仕組み、つまり第4章で説明した特徴量ストアに当たるものを持ち、約10,000の特徴量が毎日自動で計算・更新されていたと書かれています。オンラインの予測は、最も利用の多いモデルで毎秒250,000件を超え、応答時間は95%の要求が5ミリ秒未満(外部のデータベースから特徴量を引く必要がない場合)でした。事例として紹介されている UberEATS の配達時間の予測では、勾配ブースティング(決定木を順に足し合わせていく手法。共通データの基準のモデルと同じ系統)が使われています。
監視については、予測を記録しておき、後から観測された結果(実際にかかった時間など)と突き合わせて、本番での精度を測る仕組みが説明されています。回帰のモデルでは、決定係数や平均絶対誤差などの指標を社内の時系列の監視システムに送り、チームがしきい値の警報を設定できるようにしていました。これは第10章で共通データについて確かめた「正解ラベルが届いてから性能を測る監視」と同じ考え方です。共通データでは、競合の乗り換え施策で解約との関係そのものが変わった期間(第28〜36か月)に、スコアの分布の変化を表す PSI は約0.01〜0.025 にとどまりました。入力の PSI も、料金は第19か月の料金改定から大きな値が続き、利用日数は欠損事故の第25・26か月だけ跳ねて第27か月には元の水準に戻っており、第28か月に新たな動きは無く、入力と予測の分布だけを見ていては気づけませんでした。予測と結果を突き合わせる仕組みを、基盤の最初から持っていたことがこの事例の要点の1つです。
Uber は2024年5月2日の公式ブログ「予測から生成へ、Michelangelo は Uber の AI の歩みをどう加速しているか」(Kai Wang 氏ら4名による)で、その後の変化を3つの時期に分けて振り返っています。2016〜2019年は表形式のデータに対する決定木系のモデル(XGBoost など)が中心で、2019〜2023年に深層学習への対応を強め、2023年以降は生成AIを使う用途への対応を加えた、という整理です。この記事の時点の規模として、稼働中の機械学習の案件が約400、月に20,000件を超える学習ジョブ、本番のモデルが5,000本超、ピーク時に毎秒1,000万件のリアルタイムの予測、特徴量ストアの特徴量が20,000超と書かれています。
同じ記事は、学んだこととして、中央の基盤チームと、各事業のチームに配置したデータサイエンティストや機械学習エンジニアの組み合わせが開発の効率を上げたこと、案件に重要度の段階(ティア)を付けて資源と支援の配分を決めることが役に立ったことを挙げています。手法の選び方についても、深層学習は問題に合うときにだけ使うべきで、XGBoost が性能と費用の両面で深層学習を上回る場合がある、と書いています。第13章で扱った体制と、案件ごとに投資の濃淡を付ける考え方が、5,000本規模の組織でも同じように効いているということです。
Spotify・LinkedIn・Netflix、基盤を段階的に作り替えた例
Spotify の公式エンジニアリングブログには、2019年12月13日付で、TensorFlow Extended(Google が公開した機械学習のパイプラインの部品群)と Kubeflow(Kubernetes の上で機械学習の処理を動かすためのオープンソースの道具群)を使って機械学習の基盤を作り直した経緯を書いた記事(Josh Baer 氏と Samuel Ngahane 氏による)があります。記事によると、Spotify では専任の機械学習の道具づくりのチームができる前から、Discover Weekly や検索などの機械学習のシステムが本番で動いていました。最初は社内の既存のシステムに合わせた独自のライブラリで支えていましたが、Python を使う機械学習エンジニアには使いにくかったと書かれています。
そこで Spotify は、機械学習に新しく取り組むチーム向けに、推奨する製品と設定の組み合わせ(記事の言葉では「舗装された道」)を用意し、データの形式と部品を TensorFlow Extended にそろえ、さらに Kubeflow Pipelines を基盤の土台に据えました。各チームが自分でクラスターを運用しなくてよいように、中央で管理するクラスターを用意したことも書かれています。数値としては、8月に始めた試験版の時点で利用者が約100人、実行回数の合計が18,000回だったこと、初期の分析では一部のチームが7倍の実験を行うようになったことが示されています。一方で、本番に出るまでの期間がどれだけ短くなったかといった数値は示されていません。また、実行回数の急増の一部は、数週間にわたって5分おきに動き続けた予定外のジョブによるものだったと、記事自身が断っています。実行回数のような活動量の指標は、こうした要因でも増えるので、経営報告では損益や工数のような成果の指標と並べて読む必要があります。
LinkedIn は、2019年1月3日の公式エンジニアリングブログ「LinkedIn における機械学習の生産性の拡大」(Joel Young 氏ら5名による)で、2017年8月に始めた社内の取り組み Pro-ML(Productive Machine Learning の略)を紹介しています。背景として、製品ごとに別のチームが別の仕組みを作り、共有がほとんど無かったため、新しい技術者や新しい特徴量を受け入れるたびに手間がかかっていたことが書かれています。Pro-ML の目標は「機械学習エンジニアの効果を2倍にする」ことと、機械学習の道具を社内の他の技術者にも開くことでした。記事は、取り組みの層として、探索と作成、学習、配備、実行、健全性の保証、特徴量の市場(特徴量を登録して探せる仕組み)の6つを挙げています。
LinkedIn の記事で、この記事の各章と特に強く重なる記述が2つあります。1つは、学習の環境と本番の環境でスコアを計算する仕組みを別々に書くと、両者のあいだに小さな差が生まれ、原因を突き止めにくい不具合になる、という指摘です。これは第3章で扱った「学習と推論で前処理が食い違う事故」と同じ問題で、LinkedIn は1つの実行エンジンで両方を計算する形に寄せることで対処しようとしていました。もう1つは「健全性の保証」の層で、本番の入力の特徴量と学習時の特徴量が統計的に近いかどうか、本番のモデルの振る舞いが学習時に期待した精度と合っているかを自動で確かめ、異常があればコードの不具合か、データの欠落か、単に再学習が必要なだけかを切り分ける、と書かれています。第10章の監視と第11章の再学習の判断を、異常の原因の切り分けまで含めて仕組みにしたものと読めます。なお、目標とした「2倍」が達成できたかどうかの数値は、この記事には示されていません。
Netflix については、同社が開発した Python のライブラリ Metaflow の公式ドキュメントが、Metaflow はもともと Netflix でデータサイエンティストの生産性を上げるために開発されたと説明しています。ドキュメントは、扱う範囲をモデリング・配備・版の管理・処理の流れの組み立て・計算資源・データの6つの層で示し、版の管理として処理の流れ・実験・成果物を自動で記録すると書いています。第5章で説明した実験管理と第9章のパイプラインを、データサイエンティストが普段書く Python のコードの延長で使えるようにした点が特徴です。ドキュメントには、数百のデータサイエンスと機械学習の案件の経験にもとづいて設計したこと、4年を超えて本番で使われてきたことが書かれていますが、それが Netflix の事業の成果にどれだけ効いたかの数値は示されていません。
国内の事例、メルペイの与信モデルとサイバーエージェントの広告配信
国内では、メルカリグループのメルペイが、公式の技術ブログ(Mercari Engineering)で与信のモデルの運用について複数の記事を公開しています。2023年6月23日の「与信モデル更新マニュアルを作成した話」によると、メルペイの与信サービスではお客さまごとの与信枠を定期的に更新しており、与信モデルの更新は影響が大きいため、事業・リスク・プライバシーの各チームやプロダクトマネージャーなど多くの関係者が点検してきました。サービスが増えるにつれて検討すべき観点が増え、更新の意思決定に時間がかかるようになったことが、マニュアルを作った理由として書かれています。
マニュアルの中身として記事が挙げているのは、5つの要素です。1つ目は評価指標で、モデルの性能に加えて事業の KPI やお客さま体験の観点を含め、さらにモデルの出力を収益性の指標に変換して、更新が収益に与える影響を試算する仕組みを設けました。2つ目はリリース後に監視する指標で、モデル自体の指標と事業 KPI の指標を決め、与信事業の主要な数字を報告する場で共有しています。3つ目は更新を検討する契機で、新商品の導入時、与信の枠組みの変更時、監視の結果が事前に決めた基準に触れた時、事業戦略にもとづく判断をした時が定められています。4つ目は社内会議での協議から決議までの手続きとタイムライン、5つ目はマニュアルを所管する部署と改廃の決裁者です。記事は、収益の試算を評価指標に入れたことで他チームとの意思疎通がしやすくなり、リリースの判断もしやすくなったとしていますが、意思決定にかかる時間が何割短くなったといった数値は示していません。
この事例は、第6章(評価指標を業務の判断に合わせる)、第7章(承認の流れと承認者)、第11章(再学習のトリガー)、第12章(説明責任)で扱った内容を、1つの社内規程にまとめたものと読めます。特に、モデルの出力を収益の試算に翻訳して関係者の共通の言葉にした点は、この記事が共通データで AUC だけでなく損益(引き止め施策の損益)を主な指標にしてきた理由と同じです。共通データでは、第28〜36か月の競合施策の期間に、放置したモデルの AUC は 0.630、毎月再学習したモデルは 0.650 で、差は 0.02 にすぎません。ところが損益で見ると、放置が月 116.9万円、毎月再学習が月 157.4万円で、月 40万円を超える差になります。AUC の 0.02 の差では更新の判断をためらう関係者も、損益の差なら判断しやすくなります。
同じメルペイの機械学習チームは、2024年12月20日の「メルペイにおける機械学習システム運用時の工夫」で、毎月の与信枠の更新に使う機械学習システムのリリース作業を省力化した取り組みを紹介しています。毎月のリリース作業には約50個のタスクがあり、設定ファイルの記入漏れや、事業側がスプレッドシートで管理しているマスタデータを手で変換する際の誤りといった、人の作業の誤りが課題でした。対策として、変更の種類(推論だけか、再学習を伴うか、リリースに無関係か)に応じて設定ファイルを自動で検証する仕組み、マスタデータの型・値の範囲・見出しの数と名前を検証する仕組み、どの処理をいつ実行すべきかを Slack で知らせてその場から実行できるボットを作ったと書かれています。第3章のスキーマ検証と第9章のテストの考え方を、モデルそのものではなく、毎月の運用の手作業に当てはめた例です。
メルペイの事例の中で、公開事例の偏りを補う意味で特に参考になるのが、2022年12月17日の「Machine Learning 共通基盤構築の振り返り〜チーム立ち上げからクローズまで〜」です。メルペイには与信と不正検知の2つの機械学習チームがあり、扱う領域・開発の進め方・システムの構成が大きく異なっていました。将来チームが増えることを見越して、共通基盤を作る専門のチームを立ち上げましたが、各チームからの個別の開発依頼に追われて共通基盤の検討に着手できない状態が続きました。その間に、Vertex AI や Feast のようなマネージドサービスやオープンソースが登場してチームが担う予定だった機能の一部を賄うようになったこと、各チームの技術選定が離れて共通化が現実的でなくなったこと、各チームが独自に共通部品を作って共通基盤による工数の削減効果が薄れたことから、チームは既存の機械学習チームに統合されて閉じられました。
著者は反省点として、立ち上げの時点で具体的な困りごとにもとづく強い仮説が無かったこと、基盤のチームと各機械学習チームの報告の経路や開発の進め方が別で、結びつきが弱すぎたこと、分析から実装まで一貫して担う職務の定義と、基盤だけを別のチームに任せる体制が合わなかったことを挙げています。そのうえで、共通基盤化そのものを否定するのではなく、チーム間の差・方向性・技術の動向・体制を総合して判断すべきだと結んでいます。第13章で扱った「最初の1本で何を整え、何を後回しにするか」の判断を誤ると、基盤への投資が成果につながらないことを示した記録として読めます。
サイバーエージェントの公式ブログ(CyberAgent Developers Blog)には、2023年10月24日に、広告配信のプロダクト Dynalyst のデータサイエンティストが書いた「DynalystのML監視の取り組み事例」があります。監視を整える前の課題として、特定の特徴量が意図しない値のまま運用されていた、学習データの量が少しずつ減っていたことに気づけなかった、精度の指標はログに出すだけで誰も見ていなかった、本番での精度の低下を事業指標の変化でしか把握できなかった、といった点が挙げられています。
この事例で興味深いのは、何を監視しなかったかが理由とともに書かれていることです。記事によると、監視項目は学習データ(件数・特徴量の分布)、オフラインの精度、予測値の統計量(平均・分散・同じ値の割合)、オンラインの精度に絞り、既存の監視ツールで可視化しました。一方、データドリフトの指標や特徴量の重要度は、広告の領域ではデータの移り変わりが激しく判断が難しいこと、指標が抽象的なことなどを理由に採用していません。第10章では共通データに PSI と KS 検定を当てましたが、分布の変化の指標を監視に使うかどうかは、データの移り変わりの激しさなど領域の事情で判断が分かれる、ということです。クラウドの監視機能のうち SageMaker Model Monitor(第10章で紹介した AWS の監視機能)は、既存のシステムとの相性が悪かったこと、推論の記録を取る機能が SageMaker の推論用の窓口(エンドポイント)を前提としている一方で、推論の応答時間の要件からその窓口を使っていなかったことなどを理由に見送っています。警報は、新しい版のオフラインの精度が直前の版より大きく悪化したとき、学習データの件数が直前の版や1か月前より大きく減ったとき、オンラインの精度が悪化したとき、予測値が取れないとき、予測値が大きく変わったとき、に鳴るよう設計されています。進め方として、ツールを先に入れることや、機械学習のテストの網羅的な項目表(第9章で紹介した ML Test Score)をすべて満たそうとすることを避け、課題の整理、実現したい状態の合意、監視項目の選定、技術の選定の順で進めたと書かれています。定量的な成果は示されていませんが、チーム全体で見る習慣が無ければ監視は機能しない、という指摘は第10章の「鳴りすぎる警報は無視される」と同じ方向を向いています。
事例に共通すること、基盤より先に困りごとがある
ここまでの事例を、整えたものと、この記事の章との対応、資料に書かれている数値の有無で並べると次の表になります。表の「資料にある数値」の列は、各社の資料に書かれている数値をそのまま写したもので、条件の違う数値どうしを比べるためのものではありません。
| 事例(資料の公開日) | きっかけになった困りごと | 整えたもの | 対応する章 | 資料にある数値 |
|---|---|---|---|---|
| Uber Michelangelo(2017年9月) | 道具がばらばらで、再現できる処理の流れも本番に出す決まった道筋も無い | データ管理から予測の監視までの6段階を1つの基盤に、特徴量の共有 | 第3〜10章 | 特徴量 約10,000、最大で毎秒250,000件超の予測 |
| Uber Michelangelo(2024年5月) | 深層学習と生成AIへの対応 | 生成AIの入口となるゲートウェイ、プロンプトの版管理、LLMの評価の枠組み | 第13章・本章 | 案件 約400、本番のモデル 5,000本超 |
| Spotify(2019年12月) | 独自のライブラリが Python の技術者に使いにくい | 推奨構成の提示、部品の標準化、中央で管理するパイプラインの基盤 | 第5章・第9章 | 試験版で利用者 約100人・実行 18,000回、一部のチームで実験が7倍 |
| LinkedIn Pro-ML(2019年1月) | 製品ごとに別の仕組み、学習と本番の計算の食い違い | 学習・配備・実行の共通化、健全性の保証、特徴量の登録と検索 | 第3章・第4章・第10章 | 目標「効果を2倍に」(達成の数値は無し) |
| Netflix Metaflow(公式ドキュメント) | データサイエンティストの生産性 | 処理の流れ・実験・成果物の自動の版管理 | 第5章・第9章 | 事業成果の数値は無し |
| メルペイ 与信モデル更新マニュアル(2023年6月) | 関係者が多く更新の判断に時間がかかる | 収益の試算を含む評価指標、監視指標、更新の契機、決裁の手続き | 第6章・第7章・第11章・第12章 | 短縮の数値は無し |
| メルペイ 運用の工夫(2024年12月) | 毎月約50個のリリースの作業と人の誤り | 設定とマスタデータの自動検証、実行を知らせるボット | 第3章・第9章 | 作業 約50個(効果の数値は無し) |
| メルペイ 共通基盤チーム(2022年12月) | 2チームの仕組みがばらばら | 共通基盤のチームを作り、最終的に閉じた | 第13章 | 数値は無し |
| サイバーエージェント Dynalyst(2023年10月) | 特徴量の異常やデータ量の減少に気づけない | 監視項目を絞った監視と警報 | 第10章 | 数値は無し |
表を並べると、3つの共通点が読み取れます。第1に、表の事例の多くは、基盤を作ること自体ではなく、具体的な困りごと(チームごとの仕組みのばらばら、学習と本番の食い違い、更新の判断の遅さ、異常に気づけないこと)から始まっています(Netflix の「データサイエンティストの生産性」や Uber 2024年の「深層学習と生成AIへの対応」は、困りごとというより目標に近い書き方です)。メルペイの共通基盤チームの事例は、その困りごとの仮説が弱いまま基盤を作り始めると成果に結びつきにくいことを、当事者の言葉で示しています。第2に、監視の仕組みは「予測と実際の結果を突き合わせる」ことを中心に作られています。Uber は2017年の時点でそれを基盤に組み込み、Dynalyst もオンラインの精度を警報の対象にしています。第3に、事業の数字への翻訳が、関係者の判断をしやすくしています。メルペイの与信モデルの事例は、モデルの指標を収益の試算に直したことで意思疎通とリリースの判断がしやすくなったとしています(判断にかかる時間が短くなったことを示す数値は、資料にはありません)。
逆に、事例の資料からは分からないこともはっきりさせておきます。どの資料も、基盤への投資額や、投資がどれだけの損益の改善につながったかは示していません。Spotify の「7倍の実験」や Uber の「5,000本」は活動量や規模の数字で、それ自体は事業の成果ではありません。自社への投資判断では、第13章で説明したとおり、共通データの例でいえば放置と毎月再学習の24か月の損益の差 420.2万円のような、自社の業務で測った成果の差と、仕組みを整えて運用する工数とを比べる必要があります。
LLMOps とは何か、MLOps への投資を拡張するという考え方
2023年以降、多くの企業が大規模言語モデルを業務に組み込み始め、その運用を表す言葉として LLMOps、あるいは生成AIの運用(GenAIOps)という言葉が使われるようになりました。Microsoft の Azure アーキテクチャ センターの文書「MLOps に投資している組織向けの生成 AI オペレーション」(2025年9月16日付の版を確認)は、GenAIOps を「LLMOps とも呼ばれる」ものとし、生成AIの機能を本番で使うには、既存の MLOps への投資を拡張する必要がある、という立場で書かれています。つまり、LLMOps はまったく別の新しい分野ではなく、MLOps のうち使い回せる部分と、足さなければならない部分がある、という整理です。
この文書は、従来の機械学習と生成AIの違いを2点にまとめています。1つ目は、従来の機械学習が特定の作業のために新しいモデルを学習させることに重点を置くのに対し、生成AIでは幅広い用途に使える既存の生成モデルを使い、場合によっては追加の学習(ファインチューニング)をする点です。2つ目は、従来の機械学習で最も重要な資産が学習済みのモデルであるのに対し、生成AIでは、モデルに渡すプロンプト(指示文)と、それを組み立てて外部のデータや他の処理を呼び出す仕組み(文書の言葉ではオーケストレーター)が、運用で管理すべき対象の中心になる点です。
そのうえで文書は、生成AIの技術の型を、ファインチューニング、プロンプト、検索拡張生成(RAG。社内文書などを検索し、関連する部分をプロンプトに入れて回答させる方式)の3つに分けています。ファインチューニングは、データの準備・学習・評価・配備という従来の機械学習と同じ流れをたどるので、既存の MLOps の仕組みを使うべきだとしています。一方、プロンプトと RAG では拡張が必要だとして、具体的に次のような点を挙げています。文書を細かく区切って検索用の索引に入れるデータの流れは、従来のデータの流れの一部ではないので、仕組みを広げる必要があること。検索の索引の鮮度と有効性を保つために、索引の更新や定期的な作り直しが必要で、その更新はデータの鮮度に関する事業の要件や、削除を求められた情報を消すといった法令順守の要件を満たす必要があること。文書の区切り方や検索の方式を変えて試し、結果を比べ、前の版に戻せるようにするために、データの版の管理が引き続き重要であること、です。
予測モデルの運用と、大規模言語モデルを使う業務アプリ(LLMアプリ)の運用で、管理する対象を流れの順に並べると次のようになります。
| 運用 | 管理する対象(流れの順) |
|---|---|
| 予測モデルの運用 | 学習データ → モデル → 予測 → 結果との突き合わせ |
| LLMアプリの運用 | 根拠の文書と索引 → プロンプト → 外部のモデル → 回答 → 評価と利用者の反応 |
文書はさらに、運用の流れを、データの準備・実験・評価からなる内側のループと、配備・推論と監視・フィードバックからなる外側のループに分け、それぞれで生成AIに特有の作業を挙げています。配備では、オーケストレーターやデータの格納先の変更も配備の対象になり、単体テスト・結合テスト・A/B テスト・端から端までのテストや、カナリアやブルーグリーンといった段階的な切り替え(第8章で扱った方式)を適用すべきだとしています。監視では、応答時間、トークン(モデルが文章を処理する単位で、利用料や利用の上限の計算にも使われる)の使用量、利用の上限に達したことを示すエラーを追うことが重要だと書かれています。また、成熟度については、MLOps の成熟度と GenAIOps の成熟度は別々に進むので、それぞれを別に測るべきだとし、例として MLOps の成熟度モデルではレベル4でも GenAIOps ではレベル1にとどまる場合がある、と書いています。第2章で扱った成熟度の考え方を、生成AIについては改めて測り直す必要があるということです。
この文書の結びは、生成AIを含めるように MLOps への投資を広げるとき、最初からやり直す必要はない、というものです。予測モデルの運用で整えたデータの版の管理・実験の記録・評価・段階的な配備・監視は、生成AIの運用でもそのまま土台になります。そのうえで、プロンプト・検索の索引・外部のモデルという新しい管理対象と、正解が1つに決まらない出力の評価という新しい課題が加わります。次の節から、この新しい部分を、評価・版の管理・費用の順に見ていきます。
LLM の出力を評価する、正解が1つでない出力をどう測るか
予測モデルでは、解約したかどうかという正解が1か月遅れで届き、AUC や損益で性能を測れました。LLM の回答には、多くの場合、正解が1つに決まりません。そのため評価の方法そのものを設計する必要があります。この点について、公開された一次情報の中で具体的な数値まで示している国内の例が、メルペイの機械学習エンジニアが2023年12月16日に公開した「品質要件が厳しいLLMアプリケーションのトライアル評価を通じて得た知見」です。
評価の対象は、返済の相談のチャットのシミュレーターの一部で、社内の464件の文書を検索して回答する RAG 型の質問応答でした。回答には事実の正しさが求められ、回答によっては法令上のリスクに触れる領域があります。評価は、事実の正しさとリスクの2つの面で行われました。事実の正しさは、過去の質問と回答の事例を使い、30件を人が評価したところ、誤答の割合は30件中14件(47%)でした。誤答14件のうち10件は参照する文書の取り違え、4件は適切な文書がそもそも存在しなかったことが原因でした。参考として LLM に自動で採点させた結果でも、質問と回答の関連性は5点満点で4.9と高い一方、質問と参照した文書の対応は2.9、回答が参照した文書に依拠しているかは1.8と低く出ています。
リスクの面では、回答してはいけない質問57件と、回答してよい質問80件を用意し、入力の段階での判定、プロンプトでの指示、出力の添削という3層の防御の組み合わせを人が評価しました。結果は、入力の判定とプロンプトの組み合わせで防げた割合が100%・回答してよい質問まで止めてしまった割合が4%、出力の添削とプロンプトの組み合わせで98%・1%、3層すべてで100%・5%でした。調整前の初版では回答してよい質問の約70%を止めていたこと、プロンプトでの防御はほとんど効果が無かったことも書かれています。記事は、限られた領域の禁止事項であれば防御を重ねることで100%近く防げたが、100%を保証するものではないこと、事実の正しさの確保には相応の開発と運用の費用がかかること、人による評価には1件10〜15分かかったことを挙げ、これらが1つの用途・限られた調整の範囲での評価にもとづく筆者の私見であることを明記しています。
この事例から読み取れるのは、LLM の評価では、目的に合わせて評価の観点を分け、それぞれに件数と合格の基準を決めた評価用のデータを用意する必要がある、ということです。第6章で受け入れ基準として「現行のモデルとの比較で何を満たせば本番に出すか」を決めたのと同じことを、LLM では「事実の正しさ」「止めるべき質問を止められるか」「答えてよい質問を止めないか」のように複数の観点で決めることになります。人による評価には時間がかかるので、件数に上限があります。記事の1件10〜15分という数字を使って計算すると、評価用の質問を100件用意して人が評価すれば、およそ17〜25時間の作業になります。モデルやプロンプトを変えるたびにこれを繰り返すのは現実的でないので、LLM に採点させる自動評価との組み合わせが研究と実務の両方で検討されています。
LLM に採点をさせる方法(LLM-as-a-Judge と呼ばれる)について、Zheng らが NeurIPS 2023 のデータセットとベンチマークの部門で発表した論文は、GPT-4 のような強い LLM を採点者にすると、人の評価との一致率が80%を超え、人どうしの一致率と同じ水準になったと要旨で報告しています。同時に、回答の提示順で評価が変わる位置の偏り、長い回答を好む偏り、自分が生成した回答を高く評価する偏りといった限界も指摘しています。LLM の自動評価は人の評価を置き換えるものではなく、人の評価で採点の妥当性を確かめたうえで、件数を増やすために使うもの、と位置づけるのが妥当だと考えています。メルペイの事例でも、自動評価は参考として扱われ、判断の根拠は人による評価に置かれていました。
| 評価の方法 | 長所 | 短所 | 主な使いどころ |
|---|---|---|---|
| 人による評価 | 業務の文脈や法令上のリスクを踏まえて判断できる | 1件ごとに時間がかかり、件数を増やせない | 受け入れ基準の判定、自動評価の妥当性の確認 |
| LLM による自動評価 | 件数を増やせ、変更のたびに繰り返せる | 提示順・長さ・自己の回答への偏りがありうる | プロンプトやモデルの変更のたびの回帰の確認 |
| 利用者の反応(評価ボタンなど) | 本番の実際の利用に即している | 反応する利用者が偏る、遅れて集まる | 本番での監視、改善の候補の発見 |
評価の仕組みを道具として支える製品も出てきています。たとえば MLflow の公式ドキュメントのLLM とエージェントの評価のページは、評価用の質問と期待する回答をまとめて保管する評価データセット、組み込みの LLM による採点と独自の採点基準、処理の記録に人の評価を付ける機能、本番の各段階の応答時間とトークンの使用量を記録する追跡の機能を説明しています。この記事の実行環境には MLflow が入っていないので、これらの機能は実行していません。表の3つの方法を記録に残し、版ごとに比べられるようにする、という考え方は、第5章の実験管理と同じです。
プロンプトと外部のモデルの版を管理し、費用を監視する
予測モデルの運用では、第7章で説明したとおり、どのデータとコードから作ったどの版のモデルが、誰の承認で本番に出ているかを記録しました。LLM を使う業務では、プロンプトの文面、使っている外部のモデルの名前と版、検索の索引の版が、この「版」に加わります。プロンプトの1文を書き換えただけで回答の傾向が変わることがあるので、プロンプトの変更もモデルの更新と同じように扱う必要があります。
MLflow の公式ドキュメントのプロンプト登録簿(Prompt Registry)のページは、プロンプトを Git に倣ったコミットの単位で版管理し、版どうしの差分を並べて比べられること、各版は変更できず再現性を支えること、「production」のような別名を版に付け替えることで、アプリケーションのコードを変えずに A/B テストや前の版への切り戻しができること、変更の理由をコミットのメッセージとして残せることを説明しています。Uber の2024年の記事も、プロンプトを作り・試し・検証し、テンプレートを版管理とコードレビュー付きの中央の保管場所に置く道具を用意したと書いています。どちらも、第7章のモデルレジストリの考え方をプロンプトに広げたものです。
外部の LLM を API で呼び出す場合、自社が何も変えていなくても、提供元がモデルを更新することがあります。この点を測った研究として、Chen・Zaharia・Zou の「ChatGPT の振る舞いは時間とともにどう変わっているか」(arXiv、2023年)があります。要旨によると、GPT-3.5 と GPT-4 の2023年3月版と6月版を、数学の問題、答えにくい質問、意見の調査、複数の知識をつなぐ質問、コードの生成、米国の医師国家試験、視覚的な推論の7つの課題で比べたところ、GPT-4 が素数か合成数かを判定する課題の正解率は、3月版の84%から6月版の51%に下がりました。著者らは、同じ名前のモデルでも振る舞いが短い期間で大きく変わりうるので、継続的な監視が必要だと結論づけています。
これは、第10章で扱ったドリフトに、新しい原因が加わることを意味します。予測モデルでは、変化の原因は自社の顧客や業務の側(料金改定、新しい獲得経路、データ連携の不具合、競合の施策)にありました。外部の LLM を使う業務では、提供元のモデルの更新も変化の原因になります。対策は、予測モデルで正解ラベルと突き合わせたのと同じ考え方で、固定した評価用のデータを持っておき、提供元のモデルの更新があったときや定期的に評価を回し直して、結果を前回と比べることです。使うモデルの版を指定できる提供元であれば、版を固定し、新しい版は評価を通してから切り替える、という手順を第7章の承認の流れに組み込めます。
予測モデルの費用は、主に学習と推論の計算資源と、それを運用する人手でした。外部の LLM を API で使う場合、費用は呼び出しごとに処理したトークンの量に応じて発生する形が一般的になります。先の Microsoft の文書は、サービスとして提供されるモデルでは、基盤の管理ではなく、処理量・利用の上限・呼び出しの制限に重点が移り、トークンが請求・制限・上限の計算に使われるので、費用の管理と性能のために上限の使用状況を監視すべきだと書いています。この記事では料金そのものは扱いませんが、費用の監視の仕組みは、品質の監視と同じ重さで設計する必要があります。
Uber の2024年の記事は、外部の LLM と社内で動かすモデルへの統一された入口(Gen AI Gateway)を設け、そこで記録と監査、費用の歯止め、安全方針の確認、外部の LLM にデータを送る前の個人情報の除去を行っていると書いています。入口を1か所にまとめておけば、どの業務がどれだけ使っているかを把握でき、使いすぎを止めたり、送ってはいけない情報を外に出さないようにしたりできます。Microsoft の文書も、生成モデルの前にゲートウェイを置くことを一般的な形として挙げ、負荷の分散・認証・監視・入力と出力の記録・新しいモデルへの段階的な切り替えといった使い道を説明しています。
費用を下げる研究としては、Chen・Zaharia・Zou の FrugalGPT の論文(arXiv、2023年)が、費用を下げる3つの方針として、プロンプトの工夫、より安いモデルでの近似、複数のモデルを順に呼ぶ段階的な使い方(安いモデルで足りる質問は安いモデルで答え、足りない質問だけを高いモデルに回す)を挙げています。要旨では、段階的な使い方の一例である FrugalGPT が、著者らの実験の条件で、単独で最も性能の高いモデル(GPT-4 など)と同等の性能を最大98%少ない費用で達成した、あるいは同じ費用で GPT-4 より正解率を4%高めた、と報告しています。これは論文の実験の条件での数値で、どの業務でも同じだけ下がるという意味ではありません。ただ、品質の評価の仕組みが整っていれば、安いモデルへの切り替えや段階的な使い方を、品質を落とさない範囲で試せるようになります。評価の仕組みは、品質を守るためだけでなく、費用を下げる判断の前提にもなるということです。
経営指標への翻訳としては、トークンの量や1回の呼び出しの単価ではなく、業務の成果1件あたりの費用(問い合わせ1件の一次回答あたり、書類1件の要約あたりなど)で見るのが有効だと考えています。共通データで引き止め施策の損益を「施策1件の費用」と「解約する顧客に打てたときに守れる額」で計算したのと同じく、LLM の費用も、その回答によって削減できた人手の工数や防げた誤りと並べて評価しないと、使うべきかどうかを判断できません。
生成AIで MLOps の何が変わり、何が変わらないか
ここまでの内容を、この記事の各章の観点ごとに、予測モデルの運用と LLM を使う業務の運用で並べると次の表になります。左の2列の「予測モデル」は、この記事で共通データを使って扱ってきた解約予測のような運用を指します。右の列は、Microsoft の文書とこの章で紹介した資料をもとに整理したもので、すべての LLM の使い方に当てはまるわけではありません。
| 観点 | 予測モデル(この記事の共通データの例) | LLM を使う業務(RAG など) | 変わらないこと |
|---|---|---|---|
| 管理の中心になる対象 | 学習済みのモデル | プロンプト・オーケストレーター・検索の索引・外部のモデル | 何が本番で動いているかを版で言えること |
| データの品質(第3章・第4章) | 特徴量の型・範囲・欠損 | 根拠となる文書の網羅性と鮮度、索引の更新 | データの持ち主と責任の所在を決めること |
| 評価(第6章) | AUC・予測平均と解約率のずれ・損益 | 事実の正しさ・根拠への依拠・止めるべき質問の防御、人の評価と自動評価 | 受け入れ基準を出す前に決めること |
| 版の管理(第5章・第7章) | モデル・データ・コードの版 | プロンプトの版、外部のモデルの名前と版、索引の版 | 承認と切り戻しの記録 |
| 監視(第10章) | PSI、1か月遅れの正解ラベルでの性能 | 応答時間・トークンの使用量・安全性・利用者の反応・評価の再実行 | 予測と実際の結果を突き合わせること |
| 変化の原因 | 顧客・料金・獲得経路・データ連携・競合 | 左に加えて、提供元のモデルの更新、根拠の文書の改訂 | 変化を前提に作ること |
| 更新の方法(第11章) | 再学習(定期・トリガー) | プロンプトの改訂、索引の作り直し、モデルの切り替え、必要ならファインチューニング | 新しい版が現行を上回るときだけ入れ替えること |
| 費用 | 学習と推論の計算資源、人手 | 呼び出しごとのトークン、人による評価の工数 | 成果1件あたりで見ること |
表の右端の列が、この記事で最も伝えたいことの1つです。生成AIによって、管理する対象・評価の方法・変化の原因・費用の形は変わりますが、「何が本番で動いているかを版で言える」「出す前に受け入れ基準を決める」「予測や回答を実際の結果と突き合わせる」「新しい版は現行を上回るときだけ入れ替える」「成果を事業の指標で測る」という骨格は変わりません。予測モデルの MLOps を整えた組織は、その骨格を生成AIにも使えます。逆に、予測モデルで骨格が無いまま生成AIを本番に入れると、評価用のデータも、版の記録も、切り戻しの手順も無い状態で、正解が1つに決まらない出力を扱うことになります。
生成AIの登場で、MLOps の作業そのものの進め方が変わる面もあります。Microsoft の文書は、プロンプトや RAG の実験・評価は必ずしもデータサイエンティストを必要としないため、ソフトウェアエンジニアやデータエンジニアに任せたくなるが、データサイエンティストを外すと結果を科学的に評価する点で課題が生じうるので、データサイエンティストに作業を確認してもらう必要がある、と書いています。役割の分担を考えるときは、第13章で扱った責任分担表に、プロンプトと評価用データの持ち主を書き加えることになります。
研究の動向、ドリフトへの適応と継続学習
モデルを運用し続けるうえで中心になる「データや関係の変化にどう対応するか」は、研究の分野でも長く扱われてきました。この記事の第10章ではデータの分布の変化と関係そのものの変化を区別しましたが、研究の分野では後者を含む変化を概念ドリフトと呼び、2014年には ACM Computing Surveys 誌に概念ドリフトへの適応を整理したサーベイ(Gama ら)が掲載されています。その後の研究を整理したものとして、Lu らの概念ドリフトのもとでの学習のレビュー(IEEE の知識とデータ工学の論文誌 TKDE、2018年に早期公開)があります。要旨によると、このレビューは概念ドリフトに関する130を超える研究を整理し、研究の枠組みを、ドリフトの検出、ドリフトの理解、ドリフトへの適応の3つの要素で示しています。
この3つの要素は、この記事の章立てと対応しています。検出は第10章の監視、適応は第11章の再学習に当たります。間にある「理解」は、検出した変化の中身を知る段階と読めます。共通データでいえば、料金の PSI が鳴ったときに、それが性能に影響する変化なのか(対処が要る)、関係は変わっていない変化なのか(対処が要らない)を見分ける作業です。実務では、この「理解」の段階を飛ばして、警報が鳴るたびに再学習するか、鳴っても無視するかの両極端になりやすいので、変化の中身を確かめる手順と担当者を決めておくことが、研究の枠組みから得られる実務上の示唆だと考えています。
もう1つの流れが継続学習です。Wang らの継続学習の包括的なサーベイ(IEEE のパターン解析と機械知能の論文誌 TPAMI、2024年)は、要旨で、知的なシステムには生涯を通じて知識を少しずつ獲得・更新・蓄積・活用する能力が要るとし、その障害として、新しい課題を学ぶと以前の課題の性能が大きく落ちる破滅的忘却を挙げています。そして、古い知識を保つ安定性と新しい知識を取り込む柔軟性の釣り合いを取ることを、継続学習の目標の1つとして示しています。
この記事の共通データでは、毎月、直近12か月のデータでモデルを最初から学習し直す方式を使いました。表形式のデータの勾配ブースティングのように、学習し直す費用が小さいモデルでは、この方式で十分なことが多いと考えています。一方、大規模なモデルを毎回最初から学習し直すのは費用が大きいので、既存のモデルに新しいデータを少しずつ学ばせる方法が研究されており、そこで破滅的忘却が問題になります。直近のデータに合わせることと、過去に学んだことを失わないことの釣り合いは、第11章で比べた「学習に使う期間の長さ」の選択と同じ種類の問題で、規模が大きくなるほど重要になります。
研究の対象は、手法だけでなく、運用の実態そのものにも広がっています。Paleyes らの機械学習の配備の課題を事例から整理したサーベイ(ACM Computing Surveys、2022年)は、さまざまな用途で機械学習を配備した公開の報告を集め、配備の流れのすべての段階で実務家が課題に直面していると結論づけています。Shankar らの機械学習の運用に関する聞き取り調査(arXiv、2022年)は、チャットボット・自動運転・金融などさまざまな用途の機械学習エンジニア18人への半構造化インタビューから、本番の機械学習の成否を左右する変数として、速さ(Velocity)・検証(Validation)・版の管理(Versioning)の3つを挙げています。Kreuzberger らのMLOps の概観と定義と構成を論じた論文(IEEE Access、2023年)は、文献の調査・道具の調査・専門家への聞き取りを組み合わせて、MLOps に必要な原則・構成要素・役割をまとめ、MLOps の定義を示しています。いずれも、この記事の各章で扱った仕組みが、個別の会社の工夫ではなく、業界に共通する課題への対応であることを裏づけています。
事例と動向を自社の判断に落とす
この章で見た事例と動向を、経営の判断に使う形にまとめます。第1に、基盤への投資は、困りごとの仮説から始めることです。メルペイの共通基盤チームの振り返りが示すとおり、具体的な困りごとが無いまま基盤のチームを作ると、個別の依頼に追われるうちに外部の製品が追いつき、投資が成果につながりにくくなります。自社では、「どのモデルの、どの変化に、何か月気づけなかったら、いくら失うか」を先に見積もり、それを防ぐ仕組みから整えるのが筋が良いと考えています。共通データの例では、競合の施策で関係が変わった9か月間(第28〜36か月)に、放置したモデルの損益は毎月再学習したモデルより月平均で約40.5万円少なく、気づかないままでいる1か月ごとに、平均してこの程度の損が積み上がる、という見積もりになります(9か月の平均なので、どの月の気づきが遅れるかで1か月分の額は変わります。第10章の例では、気づきを第29か月末から第30か月末へ遅らせたときに増える損失は19.8万円でした)。これは架空のデータの、この設定での数字であり、自社では自社の業務の損益で同じ計算をする必要があります。
第2に、生成AIの導入では、評価用のデータと受け入れ基準を、本番で使い始める前に作ることです。メルペイの評価の事例では、事実の正しさについて30件中14件が誤答でした。このような評価を本番の前に行っていなければ、誤答が利用者の目に触れてから問題に気づくことになります。評価用のデータを作る人手(1件10〜15分の評価を数十〜数百件)は、生成AIの導入費用の一部として最初から見込んでおく必要があります。第3に、外部の LLM を使う場合は、提供元のモデルの更新を、自社のデータの変化と同じ「変化の事象」として監視の対象に入れることです。GPT-4 の3月版と6月版で特定の課題の正解率が84%から51%に変わった例が示すとおり、自社が何も変えなくても品質は変わりえます。
第4に、成熟度は予測モデルと生成AIで別々に測ることです。予測モデルの運用が整っている組織でも、生成AIの運用は初期の段階にとどまっている場合があります。逆に、予測モデルで整えたデータの版の管理・承認・監視・切り戻しの仕組みは、生成AIの運用の土台としてそのまま使えるので、予測モデルの MLOps への投資は、生成AIの時代にも無駄にはなりません。第5に、製品の選定は最後にすることです。Dynalyst の事例は、ツールを先に入れることを避け、課題の整理と実現したい状態の合意を先にしたと書いています。どの製品を選ぶかは、何を監視し、何を記録し、誰が承認するかが決まってからの問題で、クラウド各社の製品の見取り図は弊社コラム『AWS・Azure・GCPのまとめノート、クラウド主要サービスの見取り図と選び方』で整理しています。
この章では、Uber・Spotify・LinkedIn・Netflix・メルペイ・サイバーエージェントの公開資料を読み、事例ごとに重点は異なるものの、具体的な困りごとを起点にすること、予測と結果の突き合わせ、版の管理、事業の数字への翻訳が繰り返し現れることを確かめました。生成AIの運用(LLMOps)では、プロンプト・検索の索引・外部のモデルという管理対象と、正解が1つに決まらない出力の評価、トークンの費用の監視が加わりますが、MLOps の骨格はそのまま使えます。終章では、この記事全体を通じて確かめたことを、モデルを運用し続けるための考え方としてまとめます。
この章を深めたい方への参考書籍
『AIエンジニアリング 基盤モデルを用いたAIアプリケーション開発の基礎と実践』(Chip Huyen 著、加賀谷諒・菅野憲也 訳、オライリー・ジャパン):大規模言語モデルを使うアプリケーションの設計・構築・運用を扱う本で、評価の方法論と AI システムの評価に2つの章を割き、プロンプト、RAG とエージェント、ファインチューニング、推論の最適化、利用者のフィードバックまでを扱っています。この章の LLMOps の節で見た「評価・版の管理・費用」を、生成AIのアプリケーション全体の設計の中に位置づけて理解するのに向いています。
『LLMのプロンプトエンジニアリング GitHub Copilotを生んだ開発者が教える生成AIアプリケーション開発』(John Berryman・Albert Ziegler 著、服部佑樹・佐藤直生 訳、オライリー・ジャパン):GitHub Copilot の開発者が、プロンプトの内容の選び方と組み立て方、モデルの制御、LLM を使う処理の流れ、LLM アプリケーションの評価を解説した本です。この章で、プロンプトをモデルと同じく版で管理し評価すべき対象として扱った理由を、プロンプトの設計の側から具体的に確かめられます。
『大規模言語モデル入門Ⅱ 生成型LLMの実装と評価』(山田育矢 監修・著、鈴木正敏・西川荘介・藤井一喜・山田康輔・李凌寒 著、技術評論社):前作の続編で、性能評価、指示チューニング、選好チューニング、RAG、分散並列学習の章から成り、大規模言語モデルの評価を実装とあわせて学べます。LLM の評価がなぜ難しく、どのような方法とベンチマークがあるかを、技術の側から押さえたい方に向いています。
終章 モデルを運用し続けるための5つの考え方
本コラムでは、架空の定額制サービスの解約予測を共通の題材にして、機械学習のモデルを本番で使い続けるための仕組みを、データの品質から体制まで14の章で扱いました。第1章と第2章で、学習したまま放置したモデルと毎月学習し直したモデルの24か月の損益の差が420.2万円になり、その大半(364.8万円)が競合の施策という関係そのものの変化のあとに生じたことを確かめました。第3章から第9章では、モデルを本番に出すまでのデータの検証、学習データの作り方、実験の記録、評価、承認、届け方、テストを、第10章と第11章では本番に出したあとの監視と再学習を、第12章から第14章では説明責任、体制、事例を扱いました。
終章では、各章の結果を、運用の仕組みを整えるときの考え方として5つにまとめます。いずれも、この架空のデータの、この設定での結果から読み取れることです。変化の種類や大きさ、モデルの使い方が違えば、数字は変わります。考え方の筋道を、自社のモデルに当てはめて確かめる材料として使っていただくことを想定しています。
1. モデルの価値は、使い続けるあいだに目減りすると考える
第1章で見たとおり、学習したまま放置したモデルの損益は、変化の起きる前の6か月では毎月学習し直したモデルとほとんど変わらず、合計の差は-1.5万円でした。差が開いたのは、料金の改定・新しい獲得経路・データの欠損・競合の施策という4つの変化が順に起きたあとです。モデルを作った直後の評価だけで投資の成否を判断すると、この目減りは見えません。運用の仕組みへの投資は、モデルを作る費用の付け足しではなく、モデルの価値を保つための費用として、導入の時点で見込んでおくことが大事だと考えています。
2. 入力の変化と、関係の変化を分けて測る
第2章と第10章では、料金の改定のあと月額の分布の変化を表すPSIが大きな値を示し続けたのに、予測の並べ替えの正しさ(AUC)はほとんど下がらなかったことを確かめました(第2章の表では、真の確率で並べた場合の下がり方と同じ程度でした)。反対に、競合の施策による変化は、放置したモデルの出力の分布にはほとんど現れず(スコアのPSIは約0.01〜0.025)、解約の結果が届いてから当たり方を測って初めて分かりました。この設定で測った範囲では、入力や出力の分布を見張る仕組みだけでは、関係そのものの変化に気づけませんでした。入力・予測・結果の3つを、それぞれの遅れ(結果は1か月遅れて届く)を踏まえて測り、警報の規則は「鳴ったら誰が何をするか」まで決めておくことが要ります。
3. 再学習は、回数より、きっかけと入れ替えの判断で設計する
第11章では、四半期ごとの再学習(24か月で7回)が損益の合計で2,357.7万円、毎月の再学習(24回)が2,384.2万円で、回数を17回増やして得られた差は26.5万円でした。一方、放置から四半期ごとにするだけで393.7万円の差がありました。確率の水準のずれか当たり方の低下のどちらかが基準を超えたときに学習し直すトリガー型は、11回の再学習で2,367.1万円でした。ただし、当たり方(AUC)の下限だけを基準にしたトリガー型は5回で2,340.8万円と、四半期ごとの再学習を下回りました。何をきっかけにするかで結果が変わります。この設定では、再学習の効果の大半は、四半期ごとの7回、つまり「学習し直す仕組みがあるかどうか」で決まり、そこから先は費用と効果の釣り合いで頻度を選ぶ段階に入ります。あわせて、データの欠損が起きた月の記録をどう扱うか(第11章の設定では、事故の月の害は小さく、機械的に外して学習期間が短くなる害のほうが大きい場面がありました)、新しいモデルを現行のモデルと比べてから入れ替えるかどうかを、再学習の自動化より先に、人が判断する手順として決めておくことが大事だと考えています。
4. 記録と承認は、事故が起きたときのために置く
第5章では、データ・コード・ライブラリの版・設定・乱数の種を記録しておけば、同じ環境で同じモデルを作り直したときに予測が完全に一致することを、この記事のモデルで確かめました(モデルの種類やライブラリによっては、並列計算の順番の違いで結果がわずかに変わる場合があります)。同時に、学習期間から1か月が抜けるだけで、AUCは変わらないまま損益が月3.50万円下がり、検証用の10,000件のうち431件で施策の判定が入れ替わることも確かめました。第7章では、ラベルが隣の行にずれた誤った候補のモデルを審査で止めた場合と、審査なしで本番に入れていた場合を比べ、後者では3か月だけで416.5万円の損失になる設定を示しました(誤った版が出る頻度や、気づかれずに使われる期間は組織によって違います)。記録や承認は、平時には手間に見えます。その価値は、予測がおかしいと気づいたときに原因を特定し、元の版に戻せるかどうかで決まります。
5. 仕組みは、モデルの本数と影響の大きさに合わせて段階的に整える
第2章で整理した成熟度の段階は、一度に上げる必要はありません。第13章で見たように、運用の工数は再学習の頻度と自動化の有無で大きく変わり、毎月の再学習を手作業で回すと、24か月の工数は自動化した場合の約2.6倍(1,312時間対496時間。いずれも第13章で置いた架空の設定)になります。第13章では、成果の測り方を決める、最初の1本を記録と承認つきで出す、監視を始める、再学習を定期で回す、自動化して頻度を上げる、という順序を示しました。記録と承認は後から取り戻せないので後回しにできず、監視はその次に置き、パイプラインによる自動化は、モデルの本数や判断の影響が大きくなってから足していく順序が、投資の効果を確かめながら進めやすいと考えています。
運用の仕組みを経営の判断につなぐ
機械学習の運用は、技術の担当者だけの仕事に見えがちです。しかし、何をどこまで自動化し、どこで人が確かめ、誰が承認するかは、モデルの判断を誤ったときの損失をどこまで許すかという、経営の判断そのものです。本コラムの例でいえば、引き止めの施策を打つ会員を決めるしきい値、学習し直す頻度、警報が鳴ったときに施策を止めるかどうかは、いずれも損益に直結します。運用の仕組みを整えるときは、技術の指標(AUCやPSI)を、損益・施策の件数・人手の工数といった経営の指標に翻訳して、判断の材料にしていただくことをお勧めします。
本コラムで扱った手法と仕組みは、どれも単独では万能ではありません。データの検証は関係の変化を見逃し、入力の監視は結果の監視を代わりにできず、再学習は事故のデータまで取り込みます。それぞれの仕組みが何を防ぎ、何を防げないかを理解したうえで組み合わせ、結果を測って見直し続けることが、モデルの価値を保つ道筋だと考えています。
Anagraftでは、データ活用の構想づくりから、機械学習モデルの設計と実装、本番での運用の仕組みづくり、監視と再学習の設計、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 MLOpsはなぜ経営の問題なのか
『仕事ではじめる機械学習 第2版』(有賀康顕・中山心太・西林孝、オライリー・ジャパン):機械学習のプロジェクトを「仕事で使う」観点から整理した本で、第2版では機械学習システムの開発と運用の統合を扱う章や、継続的トレーニングのための基盤、施策の効果検証の章が加わっています。この章で見た「モデルを作ることと、業務で成果を出し続けることは別の問題だ」という論点を、プロジェクトの進め方の側から読むのに向いています。
『事例でわかるMLOps 機械学習の成果をスケールさせる処方箋』(杉山阿聖・太田満久・久井裕貴 編著、講談社):第1部で MLOps の背景と全体像、それを実現する技術・プロセス・文化を整理し、第2部で国内の企業や技術者による実践の事例を集めた本です。この章で整理した損失の型と、それを防ぐ仕組みが、実際の組織でどう作られているかを確かめるのに向いています。
第2章 機械学習システムの全体像と成熟度
『MLOps実装ガイド 本番運用を見据えた開発戦略』(Yaron Haviv・Noah Gift 著、井伊篤彦ほか 訳、オライリー・ジャパン):MLOps が何で、なぜ必要かから始めて、データと特徴量ストア、本番向けのモデルの開発、配置、監視と再学習までを、段階ごとにたどる本です。投資対効果や企業としての進め方を扱う節もあるので、この章で扱った「どの段階で何を整えるか」を、組織全体に広げて考えるときの手がかりになります。
『実践MLOps 作って理解する機械学習システムの構築と運用』(長江五月 著、オーム社):機械学習のパイプライン、実験の基盤、版の管理、CI・CD、推論のサービス、継続的学習、監視を、手を動かしながら1章ずつ組み立てていく構成の本です。この章の部品の一覧が、実際にはどんな仕組みとして実装されるのかを、全体を通して確かめたいときに向いています。
第3章 データの品質を守る
『実践的データ基盤への処方箋』(ゆずたそ・渡部徹太郎・伊藤徹郎、技術評論社):データ基盤を作り運用するためのノウハウを、データ・システム・人の3つの面から扱う本です。目次には、データの品質を生成元のデータソースで担保すること、マスタ・共通ID・履歴の整備、サービスレベルの設定と計測、データ品質を支えるデータスチュワードの役割といった節があり、この章の「データの持ち主」と「運用の約束」を組織の側から具体化するのに向いています。
『データエンジニアリングの基礎』(Joe Reis・Matt Housley 著、中田秀基 訳、オライリー・ジャパン):データの生成から保存・取り込み・変換・提供までを「データエンジニアリングライフサイクル」として整理した本の日本語版です。ソースシステムにおけるデータ生成、データ取り込み、機械学習へのデータの提供といった章があり、この章で扱った「データを作る側」と「使う側」の間で何が起きるかを、データの流れ全体の中で理解するのに向いています。
第4章 特徴量と学習データを正しく作る
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司、技術評論社):データ分析のコンペティションで使われる手法を、評価指標・特徴量の作成・モデルの検証の順に整理した本です。目次には、予測に有用な情報が想定外に漏れている意味でのリーク、検証の枠組みの誤りという意味でのリーク、時系列データで予測する時点より過去の情報のみを使うこと、予測に使えるデータの期間といった節があり、この章で扱ったデータリークと時点整合を、特徴量の作り方の側から具体的に学ぶのに向いています。
『機械学習のための特徴量エンジニアリング:その原理とPythonによる実践』(Alice Zheng・Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン):数値データ・テキストデータ・カテゴリ変数の扱い、特徴量のスケーリング、次元削減など、データから特徴量を作る方法を原理から説明した本です。この章で「1か所にまとめる」とした特徴量の定義の中身を、どう設計するかを学ぶのに役立ちます。
第5章 実験を記録し、再現できるようにする
『再現可能性のすゝめ』(高橋康介、共立出版):「Wonderful R」シリーズの第3巻で、R と RStudio を使った再現可能なデータ解析とレポート作成を扱っています。その場限りのデータ解析の問題点から、スクリプト化、R マークダウンによるレポート作成へと進む構成で、この章で扱った「後から同じ結果を出せるように作業を残す」考え方を、言語は違っても具体的な手順で確かめられます。
『Kaggle Grandmasterに学ぶ機械学習実践アプローチ』(Abhishek Thakur 著、石原祥太郎 訳、マイナビ出版):機械学習のコンテストで実績のある著者が、交差検証・評価指標・ハイパーパラメータの最適化などを実装とともに解説した本で、機械学習のプロジェクトの構築の章と、コードの再現性やモデルのデプロイを扱う章があります。この章の実験の繰り返しとパラメータの比較を、プロジェクトのコードの組み立て方から学ぶのに向いています。
第6章 本番に出す前にモデルを評価する
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標と KPI と目的関数の関係から始め、二値分類の章で ROC-AUC・PR-AUC などの指標に加えて、ビジネスインパクトの期待値計算とコスト考慮型学習を扱っています。この章で行った、しきい値を施策の費用と守れる粗利から決め、損益でモデルを比べる考え方を、指標の側から体系的に整理できる1冊です。
『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』(齋藤優太・安井翔太 著、ホクソエム 監修、技術評論社):機械学習の実践に潜む落とし穴から始め、予測の正確さと意思決定の性能を分けて考える枠組みを示しています。オフライン評価で測った予測の良さと、施策として打ったときの効果が一致しないという、この章のオフライン評価で分からないことの節で触れた問題を考える土台になります。
第7章 モデルを登録し、承認して版を管理する
『機械学習デザインパターン:データ準備、モデル構築、MLOpsの実践上の問題と解決』(Valliappa Lakshmanan、Sara Robinson、Michael Munn 著、鷲崎弘宜、竹内広宜、名取直毅、吉岡信和 訳、オライリー・ジャパン):機械学習の設計で繰り返し現れる問題と解決を30のパターンにまとめた本です。再現性のパターンの章に、モデルのバージョニングのパターンがあり、新しいモデルと新しい版をどう区別するか、管理サービスで版を扱う方法を説明しています。この章の版の番号と別名の考え方を、設計の型として確かめるのに向いています。
『機械学習工学』(石川冬樹、丸山宏 編著、柿沼太一、竹内広宜、土橋昌、中川裕志、原聡、堀内新吾、鷲崎弘宜 著、講談社):機械学習を使ったシステムを工学として作り、運用するための考え方をまとめた本で、機械学習システムの運用、品質のとらえ方と管理、品質に関するガイドラインの章があります。この章で扱った受け入れ基準や承認の記録を、品質を管理する仕組みの中に位置づけて考えるのに役立ちます。
第8章 モデルを届ける、バッチ推論とオンライン推論
『AIエンジニアのための機械学習システムデザインパターン』(澁井雄介、翔泳社):機械学習のモデルを本番で動かす仕組みを、繰り返し使える設計の型(パターン)として整理した本です。この本のサンプルコード集として公開されているリポジトリの一覧には、バッチ推論や同期・非同期の推論の型、推論の記録、シャドー運用での比較の型が並んでおり、この章で扱った届け方とリリースの選択肢を、具体的な構成と結びつけて確かめられます。
『Web API: The Good Parts』(水野貴明、オライリー・ジャパン):Web API の設計と運用の考え方をまとめた本です。目次には、応答のデータの設計、エラーの表現と状態コードの使い分け、API をバージョンで管理する方法が並んでおり、推論の API を業務システムから呼んでもらう窓口として設計するときの論点を、機械学習に限らない一般の API 設計の視点から確かめられます。
『動かして学ぶ!Python FastAPI開発入門』(中村翔、翔泳社):この章で推論の窓口を作るのに使った FastAPI の入門書です。ToDo アプリを題材に、要求と応答の形(スキーマ)の定義、テスト用のクライアントを使ったユニットテスト、クラウドへのデプロイまでを順に組み立てる構成で、この章のコードの背景にある使い方を手を動かして確かめられます。
第9章 機械学習のテストとパイプラインの自動化
『継続的デリバリー 信頼できるソフトウェアリリースのためのビルド・テスト・デプロイメントの自動化』(Jez Humble、David Farley 著、和智右桂、髙木正弘 訳、ドワンゴ):ソフトウェアを変更のたびに組み立て・テストし、いつでも安全にリリースできる状態に保つための考え方を体系的に扱った本で、目次には構成管理・継続的インテグレーション・テスト戦略の実装の章があります。この章で機械学習に当てはめた CI/CD の土台になっている、ソフトウェア側の作法を確かめるのに向いています。
『テスト駆動Python 第2版』(Brian Okken 著、安井力 監修、クイープ 監訳、翔泳社):この章でテストを書くのに使った pytest の入門書で、目次はテスト関数の書き方、フィクスチャ(テストの前準備を共有する仕組み)などから始まります。データやモデルのテストを、手元の確認用の関数から、変更のたびに自動で回るテストへ育てるときの実装の手引きになります。
第10章 モデルを監視する
『異常検知と変化検知』(井手剛・杉山将 著、講談社):機械学習プロフェッショナルシリーズの1冊で、異常検知と変化検知の基本的な考え方から、部分空間法による変化検知、密度比推定による変化検知までを扱っています。この章で使った PSI や KS 検定の背後にある「2つの時期のデータの分布の違いを測る」という発想を、より一般的な手法として学べます。
『入門 監視:モダンなモニタリングのためのデザインパターン』(Mike Julian 著、松浦隼人 訳、オライリー・ジャパン):監視のアンチパターンとデザインパターン、アラート・オンコール・インシデント管理、ビジネスの監視までを扱った本です。誤報の減らし方や手順書の書き方など、この章のアラートの設計(鳴りすぎる警報を減らし、対処できる通知だけを人に届ける)を、機械学習に限らない監視の一般論として補えます。
第11章 再学習を設計する
『オンライン機械学習』(海野裕也・岡野原大輔・得居誠也・徳永拓之、講談社):データが届くたびにモデルを少しずつ更新するオンライン学習の考え方と、その性能の解析、実装を扱った専門書です。この章で位置づけだけを確かめた常時の学習を、どんな用途で、どんな前提のもとで使えるかを理解するのに役立ちます。
『実践 時系列解析 統計と機械学習による予測』(Aileen Nielsen 著、山崎邦子・山崎康宏 訳、オライリー・ジャパン):時系列データを統計モデルと機械学習の両方で扱い、誤差の測り方やバックテスト(過去のある時点に立って予測し、その後の実績で採点する検証)、モデルの当てはめと提供の性能に関する考慮事項までを扱った本です。後半の章には、手持ちの全データを使うことが必ずしもよいとは限らない、という観点の節があり、この章で比べた学習期間の長さの判断を、時系列の検証の作法から考え直すのに役立ちます。
第12章 説明責任とガバナンス
『AIガバナンス入門 リスクマネジメントから社会設計まで』(羽深宏樹 著、早川書房):ハヤカワ新書の1冊(2023年12月刊)で、副題のとおり、AI のガバナンスを企業のリスクマネジメントから社会の制度設計までの広がりで論じています。この章で見たガイドラインや規則の条文を、個々の要求として読む前に、それらがどういう考え方で組み立てられているかをつかむのに向いています。
『EU AI法概説』(古川直裕・吉永京子・有坂陽子・羽深宏樹・早川政哉 編著、商事法務):別冊NBL の1冊(2025年7月刊、360ページ)で、EU の AI 規則を日本語で解説した本です。この章で抜き出した高リスクAIの記録・人による監視・市販後の監視の条文を、規則全体の構造の中で読むのに向いています。刊行は2026年のデジタル・オムニバスによる改正より前なので、適用日など改正された箇所は、最新の統合版の条文で確かめながら読む必要があります。
第13章 体制・役割・費用対効果
『信頼性の高い機械学習 SRE原則を活用したMLOps』(Cathy Chen ほか著、井伊篤彦・張凡・樋口千洋訳、オライリー・ジャパン):サービスの信頼性を守るエンジニアリング(SRE)の考え方を機械学習の運用に当てはめた本です。監視・継続的な学習・障害対応の章に加えて、機械学習を組織に組み込む方法と、実際の組織の事例を扱う章があり、この章の役割分担や体制の議論を深めるのに向いています。
『機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス』(Chip Huyen著、江川崇・平山順一訳、オライリー・ジャパン):データの扱いからデプロイ・監視・継続学習までを通して説明した本で、MLOps のインフラとツールの章に続いて、最終章で機械学習の人的側面を扱っています。その章のチーム構成の節では、機能をまたいだチームの協働や、データサイエンティストがどこまでを受け持つかを論じており、この章の役割分担を考える材料になります。
第14章 事例と最新動向
『AIエンジニアリング 基盤モデルを用いたAIアプリケーション開発の基礎と実践』(Chip Huyen 著、加賀谷諒・菅野憲也 訳、オライリー・ジャパン):大規模言語モデルを使うアプリケーションの設計・構築・運用を扱う本で、評価の方法論と AI システムの評価に2つの章を割き、プロンプト、RAG とエージェント、ファインチューニング、推論の最適化、利用者のフィードバックまでを扱っています。この章の LLMOps の節で見た「評価・版の管理・費用」を、生成AIのアプリケーション全体の設計の中に位置づけて理解するのに向いています。
『LLMのプロンプトエンジニアリング GitHub Copilotを生んだ開発者が教える生成AIアプリケーション開発』(John Berryman・Albert Ziegler 著、服部佑樹・佐藤直生 訳、オライリー・ジャパン):GitHub Copilot の開発者が、プロンプトの内容の選び方と組み立て方、モデルの制御、LLM を使う処理の流れ、LLM アプリケーションの評価を解説した本です。この章で、プロンプトをモデルと同じく版で管理し評価すべき対象として扱った理由を、プロンプトの設計の側から具体的に確かめられます。
『大規模言語モデル入門Ⅱ 生成型LLMの実装と評価』(山田育矢 監修・著、鈴木正敏・西川荘介・藤井一喜・山田康輔・李凌寒 著、技術評論社):前作の続編で、性能評価、指示チューニング、選好チューニング、RAG、分散並列学習の章から成り、大規模言語モデルの評価を実装とあわせて学べます。LLM の評価がなぜ難しく、どのような方法とベンチマークがあるかを、技術の側から押さえたい方に向いています。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 機械学習システムの隠れた技術的負債を論じた2015年の Sculley らの論文
https://proceedings.neurips.cc/paper_files/paper/2015/hash/86df7dcfd896fcaf2674f757a2463eba-Abstract.html - 同論文の本文の記述(序論・CACE原則・図1・グルーコードの5%と95%・外の世界の変化・監視の3つの出発点・再現性の負債・プロセス管理の負債・文化の負債・結論)
https://proceedings.neurips.cc/paper_files/paper/2015/file/86df7dcfd896fcaf2674f757a2463eba-Paper.pdf - Google Cloud の文書によるMLOpsの定義とDevOpsとの違い
https://docs.cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning - IPA「DX動向2026」のAIの導入状況と導入・運用上の課題
https://www.ipa.go.jp/digital/chousa/dx-trend/dx-trend-2026.html - 同報告書の本文
https://www.ipa.go.jp/digital/chousa/dx-trend/rcu1hd0000017uk8-att/dx-trend-2026.pdf - IPAのDX動向2026調査のプレス発表
https://www.ipa.go.jp/pressrelease/2026/press20260716.html - 総務省「令和8年版 情報通信白書」の企業向けアンケート
https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r08/summary/summary01.pdf - 情報通信白書の版の一覧
https://www.soumu.go.jp/johotsusintokei/whitepaper/r08.html - 参考書籍『仕事ではじめる機械学習 第2版』
https://www.oreilly.co.jp/books/9784873119472/ - 参考書籍『事例でわかるMLOps 機械学習の成果をスケールさせる処方箋』
https://www.kspub.co.jp/book/detail/5369562.html - 両書の書誌の照合
https://api.openbd.jp/v1/get?isbn=9784065369562,9784873119472
第2章
- Google Cloud の MLOps の解説文書
https://docs.cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning - Microsoft の MLOps 成熟度モデル
https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/mlops-maturity-model - データ・モデル・コードの3つの軸で変わる
https://martinfowler.com/articles/cd4ml.html - 参考書籍 MLOps実装ガイド 本番運用を見据えた開発戦略
https://ndlsearch.ndl.go.jp/books/R100000002-I034249342 - 参考書籍 MLOps実装ガイド 本番運用を見据えた開発戦略
https://www.oreilly.co.jp/books/9784814401208/ - 参考書籍 実践MLOps 作って理解する機械学習システムの構築と運用
https://ndlsearch.ndl.go.jp/books/R100000002-I034340681 - 参考書籍 実践MLOps 作って理解する機械学習システムの構築と運用
https://www.ohmsha.co.jp/book/9784274233982/
第3章
- データ品質の国際規格 ISO/IEC 25012 はデータの品質を15の特性で定義し、正確性・完全性・一貫性・信憑性・最新性の5つをデータそのものに備わる品質に、7つを両方にまたがる品質に、3つをシステムに依存する品質に分類する
https://iso25000.com/index.php/en/iso-25000-standards/iso-25012 - データ契約の公開標準 Open Data Contract Standard と、それを定める Bitol が Linux Foundation AI & Data のプロジェクトであること
https://bitol.io/ - Bitol は Linux Foundation AI & Data のプロジェクトのページで卒業の段階に位置づけられている
https://lfaidata.foundation/projects/bitol/ - ODCS はデータ契約を YAML で書く項目を定め、製品に依存しない形で書くべきとし、基本事項・スキーマ・データ品質・チーム・役割・サービスレベルの合意などの節に分かれる
https://bitol-io.github.io/open-data-contract-standard/latest/ - HistGradientBoosting は学習時に分岐ごとに欠損の送り先を学び、学習時に欠損が無かった列は予測時に件数の多い側の枝へ送る
https://scikit-learn.org/stable/modules/ensemble.html - Google の機械学習の実務の指針が training-serving skew を定義し、3つの原因と、提供時の特徴量の記録・処理のコードの共通化を勧める
https://developers.google.com/machine-learning/guides/rules-of-ml - 機械学習のためのデータ検証を論じた2019年の MLSys の論文、TFX の一部として数百の製品チームが使い1日に数ペタバイトを監視
https://proceedings.mlsys.org/paper_files/paper/2019/hash/928f1160e52192e3e0017fb63ab65391-Abstract.html - Great Expectations の Expectation の定義と検査の例
https://docs.greatexpectations.io/docs/reference/learn/terms/expectation/ - pandera はデータフレームのような形のデータを検証する API で、pandas・polars・dask・modin・ibis・pyspark が対象
https://pandera.readthedocs.io/en/stable/ - TensorFlow Data Validation のスキーマの推定・異常の検出・学習と提供の食い違いの検出、推定したスキーマを人が見直すことを強く勧める
https://www.tensorflow.org/tfx/data_validation/get_started - DVC は Git を拡張してデータの版を管理し、メタファイルを Git に入れデータ本体は手元か外部のストレージに置く
https://dvc.org/ - DVC は Git を拡張してデータの版を管理し、メタファイルを Git に入れデータ本体は手元か外部のストレージに置く
https://doc.dvc.org/use-cases/versioning-data-and-models - 参考書籍『実践的データ基盤への処方箋』ゆずたそ・渡部徹太郎・伊藤徹郎、技術評論社、2021年12月
https://gihyo.jp/book/2021/978-4-297-12445-8 - 参考書籍『データエンジニアリングの基礎』Joe Reis・Matt Housley 著、中田秀基 訳、オライリー・ジャパン、2024年3月
https://www.oreilly.co.jp/books/9784814400652/
第4章
- scikit-learn の公式ドキュメントはデータリークを予測の時点では手に入らない情報をモデルの構築に使うことと説明し、性能を楽観的に見積もり本番で性能が落ちるとし、前処理を全データから計算する原因とパイプラインの利用を挙げている
https://scikit-learn.org/stable/common_pitfalls.html - 2012年に Kaufman・Rosset・Perlich・Stitelman が ACM Transactions on Knowledge Discovery from Data に漏れを論じた論文を発表し、要旨で漏れの定義と学習と予測の分離による回避と検出の方法を述べている
https://doi.org/10.1145/2382577.2382579 - pandas の merge_asof はキーの距離による結合で、direction の既定は backward、by の列で並べる必要はなく、結合キーで昇順に並べる必要があり、allow_exact_matches の既定は True
https://pandas.pydata.org/docs/reference/api/pandas.merge_asof.html - Feast はオープンソースの特徴量ストアで、オフラインストアとオンラインストアを持ち、時点整合の特徴量の組でデータリークを避けることを目的に挙げ、汎用のデータパイプラインでもデータ倉庫の代わりでもデータベースでもないと明記している
https://docs.feast.dev/ - Feast の時点整合の結合はエンティティの表の各時刻の状態を再現し、そこから TTL の範囲で過去へさかのぼって値を探す
https://docs.feast.dev/getting-started/concepts/point-in-time-joins - Amazon SageMaker Feature Store は特徴量グループにまとめ、オンラインストアは最新の記録だけ、オフラインストアは追記のみで全履歴を持ち、異なる時点のデータを取り出せ、一貫した取り込みで学習と推論の食い違いを減らせると説明している
https://docs.aws.amazon.com/sagemaker/latest/dg/feature-store.html - Google Cloud の Feature Store は BigQuery の表やビューがオフラインストアになり別のオフラインストアを用意しない、過去の時点のデータは BigQuery で問い合わせる、オンライン提供に Bigtable の方式がある
https://docs.cloud.google.com/vertex-ai/docs/featurestore/latest/overview - Google Cloud の特徴量グループの作り方のページは、登録は任意だが、同じ ID に過去の値が何行も並ぶ時系列のデータで学習する場合、複数の BigQuery の表から列を集める場合、継続的なデータの同期を使う場合、特徴量の監視を設定する場合には登録が必要としている
https://docs.cloud.google.com/gemini-enterprise-agent-platform/machine-learning/featurestore/latest/create-featuregroup - Azure Machine Learning の管理された特徴量ストアは、検索と再利用、変換、パイプラインの運用、オンラインとオフラインの一貫性を解決する問題に挙げ、特徴量の集合は版つきで変更不可、時点整合の結合に対応
https://learn.microsoft.com/en-us/azure/machine-learning/concept-what-is-managed-feature-store - 参考書籍『Kaggleで勝つデータ分析の技術』門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社、2019年10月9日発売
https://gihyo.jp/book/2019/978-4-297-10843-4 - 参考書籍『機械学習のための特徴量エンジニアリング その原理とPythonによる実践』Alice Zheng・Amanda Casari 著、ホクソエム 訳、オライリー・ジャパン、2019年2月
https://www.oreilly.co.jp/books/9784873118680/
第5章
- MLflow Tracking はパラメータ・コードの版・指標・出力ファイルを記録する API と画面で、実行ごとに指標・パラメータ・開始と終了の時刻などのメタデータと出力ファイルを残し、実行は実験の単位でまとめられる
https://mlflow.org/docs/latest/ml/tracking/ - log_param・log_metric・log_input・set_tag の各関数、システムタグ mlflow.source.name・mlflow.user・mlflow.source.git.commit(Git のリポジトリから実行したとき)
https://mlflow.org/docs/latest/ml/tracking/tracking-api/ - mlflow.autolog を学習の前に呼ぶと記録の命令なしに指標・パラメータ・モデルが記録され、対象に scikit-learn・XGBoost・PyTorch などが含まれる
https://mlflow.org/docs/latest/ml/tracking/autolog/ - HistGradientBoostingClassifier の早期終了は既定値 auto で、標本の数が10,000を超えると有効になる
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.HistGradientBoostingClassifier.html - Pimentel らの2019年の論文(MSR 2019)
https://doi.org/10.1109/MSR.2019.00077 - Pimentel らの2019年の論文(MSR 2019)
http://leomurta.github.io/papers/pimentel2019a.pdf - 参考書籍『再現可能性のすゝめ』高橋康介、共立出版、2018年5月、ISBN 978-4-320-11243-8
https://ndlsearch.ndl.go.jp/books/R100000002-I028952926 - 参考書籍『Kaggle Grandmasterに学ぶ機械学習実践アプローチ』Abhishek Thakur 著、石原祥太郎 訳、マイナビ出版、2021年8月、ISBN 978-4-8399-7498-5
https://ndlsearch.ndl.go.jp/books/R100000002-I031605149
第6章
- Hyndman と Athanasopoulos による時系列予測の教科書 第3版の時系列の交差検証の節
https://otexts.com/fpp3/tscv.html - scikit-learn の TimeSeriesSplit は時間の順に並んだデータのためのもので、他の交差検証では将来のデータで学習し過去のデータで評価することになると説明
https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.TimeSeriesSplit.html - scikit-learn の 2値分類の predict は確率0.5を超えたかで決まり、この固定のしきい値はほとんどの用途で最適でない
https://scikit-learn.org/stable/modules/classification_threshold.html - よく較正された分類モデルの説明(確率0.8前後の顧客のおよそ8割が陽性)、較正曲線は信頼性図とも呼ばれる、CalibratedClassifierCV の sigmoid(Platt の方法)と isotonic、isotonic は約1,000件より少ないと過学習しやすい
https://scikit-learn.org/stable/modules/calibration.html - Brier スコアは予測確率と実際の結果の差の2乗の平均で、小さいほど良い
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.brier_score_loss.html - 参考書籍『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社、2023年3月、ISBN 978-4-297-13314-6
https://ndlsearch.ndl.go.jp/books/R100000002-I032637452 - 参考書籍『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社、2023年3月、ISBN 978-4-297-13314-6
https://gihyo.jp/book/2023/978-4-297-13314-6 - 参考書籍『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』齋藤優太・安井翔太 著、ホクソエム 監修、技術評論社、2021年8月、ISBN 978-4-297-12224-9
https://ndlsearch.ndl.go.jp/books/R100000002-I031576667 - 参考書籍『施策デザインのための機械学習入門 データ分析技術のビジネス活用における正しい考え方』齋藤優太・安井翔太 著、ホクソエム 監修、技術評論社、2021年8月、ISBN 978-4-297-12224-9
https://gihyo.jp/book/2021/978-4-297-12224-9
第7章
- 保存したモデルと一緒に残すべき情報として scikit-learn の公式ドキュメントが挙げる4つ
https://scikit-learn.org/stable/model_persistence.html - MLflow Model Registry の版と実行の結び付き、版の番号、タグ、別名 champion
https://mlflow.org/docs/latest/ml/model-registry/ - MLflow の段階の仕組みは 2.9.0 で非推奨、copy_model_version で本番用の登録名へ複製
https://mlflow.org/docs/latest/ml/model-registry/workflow/ - SageMaker のモデルグループと版の番号は1から1ずつ増える
https://docs.aws.amazon.com/sagemaker/latest/dg/model-registry-models.html - SageMaker の承認の状態と、承認済みにすると CI/CD による配備を始められること、対応表はプロジェクトのひな形の場合
https://docs.aws.amazon.com/sagemaker/latest/dg/model-registry-approve.html - Google Cloud の Model Registry の旧 Vertex AI の URL が Gemini Enterprise Agent Platform の名前のページへ転送される
https://cloud.google.com/vertex-ai/docs/model-registry/model-alias - Google Cloud の Model Registry の旧 Vertex AI の URL が Gemini Enterprise Agent Platform の名前のページへ転送される
https://docs.cloud.google.com/gemini-enterprise-agent-platform/machine-learning/model-registry/model-alias - Google Cloud の Model Registry の版の一覧と版の ID
https://docs.cloud.google.com/gemini-enterprise-agent-platform/machine-learning/model-registry/versioning - Azure Machine Learning で名前と版で識別、同じ名前で登録すると版が増える、タグで検索、系譜の記録
https://learn.microsoft.com/en-us/azure/machine-learning/concept-model-management-and-deployment?view=azureml-api-2 - モデルカードを提案した2019年の Mitchell らの論文
https://arxiv.org/abs/1810.03993 - モデルカードを提案した2019年の Mitchell らの論文
https://doi.org/10.1145/3287560.3287596 - モデルカードの9つの節
https://arxiv.org/pdf/1810.03993v2 - 参考書籍 機械学習デザインパターン
https://ndlsearch.ndl.go.jp/books/R100000002-I031719965 - 参考書籍 機械学習デザインパターン
https://www.oreilly.co.jp/books/9784873119564/ - 参考書籍 機械学習工学
https://ndlsearch.ndl.go.jp/books/R100000002-I032254601 - 参考書籍 機械学習工学
https://www.kodansha.co.jp/book/products/0000367726
第8章
- Azure Machine Learning の推論のエンドポイント(オンラインとバッチ)
https://learn.microsoft.com/en-us/azure/machine-learning/concept-endpoints?view=azureml-api-2 - Amazon SageMaker AI のバッチ変換
https://docs.aws.amazon.com/sagemaker/latest/dg/batch-transform.html - FastAPI の TestClient
https://fastapi.tiangolo.com/tutorial/testing/ - FastAPI の入力検証の例外
https://fastapi.tiangolo.com/tutorial/handling-errors/ - 状態コード422の意味
https://www.rfc-editor.org/rfc/rfc9110.html - ONNX Runtime の位置づけ
https://onnxruntime.ai/docs/ - sklearn-onnx の変換対象に HistGradientBoostingClassifier が含まれる
https://onnx.ai/sklearn-onnx/supported.html - ブルーグリーンデプロイメントの定義
https://martinfowler.com/bliki/BlueGreenDeployment.html - カナリアリリースの定義と A/B テストとの違い
https://martinfowler.com/bliki/CanaryRelease.html - Google の SRE のサイトの解説の第16章によるカナリアの定義
https://sre.google/workbook/canarying-releases/ - SageMaker のシャドーテスト
https://docs.aws.amazon.com/sagemaker/latest/dg/shadow-tests.html - Azure Machine Learning のミラーリングと安全なロールアウトの用語
https://learn.microsoft.com/en-us/azure/machine-learning/how-to-safely-rollout-online-endpoints?view=azureml-api-2 - 参考書籍 AIエンジニアのための機械学習システムデザインパターン 澁井雄介 著 翔泳社 2021年
https://ndlsearch.ndl.go.jp/books/R100000002-I031419179 - 参考書籍 AIエンジニアのための機械学習システムデザインパターン 澁井雄介 著 翔泳社 2021年
https://github.com/shibuiwilliam/ml-system-in-actions - 参考書籍 Web API The Good Parts 水野貴明 著 オライリー・ジャパン 2014年
https://ndlsearch.ndl.go.jp/books/R100000002-I025901139 - 参考書籍 Web API The Good Parts 水野貴明 著 オライリー・ジャパン 2014年
https://www.oreilly.co.jp/books/9784873116860/ - 参考書籍 動かして学ぶ!Python FastAPI開発入門 中村翔 著 翔泳社 2023年
https://ndlsearch.ndl.go.jp/books/R100000002-I032848914 - 参考書籍 動かして学ぶ!Python FastAPI開発入門 中村翔 著 翔泳社 2023年
https://www.hanmoto.com/bd/isbn/9784798177229
第9章
- 本番の機械学習システムのテストと監視の28項目を示した2017年の論文 ML Test Score
https://research.google/pubs/the-ml-test-score-a-rubric-for-ml-production-readiness-and-technical-debt-reduction/ - 本番の機械学習システムのテストと監視の28項目を示した2017年の論文 ML Test Score
https://storage.googleapis.com/gweb-research2023-media/pubtools/4156.pdf - Google Cloud の MLOps の文書における CI・CD・CT の整理
https://docs.cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning - Apache Airflow の公式ドキュメント
https://airflow.apache.org/docs/apache-airflow/stable/index.html - Kubeflow Pipelines の公式ドキュメント
https://www.kubeflow.org/docs/components/pipelines/overview/ - Vertex AI Pipelines のアドレスが Agent Platform Pipelines の紹介ページへ転送されること
https://docs.cloud.google.com/vertex-ai/docs/pipelines/introduction - Vertex AI Pipelines のアドレスが Agent Platform Pipelines の紹介ページへ転送されること
https://docs.cloud.google.com/gemini-enterprise-agent-platform/machine-learning/pipelines/introduction - 参考書籍 継続的デリバリー 信頼できるソフトウェアリリースのためのビルド・テスト・デプロイメントの自動化
https://ndlsearch.ndl.go.jp/books/R100000002-I028364333 - 参考書籍 テスト駆動Python 第2版
https://ndlsearch.ndl.go.jp/books/R100000002-I032326365
第10章
- Google の SRE 書籍の公開版にある分散システムの監視の章
https://sre.google/sre-book/monitoring-distributed-systems/ - 変化するデータの下での学習を整理したレビュー論文 Lu ほか 2018年 IEEE TKDE
https://doi.org/10.1109/TKDE.2018.2876857 - 変化するデータの下での学習を整理したレビュー論文 Lu ほか 2018年 IEEE TKDE
https://arxiv.org/abs/2004.05785 - PSI の目安 0.10と0.25 Yurdakul・Naranjo 2020年 Journal of Risk Model Validation
https://doi.org/10.21314/JRMV.2020.227 - SciPy の ks_2samp の帰無仮説・統計量・戻り値
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.ks_2samp.html - Evidently の既定のドリフト判定
https://docs.evidentlyai.com/metrics/customize_data_drift - Amazon SageMaker Model Monitor の4種類の監視と新規受付の終了
https://docs.aws.amazon.com/sagemaker/latest/dg/model-monitor.html - SageMaker Model Monitor のモデルの品質の監視は正解ラベルとの突き合わせが要る
https://docs.aws.amazon.com/sagemaker/latest/dg/model-monitor-model-quality.html - 異常検知と変化検知 井手剛・杉山将 著 講談社 2015年
https://ndlsearch.ndl.go.jp/books/R100000002-I026619229 - 異常検知と変化検知 井手剛・杉山将 著 講談社 2015年
https://www.kspub.co.jp/book/detail/1529083.html - 入門 監視 モダンなモニタリングのためのデザインパターン Mike Julian 著 松浦隼人 訳 オライリー・ジャパン 2019年
https://ndlsearch.ndl.go.jp/books/R100000002-I029421111 - 入門 監視 モダンなモニタリングのためのデザインパターン Mike Julian 著 松浦隼人 訳 オライリー・ジャパン 2019年
https://www.oreilly.co.jp/books/9784873118642/
第11章
- Google Cloud の MLOps の解説文書
https://docs.cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning - scikit-learn の大きなデータを扱う方策のページ
https://scikit-learn.org/stable/computing/scaling_strategies.html - 『オンライン機械学習』海野裕也・岡野原大輔・得居誠也・徳永拓之、講談社、機械学習プロフェッショナルシリーズ
https://www.kspub.co.jp/book/detail/1529038.html - 『実践 時系列解析 統計と機械学習による予測』Aileen Nielsen 著、山崎邦子・山崎康宏 訳、オライリー・ジャパン
https://www.oreilly.co.jp/books/9784873119601/
第12章
- 総務省のAI事業者ガイドライン掲載ページ
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - 経済産業省のAI事業者ガイドライン第1.2版のページ
https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/20260331_report.html - IPAのAI事業者ガイドライン検討会のページ
https://www.ipa.go.jp/disc/committee/expert-group-on-aigfb.html - AI事業者ガイドライン第1.2版の更新の論点
https://www.soumu.go.jp/main_content/001064301.pdf - AI事業者ガイドライン第1.2版本編の記述
https://www.soumu.go.jp/main_content/001064279.pdf - EUのAI規則の条文の表示に使った欧州委員会のAI Act Service Desk
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-2 - AI規則 第6条 高リスクの分類と第3項の例外
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-6 - AI規則 附属書III の高リスクの用途
https://ai-act-service-desk.ec.europa.eu/en/ai-act/annex-3 - AI規則 第12条 記録の保持
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-12 - AI規則 第14条 人による監視
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-14 - AI規則 第19条 自動生成ログの保存
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-19 - AI規則 第26条 導入者の義務
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-26 - AI規則 第72条 市販後の監視
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-72 - AI規則 第113条 適用日
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - ISO/IEC 42001 の公式ページ
https://www.iso.org/standard/42001 - NIST AI RMF の公式ページ
https://www.nist.gov/itl/ai-risk-management-framework - NIST AI RMF 1.0 本文 NIST AI 100-1
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf - SHAP を提案した2017年のNeurIPSの論文
https://proceedings.neurips.cc/paper/2017/hash/8a20a8621978632d76c43dfd28b67767-Abstract.html - SHAP の TreeExplainer の公式ドキュメント
https://shap.readthedocs.io/en/latest/generated/shap.TreeExplainer.html - AIガバナンス入門 リスクマネジメントから社会設計まで
https://ndlsearch.ndl.go.jp/books/R100000002-I033209767 - EU AI法概説
https://ndlsearch.ndl.go.jp/books/R100000002-I034184614
第13章
- MLOpsの原則・構成要素・役割・アーキテクチャを整理したKreuzbergerらの論文(arXiv版)
https://arxiv.org/abs/2205.02302 - 同論文のIEEE Access掲載版
https://doi.org/10.1109/ACCESS.2023.3262138 - Microsoft Azure Architecture Center の機械学習の運用ガイドの役割一覧
https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/machine-learning-operations-v2 - RACIの4つの関わり方と説明責任を負うのは1チーム
https://learn.microsoft.com/en-us/azure/cloud-adoption-framework/organize/raci-alignment - IPA DX動向2026 の調査概要
https://www.ipa.go.jp/digital/chousa/dx-trend/dx-trend-2026.html - DX推進人材の量の不足 85.5パーセント、大幅に不足 50.1パーセント、2023年度 62.1パーセント、2024年度 58.5パーセント
https://www.ipa.go.jp/digital/chousa/dx-trend/rcu1hd0000017uk8-att/dx-trend-2026.pdf - Rules of Machine Learning の規則1・2・4・8
https://developers.google.com/machine-learning/guides/rules-of-ml - 参考書籍 信頼性の高い機械学習 SRE原則を活用したMLOps
https://ndlsearch.ndl.go.jp/books/R100000002-I033738295 - 参考書籍 信頼性の高い機械学習 SRE原則を活用したMLOps
https://www.oreilly.co.jp/books/9784814400768/ - 参考書籍 機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス
https://ndlsearch.ndl.go.jp/books/R100000002-I033001073 - 参考書籍 機械学習システムデザイン 実運用レベルのアプリケーションを実現する継続的反復プロセス
https://www.oreilly.co.jp/books/9784814400409/
第14章
- Uber の機械学習基盤 Michelangelo を紹介した2017年の公式ブログ記事
https://www.uber.com/blog/michelangelo-machine-learning-platform/ - Michelangelo の予測から生成AIへの変遷を書いた2024年の公式ブログ記事
https://www.uber.com/blog/from-predictive-to-generative-ai/ - Spotify が TensorFlow Extended と Kubeflow で機械学習基盤を作り直した経緯の公式ブログ記事
https://engineering.atspotify.com/2019/12/the-winding-road-to-better-machine-learning-infrastructure-through-tensorflow-extended-and-kubeflow - LinkedIn の機械学習の生産性に関する2019年の公式エンジニアリングブログ Pro-ML
https://www.linkedin.com/blog/engineering/machine-learning/scaling-machine-learning-productivity-at-linkedin - Netflix で開発された Metaflow の公式ドキュメント
https://docs.metaflow.org/introduction/what-is-metaflow - メルペイの与信モデル更新マニュアルの記事
https://engineering.mercari.com/blog/entry/20230622-d8b521dd2e/ - メルペイの機械学習システム運用時の工夫の記事
https://engineering.mercari.com/blog/entry/20241219-e9ad9948c2/ - メルペイの機械学習共通基盤構築の振り返りの記事
https://engineering.mercari.com/blog/entry/20221216-99a408f17b/ - サイバーエージェント Dynalyst の機械学習監視の記事
https://developers.cyberagent.co.jp/blog/archives/44138/ - Microsoft の生成AIの運用に関する Azure アーキテクチャ センターの文書
https://learn.microsoft.com/ja-jp/azure/architecture/ai-ml/guide/genaiops-for-mlops - メルペイの品質要件が厳しいLLMアプリケーションのトライアル評価の記事
https://engineering.mercari.com/blog/entry/20231216-06b3fe8d0f/ - LLM に採点させる方法を検証した Zheng らの NeurIPS 2023 の論文
https://arxiv.org/abs/2306.05685 - MLflow の LLM とエージェントの評価のページ
https://mlflow.org/docs/latest/genai/eval-monitor/ - MLflow のプロンプト登録簿のページ
https://mlflow.org/docs/latest/genai/prompt-registry/ - ChatGPT の振る舞いの時間変化を測った Chen・Zaharia・Zou の論文
https://arxiv.org/abs/2307.09009 - 費用を下げる FrugalGPT の論文
https://arxiv.org/abs/2305.05176 - 概念ドリフトへの適応のサーベイ Gama ら 2014年
https://doi.org/10.1145/2523813 - 概念ドリフトのもとでの学習のレビュー Lu ら
https://doi.org/10.1109/TKDE.2018.2876857 - 概念ドリフトのもとでの学習のレビュー Lu ら
https://arxiv.org/abs/2004.05785 - 継続学習の包括的なサーベイ Wang ら
https://doi.org/10.1109/TPAMI.2024.3367329 - 継続学習の包括的なサーベイ Wang ら
https://arxiv.org/abs/2302.00487 - 機械学習の配備の課題を事例から整理した Paleyes らのサーベイ
https://doi.org/10.1145/3533378 - 機械学習の配備の課題を事例から整理した Paleyes らのサーベイ
https://arxiv.org/abs/2011.09926 - 機械学習の運用に関する Shankar らの聞き取り調査
https://arxiv.org/abs/2209.09125 - MLOps の概観と定義と構成を論じた Kreuzberger らの論文
https://doi.org/10.1109/ACCESS.2023.3262138 - MLOps の概観と定義と構成を論じた Kreuzberger らの論文
https://arxiv.org/abs/2205.02302 - 参考書籍『AIエンジニアリング』
https://ndlsearch.ndl.go.jp/books/R100000002-I034414476 - 参考書籍『AIエンジニアリング』
https://www.oreilly.co.jp/books/9784814401383/ - 参考書籍『LLMのプロンプトエンジニアリング』
https://ndlsearch.ndl.go.jp/books/R100000002-I034069159 - 参考書籍『LLMのプロンプトエンジニアリング』
https://www.oreilly.co.jp/books/9784814401130/ - 参考書籍『大規模言語モデル入門Ⅱ 生成型LLMの実装と評価』
https://ndlsearch.ndl.go.jp/books/R100000002-I033660006 - 参考書籍『大規模言語モデル入門Ⅱ 生成型LLMの実装と評価』
https://gihyo.jp/book/2024/978-4-297-14393-0