※本コラムは、以前に個人ブログとして公開していた内容を、加筆・再構成のうえ掲載しております。技術的な内容は執筆当時のものであり、現在とは異なる場合がございます。
こんにちは、Anagraftの伊藤です。
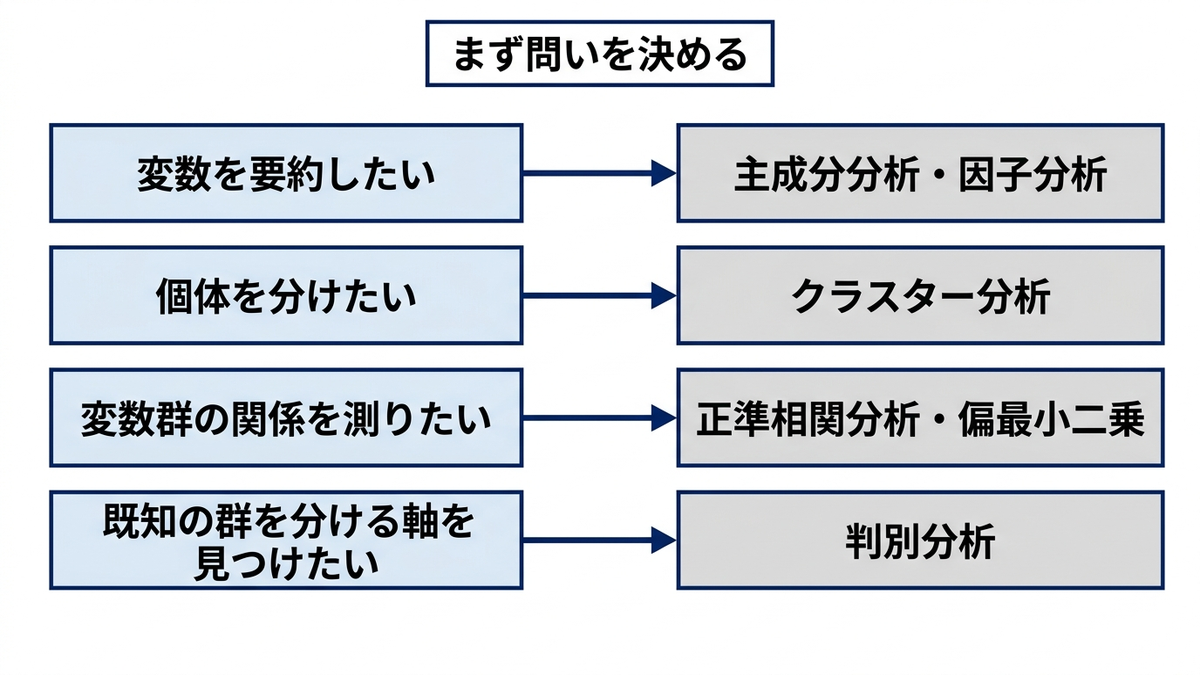
今回は、多変量解析の主な手法を「どういう問いに、どの手法を使うか」という軸で整理しました。主成分分析、因子分析、クラスター分析、判別分析、対応分析、多次元尺度構成法、数量化理論、正準相関分析と偏最小二乗、構造方程式モデリング、コンジョイント分析を、それぞれ考え方、結果の読み方、使ってはいけない場面、そして経営判断への落とし方まで含めて扱います。以前に因子分析の事例として書いていた、プロテニスの試合データからサーブ力とリターン力を推定する分析を核に据え、その前後に手法の体系を書き足す形で再構成しています。
再構成した理由は、手法の名前を知っていても、自分のデータでどれを選ぶかが決めにくいためです。アンケートの結果、購買履歴、店舗ごとの指標、財務の数値といった多変量のデータは、どの組織にも溜まっています。それを前にしたとき、変数を要約したいのか、顧客を分けたいのか、2つの指標群の関係を測りたいのか、既知の群を分ける軸を見つけたいのかで、選ぶ手法が変わります。本コラムでは、この「問いの型」から手法へたどれるように章を並べました。
各章では、架空の顧客満足度調査データを共通の題材にして、実際にコードを動かした結果を載せています。データは乱数で生成したもので、実在の顧客の声ではありませんが、生成時に「4つの潜在因子」と「4つの顧客セグメント」を仕込んであります。各手法がその構造をどこまで取り出せるか、どこで取り出しきれないかを、同じデータで横に比べられるようにしました。手法ごとに別のデータを使う解説では見えにくい、手法どうしの関係が分かるようにするためです。
想定している読者は、アンケートや顧客データの分析を任された実務者の方、分析会社から届いた報告書の読み方を確かめたい方、そして分析結果を経営判断に使う立場の方です。統計の専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にして言葉で言い換えています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
なお、本コラムには具体的な金額を書いていません。コンジョイント分析の章で価格を属性として扱う場面でも、金額ではなく「価格帯」という水準で書いています。また、どの手法が優れているという結論も書いていません。手法は問いによって選ぶものであり、優劣ではなく適不適で決まるためです。
本コラムの記述は2026年9月時点で確認したものです。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
目的別の読み方の目安を挙げておきます。アンケートの項目が多くて要約したい場合は、第2章で前処理を整えたうえで、第3章の主成分分析と第4章の因子分析をご覧ください。顧客を分けて施策を変えたい場合は第6章のクラスター分析が中心で、分けた結果を経営判断に落とす際の注意は第13章にまとめています。ブランドや商品の位置関係を図にしたい場合は第8章の対応分析と多次元尺度構成法、商品の仕様を決めたい場合は第12章のコンジョイント分析が入口になります。仮説として持っている構造がデータに合うかを確かめたい場合は第11章の構造方程式モデリングをご覧ください。
因子分析の実データへの適用がどういうものかを先に見たい場合は、第5章のプロテニスの事例から読み始める使い方も想定しています。第4章の一般論を先に読んでから第5章へ進むと、結果の読み方の根拠が分かります。機械学習との関係を知りたい方は、第14章で次元削減や埋め込み表現との接続を扱っています。

目次
- 序章 変数が多いデータは、構造を読むための手法を選んでから見る
- 全体の地図
- 第1章 多変量解析とは何か、目的別の手法の地図
- 第2章 分析の前に整えること、尺度・標準化・相関行列
- 第3章 主成分分析、変数を少数の軸に要約する
- 第4章 因子分析、観測の背後にある共通因子を推定する
- 第5章 因子分析の事例、プロテニスのサーブ力とリターン力
- 第6章 クラスター分析、似た個体をまとめる
- 第7章 判別分析、群を分ける軸を見つける
- 第8章 対応分析と多次元尺度構成法、位置関係を図にする
- 第9章 数量化理論、質的データを数量で扱う
- 第10章 正準相関分析と偏最小二乗、2つの変数群の関係を測る
- 第11章 構造方程式モデリング、仮説の構造を検証する
- 第12章 コンジョイント分析、選好の構造を測る
- 第13章 結果を経営判断につなげる、報告と誤用の型
- 第14章 多変量解析と機械学習の接続、そして生成AI時代
- 終章 手法より先に問いを決め、出力より先に検証を決める
- 本コラムで紹介した書籍一覧
- 第1章 多変量解析とは何か、目的別の手法の地図
- 第2章 分析の前に整えること、尺度・標準化・相関行列
- 第3章 主成分分析、変数を少数の軸に要約する
- 第4章 因子分析、観測の背後にある共通因子を推定する
- 第5章 因子分析の事例、プロテニスのサーブ力とリターン力
- 第6章 クラスター分析、似た個体をまとめる
- 第7章 判別分析、群を分ける軸を見つける
- 第8章 対応分析と多次元尺度構成法、位置関係を図にする
- 第9章 数量化理論、質的データを数量で扱う
- 第10章 正準相関分析と偏最小二乗、2つの変数群の関係を測る
- 第11章 構造方程式モデリング、仮説の構造を検証する
- 第12章 コンジョイント分析、選好の構造を測る
- 第13章 結果を経営判断につなげる、報告と誤用の型
- 第14章 多変量解析と機械学習の接続、そして生成AI時代
- 参考情報
序章 変数が多いデータは、構造を読むための手法を選んでから見る
アンケートの回答、顧客ごとの購買履歴、店舗ごとの業績指標、製品ごとの品質データ。どの組織にも、行が個体で列が変数という形の表が溜まっています。列が数本であれば、散布図や相関係数で全体を把握できます。ところが列が十数本、数十本になると、2つずつ組み合わせて見る方法では手に負えなくなります。20本の変数があれば組み合わせは190通りで、その一つひとつを眺めても、全体としてどういう構造があるのかは見えてきません。
多変量解析は、この「たくさんの変数を、少数の構造に要約して読む」ための手法の総称です。要約の仕方は一通りではありません。変数のほうを少数の軸にまとめる手法、個体のほうを似た群にまとめる手法、2つの変数群のあいだの関係を1つの数字に集約する手法、既に分かっている群を最もよく分ける軸を見つける手法。目的が違えば、選ぶ手法も、結果の読み方も変わります。
手法を知っていることと、選べることは違う
主成分分析、因子分析、クラスター分析といった名前は、統計の入門書に必ず出てきます。名前を知っている方は多いはずです。それでも実務の場面で困るのは、手元のデータに対してどれを使うべきかが、名前からは決まらないことです。たとえば「顧客を理解したい」という要望があったとき、それは項目を少数の観点に要約したいのか、顧客を似た者どうしに分けたいのか、満足度の項目群と購買行動の関係を知りたいのか、離反する顧客としない顧客を分ける要因を知りたいのかで、使う手法が4通りに分かれます。要望の言葉は同じでも、問いの型が違います。
本コラムでは、この問いの型を先に置き、そこから手法へたどる形で章を並べました。第1章で手法の地図を示し、第2章で分析の前に整えるべきことを扱い、第3章以降で手法を一つずつ、考え方、結果の読み方、使ってはいけない場面、経営判断への落とし方の順で書いています。手法の数式は最小限にとどめ、使う場合は必ず言葉で言い換えています。
同じデータで、手法どうしを横に比べる
手法の解説では、手法ごとに別のデータを使うことが多く、その結果、手法どうしの関係が見えにくくなります。本コラムでは、架空の顧客満足度調査データを共通の題材にしました。1,200名分の回答という設定で、商品の品質、価格への納得感、接客とサポート、店舗の利便性に関する16項目の7段階評価と、総合満足度、推奨意向、再購入の有無、購入回数、年代や会員区分といった属性を持ちます。
このデータは乱数で生成したもので、実在の顧客の声ではありません。その代わり、生成するときに構造を仕込んであります。16項目の背後には4つの潜在因子があり、回答者は4つのセグメントのいずれかに属し、総合満足度や再購入は因子から決まるようにしてあります。各手法がこの構造をどこまで取り出せるかを、同じデータで横に比べられます。主成分分析や因子分析が4つの因子を回収する様子、クラスター分析が4つのセグメントをおおよそ回収しながら一部を取り違える様子、構造方程式モデリングが仕込んだ構造と仕込んでいない構造の適合度をどう分けるかを、章をまたいで確かめていただけます。
仕込んだ構造が分かっているデータを使う利点は、手法の限界を正直に見せられることです。実データでは正解が分からないため、手法の出力がどこまで正しいかを確かめようがありません。架空のデータであれば、取り出しきれなかった部分をそのまま示せます。本コラムでは、うまく回収できた結果だけでなく、回収しきれなかった結果もそのまま載せています。
実データへの適用は、プロテニスの事例で
架空データだけでは、実データ特有の難しさが伝わりません。そこで第5章では、プロテニスの試合データから選手のサーブ力とリターン力を因子分析で推定した事例を扱います。ファーストサービスとセカンドサービスの成功率とポイント獲得率、相手のサービスに対するリターンのポイント獲得率といった観測値の背後に、少数の潜在的な力を仮定して推定する分析です。因子の数を2、3、4と変えたときに解釈がどう変わるか、どの因子数を選ぶかが解釈に依存すること、標本が小さいときの注意といった、実データならではの論点が含まれています。
手法より先に、問いを決める
本コラムを通じて繰り返しお伝えすることが一つあります。手法は、問いを決めてから選ぶということです。多変量解析の手法はどれも、与えられたデータに対して何らかの出力を返します。主成分分析は必ず主成分を返し、k-meansや階層的手法のクラスター分析は指定した数のクラスタを必ず返します。出力が返ってくることと、その出力が問いに答えていることは別です。問いが「顧客を分けて施策を変えたい」であれば、分けた群ごとに施策が変えられる程度の大きさと違いがなければ、クラスタが返ってきても使えません。問いが「この項目群は何を測っているのか」であれば、因子の数を機械的な基準で決めても、解釈できない因子は使えません。
この点は、経営判断に関わる方にとって特に大切だと考えています。分析の報告書には、バイプロットやデンドログラムといった図と、寄与率や適合度といった数字が並びます。それらが正しく計算されていることと、その分析が意思決定に使えることは、やはり別です。本コラムの第13章では、多変量解析の結果を意思決定に使うときに起きやすい誤りと、その防ぎ方をまとめました。因子の命名が解釈であって事実ではないこと、クラスタが分け方であって真実ではないこと、相関の構造から因果を読んではいけないことなど、手法の章で触れた注意を、意思決定の側から並べ直しています。
Anagraftでは、データ活用の構想づくりから分析の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。章の並びは、問いの型に沿って手法を配置する形にしました。最初の2つの章で手法の地図と分析前の準備を扱い、第3章から第5章で「変数を要約する」手法、第6章と第7章で「個体を分ける」手法、第8章と第9章で「位置関係を図にする」手法と質的データの扱い、第10章から第12章で「変数群の関係を測る」「仮説の構造を検証する」「選好の構造を測る」手法へ進みます。最後の2つの章は、それまでの章を横に貫く形で、結果を経営判断に使うときの注意と、機械学習との接続を扱います。
必要な章だけを拾って読む使い方も想定しています。その場合も、第2章で紹介する共通のサンプルデータは第3章以降のすべての章で使いますので、第2章の「共通データ」の節だけは先にご覧いただくと、各章の結果が読みやすくなります。
| 章 | 扱う内容 | この章で答えたいこと |
|---|---|---|
| 第1章 多変量解析とは何か、目的別の手法の地図 | 変数が増えると起きること、手法の4分類、教師の有無、質的と量的の区別 | 手元のデータと問いに対して、どの手法を候補にすべきか |
| 第2章 分析の前に整えること、尺度・標準化・相関行列 | 尺度の種類、標準化、欠損と外れ値、相関行列と共分散行列、多重共線性、標本の大きさ、共通データの紹介 | 手法に入る前に、データの何を確かめておくべきか |
| 第3章 主成分分析、変数を少数の軸に要約する | 分散最大の方向、固有値と寄与率、負荷量、バイプロット、主成分数の決め方、指標の合成 | 多数の変数を、情報を落とさずに少数の軸で見るには |
| 第4章 因子分析、観測の背後にある共通因子を推定する | 共通因子モデル、共通性と独自性、推定法、回転、因子数の決め方、因子得点、信頼性係数 | 項目の背後にある「測っているもの」をどう取り出し、どう名付けるか |
| 第5章 因子分析の事例、プロテニスのサーブ力とリターン力 | 試合データからの潜在的な力の推定、因子数2・3・4の比較と解釈、勝率との関係 | 実データに因子分析を当てると、解釈はどこで分かれるか |
| 第6章 クラスター分析、似た個体をまとめる | 距離と類似度、階層的手法、k-means、混合分布モデル、密度に基づく手法、クラスタ数の決め方、セグメンテーション | 顧客や店舗を分けるとき、いくつに、どう分け、どう名付けるか |
| 第7章 判別分析、群を分ける軸を見つける | 線形判別と二次判別、正準判別、誤判別率、ロジスティック回帰との使い分け | 既に分かっている群を最もよく分ける要因は何か |
| 第8章 対応分析と多次元尺度構成法、位置関係を図にする | クロス集計表の対応分析、同時布置図の読み方と誤読、多重対応分析、多次元尺度構成法、可視化手法との位置づけ | ブランドや属性の位置関係を図にしたとき、何を読んでよく、何を読んではいけないか |
| 第9章 数量化理論、質的データを数量で扱う | 数量化I類からIV類、西洋の手法との対応、ダミー変数と基準カテゴリ、順序尺度の扱い | 質的なデータを、どう数量の手法に載せるか |
| 第10章 正準相関分析と偏最小二乗、2つの変数群の関係を測る | 正準変量と正準相関、冗長性、偏最小二乗回帰、主成分回帰との違い | 項目群と行動指標群のように、群どうしの関係をどう測るか |
| 第11章 構造方程式モデリング、仮説の構造を検証する | パス図、測定モデルと構造モデル、識別、適合度指標、修正指標の注意、顧客満足度モデル | 仮説として持っている構造が、データに合っているかをどう確かめるか |
| 第12章 コンジョイント分析、選好の構造を測る | 属性と水準、直交計画、部分効用と相対重要度、選択型との違い、市場シミュレーション | 商品の仕様のどこに、顧客は価値を置いているか |
| 第13章 結果を経営判断につなげる、報告と誤用の型 | 命名の恣意性、クラスタは分け方であること、標本の偏り、標本外での再現、指標の合成、報告の作法 | 分析の出力を、意思決定に使ってよい形にするには何が要るか |
| 第14章 多変量解析と機械学習の接続、そして生成AI時代 | 次元削減と表現学習、可視化のための埋め込み、埋め込み表現、解釈への効き方、生成AIに任せるときの判断 | 多変量解析の考え方は、機械学習と生成AIの時代にどう生きるか |
問いの型と手法の対応を、あらためて一覧にしておきます。同じデータでも、問いが違えば入口の章が変わります。
| 問いの型 | 典型的な問い | 主な手法 | 章 |
|---|---|---|---|
| 変数を要約する | 項目が多すぎる。少数の観点にまとめたい。項目は何を測っているのか | 主成分分析、因子分析 | 第3章、第4章、第5章 |
| 個体を分ける | 顧客や店舗を似た者どうしに分けて、施策を変えたい | クラスター分析 | 第6章 |
| 既知の群を分ける軸を見つける | 離反した顧客としない顧客を分ける要因は何か | 判別分析 | 第7章 |
| 位置関係を図にする | ブランドと属性の関係を一枚の図で見たい | 対応分析、多次元尺度構成法 | 第8章、第9章 |
| 変数群の関係を測る | 満足度の項目群は、行動の指標群とどう結びついているか | 正準相関分析、偏最小二乗 | 第10章 |
| 仮説の構造を検証する | 「品質が満足を高め、満足が推奨を高める」という構造はデータに合うか | 構造方程式モデリング | 第11章 |
| 選好の構造を測る | 商品の仕様のどこに顧客は価値を置くか | コンジョイント分析 | 第12章 |
第1章 多変量解析とは何か、目的別の手法の地図
顧客満足度調査の16項目、購買履歴から作った数十の指標、財務諸表から並べた十数個の比率。経営の現場で扱うデータは、ほとんどの場合、1つの個体(顧客、店舗、商品、月次)について複数の変数が同時に記録されています。変数が2つなら散布図を1枚描けば全体が見えますが、16項目ともなると散布図は120枚になり、しかも1枚ずつ眺めても「全体としてどういう構造になっているか」は見えてきません。多変量解析は、このように多くの変数を同時に扱い、少数の構造に要約して読むための手法の総称です。
本章では、個々の手法の中身に入る前に、多変量解析という道具立ての全体を見渡します。まず、変数が増えると何が起きるのかを3つの現象(見かけの相関、距離の差が縮むこと、繰り返しの比較で偶然の差が出ること)で確かめます。次に、手法を4つの目的に分類し、外的基準(予測や判別の目標となる変数のことで、機械学習で言う教師にあたります)の有無と、質的・量的というデータの区別で整理します。そのうえで、経営の現場でどういう場面に使うのか、判断を誤るとどういう損失につながるのかを述べ、最後に「自分のデータで何を選ぶか」を決めるための地図を表にまとめます。各手法の考え方や計算、結果の読み方は第3章以降で1章ずつ扱いますので、本章はその入口として位置づけています。
多変量解析とは何か
統計学の入門で学ぶ平均や分散、相関係数、仮説検定は、変数が1つか2つの世界を前提にしています。売上の平均を出す、広告費と売上の相関を見る、施策の前後で平均に差があるかを検定する、といった作業です。これらは既刊の「データから正しく結論を導く統計学のまとめ」で扱っており、本コラムでは前提として扱います。多変量解析は、この延長線上で、変数が3つ以上、実務では十数個から数十個に及ぶときに、変数どうしの関係の全体像を扱う道具です。
「全体像を扱う」とは、具体的には次のような作業を指します。16項目のアンケートを、4つの合成指標に縮める。1,200人の顧客を、似た回答をした少数の集団に分ける。満足度の項目群と、再購入や推奨といった行動の指標群が、どのくらい結びついているかを1つの数で測る。あるいは、どの属性の顧客が再購入するかを、複数の変数の組み合わせで判定する。いずれも、変数を1つずつ見ていては答えが出ない問いです。
多変量解析の各手法には、それぞれ固有の「取り出すもの」があります。主成分分析は、データのばらつきを最もよく説明する少数の軸を取り出します。因子分析は、観測された項目の背後にある共通の要因を推定します。クラスター分析は、個体を似た者どうしにまとめます。判別分析は、既知の群を最もよく分ける軸を見つけます。手法の名前は似ていても取り出すものが違うので、「何を取り出したいのか」を先に決めないと、手法を選べません。本コラム全体を通じて繰り返すことになりますが、手法より先に問いを決めることが、多変量解析を使ううえで最も重要な作法だと考えています。
なお、多変量解析と機械学習の境界は曖昧です。主成分分析やk-meansといった手法は、機械学習の教科書にも次元削減やクラスタリングとして載っています。本コラムでは、多変量解析を「統計学の体系として、変数どうしの構造を読み解く道具」として扱い、機械学習の側からの位置づけは第14章と既刊の「機械学習の仕組みと使いどころ」に送ります。
変数が増えると起きること、その1:見かけの相関
変数が増えたときに最初に起きるのは、相関の数が急に増えることです。変数が \( p \) 個あれば、2つずつの組み合わせは \( p(p-1)/2 \) 通りあります。16項目なら120組、30変数なら435組の相関係数が出てきます。この中には、「意味のある関係」と、「別の変数を通じて生じた見かけの関係」が混ざっています。
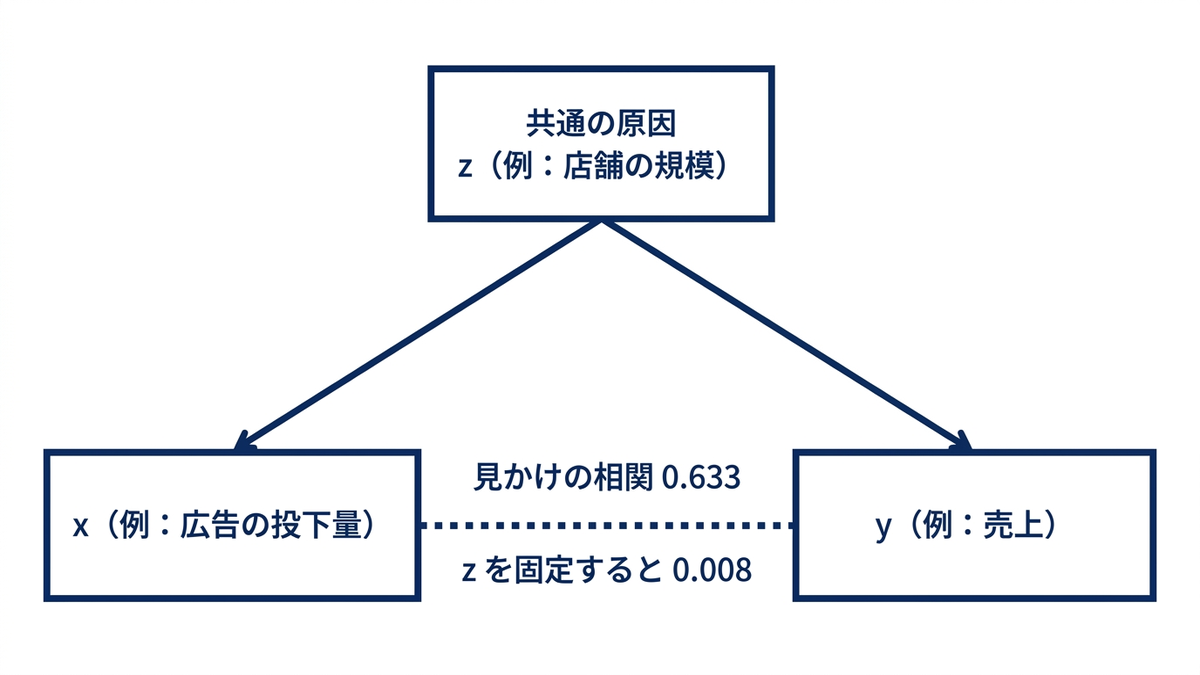
見かけの相関(疑似相関とも呼ばれます)は、2つの変数が共通の原因を持つときに生じます。たとえば、店舗ごとの広告の投下量と売上に正の相関があったとします。この相関は、広告が売上を押し上げたことを示しているかもしれませんが、大きな店舗ほど広告も売上も大きい、という第三の変数(店舗の規模)が両方を動かしているだけかもしれません。後者の場合、規模を固定して見ると、広告と売上の関係はほとんど消えます。
この現象は乱数で簡単に再現できます。本章の数値実験のスクリプト(その3の節の末尾に載せます)では、共通の原因 \( z \) を乱数で作り、\( x \) と \( y \) をどちらも \( z \) から作りました。\( x \) と \( y \) の相関係数は0.633と、一見しっかりした関係に見えます。ところが \( z \) の影響をそれぞれから取り除いて相関を取り直すと(これを偏相関と呼びます)、0.008とほぼゼロになりました。\( x \) と \( y \) の間に直接の関係は何も仕込んでいないので、これは正しい結果です。
変数が2つしかないときは、「他に原因があるのではないか」と疑うのは分析者の常識で済みます。しかし変数が30あって相関が435組あると、その1つ1つについて第三の変数を疑って回ることは現実的ではありません。多変量解析の手法の多くは、この「変数どうしが互いに絡み合っている状態」を前提にして、相関の全体を行列(相関行列)として一度に扱います。相関行列そのものの読み方と、標準化や欠損の扱いといった準備は第2章で扱います。
変数が増えると起きること、その2:距離の差が縮む
2つ目の現象は、次元が増えるにつれて「近い」と「遠い」の区別がつきにくくなることです。クラスター分析や多次元尺度構成法のように、個体どうしの距離を使う手法にとって、これは根本的な制約です。この現象を含め、次元が増えることで生じる困難の総称が次元の呪いです。この語は、Bellman が1957年の著書『Dynamic Programming』(Princeton University Press)で導入したと、Springer の『Encyclopedia of Machine Learning』の項目Curse of Dimensionalityが記しています。Bellman の文脈は動的計画法の計算量で、次元が増えると探索すべき空間の体積が指数的に増えるという意味でした。
距離の話としては、Beyer らが1999年の論文When Is “Nearest Neighbor” Meaningful?で、かなり広い条件のもとで、次元が増えると最も近い点までの距離が最も遠い点までの距離に近づいていくことを示しました。同じ論文は、実データと人工データでの実験から、この効果が10から15次元程度でも起こりうると述べています。つまり、アンケートの16項目をそのまま距離の計算に使うと、「この顧客に一番似ている顧客」は、「一番似ていない顧客」とさほど変わらない距離にいる、という状況が起こりえます。
これも乱数で確かめられます。単位立方体の中に500個の点を一様に散らし、別に置いた基準点から見た「最も近い点までの距離」を「最も遠い点までの距離」で割った比を計算しました。比が0に近ければ近い点と遠い点がはっきり区別でき、1に近ければ区別できないことを意味します。結果を次の表に示します。数値はいずれも実行ログの値です。
| 次元の数 | 最近傍の距離 ÷ 最遠点の距離(20個の基準点の中央値) |
|---|---|
| 1 | 0.001 |
| 2 | 0.017 |
| 5 | 0.143 |
| 10 | 0.300 |
| 20 | 0.434 |
| 50 | 0.601 |
| 100 | 0.717 |
| 500 | 0.864 |
| 1000 | 0.902 |
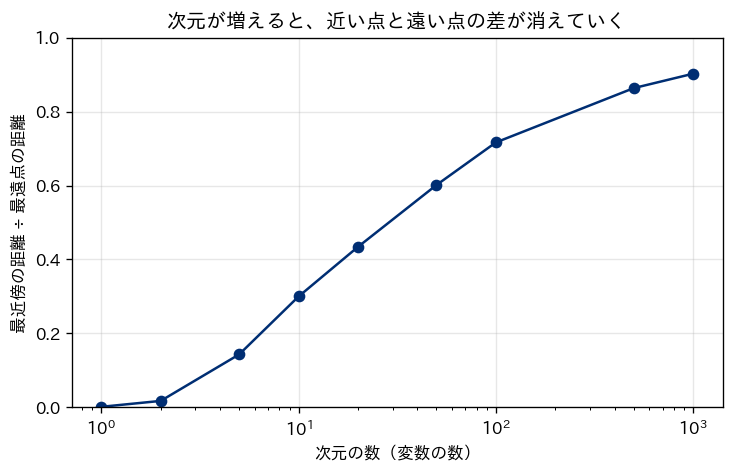
1次元や2次元では、一番近い点までの距離は一番遠い点までの距離の2%以下で、近さの区別は明瞭です。10次元で比は0.3、50次元で0.6、100次元では0.7を超え、1000次元では0.9に達します。100次元の空間では、最も近い点までの距離が、最も遠い点までの距離の7割もある、ということです。これは「変数が多いほど情報が豊かになる」という直感とは逆の結果で、変数をただ増やすだけでは、個体を見分ける力はむしろ落ちていきます。
この結果は、多変量解析の手法の多くが「まず変数を要約してから」個体を扱う理由を説明しています。16項目をそのまま距離に使うのではなく、主成分分析や因子分析で4つ程度の軸に縮めてから、その軸の上でクラスター分析を行う、という順序です。第6章では、この順序で共通データを分析し、要約した4つの尺度の上でk-meansを当てた結果を示します。なお、上の実験は一様乱数という最も単純な設定で、実データでは変数どうしに相関があるため、実効的な次元は変数の数より小さくなります。相関があるからこそ要約できる、という点が、次の章以降の手法の出発点です。
変数が増えると起きること、その3:繰り返しの比較で偶然の差が出る
3つ目の現象は、検定や比較の回数が増えることで、偶然の差を「意味のある差」と取り違える機会が増えることです。統計の入門で学ぶ有意水準5%とは、「本当は差が無いのに、差があると判定してしまう確率を5%に抑える」という約束です。この約束は検定1回についてのものなので、検定を繰り返すと、少なくとも1回は偶然の差が出る確率が積み上がっていきます。互いに独立な検定を \( m \) 回行ったとき、少なくとも1つで偶然の有意差が出る確率は \( 1-(1-0.05)^m \) で計算できます。言葉で言えば、「全部で差が出ない確率」を1から引いたものです。
| 検定の数 | 少なくとも1つ偶然の有意差が出る確率(有意水準5%、独立な検定) |
|---|---|
| 1 | 0.050 |
| 5 | 0.226 |
| 10 | 0.401 |
| 20 | 0.642 |
| 50 | 0.923 |
| 100 | 0.994 |
アンケート16項目を、年代・性別・会員区分・購入チャネルの4属性で比べると、単純な組み合わせだけで64回の比較になります。上の表の考え方をそのまま当てはめると(各比較を独立とみなす単純計算です)、何も違いが無くても、64回なら約96%の確率でどこかに「有意差」が現れます。実際の比較は互いに相関するため正確な確率はデータの構造によりますが、偶然の差が出やすいこと自体は変わりません。これが多重比較の問題です。「プラチナ会員はq07の評価が有意に低い」という報告が上がってきたとき、それが64回のうちの1回だと知っているかどうかで、施策に踏み切るかどうかの判断は変わるはずです。
多変量解析は、この問題への1つの答えでもあります。項目を1つずつ属性と比べる代わりに、項目群を少数の因子に要約してから比べれば、1属性あたりの比較は16から4に、4属性ぶんなら64から16に減ります。個体を少数のセグメントにまとめてから比べれば、「どの属性が」ではなく「どういう回答の型を持つ集団が」という問いになり、比較は少なく、解釈は太くなります。もちろん、要約や分割の仕方そのものが恣意的になりうるという別の問題があり、それは第13章で扱います。
本章の3つの数値実験は、次の1本のスクリプトで実行しました。乱数の種は固定しているので、手元で同じ数値が再現できます。共通の原因を持つ2変数の相関と偏相関、次元ごとの距離の比、検定の数ごとの偶然の有意差の確率を順に出力し、距離の比のグラフを保存します。掲載にあたって、文字コードの設定とグラフの軸ラベルなど体裁に関する行は省きました。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib

rng = np.random.default_rng(0)

# 1. 共通の原因が作る「見かけの相関」
n = 1000
z = rng.normal(size=n)                  # 共通の原因(例:店舗の規模)
x = 0.8 * z + 0.6 * rng.normal(size=n)  # 例:広告の投下量
y = 0.8 * z + 0.6 * rng.normal(size=n)  # 例:売上
r_xy = np.corrcoef(x, y)[0, 1]
rx = x - np.polyval(np.polyfit(z, x, 1), z)   # z の影響を除いた残り
ry = y - np.polyval(np.polyfit(z, y, 1), z)
r_xy_z = np.corrcoef(rx, ry)[0, 1]
print(f"x と y の相関 {r_xy:.3f} / z を固定したときの偏相関 {r_xy_z:.3f}")
# 出力: x と y の相関 0.633 / z を固定したときの偏相関 0.008

# 2. 次元が増えると、最近傍と最遠点の距離の差が縮む
dims = [1, 2, 5, 10, 20, 50, 100, 500, 1000]
ratios = []
for d in dims:
    X = rng.uniform(size=(500, d))            # 500個の点
    q = rng.uniform(size=(20, d))             # 20個の基準点
    dist = np.linalg.norm(X[None, :, :] - q[:, None, :], axis=2)
    r = float(np.median(dist.min(axis=1) / dist.max(axis=1)))
    ratios.append(r)
    print(f"{d:5d}  {r:.3f}")
# 出力: 1次元 0.001 / 10次元 0.300 / 100次元 0.717 / 1000次元 0.902

# 3. 検定を繰り返すと、偶然の「有意差」が出る確率(有意水準5%、独立な検定)
for m in [1, 5, 10, 20, 50, 100]:
    print(f"{m:6d}  {1 - 0.95 ** m:.3f}")
# 出力: 1回 0.050 / 20回 0.642 / 100回 0.994

plt.figure(figsize=(7, 4))
plt.plot(dims, ratios, marker="o", color="#002E73")
plt.xscale("log")
plt.savefig("../ch01_distance_ratio.png", dpi=120, bbox_inches="tight")
手法の4分類、何を取り出したいのか
多変量解析の手法は数が多く、名前も似ています。本コラムでは、手法を「何を取り出したいのか」という目的で4つに分けて整理します。この分け方は、本コラムの章立てを組むために採用した整理であって、教科書ごとに分類の切り方は少しずつ違います。
| 分類 | 問いの型 | 代表的な手法 | 扱う章 |
|---|---|---|---|
| 変数を要約する | 多くの変数を、少数の軸や要因にまとめて読みたい | 主成分分析、因子分析、対応分析、数量化III類 | 第3章、第4章、第5章、第8章、第9章 |
| 個体を分ける | 似た個体をまとめたい、あるいは個体の位置関係を図にしたい | クラスター分析、多次元尺度構成法、数量化IV類 | 第6章、第8章、第9章 |
| 変数群の関係を測る | 2つ以上の変数のまとまりが、どう結びついているかを測りたい | 正準相関分析、PLS回帰、構造方程式モデリング | 第10章、第11章 |
| 外的基準を予測する | ある変数(売上、群の所属、選好)を、他の変数から説明・予測したい | 重回帰分析、判別分析、数量化I類・II類、コンジョイント分析 | 第7章、第9章、第12章、既刊「ビジネスの要因分析に効く回帰分析と統計モデリングについて」 |
第1の分類「変数を要約する」は、列を減らす作業です。16項目を4つの合成指標に縮める、財務比率を少数の総合スコアにまとめる、といった使い方で、主成分分析(第3章)と因子分析(第4章)が中心になります。両者は計算の手順が似ていますが、主成分分析が「データのばらつきを最もよく説明する軸」を機械的に作るのに対し、因子分析は「観測された項目の背後にある共通の要因」を、誤差を分けたうえで推定します。この違いの詳細は第4章に送ります。クロス集計表のようなカテゴリ同士のデータを要約する場合は対応分析(第8章)を使います。
第2の分類「個体を分ける」は、行をまとめる作業です。顧客を似た者どうしの集団に分けるクラスター分析(第6章)が代表で、セグメンテーションと呼ばれる実務の作業はほぼこれに当たります。個体どうしの近さの情報から配置図を描く多次元尺度構成法(第8章)もここに入ります。第1の分類と第2の分類は、行列で言えば列を縮めるか行を縮めるかの違いで、実務では「列を縮めてから行を縮める」という順序で組み合わせることが多くなります。
第3の分類「変数群の関係を測る」は、変数を2つ以上のまとまりに分けたうえで、まとまりどうしの結びつきを扱います。満足度の項目群と行動指標の群がどのくらい結びつくかを測る正準相関分析、説明変数が多くて互いに相関が強いときに使うPLS回帰(第10章)、そして「満足が推奨を生み、推奨が再購入を生む」といった仮説の構造を明示して検証する構造方程式モデリング(第11章)がここに入ります。
第4の分類「外的基準を予測する」は、目標となる変数が明確にある場合です。売上のような量的な目標なら重回帰分析、再購入するかしないかという群の所属なら判別分析(第7章)、質的な説明変数で予測するなら数量化I類・II類(第9章)、商品の属性の組み合わせに対する選好なら、コンジョイント分析(第12章)を使います。重回帰分析そのものは既刊の「ビジネスの要因分析に効く回帰分析と統計モデリングについて」で扱っているので、本コラムでは判別分析との使い分けだけを第7章で書きます。
外的基準の有無と、質的・量的の区別
4分類のうち、第4の分類とそれ以外を分けているのは、目標となる変数があるかどうかです。本コラムでは、予測や判別の目標となる変数を外的基準と呼びます。売上、再購入の有無、所属する群、といった「答え」がデータの外側に用意されていて、それを他の変数で説明する、という構図です。外的基準がある手法は、モデルの良し悪しを「答えにどのくらい当たったか」で測れます。判別分析なら誤判別率、重回帰なら決定係数といった指標です。
外的基準が無い手法(第1・第2の分類と、第3の分類のうち正準相関分析と構造方程式モデリング。PLS回帰は目的変数を持つので除きます)には、この意味での「答え」がありません。主成分分析で取り出した軸が正しいかどうか、クラスター分析で分けた4つの集団が正しいかどうかは、当たり外れでは測れません。測れるのは、「元の情報のどのくらいを保持できたか」(寄与率)、「集団がどのくらいまとまっているか」(シルエット係数など)、「分け方が別の標本でも再現するか」(安定性)といった、間接的な指標だけです。このため、外的基準の無い手法では、結果の解釈と命名が分析者の手に委ねられ、そこに恣意性が入り込みます。この点は第13章で改めて扱います。
機械学習の言葉では、外的基準のある手法が教師あり学習、無い手法が教師なし学習に対応します。主成分分析やクラスター分析が機械学習の教科書で教師なし学習の章に置かれているのは、この対応によるものです。ただし、多変量解析の教科書では「教師」という言葉より「外的基準」や「目的変数」という言葉で書かれることが多いように思います。本コラムでは、多変量解析の文脈では外的基準、機械学習の文脈に触れるときは教師あり・教師なし、と言葉を使い分けます。
もう1つの区別は、扱うデータが質的か量的かです。量的データとは、売上や購入回数のように数値で測られ、差や比に意味があるものを指します(7段階の評定は厳密には順序尺度で、量的として扱ってよいかは後述の論点です)。質的データとは、性別、会員区分、購入チャネル、居住地域のように、カテゴリで表され、順序や大小に意味が無い(あるいは順序はあっても間隔に意味が無い)ものを指します。多変量解析の古典的な手法(主成分分析、因子分析、重回帰、判別分析)は量的データを前提に作られており、質的データを扱うには工夫が要ります。カテゴリを0と1の列に展開するダミー変数化、カテゴリ同士のクロス集計を直接扱う対応分析、そして質的データのために日本で独自に発展した数量化理論(第9章)が、その工夫にあたります。尺度の種類の詳細と、7段階評定を量的として扱ってよいかという実務上の論点は、第2章で扱います。
経営の現場での使いどころ
多変量解析が経営の現場で使われる典型的な場面を4つ挙げます。いずれも共通しているのは、「変数が多く、しかも変数どうしが絡み合っていて、1つずつ見ても全体の構造が見えない」という状況です。
第1はアンケートです。顧客満足度調査、従業員意識調査、ブランドイメージ調査は、たいてい10から50の項目を5段階や7段階で尋ねます。項目は「商品の品質」「価格の納得感」「接客」「店舗の利便性」といった数個のテーマを、それぞれ複数の項目で聞く設計になっていることが多く、因子分析でそのテーマを回収し、因子ごとの得点を合成指標として追いかける、という使い方が定番です。本コラムでは、第2章で用意する架空の顧客満足度調査(16項目、1,200件)を全章で共通して使い、この流れを実際に追います。
第2は購買履歴です。誰が、いつ、何を、いくつ、どのチャネルで買ったかという記録から、購入頻度、直近の購入からの経過、購入カテゴリの幅、チャネルの使い分けなど、顧客ごとに数十の指標を作ることができます。この指標を使って顧客をセグメントに分けるのがクラスター分析の典型的な用途で、セグメントごとに施策を変える(休眠しかけた顧客に再来店を促す、特定カテゴリに偏った顧客に隣接カテゴリを提案する)という判断につながります。
第3は財務指標です。複数の事業部、店舗、あるいは取引先について、収益性、安全性、効率性、成長性に関する十数個の比率を並べたとき、主成分分析でそれらを少数の総合スコアに縮めて順位づけしたり、判別分析で「業績が悪化した先」と「維持した先」を分ける指標の組み合わせを探したりします。与信の判断や、事業部の評価軸の設計がこれにあたります。
第4はブランド調査です。複数のブランドについて「高級感がある」「親しみやすい」「革新的だ」といったイメージ項目を尋ね、ブランドとイメージのクロス集計表を対応分析にかけると、ブランドとイメージが同じ図の上に配置され、自社ブランドがどのイメージの近くに、どの競合の近くにいるかを一望できます。ポジショニングマップと呼ばれる図は、この手法か多次元尺度構成法で作られることが多いように思います。また、新商品の仕様を決めるときに、属性の組み合わせ(容量、色、保証期間、価格帯など)に対する選好を測るコンジョイント分析も、この領域に入ります。
判断を誤ったときに何を失うか
手法の選択や結果の読み方を誤ったとき、失うのは統計的な正しさだけではありません。経営の言葉に翻訳すると、次のような損失になります。
1つ目は、施策の投資が回収できないことです。見かけの相関を因果と読み違えて「広告を増やせば売上が伸びる」と判断すれば、広告費は増えるのに売上は伸びない、という結果になります。多重比較で拾った偶然の差を根拠に「プラチナ会員向けに価格施策を打つ」と決めれば、施策の設計と運用の工数が、存在しない差の解消に費やされます。どちらも、分析の段階で防げた損失です。
2つ目は、セグメントが再現しないことです。距離の設計を誤ったクラスター分析や、標本の偏ったデータから作ったセグメントは、翌年の調査では別の分け方になります。セグメントごとに商品ラインや販促の型を作り込んでいた場合、その作り込みが1年で無駄になるだけでなく、「去年の分析は何だったのか」という組織内の不信が、次の分析への協力を得にくくします。分析結果の信頼は、精度ではなく再現性で決まる面があります。
3つ目は、意思決定が遅れることです。変数が多いまま、項目を1つずつ属性別に比べていく報告は、読む側にとっても作る側にとっても時間がかかります。要約されていない報告は、結局「で、何をすればいいのか」が決まらないまま次の会議に持ち越されます。多変量解析の要約の力は、精度のためだけでなく、判断の速さのためにあります。
4つ目は、逆に、要約を信じすぎることによる損失です。因子に付けた名前や、クラスターに付けた「価格重視層」といったラベルは、分析者の解釈であって、データが語った事実ではありません。ラベルが一人歩きして、ラベルに合わない顧客の行動を「例外」として見なくなると、市場の変化に気づくのが遅れます。手法を使わない損失と、手法を信じすぎる損失の両方があることを、本コラムでは繰り返し書いていきます。
自分のデータで何を選ぶかの地図
本章の締めくくりとして、「何を知りたいのか」と「どういうデータを持っているか」から手法を引くための表を置きます。左の列から順に、問いの型、外的基準の有無、主に扱うデータの種類を確かめると、候補となる手法と、それを扱う章にたどり着けるようにしました。
| 知りたいこと(問いの型) | 外的基準 | 主に扱うデータ | 候補となる手法 | 扱う章 |
|---|---|---|---|---|
| 多くの変数を少数の軸にまとめて、総合スコアを作りたい | 無し | 量的 | 主成分分析 | 第3章 |
| 項目の背後にある共通の要因を推定し、尺度として使いたい | 無し | 量的(評定尺度を含む) | 因子分析(探索的) | 第4章、第5章 |
| 似た個体をまとめて、セグメントを作りたい | 無し | 量的(質的は距離の定義を工夫) | クラスター分析 | 第6章 |
| 既知の群を最もよく分ける軸を見つけ、新しい個体の所属を判定したい | 有り(質的) | 量的 | 判別分析 | 第7章 |
| カテゴリ同士の位置関係を1枚の図にしたい | 無し | 質的(クロス集計表) | 対応分析、多重対応分析 | 第8章 |
| 個体どうしの近さの情報から配置図を作りたい | 無し | 距離、類似度 | 多次元尺度構成法 | 第8章 |
| 質的な説明変数で、量的な目標や群の所属を予測したい | 有り | 質的 | 数量化I類、数量化II類 | 第9章 |
| 質的データを要約し、カテゴリや個体を配置したい | 無し | 質的 | 数量化III類、数量化IV類 | 第9章 |
| 2つの変数群の結びつきの強さを測りたい | 変数群どうし | 量的 | 正準相関分析、PLS回帰 | 第10章 |
| 仮説として描いた構造(満足が推奨を生む等)が、データに合うかを検証したい | 構造を指定 | 量的 | 構造方程式モデリング | 第11章 |
| 商品の属性の組み合わせに対する選好を測り、仕様を決めたい | 有り(評価値) | 属性は質的、評価は量的 | コンジョイント分析 | 第12章 |
| 量的な目標を複数の変数で説明・予測したい | 有り(量的) | 量的 | 重回帰分析 | 既刊「ビジネスの要因分析に効く回帰分析と統計モデリングについて」 |
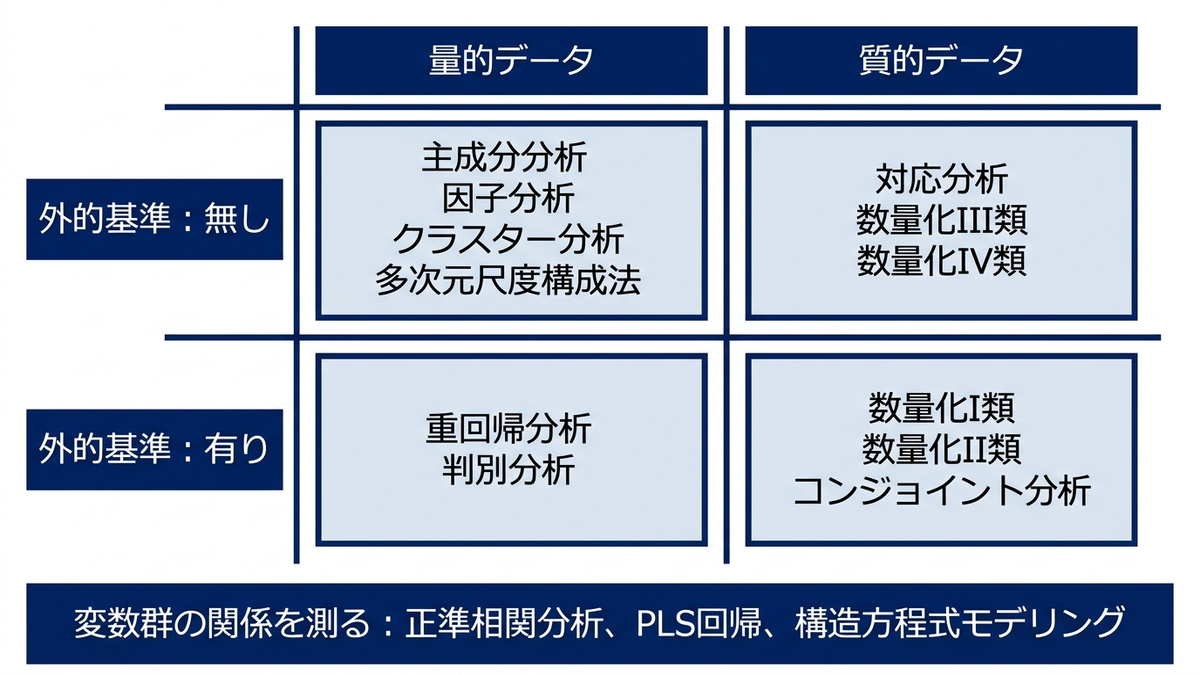
この表を使うときの注意を2つ書きます。1つは、問いが1つの行に収まらないことが多い、という点です。「顧客をセグメントに分けて、セグメントごとに満足度の構造を知りたい」という問いは、因子分析とクラスター分析の組み合わせになりますし、「どの因子が再購入に効くか」まで知りたければ、さらに判別分析や構造方程式モデリングが続きます。表は入口であって、実際の分析は複数の行を順に辿る形になります。
もう1つは、データの種類は変えられる、という点です。質的データはダミー変数化すれば量的手法に載せられますし、量的データも区切ってカテゴリにすれば質的手法に載せられます。どちらの変換にも情報の損失や前提の無理が伴うので、「持っているデータの種類」で手法を決めるより、「問いの型」で手法を決めてから、データをその手法に合う形に整える、という順序のほうが、手戻りが少ないと考えています。
本章では、多変量解析を「多くの変数を少数の構造に要約して読む道具の総称」と位置づけ、変数が増えると起きる3つの現象(見かけの相関、距離の差が縮むこと、繰り返しの比較で偶然の差が出ること)を乱数で確かめました。そのうえで手法を4つの目的に分類し、外的基準の有無と質的・量的の区別で整理して、手法選びの地図を表にまとめました。次の第2章では、どの手法にも共通する準備、すなわち尺度の種類、標準化、欠損と外れ値、相関行列と共分散行列、多重共線性、そしてサンプルサイズの目安を扱い、あわせて本コラムの全章で使う共通のサンプルデータを紹介します。
この章を深めたい方への参考書籍
『多変量解析がわかる』(涌井良幸・涌井貞美、技術評論社):技術評論社のファーストブックというシリーズの1冊で、多変量解析の入門書として、具体的な例や図を多く使った構成をうたっています。本章の「手法の地図」で候補に挙がった手法の名前を、まず絵として頭に入れるのに向いていると考えています。本コラムの第3章以降を読む前の準備としても、読んだあとの整理としても使えます。
『多変量データ解析法:心理・教育・社会系のための入門』(足立浩平、ナカニシヤ出版):副題のとおり、心理・教育・社会系の調査データを念頭に置いた入門書です。本コラムの共通データがアンケート形式であることもあり、経営の現場で調査データを扱う方には、この本の視点が近いと考えています。本文165ページと分量が抑えられているので、最初の1冊としても手に取りやすい本です。
『多変量解析入門:線形から非線形へ』(小西貞則、岩波書店):副題のとおり、線形の多変量解析から非線形のモデリングまでを1冊で扱う構成です。本章で触れた「多変量解析と機械学習の境界は曖昧である」という点を、数理の側から確かめたい方に向いていると考えています。英訳版が CRC Press から出ており、海外の文献と行き来するときの橋渡しにもなります。
第2章 分析の前に整えること、尺度・標準化・相関行列
第1章では、多変量解析を「変数を要約する」「個体を分ける」「変数群の関係を測る」「外的基準を予測する」の4つに分けて、どの問いにどの手法を当てるかの地図を確認しました。この章では、その地図のどの道を選ぶにしても必ず通ることになる準備の工程を扱います。具体的には、変数の尺度の見分け方、単位の違う変数を混ぜたときに何が起きるか、欠損と外れ値の扱い、相関行列と共分散行列の違い、多重共線性、そしてサンプルサイズの目安です。どれも手法そのものではありませんが、ここを誤ると、後の章でどれほど正しく手法を選んでも結果が歪みます。
あわせて、この記事の第3章以降で繰り返し使う共通のサンプルデータをこの章で用意します。手法ごとに別のデータを持ち出すと、手法の違いなのかデータの違いなのかが読み分けにくくなるためです。同じデータを主成分分析・因子分析・クラスター分析・判別分析と順に通していくことで、各手法が同じ構造の何を取り出しているかを比べられるようにしました。
この記事で使う共通データ:架空の顧客満足度調査
最初に断っておきます。この記事で使うデータは、実在の顧客の声ではありません。乱数のシード(種)を固定して生成した架空のサンプルで、小売業の顧客満足度調査を模した1,200件の回答という体裁にしています。実在の企業・顧客・案件とは一切関係がなく、生成のコードは記事フォルダの survey_data.py に置いてあります。同じコードを実行すれば、誰の環境でも同じ1,200件が再現されます。
架空のデータを使う理由は2つあります。1つは守秘の問題で、実務の調査データをそのまま公開することはできません。もう1つは教材としての都合で、「正解の構造」をあらかじめ仕込んでおけば、各手法がその構造をどこまで回収できるかを検証できます。生成のときに仕込んだ構造は、次の4つの潜在的なまとまり(設計上の因子)です。16項目の質問が4つずつ、この4つのまとまりに対応するように作ってあります。
| 設計上のまとまり | 項目 | 文言 | 平均 | 標準偏差 |
|---|---|---|---|---|
| 商品品質 | q01 | 商品の品質に満足している | 4.47 | 1.61 |
| 商品品質 | q02 | 商品は期待どおりの性能だった | 4.14 | 1.62 |
| 商品品質 | q03 | 商品の耐久性に満足している | 3.68 | 1.60 |
| 商品品質 | q04 | 商品のデザインが気に入っている | 4.61 | 1.57 |
| 価格納得感 | q05 | 価格は品質に見合っている | 3.55 | 1.59 |
| 価格納得感 | q06 | 他店と比べて価格に納得できる | 3.36 | 1.58 |
| 価格納得感 | q07 | セールやポイントの仕組みが分かりやすい | 3.99 | 1.60 |
| 価格納得感 | q08 | 支払った金額に対して得をしたと感じる | 3.71 | 1.61 |
| 接客サポート | q09 | 店員の説明は分かりやすかった | 4.32 | 1.56 |
| 接客サポート | q10 | 問い合わせへの対応が早かった | 3.83 | 1.59 |
| 接客サポート | q11 | 店員の態度は丁寧だった | 4.75 | 1.54 |
| 接客サポート | q12 | 困ったときに相談しやすい | 3.53 | 1.59 |
| 店舗利便性 | q13 | 店舗の場所は便利である | 4.14 | 1.61 |
| 店舗利便性 | q14 | 営業時間は都合に合っている | 4.46 | 1.57 |
| 店舗利便性 | q15 | 店内は探しやすく整理されている | 4.00 | 1.60 |
| 店舗利便性 | q16 | オンラインと店舗の使い分けがしやすい | 3.37 | 1.58 |
16項目はいずれも「そう思わない」から「そう思う」までの7段階で答えた体裁です。平均は3.36(q06)から4.75(q11)まで項目ごとに差をつけてあり、標準偏差は1.54から1.62でほぼそろっています。回答者全員が16項目に同じ値を付けた「直線回答」は、生成の仕組み上ゼロ件です。実務の調査ではこれがゼロにならないことも多いので、その点だけは実データより行儀がよいデータだと思ってください。
16項目のほかに、総合満足度 sat(1〜10の10段階、平均5.51)、推奨意向 nps(0〜10の11段階、平均5.02)、再購入の有無 repurchase(0か1、再購入した人の比率0.463)、年間購入回数 freq(0〜17回、平均3.94)と、年代・性別・会員区分・主な購入チャネルの属性が入っています。性別は女性652人と男性548人、チャネルは店舗503人・EC383人・両方314人、会員区分は一般831人・ゴールド272人・プラチナ97人です。これらの列は第7章の判別分析や第8章の対応分析、第10章の正準相関分析で使います。
もう1つ、segment_true という列に、生成時に仕込んだ「真の顧客セグメント」(品質重視・価格重視・サービス重視・低関与の4つ)が入っています。これは分析には使いません。第6章でクラスター分析の結果と答え合わせをするためだけの列で、実務では存在しない情報です。分析を進めるときは、この列と上の表の「設計上のまとまり」を知らないつもりで読み進めてください。分析者が知っているのは「16の質問への回答がある」ことだけ、という設定です。
from survey_data import load_survey, ITEM_COLS, ITEM_LABELS, FACTOR_NAMES

df = load_survey()      # 1200行 × 25列。乱数シード固定の架空データ
print(df.shape)

desc = df[ITEM_COLS].describe().T[["mean", "std", "min", "50%", "max"]].round(2)
desc.insert(0, "因子", [FACTOR_NAMES[i // 4] for i in range(16)])
desc.insert(1, "文言", [ITEM_LABELS[c] for c in ITEM_COLS])
print(desc.to_string())

# 単位が違う変数を並べたときの分散
print(df[["q01", "sat", "nps", "freq"]].var().round(2))
# 出力:
# (1200, 25)
# q01  商品品質  商品の品質に満足している  4.47  1.61  1.0  4.0  7.0
# ...
# q01     2.58
# sat     4.67
# nps     5.90
# freq    7.61
4つの尺度と、多変量解析での扱い
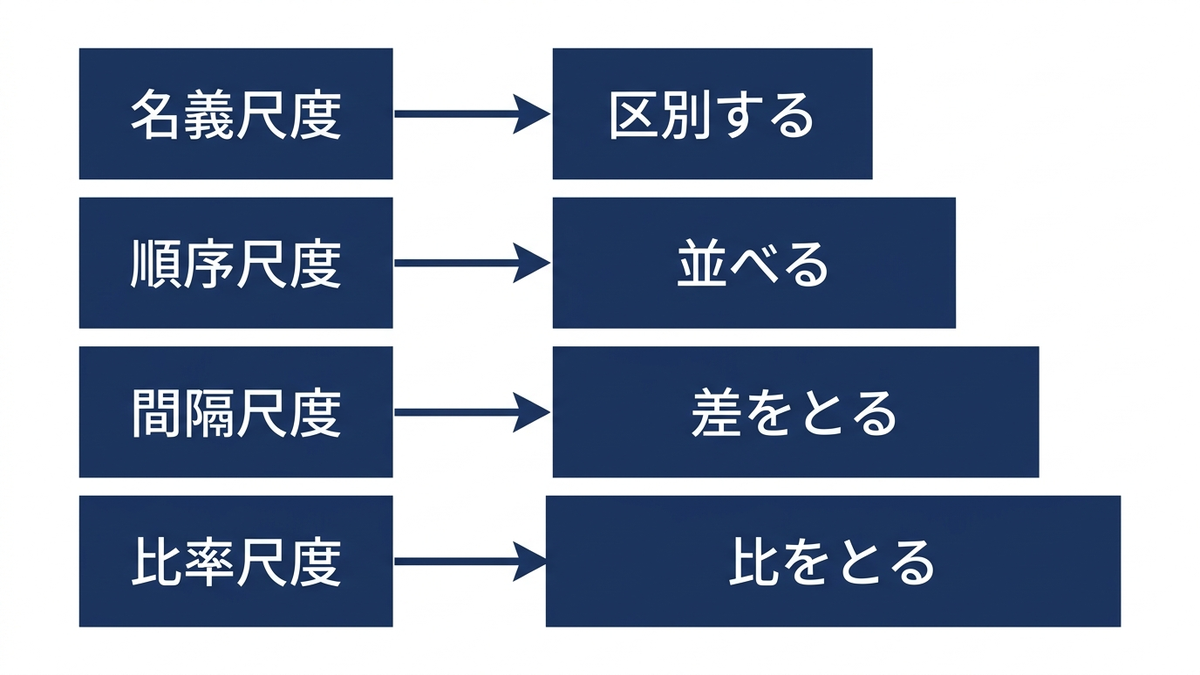
変数の性質を分ける古典的な区分に、Stevens が1946年に Science 誌の論文で示した名義尺度・順序尺度・間隔尺度・比率尺度の4分類があります。名義尺度は「店舗・EC・両方」のように、区別はできるが順序のない分類です。順序尺度は「一般・ゴールド・プラチナ」のように順序はあるが間隔が等しいとは言えないもの、間隔尺度は目盛りの間隔が等しく差に意味があるもの、比率尺度はそれに加えて「ゼロ」に意味があり比にも意味があるものです。年間購入回数は0回に意味があり、4回は2回の2倍と言えるので比率尺度です。
多変量解析でこの区分が効いてくるのは、手法の多くが「差」や「距離」や「平均」を計算するからです。名義尺度の値どうしは引き算ができません。「店舗」から「EC」を引いても意味がないので、名義尺度をそのまま数値として手法に入れることはできず、ダミー変数(該当すれば1、しなければ0)に変換する必要があります。この変換と基準カテゴリの選び方は第9章の数量化理論で扱います。順序尺度は微妙で、「一般=1、ゴールド=2、プラチナ=3」と番号を振れば計算はできてしまいますが、ゴールドと一般の差がプラチナとゴールドの差と等しいという前提を暗黙に置いたことになります。
| 尺度 | 共通データでの例 | できる計算 | 多変量解析での扱い |
|---|---|---|---|
| 名義尺度 | 性別、購入チャネル | 度数を数える、最頻値 | ダミー変数に変換する(第9章)。距離を使う手法にそのまま入れない |
| 順序尺度 | 年代、会員区分、7段階評価の項目 | 並べ替え、中央値 | 等間隔とみなして間隔尺度扱いにする慣行が広いが、前提を置いたことを記録しておく |
| 間隔尺度 | 7段階評価を等間隔とみなしたもの、総合満足度 | 差、平均、標準偏差、相関 | そのまま使える。単位が違えば標準化を検討する |
| 比率尺度 | 年間購入回数 | 比、変動係数 | そのまま使える。分布の歪みと外れ値に注意する |
アンケートの5段階や7段階の評価は、厳密には順序尺度です。それでも実務では間隔尺度とみなして平均や相関を計算することが多く、この記事でもその慣行に従います。ただしそれは「そう扱うと決めた」のであって「そうである」のではありません。段階が少ない(3段階や4段階の)項目や、回答が極端に片方へ寄った項目では、この前提のずれが大きくなります。第9章では順序尺度を順序のまま扱う方法にも触れます。
尺度の見分けは、データの列名や型を見ても分かりません。同じ整数の列でも、年代のコード、会員区分のコード、購入回数では扱いがまったく違います。分析の最初に、列ごとに「これはどの尺度か」を表に書き出して、名義尺度をうっかり数値として距離計算に入れていないかを確かめる工程を置くことをお勧めします。共通データでは、性別とチャネルが名義、年代と会員区分が順序、16項目と総合満足度・推奨意向が間隔扱い、購入回数が比率です。
標準化の要否と、相関行列か共分散行列かの決め方
次に、単位の違う変数を1つの分析に混ぜたときの問題を、共通データで実際に確かめます。使うのは商品の品質評価 q01(1〜7)、総合満足度 sat(1〜10)、推奨意向 nps(0〜10)、年間購入回数 freq(0〜17)の4つです。標準偏差はそれぞれ1.61・2.16・2.43・2.76で、目盛りの幅が広い変数ほどばらつきの数値が大きくなっています。
多変量解析の多くの手法は、変数どうしの関係を「共分散行列」か「相関行列」のどちらかにまとめてから計算を始めます。共分散は2つの変数が一緒に動く度合いを元の単位のまま測った量で、相関係数はそれを両変数の標準偏差で割って、単位に依存しないマイナス1から1の範囲に直した量です。相関係数の定義や読み方の基礎は、既刊の「データから正しく結論を導く統計学のまとめ」に譲ります。ここで見たいのは、どちらの行列から出発するかで結果が変わる、という一点です。
4変数について「ばらつきが最大になる方向」を、共分散行列と相関行列のそれぞれから求めました。この方向は第3章の主成分分析で第1主成分と呼ぶものですが、ここでは単に「4つの変数をどんな重みで足すと、回答者の違いが最も大きく出るか」と読んでください。共分散行列から求めた重みは q01 が0.294、sat が0.500、nps が0.556、freq が0.595で、目盛りの幅が広い購入回数が最も重くなっています。相関行列から求めた重みは0.467・0.544・0.526・0.457で、4変数がほぼ均等です。
ここで、q01 の単位だけを変えてみます。7点満点の評価を100点満点に換算する(7で割って100を掛ける)だけで、情報は何も変わっていません。ところが共分散行列から求めた重みは、q01 が0.995、残りの3変数が0.056・0.055・0.066になりました。標準偏差が22.97に膨らんだ q01 が、ほぼ単独で「最大のばらつきの方向」を占めてしまったのです。相関行列から求めた重みは、換算の前後で小数3桁まで一致しました。
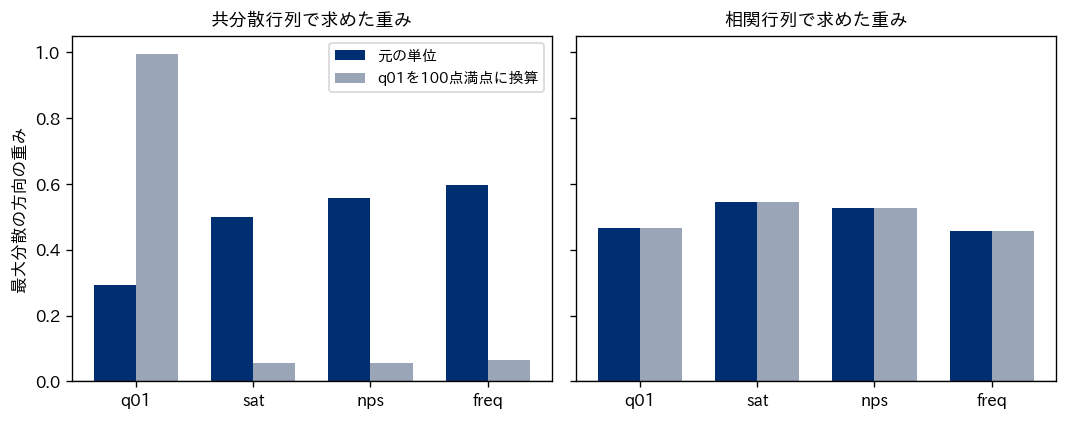
この実験が示しているのは、共分散行列を使う分析の結果は変数の単位の決め方に依存する、ということです。時間を「分」で書くか「秒」で書くか、距離を「メートル」で書くか「キロメートル」で書くかという、分析者が自由に決められる事柄で結果が動きます。それを避ける操作が標準化で、各変数から平均を引いて標準偏差で割ります。式で書くと \( z = (x – \bar{x}) / s \) で、「平均を0、標準偏差を1にそろえる」という意味です。標準化した変数どうしの共分散行列は相関行列と一致します。上の実験でも、標準化後の共分散行列と元の相関行列の差は、最大で0.0でした。
import numpy as np
import pandas as pd
X = df[["q01", "sat", "nps", "freq"]].astype(float)

def first_axis(mat):
    """行列の最大固有値に対応する固有ベクトル(ばらつきが最大の方向)"""
    vals, vecs = np.linalg.eigh(mat)
    v = vecs[:, np.argmax(vals)]
    if v[np.argmax(np.abs(v))] < 0:
        v = -v
    return pd.Series(v, index=mat.index)

print(first_axis(X.cov()).round(3))    # q01 0.294 / sat 0.500 / nps 0.556 / freq 0.595
print(first_axis(X.corr()).round(3))   # q01 0.467 / sat 0.544 / nps 0.526 / freq 0.457

X2 = X.copy()
X2["q01"] = X2["q01"] / 7 * 100        # 7点満点を100点満点に換算(情報は同じ)
print(first_axis(X2.cov()).round(3))   # q01 0.995 / sat 0.056 / nps 0.055 / freq 0.066
print(first_axis(X2.corr()).round(3))  # 換算前と同じ

Z = (X2 - X2.mean()) / X2.std()        # 標準化
print((Z.cov() - X.corr()).abs().max().max())   # 0.0
標準化すれば単位の問題は消えますが、標準化が常に正しいわけではありません。標準化は「すべての変数のばらつきを1にそろえる」操作なので、変数ごとのばらつきの大きさに意味がある場合には、その情報を捨てることになります。たとえば同じ7段階で答えた16項目の中で、ある項目だけ回答が割れている(標準偏差が大きい)なら、その項目は顧客を分ける力が強い項目です。共分散行列で分析すればその項目が重く扱われ、相関行列で分析すれば他の項目と同じ重さになります。どちらが正しいかは、問いによって決まります。
実務での判断の目安を整理すると、次のようになります。変数の単位や目盛りの幅がばらばらなら相関行列(標準化)を使います。売上・従業員数・店舗面積・顧客満足度のような財務指標と調査指標の混在は、この典型です。逆に、すべての変数が同じ尺度で測られていて、ばらつきの差そのものが情報だと考えるなら共分散行列を使います。同じ調査票の項目群だけを分析する場合はこちらを選ぶ余地があります。迷ったときは両方で分析して結果を比べ、大きく違うなら、どの変数のばらつきが結果を動かしているかを確かめてから決めます。
もう1つ、ライブラリの既定の挙動に注意が要ります。分析関数によって、入力を自動で標準化するものと、しないものがあります。同じ「主成分分析」という名前でも、既定で相関行列を使う実装と共分散行列を使う実装が混在しているので、使う前にドキュメントで確かめ、結果の報告には「相関行列に基づく」「共分散行列に基づく」を明記してください。第3章の主成分分析では、この選択が結果にどう出るかを改めて取り上げます。
この章の残りの実験と、第3章以降の分析では、16項目が同じ7段階で測られていることと、項目ごとの標準偏差が1.54から1.62でほぼそろっていることから、相関行列と共分散行列のどちらを使っても結果に大差は出ません。それでも、報告のたびにどちらを使ったかを書く習慣は付けておくことをお勧めします。分析者が変わったとき、その一行があるかないかで再現できるかどうかが決まります。
欠損の型と対処:削除するか、補うか
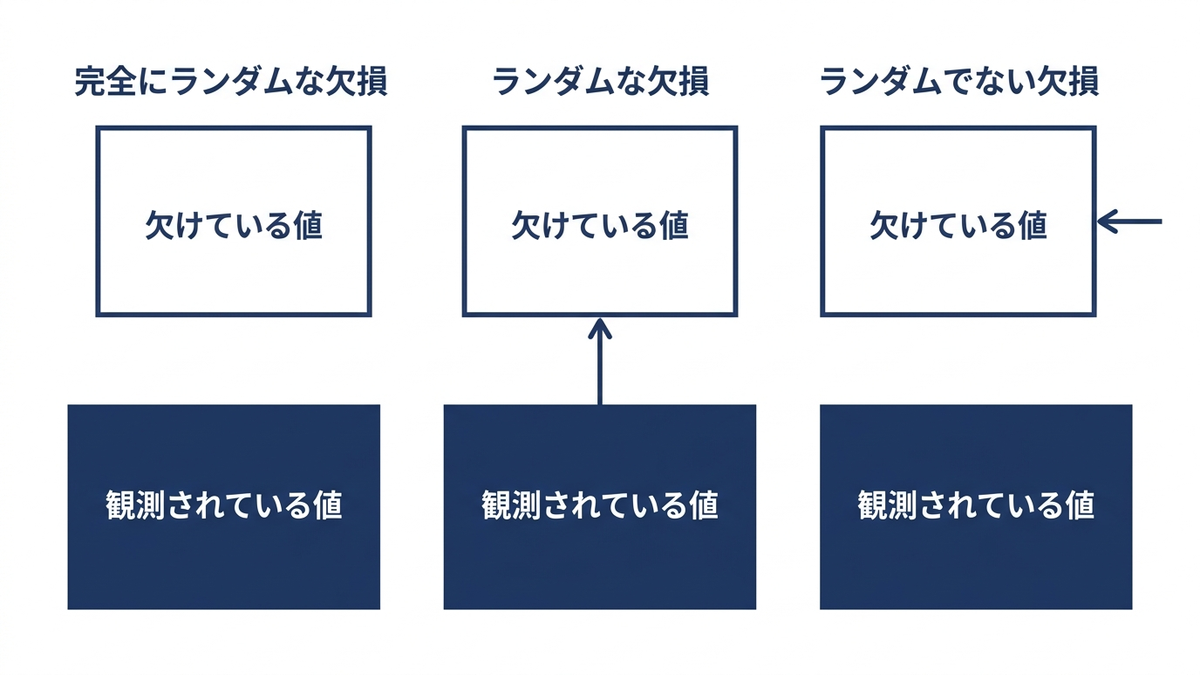
調査データには必ず欠損があります。答えなかった項目、途中で離脱した回答者、システムの不具合で落ちた記録などです。欠損の扱いを考えるときの出発点になるのが、Rubin が1976年に Biometrika 誌の論文で整理した考え方で、そこから発展した3つの型の区分が今も使われています。Sterne らが2009年に BMJ 誌で示した定義を訳すと、次のようになります。
- 完全にランダムな欠損(MCAR):欠けた値と観測された値の間に、系統的な差がない
- ランダムな欠損(MAR):欠けた値と観測された値の間の系統的な差が、観測されている他のデータで説明できる
- ランダムでない欠損(MNAR):観測されているデータを考慮してもなお、欠けた値と観測された値の間に系統的な差が残る
「ランダムな欠損」という名前は誤解を招きやすいので補足します。MAR は「欠けるかどうかがランダム」という意味ではなく、「欠けるかどうかを決めている要因が、手元の他の変数で説明できる」という意味です。たとえば、EC で買う顧客ほど店員への問い合わせをした経験がなく「問い合わせへの対応が早かった」という項目に答えない、という状況は、チャネルの列が手元にあるので MAR です。一方、対応に不満だった人ほどその項目を飛ばす、という状況は、不満の度合いそのものが観測できないので MNAR になります。どの型かはデータからは判定できず、調査の設計と回答の状況から推し量るしかありません。
まず基準として確認しやすいのが、欠損のある行を丸ごと除くリストワイズ削除(完全ケース分析)です。単純で、MCAR なら結果に偏りは出ません。問題は行数の減り方です。共通データの16項目に、各項目が独立に5%の確率で欠けるという MCAR の欠損を人工的に入れてみると、1つも欠けていない行は1,200行のうち528行しか残りませんでした。0.95の16乗に1,200を掛けた理論値528.2とほぼ一致します。項目ごとの欠損はわずか5%でも、16項目そろって答えている人は44%しかいない、ということです。この実験では q09 と q10 の相関は元データで0.645、リストワイズ削除後で0.638、ペアワイズ(相関を計算する2変数だけがそろっている行を使う)で0.642と、偏りは出ていません。減ったのはサンプルサイズだけです。
次に MAR の状況を作りました。主な購入チャネルが EC の顧客は60%、それ以外の顧客は5%の確率で q10(問い合わせへの対応が早かった)を答えない、という欠損です。結果として279件が欠け、その大半の254件が EC 顧客383人の中から出ています。ここで肝心なのは、EC 顧客の q10 の真の平均が3.50で、それ以外の3.99より低いことです。つまり「低い評価を付けるはずだった人ほど欠けている」状況で、答えた人だけで平均を計算すると偏ります。
| 対処 | q10 の平均 | q10 の標準偏差 | q09 との相関 |
|---|---|---|---|
| 欠損なし(真の値) | 3.833 | 1.590 | 0.645 |
| 答えた人だけで計算 | 3.927 | 1.594 | 0.660 |
| 平均値で補完 | 3.927 | 1.396 | 0.585 |
| 他の15項目からの回帰で補完 | 3.840 | 1.494 | 0.690 |
答えた人だけで計算した平均は3.927で、真の値3.833より高く出ました。EC 顧客の不満が数字から消えたためです。平均値で補完すると、平均は答えた人だけの値と同じ3.927のまま(同じ値を279人分足しても平均は動きません)で、標準偏差は1.590から1.396へ縮み、q09 との相関は0.645から0.585へ下がりました。全員に同じ値を入れれば、ばらつきが消えて他の変数との関係も薄まります。平均値補完は「欠損を埋めた」ように見えて、分布と相関を歪める操作なのです。
他の15項目から回帰で予測して補完する方法(scikit-learn の IterativeImputer)では、平均は3.840まで真の値に戻りました。q09 の答えが低い人の q10 も低く予測されるので、EC 顧客の不満が数字に戻ってきたわけです。ただし今度は相関が0.690と、真の値0.645より高く出ています。補完した279件だけを見ると、真の値の標準偏差は1.538なのに、回帰で入れた値の標準偏差は1.056しかありません。回帰は「予測値」を入れるので、本来あるはずの散らばりが入らず、変数どうしの関係が実際より強く見えます。
この「補完した値が本来より整いすぎる」問題に対する答えが、多重代入法です。回帰の予測値に適切な乱数の散らばりを足した補完を複数回(たとえば5回から20回)行い、それぞれの補完済みデータで分析を実行し、結果を統合します。散らばりを足すことで相関の過大評価を避け、複数回の結果の違いから「補完の不確かさ」を標準誤差に反映できます。scikit-learn の 補完のドキュメントによれば、IterativeImputer は R の MICE パッケージに着想を得た実装で、既定では1回の補完だけを返しますが、sample_posterior=True にして乱数の種を変えながら繰り返し適用すれば多重代入にも使えます。統計的な詳細は章末の参考書籍に譲り、この記事では概念にとどめます。
from sklearn.experimental import enable_iterative_imputer  # noqa: F401
from sklearn.impute import IterativeImputer

full = df[ITEM_COLS].astype(float)
rng = np.random.default_rng(0)

# ECの顧客は60%、それ以外は5%の確率で q10 を答えない(MAR)
m2 = full.copy()
p_miss = np.where(df["channel"] == "EC", 0.60, 0.05)
miss2 = rng.uniform(size=len(df)) < p_miss
m2.loc[miss2, "q10"] = np.nan
print(int(miss2.sum()))                                   # 279

mean_imp = m2["q10"].fillna(m2["q10"].mean())             # 平均値補完
imp = IterativeImputer(random_state=0, max_iter=10)      # 他の項目からの回帰で補完
reg_imp = pd.DataFrame(imp.fit_transform(m2), columns=ITEM_COLS, index=m2.index)["q10"]

for name, s in [("真の値", full["q10"]), ("答えた人だけ", m2["q10"].dropna()),
                ("平均値補完", mean_imp), ("回帰補完", reg_imp)]:
    print(name, round(s.mean(), 3), round(s.std(), 3), round(full.loc[s.index, "q09"].corr(s), 3))
# 出力:
# 真の値 3.833 1.59 0.645
# 答えた人だけ 3.927 1.594 0.66
# 平均値補完 3.927 1.396 0.585
# 回帰補完 3.84 1.494 0.69
実務での判断をまとめます。欠損が少なく(行の数%程度)MCAR とみなせるならリストワイズ削除で十分です。欠損が多い、あるいは欠け方に偏りがある(特定の属性の顧客ほど答えない)なら、平均値補完は避け、他の変数を使う補完か多重代入を検討します。どの型かの判断材料は、欠損の有無を0/1の変数にして属性とクロス集計することで得られます。共通データの実験なら、チャネル別に q10 の欠損率を見れば、EC で60%超、それ以外で5%という偏りがすぐに見つかります。この一手間が、対処法の選択を決めます。
外れ値の影響と見つけ方
外れ値は、平均・標準偏差・相関のすべてを動かします。共通データの年間購入回数 freq は最大でも17回ですが、ここに120回という値を5件混ぜてみます。月間の購入回数を年間の欄に入れてしまったような入力ミスを想定した値です。1,200件のうちわずか5件ですが、平均は3.94から4.43へ、標準偏差は2.76から7.97へ膨らみ、総合満足度との相関係数は0.538から0.183へ落ちました。混ぜた5件の総合満足度は5・5・6・6・5と平凡な値なので、「たくさん買う人の満足度はふつう」という架空の事実が5件だけで相関の3分の2を消したことになります。
同じデータで中央値は3.0のまま動かず、順位に基づくスピアマンの相関係数も0.552から0.549とほぼ変わりませんでした。順位を使う統計量は外れ値に強い、という性質が数字に出ています。分布が歪んでいる変数や、入力ミスの混入が疑われる変数では、平均と中央値の両方を見て、大きく食い違えば外れ値を疑う、という手順が有効です。
1変数ずつ見るだけでは見つからない外れ値もあります。多変量解析で問題になるのは、どの変数も単独では正常な範囲にあるのに、組み合わせが異常な回答です。たとえば「商品の品質に満足している」に7を付け、「商品は期待どおりの性能だった」に1を付ける回答者は、それぞれの値は正常でも、2つの項目が強く相関している(0.70)ことを考えると不自然です。この「組み合わせの異常さ」を測る指標がマハラノビス距離で、全体の中心からの距離を、変数どうしの相関を考慮して測ります。相関の強い2変数で逆方向に振れた回答は、この距離が大きくなります。
16項目についてマハラノビス距離の二乗を計算すると、平均は15.99で、理論どおり変数の数16に近い値になりました。データが多変量正規分布に従うなら、この二乗距離は自由度16のカイ二乗分布に近似的に従うので、その99.9%点39.25を超える回答者を数えると0人、99%点32.0を超える回答者は9人(1,200人の0.8%)でした。上位3人の回答を見ると、たとえば商品品質の4項目に6・2・4・6と付けた回答者が距離36.9で最上位に来ています。この9人を除いても16項目の相関係数の変化は最大0.009、平均0.004で、結果への影響はほとんどありません。生成した架空データなので当然ですが、実データでこの手順を踏めば、除くかどうかの判断材料が数字で得られます。
作った回答者を混ぜて、距離がどう反応するかも試しました。同じまとまりの中で1と7を交互に付けた回答者は距離168.0で明確に外れ値と判定されます。ところが16項目すべてに7を付けた回答者は距離14.5、すべてに4を付けた回答者は距離2.3で、どちらも判定されません。全部7は「すべてに満足」という一貫した回答として相関の構造に沿っているため、距離の上では正常なのです。回答の手抜きとしての直線回答は、マハラノビス距離では捕まえられず、回答のばらつき(1人の回答者の16項目の標準偏差)や回答時間のような別の指標で見る必要があります。
from scipy import stats

X = df[ITEM_COLS].astype(float)
mu = X.mean().values
S_inv = np.linalg.inv(X.cov().values)
d2 = np.einsum("ij,jk,ik->i", X.values - mu, S_inv, X.values - mu)   # 各回答者の距離の二乗

print(round(d2.mean(), 2))                       # 15.99(変数の数16に近い)
cut = stats.chi2.ppf(0.999, df=16)               # 39.25
print(int((d2 > cut).sum()))                     # 0
cut99 = stats.chi2.ppf(0.99, df=16)              # 32.0
print(int((d2 > cut99).sum()))                   # 9

# 作った回答者を当ててみる
for name, row in [("1と7を交互", np.array([1, 7] * 8, dtype=float)),
                  ("全部7", np.full(16, 7.0)), ("全部4", np.full(16, 4.0))]:
    d = float((row - mu) @ S_inv @ (row - mu))
    print(name, round(d, 1))
# 出力:
# 1と7を交互 168.0
# 全部7 14.5
# 全部4 2.3
外れ値への対処で最初にすべきことは、除くことではなく、原因を確かめることです。入力ミスや単位の取り違えなら訂正か削除、別の母集団(法人顧客が個人向け調査に混じっていた等)なら分けて分析、本当に極端な顧客なら残したうえで、外れ値に強い手法や、除いた場合との比較を報告に添えます。除いた件数と理由を記録せずに結果だけを出すと、後から検証できません。「外れ値を除いた」の一言で何件除いたかが分からない報告は、結果の信頼性を判断する材料を読み手から奪います。
相関行列を眺める:16項目に見える4つの塊
準備の最後に、16項目の相関行列を丁寧に眺めます。多変量解析の手法の多くは、この相関行列(または共分散行列)だけを入力にして動きます。つまり、相関行列に無い情報は手法からも出てきません。逆に言えば、相関行列を自分の目で読めれば、手法が何を取り出すかをあらかじめ見当づけられます。次の図は16項目の相関行列をヒートマップにしたもので、黒い線は設計上の4つのまとまりの境界です。分析者はこの境界を知らない設定ですが、図には答え合わせのために引いてあります。
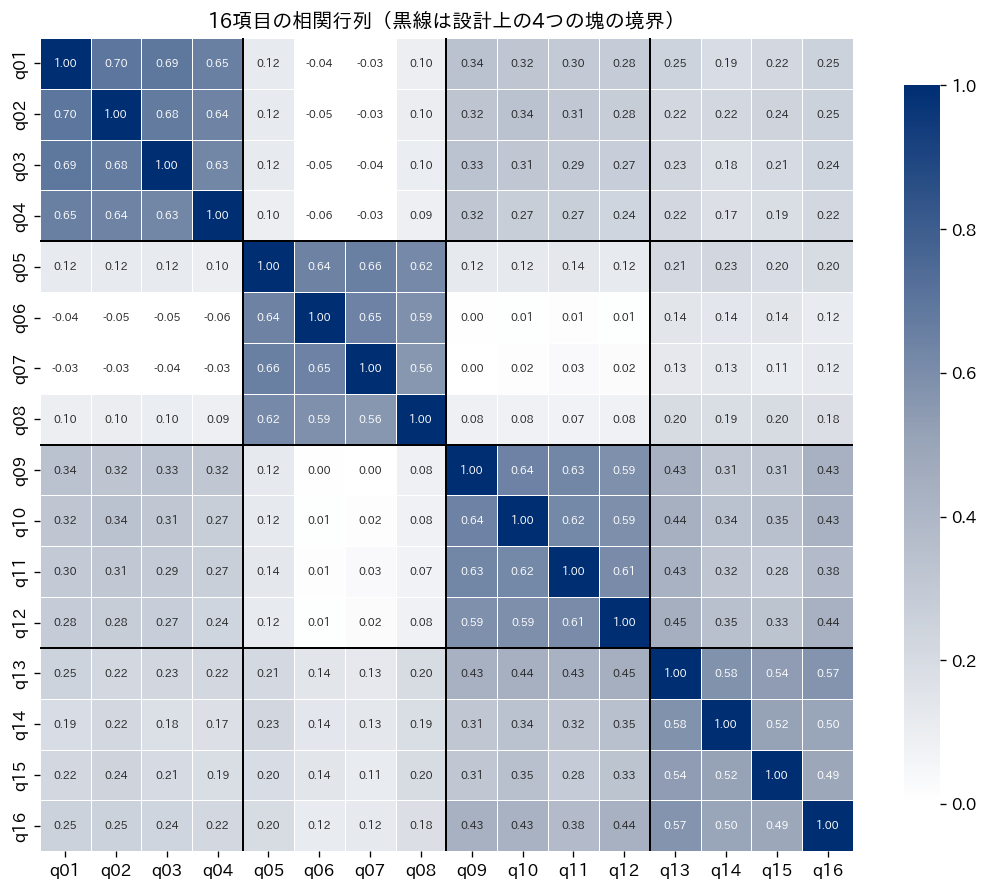
対角線に沿って、4項目ずつの濃い正方形が4つ並んでいるのが見えます。同じまとまりの中の相関係数は0.49から0.70の範囲にあり、まとまりをまたぐ相関係数はマイナス0.06から0.45の範囲にあります。まとまりごとの平均を表にすると、構造がさらにはっきりします。対角の値が同じまとまりの中の平均相関、それ以外がまとまりをまたぐ平均相関です。
| まとまり | 商品品質 | 価格納得感 | 接客サポート | 店舗利便性 |
|---|---|---|---|---|
| 商品品質 | 0.665 | 0.032 | 0.299 | 0.218 |
| 価格納得感 | 0.032 | 0.618 | 0.058 | 0.165 |
| 接客サポート | 0.299 | 0.058 | 0.614 | 0.376 |
| 店舗利便性 | 0.218 | 0.165 | 0.376 | 0.534 |
この表から読めることを言葉にします。第一に、4つの塊はどれも内側の平均相関が0.53以上で、外側との相関を大きく上回っています。16項目は4つのまとまりに分かれている、と相関行列だけから言えます。第二に、塊どうしの近さには差があります。接客サポートと店舗利便性は0.376と比較的近く、「店での体験」という上位のまとまりがありそうに見えます。商品品質と接客サポートも0.299でつながっています。第三に、価格納得感は他のどの塊とも相関が低く(0.032・0.058・0.165)、ほぼ独立した軸です。価格への納得は、商品や接客の評価とは別の理由で決まっている、と読めます。
ここまでが、相関行列を目で読んで言えることです。「塊が4つある」「そのうち2つは近い」「1つは独立している」までは分かりますが、各塊の背後にある共通の要因を数値として推定し、項目ごとにどの要因にどれだけ依存しているかを測るには、第4章の因子分析が要ります。また、16項目を少数の合成指標にまとめて回答者を並べる作業は、第3章の主成分分析で行います。この章では、手法に入る前に相関行列を眺めておくと、手法の出力が妥当かどうかを判断する基準が自分の中にできる、という点を強調しておきます。因子分析が「5因子」と出してきたとき、相関行列に塊が4つしか見えていなければ、その5番目を疑えます。
import matplotlib.pyplot as plt
from matplotlib.colors import LinearSegmentedColormap
import japanize_matplotlib
import seaborn as sns

corr = df[ITEM_COLS].astype(float).corr()
cmap = LinearSegmentedColormap.from_list("navy", ["#FFFFFF", "#9AA5B8", "#002E73"])
fig, ax = plt.subplots(figsize=(9, 7.8))
sns.heatmap(corr, vmin=0, vmax=1, cmap=cmap, annot=True, fmt=".2f",
            annot_kws={"size": 6.5}, square=True, linewidths=0.3, ax=ax)
for k in (4, 8, 12):                      # 設計上の4つの塊の境界
    ax.axhline(k, color="#000000", linewidth=1.2)
    ax.axvline(k, color="#000000", linewidth=1.2)
plt.savefig("../ch02_corr_heatmap.png", dpi=120, bbox_inches="tight")

# まとまりごとの平均相関
blk = np.zeros((4, 4))
for a in range(4):
    for b in range(4):
        sub = corr.values[a * 4:(a + 1) * 4, b * 4:(b + 1) * 4]
        blk[a, b] = sub[np.triu_indices(4, 1)].mean() if a == b else sub.mean()
print(pd.DataFrame(blk, index=FACTOR_NAMES, columns=FACTOR_NAMES).round(3))
多重共線性と分散拡大係数
相関行列の読み方に慣れたところで、相関が強すぎることによる問題にも触れておきます。変数どうしの相関が高すぎて、ある変数が他の変数の組み合わせでほぼ言い当てられてしまう状態を多重共線性と呼びます。回帰分析ではこれが係数の推定を不安定にする(係数の符号が反転する、標準誤差が膨らむ)ことが知られていますが、多変量解析でも、共分散行列や相関行列の逆行列を必要とする手法(判別分析、正準相関分析、マハラノビス距離、構造方程式モデリングの一部)は、この状態で計算が破綻するか、結果が信頼できなくなります。
多重共線性の度合いを測る代表的な指標が分散拡大係数(VIF)です。ある変数を残りの変数すべてで回帰したときの決定係数を \( R_j^2 \) とすると、VIF は \( 1 / (1 – R_j^2) \) で定義されます。「その変数が他の変数でどれだけ説明できてしまうか」を、1以上の数値に変換したものです。他の変数とまったく相関がなければ1、決定係数が0.9なら10になります。目安については、Penn State 大学の 統計学講座の教材が「4を超えたら調べる価値があり、10を超えたら深刻な多重共線性で対処が要る、というのが一般的な経験則」と述べており、statsmodels の ドキュメントは「5を超えたら強く共線的」という推奨を挙げています。ただし O’Brien は2007年に、まさに VIF の経験則への注意を題名に掲げた論文を書いており、4・5・10のどれも絶対の境界ではありません。目安を超えたら機械的に変数を捨てるのではなく、何と何が重なっているかを見て判断する材料にしてください。
共通データの16項目について、それぞれを残り15項目で回帰して VIF を計算しました。最大は q01 の2.58、最小は q15 の1.65で、すべて上の目安の下にあります。同じまとまりの中の相関は0.6前後と高めですが、4項目のそれぞれが固有の情報を持っているので、共線性の問題にはなっていません。この値は、相関行列の逆行列の対角成分と一致します。VIF を計算する道具がなくても、相関行列の逆行列を取れば同じ数が得られます。
ここで、実行して初めて分かった注意点を1つ記しておきます。statsmodels の variance_inflation_factor は、入力に定数項(切片)の列を自動では足しません。定数項なしのまま16項目を渡すと、VIF は9.93から22.21という値になり、すべての項目が「深刻な多重共線性」と判定されてしまいます。切片のない回帰では決定係数の計算の基準が変わるため、平均が0でない変数では値が膨らむのです。sm.add_constant で定数項の列を先頭に足し、定数項以外の列について計算すると、上の1.65から2.58が得られます。ライブラリの関数は前提を黙って要求することがあるので、結果が直感と合わないときは、別の計算経路(ここでは相関行列の逆行列)で検算する習慣が役に立ちます。なお、この挙動は本コラムの実行環境である statsmodels 0.14.6 のものです。0.15 系の公式ドキュメントでは引数 standardize(既定 True)が加わり、列を平均0・標準偏差1に標準化してから計算する仕様に変わっています。版が違えば同じ値になるとは限らないので、使っている版の仕様を確かめたうえで、相関行列の逆行列で検算してください。
多重共線性が実際に起きる場面も作ってみました。商品品質の4項目の平均を quality_mean という新しい変数として16項目に足すと、q01 から q04 と quality_mean の VIF はすべて無限大になり、17変数の相関行列の行列式は絶対値が10のマイナス19乗の程度で、数値誤差の範囲でゼロになります(16項目のときは3.1×10のマイナス4乗)。q01 をそのまま複製した列を足した場合は、行列式はちょうど0でした。平均は4項目の線形結合そのものなので、完全な多重共線性です。「4項目の平均も一緒に入れておけば情報が増える」という発想は、逆行列を要する手法ではそのまま計算の破綻を招きます。平均に小さな乱数の誤差を足した quality_noisy に置き換えても、その VIF は23.1、q01 から q04 の VIF は3.8から4.5に上がりました。完全でなくても、ほぼ線形結合である変数を混ぜれば、関係する変数すべての推定が不安定になります。
import statsmodels.api as sm
from statsmodels.stats.outliers_influence import variance_inflation_factor

def vif_table(frame):
    """定数項の列を先頭に足してから、定数項以外の列について VIF を計算する"""
    M = sm.add_constant(frame).values
    return pd.Series([variance_inflation_factor(M, i) for i in range(1, M.shape[1])],
                     index=frame.columns)

X = df[ITEM_COLS].astype(float)
v = vif_table(X)
print(round(v.max(), 2), round(v.min(), 2))          # 2.58 1.65
print(np.round(np.diag(np.linalg.inv(X.corr().values)), 2))   # 相関行列の逆行列の対角と一致

# 定数項を足し忘れた場合(誤り)
v_wrong = pd.Series([variance_inflation_factor(X.values, i) for i in range(16)], index=X.columns)
print(round(v_wrong.max(), 2), round(v_wrong.min(), 2))   # 22.21 9.93

# 4項目の平均を足すと完全な多重共線性
X2 = X.copy()
X2["quality_mean"] = X[["q01", "q02", "q03", "q04"]].mean(axis=1)
print(vif_table(X2)[["q01", "quality_mean"]])           # どちらも inf
print("%.3e" % np.linalg.det(X2.corr().values))           # -1.392e-19(数値誤差の範囲で0)
多変量解析の文脈で多重共線性をどう受け止めるかは、手法によって逆になります。主成分分析と因子分析は、変数どうしの相関が高いことをむしろ利用する手法で、相関の強い変数群を1つの軸にまとめます。この2つでは VIF だけで項目の除外を決める必要はなく、計算上は完全な線形従属(行列式が0)を避ければ動きます。ただし、ほぼ同じ内容の項目が重複していると、その概念が過大に重みづけられて解の解釈が歪むので、重複していないかは項目設計と解釈の観点から確認します。一方、第10章の正準相関分析や偏最小二乗回帰、第11章の構造方程式モデリングのように「どの変数がどれだけ効くか」を係数として推定する手法では、多重共線性は係数の信頼性を直接損ないます。偏最小二乗回帰は、まさにこの問題に対処するために設計された手法として第10章で扱います。
サンプルサイズの目安と、その目安の限界
「因子分析には回答者が何人必要か」という問いには、さまざまな目安が語られてきました。最もよく耳にするのは「項目数の10倍」で、Costello と Osborne は2005年の 探索的因子分析の実践に関する論文で、これを「早くからあり、今も広く使われている経験則」と位置づけています。同じ論文が心理学の学術誌2年分から集めた303件の因子分析を調べたところ、回答者数が項目数の10倍以下の研究が62.9%を占め、2倍以下の研究も約6分の1ありました。目安として語られる数と、実際に行われている分析の間には、それだけ開きがあるということです。「項目数の5倍」や「最低200人」といった目安も実務でよく語られますが、この記事を書くにあたって一次出典を確認できなかったので、ここでは「目安として語られることが多い」と述べるにとどめます。
ただし、こうした目安を機械的に当てはめることには、明確な反論があります。MacCallum らは1999年の Psychological Methods 誌の論文で、必要なサンプルサイズが「変数の数の何倍」という形で研究によらず一定であるという考えを根本的な誤解だと述べ、必要な人数は変数の共通性(各項目が共通の要因でどれだけ説明されるか)と、各因子を定める項目の数によって変わることを、理論と模擬実験の両方で示しました。共通性が高く、各因子に十分な数の項目が載っている「強いデータ」なら比較的少ない人数で母集団の構造を回収できますが、共通性が低いデータでは人数を相当増やさないと回収できません。Costello と Osborne も同じ論文で、サンプルサイズに関する厳格な規則はおおむね姿を消し、必要な人数はデータの性質で部分的に決まる、と述べています。
共通データは1,200人で16項目なので、比は75倍です。10倍の目安を大きく上回っていますが、これは架空のデータを作る側が余裕を持たせただけで、実務の調査で1,200件を集めるのは簡単ではありません。実務で使える指針を1つ挙げるなら、目安の人数を満たしているかどうかより、「各まとまりに強く載る項目が複数あるか」「項目どうしの相関が十分に高いか」を先に確かめることです。Costello と Osborne は「強いデータ」の条件として、共通性が一様に高く、交差負荷(1つの項目が複数の因子に載ること)がなく、各因子に強く載る項目が複数あることを挙げています。上の相関行列で見たように、共通データは各まとまりに4項目があり、まとまりの中の相関は0.5から0.7ですから、この条件に近いデータです。逆に MacCallum らの結果に照らせば、項目の少ないまとまりや相関の弱い項目群では、人数を増やしても構造は安定しにくいと考えられます。
経営目線:前処理を誤ると、何が起きるか
この章で行った実験を、経営上の損失に翻訳してみます。第一に、単位の混在です。売上・購入回数・満足度のような単位の違う変数を標準化せずに「総合指標」にまとめると、この章の実験で購入回数だけが重みを占めたように、目盛りの幅が最も広い変数だけを見ている指標が出来上がります。その指標で店舗を序列化し、下位店舗にてこ入れの投資を配分すれば、実際には購入回数の順に投資しているだけで、満足度も品質評価も反映されていない意思決定になります。
第二に、欠損の偏りです。EC の顧客ほど問い合わせ対応の項目に答えないという状況で、答えた人だけで集計すれば、対応への評価は真の値より高く出ます。その数字を見て「サポートは問題ない」と判断し、投資を店舗の内装に振り向ければ、EC 顧客の不満は放置されます。欠損が2割を超える項目で、しかもその欠損が特定のチャネルに偏っているなら、集計の前にその事実そのものを報告に書くべきです。数字より先に、数字が誰の声でできているかを伝える必要があります。
第三に、外れ値です。5件の入力ミスが「購入回数と満足度の関係」を0.54から0.18まで消しました。この数字を見た経営会議は「満足度を上げても購買にはつながらない」と結論づけるかもしれません。関係が無いのではなく、5件のミスが関係を隠しているだけです。逆に、少数の異常値が本当は無い関係を作り出すこともあります。多変量解析の結果を経営判断に使う前に、外れ値の有無と除外の基準を確かめる工程を、分析の手順書に固定しておくことをお勧めします。
第四に、多重共線性です。「商品品質の各項目」と「その平均」を同じモデルに入れるような重複は、推定を破綻させるか、係数の符号を反転させます。すると「品質評価が高いほど再購入が減る」という、誰も信じないが数字としては出てしまう結果が報告に載ります。報告を受けた側がそれを鵜呑みにすれば施策が逆を向き、疑って差し戻せば分析のやり直しに数週間かかります。どちらに転んでも、前処理で防げたはずの損失です。
これらに共通するのは、前処理の誤りは手法の出力の見た目には表れない、ということです。標準化を忘れた主成分分析も、平均値で補完した因子分析も、外れ値を含んだままのクラスター分析も、ソフトウェアはエラーを出さず、それらしい図表を返します。出力の妥当性を担保するのは、前処理の各工程で何をしたか(どの変数を標準化したか、欠損を何件どう扱ったか、外れ値を何件どの基準で除いたか)を記録し、報告に添えることです。第13章では、この記録を経営層向けの報告にどう組み込むかを扱います。
この章の要点をまとめます。多変量解析の結果は、尺度の見立て、標準化の有無、欠損と外れ値の扱いによって、手法を変えなくても大きく動きます。共通データの相関行列には4つの塊がはっきり見え、まとまりの中の相関は0.5から0.7、まとまりをまたぐ相関はおおむね0.4以下でした。次の第3章では、この相関行列を出発点に、16項目を少数の軸に要約する主成分分析を扱います。単位と標準化の話は、そこで固有値と寄与率という形で再び現れます。
この章を深めたい方への参考書籍
『欠測データの統計科学:医学と社会科学への応用』(高井啓二・星野崇宏・野間久史、岩波書店):この章で概念だけ紹介した欠損の扱いを、欠測データに対する最尤法、EM アルゴリズム、単一代入と多重代入、回帰分析モデルにおける欠測データ解析、脱落を伴う経時測定データの解析、欠測データメカニズムの検討という章立てで体系的に解説した一冊です。冒頭に欠測の扱いの指針をまとめた章があり、この章の実験で見た「答えた人だけで計算する」「平均値で補完する」の先に何があるかを、理論から追いかけたい方に向いています。
『改訂新版 前処理大全:SQL/pandas/Polars実践テクニック』(本橋智光・橋本秀太郎、技術評論社):データの抽出・集約・結合・分割・整形と、数値・カテゴリ・日時・文字列の変換という前処理の工程を、SQL と pandas と Polars の3つの道具で書き比べた実務書です。この章で扱ったような数値の変換やカテゴリの扱いを、実際の業務データに対して手を動かして行う段階で参照すると、どの道具でどう書くかが具体的に分かります。初版は2018年で、2024年の改訂新版では R に代えて Polars を採用しています。
『心理尺度のつくり方』(村上宣寛、北大路書房):この章で「設計上のまとまり」として与えた16項目のような質問項目群を、どう設計し、どう検証するかを扱った尺度構成の方法論の本です。統計的基礎の章で測定水準・標準化・相関係数をこの章と同じ順序で押さえたうえで、信頼性、妥当性、項目の収集と執筆、項目分析、因子分析法による尺度開発、そして実際の尺度開発の事例まで通して書かれています。顧客満足度調査の調査票を自分で設計する立場の方に、第4章の因子分析と併せて読むことをお勧めします。
第3章 主成分分析、変数を少数の軸に要約する
第2章では、尺度をそろえ、標準化の要否を決め、相関行列を眺めるところまでを整えました。共通データの相関行列では、同じ因子に属する4項目どうしの相関が平均 0.61 であるのに対し、16項目全体の平均は 0.28 で、ヒートマップには「同じ方向に動く項目の塊」が4つ現れます。本章で扱う主成分分析は、その「同じ方向に動く変数の束」を数本の軸にまとめ直す手法です。第1章の4分類でいえば「変数を要約する」側の代表で、目的変数を使わない教師なしの手法に当たります。
本章では、まず考え方を固有値問題として一度だけ数式で書き、それを言葉に言い換えます。そのうえで scikit-learn に付属する wine データ(13変数)で標準化の有無がどれほど結果を変えるかを実測し、固有値・寄与率・負荷量・バイプロットの読み方を確かめます。後半では第2章で用意した共通データ(架空の顧客満足度調査、1,200件・16項目)で主成分数の決め方を4つの基準で比べ、第1主成分を総合スコアとして使うときに何が起きるかを数字で見ます。因子分析との違いの詳細は第4章に送り、本章では「標準的な主成分分析には回転という工程がない」という一点だけ、その帰結を含めて書きます。
主成分分析は何を取り出す手法か
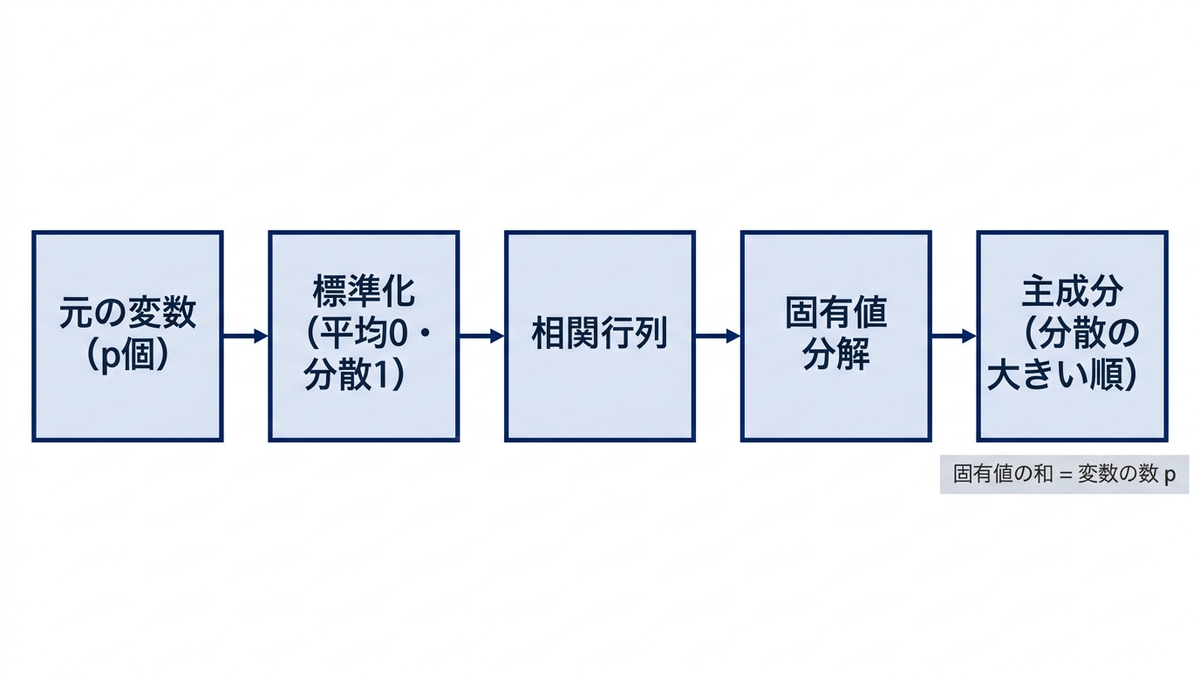
手元に \( p \) 個の変数があり、それぞれを標準化して分散を1にそろえたとします。主成分分析は、これらの変数を重みつきで足し合わせた合成変数のうち、分散が最も大きくなる重みの組を探します。分散が大きいということは、個体ごとの違いがその合成変数に最もよく現れているということです。これを第1主成分と呼びます。次に、第1主成分と無相関という条件のもとで分散が最大になる合成変数を探し、第2主成分とします。以下同様に、互いに無相関な軸を分散の大きい順に \( p \) 本まで取っていきます。
この「分散が最大になる重みを探す」問題は、相関行列 \( R \) の固有値問題そのものになります。式で書くと \( R\boldsymbol{v} = \lambda\boldsymbol{v} \) で、相関行列に固有ベクトル \( \boldsymbol{v} \) を掛けても向きは変わらず、長さだけが \( \lambda \) 倍になる、という関係です。この \( \boldsymbol{v} \) が主成分の重み(固有ベクトル)で、\( \lambda \) がその主成分の分散(固有値)に一致します。相関行列の対角成分はすべて1なので固有値の和は変数の数 \( p \) に等しく、第 \( k \) 主成分の固有値を \( p \) で割ったものが、その主成分が全体の分散のうちどれだけを占めるかを表す寄与率になります。この章で使う数式はこの1本だけで、あとは実行結果で確かめていきます。
ここで押さえておきたいのは、主成分分析が「データの背後に何かがある」という仮定を置いていないことです。相関行列を与えれば、固有値の大きい順に軸が機械的に決まります。観測の背後に共通因子を仮定し、誤差を分けて推定する因子分析とは、出発点の考え方が違います。この違いがどう結果に響くかは第4章で扱いますが、本章の範囲でも「主成分は分散を最大にする軸であって、意味のある軸とは限らない」という点は随所で効いてきます。
固有値・寄与率・累積寄与率の読み方
まず wine データで実行します。scikit-learn の load_wine は、3品種のワイン178本について、アルコール度数・リンゴ酸・灰分・マグネシウム・フェノール類・色の濃さ・プロリンなど13の化学的な測定値を持つデータです。品種のラベルは主成分分析には使わず、あとでバイプロットに色を付けるためだけに使います。次のコードで、標準化してから主成分分析を回し、固有値と寄与率を出します。scikit-learn の PCA は入力を平均0に中心化しますが、分散をそろえる処理は行わないと公式ドキュメントに明記されているので、標準化は自分で行います。
import numpy as np
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.decomposition import PCA

wine = load_wine()
X = pd.DataFrame(wine.data, columns=wine.feature_names)   # 178行 × 13列
y = wine.target

# 標準化(pandas の std は ddof=1 なので、固有値の和が変数の数 13 に一致する)
Z = ((X - X.mean()) / X.std()).values
pca_std = PCA(random_state=0).fit(Z)
eig = pca_std.explained_variance_          # 固有値
ratio = pca_std.explained_variance_ratio_  # 寄与率
print(np.round(eig, 3))
print(np.round(ratio, 4))
print(np.round(np.cumsum(ratio), 4))       # 累積寄与率
print(int((eig > 1).sum()))                # 固有値が 1 を超える主成分の数
# 出力:
# [4.706 2.497 1.446 0.919 0.853 0.642 0.551 0.348 0.289 0.251 0.226 0.169 0.103]
# [0.362  0.1921 0.1112 0.0707 0.0656 0.0494 0.0424 0.0268 0.0222 0.0193 0.0174 0.013  0.008 ]
# [0.362  0.5541 0.6653 0.736  0.8016 0.851  0.8934 0.9202 0.9424 0.9617 0.9791 0.992  1.    ]
# 3
固有値は 4.706、2.497、1.446、0.919、0.853 と続き、13個の和はちょうど 13.0 になりました(ログで相関行列を直接固有値分解した結果との最大差は \( 2.7 \times 10^{-15} \) で、計算誤差の範囲で一致しています)。寄与率はこれを13で割ったもので、第1主成分が 36.2%、第2主成分が 19.2%、第3主成分が 11.1% です。累積寄与率は第2主成分までで 55.4%、第3主成分までで 66.5%、第5主成分でようやく 80.2% に達します。つまり、13の測定値のばらつきの3分の2は3本の軸で表せるが、8割を説明したければ5本要る、という読み方になります。
ここで注意したいのは、scikit-learn の explained_variance_ が「標本数から1を引いた自由度」で分散を計算していることです。前処理に StandardScaler を使うと、こちらは母標準偏差(ddof=0)で割ると公式ドキュメントに書かれているため、標準化後の各列の分散を標本分散(ddof=1)で見ると 1 ではなく \( n/(n-1) \) になります。実測では 1.00565 でした。その状態で主成分分析を回すと固有値の和が 13 ではなく 13.073 になり、教科書の「固有値の和は変数の数」と数字が合わなくなります。寄与率はどちらでも同じなので実務上の害は小さいのですが、固有値をカイザー基準(後述)と突き合わせるときには、この 0.6% ほどの膨らみを知っておいたほうが安全です。本章のコードでは pandas の std(ddof=1)で標準化して、この食い違いを避けています。
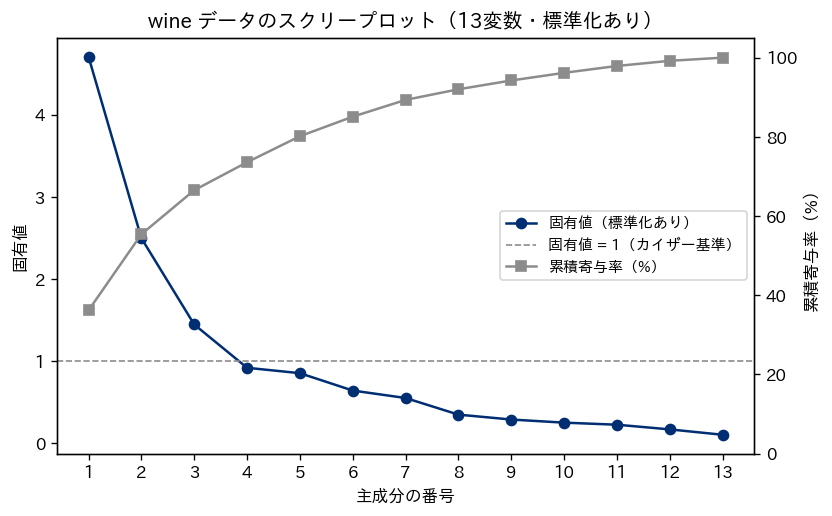
固有値を主成分の番号順に折れ線で描いたものがスクリープロットです。上の図では第1から第3までが急に下がり、第4以降は傾きが緩くなりますが、崖がどこで終わるかは目で読むしかなく、読みは人によって分かれます。この「崖が終わって瓦礫(スクリー)が続く」形の変わり目で主成分数を決めるのがスクリー基準で、Cattell(1966)が提案したものです。図に重ねた累積寄与率の線と、固有値1の横線を同時に見ると、基準ごとに答えが違うことも分かります。この点は主成分数の決め方の節で改めて扱います。
標準化の有無で結果は別物になる
同じ wine データを標準化せずに回すと、どうなるでしょうか。13変数の標準偏差を見ると、プロリン(proline)が 314.9、マグネシウム(magnesium)が 14.3 であるのに対し、非フラボノイドフェノール(nonflavanoid_phenols)は 0.124、色相(hue)は 0.229 しかありません。測定の単位が違うだけで、ばらつきの大きさが2,500倍以上ちがう変数が混ざっています。
# 標準化せずに回す(共分散行列の主成分分析)
pca_raw = PCA(random_state=0).fit(X.values)
print(np.round(pca_raw.explained_variance_ratio_[:3], 4))
w_raw = pd.Series(pca_raw.components_[0], index=X.columns)
print(w_raw.reindex(w_raw.abs().sort_values(ascending=False).index).round(4).head(3))
# 出力:
# [9.981e-01 1.700e-03 1.000e-04]
# proline              0.9998
# magnesium            0.0179
# alcalinity_of_ash   -0.0047
標準化なしでは、第1主成分の寄与率が 99.81% になり、その重みはプロリンが 0.9998 で残りの12変数はすべて 0.02 未満でした。つまり第1主成分は「プロリンの値そのもの」で、13変数を要約したことにはなっていません。分散を最大にする軸を探す以上、元の分散が桁違いに大きい変数があれば、その変数だけで軸が決まってしまうのは当然の帰結です。標準化して回した場合の第1主成分(寄与率 36.2%)が、フェノール類やフラボノイドなど複数の変数の合成になっていたのと比べると、同じデータから出たとは思えないほど違います。
では常に標準化すればよいかというと、そうとも言い切れません。すべての変数が同じ単位で測られていて、ばらつきの大きさそのものに意味がある場合(たとえば同じ試験の科目別得点で、点差の大きい科目ほど差がつく科目だと考えたい場合)は、共分散行列のまま回す選択もあります。判断の軸は「変数の分散の違いを、情報として主成分に反映させたいか、単位の違いによる雑音として消したいか」です。財務比率・アンケート項目・センサーの測定値のように単位がばらばらなデータでは、標準化しない理由はほぼありません。本章の共通データは16項目すべてが7段階評価なので単位は同じですが、項目ごとの標準偏差の差(1.54〜1.62)を主成分に反映させる理由もないため、標準化して回しています。
主成分負荷量と主成分得点の読み方
固有値と寄与率は「何本の軸で、どれだけ説明できるか」を教えてくれますが、「各軸が何を表しているか」は教えてくれません。それを読むための数字が主成分負荷量です。負荷量は、固有ベクトルの各要素に固有値の平方根を掛けたもので、標準化したデータでは「元の変数と主成分得点の相関係数」に一致します。scikit-learn の components_ は長さ1に正規化した固有ベクトル(公式ドキュメントでは principal axes と呼ばれています)であって負荷量ではないので、自分で固有値の平方根を掛けます。
# 主成分負荷量 = 固有ベクトル × sqrt(固有値)
loadings = pca_std.components_.T * np.sqrt(eig)
load_df = pd.DataFrame(loadings[:, :3], index=X.columns, columns=["PC1", "PC2", "PC3"])

# 主成分得点(各個体の、各軸の上での座標)
scores = pca_std.transform(Z)

# 負荷量が「変数と主成分得点の相関」に一致することを確かめる
r = np.array([np.corrcoef(Z[:, j], scores[:, 0])[0, 1] for j in range(Z.shape[1])])
print(float(np.abs(r - loadings[:, 0]).max()))      # 5.55e-16(一致)
print(np.round(scores[:, :3].var(axis=0, ddof=1), 3)) # [4.706 2.497 1.446](固有値に一致)
print(round(np.corrcoef(scores[:, 0], scores[:, 1])[0, 1], 6))  # -0.0(無相関)
実測では、負荷量と相関係数の最大差は \( 5.6 \times 10^{-16} \) で完全に一致し、主成分得点の分散は固有値そのもの(4.706、2.497、1.446)、第1と第2の主成分得点の相関は 0 でした。教科書に書かれている性質が、そのまま数字で確かめられます。標準化ありの第1〜第3主成分の負荷量を表にすると次のようになります。
| 変数 | 第1主成分 | 第2主成分 | 第3主成分 |
|---|---|---|---|
flavanoids(フラボノイド) | 0.917 | -0.005 | 0.181 |
total_phenols(総フェノール) | 0.856 | 0.103 | 0.176 |
od280/od315_of_diluted_wines | 0.816 | -0.260 | 0.200 |
proanthocyanins | 0.680 | 0.062 | 0.180 |
hue(色相) | 0.644 | -0.441 | 0.102 |
proline(プロリン) | 0.622 | 0.577 | -0.152 |
alcohol(アルコール) | 0.313 | 0.764 | -0.249 |
magnesium(マグネシウム) | 0.308 | 0.473 | 0.157 |
ash(灰分) | -0.004 | 0.499 | 0.753 |
color_intensity(色の濃さ) | -0.192 | 0.837 | -0.165 |
alcalinity_of_ash | -0.519 | -0.017 | 0.736 |
malic_acid(リンゴ酸) | -0.532 | 0.355 | 0.107 |
nonflavanoid_phenols | -0.648 | 0.045 | 0.205 |
読み方は、列ごとに絶対値の大きい変数を拾い、符号の向きをそろえて意味を付けることです。第1主成分はフラボノイド(0.917)、総フェノール(0.856)、OD280/OD315(0.816)、プロアントシアニン(0.680)、色相(0.644)が正の側に大きく、非フラボノイドフェノール(-0.648)、リンゴ酸(-0.532)、灰分のアルカリ度(-0.519)が負の側に来ています。フェノール類が多く酸が少ない方向、と読めます。第2主成分は色の濃さ(0.837)、アルコール(0.764)、プロリン(0.577)が正の側で、色が濃くアルコール度が高く成分が濃い方向です。第3主成分は灰分(0.753)と灰分のアルカリ度(0.736)が突出しており、灰分に関する軸です。第1と第2はどちらも複数の変数の合成で、この2本で全体の 55.4% を表しています。
主成分得点は、各個体をこれらの軸の上に置いたときの座標です。標準化したデータに固有ベクトルを掛けた値で、transform がそれを返します。得点の平均は0、分散は固有値なので、第1主成分得点が +3 のワインは、第1主成分の方向に標準偏差(\( \sqrt{4.706} \approx 2.17 \))の1.4倍ほど離れている、という位置づけになります。この得点を並べれば個体のランキングが作れますし、2本の得点を縦横に取れば散布図が描けます。それが次のバイプロットです。
符号について一言添えます。固有ベクトルは \( \boldsymbol{v} \) と \( -\boldsymbol{v} \) のどちらも同じ固有値の解なので、負荷量と得点の符号は計算の都合で決まります。実行環境やライブラリの版が変わると、同じデータで負荷量の符号が丸ごと反転することがあります。実測でも、入力の符号を全部反転して回した場合の寄与率の差は 0.0 でした。符号が反転しても軸の意味は変わらないので、「負荷量が負だから悪い軸」というような読み方はしません。ただし報告書の中で軸の向きを固定して語る場合(「右に行くほどフェノール類が多い」など)は、その向きが再実行で変わりうることを知っておく必要があります。
バイプロットで個体と変数を同時に見る
バイプロットは、主成分得点の散布図(個体)の上に、負荷量を矢印(変数)として重ねた図です。個体がどこに散らばっているかと、その方向が何を意味するかを1枚で読めるのが利点です。第1・第2主成分で描いたものが次の図で、点の形と濃さで品種を分けています。品種のラベルは主成分の計算には一切使っていないことを、もう一度書いておきます。
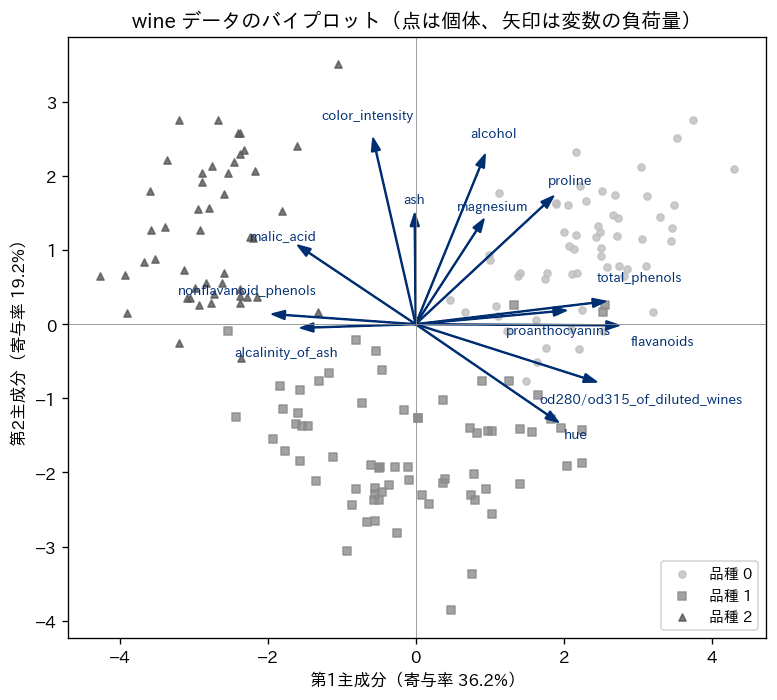
矢印の読み方は3つです。第一に、矢印の長さはその変数が第1・第2主成分でどれだけ説明されているかを表し、長い矢印ほどこの図の中で意味を持ちます。灰分(ash)の矢印は第1主成分の負荷量がほぼ0なので縦にだけ伸びていて、この2軸の図ではあまり語れない変数だと分かります。第二に、矢印どうしの角度は変数間の相関のおおよその向きを表し、同じ方向を向く矢印は正の相関、逆向きは負の相関、直角は無相関に近いことを示します。フラボノイドと総フェノールの矢印がほぼ重なり、非フラボノイドフェノールがその逆側を向いているのは、負荷量の表と同じことを図で見ているだけです。第三に、点が矢印の先端方向にあれば、その個体はその変数の値が高い傾向にあります。右上に集まる品種0のワインは、フェノール類が多く、プロリンやアルコールも高い側にある、と読めます。
気をつけたいのは、矢印の長さと点の散らばりは別の尺度で描かれているという点です。この図では負荷量を3倍に伸ばして重ねており、矢印の絶対的な長さに意味はありません。角度と相対的な長さだけを読みます。また、この図は全体の 55.4% しか表していないので、図の上で近くにある2つの点が、残りの 44.6% の軸では遠く離れていることもあります。バイプロットは要約の図であって、元のデータの距離をそのまま保った図ではない、という理解が必要です。
主成分をいくつ残すか、4つの基準を共通データで比べる
主成分は変数の数だけ作れますが、要約が目的なので、どこかで打ち切ります。その基準は主に4つあり、答えが食い違うことも珍しくありません。ここからは第2章で用意した共通データ(架空の顧客満足度調査、1,200件、7段階評価の16項目 q01〜q16)を使います。第2章で書いたとおり、このデータは設計上4つの因子(商品品質・価格納得感・接客サポート・店舗利便性)に4項目ずつ載るように乱数で生成したものなので、「4本で切れるか」が答え合わせになります。
from survey_data import load_survey, ITEM_COLS
df = load_survey()
X = df[ITEM_COLS]
n, p = X.shape                                  # (1200, 16)
Z = ((X - X.mean()) / X.std()).values
pca = PCA(random_state=0).fit(Z)
eig = pca.explained_variance_
print(np.round(eig, 3))
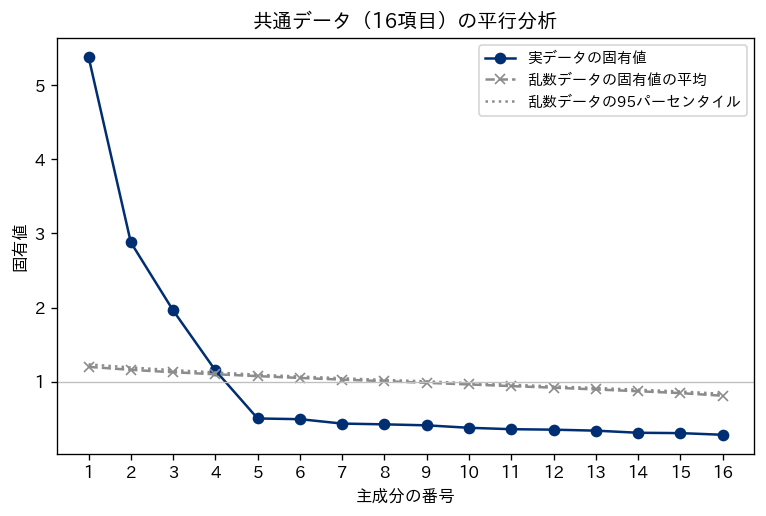
# 出力: [5.379 2.878 1.962 1.154 0.506 0.496 0.437 0.427 0.413 0.38  0.361 0.355 0.342 0.313 0.308 0.286]

# 平行分析(Horn 1965): 同じ形の標準正規乱数を 200 組作り、相関行列の固有値と比べる
rng = np.random.default_rng(0)
rand_eig = np.empty((200, p))
for i in range(200):
    R = rng.normal(size=(n, p))
    rand_eig[i] = np.sort(np.linalg.eigvalsh(np.corrcoef(R, rowvar=False)))[::-1]
rand_mean = rand_eig.mean(axis=0)
rand_p95 = np.percentile(rand_eig, 95, axis=0)
print(np.round(rand_mean[:5], 3))   # [1.201 1.161 1.129 1.102 1.076]
print(np.round(rand_p95[:5], 3))    # [1.234 1.193 1.157 1.126 1.095]
print(int((eig > rand_mean).sum()), int((eig > rand_p95).sum()))   # 4 4
固有値は 5.379、2.878、1.962、1.154 と続き、第5主成分で 0.506 に落ちて、以降は 0.5 未満がなだらかに並びます。第4と第5の間に明確な段差があります。累積寄与率は第4主成分までで 71.1%、第7主成分でようやく 80.1% です。この数字に4つの基準を当てます。
1つ目はカイザー基準で、固有値が1を超える主成分だけを残す規則です。Kaiser(1960)に由来するとされる基準で、「標準化した変数1個ぶんの分散(つまり1)より小さな分散しか持たない軸は、変数を要約したことにならない」という考え方です。共通データでは第4主成分(1.154)までが1を超え、答えは4本です。ただし wine データでは3本でした。2つ目はスクリー基準で、固有値の折れ線の「崖」が終わるところで切ります。共通データでは第4と第5の間に段差があるので4本と読めますが、wine データの図を見返すと、第3と第4の間で切るか第5の後で切るかは人によって読みが分かれます。目で判断する基準なので、報告のときに図を添える必要があります。
3つ目が平行分析で、Horn(1965)が提案した方法です。考え方は「まったく構造のない乱数のデータでも、相関行列の固有値は1より大きいものがいくつか出てしまう。だから固有値1ではなく、同じ大きさの乱数データから得られる固有値と比べるべきだ」というものです。Horn は要旨の中で、標本誤差と相関の計算過程で生じる見かけ上の膨らみを固有値から差し引く必要があると述べ、その推定に乱数変数の生成に基づく手続きを示しています。上のコードでは 1,200×16 の標準正規乱数を200組作り、固有値を並べました。乱数データの第1固有値の平均は 1.201 で、たしかに1を超えています。実データの固有値がこの乱数の平均を上回るのは第4主成分(1.154 対 1.102)まで、初めて下回るのは第5主成分(0.506 対 1.076)です。答えは4本で、設計と一致しました。本章のコードでは平均に加えて95パーセンタイル(1.126)も出しており、分布の上側と比べるので平均より厳しい判定になりますが、共通データではどちらでも4本です。
4つ目は累積寄与率で、「全体の分散の何割を表せれば十分か」を先に決めて主成分数を選ぶ方法です。ただし何割が十分かという目安は、分野や目的で違い、本章では出典のある数値を示せません。共通データで仮に8割を求めると7本、7割なら4本になり、基準の置き方で答えが3本も動きます。累積寄与率は「残した主成分でどれだけ表せているか」を報告するための数字であって、それ単独で本数を決める根拠にはしにくいと考えています。
| 基準 | 考え方 | wine(13変数) | 共通データ(16項目) | 注意点 |
|---|---|---|---|---|
| カイザー基準 | 固有値が1を超える主成分を残す | 3本 | 4本 | 乱数でも固有値1超えが出るため、変数が多いと残しすぎる |
| スクリー基準 | 固有値の折れ線の崖が終わる点で切る | 3本か5本(読みが分かれる) | 4本 | 目で判断するので、図を添えて報告する |
| 平行分析 | 乱数データの固有値を上回る主成分を残す | 本章では未実施 | 4本(平均・95パーセンタイルとも) | 乱数の組数と比較する分位点を明記する |
| 累積寄与率 | 先に決めた割合に達するまで残す | 8割なら5本 | 7割なら4本、8割なら7本 | 割合の目安に定まった出典がなく、置き方で答えが動く |
共通データで4つの基準が同じ4本を指したのは、設計した構造が強く、第4と第5の固有値の差が大きかったからです。実際の調査データでは、固有値が 1.2、1.1、0.95、0.9 のように1の周辺に並ぶことがあり、そのときカイザー基準と平行分析は逆の答えを出します。乱数データでも上位の固有値は1を超えるため、1の周辺に並ぶ固有値については、カイザー基準のほうが平行分析より多く残しやすいからです。判断に迷うときは、平行分析を主、スクリープロットを従とし、累積寄与率は「その本数でどれだけ表せたか」の報告に使う、という順序を弊社では勧めています。
共通データの主成分を読む、そして回転しないことの限界
4本残すと決めたら、次は負荷量を読みます。16項目それぞれの負荷量を1つずつ読むと長くなるので、ここでは設計上の4因子ごとに4項目の負荷量を平均した値で見ます。
| 設計上の因子(4項目の平均) | 第1主成分 | 第2主成分 | 第3主成分 | 第4主成分 |
|---|---|---|---|---|
| 商品品質(q01〜q04) | 0.610 | -0.305 | 0.528 | 0.060 |
| 価格納得感(q05〜q08) | 0.261 | 0.768 | 0.214 | -0.101 |
| 接客サポート(q09〜q12) | 0.700 | -0.132 | -0.277 | -0.352 |
| 店舗利便性(q13〜q16) | 0.637 | 0.129 | -0.292 | 0.374 |
第1主成分は16項目すべての負荷量が正(0.179〜0.715)で、接客サポート(平均 0.700)、店舗利便性(0.637)、商品品質(0.610)が高く、価格納得感(0.261)だけが低い軸です。「価格を除いた全体的な満足しやすさ」と読めます。第2主成分は価格納得感(0.768)が突出し、商品品質(-0.305)が逆側にある軸で、「価格に納得しているが品質評価は控えめ」という対比を表します。第3主成分は商品品質(0.528)と接客・店舗(-0.277、-0.292)の対比、第4主成分は店舗利便性(0.374)と接客サポート(-0.352)の対比です。
ここで、設計した4因子と主成分の対応を見比べてください。第2主成分は価格納得感にほぼ対応していますが、第1・第3・第4主成分は「商品品質」「接客サポート」「店舗利便性」に1対1で対応していません。第1主成分に3つの因子が一緒に載り、第3と第4はそれらの差分になっています。これは主成分分析が「分散の大きい順に、互いに直交する軸を取る」手法である以上、避けられない結果です。3つの因子が正の相関を持っていれば(共通データでは「総合的な満足しやすさ」を因子間の弱い相関として仕込んであります)、それらをまとめて足した方向が最も分散が大きい軸になり、個々の因子はその後の「差分」の軸に押し込まれます。
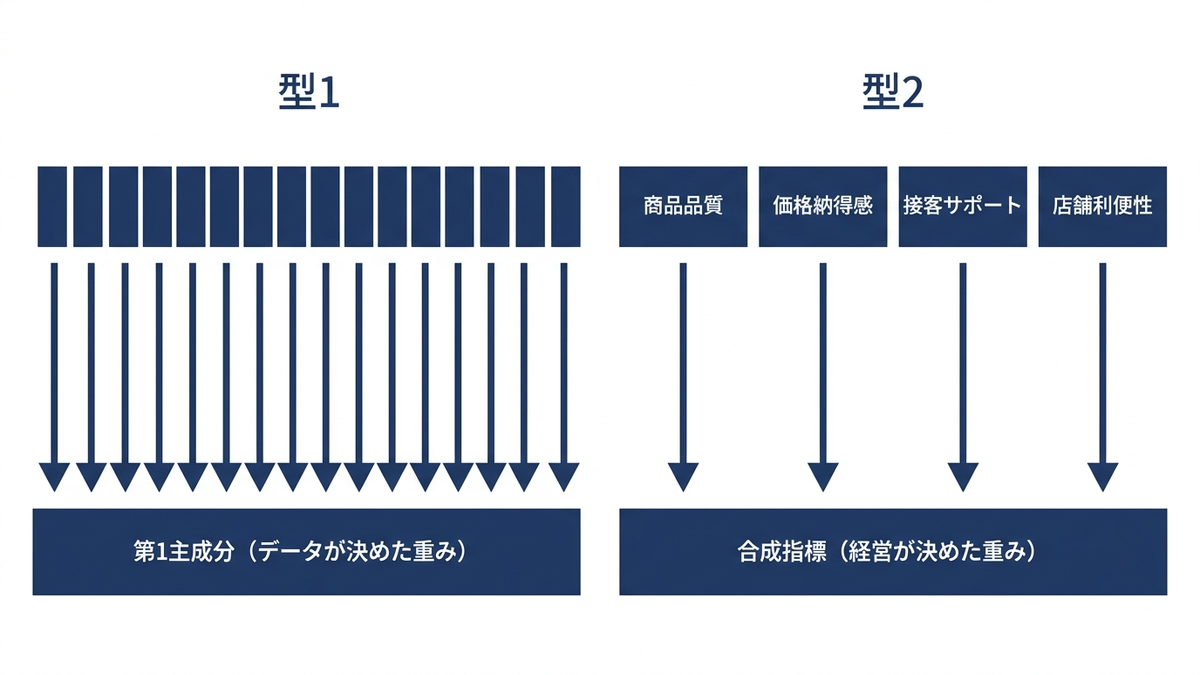
因子分析では、この直交する軸を回転させて、各変数がなるべく1つの軸にだけ高く載る「単純構造」に近づける工程があります。本章で扱う標準的な主成分分析にはその工程がありません。回転すると「第1主成分の分散が最大」という性質が崩れるからで、scikit-learn の PCA にも回転の引数はありません(解釈の目的で、保持した主成分を後から回転させる流儀は別にあり、章末の書籍紹介で触れます)。その帰結として、主成分の解釈は「第1が全体、第2以降が対比」という形になりやすく、読む人が軸に名前を付けるときに解釈を押しつけやすくなります。第1主成分を「顧客満足度」と名付けてしまうと、価格納得感(相関 0.309、後述)がほとんど入っていないのに満足度を測ったつもりになる、という事故が起きます。軸に名前を付けるときは、負荷量の表を横に置き、「何が高く、何が低い軸か」を説明できる名前にとどめるのが安全です。設計した4因子を4本の軸として取り出したいなら、それは第4章の因子分析の仕事です。
第1主成分を総合スコアにするとき
実務で主成分分析がよく使われる場面の一つが、多数の指標を1本の「総合スコア」にまとめることです。第1主成分は分散が最大の合成変数なので、指標の間で共通して動く部分を最もよく拾い、その得点で個体をランキングできます。共通データで第1主成分得点を作り、単純平均や総合満足度 sat と比べました。
scores = pca.transform(Z)
pc1 = scores[:, 0]                          # 第1主成分得点(総合スコアの候補)
simple_mean = X.mean(axis=1).values         # 16項目の単純平均
print(round(np.corrcoef(pc1, simple_mean)[0, 1], 4))   # 0.9754
print(round(np.corrcoef(pc1, df["sat"])[0, 1], 4))     # 0.7974
print(round(np.corrcoef(simple_mean, df["sat"])[0, 1], 4))   # 0.7982
for f, name in enumerate(["商品品質", "価格納得感", "接客サポート", "店舗利便性"]):
    sub = X.iloc[:, f * 4:(f + 1) * 4].mean(axis=1).values
    print(name, round(np.corrcoef(sub, pc1)[0, 1], 3))
# 出力: 商品品質 0.705 / 価格納得感 0.309 / 接客サポート 0.83 / 店舗利便性 0.79
結果は3点にまとまります。第一に、第1主成分得点と16項目の単純平均の相関は 0.975 で、ほぼ同じものでした。総合満足度 sat との相関も、第1主成分が 0.797、単純平均が 0.798 で差がありません。項目の負荷量がすべて正で、極端に小さい項目が無ければ、第1主成分は重みつき平均に近づき、単純平均とほとんど区別がつかなくなります。第二に、その重みは均等ではありません。下位尺度ごとに第1主成分得点との相関を見ると、接客サポートが 0.830、店舗利便性が 0.790、商品品質が 0.705 であるのに対し、価格納得感は 0.309 です。第1主成分を「総合スコア」と呼ぶと、価格の評価がほぼ落ちたスコアを総合と呼んでいることになります。第三に、この重みはデータが決めたものであって、経営として「価格をどれだけ重く見るか」を決めたものではありません。分散が大きい項目群ほど重くなるだけです。
したがって、第1主成分を総合スコアとして使う判断には条件があります。負荷量がすべて同じ符号で、極端に低い項目が無いこと(そうでなければ「総合」ではなく「対比」の軸になっています)。そして、その重みを経営の意図として受け入れられることです。重みを自分たちで決めたいなら、主成分分析の結果を参考にしつつ、4つの下位尺度の平均に意図した重みを掛けた合成指標を別途作るほうが説明しやすくなります。指標の合成をKPIにするときの作法は第13章でまとめて扱います。
落とし穴と、経営の現場での使いどころ
本章で触れた落とし穴を、実測を添えて整理します。1つ目は標準化の問題で、wine データの標準化なしでは第1主成分がプロリンそのものになりました(寄与率 99.8%、重み 0.9998)。財務指標で同じことをすれば、売上高や総資産のように桁の大きい指標だけの軸になり、13の指標を並べた意味がなくなります。2つ目は回転しないことによる解釈の押しつけで、共通データの第1主成分に3因子が一緒に載った例のとおりです。3つ目は符号の任意性で、環境やライブラリによって軸の向きが反転しうる以上、報告書で「右ほど良い」と固定して語るときは向きを自分で確かめてそろえる必要があります。
4つ目は外れ値への弱さで、これは実測しておきます。wine データの1行だけ、マグネシウムの値を 10000(元の最大値は 162、平均 99.7)に置き換えて、入力ミスのような外れ値を1件作りました。
wine = load_wine()
X = pd.DataFrame(wine.data, columns=wine.feature_names)   # 共通データから wine データに戻す
X_out = X.copy()
X_out.loc[0, "magnesium"] = 10000.0      # 1行だけ桁違いの値に(入力ミスを模した外れ値)
Z_out = ((X_out - X_out.mean()) / X_out.std()).values
p_out = PCA(random_state=0).fit(Z_out)
load_out = p_out.components_.T * np.sqrt(p_out.explained_variance_)
print(np.round(p_out.explained_variance_ratio_[:3], 4))   # [0.3575 0.1805 0.1103]
print(round(float(load_out[list(X.columns).index("magnesium"), 0]), 3))   # 0.141(元は 0.308)

# 標準化せずに回すと、外れ値のある変数が第1主成分を独占する
raw = PCA(random_state=0).fit(X_out.values)
print(round(float(raw.explained_variance_ratio_[0]), 4))   # 0.8487
print(round(float(raw.components_[0][list(X.columns).index("magnesium")]), 4))   # 0.9991
結果は、標準化の有無で壊れ方が違いました。標準化してから回した場合、第1主成分の寄与率は 36.2% から 35.8% へ、負荷量ベクトルの向きはコサイン類似度 0.997 でほとんど変わりませんでしたが、マグネシウムの負荷量は第1主成分で 0.308 から 0.141 へ、第2主成分で 0.473 から 0.109 へ下がりました。外れ値1件が標準化後の値で 13.3 という極端な位置に来たため、マグネシウムの列は「1点だけが飛び抜け、残りは0付近に潰れた」列になり、他の変数との相関を失って主成分から消えたのです。一方、標準化せずに回した場合は、第1主成分の寄与率が 84.9%、重みはマグネシウムが 0.9991 で、その1件の外れ値だけで軸が決まりました。外れ値の行を除いた177件で回し直すと、寄与率(36.0%、19.2%、11.2%)も第1主成分の向き(コサイン類似度 1.0)も元に戻ります。主成分分析は分散を最大にする手法なので、分散を極端に膨らませる点には正面から引きずられます。第2章で外れ値の確認を前処理に置いた理由は、ここにあります。
経営の現場での使いどころは、大きく3つあります。1つ目は、多数の指標を1〜2本の軸で見ることです。店舗別に13の運営指標を追うダッシュボードは、13本の折れ線を眺めても順位が指標ごとに入れ替わって判断がつきません。標準化して主成分分析を回し、第1・第2主成分の得点で店舗を散布図に置けば、「全体に高い店」「特定の方向に偏った店」が一目で分かり、象限ごとに施策を分けられます。2つ目は財務指標の要約で、複数の企業や複数期の財務比率(収益性・安全性・効率性の指標群)を標準化して回すと、業種や指標の設計にもよりますが、第1主成分に「全体的な財務体力」、第2以降に「成長と安定の対比」のような軸が出ることがあります。同業他社との位置関係を1枚の図で示せるのが利点です。3つ目はアンケートの要約で、数十項目の回答を数本の軸に落としてから、クラスター分析(第6章)や回帰分析の入力にする使い方です。ただしアンケートの場合、設計した尺度を取り出したいなら因子分析(第4章)のほうが適しています。
この判断を誤ったときの損失も、数字で言えます。標準化を忘れて財務指標を要約すると、「総合力ランキング」が売上高順位と同じになり、分析に費やした時間がそのまま無駄になります。共通データの第1主成分をそのまま「顧客満足度スコア」として店舗のKPIに置くと、価格納得感との相関が 0.309 しかない指標で価格施策の効果を測ることになり、値下げやポイント施策を打ってもスコアがほとんど動かず、「価格施策は効かない」という誤った結論に至ります。実際には測っていないだけです。逆に、主成分分析を通して「価格の評価は他の3つと独立に動いている」(第2主成分が価格納得感の軸になった事実)が分かれば、価格の評価は別のKPIとして単独で追う、という判断ができます。主成分分析の結果を施策に落とすときは、各主成分がどの指標を拾い、どの指標を落としているかを負荷量の表で示し、落としている指標を別途どう扱うかまで決めておくことが要ります。
本章の要点は3つです。主成分分析は相関行列の固有値問題として、分散が最大の互いに直交する軸を機械的に取り出す手法で、標準化の有無で結果が別物になります。主成分数はカイザー基準・スクリー基準・平行分析・累積寄与率で決め、迷うときは平行分析を主にします。そして標準的な手順では主成分を回転しないため第1主成分に共通部分がまとめて載りやすく、総合スコアとして使うなら重みの偏りを確かめる必要があります。設計した尺度を軸として取り出したい場合に、誤差を分けて共通因子を推定し、回転で解釈しやすい形に整える因子分析を、第4章で扱います。
この章を深めたい方への参考書籍
『主成分分析と因子分析:特異値分解を出発点として』(足立浩平・山本倫生、共立出版):統計学One Pointシリーズの第25巻で、2024年8月刊。書名のとおり特異値分解を出発点に置き、主成分分析と因子分析を次元縮約の手法として同じ土台の上で扱う構成です。本章で「回転しない」とだけ書いた主成分分析と因子分析の違いを、数理の側から確かめたい方に向いています。
『主成分分析の基本と活用』(内田治、日科技連出版社):2013年刊。版元の紹介では、主成分分析を「評価項目を測定したデータから、新たな総合的な評価項目をつくり出す統計的方法」と位置づけ、実例を使った解説と欠損値への対応まで扱うとされています。概要・基本・応用・活用・官能評価・特殊な事例の6章構成で、本章の wine データの例を手元の指標に置き換えて試したい方の最初の1冊として挙げます。
『主成分分析』(上田尚一、朝倉書店):講座〈情報をよむ統計学〉の第8巻で、2003年刊。主成分分析1つに1冊を充て、「主成分分析の適用についての考え方」「主成分の解釈と軸の回転」といった章を持ちます。本章では主成分を回転しない標準的な手順を書きましたが、この本は主成分の解釈のために後から軸を回転させる立場も扱っており、本章で触れた「軸に名前を付けるときの解釈の押しつけ」を避ける考え方を深めるのに向いています。2026年9月時点で版元では取り扱いが終わっているため、図書館や古書での入手になります。
第4章 因子分析、観測の背後にある共通因子を推定する
第3章では、主成分分析が「観測した変数の分散をできるだけ多く受け持つ合成変数」を作る手法であることと、主成分の数を固有値やスクリープロットで決める考え方を確認しました。第2章で用意した共通データの相関行列は、固有値が 5.38・2.88・1.96・1.15 と続いたあと急に小さくなります。本章で扱う因子分析は、同じ相関行列を出発点にしながら問いの立て方が逆になります。「16項目をうまく要約する軸は何か」ではなく、「16項目の回答をこのように相関させている、目に見えない原因は何か」を問います。アンケートの項目は、商品への評価・価格への納得・接客の印象といった、直接には測れない心の状態が表に出たものだと考え、その測れないものを推定するのが因子分析です。
本章では、第2章で用意した架空の顧客満足度調査(1,200件、q01〜q16 の16項目)を使い、共通因子モデルの考え方、推定法、回転、因子数の決め方、因子得点、尺度の信頼性、そして分析にかける前のデータの適否まで、探索的因子分析の一連の手順を実行結果つきで追います。因子構造を仮説として立てて検証する確認的因子分析は第11章で、プロテニスのデータに因子分析を当てた事例は第5章で扱います。
主成分分析と何が違うのか、合成する手法と説明する手法
主成分分析と因子分析は、出力の見た目がよく似ています。どちらも「項目×軸」の表が出て、値の大きい項目を拾って軸に名前を付けます。しかし、矢印の向きが逆です。主成分分析では、主成分は観測変数の重みつき合計として定義されます。観測変数から主成分が作られる、という向きです。因子分析では向きが逆で、観測変数のほうが結果で、その背後にある因子が観測変数を生み出すとモデル化します。「商品の品質に満足している」という回答が高いのは、その人の中に「商品への評価の高さ」という状態があり、それが回答に現れたからだ、と考えます。
もう1つの違いは、誤差の扱いです。主成分分析は、観測変数の分散をすべて主成分に分配します。分散が全部「意味のあるもの」として扱われます。因子分析は、各観測変数の分散を、他の項目と共有している部分と、その項目にしかない部分とに分けます。前者を共通因子が説明し、後者は独自因子と呼んで説明の対象から外します。アンケートの1項目には、質問文の言い回しの癖や、その項目だけに効く回答の揺れが必ず混じります。それを「共通の原因で説明できない部分」として最初から分けておくのが因子分析の設計思想です。
この違いは、実務では次のように効いてきます。目的が「多数の指標を少数のスコアに縮めて、順位づけや可視化に使いたい」なら主成分分析で十分です。目的が「アンケートの項目群が、どういう潜在的な評価軸を測っているのかを知りたい」「その評価軸ごとに得点を作って施策に結びつけたい」なら因子分析です。主成分分析でも軸に付ける名前は分析者の解釈でしたが、因子分析ではその注意がさらに重くなります。因子は「観測されない変数」を推定したものなので、名前を付ける行為そのものが、モデルの外側にある解釈だからです。
共通因子モデル、観測値を共通因子と独自因子に分ける
因子分析の土台になる 共通因子モデル を数式で1本だけ書きます。回答者 \( i \) の項目 \( j \) に対する標準化した回答を \( x_{ij} \) とすると、
\( x_{ij} = \sum_{k=1}^{m} \lambda_{jk} f_{ik} + \varepsilon_{ij} \)
と表します。\( f_{ik} \) は回答者 \( i \) の \( k \) 番目の共通因子の値(因子得点)、\( \lambda_{jk} \) は項目 \( j \) が因子 \( k \) からどれだけ影響を受けるかを表す係数(因子負荷量)、\( \varepsilon_{ij} \) はその項目だけに固有の独自因子です。言葉にすると、「各項目の回答は、少数の共通因子の重みつき合計に、その項目固有の揺れを足したものだ」というモデルです。直交因子モデルの基本形では、共通因子どうしは無相関、共通因子と独自因子も無相関、と仮定します(因子どうしの相関を許す斜交モデルは、回転の節で扱います)。
このモデルから、項目 \( j \) の分散(標準化しているので1)は、共通因子で説明される部分と独自因子の部分に分かれます。共通因子で説明される部分を共通性、残りを独自性と呼びます。共通因子が直交しているとき、共通性は負荷量の二乗和 \( h_j^2 = \sum_k \lambda_{jk}^2 \) に等しく、独自性は \( 1 – h_j^2 \) です。共通性が高い項目は「他の項目と一緒に、共通の何かを測っている」項目で、共通性が低い項目は「その項目だけが別の何かを測っている、あるいは雑音が多い」項目です。共通性が0.2や0.3にとどまる項目が多いなら、その尺度は共通因子でうまく説明できていません。
因子分析の推定とは、観測された相関行列 \( R \) を、負荷量の行列 \( \Lambda \) と独自性の対角行列 \( \Psi \) を使って \( R \approx \Lambda\Lambda’ + \Psi \) の形で再現することです。主成分分析が相関行列の対角(各変数の分散1)まで含めて再現しようとするのに対し、因子分析は対角に独自性を置き、相関行列の非対角、つまり「項目どうしの相関」だけを共通因子で再現しようとします。この点が、両者を分ける計算上の最も大きな違いです(推定法や回転といった因子分析に固有の工程は、この後の節で順に扱います)。
推定法、主因子法と最尤法
負荷量と独自性を求める方法には、いくつかの流儀があります。実務でよく使われるのは主因子法と最尤法です。主因子法は、相関行列の対角を共通性の推定値(初期値には各項目を他の全項目で回帰したときの決定係数 SMC を使うのが一般的です)で置き換えた「縮約相関行列」の固有値分解を行い、得られた負荷量から共通性を計算し直して対角を更新する、という反復で解を求めます。分布の仮定を置かず、計算も軽い方法です。最尤法は、データが多変量正規分布に従うと仮定し、観測された相関行列がモデルの下で最も出やすくなる負荷量と独自性を探します。分布の仮定を置く代わりに、モデルの適合度を検定できる、標準誤差が出る、といった利点があります。
statsmodels 0.14.6 の statsmodels.multivariate.factor.Factor(公式ドキュメント)は、引数 method に "pa"(主因子法)か "ml"(最尤法)を取ります。データフレームを渡すと内部で相関行列を計算し、fit() で推定します。最尤法で因子数を2から5まで変えて、それぞれの適合を比べたのが次のコードです。最尤法の適合度は、モデルが再現した相関行列 \( \hat{\Sigma} \) と観測の相関行列 \( S \) のずれ \( F = \ln|\hat{\Sigma}| – \ln|S| + \mathrm{tr}(S\hat{\Sigma}^{-1}) – p \) を、標本の大きさで伸ばしてカイ二乗統計量にします。statsmodels の結果オブジェクトはこの統計量を直接は返さないので、負荷量と独自性から自分で計算しました。
import numpy as np
import pandas as pd
from scipy import stats
from statsmodels.multivariate.factor import Factor
from survey_data import load_survey, ITEM_COLS

df = load_survey()
X = df[ITEM_COLS]
n, p = X.shape
R = np.corrcoef(X.values, rowvar=False)
_, logdet_S = np.linalg.slogdet(R)

for k in (2, 3, 4, 5):
    res = Factor(X, n_factor=k, method="ml").fit()
    L = res.loadings_no_rot
    Sigma = L @ L.T + np.diag(res.uniqueness)
    _, logdet_Sig = np.linalg.slogdet(Sigma)
    F = logdet_Sig - logdet_S + np.trace(R @ np.linalg.inv(Sigma)) - p
    chi2 = (n - 1 - (2 * p + 5) / 6 - 2 * k / 3) * F
    pval = stats.chi2.sf(chi2, res.df)
    print(k, round(chi2, 1), res.df, round(pval, 3), round(res.communality.mean(), 3))
# 出力:
# 2 2980.2 89 0.0 0.418
# 3 699.7 75 0.0 0.561
# 4 59.9 62 0.552 0.615
# 5 38.4 50 0.885 0.623
| 因子数 | カイ二乗 | 自由度 | p値 | 共通性の平均 |
|---|---|---|---|---|
| 2 | 2980.2 | 89 | 0 に近い | 0.418 |
| 3 | 699.7 | 75 | 0 に近い | 0.561 |
| 4 | 59.9 | 62 | 0.552 | 0.615 |
| 5 | 38.4 | 50 | 0.885 | 0.623 |
この検定の帰無仮説は「因子数 \( k \) のモデルで相関行列を再現できる」です。p値が小さいほど「\( k \) 個では足りない」と読みます。2因子と3因子では p値がほぼ0で、モデルが相関行列を再現できていません。4因子で p値が 0.552 となり、棄却されなくなります。5因子でも棄却されませんが、共通性の平均は 0.615 から 0.623 へわずかに増えるだけで、5つ目の因子はほとんど何も説明していません。「棄却されない最小の因子数」という読み方をすれば4因子です。ただし、この検定は標本が大きいほど小さなずれでも棄却する性質があるので、1万件規模のデータでは、実質的に意味のない5つ目・6つ目の因子まで「必要」と出ることがあります。適合度検定は因子数を決める材料の1つであって、決定打ではありません。
主因子法でも同じ4因子解を求めてみると、バリマックス回転後の負荷量は最尤法の解と最大でも 0.004 しか違いませんでした。共通性の範囲は最尤法で 0.487〜0.712、主因子法で 0.489〜0.711 です。このデータのように構造がはっきりしていて標本も十分にあるときは、推定法の違いはほとんど結果に影響しません。推定法の違いが効くのは、項目数に対して標本が少ない、分布が大きく歪んでいる、共通性が極端に高い項目がある、といった条件のときです。最尤法で「独自性がほぼ0」の警告が出る場合(ヘイウッドケースと呼ばれます)は、主因子法に切り替えるか、その項目を見直します。
因子数の決め方、スクリープロット・平行分析・適合度
因子数をいくつにするかは、因子分析で最も結果を左右する判断です。因子数を変えると、負荷量の表も、そこから付ける名前も変わります。第3章で主成分の数を決める基準として紹介したものと基本は同じで、固有値1以上を残すカイザー基準、固有値の折れ線の「肘」を見るスクリープロット、乱数データの固有値と比べる平行分析、そして因子分析に固有の材料として上で見た最尤法の適合度があります。
固有値1以上を残す規則は、その名を Kaiser(1960)の論文に由来するとされ、計算が簡単なため統計ソフトの既定値として広まりました。しかしその使い方には長く批判があります。Horn(1965)は、Guttman が相関行列の階数の下限として示した「固有値1」を標本のデータに当てると、固有値には標本誤差による上振れが含まれるため、本来の因子数の上限としてしか使えないと論じ、同じ大きさの乱数データから得た固有値を差し引いて判断する方法(平行分析)を提案しました。Zwick と Velicer は、5つの基準を条件を変えた模擬データで比較し、カイザーの方法は成分数を大幅に過大評価する傾向があった一方、平行分析と MAP(最小平均偏相関)法が全体として最も良かったと報告しています(1984年の学会報告の要旨、および1986年の Psychological Bulletin 誌の論文)。Fabrigar ら(1999)も、心理学の主要誌の論文を調査し、探索的因子分析の設計と分析の各判断で疑問の残る方法が日常的に使われていることを指摘しました。「固有値1以上だから4因子」と書くだけの報告は、この批判に答えていません。
次のコードは、観測データの固有値と、同じ大きさ(1,200行×16列)の無相関な正規乱数から得た固有値の95パーセンタイルを100回の反復で求め、両方を1枚のスクリープロットに重ねます。乱数は np.random.default_rng(0) で固定しています。
import matplotlib.pyplot as plt
import japanize_matplotlib

eig_obs = np.sort(np.linalg.eigvalsh(R))[::-1]
rng = np.random.default_rng(0)
eig_rand = np.empty((100, p))
for r in range(100):
    Z = rng.standard_normal((n, p))
    eig_rand[r] = np.sort(np.linalg.eigvalsh(np.corrcoef(Z, rowvar=False)))[::-1]
eig_95 = np.percentile(eig_rand, 95, axis=0)
print("平行分析で残る数:", int(np.sum(eig_obs > eig_95)))   # 4
print("カイザー基準で残る数:", int(np.sum(eig_obs > 1.0)))   # 4

xs = np.arange(1, p + 1)
plt.plot(xs, eig_obs, marker="o", color="#002E73", label="観測データの固有値")
plt.plot(xs, eig_95, marker="s", color="#888888", linestyle="--",
         label="乱数データの固有値(95%点)")
plt.axhline(1.0, color="#BBBBBB", linestyle=":")
plt.legend()
plt.savefig("ch04_scree_parallel.png", dpi=120, bbox_inches="tight")
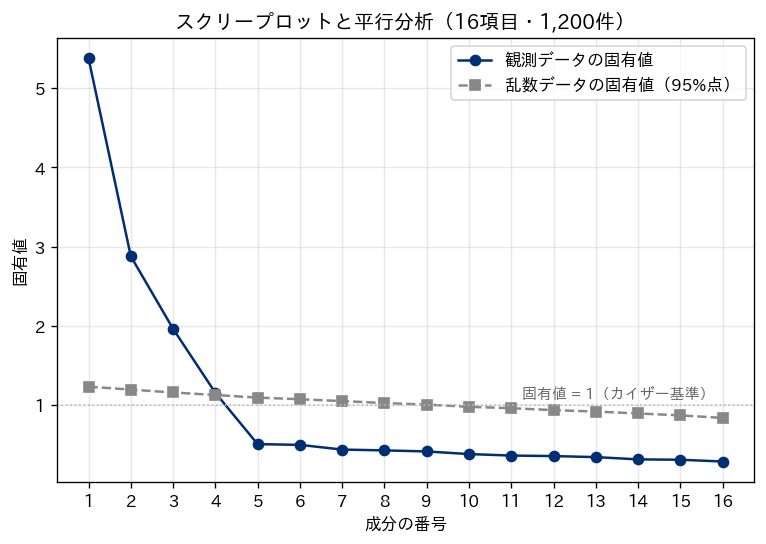
観測の固有値は 5.379・2.878・1.962・1.154 と続き、5番目で 0.506 に落ちます。乱数データの95パーセンタイルは 1.232・1.194・1.158・1.126・1.093 と緩やかに下がるので、観測が乱数を上回るのは4番目までです。平行分析の答えは4、カイザー基準の答えも4、最尤法の適合度も4で一致しました。このデータは生成時に4因子を仕込んであるので当然の結果ですが、注目してほしいのは4番目の固有値 1.154 と乱数の 1.126 の差の小ささです。カイザー基準の「1」と平行分析の「1.126」の間に4番目の固有値が入るかどうかは紙一重で、もし標本が半分なら乱数の固有値はもっと大きくなり、平行分析は3因子と答えたかもしれません。因子数の判断は、複数の基準が一致するかを見て、一致しないときは解釈のしやすさと、次章以降の用途(得点を施策に使えるか)で決めます。
因子分析の流儀として、対角を SMC に置き換えた縮約相関行列の固有値を見る方法もあります。このデータでは 4.901・2.419・1.508・0.636 のあと負の値になり、正の固有値は4つでした。主因子法の反復後の固有値は 4.992・2.517・1.598・0.733 で、5番目は 0.061 です。どの見方でも4で切れます。
回転と単純構造、バリマックスとプロマックス
因子数を決めて推定した負荷量の行列は、そのままでは解釈しにくいことがほとんどです。共通因子モデルには、因子の軸を回転させても相関行列の再現の仕方が変わらない、という性質があります。同じ適合度を持つ解が無数にあるので、その中から「読みやすい」解を選ぶ必要があり、その操作を回転と呼びます。読みやすさの基準として広く使われているのが、Thurstone(1947)が示した 単純構造 の考え方です。各項目はできるだけ1つの因子にだけ大きな負荷を持ち、他の因子への負荷は0に近い。各因子はできるだけ一部の項目にだけ大きな負荷を持つ。この状態に近づける回転の基準を数式で定めたものが、バリマックス回転(Kaiser 1958)をはじめとする各種の回転法です。
回転は直交回転と斜交回転に分かれます。直交回転は因子どうしの無相関を保ったまま軸を回します。代表がバリマックスで、各因子の負荷量の二乗の分散を最大にする、つまり負荷量を「大きいものと0に近いもの」に二極化させる基準です。斜交回転は因子どうしの相関を許して軸を回します。代表がプロマックスで、Hendrickson と White(1964)が、いったん直交回転で得た解を目標にして斜交解へ変換する手早い方法として提案しました。顧客満足度のように「商品への評価が高い人は接客への評価も高い傾向がある」ことが自然に予想される場面では、因子どうしの相関を0に固定する直交回転より、斜交回転のほうがデータの実態に合います。
まず4因子解にバリマックス回転を当てます。statsmodels では結果オブジェクトの rotate("varimax") を呼ぶと、内部で回転後の負荷量が loadings に上書きされ、回転前の負荷量は loadings_no_rot に残ります。
res4 = Factor(X, n_factor=4, method="ml").fit()
res4.rotate("varimax")
load = pd.DataFrame(res4.loadings, index=ITEM_COLS,
                    columns=["F1", "F2", "F3", "F4"])
load["共通性"] = res4.communality
load["独自性"] = res4.uniqueness
print(load.round(2))
T = res4.rotation_matrix
print(np.allclose(T.T @ T, np.eye(4)))   # True(直交回転)
因子の並び順と符号は推定のたびに任意に決まるので、下の表では設計上の因子順(商品品質・価格納得感・接客サポート・店舗利便性)に列を並べ替え、主負荷が正になるよう符号を揃えています。値は実行結果そのままです。
| 項目 | 商品品質 | 価格納得感 | 接客サポート | 店舗利便性 | 共通性 |
|---|---|---|---|---|---|
| q01 商品の品質に満足している | 0.820 | 0.015 | 0.169 | 0.101 | 0.712 |
| q02 商品は期待どおりの性能だった | 0.800 | 0.011 | 0.174 | 0.107 | 0.682 |
| q03 商品の耐久性に満足している | 0.798 | 0.013 | 0.172 | 0.081 | 0.673 |
| q04 商品のデザインが気に入っている | 0.756 | 0.003 | 0.142 | 0.088 | 0.599 |
| q05 価格は品質に見合っている | 0.105 | 0.817 | 0.084 | 0.101 | 0.696 |
| q06 他店と比べて価格に納得できる | -0.081 | 0.799 | -0.014 | 0.075 | 0.651 |
| q07 セールやポイントの仕組みが分かりやすい | -0.060 | 0.797 | 0.004 | 0.045 | 0.640 |
| q08 支払った金額に対して得をしたと感じる | 0.094 | 0.721 | 0.022 | 0.124 | 0.544 |
| q09 店員の説明は分かりやすかった | 0.236 | 0.019 | 0.737 | 0.197 | 0.639 |
| q10 問い合わせへの対応が早かった | 0.215 | 0.020 | 0.725 | 0.235 | 0.628 |
| q11 店員の態度は丁寧だった | 0.190 | 0.038 | 0.754 | 0.167 | 0.634 |
| q12 困ったときに相談しやすい | 0.164 | 0.020 | 0.689 | 0.260 | 0.570 |
| q13 店舗の場所は便利である | 0.130 | 0.129 | 0.358 | 0.686 | 0.632 |
| q14 営業時間は都合に合っている | 0.113 | 0.139 | 0.219 | 0.678 | 0.540 |
| q15 店内は探しやすく整理されている | 0.149 | 0.126 | 0.205 | 0.638 | 0.487 |
| q16 オンラインと店舗の使い分けがしやすい | 0.156 | 0.118 | 0.354 | 0.592 | 0.514 |
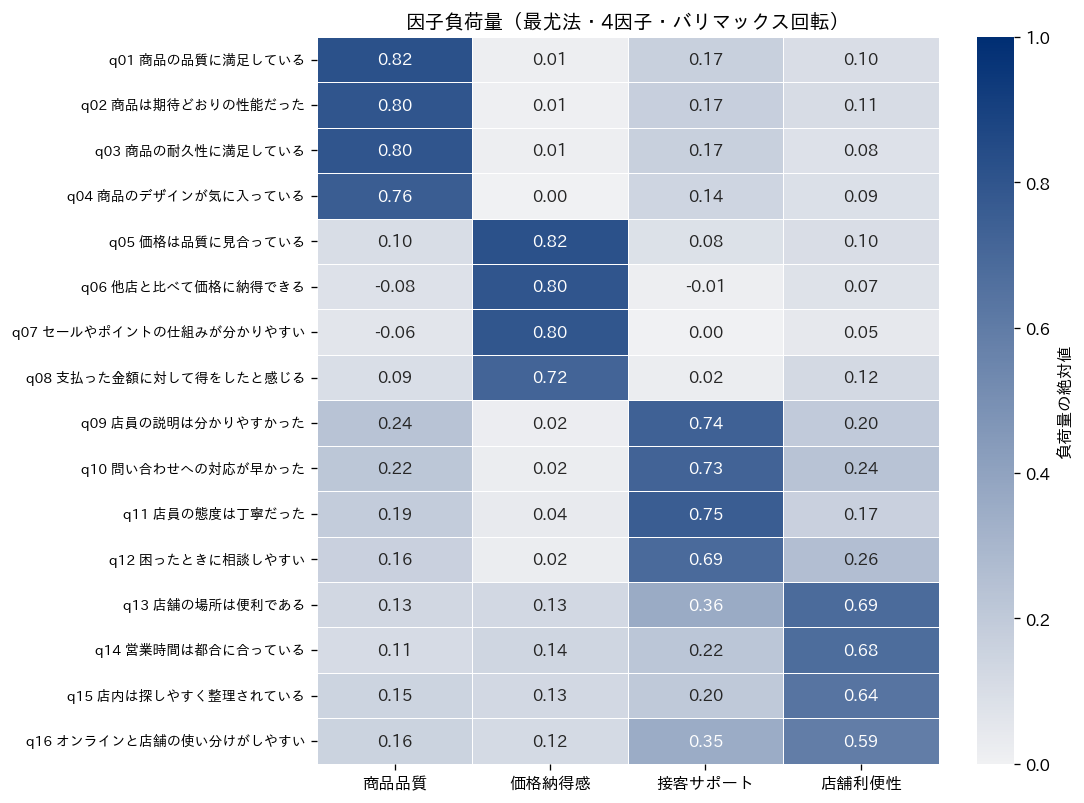
16項目すべてが設計どおりの因子に最大の負荷を持ち、主負荷は 0.592〜0.820 の範囲に収まりました。共通性は 0.487〜0.712、平均 0.615 で、4因子が16項目の分散の 61.5% を説明しています。因子ごとの説明率は商品品質 17.5%、接客サポート 16.1%、価格納得感 15.8%、店舗利便性 12.2% です。表を読むときに見てほしいのは、店舗利便性の項目 q13 と q16 が接客サポートにも 0.358・0.354 の負荷を持っている点です。「店舗の場所が便利」「オンラインと店舗の使い分けがしやすい」という項目は、接客の良さと重なる部分があります。直交回転は因子どうしの相関を0に固定するので、本来は因子間の相関として現れるはずの重なりが、こうした交差負荷として項目の側に押し出されます。
次にプロマックス回転です。statsmodels の rotate は "promax" を受け付けますが、公式ドキュメントには「varimax・quartimax・oblimin は R や Stata と照合済み。promax など一部の方法は R や Stata の既定の関数と同じ結果にならない」という注意書きがあります。実際に呼んで確かめました。
res_p = Factor(X, n_factor=4, method="ml").fit()
res_p.rotate("promax")
T = res_p.rotation_matrix
print(np.allclose(T.T @ T, np.eye(4)))                 # True(直交のまま)
print(np.abs(res_p.loadings - res4.loadings).max())    # 4.4e-16(バリマックスと同じ)

res_o = Factor(X, n_factor=4, method="ml").fit()
res_o.rotate("oblimin")
T = res_o.rotation_matrix
print(np.allclose(T.T @ T, np.eye(4)))                 # False(斜交解)
print(np.round(T.T @ T, 3))                            # 因子間相関の行列
結果は、rotate("promax") が返した負荷量はバリマックス解と小数第6位まで一致し、回転行列も直交のままでした。つまり statsmodels 0.14.6 の rotate("promax") は、この環境では斜交解を返しませんでした。理由は実装にあります。内部の関数 promax(A, k=2) は、バリマックス解 \( V \) から目標行列 \( |V|^k / V \) を作って回転しますが、既定の \( k = 2 \) では目標行列が \( V \) そのものになり、バリマックス解へ戻るだけの回転になります。\( k = 4 \) を指定して内部関数を直接呼ぶと直交でない回転行列が返りましたが、その解は交差負荷の最大が 0.537 とバリマックス解(0.358)より大きく、単純構造から遠ざかっていたので採用しませんでした。一方、rotate("oblimin")(内部では quartimin 基準)は照合済みの方法で、直交でない回転行列と、明確な斜交解を返しました。斜交解では、回転行列 \( T \) から因子間相関 \( \Phi = T’T \) が得られ、パターン行列 \( P \) と合わせて \( P\Phi P’ \) が回転前の \( \Lambda\Lambda’ \) に一致することを検算で確かめています。
| 斜交解の因子間相関 | 商品品質 | 価格納得感 | 接客サポート | 店舗利便性 |
|---|---|---|---|---|
| 商品品質 | 1.000 | 0.040 | 0.455 | 0.343 |
| 価格納得感 | 0.040 | 1.000 | 0.083 | 0.271 |
| 接客サポート | 0.455 | 0.083 | 1.000 | 0.615 |
| 店舗利便性 | 0.343 | 0.271 | 0.615 | 1.000 |
斜交解のパターン行列では、主負荷が 0.616〜0.840、交差負荷の最大が 0.138 となり、バリマックス解で 0.358 あった q13 の交差負荷が消えました。その代わりに、接客サポートと店舗利便性の因子間相関が 0.615 と高く出ています。直交解で項目の側に押し出されていた重なりが、斜交解では因子どうしの相関として表に出た、と読めます。参考までに、下位尺度ごとの平均得点どうしの相関は接客サポートと店舗利便性で 0.554、商品品質と価格納得感で 0.044 であり、斜交解の因子間相関はそれを測定誤差のぶんだけ大きくした値になっています。斜交解では、負荷量の表が2種類になる点に注意が要ります。パターン行列は「他の因子の影響を除いた、因子から項目への係数」、構造行列は「因子と項目の相関」で、構造行列は \( P\Phi \) で計算できます。このデータでは構造行列の主負荷は 0.695〜0.844 でした。因子間相関が高いほど両者の差は大きくなるので、報告するときはどちらの表かを必ず書きます。
因子得点、回帰法とバートレット法
因子は観測されない変数なので、各回答者の因子の値も「推定」するしかありません。これを因子得点と呼びます。負荷量と独自性から、標準化した回答を因子の推定値に写す係数行列を作り、回答にかけて求めます。係数の作り方で代表的なのが、回帰法とバートレット法です。回帰法は、観測値から因子を予測する回帰式の形で係数を決めます。予測値なので得点の分散は1より小さくなり、直交解でも得点どうしが少し相関します。バートレット法(Bartlett 1937)は、独自因子の分散で重みづけた最小二乗で係数を決めます。こちらは得点の分散が1より大きくなります。
sc_reg = res4.factor_scoring(method="regression")   # 1200×4
sc_bart = res4.factor_scoring(method="bartlett")
print(sc_reg.std(axis=0, ddof=1).round(3))
print(sc_bart.std(axis=0, ddof=1).round(3))
for j in range(4):
    print(j, round(np.corrcoef(sc_reg[:, j], sc_bart[:, j])[0, 1], 3))
# 総合満足度 sat との相関(列の並びと符号は推定時の任意なので、負荷量表と照らして読む)
for j in range(4):
    print(j, round(np.corrcoef(sc_reg[:, j], df["sat"])[0, 1], 3))
statsmodels の factor_scoring は method に "regression" と "bartlett" を取ります。係数行列を返す factor_score_params の公式ドキュメントには、回帰法は Stata の定義に従い、バートレット法と回帰法は照合済みだと書かれています。回帰法の得点の標準偏差は商品品質 0.933、価格納得感 0.932、接客サポート 0.893、店舗利便性 0.852 で、いずれも1より小さく、バートレット法では 1.074・1.074・1.134・1.188 と1より大きくなりました。同じ因子の得点どうしの相関は 0.998・0.999・0.987・0.988 で、どちらの方法でも回答者の順位づけはほとんど変わりません。回帰法の得点どうしの相関は最大でも 0.146(接客サポートと店舗利便性)でした。これは直交回転の解から求めた得点どうしの相関で、先ほど斜交回転で見た因子間相関 0.615 とは別の量です(斜交解では因子どうしの相関をモデルの中で許すのに対し、直交解の得点は因子どうしが無相関という前提のもとで推定されるため、値は小さく出ます)。
実務で気になるのは「因子得点と、単に4項目を平均した下位尺度得点とで、何が違うのか」でしょう。このデータでは、回帰法の因子得点と下位尺度平均の相関は 0.983・0.995・0.965・0.944 で、ほぼ同じものを測っています。総合満足度 sat との相関は、因子得点で 0.571・0.280・0.484・0.341、下位尺度平均で 0.654・0.325・0.624・0.545 と、下位尺度平均のほうが一貫して高く出ました。因子得点は「他の因子と重なる部分」を取り除こうとする分、総合的な指標との相関が下がる方向に働きます。どちらが正しいということではなく、目的が「各因子固有の効き方を分けて見る」なら因子得点、目的が「現場に配れる分かりやすいスコア」なら下位尺度平均、という使い分けになります。下位尺度平均は、項目が設計どおりに1つの因子に載っていることを因子分析で確かめたあとでなら、十分に実用的な選択です。
尺度の信頼性、クロンバックα
因子分析で「この4項目は同じ因子に載る」と確かめたあと、その4項目をまとめて1つの尺度として使ってよいかを見る指標が クロンバックα(Cronbach 1951)です。項目数を \( k \)、各項目の分散を \( s_j^2 \)、項目の合計得点の分散を \( s_T^2 \) として、
\( \alpha = \frac{k}{k-1}\left(1 – \frac{\sum_j s_j^2}{s_T^2}\right) \)
で計算します。言葉にすると、「合計得点の分散のうち、項目ごとのばらつきの単純な足し合わせでは説明できない部分、つまり項目どうしが一緒に動いている部分の割合」を、項目数で補正したものです。項目間の相関がすべて同じ \( \bar r \) なら \( \alpha = k\bar r / (1 + (k-1)\bar r) \) となり、項目間相関の平均と項目数だけで決まります。Cronbach(1951)の要旨には、αが「あらゆる折半法の信頼性係数の平均」であること、ごく短いテストを除けば第1因子への集中度の指標になること、そして明確に別の下位テストに分かれるテストは分けてから計算すべきこと、が書かれています。factor_analyzer は本コラムの環境では動かないので、上の式をそのまま実装しました。
def cronbach_alpha(items):
    k = items.shape[1]
    var_items = items.var(axis=0, ddof=1).sum()
    var_total = items.sum(axis=1).var(ddof=1)
    return k / (k - 1) * (1 - var_items / var_total)

for f, name in enumerate(["商品品質", "価格納得感", "接客サポート", "店舗利便性"]):
    cols = ITEM_COLS[f * 4:(f + 1) * 4]
    print(name, round(cronbach_alpha(X[cols]), 3))
print("16項目全部", round(cronbach_alpha(X), 3))
print("商品品質+接客サポート", round(cronbach_alpha(X[ITEM_COLS[0:4] + ITEM_COLS[8:12]]), 3))
| 下位尺度 | 項目 | 項目間相関の平均 | クロンバックα |
|---|---|---|---|
| 商品品質 | q01〜q04 | 0.665 | 0.888 |
| 価格納得感 | q05〜q08 | 0.618 | 0.866 |
| 接客サポート | q09〜q12 | 0.614 | 0.864 |
| 店舗利便性 | q13〜q16 | 0.534 | 0.821 |
| 参考:16項目全部 | q01〜q16 | 0.275 | 0.858 |
| 参考:商品品質+接客サポート | q01〜q04、q09〜q12 | 0.299(因子をまたぐ相関) | 0.865 |
4つの下位尺度のαは 0.821〜0.888 でした。αの「目安」については注意が要ります。Taber(2018)は科学教育分野の論文を調査し、0.70 前後以上が望ましいという見方が広く共有されている一方で、同じ値に付けられる形容が論文ごとにばらばらであること(「acceptable」と形容された値は 0.45 から 0.98 まであった)、そして 0.7 以上でも尺度に問題が残っている例があることを報告しています。Lance ら(2006)は、広く引用される4つの目安の出典を遡り、原典が言っていたことと引用のされ方に食い違いがあると指摘しました。0.70 を機械的な合格ラインとして扱うのではなく、用途に応じて求める水準を考え、αが低いときは項目を1つずつ除いた場合のαを見て原因の項目を探す、という使い方をお勧めします。商品品質の4項目では、q04(デザイン)を除くとαが 0.888 から 0.869 に下がり、他の3項目を除いた場合(0.847〜0.855)より下がり幅が小さいので、q04 が4項目の中では最も「他と少し違うことを測っている」項目だと分かります。
もう1つ、αについて必ず知っておくべきことがあります。αが高いことは、その項目群が1つの因子を測っていることの証明にはなりません。Cortina(1993)は、項目数と次元数と項目間相関を変えた仮想のテストでαを計算し、テストの長さと次元性がαに与える影響を示しました。Sijtsma(2009)は「αは内部一貫性の尺度ではなく、一次元性の程度の尺度でもない」と明言しています。上の表の「参考」行がその実例です。4因子構造だと分かっている16項目全部のαは 0.858 と高く、商品品質と接客サポートという別の因子の項目を8つ混ぜたαも 0.865 と、単独の下位尺度と同じ水準になります。因子をまたぐ項目間相関の平均は 0.299 と因子内の 0.640 の半分以下なのに、項目数が8に増えたことでαが持ち上がっているためです。項目間相関が 0.3 で一定なら、項目数4・8・12・16 でαは 0.632・0.774・0.837・0.873 と、項目を足すだけで上がっていきます。「αが 0.85 なので一次元の尺度です」という報告は、この意味で根拠になっていません。一次元性は因子分析で確かめ、そのうえでαを報告する、という順番が正しい使い方です。
因子分析に向くデータか、KMO とバートレットの球面性検定
因子分析は、項目どうしの相関を共通因子で説明する手法なので、そもそも項目間に十分な相関が無ければ意味のある結果は出ません。それを分析の前に確かめる指標が、KMO(Kaiser-Meyer-Olkin の標本妥当性の測度)とバートレットの球面性検定です。KMO は Kaiser(1970)が導入した標本妥当性の測度(MSA)を Kaiser と Rice(1974)が現在の形に整理した指標で、項目どうしの相関の二乗和と、他の全項目の影響を除いた偏相関の二乗和を比べます。相関係数を \( r_{ij} \)、偏相関係数を \( p_{ij} \) として、
\( \mathrm{KMO} = \frac{\sum_{i \ne j} r_{ij}^2}{\sum_{i \ne j} r_{ij}^2 + \sum_{i \ne j} p_{ij}^2} \)
です。偏相関は相関行列の逆行列から \( p_{ij} = -q_{ij} / \sqrt{q_{ii} q_{jj} } \)(\( q \) は逆行列の要素)で求まります。項目間の相関が共通因子によって生じているなら、他の項目の影響を除いた偏相関は小さくなり、KMO は1に近づきます。相関がばらばらの原因で生じているなら偏相関が残り、KMO は下がります。値の読み方として広く引用されているのは、0.9 台を marvelous、0.8 台を meritorious、0.7 台を middling、0.6 台を mediocre、0.5 台を miserable、0.5 未満を unacceptable とする区分です。この区分は Kaiser の論文に帰されるものとして R の psych パッケージの解説などに引用されていますが、原論文の要旨には「0 から 1 の間を動く指標を提案し、その較正の問題を論じた」とあるだけで、本コラムでは区分の文言を原論文の本文で直接確かめることはできていません。バートレットの球面性検定(Bartlett 1950)は、「相関行列が単位行列である(項目間に相関が無い)」を帰無仮説とし、相関行列の行列式から \( \chi^2 = -\left(n – 1 – \frac{2p+5}{6}\right)\ln|R| \) を計算します。
from scipy import stats

def kmo(corr):
    inv = np.linalg.inv(corr)
    d = np.sqrt(np.outer(np.diag(inv), np.diag(inv)))
    partial = -inv / d
    np.fill_diagonal(partial, 0.0)
    r2 = corr.copy()
    np.fill_diagonal(r2, 0.0)
    r2 = r2 ** 2
    p2 = partial ** 2
    return r2.sum() / (r2.sum() + p2.sum())

def bartlett_sphericity(corr, n):
    p = corr.shape[0]
    _, logdet = np.linalg.slogdet(corr)
    chi2 = -(n - 1 - (2 * p + 5) / 6) * logdet
    dof = p * (p - 1) / 2
    return chi2, dof, stats.chi2.sf(chi2, dof)

print(round(kmo(R), 3))                 # 0.892
print(bartlett_sphericity(R, n))        # カイ二乗 9623.9、自由度 120、p値 0
16項目の KMO は 0.892 で、項目ごとの値(MSA)も最小 0.829(q07)から最大 0.930(q16)の範囲にありました。バートレットの検定はカイ二乗 9623.9、自由度 120 で p値は0とみなせるほど小さい値です。相関行列の行列式は 0.000313 と0に近く、項目間に強い相関構造があることを示しています。比較のために、同じ大きさの無相関な正規乱数で同じ計算をすると、KMO は 0.497、バートレットの p値は 0.334 でした。因子分析にかける前に、この2つの値が「乱数と区別できない」水準でないことを確かめておくと、意味のない因子構造に名前を付ける事故を防げます。ただし、バートレットの検定は標本が大きければどんなに弱い相関でも棄却されるので、1,000件を超えるデータでは「棄却されて当然」であり、KMO のほうが判断材料として役に立ちます。
実務での読み方、因子の命名は解釈であって事実ではない
因子分析の結果を報告するとき、最も誤解を生みやすいのが因子の名前です。本章では負荷量の表に「商品品質」「価格納得感」といった名前を付けましたが、これは生成時に仕込んだ構造を知っているからできることです。実際のデータでは、分析者が負荷量の大きい項目の文言を眺め、共通する意味を推測して名前を付けます。名前はモデルの出力ではなく、分析者の解釈です。同じ負荷量の表を見て、別の人が別の名前を付けることは普通にあります。報告書には、名前とあわせて、その因子に大きく載った項目の文言と負荷量を必ず並べ、読み手が名前の妥当性を自分で判断できるようにしておくべきです。
経営の観点で言えば、因子の命名を誤ると施策の宛先がずれます。たとえば本章のデータで、店舗利便性の因子に「店舗の場所」「営業時間」「店内の整理」「オンラインとの使い分け」が載ったとき、これを「立地」と名付けてしまうと、施策は出店戦略の話になります。しかし項目を見れば、営業時間や店内の整理やオンライン連携といった、既存店舗の運営で変えられる要素が中心です。「立地」という名前は、変えにくい要因に責任を押しつけ、変えやすい要因を見えなくします。逆に、接客サポートと店舗利便性の因子間相関が 0.615 と高いことを見落として2つを別々の部署の KPI にすると、片方を改善したときに他方も動く構造が見えず、効果の帰属を巡って部署間の議論が空転します。因子分析の出力を施策に落とすときは、因子の名前ではなく、その因子に載った項目の文言に戻って「誰が、何を変えられるか」を確認するのが、損失を避ける最も確実な方法です。
もう1つの落とし穴は、因子構造を「顧客の真実」として固定してしまうことです。因子数の判断が紙一重だったことを上で見ました。項目の文言を変えれば負荷量は変わり、標本が変われば因子数が変わることもあります。探索的因子分析は「このデータから読み取れる構造の候補」を出す手法であり、その構造が別の標本でも成り立つかは、第11章の確認的因子分析で仮説として検証するのが本来の順番です。1回の調査の因子構造を、次年度以降の調査票の設計や KPI の定義に固定して使うなら、少なくとも同じ構造が翌年の標本でも再現されることを確かめてからにします。
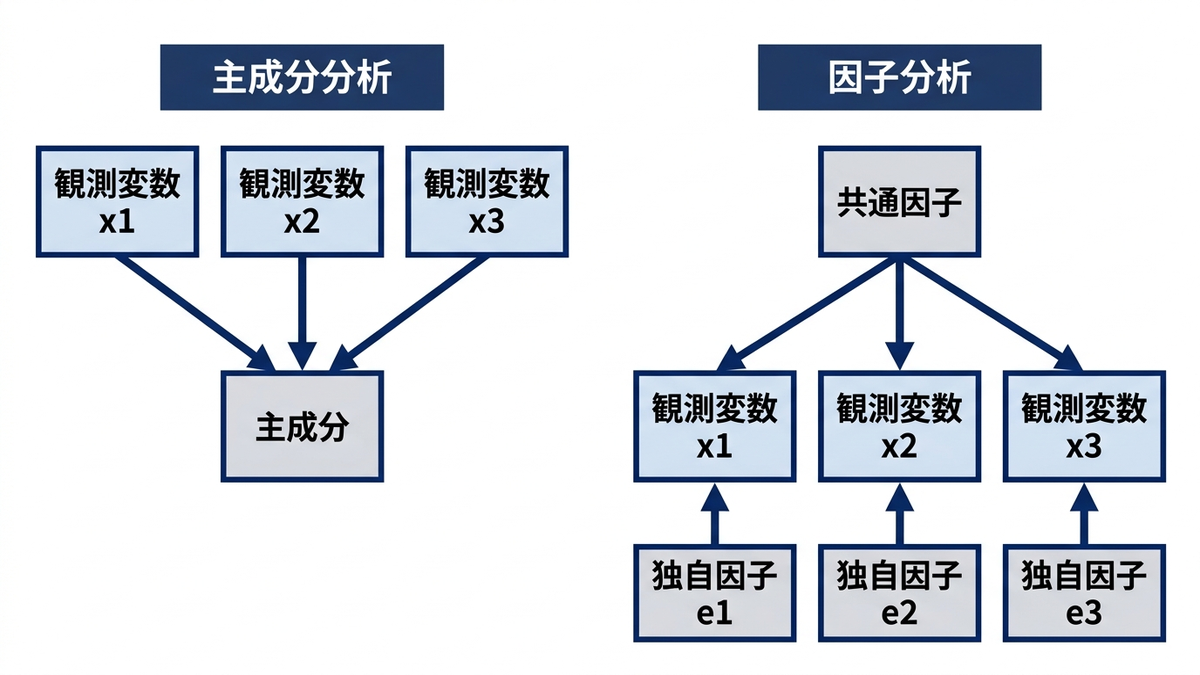
本章の要点は3つです。因子分析は観測変数を合成するのではなく、観測変数を説明する潜在変数を推定する手法であり、独自因子を分けて考える点で主成分分析と異なります。因子数は適合度・スクリープロット・平行分析を突き合わせて決め、回転は因子どうしの相関を許すかどうかで直交と斜交を使い分け、クロンバックαは一次元性を確かめたあとで報告します。そして、因子の名前は解釈であって事実ではなく、施策に落とすときは項目の文言に戻ります。次の第5章では、この手法をプロテニスの試合データに当て、サーブ力とリターン力という2つの潜在変数を取り出した事例を、初出時の実行結果をもとに紹介します。
この章を深めたい方への参考書籍
『因子分析入門:Rで学ぶ最新データ解析』(豊田秀樹 編著、東京図書):「速習・因子分析」から始まり「確認的因子分析」で終わる9章構成で、R を使って手を動かしながら探索的因子分析を学ぶ入門書です。本章の Python での手順を R で追いかけ直したい方に向いています。
『因子分析:その理論と方法』(柳井晴夫・繁桝算男・前川眞一・市川雅教、朝倉書店):因子分析モデルとその基本性質、推定、因子の回転、カテゴリカルデータの因子分析、共分散構造分析までを扱う統計ライブラリーの1冊です。本章では数式を最小限にしましたが、推定や回転の理論を式で確かめたい方のための専門書です。
『心理統計学の基礎:統合的理解のために』(南風原朝和、有斐閣):心理学研究に必要な統計学の理論と方法を、相関と回帰から線形モデル、分散分析へと積み上げ、最終章で因子分析と共分散構造分析に至る教科書です。本章の内容を統計の基礎とつなげて理解したい方に向いています。
第5章 因子分析の事例、プロテニスのサーブ力とリターン力
第4章では、観測された変数の背後に少数の共通因子を仮定し、因子負荷量と因子得点で構造を読む手順を確認しました。共通性と独自性の分け方、回転の意味、因子数の決め方といった一般論は、そこで一通り揃っています。本章では、その一般論を実データにあてはめるとどうなるかを、プロテニスの試合記録を材料にして見ていきます。教科書どおりに進まない部分、判断に迷う部分がどこに出るかを、実際の数値とともに追うのが目的です。
題材は、男子プロテニスの選手ごとのサーブとリターンの成績です。各選手には「サーブが得意」「リターンが得意」といった特徴があると語られますが、それが数値としてどの程度の強さなのかは、試合の成績表を眺めるだけでは分かりません。そこで、各選手にサーブ力とリターン力という潜在変数があると仮定し、試合ごとのポイント取得率から因子分析でその潜在変数を推定して定量化する、という試みを行いました。
本章の分析結果は、2018年時点のデータを用いて初出時に実行したものです。コードと数値の結果は当時のまま保持しており、本コラムの改訂にあたって再実行は行っていません。当時のコードには、現在のライブラリでは動かない書き方が含まれているため、書き換えの要点を章の後半に別節としてまとめました。さらに、第4章の基準に照らして当時の判断をどう評価するか、この事例の型を経営のどこに転用できるかを、今の目で見た補足として加えています。
分析の準備、ATPツアーの試合データと使った列
使ったデータセットは、Kaggle で公開されている男子プロテニスの試合記録で、URL は https://www.kaggle.com/ehallmar/a-large-tennis-dataset-for-atp-and-itf-betting です。複数のテーブルが格納されていますが、使ったテーブルは all_matches.csv です。各選手の ATPツアー の試合結果が、試合ごとのポイントの内訳まで含めて記録されており、初出時の説明では2018年の試合分まで格納されていました。このページは2026年9月時点でも存在しており、データセットの最終更新日は2018年8月27日と表示されています。
多くの列が入っていますが、この分析ではファーストサービス・セカンドサービス・リターンのポイントに関する次の列を使いました。列名は当時のものをそのまま載せています。
| 列名 | 列の意味 |
|---|---|
| player_name | 選手名 |
| player_victory | 勝敗 |
| double_faults | ダブルフォルト数 |
| first_serve_made | ファーストサービスが入った数。first_serve_points_attempted と同じ値 |
| first_serve_attempted | ファーストサービスを行った数 |
| first_serve_points_made | ファーストサービス成功時の獲得ポイント数 |
| first_serve_points_attempted | ファーストサービス成功時の全体ポイント数。first_serve_made と同じ値 |
| second_serve_points_made | セカンドサービス成功時の獲得ポイント数 |
| second_serve_points_attempted | セカンドサービス成功時の全体ポイント数 |
| first_serve_return_points_made | 相手ファーストサービス成功時(リターン)の獲得ポイント数 |
| first_serve_return_points_attempted | 相手ファーストサービス成功時(リターン)の全体ポイント数 |
| second_serve_return_points_made | 相手セカンドサービス成功時(リターン)の獲得ポイント数 |
| second_serve_return_points_attempted | 相手セカンドサービス成功時(リターン)の全体ポイント数 |
| doubles | ダブルスかどうか |
| masters | トーナメントのATPポイント(例として、2000がグランドスラム) |
データを pandas で読み込んで分析の準備をします。初出時の説明では、直近の試合で分析するために2016年以降のデータに限定し、シングルスのみを取得したとしていました。ただし、その読み込みと絞り込みのコードは初出時にも掲載されておらず、後述の前処理のコードは読み込み済みの df_matches から始まります。したがって、掲載コードの範囲で確認できる絞り込みは、後述する masters が 2000 の試合への限定だけです。データには、各選手が各試合でファーストサービスとセカンドサービスを何回打ち、何回入り、ポイントをいくつ取ったかが入っています。試合ごとの総ポイント数は試合によって異なるため、そのままの個数ではなく、その試合の中での成功率やポイント率といった割合に変換します。第2章で扱った標準化と同じ考え方で、ここでは割合への変換という形で試合ごとの単位をそろえています。
また、チャレンジャーなど下位の大会のデータも含まれており、分析対象が多すぎるため、初出時には「2016年以降に開催されたグランドスラムに出場したことがあり、かつ10回以上の白星をあげている選手」に絞ると説明していました。掲載コードを文字どおり読むと、masters が 2000 の試合だけを残し、選手ごとに各割合の平均と件数を集計したうえで、集計された試合数が10以上で勝率が0より大きい選手を残しています。説明文の「白星10回」とコードの「試合数10」は厳密には同じ条件ではありません。どちらが実際の実行に使われた条件かは、いま確かめられないため、本章では掲載コードの条件をそのまま示します。前処理のコードは次のとおりです。
df_tmp = df_matches[df_matches['masters'] == 2000]

# ファーストサービス成功率
df_tmp.loc[:, 'first_serve_rate'] = df_tmp['first_serve_made']/df_tmp['first_serve_attempted']

# ファーストサービス成功時のポイント率
df_tmp.loc[:, 'first_serve_point_rate'] = df_tmp['first_serve_points_made']/df_tmp['first_serve_points_attempted']

# セカンドサービス成功率
df_tmp.loc[:, 'second_serve_rate'] = 1-df_tmp['double_faults']/df_tmp['second_serve_points_attempted']

# セカンドサービス成功時のポイント率
df_tmp.loc[:, 'second_serve_point_rate'] = df_tmp['second_serve_points_made']/df_tmp['second_serve_points_attempted']

# 相手ファーストサービス成功時のポイント率
df_tmp.loc[:, 'first_serve_return_point_rate'] = df_tmp['first_serve_return_points_made']/df_tmp['first_serve_return_points_attempted']

# 相手セカンドサービス成功時のポイント率
df_tmp.loc[:, 'second_serve_return_point_rate'] = df_tmp['second_serve_return_points_made']/df_tmp['second_serve_return_points_attempted']

# 勝敗
df_tmp.loc[df_tmp['player_victory'] == 't', 'victory'] = 1
df_tmp.loc[df_tmp['player_victory'] == 'f', 'victory'] = 0

get_cols = [
    'player_name', 'first_serve_rate', 'first_serve_point_rate','second_serve_rate', 'second_serve_point_rate',
    'first_serve_return_point_rate', 'second_serve_return_point_rate', 'victory'
]
df_tmp = df_tmp[get_cols]

df_tmp = df_tmp.groupby('player_name').agg(['mean','count'])
df_tmp = df_tmp[(df_tmp['victory']['count'] >= 10) & (df_tmp['victory']['mean'] > 0)]
levels = df_tmp.columns.levels
labels = df_tmp.columns.labels
df_tmp.columns = [levels[0][i]+'_'+levels[1][j] for i, j in zip(labels[0], labels[1])]
df_tmp = df_tmp[[c+'_mean' for c in get_cols[1:]]]
df_tmp.columns = get_cols[1:]
df_tmp_n = (df_tmp-df_tmp.mean())/df_tmp.std()
df_tmp_n = df_tmp_n.dropna()
len(df_tmp_n) # 81
このコードで作られる df_tmp は、選手を行、6つの割合と勝率を列とする表で、各値はその選手の試合ごとの平均です。それを列ごとに平均0・標準偏差1に標準化したものが df_tmp_n で、行数は81でした。つまり、以降の因子分析は81選手×6変数の行列に対して行われます。ここで用いた条件では、試合ごとの割合を単純平均しているため、試合数の多い選手も少ない選手も1行として同じ重みで扱われます。この点は後の補足で改めて取り上げます。
相関行列で因子の仮説を確かめる
因子分析に入る前に、各列の相関を取り、サーブ力とリターン力という因子が仮定できそうかを確認します。第4章で述べたとおり、因子分析は相関の構造を少数の因子で説明する手法なので、相関行列に「まとまり」が見えなければ因子を置く根拠がありません。相関行列はヒートマップで描きました。
plt.figure(figsize=(6,5))
sns.heatmap(df_tmp.corr(), annot=True, vmax=1, vmin=-1, fmt='.2f', cmap=cm)
plt.show()
ヒートマップの数値を表に写すと次のようになります。列の見出しは、ファーストサービスを1st、セカンドサービスを2nd と略しました。
| 1st成功率 | 1stポイント率 | 2nd成功率 | 2ndポイント率 | 1stリターン率 | 2ndリターン率 | 勝率 | |
|---|---|---|---|---|---|---|---|
| 1st成功率 | 1.00 | -0.16 | 0.11 | 0.23 | 0.06 | -0.16 | 0.23 |
| 1stポイント率 | -0.16 | 1.00 | -0.29 | 0.17 | -0.21 | -0.16 | 0.41 |
| 2nd成功率 | 0.11 | -0.29 | 1.00 | 0.50 | 0.08 | 0.18 | 0.19 |
| 2ndポイント率 | 0.23 | 0.17 | 0.50 | 1.00 | 0.01 | 0.11 | 0.50 |
| 1stリターン率 | 0.06 | -0.21 | 0.08 | 0.01 | 1.00 | 0.63 | 0.39 |
| 2ndリターン率 | -0.16 | -0.16 | 0.18 | 0.11 | 0.63 | 1.00 | 0.37 |
| 勝率 | 0.23 | 0.41 | 0.19 | 0.50 | 0.39 | 0.37 | 1.00 |
この表からいくつかのことが読み取れます。まず、サーブの成功率(精度)とそのサーブでのポイント率の相関は、ファーストでは -0.16 とほとんどありません。一方、セカンドでは 0.50(2nd成功率と2ndポイント率の相関)と中程度に連動しています。初出時にはファースト・セカンドとも「あまり相関しない」と書いていましたが、セカンドの 0.50 は中程度の正の相関と読むほうが数値に忠実です。勝率との相関は、成功率よりもポイント率のほうが大きく出ています(1stポイント率 0.41、2ndポイント率 0.50 に対して、1st成功率 0.23、2nd成功率 0.19)。このデータでは、このクラスの選手のサーブの精度は勝率との関連が小さく、サーブを入れた後のポイント率のほうが勝率との関連が強く出ています。相関表だけから因果までは言えないため、「ゲームメイクのほうが勝敗を決める」とまでは断定できません。
次に、ファーストサービスでのポイント率とセカンドサービスでのポイント率の相関は 0.17 と小さく、サーブからの展開が得意な選手でも、ファーストで得意ならセカンドでも得意とは限らないことが分かります。一方、リターンは相手のファーストサービスに対するポイント率と、セカンドサービスに対するポイント率の相関が 0.63 と大きく、リターンが得意な選手は相手がどちらのサーブでも強い傾向があります。
この結果から、サーブ力とリターン力の2因子と仮定するよりも、ファーストサービスのゲームメイク力・セカンドサービスのゲームメイク力・リターン力の3因子が潜在していると解釈するほうが自然に見えます。ただし、相関行列を眺めただけで因子数を決めるのは早計なので、因子数を2から4まで変えて、それぞれの因子負荷量と各選手の因子得点を確認することにしました。因子数を指定して分析結果を返す関数と、分析結果から因子得点の散布図を描く関数を次のように作成しました。
x = df_tmp_n[target_cols].values
y = df_tmp_n.index

def fit(factor_num):
    fa = decomposition.FactorAnalysis(n_components=factor_num).fit(x)

    df_factor_loading = pd.DataFrame(columns=target_cols)
    for i in range(factor_num):
        df_factor_loading = df_factor_loading.append(pd.Series(fa.components_[i], index=target_cols, name='factor'+str(i)))

    display(df_factor_loading)
    return fa

def plot(factor_num, fa):
    transformed = fa.fit_transform(x)

    for i, j in itertools.combinations(np.arange(factor_num), 2):
        plt.figure(figsize=(8,8))
        plt.scatter(transformed[:, i], transformed[:, j], color=base_color)
        for k, y_ in enumerate(y):
            plt.annotate(y_, xy=(transformed[k, i], transformed[k, j]), size=8, alpha=0.5)
        fai = fa.components_[i]
        faj = fa.components_[j]
        for k, c in enumerate(target_cols):
            plt.arrow(0, 0, fai[k]*2, faj[k]*2, color='r', head_width=0.1, alpha=1)
            plt.text(fai[k]*2.5, faj[k]*2.5, c, color='r', fontsize=12)
        plt.axes().add_patch(plt.Circle((0, 0), radius=0.5*2, ec='r', fill=False))
        plt.xlim([-3,3])
        plt.ylim([-3,3])
        plt.xlabel('factor'+str(i))
        plt.ylabel('factor'+str(j))
        plt.title('factor'+str(i)+' x '+'factor'+str(j))
        plt.show()

    return transformed
使っているのは scikit-learn の decomposition.FactorAnalysis です。公式ドキュメントによれば、このクラスは観測値を「低次元の潜在因子の線形変換にガウス雑音を加えたもの」とみなし、因子負荷量を最尤法で推定します。components_ が因子負荷量の行列(因子×変数)、fit_transform の戻り値が各選手の因子得点(潜在変数の期待値)です。fit 関数は負荷量を表にして表示し、plot 関数は因子の組み合わせごとに、選手の因子得点を散布図にして、そこへ各変数の負荷量ベクトルを矢印で重ね、目安として半径0.5の円を描きます(図の座標では負荷量を2倍に引き伸ばしているため、円の半径も1.0で描いています)。
なお、掲載コードには target_cols・cm・base_color の定義が含まれていません。負荷量の表の列名から、target_cols は勝率を除いた6つの割合の列であることが読み取れます。display は Jupyter 上で表を整形表示する関数で、通常の Python スクリプトでは print に読み替えます。
因子数2と仮定した場合の結果と解釈
まず因子数2の場合の因子負荷量を確認します。
fa2 = fit(factor_num=2)
transformed2 = plot(factor_num=2, fa=fa2)
負荷量を小数第3位までに丸めて表にすると次のとおりです。図には元の桁数のまま載っています。
| 1st成功率 | 1stポイント率 | 2nd成功率 | 2ndポイント率 | 1stリターン率 | 2ndリターン率 | |
|---|---|---|---|---|---|---|
| factor0 | 0.010 | 0.250 | -0.324 | -0.209 | -0.746 | -0.794 |
| factor1 | -0.248 | -0.002 | -0.630 | -0.676 | 0.219 | 0.122 |
因子得点の散布図には、因子負荷量のベクトルと目安の円を同時に描いています。これを見ると、リターン力は factor0 に2つのリターン率がともに大きな負荷(-0.746 と -0.794)で載っており、1つの因子として取れそうです。一方、サーブに関する情報はうまくまとまっていません。factor1 にはセカンドサービスの成功率とポイント率(-0.630 と -0.676)が載っていますが、ファーストサービスのポイント率はどちらの因子にもほとんど載っていません(0.250 と -0.002)。強いて言えばリターン力とセカンドサービス力の2因子が潜在するという解釈にはなりますが、ファーストサービスが取り残されており、負荷量ももう少し大きく出てほしいところです。
負荷量の符号が負になっている点は、この段階では気にする必要はありません。因子分析のモデルは観測値を因子の線形変換と雑音の和として表すため、ある因子の負荷量と因子得点の符号をまとめて反転させても、観測値の説明はまったく変わりません。因子の向きは推定の都合で決まるだけのものです。ここでは「リターン率が高い選手ほど factor0 が小さい」という向きで推定されただけであり、まとめの節ではこの符号を反転させて扱っています。
因子数3と仮定した場合の結果と解釈
次に因子数3の場合を見ます。
fa3 = fit(factor_num=3)
transformed3 = plot(factor_num=3, fa=fa3)
| 1st成功率 | 1stポイント率 | 2nd成功率 | 2ndポイント率 | 1stリターン率 | 2ndリターン率 | |
|---|---|---|---|---|---|---|
| factor0 | -0.020 | -0.220 | 0.392 | 0.413 | 0.601 | 0.884 |
| factor1 | -0.204 | -0.467 | -0.305 | -0.828 | 0.276 | 0.266 |
| factor2 | 0.328 | -0.753 | 0.442 | 0.167 | -0.066 | -0.208 |
因子負荷量を見ると、この3因子解がもっとも解釈しやすい形になっています。factor0 は2つのリターン率(0.601 と 0.884)が大きく載っており、リターン力と読めます。factor1 はセカンドサービスでのポイント率(-0.828)がもっとも大きく、セカンドサービスでのポイント力です。factor2 はファーストサービスでのポイント率(-0.753)が大きく、ファーストサービスでのポイント力です。ただし、factor0 にはセカンドサービスの2つの割合も 0.4 前後で載っており、factor1 にはファーストサービスのポイント率が -0.467 で載っているなど、各変数が1つの因子だけに載る単純構造には届いていません。この点は、回転をかけていないことと関係しており、後の補足で取り上げます。
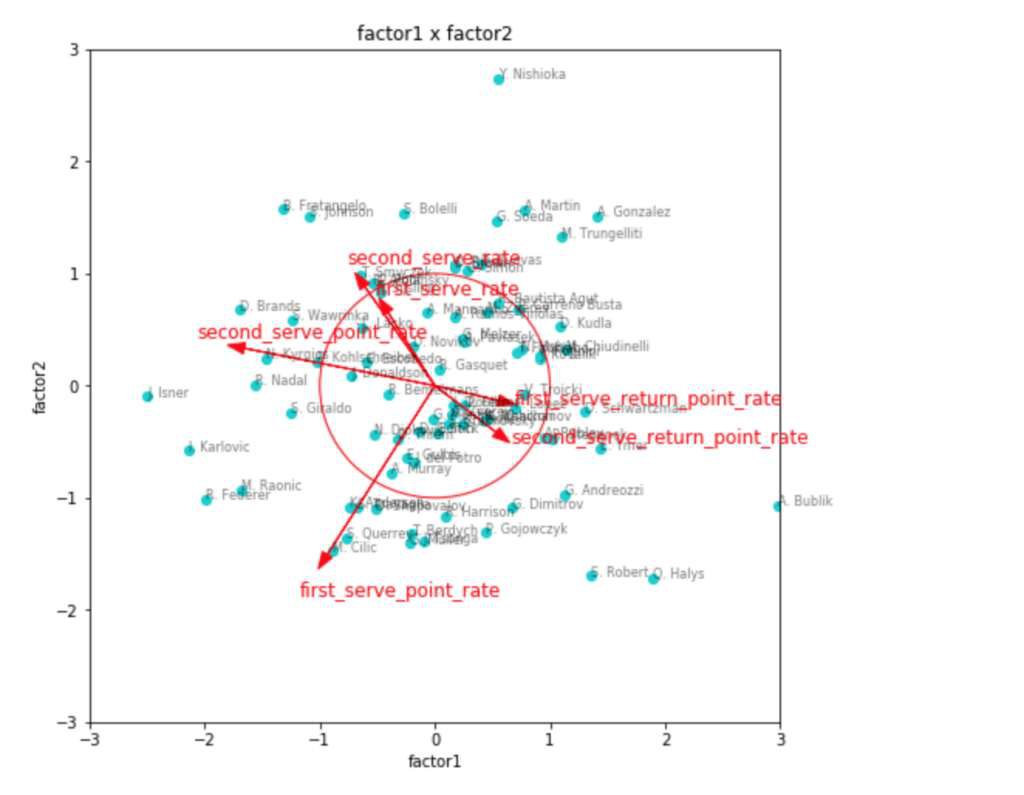
因子得点の3つ目の図(factor1 と factor2 の平面)を見ると、左下にサーブを武器とする選手が集まっています。この平面では、ファーストサービスのポイント率の矢印が左下、セカンドサービスのポイント率の矢印が左を向いているため、左下ほど両方のサーブでポイントを取れる選手ということになります。ファーストサービスの方向にはチリッチ、クエリー、アンダーソンといった選手がいて、それに加えてセカンドサービスの方向にも強い位置にいるのが、フェデラー、ラオニッチ、カルロビッチといった選手です。サービスが武器と言われる選手の中でも、勝率としてより成功している選手は、両方の軸で強い位置に出ているように見えます。
リターン力の軸(factor0)で見ると、ナダル、ジョコビッチ、シュワルツマンといった選手が強い位置にいます。1つ目の図では右側、2つ目の図でも右側です。点が重なって見えづらいところですが、錦織選手もリターン力が強い位置にいます。ここで読んでいるのはあくまでプレーの数値の位置関係であり、選手の評価そのものではないことを断っておきます。
因子数4と仮定した場合の結果
最後に因子数4の場合も試しました。
fa4 = fit(factor_num=4)
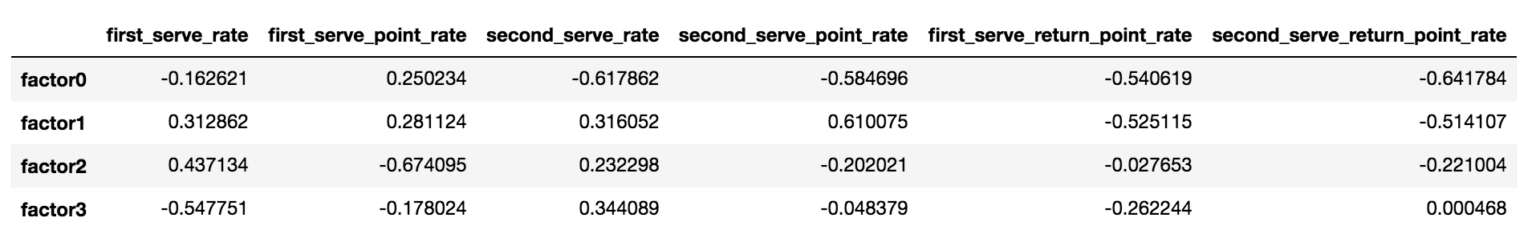
| 1st成功率 | 1stポイント率 | 2nd成功率 | 2ndポイント率 | 1stリターン率 | 2ndリターン率 | |
|---|---|---|---|---|---|---|
| factor0 | -0.163 | 0.250 | -0.618 | -0.585 | -0.541 | -0.642 |
| factor1 | 0.313 | 0.281 | 0.316 | 0.610 | -0.525 | -0.514 |
| factor2 | 0.437 | -0.674 | 0.232 | -0.202 | -0.028 | -0.221 |
| factor3 | -0.548 | -0.178 | 0.344 | -0.048 | -0.262 | 0.000 |
因子数4では、負荷量の絶対値がどれもそこそこの大きさになってしまい、どの因子が何を表しているのかがはっきりしません。factor0 にはセカンドサービスとリターンの4変数が 0.5 から 0.6 台で同時に載り、factor1 はセカンドサービスのポイント率とリターン率が逆符号で載るなど、変数のまとまりが因子をまたいで散らばっています。この結果については因子得点の散布図を省略しました。6変数に対して因子4つは多すぎる、という感触が当時の結論でしたが、これが感触ではなく数学的な制約でもあることは、後の補足で述べます。
各因子と勝率の相関、錦織選手の順位
以上から、このデータでは、ファーストサービスのゲームメイク力・セカンドサービスのゲームメイク力・リターン力の3つの因子から観測値が生成されていると解釈するのが妥当と判断しました。この3因子解を使って、各因子の得点と勝率の相関を見ます。factor1 と factor2 は負荷量が負の向きで推定されていたため、符号を反転させて「大きいほど強い」向きに揃えています。
df_results = pd.DataFrame(
    np.concatenate([np.array(y).reshape(len(y), 1), transformed3, df_tmp['victory'].values.reshape(len(y), 1)], axis=1),
    columns = ['player_name', 'factor0', 'factor1', 'factor2', 'victory_rate']
)
df_results['factor0'] = df_results['factor0'].astype(np.float32)
df_results['factor1'] = -df_results['factor1'].astype(np.float32)
df_results['factor2'] = -df_results['factor2'].astype(np.float32)
df_results['victory_rate'] = df_results['victory_rate'].astype(np.float32)

plt.figure(figsize=(6,5))
sns.heatmap(df_results.corr(), annot=True, vmax=1, vmin=-1, fmt='.2f', cmap=cm)
plt.show()
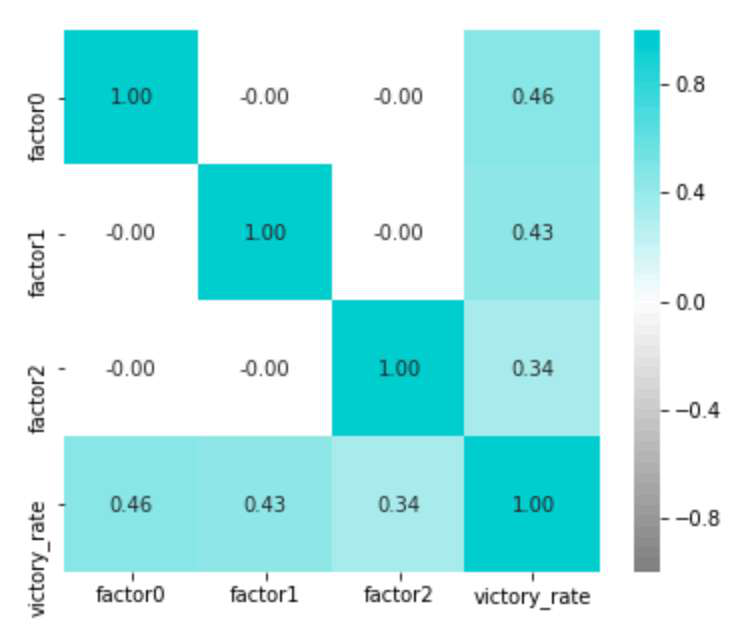
| 因子 | 解釈 | 勝率との相関 |
|---|---|---|
| factor0 | リターン力 | 0.46 |
| factor1(符号反転後) | セカンドサービスでのポイント力 | 0.43 |
| factor2(符号反転後) | ファーストサービスでのポイント力 | 0.34 |
3つの因子はいずれも勝率と正の相関を持ち、どれも勝率の高低と一緒に動いています。その中で、リターン力の因子が 0.46 ともっとも大きく出ました。勝つためにはリターンのゲームを取る必要があるため、リターン力が勝率との相関で前に出るのは筋の通った結果です。また、因子どうしの相関が 0.00 になっているのは、このモデルが因子を平均0・単位共分散のガウス分布に従う、つまり互いに無相関と仮定して推定しているためで、データの性質ではなくモデルの仮定の表れです。
最後に、これらの因子得点で定量的に見た錦織選手の順位を調べました。
print('K. Nishikori')
print('-'*50)
for i in [0, 1, 2]:
    rank = np.where(df_results.sort_values(by='factor'+str(i), ascending=False)['player_name'].values == 'K. Nishikori')
    rank = rank[0][0]+1
    print('factor'+str(i), '\t', rank, '/', len(df_results))
# 出力:
# K.Nishikori
# --------------------------------------------------
# factor0   11/81
# factor1   54/81
# factor2   31/81
リターン力(factor0)は81選手中11位と上位にいます。一方、セカンドサービスでのポイント力(factor1)は54位で、セカンドサーブから崩されやすい傾向が数値として出ています。ファーストサービスでのポイント力(factor2)は31位で中位です。因子分析によって、サーブ力やリターン力という言葉では漠然としている要素を数値にし、順位づけできるようになりました。ある選手の強みと改善点を、観戦の印象ではなく成績表の構造から言えるようになる、というのがこの事例の要点です。
現在の環境で動かす場合の書き換え
本章のコードは2018年時点のライブラリで書かれており、現在の環境ではそのままでは動かない箇所があります。以下は、各ライブラリの公式リリースノートと、2026年9月時点の環境(pandas 3.0.1、matplotlib 3.10.8、scikit-learn 1.9.0)での実測にもとづく書き換えの要点です。書き換え後のコードはテニスのデータでは実行していないため、出力は載せていません。
| 当時の書き方 | 現在の状態 | 書き換え |
|---|---|---|
df.append(...) | pandas 2.0.0(2023年4月3日)で削除。現行環境では AttributeError になる | pd.concat に置き換えるか、負荷量の行列から pd.DataFrame を直接つくる |
MultiIndex.labels | pandas 1.0.0(2020年1月29日)で削除。現行環境では AttributeError になる | MultiIndex.codes、または to_flat_index() |
plt.axes().add_patch(...) | 現行環境で実測すると、描画済みの Axes とは別の Axes を新しく作り、図の中に Axes が2つできる | plt.gca().add_patch(...) |
絞り込んだ表への .loc 代入 | pandas 3.0.0(2026年1月21日)で Copy-on-Write が常時有効になり、SettingWithCopyWarning は削除された | そのままでよい。実測でも警告は出ず、元の表は変わらない |
display(...) | Jupyter 専用の関数 | スクリプトでは print |
文字列の列を含む表への df_results.corr() | pandas 2.0.0 で numeric_only の既定値が False に変わり、現行環境では選手名の列を数値に変換できず ValueError になる | df_results.corr(numeric_only=True)、または数値の列だけを選んでから corr() |
pandas の公式リリースノートには、2.0.0 で「非推奨だった Series.append()、DataFrame.append() を削除した。代わりに concat() を使う」と記載されています。MultiIndex.labels については 1.0.0 のリリースノートに「MultiIndex.labels を削除した。代わりに MultiIndex.codes を使う」とあります。どちらも現行環境で呼ぶと属性が無い旨の AttributeError になることを、本コラムの改訂時に確かめました。また、DataFrame.corr() の公式ドキュメントには、numeric_only 引数の既定値が 2.0.0 で False に変わったと記載されています。当時のコードは選手名の文字列の列を含んだ df_results に対して corr() を呼んでおり、現行環境ではこの呼び出しが文字列を数値に変換できない旨の ValueError になることも、改訂時に確かめました。numeric_only=True を渡すか、数値の列だけを選んでから呼びます。なお、相関行列を先に描いた df_tmp.corr() は、選手名が行の見出しに移った後の数値だけの表に対する呼び出しなので、この影響を受けません。groupby(...).agg(['mean','count']) でできる2階層の列名を levels と codes から組み立てる書き方は残っていますが、to_flat_index() で組をタプルにして結合するほうが短く書けます。
matplotlib については、当時のコードは散布図を描いた後に plt.axes() を呼んで、返ってきた Axes に円を追加しています。現行の公式ドキュメントでは、引数なしの plt.axes() は「現在の図に新しい全画面の Axes を追加する」と説明されています。実際に matplotlib 3.10.8 で散布図を描いた後に plt.axes() を呼ぶと、警告は出ないまま図の中の Axes が2つになり、以後の plt.xlim や plt.xlabel は新しいほうの Axes に適用されました。初出時の図では円が散布図と同じ座標系に描かれているので、当時の環境では plt.axes() が描画済みの Axes を返していたことになります。matplotlib 2.1 の API 変更の記録には、同じ引数で add_axes を呼んだときに既存の Axes を再利用する挙動を非推奨にし、将来は常に新しい Axes を作ると書かれており、当時と現在の挙動の違いはこの方針の延長にあります。いま描いている Axes に図形を足すには、plt.gca() で現在の Axes を取得して add_patch を呼びます。
pandas 3.0 の Copy-on-Write は、当時のコードにとってはむしろ好都合な変更です。真偽値で絞り込んだ表の列に .loc で代入する書き方は、pandas 2 系までは元の表を書き換えてしまう可能性があるとして警告の対象でしたが、3.0.0 のリリースノートには「あらゆるインデックス操作の結果はコピーとして振る舞う」「SettingWithCopyWarning は削除された」とあります。実測でも、絞り込んだ表に新しい列を足しても警告は出ず、元の表には列が増えませんでした。書き換え後の主要部分は次のとおりです。
# pandas 2.0 以降・matplotlib 3 系向けの書き換え(本コラムでは実行していません)

# 2階層の列名を平坦にする(labels は codes に改名済み。to_flat_index でも同じ)
df_tmp.columns = ['_'.join(c) for c in df_tmp.columns.to_flat_index()]

def fit(factor_num):
    fa = decomposition.FactorAnalysis(n_components=factor_num).fit(x)
    # append は削除されたので、負荷量の行列から直接つくる
    df_factor_loading = pd.DataFrame(
        fa.components_,
        index=['factor'+str(i) for i in range(factor_num)],
        columns=target_cols
    )
    print(df_factor_loading)
    return fa

# plot() の中の円の描き方
ax = plt.gca()
ax.add_patch(plt.Circle((0, 0), radius=0.5*2, ec='r', fill=False))

# 選手名の列を含む表の相関(numeric_only の既定値が False になったため明示する)
sns.heatmap(df_results.corr(numeric_only=True), annot=True, vmax=1, vmin=-1, fmt='.2f', cmap=cm)
もう1点、書き換えではなく確認事項として触れておきます。plot 関数は fa.fit_transform(x) を呼んでおり、fit 関数で推定したモデルをもう一度あてはめ直しています。現行環境で FactorAnalysis の引数を確かめると、svd_method の既定値は randomized、random_state の既定値は 0 でした。既定値のままなら再あてはめの結果は同じになりますが、乱数の種を変えると負荷量の表と散布図の矢印がわずかにずれることがあり得ます。同じモデルを二度あてはめるより、fit の結果を transform で使い回すほうが、表と図の整合が保証されます。
今の目で見た補足、因子数・回転・標本・割合データ
ここからは、第4章で整理した基準に照らして、この分析の判断を読み直します。まず因子数の決め方です。この分析では、相関行列から3因子の仮説を立て、2・3・4の各因子数で負荷量を見比べて「もっとも解釈しやすい3因子」を選びました。第4章で述べたスクリープロット、平行分析、適合度による判断は行っていません。解釈のしやすさで因子数を選ぶこと自体は実務でよく行われますが、それは分析者の解釈に依存する判断であり、別の分析者が同じ表を見て2因子を選ぶこともあり得ます。3因子解がもっとも自然に見えるという判断は、数値そのものではなく、テニスの知識を持った読み手の目に支えられていることを認識しておく必要があります。
因子数4がうまくいかなかったことには、感触を超えた根拠があります。因子分析のモデルでは、変数の数を \( p \)、因子の数を \( k \) とすると、相関行列の情報量とモデルのパラメータ数の差から決まる自由度が \( \{(p-k)^2 – (p+k)\}/2 \) で与えられます。言葉で言えば「相関行列が持つ独立な数値の個数から、推定すべき負荷量と独自性の個数を引いたもの」です。6変数の場合、因子数2で 4、因子数3で 0、因子数4で -3 になります。自由度が負ということは、推定したいパラメータのほうが手がかりとなる相関の数より多い状態で、解が一意に決まりません。R の factanal 関数はこの自由度を計算して、負なら「因子が変数に対して多すぎる」として実行を止めます。scikit-learn の FactorAnalysis はそのような検査をせずに何らかの解を返すため、当時は「よく分からない結果」として観察されたわけです。因子数3も自由度が 0 で、モデルの当てはまりを検定する余地がありません。6変数で置ける因子は、実質的に2つか3つまでということになります。
次に回転です。この分析では因子の回転を行っていません。scikit-learn の FactorAnalysis に rotation 引数が追加されたのは 0.24(2020年12月)で、公式の変更履歴に「rotation 引数を追加し、None、varimax、quartimax を指定できるようにした」とあります。2018年時点のこのクラスには回転の機能がなく、当時のコードが出しているのは回転前の解です。ドキュメントには components_ が「分散が最大の成分」と説明されており、回転前の第1因子は、リターンとセカンドサービスの両方を巻き込む形で分散の大きい方向を取っています。3因子解でリターンの因子にセカンドサービスの2変数が 0.4 前後で載っていたのは、この性質の表れと読めます。第4章で述べたバリマックス回転をかければ、各変数が1つの因子に寄る単純構造に近づき、解釈がより明確になったと考えられますが、これは再実行していないので推測の域を出ません。現在なら rotation='varimax' を指定する、あるいは statsmodels の Factor で回転と適合度をあわせて確かめるのが、第4章の手順に沿ったやり方です。
標本の大きさも見ておきます。分析に使った行数は81選手で、変数は6つです。1変数あたり13.5行という比率で、第2章で述べたサンプルサイズの目安に照らすと、大きいとは言えない標本です。標本が小さいと、因子負荷量の推定値は選手の入れ替わりに敏感になります。たとえば絞り込みの条件を「試合数10以上」から「試合数15以上」に変えるだけで、対象選手が入れ替わり、負荷量の表が動く可能性があります。錦織選手の「11位」「54位」といった順位も、81人という母集団の中での順位であり、対象を広げれば変わります。この分析の結果は「掲載コードの条件(グランドスラムの試合で集計された試合数が10以上)で残った81選手の中での位置」として読むべきもので、男子プロ全体の序列ではありません。
割合データの扱いにも注意点があります。前処理では、各試合の成功率やポイント率を選手ごとに単純平均しています。この平均では、試合数の多い選手と少ない選手が同じ重みで扱われ、また各試合の中でのポイント数の違いも無視されます。ポイント数を先に合計してから割合を計算する方法(総獲得ポイント÷総ポイント)もあり、どちらを使うかで値は変わります。また、割合は0から1の範囲に収まる変数なので、極端に大きい・小さい値を取れず、標準化しても正規分布から離れた形になることがあります。最尤法による因子分析は多変量正規分布を仮定するため、この点は結果の解釈にわずかな留保をつけます。実務で同じ型の分析をするときは、割合の分母の大きさを考慮した重みづけや、ロジット変換を検討する余地があります。
最後に、この分析には答え合わせがありません。第2章で用意したサンプルデータには生成時に仕込んだ4因子の構造があり、第4章ではそれを回収できたかを確かめられました。実データにはそのような正解がなく、「3因子でサーブとリターンの構造が読めた」という結論は、勝率との相関が3因子とも正であることと、選手の位置関係が観戦の印象と整合することによって、間接的に支えられているにすぎません。実データでの因子分析の結論は、常にこの種の間接的な裏づけの上に立っていることを、次の経営目線の節でも踏まえます。
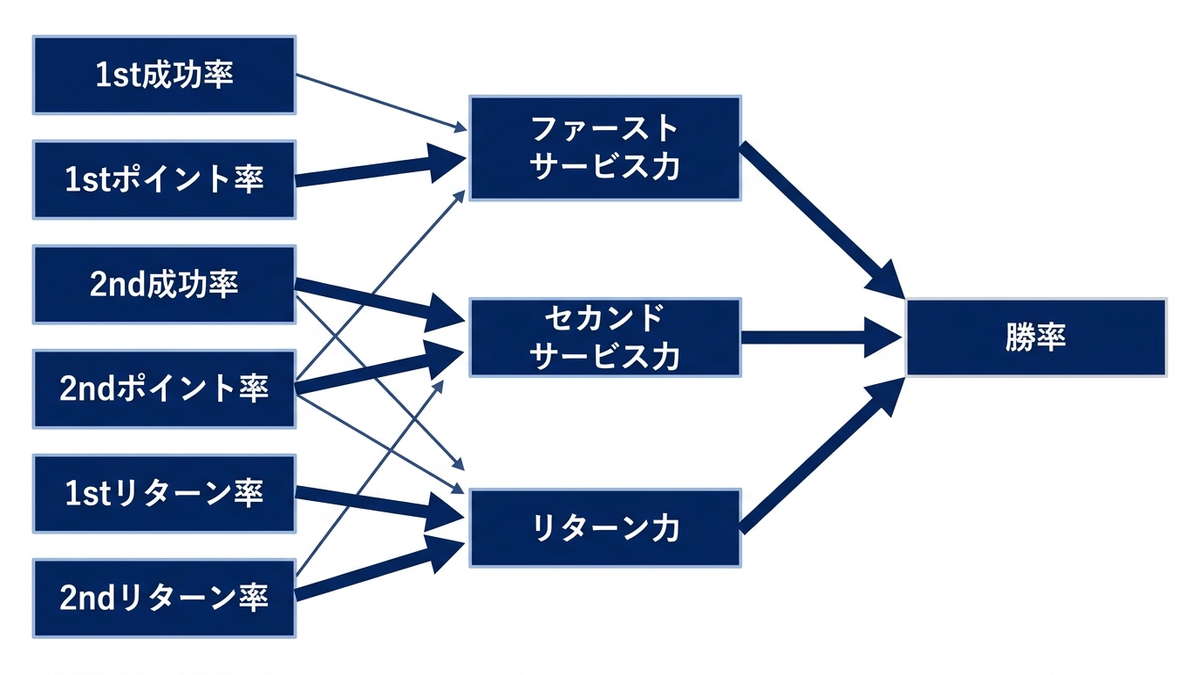
経営目線、人の強みを潜在変数として数値化する型
この事例は、手法の面ではごく標準的な因子分析ですが、型として見ると「人の強みを潜在変数として数値化する」分析です。試合ごとの成績という観測値から、サーブ力・リターン力という直接は測れない特性を推定し、選手を順位づけしました。同じ型は経営の中に数多くあります。営業担当者の商談記録から「開拓力」「関係維持力」を推定する人材評価、店舗ごとの売上・客数・客単価・リピート率から「集客力」「接客力」を推定する店舗評価、拠点ごとの処理件数・納期遵守率・品質指標から「処理能力」「安定性」を推定する拠点評価などです。いずれも、複数の観測指標の相関構造から少数の潜在的な強みを取り出し、個体を比較するという点で、本章の分析と同じ骨格を持っています。
この型の利点は、個々の指標を眺めるだけでは見えない「まとまり」を数値にできることです。本章では、サーブの成功率とポイント率が別の因子に分かれ、ファーストとセカンドのポイント率も別の因子になるという構造が分かりました。店舗評価に置き換えれば、「客数は多いが客単価が低い」という店舗と「客数は少ないが客単価が高い」という店舗を、売上という1つの指標で並べるのではなく、集客力と接客力という2つの軸で位置づけられるということです。施策も軸ごとに分かれます。集客力が低い店舗には立地や販促を、接客力が低い店舗には教育や品揃えを、という具合に、因子が施策の受け皿になります。
一方で、転用時に誤ると起きることも本章の分析から読み取れます。第一に、因子の命名は分析者の解釈です。本章で factor1 を「セカンドサービス力」と呼んだのは負荷量の並びからの読みであり、別の読み方も可能でした。人材評価で「リーダーシップ因子」と名づけた軸が、実は「発言回数」の軸にすぎない、ということは起こり得ます。命名を誤ったまま評価や配置に使えば、測っていないものを測ったつもりで人を動かすことになります。第二に、順位は母集団に依存します。錦織選手の「11位」は81人の中での位置であり、全体を広げれば変わります。特定の部署や年度の中での因子得点の順位を、全社や他年度と比べることはできません。第三に、標本が小さいと結果が不安定です。81人でも小さいと述べましたが、店舗評価や拠点評価では対象が数十件しかないことが普通で、1件の入れ替わりで負荷量が動きます。そのような状態で因子得点を人事や投資の判断に直結させると、判断の根拠が翌年には再現しないことになります。
したがって、この型を経営に転用するときの実務上の要件は、次の3つに集約されます。因子の命名を複数の目で検証し、負荷量の表を付けて根拠を残すこと。順位や得点を使うときは、比較の母集団を明示すること。標本が小さい場合は、条件を少し変えて結果が動かないかを確かめてから使うこと。これらは第13章で改めて整理しますが、本章の分析が「面白い結果」で終わらず「使える結果」になるかどうかは、この3点にかかっています。
本章では、第4章の一般論をプロテニスの実データにあてはめ、6つの割合から3つの因子(リターン力・セカンドサービス力・ファーストサービス力)を取り出し、勝率との相関と選手の順位まで求めました。あわせて、当時のコードが現在の環境で動かない箇所の書き換え、回転をかけていないことや自由度の制約といった今の目で見た補足、そしてこの型を人材評価や店舗評価に転用するときの要件を整理しました。次章では、変数をまとめる因子分析から視点を変え、個体(顧客や店舗)をまとめるクラスター分析に進みます。
この章を深めたい方への参考書籍
『誰も教えてくれなかった因子分析』(松尾太加志・中村知靖、北大路書房):数式を使わずに因子分析の考え方と結果の読み方を説明した入門書です。本章のように「負荷量の表を見て因子に名前をつける」場面で、何を根拠に判断すればよいかを平易に解説しており、回転の前後で解釈がどう変わるかを理解する助けになります。
『科学で迫る勝敗の法則:スポーツデータ分析の最前線』(小中英嗣、技術評論社):野球、サッカー、バスケットボール、ラグビー、バレーボールを題材に、セイバーメトリクス、レーティング、予測モデルといったスポーツデータ分析の手法を解説した本です。本章の題材であるテニスは扱われていませんが、「見慣れた数値は選手を評価できているか」という問いの立て方は、本章でサーブの成功率よりポイント率が勝率に効くと分かった場面と同じ発想です。
第6章 クラスター分析、似た個体をまとめる
第4章では、16項目の回答の背後に4つの共通因子があることを因子分析で確かめ、第5章ではその手法をテニスの事例に当てました。ここまでは「変数の側」をまとめる話でした。この章では向きを変えて「個体の側」、つまり回答者や顧客そのものを似た者どうしでまとめるクラスター分析を扱います。因子分析が「どの質問とどの質問が同じものを測っているか」を見つける手法だとすれば、クラスター分析は「どの顧客とどの顧客が同じような答え方をしているか」を見つける手法です。正解のラベルを与えずにデータの中の群を探す点で、第1章の分類でいう教師なしの手法にあたります。
クラスター分析は結果が直感的で、顧客セグメンテーションをはじめ経営の現場でよく使われる多変量解析の一つです。同時に、誤解されやすい手法でもあります。この章では、距離の決め方から始めて、階層的手法・k-means・混合分布モデル・密度ベースの手法の仕組みと使い分け、クラスタ数の決め方、結果の安定性の確かめ方を、第2章で用意したサンプルデータで実際に動かしながら見ていきます。そのうえで、得られたクラスタを顧客セグメントとして施策に落とすときの作法と、そこで経営が誤りやすい点を書きます。判別分析、つまり既に分かっている群を分ける軸を求める手法は第7章に送ります。
「似ている」を数で決める、距離と標準化
クラスター分析の出発点は、2つの個体がどれくらい似ているかを1つの数で表すことです。この数を距離と呼び、距離が小さい個体どうしを同じ群にまとめていきます。どの手法を使うかより先に、どの距離を使うかで結果の性格が決まります。代表的な距離は3つあります。ユークリッド距離は、各変数の差を2乗して足し、平方根をとったもので、空間上の直線距離です。マンハッタン距離は各変数の差の絶対値をそのまま足したもので、碁盤の目の街を歩く道のりにたとえられます。相関距離は、2つの個体の回答パターンの相関係数を1から引いたもので、水準の高低ではなく「形」が似ているかを測ります。scipy の定義では、それぞれの平均を引いたベクトルどうしのコサインを1から引いた値です。
この違いは実際に測ると分かりやすいので、サンプルデータの回答者0と回答者1の16項目で計算しました。ユークリッド距離は6.856、マンハッタン距離は19.0、相関距離は0.408です。次に、回答者0の全項目に一律で2点を足した架空の回答(上限は7)を作り、元の回答者0との距離を測ると、ユークリッド距離は6.403、マンハッタン距離は23.0で、回答者1との距離と同じ程度かそれ以上に離れます。ところが相関距離は0.039で、ほぼ同一人物とみなされます。答え方の形は同じで水準だけが違う回答者を「似ている」とみなしたいのか、「違う」とみなしたいのかは、分析の目的によって決めることであり、距離の選択はその目的を数に翻訳する作業です。満足度調査では、全体に甘く採点する人と辛く採点する人がいるため、水準の癖を消したいなら相関距離、水準そのものが意味を持つならユークリッド距離という使い分けになります。
もう一つ、第2章で扱った標準化がここでも効きます。ユークリッド距離もマンハッタン距離も、ばらつきの大きい変数ほど距離への寄与が大きくなります。サンプルデータの16項目は標準偏差が1.54から1.62でほぼ揃っていますが、そこに年間購入回数(標準偏差2.76)を素のまま加えて回答者0と1の距離を測ると、2乗差の合計72.0のうち購入回数だけで25.0、つまり35%を占めました。各列を標準化してから測ると、合計21.72のうち購入回数の寄与は3.29で15%に下がります。単位や範囲が違う変数を混ぜるときは、標準化をしないと「たまたま数字の大きい変数」がクラスタを決めてしまいます。逆に、意図的にある変数を重く見たい場合は、標準化のうえで重みを掛けるほうが、何を重くしたかを説明できます。
| 距離 | 何を測るか | 向いている場面 | 注意点 |
|---|---|---|---|
| ユークリッド距離 | 各変数の差の2乗和の平方根。直線距離 | 量的変数で、水準の違いそのものが意味を持つとき。ウォード法・k-means の前提 | ばらつきの大きい変数に引きずられる。標準化が要る |
| マンハッタン距離 | 各変数の差の絶対値の和 | 外れ値の影響を2乗で増幅させたくないとき | ウォード法の前提を満たさない |
| 相関距離 | 1から回答パターンの相関係数を引いた値 | 水準の高低ではなく「形」の類似を見たいとき。評価の甘辛の癖を消したいとき | 全項目に同じ点を付けた回答者は相関が定義できない |
階層的手法、デンドログラムを読んで切る
クラスター分析の手法は大きく、群を段階的に作っていく階層的手法と、あらかじめ決めた数の群に一度に分ける非階層的手法に分かれます。階層的手法のうち凝集型は、最初は1個体を1つの群とみなし、最も近い2つの群を併合する操作を全体が1つになるまで繰り返します。このとき「群と群の距離」をどう定義するかが連結法で、最短距離法(2つの群の最も近い個体間の距離)、最長距離法(最も遠い個体間の距離)、群平均法(全組み合わせの距離の平均)、そしてウォード法(併合したときに群内の平方和が最も増えにくい組を選ぶ)があります。ウォード法は1963年に Ward が提案した方法で、群内のばらつきを最小にするように併合を進めるため、大きさの揃った丸い群ができやすく、実務でもよく使われます。ただし scipy の文書にあるとおり、ウォード法はユークリッド距離のときにだけ正しく定義されます。
連結法によって結果がどれほど変わるかを、16項目を標準化したデータで確かめました。4つの群に切ったときの群の大きさは、最短距離法が1197・1・1・1、最長距離法が354・303・297・246、群平均法が492・380・325・3、ウォード法が358・355・318・169でした。最短距離法は、近い個体を鎖のように次々つないでいくため、ほとんど全員が1つの群に入り、残りは外れ値が1人ずつという結果になっています。scikit-learn の文書はこれを「持てる者がますます持つ」性質と呼び、最短距離法が最もそれに弱いと書いています。生成時に仕込んだ4つのセグメントとの一致度を後述の調整ランド指数(2つの分け方の一致度を表す指標で、完全に一致すれば1、偶然の一致と同程度なら0付近になります)で測ると、最短距離法0.000、最長距離法0.329、群平均法0.437、ウォード法0.486で、ウォード法が最も構造を回収しました。この差は手法の優劣というより、「丸い群が4つある」という今回のデータの性質にウォード法の前提が合っていたということです。
階層的手法の結果はデンドログラムという樹形図で読みます。横軸に個体、縦軸に併合したときの距離(高さ)をとり、下から上へ枝が合流していく図です。低い高さで合流した個体どうしは似ており、高い所まで合流しなかった群どうしは離れています。1,200件をそのまま描くと末端が読めないので、scipy の dendrogram に truncate_mode=”lastp” と p=30 を指定し、最後に残った30の束を末端として描きました。末端の括弧内の数字は、その束に含まれる回答者の人数です。
from scipy.cluster.hierarchy import linkage, dendrogram, fcluster
from survey_data import load_survey, ITEM_COLS

df = load_survey()
X = df[ITEM_COLS].astype(float)
Z16 = ((X - X.mean()) / X.std()).values        # 16項目を標準化

L = linkage(Z16, method="ward", metric="euclidean")
print(L.shape)                                  # (1199, 4)
print(L[-10:, 2].round(2))                      # 最後の10回の併合の高さ

dendrogram(L, truncate_mode="lastp", p=30, show_contracted=True)
lab4 = fcluster(L, t=4, criterion="maxclust")   # 4つに切る
# 出力:
# 最後の10回の併合の高さ: [17.32, 20.46, 20.83, 21.42, 25.74, 32.33, 34.81, 43.78, 68.78, 84.29]
# k=4 の切りどころ(高さ): 39.29
# k=4: クラスタサイズ [169, 318, 358, 355]
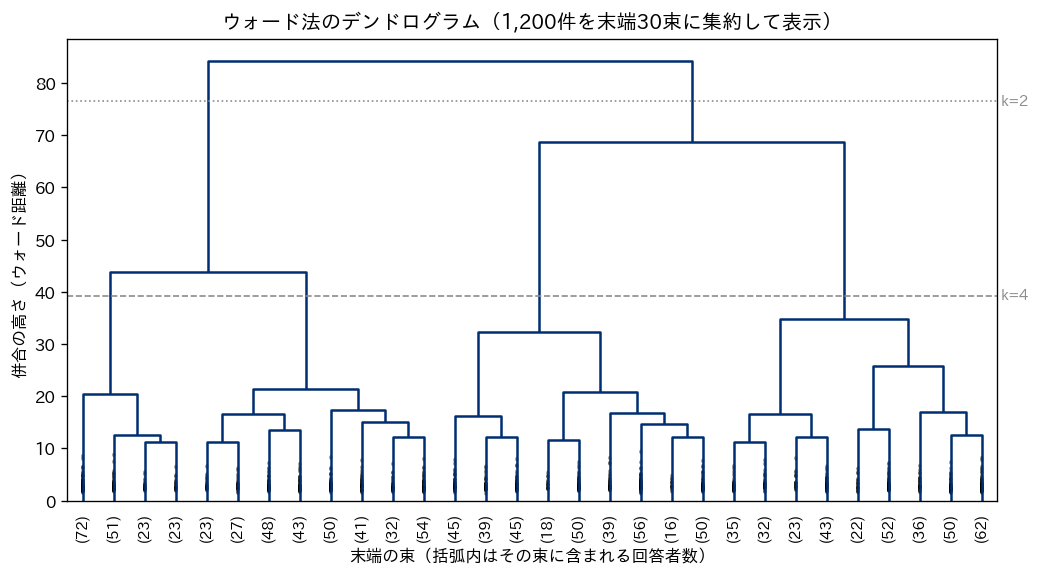
linkage が返す行列は1,199行4列で、各行が1回の併合を表し、3列目がそのときの距離、4列目が併合後の群の人数です。最後の10回の併合の高さは17.32から84.29まで並び、増分を見ると最後の3回が8.98・25.0・15.51と大きく跳ねています。デンドログラムを切るときは、この「高さが大きく跳ぶ所」の下で横線を引くのが基本です。図では k=2 に切る高さ76.53と k=4 に切る高さ39.29に横線を入れました。k=2 なら487人と713人、k=4 なら169・318・358・355人に分かれます。k=3 では487・358・355で、右側の大きな束が先に2つに割れ、左側の487人の束はそのままです。左側の束が169人と318人に割れるのは、高さ43.78の併合を切ったときで、これが k=4 にあたります。
デンドログラムの利点は、クラスタ数を決める前に構造全体を眺められることと、2つに切っても4つに切っても結果が入れ子になっていて説明しやすいことです。一方で欠点もはっきりしています。一度併合した群は後から分け直されないので、初期の併合の誤りが最後まで残ること、全個体間の距離行列が要るため個体数が数万を超えると計算量と記憶量が急に増えることです。実務では、階層的手法で構造を眺めてクラスタ数の当たりを付け、その数で次に述べる k-means を回す、という2段構えがよく使われます。
k-means と k-medoids、代表点で分ける
非階層的手法の代表がk-meansです。手順は単純で、まずクラスタ数 k を決め、k 個の中心を適当に置きます。次に各個体を最も近い中心に割り当て、割り当てられた個体の平均で中心を置き直します。この2つを、割り当てが変わらなくなるまで繰り返します。scikit-learn の文書では、これは各個体からその中心までの2乗距離の合計(慣性、inertia_)を小さくしていく Lloyd のアルゴリズムであり、非常に速い反面、局所解に落ちるので何度か初期値を変えてやり直すのが有用だと説明されています。実行時に n_init で初期値の試行回数を指定でき、慣性が最小の解が採用されます。scikit-learn 1.9 の既定値は n_init=”auto” で、既定の初期化法 init=”k-means++” のときは1回しか試行されません。k-means++ は、既に選んだ中心から遠い点が次の中心に選ばれやすくする初期化法で、乱雑に置くより収束が良くなります。本章では n_init=10 と random_state=0 を明示して固定しました。
k-means の前提は、群が丸く(凸で等方的に)まとまっていることと、ユークリッド距離が意味を持つことです。細長い群や三日月形の群は苦手で、この点は後の DBSCAN の例で実際に見ます。もう一つの弱点は、平均を使うため外れ値に引きずられることです。それを避けたのが k-medoids で、群の中心を「平均」ではなく「実在する個体の中で他の個体への距離の合計が最小のもの」に置きます。1990年に Kaufman と Rousseeuw が著書の中で PAM という名の手続きとして体系化した方法で、中心が実在の顧客なので「この群の典型はこの人」と説明できる利点があります。scikit-learn 本体には k-medoids は入っていないため、ここでは k-means の中心に最も近い個体を初期の代表点とし、割り当てと代表点の更新を交互に行う簡易版を自分で書いて動かしました。4つの下位尺度の平均得点を標準化したデータでは、1回の反復で収束し、代表点は回答者257・1015・1142・809で、k-means の割り当てとの調整ランド指数は0.873でした。代表点の素の得点を見ると、回答者257は価格納得感5.25で他が3.5から4.25、回答者1142は接客サポート6.00で店舗利便性5.75、回答者809は4尺度とも2.75から3.25と、各群の「顔」がそのまま読めます。
import pandas as pd
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score
from survey_data import load_survey, ITEM_COLS, FACTOR_NAMES

df = load_survey()
X = df[ITEM_COLS].astype(float)
# 4つの下位尺度の平均得点(商品品質 = q01〜q04 の平均、など)
sub = pd.DataFrame({FACTOR_NAMES[f]: X[ITEM_COLS[f*4:(f+1)*4]].mean(axis=1)
                    for f in range(4)})
S = ((sub - sub.mean()) / sub.std()).values     # 標準化

km4 = KMeans(n_clusters=4, n_init=10, random_state=0).fit(S)
df["cluster"] = km4.labels_
print(pd.crosstab(df["segment_true"], df["cluster"]))
print(adjusted_rand_score(df["segment_true"], df["cluster"]))
# 出力:
# cluster         0    1    2    3
# 品質重視         6  273   57   27
# 価格重視       293    9   20   36
# サービス重視     11   26  190   13
# 低関与          19    6    0  214
# 調整ランド指数(ARI): 0.565
混合分布モデルと密度ベース、所属を確率で持つ、密度で切る
k-means は各個体をどれか1つの群に必ず割り切ります。しかし実際の顧客には、2つの群の境目にいて「どちらとも言える」人がいます。そこを扱うのが混合分布モデルで、代表が混合ガウスモデル(GMM)です。データが k 個の正規分布の混ざり合いから生まれたと仮定し、各個体が各成分から生まれた確率を EM アルゴリズムで推定します。scikit-learn の GaussianMixture では、predict_proba が各個体の各成分への所属確率を返し、predict はその最大の成分を返します。k-means が「硬い割り当て」なのに対し、GMM は「柔らかい割り当て」を持てるわけです。
サンプルデータの4尺度で成分数4の GMM を当て、各個体の所属確率の最大値を集計すると、0.9以上が729人、0.7から0.9が270人、0.5から0.7が167人、0.5未満が34人でした。つまり1,200人のうち約6割は所属がはっきりしていますが、約200人は所属確率の最大値が0.7未満で、群の境目に近い位置にいます。k-means の結果を表にすると全員がどこかの群に入って見えますが、そのうちの一定数は境目の人だということを、GMM の所属確率は教えてくれます。なお GMM の割り当てと生成時のセグメントの調整ランド指数は0.642、k-means との一致は0.701でした。GMM のほうが今回は高く出ていますが、これはデータを正規分布の混合として生成したので、GMM の仮定がデータの作り方にたまたま合っているためです。scikit-learn の文書も、GMM の成分数の選択は「十分なデータがあり、かつデータが実際に正規分布の混合から生まれている」という条件の下でだけ理論的に正しく働くと注意しています。
これらと考え方がまったく違うのが密度ベースの手法で、代表が DBSCAN です。1996年に Ester らが提案した方法で、半径 eps の中に min_samples 個以上の点がある点をコア点とみなし、コア点から半径内でつながる点をたどって群を作ります。どのコア点からも届かない点はノイズとして群に入れず、scikit-learn ではラベル -1 が付きます。クラスタ数を事前に決めなくてよいこと、丸くない形の群を拾えること、外れ値を外れ値として扱えることが長所です。小さな2次元の例で確かめました。三日月が2つ向かい合った300点に、一様乱数のノイズ20点を混ぜたデータに対し、k-means(k=2)は160点ずつに真っ二つに割り、三日月の形は無視されました。DBSCAN(eps=0.2、min_samples=5)は2つの群155点と153点、ノイズ12点を返し、300点の三日月の形はほぼ正しく分けています。真の群との一致度は k-means が0.215、DBSCAN が0.987でした。混ぜた20点のノイズのうち12点がノイズと判定され、残り8点は三日月の近くに落ちたため群に吸収されています。
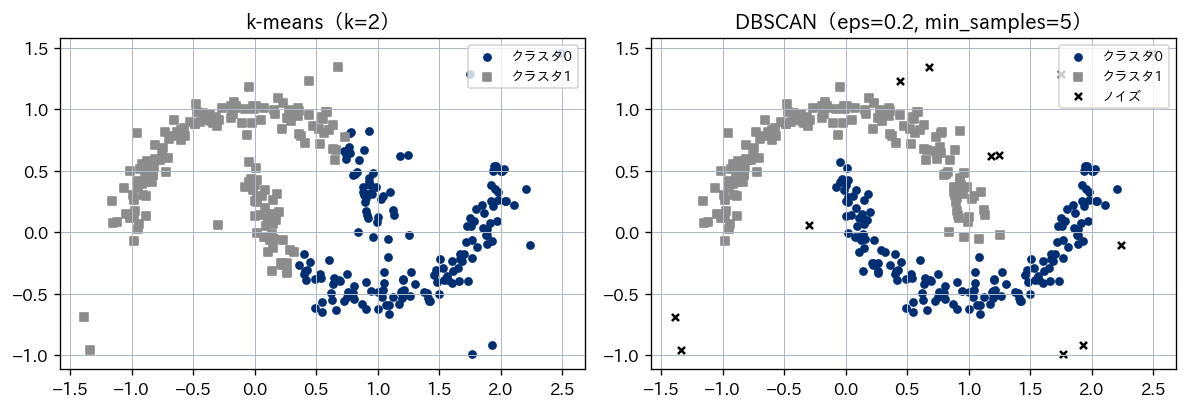
ただし DBSCAN は eps と min_samples に敏感です。同じデータで eps を0.10にすると群が14個・ノイズ56点に割れ、0.30にすると群が1つになり、0.50ではノイズが6点まで減って残りが1つの群に溶けました。「密度が高い所が群」という定義は明快ですが、密度の差が小さい満足度調査のような表形式データでは、群と群の間に密度の谷ができにくく、eps を少し変えるだけで結果が一変します。DBSCAN が向いているのは、位置データや異常検知のように「まとまり」と「散らばり」の差がはっきりしているデータであり、顧客アンケートのセグメンテーションで第一選択になることは多くないと考えています。
クラスタ数の決め方、正解はない
k-means も GMM もクラスタ数 k を先に決めなければなりません。ここが実務で最も悩む所で、よく使われる指標が3つあります。エルボー法は、k を増やしながら慣性(クラスタ内平方和)を描き、減り方が鈍る「肘」を探す方法です。シルエット係数は、各個体について、同じ群の他の個体への平均距離を a、最も近い他の群への平均距離を b として \( s = (b – a) / \max(a, b) \) で定義される値で、1987年に Rousseeuw が提案しました。1に近いほど自分の群にしっかり属し、0に近いと2つの群の境目にいて、負なら別の群のほうが近いことを意味します。全個体の平均を k ごとに比べ、平均が大きい k を選びます。scikit-learn の文書は、この係数が凸な群でうまく働き、そうでない形の群では高く出にくいと注意しています。3つ目の BIC は GMM で使う情報量規準で、モデルの当てはまりの良さ(対数尤度)とパラメータの数に応じた罰則を組み合わせた値です。scikit-learn の実装では小さいほど良く、成分を増やしすぎたときの罰則が自動で効きます。
サンプルデータの4尺度で k を2から8まで動かし、3つの指標を並べました。結果は次の表と図のとおりです。
| k | 慣性(クラスタ内平方和) | シルエット係数(平均) | GMM の BIC |
|---|---|---|---|
| 1 | 4796.0 | 定義されない | 12962.9 |
| 2 | 3235.9 | 0.283 | 12745.4 |
| 3 | 2501.2 | 0.280 | 12738.8 |
| 4 | 2097.7 | 0.266 | 12779.7 |
| 5 | 1921.2 | 0.232 | 12829.5 |
| 6 | 1757.0 | 0.231 | 12910.3 |
| 7 | 1625.4 | 0.222 | 12991.4 |
| 8 | 1524.7 | 0.219 | 13083.1 |
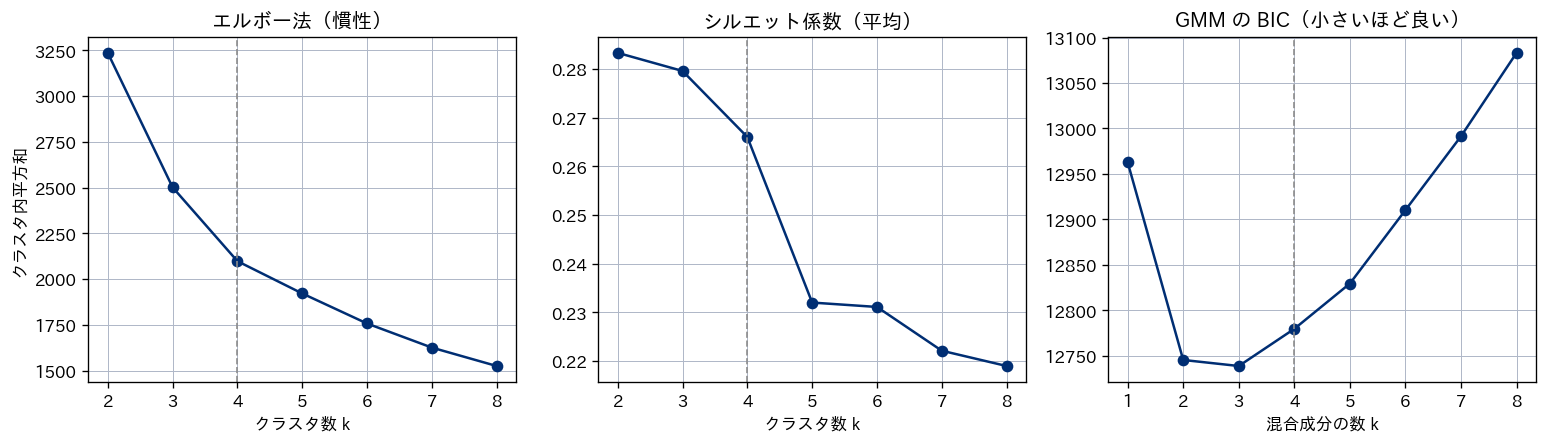
from sklearn.cluster import KMeans
from sklearn.mixture import GaussianMixture
from sklearn.metrics import silhouette_score

# S は前のコードで作った、4つの下位尺度の平均得点を標準化した配列
for k in range(2, 9):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(S)
    gm = GaussianMixture(n_components=k, covariance_type="full",
                         n_init=5, random_state=0).fit(S)
    print(k, round(km.inertia_, 1),
          round(silhouette_score(S, km.labels_), 3),
          round(gm.bic(S), 1))
# 出力:
# 2 3235.9 0.283 12745.4
# 3 2501.2 0.280 12738.8
# 4 2097.7 0.266 12779.7
# 5 1921.2 0.232 12829.5
この結果は、クラスタ数の決め方について大事なことを教えています。このデータには生成時に4つのセグメントを仕込んであるのに、3つの指標のどれも「4」を指していません。慣性は k=2 から3への減りが734.7、3から4が403.5、4から5が176.5と鈍っていくので、肘は3か4のあたりと読めますが、はっきりした角はありません。シルエット係数は k=2 の0.283が最大で、k=3 の0.280とほぼ並び、k=4 は0.266です。BIC は k=3 の12738.8が最小で、k=4 は12779.7とやや大きくなります。つまり指標に従うなら2か3を選ぶことになり、仕込んだ4は指標からは見えません。これは指標の欠陥というより、4つのセグメントの因子平均の差がノイズに対して小さく、群どうしが重なっているためです。デンドログラムでも、併合の高さの増分は k=3 に切る所(高さ68.78と43.78の間)が25.0で最も大きく、k=2 に切る所が15.51、k=4 に切る所(43.78と34.81の間)は8.98でしたので、跳びの大きさから読めば3が最有力でした。
したがって、クラスタ数に統計的な正解はない、と考えておくのが安全です。指標は候補を絞る道具であって、決める道具ではありません。決め手になるのは、その数に分けたときに各群を業務の言葉で説明でき、群ごとに違う施策を打てるかどうかです。3つでも4つでも指標がほぼ同じなら、施策の数として扱える方を選ぶという判断は、統計指標だけでは否定されにくい判断です。逆に、指標が最良とする k=2 を選んで「満足している人としていない人」に分けても、施策の設計には役立たないことが多いように思います。
仕込んだ4つのセグメントは、どこまで回収できたか
この章のサンプルデータには、第2章で述べたとおり、生成時に品質重視・価格重視・サービス重視・低関与という4つのセグメントを仕込んであります。実際の調査ではこの「正解」は存在しませんが、架空データなので、クラスター分析がどこまで構造を回収するかを答え合わせできます。この列 segment_true は分析には一切使わず、結果の突き合わせにだけ使いました。4つの下位尺度の平均得点を標準化して k=4 の k-means を当て、生成時のセグメントとクロス集計した結果が次の表です。
| 生成時のセグメント | クラスタ0 | クラスタ1 | クラスタ2 | クラスタ3 | 計 |
|---|---|---|---|---|---|
| 品質重視 | 6 | 273 | 57 | 27 | 363 |
| 価格重視 | 293 | 9 | 20 | 36 | 358 |
| サービス重視 | 11 | 26 | 190 | 13 | 240 |
| 低関与 | 19 | 6 | 0 | 214 | 239 |
| 計 | 329 | 314 | 267 | 290 | 1,200 |
クラスタ0は価格重視、1は品質重視、2はサービス重視、3は低関与に対応しており、大枠は回収できています。各クラスタを最も多い真のセグメントに対応づけると、1,200人中970人、80.8%が一致しました。セグメント別に見ると、低関与の90%、価格重視の82%、サービス重視の79%、品質重視の75%が、それぞれ対応するクラスタに集まっています。2つの分け方の一致度を1つの数で表す指標が調整ランド指数(ARI)です。1985年に Hubert と Arabie が提案したもので、全ペアについて「同じ群か違う群か」の判定が2つの分け方で一致する割合を、偶然の一致を差し引いて補正した値です。完全一致で1、無作為な分け方なら0付近になり、負にもなり得ます。今回の ARI は0.565でした。
数字だけ見れば「8割は合っている」ですが、合っていない2割の中身のほうが実務では重要です。品質重視の363人のうち57人がサービス重視のクラスタ2に、27人が低関与のクラスタ3に入っています。価格重視の358人のうち36人が低関与のクラスタ3に入っています。生成時の因子平均を見ると、品質重視は接客サポートの平均が少し高く、サービス重視は商品品質の平均が少し高いので、この2つは境目で重なります。価格重視と低関与は、どちらも商品品質と接客サポートが低いので、価格納得感の得点が平凡な価格重視の人は低関与と見分けがつきません。つまり、クラスター分析は「生成時に仕込んだ構造」を完全には回収できず、構造の重なりがそのまま誤分類として現れます。実データではこの「真のセグメント」自体が存在しないので、誤分類の割合を測ることすらできません。クラスタの表を見せられたとき、「この分け方でも2割程度は境目の人が別の群に入っているはずだ」と読む姿勢が要ります。
なお、同じ k=4 でも、16項目を標準化してウォード法で切った結果と、4尺度で k-means を回した結果の ARI は0.533でした。群の番号は手法ごとに勝手に付くので、最も一致するように群どうしを対応づけてから数えると、一致は1,200人中948人(79.0%)で、252人(21.0%)は手法を変えただけで別の群に入ります。ウォード法の結果と真のセグメントの ARI は0.486、GMM は0.642でした。どれが「正しい」かは、実データでは決められません。
結果の安定性、そしてクラスタは「分け方」であって「真実」ではない
クラスタリングの結果を報告する前に、必ず確かめるべきことが2つあります。初期値を変えても同じ結果になるか、標本を変えても同じ結果になるか、です。k-means は初期値によって局所解に落ちるので、n_init=1 で random_state を0から9まで変えて10回回し、基準解(n_init=10、random_state=0)との ARI を測りました。結果は最小0.927、中央値0.963で、初期値によるぶれは小さいと言えます。次に、1,200人から80%の960人を無作為に抜き出して k=4 の k-means を回し、抜き出した人について基準解との ARI を測る操作を10回繰り返しました。最小0.881、最大0.981、中央値0.962で、これも安定しています。
ところが、同じ操作を k=5 で行うと最小0.529、中央値0.733まで落ちました。k=3 では最小0.927、中央値0.976で安定しています。つまりこのデータでは、3つか4つに分ける限りは標本を変えても同じ群が出てきますが、5つに分けると、5つ目の群は標本のたまたまの偏りで決まっており、別の標本では別の切り方になります。「クラスタが5つ出た」という報告が、翌年の調査で再現しない典型的な場面です。安定性の確認はクラスタ数を決める補助にもなり、指標が横並びのときは、標本を変えて再現する最大の k を選ぶという決め方が実務的です。
ここまでの結果をまとめると、クラスタは「分け方」であって「真実」ではない、ということになります。距離を変えれば群が変わり、連結法を変えれば群が変わり、手法を変えれば2割の人が別の群に移り、標本を変えれば5つ目の群は消えます。それでも4つのセグメントの大枠は、どの手法でも8割前後は回収されました。クラスター分析が示すのは「データにこういう構造が見える」という一つの見方であり、その見方が業務の判断に役立つかどうかで採用を決めるものです。第13章で改めて扱いますが、「分析の結果、顧客は4つのタイプに分かれることが分かった」という言い方は正確ではなく、「4つに分けると、それぞれをこう説明でき、施策を分ける根拠になる」というのが正しい報告の形です。
顧客セグメンテーションへの適用、プロファイリングと命名と施策
クラスタが得られたら、次はそれぞれの群がどういう人たちかを描く作業、プロファイリングに移ります。ここで大事なのは、クラスタリングに使った変数(今回は4つの下位尺度)だけでなく、使っていない変数でも群の違いを見ることです。使った変数で差が出るのは当然で、使っていない総合満足度・推奨意向・再購入率・購入回数・会員区分・チャネルで差が出るなら、その群分けは行動と結びついていると言えます。k=4 の k-means の結果を表にしました。
| クラスタ | 人数 | 商品品質 | 価格納得感 | 接客サポート | 店舗利便性 | 総合満足度 | 推奨意向 | 再購入率 | 年間購入回数 | ゴールド+プラチナ | EC 中心 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 329 | 3.55 | 5.12 | 3.58 | 4.06 | 5.34 | 4.62 | 46% | 2.77 | 28.3% | 47.4% |
| 1 | 314 | 5.66 | 3.18 | 4.35 | 3.88 | 6.49 | 5.93 | 56% | 5.55 | 38.6% | 23.6% |
| 2 | 267 | 4.75 | 3.67 | 5.75 | 5.46 | 7.16 | 7.08 | 63% | 5.46 | 37.4% | 16.1% |
| 3 | 290 | 2.95 | 2.49 | 2.93 | 2.69 | 3.13 | 2.60 | 21% | 2.12 | 19.0% | 37.9% |
| 全体 | 1,200 | 4.23 | 3.65 | 4.11 | 3.99 | 5.51 | 5.02 | 46% | 3.94 | 30.8% | 31.9% |
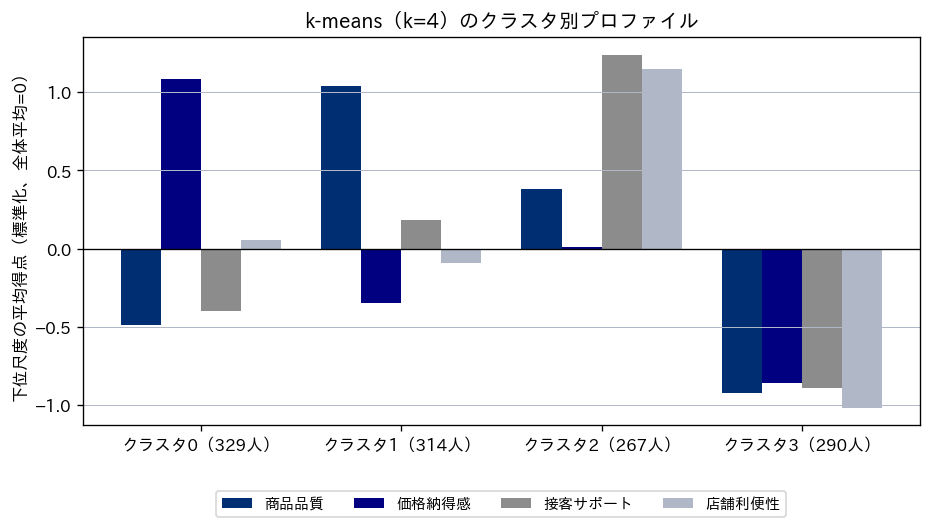
クラスタ2は接客サポート5.75と店舗利便性5.46が高く、総合満足度7.16、推奨意向7.08、再購入率63%と、全ての行動指標で最も良い群です。店舗中心の人が57.7%を占め、EC 中心は16.1%しかいません。クラスタ1は商品品質5.66が突出し、価格納得感3.18は低いものの、購入回数5.55は最多で、ゴールド以上の会員が38.6%います。クラスタ0は価格納得感5.12だけが高く、商品品質と接客は全体平均を下回り、EC 中心が47.4%と多く、購入回数2.77は少なめです。クラスタ3は4尺度すべてが最も低く、総合満足度3.13、再購入率21%、一般会員が81.0%と、離れかけている群です。
命名はこのプロファイルから付けますが、いくつか作法があります。第一に、名前はクラスタリングに使った変数の高低から付け、使っていない変数の解釈を混ぜないことです。クラスタ2を「店舗ロイヤル層」と呼ぶと、店舗中心が57.7%という結果を「店舗に来るから満足している」という因果に読み替えてしまいます。ここで言えるのは「接客と利便性の評価が高い群で、店舗利用者の比率が高い」までです。第二に、価値判断を含む名前を避けることです。「優良顧客」「問題顧客」と名付けた瞬間、施策の議論がその名前に引きずられます。第三に、名前と一緒に人数と比率を必ず添えることです。今回なら、クラスタ2は267人で全体の22%であり、「最も満足度が高い群」が最も小さい群でもあります。第四に、境目の人がいることを名前の脇に書いておくことです。GMM の所属確率で見たとおり、約200人はどの群にも五分五分の位置にいました。
施策に落とすときは、群ごとに「何を上げれば行動指標が動くか」を、クラスタリングに使わなかった指標で考えます。クラスタ0(価格納得感だけが高い群)は、価格で選んでいるので値引きを続けても購入回数は伸びにくく、商品品質の評価3.55を上げる情報提供や、接客との接点を作る施策が候補になります。クラスタ1(商品品質が高い群)は、価格納得感3.18の低さが総合満足度の天井になっている可能性があり、価格そのものより「なぜこの価格か」の説明や会員特典の見せ方が論点です。クラスタ3(全尺度が低い群)は、290人・24%と小さくない規模で再購入率21%なので、離反防止の対象ですが、4尺度のどれも低いため「何を直せば戻るか」がこの分析からは読めません。この群には別途、離反理由の聞き取りや、第7章の判別分析で「再購入した人としなかった人を分ける軸」を調べる分析が要ります。施策は群ごとに1つずつ決め、群ごとに測る指標(再購入率・購入回数・推奨意向)を先に固定してから走らせるのが、次に述べる経営上の落とし穴を避ける方法です。
経営目線、セグメントを固定して施策を走らせると何が起きるか
クラスター分析の結果は、経営の意思決定に直結しやすい分だけ、誤った使い方が損失に直結します。最もよくある誤りは、ある時点の調査で得たセグメントを「顧客の固定的な属性」として社内に定着させることです。セグメントは分け方であり、顧客は動きます。クラスタ0の価格重視の顧客が、品質の良さに気づいてクラスタ1に移ることは施策の成功そのものですが、セグメントを固定していると、その顧客は「価格重視向けの施策」を受け続け、移動は観測されません。逆に、クラスタ2の満足度の高い顧客が接客の質の低下でクラスタ3に近づいても、名簿上は「ロイヤル層」のままなので手が打たれません。セグメント別の施策を走らせるなら、少なくとも施策の評価時点で同じ手順でクラスタリングをやり直し、群の人数と各群の行動指標がどう動いたかを見る必要があります。このとき、先ほどの安定性の確認で見たように、標本が変わるだけでも割り当ては一定程度入れ替わります。今回の再抽出では ARI が0.881から0.981の範囲でしたので、「移動した」と言えるのは、その入れ替わりを超える動きだけです。
もう一つの落とし穴は、クラスタの人数配分をそのまま投資配分に使うことです。今回の例では、最も満足度が高いクラスタ2が22%で最小、最も離れかけているクラスタ3が24%です。人数で配分すればクラスタ0と1に資源が向きますが、行動指標で見ると、再購入率がクラスタ2の63%からクラスタ3の21%まで3倍の開きがあり、購入回数もクラスタ1と2が5.5回前後、0と3が2から3回です。「どの群の再購入率を何ポイント上げれば売上がいくら動くか」という試算は、群の人数と行動指標の両方から作るものであり、人数の大きさだけで優先順位を付けると、最も動かしやすい群を見落とします。クラスタ数を決める指標が2か3を指し、業務の都合で4にした、という判断をしたなら、その判断も報告に残しておくべきです。後から「4つに分かれることが統計的に証明された」という話に変わっていくのを防ぐためです。
この章では、距離の選び方が結果の性格を決めること、階層的手法と k-means と GMM と DBSCAN がそれぞれ違う前提で群を作ること、クラスタ数に統計的な正解はなく指標は候補を絞る道具であること、そして初期値と標本を変えて再現するかを確かめてから報告することを、サンプルデータで実際に確かめました。生成時に仕込んだ4つのセグメントは、どの手法でも8割前後は回収できましたが、完全には戻らず、その2割は群の境目にいる人でした。クラスタは分け方であって真実ではなく、その分け方を施策に使えるかどうかで採用を決めるものです。次の第7章では向きを変えて、既に分かっている群(例えば再購入した人としなかった人)を分ける軸を求める判別分析を扱います。クラスター分析が「群を見つける」手法なら、判別分析は「群の違いを説明し、新しい個体がどちらに入るかを予測する」手法です。
この章を深めたい方への参考書籍
『クラスター分析』(上田尚一、朝倉書店):講座「情報をよむ統計学」の1冊で、「区分けの論理」から始めて、数量データと質的データそれぞれのクラスター分析、階層的手法、時間的変化や地域データへの応用までを扱っています。クラスタを「分け方」として捉える本章の視点を、統計学の側から掘り下げたいときの土台になります。
『Rで学ぶクラスタ解析』(新納浩幸、オーム社):クラスタリングの準備から、階層的手法・k-means・混合分布モデル・ファジィクラスタリングまでを R のコードで動かしながら学ぶ本です。本章では Python を使いましたが、手法の仕組みを式とコードの両方で確かめたい方には、言語を問わず参考になります。
『マーケット・セグメンテーション:購買履歴データを用いた販売機会の発見』(中村博 編著、白桃書房):RFM 分析、クラスター分析、混合分布モデル、自己組織化マップ、決定木といった手法を、購買履歴データを使ったセグメンテーションの実例として集めた本です。本章の後半で述べたプロファイリングと施策への落とし方を、マーケティングの実務の側から補うものとして挙げます。
第7章 判別分析、群を分ける軸を見つける
第6章では、正解のラベルを持たないデータから似た個体をまとめ、クラスタという「分け方」を作りました。本章はその逆向きの問いを扱います。すでに群の所属が分かっているデータ、たとえば「再購入した顧客としなかった顧客」「返済できた先とできなかった先」「良品と不良品」が手元にあるとき、その群を最もよく分ける軸を見つけ、まだ所属の分からない新しい個体をどちらの群に振り分けるかを決める手法が判別分析です。第1章の4分類でいえば「外的基準を予測する」手法に属し、教師あり学習の側に立ちます。
本章では、フィッシャーの線形判別の考え方を数式1本と言葉で押さえ、マハラノビス距離、線形判別と二次判別の違い、正準判別による可視化、判別係数の読み方、誤判別率の見積もり方、事前確率と誤判別コストの扱いを順に確認します。コードは scikit-learn の wine データと、第2章で用意した架空の顧客満足度調査データの2つで実行し、本文の数値はすべて実行ログから取りました。最後に、同じ問いに使えるロジスティック回帰との使い分けを整理し、詳細は既刊の「ビジネスの要因分析に効く回帰分析と統計モデリングについて」へ送ります。
判別分析の問い:既知の群を最もよく分ける線形結合
判別分析が答える問いは2つあります。1つは「どの変数の、どういう組み合わせが、群の違いを最もよく表しているか」という記述の問いです。もう1つは「新しい個体を、どの群に割り当てるべきか」という予測の問いです。前者を判別、後者を分類と呼び分けることがあり、統計学の伝統では前者に重心があり、機械学習の分類器は後者に重心があると考えています。同じ線形判別分析でも、係数を読んで「品質評価と接客評価の重み付き合計が再購入を分けている」と解釈するのが判別の使い方で、正解率だけを見て運用に乗せるのが分類の使い方です。本章は前者を主に扱い、後者は既刊「機械学習の仕組みと使いどころ」に送ります。
クラスター分析との関係を整理しておきます。クラスター分析は群のラベルを持たず、距離の近さから群を「作る」手法でした。判別分析は群のラベルを持ち、それを「説明する」手法です。したがって、クラスター分析で作ったセグメントに新しい顧客を振り分けたい場面では、クラスタの所属をラベルとみなして判別分析を当てる、という組み合わせが自然に出てきます。ただし、その場合の正解率は「元のクラスタリングをどれだけ再現できたか」であって、「顧客の実態をどれだけ言い当てたか」ではないことに注意が必要です。この違いは第13章で改めて扱います。
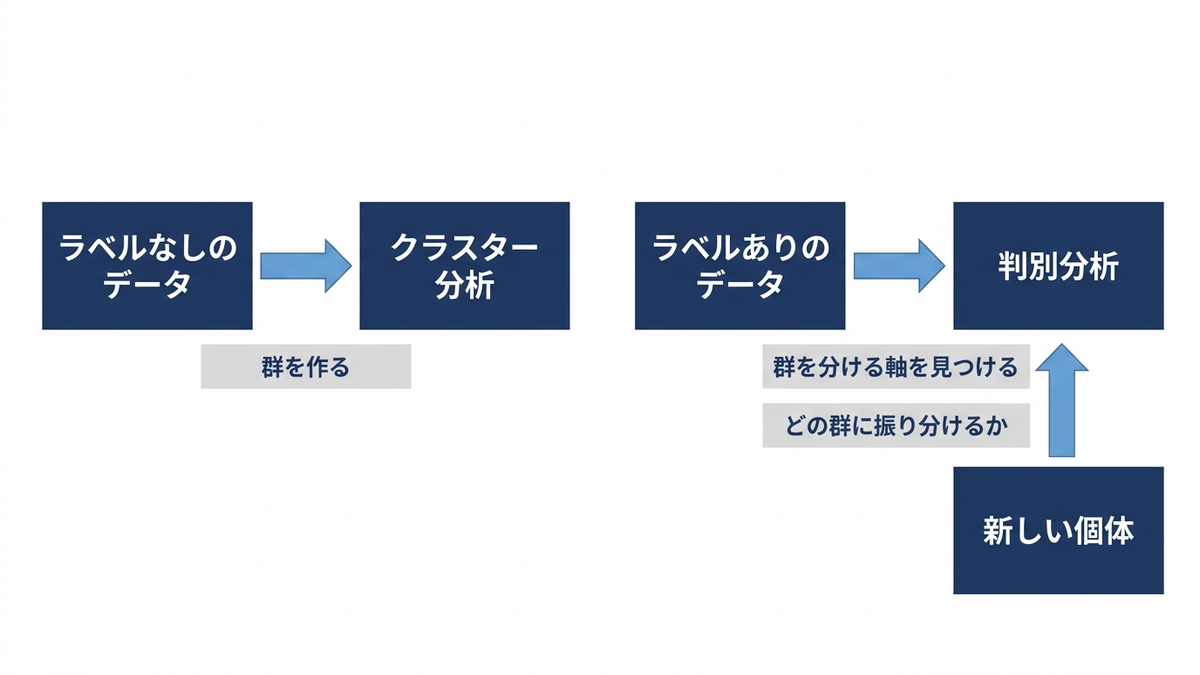
判別分析が使われる典型は、与信の可否、顧客の離反、製品の不良のように、結果が2値か少数の群で、判断を誤ったときの損失が大きい場面です。これらに共通するのは、正解率という1つの数字では足りず、「どちら向きの誤りが、どれだけ痛いか」まで含めて設計しなければ実務で使えない点です。本章の後半で、事前確率と誤判別コストとして扱います。
フィッシャーの線形判別とマハラノビス距離
線形判別分析の出発点は、1936年にフィッシャーが発表した論文「The Use of Multiple Measurements in Taxonomic Problems」です。アヤメの3品種を4つの計測値で見分けるという課題に対して、複数の変数の線形結合(重み付き合計)を1本作り、その値で群を分けるという考え方を示しました。この重み付き合計を判別関数、その値を判別得点と呼びます。
どういう重みが「最もよく分ける」のかを、フィッシャーの線形判別は次の比で定義します。
\( J(w) = \dfrac{w^{\top} S_B\, w}{w^{\top} S_W\, w} \)
ここで \( w \) が重みのベクトル、\( S_B \) が群間の散らばり(各群の平均が全体の平均からどれだけ離れているか)、\( S_W \) が群内の散らばり(各群の中で個体がどれだけばらついているか)を表す行列です。言葉にすると「判別得点で見たとき、群どうしの平均の差が大きく、かつ各群の中のばらつきが小さくなるように重みを選ぶ」ということです。群の平均が離れていても、群の中で得点が大きくばらつけば重なりが生じて誤判別が増えます。分子だけを大きくするのではなく、分母との比を最大にするところが要点です。この比を最大にする \( w \) は固有値問題を解けば得られ、群の数が \( K \) のとき、互いに無相関な判別関数が最大で \( K-1 \) 本得られます。2群なら判別関数は1本、3群なら2本です。scikit-learn の解説でも、線形判別分析による次元削減の出力次元は群の数より必ず小さいと述べられています。
群の数が3以上のときに複数の判別関数を使って個体を2次元や3次元に落とし、群の位置関係を図にする使い方を正準判別と呼びます。第3章の主成分分析が「データ全体の分散が最大になる方向」を探すのに対し、正準判別は「群間の分散が群内の分散に比べて最大になる方向」を探します。同じ2次元散布図でも、主成分の図は群を分けるために作られていないので、群を見分けたいなら正準判別の図を使うべきです。後述の wine データで、同じ1本の軸でも群の分かれ方がどれだけ違うかを実測します。
判別関数と表裏の関係にあるのがマハラノビス距離です。scipy のドキュメントの定義に沿って書くと、2つの点 \( u, v \) と共分散行列 \( V \) に対して次の量です。
\( D(u, v) = \sqrt{(u – v)^{\top} V^{-1} (u – v)} \)
普通のユークリッド距離との違いは、共分散行列の逆行列を挟んでいる点です。これにより、ばらつきの大きい方向の差は小さく、ばらつきの小さい方向の差は大きく数えられ、さらに変数どうしの相関も考慮されます。単位の違う変数を混ぜても距離が単位に引きずられません。scikit-learn の解説では、線形判別分析は「各群の平均までのマハラノビス距離が最も近い群に個体を割り当てる、ただし群の事前確率も勘案する」手法として解釈できると説明されています。つまり、フィッシャーの比を最大にする軸で判別することと、群内で共通の共分散行列を使ったマハラノビス距離で最も近い群を選ぶことは、同じ計算の2つの見方です。
線形判別と二次判別:等分散の仮定の有無
scikit-learn の線形判別分析と二次判別分析は、どちらも「各群の中で説明変数が多変量正規分布に従う」という確率モデルを置き、ベイズの規則で事後確率を計算して群を決めます。2つの違いは共分散行列の扱いだけです。二次判別分析は群ごとに別々の共分散行列を推定し、その結果として群の境界が2次曲面(曲がった境界)になります。線形判別分析はその特別な場合で、すべての群が同じ共分散行列を共有すると仮定し、境界が直線(超平面)になります。公式ドキュメントも、線形判別分析は二次判別分析の特殊ケースであり、各群のガウス分布が同じ共分散行列を共有すると仮定したものだと明記しています。
どちらを使うべきかは、群ごとにばらつきの形が違うかどうかで決まります。たとえば「離反しない顧客は評価が高い側に固まり、離反する顧客は評価が低い側に広く散らばる」というように、群によってばらつきの大きさや相関の向きが違うなら、二次判別のほうが実態に合います。一方、二次判別は群ごとに共分散行列を推定するので、変数が \( p \) 個なら群ごとに \( p(p+1)/2 \) 個の分散・共分散を推定することになり、群あたりの件数が少ないと推定が不安定になります。小さな群があるときは、共分散行列を単位行列の方へ縮める reg_param(既定値 0.0)で正則化するか、線形判別に留めるのが安全です。実務では、まず線形判別を当て、交差検証で二次判別が明確に上回るときだけ乗り換える、という順序が判断を誤りにくいと考えています。
| 観点 | 線形判別分析 | 二次判別分析 |
|---|---|---|
| 共分散行列の仮定 | 全群で共通 | 群ごとに別 |
| 群の境界の形 | 直線(超平面) | 2次曲面 |
| 推定する量 | 群の平均と共通の共分散行列1つ | 群の平均と群ごとの共分散行列 |
| 件数が少ないとき | 比較的安定 | 不安定になりやすく、正則化が要る |
| 低次元化と可視化 | 判別関数で可能(正準判別) | 正準判別軸への変換(transform)を持たないため不可 |
| 向いている場面 | 群ごとのばらつきが似ている、解釈したい | 群ごとにばらつきの形が明らかに違う |
wine データで正準判別を見る
第3章の主成分分析でも使った scikit-learn の wine データは、イタリアの同じ地域で栽培された3つの品種に由来するワイン178件について、13種類の化学成分を測ったものです(配布元の UCI の説明は「3つの品種」、scikit-learn の説明は「3つの生産者」と書かれており、本コラムは UCI に合わせて品種と呼びます)。件数は品種ごとに59・71・48です。群が3つなので判別関数は2本得られ、2次元の散布図にそのまま描けます。変数の単位がばらばらなので、係数を変数どうしで比べられるように、標準化してから当てました。
import numpy as np
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

wine = load_wine()
X = pd.DataFrame(wine.data, columns=wine.feature_names)
y = wine.target
Z = ((X - X.mean()) / X.std()).values      # 標準化(不偏標準偏差で割る)

lda = LinearDiscriminantAnalysis().fit(Z, y)
scores = lda.transform(Z)                   # 正準判別得点(178行 × 2列)
print(scores.shape[1])                      # 判別関数の数 = 群の数 - 1
print(np.round(lda.explained_variance_ratio_, 4))
# 出力: 2
# 出力: [0.6875 0.3125]

w = pd.DataFrame(lda.scalings_, index=X.columns, columns=["LD1", "LD2"])
print(w.reindex(w["LD1"].abs().sort_values(ascending=False).index).round(3))
判別関数は2本で、群間分散のうち第1判別関数 LD1 が 68.75%、第2判別関数 LD2 が 31.25% を受け持っています。explained_variance_ratio_ は、公式ドキュメントでは各成分が説明する分散の割合で、成分数を指定しなければ合計が 1.0 になると説明されています。主成分分析の寄与率と似た名前ですが、分母が「データ全体の分散」ではなく「群間の分散」である点が違います。
係数を LD1 の絶対値が大きい順に並べると、flavanoids(フラバノイド)が -1.659、proline(プロリン)が -0.847、color_intensity(色の濃さ)が 0.823、od280/od315_of_diluted_wines が -0.822、alcalinity_of_ash が 0.517 と続き、magnesium は -0.031 でほとんど効いていません。標準化した変数に対する係数なので、絶対値の大きさは判別への寄与の目安になります。ただし相関の強い変数どうしでは係数の大きさや符号が不安定になるので、群ごとの平均の差や変数間の相関も併せて読みます。LD1 はフラバノイドとプロリンが低く、色が濃いほど大きくなる軸で、品種2を右に、品種0を左に置きます。LD2 は proline が 0.898、alcohol が 0.708、ash が 0.644 で、品種1をほかの2つから引き離す軸です。
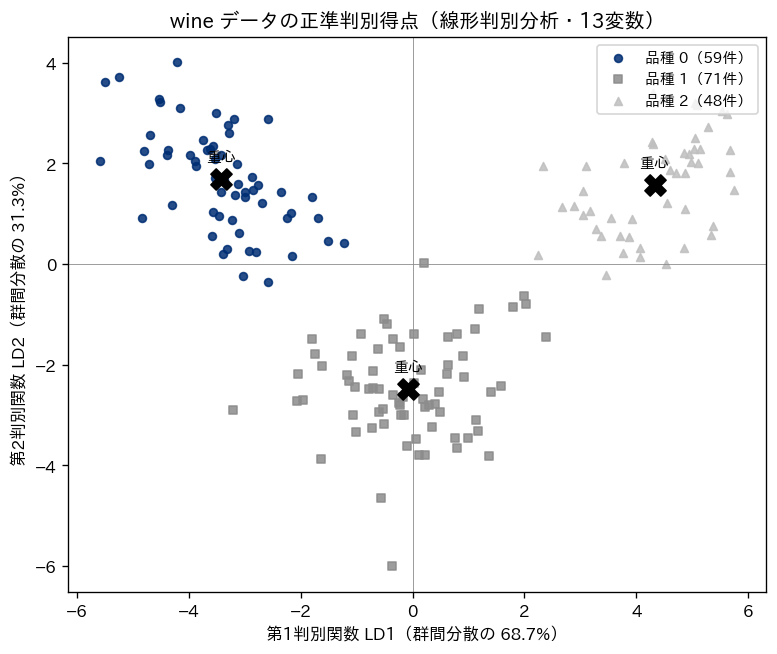
散布図では3つの品種がほとんど重ならずに分かれています。群ごとの重心は、品種0が LD1 = -3.422・LD2 = 1.692、品種1が -0.080・-2.473、品種2が 4.325・1.578 で、判別得点の群内標準偏差は LD1 で 0.99、LD2 で 0.999 でした。つまり、この図の1目盛りはほぼ群内の標準偏差1つ分に相当し、品種0と品種2の重心の差は LD1 の上で 7.747 あり、群内標準偏差の約7.8倍離れています。「全体の分散を最大にする軸」と「群を分ける軸」の違いは、数字で比べると明瞭です。LD1 について群間平方和と群内平方和の比を実測すると 9.082 でした。同じ標準化データに第3章の主成分分析を当てた第1主成分で同じ比を計算すると 3.999 で、半分以下です。1本の軸だけで品種を判別したときの再代入正解率も、LD1 では 0.9494、第1主成分では 0.8146 でした。主成分は群のラベルを見ずに分散の大きい方向を選ぶので、群を分ける目的では判別関数に及びません。
マハラノビス距離の見方でも同じ結果になることを確かめました。群内で共通の共分散行列を使って各個体から3つの群の平均までのマハラノビス距離を計算し、最も近い群に振り分けると、再代入の正解率は 1.0 でした。これは事前確率を等しいとした線形判別分析と同じ計算です。共分散行列を使わないユークリッド距離で同じことをすると正解率は 0.9775 に下がりました。変数間の相関とばらつきの違いを距離に織り込むことの効果が、この差に出ています。
from sklearn.discriminant_analysis import QuadraticDiscriminantAnalysis
from sklearn.model_selection import StratifiedKFold, cross_val_score, cross_val_predict
from sklearn.metrics import confusion_matrix
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

cv = StratifiedKFold(n_splits=10, shuffle=True, random_state=0)
pipe_lda = make_pipeline(StandardScaler(), LinearDiscriminantAnalysis())
pipe_qda = make_pipeline(StandardScaler(), QuadraticDiscriminantAnalysis())
for name, pipe in [("線形判別", pipe_lda), ("二次判別", pipe_qda)]:
    resub = pipe.fit(X.values, y).score(X.values, y)
    cv_scores = cross_val_score(pipe, X.values, y, cv=cv)
    print(name, round(resub, 4), round(cv_scores.mean(), 4))
# 出力: 線形判別 1.0 0.9889
# 出力: 二次判別 0.9944 0.9941

pred_cv = cross_val_predict(pipe_lda, X.values, y, cv=cv)
print(confusion_matrix(y, pred_cv))
# 出力: [[59  0  0]
#        [ 1 69  1]
#        [ 0  0 48]]
線形判別分析は再代入(学習に使ったデータをそのまま判別する)の正解率が 1.0、層化10分割交差検証の正解率が 0.9889(分割ごとの標準偏差 0.0222)でした。二次判別分析は再代入 0.9944、交差検証 0.9941(標準偏差 0.0176)で、reg_param=0.1 で正則化した二次判別は再代入・交差検証とも 1.0 でした。交差検証の混同行列を見ると、178件のうち誤判別は品種1の2件だけで、1件が品種0に、1件が品種2に振り分けられています。このデータは品種の違いが化学成分にはっきり出ているため、どの手法でも高い正解率になります。手法の差は誤差の範囲で、二次判別が線形判別に勝っているとは言えません。変数を flavanoids と proline の2つに絞ると交差検証の正解率は 0.8997 まで下がり、13変数を使う意味が確認できます。
誤判別率の見積もり:再代入・交差検証・ホールドアウト
判別分析の良し悪しは誤判別率(正解率の裏返し)で測りますが、どのデータで測るかによって値が変わります。学習に使ったデータをそのまま判別して測る再代入は、未知のデータに対する性能の見積もりとしては楽観的になりやすい値です。scikit-learn のドキュメントも、予測関数のパラメータを学習したのと同じデータで検証するのは方法論上の誤りであり、見たことのあるラベルを繰り返すだけのモデルでも満点になってしまうと述べ、これを過学習と呼んでいます。wine データでは再代入 1.0 に対して交差検証 0.9889 と差は小さいのですが、変数の数が件数に比べて多いときや、二次判別のように推定する量が多いときは差が大きく開きます。
楽観を避ける方法は2つあります。1つはホールドアウトで、データを学習用と検証用に一度だけ分け、学習用だけで判別関数を作り、検証用で誤判別率を測ります。単純で分かりやすい反面、分け方1回分の偶然に左右され、検証用に回した分だけ学習の件数が減ります。もう1つは交差検証で、データを \( k \) 個に分割し、そのうち \( k-1 \) 個で学習して残り1個で検証することを \( k \) 回繰り返し、その平均を報告します。scikit-learn のドキュメントに記された手順そのままです。群の割合を各分割で保つ層化(StratifiedKFold)を使うと、少数の群が特定の分割に偏ることを防げます。なお cross_val_predict は各個体が検証側に回ったときの判別結果を返す関数で、混同行列を作るのに便利ですが、ドキュメントは「汎化誤差の適切な尺度ではない」と注意しています。本章では正解率は cross_val_score の平均で報告し、混同行列の内訳だけを cross_val_predict から作っています。
| 見積もり方 | 手順 | 長所 | 短所 |
|---|---|---|---|
| 再代入 | 学習に使ったデータをそのまま判別する | 計算が1回で済む | 必ず楽観的。報告に使ってはいけない |
| ホールドアウト | 学習用と検証用に一度だけ分ける | 手順が単純で説明しやすい | 分け方1回の偶然に左右される。学習の件数が減る |
| 交差検証 | k 分割して学習と検証を k 回入れ替える | 全件を検証に使え、ばらつきも分かる | 計算が k 倍。分割ごとの結果は互いに独立ではない |
報告のときは、どの見積もり方で出した数字かを必ず添えるべきです。再代入の正解率を「モデルの精度」として経営層に示すと、運用に乗せた途端に精度が落ちて信頼を失います。共通データの例では、再代入 0.6517、10分割交差検証 0.6483、7対3のホールドアウト(学習840件・検証360件)0.6500 と3つの値が近く、これは変数5つに対して件数1,200と余裕があるためです。3つの値が大きく食い違うときは、モデルが件数に対して複雑すぎる合図です。
共通データで再購入を判別する:判別係数の読み方
第2章で用意した架空の顧客満足度調査データ(1,200件)で、再購入したかどうか(repurchase、0か1)を判別します。説明変数は、第6章と同じ作り方で16項目から作った4つの下位尺度の平均得点(商品品質は q01〜q04 の平均、価格納得感は q05〜q08、接客サポートは q09〜q12、店舗利便性は q13〜q16)と、年間購入回数 freq の5つです。再購入した人は556件(46.33%)、しなかった人は644件でした。群ごとの平均を見ると、再購入した群はどの下位尺度でも高く、商品品質で 4.656 対 3.853、接客サポートで 4.483 対 3.781、購入回数で 4.608 対 3.362 という差があります。
from survey_data import load_survey, FACTOR_NAMES
df = load_survey()
for f, name in enumerate(FACTOR_NAMES):            # 4つの下位尺度の平均得点
    cols = ["q%02d" % i for i in range(f * 4 + 1, f * 4 + 5)]
    df[name] = df[cols].mean(axis=1)
X_cols = FACTOR_NAMES + ["freq"]
X = df[X_cols]
y = df["repurchase"].values
Z = ((X - X.mean()) / X.std()).values             # 標準化

lda = LinearDiscriminantAnalysis().fit(Z, y)
print(pd.Series(lda.scalings_[:, 0], index=X_cols).round(3))   # 標準化判別係数
print(np.round(lda.priors_, 4))                                # 既定の事前確率
cv = StratifiedKFold(n_splits=10, shuffle=True, random_state=0)
print(round(cross_val_score(LinearDiscriminantAnalysis(), Z, y, cv=cv).mean(), 4))
pred = cross_val_predict(LinearDiscriminantAnalysis(), Z, y, cv=cv)
print(confusion_matrix(y, pred))
# 出力: 商品品質 0.582 / 価格納得感 0.251 / 接客サポート 0.313 / 店舗利便性 0.340 / freq 0.058
# 出力: [0.5367 0.4633]
# 出力: 0.6483
# 出力: [[435 209]
#        [213 343]]
ここでいう標準化判別係数は、各変数を全体の標準偏差で割ってから当てたときの判別関数の係数です。もとの単位のままの係数は、7段階の平均得点と購入回数のように尺度の違う変数を比べられないので、判別への寄与を読むときは標準化した係数を見ます。結果は、商品品質が 0.582 で最も大きく、店舗利便性 0.340、接客サポート 0.313、価格納得感 0.251 と続き、購入回数は 0.058 でほとんど寄与していません。判別得点は「商品品質を最も重く、店舗利便性と接客サポートをその5〜6割、価格納得感を4割ほどの重みで足し合わせた合成点」と読めます。符号がすべて正なので、どの評価も高いほど再購入の側に寄ります。判別得点の群平均は、再購入しなかった群が -0.358、した群が 0.414、群内標準偏差は 0.994 でした。
| 説明変数 | 再購入なしの平均 | 再購入ありの平均 | 標準化判別係数 | ロジスティック回帰の係数 | オッズ比 |
|---|---|---|---|---|---|
| 商品品質 | 3.853 | 4.656 | 0.582 | 0.447 | 1.564 |
| 価格納得感 | 3.490 | 3.839 | 0.251 | 0.207 | 1.230 |
| 接客サポート | 3.781 | 4.483 | 0.313 | 0.237 | 1.268 |
| 店舗利便性 | 3.685 | 4.352 | 0.340 | 0.261 | 1.298 |
| 年間購入回数 | 3.362 | 4.608 | 0.058 | 0.037 | 1.038 |
ここで注意したいのは、群ごとの平均の差が大きい変数が、そのまま係数も大きいとは限らないことです。年間購入回数は群平均の差が最も大きいのに、係数はほぼゼロです。これは、購入回数が商品品質や接客サポートの評価と相関しており、それらを入れたあとでは追加の情報をほとんど持たないためです。判別係数は「ほかの変数を固定したうえでの寄与」であり、単純な群間比較とは別の情報を与えます。第2章で扱った多重共線性の問題はここでも同じで、相関の強い変数を入れると係数の符号や大きさが不安定になります。
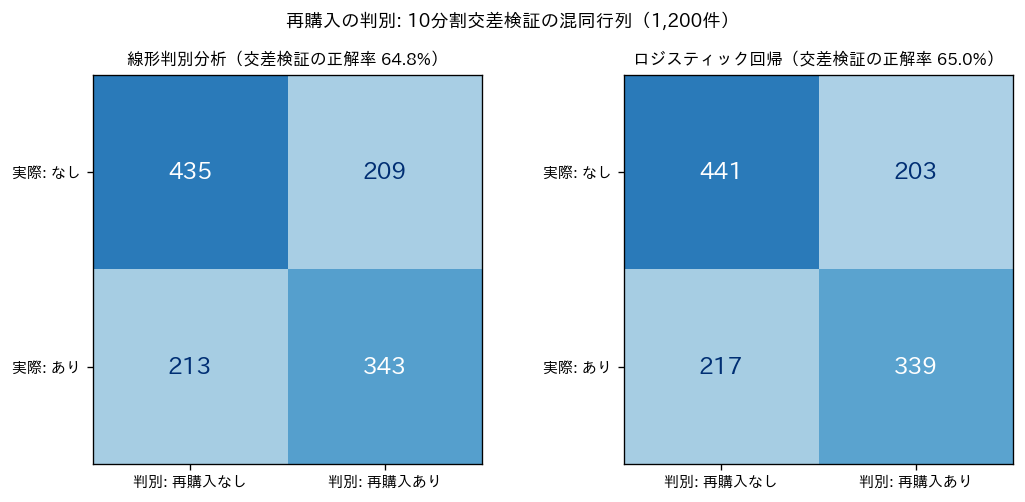
正解率は、再代入で 0.6517、10分割交差検証で 0.6483(標準偏差 0.0507)でした。交差検証の混同行列は、再購入しなかった644件のうち435件を正しく「なし」、209件を誤って「あり」と判別し、再購入した556件のうち343件を正しく「あり」、213件を誤って「なし」と判別しています。二次判別分析の交差検証の正解率は 0.6333(標準偏差 0.0444)で、線形判別を上回りませんでした。全員を多数派の「再購入なし」と判別したときの正解率は 0.5367 ですから、判別分析はそれを11ポイントほど上回るにすぎません。
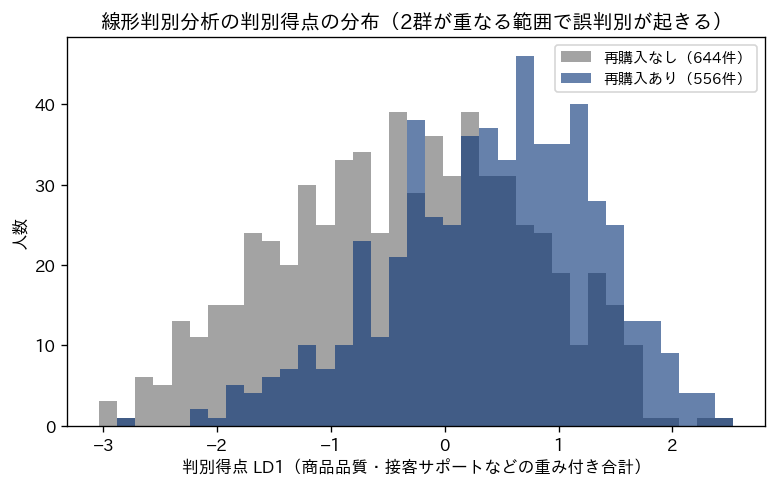
判別得点のヒストグラムを見ると理由が分かります。2つの群の分布は中心が 0.77 ほどずれているだけで、大部分が重なっています。wine データのように群の重心が群内標準偏差の7倍以上も離れていれば、どの手法でもほぼ完全に分かれますが、このデータでは差が標準偏差1つ分に満たないので、どんなに手法を工夫しても正解率には上限があります。このサンプルは、再購入の確率が満足度の潜在因子から確率的に決まるように生成されているため、満足度が高くても再購入しない人、低くても再購入する人が仕込まれています。実際の顧客データでも、態度指標だけで行動を言い当てられる範囲には限りがあり、正解率65%は「使えない」のではなく「この変数群で分かるのはここまで」という情報です。手法の性能と、データが持つ情報量を切り分けて報告することが、判別分析を経営判断に使うときの前提になります。
事前確率と誤判別コスト:経営目線で判別を設計する
線形判別分析は、各群までのマハラノビス距離に加えて、群の事前確率を勘案して割り当てを決めます。scikit-learn の priors は既定では学習データの群の割合から推定され、実行結果でも priors_ は 0.5367 と 0.4633 でした。事前確率が効くのは、判別得点が2群の境目に近い個体です。多数派の群の事前確率が高ければ、境目に近い個体はその群に寄せられます。priors=[0.5, 0.5] と等しく置くと、交差検証の混同行列は「なし」を正しく判別した件数が435件から389件に減り、「あり」を正しく判別した件数が343件から377件に増えて、正解率は 0.6383 に下がりました。学習データの割合を使うほうが正解率は高くなりますが、それが正しいとは限りません。たとえば離反顧客を集めやすくするために、離反した顧客を多めに抽出して学習データを作った場合、学習データの割合は実際の顧客全体の割合と違います。そのときは実際の割合を priors に与えるべきで、これを怠ると運用時に離反の判定が出すぎます。
さらに重要なのが、誤りの向きによってコストが違うことです。再購入の例で、「再購入しない顧客を、再購入すると判別する」誤りは、その顧客を放置して失うことを意味し、「再購入する顧客を、しないと判別する」誤りは、不要な引き止め施策の費用を意味します。前者の損失が後者の3倍だとすると、期待コストを最小にする判別は、事後確率が 0.5 を超えたら「あり」とするのではなく、次の条件を満たすときだけ「あり」とすることになります。
\( P(\text{あり} \mid x) > \dfrac{c_{FP}}{c_{FP} + c_{FN}} \)
ここで \( c_{FP} \) は「なし」を「あり」と誤る(偽陽性)コスト、\( c_{FN} \) は「あり」を「なし」と誤る(偽陰性)コストです。「あり」と判別したときの期待コストは「実際はなし」である確率に \( c_{FP} \) を掛けたもの、「なし」と判別したときの期待コストは「実際はあり」である確率に \( c_{FN} \) を掛けたもので、前者が後者より小さいときだけ「あり」と判別する、という条件を整理したものです。コスト比が3対1なら、しきい値は 3/4 = 0.75 になります。
proba = cross_val_predict(LinearDiscriminantAnalysis(), Z, y, cv=cv,
                          method="predict_proba")[:, 1]
cost_fp, cost_fn = 3.0, 1.0
thr = cost_fp / (cost_fp + cost_fn)                 # 0.75
for t in [0.5, thr]:
    p = (proba > t).astype(int)
    cm = confusion_matrix(y, p)
    total = cm[0, 1] * cost_fp + cm[1, 0] * cost_fn
    print(t, round((p == y).mean(), 4), cm[0, 1], cm[1, 0], total)
# 出力: 0.5  0.6483 209 213 840.0
# 出力: 0.75 0.5558  13 520 559.0
しきい値 0.5 では、偽陽性209件と偽陰性213件で総コストは 209 × 3 + 213 = 840 です。しきい値を 0.75 に上げると、偽陽性は13件まで減り、偽陰性は520件に増え、正解率は 0.6483 から 0.5558 に下がりますが、総コストは 559 まで減ります。正解率が下がったのに、経営上の損失は3分の2になったわけです。scikit-learn のドキュメントも、2値分類の既定のしきい値は事後確率 0.5 に固定されているが、それは多くの用途で最適ではなく、業務で定義した効用の指標を最大にするようにしきい値を調整すべきだと述べ、そのための TunedThresholdClassifierCV を用意しています。本章では仕組みを見せるためにしきい値を手で計算しましたが、コストの比が決まっていれば、そのコストを反映した評価指標を scoring に指定することで、同じことをこの道具で自動化できます(既定の指標のままではコストは反映されません)。
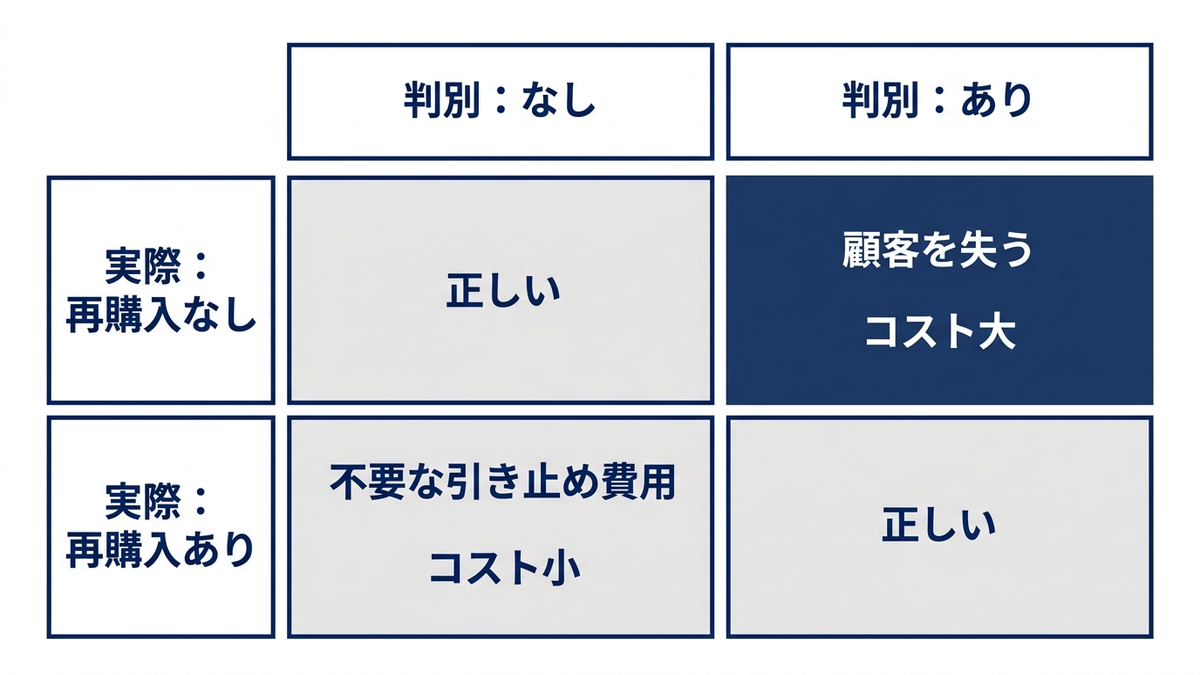
経営目線でまとめると、判別分析の設計で決めるべきは手法よりも先に「2種類の誤りのコスト比」と「運用時の群の割合」の2つです。与信なら「返せない先に貸す損失」と「返せる先を断って失う利益」の比、不良の判別なら「不良の見逃し」と「良品の過検出」の比、離反なら「離反の見逃し」と「引き止めの空振り」の比です。この比は統計から出てくるものではなく、事業側が決めるものです。比が決まっていない状態で正解率だけを比べて手法を選ぶと、正解率が最も高いモデルが、損失が最も小さいモデルではない、ということが普通に起きます。逆に、コスト比さえ決まっていれば、線形判別のような単純な手法でも損失を大きく減らせます。
判別分析とロジスティック回帰の使い分け、機械学習の分類器との位置づけ
2群を分ける問いには、判別分析のほかにロジスティック回帰も使えます。両者は「説明変数の線形結合で群を分ける」という点では同じで、結果もしばしばほとんど一致しますが、置いている仮定と、係数の解釈の言葉が違います。線形判別分析は、各群の中で説明変数が多変量正規分布に従い、共分散行列が全群で共通だという分布の仮定を置き、そこから事後確率を導きます。ロジスティック回帰は、説明変数の分布については何も仮定せず、「群に属する確率」がロジスティック関数(説明変数の線形結合を 0 から 1 の範囲に押し込む関数)で表されると直接仮定します。scikit-learn のドキュメントでは、ロジスティック回帰は名前に反して回帰ではなく分類のための線形モデルであり、確率をロジスティック関数でモデル化すると説明されています。
共通データで両方を当てて並べました。ロジスティック回帰は scikit-learn の LogisticRegression を既定の設定で使っています。既定では L2 正則化(C=1.0)が効いていることがドキュメントに明記されているので、係数はわずかに 0 の側へ縮められています。
from sklearn.linear_model import LogisticRegression
lr = LogisticRegression(max_iter=1000).fit(Z, y)
coef_lr = pd.Series(lr.coef_[0], index=X_cols)
print(coef_lr.round(3))                        # 標準化した変数の係数(対数オッズ比)
print(np.exp(coef_lr).round(3))                # オッズ比
print(round(cross_val_score(LogisticRegression(max_iter=1000), Z, y, cv=cv).mean(), 4))
pred_lr = cross_val_predict(LogisticRegression(max_iter=1000), Z, y, cv=cv)
print(confusion_matrix(y, pred_lr))
coef_lda = pd.Series(lda.scalings_[:, 0], index=X_cols)
print(round(np.corrcoef(coef_lda, coef_lr)[0, 1], 4))   # 係数ベクトルの相関
print(round((pred == pred_lr).mean(), 4))                # 判別結果の一致率
# 出力: 商品品質 0.447 / 価格納得感 0.207 / 接客サポート 0.237 / 店舗利便性 0.261 / freq 0.037
# 出力: 商品品質 1.564 / 価格納得感 1.230 / 接客サポート 1.268 / 店舗利便性 1.298 / freq 1.038
# 出力: 0.65
# 出力: [[441 203]
#        [217 339]]
# 出力: 0.9986
# 出力: 0.99
ロジスティック回帰の交差検証の正解率は 0.6500(標準偏差 0.0563)で、線形判別分析の 0.6483 とほぼ同じです。混同行列も、「なし」を正しく判別した件数が441件対435件、「あり」が339件対343件と数件しか違いません。交差検証で1,200件それぞれに付いた判別結果は、2つの手法で 99% 一致しました。係数の並びも同じで、5つの係数を並べたベクトルの相関は 0.9986、線形判別の係数をロジスティック回帰の係数で割った比は 1.2 から 1.6 の範囲に収まっています。係数の絶対的な大きさが違うのは、線形判別の係数が「判別得点の群内標準偏差が1になる」ように尺度を決めているのに対し、ロジスティック回帰の係数は対数オッズの単位で決まっているためで、方向はほぼ同じです。
違うのは解釈の言葉です。線形判別の係数は「群を最もよく分ける合成得点の重み」であり、「商品品質を 0.582、店舗利便性を 0.340 の重みで足した得点で見ると、再購入の有無が最もよく分かれる」と読みます。ロジスティック回帰の係数は対数オッズ比であり、指数をとったオッズ比で「商品品質の評価が標準偏差1つ分高い顧客は、ほかの条件が同じなら再購入のオッズが 1.564 倍になる」と読みます。経営層に伝えるときは、後者の「オッズが何倍」という言い方のほうが施策の効果に翻訳しやすく、前者の「合成得点」は、群の位置関係を1本の軸で見せたいときや、3群以上で正準判別の図を描きたいときに向いています。
| 観点 | 線形判別分析 | ロジスティック回帰 |
|---|---|---|
| 置いている仮定 | 各群で説明変数が多変量正規分布、共分散は共通 | 群に属する確率がロジスティック関数で表される。説明変数の分布は仮定しない |
| 推定するもの | 群ごとの平均と共通の共分散行列から事後確率を導く | 群に属する確率を直接当てはめる |
| 係数の読み方 | 群を分ける合成得点の重み | 対数オッズ比。指数をとればオッズ比 |
| 3群以上 | 判別関数が群の数マイナス1本得られ、図にできる | 多項ロジスティック回帰に拡張する |
| 質的な説明変数 | 正規分布の仮定に合わない | ダミー変数として扱える |
| 正規分布から外れたとき | 平均と共分散行列の推定に外れ値が直接効く | 説明変数の分布を仮定しないので、ずれ自体は問題にならない |
| 共通データでの交差検証の正解率 | 0.6483 | 0.6500 |
使い分けの目安は次のとおりです。説明変数がすべて量的で、群ごとのばらつきの形が似ているなら、線形判別分析は仮定が満たされるぶん少ない件数でも安定し、判別関数による可視化も使えます。説明変数に性別やチャネルのような質的変数が混じる、分布が大きく歪んでいる、外れ値がある、といった場合は、分布の仮定を置かないロジスティック回帰のほうが無難だと考えています。係数を「オッズが何倍」という形で説明したいなら、最初からロジスティック回帰を選ぶべきです。ロジスティック回帰の推定・検定・正則化・多項への拡張は、既刊「ビジネスの要因分析に効く回帰分析と統計モデリングについて」で扱っています。
機械学習の分類器との関係も触れておきます。決定木、ランダムフォレスト、勾配ブースティング、サポートベクターマシンといった分類器は、線形の境界に縛られず、変数間の交互作用も自動で拾うため、正解率だけを比べれば判別分析を上回ることが多いように思います。一方で「どの軸が群を分けているか」という記述の問いには、判別関数のような1本の合成得点を返しません。判別分析は、精度を競う道具というより、群の違いを少数の解釈できる軸に要約して人に説明する道具だと位置づけるのが実態に合っていると考えています。機械学習の分類器の仕組みと選び方は、既刊「機械学習の仕組みと使いどころ」に譲ります。また、本章の誤判別コストの考え方は、どの分類器を使う場合でもそのまま当てはまります。
この章の要点
判別分析は、既知の群を最もよく分ける変数の線形結合を見つける手法で、フィッシャーの線形判別は群間分散と群内分散の比を最大にする重みを求めます。これは、群内で共通の共分散行列を使ったマハラノビス距離で最も近い群に割り当てることと同じで、群ごとに共分散行列を変えたものが二次判別分析です。判別関数は群の数マイナス1本得られ、3群以上では正準判別の図として群の位置関係を可視化できます。wine データでは3品種が交差検証の正解率 0.9889 でほぼ完全に分かれ、共通データの再購入の判別では正解率 0.6483 に留まり、その差は手法ではなくデータが持つ群の重なりから来ていました。
誤判別率は再代入ではなく交差検証かホールドアウトで見積もり、どの方法で出した数字かを添えて報告します。事前確率は運用時の群の割合に合わせ、2種類の誤りのコスト比が決まっていれば、それに応じて事後確率のしきい値を動かします。共通データではしきい値を 0.5 から 0.75 に変えることで、正解率は下がりながら総コストが 840 から 559 に減りました。ロジスティック回帰はほぼ同じ精度を出しますが、分布の仮定を置かず、係数をオッズ比で読める点が違います。次の第8章では、群のラベルを使わずに、クロス集計表や距離行列から個体やカテゴリの位置関係を図にする対応分析と多次元尺度構成法を扱います。
Anagraftでは、データ活用の構想づくりから分析の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『多変量データの分類』(佐藤義治、朝倉書店):副題は「判別分析・クラスター分析」で、前半5章が判別分析に充てられています。判別規則の考え方から、多変量正規分布の標本に基づく判別関数、変数選択、質的データの判別、非線形の判別関数まで、本章で言葉で説明した内容の数理的な裏付けを順に確認できます。後半のクラスター分析は第6章の内容と対応します。
『統計的パターン認識と判別分析』(栗田多喜夫・日高章理、コロナ社):ベイズ決定理論から始めて、識別のための線形モデル、主成分分析と判別分析の関係、カーネル法による非線形判別まで進む一冊です。本章で扱ったフィッシャーの判別と、機械学習の分類器がどうつながっているかを、同じ枠組みの中で読み解けます。
『はじめてのパターン認識』(平井有三、森北出版):ベイズの識別規則、確率モデルと識別関数、線形識別関数、k最近傍法、サポートベクトルマシン、クラスタリングまでを、パターン認識に初めて触れる読者向けに解説した入門書です。本章の「判別」と既刊で扱う「分類器」の橋渡しとして、判別分析を機械学習の側から見直すのに向いています。
第8章 対応分析と多次元尺度構成法、位置関係を図にする
第7章では、群がすでに分かっているデータから「群を分ける軸」を求める判別分析を扱いました。本章で扱うのは、群を分けるためではなく、カテゴリや項目の「位置関係」を1枚の図にするための手法です。クロス集計表の行と列を同じ平面に置く対応分析、複数の質的変数をまとめて図にする多重対応分析、距離の情報だけから配置を復元する多次元尺度構成法、そして近年よく使われる t-SNE と UMAP を取り上げます。これらは結果が図として出てくるので説得力があり、経営層への報告にも好まれますが、図の読み方を誤ると、存在しない近さや遠さを施策の根拠にしてしまいます。本章では手法の仕組みと合わせて、「何を読んでよく、何を読んではいけないか」を、第2章で用意したサンプルデータの実行結果で確かめていきます。
対応分析が答える問い、クロス集計表を図にする
対応分析(コレスポンデンス分析)は、2つの質的変数のクロス集計表を入力にして、行のカテゴリと列のカテゴリを低次元の平面に配置する手法です。たとえば「顧客セグメント×主な購入チャネル」や「ブランド×イメージ語」のような表が対象になります。クロス集計表そのものを見れば、どのセルが多いかは分かります。しかし行が10、列が15もあると、表のどこに偏りがあるのかを一目で把握するのは難しくなります。対応分析は、表の「独立からのずれ」だけを取り出して、そのずれを最もよく表す少数の軸に要約します。行と列の両方を同じ図に置けることが、主成分分析や因子分析と大きく違う点です。
この手法が扱うのは「行の割合の違い」です。行ごとに度数を行の合計で割ったものを行プロファイルと呼びます。セグメントごとに「店舗が何割、ECが何割」という内訳を見るのと同じです。対応分析は、各行プロファイルが全体の平均プロファイル(列の周辺割合)からどれだけ、どの方向にずれているかを図にします。したがって図の原点は「平均的な内訳」を表し、原点から遠い点ほど平均から外れた内訳を持つカテゴリだと読みます。行の合計(度数)そのものの大小は、図の位置には直接現れません。度数の大きい行は「質量」として重みづけされ、軸の向きを決めるときに強く効きますが、点の位置は割合で決まります。
数量化理論との関係にも触れておきます。日本の実務で使われてきた数量化III類は、対応分析に相当する手法として整理されています。両者の対応関係と、ダミー変数の扱いは第9章で扱いますので、本章では対応分析という名前で統一します。
カイ二乗距離と慣性、図の座標はどこから来るか
対応分析の距離は、ふつうのユークリッド距離ではなくカイ二乗距離です。行プロファイルどうしの差を2乗し、それを対応する列の平均割合で割ってから足し合わせ、平方根をとります。式で書けば、行 \( i \) と行 \( i’ \) の距離は \( d(i,i’) = \sqrt{\sum_j (p_{ij}/r_i – p_{i’j}/r_{i’})^2 / c_j} \) です。ここで \( p_{ij} \) はセルの相対度数、\( r_i \) は行の質量、\( c_j \) は列の質量(列の周辺割合)です。言葉にすると、「もともと少ない列での割合の差は、同じ大きさでも重く数える」という距離です。ある列の平均割合が 5% しかないとき、その列で 10 ポイント差があるのは大きな違いであり、平均割合が 50% の列での 10 ポイント差より重く扱うのが妥当だ、という考え方です。
この距離のもとでの散らばりの大きさを慣性と呼びます。総慣性は、クロス集計表のカイ二乗統計量を総度数で割ったものに一致します。カイ二乗統計量は「行と列が独立だとしたときの期待度数から、観測度数がどれだけ離れているか」を測る量ですから、総慣性は「表の中にある独立からのずれの総量」だと読めます。対応分析は、この総慣性を軸ごとに分解します。各軸が受け持つ慣性が固有値で、固有値を総慣性で割ったものが軸の寄与率です。主成分分析の寄与率と同じ読み方ですが、分解しているのが「分散」ではなく「独立からのずれ」である点が違います。軸の本数の上限は、行数と列数の小さいほうから1を引いた数です。4行3列の表なら最大2軸で、2軸で慣性を使い切ります。
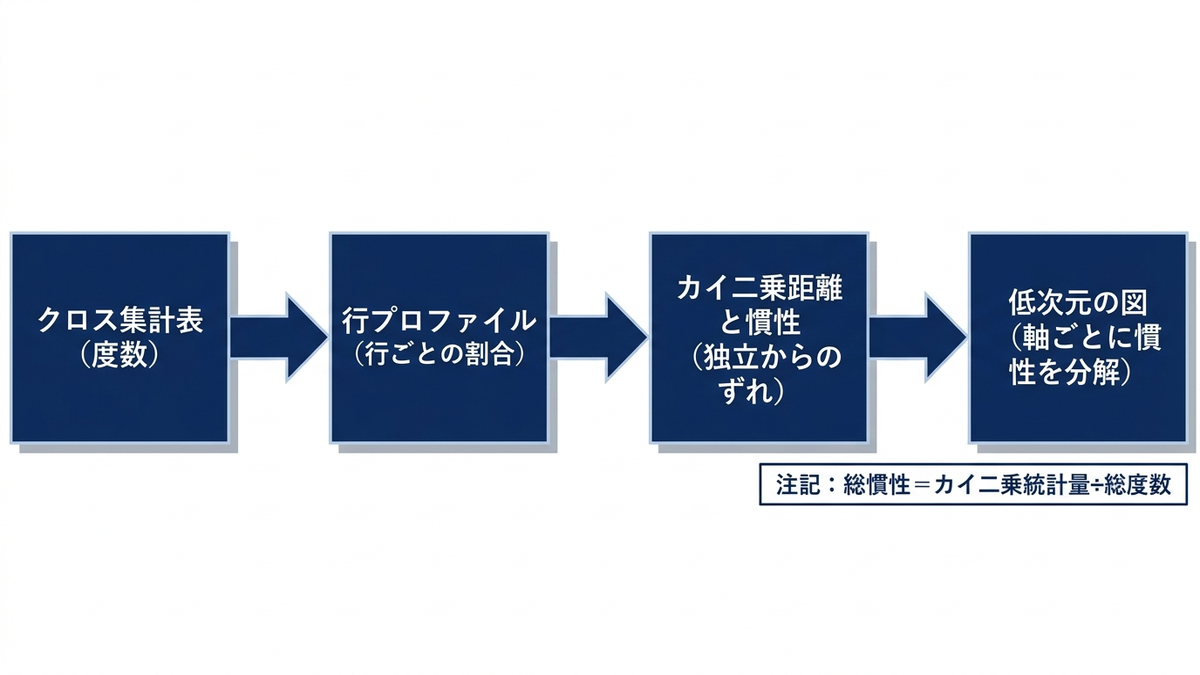
慣性の分解には、さらに2つの見方があります。1つは「各行(列)が軸の慣性にどれだけ寄与しているか」で、軸の意味づけに使います。もう1つは「各行(列)の慣性のうち、その軸でどれだけ表せているか」で、cos²(コサインの2乗)と呼ばれ、その点が図の上で信頼できるかの目安になります。cos² が低い点は、図の平面から外れた方向にずれているので、図上の位置を読み込んではいけません。
共通データで対応分析を実行する
第2章で用意した架空の顧客満足度調査データ(1,200件)を使います。行には segment_true、列には主な購入チャネル channel を取ります。ここで注意が要るのは、segment_true がデータ生成時に仕込んだ4つのセグメントであることです。実際の調査ではこの列は存在せず、第6章のクラスター分析で作ったクラスタや、会員区分のような既知の属性が行になります。本章では「対応分析が仕込んだ構造をどう図にするか」を見るために、答えの分かっているセグメントを行に置きました。
実装には、Python の prince(0.20.2)の CA を使います。クロス集計表を pandas.crosstab で作り、fit に渡すだけです。固有値は eigenvalues_、寄与率は percentage_of_variance_、総慣性は total_inertia_、行と列の座標はそれぞれ row_coordinates() と column_coordinates() で取り出せます。以下は実際に実行したコードの要点です。
import pandas as pd
import prince
from scipy.stats import chi2_contingency
from survey_data import load_survey

df = load_survey()
ct = pd.crosstab(df["segment_true"], df["channel"])
ct = ct.loc[["品質重視", "価格重視", "サービス重視", "低関与"], ["店舗", "EC", "両方"]]
n = int(ct.values.sum())

chi2, p, dof, expected = chi2_contingency(ct)
print("カイ二乗 =", round(chi2, 2), " 自由度 =", dof, " 総慣性 =", round(chi2 / n, 4))

ca = prince.CA(n_components=2, random_state=0).fit(ct)
print("total_inertia_ =", round(ca.total_inertia_, 4))
print("eigenvalues_ =", ca.eigenvalues_.round(4))
print("percentage_of_variance_ =", ca.percentage_of_variance_.round(2))
print(ca.row_coordinates(ct).round(3))
print(ca.column_coordinates(ct).round(3))
print(ca.row_contributions_.round(3))
# 出力(抜粋):
# カイ二乗 = 133.73  自由度 = 6  総慣性 = 0.1114
# total_inertia_ = 0.1114
# eigenvalues_ = [0.1094 0.0021]
# percentage_of_variance_ = [98.13  1.87]
クロス集計表と行プロファイルは次のとおりです。価格重視セグメントは EC の割合が 52.2% と平均(31.9%)を大きく上回り、サービス重視は店舗が 58.8% と平均(41.9%)を上回っています。低関与はどの列でも平均に近い内訳です。
| セグメント(生成時) | 店舗 | EC | 両方 | 合計 | 店舗の割合 | ECの割合 | 両方の割合 |
|---|---|---|---|---|---|---|---|
| 品質重視 | 170 | 79 | 114 | 363 | 46.8% | 21.8% | 31.4% |
| 価格重視 | 99 | 187 | 72 | 358 | 27.7% | 52.2% | 20.1% |
| サービス重視 | 141 | 30 | 69 | 240 | 58.8% | 12.5% | 28.7% |
| 低関与 | 93 | 87 | 59 | 239 | 38.9% | 36.4% | 24.7% |
| 全体(平均プロファイル) | 503 | 383 | 314 | 1,200 | 41.9% | 31.9% | 26.2% |
カイ二乗統計量は 133.73(自由度6)で、独立の仮説は棄却されます。総慣性は 133.73 を 1,200 で割った 0.1114 で、prince の total_inertia_ と一致しました。第1軸の固有値は 0.1094 で寄与率 98.13%、第2軸は 0.0021 で 1.87% です。つまりこの表の「独立からのずれ」は、ほぼ1本の軸で言い尽くせます。第1軸の座標は、価格重視が 0.438、低関与が 0.096、品質重視が -0.212、サービス重視が -0.429 で、列は EC が 0.479、両方が -0.159、店舗が -0.265 でした。第1軸は「EC 寄りか、店舗寄りか」の軸だと読めます。第1軸の慣性への寄与は、行では価格重視が 52.3%、サービス重視が 33.6% を占め、列では EC が 66.9% を占めています。この軸を作っているのは主に「価格重視が EC に偏り、サービス重視が店舗に偏る」という2つのずれです。
行の座標が主座標(principal coordinates)であることも確かめました。行の質量で重みづけした第1軸座標の分散は 0.1094 で、第1軸の固有値に一致します。prince の row_coordinates() と column_coordinates() は、どちらも主座標を返します。両方を主座標で描いた図を対称マップと呼び、この呼び方が次の節の「誤読」に関わってきます。
実務では行と列が1組の表だけでなく、同じ回答者を複数の属性で集計した表を横に並べて分析することも多くあります。セグメント×チャネル、セグメント×会員区分、セグメント×年代の3つの表を横に連結した4行11列の表(積み重ね表)にも対応分析を当てました。積み重ね表の総慣性は、各表の慣性の平均になります。実測では、チャネルの表が 0.1114、会員区分の表が 0.0629、年代の表が 0.0066 で、平均 0.0603 が積み重ね表の総慣性 0.0603 に一致しました。年代の表の慣性が小さいのは、生成時に年代をセグメントと無関係に振ったためで、その事実がそのまま慣性の小ささに現れています。積み重ね表の慣性の分解は次の表のとおりです。
| 軸 | 固有値(慣性) | 寄与率 | 累積寄与率 | 軸を作っている主なカテゴリ(寄与) |
|---|---|---|---|---|
| 第1軸 | 0.0456 | 75.5% | 75.5% | EC(49.0%)、店舗(19.8%)、ゴールド(9.4%)、プラチナ(8.6%) |
| 第2軸 | 0.0126 | 20.8% | 96.4% | ゴールド(38.1%)、一般(20.6%)、EC(16.6%) |
| 第3軸 | 0.0022 | 3.6% | 100.0% | プラチナ(30.2%)、両方(18.7%)、店舗(13.8%) |
積み重ね表では同じ回答者が3つの表に1回ずつ数えられるため、総度数は 3,600 になります。この表に対してカイ二乗検定の p 値を出すことはできますが、独立な観測ではないので検定として使ってはいけません。慣性の分解は記述的な道具として使えます。
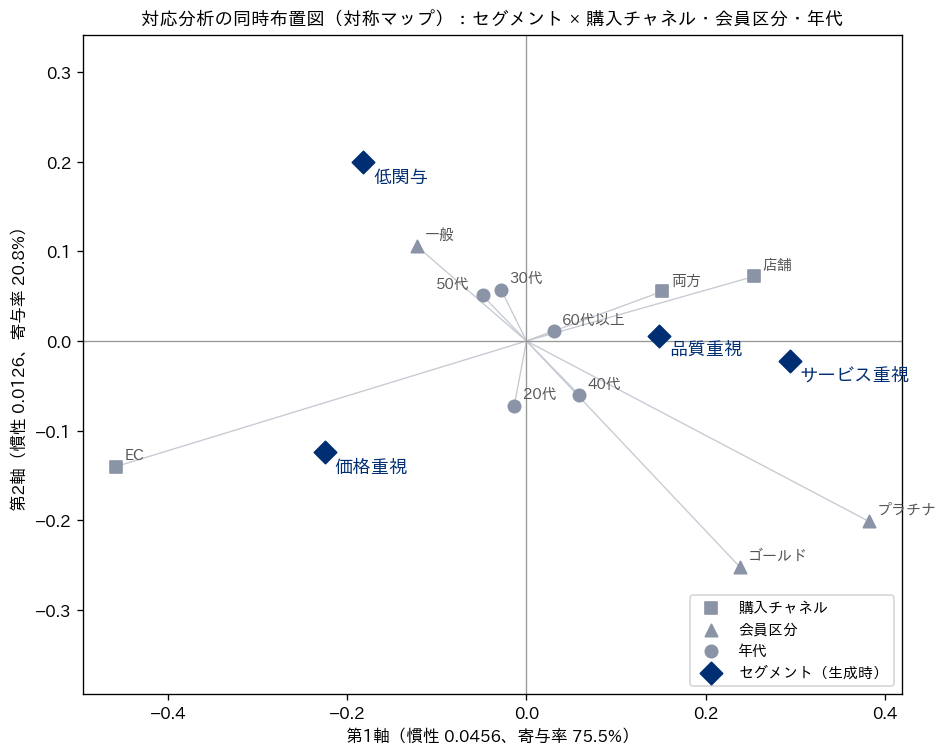
同時布置図の読み方と、よくある誤読
上の図が同時布置図です。行(セグメント)と列(属性カテゴリ)を同じ平面に描いた図の総称で、前節で触れた対称マップは、両方を主座標で描いた同時布置図の一種です。第1軸は右に店舗・両方・プラチナ・ゴールド、左に EC と一般が並び、セグメントではサービス重視と品質重視が右、価格重視と低関与が左に置かれています。第2軸は上に低関与と一般、下にゴールドとプラチナが並び、会員区分の軸だと読めます。年代のカテゴリはすべて原点の近くに集まっています。年代はセグメントとほとんど関係が無いので、どの年代の内訳も平均に近く、原点付近に置かれるのが正しい姿です。
ここからが本章で最も伝えたい点です。この図で読んでよいのは、行どうしの距離、列どうしの距離、そして原点から見た方向です。行の点と列の点の距離をそのまま「近さ」と読んではいけません。グリーナカーは、行と列の両方を主座標で描いた対称マップについて、「行と列それぞれの距離の幾何は表示されているが、この図はバイプロットではない」と明言しています(『Biplots in Practice』2010年の用語集、および第9章)。バイプロットとは、行の点と列の点の内積が表の要素を近似するように作られた図のことで、その内積は「2つのベクトルの長さの積にコサインをかけたもの」、つまり原点からの方向が揃っているほど大きくなります。対称マップは厳密にはこの性質を持ちませんが、軸の固有値が大きく違わなければ近似的に成り立つとされています。したがって、行の点と列の点の関係は「原点から同じ方向にあるか」「原点を挟んで反対側にあるか」で読み、両者の間の距離を定規で測って比べることはしない、というのが安全な読み方です。
誤読が起きやすいことを、4行3列の表の実測値で示します。図上の距離と、実際の行プロファイルを並べたのが次の表です。
| 行の点 | 列の点 | 図上の距離 | その列の行プロファイル | 平均との差 |
|---|---|---|---|---|
| 品質重視 | 両方 | 0.054 | 31.4% | +5.2 ポイント |
| 品質重視 | 店舗 | 0.114 | 46.8% | +4.9 ポイント |
| 価格重視 | EC | 0.041 | 52.2% | +20.3 ポイント |
| サービス重視 | 店舗 | 0.166 | 58.8% | +16.8 ポイント |
| 低関与 | 両方 | 0.267 | 24.7% | -1.5 ポイント |
| 低関与 | 店舗 | 0.363 | 38.9% | -3.0 ポイント |
| 低関与 | EC | 0.383 | 36.4% | +4.5 ポイント |
品質重視の点に最も近い列の点は「両方」(距離 0.054)で、「店舗」(距離 0.114)はその2倍離れています。しかし品質重視の内訳は店舗が 46.8%、両方が 31.4% で、店舗のほうがはるかに多いのです。図上の距離は「平均からのずれの方向が似ているか」を表していて、割合の大小を表していません。また、品質重視と両方の距離 0.054 は、価格重視と EC の距離 0.041 とほぼ同じですが、平均からのずれは +5.2 ポイントと +20.3 ポイントで4倍違います。低関与は原点近くにあり、3つの列の点との距離はどれも 0.27 から 0.38 と中途半端で、そこから読み取れる内訳の特徴はありません。「低関与は店舗より EC に近い」と読んで EC 施策に結びつけるのは、差 4.5 ポイントの偶然を根拠にすることになります。
一方、行どうしの距離は読んでよい量です。4行3列の表では2軸で慣性を使い切っているので、図上の行どうしのユークリッド距離は、行プロファイルのカイ二乗距離に厳密に一致します。実測では価格重視とサービス重視の距離が 0.868 で最も遠く、品質重視とサービス重視が 0.252 で最も近くなりました。列どうしも同様です。ただし、これは2軸ですべての慣性を表せている場合の話で、積み重ね表のように第3軸以降が残る場合は近似になります。近似の良さは cos² で確認します。積み重ね表では EC の cos² が第1軸と第2軸で 0.914 と 0.086(合計 1.000)、店舗が 0.898 と 0.072 で、平面上の位置を信頼できます。しかし 20代は第1軸 0.018、第2軸 0.493、第3軸 0.489 で、平面に表せているのは半分だけです。20代の点の位置を読み込んではいけない、ということが数字から分かります。
図を読むときの手順をまとめると、次のようになります。まず総慣性と寄与率を見て、平面がどれだけの情報を表しているかを確かめる。次に軸ごとの寄与を見て、どのカテゴリがその軸を作っているかを言葉にする。そのうえで、原点からの方向で行と列の対応を読み、cos² の低い点は読まない。最後に、図から読んだ関係を必ず元のクロス集計表の割合で確認する。この最後の一歩を省くと、上に示したような誤読がそのまま報告書に載ります。
ブランドポジショニングマップとしての使い方
マーケティングの現場で対応分析が最もよく使われるのは、ブランドポジショニングマップ(知覚マップ)です。行に自社と競合のブランド、列に「高品質」「手頃」「親しみやすい」「先進的」のようなイメージ語を取り、各ブランドについて各イメージ語が当てはまると答えた人数のクロス集計表を作ります。対応分析にかければ、ブランドとイメージ語が同じ平面に置かれ、「どのブランドがどのイメージで語られているか」「どのブランドどうしが似たイメージを持たれているか」「どのイメージ語が空いているか」を1枚で見られます。前節の読み方に従えば、ブランドどうしの距離は読んでよく、ブランドとイメージ語の関係は原点からの方向で読みます。
この使い方には、対応分析の性質に由来する注意が3つあります。第1に、図に現れるのは「平均からのずれ」であって、イメージの絶対的な強さではありません。すべてのブランドが「高品質」と言われている市場では、「高品質」は差をつけない語なので原点近くに置かれます。原点近くにある語を「どのブランドにも当てはまらない語」と読むのは誤りです。第2に、回答者数が少ないブランドやイメージ語は、質量が小さいので軸の形成にはほとんど寄与しないのに、プロファイルが極端になりやすく、図の外縁に置かれて目立ちます。図の端にある点ほど重要だと思い込むと、少数の回答に引きずられます。寄与と cos² を併せて見ることが欠かせません。第3に、自社ブランドの「移動」を時系列で追うときは、各時点の表を別々に分析してはいけません。軸は表ごとに決まるので、別の表の図を重ねても位置の比較になりません。基準時点の表で軸を決め、他の時点のブランドは補助点(supplementary point)として同じ軸に投影するのが定石です。補助点とは、質量をゼロにして図の作成には使わず、あとから既存の軸に投影した点のことです。
本章の積み重ね表の分析は、このポジショニングマップの考え方をセグメントと属性に当てはめたものと見ることができます。行がブランドではなくセグメントであり、列がイメージ語ではなく属性カテゴリだというだけで、読み方は同じです。セグメントごとに「どの属性が平均より多いか」を図で示し、たとえば「サービス重視セグメントは店舗チャネルとゴールド・プラチナ会員の方向にある」と言えます。このとき「サービス重視の顧客はプラチナ会員だ」と言い切ってはいけません。生成時の設定でもサービス重視のうちプラチナ会員になる確率は 15% にすぎず、実際に生成された標本の内訳では 240 人中 26 人(10.8%)でした。図が示すのは「プラチナの割合が平均より高い」という相対的なずれであり、多数派を示しているわけではありません。
多重対応分析、3つ以上の質的変数を同時に図にする
多重対応分析(MCA)は、対応分析を3つ以上の質的変数に広げたものです。回答者を行、すべてのカテゴリを列に取り、該当するカテゴリに1、それ以外に0を置いた指示行列(ダミー変数の行列)に対応分析を当てるのが基本の定義です。変数の数を \( Q \)、カテゴリの総数を \( J \) とすると、指示行列の総慣性は \( (J-Q)/Q \) という定数になります。総慣性がデータの中身と無関係に決まることが、多重対応分析の寄与率が低く出る理由で、寄与率の数字を対応分析と同じ感覚で読んではいけません。総慣性 \( (J-Q)/Q \) を軸の本数の上限 \( J-Q \) で割ると、固有値の平均は \( 1/Q \) になります。グリーナカーは、固有値が \( 1/Q \) を超える軸だけを残し、その固有値を縮めて慣性を再計算する補正を示しています。平均を超えない軸は、少なくともこの目安では構造として読まない、という扱いです。
共通データの年代・性別・会員区分・購入チャネルの4変数(カテゴリ総数 13)で prince.MCA を回しました。総慣性は 2.25 で、\( (13-4)/4 \) に一致します。固有値は第1軸から順に 0.2675、0.2649、0.2622、0.2562、0.2514 で、寄与率は 11.9%、11.8%、11.7%、11.4%、11.2% でした。5つの軸がほとんど同じ大きさで、しかも 1/Q = 0.25 をわずかに超えているだけです。correction="benzecri" を指定して補正すると、固有値は 0.00055、0.00040、0.00026 と事実上ゼロになりました。これは「4つの変数の間にほとんど関連が無い」ことを意味します。実際、2変数ずつのクロス集計表からクラメールの V を計算すると 0.024 から 0.058 で、どの組み合わせも独立と区別がつきません。生成時の設定では年代と性別はセグメントと無関係に振っており、会員区分とチャネルはセグメントに応じて確率を変えているものの、両者を直接結びつけてはいないので、この結果は設計どおりです。
import prince
from survey_data import load_survey

df = load_survey()
cols = ["age", "gender", "member", "channel"]
X = df[cols].astype(str)

mca = prince.MCA(n_components=5, random_state=0).fit(X)
print("total_inertia_ =", round(mca.total_inertia_, 4))
print("eigenvalues_ =", mca.eigenvalues_.round(4))
print("percentage_of_variance_ =", mca.percentage_of_variance_.round(2))
print(mca.column_coordinates(X).iloc[:, :2].round(3))

mca_b = prince.MCA(n_components=5, random_state=0, correction="benzecri").fit(X)
print("補正後の eigenvalues_ =", mca_b.eigenvalues_.round(5))
# 出力(抜粋):
# total_inertia_ = 2.25
# eigenvalues_ = [0.2675 0.2649 0.2622 0.2562 0.2514]
# percentage_of_variance_ = [11.89 11.78 11.65 11.39 11.17]
# 補正後の eigenvalues_ = [5.5e-04 4.0e-04 2.6e-04 7.0e-05 0.0e+00]
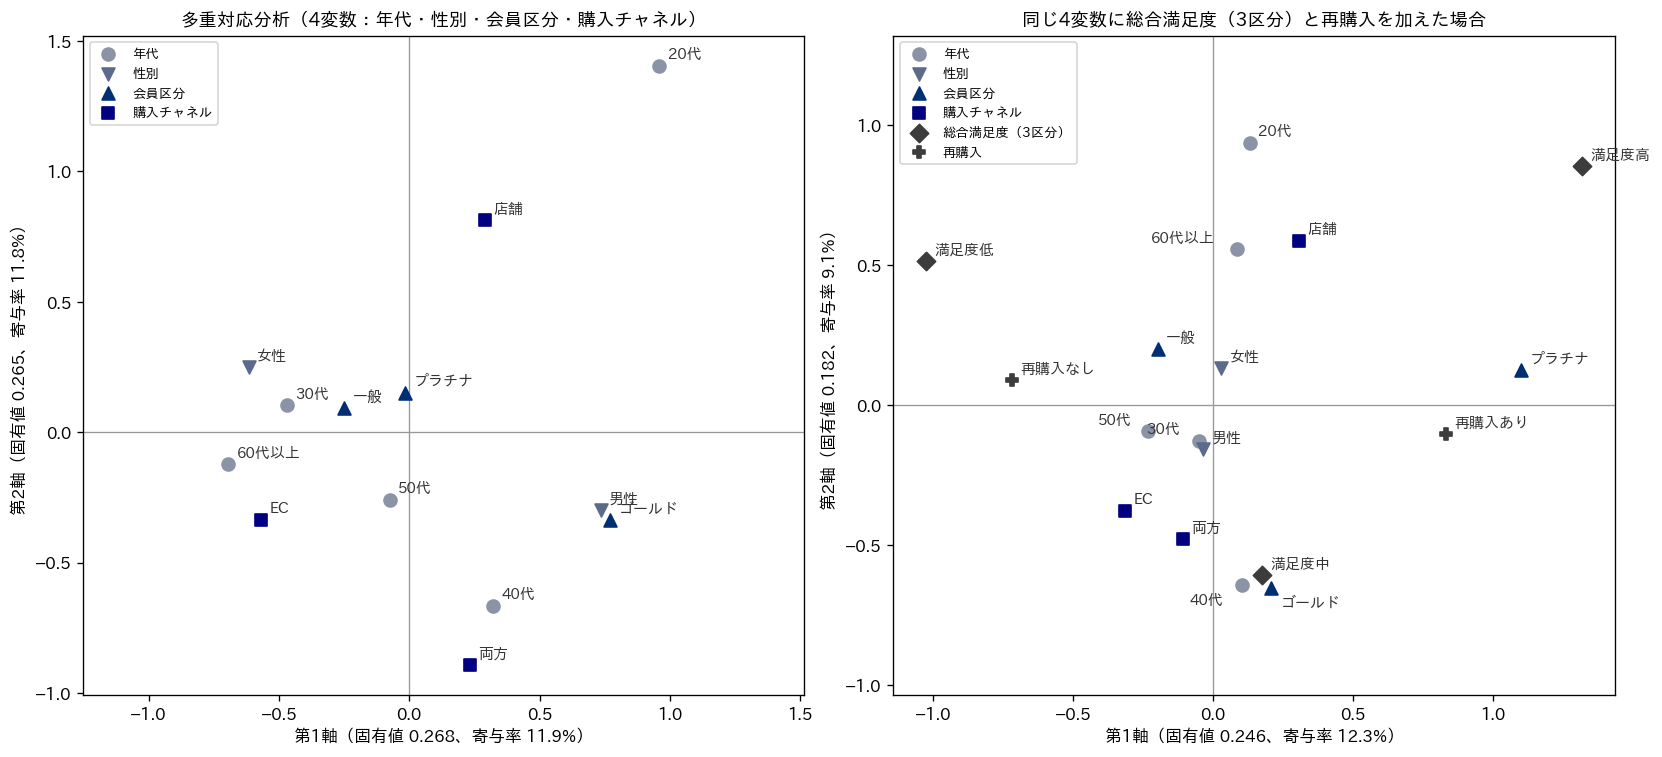
それでも図は描けます。上の左図がその布置図で、20代が右上、両方が右下、EC が左下と、もっともらしく散らばって見えます。しかし固有値の並びが示すとおり、この散らばりは構造ではなく偶然の配置です。図が描けることと、図に意味があることは別です。多重対応分析に限らず、本章の手法はどんな入力からでも図を返すので、図を見る前に固有値やストレス値といった「図の信頼度」を見る習慣が要ります。
比較のために、同じ4変数に総合満足度の3区分(低 376 人、中 614 人、高 210 人)と再購入の有無を加えた6変数でも回しました。右図がその結果です。第1軸の固有値は 0.2459 で、1/Q = 0.167 をはっきり超え、第2軸以降(0.182、0.179、0.176)から離れました。第1軸の慣性への寄与は満足度低が 22.3%、再購入ありが 21.8%、満足度高が 20.6%、再購入なしが 18.8% で、この4つで 8 割を超えます。第1軸は「満足して再購入する側と、満足せず再購入しない側」の軸であり、その軸の右側にプラチナ(座標 1.102)と店舗が、左側に EC が置かれています。満足度3区分と再購入のクラメールの V は 0.396 で、会員区分と満足度は 0.089、チャネルと満足度は 0.093 でした。図の第1軸を作っているのは満足度と再購入の強い関連であり、会員区分やチャネルはそれに弱く連動しているだけです。図を読むときは、このように「軸を作っている変数」と「軸に乗っているだけの変数」を寄与で区別します。
多次元尺度構成法、距離だけから配置を復元する
多次元尺度構成法(MDS)は、対象どうしの距離(または非類似度)の行列だけを入力にして、その距離をできるだけ再現するように対象を低次元の平面に配置する手法です。対応分析がクロス集計表、主成分分析がデータ行列を入力にするのに対し、MDS は「AとBはどれくらい似ていないか」の表さえあれば動きます。ブランドの類似度をペアごとに尋ねた調査、店舗間の移動時間、商品の共同購買から作った非類似度など、距離の形で得られるものなら何でも入力にできます。
MDS には計量 MDS と非計量 MDS があります。計量 MDS は、入力の距離の値そのものを図上の距離で再現しようとします。非計量 MDS は、距離の値ではなく順序だけを再現しようとします。「AB 間は AC 間より遠い」という順序関係が図上でも保たれていればよく、値の比率は問いません。scikit-learn の解説では、非計量 MDS は「データの順序づけに着目する」手法だと説明されています。回答者に「似ている順に並べてもらった」ような順序尺度の非類似度には、非計量 MDS が適しています。
図がどれだけ入力の距離を再現できているかを測るのがストレス値です。scikit-learn の MDS は normalized_stress=True で Stress-1 と呼ばれる正規化ストレスを返します。これは「図上の距離と目標の距離の差の2乗和を、図上の距離の2乗和で割って平方根をとったもの」です。scikit-learn の解説には、クラスカル(1964年)に基づく目安として、0 が完全、0.025 が優、0.05 が良、0.1 が可、0.2 が不良と記されています。この目安はクラスカルが非計量 MDS の論文で示したものなので、計量 MDS のストレスや、次元数・対象数の異なる状況にそのまま当てはめるのは慎重であるべきです。ストレスは次元数を減らすほど大きくなります(本章の実測でも次元数1で 0.086、3で 0.011)。目安は絶対的な合否線ではなく、次元数を変えたときの比較に使うのが実務的です。
共通データの16項目で MDS を実行しました。距離は項目間の相関係数 \( r \) から \( 1 – r \) として作りました。相関が高い項目ほど近く、無相関なら距離1になります。scikit-learn 1.9 では metric_mds=True で計量、False で非計量になり、距離行列を渡すときは metric="precomputed" を指定します。初期配置は init="classical_mds"(古典的 MDS の解から出発)としました。
import numpy as np
from sklearn.manifold import MDS
from survey_data import load_survey, ITEM_COLS

df = load_survey()
R = df[ITEM_COLS].corr()
D = (1 - R).to_numpy(copy=True)   # 相関が高いほど近い
np.fill_diagonal(D, 0.0)

for name, flag in [("計量MDS", True), ("非計量MDS", False)]:
    mds = MDS(n_components=2, metric_mds=flag, metric="precomputed",
              init="classical_mds", normalized_stress=True, random_state=0)
    X = mds.fit_transform(D)
    print(name, " Stress-1 =", round(mds.stress_, 4), " 反復 =", mds.n_iter_)

for k in [1, 2, 3, 4]:
    m = MDS(n_components=k, metric_mds=False, metric="precomputed",
            init="classical_mds", normalized_stress=True, random_state=0).fit(D)
    print("次元数", k, " Stress-1 =", round(m.stress_, 4))
# 出力:
# 計量MDS  Stress-1 = 0.1946  反復 = 49
# 非計量MDS  Stress-1 = 0.0312  反復 = 46
# 次元数 1  Stress-1 = 0.0861
# 次元数 2  Stress-1 = 0.0312
# 次元数 3  Stress-1 = 0.0113
# 次元数 4  Stress-1 = 0.0114
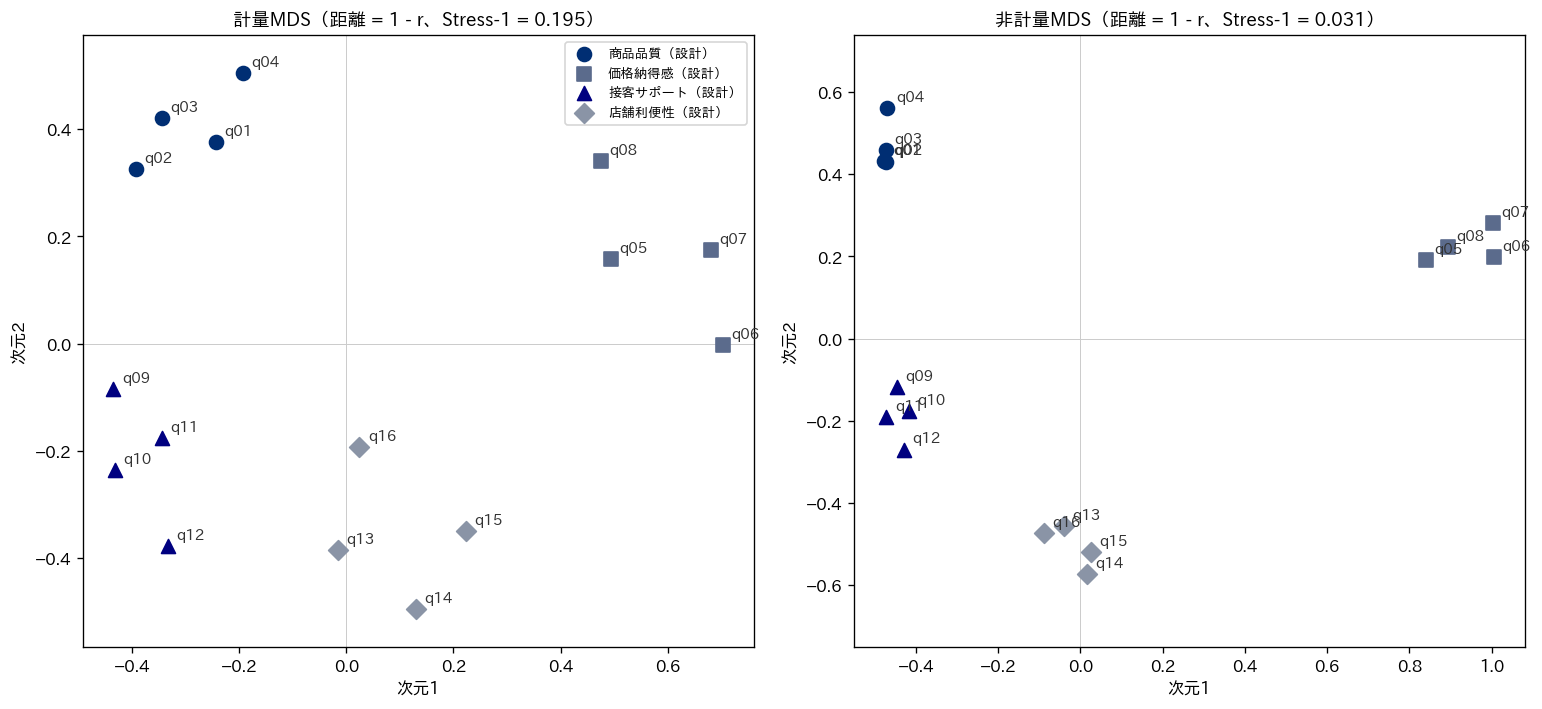
2次元の Stress-1 は、計量 MDS で 0.195、非計量 MDS で 0.031 でした。計量 MDS の値が大きいのは、この距離行列の性質によります。同じ因子に属する項目どうしの距離は 0.30 から 0.51(平均 0.39)に収まり、因子をまたぐ項目どうしは 0.55 から 1.06(平均 0.81)です。4つの塊を互いにほぼ同じ距離だけ離して置くには3次元が要るので、2次元の平面で距離の値そのものを再現するのは原理的に無理があります。非計量 MDS は順序さえ保てばよいので、同じ因子の4項目を1か所に寄せ、因子ごとの塊を離して置くことでストレスを下げています。図を見ると、非計量 MDS では商品品質(q01〜q04)、価格納得感(q05〜q08)、接客サポート(q09〜q12)、店舗利便性(q13〜q16)が4つの塊にきれいに分かれ、計量 MDS でも塊の分かれ方は同じで、塊の中の広がりが大きい、という違いになっています。設計上の因子ごとに重心を計算し、各項目が最も近い重心を調べたところ、16項目すべてが設計どおりの因子の重心に最も近く、同じ因子内の項目間の図上距離の平均は 0.095、因子をまたぐ平均は 1.057 でした。第4章の因子分析で回収した4因子構造が、距離だけを入力にした MDS でも同じ形で現れています。
次元数とストレスの関係も見ておきます。非計量 MDS で次元数を1から4に変えると、Stress-1 は 0.086、0.031、0.011、0.011 と下がり、3次元で頭打ちになりました。3次元にすれば「4つの塊を互いに等距離に置く」ことができるので、それ以上増やしても改善しないのは理にかなっています。ストレスの下がり方が鈍る次元数を採用するのは、主成分分析のスクリープロットと同じ考え方です。ただし報告に使う図は2次元にせざるを得ないことが多いので、2次元のストレスがどの程度かを図と一緒に示すのが誠実な報告です。
距離の作り方も結果に影響します。相関から距離を作る方法は \( 1 – r \) のほかに \( \sqrt{2(1-r)} \) もあり、後者は標準化した変数どうしのユークリッド距離に一致します。後者で回すと、計量 MDS の Stress-1 は 0.282 に上がり、非計量 MDS は 0.0311 と、もとの 0.0312 からほとんど変わりませんでした。非計量 MDS は距離の順序だけを使うので、順序を変えない変換であれば結果はほぼ同じになります。計量 MDS を使うときは、距離の定義が結果を左右することを覚えておく必要があります。
t-SNE と UMAP の位置づけ、可視化の道具であって距離計ではない
t-SNE(t分布型確率的近傍埋め込み)は、2008年にファン・デル・マーテンとヒントンが提案した可視化手法です。高次元での点どうしの近さを確率に変換し、低次元でも同じような近さの確率が再現されるように点を動かします。高次元側では正規分布、低次元側では裾の重い t 分布を使うため、近い点を近く保ちやすく、重い裾のおかげで点が中央に集まりすぎる問題が緩和されます。ただし、離れた点どうしの距離は保存されません。scikit-learn の解説は、t-SNE が局所構造に敏感で、複数のクラスタに分かれたデータを見せるのに強い一方、「大域的な構造は明示的には保たれない」ことと、確率的なアルゴリズムなので初期値によって異なる図が出ることを欠点として挙げています。
共通データの16項目を標準化し、sklearn.manifold.TSNE(init="pca"、learning_rate="auto"、random_state=0)を当てて、生成時のセグメントで色分けしました。perplexity(近傍として考慮する点の数の目安)を 5、30、100 と変えると、収束時の KL ダイバージェンスは 1.611、1.555、1.082 でした。KL ダイバージェンスは t-SNE の目的関数で、小さいほど高次元の近さを再現できていることを意味しますが、perplexity が違えば目的関数の定義が変わるので、この値で perplexity の良し悪しを比べることはできません。
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler
from survey_data import load_survey, ITEM_COLS

df = load_survey()
Z = StandardScaler().fit_transform(df[ITEM_COLS].astype(float))
seg = df["segment_true"].to_numpy(dtype=object)   # 生成時のセグメント。色分けにだけ使う

for perp in [5, 30, 100]:
    ts = TSNE(n_components=2, perplexity=perp, init="pca",
              learning_rate="auto", random_state=0)
    Y = ts.fit_transform(Z)
    print("perplexity =", perp, " KL =", round(ts.kl_divergence_, 4))
# 出力:
# perplexity = 5  KL = 1.6105
# perplexity = 30  KL = 1.5548
# perplexity = 100  KL = 1.0819
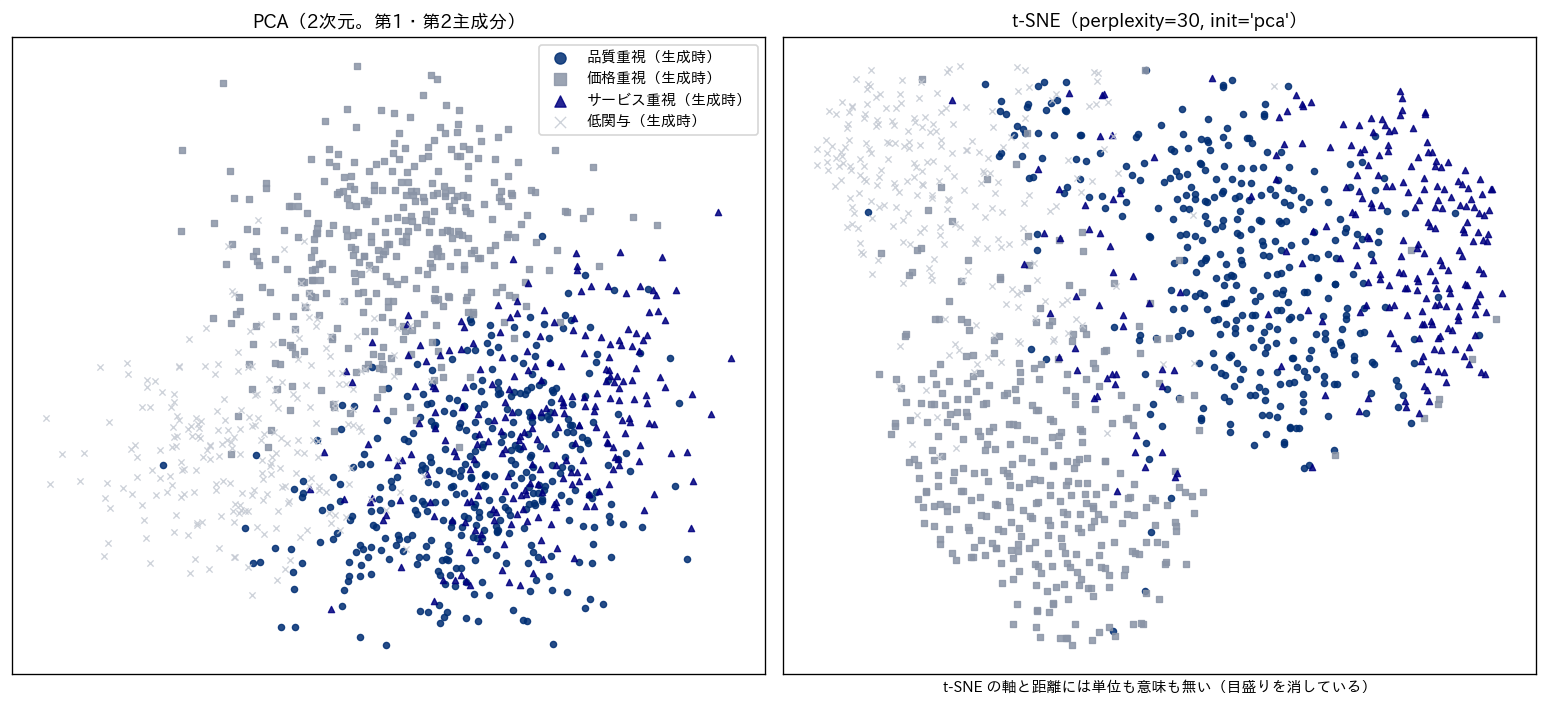
右図が perplexity 30 の t-SNE、左図が比較のための主成分分析(第1・第2主成分)です。t-SNE では価格重視と低関与がそれぞれまとまった塊になり、品質重視とサービス重視は重なり合っています。生成時の設定で品質重視とサービス重視は因子の平均が近く、もともと重なりやすいセグメントなので、この重なりはデータの姿を反映しています。図の上で「同じセグメントの人が近くにいるか」を10近傍のセグメント一致率で測ると、元の16次元で 0.748、主成分分析の2次元で 0.655、t-SNE では perplexity 5 で 0.723、30 で 0.751、100 で 0.769 でした。t-SNE は2次元に落としても、元の16次元と同じ程度に「近くの人は同じセグメント」という局所の関係を保っており、主成分分析の2次元より優れています。これが t-SNE を可視化に使う理由です。
しかし、t-SNE の図で距離を定量的に読んではいけません。無作為に選んだ 300 人について、元の16次元での距離と図上の距離の順位相関を求めると、主成分分析の2次元では 0.862 でしたが、t-SNE では perplexity 5 で 0.736、30 で 0.744、100 で 0.770 と低くなりました。局所の近さを優先する代償として、離れた点どうしの距離の順序は崩れています。セグメントの重心どうしの距離を比べるとさらにはっきりします。元の16次元では、最も近い組(品質重視とサービス重視、2.72)と最も遠い組(サービス重視と低関与、5.26)の比は 1.9 倍ですが、t-SNE の図上では 14.7 と 51.3 で 3.5 倍に広がり、しかも順序も入れ替わっています。元の空間では価格重視とサービス重視(3.83)は品質重視と低関与(4.43)より近いのに、図上では 43.6 と 36.9 で逆転しました。図上で「塊Aと塊Bは離れているから顧客像が大きく違う」と読むのは、この手法では根拠になりません。
この注意は、t-SNE の提案者らとは別のグループが2016年に Distill 誌で示した「t-SNE を効果的に使うには」という記事に整理されています。そこでは、perplexity によって図が大きく変わること、図上の塊の大きさには意味が無いこと、よく分かれた塊どうしの距離は何も意味しない場合があること、無構造の乱数からも塊に見える模様が出ることが、実験で示されています。t-SNE の図は「どの点がどの点と近傍か」を見る道具であり、塊の大きさ・塊の間の距離・軸の意味は読まない、と覚えておくのが安全です。本章の図で軸の目盛りを消しているのは、そのためです。
UMAP は、2018年にマキネスらが提案した手法で、リーマン幾何と代数的位相幾何に基づく枠組みから構成され、t-SNE と同程度の可視化品質を保ちながら計算が速く、大域的な構造をより保ちやすいとされています。埋め込む次元数を2や3に限らずより高く指定できるので、可視化だけでなく機械学習の前処理としての次元削減にも使われます。本コラムの実行環境には UMAP のライブラリを導入していないため、実行結果は載せません。読み方の注意は t-SNE と共通で、近傍関係を見る道具であり、塊の間の距離や塊の大きさを定量的に読まないという原則は変わりません。t-SNE・UMAP と機械学習の表現学習との関係は、第14章で扱います。
本章で扱った4つの手法を、入力と「読んでよいもの」で整理すると次の表になります。
| 手法 | 入力 | 図の座標の意味 | 読んでよいもの | 読んではいけないもの |
|---|---|---|---|---|
| 対応分析 | 2変数のクロス集計表 | 平均プロファイルからのずれ(カイ二乗距離) | 行どうし・列どうしの距離、原点からの方向、寄与と cos² | 行の点と列の点の距離、原点近くの点の位置 |
| 多重対応分析 | 3つ以上の質的変数(指示行列) | カテゴリの独立からのずれ | 1/Q を超える軸の方向とカテゴリの寄与 | 補正前の寄与率の大小、1/Q を超えない軸 |
| 多次元尺度構成法 | 距離(非類似度)の行列 | 入力の距離の近似(計量)または順序の近似(非計量) | 点どうしの距離(ストレスが低いとき) | 軸の意味(回転しても解は同じ)、ストレスが高い図の細部 |
| t-SNE・UMAP | データ行列(高次元) | 近傍関係の再現。距離に単位も意味も無い | どの点がどの点の近くにあるか | 塊の大きさ、塊の間の距離、軸の意味 |
経営目線、ポジショニングマップを施策に使うときの誤り
本章の手法は、経営会議の資料に載りやすい図を作ります。だからこそ、誤読がそのまま投資判断に変わる危険があります。起こりやすい誤りを、損失の形で整理します。
第1の誤りは、対応分析の図で自社ブランドとイメージ語の距離を測り、「自社は『先進的』に近づいたので、先進性の訴求が効いている」と評価することです。前節で示したとおり、行と列の点の距離は定義された量ではなく、平均からのずれの方向が似ているかを表すにすぎません。この読み方で広告の効果を判定すると、効いていない施策を継続し、効いている施策を打ち切る、という逆の判断が起きます。図から読んだ関係は、必ず元のクロス集計表の割合に戻って、何ポイント動いたかで確認します。
第2の誤りは、図の「空白地帯」を市場機会と読むことです。対応分析の図で、どのブランドも置かれていない方向にイメージ語があると、「そのイメージは誰も取っていないから狙い目だ」と読みたくなります。しかし、その語が原点近くにあるなら、それは「全ブランドに等しく当てはまる語」であって空白ではありません。また、外縁にあるなら回答者数が少ない語かもしれません。空白地帯の判断には、その語の回答者数と質量、そして cos² を確認したうえで、その方向にポジションを取ることが自社の強みと一致するかという、図の外の判断が要ります。図は「どこが空いているか」を示しても、「そこに行けるか」「行く価値があるか」は示しません。
第3の誤りは、多重対応分析や t-SNE の図が「それらしく見える」ことを構造の証拠と受け取ることです。本章の4変数の多重対応分析は、固有値がすべて独立の水準に張りついているのに、図の上ではカテゴリが散らばって見えました。この図から「20代と店舗が近いので、20代向けの店舗施策を強化する」という結論を出せば、根拠の無い投資になります。図を報告に載せる前に、固有値・ストレス値・cos² といった信頼度の数字を確認し、信頼度が低い図は載せない、という手順を分析の側に組み込んでおくべきです。
第4の誤りは、セグメントの図上の距離を「顧客像の違いの大きさ」として、そのまま施策の優先順位に翻訳することです。t-SNE の図では、塊の間の距離は元の空間の距離を保っていませんでした。「低関与セグメントは他から最も離れているので、別ブランドで対応すべきだ」といった判断は、図の作り方が変われば消える距離に基づいています。セグメント間の違いの大きさは、第6章で扱ったように、元の変数での平均の差や判別のしやすさで測るべきで、可視化の図から読むものではありません。
これらの誤りに共通するのは、図を「測定器」として使ってしまうことです。本章の手法は、複雑な表やデータの中の関係を人間が見て気づくための道具であり、気づいた関係を確かめる測定器は、元のクロス集計表、元の距離行列、元の変数です。図で仮説を立て、表で確かめ、確かめた数字で施策を決める、という順序を守ることが、これらの手法を経営に活かす条件だと考えています。
本章の要点をまとめます。対応分析はクロス集計表の「独立からのずれ」をカイ二乗距離と慣性で図にする手法で、行どうし・列どうしの距離と原点からの方向は読めますが、行の点と列の点の距離は読めません。多重対応分析は固有値が 1/Q を超える軸を中心に読み、多次元尺度構成法はストレス値を図と一緒に示します。t-SNE と UMAP は近傍関係を見る可視化の道具であり、距離を定量的に読む道具ではありません。次の第9章では、日本の実務で対応分析と同じ役割を担ってきた数量化III類を含む数量化理論を取り上げ、本章の手法との対応関係と、質的データをダミー変数で扱うときの作法を整理します。
この章を深めたい方への参考書籍
『対応分析の理論と実践 基礎・応用・展開』(Michael Greenacre 著、藤本一男 訳、オーム社):原著 Correspondence Analysis in Practice 第3版の翻訳で、対応分析の第一人者が基礎から応用・展開までを体系的に説明した定番書です。本章で引いた対称マップとバイプロットの区別や慣性の分解は同じ著者の考え方によるもので、同時布置図の誤読を避けるためにより深く学ぶなら、第一候補になる1冊です。
『対応分析入門 原理から応用まで』(Sten-Erik Clausen 著、藤本一男 訳、オーム社):書名のとおり対応分析の原理から応用までを扱う入門書で、「R で検算しながら理解する」解説が併載されています。本章の Python での計算を別のソフトで確かめながら、プロファイルと慣性の考え方を手を動かして身につけたい方に向いています。
『関連性データの解析法 多次元尺度構成法とクラスター分析法』(斎藤堯幸・宿久洋 著、共立出版):書名のとおり、距離や類似度といった関連性データを扱う多次元尺度構成法とクラスター分析法をまとめた専門書です。本章の MDS の節で触れた計量・非計量の区別やストレスの意味を、第6章のクラスター分析と合わせて深く理解したい方に向いています。
第9章 数量化理論、質的データを数量で扱う
第8章では、クロス集計表の行と列を同じ図の上に置く対応分析と、距離の情報から配置を復元する多次元尺度構成法を確認しました。どちらも、個々の変数の値そのものではなく、行と列の関係や対象どうしの近さから位置関係を取り出す手法でした。この章では、その考え方を戦後の日本で独自に体系化した数量化理論を扱います。性別・年代・会員区分・購入チャネルのように、数値ではなく「どの区分に属するか」でしか記録できないデータを、どうやって回帰や判別や布置図に載せるか、という問いに答える体系です。
数量化理論は、日本の調査会社の用語集や医学・工学の論文で今も名前が残っている一方で、scikit-learn や statsmodels といった標準的な機械学習・統計モデリングのライブラリには「数量化I類」という専用の関数は用意されていません。同じ計算が、ダミー変数を使った回帰、判別分析、対応分析、多次元尺度構成法という別の名前で実装されているからです。この章では、まず数量化理論がどこから生まれ、I類からIV類がそれぞれ何を問う手法なのかを一次情報に沿って整理し、次に第2章で用意したサンプルデータ(架空の顧客満足度調査1,200件)で数量化I類とII類を実際に動かし、カテゴリスコアとレンジの読み方、基準カテゴリの取り方で係数の見え方がどう変わるか、順序尺度をどう扱うべきかを確かめます。III類とIV類は第8章の対応分析・多次元尺度構成法と同じ計算であることを、小さな計算で1つだけ確認します。
数量化理論はどこから生まれたか
数量化理論を体系化したのは、統計数理研究所の元所長である林知己夫(1918年〜2002年)です。統計数理研究所の機関誌『統計数理』第50巻第2号に掲載された追悼文(統計数理研究所、2002年)によれば、林は1946年に統計数理研究所へ入所し、1974年に所長に就任、1986年に退官して名誉教授となりました。同じ追悼文は、数量化理論について「質的なデータを数量化することによって、複雑・曖昧な現象を計量的に理解・解明しようとする考えの下に、1940年代から先生が中心となって数量化理論が開発されました」と記し、第I類から第IV類と呼ばれる方法が「日本人の読み書き能力調査」や「仮釈放」などの具体的な問題に関連して、質的データの予測・パターン分類・判別・分類の問題を解決する過程で開発されたと説明しています。教科書の演習問題から生まれた理論ではなく、1948年の読み書き能力調査のような実際の社会調査の現場で、数値にならない回答をどう扱うかという必要に迫られて作られた道具だ、という点は押さえておく価値があります。
英文の原論文も残っています。統計数理研究所の英文誌 Annals of the Institute of Statistical Mathematics の第2巻(1950年)に「数理統計の観点からの質的データの数量化について」にあたる論文(Hayashi, 1950)が、第3巻に「質的データからの現象の予測と数量化について」にあたる論文(Hayashi, 1951)が載っています。書誌情報は CrossRef の登録で確認しました。どちらの題名にも「数理統計の観点から」という句が入っており、経験的な工夫ではなく数理統計の基準から数量を導く、という姿勢が題名に表れています。論文の本文は出版社のページを開けなかったため、この章では書誌と題名の範囲でしか引いていません。
「第I類」「第II類」という番号による呼び方は、林自身が最初から使っていたものではないようです。調査会社の日経リサーチが公開している用語集(日経リサーチ「数量化理論」)によれば、林は個別の手法を「外的基準があり数量で与えられている場合」のように呼んでおり、社会心理学者の飽戸弘が「数量化理論第○類」と番号を付けて区別したものが定着したとされます。同じ用語集は、市場調査の分野では1964年に『市場調査の計画と実際』(林知己夫・村山孝喜、日刊工業新聞社)が刊行され、数量化法を調査データに適用する事例が紹介されたこと、V類・VI類も存在するがあまり利用されていないことも記しています。命名の年や経緯の細部は、この用語集以外の一次資料で確認できていないため、ここでは「とされます」にとどめます。
追悼文はもう1つ、林の立場を「理論による現象の理解」に対する「データによって現象を理解する」という主張として要約しています。仮説を立てて検証するより、データから仮説を発見することを重んじる探索的な姿勢です。この姿勢は、第3章の主成分分析や第6章のクラスター分析にも共通する、多変量解析全体の性格でもあります。数量化理論を「古い日本の手法」として片付けるのではなく、質的データを探索的に読むための考え方の源流として位置づけると、現代のライブラリで同じ計算を回すときの見方が変わります。
I類からIV類まで、それぞれが何を問う手法か
数量化理論の4つの類は、2つの軸で整理すると見通しがよくなります。1つ目の軸は「外的基準があるか」です。外的基準とは、林の用語で、予測や判別の目標になる変数のことです。売上・満足度のように数量で与えられていれば回帰の問題になり、再購入した・しなかったのように群の区分で与えられていれば判別の問題になります。外的基準が無い場合は、データの内部構造そのものを取り出す問題になります。2つ目の軸は「入力の形」で、個体ごとの質的な回答(個体×アイテムの表)か、対象どうしの近さ・類似度(対象×対象の表)かで分かれます。
| 類 | 外的基準 | 入力 | 問い | 数理的に対応する手法 | この記事で扱う章 |
|---|---|---|---|---|---|
| 数量化I類 | あり(数量) | 個体×質的アイテム | 質的な説明変数から数量の目的変数を予測する | ダミー変数を用いた重回帰分析 | 本章 |
| 数量化II類 | あり(群の区分) | 個体×質的アイテム | 質的な説明変数からどの群に属するかを判別する | ダミー変数を用いた判別分析 | 本章(判別の一般論は第7章) |
| 数量化III類 | なし | 個体×質的アイテム、またはクロス集計表 | 似た反応をする個体とカテゴリを同じ軸の上に並べる | 対応分析・多重対応分析 | 第8章 |
| 数量化IV類 | なし | 対象×対象の親近性(類似度) | 親近性の情報から対象の配置を求める | 多次元尺度構成法 | 第8章 |
「数理的に対応する」という言い方には注意が要ります。日経リサーチの用語集は、数量化I類の結果として得られる数量と、対応する手法(用語集では分散分析を挙げています)の結果は「基準化方法が異なるだけで、相関係数は正確に1である」と説明し、数量化II類と判別分析についても同様だとしています。つまり、スコアの原点や単位の取り方が違うだけで、個体の並び順や予測値は同じになります。開発の背景や導出の道筋は違っても、同じ答えに行き着く手法が、異なる時期に異なる国で独立に作られたわけです。この対応関係があるおかげで、専用のソフトウェアが無くても、一般の多変量解析ライブラリで数量化理論の分析は再現できます。この章のコードも、数量化理論の専用関数ではなく、statsmodels の回帰と scikit-learn の判別分析、そして prince の対応分析をそのまま使います。
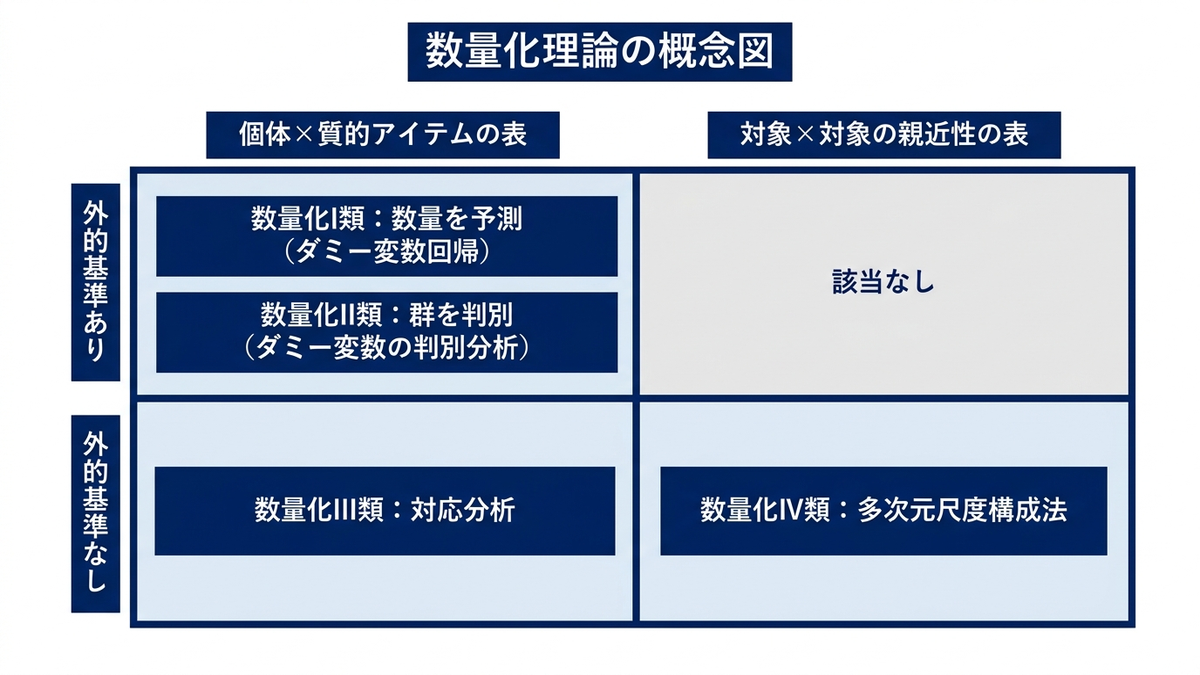
ダミー変数と基準カテゴリ、アイテムとカテゴリ
数量化理論の用語では、性別や会員区分のような質的変数をアイテム、その選択肢(女性・男性、一般・ゴールド・プラチナ)をカテゴリと呼びます。分散分析でいう因子と水準に相当します。数量化I類は、各カテゴリに1つの数量(カテゴリスコア)を与え、回答者ごとに「自分が該当するカテゴリのスコアを全アイテムについて足し合わせた値」が、目的変数にできるだけ近くなるようにスコアを決めます。これを行列で書くと、各カテゴリに該当すれば1、しなければ0を立てた0/1の列(ダミー変数)を説明変数にした重回帰分析と同じ式になります。
ここで1つ、技術的な問題が出ます。会員区分が一般・ゴールド・プラチナの3つなら、3本のダミー変数を作れますが、3本を横に足すとどの行でも必ず1になり、回帰の定数項と完全に重なってしまいます。第2章で見た多重共線性の極端な形で、係数が一意に決まりません。標準的な解決は、各アイテムで1つのカテゴリを落とし、そのカテゴリのスコアを0と置くことです。落としたカテゴリを基準カテゴリと呼び、残りのカテゴリの係数は「基準カテゴリと比べてどれだけ高いか低いか」を表します。statsmodels の式の中で C(member) と書くと、この展開を自動でやってくれます。ただし、どのカテゴリを基準に取るかは既定ではカテゴリの並びの先頭で、今回のように文字列のまま渡したデータでは辞書順の先頭になります(pandas の Categorical 型で順序を与えていれば、その順序の先頭が基準になります)。今回のデータでは会員区分の基準が「ゴールド」になります。カタカナが漢字より先に並ぶためで、分析上の意味があって選ばれたわけではありません。基準カテゴリを意識せずに係数を読むと、この後で見るように「一般会員はゴールドより0.5点低い」という文が「一般会員はプラチナより0.8点低い」という文に化けます。
日経リサーチの用語集が「基準化方法が異なるだけ」と書いていたとおり、数量化I類の出力は基準カテゴリを0に置く表示とは基準化の仕方が違います。この章では、基準カテゴリを0に置く代わりに、各アイテムのカテゴリスコアの加重平均(人数で重みを付けた平均)が0になるように全体をずらした表示を「加重平均0の表示」と呼び、基準カテゴリ0の表示と並べて使います。加重平均0の表示にすると、定数項が目的変数の平均に一致し、各カテゴリスコアは「そのカテゴリに属することで、全体平均からどれだけ上下するか」と読めるようになります。どちらの表示も同じ回帰から出てくるので、予測値は変わりません。変わるのは、スコアを読むときの比較対象が「基準カテゴリ」なのか「全体平均」なのか、という一点です。
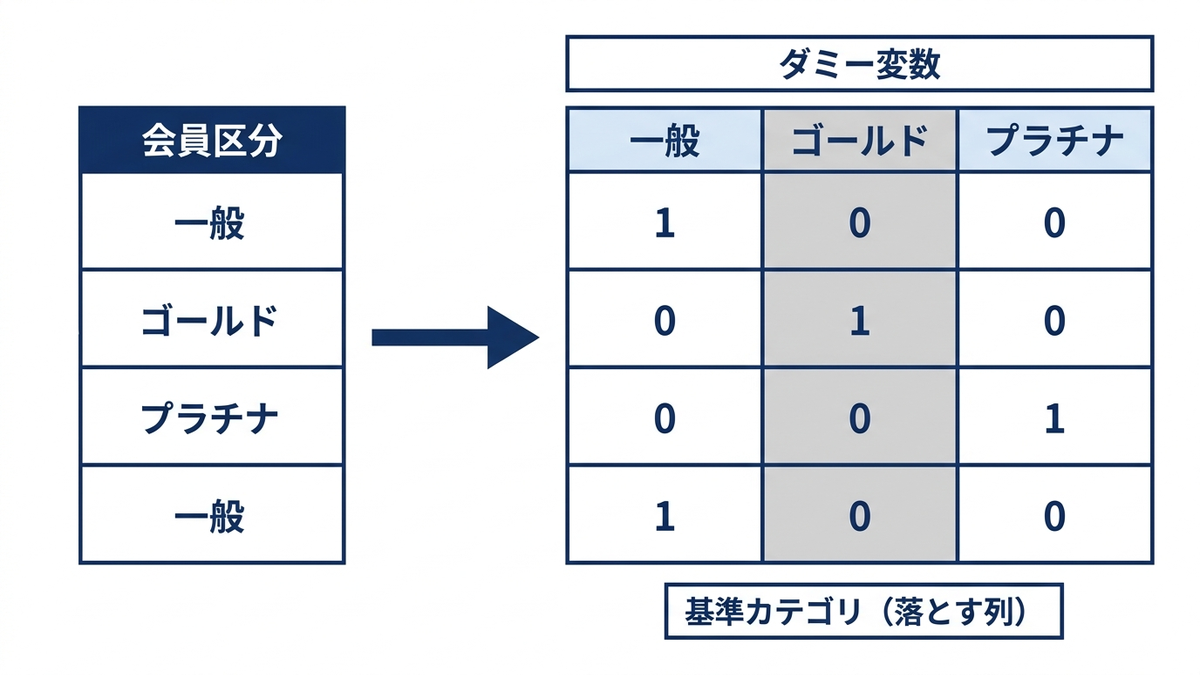
数量化I類を共通データで動かす
第2章のサンプルデータで、総合満足度 sat(1〜10点)を、年代(5区分)・性別(2区分)・会員区分(3区分)・購入チャネル(3区分)の4アイテムだけで説明してみます。回答者1,200人の内訳は、年代が20代182人・30代307人・40代309人・50代241人・60代以上161人、性別が女性652人・男性548人、会員区分が一般831人・ゴールド272人・プラチナ97人、購入チャネルが店舗503人・EC383人・両方314人です。総合満足度の平均は5.514点、標準偏差は2.161点でした。コードは次のとおりで、質的変数を C() で囲む以外は通常の重回帰と同じです。
import statsmodels.formula.api as smf
import statsmodels.api as sm
from survey_data import load_survey
df = load_survey()

# 質的変数は C() で囲むとダミー変数に展開される(基準カテゴリは既定で先頭。文字列の列なら辞書順の先頭)
formula = "sat ~ C(age) + C(gender) + C(member) + C(channel)"
m = smf.ols(formula, data=df).fit()
print("n = %d, 決定係数 R2 = %.4f, 自由度調整済み R2 = %.4f" % (m.nobs, m.rsquared, m.rsquared_adj))
print("定数項 = %.4f" % m.params["Intercept"])
print(m.params.round(4))                        # カテゴリスコア(基準カテゴリは 0)
print(sm.stats.anova_lm(m, typ=2).round(4))     # アイテム単位の F 検定
# 出力(抜粋):
# n = 1200, 決定係数 R2 = 0.0381, 自由度調整済み R2 = 0.0308
# 定数項 = 5.4656
# C(member)[T.プラチナ]   0.3042
# C(member)[T.一般]      -0.5086
# C(channel)[T.両方]      0.4234
# C(channel)[T.店舗]      0.6640
決定係数は0.0381、自由度調整済みで0.0308でした。4つの属性を全部使っても、総合満足度のばらつきの4%弱しか説明できていません。モデル全体の F 検定の p 値は5.27×10のマイナス7乗で、属性と満足度に統計的な関係はあるものの、その関係は小さい、というのが最初の結論です。これは、このデータでは総合満足度が商品品質や接客といった評価項目(第4章の4因子)から決まるように生成されており、年代や性別はセグメントと独立に振られているためです。実際の顧客調査でも、属性だけで満足度の大半が説明できることは稀で、決定係数が低いこと自体は異常ではありません。ただし、決定係数を見ずにカテゴリスコアの大小だけを報告すると、「属性が満足度を決めている」という印象を与えてしまいます。カテゴリスコアの表を出すときは、決定係数を必ず横に添えることを勧めます。
カテゴリスコアを、基準カテゴリを0とする表示(statsmodels の出力そのまま)と、各アイテムの加重平均を0とする表示の両方で並べたものが次の表です。加重平均0の表示では定数項が5.5142となり、総合満足度の平均5.5142と一致します。2つの表示の予測値の差は最大でも10のマイナス16乗のオーダーで、同じ回帰であることが確かめられます。
| アイテム | カテゴリ | 人数 | スコア(基準カテゴリ=0) | 基準との差の p 値 | スコア(加重平均=0) |
|---|---|---|---|---|---|
| 年代 | 20代 | 182 | 0(基準) | 0.0336 | |
| 年代 | 30代 | 307 | -0.0394 | 0.843 | -0.0058 |
| 年代 | 40代 | 309 | 0.0647 | 0.745 | 0.0983 |
| 年代 | 50代 | 241 | -0.2326 | 0.267 | -0.1990 |
| 年代 | 60代以上 | 161 | 0.0488 | 0.833 | 0.0824 |
| 性別 | 女性 | 652 | 0(基準) | -0.0207 | |
| 性別 | 男性 | 548 | 0.0453 | 0.714 | 0.0246 |
| 会員区分 | 一般 | 831 | -0.5086 | 0.001 | -0.1810 |
| 会員区分 | ゴールド | 272 | 0(基準) | 0.3276 | |
| 会員区分 | プラチナ | 97 | 0.3042 | 0.227 | 0.6318 |
| 購入チャネル | 店舗 | 503 | 0.6640 | 0.000 | 0.2749 |
| 購入チャネル | EC | 383 | 0(基準) | -0.3891 | |
| 購入チャネル | 両方 | 314 | 0.4234 | 0.009 | 0.0343 |
加重平均0の表示で読むと、会員区分はプラチナが全体平均より0.63点高く、一般が0.18点低い。購入チャネルは店舗が0.27点高く、ECが0.39点低い。年代と性別は、どのカテゴリも平均から0.2点以内に収まっています。同じ数字を基準カテゴリ0の表示で読むと、一般会員の「マイナス0.51」が目に付きますが、これはゴールド会員との差であって、全体平均との差ではありません。どちらの表示にも意味はありますが、報告書に載せるときは「何と比べた差か」を表の見出しに書くべきです。次の図は加重平均0の表示をアイテムごとに並べたもので、会員区分と購入チャネルの2アイテムだけが目立って動いていることが一目で分かります。
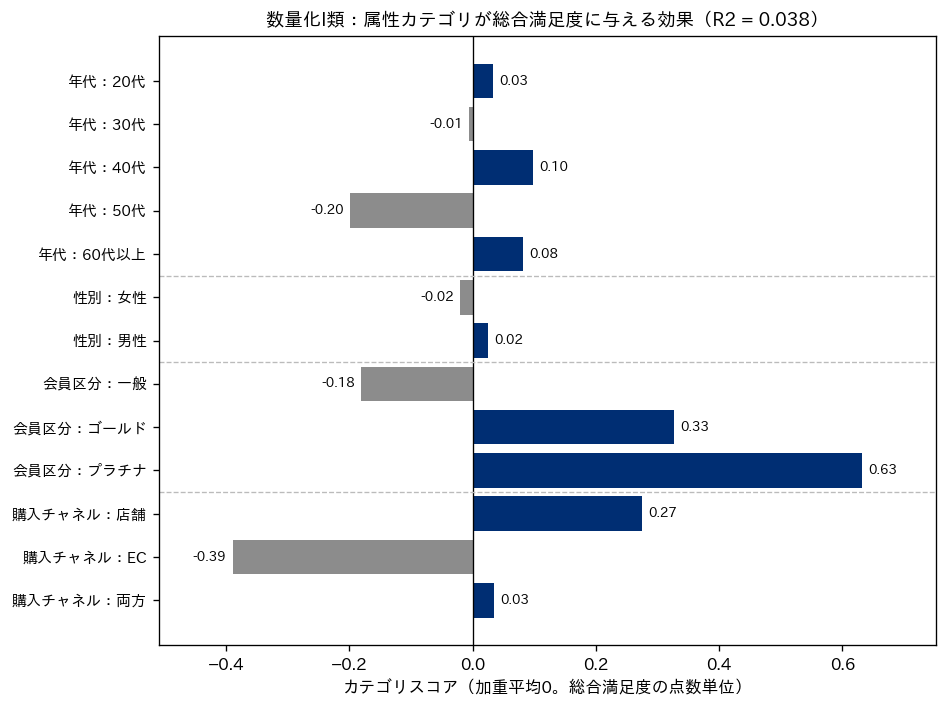
レンジ・偏相関係数・基準カテゴリ、カテゴリスコアをどう読むか
数量化I類の報告書には、カテゴリスコアの表と並んで、アイテムごとの「レンジ」と「偏相関係数」が載ることが多いように思います。レンジは、そのアイテムのカテゴリスコアの最大値と最小値の差です。基準カテゴリを0に置いても、加重平均を0に置いても、差を取るので同じ値になります。そのアイテムの中でカテゴリを入れ替えたときに、予測値が最大でどれだけ動くか、を表す量です。偏相関係数は、この章では、回答者ごとにそのアイテムの該当カテゴリのスコアを与えた「アイテム得点」と目的変数の相関を、他のアイテム得点の影響を取り除いて測ったものとして計算しました。他のアイテムを固定したとき、そのアイテムが目的変数とどれだけ結びついているか、を表します。今回の結果は次のとおりでした。
| アイテム | レンジ | レンジの順位 | 偏相関係数 | 偏相関の順位 | アイテム単位の F 検定の p 値 |
|---|---|---|---|---|---|
| 会員区分 | 0.8128 | 1 | 0.1315 | 2 | 0.0000 |
| 購入チャネル | 0.6640 | 2 | 0.1325 | 1 | 0.0000 |
| 年代 | 0.2973 | 3 | 0.0506 | 3 | 0.5495 |
| 性別 | 0.0453 | 4 | 0.0106 | 4 | 0.7143 |
レンジでは会員区分が1位、偏相関係数では購入チャネルが1位と、順位が入れ替わっています。これは珍しいことではありません。レンジは「両端のカテゴリの差」なので、人数の少ないカテゴリが極端なスコアを取ると大きくなります。会員区分のレンジ0.81は、97人しかいないプラチナのスコアに引っ張られたものです。一方、偏相関係数はアイテム全体としての目的変数との結びつきを測るので、人数の多いカテゴリの動きが効きます。購入チャネルは店舗503人とEC383人の間に0.66点の差があり、多くの回答者に関わる差なので偏相関が高くなります。レンジは「そのアイテムで最大どれだけ動きうるか」、偏相関は「そのアイテムが全体としてどれだけ効いているか」で、問いが違います。どちらか一方で重要度を決めるのではなく、両方を並べたうえで、人数の少ないカテゴリが端を作っていないかを確かめるのが安全です。
アイテム単位の F 検定(Type II の分散分析表)も添えました。これは、そのアイテムのダミー変数をまとめてモデルから落としたときに当てはまりがどれだけ悪くなるかを検定するもので、会員区分と購入チャネルは p 値が0.0001未満、年代は0.55、性別は0.71でした。年代のレンジ0.30は、50代のスコアがマイナス0.23と低いことから生じていますが、基準の20代との差の p 値は0.27で、5つの区分をまとめて見ても統計的に意味のある差とは言えません。レンジの順位表だけを見て「年代は3番目に重要」と書くと、偶然のばらつきを施策の根拠にしてしまいます。
次に、基準カテゴリの取り方で係数の見え方がどう変わるかを、実際に基準を入れ替えて確かめます。statsmodels では C(member, Treatment(reference='プラチナ')) のように書くと基準を指定できます。年代の基準を40代、性別を男性、会員区分をプラチナ、購入チャネルを両方に変えて同じ回帰を回しました。
import numpy as np
formula2 = ("sat ~ C(age, Treatment(reference='40代')) + C(gender, Treatment(reference='男性'))"
            " + C(member, Treatment(reference='プラチナ')) + C(channel, Treatment(reference='両方'))")
m2 = smf.ols(formula2, data=df).fit()
print("R2 = %.4f(同じ), 定数項 = %.4f" % (m2.rsquared, m2.params["Intercept"]))
print("会員区分の係数(基準=プラチナ):", {k.split("T.")[1].rstrip("]"): round(v, 4)
                                         for k, v in m2.params.items() if "member" in k})
print("予測値の最大絶対差 = %.2e(同一)" % np.abs(m.fittedvalues - m2.fittedvalues).max())
# 出力:
# R2 = 0.0381(同じ), 定数項 = 6.3032
# 会員区分の係数(基準=プラチナ): {'ゴールド': -0.3042, '一般': -0.8128}
# 予測値の最大絶対差 = 7.37e-14(同一)
決定係数は0.0381のまま、予測値の差は最大でも7.37×10のマイナス14乗で、計算上は同一のモデルです。変わったのは定数項(5.4656から6.3032へ)と、各カテゴリの係数です。会員区分を見ると、基準がゴールドのときは「プラチナ+0.3042、一般マイナス0.5086」だったものが、基準がプラチナのときは「ゴールドマイナス0.3042、一般マイナス0.8128」になります。レンジはどちらでも0.8128で変わりません。一般会員のスコアがマイナス0.51からマイナス0.81へ変わったように見えるのは、比較対象がゴールドからプラチナに変わったからで、一般会員の満足度が変わったわけではありません。
この性質は、報告書を読む側にとって落とし穴になります。同じデータから、「一般会員はゴールド会員より0.5点低い」という文と「一般会員はプラチナ会員より0.8点低い」という文の両方が正しく作れてしまいます。分析者が基準カテゴリを明示せずにスコアの表を出し、読む側が「一般会員は0.8点低い」だけを持ち帰ると、プラチナ会員が97人しかいないことも、プラチナとゴールドの差の p 値が0.227で統計的には区別できないことも抜け落ちます。基準カテゴリは、人数が多く、比較の対象として自然なカテゴリ(今回なら一般会員)を明示的に選ぶのが望ましいと考えています。辞書順の先頭という既定のままにしないことが、最初の一手です。
順序尺度をどう扱うか
年代のように順序のあるカテゴリは、「20代を2、30代を3、と番号を振って数量として回帰に入れる」という扱いも可能です。ダミー変数を作るより係数が1つで済み、「年代が1段階上がると満足度が何点変わる」と読めるので、報告書としては簡潔になります。ただし、この扱いは「隣り合う区分の間隔が等しい」「効果が単調に増える、または減る」という2つの仮定を置いています。仮定が成り立たないと、存在する差を打ち消してしまいます。
同じデータで、年代だけを2・3・4・5・6の数量として入れ直したところ、決定係数は0.0357(ダミー化では0.0381)、年代の傾きはマイナス0.0167で p 値は0.731でした。ダミー化したときのカテゴリスコアは、20代を0として30代マイナス0.039、40代+0.065、50代マイナス0.233、60代以上+0.049で、50代だけが下がって60代以上で戻る形をしています。直線を当てると、この谷は平らにならされ、傾きはほぼ0になります。今回は年代の効果自体が統計的に意味のある大きさではないので実害はありませんが、もし50代の谷が本物なら、数量として扱った時点で見えなくなります。順序尺度は、まずダミー変数で入れてカテゴリスコアの並びを確かめ、単調で間隔もおおむね一定だと分かってから数量に置き換える、という順番を勧めます。逆の順番、つまり最初から数量で入れてしまうと、確かめる機会が無くなります。
目的変数の側にも同じ問いがあります。この章では総合満足度の1〜10点を数量として扱いましたが、これも「1点と2点の差」と「9点と10点の差」を等しいとみなす仮定を置いています。第2章で扱った尺度の議論のとおり、7段階や10段階の評定を間隔尺度として扱うことは実務では広く行われていますが、仮定であることに変わりはありません。目的変数が「満足・どちらでもない・不満」のような少数の順序カテゴリなら、数量として回帰するより、数量化II類(判別)や、順序カテゴリをそのまま目的変数にする回帰モデル(順序ロジスティック回帰など。この記事では扱いません)を検討するほうが筋がよい場合があります。なお、ダミー変数の係数を「基準カテゴリとの差」として読む一般論は、既刊の849「ビジネスの要因分析に効く回帰分析と統計モデリングについて」の第2章でも扱っています。
数量化II類、質的な説明変数で群を判別する
数量化II類は、外的基準が「どの群に属するか」で与えられるときの手法です。数理的には、ダミー変数を説明変数にした判別分析と同じ計算になります。ここでは再購入(repurchase、1が再購入あり)を、I類と同じ4アイテムで判別してみます。scikit-learn の LinearDiscriminantAnalysis にダミー変数を入れるだけで、専用の関数は要りません。ダミー変数は pd.get_dummies(..., drop_first=True) で作り、各アイテムの辞書順の先頭(20代・女性・ゴールド・EC)を基準として落としています。判別分析の一般論(線形と二次の違い、誤判別率、ロジスティック回帰との使い分け)は第7章で扱っているので、ここでは数量化II類として読むときの要点に絞ります。
import pandas as pd
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.model_selection import StratifiedKFold, cross_val_score
from survey_data import load_survey
df = load_survey()
ITEMS = ["age", "gender", "member", "channel"]
X = pd.get_dummies(df[ITEMS], drop_first=True).astype(float)   # 9列のダミー変数
y = df["repurchase"].values

lda = LinearDiscriminantAnalysis().fit(X, y)
print("学習データでの正解率 = %.4f" % lda.score(X, y))
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
acc_cv = cross_val_score(LinearDiscriminantAnalysis(), X, y, cv=cv)
print("層化5分割交差検証の正解率 = %.4f" % acc_cv.mean())
coef = pd.Series(lda.coef_[0], index=X.columns)
print(coef.round(4))
# 出力(抜粋):
# 学習データでの正解率 = 0.5517
# 層化5分割交差検証の正解率 = 0.5492
# member_プラチナ    0.7219
# member_一般      -0.0718
# channel_両方     -0.1265
# channel_店舗      0.0845
結果は、学習データでの正解率が0.5517、層化5分割交差検証での正解率が0.5492でした。数字だけ見ると「55%当たる」ように読めますが、このデータの再購入率は0.463なので、全員を「再購入しない」と予測するだけで0.537の正解率が出ます。属性4アイテムによる判別は、その多数派予測を1.2ポイント上回るにすぎません。交差検証の予測で混同行列を作ると、再購入しなかった644人のうち553人(85.9%)は当てているのに、再購入した556人のうち当てたのは106人(19.1%)だけでした。判別関数がほとんどの回答者を「再購入しない」側に倒しているためで、正解率の高さは多数派を言い当てているだけの見かけの高さです。判別の結果を報告するときは、正解率と一緒に、少数派の群をどれだけ拾えているか(今回なら再購入者の19.1%)と、何もしないときの正解率(0.537)を必ず添えるべきです。
カテゴリごとの係数は、判別関数の重みで、正なら再購入側、負なら非再購入側にその回答者を寄せます。会員区分ではプラチナが+0.7219と大きく、一般はマイナス0.0718、年代では60代以上がマイナス0.2410、50代がマイナス0.1755、性別では男性がマイナス0.1295でした。アイテムごとのレンジは会員区分0.7937、年代0.3123、購入チャネル0.2110、性別0.1295です。I類のときと同じく、会員区分のレンジは97人のプラチナ会員が端を作っています。判別得点の群ごとの平均は、再購入ありがマイナス0.113、なしがマイナス0.181で、2つの群の中心の差が判別得点の目盛りで0.07しかありません。群の中心がこれだけ近いと、どこに境界を引いても両群が大きく重なり、判別はうまくいきません。
参考として、第7章の範囲に少しだけ踏み込んで、説明変数を変えたときの交差検証正解率を並べておきます。属性4アイテムのみでは0.5492、商品品質・価格納得感・接客サポート・店舗利便性の4つの下位尺度(各4項目の平均点、量的変数)のみでは0.6450、両方を入れると0.6417でした。属性を足しても正解率は上がらず、むしろ僅かに下がっています。再購入を分けているのは「誰か」ではなく「何をどう評価したか」であり、数量化II類が弱いのではなく、属性という説明変数が再購入を説明する力を持っていない、という話です。数量化II類が力を発揮するのは、判別に効く質的なアイテムが手元にあるときで、属性データがあるからという理由だけで回しても、多数派予測と変わらない結果しか出ません。
数量化III類とIV類、対応分析・多次元尺度構成法との関係
数量化III類は、外的基準を持たず、個体とカテゴリの両方に数量を与える手法です。その基準は、一般に「同じ個体が該当する行カテゴリの数量と列カテゴリの数量の相関係数が最大になるように数量を決める」と説明されます。この基準を行列で書き直すと、クロス集計表を行と列の比率で標準化した行列の特異値分解になり、特異値がそのまま「相関係数」、その2乗が対応分析の固有値になります。つまり数量化III類とクロス集計表の対応分析は同じ計算です。第8章の対応分析の読み方をここで繰り返す代わりに、両者が一致することを1つの表で確かめます。使うのは、会員区分(一般・ゴールド・プラチナ)と年間購入回数を3区分(少:0〜2回、中:3〜5回、多:6回以上)にしたクロス集計表です。
import numpy as np
import pandas as pd
import prince
from survey_data import load_survey
df = load_survey()
df["freq3"] = pd.cut(df["freq"], [-1, 2, 5, 1000], labels=["少(0〜2回)", "中(3〜5回)", "多(6回以上)"])
N = pd.crosstab(df["member"], df["freq3"]).loc[["一般", "ゴールド", "プラチナ"]]
N.columns = list(N.columns)

# 数量化III類を定義どおり解く(行と列の数量の相関を最大にする=標準化した表の特異値分解)
P = N.values / N.values.sum()
r = P.sum(axis=1)
c = P.sum(axis=0)
S = (P - np.outer(r, c)) / np.sqrt(np.outer(r, c))
U, sv, Vt = np.linalg.svd(S, full_matrices=False)
row_score = U[:, 0] / np.sqrt(r)     # 第1軸の行カテゴリの数量
print(np.round(sv, 4))                # [0.1536 0.0043 0.    ]

# prince.CA(対応分析)と突き合わせる
ca = prince.CA(n_components=2, random_state=0).fit(N)
print(np.round(np.asarray(ca.eigenvalues_), 4))              # [0.0236 0.    ]
rc = ca.row_coordinates(N)
print(np.round(rc.iloc[:, 0].values / row_score, 4))          # [0.1536 0.1536 0.1536]
クロス集計表は、一般会員が少313人・中352人・多166人、ゴールドが78人・103人・91人、プラチナが26人・37人・34人です。手計算した第1軸の特異値は0.1536で、回答者1,200人それぞれに自分の会員区分の数量と購入回数区分の数量を与えて相関係数を取ると、確かに0.1536になりました。第1軸の行カテゴリの数量は一般がマイナス0.6649、ゴールドが1.4253、プラチナが1.6992、列カテゴリは少がマイナス0.8236、中がマイナス0.3223、多が1.7251で、どちらも自然な順に並びます。prince の対応分析の固有値は0.0236で、これは特異値0.1536の2乗に一致します。prince が返す第1軸の行座標(一般マイナス0.1021、ゴールド0.2189、プラチナ0.2610)を手計算の数量で割ると、3つとも0.1536という同じ値になりました。座標の尺度が特異値の分だけ違うだけで、同じ軸を指しています。数量化III類の出力が「相関係数」と「カテゴリの数量」で、対応分析の出力が「固有値」と「座標」であるのは表示の流儀の違いで、中身は1つです。
数量化IV類は、入力が個体×アイテムの表ではなく、対象どうしの親近性(似ている度合い)の行列であるときに、親近性の高い対象が近くに来るように各対象に座標を与える手法です。問いの立て方は多次元尺度構成法と同じで、第8章で扱った計量的・非計量的な多次元尺度構成法に相当します。多重対応分析(複数の質的アイテムをまとめて布置する手法)も、個体×アイテムの0/1の表に数量化III類を当てたものと見ることができ、これも第8章の範囲です。この章ではコードを繰り返しません。
日本の実務で今も名前が残っている理由
同じ計算に別の名前があるなら、なぜ日本では数量化理論という名前が残っているのか、確かめられる事実を並べます。国立国会図書館サーチで題名に「数量化理論」を含む資料を国立国会図書館の蔵書に限って引くと、2026年9月時点で52件あり、その内訳は博士論文が35件、図書が16件、映像資料が1件でした。博士論文の題名には、気管支喘息の予後の推定、肝硬変の予後の解析、永久歯齲蝕の疫学研究といった医学・歯学の研究が並び、土木工学・官能検査・文字認識・地すべり予測の題名もあります。図書は1970年代から2010年代までのどの年代にも刊行があり、2010年には表計算ソフトや R で数量化理論を扱う実務書も出ています。調査会社の日経リサーチが公開している用語集には、「数量化理論」「数量化1類」「数量化3類」がそれぞれ独立した項目として載っています。名前が残っているのは学術史の話ではなく、報告書や論文を書く側と読む側の共通語として、今も使われているということです。
その背景として、弊社は3つのことが効いていると考えています。1つ目は、用語が報告書の型と結びついていることです。「アイテム」「カテゴリ」「カテゴリスコア」「レンジ」「偏相関係数」という語と、それらを並べた表の形は、数量化I類の報告書として定着しており、読む側もその型で読み慣れています。ダミー変数回帰の係数表と同じ中身でも、レンジと偏相関を添えて「アイテムごとの重要度」まで一枚に収めた型のほうが、質的データの分析結果としては読みやすいと感じる実務者が多いように思います。2つ目は、開発の経緯が社会調査と市場調査に直結していたことです。追悼文が挙げる読み書き能力調査や、1964年の市場調査の書籍のように、質問紙調査の回答(ほとんどが質的データ)を扱う必要から生まれた手法なので、調査会社の業務にそのまま載りました。3つ目は、日本語の教科書と実務書がこの名前で書かれてきたことです。国立国会図書館の蔵書に「数量化理論入門」「数量化理論とデータ処理」「数量化理論」といった題名の図書が1980年代から1990年代にかけて並んでいることは確認できました。医学系の博士論文が数量化理論の名で書かれ続けているのは、その分野の先行研究と使われてきた統計ソフトがこの名前を使っていたからだと考えるのが自然ですが、この点は個々の論文を確認したわけではないので、可能性の指摘にとどめます。
名前が残っていること自体は問題ではありません。問題になるのは、名前の違いを中身の違いだと思い込むことです。「うちは数量化I類でやっているから、Python の回帰では再現できない」という判断は誤りで、この章のコードのとおり同じ結果が出ます。逆に、「対応分析は海外の手法で、数量化III類とは別物だから両方やるべきだ」という判断も無駄になります。名前が2つあるときは、まず計算が同じかどうかを確かめる。同じなら、手元の道具で再現できるほうを使い、報告書の型は読む側に合わせて選ぶ、というのが実務的な結論です。
経営目線、カテゴリスコアを施策に落とすときの誤り
数量化I類の表は、「会員区分別」「チャネル別」の効果が1枚に並ぶので、経営会議で施策の話に直結しやすい出力です。それだけに、読み違えたときの損失も具体的です。この章の結果を使って、起きやすい誤りを4つ挙げます。
1つ目は、比較対象の取り違えです。「一般会員はマイナス0.81」という数字だけが会議に持ち込まれると、一般会員831人(全体の69%)の満足度が全体より大きく低いという理解になりますが、実際には全体平均との差はマイナス0.18点で、マイナス0.81はプラチナ会員97人との差です。10点満点の満足度で0.8点差と0.2点差では、施策の優先順位も予算の規模も変わります。カテゴリスコアを施策に落とすときは、加重平均0の表示で「全体平均との差」に直し、人数を横に添えたうえで議論するのが安全です。
2つ目は、決定係数を無視した予算配分です。属性4アイテムで説明できたのは総合満足度のばらつきの3.8%でした。この表に基づいて「ECの満足度が低いのでECのテコ入れに予算を振る」と決めても、満足度の96%はこの表の外にある要因(このデータでは商品品質や接客の評価)で動いています。属性別の施策は、属性別に施策を変える必要がある場面(チャネルごとの導線設計など)では意味がありますが、満足度そのものを動かす主戦場は第4章の因子や第11章の構造モデルが示す評価項目の側にあります。カテゴリスコアの表は「誰に」を決める材料で、「何を」を決める材料ではない、と切り分けておくと、予算の置き場所を間違えにくくなります。
3つ目は、属性の効果を因果として読むことです。EC利用者の満足度が店舗利用者より低いという結果は、「ECを使うと満足度が下がる」ことを意味しません。このデータの生成過程では、価格重視と低関与のセグメントがECを選びやすいように設定されており、チャネルの差はセグメントの差を映しているだけです。実際の顧客データでも、チャネルは顧客が自分で選ぶものなので、同じ自己選択が入ります。ここで「ECを縮小して店舗に誘導する」施策を打つと、低関与の顧客を店舗に連れてきても満足度は上がらず、ECを好んで使っていた顧客の利便性だけが下がります。数量化I類が答えているのは「どの属性の人の満足度が低いか」であって、「属性を変えれば満足度が変わるか」ではありません。この区別は第13章でも扱います。
4つ目は、正解率だけで判別モデルを採用することです。数量化II類で属性から再購入を判別した結果は正解率0.549でしたが、多数派予測の0.537とほぼ同じで、再購入者の8割を取りこぼしていました。このモデルを「再購入しそうな顧客リスト」として営業に渡すと、リストはほとんど空になるか、当たらないリストになります。判別モデルを施策に使うときは、多数派予測との差、少数派の捕捉率、そして交差検証での再現性の3つが揃って初めて、リストとして意味を持ちます。属性だけの数量化II類が弱かったのは、説明変数に判別の情報が無かったからで、下位尺度を入れると正解率は0.645まで上がりました。判別に使えるアイテムを探すことが、手法を変えることより先です。
この章の要点をまとめます。数量化理論は、林知己夫が1940年代から社会調査の現場で体系化した、質的データに数量を与えて回帰・判別・布置に載せるための考え方で、I類はダミー変数を用いた重回帰、II類はダミー変数を用いた判別分析、III類は対応分析、IV類は多次元尺度構成法と数理的に同じ計算です。この章では、共通データでI類とII類を動かし、カテゴリスコアは基準カテゴリの取り方で見え方が変わるが予測値とレンジは変わらないこと、レンジと偏相関係数は問いが違うので両方を並べて人数を確かめること、順序尺度はまずダミー変数で並びを確かめてから数量に置き換えること、III類が対応分析と一致することを実測で確かめました。次の第10章では、外的基準が1つの変数ではなく変数の「群」であるときに、2つの変数群の関係を測る正準相関分析と偏最小二乗回帰を扱います。
この章を深めたい方への参考書籍
『数量化:理論と方法』(林知己夫、朝倉書店、1993年):数量化理論を体系化した本人による理論書です。国立国会図書館サーチに登録された目次によれば、冒頭の章「数量化はどのようにして生まれたか」に「数量化前史」「数量化の濫膓:犯罪学との接触」「その後の数量化」という節があり(「濫膓」は同サーチの目次の表記のままで、物事の始まりを意味する語の通常の表記は「濫觴」です)、この章で追悼文から引いた開発の経緯を、著者自身の歴史的叙述として読めます。各類の定式化を原典で確かめたい方の出発点になる一冊です。
『調査の科学』(林知己夫、筑摩書房、2011年):同じ著者による社会調査の入門書で、ちくま学芸文庫版です。版元の紹介によれば、社会調査の論理、標本調査の考え方、質問の仕方、調査の実施、データ分析のロジック、調査結果の使い方という順に章が組まれています。数量化理論がどういう調査観の上に立っているかを、手法の手前から読める本で、質的データを扱う前に、そもそも調査でどう測るかを考え直したい方に向いています。
『数量化理論とテキストマイニング』(内田治、日科技連出版社、2010年):書名の副題に Excel・R・StatWorks とあるとおり、この3つの道具で数量化理論を動かすことを掲げた実務書で、テキストマイニングへの応用も題名に含まれています。この章では Python で同じ計算を再現しましたが、Python 以外の道具で数量化理論の出力の型を追い直したい方に向いています。国立国会図書館サーチで書誌(2010年5月刊、168ページ)を確認しました。
第10章 正準相関分析と偏最小二乗、2つの変数群の関係を測る
前章では、数量化理論を通して質的なデータを数量として扱う枠組みを確認しました。本章では視点を変えて、「変数の集まり」どうしの関係を測る手法を扱います。第3章の主成分分析や第4章の因子分析は、1つの変数群の内側にある構造を要約する手法でした。しかし実務では、「満足度調査の16項目」と「総合満足度・推奨意向・購入回数・再購入」のように、性質の違う2つの変数群を同時に手にしていて、その間にどういう関係があるのかを知りたい場面が少なくありません。この問いに答える古典的な手法が正準相関分析で、その考え方を予測に振り向けたものが偏最小二乗回帰です。本章では第2章で用意したサンプルデータを使い、両者を実際に動かして結果の読み方を確かめます。
2つの変数群の関係を測るという問い
正準相関分析は、Hotelling が1936年に Biometrika 誌に発表した論文Relations between two sets of variatesで提案した手法です。問いの立て方は単純です。変数群 X と変数群 Y のそれぞれから、重みを付けて足し合わせた合成得点を1つずつ作り、その2つの合成得点の相関が最大になるように重みを決めます。X 側の合成得点を \( U = a_1 x_1 + a_2 x_2 + \cdots + a_p x_p \)、Y 側を \( V = b_1 y_1 + \cdots + b_q y_q \) と書くと、\( \mathrm{corr}(U, V) \) を最大にする重み \( a \) と \( b \) を探す、というのが正準相関分析の中身です。言葉で言い換えると、「X 群の中で Y 群と最もよく連動する方向と、Y 群の中で X 群と最もよく連動する方向を、同時に見つける」手法です。
重回帰分析との違いは、目的変数の側にも重みを置くところにあります。重回帰は目的変数が1つで、説明変数側の重みだけを決めます。正準相関分析は Y 側にも複数の変数があり、そちらの重みも同時に決めるので、「どの項目群が、どの行動指標群と結びついているか」を両側から見ることができます。逆に言うと、重回帰は正準相関分析で Y 側の変数が1つしかない特別な場合にあたります。目的変数が1つのときは、正準相関係数はその重回帰の重相関係数に一致します(本章のデータで総合満足度だけを Y にして確かめると、どちらも 0.820 でした)。
相関を最大にする組は1組では終わりません。第1組の合成得点と無相関であるという条件のもとで、次に相関が高くなる第2組を作り、さらに第3組と続けます。作れる組の数は、2つの変数群のうち少ないほうの変数の数までです。本章のデータでは X 側が16項目、Y 側が4指標なので、最大で4組の合成得点の対が得られます。この合成得点を正準変量、対ごとの相関を正準相関係数と呼びます。
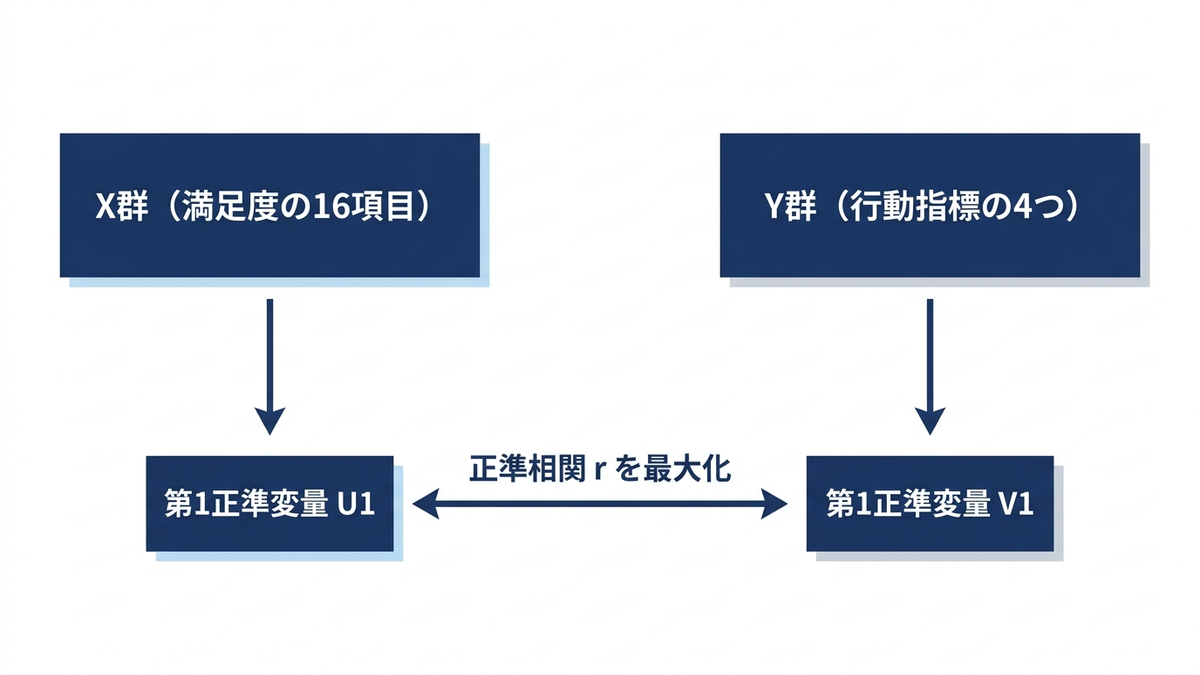
正準変量と正準相関係数、構造係数の読み方
結果を読むときに区別しておきたい数字が3種類あります。1つ目は正準変量そのもの、つまり各回答者について計算された合成得点です。2つ目は正準係数で、合成得点を作るときの重み \( a \) と \( b \) にあたります。3つ目は構造係数で、正準負荷量とも呼ばれ、元の各変数と正準変量との相関係数です。
正準係数は重回帰の偏回帰係数と同じ性質を持ちます。他の変数の影響を取り除いたうえでの寄与を表す一方、変数どうしの相関が高いと値が不安定になり、似た項目のうち一方にだけ大きな重みが付いて、他方がほとんど0になることが起きます。構造係数は「その変数が合成得点とどれだけ連動しているか」を単純な相関で表すので、この不安定さの影響を受けません。したがって、正準変量が何を表しているかを解釈するときは構造係数を軸に見て、正準係数は合成得点の作り方として補助的に見ることを勧めます。両者の差が大きい項目は、多重共線性の影響を受けている印です。
もう1つ、正準変量の符号は任意です。重みの符号をすべて反転しても相関の大きさは変わらないので、実装によって、あるいは同じ実装でもデータの並びによって、プラスとマイナスが入れ替わることがあります。読み手が迷わないように、「総合満足度が高いほど正」のように向きを揃えてから報告するのがよいと考えています。
共通データで正準相関分析を実行する
第2章で用意した架空の顧客満足度調査(1,200件)を使います。X 群は満足度の16項目(q01〜q16)、Y 群は総合満足度 sat・推奨意向 nps・年間購入回数 freq・再購入 repurchase の4指標です。Python では statsmodels の statsmodels.multivariate.cancorr.CanCorr が正準相関分析を実装しています。公式ドキュメントのとおり、左辺の変数群を endog、右辺の変数群を exog に渡し、正準相関係数は属性 cancorr、重みは x_cancoef・y_cancoef に入ります。この実装は変数を中心化するだけで標準化はしないので、係数を比べやすいように、渡す前に X も Y も平均0・標準偏差1に揃えました。
import numpy as np
from statsmodels.multivariate.cancorr import CanCorr
from survey_data import load_survey, ITEM_COLS

df = load_survey()
Y_COLS = ["sat", "nps", "freq", "repurchase"]
X = (df[ITEM_COLS] - df[ITEM_COLS].mean()) / df[ITEM_COLS].std(ddof=1)
Y = (df[Y_COLS] - df[Y_COLS].mean()) / df[Y_COLS].std(ddof=1)

cc = CanCorr(endog=Y.values, exog=X.values)
for i, r in enumerate(cc.cancorr, 1):
    print(f"第{i}正準相関: r = {r:.4f}   r^2 = {r**2:.4f}")

# CanCorr は正準変量を「二乗和が1」に規格化しているので、分散1に直して読む
n = X.shape[0]
x_coef = cc.x_cancoef * np.sqrt(n - 1)
y_coef = cc.y_cancoef * np.sqrt(n - 1)
U = X.values @ x_coef      # X 側の正準変量(列=第1, 第2, …)
V = Y.values @ y_coef      # Y 側の正準変量
print(np.corrcoef(U[:, 0], V[:, 0])[0, 1])   # cancorr[0] と一致する

# 出力:
# 第1正準相関: r = 0.8527   r^2 = 0.7271
# 第2正準相関: r = 0.3384   r^2 = 0.1145
# 第3正準相関: r = 0.2791   r^2 = 0.0779
# 第4正準相関: r = 0.1099   r^2 = 0.0121
# 0.8527089426533726
第1正準相関係数は 0.853 で、2つの変数群から作った合成得点どうしの相関としてはかなり高い値です。第2組は 0.338、第3組は 0.279、第4組は 0.110 と急に小さくなります。なお、CanCorr は正準変量の二乗和が1になるように重みを規格化しているため、そのままでは重みの値が 0.005 のような読みにくい桁になります。上のコードでは標本サイズから1を引いた値の平方根を掛けて分散1に直しており、こうすると重みが標準化偏回帰係数と同じ感覚で読めます。第1正準変量どうしの散布図が次の図です。
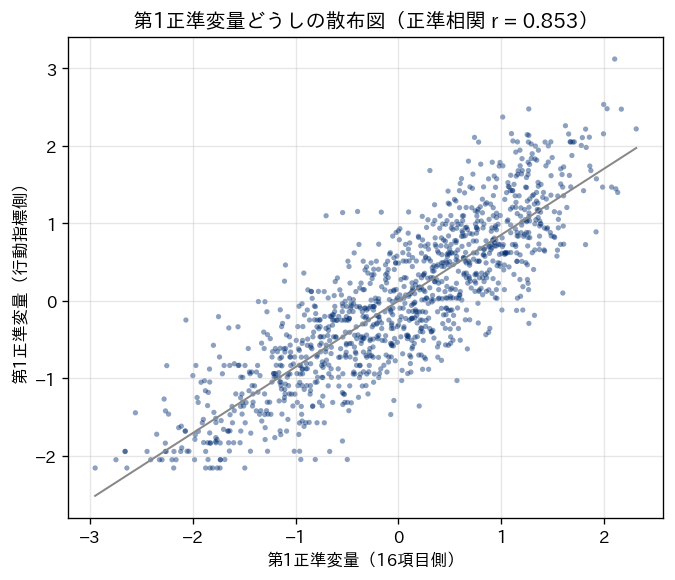
次に、各変数と正準変量の相関、すなわち構造係数を計算します。X 側の16項目と Y 側の4指標について、第1・第2正準変量との相関を求め、符号は総合満足度が正になる向きに揃えました。
def structure(Z, W):
    """各観測変数と正準変量の相関(構造係数=正準負荷量)"""
    return np.array([[np.corrcoef(Z[:, j], W[:, i])[0, 1] for i in range(W.shape[1])]
                     for j in range(Z.shape[1])])

sx = structure(X.values, U)      # 16項目 × 4
sy = structure(Y.values, V)      # 4指標 × 4
if sy[0, 0] < 0:                 # 総合満足度が正になる向きに揃える
    sx[:, 0] *= -1; sy[:, 0] *= -1; U[:, 0] *= -1; V[:, 0] *= -1
    x_coef[:, 0] *= -1; y_coef[:, 0] *= -1

for f, name in enumerate(["商品品質", "価格納得感", "接客サポート", "店舗利便性"]):
    print(name, round(sx[f*4:(f+1)*4, 0].mean(), 3))

# 出力:
# 商品品質 0.715
# 価格納得感 0.251
# 接客サポート 0.666
# 店舗利便性 0.51
| 変数 | 内容 | 標準化正準係数(第1) | 構造係数(第1) | 構造係数(第2) |
|---|---|---|---|---|
| q01 | 商品の品質に満足している | 0.184 | 0.738 | -0.293 |
| q02 | 商品は期待どおりの性能だった | 0.190 | 0.736 | -0.299 |
| q03 | 商品の耐久性に満足している | 0.185 | 0.725 | -0.301 |
| q04 | 商品のデザインが気に入っている | 0.109 | 0.663 | -0.311 |
| q05 | 価格は品質に見合っている | 0.083 | 0.363 | 0.584 |
| q06 | 他店と比べて価格に納得できる | 0.034 | 0.156 | 0.805 |
| q07 | セールやポイントの仕組みが分かりやすい | 0.036 | 0.170 | 0.721 |
| q08 | 支払った金額に対して得をしたと感じる | 0.081 | 0.317 | 0.622 |
| q09 | 店員の説明は分かりやすかった | 0.149 | 0.693 | -0.043 |
| q10 | 問い合わせへの対応が早かった | 0.137 | 0.682 | -0.042 |
| q11 | 店員の態度は丁寧だった | 0.146 | 0.666 | -0.022 |
| q12 | 困ったときに相談しやすい | 0.090 | 0.624 | 0.042 |
| q13 | 店舗の場所は便利である | 0.063 | 0.561 | 0.355 |
| q14 | 営業時間は都合に合っている | 0.071 | 0.481 | 0.354 |
| q15 | 店内は探しやすく整理されている | 0.006 | 0.454 | 0.364 |
| q16 | オンラインと店舗の使い分けがしやすい | 0.052 | 0.545 | 0.176 |
| sat | 総合満足度 | 0.562 | 0.955 | 0.274 |
| nps | 推奨意向 | 0.266 | 0.906 | 0.148 |
| freq | 年間購入回数 | 0.295 | 0.737 | -0.661 |
| repurchase | 再購入 | 0.011 | 0.414 | 0.104 |
第1正準変量から読み取れることを整理します。Y 側では総合満足度(構造係数 0.955)と推奨意向(0.906)がほぼそのまま第1正準変量に写っており、年間購入回数(0.737)がそれに続き、再購入(0.414)は連動が弱めです。つまり Y 側の第1正準変量は「満足して人に勧めたいと思う度合い」を主に表しており、再購入の情報はあまり含んでいません。X 側では商品品質の4項目(0.66〜0.74)と接客サポートの4項目(0.62〜0.69)が高く、店舗利便性(0.45〜0.56)がそれに続き、価格納得感の4項目(0.16〜0.36)は明らかに低い値です。下位尺度ごとの平均で見ると、商品品質 0.715、接客サポート 0.666、店舗利便性 0.510、価格納得感 0.251 という順になります。満足や推奨と最もよく連動しているのは商品品質と接客であり、価格への納得はそれほど連動しない、というのが第1組の要約です。
標準化正準係数と構造係数の乖離にも注目してください。たとえば q15(店内は探しやすく整理されている)は構造係数が 0.454 あるのに、正準係数は 0.006 でほとんど0です。これは同じ店舗利便性の他の項目と相関が高く、合成得点を作るうえでは他の項目が代わりを務めてしまうためで、「q15 は関係がない」という意味ではありません。正準係数だけを見て項目の重要度を語ると、この種の誤読が起きます。
第2正準変量は、X 側で価格納得感の4項目が正(0.58〜0.81)、商品品質の4項目が負(-0.29〜-0.31)という対比になっており、Y 側では年間購入回数が負(-0.661)で総合満足度がわずかに正(0.274)です。第1組の情報を除いたうえで、「品質より価格に納得している回答者ほど、年間の購入回数が少ない」という傾向が残っている、と読めます。相関は 0.338 なので強い関係ではありませんが、価格への納得と購入頻度が同じ方向に動くとは限らないことを示す例です。なお、このデータは生成時に、年間購入回数が商品品質と接客サポートの因子から決まり、価格納得感の因子からは決まらないように仕込んであります。第2組はその仕込みを拾っている形です。
scikit-learn にも sklearn.cross_decomposition.CCA があります。公式ドキュメントでは「Mode B の PLS としても知られる」と説明されており、反復法で解を求める実装です。同じ X・Y で CCA を成分数2で1回だけ実行し、transform メソッドで得た成分スコアを statsmodels の正準変量と突き合わせました。第1成分の相関は scikit-learn 側でも 0.8527、第2成分は 0.3384 で、statsmodels の値と小数第4位まで一致しました。成分スコアどうしの相関は X 側・Y 側とも +1.0000 で、今回は符号も同じ向きに出ています。符号は実装によって反転しうるので、別の環境で逆向きに出ても結果が違うわけではありません。
正準相関の数と有意性、Wilks のラムダ
4組の正準相関のうち、どこまでを「意味のある関係」として扱うかを決める必要があります。標準的な手続きは、「第 \( i \) 組以降の正準相関はすべて0である」という帰無仮説を \( i = 1, 2, \ldots \) と順に検定することです。検定統計量には Wilks のラムダを使います。これは \( \Lambda_i = \prod_{k \ge i} (1 – r_k^2) \) と定義され、第 \( i \) 組以降の正準相関の二乗を1から引いたものを掛け合わせた値です。関係が強いほど各項が小さくなるので、ラムダが小さいほど「残っている関係が大きい」ことを意味します。CanCorr の corr_test メソッドは、このラムダにもとづく近似 F 検定を各組について返します。
test = cc.corr_test()
print(test.stats.astype(float).round(4))      # 各正準相関の検定
print(test.stats_mv.astype(float).round(4))   # 多変量検定(Wilks・Pillai など)
| 組 | 正準相関係数 | Wilks のラムダ | 分子自由度 | 分母自由度 | F 値 | p 値 |
|---|---|---|---|---|---|---|
| 第1組以降 | 0.8527 | 0.2201 | 64 | 4668.7 | 34.43 | 0.0001 未満 |
| 第2組以降 | 0.3384 | 0.8067 | 45 | 3544.9 | 5.91 | 0.0001 未満 |
| 第3組以降 | 0.2791 | 0.9110 | 28 | 2388.0 | 4.07 | 0.0001 未満 |
| 第4組 | 0.1099 | 0.9879 | 13 | 1195.0 | 1.12 | 0.3342 |
第1組から第3組までは p 値が 0.0001 を下回り、第4組だけが 0.334 で有意になりません。統計的には「3組の正準相関が0ではない」という結論になります。多変量検定の側も、Wilks のラムダ 0.2201、Pillai のトレース 0.9316、Hotelling-Lawley のトレース 2.8905、Roy の最大根 2.6645(後の3つも、Wilks のラムダと同じく「関係がまったくない」という仮説を別の計算式で検定する統計量で、値そのものの読み方は本章では扱いません)のいずれも p 値がほぼ0で、「X 群と Y 群の間に関係がまったくない」という仮説は明確に棄却されます。
ただし、この検定結果をそのまま「3組とも実務で使うべき」と読むのは早計です。標本が1,200件あると、0.28 程度の正準相関でも容易に有意になります。第3組の正準相関の二乗は 0.078 で、合成得点どうしで共有している分散は8%に満たず、施策の議論に載せるほどの内容があるかは別に判断する必要があります。有意性は「0ではない」ことを言うだけで、関係の大きさや解釈のしやすさは正準相関係数と構造係数のほうで判断します。本章のデータでは、第1組を主、第2組を補助として読み、第3組以降は解釈しない、という扱いが妥当だと考えています。
冗長性係数、相関の高さと説明力は別物
第1正準相関係数 0.853 という値は、「16項目群は行動指標群をよく説明している」と読みたくなる数字です。しかし正準相関係数は、あくまで両側から作った合成得点どうしの相関であって、Y 群の各変数の分散をどれだけ説明しているかを直接には表しません。極端な例として、X 側が1項目だけ、Y 側の4指標のうち1つだけと強く相関し、他の3指標とはまったく無関係だとします。このとき正準相関係数は高くなりますが、Y 群全体の分散はほとんど説明できていません。この隙間を埋める指標が冗長性係数で、Stewart と Love が1968年にA general canonical correlation indexとして提案しました。
計算は2段階です。まず、ある正準変量が自分の側の変数群の分散をどれだけ取り出しているかを、構造係数の二乗の平均として求めます。次に、その値に正準相関係数の二乗を掛けます。「Y 群の分散のうち、Y 側の第1正準変量が取り出している割合」に「その正準変量が X 側の正準変量とどれだけ共有しているか」を掛けたものが、Y 群の分散のうち X 群によって説明される割合、すなわち Y の X に対する冗長性です。X と Y を入れ替えれば逆向きの冗長性が求まり、両者は一般に一致しません。
red_y = []
for i in range(len(cc.cancorr)):
    vx = np.mean(sx[:, i] ** 2)   # X側の抽出分散の割合
    vy = np.mean(sy[:, i] ** 2)   # Y側の抽出分散の割合
    r2 = cc.cancorr[i] ** 2
    red_y.append(vy * r2)         # Y群の分散のうち第 i 正準変量経由で X から説明される割合
    print(f"第{i+1}: X側抽出分散 {vx:.3f}  Y側抽出分散 {vy:.3f}  r^2 {r2:.3f}  Y|X 冗長性 {vy*r2:.3f}")
print("合計:", round(sum(red_y), 3))

# 出力:
# 第1: X側抽出分散 0.323  Y側抽出分散 0.612  r^2 0.727  Y|X 冗長性 0.445
# 第2: X側抽出分散 0.168  Y側抽出分散 0.136  r^2 0.115  Y|X 冗長性 0.016
# 第3: X側抽出分散 0.111  Y側抽出分散 0.048  r^2 0.078  Y|X 冗長性 0.004
# 第4: X側抽出分散 0.033  Y側抽出分散 0.204  r^2 0.012  Y|X 冗長性 0.002
# 合計: 0.467
Y 側の第1正準変量は Y 群の分散の 61.2% を取り出しており、正準相関の二乗 0.727 を掛けると、Y 群の分散のうち 44.5% が X 群の第1正準変量によって説明されることになります。第2組以降の寄与は 1.6%、0.4%、0.2% と小さく、4組の合計でも 46.7% です。正準相関係数 0.853 という印象に比べると、「行動指標群の分散の半分弱を16項目で説明している」というのが実態で、残りの半分は満足度項目では説明できない要因によるものです。
逆向きの冗長性、つまり X 群の分散が Y 群から説明される割合は、第1組で 23.5%、合計で 26.3% にとどまります。X 側の第1正準変量が16項目の分散のうち 32.3% しか取り出していないためで、これは16項目が4つの因子に分かれていて、1本の合成得点では価格納得感の項目をほとんど拾えないことの表れです。冗長性が非対称になるのは自然なことで、「満足度項目から行動を説明する」向きと「行動から満足度項目を説明する」向きでは、説明できる割合が違います。報告のときは、どちら向きの冗長性なのかを必ず添えるようにしてください。
主成分回帰と偏最小二乗回帰、成分の取り方の違い
正準相関分析は関係の記述に向いた手法ですが、「16項目から行動指標を予測したい」という目的が前面に出るときは、回帰の枠組みで考えるほうが素直です。ところが通常の重回帰には、第2章で触れた多重共線性の問題があります。本章のデータのように同じ因子に載る項目どうしの相関が高いと、偏回帰係数が不安定になります。さらに、説明変数の数が標本の数より多い場合には、重回帰は解が一意に定まらず、そのままでは使えません。分光分析で数百から数千の波長の吸光度から成分濃度を推定するような場面が典型で、変数の数が標本を大きく上回ります。
この問題への1つの答えが主成分回帰です。第3章の主成分分析で X 群を少数の主成分に要約し、その主成分得点を説明変数にして回帰します。主成分は互いに無相関なので多重共線性は消え、成分数を標本より少なくすれば解も定まります。ただし主成分は X 群の分散が最大になる方向として決まるもので、Y をまったく見ていません。X の中で分散は小さいが Y と強く関係する方向があった場合、その方向は後ろの主成分に回され、成分数を絞ると落とされてしまいます。
偏最小二乗回帰(PLS 回帰)は、この弱点を成分の作り方で軽減します。X の分散ではなく、X の合成得点と Y の合成得点の共分散が最大になる方向を成分として取り出します。scikit-learn のユーザーガイドは、PLS を「変換した X と変換した Y の共分散が最大になるように、X と Y の両方を低次元の部分空間へ射影する」手法として説明し、「予測変数の行列が観測より多くの変数を持つとき、および特徴量の間に多重共線性があるときに特に適している」と述べています。共分散は相関に両側の標準偏差を掛けたものなので、X の中で散らばりが大きく、かつ Y と連動する方向が優先されます。相関だけを最大化する正準相関分析と、X の分散だけを最大化する主成分回帰の、いわば中間に位置する成分の取り方です。
3つの手法が「成分をどう選ぶか」で並ぶことを整理しておきます。正準相関分析は相関を最大にするので、X 側と Y 側それぞれの変数の相関行列の逆行列に相当する計算を必要とし、変数が標本より多いと不安定になります。同じユーザーガイドも、CCA は逆行列を含むため「特徴量や目的変数の数が標本の数より大きいと不安定になりうる」と注記しています。主成分回帰は Y を見ずに成分を決めます。PLS 回帰は Y を見ながら、しかし逆行列を使わずに成分を決めるので、変数が多く相関が強いデータでも、交差検証で成分数を絞れば重回帰より安定して扱えます(後述のとおり、成分数を増やしすぎると過学習します)。PLS 回帰が化学計量学(ケモメトリクス)の分野で基本的な道具として発展したのは、この性質が分光データの要請にぴったり合ったためで、Wold・Sjöström・Eriksson が2001年に発表した総説PLS-regression: a basic tool of chemometricsは、題名そのものがその位置づけを示しています。
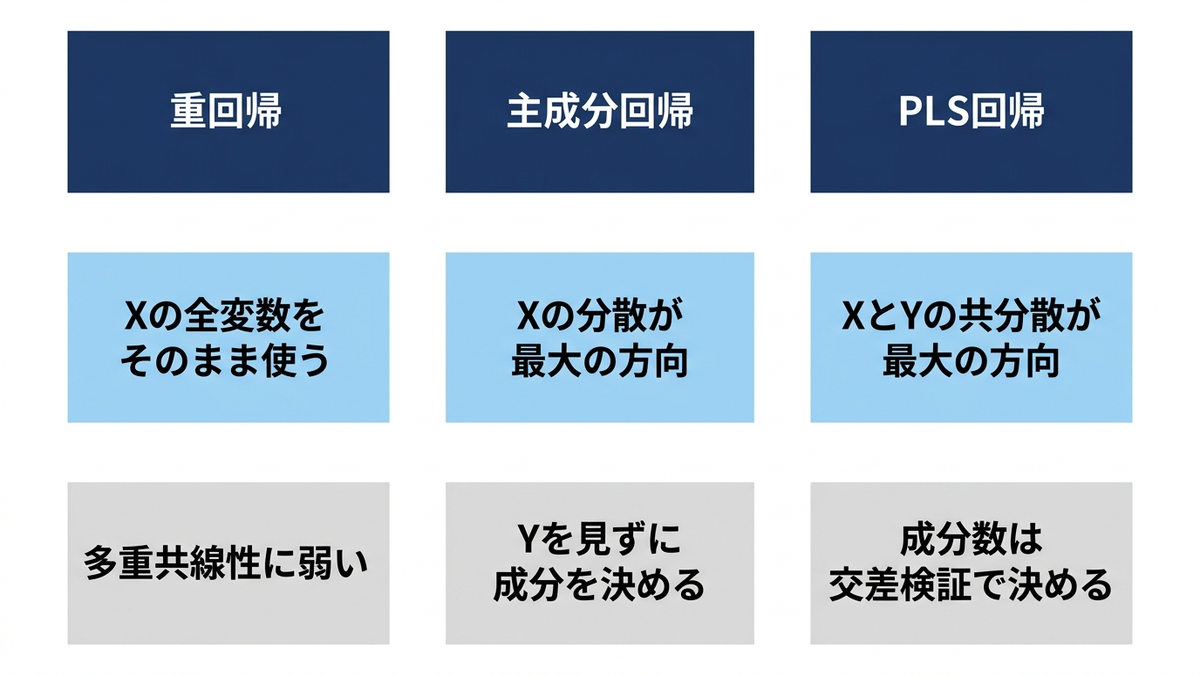
PLS の成分数を交差検証で決め、重みを読む
PLS 回帰で決めなければならないのは成分数です。成分を増やすほど学習データへの当てはまりは上がりますが、ある点を越えると新しいデータへの予測は悪化します。この点を見つける標準的な方法が交差検証で、データを複数の組に分け、1組を除いた残りでモデルを作り、除いた組で予測精度を測る、という手順を組を替えて繰り返します。scikit-learn の sklearn.cross_decomposition.PLSRegression は、公式ドキュメントによれば目的変数が1つなら PLS1、複数なら PLS2 と呼ばれる形になり、n_components で成分数を指定し、scale を True にすると X と Y を標準化します。ここでは成分数を1から6まで動かし、5分割の交差検証で決定係数(4指標の平均)を測りました。比較のために、同じ分割で主成分回帰と、16項目をすべて使う重回帰も測っています。
from sklearn.cross_decomposition import PLSRegression
from sklearn.decomposition import PCA
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import KFold, cross_val_score

Xz = X.values      # 16項目(標準化済み)
Yz = Y.values      # 4指標(標準化済み)
cv = KFold(n_splits=5, shuffle=True, random_state=0)

for k in range(1, 7):
    pls = PLSRegression(n_components=k, scale=True)
    pcr = make_pipeline(StandardScaler(), PCA(n_components=k, random_state=0), LinearRegression())
    r_pls = cross_val_score(pls, Xz, Yz, cv=cv, scoring="r2").mean()
    r_pcr = cross_val_score(pcr, Xz, Yz, cv=cv, scoring="r2").mean()
    print(f"成分数 {k}: PLS {r_pls:.4f}  主成分回帰 {r_pcr:.4f}")

ols = make_pipeline(StandardScaler(), LinearRegression())
print("重回帰:", round(cross_val_score(ols, Xz, Yz, cv=cv, scoring="r2").mean(), 4))
| 成分数 | PLS 回帰の交差検証決定係数 | 主成分回帰の交差検証決定係数 |
|---|---|---|
| 1 | 0.4285 | 0.4156 |
| 2 | 0.4459 | 0.4297 |
| 3 | 0.4511 | 0.4492 |
| 4 | 0.4520 | 0.4536 |
| 5 | 0.4471 | 0.4530 |
| 6 | 0.4457 | 0.4527 |
| 重回帰(16項目すべて) | 0.4443 | 該当なし |
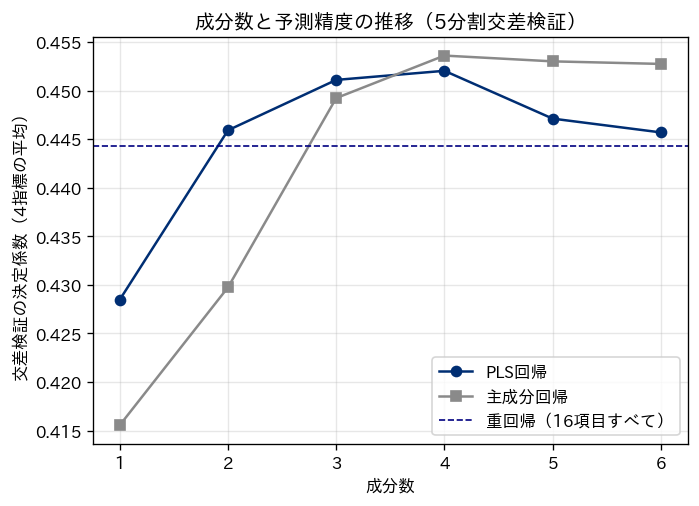
PLS 回帰の交差検証決定係数は、成分数1で 0.4285、2で 0.4459、3で 0.4511、4で 0.4520 と上がり、5以降は 0.4471、0.4457 と下がります。最大は成分数4ですが、3との差は 0.001 しかありません。本章では「最大値との差が 0.005 以内で最も少ない成分数」という単純な規則で成分数3を採用しました。交差検証の値には分割の仕方による揺れがあるため、わずかな差で多い成分数を選ぶより、同程度の精度なら少ない成分数を選ぶほうが、解釈も安定性も有利だからです。
主成分回帰と比べると、成分数が少ないところで PLS 回帰の優位がはっきり出ます。成分数1では 0.4285 対 0.4156、2では 0.4459 対 0.4297 で、Y を見ながら成分を作る PLS のほうが、少ない成分で予測に効く方向を先に取り出しています。一方で成分数を3以上にすると差は消え、4以降は主成分回帰がわずかに上回ります。重回帰の 0.4443 とも大差はありません。これは本章のデータが「標本1,200件に対して変数16個」という恵まれた条件で、多重共線性はあるものの重回帰が破綻するほどではないためです。PLS 回帰の利点が本当に効くのは、次節で見る変数が標本より多い状況や、変数どうしの相関がさらに強い状況です。
成分数3で学習した PLS 回帰の重みと回帰係数を見ておきます。第1成分の X 側の重みは16項目すべてが正で、商品品質(0.29〜0.32)と接客サポート(0.28〜0.31)が大きく、価格納得感(0.06〜0.16)が小さいという、正準相関分析の第1正準変量とよく似た形になりました。第2成分は価格納得感(0.24〜0.37)と店舗利便性(0.19〜0.29)が正、商品品質(-0.28〜-0.32)が負という対比です。Y 側の第1成分の重みは総合満足度 0.350、推奨意向 0.336、年間購入回数 0.260、再購入 0.154 で、ここでも再購入の寄与は小さめです。総合満足度に対する標準化回帰係数を下位尺度ごとに平均すると、商品品質 0.132、接客サポート 0.093、価格納得感 0.071、店舗利便性 0.053 という順になります。
重回帰の標準化係数と並べると、PLS 回帰の係数のほうがなだらかです。たとえば q04(商品のデザイン)は重回帰で 0.081、PLS で 0.118、q05(価格は品質に見合っている)は重回帰で 0.061、PLS で 0.091 と、同じ下位尺度の中で重回帰が付けた差が PLS では縮んでいます。少数の成分を通して係数を作るので、相関の高い項目どうしには似た係数が付く、というのが PLS 回帰の性質です。項目1つ1つの係数を細かく比べる用途には向きませんが、「どの項目群が効いているか」を安定して読むには都合がよい性質だと言えます。指標別の交差検証決定係数は、総合満足度 0.666、推奨意向 0.596、年間購入回数 0.437、再購入 0.117 でした。再購入は0か1の値なので線形の回帰では予測しにくく、第7章の判別分析やロジスティック回帰の領域です。
変数が標本より多いときに何が起きるか
PLS 回帰の利点が最もはっきり出る状況を、同じデータから作って確かめます。1,200件から無作為に12件だけ取り出し、16項目で総合満足度を予測する、という設定です。変数16に対して標本12なので、重回帰は学習データに完全に当てはまる解を無数に持ち、予測には使えないはずです。一つ抜き交差検証(1件を除いて学習し、その1件を予測する手順を12回繰り返す)で確かめました。
from sklearn.model_selection import LeaveOneOut, cross_val_predict
from sklearn.metrics import r2_score

rng = np.random.default_rng(0)
idx = rng.choice(len(df), size=12, replace=False)
Xs, ys = Xz[idx], Yz[idx, 0]                 # 12件 × 16項目、目的変数は総合満足度
loo = LeaveOneOut()

ols_s = make_pipeline(StandardScaler(), LinearRegression()).fit(Xs, ys)
print("重回帰 学習データ R^2:", round(ols_s.score(Xs, ys), 4))
pred = cross_val_predict(make_pipeline(StandardScaler(), LinearRegression()), Xs, ys, cv=loo)
print("重回帰 一つ抜き R^2:", round(r2_score(ys, pred), 4))
for k in (1, 2, 3):
    p = cross_val_predict(PLSRegression(n_components=k), Xs, ys.reshape(-1, 1), cv=loo)
    print(f"PLS 成分数{k} 一つ抜き R^2:", round(r2_score(ys, p.ravel()), 4))

# 出力:
# 重回帰 学習データ R^2: 1.0
# 重回帰 一つ抜き R^2: -2.5481
# PLS 成分数1 一つ抜き R^2: 0.4226
# PLS 成分数2 一つ抜き R^2: 0.2274
# PLS 成分数3 一つ抜き R^2: -0.0927
重回帰は学習データでの決定係数が 1.0、つまり完全に当てはまっていますが、一つ抜き交差検証の決定係数は -2.548 で、平均値で予測するよりはるかに悪い予測になっています。学習データに合わせすぎた典型的な過学習です。PLS 回帰は成分数1で 0.423 と、12件しかないにもかかわらず総合満足度の分散の4割を新しいデータで説明できています。ただし成分数を2にすると 0.227、3にすると -0.093 と急速に悪化します。標本が少ないときは PLS 回帰も成分を増やせば同じ罠にはまるので、成分数は必ず交差検証で決める、という原則がここでも効いています。
この実験は12件という極端な設定ですが、実務でも「項目は多いが回答は少ない」状況は珍しくありません。法人顧客向けの調査で回答企業が数十社しかない、製造ラインのセンサーが数百本あるのに不良の事例が数十件しかない、といった場面です。そこで重回帰を回して「学習データでは完璧に当たった」と報告してしまうと、施策に落としてから外れることになります。PLS 回帰と交差検証の組み合わせは、この種の状況で最初に試すべき道具の1つだと考えています。
正準相関・PLS・重回帰の使い分けと、経営目線
ここまでの内容を、手法を選ぶときの観点で表にまとめます。
| 観点 | 重回帰分析 | 主成分回帰 | PLS 回帰 | 正準相関分析 |
|---|---|---|---|---|
| 答える問い | 1つの目的変数を説明変数で予測・説明する | 多重共線性を避けて予測する | 多重共線性や変数過多のもとで予測する | 2つの変数群の関係を記述する |
| 目的変数の数 | 1つ | 1つ以上 | 1つ以上 | 複数(両側とも複数) |
| 成分を決めるときに見るもの | 成分を作らない | X の分散 | X と Y の共分散 | X と Y の相関 |
| 得意な状況 | 標本が十分で変数の相関が弱い | 変数が多く相関が強い | 変数が標本より多い、相関が強い | 両側の変数群の構造を同時に読みたい |
| 主な出力 | 偏回帰係数 | 主成分ごとの係数 | 成分の重みと回帰係数 | 正準相関係数・構造係数・冗長性 |
| 注意点 | 多重共線性、変数が標本より多いと解が定まらない | Y に効く方向を落とすことがある | 成分数は交差検証で決める | 変数が標本より多いと不安定、相関の高さと説明力は別 |
実務での使いどころを整理します。正準相関分析が向いているのは、本章の例のように「満足度の項目群」と「行動指標群」のような2つの変数群があり、どの項目群がどの行動と結びついているかを両側から記述したいときです。予測が目的ではなく、関係の全体像を1枚の表にしたい場面に合います。PLS 回帰が向いているのは、行動指標を予測したい、しかし項目が多くて相関が強い、あるいは標本が少ないときです。化学計量学で分光データから濃度を推定するのが由来ですが、アンケートの項目群から行動を予測する、製造条件の多数のパラメータから品質指標を予測する、といった場面にそのまま使えます。重回帰で十分な条件、つまり標本が十分に多く変数の相関が弱いときは、解釈が直接的な重回帰を使えばよく、本章の手法を持ち出す必要はありません。
経営目線で見ると、本章の手法の価値は「どの項目群が行動に効いているか」を1つの数字にまとめられることにあります。16項目と4指標の間には64個の相関があり、それを眺めて優先順位を決めるのは困難です。正準相関分析はこれを「第1正準変量では商品品質と接客が行動指標と最も強く連動し、価格納得感の連動は弱い」という1本の軸に要約し、PLS 回帰は「総合満足度への係数は商品品質 0.132、接客 0.093、価格 0.071、店舗 0.053」という順位に翻訳します。投資配分の議論をこの順で始められることは、大きな利点です。
同時に、この1つの数字には見落としやすい危うさが3つあります。第1に、要約された軸は Y 側の一部しか写していません。本章の第1正準変量は総合満足度と推奨意向をほぼそのまま写す一方、再購入との相関は 0.414 にとどまりました。「再購入に効く項目」を知りたいのに第1正準変量の結果を使うと、答えている問いが違います。第2に、正準相関係数 0.853 と冗長性 0.445 の差です。前者だけを報告すると「行動の85%は満足度で決まる」という誤った印象を与えかねませんが、実際に説明できている分散は半分弱で、残りは満足度調査の外にある要因です。第3に、価格納得感の構造係数が低いことを「価格施策は効かない」と読むのは、相関の記述から施策の効果へ飛躍しています。第2正準変量が示したように、価格に納得している層は購入回数が少ない傾向を持っており、その層は第6章で扱うセグメントの1つとして独自の行動をしています。価格施策を切り捨ててその層を失えば、要約の1つの数字が示した順位どおりに投資しても、全体の売上は落ちることがありえます。相関の分析が答えるのは「何と何が連動しているか」であり、「何を変えれば何が動くか」には別の手続きが要ります。
本章で確認したのは次の3点です。正準相関分析は2つの変数群からそれぞれ合成得点を作って相関を最大化し、正準相関係数・構造係数・冗長性係数の3つを揃えて読むことで、関係の強さと説明力を区別できます。PLS 回帰は X と Y の共分散を最大にする成分で回帰するため、多重共線性や変数が標本より多い状況でも安定し、成分数は交差検証で決めます。どちらの手法も相関の記述であって因果の証明ではなく、要約した1つの数字が Y 側の何を写しているかを確かめてから施策の議論に使う必要があります。次の第11章では、変数群どうしの関係を「仮説として先に描いた構造」に沿って検証する構造方程式モデリングを扱います。本章の正準相関分析が探索的に関係を見つける手法だとすれば、第11章はその関係を仮説として明示し、データがそれを支持するかを確かめる手法です。
この章を深めたい方への参考書籍
『化学者のための多変量解析 ケモメトリックス入門』(尾崎幸洋・宇田明史・赤井俊雄、講談社サイエンティフィク):PLS 回帰が発展した化学計量学の入門書で、目次の第3章が主成分分析と回帰分析を、第4章がスペクトルの前処理を扱います。版元の紹介文にある「二成分から多成分へ、最小二乗法から多変量解析へ」という分析化学の要請を背景にした本なので、PLS 回帰がどういう場面の必要から育った手法なのかを、本章の背景として読めます。
『化学のためのPythonによるデータ解析・機械学習入門(改訂2版)』(金子弘昌、オーム社):著者の研究室の紹介ページによれば、第4章の回帰分析で多重共線性・主成分回帰・クロスバリデーション・部分的最小二乗法を順に扱い、第5章でモデルの適用範囲を論じています。本章で scikit-learn を使って行った PLS 回帰と交差検証の手順を、化学データの実例で Python コードとともに追える1冊です。
『統計的学習の基礎 データマイニング・推論・予測』(Trevor Hastie・Robert Tibshirani・Jerome Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、共立出版):第3章「回帰のための線形手法」の 3.5 節「入力に対して線形変換を行う方法」で、主成分回帰と偏最小二乗回帰を縮小推定や変数選択と並べて位置づけています。本章で「成分の取り方の違い」として説明した内容を、数理的に厳密な形で確かめたいときの参照先です。
第11章 構造方程式モデリング、仮説の構造を検証する
第10章では、満足度の項目群と行動指標の群という2つの変数群のあいだの関係を、正準相関分析と偏最小二乗で測りました。どちらも「群と群の対応」を要約する手法であり、群の中の構造や、変数どうしの影響の向きを問うものではありませんでした。本章で扱う構造方程式モデリング(SEM。共分散構造分析とも呼ばれます)は、その一歩先に進み、「観測した項目の背後にどんな潜在変数があり、潜在変数どうしがどの向きに影響し合っているか」という仮説をひとつのモデルとして書き下し、データがその仮説とどれだけ整合するかを測る手法です。
本章では、第2章で用意した架空の顧客満足度調査データを使い、第4章で探索的に見つけた4因子の構造を「仮説」として書き直して検証し、さらに4つの因子が総合満足度を通じて推奨意向へつながる構造モデルを推定します。適合度指標の目安は原論文にあたって出典を示し、目安を絶対視してはいけない理由も出典つきで書きます。実装には Python の semopy(2.3.11)を使い、関数の挙動はすべて実行して確かめたものだけを載せました。
探索と検証、因子分析との役割分担
第4章の探索的因子分析は、「何因子あるか」「どの項目がどの因子に載るか」をデータに語らせる手法でした。因子数を変え、回転を変え、負荷量の表を眺めて構造を見つけるのが仕事であり、分析者は事前に構造を決めません。これに対して、構造方程式モデリングの測定モデルにあたる確認的因子分析(CFA)は、「q01からq04は商品品質に載り、他の因子には載らない」という構造を分析者が先に決め、その決めた構造がデータと矛盾しないかを検定します。探索的因子分析ではすべての項目がすべての因子に負荷量を持ち、小さいものを「無視」して解釈するのに対し、確認的因子分析では載らないと決めた負荷量を最初からゼロに固定します。この違いが、あとで見る自由度の差として現れます。
役割分担は明快です。尺度を新しく作る段階、あるいは項目の背後に何があるか分かっていない段階では探索的因子分析を使います。先行研究や前回の調査で構造が分かっていて、今回のデータでもその構造が成り立つかを確かめたい段階、あるいは因子どうしの影響関係まで含めた仮説を検証したい段階では構造方程式モデリングを使います。同じデータで探索的因子分析をしてから、その結果をそのまま確認的因子分析にかけて「適合した」と報告するのは、答えを見てから答え合わせをするのと同じで、検証の意味が薄くなります。本章が第4章と同じデータを使うのは手法の説明のためであり、実務では探索に使うデータと検証に使うデータを分けるべきだと考えています。
使ってはいけない場面もはっきりしています。仮説が無い状態で構造方程式モデリングを始めると、後述する修正指標に従ってパスを足したり消したりする作業になり、最終的に得られるのは「このデータに合うように調整したモデル」であって仮説の検証ではありません。また、標本が数十件しかない場合、推定が収束しなかったり、標準誤差が大きすぎてパス係数の符号すら定まらなかったりします。項目が順序尺度で段階数が少ない場合は、最尤法の前提である連続・正規からのずれが大きくなるので、推定法の選び方に注意が要ります。
パス図の読み方
構造方程式モデリングの仮説は、パス図という図で表します。パス図の要素は4種類しかありません。観測変数は長方形で描きます。アンケートの各設問や、総合満足度・推奨意向のように直接測った変数です。潜在変数は楕円で描きます。商品品質のように直接は測れず、複数の設問を通じて推定する変数です。誤差は小さな円か矢印だけで描き、観測変数のうち潜在変数では説明しきれない部分(測定誤差)と、内生の潜在変数のうち他の変数では説明しきれない部分(攪乱項)を表します。
矢印は2種類です。片方向の矢印は「影響」を表し、矢印の根元の変数が先端の変数を説明するという仮説です。潜在変数から観測変数へ向かう矢印が因子負荷量、変数から変数へ向かう矢印がパス係数(回帰係数)にあたります。双方向の矢印は「相関」を表し、向きを決めずに共分散だけを認めるという意味です。因子間の相関や、外生変数どうしの共分散に使います。パス図を読むときの基本は、「片方向の矢印が入ってくる変数は、その根元の変数で説明されると仮定している」「矢印が無いところは、影響も相関も無いと仮定している」の2点です。特に後者が重要で、描かれていない矢印こそがモデルの制約であり、検定の対象になります。
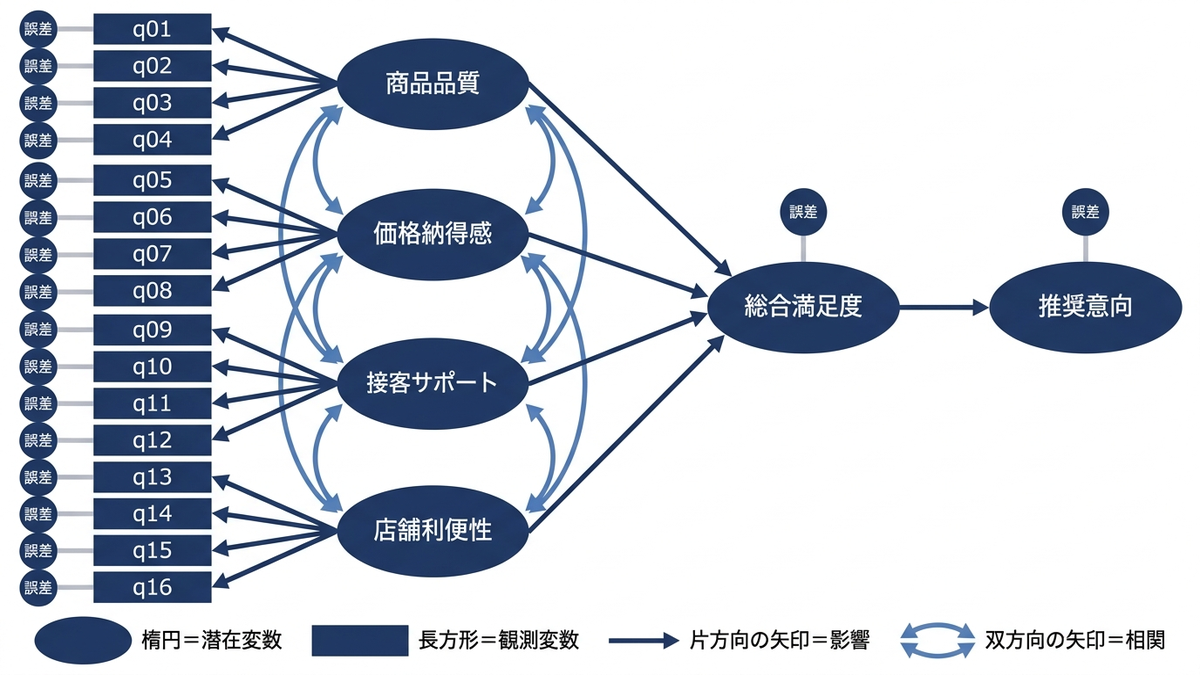
測定モデルと構造モデル、識別と推定
構造方程式モデリングは、2つの部品でできています。測定モデルは「潜在変数がどの観測変数にどう現れるか」を定めた部分で、確認的因子分析そのものです。構造モデルは「潜在変数どうし、あるいは潜在変数と観測変数のあいだにどんな影響関係があるか」を定めた部分で、回帰式の連立に相当します。本章では、まず測定モデルだけを推定して4因子の構造が成り立つかを確かめ、それが確かめられてから構造モデルを足します。測定モデルが合わないまま構造モデルを足すと、パス係数の悪さが測定の悪さなのか構造の悪さなのか分からなくなるからです。
モデルを書いたら、次に確かめるべきことは「そのモデルは推定できるか」です。これを識別といいます。データから得られる情報は、観測変数の分散と共分散の個数だけです。観測変数が \( p \) 個なら、分散・共分散は \( p(p+1)/2 \) 個あります。16項目なら136個です。一方、モデルが推定しようとする自由パラメータの数がこれより多ければ、方程式より未知数が多い状態になり、解が一意に決まりません。136個の情報で推定できるパラメータの数は最大136個で、自由度は情報の数から自由パラメータの数を引いたものになります。
ここで、潜在変数には固有の落とし穴があります。潜在変数は直接測っていないので、単位がありません。「商品品質」の分散を2倍にして負荷量を全部 \( 1/\sqrt{2} \) 倍にしても、観測変数の分散・共分散はまったく変わらないのです。単位を決めない限り、負荷量と因子分散の組み合わせは無数にあり、推定できません。そこで、各因子の負荷量のうち1つを1に固定して、その項目の単位を因子の単位として借りるという約束をします。semopy の公式ドキュメントも、測定演算子 =~ は「特に指定しない限り、潜在因子と観測変数のあいだの最初の負荷量を1.0に固定する」と説明しています。もうひとつの流儀は、因子の分散を1に固定して負荷量をすべて自由にする方法です。ただし semopy 2.3.11 では、因子分散を f1 ~~ 1*f1 と1に固定しても先頭の負荷量は1に固定されたままで、制約が二重にかかって自由度が102に増え適合が悪化することを実行で確認したので、本章では既定の流儀(先頭の負荷量を1に固定)を使います。
推定には、共通データでは最尤法を使います。最尤法は、モデルが再現する分散共分散行列と標本の分散共分散行列との「ずれ」を、多変量正規分布の尤度の意味で最小にするパラメータを探す方法です。semopy の fit() は既定で obj="MLW"(Wishart 分布に基づく最尤法)を使い、公式ドキュメントには他に ULS・GLS・WLS・DWLS・FIML が用意されていると書かれています。最尤法は観測変数が連続で多変量正規に近いことを前提にしており、7段階の評定尺度を連続量として扱うのは近似です。段階数がもっと少ない順序尺度なら順序尺度向けの推定法を検討するのが筋ですが、本章では最尤法の結果だけを載せ、他の推定法は実行していません。
共通データで確認的因子分析を推定する
それでは、第4章で抽出した4因子構造を仮説として書き、確認的因子分析を推定します。semopy のモデル記述は、R の lavaan というパッケージの記法に強く影響を受けたものだと公式ドキュメントに書かれており、=~ が測定(潜在変数 =~ 観測変数)、~ が回帰(従属変数 ~ 説明変数)、~~ が分散・共分散を表します。次のコードで、4因子の測定モデルを推定し、適合度指標と標準化推定値を取り出します。
import semopy
from survey_data import load_survey, ITEM_COLS
df = load_survey()

desc = """
f1 =~ q01 + q02 + q03 + q04
f2 =~ q05 + q06 + q07 + q08
f3 =~ q09 + q10 + q11 + q12
f4 =~ q13 + q14 + q15 + q16
"""
cfa = semopy.Model(desc)
cfa.fit(df[ITEM_COLS])            # 既定の目的関数は MLW(最尤法)
stats = semopy.calc_stats(cfa)     # 1行の DataFrame
print(stats.T)
est = cfa.inspect(std_est=True)    # 「Est. Std」列に標準化推定値が入る
print(est[est["op"] == "~"])       # 因子 → 項目 の負荷量
# 出力(抜粋):
# DoF 98 / chi2 231.49 / CFI 0.986 / TLI 0.983 / RMSEA 0.0337
# q01 ~ f1  Estimate 1.000(固定)  Est. Std 0.845
# q02 ~ f1  Estimate 0.983          Est. Std 0.826
まず識別を検算します。観測変数16個の分散・共分散は136個、自由パラメータは負荷量12個(各因子の先頭の項目は1に固定されるので16から4を引く)、因子分散4個、因子間共分散6個、誤差分散16個の合計38個で、自由度は136から38を引いた98です。calc_stats() が返す DoF も98で一致しました。自由度が正なので、このモデルは過剰識別、つまりデータに検定される余地のあるモデルです。自由度がゼロのモデル(飽和モデル)はどんなデータにも完全に適合するので、適合度で仮説を検証することができません。
標準化負荷量は次の表のとおりです。標準化推定値は、因子と項目の両方を分散1に揃えたときの係数で、探索的因子分析の負荷量と同じ感覚で読めます。非標準化の推定値は「因子が1単位動くと項目が何点動くか」を表し、先頭項目が1に固定されているので、他の項目は先頭項目との相対的な大きさになります。
| 項目 | 設問文 | 因子 | 非標準化 | 標準誤差 | 標準化 |
|---|---|---|---|---|---|
| q01 | 商品の品質に満足している | 商品品質 | 1.000 | 固定 | 0.845 |
| q02 | 商品は期待どおりの性能だった | 商品品質 | 0.983 | 0.030 | 0.826 |
| q03 | 商品の耐久性に満足している | 商品品質 | 0.963 | 0.029 | 0.819 |
| q04 | 商品のデザインが気に入っている | 商品品質 | 0.890 | 0.029 | 0.772 |
| q05 | 価格は品質に見合っている | 価格納得感 | 1.000 | 固定 | 0.825 |
| q06 | 他店と比べて価格に納得できる | 価格納得感 | 0.960 | 0.033 | 0.796 |
| q07 | セールやポイントの仕組みが分かりやすい | 価格納得感 | 0.965 | 0.033 | 0.791 |
| q08 | 支払った金額に対して得をしたと感じる | 価格納得感 | 0.900 | 0.034 | 0.735 |
| q09 | 店員の説明は分かりやすかった | 接客サポート | 1.000 | 固定 | 0.798 |
| q10 | 問い合わせへの対応が早かった | 接客サポート | 1.019 | 0.035 | 0.799 |
| q11 | 店員の態度は丁寧だった | 接客サポート | 0.968 | 0.034 | 0.783 |
| q12 | 困ったときに相談しやすい | 接客サポート | 0.965 | 0.036 | 0.754 |
| q13 | 店舗の場所は便利である | 店舗利便性 | 1.000 | 固定 | 0.805 |
| q14 | 営業時間は都合に合っている | 店舗利便性 | 0.862 | 0.036 | 0.710 |
| q15 | 店内は探しやすく整理されている | 店舗利便性 | 0.836 | 0.036 | 0.677 |
| q16 | オンラインと店舗の使い分けがしやすい | 店舗利便性 | 0.887 | 0.036 | 0.727 |
標準化負荷量は0.677から0.845の範囲にあり、16項目すべてが設計どおりの因子に強く載っています。誤差分散の標準化推定値は、1から標準化負荷量の二乗を引いた値と小数第3位までほぼ一致しており(q01 なら \( 1 – 0.845^2 = 0.286 \))、これが第4章で見た独自性にあたります。因子間相関は、商品品質と接客サポートが0.471、店舗利便性と接客サポートが0.663と高めで、商品品質と価格納得感は0.050(p値0.127)でほぼ無相関でした。第4章のバリマックス回転では因子を直交に固定していたので因子間相関はゼロでしたが、確認的因子分析では因子間の共分散を自由パラメータとして推定するので、因子どうしの関係がそのまま数字で見えます。生成時の設定で、セグメントごとに因子の平均が一緒に動くこと、そして全員に共通の「満足しやすさ」を弱く入れてあることが、この相関の正体です。
適合度指標の読み方と目安
推定が終わったら、モデルがデータとどれだけ整合するかを適合度指標で評価します。指標は多く、ソフトによって返すものが違います。semopy.calc_stats() が返すのは DoF・chi2・chi2 p-value・CFI・GFI・AGFI・NFI・TLI・RMSEA・AIC・BIC・LogLik で、SRMR は含まれていません。本章では、実務で最もよく報告されるカイ二乗検定・CFI・TLI・RMSEA・SRMR・AIC/BIC に絞って説明し、SRMR は自分で計算しました。
カイ二乗検定は、「モデルが再現する分散共分散行列は母集団の分散共分散行列と一致する」という帰無仮説の検定です。p値が大きければモデルは棄却されず、データと矛盾しないと読みます。ところが、この検定には標本サイズの問題があります。semopy の実装(ソースコードで確認しました)では、カイ二乗統計量は最尤法の目的関数の値に標本サイズを掛けたものです。同じ相関構造のまま標本サイズだけを変えると、目的関数の値0.1929に対して、標本300件ならカイ二乗はおよそ57.9、600件なら115.7、1,200件なら231.5と、ほぼ比例して大きくなります。今回の4因子モデルはカイ二乗231.5(自由度98)で、p値は0.001を大きく下回り、検定としては棄却されました。しかし後で見るように、他の指標はすべて良好です。標本が大きいほど、実用上は無視できる小さなずれまで統計的に有意になるのがカイ二乗検定の性質であり、標本が大きいときにカイ二乗検定だけでモデルを捨てるのは適切ではありません。逆に標本が小さいと、明らかに間違ったモデルでも棄却できません。
CFI と TLI は、「すべての変数が無相関」という最も悪いモデル(独立モデル)と比べて、自分のモデルがどれだけ改善しているかを、おおむね0から1の範囲で表す指標で、1に近いほど良い値です(計算式に上限の切り上げが無いため、実装やデータによっては1をわずかに超えることがあります)。TLI は自由度あたりのカイ二乗で比べるためパラメータを増やしただけでは上がりにくい性質があります。RMSEA は自由度1あたりの近似誤差を標本サイズで補正した指標で、小さいほど良く、semopy ではカイ二乗が自由度より小さいときは0を返します。SRMR は、標本の相関行列とモデルが再現した相関行列の差(残差)を二乗平均して平方根を取ったもので、「相関係数にして平均どれくらいずれているか」と読めます。AIC と BIC は、適合の良さとパラメータの数のバランスを取る情報量規準で、同じデータに当てた複数のモデルを比べるときに、小さいほうを選びます。絶対値に意味は無く、比較にだけ使います。尤度にもとづく量なので、比べられるのは同じ観測変数の組に当てたモデルどうしに限ります。
目安の数値でよく引用されるのは、Hu と Bentler が1999年に発表した論文 Cutoff criteria for fit indexes in covariance structure analysis です。要旨には、最尤法の場合、TLI・CFI などは0.95付近、SRMR は0.08付近、RMSEA は0.06付近の切断値が、仮説モデルとデータの適合が比較的良いと結論するために必要だと書かれています。同じ要旨は、SRMR ともう1つの指標を組み合わせて報告する「2指標提示」を勧め、さらに TLI と RMSEA は標本が小さいとき正しいモデルを棄却しすぎる傾向があるとも述べています。次の表は、この出典に基づく目安と、今回の4因子モデルの値を並べたものです。
| 指標 | 何を測るか | 目安(Hu と Bentler、1999年) | 4因子CFAの値 |
|---|---|---|---|
| カイ二乗検定 | 再現した分散共分散行列と標本との一致 | 目安なし。標本サイズに比例して大きくなる | 231.5(自由度98。p値は0.001未満) |
| CFI | 独立モデルからの改善度 | 0.95付近以上 | 0.986 |
| TLI | 独立モデルからの改善度(自由度で補正) | 0.95付近以上 | 0.983 |
| RMSEA | 自由度あたりの近似誤差 | 0.06付近以下 | 0.034 |
| SRMR | 相関行列の残差の大きさ | 0.08付近以下 | 0.038 |
| AIC・BIC | 適合とパラメータ数のバランス | 複数モデルの比較で小さいほう | 307.5・500.9(カイ二乗にペナルティを足した形で計算) |
この目安を「合格ライン」として絶対視してはいけない、という指摘も出典つきで書いておきます。Marsh・Hau・Wen は2004年の論文 In Search of Golden Rules で、Hu と Bentler の切断値は仮説検定の論理に基づいており適合度の評価には必ずしも適さないこと、彼らの誤設定モデルの多くは新しい厳しい基準でも「許容できる」適合を示していたこと、そして Hu と Bentler 自身が付けていた注意書きに十分な注意が払われないまま新しい基準だけが実務に取り込まれていること、を論じています。目安は、あるシミュレーション条件のもとで「この程度なら大きな誤設定は見逃さない」と示された値であって、0.949 なら失格で 0.951 なら合格という線ではありません。複数の指標を並べて見ること、そして同じデータに当てた別のモデルと比較することのほうが、単独の切断値より頼りになります。
なお、semopy 2.3.11 の calc_stats() が返す AIC と BIC には注意が要ります。ソースコードを読むと、AIC は「2 × (パラメータ数 から LogLik を引いたもの)」で計算されていて、LogLik には対数尤度ではなく最尤法の目的関数(損失)の値が入っています。実行して確かめたところ、次節で扱う適合の悪い1因子モデルの AIC が55.6、適合の良い4因子モデルが75.6となり、損失が大きいモデルほど小さく出ました。この値はモデル比較には使えません。本章では、カイ二乗にパラメータ数の2倍を足したもの(AIC)と、パラメータ数に標本サイズの対数を掛けてカイ二乗に足したもの(BIC)を自分で計算しています。同じデータに当てたモデルどうしなら、飽和モデルの対数尤度が共通の定数になるので、この形は Akaike が1974年の論文 A new look at the statistical model identification で定義した「対数尤度のマイナス2倍にパラメータ数の2倍を足したもの」と順位が一致します。ライブラリが返す値を、定義を確かめずに転記しないことは、出典を確かめることと同じくらい大切だと考えています。
構造モデルと、構造が合わないときの指標の悪化
測定モデルが成り立つことを確かめたので、構造モデルを足します。仮説は「4つの因子が総合満足度を決め、総合満足度が推奨意向を決める」という2段の構造です。semopy ではモデル記述に2行足すだけです。合わせて、比較のために「16項目がすべて1つの因子に載る」1因子モデルも推定し、適合度を並べます。
desc_sem = desc + """
sat ~ f1 + f2 + f3 + f4
nps ~ sat
"""
sem = semopy.Model(desc_sem)
sem.fit(df[ITEM_COLS + ["sat", "nps"]])
est = sem.inspect(std_est=True)
paths = est[(est["op"] == "~") & (est["lval"].isin(["sat", "nps"]))]
print(paths[["lval", "rval", "Estimate", "Est. Std", "p-value"]])

# 比較用:1因子モデル(16項目が全部1つの因子に載る)
one = semopy.Model("g =~ " + " + ".join(ITEM_COLS))
one.fit(df[ITEM_COLS])
for label, m in [("4因子CFA", cfa), ("構造モデル", sem), ("1因子", one)]:
    st = semopy.calc_stats(m).iloc[0]
    k = len(m.param_vals)                     # 自由パラメータの数
    print(label, round(st["chi2"], 1), int(st["DoF"]),
          round(st["CFI"], 3), round(st["RMSEA"], 3),
          round(st["chi2"] + 2 * k, 1))        # AIC はカイ二乗 + 2k で自分で計算
# 出力:
# 4因子CFA 231.5 98 0.986 0.034 307.5
# 構造モデル 401.1 126 0.978 0.043 491.1
# 1因子 5031.3 104 0.485 0.199 5095.3
構造モデルのパス係数(標準化)は次のとおりです。総合満足度に対しては、商品品質が0.476、接客サポートが0.333、価格納得感が0.253、店舗利便性が0.137で、いずれも有意でした(店舗利便性の p値は0.001未満、他は表示桁でゼロ)。総合満足度から推奨意向へのパスは0.862で、総合満足度の決定係数は0.724、推奨意向の決定係数は0.742です。各因子から推奨意向への間接効果はパス係数の積で求められ、商品品質が0.410、接客サポートが0.287、価格納得感が0.218、店舗利便性が0.118でした。測定モデルの標準化負荷量は、確認的因子分析だけのときと比べて最大でも0.003しか変わっておらず、構造を足しても測定の部分が歪んでいないことが確認できます。
| パス | 非標準化 | 標準誤差 | z値 | 標準化 |
|---|---|---|---|---|
| 商品品質 → 総合満足度 | 0.758 | 0.036 | 21.25 | 0.476 |
| 価格納得感 → 総合満足度 | 0.418 | 0.033 | 12.70 | 0.253 |
| 接客サポート → 総合満足度 | 0.576 | 0.052 | 11.13 | 0.333 |
| 店舗利便性 → 総合満足度 | 0.228 | 0.049 | 4.68 | 0.137 |
| 総合満足度 → 推奨意向 | 0.968 | 0.016 | 58.81 | 0.862 |
次に、構造が合わないと指標がどう悪くなるかを見ます。次の表と図は、5つのモデルの適合度を並べたものです。A は1因子モデル、B は4因子の確認的因子分析、C は B に、生成時に仕込んだ4本の交差負荷(q05 と q08 が商品品質にも、q13 と q16 が接客サポートにも載る)を許したもの、D は上の構造モデル、E は D に接客サポートから推奨意向への直接のパスを1本足したものです。
| モデル | パラメータ数 | 自由度 | カイ二乗 | CFI | TLI | RMSEA | SRMR | AIC(カイ二乗+2k) | BIC |
|---|---|---|---|---|---|---|---|---|---|
| A 1因子 | 32 | 104 | 5031.3 | 0.485 | 0.405 | 0.199 | 0.167 | 5095.3 | 5258.2 |
| B 4因子CFA | 38 | 98 | 231.5 | 0.986 | 0.983 | 0.034 | 0.038 | 307.5 | 500.9 |
| C B+交差負荷4本 | 42 | 94 | 96.8 | 1.000 | 1.000 | 0.005 | 0.015 | 180.8 | 394.6 |
| D 構造モデル(4因子→満足→推奨) | 45 | 126 | 401.1 | 0.978 | 0.974 | 0.043 | 0.042 | 491.1 | 720.1 |
| E D+接客→推奨の直接パス | 46 | 125 | 250.0 | 0.990 | 0.988 | 0.029 | 0.037 | 342.0 | 576.2 |
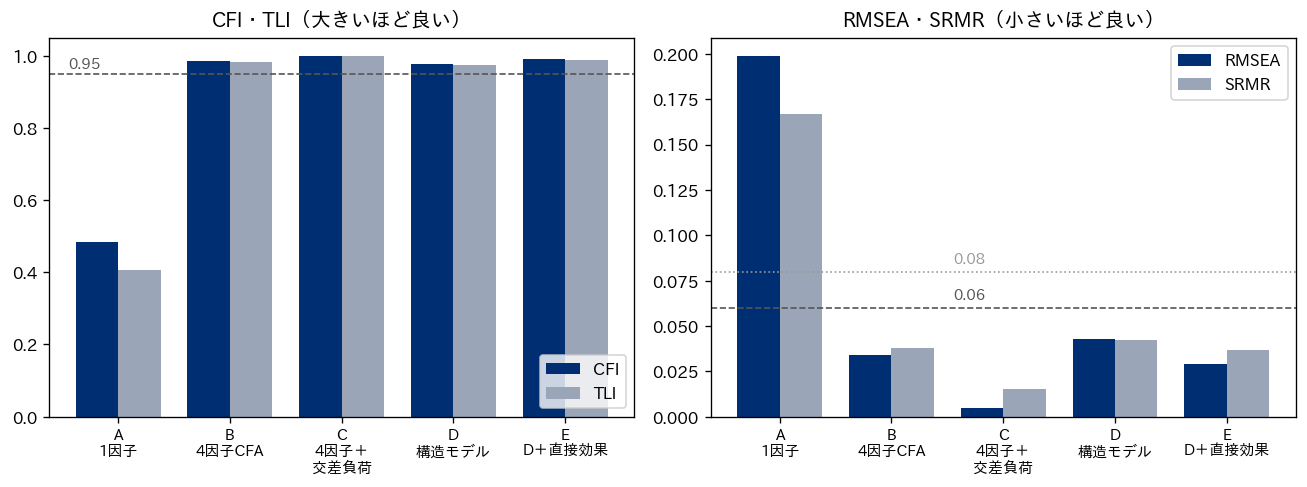
表の AIC と BIC を横に比べてよいのは、同じ16項目に当てた A・B・C のあいだと、16項目に総合満足度と推奨意向を加えた18変数に当てた D・E のあいだだけです。観測変数の組が違う B と D の AIC を比べても意味はありません。
1因子モデル A は、CFI 0.485、TLI 0.405、RMSEA 0.199、SRMR 0.167 と、どの指標でも目安から大きく外れました。16項目を1つの因子で説明しようとすると、商品品質の項目と価格納得感の項目のあいだの低い相関(因子間相関0.050)を再現できず、相関行列の残差の二乗平均平方根(SRMR)が0.167も残るからです。指標が悪いだけでなく、負荷量の解釈も崩れます。構造が合わないモデルは、こういう形で指標に現れます。逆に言えば、指標がここまで悪いときは、修正指標を見て1本ずつパスを足すのではなく、測定モデルの設計そのものに戻るべきです。
B と C の差は、交差負荷の扱いです。B は交差負荷をゼロに固定していますが、共通データの生成式にはもともと小さな交差負荷が4本入っています。C でそれを許すと、標準化交差負荷は0.151から0.198の範囲で推定され、カイ二乗は231.5から96.8へ134.7下がり(自由度の差は4)、p値は0.401になって、カイ二乗検定でも棄却されなくなりました。B が棄却されていたのは、まさにこの4本を省いていたからです。ただし B のままでも CFI 0.986・RMSEA 0.034 と目安の内側にあり、実務で「4因子構造は成り立つ」と結論するには十分です。0.2程度の交差負荷は、探索的因子分析では小さいものとして解釈から外されることもある大きさですが(目安は分野や標本サイズで変わります)、確認的因子分析でゼロに固定すると、標本が大きいときには検定に引っかかります。
D と E の差は構造モデルの側の話です。共通データの生成式では、推奨意向は総合満足度だけでなく接客サポートからも直接に影響を受けるように作ってあります。D はその直接パスを省いているのでカイ二乗は401.1(自由度126)にとどまり、E で直接パスを1本足すとカイ二乗は151.1下がりました(自由度の差は1)。E の CFI 0.990・RMSEA 0.029 は B に近い水準です。指標だけを見れば D も十分に良好ですが、D と E ではパス係数の意味が変わります。この点は経営目線の節で改めて取り上げます。
修正指標の誘惑と同値モデル
ソフトの多くは、「このパスを自由にすればカイ二乗がどれだけ下がるか」を示す修正指標を出力します。上の C や E は、生成時に仕込んだ構造を知っていたから足せたパスですが、実際の分析では真の構造は分かりません。修正指標の大きい順にパスを足していけば、カイ二乗は下がり続け、多くの指標は良く見えやすくなります(ただし TLI や RMSEA、AIC・BIC のように自由度やパラメータ数の補正を含む指標は、必ず改善するとは限りません)。しかしそれは、このデータの標本誤差に合わせてモデルを彫り込んでいるだけで、次のデータでは再現しません。MacCallum・Roznowski・Necowitz が1992年に Psychological Bulletin 誌に発表した論文の題名は「共分散構造分析におけるモデル修正、偶然への便乗の問題」で、データに合わせた修正が偶然に乗じてしまう問題を正面から扱っています。修正指標に従って足したパスは、理論的に説明でき、別の標本で再現できて初めて仮説の一部になります。それができないなら、「修正後のモデルは探索の結果であり、検証は別のデータで行う」と報告に明記すべきです。
もうひとつ、適合度指標の限界を示すのが同値モデルです。同値モデルとは、パス図の形(矢印の向き)が違うのに、どんなデータに対しても同じ再現分散共分散行列を与え、したがって同じ適合度になるモデルの組のことです。MacCallum らは1993年の論文 The problem of equivalent models in applications of covariance structure analysis でこの問題を論じています。共通データで実演します。商品品質の下位尺度平均・総合満足度・推奨意向の3変数に、次の3つのモデルを当てました。
import pandas as pd
d = pd.DataFrame({
    "quality": df[["q01", "q02", "q03", "q04"]].mean(axis=1),
    "sat": df["sat"],
    "nps": df["nps"],
})
models = {
    "M1 品質→満足→推奨": "sat ~ quality\nnps ~ sat",
    "M2 推奨→満足→品質": "sat ~ nps\nquality ~ sat",
    "M3 品質←満足→推奨": "quality ~ sat\nnps ~ sat",
}
for label, desc in models.items():
    m = semopy.Model(desc)
    m.fit(d)
    st = semopy.calc_stats(m).iloc[0]
    print(label, int(st["DoF"]), round(st["chi2"], 3), round(st["RMSEA"], 4))
# 出力:
# M1 品質→満足→推奨 2 1.076 0.0
# M2 推奨→満足→品質 2 1.076 0.0
# M3 品質←満足→推奨 2 1.076 0.0
3つのモデルのカイ二乗は1.076、自由度2、p値0.584、RMSEA は0で、3つとも完全に一致しました(CFI は1.0004と1を超えて表示されます。semopy は1で切り上げません)。M1 は「品質が満足を生み、満足が推奨を生む」という、実務で最も自然に見える仮説です。M2 はその向きをすべて逆にしたもので、「推奨する気持ちが満足を生み、満足が品質の評価を生む」という、直感には反する仮説です。M3 は満足が品質評価と推奨の両方の原因だという仮説です。この3つが同じ適合度になるのは、いずれも「品質と推奨は満足を介してだけ関係する」という同じ制約しか置いていないからで、データはこの制約が成り立つかどうかしか教えてくれません。矢印の向きは、データではなく分析者が決めているのです。なお、教科書的な数え方ではこのモデルの自由度は1ですが、semopy は外生の観測変数の分散を自由パラメータに数えない(inspect() の出力に quality の分散の行が無く、自由パラメータは4個)ため、自由度2と表示されます。
したがって、適合度が良いことは「この向きの因果が正しい」ことの証明にはなりません。適合度が示すのは、「このモデルが置いた制約は、データと矛盾しない」ということだけです。向きの根拠は、時間的な前後関係、実験や介入、あるいは理論から持ってくる必要があります。パス図を報告するときは、「このモデルには同値モデルが存在し、たとえば向きを逆にしたモデルも同じ適合度になる」と一言添えるのが誠実な作法だと考えています。
顧客満足度モデルの考え方
構造方程式モデリングが実務で最も広く使われている領域のひとつが、顧客満足度指数です。米国の ACSI(American Customer Satisfaction Index)は、公式サイトの The Science of Customer Satisfaction のページで、顧客インタビューを入力とする多方程式の計量経済モデルであること、そして左側に満足の原因(顧客期待・知覚品質・知覚価値)、中央に満足(ACSI)、右側に満足の結果(顧客の苦情と、再購入や価格許容度を含む顧客ロイヤルティ)を置いた因果モデルであることを説明しています。同じページには、満足の指数が3つの設問の加重平均として計算されること、知覚価値が支払った価格に対する品質の尺度であること、ロイヤルティが収益性の代理変数として位置づけられていること、も書かれています。指数の数値や重みの求め方は本章では書きません。
日本では、日本生産性本部のサービス産業生産性協議会が実施する JCSI(日本版顧客満足度指数)があります。公式サイトの 統計手法(JCSI因果モデルとは) のページでは、顧客期待・知覚品質・知覚価値・顧客満足・推奨意向・ロイヤルティの6つの指標を定義し、各項目間の因果関係をモデル化する手法として共分散構造分析を挙げています。JCSI のトップページには「顧客満足の原因・結果を含む6つの指標で指数化」するとあり、原因側と結果側を分ける考え方は ACSI と共通です。指標どうしの矢印の向きは公式ページの本文には言葉で書かれておらず図で示されているため、本章では向きを断定しません。
本章で推定した構造モデルは、この考え方の縮小版です。4つの因子が原因側、総合満足度が中央、推奨意向が結果側にあたります。顧客満足度指数の型で分析する利点は、「満足を上げるには何を動かせばよいか」を原因側のパス係数で、「満足を上げると何が起きるか」を結果側のパス係数で、ひとつのモデルの中で同時に読めることです。第4章の因子得点と総合満足度の相関を1つずつ見るのと違い、他の因子の影響を統制したうえでの各因子の寄与が得られます。同時に、本章で見たとおり、原因側の構造(交差負荷)と結果側の構造(直接パスの有無)の両方に仮説の置き方が入り込むので、モデルの形をどう決めたかを報告の中に残すことが欠かせません。
経営目線:適合したモデルは因果の証明ではない
構造方程式モデリングの報告書は、パス図と適合度指標が揃っているため、説得力が強く見えます。ここに経営上の危険があります。「接客サポートから総合満足度へのパスが0.333で有意、総合満足度から推奨意向へのパスが0.862で有意、モデルの CFI は0.978」という報告を受けた経営者が、「接客に投資すれば推奨が増える」と読んで研修や人員の予算を組んだとします。このとき、モデルが保証しているのは「このデータの相関構造は、この矢印の置き方と矛盾しない」ことだけです。同値モデルの節で見たとおり、矢印の向きを逆にしても適合度は変わりません。横断的なアンケート1回分のデータでは、接客の評価が高い人ほど推奨意向が高いという関係が、接客が推奨を生んだのか、もともと会社を好きな人が接客も高く評価しているのか、区別できないのです。
モデルの形の選び方も投資判断を左右します。本章の D と E は、接客サポートから推奨意向への直接パスが1本あるかないかだけの違いで、どちらも指標は目安の内側でした。しかし各因子から推奨意向への総合効果(間接効果と直接効果の和、標準化)を計算すると、D では商品品質0.410、接客サポート0.287、価格納得感0.218、店舗利便性0.118の順で、E では接客サポート0.491、商品品質0.325、価格納得感0.173、店舗利便性0.094の順になります。1位と2位が入れ替わっています。共通データの生成式には直接パスが入っているので E が真の構造に近く、D を信じて商品品質を最優先にすると、推奨意向に対して最も効く要因を2番手に置くことになります。適合度が「十分良い」モデルどうしでも施策の優先順位が変わりうるという事実は、指標の値そのものより経営にとって重要です。
実務での守り方は3つあると考えています。第一に、パス係数を因果効果として読むなら、時間的に先行するデータ(前期の接客評価と今期の推奨意向)を使うか、小規模でも介入(一部店舗で接客を変えて比較する)を組み合わせて、向きの根拠を別に持つことです。第二に、モデルを1つだけ提示せず、対立する形(直接パスの有無、向きの逆転)を並べて、どこまでがデータで決まり、どこからが仮説かを明示することです。第三に、パス係数の大きさを「1標準偏差の改善で推奨意向が何標準偏差動くか」という統計指標のまま報告せず、対象人数と現状の分布に当てはめて「推奨意向が1点上がる人が何人増えるか」「その人たちの再購入率がどれだけ変わるか」という経営指標に翻訳し、投資と比較できる形にすることです。翻訳の過程で置いた仮定(因果の向き、他の条件の不変)を注記すれば、経営者は「この数字はどこまで信じてよいか」を自分で判断できます。
本章の要点をまとめます。構造方程式モデリングは、探索ではなく仮説の検証の道具であり、測定モデルと構造モデルの2つの部品を、識別を確かめたうえで最尤法などで推定します。適合度指標には出典のある目安がありますが、目安は合格ラインではなく、複数の指標と対立モデルとの比較で読むものです。修正指標に従った修正は探索であり、同値モデルの存在により、適合したモデルは因果の向きを証明しません。次の第12章では、視点を「顧客が何を評価しているか」から「顧客が何を選ぶか」へ移し、選好の構造を測るコンジョイント分析を扱います。
この章を深めたい方への参考書籍
『共分散構造分析[入門編]:構造方程式モデリング』(豊田秀樹、朝倉書店):パス図の書き方、識別、推定、適合度指標という本章の骨格を、入門書として順に解説した1冊です。同じ著者による応用編・技術編・理論編などのシリーズの出発点にあたり、まずこの1冊で本章の内容を確かめてから次に進むのがよいと考えています。
『AMOS、EQS、CALISによるグラフィカル多変量解析:目で見る共分散構造分析』(狩野裕・三浦麻子、現代数学社、新装版):書名のとおりパス図を軸に、モデルの立て方と結果の読み方を図で見せる構成で、本章の「パス図の読み方」を深めるのに向いています。使うソフトは本章と違いますが、モデルの考え方はソフトに依存しません。
『共分散構造分析[R編]:構造方程式モデリング』(豊田秀樹編著、東京図書):R のパッケージ lavaan とその関連パッケージで共分散構造分析を実行する手順をまとめた本です。本章で使った semopy のモデル記述は lavaan の記法に倣っているので、この本のモデル記述の読み方はそのまま semopy に持ち込めます。R を使わない方にも、モデル記述の読み方の参考になります。
第12章 コンジョイント分析、選好の構造を測る
第11章では、構造方程式モデリングで「満足が推奨につながる」といった仮説の構造を、観測データに照らして検証する考え方を確認しました。そこで扱った変数は、顧客がすでに経験した商品やサービスへの評価でした。本章で扱うコンジョイント分析は、視点を一段手前に移し、まだ世に無い商品について「顧客はどの属性のどの水準に、どれだけの価値を置くか」を測る手法です。商品企画や価格帯の設計、サービスの仕様決めといった、経営判断に直結する場面で使われます。
本章では、架空の家庭用コーヒーメーカーを題材に、属性と水準の設計、直交計画による提示プロファイルの絞り込み、回帰による部分効用の推定、相対重要度の計算、選好シェアのシミュレーションまでを一通り実行します。データはすべて乱数で生成した架空のもので、実在の調査ではありません。なお本コラム全体の方針として、価格に関する属性は金額を書かず、「価格帯:低・中・高」のように水準名だけで表します。
コンジョイント分析が答える問い
商品は、複数の属性の組み合わせとして顧客に届きます。コーヒーメーカーなら、価格帯、保証期間、ミル機能の有無、配送の速さなどです。顧客に「保証期間は大事ですか」と直接たずねると、たいていの属性が「大事」と答えられてしまい、属性どうしの優先順位は見えてきません。コンジョイント分析は、属性の水準を組み合わせた商品案(プロファイルと呼びます)を丸ごと提示し、その全体評価だけを回答してもらいます。そして、多数のプロファイルへの評価を統計的に分解して、各属性の各水準が全体評価にどれだけ寄与しているかを推定します。この寄与を部分効用と呼びます。
直接たずねずに測る、という点がこの手法の核です。回答者は、「価格帯が低くて保証が1年でミル無しの商品」「価格帯が中で保証が3年でミル付きの商品」のように属性の水準を組み合わせた商品案を見て、それぞれをどれだけ好むかを評価するだけです。回答者には属性間のトレードオフを含んだ判断をしてもらい、その結果から各属性の重みを逆算します。この考え方は、Luce と Tukey が1964年に数理心理学の学術誌に発表した「コンジョイント測定」という新しい型の基礎的測定の理論にさかのぼります。マーケティング分野では、Green と Rao が1971年にマーケティング・リサーチの学術誌に、判断データを数量化するためのコンジョイント測定を論じた論文を発表しています。Green と Srinivasan が1978年に消費者研究の学術誌にまとめた総説は、1971年以降にコンジョイント分析が消費者研究の幅広い問題に応用されてきたと述べており、同じ二人は1990年にも、マーケティングにおける新しい展開を整理した総説を発表しています。
分析の出力は、大きく3つあります。第1は、各属性の各水準の部分効用です。第2は、部分効用の幅から計算する属性ごとの相対重要度です。第3は、部分効用を足し合わせて任意の商品案の総効用を見積もり、複数の案を競わせたときの選好シェアです。この3つがそろうと、「保証を1年延ばすのと、ミル機能を足すのと、どちらが顧客の評価を上げるか」「その代わりに価格帯を一段上げても評価は保てるか」といった商品設計の問いに、数字で答えられるようになります。
属性と水準の設計
コンジョイント分析の成否は、統計処理より前の「属性と水準の設計」でほぼ決まります。属性とは商品を特徴づける軸で、水準はその軸の取りうる値です。本章の架空のコーヒーメーカーでは、次の4属性を各3水準で設計しました。価格帯は「低・中・高」、保証期間は「1年・2年・3年」、ミル機能は「なし・あり・挽き目調整付き」、配送は「通常・翌日・当日」です。全部の組み合わせは3の4乗で81通りになります。
設計で守るべき点が3つあります。第1に、属性は互いに独立に変えられるものにすることです。「本体色」と「デザインシリーズ」のように片方が他方を決めてしまう属性を並べると、組み合わせに意味のない水準が生じます。第2に、水準は回答者が現実の商品として想像できる範囲にとどめることです。価格帯を「低」としながらミル機能を「挽き目調整付き」にした案は、市場に存在しにくい組み合わせかもしれません。存在しにくい組み合わせが提示に混じると、回答者はその案を「ありえない」と切り捨ててしまい、評価が属性の価値ではなく非現実さを反映してしまいます。第3に、水準の幅は分析結果に直接効きます。後の節で示すとおり、価格帯を「低・中・高」で測るか「低・中」で測るかによって、価格帯の相対重要度は51.0%から31.1%へ変わります。幅の決め方が結論を左右するのです。
価格の属性については、本コラムでは金額を書かない方針をとっています。実際の調査では価格帯の各水準に具体的な金額を対応させますが、分析の仕組みそのものは「低・中・高」という水準名で説明しきれます。むしろ、水準名で考えることで「価格帯の幅をどこまで広げるか」という設計上の論点が見えやすくなります。金額を置く段階では、自社の原価構造や競合の価格帯を踏まえて、現実に検討しうる範囲だけを水準にする必要があります。
直交計画、全部の組み合わせを提示せずに済む理由
81通りのプロファイルをすべて評価してもらうのは、回答者にとって非現実的です。しかし、部分効用を推定するだけなら、全組み合わせは要りません。各属性の主効果だけを推定する前提に立てば、「どの水準も同じ回数だけ現れ、どの2属性を取っても水準の組み合わせが均等に現れる」ように組んだ少数のプロファイルで足ります。この条件を満たす組み方を直交計画といい、その具体的な表を直交表と呼びます。工業分野の実験計画法で使われてきた道具で、コンジョイント分析はそれを調査に転用しています。
本章では、3水準の属性を4つまで割り付けられる直交表 L9 を使います。米国 NIST が公開している統計手法のハンドブック(NIST/SEMATECH e-Handbook of Statistical Methods 5.3.3.10)に掲載された L9 の表をそのまま使い、行をプロファイル、列を属性、値を水準番号として読みます。9行4列の表を手で用意し、各行の水準番号を水準名に置き換えると、次の9つのプロファイルが得られます。
| プロファイル | 価格帯 | 保証期間 | ミル機能 | 配送 |
|---|---|---|---|---|
| 1 | 低 | 1年 | なし | 通常 |
| 2 | 低 | 2年 | あり | 翌日 |
| 3 | 低 | 3年 | 挽き目調整付き | 当日 |
| 4 | 中 | 1年 | あり | 当日 |
| 5 | 中 | 2年 | 挽き目調整付き | 通常 |
| 6 | 中 | 3年 | なし | 翌日 |
| 7 | 高 | 1年 | 挽き目調整付き | 翌日 |
| 8 | 高 | 2年 | なし | 当日 |
| 9 | 高 | 3年 | あり | 通常 |
直交表の条件が本当に満たされているかは、表を眺めるだけでなく数えて確かめました。次のコードは、L9 の水準番号を水準名に置き換えてプロファイル表を作り、各列の水準の出現回数と、列どうしの組み合わせの出現回数を数えます。
import itertools
import numpy as np
import pandas as pd

ATTRS = {
    "価格帯": ["低", "中", "高"],
    "保証期間": ["1年", "2年", "3年"],
    "ミル機能": ["なし", "あり", "挽き目調整付き"],
    "配送": ["通常", "翌日", "当日"],
}
# 直交表 L9(NIST/SEMATECH e-Handbook 5.3.3.10 の表を写した)
L9 = np.array([[1, 1, 1, 1], [1, 2, 2, 2], [1, 3, 3, 3],
               [2, 1, 2, 3], [2, 2, 3, 1], [2, 3, 1, 2],
               [3, 1, 3, 2], [3, 2, 1, 3], [3, 3, 2, 1]])
names = list(ATTRS)
prof = pd.DataFrame({a: [ATTRS[a][r[j] - 1] for r in L9]
                     for j, a in enumerate(names)})

for a in names:                       # 条件1:各列の水準が均等
    print(a, prof[a].value_counts().to_dict())
for a, b in itertools.combinations(names, 2):   # 条件2:列の組み合わせが均等
    ct = pd.crosstab(prof[a], prof[b])
    print(a, "×", b, "各セル1回:", bool((ct.values == 1).all()))
# 出力:
# 価格帯 {'低': 3, '中': 3, '高': 3}   (他の3列も 3・3・3)
# 価格帯 × 保証期間 各セル1回: True   (6組すべて True)
実行結果では、4列すべてで各水準が3回ずつ現れ、6通りある列の組み合わせすべてで、9通りの水準の組み合わせがちょうど1回ずつ現れました。さらに、水準を数値に符号化した説明変数どうしの相関を計算すると、異なる属性の列どうしの相関は 0.0 でした。相関が0であることは、ある属性の部分効用を推定するときに他の属性の影響が混ざらないことを意味します。全組み合わせ81通りのうち9つだけを提示しても各属性の主効果を互いに独立に推定できるのは、この性質のおかげです。
ただし、直交表で節約できるのは「主効果だけを推定する」という前提と引き換えです。「価格帯が高いときだけ保証期間の価値が増す」といった属性間の交互作用は、L9 の9プロファイルからは推定できません。交互作用まで見たいなら、より大きな直交表か、全組み合わせに近い設計が要ります。もう1つ、L9 は4列しかないので、3水準の属性は4つまでです。属性を5つにすると全組み合わせは243通り、推定する係数は切片を含めて11個になり、L9 には収まりません。属性の数を決めることは、そのまま使える直交表と回答者の負担を決めることでもあります。
架空の評価データと、回帰による部分効用の推定
推定の手順を示すために、回答者100名分の評価データを乱数で生成しました。各回答者が9つのプロファイルを1〜10点で評価する、という設定です。生成の仕組みは次のとおりです。まず属性ごと・水準ごとに「仕込んだ部分効用」を決めます。価格帯は低が+1.2、中が+0.1、高が-1.3、保証期間は1年が-0.5、2年が+0.1、3年が+0.4、ミル機能はなしが-0.8、ありが+0.3、挽き目調整付きが+0.5、配送は通常が-0.2、翌日が+0.1、当日が+0.1です。属性ごとの合計は0にそろえてあります。次に、回答者ごとに属性の重みを与えます。価格帯を重く見る型を60名、ミル機能を重く見る型を40名として、さらに個人ごとに0.7倍から1.3倍のばらつきを乗せました。各プロファイルの評価は「5.5+重み×部分効用の和+標準偏差0.8の正規乱数」を計算し、1〜10の整数に丸めて作ります。乱数シードは固定してあるので、同じコードを実行すれば同じデータになります。仕込んだ部分効用(TRUE_PW)と重みの型を作る関数(make_weights)は、本章の補助ファイル ch12_design.py にまとめてあり、次のコードはそれを読み込む前提で書いています。
from ch12_design import make_weights, TRUE_PW   # 仕込んだ部分効用と重みの型

rng = np.random.default_rng(0)
weights = make_weights(rng)              # 回答者100名の属性ごとの重み(型2種類 × 個人差)
rows = []
for r in weights.index:                  # 回答者100名
    for _, p in prof.iterrows():         # 9プロファイル
        u = 5.5
        for a in names:
            u += weights.loc[r, a] * TRUE_PW[a][p[a]]   # 重み × 仕込んだ部分効用
        y = u + rng.normal(0, 0.8)
        rec = {"resp": r, "rating": int(np.clip(np.round(y), 1, 10))}
        rec.update({a: p[a] for a in names})
        rows.append(rec)
long = pd.DataFrame(rows)                # 900行の縦持ちデータ
for a in names:
    long[a] = pd.Categorical(long[a], categories=ATTRS[a])
できあがった900行の評価は、平均5.477、標準偏差1.683で、1点から10点まで分布しました。プロファイル別の平均評価を見ると、価格帯が低く保証が3年でミル機能が挽き目調整付きのプロファイル3が7.89と最も高く、価格帯が高くミル機能なしのプロファイル8が3.26と最も低くなっています。ここまでは集計で分かることですが、「価格帯が高いことと、ミル機能が無いことの、どちらが評価を下げているか」は集計では分かりません。それを分けるのが回帰です。
部分効用の推定には、水準をダミー変数に置き換えた最小二乗法を使います。第9章で扱った数量化I類と同じ考え方で、目的変数は評価点、説明変数は各属性の水準です。本章では statsmodels の式インターフェースで、水準の効果の合計が0になる符号化(Sum コーディング)を指定しました。statsmodels の公式ドキュメント(Contrasts Overview)には、C(x, Sum) が各水準の平均を全体平均と比べる符号化であること、C(x, Treatment(reference=...)) が基準水準との差を表すダミー変数の符号化であることが説明されています。どちらの符号化でも水準間の差は同じになるので、合計0の形が読みやすい Sum を採りました。
import statsmodels.formula.api as smf

formula = "rating ~ " + " + ".join("C(%s, Sum)" % a for a in names)
agg = smf.ols(formula, data=long).fit()      # 900行を1本の回帰にかける

def partworth(params):
    """Sum コーディングの係数から各属性3水準の部分効用(合計0)を取り出す"""
    out = {}
    for a in names:
        lv = ATTRS[a]
        v = [params["C(%s, Sum)[S.%s]" % (a, l)] for l in lv[:-1]]
        v.append(-sum(v))                    # 最後の水準は残りの符号を反転した和
        out[a] = dict(zip(lv, v))
    return out

pw = partworth(agg.params)
print(agg.nobs, agg.df_resid, round(agg.rsquared, 3))
# 出力: 900.0 891.0 0.618
集計した回帰は、観測数900、係数9個、残差の自由度891で、決定係数は0.618、残差の標準偏差は1.045でした。仕込んだ乱数の標準偏差0.8より残差が大きいのは、回答者ごとの重みの違いと整数への丸めが、集計モデルから見れば誤差に含まれるためです。推定した部分効用を、仕込んだ値の回答者平均と並べたのが次の表です。仕込んだ値は回答者ごとに重みが違うので、100名の平均を「真値」として比べています。
| 属性 | 水準 | 仕込んだ値(回答者平均) | 集計した回帰の推定 | 差 |
|---|---|---|---|---|
| 価格帯 | 低 | 1.33 | 1.29 | -0.04 |
| 価格帯 | 中 | 0.11 | 0.12 | 0.01 |
| 価格帯 | 高 | -1.44 | -1.41 | 0.03 |
| 保証期間 | 1年 | -0.44 | -0.39 | 0.05 |
| 保証期間 | 2年 | 0.09 | -0.03 | -0.12 |
| 保証期間 | 3年 | 0.36 | 0.42 | 0.06 |
| ミル機能 | なし | -0.86 | -0.88 | -0.02 |
| ミル機能 | あり | 0.32 | 0.27 | -0.05 |
| ミル機能 | 挽き目調整付き | 0.54 | 0.60 | 0.06 |
| 配送 | 通常 | -0.20 | -0.20 | 0.00 |
| 配送 | 翌日 | 0.10 | 0.10 | 0.00 |
| 配送 | 当日 | 0.10 | 0.10 | 0.00 |
12個の水準すべてで差の絶対値は0.12以内に収まり、仕込んだ構造をほぼ回収できています。切片を除く係数の標準誤差はどれも0.049で、直交計画のおかげで全係数が同じ精度で推定されていることも確認できました。基準水準との差で表すダミー変数の符号化でも推定し、価格帯の「高」と「低」の差が両方の符号化で-2.693と一致することを確かめています。切片は5.477で、仕込んだ基準の5.5に近い値です。
相対重要度の計算と、その読み方
部分効用が出たら、属性ごとに「最も高い水準と最も低い水準の差」を取ります。この差を本章では幅と呼びます。幅を全属性で合計し、各属性の幅が合計に占める割合を百分率にしたものが相対重要度です。コンジョイント分析の調査ツールを提供している Sawtooth Software 社のマニュアル(Interpreting Conjoint Analysis Data)でも、幅を百分率にして合計が100になる重要度を求める、と説明されています。集計した回帰の部分効用から計算すると、価格帯は幅2.69で51.0%、ミル機能は幅1.48で28.0%、保証期間は幅0.81で15.4%、配送は幅0.30で5.6%でした。仕込んだ値の回答者平均から計算した重要度は順に52.5%、26.5%、15.2%、5.7%で、こちらも回収できています。
相対重要度は「その属性の水準を、調査で提示した範囲の端から端まで動かしたとき、評価がどれだけ動くか」の相対値です。これは属性そのものの重みではなく、水準の幅とセットで決まる量です。上のマニュアルにも、重要度は調査で選んだ水準に依存し、価格の範囲を狭くとれば価格の重要度は下がる、と明記されています。本章の数値で確かめると、同じ推定値を使って価格帯の幅を「低・中」だけで計算し直すと、価格帯の幅は1.17に縮み、相対重要度は51.0%から31.1%へ下がります(幅と相対重要度は丸める前の部分効用から計算しているため、表の値から手で計算すると小数点以下がわずかにずれます)。それに伴ってミル機能が39.4%、保証期間が21.7%、配送が7.9%へ上がり、最も重要な属性はミル機能に入れ替わります。部分効用は1つも変えていないのに、順位が変わるのです。
もう1つの論点は、重要度を「集計した部分効用から出す」か「回答者ごとに出して平均する」かです。同じマニュアルは、グループの重要度をまとめるときは回答者ごとに計算してから平均するのがよい、と勧めています。本章でも回答者ごとに9行ずつ100本の回帰を実行しました。ここで設計上の代償が現れます。L9 の4列を使い切ると、9プロファイルに対して係数が9個になり、回答者ごとの回帰は残差の自由度が0の飽和モデルになります。実行結果でも、100名全員の決定係数が1.000で、個人ごとの標準誤差は計算できません。推定値そのものは得られるので、そこから回答者ごとの重要度を計算し平均すると、価格帯42.0%、ミル機能27.1%、保証期間17.5%、配送13.5%でした。
def importance(pw):
    """部分効用の幅(最大-最小)を全属性で割った相対重要度(%)"""
    width = {a: max(pw[a].values()) - min(pw[a].values()) for a in pw}
    total = sum(width.values())
    return {a: 100.0 * width[a] / total for a in pw}

imp_ind = {}
for r, g in long.groupby("resp"):        # 回答者ごとに9行の回帰
    m = smf.ols(formula, data=g).fit()
    imp_ind[r] = importance(partworth(m.params))
imp_df = pd.DataFrame(imp_ind).T[names]
print(imp_df.mean().round(1).to_dict())
# 出力: {'価格帯': 42.0, '保証期間': 17.5, 'ミル機能': 27.1, '配送': 13.5}
集計から出した重要度と、個人平均の重要度は、配送で5.6%と13.5%、価格帯で51.0%と42.0%と、はっきり食い違いました。生成時に仕込んだ個人ごとの重みから計算した重要度の平均は、価格帯50.9%、ミル機能27.8%、保証期間15.5%、配送5.8%なので、この架空データでは集計から出した値のほうが真値に近く、個人平均は配送を2倍以上に過大評価しています。理由は幅の定義にあります。幅は最大値と最小値の差なので、推定に雑音が乗ると、縮むよりも広がる方向に偏ります。真の幅が小さい属性ほどこの偏りの影響が相対的に大きく、飽和モデルで雑音を吸収する余地が無い本章の設計では、それが配送の13.5%として現れました。推定した個人の重要度と仕込んだ個人の重要度の相関も、価格帯は0.886、ミル機能は0.855と高い一方で、保証期間は0.338、配送は0.155にとどまっています。個人ごとに計算してから平均する方針は、個人の推定が十分に安定しているときに効く、と理解しておくのが安全です。
個人ごとの推定には、平均では見えない情報もあります。回答者100名の価格帯の重要度は最小0.0%から最大75.0%、ミル機能は4.5%から62.5%まで散らばり、標準偏差はそれぞれ18.1ポイントと15.1ポイントでした。価格帯の重要度を横軸、ミル機能の重要度を縦軸にとった散布図では、点は1か所に集まらず、左上と右下に偏って広がります。これは生成時に2種類の重みの型を仕込んだ結果です。実際の調査でこのような塊が見えたときは、回答者を群に分けて考える手がかりになります。ばらつきを手がかりに回答者を群に分けるのがセグメンテーションで、その方法は第6章のクラスター分析で扱ったとおりです。本章では「平均の重要度は、誰の重要度でもないことがある」という点だけを押さえておきます。
フルプロファイル法と選択型コンジョイント
ここまで実行してきたのは、プロファイルを1枚ずつ提示して点数を付けてもらう、評定型のフルプロファイル法です。1枚のカードに全属性の水準を書いて丸ごと評価してもらうのでフルプロファイルと呼びます。回答は点数(本章では1〜10点)なので、そのまま最小二乗法で分解できます。実行が簡単で、本章のように回答者ごとの推定もできる反面、「10点満点で7点」という回答が実際の購買行動とどう結びつくかは明らかではありません。回答者は買うつもりの無い商品にも点数を付けられるからです。
この弱点に応えるのが選択型コンジョイント、いわゆる CBC です。複数のプロファイルを同時に提示し、「この中から1つ買うならどれか」を選んでもらいます。「どれも買わない」という選択肢を含めることもできます。選ぶという行為は購買に近く、回答者にとっても自然です。選択型の設計と分析を集計データに基づいて行う方法は、Louviere と Woodworth が1983年に発表した論文で示されました。ただし、回答が「選んだ・選ばなかった」という離散的なデータになるので、最小二乗法の代わりに多項ロジットモデルを使って部分効用を推定します。
多項ロジットモデルの考え方は次のとおりです。各選択肢の効用を、観測できる部分と、観測できないランダムな部分の和と考えます。観測できる部分は部分効用の和です。ランダムな部分に特定の分布を仮定すると、ある選択肢が選ばれる確率は、その選択肢の効用の指数を、提示された全選択肢の効用の指数の合計で割った値になります。式で書けば \( P_i = \exp(V_i) / \sum_j \exp(V_j) \) です。カリフォルニア大学バークレー校のサイトで公開されている Kenneth Train の離散選択の教科書(Discrete Choice Methods with Simulation、第2版、2009年)の第3章は、この式を McFadden の1974年の研究に沿って導いており、同じ章で、この式が持つ「無関係な選択肢からの独立」という性質と、その反例として知られる赤いバスと青いバスの問題(色だけが違うよく似た選択肢を追加すると、本来は無関係なはずの他の選択肢との選択確率の比まで歪んでしまう例)を説明しています。効用の観測できる部分に含まれる係数を最尤法で求めれば、それが選択型の部分効用です。
本章では選択型の推定を実行しません。多項ロジットの推定には、選択肢ごとに属性が変わる形のデータ構造と、それに対応した最尤推定の実装が要り、評定型の最小二乗法とは別の道具立てになるからです。回答者ごとの係数をベイズ的に求める方法も、同じ教科書の第11章と第12章で扱われています。押さえるべき違いは、評定型は「どれだけ好きか」を、選択型は「どれを選ぶか」を測っており、市場シェアの見積もりには選択型のほうが素直につながる、という点です。
市場シミュレーション、部分効用の和で選好シェアを見積もる
部分効用が回答者ごとに得られると、調査で提示していない商品案についても、各回答者がどう評価するかを見積もれます。属性ごとに該当する水準の部分効用を拾って足すだけです。複数の商品案を用意し、回答者ごとに総効用を計算して、どの案が選ばれるかを集計したものが選好シェアです。これを市場シミュレーションと呼びます。本章では、自社案Aを「価格帯:中、保証期間:3年、ミル機能:あり、配送:翌日」、競合Bを「価格帯:低、保証期間:1年、ミル機能:なし、配送:通常」、競合Cを「価格帯:高、保証期間:3年、ミル機能:挽き目調整付き、配送:当日」として競わせました。
選ばれ方の決め方には2種類あります。最大効用ルールは、各回答者が総効用の最も高い案を1つ選ぶとみなし、選ばれた回数の割合をシェアとします。ロジットルールは、前の節の式にならって、各回答者の選択確率を効用の指数の比で配り、その平均をシェアとします。次のコードは両方を計算します。
# 回答者ごとの部分効用と切片(前の節と同じ、9行ずつの回帰から取り出す)
pw_ind, icpt = {}, {}
for r, g in long.groupby("resp"):
    m = smf.ols(formula, data=g).fit()
    pw_ind[r] = partworth(m.params)
    icpt[r] = float(m.params["Intercept"])
resp_ids = list(pw_ind)

concepts = {
    "自社案A": {"価格帯": "中", "保証期間": "3年", "ミル機能": "あり", "配送": "翌日"},
    "競合B": {"価格帯": "低", "保証期間": "1年", "ミル機能": "なし", "配送": "通常"},
    "競合C": {"価格帯": "高", "保証期間": "3年", "ミル機能": "挽き目調整付き", "配送": "当日"},
}

def utility(r, concept):
    """回答者 r にとっての商品案の効用(切片 + 各属性の部分効用)"""
    u = icpt[r]
    for a in names:
        u += pw_ind[r][a][concept[a]]
    return u

def simulate(concepts, scale=1.0):
    cnames = list(concepts)
    U = np.array([[utility(r, concepts[c]) for c in cnames] for r in resp_ids])
    first = np.bincount(U.argmax(axis=1), minlength=len(cnames))
    first = 100.0 * first / len(resp_ids)             # 最大効用ルール
    ex = np.exp(scale * U)
    logit = 100.0 * (ex / ex.sum(axis=1, keepdims=True)).mean(axis=0)   # ロジットルール
    return pd.DataFrame({"最大効用": first, "ロジット": logit}, index=cnames)

print(simulate(concepts).round(1))
# 出力:
#       最大効用  ロジット
# 自社案A  65.0  48.6
# 競合B   21.0  27.7
# 競合C   14.0  23.8
回答者100名の平均効用は自社案Aが6.39、競合Bが5.30、競合Cが5.20で、最大効用ルールでは自社案Aが65.0%、競合Bが21.0%、競合Cが14.0%のシェアになりました。ロジットルールでは48.6%、27.7%、23.8%と、差が縮まります。最大効用ルールは僅差でも勝った案に全部を配るので、シェアの差が極端に出ます。Sawtooth Software 社のマニュアルも、最大効用ルールで2倍のシェアを取った案が、確率的なルールでは2倍よりかなり小さい差になりうる、と注意しています。どちらが正しいというより、両方を出して幅として読むのが実務的です。
シミュレーションの本領は、自社案の水準を1つ変えたときの変化を見ることにあります。次の表は、自社案Aの属性を1つずつ変えたときのシェアです。
| 自社案Aの変更 | 最大効用ルール | 変化 | ロジットルール | 変化 |
|---|---|---|---|---|
| 変更なし | 65.0% | 48.6% | ||
| 価格帯を中から低へ | 87.0% | +22.0 | 69.8% | +21.2 |
| 価格帯を中から高へ | 21.0% | -44.0 | 22.8% | -25.8 |
| 保証期間を3年から2年へ | 43.0% | -22.0 | 39.3% | -9.3 |
| 保証期間を3年から1年へ | 29.0% | -36.0 | 32.0% | -16.6 |
| ミル機能をありから挽き目調整付きへ | 67.0% | +2.0 | 54.7% | +6.1 |
| ミル機能をありからなしへ | 28.0% | -37.0 | 27.6% | -21.0 |
| 配送を翌日から当日へ | 62.0% | -3.0 | 47.9% | -0.7 |
| 配送を翌日から通常へ | 40.0% | -25.0 | 41.7% | -6.9 |
この表から読めることは多くあります。価格帯を高にするとシェアは最大効用ルールで44.0ポイント失われ、ミル機能を外すと37.0ポイント失われます。一方でミル機能を挽き目調整付きに上げても、伸びは2.0ポイントから6.1ポイントにとどまります。競合Cがすでに挽き目調整付きを持っているので、そこで差がつかないためです。配送を当日にしても伸びず、最大効用ルールではむしろ3.0ポイント下がっていますが、集計した部分効用は翌日も当日も0.10で差が無く、回答者ごとの推定値の小さな違いが最大効用ルールの勝ち負けにそのまま反映された結果です。相対重要度の表だけを見て「ミル機能が28%で2番目に重要だから最上位の機能を載せる」と決めると、競合との位置関係を見落とします。シミュレーションは、自社案と競合案の組み合わせの中で、どの属性が効くかを教えてくれます。
限界も明確にしておきます。第1に、このシェアは「市場にこの3案しか無く、回答者全員が必ず1つ買う」という仮定の上の数字です。実際の市場シェアには、認知、店頭での入手しやすさ、ブランドへの信頼、販売員の勧めなど、調査で提示していない要因がすべて効きます。第2に、ロジットルールは効用の尺度に依存します。本章の部分効用は10点満点の評価から推定した点数なので、指数を取るときの尺度を決める根拠がありません。効用を0.5倍すると自社案Aのシェアは43.2%、2倍すると53.6%、5倍すると57.0%と変わり、尺度を大きくするほど最大効用ルールの65.0%に近づきます。選択型で推定した部分効用なら、尺度は選択データから決まりますが、評定型ではこの自由度が残ります。第3に、提示していない水準の効用は分かりません。「保証期間5年」の効用を、1年から3年の傾きを延長して見積もることはできますが、それは推定ではなく仮定です。
調査設計の注意と、経営目線での読み違え
ここまでの実行で見えた設計上の要点をまとめます。第1に、属性の数とプロファイルの数はトレードオフです。各3水準の属性が3つなら全組み合わせ27通りで推定する係数は7個、4つなら81通りで9個、5つなら243通りで11個、6つなら729通りで13個です。属性を増やすほど提示すべきプロファイルは増え、回答者の負担は重くなります。本章の L9 は9枚で済む反面、回答者ごとの回帰が飽和モデルになるという代償を払いました。回答者ごとの推定の精度まで欲しいなら、より多くの行を持つ直交表を使うか、推定に使わない検証用のプロファイルを足して、推定した部分効用がそれを予測できるかを確かめる設計にします。
第2に、回答負荷です。フルプロファイル法では1枚のカードに全属性の水準が並ぶので、属性が増えるほど回答者が全部を読み比べる負担は重くなり、評価の質が落ちるおそれがあります。属性が多いときは、提示する属性数を絞る、選択型にして比較の形にする、属性を段階的に分ける、といった工夫が要ります。第3に、非現実的な組み合わせです。直交表は機械的に組み合わせを作るので、「価格帯が低で挽き目調整付きで当日配送」のように、市場に存在しにくいプロファイルが混じることがあります。本章のプロファイル3がそれに近い例です。そのまま提示すると評価が歪むので、設計段階で属性の水準を見直すか、非現実的な組み合わせが出にくい設計に変えるかを検討します。第4に、価格帯の水準の置き方です。幅を広く取れば価格帯の重要度は上がり、狭く取れば下がります。「価格をどこまで動かす余地があるか」を先に経営側で決め、その範囲を水準にするのが、結果を判断に使える設計です。
経営目線で最も避けたい読み違えは、相対重要度を「顧客が最も重視する属性の順位」として受け取ることです。本章の数値で示したとおり、価格帯の重要度51.0%は「低・中・高」という幅の上での値であり、「低・中」なら31.1%で、最も重要な属性はミル機能に変わりました。重要度は属性の本質的な重みではなく、「この調査で動かした範囲の中で、どれだけ評価が動いたか」です。この違いを見落として「価格が51%で圧倒的に重要だから、機能を削ってでも価格帯を下げる」と結論すると、価格帯を1段しか動かせない現実の商品設計では、ミル機能を削った分の評価の低下のほうが大きくなりえます。相対重要度は必ず「どの水準の幅で測ったか」を添えて報告し、判断は市場シミュレーションのように具体的な商品案どうしの比較で行うべきです。
もう1つの読み違えは、平均の部分効用で1つの商品を設計することです。本章の散布図が示したとおり、価格帯を重く見る回答者とミル機能を重く見る回答者が混在しているとき、平均に合わせた1つの案は、どちらの群にとっても最善ではないことがあります。平均で設計した商品が「誰にとってもそこそこ」になって競合に負ける、という損失の型です。回答者ごとの部分効用を群に分け、群ごとに最適な案を設計して、どの群を狙うかを経営判断にする、という流れが、コンジョイント分析を商品戦略につなげる筋道になります。群の分け方は第6章、結果を経営判断に翻訳する作法は第13章で扱います。
本章の要点をまとめます。コンジョイント分析は、商品案への全体評価から各属性の水準の部分効用を回帰で分解する手法で、直交表を使えば全組み合わせを提示せずに主効果を独立に推定できます。相対重要度は部分効用の幅の比であり、水準の幅に依存するので、順位として読んではいけません。市場シミュレーションは、部分効用の和で商品案を競わせることで、属性の変更がシェアに与える影響を、競合との位置関係の中で見せてくれます。次の第13章では、ここまでの手法の結果を経営判断につなげるときの作法と、陥りやすい誤用の型を整理します。
この章を深めたい方への参考書籍
『例題とExcel演習で学ぶ多変量解析 回帰分析・判別分析・コンジョイント分析編』(菅民郎、オーム社):第8章がコンジョイント分析に充てられ、コンジョイントカードの枚数、直交表、直交表からのカード作成、Excel での実施までを例題で追えます。本章の直交表 L9 と回帰による部分効用の推定を、表計算の手作業で確かめたい方に向いています。
『入門実験計画法』(永田靖、日科技連出版社):コンジョイント分析が借りている直交表は、もともと工業分野の実験計画法の道具です。この本では第8章が2水準系、第9章が3水準系の直交配列表実験、第10章が直交配列表を用いた多水準法と擬水準法に充てられており、本章で使った L9 のような3水準系の表がどう組まれ、どう割り付けるかを実験計画の側から学べます。
『コンジョイント分析 第4版』(君山由良、データ分析研究所):題名のとおりコンジョイント分析を主題にした解説書で、統計解説書シリーズの1冊として版を重ね、2021年9月に第4版が出ています。本章では手法の骨格だけを示したので、1冊を通してこの手法に絞って確認したい方の足がかりになります。
第13章 結果を経営判断につなげる、報告と誤用の型
第12章では、コンジョイント分析で顧客の選好を部分効用と相対重要度に分解し、市場シミュレーションで施策の候補を比べるところまで進めました。第3章から第12章までで、多変量解析の主な手法がそれぞれ何を取り出す道具なのかを一通り確認したことになります。本章では手法から離れ、取り出した結果を経営の判断に使う場面で起きる誤りと、その防ぎ方を整理します。
多変量解析の結果のうち、固有値・負荷量・クラスタの人数・適合度といった数値は計算どおりに出ます。しかし、そこから先の「因子に名前を付ける」「クラスタを顧客像として語る」「軸を指標にする」「セグメントごとに施策を割り当てる」は、すべて人の解釈です。計算が正しいことと解釈が正しいことは別の問題で、判断を誤らせる原因の多くは計算ではなく解釈の段階で入り込みます。本章はコードを載せません。代わりに、第4章と第6章で共通データに対して実行した結果の数値を、解釈がどこで揺れるかを示す材料として引用します。
報告を受ける側がまず持つべき区別は、その数字が計算結果なのか、分析者の解釈なのか、という区別です。負荷量が0.82である、第1主成分の寄与率が33.6パーセントである、あるクラスタが290人である、といった記述は計算結果であり、同じデータと同じ設定なら誰が計算しても同じ値になります。一方で、「この因子は価格納得感を表す」「このクラスタは低関与層である」「第1主成分は総合的な満足の高さを示す」といった記述は、計算結果に人が意味を与えたものです。意味づけには根拠がありますが、同じ計算結果から別の意味を読む余地が常に残ります。
この区別が要るのは、解釈が事実の顔で経営層に届くと、後から修正がきかなくなるからです。「顧客は4つのセグメントに分かれている」と報告された経営層は、セグメントの存在を前提に組織や予算を組みます。そのあとで分析者が「実は分け方を変えると3つにも5つにもなります」と言い足しても、既に動き始めた施策は止まりません。報告書の書き方としては、計算結果と解釈を段落や表の列で分け、解釈には必ず「何を根拠にそう読んだか」を添える形が安全です。以降の節で扱う誤用の型は、どれもこの2つを混ぜたところから始まります。
因子の命名は解釈であって事実ではない
第4章では、共通データの16項目に最尤法とバリマックス回転を当て、設計どおり4因子に分かれることを確認しました。ここで注意したいのは、因子分析の中心的な出力は負荷量の行列(ほかに共通性・独自性・因子得点など)であり、因子の名前までは返さないという点です。4因子のうちの1つには「価格は品質に見合っている」「他店と比べて価格に納得できる」「セールやポイントの仕組みが分かりやすい」「支払った金額に対して得をしたと感じる」の4項目が、それぞれ0.817・0.799・0.797・0.721の負荷量で載っていました。共通データを作るときにはこの因子を「価格納得感」と呼んでいましたが、この4項目の負荷量だけを渡された分析者が、同じ名前に行き着くとは限りません。
同じ負荷量から、「お得感」「コストパフォーマンス」「価格の分かりやすさ」という名前を付けることもできます。どの名前も4項目の文言と矛盾しません。しかし、名前が違えば引き出される施策が違います。「お得感」と名付ければセールやポイント還元の強化が思い浮かび、「価格納得感」と名付ければ価格の根拠を説明する施策が思い浮かび、「価格の分かりやすさ」と名付ければ料金体系の簡素化が思い浮かびます。負荷量はこのうちどれか1つを支持しているわけではありません。命名の恣意性とは、名前を付ける行為が分析の外側にあり、名前の選び方が施策の方向を決めてしまうことを指します。
交差負荷のある項目は、命名の揺れをさらに大きくします。第4章の結果では「オンラインと店舗の使い分けがしやすい」という項目が、店舗利便性と名付けた因子に0.592、接客サポートと名付けた因子に0.354で載っていました。店舗利便性の因子を「立地と営業時間」のように狭く名付けると、この項目が持つオンラインとの連携という側面が名前から抜け落ちます。逆に「使いやすさ」のように広く名付けると、接客の側面まで含んで読まれます。項目の一部が別の因子とも関係しているという事実は、名前を1語に縮めた時点で失われます。
防ぎ方は、命名を分析の一部として扱わず、根拠つきの提案として扱うことです。具体的には、報告書に因子名だけを書かず、その因子に載った項目の文言と負荷量を必ず並べます。名前は「仮称」と明記し、候補を複数残します。さらに、命名した本人以外の人に項目の文言だけを見せて名前を付けてもらい、一致するかを確かめる手順を入れると、名前がどれだけ分析者の思い込みに依存しているかが分かります。名前が割れた因子は、名前で語るのをやめて項目の文言で語るほうが、施策の議論を誤らせません。
命名と並んで危ういのが、存在しない因子に名前を付けてしまうことです。第4章の最尤法の結果では、4因子のときの適合度検定のp値が0.552、5因子のときが0.885でした。設計上の因子は4つですが、適合度だけを見ると5因子目を採る余地が残ります。5因子目にそれらしい名前が付けば、その因子を伸ばすための施策が立案され、予算が付きます。因子数を決めるときに複数の基準を突き合わせること、そして次に述べる別標本での再現を確かめることが、存在しない因子への投資を防ぐ手段になります。
クラスタは分け方であって真実ではない
クラスター分析の結果を「顧客は4つのグループに分かれている」と読むのは、最も起きやすい誤用の1つです。第6章の実行結果を振り返ると、共通データの4つの下位尺度の平均得点に対して、クラスタ数を決める基準どうしが一致していませんでした。混合分布モデルの情報量規準はk=3を、シルエット係数はk=2を最良と示し、生成時に仕込んだセグメントは4つでした。どの基準も計算としては正しく、それぞれが違う答えを返しています。クラスタ数は、データが決めるというより、基準と分析者が決めているのです。
手法を変えたときの動きはさらに大きな違いを見せます。16項目を標準化して階層的クラスタリングをk=4で切ったとき、ウォード法では358・355・318・169人の4群になりましたが、最短距離法では1,197人・1人・1人・1人という、実務では使いようのない分け方になりました。ウォード法とk-meansの分け方の一致度は調整ランド指数で0.533、混合分布モデルとk-meansの一致度は0.701でした。調整ランド指数は、2つの分け方がどれだけ同じ組み合わせで個体をまとめているかを示す指標で、完全に一致すれば1、偶然の一致と同程度なら0付近になります。同じデータに対して、手法を変えるだけで、およそ半分から7割程度しか一致しない分け方が出てくるということです。
再現性の確かめ方は、第6章の安定性の実験がそのまま手順になります。第一に、初期値を変えて同じ手法を繰り返し、分け方が変わらないかを見ます。第二に、データの一部を無作為に抜いて分析し直し、元の分け方と比べます。第三に、手法や距離を変えて比べます。第6章では8割の標本を10回抜いてk-meansを回し、k=4では元の分け方との一致度が最小0.881・中央値0.962と高かったのに対し、k=5では最小0.529・中央値0.733まで落ちました。k=5の分け方は、標本が少し変わるだけで顔ぶれが変わる、つまり再現しない分け方だったということです。この数値を見ずにk=5を採用すれば、5つ目のセグメント向けに立てた施策は、次の調査では対象が消えている可能性があります。
経営の判断に使うときの言い方も変わります。「この顧客はセグメントBに属する」ではなく、「この分け方ではセグメントBに入る」と言うのが正確です。セグメントを組織の担当割りや予算枠に固定すると、後で分け方を見直したときに組織ごと組み替えることになります。セグメントは分析の便宜上の区切りであり、真実の顧客像ではないという前提を、報告の段階で共有しておくことが、後戻りの費用を小さくします。
回答者は顧客全体ではない、標本の偏りと標本外での再現
多変量解析の結果は、分析に使った回答者の範囲でしか成り立ちません。アンケートの回収率が3割なら、残りの7割は答えていない人であり、その7割が答えた人と同じ構造を持つ保証はありません。とくに満足度調査では、強い満足か強い不満を持つ人が答えやすく、どちらでもない人は答えにくいという偏りが起きやすいと考えられます。回答するかどうかを回答者自身が決めることで生じるこの偏りを自己選択と呼びます。調査の配布経路も偏りを作ります。メールで配ればメールアドレスを登録している顧客に寄り、店頭で配れば来店客に寄ります。
共通データは1,200件が顧客全体を代表するという設定で生成していますが、実際の調査データはそうなっていません。防ぎ方の第一歩は、回答者の属性構成を顧客台帳の構成と並べて比べることです。年代・会員区分・購入チャネルの構成が台帳と大きくずれていれば、そのずれの分だけ結果の適用範囲を狭めて報告するか、層ごとの重み付けで補正します。補正しきれない偏りは、結論の主語を「顧客は」ではなく「回答者の中では」に限定して書きます。この限定を落として報告すると、答えていない顧客に向けた施策が、答えた顧客の構造で設計されることになります。
標本の偏りと並んで重要なのが、探索的に見つけた構造を別の標本で確かめることです。主成分分析・因子分析・クラスター分析は、いずれも与えられたデータの中で最もきれいに見える構造を探す手法です。因子数や回転やクラスタ数を何通りも試して一番納得のいく解を選ぶ作業は、多くの候補の中から最も都合のよいものを選ぶ作業と同じであり、その構造が偶然に見えたものである可能性を排除できません。防ぎ方は、構造を見つけた標本とは別の標本で、同じ構造が出るかを確かめることです。時期をずらした調査、別の地域や店舗の回答、あるいは最初から半分を取り分けておいた回答を使います。因子構造の再現を確かめる道具としては、第11章で扱った確認的因子分析が、別標本に対して仮説の構造を当てはめる形で使えます。判別の精度を別標本で確かめる考え方は第7章の交差検証と同じです。
時間が経てば構造そのものが変わることにも注意が要ります。価格改定があれば、価格に関する項目の答え方が変わり、価格の因子が他の因子と混ざったり分かれたりします。オンラインのチャネルが増えれば、店舗利便性の項目の意味が変わります。競合の動きで、顧客が重視する点そのものが移ります。ある時点で見つけた因子構造やセグメント構成を、そのまま数年使い続けるのは、構造が変わらないという検証していない仮定を置いていることになります。定期的に構造を確かめ直す工程を、分析の運用に組み込んでおく必要があります。
主成分得点や因子得点をKPIにするときの注意
第3章と第4章では、多数の項目を少数の得点に合成する方法として主成分得点と因子得点を扱いました。これらを経営指標、つまり定期的に測って推移を追うKPIにしたいという要望は自然ですが、そのまま使うと3つの問題が起きます。符号・尺度・軸の更新です。
第一に符号です。主成分の向きを決める固有ベクトルは、数学的に符号が定まりません。ある向きが解なら、その正反対の向きも同じ解です。計算のたびにどちらの符号が出るかは、データと計算の手順に依存します。本文にはコードを載せませんが、裏取り用の再抽出計算として、共通データから8割を無作為に抜く操作を10回繰り返し、全データで求めた主成分と符号を比べました。第1主成分は10回とも同じ符号でしたが、第2主成分と第3主成分は10回すべてで符号が反転し、第4主成分は10回中4回反転しました。軸そのものはほとんど動いていないのに、符号だけが裏返る状態です。四半期ごとにデータを入れ替えて主成分得点を計算し直すダッシュボードを作ると、ある期には「得点が上がった」と表示されるものが、翌期には同じ変化が「下がった」と表示されることが起こりえます。
第二に尺度です。因子得点は標本の中で平均が0になるように作られます。第4章が保存した因子得点を確かめると、4つの因子とも平均は0、標準偏差は0.85から0.93でした。これは「その標本の平均に比べてどれだけ高いか」を表す相対的な値であり、翌期の調査で全員の満足が上がっても、翌期の標本の中で計算し直せば平均はまた0になります。得点が0のまま推移しているように見えて、実際には満足が上がっていた、あるいは下がっていた、ということが起きます。推移を追うなら、基準となる期間を決め、その期間の平均と標準偏差で以後も固定して標準化する必要があります。
第三に軸の更新です。主成分や因子の重みは、データから推定されます。データが更新されれば重みも変わり、KPIの定義そのものが期ごとに変わることになります。共通データを600件ずつ2つに分けて第1主成分の重みを比べたところ、16項目の重みの差は最大で0.044、重みどうしの相関は0.985と、この例では小さな動きにとどまりました。しかし動きの大きさは標本の大きさと構造のはっきりさで変わり、実務のデータでいつも小さいとは限りません。重みが動けば、KPIの変化が施策の効果なのか定義の変更なのか、区別がつかなくなります。
実務での扱いとしては、分析と運用を切り分けるのが安全です。主成分分析や因子分析は、どの項目をまとめてよいかという構造の確認に使い、運用するKPIは重みを固定した項目の単純平均で作ります。共通データで確かめると、第4章の因子得点と4項目の単純平均の相関は4つの因子でそれぞれ0.983・0.995・0.965・0.944であり、得点の上位2割を単純平均でも上位2割と判定できた割合は92.5パーセントから98.8パーセントでした。単純平均は7段階の尺度をそのまま保つので、期をまたいで比べられ、符号も反転しません。因子分析で確認した構造が今も成り立っているかは、運用とは別に年に一度など定期的に確かめ、項目のまとめ方を変えるときは、KPIの定義変更として記録します。
セグメント別の施策設計、大きさと効きとコストで優先順位を付ける
クラスター分析でセグメントができると、次に来るのは「どのセグメントに何をするか」という問いです。ここで起きやすい誤りは、セグメントの数だけ施策を並べてしまうことです。4つのセグメントに4つの施策を同時に走らせれば、予算も人手も4分割され、どの施策も効果を測れる規模に達しません。優先順位を付ける枠組みとして、セグメントの大きさ・施策の効きやすさ・施策のコストの3つの軸で評価する方法を示します。
| 軸 | 何で測るか | データの出どころ | 注意 |
|---|---|---|---|
| セグメントの大きさ | 人数、売上に占める割合、購入頻度 | クラスタの人数と、購買履歴との突き合わせ | 回答者の中の人数と顧客全体の人数は違う。標本の偏りを補正してから使う |
| 施策の効きやすさ | 施策の対象となる項目の現状の得点と、伸びしろ | クラスタごとの下位尺度平均、再購入率 | 現状の得点が低いことと、施策で上がることは別。効きは小さな試験で確かめる |
| 施策のコスト | 到達に使えるチャネル、必要な人手と期間 | クラスタごとのチャネル構成、会員区分 | 到達しにくいセグメントは、大きくてもコストが高い |
第6章のk-means(k=4)の結果を材料にすると、4つのクラスタは329人・314人・267人・290人で、総合満足度の平均はそれぞれ5.34・6.49・7.16・3.13、再購入率は0.46・0.56・0.63・0.21でした。人数だけを見れば4つはほぼ同じ大きさですが、再購入率の低いクラスタは290人と大きく、ここを底上げできれば効果は大きいように見えます。しかし、そのクラスタは4つの下位尺度すべてが低く、どの項目を伸ばせば再購入につながるかがデータからは読めません。一方で、接客と利便性の得点が高いクラスタは満足度も再購入率も最も高く、伸びしろが小さい代わりに、来店比率が57.7パーセントと高いため店舗での施策が届きやすい構造です。
この表の「効きやすさ」の列は、多変量解析の結果だけでは埋まりません。クラスタごとの得点の差は現状の差であって、施策を打ったときの変化量ではないからです。効きを見積もるには、対象を絞った小さな試験を先に打ち、その結果で埋めるのが堅実です。優先順位の枠組みで大切なのは、上位のセグメントを選ぶことと同じくらい、「今期はこのセグメントには何もしない」と決めることです。やらないセグメントを明示することで、施策の分散を防ぎ、選んだセグメントで効果を測れる規模を確保できます。
相関構造の要約であって因果ではない
主成分分析・因子分析・クラスター分析は、いずれも変数どうしの相関構造、あるいは個体どうしの近さを要約する手法です。「接客の評価が高い顧客は再購入率も高い」という結果が出ても、それは接客の評価と再購入が一緒に動いているという観察であり、接客を強化すれば再購入が増えるという主張は含んでいません。もともと購買意欲が高い顧客ほど店員と接する機会が多く、接客の評価も高くなる、という逆向きの説明も同じ相関を生みます。第11章の構造方程式モデリングは変数の間に矢印を引きますが、その矢印は分析者が仮説として置いたものであり、データが矢印の向きを証明するわけではありません。
因果を確かめるには、多変量解析とは別の設計が要ります。対象を無作為に分けて施策の有無で比べる、施策の前後を対照群と比べる、といった方法です。この記事の範囲を超えるため、既刊コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」に送ります。本章で押さえておきたいのは、多変量解析の役割分担です。多変量解析は「どこに構造があるか」「どのセグメントに何が起きているか」を見つけ、仮説を立てるところまでを担います。仮説が正しいかを確かめ、投資の根拠にするのは、効果検証の設計の仕事です。この役割分担を飛ばして、相関構造から直接投資を決めると、効果の出ない施策に予算が向かいます。
経営層への報告の作法
分析の結果を経営層に報告するとき、分析者が使った図をそのまま見せる報告書が多く見られます。バイプロット・同時布置図・デンドログラムは、いずれも分析者が構造を探すための道具であり、読み方の約束事を知らない人には誤読の余地が大きい図です。バイプロットは矢印の長さと角度に意味があり、点の位置だけで読むと誤ります。対応分析の同時布置図には、行の点と列の点の距離をそのまま近さとして読めないという約束事があります(第8章)。デンドログラムは、どの高さで切るかによって群の数が変わることが図の中に見えているため、切る位置を決めた根拠を添えなければ、見る人ごとに違う群の数を読み取ります。
経営層向けには、翻訳した図を使います。因子ごとの平均得点を並べた棒グラフ、セグメントごとの人数と主要指標を並べた表、大きさと効きやすさの2軸でセグメントを配置した優先順位のマトリクスといった形です。分析者の図を載せる場合は付録に回し、本編には「この図から読み取った事実」を1文で書き添えます。図を選ぶ基準は、経営層がその図から次の判断に必要な事実を、約束事の説明なしに読み取れるかどうかです。
言い切り方は、事実と解釈で変えます。計算結果は言い切ります。「回答者の中では、商品品質の項目群の平均が4つの項目群のうち最も高い」は事実なので、断定してよい文です。解釈は条件を付けて書きます。「この項目群を商品品質に関する因子と仮に呼ぶ」「この分け方では4つのセグメントになる」のように、名前や分け方が選択の結果であることが文の中に残る書き方にします。「顧客は4層に分かれている」と書いた瞬間に、選択の結果が事実に変わってしまいます。
不確実さは、統計の用語ではなく、経営層が判断に使える形に翻訳して伝えます。「調整ランド指数の中央値が0.962」ではなく、「標本を変えて10回分け直しても、ほぼ同じ分け方が出た」と書きます。回収率が3割なら、その数字は事実として書いたうえで、「答えていない7割の顧客については、この結果を当てはめられるかどうか確かめていない」と続けます。別の標本で再現を確かめていない段階なら、その旨を結論の直後に置きます。不確実さを隠した報告は、その場では通りやすい代わりに、結果が再現しなかったときに分析全体の信用を失います。
最後に、報告は「次に何を決めるか」で終えます。分析の結果を並べて終わる報告書は、読んだ経営層に「それで何をすればよいのか」を委ねることになります。「セグメントAに対して施策Xを小規模に試すかどうか」「第2因子の名前を確定するために追加の聞き取りをするかどうか」「次回の調査で回収経路を店頭にも広げるかどうか」のように、決めてほしい事項を選択肢と推奨と根拠の組で示します。1枚目には結論と決める事項だけを置き、負荷量の表やクラスタの安定性の数値は付録に回すのが、経営層の時間を使わない構成です。
誤用の型と、判断を誤ったときの損失
ここまでに述べた誤りを、起きる場面と経営上の損失の型、防ぎ方の3つで整理します。損失の型は、具体的な企業や金額ではなく、どの資源がどの方向に無駄になるかで書いています。
| 誤用の型 | 起きる場面 | 経営上の損失の型 | 防ぎ方 |
|---|---|---|---|
| 因子の命名を事実として扱う | 負荷量の表を見ずに因子名だけが報告に残る | 名前が示す方向の施策に資源が向かい、項目が示す実態とずれる | 項目の文言と負荷量を併記する。名前は仮称とし、第三者に命名してもらって一致を見る |
| 存在しない因子に投資する | 適合度だけで因子数を増やし、余分な因子に名前を付ける | 実体のない因子を伸ばす施策に予算と人手が付く | 因子数を複数の基準で決める。別標本で同じ因子が出るかを確かめる |
| セグメント数を増やしすぎる | 細かく分けたほうが精緻に見える | 施策が分散し、どの施策も効果を測れる規模に達しない | 標本を抜き直したときの一致度を見る。一致しないkは採らない。やらないセグメントを決める |
| 分け方を真実として組織に固定する | セグメント名で担当と予算枠を決める | 分け方を見直すたびに組織と予算を組み替える費用が発生する | 「この分け方では」と限定して報告する。分け方の見直し時期を先に決めておく |
| 回答者の構造を顧客全体に当てはめる | 回収率が低い、配布経路が偏っている | 答えていない顧客に向けた施策が、答えた顧客の構造で設計される | 回答者の属性構成を台帳と比べる。重み付けか層別で補正し、主語を「回答者の中では」に限定する |
| 探索で見つけた構造をそのまま使う | 何通りも試して一番きれいな解を選ぶ | 偶然の構造に基づく施策が、次の調査で根拠を失う | 別の時期・地域・取り分けた標本で再現を確かめる |
| 主成分得点や因子得点をそのままKPIにする | 期ごとにデータを入れ替えて計算し直す | 符号の反転や軸の更新で、施策の効果と定義の変更が区別できなくなる | 構造の確認と運用を分ける。重みを固定した単純平均を使い、基準期間で標準化する |
| 相関を因果と読む | 「評価が高い顧客ほど再購入する」から施策を決める | 効果の出ない施策に投資し、効果があった施策の検証機会を失う | 効果検証の設計を別に立てる。多変量解析は仮説を出すところまでと位置づける |
| 布置図を距離で誤読する | 対応分析の同時布置図で行と列の近さを読む | ブランドや価格帯の位置づけを誤り、価格改定や品揃えの判断を誤る | 行どうし・列どうしの比較に限定する。第8章の読み方の約束事を報告に添える |
| 分析者の図をそのまま見せる | バイプロットやデンドログラムを本編に置く | 見る人ごとに違う結論を読み取り、会議で判断が定まらない | 翻訳した図を本編に置く。分析者の図は付録に回し、読み取った事実を1文で添える |
表の中で損失が最も見えにくいのは、KPIの符号と軸の問題です。過剰なセグメントや存在しない因子は、次の調査で再現しないという形でいずれ露見しますが、KPIの定義が期ごとに変わっている場合は、数字が出続けるために誰も異常に気づきません。施策を打った部門は数字が上がれば効果があったと報告し、下がれば外部要因を挙げます。定義の変更がその両方に紛れ込んでいると、施策の評価が積み上がらず、次の投資判断の根拠が育ちません。ポジショニングマップの誤読も同じ性質を持ちます。図の読み方を誤って決めた価格改定は、売上の変化として結果が出るまでに時間がかかり、出たときには原因が図の読み方にあったと遡れなくなっています。
報告書として何を残すか
本章の最後に、多変量解析の報告書に残しておくべき項目を表にまとめます。この表は、生成AIに分析を任せるときに人が判断すべき点を扱う第14章の前提にもなります。人が判断するには、判断の材料が記録に残っていなければならないからです。表の3列目には、その項目が無いと後で何が起きるかを書きました。
| 残す項目 | 残す内容 | 無いと起きること |
|---|---|---|
| 問いと決めたいこと | 分析の前に決めた問いと、結果で何を決めるつもりだったか | 結果に合わせて問いが書き換わり、都合のよい解釈が通る |
| データの出どころと偏り | 調査時期、配布経路、回収率、回答者の属性構成と台帳との比較 | 結果の適用範囲が分からず、全顧客向けの施策に流用される |
| 前処理の記録 | 標準化の有無、欠損の扱い、外れ値の扱い、除外した回答の件数と理由 | 同じデータから別の結果が出たときに原因を特定できない |
| 手法と設定 | 手法名、距離、連結法、クラスタ数、因子数、回転、乱数の種、使ったライブラリの版 | 再現できず、結果の正しさを第三者が確かめられない |
| 採らなかった候補と理由 | 試した因子数やクラスタ数、比べた手法、それらを採らなかった根拠 | 「一番きれいな解を選んだだけ」なのかどうかを後から判定できない |
| 再現性の確認結果 | 初期値・標本・手法を変えたときの一致度と、その解釈 | 不安定な分け方が安定した事実として扱われる |
| 命名の根拠 | 各因子・各セグメントに載った項目の文言と負荷量、名前の候補、仮称である旨 | 名前だけが独り歩きし、項目が示す実態と施策がずれる |
| 別標本での確認 | 確かめた場合はその標本と結果、確かめていない場合はその旨 | 探索で見つけた構造が確認済みの構造として引き継がれる |
| 結論の言い切りの度合い | 事実として断定した文と、解釈として条件を付けた文の区別 | 解釈が事実として組織の前提になり、修正の費用が膨らむ |
| 次に決めること | 決めてほしい事項、選択肢、推奨、根拠、効果検証の計画 | 報告が読まれて終わり、判断が先送りされる |
| 見直しの時期 | 構造を確かめ直す予定の時期と、KPIの定義を変える場合の手続き | 数年前の構造が検証なしに使われ続ける |
この表は分析者のためだけのものではありません。報告を受ける側が、報告書にこれらの項目が入っているかを確かめるだけで、本章で挙げた誤用の大半は入口で止まります。命名の根拠が無ければ名前を疑い、再現性の確認結果が無ければ分け方を疑い、別標本での確認が無ければ結論の主語を狭める、という読み方ができるからです。
本章では、多変量解析の結果を経営判断に使うときの誤りを、計算結果と解釈の混同という1つの軸で整理しました。因子の名前とクラスタの分け方は解釈であり、標本の偏りと標本外での再現を確かめ、KPIは重みを固定して運用し、相関構造から因果を読まず、報告は次に決めることで終える、というのが要点です。次の第14章では、多変量解析が機械学習の次元削減や表現学習とどうつながるか、そして生成AIに分析を任せるときに人が持つべき判断は何かを扱います。本章の報告書の表は、その判断の材料になります。
この章を深めたい方への参考書籍
『多変量解析法入門』(永田靖・棟近雅彦、サイエンス社):回帰分析・判別分析・主成分分析・数量化1類から3類・多次元尺度構成法・クラスター分析を章ごとに扱い、因子分析や正準相関分析は「その他の方法」として補足する構成の教科書です。統計的方法の基礎と線形代数のまとめが前半に置かれているため、本章で「計算結果」として扱った部分を、各手法の導出に戻って確かめたいときの拠り所になります。
『分析者のためのデータ解釈学入門 データの本質をとらえる技術』(江崎貴裕、ソシム):誤差とばらつき、データに含まれるバイアス、交絡因子と因果関係、サンプリングの方法論、データ分析の罠とデータ活用の罠という章立てで、分析結果を解釈するときに入り込む誤りを扱っています。本章の標本の偏りと相関と因果の節を、より広い視点から補強する1冊です。
『Google流資料作成術』(コール・ヌッスバウマー・ナフリック著、村井瑞枝訳、日本実業出版社):「相手に伝わりやすい表現を選ぶ」「不必要な要素を取りのぞく」「相手の注意をひきつける」といった章立てで、データを意思決定者に伝えるための図の選び方と絞り込み方を扱っています。本章の報告の作法の節で述べた「分析者の図をそのまま見せない」を、実際の図の作り方に落とすときに参考になります。
第14章 多変量解析と機械学習の接続、そして生成AI時代
第13章では、多変量解析の結果を経営判断につなげるときの作法と、誤用の型を確認しました。この第14章では視点を少し外に向け、ここまで学んできた多変量解析の考え方が、機械学習のどこに生きているかを見ていきます。主成分分析はニューラルネットワークによる次元削減の出発点であり、多次元尺度構成法の「距離を保つ」という発想は t-SNE や UMAP といった可視化手法の比較軸になり、因子分析の「観測の背後に少数の潜在変数を置く」という考え方は、単語や商品の埋め込み表現を理解する足場になります。そして、機械学習モデルの「重要度」を読むときに、特徴量の相関構造を知らないまま読むと何が起きるかは、第2章と第4章で確認した相関構造の話そのものです。
章の後半では、生成AIに多変量解析を任せる場面を取り上げます。手法の選択や前処理、因子の命名やクラスタ数の決定を生成AIに任せる、という場面を想定します。本コラムで繰り返し確認してきたとおり、多変量解析の結果は「分け方」や「要約の仕方」であって真実そのものではありません。生成AIが出した結果に対して人が何を確認すべきかを、チェックリストの形に整理します。コードは第2章で用意した架空の顧客満足度調査データ(1,200件・16項目)を引き続き使い、実行結果はすべて実際に走らせたログから引いています。
次元削減の系譜、主成分分析からオートエンコーダへ
第3章で確認した主成分分析は、データの分散が最も大きい方向を順に探し、少数の軸でデータを要約する手法でした。これは「16次元の点を、情報の損失を最小にしながら2次元に写す線形の写像を求める問題」と言い換えられます。写像が線形であることは、計算が固有値問題に帰着して安定に解けるという利点と、曲がった構造を捉えられないという限界を同時に生みます。機械学習の側で発展した次元削減の手法は、この「線形」という制約を外していく系譜として読むと見通しがよくなります。
最初の一歩がカーネル主成分分析です。Schölkopf、Smola、Müller が1998年に Neural Computation 誌で発表した「カーネル固有値問題としての非線形成分分析」は、データを非線形な写像で高次元の特徴空間に送り、その空間で主成分分析を行う方法を示しました。写像を明示的に計算せず、カーネル関数(2点の内積を特徴空間で計算する関数)だけで固有値問題を解けるのが要点です。scikit-learn では sklearn.decomposition の KernelPCA クラスとして実装されています。本章では実行していませんが、主成分分析の「固有値問題を解く」という骨格を保ったまま非線形化した手法として位置づけられます。
次の一歩がオートエンコーダです。入力を一度少数の次元(ボトルネック)に圧縮し、そこから元の入力を復元するように学習するニューラルネットワークで、圧縮する側を符号化器、復元する側を復号器と呼びます。Hinton と Salakhutdinov が2006年に Science 誌で発表した「ニューラルネットワークによるデータの次元削減」の要旨は、多層のネットワークの中央に小さな層を置いて入力を復元するよう学習すると高次元データを低次元の符号に変換できること、そして重みの初期化を工夫すれば深いオートエンコーダが主成分分析よりはるかに良く働く低次元符号を学べることを述べています。主成分分析が「線形の写像を固有値問題で解く」のに対し、オートエンコーダは「写像そのものを勾配法で学習する」手法であり、非線形な層を重ねれば曲がった構造も表現できます。
この系譜をひとまとめにする言葉が表現学習です。Bengio、Courville、Vincent が2013年に発表した表現学習の総説は、機械学習アルゴリズムの成功は一般にデータの表現に依存すると述べ、データの背後にある説明的な変動要因をどれだけ分離して取り出せるかという観点で、オートエンコーダや多様体学習、深いネットワークを整理しています。主成分分析も因子分析も、この観点から見れば「観測変数の背後にある少数の変動要因を線形で取り出す表現学習」です。第4章で見た共通因子モデル、すなわち観測項目を少数の因子の線形結合と誤差で説明するモデルは、表現学習の最も古い形の一つと言えます。
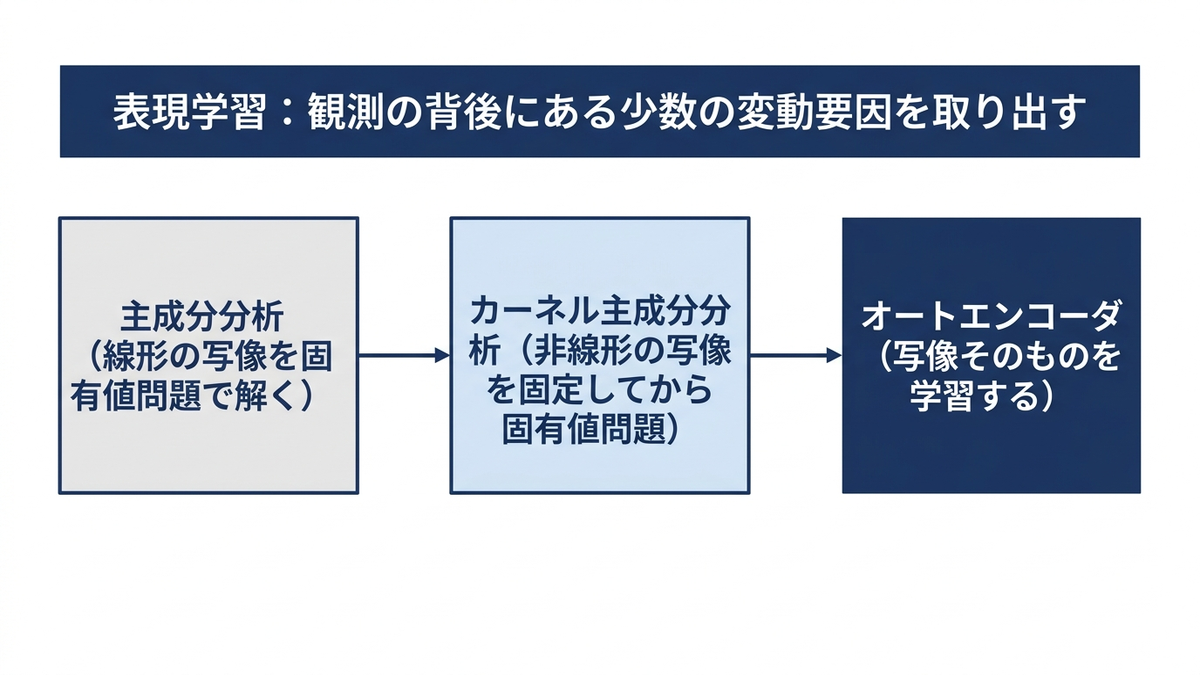
線形オートエンコーダは主成分分析と同じ平面を学ぶ
オートエンコーダと主成分分析の関係は、線形の場合について古くから知られています。Baldi と Hornik が1989年に Neural Networks 誌(第2巻第1号、53〜58ページ)に発表した「ニューラルネットワークと主成分分析」の論文は、その要旨で、線形の層からなるネットワークを二乗誤差で学習させるとき、誤差関数の最小点はただ一つで、それは訓練データの共分散行列の上位の主成分ベクトルが張る部分空間への射影に対応すること、その他の臨界点はすべて鞍点であることを示したと述べています。つまり、隠れ層が線形で損失が二乗誤差なら、オートエンコーダが学ぶのは主成分分析と同じ部分空間です。ただし、部分空間が同じであっても、個々の隠れユニットが主成分そのものに一致するとは限りません。Plaut が2018年に公開した線形オートエンコーダに関する論文の要旨も、線形活性化と二乗誤差の単層オートエンコーダの重みは主成分負荷ベクトルと同じ部分空間を張るが、負荷ベクトルそのものとは一致しないことを、よく知られた事実として述べています。
この「同じ平面を学ぶが、軸の向きは違う」という関係を、共通データで実際に確かめました。16項目を標準化し、16次元から2次元に圧縮して16次元に戻す線形オートエンコーダ(符号化器・復号器ともバイアスつきの線形層1つ)を PyTorch 2.13(CPU)で学習させます。損失は平均二乗誤差、最適化は Adam(学習率 0.01)、1,200件を一括で300エポック、乱数シードは 0 に固定しました。比較の基準は scikit-learn の主成分分析(2成分)による復元誤差です。
import numpy as np, torch, torch.nn as nn
from scipy.linalg import subspace_angles
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from survey_data import load_survey, ITEM_COLS

torch.manual_seed(0)
df = load_survey()
X = StandardScaler().fit_transform(df[ITEM_COLS].values).astype(np.float32)
Xt = torch.from_numpy(X)

pca = PCA(n_components=2, random_state=0).fit(X)
Z_pca = pca.transform(X)
mse_pca = float(((X - pca.inverse_transform(Z_pca)) ** 2).mean())

class LinearAE(nn.Module):
    def __init__(self, p, k):
        super().__init__()
        self.enc = nn.Linear(p, k)
        self.dec = nn.Linear(k, p)
    def forward(self, x):
        return self.dec(self.enc(x))

lin = LinearAE(16, 2)
opt = torch.optim.Adam(lin.parameters(), lr=0.01)
for ep in range(300):
    opt.zero_grad()
    loss = ((lin(Xt) - Xt) ** 2).mean()
    loss.backward()
    opt.step()

with torch.no_grad():
    Z_lin = lin.enc(Xt).numpy()
    mse_lin = float(((lin(Xt) - Xt) ** 2).mean())
W_dec = lin.dec.weight.detach().numpy()                 # 16×2
angles = np.degrees(subspace_angles(W_dec, pca.components_.T))
canon = np.cos(subspace_angles(Z_lin - Z_lin.mean(0), Z_pca - Z_pca.mean(0)))
print(mse_pca, mse_lin, angles, canon)
# 出力: 0.4839 0.4839 [0.007 0.   ] [1. 1.]
結果を表にまとめます。復元誤差は、主成分分析(2成分)が 0.4839、線形オートエンコーダが300エポック後に 0.4839 で、差は小数第4位まで 0 でした。学習の経過を見ると、1エポック目の 1.3626 から100エポックで 0.5081、150エポックで 0.4847 まで下がり、200エポック以降は 0.4839 で動かなくなっています。復号器の重みが張る2次元空間と、第1・第2主成分が張る空間の主角(2つの平面のなす角)は 0.007 度と 0.000 度で、実質的に同じ平面です。2次元の符号と主成分得点の正準相関(第10章で扱った、2つの変数群の間で作れる最も高い相関)は 1.000 と 1.000 でした。
| 比べたもの | 主成分分析(2成分) | 線形オートエンコーダ | 非線形オートエンコーダ(tanh) |
|---|---|---|---|
| 復元誤差(平均二乗誤差) | 0.4839 | 0.4839 | 0.4619 |
| 主成分空間との主角(度) | 基準 | 0.007 と 0.000 | 線形の復号器を持たないため計算せず |
| 主成分得点との正準相関 | 基準 | 1.000 と 1.000 | 0.958 と 0.997 |
| 2軸の相関 | 0.000 | -0.349 | 計算せず |
| 2次元の上で k-means(k=4)した調整ランド指数 | 0.434 | 0.440 | 0.459 |
一方で、軸そのものは一致しません。線形オートエンコーダの符号の第1軸と第1・第2主成分の相関は 0.527 と -0.850、第2軸は -0.980 と -0.197 でした。符号の2軸どうしの相関も -0.349 あり、主成分どうしの相関が 0.000(定義上無相関)であるのとは違います。つまり同じ平面の上で、主成分分析は「分散が最大の方向」と「それに直交する方向」という特別な座標系を選ぶのに対し、線形オートエンコーダは平面を張りさえすればどの座標系でも損失が同じなので、初期値と学習の経路で決まった任意の座標系に落ち着きます。主成分分析が持つ「第1主成分が最も情報を持つ」「軸どうしが無相関」という性質は、線形オートエンコーダでは自動的には得られません。図の中央と右を見比べると、点の配置は回転と引き伸ばしを除いて同じ形をしています。
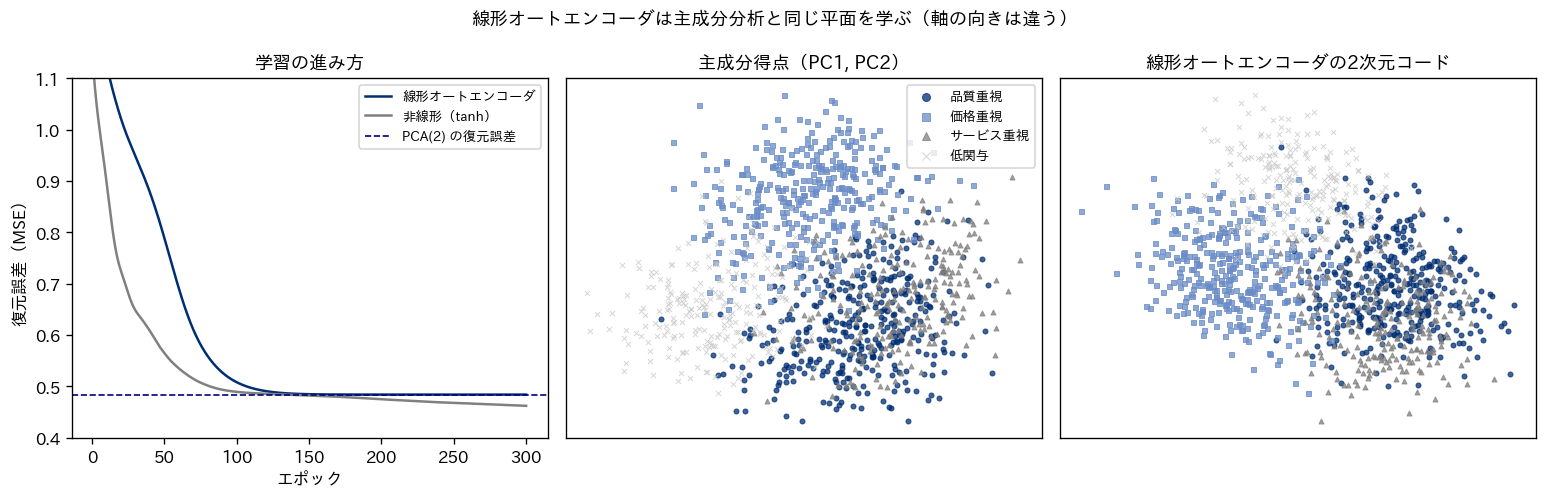
対照として、符号化器と復号器の途中に tanh の隠れ層(8ユニット)を挟んだ非線形オートエンコーダも同じ条件で学習させました。復元誤差は 0.4619 で、主成分分析の 0.4839 より 0.0220 小さくなりました。線形の最適解を下回れるのは、写像が非線形だからです。2次元の符号と主成分得点の正準相関は 0.958 と 0.997 で、線形のときの 1.000 からわずかに離れています。ただし、この差が実務上の意味を持つかどうかは別の問題です。2次元の上で k-means(k=4)を当てて生成時に仕込んだセグメントとの調整ランド指数を測ると、主成分分析 0.434、線形オートエンコーダ 0.440、非線形オートエンコーダ 0.459 で、2次元の上での値としては同程度であり、手法の違いによる差は小さいものでした。共通データは16項目が4因子の線形結合として生成されているため、非線形化の恩恵が小さいのは自然な結果です。逆に言えば、オートエンコーダが主成分分析を大きく上回ると期待しやすいのは、データに線形では捉えにくい構造があり、検証データでも改善が確認できる場合です。
実務への含意は二つあります。第一に、変数が数十程度の調査データや財務指標であれば、オートエンコーダを持ち出す前に主成分分析で十分なことが多いということです。線形の範囲では両者は同じ平面を学び、主成分分析のほうが軸に順序と無相関性があって解釈しやすく、乱数や学習率に結果が左右されません。第二に、オートエンコーダの2次元符号を「第1軸・第2軸」として解釈しようとするのは危険だということです。軸は任意の回転を受けているので、主成分負荷量のような読み方はできません。符号を使うなら、その上でクラスタリングや予測モデルを組むといった「平面そのものを使う」用途に限るのが安全です。
可視化のための埋め込み、t-SNE と UMAP、主成分分析や MDS との違い
第8章では、多次元尺度構成法(MDS)が「個体間の距離をできるだけ保って低次元に配置する」手法であること、t-SNE や UMAP が可視化のための手法として位置づけられ、距離の解釈が異なることを確認しました。本章ではその違いを数値で見ます。van der Maaten と Hinton が2008年に Journal of Machine Learning Research 誌(第9巻、2579〜2605ページ)で発表したt-SNE の論文は、高次元データを2次元または3次元の地図に可視化する手法として t-SNE を提案し、点が中央に密集する傾向を減らして、異なるスケールの構造を一枚の地図に表せることを主張しています。仕組みを言葉で言えば、高次元での「近さ」を確率に変換し、低次元でも同じような確率が再現されるように点を動かす手法で、遠い点どうしの関係は弱くしか制約されません。scikit-learn の多様体学習のユーザーガイドも、t-SNE はデータの局所構造に集中して局所的な群を取り出す傾向があり、大域構造は明示的には保存されないこと、初期化を主成分分析にすることでその問題が緩和されることを述べています。
UMAP は McInnes、Healy、Melville が2018年に公開した論文で提案された手法で、要旨によればリーマン幾何と代数的位相に基づく理論的枠組みから構成され、可視化の品質は t-SNE と競合し、大域構造をより多く保存すると論じられ、実行時間でも優れるとされています。本コラムの実行環境には UMAP のライブラリ(umap-learn)を導入していないため、本章では概念の紹介にとどめ、実行結果は載せていません。位置づけとしては t-SNE と同じ「近傍関係を保つ可視化・埋め込みの手法」であり、以下で t-SNE について述べる注意点の多くは UMAP にも当てはまると考えています。
主成分分析・MDS・t-SNE の違いを、共通データの16項目(標準化)で確かめました。3つの手法でそれぞれ2次元の図を作り、生成時に仕込んだセグメント(segment_true 列。分析には使わず答え合わせにだけ使います)で色分けします。あわせて、元の16次元での全ペア(719,400組)の距離と、2次元図の上での距離の相関を測りました。この相関が高いほど「図の上の距離を、元のデータの距離として読める」ことになります。
import numpy as np
from scipy.spatial.distance import pdist
from scipy.stats import pearsonr, spearmanr
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.manifold import MDS, TSNE
from sklearn.cluster import KMeans
from sklearn.metrics import adjusted_rand_score, silhouette_score
from survey_data import load_survey, ITEM_COLS

df = load_survey()
X = StandardScaler().fit_transform(df[ITEM_COLS].values)
seg = df["segment_true"].values

Z_pca = PCA(n_components=2, random_state=0).fit_transform(X)
Z_mds = MDS(n_components=2, metric_mds=True, n_init=1, init="random",
            max_iter=300, random_state=0).fit_transform(X)
Z_tsne = TSNE(n_components=2, perplexity=30, init="pca",
              learning_rate="auto", random_state=0).fit_transform(X)

d_orig = pdist(X)                      # 16次元での全ペアの距離
for name, Z in [("PCA", Z_pca), ("MDS", Z_mds), ("t-SNE", Z_tsne)]:
    d2 = pdist(Z)                      # 2次元図の上での距離
    km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Z)
    print(name, round(pearsonr(d_orig, d2)[0], 3),
          round(spearmanr(d_orig, d2)[0], 3),
          round(silhouette_score(Z, seg), 3),      # 真のセグメントで測る
          round(adjusted_rand_score(seg, km.labels_), 3))
# 出力:
# PCA   0.868 0.846 0.180 0.434
# MDS   0.878 0.871 0.192 0.464
# t-SNE 0.747 0.737 0.247 0.513
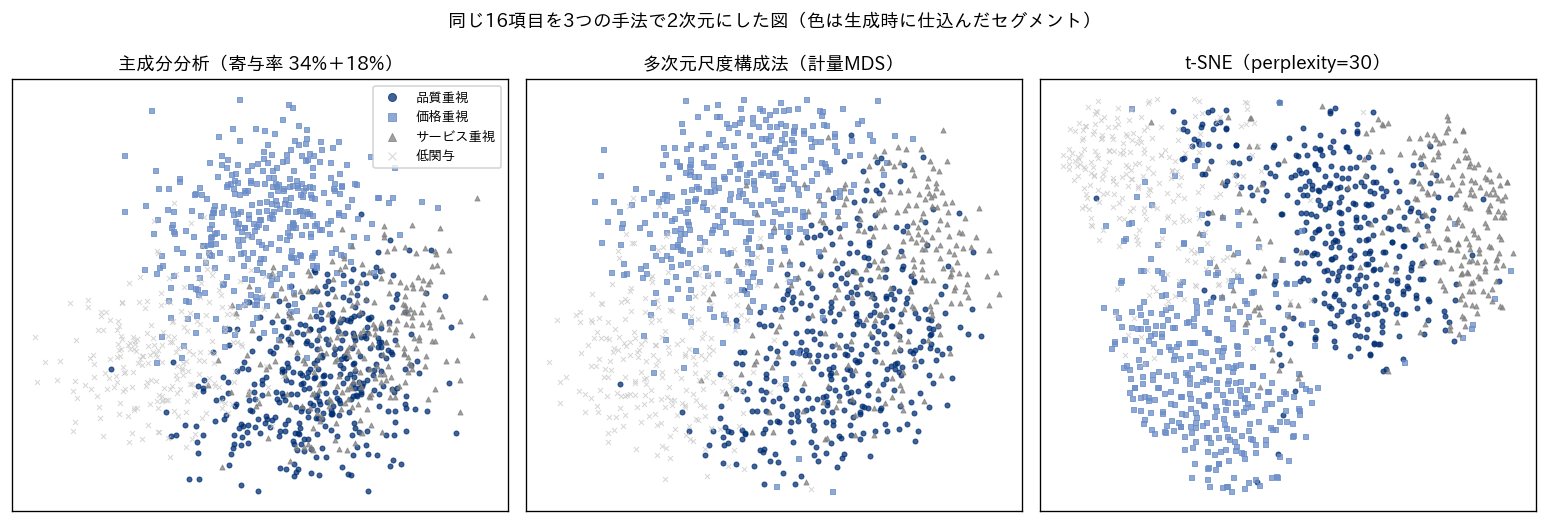
| 手法 | 元の距離との相関(Pearson) | 元の距離との相関(Spearman) | 真のセグメントでのシルエット係数 | 2次元の上で k-means(k=4)した調整ランド指数 |
|---|---|---|---|---|
| 主成分分析(寄与率 33.6%+18.0%) | 0.868 | 0.846 | 0.180 | 0.434 |
| 計量 MDS(ストレス1 は 0.253) | 0.878 | 0.871 | 0.192 | 0.464 |
| t-SNE(perplexity 30) | 0.747 | 0.737 | 0.247 | 0.513 |
| 参考:16次元のまま k-means(k=4) | 1.000 | 1.000 | 計算せず | 0.571 |
表の読み方はこうです。主成分分析と計量 MDS は、元の距離との相関が 0.85〜0.88 と高く、図の上の距離を元のデータの距離の近似として比較的読みやすい手法です(相関は全ペアの距離をまとめた指標なので、個々の2点間の距離まで常に正しく読める保証ではありません)。MDS はそもそも距離を保つことを目的関数にしているので相関が最も高く、主成分分析も今回のデータでは MDS に近い値を示しました。一方、t-SNE は相関が 0.74〜0.75 に落ちます。その代わり、真のセグメントで測ったシルエット係数(群の分かれ具合。第6章)は 0.247 と3手法で最も高く、2次元の上で k-means を当てたときの調整ランド指数も 0.513 と最も高くなりました。図を見ても、t-SNE は4つの塊が最もはっきり分かれて見えます。
この二つの数字は矛盾していません。t-SNE は近い点どうしの関係を優先して配置するので、群は分かれて見えますが、群と群の間の距離や、群の大きさは元のデータを反映しません。Wattenberg、Viégas、Johnson が2016年に Distill 誌で公開した「t-SNE を効果的に使うには」は、t-SNE が密度の違う群を均等化するように設計されているためクラスタの大きさは意味を持たないこと、クラスタ間の距離は意味を持たないことがあること、ランダムなノイズでも perplexity によってはクラスタのように見えることを、対話的な図で示しています。図の上で「このセグメントはこちらのセグメントに近い」「この群は小さい」と読むのは、主成分分析や MDS でも2次元化による歪みを承知のうえで慎重に行うべきことですが、t-SNE では特に避けるべきです。第8章で述べた「距離を定量的に読めるか」という区別は、この数値の差として現れます。
もう一つ注意したいのは、参考行の数字です。16次元のまま k-means を当てた調整ランド指数は 0.571 で、どの2次元図の上で当てたものよりも高くなりました。2次元に落とすことは可視化のためには必要ですが、情報を捨てる操作でもあります。主成分分析の2成分の累積寄与率は 51.6%ですから、残り半分の情報は図に載っていません。クラスタリングは元の次元(あるいは因子得点や下位尺度)で行い、図はその結果を見せるためだけに使う、という役割分担が基本です。この点は後の節でもう一度取り上げます。
perplexity を変えると図が変わる
t-SNE で最も影響の大きい設定が perplexity です。scikit-learn の TSNE クラスのリファレンスは、perplexity は他の多様体学習で使われる最近傍の数に関係する量で、大きなデータではより大きな値が必要になること、5〜50 の間で選ぶことを検討すべきこと、値が違うと結果が大きく異なりうることを述べています。既定値は 30 です。また同じページは、t-SNE のコスト関数は凸ではないため初期化が違えば結果も変わりうること、特徴量が非常に多い場合は先に主成分分析などで50次元程度に落とすことを強く推奨しています。共通データで perplexity を 5・30・100 に変えて同じ図を描きました。
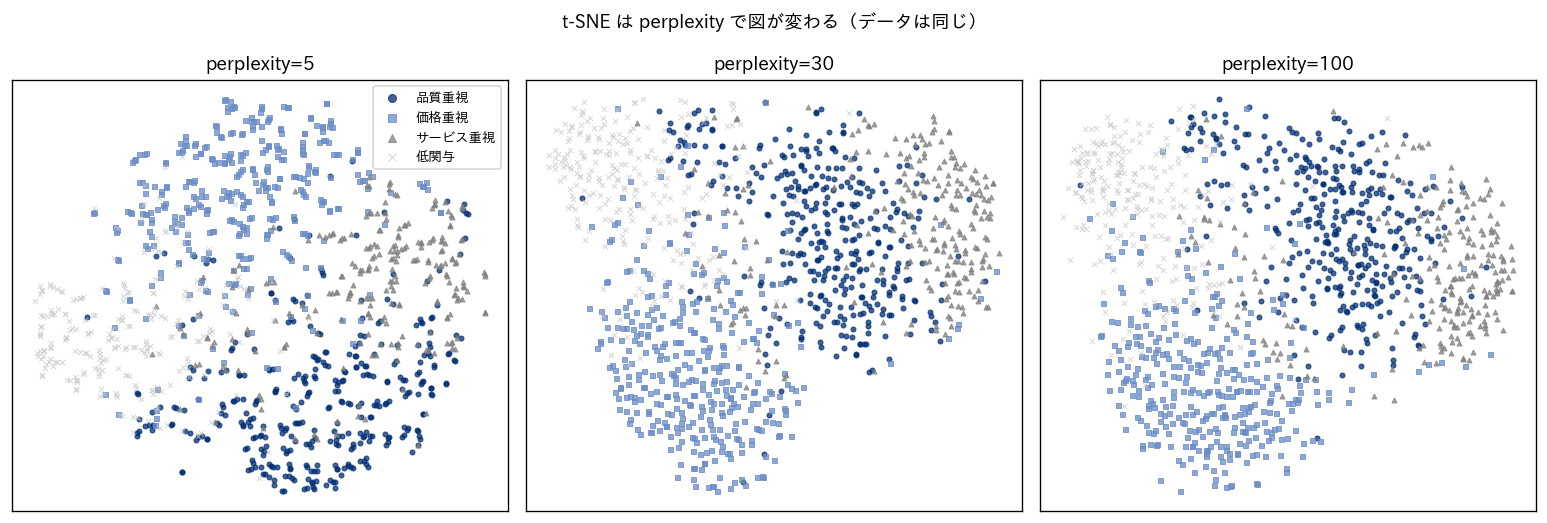
| perplexity | 最適化後の KL ダイバージェンス | 元の距離との相関(Spearman) | 2次元の上で k-means(k=4)した調整ランド指数 |
|---|---|---|---|
| 5 | 1.611 | 0.698 | 0.498 |
| 30(既定値) | 1.555 | 0.737 | 0.513 |
| 100 | 1.082 | 0.765 | 0.515 |
perplexity が 5 のときは、群の中に細かな塊が多数でき、4つのセグメントが入り組んで見えます。30 では4つの塊がはっきり分かれ、100 では塊の輪郭が滑らかになって主成分分析の図に近づきます。元の距離との相関は perplexity を上げるほど高くなり(0.698 から 0.765)、大きな perplexity ほど大域的な配置を保つ方向に働くことが分かります。調整ランド指数は 0.498〜0.515 で大きくは変わりませんでした。KL ダイバージェンス(t-SNE が最小化する目的関数の最終値)は perplexity によって尺度が変わるので、異なる perplexity の間で良し悪しを比べる指標にはなりません。
ここから引き出せる教訓は、t-SNE の図は一枚では判断材料にならない、ということです。同じデータで perplexity を数通り変え、乱数シードも変えて、どの設定でも残る構造だけを読む。塊の数が設定によって変わるなら、設定の産物である可能性が高く、その図だけをセグメント数の根拠にはできません。先ほどの Distill の記事も、複数の perplexity と複数回の実行で確かめることを勧めています。経営層への報告に t-SNE の図を1枚だけ載せて「4つのセグメントが見つかりました」と言うのは、第13章で述べた「図の選び方」の観点からも避けるべき型です。セグメントの存在を主張するなら、第6章のクラスタ数の決め方(シルエット係数・BIC・安定性)で裏を取り、図は補助に回します。
埋め込み表現と因子・主成分の共通点と違い
機械学習、とくに自然言語処理の分野では、単語や文書を数十から数百次元の実数ベクトルで表す埋め込み表現が使われています。同じ考え方は、商品や顧客をベクトルで表す推薦システムにも応用されています。Mikolov らが2013年に公開した単語ベクトルの効率的な推定に関する論文は、非常に大きなデータから単語の連続ベクトル表現を計算する手法を提案し、その品質を単語の類似度タスクで測っています。要点は、単語を「周囲にどんな単語が現れるか」を予測できるように学習した結果として得られるベクトルが、意味の近い単語どうしで近くなるということです。商品の埋め込みなら「同じ顧客が続けて買う商品」を、顧客の埋め込みなら「似た購買履歴を持つ顧客」を近づけるように学習します。
この埋め込み表現と、本コラムで扱ってきた因子得点や主成分得点には、共通点が三つあります。第一に、どちらも「観測されたたくさんの値を、少数の連続値で表す」表現です。単語の文脈の出現頻度も、16項目の回答も、少数の座標に圧縮されています。第二に、どちらも軸そのものには名前がありません。第4章で見たとおり因子には分析者が名前を付けるのであって、名前がデータから出てくるわけではありません。埋め込みの各次元にも意味のラベルはなく、あるのは「近いか遠いか」という関係だけです。第三に、どちらも「その表現の上で別の分析をする」ための中間生成物として使われます。因子得点の上でクラスタリングや回帰を行うように、埋め込みの上で最近傍探索やクラスタリングや分類を行います。
違いも三つあります。第一に、学習の目的関数が違います。主成分分析は分散を、因子分析は相関行列を再現するように軸を決めるのに対し、埋め込みは「文脈を予測する」「次に買う商品を予測する」といった予測課題を解く副産物として得られます。表現の良し悪しは、その予測課題でどれだけ役に立つかで決まり、分散の説明率のような手法内部の指標はありません。第二に、次元数と解釈可能性の関係が違います。因子分析では因子数を3〜5程度に抑え、各因子に載る項目を見て名前を付けることが解釈の中心でした。埋め込みは数百次元が普通で、個々の次元を解釈しようとはしません。第三に、必要なデータ量が違います。因子分析は数百件のアンケートでも成り立ちますが(サンプルサイズの目安は第2章)、埋め込みは大量のテキストや購買履歴を前提にした手法です。
実務で埋め込み表現を扱うときに、因子分析の経験が生きるのは「軸に名前がない表現をどう人に説明するか」という場面です。因子分析では、因子得点の高い個体と低い個体の項目回答を並べて因子の意味を確かめました。埋め込みでも同じことができます。ある方向に沿って商品を並べ、両端の商品を見て「この方向は価格帯を表しているらしい」「この方向は季節性らしい」と読む手順は、因子の命名と同じ作法です。命名が恣意的になりうることも同じで、第13章で述べた注意がそのまま当てはまります。テキストデータの埋め込みや、そこからのトピック抽出については、既刊コラム「ビジネスの声を数字に変える、自然言語処理とテキストマイニングの実践ガイド」で扱っていますので、そちらに送ります。
埋め込みの上でクラスタリングする型
第6章では、クラスタ分析を16項目の標準化データや4つの下位尺度の平均得点に対して行いました。機械学習の実務では、この「クラスタリングの入力」を埋め込み表現に置き換える型がよく使われます。顧客の購買履歴やウェブの行動ログから顧客の埋め込みを学習し、その上で k-means や混合分布モデルを当ててセグメントを作る、という流れです。入力が変わるだけで、クラスタ数の決め方や安定性の確認、命名の作法は第6章と第13章で述べたものと変わりません。
この型で注意したいのは、何次元の表現の上でクラスタリングするかです。本章の前半で見たとおり、共通データを16次元のまま k-means にかけた調整ランド指数は 0.571 でしたが、主成分分析で2次元にしてからでは 0.434、t-SNE の2次元の上では 0.513 でした。2次元は「見る」ためには必要ですが、「分ける」ためには情報が足りません。埋め込みでも同じで、可視化のために t-SNE や UMAP で2次元にした図の上でクラスタを切るのは、見えている塊に引きずられた分け方になります。クラスタリングは元の埋め込みの次元(あるいは主成分分析で適度に落とした数十次元)で行い、その結果を2次元図に色として重ねる、という順序を守るべきです。
もう一つは、埋め込みの学習に使った目的と、セグメントの用途が合っているかです。「次に買う商品を予測する」ように学習した顧客埋め込みの上でクラスタを作れば、得られるセグメントは購買の傾向で分かれたものになります。それを「顧客満足の構造」として読むと誤ります。第1章で述べた「変数を要約する」「個体を分ける」という目的の区別は、入力が埋め込みになっても変わりません。埋め込みは万能の前処理ではなく、「何を予測するように学習したか」が刻まれた表現だという点を押さえておく必要があります。
特徴量の相関構造を知らずに重要度を読む危険
多変量解析の考え方が機械学習の解釈に最も直接に効くのが、特徴量の重要度を読む場面です。ランダムフォレストや勾配ブースティングで満足度や離反を予測し、「どの項目が効いているか」を重要度で読んで経営層に報告する、という型を考えます。ここで、第2章と第4章で確認した相関構造を忘れると、読み違えが起きます。共通データでは、同じ因子に載る4項目どうしの相関が 0.55〜0.68 と高く設計されています。この状態で項目ごとの重要度を出すと何が起きるかを確かめました。
使うのは並べ替え重要度です。scikit-learn のユーザーガイドによれば、これは1つの特徴量の値をランダムに並べ替えたときにモデルの性能がどれだけ落ちるかを測る手法です。同じページの「強く相関する特徴量では誤解を招く値になる」という節は、2つの特徴量が相関しているとき一方を並べ替えてもモデルは相関する他方からその情報を得られるため、両方の重要度が実際より低く報告されると述べ、対処法の一つとして相関する特徴量をクラスタにまとめて各クラスタから1つだけ残す方法を挙げています。共通データの16項目を使って、総合満足度を予測するランダムフォレスト(300本、葉の最小サンプル数5)を学習し、検証データ(360件)で並べ替え重要度を測りました。
import numpy as np, pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.inspection import permutation_importance
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score
from survey_data import load_survey, ITEM_COLS, FACTOR_NAMES

df = load_survey()
X_tr, X_te, y_tr, y_te = train_test_split(df[ITEM_COLS], df["sat"],
                                          test_size=0.3, random_state=0)
rf = RandomForestRegressor(n_estimators=300, min_samples_leaf=5, random_state=0)
rf.fit(X_tr, y_tr)
r2_full = r2_score(y_te, rf.predict(X_te))          # 0.620

# 項目ごとの並べ替え重要度
pi = permutation_importance(rf, X_te, y_te, n_repeats=20, random_state=0,
                            scoring="r2")
imp = pd.Series(pi.importances_mean, index=ITEM_COLS)

# 因子ごとに4項目をまとめて並べ替える(ブロック単位の重要度)
rng = np.random.default_rng(0)
for f in range(4):
    cols = ITEM_COLS[f * 4:(f + 1) * 4]
    drops = []
    for _ in range(20):
        Xp = X_te.copy()
        Xp[cols] = Xp[cols].values[rng.permutation(len(Xp))]
        drops.append(r2_full - r2_score(y_te, rf.predict(Xp)))
    print(FACTOR_NAMES[f], round(imp[cols].sum(), 3), round(np.mean(drops), 3))
# 出力:
# 商品品質 0.163 0.380
# 価格納得感 0.057 0.108
# 接客サポート 0.066 0.147
# 店舗利便性 0.035 0.076
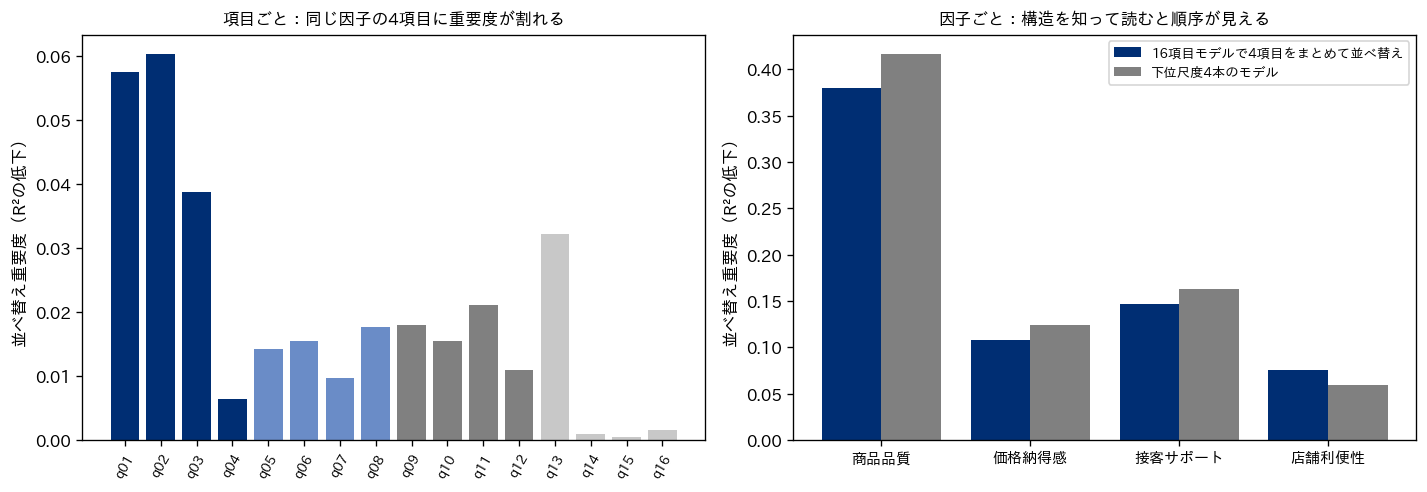
16項目のモデルの検証データでの決定係数は 0.620 でした。項目ごとの並べ替え重要度を見ると、商品品質の4項目は q01 が 0.058、q02 が 0.060、q03 が 0.039、q04 が 0.006 で、合計しても 0.163 です。接客サポートの4項目は 0.011〜0.021 で合計 0.066、価格納得感は 0.010〜0.018 で合計 0.057、店舗利便性は q13 だけが 0.032 で残りはほぼ 0 でした。この数字だけを見ると「q01 と q02 が効いていて、q04 はほとんど効いていない」「店舗利便性は q13 以外は要らない」と読みたくなります。しかし、q04 は q01〜q03 と同じ因子に載る項目で、モデルは q04 を並べ替えられても q01〜q03 から同じ情報を得られるため、重要度が小さく出ているだけです。
それを確かめるために、項目を1つ落として学習し直しました。q01 を除いたモデルの決定係数は 0.606 で、低下は 0.014 にとどまります。単独の並べ替え重要度が 0.058 だったのに対し、実際に無くしたときの損失はその4分の1程度です。q09 を除くと 0.615、q05 を除くと 0.615、q13 を除くと 0.613 で、低下はいずれも 0.004〜0.007 にとどまりました(低下の幅は丸める前の決定係数から計算しているため、表示した値どうしの引き算とは 0.001 ほどずれることがあります)。残りの3項目が同じ情報を持つため、1項目の欠落はほとんど効きません。項目ごとの重要度は「その項目が無ければどれだけ困るか」を表しておらず、「相関する項目群の中でたまたまモデルが多く使った項目はどれか」を表しているに過ぎません。
| 因子 | 項目ごとの重要度の合計 | 4項目をまとめて並べ替えた重要度 | 下位尺度4本のモデルの重要度 | 生成時に総合満足度へ与えた重み |
|---|---|---|---|---|
| 商品品質 | 0.163 | 0.380 | 0.416 | 0.55 |
| 接客サポート | 0.066 | 0.147 | 0.163 | 0.40 |
| 価格納得感 | 0.057 | 0.108 | 0.124 | 0.30 |
| 店舗利便性 | 0.035 | 0.076 | 0.059 | 0.20 |
相関構造を知ったうえで読むと、話は単純になります。同じ因子に載る4項目を一緒に並べ替える「ブロック単位の重要度」を測ると、商品品質 0.380、接客サポート 0.147、価格納得感 0.108、店舗利便性 0.076 となり、項目ごとの合計(0.163・0.066・0.057・0.035)と比べて、価格納得感で1.9倍、他の3因子で2.2倍前後の値が出ました。4項目を同時に壊すと、モデルは他の項目から情報を補えなくなるからです。さらに、第4章の手順どおり4項目の平均で下位尺度を作り、4本の下位尺度だけで学習し直したモデルは、検証データでの決定係数が 0.617 と、16項目のモデル(0.620)とほぼ同じ精度を保ちました。その並べ替え重要度は商品品質 0.416、接客サポート 0.163、価格納得感 0.124、店舗利便性 0.059 で、生成時に総合満足度へ与えた因子の重み(0.55・0.40・0.30・0.20)の順序と一致しています。16本の棒を眺めていたときには見えなかった「どの因子が満足度を動かしているか」が、因子の構造に沿ってまとめただけで読めるようになりました。
ここで扱った並べ替え重要度に限らず、ツリー系モデルの不純度ベースの重要度も、SHAP 値のような寄与の分解も、相関の強い特徴量の間では寄与が分散したり、どちらか一方に寄ったりします。SHAP 値や部分依存プロットといった説明手法の仕組みと読み方、そして線形モデルの係数が多重共線性で不安定になる話は、既刊コラム「AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド」で扱っていますので、そちらに送ります。本章で押さえておきたいのは一点だけで、機械学習モデルの重要度を読む前に、第2章の相関行列と第4章の因子構造を見ておくこと、そして相関する項目群はまとめて評価することです。機械学習の手法そのものの仕組みと使いどころは既刊コラム「機械学習の仕組みと使いどころ」に、scikit-learn のコードの逆引きは「Python実務で必ず使うデータ分析と機械学習のレシピ100選」にまとめてあります。
生成AIに多変量解析を任せるときに人が持つ判断
生成AIにデータを渡して「因子分析をして」「顧客をセグメントに分けて」と頼み、返ってきたコードと結果と解釈の文章をそのまま使う、という場面を考えます。生成AIを分析に使うこと自体は、実務の選択肢として否定するものではありません。ただし、生成AIがどの程度正しく多変量解析を遂行できるかについて、弊社は本コラムの範囲で裏付けのある評価を持っていませんし、本章でもそれを検証していません。したがってここでは生成AIの能力を論じるのではなく、「誰が分析したとしても、結果を使う前に人が確認すべき項目」を、本コラムの各章で確認してきた内容から整理します。生成AIに任せる場面では、分析の途中経過が見えにくいぶん、この確認が省かれやすいと考えています。
| 確認項目 | 人が問うこと | 確かめ方(本コラムの該当章) |
|---|---|---|
| 手法の選択理由 | なぜ主成分分析ではなく因子分析なのか。なぜ k-means なのか。目的(要約する・分ける・関係を測る・予測する)と手法が対応しているか | 第1章の4分類に照らす。目的が言えなければ手法は選べない |
| 前処理の妥当性 | 標準化したか、しなかったか。欠損と外れ値をどう扱ったか。尺度の種類(名義・順序・間隔)に合った扱いか | 第2章の手順どおりか。標準化の有無で主成分分析の結果は変わる(第3章) |
| 因子数・クラスタ数の根拠 | その数はどの基準で決めたか。別の数でも試したか。基準どうしが食い違ったときどう決めたか | 第3章・第4章のスクリープロットと平行分析、第6章のシルエット係数と BIC と安定性 |
| 因子の命名 | 名前は負荷量の高い項目から付いているか。名前が先にあって項目を後から当てはめていないか。逆の解釈も成り立たないか | 第4章の負荷量表を自分で読む。第13章の命名の恣意性 |
| 結果の再現性 | 乱数シード・初期化・perplexity・反復回数を固定して同じ結果が出るか。別のシードで塊の数が変わらないか | 本章の perplexity の実験。第6章の安定性の確認 |
| データの出所と偏り | 誰が、いつ、どの経路で集めた回答か。母集団を代表しているか。架空データや合成データが混ざっていないか | 第2章のサンプルサイズ、第13章のサンプルの偏り |
| 標本外での再現 | 別の期間・別の店舗・別の調査で同じ構造が出るか。学習データの中だけの適合ではないか | 第13章の標本外での再現。本章の検証データでの決定係数 |
| 経営指標への翻訳 | 寄与率や調整ランド指数ではなく、売上・離反率・対応コストの言葉で結果が言えるか。施策に落ちる粒度か | 第13章の KPI 設計と報告の作法 |
この表は、生成AI向けに新しく作ったものではなく、本コラムが各章で述べてきた判断をそのまま並べたものです。分析者が人であっても生成AIであっても、確認すべき項目は変わりません。変わるのは、確認を省いたときに気づく機会が減ることです。人が分析していれば「標準化はしましたか」と聞く場面が自然に生まれますが、生成AIが出した整った表と流暢な解釈文を前にすると、その問いが出にくくなります。表の「人が問うこと」の列は、そのまま生成AIへの質問として使えます。答えが返ってこない項目、あるいは答えが本コラムの該当章の内容と食い違う項目があれば、その結果はまだ使えない段階にあります。
とくに再現性の項目は、本章で見たとおり t-SNE のような手法では設定ひとつで図が変わります。生成AIに「顧客を可視化して」と頼んで返ってきた一枚の t-SNE の図から「4つのセグメントがある」と結論づけるのは、perplexity と乱数シードを変えた図を見るまでは早すぎます。同じことは k-means の初期値や、因子分析の回転の種類(第4章のバリマックスとプロマックス)にも言えます。「同じデータで別の設定にしても、この結論は残りますか」という問いを、結果を使う前に一度は投げるべきです。
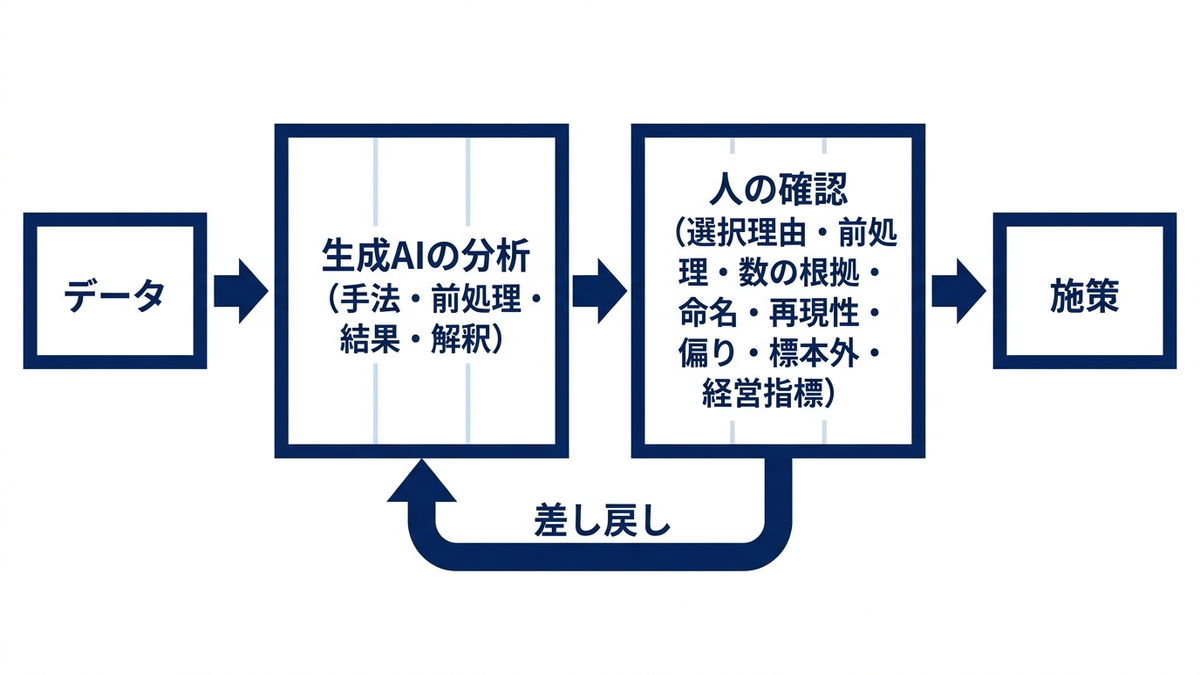
経営目線:検証していないセグメントが施策に入ると何が起きるか
最後に、この章の内容を経営の言葉に翻訳します。生成AIや機械学習が出した「セグメント」を検証せずに施策に使うと、起きることは大きく三つです。第一に、存在しない分け方に予算が配分されます。t-SNE の図の上で見えた塊が perplexity の産物だった場合、その塊ごとに設計したキャンペーンやクリエイティブは、実際には同質の顧客に別々の投資をしていることになります。第二に、施策の効果測定が成り立たなくなります。セグメント別に効果を比べても、セグメントの境界が乱数シードで動くものであれば、差が出ても出なくても解釈できません。第三に、組織の中で「セグメント」という言葉が独り歩きします。営業や店舗の現場が分け方を信じて動き始めると、後から「あの分け方は根拠が弱かった」と訂正するのは、最初に検証するより何倍も難しくなります。
本章の数字で言えば、共通データを16次元のまま分けた調整ランド指数は 0.571 で、生成時に仕込んだ4セグメントを「だいたい回収するが完全ではない」水準でした。2次元の図の上で分ければ 0.434〜0.515 まで下がります。架空のデータで構造が分かっていてもこの程度ですから、実データで構造が分からないときに、一枚の図から読み取ったセグメントの信頼度はそれよりさらに低いと考えておくのが安全です。第13章で述べた「クラスタは分け方であって真実ではない」という前提は、分析の道具が高度になっても変わりません。むしろ、道具が高度になるほど結果が整って見えるぶん、前提を忘れやすくなります。
逆に、本章の内容を正しく使えば、機械学習の結果を経営の言葉に翻訳しやすくなります。相関する項目をまとめて重要度を読めば「満足度を動かしているのは商品品質であり、次が接客サポートである」と因子の言葉で言えますし、その因子は第4章で命名し、第11章で構造を検証し、第13章で KPI に落としたものと同じです。多変量解析の各章で積み上げてきた「構造を読む」作法は、機械学習モデルの出力を読むときの共通言語になります。手法は増えても、問いの立て方と結果の確かめ方は変わらない、というのが本コラムを通じて最も伝えたいことです。
本章では、主成分分析からカーネル主成分分析、オートエンコーダへと続く次元削減の系譜を表現学習という言葉でまとめ、線形オートエンコーダが主成分分析と同じ平面を学ぶことを共通データで確かめました。t-SNE は群を分けて見せる力がある一方で図の上の距離を定量的に読めず、perplexity で図が変わること、埋め込み表現は因子や主成分と「軸に名前がない少数の連続値」という点で共通し、学習の目的で異なること、そして相関する項目群をまとめずに重要度を読むと因子の効き方を見誤ることを、いずれも実行結果で示しました。生成AIに分析を任せる場面でも、確認すべき項目は本コラムの各章で述べたものと同じです。終章では、ここまでの14章を「手法より先に問いを決める」という一点に集約し、自分のデータで手法を選ぶ手順を改めて整理します。
この章を深めたい方への参考書籍
『深層学習』(Ian Goodfellow・Yoshua Bengio・Aaron Courville 著、岩澤有祐・鈴木雅大・中山浩太郎・松尾豊 監訳、ドワンゴ/KADOKAWA):深層学習の標準的な教科書の日本語版で、原著は第14章にオートエンコーダ、第15章に表現学習の章を置いています。原著の第14章には、復号器が線形で損失が平均二乗誤差なら不完備オートエンコーダは主成分分析と同じ部分空間を張る、という本章の実験の根拠にあたる記述があります。表現学習という考え方の背景を数式を追いながら確かめたい方に向いています。
『深層学習 改訂第2版』(岡谷貴之 著、講談社):機械学習プロフェッショナルシリーズの一冊で、第9章に「説明と可視化」の章があり、第12章の生成モデルの中に自己符号化器(オートエンコーダ)の解説があります。深層学習モデルの説明と可視化、オートエンコーダの位置づけを日本語で読める一冊です。
『Pythonではじめる教師なし学習』(Ankur A. Patel 著、中田秀基 訳、オライリー・ジャパン):第3章で主成分分析・カーネル主成分分析・MDS・t-SNE などの次元削減を、第5章でクラスタリングを、第7章と第8章でオートエンコーダを、いずれも Python のコードつきで扱っています。本章で並べた手法を一冊の中で手を動かしながら比べたい方に向いています。
終章 手法より先に問いを決め、出力より先に検証を決める
第14章まで、多変量解析の手法を問いの型に沿って見てきました。変数を要約する主成分分析と因子分析、個体を分けるクラスター分析、既知の群を分ける判別分析、位置関係を図にする対応分析と多次元尺度構成法、質的データを扱う数量化理論、変数群の関係を測る正準相関分析と偏最小二乗、仮説の構造を検証する構造方程式モデリング、選好の構造を測るコンジョイント分析。手法は多いように見えますが、問いの型で整理すると数えられる程度に収まります。終章では、本コラムを通じて繰り返した2つのことを、あらためて整理して締めくくります。
問いの型が決まれば、手法の候補は絞れる
本コラムの各章は、手法から始めるのではなく問いから始める形で書きました。手元のデータが行と列の表であることは、どの問いでも同じです。違うのは、その表に対して何を知りたいかです。列を少数にまとめたいのか、行を似た者どうしにまとめたいのか、列の2つの群のあいだの関係を知りたいのか、行が既にいくつかの群に分かれているとき何がその群を分けているのかを知りたいのか。この問いの型が決まれば、候補になる手法は2つか3つに絞れます。
絞れたあとに残るのが、手法の中の選択です。主成分分析か因子分析か、階層的手法か非階層的手法か、直交回転か斜交回転か、線形判別か二次判別か。これらは問いだけでは決まらず、データの性質と、結果を何に使うかで決まります。本コラムの多くの章では、この選択の判断材料を、共通データや各章の例を実際に動かした結果とともに示しました。同じデータで手法を横に比べると、手法ごとの得意不得意が、抽象的な説明よりはっきり見えるためです。
出力が返ってくることと、答えになっていることは違う
もう一つ繰り返したのは、前提を満たして計算が収束すれば、手法は何らかの出力を返すという点です。主成分分析は主成分を返し、k-means などのクラスター分析は指定した数のクラスタを返し、構造方程式モデリングは適合度の数値を返します。返ってきた出力が問いの答えになっているかどうかは、手法の側では保証されません。因子に付けた名前は解釈であり、クラスタは分け方の一つであり、適合したモデルは因果の証明ではありません。第13章では、こうした点を意思決定の側から並べ直し、報告書として何を残すべきかを整理しました。
本コラムでは、架空のデータに構造を仕込み、各手法がその構造をどこまで回収できるかを示しました。回収できた結果だけでなく、回収しきれなかった結果もそのまま載せたのは、手法の限界を知っていることが、実データで結果を読むときの手がかりになるためです。実データの潜在構造には、仕込んだデータのような正解が用意されていません。だからこそ、別の標本で再現するか、別の手法で同じ構造が出るか、仕込んだ構造が分かっているデータで手法の癖を確かめておくといった、検証の手順を先に決めておくことが大切だと考えています。
経営判断に使うために
多変量解析の結果は、顧客セグメントの定義、商品仕様の決定、ブランドの位置づけ、満足度向上の優先順位といった、後戻りしにくい判断に使われます。分析の出力をそのまま判断に使うのではなく、出力から判断までのあいだに、解釈の根拠、標本の偏りの確認、別の分け方との比較、次に何を決めるかの明示を置いていただきたいと考えています。分析を依頼する側にとっても、報告書を受け取る側にとっても、この間の工程が書かれているかどうかが、その分析を信頼してよいかの目安になります。
本コラムの記述は2026年9月時点で確認したものです。ライブラリの仕様は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。手法の考え方そのものは、ライブラリの版が変わっても変わりません。本コラムが、手元のデータに対して何を問い、どの手法で確かめ、結果をどう読むかを決める際の一助になれば幸いです。
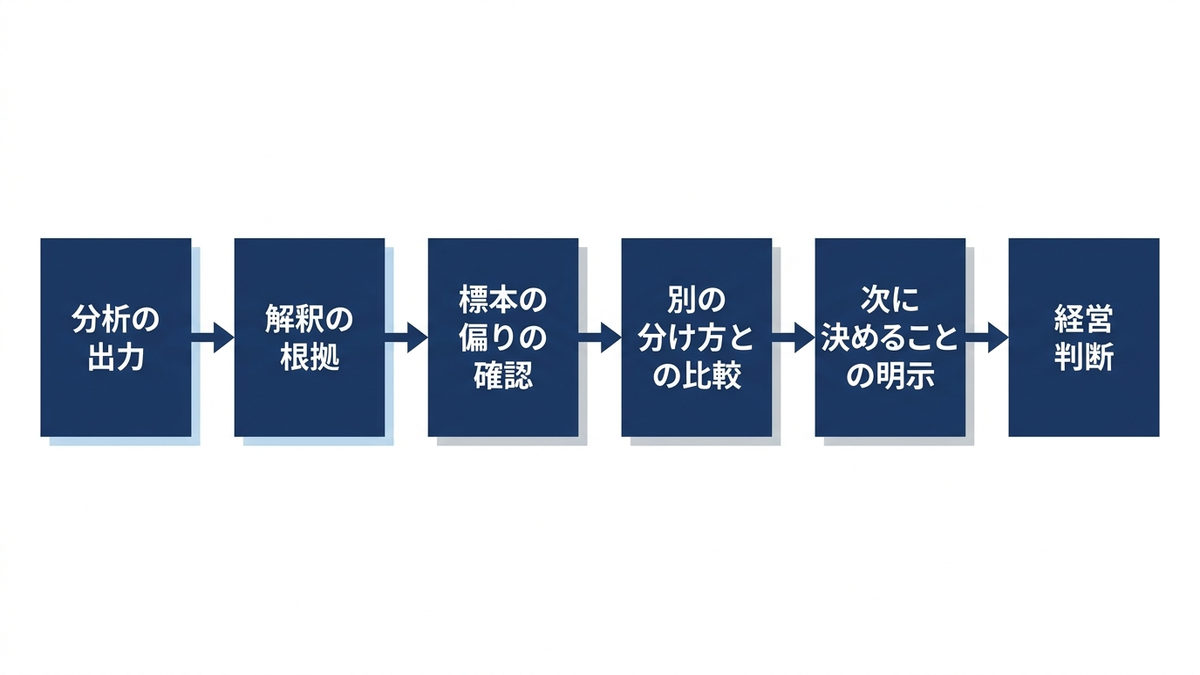
Anagraftでは、データ活用の構想づくりから分析の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 多変量解析とは何か、目的別の手法の地図
『多変量解析がわかる』(涌井良幸・涌井貞美、技術評論社):技術評論社のファーストブックというシリーズの1冊で、多変量解析の入門書として、具体的な例や図を多く使った構成をうたっています。本章の「手法の地図」で候補に挙がった手法の名前を、まず絵として頭に入れるのに向いていると考えています。本コラムの第3章以降を読む前の準備としても、読んだあとの整理としても使えます。
『多変量データ解析法:心理・教育・社会系のための入門』(足立浩平、ナカニシヤ出版):副題のとおり、心理・教育・社会系の調査データを念頭に置いた入門書です。本コラムの共通データがアンケート形式であることもあり、経営の現場で調査データを扱う方には、この本の視点が近いと考えています。本文165ページと分量が抑えられているので、最初の1冊としても手に取りやすい本です。
『多変量解析入門:線形から非線形へ』(小西貞則、岩波書店):副題のとおり、線形の多変量解析から非線形のモデリングまでを1冊で扱う構成です。本章で触れた「多変量解析と機械学習の境界は曖昧である」という点を、数理の側から確かめたい方に向いていると考えています。英訳版が CRC Press から出ており、海外の文献と行き来するときの橋渡しにもなります。
第2章 分析の前に整えること、尺度・標準化・相関行列
『欠測データの統計科学:医学と社会科学への応用』(高井啓二・星野崇宏・野間久史、岩波書店):この章で概念だけ紹介した欠損の扱いを、欠測データに対する最尤法、EM アルゴリズム、単一代入と多重代入、回帰分析モデルにおける欠測データ解析、脱落を伴う経時測定データの解析、欠測データメカニズムの検討という章立てで体系的に解説した一冊です。冒頭に欠測の扱いの指針をまとめた章があり、この章の実験で見た「答えた人だけで計算する」「平均値で補完する」の先に何があるかを、理論から追いかけたい方に向いています。
『改訂新版 前処理大全:SQL/pandas/Polars実践テクニック』(本橋智光・橋本秀太郎、技術評論社):データの抽出・集約・結合・分割・整形と、数値・カテゴリ・日時・文字列の変換という前処理の工程を、SQL と pandas と Polars の3つの道具で書き比べた実務書です。この章で扱ったような数値の変換やカテゴリの扱いを、実際の業務データに対して手を動かして行う段階で参照すると、どの道具でどう書くかが具体的に分かります。初版は2018年で、2024年の改訂新版では R に代えて Polars を採用しています。
『心理尺度のつくり方』(村上宣寛、北大路書房):この章で「設計上のまとまり」として与えた16項目のような質問項目群を、どう設計し、どう検証するかを扱った尺度構成の方法論の本です。統計的基礎の章で測定水準・標準化・相関係数をこの章と同じ順序で押さえたうえで、信頼性、妥当性、項目の収集と執筆、項目分析、因子分析法による尺度開発、そして実際の尺度開発の事例まで通して書かれています。顧客満足度調査の調査票を自分で設計する立場の方に、第4章の因子分析と併せて読むことをお勧めします。
第3章 主成分分析、変数を少数の軸に要約する
『主成分分析と因子分析:特異値分解を出発点として』(足立浩平・山本倫生、共立出版):統計学One Pointシリーズの第25巻で、2024年8月刊。書名のとおり特異値分解を出発点に置き、主成分分析と因子分析を次元縮約の手法として同じ土台の上で扱う構成です。本章で「回転しない」とだけ書いた主成分分析と因子分析の違いを、数理の側から確かめたい方に向いています。
『主成分分析の基本と活用』(内田治、日科技連出版社):2013年刊。版元の紹介では、主成分分析を「評価項目を測定したデータから、新たな総合的な評価項目をつくり出す統計的方法」と位置づけ、実例を使った解説と欠損値への対応まで扱うとされています。概要・基本・応用・活用・官能評価・特殊な事例の6章構成で、本章の wine データの例を手元の指標に置き換えて試したい方の最初の1冊として挙げます。
『主成分分析』(上田尚一、朝倉書店):講座〈情報をよむ統計学〉の第8巻で、2003年刊。主成分分析1つに1冊を充て、「主成分分析の適用についての考え方」「主成分の解釈と軸の回転」といった章を持ちます。本章では主成分を回転しない標準的な手順を書きましたが、この本は主成分の解釈のために後から軸を回転させる立場も扱っており、本章で触れた「軸に名前を付けるときの解釈の押しつけ」を避ける考え方を深めるのに向いています。2026年9月時点で版元では取り扱いが終わっているため、図書館や古書での入手になります。
第4章 因子分析、観測の背後にある共通因子を推定する
『因子分析入門:Rで学ぶ最新データ解析』(豊田秀樹 編著、東京図書):「速習・因子分析」から始まり「確認的因子分析」で終わる9章構成で、R を使って手を動かしながら探索的因子分析を学ぶ入門書です。本章の Python での手順を R で追いかけ直したい方に向いています。
『因子分析:その理論と方法』(柳井晴夫・繁桝算男・前川眞一・市川雅教、朝倉書店):因子分析モデルとその基本性質、推定、因子の回転、カテゴリカルデータの因子分析、共分散構造分析までを扱う統計ライブラリーの1冊です。本章では数式を最小限にしましたが、推定や回転の理論を式で確かめたい方のための専門書です。
『心理統計学の基礎:統合的理解のために』(南風原朝和、有斐閣):心理学研究に必要な統計学の理論と方法を、相関と回帰から線形モデル、分散分析へと積み上げ、最終章で因子分析と共分散構造分析に至る教科書です。本章の内容を統計の基礎とつなげて理解したい方に向いています。
第5章 因子分析の事例、プロテニスのサーブ力とリターン力
『誰も教えてくれなかった因子分析』(松尾太加志・中村知靖、北大路書房):数式を使わずに因子分析の考え方と結果の読み方を説明した入門書です。本章のように「負荷量の表を見て因子に名前をつける」場面で、何を根拠に判断すればよいかを平易に解説しており、回転の前後で解釈がどう変わるかを理解する助けになります。
『科学で迫る勝敗の法則:スポーツデータ分析の最前線』(小中英嗣、技術評論社):野球、サッカー、バスケットボール、ラグビー、バレーボールを題材に、セイバーメトリクス、レーティング、予測モデルといったスポーツデータ分析の手法を解説した本です。本章の題材であるテニスは扱われていませんが、「見慣れた数値は選手を評価できているか」という問いの立て方は、本章でサーブの成功率よりポイント率が勝率に効くと分かった場面と同じ発想です。
第6章 クラスター分析、似た個体をまとめる
『クラスター分析』(上田尚一、朝倉書店):講座「情報をよむ統計学」の1冊で、「区分けの論理」から始めて、数量データと質的データそれぞれのクラスター分析、階層的手法、時間的変化や地域データへの応用までを扱っています。クラスタを「分け方」として捉える本章の視点を、統計学の側から掘り下げたいときの土台になります。
『Rで学ぶクラスタ解析』(新納浩幸、オーム社):クラスタリングの準備から、階層的手法・k-means・混合分布モデル・ファジィクラスタリングまでを R のコードで動かしながら学ぶ本です。本章では Python を使いましたが、手法の仕組みを式とコードの両方で確かめたい方には、言語を問わず参考になります。
『マーケット・セグメンテーション:購買履歴データを用いた販売機会の発見』(中村博 編著、白桃書房):RFM 分析、クラスター分析、混合分布モデル、自己組織化マップ、決定木といった手法を、購買履歴データを使ったセグメンテーションの実例として集めた本です。本章の後半で述べたプロファイリングと施策への落とし方を、マーケティングの実務の側から補うものとして挙げます。
第7章 判別分析、群を分ける軸を見つける
『多変量データの分類』(佐藤義治、朝倉書店):副題は「判別分析・クラスター分析」で、前半5章が判別分析に充てられています。判別規則の考え方から、多変量正規分布の標本に基づく判別関数、変数選択、質的データの判別、非線形の判別関数まで、本章で言葉で説明した内容の数理的な裏付けを順に確認できます。後半のクラスター分析は第6章の内容と対応します。
『統計的パターン認識と判別分析』(栗田多喜夫・日高章理、コロナ社):ベイズ決定理論から始めて、識別のための線形モデル、主成分分析と判別分析の関係、カーネル法による非線形判別まで進む一冊です。本章で扱ったフィッシャーの判別と、機械学習の分類器がどうつながっているかを、同じ枠組みの中で読み解けます。
『はじめてのパターン認識』(平井有三、森北出版):ベイズの識別規則、確率モデルと識別関数、線形識別関数、k最近傍法、サポートベクトルマシン、クラスタリングまでを、パターン認識に初めて触れる読者向けに解説した入門書です。本章の「判別」と既刊で扱う「分類器」の橋渡しとして、判別分析を機械学習の側から見直すのに向いています。
第8章 対応分析と多次元尺度構成法、位置関係を図にする
『対応分析の理論と実践 基礎・応用・展開』(Michael Greenacre 著、藤本一男 訳、オーム社):原著 Correspondence Analysis in Practice 第3版の翻訳で、対応分析の第一人者が基礎から応用・展開までを体系的に説明した定番書です。本章で引いた対称マップとバイプロットの区別や慣性の分解は同じ著者の考え方によるもので、同時布置図の誤読を避けるためにより深く学ぶなら、第一候補になる1冊です。
『対応分析入門 原理から応用まで』(Sten-Erik Clausen 著、藤本一男 訳、オーム社):書名のとおり対応分析の原理から応用までを扱う入門書で、「R で検算しながら理解する」解説が併載されています。本章の Python での計算を別のソフトで確かめながら、プロファイルと慣性の考え方を手を動かして身につけたい方に向いています。
『関連性データの解析法 多次元尺度構成法とクラスター分析法』(斎藤堯幸・宿久洋 著、共立出版):書名のとおり、距離や類似度といった関連性データを扱う多次元尺度構成法とクラスター分析法をまとめた専門書です。本章の MDS の節で触れた計量・非計量の区別やストレスの意味を、第6章のクラスター分析と合わせて深く理解したい方に向いています。
第9章 数量化理論、質的データを数量で扱う
『数量化:理論と方法』(林知己夫、朝倉書店、1993年):数量化理論を体系化した本人による理論書です。国立国会図書館サーチに登録された目次によれば、冒頭の章「数量化はどのようにして生まれたか」に「数量化前史」「数量化の濫膓:犯罪学との接触」「その後の数量化」という節があり(「濫膓」は同サーチの目次の表記のままで、物事の始まりを意味する語の通常の表記は「濫觴」です)、この章で追悼文から引いた開発の経緯を、著者自身の歴史的叙述として読めます。各類の定式化を原典で確かめたい方の出発点になる一冊です。
『調査の科学』(林知己夫、筑摩書房、2011年):同じ著者による社会調査の入門書で、ちくま学芸文庫版です。版元の紹介によれば、社会調査の論理、標本調査の考え方、質問の仕方、調査の実施、データ分析のロジック、調査結果の使い方という順に章が組まれています。数量化理論がどういう調査観の上に立っているかを、手法の手前から読める本で、質的データを扱う前に、そもそも調査でどう測るかを考え直したい方に向いています。
『数量化理論とテキストマイニング』(内田治、日科技連出版社、2010年):書名の副題に Excel・R・StatWorks とあるとおり、この3つの道具で数量化理論を動かすことを掲げた実務書で、テキストマイニングへの応用も題名に含まれています。この章では Python で同じ計算を再現しましたが、Python 以外の道具で数量化理論の出力の型を追い直したい方に向いています。国立国会図書館サーチで書誌(2010年5月刊、168ページ)を確認しました。
第10章 正準相関分析と偏最小二乗、2つの変数群の関係を測る
『化学者のための多変量解析 ケモメトリックス入門』(尾崎幸洋・宇田明史・赤井俊雄、講談社サイエンティフィク):PLS 回帰が発展した化学計量学の入門書で、目次の第3章が主成分分析と回帰分析を、第4章がスペクトルの前処理を扱います。版元の紹介文にある「二成分から多成分へ、最小二乗法から多変量解析へ」という分析化学の要請を背景にした本なので、PLS 回帰がどういう場面の必要から育った手法なのかを、本章の背景として読めます。
『化学のためのPythonによるデータ解析・機械学習入門(改訂2版)』(金子弘昌、オーム社):著者の研究室の紹介ページによれば、第4章の回帰分析で多重共線性・主成分回帰・クロスバリデーション・部分的最小二乗法を順に扱い、第5章でモデルの適用範囲を論じています。本章で scikit-learn を使って行った PLS 回帰と交差検証の手順を、化学データの実例で Python コードとともに追える1冊です。
『統計的学習の基礎 データマイニング・推論・予測』(Trevor Hastie・Robert Tibshirani・Jerome Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、共立出版):第3章「回帰のための線形手法」の 3.5 節「入力に対して線形変換を行う方法」で、主成分回帰と偏最小二乗回帰を縮小推定や変数選択と並べて位置づけています。本章で「成分の取り方の違い」として説明した内容を、数理的に厳密な形で確かめたいときの参照先です。
第11章 構造方程式モデリング、仮説の構造を検証する
『共分散構造分析[入門編]:構造方程式モデリング』(豊田秀樹、朝倉書店):パス図の書き方、識別、推定、適合度指標という本章の骨格を、入門書として順に解説した1冊です。同じ著者による応用編・技術編・理論編などのシリーズの出発点にあたり、まずこの1冊で本章の内容を確かめてから次に進むのがよいと考えています。
『AMOS、EQS、CALISによるグラフィカル多変量解析:目で見る共分散構造分析』(狩野裕・三浦麻子、現代数学社、新装版):書名のとおりパス図を軸に、モデルの立て方と結果の読み方を図で見せる構成で、本章の「パス図の読み方」を深めるのに向いています。使うソフトは本章と違いますが、モデルの考え方はソフトに依存しません。
『共分散構造分析[R編]:構造方程式モデリング』(豊田秀樹編著、東京図書):R のパッケージ lavaan とその関連パッケージで共分散構造分析を実行する手順をまとめた本です。本章で使った semopy のモデル記述は lavaan の記法に倣っているので、この本のモデル記述の読み方はそのまま semopy に持ち込めます。R を使わない方にも、モデル記述の読み方の参考になります。
第12章 コンジョイント分析、選好の構造を測る
『例題とExcel演習で学ぶ多変量解析 回帰分析・判別分析・コンジョイント分析編』(菅民郎、オーム社):第8章がコンジョイント分析に充てられ、コンジョイントカードの枚数、直交表、直交表からのカード作成、Excel での実施までを例題で追えます。本章の直交表 L9 と回帰による部分効用の推定を、表計算の手作業で確かめたい方に向いています。
『入門実験計画法』(永田靖、日科技連出版社):コンジョイント分析が借りている直交表は、もともと工業分野の実験計画法の道具です。この本では第8章が2水準系、第9章が3水準系の直交配列表実験、第10章が直交配列表を用いた多水準法と擬水準法に充てられており、本章で使った L9 のような3水準系の表がどう組まれ、どう割り付けるかを実験計画の側から学べます。
『コンジョイント分析 第4版』(君山由良、データ分析研究所):題名のとおりコンジョイント分析を主題にした解説書で、統計解説書シリーズの1冊として版を重ね、2021年9月に第4版が出ています。本章では手法の骨格だけを示したので、1冊を通してこの手法に絞って確認したい方の足がかりになります。
第13章 結果を経営判断につなげる、報告と誤用の型
『多変量解析法入門』(永田靖・棟近雅彦、サイエンス社):回帰分析・判別分析・主成分分析・数量化1類から3類・多次元尺度構成法・クラスター分析を章ごとに扱い、因子分析や正準相関分析は「その他の方法」として補足する構成の教科書です。統計的方法の基礎と線形代数のまとめが前半に置かれているため、本章で「計算結果」として扱った部分を、各手法の導出に戻って確かめたいときの拠り所になります。
『分析者のためのデータ解釈学入門 データの本質をとらえる技術』(江崎貴裕、ソシム):誤差とばらつき、データに含まれるバイアス、交絡因子と因果関係、サンプリングの方法論、データ分析の罠とデータ活用の罠という章立てで、分析結果を解釈するときに入り込む誤りを扱っています。本章の標本の偏りと相関と因果の節を、より広い視点から補強する1冊です。
『Google流資料作成術』(コール・ヌッスバウマー・ナフリック著、村井瑞枝訳、日本実業出版社):「相手に伝わりやすい表現を選ぶ」「不必要な要素を取りのぞく」「相手の注意をひきつける」といった章立てで、データを意思決定者に伝えるための図の選び方と絞り込み方を扱っています。本章の報告の作法の節で述べた「分析者の図をそのまま見せない」を、実際の図の作り方に落とすときに参考になります。
第14章 多変量解析と機械学習の接続、そして生成AI時代
『深層学習』(Ian Goodfellow・Yoshua Bengio・Aaron Courville 著、岩澤有祐・鈴木雅大・中山浩太郎・松尾豊 監訳、ドワンゴ/KADOKAWA):深層学習の標準的な教科書の日本語版で、原著は第14章にオートエンコーダ、第15章に表現学習の章を置いています。原著の第14章には、復号器が線形で損失が平均二乗誤差なら不完備オートエンコーダは主成分分析と同じ部分空間を張る、という本章の実験の根拠にあたる記述があります。表現学習という考え方の背景を数式を追いながら確かめたい方に向いています。
『深層学習 改訂第2版』(岡谷貴之 著、講談社):機械学習プロフェッショナルシリーズの一冊で、第9章に「説明と可視化」の章があり、第12章の生成モデルの中に自己符号化器(オートエンコーダ)の解説があります。深層学習モデルの説明と可視化、オートエンコーダの位置づけを日本語で読める一冊です。
『Pythonではじめる教師なし学習』(Ankur A. Patel 著、中田秀基 訳、オライリー・ジャパン):第3章で主成分分析・カーネル主成分分析・MDS・t-SNE などの次元削減を、第5章でクラスタリングを、第7章と第8章でオートエンコーダを、いずれも Python のコードつきで扱っています。本章で並べた手法を一冊の中で手を動かしながら比べたい方に向いています。
参考情報
本コラムの記述は、次の資料を2026年9月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 「次元の呪い」という語は Bellman が1957年の著書『Dynamic Programming』(Princeton University Press)で導入した
https://link.springer.com/referenceworkentry/10.1007/978-0-387-30164-8_192 - 『Dynamic Programming』の版元が Princeton University Press
https://press.princeton.edu/books/paperback/9780691146683/dynamic-programming - Beyer らの1999年の論文が、広い条件のもとで、次元が増えると最近傍までの距離が最遠点までの距離に近づくことを示した
https://doi.org/10.1007/3-540-49257-7_15 - Beyer らの1999年の論文が、広い条件のもとで、次元が増えると最近傍までの距離が最遠点までの距離に近づくことを示した
https://link.springer.com/chapter/10.1007/3-540-49257-7_15 - 「外的基準」という語
https://www.ism.ac.jp/editsec/toukei/pdf/50-2-111.pdf - 「見かけの相関(疑似相関とも呼ばれます)」
https://doi.org/10.1098/rspl.1896.0076 - 参考書籍『多変量解析がわかる』(涌井良幸・涌井貞美、技術評論社)はファーストブックというシリーズの1冊で、具体的な例や図を多く使った構成をうたっている
https://ndlsearch.ndl.go.jp/books/R100000002-I000011171717 - 参考書籍『多変量データ解析法:心理・教育・社会系のための入門』(足立浩平、ナカニシヤ出版)は本文165ページ
https://ndlsearch.ndl.go.jp/books/R100000002-I000008283595 - 参考書籍『多変量解析入門:線形から非線形へ』(小西貞則、岩波書店)には英訳版が CRC Press から出ている
https://ndlsearch.ndl.go.jp/books/R100000002-I000010696362
第2章
- 名義尺度・順序尺度・間隔尺度・比率尺度の4分類は Stevens が1946年に Science 誌で示した
https://doi.org/10.1126/science.103.2684.677 - 欠損の型の区分は Rubin が1976年に Biometrika 誌で整理した考え方から発展した
https://doi.org/10.1093/biomet/63.3.581 - MCAR・MAR・MNAR の定義(系統的な差がない/観測データで説明できる/観測データを考慮しても差が残る)
https://doi.org/10.1136/bmj.b2393 - MCAR・MAR・MNAR の定義(系統的な差がない/観測データで説明できる/観測データを考慮しても差が残る)
https://pmc.ncbi.nlm.nih.gov/articles/PMC2714692/ - IterativeImputer は R の MICE に着想を得た実装で、既定では1回の補完を返し、sample_posterior=True で乱数の種を変えて繰り返せば多重代入に使える
https://scikit-learn.org/stable/modules/impute.html - VIF の定義(1を、1からR二乗を引いた値で割る)と、「4を超えたら調べる価値、10を超えたら深刻」という経験則
https://online.stat.psu.edu/stat462/node/180/ - statsmodels のドキュメントは VIF が5を超えたら強く共線的という推奨を挙げている
https://www.statsmodels.org/stable/generated/statsmodels.stats.outliers_influence.variance_inflation_factor.html - O’Brien は2007年に VIF の経験則への注意を題名に掲げた論文を書いた
https://doi.org/10.1007/s11135-006-9018-6 - 「項目数の10倍」は早くからあり今も広く使われる経験則で、調査した303件のうち62.9%が10倍以下、約6分の1が2倍以下
https://doi.org/10.7275/jyj1-4868 - MacCallum らは1999年に、必要なサンプルサイズが変数の数の何倍という形で研究によらず一定だという考えを根本的な誤解と述べ、共通性と因子の過剰決定の度合いで変わることを理論と模擬実験で示した
https://doi.org/10.1037/1082-989X.4.1.84 - 共通性が高ければ比較的少ない人数で回収でき、低ければ人数を相当増やさないと回収できない
https://quantpsy.org/pubs/maccallum_widaman_preacher_hong_2001.pdf - 『改訂新版 前処理大全:SQL/pandas/Polars実践テクニック』本橋智光・橋本秀太郎、技術評論社、2024(初版2018)
https://gihyo.jp/book/2024/978-4-297-14138-7
第3章
- scikit-learn の PCA は入力を中心化するが分散をそろえる処理は行わない
https://scikit-learn.org/stable/modules/generated/sklearn.decomposition.PCA.html - StandardScaler は母標準偏差で割る
https://scikit-learn.org/stable/modules/generated/sklearn.preprocessing.StandardScaler.html - wine データは3品種178本・13の測定値
https://scikit-learn.org/stable/modules/generated/sklearn.datasets.load_wine.html - スクリー基準は Cattell(1966)が提案
https://doi.org/10.1207/s15327906mbr0102_10 - カイザー基準は Kaiser(1960)に由来するとされる
https://doi.org/10.1177/001316446002000116 - 平行分析は Horn(1965)が提案
https://www.cambridge.org/core/product/identifier/S003331230004165X/type/journal_article - 乱数データの固有値の95パーセンタイルと比べる判定
https://doi.org/10.1177/0013164495055003002 - 『主成分分析と因子分析:特異値分解を出発点として』足立浩平・山本倫生、共立出版、統計学One Point 25、2024年8月、187ページ
https://ndlsearch.ndl.go.jp/books/R100000002-I033607282 - 『主成分分析の基本と活用』内田治、日科技連出版社、2013年10月、174ページ
https://www.juse-p.co.jp/products/view/481 - 『主成分分析』上田尚一、朝倉書店、講座〈情報をよむ統計学〉8、2003年3月、251ページ
https://www.asakura.co.jp/detail.php?book_code=12778
第4章
- statsmodels の Factor は method に pa(主因子法)と ml(最尤法)を取る
https://www.statsmodels.org/stable/generated/statsmodels.multivariate.factor.Factor.html - rotate が受け付ける方法は varimax・quartimax・biquartimax・equamax・oblimin・parsimax・parsimony・biquartimin・promax
https://www.statsmodels.org/stable/generated/statsmodels.multivariate.factor.FactorResults.rotate.html - factor_scoring の method は bartlett と regression
https://www.statsmodels.org/stable/generated/statsmodels.multivariate.factor.FactorResults.factor_score_params.html - factor_scoring の method は bartlett と regression
https://www.statsmodels.org/stable/generated/statsmodels.multivariate.factor.FactorResults.factor_scoring.html - 固有値1以上の規則の名は Kaiser(1960)の論文に由来するとされる
https://doi.org/10.1177/001316446002000116 - Horn(1965)は、Guttman が階数の下限として示した固有値1を標本に当てると上限としてしか使えないと論じ、乱数データの固有値を差し引く平行分析を提案
https://doi.org/10.1007/BF02289447 - Zwick と Velicer は5つの基準を比較し、カイザーの方法は成分数を大幅に過大評価、平行分析と MAP が最良と報告
https://eric.ed.gov/?id=ED251510 - Zwick と Velicer は5つの基準を比較し、カイザーの方法は成分数を大幅に過大評価、平行分析と MAP が最良と報告
https://doi.org/10.1037/0033-2909.99.3.432 - Fabrigar ら(1999)は主要誌の論文を調査し、探索的因子分析の各判断で疑問の残る方法が日常的に使われていると指摘
https://doi.org/10.1037/1082-989X.4.3.272 - スクリープロットは Cattell(1966)
https://doi.org/10.1207/s15327906mbr0102_10 - 単純構造は Thurstone(1947)が示した
https://ndlsearch.ndl.go.jp/api/opensearch?title=Multiple-factor%20analysis&cnt=10 - バリマックス回転は Kaiser(1958)
https://doi.org/10.1007/BF02289233 - プロマックスは Hendrickson と White(1964)が、直交回転の解を目標に斜交解へ変換する手早い方法として提案
https://doi.org/10.1111/j.2044-8317.1964.tb00244.x - バートレット法の因子得点は Bartlett(1937)
https://doi.org/10.1111/j.2044-8295.1937.tb00863.x - クロンバックαは Cronbach(1951)
https://doi.org/10.1007/BF02310555 - αの目安 0.70 前後以上が広く望ましいとされる一方、形容が論文ごとにばらばら(acceptable が 0.45〜0.98)、0.7 以上でも問題が残る例がある
https://link.springer.com/article/10.1007/s11165-016-9602-2 - Lance ら(2006)は広く引用される4つの目安の出典を遡り、原典と引用のされ方に食い違いがあると指摘
https://doi.org/10.1177/1094428105284919 - Cortina(1993)は項目数・次元数・項目間相関を変えた仮想テストでαを計算し、長さと次元性の影響を示した
https://doi.org/10.1037/0021-9010.78.1.98 - Sijtsma(2009)は αは内部一貫性の尺度ではなく一次元性の尺度でもないと明言
https://pmc.ncbi.nlm.nih.gov/articles/PMC2792363/ - Sijtsma(2009)は αは内部一貫性の尺度ではなく一次元性の尺度でもないと明言
https://doi.org/10.1007/s11336-008-9101-0 - KMO は Kaiser(1974)が提案
https://doi.org/10.1007/BF02291575 - KMO の区分(0.9 台 marvelous、0.8 台 meritorious、0.7 台 middling、0.6 台 mediocre、0.5 台 miserable、0.5 未満 unacceptable)は Kaiser に帰されて広く引用されている
https://personality-project.org/r/psych/help/KMO.html - バートレットの球面性検定は Bartlett(1950)
https://doi.org/10.1111/j.2044-8317.1950.tb00285.x - 『因子分析入門:Rで学ぶ最新データ解析』(豊田秀樹 編著、東京図書、2012)
https://ci.nii.ac.jp/ncid/BB09087133 - 『因子分析:その理論と方法』(柳井晴夫・繁桝算男・前川眞一・市川雅教、朝倉書店、1990)
https://www.asakura.co.jp/detail.php?book_code=12543 - 『心理統計学の基礎:統合的理解のために』(南風原朝和、有斐閣、2002)
https://www.yuhikaku.co.jp/books/detail/4641121605
第5章
- データセットのページは2026年9月時点でも存在し、最終更新日は2018年8月27日
https://www.kaggle.com/datasets/ehallmar/a-large-tennis-dataset-for-atp-and-itf-betting - データセットのページは2026年9月時点でも存在し、最終更新日は2018年8月27日
https://www.kaggle.com/ehallmar/a-large-tennis-dataset-for-atp-and-itf-betting - DataFrame.append は pandas 2.0.0(2023年4月3日)で削除、代わりに concat
https://pandas.pydata.org/docs/whatsnew/v2.0.0.html - MultiIndex.labels は pandas 1.0.0(2020年1月29日)で削除、代わりに codes
https://pandas.pydata.org/docs/whatsnew/v1.0.0.html - pandas 3.0.0(2026年1月21日)で Copy-on-Write が常時有効、SettingWithCopyWarning は削除
https://pandas.pydata.org/docs/whatsnew/v3.0.0.html - FactorAnalysis の rotation 引数は scikit-learn 0.24(2020年12月)で追加、None、varimax、quartimax
https://scikit-learn.org/stable/whats_new/v0.24.html - FactorAnalysis のモデルの仮定(潜在因子の線形変換にガウス雑音、因子は平均0・単位共分散)、最尤法による推定、components_ と transform の意味
https://scikit-learn.org/stable/modules/generated/sklearn.decomposition.FactorAnalysis.html - 引数なしの plt.axes は現在の図に新しい全画面の Axes を追加する
https://matplotlib.org/stable/api/_as_gen/matplotlib.pyplot.axes.html - matplotlib 2.1 の API 変更で、同じ引数で add_axes を呼んだときに既存の Axes を再利用する挙動を非推奨にし、将来は常に新しい Axes を作る
https://matplotlib.org/stable/api/prev_api_changes/api_changes_2.1.0.html - 因子モデルの自由度の式と、自由度が負なら R の factanal が「因子が変数に対して多すぎる」として止めること
https://raw.githubusercontent.com/wch/r-source/trunk/src/library/stats/R/factanal.R - R の factanal は最尤法、既定の回転は varimax
https://stat.ethz.ch/R-manual/R-devel/library/stats/html/factanal.html - 『科学で迫る勝敗の法則:スポーツデータ分析の最前線』小中英嗣、技術評論社
https://gihyo.jp/book/2024/978-4-297-13927-8 - 『心理尺度のつくり方』村上宣寛、北大路書房
https://www.hanmoto.com/bd/isbn/9784762825231
第6章
- 相関距離は、それぞれの平均を引いたベクトルどうしのコサインを1から引いた値
https://docs.scipy.org/doc/scipy/reference/generated/scipy.spatial.distance.correlation.html - 最短距離法・最長距離法・群平均法・ウォード法の定義
https://docs.scipy.org/doc/scipy/reference/generated/scipy.cluster.hierarchy.linkage.html - ウォード法は1963年に Ward が提案
https://doi.org/10.1080/01621459.1963.10500845 - 最短距離法は「持てる者がますます持つ」性質に最も弱い
https://scikit-learn.org/stable/modules/clustering.html - デンドログラムを truncate_mode=”lastp”、p=30 で切って描く
https://docs.scipy.org/doc/scipy/reference/generated/scipy.cluster.hierarchy.dendrogram.html - fcluster に criterion=”maxclust” と t=4 で4つに切る
https://docs.scipy.org/doc/scipy/reference/generated/scipy.cluster.hierarchy.fcluster.html - k-means は慣性を小さくする Lloyd のアルゴリズムで、速いが局所解に落ちるので初期値を変えて再実行するのが有用
https://scikit-learn.org/stable/modules/generated/sklearn.cluster.KMeans.html - k-medoids は1990年に Kaufman と Rousseeuw が著書の中で PAM という名の手続きとして体系化
https://doi.org/10.1002/9780470316801 - GMM は正規分布の混合を EM アルゴリズムで推定し、predict_proba が所属確率、predict が最大の成分を返す
https://scikit-learn.org/stable/modules/mixture.html - BIC は当てはまりの良さとパラメータ数の罰則を組み合わせた値で、scikit-learn の実装では小さいほど良い
https://scikit-learn.org/stable/modules/generated/sklearn.mixture.GaussianMixture.html - DBSCAN は1996年に Ester らが提案
https://cdn.aaai.org/KDD/1996/KDD96-037.pdf - シルエット係数は1987年に Rousseeuw が提案
https://doi.org/10.1016/0377-0427(87 - 調整ランド指数は1985年に Hubert と Arabie が提案
https://doi.org/10.1007/BF01908075 - 参考書籍『マーケット・セグメンテーション:購買履歴データを用いた販売機会の発見』(中村博 編著、白桃書房)
https://ndlsearch.ndl.go.jp/books/R100000002-I000010004908 - 『クラスター分析』の紹介文(区分けの論理から始めて、数量データと質的データのクラスター分析、階層的手法、時間的変化や地域データへの応用まで)
https://www.asakura.co.jp/detail.php?book_code=12777 - 『Rで学ぶクラスタ解析』の紹介文(クラスタリングの準備から、階層的手法・k-means・混合分布モデル・ファジィクラスタリングまで)
https://ebookstore.sony.jp/item/LT000135670001128613/ - 『マーケット・セグメンテーション』の紹介文(RFM 分析、クラスター分析、混合分布モデル、自己組織化マップ、決定木を購買履歴データで扱う)
https://7net.omni7.jp/detail/1102619829
第7章
- 線形判別分析の出発点は1936年にフィッシャーが発表した論文「The Use of Multiple Measurements in Taxonomic Problems」
https://doi.org/10.1111/j.1469-1809.1936.tb02137.x - アヤメの3品種を4つの計測値で見分けるという課題(フィッシャーの論文)
https://scikit-learn.org/stable/datasets/toy_dataset.html - 判別関数は群の数マイナス1本
https://scikit-learn.org/stable/modules/lda_qda.html - マハラノビス距離の定義(共分散行列の逆行列を挟んだ距離)
https://docs.scipy.org/doc/scipy/reference/generated/scipy.spatial.distance.mahalanobis.html - 二次判別の reg_param は既定値 0.0 で、共分散行列を単位行列の方へ縮める
https://scikit-learn.org/stable/modules/generated/sklearn.discriminant_analysis.QuadraticDiscriminantAnalysis.html - priors の既定は学習データの群の割合
https://scikit-learn.org/stable/modules/generated/sklearn.discriminant_analysis.LinearDiscriminantAnalysis.html - 学習に使ったデータで検証するのは方法論上の誤りで、見たラベルを繰り返すだけでも満点になる
https://scikit-learn.org/stable/modules/cross_validation.html - ロジスティック回帰は名前に反して分類のための線形モデルで、確率をロジスティック関数でモデル化する
https://scikit-learn.org/stable/modules/linear_model.html - LogisticRegression は既定で L2 正則化(C=1.0)が効く
https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.LogisticRegression.html - 2値分類の既定のしきい値は事後確率0.5に固定され、多くの用途で最適ではない
https://scikit-learn.org/stable/modules/classification_threshold.html - 『多変量データの分類』佐藤義治、朝倉書店
https://www.asakura.co.jp/detail.php?book_code=12802 - 『統計的パターン認識と判別分析』栗田多喜夫・日高章理、コロナ社
https://www.coronasha.co.jp/np/isbn/9784339028317/ - 同書の版元ページ
https://www.morikita.co.jp/books/mid/084971
第8章
- 対称マップは行と列の両方を主座標で描いた図で、厳密にはバイプロットではない
https://www.fbbva.es/wp-content/uploads/2017/05/dat/greenacre_ap0C_2010.pdf - 総慣性はカイ二乗統計量を総度数で割ったものに一致する
https://www.fbbva.es/wp-content/uploads/2017/05/dat/greenacre_c08_2010.pdf - 対称マップでは行どうし・列どうしのカイ二乗距離が近似的に表示される
https://www.fbbva.es/wp-content/uploads/2017/05/dat/greenacre_c09_2010.pdf - 多重対応分析は指示行列に対応分析を当てるのが基本の定義
https://www.fbbva.es/wp-content/uploads/2017/05/dat/greenacre_c10_2010.pdf - prince.CA の使い方
https://maxhalford.github.io/prince/ca/ - prince.MCA の使い方
https://maxhalford.github.io/prince/mca/ - MDS は距離の行列だけを入力に低次元へ配置する
https://scikit-learn.org/stable/modules/manifold.html - ストレスの目安
https://scikit-learn.org/stable/modules/generated/sklearn.manifold.MDS.html - クラスカルの原論文は非計量 MDS を扱ったもの
https://doi.org/10.1007/BF02289565 - t-SNE の提案者は van der Maaten と Hinton、2008年 JMLR
https://www.jmlr.org/papers/v9/vandermaaten08a.html - Distill 誌 2016年「How to Use t-SNE Effectively」
https://distill.pub/2016/misread-tsne/ - UMAP は McInnes らが2018年に提案
https://arxiv.org/abs/1802.03426 - 参考書籍『対応分析の理論と実践 基礎・応用・展開』Michael Greenacre 著、藤本一男 訳、オーム社、2020年11月、ISBN 978-4-274-22299-3
https://researchmap.jp/read0095338/books_etc/12407062
第9章
- 林知己夫は1918年生まれ、2002年没
https://www.ism.ac.jp/editsec/toukei/pdf/50-2-111.pdf - 統計数理研究所の英文誌第2巻1950年に質的データの数量化に関する林の論文が載っている
https://doi.org/10.1007/BF02919500 - 同誌第3巻に質的データからの現象の予測と数量化に関する林の論文が載っている、本文では1951年と表記
https://doi.org/10.1007/BF02949778 - 林は個別の手法を「外的基準があり数量で与えられている場合」のように呼んでおり、飽戸弘が「数量化理論第○類」と番号を付けて区別したものが定着したとされる
https://www.nikkei-r.co.jp/service/glossary/quantification-theory - 国立国会図書館サーチで題名に「数量化理論」を含む資料を国立国会図書館の蔵書に限って引くと52件、博士論文35件、図書16件、映像資料1件
https://ndlsearch.ndl.go.jp/api/opensearch?title=%E6%95%B0%E9%87%8F%E5%8C%96%E7%90%86%E8%AB%96&cnt=50&dpid=iss-ndl-opac - 『数量化:理論と方法』(林知己夫、朝倉書店、1993年)
https://ndlsearch.ndl.go.jp/books/R100000002-I000002293110 - 『調査の科学』(林知己夫、筑摩書房、2011年)、ちくま学芸文庫、章構成
https://ndlsearch.ndl.go.jp/books/R100000002-I000011204491 - 『調査の科学』(林知己夫、筑摩書房、2011年)、ちくま学芸文庫、章構成
https://www.chikumashobo.co.jp/product/9784480093691/ - 『数量化理論とテキストマイニング』(内田治、日科技連出版社、2010年)、副題 Excel/R/StatWorks、168ページ
https://ndlsearch.ndl.go.jp/books/R100000002-I000010869054
第10章
- 正準相関分析は Hotelling が1936年に Biometrika 誌に発表した論文で提案した
https://doi.org/10.1093/biomet/28.3-4.321 - 冗長性係数は Stewart と Love が1968年に提案した
https://doi.org/10.1037/h0026143 - PLS 回帰は化学計量学の分野で基本的な道具として発展した
https://doi.org/10.1016/S0169-7439(01 - statsmodels の CanCorr は endog・exog に変数群を渡し、cancorr・x_cancoef・y_cancoef を持ち、corr_test は近似 F 検定を返す
https://www.statsmodels.org/stable/generated/statsmodels.multivariate.cancorr.CanCorr.html - sklearn の CCA は「Mode B の PLS としても知られる」、transform は x_scores と y_scores を返す
https://scikit-learn.org/stable/modules/generated/sklearn.cross_decomposition.CCA.html - PLS は変換した X と変換した Y の共分散が最大になるように両方を低次元に射影する
https://scikit-learn.org/stable/modules/cross_decomposition.html - PLSRegression は目的変数が1つなら PLS1、複数なら PLS2
https://scikit-learn.org/stable/modules/generated/sklearn.cross_decomposition.PLSRegression.html - 書籍:化学者のための多変量解析 ケモメトリックス入門(尾崎幸洋・宇田明史・赤井俊雄、講談社サイエンティフィク、2002年)
https://www.kspub.co.jp/book/detail/1543010.html - 書籍:化学のためのPythonによるデータ解析・機械学習入門 改訂2版(金子弘昌、オーム社、2023年)
https://www.ohmsha.co.jp/book/9784274230929/ - 書籍:化学のためのPythonによるデータ解析・機械学習入門 改訂2版(金子弘昌、オーム社、2023年)
https://datachemeng.com/post-4014/ - 書籍:統計的学習の基礎 データマイニング・推論・予測(Hastie・Tibshirani・Friedman 著、杉山将・井手剛・神嶌敏弘・栗田多喜夫・前田英作 監訳、共立出版、2014年)
https://www.kyoritsu-pub.co.jp/book/b10004471.html
第11章
- CFI・TLI は0.95付近、SRMR は0.08付近、RMSEA は0.06付近が目安(Hu と Bentler、1999年)
https://doi.org/10.1080/10705519909540118 - 目安を合格ラインとして絶対視してはいけない(Marsh・Hau・Wen、2004年)
https://doi.org/10.1207/s15328007sem1103_2 - AIC の定義は対数尤度のマイナス2倍にパラメータ数の2倍を足したもの(Akaike、1974年)
https://doi.org/10.1109/TAC.1974.1100705 - 修正指標に従ったモデル修正は偶然に便乗する問題がある(MacCallum・Roznowski・Necowitz、1992年)
https://doi.org/10.1037/0033-2909.111.3.490 - 同値モデルの問題(MacCallum ほか、1993年)
https://doi.org/10.1037/0033-2909.114.1.185 - semopy のモデル記述は lavaan の記法に強く影響を受けている
https://semopy.com/syntax.html - fit の既定の目的関数は MLW
https://semopy.com/tutorial.html - semopy の論文
https://doi.org/10.1080/10705511.2019.1704289 - ACSI は顧客インタビューを入力とする多方程式の計量経済モデルで、左に原因(顧客期待・知覚品質・知覚価値)、中央に満足、右に結果(苦情、再購入と価格許容度を含むロイヤルティ)を置く因果モデル
https://theacsi.com/company/the-science-of-customer-satisfaction/ - JCSI は顧客期待・知覚品質・知覚価値・顧客満足・推奨意向・ロイヤルティの6指標を定義し、共分散構造分析で各項目間の因果関係をモデル化
https://www.jpc-net.jp/research/jcsi/causal_model/ - JCSI は日本生産性本部のサービス産業生産性協議会が実施
https://www.jpc-net.jp/research/jcsi/ - 『共分散構造分析[R編]:構造方程式モデリング』豊田秀樹編著、東京図書
https://www.tokyo-tosho.co.jp/02180/ - 『共分散構造分析[R編]』が lavaan を使うことの根拠
https://sem-toyoda-lab.w.waseda.jp/backbook/SEM_R.html - Browne と Cudeck の RMSEA の目安(0.05・0.08)
https://doi.org/10.1177/0049124192021002005 - semopy の公式トップページ
https://semopy.com/
第12章
- コンジョイント測定は Luce と Tukey が1964年に数理心理学の学術誌に発表した新しい型の基礎的測定の理論にさかのぼる
https://doi.org/10.1016/0022-2496(64 - Green と Rao が1971年にマーケティング・リサーチの学術誌に判断データを数量化するためのコンジョイント測定を論じた論文を発表した
https://doi.org/10.2307/3149575 - Green と Srinivasan の1978年の総説は、1971年以降コンジョイント分析が消費者研究の幅広い問題に応用されてきたと述べている
https://academic.oup.com/jcr/article/5/2/103/1805825 - 同じ二人は1990年にマーケティングにおける新しい展開を整理した総説を発表した
https://doi.org/10.2307/1251756 - 選択型の設計と分析を集計データに基づいて行う方法は Louviere と Woodworth が1983年に発表した論文で示された
https://doi.org/10.2307/3151440 - 直交表 L9 は NIST のハンドブック 5.3.3.10 に掲載された表をそのまま使った
https://www.itl.nist.gov/div898/handbook/pri/section3/pri33a.htm - statsmodels の Sum コーディングは各水準の平均を全体平均と比べ、Treatment は基準水準との差を表す
https://www.statsmodels.org/stable/contrasts.html - statsmodels の式インターフェースでは文字列の列がカテゴリ変数として扱われ、切片があるので1カテゴリが落とされる
https://www.statsmodels.org/stable/example_formulas.html - 相対重要度は部分効用の幅を百分率にして合計100にしたもの
https://sawtoothsoftware.com/help/lighthouse-studio/manual/interpreting-conjoint-analysis-data.html - 多項ロジットの選択確率は効用の指数を全選択肢の指数の合計で割った値
http://eml.berkeley.edu/books/choice2nd/Ch03_p34-75.pdf - Train の教科書の書誌と章構成(第3章 Logit、第11章 Individual-Level Parameters、第12章 Bayesian Procedures)
https://eml.berkeley.edu/books/choice2.html - 参考書籍『例題とExcel演習で学ぶ多変量解析 回帰分析・判別分析・コンジョイント分析編』(菅民郎、オーム社)
https://ndlsearch.ndl.go.jp/books/R100000002-I027734693 - 参考書籍『例題とExcel演習で学ぶ多変量解析 回帰分析・判別分析・コンジョイント分析編』(菅民郎、オーム社)
https://www.ohmsha.co.jp/book/9784274219658/ - 参考書籍『入門実験計画法』(永田靖、日科技連出版社)
https://ndlsearch.ndl.go.jp/books/R100000002-I000002899501 - 参考書籍『入門実験計画法』(永田靖、日科技連出版社)
https://www.juse-p.co.jp/products/view/40 - 参考書籍『コンジョイント分析 第4版』(君山由良、データ分析研究所)
https://ndlsearch.ndl.go.jp/books/R100000002-I031660145 - 参考書籍『コンジョイント分析 第4版』(君山由良、データ分析研究所)
https://ci.nii.ac.jp/ncid/BB02141773
第13章
- 調整ランド指数は完全に一致すれば1、偶然の一致と同程度なら0付近
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.adjusted_rand_score.html - 対応分析の同時布置図では行の点と列の点の距離をそのまま近さとして読めない
https://arxiv.org/html/2404.17380v1 - 既刊コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」
https://anagraft.com/column/articleID=1007/ - 参考書籍『多変量解析法入門』永田靖・棟近雅彦、サイエンス社、2001年
https://www.saiensu.co.jp/search/?isbn=978-4-7819-0980-6&y=2001 - 参考書籍『分析者のためのデータ解釈学入門 データの本質をとらえる技術』江崎貴裕、ソシム、2020年
https://www.socym.co.jp/book/1290 - 参考書籍『Google流資料作成術』コール・ヌッスバウマー・ナフリック著、村井瑞枝訳、日本実業出版社、2017年
https://www.njg.co.jp/book/9784534054722/
第14章
- カーネル主成分分析は1998年に Neural Computation 誌で発表され、非線形写像で送った特徴空間で主成分分析を行い、カーネル関数だけで固有値問題を解く
https://doi.org/10.1162/089976698300017467 - オートエンコーダの2006年の Science 論文の要旨は、中央に小さな層を置いて入力を復元するよう学習すると低次元符号に変換でき、初期化を工夫すれば深いオートエンコーダが主成分分析よりはるかに良く働く符号を学べると述べている
https://doi.org/10.1126/science.1127647 - オートエンコーダの2006年の Science 論文の要旨は、中央に小さな層を置いて入力を復元するよう学習すると低次元符号に変換でき、初期化を工夫すれば深いオートエンコーダが主成分分析よりはるかに良く働く符号を学べると述べている
https://www.cs.toronto.edu/~hinton/absps/science.pdf - 表現学習の総説は、機械学習アルゴリズムの成功はデータの表現に依存すると述べ、説明的な変動要因を分離して取り出す観点でオートエンコーダ・多様体学習・深いネットワークを整理している
https://arxiv.org/abs/1206.5538 - 1989年の Neural Networks 誌(第2巻第1号、53〜58ページ)の論文の要旨は、線形層のネットワークを二乗誤差で学習させると誤差関数の最小点はただ一つで共分散行列の上位主成分が張る部分空間への射影に対応し、他の臨界点はすべて鞍点だと述べている
https://doi.org/10.1016/0893-6080(89 - 1989年の Neural Networks 誌(第2巻第1号、53〜58ページ)の論文の要旨は、線形層のネットワークを二乗誤差で学習させると誤差関数の最小点はただ一つで共分散行列の上位主成分が張る部分空間への射影に対応し、他の臨界点はすべて鞍点だと述べている
http://www.vision.jhu.edu/teaching/learning/deeplearning19/assets/Baldi_Hornik-89.pdf - 2018年の論文の要旨は、線形活性化と二乗誤差の単層オートエンコーダの重みは主成分負荷ベクトルと同じ部分空間を張るが負荷ベクトルそのものとは一致しないことを、よく知られた事実として述べている
https://arxiv.org/abs/1804.10253 - t-SNE の論文は2008年の Journal of Machine Learning Research 第9巻 2579〜2605ページ
https://jmlr.org/papers/v9/vandermaaten08a.html - scikit-learn の多様体学習ガイドは、MDS が元の距離を近似する低次元表現を探すこと、t-SNE は局所構造に集中して局所的な群を取り出す傾向があり大域構造は明示的に保存されず、主成分分析による初期化で緩和されること、確率的で初期化により結果が変わることを述べている
https://scikit-learn.org/stable/modules/manifold.html - UMAP は2018年に公開され、要旨によればリーマン幾何と代数的位相に基づく枠組みから構成され、可視化品質は t-SNE と競合し、大域構造をより多く保存すると論じられ、実行時間でも優れるとされる
https://arxiv.org/abs/1802.03426 - Distill 誌の2016年の記事は、t-SNE のクラスタの大きさは意味を持たず、クラスタ間の距離は意味を持たないことがあり、ランダムなノイズも perplexity によってはクラスタに見えること、複数の perplexity と複数回の実行で確かめることを勧めている
https://distill.pub/2016/misread-tsne/ - scikit-learn の TSNE リファレンスは、perplexity が最近傍の数に関係し、大きなデータではより大きな値が必要で、5〜50 の間で選ぶことを検討すべきで、値が違うと結果が大きく異なりうると述べている
https://scikit-learn.org/stable/modules/generated/sklearn.manifold.TSNE.html - 2013年の単語ベクトルの論文は、非常に大きなデータから単語の連続ベクトル表現を計算する手法を提案し、品質を単語の類似度タスクで測っている
https://arxiv.org/abs/1301.3781 - scikit-learn のユーザーガイドによれば並べ替え重要度は1つの特徴量の値をランダムに並べ替えたときの性能低下を測る手法で、相関する特徴量では一方を並べ替えてもモデルは他方から情報を得られるため両方の重要度が実際より低く報告される
https://scikit-learn.org/stable/modules/permutation_importance.html - 深層学習の教科書の原著は第14章にオートエンコーダ、第15章に表現学習の章を置き、第14章に復号器が線形で損失が平均二乗誤差なら不完備オートエンコーダは主成分分析と同じ部分空間を張るという記述がある
https://www.deeplearningbook.org/ - 深層学習の教科書の原著は第14章にオートエンコーダ、第15章に表現学習の章を置き、第14章に復号器が線形で損失が平均二乗誤差なら不完備オートエンコーダは主成分分析と同じ部分空間を張るという記述がある
https://www.deeplearningbook.org/contents/autoencoders.html - 『深層学習 改訂第2版』岡谷貴之 著、講談社、機械学習プロフェッショナルシリーズ、2022年
https://www.kspub.co.jp/book/detail/5133323.html - 『Pythonではじめる教師なし学習』Ankur A. Patel 著、中田秀基 訳、オライリー・ジャパン、2020年
https://www.oreilly.co.jp/books/9784873119106/