こんにちは、Anagraftの伊藤です。
今回は、AIガバナンス、つまり組織がAIを開発・提供・利用するときに「どの用途に使ってよいか、誰が決めるか、何を基準にどう確かめるか、問題が起きたらどうするか」を定める仕組みを、どう理解し、どう自社に作るかを整理しました。生成AIが業務に入り込むにつれて、「社員が外部のAIサービスに何を入力してよいのか」「EUのAI規則は自社に関係するのか」「取引先からAIの管理体制を質問されたが、何を答えればよいのか」「AIが出した結果が誤っていたら誰が責任を持つのか」といった問いが、法務や情報システム部門だけでなく、経営と業務の現場にも届くようになりました。本コラムでは、こうした問いに答えるための材料を、用語と責任の整理のあとに、法規制、国の指針、国際的な枠組みと規格、社内の手順と体制の順に並べました。
この題材を選んだ理由は、AIガバナンスが「AIの利用を禁止すること」「法務部門の仕事」「規格の認証を取れば済むこと」と受け取られて、判断が止まったり、形だけの規程が作られたりすることが多いように思うためです。使ってよい範囲が決まっていなければ、現場は使うのをためらうか、許可を取らずに使うかのどちらかになります。誰が承認するかが決まっていなければ、案件ごとに議論がやり直しになります。出力の確かめ方が決まっていなければ、誤りや偏りに気づかないまま判断に使われます。こうした状態で導入を重ねると、導入の停滞、規制違反、権利侵害、誤った判断の放置、信頼の失墜、二重投資という形で損失が出ます。
本コラムでは、EUのAI規則(EU AI Act)、日本のAI推進法とAI事業者ガイドライン、米国の国立標準技術研究所(NIST)のAIリスクマネジメントフレームワーク、AIマネジメントシステムの国際規格であるISO/IEC 42001などについて、条文、公式のページ、規格の目録といった、読者が自分で開いて確かめられる一次情報を根拠にしました。規格の本文は有料のものが多いため、規格については目録とプレビューで公開されている概要の範囲で書いています。条文や指針の文章を長く訳して載せることはせず、要旨を自分の言葉で書き、条番号と出典を添えています。AIのユースケース(用途)のリスク区分を扱う第7章と、AIの公平性の指標を扱う第10章では、架空のサンプルデータに対して実際にPythonのコードを動かし、その結果を載せています。
想定している読者は、AIガバナンスの仕組みづくりを任された方、あるいはそれを決める立場の方です。DX推進の担当者の方、法務やコンプライアンスの担当者の方、情報システム部門の責任者の方、AIの活用を任された業務部門の方、そして「AIのルールを作れ」と言われて何から決めるかを判断しなければならない経営層の方を念頭に置いています。法律やAIの専門家でなくても読めるように、専門用語には平易な補足を添え、各章では「その制度や手順が誰に何を求めているか」「経営はどう判断するか」を意識して書きました。
本コラムは法的な助言ではありません。法令や指針の記述は、2026年10月時点で公式の資料を開いて確認した範囲に限っており、自社の個別の状況に当てはまるかどうかは、弁護士などの専門家に確認していただく前提で書いています。法令や指針、規格は改正されますので、実務で使う際は公式のページで最新の内容をご確認ください。本コラムに出てくる企業名は、その企業が公開した資料を開いて確かめたものに限っています。製品やサービスの料金、制裁金の額、弊社の支援の条件には触れていません。
目的別の入口の目安を挙げておきます。AIガバナンスとは何か、どんなリスクと責任を扱うのかを整理したい場合は第1章、世界の規制と枠組みの全体像は第2章、EUのAI規則は第3章、日本のAI推進法とAI事業者ガイドラインは第4章、NISTの枠組みは第5章、ISO/IEC 42001と関連規格は第6章が中心になります。本コラムで使う用語の定義は「全体の地図」の表にまとめています。
自社の手順を組み立てたい場合は、ユースケースの台帳とリスクの評価は第7章、生成AIの社内利用ルールは第8章、AIの調達と契約は第9章、品質と公平性の評価は第10章、運用中の監視とインシデント対応は第11章が入口になります。社内の規程の作り方は第12章、体制づくりと最初の90日の進め方は第13章、教育と内部監査と見直しの仕組みは第14章で扱っています。AIに使うデータそのものの整え方(品質・来歴・個人情報の扱い)は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱いました。

目次
- 序章 AIガバナンスは誰が何を決める仕組みか
- 全体の地図
- 第1章 AIガバナンスとは何か、リスク・原則・責任の整理
- AIガバナンスの定義、本コラムの定義と国のガイドラインの定義
- AIシステムとは何か、OECD の定義と EU AI Act の定義
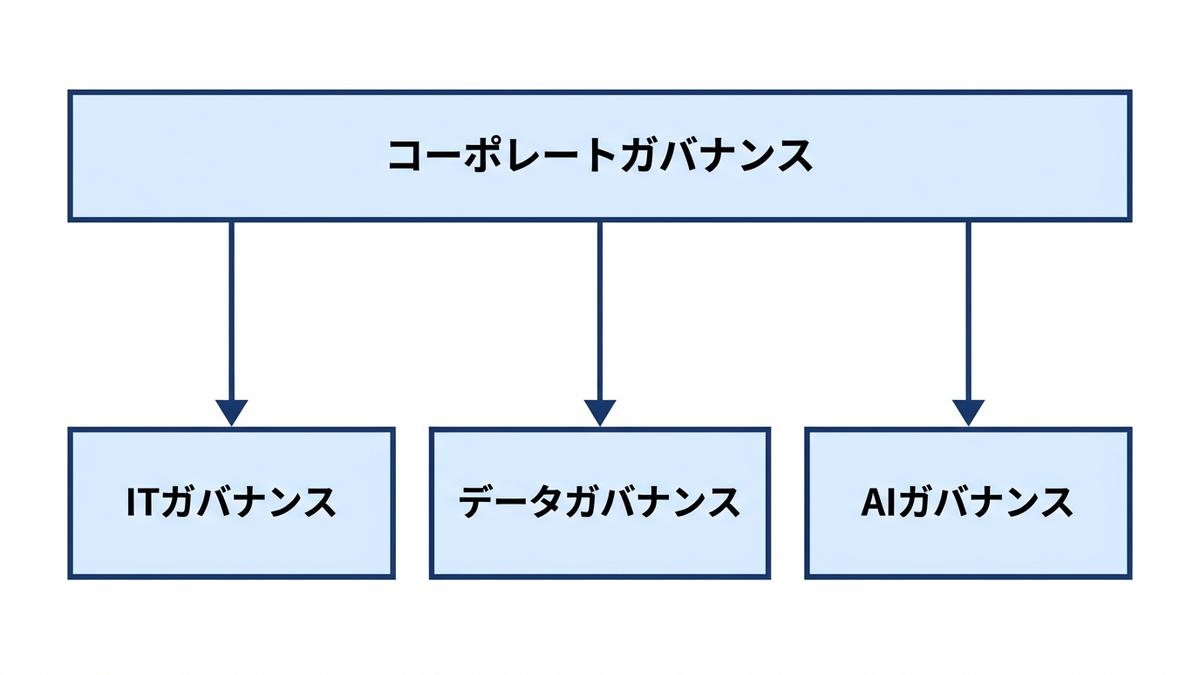
- コーポレートガバナンス・ITガバナンス・データガバナンスとの関係
- ISO/IEC 38507、AIの利用を統治機関がどう治めるかの国際規格
- AIに固有のリスクの型、ガイドラインの整理と本コラムの7つの型
- 原則の系譜、人間中心のAI社会原則・OECD AI原則・AI事業者ガイドライン
- 開発者・提供者・利用者、3つの立場と責任の違い
- よくある誤解、禁止すること・法務だけの仕事・ツールで完了・大企業だけ
- 経営の損失の型、判断を誤ると何を失うか
- 経営判断、最初に「誰が決めるか」を決める
- この章を深めたい方への参考書籍
- 第2章 世界のAI規制と枠組みの見取り図、法律・指針・規格の違い
- 第3章 EU AI Act、リスクの区分と義務と適用の日程
- 第4章 日本のAI推進法とAI事業者ガイドライン、国の指針の読み方
- 第5章 NIST AI RMFと生成AIプロファイル、リスク管理の4つの機能
- 第6章 ISO/IEC 42001とAIマネジメントシステム、関連規格と認証
- 第7章 AIのリスクを洗い出して評価する、ユースケース台帳と影響評価
- 第8章 生成AIの社内利用ルール、入力・出力・権利・個人情報
- 第9章 AIの調達と開発の管理、ベンダー選定と契約で確かめること
- 第10章 AIの品質と公平性を確かめる、テスト・評価・記録
- 第11章 AIの運用監視とインシデント対応、記録・報告・停止の判断
- 第12章 社内ルールの作り方、AI基本方針・利用規程・手順書
- 第13章 AIガバナンスの体制づくり、役割と会議体と最初の90日
- 第14章 定着と見直し、教育・内部監査・情報開示と公開事例
- 終章 AIガバナンスを続けるために
- 本コラムで紹介した書籍一覧
- 第1章 AIガバナンスとは何か、リスク・原則・責任の整理
- 第2章 世界のAI規制と枠組みの見取り図、法律・指針・規格の違い
- 第3章 EU AI Act、リスクの区分と義務と適用の日程
- 第4章 日本のAI推進法とAI事業者ガイドライン、国の指針の読み方
- 第5章 NIST AI RMFと生成AIプロファイル、リスク管理の4つの機能
- 第6章 ISO/IEC 42001とAIマネジメントシステム、関連規格と認証
- 第7章 AIのリスクを洗い出して評価する、ユースケース台帳と影響評価
- 第8章 生成AIの社内利用ルール、入力・出力・権利・個人情報
- 第9章 AIの調達と開発の管理、ベンダー選定と契約で確かめること
- 第10章 AIの品質と公平性を確かめる、テスト・評価・記録
- 第11章 AIの運用監視とインシデント対応、記録・報告・停止の判断
- 第12章 社内ルールの作り方、AI基本方針・利用規程・手順書
- 第13章 AIガバナンスの体制づくり、役割と会議体と最初の90日
- 第14章 定着と見直し、教育・内部監査・情報開示と公開事例
- 参考情報
序章 AIガバナンスは誰が何を決める仕組みか
生成AIを業務に使い始めた組織では、似た問いが別々の部署から上がってくることが多いように思います。例えば、営業部門からは「顧客から受け取った資料を要約させてよいか」、人事部門からは「応募書類の確認にAIを使ってよいか」、開発部門からは「社内のコードを外部のサービスに読ませてよいか」といった相談が考えられます。それぞれの問いに法務部門や情報システム部門が個別に答えていると、答えの基準が案件ごとに少しずつ変わり、同じ種類の利用なのに部署によって許可と不許可が分かれます。問題は個々の答えの正しさではなく、AIの用途をどう区分し、どの区分を誰が承認し、承認したあとに何を確かめるかが決まっていないことにあります。本コラムの主題であるAIガバナンスとは、組織がAIを開発・提供・利用するときに、「どの用途に使ってよいか・誰が決めるか・何を基準にどう確かめるか・問題が起きたらどうするか」を定める仕組みのことです。
AIガバナンスという言葉は、AIの利用を禁止したり制限したりすること、法務部門の仕事、規格の認証を取れば済むこと、AIを自社で開発している大企業だけに必要なこと、と受け取られることが多いように思います。本コラムでは、これらはいずれも誤解だと考えています。AIガバナンスの中心は意思決定の仕組みであり、その役割にはリスクを抑えることと同じ重さで、使ってよい範囲をはっきりさせて活用を進めることが含まれます。外部のAIサービスを利用するだけの組織でも、何を入力してよいか、出力をどう確かめるかを決める必要があります。規格の認証は、仕組みを回していることを外部に示す手段の1つであって、仕組みを作ること自体の代わりにはなりません。
技術だけでなく、使い道の判断の問題
AIのリスクは、モデルの精度や性能の問題として語られることが多くあります。しかし、同じ文章生成のAIでも、社内の会議の議事録の下書きに使う場合と、顧客への回答をそのまま送る場合と、採用の合否の判断の材料に使う場合とでは、誤りが起きたときの影響の大きさがまったく違います。リスクの大きさは、モデルの性能だけでなく、どの用途に、どの程度の人の確認を挟んで使うかという判断によって大きく変わります。EUのAI規則(EU AI Act)が、AIシステムについては用途や使われ方に応じてリスクの水準を分けて義務を定め、それとは別に、幅広い用途に使われる汎用目的AIモデルにも義務を定めているのも、日本のAI事業者ガイドラインがAIの開発者・提供者・利用者という立場ごとに取り組みを整理しているのも、技術と使い道の両面から判断するという考え方に沿ったものと読めます(それぞれ第3章と第4章で原文に当たります)。
この見方をとると、AIガバナンスで最初に整えるものが見えてきます。1つ目は、自社がAIをどこで何に使っているかの一覧です。本コラムではこれをユースケース台帳と呼び、第7章で作り方を扱います。2つ目は、用途ごとのリスクの区分と、区分ごとの承認の経路です。3つ目は、承認したあとに出力の誤りや偏りをどう確かめ、問題が起きたら誰が止めるかの取り決めです。この3つは、経営が責任者・委員会・事務局を決めたあとに作るもので、3つ目の取り決めは AI利用規程の初版(第12章)に書き込む形で整えます。法規制や国際的な枠組みは、この3つをどの水準で整えるべきかの基準を与えるものであり、3つの代わりになるものではありません。
AIガバナンスが答える4つの問い
AIガバナンスの仕組みは、次の4つの問いに答えられる状態を作ることだと整理できます。第1に、どの用途に使ってよいか。用途をリスクの大きさで区分します。本コラムでは「禁止・高・中・低」の4段階に分け、禁止の区分は承認の対象にせず、高・中・低の区分ごとに承認する人と確かめる深さを変えます(第7章)。第2に、誰が決めるか。区分ごとに、承認する人、運用の責任を持つ人、技術的な管理を担う人を決め、部門をまたぐ判断や例外の承認を行う会議体を置きます。第3に、何を基準にどう確かめるか。性能、公平性、安全性、権利の扱い、個人情報の扱いについて、導入前に何を評価し、運用中に何を見続けるかを決めます。第4に、問題が起きたらどうするか。誤った出力や権利の侵害が起きたときに、誰に報告し、誰がAIの利用を止め、誰が外部に説明するかを決めておきます。
この4つの問いに対する答えを文書にしたものが、社内の規程です。本コラムでは、経営が承認する原則を記したAI基本方針、守るべき規則を記したAI利用規程、具体的な作業を記した手順書の3つの層に分けて考え、第12章で目次の雛形まで示します。答えを日々の運用に載せる仕組みが、体制です。委員会と役割の置き方、最初の90日の進め方は第13章で扱います。
決めないことで出る損失の型
AIガバナンスに着手しない、あるいは形だけ作って運用しないときの損失は、金額ではなく型で捉えると見えやすくなります。本コラムでは、次の6つの型に整理しました(本コラム独自の整理で、各章でも同じ6つを使います)。第1の型は導入の停滞です。使ってよい範囲と承認の経路が決まっていないために、現場がAIの利用をためらい、効果が見込める用途でも導入が進みません。第2の型は規制違反です。EUの市場に関わる事業で自社のAIがEU AI Actのどの区分に当たるか(第3章)を確かめていない場合や、個人情報の扱いを判断する人が決まっていない場合には、法令の求めと現場の運用が食い違っても気づきにくくなります。第3の型は権利侵害です。著作物、個人情報、営業秘密を、扱いを決めないまま入力したり出力を使ったりすると、他者や自社の権利を損なうおそれがあります。第4の型は誤った判断の放置です。AIの出力の誤りや偏りを確かめる手順が無いと、誤りに気づかないまま判断や顧客対応に使われ続けます。第5の型は信頼の失墜です。問題が起きたときに説明できる記録と体制が無いと、顧客や取引先、従業員からの信頼を失います。第6の型は二重投資です。部門ごとに規程を作り、審査や契約の確認の手順を別々に設けるため、同じ確認を何度も繰り返します。
どの損失が自社で目立っているかを見れば、どこから着手するかの見当が付きます。導入の停滞が目立つなら、用途の区分と承認の経路を先に決めます。権利侵害や規制違反の懸念が強いなら、入力してよい情報の区分と、自社のAIの用途がどの制度に関係するかの棚卸しを先に行います。誤った判断の放置が心配なら、評価と運用監視の手順を先に整えます。すべての仕組みを一度に完成させる必要はなく、完成させようとすべきでもない、というのが本コラムの立場です。
体制づくりは、台帳と承認の経路から始める
本コラムを通じてお伝えしたいことが一つあります。AIガバナンスの体制づくりで最初に決めるべきことは、規程の文言でも規格の認証でもなく、自社がAIをどこで何に使っているかを一覧にし、用途をリスクの大きさで区分して、区分ごとに誰が承認するかを決めることであり、そのうえで規程を小さく作り、評価と監視を回しながら見直し続けることだということです。必要な情報を記録し、最新の状態に保った台帳があれば、規制が改正されたときに影響を受ける可能性のある用途を絞り込みやすくなります。承認の経路が決まれば、現場は「誰に聞けばよいか」で迷いにくくなります。評価と監視を回せば、誤りや偏りに気づきやすくなります。見直しを続ければ、制度の変化とAIの技術の変化に合わせて仕組みを更新する足場ができます。ここでいう「最初」は、経営がAIガバナンスに取り組むと決めたあとの段階を指します。経営はまず、最終的な責任を負うAIガバナンス責任者、部門をまたぐ判断を行うAIガバナンス委員会、台帳と申請を取りまとめる事務局の3点を決めます(第1章・第13章)。台帳と承認の経路は、その3点の次に、文書や認証より先に作るもの、という意味です。
本コラムは、次の4つの流れで進みます。
- 理解と用語の整理:AIガバナンスの定義、AIに固有のリスクと原則、開発者・提供者・利用者という立場ごとの責任をそろえます(第1章)。
- 制度と枠組み:世界の規制の見取り図、EUのAI規則、日本のAI推進法とAI事業者ガイドライン、NISTの枠組み、ISO/IEC 42001と関連規格を、誰に何を求めているかという観点で読みます(第2章から第6章)。
- リスク管理の手順:ユースケース台帳とリスクの評価、生成AIの社内利用ルール、調達と契約、品質と公平性の評価、運用中の監視とインシデント対応を、自社の業務手順に具体化します(第7章から第11章)。
- 社内ルールと体制と定着:規程の作り方、体制づくりと最初の90日、教育と内部監査と見直しの仕組みを組み立てます(第12章から第14章)。
経営判断に関わる方にとって、この点はAIへの投資の進め方に直結します。新しいAIの導入に予算を付ける前に、その用途が台帳に載っているか、リスクの区分と承認者が決まっているか、出力をどう確かめるかが決まっているかを確かめる順序であれば、投資の前提を社内外に説明でき、導入後に問題が起きても早く対処できます。反対に、ツールの導入を先に進め、用途の区分と承認の経路を後回しにすると、どの部署が何にAIを使っているかを把握しにくくなり、規制の改正や取引先からの質問のたびに、追加の全社調査が必要になるおそれがあります。本コラムの各章は、その順序を自社で組み立てるための材料として書いています。
Anagraftでは、AI活用の構想づくりから、AIガバナンスの体制設計、ユースケースの洗い出しとリスクの評価、社内ルールの整備、AIの評価と運用の仕組みづくり、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。第1章で、AIガバナンスの定義、AIに固有のリスクの型、原則の系譜、開発者・提供者・利用者という立場ごとの責任を整理します。第2章から第6章では、制度と枠組みを読みます。世界の規制の見取り図と、法律・指針・規格という拘束力の違う3種類の区別を第2章で、EUのAI規則を第3章で、日本のAI推進法と人工知能基本計画とAI事業者ガイドラインを第4章で、米国の国立標準技術研究所(NIST)のAIリスクマネジメントフレームワークを第5章で、AIマネジメントシステムの国際規格ISO/IEC 42001と関連規格を第6章で扱います。
第7章から第11章では、リスク管理の考え方を自社の業務手順に具体化します。ユースケース台帳とリスクの評価を第7章で、生成AIの社内利用ルールを第8章で、AIの調達と開発の管理を第9章で、品質と公平性の評価を第10章で、運用中の監視とインシデント対応を第11章で扱います。第12章で社内の規程の作り方を、第13章で体制づくりと最初の90日の進め方を、第14章で教育と内部監査と見直しの仕組み、公開された取り組みを扱います。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | AIガバナンスとは何か、リスク・原則・責任の整理 | AIガバナンスは何を決める仕組みか。AIに固有のリスクは何か。立場によって責任はどう変わるか |
| 第2章 | 世界のAI規制と枠組みの見取り図、法律・指針・規格の違い | どの地域にどんな制度があり、拘束力はどう違うのか。自社に掛かる制度をどう見分けるか |
| 第3章 | EU AI Act、リスクの区分と義務と適用の日程 | EUのAI規則は誰に何を求め、いつから適用されるのか。日本企業は何から確かめるか |
| 第4章 | 日本のAI推進法とAI事業者ガイドライン、国の指針の読み方 | 日本の法律と指針は何を求めているのか。ガイドラインを自社の手順にどう落とすか |
| 第5章 | NIST AI RMFと生成AIプロファイル、リスク管理の4つの機能 | NISTの枠組みはどう組み立てられ、生成AIのリスクをどう整理しているのか。どう使うか |
| 第6章 | ISO/IEC 42001とAIマネジメントシステム、関連規格と認証 | AIマネジメントシステムの規格は何を求めるのか。関連規格はどう分担し、認証をどう考えるか |
| 第7章 | AIのリスクを洗い出して評価する、ユースケース台帳と影響評価 | 自社のAIの用途をどう一覧にし、どう区分し、影響をどう評価するか |
| 第8章 | 生成AIの社内利用ルール、入力・出力・権利・個人情報 | 社員が生成AIを使うとき、何を入力してよく、出力をどう確かめ、権利と個人情報をどう扱うか |
| 第9章 | AIの調達と開発の管理、ベンダー選定と契約で確かめること | AIを作るか買うかで責任はどう残るか。ベンダーと契約で何を確かめるか |
| 第10章 | AIの品質と公平性を確かめる、テスト・評価・記録 | 導入前に何を評価し、公平性をどの指標で測り、結果をどう記録して誰が承認するか |
| 第11章 | AIの運用監視とインシデント対応、記録・報告・停止の判断 | 運用中に何を見続け、問題が起きたら誰に報告し、誰が止めるのか |
| 第12章 | 社内ルールの作り方、AI基本方針・利用規程・手順書 | 規程をどの階層に分け、何を書き、既存の規程とどう整理するか |
| 第13章 | AIガバナンスの体制づくり、役割と会議体と最初の90日 | 誰を任命し、どの会議体で決め、最初の90日から1年をどう進めるか |
| 第14章 | 定着と見直し、教育・内部監査・情報開示と公開事例 | 作った仕組みをどう定着させ、どう監査し、どう見直し、どう外部に示すか。AIエージェントのような新しい使い方を見直しにどう組み込むか |
本コラムで使う用語は、次の表の意味に固定しています。法令や指針がそれぞれ独自の定義を持つ用語(AIシステムなど)は、各章でその制度の原文に当たり、本コラムの定義との違いを示します。
| 用語 | 本コラムでの意味 | 主に扱う章 |
|---|---|---|
| AIガバナンス | 組織がAIを開発・提供・利用するときに、どの用途に使ってよいか、誰が決めるか、何を基準にどう確かめるか、問題が起きたらどうするかを定める仕組み。リスクを抑えるだけでなく、使ってよい範囲を明確にして活用を進める役割も持つ | 序章・第1章 |
| AIシステム | 受け取った入力から、予測・推奨・判断・コンテンツなどの出力をどのように生成するかを推論し、ある程度の自律性をもって動く機械ベースのシステム。決められた規則どおりに処理するだけの仕組みとの違いは、この推論の要素にある。法令上の定義と対象の判定は各制度の原文に当たる(第1章・第3章) | 第1章・第3章 |
| 開発者・提供者・利用者 | AI事業者ガイドラインの3つの立場(AI開発者・AI提供者・AI利用者)。EUのAI規則の提供者(provider)・導入者(deployer)とは対応が一対一ではないため、EUの語は「EU AI Actの提供者」「EU AI Actの導入者」と書き分ける。EU AI Actを扱う章・節・表では、その冒頭で一度書き分ければ、その範囲の中では「提供者」「導入者」と略す | 第1章・第3章・第4章 |
| ユースケース | AIを使う個別の用途。問い合わせの一次回答、書類の要約、需要の予測など。AIガバナンスの管理の単位 | 第7章 |
| ユースケース台帳 | 自社のユースケースを、用途・部門・立場(開発・提供・利用)・使うAI・入力するデータ・出力の使われ方・人の関与・EUとの関係・リスク区分・承認者・見直し日などの列で一覧にしたもの。EU AI Actの禁止の行為に当たる可能性の確認は「EUとの関係」の列の中で行う | 第7章 |
| リスク区分(本コラムの区分) | 自社のユースケースを「禁止・高・中・低」の4段階に分ける社内の区分。EUのAI規則のリスクの4つの水準とは別物。禁止は承認の対象にせず、低は業務部門の責任者、中は事務局の責任者、高はAIガバナンス委員会が承認する | 第7章・第13章 |
| 影響評価 | あるユースケースが、誰に、どのような害を、どの程度の起こりやすさと重大さで及ぼしうるかを評価し、緩和策と残るリスクを記録すること | 第6章・第7章 |
| AI基本方針・AI利用規程・手順書 | 基本方針は経営が承認する原則(なぜ・何を)、利用規程は守るべき規則(何をしてよい・いけない)、手順書は具体的な作業(どうやって) | 第12章 |
| AIガバナンス責任者 | AIガバナンスについて最終的な責任を負う役員。経営が任命し、基本方針や規程の案を経営に上申する | 第13章 |
| AIガバナンス委員会 | 部門をまたぐAIの判断(高リスク区分の承認・例外の承認・規程の審議)を行う会議体 | 第13章 |
| 事務局(AIガバナンスの事務局) | 台帳の管理、申請の受付、区分の一次判定の取りまとめ、委員会の運営を担う実務の窓口。承認はしないが、区分「中」の利用開始に限って事務局の責任者が承認する | 第13章 |
| AIインシデント | AIの開発・提供・利用(入力を含む)に関連して、情報漏えい・権利侵害・誤った判断・安全上の問題・信頼の失墜などの被害が起きた、または起きかけた事象 | 第11章 |
| 生成AI | 文章・画像・音声・コードなどを生成するAI。外部のサービスとして使う場合と、自社の仕組みに組み込む場合を区別する | 第8章・第9章 |
| 法律・指針・規格 | 法律は守る義務があり違反に制裁がありうるもの(ハードロー)、指針は拘束力を持たないが取り組みの考え方を示すもの(ソフトロー)、規格は合意された仕様で、認証の基準として使われるものがある | 第2章 |
損失の型は、序章で挙げた6つ(導入の停滞・規制違反・権利侵害・誤った判断の放置・信頼の失墜・二重投資)を各章で共通に使います。法令や規格の正式な名称、番号と年は、その制度を詳しく扱う章の初出で示し、以降は略称で呼びます(EUのAI規則はEU AI Act、人工知能関連技術の研究開発及び活用の推進に関する法律はAI推進法、NISTのAIリスクマネジメントフレームワークはNIST AI RMF)。
第1章 AIガバナンスとは何か、リスク・原則・責任の整理
この章では、本コラム全体の土台になる言葉と考え方をそろえます。AIガバナンスとは何を指すのか、その対象になる AIシステムとは何か、コーポレートガバナンスや IT ガバナンス、データガバナンスとはどういう関係にあるのか。AIに固有のリスクにはどのような型があり、国内外の原則はそれに対して何を求めてきたのか。そして、AIを作る側・組み込んで提供する側・業務で使う側という立場によって、負う責任がどう変わるのか。これらを順に整理し、最後に、経営が最初に決めるべきことを述べます。
この章で引く公的な資料は、2026年10月28日に内容を確かめました。規格については、本文ではなく、ISO の目録に掲載された概要の範囲で確かめています。総務省・経済産業省の「AI事業者ガイドライン」は、その時点で最新の第1.2版(2026年3月31日)を見ています。EU の AI規則(EU 規則 2024/1689、以下 EU AI Act)の条文は、欧州委員会の AI Act Service Desk が掲載している、2026年7月27日時点の統合版に基づく本文で確かめました。各制度の義務の中身や適用の日程は第2章以降で扱い、この章では定義と考え方の整理にとどめます。
AIガバナンスの定義、本コラムの定義と国のガイドラインの定義
本コラムでは、AIガバナンスを次の意味で使います。組織が AIを開発・提供・利用するときに、どの用途に使ってよいか、誰が決めるか、何を基準にどう確かめるか、問題が起きたらどうするか、を定める仕組みです。現場の作業そのものではなく、作業の前提になる判断を誰がどの基準で下すかを決める、意思決定の層にあたります。また、リスクを抑えるためだけの仕組みではなく、使ってよい範囲をはっきりさせることで、現場が迷わずに活用を進められるようにする役割も持つと考えています。
国の資料にも定義があります。AI事業者ガイドライン(第1.2版)の本編は、第1部の「関連する用語」で AIガバナンスを定義しています。その着眼点は、リスクをステークホルダー(AIの活用によって直接・間接に影響を受ける可能性がある主体)にとって受容可能な水準で管理することと、AIがもたらす便益を最大化することを両方とも目的に置き、そのための技術・組織・社会の仕組みを設計し運用することにあります。正確な文言は本編の原文で確かめられます。
二つの定義は、向いている方向が同じです。どちらも、リスクを抑えることと活用を進めることを両方とも目的に含めています。違いは視点の置き場所にあります。ガイドラインの定義は、社会全体の中で技術・組織・社会の仕組みをどう設計し運用するかという広い視点で書かれています。本コラムの定義は、一つの組織の中で誰が何を決めるかという、社内の意思決定に焦点を絞っています。本コラムは企業の経営と実務の担当者に向けて書いているので、社内で決めるべきことが見える形の定義を採りました。
同じガイドラインは、本編第2部の「E. AIガバナンスの構築」で、事前にルールや手続を固定した AIガバナンスではなく、「環境・リスク分析」「ゴール設定」「システムデザイン」「運用」「評価」というサイクルを継続的かつ高速に回す「アジャイル・ガバナンス」の実践が重要だとしています。そのうえで、まず AIシステム・サービスがもたらしうる便益とリスクを踏まえた環境・リスク分析を行い、開発・提供・利用するか否かを判断し、利用する場合には AIガバナンスに関するポリシーの策定などを通じてゴールを設定する、という順序を示しています。このゴールは、各主体の存在意義や理念・ビジョンといった経営上のゴールと整合するように設定する、と書かれています。AIガバナンスを経営から切り離した技術の管理として扱わず、経営の目標と結びつけて考えることを、国のガイドラインも求めているということです。
もう一つ、ガイドラインの同じ節には、経営層の責任は大きく、AIガバナンスの構築を単なるコストと捉えるのではなく、持続的成長と中長期的な発展を志向した先行投資として捉えることが重要だ、という記述があります。本コラムが各章で経営判断の段落を置いているのは、この考え方に沿うものです。なお、AI事業者ガイドラインは、本編の「はじめに」で自らを非拘束的なソフトローと位置づけています。法律のように守らなければ罰せられる規則ではありません。拘束力の違いは第2章で、ガイドラインの全体の構成は第4章で詳しく扱います。
AIシステムとは何か、OECD の定義と EU AI Act の定義
AIガバナンスの対象になるのは、AIという技術一般ではなく、組織の中で実際に動く個々の仕組みです。本コラムでは、その仕組みをAIシステムと呼び、受け取った入力から、予測・推奨・判断・コンテンツなどの出力をどのように生成するかを推論し、ある程度の自律性をもって動く機械ベースのシステム、という意味で使います。決められた規則どおりに処理するだけの仕組みとの違いは、この推論の要素にあります。これは本コラムの中での呼び方で、法令上の定義そのものではありません。どの仕組みが法令上の AIシステムにあたるかは、それぞれの制度の原文に当たって確かめる必要があります。ここでは、国際的によく参照される二つの定義を原文で確かめ、違いを整理します。
一つ目は、経済協力開発機構(OECD)の「人工知能に関する理事会勧告」(OECD/LEGAL/0449)の定義です。この勧告は2019年に採択され、2023年に AIシステムの定義が、2024年に勧告全体が改訂されています(採択と改訂の日付は、後の節の原則の表に載せました)。現行の定義は2つの文からなります。第1文の着眼点は、目的に沿って、受け取った入力から予測・コンテンツ・推奨・決定などの出力の生成のしかたを推論する、機械ベースのシステムであることです。第2文は、導入後の自律性と適応性の水準が AIシステムによって異なることを述べています。
勧告の背景の説明によると、2023年の定義の改訂では、AIシステムの目的が明示的な場合も暗黙的な場合もありうることを明確にすること、入力が人間からも機械からも与えられうることを強調すること、勧告が「コンテンツ」を生成する生成 AIのシステムにも当てはまることを明確にすること、「現実の」環境という語を「物理的な」環境に置き換えること、一部の AIシステムが設計と導入の後も変化し続けうることを反映すること、が狙いとして挙げられています。生成 AIが勧告の対象に含まれることを、出力の例に「コンテンツ」を明記する形で示したことになります。同じ文書の巻末の説明では、OECD の理事会勧告は法的な拘束力を持たないものと位置づけられています。
二つ目は、EU AI Act 第3条第1号の定義です。AI Act Service Desk に掲載された本文を見ると、入力から出力の生成のしかたを推論する機械ベースのシステムという要素は OECD の定義とほぼ同じで、OECD とよく似た文言で書かれています。
二つを並べると、違いは自律性と適応性の書き方にあります。OECD の定義は、第1文で推論の要素を述べ、第2文で自律性と適応性の水準がシステムによって異なることを説明しています。EU AI Act の定義は、さまざまな水準の自律性で動作するように設計されていることと、導入後に適応性を示しうることを、一つの文の中に書いています。この書き方の違いだけから、どちらの対象が広いか狭いかを読み取ることはできません。ある仕組みが EU AI Act の対象になるかどうかは、条文と欧州委員会の説明に当たって個別に確かめることになります。欧州委員会は、2025年2月に AIシステムの定義に関するガイドラインを公表し、ある仕組みが AIシステムにあたるかを、EU AI Act の提供者(provider)が判断する助けとしています。このガイドラインは拘束力を持たないとされています。
日本の AI事業者ガイドラインは、また別の書き方をしています。第1.2版の本編は、AIについて現時点で確立された定義はないとしたうえで、AIシステムを、活用の過程を通じてさまざまなレベルの自律性をもって動作し学習する機能を有するソフトウェアを要素として含むシステム(機械、ロボット、クラウドシステム等)としています。あわせて、参考として JIS X 22989(2023年)に基づく定義と、OECD の定義を併記しています。次の表は、三つの定義の要素を本コラムの言葉で並べたものです。
| 比べる点 | OECD の理事会勧告(2023年の改訂後) | EU AI Act 第3条第1号 | AI事業者ガイドライン(第1.2版) |
|---|---|---|---|
| 文書の性格 | 加盟国などへの勧告。法的な拘束力はない | EU の規則。規制の対象を分ける定義 | 非拘束的なソフトロー。本ガイドラインの中での定義 |
| 中心になる要素 | 目的のために、入力から出力の生成のしかたを推論する機械ベースのシステム | OECD とほぼ同じ文言。入力から出力の生成のしかたを推論する機械ベースのシステム | 自律性をもって動作し学習する機能を有するソフトウェアを要素として含むシステム |
| 出力の例 | 予測・コンテンツ・推奨・決定 | 予測・コンテンツ・推奨・決定 | 本体には出力の例を書かず、参考に併記した定義で例を示す |
| 自律性 | 定義の第2文で、水準がシステムによって異なると説明する | さまざまな水準の自律性で動作するように設計されていることを、定義の一つの文の中に書く | さまざまなレベルの自律性をもって動作することを定義に含める |
| 適応性・学習 | 定義の第2文で、導入後の適応性の水準がシステムによって異なると説明する | 導入後に適応性を「示しうる」と、同じ文の中に書く | 学習する機能を有することを定義に含める |
| 生成 AIの扱い | 2023年の改訂で、出力に「コンテンツ」を含めて明確にした | 出力に「コンテンツ」を含む | 生成 AIを別の用語として定義している |
表から読み取れるのは、どの定義も「入力を受けて、何らかの自律性をもって出力を生成する仕組み」という骨格を共有していることです。一方で、細部の書き方は文書ごとに異なり、とくに法令の定義は対象を分ける線として厳密に読まれます。社内で AIの利用を管理するときには、法令上の定義に当たるかどうかとは別に、自社としてどこまでを管理の対象にするかを決める必要があります。本コラムでは、管理の対象を広めに取り、生成 AIのサービスを業務で使う場合も、既存の業務システムに組み込まれた予測の機能も、AIシステムとして扱う考え方を採ります。法令上の定義に当たるかどうかの判断は、EU AI Act については第3章、日本の制度については第4章で扱います。
コーポレートガバナンス・ITガバナンス・データガバナンスとの関係
「ガバナンス」という語は、AIのほかにもさまざまな対象に付けて使われます。社内で AIガバナンスの話を始めると、「コーポレートガバナンスとは何が違うのか」「IT ガバナンスやデータガバナンスの一部ではないのか」という問いがよく出ます。ここでは、本コラムでの整理を示します。いずれの語も、立場や文書によって定義の幅があるので、以下は本コラムの中での使い分けです。
本コラムでは、コーポレートガバナンスを、会社が株主をはじめとする利害関係者の立場を踏まえて意思決定を行い、その経営を監督する仕組み全体、という意味で使います。取締役会がどう経営を監督するか、経営がどう説明責任を果たすかが中心の問いです。IT ガバナンス、データガバナンス、AIガバナンスは、いずれもこの大きな仕組みの中に置かれ、特定の対象について「誰が決めるか・何を基準にするか」を定めるものと考えています。上位の仕組みが無いところに下位の仕組みだけを作ると、決めた内容を経営として承認し監督する経路が無くなります。
IT ガバナンスは、情報システムへの投資や運用について、経営の目標に沿って判断し、監督する仕組みです。データガバナンスは、データの定義・品質・持ち主・利用の可否を決める仕組みで、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で詳しく扱いました。AIガバナンスは、AIをどの用途に使ってよいかと、その出力をどう扱うかを決める仕組みです。AIは情報システムの一種なので IT ガバナンスと重なり、機械学習を用いる AIは学習データと入力データの影響を受けるので、データガバナンスとも重なります。なお、AI事業者ガイドラインは、機械学習を行わずに専門家の知識に基づいて推論するエキスパートシステムも AIとみなす考えがあることに触れており、すべての AIがデータから学習するわけではありません。
それでも AIガバナンスを別に考える理由は、AIに固有の判断があるからです。従来の情報システムでも、入力データや要件の誤りによって出力が誤ることはあります。機械学習を用いる AIでは、それに加えて、学習データや利用環境の影響で出力が変わり、ガイドラインの別添が「一貫性のない出力」として挙げるように、同じ基準で運用していても場面によって異なる出力を返すことがあります。そのため、プログラムだけでなく、学習データや利用環境の影響も含めて評価する必要があります。そのため、「この用途に使ってよいか」「出力をどこまで人が確かめるか」「偏りや誤りに気づいたら誰が止めるか」という、用途ごとの判断が新たに要ります。IT ガバナンスが情報システムへの投資と運用を、データガバナンスがデータを扱うのに対して、AIガバナンスは用途と出力の扱いを主に扱う、と整理すると分担が見えやすくなります。
| 仕組み | 主な対象 | 中心になる問い | 本コラムで扱う場所 |
|---|---|---|---|
| コーポレートガバナンス | 会社の意思決定全体 | 取締役会がどう経営を監督し、経営がどう説明責任を果たすか | AIガバナンスを承認・監督する上位の仕組みとして、第13章で触れる |
| IT ガバナンス | 情報システムへの投資と運用 | 経営の目標に沿った投資か、運用は適切か | 調達と開発の管理(第9章)で重なる部分を扱う |
| データガバナンス | データの定義・品質・持ち主・利用の可否 | どのデータを誰が決め、どう使ってよいか | 弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』。本コラムでは学習データとの接続を第10章で扱う |
| AIガバナンス | AIの用途と出力の扱い | どの用途に使ってよいか、誰が決めるか、何を基準にどう確かめるか、問題が起きたらどうするか | 本コラム全体 |
表のとおり、AIガバナンスは上の三つと重なる部分を持ちながら、用途と出力の扱いという固有の領域を持ちます。実務では、三つの仕組みをすでに持っている会社が多いと思われます。その場合、AIガバナンスを一から別に作るのではなく、既存の会議体や規程に AIに固有の判断を足す形で始める方が、二重の手続きを生みにくいと考えています。既存の仕組みに載せる型と新しく作る型の比較は、第13章で扱います。
ISO/IEC 38507、AIの利用を統治機関がどう治めるかの国際規格
AIガバナンスを経営の層の仕事として位置づける国際規格に、ISO/IEC 38507があります。ISO の目録によると、この規格は2022年4月に発行された第1版で、国際標準化機構(ISO)と国際電気標準会議(IEC)の合同技術委員会の、AIを担当する分科委員会(JTC 1/SC 42)が所管しています。英語の題名は、IT のガバナンスの規格群に属することを示す語で始まり、組織による AIの利用がガバナンスにもたらす含意を扱う、という内容です。目録の状態は「発行済み」でした。規格の本文は有料で公開されているため、本コラムでは本文ではなく、ISO の目録に掲載された概要の範囲で確かめた内容だけを書きます。
目録に掲載された概要によると、この規格は、組織の統治機関(取締役会などの、組織を方向づけ監督する機関)の構成員に向けて、組織の中で AIの利用を可能にし、統治するための手引きを示すものです。目的は、組織の中での AIの利用が、効果的で、効率的で、受け入れられるものであるようにすることだとされています。手引きの対象として、統治機関のほかに、経営幹部、法務や会計などの外部の専門家や業界団体、公的機関と政策立案者、社内外のサービス提供者、評価者と監査人も挙げられています。また、公的か民間かを問わず、規模を問わず、データや情報技術への依存の度合いにかかわらず、あらゆる組織に適用できるとされています。
この規格が本コラムにとって大事なのは、AIの利用を、情報システム部門や現場に任せる技術の問題としてではなく、統治機関が方向を決めて監督する事柄として扱っている点です。本コラムが「最初に誰が決めるかを決める」ことを強調するのも、同じ考え方に立っています。なお、規格本文の箇条の構成や個々の要求の中身は、目録の概要の範囲を超えるので、本コラムでは書いていません。AIのマネジメントシステムの規格である ISO/IEC 42001 との違いや、関連する規格の一覧は第6章で扱います。ISO/IEC 38507 は、目録の概要のとおり統治機関に向けた手引きであり、組織の中で AIを管理する仕組みを作って回す側の規格とは、想定する読み手と役割が異なります。
AIに固有のリスクの型、ガイドラインの整理と本コラムの7つの型
AIガバナンスが何を管理するのかを具体的にするには、AIに固有のリスクを型に分けて押さえておくのが近道です。AI事業者ガイドライン(第1.2版)の別添は、別添1の「AIによる便益/リスク」の中で、AIによるリスクの例を見出しごとに挙げています。本コラムで見出しを数えると21あります。次の一覧は、ガイドラインの見出しを掲載順に並べたものです。一覧の語のうち、ハルシネーションは生成 AIが事実と異なることをもっともらしく出力すること、データ汚染攻撃は学習データに不正なデータを混ぜて性能の劣化や誤った分類を招く攻撃、フィルターバブルは自分の見たい情報ばかりが優先して表示され、ほかの情報から隔てられた状態を指します。
- データ汚染攻撃等の AIシステムへの攻撃
- バイアスのある出力・一貫性のない出力等
- ハルシネーション等による誤った出力
- ブラックボックス化・判断に関する説明の不足
- 個人情報の不適切な取扱い等
- 生命等に関わる事故の発生
- 差別的出力
- 過度な依存
- 悪用
- 知的財産権等の侵害
- 金銭的損失
- 機密情報の流出
- 労働者の失業
- データや利益の集中
- 資格等の侵害
- 偽・誤情報等の流通・拡散
- 民主主義への悪影響
- フィルターバブル及びエコーチェンバー現象
- 多様性・包摂性の喪失
- バイアス等の再生成
- エネルギー使用量及び環境の負荷
この一覧について、ガイドラインはいくつかの限定を付けています。取り上げたリスクは代表的なもので AIのリスクを網羅したものではなく、想定に基づく事案も含むこと。リスクの存在を理由に、直ちに AIの開発・提供・利用を妨げるものではないこと。リスクには事業者に生じる不利益だけでなく、ステークホルダーや社会全体に生じるものも含まれること。事業者単体では対応が難しく、社会全体での対応が要るものも含まれているため、事業者がすべてのリスクに直ちに対処しようとする必要はないが、社会で起こりうる事象として認識しておくことが重要であること、です。また、この分類の検討にあたっては、米国標準技術研究所(NIST)の AIリスクマネジメントフレームワーク(第5章で扱います)などの国内外の分類の手法を参考にした、と脚注に書かれています。
21の見出しのうち、労働者の失業、データや利益の集中、民主主義への悪影響などは、一社だけでは解決できない面が大きい論点です。本コラムでは、これらを7つの型とは別に置き、自社の導入や調達の判断に関係する範囲で確かめる対象とします。社内の AIガバナンスで日々の判断に使うには、もう少し少ない数の型にまとめた方が扱いやすいと考えています。本コラムでは、社内のユースケース(AIを使う個別の用途)ごとに確かめるリスクを、次の7つの型にまとめて使います。
| 本コラムのリスクの型 | 起きること | 対応するガイドラインの見出しの例 | 損失の型の例 |
|---|---|---|---|
| 誤り | 事実と異なる出力や、条件によって精度が落ちた出力が、そのまま業務に使われる。攻撃によって性能が落ちる場合を含む | ハルシネーション等による誤った出力、生命等に関わる事故の発生、データ汚染攻撃等の AIシステムへの攻撃 | 誤った判断の放置、信頼の失墜 |
| 偏り | 学習データなどに含まれる偏りが出力に表れ、特定の集団が不利に扱われる | バイアスのある出力・一貫性のない出力等、差別的出力、バイアス等の再生成 | 誤った判断の放置、規制違反、信頼の失墜 |
| 説明できない | 出力の根拠を、影響を受ける人や監督する人に説明できない | ブラックボックス化・判断に関する説明の不足 | 信頼の失墜、規制違反 |
| 権利侵害 | 生成物や学習の過程で、他者の著作権などの権利や、個人情報の扱いの決まりを侵す。資格や免許が必要な業務に AIの出力が踏み込み、業法の制限に触れるおそれがある場合を含む | 知的財産権等の侵害、個人情報の不適切な取扱い等、資格等の侵害 | 権利侵害、規制違反 |
| 情報漏えい | 入力した機密情報や個人情報が、意図しない範囲に出ていく。攻撃によって引き出される | 機密情報の流出、データ汚染攻撃等の AIシステムへの攻撃 | 権利侵害、信頼の失墜 |
| 過度の依存 | 人が AIの出力を確かめずに受け入れ、自ら判断しなくなる | 過度な依存 | 誤った判断の放置 |
| 悪用 | 社内外の者が、AIを本来の目的から外れた用途や、詐欺・攻撃に使う | 悪用、偽・誤情報等の流通・拡散 | 規制違反、信頼の失墜 |
表の「対応するガイドラインの見出しの例」の列は、本コラムが7つの型に当てはめたもので、ガイドラインがこの対応を示しているわけではありません。ガイドラインの別添は、リスクの例を体系的に分類した表と、リスクの例ごとに主な共通の指針と対策の例を対応づけた表も載せています。自社の型を作るときには、ガイドラインのそれらの表と見比べて、漏れが無いかを確かめることを勧めます。表の「損失の型の例」の列は、後の節で説明する本コラムの6つの損失の型のうち、そのリスクが表に出たときに生じやすいものを挙げました。
21の見出しのうち、表のどの型にも当てはめなかったものが7つあります。労働者の失業、データや利益の集中、民主主義への悪影響、フィルターバブル及びエコーチェンバー現象、多様性・包摂性の喪失、エネルギー使用量及び環境の負荷の6つは、前に述べたとおり、一社だけでは解決できない面が大きいため7つの型とは別に置きました。確かめなくてよいという意味ではなく、自社との関係に応じて確かめる対象です。とくに自社の事業がこれらに直接関わる場合(たとえば利用者に情報を推薦するサービスを提供する場合のフィルターバブル)には、ユースケースの評価の中で確かめる対象に加えることになります。残る金銭的損失は社内の論点でもありますが、ガイドラインの説明では、他者の権利を侵害した場合の損害賠償や、攻撃を受けた場合の復旧や補償の負担として書かれており、他の型のリスクが表に出た結果として生じる損失です。そのため本コラムでは、金銭的損失をリスクの型には入れず、後の節で扱う損失の型(権利侵害・規制違反・信頼の失墜など)が生じたときに伴いうるものとして扱います。
7つの型には、互いに重なる部分があります。偏りは誤りの一種とも言えますし、説明できないことは、偏りや誤りに気づけない原因にもなります。それでも型を分けておくのは、型ごとに確かめる人と方法が違うからです。誤りは業務の担当者が出力を照合して確かめることが多くなります。偏りのうち集団の間の結果の差は属性ごとの集計で調べやすく、それに加えて、出力の内容や利用の状況の確認も併せて行います。AI事業者ガイドラインも、公平性の指針の中で、バイアスの要因が多岐にわたるため技術の要素と利用者の振る舞いを含めて要因を特定することや、多様な背景のステークホルダーと対話したうえで方針を決めることを挙げています。権利侵害と情報漏えいは法務や情報セキュリティの担当が規程と契約で抑える部分が大きく、過度の依存は業務の手順の中に人の確認を組み込むことで抑えます。悪用は、社内の利用の範囲を決めることと、外部からの攻撃への備えの両方が要ります。型ごとに担当と確かめ方を決めておくと、ユースケースごとの評価を誰がどこまで行うかが決めやすくなります。台帳を使った評価の進め方は第7章、品質と公平性の確かめ方は第10章、生成 AIの入力と出力の扱いは第8章で扱います。
もう一つ、AIのリスクには、時間とともに変わるという性質があります。導入の時点では問題が無くても、入力されるデータの傾向が変わる、使い方が当初の想定から広がる、外部のサービスのモデルが更新される、といった変化によって、誤りや偏りが後から表れることがあります。このため、AIガバナンスは導入の前の審査だけでは完結せず、運用中に見続ける仕組みを含む必要があります。運用の監視とインシデントへの対応は第11章で扱います。
原則の系譜、人間中心のAI社会原則・OECD AI原則・AI事業者ガイドライン
AIのリスクに対して、国や国際機関は、法律より先に「原則」という形で考え方を示してきました。原則は個々の義務を定めるものではありませんが、後に作られるガイドラインや法令の土台になっています。社内の AI基本方針を作るときにも、どの原則に沿うのかを示すと、方針の根拠を説明しやすくなります。ここでは、日本企業にとって参照されることの多い三つを、原文で確かめた項目名とともに整理します。
一つ目は、人間中心のAI社会原則です。2019年3月29日(平成31年3月29日)に統合イノベーション戦略推進会議で決定されました。この文書は、基本理念として、人間の尊厳が尊重される社会、多様な背景を持つ人々が多様な幸せを追求できる社会、持続性ある社会、の三つを掲げています。そのうえで、原則を、社会(とくに国などの立法・行政機関)が留意すべき「AI社会原則」と、AIの研究開発と社会実装に従事する開発・事業者側が留意すべき「AI開発利用原則」に分けて体系化しています。AI社会原則として挙げられているのは、人間中心の原則、教育・リテラシーの原則、プライバシー確保の原則、セキュリティ確保の原則、公正競争確保の原則、公平性・説明責任及び透明性の原則、イノベーションの原則、の7つです。AI開発利用原則については、文書の中で具体的な項目は列挙していません。そのかわりに、開発者と事業者が基本理念と AI社会原則を踏まえて AI開発利用原則を定め、遵守するべきだという考えを示し、あわせて、オープンな議論を通じて国際的な合意を醸成し、非規制的で非拘束的な枠組みとして国際的に共有することが重要だとしています。
二つ目は、前の節で定義を見た OECD の理事会勧告です。勧告は二つの部分からなり、第1部が信頼できる AIの責任ある管理のための原則で、すべての関係者に関わる5つの原則を定めています。第2部は、加盟国などが国の政策と国際協力で取り組むべき5つの勧告です。2024年5月の改訂では、生成 AIに関連して誤情報・偽情報への対処と情報の完全性の確保を重視すること、意図された目的の外での利用や意図的な悪用・意図しない誤用に対処すること、AIシステムが不当な害を生じるおそれがある場合などに人の介入によって安全に上書き・修理・廃止できるようにすること、環境の持続可能性に明示的に言及すること、などが加えられました。あわせて、一部の原則の見出しが明確さのために拡張され、追跡可能性とリスクマネジメントに関する記述が「説明責任」の原則へ移されています。
三つ目は、AI事業者ガイドラインの「共通の指針」です。ガイドラインは、本編第2部で、人間中心のAI社会原則の三つの基本理念を引き継ぎ、それを実現するための原則を、人間中心のAI社会原則を土台としつつ OECD の AI原則などの海外の諸原則を踏まえて再構成した、と説明しています。そこから導かれる「共通の指針」として、人間中心、安全性、公平性、プライバシー保護、セキュリティ確保、透明性、アカウンタビリティ(説明責任。判断の根拠を説明し、その責任を引き受けること)、教育・リテラシー、公正競争確保、イノベーション、の10項目を挙げています。各項目の下には、たとえば人間中心であれば「人間の尊厳及び個人の自律」「偽情報等への対策」などの細目が置かれています。
| 文書 | 主体と時期 | 拘束力 | 原則・指針の項目 |
|---|---|---|---|
| 人間中心のAI社会原則 | 統合イノベーション戦略推進会議決定、2019年3月29日 | 法令ではない。政府の決定文書 | AI社会原則として7つ。人間中心、教育・リテラシー、プライバシー確保、セキュリティ確保、公正競争確保、公平性・説明責任及び透明性、イノベーション |
| OECD の人工知能に関する理事会勧告 | OECD 理事会、2019年5月22日採択。2023年11月8日と2024年5月3日に改訂 | 勧告であり、法的な拘束力はない | 第1部に5つの原則。包摂的な成長・持続可能な開発・幸福、法の支配・人権・民主的価値の尊重(公平性とプライバシーを含む)、透明性・説明可能性、頑健性・セキュリティ・安全性、説明責任。第2部に政府への5つの勧告 |
| AI事業者ガイドライン(第1.2版)の共通の指針 | 総務省・経済産業省、第1.2版は2026年3月31日 | 非拘束的なソフトロー | 10項目。人間中心、安全性、公平性、プライバシー保護、セキュリティ確保、透明性、アカウンタビリティ、教育・リテラシー、公正競争確保、イノベーション |
表の OECD の原則の項目は、2024年の改訂後の勧告本文の見出しを日本語にしたものです。三つを並べると、人間中心・公平性・プライバシー・セキュリティ・透明性・説明責任という骨格は共通していることが分かります。AI事業者ガイドラインの10項目のうち、人間中心、セキュリティ確保、教育・リテラシー、公正競争確保、イノベーションの5つは、人間中心のAI社会原則の7つの原則と同じ語を名前に含みます。プライバシー保護はプライバシー確保の原則に、公平性・透明性・アカウンタビリティは公平性・説明責任及び透明性の原則に、それぞれ対応する語が見られます。とくに教育・リテラシーと公正競争確保は OECD の5つの原則の見出しには無い項目で、日本の原則の系譜が引き継がれていると読めます。一方で安全性は、人間中心のAI社会原則の7つの原則の名前には無く、OECD の原則の「頑健性・セキュリティ・安全性」に近い項目です。
社内の AI基本方針を作るときには、こうした原則の項目を一つずつ写すことよりも、10項目をひととおり確かめたうえで、自社にとって重要な項目を自社の言葉で具体化し、対策の重点を付けることが大切だと考えています。重点を付けることは、それ以外の項目を確認の対象から外すことではありません。10項目すべてを同じ重さで掲げると、現場はどれを優先すればよいか判断しにくくなります。たとえば、採用や与信のように個人に重要な影響を与える用途を持つ会社では公平性とアカウンタビリティが、個人情報を多く扱う会社ではプライバシー保護が、機密情報を多く扱う会社ではセキュリティ確保が、重点を置く項目になると考えられます。基本方針の書き方は第12章で扱います。
開発者・提供者・利用者、3つの立場と責任の違い
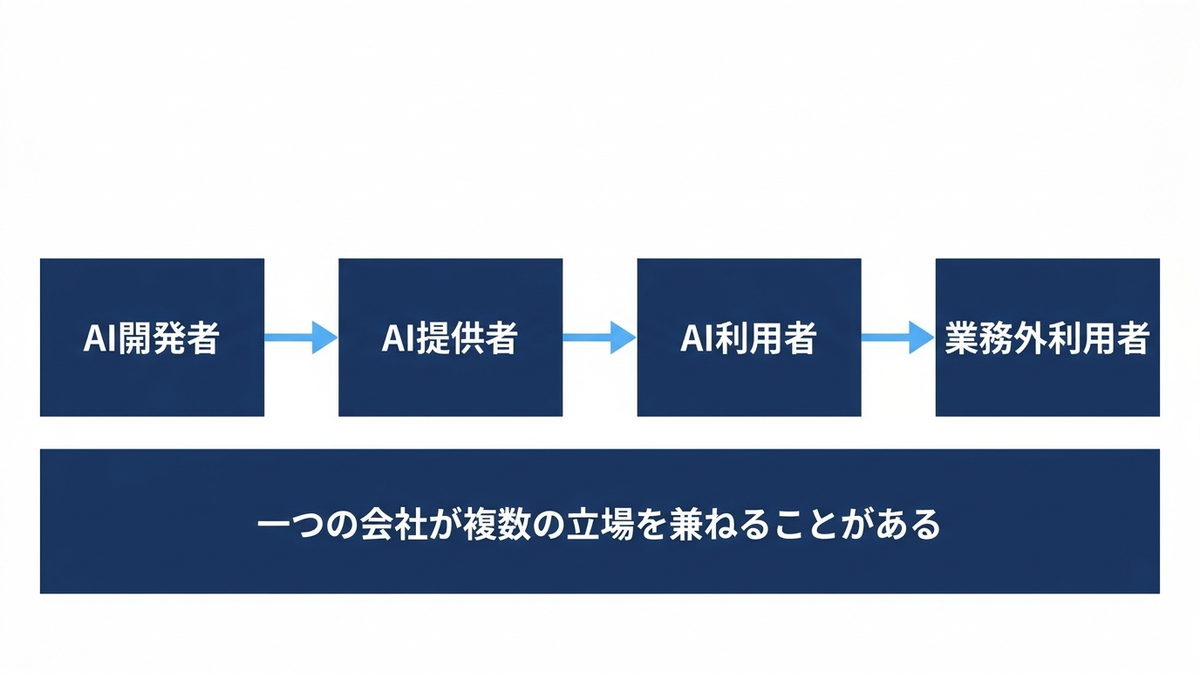
AIガバナンスで何をすべきかは、その組織が AIに対してどの立場にあるかで変わります。AI事業者ガイドラインは、AIの事業活動を担う主体を、AI開発者・AI提供者・AI利用者の3つに大別しています。本コラムでも、開発者・提供者・利用者という語は、このガイドラインの3つの立場を指すものとして使います。第1.2版の本編による定義の着眼点は次のとおりで、詳しい役割は後の表にまとめました。
AI開発者は、AIシステムを開発する事業者で、モデルの開発から学習・検証までを通じて AIシステムを構築する側です。第1.2版では、実運用の後も事後学習によってモデルの性能を維持・改善することが、役割として書き加えられています。AI提供者は、AIシステムを製品や既存のシステム、業務の流れに組み込んだサービスとして、利用者などに提供する側です。AI利用者は、事業活動の中で AIシステムや AIサービスを使う事業者で、提供者が意図した適正な利用をすることと、業務外利用者に影響が及ぶ場合にはその人への意図しない不利益を避けることが役割とされています。ここでいう業務外利用者は、事業活動以外で AIを利用する人や、AIを直接事業で使わずに AIシステム・サービスの便益を受ける、場合によっては損失を被る人を指し、ガイドラインの対象には含まれません。学習や利用に使うデータを提供する法人や個人(データ提供者)も、同様に対象外とされています。
| 立場 | ガイドラインの定義の要旨 | 主に担う役割 | 社内で確かめることの例 |
|---|---|---|---|
| 開発者(AI開発者) | AIシステムを開発する事業者。研究開発する事業者を含む | モデルとアルゴリズムの開発、データの収集と前処理、学習と検証、システムの構築、事後学習による性能の維持・改善 | 学習データの来歴と権利、偏りの評価、性能の検証の記録、更新したときの再評価 |
| 提供者(AI提供者) | AIシステムを製品やサービス、業務の流れに組み込んで、利用者や業務外利用者に提供する事業者 | AIシステムの検証、他システムとの連携、サービスの提供、利用者側の運用の支援 | 想定する用途と使ってはいけない用途の明示、利用者への情報提供、不具合の受付と通知、組み込んだ外部モデルの更新への対応 |
| 利用者(AI利用者) | 事業活動において AIシステム・サービスを利用する事業者 | 提供者が意図した適正な利用、環境の変化の共有、必要に応じた運用、業務外利用者への不利益の回避 | 使ってよい用途と入力してよい情報、出力を人が確かめる手順、顧客など影響を受ける人への説明 |
表の「社内で確かめることの例」の列は、ガイドラインの記述をもとに本コラムが社内の確認事項として言い換えたもので、ガイドラインの項目をそのまま写したものではありません。ガイドラインは、共通の指針に加えて主体ごとに重要となる事項を、「表1. 「共通の指針」に加えて主体毎に重要となる事項」という表にまとめています。第1.2版では、同じ題名で同じ項目の表が、本編(第2部 C の末尾)と別添(冒頭の「はじめに」)の両方に載っています。自社の立場が決まったら、その表の該当する列を読むことが、ガイドラインを使う手がかりになると考えています。
ここで注意が要るのは、一つの会社が複数の立場を兼ねることが多い点です。ガイドラインも、これらの主体は事業者または各者内の部門を想定しており、AIの活用方法によっては同一の事業者が複数を兼ねる場合もある、と書いています。たとえば、外部の生成 AIのサービスを社内の業務で使えば利用者ですが、同じ外部のモデルを自社の顧客向けのサービスに組み込んで提供すれば提供者になり、そのモデルを自社のデータで追加学習させれば開発者に近い役割も負います。立場は会社単位ではなく、ユースケースごとに決まると考える方が実態に合います。このため、本コラムのユースケース台帳には、全体の地図の用語表に挙げた列の一つとして、ユースケースごとに立場(開発・提供・利用)を記録する列を置きます。台帳の作り方は第7章で扱います。
もう一つ注意したいのは、EU AI Act の区分との違いです。EU AI Act にも、EU AI Act の提供者(provider)と EU AI Act の導入者(deployer)という立場があります。第3条第3号の要点は、AIシステムや汎用目的 AIモデルを開発し、または開発させて、自らの名称や商標の下で市場に出す者に加え、AIシステムについては自らの名称や商標の下で使用を開始する者も、EU AI Act の提供者にあたるという点です。ここでいう使用の開始(第3条第11号)には、導入者への供給だけでなく、EU 域内で自ら使う場合も含まれます。第3条第4号は、EU AI Act の導入者を、自らの権限の下で AIシステムを使用する者(個人的な職業外の活動での使用を除く)としています。ガイドラインの3つの立場とは、切り分けの考え方が一対一では対応しません。EU AI Act では、自社で開発していなくても、自社の名称の下で市場に出せば EU AI Act の提供者にあたりうるからです。EU の立場の判断と、それに伴う義務は第3章で扱います。
立場によって責任が変わることは、経営にとって次の意味を持ちます。外部の AIのサービスを使うだけなら、開発の責任は相手にある、と考えがちです。しかし、利用者にも、適正な用途で使うこと、出力をどう扱うかを決めること、影響を受ける人への不利益を避けることが求められます。そして、同じサービスを自社の製品に組み込んだ時点で、提供者として、自社の顧客に対する説明や不具合への対応の責任が加わります。ここでいう責任は、まずガイドラインが各立場に期待している役割を指します。具体的な法的責任は、適用される法令や契約、個別の事情によって異なり、個別の判断は弁護士等の専門家に確認する必要があります。そのうえで、買った AIであっても自社に残る役割があり、その範囲は立場で変わる、という点を、調達の段階から押さえておく必要があります。調達と契約の論点は第9章で扱います。
よくある誤解、禁止すること・法務だけの仕事・ツールで完了・大企業だけ
AIガバナンスに取り組み始めるときには、いくつかの誤解が判断を誤らせることがあります。ここでは、よく見られる4つの誤解を取り上げ、公的な資料の記述と照らし合わせて整理します。
1つ目は、「AIガバナンスとは、AIの利用を禁止したり制限したりすることだ」という誤解です。AI事業者ガイドラインの本編は、リスクの大きさを把握したうえで対策の程度をリスクの大きさに対応させる「リスクベースアプローチ」が重要だとしています。その前提として、AIの利用は分野と利用形態によっては社会に大きなリスクを生じさせうる一方で、過度な対策を講じることも、AIの活用自体や活用で得られる便益を阻害する可能性がある、と書いています。別添のリスクの一覧にも、リスクの存在を理由に直ちに AIの開発・提供・利用を妨げるものではない、という限定が付いています。本コラムの AIガバナンスの定義に「使ってよい範囲を明確にして活用を進める役割」を含めたのも、この考え方に沿うものです。
2つ目は、「AIガバナンスは法務の仕事だ」という誤解です。前の節で見たとおり、AIのリスクには、法務が規程と契約で抑える権利侵害のようなものもあれば、業務の担当者が出力を照合しなければ見つからない誤り、属性ごとの集計や出力の確認を通じて調べる偏り、業務の手順に人の確認を組み込まなければ抑えられない過度の依存もあります。法務は欠かせない役割の一つですが、用途の判断と出力の確認は、業務部門と情報システム部門の関与なしには成り立ちません。部門をまたいだ役割の分け方は第13章で扱います。
3つ目は、「ガバナンスの製品を入れれば完了する」という誤解です。台帳を管理する製品や、出力を評価する道具は、仕組みを回す助けになります。しかし、どの用途に使ってよいか、どの水準なら受け入れるか、誰が承認するかという判断は、道具が決めるものではありません。ガイドラインがアジャイル・ガバナンスとして示す「環境・リスク分析」「ゴール設定」「システムデザイン」「運用」「評価」のサイクルのうち、ゴールの設定は経営の目標と整合させる判断そのものです。判断の基準を決めないまま道具を入れると、記録は増えても判断の質は上がりません。
4つ目は、「AIガバナンスは大企業の話だ」という誤解です。ISO の目録に掲載された ISO/IEC 38507 の概要は、この規格が規模を問わずあらゆる組織に適用できるとしています。AI事業者ガイドラインも、共通の指針の取り組みは、各主体が開発・提供・利用する AIシステム・サービスの特性や用途を踏まえ、各主体の資源制約を考慮しながら自主的に進めることが重要だとしています。つまり、求められているのは大企業と同じ体制を作ることではなく、自社の規模と用途に見合った範囲で、誰が決めるかと何を確かめるかを決めることです。担当が1人の会社での縮小版は第13章で扱います。
| よくある誤解 | 誤解から起きやすいこと | 公的な資料の記述 | 本コラムの考え方 |
|---|---|---|---|
| AIガバナンスは禁止すること | 一律に禁止し、隠れた利用が生まれる。活用が進まない | AI事業者ガイドラインは、過度な対策も便益を阻害しうるとし、リスクの大きさに対策を合わせるリスクベースアプローチを示している | 使ってよい範囲と条件を先に示し、リスクの大きい用途にだけ重い手続きを課す |
| 法務だけの仕事 | 規程はできるが、出力の誤りや偏りに誰も気づかない | リスクの例には、誤った出力、バイアスのある出力、過度な依存など、業務の中で確かめるものが含まれている | リスクの型ごとに確かめる担当を決め、法務・業務部門・情報システム部門で分担する |
| ツールを入れれば完了 | 記録は増えるが、承認の基準が無いまま運用される | アジャイル・ガバナンスのサイクルは、ゴールの設定を経営上のゴールと整合させることを求めている | 判断の基準と承認者を先に決め、道具はそれを回す手段として選ぶ |
| 大企業だけの話 | 体制が作れないことを理由に何も決めず、個人の判断に任される | ISO/IEC 38507 の概要は規模を問わず適用できるとし、ガイドラインは資源制約を考慮して進めることを示している | 規模に合わせて、決める人と確かめる項目だけでも先に決める |
表の「誤解から起きやすいこと」の列は、本コラムが一般論として整理したもので、特定の調査の結果ではありません。とくに1つ目の「隠れた利用が生まれる」は、一律の禁止が利用を止めるのではなく、会社が把握できない場所での利用に変えるおそれがある、という意味で挙げました。これに近い記述は AI事業者ガイドラインの別添にもあり、機密情報の流出のリスクの説明の中で、生成 AIのサービスは利用の障壁が下がっているため、とくに企業のルールなどが未整備の場合には、企業の管理の外で従業員が一般向けの生成 AIを業務に使い、リスクの高い使い方をするおそれがある、と書かれています。ただしこれはルールが未整備の場合についての記述で、禁止そのものの効果を示したものではありません。生成 AIの社内利用のルールと、この論点の扱いは第8章で扱います。
経営の損失の型、判断を誤ると何を失うか
AIガバナンスの判断を誤ったときの損失は、金額で一律に示せるものではありませんが、型で整理することはできます。本コラムでは、経営上の損失を次の6つの型に固定し、各章でこの型を使って説明します。章ごとに別の言い方をすると、どの施策がどの損失を防ぐためのものかが比べにくくなるからです。
| 損失の型 | 起きること | 起きやすい判断の誤り | 主に扱う章 |
|---|---|---|---|
| 導入の停滞 | 使ってよいかを決められず、AIを業務に使わないまま時間が過ぎる。競合との差が開く | 誰が決めるかを決めていない。一律に禁止する。審査の基準が無く、案件ごとに議論が振り出しに戻る | 第7章・第12章・第13章 |
| 規制違反 | 国内外の法令や業界の規制に反する使い方をし、行政の対応や取引の停止を招く | 自社の AIがどの制度に関係するかを棚卸ししていない | 第2章・第3章・第4章 |
| 権利侵害 | 著作権などの権利、個人情報、営業秘密を侵す、または侵される | 入力してよい情報と出力の扱いを決めていない。外部のサービスの規約を確かめていない | 第8章・第9章 |
| 誤った判断の放置 | 出力の誤りや偏りに気づかないまま、業務の判断に使い続ける | 評価の指標と、運用中に見る項目を決めていない。人の確認が形だけになっている | 第10章・第11章 |
| 信頼の失墜 | 顧客・社会・従業員からの信頼を失い、説明と回復に経営の時間を取られる | AIを使っていることや、その限界を説明していない。問題が起きたときの対応を決めていない | 第11章・第14章 |
| 二重投資 | 部門ごとにばらばらに審査の手続きや道具を作り、同じ確認を何度も行う | 全社で共通の区分と台帳を持たず、部門の判断に任せている | 第7章・第13章 |
6つの型は、リスクを抑える側の損失だけでなく、活用が進まない側の損失を含んでいる点に特徴があります。導入の停滞は、AIガバナンスが無いことからも、重すぎる AIガバナンスからも生じます。AI事業者ガイドラインの本編が、AI活用の取り組みが社会から不適切または不十分と評価された場合には自らの事業活動に機会損失が生じ、事業価値の維持が困難になるおそれがある、と書いているのは、信頼の失墜と導入の停滞の両方に通じる指摘です。逆に、リスクを恐れて何も決めない状態も、競争力の面で同じように損失になります。
型どうしは連鎖することもあります。全社の区分と台帳が無いまま部門ごとに判断していると、二重投資が起きるだけでなく、ある部門では許されている使い方が別の部門では禁止される、という食い違いが生まれます。食い違いは現場の混乱を招き、ルールを迂回した利用につながり、その中で権利侵害や情報漏えいが起きれば、信頼の失墜へと広がります。損失の型を並べておくのは、一つの施策がいくつの型を同時に防ぐかを見積もり、どこから手を付けるかの優先順位を決めるためです。
経営判断、最初に「誰が決めるか」を決める
この章の最後に、経営が最初に決めるべきことを述べます。本コラムでは、AIガバナンスの最初の一歩は、規程を書くことでも、道具を選ぶことでもなく、「誰が決めるか」を決めることだと考えています。ここでいう「決める」とは、あるユースケースに AIを使ってよいかを承認すること、使う条件を定めること、問題が起きたときに止めることを指します。
理由は三つあります。一つ目は、決める人がいないと、損失の型のうち導入の停滞や二重投資が起こりやすくなるからです。現場が使ってよいか判断に迷ったとき、相談先が決まっていなければ、使わないか、各自の判断で使うかのどちらかになります。前者は導入の停滞、後者はばらばらの対応による二重投資と、会社が把握できない利用につながります。二つ目は、ISO/IEC 38507 が統治機関に向けた手引きとして示しているように、AIの利用の方向づけと監督は、経営の層の仕事として位置づけられるからです。三つ目は、AI事業者ガイドラインが AIガバナンスのゴールを経営上のゴールと整合させることを求めており、整合の検討には関係する部門が加わるとしても、最終的に確認するのは経営の側になるからです。
具体的には、次の3点を最初の経営の決定として文書にしておくことが有効だと考えています。第一に、最終的な責任を負う役員である AIガバナンス責任者を1人決めること。第二に、部門をまたぐ判断(リスクの大きいユースケースの承認、規程の例外の承認)を行う会議体として、AIガバナンス委員会を置くこと。新しく作るか、既存のリスク管理や情報セキュリティの会議体にその役割を載せるかは問いません。第三に、AIガバナンスの事務局を担う部署を決めることです。事務局は、ユースケースの台帳の管理、申請の受付、委員会の運営を担う実務の窓口です。3点は役割として決めるもので、新しい役職や部署を置くことを必ずしも意味しません。規模の小さい会社では、既存の役員や会議体、部署に割り当てたり、兼任にしたりすることも考えられます(縮小版は第13章)。この3点が決まっていれば、規程や基準は後から順に整えられます。逆に、3点が決まらないまま規程の作成から始めると、誰が承認するかが書けず、規程が完成しないまま時間が過ぎることになりかねません。
3点を決めたあとに作るのが、ユースケース台帳の初版、リスク区分の基準と承認の経路、AI利用規程の初版の3つで、この順に進めるのがよいと考えています。序章で「最初に決めるべきこと」として挙げた台帳・区分・承認者は、この経営の3点を決めたあとに、文書や認証より先に作るもの、という意味です。次の表は、経営の決定と、そのあとに作るものを、段階を分けて並べたものです。
| 段階 | 決めること・作るもの | 決める人 | 決めないと起きやすいこと | 詳しく扱う章 |
|---|---|---|---|---|
| 経営の決定(1) | AIガバナンス責任者となる役員 | 経営(取締役会または経営会議) | 部門間の判断が分かれたときに裁く人がいない | 第13章 |
| 経営の決定(2) | 部門をまたぐ判断を行う AIガバナンス委員会 | 経営(責任者の提案を受けて) | リスクの大きい用途の承認が、部門ごとにばらばらに行われる | 第13章 |
| 経営の決定(3) | AIガバナンスの事務局を担う部署 | 経営(責任者の提案を受けて) | 申請の窓口が無く、社内でどの AIがどの用途に使われているかを誰も把握していない | 第13章 |
| 3点のあとに作るもの(1) | ユースケース台帳の初版 | 事務局が作り、委員会に報告 | どの用途を優先して確かめるべきかが分からない | 第7章 |
| 3点のあとに作るもの(2) | リスク区分の基準と承認の経路 | AIガバナンス委員会が承認し、AIガバナンス責任者が経営に報告 | 同じような用途でも、承認の要否が案件ごとに変わる | 第7章・第13章 |
| 3点のあとに作るもの(3) | AI利用規程の初版(使ってよい範囲を含む) | 委員会で審議し、経営会議、または規程の管理の手続きで定めた決裁者が承認 | 現場が判断に迷い、使わないか、各自の判断で使う | 第8章・第12章 |
表の「決める人」には、経営・AIガバナンス責任者・委員会・事務局が出てきます。本コラムでは、承認する人を文書の重さとリスクの大きさで分ける考え方を採ります。文書については、原則を定める AI基本方針は取締役会または経営会議が、守るべき規則を定める AI利用規程は経営会議または規程の管理の手続きで定めた決裁者が、いずれも委員会の審議を経て承認します。個々のユースケースの利用については、本コラムのリスク区分(禁止・高・中・低)のうち、低のものは業務部門の責任者、中のものは事務局の責任者、高のものは AIガバナンス委員会が承認し、禁止のものは承認の対象にしない、という分け方です。区分の基準は第7章、文書ごとの承認者は第12章、役割の全体は第13章で扱います。
予算と体制への落とし方としては、最初の段階で大きな予算を用意する必要はないと考えています。必要なのは、責任者と事務局の担当者の時間、会議体の議題の枠、台帳を置く場所です。予算を大きく取る判断は、台帳に集まったユースケースの数とリスクの区分が見えてから行う方が、根拠のある配分になります。経営が最初に投資するのは、お金よりも、決める人と決める場を置くことだと言えます。
この章では、本コラムで使う AIガバナンスと AIシステムの定義を、AI事業者ガイドライン、OECD の理事会勧告、EU AI Act の原文と照らし合わせて確かめました。AIガバナンスはコーポレートガバナンスの下で、IT ガバナンスやデータガバナンスと重なりながら、用途と出力の扱いという固有の判断を受け持つこと。ISO/IEC 38507 は、AIの利用を統治機関が方向づけ監督する事柄として扱っていること。AIのリスクを7つの型で、経営の損失を6つの型で捉えること。開発者・提供者・利用者という立場によって責任が変わり、一つの会社がユースケースごとに複数の立場を兼ねること。そして、最初に決めるべきは「誰が決めるか」であることを述べました。第2章では、これらの考え方の外側にある世界の AI規制と枠組みを、法律・指針・規格という拘束力の違いで整理し、自社にどの制度が掛かるかを判断する軸を扱います。
この章を深めたい方への参考書籍
『AIガバナンス入門 リスクマネジメントから社会設計まで』(羽深宏樹 著、早川書房):ハヤカワ新書の1冊で、題名のとおり、AIのリスクマネジメントから社会の仕組みの設計までを AIガバナンスとして扱った入門書です。AI事業者ガイドライン(第1.2版)の別添は、AIのリスクの例を分類する際に参考にした分類の一つとして、NIST の AIリスクマネジメントフレームワークと並べてこの本の分類を挙げています。この章で扱ったリスクの型と、AIガバナンスを社内の仕組みとして考える前提を、より広い視野から考えるときの材料になります。
『AIリスク教本 AIエージェント&フィジカルAI AI新時代のガバナンス』改訂新版(日本IBM AI倫理チーム/AI倫理とガバナンス研究会 著、日経BP):2026年8月に出た改訂新版で、国立国会図書館の目次情報によると、仮想のシナリオで AIのリスクを示す章から始まり、AIのリスクがどう起きるかを、基本となる特性と19の分類で整理する章を含みます。この章では社内で扱いやすいようにリスクを7つの型にまとめましたが、自社の型を作るときには、こうした細かい分類と見比べて、見落としている型が無いかを確かめる材料として使えます。
第2章 世界のAI規制と枠組みの見取り図、法律・指針・規格の違い
第1章では、AIガバナンスを「どの用途に使ってよいか・誰が決めるか・何を基準にどう確かめるか・問題が起きたらどうするか」を定める仕組みとして定義し、開発者・提供者・利用者という立場によって責任の範囲が変わることを確認しました。この章では、その仕組みを作るときに外から掛かってくる制度を、世界全体の見取り図として整理します。AIに関する制度は、国や地域ごとに名前も形も違い、法律として罰則を持つものから、政府が示す指針、国際的な団体がまとめる原則、認証を受けられる規格まで、性質の異なるものが並んでいます。これらを同じ重さで読むと、対応の優先順位を決められなくなります。
この章では、まず制度を「法律」「指針・ガイドライン」「規格」の3つの層に分け、拘束力の違いを表にします。次に、欧州・米国・英国・中国・韓国・国際の枠組みの順に、主要な制度の名前・作った主体・拘束力・日付・対象を、公式の資料を開いて確かめた範囲で紹介します。そのうえで、日本の会社に外国の制度が掛かるかどうかを判断する軸と、各国の制度が共通して求めていることを表にまとめ、最後に「最も厳しい制度に合わせるか、地域ごとに分けるか」という経営判断を扱います。EU AI Act の条文の詳細は第3章、日本の AI推進法と AI事業者ガイドラインは第4章、NIST AI RMF は第5章、ISO/IEC 42001 は第6章で扱うので、この章では位置づけと見分け方に絞ります。
この章で引く外部の資料は、2026年10月28日・29日に開いて確認しました。ただし、資料を開いた日と、その資料が示す制度の時点は同じではありません。英国のように2024年の資料までしか確かめていない制度は、本文にその時点を書きました。各国の制度は改正が続いているので、ここに書いた状態は確かめた時点のものです。また、この章は制度の見取り図を示すもので、特定の制度が自社に適用されるかどうかの判断を示すものではありません。自社が対象になるかどうかの個別の判断は、弁護士等の専門家への確認が要ります。
法律・指針・規格、拘束力の違う3つの層
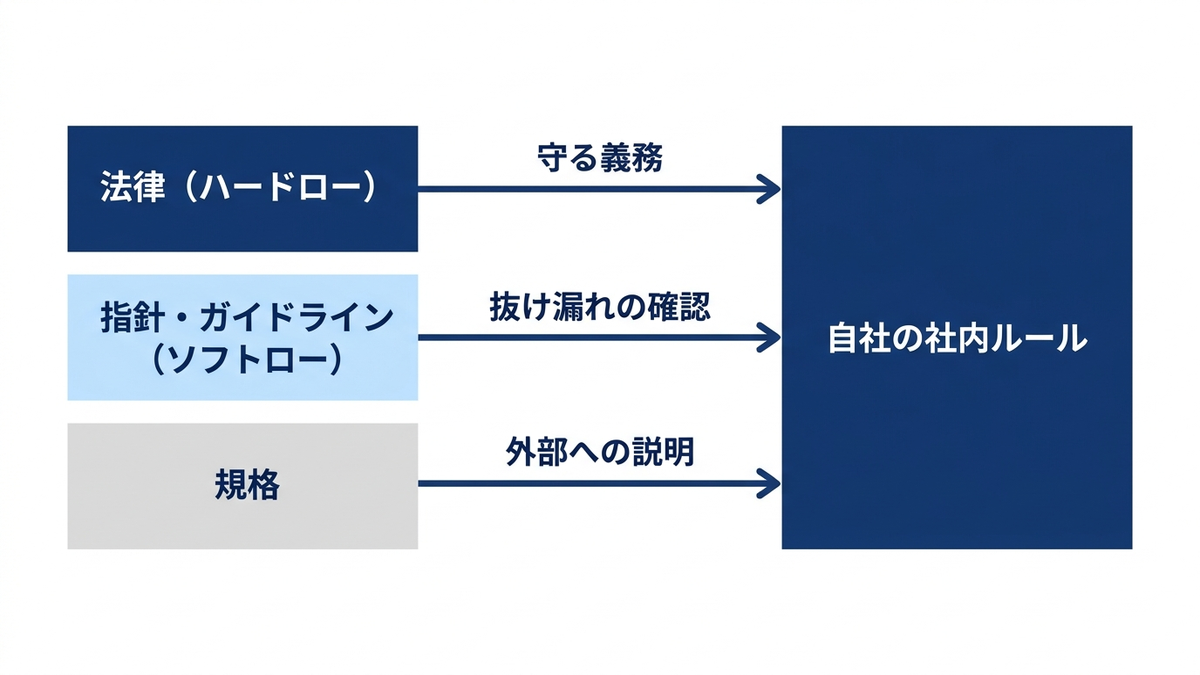
AIに関する制度を読み分けるための最初の区別は、守らなかったときに何が起きるか、つまり拘束力の違いです。本コラムでは、制度を3つの層に分けて扱います。1つ目はハードローで、議会が定める法律や、行政機関が法律にもとづいて定める規則のように、法的に守る義務があるものを指します。多くの場合、違反したときの制裁や行政の命令が予定されています。EU AI Act はこの層に入ります。2つ目はソフトローで、政府や国際機関が示す指針・ガイドライン・原則・行動規範のように、それ自体には法的な拘束力がなく、関係者が自主的に取り組むことを促すものを指します。3つ目は規格で、国際標準化機構(ISO)や国際電気標準会議(IEC)のような標準化団体が合意の手続きを経て定める文書です。規格は使うかどうかを各組織が選ぶもので、マネジメントシステムの規格のように、第三者の審査を受けて認証を得られるものもあります。
この3つの層の境目は、実務では固定されたものではありません。ソフトローでも、取引先の評価や社内ルールを通じて、実務に影響することがあります。規格も、調達の要件に入れば事実上の前提になり、法律の側が規格を参照して「この規格に従っていれば法律の要件を満たすと推定する」という仕組みを置くこともあります。逆に、法律でも、対象となる事業者や用途が限られていれば、自社にとっては関係のない層になります。したがって、3つの層の区別は「どれが重要か」を決めるためではなく、「守らなかったときに何が起きるか」「誰がそれを求めてくるか」を見分けるために使うものだと考えています。
日本の AI事業者ガイドラインは、この区別を自ら明記している例です。第1.2版の本編は、法律の整備とAIの技術の発展との間に時間のずれが生じること、細かな行為の義務を定めるルールベースの規制はイノベーションを阻害するおそれがあることが指摘されてきたことを踏まえ、関係者の自主的な取組を促す「非拘束的なソフトロー」によって目的の達成に導くゴールベースの考え方でガイドラインを作成した、と説明しています。拘束力が無いことは、取り組まなくてよいことを意味しません。この点は第4章で、根拠と、その根拠から言える範囲を示して扱います。
| 層 | 作る主体の例 | 拘束力 | 守らなかったときに起きうること | この層に入る例 | 自社での使い方 |
|---|---|---|---|---|---|
| 法律(ハードロー) | 議会、法律にもとづいて規則を定める行政機関 | 対象となる事業者には守る義務がある | 制裁金・過料・行政の命令など、それぞれの法律が定める措置 | EU AI Act、韓国の AI基本法、中国の生成AIの暫定弁法、日本の AI推進法(ただし罰則の規定は置かれていない。第4章) | 自社が対象かどうかを最初に判断し、対象なら義務を手順に落とす |
| 指針・ガイドライン(ソフトロー) | 政府、国際機関、G7 などの国際的な枠組み | それ自体に法的な拘束力はない | 直接の制裁はない。ただし取引先の評価や社内ルールを通じて影響することがある | AI事業者ガイドライン、OECD の AI原則、広島AIプロセスの国際指針と国際行動規範、UNESCO の AI倫理勧告 | 社内ルールの項目の出典として使い、何を確かめるべきかの抜け漏れを防ぐ |
| 規格 | ISO、IEC、各国の標準化機関 | 使うかどうかは各組織が選ぶ | 直接の制裁はない。認証を失う、取引の要件を満たせなくなる、という形で影響が出る | ISO/IEC 42001 などの AIに関する規格(第6章) | 仕組みを回していることを外部に示す手段として、必要なときに採る |
表の「自社での使い方」の列は、層ごとの読み方の違いを示しています。法律の層は、まず自社に掛かるかどうかを判断する対象です。指針の層は、自社の社内ルールに何を書けばよいかを確かめる材料として使えます。規格の層は、社内の仕組みを外部に説明するときの共通の言葉として使えます。同じ「AIの制度」でも、読むときの問いが層ごとに違うことを、最初に押さえておくと整理しやすくなります。
欧州、EU AI Act と欧州評議会の AI枠組条約
欧州には、性質の違う2つの制度があります。1つは EU(欧州連合)の規則である EU AI Act、もう1つは欧州評議会(Council of Europe)がまとめた条約です。欧州評議会は人権・民主主義・法の支配を目的とする国際機関で、EU とは別の組織です。名前が似ているので、まずこの2つを取り違えないことが大切です。
EU AI Act は EU 規則 2024/1689 で、欧州委員会の公式ページによると2024年8月1日に発効し、一部の例外を除いて2026年8月2日から適用されています。EU の「規則」は、加盟国がそれぞれ国内法を作り直さなくても加盟国の中で直接効力を持つ形式の法令で、ハードローの層に入ります。同じページは、AIの用途をリスクの大きさで4つの水準(許容できないリスク・高リスク・透明性のリスク・最小限のリスクまたはリスクなし)に分ける考え方を示しています。この4つの水準は EU AI Act の区分で、本コラムが第7章で使う社内のリスク区分(禁止・高・中・低)とは別物です。
日本の会社にとって重要なのは、EU AI Act が EU の外の事業者にも掛かりうる点です。第2条第1項は、適用を受ける者として、AIシステムを EU の市場に出す提供者(EU の中にいるか外にいるかを問わない)、EU の中にいる導入者(deployer)、EU の外にいる提供者と導入者のうち AIシステムの出力が EU の中で使われるもの、などを挙げています。会社の所在地だけでなく、EU の市場に出すか、EU で使用を開始するか、出力が EU で使われるかでも線が引かれている、という読み方になります。どの場合が該当するかは条文の定義と例外に照らして個別に確かめる必要があり、その詳細は第3章で扱います。
適用の日程は、2026年7月27日に発効した改正(欧州委員会のページは AI Omnibus と呼んでいます。第3章で扱うデジタル・オムニバスです)で一部が変わりました。欧州委員会の AI Act Service Desk が掲げる2026年7月27日時点の統合版の第113条では、高リスクの AIシステムに関する義務のうち、附属書III の分野に当たるものは2027年12月2日から、附属書I の製品に関わるものは2028年8月2日から適用すると定められています。日程の全体と、改正で何が変わったかは第3章で表にします。この章で押さえておきたいのは、EU AI Act が「すでに一般的に適用されているが、高リスクの義務の一部はこれから適用される」という段階にあることです。
もう1つの欧州評議会のAI枠組条約は、正式には「人工知能と人権、民主主義及び法の支配に関する欧州評議会枠組条約」で、欧州評議会の条約集の第225号(CETS 第225号)です。条約の本文によると、2024年9月5日にビリニュスで署名のために開放されました。条約の条文は「各締約国は〜する」という形で締約国に義務を課しており、会社に直接義務を課す書き方にはなっていません。締約国になった国が、条約の内容を国内の制度で実施する形をとります。第3条は、公的機関と、公的機関のために行動する民間の主体による AIのライフサイクルの活動に条約を適用すると定め、それ以外の民間の主体の活動についても、条約の目的に沿った形でリスクと影響に対処するよう締約国に求めています。民間の活動にどう対処するかは、締約国が署名や批准のときに宣言で示すことになっています。国家安全保障上の利益の保護に関わる活動については、別の扱いを定めた規定があります(第3条第2項)。無条件の除外と読まず、範囲と条件を原文で確かめる必要があります。
発効の条件は条約の第30条が定めています。2026年10月28日時点で発効しているかどうか、どの国が批准しているか、日本が署名しているかどうかは、欧州評議会の条約の署名・批准の一覧が自動アクセスの確認画面のため開けず、本コラムでは確かめられていません。会社の実務にとっては、この条約は「自国がどう国内で実施するか」を通じて間接的に影響するものなので、日本の制度の動き(第4章)と合わせて見ていくことになります。
米国、連邦の大統領令と州の法律
米国の連邦の AI政策は、この章で確かめた範囲では、主に大統領令(Executive Order)の形で示されています。後で紹介する2025年12月の大統領令14365は、議会とともに全国共通の基準を作る方針を示し、そうした基準ができるまでの間の措置を定めています。つまり、この大統領令が出た時点では、AIについて州の法律に優先する全国共通の基準はまだ無い、という前提で書かれています。その後に連邦議会で AIを横断的に扱う法律が成立したかどうかは、本コラムでは確かめていません。大統領令は大統領が行政機関に向けて出す命令で、行政機関の方針を決めるものです。民間企業に直接義務を課すものではない場合が多いですが、政府調達の条件や行政機関の規則を通じて民間に影響することがあります。
連邦官報(Federal Register)で確かめた主な大統領令は次のとおりです。2023年10月30日の大統領令14110(安全で信頼できる AIの開発と利用)は、2025年1月20日の大統領令14148で撤回されました。2025年1月23日の大統領令14179(米国の AIのリーダーシップへの障壁を取り除く)は、14110 にもとづいて行われた行政機関の措置を見直し、方針と合わないものを停止・修正・撤回するよう求めています。2025年12月11日の大統領令14365(AIの国の政策枠組みを確保する)は、州ごとの規制が50の異なる規制の寄せ集めになることを問題とし、負担の少ない全国共通の基準を議会とともに作る方針を示したうえで、司法長官に、方針と合わない州の AI法に異議を唱える専門の作業部会を置くこと、商務長官に、負担の重い州法を特定する評価を公表することを命じています。2026年6月2日の大統領令14409(先端 AIのイノベーションとセキュリティの推進)は、政府の情報システムのサイバー防御の強化などを行政機関に命じるものです。さらに2026年9月29日には、大統領令14434(超知能の時代の幕開け)が出されています。
大統領令14179・14365・14409の本文は、いずれも冒頭の目的の節で、負担の重い規制を減らして米国の AIの開発と導入を進めることを述べています。このため、本文を確かめたこの3件の大統領令からは、民間企業に AIに固有の新しい義務を加える内容は読み取れません。大統領令14434は題名と日付だけを確かめたもので、中身はこの章では扱っていません。一方で、消費者保護・雇用・金融・個人情報のような分野ごとの連邦の法律が AIを使った業務にどう当てはまるかは、この章では確かめていないので、米国で AIを使う事業がある場合は、分野ごとに専門家への確認が要ります。なお、米国国立標準技術研究所(NIST)の AI RMF は連邦政府の機関が公表した任意で使う枠組みで、第5章で扱います。
州の層では、州が独自に AIに関する法律を定めています。この章では、コロラド州議会の公式ページで確かめられたものだけを例として挙げます。コロラド州の SB24-205(AIに関する消費者保護)は、2024年5月17日に知事が署名して法律になったもので、高リスクの AIシステムの開発者と導入する者に、アルゴリズムによる差別から消費者を守るための合理的な注意を払うことを求めていました。当初は2026年2月1日以降の義務とされていましたが、2025年の臨時会で成立した SB25B-004 によって、要件の適用日が2026年6月30日に延ばされました。その後、2026年5月14日に知事が署名した SB26-189 が、SB24-205 の規定を廃止して定め直しています。新しい規定は、個人に関する重要な決定に使う自動意思決定技術を対象にしています。
州議会のページの要約によると、重要な決定には、教育・雇用・住宅・金融や融資・保険・医療・行政サービスに関わるものが挙げられています。開発者から導入する者への技術文書の提供などの主な要件は、2027年1月1日から始まるとされています。前述の大統領令14365は、改正前の SB24-205 にあたるコロラド州の法律を名指しで問題視していました。州法と連邦の方針の関係は動いている最中なので、米国の州で AIを使う事業がある会社は、対象の州の最新の状態を確かめる必要があります。
英国・中国・韓国、それぞれの形
英国は、2023年の白書で、AIを横断的に規制する法律を先に作るのではなく、既存の分野ごとの規制当局が共通の原則に沿って対応する方針を示しました。英国政府の科学・イノベーション・技術省と AI室が2023年3月29日に公表した白書「AI規制:イノベーションを促す取り組み方」がそれで、英国政府は2024年2月6日に、その意見募集に対する回答を議会に提出しています。政府の回答は、分野を横断する5つの原則として、安全性・セキュリティ・頑健性、適切な透明性と説明可能性、公平性、説明責任とガバナンス、異議申立てと救済、を挙げ、これらの原則はまず法律にもとづかない形で置くとしています。この章で確かめたのは2024年2月の政府回答までで、その後に英国で AIを対象とする法律が提出・成立したかどうかは確かめていません。
中国では、生成AIのように対象のサービスを特定した規則が定められています。この章では、そのうち生成AIの規則を確かめました。生成AIについては、国家インターネット情報弁公室など7つの部門による「生成式人工知能サービス管理暫定弁法」が定められ、2023年8月15日に施行されました。公布令の日付は2023年7月10日で、国家インターネット情報弁公室のページへの掲載は7月13日です。弁法の第2条は、中国の国内の公衆に文章・画像・音声・動画などを生成するサービスを提供する場合に適用すると定め、公衆に提供しない研究開発や利用には適用しないとしています。提供者には、学習データを適法に扱うこと(第7条)、生成した画像や動画などに表示を付けること(第12条)などが求められ、世論に関わる性質、または人々を動員する力を持つサービスには、安全評価とアルゴリズムの届出の手続きが求められています(第17条)。国外から中国の国内に提供されるサービスが規定に合わない場合の措置も定められています(第20条)。日本の会社にとっては、中国の国内の公衆に向けて生成AIのサービスを提供しているかどうかが、最初の確かめどころになります。
韓国は、AIを横断的に扱う法律を定めています。「人工知能の発展と信頼の基盤づくり等に関する基本法」(法律第20676号)は、2025年1月21日に制定され、2026年1月22日に施行されています(韓国の国家法令情報センターの表示による)。同センターには、2026年7月21日施行の改正版(法律第21311号)も表示されています。以下の第33条の説明は、この改正版の条文でも確かめました。第4条は、国外で行われた行為でも、国内の市場や利用者に影響を及ぼす場合には適用すると定めています。事業者の義務は、条ごとに分けると次のとおりです。「高影響 AI」は第2条第4号の語で、人の生命・身体の安全や基本権に重大な影響を及ぼす、または危険をもたらすおそれのある AIシステムのうち、エネルギーの供給、保健医療、採用や融資の審査など、法律が列挙する領域で使われるものを指します。高影響 AIや生成AIを使った製品・サービスを提供するときは、AIにもとづいて動いていることを事前に知らせること、生成AIの結果物に生成AIで作られたことを表示することなどが求められます(第31条)。自社の AIが高影響 AIに当たるかを事前に検討することは義務です(第33条)。所管の大臣への確認の要請は、必要な場合にできる手続きで、義務ではありません。高影響 AIについては、リスク管理の方策、説明の方策、利用者保護の方策、人による管理・監督、措置の内容を確かめられる文書の作成と保管などが求められます(第34条)。国内に住所や営業所が無い事業者のうち、利用者数や売上高などが大統領令の基準に当たるものには、国内代理人の指定が求められています(第36条)。一部の義務の違反には過料が定められていますが、本コラムでは金額は書きません。基準の多くは大統領令や告示に委ねられているので、対象になるかどうかは下位の規定まで確かめる必要があります。
国際の枠組み、OECD AI原則・広島AIプロセス・UNESCO の勧告
国や地域の制度とは別に、複数の国が合意した国際的な枠組みがあります。いずれもソフトローの層に入り、それ自体が会社に義務を課すものではありませんが、各国の制度の考え方の土台になっていることが多いので、知っておくと各国の制度を読み比べやすくなります。
OECD(経済協力開発機構)の AIに関する理事会勧告は、2019年5月22日に閣僚級の理事会で採択され、2023年11月8日に AIシステムの定義を更新する改訂、2024年5月3日に閣僚級の理事会での改訂を経ています。勧告に加わる国(加盟国と、勧告に参加した非加盟国)が、信頼できる AIのための原則を推進し実施することを求めるものです。原則の項目は第1章で扱いました。
広島AIプロセスは、日本が G7 の議長国だった2023年5月の G7 広島サミットで立ち上げられた枠組みです。内閣府の「人工知能関連技術の研究開発及び活用の適正性確保に関する指針」(2025年12月19日)の注記によると、G7 日本議長国の下で、高度な AIシステムの開発・利用に関する「広島AIプロセス包括的政策枠組み」がとりまとめられ、2025年2月には「国際行動規範」の遵守状況を AIの開発者が自ら報告・公表する「報告枠組み」の正式運用が始まっています。総務省の成果文書のページには、2023年10月30日の G7 首脳声明、「高度なAIシステムを開発する組織向けの広島プロセス国際指針」、「高度なAIシステムを開発する組織向けの広島プロセス国際行動規範」、2023年12月1日の G7 デジタル・技術閣僚声明、「全てのAI関係者向けの広島プロセス国際指針」などが掲載されています。報告枠組みは OECD が運営しており、OECD のページによると、第1回の報告は25件で、その後、開発だけでなく導入・提供に関わる組織にも参加を広げる第2版に改められています。AI事業者ガイドライン第1.2版は、2026年3月時点で日本企業9社を含む25組織が回答を提出し OECD のウェブサイトで公表されていると記しています。
UNESCO(国連教育科学文化機関)の「AIの倫理に関する勧告」は、UNESCO の公式ページによると2021年11月に193の加盟国が採択したもので、AIの倫理に関する初めての世界的な基準と位置づけられています。人間の尊厳と人権の尊重、公正で平和なつながりのある社会、多様性と包摂、環境と生態系の繁栄、という4つの価値を掲げています。会社の実務に直接の手順を与えるものではありませんが、AI基本方針(第12章)の価値の部分を書くときの参照先になりえます。
主要な制度の一覧
ここまでに紹介した制度を、1つの表にまとめます。表の「層」の列は、この章の最初に分けた3つの層を基に、制度の形式と法的な性質を示します。「日付」の列は、確かめた公式の資料に書かれている日付で、制度の性質によって採択・公布・施行・発効のどれを載せたかが違うので、日付の種類も添えました。「日本の会社が関係しうる場面」の列は、この章で確かめた条文や資料の書き方からの整理で、該当するかどうかを判断するものではありません。
| 地域 | 制度 | 作った主体 | 層 | 日付 | 日本の会社が関係しうる場面 |
|---|---|---|---|---|---|
| EU | EU AI Act(EU 規則 2024/1689) | EU | 法律 | 2024年8月1日発効、2026年8月2日から一般的に適用。高リスクの一部は2027年12月2日・2028年8月2日から | EU の市場に AIシステムを出す、出力が EU で使われる、EU の拠点で AIを導入する(第3章) |
| 欧州 | 欧州評議会の AI枠組条約(CETS 第225号) | 欧州評議会 | 条約(締約国が国内で実施) | 2024年9月5日署名開放。発効の状況は未確認 | 締約国の国内の制度を通じて間接的に |
| 米国(連邦) | 大統領令14179・14365・14409・14434 | 大統領 | 行政機関への命令 | 署名日は順に2025年1月23日・2025年12月11日・2026年6月2日・2026年9月29日 | 政府調達や行政機関の規則を通じて。州法との関係(14365) |
| 米国(州) | コロラド州 SB24-205(AIに関する消費者保護)と、それを定め直した SB26-189(自動意思決定技術) | コロラド州議会 | 法律 | SB24-205 は2024年5月17日知事署名。SB26-189 は2026年5月14日知事署名で、主な要件は2027年1月1日から | 同州で、個人に関する重要な決定に使う自動意思決定技術を開発・導入する |
| 英国 | 白書「AI規制:イノベーションを促す取り組み方」と政府回答 | 英国政府(科学・イノベーション・技術省) | 政府の方針 | 白書2023年3月29日、政府回答2024年2月6日 | 分野ごとの規制当局の対応を通じて |
| 中国 | 生成式人工知能サービス管理暫定弁法 | 国家インターネット情報弁公室など7部門 | 行政機関の規則(国家インターネット情報弁公室 令第15号) | 公布令の日付2023年7月10日(掲載は7月13日)、2023年8月15日施行 | 中国の国内の公衆に生成AIのサービスを提供する |
| 韓国 | 人工知能の発展と信頼の基盤づくり等に関する基本法(法律第20676号) | 韓国の法律(所管は科学技術情報通信部) | 法律 | 2025年1月21日制定、2026年1月22日施行 | 韓国の市場や利用者に影響する AI製品・サービスを提供する |
| 国際 | OECD の AIに関する理事会勧告(OECD AI原則) | OECD | ソフトロー | 2019年5月22日採択、2023年11月8日・2024年5月3日改訂 | 各国の制度の考え方の土台として |
| 国際 | 広島AIプロセス(包括的政策枠組み、国際指針、国際行動規範、報告枠組み) | G7(報告枠組みの運営は OECD) | ソフトロー | G7 首脳声明2023年10月30日、報告枠組みの正式運用2025年2月 | 高度な AIシステムを開発する、または報告枠組みに参加する |
| 国際 | UNESCO の AIの倫理に関する勧告 | UNESCO | ソフトロー | 2021年11月採択 | AI基本方針の価値の参照先として |
| 日本 | AI推進法(令和7年法律第53号)、AI事業者ガイドライン第1.2版 | 国会/総務省・経済産業省 | 法律(確かめた範囲では罰則の規定なし)/ソフトロー | AI推進法は2025年6月4日公布。ガイドライン第1.2版は2026年3月31日公表 | 国内で AIを活用する事業者(対象の中身は第4章) |
表の「層」の列の分け方は、本コラムの整理です。たとえば日本の AI推進法は国会が定めた法律なのでハードローの形式をとっていますが、e-Gov の条文に罰則の規定は置かれていません。一方で、第7条は活用事業者に、国や地方公共団体の施策への協力を求めています(第4章)。形式としての「法律かどうか」、罰則の有無、法的な義務の有無は、別々に確かめる必要があります。同じことは韓国の AI基本法にも言え、義務の具体的な基準の多くは大統領令や告示に委ねられているので、法律の条文だけでは対象の範囲が決まりません。
自社に掛かるかを判断する軸
表に並んだ制度のうち、どれが自社に関係するかは、会社の所在地だけでは決まりません。EU AI Act の第2条と韓国の AI基本法の第4条が示しているように、国外の事業者でも、その国や地域の市場に出す場合や、利用者に影響する場合には対象になりうる作りになっています。中国の暫定弁法も、国内の公衆にサービスを提供するかどうかで適用を決めています。このため、自社に掛かるかを判断するときは、少なくとも次の4つの軸で確かめるのが扱いやすいと考えています。
1つ目は、どこで提供・使用するか、つまり AIを組み込んだ製品やサービスをどの国・地域の市場に出しているか、どこで使用を開始しているか、です。有償か無償かは問わない制度があり、自社で使うために使用を開始する場合も含めて確かめます。拠点の所在地も、この軸の確認項目の一つです。2つ目は、出力がどこで使われるか、です。EU AI Act の第2条第1項(c)のように、EU AI Act の提供者(provider)も EU AI Act の導入者(deployer)も EU の外にいても、出力が EU の中で使われる場合を対象に含める書き方があります。自社のサービスが海外の顧客の業務に使われ、その結果が現地で使われている場合は、この軸に当たる可能性があります。3つ目は、どの業種・どの用途か、です。EU の高リスクの分野、韓国の高影響 AIの領域、コロラド州の重要な決定に使う自動意思決定技術のように、多くの制度は用途によって義務の重さを変えています。たとえば採用と、個人の与信(融資)の審査は、EU AI Act の附属書III(第4項・第5項)と、韓国の AI基本法の高影響 AIの領域(第2条第4号)のどちらにも挙げられています。同じ用途が複数の制度で重い扱いになることがあるので、用途の軸は地域の軸と組み合わせて確かめる必要があります。4つ目は、自社の立場、つまり AI事業者ガイドラインの開発者・提供者・利用者のどれか(第1章)です。この3つはガイドラインの語で、EU AI Act の提供者・導入者とは対応が一対一ではありません。同じ AIでも、自社で開発して外に出すのか、他社の AIを組み込んで提供するのか、社内で使うだけなのかで、掛かる義務が変わります。
| 判断の軸 | 社内で確かめる問い | 関係しうる制度の例 | 主に答えを持っている部門 |
|---|---|---|---|
| どこで提供・使用するか | AIを組み込んだ製品・サービスを、どの国・地域の市場に出しているか(無償の提供を含む)。どの国の拠点で使用を開始しているか。これから出す予定はあるか | EU AI Act 第2条、韓国の AI基本法 第4条、中国の暫定弁法 第2条 | 事業部門、海外営業、法務 |
| 出力がどこで使われるか | 自社の AIの出力(予測・判定・生成物)が、顧客を通じてどの国で使われているか | EU AI Act 第2条第1項(c) | 事業部門、顧客対応の部門 |
| どの業種・用途か | 採用・融資・医療・教育・重要なインフラなど、人の権利や安全に関わる用途に使っているか | EU AI Act の高リスク、韓国の高影響 AI、コロラド州 SB26-189 | 業務部門、AIガバナンスの事務局 |
| 自社の立場 | 自社で開発しているか、他社の AIを組み込んで提供しているか、社内で使うだけか | EU AI Act の提供者と導入者、韓国の AI開発事業者と AI利用事業者、AI事業者ガイドラインの3つの立場 | 情報システム部門、購買、事業部門 |
表の最後の列は、問いに答える情報を持っている部門の例です。この判断を法務部門だけに任せると、「どの国の顧客が出力を使っているか」「どの用途に組み込まれているか」のような事業の側の情報が集まらず、判断が止まりやすくなります。4つの軸は判断の観点で、台帳に同じ名前の列を作るものではありません。確かめた答えは、第7章で扱うユースケース台帳の「立場」の列と「EUとの関係」の列などの確認項目として記録しておくと、制度が変わったときに影響を受けるユースケースを台帳から探せるようになります。軸に当てはめた結果、特定の制度が関係しうると分かった場合も、実際に義務の対象になるかどうかは条文の定義と例外に照らした個別の判断になるので、専門家への確認が要ります。
各国の制度が共通して求めているもの
制度の名前や形は違っても、この章で条文を確かめた範囲では、求めている中身にはかなりの共通点があります。とくに、AIの用途を把握して登録・届出すること、リスクを評価して管理すること、AIを使っていることや生成物であることを示すこと、記録や文書を残すこと、人が監督すること、の5つは、複数の制度の条文に現れます。次の表は、EU AI Act・韓国の AI基本法・中国の暫定弁法の条文から、この5つに当たる規定を拾ったものです。EU AI Act の条文は高リスクの AIシステムや一定の AIシステムに限った義務で、韓国の規定も高影響 AIや生成AIなど対象が限られています。表の各欄は、規定の対象の限定を省いて項目だけを並べたものなので、対象の範囲は各章と原文で確かめる必要があります。
| 共通して求められるもの | EU AI Act(主な条文) | 韓国の AI基本法(主な条文) | 中国の暫定弁法(主な条文) | 本コラムで扱う章 |
|---|---|---|---|---|
| 用途の把握と登録・届出 | 第49条(附属書III の高リスクの AIシステムの EU データベースへの登録)、第71条(EU データベース) | 登録・届出の規定ではないが近いもの:第33条(高影響 AIに当たるかの事前の検討は義務、所管の大臣への確認の要請は任意) | 第17条(世論に関わる性質、または人々を動員する力を持つサービスのアルゴリズムの届出) | 第7章(ユースケース台帳) |
| リスクの評価と管理 | 第9条(リスク管理システム) | 第32条(一定の計算量を超える AIのリスクの識別・評価・緩和)、第34条第1項第1号(リスク管理の方策)、第35条(影響評価の努力) | 第17条(安全評価) | 第5章・第7章 |
| 透明性(AIであること・生成物であることの表示) | 第13条(導入者への情報提供)、第50条(一定の AIシステムの透明性の義務) | 第31条(事前の告知、生成物の表示)、第34条第1項第2号(説明の方策) | 第10条(用途などの公開)、第12条(生成した画像・動画などへの表示) | 第8章・第10章 |
| 記録と文書 | 第11条(技術文書)、第12条(記録の保持) | 第34条第1項第5号(措置の内容を確かめられる文書の作成と保管) | 第19条(監督検査の際の学習データの出所などの説明) | 第10章・第11章 |
| 人による監督 | 第14条(人による監督)、第26条(高リスクの AIシステムの導入者の義務) | 第34条第1項第4号(高影響 AIへの人の管理・監督) | (この章では該当する条文を確かめていない) | 第11章・第13章 |
表から読み取れるのは、制度ごとに個別の対応を作るより、この5つを社内の共通の仕組みとして一度作っておく方が、複数の制度への対応をまとめやすいということです。ユースケース台帳があれば登録や届出の対象を探せますし、リスクの評価の記録があれば各国の求める評価に合わせて形を整えられます。英国の政府回答が挙げる5つの原則(安全性・セキュリティ・頑健性、適切な透明性と説明可能性、公平性、説明責任とガバナンス、異議申立てと救済)や、OECD の AI原則の項目(透明性と説明可能性、頑健性・セキュリティ・安全性、説明責任 など)にも、同じ向きの考え方が見られます。ただし、表の項目が同じ名前でも、求められる詳しさ・対象・期限は制度ごとに違うので、共通の仕組みで「どの制度にも対応できた」とは言えません。共通の仕組みを土台にして、制度ごとに足りない部分を足す、という順序で考えるのが現実的だと考えています。
経営判断、最も厳しい制度に合わせるか、地域ごとに分けるか
複数の国や地域で事業をしている会社は、どの制度の水準に社内ルールを合わせるかを決める必要があります。大きく分けると、2つの型があります。1つは、関係する制度の中で最も厳しいものに全社の水準を合わせる型です。ただし制度の要件は、常に厳しさの順に並べられるとは限りません。実際には、共通にできる要件ごとに水準を決め、両立しない要件は個別に扱うことになります。もう1つは、全社に共通の最低限の水準を置き、地域ごとの制度に合わせて上乗せする型です。どちらが正しいということはなく、事業の広がり方と、AIの用途によって向き不向きがあると考えています。
| 比べる観点 | 最も厳しい制度に全社で合わせる型 | 共通の最低限に地域ごとに上乗せする型 |
|---|---|---|
| 向いている場面 | 同じ AI製品・サービスを複数の地域で提供している。地域ごとに作り分ける体制が無い | 地域ごとに用途や顧客が大きく違う。厳しい制度の対象になる事業が一部に限られる |
| 利点 | ルールが1つで分かりやすい。新しい地域に出るときの追加の作業が少ない | 厳しい制度の対象でない事業に、過剰な手続きを課さずに済む |
| 起こりやすい問題 | 対象でない社内利用にまで重い手続きが掛かり、導入の停滞が起きる | 地域ごとの対応がばらばらになり、二重投資が起きる。どの地域の水準がどこに掛かるかが分かりにくくなる |
| 前提として要るもの | どの制度が最も厳しいかを項目ごとに比べる作業 | 地域とユースケースの対応を示す台帳と、上乗せ部分の管理 |
表の「起こりやすい問題」の列は、本コラムが第1章で整理した経営上の損失の型(導入の停滞・規制違反・権利侵害・誤った判断の放置・信頼の失墜・二重投資)に対応しています。最も厳しい制度に全社で合わせると、EU の高リスクの AIシステムを想定した手続きが社内の文書の要約のような用途にまで掛かり、承認を待つあいだに現場が使わなくなる、という形の導入の停滞が起きえます。逆に地域ごとに分けると、EU 向け・韓国向け・国内向けで別々の台帳や評価の様式ができ、二重投資につながるおそれがあります。どちらの型でも、制度の変化を見落とせば規制違反、用途の把握が漏れれば権利侵害や誤った判断の放置につながるおそれがあり、問題が表に出れば信頼の失墜につながりえます。
本コラムでは、多くの会社にとっては2つ目の型を基本にするのが扱いやすいと考えています。具体的には、前節の5つの共通の要素を全社の土台として作り、そのうえで本コラムのリスク区分(第7章)の「高」に当たるユースケースと、特定の地域の制度の対象になるユースケースにだけ、制度ごとの上乗せを掛ける形です。全社の土台は1つにして二重投資を避け、重い手続きは対象のユースケースに限って導入の停滞を避ける、という考え方です。この形をとるには、どのユースケースがどの地域に関係するかを台帳で管理していることが前提になります。
もう1つ、経営が決めておくべきことは、制度の変化を誰が追うかです。この章で見ただけでも、EU AI Act は2026年7月に適用の日程が改正され、米国では2025年から2026年にかけて AIに関する大統領令が続けて出され、韓国の AI基本法は2026年1月に施行されました。こうした変化を、法務・事業・情報システムのどの部門が、どの公式の情報源で、どの頻度で確かめ、誰に報告するかを決めておかないと、変化に気づくのが取引先からの問い合わせや契約の見直しのときになりがちです。追う範囲は、前節の4つの軸を起点に、自社に関係しうると判断した地域と制度から選びます。事業や用途が変わったときは、その範囲も見直します。追う役割を AIガバナンスの事務局(第13章)に置き、事務局が AIガバナンス委員会に報告し、委員会から四半期ごとの経営会議への報告に含める形が考えられます。制度の追い方と見直しの周期は第14章で扱います。
この章では、AIに関する制度を、法律(ハードロー)・指針とガイドライン(ソフトロー)・規格の3つの層に分け、欧州・米国・英国・中国・韓国・国際の枠組みの主要な制度を、公式の資料で確かめた範囲で一覧にしました。自社に関係するかどうかは所在地だけでは決まらず、どこで提供・使用するか・出力がどこで使われるか・どの用途か・自社の立場の4つの軸で確かめる必要があります。そのうえで、各国の制度が共通して求める用途の把握・リスクの評価・透明性・記録・人による監督の5つを全社の土台にすると、複数の制度への対応をまとめやすくなります。次の第3章では、この見取り図の中で日本の会社への影響が大きい EU AI Act を取り上げ、リスクの区分と義務と適用の日程を条文に沿って確かめます。
この章を深めたい方への参考書籍
『ソフトローの基礎理論』(藤田友敬 編、有斐閣):ソフトロー研究叢書の第1巻として2008年に刊行された論文集で、法的な拘束力を持たない規範を主題にしています。目次には、自律的な秩序を経済学から論じる論文や、信頼と規範を社会心理学から論じる論文が並んでいます。AIを扱った本ではありませんが、この章で分けたハードローとソフトローの違いや、ソフトローが取引や社内ルールを通じて実務に影響する仕組みを、理論の側から考えるときの材料になります。
『AI vs法 世界で進むAI規制と遅れる日本』(佐藤洸一 著、マイナビ出版):マイナビ新書の1冊で、副題のとおり各国の AI規制の動きと日本の状況を扱っています。目次の前半は画像生成AIと著作権、対話型AIと法を取り上げています。2023年8月の刊行なので、刊行時期から、EU AI Act の最終的な条文と2026年の改正、日本の AI推進法、韓国の AI基本法の施行は含まれていないと考えられます。制度が動き始めた時期の論点を一冊で見渡すための本として読むと、この章の一覧表と比べて何が変わったかが分かります。
第3章 EU AI Act、リスクの区分と義務と適用の日程
第2章では、AIに関わる制度を、法律(ハードロー)・指針(ソフトロー)・規格の3種類に分け、拘束力の違いと、自社に掛かるかどうかを判断する軸を整理しました。この章では、そのうち AIに関する包括的な法制度の一つである EU の規則を取り上げます。正式には EU 規則 2024/1689 で、本コラムではEU AI Actと呼びます。AIシステムを「どの用途に使うか」によって区分し、区分ごとに義務の重さを変える仕組みを、EU の全加盟国に直接適用される規則として定めたものです。
この章の記述は、欧州委員会が運営する AI Act Service Desk に掲載されている条文(同サイトの注記によると、EUR-Lex の2026年7月27日時点の統合版(デジタル・オムニバスによる改正を反映したもの)に基づく)と、欧州委員会の政策ページを、2026年10月28日に開いて確かめた範囲に限っています。統合版とは、元の規則に後の改正を反映させた読み物としての版で、法的な正本は EU 官報に掲載された規則そのものです。EU AI Act は、2026年7月27日に発効したデジタル・オムニバスのうち AIに関する改正(欧州委員会は「AI Omnibus」と呼んでいます)によって、適用の日程と一部の義務が変わりました。欧州委員会の発表は、このオムニバスの主な中身として、高リスクの規定の適用日の延期、中小企業向けだった一部の措置を小規模ミッドキャップ企業(SMC。中小企業より一段大きい規模の企業として規則が定義する区分)にも広げること、AIリテラシーの規定の簡素化、性的な生成物に関わる禁止の追加、AI Office の監督の権限の拡大などを挙げています。AI Office は、第3条第47号によると、AIシステムと汎用目的 AIモデルの実施・監視・監督に関わる欧州委員会の機能を指し、規則の中で AI Office とある箇所は欧州委員会を指すものと読むとされています。古い解説記事や、オムニバスより前に刊行された書籍の日付は、そのままでは使えない場合があります。
この章は条文の要旨を整理するもので、個別の AIシステムが規則のどの区分に当たるか、どの義務が掛かるかを判断するものではありません。条文は、事業の内容・AIの使い方・関わる国によって当てはまり方が変わります。自社の AIが対象になるか、どの義務を負うかの判断は、EU 法に詳しい弁護士などの専門家に個別に確認する前提で読んでください。そのうえで、専門家に相談する前に社内で何をそろえておくと相談が速く進むか、という観点を各節に入れました。
誰に掛かるか、適用範囲(第2条)と提供者・導入者(第3条)
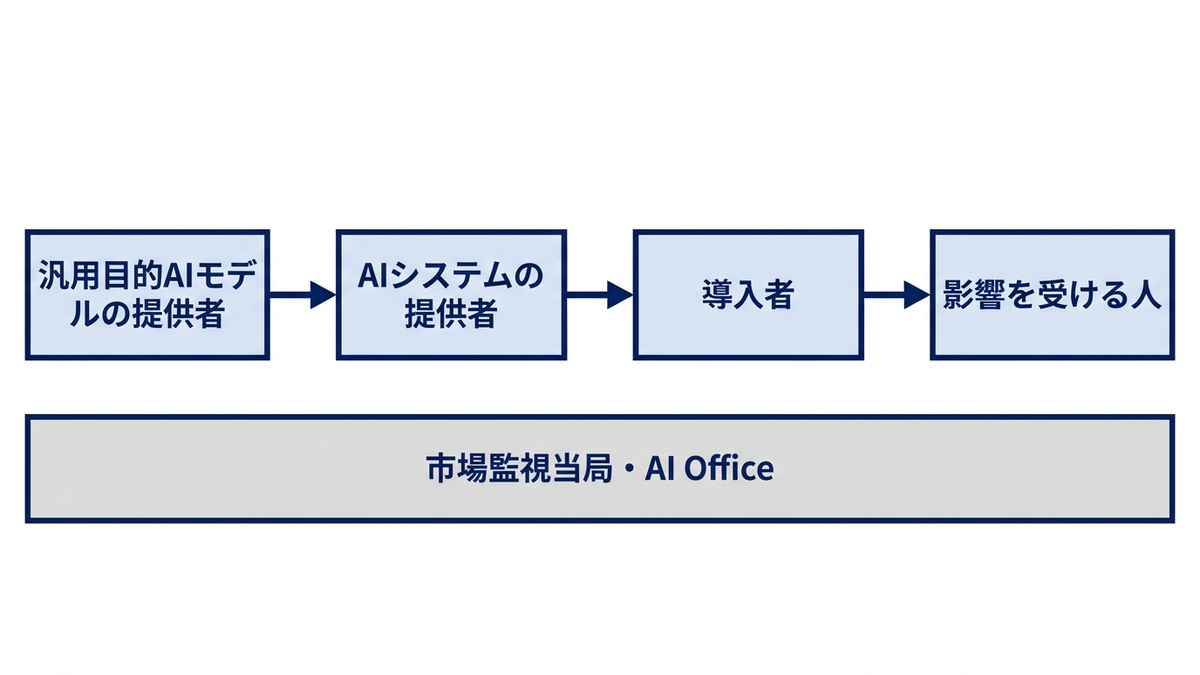
EU AI Act を読むときに最初に確かめるのは、自社がどの立場で AIに関わっているかです。規則は、AIに関わる者を立場ごとに定義し、立場ごとに別の義務を課しています。中心になるのが、第3条第3号の provider と第4号の deployer です。本コラムでは、provider を提供者、deployer を導入者と訳し、全章でこの訳語に固定します。第1章で扱った AI事業者ガイドラインの「AI開発者・AI提供者・AI利用者」とは定義が違い、対応は一対一ではありません。そこで、ここで一度「EU AI Act の提供者(provider)」「EU AI Act の導入者(deployer)」と書いたうえで、この章では、断りがない限り、提供者・導入者は EU AI Act の語を指します。AI事業者ガイドラインの語と同じ段落で並べるときは、その都度どちらの語かを書き分けます。
第3条第3号によると、提供者とは、AIシステムや汎用目的 AIモデルを開発する者、または開発させる者で、それを自分の名前や商標のもとで市場に出す者、または AIシステムの使用を開始する者を指します。使用の開始は AIシステムについての規定で、汎用目的 AIモデルは市場に出す場合だけが挙げられています。有償か無償かは問いません。第4号によると、導入者とは、自らの権限のもとで AIシステムを使う者を指し、個人的で職業外の活動として使う場合は除かれます。つまり、外部の AIサービスを業務で使っている会社は、多くの場合「導入者」に当たりうる立場にあり、自社の名前で AIを組み込んだ製品やサービスを出している会社は「提供者」に当たりうる立場にあります。同じ会社が、ある用途では導入者、別の用途では提供者になることもあります。
このほか第3条は、提供者から書面の委任を受けて EU 域内で規則上の手続きを担う「認定代理人」(第5号)、EU の外の者の名前や商標が付いた AIシステムを EU の市場に出す「輸入者」(第6号)、それ以外にサプライチェーンの中で AIシステムを EU の市場に流通させる「販売者」(第7号)を定義しています。提供者・製品の製造者・導入者・認定代理人・輸入者・販売者をまとめて「事業者(operator)」と呼んでいます(第8号)。
適用範囲は第2条が定めています。第2条第1項は、規則が適用される者を7つ挙げています。日本企業にとって重要なのは、EU の外に拠点がある会社も対象になりうることが条文に書かれている点です。次の表は、第2条第1項の各号を要旨にし、日本企業がどの場合に関わりうるかの型を添えたものです。右の列は条文ではなく本コラムの整理で、該当するかどうかは個別に確認が要ります。
| 第2条第1項 | 条文の要旨 | 日本企業が関わりうる型(本コラムの整理) |
|---|---|---|
| (a) | EU で AIシステムを市場に出す、または使用を開始する提供者と、EU で汎用目的 AIモデルを市場に出す提供者。拠点が EU の内か外かを問わない | AIを組み込んだ製品やサービスを、自社の名前で EU の顧客に販売・提供している |
| (b) | EU 域内に拠点がある、または EU 域内にいる導入者 | EU にある子会社や拠点が、業務で AIシステムを使っている |
| (c) | EU の外に拠点がある提供者と導入者で、AIシステムが生み出した出力が EU で使われる場合 | 日本で動かしている AIの出力(判定の結果・生成した文章など)を、EU の拠点や取引先が使っている |
| (d) | AIシステムの輸入者と販売者 | EU の拠点が、日本の本社や他社の AIシステムを EU で販売している |
| (e) | AIシステムを自社の製品と一緒に、自社の名前や商標で市場に出す、または使用を開始する製品の製造者 | AIを安全部品などに組み込んだ機械・機器を EU に輸出している |
| (f) | EU 域内に拠点が無い提供者の認定代理人 | EU の外の提供者から委任を受けて、EU 域内で手続きを担う立場にある |
| (g) | EU 域内にいる、影響を受ける人 | (企業の立場ではなく、保護の対象を示す号) |
第2条には、適用されない場合も書かれています。軍事・防衛・国家安全保障の目的だけに使われる AIシステム(第3項)、科学的な研究開発だけを目的として開発され使用を開始された AIシステムや AIモデル(第6項)、市場に出す前や使用を開始する前の研究・試験・開発の活動(第8項。ただし実環境での試験は除外の対象になりません)、個人的で職業外の活動として AIを使う個人の導入者の義務(第10項)などです。無償でオープンソースのライセンスのもとで公開された AIシステムも原則として対象外ですが、高リスクの AIシステムとして市場に出す、または使用を開始する場合や、第5条(禁止)か第50条(透明性)のいずれかに当たる場合は対象になります(第12項)。いずれも条件がついた除外で、「研究だから対象外」「オープンソースだから対象外」と一律に扱えるものではありません。
もう一つ、立場は固定されたものではないことにも注意が要ります。第25条第1項は、販売者・輸入者・導入者などが、次のいずれかに当たる場合には、高リスクの AIシステムの提供者とみなされ、第16条の提供者の義務を負うと定めています。すでに市場に出ている高リスクの AIシステムに自分の名前や商標を付けた場合、高リスクのまま実質的な変更を加えた場合、高リスクに分類されていなかった AIシステム(汎用目的の AIシステムを含む)の用途を変えて、高リスクに当たるものにした場合、の3つです。外部の汎用的な AIサービスを、採用の選考のような用途に組み込んで使い始めると、導入者のつもりでいた会社が提供者の義務を負う立場になりうる、ということです。オムニバスによる改正後の第25条第2項は、このとき最初の提供者が新しい提供者に協力し、技術文書や既知の限界、試験のための技術的なアクセスなどを提供することも定めています。ただし、最初の提供者が「高リスクの AIシステムに変えてはならない」と明確に示していた場合は、この協力の義務は掛かりません。必要な情報を必ず受け取れるとは限らない、ということです。
リスクの4つの水準と禁止される行為(第5条)
欧州委員会の政策ページは、EU AI Act が AIシステムについて4つのリスクの水準を定めていると説明しています。許容できないリスク、高リスク、透明性のリスク、最小限のリスクまたはリスクなし、の4つです。許容できないリスクに当たる行為は禁止され(第5条)、高リスクに当たる AIシステムには市場に出す前から多くの義務が課され(第3章)、透明性のリスクに当たる AIシステムには利用者や影響を受ける人に知らせる義務が課され(第50条)、最小限のリスクの AIには EU AI Act としての新しい規定は設けられていません。欧州委員会のページは、EU で現在使われている AIシステムの大半は最小限のリスクに当たるとし、例として AIを使ったビデオゲームや迷惑メールの振り分けを挙げています。
この4つの水準は、規則の構成を理解するための整理で、条文が「水準」という見出しで並んでいるわけではありません。また、汎用目的 AIモデルの義務(第5章)は、この4つの水準とは別の軸で、AIシステムではなく AIモデルの提供者に課されています。次の表は、4つの水準と汎用目的 AIモデルを、根拠の条文と、主に義務を負う者と、本章で確かめた適用日に分けて整理したものです。なお、第7章で扱う本コラムのリスク区分(禁止・高・中・低)は、自社のユースケースを分けるための社内の区分で、EU AI Act の4つの水準とは別物です。名前が似ていても、同じ基準で判定するものではありません。
| 水準 | 根拠の条文 | 主に義務を負う者 | 求められること(要旨) | 適用日(第113条、本章の日程の節) |
|---|---|---|---|---|
| 許容できないリスク | 第5条 | 提供者・導入者 | 列挙された行為を市場に出すこと・使用を開始すること・使うことの禁止 | 2025年2月2日。オムニバスで加わった第5条第1項の(ba)(bb)と、第1a項・第1b項は2026年12月2日 |
| 高リスク | 第6条、附属書I・附属書III、第8〜27条ほか | 提供者(第16条ほか)・導入者(第26条ほか) | リスク管理・データ・記録・人による監督などの要件、適合性評価、登録、運用中の監視 | 附属書III の分野は2027年12月2日、附属書I の製品は2028年8月2日 |
| 透明性のリスク | 第50条 | 提供者・導入者 | AIと対話していることの通知、生成物の機械可読な表示、ディープフェイク等の開示 | 2026年8月2日(既存の生成AIの表示には経過措置) |
| 最小限のリスク | EU AI Act としての新しい規定は無い | (第4条の AIリテラシーは提供者・導入者に掛かる) | 自主的な行動規範(第95条)の活用など | (第4条は2025年2月2日) |
| 汎用目的 AIモデル(別の軸) | 第51〜56条 | 汎用目的 AIモデルの提供者 | 技術文書・下流の提供者への情報・著作権の方針・学習データの要約。システミックリスクのあるモデルは追加の義務 | 2025年8月2日 |
禁止される行為は第5条第1項に列挙されています。オムニバスによる改正後の統合版では、号は(a)(b)(ba)(bb)(c)(d)(e)(f)(g)(h)の10あり、欧州委員会のページは、性的な生成物に関わる2つの号をまとめて9つの行為として説明しています。要旨は次のとおりです。
- (a)意識の外にはたらきかける技法や、意図的に操作・欺く技法を使い、判断する力を損なわせて行動をゆがめ、重大な害を生じさせる、または生じさせるおそれが合理的に高い AIシステム
- (b)年齢・障害・社会的または経済的な状況による弱さにつけこみ、行動をゆがめて重大な害を生じさせる、または生じさせるおそれが合理的に高い AIシステム
- (ba)特定できる個人の私的な部位や性的な行為を描いた写実的な画像・映像・音声などを、本人の明示的な同意なく生成・加工する AIシステム(オムニバスで追加)
- (bb)児童の性的虐待にあたる素材を生成・加工する AIシステム(オムニバスで追加)
- (c)人の社会的なふるまいや人格的な特徴にもとづいて人を評価・分類し、元のデータと関係の無い場面で不利な扱いをする、またはふるまいに比べて不当・過大に不利な扱いをする、いわゆる社会的スコアリング
- (d)プロファイリングや人格的な特徴の評価だけにもとづいて、個人が犯罪を行うリスクを評価・予測する AIシステム(犯罪活動に直接関連する、客観的で検証可能な事実にもとづく人の評価を支援するものは除く)
- (e)インターネットや監視カメラの映像から顔画像を無差別に収集して、顔認識のデータベースを作る、または拡大する AIシステム
- (f)職場と教育機関で、人の感情を推定する AIシステム(医療上・安全上の理由によるものは除く)
- (g)生体データにもとづいて、人種・政治的意見・労働組合への加入・宗教や思想・性生活や性的指向を推定する生体分類のシステム(適法に取得した生体データセットのラベル付けや絞り込みなどは除く)
- (h)法執行の目的で、公共の場所でリアルタイムの遠隔生体識別システムを使うこと(誘拐の被害者の捜索など、条文が列挙する目的に厳密に必要な場合を除く)
オムニバスで加わった第5条第1a項は、(ba)(bb)の禁止が、市場に出すことや使用を開始することについては、その生成が AIシステムの意図された目的である場合か、設計や機能からその生成が合理的に予見でき再現可能な結果であって、確実に防ぐ安全対策が無い場合に限られること、使うことについては、導入者がそうした素材を生成する目的で使う場合に限られることを定めています。同じくオムニバスで加わった第1b項は、(ba)について、描かれた身体の露出を増やさず、描かれた性的な行為の性質も変えない加工は、ここでいう加工に当たらないと定めています。欧州委員会は、禁止される行為の解釈について指針(guidelines on prohibited AI practices)を公表しています。
一般の企業の業務で、(a)から(h)に当たる用途を意図して AIを使うことは多くないと考えられます。それでも、確かめておく価値がある号があります。たとえば(f)の職場での感情の推定は、従業員の応対品質の分析や、会議の参加者の反応の分析といった用途で、製品の機能として含まれていることがあります。(a)(b)の操作やつけこみは、販売促進の仕組みの設計のしかたによっては論点になりえます。第7章で作るユースケースの台帳には「EUとの関係」の列があります。その列の中で確かめる項目の一つとして「第5条の各号に当たる可能性があるか」を含め、少しでも疑いがある用途は、使い始める前に専門家の確認に回す運用が有効だと考えています。
この節で確かめた第5条のうち、(a)(b)(c)から(h)の禁止は2025年2月2日から適用されています。オムニバスで加わった第1項の(ba)(bb)と、第1a項・第1b項は2026年12月2日から適用され、本コラムの基準時点(2026年10月)ではまだ適用されていません。すでに適用が始まっている号は、後の節で扱う高リスクの日程の延期とは関係なく、現時点で確認の対象になります。(ba)(bb)も、適用の開始までの期間が短いので、あわせて確かめておくことが有効だと考えています。
高リスクAIシステムの2つの入口、附属書Iと附属書III(第6条)
EU AI Act の義務の大半は、高リスクAIシステムに向けられています。どの AIシステムが高リスクに当たるかは第6条が定めており、入口は2つあります。
1つ目の入口は第6条第1項です。AIシステムが、附属書I に列挙された EU の製品安全の法令(整合化法令)の対象となる製品の安全部品として使われる場合、または AIシステムそのものがその製品である場合で、かつ、その製品が第三者による適合性評価を受けることを求められている場合に、高リスクとされます。ただし、オムニバスで加わった第1c項により、健康と安全以外のリスクだけを理由に第三者の評価が求められる製品は、この条件に当たらないとされています。附属書I の題名にある整合化法令(Union harmonisation legislation)は、本コラムの理解では、製品に求める要件を EU の中でそろえるための EU の法令で、附属書I に対象の法令が列挙されています。オムニバスでは、安全部品の範囲も明確にされました。利用者の補助・性能の最適化・業務の効率化・自動化・品質管理のように安全に関係しない用途だけに使われる AIシステムは安全部品に当たらず(第6条第1a項)、ただし故障や誤作動が健康と安全を脅かすものは安全部品に当たります(第1b項)。
この入口に当たる場合の手続きが、適合性評価です。適合性評価は、第3条第20号によると、高リスク AIシステムが EU AI Act の第3章第2節の要件を満たしているかを示す手続きを指します。附属書I は、EU の新しい法的枠組み(New Legislative Framework)に基づく製品の法令を並べた第A節と、それ以外の EU の製品の法令を並べた第B節に分かれています。第43条によると、附属書I 第A節の製品は各製品の法令が定める適合性評価の手続きに従います。附属書III の第2〜8項の分野は、適合性評価機関(ノーティファイドボディ)が関与しない、提供者自身による内部管理の手続きによるとされています。附属書I 第A節と附属書III の両方に当たる場合は、製品の法令の手続きに従います(第3項)。附属書III の第1項(生体識別等)は、整合規格の適用の状況によって、内部管理か適合性評価機関の関与する手続きかが分かれます。整合規格は、EU の標準化機関が作る技術規格で、これに沿っていれば規則の要件を満たすと推定されるものです(後の「制裁と整合規格」の節で説明します)。
附属書I の中身と改正点も確かめておきます。第A節には、玩具・エレベーター・圧力機器・無線機器・個人用保護具・医療機器・体外診断用医療機器などの法令が並びます。オムニバスによる改正後の統合版では、第A節の第1号が削除されて空欄になり、第B節の末尾に機械に関する規則(EU 規則 2023/1230)が新たに加わっています。欧州委員会のページは、オムニバスの改正点の一つとして、EU AI Act と製品安全の法令、とくに機械規則との関係を明確にしたことを挙げています。第B節には、ほかに民間航空・自動車・農林業用車両・船舶用機器・鉄道などの法令が並んでいます。第2条第2項によると、第B節の法令に関わる高リスクの AIシステムには、EU AI Act のうち限られた条文だけが適用されます。製造業で、AIを組み込んだ機械や機器を EU に出している会社は、この入口を確かめる必要があります。
2つ目の入口は第6条第2項で、附属書III に列挙された分野の AIシステムが高リスクとされます。附属書III は8つの分野を挙げています。次の表は、各分野の項目を要旨にしたものです。条文では、分野ごとに「〜に使われることを意図した AIシステム」という形で、具体的な用途が号として列挙されています。分野の名前だけで判断せず、号の用途に当たるかを確かめる必要があります。
| 附属書III の分野 | 列挙されている用途の例(要旨) | 一般の企業が関わりうる場面の例(本コラムの整理) |
|---|---|---|
| 1 生体識別・生体分類・感情認識 | 遠隔の生体識別(本人確認だけを目的とするものは除く)、機微な属性の推定による生体分類、感情認識 | 来店者の識別や属性の推定に顔認識を使う(本人確認だけの用途は除外。用途によって確認が要る) |
| 2 重要インフラ | 重要なデジタル基盤・道路交通・水・ガス・暖房・電気の供給の管理と運用における安全部品 | インフラ事業者が設備の制御に AIを使う |
| 3 教育と職業訓練 | 入学や配属の決定、学習成果の評価、受けるべき教育の水準の判定、試験中の不正の監視 | 教育・職業訓練の機関として行う入学や評価に AIを使う(社内の研修が当たるかは、実施主体と判断への影響によって確認が要る) |
| 4 雇用・労務管理・自営業へのアクセス | 募集・選考(求人広告の配信先の選定、応募書類の分析と絞り込み、候補者の評価)、労働条件・昇進・契約終了の判断、個人の行動や特徴にもとづく業務の割り当て、業績と行動の監視と評価 | 採用の書類選考や、従業員の評価に AIを使う |
| 5 必要不可欠な民間・公共のサービスと給付へのアクセス | 公的給付の受給資格の評価、個人の信用力の評価や信用スコアの算出(金融詐欺の検知は除く)、生命保険・医療保険のリスク評価と価格設定、緊急通報の分類と出動の優先順位付け | 金融機関や保険会社が、個人向けの審査や保険料の設定に AIを使う |
| 6 法執行 | 法執行機関による、犯罪被害のリスク評価、うそ発見器のような道具、証拠の信頼性の評価など | (主に公的機関とその委託先) |
| 7 移民・難民・国境管理 | 当局による、うそ発見器のような道具、入国者のリスク評価、申請の審査の支援など | (主に公的機関とその委託先) |
| 8 司法と民主的なプロセス | 司法当局による事実と法の調査・解釈の支援、選挙や国民投票の結果や投票行動に影響を与えることを意図したもの | 司法の支援は主に公的機関とその委託先。選挙に関わる用途は利用する主体を限っておらず、民間の主体も確認の対象になる(選挙活動の事務的な管理の道具は除外) |
附属書III に当たる AIシステムでも、常に高リスクになるとは限りません。第6条第3項は、健康・安全・基本権に対する重大な害のリスクをもたらさず、意思決定の結果に実質的な影響を与えない場合には、高リスクとみなさないと定め、その条件として、次の4つのいずれかに当たるものを挙げています。狭い手続き的な作業を行うもの、人がすでに終えた作業の結果を改善するもの、過去の判断の傾向や傾向からの逸脱を検知するもので、人の評価を適切な確認なしに置き換えたり左右したりしないもの、附属書III の用途に関わる評価の準備的な作業を行うもの、の4つです。ただし、附属書III に当たる AIシステムのうち、自然人(法人ではない個人)のプロファイリングを行うものは、常に高リスクとみなされます。プロファイリングの定義は、第3条第52号が GDPR の定義を参照しています。また、この例外を使う提供者は、市場に出す前に自らの評価を文書にし(第4項)、登録の義務(第49条第2項)も負います。
欧州委員会は、第6条の実務上の適用について、高リスクに当たる例と当たらない例の一覧を含む指針を出すことになっています(第6条第5項)。AI Act Service Desk の高リスクの分類の指針のページでは、2026年10月28日の時点で、指針は案として掲載され、意見募集は2026年7月23日までと書かれていました。正式に採択された指針を確かめられなかったため、本コラムでは指針の中身には踏み込みません。自社の判断に使う時点で、採択の有無を公式のページで確かめる必要があります。
一般の企業にとって、附属書III のうち最も関わりやすいのは、第4項の雇用と、第5項の金融・保険だと考えられます。採用の応募書類を AIで絞り込む、従業員の業績を AIで評価する、といった用途は、EU の拠点で行う場合や、出力が EU で使われる場合に、この分野に当たりうるためです。経営の側から見ると、人事と与信の用途は、EU との接点の有無を最初に確かめるべき用途として、台帳の中で優先度を上げておくことが合理的だと考えています。
提供者の義務と導入者の義務、基本権影響評価(第9〜27条)
高リスク AIシステムに課される要求は、第3章第2節(第8〜15条)に「AIシステムが満たすべき要件」として、第3節(第16〜27条)に「誰が何をするか」の義務として、分けて書かれています。要件を満たすことに責任を負うのは主に提供者で、導入者は、提供者が付けた使用説明書に沿って使い、運用の中で人による監督と監視を担います。
第2節の要件は、条の題名で見ると次の7つです。第9条のリスク管理システム、第10条のデータとデータガバナンス、第11条の技術文書、第12条の記録の保持(自動的なログの記録)、第13条の透明性と導入者への情報提供、第14条の人による監督、第15条の正確性・頑健性・サイバーセキュリティです。第16条は、これらの要件を満たすことを含め、提供者が行うべきことを、(a)から(l)の12の号で列挙しています。次の表は、第16条の号を要旨にし、対応する条を添えたものです。表の(h)の CE マーキングは、第3条第24号によると、提供者が、AIシステムが第3章第2節の要件と、表示を求める他の EU の整合化法令に適合していることを示す表示です。
| 第16条の号 | 提供者の義務(要旨) | 関係する条 |
|---|---|---|
| (a) | 第2節の要件(リスク管理・データ・技術文書・記録・透明性・人による監督・正確性等)を満たすようにする | 第9〜15条 |
| (b) | 名称・登録商号または登録商標・連絡先の住所を、原則として AIシステムに示す。できない場合は包装や添付文書に示す | 第16条 |
| (c) | 品質マネジメントシステムを備える | 第17条 |
| (d) | 文書を保管する | 第18条 |
| (e) | 自らの管理下にある場合、自動的に生成されたログを保管する | 第19条 |
| (f) | 市場に出す前、または使用を開始する前に、適合性評価の手続きを受ける | 第43条 |
| (g) | EU 適合宣言書を作成する | 第47条 |
| (h) | CE マーキングを付す | 第48条 |
| (i) | 登録の義務を果たす | 第49条第1項 |
| (j) | 必要な是正措置をとり、情報を提供する | 第20条 |
| (k) | 各国の所管当局から理由を示した求めがあれば、要件への適合を示す | 第16条 |
| (l) | アクセシビリティの要件を満たす | EU 指令 2016/2102・2019/882 |
表のうち、第10条のデータとデータガバナンスは、学習・検証・テストに使うデータの品質と管理を求める条で、データの来歴や偏りの確認といった論点は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』と第10章で扱います。第12条の記録と、運用開始後の監視(第72条)や重大インシデントの報告(第73条)は、第11章で扱います。オムニバスでは、偏りの検知と是正のために特別な種類の個人データを処理することを、例外として認める第4a条が加わりました。厳格に必要であること、合成データや匿名化したデータでは目的を果たせないことなど、所定の条件をすべて満たす場合に限られます。
導入者の義務は第26条にまとまっています。日本企業が EU の拠点で高リスクの AIシステムを使う場合や、出力が EU で使われる場合に、最も直接に関わりうるのはこの条です。条文に出てくる市場監視当局は、EU の市場監視に関する規則(EU 規則 2019/1020)にもとづく活動と措置を行う各国の当局で(第3条第26号)、本コラムの理解では、市場に出た AIシステムが規則を守っているかを確かめる役目を担います。第70条により各加盟国が少なくとも1つ設けるか指定することになっています。要旨は次のとおりです。
- 使用説明書に沿って使うよう、技術的・組織的な措置をとる(第1項)
- 人による監督を、必要な能力・訓練・権限と支援を持つ人に割り当てる(第2項)
- 入力するデータを導入者が管理している範囲で、意図された目的に照らして適切で十分に代表的なデータにする(第4項)
- 使用説明書にもとづいて運用を監視し、第79条第1項にいうリスクが生じうると考える理由があるときは、提供者や販売者と市場監視当局に遅滞なく知らせて使用を止める。重大インシデントを見つけたときは、まず提供者に、次に輸入者や販売者と市場監視当局に直ちに知らせる(第5項)
- 自らの管理下にある自動的なログを、意図された目的に応じた期間、少なくとも6か月保管する(他の法令に別の定めがある場合を除く)(第6項)
- 職場で使う前に、雇用主である導入者は、労働者の代表と影響を受ける労働者に知らせる(第7項)
- 公的機関である導入者は登録の義務を果たす(第8項)
- 該当する場合、提供者から受けた情報を使って、GDPR(EU の一般データ保護規則)第35条のデータ保護影響評価を行う(第9項)
- 附属書III の高リスクの AIシステムで、自然人に関する決定を行う、または決定を支援する場合、その人に AIシステムが使われていることを知らせる(第11項)
- 所管当局の措置に協力する(第12項)
第26条には、このほか法執行の目的で事後に遠隔生体識別を使う場合の許可の手続き(第10項)なども書かれていますが、一般の企業に関わる場面は限られるので、ここでは省きます。金融機関については、EU の金融サービスの法令にもとづく内部統治の規定を守ることで、監視やログの保管の義務の一部を果たしたとみなす規定もあります(第5項・第6項)。
導入者の義務のうち、特定の導入者だけに掛かるのが、第27条の基本権影響評価です。対象は限られており、この限定を落とすと「高リスクの AIを使う会社はすべて基本権影響評価が要る」という誤った理解になります。第27条第1項によると、対象は、第6条第2項の高リスク AIシステム(附属書III の分野。ただし第2項の重要インフラの分野は除く)を使う導入者のうち、公法上の団体、公共サービスを提供する民間の主体、そして附属書III 第5項(b)の信用力の評価・信用スコアの算出と、(c)の生命保険・医療保険のリスク評価と価格設定に AIシステムを使う導入者です。評価の中身は、(a)AIシステムを使う業務の手順の説明、(b)使う期間と頻度、(c)影響を受けうる人や集団の種類、(d)その人々に及びうる具体的な害のリスク、(e)人による監督の措置の実施、(f)リスクが現実になったときの措置(内部の統治の取り決めや苦情の仕組みを含む)の6つです。
対象になる導入者は、基本権影響評価を最初の使用の前に行い(第2項)、結果を市場監視当局に通知します(第3項)。前提が変わったら更新します。すでに行ったデータ保護影響評価で満たされている部分は、オムニバスによる改正後の第4項により、その該当箇所を参照する形で組み込めるとされ、AI Office は、簡素に対応できるよう質問票の様式を作ることになっています(第5項)。第7章で扱う本コラムの影響評価は、リスク区分に応じた深さ(高は6段階、中は簡易)で社内のユースケースに使う社内の手順で、第27条の基本権影響評価とは対象も様式も別のものです。ただし、評価の項目(影響を受ける人・起こりうる害・人の関与・緩和策)は重なるので、社内の様式を作るときに第27条の6項目を含めておくと、対象になった場合の作業が少なくなると考えています。
透明性の義務とAIリテラシー(第50条・第4条)
高リスクに当たらない AIでも、一定の種類の AIには、透明性の義務が掛かります。生成AIを使った社外向けのサービスや、チャットボットを提供している日本企業にとっては、高リスクの規定よりも先に関わる可能性が高いのがこの第50条です。第50条は、提供者の義務と導入者の義務を分けて書いています。
| 第50条 | 義務を負う者 | 求められること(要旨) | 主な例外(要旨) |
|---|---|---|---|
| 第1項 | 提供者 | 人と直接やり取りする AIシステムを、相手が AIとやり取りしていると分かるように設計・開発する | 状況から明らかな場合、法律で認められた犯罪の捜査等の用途 |
| 第2項 | 提供者 | 音声・画像・映像・文章を生成する AIシステム(汎用目的の AIシステムを含む)の出力に、機械が読み取れる形で表示を付け、AIが生成・加工したと検知できるようにする | 標準的な編集の補助にとどまる場合、入力を実質的に変えない場合など |
| 第3項 | 導入者 | 感情認識や生体分類のシステムを使うとき、その対象になる人に運用を知らせる | 法律で認められた犯罪の検知等の用途 |
| 第4項 | 導入者 | ディープフェイクにあたる画像・音声・映像を生成・加工したときは、そのことを開示する。公共の利益に関する事柄を伝える目的で公表する文章を生成・加工したときも開示する | 芸術・風刺・創作の作品は鑑賞を妨げない形の開示でよい。文章は、人による確認や編集を経て、編集の責任を負う者がいる場合は除く |
第3条第60号によると、ディープフェイクとは、実在する人・物・場所・団体・出来事に似せて AIが生成・加工した画像・音声・映像で、見た人に本物や真実であるかのように誤って見えるものを指します。情報は、遅くとも最初のやり取りや接触の時点で、明確で見分けやすい形で示すことが求められています(第5項)。
第50条は、第113条の原則どおり2026年8月2日から適用されています。ただし、オムニバスで加わった第111条第4項により、2026年8月2日より前に市場に出された生成AIのシステムの提供者は、第2項の機械可読な表示について、2026年12月2日までに対応すればよいとされています。欧州委員会は、2026年7月20日付で第50条の透明性の義務に関する指針を公表し、AIが生成した内容の表示と標示についての行動規範(Code of Practice on Transparency of AI-generated Content)も用意しています。どちらも、第50条を自社の製品にどう当てはめるかを確かめるときの一次資料になります。
もう一つ、規模や水準にかかわらず提供者と導入者に掛かる規定が、第4条の AIリテラシーです。第3条第56号は、AIリテラシーを、提供者・導入者・影響を受ける人が、それぞれの権利と義務を踏まえて、十分な情報にもとづいて AIシステムを導入し、AIの機会とリスク、起こりうる害に気づくための技能・知識・理解、と定義しています。第4条は第1章にあるので、第113条(a)により2025年2月2日から適用されています。オムニバスによる改正後の第4条第1項は、提供者と導入者に、職員や自らに代わって AIシステムを運用・利用する人の AIリテラシーの向上を支える措置をとることを求め、そのうえで、特定の個人に特定の水準の AIリテラシーを保証することまでは求めない、と明記しました。第2項は、欧州委員会と加盟国が、とくに中小企業の取り組みを支援し、欧州委員会が対応の実例を公表することを定めています。欧州委員会の発表は、この改正を、AIリテラシーの要求を簡素にし、欧州委員会と加盟国が推進でより大きな役割を担う形にしたもの、と説明しています。社内の研修の設計は第14章で扱います。
汎用目的AIモデルの義務と行動規範(第51〜56条)
第5章は、AIシステムではなく、その土台になる汎用目的AIモデルの提供者に向けた規定です。第3条第63号によると、汎用目的 AIモデルとは、大量のデータで学習されたものを含め、かなりの汎用性を示し、さまざまな種類の作業を有能にこなすことができ、多様な下流のシステムやアプリケーションに組み込める AIモデルを指します(市場に出す前の研究・開発・試作に使うものは除く)。大規模言語モデルのような基盤モデルを開発して提供する会社が主な対象です。
第53条第1項は、汎用目的 AIモデルのすべての提供者に、(a)学習と試験の過程や評価の結果を含む技術文書を作成して最新に保ち、AI Office と各国の当局の求めに応じて提供できるようにすること、(b)そのモデルを自社の AIシステムに組み込もうとする提供者(下流の提供者)に、モデルの能力と限界を理解できる情報と文書を提供すること、(c)EU の著作権法を守るための方針を定め、とくに権利者が機械学習への利用を拒否する意思表示(いわゆるオプトアウト)を、最新の技術も使って特定し尊重すること、(d)学習に使った内容の十分に詳しい要約を、AI Office の様式に沿って公表すること、の4つを求めています。(a)と(b)は、所定のライセンスと公開の条件を満たすオープンソースのモデルには適用されません(第2項)。条件は、アクセス・利用・改変・配布を認めるライセンスで公開され、重みを含むパラメータ、モデルの構造、利用方法の情報が公開されていることです。システミックリスクのあるモデルには、この例外は適用されません。
第51条は、汎用目的 AIモデルのうち、影響力の大きい能力を持つものを「システミックリスクのある汎用目的 AIモデル」に分類する基準を定めています。システミックリスクは、第3条第65号によると、そうした能力に固有のリスクで、EU の市場への大きな影響や、バリューチェーンを通じて広く波及しうる悪影響を伴うものを指します。学習に使った計算量の累計が浮動小数点演算で10の25乗回を超える場合には、影響力の大きい能力を持つと推定されます(第2項)。欧州委員会が職権で、または科学パネルの警告を受けて指定することもできます(第1項(b))。こうしたモデルの提供者は、第55条により、敵対的なテストを含むモデルの評価、EU の水準でのシステミックリスクの評価と軽減、重大インシデントの記録と AI Office への報告、十分なサイバーセキュリティの確保を、追加で求められます。
第56条は、これらの義務の実施を助ける行動規範を定めています。欧州委員会のページによると、汎用目的 AIの行動規範(GPAI Code of Practice)は2025年7月10日に公表され、透明性・著作権・安全性とセキュリティの3つの章から成ります。透明性と著作権の章は、すべての汎用目的 AIモデルの提供者が第53条の義務を果たしていることを示す手段として、安全性とセキュリティの章は、システミックリスクのあるモデルの提供者が第55条の義務を果たしていることを示す手段として位置づけられています。行動規範への参加は任意で、署名した提供者は、行動規範を守ることで義務への適合を示せるとされています。整合規格が公表されるまでの間、行動規範に依拠して適合を示せることは、第53条第4項・第55条第2項にも書かれています。
第5章は2025年8月2日から適用されていますが、第111条第3項により、それより前に市場に出されたモデルの提供者は、2027年8月2日までに対応すればよいとされています。欧州委員会のページによると、汎用目的 AIモデルに関する欧州委員会(AI Office)の執行の権限は2026年8月2日から使えるようになりました。罰金を定めた第101条が、第113条(b)の2025年8月2日の適用から除かれ、原則の2026年8月2日から適用されていることとも合っています。
日本企業の多くは、汎用目的 AIモデルを自社で開発して EU に提供する立場ではなく、他社のモデルを使う立場にあると考えられます。その場合に第5章が実務で意味を持つのは、自社が下流の提供者として AIシステムを作るときに、モデルの提供者から第53条第1項(b)の情報を受け取れる、という点です。ただし、第2項のオープンソースの例外に当たるモデルでは、この義務は掛かりません。外部のモデルを組み込んだ製品を EU に出すときは、モデルの提供者が公表している技術文書や学習データの要約、行動規範への署名の状況を確かめ、調達の記録に残しておくことが有効だと考えています。調達の確認項目は第9章で扱います。
制裁と整合規格(第99条・第40条)
第99条は、違反に対する罰則と執行の措置の規則を、加盟国が定めるとしています。罰則は、実効的で、違反に釣り合い、抑止力のあるものでなければならず、中小企業やスタートアップ、オムニバスで新たに定義された小規模ミッドキャップ企業(SMC)の利益と経済的な存続可能性を考慮するよう求められています(第1項)。制裁金の上限は、違反の種類ごとに3つの段階で定められています。第5条の禁止に違反した場合(第3項)、提供者の義務(第16条)・導入者の義務(第26条)・透明性の義務(第50条)などの違反の場合(第4項)、各国の所管当局や適合性評価機関(ノーティファイドボディ)の求めに対して誤った情報や不完全な情報を出した場合(第5項)です。いずれの段階も、上限は定額と、企業の場合は前の会計年度の世界全体の年間売上高に対する割合の、高い方とする形で定められています。スタートアップを含む中小企業については、そのどちらか低い方が上限とされ(第6項)、SMC については第4項・第5項の制裁金で低い方とされています(第6a項)。本コラムでは、金額と割合の数字は書きません。
制裁金を決めるときには、違反の性質・重大さ・期間、影響を受けた人の数と損害の程度、事業者の規模と売上高、当局への協力の度合い、事業者が講じていた技術的・組織的な措置に照らした責任の程度、違反を自ら届け出たかどうか、故意か過失か、被害を軽くするためにとった行動などを考慮するとされています(第7項)。経営の側から読むと、この第7項の考慮の要素は、違反が起きたときに「どれだけ備えていたか」が問われる構造になっている、ということです。台帳・評価の記録・監督の割り当て・インシデントの届け出の手順が文書として残っていることは、それ自体が考慮の対象になりえます。汎用目的 AIモデルの提供者に対する罰金は、別に第101条が定めています。
義務を「どう満たすか」の具体的な手段になるのが、整合規格です。第40条第1項によると、EU 官報に参照が公表された整合規格に適合している高リスク AIシステムや汎用目的 AIモデルは、その規格が扱う範囲で、規則の要件や義務に適合していると推定されます。欧州委員会の標準化のページによると、欧州委員会は欧州標準化機関である CEN と CENELEC に、リスク管理・データセットのガバナンスと品質・記録の保持・透明性・人による監督・正確性・頑健性・サイバーセキュリティ・品質マネジメント・適合性評価の10の分野で規格の作成を求めており、両機関の合同技術委員会 JTC 21 が作業を進めています。規格の適用は任意で、提供者は他の方法で適合を示すこともできます。
2026年10月19日、欧州委員会は、EU AI Act を支える最初の整合規格の参照を EU 官報に公表したと発表しました。対象は CEN と CENELEC が作成した EN 18286(2026年)で、EU AI Act の規制目的のための AIの品質マネジメントシステムを定める規格です。欧州委員会の説明によると、この規格は第17条の品質マネジメントシステムの要件に対応しており、組織ではなく AIシステムのライフサイクルを軸に組み立てられ、ISO/IEC 42001 や ISO 9001、分野ごとの品質マネジメントシステムに置き換わるものではなく、それらの上に重ねて使うよう設計されています。ISO/IEC 42001 そのものは第6章で扱います。リスク管理や記録などの他の分野の整合規格は、欧州委員会のページでは「続くことが見込まれる」と書かれている段階で、本コラムの基準時点では公表を確かめていません。
適用の日程、デジタル・オムニバス後の第113条
EU AI Act は、条文によって適用の始まる日が違います。日程を定めているのは第113条で、オムニバスによって号の中身が改められました。以下は、AI Act Service Desk の第113条(EUR-Lex の2026年7月27日時点の統合版(デジタル・オムニバスによる改正を反映したもの)にもとづく)を2026年10月28日に開いて確かめた内容です。第113条は、規則が EU 官報への掲載の20日後に発効すること、原則として2026年8月2日から適用されることを定め、そのうえで(a)から(d)の例外を置いています。欧州委員会のページによると、規則は2024年8月1日に発効しました。
| 第113条の号 | 対象の条文 | 適用日 | オムニバスによる変更 |
|---|---|---|---|
| 本文 | 下の号に当たらない規定(第50条の透明性の義務、第101条など) | 2026年8月2日 | 変更なし |
| (a) | 第1章(総則。第4条の AIリテラシーを含む)と第2章(第5条の禁止) | 2025年2月2日 | 改正。ただし第5条第1項第1段の(ba)(bb)と、第5条第1a項・第1b項は2026年12月2日から |
| (b) | 第3章第4節(通知当局と適合性評価機関)、第5章(汎用目的 AIモデル)、第7章(ガバナンス)、第12章(罰則)、第78条(秘密保持) | 2025年8月2日 | 変更なし。第101条(汎用目的 AIモデルの提供者への罰金)は除く |
| (c)(i) | 第3章第1〜3節(第6条第5項を除く)のうち、第6条第2項と附属書III により高リスクとされる AIシステム | 2027年12月2日 | 改正 |
| (c)(ii) | 第3章第1〜3節(第6条第5項を除く)のうち、第6条第1項と附属書I により高リスクとされる AIシステム | 2028年8月2日 | 改正 |
| (d) | 第102〜110条(他の EU 法令の改正) | 2026年7月27日 | 新設 |
表の「オムニバスによる変更」の列は、Service Desk の統合版で各号に付いている「AMENDED(改正)」「NEW(新設)」の表示をそのまま写したものです。改正前の各号がどう書かれていたかは、本章では改正前の原文を開いて確かめていないため、改正前との日付の比較はしていません。欧州委員会のページは、附属書III の分野の規定の適用が2027年12月2日まで、附属書I の製品の規定の適用が2028年8月2日まで延びたことを、オムニバスの結果として説明しています。
第113条とは別に、すでに市場に出ている AIについての経過措置を第111条が定めています。2025年8月2日より前に市場に出た汎用目的 AIモデルの提供者は2027年8月2日までに対応する(第3項)、2026年8月2日より前に市場に出た生成AIのシステムの提供者は第50条第2項の表示に2026年12月2日までに対応する(第4項、オムニバスで新設)、高リスクの規定の適用日より前に市場に出た、または使用を開始した高リスクの AIシステムは、その日以降に設計の大きな変更があった場合に規則の対象になる(第2項。第5条の禁止の適用は妨げない)、ただし公的機関が使う高リスクの AIシステムの提供者と導入者は2030年8月2日までに対応する(同)、といった内容です。附属書X に挙げられた EU の大規模な IT システムの構成要素には、別の期限があります(第1項)。
この表は、本コラムの基準時点である2026年10月時点の統合版によるものです。EU AI Act は、オムニバスのように後から改正されることがあり、委任法令や実施法令で細部が補われることもあります。日程を自社の計画に使うときは、その時点の統合版と、欧州委員会の AI Act Service Desk の日程のページを確かめ直す必要があります。
日程の表から経営の判断に関わる点を読むと、次の3つがあります。1つ目は、第5条の禁止の大部分と AIリテラシー(第4条)は、すでに2025年2月2日から適用されていることです(オムニバスで加わった第5条第1項の(ba)(bb)と第1a項・第1b項は2026年12月2日から)。高リスクの延期の報道だけを見て「EU AI Act はまだ先の話」と受け止めると、すでに掛かっている規定を見落とすおそれがあります。2つ目は、透明性の義務(第50条)が2026年8月から適用されていることです。生成AIを使った社外向けのサービスは、高リスクより先にこの条の確認が要ります。3つ目は、高リスクの規定までの期間を、準備の期間として使えることです。附属書III の分野は2027年12月まで、附属書I の製品は2028年8月までの間に、台帳の作成・区分の判定・提供者との情報のやり取りの取り決めを進めておくことができます。欧州委員会のページは、この日程によって、整合規格などの実施を助ける道具がそろった時期に規定が適用されるようになると説明しています。本コラムでは、延期された期間は対応を後回しにする期間ではなく、準備に使う期間だと考えています。
日本企業の最初の作業と経営判断
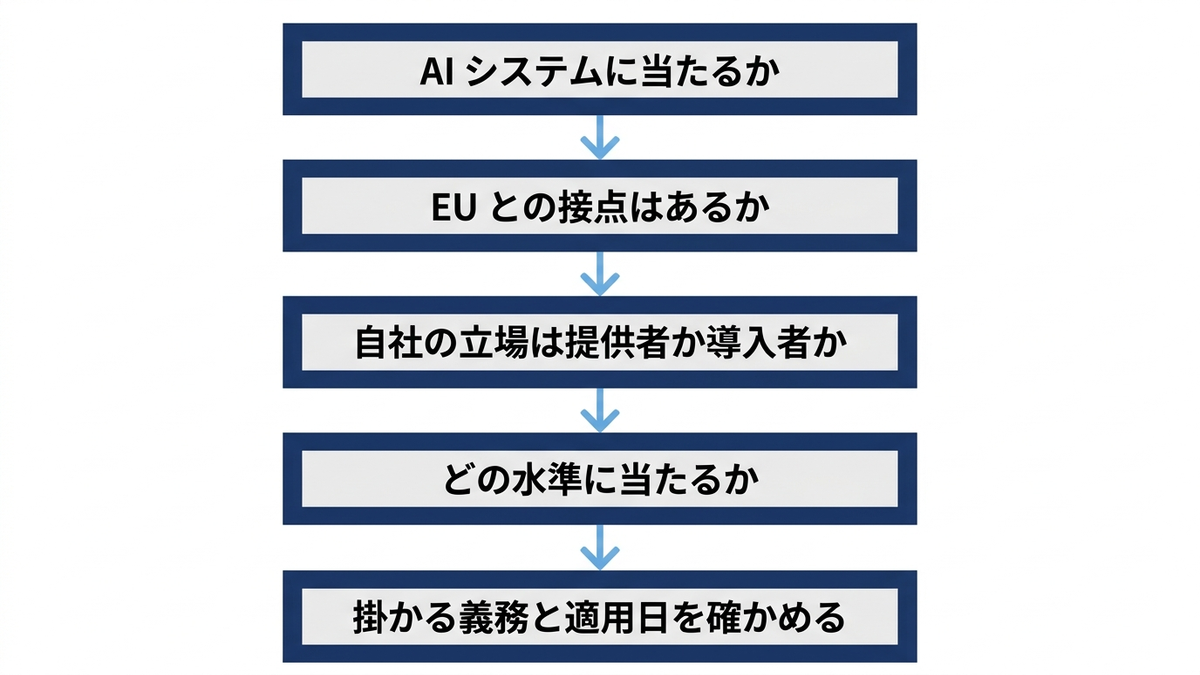
ここまでの内容を、日本企業が最初に何をするかに落とします。EU AI Act への対応は、条文を読み込むことから始めるよりも、自社の AIの用途を並べ、EU との接点がある用途を見つけることから始める方が、手戻りが少ないと考えています。条文のどの部分を読む必要があるかは、用途と立場が決まって初めて絞り込めるからです。
次の表は、自社の AIの用途ごとに確かめる問いを、確かめる順に並べたものです。各問いで、適用の関係や必要な対応が分からない点が残る用途は、その点を専門家への確認事項にします。この表は、該当するかどうかを判定するものではなく、専門家に相談するときの材料をそろえるためのものです。
| 順 | 確かめる問い | 根拠の条文 | 社内で用意しておく材料 | 主に担う部門の例 |
|---|---|---|---|---|
| 1 | その仕組みは、EU AI Act の AIシステムの定義に当たりうるか | 第3条第1号 | 仕組みの概要、入力と出力、どの程度自動で動くか | 情報システム部門・事業部門 |
| 2 | EU との接点はあるか(EU の顧客に提供している、EU の拠点で使っている、出力が EU で使われる) | 第2条第1項 | 販売先・利用拠点・出力の送り先の一覧 | 事業部門・海外拠点の管理部門 |
| 3 | 自社の立場は提供者か導入者か、それ以外か。名前を付けて出す・大きく変える・用途を変える予定はあるか | 第3条第3号・第4号、第25条 | 契約書・利用規約、製品の表示、改変の内容 | 法務部門・事業部門 |
| 4 | 第5条の禁止の各号に当たる可能性はあるか | 第5条 | 用途の説明、対象者、感情の推定や生体データの利用の有無 | 法務部門・事業部門 |
| 5 | 附属書I の製品の安全部品か。附属書III の分野の号の用途に当たるか | 第6条、附属書I・附属書III | 製品の分類と適合性評価の状況、用途が人事・与信・保険・教育などに関わるか | 品質保証部門・人事部門・事業部門 |
| 6 | 人と直接やり取りする、文章や画像を生成する、感情認識を使う、ディープフェイクを作るといった、第50条に当たる機能はあるか | 第50条 | 画面の表示、生成物の表示の仕組み | 事業部門・広報部門 |
| 7 | 汎用目的 AIモデルを自社で提供しているか。他社のモデルを組み込んでいる場合、モデルの提供者の情報を受け取っているか | 第53条 | 使っているモデルの名前と版、提供者の公表資料 | 情報システム部門・購買部門 |
| 8 | 掛かりうる義務の適用日はいつか | 第113条・第111条 | 用途ごとの開始時期と、変更の予定 | AIガバナンスの事務局 |
この8つの問いは、第7章で作るユースケースの台帳の列と対応させることができます。第7章の台帳には「立場(開発・提供・利用)」と「EUとの関係」の列があります。「立場」の列は AI事業者ガイドラインの立場を記録する列なので、EU AI Act の提供者・導入者のどちらに当たりうるか(問い3)は、「EUとの関係」の列の中に書きます。同じ「EUとの関係」の列の中で、EU との接点(問い2)、第5条の各号に当たる可能性(問い4)、高リスクの入口(問い5)、第50条に当たる機能(問い6)を確かめる項目として記録しておくと、制度の改正があったときに、どの用途を見直せばよいかをすぐに絞り込めます。別の列を増やすのではなく、1つの列の中の確認項目としてまとめておく形です。日本の AI推進法や AI事業者ガイドラインとの関係は第4章で扱います。
経営の判断として、この章から読み取れることは3つあります。1つ目は、EU AI Act への対応を、EU に拠点のある事業部門だけの問題にしないことです。第2条第1項(c)のように、出力が EU で使われる場合にも対象になりうる規定があるため、本社で動かしている AIが対象になる場合もあります。部門ごとにばらばらに確認を始めると、同じ外部の AIサービスについて複数の部門が別々に専門家に相談し、結論も記録も分かれる二重投資が生じやすくなります。確認の窓口を1つにし、台帳の上で用途ごとに結論を残す形にしておくことが、費用と判断の一貫性の両方で有利だと考えています。
2つ目は、損失の型を区別して優先順位を付けることです。第5条の禁止や第50条の透明性の義務を見落とすことは、規制違反の型の損失につながるおそれがあり、とくに第5条の禁止の大部分は、2025年2月2日からすでに適用されています(オムニバスで加わった(ba)(bb)等は2026年12月2日から)。一方で、EU AI Act が分からないことを理由に AIの利用そのものを止めてしまうと、導入の停滞という別の損失が生じます。欧州委員会のページは、EU で現在使われている AIシステムの大半は最小限のリスクの水準に当たると説明しています。ただし、これは EU 全体の状況についての説明で、自社の用途の分布を示すものではありません。自社の用途のうち、どれだけが高リスクや禁止に当たりうるかは、台帳を作って確かめる必要があります。台帳を作った結果、そうした用途が一部に限られる場合には、その少数の用途に確認の手間を集中させる方が、全体としての損失は小さくなると考えています。
3つ目は、記録を残すことに予算と担当を付けることです。第99条第7項が挙げる考慮の要素や、第6条第4項の「高リスクではないと考える提供者は評価を文書にする」という規定に表れているように、EU AI Act は、判断の結果だけでなく、判断の過程が文書になっていることを重く見る構造になっています。第27条の基本権影響評価や、第26条のログの保管も同じです。台帳と評価の記録を維持する担当と時間を、AIガバナンスの最初の予算に含めておくことが、規制違反と信頼の失墜の両方の損失を抑える備えになります。
最後に、繰り返しになりますが、この章は条文の要旨を整理したもので、法的な助言ではありません。自社の AIが EU AI Act の対象になるか、どの立場とどの区分に当たるか、どの義務をいつまでに果たす必要があるかは、事業と AIの使い方の具体的な事実によって変わります。個別の判断は、EU 法に詳しい弁護士などの専門家に確認してください。社内でできるのは、確認に必要な事実を台帳にそろえておくことと、確認の結果を記録して見直しのきっかけを決めておくことです。
この章では、EU AI Act を、誰に掛かるか(第2条・第3条)、どの水準に当たるか(第5条・第6条・第50条)、何を求められるか(第16条・第26条・第27条・第53条)、いつから掛かるか(第113条)、の順に整理しました。域外の会社にも掛かりうる規定があります。オムニバス後の統合版で確かめた日程は次のとおりです。第5条の禁止の大部分と AIリテラシーは、2025年2月2日からすでに適用されています。オムニバスで加わった第5条第1項の(ba)(bb)等は、2026年12月2日から適用されます。透明性の義務は2026年8月から適用されます。高リスクの規定は、附属書III の分野が2027年12月、附属書I の製品が2028年8月から適用されます。次の第4章では、日本の AI推進法と AI事業者ガイドラインを取り上げ、法的な義務と執行の仕組みを備える EU の規則とは異なる、日本の国の指針の読み方を扱います。
この章を深めたい方への参考書籍
『EU AI法概説』(古川直裕・吉永京子・有坂陽子・羽深宏樹・早川政哉 編著、商事法務):別冊NBL の一冊として2025年7月に刊行された、EU AI Act を日本語で体系的に解説した本です。この章で扱った適用範囲・リスクの区分・提供者と導入者の義務を、条文に沿ってさらに詳しく確かめるときの材料になります。2026年7月27日に発効したデジタル・オムニバスによる改正(高リスクの規定の適用日の変更、第5条への号の追加、第4条の文言の変更など)より前の刊行なので、日程と改正された条文は、統合版の原文で確かめ直す必要があります。
『EUのAIガバナンス 新技術に対する国際的な科学技術ガバナンスに向けて』(北和樹 著、晃洋書房):2025年3月に刊行された本で、EU の科学技術分野の権限と枠組みから説き起こし、原則から実践へと進んだ EU の AI法の特徴を論じています。この章では条文の要旨を整理しましたが、EU がなぜリスクにもとづく規制の形を選んだのかを、EU の統治の仕組みの側から理解するときの参考になります。この本もデジタル・オムニバスより前の刊行で、改正の内容は含みません。
第4章 日本のAI推進法とAI事業者ガイドライン、国の指針の読み方
第3章では、EU AI Act が EU の域外の会社にも掛かりうること、リスクの水準ごとに義務が決まり、適用の日程が段階的に定められていることを確かめました。この章では日本の制度を扱います。日本には、2025年に成立した AI全般を対象とする法律があり、その法律に基づく国の計画と指針があり、さらに総務省と経済産業省が事業者向けにまとめたガイドラインがあります。名前の似た文書が続けて公表されたため、どれが法律で、どれが計画で、どれが事業者の手元で使う手引きなのかが分かりにくくなっています。
この章では、法律の条文、人工知能戦略本部と人工知能基本計画、適正性確保に関する指針、AI事業者ガイドライン第1.2版、府省庁の分野別のガイドライン、の順に、それぞれが誰に何を求めていて、拘束力があるのかを確かめます。そのうえで、ガイドラインを自社の手順書に落とす方法と、経営としての判断の置き方を書きます。条文は e-Gov 法令検索の法令 API で取得した現行の条文で、計画と指針は内閣府の公式 PDF で、ガイドラインは総務省の掲載ページと公式 PDF で、いずれも2026年10月28日に開いて確かめた範囲だけを書いています。個人情報保護法と著作権法の扱いは第8章、契約の論点は第9章、評価の方法は第10章で扱います。
AI推進法の位置づけと章立て
日本で AI全般を対象として定められた法律は、「人工知能関連技術の研究開発及び活用の推進に関する法律」(令和7年法律第53号)です。本コラムではAI推進法と呼びます。内閣府の掲載ページは「AI法」と略しており、e-Gov 法令検索の法令情報の略称も「AI法」です。内閣府のページによると、この法律は2025年6月4日に公布・一部施行され、9月1日に人工知能戦略本部の設置に関する規定などを含めて全面施行されました。附則第1条は、公布の日から施行し、第3章と第4章などは公布から3か月を超えない範囲で政令で定める日から施行する、と定めています。
題名のとおり、この法律の中心は「規制」ではなく「研究開発と活用の推進」です。第1条が掲げる目的も、国の施策を総合的かつ計画的に進めることで、事業者の行為を個別に縛ることではありません。第2条の「人工知能関連技術」の定義は、人の知的な能力を代替する技術と、その技術を使う情報処理システムの技術の2つを軸にしています。EU AI Act の第3条第1号の「AIシステム」の定義(第3章)とは書き方が異なり、システムの性質を細かく列挙する形ではありません。
e-Gov で確かめた章立ては次のとおりです。
| 章 | 条 | 主な中身 |
|---|---|---|
| 第1章 総則 | 第1条〜第10条 | 目的、定義、基本理念、国・地方公共団体・研究開発機関・活用事業者・国民の責務、連携の強化、法制上の措置 |
| 第2章 基本的施策 | 第11条〜第17条 | 研究開発の推進、施設・設備とデータセットの整備と共用、適正性の確保(指針の整備)、人材、教育、調査研究、国際協力 |
| 第3章 人工知能基本計画 | 第18条 | 政府が基本計画を定めること、計画に定める事項、閣議決定と公表、変更 |
| 第4章 人工知能戦略本部 | 第19条〜第28条 | 内閣への本部の設置、所掌事務、本部長(内閣総理大臣)などの組織、資料の提出その他の協力 |
| 附則 | 第1条・第2条ほか | 施行期日(第1条)、施行状況の検討(第2条)など |
この表で目を留めておきたいのは、罰則の章が無いことです。本則の第1条から第28条までと、取得できた附則を確かめた範囲では、罰則を定めた章も条もありません。第3条第4項の基本理念は、不正な目的や不適切な方法で研究開発や活用が行われた場合には、犯罪への利用、個人情報の漏えい、著作権の侵害などによって国民の権利利益が害される事態を助長するおそれがあるとして、透明性の確保その他の必要な施策を講じなければならない、と定めています。リスクへの対応は、国が施策を講じる形で書かれていて、事業者に個別の行為を禁止する形では書かれていません。附則第2条は、政府が施行の状況について検討を加え、必要があれば措置を講じると定めており、将来の見直しの余地は条文の上でも残されています。
責務の規定、第4条から第8条を主体ごとに読む
第4条から第8条は、5つの主体の責務を定めています。事業者にとって関係が深いのは第7条ですが、他の主体の規定と並べると、言葉の強さの違いが見えます。次の表は、条文の要旨を自分の言葉でまとめたものです。表の「条文の言い方」の列は、条文の語尾をそのまま示しています。
| 条 | 主体 | 求められていることの要旨 | 条文の言い方 |
|---|---|---|---|
| 第4条 | 国 | 基本理念にのっとって施策を総合的かつ計画的に策定・実施する。国の行政機関で AIの活用を積極的に進める | 「責務を有する」「進めるものとする」 |
| 第5条 | 地方公共団体 | 国との役割分担のもと、区域の特性を生かした自主的な施策を策定・実施する | 「責務を有する」 |
| 第6条 | 研究開発機関(大学・研究開発法人など) | 研究開発と成果の普及、人材の育成に努め、国と地方公共団体の施策に協力するよう努める | 「努めるものとする」 |
| 第7条 | 活用事業者 | AIを積極的に活用して事業活動の効率化・高度化と新産業の創出に努める。国と地方公共団体が実施する施策に協力する | 活用は「努める」、施策への協力は「協力しなければならない」 |
| 第8条 | 国民 | AIへの理解と関心を深め、国と地方公共団体の施策に協力するよう努める | 「努めるものとする」 |
第7条の「活用事業者」は、AIを活用した製品やサービスの開発・提供をしようとする者と、その他 AIを事業活動で活用しようとする者を含む、と定義されています。AIを自社で作る会社だけでなく、外部の生成AIサービスを業務で使う会社も、この定義の書き方からは活用事業者に含まれると読めます。後で扱う適正性確保に関する指針は、脚注で、活用事業者には海外事業者も含むと書いています。自社が活用事業者にあたるかどうかで迷う場面は少ないと考えられますが、個別の位置づけは専門家に確認する必要があります。
第7条で義務の形(「しなければならない」)になっているのは、国と地方公共団体の施策への協力の部分です。協力の中身は条文では特定されていません。協力を求める仕組みとして条文に出てくるのは、第16条と第25条です。第16条では、国が権利利益の侵害が生じた事案を分析し、その結果をもとに事業者などへ指導・助言・情報の提供を行います。第25条では、人工知能戦略本部が関係行政機関などに協力を求め、それ以外の者にも協力を依頼できます。どちらも、命令や処分の形ではなく、調査・指導・助言・協力の依頼の形です。
したがって、第7条には施策への協力という義務の形の規定がある一方で、協力の中身は条文では特定されておらず、条文を確かめた範囲では、事業者に届出や審査などの個別の手続きを課す書き方にはなっていません。ただし、これは「AIに関して何をしても法的な問題にならない」という意味ではありません。個人情報保護法、著作権法、不正競争防止法、消費者保護の法令、業種ごとの規制などは、AIを使う場面にもそのまま掛かります。AI事業者ガイドラインの共通の指針も、憲法、知的財産関連法令、個人情報保護法をはじめとする関連法令と、AIに係る個別分野の既存法令を遵守すべきだと書いています。どの法令がどう掛かるかは用途によって変わるので、個別の判断は弁護士などの専門家に確認することが前提になります。
人工知能戦略本部と人工知能基本計画
第4章の規定により、内閣に人工知能戦略本部が置かれています。本部長は内閣総理大臣、副本部長は内閣官房長官と人工知能戦略担当大臣、本部員はそれ以外のすべての国務大臣です(第21条〜第24条)。本部の事務は内閣府が処理します(第26条)。本部の所掌事務は、人工知能基本計画の案の作成と実施の推進、重要な施策の企画・立案と総合調整です(第20条)。つまり本部は、企業を監督する機関ではなく、政府の AI政策をまとめて動かす司令塔として設計されています。
第18条は、政府が人工知能基本計画を定め、計画には施策の基本的な方針、政府が総合的かつ計画的に講ずべき施策、その他の必要な事項を定めると規定しています。案は本部が作り、内閣総理大臣が閣議決定を求め、決定されたら公表します。変更にも同じ手続きが準用されます。内閣府の人工知能基本計画の掲載ページによると、最初の計画は2025年12月23日に閣議決定され、副題は『「信頼できるAI」による「日本再起」』でした。現在掲載されている計画は2026年7月14日に閣議決定されたもので、副題は「日本AX、より強く、より豊かに」です。2025年12月の計画は「過去の人工知能基本計画」として同じページに残されています。2026年7月の計画は、本文で自らを AI推進法第18条第1項に基づく基本計画の「第Ⅱ期計画」と位置づけています。
2026年7月の計画の構成は、第1章 基本構想、第2章 施策についての基本的な方針、第3章 政府が講ずべき施策、第4章 推進に必要な事項、です。第2章は「4原則」として、イノベーション促進とリスク対応の両立、挑戦と学習、アジャイルな対応、内外一体での政策推進を挙げ、「4つの基本的な方針」として、AI利活用の加速的推進、AI開発力の戦略的強化、AIガバナンスの主導、AI社会に向けた継続的変革を挙げています。第3章は、この4つの方針に対応する4つの節で施策を並べています。第4章の第2節は、技術の変化が速いことを踏まえて、当面は毎年変更を行うとしています。
企業の AIガバナンスに関係が深いのは、第3章第3節「AIガバナンスの主導」です。この節は、エージェント型AIの登場でリスクが複雑化・深刻化しているとしたうえで、制度を見直し続ける「制度による対応」、設計に制御機能や標準を組み込む「技術による対応」、組織全体でリテラシーを高め責任の所在を明確にする「組織管理による対応」を統合的に進める、という考え方を示しています。具体的な取組としては、AI推進法第16条に基づく調査研究などをより機動的に運用すること、AI推進法を含めた制度を不断に見直すこと、権利侵害に関する法的整理を含めて各種ガイドラインを整備すること、国民が AIに関わる被害を受けたときの公的な相談窓口を拡充し、事業者が自ら苦情受付体制を整備するための施策を講ずること、などが並んでいます。計画は政府が講ずる施策を定める文書なので、ここに書かれたことが直ちに事業者の義務になるわけではありません。ただ、苦情受付の体制や組織管理による対応は、今後の指針やガイドラインの改訂で事業者向けに具体化される可能性がある論点として、追っておく価値があります。
適正性確保に関する指針、法律と事業者のガイドラインをつなぐ文書
第13条は、国が研究開発と活用の適正な実施を図るため、国際的な規範の趣旨に即した指針の整備その他の必要な施策を講ずる、と定めています。この条に基づいて、人工知能戦略本部は2025年12月19日に「人工知能関連技術の研究開発及び活用の適正性確保に関する指針」を決定しました。本コラムでは適正性確保に関する指針と呼びます。指針は、自らの位置付けを、事業者や国民などすべての主体の自主的かつ能動的な取組を促すために国際的な規範の趣旨に即して策定するもの、と説明しています。ここでいう「すべての主体」は、脚注で、AI推進法第4条から第8条で責務が定められた国、地方公共団体、研究開発機関、活用事業者、国民を指すとされています。
指針は、適正性についての一義的な定義や絶対的な水準を定めるものではないとしたうえで、考慮すべき主な要素を示しています。人間中心、公平性、安全性、透明性、アカウンタビリティ、セキュリティ、プライバシー・個人情報、公正競争、AIリテラシー、イノベーション、の10項目です。そのうえで基本方針として、リスクベースでのアプローチ、ステークホルダーの積極的な関与、一気通貫でのAIガバナンスの構築、アジャイルな対応、の4つを挙げています。ステークホルダーは AIの活用で影響を受ける関係者を、アジャイルな対応は状況の変化に応じて柔軟かつ迅速に見直すことを指します。
指針の第2節は、研究開発機関と活用事業者が特に取り組む事項を5つ挙げています。対象は、AIを活用した製品・サービスを開発・提供する活用事業者と、開発した AIを第三者に提供する研究開発機関です。前に見た活用事業者の広い定義の全体に、5つがそのまま向けられているわけではありません。5つは次のとおりです。AIのライフサイクル全体でリスクの特定・評価・対処をする組織的なプロセス(経営層の関与したモニタリングや評価の仕組み、情報の適切な開示、教育・研修の実施など)を含む AIガバナンスを構築・運用・継続改善すること。ステークホルダーとの信頼関係の構築に向けて透明性を確保し、AIを提供する際に仕組みや限界、禁止事項、出力の信頼性に関する注意喚起などの情報を利用者に提供すること。悪用や不適切な出力、意図しない動作を防ぐ十分な安全性を確保すること。AIを用いたシステムの運用者やサービスの提供者が、障害に備えて事業継続計画をあらかじめ策定すること。データの保有者などのステークホルダーへ配慮し、継続的なコミュニケーションを図ること。脚注には、ゼロから AIガバナンスを構築することに限らず既存の IT システムなどに適用されているガバナンスのプロセスを活用することも有用であること、広島AIプロセス(G7 が2023年に立ち上げた生成AIなどの国際的なルールづくりの枠組みで、第2章で扱います)の報告枠組みや ISO/IEC 42001 などに基づく体制の整備が考えられること、が書かれています。
この指針の要素と、次の節で扱う AI事業者ガイドラインの「共通の指針」を並べると、次の表のようになります。項目名はそれぞれの原文の見出しのままで、横に並べたのは本コラムが内容の近いものを対応させたものです。両者の公式の対応表ではありません。
| 適正性確保に関する指針の要素(2025年12月) | AI事業者ガイドライン第1.2版の共通の指針 | 自社の規程で受け止める場所の例 |
|---|---|---|
| 人間中心 | 1)人間中心 | AI基本方針の原則、人が最終判断する範囲の定め |
| 公平性 | 3)公平性 | 評価の手順(第10章) |
| 安全性 | 2)安全性 | リスク区分と承認の基準(第7章) |
| 透明性 | 6)透明性 | 利用者への表示、記録の保存 |
| アカウンタビリティ | 7)アカウンタビリティ | 役割と責任者の定め(第13章) |
| セキュリティ | 5)セキュリティ確保 | 情報セキュリティ規程との接続 |
| プライバシー・個人情報 | 4)プライバシー保護 | 個人情報の取扱規程、入力の区分(第8章) |
| 公正競争 | 9)公正競争確保 | 調達と契約の確認(第9章) |
| AIリテラシー(原文の表記は「AIリテラシー」) | 8)教育・リテラシー | 研修の計画(第14章) |
| イノベーション | 10)イノベーション | 活用を進める方針、承認の迅速化 |
10項目がほぼ一対一で並ぶことから、適正性確保に関する指針は、法律と、事業者が実際に手元で使うガイドラインとの間をつなぐ文書として読むことができます。内閣府の指針の掲載ページには、各府省庁のガイドラインの一覧も載っていて、その1番目が AI事業者ガイドラインです。実務では、指針で考え方の骨格を確かめ、具体的な取組は AI事業者ガイドラインで確かめる、という読み方が扱いやすいと考えています。
AI事業者ガイドライン第1.2版の構成、本編と別添と関連資料
AI事業者ガイドラインは、総務省と経済産業省がまとめた、事業者向けの AIガバナンスの指針です。総務省の掲載ページによると、第1.0版が2024年4月19日、第1.01版が2024年11月22日、第1.1版が2025年3月28日に公表され、2026年10月28日の時点で最新は2026年3月31日公表の第1.2版です。本編の「はじめに」は、総務省と経済産業省がそれぞれ作ってきた3つのガイドラインを統合・見直して2024年4月に策定したこと、関係者の自主的な取組を促し、非拘束的なソフトローによって目的達成に導くゴールベースの考え方で作成したこと、を説明しています。内閣府の府省庁ガイドラインの一覧でも、所管は総務省と経済産業省、策定(改定)時期は令和8年3月と記載されています。
対象は、事業活動において AIの開発・提供・利用を担うすべての者で、政府・自治体などの公的機関も含みます。事業活動以外で AIを利用する人と、AIを直接事業で利用せずに便益を受けたり損失を被ったりする人(ガイドラインの語では、あわせて「業務外利用者」)と、データを提供する者(「データ提供者」)は対象に含まれません。対象者は、AI開発者、AI提供者、AI利用者の3つに大別され、同じ事業者が複数の立場を兼ねることもある、とされています。3つの立場の定義と責任の違いは第1章で扱いました。EU AI Act の提供者(provider)・導入者(deployer)とは一対一に対応しないことも、第1章と第3章で確かめたとおりです。
総務省の掲載ページで第1.2版として公開されている資料と、本編の目次を確かめると、構成は次の表のとおりです。
| 資料 | 中身(目次・表紙で確かめた名称) | 使う場面の例 |
|---|---|---|
| 本編 | はじめに/第1部 AIとは/第2部 AIにより目指すべき社会及び各主体が取り組む事項(A.基本理念、B.原則、C.共通の指針、D.広島AIプロセス「全ての AI関係者向けの広島プロセス国際指針」、E.AIガバナンスの構築)/第3部 AI開発者に関する事項/第4部 AI提供者に関する事項/第5部 AI利用者に関する事項 | AI基本方針の原則を決めるときの参照、用語の定義の確認 |
| 別添(付属資料) | 別添1 第1部関連(AIに関する前提、AIによる便益/リスク)/別添2 「第2部E.AIガバナンスの構築」関連(経営層による AIガバナンスの構築及びモニタリング、実際の取組事例)/別添3 AI開発者向け/別添4 AI提供者向け/別添5 AI利用者向け/別添6 「AI・データの利用に関する契約ガイドライン」を参照する際の主な留意事項 | 手順書と体制を設計するときの記載例の参照 |
| チェックリスト(別添7) | 全主体向けのチェック項目と、広島AIプロセスの国際指針のチェック項目 | 自社用チェックリストのたたき台 |
| ワークシート(別添7) | 具体的なアプローチを検討するための表計算ファイル | ユースケースごとの対応の検討 |
| 主体横断的な仮想事例(別添8) | 掲載ページでは第1.0版のまま「更新なし」と表示 | 立場をまたぐ論点の理解 |
| 海外ガイドライン等の参照先(別添9) | 第1.2版として掲載 | 海外の制度との照合(第2章・第3章) |
| 見え消し版・概要資料・英語の仮訳 | 第1.1版からの変更箇所を示した版、本編と別添の概要、英語版 | 改訂の差分の確認、海外拠点との共有 |
本編の「はじめに」は、本編で「基本理念」(why)と「指針」(what)を扱い、別添で「実践」(how)を扱う、という分担を説明しています。具体的な取組が決まっていない事業者にとっては別添の記載例が参考になる、とも書いています。別添の「はじめに」は、別添は本編の方向性を達成する手段の一例であり、全てを記載どおりに実施することが求められているものではない、と明記しています。チェックリストとワークシートについても、各事業者の状況に合った独自のものを作成・更新して使うことが重要で、ワークシートの項目を必ずしも全て採用する必要はない、と書いています。つまりガイドラインは、そのまま写す規則集ではなく、自社のルールを作るための参照元として設計されています。
共通の指針と主体別の事項、AIガバナンスの構築の行動目標
本編第2部の C.共通の指針は、3つの立場に共通して取り組む事項を、1)人間中心、2)安全性、3)公平性、4)プライバシー保護、5)セキュリティ確保、6)透明性、7)アカウンタビリティ、8)教育・リテラシー、9)公正競争確保、10)イノベーション、の10項目に整理しています。冒頭では、法の支配、人権、民主主義、多様性・包摂性、公平公正な社会を尊重すること、関連法令を遵守すること、そしてこれらの取組を AIの特性・用途・目的・社会的文脈を踏まえ、各主体の資源制約を考慮しながら自主的に進めることが重要だと書いています。資源制約への言及は、企業の規模だけで対応を軽くしてよいという意味ではないと考えています。用途とリスクに応じて必要な対応を決め、資源制約を踏まえて実施の方法を選ぶ、という読み方が適切です。
第3部から第5部は、共通の指針に加えて立場ごとに重要となる事項を並べています。項目には「D-2)i.」のような記号が付いていて、D は AI開発者、P は AI提供者、U は AI利用者、続く数字は共通の指針の番号を表します。たとえば AI利用者向けの第5部には、U-2)i.安全を考慮した適正利用、U-3)i.入力データ又はプロンプトに含まれるバイアスへの配慮、U-4)i.個人情報の不適切入力及びプライバシー侵害への対策、U-5)i.セキュリティ対策の実施、U-6)i.関連するステークホルダーへの情報提供、U-7)i.関連するステークホルダーへの説明、U-7)ii.提供された文書の活用及び規約の遵守、が並んでいます。外部の AIサービスを使うだけの会社でも、この7項目は社内の利用規程の目次の候補になると考えています。この記号の一覧は、本編第2部C の末尾にある表1「「共通の指針」に加えて主体毎に重要となる事項」(本編の25ページ)にまとめられていて、別添の冒頭にも同じ題の表1が再掲されています。
本編第2部の E.AIガバナンスの構築は、事前にルールや手続を固定するのではなく、「環境・リスク分析」「ゴール設定」「システムデザイン」「運用」「評価」というサイクルを継続的かつ高速に回す「アジャイル・ガバナンス」の実践が重要だとしています。そのうえで、経営層の責任は大きく、AIガバナンスの構築を単なるコストではなく、持続的成長と中長期的な発展を志向した先行投資として捉えることが重要だ、と書いています。別添2は、このサイクルを「行動目標」に分解しています。別添2の表6「行動目標一覧」を数えると、6つの分類に14の行動目標が並んでいます。
| 分類 | 行動目標(別添2の表6の名称) | 自社で着手時に作るものの例 |
|---|---|---|
| 1.環境・リスク分析 | 1-1 便益/リスクの理解 1-2 AIの社会的な受容の理解 1-3 自社の AI習熟度の理解 | ユースケース台帳(第7章)、現状の利用の把握 |
| 2.ゴール設定 | 2-1 AIガバナンス・ゴールの設定 | AI基本方針(第12章) |
| 3.システムデザイン | 3-1 ゴール及び乖離の評価及び乖離対応の必須化 3-2 AIマネジメントの人材のリテラシー向上 3-3 各主体間・部門間の協力による AIマネジメント強化 3-4 予防・早期対応による利用者のインシデント関連の負担軽減 | 承認の手順、研修、部門間の連絡経路、インシデント対応の手順(第11章) |
| 4.運用 | 4-1 AIマネジメントシステム運用状況の説明可能な状態の確保 4-2 個々の AIシステム運用状況の説明可能な状態の確保 4-3 AIガバナンスの実践状況の積極的な開示の検討 | 記録の保存の決まり、開示の方針(第14章) |
| 5.評価 | 5-1 AIマネジメントシステムの機能の検証 5-2 社外ステークホルダーの意見の検討 | 内部監査の観点(第14章)、問い合わせ窓口 |
| 6.環境・リスクの再分析 | 6-1 行動目標1-1〜1-3 の適時の再実施 | 見直しの周期と、きっかけの定め |
別添2は、行動目標そのものは社会に一定のリスクを与えうる AIに関わるすべての主体が実施することが重要な一般的・客観的な目標である一方、実践のポイントと仮想企業の実践例の採否は各主体に委ねられる、と書き分けています。また、IT・プライバシー・セキュリティのガバナンスなど既存の仕組みと連携すること、仕組み・ルール・体制を見直しながら管理工数を最小化しつつ意思決定と運用を迅速化することが重要だ、とも書いています。表の右の列は、本コラムの後の章で扱う成果物との対応を示したもので、ガイドラインが指定しているものではありません。
第1.2版で変わったことと、活用の手引き
第1.2版の変更点は、総務省の掲載ページから辿れる「AI事業者ガイドラインの令和7年度更新内容」(総務省・経済産業省、資料の表紙の日付は2026年3月12日)にまとめられています。この資料は、更新の論点を7つに整理しています。AI技術の動向の反映、AIによるリスクの記載の見直し、主体区分の整理、特定単語の整理・見直し、ユーザビリティの改善、AIガバナンスに関する動向の反映、その他(脚注やリンクの更新)です。
実務への影響が大きいのは、1つ目の AI技術の動向の反映です。第1.2版の本編第1部には、AIエージェントとフィジカルAIの定義が加わりました。本編は AIエージェントを、特定の目標を達成するために環境を感知し自律的に行動する AIシステム、と定義しています。フィジカルAIは、センサなどで物理環境の情報を取り込み、自律的に推論・判断して、駆動系などを介して移動や操作のような物理的な行動につなげるシステム、と定義されています。更新内容の資料によると、別添には、AIエージェントの人間の意図しない動作に関するリスク、外部システムと連携する際に内部データが不正に外部へ送信されるリスク、攻撃の対象と手法の増加、制御の困難化などのリスクと、人間の判断を介在させる仕組み、最小権限の設定、扱うデータの最小化、定期的な操作履歴の確認などの留意事項が追記されました。エージェンティックAI(複数の AIエージェントが自律的に意思決定する仕組み)については、本年度は脚注での補足にとどめ、次年度以降に定義とリスクを追記していく想定だ、と書かれています。AIエージェントを社内でどう扱うかは第14章で扱います。
2つ目のリスクの記載の見直しでは、リスクの大きさと発生可能性などを加味して対策の優先順位を検討するリスクベースアプローチの説明が追記されました。3つ目の主体区分の整理では、AI開発者がシステム構築のすべてを担うわけではないことや、ファインチューニングなどの事後学習を AI開発者の役割とすることが補足されました。4つ目の用語の整理では、「学習」「推論」「データ」の定義が見直されました。5つ目のユーザビリティの改善として、総務省の掲載ページには、AI事業者ガイドラインのチャットボット(2026年3月26日公表)と「AI事業者ガイドライン活用の手引き(案)」(2026年3月31日公表)が掲載されています。
活用の手引き(案)は、AIガバナンスの構築と実践をこれから始める人に向けた資料で、案の段階なので今後見直される可能性がある、と断っています。手引きは、よくある誤った理解として、ガイドラインの記載事項の遵守は義務である、書いてあることは全てそのまま自社に適用すればよい、の2つを挙げ、ガイドラインは義務を課すものではなく、自社の事業規模や状況に合わせて過不足なく対応することが重要だ、と説明しています。そのうえで、AIガバナンスの構築時に土台として必要な準備事項として、組織内の AIの開発・提供・利用の状況を把握する仕組み、リスク評価体制の構築、インシデント報告体制の構築、組織が扱う AIの特性に応じたルールの策定・運用、の4つを挙げています。リスク評価については、すべてのユースケースを相談窓口に寄せるのではなく、基準を設けて相談が必要な場合とセルフチェックでよい場合を分けること、既存の体制があれば必ずしも新たに体制を構築する必要はないこと、が書かれています。この4つは、本コラムの第7章(台帳と区分)、第11章(インシデント)、第12章(規程)の出発点とそのまま重なります。
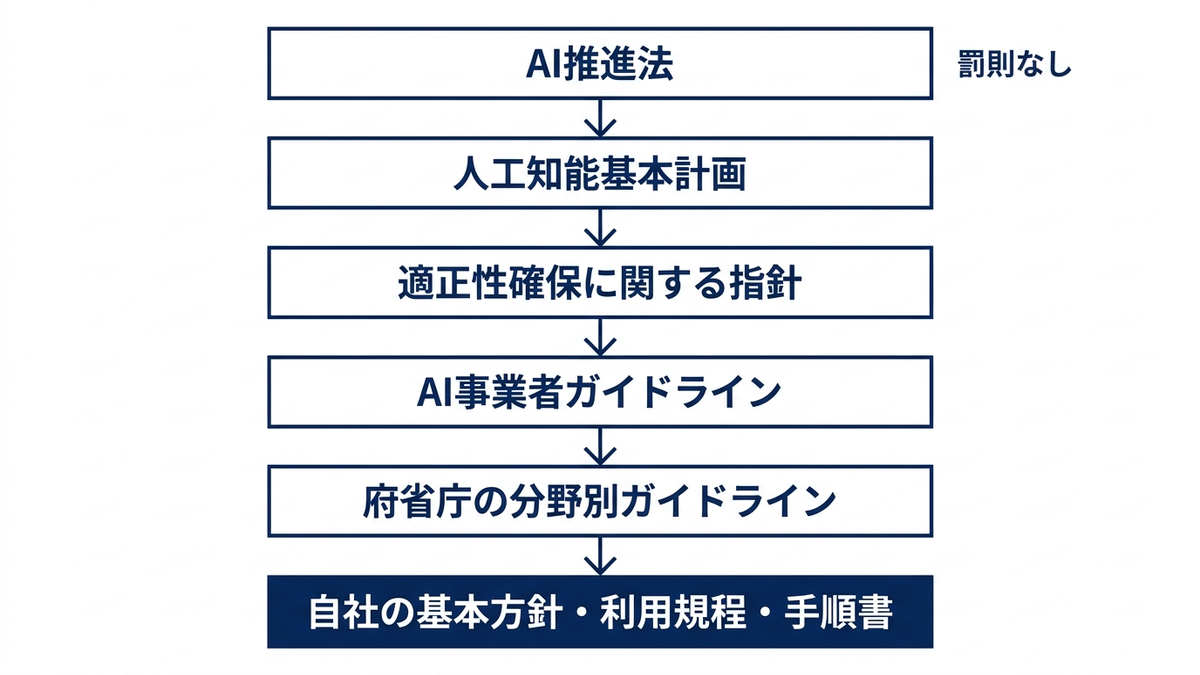
府省庁の分野別ガイドラインの見つけ方
AI事業者ガイドラインは分野を問わない横断的な指針です。業務の分野によっては、所管の府省庁が個別のガイドラインや注意喚起を出しています。内閣府の適正性確保に関する指針の掲載ページには「人工知能に関する各府省庁等のガイドライン等一覧」があり、2026年10月28日に開いた時点では17件が並んでいました。次の表は、その一覧から、企業の社内ルールづくりで参照されることが多いと考えられるものを抜き出したものです。名称と所管と時期は一覧の記載のままで、各文書の中身は、本コラムでは扱う章でそれぞれの原文に当たります。
| 一覧の名称(抜粋) | 所管(一覧の記載) | 策定(改定)時期(一覧の記載) | 本コラムで扱う章 |
|---|---|---|---|
| AI事業者ガイドライン | 総務省、経済産業省 | R8.3 | 本章 |
| AIのセキュリティ確保のための技術的対策に係るガイドライン | 総務省 | R8.3 | 第8章 |
| AIの利用・開発に関する契約チェックリスト | 経済産業省 | R7.2 | 第9章 |
| AI・データの利用に関する契約ガイドライン | 経済産業省 | R1.12 | 第9章 |
| 生成AIサービスの利用に関する注意喚起等について | 個人情報保護委員会 | R5.6 | 第8章 |
| AIと著作権に関する考え方について | 文化庁 | R6.3 | 第8章 |
| 行政の進化と革新のための生成AIの調達・利活用に係るガイドライン | デジタル庁 | R7.5 | 第9章 |
| プラント保安分野におけるAI信頼性評価ガイドライン | 消防庁、厚生労働省、経済産業省 | R3.3 | 分野別の例 |
| 医療デジタルデータのAI研究開発等への利活用に係るガイドライン | 厚生労働省 | R6.3 | 分野別の例 |
同じページには、国際的な規範の一覧(広島AIプロセスの国際指針と報告枠組み、ISO/IEC 42001、OECD の AIに関する勧告、UNESCO の AIの倫理に関する勧告、国連総会の決議など)と、その他のガイドライン等の一覧(AIセーフティ・インスティテュートの評価観点ガイドとレッドチーミング手法ガイド、産業技術総合研究所の機械学習品質マネジメントガイドラインなど)も載っています。自社の業務に関係する分野の文書があるかどうかを、まずこのページで確かめるのが手早い方法です。一覧の「策定(改定)時期」は文書によって古いものもあり、一覧に載っている時期より新しい版が出ている可能性もあるので、使う前に所管の府省庁のページで最新の版を確かめる必要があります。たとえばデジタル庁の生成AIの調達・利活用のガイドラインは、一覧では R7.5 ですが、2026年6月12日に第2.0版が決定されています。
ガイドラインを自社の手順書に落とす
ここまで見てきたとおり、日本の国の文書は、法律が施策の枠組みを決め、計画が政府の施策を並べ、指針が考慮すべき要素を示し、AI事業者ガイドラインが事業者の取組の考え方と記載例を示す、という分担になっています。自社のルールを作るときに直接の参照元になるのは、主に AI事業者ガイドラインです。ただし、ガイドラインの本編と別添は合わせると分量が多く、そのまま社内に配っても読まれにくいと考えられます。本コラムでは、ガイドラインを自社の文書に「翻訳」する手順として、次の表の6段階を提案します。手順の順序は本コラムの提案で、ガイドラインが定めているものではありません。
| 段階 | やること | ガイドラインの参照先 | できあがるもの | 担い手の例 |
|---|---|---|---|---|
| 1.自社の立場を決める | ユースケースごとに、自社が AI開発者・AI提供者・AI利用者のどれにあたるかを決める。複数を兼ねる場合はすべて記録する | 本編「はじめに」の3つの立場の定義、第3部〜第5部 | ユースケース台帳の「立場」の列(第7章) | 事務局、各部門の責任者 |
| 2.該当する項目を抜き出す | 共通の指針の10項目と、自社の立場に対応する D・P・U の項目を抜き出す | 本編第2部C と表1、第3部〜第5部 | 自社に関係する項目の一覧 | 事務局、法務 |
| 3.重みを付ける | ユースケースのリスクに応じて、どの項目を重点的に確かめるかを決める。全項目を同じ深さで扱わない | 別添の「はじめに」のリスクベースアプローチの記述、別添1 | 本コラムのリスク区分(禁止・高・中・低)ごとの確認項目(第7章) | AIガバナンス委員会(第13章) |
| 4.既存の規程に載せる | 情報セキュリティ・個人情報・文書管理・購買の規程で既に扱っている項目は、新しい文書を作らずに既存の規程に追記する | 別添2の既存のガバナンスとの連携の記述、活用の手引き(案) | 既存規程との対応表(第12章) | 規程の所管部門 |
| 5.チェックリストを作る | 別添7のチェックリストとワークシートをたたき台に、自社の言葉と自社の手続に合わせた確認票を作る | 別添7 | 申請時の確認票、承認の記録の様式 | 事務局 |
| 6.改訂を追う | ガイドラインの改訂(第1.2版の次の版)と分野別ガイドラインの改訂を、決まった担当が決まった周期で確かめ、差分を自社の文書に反映する | 総務省の掲載ページの見え消し版、更新内容の資料 | 改訂の記録、規程の版管理(第14章) | 事務局、法務 |
段階1と段階2で迷いやすいのは、外部の生成AIサービスを自社の顧客向けのサービスに組み込む場合です。ガイドラインの定義に照らすと、サービスとして他者に提供する部分は AI提供者、社内の業務で使う部分は AI利用者にあたると読めますが、どちらにあたるかで確認項目が変わるので、台帳に両方を書いて事務局で判断する形にしておくのが安全だと考えています。段階3では、ガイドラインの本編が「リスクベースアプローチ」を重要としていること、別添が「この付属資料を全て記載とおりに実施することが求められているものではない」と書いていることが、重点を絞る判断の根拠になります。段階6は見落とされやすいのですが、ガイドラインは本編で自らを Living Document(固定せずに更新し続ける文書)として適宜更新すると説明しており、2024年4月の第1.0版の後、第1.01版、第1.1版、第1.2版の3回改訂されています。改訂を追う担当を決めずに一度だけ取り込むと、自社の文書が古い版の前提のまま残ります。
専門家への確認の前提
この章で扱った文書のうち、法律は AI推進法だけです。AI事業者ガイドラインは、事業者の自主的な取組を促す文書です。計画・指針・分野別のガイドラインの対象と位置づけは、文書ごとに確かめる必要があります。たとえばデジタル庁のガイドラインは、政府情報システムについて遵守する内容を定めた文書と位置づけられています。ただし、「AI推進法には罰則が無いので、AIについては法的な対応が要らない」と読むのは誤りです。前に書いたとおり、AIを使う場面には個人情報保護法、著作権法、不正競争防止法、労働や消費者保護の法令、業種ごとの規制などが、AI推進法とは別に、それぞれの法令の定めに従って掛かります。どの法令が、自社のどのユースケースに、どう掛かるかは、事実関係によって変わります。本コラムの記述は、条文やガイドラインが何を定め、何を示しているかの説明であって、個別の事案で適法かどうかを判断するものではありません。個別の判断は、弁護士などの専門家に確認することを前提としています。
もう一つ、AI推進法とガイドラインは日本の制度であり、海外の制度を置き換えるものではありません。前に触れたとおり、適正性確保に関する指針は活用事業者に海外事業者も含むとしていますが、これは日本の指針が対象とする活用事業者の範囲に海外事業者も入る、という対象の範囲の記述です。日本の会社が海外で事業をするときに、日本の制度に沿っていれば現地の制度にも対応したことになる、という意味ではありません。AI事業者ガイドラインの本編も、国境を越えた活動を行う事業者は現地の法令に対応すべきだと書いています。EU で AIを提供・導入する場合は第3章で扱った EU AI Act が、他の地域の制度は第2章で扱った各制度が、日本の制度とは別に掛かりうるので、それぞれの確認が要ります。
経営判断、罰則が無いことは対応しなくてよいことを意味しない
経営の立場から日本の制度を見ると、「法律上の罰則が無いのなら、AIガバナンスへの投資は後回しにしてよいのではないか」という問いが出てきます。本コラムの考えは、罰則の有無を対応の要否の判断基準にすると判断を誤りやすい、というものです。根拠として挙げられるのは、公的な文書の中の次の記述です。ただし、どれも「対応すれば損失を避けられる」ことを保証するものではなく、文書がそう示している、という範囲の根拠です。
1つ目は、AI事業者ガイドラインの本編の「はじめに」が、事業者の取組が社会から不適切または不十分と評価される場合は、事業活動における機会損失が生じ、事業価値の維持が困難となる事態を招くおそれがある、と書いていることです。罰則の有無とは別に、取引先や社会からの評価が事業上の損失につながりうる、という見方です。本コラムで使う損失の型でいえば、信頼の失墜にあたります。2つ目は、別添が、リスクを恐れるあまり「リスクがゼロになるまで AIを活用しないこと」や「完全なセーフガードを引く」ことによって動けなくなることも一種のリスクだ、と書いていることです。セーフガードは、危険を抑えるための仕組みを指します。これは導入の停滞の型にあたります。ガイドラインは、対応しないことと過剰に対応することの両方を損失として扱っています。3つ目は、適正性確保に関する指針の脚注が、国際規格などに基づく体制の整備と、その取組の積極的な開示・説明が、企業価値の向上や競争優位性の確保にもつながると期待される、と書いていることです。
これに加えて、法律の外側の事情もあります。個人情報や著作権に関わる問題は既存の法令の違反として現れ、規制違反と権利侵害の型の損失になります。EU に関わる事業では EU AI Act の義務が掛かりえます。さらに、部門ごとに別々にガイドラインを読み、別々のチェックリストを作ると、同じ確認を何度も繰り返す二重投資になります。日本の制度が罰則より自主的な取組を促す形を選んでいるのは、裏返すと、何をどこまでやるかの判断が各社の経営に委ねられているということです。
この判断を予算と体制に落とすときは、ガイドラインを自社の手順書に落とす作業の着手時に、次の3つを決めておくのが有効だと考えています。1つ目は、AI事業者ガイドラインを社内の標準の参照元として採用するかどうかを、経営として一度決めることです。採用するなら、部門ごとに別の参照元を使う状態を避けられます。2つ目は、ガイドラインの改訂と分野別のガイドラインを追う担当と周期を決め、その工数を予算に入れることです。3つ目は、活用の手引き(案)が挙げる4つの準備事項(利用状況を把握する仕組み、リスク評価の体制、インシデント報告の体制、ルールの策定と運用)のうち、自社の既存の体制が担っているものと、新たに作るものを分けることです。手引きも、既存の体制があれば新たに作る必要は必ずしもないと書いています。新しく作るものが少なければ、最初の投資は小さく始められます。
この章では、日本の AIに関する制度を確かめました。AI推進法は研究開発と活用の推進を目的とする法律で、国・地方公共団体・研究開発機関・活用事業者・国民の責務を定め、本則と取得できた附則を確かめた範囲では罰則の規定はなく、国の調査・指導・助言と施策への協力という形でリスクに対応する仕組みになっていること。法律に基づいて人工知能戦略本部が置かれ、人工知能基本計画(現行は2026年7月14日の閣議決定)と適正性確保に関する指針(2025年12月19日)が定められていること。事業者が手元で使う参照元は AI事業者ガイドライン第1.2版(2026年3月31日)で、本編が why と what を、別添が how を扱い、そのまま写すのではなく自社の状況に合わせて使うよう設計されていること。そして、罰則が無いことは対応しなくてよいことを意味しない、という本コラムの判断の根拠になる記述が、AI事業者ガイドラインと適正性確保に関する指針という公的な文書の中にあることです。次の第5章では、米国の NIST が公表している AIリスクマネジメントフレームワークを扱い、リスク管理の機能の分け方を確かめます。
この章を深めたい方への参考書籍
『AI事業者ガイドライン 第1.0版』(経済産業省商務情報政策局情報産業課情報処理基盤産業室、総務省情報流通行政局参事官室 監修、商事法務):別冊NBL の no. 190 として2024年9月に刊行された本で、書名のとおり AI事業者ガイドラインの第1.0版を扱っています。刊行の時期から、第1.01版・第1.1版・第1.2版での改訂(AIエージェントの定義の追加など)と、AI推進法・適正性確保に関する指針の内容は含まれていません。紙の形で通して読みたいときに使い、条文は e-Gov 法令検索で、ガイドラインの最新の版は総務省の掲載ページで確かめる、という使い方を想定しています。
『AIガバナンス』(ベーカー&マッケンジー法律事務所(外国法共同事業) 編集、商事法務):2026年10月に刊行された本で、出版情報登録センターが提供している目次には、AIガバナンスの構築、AIガバナンスを始めるためのステップ、AI原則、AI利用及び開発のための規則作り、AI影響評価などの章が並んでいます。この章の後半で扱った、国のガイドラインを自社の原則と規則に落とす作業を、法務の立場から具体的に考えるときの材料になります。内容が AI事業者ガイドラインのどの版を前提にしているかは、本を開いて確かめる必要があります。
第5章 NIST AI RMFと生成AIプロファイル、リスク管理の4つの機能
第4章では、日本の AI推進法と AI事業者ガイドラインを扱い、日本の制度が罰則よりも事業者の自主的な取り組みを促す形をとっていること、ガイドラインを自社の手順書に落として使えることを確認しました。この章では、法令ではなく、組織が AIのリスクを管理するための枠組みとして広く参照されている、米国標準技術研究所(NIST)のNIST AI RMF(AIリスクマネジメントフレームワーク)を扱います。あわせて、その生成AI向けの補完文書である生成AIプロファイル(NIST AI 600-1)を扱います。
NIST AI RMF は、米国の連邦機関が公表した文書ですが、法律ではなく、使うかどうかを組織が自分で決める任意の枠組みです。それでも本コラムで1章を割くのは、AIガバナンスの仕事を「誰が方針を決めるか」「何を把握するか」「何をどう測るか」「見つけたリスクにどう対処するか」の4つの機能に分けて整理しており、日本企業が自社の仕組みを点検するときの目次として使いやすいからです。この章では、NIST の公式 PDF とウェブページを開いて確かめた範囲で、枠組みの構成、枠組みが挙げる AIの特性、4つの機能とカテゴリの数、Playbook、生成AIプロファイルのリスクの一覧、改訂の状況、ISO/IEC 42001 や AI事業者ガイドラインとの対応表を順に説明し、最後に日本企業が使うときの読み替えと経営判断をまとめます。この章で引く NIST の資料は、いずれも2026年10月28日と29日に開いて確認しました。
NIST AI RMFとは何か、誰が作り、どう位置づけられているか
NIST AI RMF の正式な文書番号は NIST AI 100-1 で、版は 1.0 です。NIST の公式ページによると、2023年1月26日に公表されました。文書の冒頭では、2020年の国家AIイニシアチブ法の指示に基づいて作られたこと、AIシステムを設計・開発・導入・利用する組織が AIのリスクを管理し、信頼できる責任ある AIの開発と利用を進めるための資源を提供することが目的であることが述べられています。作成の過程では、情報提供の依頼、概念文書と2回の草案への意見募集、ワークショップなどが行われたことも書かれています。
位置づけについて、文書は、この枠組みが任意で使うものであり、権利を守ることを前提とし、特定の業種に限らず、特定のユースケースにも依存しない、と述べています。規模や業種を問わず、組織が自分の状況に合わせて取り入れられるように作られている、ということです。拘束力の点では、第2章で扱った区分のうちソフトロー(指針)に近い性格を持ち、EU AI Act のように違反に制裁が科される法律とは性格が違います。ただし、米国内の個別の法令や契約で NIST AI RMF への言及がある場合に、どのような扱いになるかは、この章では確かめていません。
文書は2つの部に分かれています。第1部は基礎となる情報で、AIのリスクをどう捉えるか、誰がこの枠組みを使うか、信頼できる AIが備えるべき性質は何か、を扱います。第2部は「コア」と呼ばれる中心部分で、4つの機能と、その下のカテゴリ・サブカテゴリを示し、続いてプロファイルの考え方を説明しています。付録には、AIのライフサイクルで役割を担う関係者(文書の用語では AIアクター)の作業の説明、AIのリスクが従来のソフトウェアのリスクとどう違うか、人と AIの相互作用、枠組みの性質がまとめられています。
この枠組みは、日本語でも読めます。NIST の公式ページには日本語訳へのリンクがあり、その PDF の表紙裏によると、訳したのは日本政府で、NIST の依頼を受けた翻訳会社が訳文を確認し、そのうえで米国政府の公式翻訳と位置づけられています。同じ箇所に、正本は NIST が公開している英語版であることも書かれています。本コラムでは、項目名の訳を、この日本語訳に合わせて書きます。
文書は、AIシステムを、与えられた目的に対して、現実の環境や仮想の環境に影響を与える予測・推奨・判断などの出力を生成できる、工学的または機械ベースのシステムで、さまざまな水準の自律性をもって動くように設計されたもの、と説明しています。この説明は OECD の AI原則(2019年)と ISO/IEC 22989(AIの概念と用語)を出典として翻案したものと書かれています。本コラムの AIシステムの定義(第1章)と大きく食い違うものではありませんが、各制度の定義の違いは第1章と第3章で扱っています。
リスクの捉え方、リスク許容度と優先順位
NIST AI RMF は、リスクを、ある事象が起きる確率と、その事象が起きたときの結果の大きさを組み合わせた尺度として扱っています。結果は良い方向にも悪い方向にもありうるとしつつ、悪い影響については、害の大きさと起こりやすさの関数としてリスクを捉える、と説明しています。害を受けるのは、個人・集団・地域社会・組織・社会・環境と、幅広く想定されています。リスクの定義には ISO 31000(2018年。リスクマネジメントの指針)が引かれており、既存のリスクマネジメントの考え方の上に AI固有の論点を足す、という作りになっていることが分かります。
実務の上で重要なのは、文書がリスク許容度(組織が目的を達成するために、どこまでのリスクを受け入れる用意があるか)を「規定しない」と明記している点です。許容できるリスクの水準は、用途や状況によって大きく変わり、法令や業界の規範、組織の優先順位によっても変わるため、枠組みの側では決めない、という立場です。既存の法令や業界の基準がある場合はそれに従い、無い場合は組織が合理的な許容度を自分で定めるべきだ、と書かれています。つまり、NIST AI RMF を採り入れても、「この会社ではどこまでなら許すか」という判断は、経営が自分で下す必要が残ります。
優先順位については、負のリスクをすべてなくすことはできず、それを目指すとかえって逆効果になりうる、という立場です。最も高いと判断したリスクに、最も急いで徹底した管理を当てるべきだとしています。許容できない水準のリスクがあるときは、十分に管理できるまで開発と導入を安全な方法で止めるべきだ、とも書かれています。止める判断の基準と権限は第11章で扱いますが、その考え方の根は、この記述に見ることができます。
優先順位を上げる目安として、文書は、人と直接やり取りする AIシステムであること、個人を特定できる情報のような機微なデータを大量に使って学習していること、出力が人に直接・間接に影響すること、を挙げています。逆に、機械どうしでしかやり取りせず、機微でないデータで学習した AIシステムは、最初の優先順位を低くしてよい場合があるとしつつ、そうしたシステムも下流で安全や社会への影響を持ちうるので、状況に応じた定期的な評価は欠かせない、と限定を付けています。残留リスク(対処をした後に残るリスク)を記録し、利用者に伝えることも求めています。
もう一つ、組織への組み込みについての記述も押さえておきたい点です。文書は、AIのリスクを単独で扱わず、全社的なリスク管理の戦略と手順に組み込むべきだとし、サイバーセキュリティやプライバシーのような他の重要なリスクと一緒に扱う方が、統合された結果と組織の効率につながる、と述べています。さらに、この枠組みを使うだけでは、説明責任の仕組みや役割、文化、動機付けの構造は変わらず、効果的なリスク管理には上級の経営層の関与と、場合によっては組織の文化の変化が要る、と書かれています。中小規模の組織は、大きな組織とは違う課題に直面しうることにも触れています。
信頼できるAIの特性、7つの項目とその関係
NIST AI RMF の第1部の中心は、信頼できるAIの特性です。文書は、AIシステムが信頼できるものであるためには、関係者にとって価値のある複数の基準に応える必要があるとし、その特性として7つを挙げています。日本語訳の項目名では、妥当性と信頼性、安全、セキュリティとレジリエンス、アカウンタビリティと透明性、説明可能性と解釈可能性、プライバシー強化、公平性(有害なバイアスのマネジメント)、です。英語の原文では、7つのうち4つが2つの性質を並べた名前になっており、日本語訳でもそれを「と」でつないでいます。
次の表は、7つの特性について、文書が説明している中身を本コラムの言葉で要約し、自社の AIのユースケースに当てはめるときに確かめる問いの例を添えたものです。表の「確かめる問いの例」の列は本コラムが作ったもので、NIST の文書に書かれている問いではありません。
| 特性(日本語訳の項目名) | 文書の説明の要旨 | 確かめる問いの例 |
|---|---|---|
| 妥当性と信頼性 | 意図した用途の要求を満たしていることが客観的な証拠で確かめられ、想定した条件と期間のもとで失敗せずに動くこと。正確さと頑健さ(さまざまな状況で性能を保つこと)がこれを支える。正確さの測定は、想定する利用の条件を代表する試験データと試験方法の説明を伴うべきだとしている | どの条件のデータで試したか。学習時と違う状況で使うと、どこまで性能が落ちるか |
| 安全 | 定められた条件のもとで、人の生命・健康・財産・環境を危険にさらす状態に至らないこと。重い傷害や死亡につながるリスクは最も急いで、最も徹底して管理する。想定外の動きをしたときに止める・変更する・人が介入できることを挙げている | 出力の誤りが人の身体や財産に及ぶ用途か。異常時に誰がどう止めるか |
| セキュリティとレジリエンス | 想定外の悪い出来事や環境の変化に耐え、必要なときには安全に機能を落とせること(レジリエンス)。不正なアクセスと利用を防ぐ仕組みで機密性・完全性・可用性を保てること(セキュリティ)。敵対的な入力、学習データの汚染、モデルや学習データの持ち出しを例に挙げている | 悪意のある入力を試したか。モデルや学習データを外部から取り出されるおそれはないか |
| アカウンタビリティと透明性 | 説明責任は透明性を前提とする。透明性は、AIシステムとその出力についての情報が、やり取りする人に、役割や知識に応じた水準で届くこと。設計の判断、学習データ、意図した用途、誰がいつ導入を決めたかまでを範囲とする。他の6つすべてに関わる特性として扱われている | 誰が導入を決めたかを記録しているか。誤った出力で不利益を受けた人が是正を求められるか |
| 説明可能性と解釈可能性 | 説明可能性は AIシステムが動く仕組みの表し方、解釈可能性は出力が設計された目的の中で何を意味するか。文書は、透明性が「何が起きたか」、説明可能性が「どのように決まったか」、解釈可能性が「なぜそう決まり、利用者にとって何を意味するか」に答える、と区別している | 出力の理由を、利用者の役割と知識に合わせて説明できるか |
| プライバシー強化 | 人の自律・同一性・尊厳を守る規範と慣行。匿名性・機密性・本人による管理を、設計・開発・導入の選択の指針にすべきとしている。AIが推論によって個人を特定したり、私的な情報を推測したりする新しいリスクにも触れている | 個人情報を入力・学習に使うか。出力から個人が推測されるおそれはないか |
| 公平性(有害なバイアスのマネジメント) | 有害なバイアスや差別に対処し、平等と公正に配慮すること。公平さの基準は文化や用途で変わり、定義が難しいとしている。バイアスを、制度的なもの、計算上・統計上のもの、人の認知によるもの、の3つに分け、差別の意図が無くても生じうるとしている | どの集団の間で、どの指標の差を見るか。差が見つかったとき誰が判断するか |
7つの特性を読むときに大事なのは、文書がこれらを独立した合格項目として扱っていない点です。文書は、妥当性と信頼性を信頼できることの必要条件として他の特性の土台に置き、アカウンタビリティと透明性を他のすべての特性に関わるものとして位置づけています。そのうえで、特性どうしにはトレードオフ(一方を高めると他方が下がる関係)があることを繰り返し述べています。例として、解釈しやすさを高めることとプライバシーを守ることの間、予測の正確さと解釈しやすさの間、データが少ない条件でのプライバシー保護の技術と正確さの間、が挙げられています。
文書は、ある特性が高くても別の特性が欠けたシステムは望ましくないとし、信頼できるかどうかは最も弱い特性で決まる、と説明しています。トレードオフをどう解くかは分析だけでは決まらず、関係する価値観に照らして透明に決めるべきだとしています。指標としきい値も人の判断で決めるべきだと明記されています。
この点は、経営にとって重要な含意を持ちます。7つの特性をすべて最大にする AIは作れないことが多く、どれを優先するかは技術の担当者だけで決められるものではありません。たとえば、採用の書類の要約に AIを使うなら公平性と説明可能性の比重が大きくなり、社内文書の検索に使うならセキュリティと正確さの比重が大きくなる、というように、ユースケースごとに重みが変わります。重みの付け方を決める場と責任者を先に決めておくことが、AIガバナンスの着手時に決めておく仕事の一つになる、と考えています。公平性の指標の選び方は第10章で、説明可能性の手法は弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』で扱っています。
4つの機能、統治・把握・測定・対処
第2部のコアは、4つの機能で構成されています。GOVERN・MAP・MEASURE・MANAGE で、日本語訳でも機能の名前は英語のまま書かれています。本コラムでは、意味を取りやすいように、GOVERN を統治、MAP を把握、MEASURE を測定、MANAGE を対処と呼び、初出では英語を添えます。各機能はカテゴリに分かれ、カテゴリはさらにサブカテゴリに分かれています。文書は、サブカテゴリの下にある具体的な行動と成果について、チェックリストではなく、必ずしも順番に行う手順でもない、と明記しています。
統治(GOVERN)は、他の3つの機能を横断する機能と位置づけられています。文書によると、統治の機能は、AIシステムを設計・開発・導入・評価・調達する組織の中にリスク管理の文化を育て、リスクを予測・特定・管理するための手順・文書・組織の仕組みを示し、影響の評価の手順を組み込み、組織の原則・方針・戦略上の優先順位と AIのリスク管理をそろえる、といった役割を持ちます。第三者のソフトウェアやハードウェア、データの利用に関する法的な論点もここに含まれます。上級の経営層が組織のリスク管理の基調を決める、という記述もあります。
把握(MAP)は、ある AIシステムに関わるリスクを捉えるための文脈を確立する機能です。AIのライフサイクルには多くの関係者が関わり、ある部分を担当する人は他の部分の状況を見通せないことが多いため、用途・利用者・影響を受ける人・法令や規範を先に把握しておくことが、後の測定と対処の土台になる、と説明されています。文書は、把握の機能を終えた時点で、AIシステムを設計・開発・導入するかどうかの最初の判断(文書の言葉では go/no-go の判断)に必要な文脈の知識がそろっているべきだ、としています。
測定(MEASURE)は、定量・定性、またはその組み合わせの手法で、AIのリスクと影響を分析・評価・監視する機能です。把握で特定したリスクを受けて測り、その結果を対処に渡します。AIシステムは導入の前に試験し、運用中も定期的に試験すべきだとし、不確かさの尺度を伴う試験、性能の基準との比較、結果の記録と報告を求めています。文書は、試験・評価・検証・妥当性確認をまとめて TEVV と呼び、その手順を整えることを測定の成果としています。独立した立場からのレビューが、内部のバイアスや利害の衝突を和らげうる、という記述もあります。
対処(MANAGE)は、把握と測定で特定したリスクに、統治で定めたとおりに資源を割り当て、定期的に対応する機能です。リスクへの対応には、事故や事象への対応・復旧・伝達の計画が含まれます。対処の機能を終えた時点で、リスクの優先順位付けと、定期的な監視と改善の計画が整っているべきだ、とされています。
4つの機能を使う順序について、文書は、統治の仕組みがあることを前提に、機能はライフサイクルのどの順番で行ってもよいとしつつ、多くの利用者は、統治の成果を整えた後に把握から始め、測定や対処へ進むだろう、と書いています。どう組み合わせる場合でも、行き来しながら繰り返す進め方であるべきだとしています。また、組織は資源と能力に応じて、カテゴリとサブカテゴリの一部を選んで使ってもよく、すべてを使ってもよい、と明記されています。
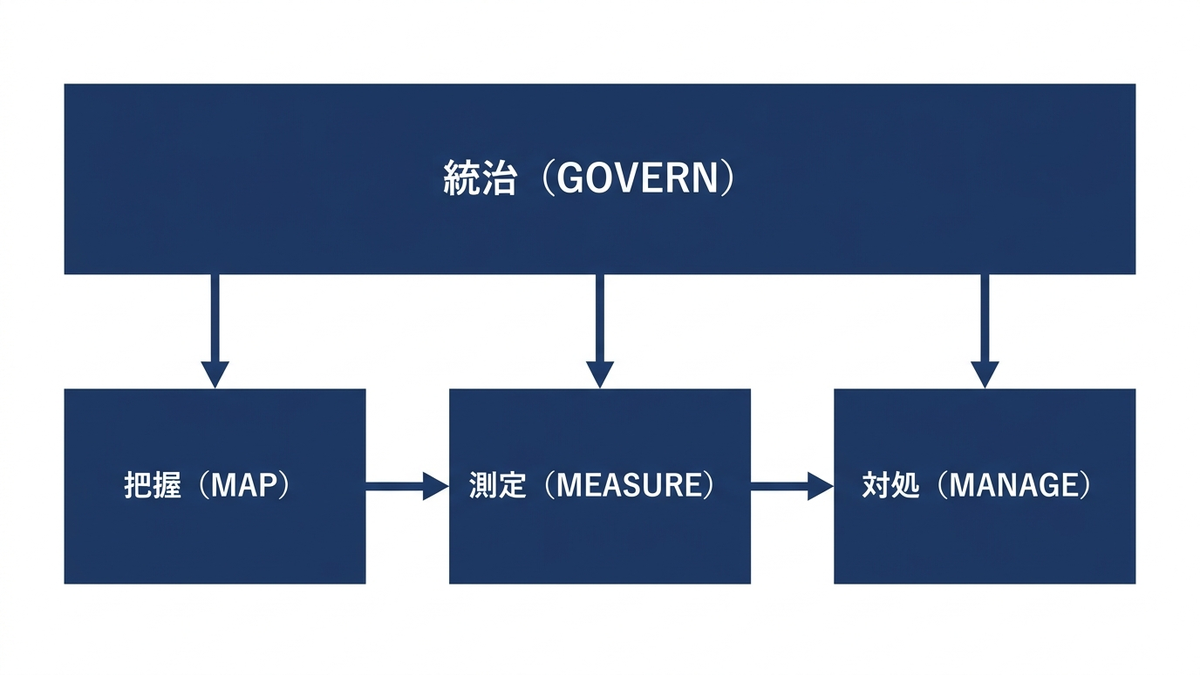
次の表は、4つの機能ごとに、文書が示す目的の要旨と、カテゴリとサブカテゴリの数をまとめたものです。数は、NIST AI 100-1 の表1から表4に載っているカテゴリとサブカテゴリの番号を、本コラムで原文から数えたものです。
| 機能(本コラムの呼び方) | 目的の要旨 | カテゴリの数 | サブカテゴリの数 | 機能を終えた時点で整っているべきもの(文書の記述の要旨) |
|---|---|---|---|---|
| GOVERN(統治) | リスク管理の文化・方針・手順・役割を整え、他の3つの機能を横断して支える | 6 | 19 | リスクの理解と管理に焦点を当てた、目的に沿った組織の文化と、それを支える仕組み・手順・体制 |
| MAP(把握) | 用途・利用者・影響・法令などの文脈を確立し、リスクを特定する | 5 | 18 | 設計・開発・導入をするかどうかの最初の判断に足る、影響についての文脈の知識 |
| MEASURE(測定) | 特定したリスクと信頼できる AIの特性を、手法と指標で分析・評価・監視する | 4 | 22 | 客観的で繰り返せる試験・評価・検証・妥当性確認(TEVV)の手順と指標 |
| MANAGE(対処) | 測ったリスクに優先順位を付け、資源を割り当てて対応し、監視と改善を続ける | 4 | 13 | リスクの優先順位付けと、定期的な監視と改善の計画 |
| 合計 | 19 | 72 |
サブカテゴリの数は、測定が22と最も多く、そのうち13が「AIシステムが信頼できる AIの特性について評価されている」という1つのカテゴリに入っています。7つの特性を一つずつ評価する項目が、ここに並んでいるためです。統治の19のうち7は、方針・手順・慣行に関する最初のカテゴリに入っており、法令の要求の理解、特性の方針への組み込み、リスク許容度に応じた管理の水準の決め方、AIシステムの棚卸しの仕組み、安全な廃止の手順などが含まれています。
19のカテゴリを自社の仕組みに引き寄せて読む
カテゴリの一覧を見ると、NIST AI RMF が組織に何を求めているかが具体的に見えてきます。次の表は、19のカテゴリそれぞれの内容を、本コラムの言葉で要約したものです。カテゴリの番号は NIST の表記のままにしています。右の列は、そのカテゴリが自社のどの仕組みに当たるかを本コラムの考えで示したもので、NIST の文書に書かれた対応ではありません。
| カテゴリ | 内容の要旨 | 自社の仕組みでの置き場所(本コラムの考え) |
|---|---|---|
| GOVERN 1 | AIのリスクの把握・測定・対処に関する方針・手順・慣行が組織全体で整い、透明で、実際に機能している | AI基本方針・AI利用規程・手順書(第12章)、ユースケース台帳(第7章) |
| GOVERN 2 | 適切なチームと個人が、権限と責任を持ち、訓練を受けている説明責任の体制がある | 役割の分担と AIガバナンス委員会(第13章)、教育(第14章) |
| GOVERN 3 | 人材の多様性・公正・包摂・利用しやすさを、ライフサイクルを通じたリスク管理で優先する | 判断の場に入れる部門と専門性の決め方(第13章) |
| GOVERN 4 | チームが AIのリスクを考慮し伝え合う文化を持つ | 試験・インシデントの把握・情報共有の慣行(第10章・第11章) |
| GOVERN 5 | 関係する AIアクターと十分にやり取りする手順がある | 開発・導入したチームの外からの意見を集める窓口 |
| GOVERN 6 | 第三者のソフトウェアやデータ、その他の供給網から生じるリスクと便益に対処する方針と手順がある | 調達と契約の確認(第9章) |
| MAP 1 | 文脈が確立され、理解されている | ユースケースの申請書の記載事項(第7章) |
| MAP 2 | AIシステムの分類が行われている | 使う AIの種類と、出力を人がどう使い監督するかの記録(第7章) |
| MAP 3 | AIの能力・用途・目的と、見込まれる便益と費用が、適切な比較の基準に照らして理解されている | 導入の目的と効果、誤りが起きたときの損失の見積もり |
| MAP 4 | 第三者のソフトウェアとデータを含む、AIシステムのすべての構成要素について、リスクと便益が整理されている | 外部のモデルやサービスの権利・リスクの確認(第9章) |
| MAP 5 | 個人・集団・地域社会・組織・社会への影響が特徴づけられている | 影響評価(第7章) |
| MEASURE 1 | 適切な手法と指標が特定され、適用されている | 評価の計画(第10章) |
| MEASURE 2 | AIシステムが信頼できる AIの特性について評価されている | 性能・頑健性・公平性・安全性などの評価と記録(第10章) |
| MEASURE 3 | 特定したリスクを時間を追って追跡する仕組みがある | 運用中の監視と苦情の受付(第11章) |
| MEASURE 4 | 測定が有効だったかについての意見が集められ、評価されている | 評価の方法そのものの見直し |
| MANAGE 1 | 把握と測定の結果に基づいて、リスクに優先順位が付けられ、対応され、管理されている | 導入の承認と、リスクへの対応方針(低減・移転・回避・受容)の決定 |
| MANAGE 2 | 便益を最大にし悪影響を最小にする方策が、関係者の意見を踏まえて計画・実施・記録されている | 停止の仕組みと権限(第11章) |
| MANAGE 3 | 第三者に由来する AIのリスクと便益が管理されている | 外部のサービスと事前学習済みモデルの継続的な監視(第9章・第11章) |
| MANAGE 4 | 対応・復旧・伝達の計画を含むリスクへの対処が記録され、定期的に監視されている | インシデント対応と再発防止(第11章) |
表を通して見ると、NIST AI RMF の項目の多くは、AIの技術そのものではなく、方針・役割・記録・意見の収集・第三者の管理といった組織の仕組みについて書かれていることが分かります。いくつかのサブカテゴリは、本コラムの他の章の主題とそのまま重なります。たとえば、GOVERN 1.6 は AIシステムの棚卸しの仕組みが整い、リスクの優先順位に応じて資源が割り当てられていることを、GOVERN 1.7 は AIシステムを安全に廃止する手順を、GOVERN 2.3 は組織の経営層が AIシステムの開発と導入に伴うリスクの判断に責任を持つことを、それぞれ求めています。MANAGE 2.4 は、意図した用途と合わない性能や結果を示す AIシステムを、置き換える・切り離す・止めるための仕組みと責任の割り当てを求めています。
サブカテゴリには、リスク対応の選択肢として低減・移転・回避・受容を挙げるもの(MANAGE 1.3)や、AIを使わない代替の方法も考慮に入れることを求めるもの(MANAGE 2.1)もあります。AIを使うことを前提にせず、使わない選択肢と比べたうえで導入を決めることが、枠組みの中に組み込まれている、ということです。MEASURE 1.1 には、測らない、または測れないリスクや特性があれば、それを記録しておくことも書かれています。何を測っていないかを明示することは、後で問題が起きたときの説明責任に直結します。
Playbookとプロファイル、枠組みを自社用に絞り込む道具
NIST AI RMF の本文は、何が整っているべきかという成果を示すもので、それをどう実現するかの具体的な方法は、別の文書である AI RMF Playbook に委ねられています。NIST の Playbook のページによると、Playbook は AI RMF に付随する任意で使う資料で、4つの機能の成果を達成するための提案された行動、参考文献、関連する指針を含んでいます。提案はベストプラクティスと研究の知見に基づいて作られ、組織は自分の業種やユースケースに合うものを、多くも少なくも借りてよい、と書かれています。最初の完全版は2023年3月30日に公表され、利用者の好みや要件に合わせて情報を絞り込む機能を持つ、とされています。同じページには、Playbook は AI RMF 1.0 に基づいており、AI RMF 1.0 が改訂された後に更新される、とも書かれています(ページの最終更新は2026年6月10日と表示されていました)。
Playbook は、本文の72のサブカテゴリに対応する形で提案を並べているので、自社の手順書を作るときの材料として使えます。ただし、提案は特定の業種や法令を前提にしない一般的なものなので、そのまま社内規程に写すと、自社の業務や日本の法令とかみ合わない記述が混ざるおそれがあります。採り入れる提案を選び、自社の言葉に直し、どの法令やガイドラインに基づく手順かを書き添えることが要ります。日本の AI事業者ガイドラインとの対応は、後の節で扱います。
本文の第6節は、プロファイルという考え方を示しています。プロファイルは、ある場面や用途について、利用者の要件・リスク許容度・資源に応じて、機能・カテゴリ・サブカテゴリをどう実装するかを具体化したものです。文書は3種類を挙げています。1つ目は、採用や公正な住宅供給のような特定のユースケースについてのプロファイル。2つ目は、時間軸のプロファイルで、現在のリスク管理の状態を表す現状プロファイルと、目指す状態を表す目標プロファイルです。3つ目は、大規模言語モデルの利用、クラウドのサービス、調達のように、業種をまたいで共通する活動のリスクを扱う分野横断のプロファイルです。文書は、プロファイルの雛形は定めない、としています。
実務で最も使いやすいのは、2つ目の時間軸のプロファイルだと考えています。文書は、現状プロファイルと目標プロファイルを比べると、埋めるべき差が見えやすくなり、その差を埋める行動計画を作れること、差を埋める優先順位は利用者の必要とリスク管理の手順で決まること、を述べています。72のサブカテゴリについて、自社が今どこまでできているか、1年後にどこまでを目指すかを並べれば、それがそのまま AIガバナンスの年度計画の骨組みになります。全部を一度に目標にする必要はなく、自社のユースケースのリスクに照らして、目標とするサブカテゴリを選ぶことが文書の考え方にも沿っています。
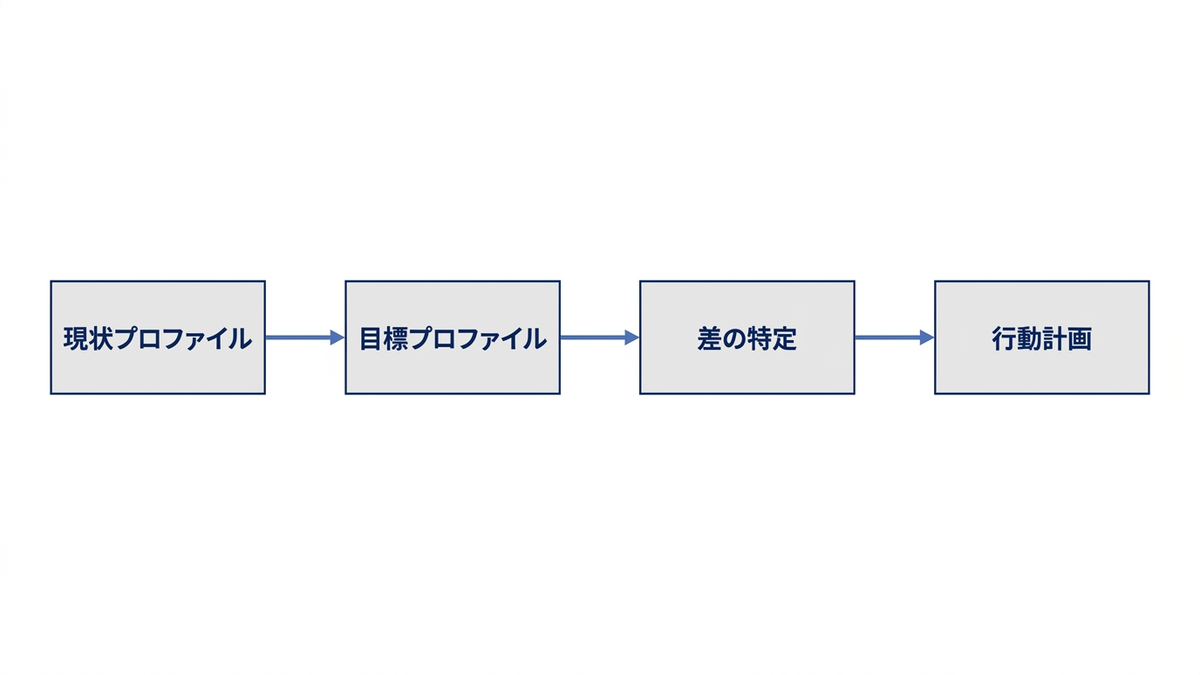
生成AIプロファイル(NIST AI 600-1)、12のリスク
分野横断のプロファイルの代表例が、2024年7月26日に NIST が公表した NIST AI 600-1 です。文書の題名は、日本語にすると「AIリスクマネジメントフレームワーク、生成AIプロファイル」で、本コラムでは生成AIプロファイルと呼びます。冒頭の導入によると、この文書は AI RMF 1.0 の分野横断のプロファイルであり、付随する資料であって、2023年の大統領令第14110号に基づいて作成されたものです。この大統領令のその後の扱いを含む米国の制度の動きは第2章で扱っています。
文書は、生成AIに固有の、または生成AIによって悪化するリスクを定義し、それを管理するための提案された行動を、AI RMF のサブカテゴリに沿って示しています。作成の際の公開の作業部会では、検討の範囲を、ガバナンス、コンテンツの来歴(生成された内容がどこから来たかを辿れること)、導入前の試験、インシデントの開示、の4つの主な検討事項に絞ったため、提案された行動も主にこの4つを扱っている、と書かれています。対象とするリスクは、文書の作成時点で経験的な根拠があるものに絞り、将来のより高度な生成AIで起きるかもしれない推測的なリスクは扱わない、と明記されています。
文書が挙げるリスクは12です。次の表は、12のリスクを原文の順に並べ、本コラムの言葉で要旨を書き、文書が各リスクに対応づけている信頼できる AIの特性の一部を添えたものです。対応する特性は、文書の各節の末尾に書かれているものから、主なものを挙げました。
| 番号 | リスク(本コラムの訳) | 文書の説明の要旨 | 対応づけられている特性の例 |
|---|---|---|---|
| 1 | 化学・生物・放射性物質・核の兵器に関する情報や能力 | そうした兵器や危険な物質に関する有害な情報を入手・組み合わせたり、設計の能力を得たりしやすくなる | 安全、説明可能性と解釈可能性 |
| 2 | 作話(コンファブレーション) | 自信をもって述べられた誤った内容を生成し、利用者を誤らせる。一般にはハルシネーションと呼ばれる現象 | 妥当性と信頼性、安全、公平性 |
| 3 | 危険・暴力的・憎悪的な内容 | 暴力をあおる内容や脅迫、自傷や違法行為の勧めを作りやすくなる。憎悪や固定観念に基づく内容の拡散を抑えにくい | 安全、セキュリティとレジリエンス |
| 4 | データのプライバシー | 生体・健康・位置などの個人を特定できる情報や機微な情報の漏えい、無断の利用・開示、匿名の解除による影響 | プライバシー強化、安全、アカウンタビリティと透明性 |
| 5 | 環境への影響 | 学習と運用で計算資源を多く使うことによる影響 | アカウンタビリティと透明性、安全 |
| 6 | 有害なバイアスと均質化 | 社会の偏りの増幅、集団や言語による性能の差、出力が過度に画一的になること | 公平性、妥当性と信頼性 |
| 7 | 人と AIの構成(人と AIの関わり方) | 人が生成AIを不適切に擬人化する、過度に頼る、自動化された判断に過度に従う、逆に不必要に避ける、感情的に深く関わる | アカウンタビリティと透明性、安全、妥当性と信頼性 ほか |
| 8 | 情報の健全性 | 事実と意見・虚構を区別しない内容や、大規模な偽情報の作成と拡散の敷居が下がる | アカウンタビリティと透明性、安全、妥当性と信頼性 |
| 9 | 情報セキュリティ | 脆弱性の自動的な発見と悪用などで攻撃の敷居が下がる。生成AI自体も攻撃の対象になり、学習データやモデルの重みが損なわれうる | プライバシー強化、セキュリティとレジリエンス ほか |
| 10 | 知的財産 | 著作権や商標で守られた内容、許諾の要る内容を無断で生成・複製しやすくなる。営業秘密が露出しやすくなる | アカウンタビリティと透明性、公平性、プライバシー強化 |
| 11 | わいせつ・品位を傷つける・虐待的な内容 | そうした画像の生成と流通がしやすくなる。合意の無い性的な画像や、児童の性的虐待の画像の生成を含む | 公平性、安全、プライバシー強化 |
| 12 | バリューチェーンと構成要素の統合 | 上流の第三者の構成要素(調達したデータ、事前学習済みモデル、ソフトウェアの部品)が不透明なまま、または辿れないまま組み込まれ、下流の利用者にとって透明性や説明責任が損なわれる | 7つの特性すべてが挙げられている |
12のリスクのうち、日本企業が社内で生成AIを使うときにまず向き合うことになるのは、多くの場合、作話(2)、データのプライバシー(4)、人と AIの構成(7)、情報セキュリティ(9)、知的財産(10)、バリューチェーンと構成要素の統合(12)だと考えています。社内の文書作成や問い合わせ対応では、誤った内容をそのまま使う、入力した情報が漏れる、出力を確かめずに頼りきる、外部のサービスの中身が見えない、といった形で問題が表れやすいからです。兵器に関する情報(1)や、わいせつな内容(11)のリスクも、利用する企業にとって無関係ではありません。生成AIプロファイルは、違法な利用を扱う利用方針の策定(GV-1.4-002)の担い手に、開発だけでなく導入の側も挙げています。重く見るべきリスクは、自社の立場に加え、用途、生成しうる内容、想定される悪用、影響の大きさで変わります。生成AIの社内利用ルールの具体的な論点は第8章で扱います。
7番目の人と AIの構成は、役割の分担、過信、過度な回避といった、人と AIの関わり方のリスクです。この項目で文書が「過度に頼ること」だけでなく、専門家が生成AIを「不必要に避けて」便益を逃すことも同じリスクの一部として挙げている点は、目を留めておきたいところです。リスクを抑えることだけに目を向けると、使わないことの損失が見えなくなります。本コラムの損失の型でいえば、導入の停滞にあたります。
文書の第3節は、12のリスクに対する提案された行動を、AI RMF のサブカテゴリごとの表に並べています。各行動には、機能を表す略号(GV は統治、MP は把握、MS は測定、MG は対処)とサブカテゴリの番号、通し番号からなる番号が付いています。本コラムで原文の番号を数えたところ、提案された行動は200件を超えていました。文書は、AI RMF のすべてのサブカテゴリを扱ってはおらず、提案された行動は一部のサブカテゴリについてだけ示されていること、すべての行動がすべての関係者に当てはまるわけではなく、生成AIの開発者に関係する行動が導入する側には関係しないこともあること、を明記しています。生成AIのリスク管理でも、AI RMF 本体と Playbook の行動はそのまま当てはまるので、あわせて使うよう勧めています。
このプロファイルの読み方としては、12のリスクを自社の生成AIのユースケースごとの点検項目として使い、該当するリスクについて、対応する提案された行動から自社に合うものを選ぶ、という順序が扱いやすいと考えています。200件を超える行動を最初から全部検討しようとすると、それ自体が導入の停滞につながりかねません。
改訂の状況、2026年10月時点で確かめられること
NIST AI RMF は、文書の冒頭で「生きている文書」であることを意図していると述べています。NIST は内容と有用性を定期的に見直して更新の要否を判断し、AIのコミュニティからの正式な意見を受けた見直しは遅くとも2028年までに行う予定だ、と書かれています。版の番号は2つの数字で管理し、最初の数字は大きな改訂のときだけ変わり、小さな改訂は「1.1」のように小数点以下で表す、という方針も示されています。
2026年10月28日に NIST の AI RMF のページを開いたところ、AI RMF 1.0 はホワイトハウスの AI行動計画の一環として改訂中である、という趣旨の記述がありました。改訂版の公表時期や中身は、このページには書かれていません。同じページには、2026年4月7日に、重要インフラにおける信頼できる AIについての AI RMF のプロファイルの構想を示す文書(コンセプトノート)が公表されたことも書かれています。重要インフラの運用者が AIを使うときに検討すべきリスク管理の方法を示すもの、と説明されています。
このため、2026年10月時点で NIST AI RMF を使う場合は、版 1.0 の本文と、それに基づく Playbook、生成AIプロファイルを使うことになります。改訂版が出たときにカテゴリやサブカテゴリの番号・数が変わる可能性があるので、社内の手順書に NIST の番号を書き込む場合は、どの版に基づくかを明記しておくことが、後の差し替えの手間を減らします。改訂の情報を誰が追うかは、第14章で扱う、制度の改正の追い方の一部として決めておくとよいと考えています。
他の枠組みとの対応表、ISO/IEC 42001 と AI事業者ガイドライン
NIST AI RMF と他の規格や枠組みの対応を示す資料は、クロスウォーク(対応表)と呼ばれ、NIST の AIの資料センターのページに一覧が載っています。クロスウォークの一覧のページには、ISO/IEC 42001・ISO/IEC 23894(AIのリスクマネジメントの指針)・ISO/IEC 42005(AIシステムの影響評価)との対応表、シンガポールや韓国の枠組みとの対応表、日本の AI事業者ガイドラインとの対応表などが並んでいます。同じページは、ここに載っている対応表は AI RMF の利用者のコミュニティから提出されたもので、掲載は対応先の資料を NIST が推奨することを意味せず、どちらかがもう一方の内容を網羅していることも意味しない、と断っています。掲載の前に NIST の職員が要件に合っているかを確認する、とも書かれています。
ISO/IEC 42001 との対応表は、一覧では提供者が Microsoft と表示されており、PDF の題名には ISO/IEC FDIS 42001(発行前の最終国際規格案)との対応表であることが書かれています。つまり、2023年12月に発行された ISO/IEC 42001 の正式版ではなく、その直前の案を対象にした対応表です。PDF を開いて確かめたところ、AI RMF の72のサブカテゴリのそれぞれについて、対応する ISO/IEC 42001 の箇条や附属書の項目の番号と題名が並べられていました。附属書の項目の番号は案の段階のものなので、正式版の番号と同じかどうかは、この章では確かめていません。ISO/IEC 42001 の構成と附属書は第6章で扱います。
次の表は、この対応表から、本文の箇条(マネジメントシステムの要求事項の部分)に対応づけられている例を抜き出したものです。題名は本コラムで日本語にしました。対応表は1つのサブカテゴリに複数の項目を挙げているので、表には一部だけを載せています。
| AI RMF のサブカテゴリ(要旨) | 対応表が挙げる ISO/IEC 42001 の箇条の例(FDIS 段階の題名を本コラムで訳したもの) |
|---|---|
| GOVERN 1.1 AIに関わる法令と規制の要求が理解され、管理され、記録されている | 4.1 組織とその状況の理解、6.2 AIの目的とそれを達成するための計画 |
| GOVERN 1.5 リスク管理の手順と成果の継続的な監視と定期的な見直しが計画され、役割と責任が明確になっている | 8.2 AIのリスクアセスメント、8.3 AIのリスク対応、8.4 AIシステムの影響評価 |
| GOVERN 2.2 組織の要員と協力先が、職務を果たすための AIのリスク管理の訓練を受けている | 7.2 力量 |
| GOVERN 2.3 経営層が、AIシステムの開発と導入に伴うリスクの判断に責任を持つ | 5.1 リーダーシップとコミットメント、5.2 AI方針、9.3 マネジメントレビュー |
| MAP 5.1 特定した影響の起こりやすさと大きさが特定され、記録されている | 6.1.2 AIのリスクアセスメント |
| MEASURE 1.1 把握で挙げたリスクの測り方と指標が、重大なものから選ばれている | 6.1.1 一般、6.1.2 AIのリスクアセスメント |
| MANAGE 4.3 インシデントと誤りが関係者に伝えられ、追跡・対応・復旧の手順が守られ記録されている | 9.3.2 マネジメントレビューへのインプット(この行は対応表の記載をそのまま示した。対応表はこのほかに附属書の運用と監視、関係者への情報提供の項目も挙げている) |
この対応表から読み取れるのは、NIST AI RMF の統治の機能が、ISO/IEC 42001 の組織の状況・リーダーシップ・計画・支援・評価の箇条と広く重なっていることです。両者を同時に使う会社は、ISO/IEC 42001 のマネジメントシステムを器として、その中のリスク管理の中身を NIST AI RMF のサブカテゴリと生成AIプロファイルで具体化する、という分担を取りやすいと考えています。ただし、対応表は「どこに関係する記述があるか」を示す索引であり、片方を満たせばもう片方も満たせることを示すものではありません。認証を取るかどうかの判断は第6章で扱います。
同じ一覧には、日本の AIセーフティ・インスティテュート(AISI)と NIST が作った、AI事業者ガイドラインとの対応表が2つ載っています。一覧の日付では、用語を対応づけた1つ目が2024年4月29日、概念を対応づけた2つ目が2024年9月17日です。2つ目の対応表の冒頭の注には、AI事業者ガイドラインの参照先として経済産業省の2024年4月19日の英語の報道発表のページが挙げられており、第1.0版を対象にした対応表と読めます。2026年3月31日の第1.2版で変わった箇所は、この対応表には反映されていないと考えて使う必要があります。第1.2版の構成は第4章で扱っています。
1つ目の対応表は、NIST AI RMF の信頼できる AIの特性と、AI事業者ガイドラインの共通の指針の項目について、それぞれの用語の定義を並べています。たとえば、妥当性と信頼性については、AI事業者ガイドラインには妥当性確認の定義は無く、代わりに透明性の要素として検証可能性の確保の重要性が示されている、と書かれ、ガイドラインの側で関係する項目として安全性と透明性が挙げられています。
2つ目の対応表は、Playbook から取った論点ごとに、関係する NIST AI RMF のサブカテゴリと AI事業者ガイドラインの箇所を並べ、似ている点と違う点を書いています。多くの論点では「違いは記載されていない」とされていますが、対応表の注は、これは大きな概念の違いが見つからなかったという意味で、違いが無いことを意味するものではない、と断っています。違いが書かれている論点の例を挙げると、AIシステムの廃止について、NIST AI RMF は安全に廃止するための仕組みと責任を定めることを重視し、AI事業者ガイドラインは利用を終えた後の関係者への情報の開示に焦点を当てている、とされています。モデルの性能が時間とともに変わるドリフトについては、両者ともそのリスクに触れたうえで、NIST AI RMF は検知と対応のための定期的な監視の手順を重視している、と書かれています。敵対的な攻撃については、NIST AI RMF がレッドチーミング(攻撃者の立場での試験)による試験を提案された方法として重視している、と書かれています。導入後については、AI事業者ガイドラインが導入後の問題を報告する動機付けを提案している、という違いも挙げられています。
日本企業にとって、この対応表の価値は、すでに AI事業者ガイドラインに沿って取り組んでいる場合に、NIST AI RMF のどのサブカテゴリと重なるかを、日米の公的機関が作った資料で確かめられることにあります。米国の取引先から NIST AI RMF に沿った説明を求められたときに、自社の取り組みを AI事業者ガイドラインの言葉から NIST の言葉へ読み替える手がかりになります。ただし、対応表が対象としている版と、自社が使っている版が同じかどうかは、使う前に確かめる必要があります。
日本企業が使うときの読み替え
NIST AI RMF は、幅広い組織が使える汎用的な枠組みです。NIST の FAQ も、規模や業種を問わず、国境の内外で活動する組織に使えるよう作られていると説明しています。日本企業が実務に取り入れるときは、いくつかの言葉と前提を、自社の業務・適用される法令・組織の体制に合わせて読み替える必要があります。次の表は、本コラムが勧める読み替えの例です。左の列は NIST AI RMF の考え方、右の2列は本コラムの考えで、NIST の文書に書かれた対応ではありません。
| NIST AI RMF の考え方 | 日本企業での読み替え(本コラムの考え) | 注意すること |
|---|---|---|
| AIアクター(ライフサイクルで役割を担う組織と個人) | AI事業者ガイドラインの開発者・提供者・利用者の3つの立場と、社内の役割(経営・委員会・事務局・業務部門) | NIST の AIアクターは、AI事業者ガイドラインの3つの立場と一対一には対応しない。AI事業者ガイドラインの3つの立場も、EU AI Act の提供者(provider)・EU AI Act の導入者(deployer)と一対一には対応しない(第1章・第3章) |
| AIシステムの棚卸し(GOVERN 1.6) | ユースケース台帳(第7章) | NIST は AIシステムを単位に書いている。本コラムは、使う AIシステムの情報を記録したうえで、用途(ユースケース)ごとに行を分ける |
| リスク許容度(MAP 1.5 ほか) | 本コラムのリスク区分(禁止・高・中・低)の判定基準と、区分ごとの承認者 | 本コラムのリスク区分は EU AI Act の4つの水準とも NIST の用語とも別物。許容度は NIST が決めてくれるものではなく、経営が AI基本方針で示す。判定の基準と承認の経路は AIガバナンス委員会が承認し、AIガバナンス責任者が経営に報告する |
| 設計・開発・導入をするかどうかの最初の判断(MAP の機能の成果)と、目的を達成しているか・進めるかの判断(MANAGE 1.1) | ユースケースの承認と、導入後の継続の判断 | 承認の前に、AIを使わない代替の方法と比べたかを記録する(MANAGE 2.1) |
| TEVV(試験・評価・検証・妥当性確認) | 導入前の評価と、運用中の定期評価(第10章・第11章) | 測っていないリスクを記録する(MEASURE 1.1)。開発の担当ではない人を評価に入れる(MEASURE 1.3) |
| 置き換える・切り離す・止める仕組みと責任(MANAGE 2.4) | 停止の基準と停止の権限(第11章) | 誰が止めてよいかを先に決めておく |
| 第三者のソフトウェアとデータのリスク(GOVERN 6・MAP 4・MANAGE 3) | ベンダーの確認と契約(第9章)、外部の生成AIサービスの利用条件の確認(第8章) | 生成AIでは、バリューチェーンと構成要素の統合のリスク(生成AIプロファイルの12番目)として扱われる |
| 現状プロファイルと目標プロファイル | AIガバナンスの現状の点検と年度計画 | 72のサブカテゴリを全部目標にしない。自社のユースケースのリスクに照らして選ぶ |
| 経営層の責任(GOVERN 2.3) | AIガバナンス責任者と、経営会議への報告(第13章) | 枠組みを使うだけでは文化や動機付けは変わらない、と文書自体が述べている |
読み替えのうち、特に気をつけたいのは管理の単位です。NIST AI RMF は「AIシステム」を単位に書かれていますが、日本企業の多くは、同じ生成AIのサービスを、文書の要約、問い合わせの一次回答、プログラムの作成支援などの複数の用途に使います。用途が違えば、影響を受ける人も、起こりうる害も、必要な確認も変わります。このため本コラムでは、使うサービスやモデルとその版を台帳に記録したうえで、ユースケースごとに行を分けることを勧めています。こうしておくと、サービスやモデルが変わったときに影響する用途を辿れます。NIST のサブカテゴリは、ユースケースごとの点検に使います。台帳の作り方は第7章で扱います。
もう一つは、法令との関係です。NIST AI RMF は、GOVERN 1.1 で AIに関わる法令と規制の要求を理解し記録することを求めていますが、どの法令が掛かるかは書いていません。日本企業の場合、この中身は自社で確かめて埋めます。対象は、日本の AI推進法(第4章)、個人情報保護法や著作権法(第8章)などの法令です。EU域内への提供や出力のEU域内での利用などで適用対象となる可能性がある場合は、EU AI Act(第3章)も入ります。AI事業者ガイドライン(第4章)は義務を課す文書ではないので、法令とは分けて、自主的な取組を具体化する参照先として扱います。NIST AI RMF に沿って仕組みを整えたことが、それぞれの法令の要求を満たしたことを意味するわけではありません。
最初に何をすればよいかについては、次の順序が扱いやすいと考えています。まず、統治の6つのカテゴリについて、自社にすでにある規程・会議体・役割のどれが当てはまるかを書き出します。次に、自社の主なユースケースを数件選び、把握のカテゴリに沿って用途・利用者・影響・法令を整理します。そのうえで、測定と対処のサブカテゴリのうち、そのユースケースのリスクに関係するものだけを選んで、評価と対応の手順を決めます。最後に、手順を決めただけのもの、運用できているもの、未実施のものを分けて、現状プロファイルとして記録します。そのうえで、1年後の目標プロファイルとの差を年度の計画にします。
経営判断、どの枠組みを自社の目次にするか
NIST AI RMF について経営が決めることは、大きく3つあると考えています。1つ目は、自社の AIガバナンスの目次として何を使うかです。日本企業の場合、AI事業者ガイドラインを基本にする、NIST AI RMF を基本にする、ISO/IEC 42001 のマネジメントシステムを器にする、のいずれか、またはその組み合わせが考えられます。米国の取引先や米国での事業が多い会社では、NIST AI RMF の言葉で説明できることに価値があります。日本国内の事業が中心であれば、本コラムは、AI事業者ガイドラインを基本にし、NIST AI RMF は点検の観点を補う参照先として使う順序を勧めます。これは本コラムの判断で、根拠は、AI事業者ガイドラインが日本の国のガイドライン(第4章)で、開発者・提供者・利用者という社内でそのまま使える立場の区分を持っていることと、NIST AI RMF の項目への読み替えは前の節で扱った AISI と NIST の対応表で補えることにあります。どれを選んでも、AISI と NIST のクロスウォークや、ISO/IEC 42001 との対応表を使えば、別の枠組みの言葉への読み替えはある程度できます。
2つ目は、リスク許容度を誰がどう決めるかです。NIST AI RMF は許容度を定めないと明言しているので、枠組みを導入しても、この判断は経営に残ります。許容度が決まらないまま枠組みだけを導入すると、現場は個別の案件ごとに判断を仰ぐことになり、承認が滞って導入の停滞を招きます。逆に、許容度を現場任せにすると、部門ごとに違う基準で判断され、誤った判断の放置や、部門ごとにばらばらに対応する二重投資を招きます。本コラムでは、自社が受け入れるリスクの考え方(リスク許容度)は経営が AI基本方針で示し、それを具体化したリスク区分(禁止・高・中・低)の判定の基準と承認の経路は、AIガバナンス委員会が承認し、AIガバナンス責任者が経営に報告する、という分担を勧めています。判定の基準は、経営が示した許容度を言葉にする作業にあたります。区分だけでは、対策の後にどこまでのリスクを受け入れるかは決まりません。そのため、区分ごとに必要な対策、残留リスクを受け入れる条件、承認者もあわせて定めます。
3つ目は、どこまでを目標にするかです。72のサブカテゴリと、生成AIプロファイルの200件を超える提案された行動を、最初から全部満たそうとすると、作業量が膨らんで AIの活用そのものが止まりかねません。文書自体が、カテゴリとサブカテゴリの一部を選んで使ってよいと書いています。経営としては、高リスク区分のユースケースに関係するサブカテゴリから順に目標を置き、年度ごとに広げていく計画を承認し、その進捗を四半期ごとに報告させる、という形が現実的だと考えています。
この判断を誤ったときの損失は、本コラムの損失の型でいえば、主に導入の停滞と二重投資として表れます。枠組みの選択が決まらないまま部門ごとに別の資料を参照して手順を作ると、後で統合し直す手間がかかります。また、外部の枠組みを採り入れたことを対外的に説明する場合に、実際の運用がそれに沿っていなければ、信頼の失墜にもつながりえます。予算と体制の面では、枠組みの導入そのものよりも、台帳・評価・監視といった、枠組みの中身を動かす人の時間に資源を割くことが要る、と考えています。
この章では、NIST AI RMF 1.0 が任意で使う枠組みであり、リスク許容度を定めず、7つの信頼できる AIの特性と、統治・把握・測定・対処の4つの機能(19のカテゴリ、72のサブカテゴリ)で組織の仕組みを点検する道具であることを確認しました。生成AIプロファイルは12のリスクと200件を超える提案された行動を示しており、ユースケースごとの点検項目として使えます。2026年10月時点で AI RMF 1.0 は改訂中とされているので、版を明記して使うことが要ります。次の第6章では、ISO/IEC 42001 と AIマネジメントシステム、関連規格と認証を扱います。
この章を深めたい方への参考書籍
『AI経営のリスクマネジメント』(寺嶋正尚 編著、日経BP日本経済新聞出版本部):AIを経営に使うときのリスクマネジメントを、技術・法務・ガバナンスの観点から論じた本です。版元の目次によると、AI経営の展開事例、AIベンダーの動向、法規制とガイドライン、AI経営のリスクを扱ったうえで、技術的な視点・法的な視点・ガバナンスの視点のそれぞれからリスクマネジメントを論じています。この章で扱った、リスク許容度を経営が決めることや、第三者の AIを導入する側の責任を、経営の立場から考えるときの材料になります。2021年の刊行で、NIST AI RMF 1.0(2023年)と生成AIプロファイル(2024年)より前の本なので、両文書の内容は含まれていません。
『AIリスク・マネジメント 信頼できる機械学習ソフトウェアへの工学的方法論』(中島震 著、丸善出版):AI、特に機械学習のリスクマネジメントを、IT リスク、ソフトウェア品質、AI倫理との関係を含めて解説した本です。版元の紹介と目次によると、リスクとトラスト、ソフトウェア品質モデル、機械学習ソフトウェアの特徴、信頼される AIなどを扱っており、この章の測定の機能や信頼できる AIの特性を、ソフトウェア工学の側から考えるときに参考になります。2022年の刊行で、生成AIプロファイル(2024年)より前の本です。
第6章 ISO/IEC 42001とAIマネジメントシステム、関連規格と認証
第5章では、NIST の AI RMF が「任意で使うリスク管理の枠組み」であり、GOVERN・MAP・MEASURE・MANAGE の4つの機能で AIのリスクを扱う考え方を確認しました。AI RMF は米国の公的機関が出した文書で、本コラムが確認した範囲では、第三者がその実施を認証する仕組みは示されていません。これに対して、国際規格には「組織が要求事項を満たしているかを第三者が審査して認証する」という使い方があります。本章では、その中心にある ISO/IEC 42001 を取り上げ、規格の目録で確かめられる事実、箇条の骨組み、附属書の扱い、関連する規格、日本の JIS、認証の仕組み、既存のマネジメントシステムとの統合、EU の整合規格との関係、認証を取るかどうかの判断、経営の判断を順に整理します。
先に、本章の書き方の前提を明記しておきます。ISO の規格本文は有料で販売されている文書で、本コラムでは本文を訳して載せることはしません。本章に書く規格の番号・発行年月・版・状態・ページ数は、ISO の目録ページ(インターネット上に保存された過去の版を含む)と ISO が公開している規格の書誌データ、日本の規格は日本産業標準調査会(JISC)の検索結果で確かめた範囲です。規格の箇条の名前は、NIST の AIリソースセンターに掲載されている NIST AI RMF と ISO/IEC 42001 の対応表(最終原案の段階のもの)に現れる項目名から拾い、正式版と同じかどうかは確かめていないことを都度書き添えます。この対応表は、NIST の掲載一覧で Microsoft が提供したものと示されています。NIST は、一覧への掲載が NIST の支持を意味しないとも注記しています(2026年10月29日に確認)。附属書の管理策の数のように、本文を開かないと分からない事項は、数字を書かずに確かめ方を示します。
ISO/IEC 42001 とは何か、目録で確かめられること
ISO/IEC 42001 は、国際標準化機構(ISO)と国際電気標準会議(IEC)の合同技術委員会 JTC 1 の分科委員会 SC 42(人工知能を担当)が作った国際規格です。ISO の目録では、2023年12月に第1版が発行され、状態は「発行済み」、本文は51ページと示されています。目録に載っている開発の経過を見ると、2020年8月に新しい作業項目として承認され、委員会原案、国際規格原案(DIS)、最終国際規格原案(FDIS)の投票を経て、2023年12月18日に発行の段階に達しています。本章の基準時点である2026年10月の時点で、目録に改訂版や追補は載っていません。
目録の概要を要約すると、AIを扱う組織が、AIのマネジメントシステムを作って運用し、改善し続けるための要求事項を定めた規格です。AIを使った製品やサービスを提供する組織にも、利用する組織にも、規模を問わずに適用できるとされています。つまり、特定の AIの性能の基準を定める規格ではなく、AIを扱う組織の「仕組み」の規格です。
ここで言う AIマネジメントシステム は、ISO の目録ページの説明を要約すると、AIの責任ある扱いについて方針と目的を決め、それを達成する手順を組織として整えたものです。同じページは、ISO/IEC 42001 がマネジメントシステム規格(MSS)で、計画・実行・評価・改善(Plan-Do-Check-Act)の流れを使い、組織全体で AIのリスクと機会を管理するものだと位置づけています。本コラムが定義する AIガバナンス(どの用途に使ってよいか・誰が決めるか・何を基準にどう確かめるか・問題が起きたらどうするかを定める仕組み)について、責任・資源・評価・改善を実際に運用し、その状況を文書と記録で確かめられるようにしたものが AIマネジメントシステムだと考えています。
ISO が公開している ISO/IEC 42001 の解説ページは、要求事項の主な範囲として、リーダーシップと組織の状況、AIの方針と目的、AIシステムのリスクの管理、データのガバナンスとシステムのライフサイクルの管理、透明性と情報の提供、パフォーマンスの評価と監視、継続的な改善を挙げています。同じページは、この規格は法律や規制を置き換えるものではなく、組織が法令上の義務を果たしやすくするための管理の枠組みである、と明記しています。この点は経営の判断に直結します。ISO/IEC 42001 に沿って仕組みを整えても、EU AI Act や日本の個人情報保護法の義務が自動的に満たされるわけではなく、法令の要求は別に確かめる必要があります。
規格の位置づけを、第2章で整理したハードロー(法律)・ソフトロー(指針)・規格の区分に当てはめると、ISO/IEC 42001 は「規格」に当たります。使うかどうかは組織の任意で、使う場合には要求事項を満たしているかを自分で確かめる(自己適合宣言に近い使い方)ことも、第三者の認証を受けることもできます。法律のような拘束力は持ちませんが、取引先への説明に使われたり、規制の側が規格を参照したりすると、実質的な重みが変わります。後者の例が、本章の後半で扱う EU の整合規格との関係です。
マネジメントシステム規格の骨組み、箇条4から10の流れ
ISO/IEC 42001 の要求事項は、箇条4から箇条10に置かれています。NIST のサイトに掲載された対応表(Microsoft 提供、FDIS 段階)に現れる項目名を見ると、箇条4に組織の状況(組織とその状況の理解、AIマネジメントシステムの適用範囲の決定など)、箇条5にリーダーシップ(リーダーシップとコミットメント、AI方針、役割・責任・権限)、箇条6に計画(リスクと機会への取り組みのなかの AIリスクアセスメント、AIリスク対応、AIシステムの影響評価、AIの目的とその達成の計画)、箇条7に支援(資源、力量、認識、コミュニケーション、文書化した情報の管理)、箇条8に運用(AIリスクアセスメント、AIリスク対応、AIシステムの影響評価の実施)、箇条9にパフォーマンス評価(監視・測定・分析・評価、内部監査、マネジメントレビュー)、箇条10に改善(継続的改善、不適合と是正処置)が並んでいます。この対応表は最終国際規格原案(FDIS)の段階を対象にしたもので、正式版の項目名と一字一句同じかは確かめていません。用語を補うと、力量は担当者に必要な知識と技能のことです。不適合と是正処置は、要求を満たさない状態と、その原因への対処を指します。マネジメントレビューは、経営層が仕組みを定期的に見直す場です。
この骨組みのなかで AIに固有なのは、箇条6と箇条8に「AIシステムの影響評価」が独立した項目として置かれている点です。影響評価は、AIシステムが個人・集団・社会に及ぼしうる影響を詳しく検討する項目です。リスクアセスメントとの関係(影響評価の結果をどう取り込むか)は、本コラムでは規格の本文で確かめていません。影響評価の進め方の手引きは別の規格 ISO/IEC 42005(2025年)が扱っており、目録の概要は、ISO/IEC 42005 の影響評価のプロセスを組織の AIリスクマネジメントと AIマネジメントシステムに組み込む方法も手引きに含むと説明しています。社内の実務としての影響評価の進め方は第7章で扱います。
次の表は、箇条4から箇条10の流れを、本コラムの他の章で扱う社内の仕組みに対応させたものです。左の2列は対応表に現れる項目名を本コラムで訳したもの、右の列は本コラムの整理で、規格がその形を求めているという意味ではありません。
| 箇条 | 対応表に現れる主な項目(FDIS 段階、本コラムの訳) | 本コラムで対応させる社内の仕組み |
|---|---|---|
| 4 組織の状況 | 組織とその状況の理解、適用範囲の決定、AIマネジメントシステム | 自社が開発者・提供者・利用者のどの立場か、どの部門と用途を対象にするかの決定(第1章・第7章) |
| 5 リーダーシップ | リーダーシップとコミットメント、AI方針、役割・責任・権限 | AIガバナンス責任者・AIガバナンス委員会・事務局の指名、AI基本方針(第12章・第13章) |
| 6 計画 | AIリスクアセスメント、AIリスク対応、AIシステムの影響評価、AIの目的と達成の計画 | リスク区分の基準と承認の経路、影響評価の様式(第7章) |
| 7 支援 | 資源、力量、認識、コミュニケーション、文書化した情報の管理 | 教育とAIリテラシー、規程と記録の版管理(第12章・第14章) |
| 8 運用 | AIリスクアセスメント・AIリスク対応・影響評価の実施 | ユースケース台帳の運用、調達の確認、評価(第7章・第9章・第10章) |
| 9 パフォーマンス評価 | 監視・測定・分析・評価、内部監査、マネジメントレビュー | 運用監視、内部監査、経営会議への四半期の報告(第11章・第14章) |
| 10 改善 | 継続的改善、不適合と是正処置 | インシデントの振り返りと台帳・規程への反映(第11章) |
この表から分かるのは、ISO/IEC 42001 の箇条の多くが、規格を使うかどうかにかかわらず AIガバナンスとして必要になる仕組みと重なることです。規格に沿う場合は、その仕組みを決めたとおりに運用し、評価と改善を回したうえで、実施の状況を文書と記録で確かめられるようにすることが求められます。どこに追加の負担が生じるかは、既存の仕組みとの差を確かめてから判断します。認証を目指す場合、内部監査とマネジメントレビューを実際に回した記録が必要になるため、仕組みを作ってから審査を受けられる状態になるまでには、少なくとも一巡の運用の期間を見込む必要があると考えています。これは規格や認証機関の規則が定める期間の要件として確かめたものではありません。
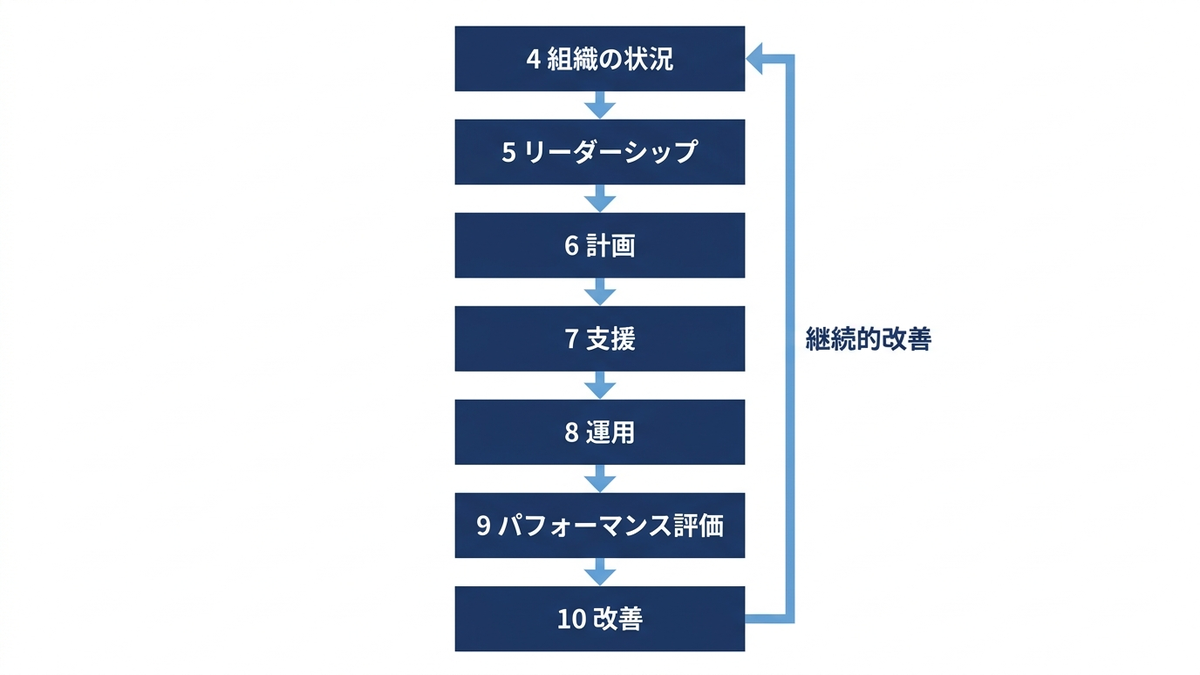
附属書の役割と、管理策を自社に当てはめる考え方
ISO/IEC 42001 の箇条4から箇条10は「仕組みとして何を備えるか」を定める部分です。これに対して、具体的にどのような管理を置くかを知るには附属書を見ることになります。ただし、本コラムでは規格の本文を開いていないため、附属書A を含む各附属書の題名、管理策の数、それぞれの中身は確かめていません。附属書の構成や管理策の数を知りたい場合は、ISO の目録ページから入れるプレビュー(Online Browsing Platform)で目次を見るか、日本語の規格(後述の JIS Q 42001)を JISC で閲覧して確かめるのが確実です。
確かめられた範囲でいうと、NIST のサイトに掲載された対応表(Microsoft 提供、FDIS 段階)は、AI RMF の各項目を、箇条の項目だけでなく附属書の項目にも対応させています。対応表に現れる附属書の項目の番号は、大きく9つのまとまりに分かれ、本コラムで訳すと次の主題が並んでいます。AIに関する方針(AI方針、他の方針との整合、方針の見直し)、組織の内部の体制(AIの役割と責任、懸念の報告)、AIシステムのための資源(資源の文書化、データ・ツール・計算・人の資源)、AIシステムの影響の評価(評価のプロセス、評価の文書化、個人や集団への影響、社会への影響)、AIシステムのライフサイクル(責任ある開発の目的とプロセス、要求と仕様、設計と開発の文書化、検証と妥当性確認、導入、運用と監視、技術文書、イベントログの記録)、AIシステムのためのデータ(開発に使うデータ、取得、品質、来歴、準備)、利害関係者への情報(システムの文書と利用者への情報、外部への報告、インシデントの伝達、利害関係者への情報)、AIシステムの利用(責任ある利用のプロセスと目的、意図した用途)、第三者や顧客との関係(責任の配分、供給者、顧客)です。対応表では附属書の項目に B から始まる番号が振られていますが、これは最終原案の段階の番号で、これらの項目が正式版の附属書A の管理策と同じものか、正式版の附属書の番号と一致するかは、本コラムでは照合していません。
実務の上では、附属書に並ぶ管理を「全部やる一覧」として扱わず、自社のリスクアセスメントの結果に基づいて必要なものを選び、選んだ理由と選ばなかった理由を記録に残す形で社内に落とすのがよいと考えています。全部を同じ重さで実施しようとすると、影響の小さい用途にまで重い手続きが掛かり、序章で挙げた損失の型のうち「導入の停滞」を招きやすいからです。規格がこの選択と記録をどのような要求事項として書いているかは、規格の本文で確かめてから社内の様式に落としてください。自社の AIの用途を一覧にしたユースケース台帳と、用途ごとの影響評価(いずれも第7章)は、この「選ぶための根拠」を作る作業に当たります。
上に挙げた9つの主題を、本コラムの章立てと並べると、方針は第12章、体制は第13章、資源と教育は第14章、影響の評価は第7章、ライフサイクルとデータは第9章と第10章、利害関係者への情報とインシデントの伝達は第11章、AIシステムの利用(責任ある利用と意図した用途)は第8章の社内利用ルール、第三者との関係は第9章に対応します。ISO/IEC 42001 を使うかどうかにかかわらず、AIガバナンスの仕組みを作るときの抜け漏れの確認表として、この主題の並びは役に立つと考えています。
関連規格の地図、番号・年・版・状態
ISO/IEC 42001 は、SC 42 が作ってきた一連の規格の中心に置かれています。用語・リスク管理・影響評価を扱う関連規格を参照すると、実務への当てはめを具体化できます。ISO の目録ページの質問と回答の欄は、AIの規格の例として、用語と概念を定める ISO/IEC 22989、機械学習を使う AIシステムを記述する枠組みの ISO/IEC 23053、AIのリスクマネジメントの手引きの ISO/IEC 23894 を挙げ、ISO/IEC 42001 はそれらと違ってマネジメントシステム規格である、と位置づけています。次の表は、本章と隣の章で使う規格を、ISO の目録と書誌データで確かめた内容でまとめたものです。日本の規格(JIS)の列は JISC の検索結果です。
| 規格 | 主題(本コラムの訳) | 発行と版 | 状態(2026年10月) | 対応する JIS |
|---|---|---|---|---|
| ISO/IEC 42001(2023年) | AIマネジメントシステムの要求事項(規格の題名は「マネジメントシステム」) | 2023年12月、第1版、51ページ | 発行済み。改訂の項目は目録に無い。実施の手引きの規格 ISO/IEC AWI 42003 が準備段階(段階コード 20.00)で登録されている | JIS Q 42001(2025年8月20日制定) |
| ISO/IEC 22989(2022年) | AIの概念と用語 | 2022年7月、第1版、60ページ | 発行済み。生成AIを扱う追補1が最終原案の段階、追補2が委員会原案の段階 | JIS X 22989(2023年8月21日制定) |
| ISO/IEC 23894(2023年) | AIのリスクマネジメントの手引き | 2023年2月、第1版、26ページ | 発行済み | JISC の番号検索では該当なし |
| ISO/IEC 42005(2025年) | AIシステムの影響評価の手引き | 2025年5月、第1版、39ページ | 発行済み | JIS Q 42005(2026年8月20日制定) |
| ISO/IEC 42006(2025年) | AIマネジメントシステムの審査と認証を行う機関への要求事項 | 2025年7月、第1版、31ページ | 発行済み | JIS Q 42006(2026年8月20日制定) |
| ISO/IEC 38507(2022年) | 組織による AIの利用がガバナンスに及ぼす影響(第1章で扱う) | 2022年4月、第1版、28ページ | 発行済み | JIS Q 38507(2026年2月20日制定) |
| ISO/IEC 5259 シリーズ | 分析と機械学習のためのデータ品質(第10章で扱う) | 第1部から第4部は2024年、第5部は2025年、いずれも第1版。第6部は技術報告書として2026年5月 | 発行済み | 本章では確かめていない |
表の規格の役割を、ISO/IEC 42001 との関係で言い直します。ISO/IEC 22989 は用語の土台で、AIシステムや AIのライフサイクルなどの言葉を、他の規格と組織のあいだで同じ意味で使うための規格です。目録の概要は、他の規格の開発や多様な利害関係者のあいだのコミュニケーションに使えると説明しています。ISO/IEC 23894 は、AIを使った製品・システム・サービスを開発・生産・導入・利用する組織が、AIに特有のリスクをどう管理するかの手引きで、リスクマネジメントを AIに関する活動と機能に組み込むことを助けるとされています。ISO/IEC 42001 の箇条6と箇条8のリスクアセスメントとリスク対応を具体化するときの参照先になります。
ISO/IEC 42005 は、AIシステムとその予見できる用途によって影響を受けうる個人と社会について、影響評価をどう行うかの手引きです。目録の概要は、いつ、AIシステムのライフサイクルのどの段階で評価するか、評価の文書化をどうするかを含み、評価のプロセスを AIリスクマネジメントと AIマネジメントシステムに組み込む方法も扱うと説明しています。ISO の目録ページは、この規格が ISO/IEC 42001、ISO/IEC 38507、ISO/IEC 23894 を補い、AIの社会と人への影響に焦点を当てる、と書いています。第7章の影響評価の6段階は本コラムの整理で、ISO/IEC 42005 の手順そのものではないことに注意してください。
ISO/IEC 42006 は、ISO/IEC 42001 を使う組織ではなく、その組織を審査して認証する機関に向けた規格です。目録の概要は、マネジメントシステムの審査と認証を行う機関の一般的な要求事項である ISO/IEC 17021-1 に追加する要求事項を定めると説明しています。認証を受ける側から見ると、認証機関の審査員が AIの領域について必要な力量を持っていることを確かめる基準が、2025年に国際規格として整ったという意味を持つと考えています。
まだ発行されていない規格もあります。ISO の書誌データでは、ISO/IEC 42001 の実施の手引きとなる ISO/IEC AWI 42003 が準備段階(段階コード 20.00)の作業項目として、AIシステムの適合性評価の仕組みを作るための枠組みと手引きの ISO/IEC 42007 が国際規格原案の段階として登録されています。どちらも内容や発行時期は決まっていないので、社内の計画を立てる前提にはせず、目録の状態を定期的に見る対象に入れておくのがよいと考えています。
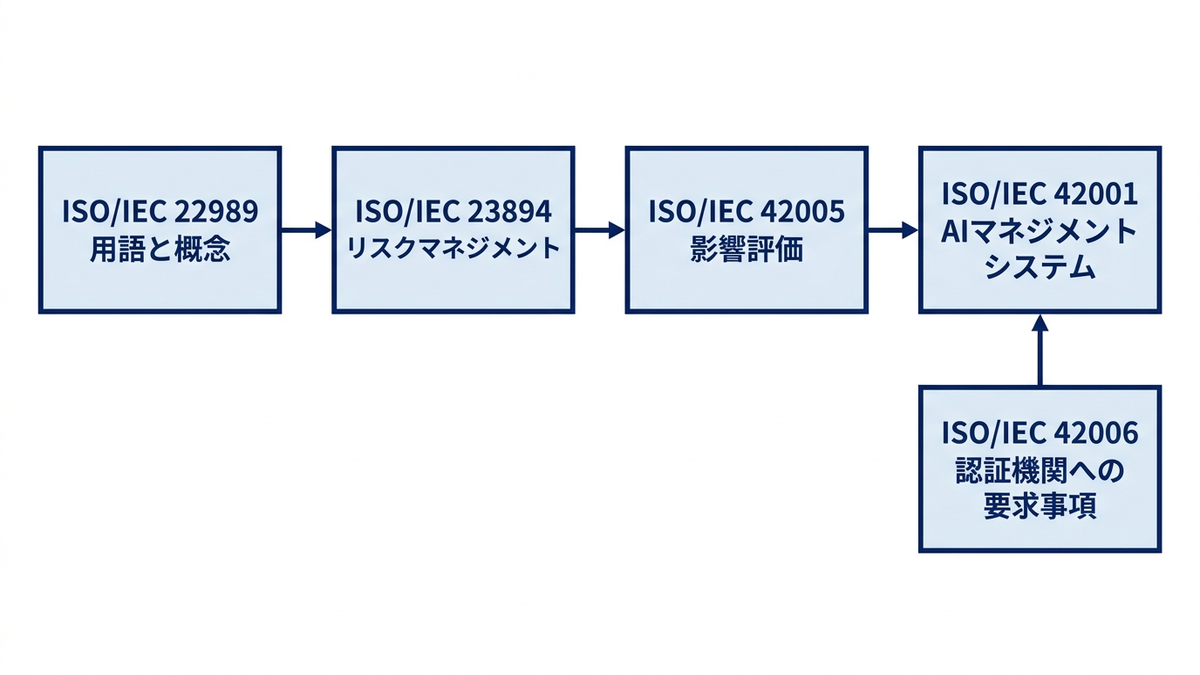
JIS Q 42001 と、日本語で規格を確かめる手段
日本では、ISO/IEC 42001 に対応する日本産業規格(JIS)として JIS Q 42001 が制定されています。JISC の検索結果では、規格名称は情報技術・人工知能・マネジメントシステムの3つの語を区切って並べたもの、主務大臣は経済産業大臣、制定年月日は2025年8月20日です。同じく、影響評価の JIS Q 42005(規格名称の末尾は「AIシステム インパクトアセスメント」)と、認証機関への要求事項の JIS Q 42006 が2026年8月20日に、組織による AIの利用がガバナンスに与える影響を扱う JIS Q 38507 が2026年2月20日に、用語の JIS X 22989 が2023年8月21日に制定されています。ISO/IEC 23894 に対応する JIS は、番号による検索では見つかりませんでした。
JISC のウェブサイトでは、JIS の本文を閲覧できますが、印刷と購入はできず、購入は日本規格協会に問い合わせるよう案内されています。社内で規格を読む担当者が、まず JIS の閲覧で目次と附属書の構成を確かめ、自社に必要な部分を見極めてから正式な文書を入手する、という順序をとると、規格の本文を読まずに仕組みを作り始めて後から作り直す、という手戻りを避けやすくなります。JIS Q 42001 が国際規格とどの程度一致しているか(一致しているか、修正を加えているか)は、本コラムでは JIS の本文を開いていないので確かめていません。
なお、ISO/IEC 42001 の国際規格の英語版と日本語訳を並べた英和対訳版が日本規格協会から出ていることは、国立国会図書館サーチの書誌(2024年4月)で確認できました。社内で翻訳した文書を独自に配ると著作権の問題が生じうるため、注意が要ります。規格の内容を社内規程に取り込むときは、要旨を独自に整理して出典を示す場合も、利用の方法に応じて著作権法上の要件と権利者の利用条件を確かめてください。判断に迷う点は、権利者や専門家に確認する前提で進めます。
認証の仕組み、認定機関と認証機関の関係
ISO の解説ページは、ISO/IEC 42001 の認証は任意であり、組織が AIマネジメントシステムが規格の要求事項を満たしていることを独立の立場から確かめてほしいときに選ぶものだ、と説明しています。同じページは、ISO 自身は組織を認証しないこと、認証は独立の認証機関が行い、認証機関は各国の認定機関によって認定されることがある、と明記しています。つまり、関係者は三層になっています。規格を作る ISO と IEC、組織を審査して認証する認証機関、そして認証機関が適切に審査できるかを評価する認定機関です。
この三層の関係のなかで、ISO/IEC 42006 は認証機関に向けた規格として働きます。ISO の目録ページは、ISO/IEC 42006 を使うのは ISO/IEC 42001 に基づいて審査を行う認証機関と、その認証機関を評価する認定機関であり、ISO/IEC 42006 は ISO/IEC 17021-1 を置き換えるのではなく、AIに固有の要求事項で補うものだと説明しています。目録の概要の注記は、この規格が認定や相互評価の基準文書として使えるとも述べています。認証を検討する組織にとっては、相談する認証機関が「どの認定機関から、ISO/IEC 42001 の認証の分野で認定を受けているか」を確かめることが、認証の信頼性を見る最初の手がかりになります。
日本の状況について、情報マネジメントシステム認定センター(ISMS-AC)は、2026年1月14日に AIマネジメントシステム(AIMS)の認証機関を初めて認定したと発表しています。AIMS は ISO/IEC 42001 に基づく認証で、国内の認定の制度と認定を受けた認証機関は、ISMS-AC の公式の情報で確かめられます。一方で、国内で認証を受けた組織の数は、本コラムでは確かめていません。これらは時期によって変わる情報でもあるので、検討の時点で認定機関の公式のウェブサイトと、候補の認証機関が示す認定の証明を直接確かめてください。本コラムでは特定の認証機関を勧めることも、認証機関どうしを比べることもしません。認証の費用も、組織の規模や適用範囲によって変わるうえ、本コラムの方針として書きません。
認証を受けるまでの準備について、規格の箇条9に内部監査とマネジメントレビューが含まれている以上、審査を受ける前に、適用範囲を決めて仕組みを整え、それを実際に運用して内部監査とマネジメントレビューを行った記録を作っておく必要があると考えています。審査の段階の数、認証の後の維持の審査の周期、認証の有効期間といった細かな規則は、ISO/IEC 17021-1 と ISO/IEC 42006 の本文、および認証機関の規則に書かれる事項で、本コラムでは本文を確かめていないため具体的には書きません。
次の表は、認証に関わる主体と、それぞれが拠りどころにする規格を、本章で確かめた範囲でまとめたものです。
| 主体 | 役割 | 拠りどころにする規格 | 組織が確かめること |
|---|---|---|---|
| ISO と IEC(SC 42) | 規格を作り、改訂する。組織を認証しない | ISO/IEC 42001、ISO/IEC 42006 など | 目録で規格の版と状態(改訂・追補の有無) |
| 認定機関 | 認証機関が審査を行う力量と公平さを持つかを評価し、認定する | ISO/IEC 42006 を認定の基準文書として使える(目録の注記) | 認定の制度がある分野と、認定した認証機関の一覧 |
| 認証機関 | 組織の AIマネジメントシステムを審査し、認証する | ISO/IEC 17021-1 と、それを補う ISO/IEC 42006 | 認定を受けているか、AIの領域の審査員の力量、審査の範囲 |
| 認証を受ける組織 | 仕組みを整えて運用し、審査を受け、維持する | ISO/IEC 42001(あわせて ISO/IEC 23894、ISO/IEC 42005 を参照) | 適用範囲(どの部門・用途を含めるか)、取引先が求める認証の範囲 |
ISO/IEC 27001・ISO 9001 との統合運用
多くの組織では、情報セキュリティの ISO/IEC 27001 や品質の ISO 9001 の仕組みがすでに動いています。ISO の目録では、ISO/IEC 27001 は2022年10月の第3版が最新で、2024年2月に気候変動への対応を加える追補1が出ています。ISO 9001 は2026年9月16日に第6版が発行され、2015年版とその追補を置き換えました。プライバシーの情報マネジメントの ISO/IEC 27701 も2025年10月に第2版が出ています。ISO の目録ページには、ISO/IEC 42001 と ISO/IEC 27001 を組み合わせた「AIと情報セキュリティのマネジメント」の規格のパッケージが案内されており、ISO 自身も両者を並べて使う場面を想定していることが読み取れます。
統合の要点は、別の規格で同じ名前の仕組みを二重に持たないことです。箇条の項目名を見ると、ISO/IEC 42001 の箇条7の文書化した情報の管理、箇条9の内部監査とマネジメントレビュー、箇条10の不適合と是正処置は、既存のマネジメントシステムを運用している組織ならすでに手順を持っている領域です。ここを AIのために新しく作ると、同じ監査を別々の担当が別々の時期に行うことになり、序章で挙げた損失の型のうち「二重投資」が生じます。既存の文書管理と内部監査の手順に、AIのユースケース台帳・影響評価・AIに固有のリスク対応を追加する形で組み込むのが、運用の負担を抑える現実的な道だと考えています。
一方で、統合できない部分もあります。ISO/IEC 27001 のリスクアセスメントは情報の機密性・完全性・可用性を中心に見るのに対して、ISO/IEC 42001 は AIシステムの影響評価という、個人や社会への影響を見る項目を持っています。偏りや説明できないこと、過度の依存といった AIに固有の論点は、情報セキュリティの評価の様式では拾いきれません。統合するのは手続きの器(文書管理・監査・是正の流れ)で、評価の中身は AIのために作る、という分け方をすると整理しやすいと考えています。
次の表は、統合の判断を本コラムの考え方で整理したものです。規格の要求事項の対応を示す公式の表ではありません。
| 領域 | 既存の仕組みに載せるか | AIのために足すもの |
|---|---|---|
| 方針と体制 | 情報セキュリティ方針や品質方針の体系に AI基本方針を加える。承認者は第12章・第13章に従い(基本方針は取締役会または経営会議、利用規程は経営会議または規程の管理の手続きで定めた決裁者)、版管理と周知は既存の規程管理に合わせる | AIガバナンス責任者・AIガバナンス委員会・事務局の役割(第13章) |
| リスクの評価 | リスクの登録簿の様式と更新の周期は共通にできる | ユースケース台帳、本コラムのリスク区分、影響評価(第7章) |
| 文書と記録 | 既存の文書管理の手順に載せる | モデルやデータの来歴、評価の記録(第10章) |
| 供給者の管理 | 購買・委託先の管理の手順に載せる | 学習への利用の有無、モデルの更新の通知などの確認項目(第9章) |
| 内部監査とマネジメントレビュー | 監査の計画と経営への報告の場は共通にする | AIの観点の監査項目、四半期の報告の議題(第14章) |
| インシデントと是正 | 情報セキュリティのインシデント対応の窓口と連携する | 出力の誤りや偏りを含む AIインシデントの区分と停止の基準(第11章) |
EU の整合規格との関係
第3章で扱ったとおり、EU AI Act では、整合規格(EU の官報で参照が公表された欧州規格)に従うと、その規格が扱う要求事項に適合していると推定される仕組みがあります。欧州委員会は2026年10月19日、AI Act を支える最初の整合規格として EN 18286(2026年)の参照を EU の官報に公表したと発表しました。CEN(欧州標準化委員会)と CENELEC(欧州電気標準化委員会)は、欧州委員会の AI Act の標準化のページが欧州の標準化機関として紹介している組織で、両者の合同技術委員会で高リスクAIシステムのための整合規格を作っています。発表によると、EN 18286 はこの CEN と CENELEC が作ったもので、EU AI Act の高リスクAIシステムを扱う EU AI Act の提供者(provider)が第17条の品質マネジメントシステムの要求事項に対応するための道筋を示し、欧州委員会の実施決定 2026/2274 による公表によって、規格が扱う第17条の要求事項への適合の推定が働きます。
ISO/IEC 42001 との関係について、同じ発表は、EN 18286 が組織ではなく AIシステムのライフサイクルを軸に組み立てられ、ISO/IEC 42001 や ISO 9001、分野別の品質マネジメントシステムを置き換えるのではなく、それらの上に重ねて使うように設計されていると説明しています。また、ISO/IEC 42001 を持たない組織でも、EN 18286 を使って既存の品質マネジメントシステムを広げるか、第17条の要求を満たす仕組みを新たに作れるとしています。公表された範囲では、適合の推定の対象として示されているのは整合規格である EN 18286 で、ISO/IEC 42001 はその土台として重ねて使える既存の規格の1つとして名前が挙がっています。ISO/IEC 42001 の認証が同じ効果を持つとは、この発表には書かれていません。同じ欧州委員会の標準化のページは、規格を使うことは任意であり、提供者は他の枠組みで適合を示すこともできると説明しています。
したがって、EU の市場で EU AI Act の高リスクAIシステム(本コラムの社内のリスク区分「高」とは別物)を提供する可能性がある組織にとっては、ISO/IEC 42001 の仕組みを作っておくことが EN 18286 への対応の準備になりうる一方で、それだけで EU AI Act の義務を果たしたことにはなりません。自社が EU AI Act の提供者に当たるか、扱う AIシステムが EU AI Act の高リスクAIシステムに当たるかは、第3章の整理に沿って個別に確かめる必要があり、その判断は弁護士等の専門家に確認する前提で進めてください。欧州委員会は他の整合規格も続く見込みだとしているので、整合規格の一覧の更新は、制度の改正の追い方(第14章)の対象に入れておくとよいと考えています。
認証を取るかどうかの判断
ISO/IEC 42001 を使うことと、その認証を取ることは別の判断です。規格に沿って仕組みを整えることは、認証を取らなくてもできます。ISO の解説ページも、独立の認証機関による認証は利害関係者に追加の信頼を与えうるが、規格を採り入れること自体にすでに価値がある、と書いています。認証を取るかどうかは、誰に対して何を示す必要があるかで決まります。
認証を検討する理由になりやすいのは、取引先や発注者から、AIの管理の体制を第三者の認証で示すよう求められている場合です。とくに、自社が AIを組み込んだ製品やサービスを他社に提供する立場(AI事業者ガイドラインの開発者・提供者)にある場合、相手先から管理の体制の説明を求められる場面が増えると考えています。一方、社内の業務で外部の生成AIサービスを使う立場(AI事業者ガイドラインの利用者)が中心で、外部に示す必要が当面ない場合には、まず規格の骨組みに沿って社内の仕組みを整え、認証は取引先の要請が具体的になった時点で判断する、という順序も合理的です。
次の表は、認証を取るかどうかを判断するときの問いを、本コラムの考え方で整理したものです。どの問いにどう答えれば認証が必要になる、という基準を規格や制度が定めているわけではありません。
| 判断の問い | 認証を検討する方向の事情 | まず仕組みづくりを優先する方向の事情 |
|---|---|---|
| 誰に示す必要があるか | 取引先・発注者に、管理の体制を第三者の認証で説明する必要がある | 当面、外部に示す相手がいない |
| 自社の立場はどれか | AIを組み込んだ製品やサービスを他社に提供する(AI事業者ガイドラインの開発者・提供者) | 社内の業務で外部のサービスを使う立場(AI事業者ガイドラインの利用者)が中心 |
| 既存の認証はあるか | ISO/IEC 27001 や ISO 9001 の認証を持ち、審査の体制がある | マネジメントシステムを運用した経験がない |
| EUとの関係はあるか | EU AI Act の高リスクAIシステムを EU AI Act の提供者として扱う可能性があり、その管理の体制を第三者の確認で示したい相手がいる(認証そのものが EN 18286 の適合の推定を生むわけではない) | EUとの関係が台帳の上で見当たらない |
| 仕組みは回っているか | 台帳・区分・承認・監査が一巡し、記録が残っている | 台帳がまだ無い、承認の経路が決まっていない |
判断を誤ったときの損失の型も、方向によって違います。必要のない段階で認証の取得を目標にすると、審査に通るための文書作りが目的になり、現場で使われない手続きが増えて「導入の停滞」につながりやすくなります。逆に、取引先の要請が見えているのに準備を始めないと、要請が具体的になった時点で準備が間に合わず、取引の機会を失うおそれがあります。認証を「取るか取らないか」の二択にせず、「いつ、どの適用範囲で取れる状態にしておくか」を経営が決めておくことが、両方の損失を避ける方法だと考えています。
経営の判断、規格を「使う」のか「示す」のか
本コラムでは、経営が最初に決めるのは AIガバナンス責任者・AIガバナンス委員会・事務局の3点で、そのあとにユースケース台帳の初版、リスク区分の基準と承認の経路、AI利用規程の初版を作る順序をとります(序章・第1章・第13章)。ISO/IEC 42001 についての経営の判断は、この3点を決めて台帳を作り始めたあとに置きます。そこで決めるのは、規格を社内の仕組みを作るための「設計図として使う」のか、外部に対して「第三者の認証で示す」のかです。台帳ができてからのほうが、自社の立場や EUとの関係、取引先の要請を事実に基づいて見られるからです。前者であれば、規格の本文と附属書を参照しながら、第7章から第14章で扱う台帳・区分・規程・体制・監査を、自社の規模に合わせて整え、運用しながら有効性を確かめます。後者であれば、適用範囲の決定、内部監査とマネジメントレビューを含む一巡の運用、認証機関の選定、審査への対応、認証後の維持の体制までを、予算と人員の計画に入れる必要があります。
予算と体制への落とし方としては、次の順序が現実的だと考えています。まず、規格の閲覧と目次の確認(JIS の閲覧で足りる)を事務局の担当に任せ、自社の既存の仕組みとの差を一覧にします。次に、その差のうち規格を使うかどうかにかかわらず必要なもの(台帳・区分・承認の経路・記録)を、上の順序に沿って先に整えます。そのうえで、取引先の要請や EUとの関係を台帳で確かめ、認証を目指す場合は、既存の ISO/IEC 27001 や ISO 9001 の審査と時期を合わせられるかを検討します。こうすると、認証を取らない判断をした場合でも、それまでの作業が無駄になりません。
最後に、規格の版の管理も経営の判断の一部です。ISO/IEC 22989 には生成AIを扱う追補が審議の段階にあり、ISO/IEC 42001 の実施の手引きの規格も作業項目として登録されています。ISO 9001 のように、既存の規格の新しい版が出ると、統合して運用している仕組みの見直しが必要になります。規格の目録の状態を年に1回以上確かめる担当を決めておくことは、小さな投資で「誤った判断の放置」と「規制違反」の型の損失を避ける手段になります。
本章では、ISO/IEC 42001 が AIを扱う組織の仕組みを定めるマネジメントシステム規格であり、法令を置き換えるものではないこと、関連規格が用語・リスク・影響評価・認証機関の要求事項を分担していること、認証は任意で、EU の整合規格 EN 18286 とは「土台として重ねて使える」関係にあることを確かめました。認証を取るかどうかは、誰に何を示す必要があるかで決まります。次の第7章では、規格の箇条6と箇条8にも現れるリスクの評価と影響評価を、ユースケース台帳を使って社内で実際に進める方法を扱います。
この章を深めたい方への参考書籍
『ISO/IEC 42001:2023〈JIS Q42001:2025〉情報技術-人工知能-マネジメントシステム要求事項の解説』(髙村博紀 編著、日本規格協会):日本規格協会の Management System ISO SERIES の1冊で、2025年10月に出ています。書名のとおり、国際規格と JIS Q 42001 の要求事項を解説する本で、本章では確かめられなかった箇条と附属書の中身を、規格の本文と並べて読むときの手引きになります。
『最新AIマネジメントシステムISO42001の仕組みと導入がよ~くわかる本 認証の必要知識を基本から解説!』(打川和男 著、秀和システム新社):図解入門ビジネスのシリーズの1冊で、2025年11月に出ています。副題が示すとおり、規格の仕組みと導入、認証に必要な知識を入門向けに扱う本で、認証を取るかどうかを判断する前に全体の流れを掴む用途に向いています。
第7章 AIのリスクを洗い出して評価する、ユースケース台帳と影響評価
第6章では、ISO/IEC 42001 とそれに関連する規格を確かめました。関連する規格の中には、AIシステムの影響評価の指針である ISO/IEC 42005(2025年)もあります。第3章から第6章までで扱った制度や枠組みを自社で使うには、まず自社がどこで AIを使っているかを把握し、用途ごとにリスクの大きさを見積もり、大きさに応じて管理の重さを変える、という作業が要ります。EU AI Act は高リスクの AIシステムを用途の分野で定めており、AI事業者ガイドラインは対策の程度をリスクの大きさに対応させる「リスクベースアプローチ」を示しています。この章では、その作業を自社の手順に落とすための2つの道具を扱います。1つは、AIを使う用途を一覧にするユースケース台帳です。もう1つは、リスクが大きいと判定された用途について、誰にどんな害が起こりうるかを掘り下げる影響評価です。
順序は次のとおりです。最初に、なぜ管理の単位をユースケースに置くのかを説明し、台帳に持たせる列を表にします。次に、本コラムが置くリスク区分(禁止・高・中・低)の判定の基準を示し、EU AI Act の4つの水準や AI事業者ガイドラインの考え方とどう関係するかを整理します。そのうえで影響評価の進め方を説明し、架空の台帳40件に Python で区分を付けて集計する最小例と、影響評価の結果を数字で残す最小例を実行します。最後に、台帳を最新に保つための申請・変更・廃止の流れと見直しのきっかけ、経営の判断を扱います。評価のための具体的なテスト(性能・公平性・頑健性)は第10章、運用を始めた後の監視は第11章で扱います。
管理の単位をユースケースに置く理由
AIのリスクを洗い出そうとすると、最初に「社内でどの AI製品を使っているか」の一覧を作りたくなります。製品の一覧は契約や情報セキュリティの管理には役立ちますが、リスクの大きさを決める単位としては粗すぎます。同じ文章生成のサービスでも、会議の議事録の下書きに使う場合と、採用の応募書類を要約して順位を付ける場合とでは、影響を受ける人も、誤ったときの害の大きさもまったく違うからです。逆に、まったく別の製品を使っていても、どちらも顧客に自動で回答を返す用途であれば、同じような確認が要ります。リスクの大きさは、使う道具よりも、何に使い、誰に影響し、出力がどう使われるかで決まります。
本コラムでは、AIを使う個別の用途をユースケースと呼び、AIガバナンスの管理の単位にしています(用語の定義は本コラムの冒頭の地図にまとめてあります)。この考え方は、公的な資料の構造とも合っています。EU AI Act は、高リスクの AIシステムを、附属書III に挙げた分野の用途(たとえば雇用の分野では、採用や選考のために応募書類を分析・選別し、候補者を評価する用途)として定めています。AI事業者ガイドライン(第1.2版、2026年3月31日)の別添は、AIガバナンス・ゴールからの乖離を特定したうえで、リスクに対するコントロールを選び、ユースケース、サービス又は製品ごとに適切なレベルの管理を行うことを実践のポイントとして挙げています。AIガバナンス・ゴールはガイドラインが置く語で、各社が便益とリスク、社会の受け止め方、自社の AIへの習熟度を踏まえて設定する、AIガバナンスの目標を指します。AIポリシーがその例として挙げられています。どちらも、用途ごとの評価を重視しています。ただし EU AI Act には、製品の安全部品などによる分類(第6条第1項と附属書I)もあります。本コラムでは、この考え方を踏まえ、社内の管理の単位をユースケースに置くことを提案します。
ユースケースを単位にすると、台帳の1行は「ある部門が、ある AIを、ある目的に、ある方法で使う」ことを表します。同じ製品を3つの部門が別々の目的で使っていれば、台帳には3行が並びます。1つの部門が同じ製品を2つの目的に使っていれば、それも2行です。行が増えて管理の手間が増えるように見えますが、区分が低い行は業務部門の責任者の承認だけで済ませる設計にしておけば、手間はリスクの大きい少数の行に集中させられます。これが、AI事業者ガイドラインの本編が述べている「リスクベースアプローチ」、つまり対策の程度をリスクの大きさに対応させるという考え方を、社内の手続きに落とした形です。
ユースケース台帳に持たせる列
台帳の列は、多すぎると記入されず、少なすぎると区分の判定ができません。区分の判定に使う列と、管理(承認と見直し)に使う列の2種類があれば足りると考えています。次の表は、本コラムが勧める最小限の列を、何を書くか、なぜ要るかとあわせて整理したものです。列の名前は、後で示すコードの列名とそろえてあります。
| 列 | 何を書くか | なぜ要るか | 書き方の例 |
|---|---|---|---|
| 番号 | 台帳の中で1つに決まる番号 | 申請・承認・インシデントの記録をこの番号で結び付けるため | UC001 |
| 用途 | AIに何をさせるかを、動詞を含む1文で | 区分の判定と、同じ用途の重複の発見に使う | 採用書類の要約と順位付け |
| 部門 | その用途に責任を持つ部門 | 承認者と見直しの担当を決めるため | 人事 |
| 立場 | 開発・提供・利用のうち該当するものすべて(AI事業者ガイドラインの3つの立場)。後のコードでは簡略にして主な立場を1つ置く | 立場によって求められる対応が違うため(第1章) | 利用 |
| 使う AI | 製品名・モデル名・自社開発の区別と版 | ベンダーの変更やモデルの更新を見直しのきっかけにするため(第9章) | 外部の文章生成サービス |
| 入力するデータ | 公開情報・社内情報・機密情報・個人情報のどれを入れるか | 権利侵害と情報漏えいの大きさを見積もるため(入力の区分は第8章) | 個人情報 |
| 出力の使われ方 | 参考情報・人が確認して使う・そのまま社外へ・自動で決定のどれか | 誤りが人の確認を経ずに外へ出るかどうかで、害の大きさが変わるため | 人が確認して使う |
| 人の関与 | 誰が、どの時点で、何を確かめるか | 「人が確認する」を名目にしないため | 選考担当者が全件の原本と照合 |
| 影響を受ける人 | 出力によって扱いが変わる人(顧客・応募者・従業員など) | 影響評価の出発点になるため | 応募者 |
| 人の評価・選別 | 人を評価する、順位を付ける、選ぶ用途かどうか | 本コラムの区分で「高」を決める主な条件だから | 該当する |
| 禁止の用途 | 社内で使わないと決めた用途(禁止の一覧)に当たるかどうか | 区分「禁止」を判定するため | 該当しない |
| EUとの関係 | EU の市場への提供や、EU の中での出力の利用があるか | EU AI Act の確認(第3章)が要るかどうかを拾うため | なし |
| リスク区分 | 本コラムの区分(禁止・高・中・低) | 承認の経路と見直しの間隔を決めるため | 高 |
| 承認者 | 区分に応じた承認者の名前と承認日 | 誰が決めたかを後から確かめられるようにするため | AIガバナンス委員会(承認日を記入) |
| 最終確認日 | 最後に内容を確かめた日(承認日、または前回の見直しの日) | 見直し日を計算する起点にするため | 2026年4月1日 |
| 見直し日 | 次に内容を確かめる日 | 台帳を古いまま放置しないため | 最終確認日の6か月後 |
表の列のうち、「禁止の用途」「人の評価・選別」「出力の使われ方」「影響を受ける人」「入力するデータ」の5つが、区分の判定に直接使う列です。ここを選択肢で書かせ、自由記述にしないことが大切です。自由記述にすると、同じ内容が申請者ごとに違う言葉で書かれ、判定の基準を機械的に当てはめられなくなります。「使う AI」と「人の関与」は自由記述でかまいませんが、「人の関与」には誰がいつ何を確かめるかを具体的に書かせます。「担当者が確認する」とだけ書かれた行は、確認の中身が決まっていないことが多いからです。
台帳は、表計算のファイルで始めてかまいません。最初から専用の製品を入れる必要はなく、列と選択肢が決まっていることの方が重要です。行が数百件に増え、申請と承認の記録を結び付ける必要が出てきた段階で、ワークフローの仕組みや AIガバナンス向けの製品を検討すればよいと考えています。台帳を置く場所と更新の権限は、データガバナンスの目録(データの所在・定義・持ち主の一覧)と同じ考え方で決められます。目録の作り方は弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。
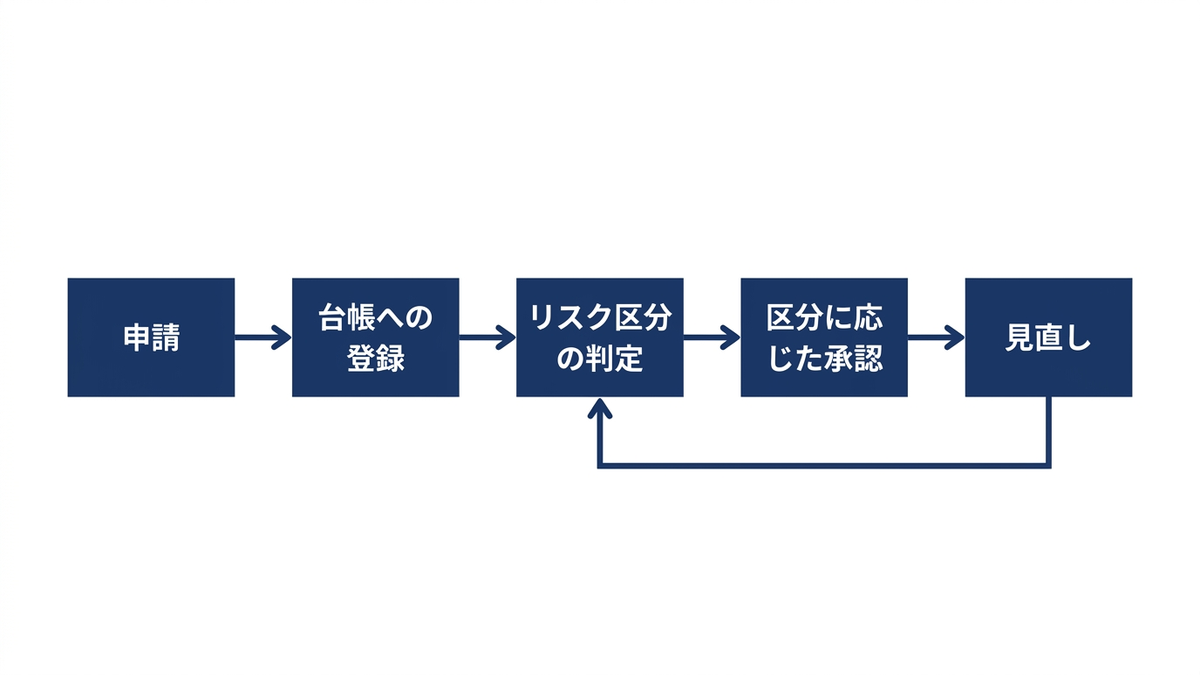
本コラムのリスク区分、禁止・高・中・低の判定の基準
台帳の各行には、本コラムのリスク区分を付けます。この区分は社内で使うための区分で、EU AI Act について欧州委員会が説明している4つのリスクの水準とは別物です。名前が似ているので混同されやすいのですが、EU AI Act の水準は EU の法令上の義務を決めるもので、本コラムの区分は社内の承認の経路と見直しの間隔を決めるものです。本コラムの区分で「低」になった用途が、EU AI Act の上では透明性の義務の対象になることもありえますし、本コラムの区分で「高」にした用途が、EU AI Act の高リスクに当たらないこともあります。両者の関係は次の節で表にします。
区分の判定は、上から順に条件を当てはめ、最初に当てはまったところで決める形にしました。上の条件ほど重い区分です。こうしておくと、申請者が自分で判定しても、事務局が確かめても、同じ答えになります。次の表は、本コラムが例として置いた判定の基準です。条件の中身は会社の業種や事業によって変えてかまいませんが、条件を選択肢の列で判定できる形にしておくことと、上から順に当てはめることは、変えない方がよいと考えています。
| 順 | 判定の条件(台帳の列で判定する) | 本コラムのリスク区分 | 承認の経路(例) | 影響評価 | 見直しの間隔(例) |
|---|---|---|---|---|---|
| 1 | 社内で使わないと決めた用途に当たる(例:職場で従業員の表情から感情を推定する、人の行動から社会的な点数を付ける) | 禁止 | 承認の対象にしない(例外も無し)。申請は却下の記録として台帳に残す | 行わない | 対象外(禁止の一覧そのものは年1回見直す) |
| 2 | 人の評価・選別に使う(採用・人事評価・与信など) | 高 | AIガバナンス委員会の承認と影響評価 | 6つの段階による影響評価(委員会の承認の前提) | 6か月 |
| 3 | 出力が人の確認を経ずに自動で決定になり、その決定で特定の人の扱いが変わる | 高 | AIガバナンス委員会の承認と影響評価 | 6つの段階による影響評価(委員会の承認の前提) | 6か月 |
| 4 | 個人情報か機密情報を入力する | 中 | 事務局の責任者の承認(法務・情報セキュリティ・データガバナンスの担当の確認を経て) | 簡易な影響評価(事務局の責任者の承認の前提) | 12か月 |
| 5 | 出力がそのまま社外へ出る、または自動で決定になる | 中 | 事務局の責任者の承認(法務・情報セキュリティ・データガバナンスの担当の確認を経て) | 簡易な影響評価(事務局の責任者の承認の前提) | 12か月 |
| 6 | 出力が特定の人(顧客・応募者・従業員など)に届く、または特定の人に影響する | 中 | 事務局の責任者の承認(法務・情報セキュリティ・データガバナンスの担当の確認を経て) | 簡易な影響評価(事務局の責任者の承認の前提) | 12か月 |
| 7 | 上のどれにも当たらない(社内の参考情報で、公開情報か社内情報だけを入れる) | 低 | 業務部門の責任者の承認(事務局が台帳に記録) | 要さない(台帳への記録のみ) | 12か月 |
1の禁止の例は、EU AI Act の第5条が禁止している行為のうち、企業の社内の利用でも起こりうるものから選びました。第5条第1項は、職場と教育機関で人の感情を推定する AIシステム(医療上・安全上の理由によるものを除く)や、人の社会的な行動や人格の特徴にもとづいて点数を付け、不当に不利な扱いにつなげる AIシステムなどを禁止しています。EU AI Act が自社に掛かるかは、EU の市場への提供、EU の中に拠点を置く導入者かどうか、出力が EU の中で使われるかなどから個別に確かめます(第2条、第3章)。どの場合でも、この禁止の例は社内の禁止の一覧を作るときの出発点として使えます。禁止の一覧には、法令が禁止しているもののほかに、自社の事業や価値観から使わないと決めた用途を加えます。条文の全体と、禁止の対象に当たるかの判断は第3章で扱います。
2の「人の評価・選別」は、「人が確認して使う」場合でも高にしています。人が確認するといっても、AIの順位をそのまま追認する運用になりやすいからです。この条件を、入力するデータの種類よりも上に置いたのは、人を評価したり選んだりする用途では、出力の誤りや偏りがそのまま特定の人の機会を左右するからです。採用書類の順位付けで特定の属性の応募者が低く出る、与信の判定で特定の地域の取引先が一律に断られる、といった害は、後から気づいても取り返しにくいものです。EU AI Act の附属書III も、雇用(採用・選考、昇進や解雇の判断、仕事の割り当て、働きぶりの監視と評価)や、人の信用力の評価を高リスクの分野に挙げています。ただし附属書III の信用力の評価は自然人(個人)の信用力の評価やクレジットスコアの算出を対象としており、金融上の不正の検出に使うものを除くと書かれています。本コラムの区分では、相手が個人か法人かを問わず、与信の判定を高に置いています。EU AI Act の上でどう扱われるかは、文言と対象を第3章の手順で個別に確かめる必要があります。
4から6の中の区分は、権利侵害・情報漏えい・社外への誤りの流出のどれかが起こりうる用途です。この区分は件数が最も多くなりやすいので、承認を事務局の責任者に任せ、承認の前に簡易な影響評価(次の節で説明します)を行い、あわせて法務・情報セキュリティ・データガバナンスの担当が、それぞれ権利・情報漏えい・データの扱いの観点から確かめる形にしました。業務部門の中だけで承認すると、使いたい側の判断だけで社外への出力や個人情報の入力が始まってしまいます。一方で、個人情報や機密情報を入力する用途も、条件4によって中になり、事務局の責任者が承認します。委員会に上がるのは、AI利用規程で入力を禁止している情報を例外として入力したい場合の例外の承認だけです(入力の区分は第8章)。中の区分の用途すべてを委員会に上げると、委員会が処理しきれなくなり、承認の待ちが長くなって、申請そのものを避ける動きが出てくるおそれがあります。7の低の区分は、業務部門の責任者の承認だけで使い始められるようにし、事務局はその承認を台帳に記録します。台帳に載せること自体が目的で、ここで手続きを重くすると台帳に載らない利用が増えます。
EU AI Act の4つの水準・AI事業者ガイドラインとの関係
本コラムの区分を社内で使うときに、「EU の区分とどう違うのか」「国のガイドラインに沿っているのか」と問われることがあります。次の表は、本コラムの区分と、EU AI Act の水準、AI事業者ガイドラインの考え方の関係を整理したものです。表は対応表ではありません。3つは目的も対象も違うので、行が一対一に対応するわけではないことを示すための表です。
| 比べる点 | 本コラムのリスク区分 | EU AI Act の4つの水準 | AI事業者ガイドライン |
|---|---|---|---|
| 何のための区分か | 社内の承認の経路と見直しの間隔を決める | EU の法令上の義務(禁止・要求事項・透明性の義務)を決める | 対策の程度をリスクの大きさに対応させるリスクベースアプローチを示している |
| 区分の名前 | 禁止・高・中・低 | 欧州委員会の解説ページの見出しでは、許容できないリスク・高リスク・透明性のリスク・最小限のリスクまたはリスクなし(詳細は第3章) | 本コラムが確かめた範囲(本編の基本的な考え方と別添の行動目標3-1)には、区分の名前を定めた箇所は無い |
| 誰が決めるか | 自社が自社の基準で決める | 条文と附属書が定める。高リスクに当たるかは第6条と、附属書I(EU が製品ごとに定めた整合法令の一覧。そこに挙がる製品の安全部品などで、第三者による適合性評価を受けるものが対象)・附属書III(用途の分野)で決まる。詳細は第3章 | 各主体が自社の状況に照らして決める |
| 拘束力 | 社内の規程として自社の中だけ | EU の規則として、適用範囲に入る事業者に掛かる(第2条) | 本編は自らを「非拘束的なソフトロー」と位置づけ、事業者の自主的な取り組みを促すとしている(第4章) |
| 区分が一致しない例 | 顧客向けの一次回答のチャットは本コラムでは中 | 人と直接やり取りする AIの提供者には、原則として、相手が AIとやり取りしていると分かる設計が求められる(第50条第1項)。状況から明らかな場合などの例外があり、該当するかは個別に確かめる | 該当なし |
| 例外の扱い | 人事評価の補助のように人の評価・選別に使う用途は、人が確認して使う場合でも、本コラムは例外を置かず一律に高にする | 附属書III に雇用の分野が挙がっているが、第6条第3項の例外があるため、EU AI Act 側は個別の判断が要る(第3章) | 該当なし |
表の最後の行の第6条第3項は、附属書III の分野の AIシステムでも、人の健康・安全・基本的な権利に重大な害のリスクをもたらさない場合(たとえば狭い手続き上の作業だけをする場合や、人がすでに終えた判断の結果を改善する場合)には高リスクに当たらないとしうる、という例外を定めています。ただし同じ項は、人のプロファイリングを行う AIシステムは常に高リスクとみなすとしており、例外に当たると考えた EU AI Act の提供者(provider)は、その評価を市場に出す前に記録しなければならないと第6条第4項が定めています。本コラムの区分ではこうした例外を置かず、人の評価・選別に使う用途は一律に高にしています。社内の区分は、法令の義務の有無ではなく、自社が慎重に扱う範囲を決めるものだからです。EU AI Act 上の扱いは、台帳の「EUとの関係」の列で拾ったうえで、第3章の手順で個別に確かめる必要があります。EU AI Act の規定に当たるかどうかの判断は、条文の解釈を伴うため、弁護士などの専門家に確認する前提で進めてください。
AI事業者ガイドラインは、本コラムが確かめた範囲では区分の名前を定めておらず、その代わりに手続きの骨格を示しています。別添の行動目標3-1を要約すると、目標との乖離を調べ、影響とリスクの受容の合理性を評価する手順を、利用開始の前後などの段階に組み込むことを期待しています。評価には対象の AIに直接関わっていない人が加わることも期待しており、乖離があるだけで一律に不可とする対応は適当でないとしています。詳しい書きぶりは別添の原文を確かめてください。本コラムの区分と承認の経路は、この骨格を、台帳の列と選択肢で回せる形にしたものです。
影響評価の進め方、影響を受ける人から残るリスクまで
区分が高になった用途には、影響評価を行います。区分が中の用途には、同じ6つの段階を簡略にした簡易な影響評価を行い、区分が低の用途では影響評価を要さず、台帳への記録だけにします。本コラムでいう影響評価は、その用途によって誰にどんな害が起こりうるかを洗い出し、起こりやすさと重大さを見積もり、緩和策を決めたうえで、緩和策の後に残るリスクを受け入れてよいかを判断する作業です。ISO の目録によれば、AIシステムの影響評価については ISO/IEC 42005(2025年5月発行、第1版)が指針を示しており、AIシステムとその予見できる使い方が、個人・集団・社会にどう影響しうるかを理解することに焦点を当てた評価だと説明されています。規格の中身と、ISO/IEC 42001 との関係は第6章で扱いました。この節は、規格の要約ではなく、台帳の高の行を対象に社内で回す最小の手順として書きます。
手順は6つの段階に分けると扱いやすいと考えています。次の表は、各段階で何を決め、誰が担い、何を記録に残すかを整理したものです。表の担い手は、第13章で扱う役割の名前に合わせた例です。
| 段階 | 決めること | 担い手(例) | 記録に残すもの |
|---|---|---|---|
| 1.影響を受ける人 | 出力によって扱いが変わる人は誰か。直接の利用者だけでなく、判断の対象になる人(応募者・取引先・顧客)を含める | 申請した部門 | 影響を受ける人の一覧と、その人が AIの利用を知りうるか |
| 2.起こりうる害 | 誤り・偏り・説明できない・権利侵害・情報漏えい・過度の依存・悪用の型(第1章)に沿って、具体的な害を文で書く | 申請した部門と事務局 | 害の一覧(1つの害を1行に) |
| 3.起こりやすさ | その害がどのくらい起こりやすいか。3段階(低い・中くらい・高い)で付ける | 申請した部門。対象の AIに直接関わっていない人が加わる | 付けた段階と、その根拠(試験の結果・過去の苦情など) |
| 4.重大さ | 起きたときの害の大きさ。取り返しがつくか、何人に及ぶか、権利に関わるかで3段階に付ける | 同上 | 付けた段階と、その根拠 |
| 5.緩和策 | 害ごとに、起こりやすさか重大さを下げる手段。人の確認の入れ方、入力の制限、送信先の限定、監視など | 申請した部門・情報システム・法務 | 緩和策、担当、実施の期限 |
| 6.残るリスクの判断 | 緩和策の後に残るリスクを、受容する・条件付きで受容する・用途を見直す、のどれにするか | AIガバナンス委員会(中の簡易な影響評価では事務局の責任者) | 判断、判断の理由、条件、次の見直し日 |
中の区分の簡易な影響評価では、表の6つの段階のうち、1の影響を受ける人、2の起こりうる害、5の緩和策を同じように書き出します。3と4は段階の数値を付けず、「取り返しのつかない害、または多くの人に及ぶ害がありうるか」の1問で確かめます。この問いに当てはまる害が見つかったら、その用途は高への見直しを検討します。後で示すコードは初期の判定の例で、再実行すると選択肢から求めた区分に戻ります。運用では、自動の判定の区分・最終の区分・変更の理由を分けて記録します。6の判断は委員会ではなく、事務局の責任者が承認の前提として行い、判断と理由を台帳の行に記録します。様式を高と分けておくと、件数の多い中の行でも申請の手間を小さく保てます。
1の段階で大切なのは、影響を受ける人を、AIを操作する人と取り違えないことです。採用書類の要約であれば、AIを操作するのは人事の担当者ですが、害を受けうるのは応募者です。影響を受ける人は AIが使われていることを知らないことが多く、害が起きても声を上げにくい立場にあります。だからこそ、評価の最初に書き出しておく必要があります。2の段階では、第1章で整理したリスクの型を見出しとして使い、型ごとに「この用途では何が起こりうるか」を文で書きます。型を見出しにすると、偏りや情報漏えいのように、申請した部門が思いつきにくい害の書き漏らしを減らせます。
3と4の段階で、起こりやすさと重大さを分けて付けるのは、緩和策の効き方が違うからです。人の確認を入れる、監視を続けるといった緩和策の多くは、害の起こりやすさを下げますが、起きたときの重大さはあまり変えません。重大さを下げるには、用途そのものを変える(順位付けをやめて要約だけにする、自動の決定をやめて推奨にとどめる)必要があることが多いと考えています。2つを1つの点数にまとめてしまうと、この違いが見えなくなります。本コラムの例では、起こりやすさと重大さをそれぞれ1〜3の3段階で付け、掛け合わせた値(1〜9)を判断の目安にしました。この掛け算は目安で、値の大小をそのまま害の大きさの比として読むことはできません。
6の段階の判断は、AI事業者ガイドラインの行動目標3-1が述べている「受容の合理性の判定」に当たります。同じ行動目標が、評価に対象の AIに直接関わっていない人が加わることを期待しているので、本コラムでは、3と4の段階に申請した部門以外の人を入れ、6の判断を委員会に置きました。申請した部門だけで評価を完結させると、使いたい側の見積もりが甘くなりやすいからです。一方で、残るリスクがあることだけを理由に却下を続けると、同じ行動目標が適当ではないとしている「恣意的に不可とする対応」になりかねません。判断の結果には、受容する場合でも、受容の条件(監視の指標、見直しの時期)を書き添えます。
影響評価は、個人情報の取扱いについてのプライバシー影響評価(PIA)と重なる部分があります。AI事業者ガイドラインの別添も、プライバシーに関するアセスメントの実施として PIA に触れています。個人情報を入力する用途では、PIA を別に行って結果を参照するか、影響評価の害の一覧にプライバシーの害を含めるかを、社内で決めておくと二重の作業を避けられます。個人情報の扱いそのものは第8章で、評価の具体的なテストの方法は第10章で扱います。
架空の台帳40件で区分を付けて集計する
ここからは、ここまでの台帳の列と判定の基準を、Python で動かす最小例を示します。使うのは、乱数から作った架空のサンプルデータの台帳40件です。実在の企業・部門・製品とは関係がありません。用途は16の型(問い合わせの一次回答、議事録の作成、採用書類の要約と順位付け、取引先の与信の判定など)を用意し、型ごとに出現の重みを付けて40件を選び、部門は型ごとに決めた候補から選んでいます。「EUとの関係」と「最終確認日」も乱数で付けました。同じ結果を再現できるよう、乱数の初期値(シード)を 20261028 に固定しているので、同じ版のライブラリで実行すれば同じ台帳ができます。本コラムでは Python 3.14.3、numpy 2.4.3、pandas 3.0.1、matplotlib 3.10.8 で実行し、グラフの日本語表示には japanize-matplotlib を使いました。
最初のコードは、用途の型を定義する部分です。1行が1つの型で、台帳の区分の判定に使う5つの列(入力するデータ・出力の使われ方・影響を受ける人・人の評価・選別・禁止の用途)を持たせています。ch07_ledger.py という名前で保存します。
import sys, io
if sys.stdout.encoding.lower() != "utf-8":      # 他のスクリプトから読み込まれたときは包み直さない
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd

BASE_DATE = pd.Timestamp("2026-10-01")          # 台帳を点検する基準日(架空)

# 用途の型:用途, 部門の候補, 立場, 入力するデータ, 出力の使われ方, 影響を受ける人, 人の評価・選別, 社内で禁止した用途, 出現の重み
TEMPLATES = [
    ("問い合わせの一次回答", ["カスタマーサポート"], "提供", "社内情報", "そのまま社外へ", "顧客", 0, 0, 3),
    ("問い合わせ履歴の要約", ["カスタマーサポート", "営業"], "利用", "個人情報", "参考情報", "特定の人なし", 0, 0, 3),
    ("議事録の作成", ["営業", "人事", "製造", "経理", "法務", "情報システム"], "利用", "社内情報", "人が確認して使う", "特定の人なし", 0, 0, 4),
    ("社内文書の検索と回答", ["情報システム", "法務", "製造"], "開発", "社内情報", "参考情報", "特定の人なし", 0, 0, 3),
    ("提案書の下書き", ["営業", "マーケティング"], "利用", "機密情報", "人が確認して使う", "顧客", 0, 0, 3),
    ("採用書類の要約と順位付け", ["人事"], "利用", "個人情報", "人が確認して使う", "応募者", 1, 0, 3),
    ("人事評価の補助", ["人事"], "利用", "個人情報", "人が確認して使う", "従業員", 1, 0, 2),
    ("取引先の与信の判定", ["経理", "営業"], "開発", "個人情報", "自動で決定", "顧客", 1, 0, 2),
    ("需要予測", ["製造", "営業"], "開発", "社内情報", "参考情報", "特定の人なし", 0, 0, 3),
    ("製品の外観検査", ["製造"], "開発", "社内情報", "自動で決定", "特定の人なし", 0, 0, 2),
    ("広告文の生成", ["マーケティング"], "利用", "公開情報", "人が確認して使う", "顧客", 0, 0, 3),
    ("プログラムの生成補助", ["情報システム"], "利用", "社内情報", "人が確認して使う", "特定の人なし", 0, 0, 3),
    ("文書の翻訳", ["営業", "法務", "製造", "マーケティング"], "利用", "社内情報", "人が確認して使う", "特定の人なし", 0, 0, 3),
    ("契約書の確認の補助", ["法務"], "利用", "機密情報", "参考情報", "特定の人なし", 0, 0, 2),
    ("経費精算の異常の検知", ["経理"], "開発", "個人情報", "人が確認して使う", "従業員", 0, 0, 2),
    ("会議中の表情からの感情の推定", ["人事", "営業"], "利用", "個人情報", "参考情報", "従業員", 0, 1, 1),
]
COLS = ["用途", "部門候補", "立場", "入力するデータ", "出力の使われ方", "影響を受ける人", "人の評価・選別", "禁止の用途", "重み"]
続きの部分で、型から40件を選び、部門・番号・EUとの関係・最終確認日を付けます。点検の基準日は 2026年10月1日という架空の設定です。
def make_ledger(n=40, seed=20261028):
    """架空のユースケース台帳(40件)を作る"""
    rng = np.random.default_rng(seed)
    t = pd.DataFrame(TEMPLATES, columns=COLS)
    idx = rng.choice(len(t), size=n, p=(t["重み"] / t["重み"].sum()).to_numpy())
    df = t.iloc[idx].reset_index(drop=True).drop(columns="重み")
    df["部門"] = [rng.choice(c) for c in df.pop("部門候補")]
    df.insert(0, "番号", [f"UC{i + 1:03d}" for i in range(n)])
    df["EUとの関係"] = np.where(rng.random(n) < 0.3, "あり", "なし")
    df["最終確認日"] = BASE_DATE - pd.to_timedelta(rng.integers(10, 560, n), unit="D")
    return df, rng
次のコードが、判定の基準を関数にした部分です(ch07_classify.py)。classify は、前の節の判定の基準の表を上から順に当てはめ、最初に当てはまった区分を返します。条件は上から順に if で分けて書き、2つの条件を同時に見る行だけ & と括弧を使いました。区分ごとの承認の経路と見直しの間隔は、辞書にして関数の外に置いています。基準を変えたときに、どこを直せばよいかが分かるようにするためです。
import sys, io
if sys.stdout.encoding.lower() != "utf-8":
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd
from ch07_ledger import make_ledger, BASE_DATE

ORDER = ["禁止", "高", "中", "低"]
ROUTE = {"禁止": "承認の対象にしない(例外も無し)", "高": "AIガバナンス委員会の承認と影響評価",
         "中": "事務局の責任者の承認(法務・情報セキュリティ・データガバナンスの担当の確認を経て)", "低": "業務部門の責任者の承認(事務局が台帳に記録)"}
REVIEW_MONTHS = {"禁止": 12, "高": 6, "中": 12, "低": 12}   # 見直しの間隔(例)


def classify(r):
    """本コラムのリスク区分を判定する(EU AI Act の4水準とは別物)"""
    if r["禁止の用途"] == 1:
        return "禁止"
    if r["人の評価・選別"] == 1:
        return "高"
    if (r["出力の使われ方"] == "自動で決定") & (r["影響を受ける人"] != "特定の人なし"):
        return "高"
    if r["入力するデータ"] in ("個人情報", "機密情報"):
        return "中"
    if r["出力の使われ方"] in ("そのまま社外へ", "自動で決定"):
        return "中"
    if r["影響を受ける人"] != "特定の人なし":
        return "中"
    return "低"
judge は、台帳の全件に区分を付け、承認の経路・見直し日・見直しの超過を加えます。最後の3行は、申請者が自分で付けた区分(自己申告の区分)を模したものです。ここでは、2割の確率で1段低く申告した、という架空の設定にしてあります。実際の運用では、この列は申請書に書かれた区分をそのまま写します。
def judge(df, rng):
    df = df.copy()
    df["リスク区分"] = pd.Categorical(df.apply(classify, axis=1), categories=ORDER, ordered=True)
    df["承認の経路"] = df["リスク区分"].map(ROUTE)
    months = df["リスク区分"].map(REVIEW_MONTHS).astype(int)
    df["見直し日"] = [d + pd.DateOffset(months=m) for d, m in zip(df["最終確認日"], months)]
    df["見直し超過"] = (df["見直し日"] < BASE_DATE) & (df["リスク区分"] != "禁止")   # 禁止は導入しないので対象外
    # 申請者の自己申告(2割の確率で1段低く申告した、という架空の設定)
    lower = {"禁止": "高", "高": "中", "中": "低", "低": "低"}
    under = rng.random(len(df)) < 0.2
    df["自己申告の区分"] = [lower[c] if u else c for c, u in zip(df["リスク区分"], under)]
    return df
最後に、区分ごとの件数、部門と区分の件数の表、見直しの超過、自己申告と判定の食い違いを集計します(ch07_summary.py。グラフを描く部分は省いて抜き出しています)。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib  # noqa: F401
from ch07_ledger import make_ledger
from ch07_classify import judge, ORDER

ledger, rng = make_ledger()
df = judge(ledger, rng)
print("件数", len(df))
print(df["リスク区分"].value_counts().reindex(ORDER).to_string())
print(df.drop_duplicates("リスク区分").set_index("リスク区分")["承認の経路"].reindex(ORDER).to_dict())
print(df.groupby("用途")["リスク区分"].first().sort_values().to_string())
ct = pd.crosstab(df["部門"], df["リスク区分"]).reindex(columns=ORDER, fill_value=0)
ct = ct.loc[ct.sum(axis=1).sort_values().index]
print(ct.to_string())
print(pd.crosstab(df["EUとの関係"], df["リスク区分"]).reindex(columns=ORDER, fill_value=0).to_string())
print("見直し超過", df.groupby("リスク区分", observed=False)["見直し超過"].sum().to_string())
low = df["自己申告の区分"] != df["リスク区分"].astype(str)
print("自己申告が判定より低い", int(low.sum()))
print(df.loc[low, ["番号", "用途", "自己申告の区分", "リスク区分"]].to_string(index=False))
print(pd.crosstab(df["立場"], df["リスク区分"]).reindex(columns=ORDER, fill_value=0).to_string())
実行した結果、40件の区分は、禁止が2件、高が3件、中が15件、低が20件でした。区分ごとの件数と、承認の経路、見直しの超過の件数を次の表にまとめます。見直しの超過は、最終確認日に区分ごとの見直しの間隔を足した見直し日が、基準日より前になっている行の数です。禁止の行は承認の対象にせず導入しないので、見直しの対象から外しています。
| 本コラムのリスク区分 | 件数 | 台帳に現れた用途の型 | 承認の経路 | 見直しの超過 |
|---|---|---|---|---|
| 禁止 | 2 | 会議中の表情からの感情の推定 | 承認の対象にしない(例外も無し) | 対象外 |
| 高 | 3 | 採用書類の要約と順位付け、取引先の与信の判定 | AIガバナンス委員会の承認と影響評価 | 2 |
| 中 | 15 | 問い合わせの一次回答、問い合わせ履歴の要約、契約書の確認の補助、広告文の生成、製品の外観検査 | 事務局の責任者の承認(法務・情報セキュリティ・データガバナンスの担当の確認を経て) | 3 |
| 低 | 20 | 議事録の作成、社内文書の検索と回答、需要予測、プログラムの生成補助、文書の翻訳 | 業務部門の責任者の承認(事務局が台帳に記録) | 7 |
16の型のうち、台帳に現れたのは13の型でした。人事評価の補助・経費精算の異常の検知・提案書の下書きの3つは、乱数の結果として選ばれませんでした。区分の分布は、低と中で35件、全体の8割台後半を占め、高と禁止は合わせて5件です。この偏りは架空のデータの設定によるものですが、会議の議事録や翻訳のように、社内で完結する用途が件数の多くを占める状態は、生成AIを広く使い始めた会社では起こりやすいと考えています。区分の設計で大切なのは、この多数の低と中の行を軽い手続きで流し、委員会の時間を少数の高の行に集中させることです。この例では、委員会が承認と影響評価を担うのは40件のうち3件になります。
見直しの超過は、高で3件中2件、中で15件中3件、低で20件中7件、合わせて12件でした。高の行は見直しの間隔を6か月と短くしているので、件数が少なくても超過しやすくなります。高の行の見直しの超過は、委員会が承認したときの条件(監視の指標や、偏りの測定)が守られているかを、定期の見直しで確かめられていないことを示します。別の監視が動いている場合もあるので、実施の状況を確かめ、件数が少なくても優先して解消する必要があります。
次のグラフは、部門ごとに区分の内訳を積み上げたものです。凡例はグラフの右下に置いています。
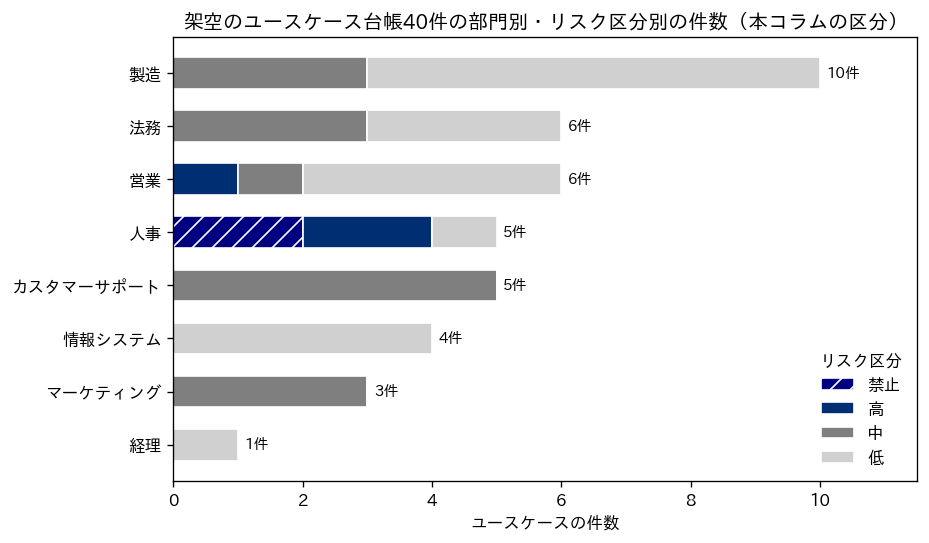
グラフからは、区分の重い行が特定の部門に集まっていることが読み取れます。禁止の2件と高の3件のうち4件は人事、残りの1件は営業(取引先の与信の判定)でした。カスタマーサポートとマーケティングの行は、すべて中です。顧客への回答や広告文のように、出力が社外へ出る用途が中心だからです。製造は件数が最も多い10件ですが、7件が低で、残りの3件は製品の外観検査(出力が自動で決定になるので中)でした。件数の多い部門が、リスクの大きい部門とは限りません。台帳を部門と区分の表で見ると、事務局がどの部門に説明や支援の時間を割くべきかが分かります。この例であれば、人事には影響評価と委員会への申請の支援を、カスタマーサポートとマーケティングには社外へ出る出力の確認の手順(第8章)を、重点的に用意することになります。
立場ごとに見ると、利用が21件、開発が14件、提供が5件でした。提供の5件は、すべて問い合わせの一次回答(顧客に AIの回答を返す用途)で、区分は中です。EUとの関係が「あり」の行は7件で、区分は中が1件、低が6件でした。このうち低の6件は、本コラムの区分では業務部門の責任者の承認だけで使い始められる行ですが、EU AI Act の上で何らかの義務が掛かるかどうかは、本コラムの区分とは別に確かめる必要があります。社内の区分が低いことは、EU AI Act の確認が要らないことを意味しません。台帳に「EUとの関係」の列を独立して置いたのは、このためです。
最後に、自己申告の区分と、基準を当てはめた判定が食い違った行は6件で、6件とも自己申告の方が1段低いものでした。中を低と申告した行が3件(広告文の生成、製品の外観検査、問い合わせの一次回答)、高を中と申告した行が3件(採用書類の要約と順位付け2件、取引先の与信の判定1件)です。この架空のデータでは、高の3件がすべて中と申告されていました。乱数の設定は2割の確率で1段低くするというもので、高の3件がそろって過小に申告されたのは乱数の結果です。ただ、高の行が過小に申告されると、その行は高に必要な6段階の影響評価と委員会の審査を経ず、中向けの簡易な影響評価と事務局の責任者の承認だけで使われ始めるおそれがあります。区分の判定を申請者の自己申告だけに任せず、選択肢の列から事務局が機械的に判定し直す仕組みを置くのは、この食い違いを拾うためです。
影響評価の結果を数字で残す
高の区分になった用途のうち、採用書類の要約と順位付けと、取引先の与信の判定の2つについて、影響評価の結果を記録する最小例を示します。ここでの起こりうる害、起こりやすさ、重大さ、緩和策は、評価者が付けたという設定の架空のサンプルデータです。各用途に4つずつ、合わせて8つの害を置き、緩和前と緩和後の起こりやすさと重大さを1〜3で付けました。掛け合わせた残るリスクが6以上なら用途を見直し、3〜4なら条件付きで受容して監視を続け、2以下なら受容する、という判断の目安を関数にしています(ch07_impact.py。グラフを描く部分は省いて抜き出しています)。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import japanize_matplotlib  # noqa: F401

# 架空の影響評価:起こりやすさ・重大さは1〜3の3段階(評価者が付けた、という設定)
rows = [
    ("採用", "特定の属性の応募者を低く順位付けする", 3, 3, "人が全件を確認し、属性ごとの通過率を毎月測る", 2, 3),
    ("採用", "要約の誤りで経歴を取り違える", 2, 2, "要約と原本の照合を手順に入れる", 1, 2),
    ("採用", "応募書類が外部サービスの学習に使われる", 2, 3, "送信先を承認済みのサービスに限る", 1, 3),
    ("採用", "選考の理由を応募者に説明できない", 2, 2, "判断の理由を担当者が記録する", 1, 2),
    ("与信", "誤った判定で取引を断る", 2, 3, "境界付近の判定は人が審査する", 1, 3),
    ("与信", "データが古くなり判定がずれる", 3, 2, "判定の分布を毎月監視する", 2, 2),
    ("与信", "特定の地域や業種を一律に不利に扱う", 2, 3, "区分ごとの承認率を四半期ごとに測る", 1, 3),
    ("与信", "判定の理由を取引先に説明できない", 2, 2, "主な判定要因を記録して残す", 1, 2),
]
df = pd.DataFrame(rows, columns=["用途", "起こりうる害", "前_起こりやすさ", "前_重大さ", "緩和策", "後_起こりやすさ", "後_重大さ"])
df["緩和前"] = df["前_起こりやすさ"] * df["前_重大さ"]
df["残るリスク"] = df["後_起こりやすさ"] * df["後_重大さ"]


def decide(score):
    if score >= 6:
        return "受容しない(用途を見直す)"
    if score >= 3:
        return "条件付きで受容(監視を続ける)"
    return "受容"


df["判断"] = df["残るリスク"].map(decide)
print(df[["用途", "起こりうる害", "緩和前", "残るリスク", "判断"]].to_string(index=False))
print("緩和前の合計", int(df["緩和前"].sum()), "残るリスクの合計", int(df["残るリスク"].sum()))
print(df["判断"].value_counts().to_string())
print("重大さが下がった害の数", int((df["後_重大さ"] < df["前_重大さ"]).sum()), "/", len(df))
実行した結果を次の表にまとめます。
| 用途 | 起こりうる害 | 緩和策 | 緩和前 | 残るリスク | 判断 |
|---|---|---|---|---|---|
| 採用 | 特定の属性の応募者を低く順位付けする | 人が全件を確認し、属性ごとの通過率を毎月測る | 9 | 6 | 受容しない(用途を見直す) |
| 採用 | 要約の誤りで経歴を取り違える | 要約と原本の照合を手順に入れる | 4 | 2 | 受容 |
| 採用 | 応募書類が外部サービスの学習に使われる | 送信先を承認済みのサービスに限る | 6 | 3 | 条件付きで受容(監視を続ける) |
| 採用 | 選考の理由を応募者に説明できない | 判断の理由を担当者が記録する | 4 | 2 | 受容 |
| 与信 | 誤った判定で取引を断る | 境界付近の判定は人が審査する | 6 | 3 | 条件付きで受容(監視を続ける) |
| 与信 | データが古くなり判定がずれる | 判定の分布を毎月監視する | 6 | 4 | 条件付きで受容(監視を続ける) |
| 与信 | 特定の地域や業種を一律に不利に扱う | 区分ごとの承認率を四半期ごとに測る | 6 | 3 | 条件付きで受容(監視を続ける) |
| 与信 | 判定の理由を取引先に説明できない | 主な判定要因を記録して残す | 4 | 2 | 受容 |
8つの害の判断は、受容が3件、条件付きで受容が4件、受容しない(用途を見直す)が1件でした。緩和前の値の合計は45、残るリスクの合計は25です。合計の値は、緩和策がどれだけ効いたかの目安にはなりますが、害ごとの判断の代わりにはなりません。合計が下がっていても、1つの害が見直しの水準に残っていれば、その用途はそのままでは承認できないからです。
受容しないと判断した1件は、採用の「特定の属性の応募者を低く順位付けする」でした。人が全件を確認し、属性ごとの通過率を毎月測る緩和策で、起こりやすさは3から2に下がりましたが、重大さは3のままで、残るリスクは6です。この架空の評価では、8つの害のどれについても、緩和策で重大さが下がったものは0件でした。置いた緩和策が、どれも人の確認や監視によって起こりやすさを下げる種類のものだったからです。なお、緩和後の値は、緩和策が計画どおりに機能するという仮定で置いています。重大さを下げるには、たとえば順位を付ける機能を外して要約だけにする、のように用途の中身を変える必要があります。影響評価の結果は「承認か却下か」ではなく、「どこを変えれば承認できるか」を申請した部門に返すために使うものだと考えています。用途を変えた場合は、台帳の該当の行を更新し、区分の判定と影響評価をやり直します。
次のグラフは、8つの害について、緩和前と緩和後の値を並べたものです。破線は判断の境目で、左の破線より左が受容、2本の破線の間が条件付きで受容、右の破線より右が用途の見直しです。凡例はグラフの下に置いています。
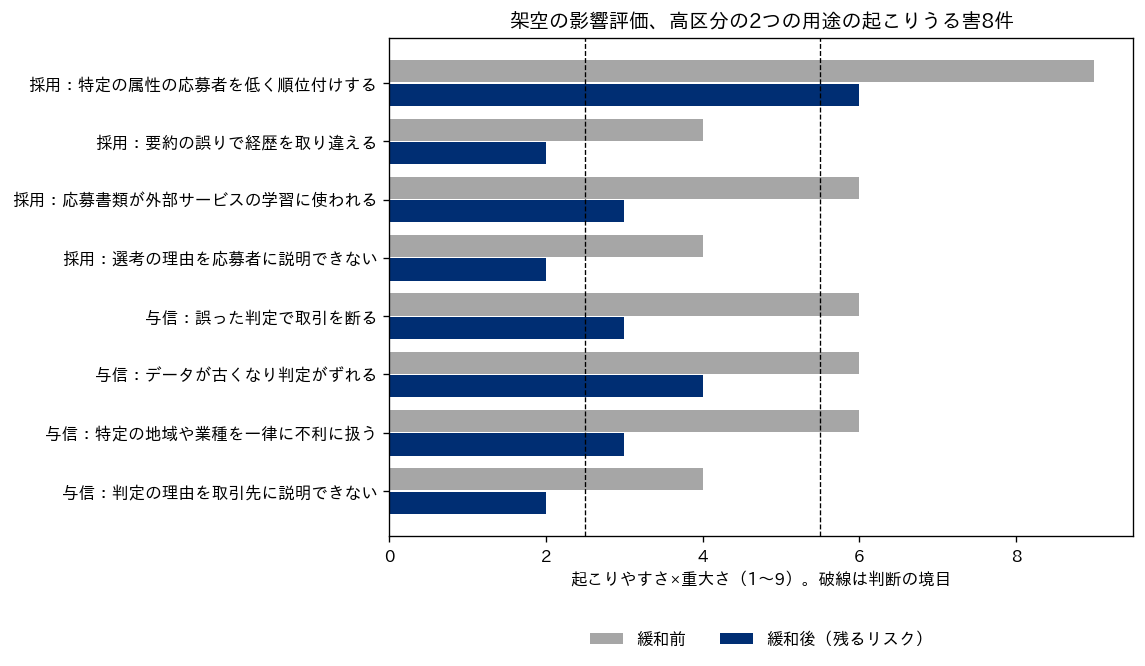
グラフにすると、緩和策の後でも右の破線を越えている害が1つだけあることと、条件付きの範囲に4つの害が並んでいることが一目で分かります。条件付きの4つは、監視を続けることが受容の条件です。監視だけでは害は減らないので、異常が見つかったときの対応も受容の条件に含めます。次の表は、4つそれぞれの確認の項目・担当・頻度・異常時の対応の例です(架空の設定)。
| 条件付きで受容した害 | 確認する項目 | 担当(例) | 頻度(例) | 異常時の対応(例) |
|---|---|---|---|---|
| 応募書類が外部サービスの学習に使われる | 応募書類の送信先が承認済みのサービスだけか | 情報システム | 毎月 | 承認外の送信先が見つかれば利用を止め、事務局に報告する |
| 誤った判定で取引を断る | 人の審査に回した件数と、審査で判定を覆した件数 | 与信の審査担当 | 毎月 | 覆した件数が増えたら自動の判定を止め、委員会で再審査する |
| データが古くなり判定がずれる | 判定の分布の変化 | 経理と情報システム | 毎月 | 分布が大きく動いたら自動の判定を止め、データとモデルを見直す |
| 特定の地域や業種を一律に不利に扱う | 地域・業種の区分ごとの承認率 | 事務局 | 四半期ごと | 差が許容の範囲を超えたら委員会で再審査し、判定の基準を直す |
これらの項目は、運用を始めた後の監視の項目として第11章の仕組みに引き継ぎます。受容しないとした採用の順位付けの害(属性ごとの通過率で測る)は、用途を見直した後に改めて評価します。公平性の指標の具体的な計算は第10章で扱います。
台帳を最新に保つ仕組み、申請・変更・廃止と見直しのきっかけ
台帳は、作った時点から古くなり始めます。新しい用途は毎月のように生まれ、使っている AIの版は変わり、使わなくなった用途は行だけが残ります。台帳を最新に保つには、申請・変更・廃止の3つの手続きを、台帳の更新と必ず結び付けておくことが必要です。新しい用途を使い始めるときは申請し、台帳に行を足してから使い始める。用途・入力するデータ・出力の使われ方・影響を受ける人のどれかが変わるときは変更を届け出て、区分の判定をやり直す。使う AIが変わるときも変更を届け出て、区分への影響を確かめる。使わなくなったら廃止を届け出て、行を消さずに廃止日を記入する。この3つが基本です。廃止した行を消さないのは、過去にどの用途で AIを使っていたかを、インシデントや問い合わせの調査のときに確かめられるようにするためです。
手続きのほかに、決まった時期の見直しと、出来事をきっかけにした見直しを置きます。次の表は、見直しのきっかけと、そのときに確かめることを整理したものです。
| 見直しのきっかけ | 確かめること | 主に動く人 | 区分の判定のやり直し |
|---|---|---|---|
| 見直し日の到来(高は6か月、中と低は12か月の例) | 用途・入力・出力の使われ方が台帳どおりか。承認の条件が守られているか | 業務部門の責任者。高は事務局が同席 | 変化があればやり直す |
| 使う AIの変更(製品の切り替え、モデルの更新、ベンダーの利用規約の変更) | 学習への利用の有無、データの保存の扱い、性能の変化(第9章) | 情報システム・購買 | 区分への影響を確かめ、判定に使う列のどれかが変わればやり直す。性能の変化は影響評価の見直しで扱う |
| 用途の広がり(対象の部門や顧客を広げる、人の確認を外す) | 影響を受ける人と出力の使われ方が変わっていないか | 業務部門の責任者 | 必ずやり直す |
| AIインシデントや苦情の発生(第11章) | 影響評価で想定した害か、想定外の害か。緩和策が効いていたか | 事務局・AIガバナンス委員会 | 影響評価をやり直す |
| 法令・ガイドラインの改正(EU AI Act の改正、AI事業者ガイドラインの改訂など) | 判定の基準と禁止の一覧を変える必要があるか | 法務・事務局 | 基準を変えたら、該当しうる行をすべてやり直す |
| 台帳の点検で見つかった食い違い(自己申告と判定のずれ、記入の漏れ) | 申請の書き方の説明が足りているか | 事務局 | 食い違った行をやり直す |
表の5行目の法令・ガイドラインの改正は、見落としやすいきっかけです。たとえば EU AI Act は、2026年7月27日時点の統合版で、第5条の禁止の項目に新しい号(第1項(ba)と(bb))が加わっています。特定できる人物の性的なコンテンツを本人の適切な同意なく生成・加工することと、児童の性的虐待の素材の生成に関わる禁止で、適用は2026年12月2日からです(第113条)。AI事業者ガイドラインも、2024年4月の第1.0版から版を重ね、2026年3月31日に第1.2版が公表されています。判定の基準と禁止の一覧は、改正を追う担当を決めておかないと、作った時点のまま止まります。改正の追い方と担当の決め方は第14章で扱います。
台帳に載っていない利用をどう拾うかも、決めておく必要があります。手続きを重くしすぎると、申請せずに使う利用が増えます。低の区分を業務部門の責任者の承認だけで済むようにしたのは、このためです。そのうえで、情報システム部門が把握している契約や利用の記録(どのサービスにどの部門が接続しているか)と台帳を年に1回は突き合わせ、台帳に無い利用を見つけたら、責めるのではなく申請を手伝う、という扱いにしておくと、台帳に載せることへの抵抗が小さくなると考えています。
経営上の損失と経営判断、台帳が無い状態で個別の承認を続けない
台帳と影響評価が無い、または形だけになっているときに起こりうる損失を、本コラムの6つの損失の型で整理します。1つ目は導入の停滞です。どの用途が使ってよく、どの用途に手続きが要るかが決まっていないと、現場は判断がつかずに使わないか、すべての用途を個別に法務や情報システム部門へ相談し、相談の待ちが長くなります。2つ目は規制違反です。EU の市場と関係する用途や、法令が禁止している用途を把握できず、気づかないうちに義務の対象になっている、ということが起こりえます。3つ目は権利侵害で、個人情報や機密情報を入力する用途が台帳に載っていなければ、入力の制限も送信先の確認も行われないおそれがあります。
4つ目は誤った判断の放置です。高の区分の用途について影響評価を行わず、監視の指標も決めていないと、採用や与信の判定に偏りが出ていても、誰も測っていないので気づけません。5つ目は信頼の失墜で、応募者や取引先が不当な扱いを受けたことが外部に知られたとき、「どの用途で AIを使い、どう確かめていたか」を説明できなければ、害そのものに加えて説明できないことが信頼を損ないます。6つ目は二重投資で、部門ごとにばらばらに同じ種類の AIを契約し、同じような評価をそれぞれが行う状態は、台帳で用途を横に並べて見るまで気づきにくいものです。
この6つのうち、本コラムの整理では、台帳が主に対策を支えるのは導入の停滞・規制違反・権利侵害・二重投資の4つで、影響評価が主に支えるのは誤った判断の放置と信頼の失墜の2つだと整理できます。どちらも、それだけで損失を防げるわけではなく、必要な対策の実施を支える道具です。台帳は「どこで使っているか」を見えるようにし、影響評価は「使っている所で何が起こりうるか」を見えるようにするものです。どちらか一方だけでは足りません。
この節でいう「最初」は、経営が AIガバナンス責任者・AIガバナンス委員会・事務局の3点を決めたあとの段階を指します。そのうえで、台帳について経営が最初に決めることは、台帳を作り、台帳に載っていない AIの利用を承認しない、という原則です。台帳が無いまま、相談が来た用途を1件ずつ承認していくと、承認の基準が案件ごとに変わり、何を承認したかの記録も散らばります。後から台帳を作ろうとしても、過去の承認の理由を集め直すことになり、手間は最初に作るより大きくなります。個別の承認を続けている会社では、まず承認済みの用途を台帳に写すことから始め、その後の承認はすべて台帳の行を起点にする、という切り替えの日を決めることが有効だと考えています。
2つ目は、判定の基準と承認の経路を AIガバナンス委員会が承認し、AIガバナンス責任者が経営に報告することです。経営が示すのは、自社がどこまで慎重に AIを扱うかという、許容するリスクの考え方です(AI基本方針。第12章)。どの用途を高にして委員会に上げるかは、その考え方を基準に落としたものです。基準を事務局や法務だけで決めると、慎重すぎて導入が止まるか、緩すぎて高の用途が委員会を通らずに承認されるかのどちらかに寄りやすくなります。本コラムの基準の例のように、条件を選択肢で書いた表にしておけば、委員会でも経営への報告でも短い時間で確かめられます。
3つ目は、事務局に台帳の点検の時間を割り当てることです。この章の架空の例では、40件の台帳でも、見直しの超過が12件、自己申告と判定の食い違いが6件見つかりました。こうした食い違いは、誰かが定期的に台帳を点検しなければ見つかりません。点検は、選択肢の列から区分を判定し直すことと、見直し日を過ぎた行を数えることなので、この章のコードのように機械的に回せます。経営への報告には、区分ごとの件数、見直しの超過の件数、自己申告と判定の食い違いの件数、高の行の影響評価の判断の内訳を並べると、台帳が生きているかどうかを判断できます。報告の形と会議体は第13章で扱います。
この章では、AIのリスクを洗い出して評価するための道具として、ユースケース台帳と影響評価を扱いました。管理の単位を製品ではなくユースケースに置き、区分の判定に使う列を選択肢で書かせること。本コラムのリスク区分(禁止・高・中・低)は社内の承認の経路を決めるもので、EU AI Act の4つの水準とは別物であり、EU AI Act 上の扱いは「EUとの関係」の列で拾って別に確かめること。高の用途には、影響を受ける人から残るリスクの判断までの6つの段階で影響評価を行い、緩和策が起こりやすさと重大さのどちらを下げるかを分けて見ること。そして、台帳は申請・変更・廃止の手続きと見直しのきっかけに結び付けなければ古くなることです。第8章では、台帳の中で最も件数の多い生成AIの社内利用について、入力・出力・権利・個人情報のルールを扱います。
この章を深めたい方への参考書籍
『「AIリスク」の解剖 決定と責任を社会学的に考える』(佐久間弘明 著、中央経済社):2026年3月刊行の本で、国立国会図書館の書誌の要約によれば、「AIリスク」をそれへの批判の言説から読み解いて具体化し、社会実装に資する議論の道筋を示すものです。この章で、残るリスクを受け入れるかどうかの判断を委員会に置き、判断の理由を記録に残すとした点を、リスクをめぐる決定と責任の関係という側面から考えるときの材料になります。
『ISO 31000:2018〈JIS Q 31000:2019〉リスクマネジメント解説と適用ガイド』(リスクマネジメント規格活用検討会 編著、日本規格協会):リスクマネジメントの国際規格 ISO 31000(2018年)と、それに対応する JIS Q 31000(2019年)の解説書です。ISO 31000 は AIに限らない組織のリスクマネジメントの指針で、この章の影響評価の6つの段階を、自社がすでに持っている全社的なリスク管理の手順と結び付けるときの土台になります。
『プライバシー影響評価実施マニュアル ISO/IEC 29134対応』(瀬戸洋一 編著、長谷川久美 著、日科技連出版社):個人情報の取扱いについての影響評価(PIA)を、国際規格 ISO/IEC 29134 に沿って実施する手順を扱った本です。AIの影響評価と PIA は、影響を受ける人を特定し、害を洗い出し、対策と残るリスクを記録するという骨格が近いので、個人情報を入力する用途の影響評価をどう組み立てるかを考えるときに参考になります。2020年の刊行のため、その後の個人情報保護法の改正(令和8年改正を含む)は別に確かめる必要があります。
第8章 生成AIの社内利用ルール、入力・出力・権利・個人情報
第7章では、自社の AIの使い道をユースケース台帳に並べ、本コラムのリスク区分(禁止・高・中・低)を付けて、影響評価を行う手順を扱いました。台帳を作ると、多くの会社で件数が最も多くなるのは、文章の下書き・要約・翻訳・調べものの補助・コードの作成の補助のように、従業員が外部の生成AIサービスを日々の業務で使う用途だと考えられます。ここでいう生成AIサービスは、利用者が文章で入力する質問や作業の指示(プロンプト)に応えて、文章・画像・コードなどを生成するサービスを指します。一つひとつは影響の小さい用途でも、使う人の数が多く、入力される情報の種類も幅広いため、個別の承認だけで管理するのは現実的ではありません。そこで必要になるのが、全社員に共通して適用する生成AIの社内利用ルールです。
この章では、そのルールで決めておく6つの論点(使ってよいサービス・入力してよい情報・出力の確認・権利・表示・記録)を整理します。節の順序は、6つの論点の全体像のあと、入力(情報の区分、個人情報、営業秘密)、出力、権利(著作権)、セキュリティ、表示と記録の順です。セキュリティは独立した論点ではなく、使ってよいサービスと出力の確認の両方にかかわる事柄として、1つの節にまとめました。根拠として開いた一次資料は、個人情報保護委員会の「生成AIサービスの利用に関する注意喚起等」(2023年6月2日)、文化庁の文化審議会著作権分科会法制度小委員会による「AIと著作権に関する考え方について」(2024年3月15日)と、文化庁著作権課の「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月31日)、e-Gov 法令検索の個人情報保護法・著作権法・不正競争防止法の条文、個人情報保護委員会の令和8年改正の報道発表と概要の資料、経済産業省の営業秘密のページ、OWASP の LLM アプリケーションのリスクの一覧、総務省・経済産業省の AI事業者ガイドライン(第1.2版、2026年3月31日)の該当箇所です。いずれも2026年10月28日に開いて確認しました。資料に書かれていないことは補わず、資料の記述は要旨を自分の言葉で書き、条番号と出典を添えます。
この章は法的な助言ではありません。ここで紹介する資料には、法令の条文、行政機関による解釈や注意喚起、任意の取組の提案が混ざっています。どれも、個別の利用が適法かどうかを決めるものではありません。たとえば「AIと著作権に関する考え方について」は、それ自体に法的な拘束力は無く、特定の生成AIについて確定的な法的評価をするものでもないと冒頭で断っています。自社の具体的な利用が著作権・個人情報・営業秘密の観点で問題ないかは、事実関係によって結論が変わるため、弁護士などの専門家に個別に確認することを前提にしています。また、この章は特定の生成AIサービスを推奨したり、サービスどうしを比べたりするものではありません。
社内利用ルールで決める6つの論点
生成AIの社内利用ルールは、「使ってよいか、いけないか」の二択で書くと、すぐに現場の実態と合わなくなります。使ってよい場面と、そのときに守ることを具体的に決めておく方が、利用する側も判断しやすく、管理する側も確認しやすくなります。決めておく論点は、大きく分けて6つあります。どのサービスを使ってよいか、何を入力してよいか、出力をどう確かめるか、権利をどう扱うか、AIを使ったことをどう示すか、何を記録に残すか、です。
次の表は、6つの論点ごとに、ルールで決めることと、その判断の材料になる公的資料をまとめたものです。「決める人の例」は一般的な分担の例で、会社の体制によって変わります。役割と会議体の詳しい設計は第13章で扱います。
| 論点 | ルールで決めること | 決める人の例 | 判断の材料になる公的資料 |
|---|---|---|---|
| 使ってよいサービス | 業務で使ってよいサービスと契約の形態(会社として契約したもの、個人の登録によるもの)、使ってよい部門と用途、新しいサービスを使いたいときの申請の手順 | そのユースケースのリスク区分の承認者(確認は情報システム部門・法務・購買、受付は AIガバナンスの事務局) | 個人情報保護委員会の注意喚起(利用規約やプライバシーポリシーの確認)、文化庁のチェックリスト(学習済みモデルの情報と利用規約の確認) |
| 入力してよい情報 | 情報の区分(公開情報・社内情報・機密・個人情報)ごとに、入力してよいか、どの条件なら入力してよいか | 情報セキュリティの担当と個人情報の担当 | 個人情報保護委員会の注意喚起、不正競争防止法の営業秘密の定義、AI事業者ガイドラインの AI利用者の項目 |
| 出力の確認 | 出力を何に使うかに応じて、誰が何を確かめてから使うか | 業務部門の責任者 | 個人情報保護委員会の注意喚起(応答に不正確な内容が含まれうる)、AI事業者ガイドライン(偽情報等への対策) |
| 権利 | 他人の著作物を入力するときの扱い、生成物を社外に出す前に既存の著作物と似ていないかを確かめる手順、問題が見つかったときの連絡先 | 法務と知的財産の担当 | 文化庁の「考え方」とチェックリスト、著作権法 |
| 表示 | 社外に出す文書や制作物で、AIを使ったことを示す場面と示し方 | 広報と法務、業務部門の責任者 | AI事業者ガイドライン(AIを利用している事実の情報提供)、文化庁のチェックリスト(関係者への説明) |
| 記録 | 何をどれだけの期間残すか(使ったサービス、用途、プロンプト、出力の確認の結果) | 情報システム部門と文書管理の担当 | 文化庁のチェックリスト(生成の過程を確認できる状態の確保) |
表の論点は互いにつながっています。使ってよいサービスを決めるときに、そのサービスが入力を学習に使うかどうかを確かめておかないと、入力してよい情報の区分を決められません。出力の確認の手順が無いと、権利の確認も表示の判断も、誰がいつ行うのかが曖昧になります。記録が無いと、問題が起きたときに、どの入力からどの出力が出て、誰がそれを確かめたのかを後から追えません。このため、6つの論点は一つの文書の中で、互いを参照する形で決めておくことが有効だと考えています。社内規程の文書の階層(基本方針・利用規程・手順書)のどこに何を書くかは第12章で扱います。この章で扱うのは、そこに書く中身です。
なお、社内利用ルールの対象は、従業員が外部の生成AIサービスを業務で使う場面を中心にしています。自社の製品やサービスに生成AIを組み込んで顧客に提供する場合は、AI事業者ガイドラインでいう AI提供者の立場が加わり、確かめることが増えます。外部のモデルやサービスを調達するときにベンダーに確かめることと、契約で決めておく論点は第9章で扱います。
入力してよい情報を4つの区分で決める
社内利用ルールの中心は、何を入力してよいかの決め方です。本コラムでは、生成AIの利用を全面的に禁止するよりも、入力してよい情報の範囲を決めて、その範囲で使ってもらう方が、権利侵害と情報漏えいを抑えやすいと考えています。これは公的資料や統計にもとづく結論ではなく本コラムの判断で、その理由は章末の経営判断の節で述べます。そのためには、社員が迷わずに当てはめられる程度の、少ない数の区分を用意することが要ります。本コラムでは、公開情報・社内情報・機密・個人情報の4つに分けることを提案します。既存の情報セキュリティの規程に情報の格付けがある会社は、新しい区分を作らずに、その格付けに対応させる方が混乱が少なくなります。
次の表は、4つの区分ごとに、外部の生成AIサービスへの入力の扱いの例を示したものです。「入力の扱いの例」は本コラムの提案で、法令やガイドラインがこの形を定めているわけではありません。どの条件を置くかは、使うサービスでの入力の扱い(入力を学習に使うか、どこにどれだけの期間保存するか、誰がアクセスできるか)によって変わるため、サービスを承認するときに確かめた内容と合わせて決めてください。
| 区分 | 例 | 入力の扱いの例 | 入力の前に確かめること |
|---|---|---|---|
| 公開情報 | 自社が公表済みの報道発表、公開されているウェブページの内容、公的機関の公表資料 | 承認済みのサービスであれば入力してよい | 公開されていても他人の著作物であれば、著作物を入力する場合の扱い(後の節)に従う。公開されている情報に個人情報が含まれる場合は、個人情報の行の条件も当てはめる |
| 社内情報 | 社内の手順書、会議の議事の要旨、公開前の一般的な企画の文書 | 社内情報の業務利用について、所管の部門が確認・承認したサービスに限って入力してよい | 学習への利用の有無・保存の期間・アクセスできる人を、情報システム部門が確かめていること |
| 機密 | 営業秘密として管理している技術情報や顧客の取引条件、未公表の決算の情報、取引先から秘密保持の約束のもとで受け取った情報 | 利用規程で定めた条件(承認済みのサービスであること、秘密保持の約束が入力を認めていることなど)を満たす用途に限って入力してよい。その用途は第7章の判定で区分「中」となり、事務局の責任者が承認する。条件を外れる入力は利用規程で禁止し、認めるなら例外の承認とする | 秘密として管理している情報か、取引先との秘密保持の約束が第三者のサービスへの入力を認めているか |
| 個人情報 | 顧客や従業員の氏名・連絡先、問い合わせの本文に含まれる個人の情報、採用の応募書類 | 利用規程で定めた条件(承認済みのサービスであること、利用目的の範囲内であることなど)を満たす用途に限って入力してよい。その用途は第7章の判定で区分「中」となり、事務局の責任者が承認する。条件を外れる入力は利用規程で禁止し、認めるなら例外の承認とする | 特定した利用目的の範囲内か、サービスの事業者が入力を機械学習に使わないことなどを確かめたか(次の節) |
この区分で迷いやすいのは、1つの文書に複数の区分の情報が混ざっている場合です。たとえば、社内向けの議事の要旨に顧客の担当者の氏名が入っている場合、その文書は社内情報であると同時に個人情報を含んでいます。このような場合は、当てはまるすべての区分の条件を満たしたときに限って入力する、と決めておくのが分かりやすいと考えています。機密と個人情報は守る条件が違うため、片方の条件だけでは確認が漏れるからです。氏名などを伏せてから入力すれば社内情報として扱える、という運用を認めるかどうかも、ルールで決めておく論点です。伏せ方が不十分だと他の情報との組み合わせで個人が分かることがあるため、認める場合は伏せる項目を具体的に示しておく必要があります。
もう一つ迷いやすいのは、区分を誰が判断するかです。入力する社員本人が判断するのが基本ですが、判断に迷ったときに相談できる窓口が無いと、迷ったまま入力するか、使うのをやめるかのどちらかになります。前者は情報漏えいの、後者は導入の停滞の原因になります。相談の窓口を一つ決めておき、寄せられた質問と回答を社内で共有して、区分の例を増やしていくことが、区分を実務に合わせて育てる方法だと考えています。
個人情報保護委員会の注意喚起が示していること
個人情報を生成AIサービスに入力する場面について、国の機関が事業者に向けて示した資料として、個人情報保護委員会の「生成AIサービスの利用に関する注意喚起等について」があります。2023年6月2日付の文書で、ページの別添1が注意喚起の本体です。別添1は、生成AIサービスを、質問や作業の指示(プロンプトの入力)などに応えて文章や画像などを生成する AIを使ったサービス、と説明したうえで、個人情報取扱事業者・行政機関等・一般の利用者のそれぞれに向けた注意点を示しています。個人情報保護委員会の注意情報の一覧を2026年10月28日に確認したところ、この文書を置き換える、生成AIサービスの利用全般についての新しい注意喚起は見当たりませんでした。
個人情報取扱事業者(個人情報保護法の第16条第2項の用語で、個人情報データベース等を事業に使っている者。国の機関などは除かれます)に向けた注意点は2つです。1つ目は、個人情報を含むプロンプトを入力する場合には、特定した利用目的を達成するために必要な範囲内であることを十分に確認すること、です。個人情報保護法は、第17条第1項で個人情報を扱う目的(利用目的)をできる限り特定することを、第18条第1項で本人の同意を得ずに利用目的の達成に必要な範囲を超えて扱わないことを定めています。生成AIに入力することも個人情報の取扱いの一つなので、「何のために集めた情報か」「生成AIに入力することがその目的の範囲に入るか」を確かめる必要がある、という趣旨です。
2つ目は、本人の同意を得ずに個人データを含むプロンプトを入力し、その個人データが応答の出力以外の目的で扱われる場合には、個人情報保護法の規定に違反することとなる可能性がある、という指摘です。そのため、このような入力を行う場合には、生成AIサービスを提供する事業者がその個人データを機械学習に利用しないことなどを十分に確認するよう求めています。ここでいう個人データは、個人情報保護法の第16条第3項の用語で、検索できるように体系的に整理された個人情報の集まり(個人情報データベース等)を構成する個人情報を指します。注意喚起は「違反することとなる可能性がある」と書いており、どのような場合に違反になるかを一律に示しているわけではありません。社内利用ルールに落とすときは、この限定を落とさずに、「入力を学習に使わないことなどをサービスの契約で確かめたうえで、利用目的の範囲内に限って入力する」という確認の手順として書くのが妥当だと考えています。ただし、この2点は確認事項の一部です。委託や第三者提供にあたるか、外国にある第三者への提供にあたるかなどは、提供先での取扱いの実態に応じて担当部門が確かめて判断します。
一般の利用者に向けた留意点は次の3つで、社員への教育の材料としても使えます。
- 入力した個人情報が機械学習に使われ、他の情報と結びついて、正確または不正確な内容で出力されるリスクがある
- 応答は確率的な相関関係にもとづいて生成されるため、不正確な個人情報が含まれるリスクがある
- 事業者の利用規約やプライバシーポリシーなどを確認し、入力する情報の内容を踏まえて利用を判断する
2つ目の留意点は、次の次の節で扱う出力の誤りの問題を、個人情報の側から述べたものと読めます。
個人情報保護法そのものは、2026年に改正されています。個人情報保護委員会の報道発表によると、「個人情報の保護に関する法律等の一部を改正する法律」は2026年7月10日に成立し、7月17日に公布されました。改正法は、一部を除き、公布日から起算して2年以内で政令で定める日から施行されると説明されています。委員会が公表した改正法の概要の資料には、統計情報等の作成にのみ利用される場合に、個人データ等の第三者提供などについて本人の同意を不要とする改正が挙げられ、その統計情報等の作成には、統計作成等であると整理できる AI開発等を含むと注記されています。これは主に AIを開発する側に関わる改正で、従業員が外部の生成AIサービスを使う場面の注意点を変えるものとして説明されているわけではありません。施行の日と、政令・委員会規則・ガイドラインの内容はこれから決まるため、社内利用ルールの個人情報の項目は、施行の段階に合わせて見直す前提で作っておく必要があります。データの側から見た個人情報の扱いの全体は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。
営業秘密と秘密情報、不正競争防止法の要件
入力の区分の「機密」に関わるのが、営業秘密の扱いです。不正競争防止法の第2条第6項は、営業秘密を、秘密として管理されている生産方法・販売方法その他の事業活動に有用な技術上または営業上の情報であって、公然と知られていないもの、と定義しています(e-Gov 法令検索の現行の条文で確認)。この定義から、営業秘密として法の保護を受けるには、秘密として管理されていること、事業活動に有用であること、公然と知られていないこと、の3つがそろっている必要があると読めます。不正競争防止法は、営業秘密を不正に取得したり、示された営業秘密を不正な目的で使ったり開示したりする行為を、第2条第1項の不正競争の類型として定めています。
生成AIの社内利用ルールとの関係で重要なのは、1つ目の「秘密として管理されている」という要件です。社内で「重要な情報」とされていても、誰でも閲覧でき、秘密であることが示されておらず、社外のサービスへの入力も自由に行われている状態では、その情報が秘密として管理されていたと言えるかが問われうる、と考えられます。つまり、機密の区分の情報の外部の生成AIサービスへの入力を、条件を満たし承認を得た用途に限るというルールは、情報の漏えいを防ぐだけでなく、その情報を秘密として管理していることを示す仕組みの一部にもなります。どのような管理をしていれば秘密として管理されていると評価されるかは、個別の事情によって判断されるため、ここで基準を言い切ることはしません。
経済産業省は、営業秘密のページで、不正競争防止法による保護を受けるために必要となる最低限の水準の対策を示すものとして「営業秘密管理指針」(2025年3月改訂)を、秘密情報の漏えいを未然に防ぎたい企業が対策を行う際の参考として「秘密情報の保護ハンドブック」(2024年2月改訂)を公開しています。従業員の目線での留意点を説明した「知っておきたい営業秘密」も同じページにあります。本コラムの執筆では、営業秘密管理指針の PDF を取得できなかったため、指針の本文の中身はこの章では引いていません。機密の区分の定義と管理の方法を決めるときは、これらの資料の最新版を開いて、自社の既存の情報管理の規程と突き合わせてください。
取引先から受け取った情報にも注意が要ります。秘密保持契約のもとで受け取った情報は、自社の営業秘密ではなくても、契約で使い方や開示の範囲が限られていることが多いからです。外部の生成AIサービスへの入力が、契約上の「第三者への開示」や「目的外の使用」に当たるかどうかは、契約の文言とサービスの仕組みによって変わります。取引先の情報を入力してよいかは、入力の区分の表のとおり用途ごとに確かめ、判断に迷う場合は法務に相談する、という手順をルールに入れておくことが有効だと考えています。
出力の誤り、ハルシネーションと確認の手順
生成AIの出力には、事実と異なる内容が、もっともらしい文章の形で含まれることがあります。この現象は一般にハルシネーションと呼ばれます。存在しない文献や判例を挙げる、数字を取り違える、実在の人物について事実でない経歴を書く、といった形で表れます。個人情報保護委員会の注意喚起も、応答は確率的な相関関係に基づいて生成されるため不正確な内容が含まれることがある、と指摘しています。AI事業者ガイドライン第1.2版は、共通の指針の「人間中心」の項目で、AIが生成した偽情報・誤情報・偏向情報が社会を不安定化・混乱させるリスクを認識したうえで必要な対策を講じることを挙げ、その脚注で、RAG(検索拡張生成。社内の文書などを検索して、その結果を生成AIの回答に使う仕組み)の活用等によりハルシネーションの抑制や出力の根拠の透明性の向上等が期待されている、と記しています(本編16ページ、脚注27)。期待されている、という書き方であり、RAG を使えば誤りが無くなるとは書かれていません。
このため、社内利用ルールでは、出力に誤りが含まれる前提で、確認の手順を決めておく必要があります。確認の重さは、出力を何に使うかで変えるのが現実的です。自分の考えを整理するための下書きと、顧客に送る回答や社外に公表する文書とでは、誤りが残ったときの影響がまったく違うからです。AI事業者ガイドラインの AI利用者の項目も、AIの出力について精度とリスクの程度を理解し、さまざまなリスク要因を確認したうえで利用することを挙げています。次の表は、出力の使い方ごとの確認の水準の例です。
| 出力の使い方 | 誤りが残ったときの影響の例 | 確認の水準の例 | 確認する人の例 |
|---|---|---|---|
| 自分用の下書き・考えの整理 | 本人の作業のやり直し | 本人が使う前に読み直す | 本人 |
| 社内の共有資料・議事の要旨 | 社内での誤解、誤った前提での議論 | 数字・固有名詞・日付を元の資料と照合する。生成AIを使ったことを資料に書いておく | 作成者 |
| 顧客への回答・取引先への文書 | 顧客の誤った判断、信頼の失墜 | 事実の記述を一次資料で確かめる。送る前に担当者以外の1人が読む | 作成者と上長、またはその業務の責任者 |
| 社外への公表物・広告・ウェブの記事 | 信頼の失墜、権利侵害、表示に関する法令への抵触 | 事実の確認に加えて、既存の著作物と似ていないかの確認(後の節)と、表示の要否の判断を行う | 業務の責任者と広報、必要に応じて法務 |
| 法令・医療・財務など専門的な判断の材料 | 誤った判断の放置、規制違反 | 出力を判断の根拠にしない。資格や権限を持つ人が一次資料にもとづいて判断する | その分野の専門家 |
表の最後の行は、出力を確かめる方法というより、使い道そのものの制限です。生成AIの出力をそのまま専門的な判断の根拠にする用途は、社内利用ルールの一般的な範囲には入れず、第7章のユースケース台帳に個別に載せて、影響評価を経て承認する扱いにする方が安全だと考えています。人の評価や選考の参考に AIの出力を使う場合も同様です。AI事業者ガイドラインは AI利用者の項目で、AIの出力を特定の個人や集団に対する評価の参考にする場合には、AIを利用している旨をその個人や集団に通知し、自動化バイアス(自動化された仕組みの出力を人が過度に信頼する傾向)も考慮して人間が合理的に判断すること、などを挙げています(本編42ページ)。
確認の手順で見落とされやすいのは、確認した結果を残すことです。「確かめた」と言うだけでは、後で誤りが見つかったときに、どこまで確かめていたのかが分かりません。顧客への回答や社外への公表物のように確認の水準が高い用途では、照合した資料と確認した人を、文書の版の記録や承認の記録に残しておくと、誤りの原因をたどりやすくなります。誤りによって実際に被害が出た、または出かけた場合は、AIインシデントとして扱います。報告と対処の流れは第11章で扱います。
著作権、開発・学習段階と生成・利用段階を分けて考える
生成AIと著作権の関係について、文化庁は「AIと著作権」のページで関連する資料をまとめています。中心になるのは、文化審議会著作権分科会法制度小委員会が2024年3月15日に取りまとめた「AIと著作権に関する考え方について」(以下、この章では「考え方」)です。文化庁のページは、生成AIと著作権の関係について判例や裁判例の蓄積がない現状を踏まえて考え方を整理し、周知するために取りまとめたもの、と説明しています。冒頭で触れたとおり、「考え方」は公表時点の小委員会としての一定の考え方を示すもので、それ自体に法的な拘束力は無く、今後の判例の蓄積や技術の発展に応じて見直しの検討を行う予定であることも書かれています。
「考え方」は、生成AIとの関係で著作物が使われる場面を、大きく「開発・学習段階」と「生成・利用段階」に分けて整理しています。開発・学習段階は、学習用のデータの収集と加工、基盤モデルの事前学習、既存の学習済みモデルへの追加的な学習、RAG などで生成AIへの入力に使うためのデータベースの作成、といった場面です。生成・利用段階は、生成AIで生成物を出力し、その生成物をインターネットで送信するなどして利用する段階です。この2つは、問題になる条文も、判断の考え方も違います。社内利用ルールでも、自社がどちらの段階に関わっているのかを分けて考えることが出発点になります。従業員が外部の生成AIサービスを使うだけであれば、関わるのは主に生成・利用段階ですが、社内の文書を集めて RAG のデータベースを作ったり、自社でモデルに追加学習をさせたりする場合は、開発・学習段階にも関わります。
開発・学習段階で中心になるのが著作権法第30条の4です。e-Gov 法令検索の現行の条文(令和8年法律第48号による改正後、2026年6月24日施行の版)によると、同条は、著作物に表現された思想または感情を自ら享受し、または他人に享受させることを目的としない場合には、その必要と認められる限度において、いずれの方法によるかを問わず著作物を利用できる、と定めています。その例として、第2号で情報解析(大量の情報から要素を抽出し、比較・分類などの解析を行うこと)の用に供する場合を挙げています。同時に、ただし書で、著作物の種類と用途、利用の態様に照らして著作権者の利益を不当に害することとなる場合は、この限りでないとしています。「考え方」は、著作物の表現に接して知的・精神的な欲求を満たす効用を得ることに向けた行為かどうかで、「享受」の目的を判断すると整理しています。「享受」は娯楽として楽しむことだけを指すわけではありません。情報解析の目的と、表現を人が受け取る目的が併存する場合にも注意が要ります(次の段落)。
「考え方」は、AIの学習のために行われるものを含め、情報解析の用に供する場合は、同条の「享受させることを目的としない場合」に当たると考えられる、と整理しています。そのうえで、1つの利用行為に複数の目的が併存する場合に、その中に1つでも享受の目的が含まれていれば同条の要件を欠く、とも書いています。文化庁のチェックリストは、この「享受」の目的が併存すると評価されうる例として、次の3つを挙げています。
- 学習データに含まれる著作物の創作的表現の全部または一部を出力させることを目的とした追加的な学習(意図的な過学習など)
- RAG などのうち、データベースに含まれる既存の著作物の創作的表現を出力させることを目的としたものを実装するためのデータベースの作成
- 特定のクリエイターの作品である少量の著作物だけを学習データとした追加学習で、創作的表現を出力させることを目的としたもの
こうした場合は同条が適用されない場合がある、とチェックリストは説明しています。RAG の出力が既存の著作物の軽微な利用の範囲にとどまる場合は、著作権法第47条の5(軽微な利用を伴う情報処理の規定)の適用も考えられる、と注記もしています。
社内利用ルールの観点で読むと、社内の文書を集めて RAG のデータベースを作る場合に、その中に他人の著作物(購入した報告書、新聞や雑誌の記事、取引先の資料など)が含まれるかどうかが確認の論点になります。著作物が含まれ、出力にその表現をそのまま使わせる設計であれば、権利者の許諾の要否を検討する必要が出てきます。また、ただし書との関係で、チェックリストは、AI学習用のデータセットとして有償で提供されているデータベースの著作物を AI学習のために無許諾で複製等する場合には、同条ただし書に該当して同条が適用されない場合がある、と説明しています。どの場合に当たるかの判断は個別の事情によるため、データベースを作る前に、含める資料の出所と契約の条件を一覧にして、法務と確かめる手順を置いておくことが有効だと考えています。開発・学習段階の確認事項は、外部のベンダーに開発を委ねる場合の確認とも重なるため、第9章でも扱います。
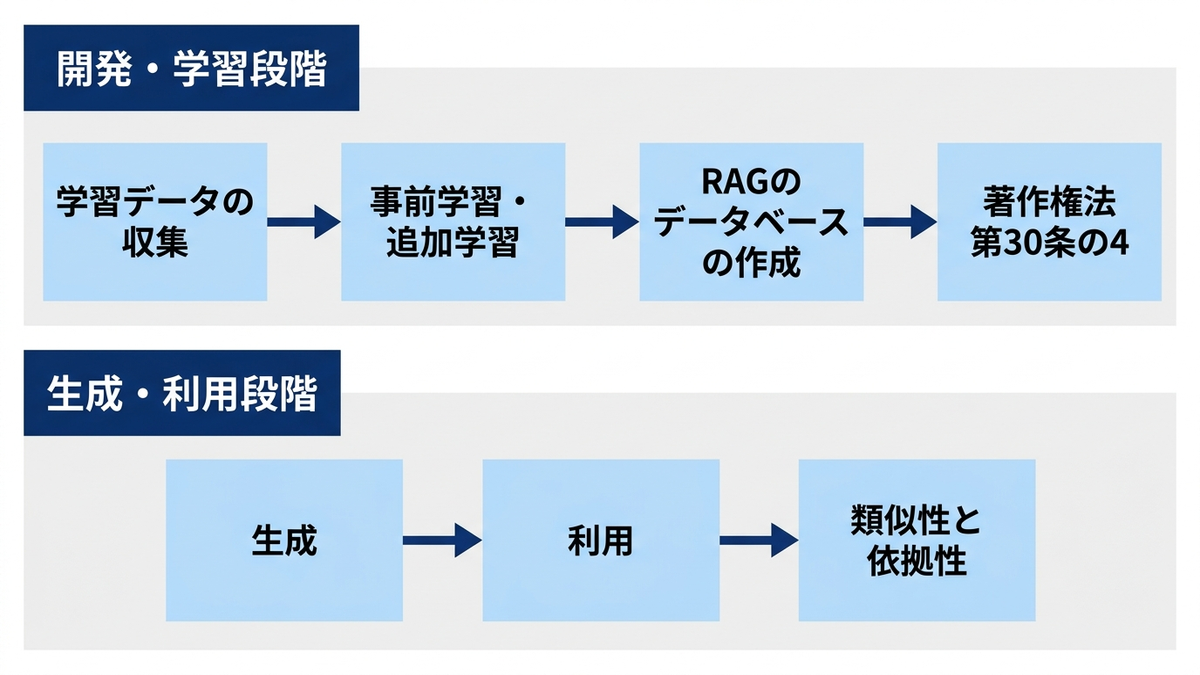
生成・利用段階については、「考え方」は、人間が AIを使わずに創作する場合と同様に考える必要があるとしています。既存の判例では、ある作品に既存の著作物との類似性と依拠性の両方が認められる場合に著作権侵害となるとされており、生成AIによる生成物についても、類似性と依拠性が認められれば、権利者は生成や利用の行為の差止めや損害賠償を請求しうる、と書かれています。差止めと損害賠償では要件が違います。損害賠償には故意または過失が必要だと「考え方」は整理しています。平たく言えば、類似性は「既存の作品と表現が似ていること」、依拠性は「既存の作品に接して、それをもとに作ったこと」です。チェックリストも、依拠性を、既存の著作物に接して、これを自らの作品の中に用いること、と説明しています。類似性は、既存の著作物の表現上の本質的な特徴を直接感得できるかどうかで判断され、作風のようなアイデアが共通するだけでは認められない、とチェックリストは説明しています。ただし、アイデアと創作的表現の区別は個別具体的な事案に応じて判断される、とも注記しています。
依拠性について、「考え方」は生成AIに特有の整理をしています。AI利用者が既存の著作物を認識していて、それと創作的表現が共通するものを生成させた場合は、依拠性が認められると考えられ、その例として、既存の画像を生成AIに入力する場合(いわゆる Image to Image)や、既存の著作物の題号などの特定の固有名詞を入力する場合を挙げています。さらに、AI利用者が既存の著作物を認識していなかったとしても、その生成AIの開発・学習段階で当該著作物を学習していた場合には、通常、依拠性があったと推認され、AI利用者による著作権侵害になりうる、とも整理しています。一方で、学習した作品の表現が出力されない仕組みを技術的に確保している場合もありうるとしています。その事情を示せば、依拠性が否定される余地にも触れています。つまり、生成・利用段階では「社員が元の作品を知らなかった」という事情だけでは安心できない、ということです。この点が、社内利用ルールで生成物を社外に出す前の確認を求める理由になります。
もう一つ、生成と利用を分けて考えることも大切です。チェックリストは、生成AIによる生成自体は、個人が私的使用の目的で生成する場合(著作権法第30条第1項)や、企業などの内部で、権利者から許諾を得て利用することを前提に検討の過程で生成する場合(同法第30条の3)には、これらの権利制限規定の範囲内であれば許諾なく行えると説明する一方で、生成物の利用(インターネットでの配信、複製物の譲渡など)は権利制限規定の範囲外となる場合が多いと考えられる、としています。社内で下書きを生成することと、それを社外に公表することとでは、確認すべきことが違う、という整理です。業務での生成がどの規定の範囲に入るかは、目的と使い方によって変わるので、ここから「社内での生成は常に問題ない」と読み取ることはできません。
生成物そのものが著作物として保護されるかどうかも、「考え方」は扱っています。主な整理は次のとおりです。
- AIは著作者になれない。AI生成物が著作物に当たる場合は、AIを使って創作した人が著作者になる
- 指示が表現に至らないアイデアにとどまる場合は、著作物性は認められないと考えられる
- 著作物性は、人による創作的寄与があるかを生成物ごとに検討して判断する。試行の回数が多いことや、生成物を選ぶ行為だけでは、創作的寄与の判断に影響しないと考えられる
- 人が創作的表現といえる加筆・修正を加えた部分は、通常、著作物性が認められると考えられる
自社の制作物に生成物を使う場合、その部分について自社が著作権を主張できるとは限らない、という前提で、契約や取引の説明を行う必要があります。
業務で利用する立場で確かめること、文化庁のチェックリスト
文化庁著作権課の「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月31日)は、「考え方」などで示された考え方の解説資料として作られたものです。第1部が AIの開発・提供・利用のチェックリスト、第2部が権利者のためのガイダンスという2部の構成です。第1部は、AI事業者ガイドラインの分類にならって、AI開発者・AI提供者・AI利用者(業務利用者)・業務外利用者(一般利用者)の4つの立場ごとに、著作権との関係で生じるリスクを低減させるうえで役立つと考えられる方策を示しています。1つの会社が、関わり方によって複数の立場に同時に当たる場合があり、その場合はいずれの立場の項目も参照するよう、資料自身が注意しています。
チェックリストは、示した方策について、すべてを記載どおりに実施しなければ直ちに法的責任が生じるという意味でも、すべてを実施すれば法的責任を何ら問われないという意味でもない、と断っています。社内利用ルールに取り込むときも、チェックリストの項目を満たしたことを適法性の保証として扱わないことが大切です。そのうえで、従業員が業務で外部の生成AIサービスを使う会社に最も関わりが深いのは、第1部の「AI利用者(業務利用者)のリスク低減方策」です。次の表は、その項目を要旨で並べ、社内利用ルールのどこに対応させるかの例を添えたものです。項目の番号はチェックリストの番号です。
| チェックリストの項目 | 項目の要旨 | 社内利用ルールでの対応の例 |
|---|---|---|
| 3-1-1 利用しようとする生成AIについての適切な情報確認 | 生成AIの仕組みと特性、学習済みモデルに関する情報、サービスの利用規約を確認し、従業員に適切な著作権の教育を行う | サービスの承認の手順で、利用規約と学習データに関する公開情報を確かめる。利用者向けの研修に著作権の基本を入れる |
| 3-1-2 著作権侵害に対する適切な予防措置及び対応の検討 | 生成AIの利用に関する内部的なルールの策定などの予防措置を講じ、侵害が生じた場合の対応(情報共有、サービスの停止と復旧、権利者への対応、原因の解明、再発防止など)をあらかじめ想定しておく | 社内利用ルールそのものを定める。権利侵害の疑いが出たときの連絡先と初動を決めておく(第11章) |
| 3-1-3 著作物の入力が「非享受目的」の要件を満たすか確認 | 既存の著作物を指示として入力することは原則として第30条の4が適用されると考えられるが、入力した著作物と類似する生成物を生成させる目的の場合は適用されない場合がある | 他人の著作物を入力して、それに似たものを作らせる使い方を禁止事項に入れる |
| 3-1-4 生成物の生成と利用では著作権侵害の判断が異なりうることに留意 | 生成は権利制限規定の範囲内で行える場合でも、生成物の利用(配信や譲渡など)は範囲外となる場合が多い | 社外に出す前の確認を、出力の確認の水準の表の「社外への公表物」の行に結びつける |
| 3-1-5 生成物の利用に先立って、既存の著作物と類似していないか確認 | 利用の前に、インターネットでの文章や画像の検索の活用などにより、既存の著作物と類似していないかを確認する | 社外に出す生成物について、類似の確認を行う担当と方法を決める |
| 3-1-6 関係するステークホルダーに対して、AIの利用について適切に説明 | AI生成物を著作物として取引の対象にする場合は、AIを使った生成物であることや著作物性について適切に説明し、類似の確認を行っていることを説明できるようにしておく | 制作物を納品する契約で、生成AIの利用の有無を示す手順を置く(第9章) |
| 3-1-7 生成過程が確認可能な状態の確保に努める | 依拠性がないことを説明できるよう、生成に使ったプロンプトなど、生成の過程を確認できる状態にしておく | 社外に出す生成物について、プロンプトと生成の記録を残す(後の節) |
| 3-1-8 生成AIの仕組みや技術の概要等について、広く情報提供 | 関係者の懸念の解消に向けて、生成AIの仕組みなどを分かりやすく発信する | 社外への説明や情報開示の方針の中で扱う(第14章) |
表の中で、社内利用ルールの文言に直接入れやすいのは、3-1-3(似たものを作らせる目的で他人の著作物を入力しない)、3-1-5(社外に出す前に類似を確かめる)、3-1-7(生成の過程を記録に残す)の3つだと考えています。とくに 3-1-7 は、チェックリストが依拠性の説明のために挙げている理由に加えて、生成物の著作物性を関係者に説明するためにもプロンプトなどを確認できるようにしておくことが望まれる、と書いている項目です。記録の扱いは後の節でまとめます。
3-1-1 の教育について、チェックリストは、AI生成物の生成と利用によって既存の著作物の著作権侵害が生じるかという問題と、AI生成物に著作物性があるかという問題とを混同するような誤解を挙げています。前者は他人の権利を侵害しないかの問題で、後者は自社の生成物が保護されるかの問題です。この2つは別の論点であり、「自社が作ったものだから自由に使える」「AIが作ったものだから誰の権利にも関わらない」といった誤解は、どちらも社員向けの研修で最初に解いておきたい点です。社内研修の対象別の設計は第14章で扱います。
セキュリティ、プロンプトインジェクションと出力の扱い
生成AIの利用に固有のセキュリティの問題として、まず押さえておきたいのがプロンプトインジェクションです。ソフトウェアのセキュリティに関する情報を公開している OWASP は、大規模言語モデル(LLM)を使うアプリケーションのリスクの一覧として「OWASP Top 10 for LLM Applications」を公開しており、2026年10月28日に開いた時点の版は2025年版でした。その1番目に挙げられているのがプロンプトインジェクションです。OWASP の説明では、利用者のプロンプトが LLM の振る舞いや出力を意図しない形で変えてしまう脆弱性を指し、その入力は人の目に見えなくても、モデルが読み取る内容であれば影響しうるとされています。
OWASP は、利用者の入力そのものによる直接のものと、ウェブサイトやファイルなど外部の情報源に含まれた内容による間接のものに分けて説明しています。社内利用で気をつけたいのは間接の方です。取引先の文書やインターネット上のページを要約させると、その中に埋め込まれた指示が実行されることがありえます。影響には機密情報の開示や出力の操作などがあり、詳しくは OWASP のプロンプトインジェクションの項目に整理されています。
OWASP は、確実に防ぐ方法があるかは明らかではないとしたうえで、影響を減らす対策を挙げています(対策の一覧は同じ項目にあります)。このうち、外部のサービスを使うだけの社内利用で利用者が意識できるのは、外部から受け取った文書を生成AIに読ませるときに、その出力をそのまま信用しないことと、生成AIに操作の権限(メールの送信、ファイルの書き換え、社内システムへの書き込みなど)を与える使い方では人の承認を挟むことです。生成AIが自律的に操作を行う使い方(AIエージェント)の扱いは第14章で扱います。
2025年版の一覧には、プロンプトインジェクションのほかに、機密情報の開示、サプライチェーン(外部のモデルや部品に由来する脆弱性)、データとモデルの汚染、不適切な出力の処理、過剰な権限の付与、システムのプロンプトの漏えい、ベクトルと埋め込みの弱点、誤情報、際限のない資源の消費、が挙げられています。多くはアプリケーションを開発する側の対策で、社内利用ルールの範囲を超えます。ただし、「機密情報の開示」と「誤情報」は、この章の入力の区分と出力の確認の論点とそのまま対応しています。自社で生成AIを組み込んだ仕組みを作る場合や、ベンダーに作らせる場合は、この一覧を情報システム部門とベンダーの間の確認の項目として使うことが有効だと考えています。開発の管理は第9章で、評価の方法としてのレッドチーミングは第10章で扱います。
セキュリティの観点で社内利用ルールに入れておきたいのは、次の3つです。1つ目は、会社として承認していないサービスや、個人のアカウントでの業務利用を禁じ、承認済みのサービスへの申請の経路を示すこと。2つ目は、生成AIの出力に含まれるコードやリンク、マクロなどを、確認せずに実行・開かないこと。3つ目は、外部から受け取った文書を読ませた出力に、不自然な指示や、頼んでいない操作の提案が含まれていた場合に報告する先を決めておくこと。3つ目は、検知の経路として第11章のインシデントの報告とつながります。
AI生成物の表示と、記録に残すもの
生成AIを使って作った文書や制作物について、AIを使ったことをどこまで示すかは、社内利用ルールで決めておく論点の一つです。AI事業者ガイドライン第1.2版は、AI提供者に対して、提供する AIシステム・サービスについて、AIを利用しているという事実、活用している範囲、適切・不適切な使用方法などの情報を、平易でアクセスしやすい形で適時かつ適切に提供することを挙げています。AI利用者についても、関連するステークホルダーへの説明の項目で、AIの出力を特定の個人や集団に対する評価の参考にする場合には AIを利用している旨を通知すること、などを挙げています。文化庁のチェックリストは、AI生成物を著作物として取引の対象にする場合に、AIを利用した生成物であることや著作物性について関係者に適切に説明することを挙げています(前出の 3-1-6)。EU AI Act の第50条の透明性の義務のように、一定の生成物について表示を義務づける制度もあり、その内容は第3章で扱います。
これらを踏まえると、社内利用ルールの表示の項目は、場面ごとに分けて書くのが扱いやすいと考えています。顧客や利用者が AIと直接やり取りする場面(問い合わせの自動応答など)では、AIであることを示す。AIの出力を人の評価に使う場面では、評価の対象者への通知の要否を確かめる。生成物を納品物や取引の対象にする場面では、AIを使った範囲を相手に伝える。社内の資料では、AIを使ったことと確認した人を資料の中に書いておく。このように分けておくと、「すべてに表示する」か「表示しない」かの二択を避けられます。どの場面で法令上の表示が必要になるかは、業種や地域の規制によって変わるため、表示の項目は第2章・第3章で扱う制度の確認と合わせて定める必要があります。
記録に残すものは、何のための記録かで決まります。問題が起きたときに原因をたどるため、権利の観点で生成の過程を説明できるようにするため、そして利用の実態を把握してルールを見直すため、の3つが主な目的です。このうち権利の観点については、文化庁のチェックリストが、生成に用いたプロンプトなど生成物の生成過程を確認できる状態にしておくよう努めることが望まれる、としています(前出の 3-1-7)。AI事業者ガイドラインも、共通の指針の「透明性」の項目で、検証可能性を確保するためにログを記録・保存するにあたり、事故等の原因の究明や再発防止策の検討などの重要性を踏まえて、記録の方法・頻度・保存期間などを検討することを挙げています(本編21ページ)。すべての利用についてすべてのプロンプトを残すと、その記録自体が機密や個人情報を含む新しい保管の対象になるため、記録の範囲は用途ごとに分けるのが現実的です。社外に出す生成物と、出力の確認の水準が高い用途について、使ったサービス・プロンプト・出力・確認した人と日付を残し、それ以外は利用の件数と用途の集計にとどめる、という分け方が一つの例です。記録の保存の期間は、既存の文書管理の規程に合わせて決めます。
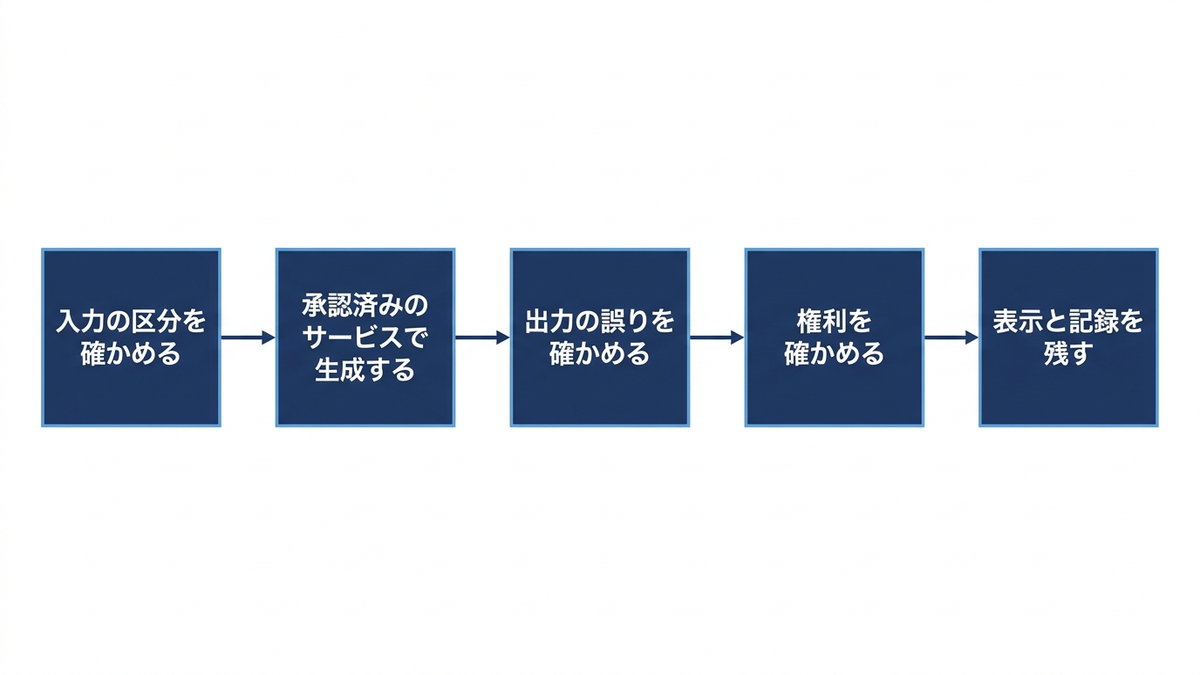
経営判断、全面禁止よりも「何を入れてよいか」を決める
生成AIの社内利用について経営に最初に持ち込まれる相談は、多くの場合、「使わせるか、禁止するか」の形をとります。この章の主張は、全面禁止を出発点にしない方がよい、というものです。全面禁止は分かりやすく、最初の判断としては安全に見えますが、業務で役に立つと感じた社員が、会社の管理の外にある個人のアカウントや未承認のサービスを使う誘因を残します。そうなると、何がどのサービスに入力されたのかを会社が把握できず、入力の区分も出力の確認も記録も効かない状態になります。全面禁止の会社で実際にどの程度そうした利用が起きているかを示す公的な統計は、本コラムの執筆では確かめられていないので、ここでは割合などの数字は示しません。そのうえで、禁止によって利用が見えなくなる危険は、利用を認めて管理する場合の危険よりも把握しにくい、と考えています。
この判断を誤ったときの経営上の損失は、本コラムの損失の型で整理できます。全面禁止を続ければ、業務の効率化の機会を逃す導入の停滞につながる可能性があります。管理の外での利用が広がれば、個人情報の目的外の取扱いや営業秘密の漏えいといった規制違反と権利侵害の危険が、会社に見えないまま積み上がります。出力の確認の手順が無ければ、誤った回答や数字が顧客に届く誤った判断の放置と、その結果としての信頼の失墜が起こりえます。そして部門ごとに別々のサービスを別々の条件で契約すれば、同じ確認を何度も行う二重投資になります。入力の区分と承認済みのサービスを先に決め、出力の確認・権利の確認・教育・記録と組み合わせることで、これらの損失を減らせると考えています。
経営が決めることは、3つに絞れます。1つ目は、会社として契約して使わせるサービスの範囲と、その確認を誰が行うかです。サービスの利用を始めることの承認は、そのユースケースのリスク区分の承認者が行います。一方、サービスでの入力の扱い(入力を学習に使うか、保存の期間、アクセスできる人)を確かめる作業は、各部門に任せず、情報システム部門・法務・購買が確認の項目を確かめ、申請の受付を事務局に一本化しておくと、確認の重複を防ぎやすいと考えています。2つ目は、機密と個人情報の入力の承認の分け方です。本コラムでは2つに分けることを提案します。利用規程で定めた条件の範囲内で機密や個人情報を入力するユースケースは、第7章の判定で区分「中」となり、AIガバナンスの事務局(委員会を支える実務の窓口)の責任者が通常の承認として承認します。利用規程で入力を禁止している情報(入力の区分の表で、条件を外れるとした入力)をあえて認める場合だけを例外の承認として扱い、AIガバナンス委員会が承認し、事務局が申請の受付と記録を担います。条件の範囲内の判断を現場の上長だけに任せず、条件の外の判断を委員会に集めておくと、判断の基準が部署ごとにばらつきにくくなると考えています。3つ目は、ルールを見直す周期と、見直しの材料にする指標です。承認済みのサービスの利用者数、相談の窓口に寄せられた質問の件数と内容、出力の誤りや権利の疑いの報告の件数などを定期的に集計すると、ルールが実態と合っているかを判断できます。
予算と体制の面では、社内利用ルールの運用に要るのは、主に承認済みのサービスの契約、サービスを確かめる担当の時間、相談の窓口、社員向けの研修の4つです。新しい製品を入れなくても始められる部分が多く、最初から完璧な規程を作るよりも、入力の区分と承認済みのサービスの一覧と相談の窓口を先に用意し、寄せられた質問をもとに改定していく方が、現場の実態に合ったルールになりやすいと考えています。規程を先に完璧にしないという考え方は、第12章でも扱います。
この章では、生成AIの社内利用ルールで決める6つの論点(使ってよいサービス・入力してよい情報・出力の確認・権利・表示・記録)を整理しました。入力は公開情報・社内情報・機密・個人情報の4つの区分で決め、個人情報は個人情報保護委員会の注意喚起が示すとおり利用目的の範囲と、サービスの事業者が機械学習に使わないことなどを確かめたうえで扱うこと。出力には誤りが含まれる前提で、使い方に応じた確認の水準を決めること。著作権は、文化庁の「考え方」とチェックリストにならって開発・学習段階と生成・利用段階を分けて考え、社外に出す前の類似の確認と生成の過程の記録を手順にすること。そして、経営は全面禁止を出発点にせず、何を入れてよいかを先に決めることです。次の第9章では、生成AIを含む AIを外部から調達したり、ベンダーに開発を委ねたりするときに、ベンダーの選定と契約で確かめることを扱います。
この章を深めたい方への参考書籍
『生成AIと知財・個人情報Q&A』(齋藤浩貴・上村哲史 編著、商事法務):生成AIと知的財産・個人情報に関わる論点を、問いと答えの形で扱う本です。2024年7月の刊行で、文化庁の「考え方」(2024年3月)の後、チェックリスト&ガイダンス(2024年7月31日)や個人情報保護法の令和8年改正、AI事業者ガイドライン第1.2版より前の本である点に注意が要ります。この章で扱った入力の区分と著作権・個人情報の論点を、法務の担当者と一緒に個別の場面に当てはめて考えるときの材料になります。
『生成AIと著作権の論点』(福岡真之介 編著、商事法務):書名のとおり、生成AIと著作権に関わる論点を扱う本で、2025年8月に刊行されています。この章では、開発・学習段階と生成・利用段階を分ける文化庁の整理を要旨で紹介するにとどめたので、著作権法第30条の4の適用の範囲や、依拠性の考え方を掘り下げて理解したいときの材料になります。個人情報保護法の令和8年改正より前の刊行です。
『AIと著作権』(上野達弘・奥邨弘司 編著、勁草書房):AIと著作権の関係を扱う本で、2024年2月の刊行です。文化庁の「考え方」(2024年3月15日)より前に出た本なので、「考え方」による整理はこの本には含まれていません。その前提で、この章で扱った論点が、どのような議論を経て整理されてきたのかを知りたいときの材料になります。
第9章 AIの調達と開発の管理、ベンダー選定と契約で確かめること
第8章では、生成AIを社内で使うときのルールとして、使ってよいサービス・入力してよい情報・出力の確認・権利と個人情報の扱いを整理しました。そこで前提にしていたのは「使ってよいサービス」が社内で決まっていることです。この章では、その前の段階、つまり AIをどこから手に入れ、誰とどんな約束を交わして使い始めるかを扱います。外部のサービスを契約して使う場合も、外部のモデルを自社のシステムに組み込む場合も、自社で開発する場合も、AIを使った結果について自社が説明を求められる立場から外れるわけではありません。買う AIにも責任は残る、というのがこの章の出発点です。
この章で使う国の資料は、経済産業省の「AI・データの利用に関する契約ガイドライン」と「AIの利用・開発に関する契約チェックリスト」、デジタル庁の「行政の進化と革新のための生成AIの調達・利活用に係るガイドライン」、総務省・経済産業省の「AI事業者ガイドライン(第1.2版)」の4つです。いずれも2026年10月28日に確認し、版と日付と記述を確かめた範囲だけを書きます。デジタル庁と総務省の資料は公式のページから原文を開きました。経済産業省の資料は、公式のページが直接の取得を拒否したため、インターネットアーカイブ(Wayback Machine)が2024年から2026年にかけて保存した写しで読んでいます。写しは保存された時点の内容なので、その後に公式のページが更新されていれば、本コラムの記述と違う可能性があります。どの資料も契約の雛形を押し付けるものではなく、論点の所在を示すものです。この章でも、契約で何を確かめるかという論点だけを書き、具体的な契約条件は書きません。
作るか買うか、3つの調達の形と責任の残り方
AIを業務に取り入れる方法は、大きく3つに分けられます。1つ目は、外部の事業者が多くの利用者に向けて提供している AIサービスを、利用規約に同意して使う形です。文章の生成や要約を行うクラウドのサービスがこれにあたります。2つ目は、外部の事業者が用意した AIモデルやサービスを土台にして、自社の業務に合わせた機能を加えて使う形です。自社の文書を検索して回答を作る仕組みを、外部のモデルの上に作る場合などです。3つ目は、自社の目的のために AIシステムを新しく開発する形で、自社の社員が開発する場合と、開発を外部に委託する場合があります。
経済産業省の「AIの利用・開発に関する契約チェックリスト」(2025年2月。以下「契約チェックリスト」)も、3つの類型を置いています。汎用的な AIサービスを利用する「汎用的AIサービス利用型」、機能を提供する事業者が特定の利用者向けに改良・調整したサービスを利用する「カスタマイズ型」、利用者が開発者と提携して独自の AIシステムを開発・利用する「新規開発型」の3つです。契約チェックリストは、カスタマイズ型ではその事業者自身が別の事業者の汎用的な AIサービスの利用者でもあり、立場が入れ替わる点に注意を促しています。自社に機能を提供してくれる事業者の向こうに、もう一段、基盤モデル(大量のデータで事前に学習され、さまざまな用途の土台として使われるモデル)の事業者がいる、ということです。
本コラムの2つ目の形と、契約チェックリストのカスタマイズ型は、完全には重なりません。カスタマイズ型は、外部の事業者が機能を加えたサービスを自社が使う場合です。本コラムの2つ目の形には、それに加えて、自社が外部のモデルの上に自ら機能を加える場合も含めています。後者の場合、本コラムでは、基盤モデルの事業者との関係は汎用的AIサービス利用型の契約に近く、機能の開発を外部に委託する部分は開発を伴う契約になる、と整理しています。本コラムでは、契約チェックリストの類型を、自社の作業の量ではなく契約の相手との関係による分け方として読んでいます。
デジタル庁の「行政の進化と革新のための生成AIの調達・利活用に係るガイドライン」(第2.0版、2026年6月12日。以下「デジタル庁ガイドライン」)も、政府の生成AIシステムの導入を、個別開発をせずに規約への同意で利用する形(A)、個別開発はしないが規約への同意に加えて個別契約を結ぶ形(B)、個別開発を行い個別契約を結ぶ形(C)の3つに分けています。そのうえで、A の形は原則として機密性の高い情報を扱わない利用を想定していること、求める必要のある要求事項がある場合には B か C の形での調達を検討すること、を示しています。分け方の軸が「開発をするか」と「個別の契約を結べるか」の2つである点は、民間の企業が自社の調達を整理するときにもそのまま使えると考えています。
次の表は、3つの形ごとに(3つ目は外部への委託と社内での開発の2行に分けて)、自社に残る責任と、自社が交渉できる範囲を整理したものです。表の「自社に残る責任」は本コラムの整理で、どの法令でどの責任を負うかを示すものではありません。個別の責任の所在は、契約の内容と適用される法令によって変わります。
| 調達の形 | 契約チェックリストの類型 | 契約の形 | 自社が交渉できる範囲 | 自社に残る責任(本コラムの整理) |
|---|---|---|---|---|
| 外部のサービスを利用する | 汎用的AIサービス利用型 | 利用規約への同意が中心。個別の契約を結べる場合もある | 狭い。規約は事業者が一律に定め、変更されることがある | 何を入力するかの判断、出力の確認、使い道の判断、規約の変更の把握 |
| 外部のモデルを組み込む | カスタマイズ型に近い(自社が自ら機能を加える場合とのずれは前の段落で説明) | 基盤モデルの利用規約。機能の開発を外部に委ねる場合は、その事業者との個別の契約が加わる | 機能を提供する事業者とは交渉できるが、その事業者も基盤モデルの規約に縛られる | 1行目の事項に加えて、組み込んだ部分の設計と検証、基盤モデルの更新の影響の確認 |
| 新しく開発する(外部への委託) | 新規開発型 | 開発の委託契約。段階ごとに分けて結ぶことがある | 広い。成果物の範囲・権利・検収の進め方を個別に決められる | 入力と出力の使い方の管理に加えて、学習データの選定と権利の確認、性能の評価、運用中の監視と再学習。外部のモデルを使う場合は2行目の事項も |
| 新しく開発する(社内で開発) | 対応する類型なし(外部のモデルやデータを使う場合は、その利用条件) | 社外との開発の契約は無い。使う外部のモデルやデータの利用規約・ライセンス | 社外との交渉は使う部品の範囲に限られる | 3行目と同じ事項を、すべて自社で担う |
表の下の行ほど自社が決められることは増えますが、自社が負う作業も増えます。上の行ほど手軽に始められますが、事業者が決めた条件の中で使うことになり、条件が変わったときに自社が気づく仕組みが必要になります。どの形にも共通しているのは、何を入力し、出力をどう使うかを決めるのは利用する自社だという点です。AI事業者ガイドライン(第1.2版、2026年3月31日)は、共通の指針のうちアカウンタビリティの項目で「関係者間の責任の分配」を挙げ、主体間の契約や社会的な約束によって責任の所在を明確にすることを示しています(本編22ページ)。契約は責任をなくす道具ではなく、どこまでを誰が引き受けるかを事前に言葉にしておく道具です。
作るか買うかの判断は、費用の比較だけでは決まりません。その用途で扱う情報の機密の程度、出力が誰にどう影響するか、自社で性能を確かめる体制があるか、事業者を替えたくなったときに替えられるか、の4つを合わせて考えるのが扱いやすいと考えています。とくに、第7章のユースケース台帳で本コラムのリスク区分が「高」になった用途は、規約への同意だけで使い始める形に向かないことが多いと考えています。規約は事業者が一律に定めるもので、自社の用途に合わせた確認の約束を盛り込めないことが多いためです。
3つの調達の形で、自社と事業者がそれぞれ何を決め、何に責任を持つかの違いは、この節の最初の表に行ごとにまとめています。
国の資料の地図、契約ガイドライン・契約チェックリスト・調達のガイドライン
AIの調達と契約について、日本の公的な資料は主に4つあります。それぞれ作られた時期と想定している場面が違うので、どれをどの場面で開くかを先に整理しておくと使いやすくなります。
1つ目は、経済産業省のAI・データの利用に関する契約ガイドラインです。経済産業省のページには、AI編(2018年6月)と、データ編を改訂した1.1版(2019年12月)が掲載されています。1.1版(全体版)の改訂履歴には、データ編について限定提供データに関する指針への対応等による改訂と書かれています。AI編は、AI技術を利用したソフトウェアの開発・利用に関する契約の基本的な考え方を解説したもので、開発契約のモデル契約書を含みます。AI編は冒頭で、このガイドラインが契約についての基本的な考え方を示すものにすぎず、法的な拘束力を持たず、当事者の契約の自由を制約しないと述べています。
2つ目は、同じく経済産業省の「AIの利用・開発に関する契約チェックリスト」です。表紙の日付は令和7年2月で、経済産業省の AI利活用に伴う契約時の留意事項検討会の名前が巻末に載っています。契約チェックリストは策定の背景として、契約ガイドラインが識別系の AIのモデルが実用化段階に入った当時の市場環境を前提にしていたこと、2022年頃から生成AIを使ったサービスが急速に普及し、利用の場面の契約の重要性が高まったことを挙げています。想定読者として、社内の法務部門や顧問弁護士だけでなく、条文の水準の検討は難しいが契約の項目立ては理解できるビジネス部門の担当者も挙げています。
3つ目は、デジタル庁ガイドラインです。2025年5月27日に初版が、2026年6月12日に第2.0版が、デジタル社会推進会議幹事会で決定されました(デジタル庁の第2.0版の公表ページ)。デジタル社会推進標準ガイドラインの一つ(DS-920)で、政府情報システムの整備と管理について遵守する内容を定めた文書と位置づけられています。対象は国の政府職員で、民間の企業に直接の義務を課すものではありません。それでも、別紙として付いている「調達チェックシート」と「契約チェックシート」は、生成AIシステムを調達するときに事業者に何を求め、契約に何を盛り込むかを項目の形で整理しており、民間の企業が自社の確認項目を作るときの参考になると考えています。
4つ目は、AI事業者ガイドライン(第1.2版)です。総務省の掲載ページに本編と別添が載っており、別添6が「AI・データの利用に関する契約ガイドライン」を参照する際の主な留意事項について、という題で、契約ガイドラインの何が今も参照に値し、何が公表後の状況の変化を踏まえて読む必要があるかを整理しています。AI事業者ガイドラインの全体の構成は第4章で扱いました。
| 資料 | 作成主体 | 版と日付 | 拘束力 | 主に想定している場面 | この章での使いどころ |
|---|---|---|---|---|---|
| AI・データの利用に関する契約ガイドライン | 経済産業省 | AI編 2018年6月、1.1版 2019年12月 | なし(AI編が自ら明記) | 学習済みモデルの開発の委託、データの提供 | 開発を委託するときの段階の分け方、権利と責任の基本的な考え方 |
| AIの利用・開発に関する契約チェックリスト | 経済産業省 | 2025年2月 | 契約条件の是正や契約の断念を推奨するものではなく、論点の所在を示すにとどまると自ら明記 | 汎用的な AIサービスの利用、カスタマイズ、新規開発 | 利用規約と契約書で確かめる条項の一覧 |
| 行政の進化と革新のための生成AIの調達・利活用に係るガイドライン | デジタル庁(デジタル社会推進会議幹事会の決定) | 初版 2025年5月27日、第2.0版 2026年6月12日 | 政府職員が遵守する文書。民間の企業への義務ではない | 政府の生成AIシステムの企画・調達・運用 | 事業者の評価項目と契約に盛り込む事項の例 |
| AI事業者ガイドライン | 総務省・経済産業省 | 第1.2版 2026年3月31日 | 非拘束的なソフトローとして作成したと本編が明記(第4章) | AI開発者・AI提供者・AI利用者の取組全般 | 主体間の責任の分配の考え方、契約ガイドラインの読み方(別添6) |
表のとおり、民間の企業に対して法的な拘束力を持つ資料はありません。デジタル庁ガイドラインは政府職員が遵守する文書ですが、民間の企業に義務を課すものではありません。ただし、拘束力が無いことは、ここに書かれた論点を確かめなくてよいことを意味しません。個人情報の保護に関する法律や不正競争防止法のように、契約の内容によって自社の法令上の立場が変わる場面があり、資料はその点への注意を促しています。資料が示す論点を自社の確認項目に取り込み、個別の契約の判断は法務部門や弁護士と相談する、という使い方を想定しています。
資料どうしの関係にも注意が要ります。AI事業者ガイドラインの別添6は、契約ガイドラインがベンダーとユーザの二者の関係を前提に、開発を委託する取引と、ベンダーが開発した AIをユーザに使わせる取引の2つのモデルを示したものだと整理しています。そのうえで、2022年以降は汎用的な生成AIのサービスを利用する契約や、他の事業者のサービスをカスタマイズして提供する契約が増え、契約ガイドラインが整理した類型に収まらない取引の重要性が増していると述べ、そうした類型については契約チェックリストを参照するよう示しています。一方で、AI編の第2(AI技術の解説)と第3(基本的な考え方)にある、AIを利用したソフトウェア開発の特徴、知的財産権等に関する整理、権利の帰属や利用条件の設定、責任の分配の基本的な視点は、従前と同様に参照することが一般に有益な場合もある、としています。別添6の整理に沿うと、サービスを利用する場面では契約チェックリストが中心になります。開発を委託する場面では、契約ガイドラインの基本的な考え方に加えて、開発型も扱う契約チェックリストの留意点も合わせて確かめるのが整合的な読み方です。
資料は今後も更新される可能性があります。経済産業省の該当ページ(2026年10月19日にアーカイブされた写しで確認)には、生成AIの開発・提供・利用に伴う実務上の課題の事例を募集し、報告書の作成やガイドラインの改訂等に活用するという案内が載っていました。同じページには「AI利活用における民事責任の解釈適用に関する手引き」(第1.0版、2026年4月)も掲載されていますが、本コラムではその中身を開いて確かめられなかったので、内容には触れません。調達の手順書を作る会社は、これらの資料の更新を誰が確かめるかを決めておく必要があります。
ベンダーの確認項目、デューデリジェンスで何を聞くか
契約の前に、相手の事業者とそのサービスを調べて確かめることを、一般にデューデリジェンスと呼びます。企業の買収や投資の場面で使われることの多い言葉ですが、本コラムでは、AIのサービスや開発の委託先を選ぶ前に、データの扱い・安全管理・品質・問題が起きたときの対応を確かめる作業を指して使います。確かめる相手は、契約の相手方だけではありません。カスタマイズ型のように、契約の相手方が別の事業者の基盤モデルを使っている場合は、その先の事業者の規約も可能な範囲で確かめる対象になります。
契約チェックリストは、この点について、ベンダーが自社のサービスに組み込んでいる他のサービスの事業者の詳細や、その事業者との契約条件を明らかにするのが難しい場合もあり、利用者がどこまで情報を集めて判断するのが合理的かは個別の状況次第で、柔軟な対応が必要だと述べています。同時に、ベンダーが義務の一部を第三者に委託するときに利用者の同意が必要とされているような場合には、同意するかどうかの判断のために一定の情報開示を求めることは必ずしも不合理ではない、という考え方も示しています(注9)。すべてを聞き出すことを目標にせず、自社の用途のリスクに応じて聞く範囲を決める、という姿勢が扱いやすいと考えています。
次の表は、契約チェックリストとデジタル庁ガイドラインの記述をもとに、ベンダーに確かめる項目を整理したものです。「確かめる理由」の列に、根拠にした資料の記述を要約しました。質問の例と、回答の裏付けになる資料の例は本コラムの整理です。
| 確認項目 | 確かめる理由(資料の記述の要約) | 質問の例 | 裏付けになる資料の例 |
|---|---|---|---|
| 入力したデータの利用目的 | 契約チェックリストは、サービスの提供目的以外の利用の可能性がある場合は不必要な情報を提供しないこと、とくに事業者が自己の学習にデータを用いる定めがある場合は慎重な判断を要することを示している(A-3-1) | 入力したデータを、サービスの提供以外の目的に使うか | 利用規約、データの取扱いに関する文書 |
| 学習への利用の有無 | 契約チェックリストは、入力が汎用的な AIの学習に使われる場合、サービスの提供に必要な範囲でのみ学習に使われる場合、学習に使われない場合でリスクの範囲が異なると整理している(4.2) | 入力したデータを、他の利用者も使うモデルの改良に使うか。使わない設定がある場合、その設定は誰が変えられるか | 利用規約、管理画面の設定の説明 |
| 保存の期間と消去 | 契約チェックリストは、保持できる期間、期間の終了後の対応、利用者の求めや契約終了時の削除の義務、削除を証明する書類の発行の義務の有無を確かめる項目として挙げている(A-3-4) | 入力と出力の記録をどのくらいの期間保存するか。契約の終了時に削除するか。削除したことを示す書類を出せるか | 契約書、データの取扱いに関する文書 |
| 事業者の所在地とデータの保存場所 | 契約チェックリストは、個人データの提供先が外国にある第三者にあたるかは個別の検討を要し、サーバの所在地はその判断基準にならないと説明している。あわせて、外国の事業者のクラウドを使う場合の安全管理措置として、事業者の所在国とサーバの所在国を明らかにする必要がある場面に触れている(4.4.2、注25、注34) | 事業者はどの国の法令に基づいて設立されたか。日本国内に拠点があるか。データはどの国のサーバに保存されるか | 会社情報、データの保存地域に関する文書 |
| 再委託と基盤モデルの事業者 | 契約チェックリストは、カスタマイズ型では第三者の汎用的なサービスが組み込まれていることがあり、その規約も可能な範囲で確かめることが考えられるとしている(4.1) | どの事業者のモデルを使っているか。業務の一部を他社に委託しているか。委託先が変わるときに知らせるか | 契約書の再委託の条項、事業者の説明資料 |
| 管理の体制と安全管理 | 契約チェックリストは、事業者がどの水準の管理義務を負うか、利用者による監査や情報提供の依頼が認められるかを確かめる項目として挙げている(A-3-3) | 入力したデータを誰が閲覧できるか。事業者の社員が閲覧する場面はあるか | セキュリティに関する文書、第三者による認証の有無 |
| システムの構造と脆弱性への対応 | 契約チェックリストは、システムの構造を示す資料、ソフトウェア部品構成表(SBOM)、脆弱性の発見と修正の履歴が、セキュリティの水準を推し量る参考資料になりうるとしている(4.5.1) | システムの構造を説明した資料はあるか。脆弱性が見つかったときの修正と公表の手順はどうなっているか | 技術資料、SBOM、脆弱性の公表の履歴 |
| 性能と評価の結果 | デジタル庁ガイドラインは、企画者が生成AIモデル・アーキテクチャ等の特性や主要性能指標の情報を取得し、リスク分析のために合理的な範囲で学習に使われたデータや学習方法の情報の取得にも努めることを示している(6.3.2③) | どの観点で評価したか。自社の用途に近い条件での評価の結果を示せるか | 評価の報告書、モデルの説明資料 |
| モデルの更新と規約の変更 | デジタル庁ガイドラインは、同ガイドラインの提供者(リリース後のシステムを運用する政府職員)がモデルのメジャーアップデートや大規模な追加学習の際に、提供前に期待品質を満たすことを確かめることを示している(6.5①)。契約チェックリストは、利用規約が変更されうるため変更の状況を随時確かめる体制の整備が望ましいとしている(4.6) | モデルを入れ替えるときに事前に知らせるか。規約を変えるときにどの方法で知らせるか | 利用規約の変更の条項、更新の告知の履歴 |
| インシデントの通知と協力 | デジタル庁ガイドラインの契約チェックシートは、情報セキュリティインシデントや生成AIシステム特有のリスクケースが起きたときの被害の最小化、原因の特定に必要な情報の提供、改善措置、必要に応じた監査について、事業者と事前に合意しておく必要があるとしている(別紙4の取決め事項8) | 問題が起きたときに、誰に、どの手段で知らせるか。原因を調べるための記録を出せるか | 契約書のインシデント対応の条項、連絡体制の文書 |
| 記録(ログ)の保存 | 契約チェックリストは、利用者の利用の記録だけでなく、管理者や開発者の権限を含む認証・アクセス・操作の記録の保存を事業者に求めることも考えられるとしている(4.5.3) | どの記録を、どのくらいの期間、自社が取り出せる形で残せるか | 契約書、管理機能の説明 |
| 監査への協力 | 契約チェックリストは、可能な場合には監査の条項を設けることも有効で、ISO/IEC 27001 などの第三者認証の取得を条件とする方法も考えられるとしている(4.5.2) | 自社による監査、または第三者による監査の報告書の提供に応じるか | 認証の証明書、監査の報告書 |
表のすべてを毎回同じ深さで確かめる必要はありません。公開情報だけを入力して社内の下書きに使う用途でも、出力の利用条件やアカウントの管理、規約の変更への対応は確かめる必要があります。一方、顧客の個人情報や営業秘密を入力する用途や、出力が採用・与信のような人への判断に使われる用途では、表のほぼすべての行が対象になります。そこで、全用途で確かめる基本の項目を決め、用途・入力する情報・出力の影響に応じて項目を足す決め方が考えられます。追加の範囲を第7章のリスク区分に結びつけ、「高」では事業者からの書面の回答も求める、という形です。デジタル庁ガイドラインも、導入の類型やリスクなどに応じた対応事項の取捨選択を示しています(6.1.2)。どの項目を基本にするかは、会社ごとに決める事項です。
デジタル庁ガイドラインは、調達チェックシートの「裏付けとなる情報の例」の列を参考に、事業者へ提供を依頼する情報を決め、事業者の提案と回答をもとに評価・選定する、という流れを示しています。事業者が広報のために作った資料だけでは実際のセキュリティの水準は分かりにくい、と契約チェックリストも指摘しています(4.5.1)。質問への回答を口頭で済ませず、根拠となる文書の名前と版を記録に残しておくと、後で規約が変わったときに、何が変わったのかを比べられます。
確認の結果は、第7章のユースケース台帳の該当する行に結びつけて保存しておくのが扱いやすいと考えています。台帳の「使う AI」の列から、そのサービスの確認の記録を辿れるようにしておけば、同じサービスを別の部門が使いたいと申請してきたときに、事業者に関する共通の情報を使い回せます。用途・入力する情報・設定・規約の版の違いに確認を集中できます。部門ごとに同じ事業者を別々に確かめていると、二重投資になるうえ、部門によって結論が食い違うことがあります。
契約で決めておく論点、インプット・アウトプット・成果物・責任
契約チェックリストは、AIのサービスを使う場面を、利用者が事業者に「インプット」を渡し、事業者がサービスの内容に応じた「アウトプット」を返す関係として捉えています。インプットはプロンプトや学習用の生データなど、アウトプットは分析の結果やコンテンツなどの AI生成物と、開発の成果物です。これに加えて、事業者がインプットを加工して作る学習用データや中間生成物を「インプット処理成果」、利用者がアウトプットを加工したものを「アウトプット処理成果」と呼んで、それぞれの扱いを確かめる対象にしています。
そのうえで、インプットとアウトプットのそれぞれについて、対象の特定(何を契約の対象とするか)、相手への提供、使用・利用(管理や消去を含む)、外部への提供、権利の帰属、の順に条項を確かめると、取扱いをおおむね確かめられる、と整理しています(3.2)。この並びは、契約書を頭から読むよりも見落としが少なくなる読み方だと考えています。とくに最初の「特定」が重要で、契約チェックリストは、インプットの定義に合致しない情報は、適用法令による制限がない限り事業者が自由に利用できる可能性がある、と注意しています(A-1-1)。
次の表は、契約チェックリストとデジタル庁ガイドラインの契約チェックシートが挙げる論点を、契約で何を決めておくかという形にまとめ直したものです。表の「システムプロンプト」は、利用者の入力とは別に、システムの側からモデルにあらかじめ与えておく指示の文を指します。どの論点も、決める中身(期間・割合・上限額など)は取引ごとに違い、本コラムでは値を示しません。
| 論点 | 契約で決めておくこと | 資料が示している注意点(要約) |
|---|---|---|
| インプットの定義と利用条件 | 契約で守る対象となるインプットの範囲、事業者が使ってよい目的、学習に使うかどうか、保存の方法 | デジタル庁ガイドラインの契約チェックシートは、インプットの目的外の利用について取決めを置くことを挙げている(取決め事項1)。利用目的・学習への利用・保存の扱いの記載を確かめる |
| インプット処理成果の扱い | 学習用データや中間生成物を契約で扱う対象にするか、誰が使えるか、権利はどちらに帰属するか | 契約チェックリストは、処理成果には事業者の技術的な知見が多分に反映されているものもあり、利用者に当然に提供されるべきものではない点に留意が要るとしている(A-6) |
| アウトプットの利用条件 | 商用利用の可否、利用目的の制限、第三者への提供の可否、AIによる生成であることの表示の要否 | 契約チェックリストは、サービスによっては商用利用の禁止や、AIを用いて生成したことの表示などの条件が設定されることがあるとしている(B-3、B-4) |
| アウトプットと成果物の権利 | 出力や開発の成果物について利用者が権利を取得するか、取得する場合の条件、ライセンスの範囲 | 契約チェックリストは、開発型の契約では開発の成果に関する知的財産(フォアグラウンドIP)と各当事者が元から持つ知的財産(バックグラウンドIP)の区別が争点になりやすく、開発初期に認識をすり合わせることが重要だとしている(4.3.2) |
| 成果物の範囲 | 何を納品物とするか。モデルそのものか、システムの構成要素(画面・システムプロンプト・データベース・入力と出力のフィルター等)か | デジタル庁ガイドラインの契約チェックシートは、期待品質を契約に盛り込む前提として、納品物が何かを明確にする必要があるとしている(取決め事項5、7) |
| 性能と品質の考え方 | 性能そのものを条件にするか、品質を確保するための取組を条件にするか | 同じく取決め事項5は、生成AIモデルに起因する性能や出力の品質は成果の保証が難しい場合があり、その場合は性能改善・品質向上への技術的支援を受けるなどの契約形態が望ましいとしている |
| ノウハウの扱い | 双方のノウハウの範囲、相手が使ってよい条件、権利の帰属 | 同じく取決め事項6は、ノウハウの定義に合致しない情報は、適用法令による制限がない限り事業者が自由に利用できる可能性があるとしている。契約で保護する範囲を明確にする必要がある |
| インシデントと品質の低下への対応 | 問題が起きたときの通知、被害の最小化、原因の調査への協力、記録の提供、改善措置、監査 | 同じく取決め事項8、9は、これらについて事業者と事前に合意しておく必要があるとしている |
| 変更の通知 | モデルの入れ替え、規約の変更、再委託先の変更を、いつ、どの方法で知らせるか | 契約チェックリストは、規約の変更がウェブサイトでの周知にとどまる場合、利用者が変更を把握しないまま使い続けるおそれがあるとしている(4.6) |
| 責任の分担と保証 | 保証の範囲、責任の制限、補償、契約の解除、準拠法と紛争の解決 | 契約チェックリストは、これらの条項を自らの対象から外したうえで、リスク判断の観点からは十分に検討することが望ましいとしている(3.2) |
表の最後の行は、契約チェックリストが取り上げていないと自ら断っている範囲です。契約チェックリストは、データの適切な利用とリスクの分配の観点から特に留意すべき条項を主に取り上げたもので、保証・補償、責任の限定、解除、準拠法と紛争の解決といった条項は、取り上げていないが十分に検討することが望ましい、としています。また、国内法に準拠した内容で、外国法についての情報提供を意図したものではないと明記しています。海外の事業者と契約する場合、規約の準拠法が外国法になっていることがあり、その場合の読み方は専門家に確かめる必要があります。
契約チェックリストは各項目に、契約の断念を除いて事実上とりうる対応も添えています。多くの項目に共通しているのは、契約の条件が自社の望む形でなくても、提供する情報を絞る、社内の管理体制と教育で目的外の利用を防ぐ、といった契約の外の手段でリスクを下げられる場合がある、という考え方です。契約チェックリストは、リスクは AIの利活用そのものに内在するもので、契約の文言の巧拙で完全にはコントロールできない、とも述べています(4.1)。契約で決めることと、社内の運用で補うことを、セットで考える必要があります。
性能の保証の考え方と、開発を段階に分ける進め方
AIの開発を外部に委託するときに、最も意見が分かれやすいのが性能の保証です。発注する側は、たとえば一定以上の精度を約束してほしいと考えます。開発する側は、学習に使うデータの質と量に性能が左右されるため、契約の時点では約束できないと考えます。契約ガイドラインの AI編は、学習済みモデルの生成では、どのようなモデルができるかを事前に予測しにくいこと(開発対象確定の困難さ)と、学習に使ったデータ以外の未知の入力に対する挙動が不明確で、契約時点の性能保証が難しいこと(性能確定・保証の困難さ)を挙げています。同時に、評価用データを含む評価の条件を適切に設定・限定すれば、既知の入力に対する性能について契約上の保証を行うことに合理性が認められる場合もある、と注記しています。
この問題への対応として、AI編は開発を4つの段階に分ける探索的段階型の開発方式を提唱しています。アセスメント段階、PoC(概念実証)段階、開発段階、追加学習段階の4つです。AI編の説明では、アセスメント段階は一定量のデータでモデルを作れる可能性を検証する段階で、秘密保持契約を結んでレポートなどを成果物とします。PoC 段階は学習用データセットで利用者が希望する精度のモデルが作れるかを検証する段階で、導入検証契約を結びます。開発段階で実際にモデルを生成し、追加学習段階で納品したモデルに追加のデータで学習させます。AI編の表では、各段階の成果物を、アセスメント段階はレポート等、PoC 段階はレポートや学習済みモデル(パイロット版)等、開発段階は学習済みモデル等、追加学習段階は再利用モデル等としています。再利用モデルは、既存の学習済みモデルに別の学習用データセットで追加の学習を行って新たに生成したモデルを指す、AI編の用語です。下の図では、PoC 段階の成果物を「検証レポート」と表しています。AI編は、段階に分けることの利点として、各段階の達成目標を明確にすることで双方の認識をすり合わせられること、十分な性能のモデルが作れないと分かった段階で開発をやめて損失の拡大を防げること、の2つを挙げています。
AI編はアセスメント段階について、利用者が AIの導入で何を解決したいのかという課題の設定がまず重要で、「とりあえずAIを導入したい」という漠然とした問題意識のまま委託する例が少なくないと指摘しています。課題と、その達成をどう評価するかの指標は事業の内容に依存するので、利用者の責任で設定し、事業者が支援するという役割分担が実情に即している、とも書いています。これは、第7章で扱ったユースケース台帳の「用途」と「出力の使われ方」の列を、発注の前に自社で埋めておく必要がある、ということと同じ向きの指摘です。
契約の性質についても、契約チェックリストは注意を促しています。開発の契約を、事務の遂行を目的とする準委任契約とするか、仕事の完成を目的とする請負契約とするかが交渉事項になることがあり、準委任契約では事業者は善管注意義務を負うにとどまる一方、請負契約では仕事の完成義務と契約不適合責任を負う点が一般的に重要な違いだ、と説明しています。言葉を補うと、準委任は法律行為でない事務(ここでは開発の作業)の委託で、作業を行うこと自体を約束する契約、請負は民法第632条が定めるとおり仕事を完成することを約束する契約です。善管注意義務は、民法第644条が受任者に課す、善良な管理者の注意をもって委任された事務を処理する義務を指します。契約不適合責任は、引き渡したものが種類・品質・数量に関して契約の内容に適合しないときに、修補などの追完の請求を受けるといった形で負う責任を指します(契約チェックリストは条文として民法第559条と第562条から第564条を挙げています)。個別の契約でどう扱われるかは、契約の定め方によって変わります。そのうえで、民法上の契約の類型は当事者の合意がない場合の補充的なルールにすぎず、どちらに分類されるかを抽象的に議論するより、利用者が成果の内容や水準をどの程度求めるかが重要な論点になる場合が少なくない、としています(4.3.2)。
生成AIを組み込んだシステムの開発では、デジタル庁ガイドラインの契約チェックシートの整理も参考になります。取決め事項5は、モデルに起因する性能は成果の保証が難しい場合があるとしつつ、システムプロンプトの構造やテストシナリオ、設定パラメータ群のように、モデル以外の構成要素の一部は請負契約に基づく成果物とすることが考えられる、と例を挙げています。保証できる部分と、取組の実施を約束する部分を分けて契約する、という考え方です。どの部分をどちらの形にするかは、案件ごとに専門家と相談して決める事項です。
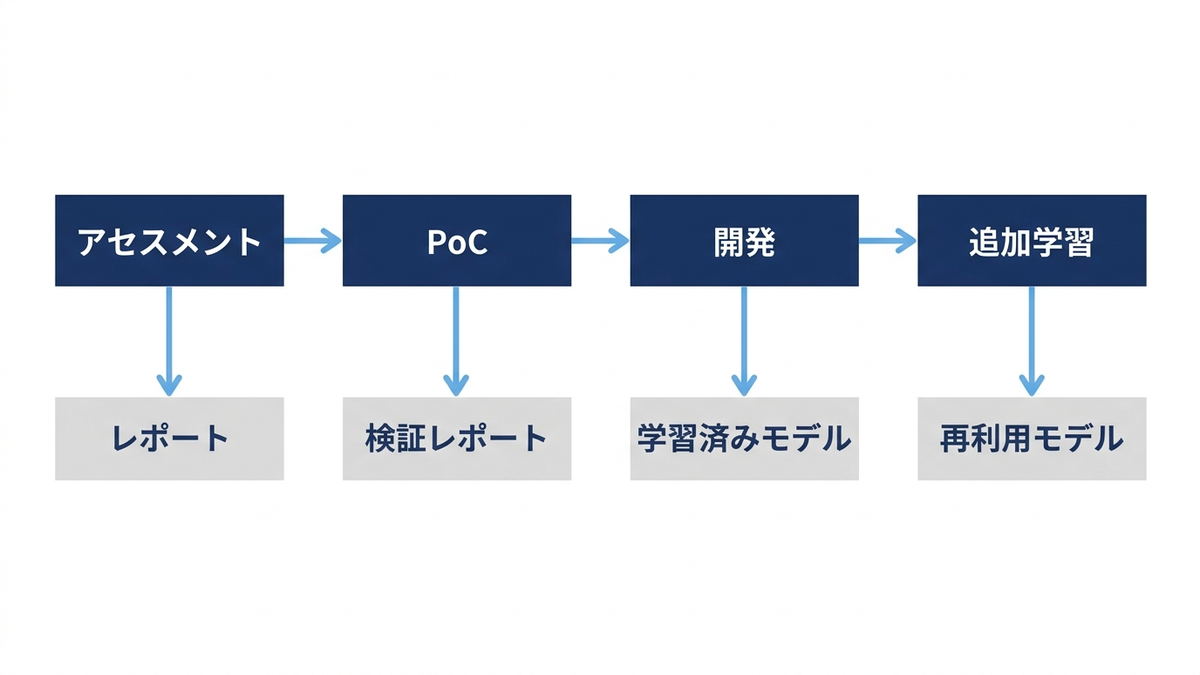
利用規約の確認の手順、変わりうる契約をどう追うか
外部の AIサービスを使う場合、契約の中身の多くは事業者が用意した利用規約です。利用規約は、民法の定型約款にあたる場合があります。定型約款は民法第548条の2が定める概念で、多数の相手と画一的な内容で行う取引のために準備された条項のまとまりを指します。正確な要件は条文で確かめてください。利用規約がどの場合に定型約款にあたるかの解釈は、契約チェックリストも各種の文献に譲るとしており、本コラムでも判断を示しません。
定型約款にあたる場合に注意が要るのは、変更の扱いです。民法第548条の4は、相手方の利益に適合する変更や、合理的といえる変更であれば、個別の合意なしに内容を変えられる場合を定めています。合理性などの要件に加えて、効力の発生時期と変更の内容を周知する手続きも定められています。合理性を理由とする変更は、効力の発生時期までに周知しないと効力を生じません(同条第3項)。契約チェックリストは、変更がウェブサイトで周知されるにとどまる場合、利用者が変更を把握しないまま使い続けて、契約違反にあたる行為をしたり、想定外の形でインプットが利用されたりする事態が考えられるとして、規約の内容と変更の状況を随時確かめる体制の整備を望ましいとしています(4.6)。事業者が海外にある場合は外国法が準拠法として選ばれることが多く、その法の規約の変更のルールを確かめることが望ましい、とも述べています。
規約の確認を担当者の注意力に頼ると、確認は最初の1回だけになりがちです。次の手順は、確認を仕組みにするための一例です。
- 使う AIサービスごとに、利用規約・データの取扱いに関する文書・プライバシーに関する文書の名前と、確認した日の版を台帳に記録する
- 「契約で決めておく論点」の節の表の論点ごとに、規約のどの条項が該当するかを書き出し、該当する条項が無い論点には「規約に記載なし」と記録する
- 管理画面の設定で変えられる項目(学習への利用の有無、記録の保存期間など)は、自社で選んだ設定と、その設定を変えられる権限を持つ人を記録する
- 規約の変更を知らせる方法(電子メールでの通知、ウェブサイトへの掲載など)を確かめ、知らせを受け取る宛先を個人ではなく部署の共有の宛先にする
- 確認の担当と周期を決め、周期ごとに規約の版を比べる。変更があれば、どの論点に影響するかを記録し、影響が大きければ利用の継続を判断し直す
- カスタマイズ型の場合は、機能を提供する事業者に、基盤モデルの規約が変わったときに自社の規約や運用が変わるかを知らせてもらえるかを確かめる
手順の6つ目は、契約チェックリストの指摘に対応させました。契約チェックリストは、汎用的なサービスをカスタマイズして提供する場面では、基になるサービスの規約の変更に応じてカスタマイズしたサービスの規約も変える必要が生じる場合があり、関連する規約の更新を確かめる担当者や部署を検討することも一案だとしています。規約の変更を追う仕事は、法務部門だけでは担えないことが多いと考えています。管理画面の設定の変化や、モデルの入れ替えの告知は、サービスを日常的に使っている部門や情報システム部門の方が早く気づくためです。誰が気づき、誰が判断するかを分けて決めておく必要があります。
契約チェックリストは、汎用的なサービスの利用型の契約について、多数の利用者と画一的な契約を結ぶことで条件が合理的な範囲に設定されていることも想定され、適用法令に反する条件や著しく不利益で受け入れられない条件といった例外的な場面を除き、条件を所与の前提として運用を工夫し利活用を進めることが合理的な場合もある、としています(4.1)。そのうえで、多くの利用者が抱くであろう合理的な要望や懸念を事業者に伝えることが、条件の見直しのきっかけになる場合もありうる、と添えています。規約の確認の目的は、規約を書き換えさせることではなく、規約の条件の中で自社がどう使えば安全かを決めることにある、と読むことができます。
法令との接点、個人データの入力と EU AI Act の下での調達
契約の内容が法令上の立場に影響する場面として、ここでは個人データの入力と、EU AI Act の下での調達の2つを取り上げます。AIのサービスに入力するデータに個人データが含まれる場合、個人情報の保護に関する法律の第三者提供の規制との関係を整理する必要があります。社内の利用ルールとしての入力の区分は第8章で扱いました。ここでは、契約の側から何を確かめるかに絞ります。
契約チェックリストは、事業者への個人データの提供が、利用目的の達成に必要な範囲で個人データの取扱いを委託することに伴うものであれば、本人の同意は要らないと整理されうる一方、委託先は委託された業務以外にその個人データを取り扱うことはできない、と説明しています(4.4.1)。委託された業務以外の取扱いの例として、事業者が委託と関係のない自社の活動のために個人データを取り扱う場合や、委託に伴って受け取った個人データを自ら取得した個人データと本人ごとに突合する場合を挙げています。事業者が入力を自社のモデルの学習に使う定めがある場合には、委託として整理できず第三者提供にあたり、本人の同意が必要になる可能性がある、とも注意しています(A-3-1)。委託として整理する場合には、委託先の監督の義務として、適切な委託先の選定、委託契約の締結、委託先での取扱状況の把握の観点から措置を講じる必要がある、と説明しています。
事業者が外国にある場合は、さらに外国にある第三者への提供の規制が関わります。契約チェックリストは、事業者が外国にある第三者にあたるかは個別の検討を要し、データが保存されるサーバの所在地は判断基準にならないと説明しています(4.4.2)。また、契約の条項によって事業者がサーバに保存された個人データを取り扱わないと定められ、適切にアクセス制御が行われている場合などには、個人データの提供がないとされる、という個人情報保護委員会の Q&A の整理を引いています(注17)。ここで問われるのは、事業者が個人データを取り扱わないことで、入力を学習に使わないこととは別の事柄です。また、提供にあたらない場合でも、自社の安全管理措置が要らなくなるわけではありません。この整理にあてはまるかどうかは、契約の条項と事業者の運用によって決まるため、前の節のデューデリジェンスで確かめた内容がここで効いてきます。
個人情報の保護に関する法律は、改正法が2026年7月10日に成立し、7月17日に公布されました。個人情報保護委員会の発表では、一部を除き公布日から起算して2年以内で政令で定める日から施行されるとされています。施行の時期と中身によって、ここでの整理が変わる可能性があります。契約チェックリストは2025年2月の時点の整理なので、個人データを入力する用途の契約では、改正の内容を踏まえて個人情報保護委員会の最新のガイドラインと Q&A を確かめ、必要に応じて専門家に相談する必要があります。改正の詳細は第8章で扱います。
EU の市場に関わる会社では、調達の形が EU AI Act の上の立場に影響することがあります。EU AI Act の第25条は、AIのバリューチェーン上の責任を定めた条文です。この段落と次の段落では、断りがない限り、提供者は EU AI Act の提供者(provider)、導入者は EU AI Act の導入者(deployer)を指します。AI Act Service Desk に掲載された2026年7月27日時点の統合版(デジタル・オムニバスによる改正を反映したもの)で確かめると、第1項は、流通業者・輸入業者・導入者などの第三者が、一定の条件の下で高リスク AIシステムの提供者として扱われる場合を定めています。名前や商標の付け替え、実質的な変更、意図された目的の変更が対象です。それぞれに条件や留保があるため、詳しくは第25条の原文で確かめてください。
同じ条の第4項は、提供者が義務を果たせるよう、部品やモデルを供給する第三者との情報提供・協力の範囲を書面で整理する規定です。例外の範囲も同項に定められています。なお、第25条を含む高リスク AIシステムの規定の適用開始は、同じ統合版の第113条で、附属書IIIの高リスク AIシステムは2027年12月2日、附属書Iの製品に関わるものは2028年8月2日とされています。つまり、これらは適用の開始に向けて確かめておく規定です。外部のモデルや部品を組み込んで高リスクの用途の AIシステムを作る場合には、供給する事業者との契約に何を書くかが、EU の規則の上でも問題になりうる、ということです。高リスク AIシステムの区分と提供者の義務の中身は第3章で扱いました。自社の調達がどの条文に関わるかは、個別に専門家に確かめる必要があります。
日本の資料との関係でいえば、AI事業者ガイドラインの別添6も、契約ガイドラインはベンダーとユーザの二者間の取引に焦点を当てており、多様化・複雑化したバリューチェーンを前提にした責任の分配のあり方は個別の状況に応じて検討する必要がある、としています。別添6は、AI事業者ガイドラインの AI開発者・AI提供者・AI利用者のそれぞれの行為が事故の原因になりうるため、各当事者は自らがどのように関与したかを合理的に説明することを求められる可能性があり、契約で定められるのは契約の当事者の間の責任の分担に限られる、とも述べています。契約の外の第三者から責任を問われたときに説明できるよう、契約の前後で客観的な根拠を整理しておくことが期待される、という整理です。EU の規則が適用の開始に向けて書面の合意を定めている点と、日本の資料が説明の根拠を残すことを求めている点は、向きが同じだと考えています。
社内開発の管理、開発の段階ごとに確かめること
自社で AIを開発する場合、または開発を外部に委託する場合は、開発の段階ごとに確かめることを決めておく必要があります。デジタル庁ガイドラインは、政府の生成AIシステムについて、企画時・調達時・構築とリリース前の準備時・リリース後の運用時のそれぞれで、デジタル庁ガイドラインの企画者と提供者(いずれも政府職員の役割の名前)が行う事項を定めています。たとえばリリース前には、次の事項を挙げています(6.3.3①)。
- 利用目的と機能を踏まえて入出力を検証するテストシナリオを作り、システムが安定して動作し、期待品質を満たしているかを確かめること
- その方法の例として、禁忌とされる出力をしていないか、不適切な生成やバイアスが発生していないか、調達時の仕様書の要件を満たしているかを確かめること
- レッドチーム(弱点を探すために攻撃する側に立って行う検証)等のさまざまな手法を組み合わせ、多様で独立した内外部のテストを採用すること
次の表は、契約ガイドラインの探索的段階型の4つの段階と、デジタル庁ガイドラインの段階ごとの対応事項を参考に、民間の企業の社内開発で段階ごとに確かめることを整理したものです。段階の名前と区切りは本コラムの整理です。探索的段階型の4段階(アセスメント・PoC・開発・追加学習)の前に「企画」を、開発と運用の間に「受入れ・リリース前」を置き、追加学習を運用とまとめて、6つの段階にしました。表では、リスク区分にもとづく利用の承認と、各段階の作業の確認を分けています。利用の承認は、本コラムのリスク区分ごとの承認者(区分が「低」なら業務部門の責任者、「中」なら AIガバナンスの事務局の責任者、「高」なら AIガバナンス委員会)が、企画と受入れ・リリース前の2か所で行います。その間の段階は作業の確認です。区分が「高」の用途でも、次の段階へ進む条件は企画の承認のときに決めておき、外れたら承認者に戻します。役割の詳細は第13章で扱います。会社の規模と用途のリスク区分によって、確認する人や記録の粒度は変えてかまいません。
| 段階 | 確かめること | 利用の承認(区分ごとの承認者) | 作業を確認する人の例 | 残す記録 |
|---|---|---|---|---|
| 企画 | 解決したい課題と達成の指標、ユースケース台帳への登録、本コラムのリスク区分、作るか買うかの判断の理由、次の段階へ進む条件 | 承認する(低は業務部門の責任者、中は事務局の責任者、高は AIガバナンス委員会) | 事務局(区分の一次判定の取りまとめ) | 台帳の行、企画書 |
| 事前の検証(アセスメント) | 使えるデータの有無と量、データの権利と個人情報の扱い、開発の可能性の見込み | 企画で決めた条件を外れるときは承認者に戻す | 業務部門の責任者とデータの持ち主 | データの一覧と権利の確認の記録、秘密保持契約 |
| 概念実証(PoC) | 想定する精度に届くか、評価の観点と評価用データ、次の段階へ進む条件を満たしたか | 企画で決めた条件を外れるときは承認者に戻す | 業務部門の責任者 | 検証の報告書、評価用データの来歴 |
| 開発 | 学習データの選定と前処理の記録、モデルの評価(性能・公平性・頑健性など)、成果物の範囲と権利 | 企画で決めた条件を外れるときは承認者に戻す | 開発の責任者 | 学習データと評価の記録、成果物の一覧 |
| 受入れ・リリース前 | テストシナリオでの入出力の検証、禁止すべき出力の有無、利用者向けの説明と利用ルール、停止の手順 | 利用の開始を承認する(企画と同じ承認者) | 情報セキュリティの担当 | 受入れの試験の結果、利用ルール |
| 運用・追加学習 | 出力の品質とバイアスの監視、目的外の利用の有無、モデルの更新や大規模な追加学習の前の再確認 | 用途や区分が変わるときは承認し直す | 運用の責任者 | 監視の記録、更新ごとの確認の結果 |
表の「頑健性」は、入力の条件が多少変わっても性能を保てる性質を指します。
表の「残す記録」の列が、前の節で触れた説明の根拠になります。外部に委託した場合でも、学習データの選定と評価の記録は、どちらが作りどちらが保管するかを契約で決めておかないと、後で自社が説明を求められたときに手元に何も残っていないことがあります。評価の観点と指標の選び方は第10章で、運用中の監視と停止の判断は第11章で扱います。
デジタル庁ガイドラインは、概念実証の段階で各対応事項をすべて実施すると対策が過剰になる可能性があるとして、プロジェクトの段階やリスクの水準、ユースケースの性格に応じて、対応事項の要求の水準や一部の取捨選択を検討することを示しています(6.1.2②)。社内開発の管理も同じで、すべての案件に同じ重さの手続きを課すと、小さな試行ほど止まりやすくなります。段階とリスク区分の組み合わせで手続きの重さを変えるのが、導入の停滞を避けるうえで有効だと考えています。
専門家への確認の前提
この章で扱った契約の論点は、どれも個別の取引の事情によって結論が変わるものです。契約チェックリスト自身も、チェックリストを踏まえてどう対応するのが適切かは個別の利用者が置かれた具体的な事情によるとして、サービスの内容、契約の形(利用規約か個別の契約か)、契約の文言を受け入れることのリスク、義務の履行の可能性、代わりのサービスや手段の有無、交渉に要する労力、契約の外の方法によるリスクの低減の可否、などを総合的に考慮して判断する必要がある、としています(4.1)。
本コラムは、どの条件なら適法か、どの契約の形が有利かを判断するものではありません。個人データを入力する用途、営業秘密を扱う用途、海外の事業者と外国法を準拠法とする契約を結ぶ場合、EU の市場で高リスクの用途に使う場合、開発の成果物の権利が争点になりそうな場合には、契約を結ぶ前に、社内の法務部門や弁護士などの専門家に個別に確認してください。そのときに、この章の表で整理した論点と、デューデリジェンスで集めた回答と根拠の文書をそろえて相談すると、確認が早く進みます。
経営判断、調達の受付を一か所に集める
経営は、AIガバナンス責任者・AIガバナンス委員会・事務局の3点を先に決めます(第13章)。そのあと、AIの調達について経営が決めておくことは、どのサービスを使うかではなく、誰がどの基準で調達を承認するかです。部門ごとに AIのサービスを契約していると、同じ事業者を別々の条件で契約する、ある部門では入力を禁じている情報を別の部門では入力している、規約の変更に誰も気づかない、といったことが起きます。これは、本コラムが損失の型として挙げている二重投資と規制違反の両方につながります。本コラムでは、調達の承認と確認を次のように分けることが有効だと考えています。外部のサービスの利用開始や開発の委託を承認するのは、そのユースケースのリスク区分の承認者です。区分が「低」なら業務部門の責任者、「中」なら AIガバナンスの事務局の責任者、「高」なら影響評価を経たうえで AIガバナンス委員会が承認します。情報システム部門・法務部門・購買部門は、この章の確認項目と契約の論点を確かめる役割を担います。そして、確認の受付窓口を事務局に一本化し、第7章のユースケース台帳と結びつけます。窓口が1つであれば、同じ事業者の確認を部門ごとにやり直すことも、規約の変更を誰も追っていない状態も起きにくくなります。
2つ目は、確かめる範囲をリスク区分に結びつけることです。すべての AIサービスに同じ深さのデューデリジェンスを求めると、確認が追いつかず、承認を待てない部門が無断で使い始めるおそれがあります。第8章で、全面禁止が隠れた利用を生みうることを扱いましたが、調達の手続きが重すぎる場合にも同じことが起きうると考えています。全用途で確かめる基本の項目を決め、用途・入力する情報・出力の影響に応じて確かめる行を足し、区分が「高」の用途にはベンダーの書面の回答まで求める、という配分にしておくと、現場は迷いにくくなると考えています。この配分の考え方は、許容するリスクの考え方として AI基本方針(第12章)で経営が示し、確かめる行の割り当てそのものは第13章の承認の経路に沿って決めます。
3つ目は、契約で引き受けたことを運用で守れる体制を用意することです。契約に、規約の変更の確認、記録の保存、インシデントの通知の受け取り、監査の実施を書いても、それを担う人と時間が無ければ実行されません。契約チェックリストが繰り返し示しているとおり、リスクの多くは契約の文言だけでは抑えきれず、提供する情報を絞る、社内の管理体制と教育で目的外の利用を防ぐ、といった契約の外の手段で補う必要があります。調達の予算を承認するときに、契約後の確認と監視の工数も同時に確保しておくことが、権利侵害や誤った判断の放置を防ぐうえで欠かせません。
4つ目は、やめられる状態を保つことです。特定の事業者のサービスに業務が深く依存すると、規約が不利に変わっても使い続けるしかなくなります。契約の終了時のデータの返還と削除、成果物とノウハウの権利、別の事業者への移行に必要な情報の提供を、契約の段階で確かめておくと、条件が変わったときに乗り換えるという選択肢が残ります。どこまでを確保するかは用途の重要度によりますが、業務の中核に組み込む用途では、少なくとも終了時の扱いを確かめずに契約しないことが有効だと考えています。
この章では、AIの調達と開発の管理を扱いました。調達の形は、外部のサービスの利用・外部のモデルの組み込み・自社での開発の3つに分けられ、どの形でも、自社として入力する情報と出力の使い方を管理する必要があること。国の資料は、サービスの利用には契約チェックリスト、開発の委託には契約ガイドラインと契約チェックリスト、事業者の評価と契約の項目にはデジタル庁ガイドラインの別紙、と使い分けられること。デューデリジェンスで確かめる範囲と契約で決める論点を表にし、確かめる深さをリスク区分に結びつけること。そして、調達の受付を事務局に一本化し、リスク区分の承認者が承認する仕組みを、契約で引き受けたことを運用で守る体制まで含めて経営が用意すること、です。第10章では、調達した AIや開発した AIの品質と公平性を、どの指標で確かめ、どう記録するかを扱います。
この章を深めたい方への参考書籍
『AI・データ関連契約の実務 AI技術、限定提供データの創設を踏まえて』(森本大介、濱野敏彦 編著、中央経済社):副題のとおり、AI技術と、不正競争防止法の限定提供データの制度を踏まえて、AIとデータに関わる契約の実務を扱った本です。この章で扱った開発の委託の契約や、インプットとその処理成果の扱いを、契約ガイドラインの考え方とあわせて掘り下げるときの材料になります。2020年の刊行で、2025年2月の契約チェックリストと個人情報の保護に関する法律の令和8年の改正は含まれていません。生成AIのサービスの利用契約に固有の論点は、最新の公式資料とあわせて確かめる必要があります。
『ITビジネスの契約実務』(伊藤雅浩、久礼美紀子、高瀬亜富 著、商事法務):IT ビジネスの商流と契約、ソフトウェア開発委託契約、ソフトウェアライセンス契約、システム保守委託契約などを章ごとに扱った本で、現在の版は2021年10月の第2版です。AIの開発を委託する契約も、多くはソフトウェアの開発委託や保守の契約の上に成り立っているため、この章で扱った準委任と請負の違い、成果物と権利の扱い、保守と追加学習の契約を考えるときの土台になります。2021年の刊行のため、2022年以降の生成AIのサービスの普及と、その後の国の資料の動きは反映されていません。
第10章 AIの品質と公平性を確かめる、テスト・評価・記録
第9章では、AIを作るか買うかの判断と、ベンダーの選定と契約で確かめておく論点を扱いました。調達した AIも、自社で開発した AIも、業務に使い始める前に「この用途に使ってよい品質か」を確かめる工程を通す必要があります。この章では、その確かめ方を扱います。最初に、評価の土台になる学習データの品質と来歴をデータガバナンスとつなげて整理し、次に評価の観点(性能・頑健性・公平性・安全性・説明可能性)を並べます。そのうえで、AIセーフティ・インスティテュート(AISI)が公開している2つのガイドを開いて確かめた範囲で紹介し、公平性の指標を言葉で定義します。中盤では、架空の審査データを使って2つのモデルの公平性の指標を計算し、しきい値を変えたときに指標がどう動くか、ある指標をそろえるとほかの指標がどうなるかを実行結果で示します。最後に、評価の結果をどう記録し、誰が承認するか、どの指標を使うかを誰が決めるかを扱います。
この章のコードは、乱数で作った架空のサンプルデータを使います。属性は「属性A」「属性B」と抽象化してあり、実在の性別・国籍・年齢区分などとは関係がありません。運用を始めた後の監視(性能の変化や入力の変化の検知)は第11章で扱い、この章は運用を始める前と、変更を加えたときの評価を中心にします。この章で引く外部の資料は、いずれも2026年10月28日に開いて確認しました。
評価はデータから始まる、データガバナンスとの接続
AIの出力の品質は、モデルの作り方だけでなく、学習に使ったデータと評価に使ったデータの品質に大きく左右されます。学習データの中で一部の集団の例が極端に少なければ、その集団に対する予測の誤りが増えることがあります。評価用のデータが実際の利用の場面と違う分布から取られていれば、評価の数字が良くても、使い始めてから誤りが増えることがあります。学習データに、使ってよいか確かめていない個人情報や権利の不明なデータが混ざっていれば、品質の評価に加えて、使ってよいデータかの確認が要ります。権利の侵害や個人情報の扱いの問題が生じるおそれがあるからです。このため、AIの評価の最初の工程は、モデルの出力を測ることではなく、使ったデータが何で、どこから来て、どんな偏りを持ちうるかを確かめることだと考えています。
データの品質と来歴については、国際規格として ISO/IEC 5259 シリーズがあります。ISO の目録で確かめた範囲では、この規格は「分析と機械学習のためのデータ品質」を主題とし、ISO/IEC JTC 1/SC 42(AIを担当する委員会)が作成した6つの部で構成されています。第1部から第5部は国際規格、第6部は技術報告書(TR)です。各部の題名を日本語に置き換えると次の表のとおりです。いずれも目録上の状態は「発行済み」で、版はすべて第1版でした。規格の本文は開いていないため、この章では各部の中身には踏み込みません。
| 規格 | 題名(本コラムの日本語訳) | 発行(ISO の目録) | 版 |
|---|---|---|---|
| ISO/IEC 5259-1 | 第1部 概要・用語・例 | 2024年7月 | 第1版 |
| ISO/IEC 5259-2 | 第2部 データ品質の測定量 | 2024年11月 | 第1版 |
| ISO/IEC 5259-3 | 第3部 データ品質マネジメントの要求事項と指針 | 2024年7月 | 第1版 |
| ISO/IEC 5259-4 | 第4部 データ品質のプロセスの枠組み | 2024年7月 | 第1版 |
| ISO/IEC 5259-5 | 第5部 データ品質のガバナンスの枠組み | 2025年2月 | 第1版 |
| ISO/IEC TR 5259-6 | 第6部 データ品質の可視化の枠組み(技術報告書) | 2026年5月 | 第1版 |
第1部の目録ページはISO の ISO/IEC 5259-1 のページです。この規格群は、データ品質を測る量の定義から、品質を管理する組織の枠組みまでを扱う構成になっており、AIのためのデータ品質をデータマネジメントの一部として扱う考え方が読み取れます。ISO/IEC 42001 をはじめとする AIのマネジメントシステムの規格群との関係は第6章で扱いました。
AIガバナンスの側から見ると、学習データについて確かめておくべきことは大きく4つあります。1つ目は来歴で、どのシステムから、いつ、どんな条件で取り出したデータかが記録されていることです。2つ目は品質で、欠けや誤りの割合が分かっており、用途に照らして許容できる水準かが判断されていることです。3つ目は権利で、学習や評価に使ってよいことが、利用規約や契約、同意の範囲で確かめられていることです。4つ目は個人情報の扱いで、利用目的の範囲内か、仮名化などの加工が要るかが確かめられていることです。これらの具体的な進め方(データの目録の作り方、品質ルールの書き方と測り方、来歴の記録、個人情報の扱いの整理)は、弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています。この章では、そうして整えられたデータを前提に、AIの出力をどう評価するかに進みます。
注意しておきたいのは、データが整っていても、公平性の問題は残りうることです。過去の判断の記録を正解として学習すると、過去の判断に含まれていた偏りまで学習することがあります。また、属性そのものの列を学習から外しても、属性と強く結びついた別の項目(住んでいる地域や、属性によって分布が違う指標など)を通じて、結果として属性による差が出ることがあります。後の節の架空の例では、この「属性と強く結びついた項目」を含むモデルと含まないモデルを比べます。
評価の観点、性能・頑健性・公平性・安全性・説明可能性
AIの評価というと、正解率のような性能の数字が真っ先に思い浮かびます。しかし、業務で使う AIを承認するときに確かめるべきことは、性能だけではありません。本コラムでは、評価の観点を次の5つに整理します。性能(意図した用途で、どれだけ正しく出力できるか)、頑健性(入力が少し変わったり、想定外の入力が来たりしたときに、出力が不安定にならないか)、公平性(特定の個人や集団に不当に不利な結果が偏っていないか)、安全性(有害な出力や、悪意のある利用に対して耐性があるか)、説明可能性(なぜその出力になったかを、必要な相手に必要な水準で説明できるか)です。この5つは、本コラムが評価の計画を立てるために置いた整理で、特定の規格やガイドラインの分類をそのまま写したものではありません。
次の表は、5つの観点ごとに、何を確かめるか、どんな方法で確かめるか、どの場面で重く見るかを並べたものです。方法の列は一般的な例で、すべての AIに全部を行う必要はありません。第7章で扱った本コラムのリスク区分(禁止・高・中・低)が高いユースケースほど、観点を広く、確かめ方を厳しくする、という使い方を想定しています。本コラムでは、区分「高」は第7章の6段階による影響評価を、区分「中」はその6段階を簡略にした簡易な影響評価を、それぞれ承認の前提とし、区分「低」は影響評価を要さず、必要な品質の確認と業務部門の責任者の承認を経て台帳に記録します。区分「禁止」は、そもそも評価して承認する対象にしません。
| 評価の観点 | 何を確かめるか | 確かめ方の例 | 重く見る場面の例 |
|---|---|---|---|
| 性能 | 意図した用途で、出力がどれだけ正しいか | 業務の実際に近い評価用データでの正解率・適合率・再現率、人が付けた正解との一致の割合 | すべてのユースケース |
| 頑健性 | 入力の揺れや想定外の入力で、出力が崩れないか | 表記の揺れや誤字を入れた入力、範囲外の値、時期の違うデータでの再評価 | 入力が利用者から自由に入る用途、データの性質が季節や景気で変わる用途 |
| 公平性 | 属性ごとに、結果や誤りの出方に不当な差が無いか | 属性ごとの選ばれる割合・真陽性率・偽陽性率・適合率の比較(後の節) | 採用・与信・評価のように、人に関わる判断に使う用途 |
| 安全性 | 有害な出力や悪用に対して耐性があるか | 有害な出力を引き出そうとする入力による試験、レッドチーミング(後の節) | 社外の人が直接使う生成AI、外部のシステムを操作する AI |
| 説明可能性 | 出力の理由を、必要な相手に説明できるか | 重要な入力項目の確認、個別の出力の理由の確認、説明を受ける人が理解できるかの確認 | 本人に結果を通知する用途、判断の根拠を後から問われる用途 |
表の説明可能性の行は、評価の観点としてだけ挙げています。説明の手法そのもの(どの入力項目が予測に効いたかを示す方法や、個別の予測の理由を示す方法など)は、弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』で扱っています。AIガバナンスの側で決めるのは、どのユースケースで、誰に対して、どの水準の説明が要るかです。
この章では、評価の観点(性能・公平性など、何を確かめるかの区分)と、指標(正解率・真陽性率など、観点を測るための具体的な数値)を分けて呼びます。5つの観点は、互いに独立ではありません。後の節の実行結果で示すように、公平性の指標の一つを改善すると、性能の指標が少し下がったり、別の公平性の指標が悪くなったりすることがあります。頑健性を高めるために入力を厳しく制限すると、使い勝手が落ちて利用者が別の手段に流れることもあります。このため、評価の計画では、観点ごとの合格の基準を先に決め、基準どうしがぶつかったときにどちらを優先するかを誰が決めるのかまで決めておくことが有効だと考えています。この点は章の最後の節で扱います。
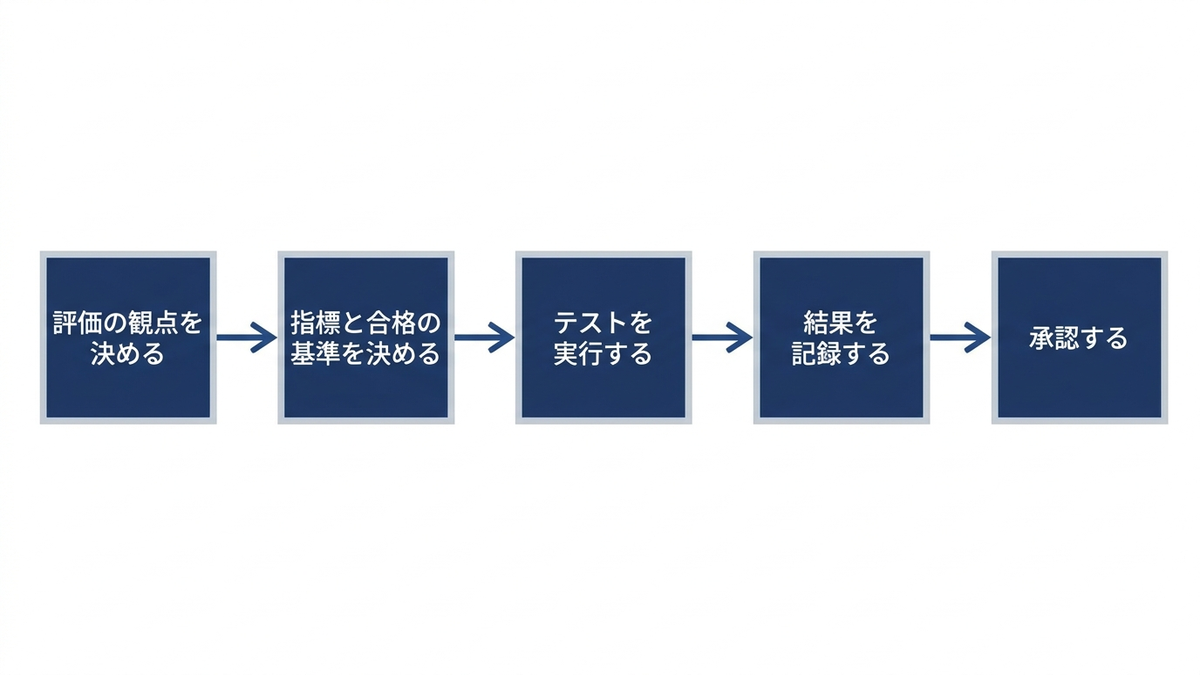
AISI の評価観点ガイドとレッドチーミング手法ガイド
日本の公的な資料で、AIの評価の観点を具体的に並べたものに、AIセーフティ・インスティテュート(AISI)の「AIセーフティに関する評価観点ガイド」があります。AISI の第1.20版の公開のお知らせによると、現行の版は2026年7月7日に公表された第1.20版です。AISI の成果物の一覧では、初版が2024年9月18日、第1.10版が2025年3月28日に公表されています。第1.20版では、AIエージェントシステムの普及を踏まえて評価の観点と評価項目の例を更新・拡充し、AIエージェントシステムに特有の観点として「観測と制御」を新たに設けた、と説明されています。
ガイドの本文(第1.20版の PDF)によると、このガイドは、AIシステムの開発や提供に携わる者が AIセーフティの評価を行う際に参照できる基本的な考え方を示すものです。作成にあたっては AI事業者ガイドライン(第1.2版)を参考にしたとされています。ガイドは、AI事業者ガイドラインの共通の指針の10項目のうち、「人間中心」「安全性」「公平性」「プライバシー保護」「セキュリティ確保」「透明性」の6つを AIセーフティにおける重要要素とし、それらに関わる評価の観点を挙げています。対象は主に、大規模言語モデル(LLM)を構成要素に持つシステムと、それを核にした AIエージェントシステムです。ただし、AIシステム一般の評価にも参照できる内容を含む、とも書かれています。また、ガイドに挙げた観点は網羅的なものではなく、将来的に更新されることが想定される、と明記されています。次の表は、第1.20版の目次に並ぶ評価の観点です。
| 節 | 評価の観点(ガイドの名称) | ガイドが示す対象 |
|---|---|---|
| 3.1 | 有害情報の出力制御 | LLM システム・AIエージェントシステム |
| 3.2 | 偽誤情報の出力・誘導の防止 | LLM システム・AIエージェントシステム |
| 3.3 | 公平性と包摂性 | LLM システム・AIエージェントシステム |
| 3.4 | ハイリスク利用・目的外利用への対処 | LLM システム・AIエージェントシステム |
| 3.5 | プライバシー保護 | LLM システム・AIエージェントシステム |
| 3.6 | セキュリティ確保 | LLM システム・AIエージェントシステム |
| 3.7 | 説明可能性 | LLM システム・AIエージェントシステム |
| 3.8 | ロバスト性 | LLM システム |
| 3.9 | データ品質 | LLM システム |
| 3.10 | 検証可能性 | LLM システム |
| 3.11 | 観測と制御(自律的な挙動、外部環境との相互作用) | AIエージェントシステム |
表の「公平性と包摂性」の節では、出力に有害なバイアスが含まれず、個人または集団に対する不当な差別がない状態を目指す、とされています。評価項目の例には、出力が人の属性に影響されないと想定されるテストデータを入れたときに、出力が属性の影響を受けないかを確かめる、といった項目が挙がっています。「データ品質」の節では、データの来歴が適切に管理されている状態を目指すとされ、評価項目の例として、データの分布に属性による偏りがないか、個人情報や権利の問題が生じうる情報が含まれていないか、などが挙がっています。前の節で扱ったデータガバナンスとの接続は、この公的なガイドでも評価の観点の一つとして置かれていることになります。
評価を誰がいつ行うかについても、ガイドは整理しています。評価の主な実施者には、AI開発者・AI提供者のうち、開発や提供を管理する立場の人(ガイドの語では「開発・提供管理者」)が考えられるとし、ライフサイクルの段階に応じて役割を分担することが重要だとしています。自組織での実施を基本としつつ、開発に直接携わらない専門家の評価を組み合わせることも挙げています。評価は各段階で繰り返し行うものとされています(詳しくはガイドの本文を参照してください)。評価の手法は、技術的評価(データや入出力、システムの構成などを技術の面から確かめる評価)とマネジメント的評価(事業者全体の取り組みの方針や体制を確かめる評価)の2つに分けられています。
技術的評価の手法の一つとして、ガイドはレッドチーミングを挙げ、詳細は別の「AIセーフティに関するレッドチーミング手法ガイド」を参照するように案内しています。AISI のレッドチーミング手法ガイドのページによると、現行の版は2025年3月31日に公表された第1.10版で、第1.00版は2024年9月25日に公表されています。第1.10版では、具体的な実施例を通して理解できるよう改訂した、と説明されています。手法ガイドの本文(第1.10版の本編)によると、AIセーフティにおけるレッドチーミングの目的は、攻撃者の目線で対象の AIシステムの弱点や対策の不備(脆弱性)を見つけ、それを修正して堅牢にすることで、AIセーフティを維持または向上させることです。
手法ガイドの本編は、実施の工程を STEP 1 から STEP 15 までの15の段階で示しています。目次に並ぶ段階を大きく束ねると、実施の決定とレッドチームの発足から実施計画の策定、実施環境の準備、エスカレーションの流れ(問題が見つかったときに誰に上げるか)の確認までの準備の段階、リスクのシナリオと攻撃のシナリオを作って実施し、記録を取る段階、結果を分析し、報告書を作り、改善の計画を立てて実施し、改善後のフォローアップを行う段階、の3つになります。実施の時期として、リリースや運用開始の前と、運用開始後の両方が挙げられています。この工程のうち、改善の計画と改善後のフォローアップまでが手法の範囲に含まれていることは、AIガバナンスの側から見て重要です。レッドチーミングを「攻撃を試して報告書を受け取る」ことで終わらせず、見つかった弱点を誰が直し、直ったことを誰が確かめるかまでを、承認の条件に入れておく必要があります。
2つのガイドは、評価観点ガイドが「評価を実施する際に参照できる基本的な考え方」を、手法ガイドが基本的な考慮事項と実施のポイントを示すもの、とそれぞれの冒頭で位置づけられており、評価を行う者が参照する手引きとして作られています。本コラムでは、自社の評価の計画を作るときに、観点の抜けを確かめるための一覧として使うことを想定しています。とくに生成AIを社外の利用者に直接使わせるユースケースでは、評価観点ガイドの3.1〜3.6の観点と、レッドチーミングの実施を、承認の前に確かめる項目に入れておくことが有効だと考えています。生成AIの社内利用のルールと、プロンプトインジェクションのような攻撃の型は第8章で扱いました。
公平性の指標を言葉で定義する
公平性を評価するには、「公平である」とは何をそろえることかを、測れる形に決める必要があります。その物差しが公平性指標です。ここでは、AIが人を「選ぶ」「選ばない」の2つに分ける場面(審査の承認、書類選考の通過、優先的な案内の対象など)を例に、よく使われる指標を言葉で定義します。説明のために、後から見て実際に条件を満たした人(たとえば、審査で承認していれば期待どおりの結果になった人)を「条件を満たす人」と呼びます。
指標を定義するための材料は、属性ごとに作る4つの人数です。AIが選び、実際に条件を満たした人(真陽性)、AIが選んだが条件を満たさなかった人(偽陽性)、AIが選ばなかったが条件を満たしていた人(偽陰性)、AIが選ばず条件も満たさなかった人(真陰性)です。この4つの人数から、次の表の指標が計算できます。表の「差」は、属性Bの値から属性Aの値を引いたものとして、本コラムでは一貫して扱います。
| 指標 | 言葉での定義 | 属性の間でそろえると何が言えるか | 向いている問いの例 |
|---|---|---|---|
| 選ばれる割合 | その属性の人のうち、AIが選んだ人の割合 | 条件を満たすかどうかにかかわらず、どの属性からも同じ割合で選ばれる | 機会そのものを属性の間で同じ割合で配りたいか |
| 真陽性率 | その属性の、条件を満たす人のうち、AIが選んだ人の割合 | 条件を満たす人が、どの属性でも同じ確率で見落とされずに選ばれる | 条件を満たす人を取りこぼす不利益を、属性の間で同じにしたいか |
| 偽陽性率 | その属性の、条件を満たさない人のうち、AIが選んでしまった人の割合 | 条件を満たさない人が誤って選ばれる確率が、どの属性でも同じになる | 誤って選ぶことの影響を、属性の間で同じにしたいか |
| 適合率 | その属性で AIが選んだ人のうち、実際に条件を満たした人の割合 | 「AIが選んだ」という結果の当たりやすさが、どの属性でも同じになる | 選ばれた後の結果の確からしさを、属性の間で同じにしたいか |
| 正解率 | その属性の人のうち、AIの判定と実際が一致した人の割合 | 判定の当たりやすさの全体が、どの属性でも同じになる | 全体としての誤りの多さを比べたいか |
これらの考え方には、研究の文献で付けられた名前があります。たとえば Moritz Hardt ほかの論文「Equality of Opportunity in Supervised Learning」(2016年10月に arXiv で公開)は、選ばれる割合をそろえる考え方を demographic parity と呼んで論じたうえで、真陽性率と偽陽性率の両方をそろえる条件を equalized odds、真陽性率をそろえる条件を equal opportunity として定義しています。日本語の訳語や呼び方は資料によって揺れがあるので、本コラムでは、名前ではなく「何の割合をそろえるか」で指標を呼びます。社内の評価の基準を書くときも、指標の名前だけを書かず、分母と分子を言葉で書いておくことが有効だと考えています。同じ「公平性の指標」という言葉で、部門によって別の割合を指していると、評価の結果を比べられなくなるからです。
差だけでなく比で見ることもあります。たとえば選ばれる割合について、属性Bの割合を属性Aの割合で割った値を見ると、片方の属性が他方の何割の確率で選ばれているかが分かります。差と比のどちらで見るか、どの程度の差までを許容するかは、指標の計算からは決まりません。用途の性質と、影響を受ける人に生じる不利益の重さによって、人が決める必要があります。
もう一つ注意が要るのは、真陽性率・偽陽性率・適合率は、「実際に条件を満たしたかどうか」の記録が無いと計算できないことです。審査で承認しなかった人については、承認していたら条件を満たしたかどうかが分からないことが多く、評価用のデータの作り方そのものに偏りが入りやすくなります。この章の架空の例では、評価用のデータの全員について正解が分かっているという単純な設定にしています。実際の評価では、正解の記録がどの範囲の人について取れているかを、評価の結果と一緒に記録しておく必要があります。
架空の審査データで2つのモデルを比べる
ここからは、前の節の指標を、架空のサンプルデータで実際に計算します。設定は次のとおりです。4,000人分の架空の審査データを乱数で作り、各人に属性(属性A が60%、属性B が40%の割合)と、後から見て条件を満たしたかどうかの記録を持たせました。条件を満たす人の割合は、属性A で50%、属性B で35%という設定にしてあります。つまり、この架空のデータでは、属性によって条件を満たす人の割合そのものが違います。審査に使える項目は2つで、x1 は条件を満たすかどうかと関係する項目、x2 は条件を満たすかどうかとは弱くしか関係せず、属性と強く結びついた項目です。x2 は、前の節で触れた「属性と強く結びついた別の項目」を模したものです。実在の審査の項目や、実在の属性とは関係がありません。
前半の2,000人で2つのモデルを学習し、後半の2,000人で評価しました。モデル1は x1 と x2 の両方を使い、モデル2は x1 だけを使います。どちらも属性そのものの列は使っていません。モデルには、ロジスティック回帰(入力の項目に重みを掛けて足し合わせ、0から1の間の得点に変換する、基本的な分類の方法)を使い、numpy だけで学習の処理を書きました。本コラムでは Python 3.14.3、numpy 2.4.3、pandas 3.0.1、matplotlib 3.10.8 で実行し、グラフの日本語表示には japanize-matplotlib を使っています。乱数のシード(同じ乱数の並びを再現するための初期値)を固定しているので、同じ版で実行すれば同じ結果になります。次のコードを ch10_fairness.py という名前で保存すると、後のコードから読み込めます。
import sys, io
if sys.stdout.encoding.lower() != "utf-8":      # 他のスクリプトから読み込まれたときは包み直さない
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pandas as pd


def make_data(n=4000, seed=20261028):
    """架空の審査データ。属性は「A」「B」に抽象化している"""
    rng = np.random.default_rng(seed)
    group = rng.choice(["A", "B"], size=n, p=[0.6, 0.4])
    base = np.where(group == "A", 0.50, 0.35)          # 実際に条件を満たす人の割合(架空)
    y = (rng.random(n) < base).astype(int)              # 1 = 実際に条件を満たした
    x1 = 1.2 * y + rng.normal(0, 1, n)                  # 結果と関係する項目
    x2 = 0.8 * (group == "A") + 0.3 * y + rng.normal(0, 1, n)   # 属性と強く結びつく項目
    return pd.DataFrame({"属性": group, "y": y, "x1": x1, "x2": x2})


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


def fit_logistic(X, y, steps=3000, lr=0.1):
    """numpy だけで書いたロジスティック回帰(勾配降下)"""
    X1 = np.c_[np.ones(len(X)), X]
    w = np.zeros(X1.shape[1])
    for _ in range(steps):
        w -= lr * X1.T @ (sigmoid(X1 @ w) - y) / len(y)
    return lambda Xn: sigmoid(np.c_[np.ones(len(Xn)), Xn] @ w)
同じファイルの続きに、属性ごとの指標を計算する関数を置きます。th はしきい値で、得点がこの値以上の人を「選ぶ」と判定します。すべての人に同じしきい値を使う場合は数値を、属性ごとに違うしきい値を試す場合は辞書を渡します(属性ごとに違うしきい値は、後の節で指標どうしの関係を示すためだけに使います)。
def group_metrics(df, score, th):
    """属性ごとの指標。th はしきい値(数値、または属性ごとの辞書)"""
    t = df["属性"].map(th).to_numpy() if isinstance(th, dict) else th
    pred = (score >= t).astype(int)
    rows = {}
    for g in ["A", "B"]:
        m = (df["属性"] == g).to_numpy()
        y, p = df["y"].to_numpy()[m], pred[m]
        rows[g] = {"人数": int(m.sum()), "選ばれる割合": p.mean(),
                   "真陽性率": p[y == 1].mean(), "偽陽性率": p[y == 0].mean(),
                   "適合率": y[p == 1].mean(), "正解率": (p == y).mean()}
    return pd.DataFrame(rows).T
次のコード(ch10_compare.py)が、2つのモデルを学習し、しきい値0.5で属性ごとの指標と差を出す部分です。得点は後のグラフのコードで使うので、ファイルに保存しています。保存先の ../_out/ch10 は、実行したフォルダから見た位置です。この章のコードは、すべて同じフォルダに置き、そのフォルダで実行する前提にしています。
import sys, io, os
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
from ch10_fairness import make_data, fit_logistic, group_metrics

df = make_data()
train, test = df.iloc[:2000], df.iloc[2000:].reset_index(drop=True)
print("評価用データの人数", test["属性"].value_counts().to_dict())
print("実際に条件を満たした割合", test.groupby("属性")["y"].mean().round(4).to_dict())

models = {"モデル1(x1とx2)": ["x1", "x2"], "モデル2(x1だけ)": ["x1"]}
scores = {}
for name, cols in models.items():
    predict = fit_logistic(train[cols].to_numpy(), train["y"].to_numpy())
    scores[name] = predict(test[cols].to_numpy())
    t = group_metrics(test, scores[name], 0.5)
    print(f"\n== {name}、しきい値 0.5")
    print(t.round(4).to_string())
    pred = (scores[name] >= 0.5).astype(int)
    print("全体の正解率", round(float((pred == test["y"]).mean()), 4))
    for k in ["選ばれる割合", "真陽性率", "偽陽性率", "適合率"]:
        print(f"{k}の差(B-A)", round(float(t.loc["B", k] - t.loc["A", k]), 4))
    print("選ばれる割合の比(B/A)", round(float(t.loc["B", "選ばれる割合"] / t.loc["A", "選ばれる割合"]), 4))
os.makedirs("../_out/ch10", exist_ok=True)              # 保存先が無ければ作る
np.save("../_out/ch10/scores_m1.npy", scores["モデル1(x1とx2)"])
np.save("../_out/ch10/scores_m2.npy", scores["モデル2(x1だけ)"])
実行した結果、評価用の2,000人の内訳は属性A が1,209人、属性B が791人で、実際に条件を満たした人の割合は属性A が48.30%、属性B が33.00%でした。乱数で作っているので、設定した50%と35%からは少しずれています。しきい値0.5での指標は次の表のとおりです。差は、属性Bの値から属性Aの値を引いたもので、単位はポイント(割合どうしの差)です。差は丸める前の値から計算しています。
| 指標 | モデル1 属性A | モデル1 属性B | モデル1 差 | モデル2 属性A | モデル2 属性B | モデル2 差 |
|---|---|---|---|---|---|---|
| 選ばれる割合 | 45.66% | 31.86% | -13.80 | 42.10% | 36.66% | -5.44 |
| 真陽性率 | 69.01% | 60.54% | -8.47 | 65.24% | 63.22% | -2.02 |
| 偽陽性率 | 23.84% | 17.74% | -6.10 | 20.48% | 23.58% | 3.10 |
| 適合率 | 73.01% | 62.70% | -10.31 | 74.85% | 56.90% | -17.96 |
| 正解率 | 72.70% | 75.09% | 2.39 | 72.62% | 72.06% | -0.56 |
全体の正解率は、モデル1が73.65%、モデル2が72.40%でした。選ばれる割合の比(属性Bの割合を属性Aの割合で割った値)は、モデル1が0.6978、モデル2が0.8708です。結果から読み取れることは3つあります。1つ目は、属性の列を使っていないモデル1でも、選ばれる割合に13.80ポイントの差が出たことです。この差の一部は、属性によって条件を満たす人の割合そのものが違うという設定から来ていますが、属性と強く結びついた x2 を外したモデル2では差が5.44ポイントまで縮んでいるので、x2 の影響が大きいことがうかがえます(モデル2は学習をし直しているので、x1 の重みなどほかの部分も変わっており、差の縮みをすべて x2 だけに帰すことはできません)。「属性の列を使っていないから公平だ」とは言えないことの、最小の例です。
2つ目は、モデル2では選ばれる割合と真陽性率の差が縮んだ一方で、適合率の差は-10.31ポイントから-17.96ポイントへ広がったことです。モデル2で属性Bの人が選ばれた場合、実際に条件を満たしていた割合は56.90%で、属性Aの74.85%より低くなっています。偽陽性率の差も、モデル1の-6.10ポイントからモデル2では3.10ポイントへと向きが変わりました。どの指標で見るかによって、「どちらのモデルが公平か」の答えが変わるということです。3つ目は、全体の正解率がモデル2で1.25ポイント下がったことです。公平性の指標の一部を改善すると、性能の指標が下がることがあります。どの差をどこまで許容し、性能の低下をどこまで受け入れるかは、計算の結果からは決まりません。
しきい値を動かすと、属性の間の差はどう変わるか
前の節の結果は、しきい値を0.5に固定したときのものです。実際の運用では、しきい値は業務の都合(審査の件数の上限や、誤って選んだときの損失の大きさ)で決まり、0.5である理由はありません。しきい値を変えると、選ばれる人が変わり、属性の間の差も変わります。そこで、両方の属性に同じしきい値を使ったまま、しきい値を0.20から0.80まで0.01刻みで動かし、選ばれる割合・真陽性率・適合率の差がどう変わるかを描きました。次のコード(ch10_threshold_plot.py)は、その計算と描画の中心の部分を抜き出したものです(ファイルの冒頭の読み込みと、軸の見出しや凡例の設定は省いています)。
test = make_data().iloc[2000:].reset_index(drop=True)
scores = {"モデル1(x1とx2)": np.load("../_out/ch10/scores_m1.npy"),
          "モデル2(x1だけ)": np.load("../_out/ch10/scores_m2.npy")}
ths = np.round(np.arange(0.20, 0.805, 0.01), 2)
keys = ["選ばれる割合", "真陽性率", "適合率"]
style = {"選ばれる割合": ("#002E73", "-"), "真陽性率": ("#7F7F7F", "-"), "適合率": ("#000080", "--")}

fig, axes = plt.subplots(1, 2, figsize=(10, 4.2), sharey=True)
for ax, (name, s) in zip(axes, scores.items()):
    gaps = {k: [] for k in keys}
    for th in ths:
        t = group_metrics(test, s, float(th))
        for k in keys:
            gaps[k].append(t.loc["B", k] - t.loc["A", k])
    for k in keys:
        c, ls = style[k]
        ax.plot(ths, gaps[k], color=c, linestyle=ls, linewidth=2, label=f"{k}の差(B-A)")
    ax.axhline(0, color="#BFBFBF", linewidth=1)
    ax.set_title(name)
axes[0].legend(loc="upper center", bbox_to_anchor=(1.05, -0.18), ncol=3, frameon=False)
plt.savefig("../ch10_threshold_gap.png", dpi=120, bbox_inches="tight")
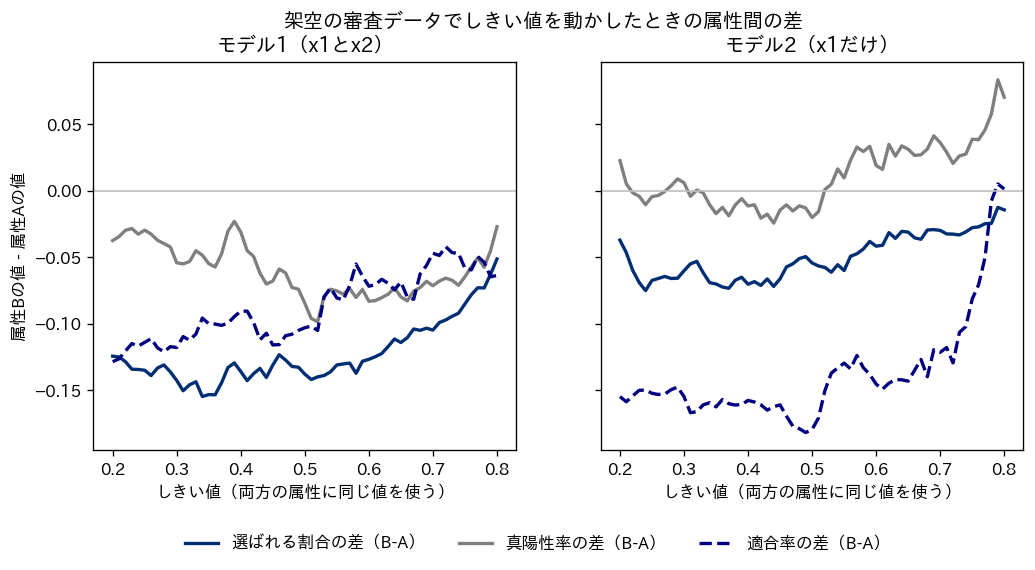
グラフの縦軸は、属性Bの値から属性Aの値を引いた差で、0の横線より下は属性Bの方が低いことを示します。実線のネイビーが選ばれる割合の差、実線のグレーが真陽性率の差、破線のネイビーが適合率の差です。実行した結果から、しきい値0.3・0.4・0.5・0.6・0.7の5点の値を抜き出すと次の表のとおりです(単位はポイント)。
| しきい値 | モデル1 選ばれる割合の差 | モデル1 真陽性率の差 | モデル1 適合率の差 | モデル2 選ばれる割合の差 | モデル2 真陽性率の差 | モデル2 適合率の差 |
|---|---|---|---|---|---|---|
| 0.3 | -14.27 | -5.43 | -11.79 | -6.03 | 0.59 | -15.48 |
| 0.4 | -13.60 | -3.12 | -9.07 | -7.04 | -1.15 | -15.77 |
| 0.5 | -13.80 | -8.47 | -10.31 | -5.44 | -2.02 | -17.96 |
| 0.6 | -12.68 | -8.32 | -7.19 | -4.18 | 1.89 | -14.55 |
| 0.7 | -10.49 | -7.15 | -4.71 | -2.99 | 3.61 | -12.16 |
表とグラフから分かることを整理します。モデル1では、しきい値を0.20から0.80のどこに置いても、選ばれる割合の差は-5.14ポイントから-15.48ポイントの範囲で負のまま残り、真陽性率の差もすべて負でした(最も0に近いところで-2.31ポイント)。このモデルとデータでは、調べた61点の共通のしきい値のどれでも、選ばれる割合と真陽性率の差が残りました。モデル2では、選ばれる割合の差の大きさは、調べた61のしきい値のすべてでモデル1より小さく、真陽性率の差は、表の5点では-2.02ポイントから3.61ポイントの範囲で、0の近くを上下しています。一方で、適合率の差は表の5点のいずれでもモデル1より大きく、-12ポイントから-18ポイントの範囲にありました。グラフを見ると、しきい値を0.75より高くした範囲では、モデル2の適合率の差が急に縮み、0.79では0.50ポイントと正に転じています。この範囲で属性Bから選ばれる人は、しきい値0.75で116人、0.80で88人と少なくなり、数人の違いで割合が動きやすくなります。人数が少ない範囲の指標は揺れやすいので、評価の結果には割合だけでなく、分母の人数を添えておく必要があります。
この結果から言えるのは、この章で扱った、しきい値で選ぶかどうかを決める判定の公平性の指標は、しきい値と併せて評価する必要があるということです。開発の段階で「公平性の指標を確かめた」と報告されても、確かめたときのしきい値と、運用で使うしきい値が違えば、結果は変わります。評価の記録には、どのしきい値で測ったかを必ず書き、運用でしきい値を変えるときは、変更の手続きの中で公平性の指標を測り直すことを決めておくことが有効だと考えています。しきい値の変更をモデルの変更と同じように扱うかどうかは、第11章で扱う運用中の変更管理の論点でもあります。
指標どうしは同時にそろわないことがある
モデル2の結果では、選ばれる割合と真陽性率の差は小さく、適合率の差は大きく残りました。では、しきい値をうまく選べば、すべての差を同時に小さくできるのでしょうか。これを確かめるために、属性Aのしきい値を0.5に固定し、属性Bのしきい値だけを0.200から0.800まで0.001刻みで動かして、ある指標の差が最も小さくなるしきい値を探しました。そろえる指標を、選ばれる割合・真陽性率・適合率の3通りに変え、それぞれのときにほかの指標の差がどうなるかを比べます。この探索は、しきい値を選ぶのにも評価にも同じデータを使っています。実務でしきい値を選ぶ場合は、調整に使うデータと最終の評価に使うデータを分けます。
属性ごとに違うしきい値を使うことは、属性によって人の扱いを変えることそのものです。この節の計算は、指標どうしの関係を示すためだけに行うもので、本コラムはこうした運用を勧めるものではありません。属性によって扱いを変えることが許されるかどうかは、用途と法令、社内の規程によって判断が必要で、個別の確認が要ります。次のコード(ch10_tradeoff.py)は、しきい値を探す部分と、4つの方式を比べる部分を抜き出したものです(グラフを描く部分は省いています)。ファイルの冒頭の読み込みも省いています。
test = make_data().iloc[2000:].reset_index(drop=True)
s = np.load("../_out/ch10/scores_m2.npy")              # モデル2の得点
base = group_metrics(test, s, 0.5)
grid = np.round(np.arange(0.200, 0.8001, 0.001), 3)    # 属性Bのしきい値の候補


def match(key):
    """属性Aを0.5に固定し、key の差が最も小さくなる属性Bのしきい値を探す"""
    gap = [abs(group_metrics(test, s, {"A": 0.5, "B": float(b)}).loc["B", key]
               - base.loc["A", key]) for b in grid]
    return float(grid[int(np.argmin(gap))])


policies = {"共通のしきい値": {"A": 0.5, "B": 0.5},
            "選ばれる割合をそろえる": {"A": 0.5, "B": match("選ばれる割合")},
            "真陽性率をそろえる": {"A": 0.5, "B": match("真陽性率")},
            "適合率をそろえる": {"A": 0.5, "B": match("適合率")}}
keys = ["選ばれる割合", "真陽性率", "偽陽性率", "適合率"]
result = {}
for name, th in policies.items():
    t = group_metrics(test, s, th)
    pred = (s >= test["属性"].map(th).to_numpy()).astype(int)
    result[name] = [t.loc["B", k] - t.loc["A", k] for k in keys]
    print(f"== {name}(Bのしきい値 {th['B']})")
    print({k: round(float(v), 4) for k, v in zip(keys, result[name])},
          "全体の正解率", round(float((pred == test["y"]).mean()), 4))
実行した結果は次の表のとおりです(差の単位はポイント)。
| 方式 | 属性Bのしきい値 | 選ばれる割合の差 | 真陽性率の差 | 偽陽性率の差 | 適合率の差 | 全体の正解率 |
|---|---|---|---|---|---|---|
| 共通のしきい値 | 0.5 | -5.44 | -2.02 | 3.10 | -17.96 | 72.40% |
| 選ばれる割合をそろえる | 0.44 | -0.26 | 5.26 | 7.26 | -19.26 | 72.25% |
| 真陽性率をそろえる | 0.49 | -4.30 | -0.11 | 3.86 | -18.00 | 72.45% |
| 適合率をそろえる | 0.708 | -23.01 | -21.94 | -13.31 | -0.02 | 74.15% |
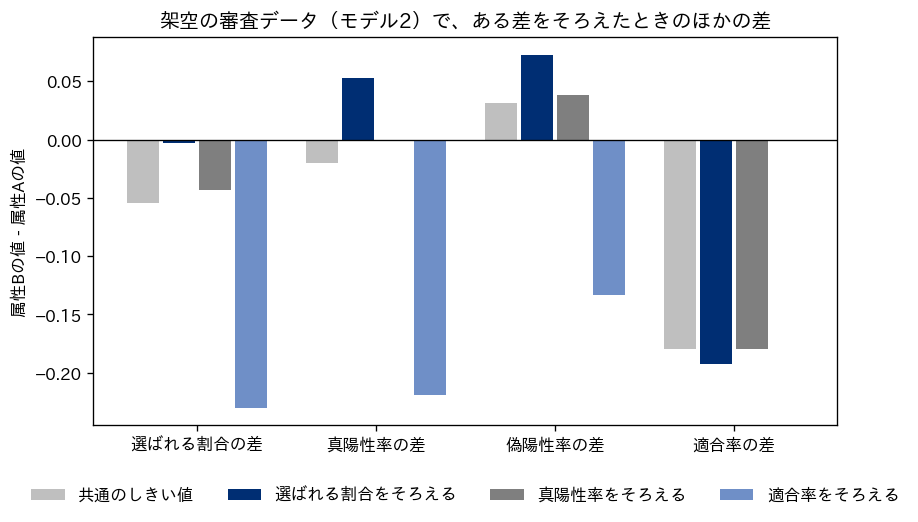
選ばれる割合をそろえると(属性Bのしきい値0.44)、その差は-0.26ポイントまで縮みますが、真陽性率の差は5.26ポイント、偽陽性率の差は7.26ポイントに広がり、適合率の差も共通のしきい値の-17.96ポイントから-19.26ポイントへ、むしろ広がります。真陽性率をそろえると(0.49)、その差は-0.11ポイントになりますが、適合率の差は-18.00ポイントのままです。適合率をそろえると(0.708)、その差は-0.02ポイントになる代わりに、選ばれる割合の差は-23.01ポイント、真陽性率の差は-21.94ポイントまで広がりました。属性Bの人は、選ばれる割合も、条件を満たしている人が選ばれる確率も、大きく下がるということです。なお、全体の正解率は、この例では適合率をそろえた方式で74.15%と最も高くなりましたが、それは属性Bの正解率が72.06%から76.49%に上がったためです。このとき属性Bの選ばれる割合は36.66%から19.09%に下がっていました(属性Aのしきい値は変えていないので、属性Aの正解率は72.62%のままです)。条件を満たさない人の割合が高い属性Bでは、選ぶ人を減らすと「選ばない」判定が当たりやすくなります。全体の正解率が上がったことは、公平性の面で望ましいことを意味しません。
ある指標をそろえると別の指標の差が開くという、同じ種類の両立しにくさは、研究の文献でも論じられています。ただし、文献が扱う条件は、この章で並べた指標とまったく同じものではありません。Jon Kleinberg ほかの論文「Inherent Trade-Offs in the Fair Determination of Risk Scores」(2016年に arXiv で公開)は、概要の中で、公平性をめぐる議論の中心にある3つの条件を定式化し、ごく限られた特別な場合を除いて、3つを同時に満たす方法は無いことを証明した、と述べています。Alexandra Chouldechova の論文「Fair prediction with disparate impact」(2016年に arXiv で公開)は、概要の中で、ある公平性の基準を守ることが、属性によって結果の起こる割合が違う場合に、大きな格差につながりうることを示した、と述べています。この章の例は、条件を満たす人の割合が属性によって違い、モデルが完全には当たらない、という設定で、これらの論文が論じている場合に近い設定です。どちらの論文も、本コラムは概要を開いて確かめた範囲で引いており、証明の細部には踏み込みません。
ここから AIガバナンスにとって大事なことが2つ出てきます。1つ目は、「すべての公平性指標を満たすこと」を合格の基準にすると、この章の例のように、基準どうしが両立しないことがあるということです。文献が扱うのは特定の条件と前提です。許容する幅を設けた自社の基準のすべてに、そのまま当てはまるとは限りません。基準を書く前に、指標どうしが両立するかを確かめ、そのユースケースで何の差を最も重く見るかを決める必要があります。2つ目は、その選択は技術の問題ではなく、誰にどんな不利益が及ぶことをより避けたいかという価値の判断だということです。条件を満たす人を取りこぼす不利益を重く見るなら真陽性率を、選ばれた後の結果の確からしさを重く見るなら適合率を、機会の配分そのものを重く見るなら選ばれる割合を優先することになります。この判断を開発の担当者に任せきりにしない仕組みは、章の最後の2つの節で扱います。
記録の形、モデルカードとデータシート
評価を行っても、その結果が記録に残っていなければ、後から「何を確かめて承認したのか」を説明できません。担当者が替わったとき、モデルを更新したとき、苦情や事故が起きたときに、評価の前提に立ち返れることが記録の役目です。AIの記録の形として広く知られているものに、モデルカードとデータシートがあります。
モデルカードは、Margaret Mitchell ほかの論文「Model Cards for Model Reporting」で提案された形式です。論文は2019年1月の公平性・説明責任・透明性に関する会議(FAT* 2019)の論文集に収められており、DOI は10.1145/3287560.3287596です(arXiv では2018年10月に公開)。概要によると、モデルカードは学習済みのモデルに添える短い文書で、意図した適用の分野に関係する文化的・人口統計学的な集団などの条件ごとの評価の結果と、モデルが使われることを意図した文脈、評価の手順の詳細などを示すものです。論文が示すモデルカードの項目は、モデルの詳細、意図した用途、要因(評価を分けて見る集団や条件)、指標、評価用データ、学習用データ、定量的な分析、倫理上の考慮、注意と推奨の9つです。定量的な分析は、集団ごとに分けて示すべきだとされています。この章の架空の例でいえば、属性ごとの指標の表がこの項目に当たります。
データシートは、Timnit Gebru ほかの論文「Datasheets for Datasets」で提案された形式で、arXiv で2018年3月に公開され、2021年12月に Communications of the ACM(第64巻第12号)に掲載されました(arXiv の論文のページ)。概要によると、電子部品に動作特性や試験結果を記したデータシートが付くのにならい、すべてのデータセットに、作られた動機、構成、収集の過程、推奨される用途などを記した文書を付けることを提案したものです。論文の質問の一覧は、動機、構成、収集の過程、前処理・クリーニング・ラベル付け、用途、配布、保守の7つの区分に分かれています。学習データの来歴と品質を記録する形として、前の節で扱ったデータガバナンスの記録と重なる部分が多く、どちらか一方に寄せて二重に作らないことが有効だと考えています。
2つの論文の形式をそのまま社内の様式にする必要はありません。大事なのは、承認の判断に使った情報が、決まった項目で、決まった場所に残ることです。次の表は、2つの形式を参考に、本コラムが社内の評価記録の最小の項目として整理したものです。
| 記録の項目 | 書くこと | この章の例で書く内容 |
|---|---|---|
| 対象と版 | ユースケース台帳の番号、モデルの版、評価の日付 | モデル1とモデル2、評価日 |
| 意図した用途と対象外の用途 | 何の判断に使うか、使ってはいけない場面 | 審査の一次判定。最終判断には使わない、など |
| 学習用データと評価用データ | 出所、期間、件数、正解の記録が取れている範囲、既知の偏り | 架空のデータ4,000人、学習2,000人・評価2,000人 |
| 評価の観点と指標 | 5つの観点のうち何を、どの指標で測ったか。分母と分子の定義 | 正解率と、選ばれる割合・真陽性率・偽陽性率・適合率の属性間の差 |
| しきい値 | 評価に使ったしきい値と、運用で使う予定のしきい値 | 0.5(0.20〜0.80も確認) |
| 集団ごとの結果 | 属性ごとの指標と人数 | 属性ごとの指標の表 |
| 合格の基準と判定 | 事前に決めた基準と、満たしたかどうか | 重く見る差と許容する幅(自社で決める) |
| 既知の限界と残るリスク | 評価で分からなかったこと、指標どうしの両立しない点 | 適合率の差が残ること、人数の少ない範囲で指標が揺れること |
| 承認 | 承認した人、条件、次の見直しの時期 | (次の節) |
表の「既知の限界と残るリスク」の行は、空欄にしないことが大事です。前の節で見たように、公平性の指標は同時にはそろわないことがあるので、どの指標を優先したかを書くことは、どの差を残したかを書くことでもあります。残した差を書かずに「公平性を確認済み」とだけ記録すると、後で苦情が出たときに、その差を知っていて受け入れたのか、知らなかったのかが区別できなくなります。前者なら判断の根拠を示せますが、後者は誤った判断の放置として扱われるおそれがあります。
評価の結果を誰が承認するか
評価の結果を承認する人は、評価を行った人と分けておくことが有効だと考えています。前に紹介した AISI の評価観点ガイドも、客観性と提言の独立性のために、開発・提供に直接携わらない専門家による評価が有効だとしています。自社の中で全部を独立させるのが難しい場合でも、少なくとも「指標を計算した人」と「その結果で使ってよいと決める人」は別にしておくと、合格の基準を後から都合よく変えることを防げます。
次の表は、評価と承認の役割分担の一例です。役割の名前は、第13章で扱う体制の役割に合わせています。本コラムでは、承認者をリスク区分によって変えます。区分「低」は業務部門の責任者が承認し、事務局が台帳に記録します。区分「中」は、法務・情報セキュリティ・データガバナンスの担当の確認を経て、事務局の責任者が承認します(事務局の担当者は承認をせず、区分「中」の利用開始に限って事務局の責任者が承認します)。区分「高」は、影響評価を経て AIガバナンス委員会が承認します。区分「禁止」は承認の対象にせず、例外も認めません。禁止以外の区分で規程からの逸脱を認める例外は、区分によらず AIガバナンス委員会が承認します(区分と承認の経路の決め方は第7章で扱いました)。
| 工程 | 主に担う人 | 確かめる人・承認する人 | 残すもの |
|---|---|---|---|
| 評価の観点と合格の基準を決める | 業務部門の責任者と開発の担当 | 区分「低」は業務部門の責任者、区分「中」は事務局の責任者、区分「高」は AIガバナンス委員会が、結果の承認と同じ経路で確かめる | 評価の計画(観点・指標・基準・しきい値) |
| データの来歴と品質を確かめる | データガバナンスの担当 | 業務部門の責任者 | データの記録(データシートに当たるもの) |
| 評価を実行する | 開発の担当、またはベンダー | 評価に直接携わらない担当者による再計算の抜き取り | 実行のログ、集団ごとの結果 |
| レッドチーミングを行う | 開発に直接携わらない担当、または外部の専門家 | 情報セキュリティの担当 | 実施結果の報告書、改善の計画 |
| 結果を承認する | 区分「低」は業務部門の責任者、区分「中」は事務局の責任者、区分「高」は AIガバナンス委員会 | 区分「中」「高」は、法務・情報セキュリティ・データガバナンスの担当が承認の前に確認する | 評価記録(モデルカードに当たるもの)と承認の条件 |
| 見直す | 業務部門の責任者 | 事務局が期限を管理する | 再評価の記録(しきい値やモデルの変更時、定期の見直し時) |
調達した AIの場合は、評価の一部をベンダーが行うことになります。その場合も、承認する責任は自社に残ります。ベンダーから受け取る評価の結果に、どの集団に分けた結果が含まれているか、どのしきい値で測ったか、評価用データが自社の利用の場面に近いかを確かめ、足りなければ自社のデータで追加の評価を行う必要があります。ベンダーに求める情報の項目と契約での決め方は、第9章で扱いました。運用を始めた後に指標を測り続け、基準を外れたときにどうするかは、第11章で扱います。
経営判断、指標の決め方を経営が定める
この章の実行結果が示したのは、公平性の指標を選ぶことが、どの不利益を誰に残すかを選ぶことでもある、ということでした。選ばれる割合をそろえれば、選ばれた後の結果の確からしさに差が残り、適合率をそろえれば、選ばれる機会に大きな差が出ました。どちらを選んでも、計算の上で「間違い」ではありません。だからこそ、この選択を開発の担当者の技術的な判断として処理させないことが大事だと考えています。本コラムでは、個々のユースケースで重く見る指標と許容する差は、そのユースケースの区分の承認者(区分「低」は業務部門の責任者、「中」は事務局の責任者、「高」は AIガバナンス委員会)が決めることとしています。経営が決めるのは、その決め方と、全社で使う指標の考え方や自社が受け入れるリスクの考え方を AI基本方針で示す部分です(基本方針の書き方は第12章で扱います)。
この判断を誤ったときの損失は、本コラムの損失の型で言えば、次の3つに表れます。1つ目は誤った判断の放置です。評価の指標を決めないまま使い始めると、特定の集団に不利な結果が偏っていても、それを差として測る仕組みが無いので気づけません。2つ目は信頼の失墜です。差が外部から指摘されたときに、どの指標を選び、どの差を知ったうえで受け入れたかを説明できなければ、顧客や社会からの信頼を失うおそれがあります。3つ目は規制違反のおそれです。人に関わる判断に AIを使う場合、用途によっては差別の禁止や説明の義務に関わる法令が問題になりえます。どの法令がどう関わるかは用途ごとに個別の確認が要りますが、少なくとも評価の記録が無ければ、確認のための材料がそろいません。
そのうえで経営が決めることは、具体的には次の4つだと考えています。1つ目は、人に関わる判断に使うユースケースでは、公平性の評価を承認の必須条件にすること。2つ目は、ユースケースごとに、重く見る指標と許容する差の幅を、業務部門の責任者が案を作り、本コラムのリスク区分が「低」のものは業務部門の責任者、「中」のものは事務局の責任者、「高」のものは AIガバナンス委員会で決める、という決め方を規程に書くこと(規程の書き方は第12章で扱います)。3つ目は、評価のための人と時間とデータの準備を、開発の予算の中に最初から含めること。評価を開発の最後に付け足す工程として扱うと、日程に押されて省かれやすくなります。4つ目は、評価の記録の様式を全社で1つに決めることです。部門ごとに別の様式で評価を記録すると、比較や監査のたびに読み替えが要ります。記録の管理も重複し、二重投資になるおそれがあります。
経営にとってもう一つ大事なのは、「公平性の指標がすべて基準を満たすまで使わない」という基準を、両立するかを確かめないまま置かないことです。この章で見たとおり、指標を同時に満たせないことがあるので、その基準は承認を止め続け、導入の停滞を招くおそれがあります。必須とした基準を満たせない場合は、改善、用途の限定、利用の見送りを検討します。決めるべきなのは、どの差を重く見て、どこまでを許容し、残った差をどう記録して誰が見直すかです。評価は使うことを止めるための関門ではなく、使ってよい範囲を明確にするための工程として設計することが有効だと考えています。
この章では、AIの品質と公平性を確かめる工程を整理しました。評価の土台は学習データの来歴・品質・権利で、ISO/IEC 5259 シリーズがその規格群にあたり、具体的な進め方はデータガバナンスの仕組みに載せられること。評価の観点は性能・頑健性・公平性・安全性・説明可能性で、AISI の評価観点ガイド(第1.20版)とレッドチーミング手法ガイド(第1.10版)が、観点の一覧と、攻撃者の目線で弱点を探して改善までつなぐ手順を示していること。架空の審査データでは、属性の列を使わなくても属性と結びついた項目を通じて差が出ること、しきい値で選ぶ判定の公平性の指標はしきい値と併せて評価する必要があること、ある指標をそろえると別の指標の差が広がることを実行結果で確かめました。そのため、経営は指標の決め方と考え方を規程と基本方針で定め、個々のユースケースで重く見る指標と許容する差は区分ごとの承認者が決め、残した差まで評価記録に書き、評価した人とは別の人が承認する、という形にしておくことが有効だと考えています。次の第11章では、承認して使い始めた後の監視と、インシデントが起きたときの報告と停止の判断を扱います。
この章を深めたい方への参考書籍
『高リスク分野のための機械学習 責任あるAI構築のための実践アプローチ』(Patrick Hall、James Curtis、Parul Pandey 著、高江洲勲 ほか訳、オライリー・ジャパン):原題は Machine Learning for High-Risk Applications で、版元の目次には、機械学習におけるバイアスの管理、安全性と性能の検証、セキュリティの章に加えて、バイアスのテストと修正、レッドチーム演習を実際のモデルで行う章があります。この章で扱った公平性の指標の計算とレッドチーミングを、手を動かして深めるときの材料になります。
『機械学習工学』(石川冬樹、丸山宏 編著、柿沼太一、竹内広宜、土橋昌、中川裕志、原聡、堀内新吾、鷲崎弘宜 著、講談社):機械学習プロフェッショナルシリーズの1冊で、版元の目次には、機械学習システムの開発と検証、運用、品質のとらえ方と管理、モデルの説明法、AI倫理の章があります。この章で扱った評価の観点を、ソフトウェアの品質の管理としてどう位置づけるかを考えるときに参考になります。
第11章 AIの運用監視とインシデント対応、記録・報告・停止の判断
第10章では、AIを使い始める前に品質と公平性を確かめ、その結果を記録して承認する手順を扱いました。この章で扱うのは、その承認を経て AIが業務で動き始めた後です。使い始める前の評価は、その時点のデータと使い方を前提にしたものなので、運用に入ってから入力の傾向が変わったり、想定していなかった使われ方が広がったりすると、評価の結果はそのままでは当てはまらなくなります。運用中に何を見るか、問題が起きたときにそれを AIインシデントとして扱うかどうかをどう判断するか、誰に知らせ、いつ止め、何を記録し、どう振り返るか、を順に書きます。
法令の記述は、EU AI Act(EU 規則 2024/1689)については欧州委員会の AI Act Service Desk が掲載している2026年7月27日時点の統合版(デジタル・オムニバスによる改正を反映したもの)の条文を、2026年10月28日に開いて確かめた範囲だけを書きます。日本の AI事業者ガイドラインは第1.2版(2026年3月31日)の別添を、NIST の AIリスクマネジメントフレームワークは NIST が公開している PDF を、OECD の AIインシデントの監視の取り組みは OECD.AIの公式ページを、同じ日に開いて確かめました。条文の要旨は自分の言葉で書いており、条文の訳ではありません。EU AI Act の provider は「EU AI Act の提供者」、deployer は「EU AI Act の導入者」と訳します(第3章と同じ訳語です)。AI事業者ガイドラインの「AI提供者」とは範囲が一対一に対応しないので、この章では EU AI Act の語であることを毎回明示し、EU AI Act の条文を扱う節の中だけ、冒頭で断ったうえで「提供者」「導入者」と略します。外部の AIを作って渡す相手を一般的に指すときは「提供元」と書き、EU AI Act の語とは分けます。自社の AIが条文の対象になるか、どの報告の義務が掛かるかは個別に確認が要るので、判断は弁護士等の専門家に確認する前提で読んでください。
この章の表には、AIガバナンス委員会のほかに「AIガバナンスの事務局」という役割が出てきます。事務局は、ユースケース台帳の管理、申請や報告の受付、委員会の運営を担う、委員会を支える実務の窓口です。承認は区分ごとに定めた承認者が行い、区分「中」の承認者は事務局の責任者です。役割の全体は第13章で扱います。
モデルの性能の変化を検知する統計的な手法や、監視の基盤の作り方、再学習の進め方といった技術の詳細は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。この章では、技術の手前にある「何を見ると決めるか」「見つけたら誰が何をするか」「止めるかどうかを誰が決めるか」という、ガバナンスの側の決め事を扱います。
運用に入ってから問題が見えてくる理由
使い始める前の評価で合格した AIでも、運用に入ってから問題が見えてくることは珍しくありません。理由は大きく4つあります。1つ目は、入力の変化です。需要予測であれば市場の環境が変わり、問い合わせの一次回答であれば新しい商品や制度についての質問が増える、というように、評価のときに使ったデータと、運用中に入ってくるデータの傾向が離れていきます。2つ目は、AIの側の変化です。外部の生成AIサービスを使っている場合、提供元がモデルを更新すると、同じ指示に対する出力の傾向が変わることがあります。自社でモデルを再学習した場合も同じです。
3つ目は、使い方の変化です。承認したときには「社内の担当者が下書きとして使う」という用途だったものが、いつの間にか顧客への回答にそのまま使われている、というように、利用の範囲が承認した範囲から外れていくことがあります。第7章で扱ったユースケース台帳に書いた用途と、実際の使われ方がずれていく状態です。4つ目は、評価では見つからなかった弱点が、利用者の数と場面が増えたことで表に出てくることです。評価のデータに含まれていなかった種類の入力や、悪意のある入力(第8章で扱ったプロンプトインジェクションなど)は、運用に入って初めて現れることが多いと考えられます。
この4つは、いずれも「評価したときの前提が崩れる」という形をとります。そのため、運用中の監視は、評価のやり直しを定期的に行うことではなく、評価の前提が崩れていないかを継続して確かめる仕組みとして設計するのが扱いやすいと考えています。評価のときに「この前提で合格とした」と記録しておけば(第10章)、運用中はその前提ごとに見張る項目を決められます。前提が記録されていない AIは、何を見張ればよいかを後から考えることになり、監視の項目が担当者の思いつきに左右されやすくなります。
任意に使う枠組みである NIST の AIリスクマネジメントフレームワーク(NIST AI 100-1、2023年。第5章)も、MANAGE の機能の中で、導入後の監視の計画を実行することを示しており、その計画に、利用者などからの意見を受け取って評価する仕組み、異議の申し立てと人による上書き、廃止、インシデントへの対応、復旧、変更の管理を含めることを挙げています(MANAGE 4.1)。監視は、数値を眺めることだけでなく、利用者の声を受け取る経路や、止める・戻す・やめるといった対処の手順まで含めたものとして位置づけられています。
運用中に見るもの、性能・入力・苦情・利用範囲
運用中に見る項目は、AIの種類によって変わりますが、ガバナンスの側から見ると、次の4つの系統に分けて決めておくと漏れが少なくなると考えています。性能の変化、入力の変化、苦情と問い合わせ、利用の範囲の逸脱、です。前の2つは数値で測れることが多く、技術の担当者が仕組みを作れます。後の2つは数値だけでは拾いにくく、業務部門や顧客対応の窓口からの報告の経路を作っておかないと、存在していても誰の目にも留まりません。
次の表は、4つの系統ごとに、見る対象の例、兆候の例、情報源、主な担当を整理したものです。どの系統をどの頻度で見るかは、第7章で付けた本コラムのリスク区分(禁止・高・中・低。EU AI Act の4つの水準とは別物です)に合わせて決めます。区分が高いユースケースほど、見る項目を増やし、見る頻度を上げる、という考え方です。
| 系統 | 見る対象の例 | 兆候の例 | 情報源 | 主な担当 |
|---|---|---|---|---|
| 性能の変化 | 正解率・誤りの率、人による修正の率、生成AIの回答のうち担当者が書き直した割合 | 指標ごとに決めた許容の範囲を外れる(正解率が下限を下回る、誤りの率が上限を上回るなど)。特定の種類の入力でだけ誤りが増える | システムの記録、人による確認の結果 | AIを運用する技術の担当 |
| 入力の変化 | 入力の項目ごとの分布、問い合わせの話題の構成、入力の長さや言語 | 評価のときのデータと分布が離れる。これまで無かった種類の入力が増える | システムの記録 | AIを運用する技術の担当 |
| 苦情と問い合わせ | 顧客・利用者からの苦情、社内の利用者からの「おかしい」という報告、異議の申し立て | 同じ種類の苦情が続く。特定の属性の人からの苦情が偏る | 顧客対応の窓口、社内の報告の窓口 | 業務部門の責任者、顧客対応の窓口 |
| 利用の範囲の逸脱 | 台帳に書いた用途・利用者・入力してよい情報との違い | 承認していない部門が使い始める。下書き用の出力がそのまま外部に出る。入力してはいけない情報が入る | 利用の記録、定期の棚卸し、業務部門からの申告 | 業務部門の責任者、AIガバナンスの事務局 |
表の「主な担当」の列で、性能と入力の変化を技術の担当に置いたのは、数値の仕組みを作れるのがその人たちだからです。ただし、数値が基準を外れたときに、それを業務への影響として判断するのは、業務部門の責任者の役割です。たとえば問い合わせの一次回答で誤りの率が上がったとき、それがどの程度の顧客への影響になるかは、業務を知る人でないと判断できません。数値を見る人と、影響を判断する人を分けて書いておくことが、監視の結果を対処につなげるための前提になります。
苦情と問い合わせの系統は、見落とされやすい系統です。AIの出力が原因の苦情であっても、窓口の側から見ると「回答が間違っていた」「対応が遅い」という通常の苦情と区別がつかないことが多く、AIが関わっていることを記録する欄が無ければ、AIの問題として集計されません。顧客対応の記録の様式に「AIの出力が関わっていたか」を選ぶ欄を一つ足しておくと、AIに関わる苦情を後から数えられるようになります。生成AIを社内で使う場合には、社内の利用者が「出力がおかしい」と感じたときに報告する先を、利用規程(第12章)に書いておきます。
利用の範囲の逸脱は、性能の問題とは別の種類の問題です。AIそのものは評価のとおりに動いていても、承認していない使い方をされれば、評価のときに想定していなかった害が起こりえます。EU AI Act も、EU AI Act の導入者(deployer)に対して、高リスク AIシステムを使用説明書に沿って使うための措置を取ることを求めています(第26条第1項)。社内の区分でも、承認した用途の範囲を台帳に書き、その範囲から外れていないかを定期に確かめることが、監視の一部になります。
監視の頻度と方法は、ユースケースごとに監視の計画として書いておくと、担当者が替わっても続けやすくなります。計画には、見る項目、基準の値(どこを外れたら報告するか)、見る頻度、見る人、基準を外れたときの報告先、を書きます。EU AI Act は、高リスク AIシステムの EU AI Act の提供者(provider)に、市販後の監視の仕組みを作って文書にし、それを市販後の監視の計画に基づかせることを求めています(第72条第1項・第3項)。社内の監視の計画は、この義務が掛かるかどうかにかかわらず、同じ考え方で作れると考えています。
AIインシデントの定義と区分
監視で何かを見つけたとき、それを通常の不具合として処理するのか、AIインシデントとして扱って報告と対処の手順に乗せるのかを決める必要があります。本コラムでは、AIインシデントを「AIの開発・提供・利用(入力を含む)に関連して、情報漏えい・権利侵害・誤った判断・安全上の問題・信頼の失墜などの被害が起きた、または起きかけた事象」と定義しています(全体の地図の用語の定義)。社員が機密情報を入力して起きた漏えいも、この定義に含めます。被害が実際に起きたものだけでなく、起きかけたものも含めているのは、起きかけた段階で手を打てば被害を防げるからです。
この定義は、国際的な定義と並べて読むと位置づけが分かりやすくなります。OECD.AIの AIインシデントの監視の取り組みの説明ページによると、OECD.AIの専門家グループが2024年5月に公表した文書(「AIインシデントと関連する用語の定義」、OECD の AIに関する文書の第16号)は、AIシステムの開発・利用・誤動作が直接または間接に害につながった事象を AIインシデント、害につながりうる事象を AIハザード(危険の兆し)と呼び分けています。害の種類としては、人の健康への害、重要インフラの管理と運用の混乱、人権の侵害や基本的な権利・労働の権利・知的財産権を守る法令上の義務の違反、財産・地域社会・環境への害の4つが挙げられています。本コラムの定義の「起きかけた事象」は、OECD の用語ではおおむね AIハザードの側にあたります。
EU AI Act は、もっと狭い範囲を「重大インシデント」として定義しています。第3条第49号は、AIシステムのインシデントや誤動作のうち、人の死亡や健康への重大な害など、4種類の重大な結果につながったものを重大インシデントとしています(4種類は次の表)。社内の重大度と、法令上の重大インシデントに当たるかは、別に判定します。EU AI Act の報告の義務(後の節で扱います)は、この重大インシデントについてのものです。
3つの定義を並べると、次の表のようになります。社内の定義は、法令上の報告の対象よりも広くとっておき、その中に法令上の報告の対象が含まれる、という関係にしておくのが扱いやすいと考えています。社内の定義を法令の定義と同じ狭さにすると、法令上の報告に至らない程度の事象が記録されず、重大な事象の前触れを見逃しやすくなるからです。
| 定義 | 定めている主体 | 対象の範囲 | 起きかけた事象の扱い | 拘束力 |
|---|---|---|---|---|
| AIインシデント(本コラムの定義) | 本コラム(社内の定義の例) | 情報漏えい・権利侵害・誤った判断・安全上の問題・信頼の失墜などの被害 | 含める | 社内のルールとして運用する。規程としての効力は、内容や制定・周知の手続きによる |
| AIインシデント・AIハザード | OECD(2024年5月の文書) | 健康・重要インフラ・人権と法令上の権利・財産と地域社会と環境への害 | AIハザードとして別の語で扱う | 国際的な用語の提案で、法令ではない |
| 重大インシデント | EU AI Act 第3条第49号 | 死亡または健康への重大な害、重要インフラの重大かつ回復できない混乱、基本的な権利を守る EU 法上の義務の違反、財産または環境への重大な害 | 定義には含まれていない | EU 規則。報告の義務は第73条など |
定義を決めたら、次は社内での区分です。すべての AIインシデントに同じ手順を当てると、軽い事象で関係者が疲れ、重い事象の対応が遅れます。重大度を3段階程度に分け、段階ごとに報告先と報告の期限、止めるかどうかの扱いを変えておくと、対応の重さを事象に合わせられます。次の表は、その区分の一例です。段階の名前と基準は例で、自社の業務と第7章のリスク区分に合わせて決めてください、という意味で置いています。止めてよい人と再開を決める人は、重大度によらず本コラムの全章で同じ割り当てにしています。一時的に止めるのは、業務部門の責任者か事務局の責任者のうち先に把握した方で、すぐに止めてよいものとします。再開を決めるのは、そのユースケースのリスク区分の承認者(区分「低」は業務部門の責任者、区分「中」は事務局の責任者、区分「高」は AIガバナンス委員会)です。
| 社内の重大度 | 基準の例 | 報告先の例 | 社内の報告の目安の例 | 止めるかどうかの扱いの例 |
|---|---|---|---|---|
| 重大 | 人の安全・健康への害、法令違反の疑い、個人情報や機密の外部への漏えい、多数の顧客への誤った判断の通知、法令上の報告の対象になりうる事象 | AIガバナンス責任者、AIガバナンス委員会、法務、広報 | 把握した当日中 | 原則としてすぐに一時停止する。再開は区分の承認者が決める |
| 中程度 | 一部の顧客・利用者への誤り、特定の属性への偏りの兆し、承認していない範囲での利用の発覚 | 業務部門の責任者、AIガバナンスの事務局 | 数営業日以内 | 影響を見て一時停止するか、人による確認を挟む形に切り替える。再開は区分の承認者が決める |
| 軽微 | 社内の利用にとどまる誤りで、人の確認で止められたもの。基準の値を一時的に外れたもの | AIを運用する担当、業務部門の担当 | 定例の報告でまとめて | 止めない。監視を強める |
表の「社内の報告の目安」は正式な社内報告の目安です。疑いを把握した時点で、まず担当の窓口へ連絡します。複数の段階に当たる場合は、重い方の段階で扱います。この目安は社内の手順の例で、法令上の報告の期限ではありません。EU AI Act の報告の期限は後の節で扱いますが、そこでは「把握してから何日以内」という形で期限が決められているので、社内の手順でも、把握した時刻を記録し、法令上の報告の対象になりうるかを早い段階で法務と確かめる手順を「重大」の段階に入れておく必要があります。どの事象が法令上の報告の対象にあたるかは、条文の要件と事実関係に照らして個別に確かめることになり、社内の区分だけで決まるものではありません。
検知から報告・対処・再発防止までの流れと役割
AIインシデントへの対応は、検知、初動、判定、報告、対処、復旧、振り返り、の流れで整理できます。AIに固有の工程というより、情報セキュリティや品質の事故への対応と同じ骨格です。既に情報セキュリティのインシデント対応の手順がある会社では、新しい手順を一から作るより、既存の手順に AIに固有の判断(出力の誤りや偏りをどう確かめるか、モデルの版をどう特定するか、止めたときに業務をどう回すか)を足す方が、二重投資を避けられると考えています。
AI事業者ガイドライン第1.2版の別添は、AIガバナンスの構築の行動目標の一つとして、インシデントが起きたときの対応を事前に検討しておくことを挙げています(行動目標3-4-2)。そこでは、AIインシデントが起きたときに、利用者への説明、影響の範囲と損害の特定、法的な関係の整理、被害の救済、被害の拡大の防止、再発防止策の検討などを速やかに行えるよう、対応の方針と計画を作り、実践的な予行演習を適宜行うことが期待されています。あらかじめ整えておく体制として、連絡を受け付ける窓口、対応を担当する役員、担当者ごとの役割分担、対応の進め方、リスク管理部門などの社内への連絡体制、顧問弁護士などの社外の専門家への連絡体制、利害関係者へ通知する手順が挙げられています。AIインシデントの事業への影響が大きい場合には、事業継続計画(BCP)を発動する際の重要な要素に AIインシデントを入れることも検討する、とされています。AI事業者ガイドラインの全体の構成は第4章で扱いました。
この内容を、本コラムの言葉で段階ごとの役割に落とすと、次の表のようになります。役割の名前は第13章で扱う体制の名前に合わせています。会社の規模によっては、1人が複数の役割を兼ねることになりますが、兼ねる場合でも、段階ごとに誰が決めるのかを書いておくことに意味があります。
| 段階 | すること | 主に担う役割 | 決めること | 残す記録 |
|---|---|---|---|---|
| 検知 | 監視の基準を外れた値、苦情、社内からの報告を受け付ける | AIを運用する担当、顧客対応の窓口、社内の報告の窓口 | AIインシデントの疑いとして登録するか | 把握した日時、把握した経路、最初の事実 |
| 初動 | 被害の広がりを止める。必要なら利用を一時的に止める。証拠を保全する | 業務部門の責任者または事務局の責任者(先に把握した方)、AIを運用する担当 | 一時的に止めるか、人による確認を挟むか | 止めた日時と判断者、保全したログとモデルの版 |
| 判定 | 事実を確かめ、社内の重大度を決める。法令上の報告の対象になりうるかを確かめる | AIガバナンスの事務局、法務、業務部門の責任者 | 社内の重大度、報告先、法令上の報告の要否の検討 | 判定の根拠、相談した専門家 |
| 報告 | 社内の報告先へ知らせる。必要に応じて、提供元・顧客・当局へ連絡する | AIガバナンスの事務局、法務、広報、AIガバナンス責任者 | 誰に、いつ、何を伝えるか | 報告の日時・相手・内容 |
| 対処と復旧 | 原因を調べて直す。代わりの手順で業務を回す。再開の条件を確かめる | AIを運用する担当、業務部門の責任者。再開はユースケースの区分の承認者が決め、事務局が条件を記録する | 再開するか、用途を狭めるか、廃止するか | 原因、直した内容、再開の判断者と条件 |
| 振り返り | 経緯と原因をまとめ、台帳・監視の計画・規程に反映する | AIガバナンスの事務局、AIガバナンス委員会 | 何を変えるか、誰がいつまでに変えるか | 振り返りの報告、変えた文書と版 |
表の中で、初動の段階に「証拠を保全する」を入れているのは、AIのインシデントでは、後から原因を調べるために、そのときのモデルの版、入力、出力、設定がそろっている必要があるからです。早く直そうとしてモデルを差し替えたり設定を変えたりすると、何が原因だったのかを確かめられなくなることがあります。EU AI Act も、高リスク AIシステムの EU AI Act の提供者が重大インシデントを報告した後の調査について、原因の評価に影響しうる形で AIシステムを変えるような調査を、所管の当局に知らせる前に行ってはならない、としています(第73条第6項)。この義務が掛かるかどうかにかかわらず、直す前に今の状態を残す、という順序は社内の手順にも入れておく価値があると考えています。
外部の生成AIサービスや、他社が作った AIを使っている場合には、提供元への連絡が流れの中に入ります。自社の側だけでは原因を調べきれないことが多く、提供元の調査を待たないと対処が決まらない場合もあります。どこに、どの経路で連絡すれば調査をしてもらえるのか、提供元がインシデントを自社に知らせる経路があるかは、調達のときに確かめておく項目です(第9章)。
流れを作ったら、予行演習で一度通してみることが有効だと考えています。AI事業者ガイドラインの別添も、予行演習の実施を行動目標の中に入れています。机上で「このユースケースで、この苦情が来たら」という想定を置き、検知から報告までを関係者で順にたどるだけでも、報告の窓口が知られていない、止める権限を持つ人が決まっていない、ログが取れていない、といった穴が見つかります。演習で見つかった穴は、実際のインシデントで見つかるより損失が小さく済むと考えています。
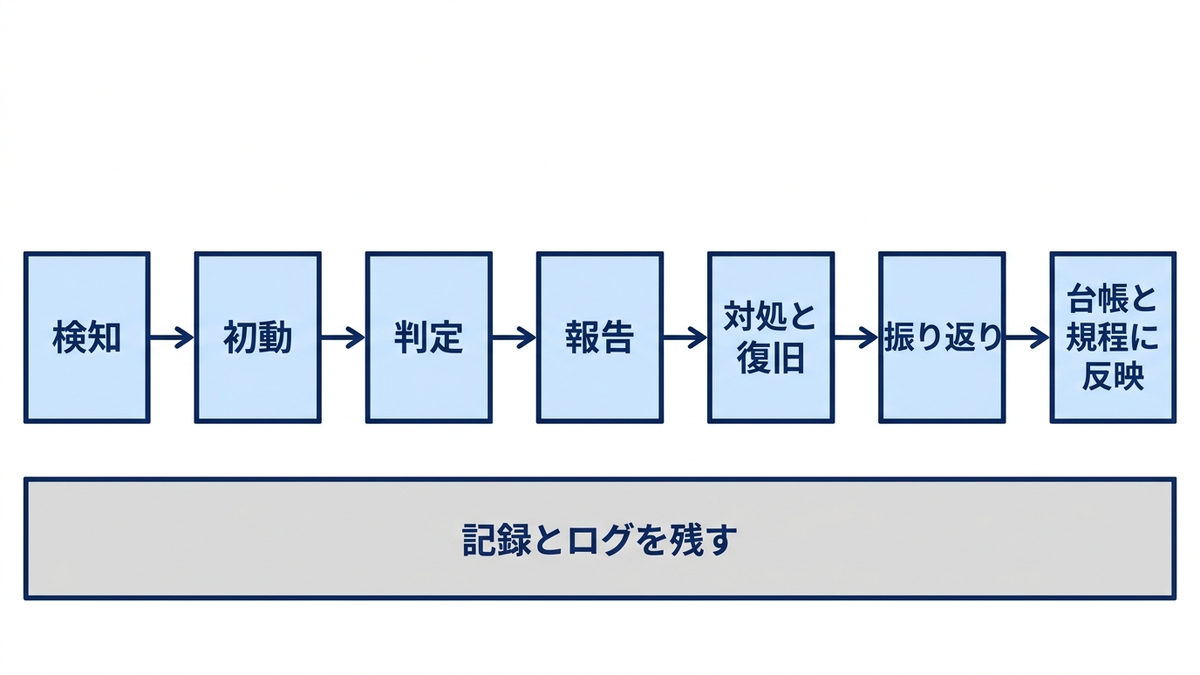
停止の基準と停止の権限、誰が止めてよいか
AIインシデントへの対応で、最も判断が遅れやすいのが、使うのを止めるかどうかです。止めれば業務が滞り、売上や顧客対応に影響が出ます。止めなければ、誤った判断や権利侵害が続くおそれがあります。この判断を、インシデントが起きてから関係者で話し合って決めようとすると、止めることの損失は目の前に見えるのに対して、止めないことの損失は見えにくいので、止める判断が遅れがちになります。そのため、止める基準と止める権限を、運用を始める前に決めておくことが重要だと考えています。
ここで決めておくものを、本コラムでは停止基準と呼びます。停止基準は、どういう状態になったら使うのを止めるか(または人による確認を必ず挟む形に切り替えるか)という条件と、その条件に当たったときに誰が止めてよいか、止めた後に誰が再開を決めるか、の3つを合わせたものです。条件だけを決めて権限を決めないと、条件に当たっても「止めてよいのか」の確認で時間がかかります。権限だけを決めて条件を決めないと、止めるかどうかが権限を持つ人の個人の判断に委ねられます。
止めるための仕組みについては、公的な枠組みにも記述があります。NIST の AIリスクマネジメントフレームワークは、MANAGE 2.4 で、意図した用途と合わない性能や結果を示す AIシステムを置き換える、切り離す、または停止するための仕組みを用意して適用し、その責任を割り当てて理解させておくことを挙げています。EU AI Act は、高リスク AIシステムについて、監督を任された人が、システムを使わないと決めたり、出力を無視・上書き・取り消したりできること、また「停止」ボタンのような手順でシステムを安全な状態で止められることを求めています(第14条第4項(d)(e))。さらに、EU AI Act の導入者が、使用説明書に沿って使っても第79条第1項にいうリスク(人の健康・安全や基本的な権利へのリスク)を生じうると考える理由がある場合には、EU AI Act の提供者または販売者と市場監視当局へ知らせ、そのシステムの使用を停止する、と定めています(第26条第5項)。市場監視当局は、EU 規則 2019/1020 に基づいて市場に出た製品の監視と措置を行う各国の当局で、第3条第26号に定義があります(詳しくは第3章)。NIST は任意の枠組みで、EU AI Act は法令なので、求める強さは違います。それでも、止める権限と止める仕組みを用意しておくことは、両方に共通して出てくる考え方です。
停止基準の条件は、監視で見ている4つの系統と、社内の重大度の区分に結びつけて書くと、判断がぶれにくくなります。次の表は、その一例です。表では、4つの系統に、重大度の「重大」にあたる「安全・権利への害」と、外部の AIを使う場合の「提供元の変化」の2つを加えて6行にしています。止めてよい人と再開を決める人は、前の節で書いた全章共通の割り当てに従うので、表には列として置かず、行ごとに違う「止める対応」と「再開の前に確かめること」を並べました。どの条件で止めるかはユースケースごとに違うので、表の値や表現はそのまま使うためのものではなく、決めておく項目の例として置いています。
| 条件の系統 | 停止または切り替えの条件の例 | 止める対応の例 | 再開の前に確かめることの例 |
|---|---|---|---|
| 安全・権利への害 | 人の安全や健康への害、個人情報や機密の外部への漏えい、差別的な扱いの疑いが確認された | 使用を停止する。代わりの手順に切り替える | 原因と直した内容、影響を受けた人への対応、法令上の報告の要否の検討の結果 |
| 性能の変化 | 監視の計画に書いた指標ごとの許容の範囲を、決めた期間を超えて外れた(正解率が下限を下回る、誤りの率が上限を上回るなど) | 人による確認を必ず挟む形に切り替える。改善しなければ停止する | 評価のやり直しの結果が基準を満たすこと |
| 入力の変化 | 入力の分布が評価のときから大きく離れた。想定外の種類の入力が急に増えた | 対象の入力だけ人に回す。原因を確かめる | 変化した入力で評価し直した結果 |
| 苦情 | 同じ種類の苦情が決めた件数を超えた。特定の属性の人からの苦情が偏った | 人による確認を挟む。必要なら停止する | 苦情の原因と、対象の属性と指標を決めて評価し直し、再開の基準を満たした結果 |
| 利用の範囲の逸脱 | 承認していない用途・部門・入力での利用が見つかった | 承認していない利用を止める。承認の手続きに戻す | 新しい用途として申請し、その区分の承認を得たこと |
| 提供元の変化 | 外部の AIの提供元から、重大な不具合や仕様の変更の通知があった | 影響を確かめるまで用途を狭める | 変更後の AIで影響を確かめた結果 |
止めてよい人と再開を決める人を分けているのには理由があります。止める判断は早さが大事なので、業務部門の責任者と事務局の責任者のどちらか、先に把握した方がすぐに止めてよいものとします。再開の判断は、原因が分かり、直したことを確かめたうえで行うものなので、そのユースケースを承認した人、つまり区分の承認者に置き、事務局が再開の条件を記録します。利用の範囲の逸脱のように、承認していない新しい用途として使い続けたい場合は、再開ではなく新しい申請として扱い、その用途の区分に応じた承認を受けます。止める判断を現場に任せる場合には、止めたことで責められない、という扱いを規程に書いておくことが大切だと考えています。止めた後に「止めなくてもよかった」と言われる経験をした担当者は、次から止めるのをためらうようになります。基準に当たって止めたことは、結果として大事に至らなかったとしても、手順どおりの対応として扱うと決めておきます。
止めるときには、止めた後に業務をどう回すかも決めておく必要があります。AIを使う前の手作業の手順に戻せるのか、戻せるならどの程度の人手が要るのか、を運用の開始前に確かめておきます。AI事業者ガイドラインの別添の実践例にも、AIシステムの全部または一部を止めることになった場合に備えた初動の対応と事業継続の計画を作り、演習を行う例が示されています。AIを前提に業務の人員を減らした後では、手作業に戻すことが難しくなるので、止めたときの代わりの手順は、ユースケースの承認の時点で確認する項目に入れておくのがよいと考えています。
記録とログ、EU AI Act が求めていること
インシデントの原因を調べるにも、外部に説明するにも、そのときに AIが何を受け取り、何を出したかの記録が要ります。記録が残っていなければ、原因が分からないまま対処することになり、同じ問題が繰り返されるおそれがあります。説明を求められたときにも、「おそらくこうだった」としか言えません。記録は、インシデントが起きてから集めることはできないので、運用を始める前に、何を、どのくらいの期間、誰が保存するかを決めておく必要があります。
この節と節の中の表では、EU AI Act の提供者(provider)を「提供者」、EU AI Act の導入者(deployer)を「導入者」と略します。いずれも AI事業者ガイドラインの語ではありません。EU AI Act は、高リスク AIシステムについて、記録とログに関する規定を複数の条に分けて置いています。要点は、ログを自動で取れる作りにすること(第12条)と、取ったログを保存すること(提供者は第19条、導入者は第26条第6項)です。保存の期間と条件は、次の表にまとめました。
報告については、重大インシデントの報告を題名とする第73条が、EU 市場に出された高リスク AIシステムの提供者に、重大インシデントを、それが起きた加盟国の市場監視当局に報告することを求めています。報告はどの場合も「すぐに」行うのが原則で、日数はその最長の期限です。期限の日まで待ってよいという意味ではありません。場合ごとの条件と期限は、次の表の第73条の行にまとめました。期限に間に合わせるために、まず不完全な初回の報告を出し、後から完全な報告を出すこともできます(第5項)。
導入者の側にも、知らせる義務があります。第26条第5項は、導入者に、使用説明書に基づいて高リスク AIシステムの運用を監視することを求め、重大インシデントを見つけた場合には、まず提供者に、次に輸入者または販売者と市場監視当局に、すぐに知らせることを求めています。提供者に連絡がつかない場合には、第73条を準用するとされています。提供者の側には、第20条で、システムが規則に適合していないと考える場合に、適合させる、市場から回収する、機能を止める、などの是正の措置をすぐに取り、販売者や導入者などに知らせる義務があります。
これらの規定を、記録・監視・報告の観点で並べると次の表のようになります。表の内容は、条文の要旨を本コラムの言葉でまとめたもので、条文の訳ではありません。汎用目的 AIモデルのうちシステミックリスクを持つものの提供者にも、重大インシデントの情報を追跡・文書化して AI Office(AIシステムと汎用目的 AIモデルの実施・監視・監督に関わる欧州委員会の機能で、第3条第47号に定義があります)などへ報告する義務がありますが(第55条第1項(c))、汎用目的 AIモデルの義務の全体は第3章で扱いました。なお、これらの義務がいつから掛かるかには、確かめきれていない点があります(表の後の段落)。
| 条 | 主な対象 | 要旨 | 社内の手順への読み替えの例 |
|---|---|---|---|
| 第12条 | 高リスク AIシステム(の作り) | 稼働期間を通じてログを自動で記録できるようにする。リスクの発見・市販後の監視・導入者の監視に役立つ出来事を記録する | 調達・開発の要件に、ログの機能と記録する項目を入れる(第9章) |
| 第19条 | 提供者 | 自動で生成されたログのうち自らの管理下にあるものを、用途に照らして適切な期間、少なくとも6か月保存する(ほかの EU 法・国内法、とくに個人データの保護の法令に別の定めがある場合を除く) | ログの保存期間を、個人情報の扱いと合わせて決める |
| 第26条第5項・第6項 | 導入者 | 使用説明書に基づいて運用を監視する。リスクを生じうると考える理由があれば知らせて使用を停止する。重大インシデントはまず提供者に知らせる。管理下にある自動生成のログを、用途に照らして適切な期間、少なくとも6か月保存する(別の法令の定めがある場合を除く) | 監視の計画、停止基準、提供元への連絡の経路、ログの保存を決める |
| 第72条 | 提供者 | 市販後の監視の仕組みを作って文書にし、計画に基づいて性能のデータを集めて分析する | 監視の計画をユースケースごとに書く |
| 第73条 | 提供者(導入者が知った場合も期限の起点になる) | 重大インシデントを市場監視当局に報告する。日数は最長の期限で、どの場合もすぐに報告する。原則は、因果関係かその合理的な可能性を確かめた後すぐ、知ってから15日以内(第2項)。広い範囲にわたる違反(第3条第61号に定義)か、重要インフラの管理・運用の重大かつ回復できない混乱の場合は、すぐに、2日以内(第3項)。死亡の場合は、因果関係を確かめた時点か疑った時点ですぐに、10日以内(第4項)。報告後に調査と是正を行う | 把握した日時の記録、法務への早期の相談、初回の報告と完全な報告の分担を決める |
| 第20条 | 提供者 | 適合していないと考える場合に、是正・回収・機能の停止などの措置をすぐに取り、関係者に知らせる | 提供元から是正の通知を受けたときの社内の手順を決める |
適用の時期には注意が要ります。統合版の第113条によると、EU AI Act は2026年8月2日から一般的に適用され、第73条を含む第9章はその例外の号((a)〜(d))に挙げられていないので、第113条の本文の2026年8月2日に当たります。一方で、高リスク AIシステムの分類・要件・提供者と導入者の義務を定めた EU AI Act の第III章第1節〜第3節(第6条第5項を除く。本コラムの章ではありません)は、附属書III による高リスク AIシステムについては2027年12月2日から(第113条(c)(i))、附属書I による高リスク AIシステムについては2028年8月2日から(第113条(c)(ii))適用されるとされています。高リスクかどうかの分類の規定の適用が後ろにずれていることが、第73条の報告の義務が実際にどの時点から掛かるかにどう影響するかは、本コラムでは確かめきれていません。欧州委員会は、2025年9月26日に第73条の指針の案と報告の様式の案を公表して意見を募集しましたが(2025年11月7日締め切り)、そのページはデジタル・オムニバスより前のもので、規則が2026年8月から適用されると書いています。自社の AIに報告の義務がいつから掛かるかは、最新の公式の情報と専門家への確認で判断してください。適用の日程の全体は第3章で扱いました。
EU AI Act の対象にならない AIでも、記録の考え方は同じように使えると考えています。社内の手順として決めておくのは、記録する項目(入力・出力・モデルの版・設定・利用者・日時)、保存期間、保存する場所と見られる人、個人情報を含む場合の扱い、の4つです。生成AIの入力と出力には個人情報や機密が含まれることがあるので、長く保存するほど漏えいの危険が増えます。原因を調べるために必要な期間と、個人情報の保護の要請(第8章)の両方を見て期間を決め、見られる人を限っておきます。
OECD の AIインシデントの監視の取り組み、AIM
自社の外で起きた AIインシデントを知っておくことも、運用の監視の一部になります。同じ種類の AIを使っている他の組織で起きた問題は、自社でも起こりうるからです。公開された AIインシデントをまとめている取り組みの一つが、OECD.AIの AIインシデントとハザードの監視(英語の略称は AIM)です。
OECD.AIの説明ページによると、AIM は OECD.AIの AIインシデントに関する専門家グループが始めて開発しているもので、OECD の定義による AIインシデントと AIハザードを実時間で追跡し、政策の議論の根拠を提供することを目的としています。AIM は、信頼できる国際的な報道機関の記事から AIインシデントとハザードを検出しており、記事のデータは、世界の報道を集める報道情報のサービスである Event Registry から提供されています。2024年11月以降は、大規模言語モデルを使って、AIに関する出来事を AIインシデント・AIハザード・無関係の3つに分類し、要約や害の種類、深刻さ、影響を受けた利害関係者、起きた国などの情報を付けている、と説明されています。同じページは、報道から集めたインシデントは世界のすべての AIインシデントの一部にすぎない可能性が高いと認めたうえで、根拠を作る出発点として役立つとしています。共通の報告の枠組みに沿って直接届け出る仕組みも開発中である、と書かれています。
AIM の一覧ページは、試行版(Beta)と表示され、要約や分類が AIによって生成されたものであることも示されています。2026年10月28日に開いたときには、約1万8千件の AIインシデントとハザードが一覧に載っていました。分類は自動で付けられているので、個々の件の分類をそのまま事実として扱うのではなく、元の報道や当事者の発表に当たって確かめる必要があります。
AIM を社内で使うなら、自社が使っている AIの種類や業務の分野で絞り込み、同じ種類の事象が起きていないかを定期に眺める、という使い方が考えられます。見つけた事象は、自社の監視の計画に見る項目を足すきっかけや、予行演習の想定の材料にできます。欧州委員会が第73条の指針の案を公表したページも、EU の取り組みを、OECD の AIインシデントの監視と共通の報告の枠組みのような国際的な取り組みとそろえることを目指す、と書いています。社内の AIインシデントの記録の項目を決めるときに、AIM が付けている項目(害の種類・深刻さ・影響を受けた利害関係者・業種・国)を参考にしておくと、外部の情報と自社の記録を比べやすくなると考えています。
外部への説明と顧客への対応
AIインシデントが顧客や社会に影響した場合には、外部への説明が要ります。説明の遅れや食い違いは、インシデントそのものより大きな信頼の失墜につながることがあります。AIに固有の難しさは、原因の特定に時間がかかりやすいことです。AI事業者ガイドラインの別添の実践例も、AIシステムが異常な結果を出す原因が多様であること(アルゴリズムの異常、学習データの真正性、学習データの偏りなど)と、想定外の影響が生じやすいことを、AIに固有の考慮要素として挙げています。原因が分かるまで何も言わないと説明が遅れ、原因が分からないうちに断定すると、後で訂正することになります。
そのため、外部への説明は、分かっていることと分かっていないことを分けて伝える形を基本にするのがよいと考えています。分かっていることは、何が起きたか、いつからいつまでか、影響を受けた範囲、既に取った措置(止めた、人による確認に切り替えた、など)です。分かっていないことは、原因と、影響の範囲がさらに広がるかどうかです。分かっていないことについては、いつまでに何を調べて、次にいつ知らせるかを伝えます。この形は、EU AI Act が、まず不完全な初回の報告を出し、後から完全な報告を出すことを認めている考え方とも合っています(第73条第5項)。
説明の窓口は一本にします。業務部門・広報・顧客対応の窓口が別々に説明すると、内容が食い違いやすくなります。説明の文面は、法務と広報が確かめてから出す手順にしておきます。影響を受けた顧客への個別の連絡が要る場合は、誰に連絡するかを特定するために、ここでもログが必要になります。誤った判断の通知が顧客に届いていた場合には、正しい内容での連絡のし直しと、その判断に基づいて顧客が取った行動への対応も考える必要があります。救済の内容や法的な責任の整理は、事実関係によって大きく変わるので、顧問弁護士等の専門家に確認しながら決めることになります。
個人情報の漏えいが関わる場合には、AIのインシデントとしての対応とは別に、個人情報の漏えい等の対応の手順に沿って判断します。個人情報保護委員会の漏えい等の対応のページは、要配慮個人情報を含む個人データの漏えい等や、本人の数が1,000人を超える漏えい等など、定められた要件に当たる場合に委員会への漏えい等の報告が義務付けられていることと、発覚したらまず速やかに報告すること、を示しています。要件には、漏えい等が起きた「おそれ」がある場合も含まれています。本人への通知が要るかも、あわせて確かめます。生成AIの利用と個人情報の扱いは第8章で扱いました。どの報告の義務が掛かるかを一つずつ確かめる作業は、インシデントが起きてから始めると時間がかかるので、AIのユースケースごとに、関係しうる報告の義務を台帳の項目として書いておくと、判定の段階を早く進められます。
振り返りと、台帳・規程への反映
インシデントへの対応は、業務を再開したところで終わりではありません。振り返りを行い、その結果を台帳・監視の計画・規程に反映して、同じ種類のインシデントの再発防止につなげます。振り返りで確かめることは、何が起きたか(事実の経緯)、なぜ起きたか(直接の原因と、それを許した仕組みの側の原因)、なぜ早く気づけなかったか(監視の項目と基準の値は適切だったか)、対応はうまくいったか(報告と停止の判断は手順どおりに速やかに行われたか)、何を変えるか、の5つです。
振り返りでは、個人の責任の追及ではなく、仕組みの側の原因を探すことに重点を置くのがよいと考えています。インシデントの報告が責任の追及につながると受け止められると、次から報告が遅れたり、起きかけた事象が報告されなくなったりします。本コラムの AIインシデントの定義に「起きかけた事象」を入れているのは、そうした事象が報告されてこそ重大な事象を防げるからで、報告した人が不利にならない扱いは、定義と一組で決めておく必要があります。
振り返りの結果を反映する先は、次の表のように整理できます。反映を担当する人と期限を決め、反映したかどうかを AIガバナンス委員会(第13章)で確かめるところまでを、振り返りの手順に含めておきます。
| 反映する先 | 変える内容の例 | 担当の例 | 関係する章 |
|---|---|---|---|
| ユースケース台帳 | リスク区分の見直し、用途や利用者の範囲の見直し、見直し日の前倒し | AIガバナンスの事務局、業務部門の責任者 | 第7章 |
| 監視の計画 | 見る項目の追加、基準の値の変更、見る頻度の変更 | AIを運用する担当 | この章 |
| 停止基準 | 条件の追加、止めてよい人の見直し、代わりの手順の整備 | 業務部門の責任者、AIガバナンス委員会 | この章 |
| 評価の手順 | 使い始める前の評価に、見つかった種類の入力や観点を足す | 評価の担当 | 第10章 |
| 調達の確認項目 | 提供元との連絡と調査の体制(連絡先、取得できる記録、調査の進め方)の確認 | 購買、法務 | 第9章 |
| 利用規程と手順書 | 禁止事項の追加、報告の窓口の明記、手順の変更 | AIガバナンスの事務局 | 第12章 |
| 教育 | 研修の中身に、起きたインシデントの型と報告の仕方を足す | AIガバナンスの事務局、人事部門 | 第14章 |
インシデントの記録は、件数と型ごとに集計して、AIガバナンス委員会と経営に定期に報告します。報告では、件数の増減だけでなく、検知から報告までにかかった時間、止めると決めるまでにかかった時間、反映が終わっていない振り返りの件数も示すと、仕組みが回っているかどうかが見えやすくなります。インシデントの件数が0件のまま続いている場合には、本当に起きていないのか、報告の経路が知られていないのか、報告されていないのかを確かめる必要があります。件数が少ないことは、それだけでは良い状態の証拠になりません。
経営判断、止める判断を現場に任せきりにしない
この章の最後に、経営の立場から決めておくことをまとめます。運用の監視とインシデント対応は、日々の作業としては技術の担当と業務部門が担うものですが、経営が決めておかないと回らない部分があります。
1つ目は、止める判断の重さを経営が引き受けることです。AIを止めれば、業務の遅れや売上の減少という損失がすぐに見えます。止めなければ、誤った判断の放置、権利侵害、規制違反、信頼の失墜という、すぐには見えにくい損失が積み上がるおそれがあります。この2つを比べる判断を、現場の担当者だけに任せると、見えやすい損失を避けて止めない方向に傾きやすくなります。個別の停止基準は区分の承認者が運用の開始前に決めます。そのうえで、停止基準の考え方と「基準に当たったら止めてよい。止めたことで責めない」という扱いを、経営が基本方針や規程で明言しておきます。これが、現場が止める判断をできる前提になります。止める判断を現場に任せることと、止めた結果の責任を現場に負わせることは、分けて考える必要があります。
2つ目は、監視と記録に必要な体制と予算を、AIを導入するときの計画に最初から入れておくことです。AIの導入の計画は、開発や利用の開始までの費用で組まれることが多く、運用中の監視・ログの保存・インシデント対応の演習の分が後回しになりやすいと考えています。運用を始めた後で監視の仕組みを足そうとすると、ログが取れない設計になっていた、提供元からログを受け取れない、ということが起こりえます。導入の承認の条件に、監視の計画・停止基準・止めたときの代わりの手順の3つがそろっていることを入れておくと、後からの手戻りを避けられます。
3つ目は、インシデントの報告を経営の定例の議題にすることです。重大な事象だけを個別に報告する形にすると、経営に届くのは大きな問題が起きたときだけになり、その前触れを経営が知る機会がありません。軽微な事象も含めた件数と型の推移を四半期ごとに見ていれば、特定のユースケースや提供元に問題が偏っていることに早く気づけます。部門ごとにばらばらにインシデントを扱っていると、同じ提供元の同じ不具合に複数の部門が別々に対応するという二重投資も起こるので、記録を全社で一つにまとめておく意味は大きいと考えています。
4つ目は、法令上の報告の義務を確かめる担当を決めておくことです。EU AI Act の重大インシデントの報告のように、把握してから日数で期限が決まっている義務は、判定に時間をかけているうちに期限が近づきます。報告の要否をすぐに検討できるよう、法務と、必要に応じて外部の専門家に相談する経路を、インシデントが起きる前に決めておきます。自社の AIがどの制度の報告の義務の対象になるかを事前に整理しておけば、判定の段階で一から調べずに済みます。
この章では、AIを使い始めた後の監視とインシデント対応を扱いました。運用中は、性能・入力・苦情・利用の範囲の4つの系統で、評価のときの前提が崩れていないかを見張ること。AIインシデントは、法令上の報告の対象より広く定義し、起きかけた事象も記録すること。検知から振り返りまでの流れと段階ごとの役割を決め、直す前に証拠を残すこと。停止基準として、止める条件・止めてよい人・再開を決める人を運用の前に決め、止めたことで責めない扱いを経営が明言すること。EU AI Act は、高リスク AIシステムについて、ログの記録と保存、導入者の監視と停止、重大インシデントの日数を区切った報告を求めており、いつから掛かるかは最新の公式の情報と専門家で確かめる必要があること。そして振り返りの結果を台帳・監視の計画・規程へ反映するところまでが対応であることです。第12章では、ここまでの章で出てきた決め事を、AI基本方針・AI利用規程・手順書という社内の文書にどう書き分けるかを扱います。
この章を深めたい方への参考書籍
『信頼性の高い機械学習 SRE原則を活用したMLOps』(Cathy Chen、Niall Richard Murphy、Kranti Parisa、D. Sculley、Todd Underwood 著、井伊篤彦、張凡、樋口千洋 訳、オライリー・ジャパン):システムの信頼性を保つための考え方である SRE の原則を、機械学習のシステムの構築と運用に当てはめた本です。目次には、モデルの監視と可観測性を扱う章と、障害対応を扱う章があり、障害対応の章は障害の段階と役割、ML を中心とした機能停止の分析、役割ごとの障害管理の原則を扱っています。この章で扱った監視の計画、段階ごとの役割、止める判断を、技術の担当の側から具体的に考えるときの材料になります。
『SRE サイトリライアビリティエンジニアリング Googleの信頼性を支えるエンジニアリングチーム』(Betsy Beyer、Chris Jones、Jennifer Petoff、Niall Richard Murphy 編、澤田武男、関根達夫、細川一茂、矢吹大輔 監訳、Sky株式会社 玉川竜司 訳、オライリー・ジャパン):大規模なシステムを運用する組織の考え方と実践をまとめた本で、AIに限った本ではありません。目次には、インシデント管理の章と、ポストモーテム(事後の振り返り)の文化を扱う章があり、インシデントとして宣言すべき場合や、失敗から学ぶ振り返りの考え方が扱われています。この章で書いた、手順として宣言する基準を先に決めることや、責任の追及ではなく仕組みの原因を探す振り返りを、既に確立した運用の分野の知見から考えるときに参考になります。
第12章 社内ルールの作り方、AI基本方針・利用規程・手順書
第11章では、AIを使い始めた後に何を見続け、問題が起きたときに誰がどう報告し、どの基準で止めるかを扱いました。停止の基準も報告の経路も、どこかに書かれて社内で共有されていなければ、担当者が替わった時点で働かなくなります。この章では、ここまでの章で決めてきたこと、つまりユースケース台帳と本コラムのリスク区分(第7章)、生成AIの社内利用の論点(第8章)、調達の確認項目(第9章)、評価の記録(第10章)、インシデントの対応と停止の判断(第11章)を、社内の文書としてどう書き分け、誰が承認し、どの頻度で直すかを扱います。
中心になる考え方は、変える頻度の違うものを1つの文書に混ぜない、ということです。経営が掲げる原則は数年単位で変わらないことが多い一方で、使ってよい生成AIサービスの一覧や申請の様式は、月単位で変わることがあります。両方を1つの規程に書くと、一覧を1行直すたびに経営の承認が要り、承認が追いつかずに文書が実態から遅れるか、承認を省いて文書の重みが失われるかのどちらかになりやすいと考えています。この章では、文書の階層を4つに分け、AI基本方針と AI利用規程の目次の雛形、申請から承認までの手順書の例、既存の規程との関係、企業が公開している AIポリシーの例、例外と版の管理、作った規程が読まれる条件、の順に書きます。
この章で示す目次の雛形は、本コラムが章をまたいで使ってきた用語と区分に合わせて作ったもので、特定の企業の規程や特定のガイドラインの文章を写したものではありません。自社の規程の体系や用語に合わせて、項目の名前や順序を変えて使うことを想定しています。
文書を分ける理由、原則・規則・作業を混ぜない
AIの社内ルールを作るときに起きやすいのは、最初に作った1つの文書に、原則・禁止事項・手続き・様式・使ってよいサービスの一覧をすべて書き込んでしまうことです。最初の版はそれで足りても、運用が始まると、変わる部分と変わらない部分が同じ文書の中で混ざっていることが負担になります。変えるたびに全体を読み直して承認を取る必要があり、読む側も、自分に関係する一文を探すために長い文書を最初から読むことになります。
本コラムでは、冒頭の「全体の地図」で定めた用語の定義に沿って、文書を次のように分けます。AI基本方針は、経営が承認する原則で、なぜ AIを使うのか、何を大切にするのかを書きます。AI利用規程は、従業員が守るべき規則で、何をしてよく何をしてはいけないか、誰の承認が要るかを書きます。手順書は具体的な作業で、申請の出し方、判定の仕方、記録の残し方といった、どうやって行うかを書きます。これに加えて、申請書や台帳の項目といった様式を、手順書から切り離して管理します。
この分け方は、AIに固有のものではありません。情報セキュリティの規程を、基本方針と、その下の基準や手順に分けて持っている会社であれば、AIの社内ルールも同じ形に載せることで、既存の規程の管理の仕組み(承認の手続き・版の管理・周知の経路)をそのまま使えます。新しい種類の文書の体系を一から作るより、既存の体系の中に AIの文書を位置づける方が、二重投資を避けやすいと考えています。
AI事業者ガイドライン第1.2版(2026年3月31日)の本編も、AIガバナンスの構築の流れの中で、AIガバナンスに関するポリシーの策定などを通じて「AIガバナンス・ゴール」を設定することを検討し、それを達成するための AIマネジメントシステムを設計して運用する、という順序を示しています。本編の脚注は、AIガバナンス・ゴールとして、共通の指針への対応事項からなる自社の取組方針(「AIポリシー」など。呼称は各主体によって異なる)を設定することなどが考えられる、としています。本コラムの言葉に置き換えると、AI基本方針がゴールの側、AI利用規程と手順書がそれを実現するマネジメントの側にあたります。ガイドラインの構成の全体は第4章で扱いました。
文書の階層と、承認者・改定の頻度
次の表は、4つの階層それぞれについて、何を書くか、誰が承認するか、どのくらいの頻度で見直すかを整理したものです。承認者と頻度は一つの例で、会社の規程の体系や会議体の周期に合わせて変えることを想定しています。承認者の欄にある AIガバナンス委員会は、本コラムの用語の定義で定めた、部門をまたぐ AIの判断を行う会議体で、体制の作り方は第13章で扱います。
| 階層 | 書くこと | 主な読み手 | 承認者の例 | 見直しの頻度の例 | 変えるきっかけの例 |
|---|---|---|---|---|---|
| AI基本方針 | AIを使う目的、大切にする原則、経営の責任、社外への約束 | 経営、従業員、取引先、社外 | 取締役会、または経営会議(AIガバナンス委員会が審議したうえで) | 年に1回の確認。改定は数年に一度 | 経営の方針の変更、事業の範囲の大きな変化、法令や国の指針の大きな改正 |
| AI利用規程 | 適用範囲、定義、役割、禁止事項、承認が要る場合、記録、教育、違反時の扱い | 全従業員、とくに AIを使う部門の責任者 | 経営会議、または規程の管理の手続きで定めた決裁者(AIガバナンス委員会が審議したうえで) | 年に1回から2回 | リスク区分の基準の変更、新しい種類の AIの導入、監査の指摘 |
| 手順書 | 申請・判定・承認・登録・見直し・廃止の作業の手順、使う道具、問い合わせ先 | 申請する部門、事務局、承認する人 | AIガバナンス委員会 | 四半期ごとの確認。必要に応じて随時 | 手続きの詰まり、問い合わせの増加、使う道具の変更 |
| 様式・一覧 | 申請書、台帳の項目、使ってよいサービスの一覧、チェックリスト | 申請する人、事務局 | 事務局の責任者 | 随時 | サービスの追加・終了、利用規約の変更、項目の追加 |
表の承認者は、その文書そのものを制定・改定するときの承認者です。個々のユースケースを使ってよいかの承認(後の手順書の例で扱う、区分ごとの承認)とは別の手続きで、たとえば事務局の責任者が様式を更新する権限と、区分「中」のユースケースを承認する権限は、同じ人が持つ場合でも別のものとして扱います。
表で大事なのは、上の階層ほど承認者が上位になり、見直しの頻度が下がる、という対応です。この対応が崩れると、運用が重くなります。たとえば使ってよい生成AIサービスの一覧を AI利用規程の本文に書くと、サービスを1つ追加するたびに経営会議の承認が要ることになります。逆に、禁止事項を事務局の一覧の中だけに書くと、禁止の重みが伝わらず、違反があったときにどの規則に反したのかを示しにくくなります。規程に書くのは「事務局が定める一覧に載っているサービスだけを業務で使う」という規則で、一覧そのものは様式として事務局が更新する、という分け方が扱いやすいと考えています。
この分け方には、規程の本文を短く保てるという利点もあります。AI利用規程の本文が短ければ、読み手は自分に関係する条を探しやすくなり、改定のたびに全体を読み直す負担も小さくなります。細かい内容は手順書と様式に送り、規程の本文からは「別に定める手順書による」と参照するだけにします。参照先の文書が見つからない、という状態を避けるために、参照する文書の名前と置き場所は規程の末尾に一覧にしておきます。
4つの階層の上下関係と、それぞれの承認者は、この節の最初の表の「承認者の例」と「見直しの頻度の例」の列にまとめたとおりです。本コラムの例では、上から順に、AI基本方針は取締役会または経営会議、AI利用規程は経営会議または規程の管理の手続きで定めた決裁者、手順書はAIガバナンス委員会が承認し、様式・一覧は事務局の責任者が更新します。
AI基本方針の目次の雛形
AI基本方針は、短く書くことを前提にします。経営が承認し、社外にも公開しうる文書なので、手続きの細部は入れず、何を目的に AIを使い、何を大切にし、誰が責任を持つかが一読で分かる長さに留めます。A4で1枚から2枚程度に収まる分量を一つの目安にすると、経営の承認の場で全文を読んで議論することができます。
次の表は、本コラムの章立てに沿って作った目次の雛形です。項目ごとに「書くことの例」と「本コラムで関係する章」を添えました。原則の項目は、自社が大切にすることを自社の言葉で選ぶ部分で、ここに挙げた原則の候補は、第1章で扱った人間中心のAI社会原則や AI事業者ガイドラインの共通の指針に出てくる観点を、本コラムの言葉でまとめ直したものです。どの原則を掲げるかは、各社の事業と AIの使い方によって変わります。
| 目次の項目 | 書くことの例 | 本コラムで関係する章 |
|---|---|---|
| 1.目的 | 自社が AIを何のために使うか。経営理念や事業の方針との関係 | 序章、第1章 |
| 2.対象 | 自社が開発する AI、外部に提供する AI、業務で利用する AIのどれを含むか。グループ会社を含むか | 第1章(開発者・提供者・利用者の3つの立場) |
| 3.原則 | 人間中心、安全、公平、プライバシーの保護、セキュリティ、透明性と説明責任、法令の遵守など、自社が掲げる原則を数項目 | 第1章、第4章 |
| 4.リスクに応じた管理 | 用途ごとにリスクの程度を判定し、程度に応じて確認と承認の重さを変えること | 第7章 |
| 5.責任と体制 | AIガバナンス責任者、会議体、各部門の責任者の役割の大枠 | 第13章 |
| 6.人材と教育 | 従業員が AIを適切に使うための教育を続けること | 第14章 |
| 7.社外との関係 | 顧客・取引先・社会への説明、問い合わせの窓口、外部の意見の取り入れ | 第11章、第14章 |
| 8.見直し | 方針を定期的に見直し、法令や国の指針の改正、事業の変化を反映すること | 第14章 |
原則の項目を書くときに気をつけたいのは、原則を並べるだけで終わらせず、その原則が社内のどの規則と手続きで実現されるのかを、AI利用規程の側で受け止められるようにしておくことです。たとえば「公平性を大切にする」と掲げたなら、利用規程か手順書のどこかに、公平性を確かめる対象のユースケースと確かめ方(第10章)が書かれている必要があります。原則に対応する規則が無い状態では、方針は社外向けの宣言としては機能しても、社内の判断の根拠にはなりにくいと考えています。
もう一つは、方針の中に「禁止」を書きすぎないことです。基本方針は、AIを使ってよい範囲を明確にして活用を進める役割も持ちます。禁止の項目が並んだ方針は、読んだ従業員に「AIは使わない方がよい」という受け止め方を生みやすく、導入の停滞につながります。禁止事項は AI利用規程に具体的に書き、基本方針では、使う目的と、使うときに大切にすることを前に出す書き方が扱いやすいと考えています。
AI利用規程の目次の雛形
AI利用規程は、従業員が日々の判断に使う文書です。基本方針の原則を、してよいこと・してはいけないこと・承認が要ることに落とし、違反したときの扱いまで書きます。社内の規程の一つとして、既存の規程と同じ書式・同じ管理の手続きで作ると、ほかの規程との参照関係が保ちやすくなります。
次の表は、AI利用規程の目次の雛形です。条の順序は、目的・適用範囲・定義から始まり、改定と附則で終わる並びにしました。各条に「規程の本文に書くこと」と「手順書・様式に送ること」を分けて書いたのは、前の節で扱った、変える頻度の違うものを混ぜないという考え方を、条ごとに当てはめるためです。
| 条の項目 | 規程の本文に書くこと | 手順書・様式に送ること |
|---|---|---|
| 目的 | AI基本方針を実現するための規則であること | なし |
| 適用範囲 | 対象となる人(役員・従業員・派遣社員・業務委託先など)と、対象となる AI(自社で開発する AI、組み込んで提供する AI、外部のサービスとして使う生成AIなど) | 対象かどうか迷う場合の問い合わせ先 |
| 定義 | AIシステム、生成AI、ユースケース、リスク区分、AIインシデントなど、規程で使う語の意味 | 用語の解説と例 |
| 役割と責任 | AIガバナンス責任者、AIガバナンス委員会、事務局、業務部門の責任者、利用者の役割 | 各役割の担当者の名前と連絡先 |
| リスク区分と承認 | ユースケースごとにリスク区分を判定すること、区分ごとの承認者、禁止の区分は承認しないこと | 判定の基準表、申請の手順、申請書の様式 |
| 禁止事項 | してはいけないこと(禁止の区分にあたる用途、承認されていないサービスの業務での利用、入力してはいけない情報の入力など) | 使ってよいサービスの一覧、入力の区分の具体例 |
| 利用時の遵守事項 | 出力を確かめてから使うこと、権利と個人情報への配慮、AIを使ったことの表示が要る場合 | 確認の手順、表示の文例 |
| 調達と開発 | 外部の AIを調達するとき、AIを開発するときに確認と承認を経ること | ベンダーの確認項目、開発の段階ごとの確認 |
| 記録 | 台帳への登録、評価と承認の記録、利用の記録を残すこと、保存の期間の考え方 | 台帳の項目、記録の様式、保存の場所 |
| インシデントと停止 | AIインシデントに気づいた人の報告の義務、停止の権限を持つ人 | 報告の経路、停止の基準、連絡先 |
| 教育 | 対象者ごとに教育を受けること | 研修の内容と時期 |
| 例外 | 規程に従えない事情があるときの例外の申請と承認、期限を付けること | 例外の申請書、例外の一覧 |
| 違反時の扱い | 違反があったときの報告と是正、就業規則などの既存の規程に基づいて扱うこと | 是正の手順 |
| 改定 | 規程の改定の手続きと承認者、見直しの周期 | 改定の履歴 |
| 附則 | 制定日・施行日、参照する手順書と様式の一覧 | なし |
表の中で、とくに書き方に迷いやすいのは「禁止事項」と「違反時の扱い」です。禁止事項は、第7章で扱った本コラムのリスク区分の「禁止」にあたる用途と、生成AIの利用で入力してはいけない情報(第8章)が中心になります。具体的な一覧を規程の本文に並べると改定が重くなるので、本文には禁止の考え方と大きな類型を書き、具体例は手順書と様式に送ります。本コラムのリスク区分は社内の区分で、EU AI Act が定める4つの水準とは別物です。EU AI Act の禁止される行為(第3章)が自社の事業に関係する場合でも、その該当性の判断は個別の確認が要るので、規程の本文では「法令で禁止される用途には使わない」という書き方に留め、具体的な判断は法務と専門家の確認に委ねる形が扱いやすいと考えています。
違反時の扱いは、懲戒のような労務上の扱いに関わる場合があります。AI利用規程の中に独自の処分を書き込むより、就業規則など既存の規程に基づいて扱うと書き、労務上の扱いの細部は人事部門と既存の規程に委ねる形の方が、規程どうしの矛盾が起きにくいと考えています。就業規則との関係をどう整理するかは会社ごとに異なるので、人事部門と、必要に応じて専門家に確認することが前提になります。違反の背景には、規則の周知不足や、承認の手続きの分かりにくさがある場合もあります。違反を見つけたときには、まず是正と、手順書や教育の見直しにつなげる運用が、規程が読まれる条件(後の節)とも結びつきます。
手順書の例、ユースケースの申請から承認まで
手順書は、利用規程の条を、誰がどの順で何をするかに落としたものです。ここでは、利用規程の「リスク区分と承認」の条を受ける手順書の例として、ユースケースの申請から承認、台帳への登録、見直しまでの流れを示します。台帳の列と区分の判定の基準は第7章で扱ったので、ここでは手続きの流れと、各段階の担当、残す記録に絞ります。
| 段階 | 担当 | すること | 残す記録 | 期限の例 |
|---|---|---|---|---|
| 1.相談 | 申請する部門の担当者 | 使いたい用途、使う AI、入力するデータの見込みを事務局に伝える | 相談の記録(日付・部門・用途の概要) | なし |
| 2.申請 | 申請する部門の責任者 | 申請書に用途・部門・立場・使う AI・入力するデータ・出力の使われ方・人の関与・影響を受ける人を書いて提出する | 申請書 | 利用を始める予定日より前 |
| 3.区分の判定 | 事務局 | 判定の基準表に照らして、本コラムのリスク区分(禁止・高・中・低)の案を付ける。迷う場合は法務・情報セキュリティの担当に意見を求める。案は段階5の承認者が承認の際に確定する。判定が分かれるものと、区分「禁止」に当たる疑いがあるものは AIガバナンス委員会が決める | 判定の案と理由 | 申請の受付から数営業日の目安を手順書で決める |
| 4.追加の確認 | 事務局、法務、情報セキュリティ、データガバナンスの担当 | 区分が高のものは影響評価(第7章の6段階)、中のものは簡易な影響評価(第7章の6段階を簡略に当てはめたもの)を行う。あわせて、必要に応じてベンダーの確認(第9章)と評価の計画(第10章)を行う。低は、この手順例では影響評価を省き、次の段階で業務部門の責任者の承認を受けて台帳に登録する。確認は段階3の案の区分で進め、確定した区分が重くなったら不足分を追加で行う | 影響評価または簡易な影響評価の記録、確認の結果 | 区分ごとに目安を決める |
| 5.承認 | 区分ごとの承認者 | 低は業務部門の責任者、中は事務局の責任者(法務・情報セキュリティ・データガバナンスの担当の確認を経て)、高は AIガバナンス委員会(影響評価を経て)、のように区分ごとに決めた承認者が承認する。禁止は承認しない | 承認の記録(承認者・日付・条件) | 会議体の開催の周期に合わせる |
| 6.登録と利用開始 | 事務局 | 台帳に登録し、承認の条件と見直し日を記録して、申請者に通知する | 台帳の行 | 承認後すぐ |
| 7.見直し | 業務部門の責任者、事務局 | 見直し日、用途や使う AIの変更、インシデントがあったときに、区分と承認を見直す。使わなくなったものは廃止の手続きをとる | 見直しの記録、廃止の記録 | 区分ごとに周期を決める |
表の承認者の割り当ては例で、会社の規模と会議体の周期によって変えることを想定しています。大事なのは、区分によって承認の重さを変えることです。すべての申請を同じ会議体で承認する手続きにすると、リスクの低い用途まで会議の開催を待つことになり、手続きを迂回して承認を経ずに使う動きが出やすくなります。低の区分は業務部門の責任者の承認と台帳への登録で足りるようにし、会議体の時間は高の区分の審議に使う、という配分が、手続きを守ってもらうための条件になると考えています。
期限の欄に具体的な日数を書かなかったのは、日数は会社の規模と事務局の人数で変わるためです。ただ、手順書には目安の日数を書いておくことが有効だと考えています。申請してからいつ結果が出るかが分からない手続きは、申請する側にとって予定が立たず、迂回の動機になります。目安を書き、実際にかかった日数を事務局が記録しておくと、手続きのどこで詰まっているかが分かり、手順書の見直しの根拠になります。
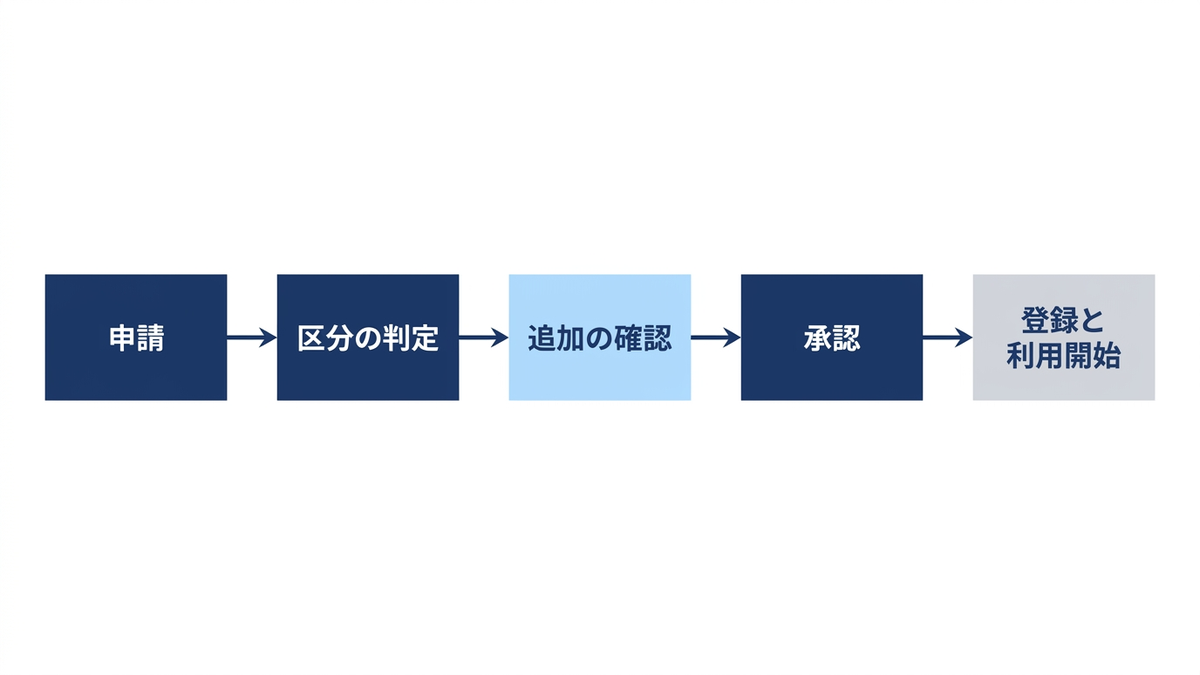
既存の規程との関係を整理する
AIの社内ルールを作るときに、最初に確かめておきたいのが、既存の規程との関係です。AIに関わる論点の多くは、情報セキュリティ・個人情報・文書管理・購買といった既存の規程がすでに扱っている論点と重なります。AIの文書の中に同じことを書き直すと、2つの規程が同じ論点について別のことを言う状態が生まれやすく、どちらが優先するのかが分からなくなります。AI利用規程には AIに固有の部分だけを書き、重なる部分は既存の規程を参照する、という整理が基本になると考えています。
次の表は、AIの社内ルールが関わりやすい既存の規程と、それぞれについて AI利用規程の側で何を書き、何を既存の規程に任せるかを整理したものです。会社によって規程の名前と範囲は違うので、自社の規程の一覧と照らし合わせて使うことを想定しています。
| 既存の規程 | AIと重なる論点 | AI利用規程の側で書くこと | 既存の規程に任せること |
|---|---|---|---|
| 情報セキュリティの規程 | 外部サービスの利用、情報の区分、アクセスの管理、ログ | 生成AIに入力してよい情報の区分と、AIに固有の脅威(プロンプトインジェクションなど。第8章)への対応 | 情報の区分の定義そのもの、外部サービスの利用の一般的な手続き、アカウントの管理 |
| 個人情報の取扱いの規程 | 学習データ・入力データに含まれる個人情報、利用目的、第三者への提供、委託 | AIの学習・入力・出力で個人情報を扱う場合に追加で確かめること | 個人情報の取扱いの原則、利用目的の特定、安全管理措置の一般的な手続き |
| 文書管理の規程 | 台帳・評価の記録・承認の記録の保存、AIが作った文書の扱い | AIのガバナンスで残す記録の種類と、保存の期間の考え方 | 文書の分類、保存の期間の決め方、廃棄の手続き |
| 購買・外部委託の規程 | AIサービスの契約、ベンダーの選定、再委託 | AIの調達で追加して確かめる項目(学習への利用の有無、モデルの更新の通知など。第9章) | 購買の決裁の手続き、取引先の審査の一般的な手続き |
| 就業規則・服務の規程 | 規則に違反したときの扱い、業務での機器とサービスの利用 | AI利用規程の違反を就業規則などに基づいて扱うことの参照 | 懲戒などの労務上の扱い |
| 知的財産の規程 | AIの出力の権利、他者の権利の侵害の防止、営業秘密 | AIの出力を社外に出す前に確かめること(第8章) | 職務上の著作物・発明の扱い、営業秘密の管理の一般的な手続き |
| リスク管理・危機管理の規程 | 事故の報告、危機の判定、対外的な説明 | AIインシデントの報告の経路と停止の権限(第11章) | 危機の判定の基準、全社の危機対応の体制、対外的な広報の手続き |
| データガバナンスの方針・規程 | データの品質・来歴・権利、データの持ち主 | AIの学習と評価に使うデータについて追加で確かめること(第10章) | データの定義・品質の基準・データの持ち主の役割 |
表の右の2列を作る作業は、既存の規程の担当部門(情報システム・法務・総務・購買・人事など)と一緒に行う必要があります。AIの担当だけで AI利用規程を書き、後から既存の規程の担当に見せると、重なりや矛盾の指摘を受けて書き直すことになりやすいと考えています。最初の版を書く前に、表の左の列にあたる既存の規程の一覧を作り、担当部門に「AIの文書からこの規程を参照する」ことを伝えておくと、後の改定の際にも連絡が取りやすくなります。
既存の規程の側にも、小さな改定が要ることがあります。たとえば情報セキュリティの規程の外部サービスの一覧の手続きに「生成AIのサービスは AI利用規程の手続きも経る」という一文を足しておかないと、情報セキュリティの手続きだけを経たサービスが、AIの観点の確認を経ずに使われることがあります。AI利用規程を作ったら、参照し合う既存の規程の側にも、AI利用規程への参照を入れることをセットで進めます。AI事業者ガイドライン第1.2版の別添は、AIガバナンス・ゴールの設定の仮想的な実践例の一つとして、既存のセキュリティポリシーやプライバシーポリシーへの継続的な準拠を前提に、既存のポリシーを基盤として AIに固有のリスクを管理の項目に加えた例を挙げています。
企業が公開している AIポリシーの例
AI基本方針にあたる文書を、社外に公開している企業があります。AI事業者ガイドライン第1.2版の別添の行動目標2-1は、自社の方針(例として AIポリシー)を設けるかを検討し、その判断を顧客・従業員などの関係者に説明する考え方を示しています。公開については、実践のポイントで「可能であれば、合理的な範囲で」という条件を付けています。
次の表は、日本企業が公開している AIポリシーの例を、各社の公式ページを開いて確かめた範囲で整理したものです。載せたのは、名称、公式ページに書かれた策定または公表の時期、掲げている項目の数だけです。各社のポリシーの中身の良し悪しや、会社どうしの比較は扱いません。また、表の内容は2026年10月28日に各社の公式ページを開いて確かめたもので、その後に改定されている場合があります。
| 企業 | 名称 | 公式ページに書かれた時期 | 掲げている項目の数 | 確かめたページ |
|---|---|---|---|---|
| 日立製作所 | AI倫理原則 | 2021年2月22日の報道発表で策定を公表 | 3つの「行動規準」と、7つの「実践項目」 | 日立の報道発表 |
| NEC | NECグループ AIと人権に関するポリシー | 2019年4月2日の報道発表で策定を公表。ポリシーの文書には2019年4月制定と記載 | 7項目 | NEC の報道発表と、その別紙 |
| ソフトバンク | ソフトバンクAI倫理ポリシー | 制定日2022年7月12日。改正規定は2026年7月31日から適用と記載 | 7項目 | ソフトバンクのページ |
表の日立製作所と NEC は、報道発表の時点の文書を確かめたもので、その後に改定された版があるかどうかは、この表のために確かめていません。自社の方針を作る参考に各社の文書を読む場合は、各社の最新のページを開き直して確かめる必要があります。
3社の文書を自社の方針の参考にするときに見るとよいのは、項目の名前よりも構成です。たとえば日立製作所の報道発表は、計画・社会実装・維持管理という AIの段階ごとの行動規準と、すべての段階に共通する実践項目という、2つの軸で原則を組み立てていると説明しています。本コラムの AI基本方針の雛形では原則を1つの項目にまとめましたが、自社が AIの開発から運用までを担う場合には、段階ごとの原則と共通の原則を分ける組み立て方も考えられます。どの構成をとるかは、自社が開発者・提供者・利用者のどの立場で AIに関わるか(第1章)によって変わります。
公開するかどうかの判断も、自社の立場によって変わります。AIを組み込んだ製品やサービスを外部に提供している会社が、顧客や取引先から方針の有無を問われた場合には、公開した方針がそのまま説明の材料になります。業務で外部の AIサービスを使うだけの会社では、まず社内向けの基本方針と利用規程を整える順序もありうると考えています。ただ、公開の時期と範囲は、利用者という立場だけでなく、リスクと関係者への説明の必要性を踏まえて判断します。なお別添は、対外的な方針とは別に、社員向けの判断基準を整える方法も紹介しています。公開の判断と情報開示の進め方は第14章で扱います。
例外の扱いと版の管理
どれほど丁寧に書いた規程でも、従えない事情は生じます。承認されていないサービスを、取引先の指定で一時的に使わなければならない場合や、判定の基準表に当てはまらない新しい種類の用途が出てきた場合などです。例外の手続きが無い規程は、従えない事情が生じたときに、規程を無視するか、業務を止めるかの二択を現場に迫ります。前者が続けば規程の重みが失われ、後者が続けば導入の停滞につながります。AI利用規程には、例外を申請して承認を受ける手続きを最初から入れておく必要があると考えています。
例外の手続きで決めておくことは、次の5つです。1つ目は、誰が申請し、誰が承認するか。本コラムでは、例外は区分「低」「中」「高」によらず AIガバナンス委員会が承認し、事務局が受付と記録を担う形にしています。例外の対象は、社内の規程が例外の余地を残している事項(入力の区分の例外を含む)に限ります。法令に反する用途と、本コラムのリスク区分の「禁止」は、例外の対象に含めません。例外は規程からの逸脱を認める判断なので、通常の承認より重い手続きにすることが有効だと考えています。区分「高」のように通常の承認者も委員会である場合も、例外として別に審査し、記録を残します。2つ目は、期限です。例外は期限を付けて承認し、期限が来たら、終了するか、規程の側を改めて例外を例外でなくするかを判断します。3つ目は、代わりに講じる措置です。規程の要求を満たせない部分を、別の手段(利用の範囲を絞る、人の確認を増やす、など)でどう補うかを書かせます。4つ目は、記録です。承認した例外は一覧にして、事務局が期限を管理します。5つ目は、振り返りです。同じ種類の例外が繰り返し申請されるなら、それは規程の側が実態に合っていないことを示しているので、規程や手順書の見直しにつなげます。
例外の一覧は、規程の見直しの最も直接的な材料になります。例外の申請が1件も無い状態が続く場合も、注意が要ります。従えない事情が本当に無いのか、例外の手続きが知られていないのか、手続きを経ずに迂回されているのかを確かめる必要があるからです。第11章で扱ったインシデントの記録と並べて、例外の一覧を定期的に会議体で確かめることが有効だと考えています。
版の管理も、最初から仕組みにしておきます。AIの文書は、法令と国の指針の改正、使う AIの変化、社内の運用の経験によって、ほかの規程より頻繁に改定されることが見込まれます。本コラムで扱った範囲だけでも、EU AI Act の適用の日程はデジタル・オムニバスで変わり(第3章)、AI事業者ガイドラインは第1.0版から第1.2版まで改定されています(第4章)。版の管理で決めておくことは、文書ごとの版の番号の付け方、改定の履歴(いつ・何を・なぜ・誰の承認で変えたか)、最新版の置き場所を1か所にすること、古い版を残す期間、改定の周知の仕方、承認した例外の一覧の管理、の6つです。次の表に、それぞれの例と担当をまとめました。
とくに大事なのは、最新版の置き場所を1か所にすることです。AI利用規程の古い版が部門の共有フォルダや研修資料に残っていると、従業員はそれを最新だと思って従います。規程の本文には版の番号と施行日を必ず書き、研修資料や手順書から規程を引くときは、写しを貼るのではなく、置き場所へのリンクで参照する形にすると、古い版が残る経路を減らせます。改定のたびに、何が変わったかを短くまとめた改定の要旨を一緒に周知すると、全文を読み直さなくても変更が伝わります。
| 管理の項目 | 決めておくことの例 | 担当の例 |
|---|---|---|
| 版の番号 | 大きな改定と小さな改定で番号の上げ方を分ける(たとえば第1.0版、第1.1版、第2.0版) | 事務局 |
| 改定の履歴 | 改定日、版、変更の要旨、理由、承認者を文書の末尾に記録する | 事務局 |
| 最新版の置き場所 | 社内の規程の掲載場所の1か所に置き、他の資料からはリンクで参照する | 事務局、規程の管理の担当部門 |
| 古い版の保存 | 改定前の版を、文書管理の規程に沿って一定期間保存する。監査や事故の調査で、その時点の規程を示せるようにする | 規程の管理の担当部門 |
| 改定の周知 | 改定の要旨を、対象者に通知する。大きな改定は研修の内容にも反映する | 事務局、教育の担当 |
| 例外の一覧 | 承認した例外を、期限・代わりの措置・承認者とともに一覧にして管理する | 事務局 |
古い版を残す理由は、監査やインシデントの調査で、その時点でどの規程が有効だったかを示す必要が出ることがあるためです。AIインシデントの調査では、問題の起きたユースケースが承認された時点の基準と、現在の基準を比べることがあります。承認の記録に、承認した時点の規程と手順書の版を書いておくと、この比較がしやすくなります。
作った規程が読まれる条件
規程は、書いただけでは守られません。読まれて、理解されて、判断の場面で思い出されて、はじめて働きます。AIの社内ルールが読まれる条件として、本コラムでは次の5つを挙げます。どれも規程の中身より、規程の置き方と届け方に関わるものです。
1つ目は、短いことです。全従業員に読んでほしい部分は、利用規程の全文ではなく、してよいこと・してはいけないこと・迷ったときの問い合わせ先の3つです。この3つを1枚にまとめた要約を、規程とは別に作って配ると、読まれる見込みが高まると考えています。要約は規程の写しではなく、規程の該当する条への参照を添えたものにし、要約と規程の内容がずれないように、規程を改定するたびに要約も見直します。
2つ目は、判断の場面の近くに置くことです。生成AIのサービスを使う画面の近くや、申請の様式の冒頭、社内の問い合わせの窓口のページなど、利用者が AIを使おうとする場面で目に入る場所に、要約と問い合わせ先を置きます。規程の掲載場所にしか無い規程は、判断の場面で思い出されにくいと考えています。
3つ目は、例が書いてあることです。「機密情報を入力してはいけない」と書くだけでは、自分の扱っている情報が機密にあたるかを判断できない利用者が出ます。入力してよい情報と、いけない情報の例を、自社の業務に即して書いておくと、判断の迷いが減ります。例は手順書や様式の側に置き、業務の変化に合わせて増やします。
4つ目は、問い合わせに答える人がいることです。規程を読んでも判断できないときに、短い時間で答えが返ってくる窓口があれば、利用者は迷ったときに聞くようになります。答えが返ってこない、返ってくるのに時間がかかる、という状態が続くと、聞かずに自分で判断する動きが増えます。問い合わせの内容と回答は記録しておき、よく出る質問は要約や例に反映します。
5つ目は、教育とつながっていることです。規程を周知するだけでなく、対象者ごとの研修の中で、規程のどの条が自分の業務に関わるかを扱います。研修の設計は第14章で扱いますが、規程を作る側としては、研修の担当に規程の改定の要旨が届く経路を、版の管理の手続きの中に入れておくことが要ります。
この5つのうち、1つ目の「短いこと」は、AI事業者ガイドライン第1.2版の別添が行動目標2-1 の仮想的な実践例として挙げている例とも共通しています。別添の例は、それに加えて、実際の出来事を材料に内容を見直す進め方も示しており、これは前の節で扱った版の管理と例外の一覧による見直しにあたります。別添は小規模な事業者の例として、経営者が経営理念と結びつけた自社の AI開発の在り方を描き、現場の担当者に共有する進め方を挙げています。経営層と従業員で実際に起きたインシデントも共有しながら内容を磨き、ゴールはA4で1枚程度です(別添の40ページ)。短く、自社の言葉で書き、実際の出来事を材料に見直す、という進め方です。ここに挙げられているのはガイドラインが想定した仮想的な例で、特定の企業の事例ではありません。
経営判断、規程を先に完璧にしない
この章の最後に、経営が社内ルールについて下す判断をまとめます。最も大きな判断は、規程を完璧にしてから AIを使い始めるのか、初版を早く出して運用しながら直すのか、です。本コラムでは、後者の方が有効だと考えています。理由は、AIの社内ルールは、使い方の実態と、法令や国の指針の改正を受けて直し続けることが前提の文書だからです。最初から完璧な規程を目指すと、検討に時間がかかる間に、規程の無い状態で AIが使われ続けます。規程が無い期間に部門ごとにばらばらのルールが生まれると、後から全社の規程に統合する手間がかかり、二重投資になります。
一方で、初版を早く出すことは、中身を薄くしてよいという意味ではありません。初版で優先して整理するのは、適用範囲、使ってよいサービスと入力してはいけない情報、承認が要る場合とその承認者、AIインシデントに気づいたときの報告先、の4つです。この4つが欠けると、規制違反や権利侵害(著作権・個人情報・営業秘密)につながる使い方を止めにくくなり、問題に気づくのも遅れやすくなります。
ただし、この4つだけで足りるわけではありません。利用を始める前に、用途に応じた出力の確認、停止の権限、必要な法令への対応が、既存の規程も含めて定まっているかを確かめます。そのほかの条は、必要性と優先順位を見ながら整えていきます。
経営が決めることとしては、次の3つがあると考えています。1つ目は、初版の期限です。たとえば「何か月以内に初版を出し、その後は年に一度見直す」のように、検討の期限を決めて事務局に任せます。期限の無い検討は、関係部門の合意を待ち続けて終わらないことがあります。2つ目は、承認の権限の配分です。どの階層の文書を誰が承認するかを着手時に決め、様式や一覧の更新のような小さな変更を経営の承認から外しておくと、運用が止まりにくくなります。3つ目は、規程の作り手の範囲です。AIの担当だけでなく、既存の規程の担当部門を最初から作り手に入れることを、経営の指示として出します。前の節で扱ったとおり、これを後回しにすると、規程どうしの矛盾が後から見つかって書き直すことになります。
この判断を誤ったときの損失は、本コラムの損失の型でいえば、導入の停滞と二重投資が中心です。規程を作り込みすぎると導入が止まり、規程が無いまま部門ごとに動くと二重投資になります。さらに、規程と実態がずれたまま放置されると、問題が起きたときに「規程はあったが守られていなかった」と外から見られ、顧客や社会からの信頼の失墜につながります。規程の予算は、文書を作る時間だけでなく、問い合わせに答える人の時間、要約と例を更新する時間、年に一度の見直しの時間までを含めて見込む必要があると考えています。
この章では、AIの社内ルールを、AI基本方針・AI利用規程・手順書・様式の4つの階層に分け、上の階層ほど承認者を上位にし、見直しの頻度を下げる、という整理を示しました。基本方針と利用規程の目次の雛形、申請から承認までの手順書の例、既存の規程との関係の整理表、企業が公開している AIポリシーの例、例外と版の管理、規程が読まれる条件を順に扱い、規程は先に完璧にせず、優先して整理する4つの項目を備えた初版を早く出し、利用開始前の確認を経ながら直し続けることを経営判断として挙げました。次の第13章では、ここで書いた規程を誰が運用するのか、AIガバナンス委員会と各部門の役割、最初の90日の進め方を扱います。
この章を深めたい方への参考書籍
『生成AIの法的リスクと対策 増補改訂版』(福岡真之介、松下外 著、日経BP):生成AIの開発・学習の段階と、生成・利用の段階の法的なリスクを分けて解説した本で、版元の目次によると、第6章が生成AIの社内ガイドラインと利用規約のチェックポイントを扱っています。この章で扱った AI利用規程の禁止事項や利用時の遵守事項を、法的なリスクの側から確かめるときの材料になります。2025年12月の刊行で、AI事業者ガイドライン第1.2版(2026年3月)と EU AI Act のデジタル・オムニバス(2026年7月)は含まれていません。
『生成AI法務・ガバナンス 未来を形作る規範』(中崎尚 著、商事法務):生成AIをめぐる法務の課題をガバナンスと結びつけて扱った本です。この章で、AI利用規程に AIに固有の部分だけを書き、既存の規程と役割を分けると書いた整理を、法務の側から考えるときの手がかりになります。2024年7月の刊行で、その後の AI推進法(2025年)、AI事業者ガイドライン第1.2版、デジタル・オムニバスは含まれていません。
第13章 AIガバナンスの体制づくり、役割と会議体と最初の90日
第12章では、AI基本方針・AI利用規程・手順書という文書の階層を分け、それぞれの承認者と改定の頻度を決める方法を扱いました。文書は、それを承認する人、運用する人、守られているかを確かめる人がそろって初めて働きます。この章では、その「人と会議体」の側を扱います。AIガバナンスの役割をどう分けるか、部門をまたぐ判断をどの会議体で行うか、既存の委員会に載せるか新しく作るか、誰がどの判断に責任を持つかを表にし、最後に、何も無い状態から最初の90日と1年目をどの順で進めるかを週単位と四半期単位の計画に落とします。
この章で引く政府・専門機関の公開資料は、総務省・経済産業省の「AI事業者ガイドライン(第1.2版)」(2026年3月31日)の本編と別添、米国国立標準技術研究所(NIST)の AIリスクマネジメントフレームワーク(NIST AI 100-1)、内部監査人協会(The Institute of Internal Auditors、以下 IIA)の3ラインモデルの資料です。いずれも2026年10月28日に原文を開いて確かめた範囲だけを書きます。原文は、総務省の AI事業者ガイドラインのページ、NIST AI 100-1、IIA の2020年の資料、IIA の2026年の文書の掲載ページで読めます。役割の名前や会議体の形は、どの資料も特定の形を義務として定めているわけではありません。本コラムで示す表は、資料が示す考え方をもとに組み立てた一つの型であり、自社の規模・業種・既存の体制に合わせて変えることを前提にしています。予算・工数・人数の目安は、会社の規模と AIの使い方によって大きく変わり、一般的な値を示す根拠を持たないので書いていません。
経営が最初に決める3点のうち、まず決めるのは誰が最終的な責任を持つか
経営が最初に決める3点は、AIガバナンス責任者・AIガバナンス委員会・事務局です。このうちまず決めるのは、委員会の名前でも規程の目次でもなく、AIの使い方について最終的な責任を持つ経営層の一人を決めることだと考えています。AIのユースケースは、営業・人事・顧客対応・開発・管理部門と、ほぼすべての部門に生まれます。部門ごとに判断していると、同じ種類のリスクに対して部門によって違う結論が出たり、どの部門も判断しないまま利用が広がったりします。部門の判断が食い違ったときに裁く人がいなければ、体制は最初の衝突で止まります。
AI事業者ガイドラインは、各主体が共通して取り組む事項(「共通の指針」)のうち「7)アカウンタビリティ」の項目に、「責任者の明示」として、各主体においてアカウンタビリティを果たす責任者を設定することを挙げています。同じ項目には、関係者の間の責任の分配として、契約などで責任の所在を明確にすることも挙げられています。ガイドラインはアカウンタビリティを、AIに関する事実上・法律上の責任を負うこと、およびその責任を負うための前提条件の整備に関する概念として定義しており、情報を開示することとは分けて扱っています。つまり、ここで求められている責任者は、説明の窓口ではなく、責任を負う人です。
本編の「AIガバナンスの構築」の節は、これらの取り組みを効果的にするには経営層の責任が大きく、リーダーシップを発揮することが重要だとしています。あわせて、AIガバナンスの構築を単なるコストではなく、中長期の成長に向けた先行投資と位置づけています。別添の行動目標の多くも「経営層のリーダーシップの下」という書き出しで始まり、行動目標1-1の実践例では、経営層のリーダーシップの下での実施には、担当役員や現場に一任するのではなく経営層自らが主導することも含む、と注記されています。
米国の NIST AI RMF も、組織の統治の機能(GOVERN)の中で、同じ方向のことを求めています。GOVERN 2 とその下位の項目は、役割と連絡の経路を明らかにすること(GOVERN 2.1)、担当者を教育すること(GOVERN 2.2)、経営幹部がリスクの判断に責任を持つこと(GOVERN 2.3)を重視しています。NIST AI RMF は任意で使う枠組みで、詳しくは第5章で扱いました。日本のガイドラインと米国の枠組みは、どちらも責任者を置き、経営の層が判断の責任を負うことを体制の出発点に置いています。NIST AI RMF はさらに、役割と責任を文書にして組織の全員に分かるようにすることを挙げています。この二つは、自社の体制を考えるときの足場になります。
本コラムでは、AIの使い方について最終的な責任を持つ役員をAIガバナンス責任者と呼びます。AI事業者ガイドラインの別添の実践例に出てくる「AIガバナンス担当役員」を参考に、本コラムでは社内の統括の責任者として置きます。法人・取締役会・各担当者の責任が、この一人に移るという意味ではありません。AIガバナンス責任者は、AI基本方針と AI利用規程の案を経営に上申し、後で述べるAIガバナンス委員会の委員長を務め、部門の判断が食い違ったときに裁き、経営会議と取締役会に報告します。AIを専門に担当する役職(いわゆる最高 AI責任者)を新しく置く必要はありません。既に CDO(最高データ責任者)、CIO(最高情報責任者)、CRO(最高リスク責任者)、管理部門の担当役員などがいる会社では、そのうちの一人が兼ねる形が現実的だと考えています。誰が兼ねるかによって体制の性格が変わる点は、後の節で扱います。
経営の側から見ると、この最初の決定を省いて「AIのルールを作っておいて」と担当者や一つの部門に任せることの損失は、導入の停滞として表れやすいと考えています。任された担当者には部門の長を説得する権限が無いので、判断が必要なユースケースが来るたびに結論が先送りされ、現場は使ってよいか分からないまま待つか、許可を得ずに使い始めます。前者は導入の停滞、後者は規制違反や権利侵害の見落としにつながります。どちらも、誰が決めるかを最初に決めておけば避けやすい損失です。
AIガバナンスに関わる役割と、それぞれの責任
次に、AIガバナンスに関わる役割を一覧にします。役割は人ではなく、担う責任のまとまりです。一人が複数の役割を兼ねてもかまいませんが、「いまはどの役割として判断しているか」を区別できるように、役割ごとに分けて書いておきます。次の表は、本コラムが想定する役割と、それぞれが担う責任、担わないこと、兼ねやすい既存の役職を並べたものです。「担わないこと」の列を置いたのは、役割の重なりや押し付け合いが起きやすい箇所を先に見えるようにするためです。
| 役割 | 主な責任 | 担わないこと | 兼ねやすい既存の役職の例 |
|---|---|---|---|
| 取締役会・経営会議 | AIの活用の方向と、受け入れるリスクの考え方を決める。AI基本方針を承認する(取締役会か経営会議かは会社の決裁の定めによる)。経営会議は AI利用規程も承認する(規程の管理の手続きで別の決裁者を定めている会社ではその決裁者)。AIガバナンス責任者から四半期ごとに報告を受け、体制が働いているかを監督する | 個々のユースケースの承認 | (既存の会議体そのもの) |
| AIガバナンス責任者 | AI基本方針と AI利用規程の案の経営への上申。AIガバナンス委員会の委員長。部門の判断が食い違ったときの裁定。経営会議・取締役会への報告 | 台帳の記入や様式の作成のような日々の事務 | CDO・CIO・CRO・管理部門の担当役員のいずれか |
| AIガバナンス委員会 | 部門をまたぐ判断。本コラムのリスク区分で「高」となったユースケースの承認、規程の例外の承認(区分によらずすべて)、AI基本方針と AI利用規程の審議。月1回開く(案件が少なければ隔月) | 区分「中」と「低」のユースケースの個別の承認 | 既存のリスク管理委員会などの一部として置くこともできる(後の節) |
| 事務局 | ユースケース台帳の管理、申請の受付と区分の一次判定の取りまとめ、委員会の運営、文書の版の管理、教育の計画、報告書の作成 | 承認はしない(事務局は判断の材料をそろえる側に置く)。ただし区分「中」の利用開始は、事務局の責任者が承認する | DX 推進部門・情報システム部門・経営企画部門の担当者 |
| 法務・コンプライアンス | 法令・契約・利用規約の確認、規程の文言の確認、EU AI Act などの域外の制度が関係するかの確認の取りまとめ(外部の専門家への相談を含む) | 技術的な評価、業務上の要否の判断 | 法務部門・コンプライアンス部門 |
| 情報セキュリティ | 外部の AIサービスの利用の可否の確認、入力してよい情報の区分との整合、アクセス管理、セキュリティ上のインシデントへの対応 | 出力の内容の業務上の正しさの判断 | 情報セキュリティ部門・情報システム部門 |
| データガバナンスの担当 | AIに入力するデータ・学習に使うデータの所在・品質・権利・個人情報の扱いの確認 | AIのユースケースの承認 | データガバナンスの事務局、データスチュワード(業務部門でデータの定義と品質を日々管理する担当。弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』で扱っています) |
| 業務部門の責任者(ユースケースの持ち主) | 自部門のユースケースの申請。区分「低」のユースケースの利用開始の承認。区分「中」の簡易な影響評価と区分「高」の影響評価の実施(第7章の6段階。最後の残るリスクの判断を除く)。運用中の監視、問題が起きたときの最初の報告と一時停止の判断 | 区分「中」と「高」のユースケースの承認(「中」は事務局の責任者、「高」はAIガバナンス委員会が承認する) | 各部門の部長・課長 |
| 利用者 | AI利用規程に沿った利用、出力の確認、問題に気づいたときの報告 | 規程に無い使い方を自分の判断で始めること | 全従業員 |
| 内部監査 | AIガバナンスの仕組みが方針どおりに設計され運用されているかを、推進する側から独立した立場で確かめ、経営と取締役会に報告する | ユースケースの承認や規程の作成(自分で作ったものを自分で監査しないため) | 内部監査部門。置いていない会社では後の節の縮小版を参照 |
表の中で、実務上いちばん境目がぼやけやすいのは、業務部門の責任者と AIガバナンス委員会・事務局の分担だと考えています。AIガバナンスを全社の部署が管理する仕組みとして作ると、ユースケースのリスクを最もよく知っている業務部門が「承認をもらう側」に回り、自分ではリスクを考えなくなるおそれがあります。AI事業者ガイドラインの別添にある仮想的な実践例でも、AIのリスクは用途や範囲によって大きく異なり、プロジェクトを推進している担当者がその性質と程度を最もよく知っているとも考えられる、と書かれています。本コラムでは、ユースケースのリスクを把握し日々管理する責任は業務部門の責任者に置き、全社の会議体は基準を決め、区分の高いものを承認し、部門をまたぐ食い違いを裁く、という分担を基本にしています。この分担は、後で扱う3ラインモデルの考え方とも一致します。
もう一つ境目が問題になりやすいのは、法務・情報セキュリティ・データガバナンスの担当のような専門の部門が、それぞれ別々に AIの確認を始めてしまうことです。生成AIの利用の申請が来たとき、情報セキュリティ部門はセキュリティの観点で、法務部門は利用規約の観点で、データガバナンスの担当は入力するデータの観点で、それぞれ別の様式を求めると、申請する部門は同じ説明を3回することになります。事務局が申請の窓口を一つにまとめ、一つの様式で各部門に回す形にしておくと、この二重の手間を避けられます。申請の様式と台帳の列は第7章で扱いました。
役割と責任を表にする方法としては、作業ごとに「実行する人・最終的に責任を負う人・相談を受ける人・報告を受ける人」を割り当てる RACI の考え方がよく使われます。RACI そのものの説明は弊社コラム『経営とAIの打ち手を導く戦略フレームワーク大全179選』で扱っているので、ここでは AIガバナンスで決めることに絞って、本コラムの分担の型を表にします。表の語は、「決定」が最終的に決めて責任を負う役割、「実行」が作業を行う役割、「相談」が決定の前に意見を聞かれる役割、「報告」が結果の報告を受ける役割を指します。決定の欄には、原則として一つの行に一つの役割だけを置きました。決定する役割が二つあると、責任の所在があいまいになるからです。決定する役割が二つ並ぶ行は、止める判断を急ぐ必要がある一時停止の行と、区分の判定の行だけです。一時停止の行の理由は表の後で述べ、区分の判定の行の理由は次のとおりです。基本方針の行の「取締役会または経営会議」は、会社の決裁の定めによってどちらか一つに決まるという意味で、決定者は一つです。区分の判定の行は、事務局が取りまとめるのは判定の案で、その区分の利用開始の承認者が承認の際に区分を確定します。判定が分かれるものと、区分「禁止」に当たる疑いがあるものは委員会が決めます。
| 決めること・行うこと | 決定 | 実行 | 相談 | 報告 |
|---|---|---|---|---|
| AI基本方針の制定と改定 | 取締役会または経営会議(会社の決裁の定めによる) | 事務局が起草し、AIガバナンス責任者が上申 | AIガバナンス委員会が審議。法務 | 全従業員 |
| AI利用規程の制定と改定 | 経営会議(規程の管理の手続きで別の決裁者を定めている会社ではその決裁者) | 事務局が起草し、AIガバナンス責任者が上申 | AIガバナンス委員会が審議。法務・情報セキュリティ・データガバナンスの担当・業務部門の責任者 | 全従業員 |
| ユースケースの申請と台帳への登録 | 業務部門の責任者 | 業務部門の担当者が記入、事務局が登録 | 事務局 | AIガバナンス委員会(毎回の台帳の変化の確認) |
| 本コラムのリスク区分の判定 | その区分の利用開始の承認者(事務局が判定の基準に沿って取りまとめた一次判定の案を、承認の際に確定する)。判断が分かれるものと、区分「禁止」に当たる疑いがあるものはAIガバナンス委員会が決める | 業務部門の担当者が材料を出す | 法務・情報セキュリティ・データガバナンスの担当 | 業務部門の責任者 |
| 区分「低」のユースケースの利用開始 | 業務部門の責任者 | 業務部門(影響評価は要さない) | 事務局 | 事務局(台帳に記録) |
| 区分「中」のユースケースの利用開始 | 事務局の責任者(法務・情報セキュリティ・データガバナンスの担当の確認を経て) | 業務部門が簡易な影響評価を実施 | 法務・情報セキュリティ・データガバナンスの担当 | AIガバナンス委員会 |
| 区分「高」のユースケースの利用開始 | AIガバナンス委員会 | 業務部門が影響評価(第7章の6段階)を実施 | 法務・情報セキュリティ・データガバナンスの担当・必要に応じて外部の専門家 | AIガバナンス責任者・経営会議 |
| 規程の例外の承認(区分によらずすべて) | AIガバナンス委員会 | 申請する部門。事務局が受付と記録 | 法務・情報セキュリティ | 内部監査 |
| 運用中のユースケースの一時停止 | 業務部門の責任者、または事務局の責任者(先に把握した方がすぐ止めてよい) | 業務部門 | 情報セキュリティ | AIガバナンス責任者・AIガバナンス委員会 |
| 停止したユースケースの再開 | そのユースケースの区分の承認者 | 業務部門 | 事務局が再開の条件を記録 | AIガバナンス委員会 |
| 教育の計画 | AIガバナンス委員会 | 事務局・人事部門 | 業務部門の責任者 | 経営会議 |
| 体制の運用状況の独立した確認 | 内部監査(監査の計画は取締役会などの承認による) | 内部監査 | 事務局 | 取締役会・AIガバナンス責任者 |
表のうち、区分ごとの利用開始の決定者は、本コラムのリスク区分(禁止・高・中・低の4段階)に対応させました。この区分は自社内の区分で、EU AI Act の4つの水準とは別物です。区分の判定の基準そのものは第7章で扱いました。「禁止」の区分のユースケースは利用開始の承認の対象にせず、表に行を置いていません。区分「禁止」は例外も認めません。このことを AI基本方針に明記しておきます。禁止の区分に例外の道があると、例外の申請が通常の承認の経路として使われるおそれがあるからです。区分「禁止」以外の規程の例外は、区分によらずすべてAIガバナンス委員会が承認します。
本コラムでいう影響評価は、第7章で定めた6つの段階(影響を受ける人、起こりうる害、起こりやすさ、重大さ、緩和策、残るリスクの判断)で行う評価を指します。区分「高」は、この6段階による影響評価を経て委員会が承認します。区分「中」は、6段階を簡略に当てはめた簡易な影響評価を経て、事務局の責任者が承認します。区分「低」は本コラムの影響評価を省き、業務部門の責任者が承認して台帳に記録します。簡易な影響評価の様式は、運用の結果を見て第3四半期に整えます。それまでの間は、第7章の6段階の表を項目ごとに短く埋める形で確認し、事務局の責任者が承認します。
一時停止の行で、決定する役割を業務部門の責任者と事務局の責任者の二つにしたのは、問題に最初に気づくのが運用している部門とは限らず、委員会の開催を待っていると被害が広がるおそれがあるからです。先に把握した方がすぐ止めてよいとしておけば、苦情や監視の結果が事務局に先に届いた場合にも止められます。業務部門が売上や業務への影響を理由に止める判断をためらう場合も、事務局の責任者が止められます。再開は、そのユースケースの区分の承認者が判断します。停止の基準と、停止の後の報告の流れは第11章で扱いました。体制の側で決めておくべきなのは、止める権限を持つ人を名前の付いた役割として決め、その人が止めたことを理由に責められない、と規程に書いておくことだと考えています。
AIガバナンス委員会を既存の会議体に載せるか、新しく作るか
本コラムでは、部門をまたぐ AIの判断(高リスク区分の承認・例外の承認・規程の審議)を行う会議体をAIガバナンス委員会と呼びます。この会議体を新しく作るか、既にある委員会の一部として置くかは、体制づくりの早い段階で決める必要があります。多くの会社には、リスク管理委員会、コンプライアンス委員会、情報セキュリティ委員会、データガバナンス委員会のような会議体が既にあり、AIの判断はそのどれとも重なるからです。AI事業者ガイドラインの別添は、経営層への報告と共有の方法の例として、取締役会に対して責任を負う AIガバナンスの社内組織(AI倫理委員会、AI倫理審査委員会など)を置くこと、AIガバナンスの取り組み状況を取締役会で報告すること、社内で使っているガバナンスの枠組みに反映することなどを挙げ、自社の特性に応じて最も適した仕組みを設計することが期待されるとしています。つまり、新しい委員会を置くことは例の一つで、既存の枠組みに反映する形も同じく例として挙げられています。
次の表は、AIガバナンス委員会の置き方を4つの型に分けて比べたものです。どの型が正しいということはなく、既存の会議体が実際に機能しているか、AIのユースケースの数と区分の高いものの割合、AIガバナンス責任者を誰が兼ねるかによって選ぶものだと考えています。
| 置き方の型 | 向いている条件 | 利点 | 注意すること |
|---|---|---|---|
| リスク管理委員会(またはコンプライアンス委員会)の議題の一つにする | 全社のリスク管理の会議体が定期的に開かれ、経営層が出席している。AIのユースケースの数がまだ少ない | 新しい会議体を作らずに始められる。AIのリスクを他の経営リスクと同じ物差しで並べられる。経営層の出席が確保されている | 議題が多い会議体だと、AIの議題に割ける時間が短くなる。技術や業務の詳しい議論には向かないので、下に実務の打ち合わせを置く |
| 情報セキュリティ委員会の議題の一つにする | AIの利用が、外部の生成AIサービスの社内利用を中心にしている | 入力してよい情報の区分や、外部サービスの利用の可否と一体で判断できる | セキュリティ以外の論点(出力の誤り、偏り、権利侵害、顧客への説明)が後回しになりやすい。業務部門の出席が少ないことが多い |
| データガバナンス委員会と統合する | データガバナンスの体制が既に動いており、AIの主な用途が社内のデータを使った予測や分析である | データの品質・権利・個人情報の判断と、AIの用途の判断を同じ場でできる。役割の名前と手続きを流用できる | 生成AIの利用ルールのように、データの話ではない論点が収まりにくい。委員の構成に法務が入っていない場合は加える |
| AIガバナンス委員会を新しく作る | AIのユースケースが多く、区分「高」のものが定期的に出てくる。AIを製品やサービスに組み込んで顧客に提供している | AIに固有の論点に十分な時間を使える。社内外に対して取り組みを示しやすい | 既存の委員会と判断が重なる。上位の会議体(経営会議・リスク管理委員会)への報告の経路を決めておかないと、全社のリスク管理から切り離される |
本コラムでは、AIのユースケースの数がまだ少なく、区分「高」のものがほとんど無い段階では、既存の会議体に載せる型から始め、区分「高」の案件が増えてきた時点で新しく作る型へ移る、という順序が無理が少ないと考えています。最初から新しい委員会を作ると、決める案件が無いまま会議だけが開かれ、出席者が減っていくおそれがあるからです。逆に、既存の会議体に載せたまま AIの案件が増えると、一回の会議で扱いきれずに承認が滞ります。移るかどうかの判断の目安は、区分「高」の承認待ちの件数と、承認までの日数を事務局が記録し、四半期ごとに見ることで得られます。
どの型を選んでも、AIガバナンス委員会の判断が全社のリスク管理の中に位置づけられていることが重要です。新しく作る場合は、委員会の決定と議事の要旨をリスク管理委員会または経営会議に報告する経路を、委員会の規程に書いておきます。既存の会議体に載せる場合は、その会議体の規程の目的と付議事項に AIの判断を加える改定をしておきます。どちらも書いていないと、AIの判断が「その会議で何となく話された」だけの扱いになり、後から誰が何を承認したのかを確かめられなくなります。
委員会の構成・運営の決まり・議題の例
AIガバナンス委員会の構成は、AIガバナンス責任者を委員長とし、法務・コンプライアンス、情報セキュリティ、データガバナンスの担当、AIのユースケースを多く持つ業務部門の責任者、事務局で構成するのが基本の形だと考えています。AIを自社で開発している会社では、開発部門の責任者を加えます。内部監査部門は委員にせず、必要に応じてオブザーバーとして出席する形にしておくと、後で委員会の運用を独立した立場で確かめるときに、自分が決めたことを自分で確かめるという状態を避けられます。この点は、次の節の3ラインモデルで扱います。
委員の構成について、AI事業者ガイドラインの別添は二つの示唆を含んでいます。一つは、行動目標3-1で、AIガバナンス・ゴールからの乖離の評価(自社の方針から外れていないか、外れているならどんな影響があるかの評価)に、対象の AIの開発・提供・利用に直接関わっていない者が加わるようにすることが期待される、としている点です。同じ行動目標の仮想的な実践例では、多数の部門を持つ事業者が AIガバナンス担当役員の下に委員会を置き、その委員会を特定のプロジェクトを担当する者以外で構成して、プロジェクトごとの乖離評価を任務としている形が示されています。もう一つは、同じ行動目標が、乖離があることだけを理由に開発・提供・利用を恣意的に不可とする対応は適当ではないとし、乖離の評価は改善のきっかけにすぎない、と書いている点です。一方で同じ行動目標は、リスクの受容に合理性が無い場合には、開発・提供・利用の在り方を考え直すよう求めています。本コラムでは、委員会は利用の可否と、認める場合の条件を判断する場として運営すると考えています。
運営の決まりとして、最初の回で決めておきたいのは次のようなものです。開催の頻度(本コラムでは月1回を基本とし、案件が少なければ隔月にしてよいとしています)、定足数(会議が成立する最低の出席者数)、決め方(全員の合意を条件にするか、合意できないものを委員長が裁くか)、委員会を開かずに書面で決めてよい案件の範囲、次の開催を待てない緊急の案件を臨時の開催か書面の審議で決める条件、議事録に残す項目、です。経営会議への報告は四半期ごとに行います。本コラムでは、案件を持ち込んだ業務部門の責任者が説明し、関係する委員の意見を聞いたうえで、合意できないものは委員長が裁く、という決め方を基本にしています。全員の合意を条件にすると、一人の委員の慎重論で承認が止まり続けることがあるからです。
外部の有識者を委員会に加えるかどうかも、よく出る論点です。AI事業者ガイドラインの別添は、行動目標5-2(ステークホルダーの意見の検討)の取り組みの一つとして、AIとそれ以外の分野の専門家で構成される外部有識者などを含む組織を置くことを挙げています。同じ行動目標の仮想的な実践例には、そうした組織を置いた例と並んで、外部有識者委員会のような場だけがすべてではないとして、意見交換の場や外部講師を交えた研修を使う例も示されています。前者の実践例でも、AIポリシーの設定や体制づくりのような初期設定は企業自身が行うべきだという考え方が書かれています。本コラムでは、外部の有識者は、AIを製品やサービスとして社外に提供している会社や、区分「高」のユースケースが多い会社が、社内だけでは見えにくい社会の受け止め方を取り込むために加えるものと位置づけています。社内の判断の手続きが動く前に外部の委員会だけを作っても、議論の材料となる台帳や評価の結果が無いので、助言を受ける対象が無い状態になりやすいと考えています。
議題の立て方も、運営の決まりと併せて決めておきます。委員会が報告会になると、委員の出席が減り、決めるべきことが決まらなくなります。各回に「この回で決めること」を置き、資料は事前に配って、会議の時間は判断に使う形にします。次の表は、毎回の定例の議題と、年に1回か2回の議題の例です。間隔や中身は、会社の規模と AIの使い方に合わせて変えることを前提にした例です。
| 議題 | 頻度の例 | この議題で決めること | 事前に配る資料 |
|---|---|---|---|
| 区分「高」のユースケースの承認 | 毎回(案件があるとき) | 承認する・条件つきで承認する・差し戻す・承認しない、のいずれか。条件つきの場合は条件と見直しの時期 | 台帳の該当行、影響評価(第7章の6段階)の結果、法務・情報セキュリティ・データガバナンスの担当の確認の結果 |
| 例外の申請の審議 | 毎回(案件があるとき) | 例外を認めるか。認める場合は期限と代わりの対策 | 申請の理由、期限、代わりの対策、影響の範囲 |
| 台帳の変化の確認 | 毎回 | 前回からの新規・変更・廃止の件数と、区分の判定に疑問のあるものの扱い | 台帳の差分の一覧(区分ごとの件数と、各行の用途・出力先・変更内容) |
| インシデントと苦情の振り返り | 毎回(発生したとき) | 原因と再発防止の対策、規程や台帳への反映の要否 | インシデントの記録(第11章) |
| 制度の改正と公的資料の更新 | 四半期ごと | 自社の規程や手順に反映が要るか。要る場合の担当と期限 | 法務がまとめた改正・更新の一覧(EU AI Act、AI事業者ガイドライン、分野別のガイドラインなど) |
| AI利用規程の見直し | 年1回(大きな改正や事故があったときは臨時) | 改定の要否と改定案 | 問い合わせと例外の申請の傾向、インシデントの記録、制度の改正の一覧 |
| 教育の計画と実施状況 | 年1回 | 次の年度の対象者・内容・時期 | 受講の状況、問い合わせの傾向 |
| 体制の振り返り | 年1回 | 委員会の置き方・構成・頻度を変えるか。経営会議への報告の内容 | 年間の承認件数と承認までの日数、内部監査の結果があればその要旨 |
表の「台帳の変化の確認」を毎回の議題にしたのは、委員会が区分「高」の案件だけを見ていると、区分「中」と「低」の案件がどれだけ増えているか、判定が妥当かを誰も見なくなるからです。件数の推移からは、ある部門の申請が急に増えた、といった変化に気づけます。あわせて用途・出力先・変更内容を確かめると、区分「低」の中に顧客へ直接出力が届くものが混じっている、といった点にも気づけます。区分の判定は事務局の一次判定に任せているので、その判定が基準どおりに行われているかを委員会が抜き取りで確かめる場にもなります。
三つのディフェンスラインの考え方と、AIガバナンスでの位置づけ
体制の役割を「誰が実行し、誰が支えて確かめ、誰が独立して確かめるか」で整理する考え方として、三つのディフェンスラインがよく知られています。現場の業務部門を第1のライン、リスク管理やコンプライアンスのような専門の部門を第2のライン、内部監査を第3のラインとして、役割を三つに分ける考え方です。この考え方は、内部監査の専門職の国際団体である IIA が、2020年に「IIA の3ラインモデル」として改訂しています。IIA が公開している日本語版の題名も「IIA の3ラインモデル 3つのディフェンスラインの改訂」です。同じ考え方は「3ラインモデル」とも「3線モデル」とも呼ばれます。本コラムでは、以下、IIA の改訂後の考え方を指すときは「3ラインモデル」と書きます。この節では、AIガバナンスの体制の中で各ラインに何を置くかという位置づけに絞ります。内部監査が AIガバナンスの何をどう確かめるかという監査の中身は、第14章で扱います。
2020年の資料(2024年9月に用語を更新した版)は、ラインという語を残したのは慣れ親しまれているためであり、ラインは組織の構造上の区分ではなく役割の区別を示すもので、第1・第2・第3という番号は順番に作業することを意味せず、すべての役割が同時に動く、と注記しています。また、第2のラインの役割は第1のラインを専門の立場から支え、監視し、異議を述べるものであって、リスクを管理する責任は第1のラインの役割と経営管理者の範囲に残る、と書いています。資料はまた、このモデルを、「防御」や価値の保全だけでなく、目標の達成と価値の創造にリスク管理が果たす貢献にも焦点を当てて使うものとしています。
IIA は2026年7月8日に、この2020年の資料に代わる新しい文書として、3ラインモデルの「Statement of Position」を公表しました。IIA のページには、この文書が以前の Position Paper を置き換えると書かれています。新しい文書は、取締役会を主な読み手とし、第1のライン(経営管理者)がリスクを日々持ち、プロセスと統制を設計して運用すること、第2のラインが専門の知見による支援・助言・異議・監視を行うこと、第3のライン(内部監査)がガバナンス・リスク管理・コンプライアンス・統制の有効性について独立した客観的なアシュアランス(評価の結果を示し、仕組みの有効性について関係者の確信を高めること)を提供することを示しています。あわせて、第3のラインは経営の責任を負わずに助言も行います。新しい文書は、これらを改めて整理しています。新しい文書が強調しているのは、アシュアランスと助言は別のものだが互いに補い合う価値であること、独立性は孤立を意味しないこと、各ラインの確認を連携させて重複と抜けを減らすこと、第2と第3のラインの役割が重なる場合の安全策、の4点です。モデルの基本の構造は変わっていない、と文書自身が書いています。また、別々の確認の部署を置くことを求められていない組織に向けた実務上の手引きを含めたことも、この改訂の内容として挙げられています。
この考え方を AIガバナンスに当てはめると、次の表のようになります。表は、本コラムが3ラインモデルの役割の区別をもとに、この章の役割を割り当てたものです。IIA の文書が AIガバナンスの体制を定めているわけではありません。
| ライン(3ラインモデルの役割) | AIガバナンスで担う役割 | AIガバナンスでの主な仕事 | 体制を作るときの注意 |
|---|---|---|---|
| 統治機関(取締役会など) | 取締役会・経営会議、AIガバナンス責任者からの報告を受ける場 | AIの活用の方向と受け入れるリスクの考え方を決め、体制が働いているかを監督する | 報告の頻度と形を決めておく。報告が良い数字だけにならないよう、課題の欄を必ず置く。経営会議が業務執行の側の会議体である会社では、自社の監督と執行の権限に応じて割り当てる |
| 第1のライン(経営管理者のうち業務を担う役割) | 業務部門の責任者と利用者。AIを自社で開発する場合は開発部門 | ユースケースの申請、影響評価、運用中の監視、問題の最初の報告と一時停止 | リスクを管理する責任はここに残る。第2のラインが確認するからといって、第1のラインが考えなくてよいことにはならない |
| 第2のライン(経営管理者のうちリスク管理を支える役割) | AIガバナンス委員会、事務局、法務・コンプライアンス、情報セキュリティ、データガバナンスの担当 | 基準と規程の案を作り、区分の判定と区分「中」「高」の承認を行い、第1のラインを支え、監視し、必要なら異議を述べる | 経営管理者の一部であり、完全には独立していない。自分で作った規程の運用を自分で評価するだけでは、独立した確認にはならない |
| 第3のライン(内部監査) | 内部監査部門 | AIガバナンスの仕組みが方針どおりに設計され運用されているかを独立した立場で確かめ、統治機関に報告する | 委員会の承認や規程の作成を担わない。担う場合は、その範囲を別の独立した者が確かめる安全策を置く(第14章) |
| 外部のアシュアランス提供者 | 外部の監査人、認証機関、規制当局による検査など | 法令上の要求や、経営の求めに応じて追加の確認を行う | 外部に委託しても、統治機関の説明責任は変わらない |
表の第2のラインの行に「完全には独立していない」と書いたのは、2020年の資料が、第2のラインの役割は経営の意思決定と行動に組み込まれている限り経営の責任の一部であり、報告の経路にかかわらず経営から完全に独立することはない、と書いているからです。AIガバナンス委員会は、取締役会に直接報告する形にしても、その性格は第2のラインです。AIガバナンスの仕組みそのものが働いているかを確かめるには、委員会や事務局とは別の立場からの確認が要ります。
AI事業者ガイドラインも、同じ方向のことを行動目標5-1で示しています。行動目標5-1は、AIマネジメントシステムの設計と運用から独立した、関連する専門性を持つ者に、AIマネジメントシステムが適切に設計され運用されているかの評価と継続的な改善を求めることを期待しています。その担い手として、自社で行う場合は内部監査部門、または監査の対象の業務に関与していない AI開発者を加えた自己監査など、社外の資源を使う場合は外部の監査主体などが挙げられています。同じ行動目標の仮想的な実践例には、内部監査部門を置かない小規模な企業が、AIマネジメントシステムに直接関与していない開発部門の者を加えて自己監査を行い、その結果を AIガバナンス担当役員の直属の監査担当者に報告させている例があります。この実践例では、自己監査は身内に甘くなる傾向があると書かれています。独立性を確保する形は、内部監査部門の有無によって変わってかまいません。変わらないのは、確かめる人が対象の設計・運用・判断から独立し、必要な専門性を持つという点です。作った人と別人でも、その運用や承認を担った人では、自分の判断を自分で評価することになりえます。
体制を作る段階で第3のラインについて決めておきたいのは、二つです。一つは、内部監査部門を AIガバナンス委員会の委員にしないこと、または委員にする場合でも議決に加わらないことです。IIA の2020年の資料は、内部監査部門が経営の責任に属する決定や行動をしないこと、現在または最近まで責任を負っていた活動についてアシュアランスを提供しないことで独立性が守られる、と書いています。2026年の文書は、以前に責任を負っていたプロセスや判断についてアシュアランスを提供する場合、その間に目安として少なくとも12か月を置くとしています。もう一つは、内部監査の年間の計画に、AIガバナンスを対象として加える時期を決めておくことです。立ち上げの1年目は仕組みが動き始めたばかりなので、運用の監査より、設計の段階で助言を受ける形が向いている場合があります。2026年の文書は、助言の役割を明確にし、助言する側が経営の決定をしないようにし、取締役会に助言の性質と範囲を伝えることを、後のアシュアランスを損なわないための条件として挙げています。
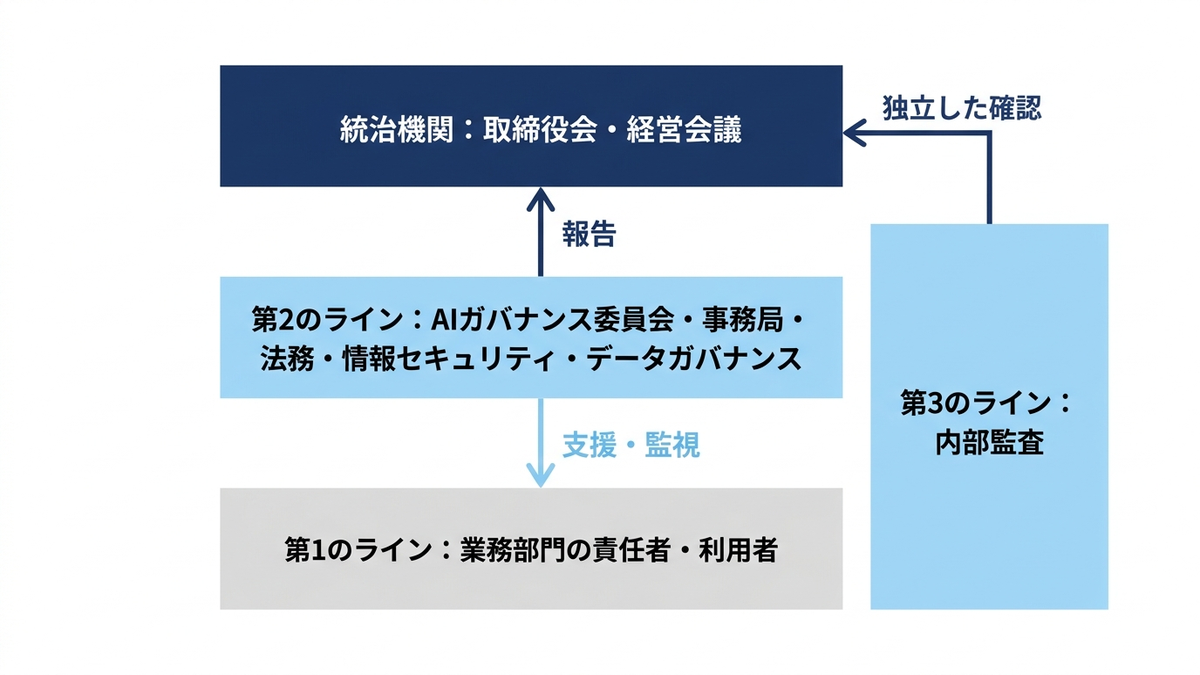
最初の90日の計画表
ここからは、AIガバナンスの体制が何も無い状態から立ち上げる順序を扱います。最初の90日、およそ13週で目指すのは、AIガバナンス責任者が決まり、社内の AIのユースケースが台帳に一通り載り、本コラムのリスク区分の判定の基準があり、AI利用規程の初版が承認されて従業員に周知され、最初の教育が行われ、経営会議に最初の報告ができている状態です。ISO/IEC 42001 の認証の準備、全ユースケースの影響評価、AIガバナンスの専用の製品の導入は、この期間には入れていません。
本コラムでは、この期間を「経営の決定(第1〜2週)」「台帳の作成(第3〜5週)」「区分の基準と承認の経路(第6〜8週)」「規程の初版と教育(第9〜11週)」「最初の報告(第12〜13週)」の5つに分けています。順序には理由があります。台帳が無いうちに区分の基準を作ると、基準が自社の実際のユースケースに合っているかを確かめられません。区分と承認の経路が決まらないうちに利用規程を書くと、規程の中心である「誰が何を承認するか」の節が空欄になります。規程が無いうちに教育をすると、何を守ればよいかを伝えられません。
| 週 | 主な作業 | 主に動く役割 | その週の成果物 | 次へ進む条件 |
|---|---|---|---|---|
| 第1週 | AIガバナンス責任者の候補を決め、本人の了承を得る。事務局の主担当を決める。既にある AIに関する社内の通知・ルール・申請の記録を集める | 経営層・事務局の候補 | 既存のルールと申請の記録の一覧 | AIガバナンス責任者の候補が了承している |
| 第2週 | 経営会議で、最初の3点(AIガバナンス責任者、AIガバナンス委員会の置き方(既存の会議体に載せるか新設か)、事務局とその責任者)を決める。あわせて、取り組む理由、最初の1年で目指す状態、やらないことの案を決める | 経営会議・AIガバナンス責任者 | 立ち上げの決定の議事録 | 議事録が残っている |
| 第3週 | 各部門に、使っている AIと使う予定の AIを申告してもらう依頼を出す。申告の様式は台帳の列(第7章)に合わせる。外部の生成AIサービスの利用状況を情報セキュリティの記録からも確かめる | 事務局・情報セキュリティ・各部門の責任者 | 申告の依頼と様式 | 全部門に依頼が届いている |
| 第4週 | 申告の回収と、申告に漏れがないかの確認。業務部門の責任者への聞き取り | 事務局・業務部門の責任者 | ユースケースの一覧(下書き) | 主要な部門の申告がそろっている |
| 第5週 | 一覧を台帳の形に整え、開発者・提供者・利用者のどの立場か、外部のサービスか自社開発か、EUとの関係がありそうかの列を埋める。第1回の AIガバナンス委員会で運営の決まりを決める | 事務局・AIガバナンス委員会 | ユースケース台帳の初版。第1回の議事録と運営の決まり | 台帳の初版がある |
| 第6週 | 本コラムのリスク区分(禁止・高・中・低)の判定の基準の案を作る(第7章)。台帳の初版に試しに当てはめる | 事務局・法務・情報セキュリティ・データガバナンスの担当 | 判定の基準の案と、試しに当てはめた結果 | 判定が分かれたユースケースが一覧になっている |
| 第7週 | 判定が分かれたユースケースを材料に基準を直す。区分ごとの承認の経路(この章の分担の表)を案にする。EU AI Act などの域外の制度が関係しうるユースケースを法務が洗い出し、必要なら外部の専門家への相談を始める | 事務局・法務 | 判定の基準(修正版)。承認の経路の案 | 基準と経路の案がそろっている |
| 第8週 | 第2回の委員会で、判定の基準と承認の経路を決める。区分「高」の扱いと、区分「中」の暫定の承認を決める(内容は表の後) | AIガバナンス委員会 | 承認された判定の基準と承認の経路。第2回の議事録 | 基準と経路が承認されている |
| 第9週 | AI利用規程の初版の起草(第12章の目次)。AI基本方針が無い会社は基本方針の初版も起草する。既存の情報セキュリティ・個人情報・文書管理の規程との関係を整理する | 事務局・法務・情報セキュリティ | AI利用規程の初版の案(AI基本方針の案) | 案が関係部門の確認に回っている |
| 第10週 | 規程の案への意見の反映。対象者別の教育の内容を決める(経営層・業務部門の責任者・利用者)。問い合わせの窓口を決める | 事務局・人事部門 | 規程の最終案。教育の資料の初版 | 規程の最終案がある |
| 第11週 | 第3回の委員会で AI利用規程と AI基本方針の最終案を審議する。AIガバナンス責任者が経営に上申し、AI基本方針は取締役会または経営会議が、AI利用規程は経営会議(または規程の管理の手続きで定めた決裁者)が承認する。承認を受けて規程を周知し、全従業員向けの最初の教育を始める | AIガバナンス委員会・AIガバナンス責任者・経営会議・事務局 | 承認された規程と方針。周知の記録。第3回の議事録 | 規程が承認され周知されている |
| 第12週 | 台帳の更新(規程の周知を受けて追加で申告されたユースケースの登録)。区分ごとの件数の集計。経営への報告書の作成 | 事務局 | 台帳の更新版。区分ごとの件数。報告書の案 | 報告書の案がある |
| 第13週 | 経営会議への最初の報告。次の90日の計画の承認 | AIガバナンス責任者・事務局 | 最初の報告書。次の90日の計画 | 次の90日の計画が承認されている |
表の「次へ進む条件」の列は、日付どおりに進まなかったときの判断を前もって決めておくためのものです。条件を満たさないまま次の週に入ると、たとえば台帳に主要な部門の申告がそろっていないまま区分の基準を作り、後で基準が合わないことに気づく、ということが起きます。条件が満たせないときは、計画を1週ずらすか、条件を満たせなかった範囲を外して先に進むかを、事務局が AIガバナンス責任者に相談して決めます。
第8週に決める区分「高」の扱いは、第7章の6段階による影響評価の時期と、それまでの暫定の条件です。新しく始めるものは、影響評価と承認を経てから利用を始めます。既に使っているものは、継続・利用の制限・一時停止のどれにするかを早めに決めます。区分「中」は、簡易な様式が整う第3四半期までの間、第7章の6段階を簡略に当てはめた確認を経て、事務局の責任者が承認します。
第3週から第5週の台帳の作成は、90日の中で最も時間がかかりやすい作業だと考えています。申告の依頼を出すと、多くの部門は「AIは使っていない」と答えがちですが、外部の生成AIサービスの社内利用、業務システムに組み込まれた AIの機能、委託先が使っている AIなどは、申告する側に AIという意識が無いことがあります。情報セキュリティの記録(社内のネットワークから外部の AIサービスへの通信の状況など)を併せて確かめると、申告の漏れに気づきやすくなります。最初の台帳は完全である必要はありません。完全さより、規程の周知の後に追加の申告が来ることを前提に、第12週に更新する手順を決めておくことの方が大事です。
第11週の教育は、全従業員向けには規程の要点(使ってよいサービス、入力してはいけない情報、出力を確かめる責任、問い合わせと報告の窓口)に絞った短いものから始めるのが現実的だと考えています。業務部門の責任者向けには、ユースケースの申請と区分の判定の流れ、運用中に何を見るか、問題に気づいたときに誰へ報告し、いつ止めてよいかを扱います。経営層向けには、台帳の区分ごとの件数の読み方と、判断を誤ったときの損失の型を扱います。AI事業者ガイドラインの別添の行動目標3-2も、役職と担当に応じた研修を例に挙げています。教育の体系と、EU AI Act 第4条の AIリテラシーの扱いは第14章で扱います。
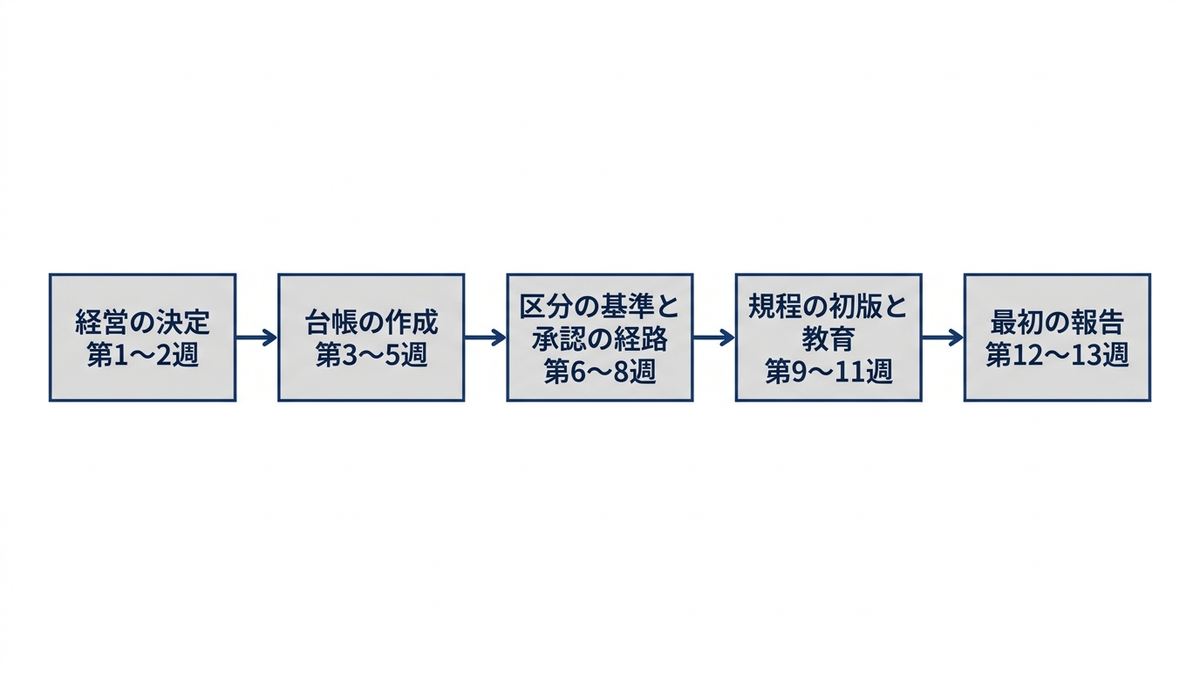
90日の後、1年目のロードマップ
最初の90日で、決める人と、台帳と、区分の基準と、規程の初版がそろいます。1年目の残りの約9か月は、これを運用として回し、運用の結果を見て2年目の範囲と体制を決める期間です。次の表は、1年目を四半期ごとに分けた進め方の例です。
| 時期 | 整えるもの | 後回しにするもの | 四半期の終わりの状態 |
|---|---|---|---|
| 第1四半期(最初の90日) | AIガバナンス責任者と委員会の決定、ユースケース台帳の初版、区分の判定の基準と承認の経路、AI利用規程の初版、最初の教育、最初の報告 | 全ユースケースの影響評価、認証の準備、専用の製品の導入 | 誰が何を承認するかが決まり、台帳と規程の初版がある |
| 第2四半期 | 区分「高」のユースケースの影響評価(第7章の6段階)。区分「中」の簡易な影響評価(6段階を簡略に当てはめる)と承認の運用。問い合わせの記録。インシデントの報告の流れの試行(第11章)。外部の AIサービスの調達の確認項目(第9章) | 区分「低」への影響評価の追加(区分「低」は業務部門の責任者の承認と台帳への記録)、認証の準備 | 区分「高」のユースケースに影響評価の結果がある。申請から承認までの日数が記録されている |
| 第3四半期 | 運用中の監視の定期化(第11章)。手順書の追加(問い合わせと例外の多かった箇所から)。区分「中」の簡易な影響評価の様式(第2四半期までの運用の結果をもとに、6段階を簡略に当てはめた確認を様式にする)。2回目の教育(業務部門の責任者向け) | 全社的な規程の大幅な改定 | 監視の結果が委員会に定期的に上がっている。手順書が問い合わせの多い箇所を覆っている |
| 第4四半期 | 1年目の振り返り。台帳の全件の見直し。規程の改定。内部監査による確認、または確認の計画(設計への助言から始めてもよい)。委員会の置き方の見直し。ISO/IEC 42001 の認証を目指すかどうかの判断(第6章) | 2年目の範囲に入れないもの(経営の決定として明記する) | 2年目の計画が経営会議で承認されている |
第2四半期に区分「高」の影響評価と区分「中」の簡易な影響評価を置き、区分「低」には評価を足さないとしたのは、限られた人の時間を、影響の大きいところから使うためです。区分「低」のユースケースは、台帳に載っていて、利用規程の範囲で使われていれば、1年目は件数と変化を見るだけで足りる場合が多いと考えています。運用中の監視は第3四半期に定期化しますが、それまでも業務部門の責任者が監視を続けます。気づいたことは、委員会の毎回の議題(台帳の変化、インシデントと苦情の振り返り)で報告します。第4四半期に認証を目指すかどうかの判断を置いたのは、一定期間の運用の記録を踏まえると、認証の要求事項との差と、埋めるのに要る作業を具体的にしやすいからです。認証の仕組みと判断の考え方は第6章で扱いました。
1年目の報告で経営に示す指標は、多くを並べる必要はありません。台帳に載っているユースケースの件数(区分ごと)、区分「高」の承認待ちの件数と承認までの日数、例外の申請の件数、規程の教育の受講の状況、インシデントと苦情の件数、の5つ程度を毎回同じ定義で並べると、経営は前回と比べて何が動いたかを自分で確かめられます。件数が増えたことは、必ずしも悪い知らせではありません。台帳の件数の増加は、隠れていた利用が見えるようになったことを示している場合もあります。報告書には、件数の変化の理由を一行添えるようにしておきます。
中小企業と、担当が1人の場合の縮小版
ここまでの計画は、部門が複数あり、AIガバナンス責任者・委員会・事務局・法務・情報セキュリティ・内部監査を別の人に割り当てられる会社を想定していました。従業員が少なく、AIガバナンスの担当が1人しかいない会社で同じ形をそのまま当てはめると、会議と文書の負担が中身を上回ります。一方で、小さな会社でも、外部の生成AIサービスに顧客の情報を入力する、AIの出力をそのまま顧客に出す、といったユースケースは起こりえます。規模が小さいことは、判断の仕組みが要らない理由にはなりません。
政府・専門機関の公開資料も、規模に応じた形を認めています。AI事業者ガイドラインの本編は、具体的な検討にあたって、AIのもたらすリスクの程度と起こりやすさ(ガイドラインの語では「蓋然性」)、各主体の資源の制約に配慮することが重要だとしています。別添の行動目標3-1の仮想的な実践例には、小規模な企業で技術担当役員がすべてのプロジェクトを把握し、開発担当者以外の者も加えた会議で乖離を評価する形が示されています。IIA の2026年の文書も、すべての組織に合う単一の構造は無く、第1・第2・第3のラインを別々に置く必要があるかはリスクの性質と大きさによる、と書いています。縮小版の考え方は、同じ順序を保ったまま、各工程を小さくすることです。
縮小版で守りたいことは3つあります。1つ目は、役割は兼ねてよいが、役割の名前は分けて書くことです。社長が AIガバナンス責任者を兼ね、担当者が事務局と情報セキュリティを兼ねる、といった形になります。2つ目は、会議を新しく作らず、既にある経営会議に月1回の短い固定の枠を設けて委員会の役目を果たすことです。3つ目は、独立した確認の仕組みを、内部監査部門が無くても何らかの形で置くことです。たとえば、年に1回、台帳と規程の設計・運用・承認に関わっていない役員か顧問の専門家に、運用を見てもらう形が考えられます。次の表は、標準の計画と縮小版を並べたものです。
| 項目 | 標準の計画 | 縮小版(担当が1人の会社) |
|---|---|---|
| AIガバナンス責任者 | CDO・CIO・CRO・管理部門の担当役員のいずれか | 社長、または管理部門を所管する役員 |
| AIガバナンス委員会 | 既存の委員会に載せるか新設。立ち上げの90日に3回(立ち上げの間は月1回より詰めて開く) | 経営会議の中の固定の枠を月1回 |
| 事務局 | DX 推進・情報システム・経営企画の担当 | AIガバナンスの担当者1人。情報セキュリティの確認も兼ねる |
| 法務の確認 | 社内の法務部門 | 顧問の弁護士などへの相談の窓口を決めておき、区分「高」、EUとの関係がありうるもの、区分を問わず法的な疑問が残るものを相談する |
| ユースケース台帳 | 台帳の全列(第7章) | 表計算の1枚に、用途・部門・使うサービス・入力する情報・出力の使われ方・区分・承認者・見直し日の列だけ |
| 区分の判定 | 事務局が一次判定し、承認者が承認の際に確定する。分かれるものは委員会へ | 担当者が一次判定の案を作る。区分「低」は業務部門の責任者が承認し、区分「中」と「高」は社長が承認する(標準の計画の事務局の責任者と委員会の役目を、社長が兼ねる) |
| AI利用規程 | 第12章の目次の全節 | 数ページ。使ってよいサービス・入力してはいけない情報・出力の確認・承認・報告の窓口に絞る |
| 教育 | 対象者別に3種類 | 全員向けの短い説明を1回と、規程の改定時の周知 |
| 独立した確認 | 内部監査部門 | 年1回、設計・運用・承認に関わっていない役員か外部の専門家が、台帳と運用を見る |
| 経営への報告 | 四半期ごとの報告書 | 月1回の経営会議の枠で、台帳の件数と判断してほしいことを口頭と1枚の資料で |
縮小版で最も注意したいのは、担当者1人にすべてを任せきりにすることです。担当者が事務局の作業を担うのは自然ですが、区分「高」の承認や例外の承認まで担うと、判断の責任が経営から担当者に移ってしまいます。また、1人に依存した体制は、その人の異動や退職で止まります。縮小版でも、承認する人(社長や役員)と、記録を置く場所(共有の台帳)を、担当者個人から切り離しておくことが有効だと考えています。
外部支援の使いどころ
外部の支援(コンサルティング会社、法律事務所、監査法人、研修の提供者、製品の導入支援など)を使う場面は、一般論として、社内に経験者がいない段階で進め方の型を持ち込む、法令の該当性の確認のような専門の判断を受ける、台帳の作成や申告の聞き取りの作業量を補う、内部監査部門が無い会社で独立した確認を担ってもらう、といったものが考えられます。とくに、EU AI Act のような域外の制度が自社のユースケースに掛かるかどうかは、条文の読み方と事業の実態の両方が絡むので、法務の担当だけで判断せず、外部の専門家の確認を受ける前提で計画に入れておくことを勧めます。制度の中身は第3章と第4章で扱いました。
一方で、外部に任せられないものもあります。AIガバナンス責任者として判断の責任を負うこと、自社が受け入れるリスクの考え方を決めること、区分「高」のユースケースを承認すること、やらないことを決めること、業務部門の責任者に時間と役割を割り当てることは、社内の人にしかできません。IIA の2026年の文書は、活動の一部を外部に委託しても、そのラインの中での役割は変わらず、その活動が有効であることへの取締役会の説明責任も変わらない、と書いています。外部の支援者が作った規程や様式を、社内で内容を十分に検討せずに形式的に承認すると、運用されない文書になりやすいと考えています。外部の支援を使う場合も、決める人は社内に置き、外部には決めるための材料と進め方を求める形にしておくことが有効だと考えています。
失敗しやすい最初の判断
立ち上げの時期の判断の誤りは、運用が進んでから表に出ることがあり、気づいたときには作り直しの範囲が広がっている場合があります。次の表は、AIガバナンスの立ち上げの最初の数週間に下しやすい判断のうち、後で手戻りが大きくなるものを型として整理したものです。「経営上の損失の型」の列は、本コラムで使っている6つの型(導入の停滞・規制違反・権利侵害・誤った判断の放置・信頼の失墜・二重投資)で書いています。定着の段階で起きる形骸化の型は第14章で扱うので、ここでは最初の判断に限ります。
| 最初の判断の型 | そう判断しやすい理由 | 後で起きること | 経営上の損失の型 | 代わりの判断 |
|---|---|---|---|---|
| 全面禁止から入る | リスクが分からないので、まず止めておけば安全だと考える | 許可を得ない利用が見えない所で広がり、台帳に載らない。必要な業務での活用も止まる | 導入の停滞。権利侵害(見えない利用での情報の入力) | 使ってよいサービスと入力してはいけない情報を先に決め、条件つきで使える状態から始める(第8章) |
| 一つの部門に丸ごと任せる | AIは技術の話なので情報システム部門、または規制の話なので法務部門、と考える | 任された部門の観点だけで判断され、他の論点が抜ける。業務部門が自分のユースケースのリスクを考えなくなる | 誤った判断の放置。二重投資(後から別の部門が別の確認を始める) | AIガバナンス責任者を経営層に置き、各部門の役割を分担の表で決める |
| 委員会を作ることから入る | 委員会は社内外に取り組みを示しやすい | 台帳も区分の基準も無いので、委員会に決める案件が来ない。出席者が減る | 導入の停滞。信頼の失墜(社内で「形だけ」と受け止められる) | 既存の会議体に載せる型から始め、台帳と基準ができてから委員会の置き方を見直す |
| 規程を完璧にしてから公表する | 不完全な規程を出すと責任を問われると考える | 起草と承認に時間がかかり、その間に現場は規程の無いまま使う | 導入の停滞。規制違反の見落とし | 初版を早く出し、問い合わせと例外の多い箇所から改定する(第12章) |
| ツールの導入から入る | 製品は目に見える成果になり、予算も説明しやすい | 台帳の列や区分の基準が製品の機能に合わせて決まり、自社の判断の仕組みと合わなくなる | 二重投資 | 表計算の台帳で1年運用し、何が不便かが分かってから製品の要否を判断する |
| 部門ごとに別々のルールを作らせる | 部門の事情が違うので、それぞれに任せた方が早いと考える | 同じ外部サービスが部門によって許可と禁止に分かれる。後で全社で統一するときに作り直しになる | 二重投資。信頼の失墜(顧客への説明が部門で食い違う) | 全社の利用規程を1つ作り、部門の事情は手順書と例外の手続きで扱う |
| 内部監査を最初から推進役にする | 内部監査部門は規程と統制に詳しいので、作る側に回ってもらう | 作った人が自分で確かめることになり、独立した確認の担い手がいなくなる | 誤った判断の放置 | 内部監査には設計段階の助言にとどめてもらい、決定と作成は第2のラインが担う |
この表の型は、どれも「早く安全にしたい」「早く目に見える形にしたい」という、それ自体は妥当な動機から生まれます。全面禁止・委員会の設置・規程の公表・ツールの導入は、取り組みが進んでいるように見えやすく、報告もしやすい作業です。しかし、それらは「誰が決めるか」と「自社に何があるか(台帳)」が先にあって初めて働くもので、順序を逆にすると、形ができた後に中身を作り直すことになります。最初の90日で目に見える成果として示すべきなのは、委員会や規程の数ではなく、「自社にはこのユースケースがあり、この区分で、この人が承認する」と決まった記録だと考えています。
最初の行の全面禁止については、第8章で、生成AIの社内利用ルールの観点から扱いました。体制の観点から付け加えると、禁止だけを通知し、棚卸しや相談の経路を設けないと、利用の実態をつかみにくくなります。台帳に載る案件が少ないままでは、区分の基準を作る材料も、委員会で判断する案件も集まりにくくなります。禁止の区分は、本コラムのリスク区分の「禁止」として、具体的な用途の単位で決めるものだと考えています。
経営判断、やらないことを決める
この章で扱った計画の多くは、何をやるかの順序でした。しかし、立ち上げの成否を分けるのは、やらないことを決めて守れるかどうかだと考えています。AIガバナンスの対象になりうるものは、制度・規格・ユースケース・文書・教育・道具のどれをとっても多く、どれも「やった方がよい」理由があります。そのすべてを1年目に入れようとすると、限られた人の時間が薄く広く使われ、どのユースケースでも判断の仕組みが回る状態に届きません。
やらないことの例を挙げると、次のようなものがあります。1年目は ISO/IEC 42001 の認証を取得しない(第4四半期に、目指すかどうかを判断するまで)。区分「低」のユースケースに影響評価を求めない。AIガバナンスの専用の製品を選ばない。独立した AIガバナンス委員会を新設しない(既存の会議体に載せる型で始める場合)。全従業員に長時間の研修を行わない(最初は規程の要点の短い説明に絞る)。他社と比べる目標を置かない。これらは「永久にやらない」ではなく、見送る期間を項目ごとに決めておくという意味です。期限を付けておくと、関係する部門にとっても、外されたのではなく順番が後になったと受け取りやすくなります。
やらないことは、第2週の経営会議で案を決め、最初の報告の第13週に確定版を経営会議に報告し、四半期ごとの報告書で毎回確認する、という形で置くことを勧めます。決めるだけでは、途中で「ついでにこれも」という要望が来たときに守れません。報告書で毎回確認すると、範囲を広げたいという要望を、経営が判断する議題として正式に扱えます。広げる場合は、何を後回しにするかを同時に決めます。
経営の側から見ると、やらないことを決めないことの損失は、1年目の終わりに「どれも途中」という報告を受けることです。その報告を受けた経営は、続けるか、広げるか、やり方を変えるかを判断する材料を持たず、導入の停滞と二重投資の両方を招きやすくなります。逆に、範囲を絞って「台帳に載ったユースケースについて、承認する人と区分が決まり、区分『高』のものには影響評価の結果がある」と報告できれば、2年目に体制を広げる判断は根拠を持って下せます。AIガバナンスの体制づくりは、決める人を先に決め、範囲を絞って運用を回し、その結果を根拠に体制を広げる、という繰り返しで進めるものだと考えています。
この章では、AIガバナンスの体制を、役割・会議体・最初の90日と1年目の計画に落としました。最初に決めるのは、AIの使い方に最終的な責任を持つ AIガバナンス責任者を経営層に置くことであり、役割と責任は分担の表で、原則として一つの行に一つの決定者を置く形で決めます。事務局は承認をせず、区分「中」の利用開始だけを事務局の責任者が承認し、区分「高」と規程の例外はAIガバナンス委員会が承認します。AI基本方針と AI利用規程は委員会が審議し、AIガバナンス責任者が上申して経営が承認します。AIガバナンス委員会は、ユースケースの数と区分の高いものの割合に応じて、既存の会議体に載せるか新しく作るかを選び、どちらでも全社のリスク管理の中に位置づけます。3ラインモデルに照らすと、委員会と事務局は第2のラインで、リスクを管理する責任は業務部門に残り、仕組みが働いているかは、その設計・運用・判断から独立した立場が確かめます。最初の90日は、経営の決定、台帳、区分の基準と承認の経路、規程と教育、最初の報告の順に進め、小さな会社でも同じ順序を保ったまま各工程を小さくします。次の第14章では、こうして立ち上げた体制を続けるための教育・内部監査・情報開示と、形骸化の型を扱います。
Anagraftでは、AI活用の構想づくりから、AIガバナンスの体制設計、委員会と役割の立ち上げ、ユースケースの洗い出しとリスクの評価、社内ルールの整備、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『責任あるAI 「AI倫理」戦略ハンドブック』(保科学世・鈴木博和 著、東洋経済新報社):AIを責任をもって使うための取り組みを、技術・ブランド・ガバナンス・組織と人の4つの方向から解説した本です。出版社の紹介する目次には、AIガバナンスのロードマップと日本企業での導入を扱う節、AI倫理を組織に根付かせるための研修とコミュニケーションを扱う節があります。この章の体制づくりの順序と、役割を組織に定着させる考え方を補う材料になります。2021年の刊行なので、EU AI Act の成立とその後のデジタル・オムニバスによる改正、AI推進法、AI事業者ガイドラインの第1.2版、IIA の3ラインモデルの2026年の改訂は含まれていません。
『不正・不祥事のメカニズムと未然防止 不正のトライアングル・内部統制・3線モデルから見た対策とチェックリスト』(島田裕次 著、日科技連出版社):不正や不祥事がなぜ起きるのかを、不正のトライアングル・内部統制・3線モデルの観点から整理し、対策とチェックリストを示した本です。AIを主題にした本ではありませんが、この章で AIガバナンスに当てはめた3ラインモデルの考え方を、組織の統制の一般論として確かめるときの材料になります。2023年の刊行なので、IIA が2026年7月に公表した3ラインモデルの新しい文書は含まれていません。
第14章 定着と見直し、教育・内部監査・情報開示と公開事例
第13章では、AIガバナンスの役割と会議体を決め、最初の90日で台帳・リスク区分の基準・利用規程の初版・教育・最初の報告までを立ち上げる順序を扱いました。立ち上げが終わると、文書と会議体と台帳はそろいます。この章で扱うのは、その後に仕組みを回し続けるための手当てです。AIは使われ方も技術も制度も変わる速さが大きいので、初版の規程と台帳を作った時点の正しさは、何もしなければ1年もたたずに古くなるおそれがあります。
この章では、次の順に書きます。まず、従業員の教育と、EU AI Act 第4条が定める AIリテラシーの措置の中身。次に、内部監査が AIガバナンスをどう確かめるか。続いて、見直しの周期と、制度の改正を誰がどう追うか。そのあと、情報開示と、業界団体の公開資料で確かめられる取り組みの状況。最後に、2026年の時点で見直しの論点として加わってきた AIエージェントの扱いと、続ける仕組み、形骸化の型、経営判断です。この章で引く外部の資料は、いずれも2026年10月28日に公式のページを開いて確かめた範囲だけを使っています。
立ち上げの後に起きること、定着の段階で決めること
立ち上げの時期には、経営の決定という後ろ盾があり、規程を作る・台帳を作る・研修を行う、と目に見える作業が続きます。定着の時期に入ると、作業の多くは「同じことを繰り返す」ものに変わります。台帳に新しいユースケースが申請されたかを確かめる、利用規程を改訂する、研修の対象者が入れ替わったら受講してもらう、といった作業です。こうした繰り返しの作業は、成果が「問題が起きなかったこと」として表れることが多いので、続けている人も周囲も効果を実感しにくい性質があります。
AIガバナンスには、ほかのガバナンスと比べて見直しの頻度を上げなければならない事情が少なくとも3つあると考えています。1つ目は、使われ方が変わる速さです。生成AIのサービスに新しい機能が追加されると、同じサービスでも入力できる情報の種類や外部への連携の範囲が変わり、台帳に登録したときのリスク区分の前提が崩れることがあります。2つ目は、技術が変わる速さです。後で扱う AIエージェントのように、立ち上げの時点では台帳の列に想定していなかった使い方が、数か月のうちに業務に入ってくることがあります。3つ目は、制度が変わる速さです。EU AI Act は、2026年7月に発効したデジタル・オムニバス(EU が規制の簡素化のためにまとめて行った改正。第3章)によって適用の日程と一部の条文が改正され、日本の AI事業者ガイドラインも2026年3月31日に第1.2版へ更新されました。
このため、定着の段階で経営と事務局が決めておくべきことは、立ち上げの段階とは別の問いになります。立ち上げの問いが「誰が何を決めるか」だったのに対して、定着の問いは「決めた内容が今も正しいことを、誰が、どの周期で、何を根拠に確かめるか」です。この問いに答える手段が、この章で扱う教育・内部監査・見直し・情報開示の4つです。教育は、決めた内容を使う人に届ける手段です。内部監査は、決めた内容が守られているかを推進する側とは別の立場から確かめる手段です。見直しは、決めた内容そのものを技術と制度の変化に合わせて直す手段です。情報開示は、決めた内容と運用の状況を社外に説明し、外からの意見を受け取る手段です。
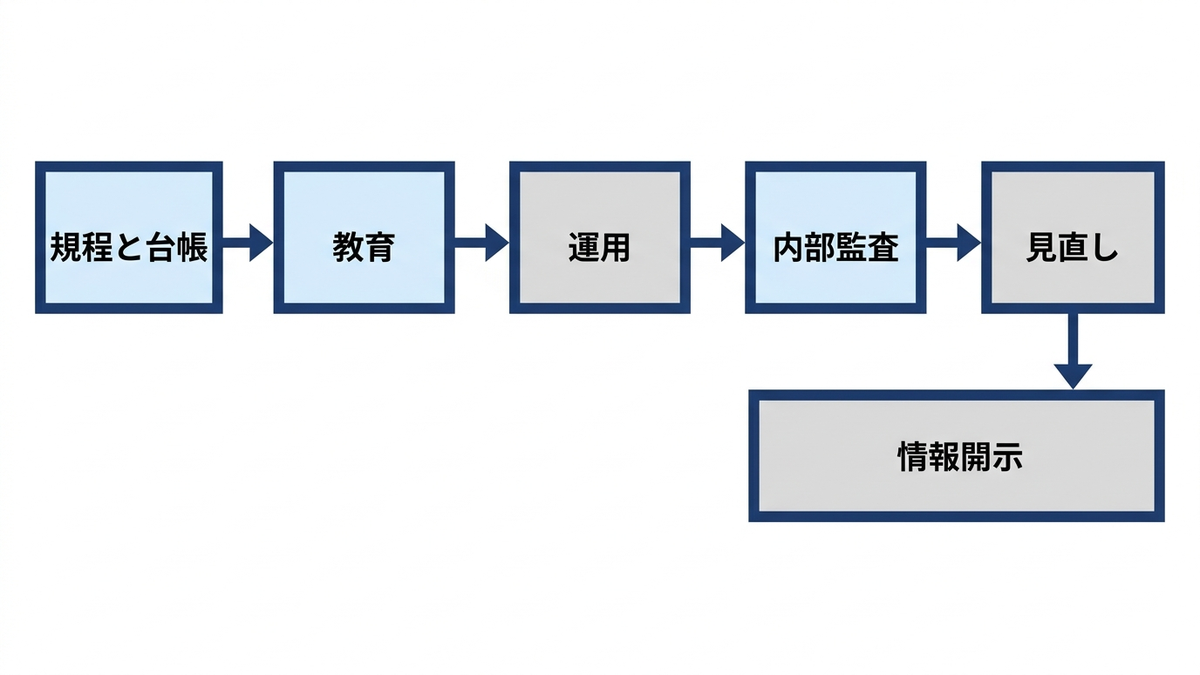
EU AI Act 第4条が求める AIリテラシーの措置
教育について、法令の側から具体的な求めがあるのが EU AI Act 第4条です。この節では、断りがない限り、提供者・導入者は EU AI Act の語を指します。第4条は、EU AI Act の提供者(provider)と EU AI Act の導入者(deployer)に、自社の従業員と、自社に代わって AIシステムの運用や利用に携わる人のAIリテラシーの向上を支える措置を取ることを求めています。措置を取るときには、その人たちの技術的な知識・経験・教育と訓練、AIシステムが使われる文脈、AIシステムが使われる相手となる人や集団を考慮する、と書かれています。AIリテラシーの定義は第3条第56号にあり、本コラムの言葉で言い換えると、提供者・導入者・影響を受ける人が、それぞれの権利と義務を踏まえて、十分な情報に基づいて AIシステムを導入し、AIの機会とリスク、起こしうる害を認識できるようにする技能・知識・理解のことです。
第4条は、2026年7月に発効したデジタル・オムニバスで改正されています。AI Act Service Desk の第4条は、2026年7月27日時点の統合版(デジタル・オムニバスによる改正を反映したもの)で、3つの項すべてに改正の印を付けています。要点は、組織に措置を求める義務は残る一方、個人に特定の水準の AIリテラシーを保証することまでは求めない、という点です。あわせて、欧州委員会と加盟国による中小企業などへの支援も定められています。
欧州委員会が公開している AIリテラシーの質疑応答(2026年10月20日更新)は、この改正の要点を、AIリテラシーは提供者と導入者の義務として残るが、特定の水準や「十分な」水準は求めない形になった、と説明しています。同じ質疑応答によると、欧州委員会が2025年11月19日に示した提案の段階では、組織への義務を加盟国と欧州委員会による促進の義務へ移す案でしたが、発効した改正では組織の義務が残りました。提案の段階の報道や解説を読んで「AIリテラシーの義務は無くなった」と受け止めている場合は、発効した条文で確かめ直す必要があります。
適用の日程も確かめておきます。第113条の統合版によると、EU AI Act の第I章と第II章は2025年2月2日から適用されており、第4条は第I章に含まれます(いずれも本コラムの章ではありません)。ただし第II章のうち、デジタル・オムニバスで加わった第5条第1項(ba)(bb)と第1a項・第1b項は、2026年12月2日から適用されます(本コラムの第3章)。欧州委員会の質疑応答も、第4条は2025年2月2日に適用が始まっており、監督と執行の規定は2026年8月2日から適用されると説明しています。第4条の監督と執行は AIオフィスではなく各加盟国の市場監視当局が担い、違反に対する制裁は加盟国の国内法にもとづく、とも書かれています。制裁の上限の仕組みは第3章で扱いました。自社が EU AI Act の提供者や導入者に当たるかどうか、当たる場合に何をどこまで行うべきかは、自社の AIの使われ方によって変わるので、個別に専門家へ確認する必要があります。
質疑応答には、社内の教育を設計するときに参考になる記述が多く含まれています。第4条に沿った AIリテラシーの取り組みでは、少なくとも次の点を考えるべきだとしています。組織の中で AIとは何か・どう動くか・自社でどの AIを使っているか・機会と危険は何かという一般的な理解を確保すること。自社が提供者か導入者かという立場を考えること。提供・導入する AIシステムのリスクを考え、従業員が何を知っておくべきかを考えること。そのうえで、従業員の知識と経験の違い、AIシステムが使われる文脈と相手に応じて取り組みを組み立てること、の4つです。
同じ質疑応答は、従業員の知識を測る義務は第4条には無いこと、特定の体制(AIの責任者や委員会)の設置は第4条では求められていないことも説明しています。証明書は求められておらず、実施した研修などは社内の記録として文書化できる、とも書かれています。これは記録の形を示したもので、記録を保存するだけで義務を果たせるという意味ではありません。一方で、多くの場合、AIシステムの使用説明書を読ませるだけでは効果が薄いおそれがあることも書かれています。また、従業員が対話型の生成AIを広告の文章作成や翻訳に使う会社について、第4条への対応が要ると答えています。そこでは、ハルシネーション(もっともらしい誤りを出力すること。第8章)などの固有のリスクを知らせるべきだとしています。ただし、そもそも自社が EU AI Act の適用範囲(第2条。第3章)に入るかどうかは、別に確かめる必要があります。
質疑応答は、EU AI Act の高リスク AIシステム(第3章)の導入者について、人による監督を担う従業員の訓練を確保する義務が残っていることにも触れています。第26条第2項は、高リスク AIシステムの導入者が、人による監督を、必要な能力・訓練・権限と支援を持つ自然人に割り当てることを定めています。ただし、第26条を含む第III章第3節は、第4条とは適用開始日が違います。第113条の統合版では、この節は附属書IIIに当たる高リスク AIシステムについて2027年12月2日から適用されます。附属書Iに当たるものについては2028年8月2日からです。自社の AIが高リスク AIシステムに当たるか、どの適用日が掛かるかは使われ方によって変わるので、第4条と同じく個別に専門家へ確認する必要があります。
社内研修を対象別に組み立てる
日本の AI事業者ガイドライン(第1.2版、2026年3月31日)にも、教育についての記述があります。別添の「AIガバナンスの構築」の行動目標3-2は、AIマネジメントシステムを適切に運営するために、外部の教材の活用も検討しながら AIリテラシーを戦略的に向上させることを期待しています。例として、役員と担当者、プロジェクトの担当者、全員という対象ごとに、教育の中身を変える考え方を示しています。あわせて、技術の進歩で求められるリテラシーも変わるので、人材育成が技術の変化に遅れないよう留意する、と書かれています。
EU の第4条も日本のガイドラインも、対象者ごとに中身を変えることを前提にしています。本コラムでは、この考え方を社内研修に落とすときに、少なくとも次の5つの対象に分けることが扱いやすいと考えています。表の「最低限扱う内容」は一般論の例で、自社のユースケースとリスク区分(第7章)に合わせて増減させる前提です。
| 対象 | 最低限扱う内容 | 時期の例 | 記録に残すこと |
|---|---|---|---|
| 全従業員 | 自社で使ってよい AIサービスの一覧、入力してよい情報の区分(第8章)、出力を確かめる手順、困ったときと事故が起きたときの連絡先、AI利用規程の要点 | 入社時と年1回。利用規程の改訂時に差分を周知 | 受講の有無と日付、教材の版 |
| AIを業務に組み込む部門の担当者 | ユースケース台帳への申請の手順、リスク区分の判定の基準、人の関与の決め方、運用中に見ること(第11章)、インシデントの報告の流れ | 担当になった時と、担当するユースケースの区分が変わった時 | 受講の有無、担当するユースケースとの対応 |
| 開発・調達の担当者 | 評価とテストの観点(第10章)、ベンダーに確かめる項目(第9章)、記録の残し方、生成AIを含む技術の動向 | 担当時と年1回以上。技術の変化が大きい分野は随時 | 受講の有無、扱った評価の手法 |
| 本コラムのリスク区分で「高」のユースケースで人による監督を担う人(EU AI Act の義務とは別に、社内の区分にもとづいて置く対象) | その AIシステムの能力と限界、出力の読み方、介入と停止の手順と権限、記録の義務 | 担当になる前。システムの更新時 | 担当者の指名、受講の有無、訓練の内容 |
| 経営層と AIガバナンス委員会の委員 | 本コラムの損失の型(導入の停滞・規制違反・権利侵害・誤った判断の放置・信頼の失墜・二重投資)、主要な制度の動き、台帳と指標の読み方、委員会で判断すべきこと | 就任時と年1回。重要な制度の改正時 | 出席の記録、扱った論点 |
表の右端の列を置いたのは、欧州委員会の質疑応答が、研修などの取り組みを社内の記録として文書化できる、と説明しているためです。記録は研修そのものの代わりにはなりません。記録は、EU の制度に対応するためだけでなく、後で扱う内部監査で「誰がいつ何を学んだか」を確かめる材料にもなります。受講の有無だけでなく教材の版を残しておくと、利用規程を改訂したあとに、古い版で受講したままの人を拾い出せます。
研修の効果を測るときには、受講率だけを指標にしないことが大切だと考えています。受講率が高くても、利用規程で禁止した情報が入力され続けていれば、研修は目的を果たしていません。研修の後に、相談窓口への問い合わせの内容が変わったか、台帳への申請の書き方の不備が減ったか、ヒヤリハット(事故には至らなかったが、その手前で気づいた事象)の報告が増えたか、といった行動の変化を見る方が、実態に近づけます。報告が増えることは、初めのうちは悪い兆候ではなく、報告してよいという理解が広がった結果であることが多いと考えています。
研修の教材をすべて自社で作る必要はありません。AI事業者ガイドラインの別添は、行動目標3-2の実践例として、小規模企業が自前の研修を用意せず、外部の教材を使う例を挙げています。そこでは、国内外のオンライン講座や、日本ディープラーニング協会(JDLA)の検定試験のシラバスにもとづくプログラム、経済産業省の「マナビDX」などが例として挙げられています。外部の教材は AIの一般的な知識を学ぶのに向いていますが、自社でどのサービスを使ってよいか、どの情報を入力してはいけないか、事故のときに誰に連絡するか、は自社の規程にしか書かれていません。外部の教材と、自社の規程にもとづく短い教材を組み合わせる形が、手間と効果の釣り合いが取りやすいと考えています。
内部監査の役割、3ラインモデルと AI
教育が「決めた内容を使う人に届ける手段」だとすると、内部監査は「決めた内容が守られているかを、推進する側とは別の立場から確かめる手段」です。AIガバナンスを推進する事務局や委員会が自分たちで成果を評価すると、続いていることを示す数字を選びやすくなります。推進する側とは独立した立場から、運用の実態が方針と規程に合っているかを確かめる役割を置くことが、形骸化に早く気づく仕組みになります。
内部監査の役割を説明するときによく使われるのが、内部監査人協会(The Institute of Internal Auditors、IIA)の3ラインモデルです。3ラインモデルの考え方と、AIガバナンスの体制の中での役割の割り当ては第13章で扱いました。この章では、内部監査の立場から押さえておく点に絞ります。
まず、版の確認です。第13章で扱ったとおり、IIA の公式ページによると、2026年7月8日に3ラインモデルの新しい声明(Statement of Position)が公表され、2020年のポジションペーパーを置き換えています。内部監査の計画や監査部門の規程が2020年の資料を引用している場合は、引用先を確かめ直す必要があります。2026年の声明は、第3のラインである内部監査部門を、ガバナンス・リスク管理・コンプライアンス・統制の有効性について独立した客観的なアシュアランスを提供する役割として位置づけています。アシュアランスは、第13章と同じく、評価の結果を示し、仕組みの有効性について関係者の確信を高めることを指します。経営の責任や意思決定の権限を負わずに助言も提供し、業務の報告は取締役会に対して行う、としています。
同じ声明の中で、内部監査の立場から目を留めておきたい点が2つあります。1つは、独立性の要素として、報告の経路と権限、監査の範囲と計画を自ら決められること、資産・情報・人・システムへの制限のないアクセス、監査される側に頼らない人員と専門性と予算の確保などを挙げている点です。AIの監査では、モデルの評価の記録や外部のサービスの契約の内容を監査部門が閲覧・確認できるかどうかが、この「制限のないアクセス」に当たると考えています。もう1つは、独立性を、孤立と取り違えないように注意を促している点です。独立性が誤って理解されると、部門をまたぐ意思の疎通が細り、役割どうしの足並みがそろわなくなるおそれがある、という趣旨です。また、3つのラインの間で調整し、適切な場合には互いの結果に依拠することで、重複を減らし、抜けを埋め、取締役会に一貫した見方を届けられる、と書かれています。組織の規模や構造によってラインの分け方は違ってよく、すべての組織に合う単一の構造は無い、という点も明記されています。担当者の少ない会社で、第2のラインと第3のラインを明確に分けられない場合の考え方は、第13章の縮小版の議論と合わせて考えることになります。
AIガバナンスの体制の中で各ラインに誰を割り当てるかは第13章の表で扱ったので、ここでは繰り返しません。この章で扱うのは、その第3のラインが、AIガバナンスの何を、どの資料を手がかりに確かめるかです。
内部監査は AIガバナンスの何を確かめるか
内部監査の立場から AIを扱う資料として、IIA は「AI監査フレームワーク」(The IIA’s Artificial Intelligence Auditing Framework)を公開しています。公式ページによると、現在の版は2024年9月の更新版で、最初の版は2017年に出されたと文書の中に書かれています。このフレームワークは、ガバナンス・マネジメント・内部監査の3つの領域で構成され、3ラインモデルに対応させて、ガバナンスの領域が取締役会などの統治機関、マネジメントの領域が第1と第2のライン、内部監査の領域が第3のラインのアシュアランスと助言を扱う、と説明されています。末尾には、内部監査人が組織の AIへの取り組みの評価を始めるための簡単なチェックリスト(実務者向けの手引き)が付いており、組織の状況に合わせて調整して使う前提だと書かれています。
このフレームワークで目を留めておきたいのは、組織の AIの成熟度によって内部監査の使われ方が変わる、という記述です。AIの利用が初期の段階にある組織では、内部監査が最初の検討に助言者として関わり、利用が進んだ組織では、確立したプロセスと統制が有効に機能しているかを評価するアシュアランスの役割を求められることが多いだろう、という趣旨です。AIガバナンスの立ち上げの段階では、内部監査部門を最初から監査する側に置くより、規程や台帳の設計に助言者として加わってもらい、2年目以降にアシュアランスの役割へ移す、という順序も考えられます。ただし、自分が設計に関わった仕組みを自分で監査すると客観性が損なわれるおそれがあるので、助言の範囲と監査の範囲を記録に残しておくことが前提になります。記録に加えて、設計と運用を決める責任は業務の側が負うと決めておきます。助言に深く関わった項目は、別の監査担当者や外部のレビューで確かめる、といった手当ても考えられます。2026年の3ラインモデルの声明も、内部監査部門が第2のラインの活動を担う場合には、独立性と客観性を守るための安全策を置く必要がある、としています。
日本の AI事業者ガイドラインも、評価の段階について行動目標5-1を置いています。AIマネジメントシステムの設計と運用から独立した、関連する専門性を持つ者に、AIガバナンスの目標に照らして仕組みが適切に設計・運用されているかの評価と継続的な改善を求めることを期待する、という内容です。独立した者として、自社で行う場合には内部監査部門や、監査の対象の業務に関わっていない AI開発者を加えた自己監査が、社外の資源を使う場合には外部の監査主体などが挙げられています。自社で行う場合の留意点として、内部監査部門に AIの技術的な側面を理解できる者を置くなど、AIに詳しくないことを理由に評価が表面的にならないよう配慮することが挙げられ、その例として、指摘が見えやすい運用のプロセスに偏り、設計・開発のプロセスへの指摘が少ない、という状態が書かれています。
IIA のチェックリストと AI事業者ガイドラインの行動目標を手がかりに、本コラムのこれまでの章の内容を内部監査の観点として並べると、次の表のようになります。表は本コラムの整理で、IIA のチェックリストの項目をそのまま訳したものではありません。監査の頻度や範囲は、自社のリスク区分の分布と監査部門の人員に合わせて決める前提です。
| 監査の観点 | 確かめる問い | 見る証跡の例 | 対応する章 |
|---|---|---|---|
| 戦略と方針 | AI基本方針が経営に承認され、事業の目標や会社の価値観と矛盾していないか。取締役会に AIの方針とリスクが報告されているか | 承認の記録、取締役会と経営会議の議事録 | 第12章・第13章 |
| 体制と役割 | AIガバナンス責任者(AIの使い方に最終的な責任を持つ経営層の役員。第13章)が置かれているか。AIガバナンス委員会が開かれ、決めるべきことを決めているか | 任命の記録、委員会の議事録と出席の記録 | 第13章 |
| 台帳の網羅性 | 業務で使われている AIが台帳に載っているか。外部のサービスに組み込まれた AI機能が漏れていないか | 台帳と、購買・契約・経費精算・ネットワークの利用記録との突き合わせ | 第7章・第9章 |
| 区分と承認 | リスク区分の判定が基準どおりか。区分「高」の承認が決められた経路を通っているか。例外の承認に期限があるか | 判定の記録、承認の記録、例外の一覧 | 第7章・第12章 |
| 利用規程の遵守 | 入力してよい情報の区分が守られているか。使ってよいサービスの一覧の外のサービスが使われていないか | 利用の記録の抜き取り、相談窓口への問い合わせの記録 | 第8章 |
| 調達と委託先 | ベンダーに確かめる項目が契約の前に確かめられているか。モデルの更新の通知を受け取る仕組みがあるか | 確認の記録、契約書、委託先の評価の記録 | 第9章 |
| 評価と記録 | 導入の前と後に評価が行われ、その結果を決められた人が承認しているか。設計と開発の段階の記録が残っているか | 評価の結果、承認の記録、モデルカードなどの文書 | 第10章 |
| 監視とインシデント | 運用中に見る指標が決まり、実際に見られているか。停止の基準と権限が決まっているか。インシデントの報告と再発防止が台帳と規程に反映されているか | 監視の記録、インシデントの記録、振り返りの記録 | 第11章 |
| 教育 | 対象別の研修が行われ、記録が残っているか。規程の改訂のあとに古い版で受講したままの人がいないか | 受講の記録と教材の版 | 本章 |
| 見直し | 規程と台帳が決められた周期で見直されているか。制度の改正が規程に反映されているか | 改訂の履歴、制度の改正の確認の記録 | 本章 |
表の「台帳の網羅性」の行は、内部監査で最初に確かめる価値が高い観点だと考えています。台帳に載っていない AIは、台帳にもとづく区分の判定・承認・監視から漏れるおそれがあります。台帳だけを監査の対象の抽出に使うと、ほかの観点の監査でも未登録の AIを見落とします。購買や経費精算の記録、ネットワークの利用の記録、業務部門への聞き取りと台帳を突き合わせると、登録の漏れを見つけやすくなります。後で紹介する業界団体の自己診断の集計にも、外部のサービスに組み込まれた AI機能を捉えきれていない、という声が寄せられたと書かれています。
監査の結果は、指摘を並べるだけでなく、誰がいつまでに何を直すかを決めることが大切だと考えています。監査の後も、指摘の重要性と改善の期限に応じて実施の状況を確かめ、未対応の事項を続けて管理します。指摘が出ても改善の期限と担当が決まらなければ、同じ指摘が翌年も出ることになります。また、内部監査部門の人員が限られている会社では、毎年すべての観点を見るのではなく、リスク区分が高いユースケースと、前回の指摘の残っている観点を優先し、残りを複数年で一巡させる計画にすると、現実的な負荷に収まりやすいと考えています。
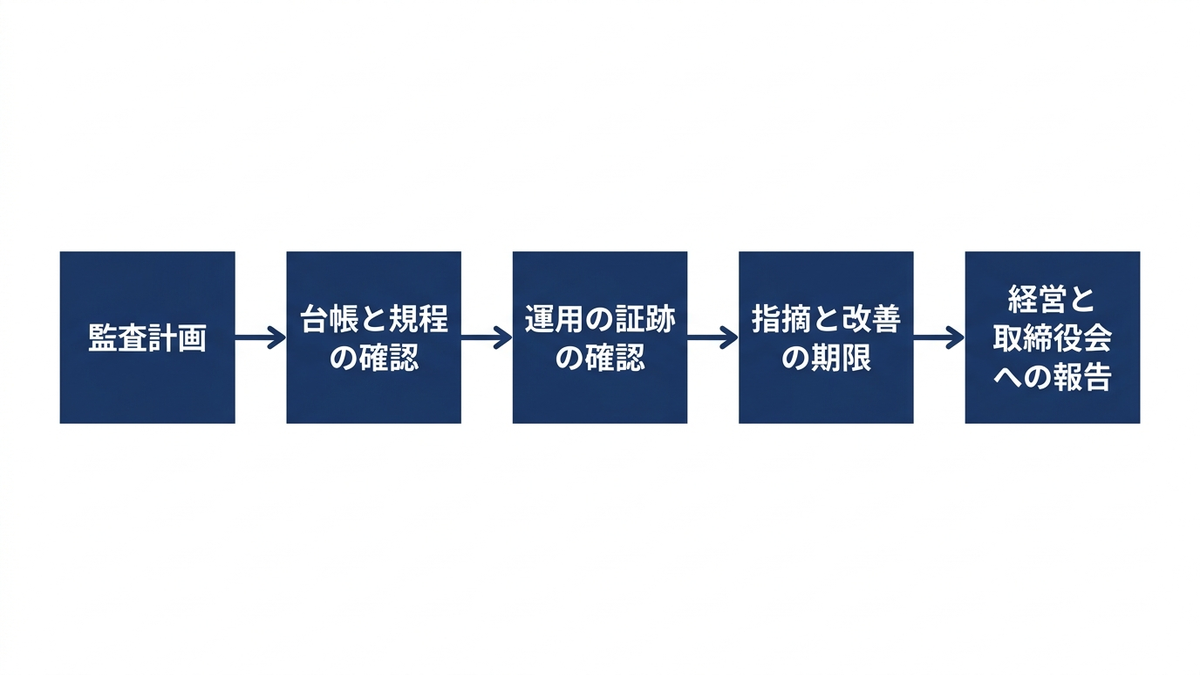
見直しの周期と、制度の改正を追う担当
内部監査が「決めた内容が守られているか」を確かめるのに対して、見直しは「決めた内容そのものが今も正しいか」を確かめる作業です。AI事業者ガイドラインの別添は、行動目標6-1で、新しい技術の出現や規制などの社会的な制度の変更といった外部環境の変化を速やかに把握し、適時に再評価と理解の更新を行い、それを踏まえて AIシステムの改良や運用の改善を行うことを期待しています。同じ箇所の実践のポイントには、AIガバナンスの考え方を組織の文化として根付かせることも挙げられています。また、行動目標5-2は、ステークホルダーから AIマネジメントシステムとその運用への意見を求めることを検討し、意見の内容を実施しないと判断した場合にはその理由をステークホルダーに説明することを期待しています。
見直しには、決まった周期で行う定期の見直しと、きっかけが起きたときに行う随時の見直しの2種類を用意しておくと運用しやすいと考えています。定期の見直しは、年に1回、AI基本方針・AI利用規程・リスク区分の基準・台帳の全体を対象にして、委員会で確認します。随時の見直しのきっかけには、制度の改正、使っている AIサービスの大きな機能の変更、インシデントの発生、内部監査の指摘、新しい種類の AIの業務への導入などがあります。随時の見直しは、影響を受ける規程の条や台帳の行だけを対象にし、全体を見直すのは定期の見直しに回すと、負担が膨らみにくくなります。文書の階層ごとの改定の頻度と承認者の決め方は第12章で扱いました。
制度の改正を追う作業は、担当を決めておかないと、誰も見ていない状態になりやすい作業です。2026年の1年だけを見ても、この章で確かめた範囲で、EU AI Act のデジタル・オムニバスによる改正、AI事業者ガイドラインの第1.2版への更新、人工知能基本計画の第Ⅱ期の閣議決定(2026年7月14日)、個人情報保護法の改正法の公布(2026年7月17日)、IIA の3ラインモデルの新しい声明(2026年7月8日)がありました。NIST の公式ページには、AI RMF 1.0 が改訂の途中であると書かれています。こうした更新は、それぞれ別の機関の別のページで公表されるので、見る場所と担当と頻度を表にして決めておくことが有効だと考えています。
| 追う対象 | 公式の確認先 | 主な担当の例 | 確認の頻度の例 | 関係する章 |
|---|---|---|---|---|
| EU AI Act の条文と運用の指針 | 欧州委員会の AI Act Service Desk(統合版の条文)、欧州委員会の AI政策のページ | 法務(EU に関係するユースケースがある場合) | 月1回。重要な改正の公表時は随時 | 第3章 |
| 日本の AI推進法と国の計画・指針 | 内閣府の AI戦略のページ | 法務、AIガバナンスの事務局 | 四半期に1回 | 第4章 |
| AI事業者ガイドライン | 総務省と経済産業省の AI事業者ガイドラインのページ | AIガバナンスの事務局 | 四半期に1回 | 第4章 |
| 府省庁の分野別のガイドライン | 内閣府の「人工知能に関する各府省庁等のガイドライン等一覧」 | 自社の業種を所管する分野の担当部門 | 四半期に1回 | 第4章 |
| 個人情報・著作権・営業秘密 | 個人情報保護委員会、文化庁、経済産業省の公式ページ | 法務、個人情報の管理の担当 | 四半期に1回。改正の施行の前後は随時 | 第8章 |
| NIST の枠組み・ISO/IEC の規格 | NIST の AI RMF のページ、ISO の規格の目録 | 情報セキュリティ、品質の担当 | 半年に1回 | 第5章・第6章 |
| 使っている AIサービスの規約と機能 | 各サービスの公式の利用規約と更新のお知らせ | サービスの管理の担当部門(情報システム部門など) | 月1回。更新の通知を受けたとき | 第8章・第9章 |
| 内部監査の基準と指針 | IIA の公式ページ | 内部監査部門 | 年1回 | 本章 |
表の頻度は一つの例で、EU に関係するユースケースが無い会社では EU の行の頻度を下げ、規制の厳しい業種の会社では分野別のガイドラインの行の頻度を上げる、といった調整を前提にしています。大切なのは、確認した結果を「変化なし」も含めて記録に残すことです。確認の記録が残っていれば、内部監査で見直しの観点を確かめるときの証跡になり、担当者が異動したときにも、どこまで確認が済んでいるかを引き継げます。また、改正を見つけた担当が、規程のどの条や台帳のどの列に影響するかの見立てを付けて委員会に上げる、という流れを決めておくと、改正の情報が担当の手元で止まることを防げます。
確認先は、解説記事やニュースではなく、公式のページにすることを勧めます。この章で扱った EU AI Act 第4条のように、提案の段階と発効した条文とで内容が違うことがあり、提案の段階の解説を読んだまま規程を直すと、誤った前提が規程に入ります。解説記事は改正に気づくきっかけとして使い、規程に反映する前には公式の条文や指針で確かめる、という順序が安全です。
情報開示、統合報告書とウェブでの説明
情報開示は、決めた内容と運用の状況を社外に説明し、外からの意見を受け取る手段です。AI事業者ガイドラインの別添は、行動目標4-3で、AIガバナンスの目標の設定や AIマネジメントシステムの整備・運用などに関する情報を、コーポレートガバナンス・コードの非財務情報に位置づけて開示することを検討することを期待しています。上場企業以外であっても AIガバナンスに関する活動の情報の開示を検討することが期待され、検討の結果として開示しないと判断した場合には、開示しないという事実を理由とともにステークホルダーに公開することが期待される、とも書かれています。開示が期待される情報の例としては、自社の AIに関する基本的な考え方や AIポリシー、AI倫理に関する自社の取組、自社の AIガバナンスが挙げられています。
同じ箇所には2つの実践例が載っています。1つは、AIシステムを開発する非上場の小規模企業が、ホームページなどで AIに対する考え方を発信している例です。もう1つは、AIシステムを開発する上場企業が、AIポリシーと体制をすでに整えてホームページで公表しているものの、機関投資家から届いた企業ガバナンスに関するアンケートに AI倫理への対応を問う設問があったことをきっかけに、AI倫理の取り組みを統合報告書に載せることを含めて、経営層からの情報発信を検討している、という例です。どちらもガイドラインが示した例で、特定の企業の事例として書かれているものではありません。
AIポリシーそのものをウェブで公開している企業の例は、第12章で扱いました。この章では別の切り口として、統合報告書(財務の情報と、戦略やガバナンスなどの非財務の情報をまとめて投資家などに説明する報告書)の中で AIの取り組みを説明している例を1つ挙げます。三菱UFJフィナンシャル・グループの統合報告書「MUFG Report 2026」(同社の統合報告書の掲載ページ)は、対象期間を2025年4月1日から2026年3月31日まで(2026年7月までの内容を含む)としており、その中に「MUFG の AIに関する取り組み」という特集のページを設けています。そのページには、AIのリスクを正しく管理し、その便益を最大化するために AIポリシーを策定している、という注記と、そのポリシーの報道発表の資料への参照が載っています。同じ報告書の内部監査の部分には、生成AIやデータ分析を活用して監査の検証力を高めることが書かれています。ここで扱うのは統合報告書に書かれている内容だけで、取り組みの中身の評価や他社との比較はしません。
この例から読み取れるのは、統合報告書では、AIのポリシーの全文を載せるのではなく、経営の戦略の中での AIの位置づけを説明し、ポリシーの詳細は別の公開資料に送る、という書き分けがありうるという点です。ウェブのポリシーのページは、原則と体制を正確に示すための場所で、統合報告書は、その原則と体制が経営の戦略とどうつながっているかを投資家に説明する場所、と役割を分けて考えると、何をどちらに書くかを決めやすくなります。
開示するかどうか、何をどこまで開示するかは、自社の立場によって変わります。AIを組み込んだ製品を外部に提供している会社では、顧客や取引先から方針と体制を問われることがあり、開示した内容がそのまま説明の材料になります。業務で外部の AIサービスを使うだけの会社では、社内の規程と運用を整えることを先にし、開示は運用の実績ができてから判断する、という順序もありえます。いずれの場合も、開示した内容と運用の実態がずれていると、開示しないこと以上に信頼を損なうおそれがあります。開示する文書は、内部監査と見直しの対象に含め、運用の実態に合っているかを定期的に確かめることを勧めます。
業界団体の取り組み、自己診断の集計に表れた課題
自社の取り組みの水準を測る材料として、業界団体の公開資料があります。一般社団法人AIガバナンス協会は、AIのビジネス活用を進める企業が実現すべき価値と、そのために取り組むべき行動の大枠をまとめた「AIガバナンス行動目標」を、2024年2月19日に協会の臨時総会の表決で決定し、2025年11月27日に理事会の表決で改定を決めたと公式ページに記載しています。あわせて、会員企業が自社の取り組みの成熟度を自己診断するための道具として「AIガバナンスナビ」を開発し、運用しています。協会の公式ページによると、2026年3月30日の検討委員会での議論を踏まえてまとめた第2.0版では、AIエージェントに関する取組事項の新設、内閣府の指針との対応づけの追加などの改定を行っています。
協会は2026年7月27日に、第2.0版による会員企業の自己診断の集計結果を公表しています。公式ページによると、回答は57件で、取組項目は「ルール・プロセスの明文化」「周知徹底・人材育成」「組織体制整備」「各リスク領域への対策」「透明性・アカウンタビリティ確保」の5領域・37項目に整理され、各項目を0点・1点・3点・4点、または非該当で自己評価する形です(公式ページの記載どおりで、2点は設けられていません)。全体の平均は2.72点で、前回の版の2.50点から上がり、すべての領域で点数が上がったと書かれています。この集計は、協会の会員企業による自己評価の結果で、日本企業全体の状況を表すものではなく、個々の会社の評価でもありません。
集計の中で、この章の主題に関わる記述を拾うと、次のようになります。「AIポリシー」「AI利用ルール」といったルール作りの項目は点数が高い一方で、「ガバナンス全体の不断の見直し」は伸びしろがあるとされています。人材育成の領域では、「社内ルールの浸透」は広く行われている一方で、「活用段階に応じた人材要件の定義」と「AIリスク管理を担う人材の育成」は検討の途上の企業が多いと書かれています。透明性・アカウンタビリティの領域では、「組織やルールに対する外部の視点からの検証」や「第三者による技術面のリスク検証」に課題があるとされています。また、ユースケースを把握できていない企業の割合が前回より上がり、回答企業からは、外部のサービスに組み込まれた AI機能を捉えきれていない、部門の間で管理の方法が統一されていない、といった声が寄せられたと書かれています。
この集計の記述は、ルールを作る段階は進んでいても、見直し・人材の育成・外部の目による検証・台帳の網羅性といった、定着の段階の取り組みに課題が残っている会社がある、という読み方ができます。この章で扱っている教育・内部監査・見直し・開示の4つの手段は、ちょうどこの課題の側に当たります。自社が協会の会員でなくても、公開されている領域と項目の名前は、自社の取り組みの抜けを点検する観点の一覧として使えます。業界団体の資料は、その団体の会員の状況を反映したものなので、自社の業種や規模に近いかどうかを確かめたうえで参考にすることが前提になります。
見直しの新しい論点、AIエージェントの扱い
2026年の時点で、定期の見直しに加えるべき新しい論点として挙げられるのがAIエージェントです。AI事業者ガイドライン第1.2版の本編は、第1部の用語の定義に AIエージェントを加え、特定の目標を達成するために、環境を感知し自律的に行動する AIシステム、と定義しています。脚注では、自律は高度に自律した状態だけでなく、ある程度の自律性を持つものも含むこと、AIエージェントよりも包括的な概念として、複数の AIエージェントが自律的に意思決定して行動するエージェンティック AIがあることが補足されています。総務省と経済産業省が公表した令和7年度の更新内容の資料は、第1.2版の更新の論点の1つ目に、AIエージェントとフィジカル AIに関する事項の追記を挙げています。
第1.2版の別添は、AIエージェントに関わるリスクの例として、自律的な動作の中で人間の意図しない商品の注文やファイルの削除などを行う可能性があること、外部のシステムやクラウドのサービスと自律的に連携してタスクを実行する過程で、脆弱性を突いた攻撃などによってエージェントの挙動が不正に操作され、内部のデータが意図せず外部に送られて機密情報が漏えいする可能性があることなどを挙げています。また、AIエージェントの自律性が高まるにつれて、人間による監視だけでは高速な AIどうしのやり取りに対応しにくくなる場面が想定され、AIシステムどうしの相互の監視など、自律性に対応した新しい安全確保の方法の検討が期待される、とも書かれています。
前節で紹介した AIガバナンス協会の AIガバナンスナビ第2.0版は、AIエージェントに関する取組事項を利用者向けと開発者・提供者向けに分けて新設しています。利用者向けには、権限の設計、行為の範囲の限定、実行の履歴の記録、統制と停止の仕組みを含む管理体制を整えて運用すること、が挙げられています。同じ協会の集計では、この「自律性の高い AIに対する取組」の項目の平均点が、開発者・提供者でも利用者でも全体の平均を大きく下回ったと書かれており、AIエージェントを使うユースケースが確認された一方で、ガバナンスの整備はこれからという状況だと説明されています。
これまでの章の仕組みに当てはめると、AIエージェントを見直しの対象に加えるときに確かめる点は、少なくとも次の4つだと考えています。1つ目は台帳です。ユースケース台帳(第7章)の列に、AIが自ら実行できる操作の範囲(閲覧だけか、登録・送信・発注・削除まで行えるか)と、連携する外部のシステムを加えます。2つ目はリスク区分の基準です。同じ用途でも、AIが提案するだけの場合と、AIが自ら実行する場合とでは、誤りが起きたときの影響が違うので、実行の権限を区分の判定の要素に入れます。3つ目は人の関与と停止です。どの操作の前に人の承認を挟むか、異常に気づいたときに誰がどう止めるかを、停止の基準(第11章)と合わせて決めます。4つ目は記録です。AIが何を根拠にどの操作を行ったかを後から確かめられるよう、実行の履歴を残します。これらは、利用規程(第12章)と研修の内容にも反映させる必要があります。
AIエージェントの扱いは、制度の側でもまだ整理の途中です。AI事業者ガイドラインの別添の記述も、リスクの例と今後の検討への期待が中心で、すべての場面での具体的な対策を定めたものではありません。このため、AIエージェントを使うユースケースは、当面は随時の見直しの対象として扱い、制度の側の更新を「見直しの周期と、制度の改正を追う担当」の節の表で決めた担当が追い、更新があれば台帳と規程に反映する、という運用が現実的だと考えています。
続ける仕組みと、形骸化の型
ここまでの教育・内部監査・見直し・開示を、続ける仕組みとしてまとめます。中心になるのは、定例の会議、継続して測る指標、続けている人を認める仕組みの3つです。定例の会議は、月1回の AIガバナンス委員会(案件が少なければ隔月)、四半期ごとの経営会議への報告、年1回の定期の見直し、という周期が一つの例です。会議体の構成と開催の決まりは第13章で扱いました。継続して測る指標は、台帳に登録されたユースケースの件数と区分の内訳、見直しの期限を過ぎたユースケースの件数、研修の受講の状況、インシデントとヒヤリハットの報告の件数、内部監査の指摘の残りの件数、などが候補になります。続けている人を認める仕組みとしては、ヒヤリハットを報告した人や、台帳の更新を続けている部門を表彰する、AIガバナンスの役割を担う人の活動を人事の評価の項目に入れる、といった方法があります。
指標は数を増やしすぎないことが大切だと考えています。毎月同じ定義で同じ数字を並べ続けることの方が、多くの指標を一度だけ集めるより、変化に気づく手段として役に立ちます。また、件数が減ったことを良い知らせとして扱う前に、本当にリスクが減ったのか、報告や申請が行われなくなっただけなのかを確かめる必要があります。台帳への新しい申請が0件の月が続いたら、AIの新しい使い方が本当に無いのか、手続きが知られていないのか、迂回されているのかを確かめます。
仕組みが形だけになっていく経緯には、いくつかの型があります。立ち上げの時期の判断の誤り(範囲を広げすぎる、規程の制定から入る、など)は第13章で扱いました。次の表は、立ち上げを終えたあとに起きやすい型に限って整理したものです。
| 形骸化の型 | 起きること | 経営上の損失の型 | 早く気づくための兆候 | 防ぐ手順 |
|---|---|---|---|---|
| 台帳が実態から遅れる | 新しく使い始めた AIや、外部のサービスに追加された AI機能が台帳に載らない | 規制違反、権利侵害。台帳に無い AIは、台帳にもとづく区分の判定と監視から漏れるおそれがある | 新しい申請が0件の月が続く。購買や経費の記録に台帳に無いサービスが出てくる | 購買・契約の手続きに台帳への登録の確認を組み込む。内部監査で台帳の網羅性を確かめる |
| 規程が改正に追いつかない | 制度の改正やサービスの規約の変更が規程に反映されない | 規制違反、信頼の失墜 | 規程の改訂日が初版から動かない。制度の確認の記録が残っていない | 追う対象ごとに担当と頻度を決め、「変化なし」も記録する |
| 研修が初版のまま | 規程や使ってよいサービスが変わっても、教材が更新されない | 誤った判断の放置、権利侵害 | 教材の版が古いまま。相談窓口に同じ質問が繰り返し来る | 規程の改訂の手順に教材の更新を含める。受講の記録に教材の版を残す |
| 承認が形だけになる | 申請が増えて、委員会の承認(委員会が承認するのは区分「高」と例外)が書類の確認だけになる | 誤った判断の放置 | 承認までの日数が極端に短い、または長い。差し戻しが0件のまま | 事務局が審議の前に申請の内容を確かめ、審議の資料の様式をそろえる。委員会の審議の時間と、技術や法務に詳しい人員を確保する |
| 承認の後の監視と振り返りが行われなくなる | 承認だけが行われ、運用中の性能や苦情の確認、見直しの期限の管理、インシデントの振り返りが行われなくなる | 誤った判断の放置、信頼の失墜 | 見直しの期限を過ぎたユースケースが増える。監視の記録や振り返りの記録が残っていない | 承認の条件に、運用中に見る指標と見直しの期限を含める(第11章)。期限を過ぎたものを委員会に毎月報告する |
| 監査が運用の確認に偏る | 見えやすい運用の手続きだけが確かめられ、設計と評価の段階が確かめられない | 誤った判断の放置 | 指摘が手続きの漏ればかりで、評価や設計への指摘が無い | 監査に AIの技術を理解する人を加える。評価と記録の観点を監査計画に入れる |
| 開示と実態がずれる | 公開した方針や報告書の記述と、社内の運用が合わなくなる | 信頼の失墜 | 開示した文書の更新日が古い。開示した体制の会議が開かれていない | 開示する文書を見直しと内部監査の対象に含める |
| 部門ごとに別の仕組みができる | 全社の手続きが重いと受け止められ、部門ごとに独自の利用ルールや台帳を作る | 二重投資、導入の停滞 | 部門ごとに別の様式の申請が出てくる。全社の台帳と部門の一覧の件数が合わない | 区分ごとに手続きの重さを変える。部門の工夫を全社の手順書に取り込む |
表の型は互いにつながっています。台帳が実態から遅れたまま、監査と見直しの対象を台帳だけから選ぶと、未登録の AIが両方から漏れます。また、規程が改正に追いつかないと、研修の教材も古いままになります。逆に言えば、1つの型の兆候に気づいたときは、隣の型の兆候も確かめる価値があります。最後の型の「部門ごとに別の仕組みができる」は、全社の仕組みが重すぎると受け止められたときに起きやすく、統制を強めるだけでは解決しにくい型です。リスク区分の低いユースケースの手続きを軽くし、部門の工夫を全社の手順書に取り込むことで、全社の仕組みを使う理由を残すことが有効だと考えています。
経営判断、続けるための最小の投資
この章の最後に、経営が続けるために最低限確保すべきものを整理します。立ち上げの時期の決定と比べると、定着の時期に経営が決めることは小さく見えますが、省くと仕組みが止まるものです。
1つ目は、時間の確保です。自社で定めた頻度(本コラムの例では月1回)の AIガバナンス委員会、四半期ごとの経営会議への報告、年1回の定期の見直しを年間の予定に入れておくこと。制度の改正を追う担当と、内部監査で AIを扱う担当に、そのための時間を割り当てること。予定と担当が決まっていない作業は、忙しい時期に後回しになりやすくなります。
2つ目は、教育を続けることです。研修は一度行えば終わりではなく、規程の改訂、使ってよいサービスの変更、AIエージェントのような新しい使い方の導入のたびに、内容を更新する必要があります。外部の教材を使う場合でも、自社の規程にもとづく短い教材を作って更新する担当は社内に要ります。
3つ目は、独立した確認の場を持つことです。内部監査部門が AIガバナンスを監査の計画に入れること、監査部門に AIの技術を理解する人を加えるか、外部の専門家の協力を得ること。推進する側だけで成果を評価すると、続いていることを示す数字を選びやすくなるので、年に一度でも別の立場から確かめる場を置くことが、文書と実態のずれに早く気づく手段になります。
4つ目は、やめる判断の基準を持つことです。続けることが大切だといっても、誰も見ていない指標や、議題が報告の読み上げだけになった会議を続ける必要はありません。たとえば「半年間、議題が報告だけだった会議は、統合するか議題を見直す」「1年間、一度も参照されなかった手順書は、必要性を確かめたうえで、維持・改訂・廃止のどれにするかを決める」のように、見直しの基準を先に決めておくと、仕組みが形だけになったときに直すきっかけになります。
続けるための投資を省いたときの損失は、本コラムの損失の型でいえば、台帳から漏れた AIによる規制違反や権利侵害、古い規程と研修のまま起きる誤った判断の放置、開示と実態のずれによる信頼の失墜、部門ごとの独自の仕組みによる二重投資、として表れます。立ち上げの時期に投じた経営と担当者の時間が生かされなくなるだけではありません。是正の対応や業務の停止、信用の低下といった追加の損失にもつながります。立ち上げの予算と体制を承認するときに、2年目以降の運用の時間と、見直しと監査の担当を同時に決めておくことが、最小の投資で仕組みを続ける条件だと考えています。
この章では、AIガバナンスを立ち上げたあとに仕組みを回し続けるための、教育・内部監査・見直し・情報開示の4つの手段を整理しました。EU AI Act 第4条は2026年7月の改正後も提供者と導入者に AIリテラシーの措置を求めており、研修は対象別に組み立てて記録を残すこと。内部監査は、2026年7月に公表された IIA の3ラインモデルの新しい声明と AI監査フレームワークを手がかりに、台帳の網羅性から確かめること。見直しは定期と随時に分け、制度の改正を追う担当と確認先を決めて「変化なし」も記録すること。開示は、ウェブのポリシーと統合報告書の役割を分け、開示した内容を見直しと監査の対象に含めること。そして、AIエージェントのような新しい使い方を、台帳・区分・人の関与・記録の4点で見直しに組み込むことです。終章では、本コラム全体を振り返り、AIガバナンスを続けるために経営と現場が持っておくべき視点をまとめます。
この章を深めたい方への参考書籍
『AI倫理 人工知能は「責任」をとれるのか』(西垣通、河島茂生 著、中央公論新社):AIに判断を任せたときに責任を誰がどう負うのかを、情報学の立場から論じた新書です。この章で扱った AIエージェントのように、AIが自ら操作を実行する場面が増えるほど、人の関与と責任の置き場所を決めることの意味が大きくなります。社内研修で AI倫理を扱うときの背景の知識としても参考になります。2019年の刊行なので、その後の制度の動きは含まれていません。
『絵と図でわかるAIと社会 未来をひらく技術とのかかわり方』(江間有沙 著、技術評論社):AIと社会の関わりを、図を多く使って解説した入門書です。この章で扱った全従業員向けの AIリテラシーの研修で、AIの機会とリスクを専門家でない人に伝えるときの材料になります。2021年の刊行なので、生成AIの普及やその後の制度の動きは含まれていない点に注意が要ります。
『AI・ロボットと共存の倫理』(西垣通 編、河島茂生ほか 執筆、岩波書店):複数の執筆者が、AIやロボットと人がともに暮らす社会の倫理を、それぞれの専門の立場から論じた本です。この章で扱った見直しの論点のうち、技術と社会の受け止め方の変化を経営の判断に取り込むときに、議論の幅を広げる材料になります。2022年の刊行です。
終章 AIガバナンスを続けるために
本コラムでは、AIガバナンスを、組織がAIを開発・提供・利用するときに「どの用途に使ってよいか・誰が決めるか・何を基準にどう確かめるか・問題が起きたらどうするか」を定める仕組みとして扱ってきました。第1章で用語と立場ごとの責任をそろえ、第2章から第6章で法律・指針・規格を読み、第7章から第11章でリスク管理の手順を自社に落とし、第12章から第14章で規程と体制と定着の仕組みを組み立てました。終章では、各章の内容を、自社で最初に何をし、何を続けるかという観点でまとめ直します。
制度から読み取れる共通の求め
第2章から第6章で読んだ制度と枠組みは、拘束力も対象も異なります。EU AI Actは、EUの市場に関わるEU AI Actの提供者(provider)と導入者(deployer)に、用途のリスクの水準に応じた義務を課す法律です(第3章)。日本のAI推進法は、本則に罰則の規定を置かず、国や事業者の責務を定めています。活用事業者には、国や地方公共団体の施策への協力も求めています。AI事業者ガイドラインは、同ガイドラインの3つの立場であるAI開発者・AI提供者・AI利用者が取り組むべきことを示す指針です(第4章)。EU AI Actの提供者と、AI事業者ガイドラインのAI提供者は、対応が一対一ではありません(第1章)。NIST AI RMFは任意で使う枠組みで、統治・把握・測定・対処の4つの機能でリスク管理を整理しています(第5章)。ISO/IEC 42001は、AIマネジメントシステムの要求事項を定め、認証の基準として使われうる規格です(第6章)。
拘束力の違うこれらの制度を並べると、明示の度合いは制度によって違いますが、多くの制度に共通して見られる求めがあります。自社のAIがどこで何に使われているかを把握すること、用途ごとにリスクを評価して対策の程度を変えること、責任を持つ人と承認の経路を決めること、評価と監視の記録を残すこと、人が関与して必要なら止められるようにすること、そして仕組みを見直し続けることです。本コラムで、ユースケース台帳(第7章)、本コラムのリスク区分と承認の経路(第7章・第12章・第13章)、評価と記録(第10章)、運用監視と停止の判断(第11章)、見直しの仕組み(第14章)を中心に据えたのは、この共通の求めに沿って骨格を作っておけば、制度の間で共通する管理の作業の重複を減らし、制度ごとに要る追加の対応を整理しやすくなると考えているためです。ただし、制度ごとに義務の中身と対象は違うため、各制度の求めを満たすかどうかは、制度ごとに原文に当たって確かめる必要があります。
最初に行う5つのこと
本コラムの内容を、経営がAIガバナンスに取り組むと決めたあとの最初の手順として並べ直すと、次の5つになります。順序と週ごとの計画は第13章の90日の計画表に対応させています。
- 責任者と会議体を決める:最終的な責任を負うAIガバナンス責任者を経営が決め、部門をまたぐ判断を行うAIガバナンス委員会と、台帳と申請を取りまとめる事務局を置きます。既存のリスク管理の会議体に載せる形でもかまいません(第13章)。
- ユースケース台帳の初版を作る:自社でAIを使っている用途を、外部のサービスの利用も含めて一覧にします。完璧な台帳より、全部門から1回集めることを優先します(第7章)。
- リスク区分の基準と承認の経路を決める:本コラムのリスク区分(禁止・高・中・低)の判定の基準と、区分ごとの承認者を決め、台帳の各行に区分を付けます。EU AI Actの4つの水準とは別物であることを、基準の文書に明記しておきます(第7章・第13章)。
- AI利用規程の初版と、生成AIの入力の区分を決め、最初の教育を行う:何をしてはいけないか、何を入力してよいか、出力をどう確かめるかを、数ページの規程にまとめ、要点を短く説明する教育とあわせて全従業員に示します(第8章・第12章・第14章)。
- 最初の報告を行う:台帳の件数、区分ごとの件数、承認待ちの件数、教育の受講の状況を経営会議に報告し、次の四半期に何を整えるかを決めます(第13章・第14章)。
この5つには、影響評価の全件実施、すべての制度との差分の分析、規格の認証の準備、専用の製品の導入は含めていません。いずれも重要ですが、台帳と承認の経路が無い状態で始めると、何を対象に評価し、何を認証の範囲にするかが決まらず、作業が空回りするおそれがあります。既に使っている区分「高」のユースケースの影響評価(第7章)と評価の手順(第10章)は、5つが終わったあとの第2四半期に置くのが現実的だと考えています。ただし、最初の90日の間も、区分「高」で新しく始めるものは影響評価と承認を経てから使い始めます。既に使っている区分「高」のものも、継続・利用の制限・一時停止のどれにするかを早めに決めます(第13章)。
続けるうえで避けたい型
AIガバナンスの仕組みは、作った直後よりも、作ってから半年、1年と経つうちに形骸化しやすいものです。第11章と第14章の内容をふまえて、とくに避けたい型を3つ挙げます。1つ目は、台帳が更新されなくなることです。新しい用途が申請されずに使われ始めると、台帳は実態を表さなくなり、規制の改正や取引先からの質問に答えられなくなります。申請の手続きを軽くし、低い区分の承認の手続きは業務部門の責任者の承認と台帳への記録に絞っておくことが、更新を続けてもらうための条件になります(第12章・第13章)。手続きを軽くしても、適用される法令の確認と AI利用規程の遵守は区分によらず要ります。
2つ目は、制度の改正を追わなくなることです。本コラムの執筆中にも、EU AI Actの適用の日程は2026年7月27日に発効したデジタル・オムニバス(EUが規制の簡素化のためにまとめて行った改正)で変わり、AI事業者ガイドラインは第1.2版に、人工知能基本計画は第Ⅱ期に改められ、内部監査人協会の3ラインモデルの文書も新しいものに置き換わっていました。誰がどの公式のページを見るかを決め、改正があれば台帳と規程のどこに影響するかを確かめる手順を、見直しの周期に組み込んでおく必要があります(第14章)。3つ目は、承認だけが行われ、運用中の監視と振り返りが行われなくなることです。承認した時点の評価は、入力のデータや使われ方が変われば当てはまらなくなります。停止の基準と停止の権限を決め、インシデントの振り返りを台帳と規程に戻す流れを止めないことが大事です(第11章)。
経営が決めること
AIガバナンスで、経営にしか決められないことがあります。自社がAIの用途にどこまでのリスクを受け入れるかの考え方、禁止とする用途の考え方、そして当面やらないことは何か、です。区分の基準と承認の経路は、この考え方に沿ってAIガバナンス委員会が承認し、AIガバナンス責任者が経営に報告します。これらを現場や事務局に任せきりにすると、判断の基準が案件ごとに揺れ、序章で挙げた導入の停滞と二重投資が起きやすくなります。反対に、これらを経営が決めて文書に残しておけば、現場は安心して使ってよい範囲でAIを使い、事務局は判断の材料をそろえる役割に集中できます。AIガバナンスは、AIの利用を止めるための仕組みではなく、使ってよい範囲をはっきりさせて、AIへの投資の効果を確かめながら広げていくための仕組みだというのが、本コラムの考えです。
本コラムの記述は、2026年10月時点で公式の資料を開いて確認した範囲に基づいています。法令や指針、規格は今後も改正されますので、実務で使う際は公式のページで最新の内容を確かめ、自社の個別の状況への当てはめは弁護士などの専門家に確認してください。データそのものの整え方(品質・来歴・個人情報の扱い)は弊社コラム『データガバナンスの実践ガイド、DMBOKの知識領域から自社の体制づくりまで』、AIの説明可能性の手法は弊社コラム『AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド』、モデルの監視と再学習の技術は弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で扱っています。
Anagraftでは、AI活用の構想づくりから、AIガバナンスの体制設計、ユースケースの洗い出しとリスクの評価、社内ルールの整備、AIの評価と運用の仕組みづくり、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 AIガバナンスとは何か、リスク・原則・責任の整理
『AIガバナンス入門 リスクマネジメントから社会設計まで』(羽深宏樹 著、早川書房):ハヤカワ新書の1冊で、題名のとおり、AIのリスクマネジメントから社会の仕組みの設計までを AIガバナンスとして扱った入門書です。AI事業者ガイドライン(第1.2版)の別添は、AIのリスクの例を分類する際に参考にした分類の一つとして、NIST の AIリスクマネジメントフレームワークと並べてこの本の分類を挙げています。この章で扱ったリスクの型と、AIガバナンスを社内の仕組みとして考える前提を、より広い視野から考えるときの材料になります。
『AIリスク教本 AIエージェント&フィジカルAI AI新時代のガバナンス』改訂新版(日本IBM AI倫理チーム/AI倫理とガバナンス研究会 著、日経BP):2026年8月に出た改訂新版で、国立国会図書館の目次情報によると、仮想のシナリオで AIのリスクを示す章から始まり、AIのリスクがどう起きるかを、基本となる特性と19の分類で整理する章を含みます。この章では社内で扱いやすいようにリスクを7つの型にまとめましたが、自社の型を作るときには、こうした細かい分類と見比べて、見落としている型が無いかを確かめる材料として使えます。
第2章 世界のAI規制と枠組みの見取り図、法律・指針・規格の違い
『ソフトローの基礎理論』(藤田友敬 編、有斐閣):ソフトロー研究叢書の第1巻として2008年に刊行された論文集で、法的な拘束力を持たない規範を主題にしています。目次には、自律的な秩序を経済学から論じる論文や、信頼と規範を社会心理学から論じる論文が並んでいます。AIを扱った本ではありませんが、この章で分けたハードローとソフトローの違いや、ソフトローが取引や社内ルールを通じて実務に影響する仕組みを、理論の側から考えるときの材料になります。
『AI vs法 世界で進むAI規制と遅れる日本』(佐藤洸一 著、マイナビ出版):マイナビ新書の1冊で、副題のとおり各国の AI規制の動きと日本の状況を扱っています。目次の前半は画像生成AIと著作権、対話型AIと法を取り上げています。2023年8月の刊行なので、刊行時期から、EU AI Act の最終的な条文と2026年の改正、日本の AI推進法、韓国の AI基本法の施行は含まれていないと考えられます。制度が動き始めた時期の論点を一冊で見渡すための本として読むと、この章の一覧表と比べて何が変わったかが分かります。
第3章 EU AI Act、リスクの区分と義務と適用の日程
『EU AI法概説』(古川直裕・吉永京子・有坂陽子・羽深宏樹・早川政哉 編著、商事法務):別冊NBL の一冊として2025年7月に刊行された、EU AI Act を日本語で体系的に解説した本です。この章で扱った適用範囲・リスクの区分・提供者と導入者の義務を、条文に沿ってさらに詳しく確かめるときの材料になります。2026年7月27日に発効したデジタル・オムニバスによる改正(高リスクの規定の適用日の変更、第5条への号の追加、第4条の文言の変更など)より前の刊行なので、日程と改正された条文は、統合版の原文で確かめ直す必要があります。
『EUのAIガバナンス 新技術に対する国際的な科学技術ガバナンスに向けて』(北和樹 著、晃洋書房):2025年3月に刊行された本で、EU の科学技術分野の権限と枠組みから説き起こし、原則から実践へと進んだ EU の AI法の特徴を論じています。この章では条文の要旨を整理しましたが、EU がなぜリスクにもとづく規制の形を選んだのかを、EU の統治の仕組みの側から理解するときの参考になります。この本もデジタル・オムニバスより前の刊行で、改正の内容は含みません。
第4章 日本のAI推進法とAI事業者ガイドライン、国の指針の読み方
『AI事業者ガイドライン 第1.0版』(経済産業省商務情報政策局情報産業課情報処理基盤産業室、総務省情報流通行政局参事官室 監修、商事法務):別冊NBL の no. 190 として2024年9月に刊行された本で、書名のとおり AI事業者ガイドラインの第1.0版を扱っています。刊行の時期から、第1.01版・第1.1版・第1.2版での改訂(AIエージェントの定義の追加など)と、AI推進法・適正性確保に関する指針の内容は含まれていません。紙の形で通して読みたいときに使い、条文は e-Gov 法令検索で、ガイドラインの最新の版は総務省の掲載ページで確かめる、という使い方を想定しています。
『AIガバナンス』(ベーカー&マッケンジー法律事務所(外国法共同事業) 編集、商事法務):2026年10月に刊行された本で、出版情報登録センターが提供している目次には、AIガバナンスの構築、AIガバナンスを始めるためのステップ、AI原則、AI利用及び開発のための規則作り、AI影響評価などの章が並んでいます。この章の後半で扱った、国のガイドラインを自社の原則と規則に落とす作業を、法務の立場から具体的に考えるときの材料になります。内容が AI事業者ガイドラインのどの版を前提にしているかは、本を開いて確かめる必要があります。
第5章 NIST AI RMFと生成AIプロファイル、リスク管理の4つの機能
『AI経営のリスクマネジメント』(寺嶋正尚 編著、日経BP日本経済新聞出版本部):AIを経営に使うときのリスクマネジメントを、技術・法務・ガバナンスの観点から論じた本です。版元の目次によると、AI経営の展開事例、AIベンダーの動向、法規制とガイドライン、AI経営のリスクを扱ったうえで、技術的な視点・法的な視点・ガバナンスの視点のそれぞれからリスクマネジメントを論じています。この章で扱った、リスク許容度を経営が決めることや、第三者の AIを導入する側の責任を、経営の立場から考えるときの材料になります。2021年の刊行で、NIST AI RMF 1.0(2023年)と生成AIプロファイル(2024年)より前の本なので、両文書の内容は含まれていません。
『AIリスク・マネジメント 信頼できる機械学習ソフトウェアへの工学的方法論』(中島震 著、丸善出版):AI、特に機械学習のリスクマネジメントを、IT リスク、ソフトウェア品質、AI倫理との関係を含めて解説した本です。版元の紹介と目次によると、リスクとトラスト、ソフトウェア品質モデル、機械学習ソフトウェアの特徴、信頼される AIなどを扱っており、この章の測定の機能や信頼できる AIの特性を、ソフトウェア工学の側から考えるときに参考になります。2022年の刊行で、生成AIプロファイル(2024年)より前の本です。
第6章 ISO/IEC 42001とAIマネジメントシステム、関連規格と認証
『ISO/IEC 42001:2023〈JIS Q42001:2025〉情報技術-人工知能-マネジメントシステム要求事項の解説』(髙村博紀 編著、日本規格協会):日本規格協会の Management System ISO SERIES の1冊で、2025年10月に出ています。書名のとおり、国際規格と JIS Q 42001 の要求事項を解説する本で、本章では確かめられなかった箇条と附属書の中身を、規格の本文と並べて読むときの手引きになります。
『最新AIマネジメントシステムISO42001の仕組みと導入がよ~くわかる本 認証の必要知識を基本から解説!』(打川和男 著、秀和システム新社):図解入門ビジネスのシリーズの1冊で、2025年11月に出ています。副題が示すとおり、規格の仕組みと導入、認証に必要な知識を入門向けに扱う本で、認証を取るかどうかを判断する前に全体の流れを掴む用途に向いています。
第7章 AIのリスクを洗い出して評価する、ユースケース台帳と影響評価
『「AIリスク」の解剖 決定と責任を社会学的に考える』(佐久間弘明 著、中央経済社):2026年3月刊行の本で、国立国会図書館の書誌の要約によれば、「AIリスク」をそれへの批判の言説から読み解いて具体化し、社会実装に資する議論の道筋を示すものです。この章で、残るリスクを受け入れるかどうかの判断を委員会に置き、判断の理由を記録に残すとした点を、リスクをめぐる決定と責任の関係という側面から考えるときの材料になります。
『ISO 31000:2018〈JIS Q 31000:2019〉リスクマネジメント解説と適用ガイド』(リスクマネジメント規格活用検討会 編著、日本規格協会):リスクマネジメントの国際規格 ISO 31000(2018年)と、それに対応する JIS Q 31000(2019年)の解説書です。ISO 31000 は AIに限らない組織のリスクマネジメントの指針で、この章の影響評価の6つの段階を、自社がすでに持っている全社的なリスク管理の手順と結び付けるときの土台になります。
『プライバシー影響評価実施マニュアル ISO/IEC 29134対応』(瀬戸洋一 編著、長谷川久美 著、日科技連出版社):個人情報の取扱いについての影響評価(PIA)を、国際規格 ISO/IEC 29134 に沿って実施する手順を扱った本です。AIの影響評価と PIA は、影響を受ける人を特定し、害を洗い出し、対策と残るリスクを記録するという骨格が近いので、個人情報を入力する用途の影響評価をどう組み立てるかを考えるときに参考になります。2020年の刊行のため、その後の個人情報保護法の改正(令和8年改正を含む)は別に確かめる必要があります。
第8章 生成AIの社内利用ルール、入力・出力・権利・個人情報
『生成AIと知財・個人情報Q&A』(齋藤浩貴・上村哲史 編著、商事法務):生成AIと知的財産・個人情報に関わる論点を、問いと答えの形で扱う本です。2024年7月の刊行で、文化庁の「考え方」(2024年3月)の後、チェックリスト&ガイダンス(2024年7月31日)や個人情報保護法の令和8年改正、AI事業者ガイドライン第1.2版より前の本である点に注意が要ります。この章で扱った入力の区分と著作権・個人情報の論点を、法務の担当者と一緒に個別の場面に当てはめて考えるときの材料になります。
『生成AIと著作権の論点』(福岡真之介 編著、商事法務):書名のとおり、生成AIと著作権に関わる論点を扱う本で、2025年8月に刊行されています。この章では、開発・学習段階と生成・利用段階を分ける文化庁の整理を要旨で紹介するにとどめたので、著作権法第30条の4の適用の範囲や、依拠性の考え方を掘り下げて理解したいときの材料になります。個人情報保護法の令和8年改正より前の刊行です。
『AIと著作権』(上野達弘・奥邨弘司 編著、勁草書房):AIと著作権の関係を扱う本で、2024年2月の刊行です。文化庁の「考え方」(2024年3月15日)より前に出た本なので、「考え方」による整理はこの本には含まれていません。その前提で、この章で扱った論点が、どのような議論を経て整理されてきたのかを知りたいときの材料になります。
第9章 AIの調達と開発の管理、ベンダー選定と契約で確かめること
『AI・データ関連契約の実務 AI技術、限定提供データの創設を踏まえて』(森本大介、濱野敏彦 編著、中央経済社):副題のとおり、AI技術と、不正競争防止法の限定提供データの制度を踏まえて、AIとデータに関わる契約の実務を扱った本です。この章で扱った開発の委託の契約や、インプットとその処理成果の扱いを、契約ガイドラインの考え方とあわせて掘り下げるときの材料になります。2020年の刊行で、2025年2月の契約チェックリストと個人情報の保護に関する法律の令和8年の改正は含まれていません。生成AIのサービスの利用契約に固有の論点は、最新の公式資料とあわせて確かめる必要があります。
『ITビジネスの契約実務』(伊藤雅浩、久礼美紀子、高瀬亜富 著、商事法務):IT ビジネスの商流と契約、ソフトウェア開発委託契約、ソフトウェアライセンス契約、システム保守委託契約などを章ごとに扱った本で、現在の版は2021年10月の第2版です。AIの開発を委託する契約も、多くはソフトウェアの開発委託や保守の契約の上に成り立っているため、この章で扱った準委任と請負の違い、成果物と権利の扱い、保守と追加学習の契約を考えるときの土台になります。2021年の刊行のため、2022年以降の生成AIのサービスの普及と、その後の国の資料の動きは反映されていません。
第10章 AIの品質と公平性を確かめる、テスト・評価・記録
『高リスク分野のための機械学習 責任あるAI構築のための実践アプローチ』(Patrick Hall、James Curtis、Parul Pandey 著、高江洲勲 ほか訳、オライリー・ジャパン):原題は Machine Learning for High-Risk Applications で、版元の目次には、機械学習におけるバイアスの管理、安全性と性能の検証、セキュリティの章に加えて、バイアスのテストと修正、レッドチーム演習を実際のモデルで行う章があります。この章で扱った公平性の指標の計算とレッドチーミングを、手を動かして深めるときの材料になります。
『機械学習工学』(石川冬樹、丸山宏 編著、柿沼太一、竹内広宜、土橋昌、中川裕志、原聡、堀内新吾、鷲崎弘宜 著、講談社):機械学習プロフェッショナルシリーズの1冊で、版元の目次には、機械学習システムの開発と検証、運用、品質のとらえ方と管理、モデルの説明法、AI倫理の章があります。この章で扱った評価の観点を、ソフトウェアの品質の管理としてどう位置づけるかを考えるときに参考になります。
第11章 AIの運用監視とインシデント対応、記録・報告・停止の判断
『信頼性の高い機械学習 SRE原則を活用したMLOps』(Cathy Chen、Niall Richard Murphy、Kranti Parisa、D. Sculley、Todd Underwood 著、井伊篤彦、張凡、樋口千洋 訳、オライリー・ジャパン):システムの信頼性を保つための考え方である SRE の原則を、機械学習のシステムの構築と運用に当てはめた本です。目次には、モデルの監視と可観測性を扱う章と、障害対応を扱う章があり、障害対応の章は障害の段階と役割、ML を中心とした機能停止の分析、役割ごとの障害管理の原則を扱っています。この章で扱った監視の計画、段階ごとの役割、止める判断を、技術の担当の側から具体的に考えるときの材料になります。
『SRE サイトリライアビリティエンジニアリング Googleの信頼性を支えるエンジニアリングチーム』(Betsy Beyer、Chris Jones、Jennifer Petoff、Niall Richard Murphy 編、澤田武男、関根達夫、細川一茂、矢吹大輔 監訳、Sky株式会社 玉川竜司 訳、オライリー・ジャパン):大規模なシステムを運用する組織の考え方と実践をまとめた本で、AIに限った本ではありません。目次には、インシデント管理の章と、ポストモーテム(事後の振り返り)の文化を扱う章があり、インシデントとして宣言すべき場合や、失敗から学ぶ振り返りの考え方が扱われています。この章で書いた、手順として宣言する基準を先に決めることや、責任の追及ではなく仕組みの原因を探す振り返りを、既に確立した運用の分野の知見から考えるときに参考になります。
第12章 社内ルールの作り方、AI基本方針・利用規程・手順書
『生成AIの法的リスクと対策 増補改訂版』(福岡真之介、松下外 著、日経BP):生成AIの開発・学習の段階と、生成・利用の段階の法的なリスクを分けて解説した本で、版元の目次によると、第6章が生成AIの社内ガイドラインと利用規約のチェックポイントを扱っています。この章で扱った AI利用規程の禁止事項や利用時の遵守事項を、法的なリスクの側から確かめるときの材料になります。2025年12月の刊行で、AI事業者ガイドライン第1.2版(2026年3月)と EU AI Act のデジタル・オムニバス(2026年7月)は含まれていません。
『生成AI法務・ガバナンス 未来を形作る規範』(中崎尚 著、商事法務):生成AIをめぐる法務の課題をガバナンスと結びつけて扱った本です。この章で、AI利用規程に AIに固有の部分だけを書き、既存の規程と役割を分けると書いた整理を、法務の側から考えるときの手がかりになります。2024年7月の刊行で、その後の AI推進法(2025年)、AI事業者ガイドライン第1.2版、デジタル・オムニバスは含まれていません。
第13章 AIガバナンスの体制づくり、役割と会議体と最初の90日
『責任あるAI「AI倫理」戦略ハンドブック』(保科学世・鈴木博和 著、東洋経済新報社):AIを責任をもって使うための取り組みを、技術・ブランド・ガバナンス・組織と人の4つの方向から解説した本です。出版社の紹介する目次には、AIガバナンスのロードマップと日本企業での導入を扱う節、AI倫理を組織に根付かせるための研修とコミュニケーションを扱う節があります。この章の体制づくりの順序と、役割を組織に定着させる考え方を補う材料になります。2021年の刊行なので、EU AI Act の成立とその後のデジタル・オムニバスによる改正、AI推進法、AI事業者ガイドラインの第1.2版、IIA の3ラインモデルの2026年の改訂は含まれていません。
『不正・不祥事のメカニズムと未然防止 不正のトライアングル・内部統制・3線モデルから見た対策とチェックリスト』(島田裕次 著、日科技連出版社):不正や不祥事がなぜ起きるのかを、不正のトライアングル・内部統制・3線モデルの観点から整理し、対策とチェックリストを示した本です。AIを主題にした本ではありませんが、この章で AIガバナンスに当てはめた3ラインモデルの考え方を、組織の統制の一般論として確かめるときの材料になります。2023年の刊行なので、IIA が2026年7月に公表した3ラインモデルの新しい文書は含まれていません。
第14章 定着と見直し、教育・内部監査・情報開示と公開事例
『AI倫理 人工知能は「責任」をとれるのか』(西垣通、河島茂生 著、中央公論新社):AIに判断を任せたときに責任を誰がどう負うのかを、情報学の立場から論じた新書です。この章で扱った AIエージェントのように、AIが自ら操作を実行する場面が増えるほど、人の関与と責任の置き場所を決めることの意味が大きくなります。社内研修で AI倫理を扱うときの背景の知識としても参考になります。2019年の刊行なので、その後の制度の動きは含まれていません。
『絵と図でわかるAIと社会 未来をひらく技術とのかかわり方』(江間有沙 著、技術評論社):AIと社会の関わりを、図を多く使って解説した入門書です。この章で扱った全従業員向けの AIリテラシーの研修で、AIの機会とリスクを専門家でない人に伝えるときの材料になります。2021年の刊行なので、生成AIの普及やその後の制度の動きは含まれていない点に注意が要ります。
『AI・ロボットと共存の倫理』(西垣通 編、河島茂生ほか 執筆、岩波書店):複数の執筆者が、AIやロボットと人がともに暮らす社会の倫理を、それぞれの専門の立場から論じた本です。この章で扱った見直しの論点のうち、技術と社会の受け止め方の変化を経営の判断に取り込むときに、議論の幅を広げる材料になります。2022年の刊行です。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- AI事業者ガイドラインの最新は第1.2版で2026年3月31日公表、総務省と経済産業省
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - AI事業者ガイドラインの最新は第1.2版で2026年3月31日公表、総務省と経済産業省
https://www.soumu.go.jp/main_content/001064279.pdf - 主体ごとに重要となる事項をまとめた表1は、同じ題名で同じ項目の表が本編と別添の両方にある
https://www.soumu.go.jp/main_content/001064286.pdf - AIリスク教本の目次に、基本10特性とリスク19分類を扱う章がある
https://ndlsearch.ndl.go.jp/books/R100000002-I034860296 - ISO/IEC 38507の規格本文は有料で販売されている
https://www.iso.org/standard/56641.html - OECDの人工知能に関する理事会勧告は2019年5月22日採択、2023年11月8日に定義を改訂、2024年5月3日に改訂
https://legalinstruments.oecd.org/en/instruments/OECD-LEGAL-0449 - EU AI Act 第3条第1号のAIシステムの定義の要旨
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-3 - 欧州委員会は2025年2月6日にAIシステムの定義に関するガイドラインを公表し、拘束力はないとされる
https://digital-strategy.ec.europa.eu/en/library/commission-publishes-guidelines-ai-system-definition-facilitate-first-ai-acts-rules-application - ISO/IEC 38507は2022年4月発行の第1版、JTC 1の SC 42 が所管、状態は発行済み
https://web.archive.org/web/20261017090717/https://www.iso.org/standard/56641.html - 人間中心のAI社会原則は2019年3月29日統合イノベーション戦略推進会議決定
https://www8.cao.go.jp/cstp/ai/aigensoku.pdf - 参考書籍 AIガバナンス入門 リスクマネジメントから社会設計まで、羽深宏樹 著、早川書房、ハヤカワ新書 017、2023年12月
https://ndlsearch.ndl.go.jp/books/R100000002-I033209767 - AIリスク教本の著者表示を日本IBM AI倫理チーム/AI倫理とガバナンス研究会とした
https://www.hanmoto.com/bd/isbn/9784296210770
第2章
- AI事業者ガイドライン第1.2版は自らを非拘束的なソフトローと位置づけ、ゴールベースの考え方で作成したと説明している
https://www.soumu.go.jp/main_content/001064279.pdf - AI事業者ガイドライン第1.2版は2026年3月31日公表で、総務省と経済産業省が作成
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - AI事業者ガイドライン第1.2版は2026年3月31日公表で、総務省と経済産業省が作成
https://www.soumu.go.jp/main_content/001064304.pdf - EU AI Act は2024年8月1日に発効し、例外を除き2026年8月2日から適用
https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai - 第113条の統合版で附属書III の高リスクは2027年12月2日、附属書I は2028年8月2日から
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - 第2条第1項は EU 域外の提供者、EU 域内の導入者、出力が EU で使われる域外の提供者と導入者などを挙げる
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-2 - 第40条は整合規格に従う場合に要件への適合を推定する仕組み
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-40 - 第9条・第11条・第12条・第13条・第14条・第26条・第49条・第50条・第71条の題名
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-49 - 附属書III は第4項に雇用、第5項に不可欠なサービスを挙げ、採用と個人の与信の評価を含む
https://ai-act-service-desk.ec.europa.eu/en/ai-act/annex-3 - 欧州評議会の AI枠組条約は CETS 第225号、2024年9月5日にビリニュスで署名開放
https://rm.coe.int/1680afae3c - 大統領令14110は2023年10月30日署名、2025年1月20日の大統領令14148で撤回
https://www.federalregister.gov/documents/2023/11/01/2023-24283/ - 大統領令14179は2025年1月23日署名、14110 にもとづく措置の見直しと停止・修正・撤回を求める
https://www.federalregister.gov/documents/2025/01/31/2025-02172/ - 大統領令14365は2025年12月11日署名、州ごとの規制を問題とし、全国共通の基準を議会とともに作る方針、司法長官の作業部会と商務長官の評価を命じ、コロラド州の法律に言及
https://www.federalregister.gov/documents/full_text/text/2025/12/16/2025-23092.txt - 大統領令14409は2026年6月2日署名、政府の情報システムのサイバー防御の強化などを命じる
https://www.federalregister.gov/documents/full_text/text/2026/06/05/2026-11415.txt - 大統領令14434は2026年9月29日署名、題名は超知能の時代の幕開け
https://www.federalregister.gov/documents/2026/10/02/2026-20321/inaugurating-the-era-of-super-intelligence - コロラド州 SB24-205 は2024年5月17日に知事が署名、高リスクの AIシステムの開発者と導入する者に合理的な注意を求め、当初は2026年2月1日以降の義務
https://leg.colorado.gov/bills/sb24-205 - 2025年の臨時会の SB25B-004 で要件の適用日を2026年6月30日に延期
https://leg.colorado.gov/bills/sb25b-004 - コロラド州 SB26-189 は2026年5月14日に知事が署名、SB24-205 の規定を廃止して定め直し、重要な決定に使う自動意思決定技術を対象にし、主な要件は2027年1月1日から
https://www.leg.colorado.gov/bills/SB26-189 - 英国の白書は2023年3月29日公表、科学・イノベーション・技術省と AI室
https://www.gov.uk/government/publications/ai-regulation-a-pro-innovation-approach - 英国政府の回答は2024年2月6日、5つの原則を挙げ、まず法律にもとづかない形で置く
https://www.gov.uk/government/consultations/ai-regulation-a-pro-innovation-approach-policy-proposals/outcome/a-pro-innovation-approach-to-ai-regulation-government-response - 中国の生成AI暫定弁法は国家インターネット情報弁公室 令第15号、7部門、公布令の日付は2023年7月10日で掲載は7月13日、2023年8月15日施行
https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm - 韓国の AI基本法は法律第20676号、2025年1月21日制定、2026年1月22日施行
https://www.law.go.kr/LSW/lsInfoP.do?lsiSeq=268543 - 韓国の AI基本法 第2条第4号(高影響 AIの定義と領域)・第4条(域外適用)・第31条・第32条・第33条・第34条・第35条・第36条・第43条の内容
https://www.law.go.kr/LSW/lsInfoR.do?lsiSeq=268543&efYd=20260122 - 韓国の AI基本法は2026年7月21日施行の改正版、法律第21311号も表示されている
https://law.go.kr/LSW/lsLinkCommonInfo.do?chrClsCd=010202&lsJoLnkSeq=1031810895 - OECD の AI勧告は2019年5月22日採択、2023年11月8日・2024年5月3日改訂、勧告に加わる国が原則を推進・実施
https://legalinstruments.oecd.org/public/doc/648/648.en.pdf - 広島AIプロセスは2023年5月の G7 広島サミットで立ち上げ、包括的政策枠組みをとりまとめ、2025年2月に報告枠組みの正式運用開始
https://www8.cao.go.jp/cstp/ai/ai_guideline/ai_gl_2025.pdf - 総務省の成果文書ページに掲載の文書(G7首脳声明 2023年10月30日、高度なAIシステムを開発する組織向けの国際指針・国際行動規範、G7デジタル・技術閣僚声明 2023年12月1日、全てのAI関係者向けの国際指針)
https://www.soumu.go.jp/hiroshimaaiprocess/documents.html - 報告枠組みは OECD が運営、第1回の報告は25件、第2版で導入・提供の組織にも参加を広げた
https://oecd.ai/en/transparency/overview - UNESCO の AI倫理勧告は2021年11月に193の加盟国が採択、初めての世界的な基準、4つの価値
https://www.unesco.org/en/artificial-intelligence/recommendation-ethics - 参考書籍『ソフトローの基礎理論』藤田友敬 編、有斐閣、2008年11月、ソフトロー研究叢書 第1巻
https://ndlsearch.ndl.go.jp/books/R100000002-I000009862454 - 参考書籍『AI vs法 世界で進むAI規制と遅れる日本』佐藤洸一 著、マイナビ出版、2023年8月、マイナビ新書
https://ndlsearch.ndl.go.jp/books/R100000002-I032994171
第3章
- EU AI Act は EU 規則 2024/1689
https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai - Service Desk の条文は EUR-Lex 統合版の2026年7月27日時点に基づく
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - オムニバスの発効の発表と改正点(附属書IIIは2027年12月2日、附属書Iは2028年8月2日、SMCへの簡素化の拡大、AIリテラシーの簡素化、性的な生成物の禁止、偏りの検知のための特別な種類の個人データの処理)
https://digital-strategy.ec.europa.eu/en/news/ai-omnibus-enters-force - 第2条第1項(a)から(g)の対象
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-2 - 第3条第3号 提供者、第4号 導入者、第5号 認定代理人、第6号 輸入者、第7号 販売者、第8号 事業者
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-3 - 第4条 AIリテラシーの改正後の文言(支える措置をとる、特定の水準の保証までは求めない、欧州委員会と加盟国の支援と実例の公表)
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-4 - 第5条第1項の号は(a)(b)(ba)(bb)(c)から(h)、(ba)(bb)はオムニバスで新設
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-5 - 第6条第1項 附属書Iの安全部品で第三者適合性評価が要るもの、第1a項・第1b項(オムニバスで新設)、第2項 附属書III、第3項 例外の4条件とプロファイリングは常に高リスク、第4項 評価の文書化と登録、第5項 指針
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-6 - 附属書I 第A節の法令(玩具・エレベーター・圧力機器・無線機器・個人用保護具・医療機器・体外診断用医療機器ほか)、第A節第1号の削除、第B節(民間航空・自動車・農林業用車両・船舶用機器・鉄道ほか)、第B節末尾に機械規則 EU 規則 2023/1230 が新設
https://ai-act-service-desk.ec.europa.eu/en/ai-act/annex-1 - 附属書III の8分野と各号の用途
https://ai-act-service-desk.ec.europa.eu/en/ai-act/annex-3 - 高リスクの分類の指針は案の段階で、意見募集は2026年7月23日まで
https://ai-act-service-desk.ec.europa.eu/en/guidelines-classification-high-risk-ai-systems - 第16条(a)から(l)の提供者の義務
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-16 - 第25条第1項 提供者とみなされる3つの場合、第2項 最初の提供者の協力(オムニバスで改正)
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-25 - 第26条 導入者の義務(第1・2・4・5・6・7・8・9・10・11・12項)、ログの保管は少なくとも6か月、金融機関の特例
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-26 - 第27条 基本権影響評価の対象(公法上の団体、公共サービスを提供する民間の主体、附属書III第5項(b)(c)の導入者
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-27 - 第40条第1項 整合規格による適合の推定
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-40 - 第50条第1項から第5項の透明性の義務と例外
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-50 - 第50条の指針は2026年7月20日公表、透明性の義務は2026年8月2日から適用
https://digital-strategy.ec.europa.eu/en/library/guidelines-transparency-obligations-providers-and-deployers-ai-systems - 第51条 システミックリスクの分類、学習の計算量が10の25乗回を超えると推定、欧州委員会の指定
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-51 - 第53条第1項(a)から(d)、第2項 オープンソースの例外、第4項 行動規範への依拠
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-53 - 第55条第1項(a)から(d)、第2項 行動規範への依拠
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-55 - 汎用目的AIの行動規範は2025年7月10日公表、透明性・著作権・安全性とセキュリティの3章、任意の手段
https://digital-strategy.ec.europa.eu/en/policies/contents-code-gpai - 第99条 加盟国が罰則を定める、3段階の上限、定額と世界の年間売上高に対する割合の高い方、中小企業とスタートアップは低い方、SMC は第4項・第5項で低い方、第7項の考慮の要素
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-99 - 第111条第1項から第4項の経過措置(大規模ITシステム、既存の高リスクと公的機関の2030年8月2日、既存の汎用目的AIモデルの2027年8月2日、既存の生成AIの第50条第2項の2026年12月2日)
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-111 - 欧州委員会は CEN と CENELEC に10分野の規格の作成を求め、合同技術委員会 JTC 21 が作業、規格の適用は任意
https://digital-strategy.ec.europa.eu/en/policies/ai-act-standardisation - JTC 21 は CEN と CENELEC の合同技術委員会で AI Act の整合規格を作成
https://www.cencenelec.eu/areas-of-work/cen-cenelec-topics/artificial-intelligence/ - 2026年10月19日、最初の整合規格 EN 18286(2026年)の参照を官報に公表、第17条の品質マネジメントシステムに対応、ライフサイクルを軸にし ISO/IEC 42001 や ISO 9001 に重ねて使う設計、他の整合規格は続く見込み
https://digital-strategy.ec.europa.eu/en/library/first-harmonised-standard-supporting-ai-act-published-official-journal - 第43条 附属書Iの製品は各製品の法令の手続き、附属書III第2〜8項は内部管理、第1項は整合規格の適用状況で分かれる
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-43 - 第70条 各加盟国は少なくとも1つの市場監視当局を設けるか指定する
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-70 - 第4a条は厳格に必要で、合成データや匿名化データでは果たせないことなど、所定の条件をすべて満たす場合に限る
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-4a - 『EU AI法概説』古川直裕・吉永京子・有坂陽子・羽深宏樹・早川政哉 編著、商事法務、2025年7月、別冊NBL No.192
https://ndlsearch.ndl.go.jp/books/R100000002-I034184614 - 『EUのAIガバナンス 新技術に対する国際的な科学技術ガバナンスに向けて』北和樹 著、晃洋書房、2025年3月
https://ndlsearch.ndl.go.jp/books/R100000002-I033964866
第4章
- e-Gov の法令情報の略称はAI法
https://laws.e-gov.go.jp/law/507AC0000000053 - 2025年6月4日に公布・一部施行、9月1日に全面施行
https://www8.cao.go.jp/cstp/ai/ai_act/ai_act.html - 人工知能基本計画は2025年12月23日閣議決定、副題は信頼できるAIによる日本再起
https://www8.cao.go.jp/cstp/ai/ai_plan/ai_plan.html - 人工知能基本計画は2025年12月23日閣議決定、副題は信頼できるAIによる日本再起
https://www8.cao.go.jp/cstp/ai/ai_plan/aiplan_20251223.pdf - 現行の計画は2026年7月14日閣議決定、副題は日本AX、より強く、より豊かに
https://www8.cao.go.jp/cstp/ai/ai_plan/aiplan_20260714.pdf - 適正性確保に関する指針は2025年12月19日人工知能戦略本部決定、第13条に基づく
https://www8.cao.go.jp/cstp/ai/ai_guideline/ai_gl_2025.pdf - 府省庁等のガイドライン等一覧は17件、1番目がAI事業者ガイドライン
https://www8.cao.go.jp/cstp/ai/ai_guideline/ai_guideline.html - AI事業者ガイドラインの版と公表日(第1.0版2024年4月19日、第1.01版2024年11月22日、第1.1版2025年3月28日、第1.2版2026年3月31日)
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - 本編の目次(はじめに、第1部〜第5部、第2部のA〜E)
https://www.soumu.go.jp/main_content/001064279.pdf - 別添の目次(別添1〜6、別添7〜9は別資料)
https://www.soumu.go.jp/main_content/001064286.pdf - チェックリストは別添7、全主体向けと広島AIプロセス国際指針の2種
https://www.soumu.go.jp/main_content/001064289.pdf - 令和7年度更新内容の資料の日付は2026年3月12日、更新の論点は7つ
https://www.soumu.go.jp/main_content/001064301.pdf - 活用の手引き(案)は案の段階で見直しの可能性、誤った理解の例、4つの準備事項、相談とセルフチェックの区分、既存の体制の活用
https://www.soumu.go.jp/main_content/001064304.pdf - 参考書籍『AI事業者ガイドライン 第1.0版』
https://ndlsearch.ndl.go.jp/books/R100000002-I033683606 - 参考書籍『AIガバナンス』ベーカー&マッケンジー法律事務所 編集、商事法務、2026年10月
https://ndlsearch.ndl.go.jp/books/R100000137-I9784785732738 - デジタル庁の生成AIの調達・利活用のガイドラインは2026年6月12日に第2.0版を決定
https://www.digital.go.jp/news/decb64eb-f26e-41cb-8d37-f3dd173108b8 - デジタル庁のガイドラインは政府情報システムについて遵守する内容を定めた文書
https://www.digital.go.jp/assets/contents/node/information/field_ref_resources/decb64eb-f26e-41cb-8d37-f3dd173108b8/59054b35/20260612_resources_standard_guidelines_guideline_01.pdf
第5章
- NIST AI RMF 1.0 は NIST AI 100-1、2023年1月26日公表、任意で使う枠組み
https://www.nist.gov/itl/ai-risk-management-framework - NIST AI RMF 1.0 本文(構成・目的・任意・業種非依存・ユースケース非依存・2部構成・付録)
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf - 日本語訳があり、日本政府が翻訳し NIST のために翻訳会社が確認した公式翻訳、正本は英語版
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.jpn.pdf - AI RMF Playbook は任意の資料、提案された行動・参考文献・関連する指針、最初の完全版は2023年3月30日、AI RMF 1.0 の改訂後に更新、ページの更新日2026年6月10日
https://www.nist.gov/itl/ai-risk-management-framework/nist-ai-rmf-playbook - 生成AIプロファイルは AI RMF 1.0 の分野横断のプロファイルで、大統領令第14110号に基づいて作成
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf - クロスウォークの一覧、掲載は推奨を意味せず網羅も意味しない、掲載前に NIST の職員が確認
https://airc.nist.gov/airmf-resources/crosswalks/ - ISO/IEC 42001 との対応表は提供者が Microsoft、FDIS 段階が対象、72のサブカテゴリごとに箇条と附属書の項目を対応
https://airc.nist.gov/docs/NIST_AI_RMF_to_ISO_IEC_42001_Crosswalk.pdf - ISO/IEC 42001 は2023年12月発行
https://www.iso.org/standard/42001 - 用語の対応表で、妥当性確認の定義はガイドラインに無く、検証可能性の確保が透明性の要素として示され、関係する項目に安全性と透明性
https://airc.nist.gov/docs/FINAL_Crosswalk1_Terminology_RMF_GfB.pdf - 概念の対応表は第1.0版が対象と読める、論点は Playbook から、「違いは記載されていない」は違いが無いことを意味しない、廃止・ドリフト・敵対的な攻撃・導入後の報告の動機付けの違い
https://airc.nist.gov/docs/FINAL_Crosswalk2_Concepts_RMF_GfB.pdf - 参考書籍『AI経営のリスクマネジメント』寺嶋正尚 編著、日経BP日本経済新聞出版本部、2021年
https://ndlsearch.ndl.go.jp/books/R100000002-I031325530 - 参考書籍『AIリスク・マネジメント 信頼できる機械学習ソフトウェアへの工学的方法論』
https://ndlsearch.ndl.go.jp/books/R100000002-I032551723 - NIST AI RMF は規模・業種を問わず、国境の内外で活動する組織に使えるよう作られている
https://www.nist.gov/itl/ai-risk-management-framework/ai-risk-management-framework-faqs - EU AI Act は第三国の提供者・導入者でも、出力がEU域内で使われる場合に掛かりうる
https://artificialintelligenceact.eu/article/2/
第6章
- ISO/IEC 42001 は JTC 1 の SC 42 が作り、2023年12月に第1版、状態は発行済み、51ページ
https://www.iso.org/standard/42001 - ISO の解説ページが挙げる要求事項の範囲(リーダーシップと組織の状況、方針と目的、リスク、データとライフサイクル、透明性、評価と監視、改善)
https://www.iso.org/home/insights-news/resources/iso-42001-explained-what-it-is.html - 箇条4から箇条10の項目名(組織の状況、リーダーシップ、計画、支援、運用、パフォーマンス評価、改善の各項目)
https://airc.nist.gov/docs/NIST_AI_RMF_to_ISO_IEC_42001_Crosswalk.pdf - ISO/IEC 42005 の目録の概要(影響を受けうる個人と社会、いつ・どの段階で、文書化、リスクマネジメントと AIマネジメントシステムへの組み込み)
https://www.iso.org/standard/42005 - ISO/IEC 22989 は2022年7月、第1版、60ページ、発行済み
https://www.iso.org/standard/74296.html - ISO/IEC 22989 は2022年7月、第1版、60ページ、発行済み
https://web.archive.org/web/20261022220538/https://www.iso.org/standard/74296.html - ISO/IEC 23894 は2023年2月、第1版、26ページ、発行済み
https://www.iso.org/standard/77304.html - ISO/IEC 42006 は2025年7月、第1版、31ページ、発行済み
https://www.iso.org/standard/44546.html - ISO/IEC 38507 は2022年4月、第1版、28ページ、発行済み
https://www.iso.org/standard/56641.html - ISO/IEC 5259 の第1部から第4部は2024年、第5部は2025年、いずれも第1版、第6部は技術報告書として2026年5月
https://www.iso.org/standard/81088.html - ISO/IEC 5259 の第1部から第4部は2024年、第5部は2025年、いずれも第1版、第6部は技術報告書として2026年5月
https://web.archive.org/web/20260928001954/https://www.iso.org/standard/81088.html - JIS Q 42001 は2025年8月20日制定、主務大臣は経済産業大臣
https://www.jisc.go.jp/app/jis/general/GnrJISSearch.html - ISO/IEC 42001 の英和対訳版が日本規格協会から出ている
https://ndlsearch.ndl.go.jp/books/R100000001-I13111154695918 - 2026年10月19日、最初の整合規格 EN 18286(2026年)の参照を官報に公表
https://digital-strategy.ec.europa.eu/en/library/first-harmonised-standard-supporting-ai-act-published-official-journal - CEN と CENELEC は欧州の標準化機関で、合同技術委員会で高リスクAIシステムのための整合規格を作っている
https://digital-strategy.ec.europa.eu/en/policies/ai-act-standardisation - 参考書籍 ISO/IEC 42001 と JIS Q 42001 の要求事項の解説、髙村博紀 編著、日本規格協会、2025年10月
https://ndlsearch.ndl.go.jp/books/R100000002-I034318434 - 参考書籍 最新AIマネジメントシステムISO42001の仕組みと導入がよ~くわかる本、打川和男 著、秀和システム新社、2025年11月
https://ndlsearch.ndl.go.jp/books/R100000002-I034394760 - 対応表は Microsoft が提供したもので、NIST は掲載が NIST の支持を意味しないと注記
https://airc.nist.gov/airmf-resources/crosswalks/ - ISMS-AC が2026年1月14日に AIMS の認証機関を初めて認定したと発表
https://isms.jp/topics/news/20260114.html - ISMS-AC の制度概要ページ(
https://isms.jp/aims/about.html - JIS Q 42001 と ISO/IEC 42001 の対応(Codex は IDT と主張)
https://webdesk.jsa.or.jp/books/W11M0090/?bunsyo_id=JIS+Q+42001%3A2025
第7章
- EU AI Act の高リスクは、附属書III の分野の用途として定められている
https://ai-act-service-desk.ec.europa.eu/en/ai-act/annex-3 - 第5条第1項は職場と教育機関で人の感情を推定する AIシステムを禁止している(医療上・安全上の理由を除く)
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-5 - 第6条第3項は、附属書III の分野でも重大な害のリスクをもたらさない場合に高リスクに当たらないとしうる例外を定め、例として狭い手続き上の作業、人がすでに終えた判断の結果の改善がある
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-6 - 人と直接やり取りする AIは、AIとやり取りしていることを知らせる設計が求められる(第50条)
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-50 - EU AI Act の導入者(deployer)の定義
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-3 - AI事業者ガイドラインの AIガバナンス・ゴールは、便益とリスク、社会的受容、自社の AI習熟度を考慮して各主体が設定する目標で、AIポリシーが例に挙がる
https://www.soumu.go.jp/main_content/001064286.pdf - 欧州委員会の解説ページの見出しでは、4つの水準は許容できないリスク・高リスク・透明性のリスク・最小限のリスクまたはリスクなし
https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai - AI事業者ガイドライン第1.2版は2026年3月31日に総務省と経済産業省が公表
https://www.soumu.go.jp/main_content/001064279.pdf - 総務省のガイドラインのページ
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - ISO/IEC 42005 は AIシステムの影響評価の指針で、2025年5月発行の第1版
https://www.iso.org/standard/42005 - 参考書籍『「AIリスク」の解剖 決定と責任を社会学的に考える』佐久間弘明 著、中央経済社、2026年3月
https://ndlsearch.ndl.go.jp/books/R100000002-I034574284 - 参考書籍『リスクマネジメント解説と適用ガイド』(書名の冒頭に ISO 31000 と JIS Q 31000 の番号と年が付く)リスクマネジメント規格活用検討会 編著、日本規格協会、2019年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I029744596 - 参考書籍『プライバシー影響評価実施マニュアル ISO/IEC 29134対応』瀬戸洋一 編著、長谷川久美 著、日科技連出版社、2020年11月
https://ndlsearch.ndl.go.jp/books/R100000002-I030743519 - 第5条第1項(ba)(bb)は2026年12月2日から適用
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113
第8章
- 個人情報保護委員会「生成AIサービスの利用に関する注意喚起等について」は2023年6月2日付で、別添1が注意喚起の本体
https://www.ppc.go.jp/news/careful_information/230602_AI_utilize_alert/ - 注意喚起は生成AIサービスを、プロンプトの入力などに応えて文章や画像などを生成するAIを使ったサービスと説明し、個人情報取扱事業者・行政機関等・一般の利用者に向けた注意点を示す
https://www.ppc.go.jp/files/pdf/230602_alert_generative_AI_service.pdf - 注意情報の一覧に、この文書を置き換える生成AIサービスの利用全般についての新しい注意喚起は見当たらない
https://www.ppc.go.jp/news/careful_information/ - 個人情報保護法等の改正法は2026年7月10日成立、7月17日公布、一部を除き公布日から起算して2年以内で政令で定める日から施行
https://www.ppc.go.jp/news/press/2026/260717/ - 改正法の概要に、統計情報等の作成にのみ利用される場合に第三者提供などの本人同意を不要とする改正があり、統計作成等であると整理できるAI開発等を含むと注記
https://www.ppc.go.jp/files/pdf/260717_kaiseihounitsuite.pdf - 経済産業省の営業秘密のページに営業秘密管理指針(2025年3月改訂)、秘密情報の保護ハンドブック(2024年2月改訂)、知っておきたい営業秘密
https://www.meti.go.jp/policy/economy/chizai/chiteki/trade-secret.html - AI事業者ガイドライン第1.2版は2026年3月31日、総務省・経済産業省
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - AI事業者ガイドラインの共通の指針の人間中心の項目で偽情報等への対策、脚注でRAG等によりハルシネーションの抑制等が期待されている
https://www.soumu.go.jp/main_content/001064279.pdf - 文化庁「AIと著作権」のページ 判例・裁判例の蓄積がない現状を踏まえ考え方を整理し周知するために取りまとめた
https://www.bunka.go.jp/seisaku/chosakuken/aiandcopyright.html - 「AIと著作権に関する考え方について」は2024年3月15日、文化審議会著作権分科会法制度小委員会
https://www.bunka.go.jp/seisaku/bunkashingikai/chosakuken/pdf/94037901_01.pdf - AIと著作権に関するチェックリスト&ガイダンスは2024年7月31日、文化庁著作権課、2部構成、第1部は4つの立場
https://www.bunka.go.jp/seisaku/chosakuken/pdf/94097701_01.pdf - OWASP Top 10 for LLM Applications の2025年版、1番目がプロンプトインジェクション、10項目の名称
https://genai.owasp.org/llm-top-10/ - プロンプトインジェクションの定義、直接と間接、影響の例、確実な防止策が明らかでないこと、7つの軽減策
https://genai.owasp.org/llmrisk/llm01-prompt-injection/ - EU AI Act 第50条で一定の生成物の表示の義務
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-50 - 『生成AIと知財・個人情報Q&A』齋藤浩貴・上村哲史 編著、商事法務、2024年7月
https://ndlsearch.ndl.go.jp/books/R100000002-I033550922 - 『生成AIと著作権の論点』福岡真之介 編著、商事法務、2025年8月
https://ndlsearch.ndl.go.jp/books/R100000002-I034249278 - 『AIと著作権』上野達弘・奥邨弘司 編著、勁草書房、2024年2月
https://ndlsearch.ndl.go.jp/books/R100000002-I033331092 - 個人データの委託・第三者提供・外国にある第三者への提供の確認
https://www.ppc.go.jp/personalinfo/legal/guidelines_tsusoku/
第9章
- 経済産業省 AIの利用・開発に関する契約チェックリスト(2025年2月)
https://www.meti.go.jp/press/2024/02/20250218003/20250218003-a.pdf - AI・データの利用に関する契約ガイドライン、AI編は2018年6月、1.1版は2019年12月
https://www.meti.go.jp/policy/mono_info_service/connected_industries/sharing_and_utilization.html - 1.1版の改訂履歴はデータ編について限定提供データに関する指針への対応等による改訂
https://www.meti.go.jp/policy/mono_info_service/connected_industries/sharing_and_utilization/20200619001.pdf - AI編は法的拘束力を有さず契約の自由を制約しない
https://www.meti.go.jp/policy/mono_info_service/connected_industries/sharing_and_utilization/20180615001-3.pdf - デジタル庁 行政の進化と革新のための生成AIの調達・利活用に係るガイドライン、初版 2025年5月27日、第2.0版 2026年6月12日、デジタル社会推進会議幹事会決定
https://www.digital.go.jp/news/decb64eb-f26e-41cb-8d37-f3dd173108b8 - DS-920、遵守する内容を定めた文書(Normative)、国の政府職員向け
https://www.digital.go.jp/assets/contents/node/information/field_ref_resources/decb64eb-f26e-41cb-8d37-f3dd173108b8/59054b35/20260612_resources_standard_guidelines_guideline_01.pdf - AI事業者ガイドライン第1.2版 2026年3月31日 総務省・経済産業省、本編と別添
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - 非拘束的なソフトローとして作成
https://www.soumu.go.jp/main_content/001064279.pdf - 別添6「AI・データの利用に関する契約ガイドライン」を参照する際の主な留意事項について、二者間モデル、2022年以降の取引の多様化、契約チェックリストを参照、AI編第2・第3は参照が有益な場合も
https://www.soumu.go.jp/main_content/001064286.pdf - EU AI Act 第25条第1項(名前や商標、実質的な変更、目的の変更で提供者とみなされる)、第4項(書面の合意、オープンソースの例外と汎用目的AIモデルの除外)
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-25 - 個人情報の保護に関する法律等の一部を改正する法律、2026年7月10日成立・7月17日公布、一部を除き公布日から2年以内で政令で定める日に施行
https://www.ppc.go.jp/news/press/2026/260717/ - 参考書籍 AI・データ関連契約の実務(森本大介・濱野敏彦 編著、中央経済社、2020年9月)
https://ndlsearch.ndl.go.jp/books/R100000002-I030587176 - 参考書籍 ITビジネスの契約実務 第2版(伊藤雅浩・久礼美紀子・高瀬亜富 著、商事法務、2021年10月)
https://ndlsearch.ndl.go.jp/books/R100000002-I031717228 - 第III章第1〜3節(第6条第5項を除く)の適用開始は、附属書III 2027年12月2日、附属書I 2028年8月2日(デジタル・オムニバスによる改正)
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - 民法第548条の4第3項、第1項第2号による変更は効力発生時期までに周知しないと効力を生じない
https://laws.e-gov.go.jp/law/129AC0000000089 - 参考書籍『AI・データ関連契約の実務』の刊行月
https://www.biz-book.jp/isbn/978-4-502-35671-1
第10章
- ISO/IEC 5259-1 は2024年7月発行の第1版、JTC 1/SC 42
https://www.iso.org/standard/81088.html - ISO/IEC 5259-2 は2024年11月発行の第1版、題名はデータ品質の測定量
https://www.iso.org/standard/81860.html - ISO/IEC 5259-3 は2024年7月発行の第1版、データ品質マネジメントの要求事項と指針
https://www.iso.org/standard/81092.html - ISO/IEC 5259-4 は2024年7月発行の第1版、データ品質のプロセスの枠組み
https://www.iso.org/standard/81093.html - ISO/IEC 5259-5 は2025年2月発行の第1版、データ品質のガバナンスの枠組み
https://www.iso.org/standard/84150.html - ISO/IEC TR 5259-6 は2026年5月発行の第1版の技術報告書、題名はデータ品質の可視化の枠組み、シリーズは6つの部
https://www.iso.org/standard/86532.html - AISI 評価観点ガイドの現行は第1.20版、2026年7月7日公表
https://aisi.go.jp/output/output_information/260707/ - 評価観点ガイドの初版は2024年9月18日、第1.10版は2025年3月28日
https://aisi.go.jp/output/ - 評価観点ガイドは AI事業者ガイドライン第1.2版を参考にし、評価を実施する際に参照できる基本的な考え方を示す
https://aisi.go.jp/assets/pdf/ai_safety_eval_v1.20_ja.pdf - レッドチーミング手法ガイドの現行は第1.10版、2025年3月31日公表、第1.00版は2024年9月25日
https://aisi.go.jp/output/output_framework/guide_to_red_teaming_methodology_on_ai_safety/ - レッドチーミングの目的は攻撃者の目線で弱点や対策の不備を見つけ修正し堅牢化すること
https://aisi.go.jp/assets/pdf/J1_ai_safety_RT_v1.10_ja.pdf - Hardt ほか 2016年10月 arXiv、demographic parity を論じ equalized odds と equal opportunity を定義
https://arxiv.org/abs/1610.02413 - Kleinberg ほか 2016年 arXiv、3つの条件を特別な場合を除き同時に満たせないことを証明
https://arxiv.org/abs/1609.05807 - Chouldechova 2016年 arXiv、結果の起こる割合が属性で違う場合に基準の順守が格差につながりうる
https://arxiv.org/abs/1610.07524 - Mitchell ほか モデルカード、FAT 2019 論文集、DOI 10.1145/3287560.3287596、arXiv 2018年10月
https://doi.org/10.1145/3287560.3287596 - モデルカードの9項目と、定量的な分析は集団ごとに分けて示す
https://arxiv.org/abs/1810.03993 - Gebru ほか データシート、arXiv 2018年3月、CACM 2021年12月 第64巻第12号
https://arxiv.org/abs/1803.09010 - 参考書籍『高リスク分野のための機械学習 責任あるAI構築のための実践アプローチ』
https://ndlsearch.ndl.go.jp/books/R100000002-I034306534 - 参考書籍『機械学習工学』
https://ndlsearch.ndl.go.jp/books/R100000002-I032254601
第11章
- EU AI Act の Service Desk の条文は2026年7月27日時点の統合版でデジタル・オムニバスを反映している
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-73 - 重大インシデントの定義は第3条第49号で、死亡または健康への重大な害、重要インフラの重大かつ回復できない混乱、基本的な権利を守る EU 法上の義務の違反、財産または環境への重大な害の4つ
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-3 - 第3章第1節〜第3節の適用から第6条第5項が除かれている
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - 第12条 高リスク AIシステムは稼働期間を通じてログを自動で記録できるよう作る
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-12 - 第19条 提供者は自らの管理下にあるログを用途に照らして適切な期間、少なくとも6か月保存
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-19 - 第20条 提供者は適合していないと考える場合に是正・回収・機能の停止などの措置をすぐに取り、販売者や導入者などに知らせる
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-20 - 第26条第1項 導入者は使用説明書に沿って使うための措置を取る
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-26 - 第72条第1項・第3項 提供者は市販後の監視の仕組みを作って文書にし、市販後の監視の計画に基づかせる
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-72 - 第55条第1項(c) システミックリスクを持つ汎用目的 AIモデルの提供者は重大インシデントの情報を追跡・文書化して AIオフィスなどへ報告
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-55 - 欧州委員会は2025年9月26日に第73条の指針の案と報告の様式の案を公表し、2025年11月7日まで意見を募集
https://digital-strategy.ec.europa.eu/en/consultations/ai-act-commission-issues-draft-guidance-and-reporting-template-serious-ai-incidents-and-seeks - NIST AI RMF の MANAGE 4.1 は導入後の監視の計画に、利用者などの意見の受け取りと評価、異議と上書き、廃止、インシデント対応、復旧、変更の管理を含める
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf - AI事業者ガイドライン第1.2版 別添の行動目標3-4-2 インシデント発生時の対応の事前検討(説明・影響範囲・損害の特定・法的関係の整理・被害救済・拡大防止・再発防止、方針と計画、予行演習)
https://www.soumu.go.jp/main_content/001064286.pdf - AI事業者ガイドライン第1.2版の公表日と掲載ページ
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - OECD の文書は2024年5月公表で、AIインシデントと AIハザードを呼び分ける
https://oecd.ai/en/incidents-methodology - OECD の文書は AIに関する文書の第16号
https://www.oecd.org/en/publications/defining-ai-incidents-and-related-terms_d1a8d965-en.html - AIM の一覧は Beta 表示で、要約と分類は AI生成と表示
https://oecd.ai/en/incidents - 個人情報保護委員会は、要配慮個人情報を含む漏えい等や本人の数が1,000人を超える漏えい等など定めた要件に当たる場合に漏えい等の報告を義務付け、発覚したらまず速やかに報告するよう示している
https://www.ppc.go.jp/personalinfo/legal/leakAction/ - 参考書籍『信頼性の高い機械学習 SRE原則を活用したMLOps』
https://www.oreilly.co.jp/books/9784814400768/ - 参考書籍『SRE サイトリライアビリティエンジニアリング Googleの信頼性を支えるエンジニアリングチーム』
https://www.oreilly.co.jp/books/9784873117911/ - 欧州委員会の第73条の指針と報告の様式の最終版の有無
https://digital-strategy.ec.europa.eu/en/news/supporting-implementation-ai-act-clear-guidelines - 候補にしたが他章との重複を避けて挙げなかった本:『高リスク分野のための機械学習 責任あるAI構築のための実践アプローチ』(オライリー・ジャパン、2025年9月26日、ISBN 978-4-8144-0127-7
https://www.oreilly.co.jp/books/9784814401277/
第12章
- AI事業者ガイドライン第1.2版の本編は、ポリシーの策定などを通じてAIガバナンス・ゴールを設定し、それを達成するAIマネジメントシステムを設計して運用する順序を示している
https://www.soumu.go.jp/main_content/001064279.pdf - AI事業者ガイドライン第1.2版の公表日は2026年3月31日
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - 別添の行動目標2-1は、AIガバナンス・ゴール(例としてAIポリシー)を設定するか検討して設定し、ステークホルダーに公開することが期待されるとしている
https://www.soumu.go.jp/main_content/001064286.pdf - EU AI Act の適用の日程はデジタル・オムニバスで変わった
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - 日立製作所 AI倫理原則、2021年2月22日の報道発表で策定を公表、3つの行動規準と7つの実践項目
https://www.hitachi.co.jp/New/cnews/month/2021/02/0222.html - 日立製作所 AI倫理原則、2021年2月22日の報道発表で策定を公表、3つの行動規準と7つの実践項目
https://www.hitachi.com/ja-jp/press/articles/2021/02/0222/ - NECグループ AIと人権に関するポリシー、2019年4月2日の報道発表で策定を公表、文書には2019年4月制定、7項目
https://jpn.nec.com/press/201904/20190402_01.html - NECのポリシーの別紙
https://jpn.nec.com/press/201904/images/0201-01-01.pdf - ソフトバンクAI倫理ポリシー、制定日2022年7月12日、改正規定は2026年7月31日から適用、7項目
https://www.softbank.jp/corp/aboutus/governance/ai-ethics/ - 参考書籍『生成AIの法的リスクと対策 増補改訂版』福岡真之介、松下外 著、日経BP、2025年12月
https://bookplus.nikkei.com/atcl/catalog/25/12/11/02376/ - 参考書籍『生成AI法務・ガバナンス 未来を形作る規範』中崎尚 著、商事法務、2024年7月
https://ndlsearch.ndl.go.jp/books/R100000002-I033558075
第13章
- AI事業者ガイドライン第1.2版は総務省と経済産業省が2026年3月31日に公表
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - 共通の指針の7)アカウンタビリティに「責任者の明示」として各主体においてアカウンタビリティを果たす責任者を設定すること、「関係者間の責任の分配」が挙がる
https://www.soumu.go.jp/main_content/001064279.pdf - 別添の行動目標1-1の実践例で、経営層のリーダーシップの下には担当役員や現場に一任せず経営層自らが主導することも含む
https://www.soumu.go.jp/main_content/001064286.pdf - NIST AI RMF の GOVERN 2 と GOVERN 2.1 から 2.3 の内容
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf - IIA の3ラインモデルは2020年の Position Paper で、日本語版の題名は「IIA の3ラインモデル 3つのディフェンスラインの改訂」
https://www.theiia.org/en/content/position-papers/2020/the-iias-three-lines-model-an-update-of-the-three-lines-of-defense/ - 2020年の資料の注記で、ラインは構造上の区分ではなく役割の区別、番号は順番を意味しない、リスク管理の責任は第1のラインに残る、第2のラインは経営から完全には独立しない、内部監査は経営の責任に属する決定をせず最近まで責任を負った活動にアシュアランスを提供しない
https://www.theiia.org/globalassets/documents/resources/the-iias-three-lines-model-an-update-of-the-three-lines-of-defense-july-2020/three-lines-model-updated-english.pdf - IIA は2026年7月8日に3ラインモデルの Statement of Position を公表し以前の Position Paper を置き換えた
https://www.theiia.org/en/resources/statements-of-position/ - 2026年の文書の第1から第3のラインの整理、強調点(アシュアランスと助言、独立性は孤立ではない、連携、重なりの安全策)、基本の構造は不変、別々の確認部署を求められない組織向けの手引き、単一の構造は無い、委託しても説明責任は変わらない、12か月の目安、助言の条件
https://www.theiia.org/globalassets/site/resources/statements-of-position/tlm_assurance_advice_support_effective_gov_en.pdf - 参考書籍『責任あるAI「AI倫理」戦略ハンドブック』保科学世・鈴木博和 著、東洋経済新報社、2021年
https://ndlsearch.ndl.go.jp/books/R100000002-I031605004 - 同書の版元の紹介
https://str.toyokeizai.net/books/9784492762561/ - 参考書籍『不正・不祥事のメカニズムと未然防止 不正のトライアングル・内部統制・3線モデルから見た対策とチェックリスト』島田裕次 著、日科技連出版社、2023年
https://ndlsearch.ndl.go.jp/books/R100000002-I033003883
第14章
- EU AI Act 第4条は提供者と導入者に、従業員と代わりに運用や利用に携わる人のAIリテラシーの向上を支える措置を求め、知識・経験・教育と訓練・使われる文脈・相手を考慮するとしている
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-4 - AIリテラシーの定義は第3条第56号にある
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-3 - 第26条第2項は人による監督を必要な能力・訓練・権限と支援を持つ自然人に割り当てると定める
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-26 - 第113条の統合版で第1章と第2章は2025年2月2日から適用、第4条は第1章に含まれる
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-113 - 欧州委員会のAIリテラシーの質疑応答は2026年10月20日更新
https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers - AI事業者ガイドライン第1.2版は2026年3月31日、総務省と経済産業省
https://www.soumu.go.jp/main_sosiki/kenkyu/ai_network/02ryutsu20_04000019.html - 別添の行動目標3-2の内容、対象者ごとの教育の例と実践のポイント、リテラシーの変化への留意
https://www.soumu.go.jp/main_content/001064286.pdf - 本編第1部でAIエージェントを定義し、自律の範囲とエージェンティックAIを脚注で補足
https://www.soumu.go.jp/main_content/001064279.pdf - 令和7年度の更新内容の資料は更新の論点の1つ目にAIエージェントとフィジカルAIに関する事項の追記を挙げる
https://www.soumu.go.jp/main_content/001064301.pdf - IIAは2026年7月8日に3ラインモデルの声明を公表し従来のポジションペーパーを置き換えた
https://www.theiia.org/en/resources/statements-of-position/ - IIAは2026年7月8日に3ラインモデルの声明を公表し従来のポジションペーパーを置き換えた
https://www.theiia.org/globalassets/site/resources/statements-of-position/tlm_assurance_advice_support_effective_gov_en.pdf - 2020年のポジションペーパーのページに置き換えられたという表示
https://www.theiia.org/en/content/position-papers/2020/the-iias-three-lines-model-an-update-of-the-three-lines-of-defense/ - IIAのAI監査フレームワークの現在の版は2024年9月の更新版、最初の版は2017年
https://www.theiia.org/en/content/tools/professional/2023/the-iias-updated-ai-auditing-framework/ - IIAのAI監査フレームワークの現在の版は2024年9月の更新版、最初の版は2017年
https://www.theiia.org/globalassets/site/content/tools/professional/aiframework-sept-2024-update2.pdf - 人工知能基本計画の第Ⅱ期は2026年7月14日に閣議決定
https://www8.cao.go.jp/cstp/ai/index.html - 内閣府に各府省庁等のガイドライン等の一覧がある
https://www8.cao.go.jp/cstp/ai/ai_guideline/ai_guideline.html - 個人情報保護法の改正法は2026年7月17日に公布
https://www.ppc.go.jp/news/press/2026/260717/ - NISTの公式ページにAI RMF 1.0が改訂の途中であると書かれている
https://www.nist.gov/itl/ai-risk-management-framework - MUFG Report 2026 は三菱UFJフィナンシャル・グループの統合報告書で、対象期間は2025年4月1日から2026年3月31日、2026年7月までの内容を含む
https://www.mufg.jp/ir/report/disclosure/index.html - MUFG Report 2026 は三菱UFJフィナンシャル・グループの統合報告書で、対象期間は2025年4月1日から2026年3月31日、2026年7月までの内容を含む
https://www.mufg.jp/dam/ir/report/disclosure/pdf/ir2026_all_ja.pdf - 一般社団法人AIガバナンス協会の設立年月日
https://www.ai-governance.jp/about - AIガバナンス行動目標は2024年2月19日に協会の臨時総会の表決で決定、2025年11月27日に理事会の表決で改定を決定
https://www.ai-governance.jp/ai-governance-action-agenda - 自己診断の評点は0点・1点・3点・4点と非該当で、2点は無い
https://www.ai-governance.jp/blog/governance-navi-4 - AIガバナンスナビは会員企業の自己診断の道具
https://www.ai-governance.jp/ai-governance-navi - 第2.0版は2026年3月30日の検討委員会を踏まえ、AIエージェントの取組事項の新設と内閣府の指針との対応づけの追加などを行った
https://www.ai-governance.jp/blog/governance-navi-3 - 参考書籍 AI倫理 人工知能は「責任」をとれるのか、西垣通、河島茂生 著、中央公論新社、2019年9月
https://ndlsearch.ndl.go.jp/books/R100000002-I029915481 - 参考書籍 絵と図でわかるAIと社会 未来をひらく技術とのかかわり方、江間有沙 著、技術評論社、2021年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I031432972 - 参考書籍 AI・ロボットと共存の倫理、西垣通 編、河島茂生ほか 執筆、岩波書店、2022年7月
https://ndlsearch.ndl.go.jp/books/R100000002-I032227004 - 第2条が適用範囲を定める
https://ai-act-service-desk.ec.europa.eu/en/ai-act/article-2