こんにちは、Anagraftの伊藤です。
今回は、顧客がいつ離れ、離れるまでにどれだけの価値を残すかを測り、その結果を引き止めや獲得の予算の判断に使うための方法を整理しました。月額制のサービスや定期購入、会員制の事業では、今期の売上は在籍している顧客の数で決まり、来期の売上は今期にどれだけの顧客が離れずに残るかで決まります。一方で、解約率を1つの数字で見ていて集団ごとの違いを見落とす、獲得の費用を回収できているチャネルとできていないチャネルを区別せずに予算を配る、解約の予測モデルを作ったものの施策につながらない、といった悩みもよく聞かれます。本コラムでは、顧客ごとの加入と解約の記録、月ごとの利用の記録、購買の記録から、離脱の速さと顧客の価値を正しく測り、その結果を施策の優先順位と予算の判断にどうつなげるかを、架空のデータを通して実際にコードを動かしながら説明します。
この題材を選んだ理由は、顧客の離脱と生涯価値が、多くの事業で毎期くり返される予算判断の根拠になるべきものでありながら、解約率の平均や前年の実績に頼って決められていることが多いように思うためです。解約率は、どの集団の、加入から何か月目の数字かによって大きく違います。観測の途中で記録が終わる顧客(まだ在籍している顧客)を数え損ねると、平均の在籍期間は短くも長くも出ます。解約の予測はある程度までしか当たらず、予測の高い顧客の多くは施策が無くても残ります。こうした性質を踏まえずに判断すると、顧客生涯価値の低いチャネルの獲得単価を回収できない水準まで引き上げ、施策の費用を解約しない顧客に配り、本当に価値の高い顧客の離脱に気づくのが遅れます。
各章では、架空の家庭向け食材宅配の定期便(月額制)の顧客12,000人の3年分の記録と、架空の単品通販の顧客6,000人の2年分の購買記録を共通の題材にして、実際にコードを動かした結果を載せています。データは乱数で生成したもので、実在の企業やサービスの記録ではありません。その代わり、データを作った側は「本当の解約の起きやすさ」と「本当にまだ買い続けているかどうか」を知っているので、推定した結果がどれだけ当たっているか、その推定に従って施策の対象や獲得の予算を決めると粗利がどれだけ変わるかを、答え合わせできます。
想定している読者は、顧客の引き止めや獲得にかける予算を決める、あるいは決める材料を作る立場の方です。事業部門の責任者の方、マーケティングや顧客対応の責任者の方、DX推進やデータ分析チームのリーダーの方、そして顧客への投資の妥当性を判断する経営層の方を念頭に置いています。統計の専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にしています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各手法について「何を測るためのものか」「それが無いと何を誤るか」「どの規模や段階から要るか」「結果をどう読み、予算や施策の判断にどう翻訳するか」を書くようにしました。顧客分析のための製品やサービスは数多くありますが、どれを選ぶかより先に、自社のデータの量と粒度、事業の型(解約が観測できるか、購買が止まったかどうかしか分からないか)、判断を誤ったときの影響の大きさから、どの手法をどの順で組み合わせるかを決めることが大事だと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムに出てくる月額、粗利、獲得費用、施策の費用の金額は、すべて架空の設定による例題の値です。製品・サービスの料金には触れていません。本コラムの記述は2026年10月時点で確認したものです。ライブラリの関数名や引数は版によって変わりますので、実務で使う際は公式のページで最新の内容をご確認ください。計算時間は本コラムの実行環境で測った値であり、計算機が変われば変わります。
目的別の入口の目安を挙げておきます。顧客の離脱と生涯価値を経営の問題としてどう見るかを整理したい場合は、第1章と第13章が入口になります。解約が観測できる事業とできない事業の違いと、本コラムで使うデータを知りたい場合は第2章をご覧ください(指標の定義は「全体の地図」の表にまとめ、第2章で読者向けに説明しています)。データの集め方は第3章、加入時期ごとの継続率の読み方は第4章、解約率の正しい測り方は第5章、離脱の要因の分析は第6章、解約の予測は第7章、予測を施策につなぐ考え方は第8章が中心になります。
顧客生涯価値の計算は第9章(解約が観測できる事業)と第10章(購買の記録しかない事業)、顧客の価値の分布と施策の優先順位は第11章、施策の効果の確かめ方は第12章、組織での使い続け方は第13章、公開された道具と事例を含む最新の動向は第14章で扱っています。

目次
- 序章 顧客の価値は、今期の売上だけでは測れない
- 全体の地図
- 第1章 顧客の離脱と生涯価値はなぜ経営の問題なのか
- 第2章 顧客分析の全体像、契約型と非契約型・指標の定義・共通データ
- 契約型と非契約型、離脱が見えるかどうかで分析の道具が変わる
- 手法の地図、それぞれの手法は何に答えるか
- 指標の定義、全章で同じ意味に固定する
- 共通データ A、架空の家庭向け食材宅配の定期便(契約型)
- 共通データ B、架空の単品通販(非契約型)
- 真の値と推定を書き分ける
- 基準の結果1、チャネル別のカプラン・マイヤー推定は真の継続率をよく言い当てる
- 基準の結果2、チャネル別の LTV は定義によって大きく変わる
- 基準の結果3、仮定どおりのデータでは BG/NBD モデルが真のパラメータを回復した
- 基準の計算の構造、補助モジュールの使い方
- 経営の判断に翻訳する、型と定義を決めてから数字を出す
- この章を深めたい方への参考書籍
- 第3章 顧客データを集めて整える
- 第4章 コホート分析で継続率の推移を読む
- 第5章 解約率の正しい測り方、打ち切りと生存分析
- 第6章 離脱の要因を探る、ハザードモデルと説明変数
- 第7章 解約を予測する、機械学習モデルの設計と評価
- 第8章 予測を施策につなぐ、対象の選び方と費用対効果
- 第9章 生涯価値(LTV)を計算する、契約型の顧客
- 第10章 購買履歴から生涯価値を推定する、非契約型の顧客とBG/NBD
- 非契約型では離脱が観測できない
- RFM の2つの意味:BG/NBD の流儀と一般の RFM 分析
- 「最近買っていない=離脱」の誤り:頻度で意味が変わる
- BG/NBD モデルの仮定:購買の速さと離脱のしやすさを分けて考える
- 尤度と最尤推定、在籍確率の答え合わせ
- この先52週の購買回数を予測し、実現と比べる
- frequency 0 の顧客は常に在籍するという仮定と MBG/NBD
- 金額の側:ガンマ・ガンマモデルで1回あたりの金額を縮小推定する
- 非契約型の LTV:購買回数の期待値×1回あたり金額×粗利率
- ツールの紹介:lifetimes・PyMC-Marketing・BTYD
- 経営の判断に翻訳する:生きている顧客数と、在籍確率の使い方
- この章を深めたい方への参考書籍
- 第11章 顧客の価値の分布を見て、施策の優先順位を決める
- 第12章 施策の効果を確かめる、実験と効果の持続
- 第13章 顧客分析を組織で使い続ける
- 第14章 事例と最新動向
- 終章 顧客の離脱と生涯価値を測り続けるための5つの考え方
- 本コラムで紹介した書籍一覧
- 第1章 顧客の離脱と生涯価値はなぜ経営の問題なのか
- 第2章 顧客分析の全体像、契約型と非契約型・指標の定義・共通データ
- 第3章 顧客データを集めて整える
- 第4章 コホート分析で継続率の推移を読む
- 第5章 解約率の正しい測り方、打ち切りと生存分析
- 第6章 離脱の要因を探る、ハザードモデルと説明変数
- 第7章 解約を予測する、機械学習モデルの設計と評価
- 第8章 予測を施策につなぐ、対象の選び方と費用対効果
- 第9章 生涯価値(LTV)を計算する、契約型の顧客
- 第10章 購買履歴から生涯価値を推定する、非契約型の顧客とBG/NBD
- 第11章 顧客の価値の分布を見て、施策の優先順位を決める
- 第12章 施策の効果を確かめる、実験と効果の持続
- 第13章 顧客分析を組織で使い続ける
- 第14章 事例と最新動向
- 参考情報
序章 顧客の価値は、今期の売上だけでは測れない
月額制のサービスや定期購入のように、顧客が継続して料金を払う事業では、今期の売上は在籍している顧客の数と単価で決まります。しかし、その売上の数字には、顧客がこの先どれだけの期間残るか、つまり来期以降にどれだけの売上と粗利を残すかは書かれていません。同じ売上の2つの事業でも、顧客が平均して1年で離れる事業と3年残る事業とでは、獲得した1人の顧客が残す価値も、獲得にかけてよい費用も、引き止めにかけてよい費用もまったく違います。1人の顧客が加入から離脱までに残す粗利の見込みを顧客生涯価値(英語の頭文字からLTVと呼ばれます)といいます。本コラムの主題は、顧客の離脱の速さと生涯価値を正しく測る方法と、その結果を施策の優先順位と予算の判断に使う方法です。
顧客の離脱と価値は、解約率の平均や売上の合計からは見えにくいものです。解約率は、どの集団の、加入から何か月目の数字かで大きく違います。観測の途中で記録が終わる顧客(まだ在籍している顧客)の扱いを誤ると、平均の在籍期間は短くも長くも出ます。解約の予測はある程度までしか当たらず、予測が高い顧客の多くは施策が無くても残ります。購買の記録しかない事業では、顧客が離れたかどうかそのものが観測できません。こうした性質を、答えの分かっている架空のデータで確かめながら、測り方と判断の手順を整理していきます。
解約率の平均は、集団と時間で分けないと違いが見えない
共通の題材の1つは、架空の家庭向け食材宅配の定期便(月額制)の顧客12,000人の記録です。加入月は第1〜30か月、観測できるのは第1〜36か月までで、紹介・検索広告・SNS広告・チラシの4つの獲得チャネル、標準と大容量の2つのプラン、月ごとの注文回数と問い合わせ回数をそろえました。データは乱数で生成したもので、実在の企業やサービスの記録ではありません。データを作った側は、顧客ごとの本当の解約の起きやすさを知っています。現実の企業には見えませんが、本コラムではこれを「真の値」と呼び、推定がどれだけ当たっているかを確かめる物差しとして使います。ただし、真の継続率や真の顧客生涯価値、施策の答え合わせなどの値は、データを作った仕組みのもとでシミュレーションを繰り返して求めた近似値で、乱数による誤差を含みます。
このデータの観測期間の月次解約率(解約数を顧客月数で割ったもの)は、全体で3.27%です。この数字の逆数を取ると、平均の在籍期間は30.6か月と計算できます。ところが、同じ数字を獲得チャネルごとに見ると、紹介経由の顧客は月1.60%、チラシ経由の顧客は月6.45%で、4倍の開きがあります。加入から36か月目まで残っている割合は、真の値で紹介経由が61.2%、チラシ経由が18.4%です。全体の平均の解約率で施策や予算を考えると、この違いが見えません。
さらに、解約率の逆数で在籍期間を見積もる方法そのものにも偏りがあります。この公式は、解約の起きやすさが在籍の長さによらず一定であること、期間に上限が無いことを仮定しています(月次粗利を掛けて顧客生涯価値にするときは、将来の粗利を割り引かないことも仮定に加わります)。このデータでは、解約の起きやすさは在籍が長くなるほど下がります。期間をそろえて(どちらも60か月で打ち切って)比べると、一定の解約率から計算した期待在籍月数は、紹介経由で38.7か月、チラシ経由で15.2か月であるのに対し、真の値は40.2か月と17.7か月で、4つのチャネルとも公式のほうが短く見積もります。一方、期間をそろえずに、上限の無い逆数(紹介経由で62.4か月)と60か月で打ち切った真の値(40.2か月)を並べると、公式のほうが長く見えます。定義の違う数字を並べると、偏りの向きさえ逆に見える、ということです。第4章と第5章では、この偏りがどこから来るのかを在籍月数ごとの解約率で確かめ、打ち切りを正しく扱う生存分析で継続率を推定します。
予測には幅があり、予測の高さだけでは施策の対象を決められない
解約を事前に予測できれば、離脱しそうな顧客に先回りして手を打てます。本コラムでは、ある月末に在籍している顧客について、それまでの記録から特徴量(予測に使う手がかり。注文回数の推移など)を作り、その先3か月以内に解約するかを予測するモデルを、ロジスティック回帰と勾配ブースティング(LightGBM)という、予測によく使われる2つの手法で作りました。検証期間での予測の精度(AUC。1に近いほど解約する人としない人をよく並べ分けている)は、どちらのモデルも0.674でした。この数字は低く見えるかもしれません。しかし、顧客ごとの隠れた利用意欲まで知っている真のモデルの推定確率で同じ検証をしても、実際に起きた解約に対するAUCは0.684でした。この架空データのこの設定では、解約には予測しようのない偶然の部分が大きく、どちらのモデルも、答えを知っているモデルと大きくは変わらないところまで来ています。予測の精度を競うより、予測を施策にどうつなぐかが結果を左右します。
予測が高い順に施策の対象を選ぶと、何が起きるかも確かめました。予測の上位10%(733人)の3か月以内の真の解約確率は平均18.3%です。つまり、上位10%に選んだ人も、施策が無ければ平均して約8割が3か月のあいだ解約しない見込みです。1人あたり500円の引き止めクーポン(当てた月から3か月のあいだ、解約の起きやすさ(解約確率を継続確率で割ったオッズ)を0.7倍にする、という架空の前提)を配ったときの24か月の粗利の増え方を、真のモデルで答え合わせすると、費用を差し引いた純増は、予測の上位10%に配ると約48.6万円(乱数の種を変えた5回の計算では42.3万円から48.6万円)、無作為に選んだ10%なら約9.0万円でした。この1回の計算では、予測で選ぶほうが、同じ費用で約5倍の純増です。予測は有効ですが、それだけでは対象の人数を決められません。全員(7,324人)に配ると純増は約89.4万円(同じく5回で71.1万円から89.4万円)と上位10%より大きくなりますが、費用は366万円かかり、1人あたりの粗利の増分は622円で費用の500円に近づきます。損益の分かれ目は、全員への配布で1人あたりおよそ600円(乱数の種を変えた計算では597円から622円)、上位10%への配布でおよそ1,100円(同じく1,077円から1,163円)で、施策の費用がそこを超えると純増は赤字に転じます。ここで比べた選び方(予測の上位10%・20%・30%、無作為の10%・20%・30%、全員)の中では、費用1円あたりの純増は上位10%が最も大きく、純増の総額は対象を広げるほど増えてから減ります。施策の対象は、予測の高さに加えて、解約確率の下がり幅と顧客の残存価値と費用の釣り合いで決める必要があります。この考え方は第7章と第8章、価値の分布を踏まえた優先順位は第11章で扱います。
獲得チャネルごとに、顧客の価値と獲得費用の釣り合いは大きく違う
顧客生涯価値を獲得チャネルごとに計算すると、獲得にかけてよい費用の上限が見えてきます。本コラムでは、加入から60か月以内に見込める月次の粗利(月額の30%。架空の設定)を、年5%の割引率で現在の価値に直して合計したものを顧客生涯価値と定義しました(獲得費用を差し引く前の値です)。真の値で、紹介経由の顧客は約64,800円、検索広告経由は約50,400円、SNS広告経由は約38,500円、チラシ経由は約29,700円です。これを1人あたりの獲得費用(架空の設定で、紹介2,000円・検索広告6,000円・SNS広告9,000円・チラシ12,000円)で割ると、紹介は32.4倍、検索広告は8.4倍、SNS広告は4.3倍、チラシは2.5倍になります。獲得費用を粗利で回収するまでの月数は、紹介で2か月、チラシで11か月でした。この例では、チャネルの平均(期待値)で見れば4つのチャネルとも獲得費用を回収できる計算ですが、チャネルを分けずに平均の顧客生涯価値をそのまま獲得単価の上限にすると、チラシではその上限が真の顧客生涯価値(約29,700円)を上回ります。上限いっぱいまでチラシの獲得単価を上げれば、超えた分は回収できません。計算の方法と、観測できない将来の在籍をどう見積もるかは第9章で、購買の記録しかない事業での推定は第10章で扱います。
平均ではなく、集団と時間と費用で判断する
本コラムを通じてお伝えしたいことが一つあります。顧客の離脱と価値の判断で大事なのは、解約率や顧客生涯価値を1つの平均で持つことではなく、集団(獲得チャネルや加入時期)と時間(加入から何か月目か)で分けて測り、予測の高さだけでなく費用と残存価値の釣り合いで施策の対象を決め、その効果を実験で確かめる循環を、毎期の予算の判断に組み込んでおくことだということです。上の例のように、全体の解約率は3.27%でも、集団によって4倍の開きがあり、定義をそろえずに数字を並べると偏りの向きさえ逆に見えます。予測の上位に一律に施策を打てば、費用の多くは解約しない顧客に配られます。
この循環は、次の5つの段階で成り立ちます。
- データの整備:顧客台帳・契約の履歴・利用の記録・施策の配信の記録を、同じ定義と粒度でそろえます(第3章)。
- 離脱の測定:加入時期ごとの継続率を並べ、打ち切りを正しく扱って集団ごとの継続率と解約の要因を推定します(第4章から第6章)。
- 解約の予測:時点を区切って特徴量を作り、予測の精度と幅を確かめます(第7章)。
- 価値と優先順位:顧客生涯価値と残存価値を計算し、費用と釣り合う対象を選びます(第8章から第11章)。
- 実験と運用:施策の効果を実験で確かめ、指標と更新の手順を組織に組み込みます(第12章・第13章)。
経営判断に関わる方にとって、この点は顧客への投資の進め方に直結します。解約率の平均を四半期ごとに眺め、下がれば安心し、上がれば一律のキャンペーンを打つ、という使い方は、費用の多くを解約しない顧客に配ります。反対に、予測モデルの精度を上げることに時間をかけ、施策につなげずに終われば、分析の費用だけが残ります。集団と時間で分けた継続率を定期的に見て、施策で見込める粗利の増分が費用を大きく上回る対象から手を打ち、獲得費用の上限を顧客生涯価値から決める順序であれば、効果を確かめながら予算を組み替えられます。組織での使い方は第13章で扱います。
Anagraftでは、データ活用の構想づくりから、顧客データの整備、離脱と生涯価値のモデルの設計と実装、施策の優先順位づけの意思決定への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。第1章と第2章で、顧客の離脱と生涯価値がなぜ経営の問題になるのか、解約が観測できる事業とできない事業で測り方がどう違うのかを整理し、本コラムで使う指標の定義と、共通の題材である架空のデータと基準の結果を紹介します。第3章から第6章では、データの集め方、加入時期ごとの継続率の読み方、打ち切りを正しく扱う生存分析、離脱の要因を探るハザードモデルの順に、離脱を測る手順を扱います。第7章と第8章は、解約の予測と、予測を施策につなぐ考え方です。第9章から第11章で、顧客生涯価値の計算(解約が観測できる事業と、購買の記録しかない事業)と、価値の分布を踏まえた施策の優先順位を、第12章で施策の効果の確かめ方を、第13章で組織での使い続け方を、第14章で公開された道具と事例、最新の動向を扱います。
各章の題と、その章で答える問いは次の表のとおりです。
| 章 | 題 | その章で答える問い |
|---|---|---|
| 第1章 | 顧客の離脱と生涯価値はなぜ経営の問題なのか | 顧客の離脱はなぜ今期の売上から見えないのか。測り方を誤ると、どういう損失がどれだけ出るのか |
| 第2章 | 顧客分析の全体像、契約型と非契約型・指標の定義・共通データ | 解約が観測できる事業とできない事業で何が違うのか。本コラムの指標と題材はどう定義されているのか |
| 第3章 | 顧客データを集めて整える | どのデータを、どの定義と粒度でそろえればよいか。定義や観測期間の違いで解約率はどう変わるか |
| 第4章 | コホート分析で継続率の推移を読む | 加入時期ごとの継続率をどう並べ、何が読めて何が読めないのか |
| 第5章 | 解約率の正しい測り方、打ち切りと生存分析 | まだ在籍している顧客を数え損ねずに、継続率と在籍期間をどう推定するか |
| 第6章 | 離脱の要因を探る、ハザードモデルと説明変数 | どの属性や利用状況が離脱と結びついているかを、どう推定し、どう読むか |
| 第7章 | 解約を予測する、機械学習モデルの設計と評価 | 時点を区切った予測をどう設計し、どの指標で評価し、どこまで当たるのか |
| 第8章 | 予測を施策につなぐ、対象の選び方と費用対効果 | 予測の結果から、誰に、いくらまでかけて施策を打つかをどう決めるか |
| 第9章 | 生涯価値(LTV)を計算する、契約型の顧客 | 解約が観測できる事業で、顧客1人の価値と獲得費用の上限をどう計算するか |
| 第10章 | 購買履歴から生涯価値を推定する、非契約型の顧客とBG/NBD | 購買の記録しかない事業で、顧客がまだ買い続けているかと、この先の購買をどう推定するか |
| 第11章 | 顧客の価値の分布を見て、施策の優先順位を決める | 価値と離脱のリスクの分布から、予算の範囲で誰を優先するかをどう決めるか |
| 第12章 | 施策の効果を確かめる、実験と効果の持続 | 施策の効果をどう実験で測り、効果が続いているかをどう確かめるか |
| 第13章 | 顧客分析を組織で使い続ける | 誰が何を担い、どの指標をどの頻度で見て、予算の会議にどう組み込むか |
| 第14章 | 事例と最新動向 | 公開されている道具と事例から何が分かり、顧客分析はどこへ向かっているか |
本コラムで使う指標と言葉
各章で共通して使う指標と言葉を、先に定義しておきます。詳しい説明は、初めて使う章で行います。金額の単位は円で、すべて架空の設定による例題の値です。
| 言葉 | 本コラムでの意味 |
|---|---|
| 解約(離脱) | 解約が観測できる事業では、月額の支払いをやめること。最後に料金を払った月の月末に解約したと数えます。購買の記録しかない事業では、この先もう購買しなくなること。購買の間が一時的に空いているだけなのか、離れたのかは直接は観測できないので、確率で表します |
| 月次解約率 | ある月の在籍者(その月の料金を払う人)のうち、その月末に解約した割合。観測期間の解約数を顧客月数(顧客ごとの在籍月数の合計)で割ったものを「素朴な解約率」と呼びます |
| 継続率 | 加入から t か月目の料金を払っている確率。生存分析では生存率と呼びます。1か月目は1です。「12か月目の継続率が0.8」なら、12か月目の料金を払わない人(12か月目より前に解約した人)が2割です |
| 在籍月数 | 料金を払った月数。観測の終わりにまだ在籍している顧客の在籍月数は「打ち切り」(本当の在籍月数はそれ以上)です |
| その月の在籍者と月末の在籍者 | 「その月の在籍者」は、その月の料金を払う人で、その月の月末に解約する人も含みます。「月末に在籍している人」は、その月の月末に解約しなかった人(翌月も料金を払う人)です。たとえば第2章で示す共通データの第30か月の在籍者は7,562人で、その月末に238人が解約したので、第30か月末に在籍している人は7,324人です(第7章・第8章の予測と施策はこの7,324人が対象です) |
| 第Nか月と Nか月目 | 「第Nか月」は暦の月(観測の始まりから数えた月。第1〜36か月)、「Nか月目」は在籍月数(その顧客の加入から数えた月)です。本コラムではこの2つを使い分けます |
| ハザード | その月まで在籍した顧客が、その月末に解約する確率。在籍月数ごとの月次解約率です |
| 月次粗利 | 月額に粗利率(架空の設定で0.30)を掛けたもの。標準プランで1,500円、大容量プランで2,400円です |
| 顧客生涯価値(LTV) | 加入時点から60か月以内に見込める月次粗利を、年5%の割引率で現在の価値に直して合計した期待値。獲得費用を差し引く前の値で、獲得費用との比較は別に行います。粗利率は注文回数によらず0.30で固定し、初回クーポンの原資は含めません。在籍中の顧客について、その時点から先の同じ定義の値を「残存価値」と呼びます(第9章と第11章では、その時点から先24か月で打ち切って計算します) |
| 顧客獲得費用(CAC) | 1人の顧客を獲得するためにかかった費用。本コラムでは獲得チャネルごとの架空の設定です |
| 回収月数 | 加入からの累積の割引後の粗利の期待値(同じチャネルの顧客の集団で見た値)が、獲得費用に達する最初の月。顧客1人ずつの回収月数の平均ではありません |
| 3か月解約確率 | ある月の月末に在籍している顧客(その月末に解約しなかった人)が、その先3か月のどこかの月末に解約する確率。第7章の予測の目的変数です |
| リフト | 予測の上位 k% の解約率を、全体の解約率で割った値。どちらも同じ検証の対象について、その先3か月に実際に解約した人の割合で比べます。予測が無作為より何倍うまく解約する顧客を集めているかを表します |
| RFM | 購買の記録しかない事業で、顧客ごとの購買を要約した数。本コラムでは第10章のモデルの流儀に合わせ、2回目以降の購買回数、初回から最後の購買までの週数、初回から観測の終わりまでの週数、1回あたりの平均金額の4つを使います。一般のRFM分析(最後の購買からの経過日数・頻度・金額で顧客を段階に分ける方法)とは、期間の測り方が違います |
| 在籍確率 | 購買の記録しかない事業で、顧客が観測の終わりの時点でまだ離脱していない確率(第10章) |
| 真の値 | データを作った側だけが知っている本当の解約の起きやすさや離脱の状態。現実の企業には見えませんが、本コラムでは推定の答え合わせに使います |
共通のデータと基準の計算の詳しい設定は第2章で示します。第3章以降は、第2章で用意したデータを使って、各手法を実際に動かした結果を載せています。各章の数字は、特に断らない限り、この架空のデータの、その章の設定での結果です。
本コラムの章の流れは、データの整備(第3章)、離脱の測定(第4章から第6章)、解約の予測(第7章)、価値と優先順位(第8章から第11章)、実験と運用(第12章・第13章)の順に進み、実験と運用の結果を次のデータの整備に戻す循環になっています。
第1章 顧客の離脱と生涯価値はなぜ経営の問題なのか
月額制や会員制の事業では、今月の売上の大半は、先月までに獲得して今月もまだ契約を続けている顧客から生まれます。毎月の獲得の人数が大きく変わらなければ、今月新しく獲得した顧客が今月の売上に占める割合は、事業が数年続くと小さくなっていきます。そのため、顧客がどれだけの期間とどまるか、つまり離脱の速さが、獲得の人数や単価と並んで、来期以降の売上と利益を大きく左右します。この章では、顧客の集まりを、獲得で増え離脱で減る「在庫」のようなものとして捉える見方を最初に示し、月次の解約率の小さな差が3年後に残る顧客の数をどれだけ変えるか、獲得にかけた費用がどれだけの期間で回収されるか、という2つの問いを、第2章で詳しく紹介する架空の定期便のデータで確かめます。そのうえで、定期購入やサブスクリプション型の事業が広がっていることを確認できた範囲で示し、顧客の離脱と生涯価値の判断を誤ったときに経営上どのような損失が出るかを、型に分けて整理します。指標の正確な定義と共通データの設定は第2章で、継続率の推定の方法は第5章で、生涯価値の計算の手順は第9章で扱います。この章では要点だけを述べます。
顧客基盤をストックとして見る
経営の数字には、ある時点の量を表すものと、ある期間に動いた量を表すものがあります。会計でいえば、貸借対照表の残高が前者、損益計算書の売上や費用が後者です。前者をストック、後者をフローと呼びます。顧客の集まりもこの2つに分けて見ることができます。その月の料金を払っている顧客(その月の在籍者)の数がストックで、その月に新しく加わった顧客の数(獲得)と、その月の月末に契約をやめた顧客の数(解約)がフローです。翌月の在籍者数は、今月の在籍者数から今月末の解約を引き、翌月の獲得を足したものになります。
月額制の事業の今月の売上は、おおむね「今月の在籍者数×1人あたりの月額」で決まります。つまり売上はストックに比例します。獲得は、このストックを増やす入口であり、解約は出口です。入口の量だけを見ていると、出口の量が見えなくなります。たとえば毎月1,000人を獲得している事業でも、在籍者が2万人で月次の解約率が5%なら、毎月1,000人が出ていくので、在籍者は増えません。獲得を増やす努力と同じだけ、出口を小さくする努力が売上を増やします。
解約が経営の問題になるもう1つの理由は、その損失が遅れて表に出ることです。本記事の共通データの設定では、解約する顧客はその月の料金を払ったうえで月末に解約するので、今月の売上には変化が出ません(即時の解約で返金をする契約などでは、当月の売上が変わることもあります)。失われたのは、その顧客が来月以降に払うはずだった売上です。会計の数字は過去の期間のフローを記録するので、解約による損失は、損益計算書には翌月以降の売上の伸び悩みとして少しずつ現れ、ある月の解約が原因だとは書かれません。獲得の費用は獲得した月の費用として計上されるのに対して、解約の損失は将来の売上が少しずつ減る形でしか見えない、という非対称があります。
この「将来に見込める粗利」を、顧客1人あたりで、加入した時点から合計したものが、序章で触れた顧客生涯価値(LTV)です。本記事では、加入時点から60か月以内に見込める月次の粗利を、年5%の割引率で割り引いて合計した期待値と定めています(第2章で定義を表にまとめ、第9章で計算の手順を扱います)。ストックの見方に置き直すと、LTV は、入口から入った1人がストックの中にとどまる期間のあいだに生む粗利の合計であり、解約が速いほど小さくなります。
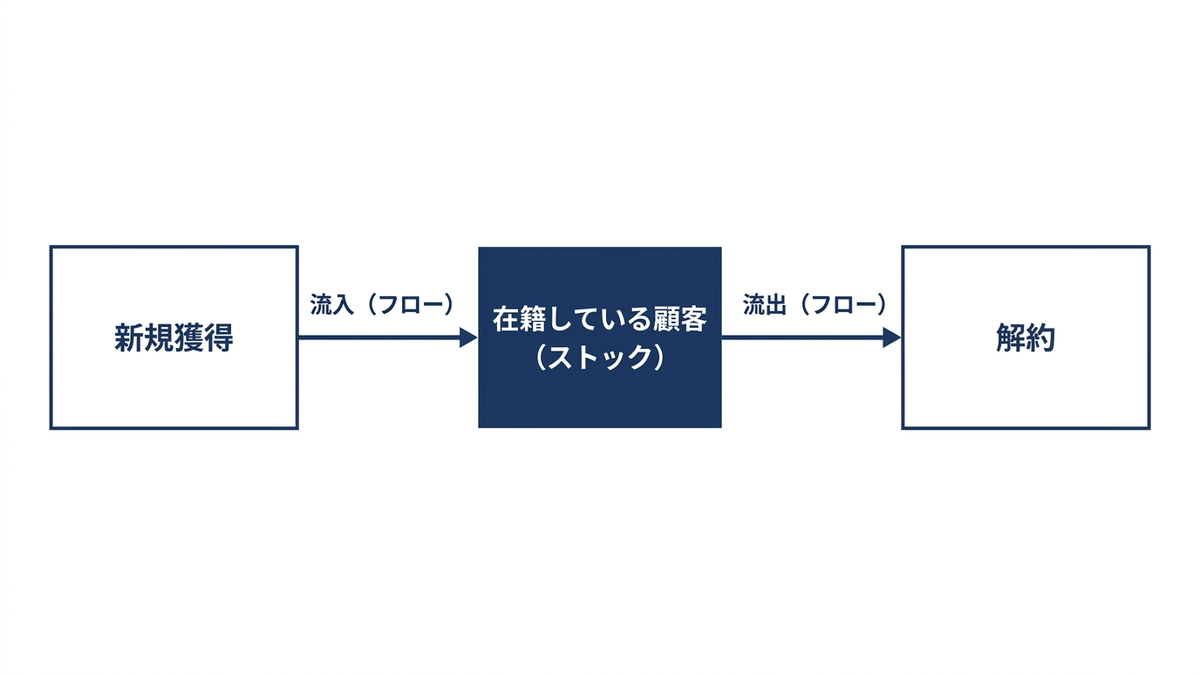
ストックとフローで考えると、経営上の問いは次の3つに整理できます。1つ目は、出口の速さがどれだけかです。月次の解約率、あるいは加入から何か月目まで残っているかを表す継続率で測ります。2つ目は、入口にいくらかけているか、それは何か月で回収できるかです。1人の顧客を獲得するのにかかった費用を顧客獲得費用(CAC)と呼びます。3つ目は、その2つを合わせて、獲得した顧客がかけた費用以上の粗利を残すかどうかです。この章の残りでは、この3つを順に数字で見ていきます。
月次解約率の小さな差が、3年後の残存を大きく変える
月次の解約率が毎月同じだと仮定すると、加入者のうち t か月目の料金を払っている割合(継続率)は、1から月次解約率を引いた値(毎月残る割合)を、t から1を引いた回数だけ掛けたものになります。数式で書くと \( S(t) = (1-h)^{t-1} \) で、\( h \) が月次解約率です。言葉で言い換えると、毎月「残る割合」を掛け続けた値が、t か月目まで残っている割合です。月次解約率を1%から6%まで変えて、12か月目・36か月目・60か月目の継続率を計算しました。
| 月次解約率(毎月一定と仮定) | 12か月目の継続率 | 36か月目の継続率 | 60か月目の継続率 |
|---|---|---|---|
| 1% | 0.895 | 0.703 | 0.553 |
| 2% | 0.801 | 0.493 | 0.304 |
| 3% | 0.715 | 0.344 | 0.166 |
| 4% | 0.638 | 0.240 | 0.090 |
| 5% | 0.569 | 0.166 | 0.048 |
| 6% | 0.506 | 0.115 | 0.026 |
表の「36か月目の継続率」の列を見ると、月次解約率が2%なら加入者の約半分(0.493)が36か月目にも残りますが、4%では約4分の1(0.240)、6%では約9分の1(0.115)しか残りません。月次の解約率の差は「2%と4%」のように2ポイントの差にしか見えませんが、3年分を掛け合わせると、残る顧客の数は2倍、4倍と開きます。「60か月目の継続率」の列では、1%の0.553と6%の0.026で20倍以上の差になります。月次の数字は小さいので、会議の資料で「先月の解約率は3.1%、今月は3.4%」と並べても大きな変化には見えませんが、その差が続けば、数年後のストックの大きさにはっきり表れます。
ただし、この表は「月次解約率が在籍月数によらず一定」という仮定の上の計算です。共通データの継続率曲線は、次の節で見るとおり、加入して間もない時期に大きく下がり、その後なだらかになります。現実の事業でも同じ形になるとは限らないので、形は自社のデータで測る必要があります。継続率曲線が一定の割合で下がらないとき、観測した期間全体の解約数を顧客月数で割った「素朴な解約率」を1つの数字として使い、それが毎月続くと仮定して残る顧客の数を計算すると、実際の残り方とずれます。共通データで、素朴な解約率が一定で続くとして60か月で打ち切った期待在籍月数(加入した1人が60か月のうちに平均して何か月分の料金を払うか)を計算すると、紹介経由の顧客で38.7か月、チラシ経由で15.2か月でした。同じ60か月の打ち切りで数えた真の値は40.2か月と17.7か月で、この例では4つのチャネルすべてで、素朴な計算のほうが短くなりました。また、同じ「解約率が毎月一定」という仮定でも、60か月の上限を置くかどうかで数字は大きく変わります(紹介では、上限を置かない「1÷解約率」だと62.4か月)。期間をそろえずに比べると、計算の仕方の違いと仮定の誤りの区別がつかなくなります。ずれの理由と、どう測れば正しいのかは第5章で扱います。この章では、月次の解約率を1つの数字で語ることには危うさがある、という点だけを押さえておきます。
獲得チャネルによって継続率曲線が違う
本記事で使う共通データは、架空の家庭向け食材宅配の定期便(月額制)の顧客12,000人です。実在の企業やサービスの記録ではなく、乱数の種を固定して作ったもので、設定の詳細は第2章で示します。顧客は4つの獲得チャネル(紹介・検索広告・SNS広告・チラシ)のどれかから加入しており、チャネルによって解約のしやすさが違うように作ってあります。データを作った側は本当の解約の仕組みを知っているので、現実の企業には見えない「真の継続率」を計算できます。真の値は、現実には分からないものですが、この記事では推定や判断の答え合わせに使います。
次の図は、データと同じ顧客の構成(プラン・初回クーポンの利用・世帯人数)で各チャネルの顧客を2万人ずつ新たに生成し、加入から60か月目までの継続率を数えたものです。生成の仕組みから厳密に計算した値ではなく、シミュレーションによる近似値です。共通データの観測は第36か月までなので、点線より右は現実の企業ならまだ見えていない範囲です。
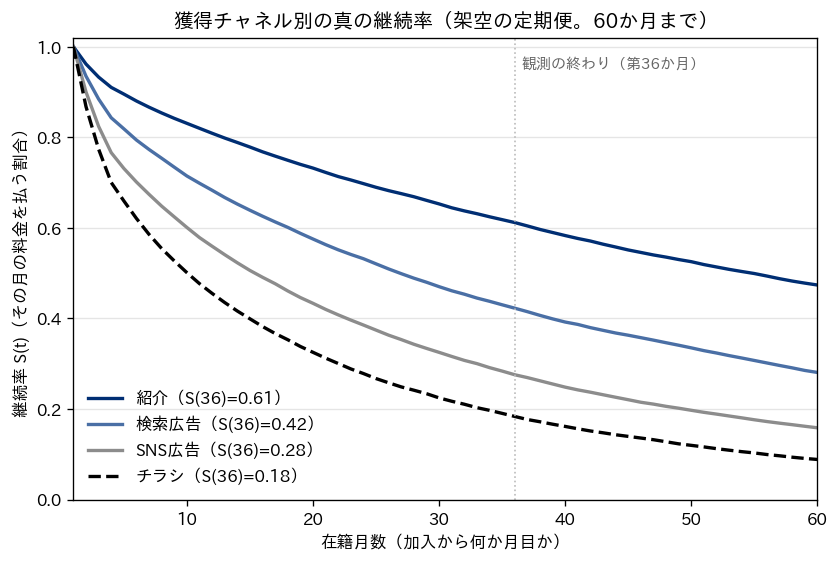
| 獲得チャネル | 3か月目の継続率 | 12か月目の継続率 | 36か月目の継続率 | 60か月目の継続率 | 期待在籍月数(60か月で打ち切り) |
|---|---|---|---|---|---|
| 紹介 | 0.933 | 0.809 | 0.612 | 0.474 | 40.19 |
| 検索広告 | 0.884 | 0.683 | 0.423 | 0.281 | 30.66 |
| SNS広告 | 0.824 | 0.559 | 0.276 | 0.159 | 22.94 |
| チラシ | 0.774 | 0.455 | 0.184 | 0.089 | 17.67 |
表の「36か月目の継続率」の列では、紹介経由の顧客は36か月目にも6割(0.612)が残るのに対し、チラシ経由の顧客は2割弱(0.184)しか残りません。同じ商品を同じ月額で売っていても、どの入口から入ってきた顧客かによって、36か月目に残る割合が3倍以上違います。「期待在籍月数」の列は、加入した1人が60か月のうち平均して何か月分の料金を払うかを表し、紹介の40.19か月に対してチラシは17.67か月です。
図の曲線は、どのチャネルでも最初の数か月の下がり方が急です。加入から1年(1〜12か月目)の月末までに解約した割合のうち、最初の3か月(1〜3か月目)の月末までに解約した割合を数えました。ここで注意が要るのは、本記事の継続率が「その月の料金を払っている割合」だという点です。12か月目の月末に解約した人も12か月目の料金は払っているので、「12か月目の月末までに解約した割合」は、1から13か月目の継続率を引いた値になり、表の12か月目の継続率から計算した値とは1か月ずれます。同じように、「3か月目の月末までに解約した割合」は1から4か月目の継続率を引いた値です。紹介では、13か月目の継続率が0.798なので1年目の解約は0.202、4か月目の継続率が0.910なので最初の3か月の解約は0.090でした。チラシでは、13か月目0.435・4か月目0.700から、1年目の解約0.565のうち0.300です。どのチャネルでも、1年目の解約のおよそ半分(0.45〜0.53)が最初の3か月に集中していました。この共通データでは、初回クーポンを使った顧客が最初の3か月だけ解約しやすいように作ってあり、在籍が長くなるほど解約しにくくなる設定も入っています(設定は第2章、在籍月数ごとの解約のしやすさは第5章で扱います)。こうした形の曲線では、加入直後の数か月の扱いが、残る顧客の数を大きく左右します。
この違いは、経営の数字では「獲得の質」の違いとして現れます。獲得の件数と1件あたりの獲得費用だけを見て広告の効果を評価すると、チラシと紹介は「1件の獲得」として同じに数えられます。しかしストックへの貢献で見ると、チラシで獲得した1人は、紹介で獲得した1人の半分以下(17.67÷40.19で約0.44)の期間しかとどまりません。獲得のチャネルを選ぶ判断には、獲得した後の継続率曲線を必ず添える必要があります。
獲得を続けたときにストックはどう積み上がるか
継続率曲線の違いがストックの大きさにどう効くかを、単純な計算で確かめました。あるチャネルだけで毎月1,000人を獲得し続けたとします。第36か月の在籍者(第36か月の料金を払う人)は、第1か月に加入した1,000人のうち36か月目の料金を払っている人、第2か月に加入した1,000人のうち35か月目の料金を払っている人、と足していったものなので、1,000人に「在籍月数1〜36の継続率の合計」を掛けた値になります。逆に、第36か月の時点で在籍者を1万人にしたいなら、毎月の獲得人数は1万人をこの合計で割った値です。次のコードは、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。cd.true_survival_mix は、上の図の真の継続率を返す関数で、cd.CAC は架空の獲得費用(円/人)です。
import cust_data as cd

cust, monthly = cd.make_subscription()
for c in cd.CHANNELS:
    s = cd.true_survival_mix(cust, c)       # 真の継続率 S(1)〜S(60)
    k36 = s.values[:36].sum()               # 在籍月数1〜36の継続率の合計
    stock = 1000 * k36                      # 毎月1,000人を36か月獲得したときの第36か月の在籍者
    need = 10000 / k36                      # 第36か月に在籍者1万人にするのに毎月要る獲得
    cost = need * 36 * cd.CAC[c]            # その36か月の獲得費用(架空の CAC)
    print("%s S(12)=%.3f S(36)=%.3f 在籍者 %.0f人 毎月の獲得 %.0f人 獲得費用 %.0f万円"
          % (cd.CHANNEL_JA[c], s[12], s[36], stock, need, cost / 1e4))
# 出力:
# 紹介 S(12)=0.809 S(36)=0.612 在籍者 27353人 毎月の獲得 366人 獲得費用 2632万円
# 検索広告 S(12)=0.683 S(36)=0.423 在籍者 22402人 毎月の獲得 446人 獲得費用 9642万円
# SNS広告 S(12)=0.559 S(36)=0.276 在籍者 17965人 毎月の獲得 557人 獲得費用 18035万円
# チラシ S(12)=0.455 S(36)=0.184 在籍者 14596人 毎月の獲得 685人 獲得費用 29596万円
毎月1,000人を36か月、合計36,000人を獲得した結果、第36か月の在籍者は、紹介なら27,353人、チラシなら14,596人でした。獲得した人数は同じでも、ストックは2倍近く違います。60か月続けた場合(獲得の合計は60,000人)は、紹介で40,185人、チラシで17,669人と、差はさらに開きました。
ストックが大きくなると、出口から出ていく人数も増えます。毎月1,000人を獲得し続けた場合、第36か月の月末に解約する人数は、紹介で396人(その月の在籍者の0.014)、検索広告で585人(0.026)、SNS広告で730人(0.041)、チラシで823人(0.056)でした。チラシだけで獲得している事業では、第36か月の時点で、毎月の獲得1,000人のうち823人分が、出ていく顧客の穴埋めに使われていることになります。在籍者の伸びが鈍ってきたとき、獲得を増やすことだけで伸びを取り戻そうとすると、この穴埋めの部分にも費用をかけ続けることになります。
| 獲得チャネル | 第36か月に在籍者1万人にするのに毎月要る獲得(人) | 36か月の獲得の合計(人) | 36か月の獲得費用(万円。架空の CAC) |
|---|---|---|---|
| 紹介 | 366 | 13,161 | 2,632 |
| 検索広告 | 446 | 16,070 | 9,642 |
| SNS広告 | 557 | 20,039 | 18,035 |
| チラシ | 685 | 24,664 | 29,596 |
表は、第36か月の時点で同じ1万人の在籍者を持つために必要だった獲得の量と費用です。合計と費用は、丸める前の毎月の獲得人数から計算しています(366人×36か月が13,161人と一致しないのはそのためです)。「36か月の獲得の合計」の列では、チラシは紹介の約1.9倍の人数を獲得する必要があります。「36か月の獲得費用」の列では、継続率の違いに1人あたりの獲得費用の違い(架空の設定で紹介2,000円、チラシ12,000円)が掛け合わさり、紹介の2,632万円に対してチラシは2億9,596万円と、10倍を超えました。同じ規模の顧客基盤を作るための費用は、獲得単価の比(6倍)よりも大きく開きます。継続率の低いチャネルでは、同じストックを作るのにより多くの人数を獲得しなければならないからです。
この計算は、各チャネルでいくらでも獲得できるという単純化を置いています。現実には、チャネルごとに1か月に獲得できる人数には上限があり、紹介のように継続率の高いチャネルだけで必要な人数をまかなえるとは限りません。また、1つのチャネルに予算を寄せるほど、追加の1人を獲得する費用が上がることもあります。この表は「どのチャネルに寄せるべきか」の答えではなく、獲得の件数だけで比べると見えない費用の差がどれほど大きいかを示すものです。チャネルごとにいくらまでかけてよいかは、次の節の LTV と CAC の比較で考えます。
獲得費用は何か月で回収されるか:LTV と CAC
獲得費用は、獲得した月にまとめて出ていきます。その費用が取り戻されるのは、獲得した顧客から毎月の料金を受け取り、そこから原価を差し引いた粗利が積み上がった後です。共通データの架空の設定では、粗利率は0.30で、月次の粗利は標準プラン(月額5,000円)で1,500円、大容量プラン(月額8,000円)で2,400円です。チャネルごとのプランの構成を反映した月次の粗利の平均は、どのチャネルもほぼ同じ1,759〜1,776円でした。月額も粗利もほぼ同じなので、チャネルの間の LTV の違いは、ほぼ継続率の違いだけから生まれます。
次の表は、記事全体の基準の計算(第2章で紹介します)のうち、チャネル別の LTV と CAC を比べた部分です。「真の LTV」は、データを作った側だけが知る本当の値で、現実の企業には分かりません。上の図と同じように各チャネルの顧客を2万人ずつ生成し、1人ずつ「料金を払った月数」と「その人の月額」から割引後(年5%)の粗利を計算して、加入時点から60か月以内の合計を平均したものです。獲得費用は差し引いていません。「回収月数」は、加入からの累積の割引後の粗利が CAC に達する月です。
| 獲得チャネル | 月次粗利の平均(円) | 真の LTV(円) | CAC(円。架空) | 真の LTV÷CAC | 回収月数(真) |
|---|---|---|---|---|---|
| 紹介 | 1,759 | 64,767 | 2,000 | 32.4 | 2 |
| 検索広告 | 1,768 | 50,362 | 6,000 | 8.4 | 4 |
| SNS広告 | 1,776 | 38,485 | 9,000 | 4.3 | 7 |
| チラシ | 1,762 | 29,689 | 12,000 | 2.5 | 11 |
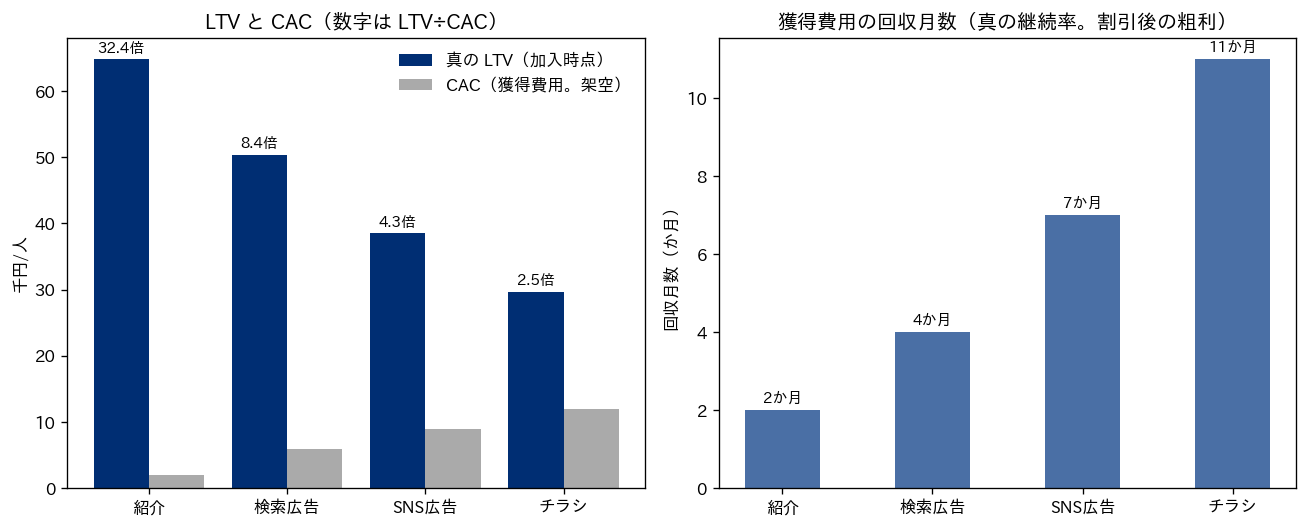
表の「真の LTV÷CAC」の列は、獲得にかけた1円が、60か月のうちに何円の割引後の粗利になって返ってくるかを表します。この架空の設定では、4つのチャネルすべてで1を上回り、どのチャネルの獲得も、集団の期待値で見れば60か月のうちに費用を回収できる計算です。ただし、その倍率は紹介の32.4倍からチラシの2.5倍まで、10倍以上の開きがあります。「回収月数(真)」の列では、紹介は2か月目、チラシは11か月目に、累積の粗利が獲得費用に達します。
回収月数は、資金繰りの目安でもあります(ここでの粗利は、入金と支払いの時期の違いを省いた目安です)。獲得費用は先に出ていき、粗利は後から入ってくるので、回収月数が長いチャネルで獲得を増やすほど、手元の資金が一時的に多く出ていきます。同じ時期に加入した1,000人の集まりで見ます(このように加入の時期で束ねた顧客の集まりを、第4章でコホートと呼んで詳しく扱います)。チラシでは獲得費用1,200万円に対して、12か月目までの累積の割引後の粗利は約1,348万円(13,481,122円)、36か月目までで約2,493万円(24,931,133円)でした。紹介では獲得費用200万円に対して、12か月目までで約1,841万円(18,405,590円)です。月々の獲得を急に増やした期は、回収月数の長いチャネルの比重が大きいほど、その期の利益と資金を圧迫します。回収月数と資金繰りの関係は第9章で扱います。
この表の CAC を見方を変えて読むと、「獲得費用はいくらまでなら回収できるか」の上限が分かります。60か月で回収できる獲得費用の上限は、そのチャネルの真の LTV そのもので、チラシなら1人29,689円です。獲得費用がこの額を超えると、60か月の粗利では獲得費用を取り戻せません。現実の事業では、真の LTV は分からず、推定した LTV を使うことになり、推定の誤差の分だけ余裕を見る必要があります。どのくらいの倍率を目標にするかは、事業の資金の状況や推定の確かさによって決めるもので、本記事では一般的な基準の値を示しません。チャネルごとの予算の上限の決め方は第9章で、獲得と引き止めの予算の配分は第11章で扱います。
もう1つ注意したいのは、LTV という同じ名前でも、計算の仕方によって数字が大きく違うことです。「月次の粗利÷月次の解約率」という簡単な公式(本記事では素朴な公式と呼びます)で紹介チャネルの LTV を計算しました。使ったのは、紹介チャネルの月次粗利の平均(表の1,759円)と、観測期間全体の素朴な解約率(0.0160)です。どちらも四捨五入する前の値で割ると109,708円になり、真の値64,767円の1.7倍でした(表示した桁の数字で割ると、端数の分だけ結果が少しずれます)。この公式は、解約率が在籍月数によらず一定であることに加えて、割引をせず、期間の上限を置かないことを前提にしています。真の LTV と同じ60か月の上限と年5%の割引をそろえ、解約率だけを一定と置いて計算し直すと61,736円で、真の値との差はずっと小さくなりました。同じ公式の考え方でも、期間と割引の定義が違えば数字は大きく違うということです。社内の資料に「LTV」と書かれた数字があるときは、どの定義で計算したものかを確かめてから、獲得費用と比べる必要があります。LTV の定義は第2章で、解約率の測り方は第5章で、LTV の計算の手順は第9章で扱います。
定期購入・サブスクリプション型の事業の広がり
ここまでの話が当てはまるのは、顧客が継続して料金を払う形の事業です。そうした事業の広がりを示す業界調査として、株式会社矢野経済研究所が2023年12月18日に公表した、サブスクリプションサービス市場の調査があります。この調査は、サブスクリプションサービスを、月1回以上の定額の支払いが発生し、継続して利用することを前提としたサービスと定義しています。そのうえで、消費者向けのサービスのうち、レンタルなど「利用する」形のサービス(ファッション・飲食店サービスとテイクアウト・ライフスタイル・レジャーとエンタメ・情報コンテンツ・教育・メディカルとヘルスの7分野)を対象にし、2023年の国内市場規模(7市場計、消費者の支払額ベース)を、前年比5.2%増の9,430億3,000万円と見込んでいます。
この数字を使うときには、範囲に注意が要ります。同じ調査は、定期宅配のように商品を届けて所有してもらう形のサービスを市場規模に含めていません。本記事の共通データの題材である食材の定期便は、この除かれた側に当たるので、この数字は題材の市場の大きさを示すものではありません。ここで示したいのは、定期宅配を除いても、月々の定額の支払いで成り立つ消費者向けのサービスが9,000億円を超える規模の支払いを集めている(2023年の見込み)という点です。そうした事業では、この章で見たとおり、売上が在籍している顧客の数に比例するので、解約と LTV の測り方が売上の見通しに直結します。また、この数字は2023年の見込みの値です。調査の公表資料は、サブスクリプションサービスがデジタルコンテンツの業界を中心に2010年代中頃から広がり、近年は衣食住など日常生活に欠かせないものを提供する業界にも、継続してサービスを提供する形が広がっている、と説明しています。本記事の基準時点(2026年10月)までに、同じ調査のより新しい版が公表されているかどうかは確認できませんでした。
業界の統計は、事業の外側の環境を知るためのものです。自社の顧客が何か月とどまり、獲得にかけた費用が何か月で戻るかは、外部の統計からは分かりません。この記事で扱う手法は、すべて自社の顧客の記録からそれを測るためのものです。
判断を誤ったときの損失の型
顧客の離脱と生涯価値をめぐる判断の誤りは、いくつかの型に分けられます。ここでは共通データで大きさを測れる4つの型を取り上げ、それぞれを詳しく扱う章を示します。
1つ目は、解約率を1つの平均で見ることです。共通データの観測期間(第1〜36か月)の解約数を顧客月数で割った素朴な解約率は、全体では0.0327でした。チャネル別に分けると、紹介0.0160、検索広告0.0274、SNS広告0.0456、チラシ0.0645で、4倍の開きがあります。全体の0.0327という1つの数字だけを見ていると、この開きは見えません。さらに、平均は顧客の構成が変わると動きます。共通データでは、加入時期が後ほど紹介経由の顧客の割合が減り(加入月1〜6の33%から加入月25〜30の22%へ)、チラシ経由が増えています(16%から29%へ)。加入時期を6か月ごとに分けて12か月目の継続率を比べると、全体では加入月1〜6の0.679から加入月25〜30の0.620へ下がって見えますが、紹介経由の顧客だけに絞ると0.830から0.808で、ほぼ横ばいでした。ただし、加入月25〜30の値は、観測の終わり(第36か月)までに12か月目に届いた第25か月の加入者432人(紹介経由だけなら99人)だけから計算したもので、人数が少ないぶん偶然の揺れが大きい数字です。全体の数字だけを見て「サービスの質が落ちた」と判断し、サービスの改善に予算を振り向けたとします。全体の下落の原因が獲得の構成の変化なら、その構成の変化による下落分は、サービスの改善では戻りません。これは改善の効果そのものが無いという意味ではなく、各チャネルの中の継続率が改善で上がれば、全体の継続率もその分は上がります。戻らないのは、継続率の低いチャネルの割合が増えたことによる下落分です。見かけの悪化かどうかをコホート分析で見分ける方法は第4章で扱います。
2つ目は、獲得チャネルごとの LTV を見ずに獲得費用を配ることです。共通データの12,000人のチャネル構成(紹介26.8%、検索広告30.2%、SNS広告20.5%、チラシ22.4%)を重みにして、4チャネルの真の LTV を加重平均すると、47,160円になります。この平均の LTV を全チャネルに当てはめて LTV÷CAC を計算すると、チラシは3.93、SNS広告は5.24に見えますが、チャネル別の真の値は2.47と4.28でした。逆に紹介は、平均で見ると23.58、真の値は32.38で、実際より低く評価されます。継続率の低いチャネルを高く、高いチャネルを低く見積もる向きの誤りです。
この共通データでは、期待値の上ではどのチャネルも獲得費用を回収できるので、この誤りは獲得費用を回収できないという形の損失にはまだなっていません(限られた予算をどのチャネルに配るかで得られる粗利が変わる、という機会の損失は別にあります)。回収できない損失になるのは、次のような場合です。仮に、チラシの獲得単価が今の12,000円から上がり、29,689円を超えて47,160円を下回る範囲になったとします。獲得費用の上限を平均の LTV で決めていると、この単価でも回収できるように見えますが、チラシの真の LTV では60か月のうちに回収できません。そうなったチャネルに獲得費用を積み続けると、獲得の件数とストックは増えても、その分だけ将来の利益が減っていきます。獲得単価は、競争や媒体の状況で変わりうるので、上限はチャネルごとの LTV で決めておく必要があります。
3つ目は、離脱してから気づくことです。共通データの設定では、解約は支払いが止まった時点で初めて記録に残ります。解約の申し出や解約の予約を受け付けて記録する仕組みがあれば、支払いが止まるより前に分かりますが、それも顧客が解約を決めた後の記録です。共通データでは、1年目の解約のおよそ半分が最初の3か月に集中していました。たとえば、ある月に加入した顧客の解約が増えたことに、加入から数か月後の月次の報告で気づいたとすると、その時点で顧客たちは解約の多い最初の3か月をすでに過ぎていて、解約した人に手を打つ時期は過ぎています。しかも、「顧客基盤をストックとして見る」の節で述べたとおり、解約の損失は将来の売上の減少として遅れて表に出ます。解約の兆しを利用の記録(注文の回数や問い合わせ)から事前につかむ方法は、第6章(要因)と第7章(予測)で扱います。ただし、共通データの生成の設定とこの検証の集団では、隠れた利用意欲まで知っている真のモデルの推定確率でも、実際に起きた3か月以内の解約を当てる力(AUC。第7章で説明します)は0.684でした。1回の検証の AUC には偶然による幅もあります。この例では、解約には予測できない偶然の部分が大きく、事前に全部をつかめるわけではありません。
4つ目は、解約しそうだと予測された人の全員に引き止めの施策を打つことです。記事全体の基準の計算では、第30か月末の在籍者7,324人に、1人500円の架空の引き止め施策(3か月間、解約の起きやすさ(オッズ)を0.7倍にするという架空の前提)を当てる場合を、真の仕組みで答え合わせしました。予測の上位10%(733人)に当てると、24か月の割引後の粗利の純増(粗利の増分から施策の費用を引いたもの)は486,054円でした(この1回の計算の値。乱数の種を変えた5回の計算では422,960円から486,054円)。しかし、その733人の真の3か月解約確率の平均は0.183で、選ばれた人も、施策が無ければ平均して約8割が3か月のうちには解約しない見込みです。全員に当てると純増は893,973円(5回で711,494円から893,973円)で、総額では上位10%より大きくなりますが(比べた候補の中で総額が最も大きかったのは上位30%の994,293円。5回の計算のどれでも上位30%が全員を上回りました)、全員に配ったときの1人あたりの粗利の増分は622円(5回で597円から622円)で、施策の費用500円との差は小さくなります。施策の費用が1人およそ600〜620円(5回の計算で597円から622円)を超えると全員への配布は赤字になり、およそ1,080〜1,160円(同じく1,077円から1,163円)を超えると上位10%に絞っても赤字になります(この例で、24か月の評価期間と固定した施策の効果を前提にした推定値)。予測の高さだけで対象を決めず、費用と救える粗利で決める考え方は第8章で、ここで架空の前提として置いた施策の効果を現実に実験で測る方法は第12章で扱います。
| 損失の型 | 共通データで見えたこと | 主に扱う章 |
|---|---|---|
| 解約率を1つの平均で見る | 全体の素朴な解約率0.0327の内側に、チャネル別で0.0160〜0.0645の開きがある。全体の12か月目の継続率の低下(0.679から0.620。0.620は第25か月の加入者432人の値)は、紹介経由だけなら横ばい(0.830から0.808) | 第4章・第5章 |
| 獲得チャネルごとの LTV を見ずに獲得費用を配る | 平均の LTV 47,160円で見るとチラシの LTV÷CAC は3.93、真の値は2.47(この例では全チャネルが期待値で回収できる。獲得単価が上がったときに回収できない損失になる) | 第9章・第11章 |
| 離脱してから気づく | 1年目の解約のおよそ半分が最初の3か月に集中。隠れた利用意欲を知る真のモデルの推定確率でも、3か月以内の解約に対する AUC は0.684(この例の1回の検証での値。偶然による幅がある) | 第6章・第7章 |
| 予測の高い人全員に施策を打つ | 予測の上位10%でも、平均して約8割は3か月のうちに解約しない見込み。全員への配布は1人あたりの粗利の増分622円(乱数の種を変えた5回で597〜622円)で、費用500円との差が小さい | 第8章(対象の選び方)・第12章(施策の効果の測り方) |
表の4つの型に共通するのは、まとめた数字や、遅れて届く数字で判断している点です。全体の解約率、全チャネルの平均の LTV、支払いが止まってから集計される解約の数、解約しそうな人の平均の解約確率、施策1件あたりの平均の効果、のどれも、それ自体は正しく計算された数字ですが、判断に必要な「どの集団の」「どの時点の」「追加の1人あたりの」数字とは違います。この記事の各章は、まとめた数字を、判断に使える単位と時点に分け直すための手法を扱います。
経営の判断に翻訳する
この章の結果を、予算と報告の形に落とすと、次の4つになります。1つ目は、顧客の数を報告するときに、在籍者数(ストック)と、獲得・解約(フロー)を分けて示すことです。在籍者数の推移だけを報告していると、獲得を増やして解約の増加を埋めている状態と、解約が少なく獲得がそのまま積み上がっている状態の区別がつきません。共通データの計算では、チラシだけで毎月1,000人を獲得し続けた場合、第36か月には獲得の8割以上が解約の穴埋めに回っていました。
2つ目は、解約率を、獲得チャネル別・加入時期別・在籍月数別に分けて報告することです。全体の解約率の上下は、獲得の構成の変化だけでも起きます。分けて見ることで、獲得の質が変わったのか、サービスに問題が起きたのかを区別しやすくなり、手を打つ部署(獲得を担う部署か、サービスを担う部署か)を誤りにくくなります。チャネルで分けても区別できるのはチャネルの範囲までで、プランや初回の特典など分けなかった属性の影響は残ります(第4章で扱います)。
3つ目は、獲得費用の上限を、チャネルごとの LTV と回収月数から決めることです。共通データでは、どのチャネルも期待値で見れば60か月のうちに回収できる計算でしたが、LTV÷CAC は2.5倍から32.4倍まで、回収月数は2か月から11か月まで違いました。獲得の予算を件数や獲得単価だけで配ると、この違いが予算に反映されません。LTV は推定値なので、どの定義で、どのデータから計算したかを添え、推定の誤差の分だけ余裕を持たせて上限を決めることが有効だと考えています。
4つ目は、引き止めの施策を、予測の精度ではなく、費用と救える粗利で評価することです。施策の効果そのものは、この記事の例では架空の前提として置いていますが、現実には実験で測る必要があります(第12章で扱います)。顧客の離脱と生涯価値の分析は、データ分析の担当者だけの仕事ではなく、獲得の予算・サービスの改善・引き止めの施策のそれぞれに責任を持つ部署が、同じ定義の数字を見て判断するための仕組みだと考えています。組織での使い方は第13章で扱います。
この章の要点は3つです。第一に、月額制の事業の売上は在籍している顧客の数(ストック)に比例し、解約はその出口です。解約の損失は将来の売上の減少として遅れて表に出るので、会計の数字だけでは見えにくくなります。第二に、月次の解約率の小さな差は、掛け合わさって数年後のストックを大きく変えます。共通データでは、獲得チャネルによって36か月目の継続率が0.184から0.612まで違い、同じ1万人の在籍者を作るための獲得費用は10倍以上違いました。第三に、獲得費用は LTV と回収月数でチャネルごとに評価する必要があり、平均の解約率で判断するとチャネルの違いが見えなくなり、平均の LTV で判断すると、継続率の低いチャネルを高く評価する向きの誤りが起きます。次の第2章では、この記事で使う指標の定義と、ここで使った共通データの設定、記事全体の基準の結果を、表にまとめて紹介します。
この章を深めたい方への参考書籍
『顧客投資マネジメント 顧客価値の可視化によるファイナンスとマーケティングの融合』(スニル・グプタ、ドナルド・R.レーマン 著、スカイライトコンサルティング株式会社 訳、英治出版):「顧客は資産である」「顧客の価値をはかる」から始まり、顧客価値に基づく戦略・企業評価・プランニング・組織までを扱う本です。この章で述べた、顧客の集まりをストックとして捉え、獲得にかける費用を将来の粗利で回収する投資として見る考え方を、マーケティングとファイナンスをつなぐ枠組みとして体系立てて学べます。
『カスタマーセントリシティ 「正しい顧客」に集中する経営戦略』(ピーター・フェーダー 著、倉橋健太 監訳、三本木亮 訳、ダイヤモンド社):製品を中心にした経営から顧客を中心にした経営への転換を論じ、顧客エクイティ・顧客生涯価値(CLV)・CRM(顧客関係管理)を章として扱う本です。著者は米国ペンシルベニア大学ウォートンスクールの教授で、版元の紹介によれば顧客生涯価値や CRM を研究しています。顧客ごとの価値の違いを経営の判断にどう生かすかという、この章の「平均で見ない」という論点を経営戦略の側から考えるのに向いています。
第2章 顧客分析の全体像、契約型と非契約型・指標の定義・共通データ
第1章では、顧客基盤を在籍している顧客の集まり(ストック)として見ると、月次解約率のわずかな差が3年後に残る顧客数を大きく変え、獲得チャネルごとに獲得費用の回収のしやすさがまったく違うことを確かめました。この章では、第3章以降で使う道具と材料をそろえます。最初に、顧客の離脱が「見える」事業と「見えない」事業を分ける分類を、研究者の論文と講義資料を開いて確かめた範囲で説明します。次に、この記事で扱う手法がそれぞれ何に答えるのかを1枚の地図にまとめ、解約率・継続率・LTV などの指標の定義を全章で固定します。最後に、記事全体で使う2つの架空のサンプルデータ(月額制の定期便と、単品通販)を紹介し、それを使った基準の計算の結果(カプラン・マイヤー推定と真の値の比較、チャネル別の LTV、BG/NBD モデルの推定)を先に示します。各手法の仕組みと読み方は、それぞれの章で扱います。
契約型と非契約型、離脱が見えるかどうかで分析の道具が変わる
顧客分析を始める前に確かめておきたいのは、自社の事業で「顧客がいつ離れたか」が記録に残るかどうかです。この区別は、顧客の購買や継続を確率のモデルで表す研究を共同で発表してきた Peter Fader(ペンシルベニア大学ウォートン校)と Bruce Hardie(ロンドン・ビジネス・スクール)が、顧客基盤分析(customer-base analysis。顧客の集まり全体について、誰がまだ顧客で、これから何をどれだけ買い、どれだけの価値があるかを推定する分析)の出発点として説明しているものです。
2人が2016年の第27回 Advanced Research Techniques Forum(マーケティングの分析手法を扱う会議)の講習で配布した資料(題は Probability Models for Customer-Base Analysis。Hardie のウェブサイトで公開されています)は、事業の状況を分類するときに、契約型と非契約型を区別することが重要だとしています。契約型(contractual)は、顧客が企業との関係を終えた時点を企業が観測できる状況です。非契約型(noncontractual)は、顧客がいつ離れたかが観測されない状況で、資料はこれを「離脱が潜在的(latent)である」と表現しています。同じ資料は、非契約型の難しさを、関係を終えた顧客と、単に次の購買までの間隔が長く空いているだけの顧客を、どう見分けるかという問いとして示しています。
2人が Jen Shang と共著で2010年に Marketing Science 誌(29巻6号)に発表した、離散的な時点でしか購買が記録されない非契約型の顧客基盤分析の論文(題は Customer-Base Analysis in a Discrete-Time Noncontractual Setting)は、脚注でこの区別に例を添えています。契約型の例はスポーツジムの会員・ケーブルテレビ・劇場の定期会員で、顧客が企業との正式な関係を終えた時点が観測されます。非契約型の例は従来型の通信販売と小売店の利用で、顧客が離れた時点は企業から見えず、顧客は離れることを企業に知らせない、と説明しています。同じ論文は、購買の機会が連続的な時間のどこでも起こりうる場合と、決まった時点(年1回の寄付の呼びかけなど)にしか起こらない場合の区別も論じ、後者のための専用のモデルを提案しています。Fader と Hardie が2009年に Journal of Interactive Marketing 誌(23巻1号)に発表した、確率モデルによる顧客基盤分析の概説論文(題は Probability Models for Customer-Base Analysis)も、要旨で、事業の状況や顧客との関係の種類の主な違いをとらえる分類を示し、顧客の離脱が観測できない非契約型と、観測できる契約型のそれぞれのモデルを扱うと述べています。この概説論文は本文を開けなかったので、ここでは要旨に書かれた範囲だけを紹介しました。この章で触れた論文と資料の所在は、記事末尾の参考情報に載せました。
この区別が分析の道具を変える理由は、「解約」という記録の有無にあります。月額制の定期便では、顧客が支払いをやめた月が記録に残るので、在籍月数と解約の有無から継続率を直接推定できます。ただし、観測の終わりの時点でまだ在籍している顧客は「観測の終わりまでは解約しておらず、その後いつ解約するかは分からない」状態なので、その扱いに専用の道具(第5章の生存分析)が要ります。通販や小売では、最後の購買から半年たった顧客が離れたのか、たまたま間隔が空いているだけなのかは、記録からは分かりません。そこで、購買の回数と最後の購買の時期から「まだ顧客である確率」を推定する確率モデル(第10章の BG/NBD モデル)を使います。契約型のデータに非契約型の道具を当てたり、その逆をしたりすると、手元にある情報を捨てるか、手元に無い情報を勝手に補うことになります。
実際の事業には、両方の性質を持つものも多くあります。定期便の会員でありながら、単品の追加注文もできるサービスでは、会員の解約は契約型として、追加注文は非契約型として扱うのが自然です。会員制の小売店では、年会費の更新は契約型ですが、来店と購買は非契約型です。どちらの型かは業種で決まるのではなく、「分析したい行動について、終わった時点が記録に残るか」で決まります。この記事では、契約型の例として月額制の定期便(共通データ A)、非契約型の例として単品通販(共通データ B)を用意しました。
| 観点 | 契約型(共通データ A の定期便) | 非契約型(共通データ B の単品通販) |
|---|---|---|
| 離脱の記録 | 解約した月が残る | 残らない。購買が止まったことしか分からない |
| 例(Fader らの論文の脚注) | スポーツジムの会員、ケーブルテレビ、劇場の定期会員 | 従来型の通信販売、小売店の利用 |
| 主に知りたいこと | 在籍月数ごとの継続率、解約の要因、誰が近く解約しそうか | まだ顧客である確率、この先の購買回数 |
| 難しさ | 観測の終わりにまだ在籍している人(打ち切り)の扱い | 離脱した人と、購買の間隔が空いているだけの人の見分け |
| この記事の主な道具 | コホート分析(第4章)、生存分析(第5章)、ハザードモデル(第6章)、解約予測(第7章)、LTV(第9章) | RFM と BG/NBD モデル(第10章) |
手法の地図、それぞれの手法は何に答えるか
顧客の離脱と生涯価値をめぐる手法は数が多く、名前だけを並べると何から手を付ければよいかが分かりにくくなります。この記事では、手法を「どの問いに答えるか」で並べました。次の表は、各手法が答える問い、使うデータ、答えを経営の判断に使う場面を整理したものです。
| 手法 | 答える問い | 使うデータ | 判断に使う場面 | 章 |
|---|---|---|---|---|
| コホート分析 | 加入時期ごとに、継続率は良くなっているか悪くなっているか | 加入月と、在籍月数ごとの在籍の有無 | 獲得の質やサービスの変化の早期発見 | 第4章 |
| 生存分析(カプラン・マイヤー推定) | 打ち切りを正しく扱うと、在籍月数ごとの継続率と解約率(ハザード)をどう推定できるか | 在籍月数と、解約したか打ち切りか | 解約率の正しい報告、チャネルの比較 | 第5章 |
| ハザードモデル | どの属性・利用状況の顧客が、どれだけ解約しやすいか | 上に加えて、顧客の属性と月ごとの利用状況 | 施策の候補になる要因の洗い出し | 第6章 |
| 解約予測(機械学習) | いま在籍している顧客のうち、誰が近く解約しそうか | ある時点までの利用履歴と、その後の解約 | 引き止め施策の対象の候補 | 第7章・第8章 |
| LTV(契約型) | 1人の顧客が加入から生む粗利は、割り引いて合計いくらか | 継続率、月次粗利、割引率 | 獲得費用の上限、チャネル別の予算 | 第9章 |
| BG/NBD モデル(非契約型) | まだ顧客である確率と、この先の購買回数はいくつか | 購買の回数・最後の購買の時期・観測期間 | 通販の「生きている顧客数」、顧客ごとの価値 | 第10章 |
| 価値の分布と優先順位 | 限られた予算を、どの顧客から順に使うか | 残存価値と解約確率 | 引き止め予算の配分 | 第11章 |
| 実験(ホールドアウト) | 施策は本当に解約を減らし、粗利を増やしたか | 施策を当てた群と当てなかった群の結果 | 施策を全体へ広げるかどうか | 第12章 |
表の上から下へ、記事の章もおおむね同じ順に並んでいます。コホート分析で「何かが変わったか」に気付き、生存分析で継続率と解約率を正しく測り、ハザードモデルで「なぜ」の候補を探し、予測で「誰が」を絞り、LTV で「いくらの価値か」を測り、実験で「打った施策が効いたか」を確かめる、という流れです。この順に積み上げる理由は、後ろの手法ほど前の手法の結果を前提に使うからです。たとえば、LTV の計算には継続率が要り、継続率を誤って測っていれば LTV も誤ります。引き止め施策の採算は、施策で増える割引後粗利の期待値と施策の費用を比べて決まり、粗利の増分は解約確率・残存価値・施策の効果のどれによっても変わります。どれか1つでも誤れば結論が変わります。
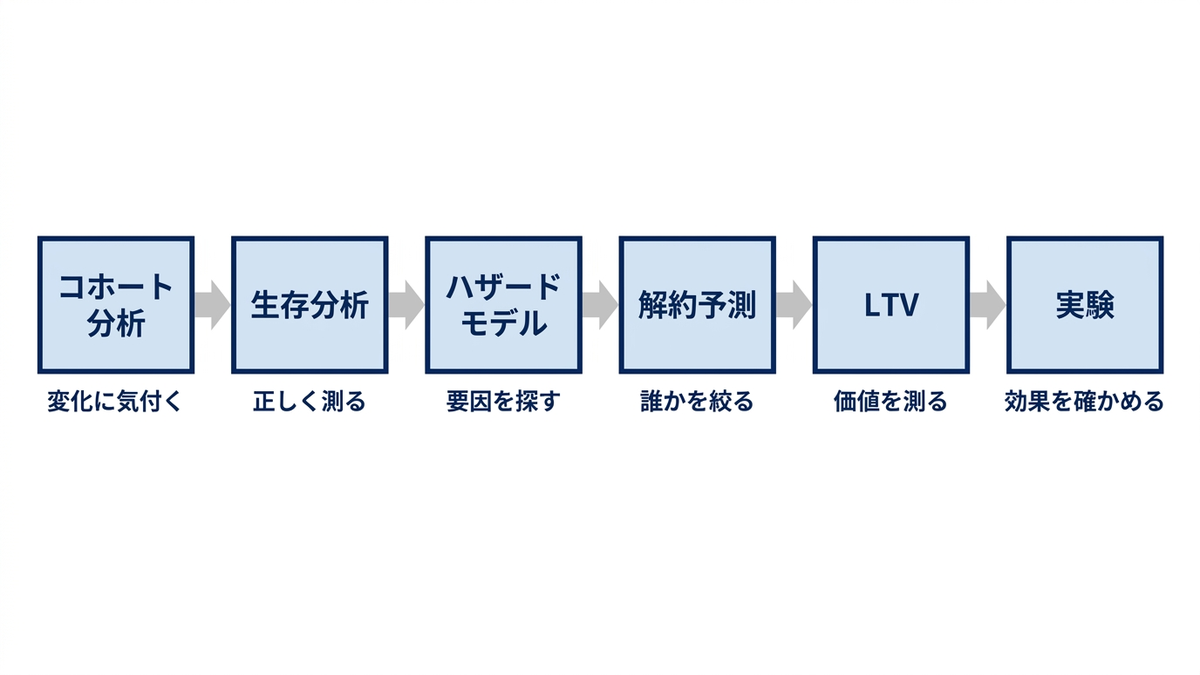
すべての手法がすべての事業に要るわけではありません。ここから先の規模の目安は、データや文献から導いたものではなく、弊社の考えとして示すものです。顧客が数百人規模で、解約の件数が月に数件しかない段階では、ハザードモデルや機械学習の予測は、解約の事例が少ないために推定が不安定になりやすく、手間に見合わないことが多いと考えています。その段階では、解約の定義をそろえ(第3章)、コホート表を毎月更新し(第4章)、カプラン・マイヤー推定で継続率を測る(第5章)ところまでで、判断に必要な材料の大半はそろうと考えています。予測や実験が効いてくるのは、在籍者が数千人を超え、引き止め施策に毎月まとまった費用をかけるようになってからだと考えています。この記事の共通データ A は、在籍者が数千人を超えた段階の事業を想定して作りました。在籍者は最も多い月で7,562人で、暦の月ごとの解約者は37〜240人です(37人は加入が始まったばかりの暦の第1か月の値です)。必要な人数を自社のデータで見積もる方法としては、第12章で施策の効果を検出するのに要る人数を計算します。逆に、規模が大きくなってからもコホート表と継続率だけで判断していると、誰に施策を打つかを決める根拠が持てず、全員に同じ施策を配ることになりがちです。
指標の定義、全章で同じ意味に固定する
顧客分析の議論がかみ合わない原因の多くは、同じ名前の指標を人によって違う意味で使っていることにあります。「解約率3%」が、ある月の在籍者に対する割合なのか、年間の解約者を年初の在籍者で割ったものなのか、解約の手続きをした人を数えたのか支払いが止まった人を数えたのかで、数字は大きく変わります。この記事では、次の表の定義を全章で固定しました。定義の選び方そのもの(どの事象を解約と数えるか、部門ごとの定義のずれ)は第3章と第13章で扱います。
| 指標 | この記事での定義 | 補足 |
|---|---|---|
| 解約(離脱) | 契約型では月額の支払いをやめること。最後に料金を払った月の月末に解約したと数える。非契約型では購買が止まること | 非契約型の離脱は直接は観測できないので、確率で表す |
| 月次解約率 | ある月に在籍していた顧客のうち、その月末に解約した人の割合 | 観測期間の解約数を顧客月数(在籍者数を月ごとに足したもの)で割ったものを「素朴な解約率」と呼ぶ |
| 継続率 S(t) | 加入から t か月目の料金を払っている確率 | 生存率とも呼ぶ。加入した月は全員が払うので S(1)=1 |
| 「第 N か月」と「N か月目」 | 「第 N か月」は暦の上の月(共通データ A では観測の始まりから数えた月)、「N か月目」は加入から数えた在籍の月 | 第1か月の月次解約率は暦の月の値で、在籍1か月目のハザードとは別のもの |
| 在籍月数 | 料金を払った月数 | 観測の終わりにまだ在籍している人の在籍月数は「打ち切り」で、本当の在籍月数はそれ以上 |
| ハザード | その月まで在籍した顧客が、その月末に解約する確率 | 在籍月数ごとの月次解約率のこと |
| 月次粗利 | 月額×粗利率0.30(架空) | 標準プランは1,500円、大容量プランは2,400円 |
| LTV(顧客生涯価値) | 加入時点から60か月以内に見込める月次粗利を、年5%(架空)で割り引いて合計した期待値(円) | 獲得費用は含めない。在籍中の顧客について、その時点から先の同じ定義の値を「残存価値」と呼ぶ |
| CAC(顧客獲得費用) | 1人の顧客を獲得するためにかかった費用 | チャネル別に置く(架空) |
| 回収月数 | 加入からの累積の割引後粗利の期待値(同じチャネルの顧客の集団で見た値)が CAC に達する最初の月 | 獲得費用の資金繰りの目安 |
| 3か月解約確率 | ある月の月末に在籍している顧客(その月末に解約しなかった人)が、その後3か月のどこかの月末に解約する確率 | 第7章の予測の対象 |
| リフト | 予測の上位 k% の解約率を、全体の解約率で割った値 | 予測で絞り込むと解約者の割合が何倍に濃くなるか |
| RFM | BG/NBD の流儀の要約。2回目以降の購買回数(frequency)、初回から最後の購買までの週数(recency)、初回から観測終了までの週数(T)、1回あたりの平均金額(monetary) | 単位は frequency が回、recency と T が週、monetary が円。最近・頻度・金額で顧客を段階に分ける一般の RFM 分析とは別のもの。recency は一般の用法(最後の購買からの経過期間)と違い、初回から最後の購買までの長さ |
| 在籍確率(P alive) | 非契約型の顧客が、観測の終わりの時点でまだ離脱していない確率 | 第10章で BG/NBD モデルから計算する |
| 真の値 | データを作った側だけが知る答え | 現実の企業には分からない。この記事では推定の答え合わせに使う |
表の中で特に注意したいのは、LTV の定義です。LTV は「顧客が生涯にもたらす価値」と説明されることが多い言葉ですが、売上で数えるか粗利で数えるか、将来の金額を割り引くかどうか、何年先まで数えるか、獲得費用を差し引くかどうかで、同じ顧客について何倍も違う数字になります。この記事では、粗利で数え、年5%で割り引き、60か月で打ち切り、獲得費用は差し引かずに LTV÷CAC として別に比べる、と決めました。60か月で打ち切るのは、5年より先の継続率は観測の外への延長に頼るしかなく、事業の環境もそれだけ変わりうるからです。割り引くのは、5年後の1,500円と今月の1,500円は同じ価値ではないからです。月次の割引率は、年5%を12か月に均した約0.407%を使います。細かな前提も固定しておきます。粗利率は注文回数によらず0.30で一定(月額制なので、その月の売上は月額で決まる)とし、初回クーポンの値引きの原資は LTV に含めません。割引は、各月の粗利をその月の初めに受け取る前提で計算します(1か月目は割り引かない)。回収月数は、ある集団の期待累積粗利が CAC に達する月であって、顧客1人ずつの回収月数の平均ではありません。
月次粗利が一定の集団(たとえば同じプランの顧客)について式で書くと、月次粗利を \( m \)、継続率を \( S(t) \)、月次の割引率を \( d \) として、LTV は \( \sum_{t=1}^{60} m \, S(t) \, (1+d)^{-(t-1)} \) です。言葉で言い換えると、「t か月目の料金を払っている確率に、その月の粗利を掛け、t か月目までの割引を効かせたものを、1か月目から60か月目まで足し合わせたもの」です。月次粗利・割引率・期間を固定すれば、継続率の誤りはそのまま LTV の誤りになります。この式の細部と、観測期間の外へ継続率を延ばす方法は第9章で扱います。
共通データ A、架空の家庭向け食材宅配の定期便(契約型)
この記事では、全章で同じサンプルデータを使います。どの章の結果も同じデータの上で比べられるようにするためです。以下の2つのデータは、実在の企業・サービスの記録ではなく、乱数の種を固定して生成した架空のデータです。月額・粗利率・獲得費用・割引率・施策の費用などの金額や設定も、すべて例題のために置いた架空の値です。
共通データ A は、架空の家庭向け食材宅配の定期便(月額制)の顧客12,000人の記録です。顧客は第1〜30か月のいずれかの月に加入し、記録を見られるのは第1〜36か月までです。第36か月の月末にまだ在籍している人は、その先いつ解約するかが分からないので「打ち切り」になります。データを作るときには第60か月まで生成してあり、第37か月以降の記録は、現実には見えない答え合わせの材料として使います。顧客ごとに、加入月・獲得チャネル(紹介・検索広告・SNS広告・チラシ)・プラン(標準 月額5,000円/大容量 月額8,000円)・初回クーポンの利用の有無・世帯人数(1〜4人)があり、月ごとに注文回数(0〜4回)・問い合わせ回数・解約の有無が記録されています。
データの作り方を、次の表にまとめました。表の値は、記事のために置いた架空の設定です。
| 項目 | 設定(架空) |
|---|---|
| 顧客数・加入月 | 12,000人。加入月は第1〜30か月から等確率で選ぶ(月あたり平均400人) |
| 観測できる期間 | 第1〜36か月(答え合わせ用に第60か月まで生成) |
| 獲得チャネルの構成 | 紹介は加入時期の最初の35%から最後の20%へ、チラシは15%から30%へ直線的に変わる。検索広告は30%で一定、SNS広告は残り(20%) |
| プラン | 大容量30%・標準70% |
| 初回クーポンの利用 | 45% |
| 世帯人数 | 1人25%・2人35%・3人25%・4人15% |
| 月額・月次粗利 | 標準5,000円・大容量8,000円。粗利率0.30で月次粗利は1,500円・2,400円 |
| 獲得費用(CAC) | 紹介2,000円・検索広告6,000円・SNS広告9,000円・チラシ12,000円 |
| 割引率 | 年5%(月次に直すと約0.407%) |
| 引き止め施策(第8章・第11章・第12章で使う) | クーポン。費用は1人500円。当てた月から3か月、解約の起きやすさ(オッズ=解約確率÷継続確率)を0.7倍にする。確率が小さい範囲では、解約確率をおよそ0.7倍するのとほぼ同じ(効果は全員同じという前提) |
解約の起こり方は、次の「真のモデル」で決めました。毎月の月末に、その月の状態に応じた確率で解約するかどうかが決まります。確率は、表の各項目を足し合わせた値をシグモイド関数(どんな値も0から1の間の確率に変換する、S字の関数)に通して計算します。足し合わせる値が大きいほど解約しやすくなります。
| 解約確率に足し込む項目 | 真のパラメータ(架空) | 意味 |
|---|---|---|
| 基準の値 | -3.3 | 他の項目がすべて0のとき、月の解約確率は約3.6% |
| 獲得チャネル | 紹介 -0.5・検索広告 0・SNS広告 +0.35・チラシ +0.6 | チラシ経由が最も解約しやすく、紹介経由が最も解約しにくい |
| プラン | 大容量 -0.3(標準は0) | 大容量プランのほうが解約しにくい |
| 初回クーポン | 利用者は在籍3か月以内だけ +0.8 | クーポン目当ての加入者は最初の3か月に解約しやすい |
| 在籍月数 | -0.35×log(在籍月数) | 在籍が長くなるほど解約しにくくなる |
| その月の注文回数 | +0.55×(2回に足りない回数。2回以上なら0) | 注文が0回の月は +1.1、1回の月は +0.55 |
| その月の問い合わせ回数 | +0.45×回数 | 問い合わせが多い月ほど解約しやすい |
注文回数は、顧客ごとの見えない「利用意欲」で決まります。利用意欲の初期値はチャネルで違い(紹介 0.8・検索広告 0.4・SNS広告 0・チラシ -0.2。世帯人数が1人増えるごとに +0.2、ばらつきの標準偏差0.8)、毎月わずかに下がる傾向(-0.03)とノイズ(標準偏差0.35)を伴って動きます。注文回数は、利用意欲をシグモイド関数に通した確率で、月4回の機会のうち何回注文するかとして決まります。問い合わせは、平均0.08回に、注文が1回以下の月だけ0.25回を足した回数で起きます。この利用意欲は企業の記録には残らない設定なので、解約の予測(第7章)では、注文回数や問い合わせ回数の記録から間接的に推し量るしかありません。
この設定には、現実のデータで起こりがちな難しさを意図して入れてあります。1つ目は、解約のしやすさ(ハザード)が在籍とともに下がることです。解約率を1つの平均で見ると、加入して間もない顧客の多い集団ほど解約率が高く見えます(第5章)。2つ目は、獲得チャネルの構成が時期とともに変わることです。加入時期が後の顧客ほど解約しやすいチラシ経由の割合が高いので、全体の継続率は悪化して見えますが、チャネルごとの解約のしやすさの設定は加入時期によらず同じです(加入時期ごとの継続率の比べ方は第4章)。3つ目は、初回クーポンの効果が最初の3か月だけにあることです。比例ハザード(ある属性の顧客の解約のしやすさが、他の顧客の何倍かという比が、在籍月数によらず一定だという仮定)という、よく使われるモデルの仮定が崩れる箇所になっています(第6章)。
実際に生成したデータの中身は次のとおりです。顧客12,000人のチャネル別の人数は、紹介3,221人・検索広告3,627人・SNS広告2,465人・チラシ2,687人です。プランは大容量29.6%、初回クーポンの利用は44.6%でした。観測期間内に解約したのは5,686人、第36か月の月末を過ぎても在籍していて打ち切りになったのは6,314人で、顧客と月の組み合わせ(顧客月)の行数は173,851行です。月ごとの注文回数の平均は2.18回、問い合わせは0.165回でした。次のコードは、このデータを読み込んで中身を確かめるものです。コードを読まなくても、本文と表だけで結果を追えるように書いています。補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。補助モジュールは配布していないので、データの設定は上の表で示しました。
import cust_data as cd

cust, monthly = cd.make_subscription()        # 観測できる範囲(第1〜36か月)
print(cust.shape, monthly.shape)
print(cust[["acq_month", "channel", "plan", "coupon", "household",
            "price", "churned", "tenure_obs"]].head(3))
print(monthly.head(3))
print(cust["channel"].value_counts().to_dict())
# 出力:
# (12000, 11) (173851, 6)
#    acq_month   channel      plan  coupon  household  price  churned  tenure_obs
# 0         26    social  standard       0          2   5000        1           3
# 1         20     flyer  standard       0          1   5000        1           9
# 2         16  referral  standard       0          3   5000        0          21
#    cust_id  month  tenure  orders  support  churn
# 0        7      1       1       4        0      0
# 1       23      1       1       2        0      0
# 2       34      1       1       3        0      0
# {'search': 3627, 'referral': 3221, 'flyer': 2687, 'social': 2465}
cust は1行が1人の顧客の表で、churned は観測期間内に解約したら1、tenure_obs は観測できた在籍月数です。1行目の顧客は第26か月にSNS広告経由で加入し、3か月払ったところで解約しています。3行目の顧客は第16か月に紹介経由で加入し、第36か月の月末にまだ在籍しているので、在籍月数21か月で打ち切りです。この人の本当の在籍月数は21か月以上ですが、いくつになるかは観測期間の中では分かりません。monthly は1行が1人の顧客の1か月で、在籍月数・注文回数・問い合わせ回数・その月末の解約の有無が入っています。
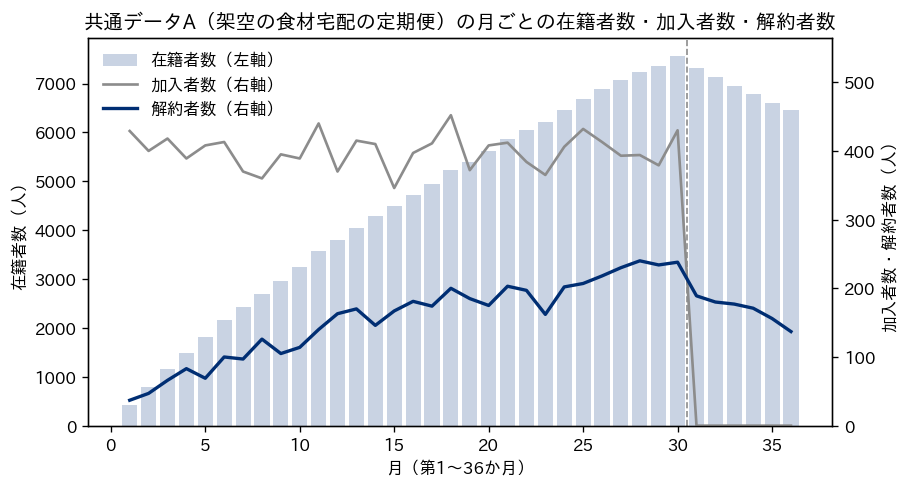
図は、月ごとの在籍者数・加入者数・解約者数です。加入は第1〜30か月まで毎月約400人ずつ続き、在籍者数は第30か月の7,562人まで増えます。第31か月からは加入が無いので、在籍者数は減る一方になり、第36か月には6,451人です。この6,451人は第36か月の料金を払った人数で、そのうち137人は第36か月の月末に解約しました(この記事では、最後に料金を払った月の月末に解約したと数えるため)。残る6,314人が、第36か月の月末を過ぎても在籍している打ち切りの人数です。暦の月ごとの解約率(その月の解約者数÷その月の在籍者数)は、暦の第1か月の0.0862から、第12か月0.0429、第24か月0.0313、第36か月0.0212と下がっていきます。これは暦の月の値で、在籍1か月目・12か月目のハザードとは別のものです。暦の第1か月の在籍者は全員が在籍1か月目ですが、時期が進むほど在籍の長い顧客の割合が増えます。同じ顧客の集まりでも、在籍の浅い顧客が多い時期ほど月次解約率が高く出るということで、ここに、解約率を1つの平均で見ることの危うさが表れています。チャネル別の観測期間内の月次解約率(解約数÷顧客月数)は、紹介0.0160・検索広告0.0274・SNS広告0.0456・チラシ0.0645、全体で0.0327でした。
共通データ B、架空の単品通販(非契約型)
共通データ B は、架空の単品通販の顧客6,000人の購買記録です。契約が無いので、顧客がいつ離れたかは記録に残りません。あるのは、いつ・いくら買ったかだけです。顧客の初回購買は第0〜80週のいずれかの時点で、記録を見られるのは第104週までです。答え合わせ用に第156週まで生成してあります。
このデータは、第10章で扱う BG/NBD モデルの仮定どおりに作りました。BG/NBD モデルは、Fader・Hardie・Lee が2005年に Marketing Science 誌に発表した、顧客の購買回数と離脱を同時に扱う確率モデルです。仮定は次のとおりです。顧客は、離脱するまでの間、顧客ごとに決まった購買率(1週あたりの平均購買回数)で、でたらめな間隔で購買します。購買率は顧客によって違い、その違いはガンマ分布(正の値をとり、右に裾が長い分布)に従います。顧客は購買のたびに、顧客ごとに決まった確率で離脱し、その確率の違いはベータ分布(0から1の間の値をとる分布)に従います。この記事のデータでは、離脱の機会は2回目以降の購買の直後に置きました。初回の購買だけで終わった人は、離脱していないことになります。この仮定の限界は第10章で扱います。
| 項目 | 設定(架空) | 意味 |
|---|---|---|
| 顧客数・観測期間 | 6,000人。初回購買は第0〜80週、観測は第104週まで(答え合わせ用に第156週まで) | 観測の終わりまでの週数(T)は人によって24〜104週 |
| 購買率のばらつき(ガンマ分布) | r=0.6、α=8.0 | 平均の購買率は 0.6÷8.0=週0.075回(約13週に1回)。人による差が大きい |
| 離脱確率のばらつき(ベータ分布) | a=0.8、b=2.5 | 購買のたびに離脱する確率の平均は 0.8÷3.3=約0.24 |
| 1回あたりの金額 | 顧客ごとの平均(ガンマ分布で平均6,000円)のまわりでばらつく | 金額の扱いは第10章 |
表の r・α・a・b の4つが、BG/NBD モデルが推定する「真のパラメータ」です。データを作った側はこの値を知っているので、第10章で推定した値が真の値にどれだけ近いかを確かめられます。生成したデータでは、観測期間内の購買は20,496件(1人あたり3.42回)、購買1回あたりの平均金額は6,026円でした。第104週の時点で本当に離脱していない人の割合(真の在籍率)は0.621です。次のコードは、このデータを読み込み、BG/NBD の流儀の RFM(frequency・recency・T・monetary)にまとめるものです。
tx, cust_tx = cd.make_purchases()             # 観測できる範囲(第104週まで)
rfm = cd.rfm_table(tx)                        # BG/NBD の流儀の RFM
print(tx.head(3).round(2))
print(rfm.head(3).round(1))
print("frequency 0 の割合", round((rfm["frequency"] == 0).mean(), 3))
# 出力:
#    cust_id   week  amount
# 0        0  40.14  5419.0
# 1        0  42.06  6914.0
# 2        0  49.97  2531.0
#          frequency  recency      T  monetary
# cust_id
# 0                3     11.8   63.9    8963.0
# 1                3     23.9  100.0    3288.5
# 2                5     26.7   29.1    7132.5
# frequency 0 の割合 0.287
tx は1行が1回の購買で、week は観測開始からの週(小数)、amount は金額(円)です。rfm の1行目の顧客は、第40.14週に初めて買い、その後3回買っています(frequency は2回目以降の購買回数なので3)。初回から最後の購買までが11.8週(recency)、初回から観測の終わりまでが63.9週(T)です。つまり、この顧客は最後の購買から約52週、1年近く買っていません。離れたのか、間隔が空いているだけなのかは、この記録からは分かりません。この問いに確率で答えるのが第10章の BG/NBD モデルです。
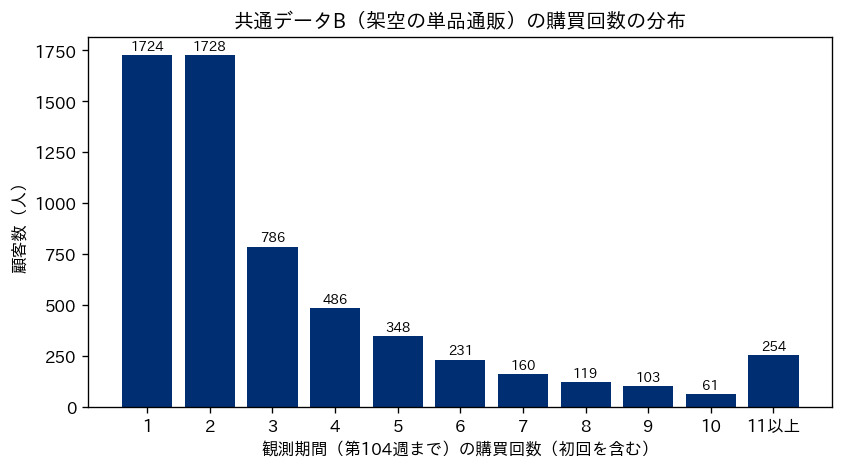
図は、観測期間内の購買回数(初回を含む)の分布です。1回だけの人が1,724人(28.7%)、2回の人が1,728人(28.8%)で、この2つで6割近くを占めます。3回以上は回数が増えるほど少なくなりますが、11回以上の人も254人(4.2%)いて、最も多い人は61回でした。購買回数の中央値は2回、平均は3.42回で、少数のよく買う顧客が平均を押し上げています。
真の値と照らし合わせると、購買回数と「まだ顧客であるか」の関係は直感どおりではありません。第104週の時点の真の在籍率は、購買1回だけの人が1.000(この設定では初回の後には離脱しないため)、2〜3回の人が0.402、4〜9回の人が0.535、10回以上の人が0.692でした。観測期間内の購買が2〜3回の2,514人のうち、6割近くはすでに離れているということです。
ここに「最後の購買から観測の終わり(第104週)までに何週たっているか」を重ねると、違いはさらにはっきりします。観測の長さ(T)は初回購買の時期によって24〜104週と人ごとに違うので、同じ「2〜3回」でも、最近買った人と1年以上前に買ったきりの人が混ざっているからです。購買が2〜3回の人の真の在籍率は、最後の購買から13週以内の454人で0.707、13週を超え52週以内の1,240人で0.435、52週を超える820人で0.182でした。購買が4回以上の人では、同じ区分で0.824(858人)・0.410(671人)・0.043(233人)です。一方、購買1回だけの1,724人のうち986人は最後の(初回の)購買から52週を超えていますが、この設定では全員がまだ顧客です。購買回数だけ、あるいは最後の購買からの経過週数だけで「生きている顧客」を判定すると、こうした違いを取りこぼします。回数・最後の購買の時期・観測期間の3つを同時に使う理由は第10章で扱います。
真の値と推定を書き分ける
この記事では、推定した値と「真の値」を並べて示します。真の値は、データを作った側だけが知っている答えです。共通データ A なら、各顧客の本当の解約確率、第37か月以降の在籍の有無、チャネルごとの本当の継続率がこれに当たります。共通データ B なら、各顧客の本当の購買率と離脱確率、第104週の時点で本当に離脱しているかどうかが当たります。
現実の企業には真の値は見えません。見えるのは記録だけで、記録から推定した継続率や LTV が正しいかどうかは、何年も待たなければ確かめられず、待っても1回分の結果しか得られません。架空のデータで分析を練習する意味は、ここにあります。手法がどの条件で真の値を言い当て、どの条件で外すのかを、答えを見ながら確かめられるからです。ただし、この記事の結果は「この架空データの、この設定での結果」です。ある手法がこの記事のデータで真の値によく合ったとしても、自社のデータで同じように合うとは限りません。真の値は答え合わせのためだけに使い、推定の計算には使わないように区別しました。
真の継続率は、データと同じ構成(プラン・クーポン・世帯人数)の顧客をチャネルごとに新たに20,000人ずつ生成し、60か月目まで追って数えたものです。有限の人数を生成して数えた値なので、乱数による誤差を含みます。紹介の真の S(12)は0.809・S(36)は0.612・S(60)は0.474、検索広告は0.683・0.423・0.281、SNS広告は0.559・0.276・0.159、チラシは0.455・0.184・0.089でした。チラシ経由の顧客は、5年たつと1割も残らない設定です。
基準の結果1、チャネル別のカプラン・マイヤー推定は真の継続率をよく言い当てる
記事全体で使う基準の計算を、先に紹介しておきます。各章は、この結果を出発点に、手法の仕組みや別の条件での振る舞いを掘り下げます。最初は、共通データ A の継続率です。観測期間(第1〜36か月)の記録から、第5章で扱うカプラン・マイヤー推定(打ち切りのある在籍月数から継続率を推定する方法)で、チャネル別の継続率を推定し、真の値と比べました。
| チャネル | S(6)推定 | S(6)真の値 | S(12)推定 | S(12)真の値 | S(24)推定 | S(24)真の値 | S(36)推定 | S(36)真の値 | 在籍月数の中央値(推定) |
|---|---|---|---|---|---|---|---|---|---|
| 紹介 | 0.870 | 0.880 | 0.804 | 0.809 | 0.697 | 0.698 | 0.619 | 0.612 | 推定できない |
| 検索広告 | 0.807 | 0.794 | 0.703 | 0.683 | 0.549 | 0.532 | 0.442 | 0.423 | 29か月 |
| SNS広告 | 0.712 | 0.701 | 0.555 | 0.559 | 0.388 | 0.386 | 0.296 | 0.276 | 15か月 |
| チラシ | 0.619 | 0.621 | 0.450 | 0.455 | 0.280 | 0.278 | 0.182 | 0.184 | 9か月 |
| 全体(チャネル別の推定を加入者のチャネル構成で加重) | 0.762 | 0.759 | 0.643 | 0.640 | 0.495 | 0.490 | 0.401 | 0.390 | (出していない) |
表の「S(36)推定」と「S(36)真の値」の列を比べると、紹介0.619対0.612、検索広告0.442対0.423、SNS広告0.296対0.276、チラシ0.182対0.184で、差は最大でも0.020でした。観測できるのは第36か月までで、しかも加入が遅い顧客ほど観測できる在籍月数が短いにもかかわらず、カプラン・マイヤー推定は打ち切りを正しく扱うことで、真の継続率に近い値を出しています。在籍月数の中央値(半分の顧客が解約するまでの月数)は、検索広告29か月・SNS広告15か月・チラシ9か月でした。紹介は観測期間の中で継続率が0.5を下回らないので、中央値は推定できません。
表の「全体」の行は、全顧客をひとまとめにしてカプラン・マイヤー推定をしたものではなく、チャネルごとの推定を、加入者のチャネル構成(紹介3,221人・検索広告3,627人・SNS広告2,465人・チラシ2,687人の比)で加重して足したものです。共通データ A では、加入時期が遅いほど解約しやすいチラシ経由の割合が高く、加入が遅い顧客ほど観測できる期間が短い(早く打ち切られる)ので、全顧客をひとまとめにすると「打ち切られやすい人ほど解約しやすい」という偏りが入ります。カプラン・マイヤー推定は、打ち切りが解約の起きやすさと無関係であることを前提にしているので、ひとまとめの推定はこの前提から外れます。実際、ひとまとめにした推定の S(36)は0.409で、加重した値0.401より、真の値0.390から離れていました。
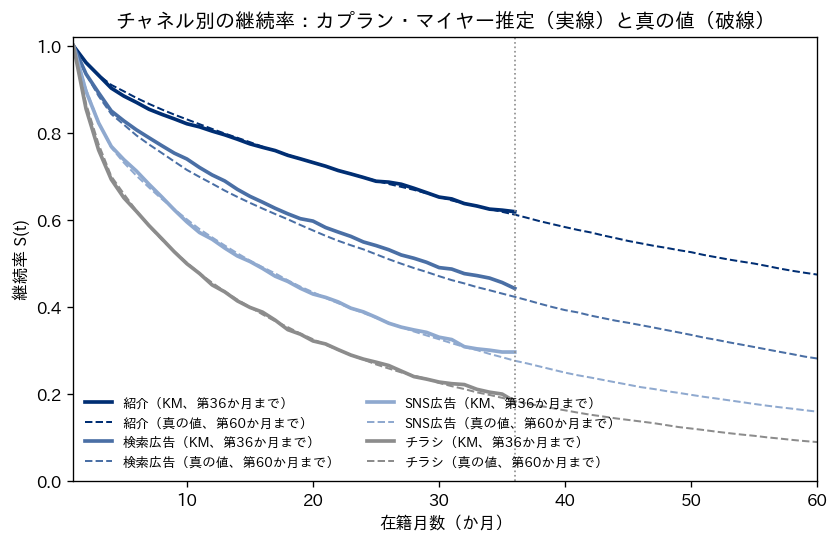
図の実線(推定)と破線(真の値)は、在籍36か月目まではほぼ重なっています。その先の破線は、現実には見えない部分です。37か月目以降の継続率をどう延ばすかで LTV が変わるので、延長の仮定は第9章で扱います。
これに対して、解約率を1つの平均で見る素朴な方法は、真の値から外れます。観測期間の解約数を顧客月数で割った素朴な月次解約率は、紹介0.0160・検索広告0.0274・SNS広告0.0456・チラシ0.0645でした。この逆数(1÷解約率)は、「解約率が毎月一定なら、平均で何か月在籍するか」を表す、よく使われる計算です。紹介は62.4か月・検索広告36.5か月・SNS広告21.9か月・チラシ15.5か月になります。一方、60か月で打ち切った真の期待在籍月数は、紹介40.2か月・検索広告30.7か月・SNS広告22.9か月・チラシ17.7か月です。ただし、1÷解約率は期間の上限を置かない値なので、60か月で打ち切った真の値とはそのまま比べられません。同じ「解約率が毎月一定」という仮定のまま60か月で打ち切ると、紹介38.7か月・検索広告29.6か月・SNS広告20.6か月・チラシ15.2か月となり、4チャネルとも真の値より短くなりました。実際の解約のしやすさは在籍が長くなるほど下がるのに、観測期間の解約数を顧客月数で割った値には、在籍の浅い(解約しやすい)時期の顧客月が多く含まれるので、長く在籍する顧客の分を短く見積もるためだと考えられます。在籍月数ごとのハザードを使った確認は第5章で行います。
基準の結果2、チャネル別の LTV は定義によって大きく変わる
次は、共通データ A のチャネル別の LTV です。同じ顧客について、4つの方法で LTV を計算しました。1つ目は「素朴な公式(無期限)」で、月次粗利を素朴な月次解約率で割ったものです。割り引かず、期間の上限も置かず、解約率が毎月一定だと仮定しています。2つ目は「素朴な公式(60か月)」で、同じく解約率が毎月一定だと仮定したうえで、この記事の定義どおり60か月で打ち切り、年5%で割り引いたものです。3つ目は「KM+延長」で、チャネルとプランの組ごとにカプラン・マイヤー推定の継続率を在籍36か月目まで使い、その先は24か月目と36か月目の継続率の比から逆算した一定のハザードが続くとして60か月目まで延ばし、割り引いて合計し、加入者のプラン構成で加重したものです。37か月目より先は観測ではなく、延長の仮定です。4つ目は真の値で、データと同じ構成(プラン・クーポン・世帯人数)の顧客をチャネルごとに新たに20,000人ずつ真のモデルで生成し、1人ずつの支払った月数(60か月で打ち切り)とその人の月額から割引後粗利を計算して平均したものです。月額の高い大容量プランの顧客ほど解約しにくいので、平均の粗利に平均の継続率を掛けるのではなく、1人ずつ計算しています。
| チャネル | 月次粗利の平均(円) | 素朴な公式(無期限、円) | 素朴な公式(60か月、円) | KM+延長(円) | 真の値(円) | CAC(円) | 真の LTV÷CAC | 回収月数(真の値) |
|---|---|---|---|---|---|---|---|---|
| 紹介 | 1,759 | 109,708 | 61,736 | 64,920 | 64,767 | 2,000 | 32.4 | 2か月 |
| 検索広告 | 1,768 | 64,525 | 48,063 | 51,569 | 50,362 | 6,000 | 8.4 | 4か月 |
| SNS広告 | 1,776 | 38,918 | 34,171 | 39,171 | 38,485 | 9,000 | 4.3 | 7か月 |
| チラシ | 1,762 | 27,332 | 25,441 | 29,516 | 29,689 | 12,000 | 2.5 | 11か月 |
表には「全体」の行を置いていません。LTV は獲得費用と比べて獲得チャネルごとの予算を決めるために使うもので、チャネルをまとめた平均の LTV で判断すると誤る理由を第1章で示したからです。
表の「KM+延長」の列は、真の値との差が紹介で153円(0.2%)、検索広告で1,207円(2.4%)、SNS広告で685円(1.8%)、チラシで -174円(-0.6%)と、この1回の推定では、どのチャネルでも3%以内に収まりました。これに対して「素朴な公式(無期限)」の列は、真の値に対して、紹介で44,941円(69.4%)大きく、検索広告で14,163円(28.1%)大きく、SNS広告ではほぼ同じ(433円、1.1%大きい)で、チラシでは逆に2,357円(7.9%)小さくなりました。無期限の素朴な公式がいつも大きく出るわけではありません。
この違いがどこから来るかを、素朴な公式の前提を1つずつこの記事の定義にそろえて分解しました。次の表は、無期限・割引なしの値から、60か月で打ち切り(割引なし)、さらに年5%で割り引いた値へと順に直し、最後に真の値と比べたものです。
| チャネル | 素朴な公式(無期限・割引なし、円) | 60か月で打ち切る効果(円) | 割引の効果(円) | 素朴な公式(60か月・割引あり、円) | 真の値との差(円) |
|---|---|---|---|---|---|
| 紹介 | 109,708 | -41,603 | -6,369 | 61,736 | -3,031(-4.7%) |
| 検索広告 | 64,525 | -12,178 | -4,284 | 48,063 | -2,299(-4.6%) |
| SNS広告 | 38,918 | -2,359 | -2,388 | 34,171 | -4,315(-11.2%) |
| チラシ | 27,332 | -502 | -1,390 | 25,441 | -4,249(-14.3%) |
表の「60か月で打ち切る効果」の列は、チャネルによって大きさがまったく違います。紹介では -41,603円で、無期限の値の約38%が60か月より先の分でした。素朴な月次解約率が0.0160と小さいので、一定の解約率のもとでは61か月目以降も在籍が長く続く計算になるからです。チラシでは -502円で、無期限の値の約2%にすぎません。素朴な月次解約率が0.0645と大きく、60か月より先まで残る分がほとんど無い計算になるからです(真の期待在籍月数も17.7か月と短い)。SNS広告では、打ち切りの効果(-2,359円)と割引の効果(-2,388円)がほぼ同じ大きさでした。
表の「真の値との差」の列は、期間と割引をそろえると、4チャネルとも素朴な公式が真の値より小さいことを示しています。60か月に打ち切った期待在籍月数で比べても、素朴な公式は紹介38.7・検索広告29.6・SNS広告20.6・チラシ15.2か月で、真の値の40.2・30.7・22.9・17.7か月より短くなっていました。つまり、無期限の素朴な公式には「期間の上限を置かないので大きく出る」側と、期間をそろえても残る「真の値より小さく出る」側の2つが同時に入っていて、紹介と検索広告では前者が上回り、チラシでは前者がほとんど効かないので後者が表に出て、無期限の値でも真の値より小さくなった、と読めます。後者の理由としては、前の節で述べたように、解約率を一定と置くことで長い在籍を短く見積もることが考えられます。そろえた後に残った差のうち、どれだけが解約率を一定と置いたことによるもので、どれだけが平均の粗利でまとめて扱ったこと(月額の高い大容量プランの顧客ほど解約しにくい)によるものかは、この章の計算では分けていません。在籍月数ごとのハザードを使った確認は第5章で、LTV の計算方法ごとの比較は第9章で行います。同じ「LTV」という名前でも、定義と計算方法が違えば、数字はここまで変わります。
「真の LTV÷CAC」の列は、獲得費用1円あたり何円の割引後粗利が返ってくるかを表します。紹介は32.4、検索広告8.4、SNS広告4.3、チラシ2.5で、この架空の設定では、どのチャネルも獲得費用を上回る粗利を生んでいますが、その倍率には約13倍の開きがあります。「回収月数」の列は、そのチャネルの顧客の集団について、加入からの累積の割引後粗利の期待値が CAC に達する月で、紹介は2か月目、チラシは11か月目です。チラシで獲得した顧客の集団は、獲得費用を取り戻すまでに11か月かかり、その間の獲得費用は先払いの資金として寝ることになります。LTV の計算の細部、延長の仮定の感度、割引率の影響、残存価値は第9章で扱います。
基準の結果3、仮定どおりのデータでは BG/NBD モデルが真のパラメータを回復した
最後は、共通データ B に BG/NBD モデルを当てはめた結果です。RFM(frequency・recency・T)だけから、最尤推定(観測されたデータが最も起こりやすくなるようにパラメータを選ぶ方法)で4つのパラメータを推定しました。専用のライブラリは使わず、論文の尤度の式を scipy(Python の科学計算のライブラリ)で実装しています。
| 項目 | 推定 | 真の値 |
|---|---|---|
| r(購買率のばらつきの形) | 0.598 | 0.6 |
| α(購買率のばらつきの尺度。平均の購買率は r÷α) | 8.24 | 8.0 |
| a(離脱確率のばらつき) | 0.78 | 0.8 |
| b(離脱確率のばらつき) | 2.53 | 2.5 |
| 第104週の在籍確率(P alive)の平均と、真の在籍率 | 0.628 | 0.621 |
| 在籍確率で、本当に在籍している人を見分ける力(AUC) | 0.908 | (該当なし) |
| 在籍確率0.5で切ったときの正答率 | 0.823 | (該当なし) |
| この先52週の購買回数の合計(予測と実現) | 6,625 | 6,661(実現) |
| この先52週の購買回数の、顧客ごとの予測と実現の相関 | 0.727 | (該当なし) |
表の「推定」と「真の値」の列を比べると、4つのパラメータはいずれも真の値に近く、r は0.598対0.6、α は8.24対8.0、a は0.78対0.8、b は2.53対2.5でした。購買の回数と時期という限られた記録から、目に見えない離脱の起こり方まで推定できているということです。在籍確率の平均は0.628で、真の在籍率0.621とほぼ一致しました。AUC(本当に在籍している人に、離脱した人より高い確率を付けられているかを表す指標。0.5なら当て推量と同じで、1に近いほど見分けがよい)は0.908です。この先52週の購買回数は、6,000人の合計で予測6,625回に対して実現6,661回でした。予測の大きさで顧客を5等分すると、各組の1人あたりの予測と実現は、0.134対0.115、0.343対0.324、0.536対0.529、0.934対0.967、3.573対3.616と、よく合っています。
ただし、この結果は、BG/NBD モデルの仮定(購買率と離脱確率が顧客ごとに独立に決まる、1人の購買率は時間がたっても変わらない、離脱は2回目以降の購買の直後にだけ起きる、離脱した顧客は戻らない)どおりに生成した、1つの乱数系列のデータでの回復例です。モデルが現実のデータでも同じように働くことや、現実で長く買っていない人も顧客であり続けることの根拠にはなりません。たとえば、初回の購買だけの人は、モデルの上でも真の値でも在籍確率が常に1になります。現実の顧客は初回の購買の直後にも離れるので、この仮定は現実のデータでは崩れることがあります。仮定が崩れたときの振る舞いと、それを直したモデルは第10章で扱います。
基準の計算の構造、補助モジュールの使い方
基準の結果は、補助モジュール baseline.py にまとめた関数で計算しました。各章は、必要な関数だけを呼び出して使います。次のコードは、この章で紹介した3つの結果(カプラン・マイヤー推定、LTV の表、BG/NBD の推定)を、その関数で出すものです。補助モジュール(cust_data.py と baseline.py)と同じフォルダに置き、前の2つのコードの続きとして実行する形です。
import baseline as bl

kms = bl.km_by_channel(cust)                  # チャネルごとのカプラン・マイヤー
print({c: round(bl.km_surv_at(kms[c], 36), 3) for c in cd.CHANNELS})
lt = bl.ltv_table(cust, monthly)              # 4通りの LTV とCAC
print(lt[["channel", "ltv_naive_inf", "ltv_naive_cap", "ltv_km_ext",
          "ltv_true"]].round(0))
params = bl.bgnbd_fit(rfm)                    # BG/NBD の最尤推定
print({k: round(float(params[k]), 3) for k in ("r", "alpha", "a", "b")})
# 出力:
# {'referral': 0.619, 'search': 0.442, 'social': 0.296, 'flyer': 0.182}
#     channel  ltv_naive_inf  ltv_naive_cap  ltv_km_ext  ltv_true
# 0  referral       109708.0        61736.0     64920.0   64767.0
# 1    search        64525.0        48063.0     51569.0   50362.0
# 2    social        38918.0        34171.0     39171.0   38485.0
# 3     flyer        27332.0        25441.0     29516.0   29689.0
# {'r': 0.598, 'alpha': 8.244, 'a': 0.782, 'b': 2.533}
bl.km_by_channel は、チャネルごとに statsmodels の SurvfuncRight(打ち切りのある生存時間のカプラン・マイヤー推定)を作る関数です。bl.km_surv_at は、その結果から t か月目の継続率を取り出します。bl.ltv_table は、素朴な公式(無期限と60か月)・KM+延長・真の値の4通りの LTV と、CAC・LTV÷CAC・回収月数を1つの表にします(コードでは LTV の4列だけを表示しました)。真の値の列は、答え合わせのために補助モジュールの中で顧客を真のモデルで新たに生成して計算しているので、現実のデータでは作れない列です。bl.bgnbd_fit は、RFM の表から BG/NBD モデルの4つのパラメータを最尤推定します。
次のコードは、baseline.py から、カプラン・マイヤー推定の2つの関数を抜き出したものです(説明の文字列は短くしました)。baseline.py の冒頭で import numpy as np と from statsmodels.duration.survfunc import SurvfuncRight を読み込んでいるので、抜き出した部分だけを写すときはこの2行も要ります。
def km_by_channel(cust):
    out = {}
    for c in cd.CHANNELS:
        sub = cust[cust['channel'] == c]
        sf = SurvfuncRight(sub['tenure_obs'].values, sub['churned'].values)
        out[c] = sf
    return out


def km_surv_at(sf, t):
    """S(t) = t か月目まで在籍している確率。S(t)=P(tenure >= t)=surv(t-1)。"""
    if t <= 1:
        return 1.0
    times = sf.surv_times
    probs = sf.surv_prob
    k = np.searchsorted(times, t - 1, side='right') - 1
    return 1.0 if k < 0 else float(probs[k])
SurvfuncRight に渡しているのは、顧客ごとの観測できた在籍月数(tenure_obs)と、観測期間内に解約したかどうか(churned。打ち切りなら0)の2列だけです。打ち切りの顧客を捨てずに「少なくともこの月数までは在籍した」という情報として使うことが、カプラン・マイヤー推定が真の値をよく言い当てた理由です。km_surv_at で t から1を引いているのは、在籍月数 k で解約した顧客は k か月目の料金を払っている、というこの記事の解約の数え方に合わせるためです。SurvfuncRight が返すのは「時点 t までに解約が起きていない確率」なので、「t か月目の料金を払っている確率」である S(t)は、時点 \( t-1 \) の値になります。この「1か月のずれ」は、解約を月初に数えるか月末に数えるかで変わる細部ですが、ずれたまま LTV を計算すると、全チャネルの LTV が1か月分ずれます。定義を固定して、計算の側をそれに合わせる必要があります。
基準の計算には、この章で紹介した3つのほかに、加入時期別の継続率(第4章)、解約予測のモデルと評価(第7章)、引き止め施策の対象の選び方の答え合わせ(第8章)も入っています。それぞれの結果は、扱う章で紹介します。全部を通して計算した時間は、この記事の実行環境(一般的なノートPC)での実測で約53秒でした。
経営の判断に翻訳する、型と定義を決めてから数字を出す
この章の内容を経営の判断に結び付けると、3つの点になります。1つ目は、事業が契約型か非契約型か、あるいは行動ごとにどちらの型かを、分析を始める前に決めることです。非契約型の通販で「最後の購買から90日買っていない人は離脱」と決めて解約率を出すと、その数字は離脱の実態ではなく、決めた日数を映したものになります。共通データ B では、最後の購買から52週を超えて買っていない顧客でも、購買が4回以上の人の真の在籍率は0.043、2〜3回の人は0.182で、購買1回だけの人は(この設定では)全員がまだ顧客でした。最後の購買から52週を超えているという同じ区分でも、購買の回数で分けて集計すると「まだ顧客である」見込みはこれだけ違います。最後の購買からの日数だけで判定すれば、引き止めや再購買の施策をかける相手を取り違えます。ただし、購買1回だけの人が全員まだ顧客なのは、データを作るときに置いた仮定(離脱の機会は2回目以降の購買の直後だけ)の結果で、現実の顧客について同じことが言えるわけではありません。
2つ目は、指標の定義を、数字を出す前に社内で固定することです。この章の LTV の表では、同じ紹介チャネルの顧客について、無期限の素朴な公式は109,708円、定義どおりの真の値は64,767円でした。仮に「LTV の範囲内なら獲得費用をかけてよい」という基準で予算を決めていると、無期限の素朴な公式に従えば紹介チャネルに1人あたり約11万円まで出せることになり、真の値の約6.5万円との差の約4.5万円は、回収できない獲得費用になりえます。一方、期間と割引をそろえた素朴な公式は、4チャネルとも真の値を下回り、チラシでは14.3%、SNS広告では11.2%小さく見積もっていました。こちらに従うと、回収できる獲得まで控える方向に誤ります。どちらの誤りも、計算の前提(期間・割引・解約率の形)を書かずに「LTV」という1つの数字だけを報告していると、受け取った側は気付けません。
3つ目は、推定の方法を、答え合わせができる形で確かめておくことです。現実には真の値が見えないので、ある推定方法が自社のデータで正しく働いているかを直接は確かめられません。そこで、この記事のように、構造の分かった架空のデータで手法の癖をつかんでおくこと、そして自社のデータでは、時間を区切って過去のある時点までの記録で推定し、その後の実績と比べる(第7章・第9章・第10章で行う、時間で分けた検証)ことが有効だと考えています。数字の正しさを確かめる仕組みが無いまま、毎月の会議で LTV や解約率を報告し続けると、誤った数字が予算の前提として定着します。
この章の要点は3つです。第一に、顧客の離脱が記録に残る契約型と、残らない非契約型では、使う道具が違います。この区別は Fader と Hardie が顧客基盤分析の出発点として示しているもので、契約型では打ち切りを扱う生存分析、非契約型では在籍確率を推定する確率モデルを使います。第二に、解約率・継続率・LTV などの指標は、この記事では表のとおりに定義を固定しました。同じ LTV という名前でも、定義と計算方法が違えば、この例の紹介チャネルのように109,708円と64,767円ほど違ってきます。第三に、記事全体で使う2つの架空のサンプルデータでは、チャネル別のカプラン・マイヤー推定が真の継続率を、BG/NBD モデルが(モデルの仮定どおりに作ったデータで)真のパラメータを、それぞれよく言い当てました。次の第3章では、こうした分析の材料になる顧客データを、どう集め、どう整えるかを扱います。
この章を深めたい方への参考書籍
『顧客生涯価値マーケティング:持続的な関係性をつくる』(岩永洋平、中央経済社):顧客生涯価値(LTV)を高めることを主題にした、マーケティングの研究書です。ロイヤルティやリレーションシップ・マーケティングの研究を整理したうえで、D2C(メーカーが消費者に直接販売する事業)の事業者への調査から LTV を高めるビジネスモデルを論じ、LTV の視点で見る重要な成果指標にも触れています。この章で固定した LTV の定義を、計算の外側にある「顧客とどう関係を続けるか」という事業の設計の問題につなげて考えるのに向いています。
『マーケティング・サイエンス入門 新版:市場対応の科学的マネジメント』(古川一郎・守口剛・阿部誠、有斐閣):データと論理に基づいて市場をとらえるマーケティング・サイエンスの考え方と手法を、マーケティング計画の流れに沿って解説する入門書です。消費者行動、マーケティング情報の収集と活用、テストとコントロールなどの章に加えて、データベース・マーケティングの章があります。この章で示した手法の地図を、顧客分析だけでなくマーケティングの意思決定全体の中に位置づけ直すのに向いています。
第3章 顧客データを集めて整える
第2章では、契約型と非契約型の区別、この記事で使う指標の定義、第2章で用意したサンプルデータ(架空の家庭向け食材宅配の定期便と、架空の単品通販)を確かめました。この章では、その手前にある作業、つまり分析に使える顧客データをそろえる作業を扱います。継続率もLTVも解約予測も、「誰が、いつ加入し、いつ解約したか」という記録の上に計算されます。その記録の作り方が部門ごとに違っていたり、解約の数え方が人によって違っていたりすると、後の章のどの手法を使っても、出てくる数字は経営の判断に使えません。この章では、必要なデータの一覧と粒度、解約の定義、観測期間と打ち切り、データの点検、特徴量の時点とリーク(情報の漏れ)、部門ごとの台帳のずれ、個人情報の扱い、データ整備の体制を順に扱い、解約の定義と観測の終わりを変えると数字がどれだけ動くかを、共通データで実行して確かめます。打ち切りを正しく扱う計算の仕組みは第5章で扱います。
顧客分析に必要なデータの一覧と粒度
契約型の事業で継続率・解約予測・LTVを計算するために必要なデータは、大きく7種類に分けられます。顧客台帳、契約や申込の履歴、請求と支払い、利用の記録、問い合わせの記録、獲得チャネル、施策の配信履歴です。多くの企業では、これらが別々のシステムに入っています。顧客台帳は会員管理のシステム、請求と支払いは課金や会計のシステム、利用の記録は注文や配送のシステム、問い合わせはコールセンターやチャットの管理ツール、獲得チャネルは広告やアフィリエイトの管理画面、施策の配信履歴はメール配信やCRMのツール、という具合です。分析の第一歩は、これらを顧客IDでつなげられる状態にすることです。
次の表は、それぞれのデータが何に使われ、最低限どの項目が要るかを整理したものです。第2章で用意したサンプルデータ(共通データA)のどの列に当たるかも添えました。共通データAは、すでにつながった状態で用意してあるので、現実の企業のデータ整備の手間はありません。現実には、この表の「最低限の項目」の列をそろえるところに、分析そのものより長い時間がかかることが多いように思います。
| データ | 何に使うか | 最低限の項目 | 共通データAでの対応 |
|---|---|---|---|
| 顧客台帳 | 分析の単位(1行1顧客)を決める | 顧客ID、加入日、属性(世帯人数など) | cust の cust_id・acq_month・household |
| 契約・申込の履歴 | プラン、休止、プラン変更、解約の手続きを時系列で追う | 顧客ID、手続きの種類、手続きの日、適用の開始日 | plan(固定。変更は無い設定) |
| 請求と支払い | 解約(支払いの停止)の月と、月次粗利を決める | 顧客ID、請求の対象月、金額、支払いの状態 | price・churn_month・monthly の行の有無 |
| 利用の記録 | 利用の減少を解約の前触れとして見る | 顧客ID、月(または日)、注文や利用の回数 | monthly の orders |
| 問い合わせの記録 | 不満や困りごとの兆しを見る | 顧客ID、日時、種類(不具合、配送、解約の相談など) | monthly の support |
| 獲得チャネル | チャネル別の継続率・LTV・CACを比べる | 顧客ID、最初に接点を持った経路、獲得費用の計上先 | channel |
| 施策の配信履歴 | 引き止め施策の対象と効果を後から検証する | 顧客ID、施策の種類、配信日、対象の選び方(無作為か予測上位か) | 無し(第8章・第12章で真のモデルを使って当てる) |
表の最後の行の施策の配信履歴は、見落とされやすいデータです。引き止めのクーポンを誰に配ったかが残っていないと、第12章で扱う効果の検証ができません。さらに、配った相手を「予測の上位から選んだ」のか「無作為に選んだ」のかが残っていないと、配った人と配らなかった人の継続率の差が、施策の効果なのか選び方の偏りなのかを区別できなくなります。施策を始める前から、配信の記録に「選び方」の列を設けておくことが有効だと考えています。
粒度(1行が表す時間の長さ)は、月次でそろえるのが扱いやすいと考えています。月額制の事業では請求が月単位なので、「その月の料金を払ったか」が月ごとにはっきり決まります。共通データAの monthly も、1行が1顧客の1か月で、在籍月数・その月の注文回数・問い合わせ回数・その月末に解約したかを持っています。日次の利用ログ(アプリの起動やページの閲覧)は、そのままでは行数が膨大になり、また解約の判断は月単位で行われるので、月ごとに回数や日数へ集計してから使います。ただし、元の日次ログは、解約の定義を変えたときの集計し直しや記録の検証にも使うので、月次に集計した後も保存しておくことが有効だと考えています。日次の粒度のまま分析する意味があるのは、解約の手続きの直前の数日の行動を見たいときや、週単位で配信する施策の効果を見たいときなどです。
月次に集計するときに決めておくべきことが2つあります。1つは「月」の区切りです。暦の月(1日〜月末)で区切るのか、契約上の請求期間(加入日を起点にした毎月の応当日など)で区切るのかで、在籍月数の数え方が変わります。請求の締め日が顧客ごとに違う事業では、請求期間に合わせた区切りの方が請求と合います。30日ごとに請求する契約なら、30日単位でそろえます。もう1つは、記録が無い月の扱いです。注文が無かった月を「0回」の行として残すか、行そのものを作らないかで、後の計算が変わります。共通データAは、在籍している月にはすべて行があり、注文が無い月は orders が0の行として残っています。行が無い月を「在籍していない月」と読む計算と、「注文が無かった月」と読む計算が混ざると、継続率が大きくずれます。
解約の定義を決める:支払い停止・休止・プラン変更・退会手続き
この記事では、第2章で定めたとおり、契約型の解約を「月額の支払いをやめること」とし、最後に料金を払った月の月末に解約したと数えます。ただし、現実の事業では、この1行で決まらない場面がいくつもあります。代表的なのは、休止(一時的に配送を止め、数か月後に再開できる仕組み)、プラン変更(大容量から標準へ下げるなど)、退会手続きと最後の支払いの月のずれ、支払いの失敗(カードの期限切れなどで請求が通らない)、いったん解約した人の再加入です。どれを解約と数えるかで、解約率も在籍月数も変わります。
| 場面 | 区切りを早く置く案 | 在籍が続いているとみなす案 | 決めておくこと |
|---|---|---|---|
| 休止 | 休止に入る前の、最後に料金を払った月の月末で解約とし、再開したら新しい加入とする | 在籍のまま扱い、休止の月は粗利0の月とする | 休止の上限の長さ、上限を超えたら解約とみなすか |
| プラン変更(下げる) | 旧プランの解約と新プランの加入に分ける | 同じ顧客の在籍が続くとし、月次粗利だけ変える | プラン別の継続率を出すときに、どちらのプランの在籍に数えるか |
| 退会手続きと最後の支払い | 手続きの月で解約とする | 最後に料金を払った月で解約とする | 部門ごとの記録のどちらを正とするか |
| 支払いの失敗 | 請求が通らなかった月で解約とする | 猶予の期間内に支払いが戻れば在籍とする | 猶予の期間(何か月まで待つか) |
| 再加入 | 別の顧客として新しく数える | 同じ顧客の在籍が中断したものとする | 再加入の顧客を、どのコホート(加入時期の集団)に入れるか |
どの考え方にも理由があり、一般に正しい答えがあるわけではありません。大切なのは、会社として1つに決めて文書に残し、すべての部門が同じ定義で数えることです。休止を在籍として扱う会社と、解約として扱う会社では、同じ顧客の動きでも解約率が違って見えます。同業他社や公開資料の解約率と自社の数字を比べるときも、相手の定義が分からなければ、比べること自体ができません。定義を変えるときは、変更前の期間も新しい定義で数え直し、どちらの定義の数字かを報告に明記することが有効だと考えています。決め方の手順としては、まず「売上が止まった時点」に合わせる(最後に月次粗利が入った月の月末を解約とする。この記事の「最後に料金を払った月の月末」と同じ数え方で、支払いが無くなる最初の月ではない。この手順に従うと、休止は休止に入る前の月の月末で解約と数えることになる。休止を在籍のまま扱う表の右の案を選ぶなら、それも理由とともに文書に残す)、次に「記録が確実に残るシステム」に合わせる(多くの場合は請求の記録)、最後に、それでも決まらない場面(プラン変更や再加入)は、分析の目的に合わせて決めて文書に残す、という順が整理しやすいと考えています。
もう1つ考えておきたいのが、利用ベースの定義です。料金は払い続けているのに、ほとんど使っていない顧客がいます。非契約型の事業では支払いの停止という区切りが無いので、「一定期間、購買が無ければ離脱」とする定義が使われることがあります(その問題点は第10章で扱います)。契約型でも、「解約の前触れ」を早く捉えたいという理由で、利用が止まった時点を離脱とみなしたくなることがあります。この2つの定義でどれだけ数字が変わるかを、次の節で実測します。
定義を変えると解約率はどう変わるか:共通データでの実測
共通データAには、支払いの停止(churn_month)と、毎月の注文回数(orders)の両方があります。そこで、正式な解約(支払い停止)に加えて、「注文0の月が k か月続いたら、k か月続いた月の月末に離脱。ただし、それより前に支払いを止めた人は支払い停止の月で離脱」という利用ベースの定義を、k=1・2・3の3通り置き、それぞれの月次解約率(解約数÷その定義で在籍とみなす顧客月数)と、12か月目・24か月目の継続率を計算しました。継続率は、第5章で扱うカプラン・マイヤー推定(打ち切りを正しく扱う推定)で出しています。共通データAでは、在籍中の顧客月のうち注文0の月は14.04%ありました。次のコードは、利用ベースの定義の離脱月を作る部分を抜き出したもので、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。
import numpy as np
import pandas as pd
import cust_data as cd

cust, monthly = cd.make_subscription()          # 第2章の共通データA
m = monthly.sort_values(["cust_id", "month"]).copy()
m["zero"] = (m["orders"] == 0).astype(int)
# 注文0の月が何か月続いているか(その月を含む)
run_id = (m["zero"] != m.groupby("cust_id")["zero"].shift()).cumsum()
m["zero_run"] = m.groupby(["cust_id", run_id])["zero"].cumsum() * m["zero"]

def usage_def(k):
    """注文0が k か月続いた月と、支払い停止の月の早い方を離脱月とする(無ければ 0)"""
    hit = m[m["zero_run"] >= k].groupby("cust_id")["month"].min()
    dep = pd.Series(0, index=cust["cust_id"].values)
    dep.loc[hit.index] = hit.values
    pay = cust.set_index("cust_id")["churn_month"]
    both = (dep > 0) & (pay > 0)
    return pd.Series(np.where(both, np.minimum(dep, pay), np.maximum(dep, pay)),
                     index=dep.index)

for k in (1, 2, 3):
    dep = usage_def(k)
    end = np.where(dep > 0, dep, cust["end_month"])
    months_at_risk = (end - cust["acq_month"] + 1).sum()
    print(k, int((dep > 0).sum()), round((dep > 0).sum() / months_at_risk, 4))
# 出力:
# 1 9086 0.0807
# 2 7340 0.0489
# 3 6655 0.0411
結果を表にまとめます。「離脱と数えた人数」は観測の終わり(第36か月)までにその定義で離脱した人数、「月次解約率」はその定義での解約数÷顧客月数、「12か月目の継続率」「24か月目の継続率」は、その定義の離脱を解約とみなしたカプラン・マイヤー推定の値です(全顧客をひとまとめにした推定です。第2章の表の全体の行の0.643は、チャネル別の推定を構成で加重した別の値です)。
| 解約の定義 | 離脱と数えた人数 | 月次解約率(全体) | 紹介 | 検索広告 | SNS広告 | チラシ | 12か月目の継続率 | 24か月目の継続率 |
|---|---|---|---|---|---|---|---|---|
| 支払い停止(正式な解約) | 5,686人 | 3.27% | 1.60% | 2.74% | 4.56% | 6.45% | 0.644 | 0.499 |
| 注文0が1か月、または支払い停止 | 9,086人 | 8.07% | 4.87% | 7.15% | 11.27% | 14.85% | 0.366 | 0.206 |
| 注文0が2か月続く、または支払い停止 | 7,340人 | 4.89% | 2.78% | 4.23% | 6.71% | 9.08% | 0.542 | 0.349 |
| 注文0が3か月続く、または支払い停止 | 6,655人 | 4.11% | 2.23% | 3.52% | 5.66% | 7.73% | 0.598 | 0.411 |
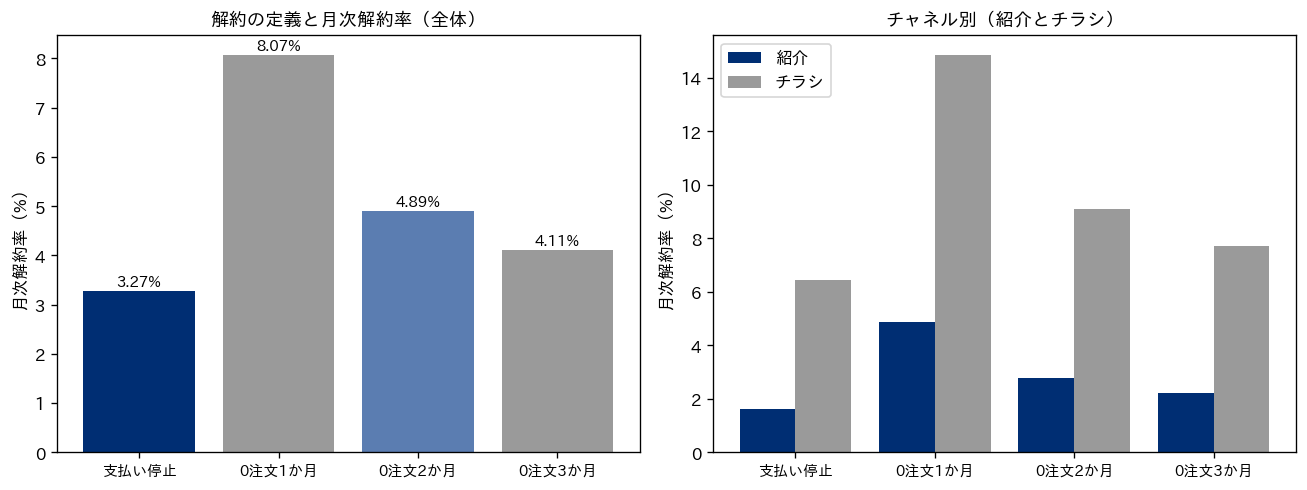
表の「月次解約率(全体)」の列を見ると、支払い停止で数えた3.27%に対して、「注文0が2か月続く、または支払い停止」の定義では4.89%と、約1.5倍になりました。注文0が1か月で離脱とみなすと8.07%で、約2.5倍です。12か月目の継続率も、支払い停止の0.644に対して、2か月の定義では0.542、1か月の定義では0.366まで下がります。同じ顧客の同じ記録から計算しても、定義の置き方1つで「1年後に3人に2人が残る事業」にも「3人に1人しか残らない事業」にも見えるということです。チャネルの順位(紹介が最も低く、チラシが最も高い)はどの定義でも変わりませんでしたが、チラシの月次解約率は6.45%から9.08%(2か月の定義)へ上がり、紹介との差の大きさも定義によって変わります。
2つの定義がどれだけ食い違っているかを、支払いを見ずに「注文0が2か月続いたか」だけで判定した場合と、支払い停止とで突き合わせました。
| 突き合わせの区分 | 人数 |
|---|---|
| 注文0が2か月続いた顧客 | 2,739人 |
| そのうち、観測内に支払いも止めた顧客 | 1,085人 |
| そのうち、第36か月の観測の終わりまで支払いを続けた顧客 | 1,654人 |
| 支払いを止めたが、その前に注文0が2か月続かなかった顧客 | 4,601人 |
| 第36か月に料金を払っていて、直近2か月が注文0の顧客 | 597人(第36か月に料金を払った6,451人のうち) |
表の最後の行の6,451人と、この章の後の節で打ち切りとして数える6,314人の差の137人は、第36か月の料金を払い、その月末に解約した人です。この記事では最後に料金を払った月の月末に解約したと数えるので(第2章と同じ定義)、この137人は第36か月には在籍していますが、打ち切りではなく観測内の解約に入ります。
表から読めることは3つあります。1つ目に、支払いを止めた5,686人のうち4,601人(約8割)は、止める前に注文0が2か月続くことがありませんでした。この架空データでは、支払いを止めた人の約8割が、それまでに2か月続けて注文が無い時期を経ていなかったということです(解約した月だけ注文が0だった人もこちらに入ります)。利用ベースの定義だけで解約を捉えようとすると、解約の大半を見落とします。2つ目に、注文0が2か月続いた2,739人のうち1,654人は、観測の終わりまで料金を払い続けていました。利用ベースの定義は、この人たちを「離脱した」と数えます。注文0が2か月続いた月より後にも月次の記録がある(料金を払った月がある)2,446人のうち、2,178人(89.0%)は後で注文を再開していました。2,739人との差の293人は、2か月続いた月の月末に解約した人(支払いも止めた1,085人のうち、同じ月だった19.3%にあたる209人)と、2か月続いた月が観測の終わりの第36か月だった人(残りの84人)です。3つ目に、注文0が2か月続いた月から実際に支払いを止めた月までの間隔は、両方がある1,085人で平均5.57か月、中央値4か月でした。同じ月だったのは19.3%で、3か月以上先だったのが60.6%です。利用の停止は、解約の前触れとしては早すぎることも、遅すぎることもあります。
この結果は、この架空データの設定(注文回数が隠れた利用意欲で決まり、月ごとのばらつきが大きい)での話です。注文回数の月ごとのばらつきが小さい事業や、利用が止まるとすぐに解約する事業では、2つの定義はもっと近くなります。それでも、「定義を変えれば数字が大きく変わる」ことと、「利用ベースの定義は、払っているのに使っていない人と、使っているのに解約する人の両方を取り違える」ことは、どの事業でも確かめる価値があります。自社のデータで同じ突き合わせの表を1枚作っておくと、どの定義を正式な解約とし、どの定義を「解約の前触れの指標」として別に持つかを決める材料になります。
経営の数字に翻訳すると、定義の違いは売上の見込みの違いになります。2か月の定義で「離脱」と数えた人のうち1,654人は、実際には料金を払い続けていました。共通データの架空の月次粗利は標準プランで1,500円、大容量プランで2,400円なので、この人たちを離脱として扱って売上の見込みから外すと、その人数分の月次粗利が見込みから消えます。逆に、支払い停止だけを見ていると、直近2か月が注文0のまま払い続けている597人の存在に気づきません。この人たちが本当に解約しやすいのかは、前の段落の「89.0%が後で注文を再開した」という結果だけでは分からないので、答え合わせ用に第60か月まで生成したデータ(現実には見えないもの)で確かめました。比べる相手をそろえるため、第36か月に料金を払った6,451人から、第36か月末に解約した137人を除き、打ち切りの6,314人(第37か月以降も在籍している人)に絞りました。597人のうち26人はこの137人に含まれるので、597人側は571人、残りの直近2か月に注文があった側は5,743人です(571+5,743=6,314)。571人について、第37〜39か月のどこかの月末に解約した割合は11.2%、第37〜48か月では32.2%でした。5,743人では、それぞれ6.0%と20.7%です。直近2か月が注文0の人は、この架空データでは3か月以内の解約の割合が約1.9倍でした。ただし、この比較は加入の時期や獲得チャネルをそろえていないので、差のすべてが注文0によるものとは限りません。一方で、この571人のうち52.9%は第37〜39か月に1回以上注文しています。利用の停止は「多くが利用に戻るが、解約の割合も高い集団」の目印であり、解約そのものではありません。正式な解約の定義は支払い停止で1つに固定し、利用の停止は「解約の候補」を示す別の指標として持つ、という使い分けが有効だと考えています。
観測期間と打ち切り:観測の終わりを第24か月にすると何が起きるか
顧客データには必ず「観測の終わり」があります。分析に使うデータを取り出した日が観測の終わりで、その時点でまだ在籍している顧客は、本当はいつ解約するのかが分かりません。この状態を打ち切りと呼びます。共通データAでは、第36か月末に解約せず、その先も在籍している6,314人が打ち切りです。打ち切られた顧客の在籍月数は「少なくともこれだけ」という下限しか分かりません。加入が最近の顧客ほど、在籍月数が短く見えるのは、解約しやすいからではなく、観測できた期間が短いからです。
観測の終わりが変わると、同じ計算でも数字が変わります。共通データAを第12・18・24・30・36か月で切り、それぞれの時点で手元にあるデータだけを使って計算し直しました。観測の終わりを第24か月にするのは、データが2年分しか無い会社を想定したものです。「全員を分母にした12か月継続の割合」は、その時点までに加入した全員のうち、在籍月数が12か月以上の人の割合です。「12か月目を観測できる人だけの割合」は、加入から12か月目が観測の終わりより前に来る人に絞った割合です。「打ち切りを扱った推定」は、第5章で扱うカプラン・マイヤー推定の12か月目の継続率で、ここでは全顧客をひとまとめにして推定しています。真の12か月目の継続率は、データを作った側だけが知る値で、データ全体のチャネル構成で重み付けすると0.640でした。
| 観測の終わり | 顧客数 | 打ち切りの割合 | 素朴な月次解約率 | 1÷月次解約率(か月) | 解約者だけの平均在籍月数 | 全員を分母にした12か月継続の割合 | 12か月目を観測できる人だけの割合 | 打ち切りを扱った推定 |
|---|---|---|---|---|---|---|---|---|
| 第12か月 | 4,781人 | 76.0% | 4.33% | 23.1 | 3.3 | 0.060 | 0.667(429人) | 0.672 |
| 第18か月 | 7,212人 | 69.7% | 4.03% | 24.8 | 4.4 | 0.265 | 0.676(2,827人) | 0.655 |
| 第24か月 | 9,559人 | 65.4% | 3.68% | 27.1 | 5.5 | 0.357 | 0.657(5,196人) | 0.653 |
| 第30か月 | 12,000人 | 61.0% | 3.53% | 28.4 | 6.5 | 0.413 | 0.654(7,584人) | 0.647 |
| 第36か月 | 12,000人 | 52.6% | 3.27% | 30.6 | 8.0 | 0.541 | 0.649(9,991人) | 0.644 |
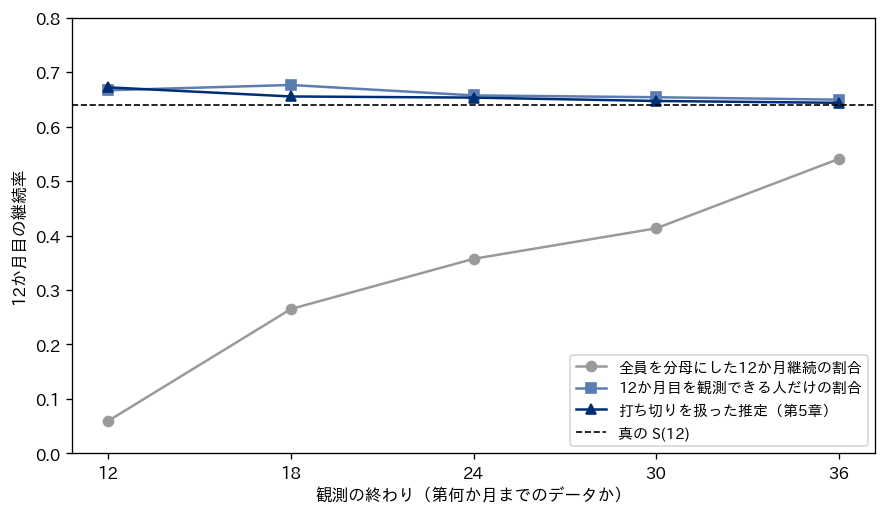
表の「全員を分母にした12か月継続の割合」の列は、観測の終わりが第24か月のとき0.357、第36か月のとき0.541と、真の0.640から大きく外れ、しかもデータが増えるほど上がっていきます。最近加入して、まだ12か月たっていない人を「12か月続かなかった人」として分母に入れているためです。この数字を毎月の報告に載せると、何も変わっていないのに継続率が改善し続けているように見えます。これに対して、「12か月目を観測できる人だけの割合」と「打ち切りを扱った推定」は、観測の終わりが第24か月でも0.657と0.653で、真の値に近い値でした。この架空データでは、全顧客をひとまとめにした推定でも、打ち切りを扱えば2年分のデータから12か月目の継続率を真の値に近く推定できました。観測の終わりが第12か月の行の値は0.67前後とやや高めです。この時点のデータ(第1〜12か月の加入者)は紹介が31.6%で、データ全体の26.8%より多く、チラシは18.1%でデータ全体の22.4%より少なくなっています。チャネルごとの真の12か月目の継続率を、この時点のデータの構成で重み付けし直すと0.656になり、真の値そのものが0.640より高くなります。チャネル構成の違いで0.016です。残りの差(推定の0.672と0.656の差)には、12か月目まで観測できる人が少ない時点での推定のばらつきに加えて、全顧客をひとまとめにした推定であることによる偏り(加入時期によってチャネルの構成と観測できる期間が同時に変わり、打ち切りと解約のしやすさが無関係でなくなる。第2章)も入りうるので、この比較だけでは2つを分けられません。加入時期によってチャネル構成が変わることの影響は第4章で扱います。
「解約者だけの平均在籍月数」の列も、観測の終わりとともに3.3か月から8.0か月へ伸びています。観測の期間が短いと、長く在籍してから解約する人はまだ解約しておらず、早く解約した人だけが「解約者」として数えられるからです。解約者だけで平均在籍月数を出す誤りは、第5章で真の期待在籍月数と比べて詳しく扱います。
素朴な月次解約率(観測内の解約数÷顧客月数)も、観測の終わりによって4.33%から3.27%へ動きました。共通データでは、解約のハザード(在籍月数ごとの月次解約率)が在籍が長くなるほど下がる設定なので、観測の期間が短いほど、解約しやすい在籍の浅い顧客月の比率が高くなり、素朴な解約率が高めに出ます。チャネル別に、観測の終わりが第24か月と第36か月で比べると次のとおりです。
| チャネル | 素朴な月次解約率(第24か月まで) | 素朴な月次解約率(第36か月まで) | 1÷解約率(第24か月まで) | 1÷解約率(第36か月まで) | 打ち切りを扱った12か月目の継続率(第24か月まで) | 同(第36か月まで) | 真の12か月目の継続率 |
|---|---|---|---|---|---|---|---|
| 紹介 | 1.84% | 1.60% | 54.3か月 | 62.4か月 | 0.807 | 0.804 | 0.809 |
| 検索広告 | 3.07% | 2.74% | 32.6か月 | 36.5か月 | 0.705 | 0.703 | 0.683 |
| SNS広告 | 5.27% | 4.56% | 19.0か月 | 21.9か月 | 0.549 | 0.555 | 0.559 |
| チラシ | 7.16% | 6.45% | 14.0か月 | 15.5か月 | 0.457 | 0.450 | 0.455 |
表の「1÷解約率」の列は、素朴な月次解約率の逆数で、「平均で何か月在籍するか」の目安として使われることがある数字です。紹介チャネルでは、データが2年分なら54.3か月、3年分なら62.4か月と、観測の終わりを延ばし、その間に加入した顧客も加えると、8か月以上伸びました。この数字は、観測の期間の長さで変わってしまうということです。「1÷解約率」は期間の上限を置かない値なので、この記事の LTV で使う「60か月で打ち切った真の期待在籍月数」とは、そのままでは比べられません。期間をそろえたうえでの真の値との比較は第5章で扱います。一方、打ち切りを扱った12か月目の継続率は、第24か月までのデータでも第36か月までのデータでも、4チャネルとも真の値から0.03以内に収まりました。ただし、検索広告だけは、どちらの期間でも推定が真の値より約0.02高いままです(第24か月までで0.705対0.683、第36か月までで0.703対0.683)。観測の期間を延ばしても差は約0.02のまま残りましたが、この比較だけでは原因を特定できず、この差の原因は、この章の計算では確かめていません。この架空データの12か月目の継続率については、観測の期間が短いこと自体よりも、打ち切りを無視した計算のほうが大きな誤りを生みました。打ち切りを扱う計算の仕組みと、なぜ「1÷解約率」がずれるのかは第5章で扱います。
データ整備の段階で押さえておくべきことは、観測の終わりの日付を、分析の結果と一緒に必ず残すことです。同じ「継続率」でも、どの日までのデータで計算したかが違えば値が変わります。データを取り出した日、各顧客の観測の最後の月(共通データAの end_month)、観測の終わりまでに解約が観測されたかどうか(打ち切りの印。共通データAでは、観測内に解約が無い churned が0の顧客が打ち切り)の3つは、顧客台帳の列として必ず持つことが有効だと考えています。
データを点検する:分析の前に確かめる項目
複数のシステムからデータを集めてつなぐと、重複、抜け、矛盾が入り込みます。分析を始める前に、少なくとも次の項目を機械的に点検します。次のコードは、共通データAに対して点検を行ったものから抜き出したもので、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。共通データAは乱数から生成したデータなので、すべて0件になります。現実のデータでは、ここで0件にならない項目が必ずと言ってよいほど出てきます。
import cust_data as cd

cust, monthly = cd.make_subscription()
print("顧客IDの重複", cust["cust_id"].duplicated().sum())
print("顧客月の重複", monthly.duplicated(["cust_id", "month"]).sum())
g = monthly.groupby("cust_id").agg(first=("month", "min"), last=("month", "max"),
                                    n=("month", "size"), churn_sum=("churn", "sum"))
chk = cust.set_index("cust_id").join(g)
print("初月が加入月と違う", (chk["first"] != chk["acq_month"]).sum())
print("最終月が観測の最後の月と違う", (chk["last"] != chk["end_month"]).sum())
print("途中の月が抜けている", (chk["n"] != chk["last"] - chk["first"] + 1).sum())
print("台帳と月次で解約の有無が違う", (chk["churned"] != chk["churn_sum"]).sum())
print("解約月より後に行がある",
      ((chk["churned"] == 1) & (chk["last"] > chk["churn_month"])).sum())
# 出力:
# 顧客IDの重複 0
# 顧客月の重複 0
# 初月が加入月と違う 0
# 最終月が観測の最後の月と違う 0
# 途中の月が抜けている 0
# 台帳と月次で解約の有無が違う 0
# 解約月より後に行がある 0
それぞれの点検が何を防ぐかを整理しておきます。顧客IDの重複の点検が見つけるのは、同じ顧客IDが複数の行に現れる誤り(台帳の取り込みを2回行った、など)です。同じ人が別のIDで2回登録されている場合(メールアドレスの変更や、退会後の再登録など)は、この点検では見つからないので、氏名や連絡先で同じ人を突き合わせる名寄せで別に確かめます。同じ人に別のIDが付いていると、1人の解約と再加入が「1人の解約と1人の新規加入」に見え、獲得の数と解約の数がともに膨らみます。顧客月の重複は、システムをつなぐときの結合の誤り(1人に2件の契約があり、月次の行が2倍になるなど)で起きます。途中の月の抜けは、休止の月や請求の失敗の月を「行を作らない」形で記録していると起きます。抜けた月を在籍していない月と読むか、在籍しているが利用が無い月と読むかで、在籍月数が変わります。台帳と月次で解約の有無が違うのは、顧客台帳の状態(在籍・退会)と請求の記録を別々の部門が更新しているときに起きます。解約月より後に行があるのは、退会手続きの後に最後の請求が出る、解約した人が再加入した、といった場合に起きます。
点検で見つかった問題は、その場で修正するより先に、件数と原因を記録します。どのシステムのどの処理で生じたかが分かれば、元のシステムの側で直せることが多く、毎月の集計のたびに同じ修正を繰り返さずに済みます。点検の項目は、分析の初回だけでなく、毎月の集計の最初に自動で回し、件数が前月から大きく変わったら集計を止める、という運用が有効だと考えています。
特徴量の時点とリーク:未来の情報が混ざると予測が当たって見える
第7章で扱う解約予測では、ある月末の時点で在籍している顧客について、その時点までの記録から特徴量(予測に使う手がかり)を作り、その先3か月の解約をラベル(正解)にします。このとき、予測する時点より後の情報が特徴量に混ざることをリーク(情報の漏れ)と呼びます。リークがあると、検証のときには予測がよく当たって見えますが、実際の運用では未来の情報は手に入らないので、予測は当たりません。
データ整備の段階で起きやすいリークは、顧客台帳の「最新の状態」をそのまま使うことです。顧客台帳の在籍月数や状態の列は、データを取り出した日の値で上書きされています。過去のある時点の予測を作るのにその列を使うと、その時点では分からなかった「その後どれだけ在籍したか」が特徴量に入ります。共通データAで確かめました。第7章で扱う基準の解約予測と同じ設計(第6〜27か月の各月末の在籍者で学習し、第30か月末の在籍者7,324人で検証する。7,324人は、第30か月の在籍者7,562人から、その月末に解約した238人を除いた人数。特徴量はそれぞれの月末までの記録だけから作る)でロジスティック回帰を当てると、AUC(予測の順位の正しさを測る指標。0.5で当て推量、1で完全)は0.674でした。ここに、第36か月時点の顧客台帳にある「観測できた在籍月数」(tenure_obs)を1列足すと、AUCは1.000になりました。この列には、第31〜33か月に解約した人は在籍月数が短く記録されているので、答えそのものが入っていたことになります。
AUC 1.000のような完全な予測は、それ自体がリークを疑う合図になりますが、実際のリークはもっと見分けにくい形で起きます。解約の手続きの電話で記録された問い合わせ、解約月に送られた引き止めのメールの開封、解約後に集計された満足度調査の回答などは、日付をよく見ないと「解約の前の行動」に見えます。データを整備するときは、すべての記録に「いつ起きたか」と「いつ記録されたか」の日付を持たせ、特徴量は予測の時点より前に記録されたものだけから作れるようにしておくことが重要です。データ整備の段階でできる見つけ方は2つあります。1つは、特徴量に使う列ごとに「その値は、いつの時点で決まるか」を一覧にし、予測の時点より後に決まる列(在籍月数や状態のように上書きされる列、解約の後に記録される列)を外すことです。もう1つは、足しただけで予測が異常によく当たるようになる列(この例のように、1列足しただけで AUC が1.000に跳ねる列)がないかを、列を1つずつ足し引きして確かめることです。予測の時点を決めて特徴量とラベルを作る設計(スナップショット)と、リークの実演は第7章で扱います。
部門ごとの台帳のずれ:同じ顧客の記録が部門によって違う
多くの企業で、顧客の記録は部門ごとに別々に持たれています。カスタマーサポート(CS)は問い合わせ管理のツールに、経理は請求と入金のシステムに、マーケティングは広告やメール配信のツールに、それぞれ顧客の記録を持っています。この3つで、顧客ID、解約日、獲得チャネルが食い違うことがよくあります。
| 項目 | CS(問い合わせ管理) | 経理(請求・入金) | マーケティング(広告・配信) | 食い違いが起こす誤り |
|---|---|---|---|---|
| 顧客ID | 電話番号やメールアドレスで顧客を探す | 請求先の契約番号で管理する | 広告の計測ツールのIDやメール配信のIDで管理する | つなげない顧客が出て、問い合わせや獲得チャネルが分析から抜ける |
| 解約日 | 退会の申し出を受けた日 | 最後の請求の月、または入金が止まった月 | 配信停止の日、または最後の購買の日 | 部門ごとに解約率と在籍月数が違って見える |
| 獲得チャネル | 持っていないことが多い | 持っていないことが多い | 最初に接点を持った経路と、最後に接点を持った経路で答えが変わる | チャネル別のLTVとCACが、どちらの経路で数えたかで変わる |
解約日のずれは、前の節で確かめた定義の違いと同じ影響を持ちます。CSの「退会の申し出の日」と、経理の「最後の請求の月」は、同じ月になるとは限りません。たとえば、月の途中に退会を申し出ても、その月の分まで請求する仕組みであれば、申し出の月と最後の請求の月が同じになり、翌月分まで請求する仕組みであれば、1か月ずれます。在籍月数が1か月違えば、短い在籍の顧客ほど相対的な差が大きくなり、早期の解約率や回収月数(第9章)の数字が変わります。獲得チャネルのずれは、第9章で扱う獲得チャネル別のLTVとCACの比較を直接動かします。紹介で来た人が、加入の直前に検索広告をクリックしていた場合、「最初の接点」で数えれば紹介、「最後の接点」で数えれば検索広告になります。どちらで数えるかは、獲得費用の計上の仕方と合わせて決める必要があります。
このずれを解消する方法は、技術よりも取り決めの問題です。会社として「この項目はこのシステムの値を正とする」と決め、他のシステムの値は参考として持つ、という形が現実的だと考えています。たとえば、解約日は経理の請求と入金の記録を正とし(この記事の定義に合わせるなら、入金が確認できた最後の月の月末)、CSの退会の申し出の日は「解約の手続きを始めた日」という別の列として残す、といった決め方です。正とするシステムを決めておけば、部門ごとに別の解約率が報告される状態を避けられます。組織として解約の定義を統一する進め方は第13章で扱います。
個人情報の扱い:利用目的の特定と安全管理
顧客分析に使うデータの多くは、氏名・住所・メールアドレスと結び付いた個人情報です。日本では個人情報の保護に関する法律(平成十五年法律第五十七号。以下、個人情報保護法)が、個人情報を取り扱う事業者の義務を定めています。この節では、e-Gov 法令検索で条文を、個人情報保護委員会のガイドライン(通則編)を、それぞれ2026年10月16日に開いて確かめた範囲だけを書きます。条文はe-Gov 法令検索の個人情報の保護に関する法律のページ、ガイドラインは個人情報保護委員会の個人情報の保護に関する法律についてのガイドライン(通則編)のページで読めます。個別の取扱いが法令に適合するかどうかは、条文とガイドラインの全体、および事業の実態によって決まるので、実際の判断は自社の法務部門や専門家に確かめる必要があります。
顧客分析に最も関係が深いのは、利用目的の特定です。個人情報保護法の第17条第1項は、個人情報取扱事業者は、個人情報を取り扱うに当たっては、その利用の目的をできる限り特定しなければならない、と定めています。第18条第1項は、あらかじめ本人の同意を得ないで、特定された利用目的の達成に必要な範囲を超えて個人情報を取り扱ってはならない、と定めています。第21条第1項は、個人情報を取得した場合は、あらかじめその利用目的を公表している場合を除き、速やかに、その利用目的を本人に通知し、または公表しなければならない、と定めています。第17条第2項は、利用目的を変更する場合には、変更前の利用目的と関連性を有すると合理的に認められる範囲を超えて行ってはならないとし、第21条第3項は、利用目的を変更した場合は、変更された利用目的について本人に通知し、または公表しなければならない、と定めています。
解約予測や顧客ごとの価値の推定のように、購買や利用の記録を分析して顧客の行動を見積もる取扱いについては、個人情報保護委員会のガイドライン(通則編。2026年10月時点で開いた版は、平成28年11月に策定され、令和8年6月に一部改正されたもの)に具体的な記述があります。ガイドラインは、利用目的の特定の趣旨を、個人情報が取り扱われる範囲を確定するとともに本人の予測を可能とすることだと説明し、本人から得た情報から本人に関する行動・関心等の情報を分析する場合は、どのような取扱いが行われているかを本人が予測・想定できる程度に利用目的を特定しなければならない、としています。具体的に特定している事例として、閲覧履歴や購買履歴等の情報を分析して、趣味・嗜好に応じた新商品・サービスに関する広告のために利用する、という書き方が挙げられています。一方、「事業活動に用いるため」「マーケティング活動に用いるため」は、具体的に利用目的を特定していない事例として挙げられています。
データ整備の実務に置き換えると、解約予測や引き止め施策のためにデータを使う前に、自社のプライバシーポリシーなどで公表している利用目的が、その使い方を本人が予測・想定できる程度に書かれているかを確かめる、ということになります。たとえば、利用の記録や問い合わせの記録を分析して、継続のご案内や特典のお知らせに使うのであれば、その旨が利用目的から読み取れるかを、法務部門と確かめておく必要があります。分析を始めてから利用目的の不足に気づくと、利用目的の変更の手続きが要り、変更できる範囲にも第17条第2項の制限があります。データ整備の計画の最初に、利用目的の確認を工程として入れておくことが有効だと考えています。
安全管理については、第23条が、個人情報取扱事業者は、その取り扱う個人データの漏えい、滅失または毀損の防止その他の個人データの安全管理のために必要かつ適切な措置を講じなければならない、と定めています。ガイドライン(通則編)は、講ずべき安全管理措置の内容として、基本方針の策定、個人データの取扱いに係る規律の整備、組織的安全管理措置、人的安全管理措置、物理的安全管理措置、技術的安全管理措置、外的環境の把握の項目を挙げています。分析の実務では、継続率や解約予測の計算そのものに氏名・住所・メールアドレスは使わないことが多いと考えています。分析用のデータは顧客IDで管理し、氏名などの項目を外した形で分析担当者に渡し、氏名と顧客IDの対応表は別の担当が管理する、という分け方が、安全管理の上でも作業の上でも扱いやすいと考えています。また、第27条第1項は、法令に基づく場合などの例外を除き、あらかじめ本人の同意を得ないで個人データを第三者に提供してはならない、と定めています。分析を社外の事業者と行う場合や、外部のツールにデータを置く場合は、どの規定に基づいてデータを渡すのかを、事前に法務部門と確かめる必要があります。
もう1つ、法令とは別に、この記事の立場として添えておきます。解約予測やLTVの推定は、顧客を区別して扱うための道具です。予測の結果を使って、特定の属性の顧客にだけ不利な条件を出すような使い方は勧めません。この記事で扱う施策は、引き止めの特典を誰に配るか、どのチャネルの獲得に予算を使うかを決めるためのものです。
データ整備の体制:誰がどの数字の持ち主か
データ整備で最も時間がかかり、最も後回しにされやすいのは、技術ではなく「誰がその数字の持ち主か」を決めることです。持ち主とは、その項目の定義を決め、値が正しいことに責任を持ち、定義を変えるときに関係者に知らせる人や部門のことです。持ち主がいない数字は、部門ごとに少しずつ違う計算がされ、どれが正しいのかを誰も答えられない状態になります。
| 項目 | 持ち主の例 | 持ち主が決めること |
|---|---|---|
| 解約の定義と解約日 | 事業責任者(経理の請求の記録を正とする) | 休止・プラン変更・支払いの失敗・再加入の扱い |
| 獲得チャネルと獲得費用 | マーケティング | 最初の接点か最後の接点か、獲得費用をどのチャネルに計上するか |
| 月額と粗利率 | 財務・経理 | 月次粗利に含める費用(配送費・決済手数料など) |
| 利用・問い合わせの記録 | サービスの運営部門・CS | 月次への集計の仕方、問い合わせの種類の分け方 |
| 施策の配信履歴 | CRMの担当 | 対象の選び方の記録、効果を比べるためにあえて施策を配らずに残す群(第12章で扱うホールドアウト)の残し方 |
| 個人情報の取扱い | 法務・情報システム | 利用目的の確認、分析用データの項目と保管の仕方 |
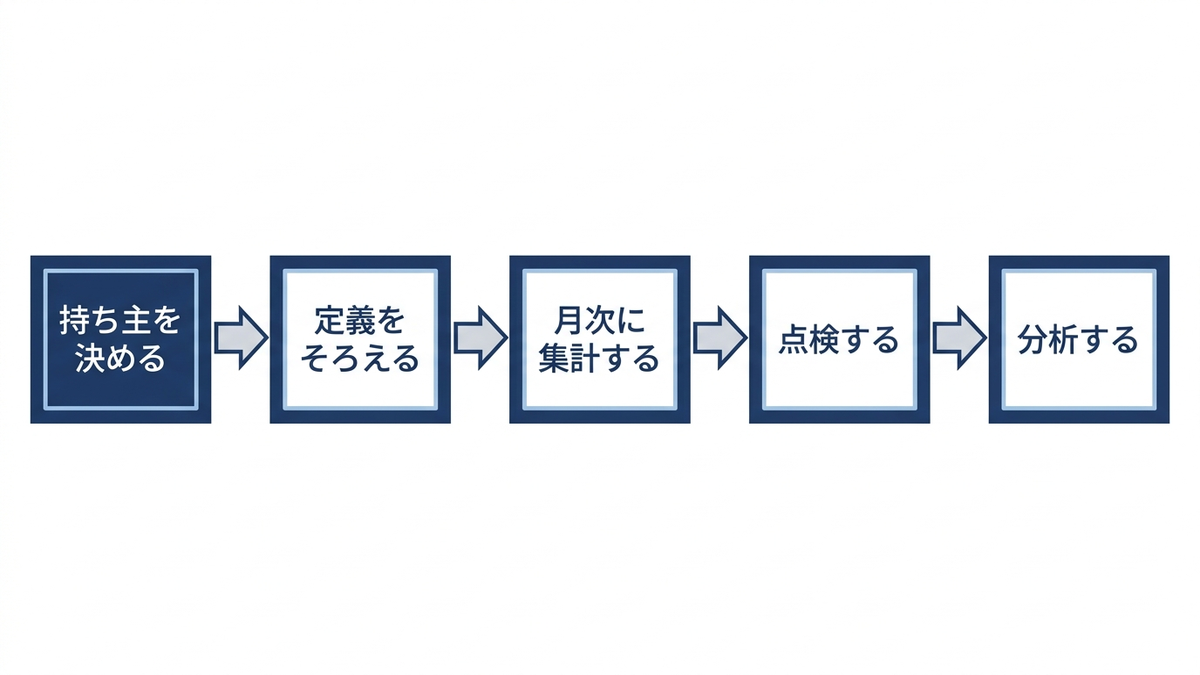
整備の順序は、持ち主を決める、定義をそろえる、月次に集計する、点検する、分析する、の順が有効だと考えています。定義を決める前に集計を始めると、集計のプログラムの中に、担当者がその場で決めた定義が埋め込まれます。後で定義を見直したときに、どの数字がどの定義で計算されたかが分からなくなります。定義は文書にして持ち主が管理し、集計のプログラムはその文書を参照して作る、という分担にしておくと、定義の変更が数字にどう効いたかを追えるようになります。
経営の判断:整備にかける期間と、最初にそろえる最小限の項目
データ整備には終わりがありません。すべてのシステムをつなぎ、すべての項目をそろえてから分析を始めようとすると、分析が始まる前に予算と関心が尽きます。逆に、何もそろえずに分析を始めると、この章で見たように、定義と打ち切りの扱い1つで数字が大きく動き、結論を信用できません。経営として決めるべきことは、最初にそろえる最小限の項目と、そこまでにかける期間です。
この記事の後の章のうち、コホート分析と生存分析を動かすのに最低限要る項目は、顧客ID・加入月・解約月(支払い停止で数えたもの)・観測の最後の月・月額(または月次粗利)・獲得チャネルの6つです。共通データAで言えば、cust の cust_id・acq_month・churn_month・end_month・price・channel に当たります。この6つがそろえば、第4章のコホート表と、第5章のチャネル別の継続率曲線までは計算できます。第9章のチャネル別のLTVとCACの比較に進むには、さらに粗利率(月額のうち粗利になる割合。財務・経理が持ち主)と、チャネル別の獲得費用(マーケティングが持ち主)の2つが要ります。この2つは顧客1人ずつの記録でなくてもよく、チャネルごと・プランごとの値があれば足ります。月次の利用の記録と問い合わせの記録は、第6章の要因の分析と第7章の解約予測に進むときに加えます。施策の配信履歴は、引き止め施策を始める前にそろえます。
判断を誤ったときの損失は、次のような形で表れます。解約の定義が部門ごとに違うまま経営会議で議論すると、同じ事業について、ある部門は3.27%、別の部門は4.89%という数字を持ち寄ることになり、どちらが正しいかの議論に時間が使われて、施策の判断が遅れます。打ち切りを無視した「全員を分母にした12か月継続の割合」を報告に使うと、この架空データでは真の0.640に対して0.357(2年分のデータ)や0.541(3年分のデータ)と報告され、しかも観測の終わりを延ばすたびに改善しているように見えるので、本当の悪化を見逃します。顧客台帳の最新の状態を予測に使えば、検証では完全に当たる予測が、実際の施策では役に立ちません。いずれも、分析の手法を高度にするだけでは防げない誤りで、データ整備の段階から、集計・推定・検証の各段階で防ぐ必要があります。
この章の要点は3つです。第一に、解約の定義は会社として1つに決め、文書にして持ち主を置く必要があります。共通データでは、支払い停止の月次解約率3.27%が、「注文0が2か月続く、または支払い停止」の定義では4.89%になり、12か月目の継続率は0.644から0.542に下がりました。利用の停止は、正式な解約とは別の「解約の候補」の指標として持つのが有効です。第二に、観測の終わりの後に在籍している顧客は打ち切りで、打ち切りを無視した計算は、観測の期間によって結果が大きく変わります。この架空データでは、打ち切りを扱った推定は、全顧客をひとまとめにした推定でも、2年分のデータから12か月目の継続率を真の値に近く出しました。第三に、データの点検、特徴量の時点の管理、部門ごとの台帳の正の決め方、個人情報の利用目的の確認は、分析を始める前に済ませておくべき工程です。次の第4章では、こうして整えたデータから、加入時期ごとに顧客を束ねて継続率の推移を読むコホート分析を扱います。
この章を深めたい方への参考書籍
『データマネジメント知識体系ガイド 第2版 改定新版』(DAMA International 編著、DAMA日本支部・Metafindコンサルティング株式会社 監訳、日経BP):データマネジメントの知識体系をまとめた本で、データ取扱倫理、データガバナンス、データアーキテクチャ、データモデリングとデザインなどの章を持ちます。この章で扱った「誰がどの数字の持ち主か」「定義をどう統一するか」を、組織の仕組みとして考えるための枠組みが得られます。
『前処理大全 SQL/pandas/Polars実践テクニック 改訂新版』(本橋智光・橋本秀太郎 著、技術評論社):分析の前のデータの加工を、SQL・pandas・Polarsの3つで書き分けて示す本です。この章の、顧客月の行を作る、連続した月数を数える、重複や抜けを点検する、といった作業を、自社のデータベースや分析環境で書くときの手引きになります。
『新・個人情報保護法の逐条解説』(宇賀克也 著、有斐閣):令和2年と令和3年の改正に対応した個人情報保護法を、条文ごとに解説した本です。この章で触れた利用目的の特定、利用目的による制限、取得に際しての利用目的の通知、安全管理措置の各条を、条文の趣旨から確かめるのに向いています。出版後の改正については、e-Gov 法令検索の最新の条文と、個人情報保護委員会のガイドラインで確かめる必要があります。
第4章 コホート分析で継続率の推移を読む
第3章では、何を解約と数えるか、観測期間の終わりで在籍月数が途中で切れる打ち切りをどう扱うかなど、顧客データを分析に使える形に整える手順を確かめました。この章からは、整えたデータで顧客の離脱を測ります。最初に扱うのはコホート分析です。顧客を加入した月ごとに束ね、それぞれの束が加入から1か月目・2か月目・3か月目と在籍月数を重ねるにつれて何割残っているかを並べる方法で、顧客の離脱を測る手法の中で最も仕組みが単純で、表計算ソフトでも作れます。単純であるぶん、読み方を誤ると、獲得の質の変化をサービスの悪化と取り違えるといった、予算の判断を誤らせる結論を出してしまうこともあります。この章では、第2章で用意したサンプルデータ(架空の家庭向け食材宅配の定期便。12,000人・第1〜36か月を観測)で、加入月×在籍月の三角形の表を作り、継続率が加入から何か月目で大きく下がるのか、加入時期が後になるほど継続率が下がって見える現象が何によるのか、売上が加入時期ごとの層の積み重ねでできていることを、実際に計算して確かめます。
コホート分析は何を測り、何を防ぐためのものか
この記事では、同じ月に加入した顧客の集まりをコホートと呼びます。必要に応じて、同じ四半期や同じ半年に加入した顧客をまとめて1つのコホートとして扱うこともあります。コホート分析は、コホートごとに「加入から t か月目の料金を払った人の割合」、つまり第2章で定義した継続率 \( S(t) \) を並べ、加入時期の違う顧客を「加入からの経過月数」という同じ物差しの上で比べられるようにします。
この並べ方が必要になるのは、事業全体の解約率を毎月1つの数字で追う方法に、2つの弱点があるからです。1つ目は、在籍月数の違う顧客が混ざることです。共通データでは、解約しやすさ(ハザード)が在籍月数とともに下がるように作ってあります。加入したばかりの顧客は解約しやすく、長く続けている顧客は解約しにくいので、ある月の全体の解約率は、その月に加入直後の顧客がどれだけ混ざっているかで上下します。新規の獲得を増やした月には、サービスに何の変化が無くても全体の解約率が上がり、獲得を絞ると下がります。2つ目は、加入時期の違う顧客が混ざることです。ある時期から獲得チャネルや初回の特典を変えたなら、その時期以降に加入した顧客は、それ以前の顧客と性質が違うかもしれません。全体の数字では、この違いが在籍の長い既存顧客の数字に薄められて見えにくくなります。
コホート分析は、この2つを分けて見るための道具です。在籍月数をそろえて比べるので1つ目の混ざりが消え、加入時期ごとに行を分けるので2つ目の違いが行の差として見えます。1つ目の混ざりの大きさを共通データで確かめるため、全体の月次解約率(その月に在籍していた顧客のうち、その月末に解約した割合)を暦の月ごとに計算しました。第6か月 0.0464、第12か月 0.0429、第18か月 0.0383、第24か月 0.0313 と下がり、第30か月は 0.0315 と横ばいで、第36か月には 0.0212 まで下がりました。この章では、暦の上の月を「第N か月」(観測の始まりから数えた月)、加入から数えた在籍月数を「N か月目」と書き分けます。同じ月の在籍者の平均在籍月数は、第6か月 3.4か月、第12か月 6.2か月、第24か月 11.4か月、第36か月 20.2か月と延びていました。共通データの真のモデル(第2章)には、暦の月によって解約しやすさが変わる仕組みは入っていません。それでも全体の解約率が下がって見えた(第36か月には第6か月の半分以下)のは、在籍の長い顧客の割合が増えたからです。共通データでは第31か月以降に新しい加入が無いので、第36か月の 0.0212 は、在籍の短い顧客がいなくなった影響も受けています。この数字だけを見て「サービスの改善で解約率が半減した」と報告すると、事実と違う結論になります。
どの規模から要るかについては、毎月の新規加入がある程度の人数に達していれば、コホート表は最初に作る分析として向いていると考えています。必要なデータは、顧客ごとの加入月と、最後に料金を払った月(解約していなければ観測の終わり)の2つだけで、獲得チャネルなどの属性があれば行を分けて比べられます。逆に、1か月の加入が数十人程度だと、後で見るとおり、加入月ごとの継続率は偶然のばらつきが大きく、行と行の差を読むことが難しくなります。その場合は、加入月を四半期や半年ごとにまとめた表から始めます。
コホート表を作る:加入月×在籍月の三角形
コホート表は、行に加入月、列に在籍月数をとり、各マスに「その加入月の顧客のうち、t か月目の料金を払った人の割合」を書いた表です。共通データでは、加入月は第1〜30か月、観測できるのは第36か月までなので、第1か月に加入した顧客は在籍36か月目まで観測できますが、第30か月に加入した顧客は在籍7か月目(暦の第36か月)までしか観測できません。加入が後になるほど観測できる在籍月数が短くなるので、表は右下が欠けた三角形になります。
この章では、各マスの継続率を「t か月目を観測できる人だけ」で計算しました。加入月が a の顧客の t か月目は暦の第 \( a + t – 1 \) か月に当たるので、それが第36か月以内の顧客だけを分母にし、そのうち在籍月数が t 以上だった人の割合を出しています。1か月ごとの加入月で作ると、行が30、列が36で、観測できるマスは1,080マスのうち645マスでした。次の図は、その三角形を色の濃さで描いたものです。
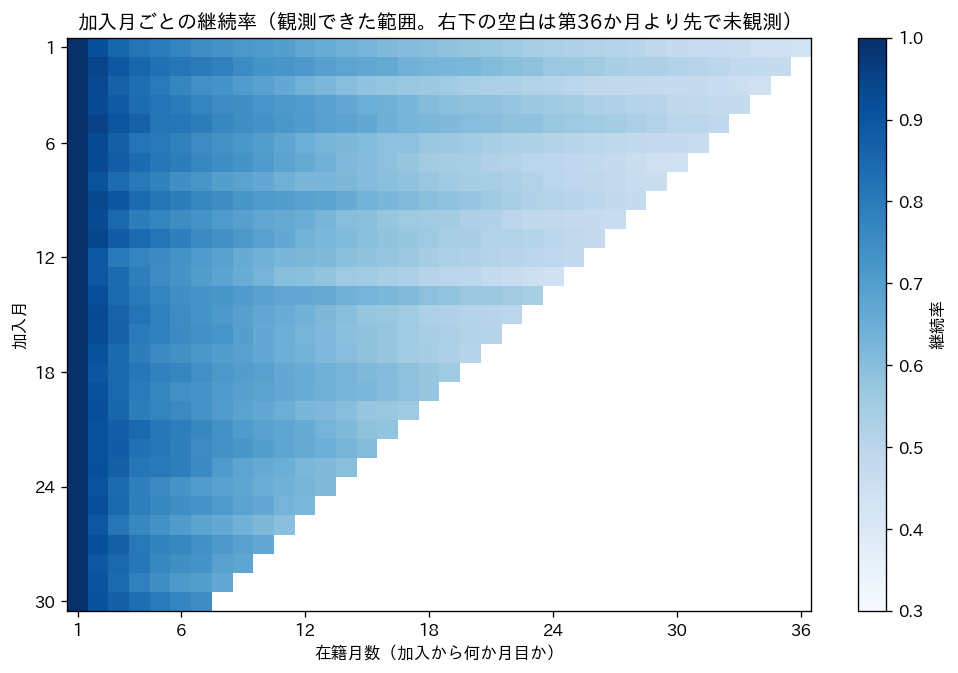
図の各マスの色は継続率を表し、濃いネイビーほど継続率が高く(1.0に近く)、白に近い薄い青ほど低く(0.3に近く)なります。どの行も、左端(在籍1か月目、継続率1.0)の最も濃い色から、右へ行くほど色が薄くなります。行ごとの色の薄まり方はおおむね同じで、行によって多少のむらがあります。1か月ごとの加入月の人数は346〜452人(平均400人)で、12か月目の継続率は加入月によって0.593から0.715まで散らばり、加入月の間の標準偏差(散らばりの大きさを表す値)は0.030でした。継続率が0.65程度で400人の集団なら、偶然だけで生じるばらつき(標準誤差)の目安は約0.024なので、実際の散らばりは偶然だけの目安より大きく出ています。
この差の分には、加入月ごとのチャネル構成の動きが混ざっています。12か月目を観測できる第1〜25か月の加入月で見ると、紹介の割合は加入月によって20.6%から35.6%まで、チラシの割合は13.5%から28.9%まで動いていました。そこで、データを作った側だけが知るチャネル別の真の12か月目の継続率を、加入月ごとのチャネル構成で混ぜた「構成だけで決まる値」を計算すると、その加入月の間の標準偏差は0.015でした。実測の継続率からこの値を引いた残りの標準偏差は0.024で、偶然だけの目安0.024とほぼ同じになり、残りが目安の2倍を超えた加入月は25か月のうち1か月だけでした。つまり、加入月ごとの散らばりは、チャネル構成の動き(この章の後半の主題です)と偶然のばらつきの2つでほぼ説明できます。共通データの真のモデルには、加入月そのものが継続率を変える仕組みは入っていないので、この散らばりは「ある月の加入者だけが特別に悪かった」ことを意味しません。1か月ごとの表で、ある行が隣の行より3〜5ポイント低いことを見つけたら、まずその月のチャネル構成と人数を確かめ、それでも説明できない差が続くときに原因を探しに行く、という順序が有効だと考えています。
三角形の表には、読む向きが3つあります。行に沿って左から右へ読むと、1つのコホートが在籍月数を重ねて減っていく様子、つまりそのコホートの継続率曲線が見えます。列に沿って上から下へ読むと、同じ在籍月数での継続率を加入時期ごとに比べられ、獲得した顧客の質が時期によって変わったかが見えます。右上から左下への斜めの線に沿って読むと、同じ暦の月に起きたことが見えます。たとえば第20か月に値上げやサービスの障害があり、その月末の解約が増えたなら、その影響は継続率の表では翌月の第21か月のマス、つまり「第1か月加入の在籍21か月目」「第2か月加入の在籍20か月目」…と、斜めの線の上にそろって現れます。継続率は「その月の料金を払ったか」で数えるので、ある月の月末の解約は、翌月のマスから表に出ます。共通データには暦の月に効く仕組みが無いので、先のヒートマップの図に斜めの筋は現れていません。
3つの読み方を、次の表にまとめます。
| 読む向き | 表のどこを見るか | 見えること |
|---|---|---|
| 行に沿って読む | 1つの加入月の行を、左から右へ | 継続率曲線の形(在籍月数を重ねて減っていく様子) |
| 列に沿って読む | 同じ在籍月数の列を、上から下へ | 加入時期による違い(獲得した顧客の質の変化) |
| 斜めに沿って読む | 右上から左下への斜めの線 | 同じ暦の月の出来事(値上げ・サービスの障害など) |
6か月ごとにまとめた表と、その読み方
1か月ごとの表は偶然のばらつきが大きいので、報告には加入月を6か月ごとにまとめた表を使いました。第1〜6か月加入を第1期、第7〜12か月加入を第2期、と数え、第25〜30か月加入の第5期まで5つの行になります。次のコードは、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。
import pandas as pd
import cust_data as cd

cust, monthly = cd.make_subscription()             # 第2章の共通データ A
cust["cohort"] = (cust["acq_month"] - 1) // 6 + 1  # 6か月ごとの加入時期(1〜5)

rows = {}
for coh, sub in cust.groupby("cohort"):
    r = {}
    for t in [3, 6, 12, 18, 24, 30]:
        obs = sub[sub["acq_month"] + t - 1 <= cd.OBS_MONTHS]   # t か月目を観測できる人だけ
        if len(obs) > 0:
            r[t] = round((obs["tenure_obs"] >= t).mean(), 3)   # t か月目の料金を払った割合
    rows[coh] = r
print(pd.DataFrame(rows).T)
# 出力:
#       3      6      12     18     24     30
# 1  0.877  0.789  0.679  0.598  0.542  0.487
# 2  0.858  0.766  0.646  0.564  0.497  0.441
# 3  0.850  0.749  0.636  0.550  0.441    NaN
# 4  0.861  0.766  0.641  0.575    NaN    NaN
# 5  0.849  0.741  0.620    NaN    NaN    NaN
この結果を、計算に使った人数とあわせて表にしました。12か月目の列は、第2章で紹介した基準の計算(baseline.cohort_retention)の値と一致することを確かめています。
| 加入時期 | 人数 | 3か月目 | 6か月目 | 12か月目 | 18か月目 | 24か月目 | 30か月目 |
|---|---|---|---|---|---|---|---|
| 第1期(第1〜6か月加入) | 2,457 | 0.877 | 0.789 | 0.679 | 0.598 | 0.542 | 0.487 |
| 第2期(第7〜12か月加入) | 2,324 | 0.858 | 0.766 | 0.646 | 0.564 | 0.497 | 0.441(370人) |
| 第3期(第13〜18か月加入) | 2,431 | 0.850 | 0.749 | 0.636 | 0.550 | 0.441(415人) | 観測できない |
| 第4期(第19〜24か月加入) | 2,347 | 0.861 | 0.766 | 0.641 | 0.575(372人) | 観測できない | 観測できない |
| 第5期(第25〜30か月加入) | 2,441 | 0.849 | 0.741 | 0.620(432人) | 観測できない | 観測できない | 観測できない |
表の「人数」の列は、その時期に加入した全員の数です。第2〜5期の各行で値がある最も右のマスだけは、時期の6か月のうち最初の1か月に加入した人しか観測できないので、括弧内に計算に使った人数を書きました(第1期の30か月目は、第1〜6か月の加入者2,457人全員が対象です)。たとえば第5期の12か月目の0.620は、第25か月に加入した432人だけの値です。括弧の付いたマスは、ほかのマスより人数が少なく、偶然のばらつきも大きいことに注意が要ります。
表を列ごとに上から下へ読むと、3か月目は0.849〜0.877、6か月目は0.741〜0.789、12か月目は0.620〜0.679で、どの列も第1期が最も高く、後の時期ほど低い傾向があります。12か月目の列では、第1期の0.679から第5期の0.620まで、約6ポイント下がりました。この「加入時期が後ほど継続率が悪い」という見え方が何によるのかは、後の節でチャネル別に分けて確かめます。表を行ごとに左から右へ読むと、第1期は3か月目で0.877、6か月目で0.789、12か月目で0.679、24か月目で0.542、30か月目で0.487と下がります。1か月目から6か月目にかけて約21ポイント減り、6か月目から12か月目にかけて約11ポイント、12か月目から24か月目にかけて約14ポイントと、減り方は後になるほど緩やかです。継続率は t か月目の料金を払った割合なので、6か月目の値に表れるのは1〜5か月目の月末の解約です。この形が次の節の主題です。
継続率曲線の形:最初の数か月で大きく減る
コホート表の行を線で描いたものが継続率曲線です。横軸に在籍月数、縦軸に継続率をとり、在籍1か月目の1.0から右下へ下がっていく線になります。全員をまとめて観測できた人だけで計算すると、6か月目 0.762、12か月目 0.649、24か月目 0.514 でした。1か月目から6か月目にかけて約24ポイント下がり、6か月目から12か月目にかけては約11ポイント、12か月目から24か月目にかけての12か月でも約14ポイントしか下がりません。加入直後の数か月で大きく減り、その後はなだらかに減るという形は、共通データの真のモデルが「ハザードは在籍が長くなるほど下がる」ように作ってあることの反映です。
曲線の最初の数か月の落ち込みを、さらに分けて見たのが、初回クーポンの利用者と非利用者の比較です。共通データでは、加入者の44.6%(5,351人)が初回クーポンを使っています。真のモデルでは、初回クーポンの利用者は在籍3か月目までだけ解約しやすく(第2章で説明した真のモデルで、確率に変換する前の値に0.8を足す)、4か月目以降は非利用者と同じ式に戻ります。たとえば、割引を目当てに加入して割引が終わる前後でやめる顧客がいる、といった状況に当たる架空の設定です。次の図の右側が、利用者と非利用者の継続率曲線です。
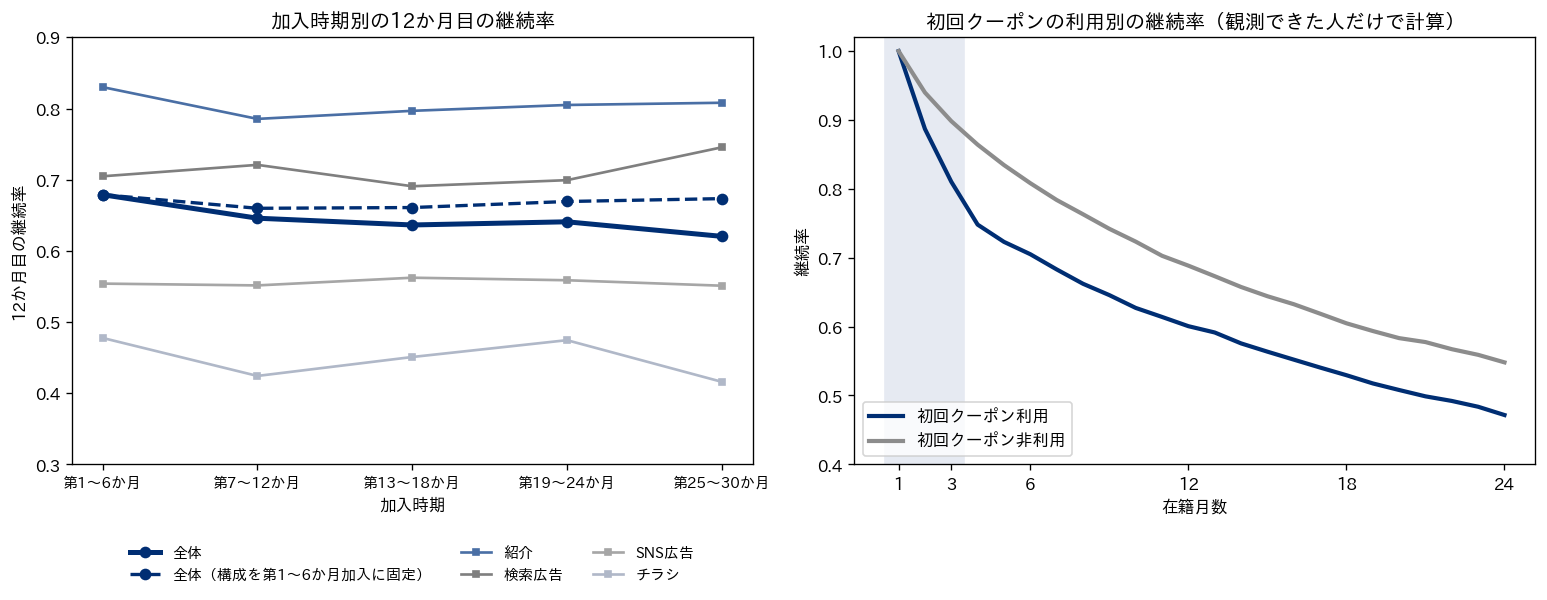
| 在籍月数 | 月次解約率(初回クーポン利用) | 月次解約率(初回クーポン非利用) | 継続率(利用) | 継続率(非利用) | 継続率の差(利用から非利用を引いた値) |
|---|---|---|---|---|---|
| 1か月目 | 0.1131 | 0.0602 | 1.000 | 1.000 | 0.000 |
| 2か月目 | 0.0864 | 0.0442 | 0.887 | 0.940 | -0.053 |
| 3か月目 | 0.0768 | 0.0380 | 0.810 | 0.898 | -0.088 |
| 4か月目 | 0.0335 | 0.0343 | 0.748 | 0.864 | -0.116 |
| 6か月目 | 0.0313 | 0.0301 | 0.705 | 0.808 | -0.103 |
| 12か月目 | 0.0198 | 0.0233 | 0.601 | 0.688 | -0.088 |
| 24か月目 | 計算していない | 計算していない | 0.472 | 0.548 | -0.076 |
表の「月次解約率」の2列は、その在籍月数まで残った人のうち、その月末に解約した人の割合です。在籍月数ごとの月次解約率は第5章でハザードとして詳しく扱いますが、ここでは観測できた人だけで単純に割り算しています。「継続率」の2列も、その月を観測できる加入月の人だけで数えた割合です(12か月目は第1〜25か月、24か月目は第1〜13か月の加入者)。打ち切りの人の途中までの記録も使うカプラン・マイヤー推定で同じ比較をした値は、第5章で示します。この表の「1か月目」「2か月目」は加入から数えた在籍月数で、この章の冒頭で見た暦の月ごとの全体の解約率(第6か月 0.0464 など)とは別の数え方です。初回クーポンの利用者の月次解約率は、在籍1か月目 0.1131・2か月目 0.0864・3か月目 0.0768 と、非利用者(0.0602・0.0442・0.0380)のおよそ2倍でした。4か月目からは 0.0335 対 0.0343 とほぼ同じになり、12か月目は 0.0198 対 0.0233 です。
この結果、「継続率」の2列の差は4か月目に -0.116 まで開きます。その後、差の幅は12か月目 -0.088、24か月目 -0.076 と少しずつ縮みますが、これは両方の継続率がともに下がって差を取る元の値が小さくなるためで、4か月目に開いた差が取り戻されているわけではありません。差が開くのは、最初の3か月の月末の解約が表れる4か月目までで、その後の減り方は、このデータではおおむね近い結果でした。このことは、4か月目の料金を払った人だけでその後の継続を比べると、よりはっきりします。比べる集団をそろえるため、12か月目を観測できる第1〜25か月の加入者に限って、4か月目の料金を払った人のうち12か月目の料金も払った人の割合を数えると、利用者 0.802(3,329人中2,671人)、非利用者 0.793(4,814人中3,817人)でした。24か月目を観測できる第1〜13か月の加入者に限って同じように数えると、24か月目まで残った割合は 0.629(1,744人中1,097人)対 0.620(2,538人中1,573人)です。最初の3か月を乗り越えた利用者は、このデータでは非利用者とおおむね同じように続けています。ただし、これは3か月を越えて残った人どうしの比較なので、残った人の性質の偏りが混ざりえます(この点は第6章で扱います)。
この差はチャネルを分けても残りました。12か月目の継続率の差(利用から非利用を引いた値)は、紹介 -0.064、検索広告 -0.048、SNS広告 -0.106、チラシ -0.136 です。チャネルごとのクーポンの利用率は0.440〜0.456とほぼ同じなので、クーポンの利用者に特定のチャネルの顧客が多いことで生じた差ではありません。なお、継続率曲線を36か月目まで延ばすと、利用者 0.337、非利用者 0.511 と差が広がって見えますが、36か月目を観測できるのは第1か月の加入者だけで、計算に使った人数は利用者196人・非利用者233人にすぎません。打ち切りを扱う第5章の推定(チャネル別に推定して構成で加重した値)では、36か月目は利用者0.373、非利用者0.424です。曲線の右端は人数が少なく、偶然で大きく動くので、24か月目までで図を切りました。
経営の言葉に直すと、初回クーポンで獲得した顧客1,000人は、12か月目にはクーポンを使わなかった顧客1,000人より約87人少なくなっています(0.688と0.601の差。12か月目を観測できる第1〜25か月の加入者だけで数えた割合で、第5章のカプラン・マイヤー推定では0.679と0.599、差は約80人です)。初回クーポンの費用は、割引の額だけではなく、最初の3か月で余計に失う顧客の分も含めて考える必要があります。ただし、この比較が「クーポンが解約を増やした」ことを示すのは、共通データでクーポンの利用が顧客の性質と無関係に(乱数で)決まっているからです。現実のデータでは、クーポンを使う人と使わない人はもともと性質が違うかもしれず、コホート表の比較だけでは、クーポンそのものの効果なのか、クーポンに反応する顧客の性質なのかを分けられません。この区別は第6章(要因の分析)と第12章(実験)で扱います。
加入時期が後ほど悪く見える理由:チャネル構成の効果
6か月ごとの表では、12か月目の継続率が第1期の0.679から第5期の0.620へ下がっていました。この表だけを経営会議に出すと、「最近の顧客は続かなくなっている。サービスの品質が落ちたのではないか」という議論になりがちです。ところが共通データの真のモデルには、加入時期によって継続のしやすさが変わる仕組みは入っていません。変わったのは、獲得チャネルの構成です。共通データでは、加入時期が後になるほど紹介経由の顧客が減り、チラシ経由の顧客が増えるように作ってあります。チャネル別に分けてコホート表を作り直すと、何が起きているかが見えます。次のコードは、12か月目を観測できる人について、チャネル別の継続率と、チャネル構成を第1期に固定した場合の全体の継続率を計算するものです。補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。
import pandas as pd
import cust_data as cd

cust, monthly = cd.make_subscription()
cust["cohort"] = (cust["acq_month"] - 1) // 6 + 1
obs = cust[cust["acq_month"] + 11 <= cd.OBS_MONTHS].copy()   # 12か月目を観測できる人
obs["kept"] = obs["tenure_obs"] >= 12                         # 12か月目の料金を払ったか

ret = obs.pivot_table(index="cohort", columns="channel", values="kept",
                      aggfunc="mean")[cd.CHANNELS]            # チャネル別の継続率
mix = pd.crosstab(obs["cohort"], obs["channel"],
                  normalize="index")[cd.CHANNELS]             # 時期ごとのチャネル構成
overall = obs.groupby("cohort")["kept"].mean()                # 全体の継続率
fixed = (ret * mix.loc[1]).sum(axis=1)                        # 構成を第1期に固定した継続率
print(pd.DataFrame({"全体": overall, "構成を第1期に固定": fixed}).round(3))
print(ret.round(3))
# 出力:
#            全体  構成を第1期に固定
# cohort
# 1       0.679      0.679
# 2       0.646      0.660
# 3       0.636      0.661
# 4       0.641      0.669
# 5       0.620      0.673
# channel  referral  search  social  flyer
# cohort
# 1           0.830   0.705   0.554  0.478
# 2           0.785   0.721   0.551  0.424
# 3           0.797   0.691   0.562  0.451
# 4           0.805   0.699   0.559  0.474
# 5           0.808   0.745   0.551  0.416
「構成を第1期に固定した継続率」は、各時期のチャネル別の継続率を、第1期のチャネル構成(紹介 33.0%・検索広告 30.6%・SNS広告 20.0%・チラシ 16.4%)の比率で重み付けして平均したものです。「もし獲得チャネルの構成が第1期のまま変わらなかったら、全体の継続率はいくつだったか」を表します。結果を、チャネル構成と、データを作った側だけが知る真の値とあわせて表にしました。
| 加入時期 | 紹介の割合 | チラシの割合 | 全体の12か月目の継続率 | 構成を第1期に固定した継続率 | 紹介 | 検索広告 | SNS広告 | チラシ | 真の値を各期の構成で混ぜた値 |
|---|---|---|---|---|---|---|---|---|---|
| 第1期 | 33.0% | 16.4% | 0.679 | 0.679 | 0.830 | 0.705 | 0.554 | 0.478 | 0.663 |
| 第2期 | 30.1% | 19.9% | 0.646 | 0.660 | 0.785 | 0.721 | 0.551 | 0.424 | 0.650 |
| 第3期 | 25.3% | 22.2% | 0.636 | 0.661 | 0.797 | 0.691 | 0.562 | 0.451 | 0.637 |
| 第4期 | 24.0% | 25.1% | 0.641 | 0.669 | 0.805 | 0.699 | 0.559 | 0.474 | 0.632 |
| 第5期 | 22.9% | 28.9% | 0.620 | 0.673 | 0.808 | 0.745 | 0.551 | 0.416 | 0.618 |
「紹介の割合」と「チラシの割合」の2列は、12か月目を観測できる人の中での構成です。第1〜4期は加入者全員と同じで、第5期だけは第25か月の加入者432人の構成です(第5期の加入者全員では紹介 21.8%・チラシ 28.5%)。紹介の割合は33.0%から22.9%へ減り、チラシの割合は16.4%から28.9%へ増えました。
「紹介」の列は、0.830・0.785・0.797・0.805・0.808 と、第1期から第5期までほぼ横ばいです。「SNS広告」の列も0.551〜0.562でほぼ一定です。「検索広告」と「チラシ」の列は時期によって上下しますが、一方向に下がってはいません。第5期の検索広告 0.745 とチラシ 0.416 は、それぞれ110人と125人で計算した値なので、偶然のばらつきが大きいマスです。チャネルの中で見れば、加入時期が後の顧客ほど続かない、という傾向は見当たりません。
それでも全体が下がって見えたのは、継続率の高い紹介の割合が減り、継続率の低いチラシの割合が増えたからです。「構成を第1期に固定した継続率」の列は 0.679・0.660・0.661・0.669・0.673 で、第1期と第5期の差は -0.005 しかありません。全体の差 -0.059 のうち、-0.053 がチャネル構成の変化で説明される計算になります(四捨五入のため、差の合計は一致しません)。このように、集団の中身の構成が変わることで、どの部分も悪化していないのに全体の平均が動いて見えることを、この記事では構成の効果と呼びます。前の図の左側は、この表の「全体」(ネイビーの太い実線)、「構成を第1期に固定」(ネイビーの破線)、チャネル別の4本(細い線)を描いたもので、全体の線だけが右下がりで、ほかの線はほぼ横ばいです。
表の右端の列「真の値を各期の構成で混ぜた値」は、真のモデルから求めたチャネル別の真の12か月目の継続率(紹介 0.809・検索広告 0.683・SNS広告 0.559・チラシ 0.455)を、各時期のチャネル構成で混ぜたものです。真のモデルでは、チャネルの中の継続率は加入時期によって変わらないので、この列の変化はすべて構成の効果です。この列は 0.663 から 0.618 へ -0.045 下がり、実際に観測した全体の継続率(0.679 から 0.620 へ -0.059)と同じ向きに、大きさも近い下がり方をしています。
構成の効果の大きさは、この真の値で見た -0.045 と、先の「構成を第1期に固定」から求めた -0.053 の2通りが出ています。違いは、後者が観測したチャネル別の継続率を使っているためです。第1期の観測値は、紹介 0.830(真の値 0.809)・検索広告 0.705(0.683)・チラシ 0.478(0.455)と、SNS広告(0.554、真の値 0.559)を除く3つのチャネルで偶然に真の値より2ポイント前後高めに出ていて、そのぶん第1期の全体の0.679も真の値で混ぜた0.663より高くなっています。観測した下落 -0.059 のうち、構成の効果が -0.045〜-0.053 で大部分を占め、残りは第1期が偶然高めに出たことなどによるばらつきと読めます。
同じことを、5つの時期がすべて欠けずに観測できる6か月目でも確かめました。全体の6か月目の継続率は第1期 0.789 から第5期 0.741 へ -0.048 下がりましたが、構成を第1期に固定すると 0.789 から 0.774 へ -0.015 の差に縮みました。紹介だけなら 0.882・0.853・0.865・0.878・0.872 で横ばいです。6か月目では構成を固定しても -0.015 の差が残りますが、真のモデルに加入時期の効果は無いので、この残りは偶然のばらつきの範囲だと考えられます。なお、チャネル以外の構成も確かめておくと、初回クーポンの利用率は時期ごとに0.436〜0.452、大容量プランの割合は0.293〜0.303で、どちらも時期によってほとんど変わっていませんでした。
実務でコホート表を見るときは、全体の表と並べて、獲得チャネル別の表と、構成をある基準の時期に固定した継続率を必ず作っておくことが有効だと考えています。チャネル以外にも、初回の特典、プラン、加入した地域や端末など、時期によって構成が変わりうる属性は、同じように分けて確かめます。分ける属性を増やすほど1マスの人数は減るので、人数を確かめずに細かく分けた表の差を読まないことも大切です。
売上のコホート:売上は加入時期ごとの層の積み重ね
ここまでは顧客の人数の継続率を見てきました。同じコホートの考え方で、売上を加入時期ごとの層に分けて積み上げることもできます。ある月の売上は、その月に在籍している顧客の月額の合計で、その顧客は全員どこかの時期に加入しています。そこで、暦の月ごとの売上を、加入時期の6か月ごとに分けて積み上げました。売上はここでは月額の合計(粗利率を掛ける前の値)です。次のコードも、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。
import pandas as pd
import cust_data as cd

cust, monthly = cd.make_subscription()
cust["cohort"] = (cust["acq_month"] - 1) // 6 + 1
mm = monthly.merge(cust[["cust_id", "cohort", "price"]], on="cust_id")

# 暦の月 × 加入時期 の売上(その月に料金を払った人の月額の合計。万円)
rev = mm.pivot_table(index="month", columns="cohort", values="price",
                     aggfunc="sum", fill_value=0) / 1e4
print(rev.loc[[12, 24, 30, 36]].round(1))
print("合計", rev.sum(axis=1).loc[[12, 24, 30, 36]].round(1).to_dict())
# 出力:
# cohort       1       2      3       4       5
# month
# 12      1051.2  1190.2    0.0     0.0     0.0
# 24       827.2   829.4  981.6  1199.8     0.0
# 30       747.9   729.9  851.6   962.5  1214.8
# 36       679.6   648.2  742.3   822.8   961.4
# 合計 {12: 2241.4, 24: 3838.0, 30: 4506.7, 36: 3854.3}
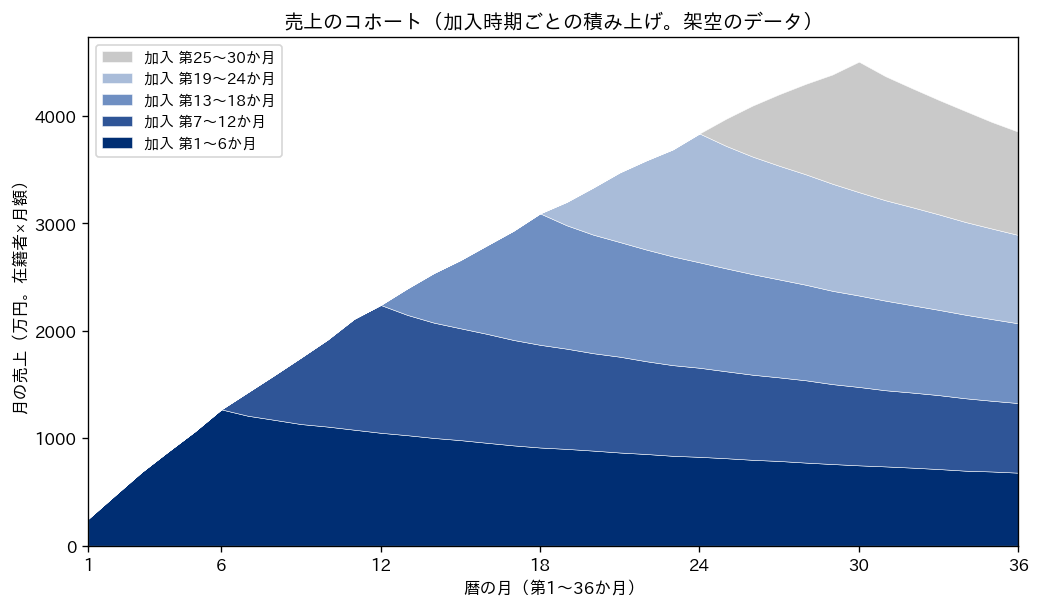
図の一番下の層(第1期の加入者)は、加入の6か月間で月1,269.2万円(第6か月)まで厚くなり、その後は第12か月 1,051.2万円、第24か月 827.2万円、第36か月 679.6万円と薄くなっていきます。第36か月の層の厚さは、第6か月の約54%です。後の時期の層も同じように、加入の6か月で厚くなってから薄くなる形をしています。全体の売上は、層が1枚ずつ積み重なることで第12か月 2,241.4万円、第24か月 3,838.0万円、第30か月 4,506.7万円と増えました。
この図から読み取れる経営上の要点は2つあります。1つ目は、今月の売上の大部分は過去に獲得した顧客から来ていることです。その月に加入したばかりの顧客の売上が全体に占める割合は、第12か月で9.6%、第24か月で6.3%、第30か月で5.7%でした。第36か月の売上の構成比は、第1期 17.6%・第2期 16.8%・第3期 19.3%・第4期 21.3%・第5期 24.9%で、2年以上前に加入した顧客(第1〜2期)が3分の1以上を占めています。今期の継続率の改善は、今期だけでなく翌期以降の層の厚さを変えます。
2つ目は、獲得を止めると売上はすぐに減り始めることです。共通データでは第31か月以降に新しい加入が無い設定なので、売上は第30か月の4,506.7万円から第36か月の3,854.3万円へ、6か月で約14.5%減りました。毎月の獲得は、層が薄くなる分を埋め合わせている面があります。売上が伸びているときにも、それが新しい層の積み増しによるものか、既存の層が薄くなりにくくなったことによるものかは、全体の売上の線からは区別できません。売上を層に分けておくと、獲得の勢いが落ちたときに何か月で売上が減り始めるかを、層の薄くなり方から見積もれます。
売上で見た継続率(在籍 t か月目の売上 ÷ 在籍1か月目の売上)は、人数で見た継続率よりわずかに高くなりました。第1期の12か月目は人数 0.679 に対して売上 0.684、24か月目は 0.542 に対して 0.549 です。月額の高い大容量プランの顧客は、真のモデルで解約しにくく設定されています(確率に変換する前の値に -0.3 を足す)。実際に第1期で確かめると、12か月目の継続率は標準プラン 0.664、大容量プラン 0.715 で、大容量プランの割合は加入時の29.3%から、12か月目まで残った人では30.9%、24か月目まで残った人では31.8%へ増えていました。残った顧客の中で月額の高い顧客の割合が増えるので、売上の継続率が人数の継続率を上回ります。この記事の共通データでは途中のプラン変更や値上げが無いので差は小さいですが、上位プランへの切り替えや値上げがある事業では、売上で見た継続率が人数で見た継続率を上回ることがあります。人数の継続率と売上の継続率は、別の数字として並べて報告します。
コホートの比較で答えられること、答えられないこと
コホート表で答えられるのは、「いつ加入した、どの属性の顧客が、加入から何か月目に、どれだけ残っているか」という記述です。この章の結果で言えば、継続率は最初の数か月で大きく下がること、初回クーポンの利用者は最初の3か月の離脱が多いこと、加入時期が後ほど全体の継続率が下がって見えるのはチャネル構成の変化でほぼ説明できること、売上の大部分は過去の加入時期の層から来ていること、です。どれも、経営の会議で「何が起きているか」を共有するのに十分な情報です。
答えられないのは、「なぜそうなっているか」と「何をすれば変わるか」です。コホート表の差は、獲得チャネルの構成、初回の特典、価格、季節、競合の動き、サービスの品質など、多くのことが同時に重なった結果です。この章でチャネル構成の効果を取り出せたのは、チャネルという属性で表を分けたからで、分けなかった属性の影響は表の中に残ったままです。共通データでは真のモデルが分かっているので「下落の大部分は構成の効果で、残りは偶然のばらつきの範囲」と確かめられましたが、現実のデータでは、分けた後に残った差が何によるのかは分かりません。複数の要因を同時に考えてそれぞれの大きさを見積もるのは第6章のハザードモデルの役割で、施策が本当に効くかを確かめるのは第12章の実験の役割です。
もう1つ、コホート表は「過去に獲得した顧客の記録」なので、今後の顧客が同じように続くかは保証しません。第5期の12か月目のように、加入が最近の時期の値は、まだ一部の人しか観測できていない不確かな値です。最新の時期の継続率がいくつになりそうかを早く知りたいときは、3か月目や6か月目のように早く観測できる列で比べ、12か月目以降は後から確かめる、という読み方になります。
観測できた人だけで計算する継続率の限界
この章の継続率は、すべて「t か月目を観測できる人だけ」で計算しました。この計算は分かりやすい一方で、在籍月数が長い側ほど、使える人が少なくなります。全員をまとめた継続率で比べると、12か月目は12,000人のうち9,991人、24か月目は5,196人、36か月目は429人しか計算に使えていません。24か月目の計算から外れた6,804人も、観測の終わりまで何か月在籍したかという途中までの記録は持っていますが、この計算ではその記録を捨てています。さらに、24か月目の値は第1〜13か月の加入者だけで決まるので、紹介の割合が高かった時期の顧客だけを見ていることになります。
実際に、全員をまとめた継続率を、観測できた人だけの計算、第5章で扱うカプラン・マイヤー推定、真の値(12,000人のチャネル構成で混ぜたもの)の3つで並べると、12か月目は 0.649・0.644・0.640、24か月目は 0.514・0.499・0.490、36か月目は 0.431・0.409・0.390 でした。観測できた人だけの計算は、在籍月数が長い側ほど真の値より高くなり、36か月目では約4ポイント上回っています。途中までの記録を捨てずに使うカプラン・マイヤー推定は、この例では真の値により近い値になりました。ただし、この例では加入時期とチャネル構成が関係しているので、全員をひとまとめにしたカプラン・マイヤー推定にも少し偏りが残ります。第5章では、チャネルごとに推定して加入者の構成で加重する方法を扱い、36か月目の継続率は0.401(ひとまとめの推定は0.409、真の値は0.390)になります。途中までしか観測できていない顧客(打ち切り)を正しく扱う方法と、その仮定は第5章で扱います。コホート表は、在籍月数の短い側の比較と、加入時期ごとの行の比較に使い、在籍月数の長い側の継続率や平均在籍月数を報告するときは、第5章の方法に切り替えることが有効だと考えています。
経営報告の形と、経営判断への翻訳
コホート表は、毎月更新して経営報告に載せる形に向いています。月が1つ進むと、表には新しい加入月の行が1つ増え、既存の行には右に1マスずつ値が増えます。報告で毎月見る列は、目的に応じて2つに絞るのがよいと考えています。1つは3か月目の継続率です。2か月目の継続率や1か月目の月次解約率でも早期の変化は見えますが、この章では、加入から3か月で観測でき、初回の特典や加入直後の体験の良し悪し、獲得した顧客の質の変化を早く確かめる指標として3か月目を選びました。3か月目の継続率に表れるのは1〜2か月目の月末の解約で、3か月目の月末の解約は4か月目の列に表れます。この章の初回クーポンの例では、早期の離脱の差は最初の3か月の月末の解約で開き(継続率の差は4か月目に最大の -0.116)、その後に取り戻されることはありませんでした。もう1つは12か月目の継続率で、結果が出るまで1年かかりますが、顧客の価値(第9章で扱う生涯価値)に直結する列です。表は全体だけでなく獲得チャネル別に分け、構成をある基準の時期に固定した全体の値を並べて載せます。あわせて、月の売上を加入時期ごとの層に分けた表と図を毎月作り、報告に載せることを勧めます。獲得と継続のどちらが売上の増減を生んでいるか、獲得の勢いが落ちたら何か月で売上が減り始めるかを、全体の売上の線ではなく層の厚さで説明できるようになります。
この章で最も伝えたい経営判断は、「継続率が下がっている」と分かったとき、それが獲得の質の変化なのか、サービスの問題なのかを分けてから手を打つことです。チャネルで分けた範囲では、チャネル別の行がどれも横ばいで全体だけが下がっているなら、原因は獲得の構成で、打ち手は獲得側にあると考えられます。共通データで言えば、継続率の低いチラシの割合が16.4%から28.9%へ増えたことが原因です。チャネル別の行がそろって、ある暦の月から下がっているなら(三角形の表で斜めの線に沿って値が落ちているなら)、その月に起きたサービスや価格の変化を疑います。
この区別を誤ると、2つの方向で損失が出ます。全体の下落の原因が獲得の構成の変化なのにサービスの悪化と取り違えると、サービスの改善に予算を使っても、構成の変化による下落分は戻りません。サービスの改善でチャネルの中の継続率が上がれば全体の継続率も上がりますが、それは構成の変化とは別の分の改善で、継続率の低いチャネルから獲得する顧客の割合は、獲得の配分を変えない限りそのままだからです。獲得の構成が今の方向に動き続けるなら、全体の継続率はその分だけ下がって見え続けます。逆に、サービスの悪化を獲得の構成のせいにすると、品質の問題が放置され、すべてのチャネルの顧客の離脱が続きます。
構成の効果の大きさを、顧客数と粗利に直しておきます。第5期の12か月目の継続率は、構成を第1期に固定した場合の0.673に対して実際は0.620で、差は0.053でした(この0.620は、12か月目を観測できる第25か月の加入者432人の値です)。第25か月の加入者で見たこの差が第26〜30か月の加入者にも同じように当てはまると仮定して、第5期の加入者2,441人全員に当てはめると(第5期全員のチャネル構成は、この432人の構成と少し違います)、約110〜129人(2,441人×0.045〜0.053。構成の効果の大きさを、先に求めた2通りの -0.045〜-0.053 の幅で見た値)が、チャネル構成が第1期のままだった場合に比べて12か月目までに多く離脱する計算になります。これは「第1期の構成を基準にしたら」という仮定の上の数字で、基準の時期を変えれば人数も変わります。実際に引き止められた人数や、施策で防げる人数を表すものではありません。第2章で紹介した基準の結果(チャネル別 LTV の表)では、月次粗利の平均は1人あたり約1,760円(チャネルによって1,759〜1,776円)なので、この110〜129人は、12か月目のその1か月分の月次粗利だけで見て、およそ19万〜23万円に当たります(累計の粗利ではなく、上の仮定と月次粗利の平均を使った概算です)。この差は、獲得チャネルの構成(どのチャネルから何人獲得するか)で決まる部分が大きいものです。構成が変わった理由(予算の配り方、紹介の自然な減少、競合の動きなど)は、現実のデータでは別に調べる必要があります。チャネルごとの獲得費用と、それを回収できるかどうかは第1章と第9章で扱います。12か月目の結果を待たずに早く気づけるかについては、この例では、5つの時期をすべて観測できる6か月目の列でも、全体の差 -0.048 のうち -0.033 が構成の効果(構成を第1期に固定した値で計算。真の値で混ぜた値でも -0.032)でした。コホート表をチャネル別に分けて毎月見ていれば、6か月目の列で構成の変化の影響の多くに気づける、というのがこの例で確かめられた範囲です。
この章の要点は3つです。第一に、コホート表は加入月×在籍月数の三角形の表で、在籍月数をそろえて比べることで、暦の月ごとの全体の解約率に混ざる在籍月数の違いを取り除けます。1か月ごとの表は偶然のばらつきと加入月ごとの構成の動きが大きいので、報告には加入時期をまとめた表を使い、行・列・斜めの3つの向きで読みます。第二に、継続率曲線は最初の数か月で大きく下がり、その後はなだらかになります。共通データでは、初回クーポンの利用者の月次解約率は最初の3か月だけ非利用者の約2倍で、そこで開いた差は4か月目以降も取り戻されませんでした。第三に、加入時期が後ほど12か月目の継続率は0.679から0.620へ下がって見えましたが(第5期の0.620は第25か月の加入者432人の値)、紹介チャネルだけなら0.830から0.808(第5期は99人の値)でほぼ横ばいで、下落の大部分はチャネル構成の変化による構成の効果でした。継続率の悪化を見たら、獲得の質の変化かサービスの問題かを分けてから手を打ちます。この章の継続率は観測できた人だけで計算したもので、在籍月数の長い側では真の値より高めに出ました。次の第5章では、途中までしか観測できていない顧客を正しく扱う生存分析とカプラン・マイヤー推定で、解約率と継続率を測り直します。
この章を深めたい方への参考書籍
『Lean Analytics スタートアップのためのデータ解析と活用法』(アリステア・クロール、ベンジャミン・ヨスコビッツ 著、角征典 訳、オライリー・ジャパン):事業の段階とビジネスモデルごとに、どの指標を追うべきかを整理した本です。2章の「セグメント・コホート・A/Bテスト・多変量解析」の節でコホートの考え方を扱い、SaaS などのモデルの章でチャーン(解約)を、18章で顧客ライフタイムバリューと顧客獲得コストの関係を扱っています。この章のコホート表を、事業の指標の体系の中で位置づけ直すのに向いています。
『Hacking Growth グロースハック完全読本』(ショーン・エリス、モーガン・ブラウン 著、門脇弘典 訳、日経BP社):成長のための実験を組織で高速に回す方法を、獲得・活性化・維持(リテンション)・収益化の段階に分けて解説した本です。第7章「維持(リテンション)をハックする」が顧客の維持を扱っています。この章で見た加入直後の離脱を、獲得・活性化・維持のどの段階の問題として捉え、どう実験で改善していくかを考えるのに向いています。
第5章 解約率の正しい測り方、打ち切りと生存分析
第4章では、加入月ごとに顧客を束ねたコホートの継続率を並べ、全体の継続率が加入時期とともに下がって見えたのは、獲得チャネルの構成が変わったことによる見かけの悪化だったことを確かめました。この章では、その継続率と解約率を「どう数えれば正しいか」を扱います。月額制の事業では、観測を締めた時点でまだ在籍している顧客が必ずいます。その人たちが最終的に何か月在籍するかは、まだ分かりません。この「途中までしか分からない」記録を捨てたり、解約していない扱いにしたりすると、平均在籍月数も継続率も系統的にずれます。この章では、第2章で用意したサンプルデータ(架空の食材宅配の定期便)を使い、よく使われる2つの素朴な計算(解約した人だけの平均在籍月数と「1÷月次解約率」)がどれだけずれるか、なぜずれるかを実測し、そのずれを正しく扱う生存分析の基本の道具であるカプラン・マイヤー推定とハザード、チャネルの差を確かめるログランク検定を、statsmodels で実行して確かめます。どの要因がどれだけ解約を増やすかを説明変数で分析するモデルは第6章で扱います。
解約した人だけで平均在籍月数を出すと何が起きるか
「顧客は平均で何か月続くのか」という問いに、手元の解約者の記録だけで答えようとすることがあります。解約した人については、加入から解約までの月数が確定しているので、それを平均すれば答えになりそうに見えます。しかし、この計算には観測の締めの時点でまだ在籍している人が入りません。長く続く人ほど、締めの時点で在籍している確率が高いので、解約した人だけを集めると、短く終わった人ばかりが残ります。在籍月数の分布の、短い側だけを見て平均を出していることになります。
第2章で用意したサンプルデータ A は、12,000人の顧客が第1〜30か月に加入し、第36か月の末までを観測できる設定です。第36か月の末にまだ在籍している人は、在籍月数が「少なくともここまで」としか分からない打ち切りの状態にあります。第3章で定義したとおり、打ち切りは解約とは別のもので、観測の終わりで記録が切れているだけです。このデータでは、観測内に解約した人は5,686人、打ち切りの人は6,314人で、全体の53%が打ち切りです。次のコードは、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形で、平均在籍月数を3つの方法で出したものです。
import numpy as np
from statsmodels.duration.survfunc import SurvfuncRight
import cust_data as cd

cust, monthly = cd.make_subscription()          # 第2章の共通データ A


def s_at(sf, t):
    """t か月目の料金を払う確率 S(t)。解約は在籍 k か月目の月末に数えるので、
    SurvfuncRight の「時刻 t-1 までに解約していない確率」を読む。"""
    k = np.searchsorted(sf.surv_times, t - 1, side="right") - 1
    return 1.0 if k < 0 else float(sf.surv_prob[k])


churned = cust[cust["churned"] == 1]
print("解約した人だけの平均在籍月数 %.2f" % churned["tenure_obs"].mean())
print("打ち切りの人も含めた観測上の平均 %.2f" % cust["tenure_obs"].mean())

w = cust["channel"].value_counts() / len(cust)     # 加入者のチャネル構成
total = 0.0
for c in cd.CHANNELS:                                 # チャネル別に推定して構成で加重
    sub = cust[cust["channel"] == c]
    sfc = SurvfuncRight(sub["tenure_obs"].values, sub["churned"].values)
    total += w[c] * sum(s_at(sfc, t) for t in range(1, 37))
print("継続率を1〜36か月目で足した値 %.2f" % total)
# 出力:
# 解約した人だけの平均在籍月数 8.02
# 打ち切りの人も含めた観測上の平均 14.49
# 継続率を1〜36か月目で足した値 21.25
1行目の出力は、解約した5,686人だけの平均で8.02か月です。2行目は、打ち切りの人についても観測できた月数(第36か月までの在籍月数)をそのまま使った平均で、14.49か月です。打ち切りの人を「観測の終わりで解約した」とみなしたことになるので、これも短めに出ます。3行目は、この章の後半で説明するカプラン・マイヤー推定で求めた継続率を、1か月目から36か月目まで足し合わせたものです。継続率を足し合わせた値は、「36か月を上限としたときの平均在籍月数」に当たります(毎月、その月に在籍している確率を1か月ぶんずつ数えるので、合計が在籍月数の期待値になります)。
確率を足すと月数になる理由を、架空の小さな例で確かめます。100人が加入し、1か月目の料金は100人全員が、2か月目は90人が、3か月目は80人が払い、3か月で数えるのをやめるとします。料金を払った延べの月数は100+90+80=270人月で、1人あたりにすると2.7か月です。一方、各月の継続率は1か月目1.0、2か月目0.9、3か月目0.8で、足すと同じ2.7になります。継続率を足し合わせることは、「1人あたり何か月分の料金を払ったか」を数えることと同じです。表の「カプラン・マイヤー 36か月まで」の列は、これを36か月目まで行ったものです。
3行目では、全員をひとまとめにして推定せず、チャネルごとに推定した継続率を、加入者のチャネル構成(検索広告30.2%・紹介26.8%・チラシ22.4%・SNS広告20.5%)で加重して合計しています。共通データでは、加入時期が遅いほどチラシ経由の顧客が多く(第1〜15か月の加入者では18.6%、第16〜30か月の加入者では26.1%)、加入が遅い人ほど観測できる月数が短くなります。つまり、「観測の終わりで記録が切れるまでの長さ」と「解約のしやすさ」が、チャネルを通じてつながっています。カプラン・マイヤー推定は、同じ在籍月数で比べたとき、そこで観測が終わって打ち切りになった人と、その先も観測を続けられた人とで、その後の解約のしやすさが同じであることを前提にしています。全員をひとまとめにすると、打ち切りになりやすい加入の遅い人ほどチラシ経由が多いので、この前提が崩れます。共通データの作り方では、加入月によって変わるのはチャネルの構成だけで、プラン・初回クーポン・世帯人数は加入月と無関係に乱数で決めてあり、チャネルの中の解約のしやすさも加入月によって変わりません。そのため、チャネルごとに分ければ前提が成り立ちます。この例でのひとまとめの推定値は、36か月まで足した値で21.34か月、36か月目の継続率で0.409と、加重した値(21.25か月、0.401)より少し大きく、真の値(21.07か月、0.390)からも少し離れました。
この3つを、データを作った側だけが知る真の値と並べたのが次の表です。「真の期待在籍月数(60か月で打ち切り)」は、第2章で紹介した真の継続率(データと同じ顧客構成で20,000人を新たに生成して数えたもの)を60か月目まで足した値で、第9章の LTV の定義と同じ上限を置いています。全体の行のカプラン・マイヤーと真の値は、どちらも4チャネルの値を加入者の人数で重み付けて平均したものです。
| チャネル | 人数 | 打ち切りの割合 | 解約した人だけの平均(か月) | 観測上の平均(か月) | カプラン・マイヤー 36か月まで(か月) | 真の値 36か月まで(か月) | 真の期待在籍月数 60か月で打ち切り(か月) |
|---|---|---|---|---|---|---|---|
| 紹介 | 3,221 | 71% | 9.64 | 18.36 | 27.28 | 27.35 | 40.19 |
| 検索広告 | 3,627 | 58% | 8.89 | 15.40 | 23.04 | 22.40 | 30.66 |
| SNS広告 | 2,465 | 42% | 7.69 | 12.65 | 18.01 | 17.96 | 22.94 |
| チラシ | 2,687 | 34% | 6.66 | 10.30 | 14.59 | 14.60 | 17.67 |
| 全体 | 12,000 | 53% | 8.02 | 14.49 | 21.25 | 21.07 | 28.72 |
表の「解約した人だけの平均」の列は、全体で8.02か月です。同じ36か月までの範囲で比べると、真の値(「真の値 36か月まで」の列)は21.07か月なので、解約した人だけの平均は真の値の約38%にすぎません。60か月を上限とした真の期待在籍月数28.72か月と比べると、約28%です。解約した人だけの在籍月数の中央値は5か月で、平均よりさらに短くなりました。一方、「カプラン・マイヤー 36か月まで」の列は、4チャネルとも真の値との差が0.7か月以内に収まっています。同じデータを使っていても、打ち切りの人の記録を「ここまでは在籍していた」という情報として正しく使えば、真の値に近い答えが出ます。
ずれ方はチャネルによって違います。紹介は打ち切りの割合が71%と最も高く、解約した人だけの平均9.64か月は、36か月までの真の値27.35か月の約35%です。チラシは打ち切りの割合が34%と低く、解約した人だけの平均6.66か月は真の値14.60か月の約46%です。長く続く顧客が多いチャネルほど打ち切りの割合が高くなり、解約した人だけを見る計算は、そのチャネルの良さを大きく削ってしまいます。解約した人だけの平均で獲得チャネルを比べると、紹介とチラシの差は約3か月(9.64対6.66)に見えますが、36か月までの真の値では約13か月(27.35対14.60)の差があります。チャネルの順位(紹介、検索広告、SNS広告、チラシの順に長い)はこの例では真の値と同じですが、チャネル間の差を4分の1程度に小さく見ることになり、獲得チャネルごとにかけてよい費用の差を見誤ります。
この誤りは、人数が足りないことによる偶然のばらつきではなく、打ち切りの人を除くという処理の向きから来ています。除かれるのは、締めの時点で在籍している、つまり在籍月数の長い側の人なので、人数を増やしても除かれ方の偏りは変わりません(この章では人数を変えた計算はしていません。理屈の上での話です)。観測期間を延ばせば打ち切りの割合は下がりますが、事業が続いている限り、締めの時点で在籍している顧客は必ずいます。しかも、事業にとって価値が高いのは、その在籍し続けている顧客です。
打ち切りの考え方を、5人の顧客の説明用の例(共通データの実際の顧客ではありません)で整理すると次の表のようになります。
| 顧客 | 観測できた在籍月数 | 観測の終わりの状態(解約・打ち切り) | 本当の在籍月数は分かるか |
|---|---|---|---|
| 顧客A | 5か月 | 解約 | 分かる(5か月) |
| 顧客B | 12か月 | 打ち切り | 分からない(12か月以上であることだけが分かる) |
| 顧客C | 20か月 | 解約 | 分かる(20か月) |
| 顧客D | 30か月 | 打ち切り | 分からない(30か月以上であることだけが分かる) |
| 顧客E | 7か月 | 打ち切り | 分からない(7か月以上であることだけが分かる) |
解約した人だけの平均は、この表の顧客Aと顧客Cだけを使い、顧客B・D・Eの「少なくともここまでは在籍していた」という情報を捨てた計算です。この章の後半で扱うカプラン・マイヤー推定は、顧客B・D・Eの記録も、観測できた月までは在籍していた人として使います。
「1÷月次解約率」が置いている2つの仮定
もう1つよく使われるのが、月次解約率から平均在籍月数を出す計算です。月次解約率が2%なら、1÷0.02で平均50か月続く、という考え方です。この計算は、解約数÷顧客月数という素朴な解約率(観測期間に解約した人数を、全員が在籍した月数の合計で割ったもの)から出すことが多く、計算が簡単です。打ち切りの人も、在籍した月数がそのまま分母に入るので、ハザード(在籍月数ごとの解約率。後の節で詳しく扱います)が在籍月数によらず一定なら、解約数÷顧客月数は打ち切りを正しく扱った解約率の推定になります。問題は、その「一定」という仮定のほうにあります。
「1÷月次解約率」が平均在籍月数になるのは、次の2つの仮定がそろったときです。1つ目は、毎月の解約率が在籍月数によらず一定であること(加入した月も、3年続いた後も、同じ確率で解約する)。2つ目は、在籍月数に上限を置かないこと(解約率が1%なら平均100か月、つまり8年以上続くことになり、その先も数え続ける)。2つ目は計算の前提というより定義の問題で、何か月先までを数えるかを決めれば、その上限で打ち切った計算に直せます。この記事では、第9章の LTV の定義に合わせて60か月を上限にしています。共通データでは1つ目の仮定が成り立っていません。どちらの仮定がどれだけ効いているかを、分けて測りました。
次のコードは、チャネルごとの素朴な月次解約率から「1÷解約率」を出し、あわせて、同じ解約率が一定のまま続くとして60か月で打ち切った期待在籍月数と、真の値(60か月で打ち切り)を並べたものです。補助モジュール(cust_data.py)と同じフォルダに置き、1つ前のコードに続けて実行する形です。
mm = monthly.merge(cust[["cust_id", "channel"]], on="cust_id")
for c in cd.CHANNELS:
    h = mm.loc[mm["channel"] == c, "churn"].mean()          # 素朴な月次解約率
    cap60 = sum((1 - h) ** (t - 1) for t in range(1, 61))  # 一定のまま60か月で打ち切り
    true60 = cd.true_survival_mix(cust, c, horizon=60).sum()
    print("%s 1÷解約率 %.1f / 一定で60か月打ち切り %.1f / 真の値 %.1f" % (
        cd.CHANNEL_JA[c], 1 / h, cap60, true60))
# 出力:
# 紹介 1÷解約率 62.4 / 一定で60か月打ち切り 38.7 / 真の値 40.2
# 検索広告 1÷解約率 36.5 / 一定で60か月打ち切り 29.6 / 真の値 30.7
# SNS広告 1÷解約率 21.9 / 一定で60か月打ち切り 20.6 / 真の値 22.9
# チラシ 1÷解約率 15.5 / 一定で60か月打ち切り 15.2 / 真の値 17.7
コードの monthly は1行が1人の顧客の1か月で、churn 列はその月末に解約したら1です。チャネルごとに churn の平均をとると、解約数÷顧客月数、つまり素朴な月次解約率になります。cap60 は、毎月 h の確率で解約する顧客が、1か月目、2か月目と在籍している確率(1、1から h を引いた値、その2乗、と続く値)を60か月目まで足したもので、仮定の2つ目(上限を置かない)だけを外し、真の値と期間をそろえた値です。結果を、上限の効果と、それ以外のずれに分けて表にまとめます。
| チャネル | 素朴な月次解約率 | 1÷解約率(か月) | 同じ解約率で60か月打ち切り(か月) | 真の期待在籍月数 60か月で打ち切り(か月) | 上限を置いた効果(か月) | 期間をそろえたずれ(か月) |
|---|---|---|---|---|---|---|
| 紹介 | 0.0160 | 62.4 | 38.7 | 40.2 | -23.7 | +1.5 |
| 検索広告 | 0.0274 | 36.5 | 29.6 | 30.7 | -6.9 | +1.1 |
| SNS広告 | 0.0456 | 21.9 | 20.6 | 22.9 | -1.3 | +2.4 |
| チラシ | 0.0645 | 15.5 | 15.2 | 17.7 | -0.3 | +2.4 |
表の右の2列の計算は、「上限を置いた効果」=(同じ解約率で60か月打ち切り)から(1÷解約率)を引いた値、「期間をそろえたずれ」=(真の期待在籍月数)から(同じ解約率で60か月打ち切り)を引いた値です。「期間をそろえたずれ」が正なら、解約率を一定とした計算が真の値より短いことを表します。
まず、期間をそろえた比較を見ます。表の「期間をそろえたずれ」の列は、真の値から「同じ解約率で60か月打ち切り」を引いた値です。4チャネルとも正(+1.1〜+2.4か月)で、解約率が一定だとする計算は、期間をそろえると4チャネルとも真の値より短く見積もっていました。真の値に対する割合で見ると、紹介3.6%・検索広告3.5%・SNS広告10.3%・チラシ13.8%の過小で、解約率の高いチャネルほどずれが大きくなっています。このずれと「ハザードが一定」という仮定の関係を、次の節で測ります。
次に、期間をそろえずに比べると何が起きるかです。「上限を置いた効果」の列は、上限を置くことで「1÷解約率」がどれだけ変わるかを表し、紹介では-23.7か月、チラシでは-0.3か月でした。紹介の素朴な解約率0.0160は平均62か月、つまり5年以上続くことを意味する低い値なので、上限の有無で答えが大きく変わります。チラシでは、素朴な解約率0.0645のもとで60か月まで残る人はわずかなので、ほとんど変わりません。そのため、無期限の「1÷解約率」を60か月で打ち切った真の値とそのまま並べると、紹介は62.4か月対40.2か月で「過大」、チラシは15.5か月対17.7か月で「過小」と、チャネルによってずれの向きが逆に見えます。しかしこれは、上限の無い値と上限のある値という、定義の違う2つの数字を比べた結果です。架空の真のモデルをそのまま240か月まで延ばして数えると、紹介の真の期待在籍月数は240か月までの分だけで82.1か月あり、240か月目でもまだ10.1%が在籍していました。上限を置かない期待在籍月数はそれ以上になるので、上限を置かない値として比べても、紹介の「1÷解約率」62.4か月は短すぎます。在籍期間や LTV の数字を比べるときは、何か月先までを数えた値かを先にそろえる必要があり、そろえずに比べると、向きまで誤った結論が出ることがあります。
在籍月数ごとのハザードを測ると、ずれの理由が見える
期間をそろえても残るずれ(表の「期間をそろえたずれ」の列)の正体を確かめるために、在籍月数ごとの解約率を測ります。在籍 k か月目まで料金を払った顧客のうち、その月末に解約した人の割合を、在籍 k か月目のハザードと呼びます。第2章の定義のとおり、ハザードは「在籍月数ごとの月次解約率」です。素朴な月次解約率は、全員のすべての月をひとまとめにして1つの割合にしたものなので、ハザードを在籍月数ごとに並べると、その1つの数字の中に何が混ざっていたかが見えます。
次の表は、チャネルごとに、在籍月数を5つの帯に分けて、帯ごとのハザード(その帯の顧客月のうち月末に解約した割合)と、その帯の顧客月がチャネル全体の顧客月に占める割合を並べたものです。
| チャネル | 素朴な月次解約率 | ハザード 1〜3か月 | ハザード 4〜6か月 | ハザード 7〜12か月 | ハザード 13〜24か月 | ハザード 25〜36か月 | 顧客月のうち1〜3か月の割合 | 顧客月の在籍月数の平均 |
|---|---|---|---|---|---|---|---|---|
| 紹介 | 0.0160 | 0.0336 | 0.0183 | 0.0119 | 0.0119 | 0.0100 | 15.8% | 12.6 |
| 検索広告 | 0.0274 | 0.0529 | 0.0249 | 0.0222 | 0.0206 | 0.0177 | 18.4% | 11.5 |
| SNS広告 | 0.0456 | 0.0851 | 0.0393 | 0.0401 | 0.0294 | 0.0246 | 21.5% | 10.5 |
| チラシ | 0.0645 | 0.1174 | 0.0542 | 0.0495 | 0.0394 | 0.0335 | 25.4% | 9.4 |
表から読み取れることは2つあります。1つ目は、どのチャネルでもハザードが在籍とともに下がることです。チラシは在籍1〜3か月の0.1174から、25〜36か月の0.0335へ、約3.5分の1に下がります。紹介も0.0336から0.0100へ、約3.4分の1に下がります。真のハザード(データを作った側が知る値。真の継続率の月ごとの減り方から計算)で見ても、チラシは1か月目0.132・12か月目0.044・36か月目0.037、紹介は0.038・0.013・0.012と、同じ形で下がっていました。共通データの真のモデルには、在籍月数の対数に比例してハザードを下げる項と、初回クーポン利用者の最初の3か月だけハザードを上げる項が入っているので、この下がり方はデータの作り方どおりです。
ハザードが下がるとき、「解約率は一定」とする計算は、早く解約しやすい時期の高いハザードと、生き残った人の低いハザードを平均した1つの値を、在籍のすべての月に当てはめます。実際には、最初の数か月を越えた顧客は、平均より低いハザードのもとで在籍を続けます。後半の月の解約を平均の値で多めに数えてしまうぶん、一定の解約率による計算は在籍月数を短く見積もると考えられます。前の表の「期間をそろえたずれ」が4チャネルとも正になったことと、この表のハザードの下がり方は、同じ向きを示しています。チラシは最初の帯と後の帯のハザードの差が0.084と大きく、紹介は0.024と小さいので、ずれもチラシの方が大きく出ます。
2つ目は、ハザードが一定でないと、解約数÷顧客月数という1つの数字が、どの在籍月数の顧客月をどれだけ含んでいるかに左右されることです。ハザードが一定なら、顧客月の内訳がどうであれ同じ値になりますが、在籍とともに下がるときは、在籍の浅い顧客月の比重が大きいほど高く出ます。表の「顧客月のうち1〜3か月の割合」の列は、紹介15.8%に対してチラシ25.4%で、チラシの顧客月はハザードの高い加入直後に偏っています。チラシは解約が早いので長い在籍の顧客月が少なく、さらに、第4章で見たとおり後から加入した顧客ほどチラシが多くなっていて、後から加入した人は加入直後の月しか観測されていません。この比重の大きさを測るため、1つのコホートを36か月目まで追い切った場合の「解約数÷顧客月数」を真の継続率から計算すると、紹介0.0145・検索広告0.0261・SNS広告0.0407・チラシ0.0564でした。観測データの素朴な解約率(紹介0.0160、チラシ0.0645)は、これより紹介で約10%、チラシで約14%高く出ています。ハザードが在籍とともに下がるこのデータでは、在籍の浅い顧客月の比重が大きいことが、素朴な解約率を押し上げ、「1÷解約率」を短くする向きに働いていると読めます。この差はチラシの方が大きく出ました。
まとめると、期間をそろえた比較では、「1÷月次解約率」は4チャネルとも在籍期間を短く見積もりました。この章で測った範囲では、そのずれは、解約数÷顧客月数を「一定の解約率」として在籍のすべての月に当てはめたことと同じ向きを示しています。実際のハザードは在籍とともに下がり、観測された解約数÷顧客月数には在籍の浅い顧客月が重く入っているので、在籍が長くなった顧客の解約を多めに数えることになります。ずれが大きかったのは、ハザードの下がり方が大きく、在籍の浅い顧客月の比重が大きいチラシでした。ただし、チャネルの中のプランや初回クーポンの構成の違いがどれだけ効いているかは、この章では分けて測っていません(要因ごとの効き方は第6章で扱います)。だからこそ、1つの解約率で在籍期間を見積もるのではなく、打ち切りを正しく扱いながら在籍月数ごとのハザードと継続率を直接推定する方法が要ります。それが次に扱うカプラン・マイヤー推定です。
生存分析とカプラン・マイヤー推定の仕組み
生存分析は、「ある出来事が起きるまでの時間」を扱う統計の分野です。出来事を死亡とすれば、時間は生存していた期間になるので、この名前で呼ばれます。顧客分析では、出来事を解約、時間を在籍月数に置き換えると、そのまま使えます。生存分析の中心にあるのが、この章で扱っている打ち切りの扱いです。調べ終わった時点でまだ出来事が起きていない人の記録を、捨てずに「この時点までは出来事が起きていなかった」という情報として使います。
その最も基本的な方法が、カプラン・マイヤー推定です。E. L. Kaplan と Paul Meier が、米国の統計学の学術誌(Journal of the American Statistical Association)の第53巻第282号(1958年)に発表した、不完全な観測からのノンパラメトリックな推定(分布の形を仮定しない推定)を題にした論文(457〜481ページ)に由来し、二人の名前で呼ばれています。計算の考え方は、言葉で書くと次のとおりです。
- 在籍1か月目について、1か月目に在籍していた人(全員)のうち、1か月目の月末に解約した人の割合を出す
- 在籍2か月目について、2か月目にまだ在籍していた人のうち、2か月目の月末に解約した人の割合を出す。1か月目の末で打ち切りになった人は、2か月目の分母に入れない
- 同じことを3か月目、4か月目と続ける。各月の分母は「その月まで在籍していて、その月を観測できた人」で、打ち切りの人は、観測できた最後の月までは分母に入り、その先の月の分母から外れる
- 各月の「残った割合」(1から解約の割合を引いた値)を、1か月目から順に掛け合わせる。k か月目まで掛け合わせた値が、k か月目の末まで在籍している確率の推定値になる
手順2と3が打ち切りの扱いです。打ち切りの人は、観測できた月までは「その月を生き残った人」として分母に入り、解約の割合を下げる方向に正しく貢献します。観測できなかった月については、その人が解約したかどうかを分からないものとして、分母からも分子からも外します。前の節で見た「解約した人だけの平均」は、打ち切りの人を最初から全部捨てていました。「観測上の平均」は、打ち切りの人を観測の終わりで解約したものとして扱っていました。カプラン・マイヤー推定は、そのどちらでもなく、分かっている範囲だけを使います。これが正しい答えを与えるためには、「同じ在籍月数で比べたとき、そこで打ち切りになった人と、その先も観測を続けられた人とで、その後の解約しやすさが同じ」という前提が要ります。共通データでは、同じチャネルの中で見れば、打ち切りは観測の終わりという暦の都合で起き、チャネルの中の解約しやすさは加入月によって変わらないので、この前提が成り立っています。最初の節で述べたとおり、全員をひとまとめにすると、加入の遅い人ほどチラシ経由が多いために前提が崩れるので、この章ではチャネルごとに推定します。
手順4の掛け合わせは、継続率は「各月を越えられる確率」の積になる、という考え方によります。在籍12か月目の料金を払うには、1か月目の末に解約せず、2か月目の末にも解約せず、と11回続けて越える必要があります。各月の越えられる確率を、その月まで残っていた人の中で数えて掛け合わせれば、全員を最後まで追えなくても、12か月目の継続率を推定できます。
計算の仕組みを確かめるために、共通データの全員について在籍1〜6か月目の計算を手で行い、statsmodels の SurvfuncRight に全員をまとめて渡した結果と比べたのが次の表です(後で述べるとおり、この範囲には打ち切りが無いので、まとめても前提の崩れは効きません)。
| 在籍月数 | その月の継続率(その月の料金を払う確率) | その月まで残っていた人 | その月末の解約 | 解約の割合 | 掛け合わせた値=その月末を越えて残る確率(手計算) | SurvfuncRight の surv_prob |
|---|---|---|---|---|---|---|
| 1か月目 | 1.0000 | 12,000 | 1,005 | 0.0838 | 0.9163 | 0.9163 |
| 2か月目 | 0.9163 | 10,995 | 686 | 0.0624 | 0.8591 | 0.8591 |
| 3か月目 | 0.8591 | 10,309 | 560 | 0.0543 | 0.8124 | 0.8124 |
| 4か月目 | 0.8124 | 9,749 | 331 | 0.0340 | 0.7848 | 0.7848 |
| 5か月目 | 0.7848 | 9,418 | 271 | 0.0288 | 0.7623 | 0.7623 |
| 6か月目 | 0.7623 | 9,147 | 280 | 0.0306 | 0.7389 | 0.7389 |
表の2列目「その月の継続率」は、第2章で定義した継続率(その月の料金を払う確率。1か月目は全員が払うので1)です。6列目の「掛け合わせた値」は、その月の月末に解約せずに残る確率で、次の月の継続率に当たります。たとえば1か月目の行の0.9163は、2か月目の継続率です。表の「その月まで残っていた人」の列は、SurvfuncRight の n_risk 属性(各時点の直前に観測の対象に残っている人数)と一致し、「掛け合わせた値」の列は surv_prob 属性と小数第4位まで一致しました。共通データでは、最も遅く加入した人(第30か月)でも7か月分を観測できるので、在籍6か月目までは打ち切りが1人もいません。この範囲では、カプラン・マイヤー推定は「解約しなかった人数÷全員」と同じ値になります。打ち切りが効いてくるのは在籍7か月目以降です。
数字の読み方に1つ注意があります。SurvfuncRight の surv_prob は、「時刻 t までに出来事が起きていない確率」です。この記事では、在籍 k か月目の月末に解約した人の在籍月数を k と記録しているので、時刻1の surv_prob 0.9163 は「1か月目の末に解約しなかった確率」、つまり2か月目の料金を払う確率です。第2章で定義した継続率 S(t)(t か月目の料金を払う確率。S(1)=1)に直すには、t より1つ前の時刻の値を読みます。最初のコードの s_at 関数がこの読み替えを行っていて、補助モジュール(baseline.py)の km_surv_at も同じ計算です。在籍月数を「何か月目の料金を払ったか」で数えるか、「何か月たったか」で数えるかで1か月ずれるので、継続率を報告するときは、どちらの数え方かを決めておく必要があります。
打ち切りの扱い方で継続率がどれだけ変わるかを、全体の12か月目・24か月目・36か月目の継続率で比べました。
| 数え方 | 12か月目の継続率 | 24か月目の継続率 | 36か月目の継続率 |
|---|---|---|---|
| 全員を分母にし、打ち切りの人は「残った」と数える | 0.649 | 0.551 | 0.526 |
| その月まで観測できなかった打ち切りの人を除く | 0.607(1,305人を除外) | 0.332(3,947人を除外) | 0.032(6,131人を除外) |
| 解約した人だけで数える | 0.260 | 0.053 | 0.000 |
| カプラン・マイヤー推定(チャネル別を加入者の構成で加重) | 0.643 | 0.495 | 0.401 |
| 参考:カプラン・マイヤー推定(全員をひとまとめ) | 0.644 | 0.499 | 0.409 |
| 真の値(4チャネルを加入者の構成で加重) | 0.640 | 0.490 | 0.390 |
1行目の「打ち切りの人は残ったと数える」方法は、まだ観測できていない月にも全員が在籍し続けると仮定するので、継続率を高めに出します。12か月目では打ち切りの人が少ないので真の値0.640に近い0.649ですが、36か月目では0.526と、真の0.390を0.136上回ります。2行目の「観測できなかった人を除く」方法は、在籍し続けている人ほど除かれるので、継続率を低めに出し、36か月目では0.032と、ほとんど意味のない値になります。3行目の「解約した人だけ」は、36か月目の料金を払ってその月末に解約した2人しか36か月目に残らないので、36か月目の継続率は5,686人のうち2人(0.00035)で、小数第3位までの表示では0.000になります。チャネル別に推定して加重したカプラン・マイヤー推定は、3つの時点とも真の値との差が0.011以内でした。全員をひとまとめにした推定は、36か月目で0.409と、真の0.390との差が0.019に広がります。打ち切りの扱いを誤ると、同じデータから0.000(解約した人だけ)から0.526(打ち切りの人は残ったと数える)まで、まったく違う「36か月目の継続率」が出てきます。なお、第4章の「その月を観測できる加入月の人だけ」で数えた継続率(12か月目0.649・24か月目0.514・36か月目0.431)は、加入月で対象を絞る別の数え方で、この表のどの行とも違います(12か月目の0.649が1行目と同じなのは、たまたまです)。
チャネル別の継続率曲線を描き、真の値と比べる
カプラン・マイヤー推定で描いた継続率曲線をチャネル別に出し、真の値と比べます。次のコードは、チャネルごとに SurvfuncRight を当て、12か月目・36か月目の継続率と中央値を出し、最後にチャネルの差のログランク検定(後の節で説明します)を行うものです。補助モジュール(cust_data.py)と同じフォルダに置き、最初のコードに続けて実行する形です。
from statsmodels.duration.survfunc import survdiff
from scipy.stats import chi2

for c in cd.CHANNELS:
    sub = cust[cust["channel"] == c]
    sfc = SurvfuncRight(sub["tenure_obs"].values, sub["churned"].values)
    print("%s 12か月目 %.3f / 36か月目 %.3f / 中央値 %s" % (
        cd.CHANNEL_JA[c], s_at(sfc, 12), s_at(sfc, 36), sfc.quantile(0.5)))

stat, p = survdiff(cust["tenure_obs"].values, cust["churned"].values,
                   cust["channel"].values)
print("ログランク検定 カイ二乗 %.1f / 戻り値のp値 %s / 自由度3の上側確率 %.3g" % (
    stat, p, chi2.sf(stat, 3)))
# 出力:
# 紹介 12か月目 0.804 / 36か月目 0.619 / 中央値 nan
# 検索広告 12か月目 0.703 / 36か月目 0.442 / 中央値 29
# SNS広告 12か月目 0.555 / 36か月目 0.296 / 中央値 15
# チラシ 12か月目 0.450 / 36か月目 0.182 / 中央値 9
# ログランク検定 カイ二乗 1251.8 / 戻り値のp値 0.0 / 自由度3の上側確率 4.21e-271
SurvfuncRight の最初の引数 time には在籍月数を、2番目の引数 status には解約なら1・打ち切りなら0を渡します。この章で使う結果は、属性 surv_times(継続率が変わる時点)・surv_prob(その時点の推定値)・surv_prob_se(その標準誤差)・n_risk(その時点の直前に残っていた人数)と、メソッド quantile(中央値などを求める)だけです(この記事の実行環境の statsmodels 0.14.6 で、実行して存在を確かめました)。statsmodels の公式ドキュメントは、説明変数を渡す引数 exog を使わないときは、標準的なカプラン・マイヤー推定量を使うと説明しています。
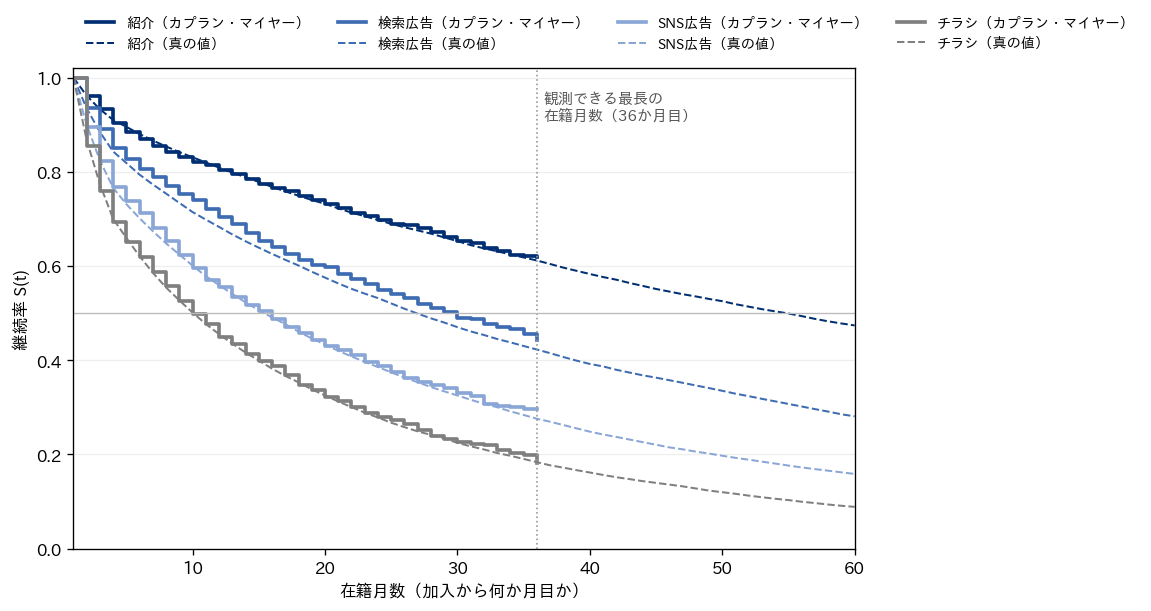
図の実線(カプラン・マイヤー推定)と破線(真の値)は、4チャネルともほぼ重なっています。数字で比べると、12か月目の継続率は、紹介0.804(真0.809)・検索広告0.703(真0.683)・SNS広告0.555(真0.559)・チラシ0.450(真0.455)、36か月目は、紹介0.619(真0.612)・検索広告0.442(真0.423)・SNS広告0.296(真0.276)・チラシ0.182(真0.184)でした。36か月目の推定値の標準誤差(surv_prob_se)は0.012〜0.017なので、検索広告とSNS広告の36か月目の推定値と真の値の差(約0.02)は、標準誤差の1.4倍程度です。検索広告は12か月目でも0.020高めに出ていて、この例では検索広告の推定がやや高めでした。この差がなぜ生じたかは、この章の計算では切り分けていません。
図から分かるもう1つのことは、カプラン・マイヤー推定は、観測できる最長の在籍月数(第1か月に加入した人の36か月目)より先を何も教えてくれないことです。実線は36か月目で終わり、破線(真の値)だけがその先へ延びています。各チャネルの曲線の最後の解約の時点で観測の対象に残っていた人数は、紹介89人(在籍36か月)・検索広告68人(36か月)・SNS広告71人(34か月)・チラシ23人(35か月)で、曲線の右端ほど少ない人数で推定していることにも注意が要ります。36か月目の月末の解約までは観測しているので、厳密には37か月目の継続率までは推定できますが、この記事では第9章も含めて36か月目までを推定の範囲として扱い、第9章で LTV を60か月まで計算するときは、37か月目以降をどう延ばすかの仮定を置きます。
中央値は推定した継続率が0.5を下回ったときにだけ出る
平均在籍月数の代わりに、在籍月数の中央値(顧客の半数が解約するまでの月数)を報告することもあります。SurvfuncRight の quantile(0.5) は、推定した生存確率(surv_prob)が0.5を下回る最初の時点を返します。前のコードの出力では、検索広告29・SNS広告15・チラシ9でした。この記事の数え方では、「チラシ経由の顧客は、在籍9か月目の月末までに半数が解約する」と読みます。推定には偶然のばらつきがあるので、quantile_ci(0.5) で中央値の95%信頼区間(同じやり方で何度もデータを取り直して区間を作ると、そのうち95%が本当の値を含むように作った幅)を求めると、検索広告26〜31・SNS広告13〜16・チラシ9〜10でした(既定の method は 'cloglog' で、実行して確かめました)。真の継続率から同じ数え方で中央値を出すと、検索広告26・SNS広告15・チラシ10で、どれも信頼区間の中に入っています。全体の中央値は、チャネル別の継続率を加入者の構成で加重した曲線から読むと23で、真の値(同じ加重)は22でした。全員をひとまとめにした quantile(0.5) も23を返しましたが、最初の節で述べた前提の崩れがあるので、全体の値はチャネル別から組み立てたものを使うのが安全です。
紹介は nan(数値ではない、という意味の値)になりました。紹介の継続率は36か月目でも0.619で、観測の中で0.5を下回らないからです。真の継続率では、紹介の中央値は54で、観測の終わりのずっと先にあります。中央値が出ないことは計算の失敗ではなく、「観測した36か月の間に、推定した継続率が0.5を下回らなかった」という情報です。中央値が出るかどうかは、観測した解約の人数が加入者の半数に達したかではなく、打ち切りを扱って推定した継続率が0.5を下回ったかで決まります(検索広告は打ち切りが58%ですが、推定した継続率が0.5を下回るので中央値29が出ています)。ここで、中央値が出ないからといって解約した人だけで中央値を出すと、前の節の誤りに戻ってしまいます。紹介の解約した人だけの在籍月数の中央値は7か月でした。
中央値が出ないチャネルがあるときの報告の仕方としては、「何か月目の継続率」をそろえて並べる方法が実務では扱いやすいと考えています。たとえば「12か月目の継続率」と「36か月目の継続率」なら、どのチャネルでも観測の中で推定できます。また、前の節のように継続率を36か月目まで足し合わせた値(36か月を上限とした平均在籍月数。生存分析では境界内平均生存時間、英語の頭文字で RMST と呼ばれます)も、観測の中で計算でき、チャネル間で比べられます。この章の最初の表の「カプラン・マイヤー 36か月まで」の列がそれで、紹介27.28か月・チラシ14.59か月でした。
ログランク検定でチャネルの差を確かめる
継続率曲線を並べると差があるように見えても、それが偶然のばらつきの範囲かどうかは、人数が少ないときには見ただけでは分かりません。継続率曲線の差を検定する標準的な方法がログランク検定です。考え方は次のとおりです。各月について、その月まで残っていた人をグループ(ここではチャネル)ごとに数え、その月の解約の合計を、もしグループ間でハザードが同じなら各グループに何人ずつ出るはずか(残っていた人数の割合で按分した人数)を計算します。これを「期待される解約数」として、実際の解約数との差を全部の月で足し合わせます。差の合計が、偶然で説明できる大きさ(分散から決まる)に比べて大きければ、「ハザードは同じ」という仮定を退けます。statsmodels の survdiff のソースコードでは、この差のベクトルと分散の行列からカイ二乗の統計量を計算し、自由度を「グループの数から1を引いた数」としていることを確かめました。
用語を3つだけ補います。カイ二乗(の統計量)は、観測と期待の差を1つにまとめた数字で、大きいほど差が大きいことを表します。自由度は、その大きさを判定するときの物差しを決める数で、ここでは比べるグループの数から1を引いた数です。p値は、「本当は差が無い」としたときに、これと同じかそれより大きなカイ二乗が出る確率で、小さいほど、検定の前提のもとでは「差が無い」という仮定と合いにくい結果であることを表します。p値は「差が偶然で生じた確率」そのものではなく、差の大きさも表しません。差の大きさは別に確かめる必要がある、という点が要点です。前のコードの最後の出力が、4チャネルをまとめて検定した結果で、カイ二乗の値は1251.8でした。survdiff は統計量とp値の2つを返します。ただし、この例では戻り値のp値が0.0になりました。ソースコードでは p 値を「1からカイ二乗分布の累積確率を引く」形で計算していて、統計量が非常に大きいと、計算機の精度の限界で0になるためです。scipy.stats.chi2.sf(上側確率を直接計算する関数)で自由度3の上側確率を計算し直すと、4.21×10の-271乗でした。いずれにしても、検定の前提のもとでは、チャネル間で継続率曲線が同じだという仮定とは合いにくい結果です。なお、statsmodels の公式ドキュメントの survdiff の説明は「2つのグループ」「自由度1」と書いていますが、3つ以上のグループを渡すと、上で述べたとおり自由度はグループの数から1を引いた数で計算されます。この章ではその挙動を、ソースコードと実行結果で確かめた範囲で使っています。
隣り合うチャネルの組ごとに検定した結果と、初回クーポンの有無で分けた結果を表にまとめます。survdiff の引数 strata に層(ここではチャネル)を渡すと、層ごとに観測と期待の差を計算してから合計する、層別のログランク検定になります。
| 比べたもの | カイ二乗 | 自由度 | p値(chi2.sf で計算) |
|---|---|---|---|
| 4チャネル | 1251.8 | 3 | 4.21×10の-271乗 |
| 紹介 対 検索広告 | 149.1 | 1 | 2.69×10の-34乗 |
| 検索広告 対 SNS広告 | 168.8 | 1 | 1.37×10の-38乗 |
| SNS広告 対 チラシ | 70.2 | 1 | 5.23×10の-17乗 |
| 初回クーポンの有無 | 79.6 | 1 | 4.6×10の-19乗 |
| 初回クーポンの有無(チャネルで層別) | 91.6 | 1 | 1.05×10の-21乗 |
表のp値はどれも極めて小さく、検定の前提のもとでは、どの組でも「継続率曲線が同じ」という仮定とは合いにくい結果でした。ただし、p値がここまで小さくなったのは、差の大きさに加えて、1つのチャネルに2,465〜3,627人がいる大きなデータであることも効いています。ログランク検定が答えるのは「差があるかどうか」で、「差がどれだけ大きいか」ではありません。人数が多ければ、経営上は意味のない小さな差でもp値は小さくなります。差の大きさは、12か月目の継続率の差(たとえば検索広告0.703対SNS広告0.555)や、36か月を上限とした平均在籍月数の差(23.04か月対18.01か月)で示すのがよいと考えています。
逆に、人数が少ないときには、本当にある差を見逃します。検索広告とSNS広告の顧客をそれぞれ n 人ずつ無作為に選んでログランク検定を行うことを200回繰り返し、p値が0.05を下回った割合を数えました。各50人では0.35、各100人では0.63、各200人では0.93、各400人では0.99でした。この2つのチャネルの真の継続率は、12か月目で0.683対0.559、36か月目で0.423対0.276と、経営上は無視できない差がありますが、各50人の比較では3回に2回近く「有意な差なし」になります。新しい獲得チャネルを小さく試したときに「既存のチャネルと差が無かった」という結論が出ても、それは「差が無い」ことの証拠ではなく、「この人数では差を見分けられなかった」という意味である場合があります。施策の効果を検定するときの人数の決め方(検出力)は、第12章で扱います。
ハザードの形を見る、初回クーポン利用者の1〜3か月目の山
継続率曲線は、各月の解約せずに残る確率(1からハザードを引いた値)を掛け合わせた結果なので、どの時期に解約が集中しているかは、曲線よりもハザードそのものを並べたほうが読み取りやすくなります。次のコードは、初回クーポンの利用の有無で分けて、在籍月数ごとのハザードを出したものです。補助モジュール(cust_data.py)と同じフォルダに置き、最初のコードに続けて実行する形です。
mm = monthly.merge(cust[["cust_id", "coupon"]], on="cust_id")
hz = mm.groupby(["tenure", "coupon"])["churn"].mean().unstack()   # 在籍月数ごとのハザード
hz.columns = ["クーポン無し", "クーポン利用"]
print(hz.loc[[1, 2, 3, 4, 6, 12, 24]].round(4))
# 出力:
#         クーポン無し  クーポン利用
# tenure
# 1       0.0602  0.1131
# 2       0.0442  0.0864
# 3       0.0380  0.0768
# 4       0.0343  0.0335
# 6       0.0301  0.0313
# 12      0.0233  0.0198
# 24      0.0159  0.0201
月ごとの顧客の記録(monthly)は、在籍している月ごとに1行あり、その月末に解約したら churn が1なので、在籍月数ごとに churn の平均をとれば、その月まで在籍した人のうち月末に解約した割合、つまりハザードになります。打ち切りの人は、観測の終わりの月までは行があり、その先の行が無いので、カプラン・マイヤー推定と同じく、観測できた月だけが分母に入ります。
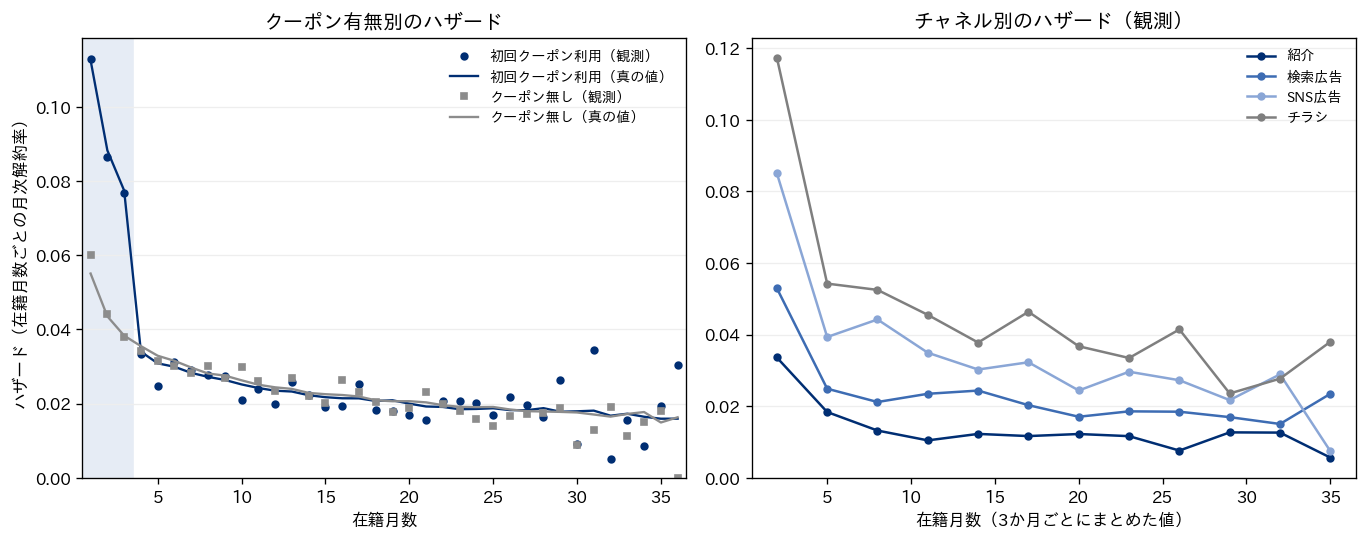
図の左側と出力の表から、初回クーポンの利用者は、在籍1〜3か月目のハザードがクーポン無しの約2倍あることが分かります(1か月目0.1131対0.0602、3か月をまとめると0.0934対0.0479)。4か月目には0.0335対0.0343と、クーポン無しと同じ水準に急に下がり、その後はほぼ重なります(4〜6か月をまとめると0.0299対0.0320、7〜12か月は0.0251対0.0276、13〜36か月は0.0201対0.0201)。共通データの真のモデルは、初回クーポンの利用者の在籍3か月以内だけハザードを上げる設定なので、観測したハザードはデータの作り方どおりの形を示しています。図の線(真の値)は、その月に在籍していた人たちの真のハザードの平均で、観測値(丸と四角)とよく重なっています。
この山は、継続率曲線では次のように見えます。カプラン・マイヤー推定の4か月目の継続率(3か月目の末まで解約しなかった割合)は、クーポン利用者0.748・クーポン無し0.864で、差は0.116でした。12か月目は0.599対0.679(差0.080)、36か月目は0.373対0.424(差0.051)です。36か月目は、全員をひとまとめにしたときと同じ前提の崩れを避けるため、クーポンの有無ごとにチャネル別に推定し、それぞれの群のチャネル構成で加重した値です(ひとまとめにすると0.379対0.434。4か月目と12か月目は、加重してもひとまとめでも同じ値でした)。第4章の表の0.601対0.688(12か月目)と0.337対0.511(36か月目)は、その月を観測できる加入月の人だけで数えた割合で、打ち切りを扱ったこの章のカプラン・マイヤー推定とは数え方が違います(とくに36か月目は第1か月の加入者だけの値です)。4か月目以降のハザードはほぼ同じなのに、最初の3か月で開いた差は埋まりません。継続率は各月の越えられる確率の掛け算なので、序盤に失った顧客は戻らず、その後は残った人数に同じ割合が掛かるだけだからです(差の絶対値が縮んでいくのは、両方の継続率が下がるにつれて、同じ割合の差が小さな幅になるためです)。
図の右側のチャネル別のハザード(3か月ごとにまとめた値)を見ると、どのチャネルでも最初の3か月が最も高く、その後は低い水準でなだらかに推移し、チラシが最も高く紹介が最も低い順序は、ほぼすべての期間で変わりません。チャネルの差は「序盤だけの差」ではなく、在籍が長くなってもハザードの水準そのものが違うということです。この点が、初回クーポンの効果(序盤だけ)との違いです。在籍月数によらずハザードの水準が違い続ける要因(チャネル)と、特定の時期だけ違う要因(初回クーポン)を、1つのモデルでどう扱うかは、第6章の比例ハザードの仮定の話につながります。
ハザードを在籍月数ごとに細かく見るときは、右端のばらつきに注意が要ります。在籍36か月目まで観測できるのは第1か月に加入した人だけで、その月に残っていた人は185人でした。左の図で在籍30か月を超えたあたりから丸と四角が上下に散らばっているのは、このためです。帯ごとに、観測した解約数と、その人たちの真のハザードを足した値(解約数の期待値)を比べると、在籍1〜3か月は2,251人対2,224.3人、4〜12か月は2,098人対2,140.1人、13〜24か月は1,081人対1,087.2人、25〜30か月は191人対206.7人、31〜36か月は65人対68.5人で、帯でまとめれば観測値は真の値とよく合っています。1か月ごとの値が急に跳ねても、人数が少ない時期なら、すぐに「その在籍月数で解約が増えた」とは読まないことが大切です。
経営の判断に翻訳する、解約率には「どの集団の、どの在籍月数の」を添える
この章の結果を、経営の判断に使える形に整理します。1つ目は、在籍期間や継続率の報告の仕方です。共通データでは、解約した人だけで出した平均在籍月数8.02か月は、60か月を上限とした真の期待在籍月数28.72か月の約28%でした。顧客1人あたりの価値をこの在籍月数から計算すると、価値を大きく過小評価し、獲得や引き止めに使ってよい予算を小さく決めてしまいます。逆に、打ち切りの人を「残った」と数えると、36か月目の継続率は0.526と、真の0.390を大きく上回ります。継続率や在籍月数を報告するときは、打ち切りをカプラン・マイヤー推定で扱った値であること、何か月目の値か、何か月を上限にした平均かを、必ず添える必要があります。
2つ目は、このデータのようにハザードが在籍月数で変わるときは、「1÷月次解約率」で在籍期間や LTV を出さないことです。第2章で紹介した基準の結果では、素朴な解約率を一定として60か月で打ち切り、年5%で割り引いた LTV は、紹介で61,736円(真の LTV 64,767円)、チラシで25,441円(真29,689円)でした(どれも架空の値)。期間をそろえると、紹介で約5%、チラシで約14%低く見積もることになり、解約率の高いチャネルほど価値を小さく見て、獲得にかけてよい費用の上限を低く置きすぎます。一方、同じ解約率から上限も割引も置かずに出した LTV(月次粗利÷月次解約率。月次粗利は、紹介経由の加入者の標準・大容量のプラン構成で平均した約1,759円)は紹介で109,708円になり、これを60か月で打ち切った真の値と並べると「紹介は過大」に見えます。これは定義の違う数字を比べた結果で、チャネル間の LTV の比較では、上限と割引の置き方をそろえた数字だけを並べる必要があります。LTV の計算は、カプラン・マイヤー推定の継続率から積み上げる方法を第9章で扱います。
3つ目は、月次解約率を1つの数字で追う指標の読み方です。共通データでは、観測内のすべての解約5,686件のうち2,251件(約40%)が在籍1〜3か月目に起きていましたが、在籍1〜3か月目の顧客月は全体の約19%(173,851のうち33,304)でした。ハザードが在籍月数でこれだけ違うと、全体の月次解約率は、新しく加入した顧客の割合が増えれば、どの在籍月数のハザードも変わらなくても上がりえます。全体の月次解約率が上がったときは、それが顧客構成の変化(加入直後の顧客や、チラシ経由の顧客が増えた)によるのか、同じ在籍月数・同じチャネルの顧客のハザードが上がったのかを分けてから、手を打つ必要があります。第4章のコホート表が獲得チャネルで分けて読む必要があったのと同じ理由です。報告の形としては、「チャネル別の在籍1〜3か月目のハザード」「在籍4か月目以降のハザード」のように、どの集団の、どの在籍月数の解約率かを添えた数字を並べることが有効だと考えています。
4つ目は、序盤の解約への手当てです。共通データでは、どのチャネルでも最初の3か月のハザードが最も高く、初回クーポンの利用者はその期間のハザードがさらに約2倍でした。最初の3か月で開いた継続率の差は、その後埋まりませんでした。加入直後の時期に何が起きているかを把握し、その時期に限った手当てを考えることは、在籍が長くなった顧客全体に同じ施策を配るより、狙いを絞りやすいと考えています。ただし、この章の分析は、クーポン利用者の序盤のハザードが高いことを示しただけで、クーポンをやめれば解約が減るかどうかは分かりません。クーポンが無ければ、そもそも加入しなかった人かもしれないからです。要因とハザードの関係の分析は第6章、施策の効果の確かめ方は第12章で扱います。
5つ目は、検定の結果の伝え方です。ログランク検定のp値は、人数が多ければ小さな差でも小さくなり、人数が少なければ大きな差でも大きくなります。新しいチャネルや施策を少人数で試した結果を「有意差なし」として退けたり、大人数のデータで出た「有意差あり」をそのまま「大きな差」と受け取ったりする誤りは、予算の判断を直接ゆがめます。経営への報告には、p値ではなく、12か月目の継続率の差や36か月を上限とした平均在籍月数の差のような、差の大きさを示す数字を主役に置くのがよいと考えています。
この章の要点は3つです。第一に、解約した人だけの平均在籍月数は、打ち切りの人を捨てることで短い側だけを見てしまい、共通データでは60か月で打ち切った真の値の約3割(36か月までの真の値と比べれば約4割)になりました。第二に、「1÷月次解約率」は、ハザードが一定という仮定に頼るため、真の値と期間をそろえて比べると、4チャネルとも在籍期間を短く見積もりました(チラシで約14%)。上限を置かない値を60か月の真の値と並べると紹介と検索広告では過大に見えますが、それは定義の違う数字を比べた誤りです。在籍月数ごとのハザードを測ると、どのチャネルでも最初の3か月が最も高く、初回クーポンの利用者はその期間だけさらに約2倍でした。第三に、カプラン・マイヤー推定は、各月の解約の割合をその月まで残っていた人で数えて掛け合わせることで打ち切りを正しく扱い、4チャネルそれぞれの継続率を真の値の近くで推定しました。全体の継続率は、チャネル別の推定を加入者の構成で加重して組み立てます。チャネルの差はログランク検定で確かめられますが、伝えるべきは差の大きさです。次の第6章では、チャネル・プラン・初回クーポン・利用状況といった複数の要因が、それぞれハザードをどれだけ動かすかを、ハザードモデルで分けて測ります。
この章を深めたい方への参考書籍
『生存時間解析 第2版』(大橋靖雄・浜田知久馬・魚住龍史、東京大学出版会):生存時間解析の基本概念と用語から始め、第2章で生存関数のノンパラメトリックな推定と検定、第3章でコックス回帰を扱う教科書で、付録には境界内平均生存時間(RMST)も入っています。SAS のプログラムで書かれていますが、この章で扱った、打ち切りのあるデータから生存関数を推定し、グループ間の差を検定する考え方を、日本語で体系立てて確かめるのに向いています。
『生存時間解析入門 原書第2版』(デビッド・ホスマー、スタンリー・レメショウ、スーザン・メイ 著、五所正彦 監訳、東京大学出版会):Hosmer らの生存時間解析の教科書の第2版の全訳で、第2章で生存時間データの記述法を、第3章以降で比例ハザードモデルとその解釈・モデル構築・妥当性の評価を扱います。この章のカプラン・マイヤー推定から、第6章のハザードモデルへ進むときの橋渡しになります。
第6章 離脱の要因を探る、ハザードモデルと説明変数
第5章では、打ち切りを正しく扱うカプラン・マイヤー推定で継続率曲線を描き、在籍月数ごとの月次解約率であるハザードが、在籍が長くなるほど下がること、初回クーポンを使った顧客では最初の3か月に山があることを確かめました。カプラン・マイヤー推定は「ある集団の継続率」を正しく測る道具ですが、チャネル・プラン・クーポン・世帯人数のように、解約に関係しそうな要因が同時にいくつもあるとき、それぞれの要因がハザードをどれだけ動かしているかを分けて示すことはできません。チラシ経由の顧客の継続率が低いのは、チラシという獲得経路のためなのか、チラシ経由に標準プランやクーポン利用者が多いためなのかを、集団を細かく分けて継続率を比べるだけで答えようとすると、組み合わせの数だけ集団が細かくなり、1つの集団の人数がすぐに足りなくなります。この章では、複数の要因を同時に入れてハザードとの関係を推定する回帰の方法として、加入時に決まる属性を使うCox 比例ハザードモデルと、その結果を読むためのハザード比、毎月変わる利用状況まで入れられる離散時間ハザードモデルを、第2章で用意したサンプルデータ(架空の家庭向け食材宅配の定期便、12,000人)で実行して確かめます。推定した結果を、12か月目の継続率と粗利の差に翻訳するところまでを扱い、解約の予測そのものは第7章に送ります。
要因を分けて測るとは何をすることか
共通データでは、チャネル別の素朴な月次解約率は紹介 0.0160、検索広告 0.0274、SNS広告 0.0456、チラシ 0.0645 でした(第2章)。この差には、獲得チャネルそのものの違いのほかに、プランの構成、初回クーポンの利用率、世帯人数、加入時期の違いが混ざっています(この章のモデルには加入時期を入れていないので、加入時期の違いは分けて測れていません)。経営の判断で知りたいのは、たとえば「同じプラン・同じクーポンの条件でそろえたとき、チラシ経由の顧客は紹介経由の顧客の何倍解約しやすいのか」であり、「チラシ経由に大容量プランを勧めたら解約はどれだけ減りそうか」です。このように、他の要因をそろえたうえでの1つの要因の効き方を推定するのが回帰の役割で、解約までの時間を扱う回帰を、この記事ではハザードモデルと呼びます。
ハザードモデルが答えるのは「どの要因が、どの向きに、どれくらいの大きさでハザードと結び付いているか」です。答えないのは「その要因を変えたら解約が減るか」です。後者は因果の問いで、観察されたデータの回帰だけでは原則として答えられません。この区別は、利用状況(注文回数・問い合わせ)を説明変数に入れる節で、具体的な数字で確かめます。
ハザードモデルが要るのは、獲得チャネル・プラン・施策の経験など、複数の要因を同時にそろえて比べたいとき(とくに、それらが互いに偏って分布しているとき)や、世帯人数・注文回数のような連続した量と解約までの時間の関係を推定したいときです。チャネルが1つしかない、あるいは比べたい要因が1つで、ほかの属性の構成がどの集団でもほぼ同じという段階なら、第5章のカプラン・マイヤー推定を集団ごとに描いて比べるだけで十分なことが多いと考えています。反対に、獲得チャネルごとの獲得費用の上限を決める、引き止め施策の対象の条件を決めるといった判断の材料を作る段階では、要因を分けて測らないと、チャネルの差とプランの差を取り違えたまま予算を配ることになります。
Cox 比例ハザードモデルの考え方
Cox 比例ハザードモデルは、統計学者の David Cox が1972年に英国王立統計学会の学会誌(シリーズB)に発表した、回帰モデルと生命表を論じた論文で提案された方法です。考え方の中心は、顧客ごとのハザードを、全員に共通の「基準のハザード」と、説明変数で決まる「倍率」の掛け算に分けることにあります。在籍月数 \( t \) の時点の、説明変数 \( x \) を持つ顧客のハザードを \( h(t \mid x) \) と書くと、次の形です。
\( h(t \mid x) = h_0(t) \times \exp(\beta_1 x_1 + \beta_2 x_2 + \cdots) \)
言葉で言い換えると、「ある顧客の、在籍 t か月目のハザードは、基準の顧客のその月のハザードに、その顧客の属性で決まる倍率を掛けたもの」です。基準のハザード \( h_0(t) \) は在籍月数とともにどう動いてもよく、係数を推定する段階では、その形を前もって決める必要がありません。この段階で推定するのは係数 \( \beta \) だけです。継続率に直すときは、基準の累積ハザードもデータから推定します(後の節で扱います)。この「基準のハザードの形を決めずに、倍率の部分だけを推定する」点が、このモデルが広く使われている理由の1つです。なお、Cox のモデルのハザードは、連続した時間の上での瞬間的な解約の起きやすさとして定義される量で、この記事で「在籍月数ごとの月次解約率」と定義したハザード(離散時間のハザード)とは厳密には別のものです。そのため、Cox のハザード比は、月次の解約確率が何倍になるかとしてそのまま読むことはできません。継続率に直すときは、後の節の式を使います。第5章で見たとおり、共通データのハザードは在籍が長くなるほど下がるので、ハザードが一定だと仮定するモデルでは当てはまりません。Cox 比例ハザードモデルは、その下がり方を形として決めずにおけます。
係数 \( \beta \) を指数にした \( \exp(\beta) \) がハザード比です。statsmodels の公式ドキュメントも、Cox 比例ハザードモデルの推定結果のクラスの説明で、係数はそれぞれ対数のハザード比に当たると書いています。たとえばチラシのダミー(チラシ経由なら1、そうでなければ0)の係数が1.286なら、ハザード比は \( \exp(1.286) \)=3.62 で、「ほかの説明変数が同じなら、チラシ経由の顧客のハザードは、基準のチャネル(この章では紹介)の顧客の3.62倍」と読みます。ハザード比が1なら差が無く、1より大きければ解約しやすく、1より小さければ解約しにくいという意味です。
このモデルの名前にある「比例」は、倍率が在籍月数によらず一定だという仮定を指しています。チラシ経由の顧客のハザードは、加入1か月目でも30か月目でも、紹介経由の顧客の3.62倍だと置いているということです。2つの集団のハザードの比が時間によらず一定なので、比例ハザードと呼ばれます。この仮定が成り立たない要因があると、推定したハザード比はその要因の「期間を通した平均的な倍率」になり、ある時期には過大、別の時期には過小になります。共通データの初回クーポンが、まさにその例です。
statsmodels の PHReg で推定する
Cox 比例ハザードモデルは、statsmodels の statsmodels.duration.hazard_regression.PHReg で推定できます。公式ドキュメントによると、引数は観測された時間(解約した時点か、打ち切られた時点)、説明変数、解約したかどうかの印(status。1が解約、0が打ち切り)で、ほかに左側の切断を表す entry、層別の strata、同じ時点に複数の解約がある場合の扱いを決める ties("breslow" か "efron"。既定は "breslow")を指定できます。共通データでは、時間に観測できた在籍月数(tenure_obs)、解約の印に観測内に解約したかどうか(churned)を使います。説明変数は加入時に決まって変わらない4つ、すなわち獲得チャネル(紹介を基準にした3つのダミー)、プラン(大容量なら1)、初回クーポン(利用なら1)、世帯人数(1〜4人)です。次のコードは、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。
import numpy as np
import pandas as pd
from statsmodels.duration.hazard_regression import PHReg
import cust_data as cd

cust, monthly = cd.make_subscription()          # 第2章の共通データ
X = pd.DataFrame({
    "検索広告": (cust["channel"] == "search").astype(float),
    "SNS広告": (cust["channel"] == "social").astype(float),
    "チラシ": (cust["channel"] == "flyer").astype(float),   # 紹介が基準
    "大容量": (cust["plan"] == "large").astype(float),
    "初回クーポン": cust["coupon"].astype(float),
    "世帯人数": cust["household"].astype(float),
})
time_ = cust["tenure_obs"].values.astype(float)  # 観測できた在籍月数
event = cust["churned"].values                   # 1=観測内に解約、0=打ち切り
res = PHReg(time_, X, status=event, ties="efron").fit()
ci = res.conf_int()
print(pd.DataFrame({"係数": res.params, "ハザード比": np.exp(res.params),
                    "下限95": np.exp(ci[:, 0]), "上限95": np.exp(ci[:, 1])},
                   index=X.columns).round(3))
# 出力:
#            係数  ハザード比   下限95   上限95
# 検索広告    0.503  1.653  1.525  1.793
# SNS広告   0.987  2.682  2.470  2.913
# チラシ     1.286  3.619  3.342  3.918
# 大容量    -0.262  0.769  0.725  0.816
# 初回クーポン  0.259  1.296  1.230  1.365
# 世帯人数   -0.044  0.957  0.932  0.982
推定に使ったのは12,000人、そのうち観測内に解約した5,686人です。次の表は、この出力を読みやすく並べ直したものです。「95%信頼区間」の列は、ハザード比の下限と上限です。信頼区間は、データの偶然のばらつきを考えたときに、ハザード比がこの範囲にあると見てよいという幅の目安で、区間が1をまたいでいなければ「差が無い」とは言いにくい、と読みます。
| 説明変数 | 係数 | ハザード比 | 95%信頼区間 | 読み方(ほかの説明変数が同じとき) |
|---|---|---|---|---|
| 検索広告(紹介が基準) | 0.503 | 1.653 | 1.525〜1.793 | 紹介経由の約1.65倍のハザード |
| SNS広告(紹介が基準) | 0.987 | 2.682 | 2.470〜2.913 | 紹介経由の約2.68倍 |
| チラシ(紹介が基準) | 1.286 | 3.619 | 3.342〜3.918 | 紹介経由の約3.62倍 |
| 大容量(標準が基準) | -0.262 | 0.769 | 0.725〜0.816 | 標準プランの約0.77倍(約23%低い) |
| 初回クーポン(利用なしが基準) | 0.259 | 1.296 | 1.230〜1.365 | 期間を通した平均では約1.30倍(次の節で分解する) |
| 世帯人数(1人増えるごと) | -0.044 | 0.957 | 0.932〜0.982 | 1人増えるごとに約4%低い |
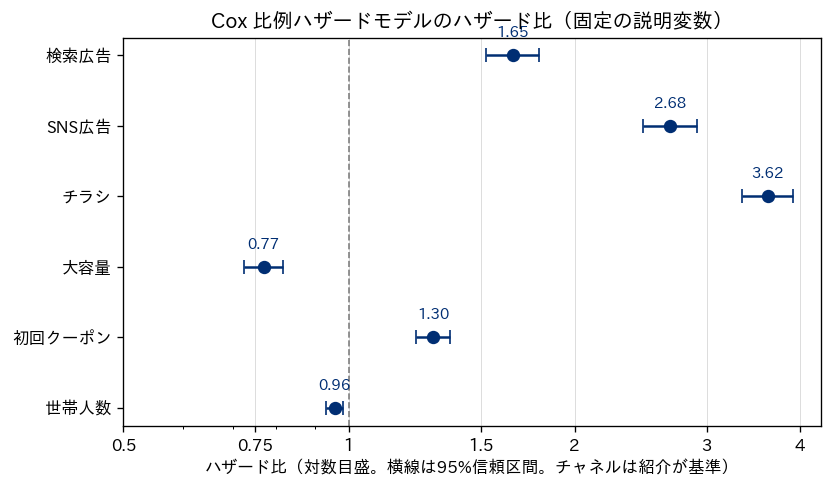
表と図から読めることを、経営の言葉に直すと次のとおりです。獲得チャネルの差は、プラン・クーポン・世帯人数をそろえても大きく、チラシ経由の顧客のハザードは紹介経由の約3.6倍、SNS広告経由は約2.7倍、検索広告経由は約1.65倍です。チャネルの間の差は、プランやクーポンの構成の違いでは説明しきれないということです。大容量プランの顧客は標準プランの顧客よりハザードが約23%低く、世帯人数が1人多いとハザードが約4%低くなっています。この推定の幅(信頼区間)はどれも狭く、1をまたいでいません。12,000人・解約5,686人という規模なら、この程度の大きさの差は偶然のばらつきと区別できます。
ここで、この架空データを作った側だけが知る真のモデルと見比べておきます。真のモデル(第2章)では、ハザードのロジット(確率を対数のオッズに直したもの。オッズは起きる確率÷起きない確率)に、紹介 -0.5・検索広告 0・SNS広告 +0.35・チラシ +0.6 のチャネル効果が入っていて、紹介とチラシの差は1.1です。Cox の係数では、紹介とチラシの差は1.286で、真の差1.1より大きく出ています。また、真のモデルの式には世帯人数は直接入っていません(世帯人数の効果は0)。それなのに Cox では世帯人数のハザード比が0.957と、1より小さく出ました。Cox の係数は対数のハザード比、真のモデルの係数はロジット(対数のオッズ)の上の値で、尺度が違うので、この差の全部を1つの理由に帰すことはできません。主な理由は、この Cox のモデルに注文回数を入れていないことです。後の節で、同じ離散時間のモデルどうしで、注文回数を入れない形(チラシと紹介の係数の差1.311)と入れた形(1.096)を比べて確かめます。真のモデルでは、獲得チャネルと世帯人数が隠れた「利用意欲」の初期値を決め、利用意欲が注文回数を決め、注文回数がハザードを動かします。注文回数を入れないモデルでは、チャネルや世帯人数のハザード比は「注文回数を通した間接の経路」まで含んだ値になります。このことは、後で注文回数を入れた離散時間ハザードモデルで確かめます。
同じ時点に複数の解約がある場合(同順位、ties)の扱いにも触れておきます。在籍月数は月単位の整数なので、同じ在籍月数で解約した顧客が大量にいます。Cox のモデルの推定は、解約が起きた時点ごとに「その時点で在籍していた顧客(リスク集合)の中で、誰が解約したか」を比べる仕組みなので、同じ時点の解約が多いと、その並べ方の近似が結果に効きます。statsmodels の既定の "breslow" で推定し直すと、チラシのハザード比は3.512、初回クーポンは1.280になり、"efron" の3.619・1.296よりやや小さく出ました。月単位のデータで Cox のモデルを使うときは、同順位の扱いを明記し、扱いを変えても結論が変わらないことを確かめておくのがよいと考えています。同順位が多いこと自体が、次に扱う離散時間ハザードモデルを使う理由の1つにもなります。
比例ハザードの仮定が崩れる例:初回クーポンの効果は最初の3か月だけ
前の表で初回クーポンのハザード比は1.296でした。これを「クーポン利用者は、ずっと約1.3倍解約しやすい」と読むと誤ります。共通データの真のモデルでは、初回クーポン利用者のハザードが高いのは在籍3か月目までだけで、4か月目以降は利用しなかった人と変わりません(第2章の設定)。第5章でハザードを描いたときに見えた、クーポン利用者の最初の3か月の山です。在籍月数ごとの観測のハザード(その月に在籍していた顧客のうち、その月末に解約した割合)をクーポンの有無で並べると、次のとおりです。
| 在籍月数 | クーポン利用なしのハザード | クーポン利用ありのハザード | 比(あり÷なし) |
|---|---|---|---|
| 1か月目 | 0.0602 | 0.1131 | 1.88 |
| 2か月目 | 0.0442 | 0.0864 | 1.95 |
| 3か月目 | 0.0380 | 0.0768 | 2.02 |
| 4か月目 | 0.0343 | 0.0335 | 0.98 |
| 5か月目 | 0.0315 | 0.0248 | 0.79 |
| 6か月目 | 0.0301 | 0.0313 | 1.04 |
| 7か月目 | 0.0282 | 0.0290 | 1.03 |
| 8か月目 | 0.0302 | 0.0278 | 0.92 |
表の「比(あり÷なし)」の列は、1〜3か月目には約2倍で、4か月目からは1の前後を行き来します。2つの集団のハザードの比が在籍月数によって変わっているので、比例ハザードの仮定はクーポンについて成り立っていません。全期間で1つのハザード比を推定した1.296は、「最初の3か月の約2倍」と「4か月目以降の約1倍」という時間で変わる関係を、1つの一定の倍率で要約した値です。この値をそのまま使うと、最初の3か月のクーポン利用者のハザード比を、区間で分けて推定した約2.0(次の節)の約65%(1.296÷2.003)に見積もり、4か月目以降のクーポン利用者を必要以上に危ない顧客として扱うことになります。
仮定が崩れていることは、モデルの出力からも確かめられます。statsmodels の推定結果には、シェーンフェルド残差(schoenfeld_residuals)が用意されています。シェーンフェルド残差は、解約が起きた時点ごとに「解約した人の説明変数の値」から「その時点のリスク集合の、モデルが見込む平均」を引いたもので、比例ハザードの仮定が成り立っていれば、在籍月数によらず0のまわりにばらつきます。全期間のモデルについて初回クーポンの列の残差を在籍月数の帯ごとに平均すると、1〜3か月目の解約では +0.0997、4〜6か月目では -0.0730、7〜12か月目では -0.0792、13〜24か月目では -0.0715、25〜36か月目では -0.0133 でした。最初の3か月は「モデルの平均的なハザード比が見込むより、クーポン利用者がよく解約している」、4か月目以降は「見込むほど解約していない」という向きで、在籍月数とともに符号が変わっています。符号が時期によって入れ替わるのは、1つのハザード比では、ある時期の解約しやすさを小さく、別の時期を大きく見ている、という合図です。
区間で分けて推定する、時間で変わる効果として扱う
比例ハザードの仮定が崩れたときの対処はいくつかありますが、効果の変わる時期の見当が付いているなら、最も分かりやすいのは在籍月数の区間で分けて推定する方法です。ここでは、1〜3か月目と4か月目以降の2つの区間に分けました。1〜3か月目の推定は、全員について在籍月数3か月で打ち切ったデータで行います(3か月目までに解約した人は解約、それ以外は3か月で打ち切り)。4か月目以降の推定は、3か月目を越えて在籍した9,749人だけを使い、「3か月目の終わりまで在籍したことを条件にする」ための entry を指定します。entry は、その行がいつから観察の対象に入ったか(ここでは3か月目の終わり)を表す引数で、それより前の解約の比較には加えない、という指定です(左側の切断と呼ばれます)。
2つの区間を1つのモデルで推定することもできます。各顧客を「1〜3か月目の行」と「4か月目以降の行」(3か月目を越えて在籍した人だけ)に分け、クーポンの説明変数を「クーポン×1〜3か月目」と「クーポン×4か月目以降」の2つに分けます。他の説明変数の係数は2つの区間で共通にし、クーポンの効果だけが区間で変わるモデルです。これが、時間で変わる効果(時間依存の係数)を扱う最も簡単な形です。次のコードは、補助モジュール(cust_data.py)と同じフォルダに置き、前のコードの X・time_・event を作った後に続けて実行する形です。
late = time_ > 3                                  # 3か月目を越えて在籍した人
e_early = ((event == 1) & (time_ <= 3)).astype(int)
ep1 = pd.DataFrame({"entry": 0.0, "time": np.minimum(time_, 3.0),
                    "status": e_early, "early": 1.0, "idx": np.arange(len(cust))})
ep2 = pd.DataFrame({"entry": 3.5, "time": time_[late],   # 3.5 の理由は本文
                    "status": event[late], "early": 0.0, "idx": np.where(late)[0]})
ep = pd.concat([ep1, ep2], ignore_index=True)
Xe = X.iloc[ep["idx"].values].reset_index(drop=True).copy()
Xe["クーポン×1〜3か月"] = Xe["初回クーポン"] * ep["early"].values
Xe["クーポン×4か月以降"] = Xe["初回クーポン"] * (1 - ep["early"].values)
Xe = Xe.drop(columns=["初回クーポン"])
r_tv = PHReg(ep["time"].values, Xe, status=ep["status"].values,
             entry=ep["entry"].values, ties="efron").fit()
print(np.exp(r_tv.params).round(3), len(ep))
# 出力(ハザード比):
# 検索広告 1.658 / SNS広告 2.678 / チラシ 3.608 / 大容量 0.769 / 世帯人数 0.957
# クーポン×1〜3か月 2.003 / クーポン×4か月以降 0.972   行数 21749
コードの中で4か月目以降の行の entry を3ではなく3.5にしているのは、区間の境目の扱いに、ライブラリの実装による落とし穴があるためです。statsmodels の PHReg では、entry を3にすると、3か月目の解約の比較に同じ人の4か月目以降の行が重ねて入る実装になっていました(ソースコードで確認)。この例では entry を3にすると、クーポンのハザード比が1〜3か月目 2.561・4か月目以降 0.886 と、区間を別々に推定した値(次の表の2.003・0.971)から大きくずれました。3.5にすると第3か月の比較に後半の行が入らなくなり、1つのモデルのクーポンのハザード比は2.003・0.972と、別々に推定した値に近くなりました。ほかの説明変数は、1つのモデルでは2つの区間で共通の係数にしているので、別々に推定した値とは一致しません(たとえば大容量は、別々に推定すると0.732・0.793、1つのモデルでは0.769)。区間に分けて推定するときは、境目の時点の比較にどの行が入るかを確かめ、区間で変えた係数が別々に推定した結果と近いかを、一度は確かめておくのがよいと考えています。
区間で分けて推定した結果を、全期間の推定と並べたのが次の表と図です。
| 説明変数 | 全期間のハザード比 | 1〜3か月目のハザード比(95%信頼区間) | 4か月目以降のハザード比(95%信頼区間) |
|---|---|---|---|
| 初回クーポン | 1.296 | 2.003(1.841〜2.180) | 0.971(0.907〜1.040) |
| 大容量 | 0.769 | 0.732(0.665〜0.807) | 0.793(0.736〜0.854) |
| チラシ(紹介が基準) | 3.619 | 3.661(3.214〜4.170) | 3.550(3.209〜3.928) |
| SNS広告(紹介が基準) | 2.682 | 2.628(2.289〜3.016) | 2.706(2.441〜3.000) |
| 検索広告(紹介が基準) | 1.653 | 1.604(1.396〜1.844) | 1.688(1.527〜1.865) |
| 世帯人数(1人あたり) | 0.957 | 0.958(0.920〜0.999) | 0.956(0.924〜0.988) |
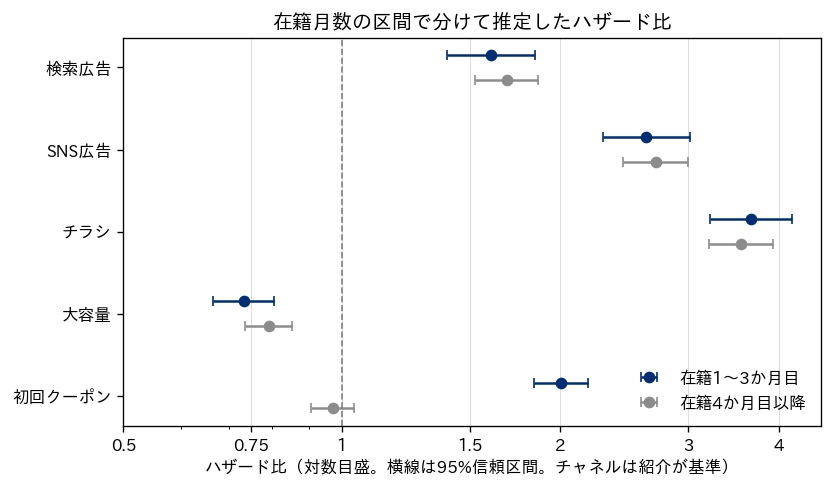
表の「初回クーポン」の行は、1〜3か月目のハザード比が2.003で、4か月目以降は0.971、その95%信頼区間0.907〜1.040は1をまたいでいます。最初の3か月はクーポン利用者のハザードが約2倍で、4か月目以降は利用しなかった人との差がはっきりしない、という読み方になり、真のモデルの設定(効果は在籍3か月以内だけ)と一致します。区間が1をまたぐことは「差が無いと確かめた」ことではなく、「このデータの量では差を見分けられなかった」ことを意味します。チャネル・プラン・世帯人数は、2つの区間でハザード比がほとんど変わらず、信頼区間も大きく重なっています。今回の2区間の比較では、クーポンに明瞭な変化が見られ、ほかの変数には同程度の変化は見られませんでした。2区間の推定値が近いことは、区間の中まで含めてハザード比が一定であることの証明ではない点には注意が要ります。
1つ補足があります。4か月目以降のクーポンのハザード比0.971は1より少し小さい側にあり、ここには生き残りの偏りが混ざりえます。答え合わせ用のデータで隠れた利用意欲(現実には見えない値)の平均を見ると、在籍1か月目ではクーポン利用者0.333、利用なし0.326とほぼ同じでしたが、在籍4か月目の在籍者ではクーポン利用者0.374、利用なし0.286と差が開いていました。最初の3か月の高いハザードを越えて残ったクーポン利用者は、利用意欲の高い人に偏っているということです。利用意欲が高いほど注文が多く、ハザードが低いので、この偏りは4か月目以降のクーポンのハザード比を1より小さい側へ引く向きに働きます。この例では区間が1をまたぎ、はっきりした差にはなりませんでした。区間で分けて推定したハザード比は、「その区間まで残った人どうし」の比較だという点に注意が要ります。
実務の手順としては、まず全期間のモデルを推定し、シェーンフェルド残差や、区間で分けた推定で、ハザード比が在籍月数で変わっていないかを変数ごとに確かめます。変わっている変数が見つかったら、効果が変わる時期の見当(施策の期間、無料期間、契約の更新月など、事業の仕組みから分かるもの)を手がかりに区間を切ります。初回の割引や無料期間のある事業では、その期間の前後で解約の起き方が変わる可能性を最初から考えに入れ、区間を分けた推定を一度は行っておくのがよいと考えています。
離散時間ハザードモデル:顧客月のデータにロジスティック回帰を当てる
Cox のモデルの説明変数は、ここまで加入時に決まる属性だけでした。ところが、解約と最も強く結び付いていそうなのは、その月に何回注文したか、問い合わせが何回あったかといった、毎月変わる利用状況です。毎月変わる説明変数を扱う方法として、この章では離散時間ハザードモデルを使います。考え方は単純で、データを「1行1顧客」から「1行1顧客月」に直し、各行について「その月末に解約したかどうか」(0か1)を、その月の説明変数で説明するロジスティック回帰を当てます。共通データの monthly はもともとこの形(173,851行)で、解約した顧客は最後に料金を払った月の行だけが1、打ち切られた顧客はすべての行が0です。
この形で推定してよい理由は、ハザードの定義そのものにあります。ハザードは「その月まで在籍した顧客が、その月末に解約する確率」でした。顧客月の各行は「その月まで在籍した顧客」の1か月分なので、行ごとの解約の割合を説明変数で説明するロジスティック回帰は、そのままハザードを説明変数で説明するモデルになります。打ち切られた顧客は、観測できた月までの行が0として入るので、打ち切りも自然に扱われます。ただし、説明変数をそろえた後も、解約しやすい顧客ほど記録が途中で途切れるような打ち切りでは、この扱いは成り立たず、別の対応が要ります(第5章のカプラン・マイヤー推定の前提と同じです)。在籍月数を説明変数に入れれば、基準のハザードが在籍とともに下がる形も表せます。時間を連続ではなく月や週のような区切りで数える分析を、離散時間の分析と呼びます。離散時間の手法を題にした論文として、社会学の方法論の年報に掲載された1982年の Paul Allison の論文があります。
離散時間ハザードモデルには、Cox のモデルと比べて実務上の利点がいくつかあります。1つ目は、毎月変わる説明変数(その月の注文回数・問い合わせ回数・施策を受けたかどうか)をそのまま列として入れられることです。2つ目は、在籍月数の効き方(対数・区間のダミーなど)と、在籍月数で変わる効果(クーポン×在籍3か月以内のような掛け算の項)を、普通の回帰と同じ書き方で入れられることです。3つ目は、月単位のデータで同じ時点の解約が大量にあっても、同順位の近似の問題が起きないことです。4つ目は、ロジスティック回帰の道具(statsmodels の Logit や GLM、scikit-learn など)がそのまま使えることです。弱点は、データの行数が「顧客数×在籍月数」に増えることですが、共通データの17万行程度なら、ロジスティック回帰の推定は1秒もかかりません(この記事の実行環境(一般的なノートPC)での実測で0.28秒)。
ここで当てるモデルの説明変数は、真のモデル(第2章)と同じ形にしました。チャネルのダミー(検索広告が基準。紹介・SNS広告・チラシ)、大容量のダミー、クーポン×在籍3か月以内(クーポン利用者の1〜3か月目だけ1)、在籍月数の対数、注文不足(2からその月の注文回数を引いた値。0未満は0。注文が月2回以上なら0、1回なら1、0回なら2)、その月の問い合わせ回数です。次のコードは、補助モジュール(cust_data.py)と同じフォルダに置いて実行する形です。
import numpy as np
import pandas as pd
import statsmodels.api as sm
import cust_data as cd

cust, monthly = cd.make_subscription()
d = monthly.merge(cust[["cust_id", "channel", "plan", "coupon", "household"]],
                  on="cust_id")                        # 1行1顧客月(173,851行)
X = pd.DataFrame({
    "定数": 1.0,
    "紹介": (d["channel"] == "referral").astype(float),  # 検索広告が基準
    "SNS広告": (d["channel"] == "social").astype(float),
    "チラシ": (d["channel"] == "flyer").astype(float),
    "大容量": (d["plan"] == "large").astype(float),
    "クーポン×在籍3か月以内": (d["coupon"] * (d["tenure"] <= 3)).astype(float),
    "log在籍月数": np.log(d["tenure"].astype(float)),
    "注文不足": np.maximum(0, 2 - d["orders"]).astype(float),
    "問い合わせ回数": d["support"].astype(float),
})
res = sm.Logit(d["churn"].values, X).fit(disp=0)   # その月末に解約=1
ci = res.conf_int()
print(pd.DataFrame({"推定": res.params, "下限95": ci[0], "上限95": ci[1]}).round(3))
g = sm.GLM(d["churn"].values, X, family=sm.families.Binomial()).fit()
print(np.max(np.abs(g.params - res.params)))       # GLM でも同じ係数になる
# 出力(推定 / 下限95 / 上限95):
# 定数 -3.313 / -3.400 / -3.225      紹介 -0.437 / -0.520 / -0.354
# SNS広告 0.400 / 0.325 / 0.475      チラシ 0.659 / 0.587 / 0.731
# 大容量 -0.282 / -0.343 / -0.221    クーポン×在籍3か月以内 0.762 / 0.681 / 0.842
# log在籍月数 -0.377 / -0.410 / -0.344
# 注文不足 0.552 / 0.518 / 0.587     問い合わせ回数 0.483 / 0.435 / 0.531
# 2.7e-13
Logit と GLM(二項分布)の係数の差は最大でも 2.7×10の-13乗で、同じモデルを2つの道具で推定しただけだと分かります。
推定した係数を真の値と答え合わせする
このデータは、ここで当てたモデルと同じ形の式で作られています。したがって、推定した係数がデータを作るときに使った係数(真の値)にどれだけ近いかで、離散時間ハザードモデルが要因の大きさを正しく取り出せるかを確かめられます。真の値を知っているのはデータを作った側だけで、現実の企業のデータでは、このような答え合わせはできません。この記事では、方法の確かさを確かめる物差しとして使います。
| 説明変数 | 真の値 | 推定 | 95%信頼区間 | 推定と真の値の差 | オッズ比(推定の指数) |
|---|---|---|---|---|---|
| 定数(切片) | -3.30 | -3.313 | -3.400〜-3.225 | -0.013 | 0.036(オッズ比ではなく、説明変数がすべて0の条件のオッズ) |
| 紹介(検索広告が基準) | -0.50 | -0.437 | -0.520〜-0.354 | +0.063 | 0.646 |
| SNS広告(検索広告が基準) | +0.35 | 0.400 | 0.325〜0.475 | +0.050 | 1.491 |
| チラシ(検索広告が基準) | +0.60 | 0.659 | 0.587〜0.731 | +0.059 | 1.933 |
| 大容量 | -0.30 | -0.282 | -0.343〜-0.221 | +0.018 | 0.754 |
| クーポン×在籍3か月以内 | +0.80 | 0.762 | 0.681〜0.842 | -0.038 | 2.142 |
| log在籍月数 | -0.35 | -0.377 | -0.410〜-0.344 | -0.027 | 0.686 |
| 注文不足 | +0.55 | 0.552 | 0.518〜0.587 | +0.002 | 1.737 |
| 問い合わせ回数 | +0.45 | 0.483 | 0.435〜0.531 | +0.033 | 1.621 |
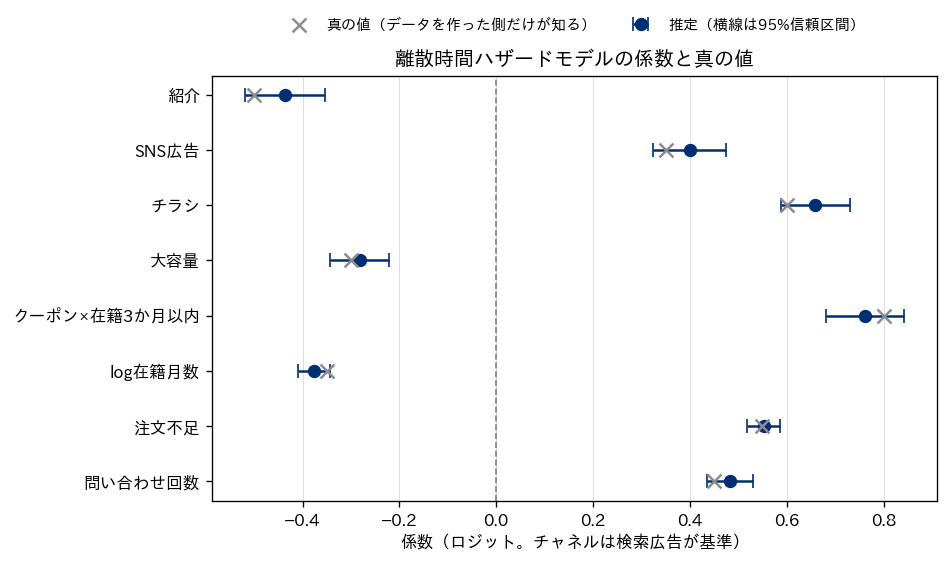
表の「推定と真の値の差」の列は、定数(切片)を含む9つの係数すべてで ±0.07 以内に収まり、「95%信頼区間」の列はすべて真の値を含んでいました(図には切片を除く8つを描いています)。最も近いのは注文不足(0.552 対 真の0.55)で、最も離れたのは紹介(-0.437 対 真の -0.5)です。この乱数データ(12,000人・36か月分)では、真のモデルと同じ形のモデルで、要因の大きさをこの精度で推定できました。
表の「オッズ比」の列は、係数を指数にしたものです。ロジスティック回帰の係数の指数はオッズ比(解約する確率と解約しない確率の比が何倍になるか)で、ハザード比とは厳密には別の量ですが、月次のハザードのように確率が小さい(共通データでは平均約3%)ときは、オッズ比は確率の倍率に近い値になります。たとえばクーポン×在籍3か月以内のオッズ比2.142は、「最初の3か月、クーポン利用者の月次の解約のオッズは、ほかの条件が同じなら約2.1倍」と読みます。確率の倍率はこれより小さく、クーポンを使わない人の月次解約確率が10%の条件なら、クーポン利用者は約19.2%で、確率の倍率は約1.92倍です。確率の倍率は、比べる元の確率が高い条件ほどオッズ比から離れます。Cox のモデルで区間を分けて推定した1〜3か月目のハザード比2.003と、近い大きさです。
推定の精度がデータの量にどう依存するかも確かめました。12,000人から無作為に2,000人を選んで同じモデルを推定することを20回繰り返すと、係数の標準偏差(推定のばらつき)は、紹介で0.076、SNS広告で0.091、クーポン×在籍3か月以内で0.086でした。4,000人では、それぞれ0.053・0.045・0.063です。チャネルのように0.3〜0.5程度の差を見分けたい要因では、顧客数が2,000人規模だと、1回の推定の誤差が差そのものの2割前後になりえます。顧客数が数千人規模の事業では、係数の大小を細かく比べるより、信頼区間を必ず添えて向きと大きさの見当をつかむ使い方が向いていると考えています。
利用状況を入れると、チャネルと世帯人数の係数が変わる
Cox のモデルで、チラシと紹介の係数の差は1.286(ハザード比3.62)と、真の差1.1より大きく出ていました。世帯人数も、真のモデルの式には入っていないのにハザード比0.957と出ていました。その理由を確かめるため、離散時間ハザードモデルを、利用状況(注文不足・問い合わせ回数)を入れない形と入れる形で推定して比べました。「利用状況なし」は世帯人数を加えて推定したもの、「利用状況あり」は前の節のコードのモデル(世帯人数は入れていない)そのもの、「利用状況あり+世帯人数」は前の節のモデルに世帯人数を加えて推定し直したものです。
| 説明変数 | 利用状況なし(世帯人数を加える) | 利用状況あり(前の節のコード) | 利用状況あり+世帯人数 | 真の値 |
|---|---|---|---|---|
| 紹介(検索広告が基準) | -0.512 | -0.437 | -0.437 | -0.50 |
| SNS広告(検索広告が基準) | 0.490 | 0.400 | 0.400 | +0.35 |
| チラシ(検索広告が基準) | 0.799 | 0.659 | 0.659 | +0.60 |
| 大容量 | -0.268 | -0.282 | -0.282 | -0.30 |
| クーポン×在籍3か月以内 | 0.747 | 0.762 | 0.762 | +0.80 |
| log在籍月数 | -0.310 | -0.377 | -0.377 | -0.35 |
| 世帯人数 | -0.046 | (入れていない) | 0.002 | 0(式に入っていない) |
| 注文不足 | (入れていない) | 0.552 | 0.553 | +0.55 |
| 問い合わせ回数 | (入れていない) | 0.483 | 0.483 | +0.45 |
「利用状況なし」の列で、チラシと紹介の係数の差は 0.799 から -0.512 を引いた1.311で、Cox のモデルの1.286とほぼ同じです。世帯人数の係数 -0.046 も、Cox の -0.044 とほぼ同じでした。「利用状況あり(前の節のコード)」の列では、チラシと紹介の差は 0.659 から -0.437 を引いた1.096となり、真の差1.1にほぼ一致します。世帯人数を加えても、ほかの係数は小数第3位まで変わらず(注文不足だけ0.552から0.553)、世帯人数の係数は0.002で、95%信頼区間は -0.025〜0.029 と0を含みました。注文回数をそろえると、このデータの量では世帯人数による差を見分けられなかった、ということです(真のモデルの式にも世帯人数は入っていません)。
利用状況を入れるかどうかで係数が変わった理由は、データの作り方から説明できます。真のモデルでは、獲得チャネルと世帯人数が利用意欲の初期値を決め、利用意欲が注文回数を決めています。実際、顧客月あたりの注文回数の平均は、紹介2.427・検索広告2.209・SNS広告1.966・チラシ1.825回、世帯人数1人1.990回から4人2.366回へと、チャネルと世帯人数で違っていました。注文回数を入れないモデルでは、チャネルと世帯人数の係数が「注文が少なくなりやすい」という経路の分まで背負うので、チャネルの差は大きく、世帯人数にも効果があるように見えます。注文回数を入れたモデルでは、その経路の分が注文不足の係数に移り、チャネルと世帯人数の係数は「注文回数が同じときの差」になります。
どちらの係数が正しいということではなく、問いが違います。「チラシで獲得した顧客は、紹介で獲得した顧客と比べて、全体としてどれだけ解約しやすいか」という獲得チャネルの評価の問いには、利用状況を入れない係数(同じ離散時間のモデルでは、チラシと紹介の係数の差1.311の指数でオッズ比約3.7倍。Cox のハザード比約3.6倍も近い値です)が答えます。獲得の時点では、その顧客が将来何回注文するかは分からないからです。「同じように注文している顧客どうしでも、チラシ経由の顧客は解約しやすいか」という問いには、利用状況を入れた係数(チラシと紹介の係数の差1.096の指数で、オッズ比約3.0倍)が答えます。前半の Cox は紹介が基準、離散時間のモデルは検索広告が基準なので、チラシと紹介を比べるときは、どちらも「チラシと紹介の係数の差」に直して比べています。獲得費用の上限を決める判断(第9章)には前者を、在籍中の顧客の誰に引き止め施策を打つかの判断(第7章・第8章)には後者に近い考え方を使う、という使い分けになります。説明変数を何にするかは、統計の技術の問題である前に、どの判断の材料を作るのかという問いの選び方の問題です。
注文回数・問い合わせの係数は相関であって、施策の効果ではない
真のモデルと同じ形の離散時間ハザードモデルでは、注文不足の係数が0.552(オッズ比1.74)、問い合わせ回数の係数が0.483(オッズ比1.62)でした。「問い合わせが1回多い月は、ほかの条件が同じなら解約のオッズが約1.6倍」という読み方は、データの中の関係の記述としては正しいものです。しかし、これを「問い合わせを減らせば解約が減る」と読むことはできません。
共通データでは、問い合わせは注文が少ない月に増えるように作られていて、注文が月1回以下の月の問い合わせの平均は0.332回、月2回以上の月は0.081回でした。注文が少ない月は解約も多く、注文1回以下の月の解約率は0.0546、2回以上の月は0.0218です。問い合わせの多さは、利用意欲が下がっていること、あるいは何か困りごとがあることの表れです。この架空データの真のモデルでは問い合わせの回数そのものがハザードを上げる式になっていますが、現実のデータでは、問い合わせの回数とハザードの関係が「問い合わせという出来事が解約を招く」のか「解約したくなる事情が問い合わせとして表れる」のかを、観察されたデータの回帰だけで見分けることはできません。問い合わせの窓口を減らしたり、問い合わせしにくくしたりして回数を減らしても、その背後にある不満が消えなければ、解約は減らないどころか、不満を聞く機会を失うことになります。
注文回数も同じです。注文不足の係数は「注文が少ない月は解約しやすい」ことを示しますが、「クーポンを配って注文回数を増やせば解約が減る」ことは示しません。利用意欲が下がって注文が減った顧客に、クーポンで注文させても、利用意欲そのものが戻るとは限らないからです。利用状況の係数は、施策の効果の見積もりとして使ってはいけません。また、この係数は「その月の注文・問い合わせ」と「その月末の解約」の関係を表すもので、過去の記録から先の解約を当てる予測の課題(第7章)で同じように役に立つとは限りません。第7章の結果では、過去3か月の問い合わせ回数は、予測の手がかりとしては弱いものでした。施策の効果は、施策を打つ群と打たない群を無作為に分けた実験で測る必要があり、それは第12章で扱います。回帰の係数を因果の効果と読み違える問題の一般論は、弊社コラム「ビジネスの要因分析に効く回帰分析と統計モデリングについて」でも扱っています。
同じ注意は、チャネルやプランの係数にも当てはまります。共通データの真のモデルでは大容量プランのハザードを下げる効果を直接置いていますが、現実のデータで大容量プランの顧客のハザードが低いのは、もともと食材をたくさん使う、利用意欲の高い家庭が大容量プランを選んでいるからかもしれません。その場合、標準プランの顧客に大容量プランを勧めても、ハザードが0.77倍になるとは限りません。ハザードモデルの係数は「どこに差があるか」を示す地図であり、「どこを動かせば差が縮むか」は、施策として試して測る必要があります。
ハザード比を継続率と粗利に翻訳する
「チラシ経由のハザード比は3.6」と報告しても、経営の会議では「それで、いくら違うのか」が伝わりません。ハザード比は、継続率や粗利に翻訳して初めて判断の材料になります。Cox のモデルでは、説明変数 \( x \) を持つ顧客の継続率は、基準の顧客の継続率をハザード比で累乗した形になります。
\( S(t \mid x) = S_0(t)^{\,\exp(\beta x)} \)
言葉で言い換えると、「基準の顧客の継続率(1より小さい数)を、ハザード比の回数だけ掛け合わせたものが、その顧客の継続率」です。ハザード比が2なら継続率は基準の2乗、0.5なら平方根になります。statsmodels の PHReg の推定結果には、基準の顧客(説明変数がすべて0の顧客)の累積ハザードと継続率を返す baseline_cumulative_hazard があるので、これに説明変数の値を当てれば、任意の条件の顧客の継続率を計算できます。
上の式は、顧客の倍率が在籍月数によらず一定の場合の式です。ここでは、前の節で区間を分けたモデル(クーポンの効果が1〜3か月目と4か月目以降で違うもの)を使うので、上の式をそのままは使わず、基準の累積ハザードの1〜3か月目の月末までの増分には前半の倍率を、4か月目以降の増分には後半の倍率を掛けて足し合わせ、その合計から継続率を計算しました。このモデルで、標準プラン・世帯2人の顧客について、チャネルとクーポンの条件ごとに、12か月目と36か月目の継続率、36か月以内の期待在籍月数を計算しました。粗利は、継続率を足し合わせた期待在籍月数に、標準プランの月次粗利1,500円(架空)を掛けた概算です。割引も、37か月目以降も入れていないので、この記事で定義する LTV(60か月・年5%の割引)とは別の、要因の大きさを円で比べるための目安です。LTV の正しい計算は第9章で扱います。
| 獲得チャネル | 初回クーポン | S(12) | S(36) | 36か月以内の期待在籍月数 | 粗利の概算(円。1,500円×期待在籍月数) |
|---|---|---|---|---|---|
| 紹介 | なし | 0.818 | 0.616 | 27.6 | 41,447 |
| 紹介 | あり | 0.763 | 0.579 | 26.0 | 38,932 |
| 検索広告 | なし | 0.717 | 0.448 | 23.5 | 35,192 |
| 検索広告 | あり | 0.639 | 0.404 | 21.2 | 31,751 |
| SNS広告 | なし | 0.584 | 0.273 | 18.5 | 27,777 |
| SNS広告 | あり | 0.485 | 0.232 | 15.7 | 23,594 |
| チラシ | なし | 0.485 | 0.174 | 15.2 | 22,777 |
| チラシ | あり | 0.378 | 0.139 | 12.2 | 18,361 |
表の数値は、標準プラン・世帯2人の顧客について、区間を分けたモデルから計算した値です。
表の「S(12)」の列で、クーポンなしの紹介経由は0.818、チラシ経由は0.485です。ハザード比3.6倍は、「12か月目まで残る顧客が、紹介経由では10人中8人強、チラシ経由では10人中5人弱」という差に当たります。継続率が3.6分の1になるわけではない点に注意が要ります。36か月以内の期待在籍月数では27.6か月対15.2か月で約12か月、粗利の概算では41,447円対22,777円で約1.9万円の差です。獲得費用(第2章で設定した架空の値)は紹介2,000円、チラシ12,000円なので、チラシ経由の顧客は、獲得費用で1万円高く、36か月以内の粗利で約1.9万円少ない、という比べ方ができます。ただしこれは割引も37か月目以降も入れない概算どうしの比較で、桁の見当をつけるためのものです。獲得費用の上限の判断には、第9章の LTV を使います。
初回クーポンの差は、同じチャネルの中で見ると、S(12)で紹介0.055、検索広告0.078、SNS広告0.099、チラシ0.107の低下、粗利の概算では紹介で2,515円、検索広告で3,440円、SNS広告で4,182円、チラシで4,415円の減少でした。ハザード比は同じ(最初の3か月で約2倍)でも、今回の4チャネル・36か月の比較では、モデルの上では、もともとのハザードが高いチャネルほど、円で見た差は大きくなりました(第4章の観測した継続率の差は、人数が少ないこともあり、この順にはなっていません)。同じハザード比でも、どの集団に当てはまるかで経営上の重みが変わる、ということです。初回クーポンの是非を判断するときは、この減少分と、クーポンによって増えた獲得数の価値を比べる必要があります。クーポンが獲得数をどれだけ増やしたかは、このデータには入っていないので、この章では判断できません。
大容量プランについても同じ翻訳をしました。月次粗利を標準プランと同じ1,500円のままにして、ハザードだけを大容量プランのもの(ハザード比0.769)にすると、36か月以内の期待在籍月数は、紹介経由で1.69か月、検索広告で2.32か月、SNS広告で2.81か月、チラシで2.94か月延びます。ここでも、この4チャネルの比較では、ハザードの高いチャネルほど同じハザード比の効き目が大きくなりました。ただし前の節で述べたとおり、これは「大容量プランの顧客はハザードが低い」という関係を当てはめた計算で、標準プランの顧客に大容量プランを勧めたときに在籍がこれだけ延びることを示すものではありません。
この翻訳の数字は、モデルの仮定を通した計算である点にも注意が要ります。クーポンなし・標準プラン・世帯2人・紹介経由という条件にちょうど当てはまる452人だけでカプラン・マイヤー推定をすると、S(12)は0.860で、モデルから計算した0.818より0.04高く出ました。452人では推定のばらつきも大きく、モデルの比例の仮定(チャネル・プラン・世帯人数の効果が在籍月数によらず一定)が完全には成り立っていない分も混ざりえます。モデルからの翻訳は、要因の大きさを円の桁で比べるための目安として使い、予算の上限のような数字を決めるときは、第9章の方法で LTV を計算し直すのがよいと考えています。
経営の判断に翻訳する:要因の「大きさ」と「動かせるか」を分ける
ハザードモデルの結果を施策の候補に落とすときは、要因ごとに、ハザードとの関係の大きさと、会社がその要因を動かせるかどうかを分けて整理することが有効だと考えています。大きいが動かせない要因に施策の予算は使えず、動かせるが小さい要因に大きな予算を使っても成果は限られます。共通データの結果を、この2つの軸で整理したのが次の表です。
| 要因 | ハザードとの関係の大きさ(この例) | 会社が動かせるか | 施策の候補 | 効果の確かめ方 |
|---|---|---|---|---|
| 獲得チャネル | チラシは紹介の約3.6倍(利用状況を入れない Cox) | 在籍中の顧客のチャネルは変えられない。これからの獲得の配分は変えられる | 獲得予算の配分を LTV÷CAC で見直す | チャネル別の LTV と回収月数(第9章) |
| 初回クーポン | 最初の3か月だけ約2倍、4か月目以降は差がはっきりしない | クーポンの条件・対象・期間は変えられる | クーポン利用者への最初の3か月の接点、クーポンの条件の見直し | 無作為に分けた実験(第12章) |
| プラン | 大容量は標準の約0.77倍 | 勧めることはできるが、選んだ人の性質の差が混ざりうる | プランの提案 | 実験。提案を受けた群と受けない群を比べる |
| 世帯人数 | 利用状況を入れると、信頼区間が0を含み差を見分けられない | 動かせない | なし(対象を選ぶ手がかりに留める) | (該当なし) |
| 注文回数・問い合わせ | 注文が少ない月・問い合わせのある月は解約しやすい(オッズ比1.6〜1.7) | 回数を直接動かしても、背後の不満や利用意欲が変わるとは限らない | 解約の兆しとして早く見つけ、事情を聞く | 予測(第7章)と、施策の実験(第8章・第12章) |
表の「会社が動かせるか」の列で、獲得チャネルは「在籍中の顧客には動かせないが、これからの獲得には動かせる」要因です。この章の結果で最も大きな金額の差を生んでいたのは獲得チャネルでしたが、在籍中の顧客について、この差そのものを引き止め施策で動かすことはできず、この差を使える判断は、これからの獲得予算の配分です。ただし、チャネルの差には、チャネルそのものの違いだけでなく、そのチャネルで集まる客層の違いが混ざりえます。また、この章では引き止め施策の効果を測っていないので、獲得の配分と引き止め施策のどちらが在籍の長さに効くかを比べることはできません。逆に、初回クーポンのように会社が設計を変えられる要因は、ハザードとの関係が期間限定でも、施策の候補として、実験で効果を確かめる対象に優先して選ぶ価値があります(クーポンをやめる・変えると決める根拠ではありません)。
判断を誤ったときの損失の型も2つ挙げておきます。1つ目は、比例ハザードの仮定を確かめずに1つのハザード比で報告することです。初回クーポンを「ずっと1.3倍」と報告すると、クーポン利用者への手当てを加入後の全期間に薄く広げることになり、本当に解約が集中している最初の3か月の手当てが手薄になります。2つ目は、利用状況の係数を施策の効果と読み違えることです。「問い合わせ1回でオッズ比1.6」を根拠に問い合わせを減らす施策に予算を付けても、解約が減る保証はありません。ハザードモデルは、施策の候補を絞り込み、実験で確かめる対象の優先順位を付けるための道具として使うのが、費用に見合った使い方だと考えています。回帰モデルの解釈と、説明変数の選び方の一般論は、弊社コラム「ビジネスの要因分析に効く回帰分析と統計モデリングについて」で扱っています。
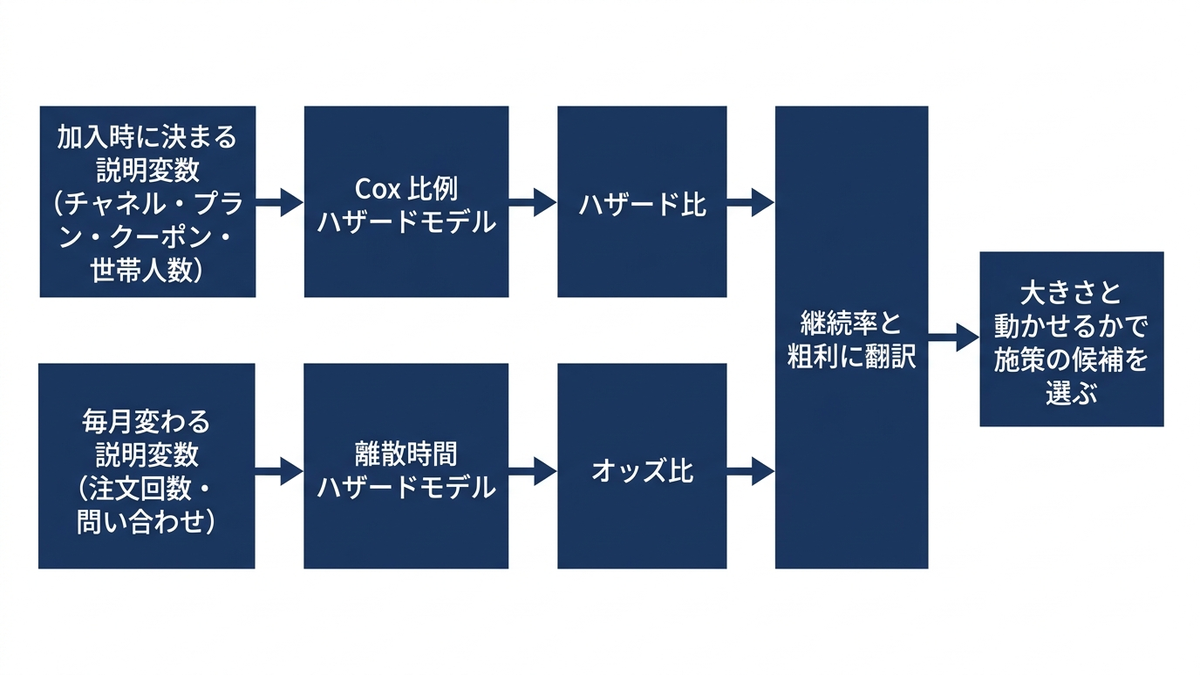
この章の要点は3つです。第一に、Cox 比例ハザードモデルは、在籍月数とともに変わる基準のハザードの形を決めずに、説明変数ごとのハザード比を推定でき、共通データではチラシ経由のハザードが紹介経由の約3.6倍、大容量プランが標準プランの約0.77倍と推定されました。ただし、初回クーポンのように効果が期間で変わる要因では比例ハザードの仮定が崩れ、全期間のハザード比1.30は「最初の3か月の約2倍」と「その後のはっきりしない差」を1つの倍率で要約した値になってしまうので、区間で分けるか、時間で変わる効果として扱う必要があります。第二に、顧客月のデータにロジスティック回帰を当てる離散時間ハザードモデルは、毎月変わる利用状況まで入れられ、真のモデルと同じ形で推定すると、9つの係数すべてで真の値が95%信頼区間に入りました。利用状況を入れるかどうかでチャネルの係数は変わり、どちらを使うかは、獲得の評価か在籍中の顧客への施策かという問いで決まります。第三に、利用状況の係数は相関であって施策の効果ではなく、ハザード比は継続率と粗利に翻訳し、「大きさ」と「動かせるか」で分けて施策の候補に落とします。次の第7章では、この章で要因として見た在籍月数・注文回数・問い合わせなどを特徴量にして、在籍中の顧客の3か月解約確率を予測するモデルを、スナップショットの設計と評価の指標から扱います。
この章を深めたい方への参考書籍
『エモリー大学クラインバウム教授の生存時間解析 基礎から学べる教科書』(David G. Kleinbaum・Mitchel Klein 著、神田英一郎・藤井朋子 訳、サイエンティスト社):生存時間解析を独習できるように書かれた教科書の原著第3版の翻訳です。原著の目次には、Cox 比例ハザードモデルとその性質、比例ハザードの仮定の評価、時間依存の説明変数への Cox のモデルの拡張の章があり、この章で扱ったハザード比の読み方、初回クーポンのように仮定が崩れる場合の確かめ方と対処を、順を追って学び直すのに向いています。
『イベント・ヒストリー分析』(Paul D. Allison 著、福田亘孝 訳、共立出版):社会科学の計量分析の叢書「計量分析One Point」の1冊で、原著第2版の翻訳です。原著の目次には、離散時間の手法、連続時間のデータのためのパラメトリックな手法、Cox 回帰、複数の種類のイベント、繰り返し起きるイベントの章が並んでいます。この章の離散時間ハザードモデル(顧客月のデータにロジスティック回帰を当てる方法)を Cox のモデルと並べて位置づけ直すのに向いています。本文で触れた1982年の論文の著者による本です。
第7章 解約を予測する、機械学習モデルの設計と評価
第6章では、離散時間ハザードモデルで解約の要因を推定し、チャネル・プラン・初回クーポン・その月の注文回数や問い合わせ回数が、解約のしやすさにどれだけ効いているかを確かめました。要因が分かれば、次に知りたくなるのは「来月から先、どの顧客が解約しそうか」です。この章では、第2章で用意したサンプルデータ(架空の家庭向け食材宅配の定期便)を使い、ある月の月末に在籍している顧客について、その先3か月のうちに解約するかどうかを予測するモデルを作ります。扱うのは、学習用のデータの作り方(スナップショット)、特徴量の作り方、学習と検証を時間で分ける理由、ロジスティック回帰と LightGBM の比較、評価の指標(AUC・AP(平均適合率)・上位の解約率とリフト・較正)、そして予測を誤って良く見せてしまう2つの落とし穴(未来の情報の混入と、時間で分けない検証)です。サンプルデータは乱数で作った架空のものなので、データを作った側は、顧客ごとの本当の解約しやすさ(真の値)を知っています。この真の値を使って、隠れた状態まで知る真のモデルの確率で顧客を並べた場合の AUC とも比べます。予測した確率を、誰にいくらの施策を打つかという判断に変える計算は第8章で扱います。
スナップショットで「誰の、いつの、何を」当てるかを決める
解約予測のモデルを作るとき、最初に決めるのはアルゴリズムではなく、予測の問いの形です。「解約しそうな顧客を当てる」と言っても、誰について、どの時点で、どの期間の解約を当てるのかが決まっていなければ、学習用のデータが作れません。この記事では、問いを次のように固定しました。「第 t か月の月末に在籍している顧客について、第 t か月までの記録だけを使い、第 t+1〜t+3 か月のどこかの月末に解約するかどうかを当てる」。当てる対象は、第2章で定義した3か月解約確率です。この「ある月の月末で時間を止めて、その時点の在籍者の姿を写し取る」作り方をスナップショットと呼びます。t を観測月、t 以前の記録を使う期間を特徴量の窓、t+1〜t+3 を予測の窓と呼ぶことにします。
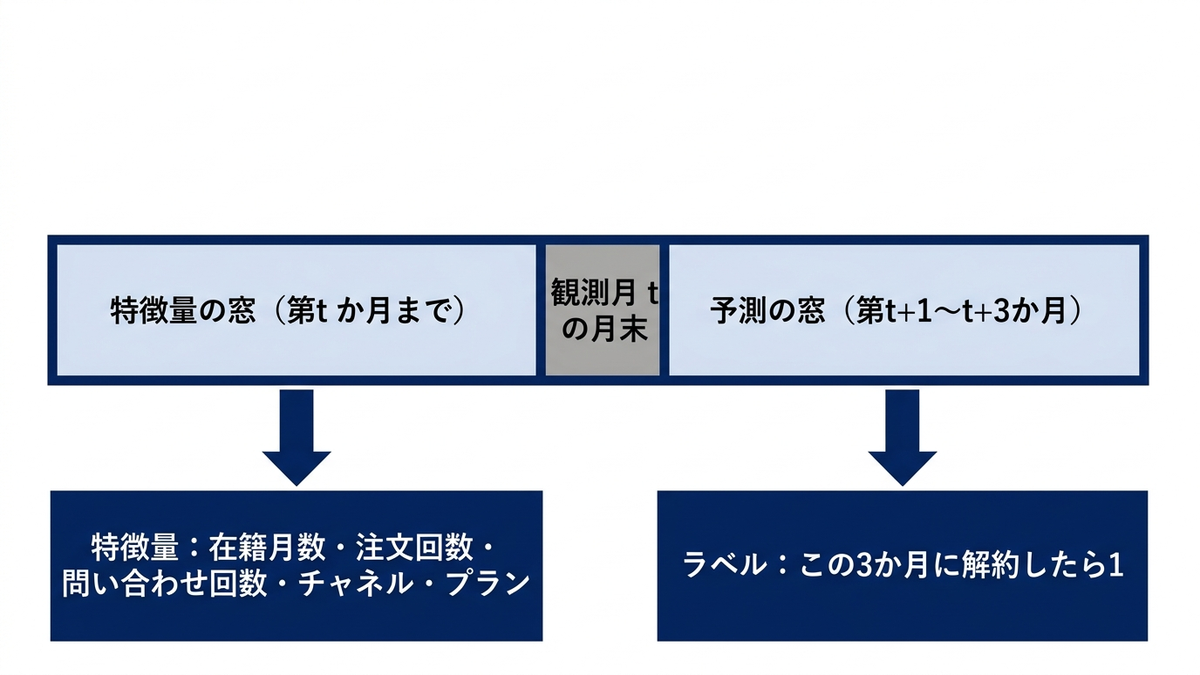
スナップショットを1か月分だけ作ると、学習に使える行は、その月末の在籍者の人数分しかありません。そこで、観測月 t をずらしながら何か月分も作り、縦に積み上げます。同じ顧客が第10か月末にも第11か月末にも在籍していれば、その顧客は2つの行として現れます。行ごとに「その時点での在籍月数」や「その時点までの注文回数」が違うので、モデルは「在籍5か月で注文が減ってきた人」と「在籍20か月で注文が安定している人」の違いを、同じ顧客の別の時点からも学ぶことができます。
この作り方の利点は、学習のときと、実際に予測を使うときの条件がそろうことです。実務では、毎月の月末に、その時点の在籍者全員に予測を出し、翌月の施策の対象を選びます。スナップショットは、その月末の作業を過去の各月について再現したものなので、学習用のデータの1行と、本番で予測する1行が、同じ定義で作られます。逆に、顧客1人を1行にまとめ、「最終的に解約したか」をラベルにしてしまうと、加入して2か月の人と30か月の人を同じ土俵で比べることになり、在籍が長い人ほど解約の機会が多いという、予測したいこととは関係のない差を学んでしまいます。また、打ち切りの顧客(観測の終わりにまだ在籍している人。第5章)の「解約していない」が、本当に解約しない人なのか、まだ解約していないだけの人なのかが区別できません。スナップショットは、ラベルを「t+1〜t+3 の3か月に解約したか」という、観測の終わりまでに必ず答えが出る問いにすることで、この問題を避けています。
第2章で紹介した補助モジュール(baseline.py)の build_snapshots は、この作り方を実装しています。次のコードは、その関数から、在籍者の選び方・特徴量・ラベルの要所を抜き出したものです(チャネルの0か1かの列を作る部分などは省略しました)。
def build_snapshots(cust, monthly, months, horizon=3):
    piv_o = monthly.pivot(index='cust_id', columns='month', values='orders')
    piv_s = monthly.pivot(index='cust_id', columns='month', values='support')
    rows = []
    for t in months:
        # t 月末に在籍している顧客(t 月までに加入し、t 月より後に解約するか、まだ解約していない)
        act = cust[(cust['acq_month'] <= t) & ((cust['churn_month'] == 0) | (cust['churn_month'] > t))]
        ids = act['cust_id'].values
        o, s = piv_o.loc[ids], piv_s.loc[ids]
        cols3 = [m for m in (t - 2, t - 1, t) if m in o.columns]      # 直近3か月(t を含む)
        prev = [m for m in (t - 3, t - 2, t - 1) if m in o.columns]   # 1か月前にずらした3か月
        f = pd.DataFrame({'cust_id': ids, 'snapshot': t})
        f['tenure'] = t - act['acq_month'].values + 1                 # 在籍月数
        f['orders_last'] = o[t].values                                # t 月の注文回数
        f['orders_3m'] = o[cols3].mean(axis=1).values                 # 直近3か月の平均
        f['support_3m'] = s[cols3].sum(axis=1).values                 # 直近3か月の問い合わせ
        f['orders_trend'] = (o[t] - o[prev].mean(axis=1)).fillna(0).values
        f['zero_months_3m'] = (o[cols3] == 0).sum(axis=1).values      # 注文0の月数
        # (plan_large・coupon・household・チャネルの列は省略)
        cm = act['churn_month'].values
        f['label'] = ((cm > t) & (cm <= t + horizon)).astype(int)   # t+1〜t+3 に解約したら1
        rows.append(f)
    return pd.concat(rows, ignore_index=True)
要点は3つあります。1つ目は、在籍者の選び方です。churn_month は最後に料金を払った月(その月末に解約)なので、「churn_month が0(観測内に解約していない)か、t より後」の人が、t 月末にまだ在籍している人です。t 月末に解約した人は、t 月の料金は払っていますが、t+1 か月には在籍しないので、この時点の予測の対象から外れます。2つ目は、特徴量がすべて t 月以前の列(t - 3 から t まで)から作られていることです。t+1 か月以降の列には一度も触れていません。3つ目は、ラベルが「解約した月が t+1 以上 t+3 以下」で決まることです。t+3 が観測の最後の月(第36か月)を超えなければ、在籍者全員について、ラベルの答えが観測の中で確定します。
この関数で、学習用に観測月 t=6〜27 の22か月分、検証用に t=30 の1か月分を作りました。学習用は101,103行(顧客の数では9,674人)で、t=6 の2,055行から t=27 の6,833行まで、加入者が積み上がるにつれて1か月あたりの行数が増えます。検証用は第30か月末の在籍者7,324行です。ラベルが1の行の割合(正例率)は、学習用が0.0794、検証用が0.0745でした。在籍者のうち、その先3か月で解約するのは13〜14人に1人ということです。学習の101,103行は、9,674人の顧客を時点を変えて繰り返し観測したもので(1人あたり平均10.45行)、互いに独立な101,103人分の情報ではありません。検証の7,324人のうち6,295人(86.0%)は、学習にも別の時点で出てくる顧客です。この章の評価は、新しく現れる顧客ではなく、すでにいる顧客を将来の時点で予測する力を測るものです。
| 区分 | 観測月 t | 特徴量の窓 | 予測の窓(ラベル) | 行数 | 正例率 |
|---|---|---|---|---|---|
| 学習 | 第6〜27か月(22か月分) | 各 t の第 t-3〜t か月 | 各 t の第 t+1〜t+3 か月(最も遅いもので第28〜30か月) | 101,103 | 0.0794 |
| 検証 | 第30か月 | 第27〜30か月 | 第31〜33か月 | 7,324 | 0.0745 |
観測月の始まりを第6か月に置いたのは、記事全体の基準の計算に合わせたものです。データは第1か月から始まるので、早い月の月末には加入して間もない顧客しかおらず、第6か月末でも在籍者は2,055人です。第6か月であれば、第1か月に加入した顧客について、直近3か月とその1か月前にずらした3か月の記録がそろいます。なお、在籍月数が3か月に満たない顧客も、t=6 以降のスナップショットには含まれます。その場合の「直近3か月」は、加入してからの月だけで計算されます(加入前の月は記録が無く、平均や合計から外れます)。
特徴量は観測月までの記録だけで作る
特徴量は、モデルに渡す「その顧客のその時点の姿」を表す列です。補助モジュールの FEATURES は、次の13列を使っています。大きく分けると、時間とともに変わる利用の記録(在籍月数・注文回数・問い合わせ回数)と、加入時に決まって変わらない属性(プラン・初回クーポン・世帯人数・獲得チャネル)の2種類です。
| 列名 | 中身 | 種類 | 検証(t=30)の平均 |
|---|---|---|---|
tenure | 在籍月数(t 月が何か月目の在籍か) | 利用の記録 | 13.939 |
orders_last | t 月の注文回数(0〜4回) | 利用の記録 | 2.173 |
orders_3m | 第 t-2〜t か月の注文回数の平均 | 利用の記録 | 2.194 |
support_3m | 第 t-2〜t か月の問い合わせ回数の合計 | 利用の記録 | 0.470 |
orders_trend | t 月の注文回数から、第 t-3〜t-1 か月の平均を引いた値(傾き) | 利用の記録 | -0.045 |
zero_months_3m | 第 t-2〜t か月のうち注文が0回だった月の数 | 利用の記録 | 0.412 |
plan_large | 大容量プランなら1 | 固定の属性 | (省略) |
coupon | 初回クーポンを使って加入したら1 | 固定の属性 | (省略) |
household | 世帯人数(1〜4) | 固定の属性 | (省略) |
ch_referral ほか3列 | 獲得チャネル(紹介・検索広告・SNS広告・チラシ)のどれかなら1 | 固定の属性 | (省略) |
この選び方は、第6章で確かめた真のモデルの形をなぞっています。サンプルデータの真の解約ハザードは、チャネル・プラン・初回クーポン(在籍3か月以内だけ)・在籍月数の対数・その月の注文回数(2回を下回った分)・その月の問い合わせ回数で決まります。ただし、真のモデルが使っている「その月の注文回数」は、解約するかどうかが決まる、まさにその月の値です。予測の窓は t+1〜t+3 なので、予測する時点では、その3か月の注文回数はまだ分かりません。分かっているのは t 月までの注文回数だけで、モデルはそこから「この人の注文回数はこの先も少なそうか」を推し量るしかありません。サンプルデータの注文回数は、表には出てこない「利用意欲」(毎月少しずつ揺れ動く、隠れた値)で決まっています。直近3か月の平均や傾きは、この隠れた利用意欲を外から推し量るための手がかりです。
現実のデータでは、ログインの回数、配送の日時の変更、支払いの失敗、商品の評価、問い合わせの内容の種類など、ほかの記録も候補になります。何を足すかを考えるときの物差しは、「その記録は、観測月の月末の時点で、本当に手元にあるか」です。たとえば、月末の締め処理が翌月に入ってから終わる請求データや、問い合わせの対応が終わってから付く「解約の申し出」のような区分は、記録の日付が月内でも、月末の時点ではまだ確定していないことがあります。第3章で扱った特徴量の時点の問題は、ここで具体的な形になります。この章の後半では、未来の情報を1列だけ混ぜたときに予測がどう見えるかを実測します。
学習と検証を時間で分ける
モデルの良し悪しは、学習に使わなかったデータで測ります。この章では、学習に観測月 t=6〜27、検証に t=30 を使い、学習と検証を時間で分けました。t=28 と t=29 を使わず、学習の最後を t=27 で止めているのには理由があります。第30か月の月末にモデルを作る場面を考えると、その時点で答え(ラベル)が確定しているのは、予測の窓 t+1〜t+3 が第30か月までに収まるスナップショット、つまり t=27 までです。t=28 のスナップショットのラベルは第29〜31か月の解約で、第31か月の分は第30か月末にはまだ分かりません。学習を t=27 で止めることで、「第30か月の月末に、その時点で手に入るデータだけで作ったモデルが、その先3か月をどれだけ当てるか」という、実際の運用と同じ条件で検証できます。
時間で分けるもう1つの理由は、顧客の構成や行動が時間とともに変わることです。第4章で見たとおり、サンプルデータでは加入時期が後になるほど、紹介チャネルの割合が下がり、チラシの割合が上がっています。現実には、サービスの改定・価格の変更・競合の動き・季節によって、解約のしやすさそのものが変わることもあります。行を無作為に学習と検証に分けると、検証の行と同じ時期の行が学習にも入るので、「未来の時期の傾向を学んだうえで、その時期を当てる」形になり、本番よりも良い数字が出やすくなります。この差がサンプルデータでどの程度になるかは、この章の後半で実測します。
実務では、検証を1つの月だけで行うと、その月にたまたま起きたことに結果が左右されます。モデルを作り直すたびに、学習の終わりを1か月ずつずらして何回か検証し、指標のばらつきを見ておくと安心です。スナップショットの学習と検証は、この章のように観測月 t の値で区切るのが分かりやすいと考えています。時系列のデータで学習と検証を時間の順に分ける考え方は、ライブラリの機能としても用意されています。scikit-learn の TimeSeriesSplit は、公式ドキュメントによれば、時間の順に並んだデータで「未来のデータで学習して過去のデータで評価する」ことを避けるための分け方で、学習の終わりと検証の始まりの間に空ける行数を gap で指定できます。ただし、この関数は行が等しい時間間隔で並んでいることを前提にしていて、gap も行の数で数えます。スナップショットは月ごとの行数が違い、同じ月に何千行も並ぶので、この関数の行数の指定をそのまま使うより、観測月 t の値で区切り、ラベルの窓の長さ(この章では3か月)だけ学習の終わりと検証の始まりの間を空けるほうが、間違いが起きにくいと考えています。
2つのモデルを学習し、正答率ではなく AUC で比べる
補助モジュールの fit_models は、同じ学習用のデータで2つのモデルを学習します。1つはロジスティック回帰です。特徴量を標準化(平均0・標準偏差1にそろえる処理)してから、scikit-learn の LogisticRegression で、解約する確率のロジット(確率を「起きる確率÷起きない確率」の対数に直した値)を特徴量の重み付きの和で表します。第6章の離散時間ハザードモデルと同じ形の式で、係数の向きと大きさを読むことができます。ただし、ここでの係数は過去3か月の記録から将来の解約を当てるための重みで、解約の原因の強さを表すものではありません。もう1つは LightGBM です。決定木(特徴量の値で「はい・いいえ」の分岐を繰り返して予測する木)をたくさん作り、前の木が外した分を次の木が補うように足し合わせる、勾配ブースティングと呼ばれる方法の実装の1つで、特徴量どうしの組み合わせや、直線では表せない関係を自動的に拾えるのが特徴です。設定は、木の数300・学習率0.03・葉の数の上限15・葉ごとの最小の行数50などです。
次のコードは、補助モジュール(cust_data.py と baseline.py)と同じフォルダに置いて実行する形です。スナップショットを作り、2つのモデルを学習し、検証の t=30 について指標を出します。
import numpy as np
from sklearn.metrics import roc_auc_score, average_precision_score, accuracy_score
import cust_data as cd
import baseline as bl

cust, monthly = cd.make_subscription()
train = bl.build_snapshots(cust, monthly, range(6, 28))   # 学習 t=6〜27
test = bl.build_snapshots(cust, monthly, [30])            # 検証 t=30
print("学習 %d行 正例率 %.4f / 検証 %d行 正例率 %.4f"
      % (len(train), train["label"].mean(), len(test), test["label"].mean()))
models, X_te, y_te = bl.fit_models(train, test)
print("全員を「解約しない」とした正答率 %.4f" % accuracy_score(y_te, np.zeros_like(y_te)))
for name, m in models.items():
    p = m.predict_proba(X_te)[:, 1]
    lift, top, n = bl.lift_at(y_te, p, 0.10)
    print("%-6s AUC %.3f AP %.3f 上位10%%(%d人)の解約率 %.3f リフト %.2f"
          % (name, roc_auc_score(y_te, p), average_precision_score(y_te, p), n, top, lift))
# 出力:
# 学習 101103行 正例率 0.0794 / 検証 7324行 正例率 0.0745
# 全員を「解約しない」とした正答率 0.9255
# logit  AUC 0.674 AP 0.146 上位10%(733人)の解約率 0.192 リフト 2.58
# lgbm   AUC 0.674 AP 0.140 上位10%(733人)の解約率 0.177 リフト 2.38
出力の2行目が、正答率(予測が当たった行の割合)を使わない理由です。検証の7,324人のうち、その先3か月に解約したのは546人(7.45%)だけなので、モデルを作らずに全員を「解約しない」と予測しても、正答率は92.55%になります。実際、2つのモデルが出した解約の確率は、最も高い人でもロジスティック回帰で0.311、LightGBM で0.494で、確率0.5を境に「解約する・しない」に分けると、どちらのモデルも全員を「解約しない」と判定し、正答率は同じ92.55%でした。正答率は、解約する人を1人も見つけていないモデルと、何も考えずに全員を「解約しない」とした場合とを区別できません。正例(この章では解約)がまれな問題を不均衡なデータと呼び、不均衡なデータでは正答率は評価に向きません。不均衡なデータの扱い全般は、弊社コラム「機械学習の仕組みと使いどころ」で扱っています。
代わりに使うのが AUC です。AUC は、ROC 曲線(判定の境目を動かしたときの、解約した人を正しく拾えた割合と、解約しなかった人を誤って拾った割合の関係を描いた曲線)の下の面積で、「解約した人と解約しなかった人を1人ずつ無作為に選んだとき、解約した人のほうに高い確率を付けている割合」と言い換えられます。0.5なら当てずっぽうと同じ、1.0なら全員を完全に並べ分けられる状態です。AUC は境目の位置に左右されず、正例率が低くても全員「解約しない」のような予測を高く評価しません。この例では、ロジスティック回帰も LightGBM も AUC 0.674 で、解約した人と解約しなかった人の組のうち、約67%の組で解約した人のほうに高い確率を付けていることになります。
AP(平均適合率)は、scikit-learn の average_precision_score が計算する値で、PR 曲線(適合率と再現率の関係を描いた曲線)の下の面積の近似です。PR-AUC と呼ばれることもありますが、台形で面積を求める計算とは異なるので、この記事では AP と書きます。AP は、予測の高い順に顧客を拾っていったときの「拾った人のうち本当に解約した人の割合(適合率)」を、解約した人を拾い切るまで平均した値です。何も分からずに選んだときの値は、おおよそ正例率になります。この例で、検証の7,324人に無作為な順位を付けて AP を計算することを200回繰り返すと、平均は0.0755で、正例率0.0745とほぼ同じでした。AUC と違って「0.5が当てずっぽう」という決まった目安は無く、当てずっぽうの水準は正例率によって変わります。この例の AP はロジスティック回帰が0.146、LightGBM が0.140で、正例率の約2倍です。AP は、解約する人がまれなときに、上位の顧客の当たり具合をより強く反映します。
2つのモデルの AUC は小数第3位まで同じで、上位10%の解約率ではロジスティック回帰のほうが高くなりました。この例では、勾配ブースティングにしても予測は良くなっていません。この章では原因を切り分けていませんが、事実として、サンプルデータの真のモデルは、ロジスティック回帰と同じ「重み付きの和をシグモイド関数(任意の値を0〜1の確率に変える関数)に通す」形で作られています。現実のデータで同じ結果になるとは限りません。モデルを選ぶときは、どちらか一方に決めてかかるのではなく、両方を同じ検証で比べ、差が小さければ、係数を読めて説明しやすいロジスティック回帰を残すという判断も十分にありえます。
上位 k% の解約率とリフト:施策の対象を選ぶ場面の指標
AUC は全員の並べ方の良さを1つの数字にまとめた指標ですが、施策の現場で知りたいのは、もっと具体的なことです。「予測の高い順に上位10%を選んで引き止めの連絡をしたら、そのうち何人が本当に解約しそうな人なのか」。これに直接答えるのが、上位 k% の解約率とリフトです。リフトは、第2章で定義したとおり、予測上位 k% の解約率を全体の解約率で割った値で、「無作為に選んだ場合の何倍、解約しそうな人を集められたか」を表します。補助モジュールの lift_at は、予測の高い順に上位 k% の人数(端数は切り上げ)を選び、その人たちの実際の解約率とリフトを返します。
次の表は、検証の t=30 で、k を5%から50%まで変えて計算したものです。「真の確率」の行は、データを作った側だけが知る、隠れた利用意欲まで使った真のモデルで、3か月の先を300回シミュレーションして出した、顧客ごとの3か月解約確率です。現実には手に入らない、答え合わせのための参考の行です。「拾えた解約者の割合」は、検証の解約者546人のうち、上位 k% に入っていた人の割合です。
| 上位 k% | 人数 | 解約率 ロジスティック回帰 | 解約率 LightGBM | 解約率 真の確率 | リフト ロジスティック回帰 | リフト LightGBM | 拾えた解約者の割合 LightGBM |
|---|---|---|---|---|---|---|---|
| 5% | 367 | 0.207 | 0.196 | 0.218 | 2.78 | 2.63 | 13.2% |
| 10% | 733 | 0.192 | 0.177 | 0.196 | 2.58 | 2.38 | 23.8% |
| 20% | 1,465 | 0.155 | 0.146 | 0.156 | 2.08 | 1.96 | 39.2% |
| 30% | 2,198 | 0.131 | 0.135 | 0.136 | 1.76 | 1.81 | 54.4% |
| 50% | 3,662 | 0.108 | 0.109 | 0.108 | 1.45 | 1.46 | 73.1% |
表の「解約率 LightGBM」の列で上位10%を見ると、選んだ733人の3か月解約率は0.177で、全体の0.0745の2.38倍です。無作為に733人を選べば約55人しか解約者が含まれないところ、モデルで選べば130人が含まれます。一方、「拾えた解約者の割合」の列が示すとおり、上位10%に入っていたのは解約者546人のうち23.8%だけで、上位50%まで広げても73.1%です。予測の上位だけを見ていると、解約者の多くを取りこぼすことになります。逆に言えば、上位10%に選んだ733人のうち、82%余りの人は、施策が無くても3か月は解約しません。この数字は、第8章で施策の費用対効果を考えるときの出発点になります。
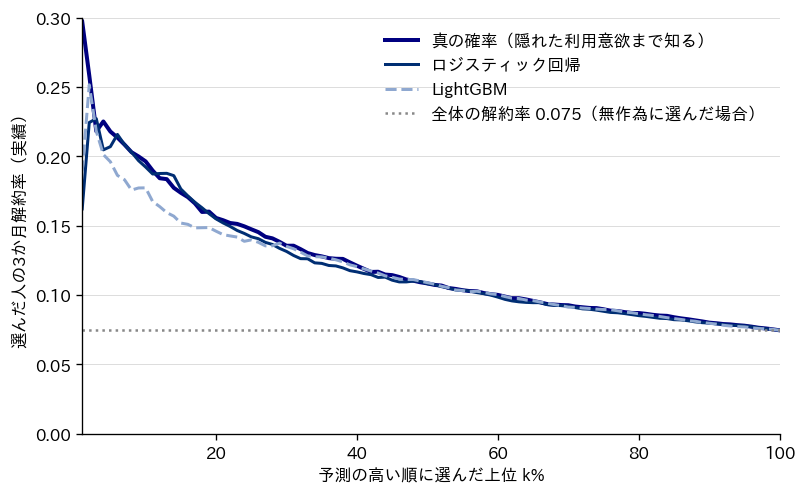
図は、k を1%刻みで100%まで動かしたときの上位 k% の解約率です。3本の線は、ほとんど重なっています。上位の数%では線が大きく上下していますが、これは選んだ人数が数十人と少なく、偶然の当たり外れが大きく出るためです。表の上位5%と10%の行では、真の確率で選んだ場合(0.218、0.196)がロジスティック回帰(0.207、0.192)を上回りますが、差は0.01前後です。上位50%の行では、LightGBM(0.109)が真の確率(0.108)をわずかに上回っています。ラベルを引き直して平均で比べると真の確率のほうが良い並べ方になりますが(次の節で確かめます)、1回の検証では、モデルのほうが上に出ることもあります。7,324人・解約者546人という規模の検証では、指標の小数第2位の差には、偶然のばらつきが大きく混じっているということです。2つのモデルのリフトの差(上位10%で2.58と2.38)も、どちらかが確実に優れていると読むことはできません。検証の顧客を復元抽出(同じ人数を、重なりを許して選び直すこと)して両方のモデルを同じ顔ぶれで測り直すことを200回繰り返すと、上位10%のリフトの差は、中央の95%が -0.02〜0.44 の範囲に散らばり、0をまたぎました。
較正:予測確率をそのまま確率として使えるか
AUC とリフトは、顧客の並べ方の良さを測る指標です。並べ方が正しければ、予測確率の値そのものが2倍に膨らんでいても AUC は変わりません。しかし、第8章で扱う施策の期待値の計算では、「この人が3か月以内に解約する確率は0.18」という値そのものを掛け算に使います。予測確率が実際の解約の起きやすさと合っているかどうかを、較正(キャリブレーション)と呼びます。較正が取れているモデルでは、「予測確率が0.18前後の人を集めると、実際に約18%が解約する」という関係が成り立ちます。
補助モジュールの calibration は、予測確率の大きさで検証の顧客を10等分し(10分位)、それぞれの組で予測確率の平均と実際の解約率を並べます。scikit-learn にも、同じ考え方の calibration_curve が用意されています。
| 10分位(予測の低い順) | 人数 | 予測の平均 ロジスティック回帰 | 実際の解約率 ロジスティック回帰 | 予測の平均 LightGBM | 実際の解約率 LightGBM |
|---|---|---|---|---|---|
| 1 | 733 | 0.017 | 0.027 | 0.018 | 0.030 |
| 2 | 732 | 0.026 | 0.037 | 0.028 | 0.023 |
| 3 | 733(LightGBM は732) | 0.034 | 0.037 | 0.039 | 0.053 |
| 4 | 732(LightGBM は733) | 0.042 | 0.053 | 0.049 | 0.037 |
| 5 | 732 | 0.051 | 0.051 | 0.058 | 0.057 |
| 6 | 733(LightGBM は732) | 0.061 | 0.074 | 0.068 | 0.063 |
| 7 | 732(LightGBM は733) | 0.075 | 0.072 | 0.081 | 0.076 |
| 8 | 732 | 0.093 | 0.085 | 0.097 | 0.113 |
| 9 | 732 | 0.119 | 0.117 | 0.121 | 0.115 |
| 10 | 733 | 0.174 | 0.192 | 0.184 | 0.177 |
表の LightGBM の列を見ると、予測の平均が0.018の最も低い組では実際の解約率が0.030、予測の平均が0.184の最も高い組では0.177でした。予測の低い組から高い組へ、実際の解約率もおおむね同じ順に上がっています。ずれが偶然の範囲かどうかを見るため、組ごとに「実績から予測を引いた値」を、予測どおりに解約が起きるとしたときの標準誤差(二項分布のばらつき。約730人の組で、予測0.02なら約0.005、予測0.18なら約0.014)で割りました。この値の絶対値が約2を超える組は、偶然だけでは起きにくいずれと見るのが一つの目安です。10組を1組ずつ見る探索のための目安で、厳密な検定ではありません。予測の高い側の6組(表の5〜10)では、この値は2つのモデルとも -0.8〜1.5 の範囲で、この近似的な点検では、はっきりしたずれは見つかりませんでした。一方、最も低い組では、実績が予測の約1.6倍(ロジスティック回帰)・約1.7倍(LightGBM)で、この値は2.1・2.5でした。ロジスティック回帰では予測の低い側の4組すべてで実績が予測を上回り、LightGBM では上回る組と下回る組が混ざっています(3番目に低い組も、この値が2.0でした)。この例の2つのモデルは、確率の高い側ではおおむね較正が取れていますが、確率の低い側、とくに最も低い組では、解約のしやすさが小さめに出ている、というのが実測から言えることです。全体で見ると、検証の予測確率の平均はロジスティック回帰が0.0694、LightGBM が0.0742で、実際の正例率0.0745に近い値です。第8章のように確率の値を掛け算に使うとき、予測の低い顧客については、確率を小さめに見積もっている可能性を含めて読む必要があります。
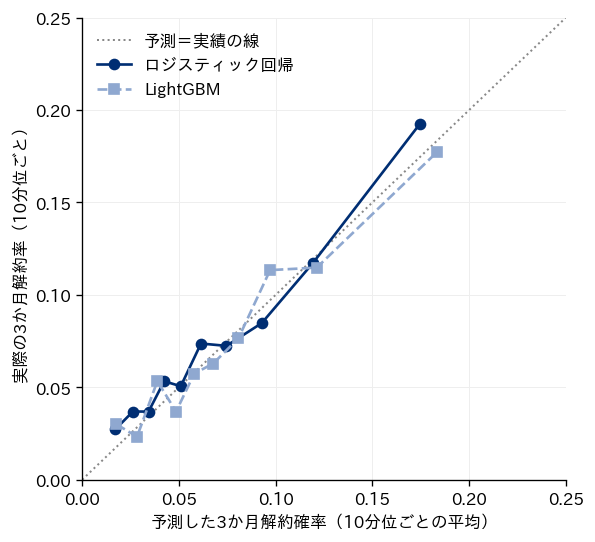
予測確率のずれを、1つの数字で測る指標もあります。ブライアスコアは、各顧客の予測確率と、実際の結果(解約なら1、しなければ0)の差の2乗を平均したもので、小さいほど良い指標です。確率の予測の総合的な誤差を測るもので、較正のずれだけでなく、顧客を並べ分ける力も反映するので、ブライアスコアが小さいことだけでは較正が良いとは言えません(scikit-learn の較正の解説も、この点を注意しています)。この例では、ロジスティック回帰が0.0668、LightGBM が0.0672でした。比べる基準として、全員に同じ確率0.0745(正例率)を出した場合のブライアスコアを計算すると0.0690です。モデルは全員一律の確率よりは良い値ですが、その差は小数第3位に現れる程度です。全員一律の確率のブライアスコアは「正例率×(1から正例率を引いた値)」で決まるので、正例率が低い問題ではもともと小さな値になります。ブライアスコアを見るときは、値そのものではなく、この全員一律の場合と比べてどれだけ下がったかを見る必要があります。この例の2つのモデルの差(0.0668と0.0672)は、どちらを選ぶかの根拠にするには小さすぎます。
較正が崩れる典型的な場面が、不均衡なデータへの対処として、正例に重みを付けて学習する場合です。scikit-learn の LogisticRegression には、正例と負例の数の比に応じて自動で重みを付ける class_weight="balanced" という指定があります。同じ特徴量でこの指定を付けて学習すると、検証の AUC は0.676とほとんど変わりませんでしたが、予測確率の平均は0.420になり、実際の正例率0.0745の5倍以上に膨らみました。予測の低い10分位の組でも予測の平均は0.169(実際は0.027)、高い組では0.704(実際は0.192)です。ブライアスコアは0.2004と、全員一律の0.0690より大きく悪化しました。この例では、顧客の並べ方はほとんど変わらず(重みを付けない学習との順位相関(並べた順番がどれだけ一致するかを表す値で、1なら完全に一致)0.9994、上位10%の733人のうち709人が重なり、上位10%の解約率はどちらも0.192)、確率の値だけが使えなくなっているということです。上位 k% を選ぶだけなら、この例では困りません。ただし、重みを変えて学習し直すと順位が変わることもあるので、学習し直したら上位の解約率とリフトは確かめ直します。確率を施策の期待値の計算に使うなら、重みを付けない学習にするか、較正をやり直す(scikit-learn の CalibratedClassifierCV などで、予測確率を実際の頻度に合わせ直す)必要があります。CalibratedClassifierCV は、既定では二値の分類に層化した5分割の交差検証を使い、時間の順を保ちません。較正に使うデータもこの章の学習と検証と同じく時間の順に分け、ラベルが確定した期間だけを使い、最後は較正に使っていない先の期間で確かめる必要があります。
隠れた状態を知る確率でも AUC は0.684:偶然の大きさを測る
AUC 0.674 という数字だけを見ると、「もっと良いアルゴリズムや特徴量があれば、0.8や0.9まで上げられるのではないか」と考えたくなります。この記事のサンプルデータでは、その問いに答えを出すことができます。データを作った側は、顧客ごとの隠れた利用意欲と真の解約ハザードを知っているからです。第30か月末の在籍者7,324人それぞれについて、第30か月末の利用意欲から先を真のモデルで300回シミュレーションし、3か月以内に解約する確率(真の3か月解約確率)を出しました。300回のうち解約した回の割合なので、確率0.075の人で標準誤差およそ0.015のシミュレーションの誤差を含む、真の確率の近似値です。この真の確率で検証の顧客を並べたときの AUC は0.684でした。この生成設定・この検証集団では、隠れた状態まで知るモデルの推定確率でも、実際に起きた解約に対する AUC は0.684だったということです。2つのモデルの0.674との差は、この1回の検証では0.01でした。この差が偶然のばらつきの中でどの程度のものかは、次の段落で見ます。
隠れた状態を知っていても AUC がこの程度にとどまるのは、このデータの作り方では、解約が起きるかどうかに偶然が入るからです。真の3か月解約確率は、検証の7,324人の平均で0.075、中央値で0.060、最も高い人で0.510でした。確率が0.5以上の人は1人だけで、0.3以上の人も34人です。最も解約しやすい部類の人でも、多くは半分前後かそれ以上の確率で3か月は在籍を続け、最も解約しにくい部類の人でも、一定の確率で解約します。サンプルデータの作り方では、解約は毎月の解約確率に従って偶然に起き、その解約確率自体も、その月の注文回数・問い合わせ回数(隠れた利用意欲から、毎月偶然に決まる値)によって動きます。予測の時点では、予測の窓の3か月の注文回数も、解約が起きるかどうかの偶然も、まだ決まっていません。この生成設定では、どれだけ情報を集めても、この偶然までは当てられないということです。
AUC の0.684という値自体にも、偶然のばらつきがあります。真の確率が正しいとしても、実際にどの人が解約するかは確率に従って決まるので、もう一度同じ3か月が来れば、解約する人の顔ぶれは変わります。真の確率どおりに解約する人を引き直して AUC を計算することを200回繰り返すと、真の確率の AUC は平均0.703、最も低い回で0.675、最も高い回で0.738でした(この0.703も、上で述べた近似値の真の確率から引き直した値で、データを作った仕組みそのものの厳密な性能ではありません)。実際に起きた1回の結果での0.684は、この平均より低い側(200回の下から2.5%の点0.682に近い位置)にあります。偶然の不運によるのか、近似値である真の確率の誤差によるのかは、切り分けていません。同じ200回の引き直しのラベルで LightGBM の予測を評価すると、平均0.680(最も低い回0.646、最も高い回0.712)でした。1回の検証で測った AUC には、上下に0.03程度の幅があると見ておくのが妥当です。ただし、これは AUC そのものの幅で、同じ顧客で測った2つの AUC の差の幅とは別物です。差そのものを、同じ引き直しのラベルで両方を評価して数えると、真の確率と LightGBM の差は平均0.023で、200回の中央の95%が0.014〜0.033に入り、200回すべてで真の確率が上回りました。真の確率どおりに解約が起きるなら、隠れた状態を知る確率のほうが並べ方は良いということです。一方、実際に起きた1回の解約について、検証の顧客を復元抽出して2つの AUC を同じ顔ぶれで測り直すことを200回繰り返すと、差は平均0.011、中央の95%が -0.003〜0.023 で、0をまたぎました。この1回の検証の結果だけでは、差を偶然のばらつきと見分けられない、ということです。ロジスティック回帰と LightGBM の AUC の差は、同じ復元抽出で中央の95%が -0.008〜0.011 で、どちらとも言えませんでした。ここで示した幅は200回の再標本から数えた目安で、厳密な信頼区間ではありません。いずれにしても、改善の余地がどれだけ残っているかを、この差から決めることはできません。比べるための参考として、検証の顧客に無作為な順位を付けて AUC を計算することを200回繰り返すと、平均0.500に対して0.466〜0.529の幅がありました。
差の幅を、何を変えた200回かで分けて並べると次のとおりです。
| 200回で変えたもの | 比べたもの | 差の平均 | 差の中央の95% |
|---|---|---|---|
| 解約する人を真の確率どおりに引き直す(顧客の顔ぶれは同じ) | 真の確率から LightGBM を引いた値 | 0.023 | 0.014〜0.033 |
| 同上 | ロジスティック回帰から LightGBM を引いた値 | 0.001 | -0.008〜0.011 |
| 実際に起きた解約のまま、顧客の顔ぶれを復元抽出で選び直す | 真の確率から LightGBM を引いた値 | 0.011 | -0.003〜0.023 |
| 同上 | ロジスティック回帰から LightGBM を引いた値 | 0.001 | -0.008〜0.011 |
前者は「真の確率どおりに解約が起きるなら、どれだけ差があるか」、後者は「実際に起きた1回の結果から、差があると言えるか」を見ています。
この結果は、この架空データの、この生成設定・この検証集団での話です。現実の解約予測で AUC がどの程度になるかは、事業・データ・予測の窓の長さによって違い、一般的な数字はありません。この例から言えるのは、予測の時点で決まっていない偶然が大きい問題では、隠れた状態まで知っていても AUC が高くならないことがある、ということです。現実のデータでは真の確率は誰にも分からないので、改善の余地がどれだけ残っているかを、AUC の値だけから判断することはできません。AUC を0.674から0.70に上げるために特徴量の追加やモデルの調整に何か月もかける前に、モデルの改善で得られる利益の増分と、予測の使い方(誰に、いくらの施策を打つか)や施策を始める時期を詰めることで得られる利益の増分を比べて決めるのがよいと考えています。この章ではその比較はしていません。予測の使い方の側の計算は第8章で扱います。
当たって見える落とし穴:未来の情報と、時間で分けない検証
解約予測の検証で最も警戒すべきなのは、本番では手に入らない情報が学習や検証に混ざり、予測が実力以上に当たって見えることです。この節では、サンプルデータで2つの混ざり方を実演します。1つ目は、特徴量に未来の情報を入れてしまう場合です。スナップショットの特徴量は t 月以前の記録から作る決まりでしたが、ここではわざと、t+1 か月の注文回数(予測の窓の最初の月の値)を足してみます。もう1つ、t+3 か月の注文回数も足してみます。t+3 か月より前に解約した人には t+3 か月の記録が無いので、その場合は -1 を入れます。データを集計するときに「直近の月の注文回数」を取ったつもりが、抽出した日付の関係で予測の窓の月が混ざってしまう、というのが現実に起きうる形です。次のコードは、前のコードの続きとして実行する形です。
import lightgbm as lgb

piv_o = monthly.pivot(index="cust_id", columns="month", values="orders")


def future_orders(df, k):
    """スナップショット t の k か月後の注文回数(記録が無ければ -1)。未来の情報なので本番では使えない。"""
    out = np.empty(len(df))
    for t in df["snapshot"].unique():
        m = (df["snapshot"] == t).to_numpy()
        ids = df.loc[m, "cust_id"].to_numpy()
        out[m] = piv_o.reindex(columns=[t + k]).loc[ids, t + k].fillna(-1).to_numpy()
    return out


def auc_lgbm(tr, te, feats):
    gbm = lgb.LGBMClassifier(n_estimators=300, learning_rate=0.03, num_leaves=15, min_child_samples=50,
                             subsample=0.8, subsample_freq=1, colsample_bytree=0.8, random_state=0, verbose=-1)
    gbm.fit(tr[feats], tr["label"])
    return roc_auc_score(te["label"], gbm.predict_proba(te[feats])[:, 1])


for df in (train, test):
    df["orders_next"] = future_orders(df, 1)
    df["orders_t3"] = future_orders(df, 3)
print("基本             AUC %.3f" % auc_lgbm(train, test, bl.FEATURES))
print("+ t+1 の注文回数 AUC %.3f" % auc_lgbm(train, test, bl.FEATURES + ["orders_next"]))
print("+ t+3 の注文回数 AUC %.3f" % auc_lgbm(train, test, bl.FEATURES + ["orders_t3"]))
# 出力:
# 基本             AUC 0.674
# + t+1 の注文回数 AUC 0.679
# + t+3 の注文回数 AUC 0.901
t+1 か月の注文回数を足すと、LightGBM の AUC は0.674から0.679へ上がりました(同じ列をロジスティック回帰に足すと0.674から0.681)。検証の顧客で t+1 か月の注文回数の平均を比べると、その後3か月に解約した人は1.604回、解約しなかった人は2.166回で、解約の手がかりになる情報を含んでいます。上がり幅は0.005と小さく、検証の数字を見ただけでは「少し良い特徴量が見つかった」としか見えません。しかし、この列は第30か月の月末には存在しない値なので、本番でこのモデルを動かすことはできません。無理に動かそうとして、t+1 か月の列に t 月の値を入れる、といった代用をすれば、検証で測った0.679はもう成り立ちません。小さなリーク(情報の漏れ)ほど見つけにくく、気づかれないままモデルの評価を水増しします。
t+3 か月の注文回数を足すと、AUC は0.901まで跳ね上がりました。同じ実行で計算した AP は0.774、上位10%の解約率は0.542(リフト7.27)で、基本のモデルの0.177(リフト2.38)の3倍です。仕組みは単純で、その後3か月に解約した人の67.6%は、t+1 か月か t+2 か月の月末に解約していて、t+3 か月の記録がありません。解約しなかった人で記録が無い人は0%です。モデルは「t+3 か月の記録が無い人は解約した人」という、答えそのものを読んでいるだけです。隠れた状態を知る真の確率でも AUC は0.684だったので、それを大きく超えていることが、この例ではリークを疑う手がかりになります。現実のデータでは真の確率は分かりませんが、「検証の AUC が、以前のモデルから急に大きく上がった」「1つの特徴量だけが重要度の大半を占める」ときは、その特徴量がいつの時点の記録から作られているかを、データの抽出の処理までさかのぼって確かめる必要があります。
2つ目は、学習と検証を時間で分けずに、行を無作為に分ける場合です。観測月 t=6〜30 のスナップショットをまとめて122,546行とし、scikit-learn の train_test_split で8対2に無作為に分けて、同じ LightGBM で学習・検証しました。
from sklearn.model_selection import train_test_split

pool = bl.build_snapshots(cust, monthly, range(6, 31))   # t=6〜30 をまとめる
tr_r, te_r = train_test_split(pool, test_size=0.2, random_state=0)
print("行を無作為に分けた AUC %.3f(検証 %d行)" % (auc_lgbm(tr_r, te_r, bl.FEATURES), len(te_r)))
print("ラベルの窓が第31か月以降にかかる学習の行 %d" % (tr_r["snapshot"] >= 28).sum())
# 出力:
# 行を無作為に分けた AUC 0.686(検証 24510行)
# ラベルの窓が第31か月以降にかかる学習の行 17137
行を無作為に分けた検証の AUC は0.686で、時間で分けた0.674より0.012高く出ました。検証に入った顧客の96.9%は、別の観測月の行として学習にも入っています。また、学習に入った行のうち17,137行は、観測月 t が28〜30で、ラベルの窓が第31か月以降にかかっています。第30か月末の時点では、まだ答えが出ていないはずのラベルです。同じ実行で、無作為に分けた検証のうち t=30 の行(1,468行)だけを取り出して AUC を計算すると0.685で、t=30 の顧客を当てるという同じ問いでも、時間で分けた場合の0.674より高く出ました。さらに、無作為に分けたうえで t+1 か月の注文回数を足すと、AUC は0.691になりました。ただし、時間で分けた検証(7,324行)と無作為に分けた検証(24,510行、t=30 だけなら1,468行)は、検証に使った顧客の集まりそのものが違います。差の0.012には偶然のばらつきも含まれていて、この章ではその大きさを確かめていません。学習に第31か月以降の答えを含む行が入ることが一因と考えられますが、この章ではどれだけがその影響かを切り分けていません。確かなのは、無作為に分けた検証は、第30か月末に実際にモデルを作る場面とは違う条件で測っているので、その数字を本番の性能の見込みとして使う根拠にはならない、ということです。
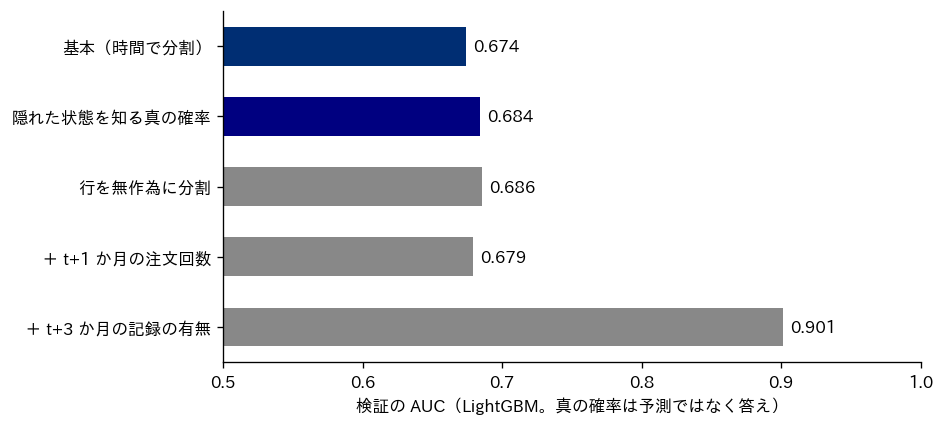
| 検証のしかた | LightGBM の AUC | 本番と同じ条件の検証か |
|---|---|---|
| 基本(t 以前の記録だけ、時間で分割) | 0.674 | 同じ |
| + t+1 か月の注文回数 | 0.679 | 違う(第30か月末には無い値を使う) |
| + t+3 か月の注文回数(無ければ -1) | 0.901 | 違う(解約したかどうかを読んでいる) |
| 行を無作為に分割 | 0.686 | 違う(答えの出ていない時期のラベルで学習。検証の顧客も別) |
| 行を無作為に分割+ t+1 か月の注文回数 | 0.691 | 違う |
| (参考)隠れた状態を知る真の3か月解約確率 | 0.684 | (予測ではなく答え合わせの値) |
表の「本番と同じ条件の検証か」の列が「違う」の行は、どれも検証の数字だけを見れば基本のモデルより良く見えますが、本番でその数字が出る根拠にはなりません。リークが混ざった検証は、モデルを過大に評価するだけでなく、リークの無い正しいモデルを「劣ったモデル」として退ける判断にもつながります。検証の設計を決めるのは、モデルを作る人ではなく、そのモデルで何を決めるかを知っている人を含めた場で行うのが有効だと考えています。「第何か月の月末に、どの記録が確定しているか」は、データの担当者だけでは決めきれないことが多いからです。
特徴量の重要度と SHAP は、予測の理由を確かめる道具として軽く使う
予測を現場で使うときには、「なぜこの顧客の解約の確率が高いのか」を説明できると、施策の中身を選びやすくなります。LightGBM には、特徴量ごとの重要度を出す機能があります。重要度には種類があり、その特徴量が木の分岐に使われた回数(split)と、その特徴量の分岐で損失がどれだけ減ったかの合計(gain)を選べます。もう1つ、よく使われるのが SHAP です。SHAP は、1人ひとりの予測値を「全体の平均的な予測」からの差として、特徴量ごとの寄与に分解する方法で、その絶対値を全員で平均すると、特徴量ごとの影響の大きさの目安になります。次の表は、基本の LightGBM について、13列のうち主な8列の3つの値を並べたものです(残りの5列は省略。gain は13列の合計を1とした割合、SHAP はロジット(確率をロジットに直した値)の単位での平均絶対値)。
| 特徴量 | 分岐の回数(split) | 損失の減少の割合(gain) | SHAP の平均絶対値 |
|---|---|---|---|
| 在籍月数(tenure) | 926 | 0.202 | 0.2547 |
| 直近3か月の注文回数の平均(orders_3m) | 660 | 0.175 | 0.2464 |
| 紹介チャネル(ch_referral) | 167 | 0.156 | 0.3004 |
| チラシ(ch_flyer) | 128 | 0.117 | 0.1036 |
| 大容量プラン(plan_large) | 256 | 0.044 | 0.1184 |
| 注文回数の傾き(orders_trend) | 534 | 0.039 | 0.0306 |
| 世帯人数(household) | 408 | 0.037 | 0.0263 |
| t 月の注文回数(orders_last) | 190 | 0.025 | 0.0522 |
表の「分岐の回数」の列では、注文回数の傾きが534回、世帯人数が408回と上位に来ますが、「損失の減少の割合」と「SHAP の平均絶対値」の列では、どちらも小さな値です。分岐に使われた回数の多さは、予測への効き方の大きさとは一致しないことがあります。サンプルデータの真のモデルでは、世帯人数は解約ハザードに直接は入っておらず、利用意欲の初期値を通して注文回数に影響するだけです。分岐の回数だけを見て「世帯人数が解約の重要な要因だ」と報告すれば、誤りになります。逆に、紹介チャネルは分岐の回数では167回と少ないものの、SHAP の平均絶対値では最も大きく、これは予測への寄与の大きさで、紹介チャネルが解約を減らす原因の強さを測ったものではありません。重要度を見るときは、どの種類の重要度かを必ず添え、できれば複数の種類を並べて見るのがよいと考えています。
SHAP は1人ひとりについても使えます。検証の顧客のうち、LightGBM の予測確率が最も高かった人(0.494)は、第30か月に加入したばかり(在籍1か月)・その月の注文0回・初回クーポン利用・チラシ経由の人でした。SHAP で分解すると、全体の平均的な予測(ロジットで -2.648)に対して、在籍月数が +0.759、直近3か月の注文回数の平均が +0.504、チラシ経由が +0.459、初回クーポンが +0.246 だけ、予測を押し上げていました。この4つの合計は +1.967 で、残りの9列の寄与を合わせた +0.657 を足すと +2.624 になり、基準値 -2.648 と合わせたロジット -0.024 が、予測確率0.494に当たります。「加入直後で、まだ注文がなく、初回クーポンを使ってチラシから加入した人」という説明は、施策(最初の注文を後押しする連絡など)を考える手がかりになります。ただし、この人は実際には3か月のうちに解約しませんでした。予測確率0.494は、半分強の確率で解約しないという意味でもあります。
重要度も SHAP も、モデルが予測にどの特徴量を使ったかを示すもので、その特徴量を変えれば解約が減るという因果関係を示すものではありません。この点は第6章で離散時間ハザードモデルの係数について述べたことと同じです。もう1つ、問いの違いにも注意が要ります。サンプルデータの真のモデルでは、その月の問い合わせ回数がその月の解約のしやすさを上げます。一方、この章のモデルが解いているのは、過去3か月の問い合わせ回数から、その先3か月の解約を当てる問題です。表に出していない問い合わせの列(support_3m)の SHAP の平均絶対値は0.0230と小さく、ロジスティック回帰の標準化係数(特徴量を平均0・標準偏差1にそろえたときの係数)もほぼ0でしたが、これは「問い合わせは解約に関係しない」という意味ではなく、過去の問い合わせ回数が将来の解約を当てる手がかりとしては弱かった、という意味にすぎません。SHAP の仕組みと読み方は、弊社コラム「AIはなぜその答えを出したのか、説明可能AI(XAI)の実践ガイド」で詳しく扱っています。また、作ったモデルは、顧客の構成やサービスが変われば、いずれ当たらなくなります。毎月の予測と実際の解約を突き合わせて較正と上位の解約率を見続けること、学習のし直しの時期を決めることは、弊社コラム「機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで」で扱っています。
経営の判断に翻訳する:AUC を競わず、較正された確率と上位の解約率で決める
この章の結果を、経営の判断に使える形に整理します。1つ目は、AUC だけをモデルの目標にしないことです。この例では、2つのモデルの AUC 0.674と、現実には誰も知り得ない隠れた状態まで使った真の確率で並べた場合の0.684との差(約0.01)は、検証の顧客を復元抽出して測り直すと0をまたぐ大きさで、1回の検証では偶然のばらつきと見分けられませんでした。一方、真の確率どおりに解約を引き直した200回では、真の確率と LightGBM の差は平均約0.02で、200回すべてで真の確率が上回りました。真の確率どおりに解約が起きるなら約0.02の余地があるものの、現実にはその余地は誰にも見えず、1回の検証からも確かめられません。AUC の小さな違いは、1回の検証の偶然でも生じます。「AUC を0.70に上げる」を目標に掲げてモデルの改良に何か月もかければ、その間、予測を使った施策は始まらず、解約は起き続けます。予測の改良にかける期間は、それで得られる上位の解約率の改善と、施策の開始が遅れることの損失を比べて決めるのが妥当です。
あわせて、このモデルの評価がどの顧客についてのものかを、報告に添える必要があります。この章の検証の7,324人のうち6,295人は学習にも別の時点で出てくる顧客で、残りの1,029人は第28〜30か月に加入した、学習に一度も出てこない顧客です。同じ実行で分けて計算すると、学習に出てくる顧客での LightGBM の AUC は0.667、学習に出てこない加入直後の顧客では0.621でした(正例率は0.0666と0.1234、解約者は419人と127人)。全体の0.674がどちらの集団の値よりも高いのは、2つの集団で解約率も予測の平均(0.0663と0.1223)も違い、集団の違いそのものが並べ分けに効くためで、合わせた値が部分の値より高くなることはあります。後者は人数が少なく、1回の検証の値なので幅を持って読む必要がありますが、全体の0.674という数字を、加入したばかりの顧客にもそのまま期待してよいとは言えません。新しく加入した顧客への予測の精度は、別に分けて確かめることが有効だと考えています。
2つ目は、経営に報告する指標を、AUC ではなく「上位 k% に選んだ人の解約率」と「解約者を何人集められるか」にすることです。この例の第30か月末の在籍者7,324人で、予測上位10%の733人を選ぶと、その中の解約者は LightGBM で130人、無作為に選んだ場合の期待値は約55人です。同じ733人に施策を打つなら、予測を使うことで、解約しそうな人に届く数が約2.4倍になります。この数字は、施策の担当者にも財務の担当者にも、そのまま伝わります。一方で、上位10%でも8割余りは施策が無くても3か月は解約しないので、施策の費用はこの8割にもかかります。その費用に見合うかどうかの計算は、第8章で扱います。
3つ目は、確率の値を施策の期待値の計算に使うなら、較正を確かめることです。この例の2つのモデルは確率の高い側では較正がおおむね取れていましたが(最も低い組では実績が予測の約1.6〜1.7倍)、不均衡への対処として重みを付けた学習をすると、AUC はほとんど変わらない(0.674から0.676)のに、予測確率の平均が0.0694から0.420に上がり、実際の正例率0.0745を大きく上回りました。この確率をそのまま「1人あたりの救える粗利」の計算に使えば、施策の効果を大幅に過大評価するおそれがあります。モデルの担当者からは AUC だけでなく、10分位の較正の表を必ず受け取ることが有効だと考えています。
4つ目は、リークの混ざった検証の数字で予算を組まないことです。t+3 か月の記録が混ざったモデルの検証では、上位10%の解約率が0.542と出ました。リークの無い基本のモデルの今回の検証では0.177だったので、この数字を信じて「上位10%に施策を打てば、対象の半数以上が解約しそうな人だ」と見込んで予算を組めば、施策が届く解約しそうな人の数を約3倍に見積もることになります。検証の数字が良すぎるときは喜ぶ前に疑い、特徴量の時点と、学習と検証の分け方を確かめるのが、予算の前提を守ることにつながります。
この章の要点は3つです。第一に、解約予測は、観測月の月末の在籍者について、その月までの記録だけで特徴量を作り、その先3か月の解約をラベルにするスナップショットで作り、学習と検証を時間で分けて評価します。第二に、正例率7.45%の不均衡なデータでは、全員を「解約しない」とするだけで正答率が92.55%になるので、正答率は使わず、AUC・AP(平均適合率)・上位 k% の解約率とリフト・較正で評価します。この例ではロジスティック回帰も LightGBM も AUC 0.674で、隠れた状態を知る真の確率の0.684との差(約0.01)は、検証の顧客を復元抽出して測り直すと0をまたぐ大きさでした。一方、真の確率どおりに解約を引き直した200回では、差は平均約0.02で、200回すべてで真の確率が上回りました。1回の検証では偶然と見分けられないものの、真の確率どおりに解約が起きるなら約0.02の余地があり、それを取りに行く価値は、第8章で計算する予測の使い方の効果と比べて決めます。上位10%のリフトは2.4〜2.6倍でした。較正は確率の高い側ではおおむね取れていましたが、最も低い組では実績が予測の約1.6〜1.7倍でした。2つのモデルの差も同じ測り直しで0をまたぎ、この章の結果だけではどちらが優れているとは決められません。第8章では、記事全体の基準の計算に合わせて LightGBM の予測確率を使います。また、この評価はすでにいる顧客を将来の時点で予測したもので、学習に出てこない加入直後の顧客だけで見ると AUC は0.621でした。第三に、未来の情報を1列混ぜる、行を無作為に分けるといった誤りは、検証の数字を良く見せるだけで本番の性能を上げません。この例では、t+3 か月の記録を混ぜると AUC が0.901まで跳ねました。次の第8章では、この章で作った予測確率を、引き止め施策の対象と予算の判断に変えます。予測上位の人に施策を打つことが、本当に費用に見合うのかを、期待値と損益分岐で計算します。
この章を深めたい方への参考書籍
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標と KPI の関係から始めて、二値分類の章で正解率・適合率・再現率・ROC-AUC・PR-AUC などを扱い、同じ章でビジネスへの影響の期待値の計算や、誤りの費用を考えた学習にも触れている本です。この章の「正答率を使わない理由」「AUC と AP(平均適合率)の違い」を掘り下げ、第8章の期待値の計算へ橋をかけるのに向いています。
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):データ分析のコンペティション(Kaggle)で使われる技術をまとめた本で、評価指標の章に加えて、バリデーションの章で時系列データの検証の分け方とその落とし穴を、別の節でリーク(情報の漏れ)を扱っています。この章のスナップショットの学習と検証を時間で分ける理由、未来の情報が特徴量に混ざる問題を、より多くの例で確かめるのに向いています。
第8章 予測を施策につなぐ、対象の選び方と費用対効果
第7章では、第30か月末の在籍者 7,324人について、この先3か月に解約するかを予測するモデルを作り、LightGBM の AUC が 0.674、予測上位10%の解約率が 0.177(全体の 0.075 の 2.38倍)になることを確かめました。この生成設定・この検証集団では、隠れた利用意欲まで知る真のモデルの推定確率でも AUC は 0.684 で、予測の精度をこれ以上大きく上げる余地はあまり残っていません。この章では、その予測を引き止め施策の対象の選び方につなぎます。予測確率の高い順に施策を打つと何が起きるのか、何人に打つのがよいのか、施策の費用がいくらまでなら黒字なのかを、第2章で用意したサンプルデータで答え合わせしながら測ります。施策を打つかどうかを1人ずつ期待値で判断する考え方と、費用がいくらを超えると赤字になるかという損益分岐の見方が、この章の中心です。残存価値(在籍中の顧客がこの先にもたらす粗利)の計算そのものは第9章、予算の上限がある中での優先順位は第11章、施策の効果を実験で確かめる方法は第12章で扱います。
予測確率の高い人に施策を打つと、何が無駄になるか
解約予測のモデルができると、多くの場合、最初に考えるのは「解約しそうな人の上位に引き止めのクーポンを配る」という使い方です。予測上位10%の人は全体の2倍以上の割合で解約するので、無作為に配るよりは無駄が少なく見えます。ただし、上位10%の人の多くは、施策が無くても解約しません。
共通データで確かめます。第30か月末の在籍者 7,324人のうち、LightGBM の予測確率が高い順に上位10%の 733人を選ぶと、この人たちの3か月解約確率は、隠れた利用意欲(第2章で説明した、毎月の注文回数を左右する、データには現れない顧客ごとの値)を知る真のモデルで 0.183 でした(データを作った側だけが知る真の値です。現実の企業には見えません)。第7章の 0.177 は、同じ 733人のうち実際に3か月以内に解約した人の割合(実績)で、0.183 はその確率の見込み(期待値)です。実績は偶然で上下するので、2つは少し違います。つまり、上位10%に選んだ人の約8割(81.7%)は、施策が無くても3か月は解約しません。この人数は約599人です。
この事実を費用の言葉に直します。この章では、引き止め施策として、1人あたり 500円の費用がかかるクーポンを想定します。施策の効果は、当てた月から3か月のあいだ、解約の起きやすさ(オッズ=解約確率÷継続確率)を0.7倍にするものと置きます。解約確率が小さい範囲では、確率をおよそ0.7倍するのとほぼ同じです(月の解約確率が 0.2 の人なら、0.2 の0.7倍の 0.14 ではなく 0.149 になります)。施策の費用 500円も、オッズを0.7倍にするという効果も、共通データに置いた架空の前提です。現実の施策の効果は、実験で測らないと分かりません(第12章)。
この前提で上位10%に配ると費用は 366,500円で、そのうち約30.0万円(費用の81.7%)は、配らなくても3か月は残っていた人に配った分です。真のモデルで40回シミュレーションすると、この施策によって3か月以内の解約を回避または先延ばしにした人数の期待値は 36.15人でした。この人数で費用を割ると、1人あたり約10,138円です。同じ 733人を無作為に選ぶと、この人数は 16.73人で、1人あたり約21,913円かかります。全員 7,324人に配ると 159.5人で、1人あたり約22,959円です。なお、ここでの人数は、施策なしと比べて「3か月以内に解約しなかった人」が増えた人数の期待値で、そのうち何人が3か月より後に解約するか(解約を止めたのか、先に延ばしただけなのか)は、この数字だけでは分かりません。この区別は第12章で扱います。
経営の指標に直すと、「上位10%に配ったクーポンの8割は、3か月の引き止めの効果を生まない費用だった」ということになります。これは予測の順位づけの欠点ではありません。無作為に選んでも全員に配っても、対象の3か月解約確率は 0.08 前後なので、対象の9割以上は施策が無くても3か月は残ります。予測の高い順に選ぶと、この割合が8割まで下がるだけです。この例では、解約には予測できない偶然の部分が大きく、どの選び方でも、費用の大半は施策が無くても残る人に配られます。したがって問うべきは「無駄をなくせるか」ではなく、「無駄を含めても、増える粗利が費用を上回るか」です。その釣り合いを1人ずつ見る物差しが、次の期待値です。
期待値で決める:施策ありとなしの期待粗利の差から費用を引く
施策を打つかどうかを1人ずつ判断するときの物差しが期待値です。期待値は、起こりうる結果に、それが起きる確率を掛けて足し合わせた値で、「同じ判断を何度も繰り返したときの平均の損得」と読めます。1人の顧客に引き止め施策を打つ価値は、もとの定義では「施策を打った場合のこの先の割引後粗利の期待値から、打たなかった場合の期待値を引き、さらに施策の費用を引いたもの」です。この差を、解約確率と残存価値に分けて近似すると、次の式になります。
\( \text{施策を打つ価値} \approx (p_{\text{施策なし}} – p_{\text{施策あり}}) \times V – c \)
言葉で言い換えると、「施策によって解約確率がどれだけ下がるか」に「その人が残った場合にこの先もたらす粗利(残存価値)」を掛け、そこから施策の費用を引いたものです。\( p \) は解約確率、\( V \) は残存価値、\( c \) は1人あたりの費用です(式の \( V \) は「残った場合」にもたらす粗利ですが、この章の表で掛けているのは、後述の「24か月の割引後粗利の期待値」で、この先の解約も織り込んだ平均です。2つは別の量で、表の概算がシミュレーションの値とずれる理由の1つになります)。この近似は、施策の効果が「その期間に解約するかどうか」だけを変えるという単純化の上に立っていて、解約を先に延ばしただけの効果や、残った人ごとの残存価値の違いは表しません。この章で判断に使う数字(後の表の「1人あたり増分」)は、近似ではなく、施策ありと施策なしの期待粗利の差をシミュレーションで直接測ったものです。この真のモデルでは、ある人に施策を当てても他の人の解約には影響しないので、もとの定義の価値が正の人にだけ施策を打てば、予算に上限が無い場合には全体の得が最大になります。データ分析をビジネスの判断に使うための考え方を整理した Provost と Fawcett の教科書(日本語版『戦略的データサイエンス入門』)も、分類のモデルを使う枠組みとして期待値を挙げ、ビジネスの問題を確率と損得に分解する方法として章を割いています。
この式は、予測モデルの出力だけでは計算できないことに注意が要ります。必要なのは3つで、1つ目は施策が無いときの解約確率(予測モデルが出すもの)、2つ目は施策によって解約確率がどれだけ下がるか(施策の効果。実験で測るもの)、3つ目は残った場合の残存価値(第9章で計算するもの)です。予測モデルが答えるのは1つ目だけで、2つ目と3つ目はモデルの外から持ってくる必要があります。そのため一般には、解約リスクの順位は、施策による粗利の増分(増分利益)の順位と同じではありません。この例でどの程度ずれるかは、次の表と、後のプラン別の表で確かめます。
共通データで、この式の中身を予測の10分位(予測確率の高い順に10等分した群)ごとに見ました。全員に施策を当てた場合と当てない場合を、真のモデルでそれぞれ40回シミュレーションし、1人ずつの差を群ごとに平均したものです。シミュレーションは共通乱数(施策の有無で、同じ顧客の同じ月に同じ乱数を使う方法)で行っているので、施策の有無による差が、乱数の違いに埋もれにくくなります。「24か月の割引後粗利の期待値」は、施策が無い場合に、この先24か月に払う月額の粗利を年5%で割り引いて足した値の期待値です。この記事の残存価値(その時点から先24か月で打ち切った値)を、データを作った側の真のモデルで計算したものに当たります(第9章は、同じ定義の残存価値を、第36か月末の在籍者について継続率から推定します)。
| 予測の10分位 | 予測確率の平均 | 3か月解約確率(真) | 3か月解約確率の下がり幅 | 24か月の割引後粗利の期待値(円) | 下がり幅×粗利の期待値(円。概算) | 1人あたり増分(円) | 費用500円を引いた純増(円) |
|---|---|---|---|---|---|---|---|
| 1(最も高い10%) | 0.184 | 0.183 | 0.049 | 22,190 | 1,094 | 1,163 | 663 |
| 2 | 0.121 | 0.124 | 0.034 | 26,248 | 882 | 852 | 352 |
| 3 | 0.097 | 0.097 | 0.030 | 29,043 | 872 | 842 | 342 |
| 4 | 0.081 | 0.083 | 0.023 | 30,712 | 710 | 665 | 165 |
| 5 | 0.068 | 0.063 | 0.019 | 32,815 | 637 | 593 | 93 |
| 6 | 0.058 | 0.061 | 0.018 | 34,212 | 602 | 566 | 66 |
| 7 | 0.049 | 0.052 | 0.015 | 35,556 | 542 | 513 | 13 |
| 8 | 0.039 | 0.041 | 0.013 | 36,931 | 481 | 442 | -58 |
| 9 | 0.028 | 0.032 | 0.009 | 36,753 | 328 | 312 | -188 |
| 10(最も低い10%) | 0.018 | 0.024 | 0.008 | 39,689 | 299 | 272 | -228 |
表の「1人あたり増分」の列は、施策によって増える24か月の割引後粗利の、1人あたりの期待値です。予測が最も高い10分位1では 1,163円で、費用 500円を引いても 663円の得になります。10分位が下がるにつれて増分はおおむね小さくなり、10分位6(純増 66円)までは黒字、10分位8から先は赤字でした。10分位7の純増 13円は、損益分岐とほぼ同じです。乱数の種を変えて同じ40回の計算を5通り行うと、10分位7の1人あたり増分は 434〜513円の範囲で動き、費用 500円を上回るとも下回るとも言えませんでした。施策の効果を「解約のオッズを0.7倍にする」と置いているので、もともと解約しやすい人ほど、解約確率の下がり幅(表の「3か月解約確率の下がり幅」の列)が大きくなります。10分位1では 0.049、10分位10では 0.008 です。
一方で、表の「24か月の割引後粗利の期待値」の列は逆の向きに並んでいます。予測が高い人ほど、この先も解約しやすいので、残っている間に払う粗利の期待値は小さく、10分位1で 22,190円、10分位10で 39,689円です。施策を打つ価値は、下がり幅と残存価値の掛け算なので、予測が高いほど一方的に価値が高いわけではありません。この例では下がり幅の差が大きいので、10分位の単位で見ると、予測の高い順と1人あたり増分の高い順はほぼ同じ向きに並びました。つまり、この例では10分位の並びでは2つの順位の違いは小さく、違いが出うるのは同じ10分位の中の残存価値の違いです。この章では、そのうちプランの違いを後で確かめます。残存価値の差がもっと大きい事業では、10分位の単位でも順番が入れ替わることがあります。予算の上限がある中で、残存価値を入れて並べ直すと対象がどう変わるかは、第11章で扱います。
表の「下がり幅×粗利の期待値」の列は、期待値の式を素朴に当てはめた概算で、シミュレーションで測った「1人あたり増分」と近い大きさになりました(10分位1で 1,094円 対 1,163円、10分位5で 637円 対 593円)。ぴったり一致しないのは、概算では、解約を免れた人の残存価値をその群の平均で置き換えていること、3か月より後の解約への影響(先延ばしにしただけで後で解約する人がいること)を扱っていないことなどによると考えられます。この章の計算では、ずれの原因を切り分けてはいません。式は判断の骨組みとして使い、数字はシミュレーションか実験で確かめるのがよいと考えています。
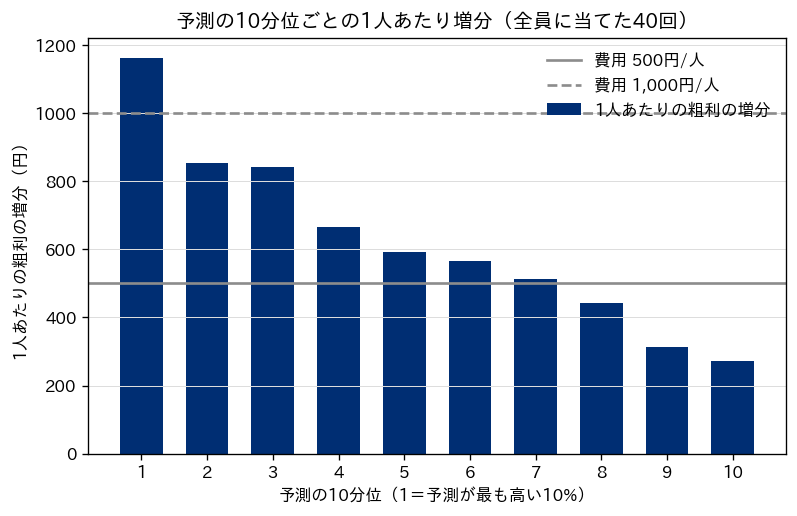
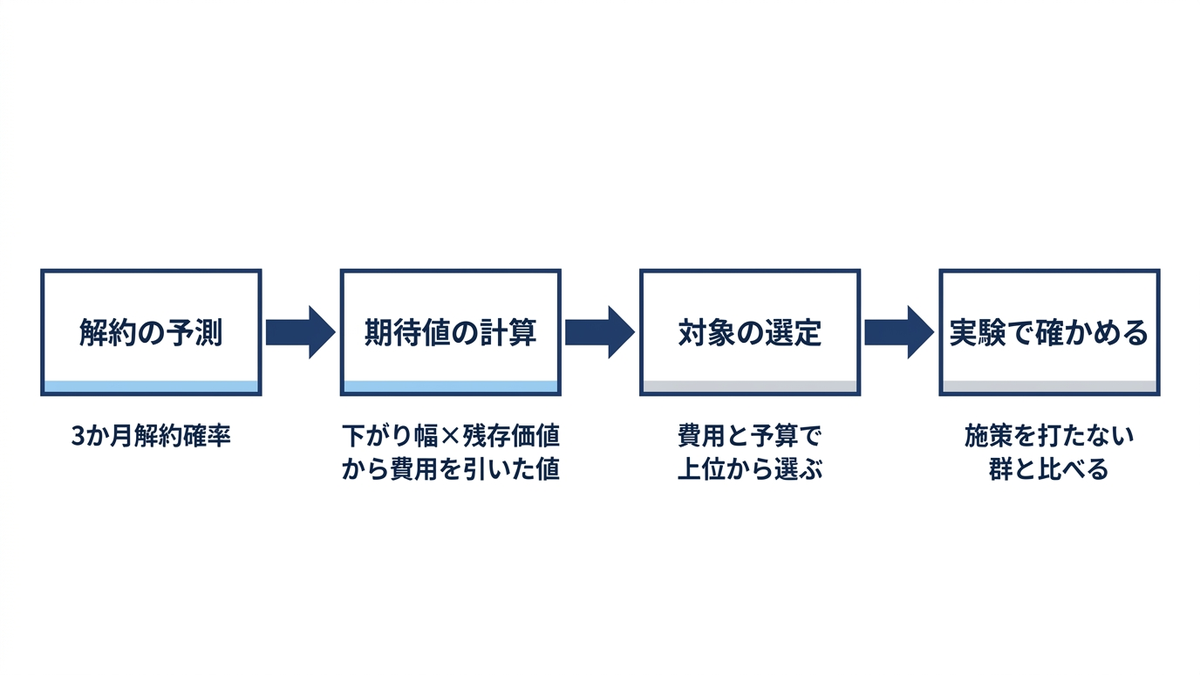
予測上位・無作為・全員を比べる:選び方ごとの純増
次に、対象の選び方を丸ごと比べます。第30か月末の在籍者 7,324人に対して、第31〜33か月に施策を当てる選び方を7通り用意し、この先24か月の割引後粗利の増分を、隠れた利用意欲を知る真のモデルで40回シミュレーションして測りました。粗利の増分から費用を引いたものが純増です。数字は第2章で紹介した基準の結果と同じもので、この章のスクリプトで同じ計算を再実行して一致することを確かめています。
| 選び方 | 対象 | 費用(円) | 粗利の増分(円) | 純増(円) | 対象の3か月解約確率(真) | 1人あたり増分(円) |
|---|---|---|---|---|---|---|
| 予測上位10% | 733人 | 366,500 | 852,554 | 486,054 | 0.183 | 1,163 |
| 無作為10% | 733人 | 366,500 | 456,390 | 89,890 | 0.079 | 623 |
| 予測上位20% | 1,465人 | 732,500 | 1,476,542 | 744,042 | 0.154 | 1,008 |
| 無作為20% | 1,465人 | 732,500 | 890,511 | 158,011 | 0.078 | 608 |
| 予測上位30% | 2,198人 | 1,099,000 | 2,093,293 | 994,293 | 0.135 | 952 |
| 無作為30% | 2,198人 | 1,099,000 | 1,402,063 | 303,063 | 0.076 | 638 |
| 全員 | 7,324人 | 3,662,000 | 4,555,973 | 893,973 | 0.076 | 622 |
表の「粗利の増分」は、隠れた利用意欲を知る真のモデルで40回シミュレーションした、この先24か月の割引後粗利(年5%で割引)の、施策ありと施策なしの差です。現実の企業がこの数字を事前に知ることはできません。この記事では答え合わせのために、データを作った側の立場で測っています。
表から読めることは3つあります。1つ目は、同じ人数・同じ費用なら、予測の高い順に選ぶほうが無作為よりはるかに得になることです。10%では純増が 486,054円 対 89,890円で約5.4倍、30%では 994,293円 対 303,063円で約3.3倍でした。ただし、無作為との比較は「同じ人数・同じ費用で選ぶなら」という条件での比較です。モデルが無いときに実際に取る選び方は、全員に配る、配らない、加入からの月数のような既存のルールで選ぶ、担当者が判断する、予算の範囲で無作為に選ぶなど、事業によって違います。予測モデルの価値の測り方は、経営の判断の節で全員配布との比較も含めて扱います。
2つ目は、費用1円あたりの純増(費用効率)と純増の総額は、別々に見る必要があることです。費用効率は予測上位10%が最も大きく、費用 366,500円で純増 486,054円(費用1円あたり約1.33円)でした。上位20%は約1.02円、上位30%は約0.90円、全員は約0.24円と、対象を広げるほど下がります。一方、純増の総額は、比較した7通りの候補の中では上位30%(994,293円)が最大で、全員配布(893,973円)がそれに続き、上位20%(744,042円)、上位10%(486,054円)の順です。予算が限られていて費用1円の効率を重視するなら上位10%、施策にかけられる費用に余裕があって総額を重視するなら、この候補の中では上位30%が答えになります。どちらを重視するかは、予算の制約によって変わります。
3つ目は、全員に配っても純増は正だということです。ただし、「1人あたり増分」の列で全員は 622円と、費用 500円に近く、費用の見積もりが少し狂えば赤字に転じる可能性があります。なお、無作為10%の1人あたり増分 623円が全員の 622円とほぼ同じなのは偶然ではありません。無作為に選んだ集団の平均は、全員の平均と同じ値の近くに来るからです(無作為20%の 608円、30%の 638円も同じ理由で近い値です)。
計算の中身は、記事全体の補助モジュール(baseline.py)の policy_value にまとめてあります。次のコードは、その中心の部分を抜き出したものです。補助モジュール(cust_data.py と baseline.py)と同じフォルダに置いて実行する形の関数で、施策なしの未来と、選んだ人に施策を当てた未来を共通乱数でシミュレーションし、選んだ人の粗利の差を足し上げています。
# baseline.policy_value の中心部分(抜き出したもの)
base = cd.simulate_future(cust_f, monthly_f, start_month=30, horizon=24,
                          n_sims=n_sims, seed=seed).set_index("cust_id")
ids = test["cust_id"].values                 # 第30か月末の在籍者
order = np.argsort(-p_score)                 # 予測確率の高い順
for frac in fracs:
    n = int(np.ceil(len(ids) * frac))
    for how in ("model", "random"):
        if how == "model":
            target = ids[order[:n]]
        else:
            target = rng.choice(ids, size=n, replace=False)
        mask = np.zeros(cd.N_SUB, dtype=bool)
        mask[target] = True                  # 施策を当てる人
        treat = cd.simulate_future(cust_f, monthly_f, start_month=30, horizon=24,
                                   n_sims=n_sims, offer_mask=mask,
                                   seed=seed).set_index("cust_id")
        gain = (treat.loc[target, "exp_margin"]
                - base.loc[target, "exp_margin"]).sum()   # 粗利の増分
        net = gain - n * cd.OFFER_COST                    # 純増(費用 500円/人)
cd.simulate_future は、第30か月末の在籍者について、隠れた利用意欲から先を真のモデルで繰り返しシミュレーションし、この先24か月に払う月数と割引後粗利の期待値を返す関数です。同じ seed なら、施策の有無にかかわらず、同じ顧客の同じ月に同じ乱数が使われます(共通乱数)。offer_mask で施策を当てる人を指定すると、その人の第31〜33か月の解約のオッズが 0.7倍になります。施策の費用 cd.OFFER_COST は 500円、オッズの倍率 cd.OFFER_MULT は 0.7、施策が続く月数 cd.OFFER_MONTHS は3で、どれも架空の設定です。現実にはこのシミュレーションはできないので、同じ比較は施策を打たない群を残した実験で行います(第12章)。
損益分岐:施策の費用がいくらまでなら黒字か
前の表の「1人あたり増分」は、そのまま損益分岐の費用になります。1人に施策を打って増える粗利が、1人あたりの費用を上回っていれば黒字、下回れば赤字です。共通データでは、全員に配る選び方の損益分岐は約622円、予測上位10%は約1,163円、上位20%は約1,008円、上位30%は約952円、無作為10%は約623円でした。これらは、24か月の評価期間、全員に同じ施策の効果(オッズ0.7倍)、1人1回の費用という前提での推定値です。評価期間を延ばしたり、効果の見積もりを変えたりすれば値は動くので、損益分岐の近くの費用について、丸めた金額で黒字か赤字かを言い切ることはできません。シミュレーション自体にも揺れがあります。同じ40回の計算を乱数の種だけ変えて5通り行うと、1人あたり増分は、全員配布で 597〜622円、予測上位10%で 1,077〜1,163円の範囲で動きました(この章の表の値は、5通りの中で高めの側です)。5通りの最小と最大は信頼区間ではなく、揺れの大きさのおおよその目安です。目安として読むと、費用がおよそ 622円を超えると全員配布は赤字に近づき、およそ 1,163円を超えると上位10%に絞っても赤字に近づく(この例での話)ということです。
施策の費用は、クーポンの額面を変えたり、電話で連絡したりすると大きく変わります。粗利の増分は費用によらないので、費用を変えたときの純増は「粗利の増分から、対象人数×費用を引いた値」で計算できます。費用を 300円・500円・1,000円・1,500円に変えて、7通りの選び方の純増を並べました。施策の効果(オッズ0.7倍)は費用によらず同じと置いた計算で、額面を上げれば効果も上がるという関係は入れていません。
| 選び方 | 損益分岐の費用(円/人。推定) | 費用300円の純増(円) | 費用500円の純増(円) | 費用1,000円の純増(円) | 費用1,500円の純増(円) |
|---|---|---|---|---|---|
| 予測上位10% | 1,163 | 632,654 | 486,054 | 119,554 | -246,946 |
| 無作為10% | 623 | 236,490 | 89,890 | -276,610 | -643,110 |
| 予測上位20% | 1,008 | 1,037,042 | 744,042 | 11,542 | -720,958 |
| 無作為20% | 608 | 451,011 | 158,011 | -574,489 | -1,306,989 |
| 予測上位30% | 952 | 1,433,893 | 994,293 | -104,707 | -1,203,707 |
| 無作為30% | 638 | 742,663 | 303,063 | -795,937 | -1,894,937 |
| 全員 | 622 | 2,358,773 | 893,973 | -2,768,027 | -6,430,027 |
費用 300円なら、7通りすべてが黒字で、純増の総額が最も大きいのは全員配布(2,358,773円)です。費用 500円では、全員配布の純増(893,973円)は上位30%(994,293円)を下回ります。費用 1,000円では、純増が正なのは予測上位10%(119,554円)だけと見るのが安全です。上位20%の純増 11,542円は、費用 1,000円が損益分岐の約1,008円とほぼ同じであるために出た小さな値で、黒字か赤字かは言い切れません。全員配布は 2,768,027円の赤字になります。費用 1,500円では、7通りすべてが赤字です。同じ予測モデル・同じ効果でも、費用の水準によって「誰に打つべきか」の答えは「全員」から「上位10%」、さらに「この候補の中には黒字が無い」まで変わるということです。
この表は、施策を企画する段階で使えます。たとえば、電話による引き止めのように1人あたりの費用が高い施策を検討するときは、まず損益分岐の費用と比べて、そもそも黒字になりうる対象があるかを確かめます。この例で1人 1,500円かかる施策は、施策の効果がオッズ0.7倍程度なら、予測上位10%に絞っても赤字です。黒字にするには、効果がもっと大きいことを実験で示すか、費用を下げるか、対象をさらに絞る必要があります。
対象の割合 k を、費用と予算から決める
予測上位10%・20%・30%の3点だけでは、何%まで広げるのがよいかは分かりません。そこで、上位 k% の k を 5%から100%まで 5%刻みで振り、それぞれの純増を測りました。1つの k ごとに、予測の高い順に選んだ場合と無作為に選んだ場合の2回のシミュレーションが要り、施策なしの分と全員の分を合わせて全部で42回になります。計算時間を抑えるため、ここではシミュレーションの回数を40回から15回に減らしています(40回の値との違いは後で示します)。補助モジュールの関数に k の候補を渡すだけで計算できます。
import numpy as np
import cust_data as cd
import baseline as bl

cust, monthly = cd.make_subscription()
cust_f, monthly_f = cd.make_subscription(full=True)       # 答え合わせ用
train = bl.build_snapshots(cust, monthly, range(6, 28))   # 学習 t=6〜27
test = bl.build_snapshots(cust, monthly, [30])            # 第30か月末の在籍者
models, X_te, y_te = bl.fit_models(train, test)
p = models["lgbm"].predict_proba(X_te)[:, 1]              # LightGBM の予測確率

fracs = tuple(np.round(np.arange(0.05, 1.0001, 0.05), 2))  # k = 5%〜100%
grid, base = bl.policy_value(cust_f, monthly_f, test, p, fracs=fracs, n_sims=15)
grid = grid[grid["how"] != "all"]
print(grid[["how", "frac", "n_target", "margin_gain", "net"]].round({"margin_gain": 0, "net": 0}))
# 出力(抜粋。予測の高い順に選んだ行。15回の値なので、40回の表の値とは違う):
#        how  frac  n_target  margin_gain        net
# 2    model  0.10       733     892672.0   526172.0
# 10   model  0.30      2198    2161003.0  1062003.0
# 28   model  0.75      5493    4154348.0  1407848.0
# 38   model  1.00      7324    4677703.0  1015703.0
この k の格子の計算(学習を含む)は、この記事の実行環境(一般的なノートPC)での実測で約107秒かかりました。この章のそれ以外の計算(40回の基準の再現、全員に当てた40回のシミュレーション、後述の足し上げと図の作成)は、別のスクリプトで約76秒です。
次の表は、k の主な点について、24か月の純増(費用 500円/人、真のモデルで15回のシミュレーション)を、予測の高い順に選んだ場合と無作為に選んだ場合で並べたものです。
| 対象の割合 k | 対象 | 予測の高い順に選んだ場合の純増(円) | 無作為に選んだ場合の純増(円) |
|---|---|---|---|
| 5% | 367人 | 308,986 | 79,886 |
| 10% | 733人 | 526,172 | 114,808 |
| 20% | 1,465人 | 790,407 | 210,688 |
| 30% | 2,198人 | 1,062,003 | 337,835 |
| 40% | 2,930人 | 1,207,830 | 376,891 |
| 50% | 3,662人 | 1,266,617 | 604,471 |
| 55% | 4,029人 | 1,304,339 | 540,609 |
| 60% | 4,395人 | 1,334,306 | 612,599 |
| 70% | 5,127人 | 1,381,958 | 735,741 |
| 75% | 5,493人 | 1,407,848 | 684,342 |
| 80% | 5,860人 | 1,346,237 | 851,564 |
| 90% | 6,592人 | 1,223,783 | 888,760 |
| 100%(全員) | 7,324人 | 1,015,703 | 1,015,703 |
表の「予測の高い順に選んだ場合の純増」の列は、k 5%の 308,986円から30%の 1,062,003円まで上がり、その後はなだらかに増えて k 75%で最大の 1,407,848円になり、そこから下がって100%で 1,015,703円になります。「無作為に選んだ場合の純増」の列は、k 100%で同じ値になるまで、どの k でも予測の高い順の列より小さい値です。共通乱数でシミュレーションしているので、予測の高い順の列は k に沿って滑らかに動き、k による形は読み取れます。ただし、水準は結論に使いません。同じ k を40回で測った値と比べると、上位10%は 526,172円 対 486,054円、上位30%は 1,062,003円 対 994,293円、全員は 1,015,703円 対 893,973円で、15回の値は 5%刻みの20点すべてで、40回の値(後述の足し上げの計算)より4〜15%高く出ました。今回の乱数では、15回の推定値が40回の推定値より高く出たということです。20点は同じ乱数と重なり合う対象者から計算しているので互いに独立ではなく、20点すべてが同じ向きにずれたことだけでは、回数が少ないことによる系統的な偏りとは判断できません。シミュレーションの結果を単純に平均するモンテカルロ法の推定は、回数が少なくても平均としては偏らず、回数が少ないと揺れが大きくなる性質のものです(Art Owen のモンテカルロ法の教科書の第2章)。この章では、15回の値を、40回の値より揺れの大きいものとして扱います。最大の位置も、15回では k 75%、40回では k 66.1%と食い違います。この表は「予測の高い順が無作為より上にあり、k を広げると途中で頭打ちになる」という形を見るためだけに使い、本文の結論には、次に示す40回の値を使います。無作為の列には、k 50%の 604,471円から55%の 540,609円へ下がるような上下も残っています。
40回の値は、別の計算で求めました。この真のモデルでは、ある人に施策を当てても他の人の解約には影響しないので、ある集団に施策を当てたときの粗利の増分は、1人ずつの増分の和になります。そこで、全員に施策を当てた40回のシミュレーションから1人ずつの増分を出し(前の10分位の表と同じもの)、予測の高い順に足し上げて、費用ごとの純増の曲線を描きました。共通乱数を使っているので、足し上げた値は、選び方の表の予測上位10%・20%・30%・全員の粗利の増分(852,554円・1,476,542円・2,093,293円・4,555,973円)と一致します。この40回の値にも揺れがあり、乱数の種だけを変えて5通り計算すると、費用 500円で純増が最大になる対象は上位57.9〜66.1%、その純増は 1,162,213〜1,272,866円の範囲で動きました。
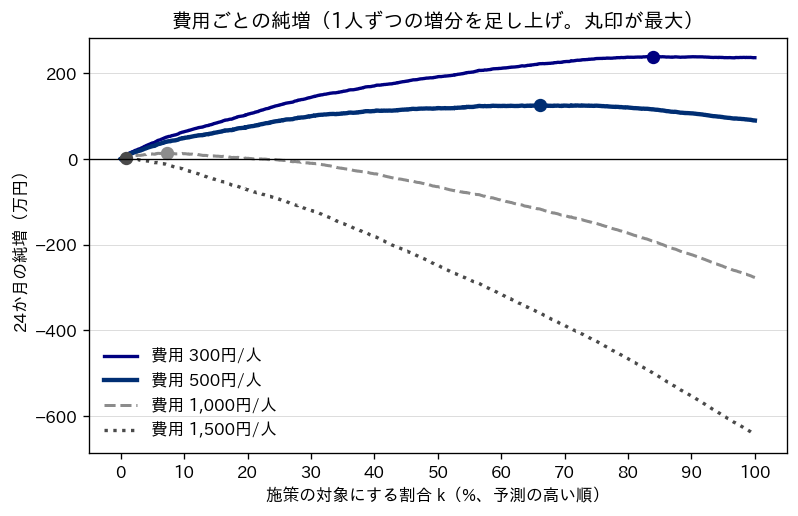
| 費用(円/人) | 純増が最大になる対象 | 最大の純増(円) | 上位10%の純増(円) | 上位30%の純増(円) | 全員の純増(円) |
|---|---|---|---|---|---|
| 300 | 6,142人(上位83.9%) | 2,385,544 | 632,654 | 1,433,893 | 2,358,773 |
| 500 | 4,838人(上位66.1%) | 1,251,338 | 486,054 | 994,293 | 893,973 |
| 1,000 | 529人(上位7.2%) | 137,758 | 119,554 | -104,707 | -2,768,027 |
| 1,500 | 64人(上位0.9%) | 18,835 | -246,946 | -1,203,707 | -6,430,027 |
費用 500円の曲線は、k が約50%から80%の間でほとんど平らで、最大は上位66.1%(4,838人)の 1,251,338円でした。上位50%で 1,183,071円、上位80%で 1,197,952円なので、この範囲のどこで切っても純増はほぼ同じです。曲線が平らな範囲では、対象を広げても純増はほとんど増えず、費用だけが増えます。上位50%なら費用は 1,831,000円、上位80%なら 2,930,000円で、ほぼ同じ純増に約1.6倍の費用をかけることになります。予算に限りがあるなら、平らな範囲の左端で止めるのが合理的です。
費用が変わると、最大の点は大きく動きます。費用 300円では上位83.9%、500円では66.1%、1,000円では7.2%、1,500円では0.9%(64人で純増 18,835円)でした。費用 1,500円の最大の点はごく小さな値です。この64人という点は5%刻みの15回の格子には含まれておらず(格子の最小の k 5%は -58,014円の赤字)、40回の同じ乱数で最大の点を選び、その点を同じ乱数で評価しているので、値は楽観の側に寄りやすくなります。別の乱数で評価し直してはいないので、黒字になる対象が「ある」とは言い切れません。費用が高くなるほど、得になりうるのは予測の最上位の人だけになり、対象は急に狭くなります。図の曲線の傾きは、そこで新たに加わる人の「1人あたり増分から費用を引いた値」です。純増が最大になる k は、対象の人数ごとに累積の純増を計算し、その中で最大になる人数として選びました(この章のスクリプトも同じ方法です)。予測の高い順に並べても、新たに加わる人の増分が順に小さくなるとは限らず、人数は1人単位で飛ぶので、傾きがちょうど0になる点があるとも限りません。増分がおおむね順に小さくなる場合の目安としては、新たに加わる人の1人あたり増分が費用とほぼ等しくなるあたりが最大の点になります。前の10分位の表で言えば、費用 500円なら1人あたり増分が損益分岐とほぼ同じ10分位7のあたり、費用 1,000円なら10分位1の途中が、それに当たります。
k を決める手順をまとめると、次のようになります。
- 施策の効果(解約確率の下がり幅)を、施策を打たない群を残した小さな実験で見積もる(第12章で扱います)
- 施策の1人あたりの費用を見積もる(クーポンの額面だけでなく、配る手間や、使われなかった分も含めて考える)
- 予測の高い順に並べた顧客について、群ごとの1人あたり増分(施策ありと施策なしの期待粗利の差。概算なら解約確率の下がり幅×残存価値)を見積もる
- 1人あたり増分が費用を上回る群までを、施策の対象の上限とする
- 予算がその上限に届かないときは、1人あたり増分の大きい群から順に、予算の範囲で選ぶ(第11章で扱います)
- 純増の曲線が平らな範囲では、対象を広げても得は増えないので、予算を他の施策に回すことを検討する
解約確率が同じでも価値が違う:残存価値を入れる理由
ここまでは、予測確率の高い順に並べて上位を選んできました。しかし、期待値の式には残存価値が入っています。解約確率の下がり幅が同じでも、残ったときにもたらす粗利が大きい人のほうが、施策を打つ価値は高くなります。共通データでは、標準プラン(月額 5,000円、月次粗利 1,500円)と大容量プラン(月額 8,000円、月次粗利 2,400円)で、残ったときの粗利が1.6倍違います(いずれも架空の設定です)。予測上位20%の 1,465人を、プランで分けて比べました。
| 予測上位20%のうち | 人数 | 予測確率の平均 | 3か月解約確率(真) | 24か月の割引後粗利の期待値(円) | 1人あたり増分(円) |
|---|---|---|---|---|---|
| 大容量プラン | 293人 | 0.144 | 0.151 | 35,586 | 1,513 |
| 標準プラン | 1,172人 | 0.155 | 0.154 | 21,376 | 882 |
表の「3か月解約確率(真)」は、大容量プラン 0.151、標準プラン 0.154 とほぼ同じで、「予測確率の平均」は標準プランのほうがわずかに高くなっています(0.155 対 0.144)。予測の高い順に選ぶ限り、標準プランの人がやや先に選ばれやすくなります。ところが、「1人あたり増分」の列では、大容量プランが 1,513円、標準プランが 882円で、大容量プランの人に施策を打つほうが約1.7倍の得になります。残ったときの粗利(「24か月の割引後粗利の期待値」の列)が、大容量プランで 35,586円、標準プランで 21,376円と大きく違うからです。在籍者全員で見ても、大容量プランの1人あたり増分は 775円、標準プランは 549円でした。
前の10分位の表では、予測の高い順と1人あたり増分の高い順が、10分位の単位ではほぼ同じ向きに並んでいました。並べ直す意味が出るとすれば、同じ10分位の中で残存価値が違う人どうしです。この章で確かめたのは、そのうちプランの違い(残存価値の違い)です。世帯人数や初回クーポンのような他の属性による違いは調べていません。解約リスクの順位と増分利益の順位は、残存価値の違いの分だけずれます。この例のように同じ予測確率の帯の中で残存価値が大きく違うときは、施策による粗利の増分(施策ありと施策なしの期待粗利の差)を1人ずつ見積もって並べ直すと、同じ費用で得られる純増が増える可能性があります。予測確率に残存価値を掛けた値で並べるのは、その近似です。施策の効果をオッズで一律に置いても、解約確率の下がり幅は元の確率に比例するわけではないので、近似の順位が増分の順位と一致するとは限りません。どれだけ増えるかは、この章では計算していません。残存価値をどう計算するか(在籍月数に応じた継続率で条件付ける方法と、先24か月で打ち切る置き方)と、加入時点の LTV を60か月で打ち切る理由や割引率の置き方は第9章で扱い、価値と解約リスクを組み合わせて予算の範囲で対象を選ぶ方法は第11章で扱います。
なお、残存価値を入れて優先順位を付けることは、「価値の低い顧客を切り捨てる」ことと同じではありません。引き止めの施策は費用対効果の順に配り、価値の低い顧客にはもっと費用の小さい施策(案内のメールなど)を当てる、という形で考えるのがよいと考えています。また、施策の優先順位は、残存価値や解約確率のように事業上の損得から決めるもので、個人の属性によって不利益な扱いをすることとは区別して設計する必要があります。
「予測が高い=施策が効く」ではない
ここまでの計算は、施策の効果を「誰に対しても、解約のオッズを0.7倍にする」と置いた架空の前提に立っています。この前提のもとでは、もともと解約しやすい人ほど解約確率の下がり幅が大きくなるので、予測の高い順に選ぶことが、効果の大きい順に選ぶことにほぼ一致しました。しかし、現実の施策の効果は人によって違い、解約しやすい人ほど効くとは限りません。
施策の効果を人ごとに見ると、少なくとも4通りの人がいます。施策を受けると残るが、受けなければ解約する人。施策の有無にかかわらず残る人。施策の有無にかかわらず解約する人。そして、施策を受けたことでかえって解約する人です。予測モデルが見つけるのは「施策が無いときに解約しやすい人」で、その中には「施策の有無にかかわらず解約する人」も多く含まれます。解約を決めている人にクーポンを送っても、費用だけがかかります。施策によって行動がどれだけ変わるか(施策を受けた場合と受けなかった場合の差)を予測するのがアップリフトモデリングです。同じ人について両方の結果を観測することはできないので、実際には、施策を受けた群と受けなかった群を比べて、似た特徴を持つ顧客の集まりでの平均的な差を推定し、それを1人ずつの対象選びに使います。仕組みと実装は、弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」の第11章で扱っています。
4つ目の、施策を受けたことでかえって解約する人は、眠れる犬(Sleeping Dogs。弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」では天邪鬼層と呼んでいます)と呼ばれます。たとえば、契約のことを忘れて払い続けていた人に引き止めの連絡をすると、契約を見直すきっかけになって解約される、ということが起こりえます。アップリフトモデリングの実務を整理した Radcliffe と Surry の2011年の技術報告書(報告書のPDFの6ページ)は、ある携帯電話会社の解約抑止の施策が、アップリフトモデリングを使う前は解約率を9%から10%へかえって上げていたと報告された事例を紹介しています(同じ報告書の紹介では、効果の見込める3割に絞ったことで、全体の解約率は9%から8%未満に下がり、施策の費用は7割減ったと報告されています。報告書が引いている元の報告は、この記事では開いていません)。予測の高い人に一律に施策を打つと、このような層にも施策が届きます。
共通データには眠れる犬はいません。施策の効果を全員同じ倍率で置いたからです。この章の数字は、「施策の効果が全員同じなら、予測をこう使えばこれだけ得になる」という計算であって、現実の施策の効果を示すものではありません。現実には、施策の効果が人によって違うかどうかも、実験で確かめるまで分かりません。
施策の種類と費用のかかり方
引き止めの施策には、クーポン(割引)、担当者からの連絡、プランの変更の提案などがあります。どれを選ぶかで、期待値の式の「費用」と「解約確率の下がり幅」の両方が変わります。
クーポンは、配った全員に費用がかかるとは限りません。使われた分だけ費用がかかる形なら、使わなかった人の分は費用になりません。ただし、使う人の多くは、もともと解約するつもりの無かった人である可能性があります。上位10%の8割は施策が無くても3か月は解約しないので、この人たちがクーポンを使えば、その分は純粋な値引きになります。この章の計算は、1人 500円を対象の全員に1回ずつかけると置いたものです。使われた分だけ費用がかかる形で計算するなら、クーポンを使う人の割合と、その人たちが解約しやすいかどうかを別に見積もる必要があります。
担当者からの連絡(電話やメッセージ)は、1人あたりの費用が人件費で決まり、クーポンより高くなることが多いと考えられます。損益分岐の表で見たとおり、費用が高い施策は、対象を予測の最上位に絞らないと黒字になりません。一方で、連絡によって不満の原因(配送の遅れ、量の多すぎなど)が分かれば、施策の効果はクーポンより大きくなる可能性もあります。どちらが得かは、費用と効果の両方を測ってから決めることになります。
プランの変更の提案(大容量から標準への切り替えや、配送の間隔を延ばす提案など)は、解約を防ぐ代わりに月次粗利を下げます。期待値の計算では、施策ありの側の残存価値を変更後のプランの粗利で計算し直すだけでは足りません。提案が無くても元のプランのまま残っていた人が安いプランに移ると、その人の粗利は下がるので、その減少も差し引く必要があります。単純化して式で書けば、提案の価値は \( (1-p_{\text{提案あり}}) \times V_{\text{変更後}} – (1-p_{\text{提案なし}}) \times V_{\text{変更前}} – c \) です(p は提案の効果が続く期間の解約確率、V はその後の残存価値で、先の近似式と同じく単純化した式です)。解約されて粗利が0になるより、粗利が下がっても残ってもらうほうが得なら提案する価値がありますが、解約するつもりの無かった人まで安いプランに移ると、その分は損になります。施策の種類ごとに、誰にどの施策を当てるかを決めるには、施策ごとの効果を実験で測ることが前提になります(第12章)。
経営の判断に翻訳する:施策の予算は「増える粗利」から逆算する
この章の結果を、予算の判断に使える形に整理します。1つ目は、引き止め施策の予算の決め方です。この章の計算は、第30か月末の在籍者に1回だけ施策を打つ場合のものです。「1回の施策にいくらまで使ってよいか」は、施策で増える見込みの粗利から逆算できます。共通データで、費用 500円・効果オッズ0.7倍という前提なら、在籍者 7,324人の、この先24か月の割引後粗利が増える見込み(3か月の解約を先延ばしにしただけで後で解約する人の分を含みます)は、全員に配って 4,555,973円、そこから費用を引いた純増は 893,973円です。予測上位10%に配ると粗利の増分は 852,554円(純増 486,054円)、上位30%なら 2,093,293円(純増 994,293円)です。予算の枠を先に決めて対象を割り振るのではなく、「1人あたり増分が費用を上回る人の数×費用」を1回の施策の予算の上限として示すのがよいと考えています。施策を毎月繰り返す場合は、同じ人に何度も当たることや、効果の重なりを別に見積もる必要があり、この章では扱っていません。
2つ目は、予測モデルの価値の測り方です。予測モデルに投資する価値は、AUC の改善ではなく、モデルが無いときに実際に取る選択肢との純増の差で測るのがよいと考えています。比べる相手は、同じ予算と運用の制約のもとで実際に取りうる現行の選び方にするのがよいと考えています。ここでは、モデルが無くても実行できる単純な選び方として全員配布と比べます。ただし、上位30%の費用は 1,099,000円、全員配布は 3,662,000円で、同じ予算で実行できる選び方どうしではありません。この例で全員配布と比べると、上位30%に配る場合の純増は 994,293円、全員配布は 893,973円で、差は約10万円でした。足し上げの曲線で純増が最大になる上位66.1%(1,251,338円)でも、全員配布との差は約36万円です。上位10%に絞ると、純増の総額は全員配布より約41万円少なくなります(費用は約330万円少なくて済みます)。乱数の種を変えた5通りの計算では、上位30%と全員配布の差は約10万〜25万円の範囲で動きました。無作為に選ぶ場合との差(上位30%で約69万円)は、同じ人数・同じ費用で比べた値で、予算が先に決まっていて対象の人数が限られる場合の比較相手になります。予算に上限が無く、モデルが無ければ全員に配っていたという場合は、全員配布との差のほうが比較相手として近くなります。どちらを使うかは、モデルが無いときに実際に取る選び方で決まります。この差は1回の施策あたりの値なので、施策を何回打つかによって、モデルにかけてよい費用の上限が変わります。
3つ目は、施策の費用を変えるときの見直しです。損益分岐の表のとおり、費用が 500円から 1,000円に上がると、純増が正だと言えるのは予測上位10%だけになり(上位20%は損益分岐とほぼ同じで、黒字か赤字かは言い切れません)、全員配布は約277万円の赤字になります。クーポンの額面を上げる、連絡の手段を変えるといった施策の変更は、そのたびに対象の割合 k の見直しを伴います。対象の割合を固定したまま施策の中身だけを変えると、黒字の施策が赤字に転じても気づきません。
4つ目は、この章の数字がすべて「施策の効果」という前提の上に立っていることです。オッズ0.7倍という効果は架空の設定で、現実の施策の効果は、施策を打たない群を無作為に残す実験で確かめるのが基本です(観察データから推定する方法もありますが、強い仮定が要ります。弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」で扱っています)。効果がオッズ0.9倍のように小さければ、増える粗利は減り、損益分岐の費用も下がると考えられます(この章では0.9倍の場合を計算していません)。予測モデルを作った段階で施策の予算を決めるのではなく、まず小さな規模で施策と施策を打たない群を比べ、効果を測ってから対象と予算を広げる順番が有効だと考えています。実験の設計は第12章で扱います。
この章の要点は3つです。第一に、この例では解約に偶然の部分が大きく、予測上位10%に選んでも8割は施策が無くても3か月は解約しません(無作為や全員なら9割以上)。どの選び方でも費用の大半はその人たちに配られるので、判断は、施策ありと施策なしの期待粗利の差から費用を引いた期待値(概算では、解約確率の下がり幅×残存価値から費用を引いた値)で、増える粗利と費用の釣り合いを見て行います。一般に解約リスクの順位は増分利益の順位と同じではなく、この例では、その違いがプラン(残存価値)の違いとして表れることを確かめました(他の属性による違いは調べていません)。第二に、費用1円あたりの純増は予測上位10%が最も大きく、純増の総額は比較した候補の中では上位30%が最大でした。損益分岐の費用は、全員配布で約622円、予測上位10%で約1,163円という推定値(乱数の種を変えると、それぞれ597〜622円、1,077〜1,163円)で、損益分岐の近くの費用では黒字か赤字かを言い切れません。費用が変わると純増が最大になる対象の割合は大きく動き、全員配布と比べたモデルの価値は、上位30%で約10万円と、無作為と比べた値(約69万円)よりずっと小さく、モデルの価値はどの選び方と比べるかで大きく変わります。第三に、ここでの計算は施策の効果を全員同じと置いた架空の前提によるもので、現実には「予測が高い=施策が効く」とは限らず、効果は実験で測る必要があります。次の第9章では、この章で何度も使った残存価値と、加入時点の生涯価値(LTV)を、継続率から計算する方法を扱います。
この章を深めたい方への参考書籍
『戦略的データサイエンス入門』(Foster Provost、Tom Fawcett 著、竹田正和 監訳、オライリー・ジャパン):データ分析をビジネスの意思決定に使うための考え方を、事例とともに解説した本です。分類器を使う枠組みとしての期待値、利益曲線、顧客の乗り換え(解約)の予測と性能分析を扱う節があり、この章の「施策を打つ価値は、施策ありとなしの期待粗利の差から費用を引いたもの(概算では、施策による解約確率の下がり幅×残存価値から費用を引いたもの)」という考え方や、対象の割合 k を変えたときの純増の曲線を、より一般的な形で学べます。
『意思決定理論入門』(イツァーク・ギルボア 著、川越敏司・佐々木俊一郎 訳、NTT出版):期待効用理論、ベイズの定理、プロスペクト理論などの意思決定理論の基礎を、数式をほとんど使わずに問題集形式で解説した本です。リスク下の意思決定と不確実性下の意思決定を章を分けて扱っており、この章の期待値による判断が、どのような前提の上に立っているのか、確率が分からないときにどう考えるのかを見直すのに向いています。
第9章 生涯価値(LTV)を計算する、契約型の顧客
第8章では、引き止め施策の対象を、予測した解約確率の高さだけでなく、施策ありと施策なしの期待粗利の差(概算では「解約確率の下がり幅×その人の残存価値」)から施策の費用を引いた期待値で選ぶ考え方を確かめました。その式に出てくる残存価値と、獲得チャネルごとに獲得費用をいくらまでかけてよいかの根拠になる生涯価値(LTV)を、この章で計算します。対象は、第2章で用意したサンプルデータのうち、解約が観測できる契約型の顧客(架空の家庭向け食材宅配の定期便)です。LTV の定義とその定義を置く理由、よく使われる素朴な公式「月次粗利÷月次解約率」が置いている仮定、第5章のカプラン・マイヤー推定の継続率から LTV を計算する方法、観測の外をどう延ばすか、割引率をどう置くか、獲得費用の回収月数、チャネル×プランのセグメント別の LTV、在籍中の顧客の残存価値を、共通データで実行して確かめます。購買の記録しか無い非契約型の顧客の LTV は第10章で扱います。
LTV の定義:60か月・年5%の割引・粗利・CAC を含めない
この記事では、LTV(顧客生涯価値)を「加入時点から60か月以内に見込める月次粗利の、年5%で割り引いた合計の期待値(円)」と定義しています。月次粗利は月額に粗利率0.30を掛けたもので、共通データでは標準プラン(月額5,000円)で1,500円、大容量プラン(月額8,000円)で2,400円です。月額・粗利率・割引率・獲得費用はいずれも架空の設定です。式で書くと次のとおりです。
\( \text{LTV} = \sum_{t=1}^{60} m \times S(t) \times (1+r)^{-(t-1)} \)
言葉で言い換えると、「t か月目の料金を払っている確率 \( S(t) \)(継続率)に月次粗利 m を掛けて、その月の粗利の期待値を出し、t か月目の分を月次の割引率 r で割り引いてから、1か月目から60か月目まで足す」です。プランの違う顧客が混ざる集団では、プランごとにこの計算をしてから、人数の構成比で加重します。1か月目は加入した月の料金なので割り引かず、2か月目から割り引きます。つまり、各月の粗利をその月の初めに受け取る(前払い)という前提で割り引いています。年5%を月次に直した割引率は \( (1.05)^{1/12} – 1 \) で約0.407%で、60か月目の粗利1円は加入時点の約0.787円の価値になります。本記事の計算で確かめた値です。
この定義には、いくつかの選択が入っています。1つ目は売上ではなく粗利で測ることです。獲得費用や引き止め施策の費用と比べる相手は、顧客が残してくれる利益の側であるべきで、売上で比べると、原価を払った後に残らない部分まで回収の原資に数えることになります。共通データは月額制で、注文の回数によらず月額が決まっているので、粗利率は0.30で固定しています。初回クーポンの割引の原資(クーポンで値引いた分)は LTV に含めていません。クーポンを獲得の費用として見るなら、CAC の側に入れて比べることになります。
2つ目は割り引くことです。今月の1,500円と4年後の1,500円は、企業にとって同じ価値ではありません。手元の資金は他の投資に回せますし、4年後の粗利は事業環境の変化で実現しないかもしれません。割引率は、その「待つことの費用」と「不確かさ」を1つの数字に込めたものです。どの値を使うかは、各社の資本コスト(資金を調達するのにかかる費用の率)や、投資判断で使っている率に合わせるのが自然だと考えています。3つ目は60か月で打ち切ることです。5年より先の継続率はデータからほとんど分からず、事業の前提(価格・商品・競合)も変わる可能性が高いので、期間に上限を置きます。4つ目は獲得費用(CAC)を差し引く前の値にすることです。LTV は「獲得した後の顧客がどれだけの価値を持つか」を表す数字とし、獲得費用は「LTV÷CAC」の形で別に比べます。獲得費用を引いた値を LTV と呼ぶ流儀もあるため、社内で LTV という言葉を使うときは、どちらの定義かを最初にそろえておく必要があります。
回収月数も、ここで定義しておきます。この記事の回収月数は、加入した集団の「1人あたりの累積の割引後粗利の期待値」が CAC に達する月です。顧客1人ずつの回収月数を出して平均したものではありません。早く解約して最後まで獲得費用を回収できない顧客もいるので、1人ずつの回収月数はそもそも定まらないことがあります。回収月数は、集団として獲得費用がいつ戻るかを表す数字です。
定義をそろえる必要性は、次の節の表で具体的に見えます。同じ「紹介チャネルの LTV」が、割引も期間の上限も置かない素朴な公式では109,708円、この記事の定義では真の値で64,767円と、1.69倍の差になります。LTV の金額を会議の資料に載せるときは、粗利か売上か、割引率は何%か、何か月で打ち切ったか、獲得費用を引いたかを、数字の脇に必ず添えるのが有効だと考えています。
素朴な公式「月次粗利÷月次解約率」の3つの仮定
LTV の計算として最もよく見かけるのは、「月次粗利÷月次解約率」という公式です。月次解約率が2%なら平均の在籍期間は50か月なので、月次粗利の50か月分が LTV だ、という考え方です。この公式は、次の3つを仮定しています。第一に、解約のハザード(その月まで在籍した顧客がその月末に解約する確率)が在籍月数によらず一定であること。第二に、将来の粗利を割り引かないこと。第三に、期間に上限を置かず、無限の先まで足すこと。あわせて、月次粗利が在籍期間を通じて一定であることも前提にしています。プランのように粗利と継続率の両方が違う顧客が混ざるときは、分けて計算する必要があります(後の節で、チャネル×プランに分けて計算します)。ハザードが一定で h なら、継続率は \( S(t) = (1-h)^{t-1} \) となり、これを無限に足すと \( 1/h \) になります。「1÷解約率が平均の在籍期間」という言い方は、この計算の言い換えです。
素朴な公式とこの記事の定義の差を、仮定を1つずつ外して分解しました。月次解約率には、観測期間(第1〜36か月)の解約数÷顧客月数を使い、月次粗利はそのチャネルの顧客の平均です。「割引だけ足す」は一定のハザードのまま年5%で割り引いて無限の先まで足したもの、「割引+60か月」はさらに60か月で打ち切ったもので、期間と割引をこの記事の定義にそろえた素朴な公式に当たります。
| チャネル | 月次解約率(観測内) | 素朴な公式(割引なし・上限なし)(円) | 割引だけ足す(上限なし)(円) | 割引+60か月(一定ハザード)(円) | 真の値(円) | 割引+60か月÷真の値 |
|---|---|---|---|---|---|---|
| 紹介 | 0.0160 | 109,708 | 87,833 | 61,736 | 64,767 | 0.953 |
| 検索広告 | 0.0274 | 64,525 | 56,404 | 48,063 | 50,362 | 0.954 |
| SNS広告 | 0.0456 | 38,918 | 35,875 | 34,171 | 38,485 | 0.888 |
| チラシ | 0.0645 | 27,332 | 25,812 | 25,441 | 29,689 | 0.857 |
表の「真の値」の列は、データを作った側だけが知る真のモデルで、各チャネルと同じ構成(プラン・初回クーポン・世帯人数)の顧客20,000人を新たに生成し、1人ずつの支払月数とその人の月額から割引後の粗利を計算して平均したものです。現実には分からない値ですが、この記事では答え合わせに使えます。
期間と割引をそろえた「割引+60か月」の列は、4チャネルとも真の値より小さくなりました。真の値に対する比は紹介 0.953・検索広告 0.954・SNS広告 0.888・チラシ 0.857 で、解約率の高いチャネルほど小さく見積もっています。60か月で打ち切った在籍月数の期待値で見ても、一定のハザードでは紹介 38.7・検索広告 29.6・SNS広告 20.6・チラシ 15.2か月で、真の値の 40.2・30.7・22.9・17.7か月より短く出ました。共通データでは、在籍が長くなるほどハザードが下がります(第5章で在籍月数別のハザードを実測しました)。後で見るとおり、在籍月数ごとのハザードの変化をそのまま使う方法(KM+延長)は真の値に近くなります。ただし KM+延長はチャネル×プランごとに計算しているので、この比較で変えている条件は、ハザードを一定と置くかどうかだけではなく、プランごとの月額と継続の違いを反映するかどうかも含みます。ハザードを一定と置いたことだけの影響は、この章では切り分けていません。一定のハザードの仮定は、最初の数か月を乗り越えた顧客が観測内の平均の解約率より長く残ることを表せません。
一方、割引も上限も置かない素朴な公式(表の左から3列目)は、紹介で109,708円と、真の値の1.69倍になりました。これは定義そのものが違う別の数字です。紹介チャネルの月次解約率0.0160では、1÷解約率が62.4か月と60か月を超え、割引のない無限の足し算が大きく効きます。この簡易な公式でチャネルを比べると、紹介の LTV はチラシの4.0倍に見えますが、真の値では2.2倍です。紹介チャネルへの獲得費用を、この公式に基づいて大きく増やすと、見込んだほどの粗利は返ってきません。割引も上限も置かない素朴な公式でも、期間と割引をそろえた一定のハザードの素朴な公式でも、この例ではチャネル間の差の見え方が真の値と変わりました。紹介の LTV がチラシの何倍かは、真の値の2.18倍に対して、前者で4.01倍、後者で2.43倍です。次の節で見るとおり、カプラン・マイヤーの継続率を使う方法では、チャネルごとの LTV が真の値に近くなり、この比も2.20倍と真の値とほぼ同じになります。大きくずれるのは素朴な公式の側です。
カプラン・マイヤーの継続率から LTV を計算する
素朴な公式の代わりに、継続率曲線を直接使って、定義の式どおりに足し上げます。継続率には、第5章で打ち切りを正しく扱う方法として紹介したカプラン・マイヤー推定(KM)を使います。ただし、共通データで観測できるのは第36か月までなので、第37〜60か月の継続率は何らかの仮定で延ばす必要があります。記事全体の基準の計算(第2章で紹介した補助モジュール baseline.py の ltv_table)は、\( S(36) / S(24) \) から逆算した一定の月次ハザードがその先も続くと仮定しています。この値は、第24〜35か月の各月の継続の確率(1からその月末の解約ハザードを引いた値)の幾何平均(掛け合わせて月数で根を取った平均)を、1から引いたものに当たります。第36か月より先は観測ではなく、この仮定による外挿です。また、基準の計算はチャネル×プランごとに KM を計算し、そのチャネルの加入者のプランの構成比で加重しています。大容量プランは月額が高いうえに解約しにくいので、プランを混ぜた継続率に平均の月次粗利を掛けると、この「月額の高い人ほど長く残る」関係を取りこぼすからです。次のコードは、その計算を読みやすく書き直したもので、補助モジュール(cust_data.py と baseline.py)と同じフォルダに置いて実行する形です。
import numpy as np
import cust_data as cd
import baseline as bl
from statsmodels.duration.survfunc import SurvfuncRight

cust, monthly = cd.make_subscription()               # 観測は第36か月まで
disc = (1 + cd.MONTHLY_DISCOUNT) ** -np.arange(60)   # 1か月目は割り引かない

def km_ext(sub):                                     # KM(第36か月まで)+延長(第60か月まで)
    sf = SurvfuncRight(sub["tenure_obs"].values, sub["churned"].values)
    s = np.array([bl.km_surv_at(sf, t) for t in range(1, 37)])
    h = 1 - (s[35] / s[23]) ** (1 / 12)              # S(36)/S(24) から月次ハザードを逆算
    return np.concatenate([s, s[-1] * (1 - h) ** np.arange(1, 25)])

for c in cd.CHANNELS:
    sub = cust[cust["channel"] == c]
    ltv = 0.0
    for p in cd.PLANS:                               # プラン別に計算して構成比で加重
        sp = sub[sub["plan"] == p]
        m = cd.PRICE[p] * cd.GROSS_MARGIN            # 月次粗利 1,500円・2,400円
        ltv += len(sp) / len(sub) * m * (km_ext(sp) * disc).sum()
    print("%-8s LTV(KM+延長)%.0f 円" % (c, ltv))
# 出力:
# referral LTV(KM+延長)64920 円
# search   LTV(KM+延長)51569 円
# social   LTV(KM+延長)39171 円
# flyer    LTV(KM+延長)29516 円
コードの s[35] / s[23] は \( S(36) / S(24) \)、つまり第24か月に在籍していた人が第36か月にも在籍している割合です。これが12か月分の継続なので、12乗根を取って1から引くと、延長に使う一定の月次ハザードになります。延長のハザードは、標準プランで紹介 0.0119・検索広告 0.0201・SNS広告 0.0248・チラシ 0.0419、大容量プランで 0.0053・0.0135・0.0186・0.0256 でした。結果を、記事全体の基準の結果と並べたのが次の表です。
| チャネル | 月次粗利の平均(円) | 素朴な公式(割引なし・上限なし)(円) | 素朴な公式(一定ハザード・60か月・割引あり)(円) | KM+延長(円) | 真の値(円) | CAC(円) | 真の LTV÷CAC | KM+延長の LTV÷CAC | 回収月数(真/KM+延長) |
|---|---|---|---|---|---|---|---|---|---|
| 紹介 | 1,759 | 109,708 | 61,736 | 64,920 | 64,767 | 2,000 | 32.38 | 32.46 | 2/2 |
| 検索広告 | 1,768 | 64,525 | 48,063 | 51,569 | 50,362 | 6,000 | 8.39 | 8.59 | 4/4 |
| SNS広告 | 1,776 | 38,918 | 34,171 | 39,171 | 38,485 | 9,000 | 4.28 | 4.35 | 7/7 |
| チラシ | 1,762 | 27,332 | 25,441 | 29,516 | 29,689 | 12,000 | 2.47 | 2.46 | 11/11 |
「KM+延長」の列は、4チャネルとも真の値との差が2.4%以内に収まりました(紹介 +0.2%、検索広告 +2.4%、SNS広告 +1.8%、チラシ -0.6%)。期間と割引をそろえた素朴な公式が真の値の0.857〜0.954倍(差の大きい順にチラシ 14.3%・SNS広告 11.2%・紹介 4.7%・検索広告 4.6%小さい)だったのと比べると、継続率曲線をチャネル×プランごとに使うと、この例ではチャネルごとの LTV が真の値の近くに来ました。CAC は架空の獲得費用(紹介 2,000円・検索広告 6,000円・SNS広告 9,000円・チラシ 12,000円)です。LTV÷CAC と回収月数は後の節で扱います。
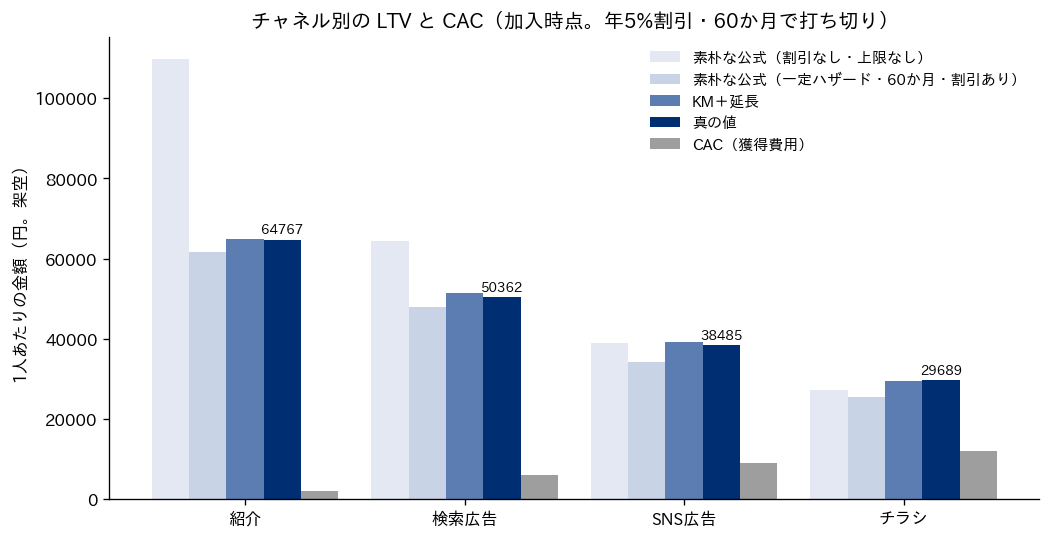
図は、同じ表を棒グラフにしたものです。紹介チャネルの最も薄い青の棒(割引なし・上限なしの素朴な公式)だけが突出していて、期間と割引をそろえた素朴な公式(2本目)は、どのチャネルでも真の値(4本目)より低くなっています。KM+延長(3本目)と真の値の棒はどのチャネルでもほぼ同じ高さです。グレーの CAC の棒は、紹介では LTV の棒に比べてごく低く、チラシでは LTV の棒の4割ほどの高さがあります。
観測の外をどう延ばすか:延長の仮定で LTV はどれだけ動くか
KM+延長の LTV が真の値に近かったのは、共通データでは、延長の仮定が第37か月以降の真の継続のしかたと大きく食い違わなかったからです。LTV を第1〜36か月の分と第37〜60か月の分に分けると、第37〜60か月の分は KM+延長で紹介 19,639円・検索広告 12,869円・SNS広告 8,344円・チラシ 4,538円、真の値で 19,099円・12,527円・7,682円・4,758円でした。現実には、第37か月以降の継続は観測できないので、この一致は確かめようがありません。そこで、延長の仮定を変えると LTV がどれだけ動くかを測りました。仮定Aは記事の基準と同じ「\( S(36) / S(24) \) から逆算した一定のハザードが続く」、仮定Bは「第36か月の継続率のまま一定(第37か月以降は誰も解約しない)」、仮定Cは「第36か月の直後に全員が解約する(第37か月以降の粗利を数えない)」、仮定Dは「延長部分のハザードが仮定Aの2倍」です。BとCは現実には起こりにくい両端で、LTV がとりうる幅を示すために置きました。どれもチャネル×プランで計算してプランの構成比で加重しています。
| チャネル | 第1〜36か月の分(円) | 仮定A 一定のハザードが続く(円) | 仮定B 解約ゼロ(円) | 仮定C 全員解約(円) | 仮定D ハザード2倍(円) | 真の値(円) | LTV のうち第1〜36か月の割合(仮定A) |
|---|---|---|---|---|---|---|---|
| 紹介 | 45,281 | 64,920 | 67,190 | 45,281 | 62,969 | 64,767 | 69.7% |
| 検索広告 | 38,700 | 51,569 | 54,493 | 38,700 | 49,318 | 50,362 | 75.0% |
| SNS広告 | 30,827 | 39,171 | 41,625 | 30,827 | 37,397 | 38,485 | 78.7% |
| チラシ | 24,978 | 29,516 | 31,649 | 24,978 | 28,219 | 29,689 | 84.6% |
表の「仮定B 解約ゼロ」の列は、仮定Aより紹介で3.5%、検索広告で5.7%、SNS広告で6.3%、チラシで7.2%高いだけでした。第37か月以降に誰も解約しないという極端な仮定を置いても、LTV はこの程度しか増えません。共通データでは、第36か月の時点ですでにハザードが低く(紹介の大容量プランで月0.5%前後)、延長部分の大半は仮定Aでも残っているからです。仮定Dのハザード2倍でも、LTV は3.0〜4.5%下がるだけでした。一方、「仮定C 全員解約」の列は、仮定Aより紹介で30.3%、チラシで15.4%低くなります。仮定Cの値は「第1〜36か月の分」と同じで、観測できた範囲だけで LTV を計算したときの値に当たります。
この表から読めることは2つあります。1つ目は、延長の仮定が LTV に効く大きさは、チャネルによって違うことです。「LTV のうち第1〜36か月の割合」の列は、紹介で69.7%、チラシで84.6%でした。継続率の高いチャネルほど、LTV のうち観測の外で稼ぐ分が大きく、その分だけ延長の仮定に頼っています。紹介チャネルの LTV の約3割は、データでは確かめられない仮定の上に立っています。2つ目は、観測の外を数えない(仮定C)と、継続率の高いチャネルほど LTV を小さく見積もることです。観測期間が短い事業で、「観測できた範囲の粗利の合計」を LTV と呼ぶと、紹介のような良いチャネルの価値を系統的に低く見ることになります。
上限の60か月をさらに延ばした場合も測りました。仮定Aのまま120か月まで足すと、KM+延長の LTV は紹介で64,920円から94,164円へ45.0%増え、チラシでは29,516円から32,438円へ9.9%増えるだけでした。真の値でも、紹介は92,591円(43.0%増)、チラシは33,448円(12.7%増)と同じ傾向です。期間の上限は、解約率の低いチャネルの LTV を大きく左右します。上限を何か月に置くかは、データの量ではなく、「何年先までの粗利を今の判断の根拠にしてよいか」という経営の判断で決めることになります。この記事では、5年より先は事業の前提が変わる可能性が高いと考えて60か月にしました。
実務では、延長の仮定を1つに決めて終わりにせず、基準の仮定と、それより厳しい仮定(仮定Cや仮定D)の両方で LTV を出しておき、厳しい側の値でも獲得費用の判断が変わらないかを確かめるのが有効だと考えています。共通データでは、仮定Dでもチラシの LTV÷CAC は2.35(28,219÷12,000)で、仮定Aの2.46から大きくは変わりませんでした。判断が変わるチャネルは、延長の仮定に判断を預けているチャネルなので、観測期間が延びて第37か月以降のデータがたまるまで、獲得費用の増額を控えめにする理由になります。
割引率の感度:年0%・5%・10%
割引率は、この記事では年5%という架空の値に置いています。この値を年0%(割り引かない)と年10%に変えて、KM+延長(仮定A)の LTV と真の値を計算しました。年10%の月次の割引率は約0.797%で、60か月目の粗利1円は加入時点の約0.626円の価値になります(年5%では約0.787円)。
| チャネル | KM+延長 年0%(円) | KM+延長 年5%(円) | KM+延長 年10%(円) | 年10%の値÷年5%の値 | 真の値 年0%・5%・10%(円) |
|---|---|---|---|---|---|
| 紹介 | 72,090 | 64,920 | 59,014 | 0.909 | 71,835・64,767・58,940 |
| 検索広告 | 56,690 | 51,569 | 47,321 | 0.918 | 55,342・50,362・46,231 |
| SNS広告 | 42,682 | 39,171 | 36,243 | 0.925 | 41,852・38,485・35,672 |
| チラシ | 31,772 | 29,516 | 27,614 | 0.936 | 31,982・29,689・27,759 |
割引率を年5%から10%に上げると、LTV は紹介で9.1%、チラシで6.4%下がりました。年0%から5%へ上げたときの下がり幅も、紹介で9.9%、チラシで7.1%です。割引の効き方がチャネルで違うのは、計算の仕組みとして、割引が遠い将来の粗利ほど強く効くからです。紹介のように長く残る顧客が多いチャネルは、粗利の多くを遠い将来に稼ぐので、割引率の影響を大きく受けます。延長の仮定と同じ構造です。
ただし、この例では、割引率を0%から10%まで動かしても、チャネルの順位(紹介>検索広告>SNS広告>チラシ)は変わりませんでした。LTV の下がり幅は、年0%から10%までで13〜18%(紹介 18.1%・検索広告 16.5%・SNS広告 15.1%・チラシ 13.1%)、年5%を挟んだ片側ずつ(0%から5%、5%から10%)では6〜10%でした。観測の外を数えない場合(仮定Cで最大3割減)や期間の上限(120か月で最大45%増)に比べると、割引率は LTV を動かすつまみとしては小さい部類です。割引率を何%にするかを議論するより先に、粗利で測っているか、期間の上限と延長の仮定は何かをそろえる方が、LTV の数字の信頼性には効くと考えています。とはいえ、割引率の値は財務の部門と合わせておく必要があります。獲得費用を投資として扱い、他の投資と比べるのであれば、財務の部門と評価の方針をそろえ、対象のリスクに応じた割引率で比べることになります。
回収月数への影響も測りました。共通データの回収月数は2〜11か月と短く、割引率を年0%・5%・10%と変えても、紹介 2・検索広告 4・SNS広告 7か月は変わらず、チラシだけが年0%で10か月、年5%と10%で11か月でした。割引率が回収月数に効いてくるのは、回収に数年かかる事業や、遠い将来の粗利を根拠に大きな獲得費用をかける判断のときです。
LTV÷CAC と回収月数:獲得費用の上限を決める
LTV を獲得費用の判断に使うには、2つの数字を並べます。1つは LTV÷CAC で、獲得費用1円あたり、獲得した顧客が60か月で何円の割引後粗利を返すかを表します。もう1つは回収月数で、獲得費用を取り戻すまでに何か月かかるかを表します。前者は「最終的に儲かるか」、後者は「いつ資金が戻るか」に答えます。共通データでは、KM+延長で計算した LTV÷CAC は紹介 32.46・検索広告 8.59・SNS広告 4.35・チラシ 2.46 で、真の値で計算した 32.38・8.39・4.28・2.47 とほぼ同じでした。回収月数は、KM+延長でも真の値でも、紹介 2・検索広告 4・SNS広告 7・チラシ 11か月で一致しました。
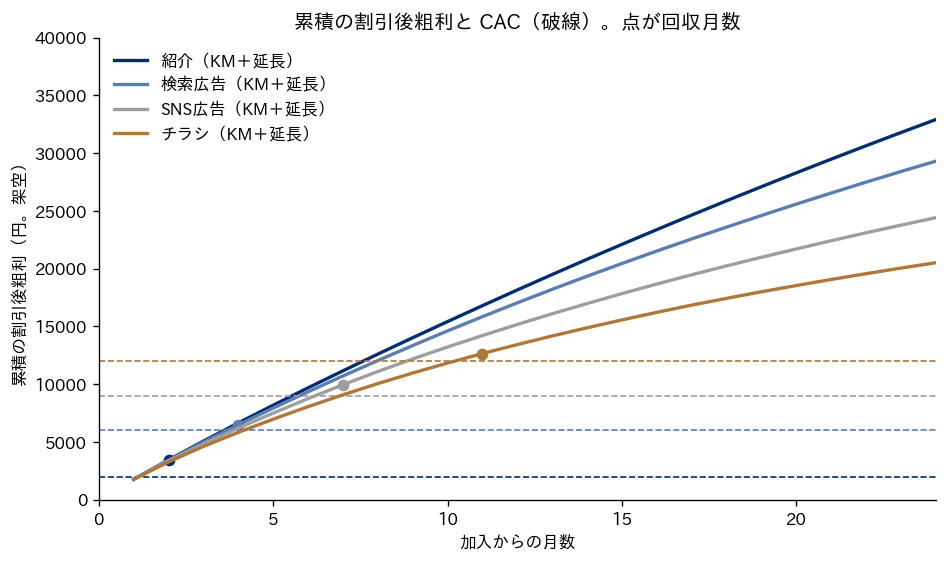
図は、加入からの1人あたりの累積の割引後粗利の期待値(KM+延長)を、チャネルごとの CAC(破線)と重ねたものです。4チャネルの曲線は最初の数か月はほぼ重なっていて、差が開くのは半年を過ぎてからです。12か月の時点の累積は紹介 18,156円・チラシ 13,428円、24か月で 32,912円・20,513円でした。回収月数の違いを、獲得費用の違いと継続率の違いに分けてみます。紹介チャネルの累積の曲線のまま CAC だけをチラシの12,000円にすると、回収月数は8か月でした。逆に、チラシの曲線で CAC を紹介の2,000円にすると2か月です。紹介の2か月とチラシの11か月の差9か月を分けると、紹介の曲線から出発する順では獲得費用の違いが6か月・継続率の違いが3か月、チラシの曲線から出発する順では獲得費用の違いが9か月・継続率の違いが0か月になります。内訳はどちらの順で分けるかで変わるので、1つの数字には決まりません。この例で言えるのは、どちらの順でも獲得費用の違いの分の方が大きいことです。継続率の差は、回収までの短い期間より長い期間で大きく表れます。12か月の時点の累積は紹介がチラシの1.35倍(18,156円対13,428円)ですが、60か月の LTV では2.20倍(64,920円対29,516円)です。
この2つの数字から、獲得チャネルごとの獲得費用の上限を決めることができます。最も単純な決め方は、「獲得費用は LTV の一定の割合まで」という目標の比率を決め、LTV にその比率を掛けることです。LTV÷CAC が1を超えれば、60か月の割引後粗利で獲得費用は回収できますが、LTV は推定値で、延長の仮定や将来の事業環境の変化による不確かさを含みます。さらに、LTV は粗利から先の費用(顧客対応や販売管理などの固定費の配賦)を引いていないので、LTV÷CAC がちょうど1では、会社としての利益は残りません。どの比率を目標にするかは、各社の固定費の大きさ、延長の仮定への信頼、資金の余裕で決まる経営の判断です。この記事では、比率の目安の値を示すことはせず、比率を変えると上限がどう変わるかを示します。
| チャネル | LTV(KM+延長)(円) | LTV の2分の1(円) | LTV の3分の1(円) | LTV の5分の1(円) | 現在の CAC(円) | 現在の CAC÷LTV | 3分の1まで使ったときの回収月数 |
|---|---|---|---|---|---|---|---|
| 紹介 | 64,920 | 32,460 | 21,640 | 12,984 | 2,000 | 0.031 | 15 |
| 検索広告 | 51,569 | 25,785 | 17,190 | 10,314 | 6,000 | 0.116 | 13 |
| SNS広告 | 39,171 | 19,585 | 13,057 | 7,834 | 9,000 | 0.230 | 10 |
| チラシ | 29,516 | 14,758 | 9,839 | 5,903 | 12,000 | 0.407 | 8 |
表の「現在の CAC÷LTV」の列を見ると、チラシは LTV の40.7%を獲得費用に使っていて、目標の比率を3分の1に置くとすでに上限(9,839円)を超え、5分の1に置くと上限の5,903円の2倍以上を使っていることになります。紹介は LTV の3.1%しか使っておらず、3分の1まで使うとすれば1人あたり21,640円まで獲得費用をかけられる計算です。ただし、この上限は「1人あたりの獲得費用がこの額でも採算が合う」という意味で、紹介の獲得費用を10倍にすれば紹介で獲得できる人数が10倍になる、という意味ではありません。紹介のようなチャネルは、費用をかけても獲得数が比例して増えるとは限りません。費用を増やしたときの獲得数の増え方は、この章の計算では扱っていません。広告の費用と効果の関係は、弊社コラム「広告の効果を測るマーケティング・ミックス・モデリング、効果の分解から広告予算の最適配分まで」で扱っています。
表の最後の列は、上限まで獲得費用を使ったときの回収月数です。紹介で3分の1(21,640円)まで使うと、回収に15か月かかります。上限を決めるときは LTV÷CAC だけでなく、この回収月数も確かめる必要があります。獲得費用は加入時点で一度に出ていき、粗利は毎月少しずつ戻ってくるので、回収月数が長いチャネルに獲得費用を積むほど、資金が寝る期間と額が大きくなります。例えば、チラシで毎月1,000人を獲得すると、獲得費用は毎月1,200万円(架空)で、その1,200万円が戻るまでに11か月かかります。毎月の獲得費用が、それまでに獲得した顧客から戻る粗利を上回っている間は、必要な資金が増え続けます。資金繰りは、月ごとの入金と出金を並べて確かめることになります。LTV÷CAC が十分に高くても、回収月数が手元資金の余裕より長ければ、獲得を急ぐことはできません。
もう1つ、平均の LTV で全チャネルを評価する誤りも測りました。ここでの「平均の LTV」は、チャネル別の KM+延長の LTV(チャネル×プランで計算したもの)を、加入者のチャネル構成(紹介 26.8%・検索広告 30.2%・SNS広告 20.5%・チラシ 22.4%)で加重平均した推定値で、47,668円でした。第1章では、同じ構成で真の値を加重平均した47,160円を平均の LTV として示しています。どちらも同じ考え方の平均で、真の値の加重平均は47,160円、推定(KM+延長)の加重平均は47,668円です。全顧客をひとまとめにして1本の KM を引く方法は使っていません。共通データでは加入時期が遅いほどチラシの顧客が多く、観測できる期間の長さと解約の起きやすさが無関係ではないので、ひとまとめの KM は正しい継続率になりません。この平均の LTV(47,668円)で各チャネルの LTV÷CAC を出すと、紹介 23.83・検索広告 7.94・SNS広告 5.30・チラシ 3.97 になります。チャネル別の LTV で出した値(紹介 32.46・検索広告 8.59・SNS広告 4.35・チラシ 2.46)と比べると、チラシは実際の1.6倍の効率に見え、紹介は実際の4分の3ほどに見えます。平均の LTV を使うと、LTV が平均より低いチャネル(この例ではチラシと SNS広告)は効率が良く、平均より高いチャネル(紹介と検索広告)は効率が悪く見え、この例ではチャネル間の差が縮んで見えました。目標の比率を3分の1に置いた場合、平均の LTV からは上限15,889円が出て、チラシの現在の CAC 12,000円は上限の内側に見えますが、チャネル別の LTV ではすでに上限(9,839円)を超えています。
セグメント別の LTV:チャネル×プラン
チャネル別の LTV は、そのチャネルのプランの構成で加重した平均です。プランによって月次粗利(標準 1,500円・大容量 2,400円)も継続率も違うので、チャネル×プランの8つのセグメントそれぞれの LTV を、KM+延長(仮定A)で並べました。真の値は、各セグメントと同じ構成の顧客20,000人を生成して求めています。
| チャネル | プラン | 人数 | 月次粗利(円) | 36か月目の継続率(KM) | 36か月目の継続率(真) | LTV(KM+延長)(円) | LTV(真の値)(円) | LTV÷CAC(KM+延長) |
|---|---|---|---|---|---|---|---|---|
| 紹介 | 標準 | 2,295 | 1,500 | 0.591 | 0.591 | 52,845 | 52,962 | 26.4 |
| 紹介 | 大容量 | 926 | 2,400 | 0.689 | 0.680 | 94,844 | 94,351 | 47.4 |
| 検索広告 | 標準 | 2,545 | 1,500 | 0.415 | 0.394 | 41,312 | 39,841 | 6.9 |
| 検索広告 | 大容量 | 1,082 | 2,400 | 0.505 | 0.496 | 75,695 | 74,720 | 12.6 |
| SNS広告 | 標準 | 1,708 | 1,500 | 0.262 | 0.244 | 30,003 | 29,329 | 3.3 |
| SNS広告 | 大容量 | 757 | 2,400 | 0.370 | 0.341 | 59,855 | 57,973 | 6.7 |
| チラシ | 標準 | 1,906 | 1,500 | 0.151 | 0.160 | 22,253 | 22,872 | 1.9 |
| チラシ | 大容量 | 781 | 2,400 | 0.252 | 0.248 | 47,239 | 47,009 | 3.9 |
8つのセグメントのすべてで、KM+延長の LTV は真の値との差が4%以内でした(-2.7%〜+3.7%)。今回の生成データでは、人数が757〜2,545人のセグメントでも、LTV の点推定は真の値に近くなりました。推定のばらつきの大きさ(信頼区間)は、この章では計算していません。セグメントの間の差は大きく、最も高い紹介×大容量(94,844円)は、最も低いチラシ×標準(22,253円)の4.3倍です。大容量プランの LTV は、同じチャネルの標準プランの1.8〜2.1倍になりました。月次粗利が1.6倍であることに加えて、大容量プランの方が継続率も高い(36か月目の継続率が0.09〜0.11高い)からです。
この表は、獲得の判断に2つのことを示しています。1つ目は、チラシで獲得した顧客でも、大容量プランなら LTV÷CAC は3.9で、SNS広告の標準プラン(3.3)より高いことです。チャネル単位で「チラシは効率が悪い」と一括りにすると、チラシの中にも採算の良いセグメントがあることを見落とします。ただし、これはこの例でのプランと継続率の相関で、訴求を変えて大容量プランの申し込みを増やせば、増えた顧客も同じ継続率になるとは限りません。第6章で見たとおり、大容量プランの顧客のハザードが低いことには、実務のデータでは、もともと利用意欲の高い家庭が大容量を選んでいる、という選んだ人の性質の差が混ざりえます(共通データではプランを利用意欲と無関係に割り当てているので、この例の差は真のモデルに置いたプランの効果によるものです)。大容量プランへの誘導に獲得費用を寄せるかどうかは、この章の計算では判断できず、第12章で扱う実験のように、誘導した顧客の継続率を実際に測ってから決めることになります。2つ目は、チラシ×標準の LTV÷CAC が1.9で、全セグメントで最も低いことです。固定費の配賦を考えると、このセグメントの獲得は、採算の余裕が最も小さいところにあります。
ただし、セグメントを細かく分けるほど、1つのセグメントの人数が減り、KM の継続率のばらつきが大きくなります。また、セグメントの数が増えると、たまたま高く出たセグメントを選んでしまう危険も増えます。共通データの8セグメント(各757人以上)では点推定が真の値に近くなりましたが、加入の少ない事業でチャネル×プラン×地域×年齢のように掛け合わせると、1セグメントが数十人になり、継続率曲線の推定の幅が大きくなります。とくに在籍月数の後半の継続率は、加入者の総数ではなく、その時点でまだ観測されている人数と解約の数で精度が決まります(statsmodels の SurvfuncRight も、標準誤差・その時点の人数・解約の数を別々に返します)。属性が多いときは、第6章のハザードモデルで属性の効果を推定し、そこから継続率を計算する方法もあります。属性の効果を足し算で表すといったモデルの仮定と引き換えに、人数の少ないセグメントでも継続率を出せます。なお、セグメント別の LTV は獲得費用や施策の配分に使うためのもので、属性によって価格を変えるような使い方は、この記事では勧めません。
在籍中の顧客の残存価値:条件付き継続率で計算する
ここまでの LTV は、加入時点で見た値です。第8章の施策の判断や第11章の優先順位づけで必要になるのは、いま在籍している顧客が、この先どれだけの粗利を残すかという残存価値です。この記事では、残存価値を「その時点から先の、LTV と同じ定義(月次粗利・年5%の割引・前払いの前提)の値」としています。ここでは、この先24か月で打ち切って計算します。第8章の「24か月の割引後粗利の期待値」も同じ定義の値で、第8章は第30か月末の在籍者について真のモデルで計算したもの、この章は第36か月末の在籍者について継続率から推定し、真のモデルの値と比べます。
在籍中の顧客の残存価値を、加入時点の LTV から「すでに払った分」を引いて求めるのは誤りです。在籍月数 t まで残った顧客は、すでに解約した人を含まない集団なので、その先の継続の見込みは加入時点の顧客全体より高くなります。そこで使うのが条件付き継続率です。在籍月数 t(t か月分の料金を払った)の顧客が t か月目の月末の解約を免れて在籍しているとき、この記事の解約の数え方(最後に料金を払った月の月末に解約)では、t+1 か月目の料金を払うことは決まっています。この顧客が t+k か月目の料金も払う確率は、\( S(t+k) / S(t+1) \) で求められます。言葉で言い換えると、「加入した人のうち t+k か月目まで残る割合を、t+1 か月目まで残った割合で割る」ことで、t+1 か月目まで残ったという条件を付けた継続率になります(k=1 では1です)。残存価値は、これに月次粗利を掛け、割り引いて、k=1〜24 まで足したものです。次のコードは、第36か月末の在籍者について、チャネル×プランの KM(延長は仮定A)から残存価値を計算し、真のモデルのシミュレーション(cd.simulate_future。隠れた利用意欲から先を真のモデルで30回シミュレーションしたもの)の値と比べるものです。補助モジュールと同じフォルダに置いて実行する形です。
import numpy as np
import cust_data as cd
import baseline as bl
from statsmodels.duration.survfunc import SurvfuncRight

def km_ext(sub):                                      # 前のコードと同じ(S(1)〜S(60))
    sf = SurvfuncRight(sub["tenure_obs"].values, sub["churned"].values)
    s = np.array([bl.km_surv_at(sf, t) for t in range(1, 37)])
    h = 1 - (s[35] / s[23]) ** (1 / 12)
    return np.concatenate([s, s[-1] * (1 - h) ** np.arange(1, 25)])

cust, monthly = cd.make_subscription()
disc = (1 + cd.MONTHLY_DISCOUNT) ** -np.arange(24)   # この先24か月
S = {(c, p): km_ext(cust[(cust["channel"] == c) & (cust["plan"] == p)])
     for c in cd.CHANNELS for p in cd.PLANS}

def residual(s, t, price):                            # 在籍月数 t の人の残存価値
    cond = s[t:t + 24] / s[t]                         # S(t+k)/S(t+1), k=1..24
    return price * cd.GROSS_MARGIN * (cond * disc).sum()

alive = cust[cust["churned"] == 0].copy()             # 第36か月末の在籍者
alive["t"] = 36 - alive["acq_month"] + 1
alive["km"] = [residual(S[(c, p)], t, pr) for c, p, t, pr in
               zip(alive["channel"], alive["plan"], alive["t"], alive["price"])]
cust_f, monthly_f = cd.make_subscription(full=True)   # 答え合わせ用
fut = cd.simulate_future(cust_f, monthly_f, start_month=36, horizon=24, n_sims=30)
alive = alive.merge(fut[["cust_id", "exp_margin"]], on="cust_id")
print(alive.groupby("channel")[["km", "exp_margin"]].mean().round(0))
# 出力:
#                km  exp_margin
# channel
# flyer     28339.0     28228.0
# referral  36475.0     36127.0
# search    33584.0     33541.0
# social    31959.0     31114.0
第36か月末の在籍者は6,314人で、在籍月数は7〜36か月です。出力の km の列が KM の条件付き継続率から計算した残存価値の平均、exp_margin の列が真の値(この先24か月の割引後粗利の期待値)の平均です。在籍月数の帯に分けて比べたのが次の表です。
| チャネル | 在籍月数の帯 | 人数 | 残存価値(KM)(円) | 残存価値(真の値)(円) | KM の差 |
|---|---|---|---|---|---|
| 紹介 | 7〜12か月 | 430 | 35,637 | 35,607 | +0.1% |
| 紹介 | 13〜24か月 | 873 | 36,380 | 36,059 | +0.9% |
| 紹介 | 25〜36か月 | 970 | 36,933 | 36,418 | +1.4% |
| 検索広告 | 7〜12か月 | 521 | 32,637 | 32,750 | -0.3% |
| 検索広告 | 13〜24か月 | 870 | 33,682 | 33,397 | +0.9% |
| 検索広告 | 25〜36か月 | 705 | 34,163 | 34,303 | -0.4% |
| SNS広告 | 7〜12か月 | 287 | 30,271 | 30,103 | +0.6% |
| SNS広告 | 13〜24か月 | 446 | 31,874 | 31,244 | +2.0% |
| SNS広告 | 25〜36か月 | 309 | 33,649 | 31,865 | +5.6% |
| チラシ | 7〜12か月 | 325 | 27,228 | 27,099 | +0.5% |
| チラシ | 13〜24か月 | 376 | 28,734 | 28,213 | +1.8% |
| チラシ | 25〜36か月 | 202 | 29,393 | 30,072 | -2.3% |
表の「KM の差」の列は、12の組のうち9で正になり、-2.3%〜+5.6%の範囲でした。チャネル単位では紹介 +1.0%・検索広告 +0.1%・SNS広告 +2.7%・チラシ +0.4%、6,314人の合計では KM 2億1,219万円に対して真の値 2億1,033万円で、KM は約0.9%高く見積もりました。KM をチャネル別だけで計算し、プランを分けずに同じ計算をすると、チャネル単位の値は4チャネルとも0.6〜1.3%低くなり、真の値との差は紹介 +0.2%・検索広告 -0.5%・SNS広告 +1.9%・チラシ -0.9%でした。プランを混ぜた継続率では、継続率が高く月次粗利も大きい大容量プランの人の残る月数を短めに数えるためと考えられます。この例では、プランを分けない計算のほうが真の値との差が小さいチャネルもありました。チャネル×プランに分けても残る差(SNS広告で +2.7%)の原因は、この章の計算では切り分けていません。
残存価値は、加入時点の LTV と比べると性質がよく分かります。KM で計算した「加入時点の最初の24か月の割引後粗利」は、紹介 32,912円・検索広告 29,306円・SNS広告 24,414円・チラシ 20,513円でした。第36か月末の在籍者の、この先24か月の残存価値の平均(紹介 36,475円・チラシ 28,339円)は、同じ24か月で比べても加入時点より大きく、差は紹介で11%、チラシで38%です。チラシで獲得した顧客でも、7か月以上残っている人は、加入時点のチラシの顧客全体よりずっと価値が高いということです。加入直後の解約の多さだけでチャネルの顧客を一括りに見ると、残っている顧客の価値を低く見積もります。
一方で、KM の残存価値には、顧客ごとの利用状況が入っていません。同じチャネル・同じプラン・同じ在籍月数の人は、すべて同じ残存価値になります。真のモデルでは、解約のハザードはその月の注文回数や問い合わせ回数で変わり、注文回数は隠れた利用意欲で決まります。その差がどれだけ残るかを、第36か月の注文回数ごとに「真の値÷KM の値」の平均を出して確かめました。
| 第36か月の注文回数 | 人数 | 真の値÷KM の値(平均) |
|---|---|---|
| 0回 | 1,138 | 0.898 |
| 1回 | 1,223 | 0.953 |
| 2回 | 1,225 | 0.997 |
| 3回 | 1,300 | 1.037 |
| 4回 | 1,428 | 1.061 |
第36か月に注文が0回だった人の真の残存価値は、KM の値の0.898倍、4回だった人は1.061倍でした。0.898倍は、KM の値が真の値より約1割高いということです。KM は、注文の少ない人の残存価値を高めに、多い人を低めに見積もっています。個人単位の相関で見ると、KM と真の値の相関は全体では0.938と高く出ますが、これは主に月額の違い(大容量か標準か)によるもので、プランの中に限ると標準 0.680・大容量 0.659 に下がりました。この相関には、真の値を30回のシミュレーションの平均で求めたことによるばらつきも含まれています。今回の設定では、チャネルや在籍月数の帯の平均は真の値に近くなりました(帯ごとの差は -2.3%〜+5.6%)。実務で使うときは、この程度の推定の誤差で施策の判断が変わらないかを確かめることになります。顧客1人ずつの残存価値を施策の対象選びに使うなら、利用状況を入れて月ごとの解約確率を推定し、それを積み上げて継続率を作る方法(第6章の離散時間ハザードモデル)の方が、個人差をとらえられます。第7章の3か月解約確率は、そのままでは24か月分の月ごとの継続率にならないので、使うなら月ごとの確率への置き換えに別の仮定が要ります。また、利用状況から作った継続率でも、隠れた利用意欲そのものは観測できないので、真の値との差はゼロにはなりません。その目安として、第7章で見たとおり、この生成設定・この検証集団では、隠れた利用意欲を知る真のモデルの推定確率でも、3か月解約に対する AUC は0.684でした。AUC は解約の当てやすさの指標で、残存価値の推定の誤差を直接測るものではありません。
残存価値を計算するときの注意をもう1つ添えます。在籍月数が長い人ほど、\( S(t+k) \) の t+k が観測の外(第37か月以降)に入る割合が増えます。第36か月末に在籍月数36か月の人の残存価値は、最初の1か月(在籍月数が1つ進んだ37か月目。この人では暦の第37か月)の支払いは決まっているものの、その先の23か月分の継続率はすべて延長の仮定から来ています。SNS広告の25〜36か月の帯で KM の差が +5.6% と最も大きかったことが延長の仮定と関係しているかは、この章の計算では確かめていません。残存価値を報告するときも、延長の仮定に頼っている割合を添えるのが有効だと考えています。
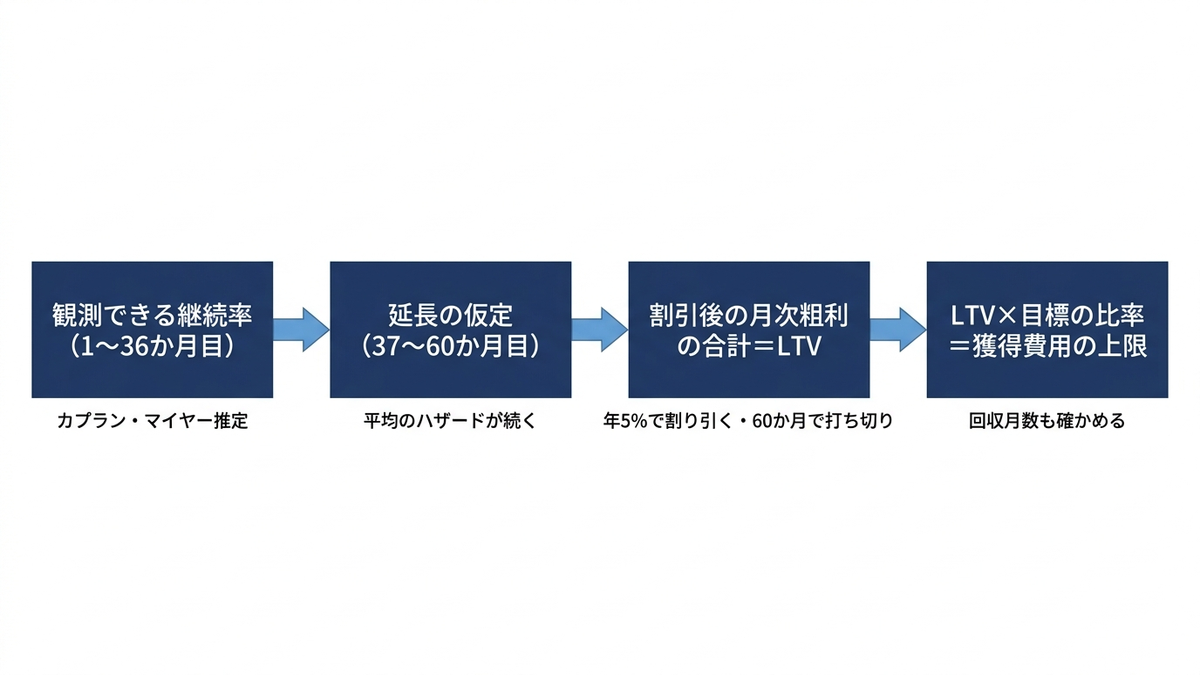
経営の判断に翻訳する:獲得費用の上限は LTV から、チャネル別に決める
この章の結果を、獲得と引き止めの予算の判断に使える形に整理します。1つ目は、LTV の数字には必ず定義を添えることです。共通データの紹介チャネルでは、割引も期間の上限も置かない素朴な公式で109,708円、この記事の定義の真の値で64,767円と、同じ「LTV」が1.69倍違いました。期間と割引をそろえても、ハザードを一定と置き、プランも分けない素朴な公式では、4チャネルとも真の値の0.857〜0.954倍と小さく出ました(2つの条件のどちらがどれだけ効いたかは切り分けていません)。獲得費用の上限を LTV から決めるとき、大きく出る定義の LTV を使えば、その分だけ獲得費用を使いすぎ、小さく出る定義を使えば獲得の機会を逃します。LTV を経営の指標にするなら、粗利で測る・割引率は財務と同じ値・期間の上限・延長の仮定・獲得費用を差し引く前の値、という定義を社内で1つに決め、資料のたびに添えることが有効だと考えています。
2つ目は、獲得費用の上限をチャネル別の LTV から決めることです。チャネル別の LTV を加入者の構成で加重平均した LTV(推定 47,668円)で評価すると、チラシの LTV÷CAC は3.97に見えますが、チャネル別では2.46でした。この共通データでは、平均の LTV はチラシの効率を高く、紹介の効率を低く見せました。平均の LTV で評価して高く見えるのは LTV が平均より低いチャネルで、LTV÷CAC で見た効率の良し悪しと必ず一致するわけではありませんが、平均の LTV で獲得費用の上限を決めると、LTV の低いチャネルに見合う以上の獲得費用を配ってしまう可能性があります。チャネル別、可能ならチャネル×プランのように獲得費用の配分の単位に合わせて LTV を計算し、「LTV×目標の比率」を上限として、上限を超えているチャネルから獲得費用を見直すのが筋だと考えています。目標の比率は、固定費の大きさ、延長の仮定への信頼、資金の余裕から経営が決めるもので、分析の担当者が決める数字ではありません。
3つ目は、LTV÷CAC と回収月数を必ず一緒に見ることです。LTV÷CAC は最終的な採算を、回収月数は資金の寝る期間を表します。獲得を増やす判断は、LTV÷CAC が目標を上回っていても、回収月数の間に積み上がる資金の持ち出しに耐えられるかで制約されます。共通データでは、紹介の獲得費用を LTV の3分の1まで増やすと、回収月数は2か月から15か月へ延びました。上限の議論と資金繰りの議論は、同じ表の上で行うのが有効です。
4つ目は、延長の仮定と期間の上限が LTV を大きく動かすことです。この例では、割引率を年0%から10%まで動かすと LTV は13〜18%下がりましたが、観測の外を数えないと紹介で3割減り、期間を120か月に延ばすと45%増えました。観測期間が短い事業ほど、LTV の大部分が仮定の上に立ちます。観測期間が延びるたびに LTV を計算し直し、仮定に頼っている割合が減っていくのを確かめながら、獲得費用の上限を段階的に見直す運用が現実的だと考えています。LTV は一度計算して終わりの数字ではありません。更新の頻度と会議体は第13章で扱います。
5つ目は、在籍中の顧客の価値を、加入時点の LTV から引き算で求めないことです。共通データでは、第36か月末に在籍しているチラシの顧客の、この先24か月の残存価値は、加入時点のチラシの顧客全体の最初の24か月の値より38%高くなりました。引き止め施策の予算を「残存価値×救える確率」から逆算するとき(第8章)、残存価値を条件付き継続率で計算しないと、長く残っている顧客を引き止める価値を低く見積もります。
この章の要点は3つです。第一に、LTV は定義で大きく変わります。割引も期間の上限も置かない素朴な公式「月次粗利÷月次解約率」は、紹介チャネルで真の値の1.69倍になり、期間と割引をそろえても、一定のハザードを仮定しプランも分けない素朴な公式では、4チャネルとも真の値より小さく出ました。カプラン・マイヤー推定の継続率をチャネル×プランごとに定義の式どおりに足し上げると、4チャネルとも真の値との差は2.4%以内でした。第二に、観測の外を数えるかどうかと期間の上限は LTV を大きく動かし、割引率の影響は相対的に小さい部類でした。継続率の高いチャネルほど、LTV のうち仮定に頼る部分が大きくなります。第三に、獲得費用の上限は「チャネル別の LTV×目標の比率」で決め、回収月数で資金繰りを確かめます。在籍中の顧客の残存価値は、条件付き継続率 \( S(t+k) / S(t+1) \) で計算します。ただし KM による残存価値には顧客ごとの利用状況が入らないので、個人単位の判断には限界があります。次の第10章では、解約が観測できない非契約型の顧客について、購買の記録から生涯価値を推定する BG/NBD モデルを扱います。
この章を深めたい方への参考書籍
『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』(マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社):マーケティングの成果を測る指標を15に絞って解説した本です。版元の目次では、第5章で正味現在価値(NPV)・内部収益率(IRR)・投資回収期間を「マーケティング担当者向けの財務系指標」として扱い、第6章で顧客生涯価値の定義を扱っています。この章の割引・回収月数と LTV を、マーケティングの投資判断の言葉で整理し直すのに向いています。
『コーポレートファイナンス入門〈第2版〉』(砂川伸幸 著、日本経済新聞出版社、日経文庫):企業財務の考え方を新書の分量でまとめた入門書です。版元ドットコムの目次では、「キャッシュフローの割引現在価値」「企業の投資決定」の章があります。この章で LTV の定義に入れた割引率を、資本コストや投資の判断というファイナンスの枠組みの中で理解し直し、財務の部門と同じ言葉で獲得費用を議論するための土台になります。
第10章 購買履歴から生涯価値を推定する、非契約型の顧客とBG/NBD
第9章では、契約型の顧客(第2章で用意した架空の食材宅配の定期便)について、継続率の曲線から LTV を計算し、獲得チャネルごとの LTV÷CAC と回収月数を確かめました。契約型では、顧客が解約したことが支払いの停止として記録に残るので、継続率もハザードも直接数えることができます。この章では、解約の記録が無い非契約型の顧客を扱います。通販や小売の顧客は、買うたびに記録が残るだけで、「もう買わない」と決めた日はどこにも記録されません。そこで、購買の回数と時期の記録から、顧客がまだ在籍している確率と、この先に買う回数の期待値を推定する確率モデルが要ります。この章では、その代表であるBG/NBD モデルの仮定と推定の仕組みを、原論文を開いて確かめた範囲で説明し、第2章で用意した架空の単品通販のデータで、推定した値を真の値と突き合わせます。あわせて、1回あたりの金額を推定するガンマ・ガンマモデルと、BG/NBD の仮定の弱点を直した変種を扱い、最後に非契約型の LTV と「生きている顧客数」を経営の数字に翻訳します。価値の分布を見て施策の優先順位を決める話は第11章で扱います。
非契約型では離脱が観測できない
非契約型の顧客基盤を分析するときの最初の難しさは、離脱した顧客と、たまたましばらく買っていないだけの顧客を、記録の上で区別できないことです。定期便であれば、解約した顧客の記録には最後の支払いの月があり、在籍中の顧客の記録とははっきり違います。単品通販では、半年前に最後に買った顧客が、すでに他の店に移ったのか、次に買う時期がまだ来ていないだけなのかは、記録を見ても分かりません。第2章で用意した共通データ B(架空の単品通販のサンプルデータ。顧客 6,000人、初回の購買は第0〜80週、観測できるのは第104週まで)でも、記録にあるのは顧客ごとの購買の時刻と金額だけです。
このデータは、データを作った側だけが、各顧客が第104週の時点で離脱していないかどうか(真の値)を知っています。実測すると、第104週の時点で離脱していない顧客は 6,000人のうち 3,726人(真の在籍率 0.621)でした。現実の企業には、この 3,726人という数は見えません。見えないものを推定する方法がこの章の主題で、推定の良し悪しは、このデータでは真の値と比べて確かめることができます。比べる相手は、在籍しているかどうかだけではありません。答え合わせ用に第156週まで生成してある購買の記録を使えば、第105〜156週の52週に実際に起きた購買の回数と金額とも比べられます。
「在籍しているか分からない」ことは、経営の数字に直接響きます。契約型の事業で「今月の在籍者数」と呼ぶ数は、非契約型の事業では定義からして決まりません。そのため、通販や小売では「最後の購買から一定の期間(たとえば26週)買っていない顧客を離脱とみなす」という社内ルールで在籍者数を数えることが多いように思います。この章の後半で実測するとおり、このルールで数えた在籍者数は、この例では真の在籍者数を大きく下回りました。ただし、その差の大部分は、1回しか買っていない顧客を全員在籍とするこのデータの作り方から来ています(後の節で、frequency 1以上の顧客に限った比較も示します)。どの顧客に再購買を促す連絡を送るか、顧客基盤がいくらの価値を持つか、といった判断の土台が、このルールの置き方で変わります。
RFM の2つの意味:BG/NBD の流儀と一般の RFM 分析
購買の記録を顧客ごとに要約するときによく使われるのがRFMです。R は最近(Recency)、F は頻度(Frequency)、M は金額(Monetary)を表します。同じ RFM という名前で、2つの違うものが呼ばれているので、この記事では区別して書きます。
1つ目は、BG/NBD モデルの入力としての RFM です。2005年の Fader・Hardie・Lee の論文(BG/NBD モデルを提案した論文。以下、原論文)は、各顧客の購買履歴を、観測期間(0, T]の購買回数 x と、最後の購買の時刻 \( t_x \) の2つで要約し、モデルの計算にはこの2つと T だけがあれば足りる、としています。購買の一つひとつの時刻は要らない、ということです。原論文の実証分析では、初回の購買を数えず、2回目以降の購買(リピート購買)だけを数え、T は観測の終わりから初回の購買の時刻を引いた長さにしています。共通データの補助モジュール(cust_data.py)の rfm_table も同じ流儀で、frequency は2回目以降の購買回数、recency は初回から最後の購買までの週数、T は初回から観測終了(第104週)までの週数、monetary は購買1回あたりの平均金額です。1回しか買っていない顧客は frequency 0・recency 0 になります。
2つ目は、一般の RFM 分析です。顧客を「最後の購買からの日数」「購買回数」「購入金額」でそれぞれ数段階に分け、点数の組み合わせで顧客を区分して、区分ごとに施策を変える使い方を指します。ここで R として使うのは「最後の購買からどれだけたったか」で、BG/NBD の recency(初回から最後の購買まで)とは向きが逆の量です。BG/NBD の記号で書けば、最後の購買からの週数は \( T – t_x \) に当たります。同じ「R」でも、片方は(T が同じ顧客どうしなら)値が大きいほど最近まで買っていた顧客、もう片方は値が大きいほど長く買っていない顧客を表すので、ツールの出力や社内資料を読むときは、どちらの定義かを最初に確かめる必要があります。
共通データの RFM を実測すると、次の表のようになりました。
| 項目 | 平均 | 中央値 | 最小 | 最大 |
|---|---|---|---|---|
| frequency(2回目以降の購買回数) | 2.42 | 1 | 0 | 60 |
| recency(初回から最後の購買までの週数) | 23.96 | 15.33 | 0 | 103.03 |
| T(初回から観測終了までの週数) | 64.43 | 64.67 | 24.01 | 103.99 |
| 最後の購買からの週数(T から recency を引いた値) | 40.48 | 36.68 | (表示していない) | (表示していない) |
| monetary(1回あたり平均金額、円) | 5,953 | 4,959 | 186 | 68,283 |
frequency 0、つまり初回の購買のあと一度も買っていない顧客は 1,724人で、全体の 28.7%でした。frequency の平均は 2.42 ですが中央値は 1 で、少数の顧客が何十回も買う、右に長く裾を引いた分布です。monetary も平均 5,953円に対して中央値 4,959円と、右に裾を引いています。
一般の RFM 分析の考え方で、最後の購買からの週数を5段階(各 1,200人)に分け、最近買った顧客ほど点数が高くなるよう R の点数を付けて、段階ごとに真の在籍率と、第105〜156週に実際に買った回数の平均を並べました。在籍確率の平均は、この後で推定する BG/NBD モデルの値です。
| R の点数 | 最後の購買からの週数 | 人数 | 真の在籍率 | 在籍確率の平均(BG/NBD) | 第105〜156週の購買回数の平均(実現) |
|---|---|---|---|---|---|
| 5(最も最近) | 0.0〜11.4 | 1,200 | 0.790 | 0.810 | 3.298 |
| 4 | 11.4〜28.6 | 1,200 | 0.622 | 0.624 | 1.198 |
| 3 | 28.6〜45.4 | 1,200 | 0.577 | 0.583 | 0.548 |
| 2 | 45.4〜68.4 | 1,200 | 0.522 | 0.537 | 0.292 |
| 1(最も古い) | 68.4〜103.8 | 1,200 | 0.594 | 0.587 | 0.215 |
表の「第105〜156週の購買回数の平均(実現)」の列は、R の点数が高いほどきれいに大きくなっていて、R の点数はこの先の購買の多さをよく並べています。一方、「真の在籍率」の列は、R が最も低い段階(0.594)のほうが1つ上の段階(0.522)より高く、R の点数の順になっていません。最後の購買から最も長くたった段階には、初回の購買のあと一度も買っていない顧客が 1,200人のうち 640人含まれていて(1つ上の段階では 496人)、この共通データでは、BG/NBD の仮定どおりに、そうした顧客は全員が離脱していない設定で作ってあるからです(この設定の意味と限界は後の節で扱います)。R の点数の段階で「在籍しているか」を読もうとすると、頻度の違う顧客が混ざっているせいで、見かけの在籍率が順に並ばないことがあります。一般の RFM 分析の点数は顧客を並べる道具としては役に立ちますが、点数そのものは確率ではないので、「R が1なら離脱」と読むことはできません。
「最近買っていない=離脱」の誤り:頻度で意味が変わる
最後の購買からの週数が同じでも、その意味は、その顧客がふだんどのくらいの間隔で買っているかによって変わります。週に1回買っていた顧客が20週買っていなければ、離脱した可能性が高いと考えるのが自然です。一方、半年に1回しか買わない顧客が20週買っていないのは、いつもどおりの間隔の範囲です。この違いを数字で確かめるため、最後の購買からの週数と frequency の組み合わせごとに、真の在籍率と BG/NBD の在籍確率の平均を並べました。
| frequency | 最後の購買からの週数 | 人数 | 真の在籍率 | 在籍確率の平均(BG/NBD) | 第105〜156週の購買回数の平均(実現) |
|---|---|---|---|---|---|
| 1〜2 | 0〜13週 | 454 | 0.707 | 0.739 | 1.115 |
| 1〜2 | 13〜26週 | 460 | 0.583 | 0.585 | 0.954 |
| 1〜2 | 26〜52週 | 780 | 0.349 | 0.382 | 0.406 |
| 1〜2 | 52週超 | 820 | 0.182 | 0.184 | 0.151 |
| 3〜5 | 0〜13週 | 422 | 0.789 | 0.804 | 2.493 |
| 3〜5 | 13〜26週 | 219 | 0.621 | 0.576 | 1.516 |
| 3〜5 | 26〜52週 | 232 | 0.297 | 0.302 | 0.603 |
| 3〜5 | 52週超 | 192 | 0.042 | 0.053 | 0.078 |
| 6以上 | 0〜13週 | 436 | 0.858 | 0.863 | 5.991 |
| 6以上 | 13〜26週 | 110 | 0.473 | 0.472 | 2.364 |
| 6以上 | 26〜52週 | 110 | 0.164 | 0.150 | 0.409 |
| 6以上 | 52週超 | 41 | 0.049 | 0.008 | 0.220 |
最後の購買から26〜52週たった顧客の「真の在籍率」の列を見ると、frequency 1〜2 では 0.349、3〜5 では 0.297、6以上では 0.164 です。26〜52週の行では、同じだけ買っていなくても、よく買っていた顧客ほど離脱している割合が高いということです。52週を超えると、1〜2 では 0.182 がまだ在籍しているのに対し、3〜5 では 0.042、6以上では 0.049 で、どちらも5%前後です。この2つの区分の間の差は、6以上・52週超が 41人しかいないこともあり、この表からは読み取れません。逆に、最後の購買から13週以内の顧客では、6以上の 0.858 が最も高く、1〜2 の 0.707 が最も低くなっています。頻度の高い顧客は、最近買っていれば在籍している可能性が高く、しばらく買っていなければ離脱している可能性が高い、という両極端に分かれます。「在籍確率の平均」の列は、表のすべての区分で真の在籍率と 0.05 以内に収まっていました。次の図は、同じことを区間を細かくして描いたものです。
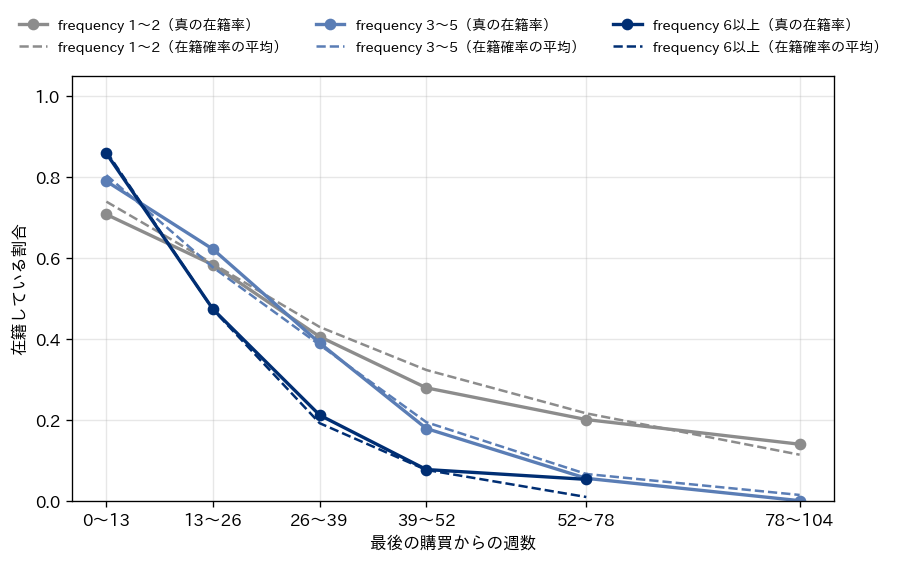
図の0〜13週の区間では濃いネイビーの線(frequency 6以上)が最も上にあり、39〜52週の区間では最も下にあります。線が交差していることが、「最後の購買からの週数」だけでは在籍しているかを判断できないことを示しています。
具体的な顧客で見ると、違いはもっとはっきりします。推定した BG/NBD のパラメータ(後の節で示します)を使い、初回の購買から80週たった顧客(T=80週)で、最後の購買が初回から40週の時点、つまり最後の購買から40週たっている顧客の在籍確率を、frequency を変えて計算しました。frequency 1 なら 0.552、3 なら 0.397、8 なら 0.063、15 なら 0.002 です。最後の購買が4週前の顧客では、frequency 1 で 0.750、3 で 0.831、8 で 0.891、15 で 0.911 と、順位が逆になります。40週前に最後に買った frequency 15 の顧客は、最初の40週で16回買っていた、つまり2〜3週に1回買っていた人で、その人が40週買っていないので、このモデルの仮定のもとでは、離脱した可能性が非常に高いと推定されます(在籍確率 0.002)。BG/NBD モデルは、この直感を確率として計算します。
では、「最後の購買から26週以内なら在籍、それより長く買っていなければ離脱」という素朴なルールで在籍を判定すると、どのくらい当たるか。全員で数えると、このルールで在籍と判定されるのは 2,171人で、真の在籍・離脱と一致した割合(正答率)は 0.535 でした。13週で切ると 1,312人・0.503、52週で切ると 3,961人・0.579 です。BG/NBD の在籍確率が 0.5 以上の人を在籍とみなすと、3,876人・0.823 でした。在籍を並べる力を測る AUC(第7章で扱った指標。1なら完全に並べられ、0.5なら当てずっぽうと同じ)は、在籍確率が 0.908、最後の購買からの週数(短いほど在籍とみなす)が 0.585 です。
ただし、この差の大きさには、データの設定が効いていることを断っておきます。共通データでは、初回のあと一度も買っていない顧客は全員が離脱していないという設定なので、最後の購買から長くたった frequency 0 の顧客を「離脱」と判定する素朴なルールは、この 1,724人の多くを外します。frequency が1以上の 4,276人だけで比べると、AUC は在籍確率 0.829 に対して最後の購買からの週数 0.798、正答率は在籍確率 0.752 に対して26週のルール 0.735 で、差はずっと小さくなりました。素朴なルールが大きく外れるのは、主に1回しか買っていない顧客の扱いの違いによります。frequency 0 の顧客を本当に「在籍」とみなしてよいかは、データからは確かめられない仮定の問題で、この点は後の節で扱います。
BG/NBD モデルの仮定:購買の速さと離脱のしやすさを分けて考える
BG/NBD モデルは、2005年に Fader・Hardie・Lee が学術誌 Marketing Science に発表した論文で提案されました。原論文は、それ以前から知られていた Schmittlein・Morrison・Colombo の1987年のモデル(Pareto/NBD モデル。顧客がいつでも離脱しうるとし、離脱までの時間と購買の回数をそれぞれ確率分布で表したもの)を高く評価しつつ、そのパラメータの推定が計算の上で難しいことを課題に挙げています。BG/NBD モデルは、顧客が離脱する時点についての仮定を少しだけ変えることで、推定を大幅に簡単にしたもので、原論文はパラメータを Microsoft Excel でも推定できることを示しています。
原論文を開いて確かめた BG/NBD モデルの仮定は、次の5つです。
- 在籍している間、顧客の購買は購買率 λ のポアソン過程(購買が一定の平均の速さで、ばらばらの時刻に起きる仕組み)に従う。言い換えると、購買と購買の間隔は、平均 1/λ の指数分布(短い間隔ほど起きやすく、長い間隔ほど起きにくい分布)に従う
- 購買率 λ は顧客ごとに違い、その散らばりはガンマ分布(形を決める値 r と、尺度を決める値 α を持つ分布)に従う
- 顧客は、購買のたびに、その直後に確率 p で離脱する。したがって、何回目の購買の直後に離脱するかは(ずらした)幾何分布(毎回同じ確率のくじを、当たるまで引き続けたときの回数の分布)に従う
- 離脱の確率 p は顧客ごとに違い、その散らばりはベータ分布(0から1の間の値をとる分布で、2つの値 a と b で形が決まる)に従う
- 購買率 λ と離脱の確率 p は、顧客の間で互いに独立に散らばる
言葉で言い換えると、顧客にはそれぞれ「買う速さ」と「離脱しやすさ」があり、その2つは人によって違っていて、2つの間に関係は無い、と仮定しています。買う速さの散らばりにガンマ分布、離脱しやすさの散らばりにベータ分布を使うと、尤度(データがそのパラメータのもとで起きる確率)が、ガンマ関数とベータ関数だけを使った式で書けることを、原論文は示しています。共通データ B は、この仮定どおりに、r 0.6・α 8.0・a 0.8・b 2.5 という架空の真の値で作ってあります。購買率の平均は r/α で週あたり 0.075回(約13週に1回)、離脱の確率の平均は a/(a+b)で 0.242 です。
Pareto/NBD との違いは3つ目の仮定にあります。原論文は、Pareto/NBD の離脱の時点のモデルは購買の有無と関係なくいつでも離脱が起きうると仮定するのに対し、BG/NBD は離脱が購買の直後に起きると仮定する、と説明しています。この仮定から、BG/NBD では、観測期間の初めの時点ではすべての顧客が在籍していて、少なくとも1回は買ってからでないと離脱できないことになります。原論文は、81通りの購買の環境を作ったシミュレーションで、BG/NBD が Pareto/NBD の購買の推移をよく再現すること(原論文6節と表1。52週の予測の平均絶対誤差率は平均 2.68%、最も悪い条件で 6.97%)を示したうえで、誤差が大きかったのは購買する顧客の割合や購買の頻度が非常に低い条件で、その理由はこの「最初の購買の前には離脱できない」違いにあると書いています。この限界は、後の節で扱う「frequency 0 の顧客は常に在籍」という性質と同じ根から出ています。
原論文は、実務で使うときの注意として、獲得の時期(四半期など)や獲得チャネルで分けた顧客の集団ごとにモデルを当てはめること、ある集団のパラメータを別の集団に使うときは2つの集団が比べられるものであることを確かめること、この先の販促などの働きかけが過去と基本的に同じだという暗黙の前提を置いていること、生涯価値の計算に使うには購買金額のモデルを足す必要があること、を挙げています。最後の点は、この章の後半でガンマ・ガンマモデルとして扱います。
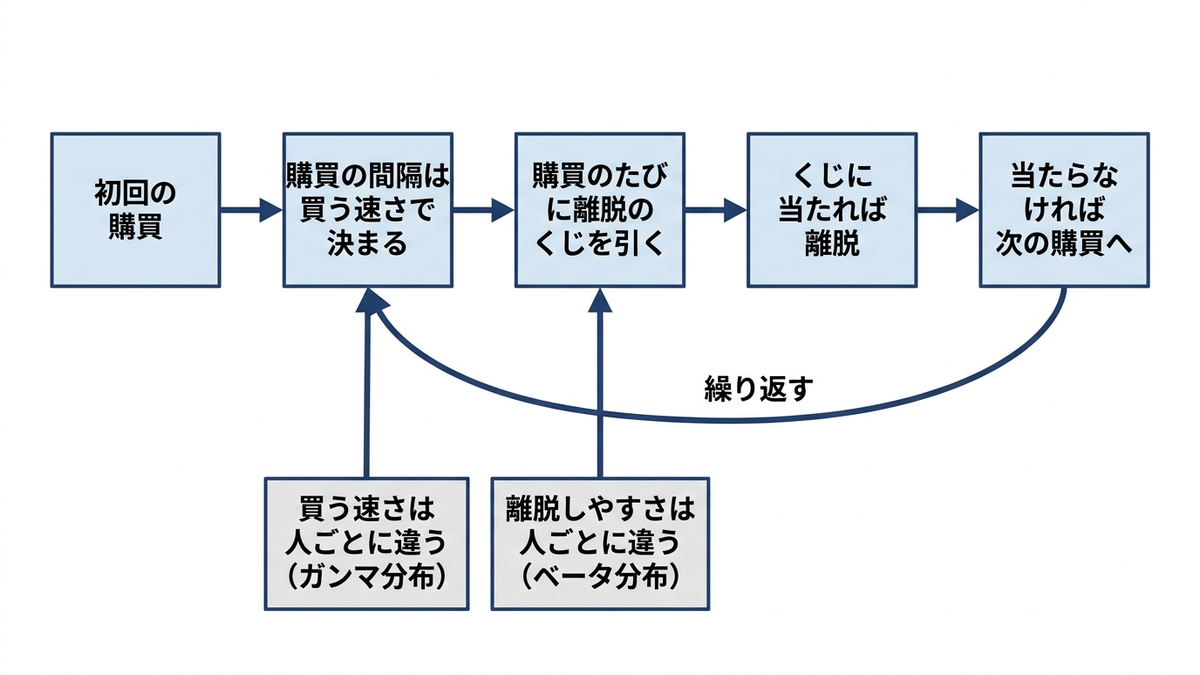
尤度と最尤推定、在籍確率の答え合わせ
BG/NBD モデルのパラメータ r・α・a・b は、最尤推定(観測されたデータが最も起きやすくなるパラメータを探す方法)で求めます。原論文は、ランダムに選んだ顧客の購買履歴(x, \( t_x \), T)の尤度を、ガンマ関数とベータ関数だけを使った式で示し、全顧客の対数尤度の合計を標準的な数値最適化で最大化すればよい、としています。記事全体の補助モジュール(baseline.py)の bgnbd_loglik は、この式をそのまま実装したものです。次のコードは、その関数を抜き出したものです。
import numpy as np
from scipy.special import gammaln, betaln

def bgnbd_loglik(params, x, tx, T):
    r, alpha, a, b = np.exp(params)      # 4つのパラメータは対数で受け取り、正の値に戻す
    A1 = gammaln(r + x) - gammaln(r) + r * np.log(alpha)
    # 場合1:最後の購買の後も在籍していて、T までに買わなかった
    term1 = A1 + betaln(a, b + x) - betaln(a, b) - (r + x) * np.log(alpha + T)
    # 場合2:最後の購買(時刻 tx)の直後に離脱した。リピート購買が1回以上ある人だけ
    term2 = np.where(x > 0,
                     A1 + betaln(a + 1, np.maximum(b + x - 1, 1e-9)) - betaln(a, b)
                     - (r + x) * np.log(alpha + tx),
                     -np.inf)
    ll = np.logaddexp(term1, term2)      # log(exp(term1) + exp(term2))
    return -ll.sum()                     # 最小化するので符号を反転
式の読み方は、コメントに書いた2つの場合の足し算です。観測の終わり T までの記録が「x 回買って、最後の購買が \( t_x \)」である顧客には、2つの可能性があります。1つは、最後の購買の後も在籍していて、\( t_x \) から T までの間にたまたま買わなかった場合です。もう1つは、最後の購買の直後に離脱した場合です。原論文の尤度は、この2つの場合の確率を、買う速さと離脱しやすさの散らばり(ガンマ分布とベータ分布)について平均したものの和になっています。リピート購買が一度も無い(x=0。初回の購買だけの)顧客には、離脱する機会が無かったので、1つ目の場合しかありません。コードの np.where(x > 0, ...) がこの区別です。gammaln と betaln はガンマ関数とベータ関数の対数で、大きな数を扱っても桁あふれしないよう、対数のまま計算しています。
この2つの場合の分け方から、在籍確率の式も出てきます。原論文自体は在籍確率の式を載せていませんが、著者らが2008年に公開したノート(BG/NBD モデルで在籍確率を計算する方法を説明したもの)は、尤度の1つ目の項が「在籍している」場合、2つ目の項が「最後の購買の直後に離脱した」場合を表すことから、ベイズの定理で次の式が得られると説明しています。
\( \text{在籍確率} = \dfrac{1}{1 + \delta_{x>0} \dfrac{a}{b + x – 1} \left( \dfrac{\alpha + T}{\alpha + t_x} \right)^{r + x}} \)
言葉で言い換えると、「最後の購買の直後に離脱した」場合の確率が「在籍している」場合の確率の何倍かを分母に足したものです。\( \delta_{x>0} \) はリピート購買が1回以上なら1、0回なら0をとる記号です。括弧の中の比は、最後の購買からの空白が長い(T が \( t_x \) より大きい)ほど大きくなり、それを r+x 乗するので、購買回数 x が多い顧客ほど、同じ空白で在籍確率が大きく下がります。前の節で見た「頻度の高い顧客ほど、しばらく買っていないと離脱している可能性が高い」は、この指数 r+x の働きです。
補助モジュールの bgnbd_fit は、この対数尤度を scipy の minimize(Nelder-Mead 法。微分を使わずに最小の点を探す数値計算の方法の1つ)で最小化します。共通データで推定した結果と、真の値を並べました。95%区間は、対数尤度の2階微分(ヘッセ行列。推定値のまわりで尤度がどれだけ鋭くとがっているかを表すもの)を数値的に計算して標準誤差を出し、対数の尺度で推定値±1.96×標準誤差をとってから元の尺度に戻したものです。
| パラメータ | 意味 | 推定値 | 95%区間 | 真の値 |
|---|---|---|---|---|
| r | 買う速さの散らばりの形 | 0.598 | 0.569〜0.629 | 0.6 |
| α | 買う速さの散らばりの尺度 | 8.244 | 7.671〜8.859 | 8.0 |
| a | 離脱しやすさの散らばり(1つ目の値) | 0.782 | 0.662〜0.925 | 0.8 |
| b | 離脱しやすさの散らばり(2つ目の値) | 2.533 | 2.031〜3.159 | 2.5 |
4つのパラメータはどれも真の値に近く、真の値はすべて95%区間に入りました。推定値から計算した購買率の平均(r/α)は週あたり 0.0726回(真の値の仮定では 0.0750回)、離脱の確率の平均(a/(a+b))は 0.236(同 0.242)です。区間の幅を推定値に対する割合で見ると、離脱しやすさの値 a・b(a は 0.662〜0.925、b は 2.031〜3.159)は、買う速さの値 r・α(r は 0.569〜0.629)より相対的に広くなっています。この例のデータでは、離脱しやすさのほうが買う速さより不確かにしか決まらない、ということです。ただし、この結果は、モデルの仮定どおり(購買率 λ と離脱の確率 p は互いに独立、購買率は同じ顧客の中では一定、離脱は2回目以降の購買の直後にだけ起き、離脱した顧客は戻らない)に生成した1つの乱数の系列で、パラメータが回復できた例にすぎません。BG/NBD モデルが現実のデータで役に立つことの一般的な根拠にはなりません。現実のデータでは、仮定がどこまで成り立つかを、この後で示すような予測と実現の突き合わせで確かめる必要があります。
推定したパラメータを在籍確率の式に入れ、顧客ごとの在籍確率を計算しました。記事全体の基準の結果(第2章で紹介したもの)のとおり、在籍確率の平均は 0.628 で、真の在籍率 0.621 とほぼ一致し、AUC は 0.908、在籍確率 0.5 で切って在籍・離脱を判定したときの正答率は 0.823 でした。frequency 0 の 1,724人は、モデルの仮定によって在籍確率が全員1になります。この共通データでは、その人たちの真の在籍率も1ですが、これはデータをそう作ったからで、長く買っていない1回だけの顧客が現実に在籍していることの根拠にはなりません。
確率として信用できるかどうか(較正)を確かめるため、在籍確率が1にならない frequency 1以上の 4,276人を、在籍確率の高さで5つの組(各 855〜856人)に分け、組ごとに在籍確率の平均と真の在籍率を比べました。
| 在籍確率の5分位 | 人数 | 在籍確率の平均 | 真の在籍率 |
|---|---|---|---|
| 第1分位(在籍確率が低い) | 856 | 0.074 | 0.061 |
| 第2分位 | 855 | 0.265 | 0.275 |
| 第3分位 | 855 | 0.502 | 0.484 |
| 第4分位 | 855 | 0.701 | 0.689 |
| 第5分位(在籍確率が高い) | 855 | 0.849 | 0.833 |
どの組でも、在籍確率の平均と真の在籍率の差は 0.02 以内でした。在籍確率 0.5 前後の組では、実際にほぼ半分が在籍しています。この例では、在籍確率を「その確率で在籍している」とそのまま読んでよい精度が出ています。在籍確率を合計すると 3,768人で、真の在籍者数 3,726人との差は 42人(1.1%)でした。frequency 1以上の人に限っても、在籍確率の合計 2,044人に対して真の在籍者は 2,002人です。顧客基盤の「生きている顧客数」を、在籍確率の合計として推定できるということです。同じデータで「26週以内に買った人を在籍とみなす」ルールで数えると 2,171人で、真の在籍者数を 1,555人下回ります。ただし、この差のほとんどは frequency 0 の顧客から来ています。frequency 0 の 1,724人は、このデータの作り方では全員が在籍していますが、初回の購買から24週以上たっているので、このルールで在籍と数えられるのは 70人だけです。frequency 1以上の 4,276人に限ると、ルールで在籍と数えるのは 2,101人、真の在籍者は 2,002人で、差は 99人の数えすぎでした。同じ frequency 1以上の顧客でも、13週で切ると 1,312人(690人の数え落とし)、52週で切ると 3,223人(1,221人の数えすぎ)で、数はどこで切るかで大きく変わります。
この先52週の購買回数を予測し、実現と比べる
在籍確率は「今いるか」の推定ですが、経営の計算に要るのは「この先どれだけ買うか」です。原論文は、購買履歴が(x, \( t_x \), T)の顧客が、この先 t の期間に買う回数の期待値を、ガウスの超幾何関数(数値計算のライブラリで計算できる特殊な関数)を1回だけ使う式で示しています。補助モジュールの bgnbd_expected がこの式の実装です。次のコードは、推定から予測、実現との突き合わせまでを行うもので、補助モジュール(cust_data.py と baseline.py)と同じフォルダに置いて実行する形です。
import numpy as np
import cust_data as cd
import baseline as bl

tx, cust_tx = cd.make_purchases()              # 観測できる範囲(第104週まで)
tx_f, _ = cd.make_purchases(full=True)         # 答え合わせ用(第156週まで)
rfm = cd.rfm_table(tx)
x, txr, T = rfm["frequency"].values.astype(float), rfm["recency"].values, rfm["T"].values

params = bl.bgnbd_fit(rfm)                     # r, alpha, a, b の最尤推定
pa = bl.bgnbd_p_alive(params, x, txr, T)       # 在籍確率
ex52 = bl.bgnbd_expected(params, x, txr, T, 52.0)   # この先52週の購買回数の期待値

fut = tx_f[(tx_f["week"] > 104) & (tx_f["week"] <= 156)]
real = fut.groupby("cust_id").size().reindex(rfm.index).fillna(0).values
print("生きている顧客数(在籍確率の合計) %.0f" % pa.sum())
print("52週の購買回数 予測 %.0f / 実現 %.0f / 相関 %.3f"
      % (ex52.sum(), real.sum(), np.corrcoef(ex52, real)[0, 1]))
# 出力:
# 生きている顧客数(在籍確率の合計) 3768
# 52週の購買回数 予測 6625 / 実現 6661 / 相関 0.727
この先52週(第105〜156週)の購買回数の合計は、予測 6,625回に対して実現 6,661回で、差は 0.5%でした。顧客ごとの予測と実現の相関は 0.727 です。この相関がどの程度の水準なのかを知るため、真の購買率 λ・離脱の確率 p・第104週時点の在籍の有無を知っている場合の期待値(データを作った側だけが計算できる、この先52週の購買回数の期待値)を計算し、実現と比べました。その相関は 0.889 で、合計は 6,571回でした。真の値をすべて知っていても相関が1にならないのは、在籍している顧客がこの先いつ買うか、いつ離脱するかには、偶然のばらつきが残るからです。予測 0.727 と真の値を知る場合 0.889 の差には、λ・p だけでなく第104週時点の在籍の有無まで知っているかどうかという、使える情報の違いが表れています。原論文の実データ(オンラインの CD 小売の顧客 2,357人。39週で推定し、続く39週を予測)では、予測と実現の相関は 0.626 と報告されていて(原論文7節の表3)、原論文自身はこの値が高いか低いかを判断する比較の材料が無いと書いています。データも期間も違うので、この記事の 0.727 と直接は比べられません。
予測の高さで顧客を5つの組(各 1,200人)に分け、組ごとに予測・実現・真の値を知る期待値の平均を並べました。
| 予測の5分位 | 人数 | 予測の平均(回) | 実現の平均(回) | 真の値を知る期待値の平均(回) | 実現の購買回数に占める割合 |
|---|---|---|---|---|---|
| 第1分位(予測が低い) | 1,200 | 0.134 | 0.115 | 0.123 | 2.1% |
| 第2分位 | 1,200 | 0.343 | 0.324 | 0.330 | 5.8% |
| 第3分位 | 1,200 | 0.536 | 0.529 | 0.526 | 9.5% |
| 第4分位 | 1,200 | 0.934 | 0.967 | 0.937 | 17.4% |
| 第5分位(予測が高い) | 1,200 | 3.573 | 3.616 | 3.560 | 65.1% |
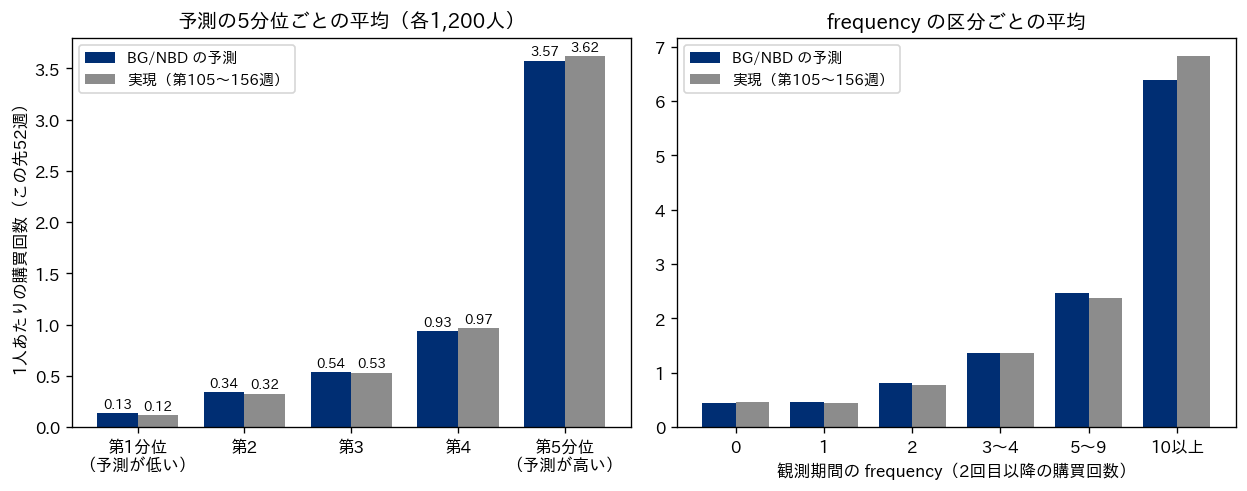
表の「予測の平均」と「実現の平均」の列は、5つの組のすべてで近い値でした。「実現の購買回数に占める割合」の列が示すとおり、予測が高い上位20%の顧客が、この先52週の購買回数の 65.1%を占めています。図の右側は、観測期間の frequency の区分ごとの比較です。frequency 0 の 1,724人は、予測 0.449回に対して実現 0.470回でした。1回しか買っていない顧客も、合計すると 810回、この先52週の購買全体の約12%を買っています。原論文も、7節で、リピート購買が無い顧客の集団(論文の例では 2,357人のうち 1,411人)が予測期間の購買の18%を占めていたことを挙げ、この「静かな」集団の予測が特に大事だと書いています。frequency 10以上の 254人は、予測 6.377回に対して実現 6.819回と、予測がやや低めでした。
比較のために、「直近52週(第53〜104週)の購買回数が、この先52週もそのまま続く」という素朴な見込みも計算しました。合計は 11,596回と実現 6,661回の約1.7倍になり、顧客ごとの実現との相関も 0.642 と、BG/NBD の 0.727 より低くなりました。直近52週の購買には、その間に初めて買った顧客の初回の購買と、その後に離脱した顧客の購買も含まれていて、素朴な見込みはそれをそのまま将来に伸ばしています。合計が大きくなったのはこのためと読めますが、どちらがどれだけ効いたかは、この計算では分けていません。過去の購買実績をそのまま将来の売上の見込みに使うと、非契約型の顧客基盤の価値を大きく見積もりすぎることがある、という例です。
frequency 0 の顧客は常に在籍するという仮定と MBG/NBD
BG/NBD モデルでは、初回の購買のあと一度も買っていない顧客の在籍確率は、何週たっていても1です。在籍確率の式の \( \delta_{x>0} \) が0になるからです。前述の2008年のノートは、これを、離脱は購買の後に起きるというモデルの仮定と、すべての顧客が観測期間の初めに在籍しているという仮定から出てくる性質だとし、在籍確率に関心がある人にとってはモデルの欠点と見られうる、と書いています。共通データ B はこの仮定どおりに作ってあるので、frequency 0 の顧客は真の値でも全員在籍しています。しかし現実のデータで、初回に1度買っただけで二度と来ない顧客がいれば、その顧客を全員「在籍」と数えることになり、生きている顧客数を多く見積もります。
この点を直した変種の1つが、Batislam・Denizel・Filiztekin が2007年に International Journal of Research in Marketing に発表した論文の MBG/NBD モデルです。著者らが公開している論文の原稿を開いて確かめた範囲では、この論文は食品小売の取引データで Pareto/NBD と BG/NBD の予測の性能を比べたもので、BG/NBD がリピート購買の無い顧客を観測期間の終わりの時点でもその後も在籍しているとして扱う点を問題に挙げ、離脱の機会を1つ追加して、そうした顧客をより現実的に扱えるようにしています。その変種を MBG/NBD と呼んでいます。追加した離脱の機会は、時刻0、つまり初回の購買の直後です。前述の2008年のノートは、この変種の尤度と在籍確率の式を示し、在籍確率の式の分母の \( \frac{a}{b + x – 1} \) が \( \frac{a}{b + x} \) に変わり、リピート購買が1回も無い顧客でも在籍確率が1より小さくなる、と説明しています。同じノートは、この変種が原論文のデータ(CD 小売)ではより良い当てはまりを示さなかったので原論文では扱わなかった、とも書いています。なお、この変種については、同じ学術誌の2008年の号に Wagner・Hoppe による訂正の指摘と、Batislam らによる回答が載っていることを、論文の書誌データベース(Crossref)で確かめました。その中身は開いていません。
ノートが示す尤度の式を実装し、2つのデータで BG/NBD と MBG/NBD を比べました。1つは共通データ B(BG/NBD の仮定どおり)です。もう1つは、この章だけの架空の変種で、共通データ B と同じ r 0.6・α 8.0・a 0.8・b 2.5 を使い、初回の購買の直後にも離脱のくじを引くように作ったもの(MBG/NBD の仮定どおり。顧客 6,000人、乱数の種 10)です。この変種では、frequency 0 の顧客は 2,737人(45.6%)、その人たちの真の在籍率は 0.461、全体の真の在籍率は 0.501 でした。
| データ | モデル | 対数尤度 | frequency 0 の人の在籍確率の平均 | frequency 0 の人の真の在籍率 | 在籍確率の合計(人) | 真の在籍者数(人) | 在籍確率の AUC | 52週の購買回数 予測/実現 |
|---|---|---|---|---|---|---|---|---|
| 共通データ B(BG/NBD の仮定どおり) | BG/NBD | -55,539.6 | 1.000 | 1.000 | 3,768 | 3,726 | 0.908 | 6,625/6,661 |
| 共通データ B(BG/NBD の仮定どおり) | MBG/NBD | -55,667.6 | 0.406 | 1.000 | 2,763 | 3,726 | 0.739 | 6,179/6,661 |
| 第10章の変種(初回の直後にも離脱) | BG/NBD | -46,979.9 | 1.000 | 0.461 | 4,606 | 3,008 | 0.561 | 6,119/6,021 |
| 第10章の変種(初回の直後にも離脱) | MBG/NBD | -46,962.9 | 0.470 | 0.461 | 3,061 | 3,008 | 0.745 | 6,048/6,021 |
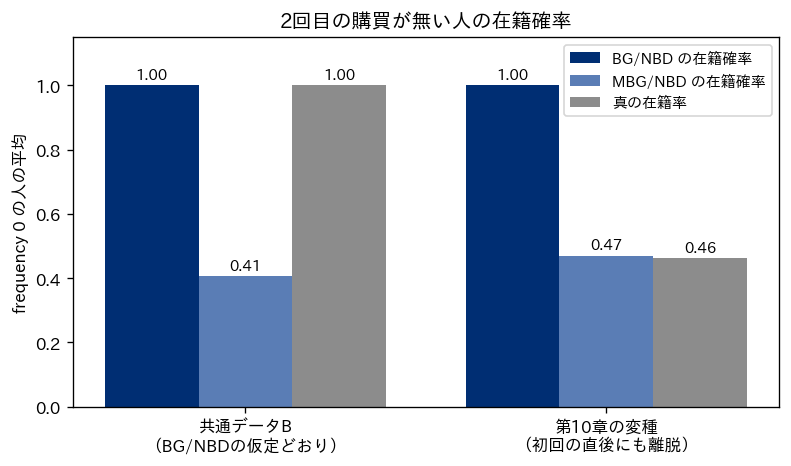
表の「在籍確率の合計」の列を見ると、データの作り方とモデルの仮定が合っている組み合わせ(共通データ B に BG/NBD、変種に MBG/NBD)では、在籍確率の合計が真の在籍者数に近くなりました(3,768人対 3,726人、3,061人対 3,008人)。AUC は、同じデータの中で2つのモデルを比べると、どちらのデータでも作り方に合ったモデルのほうが高くなりました(共通データ B で BG/NBD 0.908 対 MBG/NBD 0.739、変種で MBG/NBD 0.745 対 BG/NBD 0.561)。データの違いをまたいで AUC の値を比べることはしていません。仮定が合っていない組み合わせでは、在籍確率の合計が大きく外れます。変種のデータに BG/NBD を当てると、1回しか買っていない 2,737人を全員在籍とみなすので、在籍確率の合計は 4,606人と真の値を 1,598人上回り、AUC は 0.561 まで下がりました。反対に、共通データ B に MBG/NBD を当てると、本当は全員在籍している frequency 0 の人の在籍確率を 0.406 とし、合計を 963人少なく見積もりました。
この比較から読み取れることは3つあります。1つ目は、1回しか買っていない顧客の在籍確率は、データが決めているのではなく、モデルの仮定が決めているということです。2回目の購買が無い顧客について、記録が教えてくれるのは「T 週の間に買わなかった」ことだけで、初回の直後に離脱したのか、買う速さが遅いだけなのかを区別する手がかりは、他の顧客の行動から借りるしかありません。2つ目は、対数尤度の比較が、どちらの仮定がデータに合うかの手がかりになることです。この例では、どちらのデータでも、作り方に合ったモデルのほうが対数尤度が大きくなりました(差は共通データ B で 128.0、変種で 17.0)。3つ目は、52週の購買回数の合計の予測の崩れ方は、在籍確率の崩れ方より小さかったことです(変種のデータでは BG/NBD 6,119回・MBG/NBD 6,048回に対して実現 6,021回で、差は2%以内。共通データ B に MBG/NBD を当てた場合は 6,179回対 6,661回で約7%少ない)。仮定の違いが大きく効くのは、在籍確率と、それを合計した「生きている顧客数」のほうです。在籍確率で再購買を促す対象を選ぶ、生きている顧客数を経営の指標にする、といった使い方をするときほど、frequency 0 の扱いの仮定を確かめる必要があります。実務では、両方のモデルを当てはめ、第105週以降のような手元に残しておいた期間で、この先の購買回数の予測と実現を比べるのが有効だと考えています。ただし、この表のとおり、購買回数の予測が実現に近くても、在籍確率が正しいことまでは確かめられません。在籍確率については、対数尤度の比較と、1回しか買っていない顧客の扱いの仮定が事業の実態に合うかとをあわせて判断することになります。
金額の側:ガンマ・ガンマモデルで1回あたりの金額を縮小推定する
BG/NBD は購買の回数と時期のモデルで、金額は扱いません。原論文は、生涯価値の計算に使うには購買金額のモデルを足す必要があるとし、候補として正規分布を組み合わせたモデルとガンマ分布を組み合わせたモデルを挙げています。後者が、Fader と Hardie が2013年に公開したノートで詳しく説明しているガンマ・ガンマモデルです。ノートは、このモデルの前提として次の3つを挙げています。1回ごとの購買金額は、その顧客の平均のまわりでばらつく。平均の金額は顧客ごとに違うが、同じ顧客の中では時間がたっても変わらない。平均の金額の顧客の間での散らばりは、購買の回数や時期とは独立である。
ノートの導き方では、1回ごとの金額が形の値 p のガンマ分布に従い、その尺度に当たる値 ν が顧客ごとに違ってガンマ分布(値 q と γ)に従う、と置きます。このとき、ある顧客の本当の平均金額の推定値(観測した平均金額 \( \bar{z} \) と購買回数 x が与えられたときの条件付き期待値)は、次の式になるとノートは示しています。
\( E(Z \mid \bar{z}, x) = \dfrac{q – 1}{p x + q – 1} \cdot \dfrac{p \gamma}{q – 1} + \dfrac{p x}{p x + q – 1} \cdot \bar{z} \)
言葉で言い換えると、「顧客全体の平均金額」と「その顧客の観測した平均金額」の重み付き平均です。ノートは、購買回数 x が増えるほど全体の平均への重みが小さくなり、その顧客自身の平均への重みが大きくなる、と説明しています。1回しか買っていない顧客の平均金額は1回分の偶然を強く含むので全体の平均の側へ引き寄せ、何回も買っている顧客の平均金額はほぼそのまま使う、という考え方で、このように個人の観測値を全体の平均の側へ縮める推定を縮小推定と呼びます。
ノートは、リピート購買のある顧客の、リピート購買だけの平均金額でパラメータを推定しています。この共通データでは、初回の購買の金額も2回目以降と同じ仕組みで決まるので、この記事では初回を含めた全購買の平均金額と全購買回数(frequency+1)を使い、全 6,000人で推定しました。次のコードは、ノートの式(観測した平均金額の分布の対数)を書き下して推定し、縮小推定を計算するもので、補助モジュールと同じフォルダに置いて実行する形です。
import numpy as np
from scipy.special import gammaln
from scipy.optimize import minimize
import cust_data as cd

tx, cust_tx = cd.make_purchases()
rfm = cd.rfm_table(tx)
n = rfm["frequency"].values + 1.0          # 購買回数(初回を含む)
zbar = rfm["monetary"].values              # 1回あたりの平均金額(初回を含む)

def gg_nll(v, n, z):                       # 観測した平均金額の分布の対数尤度(符号反転)
    p, q, g = np.exp(v)
    ll = (gammaln(p * n + q) - gammaln(p * n) - gammaln(q) + (p * n - 1) * np.log(z)
          + p * n * np.log(n) + q * np.log(g) - (p * n + q) * np.log(g + n * z))
    return -ll.sum()

res = minimize(gg_nll, np.log([2.0, 3.0, 5000.0]), args=(n, zbar), method="Nelder-Mead",
               options={"maxiter": 4000, "xatol": 1e-7, "fatol": 1e-8})
p, q, g = np.exp(res.x)
pop_mean = p * g / (q - 1)                 # 顧客全体の平均金額
w = (q - 1) / (p * n + q - 1)              # 全体の平均への重み
est = w * pop_mean + (1 - w) * zbar        # 縮小推定
print("p %.3f q %.3f 全体の平均 %.0f円" % (p, q, pop_mean))
# 出力:
# p 1.927 q 5.554 全体の平均 6040円
推定した q は 5.554 で、1を超えていました。q が1以下では顧客全体の平均金額が有限の値に定まらず、上の重み付き平均の形にもならないので、使う前に確かめておく点です(今回の最適化は収束しました)。推定した顧客全体の平均金額は 6,040円で、6,000人の真の平均金額(データを作った側だけが知る、顧客ごとの平均金額の平均)5,959円に近い値でした。一方、1回ごとの金額のばらつきの形を表す p は 1.927 と推定され、データを作ったときの値 3.0 から外れました。外れた原因をこの計算で切り分けたわけではありませんが、モデルの仮定とデータの作り方には違いが1つあります。この共通データは顧客ごとの平均金額そのものをガンマ分布から作っていますが、ノートの置き方では、ガンマ分布に従うのは尺度の値 ν のほうで、ノートによると顧客ごとの平均金額は逆ガンマ分布に従うことになります。それでも縮小推定がどれだけ役に立つかを、顧客ごとの真の平均金額との誤差で確かめました。誤差は、推定と真の値の差の二乗の平均の平方根(二乗平均平方根誤差。RMSE と略されます。円)です。
| 観測期間の購買回数 | 人数 | 全体の平均への重みの平均 | 誤差 観測した平均金額をそのまま使う(円) | 誤差 縮小推定(円) | 誤差 全員に観測した平均金額の平均 5,953円を使う(円) |
|---|---|---|---|---|---|
| 1回 | 1,724 | 0.703 | 3,911 | 2,406 | 3,003 |
| 2回 | 1,728 | 0.542 | 2,694 | 2,044 | 2,951 |
| 3〜4回 | 1,272 | 0.414 | 2,204 | 1,765 | 2,997 |
| 5回以上 | 1,276 | 0.244 | 1,385 | 1,245 | 2,917 |
| 全員 | 6,000 | (表示していない) | 2,815 | 1,964 | 2,969 |
「誤差 縮小推定」の列は、どの購買回数の区分でも、観測した平均金額をそのまま使う場合と、全員に観測した平均金額の平均(5,953円。縮小推定の式の中の全体の平均 6,040円とは別の値)を使う場合の両方より小さくなりました。差が最も大きいのは1回しか買っていない顧客で、観測した金額をそのまま使うと誤差 3,911円、全員に 5,953円を使うと 3,003円のところ、縮小推定では 2,406円です。たとえば、1回だけ買って金額が 15,000円だった顧客の縮小推定は 8,705円(全体の平均への重み 0.70)、2回買って平均 15,000円なら 10,148円、10回買って平均 15,000円なら 13,288円になります。1回の高額の購買だけで「高額の顧客」と決めつけない、という考え方を数字にしたものです。
ノートの3つ目の前提(金額と購買の回数・時期が独立)は、使う前に確かめておく必要があります。オープンソースのライブラリ lifetimes の公式ドキュメントも、ガンマ・ガンマモデルは金額と購買の頻度に関係が無いと仮定しているとし、実務では2つの相関が0に近いことを確かめるよう書いています。この共通データでは、frequency 1以上の顧客の frequency と平均金額の相関は 0.014 でした。データを作るときには、顧客ごとの真の平均金額を、購買の回数と時期とは独立に決めています。観測した平均金額の散らばりは購買回数によって変わるので、観測した値どうしが独立とまでは言えませんが、相関は小さい結果でした。現実のデータで、よく買う顧客ほど1回あたりの金額が小さい(まとめ買いをしない)といった関係があるときは、この前提が崩れます。
非契約型の LTV:購買回数の期待値×1回あたり金額×粗利率
BG/NBD とガンマ・ガンマを組み合わせると、非契約型の顧客の、この先のある期間の価値を見積もれます。この章では、答え合わせができる期間に合わせて、この先52週の粗利の見込みを次のように計算しました。
\( \text{この先52週の粗利の見込み} = \text{52週の購買回数の期待値(BG/NBD)} \times \text{1回あたり金額の縮小推定(ガンマ・ガンマ)} \times 0.30 \)
0.30 は、契約型の共通データと同じ架空の粗利率です。第9章の LTV は加入時点から60か月の割引後の粗利で定義しましたが、この章の値は、第104週の時点の顧客について1年先までを見たもので、割引はしていません。第9章の言葉に寄せて言えば、「残存価値」を52週で打ち切ったものに近い値ですが、対象が違います。第9章の残存価値は在籍中の顧客だけが対象で、この章の見込みは、すでに離脱しているかもしれない顧客も含む 6,000人全員を、在籍確率で重み付けした形で対象にしています。期間を長くとる場合は、第9章と同じく割引率を入れる必要があります。また、この掛け算は、購買の回数と1回あたりの金額が独立であるというガンマ・ガンマの前提があって初めて成り立ちます。
実測の結果は、6,000人の合計で、予測 12,045,913円に対して、第105〜156週の実際の購買金額に粗利率を掛けた実現の値は 12,077,404円で、差は 0.3%でした。1人あたりでは予測 2,008円、実現 2,013円です。真の購買率・離脱の確率・平均金額・在籍の有無をすべて知っている場合の期待値は 11,778,426円でした。顧客ごとの実現との相関は、予測 0.734、真の値を知る場合 0.890 です。「直近52週(第53〜104週)の購買回数がこの先52週もそのまま続く」とし、それに顧客ごとの観測期間全体の1回あたり平均金額と粗利率 0.30 を掛けた素朴な粗利の見込みは、合計 21,042,426円で実現の約1.7倍、相関は 0.649 でした。予測の高さで5つの組(各 1,200人)に分けると、次のようになりました。
| この先52週の粗利の見込みの5分位 | 人数 | 予測の平均(円) | 実現の平均(円) | 真の値を知る期待値の平均(円) |
|---|---|---|---|---|
| 第1分位(見込みが低い) | 1,200 | 222 | 186 | 206 |
| 第2分位 | 1,200 | 584 | 528 | 536 |
| 第3分位 | 1,200 | 921 | 897 | 912 |
| 第4分位 | 1,200 | 1,638 | 1,573 | 1,561 |
| 第5分位(見込みが高い) | 1,200 | 6,674 | 6,881 | 6,601 |
「予測の平均」と「実現の平均」の列は、5つの組のすべてで近い値でした。第1〜4分位では予測がやや高め、第5分位ではやや低めに出ています。上位20%の顧客の粗利の見込みは平均 6,674円で、下位20%の約30倍です。この違いをどう施策の優先順位に使うかは、第11章で扱います。参考として、1回あたりの金額に縮小推定ではなく観測した平均金額をそのまま使った予測も計算すると、合計は 11,991,863円、実現との相関は 0.727 で、縮小推定を使った場合の 0.734 をわずかに下回りました。この例では、合計の見込みは金額の推定方法でほとんど変わらず、顧客ごとの実現との相関がわずかに高まる程度でした。
ツールの紹介:lifetimes・PyMC-Marketing・BTYD
この章の計算は、numpy と scipy で式を書き下して行いました。同じモデルを実装したオープンソースのライブラリもあります。この記事の実行環境にはどれも入っていないので、以下は公式ドキュメント・公式リポジトリを開いて確かめた範囲の紹介で、実行はしていません。
lifetimes(Python のライブラリ)は、公式ドキュメントのクイックスタートで、取引の記録から frequency・recency・T の要約を作る summary_data_from_transaction_data、BG/NBD モデルの BetaGeoFitter(この先の購買回数の期待値を返す conditional_expected_number_of_purchases_up_to_time など)、ガンマ・ガンマモデルの GammaGammaFitter(購買回数のモデルと組み合わせて生涯価値を計算する customer_lifetime_value。期間 time と割引率 discount_rate を指定する)を紹介しています。ただし、公式リポジトリの README は、このプロジェクトはアーカイブの状態に移り、新しい機能の追加や改善だけでなく、問い合わせ(Issue)への回答も行わないと書き、後継として PyMC-Marketing を案内しています。リポジトリは2024年6月28日に所有者によってアーカイブされ、読み取り専用になっていました。
PyMC-Marketing の CLV モジュールは、公式ドキュメントの API の一覧に、BG/NBD(BetaGeoModel)・MBG/NBD・Pareto/NBD・ガンマ・ガンマ・shifted Beta-Geometric などのモデルと、取引の記録から RFM の要約を作る rfm_summary・生涯価値を計算する customer_lifetime_value などの関数を載せています。BetaGeoModel のページによると、在籍確率を返す expected_probability_alive、この先の購買回数の期待値を返す expected_purchases などのメソッドがあり、推定は既定の MCMC(ベイズ推定でパラメータの分布を標本として得る方法)と、より速い MAP(事後分布の最も高い点を求める方法)から選べます。この章の最尤推定でもパラメータの95%区間は計算しましたが、MCMC ではパラメータの事後分布の標本をそのまま在籍確率や購買回数の計算に渡せるので、それらの値の不確かさも表しやすくなります。同じページの例は、MAP は大きなデータでも速く推定できる一方で、予測の不確かさについて分かることは限られる、と書いています。ライブラリの詳しい比較は第14章で扱います。
R には、BG/NBD・Pareto/NBD・ガンマ・ガンマなどのモデルについて、データの準備・パラメータの推定・予測・図示の関数をまとめた BTYD パッケージがあり、CRAN の公式ページでは版 2.4.3(2021年11月17日公開)と記載されていました。
経営の判断に翻訳する:生きている顧客数と、在籍確率の使い方
この章の結果を、通販や小売の顧客基盤の管理に使える形に整理します。1つ目は、顧客基盤の大きさを「生きている顧客数」として、在籍確率の合計で報告することです。共通データでは、在籍確率の合計 3,768人が真の在籍者数 3,726人とほぼ一致したのに対し、「26週以内に買った人」で数えると 2,171人で、真の在籍者数を4割以上(1,555人)下回りました。ただし、この差の大部分は、1回しか買っていない顧客を全員在籍とするこのデータの作り方によるものです。frequency 1以上の顧客に限ると、26週のルールで数えた 2,101人は真の在籍者 2,002人を 99人上回る程度で、数の上ではむしろ近い値でした。一方、同じ範囲で13週で切ると 690人少なく、52週で切ると 1,221人多く数えます。素朴なルールで数えた在籍者数は、何週で切るかと、1回しか買っていない顧客をどう扱うかで大きく動き、その切り方を決める根拠はルールの中にはありません。この例では、1回しか買っていない顧客を在籍とする設定のもとで、26週のルールは顧客基盤を実際より小さく見せ、まだ在籍している顧客を「離脱した」として扱うことになりました。逆に、「一度でも買った人」を全員顧客基盤に数えれば、6,000人と大きく見積もりすぎます。在籍確率の合計は、その間の値を確率の根拠つきで示します。ただし、前の節で見たとおり、1回しか買っていない顧客の扱いの仮定(BG/NBD か MBG/NBD か)で、この数は変わります。報告には、どちらの仮定で計算したかを添える必要があります。
2つ目は、再購買を促す施策の対象を選ぶときに、「最後の購買からの日数」だけで選ばないことです。この章の例では、最後の購買から26〜52週たった顧客の真の在籍率は、frequency 1〜2 で 0.349、6以上で 0.164 でした。「しばらく買っていない上得意」に連絡を集中させると、すでに離脱した顧客に費用をかけることになりやすく、逆に、間隔の長い顧客を「離脱した」として連絡の対象から外すと、まだ在籍している顧客を手放すことになります。在籍確率と購買回数の期待値の両方を見て、「在籍しているが購買の見込みが下がっている」顧客を探すのが筋だと考えています。ただし、在籍確率は「施策を打てば買う」確率ではありません。予測と施策の効果が別物であることは第8章で、効果の測り方は第12章で扱います。
3つ目は、この先の売上の見込みに、過去の実績をそのまま伸ばした数字を使わないことです。共通データでは、直近52週の購買回数がそのまま続くとした素朴な粗利の見込みは、この先52週の実際の粗利の約1.7倍でした。非契約型の顧客基盤の価値を、事業計画や顧客獲得の予算の上限の根拠にするときは、離脱を織り込んだモデルの見込みを使い、過去の実績との差を説明できるようにしておくことが有効だと考えています。獲得チャネルごとに顧客の集団を分けてモデルを当てはめれば、第9章と同じ考え方で、チャネルごとの獲得費用の上限を非契約型の顧客にも置けます。原論文が獲得時期やチャネルで分けて当てはめるよう勧めているのは、この使い方とも合います。
最後に、このモデルが前提にしていることを、報告を受ける側も知っておく必要があります。原論文が書いているとおり、BG/NBD の予測は、この先の販促などの働きかけが過去と基本的に同じだという前提に立っています。大きな値引きや、新しい会員制度の開始のように、顧客の買い方そのものを変える施策を打つ期間には、過去のデータで推定したパラメータの予測は当てはまらなくなります。そのような期間には、施策を打たない比較の群を残して効果を測る設計(第12章)と組み合わせて使うことになります。
この章の要点は3つです。第一に、非契約型の顧客は離脱が記録に残らないので、在籍しているかどうかを確率で表す必要があり、「最近買っていない=離脱」と決めるルールは、頻度の違う顧客を同じに扱います。この章の例では、最後の購買から26〜52週たった顧客の真の在籍率は、よく買っていた顧客ほど低くなりました。そのルールで数えた在籍者数は、何週で切るかと、1回しか買っていない顧客をどう扱うかで大きく変わりました。第二に、BG/NBD モデルは、買う速さ(ガンマ分布)と離脱しやすさ(ベータ分布)を顧客ごとに分けて考え、離脱は購買の直後にだけ起きると仮定するモデルで、モデルの仮定どおりに生成した共通データでは、真のパラメータを回復し、在籍確率の合計 3,768人(真 3,726人)、この先52週の購買回数 6,625回(実現 6,661回)と、顧客基盤全体の数字をよく当てました。これは仮定どおりに作った1つの乱数の系列での例で、現実のデータでの実用性の根拠ではありません。ただし、1回しか買っていない顧客の在籍確率は仮定が決めるもので、MBG/NBD との比較で確かめる必要があります。第三に、ガンマ・ガンマモデルの縮小推定で1回あたりの金額を見積もり、購買回数の期待値と粗利率を掛けると、非契約型の顧客の価値を、この例では実現と 0.3%の差で見積もれました。次の第11章では、第9章の残存価値とこの章の価値の見込みの分布を見て、どの顧客にどの順で施策の予算を配るかを扱います。
この章を深めたい方への参考書籍
『データ解析のための統計モデリング入門 一般化線形モデル・階層ベイズモデル・MCMC』(久保拓弥、岩波書店):確率分布と最尤推定(第2章)から始めて、一般化線形混合モデル(第7章)、MCMC 法とベイズ統計モデル(第8章)、階層ベイズモデル(第10章)へ進む教科書です。この章の BG/NBD とガンマ・ガンマは、「人ごとに違う値」を確率分布で表し、その分布のパラメータを最尤推定で求めるモデルでした。同じ考え方を一般の統計モデルの中で学び直すのに向いていて、PyMC-Marketing のように MCMC で推定するときの考え方の土台にもなります。
『マーケティングの統計モデル』(佐藤忠彦、朝倉書店):統計解析スタンダードのシリーズの1冊で、統計モデルの基本事項、消費者の市場反応・選択行動・セグメンテーションのモデル化、ベイズモデルによるマーケティング現象のモデル化を扱い、付録で確率分布の基本事項を整理しています。版元の目次には、回数のデータを扱うポアソン回帰の節もあります。購買の記録を確率モデルで読むというこの章の発想を、マーケティングの他の問題にも広げて学ぶのに向いています。
第11章 顧客の価値の分布を見て、施策の優先順位を決める
第9章では契約型の顧客の生涯価値(LTV)と、在籍中の顧客がこの先にもたらす粗利である残存価値を計算し、第10章では購買履歴だけから非契約型の顧客の購買回数の期待値を推定しました。第8章では、解約予測の上位 k% に引き止め施策を当てたときの純増を、真のモデルで答え合わせしました。この章では、これらの結果を1つの判断にまとめます。まず、顧客ごとの残存価値や購買金額の予測が、顧客の間でどれだけ偏っているかを、第2章で用意したサンプルデータで測ります。次に、残存価値と3か月解約確率を組み合わせて顧客を4つに分け、それぞれにどんな打ち手が合うかを整理します。そのうえで、限られた予算の中で誰に施策を当てるかを、1人あたりの期待純増の順に選ぶ方法と、数理最適化の問題として解く方法の両方で求め、第8章の「予測上位 k%」と比べてどれだけ純増が変わるかを真のモデルで確かめます。最後に、新しい顧客の獲得と、いまの顧客の引き止めに、同じ粗利の物差しで予算を割り振る考え方を示します。施策の効果を実験で確かめる方法は第12章で扱います。
残存価値をもう一度定義する:第30か月末の在籍者に当てはめる
この章で使う残存価値は、第9章の考え方をそのまま使います。在籍月数が a か月の顧客について、カプラン・マイヤー推定で求めた継続率を使い、「第30か月末の解約を免れて在籍している人が、さらに k か月先の料金も払う確率」を \( S(a+k)/S(a+1) \) で求めます。この記事の解約の数え方(最後に料金を払った月の月末に解約)では、月末の解約を免れた人は a+1 か月目の料金を払うことが決まっているので、条件に使うのは \( S(a+1) \) です。言葉で言い換えると、「a+1 か月目まで残る人のうち、a+k か月目にも残っている人の割合」です(k=1 では1です)。この確率に月次粗利(月額×粗利率0.30。標準プラン1,500円、大容量プラン2,400円)を掛け、年5%の割引率を月に直した値で割り引いて、1か月先から24か月先までを足し合わせます。1か月先の粗利は割り引かず、2か月先から割り引きます。補助モジュールの cd.discounted_margin と同じ数え方です。
第9章が第36か月末(観測の終わり)の在籍者を対象にしたのに対し、この章では第30か月末の在籍者 7,324人を対象にします。第7章と第8章が解約予測の検証に使った時点と同じにして、予測の3か月解約確率と組み合わせられるようにするためです。第30か月末に判断する人は、第31か月以降の記録を見られません。そこで、カプラン・マイヤーの推定には第30か月までの記録だけを使い、第31か月以降に解約した人は第30か月で打ち切られたものとして扱いました。チャネル(4つ)とプラン(2つ)を掛け合わせた8つの群ごとに継続率を推定し、観測できる最長の在籍月数(第30か月)より先は、第18か月から第30か月までの継続率の比 \( S(30)/S(18) \) から逆算した一定の月次ハザードが続くと置いて延ばしました。第9章が第36か月末で \( S(36)/S(24) \) から延ばしたのと同じ考え方を、6か月前の時点に当てはめたものです。24か月で打ち切るのは、第8章の施策の答え合わせと同じ期間で比べるためです。
次のコードは、この残存価値を在籍者ごとに計算するものです。補助モジュール(cust_data.py と baseline.py)と同じフォルダに置いて実行する形です。
import numpy as np
from statsmodels.duration.survfunc import SurvfuncRight
import cust_data as cd
import baseline as bl

T, H = 30, 24
cust, monthly = cd.make_subscription()
c30 = cust[cust["acq_month"] <= T].copy()       # 第30か月末に見えている記録だけを使う
churn30 = (c30["churn_month"] > 0) & (c30["churn_month"] <= T)
c30["churned30"] = churn30.astype(int)
c30["tenure30"] = np.where(churn30, c30["churn_month"], T) - c30["acq_month"] + 1
disc = (1.0 + cd.MONTHLY_DISCOUNT) ** (-(np.arange(1, H + 1) - 1))


def km_curve_ext(sub, tmax=T, horizon=T + H):
    sf = SurvfuncRight(sub["tenure30"].values, sub["churned30"].values)
    s = np.array([bl.km_surv_at(sf, t) for t in range(1, tmax + 1)])
    h = 1.0 - (s[tmax - 1] / s[tmax - 13]) ** (1.0 / 12.0)    # S(30)/S(18) から一定のハザード
    tail = s[-1] * (1.0 - h) ** np.arange(1, horizon - tmax + 1)
    return np.concatenate([s, tail])


curves = {(c, p): km_curve_ext(c30[(c30["channel"] == c) & (c30["plan"] == p)])
          for c in cd.CHANNELS for p in cd.PLANS}
alive = c30[c30["churned30"] == 0].copy()
alive["a"] = T - alive["acq_month"] + 1          # 在籍月数


def remaining_value(r):
    s = curves[(r["channel"], r["plan"])]
    cond = s[r["a"]: r["a"] + H] / s[r["a"]]      # S(a+k)/S(a+1), k=1..24
    return r["price"] * cd.GROSS_MARGIN * (cond * disc).sum()


alive["v_est"] = alive.apply(remaining_value, axis=1)
v = np.sort(alive["v_est"].values)[::-1]
print(len(alive), round(v.mean()), round(np.median(v)))
print("上位20%%の割合 %.3f" % (v[: int(np.ceil(len(v) * 0.2))].sum() / v.sum()))
# 出力:
# 7324 32508 29580
# 上位20%の割合 0.293
在籍者 7,324人の残存価値の推定は、平均 32,508円、中央値 29,580円でした。合計は約2億3,809万円で、これが「第30か月末の顧客基盤が、この先24か月に生むと見込める割引後の粗利」の推定です。答え合わせとして、隠れた利用意欲まで知っている真のモデルで、同じ7,324人の先24か月を30回シミュレーションし、真のモデルのもとでの割引後粗利の期待値を、その平均で近似しました(以下、真の値と呼びます)。真の値の平均は 32,489円、合計は約2億3,795万円で、推定は合計でほぼ同じ(約0.06%大きい)でした。顧客ごとの推定と真の値の相関は 0.938 でした。
ただし、この相関の高さには、プランの違い(月次粗利が1,500円か2,400円か)が大きく効いています。プランごとに分けて相関を測ると、大容量プランの 2,363人で 0.701、標準プランの 4,961人で 0.728 に下がりました。推定は、チャネル・プラン・在籍月数が同じ人には同じ値を出すので、同じ条件の中で利用意欲が高い人と低い人を区別できません。推定の最小値は 18,272円、真の値の最小値は 8,273円で、推定は「この先すぐに解約しそうな人」の価値を高めに、「長く残りそうな人」の価値を低めに見積もる傾向があります。真の値の上位10%の境目(90パーセンタイル)が 48,633円なのに対し、推定では 47,047円でした。残存価値の推定を個人の利用状況まで使って細かくするには、第6章の離散時間ハザードモデルや第7章の予測モデルで、個人ごとの月次のハザードを予測して積み上げる方法がありますが、この章では第9章の定義どおりの推定をそのまま使います。
価値はどれだけ上位に偏っているか:定期便と通販で測る
施策の優先順位を考える前に、顧客の価値がどれだけ一部の顧客に偏っているかを確かめておきます。「売上の大半は一部の顧客から来る」という見方はよく語られますが、その偏りの大きさは顧客基盤によって違いえます。偏りが大きければ、上位の顧客を守ることが事業全体を守ることにほぼ等しくなり、偏りが小さければ、上位だけを見ていても顧客基盤の多くを取りこぼします。どちらなのかは、自社のデータで測らないと分かりません。
測り方は単純です。顧客を価値の大きい順に並べ、上位10%・20%・50%の顧客が価値の合計の何割を持っているかを数えます。第2章で用意したサンプルデータには、契約型の定期便(共通データ A)と非契約型の単品通販(共通データ B)の2つがあります。定期便では、上で求めた第30か月末の在籍者 7,324人の、先24か月の残存価値を使いました。単品通販では、観測の終わり(第104週)までに一度でも買った顧客 6,000人全員について、第10章の BG/NBD モデル(補助モジュールの bl.bgnbd_fit で推定したもの)が予測する、この先52週の購買回数の期待値に、顧客ごとの観測期間の1回あたり平均金額を掛けた「この先52週の購買金額の予測」を使いました。粗利率を掛けても割合は変わらないので、ここでは購買金額のまま比べます。B では答え合わせとして、観測の終わりの直後の52週(第105〜156週。答え合わせ用に作ってある、現実には見えない期間)に実際に起きた購買の金額でも同じ割合を出しました。この章では、これを「実現」と呼びます。2つのデータでは、対象の人(在籍者だけか、全顧客か)も、指標(残存価値か購買金額か)も、期間(24か月か52週か)も違うので、表の A と B の数字は同じ物差しで比べられるものではありません。
| データと価値の指標 | 上位10%の割合 | 上位20%の割合 | 上位50%の割合 |
|---|---|---|---|
| A 定期便:残存価値(推定で並べて推定の合計に占める割合) | 15.4% | 29.3% | 61.2% |
| A 定期便:残存価値(真の値で並べて真の値の合計に占める割合) | 15.7% | 30.0% | 61.6% |
| A 定期便:推定で並べた上位が持つ真の値の割合 | 15.2% | 29.2% | 60.9% |
| B 通販:52週の購買金額(予測で並べて予測の合計に占める割合) | 52.5% | 69.6% | 91.3% |
| B 通販:52週の購買金額(実現で並べて実現の合計に占める割合) | 70.5% | 89.8% | 100.0% |
| B 通販:予測で並べた上位が持つ実現の金額の割合 | 50.8% | 67.7% | 88.4% |
表の「上位20%の割合」の列を見ると、定期便では上位20%の在籍者が残存価値の29.3%(真の値で並べても30.0%)しか持っていません。残存価値の推定の最小は 18,272円、最大は 51,350円で、その比は約2.8倍にとどまります。この定期便の残存価値は上位に偏るものの、全員が同じ価値を持つ場合(図の対角線)を基準にすれば、この定期便の中での偏りは小さいということです。推定の上位20%の 1,465人は全員が大容量プランで、在籍月数の平均は17.1か月(在籍者全体では13.9か月)でした(上位20%の境目の値と同じ値の人を含めると 1,490人で、在籍月数の平均は16.9か月)。この推定は、プラン(月次粗利)とチャネル・在籍月数(この先の継続率)の組み合わせで決まるので、価値の差もその組み合わせの差の範囲に収まっています。
通販は、この定期便とは対象・指標・期間が違うので同じ物差しでは比べられませんが、その指標の中での集中は大きく見えます。予測で見た上位20%が予測の購買金額の69.6%を持ち、実現の金額で見ると上位20%が89.8%を持っていました。第105〜156週に1回も買わなかった人が64.3%いて、上位50%に実現の金額のすべてが入ってしまうほどです。購買率が人によって大きく違い、離脱した人は以後まったく買わない、という BG/NBD の仮定どおりに作ったデータでは、価値は一部の人に強く集まります。予測で並べた上位20%は、実現の金額の67.7%を持っていました。実現で並べた上位20%が持つ89.8%には届きませんが、予測で上位とした人たちが実際にも多く買っていたということです。予測の曲線は実現の曲線より緩やかです。予測は期待値なので、「たまたまたくさん買った人」と「たまたま買わなかった人」の差を平らにならすことが一因と考えられます。実現の曲線は実現の金額そのもので並べているので、並べ方の違いも効いています。上位の割合を予測で見積もると、実現の偏りより小さく見えることになります。
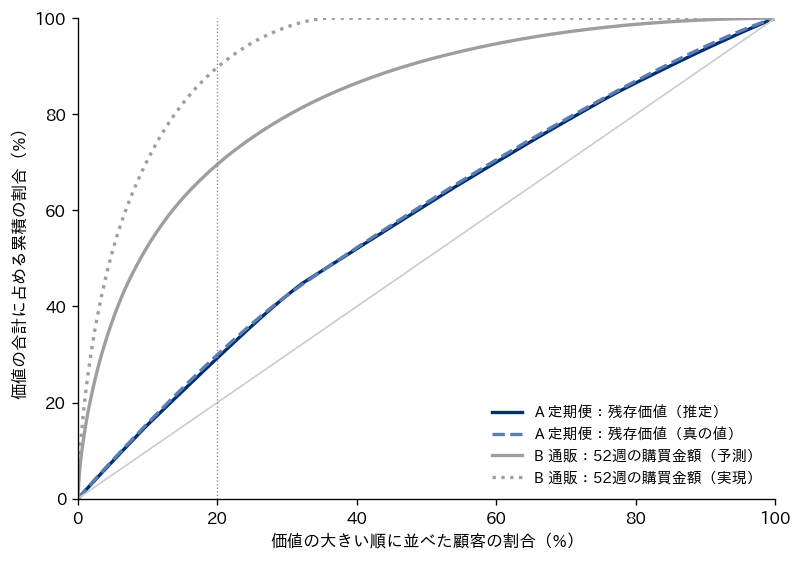
図は、表の数字を曲線にしたものです。曲線が左上に膨らむほど、価値が一部の顧客に集まっています。定期便の2本の曲線(推定と真の値)はほぼ重なっていて、集まり方そのものは推定でも正しくとらえられています。定期便の曲線が横軸30%あたりで折れ曲がっているのは、そこまでがほぼ大容量プランの人(在籍者の32.3%)で占められているためです。
上位の顧客が価値の大部分を持つことを指して、俗に「上位2割が8割を生む」という言い方がされることがあります。この記事では、この言い方の原典を確かめていないので、その名前では呼びません。この2つの架空データで確かめられたのは、上位20%が持つ割合が、定期便の在籍者の残存価値では約30%、通販の全顧客の購買金額では予測で約70%・実現で約90%と、決まった比率にはならないということです。上で断ったとおり、2つは対象・指標・期間が違うので、どちらの事業のほうが偏りやすいかをこの比較から言うことはできません。言えるのは、自社の偏りの大きさを測らずに決まった比率を前提にすると、この定期便のように偏りの小さい顧客基盤では、上位の一部に絞った施策が顧客基盤の価値の大部分を施策の外に置くことになる、ということです。
価値と離脱リスクの4象限:顧客を4つに分けて打ち手を考える
価値の大きさだけでは、施策の優先順位は決まりません。価値が大きくても解約しそうにない人に引き止め施策を当てても、守れる粗利はほとんど増えないからです。第8章で見たとおり、引き止め施策の価値は、施策ありとなしの期待粗利の差から費用を引いたもので、概算では「解約確率の下がり幅×その人の残存価値」から費用を引いたものになります。そこで、残存価値(推定)と3か月解約確率の2つの軸で顧客を4つに分ける価値と離脱リスクの4象限を作ります。3か月解約確率は、第7章と同じ設定の LightGBM(補助モジュールの bl.build_snapshots で第6〜27か月のスナップショットを作り、bl.fit_models で学習したもの)が、第30か月末の在籍者に出した予測です。それぞれの中央値(残存価値 29,580円、3か月解約確率 6.26%)で高低を分けました。
| 象限 | 人数 | 価値の割合(推定) | 平均の3か月解約確率(予測) | 平均の3か月解約確率(真の値) |
|---|---|---|---|---|
| 高価値×高リスク | 1,128 | 19.1% | 9.60% | 9.38% |
| 高価値×低リスク | 2,568 | 42.5% | 3.49% | 3.77% |
| 低価値×高リスク | 2,534 | 25.8% | 11.64% | 11.44% |
| 低価値×低リスク | 1,094 | 12.6% | 4.61% | 4.93% |
表の「人数」の列を見ると、4つの象限は同じ大きさになりません。高価値×低リスクが 2,568人、低価値×高リスクが 2,534人と多く、高価値×高リスクは 1,128人、低価値×低リスクは 1,094人です。残存価値と3か月解約確率の相関が -0.420 と負になっているためで、解約しやすい人ほど残存価値も小さく見積もられる、という当たり前の関係が表れています。残存価値は「この先も残る確率」から計算しているので、解約しやすいチャネルや短い在籍月数の人は、両方の軸で不利になります。チャネル別に見ると、高価値×低リスクの 2,568人のうち 1,847人が紹介経由、低価値×高リスクの 2,534人のうち 776人がチラシ経由、914人が検索広告経由、710人が SNS 広告経由でした。
表の「平均の3か月解約確率(予測)」と「(真の値)」の列は、どの象限でも差が0.5ポイント以内でした。第31〜33か月に実際に解約した人の割合は、高価値×高リスクで11.08%(予測の平均 9.60%)、高価値×低リスクで3.58%、低価値×高リスクで10.81%、低価値×低リスクで5.03%(予測の平均 4.61%)で、高価値×高リスクでは予測より1ポイント以上高くなりました。第7章で見たとおり、予測の確率には実際とずれの残る組があるので、象限の解約確率は目安として読む必要があります。「価値の割合(推定)」の列では、価値の42.5%が高価値×低リスクにあり、高価値×高リスクは19.1%でした。残存価値の合計(推定)で見ると、順に約4,541万円・約1億127万円・約6,140万円・約3,000万円で、真の値の合計(約4,325万円・約1億261万円・約6,057万円・約3,151万円)と大きくは違いません。1人あたりの残存価値の平均(推定)は、高価値の2象限で約4万円と約3万9千円、低価値の2象限で約2万4千円と約2万7千円です。大容量プランの人の割合は、高価値×高リスクで84.6%、高価値×低リスクで54.9%で、低価値の2象限には大容量プランの人はいません。
象限ごとの打ち手の考え方は、次のように整理できます。
- 高価値×高リスク:引き止めの優先度が最も高い象限です。1人あたりの残存価値が大きく、解約確率も高いので、解約確率を少し下げるだけで守れる粗利が大きくなります。費用の高い施策(担当者からの連絡、プランの見直しの提案など)を検討してよいのはこの象限です
- 高価値×低リスク:維持の象限です。価値の4割強がここにありますが、引き止め施策を当てても下げられる解約の量が小さいので、割引クーポンのような費用のかかる施策は割に合わないことが多くなります。サービスの品質を保ち、利用状況の変化(注文回数の低下など)を監視して、高リスクへ移った時点で手を打つのが基本です
- 低価値×高リスク:費用の安い施策に限る象限です(この例の500円のクーポンなら、次の節で見るとおり 2,534人中 2,463人は当てる価値があります)。解約確率は最も高いのですが、1人あたりの価値が小さいので、費用の高い施策では元が取れません。自動で送れる連絡や、費用のかからない利用の案内など、1人あたりの費用が小さい施策に限るのが合理的です
- 低価値×低リスク:育成の象限です。いますぐ解約しそうではないので引き止めの優先度は下がる傾向にありますが(それでもこの象限の 1,094人中 77人は期待純増が正でした。期待純増の定義は次の節)、個別には期待純増で判断します。そのうえで、上位のプランへの移行や利用の定着で価値を上げる余地があります。引き止めの予算ではなく、育成の施策(プランの案内など)の対象として扱います
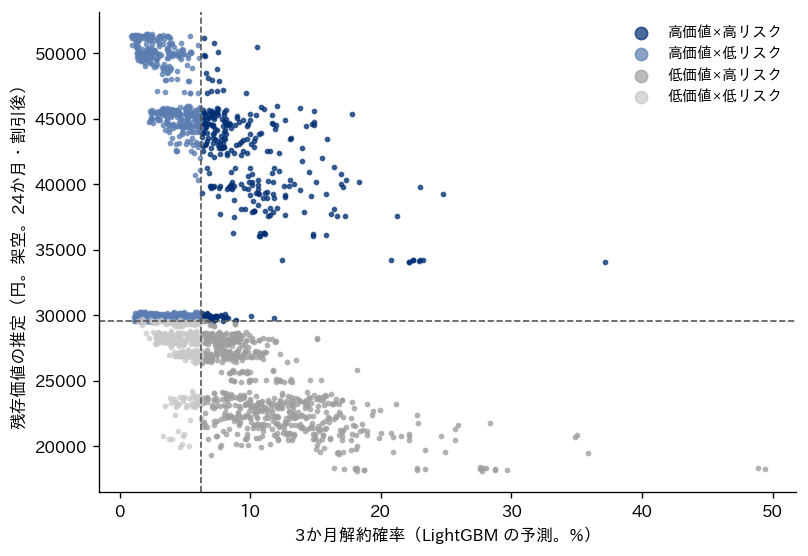
散布図は、4象限の境目が恣意的であることも示しています。縦軸の残存価値は、プランと在籍月数でいくつかの帯に分かれていて、中央値の線(29,580円)のすぐ上に、標準プランの点がつくる横長の帯が接しています。中央値は在籍者の真ん中の人の値なので、線の近くには人が密集していて、境目の置き方しだいで象限が変わる人が少なくありません。4象限は、顧客基盤の構成を経営の会議で共有し、象限ごとに打ち手の種類を決めるための整理には向いていますが、誰に施策を当てるかの最終的な選び方としては粗すぎます。たとえば低価値×高リスクの象限は、「費用の安い施策か見送り」とまとめましたが、象限の中には期待純増が正になる人が 2,534人中 2,463人いました(期待純増の定義は次の節)。施策の費用が 500円のクーポンなら、この象限の大半は当てる価値があるということです。象限で打ち手の種類を決め、その中で誰に当てるかは、次の節の期待純増で決めるのがよいと考えています。
もう1つ、象限ごとに、予測の3か月解約確率で重み付けした残存価値の推定の合計(ここでは「失いうる価値」と呼びます)を見ておきます。残存価値はすでにこの先の解約を織り込んだ期待値なので、これは失われる粗利の期待値そのものではなく、引き止めの対象としての大きさを象限の間で比べるための近似の目安です。足し合わせると、高価値×高リスクで約433万円、低価値×高リスクで約691万円、高価値×低リスクで約357万円、低価値×低リスクで約138万円でした。「失いうる価値」の総額が最も大きいのは、高価値×高リスクではなく、人数の多い低価値×高リスクです。4象限の合計は約1,619万円で、高価値の2象限を合わせても約790万円(約5割)です。高価値の顧客だけを守る運用は、1人あたりの効率は良くても、「失いうる価値」の半分前後を、高価値×高リスクだけを守るなら7割強を、施策の外に置くことになりえます。
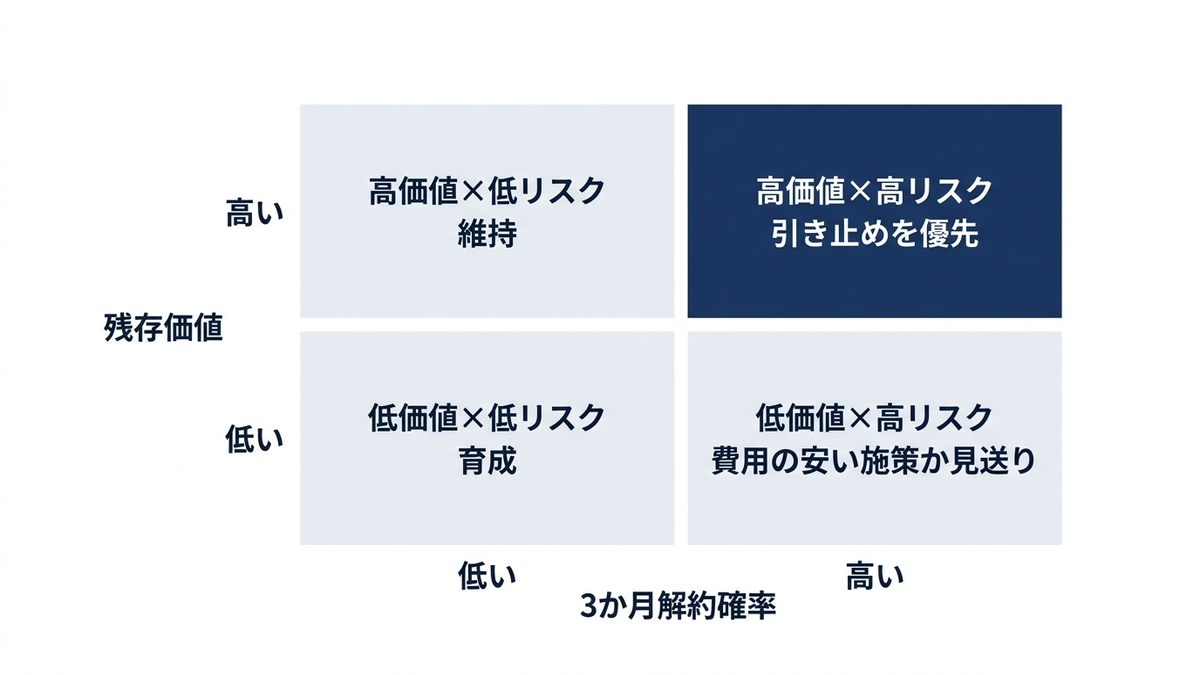
1人あたりの期待純増で並べる:解約確率と残存価値を掛け合わせる
象限の粗さを避けるには、顧客1人ずつについて「この人に施策を当てると、費用を引いていくら得をするか」を見積もり、その順に並べます。この章では、この見積もりを期待純増と呼びます。第8章と同じ架空の前提(施策の費用は1人500円、当てた月から3か月のあいだ、解約の起きやすさ(オッズ=解約確率÷継続確率)を0.7倍にする。解約確率が小さい範囲では、確率をおよそ0.7倍するのとほぼ同じ)を使うと、期待純増は次の式で近似できます。
\( \text{期待純増} \approx 0.3 \times p_{3} \times V – 500 \)
言葉で言い換えると、「3か月解約確率 \( p_{3} \) が3割下がり、下がった分だけこの人の残存価値 \( V \) が守られるとして、そこから施策の費用500円を引いたもの」です。0.3は、オッズを0.7倍にすることを「解約確率をおよそ0.7倍にする(3割下げる)」と読み替えた、解約の下がり幅の近似です。この式は3つの点で近似です。1つ目に、オッズの0.7倍は、解約確率が小さい範囲でしか確率の0.7倍とほぼ同じになりません(月ごとの解約確率が10%ならオッズ0.7倍で約7.2%になり、0.7倍の7%よりわずかに大きくなります)。2つ目に、施策は月ごとの解約に効くので、3か月を通した解約確率がちょうど0.7倍になるわけではありません。3つ目に、残存価値 \( V \) はすでにこの先の解約を織り込んだ期待値なので、「解約を免れた人がこの先に生む粗利」と同じではなく、解約を3か月だけ先に延ばした人の分なども正しくは表しません。正確な期待純増は、施策ありとなしの将来の割引後粗利の期待値の差から費用を引いたもので、この式は順位づけに使うための近似です。近似がどれだけ当たっているかは、この後で真のモデルを使って確かめます。
この式で第30か月末の在籍者 7,324人の期待純増を計算すると、期待純増が正になる(施策を当てる価値があると見積もられる)人は 4,543人で、その期待純増の合計は約169万円でした。期待純増の中央値は 102円、上位10%の境目は 634円、最大は 3,475円で、負の側では最小が -411円でした。期待純増が正になる条件は「3か月解約確率×残存価値」が約1,667円(500円÷0.3)を超えることで、たとえば残存価値が4万円の人なら解約確率4.2%以上、2万円の人なら8.3%以上が目安になります。解約確率が同じでも残存価値が2倍なら、費用を引く前の粗利の増分の近似値も2倍です(費用を引いた期待純増は2倍にはなりません)。第8章が予告した「解約確率が同じでも大容量プランの人を優先する理由」は、この式に表れています。
期待純増の順に上位1,000人を選ぶと、その内訳は高価値×高リスクが 597人、低価値×高リスクが 403人でした。予測の3か月解約確率の順に上位1,000人を選ぶと、低価値×高リスクが 836人、高価値×高リスクが 164人で、2つの選び方で重なるのは 565人です。残存価値を掛けることで、解約確率はやや低くても価値の大きい人が選ばれるようになり、選ばれる顔ぶれの4割強が入れ替わります。
予算の範囲で選ぶ:ナップサック問題として解いても同じになる
施策の予算が決まっているときは、期待純増が正の人を、大きい順に、予算が尽きるまで選びます。費用が1人500円で全員同じなら、予算50万円で選べるのは 1,000人、100万円なら 2,000人です。この選び方が本当に「予算の範囲で期待純増の合計を最大にする」選び方になっているかは、数理最適化の問題として解いて確かめられます。予算の範囲で、それぞれの品物を「入れる・入れない」の2択で選び、価値の合計を最大にする問題は、ナップサック問題(容量の決まった袋に、価値の合計が最大になるように品物を詰める問題)と呼ばれ、整数計画の代表的な問題の1つです。ここでは、顧客を品物、施策の費用を品物の大きさ、期待純増を品物の価値、予算を袋の容量とみなします。
次のコードは、予算50万円について、期待純増の順に選んだ対象と、PuLP(Python から数理最適化の問題を書いて解くためのライブラリ)で 0-1 ナップサック問題として解いた対象が一致するかを確かめるものです。読み込んでいるファイル(alive30.csv)は、この章の計算用のスクリプトが、前のコードと同じ方法で計算した残存価値(列 v_est)と、第7章と同じ設定の LightGBM の3か月解約確率(列 p3_pred)を、在籍者の顧客番号ごとに保存したものです(保存する部分は掲載していません)。補助モジュール(cust_data.py)と同じフォルダに置き、そのフォルダで実行する形です(ファイルの場所はそのフォルダから見た相対パスで書いています)。
import time
import pandas as pd
import pulp
import cust_data as cd

al = pd.read_csv("../_out/ch11/alive30.csv", index_col=0)   # 残存価値の推定と3か月解約確率
al["gain"] = (1.0 - cd.OFFER_MULT) * al["p3_pred"] * al["v_est"] - cd.OFFER_COST
budget = 500000
# 1) 期待純増が正の人を、大きい順に、予算で買える人数まで
order = al.loc[al["gain"] > 0, "gain"].sort_values(ascending=False)
picked = set(order.index[: budget // cd.OFFER_COST])
# 2) 0-1 ナップサック問題として解く
prob = pulp.LpProblem("retention", pulp.LpMaximize)
x = {i: pulp.LpVariable("x_%d" % i, cat="Binary") for i in al.index}
prob += pulp.lpSum(al.at[i, "gain"] * x[i] for i in al.index)
prob += pulp.lpSum(cd.OFFER_COST * x[i] for i in al.index) <= budget
t = time.time()
prob.solve(pulp.PULP_CBC_CMD(msg=0))
assert prob.status == pulp.LpStatusOptimal          # 最適解が得られたことを確かめてから読む
chosen = {i for i in al.index if x[i].value() > 0.5}
print(len(picked), len(chosen), picked == chosen, round(pulp.value(prob.objective)),
      "%.2f秒" % (time.time() - t))
# 出力:
# 1000 1000 True 873836 0.43秒
出力のとおり、期待純増の順に選んだ 1,000人と、ナップサック問題の最適解の 1,000人は完全に一致し、期待純増の合計はどちらも 873,836円でした。コードでは、解が最適と判定されたこと(LpStatusOptimal)を確かめてから選ばれた人を読んでいます。期待純増がちょうど同じ顧客がいれば、選ばれた集合が違っても目的関数の値が同じ最適解になりうるので、集合の一致まで見るときはこの点にも注意が要ります。7,324人ぶんの 0-1 変数を持つ問題を解くのにかかった時間は、このコードの実行で 0.43秒でした(この記事の実行環境、一般的なノートPCでの実測。他の計算と同時に動かしたので、実行のたびに揺れます)。予算を25万円・50万円・100万円・150万円にして同じことをした別の実行でも、結果はすべて一致しました(そのときの解く時間は 0.43〜0.92秒)。費用が全員同じなら、ナップサック問題を解くまでもなく、期待純増の順に並べるだけで最適になるということです。なお、このコードは PuLP 3.3.2 で実行しました。3.3.2 は、最適化のソルバー(CBC)を同梱していた側の版です。PuLP の配布ページ(PyPI)の説明では、同梱していた CBC と、それを呼び出す PULP_CBC_CMD は取り除かれたとされ、移行の案内は 4.0 を区切りにしています(2026年10月時点の最新版は 4.0.1)。このコードをそのまま動かすときは、3.3.2 を指定して入れる必要があります。
ナップサック問題として書く意味が出てくるのは、施策の費用が人によって違うときです。架空の設定として、大容量プランの人には額の大きいクーポン(800円)、標準プランの人には500円のクーポンを当て、効果はどちらも同じ(オッズ0.7倍)とした場合を解きました。
| 予算 | 選び方 | 対象の人数 | 期待純増の合計(円) |
|---|---|---|---|
| 50万円 | 期待純増の大きい順 | 814 | 646,794 |
| 50万円 | 費用1円あたりの期待純増の大きい順 | 884 | 665,037 |
| 50万円 | ナップサック問題の最適解(PuLP) | 883 | 665,119 |
| 100万円 | 期待純増の大きい順 | 1,683 | 974,519 |
| 100万円 | 費用1円あたりの期待純増の大きい順 | 1,766 | 986,419 |
| 100万円 | ナップサック問題の最適解(PuLP) | 1,766 | 986,419 |
表の「期待純増の合計」の列のとおり、費用が人によって違うと、期待純増の大きい順に選ぶ方法は最適から外れます(予算50万円で 646,794円対 665,119円)。費用の高い人を先に選んでしまい、同じ予算で当てられる人数が減るからです。費用1円あたりの期待純増の順に選ぶ方法は最適にかなり近づき、予算100万円では最適解と同じ値になりましたが、予算50万円ではわずかに届きませんでした(82円の差)。この例では差はわずかですが、施策の種類が複数あって1人に1つだけ選ぶ場合や、チャネルごとの上限・担当者の対応件数の上限のような制約が加わる場合には、並べるだけの方法では制約を満たすことすら難しくなります。そのときは、この節のようにナップサック問題(あるいはそれを広げた整数計画の問題)として書いて解くのが確実です。制約の書き方の型は、弊社コラム『数理最適化の定式化パターン集』で扱っています。
真のモデルで答え合わせ:残存価値を入れると純増はどれだけ変わるか
期待純増は、予測の解約確率と残存価値の推定から作った見積もりです。それで選んだ対象が本当に第8章の「予測上位 k%」より多くの粗利を守るのかを、真のモデルで確かめました。第8章と同じく、選んだ顧客に第31〜33か月の施策を当て、隠れた利用意欲まで知る真のモデルで先24か月を40回シミュレーションし、施策を当てなかった場合との割引後粗利の差から費用を引いた純増を出しています。施策を当てた場合と当てなかった場合では、同じ顧客の同じ月に同じ乱数を使う(共通乱数)ので、施策の有無による差が乱数の違いに埋もれにくくなります。ここでの値も、真のモデルのもとでの期待値を40回の平均で近似したものです。比べた選び方は3つで、期待純増の順、予測の3か月解約確率の順(第8章の「予測上位 k%」と同じ考え方)、残存価値の推定の順です。どの選び方も、予算で決まる同じ人数を選びます。
| 予算 | 選び方 | 対象 | 粗利の増分(円) | 純増(円) | 救えた人数(3か月) | 対象の3か月解約確率(真の値) | 対象の残存価値の平均(真の値。円) |
|---|---|---|---|---|---|---|---|
| 25万円 | 期待純増の順 | 500人 | 693,451 | 443,451 | 22.8 | 0.166 | 31,261 |
| 25万円 | 予測の解約確率の順 | 500人 | 634,517 | 384,517 | 27.1 | 0.196 | 21,612 |
| 25万円 | 残存価値の順 | 500人 | 189,445 | -60,555 | 4.2 | 0.026 | 49,896 |
| 50万円 | 期待純増の順 | 1,000人 | 1,199,537 | 699,537 | 41.1 | 0.148 | 30,924 |
| 50万円 | 予測の解約確率の順 | 1,000人 | 1,073,124 | 573,124 | 45.8 | 0.168 | 22,912 |
| 50万円 | 残存価値の順 | 1,000人 | 500,273 | 273 | 11.2 | 0.036 | 48,599 |
| 100万円 | 期待純増の順 | 2,000人 | 2,012,593 | 1,012,593 | 72.0 | 0.127 | 30,811 |
| 100万円 | 予測の解約確率の順 | 2,000人 | 1,934,952 | 934,952 | 77.1 | 0.137 | 25,579 |
| 100万円 | 残存価値の順 | 2,000人 | 1,314,107 | 314,107 | 31.2 | 0.052 | 46,154 |
| 150万円 | 期待純増の順 | 3,000人 | 2,669,577 | 1,169,577 | 95.5 | 0.113 | 31,192 |
| 150万円 | 予測の解約確率の順 | 3,000人 | 2,620,298 | 1,120,298 | 101.0 | 0.117 | 27,365 |
| 150万円 | 残存価値の順 | 3,000人 | 2,018,186 | 518,186 | 51.6 | 0.058 | 41,700 |
表の「純増」の列で、期待純増の順は、この1回の計算では4つの予算すべてで予測の解約確率の順を上回りました。予算25万円では約44.3万円対約38.5万円、50万円では約70.0万円対約57.3万円、100万円では約101.3万円対約93.5万円、150万円では約117.0万円対約112.0万円で、差は約4.9万円から約12.6万円です。この1組目では、差が最も大きかったのは予算50万円でした。ただし、次に述べる2組目の計算では差の動き方が一致しなかったので、予算の大きさと差の関係は、この例からは読めません。期待純増が正の 4,543人全員(費用 227.2万円)に当てた場合の純増(真のモデル)は 1,301,272円で、予算150万円の約117.0万円から、費用を77.2万円積み増しても、粗利の増分は約90.3万円しか増えず、純増の増加は約13.2万円にとどまりました。この例では、150万円を超えて積んだ予算は、費用を2割弱上回る粗利(費用1円あたり約1.17円)しか生まず、純増はほとんど増えないということです。
シミュレーションのぶれを確かめるため、4つの予算すべてについて、乱数の種を変えてもう一度同じ比較を行いました(40回のシミュレーションをもう1組)。期待純増の順と予測の解約確率の順の純増は、予算25万円で約38.2万円対約32.2万円、50万円で約65.7万円対約53.4万円、100万円で約100.7万円対約85.5万円、150万円で約120.1万円対約107.1万円で、差は約5.9万円・約12.3万円・約15.2万円・約13.0万円でした。2組とも、4つの予算すべてで期待純増の順が上回り、順位は入れ替わりませんでした。ただし、確かめたのは2組だけで、純増そのものは種によって、期待純増の順で最大約6万円(予算25万円で約44.3万円と約38.2万円)、予測の解約確率の順で最大約8万円(予算100万円で約93.5万円と約85.5万円)動いています。差が最も小さかった予算150万円の1組目の差(約4.9万円)は、このぶれより小さいくらいの大きさです。表の数字は「この架空データの、この設定での目安」として読む必要があります。
この答え合わせには、大事な限定があります。真のモデルでは、施策の効果を全員同じ(オッズ0.7倍)として計算していて、期待純増の式も同じ前提から作っています。前提が同じなので、この比較は期待純増の順に有利な結果が出やすい形をしています。現実には施策が効きやすい人と効きにくい人がいて、その違い(アップリフト)が大きければ、どの選び方の純増が大きいかの順位は変わりえます。この節の結果は「効果が全員同じというこの設定で比べた範囲では、残存価値を掛けた順のほうが粗利を多く守った」というもので、効果の違いがある場合の答えではありません。
表の「救えた人数(3か月)」の列には、もう1つ大事な点が表れています。予算50万円で、予測の解約確率の順は 45.8人を救い、期待純増の順の 41.1人より多いのに、純増は小さくなっています。解約しやすい人を選ぶ方法は、救える人数を最大にしようとしますが、救った人の残存価値(対象の平均で約2.3万円)が小さいので、守れる粗利は少なくなります。施策の成果を「救えた人数」や「解約率の下がり方」で報告していると、粗利を多く守る選び方のほうが成果が小さく見えることになります。施策の評価の指標を、人数ではなく守れた粗利にそろえることが有効だと考えています。
残存価値の順だけで選ぶ方法は、予算25万円で純増が負(約 -6.1万円)、50万円でもほぼ0(273円)で、どの予算でも3つの選び方の中で最も純増が小さくなりました。選ばれた人の真の3か月解約確率は 2.6〜5.8%と低く、施策を当てても下げられる解約の量が少ないからです。価値の高い顧客を「大事なお客様」として優先的に手厚く扱うことは、顧客対応の方針としてはありえますが、解約を減らす施策の対象の選び方としては、この例では最も損の大きい選び方でした。
期待純増の近似がどれだけ当たっていたかも見ておきます。期待純増の順の対象について、近似で見積もった粗利の増分(期待純増の合計+費用)は、予算25万円で約80.9万円、50万円で約137.4万円、100万円で約229.5万円、150万円で約304.9万円でした。真のモデルでの粗利の増分(表の「粗利の増分」の列)はそれぞれ約69.3万円・約120.0万円・約201.3万円・約267.0万円で、近似はどの予算でも1割強(14〜17%)過大でした。この設定で比べた範囲では、この近似で並べた順のほうが純増は大きくなりましたが、「この予算でいくら守れるか」を経営に報告するときは、近似の値を割り引いて伝えるか、実験(第12章)で確かめた値を使う必要があります。
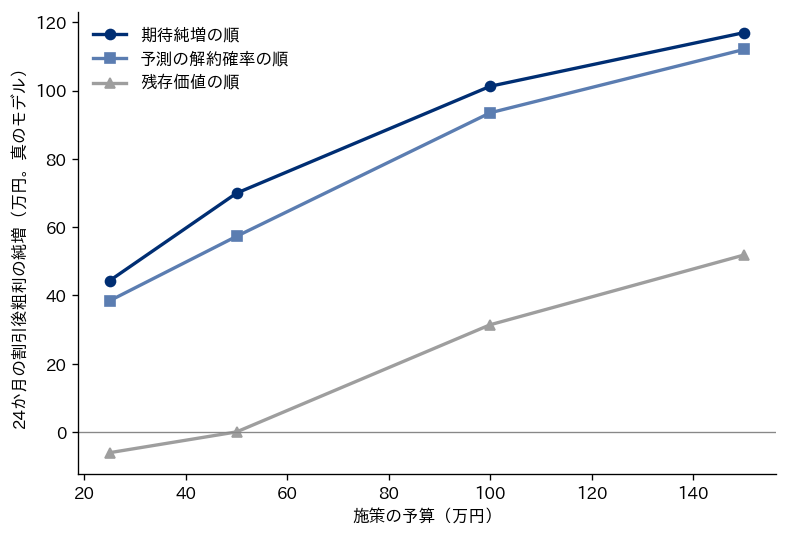
獲得と引き止めを同じ物差しで比べる
引き止めの予算をいくらにするかは、引き止めの中だけでは決まりません。同じお金を新しい顧客の獲得に回したほうが粗利が増えるなら、引き止めの予算は減らすべきだからです。獲得と引き止めは、社内では別の部門(マーケティングと CS・CRM)が別の指標で管理していることが多く、比べる物差しがそろっていないことがよくあります。獲得は「1人あたりの獲得費用(CAC)」、引き止めは「解約率が何ポイント下がったか」で報告されていると、どちらにお金を足すべきかを判断できません。
物差しをそろえる1つの方法は、どちらも「粗利1円を得るのにかかる費用」に直すことです。獲得の側は、CAC をその顧客が生む割引後の粗利で割ります。引き止めの側は、施策の費用を、真のモデルで測った粗利の増分で割ります。期間もそろえる必要があります。引き止めの粗利の増分は先24か月で測っているので、獲得の側も、第9章と同じく1人ずつの支払月数と月額から計算した真の LTV(年5%割引)を、加入から24か月で打ち切って使いました。比べるのは、この24か月でそろえた値です。60か月の LTV(第9章の定義)から計算した値も参考に並べますが、これは獲得の側だけで、引き止めの側の60か月の値は測っていません。
| 予算の使い道 | 費用(獲得は1人あたり、引き止めは救えた1人あたり。円) | 粗利(獲得は1人あたり、引き止めは対象全体の合計。24か月。円) | 粗利1円を得る費用(24か月) | 参考 粗利1円を得る費用(60か月の LTV。獲得だけ) |
|---|---|---|---|---|
| 獲得 紹介 | CAC 2,000 | 33,282 | 0.060 | 0.031 |
| 獲得 検索広告 | CAC 6,000 | 28,786 | 0.208 | 0.119 |
| 獲得 SNS広告 | CAC 9,000 | 24,476 | 0.368 | 0.234 |
| 獲得 チラシ | CAC 12,000 | 20,569 | 0.583 | 0.404 |
| 引き止め 期待純増の順 予算25万円 | 1人を救う費用 10,977 | 粗利の増分 693,451(500人の合計) | 0.361 | (測っていない) |
| 引き止め 期待純増の順 予算50万円 | 1人を救う費用 12,165 | 粗利の増分 1,199,537(1,000人の合計) | 0.417 | (測っていない) |
| 引き止め 期待純増の順 予算100万円 | 1人を救う費用 13,894 | 粗利の増分 2,012,593(2,000人の合計) | 0.497 | (測っていない) |
| 引き止め 期待純増の順 予算150万円 | 1人を救う費用 15,707 | 粗利の増分 2,669,577(3,000人の合計) | 0.562 | (測っていない) |
表の「1人を救う費用」は、施策の費用を、3か月以内の解約を免れた人数の期待値(真のモデル)で割ったものです。予算25万円の期待純増の順なら、500人に配って救えるのは 22.8人なので、1人を救うのに 10,977円かかっています。表の「粗利1円を得る費用」は、獲得の行では CAC÷1人あたりの粗利、引き止めの行では予算の総額÷対象全体の粗利の増分で計算しているので、行ごとに費用と粗利の数え方はそろっています。第2章で紹介した基準の結果(第8章の表)でも、予測上位10%の 733人に配ったときの1人を救う費用は約1.01万円(366,500円÷36.15人)、全員に配ったときは約2.30万円(3,662,000円÷159.5人)でした。ここで「救えた」は、3か月以内の解約を免れた、または先に延ばした人数の期待値です。この数字だけを CAC(2,000〜12,000円)と並べると、「1人を救うより1人を獲得するほうが安い」と読みたくなります。しかし、救った1人と獲得した1人は同じ価値ではありません。救った人はすでに何か月も在籍してきた人で、在籍が長いほどハザードが下がるこの例の真のモデル(第5章・第6章で見た在籍月数の効果)では、獲得したばかりの人より解約しにくい一方、「3か月だけ解約を免れて、その後に解約する」人も含まれます。人数で比べず、粗利で比べる必要があるのはこのためです。
表の「粗利1円を得る費用(24か月)」の列で比べると、紹介(0.060)と検索広告(0.208)の獲得が最も効率が良く、予算25万円の引き止め(0.361)と SNS広告の獲得(0.368)がほぼ並び、予算を増やした引き止め(0.417〜0.562)、チラシの獲得(0.583)の順になりました。引き止めの欄の値は予算全体の平均です。予算を積み増したときに追加の1円で得られる粗利(限界の効率)で見ると、真のモデルでの粗利の増分の差から、予算25万円から50万円への追加分は粗利1円を得る費用が約0.494、50万円から100万円は約0.615、100万円から150万円は約0.761でした。24か月で切ったこの比較では、引き止めの予算を50万円より先に積み増した分の効率は、チラシの獲得(0.583)と近いか、それより悪い値になりました。ただし、0.615と0.583の差はシミュレーションのぶれの範囲に入りうるので、50万円から100万円の追加分がチラシより悪いとまでは言えません。また、引き止めで救った顧客は24か月より先にも粗利を生みうるので、24か月で切ると引き止めの側を不利に見ている可能性がありますが、その大きさはこの章では測っていません。
この比較には限界もあります。獲得の側の CAC は、共通データでは1人あたり一定の架空の値ですが、現実の広告では、出稿を増やしたときに1人あたりの獲得費用が一定のままとは限りません。紹介のように、費用を積めば人数が増えるとは限らないチャネルもあります。獲得の側も、予算を積み増したときの限界の効率で比べる必要があります。広告の出稿量と獲得の効果の関係を測る方法は、弊社コラム『広告の効果を測るマーケティング・ミックス・モデリング、効果の分解から広告予算の最適配分まで』で、獲得と引き止めのように効率の曲線が違う複数の使い道に予算を配る計算は、弊社コラム『投資配分を決める数理モデル、ポートフォリオ最適化から事業投資の予算配分まで』で扱っています。この章で示したかったのは、獲得と引き止めの予算を同じ「粗利1円を得る費用」の物差しに載せれば、部門をまたいで比べられるということです。
顧客の分け方と、この章で扱わないこと
この章の4象限は、残存価値と解約確率という、施策の判断に直接使う2つの数字で顧客を分けました。顧客を分ける方法には、このほかに、購買の内容や利用の仕方の似ている顧客をデータから自動的にまとめるクラスター分析などのセグメンテーションの手法があります。そうした分け方は、顧客の好みや利用の型を理解して、施策の中身(何を勧めるか、どんな言葉で連絡するか)を変えるのに役立ちます。一方、誰に予算を使うかの順位づけには、この章のように施策の損得を直接表す数字で並べるほうが向いていると考えています。セグメンテーションの手法は、弊社コラム『データの構造を読み解く多変量解析、主成分分析・因子分析からクラスター分析まで』で扱っています。
また、この章の期待純増は、施策の効果が全員同じ(解約のオッズ0.7倍)という架空の前提の上に立っています。現実には、施策が効きやすい人と効きにくい人がいて、効果の大きさそのものも分かりません。施策の効果を実験で測る方法は第12章で、人によって違う効果を予測するアップリフトモデリングは弊社コラム『施策の効果を正しく測る、因果推論と効果検証の進め方』で扱っています。効果が人によって違うことが分かれば、人ごとの効果を解約確率の相対的な下がり方(何割下がるか)として推定する場合は式の0.3を、施策ありとなしの解約確率の差として推定する場合は「0.3×3か月解約確率」の全体を、その推定に置き換えることで、この章の選び方はそのまま使えます。どちらの場合も、長期の粗利への換算には近似が残ります。
経営の判断に翻訳する:価値の低い顧客を切り捨てるのではなく、費用対効果の順で配る
この章の結果を、予算と施策の判断に使える形に整理します。1つ目は、自社の価値の偏りを測ってから、施策の絞り方を決めることです。この例の定期便では上位20%の在籍者が先24か月の残存価値の約30%しか持たず、通販では上位20%の顧客が先52週の購買金額の約70%(予測)から約90%(実現)を持っていました(対象・指標・期間が違うので、2つの事業の偏りやすさを比べた数字ではありません)。この定期便のように偏りの小さい(集中の曲線が対角線に近い)顧客基盤で上位の顧客だけを手厚く扱うと、顧客基盤の価値の大部分を施策の外に置くことになります。逆に、偏りの大きい事業では、上位の顧客の離脱が事業全体の数字を大きく動かします。どちらなのかは、価値の集中の曲線を1枚描けば分かります。
2つ目は、「価値の高い顧客」でも「解約しそうな顧客」でもなく、「施策を当てると得をする顧客」から順に予算を配ることです。この例では、価値の高い順に配ると予算25万円で純増が負、50万円でもほぼ0になり、解約確率の高い順に配ると、乱数の種を変えた2組の計算で、4つの予算とも期待純増の順より約5万〜15万円少ない純増になりました。期待純増の順に並べるための材料は、第7章の解約予測と第9章の残存価値で、どちらもすでに手元にある数字です。施策の効果が全員同じという前提の下では、2つを掛け合わせるだけで、この例では同じ予算で守れる粗利が増えました。ただし、現実に効果が人によって違えば(アップリフト)、順位は変わりえます。効果が人によってどれだけ違うかは第12章の実験で確かめ、違いが大きければ、期待純増の式の効果の部分(0.3、または0.3×3か月解約確率)を人ごとの効果の推定に置き換える必要があります。
3つ目は、価値の低い顧客を切り捨てることと、費用対効果の順で配ることを区別することです。この例の低価値×高リスクの象限は、1人あたりの価値は小さいものの、500円のクーポンであれば 2,534人中 2,463人の期待純増が正で、象限ごとの「失いうる価値」(解約確率で重み付けした残存価値の近似の目安)の合計も4象限の中で最も大きくなっていました。期待純増の順で選んだ対象のうち約4割(予算50万円で 1,000人中 403人)はこの象限の人です。価値の低い顧客に施策を当てないのは、その人を軽く扱うからではなく、その施策の費用に見合わないからです。費用の安い施策を用意すれば、同じ顧客が対象に入ります。施策の費用と効果が決まれば、誰に当てるかは計算で決まる、という順序で考えることが有効だと考えています。なお、ここでの選び方は、利用状況や在籍の長さから見積もった価値と解約確率によるもので、個人の属性によって価格や扱いに不利な差をつけることを勧めるものではありません。
4つ目は、施策の予算の上限を、純増が増えなくなる点から決めることです。この例では、期待純増が正の 4,543人全員に配っても(費用 227.2万円)、真のモデルで測った純増は約130万円で、予算150万円の約117.0万円から約13.2万円しか増えませんでした(効果が全員同じという前提の下での結果です)。24か月で切った比較では、予算を積み増したときの追加の1円あたりの粗利は、50万円を超えたあたりでチラシの獲得に近づくか、それより悪くなっています(24か月より先の粗利は、獲得・引き止めのどちらの側でも数えていません)。「引き止めは獲得より安いはずだ」という前提で予算を積むのではなく、追加の予算でどれだけの粗利が増えるかを獲得の側と同じ物差しで比べ、効率の良い使い道から順に予算を配るのがよいと考えています。
この章の要点は3つです。第一に、顧客の価値の偏りは決まった比率にはならず、この2つの架空データでは、定期便の在籍者の上位20%が先24か月の残存価値の約30%、通販の全顧客の上位20%が先52週の購買金額の約70%(予測)から約90%(実現)を持っていました。第二に、残存価値と3か月解約確率で顧客を4つに分けると、象限ごとの打ち手の種類を整理できますが、誰に施策を当てるかは「0.3×3か月解約確率×残存価値」から費用を引いた期待純増の順に決めるのがよく、費用が全員同じならこの順に並べることがナップサック問題の最適解と一致しました。施策の効果が全員同じという前提の真のモデルで答え合わせすると、比べた4つの予算すべてで、第8章の「予測上位 k%」と同じ考え方の選び方より大きな純増を生みました(乱数の種を変えた2組とも。差は約5万〜15万円)。第三に、獲得と引き止めは「粗利1円を得る費用」の物差しに、期間をそろえて載せれば比べられます。24か月で切ったこの例の比較では、引き止めの予算を50万円より先に積み増した分の効率は、チラシの獲得に近いか、それより悪くなりました。ただし、この章の期待純増は「施策の効果は全員同じで、解約のオッズを0.7倍にする」という架空の前提に立っています。次の第12章では、この前提を現実のデータで確かめる方法、つまり施策の効果を実験で測り、その効果がどれだけ続くかを確かめる方法を扱います。
Anagraftでは、顧客データの整備から、離脱と残存価値のモデルの設計と実装、施策の優先順位づけと予算配分の意思決定への組み込みまで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『カスタマー・エクイティ ブランド、顧客価値、リテンションを統合する』(ローランド・T.ラスト、バレリー・A.ザイタムル、キャサリン・N.レモン著、近藤隆雄訳、ダイヤモンド社):原題は Driving Customer Equity です。同じ著者らが2004年に学術誌 Journal of Marketing に発表した論文の要旨では、カスタマー・エクイティは現在と将来の顧客の生涯価値を合計したものとされ、マーケティングの選択肢を「カスタマー・エクイティの増分÷そのために追加で使う費用」で比べる枠組みが示されています。本書は副題のとおり、ブランド・顧客価値・リテンション(引き止め)を1つの枠組みで扱います。この章で行った、獲得と引き止めを同じ粗利の物差しで比べ、顧客基盤全体の価値が増える使い道に予算を配るという発想を、マーケティングの戦略の側から整理し直すのに向いています。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画・非線形計画・整数計画と組合せ最適化を、問題の定式化から解き方まで扱った教科書です。整数計画と組合せ最適化の章で、貪欲法やナップサック問題、分枝限定法を扱っています。この章の「費用が全員同じなら並べるだけで最適、費用が違うと並べるだけでは最適にならない」という結果がなぜ起きるのかを、ナップサック問題の性質と解き方から理解するのに向いています。
『意思決定分析と予測の活用 基礎理論からPython実装まで』(馬場真哉、講談社):期待値に基づく意思決定、情報の価値、コスト/ロスモデルと予測の価値、確率予測の活用などを、Python の実装とともに扱う本です。この章の期待純増は、「予測された解約確率をもとに、施策を当てる・当てないの2択を期待値で決める」問題で、予測の確率をどう判断の損得に結びつけるかを、決定分析の枠組みで学び直すのに向いています。
第12章 施策の効果を確かめる、実験と効果の持続
第11章では、残存価値と3か月解約確率を組み合わせ、1人あたりの期待純増の順に予算の範囲で施策の対象を選ぶ方法を確かめました。第8章からここまでの計算はすべて、「引き止めのクーポンを配ると、その月から3か月の解約の起きやすさ(オッズ)が0.7倍になる」という前提の上に立っています。この0.7倍は、第2章で用意したサンプルデータの架空の設定で、データを作った側が決めた数字です。現実の企業には、この数字を教えてくれる人はいません。この章では、施策の効果そのものを測る方法として、対象の一部に施策を打たない群を残すホールドアウトの設計、効果を見逃さないために何人必要かを決める検出力とサンプルサイズの計算、施策が「解約を止めた」のか「先延ばしにした」のかを見分ける効果の持続の測り方、どの指標で効果を判定するか、そして施策を受けた人と受けなかった人を素朴に比べるとなぜ誤るのかを、共通データで実行して確かめます。
予測の精度と施策の効果は別の問い
第7章で作った解約予測のモデルは、第30か月末の在籍者 7,324人について、この先3か月に解約しそうな順に並べるものでした。この例のモデルの AUC は0.674で、隠れた利用意欲まで知る真のモデルの0.684に近く、この例では予測としてこれ以上大きく伸ばしにくい水準にあります。しかし、このモデルが答えているのは「誰が解約しそうか」であって、「誰にクーポンを配れば解約が減るか」「クーポンで解約がどれだけ減るか」ではありません。予測がいくら正確でも、施策の効果が小さければ、施策の費用は回収できません。逆に、予測の精度がそこそこでも、施策の効果が大きければ、費用を十分に上回る粗利を残せます。
第8章で見た基準の結果は、このことを数字で示しています。予測上位10%の733人に500円のクーポンを配ると、24か月の割引後粗利の純増は486,054円で、無作為の10%に配った場合(89,890円)の約5.4倍でした。ただし、この計算の中の「オッズ0.7倍」という効果の大きさは、予測モデルからは一切出てきません。効果が弱ければ、どの選び方でも純増は大きく減り、効果がまったく無ければ、どの選び方でも費用の分だけ赤字です。予測上位を選ぶ判断が正しいかどうかは、効果の大きさがどれだけかに懸かっています。
効果の大きさは、施策を実際に打ち、打たなかった場合と比べて測るしかありません。ここで難しいのは、同じ顧客について「クーポンを配った場合」と「配らなかった場合」の両方を観察することはできない点です。ある顧客がクーポンを受け取って3か月解約しなかったとしても、その人がクーポンが無くても解約しなかったのかどうかは分かりません。この観察できない側の結果を、施策を打たなかった別の顧客の集団で代わりに測るのが、この章で扱う実験の考え方です。
共通データは架空のデータなので、データを作った側は、同じ顧客について「配った場合」と「配らなかった場合」を、同じ乱数のもとで両方シミュレーションできます。この章では、この両方を知る立場から計算した差を「真の効果」と呼び、現実の企業が実験で見ることができる差と並べて示します。現実には真の効果は見えませんが、この記事では、実験の結果がどれだけ真の効果に近いかを答え合わせに使えます。
ホールドアウトの設計:在籍者を無作為に2群に分ける
施策の効果を測る最も確実な方法は、施策の対象になりうる顧客を無作為に2つの群に分け、片方(処置群)にだけ施策を打ち、もう片方(対照群)には何もしないで、同じ指標を同じ期間で比べることです。施策を打たずに残しておく群をホールドアウト、あるいは対照群と呼びます。医療の臨床試験やウェブサイトの A/B テストと同じ考え方で、無作為に分けた比較実験はランダム化比較試験とも呼ばれます。
無作為に分けることが要になるのは、そうしないと2群の違いが施策以外の理由で生まれるからです。たとえば「最近注文が減っている人」にだけクーポンを配って、配らなかった人と比べれば、2群は施策を打つ前から解約のしやすさが違います。無作為に分ければ、注文の多さ、加入チャネル、プラン、隠れた利用意欲といった、解約に効く性質が、2群で平均的にそろいます。観察できる性質だけでなく、データに無い性質もそろう点が、無作為化の強みです。2群の結果の差は、偶然のばらつきを除けば、施策の効果だと読めます。
この章の実験は、次の設定で行いました。対象は、第7章の検証に使った第30か月末の在籍者 7,324人です。乱数の種を固定して無作為に並べ替え、前半の3,662人を処置群、残りの3,662人を対照群にしました。処置群には第31か月から第33か月までの3か月間、引き止めのクーポンを配ります。共通データの架空の設定では、クーポンの費用は1人500円、効果はその3か月間の解約の起きやすさ(オッズ=解約確率÷継続確率)を0.7倍にすることです。解約確率が小さい範囲では、確率をおよそ0.7倍するのとほぼ同じです。効果は全員に同じです。対照群には何もしません。そのうえで、第2章で紹介した答え合わせ用の関数 cd.simulate_future を使い、第31か月から第54か月までの24か月を、隠れた利用意欲から先を真のモデルで30回シミュレーションしました。30回の平均を取るのは、シミュレーションの偶然による揺れを小さくして、施策が平均してどれだけ効くかを見るためです。現実の実験は1回しか起きないので、1回きりの結果がどれだけ揺れるかは、後の節で別に確かめます。
| 設計の項目 | この章の実験での設定(架空) | 決めておく理由 |
|---|---|---|
| 対象 | 第30か月末の在籍者 7,324人 | 施策を本番で配る相手と同じ集団で測るため |
| 割り付け | 無作為に半分ずつ(処置群 3,662人・対照群 3,662人) | 施策以外の性質を2群でそろえるため |
| 施策 | 第31〜33か月にクーポン(1人500円) | 費用と期間が決まっていないと、効果を費用と比べられない |
| 主な指標 | 3か月解約率、12か月・24か月の継続率と割引後粗利 | 先に決めないと、結果を見てから都合のよい指標を選んでしまう |
| 観察の期間 | 第54か月まで(24か月) | 施策が終わった後に効果が残るかを見るため |
| 必要な人数 | 検出力の計算で決める(後の節) | 人数が足りないと、効果があっても見逃す |
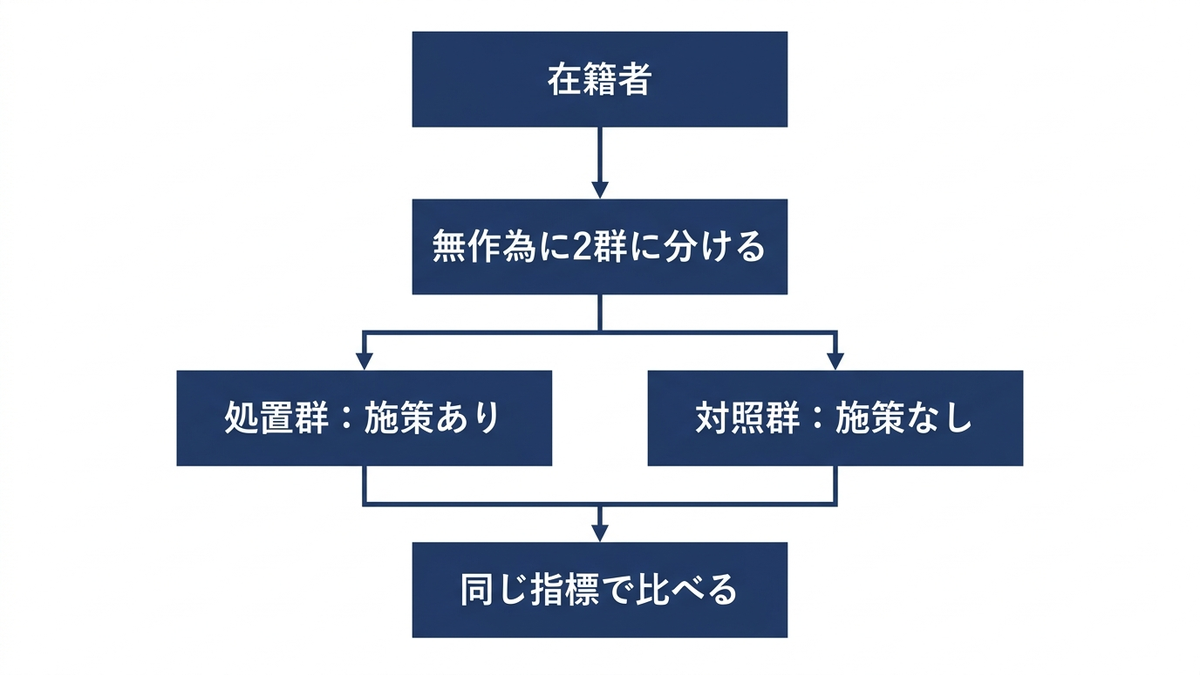
実験の結果:3か月後・12か月後・24か月後の差
次のコードは、上の設定で実験を行い、処置群と対照群について cd.simulate_future が返す4つの列の平均を出すものです。補助モジュール(cust_data.py と baseline.py)と同じフォルダに置いて実行する形です。p_churn_3m と p_churn_12m は、第30か月末から3か月以内・12か月以内に解約する確率、exp_months はこの先24か月のうち料金を払う月数の期待値、exp_margin はその割引後粗利(年5%で割り引いた月次粗利の合計)の期待値で、いずれも30回のシミュレーションの平均です。
import numpy as np
import cust_data as cd
import baseline as bl

cust, monthly = cd.make_subscription()
cust_f, monthly_f = cd.make_subscription(full=True)      # 答え合わせ用(真のモデル)
ids = bl.build_snapshots(cust, monthly, [30])["cust_id"].values   # 第30か月末の在籍者

rng = np.random.default_rng(0)
treat_ids = rng.permutation(ids)[: len(ids) // 2]        # 無作為に半分を処置群に
mask = np.zeros(cd.N_SUB, dtype=bool)
mask[treat_ids] = True

sf = cd.simulate_future(cust_f, monthly_f, start_month=30, horizon=24,
                        n_sims=30, offer_mask=mask, seed=2)
is_t = mask[sf["cust_id"].values]
print("処置群 %d人 / 対照群 %d人" % (is_t.sum(), (~is_t).sum()))
for col in ["p_churn_3m", "p_churn_12m", "exp_months", "exp_margin"]:
    print("%-12s 処置群 %10.4f  対照群 %10.4f" % (col, sf.loc[is_t, col].mean(), sf.loc[~is_t, col].mean()))
# 出力:
# 処置群 3662人 / 対照群 3662人
# p_churn_3m   処置群     0.0522  対照群     0.0757
# p_churn_12m  処置群     0.2191  対照群     0.2387
# exp_months   処置群    19.2259  対照群    18.7852
# exp_margin   処置群 33026.8548  対照群 32550.8560
3か月以内に解約する確率は、対照群の0.0757に対して処置群は0.0522で、実験で見える相対の減少は31.1%でした。この31.1%は、処置群と対照群を比べて得る値で、現実の企業が実験で目にする数字に当たります(ただし、ここでは30回のシミュレーションの平均です)。データを作った側だけが知る真の減少(同じ処置群の人たちが施策を受けなかった場合の0.0735から、受けた場合の0.0522への減少)は29.1%で、実験で見える値とは2ポイントの開きがあります。この開きの理由は、表の後で説明します。12か月以内に解約する確率は0.2387に対して0.2191で、差は0.0196です。24か月のうち料金を払う月数の期待値は18.79か月に対して19.23か月で、1人あたり0.44か月の差です。割引後粗利は32,551円に対して33,027円で、1人あたり476円の差でした。
この実験の結果を、データを作った側だけが知る真の効果と並べたのが次の表です。表の「継続率」は、第30か月末の在籍者を起点にして、そこから数えて k か月後の月末にまだ解約していない割合で、1から k か月以内の解約確率を引いたものです。第2章で定義した継続率(加入から数えて t か月目の料金を払っている確率で、1か月目は必ず1)とは起点が違うので、1か月後の値は1になりません。「実験で見える差」は処置群から対照群を引いた値、「真の差」は、処置群の3,662人について、施策を当てた場合から当てなかった場合を引いた値です。粗利の列は、この先 k か月に払う月数ぶんの割引後粗利の、1人あたりの平均です。どれも30回のシミュレーションの平均です。1か月後の継続率は第31か月の月末に解約していない割合、1か月後の粗利は第31か月に払った額なので、継続率に差があっても、1か月後の粗利の真の差は0円になります。
| 経過月数 k(第30か月末から) | 継続率 処置群(第30か月末を起点) | 継続率 対照群(第30か月末を起点) | 継続率の差 実験で見える差(ポイント) | 継続率の差 真の差(ポイント) | 粗利の差 実験で見える差(円/人) | 粗利の差 真の差(円/人) |
|---|---|---|---|---|---|---|
| 1か月後 | 0.9808 | 0.9721 | +0.87 | +0.82 | -13 | 0 |
| 3か月後 | 0.9478 | 0.9243 | +2.35 | +2.14 | +5 | +40 |
| 6か月後 | 0.8851 | 0.8631 | +2.20 | +1.93 | +85 | +146 |
| 12か月後 | 0.7809 | 0.7613 | +1.96 | +1.60 | +229 | +326 |
| 18か月後 | 0.6963 | 0.6787 | +1.76 | +1.36 | +359 | +476 |
| 24か月後 | 0.6262 | 0.6090 | +1.73 | +1.17 | +476 | +601 |
継続率の真の差は、3か月後の2.14ポイントが最大で、施策が終わったあとは少しずつ縮み、24か月後には1.17ポイントになりました。粗利の差は逆に、時間とともに積み上がります。解約を免れた人が払い続ける月数のぶん、粗利が増えていくからです。3か月後の真の粗利の差は1人40円にすぎず、12か月後に326円、18か月後に476円、24か月後に601円になります。施策の費用は1人500円なので、この例では、18か月の時点でもまだ費用に届かず、24か月たってようやく費用を上回る粗利が積み上がる、という時間の感覚になります。
表の「実験で見える差」と「真の差」には、継続率でも粗利でも開きがあります。3か月後の継続率の差は、実験では2.35ポイント、真の値は2.14ポイントで、24か月後の粗利の差は、実験では476円、真の値は601円でした。理由の1つは、2群がもともと同じではないことです。処置群が施策を受けなかったとした場合の3か月解約率(真の値)は0.0735で、対照群の0.0757より少し低く、処置群のほうが少し解約しにくい顧客の集まりでした。1か月後の行も手がかりになります。共通データでは、第31か月の料金は全員が払うので、1か月後の粗利は施策が効きようのない数字で、真の差は0円です。それでも実験では対照群のほうが13円高く出ました。2群のプラン別の人数を数えると、処置群は標準2,507人・大容量1,155人、対照群は標準2,454人・大容量1,208人で、対照群のほうが大容量の人が53人多く、1人あたりの月次粗利の平均は処置群1,783.9円、対照群1,796.9円と、13.0円の差がありました。1か月後の粗利は全員が1か月分を払った額なので、この13円は、この月次粗利の平均の差と一致します。無作為に分けても、2群は同じ人ではないので、偶然の違いは残ります。30回のシミュレーションを平均しても、この違いは消えません。2群の分け方は1回きりで、シミュレーションの回数を増やしても同じ2群を比べ続けるからです。実験の結果にはこの偶然の幅がつきまとうので、後の節で、その大きさを確かめます。
この表の結果を、施策の採算に直しておきます。処置群 3,662人に配ったクーポンの費用は1,831,000円です。処置群の24か月の割引後粗利の増分(真の値)は2,199,634円で、費用を引いた純増は368,634円、1人あたりの増分601円は費用500円の1.20倍でした。第8章で見た基準の結果では、第30か月末の在籍者全員に配ったときの1人あたりの増分は622円でした(40回のシミュレーション)。この章で後に、同じ全員配布を30回・別の乱数の種で計算し直すと609円で、第8章で乱数の種を変えて5通りに計算した範囲(597〜622円)に収まります。どちらも同じ量を、回数と乱数の違うシミュレーションで近似した値で、差はそのぶれの範囲です。無作為に選んだ半分の601円も、同じ水準にあります。
解約を止めたのか、先延ばしにしたのか
引き止めの施策を評価するときに見落とされやすいのが、施策が解約を「止めた」のか、それとも「先延ばしにした」だけなのか、という区別です。クーポンを配った3か月間に解約が減っても、クーポンが切れた途端にその人たちが解約すれば、施策の効果は数か月ぶんの月額にとどまります。次の図の左は、処置群の継続率の真の差(施策を当てた場合から当てなかった場合を引いたもの)と、実験で見える差(処置群から対照群を引いたもの)の推移、右は処置群の月ごとのハザード(その月まで在籍した人が、その月末に解約する割合)を、施策を当てた場合と当てなかった場合で描いたものです。どちらも30回のシミュレーションの平均です。
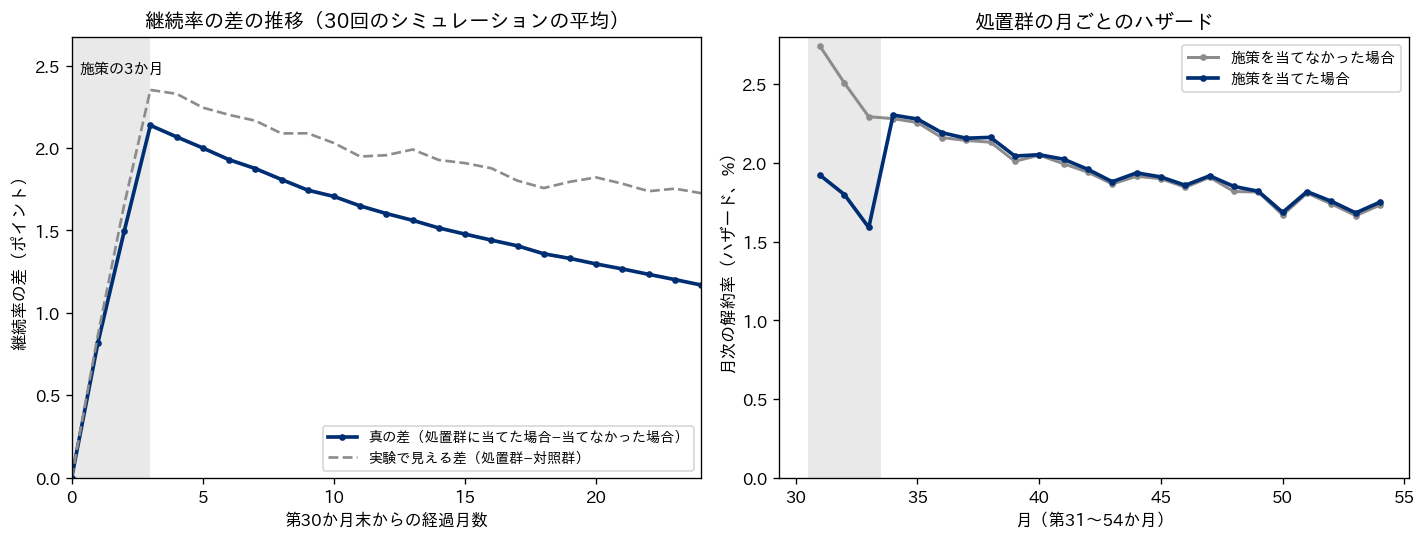
右の図のとおり、施策を当てた場合のハザードは、第31〜33か月だけ当てなかった場合の0.69〜0.72倍に下がり、第34か月には1.010倍と、元の水準に戻りました。その後も第36か月が1.014倍、第42か月が1.009倍、第48か月が1.018倍と、1倍をわずかに上回る水準で推移しています。共通データの施策は、効いている3か月のあいだだけハザードを下げるもので、施策が終わったあとまで解約しにくい体質を作るものではありません。これはデータを作るときに決めた架空の設定どおりの結果です。施策が終わった後のハザードが1倍をわずかに上回る理由は、この章の計算では切り分けていません。
数で見ると、処置群の3,662人のうち、施策のおかげで第31〜33か月の解約を免れた人は、真の値で78.3人でした。一方、施策が終わった後の第34〜54か月に解約した人は、施策を当てなかった場合より35.5人多くなりました。3か月のあいだに引き止めた人のうち、半分弱(約45%)は24か月の観察期間のうちに結局解約し、残りの約43人が第54か月の月末にもまだ在籍している、ということです。継続率の真の差が3か月後の2.14ポイントから24か月後の1.17ポイント(最大の55%)に縮んだのは、この先延ばしの分です。この例の施策は、引き止めた人の半分弱については解約を先延ばしにしただけで、残りの半分強については、少なくとも24か月の範囲では解約を止めた、と言えます。なお、この計算は第54か月までで、その先は測っていません。
この区別が経営の判断に効くのは、施策の価値を「3か月で救った人数」で数えると過大になるからです。78.3人を救ったと報告すれば、1人あたりの残存価値を掛けて大きな金額を見込みたくなりますが、そのうち半分近くは数か月から2年のうちに去っていきます。施策の価値は、引き止めた人がその後に払う月数で決まります。この例で24か月の粗利の増分が1人601円と、費用500円を少し上回る程度にとどまったのは、先延ばしの分が大きいからです。
左の図には、もう1つ読み取れることがあります。実験で見える差(グレーの破線)は、真の差と同じ形をたどりながら、全期間にわたって少し上を通り、24か月後には約1.7ポイントと、真の1.17ポイントより大きく出ています。一方、粗利の差は、前の節の表のとおり実験のほうが小さく出ました(24か月後に476円、真の値は601円)。この1回の分け方では、継続率では効果を大きめに、粗利では小さめに見せる向きに外れたことになります。前の節で見た2群の違い(処置群のほうが施策が無くても少し解約しにくいこと、対照群のほうが月次粗利の高い大容量プランの人が53人多いこと)が両方関わっていると見られますが、それぞれがどれだけ効いているかは、この章の計算では切り分けていません。分け方が違えば、外れる向きも変わります。1回の実験の結果がどれだけ揺れうるかを、次の節で確かめます。
1回きりの実験の結果は揺れる
ここまでの結果は、30回のシミュレーションを平均した、いわば「平均的な世界」での実験です。現実の企業が行う実験は1回きりで、解約は1人1回しか起きません。そこで、2群の分け方の乱数とシミュレーションの乱数をどちらも変えて、シミュレーション1本だけの実験を100回繰り返しました。1回ごとに、3か月解約率の差について比率の差の検定(statsmodels.stats.proportion.proportions_ztest。2群の割合の差を正規分布で近似して検定するもの)を、12か月・24か月の粗利の差について2群の平均の差の検定(scipy.stats.ttest_ind の equal_var=False。2群の分散が等しいと仮定しない Welch の t 検定)を行い、p 値を出しています。p 値は、本当は効果が無いという仮定(帰無仮説)を置き、検定の前提が成り立つとしたときに、今回と同じかそれ以上に極端な差が偶然に出る確率を表す数字で、この記事では0.05未満を「有意」と呼びます。検定の詳しい考え方は、弊社コラム「データから正しく結論を導く統計学のまとめ」で扱っています。次の表は100回のうち最初の10回です。
| 回 | 3か月解約率 処置群 | 3か月解約率 対照群 | 相対の減少(実験で見える値) | 3か月解約率の差の p 値 | 12か月の粗利の差(円/人) | 24か月の粗利の差(円/人) |
|---|---|---|---|---|---|---|
| 1 | 5.27% | 7.37% | 28.5% | 0.0002 | 383 | 800 |
| 2 | 5.76% | 7.40% | 22.1% | 0.0047 | 507 | 1,033 |
| 3 | 5.41% | 7.37% | 26.7% | 0.0006 | 130 | 22 |
| 4 | 5.35% | 7.13% | 24.9% | 0.0017 | 442 | 923 |
| 5 | 5.84% | 7.13% | 18.0% | 0.0257 | 363 | 741 |
| 6 | 4.40% | 8.08% | 45.6% | 0.00005未満 | 606 | 1,172 |
| 7 | 5.11% | 8.19% | 37.7% | 0.00005未満 | 349 | 609 |
| 8 | 5.68% | 7.86% | 27.8% | 0.0002 | 365 | 820 |
| 9 | 5.82% | 7.95% | 26.8% | 0.0003 | 275 | 322 |
| 10 | 5.24% | 7.51% | 30.2% | 0.0001 | 444 | 566 |
前の節の真の効果(3か月解約率の29.1%減)は、最初に分けた処置群3,662人についての値です。この節の100回の実験は、毎回処置群を選び直しているので、比べる基準には在籍者全員の平均の真の効果を使います。7,324人全員に施策を当てた場合と当てなかった場合を30回のシミュレーションで比べると、3か月解約率は0.0746から0.0532へ28.7%減り、24か月の割引後粗利は1人あたり609円増えました。この基準に対して、1回きりの実験で見える相対の減少は、最初の10回だけでも18.0%から45.6%まで散らばっています。100回全体では、平均27.7%、最小11.6%、最大45.6%、標準偏差6.0ポイントでした。同じ施策を同じ規模で試しても、ある実験では「1割強しか減らない」、別の実験では「4割以上減る」という結果が出うるということです。それでも、3か月解約率の差が有意になったのは100回のうち96回で、この例の規模(1群3,662人)なら、3割前後の減少はほとんどの場合に検出できました。1回の結果がどれだけ揺れうるかは、信頼区間で添えることができます。第1回の実験では、3か月解約率の差(処置群から対照群を引いたもの)は -2.10 ポイントで、その95%信頼区間(statsmodels.stats.proportion.confint_proportions_2indep で計算)は -3.22 から -0.99 ポイントでした。相対の減少の幅を知るには、差の区間を対照群の解約率で割るのではなく(対照群の解約率も推定値なので、それでは相対の減少の区間になりません)、2群の解約率の比(処置群÷対照群)の区間を求めます。同じ関数で compare="ratio" とすると、比は0.715、その95%信頼区間は0.598から0.855で、相対の減少に直すと14.5%から40.2%でした。この第1回の実験から言えるのは、「信頼区間が0を含まないので、3か月解約率が減ったと有意水準5%で判断できるが、減少の大きさは1割半ばから4割程度までの幅を持って見る必要がある」という程度です。
粗利の差は、揺れがもっと大きくなります。24か月の粗利の差は、在籍者全員の平均の真の値609円(最初の処置群についての真の値は601円)に対して、100回の平均は564円、最小は -430 円、最大は1,468円で、負になった回が5回、費用の500円を下回った回が45回ありました。有意になったのは36回だけです。12か月の粗利の差も、平均321円、最小 -141 円、最大799円で、有意になったのは49回でした。採否の基準をどう置くかで、誤った判定の回数は変わります。基準を「24か月の粗利の差の推定値が費用500円を超えたら採用」とすると、100回のうち45回は不採用になります。基準を「差が有意で、かつ推定値が500円を超えたら採用」とすると、採用になるのは36回で、64回は不採用です。なお、この2つ目の基準も、粗利の差が0円と違うかを検定しているだけで、増分が費用500円を上回ることを統計的に確かめたものではありません。それを確かめるには、増分から費用を引いた純増が0円を上回るかを検定する形に、帰無仮説と人数を設計し直す必要があります(この章では計算していません)。この例の施策は、真の値では1人600円前後(最初の処置群で601円、在籍者全員の平均で609円)と、費用を100円ほどわずかに上回る施策です。それでも、1回きりの実験の24か月の粗利で採否を決めると、1つ目の基準では100回中45回、2つ目の基準では64回、この施策を不採用にすることになります。表の第3回は、3か月解約率では26.7%の減少が有意に出ているのに、24か月の粗利の差は22円しかありません。第9回も、26.8%の減少に対して24か月の粗利の差は322円で、費用500円に届いていません。
粗利の差がこれほど揺れるのは、1人ひとりの粗利のばらつきが、施策による差に比べてとても大きいからです。1回の実現での1人あたりの割引後粗利の標準偏差は、12か月で6,988円、24か月で15,604円でした。第31か月だけ払って解約し、1か月分の粗利(標準プランで1,500円)しか残さない人から、大容量プランで24か月払い続けて5万円を超える割引後粗利を残す人までいるからです。この大きなばらつきの中で、1人あたり数百円の差を見分けなければなりません。これに対して3か月解約率は、0か1かの指標で、3か月のあいだに施策の効果が集中して表れるので、相対的に見分けやすくなります。どの指標でどれだけの人数があれば見分けられるかを、計算で決めるのが次の節の検出力です。
検出力とサンプルサイズ:何人いれば効果を見逃さないか
実験を始める前に決めておくべき最も大事な数字が、1群に何人を割り付けるかです。人数が少なすぎると、本当は効果がある施策でも、偶然の揺れに埋もれて有意な差が出ず、「効果が確認できなかった」という結論になります。この見逃しの起きにくさを表すのが検出力で、「本当に効果があるときに、検定がその効果を有意として検出できる確率」です。statsmodels の公式ドキュメントも、検出力を、対立仮説が正しいときに検定が帰無仮説を正しく棄却する確率と説明しています。この章では、有意水準(効果が無いのに有意と判定してしまう確率の上限)を5%、検出力を80%に置いて必要な人数を計算しました。
必要な人数は、効果の大きさで決まります。比率の差では、効果の大きさを効果量という1つの数字に直して計算します。statsmodels の proportion_effectsize は、2つの比率 \( p_1 \)、\( p_2 \) から、次の式で効果量 \( h \) を計算する関数だと公式ドキュメントに書かれています。同じドキュメントは、この形が R の pwr パッケージの検出力の関数に合わせたものだと注記しています。
\( h = 2 \arcsin\sqrt{p_1} – 2 \arcsin\sqrt{p_2} \)
言葉で言い換えると、「比率をそのまま引き算するのではなく、比率の平方根を逆正弦(arcsin)で変換してから差を取り、2倍したもの」です。この変換のため、同じ差でも比率の水準によって効果量が変わります。本記事の計算では、7.5%から5.25%への2.25ポイントの差の効果量は0.0924でしたが、50%から47.75%への同じ2.25ポイントの差では0.0450と、半分以下でした。解約率のように小さな比率の差は、50%付近の同じ大きさの差より見分けやすいということです。この効果量と有意水準・検出力を NormalIndPower(2群の比較の検出力を正規分布の近似で計算するクラス)の solve_power に渡すと、値を指定しなかった引数、ここでは1群あたりの人数が返ります。次のコードは、補助モジュールが無くても statsmodels だけで動く部分を抜き出したものです。
import numpy as np
from statsmodels.stats.power import NormalIndPower
from statsmodels.stats.proportion import proportion_effectsize

pw = NormalIndPower()
base = 0.075                                             # 対照群の3か月解約率
for rel in [0.30, 0.10]:                                 # 相対の減少(30%減・10%減)
    h = proportion_effectsize(base, base * (1 - rel))    # 効果量 h
    n = pw.solve_power(effect_size=h, alpha=0.05, power=0.8, ratio=1.0,
                       alternative="two-sided")          # 1群あたりの必要人数
    have = pw.power(effect_size=h, nobs1=3662, alpha=0.05, ratio=1.0,
                    alternative="two-sided")             # 1群3,662人での検出力
    print("%.0f%%減(%.4f→%.4f)h=%.4f  1群あたり %.0f人  1群3,662人での検出力 %.3f"
          % (100 * rel, base, base * (1 - rel), h, np.ceil(n), have))
# 出力:
# 30%減(0.0750→0.0525)h=0.0924  1群あたり 1837人  1群3,662人での検出力 0.977
# 10%減(0.0750→0.0675)h=0.0292  1群あたり 18455人  1群3,662人での検出力 0.239
3か月解約率7.5%を30%減らして5.25%にする効果を、有意水準5%(両側)・検出力80%で検出するには、1群あたり1,837人、2群で3,674人が要ります。第30か月末の在籍者 7,324人を半分ずつに分けたこの章の実験(1群3,662人)は、その2倍の人数があるので、検出力は0.977でした。前の節で、100回の実験のうち96回で有意になったのは、この計算とほぼ合っています(シミュレーションの真の効果は29.1%減で、30%減よりわずかに小さい)。ところが、効果が10%減(7.5%→6.75%)だと、必要な人数は1群あたり18,455人と約10倍になり、1群3,662人での検出力は0.239しかありません。10%減の効果がある施策を、この会社の在籍者全員を使って試しても、4回に3回は「有意な差は出なかった」で終わる計算です。
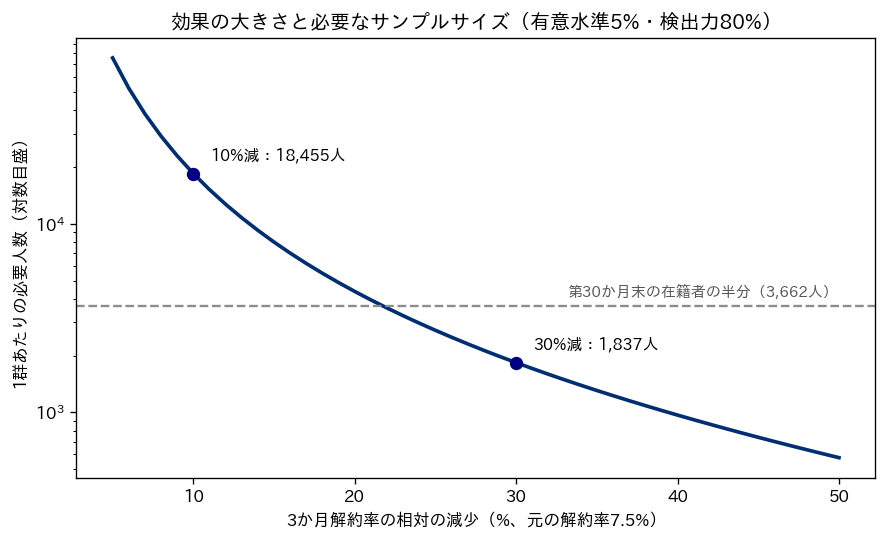
図のとおり、必要な人数は、見分けたい効果が小さくなるにつれて急に増えます。この表の範囲では、効果の大きさ(相対の減少)が半分になると、必要な人数は約4倍になりました(30%減の1,837人に対して15%減は7,996人、10%減の18,455人に対して5%減は75,648人)。次の表は、相対の減少ごとの必要人数と、この章の実験の規模(1群3,662人)での検出力をまとめたものです。
| 3か月解約率の相対の減少 | 処置群の3か月解約率 | 効果量 h | 1群あたりの必要人数(検出力80%) | 1群3,662人での検出力 |
|---|---|---|---|---|
| 5% | 7.125% | 0.0144 | 75,648 | 0.095 |
| 10% | 6.75% | 0.0292 | 18,455 | 0.239 |
| 15% | 6.375% | 0.0443 | 7,996 | 0.475 |
| 20% | 6.00% | 0.0599 | 4,379 | 0.726 |
| 25% | 5.625% | 0.0759 | 2,725 | 0.901 |
| 30% | 5.25% | 0.0924 | 1,837 | 0.977 |
| 40% | 4.50% | 0.1273 | 969 | 1.000 |
| 50% | 3.75% | 0.1651 | 577 | 1.000 |
表の「1群3,662人での検出力」の列を見ると、この会社の在籍者全員を使える規模の実験でも、検出力が0.9を超えるのは25%以上の減少で、20%の減少では検出力0.726、15%の減少では0.475と、見逃す確率が大きくなります。検出力を90%に上げると、30%減で1群2,459人、10%減で1群24,706人が要りました。「1.000」は小数第3位で丸めた値です。
実務では、対照群を半分も取ると、施策を打てる顧客がその分減ることが気になります。2群の人数を同じにしなくても実験はできます。solve_power の ratio(2群目の人数が1群目の何倍か)を9にして、処置群と対照群を9対1に分けた場合を計算すると、30%減の検出に必要なのは対照群1,021人・処置群9,184人で、合計10,205人でした。半分ずつに分ける場合の合計3,674人の約2.8倍の顧客が要りますが、施策を打たない顧客は1,021人にとどまります。対照群を小さくするほど施策を打てる顧客は増えますが、実験全体に必要な人数は増え、この例の7,324人の在籍者では、9対1の実験は1回では組めません。対照群の大きさは、「施策を打たないことで失う粗利」と「実験に必要な規模」の釣り合いで決めることになります。
検出力の計算に必要なのは、対照群の解約率の見込みと、見分けたい効果の大きさです。前者は過去のデータ(この例では第7章の検証の正例率0.075)から分かります。難しいのは後者で、まだ測っていない効果の大きさを先に置かなければなりません。この記事では、効果の大きさを「起きると期待する値」ではなく、「この大きさ以上の効果でなければ、費用に見合わないので採用しない」という損益分岐から決めることが有効だと考えています。この例で、施策の効果の倍率(解約のオッズに掛ける値)を0.70から0.95まで0.05刻みで変え、在籍者全員に当てた場合と当てなかった場合の24か月の粗利の増分を30回のシミュレーションで計算し直すと、倍率0.70で1人609円(3か月解約率の28.7%減)、0.75で505円(23.8%減)、0.80で402円(18.9%減)でした。増分が費用500円にちょうど届くのは、格子の間を直線で補間して、3か月解約率の相対の減少でおよそ23.5%です。つまり、この例の損益分岐は約3割減ではなく約24%減で、24%から30%のあいだの効果は、小さくても採算に合います。30%減を検出できる人数(1群1,837人)で実験を組むと、この範囲の効果を見逃しやすくなります。損益分岐に当たる効果を検出力80%で見分けたいなら、前の表の25%減(1群2,725人)と20%減(1群4,379人)のあいだの人数が要ります。サンプルサイズの決め方と、信頼区間に基づく考え方は、弊社コラム「データから正しく結論を導く統計学のまとめ」で詳しく扱っています。
指標の選び方:3か月の解約率だけでなく粗利で見る
ここまでの結果から、指標によって「見分けやすさ」と「経営上の意味」が逆向きになることが分かります。3か月解約率は、施策の効果が集中して表れるので見分けやすく、30%減なら1群1,837人で検出できます。ただし、3か月解約率は、施策が終わったあとに解約が戻る分(この例では引き止めた人の半分弱)を数えません。3か月解約率だけで判定すると、「解約を3割減らした成功した施策」という報告になり、24か月の粗利の増分が1人601円と費用500円をわずかに上回る程度だという事実は表に出てきません。
一方、粗利で見ると、経営上の意味ははっきりしますが、見分けるのに多くの人数が要ります。この実験の真の効果(12か月の割引後粗利で1人326円、24か月で1人601円)を、1回の実現での1人あたりの標準偏差(12か月6,988円、24か月15,604円)で割って効果量に直し、同じ NormalIndPower で必要な人数を計算すると、12か月の粗利では1群7,194人、24か月の粗利では1群10,595人になりました。これは、粗利の増分が0円と違うことを検出するための人数で、増分が費用500円を上回ることを検出するための人数ではありません。3か月解約率の1,837人に比べて、それぞれ約3.9倍、約5.8倍です。この会社の在籍者 7,324人を半分に分けた規模では、粗利の差は、効果があっても有意にならないことが多い、という前の節の結果(100回のうち、12か月で49回、24か月で36回しか有意にならない)とも合っています。
| 指標 | 真の効果(処置群1人あたり) | 1群あたりの必要人数(効果が0と違うことを、有意水準5%・検出力80%で検出する場合) | 結果が読めるまでの期間 | 経営上の意味 |
|---|---|---|---|---|
| 3か月解約率 | 29.1%減(0.0735→0.0522) | 1,837人(30%減として) | 3か月(第33か月末) | 施策が効いたかどうかは分かるが、先延ばしの分を数えない |
| 12か月の割引後粗利 | 326円 | 7,194人 | 12か月(第42か月末) | 12か月では費用500円に届いていないことが分かる |
| 24か月の割引後粗利 | 601円 | 10,595人 | 24か月(第54か月末) | 24か月での採算を判断する材料になる。ただし、この人数は増分が0円と違うことを見分けるためのもので、費用500円を上回ることを確かめるには別の設計が要る |
この表は、1つの指標で全部をまかなうことはできないことを示しています。この記事では、指標を2段に分けることが有効だと考えています。1段目は、施策が効いているかどうかを早く確かめる指標で、3か月解約率がこれに当たります。この指標で効果が見えなければ、粗利を待つまでもなく施策を見直せます。2段目は、施策が採算に合うかどうかを確かめる指標で、実験の前に決めた回収の期間(この例では24か月)の累積の割引後粗利がこれに当たります。この例では、12か月の時点の真の増分は1人326円で、費用500円をまだ回収していません。12か月で回収することを採用の条件にするなら、この施策はその条件を満たしません。そこで、12か月の粗利は中間の評価として使います。12か月の粗利は、先延ばしの分の多くを含み(この例では、継続率の真の差が2.14ポイントから1.17ポイントへ縮む分のうち、半分あまりに当たる2.14ポイントから1.60ポイントへの縮みは、12か月後までに表れています)、この時点で増分が見込みから大きく外れていれば、24か月を待たずに施策を見直せます。最終の判断は24か月の累積の粗利で行い、それまでのあいだは、継続率の差の推移(前の節の図の左)を見て、差が縮み続けているのか、横ばいになったのかで補います。どちらの指標で何を判定するかは、結果を見る前に決めて記録しておく必要があります。結果を見てから、差が出た指標を選んで報告すると、偶然の差を効果と取り違えやすくなるからです。
クーポンは解約しなかった人にも配られる
施策の費用を考えるときに忘れてはいけないのは、クーポンは、施策が無くても解約しなかった人にも配られることです。この実験の処置群3,662人のうち、施策が無くても3か月は解約しなかった人は、真の値で92.6%でした。施策の費用1,831,000円の9割以上は、施策が無くても残っていた人に配られたことになります。3か月以内の解約を1件防ぐのにかかった費用は、1,831,000円を防いだ解約78.3件で割って、23,394円でした。
第8章で見た基準の結果にも同じ構図があります。第30か月末の在籍者全員(7,324人)に配った場合、費用は3,662,000円で、3か月以内の解約を防いだ数は真の値で159.5件、1件あたりの費用は約22,960円でした。予測上位10%(733人)に絞った場合でも、対象の3か月解約確率は0.183で、8割以上の人は施策が無くても3か月は解約しません。費用366,500円で防いだ解約は36.2件、1件あたり約10,138円です。予測で対象を絞ると、解約1件を防ぐ費用は半分以下になりますが、それでも費用の大半は解約しなかった人に配られます。なお、この節の第8章の数字(基準の結果。真のモデルで40回のシミュレーション)と、この章の後の節で同じ予測上位10%の733人について出す数字(30回のシミュレーション。乱数も別)は、シミュレーションの回数と乱数が違う別の計算で、値が少しずれています。回数と乱数が違うことがずれの一因と考えられますが、それがすべてかは確かめていません。たとえば、施策が無い場合の3か月解約確率は、基準の結果では0.183、この章の計算では18.0%(0.180)です。
この数字は、施策の設計そのものを考え直す材料になります。1件の解約を防ぐのに2万円以上かかっているなら、1人500円のクーポンを広く配るよりも、1人あたりの費用が高くても解約しそうな人に効く施策(担当者からの連絡や、利用の少ない人へのプランの提案など)のほうが、費用対効果が良い可能性があります。どちらが良いかは、それぞれの施策で実験をして確かめるしかありません。また、施策が「誰に効くか」が人によって違う場合(この記事の共通データでは効果を全員に同じとしています)には、解約しそうな人と施策が効く人が一致するとは限りません。施策が効く人を推定するアップリフトモデリングは、弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」で扱っています。
観察データで効果を測る誤り:施策を受けた人のほうが解約している
実験をせずに施策の効果を測ろうとすると、手元にある「施策を受けた人」と「受けなかった人」のデータを比べたくなります。この比較がどれほど誤るかを、共通データで確かめました。第8章の考え方どおり、LightGBM の予測で3か月解約確率の上位10%に入った733人にだけクーポンを配り、残りの6,591人には配らなかったとします。そのうえで、施策を受けた群と受けなかった群の3か月解約率を、30回のシミュレーションの平均で比べました。
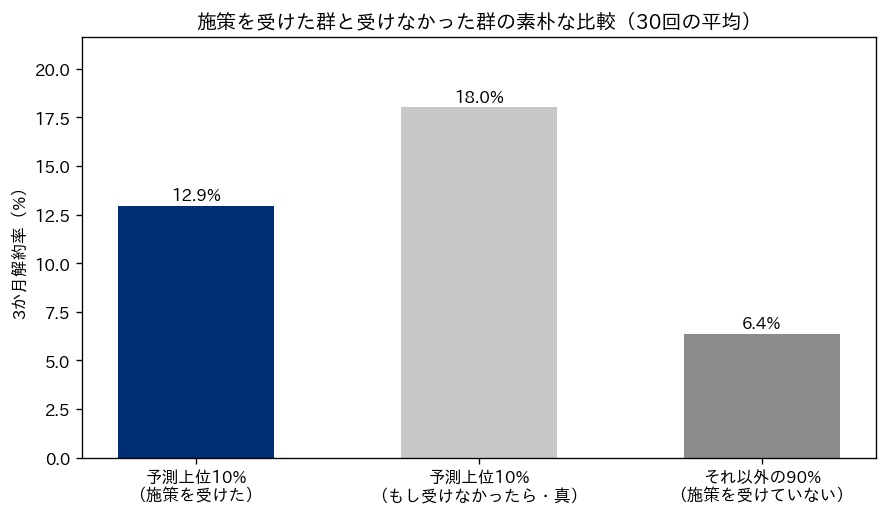
施策を受けた予測上位10%の3か月解約率は12.9%、受けなかった残りの90%は6.4%でした。素朴に比べると、施策を受けた群のほうが2.03倍も解約していて、「クーポンを配ると解約が増える」という、施策の効果とは逆向きの結論が出ます。シミュレーション1本だけの比較を20回繰り返しても、施策を受けた群の解約率が受けなかった群を上回った回数は20回中20回で、差の平均は6.72ポイントでした。偶然ではなく、毎回この向きに出ます。
実際には、施策は効いています。予測上位10%の733人が施策を受けなかったとしたら(データを作った側だけが知る真の値)、3か月解約率は18.0%でした。施策はこれを12.9%へ、5.07ポイント(相対で28.1%)下げています。素朴な比較が逆向きになったのは、施策を受けた人が、もともと解約しやすい人として選ばれていたからです。受けた群と受けなかった群は、施策を打つ前から解約のしやすさが大きく違い(18.0%対6.4%)、その違いが施策の効果(5.07ポイント)より大きいので、比較の結果が逆になります。このように、比べる群の選ばれ方の違いが結果に混ざることを選択バイアスと呼びます。24か月の割引後粗利で見ても、施策を受けた群は1人23,421円、受けなかった群は33,602円で、受けた群のほうが1万円以上少なく見えますが、同じ733人が施策を受けなかった場合の22,269円と比べれば、1人1,152円増えています。第8章の基準の結果では、同じ733人の1人あたりの増分は1,163円でした。前の節で断ったとおり、シミュレーションの回数と乱数が違う別の計算で、ずれの原因のすべてを確かめたわけではありません。
この誤りは、施策を「解約しそうな人」に選んで打つ限り、付いて回ります。逆向きの選び方、たとえば「優良顧客にだけ感謝のクーポンを配る」場合には、施策を受けた群の解約率が低く見え、施策の効果が過大に見えます。どちらの向きに外れるかは、対象の選び方で決まります。施策の後に「施策を受けた顧客の解約率は何%だった」という報告を見たら、比べている相手は誰か、その相手は施策を受けた顧客と同じように選ばれていたか、を確かめる必要があります。
観察データしか無いときに、選択バイアスを小さくする方法もあります。施策の前後の変化を、施策を受けなかった群の前後の変化と比べる差の差(DID)や、施策を受ける確率をそろえた人どうしを比べる傾向スコアの方法です。ただし、どちらもデータでは確かめきれない仮定に頼り、その仮定は手法ごとに違います。差の差の中心になる仮定は、施策が無ければ2群の指標が同じように推移したはずだという平行トレンドの仮定で、2群の水準の違いが時間によらず一定であれば、その違いは差し支えありません。傾向スコアの方法は、観察できる特徴量で調整すれば、施策の割り付けと結果の両方に効く違いはほかに残っていないという仮定と、同じような特徴量の顧客の中に、施策を受けた人と受けなかった人の両方がいるという条件を必要とします。この例でいえば、データに無い隠れた利用意欲の違いは、観察できる特徴量だけから作る傾向スコアでは直接は調整できません。さらに、この例では予測の点数の順位で施策を当てる人を決めているので、点数が上位10%に入る顧客には施策を受けなかった人がいません。同じような特徴量の比べる相手が、そもそもいないということです。これらの方法の考え方と限界は、弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」で扱っています。施策を打つ側が対象を選べる立場にあるなら、最初から無作為に対照群を残すほうが、後から観察データを調整するより確実です。
経営の判断に翻訳する:施策は実験として始め、確かめてから広げる
この章の結果を、引き止めの施策の予算と運用の判断に落とします。1つ目は、施策は最初から実験として設計することです。新しい引き止めの施策を全員に一斉に打つと、その効果を測る手段は、選択バイアスを含む観察データの比較か、施策前後の解約率の比較(季節や獲得チャネルの構成の変化と区別できません)しか残りません。対象の一部を無作為に対照群として残しておけば、効果を偏り無く測れます。この章の例では、第30か月末の在籍者を半分ずつに分けた実験で、3か月解約率の約3割減を検出力0.977の規模で測れました。全員に配る場合を基準にしたときの実験の機会費用は、対照群に施策を打たないことで失う純増で、この例では対照群3,662人×1人あたりの純増101円(601円から費用500円を引いたもの)で約37万円です。これは実験そのものの支出とは別のもので、支出としては処置群へのクーポンの費用1,831,000円がかかります。ただし、この601円はデータを作った側だけが知る真の値から出したもので、実験の前の企業には分かりません。実験の前には、見込みの効果から計算した見積もりしかありません。効果が確かめられないまま全員に配り続ける場合の損失の可能性(効果が無ければ、全員配布の費用3,662,000円がそのまま失われます)と比べて判断します。
2つ目は、実験の前に、人数・指標・期間・判定の基準を決めて記録しておくことです。この章で見たとおり、3か月解約率の30%減を見分けるなら1群1,837人で足りますが、この例の採算の境目(約24%減)を見分けるなら1群2,725人(25%減)から4,379人(20%減)のあいだの人数が要り、12か月の粗利で見分けるには1群7,194人が要ります。どちらの指標で何を判定するかによって、必要な規模も、結果が出るまでの期間(3か月か12か月か)も変わります。「どれだけの効果があれば全体に広げるか」は、施策の費用と粗利の増分の損益分岐(第8章)から決めておきます。1回きりの実験の結果は、この例でも3か月解約率の減少が11.6%から45.6%まで揺れました。1回の結果の数字をそのまま全体の見込みに使わず、信頼区間の幅を添えて報告することが必要です。この章の第1回の実験では、3か月解約率の比の95%信頼区間を相対の減少に直すと14.5%から40.2%でした(「1回きりの実験の結果は揺れる」の節)。
3つ目は、施策の効果を、施策が終わった後まで追うことです。この例の施策は、3か月の解約率を約3割減らしましたが、引き止めた人の半分弱は24か月のうちに解約し、24か月の粗利の増分は1人601円と、費用500円をわずかに上回る程度でした。3か月の結果で「成功」と判断して予算を増やすと、粗利で見た実態より大きな成果を見込むことになります。施策の評価は、短期の指標で効いているかを確かめ、実験の前に決めた回収の期間の累積の粗利で採算を確かめる2段構え(12か月の粗利は中間の評価)にし、継続率の差が縮み続けていないかを追うことが有効だと考えています。
4つ目は、全体へ広げたあとも、小さな対照群を残し続けることです。施策の効果は、顧客の構成や競合の動き、施策そのものへの慣れによって、時間とともに変わりうるものです。全員に広げてしまうと、同時期の無作為な対照群がなくなり、解約率の動きを見ても、施策の効果が落ちたのか、ほかの変化によるのかを区別しにくくなります。この章の計算では、30%減を検出するのに9対1の割り付けで対照群1,021人・合計10,205人が要りました。在籍者が十分に多い事業(この例の設定で30%減を見分けるなら、9対1の割り付けで合計約1万人以上)であれば、毎期の対象の1割程度を施策を打たない群として残し、効果を測り続ける運用が考えられます。在籍者が少なく、この規模の対照群を取れない事業では、効果が大きい施策(検出しやすい)に絞って実験するか、複数の期の結果を合わせて判断することになります。
最後に、予測モデルと実験の役割分担を整理しておきます。予測モデルは「誰が解約しそうか」を、実験は「施策でどれだけ解約が減るか」を答えます。第8章と第11章の対象の選び方は、この2つの掛け算でできていて、どちらが欠けても施策の予算は決められません。予測の精度を上げる投資と、施策の効果を測る実験への投資は、別のものとして計画に入れる必要があります。
この章の要点は3つです。第一に、予測の精度と施策の効果は別の問いで、施策の効果は、対象の一部を無作為に対照群として残すホールドアウトの実験で測ります。施策を受けた人と受けなかった人を素朴に比べると、この例では施策を受けた群の解約率が2.03倍に見え、施策の効果とは逆向きの結論になりました。第二に、実験の規模は検出力の計算で決めます。3か月解約率7.5%を30%減らす効果なら1群1,837人で検出できますが、この例の採算の境目(約24%減)を見分けるには1群2,725人から4,379人のあいだ、10%減なら1群18,455人が要り、粗利で効果を見分けるにはさらに多くの人数が要ります。第三に、施策の効果は施策が終わった後まで追います。この例の施策は3か月の解約率を約3割減らしましたが、引き止めた人の半分弱は24か月のうちに解約し、効果の半分近くは解約の先延ばしでした。次の第13章では、ここまでの分析を組織で使い続けるための役割分担と、報告の指標、導入の順序を扱います。
この章を深めたい方への参考書籍
『RCT大全 ランダム化比較試験は世界をどう変えたのか』(アンドリュー・リー 著、上原裕美子 訳、みすず書房):被験者を2つのグループに無作為に割り当てて介入の効果を測るランダム化比較試験が、医療・教育・経済・産業などの分野でどう使われてきたかを紹介する本です。目次には「農場と企業とフェイスブック」の章があり、巻末には「RCT実施の10の掟」が収められています。この章のホールドアウトの考え方を、数式を使わずに経営の言葉で説明するときの材料になります。
『入門サンプルサイズ設計 基本理論から計算方法まで』(山本紘司 著、東京図書):検出力に基づくサンプルサイズ設計と、信頼区間に基づくサンプルサイズ設計を章を分けて扱い、各種の検定の検出力の導出や、シミュレーションによるサンプルサイズ設計の章も設けた入門書です。この章で NormalIndPower を使って計算した必要人数と、1回きりの実験を繰り返して有意になる割合を数えた方法を、理論の側から確かめ直すのに向いています。
第13章 顧客分析を組織で使い続ける
第12章では、引き止め施策の効果を予測の精度とは切り離して測るために、施策を打たない群を残す実験の設計と、施策が終わった後に効果が続くのかを確かめました。ここまでの章は、コホート分析・生存分析・ハザードモデル・解約予測・LTV・確率モデル・実験を、1回の分析として順に扱ってきました。この章では、それらの分析を毎月の報告と毎期の予算判断に組み込み、使い続けるための仕組みを扱います。誰がどの数字に責任を持つか、解約の定義をどう1つに決めるか、経営報告に何を載せるか、どのくらいの間隔で数字とモデルを更新するか、最初の四半期で何から整えるか、どういう失敗の型があるか、個人情報と倫理の面で何に気をつけるかを順に説明します。この章にはコードはありません。数値は、第2章で示した基準の結果と、公式の文書を開いて確かめた範囲だけを使います。
1回の分析と、使い続ける仕組みの違い
顧客分析の結果は、作った時点のデータと定義から出た1つの推定です。獲得チャネルの構成は毎期変わり、商品やサービスの内容も、競合の動きも変わります。第4章で見たとおり、第2章で用意したサンプルデータ(架空の家庭向け食材宅配の定期便)では、加入時期が後になるほど獲得チャネルの構成が紹介からチラシへ移り、全体の12か月目の継続率は 0.679 から 0.620 へ下がって見えました。紹介チャネルだけなら 0.830 から 0.808 で、ほぼ横ばいです。半年前に計算した継続率や LTV をそのまま翌年の獲得予算に使い続けると、このような構成の変化を見落とし、推定と現実の差が広がっていきます。
逆に、毎月の報告で同じ定義の数字を並べ、四半期ごとにモデルを推定し直し、その結果を予算や施策の対象の選び方に反映し、反映した結果を次の推定の材料にする、という循環ができると、顧客分析は「一度出した報告書」ではなく「予算と施策を決める手順の一部」になります。この章で扱うのは、後者を作るための段取りです。手法そのものの説明は前の章までで終わっているので、ここでは手法をつなぐ役割・定義・報告・日程・記録に焦点を当てます。
経営の側から見ると、仕組みが無いことの損失は「判断の遅れ」と「数字の食い違いによる議論の空転」として表れます。第2章の基準の結果では、第30か月末の在籍者 7,324人のうち予測の上位10%(733人)に引き止め施策(架空の前提。費用 500円/人)を当てると、24か月の割引後粗利の純増は 486,054円でした。同じ人数を無作為に選ぶと純増は 89,890円です。この1回の比較では、対象の選び方によって期待純増に約40万円の差が生じました(無作為に選ぶ場合との比較で、第8章で述べたとおりモデルの価値を大きめに見せる側の比較です)。施策を毎月繰り返す場合は、対象者と効果の期間が重なるので、この額をそのまま回数分足し合わせられるとは限らず、繰り返したときの利益は別に評価する必要があります。予測を施策の対象選びにつなぐ仕組みが無く、予測の結果が報告書のまま止まると、こうした差はそもそも得られません。金額はこの架空データの、この設定での値です。そのうえで、「予測を作ること」と「予測を施策に流すこと」は別の作業で、後者が無いと前者の価値が出にくい、という構造は、この例に限らず当てはまることが多いと考えています。
役割と責任分担
顧客分析を使い続けるには、少なくとも6つの立場が関わります。事業責任者、マーケティング(獲得の担当)、CS・CRM(顧客対応と既存顧客への施策の担当)、財務(経理・経営企画)、データ分析の担当、情報システムの担当です。それぞれが持っている情報と、決める権限が違います。解約率や LTV の数字は、獲得チャネルごとの予算、引き止め施策の対象と費用、サービスの改善の優先順位に直結するので、責任の所在があいまいなままだと、結果を受け取った側が「自分の部門の数字が悪く見えるのは定義が違うからだ」と反論し、議論が止まります。最初に、誰がどの数字の持ち主で、誰が何を決めるのかを表にしておくことが有効だと考えています。
次の表は、役割ごとの責任分担の一例です。組織の規模によっては1人が複数の役割を兼ねますが、役割そのものは分けて書いておくと、兼務している人が「いまどの立場で発言しているか」を自覚しやすくなります。
| 役割 | 持っている情報 | 顧客分析で責任を持つもの | 決める権限 |
|---|---|---|---|
| 事業責任者 | 事業の方針、商品・価格・サービスの計画、全体の予算 | 解約の定義の最終決定。獲得と引き止めの予算の配分の判断 | 獲得と引き止めの予算の総額。定義の変更の承認 |
| マーケティング(獲得) | 獲得チャネルごとの費用と獲得数、キャンペーンの予定 | チャネル別の CAC の正しさ。チャネル別の LTV÷CAC と回収月数を獲得予算に翻訳すること | チャネルごとの獲得予算の案 |
| CS・CRM(既存顧客) | 問い合わせの記録、施策の配信履歴、解約の申し出の理由 | 施策の配信の記録の正しさ。予測の対象者に施策を実行し、施策を打たない群を残すこと | 施策の種類と対象の選び方(予算の範囲内で) |
| 財務(経理・経営企画) | 請求と入金の実績、粗利率、割引率、獲得費用の確定値 | 解約月と売上の数字が会計の数字と一致していること。LTV に使う粗利率と割引率 | 粗利率・割引率の値。施策の費用対効果を判断する基準 |
| データ分析の担当 | モデルの仕様、推定と検証の結果、不確実性の幅 | 指標の計算・モデルの更新・検証・記録。結果の幅と限界を報告すること | モデルの技術的な変更の提案 |
| 情報システムの担当 | 顧客台帳・契約・請求・利用ログのシステムと、その項目の意味 | データの抽出の手順と、項目の意味の変更の記録。アクセス権限の管理 | データの保管場所と権限の設定 |
この表で大事なのは、解約の定義の最終決定を、データ分析の担当ではなく事業責任者に置いている点です。解約の定義は、どの顧客を失ったと数えるかという事業の判断で、統計の手法では決まりません(定義の選び方そのものは第3章で扱いました)。データ分析の担当は、定義の候補ごとに解約率や継続率がどう変わるかを並べて示し、決まった定義を記録する役目を負います。決めた人と理由が残っていれば、後から定義を見直すときに、どの判断を変えるのかをたどれます。
財務の関与も欠かせません。顧客分析の「解約月」と「月次粗利」が、会計で確定した請求・入金の数字とずれていると、経営会議で「LTV の合計は、決算の売上とどう対応しているのか」と問われたときに答えられません。この記事の定義では、解約は最後に料金を払った月の月末に起きたと数え、月次粗利は月額に粗利率を掛けたものです(共通データでは架空の 0.30)。LTV の割引率(共通データでは架空の年5%)も、財務が持つ数字です。粗利率と割引率を誰がいつ決めたかを報告に書いておくと、値を変えたときに LTV がなぜ動いたのかを説明できます。
マーケティングと CS・CRM の間には、もう1つ調整の要る点があります。獲得の担当は新しい顧客の数と獲得費用で評価されやすく、既存顧客の担当は解約の数で評価されやすいので、獲得の数を増やすために解約しやすいチャネル(共通データではチラシ。真の S(36) は 0.184)へ予算を寄せると、その結果は数か月遅れて既存顧客の担当の数字に表れます。第1章・第9章で見た LTV÷CAC と回収月数を、獲得の担当の評価にも入れておくと、獲得と引き止めの判断が同じ物差しでつながります。共通データでは、真の LTV÷CAC が紹介 32.4、検索広告 8.4、SNS広告 4.3、チラシ 2.5、回収月数(真)が 2・4・7・11か月でした。
情報システムの担当は、顧客分析にとっては入力データの持ち主です。請求システムの改修で「休止」の扱いが変わった、会員の ID の付け方が変わった、問い合わせの分類が変わった、といった変更は、記録が無ければ、ある月から急に解約率が動いたように見えます。システムの変更の予定と履歴を、データ分析の担当が受け取れる経路を決めておくことが有効だと考えています。
解約の定義を1つに決め、定義書に残す
組織で顧客分析を使うときに最初に起きやすい問題は、部門ごとに別の「解約率」が出てくることです。どの部門も間違った計算をしているわけではなく、それぞれの業務に自然な分子と分母で数えているだけですが、同じ会議に並ぶと、どの数字を信じてよいか分からなくなります。第2章で用意したサンプルデータから、「解約率」と呼ばれうる数字を4つ出して並べると、次の表になります。
| 呼び方の例 | 計算のしかた | 共通データでの値 | 使いやすい部門の例 | この数字だけで判断したときの注意 |
|---|---|---|---|---|
| 月次解約率 | 観測期間の解約数÷顧客月数 | 0.0327 | CS・CRM(毎月の解約の件数を見ている) | 顧客の在籍月数の構成によって値が動く。共通データでは在籍が長くなるほどハザードが下がる設定になっている(第5章) |
| 平均在籍月数(1÷月次解約率) | 月次解約率の逆数 | 30.58か月 | マーケティング(獲得費用の回収の目安にする) | ハザードが一定と仮定している。紹介チャネルでは 62.4か月と出るが、60か月で打ち切った真の期待在籍月数は 40.2か月(第5章) |
| 12か月目の料金を払う前に解約した割合 | 1からカプラン・マイヤーの S(12)(12か月目の料金を払っている確率)を引いた値 | 0.356(S(12) は 0.644) | 事業責任者(加入した人がどれだけ残るか) | 加入時期とチャネルの構成で動く(第4章) |
| 観測期間中に解約した人の割合 | 解約者数÷顧客数 | 0.474(5,686÷12,000) | 財務(台帳の件数から数える) | 観測の長さで変わる。加入が最近の顧客ほど解約する時間が無かったので、低めに出る(第3章の打ち切り) |
4つとも同じ 12,000人のデータから計算した数字で、どれも計算の誤りではありません。しかし、0.0327 と 0.474 は一桁以上違い、会議でこの2つが「解約率」として並ぶと、議論が数字の比較ではなく言葉の定義の確認に費やされます。さらに困るのは、部門ごとに違う数字を使って予算を要求する場合です。獲得の担当が「平均在籍 62か月」を根拠に紹介チャネルの獲得費用の上限を高く見積もり、既存顧客の担当が別の数字で引き止めの予算を要求すると、同じ顧客の価値が2つの予算案で別々に計算され、合計すると会社全体の見込みが過大になります。
これを防ぐために、指標の定義を1つの文書にまとめ、全部門がそれを参照する形にすることが有効だと考えています。この章では、その文書を指標の定義書と呼びます。定義書には、少なくとも次の項目を書きます。解約をいつ起きたと数えるか(この記事では、最後に料金を払った月の月末)。休止・プラン変更・再加入をどう扱うか。月次解約率の分子と分母。継続率と在籍月数の数え方。打ち切りの扱い(観測の終わりの時点でまだ在籍している人を、解約していないとして数える)。LTV の期間・割引率・粗利率と、獲得費用を含めるかどうか(この記事では60か月・年5%・0.30・含めない)。CAC に何の費用を入れるか。それぞれの定義を決めた日と、決めた人。定義の候補の選び方は第3章で扱ったので、ここでは「決めたものを1か所に置き、変えるときの手順を決める」ことに焦点を当てます。
定義書を作ったあとも、部門の業務で別の数え方が必要になることはあります。たとえば CS の現場では、退会の手続きの件数を日次で見る必要があり、それは月末の支払い停止で数える解約とはずれます。こうした業務用の数字を禁止する必要はありません。大事なのは、業務用の数字に別の名前を付け(「退会の申し出の件数」など)、経営報告と予算の判断には定義書の数字だけを使う、という線を引くことです。名前を分けておけば、2つの数字が違っていても、それが定義の違いによるものだとすぐに分かります。
定義を変える必要が出たときの手順も決めておきます。定義を変えると、過去の数字と比べられなくなるので、変更の前後で両方の定義の数字を一定期間並べて出し、どれだけ変わるかを確かめてから切り替えるのが有効だと考えています。変更は事業責任者が承認し、定義書に日付と理由を残します。この手順が無いと、ある月から解約率が急に下がったように見えたときに、それがサービスの改善によるものか、定義の変更によるものかを区別できません。
経営報告の指標と、ダッシュボードの最小構成
経営会議に出す顧客分析の報告は、技術的な指標(AUC・係数・p 値)ではなく、予算と施策の判断に使う指標で組み立てます。この記事で定義を固定した指標のうち、経営報告の中心に置くのは、コホート別の継続率、チャネル別の継続率、在籍月数別のハザード、チャネル別の LTV÷CAC と回収月数、予測上位の集団の解約率と較正、施策の純増の6つの指標です(次の表の6行)。解約予測の精度(AUC)は、モデルが使える状態かどうかの確認として添える程度にとどめます。第7章で見たとおり、この例では、隠れた状態を知る真のモデルの推定確率でも、実際に起きた解約に対する AUC は 0.684 で、ロジスティック回帰と LightGBM の 0.674 との差 0.010 は、1回の検証では偶然のばらつきと区別しにくい大きさでした。第7章で真の確率どおりに解約を200回引き直した計算では、真の確率の AUC は 0.675〜0.738 の範囲で動き、同じ引き直しで評価した LightGBM の平均 0.680 と真の確率の平均 0.703 の差は約0.02でした(この架空データの検証での値です)。AUC の小さな上下を報告の冒頭に置くと、予算の判断に関係の薄い数字に議論が集まります。
共通データの基準の結果を、経営報告の形に並べると次の表になります。値はすべて第2章で示した基準の結果で、この架空データの、この設定での値です。真の値は現実には分からないので、現実の報告では、推定の列だけが並びます(ここでは、回収月数のように基準の結果に真の値しか無いものは、そのことを明記しています)。
| 指標 | 答える問い | 扱った章 | 共通データでの値(この例) | 主に使う人 | 更新 |
|---|---|---|---|---|---|
| コホート別の継続率(加入時期×在籍月数) | 新しく加入した顧客の残り方は、前の時期より悪くなっているか | 第4章 | 12か月目の継続率は全体で 0.679→0.620、紹介チャネルだけなら 0.830→0.808 | 事業責任者・マーケティング | 月次 |
チャネル別の継続率 S(12)・S(36) | どの獲得チャネルの顧客がどれだけ残るか | 第5章 | カプラン・マイヤーの S(36) は紹介 0.619・検索広告 0.442・SNS広告 0.296・チラシ 0.182 | マーケティング | 月次 |
| 在籍月数別のハザード | 加入から何か月目の解約が多いか。どこに施策を打つか | 第5章・第6章 | 初回クーポン利用者は最初の3か月だけハザードが高い(真のモデルの設定) | CS・CRM | 月次 |
| チャネル別の LTV÷CAC と回収月数 | どのチャネルの獲得費用が回収できるか | 第9章 | LTV÷CAC(真)は紹介 32.4・検索広告 8.4・SNS広告 4.3・チラシ 2.5。回収月数(真)は 2・4・7・11か月 | マーケティング・財務 | 四半期 |
| 予測上位の集団の解約率と較正 | 予測で選んだ人は本当に解約しやすいか | 第7章 | ロジスティック回帰の上位10%の解約率 0.192(リフト 2.58)。LightGBM の較正は10分位の最下位と最上位で予測の平均 0.018・0.184、実際の解約率 0.030・0.177。10分位すべてで予測と実際の差は 0.016 以内 | データ分析・CS・CRM | 月次 |
| 施策の純増 | 施策の費用を差し引いて、粗利がどれだけ増えたか | 第8章・第12章 | 予測上位10%に当てると 486,054円、無作為の10%なら 89,890円(施策の効果は架空の前提) | CS・CRM・財務 | 施策ごと |
表の語を補っておきます。リフトは、予測の上位の集団の解約率が全体の解約率の何倍かを表します(第7章)。較正は、予測した確率と実際の解約の割合が合っているかどうかのことで、たとえば予測が平均 0.1 の集団で実際に1割が解約していれば、較正が取れていると言います(第7章)。また、コホート別の継続率の行のうち最後の加入時期(第25〜30か月の加入)は、観測の終わり(第36か月)までに12か月目に達したのは第25か月の加入者 432人だけなので、12か月目の継続率 0.620 はその 432人から計算した値です。
この表から、ダッシュボードの最小構成を考えます。最初から多くの画面を作る必要はなく、上の6行を、1枚に収まる形で毎月同じ順に並べることが出発点になると考えています。具体的には、表の6行に1つずつ対応させて、1つ目にコホート表(加入時期を行、在籍月数を列にした三角形の表)、2つ目にチャネル別の継続率曲線、3つ目に在籍月数別のハザード、4つ目にチャネル別の LTV÷CAC と回収月数の表、5つ目に予測上位の集団の解約率と、3か月前の月末に出した予測と、同じ顧客群のその後3か月の実際の解約の比較、6つ目に実行中・実行済みの施策の純増と、その推定の幅を置きます。各画面の隅には、データの期間、定義書の版、モデルを推定した日を必ず書きます。これが無いと、古い推定が使われ続けていることに気づけません。
報告の形を毎回同じにしておくことにも意味があります。列と定義が固定されていれば、前回の報告と並べて、どのチャネルのどの在籍月数の数字が動いたかを経営層が自分で確かめられます。分析の担当者が毎回見せたい図を選ぶ形にすると、都合のよい切り取りが入り込んでいないかを確かめる手段が無くなります。新しい図を足したいときは、足す理由を定義書と同じ手順で記録し、次の報告から固定の枠に入れます。
経営報告で避けたいのは、全体の月次解約率を1つの平均として大きく載せ、その上下で一喜一憂することです。第4章で見たとおり、共通データでは全体の12か月目の継続率が下がって見えましたが、紹介チャネルだけなら横ばいで、悪化の主な理由は獲得チャネルの構成の変化でした。全体の平均だけを見て「サービスの質が落ちた」と判断し、サービス改善の投資を急ぐと、実際の問題(解約しやすいチャネルへの獲得予算の偏り)に手を打たないまま費用を使うことになります。報告では、全体の数字の横に、チャネル別と加入時期別の数字を必ず並べることが有効だと考えています。
更新頻度は、数字ごとに分けて決める
ここでいう更新頻度とは、新しい月のデータを加えて指標を計算し直す間隔と、モデル(ハザードモデル・解約予測・LTV の延長の仮定)を推定し直す間隔のことです。間隔が長すぎると、獲得チャネルの構成やサービスの変化を反映できません。短すぎると、加えたデータが少ないので推定が揺れ、そのたびに施策や予算を動かすと判断がかえって不安定になります。顧客分析では、すべての数字を同じ間隔で更新する必要はなく、数字の性質ごとに分けて決めるのが有効だと考えています。
機械学習のモデルの再学習の間隔について、公式の文書が示している考え方を、開いて確かめた範囲で紹介します。Google Cloud のアーキテクチャセンターにある機械学習の継続的デリバリーと自動化のパイプラインを解説した文書(2024年8月28日更新の版を2026年10月16日に確認)は、新しいデータでモデルを再学習する契機として、必要に応じた手動の実行、決まった日程(新しいラベル付きのデータが日次・週次・月次で揃う場合)、新しい学習データが手に入ったとき、モデルの性能の低下が目立ったとき、予測に使う特徴量の分布が大きく変わったとき、の5つを挙げています。日程で再学習する場合の頻度は、データの傾向がどのくらいの頻度で変わるかと、再学習にかかる費用によっても決まる、と書いています。また、本番のモデルの品質を監視することで、性能の低下やモデルが古くなったことを検知できる、としています。
この考え方を、この記事の指標に当てはめると、次のようになります。まず、解約予測の正解ラベル(その後3か月以内に解約したかどうか)には、確定するまでに3か月かかるという特徴があります。スナップショット月 t の月末の在籍者が第 t+1〜t+3 か月に解約したかどうかは、第 t+3 か月の月末にならないと分かりません。第7章の基準の結果では、観測が第36か月まである状態で、学習に t=6〜27、検証に t=30 を使いました。毎月データが1か月分増えても、新しく使えるラベル付きのスナップショットは1か月分ずつしか増えないので、予測モデルを毎月推定し直しても、学習データに占める新しい部分はわずかです。一方で、予測の点数を付け直す作業(今月末の在籍者それぞれの3か月解約確率を計算すること)は、毎月の施策の対象を選ぶために毎月必要です。モデルの推定と、推定したモデルによる点数付けは、別の間隔で回せます。
次に、LTV です。第9章で見たとおり、観測が第36か月までしかないと、第37か月以降の継続率は延長の仮定で補う必要があります。四半期ごとに観測が3か月延びると、延長に頼る部分が少しずつ減り、LTV の推定が仮定に左右される度合いが下がります。LTV は獲得予算の上限の根拠になるので、四半期の予算の見直しに合わせて計算し直し、前回の値と並べて報告するのが自然だと考えています。粗利率と割引率は財務が決める数字なので、年次の見直しで変えるのが扱いやすいでしょう。
これらを、間隔ごとに整理すると次の表のようになります。これは一例で、どの作業をどの間隔で行うかは、予算と施策を決める周期と、請求・入金のデータが確定するまでの日数で決めます。
| 間隔 | 主な作業 | 見るもの | 決めること |
|---|---|---|---|
| 月次 | 前月のデータの取り込みと点検。コホート表・継続率・ハザードの更新。今月末の在籍者への予測の点数付け | 件数の急な変化、定義書と合わない記録、3か月前の月末に予測した顧客群についての、予測の合計とその後3か月の実際の解約数の差 | 今月の施策の対象(予算の範囲内で)。データの修正 |
| 四半期 | 予測モデル・ハザードモデルの推定のやり直しと検証。LTV と回収月数の再計算。前回との比較 | 検証期間の上位 k% の解約率と較正、チャネル別の LTV÷CAC の前回からの変化 | 次の四半期のチャネル別の獲得予算。予測モデルを入れ替えるかどうか |
| 年次 | 定義書の見直し。粗利率・割引率・LTV の期間の見直し。実験の結果の取り込み。外部の目による検証(分析の担当以外の人による計算の確かめ直し) | 定義の妥当性、実験で測った施策の効果と、施策の計画で置いた前提の差 | 翌年度の獲得と引き止めの予算の総額。翌年度に行う実験の計画 |
| 随時 | システムの変更・価格改定・大きなキャンペーンの後の点検 | 特徴量の分布の変化、予測と実際の差の急な拡大 | 予定外の再推定を行うかどうか |
表の「決めること」の列は、間隔が長いほど大きな判断になるように並べました。月次では、決まった予算の中で施策の対象を選ぶだけにとどめ、予算そのものは動かしません。四半期では、獲得チャネルの予算を LTV÷CAC と回収月数に基づいて見直します。年次では、総額と定義に踏み込みます。この順にしておくと、1か月分のデータの揺れで予算が大きく振れることを防げます。最後の「随時」の行は、Google Cloud の文書が挙げていた「性能の低下」や「特徴量の分布の変化」を契機にした再学習に当たります。価格を改定した月や、新しい獲得チャネルを始めた月は、過去のデータで学習したモデルの前提が崩れやすいので、日程を待たずに点検する候補にします。
毎月の点検で最も手軽で効果が大きいのは、3か月前の月末に出した予測の合計と、同じ顧客群のその後3か月の実際の解約数を並べることだと考えています。予測しているのが3か月以内の解約なので、前月の予測は翌月にはまだ答え合わせができません。第7章の基準の結果では、LightGBM の予測確率を10分位に分けると、最下位の10分位で予測の平均 0.018 に対して実際の解約率 0.030、最上位で 0.184 に対して 0.177 で、10分位すべてで予測と実際の差は 0.016 以内と、おおむね一致していました。この一致が崩れ始めたら、施策の実施状況(引き止めの施策が効けば、施策を打つ前の予測より実際の解約は減ります)、偶然の変動、データの取り込みの問題、モデルが古くなったこと、を順に確かめます。モデルそのものの評価には、施策を打たない群の顧客での予測と実際を使うと、施策の効果と混ざらずに済みます。モデルの版の管理・監視・再学習の仕組みは機械学習のモデル全般に共通する話題で、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で詳しく扱っています。
結果を予算と施策に届ける会議体
顧客分析の結果が予算と施策に反映されるかどうかは、結果がどの会議に、どの時期に、どの形で出るかで決まります。分析の担当者が報告書を配っただけでは、予算を決める場に届かないことが多いと思われます。ここでは、分析の結果を受け取り、施策の対象や獲得予算の変更を決める場を会議体と呼びます。新しい会議を作る必要は必ずしもなく、既にある月次の事業会議や四半期の予算会議の議題に、顧客分析の報告を固定の枠として入れる形でもかまいません。
会議体を設計するときに決めておくことは、次の5つだと考えています。1つ目は時期です。月末に締めたデータの点検と点数付けが終わってから会議を開かないと、前月の数字の確認が間に合いません。請求の締め日から逆算して、データの取り込み・点検・報告の日程を固定します。2つ目は出席者です。前出の役割の表のうち、事業責任者・CS・CRM・データ分析の担当は月次の会議に毎回出席し、マーケティングと財務は四半期の会議に必ず加わる形が考えられます。3つ目は、その場で決められることの範囲です。たとえば「月次の会議では、決まった引き止めの予算の範囲で対象を選ぶ。予算の増減とチャネル別の獲得予算の変更は四半期の会議で決める」と、あらかじめ権限を決めておきます。4つ目は、分析の結果と現場の感覚が食い違ったときの手順です。「食い違いが大きいものは、次の実験の候補にする」のように、議論で決着させずに確かめる手順へ回すと、会議が感想の応酬になることを防げます。5つ目は、決めたことの記録です。施策の対象・費用・施策を打たない群の大きさ・決めた理由を残しておくと、第12章の方法で後から効果を測れます。
会議体で特に大事なのは、施策の対象を選ぶときに、必ず施策を打たない群を残すという約束を、会議の決まりとして置くことです。第8章の結果は、施策の効果を「施策を当てた第31〜33か月の、解約の起きやすさ(オッズ)を 0.7倍にする」という架空の前提で計算したもので、現実にはこの値は分かりません。施策を打たない群が無いと、施策の後に解約が減っても、それが施策の効果なのか、もともと解約しにくい人を選んだからなのかを区別できず、翌年の施策の予算を決める根拠が残りません。予測の上位に選んだ人を全員施策の対象にしたい、という現場の要望は自然ですが、その一部を残すことの費用は、翌年以降の判断の精度を買う費用だと考えています。残す群の大きさは、第12章の検出力の計算で決めます。第12章の例では、3か月解約率の30%減を見分けるのに1群約1,800人、採算の境目(約24%減)を見分けるなら1群約2,700〜4,400人が要りました。
経営の側から見ると、会議体が無いことの損失は、判断の遅れが毎月積み上がることです。第2章の基準の結果では、予測上位10%に施策を当てたときの純増は1回あたり 486,054円で、全員に配ったとき(893,973円)より小さいものの、費用は10分の1(366,500円 対 3,662,000円)でした。施策の費用が1人 約622円を超えると全員配布は赤字になり、約1,163円を超えると上位10%でも赤字になります(この例)。どこまで費用をかけられるかは、施策の効果を測り、その結果を次の施策の設計に戻すまでの循環の速さで決まります。予測の精度を上げることと、分析を施策に反映するまでの時間を短くすることは、同じ重さで扱う必要があると考えています。
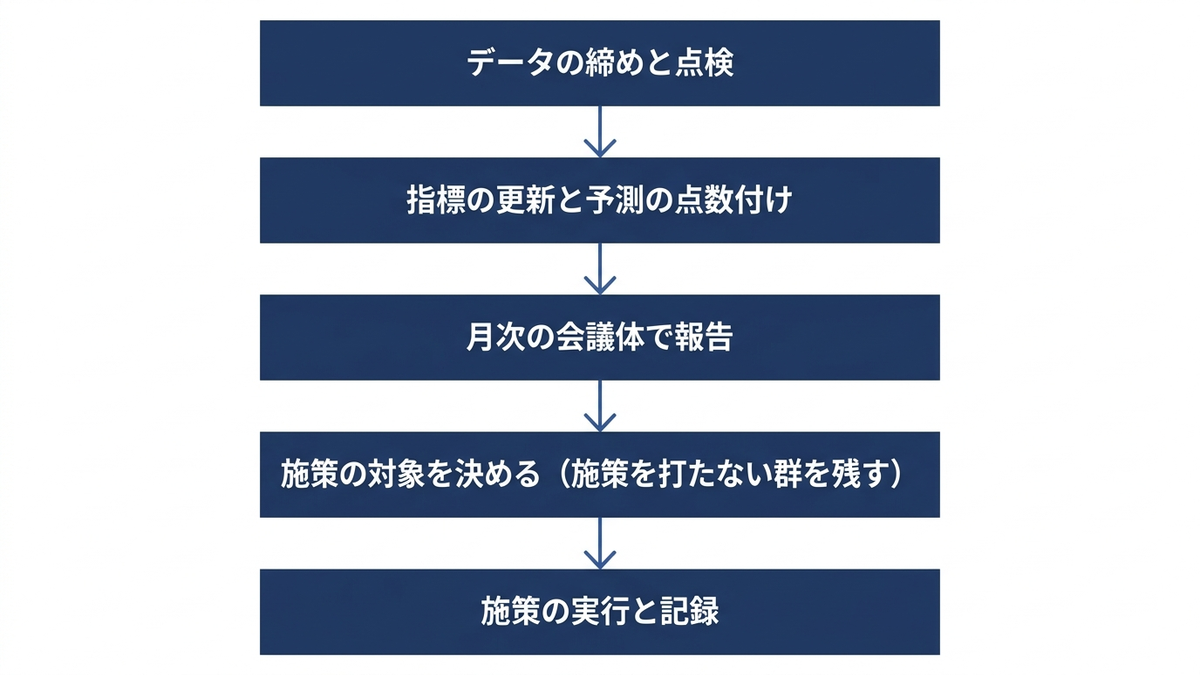
導入の順序、最初の四半期で整えるもの
顧客分析を初めて組織に導入するときは、この記事で扱った手法を全部一度に整えようとすると、最初の結果が出るまでに時間がかかり、その間に関心が薄れます。逆に、定義書やデータの持ち主を後回しにして予測モデルだけを先に作ると、予測の点数が出ても、それをどの施策にいくらまで使うかを決める材料(LTV と施策の効果)が無く、結果が施策につながりません。手法には、前の手法の出力を次の手法が使うという順序の関係があるので、その順に整えるのが有効だと考えています。
この記事の章の順序に沿って依存関係を書くと、次のようになります。コホート表(第4章)は、解約の定義と加入月さえ揃えば作れ、最初の報告になります。生存分析(第5章)は、同じデータに打ち切りの扱いを加えたもので、チャネル別の継続率曲線とハザードを正しく出します。LTV(第9章)は、プラン別の継続率と月次粗利から各月の期待粗利を求め、割引率で現在価値に割り引いて60か月分を合計して作るので、生存分析の後になります。解約予測(第7章)は、それだけでも作れますが、予測を施策の対象選びに使うには、対象ごとの残存価値(第9章・第11章)と施策の効果の見込み(第8章)が要ります。施策の効果は、この記事では、無作為に割り付けた実験(第12章)で確かめることを基本の手段にしています(観察データから仮定のもとで推定する方法とその仮定は、第12章で触れました)。次の表は、この依存関係を四半期の単位に割り当てた導入の順序の一例です。
| 時期 | 整えるもの | 後回しにするもの | この時期の成果物 |
|---|---|---|---|
| 最初の四半期 | 解約の定義の決定と定義書。顧客台帳・請求・獲得チャネルのデータの持ち主の決定。顧客 ID の突き合わせ。コホート表とチャネル別の継続率(カプラン・マイヤー)の最初の報告 | 解約予測のモデル。ダッシュボードの自動化。利用ログの細かい特徴量 | 定義書の初版。データの持ち主の一覧。最初のコホート表と継続率曲線 |
| 2四半期目 | 在籍月数別のハザードと要因の分析(第6章)。チャネル別の LTV÷CAC と回収月数。月次の報告の固定化 | 予算の大きな変更 | 経営報告の1枚の表。獲得予算の見直しの論点の一覧 |
| 3四半期目 | 解約予測のモデルと、毎月の点数付け。予測上位の一部に施策を打ち、施策を打たない群を残す最初の実験 | 全顧客への施策の展開 | 予測の較正と上位の解約率の報告。実験の設計書 |
| 4四半期目 | 実験の中間の分析(第12章)。3か月解約率で施策が効いたかを判定し、第8章で仮に置いた施策の効果(オッズ0.7倍)を、実験で測った値に置き換える。定義書と粗利率・割引率の年次の見直し | 粗利での採算の確定(12か月後に中間の評価、事前に決めた回収の期間(この例では24か月)の後に確定。翌年度以降になる) | 翌年度の獲得と引き止めの予算の根拠の資料(引き止めの効果は3か月解約率による暫定の値)。翌年度の実験計画 |
最初の四半期で定義書とデータの持ち主を先頭に置いたのは、この2つが無いと、2回目の報告で前回の数字を再現できないからです。コホート表と継続率曲線は、計算そのものは難しくありませんが、部門ごとにばらばらだった解約の数え方を1つにまとめた最初の成果物として、組織の中で定義を共有するきっかけになります。予測モデルを3四半期目に置いたのは、予測を作ることより、予測を施策に流す経路(対象の選び方・費用・施策を打たない群の残し方)を先に決めておく方が、予測の価値が出やすいと考えるからです。
後回しにするものに「ダッシュボードの自動化」を入れたのは、定義と報告の形が固まる前に自動化すると、定義を変えるたびに自動化した仕組みを作り直すことになるからです。最初の2四半期は、手作業を含む月次の集計で報告の形を固め、形が決まってから自動化するのが手戻りの少ない順序だと考えています。
経営の側から見ると、導入の初年度に期待してよいのは「解約が大きく減ること」ではなく、「獲得と引き止めの予算の根拠を、全部門が同じ数字で説明できる状態になること」と「施策の効果を測る仕組みができること」だと考えています。第2章の基準の結果で、チャネル別の LTV÷CAC が紹介 32.4 からチラシ 2.5 まで10倍以上違ったように、獲得予算の配分を見直す余地は、解約そのものを減らす施策より先に見つかることがあります。初年度の成果を解約率の改善だけで評価すると、2年目以降の仕組みに投資する判断を誤ります。
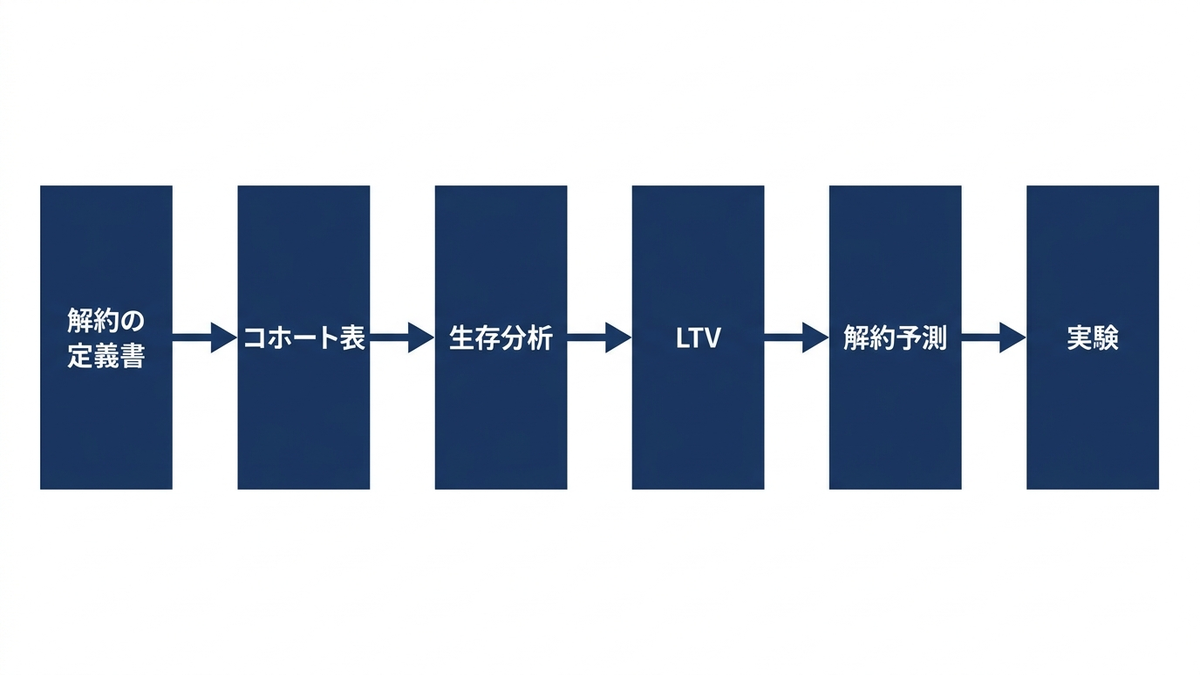
個人情報と倫理、分析と施策の間で気をつけること
顧客データの利用目的の特定・通知や安全管理は第3章で扱いました。この節では、分析を組織で使い続けるときに関わってくる点に絞り、個人情報の保護に関する法律(以下、個人情報保護法)の条文と、個人情報保護委員会のガイドラインを開いて確かめた範囲だけを書きます。条文は e-Gov 法令検索の個人情報保護法(2026年10月1日施行の版。2026年10月16日に確認)によります。個別の取扱いが法令に合うかどうかは、自社の法務や個人情報の担当、必要に応じて専門家と確かめる必要があります。
1つ目は、分析用のデータと、施策を実行するためのデータの関係です。個人情報保護法には、他の情報と照合しない限り特定の個人を識別できないように個人情報を加工した「仮名加工情報」という区分があります(第2条第5項)。第41条第7項は、仮名加工情報を取り扱うに当たって、その作成に用いられた個人情報の本人を識別するために、他の情報と照合してはならないと定めています。第41条第8項は、仮名加工情報を取り扱うに当たって、電話をかける、郵便などで送る、電子メールなどの電磁的方法で送る、住居を訪問する、といった目的で、仮名加工情報に含まれる連絡先その他の情報を利用してはならないと定めています。個人情報保護委員会の仮名加工情報・匿名加工情報についてのガイドライン(令和8年4月一部改正の版。2026年10月16日に確認)は、この電磁的方法に当たる例として、SNS のメッセージ機能でメッセージを送る方法や、Cookie ID で受信者を特定して固有の内容のインターネット広告を表示する方法を挙げています。同じガイドラインは、識別行為に当たらない例として、複数の仮名加工情報を組み合わせて統計情報を作ることを、当たる例として、仮名加工情報をその作成の元となった個人情報と照合することを挙げています。
組織の設計に引きつけると、分析用のデータを仮名加工情報として扱う場合、そのデータから直接、引き止めの連絡先の一覧を作る流れは、これらの規定に触れうるということです。解約予測で点数を付けた顧客に施策を届けるには、どのデータを、どの区分で、どの利用目的の範囲で扱うのかを、施策の流れを作る前に決めておく必要があります。データ分析の担当・CS・CRM・情報システムの担当が、それぞれ別の前提でデータを扱うと、この線引きがあいまいになりやすいので、役割の表の「情報システムの担当」と「事業責任者」が、法務や個人情報の担当と一緒に最初の四半期で決めておく項目に入れるのが有効だと考えています。
2つ目は、本人からの利用停止などの請求への対応です。第35条は、本人が、自分が識別される保有個人データについて、第18条(利用目的による制限)・第19条(不適正な利用の禁止)に違反して取り扱われているとき、または第20条に違反して取得されたものであるときに、利用の停止または消去を請求できると定めています(第1項)。さらに第5項は、事業者がその保有個人データを利用する必要がなくなった場合や、本人の権利または正当な利益が害されるおそれがある場合などにも、利用停止などを請求できると定めています。請求に理由があると分かったときは、必要な限度で遅滞なく対応しなければならない、とされています(第2項・第6項)。顧客分析を組織で回していると、同じ顧客のデータが、顧客台帳・分析用のデータ・予測の点数・施策の対象の一覧と、複数の場所に写されていきます。CS で受け付けた請求が、分析用のデータや次の月の施策の対象の一覧にまで確実に反映される経路を、データの持ち主の一覧と合わせて決めておくことが有効だと考えています。ここでいう請求への対応は、通常の保有個人データとして扱っているデータが対象です。第41条第9項は、仮名加工情報である保有個人データについては、第35条を含む第32条から第39条までの規定を適用しないと定めています。分析用のデータを仮名加工情報として扱っている場合に、請求に応じるつもりでそのデータを本人と照合すると、前の段落の第41条第7項の禁止に触れうるので、どのデータをどの区分で扱っているかを先に確かめておく必要があります。
3つ目は、法令とは別の、倫理の面です。解約予測や LTV は、顧客ごとに「解約しやすさ」や「価値」の点数を付けます。この点数を、施策の費用をどこに配るかを決めるために使うことと、特定の顧客に不利な条件を課すために使うことは、まったく別のことです。たとえば、LTV が低いと推定された顧客にだけ高い価格を示す、解約しやすいと予測された顧客の解約の手続きだけを難しくする、問い合わせへの対応の質を点数で変える、といった使い方は、顧客の信頼を損ない、結果として継続率と LTV そのものを下げるおそれがあります。世帯人数のような属性は、この記事の共通データでもモデルの説明変数に入っていますが、それは継続率を推定するためで、属性で顧客を不利に扱うためではありません。点数は「施策として何かを提供する対象の優先順位」に使い、「不利益を与える対象の選別」には使わない、という線を、定義書と同じ場所に明文化しておくことが有効だと考えています。
使われなくなる失敗の型
顧客分析が組織の中で使われなくなる経緯には、いくつかの型があります。どれも手法の誤りではなく、手順と役割の欠けから起きるものです。型ごとに、起きること・経営上の損失・防ぐ手順を次の表にまとめました。
| 失敗の型 | 起きること | 経営上の損失 | 防ぐ手順 |
|---|---|---|---|
| 予測モデルを作って施策につなげない | 予測の精度の報告で終わり、毎月の対象選びに使われない | この例では、予測上位10%に施策を当てたときと無作為の10%との純増の差(約40万円。486,054円と 89,890円の差。1回の施策の24か月分)を見送る。繰り返す場合の差は別に評価が要る | 予測より先に、対象の選び方・費用・施策を打たない群を決める。月次の会議体で対象を決める |
| 解約率が部門ごとに違う | 月次解約率 0.0327 と、観測期間中の解約の割合 0.474 が同じ「解約率」として並ぶ | 議論が定義の確認に費やされ、判断が遅れる。部門ごとの予算要求で顧客の価値が二重に数えられる | 定義書を1つにし、業務用の数字には別の名前を付ける。定義の変更は事業責任者が承認する |
| LTV を一度計算して更新しない | 最初に計算した LTV が、獲得チャネルの構成や継続率が変わった後も獲得予算の根拠に使われ続ける | 回収の遅いチャネルへの配分を見直せず、獲得費用の回収が遅れる。この例では、チラシの回収月数(真)は11か月で、紹介の2か月より長い | LTV と回収月数を四半期ごとに計算し直し、前回の値と並べて報告する。報告に推定した日を書く |
| LTV の定義が部門ごとに違う | 素朴な公式(粗利÷解約率)と、継続率から割り引いて計算した値が混在する | この例では、紹介チャネルの LTV が素朴な公式で 109,708円、真の値は 64,767円で、獲得費用の上限を大きく見誤る | LTV の期間・割引率・粗利率を定義書に固定する |
| 個人の属性で不利益な扱いをする | 予測の点数や LTV を、価格・解約手続き・対応の質の差別化に使う | 顧客の信頼を損ない、継続率と LTV そのものを下げるおそれ。法令との関係も法務と確かめる必要がある | 点数の使い道を「提供の優先順位」に限ると明文化する。法務・個人情報の担当と使い道を確かめる |
| 1人に依存する | 定義・データの処理・モデルの仕様が担当者の手元にしかない | 担当者の異動・退職で更新が止まり、前回の数字を再現できなくなる | 定義書・データ・仕様・結果・決定を1か所に記録する。作る人と確かめる人を分ける |
1つ目の型は、データ分析の担当が予測の精度を上げることに力を注ぎ、施策の担当との接点が無いときに起きやすいと思われます。第7章で見たとおり、この例では、隠れた状態を知る真のモデルの推定確率でも、実際に起きた解約に対する AUC は 0.684 で、2つのモデルの 0.674 との差は 0.010 でした。第7章で解約を200回引き直した計算では、真の確率の AUC は 0.675〜0.738 の範囲で動き、LightGBM との差は平均で約0.02でした。1回の検証で見えた差から改善の余地を決めることはできません。一方で、予測を施策の対象選びに使うかどうかで、純増は 486,054円と 89,890円に分かれました(第8章)。AUC をどれだけ上げると純増がいくら増えるかは、この記事では計算していません。精度の改善に手間をかける前に、予測を施策に流す経路があるかを確かめる方が、この例では先にすべきことだと考えています。
3つ目の型は、最初の LTV の計算が丁寧であるほど起きやすい型です。手間をかけて計算した数字ほど、作り直す動機が弱くなるからです。第4章で見たように、共通データでは加入時期が後になるほど獲得チャネルの構成が紹介からチラシへ移っていました。全体の平均の LTV を一度計算して固定すると、この構成の変化が反映されず、新しく獲得している顧客の価値を過大に見積もります。チャネル別に計算し、四半期ごとに更新するのはこのためです。
4つ目の型は、2つ目の型(解約率が部門ごとに違う)と同じ根を持っています。第9章で見たとおり、この例では、紹介チャネルで、無期限・割引なしの素朴な公式(109,708円)が、60か月・割引ありの真の値(64,767円)を上回りました。素朴な公式を60か月で打ち切って割り引くと 61,736円で、真の値をむしろ下回るので、この差の主な理由は期間の上限と割引の有無の違いです。どちらの定義の値を使うかで獲得費用の上限が約1.7倍(109,708÷64,767)変わるので、定義書で LTV の計算方法まで固定しておくことが欠かせないと考えています。
人材と組織、運用の仕組みへのつなぎ
この章で扱った役割のうち、データ分析の担当には、統計の手法・データの整備・事業の理解の3つが求められます。この3つを1人で満たす人を外部から採用するのは簡単ではなく、社内で育てる仕組みが要ります。データ分析の人材の育て方や組織の作り方は、弊社コラム『データサイエンティストの学習とキャリアのノート』で扱っています。また、予測モデルの版の管理・監視・再学習の自動化は、弊社コラム『機械学習モデルを運用し続けるMLOps、実験管理からモデル監視と再学習まで』で詳しく扱っています。この章で示した運用の例では、扱うモデルを絞り、更新を月次と四半期に分けているので、最初から大きな仕組みを入れる必要はありませんが、定義書の版・使ったデータの期間・モデルの仕様・結果・決めたことを1か所にまとめる記録は、最初の報告から始めておくのが有効だと考えています。
外部の分析会社や CRM・顧客データ基盤(CDP)の製品を使う場合も、この章で扱った役割と手順は変わりません。製品が解約の予測や LTV の計算の機能を持っていても、その数字がどの定義で計算されているか(解約をいつと数えるか、LTV の期間・割引率・粗利率は何か)を定義書と突き合わせ、違っていれば別の名前で扱う必要があります。どの製品にどの機能があるかは、公式の文書で確かめた範囲を第14章で紹介します。
この章では、顧客分析を1回の分析で終わらせず、予算と施策を決める手順の一部として使い続けるための段取りを整理しました。役割と責任を分け、解約の定義の最終決定を事業責任者に置き、指標の定義書を1つにして部門ごとに別の解約率が出ないようにします。経営報告はコホート別の継続率・チャネル別の継続率・在籍月数別のハザード・チャネル別の LTV÷CAC と回収月数・予測上位の集団の解約率と較正・施策の純増の6行を毎月同じ形で並べ、更新頻度は数字ごとに月次・四半期・年次に分けます。導入は、定義書とコホート表から始め、生存分析・LTV・予測・実験の順に、前の手法の出力を次の手法が使う順で整えます。予測の点数は施策として何かを提供する優先順位に使い、不利益を与える選別には使いません。
最後の第14章では、この記事で statsmodels・scikit-learn・LightGBM・scipy・numpy を使って実装してきた考え方を、公開された道具(lifelines・scikit-survival・PyMC-Marketing など)がどう扱っているかと、公開された一次情報で確かめられる事例と研究の動向とあわせて紹介します。
この章を深めたい方への参考書籍
『カスタマーサクセス サブスクリプション時代に求められる「顧客の成功」10の原則』(ニック・メータ、ダン・スタインマン、リンカーン・マーフィー 著、バーチャレクス・コンサルティング株式会社 訳、英治出版):既存顧客の保持が重要になる定期収益型の事業で、顧客を積極的に支援する考え方と、そのための組織とマネジメントを扱った本です。目次には、カスタマーサクセスの組織や、定期収益型でない事業での適用を扱う章があります。この章で扱った CS・CRM の役割と、解約の数字を誰が持つかを考えるときの材料になります。
『THE MODEL マーケティング・インサイドセールス・営業・カスタマーサクセスの共業プロセス』(福田康隆 著、翔泳社):書名のとおり、マーケティング・インサイドセールス・営業・カスタマーサクセスの各部門が分業しながら連携する仕組みを扱った本です。この章で触れた、獲得の担当と既存顧客の担当の評価が分かれていると、獲得の判断の結果が数か月遅れて別の部門の数字に表れるという問題を、部門のつなぎ方の側から考えるときに参考になります。
第14章 事例と最新動向
第13章では、解約の定義を部門のあいだでそろえ、コホート表・生存分析・LTV・予測・実験を順に組織の報告と会議に組み込む手順を整理しました。この章では視点を社外に移し、顧客の離脱と生涯価値を測るときに候補になるオープンソースの道具、公開された一次情報で確認できる企業の事例、研究の動きを整理します。取り上げる道具は、Python の生存分析のライブラリ lifelines と scikit-survival、PyMC Labs が中心になって開発している PyMC-Marketing の顧客生涯価値のモジュール、その前身にあたる lifetimes、R の BTYD パッケージ、そしてこの記事の計算に使った statsmodels の生存分析の機能です。いずれも2026年10月16日に公式ドキュメント・公式リポジトリ・パッケージの配布元を開いて確かめた範囲だけを書きます。
この節で紹介する道具のうち、この記事の実行環境に入っているのは statsmodels(版 0.14.6)だけです。lifelines・scikit-survival・PyMC-Marketing・lifetimes・BTYD は実行していません。この記事の計算は、第5章・第6章のカプラン・マイヤー推定と Cox 比例ハザードモデルを statsmodels で、第7章の解約予測を scikit-learn のロジスティック回帰と LightGBM で、第10章の BG/NBD モデルの最尤推定を scipy で、それぞれ最小限に書いたものです。企業の事例については、公式の技術ブログ・論文・公式のケーススタディを開いて、そこに書かれている数字だけを引きます。ツールや支援サービスの料金は書きません。製品どうしの優劣も断定しません。どれを選ぶかは、自社のデータの形(契約型か非契約型か)と、分析を担う人の言語や体制で決まる部分が大きいからです。道具を選ぶ前に経営として決めておきたい4つの点は、この章の終わりの「道具と事例を自社の判断にどう使うか」の節にまとめました。
オープンソースの道具、生存分析の系統
lifelines は、Cam Davidson-Pilon が開発している Python の生存分析のライブラリです。公式ドキュメントは自らを、純粋な Python で書かれた完全な生存分析のライブラリと説明し、右側の打ち切り(観測の終わりにまだ解約していない)だけでなく、左側の打ち切りや区間の打ち切りも扱えること、よく使われるパラメトリック・セミパラメトリック・ノンパラメトリックのモデルを含むことを利点として挙げています。公式リポジトリの説明は、生存分析が医療や保険数理の分野で発達してきたことに触れたうえで、それ以外の応用の例として、SaaS の事業者が契約者の在籍期間を測ることを最初に挙げています。Python のパッケージ配布元(PyPI)で確かめた最新版は、2026年3月5日(UTC)に登録された 0.30.3 で、Python 3.11 以上を求めています。ライセンスは MIT です。
公式ドキュメントの API の一覧で確かめると、第5章で扱ったカプラン・マイヤー推定(KaplanMeierFitter)と累積ハザードを推定するネルソン・アーレン推定(NelsonAalenFitter)、第6章で扱った Cox 比例ハザードモデル(CoxPHFitter)と、説明変数が時間とともに変わる場合の版(CoxTimeVaryingFitter)があります。そのほか、ワイブル分布などの形を置いて在籍月数そのものをモデルにする加速故障時間モデル(WeibullAFTFitter・LogNormalAFTFitter・LogLogisticAFTFitter)、区間ごとにハザードが一定と見なす区分指数モデル、いつまでも解約しない人が一定の割合でいると見なす治癒モデル(MixtureCureFitter)などが並んでいます。公式ドキュメントの目次には「比例ハザードの仮定の検定」と「比例ハザードの仮定を気にする必要があるか」という章があり、第6章で見た初回クーポンの効果が最初の3か月だけ強いという、比例ハザードの仮定が崩れる場面の扱いを解説しています。なお、BG/NBD モデルを推定する BetaGeoFitter は lifelines ではなく、同じ開発者による別のライブラリ lifetimes に入っています。lifelines の API の一覧に BG/NBD のモデルはありません。
scikit-survival は、Sebastian Pölsterl らが開発している、機械学習のライブラリ scikit-learn の上に作られた生存分析のライブラリです。公式ドキュメントは、scikit-learn の前処理や交差検証の仕組みを使いながら生存分析ができること、生存分析が通常の機械学習と違うのは学習データの一部が打ち切りで部分的にしか観測されない点であること、を説明しています。PyPI で確かめた最新版は、2026年7月5日(UTC)に登録された 0.28.0 で、Python 3.11 以上を求めています。API の一覧には、Cox 比例ハザードモデルとその罰則つきの版(CoxnetSurvivalAnalysis)、生存時間の木と森(RandomSurvivalForest)、勾配ブースティングの生存分析(GradientBoostingSurvivalAnalysis)、生存分析のサポートベクターマシンが並びます。評価の指標として、打ち切りを考えた順位の一致度(concordance_index_censored・concordance_index_ipcw)、時点ごとの AUC(cumulative_dynamic_auc)、予測した継続率と実際の差を測るブライアースコア(brier_score・integrated_brier_score)を持っている点が、第7章の解約予測の評価とつながります。第7章では「3か月以内に解約するか」という二値のラベルを作ってロジスティック回帰と LightGBM で予測しましたが、scikit-survival の系統の道具は、「3か月以内に解約したか」という決まった期間の二値のラベルに変換せず、観測できた在籍月数と、解約したのか打ち切りなのかの印を組にして学習します。
statsmodels は、この記事の第5章・第6章で使った統計モデルのライブラリです。公式ドキュメントの生存分析の章は、打ち切りのある期間のデータを扱う標準的な方法を実装していること、現在は右側の打ち切りだけを扱うこと、を明記しています。中身は、カプラン・マイヤー推定の SurvfuncRight(在籍月数の中央値などの分位点とその信頼区間や、継続率曲線の信頼帯を出せる)、競合するリスクがあるときの累積発生率の CumIncidenceRight、継続率の分布を比べる検定の survdiff、比例ハザードの回帰の PHReg です。この記事の実行環境の版は 0.14.6 ですが、2026年10月16日に開いた公式ドキュメントは 0.15.0 の版で、PyPI では 2026年8月27日(UTC)に 0.15.0 が登録されていました。掲載したコードは 0.14.6 で実行したものです。lifelines や scikit-survival に比べて機能は絞られていますが、カプラン・マイヤー・ログランク検定・Cox 回帰という、第5章と第6章の判断に必要な部分はそろっています。
オープンソースの道具、顧客基盤分析の系統
非契約型の顧客について、購買の記録から在籍確率と今後の購買回数を推定する道具は、生存分析の道具とは別の系統で発達してきました。第10章で扱った BG/NBD モデルの系統で、英語では「買うのをやめるまで買い続ける」という意味の Buy ‘Til You Die(BTYD)と呼ばれることがあります。
lifetimes は、lifelines と同じ開発者による Python のライブラリで、公式ドキュメントで確かめると、BG/NBD モデル(BetaGeoFitter)、Pareto/NBD モデル(ParetoNBDFitter)、MBG/NBD モデル(ModifiedBetaGeoFitter)、購買の機会が決まった回数しかない場合の BG/BB モデル(BetaGeoBetaBinomFitter)、1回あたりの金額のガンマ・ガンマモデル(GammaGammaFitter)を持っています。ただし、公式リポジトリは2024年6月28日に所有者によってアーカイブされ、読み取り専用になっています。リポジトリの冒頭には、新しい機能の追加も改善も行わず、質問にも答えないこと、後継のプロジェクトとして PyMC-Marketing があることが書かれています。PyPI で確かめた最後の版は、2020年7月6日(UTC)に登録された 0.11.3 です。過去に lifetimes で顧客の価値を計算する仕組みを作った場合は、支援の終わった道具の上で判断を続けることになるので、移行の計画が要ります。
PyMC-Marketing は、Python のベイズ推定のライブラリ PyMC の上に作られたマーケティング分析の道具箱で、姉妹記事の弊社コラム「広告の効果を測るマーケティング・ミックス・モデリング、効果の分解から広告予算の最適配分まで」では広告の効果測定の側から取り上げました。公式リポジトリは、顧客生涯価値(CLV)のモデルについて、契約型と非契約型の両方、購買の機会が連続の場合と離散の場合の両方に対応していると説明しています。公式ドキュメントの CLV モジュールの API で確かめたモデルは、BG/NBD(BetaGeoModel)、Pareto/NBD(ParetoNBDModel)、MBG/NBD(ModifiedBetaGeoModel)、BG/BB(BetaGeoBetaBinomModel)、契約型の解約を扱うシフト・ベータ幾何分布のモデル(ShiftedBetaGeoModel)、金額のガンマ・ガンマモデル(GammaGammaModel)です。公式リポジトリの例の一覧は、非契約型・連続の例にオンラインの購買、契約型・離散の例に定期的な契約(サブスクリプション)を挙げています。PyPI で確かめた最新版は、2026年9月29日(UTC)に登録された 1.2.0 で、Python 3.12 以上を求めています。ライセンスは Apache 2.0 です。
ベイズ推定の道具を使う利点は、第10章で scipy の最尤推定で求めた r・α・a・b のようなパラメータを、1つの値ではなく分布として得られることです。在籍確率や今後の購買回数の予測にも幅がつくので、たとえば(説明のための仮の数字で)「この顧客の在籍確率は0.6」という1つの値ではなく、「90%の確率で0.4から0.8のあいだ」という区間(信用区間。モデルと事前分布の置き方によって変わります)で、不確かさを施策の判断に持ち込めます。その代わり、MCMC(乱数を使って事後分布からの標本を得る計算法)の計算に時間がかかり、事前分布の置き方を決める手間が増えます。
R では、CRAN(R の公式の配布元)で BTYD パッケージが公開されています。CRAN のページで確かめると、版は 2.4.3(2021年11月17日公開)で、BG/BB、BG/NBD、Pareto/NBD、ガンマ・ガンマのモデルについて、データの準備・パラメータの推定・評価・図示の関数を持つと説明されています。題には、計算の途中で数値があふれるのを防ぐ修正(対数の和の計算の工夫)を入れた版であることが書かれています。最終の公開から5年近くたっているので、R で使う場合も、手元の R の版で動くかを確かめてから採用することが要ります。
道具を並べて見る
ここまでの内容を、公式の資料で確かめた範囲で1つの表にまとめます。版と日付は2026年10月16日に PyPI と CRAN で確かめたものです。表は優劣の比較ではなく、「自社のデータの形と体制なら、どれが動かしやすいか」を考える材料として並べています。表の「受け持てる章」の列は、この記事のどの章の計算を、公式の資料にある機能で受け持てるかを示すもので、この記事でその道具を使ったという意味ではありません。公式のドキュメントとリポジトリは、lifelines、scikit-survival、statsmodels の生存分析、PyMC-Marketing の CLV モジュール、lifetimes、BTYD です。
| 道具 | 系統 | 主な対象 | 受け持てる章(この記事で使ったかは問わない) | 確認した最新版 | この記事での扱い |
|---|---|---|---|---|---|
| statsmodels(生存分析) | 生存分析 | カプラン・マイヤー、ログランク検定、Cox 回帰、競合リスクの累積発生率。右側の打ち切りのみ | 第5章・第6章 | 0.15.0(2026年8月27日 UTC) | 実行した(版 0.14.6) |
| lifelines | 生存分析 | カプラン・マイヤー、Cox 回帰(時間で変わる説明変数を含む)、加速故障時間モデル、治癒モデル。左側・区間の打ち切りも扱う | 第5章・第6章・第9章 | 0.30.3(2026年3月5日 UTC) | 実行していない |
| scikit-survival | 生存分析+機械学習 | Cox 回帰と罰則つきの版、生存時間の森、勾配ブースティング、打ち切りを考えた評価指標 | 第6章・第7章 | 0.28.0(2026年7月5日 UTC) | 実行していない |
| PyMC-Marketing(CLV モジュール) | 確率モデル(ベイズ推定) | BG/NBD、Pareto/NBD、MBG/NBD、BG/BB、シフト・ベータ幾何分布、ガンマ・ガンマ | 第9章・第10章 | 1.2.0(2026年9月29日 UTC) | 実行していない |
| lifetimes | 確率モデル(最尤推定) | BG/NBD、Pareto/NBD、MBG/NBD、BG/BB、ガンマ・ガンマ | 第10章 | 0.11.3(2020年7月6日 UTC)。2024年6月28日にアーカイブ | 実行していない |
| BTYD(R) | 確率モデル(最尤推定) | BG/BB、BG/NBD、Pareto/NBD、ガンマ・ガンマ | 第10章 | 2.4.3(2021年11月17日) | 実行していない |
表から読み取れるいちばん大きな分かれ目は、契約型か非契約型かです。第2章で整理したとおり、月額制の定期便のように解約が記録に残る契約型の事業では、在籍月数と打ち切りを扱う生存分析の系統の道具が中心になります。単品通販のように離脱が観測できない非契約型の事業では、購買の記録から在籍確率を推定する確率モデルの系統の道具が中心になります。PyMC-Marketing のシフト・ベータ幾何分布のモデルのように、確率モデルの系統から契約型を扱うものもあり、2つの系統は完全には分かれていません。
もう1つの分かれ目は、競合するリスクを扱えるかです。第3章で見たとおり、「解約」には退会のほか、休止やプラン変更のような別の終わり方が混ざることがあります。どれか1つが起きるとほかは観測できなくなる状態を、生存分析では競合リスクと呼びます。ただし、休止やプラン変更の後にも解約は起こりうるので、これらが自動的に解約と競合する出来事になるわけではありません。競合リスクとして扱えるのは、解約・休止・プラン変更のうち最初に起きた出来事を分析する場合です。休止から戻る、プラン変更の後に解約する、といった続きまで追うなら、状態のあいだの移り変わりを扱う多状態モデルのような別の枠組みが要ります。statsmodels の CumIncidenceRight、lifelines の AalenJohansenFitter、scikit-survival の cumulative_incidence_competing_risks は、いずれも競合リスクのもとでの累積発生率を推定する機能として API の一覧に載っています。休止を解約と別に数えたい事業では、この機能の有無が道具を選ぶ材料になります。
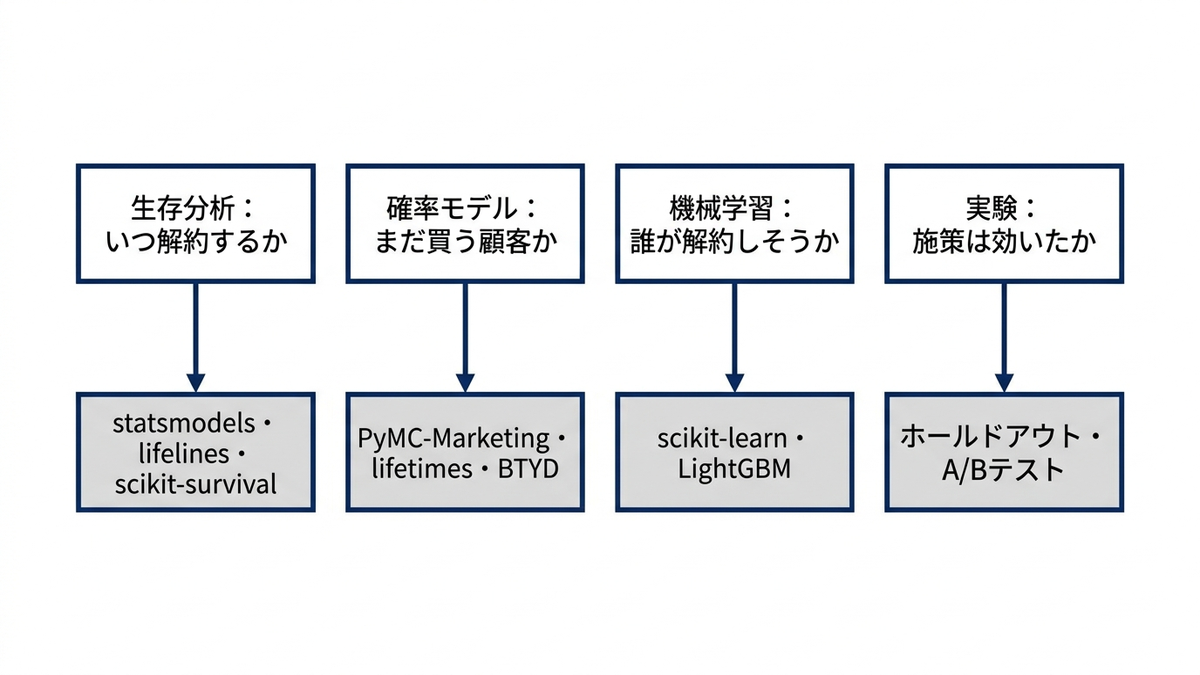
経営の側から見ると、この記事の作業では、手間の中心はソフトウェアではなく、解約の定義をそろえ、データを整え、結果を施策と予算の判断につなぐ人の時間にありました。この記事の第5章のカプラン・マイヤー推定は、statsmodels の SurvfuncRight で真の継続率とよく合う値を出しました(紹介チャネルの S(36)が推定 0.619、真の値 0.612)。難しかったのは計算そのものではなく、第3章の解約の定義と打ち切りの扱い、第8章の施策の費用との突き合わせでした。道具の選定に時間をかけるより、どの判断に使うかを先に決めておく方が、判断の質に効くと考えています。
クラウドと製品に組み込まれた予測の機能
オープンソースの道具とは別に、分析の製品やクラウドの機能として、解約の予測や顧客生涯価値の予測が組み込まれたものもあります。ここでは、公式のヘルプやドキュメントを開いて、何を予測し、どのデータを求めるかを確かめた2つを取り上げます。料金や機能の優劣は書きません。
1つめは、Google アナリティクス 4(GA4)の予測指標です。公式のヘルプのページは、予測指標を4つ定義しています。「購入の可能性」は、過去28日間に操作を行ったユーザーが今後7日以内に特定のキーイベントを記録する可能性、「離脱の可能性」は、過去7日以内にアプリやサイトで操作を行ったユーザーが今後7日以内に操作を行わない可能性、「予測収益」は、過去28日間に操作を行ったユーザーが今後28日間の購入で生む総収益の予測、「アプリ内購入の可能性」は、アプリ内購入のイベントを起こす可能性です。英語版のヘルプは前提条件として、過去28日間のうちの7日間で、購入や離脱の条件に当てはまったリピーターと当てはまらなかったリピーターがそれぞれ1,000人以上いることを挙げ、予測は条件を満たすモデルについて各ユーザーに1日1回作られること、モデルの品質が基準を下回ると予測の更新が止まることを書いています。
この「離脱の可能性」は、7日間操作が無いことを離脱と見なす定義で、この記事の契約型の「解約」(月額の支払いをやめること)とは別のものです。第3章で、注文0の月が続くことを離脱と見なすと解約率が変わる様子を見ました。製品が出す「離脱」の数字を社内の解約率の報告と並べるときは、定義の違いを必ず添える必要があります。
2つめは、Microsoft の Dynamics 365 Customer Insights – Data の予測の機能です。公式ドキュメント(日本語版。予測の一覧のページは2026年8月13日更新の版で確認)は、既定の予測モデルとして、顧客生涯価値、製品の推奨、サブスクリプションの離反(解約)、トランザクションの離反(購買の停止)、感情分析を挙げています。前提条件として、少なくとも12か月の取引かサブスクリプションの履歴(2〜3年が望ましい)を求めています。同じページは、予測の価値とその効果、倫理的でない形で入り込みうる偏りとの釣り合いを取るよう強く勧めています。
サブスクリプションの離反の予測のページ(2026年7月14日更新の版で確認)は、解約したと見なすのはサブスクリプションの終了から何日後かを利用者が決め、例として今後90日間の解約のリスクを予測する設定を示しています。データは選んだ期間の少なくとも2倍の長さ(2〜3年分が望ましい)を求め、ほとんどの企業は月に1回モデルを学習し直すことで予測の精度を高められる、と書いています。モデルの出来はA・B・Cの3段階で示され、Aの条件は、予測全体の少なくとも50%が正しく、かつ解約した顧客を正しく予測した割合が過去の平均の解約率より少なくとも10%大きいこと、と説明されています。この記事の第7章の検証データでは、3か月解約の正例率が 0.0745 でした。この割合なら、全員を「解約しない」と予測するだけで 92.5% が正しくなるので、条件の前半だけでは予測の良し悪しはほとんど分かりません。後半の条件が具体的にどう計算されるかは、ページの記述だけでは細部まで確かめられませんでした。第7章で、上位10%の解約率とリフトや較正で評価した理由と同じで、製品の出す等級だけでなく、自社のデータで上位の集団の解約率を確かめることが要ります。具体的には、製品が出した予測を時間で分けた後の期間の実績と突き合わせ、予測の高い順に並べた上位10%の実際の解約率を全体の解約率で割ったリフトと、予測確率の10分位ごとに予測と実際の解約率を並べた較正の表を作ります(第7章で作ったものと同じ形です)。
顧客生涯価値の予測のページ(2026年7月10日更新の版で確認)は、今後12か月の値を予測するなら少なくとも18〜24か月の履歴データが要る、という目安を示しています。価値の高い顧客を決める既定の方法として、過去に累積収益の80%を生んだ顧客の割合を使う規則を挙げ、通常は30〜40%未満の顧客が累積収益の80%を生むが業種によって違う、と書いています。この記事の第11章は、これとは逆の向きの指標(上位20%の顧客が価値の合計の何割を持つか)を架空のデータで実測しています。第2章で用意した定期便では、第30か月末の在籍者の上位20%が残存価値の推定の 29.3% を持っていました。単品通販では、この先52週の購買金額の予測の上位20%が、予測の合計の 69.6% を持っていました。この2つは、測っている量(残存価値と購買金額の予測)も期間も違うそれぞれの定義での値で、同じ物差しで並べたものではありません。どちらも製品の「累積収益の80%」の規則とも定義が違うので、製品の既定の規則や「通常」の割合をそのまま受け取らず、自社のデータで、自社の判断に使う定義で確かめるのが筋だと考えています。なお、この記事の LTV は加入から60か月の割引後の粗利の期待値で、製品の「顧客生涯価値」は予測期間内の収益を対象にしています。同じ名前でも定義が違うことは、第9章で素朴な公式と真の値が大きく違った(紹介チャネルで 109,708円 対 64,767円)のと同じ種類の注意です。
Google Cloud の BigQuery ML のように、汎用の機械学習をデータベースの中で動かす機能もあります。この章で開いた BigQuery ML の概要のページには、解約や顧客生涯価値に特化した機能の記載は見当たりませんでした。この記事では、BigQuery ML で解約の予測を組む手順は確かめていません。
公開された一次情報で確認できた事例
解約の予測や顧客生涯価値の推定の事例は、企業の技術ブログや支援会社の発信に多く見られますが、成果の数字の出どころを確かめられるものは多くありません。この節では、論文として公開され、要旨を開いて確かめられた事例だけを並べます。成果の数字は、要旨に書かれたものだけを引きます。この章で調べた範囲では、日本企業が自社の名前を出して解約の予測や顧客生涯価値の成果の数字を公開した技術ブログの事例は見つかりませんでした。日本の企業または研究者が関わった事例として確かめられたのは、下の表のシリコンスタジオの論文と、東京大学の阿部誠氏の論文です。
| 企業・研究(概要) | 出典の種類 | 何をしたか | 要旨に書かれた成果 | この記事との関係 |
|---|---|---|---|---|
| ASOS(要旨の表現では世界規模のオンラインのファッション小売) | KDD 2017 の論文(Chamberlain ら) | 実際に運用している顧客生涯価値の予測の仕組みを説明。全顧客の将来の価値を毎日推定 | 顧客の埋め込み表現(行動から自動で学ぶ特徴量)を加えると、手作りの特徴量の網羅的な組より大きく改善した、と記載。数値は要旨に無し | 第7章の特徴量、第9章の LTV |
| シリコンスタジオ(日本のゲーム会社) | DSAA 2016 の論文(Periáñez ら) | 自社が開発したモバイル向けのソーシャルゲームで、課金額の大きい少数の利用者を対象に、10日続けて接続しないことを離脱と定義して、その離脱を生存分析の木の集まり(生存時間の森)で予測 | 時間の関数として離脱の確率を予測し、Cox 回帰より精度と頑健さが大きく改善した、と記載。数値は要旨に無し | 第5章の打ち切り、第6章の Cox 回帰 |
| Google の研究者 | 2019年の論文(Wang ら)と公開リポジトリ | 一度しか買わない人が多く、ごく一部の人の値が極端に大きい顧客生涯価値の分布を、0の点と対数正規分布の混合で表す損失関数を提案 | 公開データ2つで予測の性能を示した、と記載。評価には正規化したジニ係数(予測の順位が、実際の値の大きい順にどれだけ合っているかを表す指標)と、十分位の表での較正の確認を勧める | 第7章の較正、第10章・第11章の価値の分布 |
| Ascarza(論文の所属はコロンビア大学のビジネススクール) | 2018年の論文 | 2つのフィールド実験と機械学習を組み合わせ、解約の危険が高い顧客が引き止め施策の最良の対象かを検証 | 危険が最も高い顧客が最良の対象とは限らない。施策への反応の違いで対象を選ぶ方が、危険の高い順より大きく効果的だった、と記載 | 第8章の対象の選び方、第12章の実験 |
| 阿部誠(東京大学) | 2009年の論文 | Pareto/NBD モデルを階層ベイズに拡張し、購買率と離脱率の独立の仮定を外し、顧客の特性を説明変数として入れた | 音楽CDの通販、百貨店のフリークエント・ショッパーズ・プログラム(FSP)のデータ、音楽CDのチェーンの3種類のデータで、基準の Pareto/NBD モデルと比較した、と記載 | 第10章の確率モデル |
表の事例を読むときに大事なのは、要旨の成果の多くが「どの手法が既存の手法より良かったか」という比較で、「解約がどれだけ減り、粗利がどれだけ増えたか」という経営の成果の数字ではないことです。ASOS とシリコンスタジオの論文は、予測の仕組みを実際の事業のデータで作ったことを示していますが、その予測で打った施策の効果までは要旨に書かれていません。
その中で、Ascarza の論文は施策の効果まで踏み込んでいます。要旨によれば、2つのフィールド実験を通じて、解約の危険が最も高い顧客が引き止め施策の最良の対象とは限らないことを示し、施策の効果がどの顧客で大きいかという違いに注目して対象を選ぶべきだ、と述べています。この記事の第8章では、予測の上位10%を選んでも、その人たちの3か月解約確率(真の値)は 0.183 で、約8割は施策が無くても3か月は解約しないことを見ました。ただし、第8章の計算は、施策で解約の起きやすさ(オッズ)に掛ける倍率を全員同じ0.7と置いた架空の前提で(解約確率の下がり幅は、元の解約確率によって人ごとに違います)、この倍率そのものが人によって違う場合は扱っていません。Ascarza の論文は、効果が人によって違う現実のデータでは、危険の高さで選ぶこと自体が外れうることを、実験で示した例です。効果の違いを推定するアップリフトモデリングは、弊社コラム「施策の効果を正しく測る、因果推論と効果検証の進め方」の第11章で扱っています。
Google の研究者の論文は、顧客生涯価値の予測に特有の難しさを要旨で明言しています。一度しか買わずに戻らない顧客が多く、ごく一部の顧客の値が極端に大きいので、よく使われる二乗誤差の損失は、値が0の多くの顧客にうまく合わず、極端に大きい値に引きずられる、という指摘です。この記事の第10章の単品通販のデータでも、2回目以降の購買が無い顧客が 28.7% いました。論文の公開リポジトリは2026年4月18日に所有者によってアーカイブされ、読み取り専用になっています。考え方を参考にすることはできますが、道具として使い続けるなら、その前提で判断する必要があります。
研究の動き、深層学習と系列モデル
生存分析と解約の予測の研究では、深層学習を使う流れが続いています。次の表は、原論文の一次ページ(arXiv か出版社の DOI のページ)で書誌と要旨を確かめたものです。題名は日本語で言い換えています。
| 年 | 論文の主題(著者) | 要旨で述べられていること | この記事との関係 |
|---|---|---|---|
| 2018 | Cox 比例ハザードモデルを深層ニューラルネットワークにした DeepSurv(Katzman ら) | 線形の Cox モデルでは手で作り込む必要があった説明変数どうしの組み合わせの効果を、ネットワークに学ばせる。シミュレーションと実データで、他の生存分析の手法と同等か上回る性能を示し、個人ごとの治療の推奨に使えることを示す | 第6章の Cox 回帰 |
| 2018 | 競合リスクを扱う深層学習の生存分析 DeepHit(Lee ら) | 生存時間の分布を深層ニューラルネットワークで直接学ぶ。背後の確率過程に仮定を置かず、説明変数とリスクの関係が時間とともに変わることを許し、競合リスクを扱える。実データと合成データで、従来の手法より統計的に有意に大きく改善したと報告 | 第3章の解約の定義(休止・プラン変更)、第6章の比例ハザードの仮定 |
| 2019 | 系列データと深層ニューラルネットワークによる解約予測の比較(Mena ら) | 金融サービスの事業者の最近・頻度・金額のデータの時系列を LSTM(系列を扱うニューラルネットワーク)に入れると、人口統計の変数を使った罰則つきロジスティック回帰より、上位10%のリフトと期待最大利益の指標(解約予測を施策の利益に換算して比べる指標)が大きい。LSTM の予測確率をロジスティック回帰の特徴量に加えると、静的な特徴量だけのモデルより検証データでの性能が25%上がる | 第7章の特徴量(3か月平均や傾き) |
| 2024 | 出来事までの時間を予測する深層生存分析の入門(Chen) | 顧客がいつサブスクリプションを解約するかを例に挙げ、Cox モデルから深層学習の手法までを体系的に解説。競合リスクと、時間とともに長くなる時系列から予測する場面も扱う。公平性・因果・解釈可能性にも触れ、全モデルのコードを公開 | 第5章〜第7章の全体 |
DeepSurv と DeepHit は、もともと医療のデータを主な対象とした研究で、解約の予測に使うには事業のデータに合わせた検討が要ります。それでも、この記事の論点とは2つの点でつながります。1つは比例ハザードの仮定です。第6章で、初回クーポンの効果が最初の3か月だけ強く、比例ハザードの仮定が崩れる例を見ました。DeepHit の要旨は、説明変数とリスクの関係が時間とともに変わることを許すと書いており、この種のずれをモデルの側で吸収しようとする設計です。もう1つは競合リスクです。休止や上位プランへの変更を、解約とは別の終わり方として扱いたい事業では(最初に起きた出来事を分析する場合)、DeepHit の系統の手法や、先に挙げた累積発生率の推定が選択肢になります。
Mena らの論文が比べているのは、時間とともに変わる利用の記録を、集計してから入れるか、系列のまま入れるかです。要旨は、罰則つきのロジスティック回帰のような既製の手法は、時系列の特徴量をあらかじめ集計しないと使えないと書いています。この記事の第7章でも、注文回数の直近の値・3か月平均・傾き・0注文の月数という集計した特徴量を作りました。LSTM は、その集計の仕方をデータから学ぶ方法だと言えます。ただし、第7章で見たとおり、この記事の架空のデータの検証集団では、隠れた利用意欲まで知る真のモデルでも AUC は 0.684 で、ロジスティック回帰と LightGBM はいずれも 0.674 でした(この生成設定・この検証集団での1回の結果です)。この例のように、予測の上限がデータに含まれる情報で決まっていて、今のモデルがその上限に近い場合は、モデルを柔らかくしても予測の指標を伸ばせる余地は小さいと考えられます。上限がどこにあるかはデータごとに違い、この記事の値をほかのデータに当てはめることはできません。新しい手法を試す前に、今のモデルが上限にどれだけ近いかを見積もる手順を持っておくことが、開発の費用を無駄にしない順序だと考えています。ただし、現実のデータでは、この記事のように真のモデルと比べることはできず、上限は直接は分かりません。時間で分けた検証や、学習データの量を変えたときの指標の伸び方を見て、改善の余地を見積もることになります。
研究の動き、確率モデルの拡張と施策の効果の予測
非契約型の顧客の確率モデルは、1987年の Pareto/NBD モデルから始まる研究の系譜があります。次の表は、Crossref の書誌情報と要旨、または論文の一次ページで確かめたものです。
| 年 | 論文の主題(著者) | 確認した内容 | この記事との関係 |
|---|---|---|---|
| 1987 | まだ活動している顧客を数え、特定するモデル(Schmittlein、Morrison、Colombo) | 過去の取引の回数と時期にもとづいて、各顧客がまだ活動している確率を計算するモデル(Pareto/NBD)を提案。顧客基盤の規模と成長の監視、新商品の試し買いと再購入の評価、広告や販促の対象の選定に使えると要旨に記載 | 第10章の在籍確率 |
| 2005 | Pareto/NBD を簡単に推定できる代替のモデル(Fader、Hardie、Lee) | BG/NBD モデルを提案。Pareto/NBD はパラメータの推定の計算が難しいが、BG/NBD は表計算ソフトでも推定でき、幅広い購買の環境で2つのモデルはよく似た結果を出すと要旨に記載 | 第10章の BG/NBD |
| 2007 | 顧客の継続率を将来へ延ばす方法(Fader、Hardie) | 契約型の事業の継続率の推移を、曲線を当てはめる回帰ではなく、解約の過程を確率で表すモデル(シフト・ベータ幾何分布)で延ばす。表計算ソフトで実装でき、精度の高い予測を出すと要旨に記載 | 第9章の観測の外への延長 |
| 2007 | 顧客基盤分析のモデルの実証的な検証と比較(Batislam、Denizel、Filiztekin) | MBG/NBD モデルの論文として lifetimes・PyMC-Marketing の実装の名前と対応する。この章では書誌(International Journal of Research in Marketing、第24巻第3号)だけを確認し、要旨は開けなかった | 第10章の MBG/NBD |
| 2009 | 顧客を1人ずつ数える、Pareto/NBD の階層ベイズの拡張(阿部) | 購買はポアソン過程、離脱は記憶の無い過程(ハザード一定)、顧客ごとの違い、という3つの仮定を保ちながら、購買率と離脱率の独立の仮定を外し、顧客の特性を説明変数として入れる。MCMC の推定の副産物として、顧客ごとの在籍期間と継続率が得られると要旨に記載 | 第10章の確率モデル、第11章の価値の分布 |
この系譜で一貫しているのは、「データから直接は見えない離脱を、購買の回数と時期のパターンから確率として推定する」という考え方です。拡張の方向は、推定を簡単にする(BG/NBD)、仮定の不自然な点を直す(MBG/NBD は、第10章で見た「一度しか買っていない人は離脱していない」という BG/NBD の仮定を改めたものとして第10章で紹介しています)、顧客の特性を入れて個人ごとの違いを説明する(阿部の階層ベイズ)、の3つに分けられます。PyMC-Marketing の CLV モジュールは、このうち複数のモデルをベイズ推定の形で1つの道具箱にまとめたものと位置づけられます。
もう1つの研究の流れは、解約の予測とアップリフト、つまり施策の効果の予測の統合です。先に見た Ascarza の2018年の論文は、解約の危険を予測するのではなく、施策でどれだけ解約が減るかの違いを推定して対象を選ぶべきだ、と主張しました。この記事の第8章の期待値の式(1人に施策を打つ価値は、施策ありとなしの期待粗利の差から費用を引いたもの。概算では、解約確率の下がり幅に残存価値を掛け、施策の費用を引いたもの)でいえば、「解約確率の下がり幅」の部分が人によって違うことを、実験で測って推定に入れる方向です。この方向に進むほど、第12章で扱ったホールドアウトの実験は、効果を確かめるためだけでなく、効果の違いを学ぶためのデータを集める手段としての意味を持ちます。
定期購入をめぐる統計
定期購入やサブスクリプション型の事業の規模を示す公的統計は、この章では、開いて中身を確かめられた範囲では見つけられませんでした。事業が広がっていることの背景は第1章で扱っています。一方で、定期購入の解約をめぐる消費者の相談の件数は、国民生活センターの公表資料で確かめられます。国民生活センターが2026年8月5日に公表した「2025年度 全国の消費生活相談の状況」によれば、全国の消費生活センター等が受け付けて全国消費生活情報ネットワークシステム(PIO-NET)に登録された相談のうち、販売方法・手口別で「定期購入」は 98,455件で2位でした(2024年度は 94,559件で、同じく2位)。資料は、1位の「インターネット通販」と2位の「定期購入」では、化粧品や健康食品などのインターネット通販での定期購入契約に関連する相談が多い、と書いています。また、商品・役務等別の主な相談内容の項目には「解約」が並んでいます。
この統計は、定期購入の事業の規模を示すものではありません。1件の相談に複数の手口が含まれる場合はそれぞれに数える、という集計の注記もあります。この統計が示しているのは、定期購入をめぐる相談が多く寄せられているという事実までで、相談が事業の評判にどう響くかまでは示していません。そのうえで、解約の手続きを分かりにくくして解約率を下げることは、この記事で扱ってきた「引き止め」とは別物で、相談や苦情を通じて事業の評判と顧客基盤そのものを損なうおそれがあると考えています。この記事で測ってきた解約のハザードの低下は、顧客が使い続けたいと思う理由を増やした結果として得るものだと考えています。
生成AIと基盤モデルとの関係
生成AIとの関係では、この章で一次情報を確かめられた動きは2つです。1つは、表形式のデータ向けの基盤モデル(大量のデータであらかじめ学習しておき、新しいデータで学習し直さずに予測するモデル)を解約の予測に当てた比較です。2026年の機械学習の国際会議 ICML のワークショップ「構造化データのための基盤モデル」で発表されたポスター(Seyedzadeh、Karimi)の要旨は、古典的な手法・深層学習・木の集まりの手法・6つの表形式の基盤モデルの計16のモデルを、7つの業種にわたる9つの公開データで比べ、基盤モデルがほかの手法を上回ったと報告しています。最も良かった TabICL v2 は9つのデータのうち8つで上位3位に入り、XGBoost を PR-AUC(解約する人が少ないデータで、上位に解約者を集められているかを見る指標。第7章の AP に近いもの)で最大 9.23ポイント上回ったとしています。これはワークショップのポスターの要旨にある著者の主張で、査読付きの論文誌の結果ではありません。
もう1つは、大規模言語モデルが作る埋め込み表現(文章や記録を数値の並びに変えたもの)を解約の予測の特徴量に使う研究です。2024年12月の論文誌 Future Internet の論文の要旨は、通信業の解約の予測で、複数の埋め込みの手法と分類の手法を比べ、OpenAI の埋め込みのモデル(text-embedding-ada-002)で作った特徴量をロジスティック回帰に入れたものが最も良く、正答率 89% だったと書いています。第7章で説明したとおり、解約する人が少ないデータでは正答率は予測の良し悪しを表しにくい指標です。このデータで解約した人の割合は、要旨からは確かめられませんでした。
この2つの報告が示しているのは、それぞれのデータと評価の方法のもとで、表形式の基盤モデルや埋め込みを使った予測の指標が、比べたほかの手法より良かったということです。自社のデータで同じ改善が得られるかは、この章で確かめた範囲では分かりません。この記事の架空のデータでは、真のモデルの AUC が 0.684、ロジスティック回帰と LightGBM が 0.674 で(第7章)、この設定では予測の指標を伸ばせる余地は小さいものでした。ただし、これは架空のデータのこの設定での話で、ほかのデータには広げられません。一方で、予測の指標がどれだけ上がっても、解約の定義と打ち切りの扱い(第3章・第5章)、コホートの構成の変化による見かけの悪化(第4章)、予測の高さと施策の効果の違い(第8章)、LTV の定義の違い(第9章)は、人が判断して決める部分として残ります。新しいモデルの予測の数字が良く見えたときほど、正答率なのか上位の集団の解約率なのか、検証データは時間で分けたのか(第7章のリーク)、を確かめる手順を決めておくことが有効だと考えています。
道具と事例を自社の判断にどう使うか
ここまでの内容を、経営の判断の形にまとめます。オープンソースの道具は無料で手に入り、分析の製品にも解約や生涯価値の予測が組み込まれるようになりました。どれを使っても、解約の定義をそろえ、打ち切りを扱い、予測を施策の費用と突き合わせ、実験で効果を確かめるのにかかる人の時間は同じように要ります。そのため、道具を選ぶ前に決めておくべきことは、道具の機能の比較ではなく、次の4つだと考えています。
- 自社の顧客は契約型か非契約型か。契約型なら生存分析の系統、非契約型なら確率モデルの系統が中心になる。休止やプラン変更を解約と分け、最初に起きた出来事を見たいなら、競合リスクを扱えるかを確かめる。休止からの復帰まで追うなら多状態モデルを検討する(第2章・第3章)
- 何の判断に使うか。獲得チャネルごとの獲得費用の上限を決めるなら LTV(第9章)、引き止め施策の対象を決めるなら解約の予測と期待値(第7章・第8章)、通販の顧客基盤の規模を見るなら在籍確率(第10章)
- 製品や道具の出す数字の定義が、社内の報告の定義と同じか。GA4 の「離脱の可能性」は7日間の不活動、製品の「顧客生涯価値」は予測期間内の収益で、この記事の解約や LTV とは違う
- 施策の効果をどう確かめるか。予測の精度の改善は、施策の効果の改善を意味しない。対象の一部を施策の外に残すホールドアウトの計画まで含めて予算を組む(第12章)
判断を誤ったときの損失は、道具の選択そのものより、道具の出した数字をそのまま予算に反映することから生まれうると考えています。この記事の架空のデータでは、予測の上位10%に施策を打つと24か月の割引後粗利の純増は 486,054円、無作為に10%を選ぶと 89,890円でした(第8章。施策の効果は解約の起きやすさ(オッズ)を0.7倍、費用は1人500円という架空の前提)。この例では、予測は対象を選ぶのに役立っています。同じ施策を全員に打つと純増は 893,973円でしたが、1人あたりの粗利の増分は約622円で、施策の費用が約622円を超えると全員配布は赤字になり、約1,163円を超えると上位10%に絞っても赤字になります。この例のように、1人あたりの増分(全員配布で約622円)と費用(500円)の差が小さい施策ほど、費用の見積もりの少しの違いで損益が入れ替わるので、実験で確かめてから広げる必要があります。予測の精度を上げたときに純増がどれだけ変わるかは、この記事では計算していません。そのため、精度の改善と費用の見直しのどちらが効くかは比べられませんが、施策1回の費用と1人あたりの増分を突き合わせ、対象の範囲を決め、実験で確かめる手順は、どの予測モデルを使う場合にも要ると考えています。事例の論文が示す「既存の手法より良かった」という比較の結果は、自社で同じ利益が得られることの根拠ではありません。自社のデータで、上限と費用と効果を確かめる手順を先に持つことが、道具を活かす前提になると考えています。
この章のまとめ
生存分析の系統(statsmodels・lifelines・scikit-survival)と確率モデルの系統(PyMC-Marketing・lifetimes・BTYD)の道具は、いずれもオープンソースで手に入り、契約型か非契約型かで使い分けます。lifetimes は2024年にアーカイブされ、後継として PyMC-Marketing が案内されています。公開された事例の多くは「既存の手法より予測が良かった」という比較で、施策の効果まで示したものは Ascarza の実験のように限られます。研究は、深層学習と系列モデル、確率モデルの拡張、施策の効果の違いを推定する方向に進んでいますが、予測の上限と施策の費用対効果を確かめる判断は人に残ります。この記事の終章では、ここまでの14章を、顧客の離脱と生涯価値を測り続けるための考え方としてまとめます。
この章を深めたい方への参考書籍
『あのサービスはなぜ継続率が高いのか? 顧客の習慣化を促すハビットデザインメソッド』(松迫崇道 著、日本実業出版社):2025年12月に刊行された、利用者の使用の習慣を設計して、使い続けてもらえるサービスをつくることを主題にした本です(NDL サーチに載っている版元の内容紹介による)。この記事で測ってきた継続率を上げ、解約のハザードを下げるにはどうすればよいかを、施策の側から考える材料になります。この章の統計の節で触れたとおり、解約の手続きを分かりにくくするのではなく、使い続けたいと思う理由を増やすことで解約のハザードを下げる、という方向を考えるのに向いています。
『Pythonで体験するベイズ推論 PyMCによるMCMC入門』(キャメロン・デビッドソン=ピロン 著、玉木徹 訳、森北出版):原書は、この章で紹介した lifelines と lifetimes と同じ GitHub のアカウントで公開されているベイズ推論の入門書で、Python の PyMC を使ってベイズ推論の考え方と MCMC の仕組みを、数式より計算を先に立てて解説しています。PyMC-Marketing の CLV モジュールが出す事後分布や在籍確率の幅を、どういう計算から出てきたものかを理解して読むための準備に向いています。
終章 顧客の離脱と生涯価値を測り続けるための5つの考え方
本コラムでは、架空の食材宅配の定期便(月額制)の顧客12,000人の3年分の記録と、架空の単品通販の顧客6,000人の2年分の購買記録を使い、データの整備から、加入時期ごとの継続率の読み方、打ち切りを正しく扱う生存分析、離脱の要因を探るハザードモデル、解約の予測とその評価、予測を施策につなぐ期待値の考え方、顧客生涯価値の計算、価値の分布を踏まえた優先順位、実験による効果の確認、組織での使い続け方までを、実際にコードを動かしながら見てきました。この章では、各章の結果から、顧客の離脱と生涯価値を測り、予算の判断に使い続けるための考え方を5つにまとめます。いずれも、この架空のデータとその設定での結果から導いたものです。顧客の数や解約の起きやすさ、月額や獲得費用が違えば数字は変わりますが、判断の手順としては一般に通用する部分が大きいと考えています。
1. 解約率は、集団と時間で分けて、定義をそろえて測る
第1章と第2章で見たとおり、観測期間の月次解約率は全体で3.27%でも、獲得チャネルごとに見ると紹介経由の1.60%からチラシ経由の6.45%まで4倍の開きがありました。加入から36か月目まで残る割合は、真の値で紹介経由が61.2%、チラシ経由が18.4%です。第4章では、加入時期が後ほど12か月目の継続率が下がって見える(0.679から0.620。最後の値は第25〜30か月の加入者のうち、12か月目まで観測できる第25か月の加入者432人の値で揺れが大きい)のに、紹介チャネルだけを見ると、0.830から0.808へ2.2ポイントの低下にとどまり(最後の値は99人の値)、全体の5.9ポイントよりずっと小さいことを確かめました。下がって見えた大部分は、紹介の割合が減りチラシの割合が増えたという獲得チャネルの構成の変化で説明できます。全体の解約率や継続率の動きだけを見て施策を決めると、原因が獲得の構成にあるのにサービスの改善に予算を使う、という取り違えが起きます。
測り方の定義をそろえることも同じくらい大事です。第5章では、解約した人だけで平均の在籍月数を出すと8.0か月にしかならない一方、まだ在籍している人(打ち切り)を正しく扱うカプラン・マイヤー推定では、36か月までの期待在籍月数が21.3か月(真の値21.1か月)になることを確かめました。解約率の逆数で在籍期間を見積もる公式は、解約の起きやすさが在籍の長さによらず一定で、期間に上限が無く、割引もしないという仮定を置いています。期間をそろえて比べると、この公式は4つのチャネルとも真の期待在籍月数より短く見積もり、期間をそろえずに比べると、紹介経由では逆に長く見えました。解約率や在籍期間の数字を報告するときは、どの集団の、加入から何か月目の、どの定義の数字かを必ず添えることが、判断の取り違えを防ぐ最初の手順だと考えています。
2. 離脱の要因と、離脱の予測は、別の問いとして扱う
第6章では、Cox比例ハザードモデルと離散時間のハザードモデルで、獲得チャネル・プラン・初回クーポン・利用状況が解約の起きやすさとどう結びついているかを推定しました。この架空データでは、データを作る際に置いた真の係数を、離散時間モデルがほぼ回復しました。ただし、推定した係数は「結びつきの強さ」であって、その要因を動かせば解約が減るという意味ではありません。問い合わせが多い顧客の解約の起きやすさが高いからといって、問い合わせの窓口を狭めれば解約が減るわけではない、ということです。要因の分析は、どの集団に目を向けるか、どの施策を試す候補にするかを決める材料として使います。
第7章では、ある月末の在籍者がその先3か月以内に解約するかを予測するモデルを作り、検証期間のAUCがロジスティック回帰と勾配ブースティングのどちらも0.674であること、顧客ごとの隠れた利用意欲まで知っている真のモデルの推定確率でも、実際に起きた解約に対するAUCは0.684にとどまることを確かめました。この架空データのこの設定では、解約には予測しようのない偶然の部分が大きく、予測の精度を上げる余地は小さいということです。現実のデータで同じ数字になるわけではありません。この架空データの検証では、真の確率どおりに解約を200回引き直すだけで、真の確率のAUCが0.675から0.738まで動きました。精度の数字には、このような幅があります。精度の数字を競うよりも、較正された確率と、予測の上位の集団の実際の解約率を、施策の設計にどうつなぐかに時間を使うほうが、結果に効くと考えています。予測の設計で何より大事なのは、予測の時点より後に決まる情報を特徴量に入れないことです。第3章と第7章で見たとおり、未来の情報が1列混ざるだけで、検証の数字は本当の実力よりはるかに良く見えます。
3. 施策の対象は、予測の高さだけでなく、下がり幅と残存価値と費用の釣り合いで決める
第8章では、1人あたり500円の引き止めクーポン(当てた月から3か月のあいだ、解約の起きやすさを0.7倍にするという架空の前提)を、誰に配るかで24か月の粗利の純増がどう変わるかを、真のモデルで答え合わせしました。予測の上位10%に配ると純増は約48.6万円、無作為に選んだ10%なら約9.0万円で、予測で選ぶほうが同じ費用で約5.4倍の純増です。一方、全員に配ると純増は約89.4万円と総額では大きくなりますが、費用1円あたりの純増は上位10%が最も大きく、1人あたりの粗利の増分は全員配布で622円と費用の500円に近づきます。損益の分かれ目は、全員への配布で1人あたりおよそ600円(乱数の種を変えた計算では597円から622円)、上位10%への配布でおよそ1,100円(同じく1,077円から1,163円)で、施策の費用がそこを超えると純増は赤字に転じます。予測の上位10%に選んだ人でも、8割は施策が無くても3か月は解約しません。施策の対象と人数は、予測の順位だけでは決まらず、解約確率の下がり幅と、その顧客が残す粗利(残存価値)と、1人あたりの費用の釣り合いで決まります。
第11章では、残存価値の高低と解約リスクの高低で顧客を4つに分け、予算の範囲で期待される純増が大きい順に対象を選ぶ方法を扱いました。乱数の種を変えた2組の計算とも、試した4つの予算(25万円から150万円)のすべてで、期待純増の順に選ぶほうが予測の解約確率の順に選ぶより純増が5万円から15万円大きくなりました(ただし、施策で解約の起きやすさに掛ける倍率を全員0.7とした前提を共有した比較で、解約確率の下がり幅は人ごとに違います)。引き止めの予算と獲得の予算は、「粗利1円を得るためにいくらかかるか」という同じ尺度で比べられます。この例では、24か月で区切った比較で、引き止めの予算を50万円より先に積み増した追加分の効率は、チラシ経由の獲得に近いか、それより悪く、両者の差はぶれの範囲に入りうるものでした。価値の低い顧客を切り捨てるのではなく、費用対効果の順に施策を配ることが、限られた予算で顧客基盤の粗利を増やす方法だと考えています。この例のように1人あたりの費用が全員同じで、各人の増分を足し合わせられる場合は、期待純増の大きい順に選べば足ります。費用が人によって違う場合は、第11章で扱ったとおり、並べるだけでは最適にならないことがあります。
4. 顧客生涯価値は定義を固定し、獲得チャネルごとに獲得費用の上限を決める
第9章では、顧客生涯価値を「加入から60か月以内に見込める月次粗利を年5%で割り引いて合計した期待値(獲得費用を差し引く前)」と定義し、その計算方法で数字が大きく変わることを確かめました。紹介経由の顧客で、解約率の逆数を使う素朴な公式(無期限・割引なし)では約109,700円、同じ一定の解約率でも60か月で打ち切って割り引くと約61,700円、カプラン・マイヤーの継続率に外挿を足した推定では約64,900円、真の値は約64,800円でした。同じ「LTV」という言葉で、定義が違えば2倍近く違う数字が出ます。社内で顧客生涯価値を使うときは、期間・割引率・粗利の定義・獲得費用を含めるかどうかを文書で固定し、部門ごとに別の数字を持たないことが前提になります。
定義を固定したうえで獲得チャネルごとに計算すると、獲得にかけてよい費用の上限が見えます。真の値で、紹介経由は約64,800円、検索広告経由は約50,400円、SNS広告経由は約38,500円、チラシ経由は約29,700円で、架空の獲得費用に対する比率は紹介の32.4倍からチラシの2.5倍まで、獲得費用を粗利で回収する月数は2か月から11か月まで開きました。チャネルを分けずに、加入者の構成で加重した平均の顧客生涯価値(真の値で約47,200円、第9章の推定で約47,700円)をそのまま全チャネルの獲得単価の上限にすると、チラシではその上限が真の価値(約29,700円)を上回り、上限いっぱいまで獲得単価を上げれば超えた分は回収できません(第9章のように上限を顧客生涯価値の3分の1などの比率で置けば、この例ではチラシでも回収できます)。購買の記録しかない事業では、第10章で見たとおり、顧客がまだ買い続けている確率(在籍確率)とこの先の購買回数を確率モデルで推定し、同じ考え方で価値を見積もります。この架空データでは、BG/NBDモデルの推定が、在籍しているかどうかの判別でAUC0.908、この先52週の購買回数の合計で予測6,625回に対して実現6,661回と、合計は実現した値に近い結果でした。合計が近いことは顧客ごとの予測の精度までは示さず、顧客ごとの予測と実現の相関は0.727でした。ただしこれは、モデルの仮定どおりに作ったデータでの結果です。
5. 施策の効果は実験で確かめ、効果の持続まで見る
第12章では、第8章と第11章で前提にした「解約の起きやすさを0.7倍にする」という効果が、現実には実験で測るものであることを確かめました。第30か月末の在籍者を無作為に半分に分け、片方に施策を当てた架空の実験で、分け方は1回とし、シミュレーションを30回行って平均すると、3か月の解約率は対照群の7.57%に対して処置群で5.22%でした(実験で見える相対の減少は約31%。同じ処置群が施策を受けなかった場合の7.35%と比べた真の減少は29.1%で、2つの数字の差は、2つの群の偶然の違いが理由の1つです)。一方、24か月の粗利の増分は1人あたり601円で、費用の500円をわずかに上回る程度でした。施策が終わる第34か月以降は解約の起きやすさがほぼ元に戻り、3か月で解約を免れた人の半分弱は24か月以内に結局解約しました。解約を止めたのか、先延ばしにしただけなのかは、3か月の解約率だけでは分かりません。指標は、短期の解約率に加えて、12か月や24か月の粗利で見る必要があります。
実験には規模も要ります。3か月の解約率7.5%を30%減らす効果を有意水準5%・検出力80%で検出するには、1群あたり1,837人、10%減なら18,455人が要るという計算になりました(2群同数・両側検定・比率の効果量にもとづく正規近似での計算です)。この例の採算の境目は約24%減で、それを見分けるには、さらに多い1群2,725人から4,379人のあいだの人数が要ります。同じ条件の1回きりの実験を、2群の分け方とシミュレーションの乱数を変えて100回くり返すと、相対の減少は11.6%から45.6%まで揺れました。また、予測の上位10%に施策を当て、当てなかった残りと解約率を素朴に比べると、施策を受けた群のほうが解約率が高く見えます(12.9%対6.4%)。実際には、同じ人たちが施策を受けなかった場合の18.0%から下がっています。もともと解約しやすい人に施策を当てているので、受けた人と受けていない人の単純な比較は、施策の効果とは逆向きに見えるのです。施策は、最初から対照群を残した実験として設計し、効果と持続を確かめてから全体に広げることが、費用を解約しない顧客に配り続けないための現実的な進め方だと考えています。
顧客分析を、予算の判断の手順に組み込む
顧客の離脱と生涯価値の分析は、一度計算して終わる報告書ではなく、解約率の集団別・時間別の測定、要因の分析、予測、価値と優先順位、実験という循環を、毎期の予算の会議に固定の手順として組み込んで初めて、判断を変える力を持つと考えています。第13章で見たとおり、解約の定義を部門をまたいで1つに決め、加入時期別とチャネル別の継続率・在籍月数別の解約率・顧客生涯価値と獲得費用の比率と回収月数・予測の上位の集団の実際の解約率・施策の純増といった、第13章の表にまとめた指標を毎月見る体制が、その土台になります。公開されている道具(第14章)を使えば、標準的な推定の処理を一から実装する手間を減らせます。
最初の一歩としては、顧客台帳・契約の履歴・請求と支払いの記録を同じ顧客IDでつなぎ、解約の定義を1つに決め、加入月ごとの継続率の表を作ることから始めるのがよいと考えています。第3章で見たとおり、6つの項目(顧客ID・加入月・解約月・観測の最後の月・月額・獲得チャネル)がそろえば、コホート表と継続率曲線までは計算できます。そこに粗利率とチャネル別の獲得費用を足せば、獲得費用の上限と回収月数まで出せます。そのうえで、集団ごとの継続率の差が大きいところ、価値が高くて離脱の起きやすい集団から、実験として施策を試す順序であれば、大きな投資をする前に、自社のデータで何が測れるかを確かめながら進められます。
Anagraftでは、データ活用の構想づくりから、顧客データの整備、離脱と生涯価値のモデルの設計と実装、施策の実験の設計、優先順位づけの意思決定への組み込み、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 顧客の離脱と生涯価値はなぜ経営の問題なのか
『顧客投資マネジメント 顧客価値の可視化によるファイナンスとマーケティングの融合』(スニル・グプタ、ドナルド・R.レーマン 著、スカイライトコンサルティング株式会社 訳、英治出版):「顧客は資産である」「顧客の価値をはかる」から始まり、顧客価値に基づく戦略・企業評価・プランニング・組織までを扱う本です。この章で述べた、顧客の集まりをストックとして捉え、獲得にかける費用を将来の粗利で回収する投資として見る考え方を、マーケティングとファイナンスをつなぐ枠組みとして体系立てて学べます。
『カスタマーセントリシティ 「正しい顧客」に集中する経営戦略』(ピーター・フェーダー 著、倉橋健太 監訳、三本木亮 訳、ダイヤモンド社):製品を中心にした経営から顧客を中心にした経営への転換を論じ、顧客エクイティ・顧客生涯価値(CLV)・CRM(顧客関係管理)を章として扱う本です。著者は米国ペンシルベニア大学ウォートンスクールの教授で、版元の紹介によれば顧客生涯価値や CRM を研究しています。顧客ごとの価値の違いを経営の判断にどう生かすかという、この章の「平均で見ない」という論点を経営戦略の側から考えるのに向いています。
第2章 顧客分析の全体像、契約型と非契約型・指標の定義・共通データ
『顧客生涯価値マーケティング:持続的な関係性をつくる』(岩永洋平、中央経済社):顧客生涯価値(LTV)を高めることを主題にした、マーケティングの研究書です。ロイヤルティやリレーションシップ・マーケティングの研究を整理したうえで、D2C(メーカーが消費者に直接販売する事業)の事業者への調査から LTV を高めるビジネスモデルを論じ、LTV の視点で見る重要な成果指標にも触れています。この章で固定した LTV の定義を、計算の外側にある「顧客とどう関係を続けるか」という事業の設計の問題につなげて考えるのに向いています。
『マーケティング・サイエンス入門 新版:市場対応の科学的マネジメント』(古川一郎・守口剛・阿部誠、有斐閣):データと論理に基づいて市場をとらえるマーケティング・サイエンスの考え方と手法を、マーケティング計画の流れに沿って解説する入門書です。消費者行動、マーケティング情報の収集と活用、テストとコントロールなどの章に加えて、データベース・マーケティングの章があります。この章で示した手法の地図を、顧客分析だけでなくマーケティングの意思決定全体の中に位置づけ直すのに向いています。
第3章 顧客データを集めて整える
『データマネジメント知識体系ガイド 第2版 改定新版』(DAMA International 編著、DAMA日本支部・Metafindコンサルティング株式会社 監訳、日経BP):データマネジメントの知識体系をまとめた本で、データ取扱倫理、データガバナンス、データアーキテクチャ、データモデリングとデザインなどの章を持ちます。この章で扱った「誰がどの数字の持ち主か」「定義をどう統一するか」を、組織の仕組みとして考えるための枠組みが得られます。
『前処理大全 SQL/pandas/Polars実践テクニック 改訂新版』(本橋智光・橋本秀太郎 著、技術評論社):分析の前のデータの加工を、SQL・pandas・Polarsの3つで書き分けて示す本です。この章の、顧客月の行を作る、連続した月数を数える、重複や抜けを点検する、といった作業を、自社のデータベースや分析環境で書くときの手引きになります。
『新・個人情報保護法の逐条解説』(宇賀克也 著、有斐閣):令和2年と令和3年の改正に対応した個人情報保護法を、条文ごとに解説した本です。この章で触れた利用目的の特定、利用目的による制限、取得に際しての利用目的の通知、安全管理措置の各条を、条文の趣旨から確かめるのに向いています。出版後の改正については、e-Gov 法令検索の最新の条文と、個人情報保護委員会のガイドラインで確かめる必要があります。
第4章 コホート分析で継続率の推移を読む
『Lean Analytics スタートアップのためのデータ解析と活用法』(アリステア・クロール、ベンジャミン・ヨスコビッツ 著、角征典 訳、オライリー・ジャパン):事業の段階とビジネスモデルごとに、どの指標を追うべきかを整理した本です。2章の「セグメント・コホート・A/Bテスト・多変量解析」の節でコホートの考え方を扱い、SaaS などのモデルの章でチャーン(解約)を、18章で顧客ライフタイムバリューと顧客獲得コストの関係を扱っています。この章のコホート表を、事業の指標の体系の中で位置づけ直すのに向いています。
『Hacking Growth グロースハック完全読本』(ショーン・エリス、モーガン・ブラウン 著、門脇弘典 訳、日経BP社):成長のための実験を組織で高速に回す方法を、獲得・活性化・維持(リテンション)・収益化の段階に分けて解説した本です。第7章「維持(リテンション)をハックする」が顧客の維持を扱っています。この章で見た加入直後の離脱を、獲得・活性化・維持のどの段階の問題として捉え、どう実験で改善していくかを考えるのに向いています。
第5章 解約率の正しい測り方、打ち切りと生存分析
『生存時間解析 第2版』(大橋靖雄・浜田知久馬・魚住龍史、東京大学出版会):生存時間解析の基本概念と用語から始め、第2章で生存関数のノンパラメトリックな推定と検定、第3章でコックス回帰を扱う教科書で、付録には境界内平均生存時間(RMST)も入っています。SAS のプログラムで書かれていますが、この章で扱った、打ち切りのあるデータから生存関数を推定し、グループ間の差を検定する考え方を、日本語で体系立てて確かめるのに向いています。
『生存時間解析入門 原書第2版』(デビッド・ホスマー、スタンリー・レメショウ、スーザン・メイ 著、五所正彦 監訳、東京大学出版会):Hosmer らの生存時間解析の教科書の第2版の全訳で、第2章で生存時間データの記述法を、第3章以降で比例ハザードモデルとその解釈・モデル構築・妥当性の評価を扱います。この章のカプラン・マイヤー推定から、第6章のハザードモデルへ進むときの橋渡しになります。
第6章 離脱の要因を探る、ハザードモデルと説明変数
『エモリー大学クラインバウム教授の生存時間解析 基礎から学べる教科書』(David G. Kleinbaum・Mitchel Klein 著、神田英一郎・藤井朋子 訳、サイエンティスト社):生存時間解析を独習できるように書かれた教科書の原著第3版の翻訳です。原著の目次には、Cox 比例ハザードモデルとその性質、比例ハザードの仮定の評価、時間依存の説明変数への Cox のモデルの拡張の章があり、この章で扱ったハザード比の読み方、初回クーポンのように仮定が崩れる場合の確かめ方と対処を、順を追って学び直すのに向いています。
『イベント・ヒストリー分析』(Paul D. Allison 著、福田亘孝 訳、共立出版):社会科学の計量分析の叢書「計量分析One Point」の1冊で、原著第2版の翻訳です。原著の目次には、離散時間の手法、連続時間のデータのためのパラメトリックな手法、Cox 回帰、複数の種類のイベント、繰り返し起きるイベントの章が並んでいます。この章の離散時間ハザードモデル(顧客月のデータにロジスティック回帰を当てる方法)を Cox のモデルと並べて位置づけ直すのに向いています。本文で触れた1982年の論文の著者による本です。
第7章 解約を予測する、機械学習モデルの設計と評価
『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社):評価指標と KPI の関係から始めて、二値分類の章で正解率・適合率・再現率・ROC-AUC・PR-AUC などを扱い、同じ章でビジネスへの影響の期待値の計算や、誤りの費用を考えた学習にも触れている本です。この章の「正答率を使わない理由」「AUC と AP(平均適合率)の違い」を掘り下げ、第8章の期待値の計算へ橋をかけるのに向いています。
『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社):データ分析のコンペティション(Kaggle)で使われる技術をまとめた本で、評価指標の章に加えて、バリデーションの章で時系列データの検証の分け方とその落とし穴を、別の節でリーク(情報の漏れ)を扱っています。この章のスナップショットの学習と検証を時間で分ける理由、未来の情報が特徴量に混ざる問題を、より多くの例で確かめるのに向いています。
第8章 予測を施策につなぐ、対象の選び方と費用対効果
『戦略的データサイエンス入門』(Foster Provost、Tom Fawcett 著、竹田正和 監訳、オライリー・ジャパン):データ分析をビジネスの意思決定に使うための考え方を、事例とともに解説した本です。分類器を使う枠組みとしての期待値、利益曲線、顧客の乗り換え(解約)の予測と性能分析を扱う節があり、この章の「施策を打つ価値は、施策ありとなしの期待粗利の差から費用を引いたもの(概算では、施策による解約確率の下がり幅×残存価値から費用を引いたもの)」という考え方や、対象の割合 k を変えたときの純増の曲線を、より一般的な形で学べます。
『意思決定理論入門』(イツァーク・ギルボア 著、川越敏司・佐々木俊一郎 訳、NTT出版):期待効用理論、ベイズの定理、プロスペクト理論などの意思決定理論の基礎を、数式をほとんど使わずに問題集形式で解説した本です。リスク下の意思決定と不確実性下の意思決定を章を分けて扱っており、この章の期待値による判断が、どのような前提の上に立っているのか、確率が分からないときにどう考えるのかを見直すのに向いています。
第9章 生涯価値(LTV)を計算する、契約型の顧客
『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』(マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社):マーケティングの成果を測る指標を15に絞って解説した本です。版元の目次では、第5章で正味現在価値(NPV)・内部収益率(IRR)・投資回収期間を「マーケティング担当者向けの財務系指標」として扱い、第6章で顧客生涯価値の定義を扱っています。この章の割引・回収月数と LTV を、マーケティングの投資判断の言葉で整理し直すのに向いています。
『コーポレートファイナンス入門〈第2版〉』(砂川伸幸 著、日本経済新聞出版社、日経文庫):企業財務の考え方を新書の分量でまとめた入門書です。版元ドットコムの目次では、「キャッシュフローの割引現在価値」「企業の投資決定」の章があります。この章で LTV の定義に入れた割引率を、資本コストや投資の判断というファイナンスの枠組みの中で理解し直し、財務の部門と同じ言葉で獲得費用を議論するための土台になります。
第10章 購買履歴から生涯価値を推定する、非契約型の顧客とBG/NBD
『データ解析のための統計モデリング入門 一般化線形モデル・階層ベイズモデル・MCMC』(久保拓弥、岩波書店):確率分布と最尤推定(第2章)から始めて、一般化線形混合モデル(第7章)、MCMC 法とベイズ統計モデル(第8章)、階層ベイズモデル(第10章)へ進む教科書です。この章の BG/NBD とガンマ・ガンマは、「人ごとに違う値」を確率分布で表し、その分布のパラメータを最尤推定で求めるモデルでした。同じ考え方を一般の統計モデルの中で学び直すのに向いていて、PyMC-Marketing のように MCMC で推定するときの考え方の土台にもなります。
『マーケティングの統計モデル』(佐藤忠彦、朝倉書店):統計解析スタンダードのシリーズの1冊で、統計モデルの基本事項、消費者の市場反応・選択行動・セグメンテーションのモデル化、ベイズモデルによるマーケティング現象のモデル化を扱い、付録で確率分布の基本事項を整理しています。版元の目次には、回数のデータを扱うポアソン回帰の節もあります。購買の記録を確率モデルで読むというこの章の発想を、マーケティングの他の問題にも広げて学ぶのに向いています。
第11章 顧客の価値の分布を見て、施策の優先順位を決める
『カスタマー・エクイティ ブランド、顧客価値、リテンションを統合する』(ローランド・T.ラスト、バレリー・A.ザイタムル、キャサリン・N.レモン著、近藤隆雄訳、ダイヤモンド社):原題は Driving Customer Equity です。同じ著者らが2004年に学術誌 Journal of Marketing に発表した論文の要旨では、カスタマー・エクイティは現在と将来の顧客の生涯価値を合計したものとされ、マーケティングの選択肢を「カスタマー・エクイティの増分÷そのために追加で使う費用」で比べる枠組みが示されています。本書は副題のとおり、ブランド・顧客価値・リテンション(引き止め)を1つの枠組みで扱います。この章で行った、獲得と引き止めを同じ粗利の物差しで比べ、顧客基盤全体の価値が増える使い道に予算を配るという発想を、マーケティングの戦略の側から整理し直すのに向いています。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画・非線形計画・整数計画と組合せ最適化を、問題の定式化から解き方まで扱った教科書です。整数計画と組合せ最適化の章で、貪欲法やナップサック問題、分枝限定法を扱っています。この章の「費用が全員同じなら並べるだけで最適、費用が違うと並べるだけでは最適にならない」という結果がなぜ起きるのかを、ナップサック問題の性質と解き方から理解するのに向いています。
『意思決定分析と予測の活用 基礎理論からPython実装まで』(馬場真哉、講談社):期待値に基づく意思決定、情報の価値、コスト/ロスモデルと予測の価値、確率予測の活用などを、Python の実装とともに扱う本です。この章の期待純増は、「予測された解約確率をもとに、施策を当てる・当てないの2択を期待値で決める」問題で、予測の確率をどう判断の損得に結びつけるかを、決定分析の枠組みで学び直すのに向いています。
第12章 施策の効果を確かめる、実験と効果の持続
『RCT大全 ランダム化比較試験は世界をどう変えたのか』(アンドリュー・リー 著、上原裕美子 訳、みすず書房):被験者を2つのグループに無作為に割り当てて介入の効果を測るランダム化比較試験が、医療・教育・経済・産業などの分野でどう使われてきたかを紹介する本です。目次には「農場と企業とフェイスブック」の章があり、巻末には「RCT実施の10の掟」が収められています。この章のホールドアウトの考え方を、数式を使わずに経営の言葉で説明するときの材料になります。
『入門サンプルサイズ設計 基本理論から計算方法まで』(山本紘司 著、東京図書):検出力に基づくサンプルサイズ設計と、信頼区間に基づくサンプルサイズ設計を章を分けて扱い、各種の検定の検出力の導出や、シミュレーションによるサンプルサイズ設計の章も設けた入門書です。この章で NormalIndPower を使って計算した必要人数と、1回きりの実験を繰り返して有意になる割合を数えた方法を、理論の側から確かめ直すのに向いています。
第13章 顧客分析を組織で使い続ける
『カスタマーサクセス サブスクリプション時代に求められる「顧客の成功」10の原則』(ニック・メータ、ダン・スタインマン、リンカーン・マーフィー 著、バーチャレクス・コンサルティング株式会社 訳、英治出版):既存顧客の保持が重要になる定期収益型の事業で、顧客を積極的に支援する考え方と、そのための組織とマネジメントを扱った本です。目次には、カスタマーサクセスの組織や、定期収益型でない事業での適用を扱う章があります。この章で扱った CS・CRM の役割と、解約の数字を誰が持つかを考えるときの材料になります。
『THE MODEL マーケティング・インサイドセールス・営業・カスタマーサクセスの共業プロセス』(福田康隆 著、翔泳社):書名のとおり、マーケティング・インサイドセールス・営業・カスタマーサクセスの各部門が分業しながら連携する仕組みを扱った本です。この章で触れた、獲得の担当と既存顧客の担当の評価が分かれていると、獲得の判断の結果が数か月遅れて別の部門の数字に表れるという問題を、部門のつなぎ方の側から考えるときに参考になります。
第14章 事例と最新動向
『あのサービスはなぜ継続率が高いのか? 顧客の習慣化を促すハビットデザインメソッド』(松迫崇道 著、日本実業出版社):2025年12月に刊行された、利用者の使用の習慣を設計して、使い続けてもらえるサービスをつくることを主題にした本です(NDL サーチに載っている版元の内容紹介による)。この記事で測ってきた継続率を上げ、解約のハザードを下げるにはどうすればよいかを、施策の側から考える材料になります。この章の統計の節で触れたとおり、解約の手続きを分かりにくくするのではなく、使い続けたいと思う理由を増やすことで解約のハザードを下げる、という方向を考えるのに向いています。
『Pythonで体験するベイズ推論 PyMCによるMCMC入門』(キャメロン・デビッドソン=ピロン 著、玉木徹 訳、森北出版):原書は、この章で紹介した lifelines と lifetimes と同じ GitHub のアカウントで公開されているベイズ推論の入門書で、Python の PyMC を使ってベイズ推論の考え方と MCMC の仕組みを、数式より計算を先に立てて解説しています。PyMC-Marketing の CLV モジュールが出す事後分布や在籍確率の幅を、どういう計算から出てきたものかを理解して読むための準備に向いています。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 矢野経済研究所のサブスクリプションサービス市場の調査(2023年12月18日公表)
https://www.yano.co.jp/press-release/show/press_id/3416 - 参考書籍『顧客投資マネジメント 顧客価値の可視化によるファイナンスとマーケティングの融合』スニル・グプタ、ドナルド・R.レーマン 著、スカイライトコンサルティング株式会社 訳、英治出版、2005年
https://ndlsearch.ndl.go.jp/books/R100000002-I000007957530 - 同書の目次
https://www.kinokuniya.co.jp/f/dsg-01-9784901234740 - 参考書籍『カスタマーセントリシティ 「正しい顧客」に集中する経営戦略』ピーター・フェーダー 著、倉橋健太 監訳、三本木亮 訳、ダイヤモンド社、2026年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I034756722 - 同書の目次と著者紹介
https://www.diamond.co.jp/book/9784478123980.html
第2章
- Fader と Hardie の講習会資料による契約型と非契約型の区別
https://www.brucehardie.com/talks/cba_tut_art_16_HO.pdf - 離散的な時点でしか購買が記録されない非契約型の顧客基盤分析の論文(Fader・Hardie・Shang、2010年、Marketing Science)
https://www.brucehardie.com/papers/020/ - 確率モデルによる顧客基盤分析の概説論文(Fader・Hardie、2009年、Journal of Interactive Marketing)
https://doi.org/10.1016/j.intmar.2008.11.003 - 顧客の購買回数と離脱を同時に扱う BG/NBD モデルの論文(Fader・Hardie・Lee、2005年、Marketing Science)
https://doi.org/10.1287/mksc.1040.0098 - 書籍『顧客生涯価値マーケティング:持続的な関係性をつくる』岩永洋平、中央経済社
https://www.biz-book.jp/isbn/978-4-502-53761-5 - 書籍『マーケティング・サイエンス入門 新版:市場対応の科学的マネジメント』古川一郎・守口剛・阿部誠、有斐閣
https://www.yuhikaku.co.jp/book/b10187848.html
第3章
- 個人情報の保護に関する法律(平成十五年法律第五十七号)の法令名と法令番号
https://laws.e-gov.go.jp/law/415AC0000000057 - 個人情報保護委員会 ガイドライン通則編の版(平成28年11月、令和8年6月一部改正)
https://www.ppc.go.jp/personalinfo/legal/guidelines_tsusoku/ - データマネジメント知識体系ガイド 第2版 改定新版(DAMA International 編著、DAMA日本支部・Metafindコンサルティング株式会社 監訳、日経BP、2024年7月)
https://ndlsearch.ndl.go.jp/books/R100000002-I033578813 - 前処理大全 SQL/pandas/Polars実践テクニック 改訂新版(本橋智光・橋本秀太郎 著、技術評論社、2024年6月)
https://ndlsearch.ndl.go.jp/books/R100000002-I033469943 - 新・個人情報保護法の逐条解説(宇賀克也 著、有斐閣、2021年12月)
https://ndlsearch.ndl.go.jp/books/R100000002-I031859638
第4章
- 参考書籍 Lean Analytics スタートアップのためのデータ解析と活用法
https://ndlsearch.ndl.go.jp/books/R100000002-I026034035 - 同書の目次 2.8節 セグメント・コホート・A/Bテスト・多変量解析、9.2節 チャーン、18.4節 顧客ライフタイムバリューと顧客獲得コスト
https://www.oreilly.co.jp/books/9784873117119/ - 参考書籍 Hacking Growth グロースハック完全読本
https://ndlsearch.ndl.go.jp/books/R100000002-I029216726 - 同書の目次 第7章 維持(リテンション)をハックする
https://bookplus.nikkei.com/atcl/catalog/18/P55820/
第5章
- カプラン・マイヤー推定の由来となった1958年の Kaplan と Meier の論文(米国の統計学の学術誌 第53巻第282号 457〜481ページ)
https://doi.org/10.1080/01621459.1958.10501452 - statsmodels の SurvfuncRight の公式ドキュメント(exog を渡さないときは標準的なカプラン・マイヤー推定量を使う
https://www.statsmodels.org/stable/generated/statsmodels.duration.survfunc.SurvfuncRight.html - statsmodels の survdiff の公式ドキュメント(既定はログランク検定、引数 strata で層別、戻り値は統計量とp値
https://www.statsmodels.org/stable/generated/statsmodels.duration.survfunc.survdiff.html - 生存時間解析 第2版(大橋靖雄・浜田知久馬・魚住龍史、東京大学出版会、2022年)
https://ndlsearch.ndl.go.jp/books/R100000002-I032326362 - 生存時間解析入門 原書第2版(デビッド・ホスマー、スタンリー・レメショウ、スーザン・メイ 著、五所正彦 監訳、東京大学出版会、2014年)
https://ndlsearch.ndl.go.jp/books/R100000002-I025390129
第6章
- Cox が1972年に英国王立統計学会の学会誌シリーズBに発表した回帰モデルと生命表の論文
https://doi.org/10.1111/j.2517-6161.1972.tb00899.x - 離散時間の手法を題にした1982年の Paul Allison の論文
https://doi.org/10.2307/270718 - statsmodels の PHReg の引数(status・entry・strata・ties
https://www.statsmodels.org/stable/generated/statsmodels.duration.hazard_regression.PHReg.html - PHReg の推定結果の係数はそれぞれ対数のハザード比に当たる
https://www.statsmodels.org/stable/generated/statsmodels.duration.hazard_regression.PHRegResults.html - statsmodels の生存分析のモジュールの一覧
https://www.statsmodels.org/stable/duration.html - statsmodels の Logit
https://www.statsmodels.org/stable/generated/statsmodels.discrete.discrete_model.Logit.html - エモリー大学クラインバウム教授の生存時間解析 基礎から学べる教科書(Kleinbaum・Klein 著、神田英一郎・藤井朋子 訳、サイエンティスト社)
https://ndlsearch.ndl.go.jp/books/R100000002-I034056614 - 上の本の原著第3版の目次(Cox 比例ハザードモデル、比例ハザードの仮定の評価、時間依存の説明変数への拡張の章)
https://link.springer.com/book/10.1007/978-1-4419-6646-9 - イベント・ヒストリー分析(Paul D. Allison 著、福田亘孝 訳、共立出版、計量分析One Point)
https://ndlsearch.ndl.go.jp/books/R100000002-I031736735 - 上の本の原著第2版の目次(離散時間の手法、連続時間のパラメトリックな手法、Cox 回帰、複数の種類のイベント、繰り返し起きるイベント)
https://woodslane.com.au/products/9781412997706
第7章
- scikit-learn の roc_auc_score は予測スコアから ROC 曲線の下の面積を計算する
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.roc_auc_score.html - AUC は無作為に選んだ正例と負例について正例を上位に並べる確率と言い換えられ、0.5は当てずっぽうと同じ
https://developers.google.com/machine-learning/crash-course/classification/roc-and-auc - scikit-learn の average_precision_score が計算する AP(平均適合率)は各閾値の適合率を再現率の増分で重み付けした平均で、台形で面積を求める計算とは異なる
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.average_precision_score.html - 較正の意味と、scikit-learn の calibration_curve・CalibratedClassifierCV
https://scikit-learn.org/stable/modules/calibration.html - ブライアスコアは予測確率と実際の結果の差の2乗の平均で、小さいほど良い
https://scikit-learn.org/stable/modules/generated/sklearn.metrics.brier_score_loss.html - LogisticRegression の class_weight=”balanced” は正例と負例の数の比に応じて自動で重みを付ける
https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.LogisticRegression.html - TimeSeriesSplit は未来のデータで学習して過去のデータで評価することを避ける分け方で、gap で間を空けられる
https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.TimeSeriesSplit.html - train_test_split は行を無作為に学習と検証に分ける
https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.train_test_split.html - LightGBM の既定の学習法は勾配ブースティング決定木で、木の数・学習率・葉の数の上限・葉ごとの最小の行数などを指定できる
https://lightgbm.readthedocs.io/en/stable/pythonapi/lightgbm.LGBMClassifier.html - LightGBM の重要度は分岐に使われた回数(split)と分岐による利得の合計(gain)を選べる
https://lightgbm.readthedocs.io/en/stable/pythonapi/lightgbm.Booster.html - SHAP の TreeExplainer は木のモデルの予測を特徴量ごとの寄与に分け、寄与の合計と基準値の和がモデルの出力になる
https://shap.readthedocs.io/en/latest/generated/shap.TreeExplainer.html - 『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社、2023年)
https://ndlsearch.ndl.go.jp/books/R100000002-I032637452 - 『評価指標入門 データサイエンスとビジネスをつなぐ架け橋』(高柳慎一・長田怜士 著、ホクソエム 監修、技術評論社、2023年)
https://gihyo.jp/book/2023/978-4-297-13314-6 - 『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社、2019年)
https://ndlsearch.ndl.go.jp/books/R100000002-I029976550 - 『Kaggleで勝つデータ分析の技術』(門脇大輔・阪田隆司・保坂桂佑・平松雄司 著、技術評論社、2019年)
https://gihyo.jp/book/2019/978-4-297-10843-4
第8章
- Provost と Fawcett の教科書の日本語版『戦略的データサイエンス入門』に、分類器を使う枠組みとしての期待値、利益曲線、乗り換えの予測の節がある
https://www.oreilly.co.jp/books/9784873116853/ - 『戦略的データサイエンス入門』の書誌 Foster Provost、Tom Fawcett 著、竹田正和 監訳、オライリー・ジャパン、2014年
https://ndlsearch.ndl.go.jp/books/R100000002-I025570538 - 『意思決定理論入門』の書誌 イツァーク・ギルボア 著、川越敏司・佐々木俊一郎 訳、NTT出版、2012年
https://ndlsearch.ndl.go.jp/books/R100000002-I023742999 - 『意思決定理論入門』は問題集形式で期待効用理論・ベイズの定理・プロスペクト理論を数式をほとんど使わずに解説、リスク下の意思決定と不確実性下の意思決定の章がある
https://www.kinokuniya.co.jp/f/dsg-01-9784757122826 - Radcliffe と Surry の2011年の技術報告書が、携帯電話の解約抑止の施策が導入前に解約率を9%から10%へ上げていた報告と、3割に絞って全体の解約率が9%から8%未満、費用が7割減った報告を紹介(6ページ)
https://stochasticsolutions.com/pdf/sig-based-up-trees.pdf - 単純なモンテカルロ法の推定は回数が少なくても平均としては偏らず、回数が少ないと揺れが大きくなる(Art Owen のモンテカルロ法の教科書の第2章)
https://artowen.su.domains/mc/Ch-intro.pdf
第9章
- 割引率は対象のキャッシュフローのリスクに応じて置き、リスクの高いキャッシュフローほど高い率で割り引く(ニューヨーク大学の Damodaran の評価の資料)
https://pages.stern.nyu.edu/~adamodar/New_Home_Page/problems/dcfprob.htm - 参考書籍『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社、2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I028101232 - 参考書籍『データ・ドリブン・マーケティング:最低限知っておくべき15の指標』マーク・ジェフリー 著、佐藤純・矢倉純之介・内田彩香 共訳、ダイヤモンド社、2017年
https://www.diamond.co.jp/book/9784478039632.html - 参考書籍『コーポレートファイナンス入門〈第2版〉』砂川伸幸 著、日本経済新聞出版社、日経文庫、2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I027818430 - 参考書籍『コーポレートファイナンス入門〈第2版〉』砂川伸幸 著、日本経済新聞出版社、日経文庫、2017年
https://www.hanmoto.com/bd/isbn/9784532113681
第10章
- 顧客の購買回数と離脱を同時に扱う2005年の Fader・Hardie・Lee の論文(BG/NBD モデルの原論文)
https://doi.org/10.1287/mksc.1040.0098 - 顧客の購買回数と離脱を同時に扱う2005年の Fader・Hardie・Lee の論文(BG/NBD モデルの原論文)
http://brucehardie.com/papers/018/fader_et_al_mksc_05.pdf - Schmittlein・Morrison・Colombo の1987年のモデル(Pareto/NBD)
http://brucehardie.com/notes/021/palive_for_BGNBD.pdf - リピート購買の無い顧客を扱うよう BG/NBD を修正した2007年の Batislam・Denizel・Filiztekin の論文(MBG/NBD)
https://doi.org/10.1016/j.ijresmar.2006.12.005 - リピート購買の無い顧客を扱うよう BG/NBD を修正した2007年の Batislam・Denizel・Filiztekin の論文(MBG/NBD)
https://research.sabanciuniv.edu/id/eprint/20/ - 同じ学術誌の2008年の号に Wagner・Hoppe による訂正の指摘と Batislam らの回答がある
https://doi.org/10.1016/j.ijresmar.2008.06.003 - Fader と Hardie の2013年のガンマ・ガンマモデルのノート
http://brucehardie.com/notes/025/gamma_gamma.pdf - lifetimes の公式ドキュメントのクイックスタート
https://lifetimes.readthedocs.io/en/latest/Quickstart.html - lifetimes はアーカイブの状態で新しい機能の追加や改善、問い合わせへの回答も行わず、後継として PyMC-Marketing を案内、2024年6月28日にアーカイブ
https://github.com/CamDavidsonPilon/lifetimes - PyMC-Marketing の CLV モジュールのモデルの一覧
https://www.pymc-marketing.io/en/stable/api/generated/pymc_marketing.clv.models.html - PyMC-Marketing の CLV モジュールの関数
https://www.pymc-marketing.io/en/stable/api/generated/pymc_marketing.clv.utils.html - PyMC-Marketing の BetaGeoModel
https://www.pymc-marketing.io/en/stable/api/generated/pymc_marketing.clv.models.beta_geo.BetaGeoModel.html - R の BTYD パッケージ
https://cran.r-project.org/package=BTYD - 『データ解析のための統計モデリング入門 一般化線形モデル・階層ベイズモデル・MCMC』(久保拓弥、岩波書店)
https://www.iwanami.co.jp/book/b257893.html - 『マーケティングの統計モデル』(佐藤忠彦、朝倉書店)
https://www.asakura.co.jp/detail.php?book_code=12853
第11章
- PuLP の配布ページの説明 以前の版に同梱されていた CBC と PULP_CBC_CMD は取り除かれた
https://pypi.org/project/PuLP/ - カスタマー・エクイティは現在と将来の顧客の生涯価値の合計で、マーケティングの選択肢をその増分と追加の費用で比べる枠組み
https://doi.org/10.1509/jmkg.68.1.109.24030 - 『カスタマー・エクイティ ブランド、顧客価値、リテンションを統合する』ローランド・T.ラスト、バレリー・A.ザイタムル、キャサリン・N.レモン著、近藤隆雄訳、ダイヤモンド社
https://ndlsearch.ndl.go.jp/books/R100000002-I000003021210 - 『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』梅谷俊治、講談社
https://ndlsearch.ndl.go.jp/books/R100000002-I030691339 - 『しっかり学ぶ数理最適化』の目次
https://www.kspub.co.jp/book/detail/5212707.html - 『意思決定分析と予測の活用 基礎理論からPython実装まで』馬場真哉著、講談社
https://ndlsearch.ndl.go.jp/books/R100000002-I031281307
第12章
- statsmodels の proportion_effectsize による比率の差の効果量 h の式
https://www.statsmodels.org/stable/generated/statsmodels.stats.proportion.proportion_effectsize.html - statsmodels の NormalIndPower の solve_power は指定しなかった引数を解き、検出力は対立仮説が正しいときに帰無仮説を正しく棄却する確率
https://www.statsmodels.org/stable/generated/statsmodels.stats.power.NormalIndPower.solve_power.html - statsmodels の proportions_ztest は比率の差を正規近似で検定する
https://www.statsmodels.org/stable/generated/statsmodels.stats.proportion.proportions_ztest.html - scipy の ttest_ind で equal_var=False とすると Welch の t 検定
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.ttest_ind.html - statsmodels の confint_proportions_2indep で2つの比率の差の信頼区間を計算する
https://www.statsmodels.org/stable/generated/statsmodels.stats.proportion.confint_proportions_2indep.html - 差の差の中心の仮定は平行トレンドで、時間によらない2群の水準の違いは問題にならない
https://pmc.ncbi.nlm.nih.gov/articles/PMC8522571/ - 傾向スコアの方法は、測っていない交絡が無いという仮定と、各人が施策を受ける確率が0でも1でもないという条件を必要とする
https://pmc.ncbi.nlm.nih.gov/articles/PMC3144483/ - 『RCT大全 ランダム化比較試験は世界をどう変えたのか』アンドリュー・リー 著、上原裕美子 訳、みすず書房、2020年
https://ndlsearch.ndl.go.jp/books/R100000002-I030617819 - 『RCT大全 ランダム化比較試験は世界をどう変えたのか』アンドリュー・リー 著、上原裕美子 訳、みすず書房、2020年
https://www.msz.co.jp/book/detail/08933/ - 『入門サンプルサイズ設計 基本理論から計算方法まで』山本紘司 著、東京図書、2024年
https://ndlsearch.ndl.go.jp/books/R100000002-I033572388 - 『入門サンプルサイズ設計 基本理論から計算方法まで』山本紘司 著、東京図書、2024年
https://www.kinokuniya.co.jp/f/dsg-01-9784489024238
第13章
- 機械学習の継続的デリバリーと自動化のパイプラインを解説した Google Cloud の文書
https://docs.cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning - 個人情報保護法の条文(e-Gov 法令検索)
https://laws.e-gov.go.jp/law/415AC0000000057 - 個人情報保護委員会 仮名加工情報・匿名加工情報についてのガイドライン
https://www.ppc.go.jp/personalinfo/legal/guidelines_anonymous/ - カスタマーサクセス サブスクリプション時代に求められる「顧客の成功」10の原則
https://ndlsearch.ndl.go.jp/books/R100000002-I028994194 - カスタマーサクセスの版元の書誌
https://eijipress.co.jp/products/2260 - THE MODEL マーケティング・インサイドセールス・営業・カスタマーサクセスの共業プロセス
https://ndlsearch.ndl.go.jp/books/R100000002-I029449647
第14章
- lifelines の公式ドキュメント
https://lifelines.readthedocs.io/en/latest/ - lifelines の API の一覧
https://lifelines.readthedocs.io/en/latest/References.html - lifelines の公式リポジトリ
https://github.com/CamDavidsonPilon/lifelines - lifelines の最新版
https://pypi.org/pypi/lifelines/json - scikit-survival の公式ドキュメント
https://scikit-survival.readthedocs.io/en/stable/ - scikit-survival の API の一覧
https://scikit-survival.readthedocs.io/en/stable/api/index.html - scikit-survival の最新版
https://pypi.org/pypi/scikit-survival/json - statsmodels の生存分析の機能
https://www.statsmodels.org/stable/duration.html - statsmodels の最新版
https://pypi.org/pypi/statsmodels/json - lifetimes の公式リポジトリ
https://github.com/CamDavidsonPilon/lifetimes - lifetimes のモデルの一覧
https://lifetimes.readthedocs.io/en/latest/lifetimes.fitters.html - lifetimes の最後の版
https://pypi.org/pypi/lifetimes/json - PyMC-Marketing の CLV モジュール
https://www.pymc-marketing.io/en/stable/api/generated/pymc_marketing.clv.html - PyMC-Marketing の公式リポジトリ
https://github.com/pymc-labs/pymc-marketing - PyMC-Marketing の最新版
https://pypi.org/pypi/pymc-marketing/json - R の BTYD パッケージ
https://CRAN.R-project.org/package=BTYD - GA4 の予測指標の定義
https://support.google.com/analytics/answer/9846734?hl=ja - GA4 の予測指標の前提条件
https://support.google.com/analytics/answer/9846734?hl=en - Dynamics 365 Customer Insights の予測の一覧
https://learn.microsoft.com/ja-jp/dynamics365/customer-insights/data/predictions - Dynamics 365 Customer Insights のサブスクリプションの離反の予測
https://learn.microsoft.com/ja-jp/dynamics365/customer-insights/data/predict-subscription-churn - Dynamics 365 Customer Insights の顧客生涯価値の予測
https://learn.microsoft.com/ja-jp/dynamics365/customer-insights/data/predict-customer-lifetime-value - Dynamics 365 Customer Insights のトランザクションの離反の予測
https://learn.microsoft.com/ja-jp/dynamics365/customer-insights/data/predict-transactional-churn - BigQuery ML の概要のページ
https://cloud.google.com/bigquery/docs/bqml-introduction - ASOS の顧客生涯価値の予測の仕組みの論文
https://arxiv.org/abs/1703.02596 - シリコンスタジオの論文の予測の対象と離脱の定義
https://arxiv.org/html/1710.02264v1 - 競合リスクは1つの出発の状態から複数の終わりの状態の1つへ1回だけ移る場合で、多状態モデルはその先の移り変わりも扱う
https://cran.r-project.org/web/packages/survival/vignettes/compete.pdf - シリコンスタジオの離脱予測の論文
https://arxiv.org/abs/1710.02264 - Google の研究者の顧客生涯価値の論文
https://arxiv.org/abs/1912.07753 - Google の顧客生涯価値の公開リポジトリ
https://github.com/google/lifetime_value - Ascarza の2018年の論文
https://doi.org/10.1509/jmr.16.0163 - 阿部誠の2009年の論文
https://doi.org/10.1287/mksc.1090.0502 - Cox 比例ハザードの深層ニューラルネットワーク DeepSurv
https://arxiv.org/abs/1606.00931 - 競合リスクを扱う深層学習の生存分析 DeepHit
https://doi.org/10.1609/aaai.v32i1.11842 - 系列データと深層ニューラルネットワークによる解約予測の比較
https://arxiv.org/abs/1909.11114 - 深層生存分析の入門の論文
https://arxiv.org/abs/2410.01086 - まだ活動している顧客を数えるモデルの1987年の論文
https://doi.org/10.1287/mnsc.33.1.1 - BG/NBD モデルの2005年の論文
https://doi.org/10.1287/mksc.1040.0098 - 顧客の継続率を延ばすシフト・ベータ幾何分布の2007年の論文
https://doi.org/10.1002/dir.20074 - 顧客基盤分析のモデルの実証的な検証と比較の2007年の論文
https://doi.org/10.1016/j.ijresmar.2006.12.005 - 国民生活センターの2025年度の消費生活相談の状況
https://www.kokusen.go.jp/pdf/n-20260805_1.pdf - 表形式の基盤モデルによる解約予測の比較
https://icml.cc/virtual/2026/71540 - 大規模言語モデルの埋め込みによる解約予測の論文
https://doi.org/10.3390/fi16120453 - 参考書籍 あのサービスはなぜ継続率が高いのか
https://ndlsearch.ndl.go.jp/books/R100000002-I034456953 - 参考書籍 Pythonで体験するベイズ推論
https://ndlsearch.ndl.go.jp/books/R100000002-I028069720 - 参考書籍の原書の公開元
https://github.com/CamDavidsonPilon/Probabilistic-Programming-and-Bayesian-Methods-for-Hackers