こんにちは、Anagraftの伊藤です。
今回は、限られた資金をどこにどれだけ振り向けるかという意思決定を、数理モデルの立場から整理しました。年金や余資のような資産の運用で、株式・債券・不動産といった資産クラスへの配分をどう決めるかという問題と、事業会社が設備投資・情報システム・研究開発・新規事業といった案件に3年間の予算をどう配分するかという問題は、一見すると別の仕事に見えます。しかしどちらも「見込みのリターンと、外れたときの損失を見比べながら、制約のもとで配分を決める」という同じ構造を持っています。本コラムでは、この2つを同じ数理の言葉で扱い、資産配分の理論で蓄積されてきた考え方を、事業投資の予算配分にも使える形で紹介します。
この題材を選んだ理由は、投資配分が企業の将来の収益を最も大きく左右する判断の一つでありながら、その決め方が前年の配分の踏襲、声の大きい部門への傾斜、NPV(正味現在価値)の順位表の上から予算が尽きるまで、といった慣習に委ねられていることが多いためです。原材料や金利の環境が動く局面では、どの資産にどれだけ置くか、どの案件を今年やってどの案件を見送るかという判断が毎年のように求められます。期待リターンの見込みは必ず外れます。外れることを前提に、どこまでを計算に任せ、どこから先を人が判断するかを見極める道具として、数理モデルの手法を紹介します。
各章では、2つの架空のデータを共通の題材にして、実際にコードを動かした結果を載せています。一つは、国内株式・外国株式・国内債券・外国債券・不動産投資信託・短期資産という6つの資産クラスの、20年分(240か月)の月次リターンの記録です。もう一つは、架空の中堅製造業が抱える30件の投資案件と、3年間の年度予算です。どちらも乱数で生成したもので、実在の市場や企業の記録ではなく、将来の予測でもありません。その代わり、データを作った側は「本当の分布」を知っているので、過去の記録から推定した見込みで決めた配分が、本当はどれだけのリターンや損失を生むかを答え合わせできます。現実の企業には本当の分布は見えませんので、推定の誤差が配分の判断をどれだけ狂わせるかを、この答え合わせで示すことにしました。
想定している読者は、経営企画や財務、事業企画、研究開発企画で投資案件の審査や予算配分に関わる方、企業年金や余資の運用方針について説明を受けたり承認したりする立場の方、投資委員会の資料を作る実務者の方、そしてこうした判断を仕組みとして整えたいDX推進担当の方です。金融工学やオペレーションズ・リサーチの専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にして言葉で言い換えています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各手法について「何を決める手法か」「どういう前提で使えるか」「使ってはいけないのはどういうときか」「結果を経営指標にどう翻訳するか」を書くようにしました。配分の理論の多くは教科書に載っていますが、実務で難しいのは、手元の記録で見込みをどこまで信じてよいのか、最適化の答えが一部の資産や案件に極端に偏ったときにどう扱うか、期待値だけでなく最悪のときの損失をどう見るか、現在の配分から動かす費用をどう織り込むかを見極めるところだと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムは投資や財務の助言ではありません。特定の金融商品や銘柄、特定の配分比率を勧めるものではなく、本コラムに出てくる期待リターン・リスク・投資額・NPVの数値は、すべて架空の設定による例題の値です。公的な制度として公表されている資産構成割合に触れる箇所は、事実の紹介にとどめています。実際の判断は、自社の状況を踏まえて専門家にご相談ください。本コラムの記述は2026年10月時点で確認したものです。制度や公的統計は更新がありますので、実務で使う際は所管の機関のページで最新の内容をご確認ください。ライブラリの関数名や引数も版によって変わります。計算時間は本コラムの実行環境で測った値であり、計算機が変われば変わります。
目的別の入口の目安を挙げておきます。投資配分を経営指標としてどう見るかを整理したい場合は、第1章と第13章が入口になります。自社の配分の問題がどの種類に当たるかを見極めたい場合は、第2章の分類をご覧ください。手元の記録から期待リターンやリスクの見込みをどこまで信じてよいかを知りたい場合は第3章、資産クラスへの配分を最適化の答えとして出したい場合は第4章と第5章、見込みに頼らずリスクの大きさで配分したい場合は第6章と第7章、取引コストや本数の上限といった現場の制約を入れたい場合は第8章、配分の見直しの頻度や乖離幅を決めたい場合は第9章が中心になります。
事業投資の案件をどう選ぶかは第10章、成功確率のある研究開発や新規事業のテーマの選び方は第11章、見込みが外れたときの損失まで含めて案件を選びたい場合は第12章が入口です。投資委員会や事後評価といった運用の仕組みは第13章、公開された事例と研究の動向は第14章で扱っています。

目次
- 序章 投資配分は、推定の上で決める変数である
- 全体の地図
- 第1章 投資配分はなぜ経営の問題なのか
- 第2章 投資配分の問題を記述する
- 第3章 リターンとリスクを推定する
- 第4章 平均分散最適化とその弱点
- 第5章 推定誤差に強くする
- 第6章 リスクで配分する
- 第7章 下方リスクと CVaR で配分する
- 第8章 取引コスト・保有制約・銘柄数の上限
- 第9章 多期間の配分とリバランス
- 第10章 事業投資案件の選択
- 第11章 研究開発テーマと新規事業のポートフォリオ
- 第12章 不確実性のもとで事業に配分する
- 第13章 現場に入れる
- 第14章 事例と最新動向
- 終章 投資配分の判断を、前提を記録して測り直す仕組みにする
- 本コラムで紹介した書籍一覧
- 参考情報
序章 投資配分は、推定の上で決める変数である
企業が将来の収益のために使える資金には限りがあります。年金や余資の運用であれば、株式・債券・不動産といった資産クラスにどれだけずつ置くか。事業であれば、設備の更新、新しい工場、情報システム、研究開発、新規事業といった案件に、今年と来年の予算をどう振り向けるか。どちらも、一つの資産や案件に置いた資金は別の用途には使えないという意味で、配分の判断です。そしてどちらも、置いた先がどれだけの収益を生むかは、決める時点では見込みでしか分かりません。限られた資金を、見込みのリターンと外れたときの損失を見比べながら、制約のもとで配分する仕事、すなわちポートフォリオ最適化が、本コラムの主題です。
資産の運用と事業への投資は、担当する部署も使う言葉も違います。しかし数理モデルの立場から見ると、決めるもの(どこに・いくら)、守るべき制約(合計、上下限、予算、前提となる案件、同時に選べない案件)、目的(期待されるリターンや正味現在価値を大きく、外れたときの損失を小さく)という3つの部品で書ける点は同じです。本コラムでは、この共通の構造を第2章で整理したうえで、資産配分の理論が半世紀以上かけて蓄積してきた手法を第3章から第9章で、事業投資の案件選択と予算配分への応用を第10章から第12章で扱います。ただし、どの手法にも共通する前提が一つあります。置いた先がどれだけの収益を生み、どれだけ外れうるかを、何らかの形で見積もらなければ、配分は決められないということです。
配分の判断は、見込みの推定と最適化の2段で成り立つ
投資配分を数理モデルで決める作業は、2つの段に分かれます。1段目は、過去の記録や専門家の見立てから、各資産や各案件の期待リターン、そのばらつき、互いの連動の強さを推定する段です。2段目は、推定した見込みと守るべき制約をもとに、目的が最も良くなる配分を計算する段です。教科書の多くは2段目の計算を中心に説明しますが、実務で結果を左右するのは1段目であることが多いと考えています。見込みが狂っていれば、2段目の計算がどれほど正確でも、出てくる配分は狂った見込みに対して正しいだけだからです。しかも最適化の計算は、見込みのわずかな誤差を配分の大きな偏りに増幅する性質を持っています。
本コラムでは、この2段を分けて書き、2段目の結果がどれだけ1段目に依存するかを、実際の数字で示すことを方針にしました。そのために、答えが分かっている架空のデータを2つ用意しました。
答えの分かっている架空のデータで、推定と最適化を確かめる
一つ目の共通の題材は、架空の6つの資産クラスです。国内株式・外国株式・国内債券・外国債券・不動産投資信託・短期資産について、20年分(240か月)の月次リターンの記録があります。二つ目は、架空の中堅製造業の投資案件です。設備更新・能力増強・情報システム・研究開発・新規事業の30件について、3年間の投資額、正味現在価値(案件が生む将来の現金を今の価値に直し、投資額を差し引いた値。以下ではNPVとも書きます)の見込みとそのばらつき、成功確率、前提となる案件や同時に選べない案件の関係が整理されており、3年間の年度予算は案件の投資額の合計の半分に届きません。どちらのデータも乱数で生成したもので、実在の市場や企業の記録ではなく、将来の予測でもありません。データを作った側は、リターンや正味現在価値の本当の分布(本コラムでは「真のモデル」と呼びます)を知っています。現実の企業に見えるのは記録と見積りだけで、真のモデルは見えません。そこで本コラムでは、記録から推定した見込み(「推定モデル」と呼びます)で配分を決め、その配分を真のモデルで評価して答え合わせをします。
参考までに、第4章と第10章で説明する基準の計算の結果を先に示します。資産配分では、240か月の記録から計算した各資産の平均と、ばらつきと資産どうしの連動の強さ(分散・共分散)を使い(これが推定モデルです)、現在の配分方針と同じリスクの大きさに抑えたまま期待リターンを最大にする配分を求めました。答えは、国内株式に52%、国内債券に48%、残りの4つの資産は0%という、極端に偏った配分でした。推定モデルは、この配分で年率の期待リターンが現在の配分より0.93ポイント高くなると見込みました。同じ配分を真のモデルで評価すると、期待リターンは現在の配分より0.27ポイント低く、リスクはわずかに大きくなっていました。真のモデルを知っていれば到達できた改善の上限は0.04ポイントで、現在の配分はすでに最適に近かったのです。記録を作り直して同じ計算を20回繰り返すと、推定モデルで決めた配分が真のモデルで現在の配分を下回った回数は20回中18回でした。
事業投資では、30件の案件から、年度ごとの予算、必須の案件、前提と排他の関係を守りながら正味現在価値の見込みの合計を最大にする組み合わせを、整数計画(案件を選ぶか選ばないかを0と1の変数で表して解く最適化)で求めました。答えは14件で、見込みの合計は3,155百万円です。正味現在価値の大きい順に予算が許す限り選ぶ規則では2,880百万円、投資額あたりの正味現在価値の大きい順では2,905百万円でしたので、組み合わせを計算で選ぶ効果は見込みの上では確かにあります。しかし、同じ14件を真のモデルから作った1,000通りの将来で評価すると、下位5%の平均は572百万円の損失で、合計が負になる確率は4.5%ありました。見込みの合計を最大にする組み合わせが、成功するかどうかが分かれる研究開発と新規事業の案件に寄っていたことに加えて、景気が悪い将来では複数の案件が同時に沈むためで、その中身は第11章と第12章で確かめます。
この2つの結果は、推定の誤差と、期待値だけを見る目的の置き方が、そのまま配分の判断に入り込むことを示しています。しかも資産のデータは、20年分の記録があり、6つの資産の性質が安定しているという、推定にとって恵まれた条件で作っています。現実の記録はもっと短く、資産や事業の性質は途中で変わります。第3章では、記録の長さと推定の誤差の関係を、第4章では、推定の誤差が配分の偏りと期待リターンの損失にどうつながるかを、第12章では、期待値を少し下げる代わりに最悪のときの損失をどれだけ減らせるかを、それぞれ実測で示します。
見込みと実績の差を、配分の判断に戻す
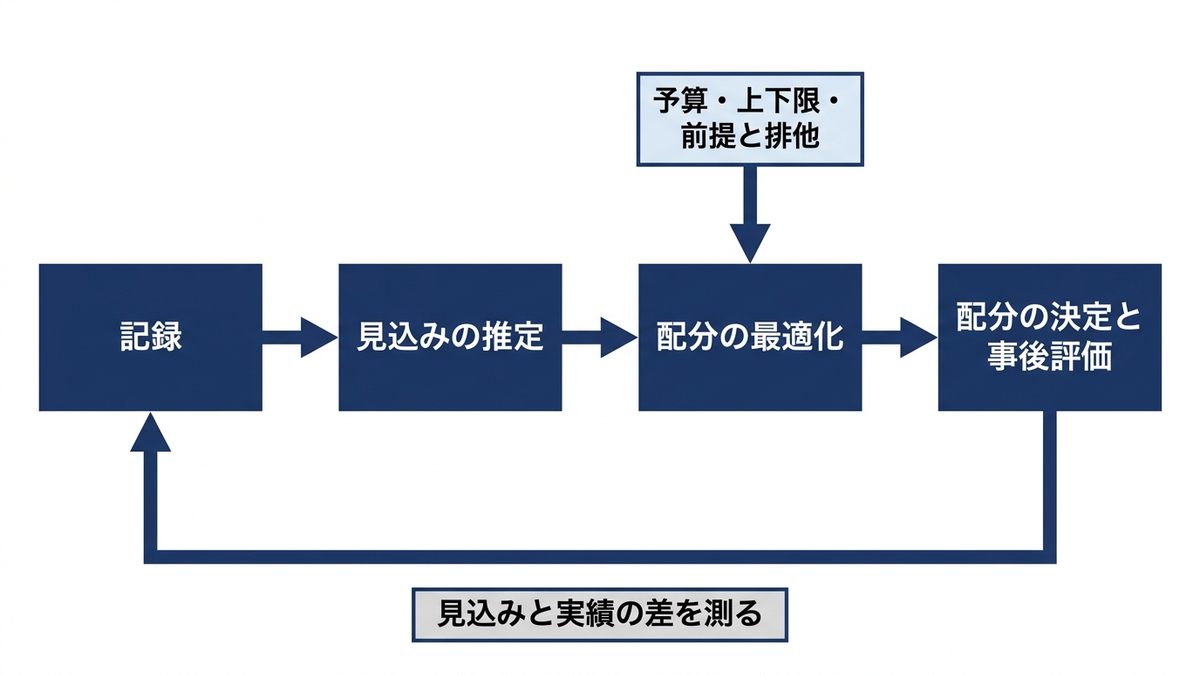
本コラムを通じてお伝えしたいことが一つあります。投資配分で大事なのは、一度きりの最適な配分ではなく、配分を決めた前提を記録し、結果を測り、見込みと実績の差で前提を直して、次の配分の判断に戻す循環を回し続けることだということです。上の例のように、推定モデルの見込みと真の結果には差が出ます。その差を測る仕組みがなければ、見込みどおりの成果が出なかった理由が、推定の誤りなのか、環境の変化なのか、配分の判断そのものの誤りなのかを区別できません。前提を置いた人と根拠、比べる相手、測る期間を、配分を決める前に決めておくことが、次の判断の質を決めると考えています。
この循環は、次の4つの段階で成り立ちます。
- 記録:資産ならリターンの履歴、案件なら見積りと実績を、前提とともに残します。
- 推定:記録と見立てから、期待リターンやNPVの見込みと、そのばらつきと連動を推定します(1段目)。
- 最適化:推定した見込みに制約を加え、期待リターンや最悪時の損失といった目的が最も良くなる配分を計算します(2段目)。
- 配分と事後評価:計算した配分を人が点検して決め、結果を測って記録に加え、推定をやり直します。
経営判断に関わる方にとって、この点は導入の目標の置き方に直結します。最適化の仕組みを入れれば最適な配分が出るという期待で始めると、推定の誤差や制約の抜けによって、一部の資産や案件に極端に偏った答えが出て、現場が受け入れられずに使われなくなることが多いように思います。まず現在の配分の決め方と、前提や見積りの記録の残り方を確かめ、計算の答えと現在の配分を並べて見るところから始め、結果を見ながら計算に任せる範囲を広げていくという順序であれば、投資の効果を数字で確かめながら進められます。導入の順序は第13章で扱います。
なお、本コラムは投資や財務の助言ではありません。特定の金融商品や銘柄、特定の配分比率を勧めるものではなく、本文の数値はすべて架空の設定による例題の値です。
Anagraftでは、データ活用の構想づくりから、投資配分や予算配分のような業務課題の定式化、見込みの推定と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムの本編は第1章から第14章までの14の章で、その後に終章を置いています。第1章と第2章で、投資配分を経営の問題として位置づけ、資産の配分と事業投資の案件選択を同じ言葉で記述します。第3章から第5章では、序章で述べた2段の順に解き方を扱います。記録から期待リターンとリスクを推定する工程、推定した見込みのもとで配分を最適化する工程、そして推定の誤差に配分が振り回されないようにする工程の順です。
第6章から第9章は、資産配分の判断を現実の運用に近づける場面を扱います。期待リターンの見込みに頼らずリスクの大きさで配分する方法、最悪のときの損失で配分する方法、取引コストや本数の上限といった現場の制約、そして時間とともに動く配分の見直しです。第10章から第12章では、同じ数理を事業投資に当てはめます。予算のもとで案件を選ぶ整数計画、成功確率のある研究開発や新規事業のテーマの選び方、見込みが外れたときの損失まで含めた配分です。第13章で現場への導入と運用を、第14章で公開された事例と研究の動向をまとめ、終章で全体を振り返ります。
| 章 | 題 | 主に扱う手法と題材 |
|---|---|---|
| 第1章 | 投資配分はなぜ経営の問題なのか | 配分の規模、分散の効果、配分を決める層、損失の型、経営指標の定義 |
| 第2章 | 投資配分の問題を記述する | 問題の分類、決めることと制約と目的、共通データの紹介、素朴な配分規則との比較 |
| 第3章 | リターンとリスクを推定する | 標本平均の誤差と記録の長さ、共分散の縮小推定、荒れた月の相関、案件のNPVの見積り |
| 第4章 | 平均分散最適化とその弱点 | 効率的フロンティア、基準の計算の読み方、推定誤差の増幅、制約の効果、均等配分との比較 |
| 第5章 | 推定誤差に強くする | 縮小推定、ブラック・リッターマン、リサンプリング、ロバスト最適化 |
| 第6章 | リスクで配分する | 最小分散、リスクパリティ、リスク寄与度、事業領域のリスク予算 |
| 第7章 | 下方リスクと CVaR で配分する | VaRとCVaR、線形計画による定式化、シナリオ、分散との違い |
| 第8章 | 取引コスト・保有制約・銘柄数の上限 | 回転率とコスト、上下限、本数の上限と整数計画、平均絶対偏差モデル、ESG制約 |
| 第9章 | 多期間の配分とリバランス | リバランスの規則、取引コストとの兼ね合い、積立と取り崩し、目標到達確率 |
| 第10章 | 事業投資案件の選択 | 資本予算配分、収益性指数、ナップサック型の整数計画、前提と排他、予算の限界価値 |
| 第11章 | 研究開発テーマと新規事業のポートフォリオ | 成功確率と段階投資、期待値と分散、多目的最適化、人員の制約 |
| 第12章 | 不確実性のもとで事業に配分する | シナリオ、CVaR制約つき整数計画、ロバスト最適化、景気との相関、ストレステスト |
| 第13章 | 現場に入れる | 投資委員会の流れ、前提の記録、ガードレール、事後評価、KPI、導入の順序、失敗の型 |
| 第14章 | 事例と最新動向 | 公開一次情報のある事例、研究の動向、生成AIとの分担 |
読者の立場ごとに、問いから章を引けるように対応表も置きました。一つの問いに複数の章が関わる場合は、入口になる章を先に書いています。
| 問い | 入口になる章 | あわせて読む章 |
|---|---|---|
| 投資配分の良し悪しを経営の数字でどう測るか | 第1章 | 第2章、第13章 |
| 自社の配分の問題はどの種類に当たるか | 第2章 | 第4章、第10章 |
| 過去の記録から出した期待リターンの見込みをどこまで信じてよいか | 第3章 | 第4章、第5章 |
| 最適化の答えが一部の資産に極端に偏る | 第4章 | 第5章、第8章 |
| 見込みに自信が無いまま配分を決めなければならない | 第5章 | 第6章 |
| 期待リターンを使わずに配分を説明したい | 第6章 | 第7章 |
| 最悪の年にいくら減るかで配分を決めたい | 第7章 | 第12章 |
| 配分を動かす費用や本数の上限を計算に入れたい | 第8章 | 第9章 |
| 配分の見直しの頻度と乖離幅をどう決めるか | 第9章 | 第13章、第14章 |
| 予算のもとでどの案件を今年やるか | 第10章 | 第2章、第12章 |
| 成功するか分からない研究開発や新規事業にいくら配るか | 第11章 | 第12章 |
| 案件の見込みが外れたときの損失まで含めて選びたい | 第12章 | 第7章、第10章 |
| 最適化の仕組みを入れても投資委員会で使われない | 第13章 | 第14章 |
本コラムでは、数字を比べる単位が章によって異なります。資産配分の章は年率の期待リターンとリスク(%)で比べ、最悪時の損失は月次のリターンの下位5%の平均(CVaR)で見ます。事業投資の章は百万円で、3年間の案件の正味現在価値(NPV)の合計を比べます。各章の単位は次の表のとおりです。数値はすべて架空の設定による例題の値です。
| 章 | 主に比べる指標 | 単位・条件 |
|---|---|---|
| 第1章〜第6章 | 期待リターンとリスク、シャープ・レシオ | 年率(%)。月次の平均と共分散を12倍。無リスク金利は年率0.5%。第3章後半と第6章末尾の案件の例だけは百万円 |
| 第7章 | CVaR(下位5%の平均) | 月次リターン(%)。信頼水準95%。年の金額に直すときは本文で断る |
| 第8章 | 期待リターン、取引コスト、平均絶対偏差 | 年率(%)。取引コストは現在の配分からの乖離に架空の率を掛けたもの |
| 第9章 | 最終資産、株式比率、回転率 | 10年のシミュレーション。初期資産を1とした倍率、または目標額に届く確率 |
| 第10章〜第12章 | NPV(正味現在価値)の合計 | 百万円。3年間に選んだ案件の合計。投資額を差し引いた正味の値。CVaRはシナリオ1,000本の下位5%の平均 |
各章の末尾には、その章の主題を深めるための参考書籍を挙げ、巻末に一覧としてまとめました。本文で引いた論文や公式ドキュメント、公的機関の資料は、巻末の参考情報に章ごとに載せています。
第1章 投資配分はなぜ経営の問題なのか
企業の手元にあるお金は、どこかに置かなければなりません。工場の設備に置くか、基幹システムに置くか、研究開発のテーマに置くか、新しい事業に置くか、あるいは企業年金や余裕資金として国内株式や外国債券に置くか。どこに置くかを決めることを、この記事では投資配分と呼びます。投資配分は、財務部門や運用担当者の専門業務と見られがちですが、置き場所の組み合わせによって、会社が数年後に手にする成果の平均だけでなく、悪い年にどれだけ沈むかまでが決まります。この章では、日本の企業や公的な年金がどれだけの規模で配分を決めているかを公的統計で確かめ、組み合わせによってリスクが下がる仕組みを架空のデータで実測し、配分を決める層と判断を誤ったときの損失の型を整理します。最後に、この記事全体で使う経営指標の定義を固定します。
あらかじめお断りしておきます。本記事は投資や財務の助言ではありません。特定の金融商品・銘柄・配分比率を勧めるものではなく、数値の例はすべて架空の設定です。実際の資産運用や投資の判断は、ご自身の状況に合わせて専門家に相談してください。
配分の規模を公的統計で確かめる
まず、日本で毎年どれだけの金額が配分の判断を経ているかを、公的統計で見ておきます。ここで挙げるのは、2026年10月の時点で公表されている最新版を、実際に開いて数字を確かめたものだけです。
事業会社の設備投資は、財務省の法人企業統計調査で見ることができます。2026年9月1日に公表された年次別法人企業統計調査(令和7年度)の報道発表資料によると、金融業と保険業を除く全産業の設備投資(ソフトウェアを含む)は57兆8,999億円で、前年度に比べ4.3%増えました。内訳は製造業が18兆4,924億円、非製造業が39兆4,075億円です。同じ資料は、この金額をソフトウェアを含む設備投資の統計がある平成13年度以降で最も大きい値としています。
研究開発については、総務省の科学技術研究調査があります。2025年(令和7年)科学技術研究調査の結果の概要(2025年12月12日公表)によると、2024年度の日本の科学技術研究費は23兆7,925億円で、そのうち企業が17兆4,303億円(研究費全体の73.3%)を占め、企業の研究費は前年度に比べ8.1%増えています。研究を実施している企業の売上高に対する研究費の比率は3.24%でした。売上高の3%強を、成果の出方が読みにくい研究テーマに毎年振り分けているということです。
資産運用の側では、公的年金の積立金を運用する年金積立金管理運用独立行政法人(GPIF)の運用状況のページが、運用資産額を317兆7,596億円(2026年度第1四半期末現在)と公表しています。これだけの資産を、国内外の債券と株式にどの割合で置くかという配分の方針が、運用の結果の大部分を左右します。公的年金が定めている資産構成の割合とその考え方は、第14章で公式の資料に沿って紹介します。
| 領域 | 統計・資料 | 金額 | 対象の時点 |
|---|---|---|---|
| 事業会社の設備投資(ソフトウェアを含む。金融業・保険業を除く) | 財務省 年次別法人企業統計調査(令和7年度) | 57兆8,999億円 | 令和7年度(2025年度) |
| 企業の研究費 | 総務省 2025年科学技術研究調査 結果の概要 | 17兆4,303億円(研究費全体は23兆7,925億円) | 2024年度 |
| 公的年金積立金の運用資産額 | GPIF 運用状況 | 317兆7,596億円 | 2026年度第1四半期末 |
3つの数字は対象も時点も違うので、足し合わせることに意味はありません。読み取ってほしいのは、設備投資だけで年に50兆円を超え、企業の研究費が17兆円を超えるという規模です。その配分を1%動かすだけで、設備投資なら5,000億円以上の行き先が変わります。研究費については、研究を実施している企業の平均で売上高の3.24%という比率が出ていました。配分の良し悪しは、数年後の利益と資本の効率にあらわれます。配分を「前年の比率を少し直す」作業として扱うか、「根拠を置いて選ぶ」判断として扱うかで、その後の結果は大きく変わりうると考えています。
配分を決める4つの層と本記事の範囲
投資配分の判断は、1回の決定ではなく、粒度の違う4つの層に分かれています。いちばん上は資本配分の方針です。稼いだ現金を、成長のための投資、手元資金、借入の返済、株主への還元にどう振り分けるか、どれだけの損失なら耐えられるかを決める層で、取締役会や経営会議が担います。2つ目は、資産クラス(国内株式・外国債券のような、性質の似た資産をまとめた大きな区分)や事業領域への配分です。運用であれば国内株式・外国債券などへの比率、事業投資であれば設備更新・能力増強・IT・研究開発・新規事業への予算の枠を決めます。3つ目は個別の案件や銘柄の選択で、予算の枠の中でどの案件を採るかを決めます。4つ目は見直しとリバランスで、実行したあとに実績と見込みの差を測り、比率が方針から外れたら戻します。
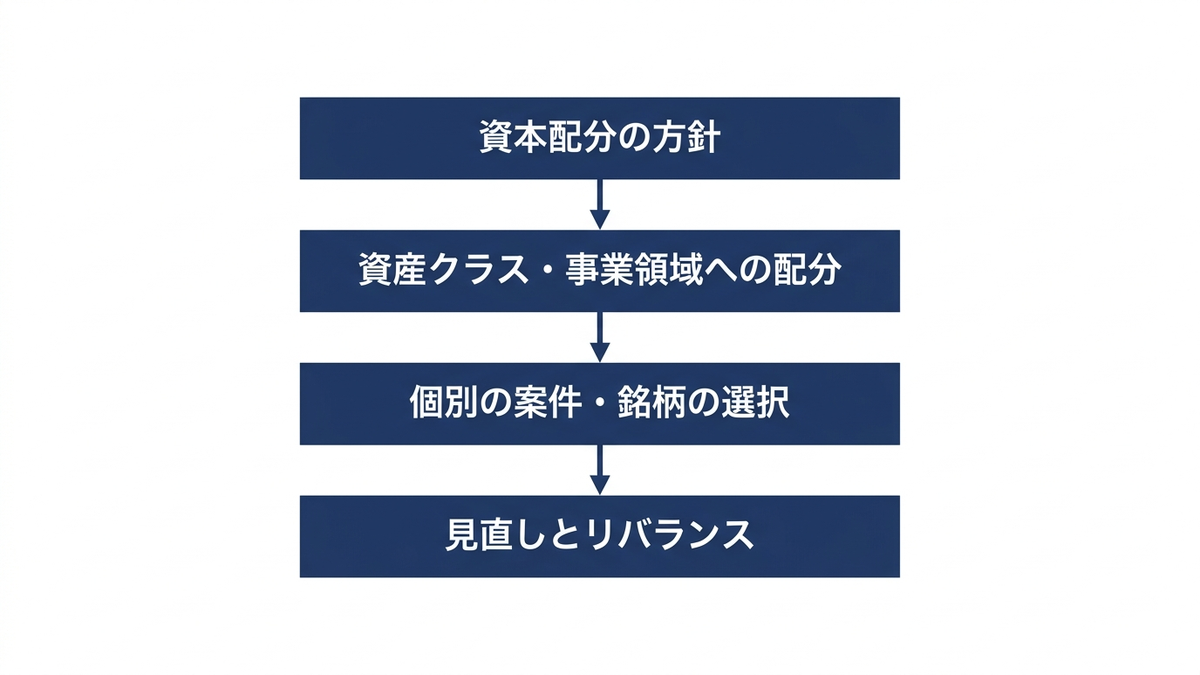
本記事は、この4つの層のうち2つ目から4つ目を、数理モデルで支える方法を扱います。特徴は、資産運用と事業投資の両方を同じ数理で扱うことです。国内株式と外国債券への比率を決める問題と、30件の投資案件から予算内で何件を採るかを決める問題は、見た目は違いますが、「不確かな成果を持つ候補に、限られた資金を振り分け、平均の成果と悪いときの損失の両方を見て選ぶ」という同じ骨格を持っています。運用の世界で育った平均分散最適化(期待リターンとリスクの釣り合いで比率を決める方法。第4章)・リスクパリティ(各資産が全体のリスクに占める割合をそろえる方法。第6章)・CVaR(悪い方の5%に入ったときの平均の損失。下の指標の表と第7章)といった道具は、事業投資の予算配分にもそのまま、あるいは少し形を変えて使えます。1つ目の層である資本配分の方針そのもの(還元と投資の比率、財務の健全性の目標)は、数理モデルが答えを出す対象ではなく、モデルに与える制約や目標として扱います。
各層の判断には、それぞれ固有の誤り方があります。上の層の誤りは下の層の工夫では取り返せません。耐えられる損失の大きさを決めないまま2つ目の層の比率を最適化すると、モデルは期待リターンの高い資産や案件に寄せた答えを返し、その答えがどれだけ沈みうるかを誰も判断できなくなります。逆に、方針がしっかりしていても、3つ目の層で見積りの甘い案件を採れば、配分の比率は計画どおりでも成果は計画に届きません。数理モデルを入れるときは、どの層の判断を支えるモデルなのかを最初に明らかにしておくことが大切です。
この記事で使う経営指標の定義
投資配分の議論が噛み合わない原因の多くは、同じ言葉を人によって違う意味で使っていることにあります。「リスクが高い」が、ばらつきが大きいことを指すのか、損をする確率が高いことを指すのか、最悪のときの損失が大きいことを指すのかで、結論は変わります。そこで、この記事では次の指標を全章で同じ定義で使います。
| 指標 | この記事での定義 | 経営の言葉での読み方 |
|---|---|---|
| 期待リターン | 年率。月次リターンの平均を12倍した値(%) | 平均的な年に、配分した資金がどれだけ増えるか |
| リスク | 年率の標準偏差。月次の共分散を12倍した行列から計算(%) | 年ごとの成果が平均の上下にどれだけぶれるか |
| シャープ・レシオ | 期待リターンから無リスク金利(年0.5%)を引いた値を、リスクで割った値 | ぶれ1単位あたりに、安全な置き場所より何%多く稼げるか |
| 最悪時の損失 | 悪い方から数えて5%の位置の値(5%点)、またはその先の平均 | 年間の値なら20年に1度の悪い年に、月次の値なら20か月に1度の悪い月に、いくら減るか |
| CVaR | 特に断らない限り、月次リターンの下位5%の平均(信頼水準95%) | 悪い方の5%に入ったとき、平均していくら減るか |
| NPV | 案件が生む将来の現金を割り引いた現在価値から投資額を差し引いた正味の価値(百万円) | その案件を実行すると、企業価値が今の価値でいくら増えるか |
このうち、配分の良し悪しを1つの数字で比べるときによく使うのがシャープ・レシオです。期待リターンが高くても、それ以上にリスクが大きければ、ぶれ1単位あたりの稼ぎは小さくなります。シャープ・レシオは、安全な置き場所(この記事では無リスク金利を年0.5%と置きます)より余分に得られる期待リターンを、リスクで割った値です。式で書くと、期待リターンを \( \mu \)、無リスク金利を \( r_f \)、リスクを \( \sigma \) として \( (\mu – r_f) / \sigma \) です。言葉で言えば「ぶれを1%引き受けるごとに、安全な置き場所よりどれだけ多く稼げるか」を表します。
リスクを標準偏差で測る定義は、計算が簡単で組み合わせの効果を式で追いやすいという長所があります。一方で、標準偏差は上振れと下振れを同じ重さで数えるので、「悪い年にいくら減るか」という経営者の関心には直接答えません。そのため、この記事では標準偏差と並べて、最悪時の損失と CVaR を必ず添えます。CVaR の詳しい定義と計算は第7章、NPV の扱いは第10章で説明します。
もう1つ、この記事全体で守る書き分けがあります。この記事のサンプルデータは乱数で作った架空のデータなので、データを作った側は本当の分布を知っています。これを真のモデルと呼びます。現実の企業には真のモデルは見えず、過去の履歴から計算した平均や共分散、つまり推定モデルを使うしかありません。この記事では、真のモデルを「現実には分からないが、答え合わせには使えるもの」として扱い、「最適」と書くときはどちらのモデルでの最適かを必ず添えます。この章で分散の効果を測る計算は、すべて真のモデルで行っています。章の後半の損失の型の節で触れる推定誤差の例だけは、推定モデルでの見込みと、推定モデルで求めた配分を真のモデルで評価した値を並べています。サンプルデータの中身と、それが架空であることの詳しい説明は第2章で行います。
分散の効果を架空のデータで測る
投資配分を数理で扱う出発点は、分散投資の効果、つまり値動きの揃わない資産を組み合わせると、全体のリスクが個々のリスクの平均より小さくなるという性質です。この性質を配分の決め方として理論にまとめたのが、ハリー・マーコウィッツが1952年に The Journal of Finance 誌(第7巻第1号)に発表した、ポートフォリオ選択を題にした論文です。論文の中身と、そこから生まれた平均分散最適化は第4章で扱い、ここでは、その効果がどれくらいの大きさかを第2章で用意する架空の6資産のデータで実測します。
次のコードは、6つの資産をそれぞれ単独で100%持つ場合と、現在の配分(架空の方針。国内株式25%・外国株式20%・国内債券35%・外国債券15%・不動産投資信託5%・短期資産0%)について、真のモデルでの期待リターンとリスクを計算します。最後の行では、各資産のリスクを配分比率で平均した値と、実際の配分のリスクを並べています。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
from port_data import *

w_cur = CURRENT.values
for c in CODES:
    w = np.eye(N)[CODES.index(c)]          # その資産だけを100%持つ配分
    s = true_stats(w)
    print("%-8s 期待リターン %5.2f%% / リスク %5.2f%%" % (ASSETS.loc[c, "name"], 100 * s["mu"], 100 * s["sig"]))
s = true_stats(w_cur)
print("現在の配分 期待リターン %5.2f%% / リスク %5.2f%% / シャープ %.3f" % (100 * s["mu"], 100 * s["sig"], s["sharpe"]))
avg = w_cur @ TRUE_SIG                      # 各資産のリスクを配分比率で平均した値
print("リスクの加重平均 %.2f%% / 実際のリスク %.2f%%" % (100 * avg, 100 * s["sig"]))
# 出力:
# 国内株式     期待リターン  5.50% / リスク 16.09%
# 外国株式     期待リターン  6.50% / リスク 18.11%
# 国内債券     期待リターン  1.00% / リスク  3.07%
# 外国債券     期待リターン  2.50% / リスク  9.34%
# 不動産投資信託  期待リターン  4.50% / リスク 14.44%
# 短期資産     期待リターン  0.50% / リスク  0.42%
# 現在の配分 期待リターン  3.62% / リスク  8.30% / シャープ 0.376
# リスクの加重平均 10.84% / 実際のリスク 8.30%
シャープ・レシオも加えて表にまとめると次のとおりです(真のモデル・年率。均等配分は6資産に1/6ずつ置く配分です)。
| 配分 | 期待リターン | リスク | シャープ・レシオ |
|---|---|---|---|
| 国内株式だけ | 5.50% | 16.09% | 0.311 |
| 外国株式だけ | 6.50% | 18.11% | 0.331 |
| 国内債券だけ | 1.00% | 3.07% | 0.163 |
| 外国債券だけ | 2.50% | 9.34% | 0.214 |
| 不動産投資信託だけ | 4.50% | 14.44% | 0.277 |
| 短期資産だけ | 0.50% | 0.42% | 0.000 |
| 現在の配分 | 3.62% | 8.30% | 0.376 |
| 均等配分 | 3.42% | 7.98% | 0.365 |
表の「シャープ・レシオ」の列を見ると、現在の配分(0.376)と均等配分(0.365)は、どの資産を単独で持つ場合(最大は外国株式だけの0.331)よりも高くなっています。期待リターンでは外国株式だけ(6.50%)や国内株式だけ(5.50%)に及びませんが、リスクを1%引き受けるごとの稼ぎでは、組み合わせた配分のほうが効率が良いということです。
リスクの下がり方も確かめておきます。現在の配分で、各資産のリスクを配分比率で平均すると10.84%になります。もし6つの資産がいつも完全に同じ方向に同じ割合で動くなら、配分全体のリスクはこの加重平均と一致します。実際の現在の配分のリスクは8.30%で、加重平均より2.54ポイント、比率にして23.4%低くなっています。均等配分でも、加重平均10.24%に対して実際は7.98%で、22.1%低くなっています。期待リターンは配分比率による単純な加重平均のままなので、リスクだけが割り引かれていることになります。これが分散投資の効果の大きさを、この架空のデータで測った値です。
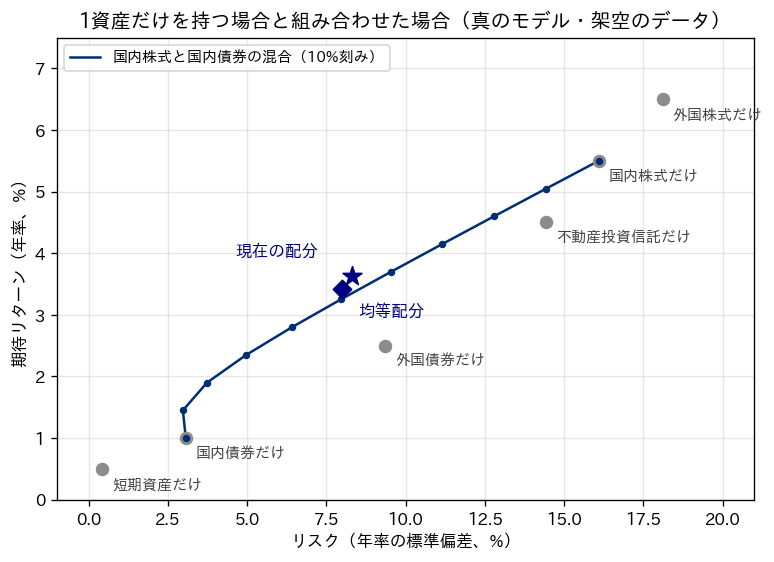
図は、横軸にリスク、縦軸に期待リターンをとった平面に、6つの資産を単独で持つ点(灰色)と、現在の配分(星)・均等配分(菱形)を置いたものです。ネイビーの線は、国内株式と国内債券の2資産だけを10%刻みで混ぜた組み合わせをたどっています。現在の配分と均等配分は、国内株式と国内債券を結ぶ線のすぐ上にあり、同じくらいのリスクで、2資産の混合より少し高い期待リターンを得ています。この平面は記事全体で何度も使います。
相関の低さが下げ幅を決める
分散の効果の大きさは、組み合わせる資産どうしの相関(2つの資産の値動きがどれだけ揃っているかを -1 から 1 で表した値)で決まります。相関が1に近い資産どうしを混ぜても、リスクはほとんど下がりません。相関が低い、あるいは負の資産を混ぜると、2つの値動きが平均して同じ向きにそろいにくくなるので、全体のぶれが小さくなります。ただし相関は平均的な連動の度合いを表す値で、一方が下がった月にもう一方が必ず下がらない、あるいは必ず上がるという意味ではありません。次の表は、国内株式に別の1資産を50%ずつ混ぜた場合の、真のモデルでの値です。「2資産のリスクの平均」は、2つの資産のリスクを単純に平均した値で、「低下率」は、実際のリスクがその平均より何%低いかを表します。
| 組み合わせ(50%ずつ) | 相関 | 期待リターン | リスク | 2資産のリスクの平均 | 低下率 |
|---|---|---|---|---|---|
| 国内株式+外国株式 | 0.726 | 6.00% | 15.89% | 17.10% | 7.1% |
| 国内株式+不動産投資信託 | 0.656 | 5.00% | 13.89% | 15.26% | 9.0% |
| 国内株式+外国債券 | 0.326 | 4.00% | 10.53% | 12.71% | 17.1% |
| 国内株式+国内債券 | -0.153 | 3.25% | 7.96% | 9.58% | 16.9% |
「相関」の列が0.726の国内株式と外国株式を混ぜても、リスクは平均より7.1%しか下がりません。相関0.326の外国債券と混ぜると17.1%下がります。相関が負(-0.153)の国内債券との組み合わせの低下率が16.9%と外国債券の場合とほぼ同じなのは、国内債券のリスク(3.07%)が国内株式(16.09%)に比べて小さく、打ち消す相手としての力が限られるためです。低下率は相関だけでなく、2つの資産のリスクの大きさの釣り合いにも左右されます。
国内株式と国内債券の混合をもう少し細かく見ると、別の性質も見えます。国内債券だけ(リスク3.07%)から国内株式を10%混ぜると、リスクは2.98%へとかえって下がり、期待リターンは1.00%から1.45%に上がります。リスクを増やさずに期待リターンを上げられる、いわば「ただで手に入る改善」があるということです。シャープ・レシオは国内株式20%で0.375まで上がり、そこから国内株式を増やすにつれて下がって、100%では0.311になります。どの比率が良いかは、どれだけのリスクを受け入れるかで変わりますが、どちらか一方に寄せきった配分が、ぶれ1単位あたりの効率では劣ることは、このデータでははっきりしています。
ただし、ここで使った相関は、平常の月と荒れた月を混ぜた全期間の平均の値です。共通データの真のモデルでは、荒れた月(確率8%)に株式系どうしの相関が0.85まで上がるように設定してあります。こういう設定のもとでは、悪い月ほど資産がそろって下がり、分散の効果は平均の相関から想像するより薄れます。分散の効果を見積もるときに平常時の相関だけを使うと、悪い局面での効果を大きく見積もりすぎるおそれがあります。荒れた月の相関の測り方は第3章で、相関が上がる局面への備え方は第7章と第12章で扱います。
最悪の年で見ると分散の効果はどう見えるか
標準偏差の差は、経営会議では伝わりにくい数字です。そこで、真のモデルから120,000か月分の月次リターンを抽出し、連続する12か月を複利でつないで10,000年分の年間リターンを作り、悪い年の損失で比べました。比べやすいように、架空の運用資産を10,000百万円(100億円)と置いて金額に直しています。「年間の期待値」は10,000年分の年間リターンの平均で、月次の平均を12倍した期待リターンとは計算の仕方が違うため、表の上の期待リターンとはわずかにずれます。
| 配分 | 年間の期待値 | 年間の5%点 | 年間の下位5%の平均 | 年間がマイナスになる割合 | 月次の CVaR |
|---|---|---|---|---|---|
| 国内株式だけ | +550百万円 | -2,121百万円 | -2,719百万円 | 38.5% | -10.75% |
| 外国株式だけ | +640百万円 | -2,404百万円 | -3,051百万円 | 38.5% | -12.14% |
| 現在の配分 | +356百万円 | -1,059百万円 | -1,433百万円 | 34.1% | -5.64% |
| 均等配分 | +336百万円 | -1,027百万円 | -1,400百万円 | 34.1% | -5.52% |
架空の100億円を国内株式だけに置くと、平均的な年には5億5,000万円増えますが、20年に1度の悪い年(年間の5%点)には21億2,100万円減り、悪い方の5%に入った年の平均(年間の下位5%の平均)では27億1,900万円減ります。現在の配分では、平均的な年の増加は3億5,600万円に下がる一方、悪い方の5%の年の平均の損失は14億3,300万円で、国内株式だけの場合の約半分です。期待値を1億9,400万円あきらめて、悪い年の損失を約12億9,000万円小さくしている、と読むことができます。この取引が割に合うかどうかは、数理モデルではなく、その企業がどれだけの損失に耐えられるかで決まります。この判断こそが、先に述べた1つ目の層、資本配分の方針で決めるべきことです。
年間がマイナスになる割合は、国内株式だけで38.5%、現在の配分で34.1%と、思ったほど差がありません。この架空データの比較では、分散で大きく小さくなったのは「負ける年の数」よりも「負けたときの深さ」でした。これは分散投資にいつも成り立つ性質ではなく、組み合わせる候補の期待値とばらつきの釣り合いによっては、マイナスになる割合そのものも大きく下がります。次の節で見る事業投資の案件の組み合わせが、その例です。この例のような資産配分について、経営会議で「分散すれば損をしにくくなる」とだけ説明すると誤解を生みます。この例であれば、「損をする年の割合は大きくは減らないが、悪い年の損失の深さは約半分になる」と、深さで説明するのが正確です。
事業投資にも同じ構造がある
分散の効果は、金融資産だけの話ではありません。第2章で用意するもう1つの架空のデータ(中堅製造業の投資案件30件と3年間の予算)でも、同じ構造が見えます。案件ごとの NPV を、景気の共通要因・部門の要因・案件固有の要因と成功・失敗の二択から作った1,000本のシナリオで見ると、成功確率0.25の基礎研究の案件(新素材Xの基礎研究。NPV の期待値300百万円)は、単独では NPV がマイナスになる確率が74.4%あります。成功確率0.45の海外販売拠点の案件(NPV の期待値320百万円)も、単独では55.8%の確率でマイナスです。ところが、これらを含む14件を組み合わせた基準の選択(第2章で説明します)では、NPV の合計がマイナスになる確率は4.5%まで下がります。
理由は資産運用の場合と同じで、研究テーマや新規事業の成功・失敗が案件ごとにおおむね独立に起きるので、1つの失敗を別の成功が埋め合わせるからです。逆に、景気の共通要因と部門の要因を共有して連動する能力増強の案件どうし(このデータでは、同じ生産本部の B工場の新棟建設と、その新棟内の第2ライン増設の NPV の相関が0.34)を重ねると、悪い年にそろって沈みやすくなります。事業投資の予算配分でも、「1件ごとに見て良い案件を上から採る」だけでは、案件どうしの連動を見落とします。案件の組み合わせとしての評価は第10章から第12章で扱います。
研究開発の予算配分では、この性質がとくに重要です。1件ごとに見れば失敗する確率のほうが高いテーマでも、複数のテーマを組み合わせれば、全体としてマイナスになる確率を小さくできます。反対に、少数の大型テーマに予算を集中させると、期待値が同じでも、全体が失敗に終わる確率が上がります。研究を実施している企業の売上高に対する研究費の比率が3%強という規模を考えると、テーマの数と1件あたりの規模の釣り合いは、配分の比率と同じくらい重い経営判断です。この論点は第11章で詳しく扱います。
判断を誤ったときの損失の型
投資配分の判断を誤ったとき、損失は決まった型であらわれます。この記事の各章は、どれか1つ以上の型を防ぐための道具を扱っています。型ごとに、経営上どういう損失になるか、どの章で扱うかを整理しておきます。
| 損失の型 | 起きること | 経営上の損失 | 扱う章 |
|---|---|---|---|
| 集中 | 期待リターンの高い資産や大型案件に寄せすぎる | 悪い年の損失が深くなり、財務の制約に触れて計画の見直しを迫られる | 第4章・第6章・第11章 |
| 推定誤差の増幅 | 過去の平均を真の値と見なして最適化し、たまたま良かった候補に寄せる | 見込んだ改善が実際には得られず、かえって悪化する | 第3章・第4章・第5章 |
| 取引コストと流動性の無視 | 配分の変更にかかる費用や、すぐに売れない資産を数えない | 理論上の改善が費用で消える。必要なときに資金を引き出せない | 第8章・第9章 |
| 期待値だけを見て最悪時を見ない | NPV や期待リターンの合計だけで選ぶ | 平均では良くても、悪い場合に大きく沈む | 第7章・第12章 |
| 決めっぱなし | 配分や案件の採択を決めたあと、実績と見込みの差を測らない | 比率が方針から外れたまま放置され、見積りの癖も直らない | 第9章・第13章 |
このうち、推定誤差の増幅は数理モデルを入れたときに特有の型なので、もう少し説明しておきます。この記事の共通データでは、240か月分の履歴から計算した国内株式の平均の期待リターンは年3.58%で、真の値の5.5%から外れています。外国株式は1.95%で、真の6.5%から大きく外れています。この推定モデルを使って、現在の配分と同じリスクのもとで期待リターンを最大にすると、推定モデルの上では期待リターンが0.93ポイント改善する配分(国内株式52.3%・国内債券47.7%)が出てきますが、真のモデルで評価すると逆に0.27ポイント悪化します。最適化は、推定の誤りを「たまたま良く見える候補に寄せる」形で増幅してしまうのです。この結果の詳しい読み方は第4章で、対処の方法は第5章で扱います。
決めっぱなしの損失は、目立たないぶん長く続きます。毎年の予算配分が前年の比率を出発点にして少しずつ直すだけになっていると、どの領域に配分した資金がどれだけの成果を生んだかを測る機会がなくなり、見積りの楽観の癖も、過去に失敗した領域への配分も、そのまま翌年に引き継がれます。数理モデルを入れる価値の半分は、最適な配分を出すことよりも、前提を数字で書き残し、あとで見込みと実績を比べられるようにすることにある、と考えています。
投資配分を経営の問題として扱うために
ここまでの内容を、経営の判断にどう結びつけるかをまとめておきます。第一に、配分の議論は期待リターンだけでなく、最悪時の損失と並べて行うべきです。この章の例で、現在の配分は国内株式だけの場合より期待値が1億9,400万円低い一方で、悪い年の平均の損失が約12億9,000万円小さくなっていました。どちらを選ぶかは、耐えられる損失の大きさという資本配分の方針から決まります。方針が決まっていなければ、数理モデルは答えを出せません。
第二に、資産運用と事業投資の配分は、同じ骨格の問題として扱えます。どちらも、不確かな成果を持つ候補に限られた資金を振り分け、組み合わせとしての成果の平均とばらつきを見て選ぶ問題です。この共通点を押さえておくと、運用の側で発達した道具を事業投資の予算配分に持ち込むことができ、逆に、事業投資に固有の制約(必須案件・前提と排他・人員の余力)を運用の言葉で説明することもできます。
第三に、数理モデルの答えをそのまま採らないことです。モデルの答えは、入れた推定値の誤りを増幅することがあります。答えを真のモデルで評価できない現実の企業では、答えが推定の誤りにどれだけ敏感かを確かめ、上限や乖離幅のようなガードレールを置いたうえで、人が最終判断する運用が必要です。この運用の組み立て方は第13章で扱います。
この章では、日本の設備投資・研究開発・公的年金の配分の規模を公的統計で確かめ、組み合わせによってリスクが個々の加重平均より2割強下がることと、その下がり方が相関で決まることを架空のデータで実測しました。この架空データの資産配分の比較では、分散で大きく小さくなったのは損をする年の数よりも損の深さでした。組み合わせで全体のぶれを抑える構造は事業投資の案件の組み合わせにもあらわれ、そちらではマイナスになる確率そのものも大きく下がりました。第2章では、投資配分の問題を「何を決めるか・何に縛られるか・何を目指すか」の3つに分けて記述し、この記事で使う2つの共通データと、素朴な配分規則の結果を紹介します。
この章を深めたい方への参考書籍
『ROIC経営 稼ぐ力の創造と戦略的対話』(KPMG FAS、あずさ監査法人、日本経済新聞出版社):投下資本利益率(ROIC)を軸に、事業ごとに資本をどう使い、その成果を投資家とどう対話するかを扱う本です。この章で整理した4つの層のうち、いちばん上の資本配分の方針と、事業領域への配分の考え方を経営の言葉で確かめるのに向いています。
『戦略的コーポレートファイナンス』(中野誠、日本経済新聞出版社):企業価値と財務の意思決定を、経営戦略と結びつけて論じる教科書です。投資の判断を NPV や資本コストで評価する考え方の土台を固めておくと、第10章以降の事業投資の予算配分を読むときの前提がそろいます。
第2章 投資配分の問題を記述する
第1章では、投資配分が経営の問題である理由と、この記事で使う指標(期待リターン・リスク・シャープ・レシオ・NPV・CVaR)の定義を確認しました。この章では、手法に入る前に、投資配分の問題そのものを記述します。何を決める問題なのか、何がその決定を縛っているのか、何を良しとするのかを言葉と表で書き出し、問題の型を分類します。そのうえで、以降の章で繰り返し使う2つの共通データ(架空の6資産の月次リターンと、架空の事業会社の投資案件30件)を紹介し、最適化を使わない素朴な配分規則がどの程度の結果を出すかを、基準の結果と並べて測ります。定式化の細部、つまり平均分散最適化の式は第4章、案件選択の整数計画の式は第10章で扱います。
投資配分の問題は6つの型に分けて考える
「投資配分」と一口に言っても、決める対象と時間の扱いによって、問題の形がかなり違います。企業年金の資産をどの資産クラスにどれだけ振り向けるかという問題と、来年度の設備投資予算でどの案件を採るかという問題は、どちらも限られた資金を複数の行き先に割り振る問題ですが、決める量が連続的な割合なのか、採るか採らないかの二択なのかが違います。1回決めれば終わるのか、毎年見直すのかでも、使う道具が変わります。問題の型を取り違えると、使うべき手法の章を取り違えることになるので、最初に型を分けておきます。
次の表は、この記事で扱う投資配分の問題を6つの型に分けたものです。「決める量」の列は、答えがどんな形で出てくるかを表します。「割合」は0%から100%までの連続的な値、「二択」は採るか採らないか、「金額の時系列」は年度ごとの金額です。「主に扱う章」は、その型の中心的な手法を説明する章です。
| 問題の型 | 決める量 | 典型的な場面 | 主に扱う章 |
|---|---|---|---|
| 資産クラスへの配分 | 割合(連続) | 企業年金・余資の運用方針で、国内株式・外国債券などの比率を決める | 第4章〜第7章 |
| 銘柄や運用商品の選択 | 割合と二択(何本持つか) | 資産クラスの中で、保有する対象の本数と比率を決める | 第8章 |
| 事業投資案件の選択 | 二択(採る・採らない) | 設備更新・能力増強・IT・研究開発・新規事業の案件から、予算内で採る組み合わせを決める | 第10章〜第12章 |
| 多期間の予算配分 | 金額の時系列 | 3年の中期計画で、年度ごとの投資額と案件の着手時期を決める | 第10章 |
| リスク予算の配分 | リスクの割り当て(割合) | 全体で許容する損失の幅を、資産クラスや事業部門に割り振る | 第6章・第7章 |
| 積立と取り崩し | 金額の時系列と割合 | 毎年の拠出と支払いがある資金で、目標額に届くように配分と見直しの規則を決める | 第9章 |
表の上3行は「何に配るか」の違い、下3行は「どの単位で、どの時間軸で配るか」の違いです。実務の問題は、たいていこのうち2つ以上が重なっています。たとえば中期経営計画の投資枠を決める作業は、事業投資案件の選択(どの案件を採るか)と多期間の予算配分(どの年度にいくら使うか)を同時に解いています。企業年金の運用方針は、資産クラスへの配分と、リスク予算の配分(どの資産でどれだけの変動を受け持つか)を同時に決めています。1つの問題がどの型の組み合わせなのかを最初に書き出しておくと、どの章の手法を組み合わせればよいかが見えます。
資産運用と事業投資を同じ記事で扱う理由も、この表から読み取れます。どちらも、将来の成果が不確かな複数の行き先に、合計が決まった資源を割り振る問題です。違いは、資産運用では行き先が少数で量を連続的に変えられ、過去のリターンの記録が長く残っていることが多いのに対し、事業投資では行き先が多数で採るか採らないかの二択になり、同じ案件の過去の記録がほとんど無いことです。この違いのために、資産運用では「推定の誤り」が、事業投資では「組み合わせの数の多さ」と「見積りの偏り」が主な難所になります。
決めること:どこに、いつ、いくら
数理モデルで問題を記述するときは、決める量を決定変数と呼びます。投資配分の決定変数は、ほぼ必ず「どこに」「いつ」「いくら」の3つの組み合わせで書けます。「どこに」は行き先の一覧(6つの資産クラス、30件の案件)、「いつ」は期間の区切り(1回限り、毎年、毎月)、「いくら」は量の単位(全体に占める割合、金額、採るか採らないかの二択)です。
資産クラスへの配分では、決定変数は「各資産クラスに資金の何%を置くか」という6つの割合です。合計は100%になります。案件の選択では、決定変数は「各案件を採るか採らないか」という30個の二択で、採るなら1、採らないなら0という値を取ります。案件を半分だけ実施することはふつうできないので、割合ではなく二択になります。ただし、段階的に投資できる案件や、規模を選べる案件(工場の増設を2ラインにするか1ラインにするか)は、二択を複数用意するか、割合の変数を使って表します。この部分実施の扱いは第10章で説明します。
「いつ」を決定変数に含めるかどうかで、問題の大きさが変わります。今年1回だけ配分を決めるのであれば、決定変数は行き先の数だけです。毎年見直すことを前提にすると、「来年の配分は来年の状況を見てから決める」という変数が加わり、今の決定と将来の決定のつながりを扱う必要が出てきます。資産運用ではこれがリバランス(決めた配分からずれた比率を戻す売買)の問題で第9章、事業投資では「今決める案件と来年見直す案件を分ける」問題で第12章で扱います。この章の共通データでは、資産配分は比率を1回決め、毎月その比率で運用したものとして評価する問題(比率を保つための売買の費用は第8章・第9章で加えます)、案件選択は3年分の着手を今まとめて決める問題として記述しています。
決定変数を書き出すときに見落としやすいのは、「何もしない」という選択肢です。資産配分では、短期資産(現金に近い資産)に置いておくことがそれに当たります。案件選択では、予算を使い切らずに残すことがそれに当たります。何もしない選択肢を変数に含めていないと、モデルは必ずどこかに資金を振り向ける答えを返します。共通データAでは短期資産を6つ目の資産として含め、共通データBでは予算を使い切ることを求めない(予算以下であればよい)形で記述しました。
何が配分を縛るか:制約の一覧
資産配分で、期待リターンを最大にすることだけを目的にし、各資産を0%以上・合計100%とする以外に条件を置かなければ、答えは「最も期待リターンの高い1か所に全額を置く」になります。実際の配分がそうならないのは、リスクも抑えたいという目的の置き方(次の節で扱います)と、配分を縛るさまざまな条件があるからです。数理モデルではこの条件を制約と呼び、等式か不等式で書きます。投資配分でよく現れる制約を、資産運用と事業投資の両方について並べたのが次の表です。「共通データでの扱い」の列は、この記事の共通データにその制約を入れているかどうかを表します。
| 制約 | 資産運用での例 | 事業投資での例 | 共通データでの扱い |
|---|---|---|---|
| 合計 | 配分の合計が100% | 年度ごとの投資額が予算以下 | A・Bとも入れている |
| 上下限 | 1資産あたり0%以上(借りて売らない)・上限○% | 1部門あたりの投資額の上限 | Aは0%以上100%以下。上限の効果は第4章・第8章 |
| 前提と排他 | なし(ふつうは無い) | 新棟を建てないと増設ラインは置けない、2つの国の拠点はどちらか一方 | Bに前提2組・排他2組 |
| 必須 | 流動性確保のための最低限の短期資産 | 法令対応・取引先要請の案件 | Bに必須2件 |
| 取引コスト | 売買のたびにかかる費用、配分を変える幅 | 着手後の中止にかかる費用 | 第8章・第9章で加える |
| 人員 | なし | 社内で実行できる人月の上限 | Bに人月を持たせ、第11章で加える |
| 規制・方針 | 運用方針で定めた資産構成の幅 | 投資委員会の承認基準 | 第13章・第14章で扱う |
制約は、問題を記述する人の判断がもっとも強く入る部分です。たとえば「1資産あたり最大40%」という上限は、数学から出てくる値ではなく、集中を避けたいという方針から置く値です。上限を置けば、推定の誤りに振り回されて1つの資産に寄る答えを防げますが、上限そのものが答えの大半を決めてしまうこともあります。第4章では、上限の有無で推定モデルの最適配分がどう変わるかを実測します。
事業投資では、制約の書き漏らしが答えを大きく狂わせます。前提関係(P07 は P03 が無いと実施できない)を書き漏らすと、モデルは P07 だけを選ぶ答えを返すことがあり、その答えは現実には実行できません。必須案件を書き漏らすと、NPV が負の案件は必ず外され、法令対応の投資が抜けた計画になります。こうした書き漏らしは計算結果を見ても気づきにくく、モデルの答えが「なぜか良すぎる」ときに疑うべき箇所です。制約の一覧を表にして、案件の起案者と一緒に確かめる手順は、第13章で扱います。
逆に、制約を必要以上に強く置くと、モデルが探せる範囲が狭まり、結果として「前年と同じ配分」しか出てこなくなります。たとえば各資産の比率を前年の配分から上下2%以内に縛れば、どんな推定を入れても答えは前年の配分の近くにとどまります。これは推定の誤りに対する守りとしては有効ですが、配分を見直す機会を自ら閉じることにもなります。制約は、守りたいもの(集中の回避・実行可能性・規制)と、変えたいもの(期待リターンの改善)の両方を見ながら置く必要があります。
何を良しとするか:目的と確率モデル
決定変数と制約が決まると、残るのは「どの配分が良いか」を測る物差しです。数理モデルではこれを目的関数と呼び、最大にするか最小にするかを指定します。投資配分の目的は、第1章で定義した経営指標のどれか、またはその組み合わせです。期待リターン(平均してどれだけ増えるか)、リスク(どれだけばらつくか)、NPV の期待値(案件が生む正味の価値の平均)、最悪時の損失(下位5%の平均であるCVaRなど)がその代表です。
この4つは互いに引っ張り合います。期待リターンを高くしようとすると、ふつうはリスクも大きくなり、最悪時の損失も大きくなります。そのため、実務の目的は「リスクを現在と同じ水準に保ったうえで期待リターンを最大にする」「NPV の期待値を最大にするが、CVaR が一定額を下回らないようにする」のように、1つを目的にし、残りを制約に回す形で書くことが多くなります。この記事の基準の結果(後述)も、資産配分は「現在の配分と同じリスクのもとで期待リターンを最大にする」、案件選択は「予算などの制約のもとで NPV の期待値の合計を最大にする」という形で記述しています。どれを目的にし、どれを制約に回すかの選び方は、第4章(リスクと期待リターン)、第7章(CVaR)、第11章(NPV と戦略適合の多目的)で扱います。
投資配分の目的には、もう1つ特徴があります。期待リターンもリスクも NPV も、将来のことなので、直接は観測できません。目的関数を計算するには、将来の成果がどんな確率でどんな値を取るかを表す確率モデルが要ります。決定変数・制約・目的関数の3つの部品は、確率モデルの上に乗っていて、確率モデルが変われば目的関数の値も、最適な配分も変わります。投資配分の問題が他の最適化の問題(配送ルートや人員配置)と違って難しいのは、この確率モデルを過去の記録や見積りから推定するしかなく、その推定に大きな誤差が入るからです。
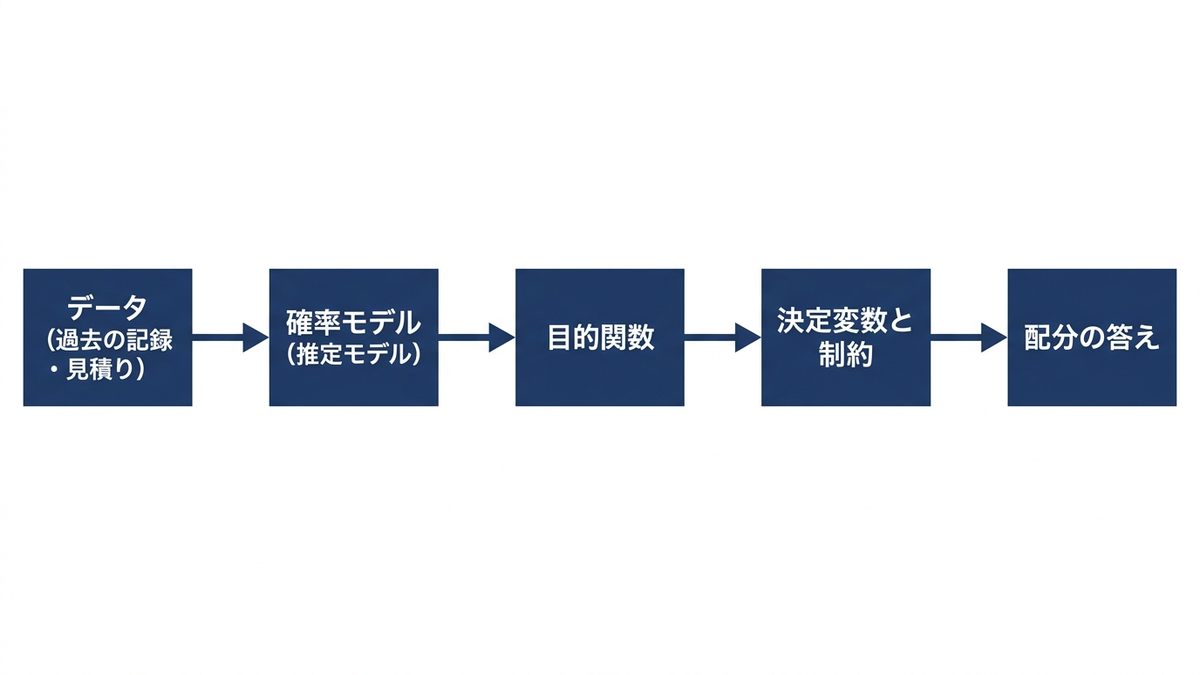
真のモデルと推定モデルを書き分ける
この記事では、確率モデルを2種類に分けて書きます。1つは真のモデルで、将来の成果が本当に従っている確率の法則です。もう1つは推定モデルで、過去の記録や見積りから計算した、真のモデルの近似です。現実の企業には真のモデルは見えません。手に入るのは推定モデルだけで、最適化もこれを使って行います。
この記事の共通データは、乱数で作った架空のデータです。データを作った側は、乱数を発生させた確率の法則、つまり真のモデルを知っています。そこで、この記事では真のモデルを「現実には分からないが、この記事では答え合わせに使えるもの」として扱います。推定モデルで最適化した配分を真のモデルで評価すれば、推定の誤りがどれだけの損につながるかを測れます。現実の企業ではこの答え合わせはできませんが、答え合わせができる環境で手法の癖を知っておけば、現実の判断でどこを疑えばよいかが分かります。
この記事で「最適」と書くときは、「推定モデルでの最適」なのか「真のモデルでの最適」なのかを必ず添えます。推定モデルで最適な配分は、推定モデルの中では最も良く見えますが、真のモデルで評価すると最適から遠いことがあります。この食い違いがどれほど大きいかは、この章の後半と第4章で実測します。弊社コラム「価格を決める数理モデル、需要曲線の推定からダイナミックプライシングまで」でも、需要曲線について同じ書き分けを使いました。
共通データA:架空の6資産の月次リターン240か月
資産運用の章(第3章〜第9章)で使う共通データAを紹介します。このデータは乱数シードを固定して生成した架空のサンプルで、実在の市場の記録でも予測でもありません。資産クラスの名前は一般名を借りていますが、期待リターン・リスク・相関はすべて架空の設定値です。本記事は投資の助言ではなく、ここに示す数値や配分を勧めるものではありません。
データは6つの資産クラスの月次リターン(1か月で資産が何%増減したか)を、第1か月から第240か月まで(20年分。暦の年月は定めていません)並べたものです。真のモデルは、毎月8%の確率で「荒れた月」になり、残りは「平常の月」になるという2つの状態の混合です。平常の月と荒れた月では、6資産のリターンがそれぞれ別の多変量正規分布(6資産が互いに相関を持ちながら釣鐘型にばらつく分布)に従います。荒れた月には、株式系(国内株式・外国株式・不動産投資信託)の平均が負になり、ばらつきが平常の月の2倍になり、株式系どうしの相関が0.85に上がります。国内債券は荒れた月に株式と逆に動く設定です。この設定で作った240か月の履歴では、荒れた月が22か月ありました。
次の表は資産マスタです。「真の期待リターン」と「真のリスク」は真のモデルの値(年率)で、データを作った側だけが知っている答えです。「標本平均」と「標本の標準偏差」は、240か月の履歴から計算した推定モデルの値(年率)です。この記事では、手元の履歴から計算した値を「標本の値」と呼び、履歴から計算した平均を標本平均と呼びます。期待リターンは月次の算術平均を12倍した値、リスクは月次の標準偏差を年率に直した値で、第1章の定義と同じです。「240か月後の資産倍率」は、第0か月に1だった資産が、履歴のリターンを複利で積み重ねて第240か月にいくらになったかを表します。
| コード | 資産クラス(架空) | 真の期待リターン | 真のリスク | 標本平均 | 標本の標準偏差 | 240か月後の資産倍率 | 最悪の月 |
|---|---|---|---|---|---|---|---|
| DE | 国内株式 | 5.5% | 16.1% | 3.58% | 15.1% | 1.625倍 | -19.9% |
| FE | 外国株式 | 6.5% | 18.1% | 1.95% | 17.7% | 1.081倍 | -13.8% |
| DB | 国内債券 | 1.0% | 3.1% | 0.56% | 3.0% | 1.109倍 | -2.1% |
| FB | 外国債券 | 2.5% | 9.3% | -1.71% | 9.2% | 0.652倍 | -8.5% |
| RE | 不動産投資信託 | 4.5% | 14.4% | -0.22% | 14.8% | 0.767倍 | -17.9% |
| CA | 短期資産 | 0.5% | 0.4% | 0.44% | 0.4% | 1.092倍 | -0.3% |
表の「真のリスク」と「標本の標準偏差」の列を比べると、両者は近い値です(国内株式で16.1%と15.1%、外国株式で18.1%と17.7%)。一方、「真の期待リターン」と「標本平均」の列は大きく食い違います。外国株式は真の期待リターンが6.5%なのに標本平均は1.95%、外国債券は2.5%に対して -1.71%、不動産投資信託は4.5%に対して -0.22%です。期待リターンが高い順に並べると、真のモデルでは外国株式・国内株式・不動産投資信託・外国債券・国内債券・短期資産の順ですが、標本平均では国内株式・外国株式・国内債券・短期資産・不動産投資信託・外国債券の順になります。20年分の記録があっても、平均の推定は順位が入れ替わるほどずれる、ということです。リスクは比較的正確に推定でき、期待リターンの推定は難しいという性質は、第3章で標本平均の標準誤差として測ります。
同じ240か月を前半120か月と後半120か月に分けて標本平均を計算すると、ずれはさらに大きくなりました。外国株式は前半が -2.82%、後半が6.73%、不動産投資信託は前半が -4.01%、後半が3.57%です。期待リターンが高い順は、前半では国内株式・国内債券・外国債券・短期資産・外国株式・不動産投資信託、後半では外国株式・国内株式・不動産投資信託・短期資産・国内債券・外国債券でした。真のモデルは240か月を通して変わっていないので、この入れ替わりは市場環境の変化ではなく、偶然のばらつきだけで生じたものです。
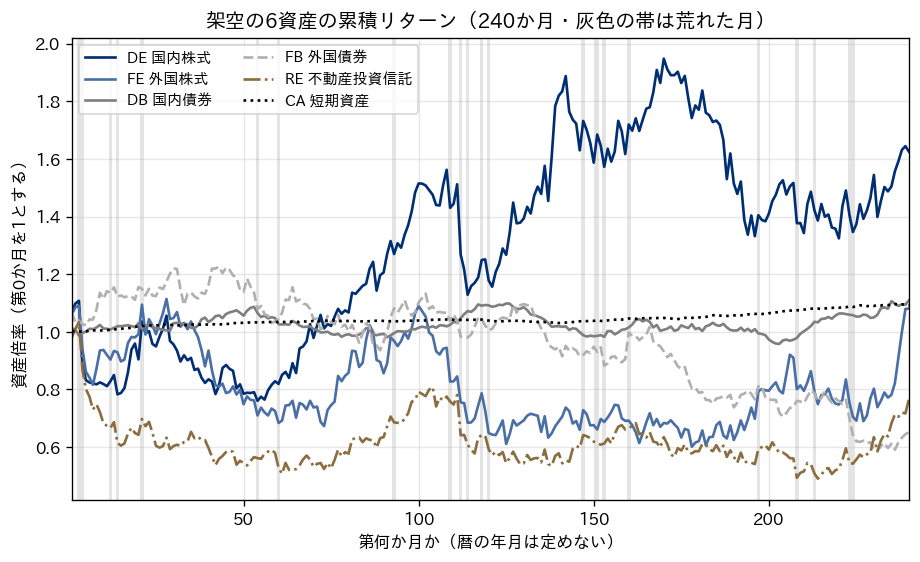
上の図は、6資産の累積リターン(第0か月を1としたときの資産倍率)を描いたものです。灰色の帯は荒れた月です。国内株式は途中で2倍近くまで増えたあと、荒れた月が続いた時期に大きく下がり、第240か月に1.625倍で終わっています。外国株式は図の期間の大半で1を下回り、最後の十数か月で1.081倍まで戻しました。真の期待リターンが最も高い資産でも、20年の記録が元本割れの期間ばかりに見えることがある、ということです。
表の「標本平均」と「240か月後の資産倍率」の列には、もう1つ違いがあります。外国株式の標本平均は年率1.95%ですが、資産倍率1.081倍を20年の複利の年率に直すと約0.4%です。標本平均は月次の算術平均で、複利で積み重ねた伸びは、月々のばらつきが大きいほど算術平均より低くなります。この記事の「期待リターン」は第1章で定義したとおり算術平均で、資産が実際に何倍になったかとは一致しないことに注意が要ります。
共通データAには、資産マスタと履歴のほかに、比較の出発点となる「現在の配分」(架空。国内株式25%・外国株式20%・国内債券35%・外国債券15%・不動産投資信託5%・短期資産0%)と均等配分(各資産1/6)を用意しました。現在の配分は、真のモデルで期待リターン3.62%・リスク8.30%・シャープ・レシオ0.376です。履歴から作った推定モデルで評価すると、同じ配分の期待リターンは1.21%・リスク7.79%と見積もられます。現在の配分の期待リターンの評価だけでも、真のモデルと推定モデルで2.4ポイント違うことになります。
共通データB:架空の事業会社の投資案件30件
事業投資の章(第10章〜第12章)で使う共通データBを紹介します。このデータも乱数シードを固定して生成した架空のサンプルで、実在の企業・案件の記録ではありません。案件名・金額(百万円)・NPV・成功確率はすべて架空の設定値です。
想定しているのは、中堅の製造業が3年間の投資計画を立てる場面です。4つの部門(第一事業部・第二事業部・生産本部・全社)から、5つの種別(設備更新・能力増強・IT・研究開発・新規事業)の案件が合わせて30件起案されています。各案件には、1〜3年目の投資額、NPV の期待値(投資額を差し引いた正味の価値。割引率は織り込み済みの設定値)、NPV のばらつき、景気への感応度、成功確率、戦略適合スコア(1〜5)、必要な人月が付いています。次の表は、部門別・種別の件数と投資額(3年合計)です。
| 部門 | 設備更新 | 能力増強 | IT | 研究開発 | 新規事業 | 件数の計 | 投資額の計 |
|---|---|---|---|---|---|---|---|
| 生産本部 | 4件・1,620 | 3件・3,200 | なし | なし | なし | 7件 | 4,820 |
| 第一事業部 | 1件・500 | なし | 1件・120 | 2件・860 | 4件・1,770 | 8件 | 3,250 |
| 第二事業部 | 2件・600 | 2件・950 | なし | 1件・240 | 1件・500 | 6件 | 2,290 |
| 全社 | 1件・500 | なし | 5件・2,120 | 3件・810 | なし | 9件 | 3,430 |
| 計 | 8件・3,220 | 5件・4,150 | 6件・2,240 | 6件・1,910 | 5件・2,270 | 30件 | 13,790 |
表の金額は百万円で、「4件・1,620」は件数と投資額の合計を表します。投資額の合計は13,790百万円で、3年の予算の合計6,500百万円の2.12倍です。年度ごとに見ると、1年目は案件の投資額の合計6,310に対して予算2,500(2.52倍)、2年目は4,890に対して2,200(2.22倍)、3年目は2,590に対して1,800(1.44倍)で、1年目の予算がもっとも窮屈です。起案された案件の投資額のうち、予算に入るのは半分に届かない(47%)という前提の問題です。
種別ごとの性格も、設定で分けています。研究開発と新規事業の11件だけが成功確率1未満(0.25〜0.80)で、失敗すると投資額の7割が損失になります。設備更新・能力増強・IT の19件は成功確率1で、NPV は景気・部門・案件固有の要因で正規分布に従ってばらつきます。戦略適合スコアの平均は、新規事業が4.20、研究開発が3.83と高く、設備更新は2.38と低めです。経営が掲げる方針に沿った案件ほど、成功するかどうかが不確かな設定になっています。
案件どうしの関係も入れてあります。必須案件が2件(P02 の老朽ボイラー更新と P11 の情報セキュリティ強化。どちらも NPV は負で、2件合わせて投資額450・NPV -70)、前提関係が2組(P07 の増設ラインは P03 の新棟が前提、P20 の試作ラインは P19 の基礎研究が前提)、排他が2組(P13 と P14 の海外拠点はどちらか一方、P21 の設備増強と P22 の外部委託への切替もどちらか一方)です。NPV の真のモデルは、景気の共通要因・部門の要因・案件固有の要因と、成功・失敗の二択を組み合わせたもので、データを作った側はこの分布から1,000本のシナリオを抽出して答え合わせに使えます。
素朴な配分規則で資産を配分してみる
最適化の手法に入る前に、最適化を使わない素朴な規則がどの程度の結果を出すかを測っておきます。素朴な規則が十分に良いなら、複雑な手法を入れる必要はありません。逆に、どの程度の差があるかを知っておくと、以降の章の手法の効果を正しい物差しで測れます。資産配分については、次の5つの規則を試しました。均等配分(6資産に1/6ずつ)、現在の配分をそのまま続ける前年踏襲、標本平均の上位3資産に1/3ずつ、標本平均が正の資産に標本平均の大きさに比例して配る規則、標本平均の最上位1資産に全額を置く規則です。後の3つは、過去の成績が良い資産に寄せるという、会議でよく出る発想を規則にしたものです。
次のコードは、3つの規則について、推定モデルでの期待リターンの見込みと、真のモデルでの値を並べて出力します。共通データAを作る補助モジュール port_data.py と同じフォルダに置いて実行する形です。このモジュール自体は本コラムでは配布していませんが、真のモデルの主な設定値(各資産の期待リターンとリスク、荒れた月の確率と動き方)は本章で示したとおりで、乱数の種を固定して生成しています。以降の章の掲載コードも、同じモジュールと、基準の計算(推定・最適化・案件選択)をまとめた補助モジュール baseline.py を前提にしています。
import numpy as np
from port_data import *

df = history()                       # 架空の240か月(seed 0)
mu_hat, cov_hat = estimate(df)       # 推定モデル(標本平均・標本共分散、年率)

def top_k_equal(mu, k):
    """標本平均の上位 k 資産に均等に配る規則。"""
    w = np.zeros(len(mu))
    w[np.argsort(-mu)[:k]] = 1.0 / k
    return w

rules = {"均等配分": EQUAL.values,
         "現在の配分": CURRENT.values,
         "標本平均の上位3": top_k_equal(mu_hat, 3)}
for name, w in rules.items():
    e = est_stats(w, mu_hat, cov_hat)    # 推定モデルでの見込み
    t = true_stats(w)                    # 真のモデルでの値(答え合わせ)
    print("%s 推定 %.2f%% / 真 %.2f%% / 真のリスク %.2f%% / 真のシャープ %.3f"
          % (name, 100 * e["mu"], 100 * t["mu"], 100 * t["sig"], t["sharpe"]))
# 出力:
# 均等配分 推定 0.77% / 真 3.42% / 真のリスク 7.98% / 真のシャープ 0.365
# 現在の配分 推定 1.21% / 真 3.62% / 真のリスク 8.30% / 真のシャープ 0.376
# 標本平均の上位3 推定 2.03% / 真 4.33% / 真のリスク 10.47% / 真のシャープ 0.366
5つの規則と、基準の結果(推定モデルでの平均分散最適化。中身は第4章で説明します)をまとめたのが次の表です。「推定の期待リターン」は推定モデルでの見込み、「真の期待リターン」「真のリスク」「真のシャープ」は真のモデルでの値、「真の月次CVaR」は真のモデルから120,000か月を抽出して計算した、月次リターンの下位5%の平均です。値はすべて年率(CVaR だけ月次)です。
| 規則 | 配分(%) | 推定の期待リターン | 真の期待リターン | 真のリスク | 真のシャープ | 真の月次CVaR |
|---|---|---|---|---|---|---|
| 均等配分 | 各16.7 | 0.77% | 3.42% | 7.98% | 0.365 | -5.52% |
| 現在の配分(前年踏襲) | DE 25・FE 20・DB 35・FB 15・RE 5 | 1.21% | 3.62% | 8.30% | 0.376 | -5.64% |
| 標本平均の上位3資産に均等 | DE・FE・DB 各33.3 | 2.03% | 4.33% | 10.47% | 0.366 | -7.08% |
| 標本平均が正の資産に比例 | DE 54.8・FE 29.9・DB 8.6・CA 6.8 | 2.62% | 5.07% | 13.23% | 0.346 | -9.01% |
| 標本平均の最上位1資産 | DE 100 | 3.58% | 5.50% | 16.09% | 0.311 | -10.75% |
| 基準(推定モデルの平均分散最適化) | DE 52.3・DB 47.7 | 2.14% | 3.35% | 8.32% | 0.343 | -5.45% |
表から読み取れることは3つあります。1つ目に、推定モデルの見込みと真のモデルの値は、どの規則でも大きく違います。推定モデルは期待リターンを全体に低く見積もっていて、これは履歴の標本平均がたまたま真の値より低く出たためです。2つ目に、「真の期待リターン」の列だけを見ると、標本平均の高い資産に寄せる規則ほど期待リターンが高くなっています。しかし「真のリスク」と「真の月次CVaR」の列を見ると、その分だけリスクも、悪い側5%の月の平均の損失も大きくなり、リスクあたりの効率である「真のシャープ」の列では、どの規則も現在の配分(0.376)を下回りました。最上位1資産に全額を置く規則は、期待リターンが5.50%と最も高い一方、月次CVaRは -10.75%で、現在の配分の約1.9倍の深さです。
3つ目に、基準の結果(推定モデルで、現在の配分と同じ推定リスクのもとで期待リターンを最大にした配分)は、推定モデルの中では期待リターンを1.21%から2.14%へ0.93ポイント改善する見込みでしたが、真のモデルで評価すると3.62%から3.35%へ0.27ポイント下がりました。「真の月次CVaR」の列では基準が -5.45%、現在の配分が -5.64%で、悪い側5%の月の平均の深さはほとんど変わらず、差が出たのは期待リターンの側です。推定モデルの最適は、推定モデルの誤りまで含めて「最適」に仕立てているためです。なお、真のモデルで同じ最適化をした配分(データを作った側だけが知る上限)でも、現在の配分からの改善は0.04ポイントにとどまります。この共通データでは、現在の配分がすでに真のモデルでの最適に近い位置にあります。
1つの履歴だけで判断しないために、履歴を作り直した20回(乱数シード1〜20。それぞれ240か月)でも、標本平均で決める3つの規則を試しました。真のシャープ・レシオの20回の平均は、上位3資産に均等が0.341(最小0.237・最大0.366)、正の資産に比例が0.344(最小0.229・最大0.359)、最上位1資産が0.310(最小0.163・最大0.331)で、3つの規則とも20回すべてで現在の配分(0.376)を下回りました。基準の平均分散最適化も、20回の平均は0.328で、20回中18回が現在の配分を下回っています。標本平均の上位3資産に選ばれた回数は、外国株式と不動産投資信託が18回、国内株式が14回、外国債券が4回、国内債券と短期資産が3回で、最上位1資産になった回数は外国株式が13回、国内株式が4回、残りの3資産が1回ずつでした。履歴が変わるたびに「過去の成績が良い資産」が入れ替わり、それに寄せる規則の配分も入れ替わります。
素朴な規則で案件を選んでみる
案件の選択についても、3つの素朴な規則を試しました。いずれも、必須の2件を先に入れたうえで、案件をある順に並べ、上から順に「予算・前提・排他の制約を破らない案件だけ採る」規則です。並べる順は、NPV の期待値の大きい順、投資額あたり NPV(NPV の期待値を投資額の合計で割った値)の大きい順、戦略適合スコアの高い順(同点は NPV の大きい順)の3通りです。比べる相手は、NPV の期待値の合計を整数計画で最大にした基準の結果です。整数計画の中身は第10章で説明します。金額は百万円で、シナリオの列は1,000本のシナリオでの NPV 合計の要約です。
| 規則 | 件数 | NPV期待値の合計 | 基準との差 | 投資額(3年合計) | シナリオの平均 | シナリオのCVaR(下位5%の平均) | 負になる確率 |
|---|---|---|---|---|---|---|---|
| 整数計画(基準) | 14件 | 3,155 | 0 | 6,400 | 3,130 | -572 | 4.5% |
| NPV の大きい順 | 11件 | 2,880 | -275 | 6,280 | 2,851 | -735 | 5.7% |
| 投資額あたり NPV の大きい順 | 19件 | 2,905 | -250 | 5,490 | 2,871 | -650 | 5.7% |
| 戦略適合スコアの高い順 | 12件 | 2,925 | -230 | 6,350 | 2,887 | -769 | 5.9% |
「基準との差」の列のとおり、3つの規則はいずれも、NPV 期待値の合計で基準を230〜275百万円下回りました。基準の3,155百万円に対して7〜9%の差です。規則ごとに外れ方の理由が違います。NPV の大きい順の規則は、NPV が最大の P03(B工場の新棟。投資額1,900)を先に採り、その後も大きな案件から採るので、11件で予算の大半を使い切り、小さくても効率の良い案件が入る余地がなくなります。投資額あたり NPV の大きい順の規則は、19件と多くの案件を採りましたが、投資額は5,490で予算6,500のうち1,010を使い残しました。年度別に見ると、1年目は予算2,500のうち2,360を使って残りが140になり、採られなかった11件はどれも、1年目に150以上の投資が要る(最小は省エネ設備の150)か、前提の P03 が採られていない P07 でした。1年目の枠に入る案件が無くなったため、2年目に410、3年目に460、合わせて870が使われずに残っています。効率の良い小さな案件で1年目の予算が先に埋まり、残った枠に入る大きさの案件が無くなったということです。戦略適合スコアの高い順の規則は、スコア5の4件(P03・P13・P15・P19)を優先して採り、NPV の期待値ではなく方針への合致で枠を埋めています。
基準の整数計画は、こうした順番に頼らず、30件の採否の組み合わせ全体の中から、年度ごとの予算・必須・前提・排他をすべて満たし、NPV 期待値の合計が最大になる組み合わせを探します。選ばれた14件(P02・P03・P06・P07・P11・P12・P13・P15・P16・P17・P19・P20・P22・P23)は、研究開発と新規事業に寄っています。並べ替えの規則は「1件ずつの良さ」を見るのに対し、整数計画は「組み合わせの良さ」を見る、というのが差の出どころです。
ただし、表の右の3列を見ると、基準の選択も安全ではありません。1,000本のシナリオでの NPV 合計は、平均3,130に対して、下位5%の平均(CVaR)が -572、負になる確率が4.5%でした。NPV の期待値だけを目的にすると、成功確率の低い研究開発・新規事業が多く入り、悪い場合に大きく沈む組み合わせになります。この点は第12章で、CVaR を制約に入れた整数計画として扱います。素朴な規則の CVaR は -650〜-769で、基準より深い値でした。この共通データでは、素朴な規則は期待値でも最悪時でも基準に及ばない、という結果です。
問題の記述を誤ると何を失うか
この章で扱った「問題の記述」は、計算の前の作業なので軽く見られがちですが、誤ったときの損失は計算の誤りより大きくなることが多いと考えています。理由は、記述の誤りは計算を正しく行っても直らないからです。制約を書き漏らせば、モデルは実行できない計画を「最適」として返します。目的を取り違えれば、正しい計算で間違った問題を解くことになります。
共通データの結果を経営指標に翻訳すると、損失の大きさが見えます。案件選択では、並べ替えの素朴な規則と基準の差は、3年間の NPV 期待値で230〜275百万円でした。この差は、会議で「NPV の大きい順に採る」と決めるか、「組み合わせ全体で最大にする」と決めるかという、問題の記述の違いだけから生じています。投資額あたり NPV の規則では1,010百万円の予算が使われずに残り、その分の投資機会を逃しています。予算を残すこと自体は悪いことではありませんが、それが意図した判断ではなく、規則の副作用として起きている点が問題です。
資産配分では、推定モデルで最適化した基準の配分が、推定モデルでは期待リターンを0.93ポイント改善する見込みだったのに、真のモデルでは0.27ポイント悪化していました。運用資産が100億円であれば、見込みと実際の差は年1.2億円に相当します(0.93ポイントと0.27ポイントの差1.2ポイントを掛けた額。期待リターンの差は平均の差で、毎年その額が生じることを意味しません)。この食い違いは、「推定した期待リターンを正しいものとして最適化する」という問題の記述から生じています。推定の誤りをどう扱うかを問題の記述に含めることが、第3章から第5章の主題です。
施策に落とすと、問題を記述する段階でやるべきことは3つあります。1つ目に、決定変数・制約・目的を表にして、案件の起案者や運用の担当者と一緒に確かめることです。この章の制約の表は、その雛形として使えます。2つ目に、素朴な規則(この章で試した前年踏襲・均等配分・標本平均に寄せる規則・案件の並べ替えの規則など)の結果を必ず並べて出すことです。最適化の答えが素朴な規則よりどれだけ良いのかを示せなければ、最適化を使う理由を説明できません。3つ目に、確率モデルが推定であることを資料に明記し、推定の幅を添えることです。第3章では、その推定の幅を測る方法を扱います。
この章の要点をまとめます。投資配分の問題は、決定変数(どこに・いつ・いくら)、制約(合計・上下限・前提と排他・必須・取引コスト・人員・規制)、目的関数(期待リターン・リスク・NPV・最悪時の損失)の3つの部品で記述でき、その3つは将来の成果を表す確率モデルの上に乗っています。共通データでは、推定モデルの見込みと真のモデルの値が大きく食い違い、標本平均に寄せる素朴な規則は20回の作り直しのすべてで現在の配分のシャープ・レシオを下回り、案件の並べ替えの規則は整数計画の基準を230〜275百万円下回りました。次の第3章では、確率モデルの推定そのものに目を向け、期待リターンとリスクの推定がどれだけ誤るか、その誤りをどう測るかを扱います。
この章を深めたい方への参考書籍
『意思決定のための「分析の技術」 最大の経営成果をあげる問題発見・解決の思考法』(後正武、ダイヤモンド社):経営の意思決定に向けて、問題を正しく捉え、実行できる施策を立てるための分析の進め方を扱った本です。この章で行った、決めること・縛る条件・良しとする基準を書き出す作業を、数式を使わない側から考えるときの手がかりになります。
『道具としてのファイナンス 増補改訂版』(石野雄一、日本実業出版社):現場の意思決定に使うファイナンスの基本を、難しい数式は表計算ソフトに任せる方針で説明した本です。共通データBの案件に付けた NPV のような、投資判断に使う数字の背後にある考え方を確かめたいときに役立ちます。
『ファイナンス思考 日本企業を蝕む病と、再生の戦略論』(朝倉祐介、ダイヤモンド社):前年比の売上や利益の増減にとらわれる考え方と、将来の価値を見て判断する考え方を対比し、後者を経営の判断に生かすことを論じた本です。この章で扱った「何を目的に置くか」という問題の記述が、経営の考え方そのものに左右されることを確かめられます。
第3章 リターンとリスクを推定する
第2章では、投資配分の問題を「どこに・いつ・いくら」を決める問題として書き下し、第2章で用意したサンプルデータ(架空の6資産クラスの月次リターン240か月と、架空の事業会社の投資案件30件)を使って、素朴な配分規則と最適化の基準を比べました。そこで見えたのは、240か月の履歴から計算した標本平均で最適化した配分が、推定モデルでは期待リターンを0.93ポイント上げる見込みだったのに、真のモデルで評価すると逆に0.27ポイント下げていた、という結果です。最適化の前に置いた「期待リターンはいくらか」「リスクはいくらか」という入力の段階で、すでに大きな誤りが入っていたことになります。この章では、最適化に入る前の推定そのものを取り上げます。期待リターン、リスク(標準偏差)、資産どうしの相関、そして事業案件の NPV の分布を、どの程度の精度で推定できるのか、精度を上げる手段に何があるのかを、共通データで実際に計算して確かめます。推定の誤りが配分をどこまで動かすかの実測は第4章で扱い、この章ではその手前までを扱います。
配分の判断に入る数字は、すべて推定値である
資産の配分でも案件の選択でも、最適化の計算に入る数字は、期待リターン(年率。月次の算術平均を12倍した値)、リスク(年率の標準偏差)、資産や案件どうしの相関、そして案件ごとの NPV とそのばらつきです。これらは観測できる量ではありません。観測できるのは過去の月次リターンの履歴や、過去の似た案件の実績、担当部門の見積りだけで、配分に使う数字はそこから推定した値です。この記事では、第2章で定めたとおり、データを作った側が知っている本当の分布を「真のモデル」、履歴から計算した値を「推定モデル」と呼んで書き分けます。現実の企業には真のモデルは見えません。この記事の共通データは乱数で作った架空のデータなので、真のモデルを答え合わせに使うことができます。
推定の精度は、推定する量によって大きく異なります。結論を先に書くと、共通データでは、リスクと全期間の相関は240か月の履歴があれば実用上十分な精度で推定できる(ただし相関は荒れた月に上がり、全期間の値ではその上昇が見えません)のに対し、期待リターンは240か月あっても資産によっては真の値の大きさと同じくらいの誤差が残ります。この章の計算は、推定する量によって精度がどれだけ違うかを数字で示すことを目的にしています。事業案件の NPV も同じ構造を持っていて、期待値の見積りの誤りは、ばらつきの見積りの誤りより判断を大きく動かします。
この章で使う推定の方法を、何を推定するかの順に並べると次の表になります。いずれも特別な道具は要らず、numpy・pandas・scikit-learn の範囲で計算できます。
| 推定するもの | この章の推定方法 | 精度を決めるもの | この章の答え合わせ |
|---|---|---|---|
| 期待リターン | 標本平均(月次の平均×12) | 履歴の年数とリスクの大きさ | 履歴を20回作り直し、60・120・240か月で真の値との差を測る |
| リスク(標準偏差) | 標本の標準偏差(×√12) | 観測の本数 | 同じ20回で相対誤差を測る |
| 共分散・相関 | 標本共分散と縮小推定(Ledoit-Wolf) | 観測の本数と資産の数 | 真の共分散との距離を比べる |
| 相関の局面による違い | 平常の月と荒れた月に分けた標本相関 | 荒れた月の本数 | 真のモデルの設定値と比べる |
| 案件の NPV の分布 | 三点見積り・シナリオ・成功確率 | 見積りの前提と偏り | 真のモデルのシナリオ1,000本と比べる |
標本平均の標準誤差は、履歴の年数でしか縮まない
期待リターンの推定に使う最も素直な方法は、過去の月次リターンの平均を取って12倍することです。この推定値は、履歴がたまたまどういう月の並びだったかによって揺れます。その揺れの大きさを表すのが標本平均の標準誤差で、月次リターンが毎月独立に同じ分布から出てくると仮定すると、年率に直した標本平均の標準誤差は次の式になります。
\( \mathrm{SE} = \dfrac{12\,\sigma_{m}}{\sqrt{T}} = \dfrac{\sigma_{a}}{\sqrt{Y}} \)
ここで \( \sigma_{m} \) は月次リターンの標準偏差、\( T \) は履歴の月数、\( \sigma_{a} \) は年率のリスク(\( \sigma_{m} \) の√12倍)、\( Y \) は履歴の年数(\( T \) の12分の1)です。左の形から右の形へは、\( \sigma_{a}=\sqrt{12}\,\sigma_{m} \) と \( T=12Y \) を代入するだけで移れます。言葉にすると、「期待リターンの推定の誤差は、年率のリスクを履歴の年数の平方根で割った大きさになる」ということです。右の形には月数ではなく年数が入っています。分散が期間の長さに比例するとみなせる前提のもとでは、同じ20年間を月次で測っても週次で測っても、標準誤差は変わりません。観測の回数を増やしても、1回あたりのリターンが小さくなる分だけばらつきとの比が変わらないためで、平均の精度を上げるには、観測の頻度ではなく期間の長さを延ばすしかありません。
この点は、ロバート・マートンが1980年に Journal of Financial Economics 誌(第8巻第4号)に発表した、市場の期待リターンの推定を題にした論文で論じられています。同年のNBER ワーキングペーパー版の付録で、期待リターンの推定量の精度は観測期間の全長だけで決まり、観測の回数には依存しないこと、したがって観測の間隔を細かくしても期待リターンの推定の精度は上がらないこと、一方で分散の推定の精度は、データが年次か四半期か月次か日次かに大きく依存することを示しています。論文の本文でも、分散は期待リターンより精度よく推定できると述べています。以下の共通データの計算は、この2つの性質を確かめるものです。
この式を共通データの真のモデルに当てはめた結果が次の表です。リスクは真のモデルの年率の値、標準誤差は上の式で計算した理論値で、いずれも%です。「標準誤差を1ポイントにするのに要る年数」は、式を \( Y \) について解いた値です。
| 資産 | 真の期待リターン | 真のリスク | 標準誤差(60か月) | 標準誤差(120か月) | 標準誤差(240か月) | 標準誤差を1ポイントにするのに要る年数 |
|---|---|---|---|---|---|---|
| 国内株式 | 5.5 | 16.1 | 7.19 | 5.09 | 3.60 | 約259年 |
| 外国株式 | 6.5 | 18.1 | 8.10 | 5.73 | 4.05 | 約328年 |
| 国内債券 | 1.0 | 3.1 | 1.37 | 0.97 | 0.69 | 約9年 |
| 外国債券 | 2.5 | 9.3 | 4.18 | 2.95 | 2.09 | 約87年 |
| 不動産投資信託 | 4.5 | 14.4 | 6.46 | 4.57 | 3.23 | 約209年 |
| 短期資産 | 0.5 | 0.4 | 0.19 | 0.13 | 0.09 | 1年未満 |
国内株式を見ると、240か月(20年)の履歴があっても標準誤差は3.60ポイントで、真の期待リターン5.5%の3分の2ほどの大きさです。おおまかに「推定値から標準誤差の2倍ほど上下した範囲に真の値が入る」と読むと、20年の履歴から計算した国内株式の標本平均には、上下に約7.2ポイントずつの幅が付くことになります。真の期待リターンが5.5%の資産について、推定値が5%前後なのか、0%に近いのか、10%を超えるのかを、20年の履歴では区別しきれないということです。標準誤差を1ポイントまで縮めるには約259年分の履歴が要ります。どの資産も、真の期待リターンに対して標準誤差が小さいとは言えず、リスクの大きい資産ほど推定が粗くなります。期待リターンの差が数ポイントしかない資産どうしを、20年の標本平均で並べ替えることには、統計的な裏付けがほとんど無いということです。
この式が置いている「毎月独立に同じ分布から出てくる」という前提は、共通データの真のモデルでは成り立っています(荒れた月が来るかどうかも毎月独立に決めています)。現実の市場では、ばらつきの大きさが時期によって変わったり、期待リターン自体が時期によって変わったりするので、この前提は近似です。前提が崩れている場合、標本平均の誤差は上の表より大きくなることはあっても、推定の難しさがなくなるわけではありません。
60・120・240か月で推定をやり直すと何が起きるか
理論の標準誤差が実際の推定の揺れと合っているかを、共通データで確かめました。第2章で使った履歴(乱数シード0)の代わりに、シードを1から20まで変えて240か月の履歴を20本作り直し、それぞれの先頭60か月・120か月・240か月で標本平均を計算して、真の期待リターンとの差を測りました。履歴を作り直すことは、「同じ真のモデルのもとで、別の20年間が実現していたら」を試すことに当たります。次のコードは、共通データAを作る補助モジュール port_data.py と同じフォルダに置いて実行する形です。
import numpy as np
from port_data import *

# 標本平均(年率)の標準誤差の理論値:12 × 月次の標準偏差 ÷ √T
sig_m = np.sqrt(np.diag(TRUE_COV_M))
for T in [60, 120, 240]:
    se = 12 * sig_m / np.sqrt(T)
    print("T=%3d 理論の標準誤差(%%)" % T, np.round(se * 100, 2))

# 履歴を20回作り直し、先頭 T か月の標本平均と真の値の差を測る
for T in [60, 120, 240]:
    err = np.array([history(seed=s).iloc[:T].mean().values * 12 - TRUE_MU
                    for s in range(1, 21)])
    print("T=%3d 差の標準偏差(%%)" % T, np.round(err.std(axis=0, ddof=1) * 100, 2))
print("資産の並び", CODES)
# 出力:
# T= 60 理論の標準誤差(%) [7.19 8.1  1.37 4.18 6.46 0.19]
# T=120 理論の標準誤差(%) [5.09 5.73 0.97 2.95 4.57 0.13]
# T=240 理論の標準誤差(%) [3.6  4.05 0.69 2.09 3.23 0.09]
# T= 60 差の標準偏差(%) [ 8.67 10.03  1.14  4.68  7.97  0.15]
# T=120 差の標準偏差(%) [6.52 6.28 1.03 3.36 4.63 0.11]
# T=240 差の標準偏差(%) [5.23 5.55 0.87 2.35 3.72 0.09]
# 資産の並び ['DE', 'FE', 'DB', 'FB', 'RE', 'CA']
20回で測った「差の標準偏差」は、期間を延ばすと縮んでいきますが、理論値よりやや大きく出ています。たとえば240か月の国内株式は、理論の3.60ポイントに対して5.23ポイントです。20回という少ない回数で測ったばらつきそのものが揺れるためで、同じ計算を500回(シード1〜500)に増やすと、240か月の国内株式で3.71ポイント、外国株式で4.14ポイントと、理論の3.60ポイント・4.05ポイントにほぼ一致しました。500回を20回ずつ25組に分けて国内株式の差の標準偏差を計算すると、組によって2.30ポイントから5.23ポイントまで揺れ、シード1〜20の組はその最大でした。また500回のうち、真の値から理論の標準誤差の2倍を超えて外れた割合は、資産によって4%から6%で、正規分布で期待される約5%と合っていました。理論の式は、この共通データの推定の揺れをよく表しています。
図は、20回の標本平均を資産ごとに点で並べ、真の期待リターンを横線で示したものです。
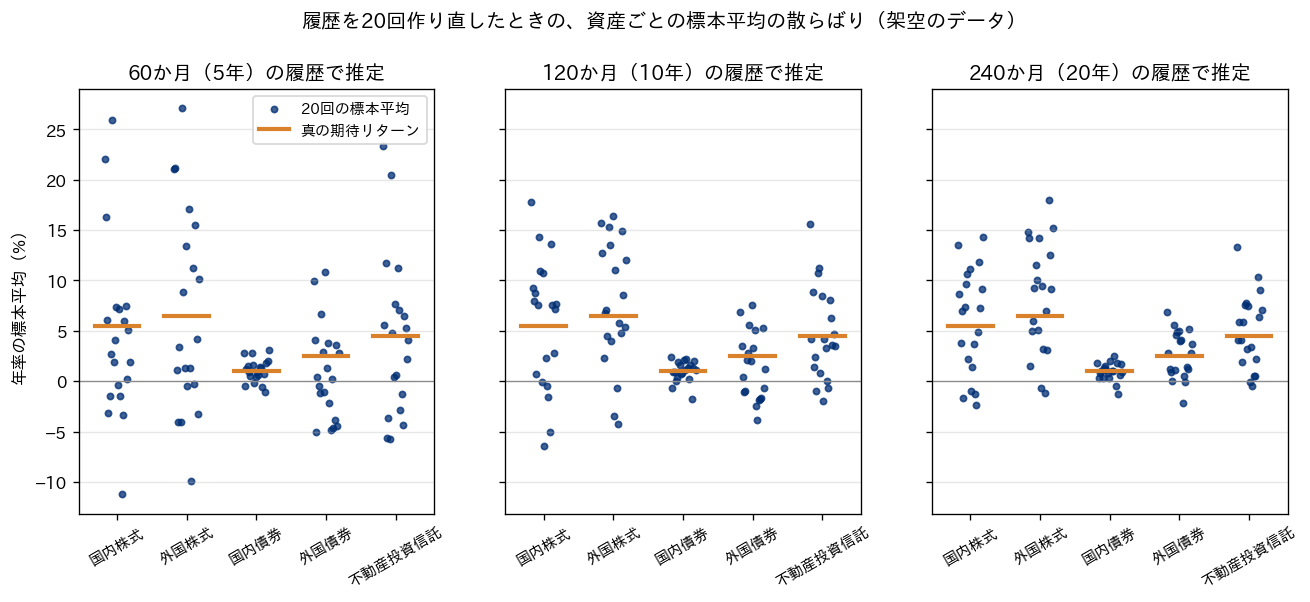
60か月(5年)の履歴では、国内株式の標本平均は -11% 台から25% 台まで散らばり、外国株式も -9% 台から27% 台まで散らばっています。240か月(20年)に延ばすと幅は縮みますが、それでも国内株式で -2% 台から14% 台、外国株式で -1% 台から17% 台に広がっています。20本の履歴のうち、外国株式の標本平均が負になった回数は、60か月で6回、120か月で3回、240か月で2回でした。真の期待リターンが6.5%の資産でも、20年の履歴の10本に1本では「この資産は損をする資産だ」という推定になったということです。
配分の判断にとってより直接的なのは、資産の順位が入れ替わることです。真のモデルで期待リターンが最も高いのは外国株式(6.5%)ですが、20本の履歴のうち、標本平均で外国株式が1位になったのは、60か月で9回、120か月で11回、240か月で13回でした。240か月でも7回は、国内株式・不動産投資信託・外国債券・国内債券のどれかが1位になっています。外国株式の標本平均が国内債券(真の期待リターン1.0%)の標本平均を下回った回数も、60か月で8回、240か月でも2回ありました。期待リターンの高い順に資産を並べる判断は、20年の履歴を使っても、外れる回数がかなり多いということです。
第2章の基準で使った履歴(シード0)では、240か月の標本平均が国内株式3.58%・外国株式1.95%・外国債券 -1.71%・不動産投資信託 -0.22% で、外国株式・外国債券・不動産投資信託の3資産が、真の値より4ポイント以上低く出ていました。上の20回の結果と照らすと、資産ごとに見れば、外国株式の差が標準誤差の約1.1倍、不動産投資信託で約1.5倍、外国債券で約2.0倍という、20年の標本平均では珍しくない大きさの外れ方です。3資産がそろって低く出る確率までは、ここでは測っていません。この記事の後の章で、推定モデルの最適が真のモデルではうまくいかない場面が繰り返し出てきますが、その出発点はこの表にあります。
リスクと相関の推定は、平均ほど荒れない
同じ20本の履歴で、年率のリスク(標準偏差)の推定がどれだけ揺れるかも測りました。真のリスクに対する推定値の相対誤差(推定値を真の値で割って1を引いた値)の、20回の標準偏差は次のとおりです。
| 資産 | 60か月 | 120か月 | 240か月 |
|---|---|---|---|
| 国内株式 | 17.2% | 12.4% | 8.3% |
| 外国株式 | 14.4% | 11.0% | 8.5% |
| 国内債券 | 7.9% | 7.9% | 5.0% |
| 外国債券 | 13.2% | 8.5% | 5.5% |
| 不動産投資信託 | 14.2% | 10.6% | 8.5% |
| 短期資産 | 10.9% | 7.3% | 5.7% |
240か月の国内株式で相対誤差8.3%は、真のリスク16.1%に対して、推定値がおよそ1.3ポイントの幅で揺れるという意味です。期待リターンの標準誤差(3.60ポイント)が真の値(5.5%)の3分の2ほどもあったのと比べると、リスクの推定はずっと安定しています。第2章のシード0の履歴でも、標本の標準偏差は国内株式15.1%(真16.1%)、外国株式17.7%(真18.1%)と、真の値に近い値になっていました。
平均とばらつきで精度がこれほど違う理由は、推定に使える情報の量の違いにあります。平均の推定では、20年間の上がり下がりが打ち消し合った残りだけが手がかりになり、その残りは期間の長さでしか増えません。ばらつきの推定では、毎月の上がり下がりの大きさそのものが手がかりなので、観測の本数が増えれば精度が上がります。標準偏差の推定の相対誤差は、正規分布のもとではおおよそ観測の本数の平方根に反比例して縮み、上の表も、多くの資産でその傾向(60か月から240か月で観測が4倍になり、誤差がおよそ半分になる)を示しています。共通データの真のモデルは平常の月と荒れた月を混ぜた分布なので正規分布ではありませんが、傾向は同じでした。
この違いは、配分の手法を選ぶうえで大事な手がかりになります。期待リターンを使わず、リスクと相関だけで配分を決める方法(第6章で扱う最小分散やリスクパリティ)が実務で好まれる理由の1つは、推定の粗い期待リターンを入力から外せることです。一方で、期待リターンを使わない方法は、期待リターンの差を判断に反映できません。どちらを取るかは、期待リターンについて履歴以外の根拠(経済の見通しや、第5章で扱う市場の均衡からの逆算など)を持っているかどうかで決まります。
共分散を縮小推定で安定させる
資産どうしの共分散(相関とリスクを掛け合わせたもの)は、平均ほど荒れないとはいえ、資産の数が増えると別の問題が出ます。6資産なら共分散行列の独立な要素は21個ですが、30資産なら465個、100資産なら5,050個です。履歴の月数に比べて推定する要素が多くなると、標本共分散は極端な値を含みやすくなり、行列として「ほとんど逆行列が取れない」状態に近づきます。平均分散最適化は、解析解では共分散行列の逆行列が現れ、制約つきの数値計算でも共分散行列の条件の悪さの影響を受けやすいので、この状態では、たまたま小さく推定された分散の方向に配分が大きく偏ります。
これを和らげる代表的な方法が縮小推定です。標本共分散を、構造の単純な行列(目標)と混ぜ合わせ、極端な値を目標の方へ引き寄せます。混ぜる割合を縮小の強さと呼び、0なら標本共分散そのもの、1なら目標そのものです。オリヴィエ・ルドワとミヒャエル・ヴォルフが2004年に Journal of Multivariate Analysis 誌(第88巻第2号)に発表した、大きな次元の共分散行列のための「条件のよい」推定量を題にした論文は、要旨で次のことを述べています。大きな次元の標本共分散は、一般に条件が悪く(逆行列を取ると推定誤差を増幅する状態になり)、逆行列が取れないことすらある。そこで、標本共分散と単位行列を凸結合(足して1になる重みで混ぜ合わせる)した推定量を提案し、観測の本数と変数の数がともに大きくなる極限で、2乗の損失の意味で最適になることを示す。推定量は分布の形を仮定しない(RePEc に収録された要旨で確認しました)。この記事では、提案者の名前からこの方法を Ledoit-Wolf の縮小推定と呼びます。
scikit-learn の sklearn.covariance.LedoitWolf は、この方法を実装しています。公式ドキュメントによると、縮小後の共分散は、標本共分散に「1から縮小の強さを引いた値」を掛けたものに、縮小の強さ×(標本共分散の対角成分の平均)×単位行列を足したものです。つまり目標は、すべての資産の分散を分散の平均にそろえ、資産どうしの共分散を0にした行列です。ここでの標本共分散は、観測の本数 \( n \) で割る最尤推定の形で、np.cov の既定(\( n-1 \) で割る)とはわずかに異なります。縮小の強さは、データから自動で決まり、属性 shrinkage_ に入ります。縮小後の共分散は属性 covariance_ です。共通データで、標本共分散と縮小推定のどちらが真の共分散に近いかを、60・120・240か月、20本の履歴で比べました。真の共分散との距離には、行列の要素ごとの差を2乗して合計した値の平方根(フロベニウスノルム)を使います。月次の値どうしの比較なので、数字そのものは小さくなります。
import numpy as np
from sklearn.covariance import LedoitWolf
from port_data import *

for T in [60, 120, 240]:
    rows = []
    for s in range(1, 21):
        X = history(seed=s).iloc[:T].values           # T か月 × 6資産(月次)
        S = np.cov(X, rowvar=False)                   # 標本共分散
        lw = LedoitWolf().fit(X)                      # 縮小推定
        rows.append([lw.shrinkage_,
                     np.linalg.norm(S - TRUE_COV_M),  # 真の共分散との誤差
                     np.linalg.norm(lw.covariance_ - TRUE_COV_M),
                     np.sqrt(lw.covariance_[5, 5] * 12)])  # 短期資産のリスク(年率)
    r = np.array(rows)
    print("T=%3d 縮小の強さ 平均 %.3f / 誤差 標本 %.6f・縮小 %.6f / 縮小が勝った回数 %d / 短期資産のリスク %.2f%%"
          % (T, r[:, 0].mean(), r[:, 1].mean(), r[:, 2].mean(), (r[:, 2] < r[:, 1]).sum(), r[:, 3].mean() * 100))
# 出力:
# T= 60 縮小の強さ 平均 0.107 / 誤差 標本 0.001651・縮小 0.001459 / 縮小が勝った回数 10 / 短期資産のリスク 4.03%
# T=120 縮小の強さ 平均 0.066 / 誤差 標本 0.001259・縮小 0.001153 / 縮小が勝った回数 10 / 短期資産のリスク 3.15%
# T=240 縮小の強さ 平均 0.037 / 誤差 標本 0.000975・縮小 0.000933 / 縮小が勝った回数 8 / 短期資産のリスク 2.35%
結果を表にまとめます。「誤差」は20回の平均、「縮小が近かった回数」は20回のうち縮小推定の誤差が標本共分散より小さかった回数です。「現在の配分のリスクの揺れ」は、第2章の現在の配分(国内株式25%・外国株式20%・国内債券35%・外国債券15%・不動産投資信託5%)の年率のリスクを、それぞれの推定で計算したときの20回の標準偏差です。真のモデルでの現在の配分のリスクは8.30%です。
| 履歴の長さ | 縮小の強さ(平均) | 誤差(標本共分散) | 誤差(縮小推定) | 縮小が近かった回数 | 現在の配分のリスクの揺れ(標本/縮小) | 短期資産のリスクの推定(縮小) |
|---|---|---|---|---|---|---|
| 60か月 | 0.107 | 0.001651 | 0.001459 | 20回中10回 | 1.36ポイント/1.19ポイント | 4.03% |
| 120か月 | 0.066 | 0.001259 | 0.001153 | 20回中10回 | 1.01ポイント/0.93ポイント | 3.15% |
| 240か月 | 0.037 | 0.000975 | 0.000933 | 20回中8回 | 0.75ポイント/0.72ポイント | 2.35% |
縮小の強さは、履歴が短いほど大きく(60か月で平均0.107)、長いほど小さく(240か月で0.037)なりました。データが少ないほど標本共分散を信用せず目標へ寄せる、という設計どおりの動きです。真の共分散との誤差の平均は、どの長さでも縮小推定の方が小さく、60か月では約12%小さくなりました。現在の配分のリスクの推定の揺れも、60か月で1.36ポイントから1.19ポイントへ縮んでいます。
ただし、この結果には2つの注意が付きます。1つ目は、平均では縮小推定が近くても、1本ずつ見ると20回中10回(240か月では8回)しか標本共分散に勝っていないことです。誤差の平均が小さいのは、標本共分散が大きく外れた回に縮小推定が大きく改善しているためで、どの履歴でも改善するわけではありません。6資産に対して60か月以上の履歴があるこの条件では、表の「現在の配分のリスクの揺れ」の列のとおり、縮小推定で縮む幅は60か月で0.17ポイント(1.36ポイントから1.19ポイント)、240か月で0.03ポイント(0.75ポイントから0.72ポイント)と小さく、縮小推定の出番は大きくありません。揺れそのものが小さいわけではなく、60か月の1.36ポイントは真のリスク8.30%の約16%にあたります。この揺れを縮めるのは、縮小推定よりも履歴の長さです。縮小推定が本領を発揮するのは、資産や銘柄の数が履歴の月数に近いか、それを超える場面です。
2つ目は、目標の選び方です。scikit-learn の LedoitWolf の目標は、すべての資産の分散を同じ値(分散の平均)にそろえ、相関を0にした行列です。共通データのように、短期資産(真のリスク0.4%)と外国株式(18.1%)が混ざっていると、短期資産の分散が平均の方へ大きく引き上げられます。表の右端の列のとおり、縮小推定は短期資産のリスクを60か月で4.03%、240か月でも2.35%と推定しました。標本の標準偏差は0.41%から0.42%で真の値に近かったので、縮小推定はこの資産についてだけ大きく悪化させています。真の共分散との距離(フロベニウスノルム)は値の大きい株式の要素に支配されるので、この悪化は合計の誤差にはほとんど表れません。
この問題を避けるには、資産ごとに標準偏差で割ってそろえてから縮小し(相関行列に縮小をかけ)、標準偏差を掛け戻す方法があります。同じ20本で試すと、縮小の強さは60か月で平均0.246と大きくなりましたが、真の共分散との誤差の平均は0.001673で標本共分散(0.001651)とほぼ同じになり、縮小の方が近かった回数は各長さで20回中7回でした。6資産・60か月以上という条件では、どちらの縮小でも標本共分散からの改善は小さく、改善するかどうかは履歴次第です。縮小推定を使うときは、どの目標へ縮めているかを確かめ、縮小前後で各資産のリスクの推定値を並べて、不自然に動いた資産がないかを見ることが欠かせません。
荒れた月には相関が上がる
相関の推定には、もう1つ別の問題があります。相関そのものが局面によって変わることです。共通データの真のモデルは、平常の月(確率0.92)と荒れた月(確率0.08)の2つの分布を混ぜたもので、荒れた月には株式系の平均が負になり、ばらつきが2倍になり、株式系どうしの相関が0.85に上がるように設定しています(第2章の資産マスタ)。標本相関を全期間で1つ計算すると、この2つの局面の相関を混ぜた値になります。
シード0の240か月の履歴は、荒れた月が22か月、平常の月が218か月でした。月ごとの区分(データを作った側だけが知っている情報)を使って、平常の月と荒れた月に分けて標本相関を計算しました。
import numpy as np
from port_data import *

df = history(seed=0)
reg = df.attrs["regime"]                      # 0=平常の月、1=荒れた月
calm, storm = df[reg == 0], df[reg == 1]
print("平常の月 %d か月 / 荒れた月 %d か月" % (len(calm), len(storm)))
for a, b in [("DE", "FE"), ("DE", "RE"), ("FE", "DB")]:
    i, j = CODES.index(a), CODES.index(b)
    print("%s-%s 平常 %.3f(設定 %.2f)/ 荒れた %.3f(設定 %.2f)/ 全期間 %.3f"
          % (a, b, calm.corr().loc[a, b], CORR_NORMAL[i, j],
             storm.corr().loc[a, b], CORR_STRESS[i, j], df.corr().loc[a, b]))
for lab, sub in [("平常の月", calm), ("荒れた月", storm)]:
    r = sub.values @ CURRENT.values           # 現在の配分の月次リターン
    print("%s 現在の配分 平均 %.2f%% / 標準偏差 %.2f%%" % (lab, r.mean() * 100, r.std(ddof=1) * 100))
# 出力:
# 平常の月 218 か月 / 荒れた月 22 か月
# DE-FE 平常 0.591(設定 0.65)/ 荒れた 0.823(設定 0.85)/ 全期間 0.664
# DE-RE 平常 0.574(設定 0.55)/ 荒れた 0.859(設定 0.85)/ 全期間 0.672
# FE-DB 平常 -0.056(設定 -0.10)/ 荒れた -0.540(設定 -0.30)/ 全期間 -0.121
# 平常の月 現在の配分 平均 0.28% / 標準偏差 1.95%
# 荒れた月 現在の配分 平均 -1.66% / 標準偏差 3.83%
同じ計算を6つの組について表にしました。「設定」は真のモデルで置いた相関(平常の月は CORR_NORMAL、荒れた月は CORR_STRESS)、「真のモデル(混合)」は2つの局面を混ぜた分布の相関です。
| 資産の組 | 平常の月の標本相関 | 平常の月の設定 | 荒れた月の標本相関 | 荒れた月の設定 | 全期間の標本相関 | 真のモデル(混合) |
|---|---|---|---|---|---|---|
| 国内株式と外国株式 | 0.591 | 0.65 | 0.823 | 0.85 | 0.664 | 0.726 |
| 国内株式と不動産投資信託 | 0.574 | 0.55 | 0.859 | 0.85 | 0.672 | 0.656 |
| 外国株式と不動産投資信託 | 0.472 | 0.50 | 0.821 | 0.85 | 0.579 | 0.622 |
| 外国株式と外国債券 | 0.474 | 0.45 | 0.395 | 0.60 | 0.465 | 0.502 |
| 国内株式と国内債券 | -0.073 | -0.10 | -0.578 | -0.30 | -0.158 | -0.153 |
| 外国株式と国内債券 | -0.056 | -0.10 | -0.540 | -0.30 | -0.121 | -0.153 |
株式系どうしの3組は、平常の月の標本相関が0.47から0.59なのに対し、荒れた月には0.82から0.86へ上がりました。真のモデルの設定(平常0.50から0.65、荒れた月0.85)をよく再現しています。全期間の標本相関(0.58から0.67)は、平常の月の値に近い位置にあります。240か月のうち218か月が平常の月なので、全期間の相関は平常の月の動き方で決まり、荒れた月の相関の高さは平均の中に埋もれてしまうということです。株式と国内債券の組では逆に、荒れた月に相関が負の方向へ大きくなりました(設定は -0.30 ですが、標本では -0.58 と -0.54)。国内債券は、荒れた月に株式の下落を一部打ち消す役割を果たしていたことになります。
国内株式と外国株式の組について、同じシード0の240か月の月次リターンを、平常の月と荒れた月に分けて集計しました。
| 局面 | 月数 | 国内株式の月次リターンの平均 | 外国株式の月次リターンの平均 | 2資産がそろって下がった月の割合 | 2資産がそろって -3% 以下だった月数 | 標本相関 |
|---|---|---|---|---|---|---|
| 平常の月 | 218 | 0.58% | 0.51% | 30.7% | 22 | 0.591 |
| 荒れた月 | 22 | -2.48% | -3.28% | 63.6% | 10 | 0.823 |
| 全期間 | 240 | 0.30% | 0.16% | 33.8% | 32 | 0.664 |
荒れた月は、2つの資産の月次リターンの平均がそろってマイナスになり(国内株式 -2.48%、外国株式 -3.28%)、22か月のうち63.6%の月で2つの資産がそろって下がりました。平常の月では、そろって下がった月の割合は30.7%です。2つの資産がそろって -3% 以下になった月は、荒れた月の22か月のうち10か月ありました。分散投資の効果は、資産どうしが別々に動くことから生まれますが、その効果がいちばん欲しい荒れた月に、株式系の資産どうしはそろって動きます。この性質を、この記事では相関の不安定性と呼んでおきます。全期間の相関を1つだけ使った推定モデルは、荒れた月の分散投資の効果を過大に見積もります。
現在の配分で見ると、平常の月の月次リターンは平均0.28%・標準偏差1.95%、荒れた月は平均 -1.66%・標準偏差3.83%でした。荒れた月は標準偏差がほぼ2倍で、平均もマイナスです。年率のリスク(標準偏差)という1つの数字は、この2つの局面を平均したものなので、荒れた月の損失の大きさを直接は表しません。下方リスクを別の指標で測る方法(CVaR)は第7章で扱います。
荒れた月の相関の推定は、精度の面でも難しさを抱えています。荒れた月は全体の8%しかないので、20年の履歴でも20か月前後しか観測できません。20本の履歴を作り直すと、荒れた月の数は11か月から26か月まで揺れ、荒れた月だけで計算した国内株式と外国株式の標本相関は、平均0.841に対して最小0.576、最大0.943まで散らばりました。また、現実のデータには「この月は荒れた月だった」という区分が付いていません。区分を推定するには、景気の後退期や市場の急落期を外部の情報で定めるか、統計モデルで推定する必要があり、その区分自体にも誤りが入ります。実務で区分を使わずに局面の変化を見るには、一定の期間ごとに相関を計算し直す方法(移動相関)があります。シード0の履歴で、36か月の窓をずらしながら国内株式と外国株式の相関を計算すると、第150か月から第185か月の36か月で0.351、第96か月から第131か月の36か月で0.810と、0.351から0.810の範囲を動きました。同じ真のモデルから出たデータでも、どの3年間を見るかで相関の推定は倍以上変わるということです。
推定の誤りは、配分の判断にどう効くか
ここまでの結果を、配分の判断の側から整理します。共通データでは、期待リターンの推定誤差が最も大きく、リスクの推定誤差は小さく、相関の推定誤差は局面の違いを無視したときに大きくなりました。平均分散最適化のように期待リターンを直接使う手法は、この最も粗い入力に、最も強く反応します。第2章の基準では、240か月の標本平均で最適化した配分(国内株式52.3%・国内債券47.7%・他は0%)が、推定モデルでは期待リターンを0.93ポイント上げる見込みだったのに、真のモデルで評価すると0.27ポイント下がっていました。この配分では、標本平均が真の値より4ポイント以上低く出た外国株式・外国債券・不動産投資信託の3資産が、いずれも0%になっていました。外国株式の標本平均だけを動かすと配分がどう変わるかは、第4章で確かめます。
最適化は、推定値の中で「たまたま高く出た資産」に配分を寄せ、「たまたま低く出た資産」を外す方向に働きます。推定の誤りが資産の間で打ち消し合わず、配分の偏りとして増幅されるということです。この増幅が、20本の履歴でどの程度の損失になるのか、制約や均等配分との比較でどこまで抑えられるのかは、第4章で実測します。推定誤差に強い推定と最適化の方法(期待リターンの縮小、ブラック・リッターマン、ロバスト最適化)は第5章で扱います。この章で押さえておきたいのは、どの手法を選ぶにせよ、入力の推定値がどれくらいの幅を持っているかを先に数字で把握しておく必要がある、ということです。
案件の NPV の分布を見積もる
事業投資の案件でも、配分の判断に入る数字は推定値です。案件の NPV(将来のキャッシュフローを割り引いた現在価値から、投資額を差し引いた正味の価値)は、売上の見込み、原価、稼働の立ち上がり、割引率といった前提から計算され、前提のそれぞれに見積りの誤りが入ります。資産のリターンと違うのは、同じ案件を何十回も繰り返して平均を取ることができない点です。過去の履歴から標本平均を取る方法は使えず、担当部門の見積りと、似た案件の実績から分布を組み立てることになります。この節では、分布の組み立て方を3つ、第2章で用意した30案件の設定を例に説明します。
1つ目は三点見積りです。案件の NPV(あるいはその構成要素である売上や工期)について、楽観・最頻・悲観の3つの値を担当者に出してもらい、そこから平均とばらつきを計算します。工期の見積りを確率の言葉で表す考え方は、1959年に Operations Research 誌(第7巻第5号)に載った、マルコムらの研究開発計画の評価技法を題にした論文(PERT と呼ばれる手法の原典)にさかのぼり、要旨には、時間の見積りを技術の担当者から得て確率の言葉で表すことが書かれています。3つの値から平均と標準偏差を出す式にはいくつかの流儀があり、この記事では最も単純な仮定として、悲観から楽観までの間で最頻の値を頂点とする三角形の分布(三角分布)を置きました。たとえば、ある架空の案件で悲観 -490・最頻 500・楽観 900(百万円)と見積もった場合、三角分布の平均は3つの値を足して3で割った303.3百万円、標準偏差は292.1百万円、5%点は -227.7百万円、NPV が負になる確率は17.4%になります(scipy の scipy.stats.triang で計算しました)。最頻の500百万円と平均の303.3百万円の差196.7百万円は、悲観の側に長く伸びた見積りの形から生じています。最頻の値だけを「この案件の NPV」として報告すると、この差が消えます。三点見積りの長所は、担当者に「1つの数字」ではなく「幅」を言ってもらう形式そのものにあります。最頻の値だけを聞くと、その値が楽観寄りなのか中央なのかが伝わりません。
2つ目はシナリオです。景気の良い場合・普通の場合・悪い場合のように、案件の外にある要因の状態を数通り決め、それぞれで NPV を計算します。共通データBは、この考え方を確率的に広げたもので、景気の共通要因・部門の要因・案件固有の要因の3つを乱数で動かして、NPV のシナリオを1,000本作っています(第2章)。景気への感応度(beta)が大きい案件ほど、景気要因の動きに連動して NPV が動きます。たとえば B工場 新棟建設(P03。架空)は、NPV の期待値650百万円・ばらつき(npv_sd)420百万円・景気への感応度1.3で、1,000シナリオでの5%点は -62.2百万円、中央値は673.6百万円、95%点は1,302.5百万円、NPV が負になるシナリオは6.7%でした。シナリオを作っておくと、案件どうしが同じ景気要因や部門の要因で一緒に悪くなる関係(第1章で触れた P03 と P07 の相関0.34など)を、案件の選択の評価に持ち込めます。その評価は第12章で行います。
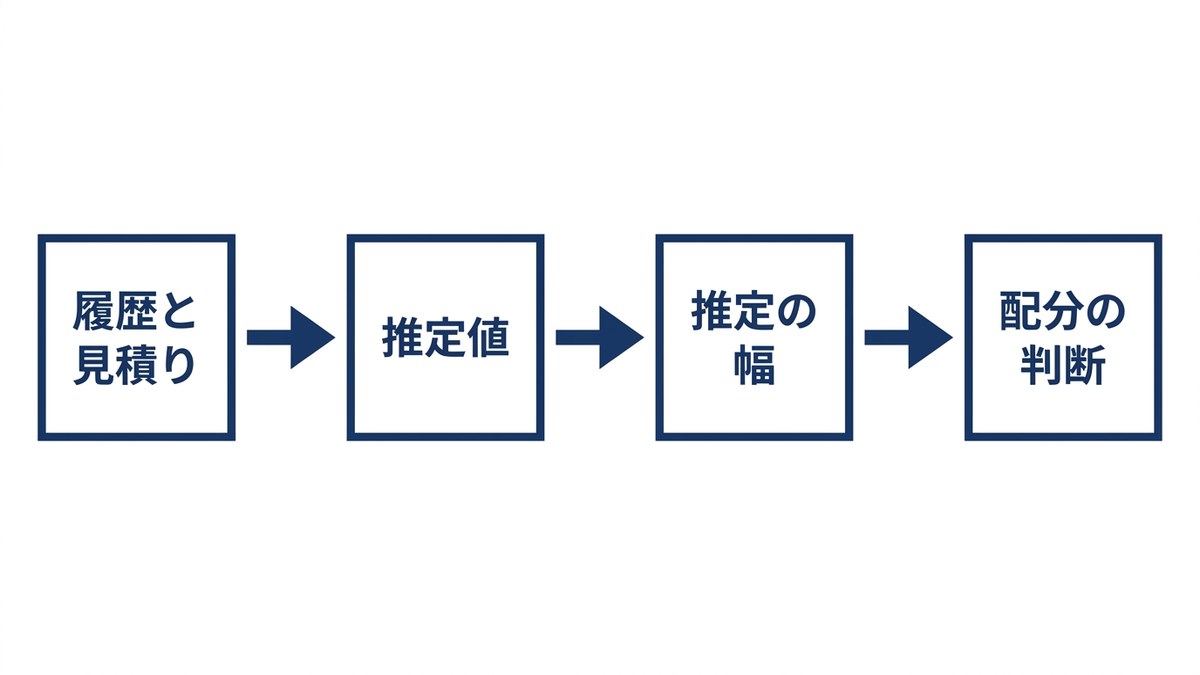
ここまでの2つと、次に述べる成功確率を組み合わせて案件の NPV の分布を作る流れを、本文で説明した順に並べると次のようになります。
- 三点見積り
- シナリオ
- 成功確率
- NPV の分布
研究開発や新規事業の案件は、「うまくいけば大きな価値が出るが、一定の確率で失敗し、投じた費用の多くが回収できない」という形をしています。この形を正規分布1つで表すと、失敗の確率を表せません。共通データBでは、研究開発・新規事業の11案件に成功確率(success。0.25〜0.80)を置き、失敗した場合は投資額の7割が損失になる、成功した場合は成功時の中心の値の周りにばらつく(ばらつきの幅が npv_sd)、という二段の形にしました。成功時の中心は、期待値が案件マスタの NPV 期待値(npv)に一致するように逆算しています。次のコードは、主力製品の次世代機開発(P15。架空)について、その逆算と、真のモデルのシナリオでの分布を計算します。
import numpy as np
import project_data as pj

r = pj.PROJECTS.loc["P15"]                    # 主力製品の次世代機開発(架空)
q = r.success                                 # 成功確率 0.6
loss = pj.FAIL_LOSS_RATE * r.inv_total        # 失敗時の損失 = 投資額の7割
v = (r.npv + (1 - q) * loss) / q              # 期待値が npv になる成功時の中心
print("成功時の中心 %.1f / 失敗時 %.0f / 期待値 %.1f" % (v, -loss, q * v - (1 - q) * loss))
for qq in [0.5, 0.6, 0.7]:                    # 成功確率だけを動かす
    print("成功確率 %.1f → 期待 NPV %.1f" % (qq, qq * v - (1 - qq) * loss))

x = pj.scenarios()["P15"].values              # 真のモデルの1,000シナリオ
s = pj.summarize_npv(x)
print("シナリオ 平均 %.1f / 標準偏差 %.1f / 5%%点 %.1f / 負の確率 %.3f"
      % (s["mean"], s["sd"], s["q05"], s["p_neg"]))
# 出力:
# 成功時の中心 1193.3 / 失敗時 -490 / 期待値 520.0
# 成功確率 0.5 → 期待 NPV 351.7
# 成功確率 0.6 → 期待 NPV 520.0
# 成功確率 0.7 → 期待 NPV 688.3
# シナリオ 平均 507.0 / 標準偏差 899.7 / 5%点 -490.0 / 負の確率 0.408
P15 は投資額700百万円・成功確率0.6・NPV 期待値520百万円の案件です。失敗すると投資額の7割の490百万円が損失になり、期待値が520百万円になるためには、成功したときに平均1,193.3百万円の NPV が出る必要があります。案件マスタに載っている「NPV 520」は、この1,193.3と -490 を6対4で混ぜた値で、実際にはどちらかしか起きません。図は、真のモデルの1,000シナリオでの P15 の NPV の分布です。
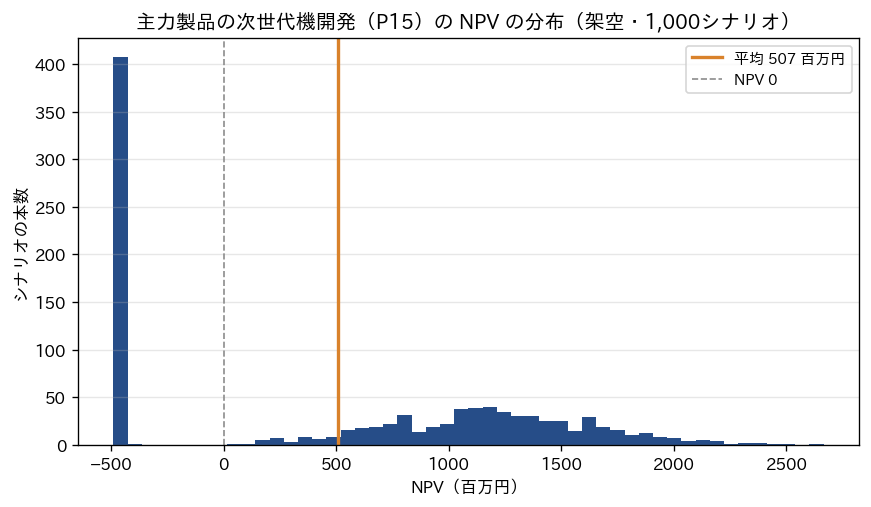
1,000シナリオのうち407本が失敗で -490百万円の1点に集まり、残りは成功時の中心の周りに広がっています。平均(507.0百万円)の付近には、ほとんどシナリオがありません。NPV が負になる確率は40.8%、標準偏差は899.7百万円で、案件マスタのばらつき(npv_sd)450百万円の2倍に達します。npv_sd は成功したときの幅であり、案件全体の不確実性の大部分は成功か失敗かの二択から来ているということです。同じ種類の4案件を並べると次のとおりです(金額は百万円、いずれも架空)。
| 案件 | 投資額 | NPV 期待値 | 成功確率 | 成功時の中心 | 失敗時の損失 | シナリオの標準偏差 | NPV が負になる確率 |
|---|---|---|---|---|---|---|---|
| P03 B工場 新棟建設 | 1,900 | 650 | 1.00 | 650.0 | なし | 423.7 | 6.7% |
| P15 主力製品の次世代機開発 | 700 | 520 | 0.60 | 1,193.3 | -490 | 899.7 | 40.8% |
| P13 海外販売拠点(X国) | 600 | 320 | 0.45 | 1,224.4 | -420 | 864.7 | 55.8% |
| P19 新素材Xの基礎研究 | 360 | 300 | 0.25 | 1,956.0 | -252 | 984.8 | 74.4% |
P19 は NPV 期待値300百万円ですが、成功確率0.25なので、期待値を成り立たせるには成功時に1,956.0百万円の NPV が要ります。投資額360百万円の基礎研究に、成功すれば約2,000百万円の価値が出るという前提を置いていることになります。期待値だけを並べた一覧では、この前提は見えません。案件の審査では、期待値に加えて「成功確率」と「成功したときにいくらを見込んでいるか」の2つを分けて書いてもらうことが、見積りの妥当性を確かめる最初の手がかりになると考えています。期待値と成功時の値の関係をどう判断に使うかは、第11章で研究開発と新規事業の配分として扱います。
成功確率の見積りは、案件の期待値を大きく動かします。上のコードの後半のとおり、P15 の成功時の中心と失敗時の損失をそのままにして、成功確率だけを0.6から0.7に上げると期待 NPV は520.0百万円から688.3百万円へ約3割増え、0.5に下げると351.7百万円へ約3割減ります。成功確率を0.1動かすだけで、期待 NPV が168.3百万円動くということです。成功時の価値(1,193.3)と失敗時の損失(-490)の差が1,683.3百万円あり、成功確率はこの差に掛かるためです。
見積りには楽観の偏りが入りやすい
見積りの分布の形を整えても、見積りの中心そのものがずれていれば、分布全体がずれます。事業投資の見積りでは、このずれが楽観の方向に偏りやすいことが知られています。英国財務省の公共事業の評価指針(グリーンブック)の補足ガイダンスで、楽観バイアスを扱ったもの(2013年4月に gov.uk に掲載)は、事業の評価を行う人には体系的に楽観しすぎる傾向が実証されているとして、費用・便益・期間の見積りに、過去の事業や類似の事業のデータに基づく明示的な補正を加えるよう求めています。同ガイダンスは過去の公共事業の調査をもとに、事業の種類ごとに資本支出の上振れ率の上限と下限を示しており、たとえば資本支出の上限は、標準的な建物で24%、標準的でない建物で51%、設備・開発で200%です。上限は、事業の構想段階の見積りで過去に平均して生じた楽観の大きさを表すとされています。一方で、便益が見込みに届かない側の偏りについては、データが足りず上下限を示せないとして、感度分析で確かめるよう求めています。
見積りが楽観に偏る仕組みについては、ダニエル・カーネマンとダン・ロバロが1993年に Management Science 誌(第39巻第1号)に発表した、慎重な選択と大胆な予測を対比した論文の要旨が、過度に楽観的な予測は、目の前の計画やシナリオに予測を固定してしまう「内側からの見方」を取ることから生じ、過去の統計を無視することにつながる、と述べています(論文の書誌)。この指摘は、この章の推定の話と同じ構造をしています。担当部門が案件ごとに積み上げた見積りは「内側からの見方」で、過去の似た案件で見込みと実績がどれだけ離れたかという統計を当てはめることが、偏りを補正する手がかりになります。
共通データBの P15 で言えば、成功確率を0.6ではなく0.7と楽観に置くだけで、期待 NPV は520.0百万円から688.3百万円へ約3割増えました。このような楽観が複数の案件に同じ向きで入ると、案件の選択では楽観に置かれた案件ほど選ばれやすくなるので、選ばれた案件の集合では偏りが打ち消し合わず、残ります。選んだ案件の見込みの合計は、見積りの偏りの分だけ実績より高く出ます。対策は2つです。1つ目は、事業の種類ごとに過去の見込みと実績の比を記録し、新しい見積りに補正として掛けることです。英国のガイダンスが示す上振れ率の表は、その考え方を制度にしたものです。2つ目は、補正が難しい便益の側について、見込みを一定の割合で下げても選択が変わらないかを感度分析で確かめることです。見積りを動かしたときに選択がどう変わるかの実測は第10章で行い、見込みと実績の差を測って次の見積りに戻す仕組みは第13章で扱います。
推定の幅を会議資料にどう書くか
ここまでの計算から、経営の判断に持ち込むべきことを整理します。配分の判断を誤ったときの損失は、多くの場合、最適化の計算の誤りではなく、入力の推定値を「確かな数字」として扱ったことから生まれます。20年の履歴から計算した国内株式の期待リターン3.58%(シード0の標本平均)は、標準誤差3.60ポイントの幅を持つ推定値です。この幅を書かずに「国内株式の期待リターンは3.58%」とだけ資料に書くと、会議の参加者は、それが真の5.5%から2ポイント外れている可能性も、10ポイント外れている可能性も判断できません。
会議資料には、推定値の隣に推定の幅と、その幅が何に由来するかを書くのが有効だと考えています。資産運用の配分の資料なら、次の表のような形が考えられます(数値は共通データの架空のもので、資料の様式の例です)。
| 項目 | 推定値 | 推定の幅(標準誤差の2倍の範囲) | 根拠と注意 |
|---|---|---|---|
| 国内株式の期待リターン | 3.58% | -3.6% から 10.8% | 240か月の標本平均。年数でしか縮まない。順位の判断には使えない幅 |
| 国内株式のリスク | 15.1% | 相対誤差 約8%(240か月) | 240か月の標本の標準偏差。荒れた月の比率に左右される |
| 国内株式と外国株式の相関 | 0.66(全期間) | 平常の月 0.59、荒れた月 0.82 | 荒れた月は22か月しかない。荒れた月の値を別に示す |
| 現在の配分の荒れた月の月次リターン | 平均 -1.66% | 標準偏差 3.83% | 荒れた月の区分は過去の局面から定めたもの |
案件の審査の資料なら、NPV の期待値1つではなく、成功確率・成功時の値・失敗時の損失・シナリオでの5%点を並べ、それぞれの値を誰がいつどの根拠で置いたかを記録しておくことが、後で見込みと実績を比べるための前提になります。前提の記録と事後評価の仕組みは第13章で扱います。
推定の幅を書くと、会議の議論の焦点が変わります。「期待リターンが高い資産に寄せるべきか」という問いは、「この幅の中で、どの資産が高いかは分からない」という事実の前では成り立たず、「推定の幅を前提に、どの程度まで現在の配分から動かすか」という問いに置き換わります。配分を大きく変えるには、売買の費用、組織の手間、説明の負担がかかります(第8章・第9章)。推定の幅が大きいときに配分を大きく動かすと、費用だけを払って期待した改善は得られない、という結果になりやすいと考えています。逆に、推定の幅が小さいリスクと相関については、局面ごとの値を示したうえで、荒れた月の損失に耐えられるかを確かめる判断に使えます。
もう1つの使い方は、推定の幅そのものを意思決定の基準にすることです。たとえば「期待リターンの差が標準誤差の2倍に満たない資産どうしは、同じ期待リターンとして扱う」「新しい配分案は、推定モデルでの改善が標準誤差の範囲に収まるなら採らない」といった規則を、委員会で事前に決めておく方法です。こうした規則は、推定の誤りに振り回されて毎年配分を入れ替えることを防ぎます。規則の数値は、組織の目的とリスクの許容度から決める必要があり、この記事で特定の値を勧めるものではありません。
この章では、期待リターンの推定が最も粗く、20年の履歴でも標準誤差が真の値と同じくらいの大きさになること、リスクと相関は比較的安定して推定できるが、相関は荒れた月に上がり、全期間の値ではその上昇が見えなくなること、縮小推定は共分散を安定させるが、目標の選び方によっては一部の資産を歪めること、案件の NPV の分布は成功確率と成功時の値を分けて見積もる必要があることを、共通データで確かめました。次の第4章では、これらの推定値を入力にして平均分散最適化を解き、推定の誤りが配分をどこまで動かし、真のモデルでどれだけの損失になるかを実測します。
この章を深めたい方への参考書籍
『経済・ファイナンスデータの計量時系列分析』(沖本竜義、朝倉書店):定常性と自己相関の基礎からARMA・VAR・単位根・共和分を経て、GARCHモデル、多変量GARCHと相関が時間とともに変わるモデル、状態の変化を伴うモデルまでを扱う教科書です。この章で見た、荒れた月にばらつきと相関が変わる現象を、統計モデルとして推定する方法を学べます。
『ファイナンスへの計量分析』(小暮厚之、朝倉書店):金融のデータの整理、収益率の確率モデル、標本分布と推定・検定、条件つき分散のモデルを順に扱う、ファイナンス講座の1冊です。標本平均や標本の標準偏差がどれだけ揺れるかという、この章の標準誤差の話の土台を、ファイナンスの文脈で確かめられます。
『金融データ解析の基礎』(金明哲 編、高柳慎一・井口亮・水木栄 著、共立出版):Rを使って金融のデータを取得し、変化率の計算、リスク(標準偏差)と相関係数の算出、外れ値の扱い、可視化、時系列解析までを手を動かして進める本です。この章の計算を、自社のデータで再現するときの手順の参考になります。
第4章 平均分散最適化とその弱点
第3章では、履歴から推定した期待リターン(標本平均)の誤差が大きく、期間を長くしてもなかなか縮まないことを確かめました。第2章で用意したサンプルデータ(架空の6資産クラスの月次リターン240か月)でも、240か月の標本平均は外国株式で1.95%(真の値は6.5%)、不動産投資信託で -0.22%(真の値は4.5%)と大きく外れる一方、標本の標準偏差は外国株式で17.66%(真の値は18.11%)と真の値に近くなっています。この章では、その推定値をそのまま使って配分を決める、最も基本的な数理モデルを扱います。期待リターンとリスクの2つだけで配分の良し悪しを測り、同じリスクなら期待リターンが最も高い配分を選ぶ、という考え方です。
この章で確かめることは5つあります。1つ目は、この考え方がどこから来たのかと、何を決める手法なのか。2つ目は、リスクの水準ごとに最も良い配分をつないだ線を、真のモデルと推定モデルの両方で描いたときに何が見えるか。3つ目は、第2章で示した基準の最適化がどういう構造で、その結果をどう読むべきか。4つ目は、推定の誤りが最適化によってどう増幅されるかと、配分に上下限を設けるとそれがどれだけ抑えられるか。5つ目は、配分を少し変えても期待リターンがほとんど変わらないという、最適の付近の平らさです。推定の誤りへの本格的な対処法(期待リターンを全体の平均へ寄せる縮小推定、ブラック・リッターマン、ロバスト最適化)は第5章で、期待リターンを使わずリスクだけで配分を決める方法は第6章で扱います。
この章でも、データを作った側だけが知っている本当の分布を「真のモデル」、240か月の履歴から計算した標本平均と標本共分散を「推定モデル」と呼びます。現実の企業には真のモデルは見えません。この章では、真のモデルを「現実には分からないが、答え合わせに使えるもの」として使い、推定モデルで決めた配分を真のモデルで評価します。「最適」と書くときは、どちらのモデルでの最適かを必ず添えます。なお、この章は資産クラスへの配分を例にしていますが、特定の金融商品や配分比率を勧めるものではなく、投資や財務の助言ではありません。数値はすべて架空のデータでの計算結果です。
平均分散最適化は何を決める手法か
平均分散最適化は、資産ごとの期待リターンと、資産どうしのリスクの関係(共分散)を入力にして、資産への配分の割合を出力する手法です。決めるのは「各資産に何%を配分するか」という重みの組だけで、目的は「決められたリスクの範囲で期待リターンを最大にする」か、その裏返しの「決められた期待リターンを、最も小さいリスクで実現する」かのどちらかです。この記事でいうリスクは、年率のリターンの標準偏差です(第1章の定義)。
この考え方の出発点は、ハリー・マーコウィッツが1952年に The Journal of Finance 誌の第7巻第1号(77〜91ページ)に発表した論文 “Portfolio Selection” です。書誌は Crossref の登録情報で確認しました。1990年のノーベル経済学賞の発表文(スウェーデン王立科学アカデミー)は、マーコウィッツの授賞理由をポートフォリオ選択の理論を発展させたこととし、その仕事が最初に1952年のこの論文で発表されたと説明しています。同じ発表文は、一定の条件のもとで投資家の配分の選択が「ポートフォリオの期待リターンとその分散」という2つの次元の釣り合いに帰着すること、ポートフォリオのリスクは個々の資産の分散だけでなく、すべての資産の組の共分散にも依存すること、したがって資産のリスクで本質的なのは単独でのリスクではなく全体のリスクへの寄与であること、を要点として挙げています。最適な配分を実際に計算する方法は、1956年の論文で2次計画問題として示された、とも書かれています。
式で書くと、配分の重みを \( w \)、期待リターンのベクトルを \( \mu \)、共分散行列を \( \Sigma \) として、ポートフォリオの期待リターンは \( w^{\top}\mu \)、リスクは \( \sqrt{w^{\top}\Sigma w} \) です。言葉で言えば、期待リターンは各資産の期待リターンを重みで平均したもので、リスクは重みと共分散から計算される全体のばらつきです。リスクのほうは単純な重みつき平均にはならず、相関が低い資産を組み合わせるほど小さくなります。この性質が、第1章で実測した分散投資の効果の正体です。
この手法を使ってよいのは、次の2つの前提がおおむね成り立つときです。1つは、配分の良し悪しを期待リターンと標準偏差の2つで測ってよいことです。リターンの分布が左に長い裾を持つとき(大きく負ける月が、正規分布が想定するより多く起きるとき)、標準偏差は最悪時の損失を十分に表しません。共通データの真のモデルも荒れた月を含む混合分布で、現在の配分の月次リターンの歪度(分布の左右の偏りを表す値。負なら、大きく負ける側に裾が長い)は -0.71 と左に偏っています。最悪時を直接扱う方法は第7章で扱います。もう1つは、期待リターンと共分散が十分な精度で分かっていることです。こちらがこの章の主題で、現実にはこの前提が成り立ちにくいことを、以下の節で共通データを使って示します。
効率的フロンティアを共通データで描く
リスクの上限を1%、2%、…と変えながら、そのリスクのもとで期待リターンを最大にする配分を求め、その配分のリスクと期待リターンを平面上の点として結ぶと、右上がりの曲線ができます。これを効率的フロンティアと呼びます。曲線より上の点は、そのリスクでは実現できない組み合わせです。曲線より下の点は、同じリスクでもっと高い期待リターンを取れる配分がほかにある、つまり改善の余地がある配分です。経営の言葉にすると、効率的フロンティアは「このリスクを引き受けるなら、期待リターンはここまで取れる」という上限の一覧表です。
共通データで、ショートなし(各資産の重みは0〜100%)・合計100%の条件のもとで、効率的フロンティアを2通り計算しました。1つは真のモデル(データを作った側が知っている期待リターンと共分散)で計算したもの、もう1つは推定モデル(240か月の標本平均と標本共分散)で計算したものです。最適化には、第2章で紹介した基準のスクリプトの関数 mean_variance をそのまま使いました。さらに3つ目として、推定モデルのフロンティア上の配分を真のモデルで評価し直しました。あわせて、現在の配分(第2章で定めた架空の方針)、均等配分(6資産に1/6ずつ)、基準(推定モデルで最適化した配分)、真のモデルの最適の4つの配分を、いずれも真のモデルで評価しました。
フロンティアの主な値を表にしました。「リスク上限」は最適化で与えたリスクの上限、「真のモデルのフロンティア」はそのリスク上限で真のモデルが示す期待リターンの最大値、「推定モデルのフロンティア(見込み)」は推定モデルが示す期待リターンの最大値です。右の2列は、推定モデルで選んだ配分を真のモデルで評価した期待リターンとリスクです。
| リスク上限 | 真のモデルのフロンティア(期待リターン) | 推定モデルのフロンティア(見込みの期待リターン) | 推定モデルの配分を真のモデルで評価した期待リターン | 同じ配分の真のモデルでのリスク |
|---|---|---|---|---|
| 2% | 1.31% | 0.88% | 1.27% | 2.13% |
| 4% | 2.15% | 1.32% | 2.05% | 4.27% |
| 6% | 2.90% | 1.77% | 2.80% | 6.40% |
| 8% | 3.57% | 2.18% | 3.42% | 8.54% |
| 10% | 4.21% | 2.59% | 4.02% | 10.68% |
| 12% | 4.84% | 2.98% | 4.61% | 12.81% |
| 15% | 5.77% | 3.57% | 5.48% | 16.01% |
4つの配分の値は次の表のとおりです。「真のモデル」の3列は答え合わせの値、右の2列は同じ配分を推定モデルで評価した見込みの値です。
| 配分 | 真のモデルの期待リターン | 真のモデルのリスク | 真のモデルのシャープ・レシオ | 推定モデルでの見込みの期待リターン | 推定モデルでの見込みのリスク |
|---|---|---|---|---|---|
| 現在の配分 | 3.62% | 8.30% | 0.376 | 1.21% | 7.79% |
| 均等配分 | 3.42% | 7.98% | 0.365 | 0.77% | 7.58% |
| 基準(推定モデルの最適) | 3.35% | 8.32% | 0.343 | 2.14% | 7.79% |
| 真のモデルの最適 | 3.67% | 8.30% | 0.381 | 1.48% | 7.92% |
読み取れることは3つあります。1つ目は、推定モデルのフロンティアが真のモデルのフロンティアより、どのリスク上限でも大きく低いことです。リスク上限8%で、真のモデルでは3.57%取れるのに、推定モデルは2.18%しか見込んでいません。これは、240か月の標本平均がたまたま真の値より低く出た(外国株式・外国債券・不動産投資信託で特に低い)ためで、推定モデルは世界を実際より悲観的に見ています。推定モデルのフロンティアがリスク15.07%で終わっているのは、推定モデルでは国内株式の標本平均3.58%が6資産で最も高く、リスクの上限を上げていくと国内株式100%に行き着き、それ以上は伸ばせないからです。真のモデルでは外国株式(6.5%)が最も高いので、真のモデルのフロンティアはリスク18%付近まで続きます。
2つ目は、推定モデルで選んだ配分を真のモデルで評価すると、表に示したどのリスク上限でも期待リターンが真のフロンティアを下回り、しかもリスクが上限を超えていることです。リスク上限8%で選んだ配分は、真のモデルでは期待リターン3.42%(真のフロンティアより0.15pt低い)、リスク8.54%(上限より0.54pt高い)でした。推定モデルは、期待リターンを悲観していた一方で、選んだ配分のリスクは小さく見積もっていたことになります。推定の偏りの向きは資産ごとに違い、それが配分を通じて合成されると、見込みと実際のずれ方は単純には予想できません。
3つ目は、2つ目の表に並べた4つの配分の関係です。現在の配分(真のモデルで期待リターン3.62%・リスク8.30%)は、真のモデルの最適(同じリスク8.30%で3.67%)とリスクが同じで、期待リターンもほとんど変わりません。基準(推定モデルの最適)は、推定モデルでは2.14%の見込みでしたが、真のモデルでは3.35%・リスク8.32%で、リスクを下げないまま、期待リターンだけが現在の配分より低い位置に来ました。均等配分は3.42%・7.98%です。つまり、推定モデルで最適化した配分は、真のモデルで見ると、現在の配分にも均等配分にも及ばない位置にありました。この結果の理由を、次の2つの節で順に見ていきます。
基準の最適化の構造
第2章で示した基準は、推定モデルのもとで「現在の配分と同じ推定リスク(7.79%)を上限として、推定の期待リターンを最大にする」配分を、ショートなし・合計100%の条件で求めたものです。関数 mean_variance の要所を抜き出したものが次のコードです(関数の一部だけを抜き出したもので、このままでは単独で実行できません。全体は第2章で用意したスクリプトにあります)。
# baseline.py の mean_variance から要所を抜き出したもの
cons = [{"type": "eq", "fun": lambda w: np.sum(w) - 1.0},                 # 合計100%
        {"type": "ineq", "fun": lambda w: target_sig ** 2 - w @ cov @ w}]  # リスクの上限
bounds = [(lb, ub)] * n                                                   # 各資産の下限と上限
rng = np.random.default_rng(seed)
starts = [np.full(n, 1.0 / n)] + [rng.dirichlet(np.ones(n)) for _ in range(n_starts - 1)]
for w0 in starts:                                                         # 初期値20通り
    res = minimize(lambda w: -(w @ mu), w0, method="SLSQP", bounds=bounds, constraints=cons,
                   options={"maxiter": 500, "ftol": 1e-12})
構造は4つの部品でできています。目的は、期待リターン \( w^{\top}\mu \) の最大化です(scipy の minimize は最小化しかしないので、符号を反転して最小化しています)。制約は、重みの合計が1であること、ポートフォリオの分散 \( w^{\top}\Sigma w \) がリスク上限の2乗以下であること、各資産の重みが下限 lb と上限 ub の間にあることの3つです。既定は lb=0.0・ub=1.0 で、これがショートなし(空売りをしない)の条件にあたります。解法は scipy の SLSQP(逐次2次計画法。制約つきの滑らかな問題を、2次の近似問題を繰り返し解いて解く方法)で、均等配分と、乱数で作った19通りの配分の計20通りを初期値にして解き、制約を満たす解のうち期待リターンが最も高いものを返します。この問題は、目的が重みの一次式で、制約が一次式の等式と上下限、それに共分散行列から作った分散の上限でできています。共分散行列が半正定値(どの重みについても分散が0以上になる性質)であれば、分散の上限を満たす重みの集まりは凸な領域になるので、全体は凸最適化問題(その付近で最も良い解が、そのまま全体で最も良い解になる問題)です。共通データの推定モデルの共分散行列も真のモデルの共分散行列も、固有値を計算するとすべて正で、この条件を満たしていました。数理モデルとしては、最初から全体で最も良い解を探す問題です。それでも初期値を20通り変えて解くのは、SLSQP が数値計算の都合で収束に失敗したり、許容誤差の範囲で制約をわずかに外れた解を返したりすることへの備えです。関数は、解法が成功を報告し、重みを上下限の範囲に収めて合計を1に直したうえでリスクの上限を満たす解だけを残し、その中で期待リターンが最も高いものを採ります。
この構造の中で、入力として外から与えるのは期待リターン \( \mu \) と共分散 \( \Sigma \) とリスク上限だけです。数理モデルとしての最適化は、与えられた入力のもとで最良の配分を探します。問題が起きるとすれば、入力のほうです。次のコードは、基準と同じ計算を、上限なし(各資産0〜100%)と上限30%の2通りで行い、それぞれの配分を推定モデルの見込みと真のモデルの答え合わせで並べたものです。共通データAを作る補助モジュール port_data.py と、関数 mean_variance を含む基準のスクリプト baseline.py と同じフォルダに置いて実行する形です。
import numpy as np
from port_data import *
from baseline import mean_variance

df = history()                          # 第1〜240か月の架空の履歴
mu_hat, cov_hat = estimate(df)          # 推定モデル(標本平均・標本共分散、年率)
w_cur = CURRENT.values
tgt = np.sqrt(w_cur @ cov_hat @ w_cur)  # 現在の配分の推定リスク

for label, ub in [("上限なし", 1.0), ("上限30%", 0.3)]:
    w = mean_variance(mu_hat, cov_hat, tgt, ub=ub)
    e = est_stats(w, mu_hat, cov_hat)   # 推定モデルでの見込み
    t = true_stats(w)                   # 真のモデルでの答え合わせ
    print(label, " ".join("%s %.1f%%" % (c, 100 * x) for c, x in zip(CODES, w)))
    print("  見込み 期待R %.2f%% / 真 期待R %.2f%% リスク %.2f%% シャープ %.3f"
          % (100 * e["mu"], 100 * t["mu"], 100 * t["sig"], t["sharpe"]))
# 出力:
# 上限なし DE 52.3% FE 0.0% DB 47.7% FB 0.0% RE 0.0% CA 0.0%
#   見込み 期待R 2.14% / 真 期待R 3.35% リスク 8.32% シャープ 0.343
# 上限30% DE 30.0% FE 23.3% DB 30.0% FB 0.0% RE 0.0% CA 16.7%
#   見込み 期待R 1.77% / 真 期待R 3.55% リスク 8.30% シャープ 0.367
結果の読み方:見込みと答え合わせを分けて書く
上限なしの結果が第2章の基準と同じ配分(国内株式52.3%・国内債券47.7%・他の4資産は0%)です。第2章の基準の結果から、各配分の推定モデルでの見込みと真のモデルでの値を表にまとめました。「推定」の3列は240か月の標本で計算した値、「真」の3列はデータを作った側が知っている真のモデルでの値です。
| 配分 | 推定:期待リターン | 推定:リスク | 推定:シャープ・レシオ | 真:期待リターン | 真:リスク | 真:シャープ・レシオ |
|---|---|---|---|---|---|---|
| 現在の配分 | 1.21% | 7.79% | 0.092 | 3.62% | 8.30% | 0.376 |
| 均等配分 | 0.77% | 7.58% | 0.035 | 3.42% | 7.98% | 0.365 |
| 基準(推定モデルの最適) | 2.14% | 7.79% | 0.211 | 3.35% | 8.32% | 0.343 |
| 真のモデルの最適(参考) | 1.48% | 7.92% | 0.123 | 3.67% | 8.30% | 0.381 |
「推定」の列だけを見ると、基準は現在の配分より期待リターンが0.93pt高く(1.21%から2.14%)、リスクは同じ7.79%で、シャープ・レシオは0.092から0.211へ2倍以上に改善します。最適化の報告書がこの列だけを載せていたら、配分の変更は承認に傾きやすいと考えられます。ところが「真」の列では、基準の期待リターンは3.35%で、現在の配分の3.62%より0.27pt低く、リスクは8.32%と現在(8.30%)よりわずかに高くなっています。見込みでは +0.93pt の改善だったものが、答え合わせでは -0.27pt の悪化でした。見込みと実際の差は1.2pt です。
もう1つ注目したいのは、真のモデルの最適(参考)の行です。真のモデルで最適化した配分を推定モデルで評価すると、期待リターンは1.48%で、基準の見込み2.14%より低く見えます。推定モデルの目からは、本当に良い配分が「劣った配分」に見えているということです。推定モデルの中で最適化をしている限り、推定モデルが間違っている方向に向かって、最も遠くまで進んでしまいます。
経営指標に翻訳してみます。仮に運用資産が100億円(架空)だとすると、推定モデルが約束した改善は年0.93pt、つまり年9,300万円の期待リターンの上乗せです。実際に起きるのは年0.27pt、つまり年2,700万円の期待リターンの目減りで、リスク(標準偏差)はほぼ変わりません。しかも、配分の変更には売買の費用がかかります(取引コストの扱いは第8章)。最適化の結果を報告するときは、「推定モデルでの見込み」であることを明記し、その見込みがどれだけ外れうるかを併記することが欠かせないと考えています。どれだけ外れうるかを測る方法の1つが、次の節で行う履歴の作り直しです。
上限30%の結果も見ておきます。上限を設けると、推定モデルでの見込みは1.77%と上限なし(2.14%)より下がります。推定モデルの中では、制約を加えれば見込みは必ず悪くなります。ところが真のモデルでは、期待リターン3.55%・シャープ・レシオ0.367で、上限なしの3.35%・0.343を上回りました。推定モデルの見込みが下がる操作で、実際の成績が上がる。この逆転が、この章の後半の主題です。ただし、上限30%でも真のモデルの期待リターンは現在の配分(3.62%)をなお0.07pt下回っています(100億円の架空の例で年700万円)。
推定誤差の増幅:最適化は推定の誤りを探しにいく
推定モデルで最も良い配分が真のモデルでは悪くなる理由は、最適化の仕組みにあります。最適化は、期待リターンが高く見える資産に重みを寄せます。標本平均が高く見える資産には、本当に期待リターンが高い資産と、たまたま標本平均が高く出た資産(推定の誤りが上向きに出た資産)が混ざっています。最適化はこの2つを区別できないので、上向きの誤りが大きい資産ほど重みを大きくし、下向きの誤りが大きい資産を0%にします。結果として、最適化した配分は推定の誤りが最も都合よく見える方向に偏ります。この記事ではこれを推定誤差の増幅と呼びます。推定の誤りそのものは第3章で見たとおり避けられませんが、最適化はその誤りを選んで拾い上げ、配分の偏りという形で大きくしてしまいます。
共通データの基準では、240か月の標本平均は国内株式3.58%、外国株式1.95%、国内債券0.56%、外国債券 -1.71%、不動産投資信託 -0.22%、短期資産0.44%でした。真の値(5.5%・6.5%・1.0%・2.5%・4.5%・0.5%)と比べると、国内株式の誤りは -1.92pt で、外国株式(-4.55pt)・外国債券(-4.21pt)・不動産投資信託(-4.72pt)よりずっと小さく、相対的に国内株式だけが良く見えています。最適化はこれを正確に拾い、リスク上限の範囲で国内株式に52.3%を寄せ、リスクを抑える役として国内債券を47.7%組み合わせ、残りの4資産を0%にしました。真のモデルで最も期待リターンが高い外国株式は0%です。
入力の小さな変化にどれだけ配分が反応するかを確かめるため、外国株式の標本平均だけを1ptずつ上げて、同じ最適化をやり直しました(他の資産の標本平均と標本共分散、リスク上限は基準と同じ)。
| 外国株式の標本平均 | 国内株式 | 外国株式 | 国内債券 | 他の3資産 | 真のモデルのシャープ・レシオ |
|---|---|---|---|---|---|
| 1.95%(基準のまま) | 52.3% | 0.0% | 47.7% | 0.0% | 0.343 |
| 2.95%(+1pt) | 51.3% | 1.3% | 47.4% | 0.0% | 0.346 |
| 3.95%(+2pt) | 32.1% | 21.5% | 46.4% | 0.0% | 0.376 |
| 4.95%(+3pt) | 14.3% | 35.4% | 50.3% | 0.0% | 0.380 |
外国株式の標本平均を2pt上げただけで、外国株式の重みは0%から21.5%に、国内株式は52.3%から32.1%に動きました。表の「外国株式の標本平均」の列のとおり、2pt上げた時点(3.95%)で、外国株式の標本平均は国内株式の標本平均(3.58%)を上回り、標本平均の順位が入れ替わっています(入れ替わるのは約1.63pt上げたところです)。重みの大小まで入れ替わるのは3pt上げたときで、外国株式35.4%・国内株式14.3%になります。一方、国内株式の標本平均を1pt下げても1pt上げても(2.58%・4.58%)、配分は52.3%・47.7%のまま変わりませんでした。国内株式が6資産で最も標本平均が高い状態が変わらないからです。配分は、標本平均の「順位」が入れ替わる付近で大きく跳び、それ以外ではほとんど動きません。
この1ptから3ptという幅は、推定の誤りとしては小さいものです。外国株式の標本の標準偏差は年率17.66%なので、20年分の年次の平均の標準誤差は、おおよそ 17.66%÷√20 ≒ 3.95pt になります(標準誤差の考え方は第3章)。つまり、推定の誤りとしてごく普通に起きる大きさの変化で、最適化の答えの株式の部分は、国内株式中心から外国株式中心へと入れ替わります。最適化の答えを「データが示した結論」として扱うことの危うさは、ここにあります。
履歴を作り直すと、最適な配分は毎回入れ替わる
基準の結果が「たまたま運の悪い履歴だった」だけなのかを確かめるため、乱数シードを1から20まで変えて、同じ真のモデルから240か月の履歴を20回作り直しました。それぞれの履歴から推定モデルを作り、基準と同じ条件(ショートなし・現在の配分と同じ推定リスク)で最適化した配分を並べたのが次の図です。現実の企業が手にする履歴は、この20本のうちのどれか1本のようなものです。
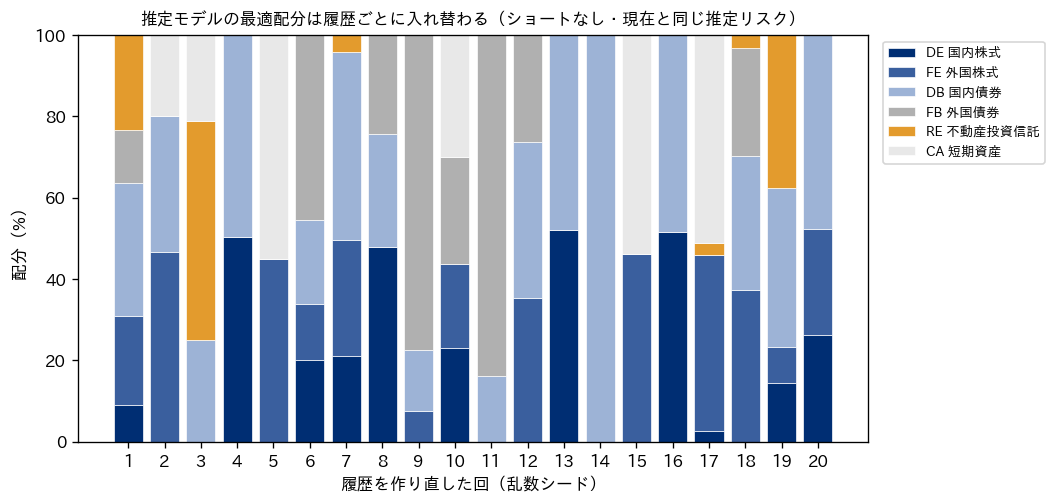
同じ真のモデルから作った履歴なのに、最適な配分は回ごとに大きく入れ替わりました。国内株式と国内債券がほぼ半々の回(第4・13・16回)、外国株式と短期資産がほぼ半々の回(第5・15・17回)、外国債券が77.4%や83.8%を占める回(第9・11回)、国内債券が100%の回(第14回)があります。20回の平均で、0%でない資産は6つのうち3.0個でした。各資産が0%になった回数は、国内株式9回・外国株式7回・国内債券4回・外国債券12回・不動産投資信託13回・短期資産14回です。真のモデルでは外国株式の期待リターンが最も高いのに、20回中7回はその外国株式が0%でした。
配分の中身がこれだけ揺れることは、それ自体が経営上の損失につながります。毎年、新しい1年分のデータを加えて最適化をやり直すと、配分が大きく入れ替わる可能性があり、そのたびに売買の費用がかかります。また、「昨年は国内株式が最適と言い、今年は外国株式が最適と言う」モデルの答えを、投資委員会や取締役会にどう説明するかという問題も生じます。配分を決める側から見ると、最適化の答えの揺れは、その答えがどれだけ推定の誤りに支配されているかを表す指標と読めます。
ショートなし・上下限の制約が推定誤差を抑える
20回の履歴のそれぞれについて、重みの制約だけを変えて最適化をやり直し、真のモデルでのシャープ・レシオを比べました。制約は、空売りを各資産 -100%まで認める場合(重みは -100%〜200%)、基準と同じショートなし(0〜100%)、各資産の上限40%、上限30%、下限5%・上限30%の5通りです。リスク上限は、どの場合も各回の推定モデルでの現在の配分のリスクです。
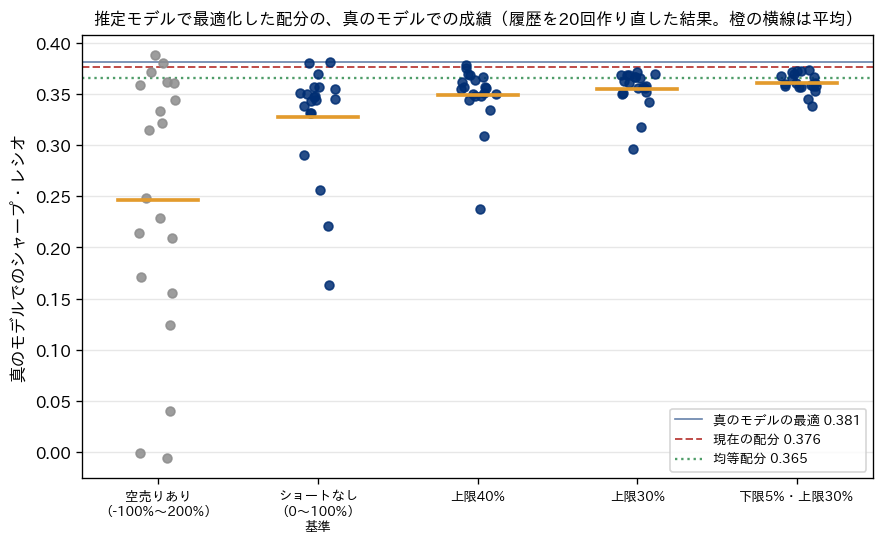
表の「平均」「最小」「中央値」「最大」は、20回の真のシャープ・レシオの統計です。「現在の配分を下回った回数」は、真のシャープ・レシオが現在の配分(0.376)より低かった回数、「均等配分を下回った回数」は均等配分(0.365)より低かった回数です。「推定モデルでの見込み(平均)」は、同じ配分を各回の推定モデルで評価したシャープ・レシオの20回平均、「最大の重み(平均)」は、各回の配分で絶対値が最も大きい重みの20回平均です。
| 制約 | 平均 | 最小 | 中央値 | 最大 | 現在の配分を下回った回数 | 均等配分を下回った回数 | 推定モデルでの見込み(平均) | 最大の重み(平均) |
|---|---|---|---|---|---|---|---|---|
| 空売りあり(-100%〜200%) | 0.246 | -0.006 | 0.282 | 0.388 | 18回 | 17回 | 0.735 | 122% |
| ショートなし(0〜100%、基準) | 0.328 | 0.163 | 0.346 | 0.381 | 18回 | 17回 | 0.608 | 52% |
| 上限40% | 0.349 | 0.237 | 0.355 | 0.378 | 19回 | 15回 | 0.572 | 39% |
| 上限30% | 0.355 | 0.296 | 0.359 | 0.372 | 20回 | 12回 | 0.546 | 30% |
| 下限5%・上限30% | 0.361 | 0.339 | 0.360 | 0.374 | 20回 | 13回 | 0.531 | 30% |
制約を強めるほど、真のモデルでの成績の平均は上がり、ばらつきは小さくなりました。空売りを認めた場合の平均は0.246で、最小は -0.006(無リスク金利にも届かない配分)でした。ショートなしにすると平均0.328・最小0.163、上限30%で平均0.355・最小0.296、下限5%・上限30%で平均0.361・最小0.339です。図で見ると、空売りありの点は0から0.39まで広く散らばり、制約を強めるにつれて点が上の狭い範囲に集まっていきます。
逆に「推定モデルでの見込み(平均)」の列は、制約を強めるほど下がっています(0.735から0.531)。推定モデルの中では、制約は見込みを悪くするだけの条件です。それでも真のモデルでの成績は上がります。制約は、推定の誤りに乗じて極端な重みを取ることを物理的に禁じるので、増幅の幅を抑えるからです。見込みと真の成績の差(空売りありで0.735と0.246、ショートなしで0.608と0.328)は、推定モデルの中の最適がどれだけ楽観的に見積もられているかを示しています。どの制約でも、推定モデルでの見込みの平均は真の成績の平均を大きく上回りました。最適化で選んだ配分の見込みは、選んだという事実そのものによって上振れしている、と読むべきです。
この現象は、実際の市場データを使った研究でも報告されています。ジャガナサンとマ(Ravi Jagannathan と Tongshu Ma)が2003年に The Journal of Finance 誌(第58巻第4号、1651〜1683ページ)に発表した大規模なポートフォリオのリスク低減に関する論文の要旨は、重みを非負に制約する(空売りを禁じる)ことが、その制約が本当は正しくない場合でも、推定した最適な配分のリスクを下げうる理由を説明したとしています。さらに要旨は、空売りなしの制約を置くと、標本共分散行列が、ファクターモデルや縮小推定、日次データにもとづく共分散の推定と同程度の成績を示したと述べています。この論文が扱っているのは主にリスクの低減で、この章の計算はシャープ・レシオで見ているという違いはありますが、「推定モデルの中では余計な制約が、推定の誤りに対しては歯止めとして働く」という向きは共通しています。
ただし、制約にも限界があります。上限30%の場合、現在の配分(0.376)を上回った回は20回中1回もありませんでした。制約は最悪の結果を防ぎますが、推定の誤りそのものを消すわけではありません。上下限の幅をどう決めるかも、推定ではなく方針の問題です。上限を狭くするほど、最適化の答えは「上限と下限の組み合わせ」に近づき、最適化をする意味が薄れていきます。その極限が、次の節の均等配分です。
均等配分(1/N)と比べる
均等配分は、期待リターンも共分散も使わず、6資産に1/6ずつ配分する規則です。推定を一切使わないので、推定の誤りの影響も受けません。共通データでは、均等配分の真のシャープ・レシオは0.365で、真のモデルの最適(0.381)より0.016低いだけでした。これを、推定モデルで最適化した配分と比べたのが次のコードです。こちらも port_data.py と baseline.py と同じフォルダに置いて実行する形です。
import numpy as np
from port_data import *
from baseline import mean_variance

w_cur = CURRENT.values
sh = {"上限なし": [], "上限30%": []}
for seed in range(1, 21):               # 履歴を20回作り直す
    m, c = estimate(history(seed=seed))
    tgt = np.sqrt(w_cur @ c @ w_cur)
    sh["上限なし"].append(true_stats(mean_variance(m, c, tgt))["sharpe"])
    sh["上限30%"].append(true_stats(mean_variance(m, c, tgt, ub=0.3))["sharpe"])

eq = true_stats(EQUAL.values)["sharpe"]
print("均等配分の真のシャープ %.3f" % eq)
for k, v in sh.items():
    v = np.array(v)
    print("%s: 平均 %.3f 最小 %.3f / 均等配分に負けた回数 %d/20"
          % (k, v.mean(), v.min(), (v < eq).sum()))
# 出力:
# 均等配分の真のシャープ 0.365
# 上限なし: 平均 0.328 最小 0.163 / 均等配分に負けた回数 17/20
# 上限30%: 平均 0.355 最小 0.296 / 均等配分に負けた回数 12/20
上限なし(ショートなし)の最適化は、20回中17回で均等配分に負けました。上限30%を設けても12回負けています。真のシャープ・レシオの平均で見ても、上限なしの0.328、上限30%の0.355はどちらも均等配分の0.365に届きません。推定モデルで最適化することで得られるはずの改善より、推定の誤りで失う分のほうが大きかったということです。
デミゲル、ガルラッピ、ウッパル(Victor DeMiguel、Lorenzo Garlappi、Raman Uppal)が Review of Financial Studies 誌(第22巻第5号、1915〜1953ページ。2009年)に発表した最適な分散投資と単純な分散投資を比べた論文は、同じ問いを実データで調べています。要旨によると、標本にもとづく平均分散モデルと、推定誤差を減らすために考えられたその拡張の計14のモデルを、7つの実証データで、標本外(推定に使っていない期間)の成績について1/N の規則と比べたところ、シャープ・レシオ、確実性等価リターン、回転率のいずれでも、一貫して1/N より良いモデルはありませんでした。要旨は、標本外では最適な分散投資から得られる利益が推定誤差によって打ち消されていることを示す、と結論づけています。さらに、米国の株式市場に合わせて設定したパラメータでの解析とシミュレーションでは、標本にもとづく平均分散の戦略とその拡張が1/N を上回るのに必要な推定期間は、25資産で約3,000か月、50資産で約6,000か月だったとしています。
この記事の共通データは6資産・240か月で、条件はこの論文と違います。それでも、240か月(20年)の履歴では推定モデルの最適化が均等配分を安定して上回れなかったという結果は、論文の結論と同じ向きです。経営の文脈に置き換えると、「何も推定しない単純な規則」は、精緻なモデルの比較対象として必ず置くべき基準だということです。精緻なモデルが単純な規則に勝てることを、答え合わせのできる形で示せないなら、そのモデルの答えを採る理由は弱いと考えています。
一方で、均等配分にも欠点があります。資産の分け方に答えが左右されることです。たとえば、国内株式を大型株と小型株の2つに分けて7資産にすれば、株式の比率は自動的に上がります。均等配分は「何に分けるか」という分類の決定を、配分の決定にすり替えています。また、均等配分は短期資産にも1/6を配分するので、その分だけ期待リターンを放棄しています(共通データの均等配分の真の期待リターンは3.42%で、現在の配分の3.62%より0.20pt低い)。均等配分の価値は「最適な配分」ではなく、「推定に頼らない比較の基準」であることにあります。
フロンティアの平らさ:最適の付近では配分を変えても差が小さい
平均分散最適化の答えをそのまま採るべきでない理由は、推定の誤りのほかにもう1つあります。真のモデルで計算しても、最適の付近では、配分を大きく変えても期待リターンがほとんど変わらないことです。真のモデルのもとで、現在の配分と同じリスク(8.30%)を上限にして、国内株式・外国株式・国内債券のどれか1つの重みを固定し、残りの資産の配分を最適化し直しました。表の値は、そのときの真のモデルでの期待リターンと、真のモデルの最適(3.67%)との差です。
| 固定した資産と重み | 真のモデルでの期待リターン | 真のモデルの最適との差 |
|---|---|---|
| 国内株式 0% | 3.59% | -0.07pt |
| 国内株式 10% | 3.65% | -0.01pt |
| 国内株式 20% | 3.66% | 0.00pt |
| 国内株式 30% | 3.64% | -0.03pt |
| 国内株式 40% | 3.55% | -0.11pt |
| 国内株式 50% | 3.40% | -0.27pt |
| 外国株式 10% | 3.57% | -0.09pt |
| 外国株式 20% | 3.64% | -0.02pt |
| 外国株式 30% | 3.67% | 0.00pt |
| 外国株式 40% | 3.62% | -0.04pt |
| 国内債券 20% | 3.56% | -0.10pt |
| 国内債券 30% | 3.61% | -0.05pt |
| 国内債券 40% | 3.66% | -0.01pt |
| 国内債券 50% | 3.63% | -0.03pt |
国内株式の重みを10%から30%まで動かしても、期待リターンの低下は0.03pt以内でした(真のモデルの最適の国内株式は18.4%)。外国株式を20%から40%まで動かしても0.04pt以内、国内債券を40%から50%まで動かしても0.03pt以内です。差の欄の「0.00pt」は、小数第2位まで丸めると差が見えないという意味です。表は最適の付近に絞って載せており、最適から離れると差は広がります。同じ計算で、外国株式を0%に固定すると -0.21pt、国内債券を0%に固定すると -0.21pt、国内債券を60%に固定すると -0.47pt で、国内株式を60%、外国株式を50%に固定すると、リスク上限を満たす配分がありませんでした。
別の角度からも確かめました。6資産の配分を乱数で200,000通り作り、真のモデルでのリスクが現在の配分以下で、期待リターンが真のモデルの最適から0.1pt以内に入るものを数えると、154通りありました。その154通りの重みの範囲は、国内株式0.4〜31.2%、外国株式13.3〜41.5%、国内債券24.6〜48.5%、外国債券0〜22.1%、不動産投資信託0〜23.7%、短期資産0〜15.4%です。国内株式の重みが1%未満でも30%超でも、期待リターンの差は0.1pt以内に収まる配分があるということです。100億円の架空の例で言えば、0.1ptは年1,000万円の期待リターンにあたります。
この平らさは、経営判断にとって2つの意味を持ちます。1つは、最適化の答えを小数点以下まで信じる必要がないことです。真のモデルが分かっていても、最適の付近の広い範囲で成績はほとんど変わらないので、「国内株式18.4%」という答えの18.4という数字そのものには、経営上の意味はほとんどありません。もう1つは、推定の誤りに対する感度の高さと表裏であることです。期待リターンの差が小さい配分どうしは、推定の誤りが少し加わるだけで順位が入れ替わります。前の節で、外国株式の標本平均を2pt変えただけで配分が大きく動いたのも、これと同じ型の現象と考えています。ただし、前の節は推定モデルでの計算、この節は真のモデルでの計算で、推定モデルの側の平らさは測っていません。平らな地形で最も高い点を探すと、わずかな測量の誤差で「頂上」の位置が大きく動きます。
共通データの現在の配分は、真のモデルの最適との期待リターンの差が丸める前の値でわずか0.04pt(小数第2位までの表示では3.62%と3.67%)で、すでにこの平らな領域の中にあります。この状態で推定モデルの最適化の答えに従って配分を大きく動かすと、この章の前半で見たとおり、得られるはずの小さな改善より、推定の誤りで失う分のほうが大きくなりました。
経営判断:最適化の答えをそのまま採らない
この章の計算から、平均分散最適化を経営判断に使うときの考え方を4つにまとめます。
1つ目は、最適化の答えを「決定」ではなく「方向の示唆」として扱うことです。共通データでは、推定モデルの最適は「国内株式を増やし、外国株式・外国債券・不動産投資信託を0%にする」ことを示しましたが、真のモデルの最適は、現在の配分から「外国株式と国内債券を増やし、外国債券と国内株式を減らす」方向でした(真のモデルの最適は国内株式18.4%・外国株式29.3%・国内債券45.9%・外国債券0%・不動産投資信託6.4%)。推定モデルが示した方向が正しいかどうかは、推定の精度しだいです。配分を変える場合も、現在の配分から一度に大きく動かすのではなく、変更の幅に上限を設けて少しずつ動かすほうが、推定の誤りに対して安全だと考えています。
2つ目は、見込みと答え合わせの差を、報告に必ず書くことです。推定モデルでの改善幅(共通データでは +0.93pt)だけを報告すると、意思決定者は改善を過大に評価します。履歴の作り直し(この章の20回のような計算)や、期間を分けた検証で、見込みがどれだけ外れうるかを示し、「推定モデルでの見込み」と「その見込みの信頼できる幅」を並べて書くべきです。
3つ目は、比較の基準として、現在の配分と均等配分を常に置くことです。最適化の答えが、この2つを答え合わせのできる形で上回れないなら、配分を変える根拠は弱いと判断します。共通データでは、ショートなしの最適化は20回中18回で現在の配分を、17回で均等配分を下回りました。
4つ目は、上下限の制約を「推定の誤りに対する保険」として設計することです。この章の計算では、上限30%を置くと真のシャープ・レシオの最小値が0.163から0.296に上がりました。上下限は、資産ごとの事情(流動性、規制、組織の方針)から決めることが多いと思いますが、推定の誤りを抑える役割も持つことを意識して幅を決めると、最適化の答えが極端になることを防げます。
以上の考え方を踏まえて、平均分散最適化の答えを経営判断に使うまでの流れを4つの段階にまとめると、次のようになります。
- 推定モデルで最適化する
- 履歴を作り直して答えの揺れを測る
- 現在の配分と均等配分に勝てるかを確かめる
- 上下限と変更幅の上限を付けて採用する
事業投資の予算配分にも同じことが言えます。第10章で扱う案件選択の整数計画は、NPV の見積りを入力にして、予算の範囲で NPV の合計が最大になる組み合わせを選びます。NPV の見積りが楽観に偏った案件ほど選ばれやすいという構造は、この章で見た推定誤差の増幅と同じです。見積りの誤りが選択をどう動かすかは、第10章の感度分析と第12章の不確実性のもとでの配分で確かめます。
この章では、平均分散最適化が期待リターンと共分散を入力に配分を決める手法であること、推定モデルの最適は真のモデルで答え合わせをすると現在の配分にも均等配分にも及ばないことが多いこと、その主な原因が推定の誤りを最適化が拾い上げて増幅することにあり、上下限の制約がそれを抑えること、そして最適の付近ではフロンティアが平らで配分の細かな違いに経営上の意味は小さいことを確かめました。第5章では、推定の誤りそのものに手を入れる方法として、期待リターンの縮小推定、ブラック・リッターマン、リサンプリング、ロバスト最適化を取り上げ、それぞれが何を犠牲にして誤りに強くなるのかを、同じ真のモデルで比べます。
この章を深めたい方への参考書籍
『新・証券投資論 I 理論篇』(小林孝雄・芹田敏夫 著、日本証券アナリスト協会 編、日本経済新聞出版社):証券投資の理論を体系立てて学ぶための教科書です。この章で扱った期待リターンとリスクによる配分の考え方を、資産価格の理論やリスクの測り方と合わせて位置づけ直すのに向いています。
『金融工学入門 第2版』(David G. Luenberger著、今野浩・鈴木賢一・枇々木規雄訳、日本経済新聞出版社):金融工学の入門書の翻訳で、2015年に第2版が出ています。この章で使った期待リターンと共分散の計算の背景を、教科書の体系の中で数式を追って確かめたい方に向いています。
第5章 推定誤差に強くする
第4章では、240か月の履歴から推定した平均と共分散(推定モデル)でリスクを現在の配分と同じに抑えて期待リターンを最大にすると、国内株式52.3%・国内債券47.7%という偏った配分が出て、真のモデルで評価すると期待リターンが現在の配分より0.27pt下がることを確かめました。履歴を20回作り直しても、推定モデルで最適な配分の真のシャープ・レシオは平均0.328で、現在の配分の0.376を20回中18回下回りました。最適化そのものに誤りがあるのではなく、最適化に渡した期待リターンの推定が粗く、その粗さを最適化が増幅していることが原因でした。
この章では、推定の粗さを前提にしたまま、配分の判断を壊れにくくする方法を順に試します。期待リターンの推定値そのものを穏やかにする平均の縮小推定、現在の配分を出発点にして見方を少しずつ足すブラック・リッターマン、標本を作り直して解いた配分を平均するリサンプリング、平均の誤差の範囲で最悪の場合に備えるロバスト最適化、そして上下限の制約を他の手法と組み合わせる使い方です。どの手法も、第2章で用意したサンプルデータ(架空の6資産クラスの月次リターン)で同じ条件に揃えて解き、真のモデルで答え合わせをします。最後に、20回作り直した履歴で手法ごとの真のシャープ・レシオを並べ、推定誤差に強い方法が何を犠牲にしているかを確かめます。
本章は架空のデータで手法の性質を確かめるもので、特定の資産や配分比率を勧めるものではありません。本記事は投資や財務の助言ではないので、実際の配分は専門家に相談のうえ判断してください。
比べる条件をそろえる
手法を公平に比べるために、この章のすべての計算で、最適化の枠を第4章の基準と同じにしました。決めるのは6資産の重みで、合計は100%、空売りはしない(各資産0%以上)という条件です。目的は「推定モデルで見た期待リターンを最大にする」ことで、制約は「推定モデルで見たリスクが、現在の配分の推定リスク(年率7.79%)を超えない」ことです。手法ごとに違うのは、最適化に渡す期待リターンの値だけです。標本平均をそのまま渡すのが第4章の基準で、この章の手法はそれぞれのやり方で作った別の期待リターンを渡します。共分散は、断らない限り240か月の標本共分散をそのまま使います。共分散の推定を改善する方法(縮小推定による共分散)は第3章で扱いました。
評価は真のモデルで行います。共通データは乱数で作った架空のデータなので、データを作った側は本当の期待リターンと共分散を知っています。現実の企業には見えないものですが、この記事では答え合わせに使えます。各手法の配分について、真のモデルでの期待リターン・リスク・シャープ・レシオを計算します。比べる相手は、現在の配分(真のモデルで期待リターン3.62%・リスク8.30%・シャープ・レシオ0.376)と、真のモデルで同じ最適化をした配分(期待リターン3.67%・リスク8.30%・シャープ・レシオ0.381。以下「真の最適」と呼びます)です。真の最適は、データを作った側だけが知る答えで、リスクを現在の配分と同じ年率8.30%に抑えるという条件のもとでの真の最適です。真のモデルで見たリスクが8.30%以下の配分の中では、真の期待リターンが3.67%を超える配分はありません。ただし、条件の違う配分、たとえばリスクをもっと小さくした配分は、シャープ・レシオで0.381を上回ることがありえます。0.381はシャープ・レシオそのものの上限ではないということで、この章の後半の20回の比較でも、リスクを大きく下げた配分がシャープ・レシオで0.381を上回る回が出てきます。
ここで1つ、結果を読む前に押さえておく数字があります。真の最適と現在の配分のシャープ・レシオの差は0.005、期待リターンの差は0.04ptしかありません。第4章で見たとおり、この共通データでは現在の配分がすでに真のモデルの最適の近くにあり、効率的フロンティアが平らです。つまり、どの手法を使っても、現在の配分より大きく良くなる余地はもともとありません。この章の手法の価値は「上振れを取ること」ではなく、「推定の誤りで大きく沈むのを防ぐこと」で測ることになります。もう1つ、表に「入替率」という列を置きました。現在の配分から何割の資産を売り買いするかを表す値で、各資産の重みの差の絶対値を合計して2で割ったものです。入替率0.40は、資産全体の40%を別の資産に入れ替えることを意味します。入れ替えには売買の費用がかかり、その扱いは第8章で述べます。
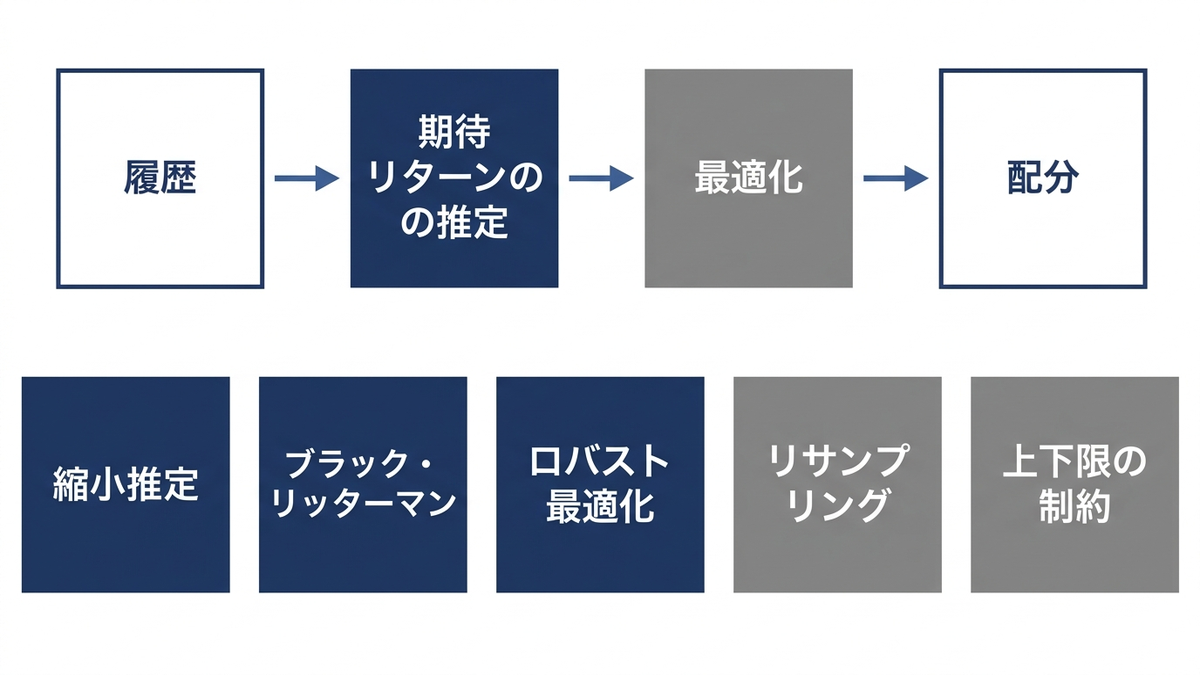
標本平均の誤差の大きさを確かめる
手法に入る前に、推定の粗さを数字で確かめます。標本平均の標準誤差は、各資産のリスク(年率の標準偏差)を観測年数の平方根で割った値です。240か月は20年なので、平方根は約4.47です。seed 0 の履歴で計算すると、年率の標本平均の標準誤差は、国内株式3.37%・外国株式3.95%・国内債券0.67%・外国債券2.06%・不動産投資信託3.30%・短期資産0.09%でした。国内株式の真の期待リターンは5.5%、外国株式は6.5%なので、標準誤差はその半分以上の大きさです。20年の履歴があっても、株式の期待リターンは「真の値から±3〜4pt程度ずれていても不思議ではない」精度でしか分かりません。標準誤差の考え方は第3章で説明したとおりです。
一方、資産どうしの期待リターンの差は小さく、真のモデルで外国株式と国内株式の差は1.0pt、国内株式と不動産投資信託の差も1.0ptです。最適化は、この小さな差を手がかりに重みを決めます。差の大きさが1pt程度で、推定の誤差が3〜4ptあれば、推定値の順位は簡単に入れ替わります。seed 0 の標本平均では外国株式が1.95%、不動産投資信託が -0.22% と真の値を4pt以上下回り、最適化はこの2資産を0%にしました。第4章の偏った配分は、この順位の入れ替わりがそのまま重みに出たものです。この章の手法はどれも、「推定値の小さな差を、そのまま信じて重みに反映させない」ための工夫だと言えます。
平均の縮小推定は、目的の置き方で効いたり効かなかったりする
最初の手法は、期待リターンの推定値を全体の平均へ寄せる方法です。資産ごとの標本平均は誤差が大きいので、6資産の標本平均の単純平均(seed 0 では年率0.77%)に向けて、各資産の推定値を一定の割合だけ近づけます。寄せる割合を「縮小の強さ」と呼び、0なら標本平均のまま、1ならすべての資産が同じ0.77%になります。強さ0.5なら、国内株式の推定値は3.58%から2.17%に、外国債券は -1.71% から -0.47% に変わります。極端な推定値ほど大きく動き、資産どうしの差が縮みます。共分散の縮小推定は第3章で扱いました。ここで寄せるのは平均のほうです。
平均を縮める考え方を、ポートフォリオの分析に持ち込んだ論文として、ジョリオンが1986年に学術誌 JFQA(第21巻第3号)に載せた、ポートフォリオ分析のためのベイズ・スタイン推定を題にした論文があります(書誌は Crossref で確認しました。本文は開けなかったので、論文の主張の中身はこの章では引きません)。この章では、題名にある「ベイズ・スタイン型」の縮小として、寄せる先を最小分散ポートフォリオ(推定モデルでリスクが最も小さい配分)の平均にし、縮小の強さをデータから決める形の式を実装しました。seed 0 では、寄せる先が年率0.45%、データから決まった縮小の強さが0.620でした。
結果は意外なものでした。この章の比べる条件(推定リスクを7.79%以下に抑えて期待リターンを最大化)では、縮小の強さを0.25・0.50・0.75のどれにしても、ベイズ・スタイン型にしても、最適な配分は基準とまったく同じ国内株式52.3%・国内債券47.7%のままでした。理由は式の形にあります。すべての資産の推定値を同じ定数へ同じ割合だけ寄せると、どの配分でも推定の期待リターンは「元の値に一定の数を掛けて、一定の数を足したもの」に変わるだけで、配分どうしの順位は変わりません。重みの合計が100%と決まっていて、リスクの上限が固定されている問題では、順位が変わらなければ最適な配分も変わらないのです。縮小の強さを1にすると、すべての資産の期待リターンが同じになって目的がどの配分でも等しくなり、最適な配分は1つに決まらなくなります(計算機はどこかで止まって答えを返しますが、その答えには意味がありません)。
この章のように全資産を同じ値へ同じ割合で寄せる縮小では、配分が動くのは、目的に期待リターンとリスクの両方が入っている場合です。寄せる先や寄せる割合が資産ごとに違う縮小なら、リスクの上限を固定した形でも配分は変わりえます。期待リターンからリスクの2乗の一定倍を差し引いた値を最大にする形(以下「リスク回避度の形」と呼びます)に書き換えると、期待リターンの差が縮んだ分だけリスクを減らすほうが得になり、配分が変わります。比べやすいように、標本平均での最適が推定リスク7.79%付近になるようにリスク回避度を置き(2.63になりました)、そのリスク回避度のまま平均を縮めて解いた結果が次の表です。
| 期待リターンの推定 | 国内株式 | 国内債券 | 短期資産 | 真の期待リターン | 真のリスク | 真のシャープ・レシオ |
|---|---|---|---|---|---|---|
| 標本平均(縮小なし) | 52.3% | 47.7% | 0.0% | 3.35% | 8.32% | 0.343 |
| 縮小の強さ0.25 | 40.8% | 59.2% | 0.0% | 2.84% | 6.54% | 0.357 |
| 縮小の強さ0.50 | 27.9% | 48.9% | 23.3% | 2.14% | 4.51% | 0.363 |
| 縮小の強さ0.75 | 13.9% | 25.3% | 60.8% | 1.32% | 2.28% | 0.361 |
| ベイズ・スタイン型(強さ0.620) | 21.2% | 37.5% | 41.3% | 1.75% | 3.43% | 0.363 |
| (参考)現在の配分 | 25.0% | 35.0% | 0.0% | 3.62% | 8.30% | 0.376 |
表の外国株式・外国債券・不動産投資信託の列は省きました。どの行も0%で、現在の配分だけが外国株式20%・外国債券15%・不動産投資信託5%です。縮小を強めるほど、短期資産の比率が上がり、真のリスクと真の期待リターンがそろって下がりました。真のシャープ・レシオは0.343から0.36前後に上がりましたが、現在の配分の0.376には届いていません。縮めても、標本平均が外国株式と不動産投資信託を低く見積もっている順位はそのまま残るので、この2資産は0%のままだからです。縮小推定が直したのは「誤差の大きい期待リターンを信じてリスクを取りすぎること」で、「どの資産が有望かの見誤り」は直っていません。
経営の言葉に直すと、縮小推定は「自信のない見込みでは大きく張らない」という規律を式にしたものです。代わりに失うのは期待リターンで、縮小の強さ0.50の行では、真の期待リターンが3.35%から2.14%へ1.21pt下がりました。運用資産100億円(架空)なら年1億2,100万円の期待収益をあきらめて、リスクを8.32%から4.51%に下げたことになります。この取引が割に合うかは、組織がリスクをどこまで取れるかで決まり、手法は答えを出しません。縮小の強さは、投資委員会が「見込みをどこまで割り引くか」を決める値として扱い、決めた根拠を記録しておくのがよいと考えています。
ブラック・リッターマンは「現在の配分」を出発点にする
平均を縮めても資産の順位の見誤りが残るのは、寄せる先が「全資産で同じ値」という情報の少ない目標だからです。寄せる先に、もっと筋の通った期待リターンを置けば、順位の見誤りも和らぐはずです。その代表がブラック・リッターマンと呼ばれる方法です。ブラックとリッターマンには、1992年に Financial Analysts Journal(第48巻第5号)に載った、世界の資産への配分の最適化を題にした論文があります(書誌は Crossref で確認しました。出版社のページは開けなかったので、原論文の記述はこの章では引きません。以下の説明は、この章で実装して計算した内容です)。
この方法は2段階で期待リターンを作ります。1段階目は「逆算」です。ある配分が最適になっているとしたら、各資産の期待リターンはいくらでなければならないかを、共分散から逆に計算します。出発点には市場全体の時価の比率(市場均衡)を置く形もありますが、事業会社の年金や余資の運用では、市場全体の比率より「いま自社が採っている配分」のほうが社内で説明しやすいと考えています。そこでこの章では、現在の配分を出発点にしました。逆算の式は次のとおりです。
\( \pi = r_f + \delta \, \Sigma \, w_{\mathrm{cur}} \)
\( \pi \) が逆算した期待リターン、\( r_f \) が無リスク金利0.5%、\( \Sigma \) が推定した共分散、\( w_{\mathrm{cur}} \) が現在の配分、\( \delta \) がリスク回避度です。言葉で言うと、「現在の配分のリスクに多く効いている資産ほど、高い期待リターンを見込んでいるはずだ」という逆算です。リスク回避度は、現在の配分の推定シャープ・レシオ(0.092)を推定リスク(7.79%)で割って1.178と置きました。こう置くと、逆算した期待リターンで評価した現在の配分の期待リターンが、標本平均で評価した値(1.21%)と一致します。つまり、配分全体の期待リターンの水準だけは標本平均に合わせ、それを資産ごとにどう割り振るかは共分散から決める、という置き方です。標本平均の資産ごとの値は誤差が大きくても、配分全体の水準を1つに合わせるだけなら、資産ごとの順位の見誤りは持ち込まれません。逆算の結果は、国内株式1.70%・外国株式1.95%・国内債券0.51%・外国債券0.97%・不動産投資信託1.48%・短期資産0.50%でした。外国債券や不動産投資信託が正の値になり、標本平均で負だった資産の見誤りが消えています。この逆算した期待リターンをそのまま最適化に渡すと、答えは現在の配分(国内株式25%・外国株式20%・国内債券35%・外国債券15%・不動産投資信託5%)に戻りました。逆算の定義どおりで、計算の確かめになります。
2段階目で「見方」を足します。見方は、「外国株式は国内株式を年率1pt上回る」のように、資産の期待リターンの差や水準についての判断を1つの式で表したものです。見方ごとに「どれだけ確信しているか」を、見方のばらつきの大きさとして与えます。逆算した期待リターンと見方を、それぞれの確からしさで重みをつけて混ぜたものが、最適化に渡す期待リターンになります。確信が強い見方ほど強く反映され、確信が弱い見方はほとんど効きません。この混ぜ方はベイズ統計の事前分布と観測から事後分布を作る計算と同じ形をしていて、逆算した期待リターンが事前の見込み、見方が新しい情報にあたります。ベイズ統計の考え方は弊社コラム『ベイズ統計の考え方と使い方、MCMCから階層ベイズまで』で扱っています。この章の実装では、逆算の不確かさの大きさを共分散の0.05倍とし、見方のばらつきは「見方の式に当てはめた共分散の0.05倍」を基準(確信の倍率1)にしました。倍率を0.25にすると4倍強く信じ、4にすると4分の1の強さで信じることを意味します。
見方を1つ足すと配分はどう動くか
次のコードは、現在の配分から期待リターンを逆算し、「外国株式は国内株式を年率1pt上回る」という見方を1つ足して、事後の期待リターンを計算するものです。共通データの読み込みと推定は第2章・第3章と同じです。
import numpy as np
from port_data import *
from baseline import mean_variance

mu_hat, cov = estimate(history(seed=0))       # 推定モデル(標本平均・標本共分散、年率)
w_cur = CURRENT.values
sig = np.sqrt(w_cur @ cov @ w_cur)            # 現在の配分の推定リスク 0.0779
delta = ((w_cur @ mu_hat - RF_ANNUAL) / sig) / sig   # 推定シャープ ÷ 推定リスク
pi = RF_ANNUAL + delta * cov @ w_cur          # 現在の配分から逆算した期待リターン

P = np.array([[-1, 1, 0, 0, 0, 0]])           # 見方:外国株式から国内株式を引いた差が
Q = np.array([0.01])                          #       年率 +1pt
tau = 0.05
omega = np.diag(np.diag(P @ (tau * cov) @ P.T))   # 見方の不確かさ(確信の倍率1)
A = np.linalg.inv(tau * cov) + P.T @ np.linalg.inv(omega) @ P
b = np.linalg.inv(tau * cov) @ pi + P.T @ np.linalg.inv(omega) @ Q
mu_bl = np.linalg.solve(A, b)                 # 見方を足した期待リターン

w = mean_variance(mu_bl, cov, sig)
print("delta %.3f" % delta)
print("逆算", np.round(pi, 4))
print("事後", np.round(mu_bl, 4))
print("配分", np.round(w, 3), "真のシャープ %.3f" % true_stats(w)["sharpe"])
# 出力:
# delta 1.178
# 逆算 [0.017  0.0195 0.0051 0.0097 0.0148 0.005 ]
# 事後 [0.016  0.0223 0.0051 0.0105 0.0148 0.005 ]
# 配分 [0.071 0.338 0.32  0.136 0.045 0.089] 真のシャープ 0.370
見方を足す前、逆算した期待リターンでの外国株式と国内株式の差は0.25ptでした。見方(差は1pt)を確信の倍率1で足すと、差は0.62ptに広がりました。見方の1ptがそのまま入るのではなく、逆算の0.25ptと見方の1ptの中間に落ちています。最適化の結果は、国内株式が25.0%から7.1%に減り、外国株式が20.0%から33.8%に増えました。見方に名前の出てこない国内債券・外国債券・不動産投資信託・短期資産も少しずつ動いています。外国株式と国内株式は相関が高い(推定モデルで0.66)ので、一方を増やしてもう一方を減らすと、リスクの構成が変わり、他の資産で調整が要るからです。確信の強さと見方の数を変えた結果を、次の表にまとめました。
| 見方と確信 | 国内株式 | 外国株式 | 国内債券 | 外国債券 | 不動産投資信託 | 短期資産 | 入替率 | 真のシャープ・レシオ |
|---|---|---|---|---|---|---|---|---|
| 見方なし(逆算のみ) | 25.0% | 20.0% | 35.0% | 15.0% | 5.0% | 0.0% | 0.000 | 0.376 |
| 見方1、確信の倍率4(弱く信じる) | 17.6% | 26.1% | 34.0% | 14.5% | 4.9% | 2.9% | 0.090 | 0.376 |
| 見方1、確信の倍率1 | 7.1% | 33.8% | 32.0% | 13.6% | 4.5% | 8.9% | 0.227 | 0.370 |
| 見方1、確信の倍率0.25(強く信じる) | 0.0% | 39.1% | 30.9% | 12.6% | 3.3% | 14.2% | 0.333 | 0.360 |
| 見方1と見方2、確信の倍率1 | 0.0% | 31.2% | 34.6% | 23.9% | 10.3% | 0.0% | 0.254 | 0.364 |
| 逆の見方、確信の倍率1 | 48.8% | 0.0% | 39.7% | 9.0% | 2.5% | 0.0% | 0.285 | 0.349 |
| (参考)真のモデルの最適 | 18.4% | 29.3% | 45.9% | 0.0% | 6.4% | 0.0% | 0.216 | 0.381 |
見方1は「外国株式は国内株式を年率1pt上回る」、見方2は「国内債券の期待リターンは年率1.0%」、逆の見方は「外国株式は国内株式を年率1pt下回る」です。共通データの真のモデルでは、外国株式6.5%・国内株式5.5%・国内債券1.0%なので、見方1と見方2はどちらも真のモデルに照らして正しい見方で、逆の見方は誤った見方です。現実には見方が正しいかどうかは分からず、ここでは答え合わせができるので正誤を書いています。
表から読み取れることが3つあります。1つ目は、確信の強さで配分の動きの大きさを調整できることです。倍率4では入替率0.090と小さな修正にとどまり、倍率0.25では国内株式が0%になるまで動きました。2つ目は、正しい見方でも、強く信じすぎると真のシャープ・レシオが下がることです。倍率4の0.376から、倍率1で0.370、倍率0.25で0.360へと下がりました。真のモデルの最適は外国株式29.3%・国内株式18.4%で、外国株式を39.1%まで増やし国内株式を0%にした配分は、正しい方向に動きすぎています。3つ目は、誤った見方の損です。逆の見方を確信の倍率1で足すと、配分は国内株式48.8%・外国株式0%と第4章の基準に近い形になり、真のシャープ・レシオは0.349に下がりました。現在の配分の0.376からの下がり幅は0.027で、第4章の基準(0.376から0.343へ、0.033の低下)より小さく、入替率も0.285で基準の0.400より小さく収まりました。出発点が現在の配分なので、誤った見方を入れても、標本平均を丸ごと信じる場合ほどは崩れません。
もう1つ、リスク回避度の置き方が結果を左右することも確かめました。現在の配分の推定シャープ・レシオ0.092から置いたリスク回避度1.178では、逆算した期待リターンの水準が低く(外国株式と国内株式の差が0.25pt)、1ptの見方が相対的に大きく効きます。仮に現在の配分のシャープ・レシオを0.3と置いてリスク回避度を3.851にすると、逆算の差は0.81ptになり、同じ見方1を足しても事後の差は0.91ptにしか広がらず、配分の入替率は0.017とほとんど動きませんでした。シャープ・レシオを0.4と置くと逆算の差は1.08ptで、見方1はむしろ差を1.04ptへ縮める方向に働きました。つまり、見方の「1pt」が大きいか小さいかは、逆算した期待リターンの水準との比較で決まります。見方を出す担当者と、リスク回避度を置く担当者が別々だと、意図より大きく配分が動くことがあります。見方を入れる前に、逆算した期待リターンの表を会議で共有し、「見方はこの表のどの数字をどれだけ動かすのか」を確かめるのがよいと考えています。
経営の判断として見ると、ブラック・リッターマンの長所は、議論の出発点が「いまの配分」になることです。標本平均から出発する最適化は、毎回まったく新しい配分を提案するので、委員会は提案の全体を一から審議しなければなりません。現在の配分から出発すれば、見方がなければ配分は変わらず、見方を1つ足すとその分だけ動く、という形で変更の理由を1つずつ説明できます。犠牲になるのは、見方を出さない限り何も改善しないことです。改善の大きさは見方の質で決まり、見方が誤っていれば損をします。見方の質は、出した見方と後の実績を記録して事後に評価するしかなく、その仕組みは第13章で扱います。
リサンプリングは「別の履歴だったら」を平均する
3つ目の手法はリサンプリングです。手元の履歴は、たまたま出た1本の標本にすぎません。そこで、推定モデル(標本平均と標本共分散)を仮の真の姿とみなして、そこから240か月の履歴を乱数で何本も作り直し、作り直した履歴ごとに平均と共分散を推定して最適化を解き、得られた配分を平均します。1本の履歴に強く依存した偏りが、平均を取ることで薄まるという考え方です。この方法にはいくつかの流儀がありますが、この章では原典の手順に合わせることはせず、以下の単純な実装で性質を確かめます。
この章の実装では、作り直しを100回行いました。各回で、その回の推定共分散で見た現在の配分のリスクを上限にして期待リターンを最大化し、100個の配分の単純平均を取りました。seed 0 の結果は、国内株式28.7%・外国株式11.8%・国内債券34.8%・外国債券1.9%・不動産投資信託2.2%・短期資産20.6%で、基準の「2資産だけ」とは違い、6資産すべてに重みが付きました。真のモデルでの期待リターンは2.94%、リスクは6.58%、シャープ・レシオは0.372で、基準の0.343より現在の配分(0.376)に近づいています。100回分の実行時間は2.8秒で、この記事の実行環境(一般的なノートPC)での実測です。
注意したい点が2つあります。1つは、平均を取った配分のリスクが、上限の7.79%より下がることです。真のモデルでのリスクは6.58%で、現在の配分の8.30%より低くなりました。各回の配分はリスクの上限いっぱいまで取っていても、違う資産に偏った配分を平均すると分散の効果でリスクが下がります。結果として期待リターンも下がり、現在の配分の3.62%より0.68pt低い2.94%になりました。シャープ・レシオで見れば遜色がなくても、リスクの水準を目標に合わせたい場合は、平均した後で水準を調整する必要があります。もう1つは、リサンプリングは推定モデルを出発点にしているので、標本平均の順位の見誤りそのものは直せないことです。作り直した履歴はどれも「外国株式1.95%・不動産投資信託 -0.22%」の推定モデルから作られるので、平均しても外国株式は11.8%、不動産投資信託は2.2%と、現在の配分より少なくなりました。リサンプリングが減らすのは「推定のたまたまの揺れに配分が振り回されること」で、「推定の中心のずれ」ではありません。
実務の言葉にすると、リサンプリングは「同じ判断を100回やり直したら平均してどこに落ち着くか」を見る方法です。偏った配分が出たとき、それが1本の履歴のたまたまによるものか、どの履歴でも出る傾向なのかを見分ける材料になります。配分そのものを決める手法としてだけでなく、各資産の重みが100回の中でどれだけばらついたかを示す診断の道具としても使えると考えています。
ロバスト最適化は「誤差の範囲での最悪」に備える
4つ目はロバスト最適化です。期待リターンを1つの値と見る代わりに、「本当の期待リターンは、推定値から標準誤差の何倍かの範囲のどこかにある」と範囲(不確実集合)で考え、その範囲の中で最も都合の悪い値が出ても困らない配分を選びます。範囲を資産ごとに独立した幅で取る形を箱型と呼びます。空売りをしない配分(重みがすべて0以上)では、箱型の範囲の中で最悪になるのは、どの資産の期待リターンも範囲の下端にある場合です。したがって箱型のロバスト最適化は、各資産の期待リターンを「標本平均から、標準誤差の δ 倍を引いた値」に置き換えて、普通の最適化を解くのと同じになります。
\( \tilde{\mu}_i = \hat{\mu}_i – \delta \times \mathrm{SE}_i \)
\( \hat{\mu}_i \) が資産 \( i \) の標本平均、\( \mathrm{SE}_i \) がその標準誤差、\( \delta \) が範囲の広さを決める係数です。言葉で言うと、「誤差が大きい資産ほど、見込みを大きく割り引く」ということです。標準誤差は株式系(国内株式・外国株式・不動産投資信託)で3%台、国内債券で0.67%、短期資産で0.09%なので、δ を大きくすると株式系の見込みが大きく下がります。δ を変えて解いた結果が次の表です。
| 範囲の広さ δ | 国内株式 | 国内債券 | 短期資産 | 最悪の場合の期待リターン(推定) | 真の期待リターン | 真のリスク | 真のシャープ・レシオ |
|---|---|---|---|---|---|---|---|
| 0(基準と同じ) | 52.3% | 47.7% | 0.0% | 2.14% | 3.35% | 8.32% | 0.343 |
| 0.5 | 51.6% | 0.0% | 48.4% | 1.17% | 3.08% | 8.31% | 0.311 |
| 1.0 | 0.0% | 0.0% | 100.0% | 0.35% | 0.50% | 0.42% | 0.000 |
| 1.5 | 0.0% | 0.0% | 100.0% | 0.31% | 0.50% | 0.42% | 0.000 |
| 2.0 | 0.0% | 0.0% | 100.0% | 0.26% | 0.50% | 0.42% | 0.000 |
外国株式・外国債券・不動産投資信託の列は、どの行も0%なので省きました。結果は手法への期待を裏切るものでした。δ が0.5で、国内債券が0%になり短期資産が48.4%になりました。国内債券は標準誤差が小さいので割引が小さいはずですが、国内債券の見込み0.56%から0.5×0.67%を引くと0.22%になり、短期資産の0.44%から0.5×0.09%を引いた0.40%を下回ります。そのため、リスクの小さい資産の役割が国内債券から短期資産に移りました。真のシャープ・レシオは0.311に下がり、基準より悪くなりました。δ が1以上では、株式系の見込みがすべて短期資産より低くなり、短期資産100%が最適になりました。真のモデルでの期待リターンは0.50%で、現在の配分の3.62%を3.12pt下回ります。
箱型が極端な答えを出したのは、資産ごとの誤差がすべて同時に最悪の側に振れると仮定しているからです。実際には、6資産の推定の誤差が同時にそろって下端に来ることは考えにくく、複数の資産に分けて持てば、誤差の一部は打ち消し合います。この打ち消し合いを織り込むのが、範囲を楕円の形で取る楕円型の不確実集合です。最悪の場合の期待リターンは「配分の推定期待リターンから、配分全体の推定誤差の大きさの κ 倍を引いた値」になり、配分全体の推定誤差は資産どうしの相関を通じて小さくなります。同じ条件で解くと、κ=1では国内株式17.3%・国内債券31.0%・短期資産51.7%(真のシャープ・レシオ0.362、真の期待リターン1.52%)、κ=1.5では短期資産92.0%(同0.260、0.65%)になりました。κ=0.5では基準と同じ配分のままでした。箱型より穏やかですが、範囲を広げるほど短期資産に逃げる性質は同じです。楕円型は目的が非線形になるので、この章では scipy の SLSQP(制約のついた非線形の最適化問題を数値計算で解く方法の名前)で解きました。
ロバスト最適化を経営の言葉に直すと、「見込みが外れた場合の損を、どこまで許容するか」を範囲の広さで指定する方法です。δ や κ を大きくすることは、「期待リターンの推定はほとんど当てにならない」と宣言するのと同じで、その宣言を受けた最適化は、推定に頼らない資産、この例では短期資産に逃げます。短期資産100%は、最悪の場合の推定の期待リターンを最大にするという意味では筋が通っていますが、真のモデルでは期待リターンを年3pt以上失う選択です。運用資産100億円(架空)なら、年3億円強の期待収益を手放すことになります。範囲の広さは統計の都合で決めるのではなく、「どれだけの期待収益を手放してでも、見込み違いに備えたいか」という経営判断として決め、δ を2〜3通り変えた結果を並べて審議するのがよいと考えています。事業投資の案件選択で NPV の最悪ケースに備えるロバスト最適化は、第12章で扱います。
上下限の制約は、他の手法と組み合わせて使う
最後の手法は、各資産の重みに上限を置くことです。上下限の制約が推定誤差を抑える働きそのものは第4章で確かめたので、ここでは他の手法と組み合わせたときにどうなるかを見ます。各資産の上限を35%(現在の配分の最大の重みと同じ)にして解いた結果が次の表です。
| 手法 | 上限なしの配分 | 上限なしの真のシャープ・レシオ | 上限35%の配分 | 上限35%の真のシャープ・レシオ |
|---|---|---|---|---|
| 標本平均 | 国内株式52.3%・国内債券47.7% | 0.343 | 国内株式35.0%・外国株式18.8%・国内債券35.0%・短期資産11.2% | 0.367 |
| 縮小0.5(リスク上限の形) | 国内株式52.3%・国内債券47.7% | 0.343 | 国内株式35.0%・外国株式18.8%・国内債券35.0%・短期資産11.2% | 0.367 |
| ロバスト箱型 δ=1 | 短期資産100% | 0.000 | 国内株式35.0%・国内債券30.0%・短期資産35.0% | 0.341 |
| ブラック・リッターマン 見方1 | 国内株式7.1%・外国株式33.8%・国内債券32.0%・外国債券13.6%・不動産投資信託4.5%・短期資産8.9% | 0.370 | 上限なしと同じ | 0.370 |
標本平均に上限を加えると、真のシャープ・レシオは0.343から0.367に上がりました。上限で国内株式と国内債券が35%に抑えられ、余った分が外国株式と短期資産に回りました。縮小0.5は、この章の比べる条件(リスクの上限を固定する形)では標本平均と同じ配分になるので、上限を加えても標本平均と同じ結果です。ロバスト箱型 δ=1 は、短期資産100%から、短期資産が35%で頭打ちになり、残りが国内株式と国内債券に回って0.341まで戻りました。ブラック・リッターマンの見方1は、もともとどの資産も35%以下なので、上限は効きませんでした。
この結果から、上限の制約と他の手法の役割の違いが読み取れます。上限は、推定値の中身を見ずに「どんな推定でも1資産に35%を超えて寄せない」という外枠を置くものです。推定値が極端なときに効き、推定値が穏やかなときには何もしません。逆に、ブラック・リッターマンのように推定値そのものを穏やかにする手法は、上限に当たらない配分を出すので、上限と重ねても同じ結果になります。両者は競合するものではなく、推定値を穏やかにする手法を主に使い、上限は「手法の設定を誤ったときの安全装置」として重ねるのが実務的な組み合わせだと考えています。ロバスト箱型の δ を広く取りすぎた場合のように、手法が想定外の極端な答えを出したとき、上限がそれを途中で止めてくれます。上限の値そのものは推定ではなく方針で決めるもので、取引コストや資産クラス別の枠を含めた制約の置き方は第8章で扱います。
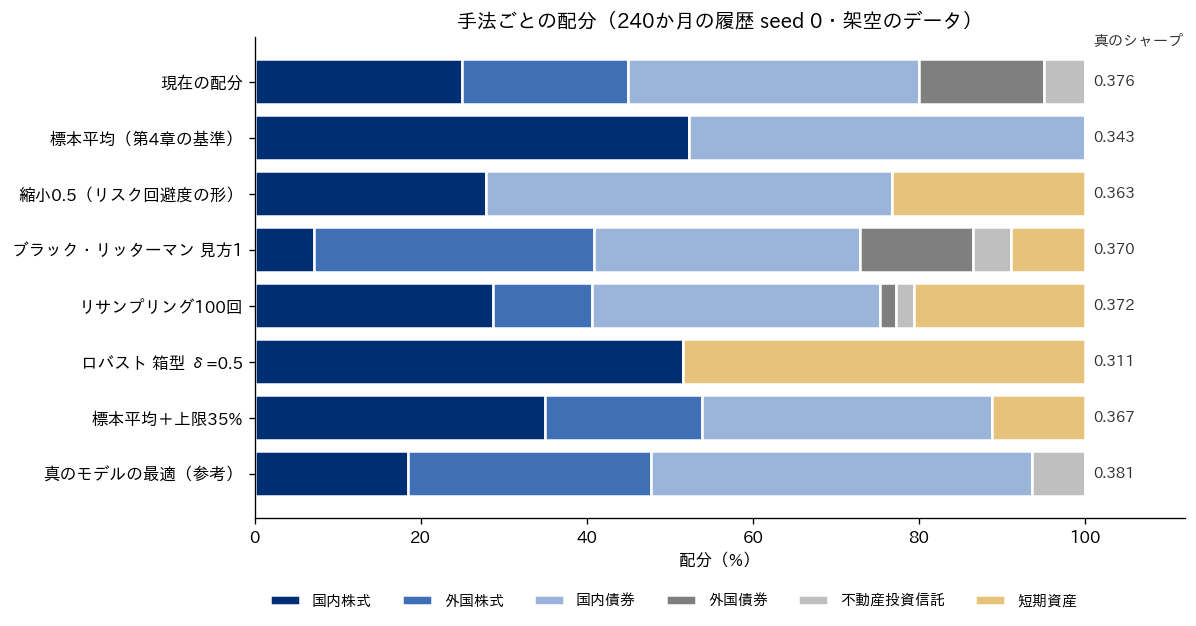
上の図は、seed 0 の履歴で各手法が出した配分を並べたものです。右端の数字は真のモデルでのシャープ・レシオです。標本平均とロバスト箱型 δ=0.5 は2資産に集中し、縮小0.5は国内株式・国内債券・短期資産の3資産、ブラック・リッターマンとリサンプリングは6資産すべてに重みを付けました。真のモデルの最適(最下段)に形が近いのは、外国株式と国内債券に厚く配分したブラック・リッターマンと、上限35%を付けた標本平均です。ただし、これは1本の履歴での結果です。手法の良し悪しを1本の履歴で判断すると、その履歴のたまたまの性質に引きずられます。次の節で、履歴を20回作り直して比べます。
20回作り直した履歴で手法を比べる
第4章と同じく、乱数シードを1から20に変えて240か月の履歴を20本作り、各履歴で手法ごとに配分を解いて、真のモデルで評価しました。リサンプリングは、計算時間を抑えるため作り直しの回数を各履歴で50回にしました。20本×11通りの計算全体の実行時間は78.6秒で、この記事の実行環境(一般的なノートPC)での実測です。表の「真のシャープ・レシオ」の3列は20回の平均・最小・最大、「現在未満の回数」は真のシャープ・レシオが現在の配分の0.376を下回った回数、「最大の重みの平均」は各回の配分で最も大きい重みの20回平均、「入替率の平均」は現在の配分から動かす割合の20回平均です。
| 手法 | 真のシャープ・レシオ 平均 | 最小 | 最大 | 真の期待リターン 平均 | 真のリスク 平均 | 現在未満の回数 | 最大の重みの平均 | 入替率の平均 |
|---|---|---|---|---|---|---|---|---|
| 標本平均(第4章の基準) | 0.328 | 0.163 | 0.381 | 3.17% | 7.99% | 18 | 0.52 | 0.464 |
| 標本平均+上限35% | 0.351 | 0.237 | 0.375 | 3.33% | 7.98% | 20 | 0.35 | 0.336 |
| 縮小0.5(リスク回避度の形) | 0.341 | 0.163 | 0.410 | 1.99% | 4.32% | 15 | 0.62 | 0.536 |
| ベイズ・スタイン型(リスク回避度の形) | 0.340 | 0.163 | 0.403 | 2.16% | 4.78% | 16 | 0.60 | 0.512 |
| ブラック・リッターマン 見方1(確信の倍率1) | 0.372 | 0.349 | 0.377 | 3.61% | 8.37% | 14 | 0.37 | 0.123 |
| ブラック・リッターマン 見方1(確信の倍率4) | 0.364 | 0.163 | 0.377 | 3.49% | 8.07% | 12 | 0.38 | 0.088 |
| ブラック・リッターマン 逆の見方(確信の倍率1) | 0.345 | 0.000 | 0.376 | 3.36% | 7.91% | 20 | 0.43 | 0.203 |
| リサンプリング50回 | 0.354 | 0.255 | 0.380 | 3.17% | 7.56% | 17 | 0.41 | 0.375 |
| ロバスト箱型 δ=0.5 | 0.321 | 0.163 | 0.381 | 3.11% | 7.99% | 18 | 0.54 | 0.540 |
| ロバスト楕円型 κ=1 | 0.331 | 0.163 | 0.381 | 3.02% | 7.53% | 18 | 0.55 | 0.470 |
| ロバスト箱型 δ=0.5+上限35% | 0.345 | 0.237 | 0.374 | 3.21% | 7.72% | 20 | 0.35 | 0.380 |
参考までに、現在の配分は真のシャープ・レシオ0.376、均等配分は0.365、真の最適(リスクを現在の配分と同じ8.30%に抑えるという条件のもとでの最適)は0.381です。
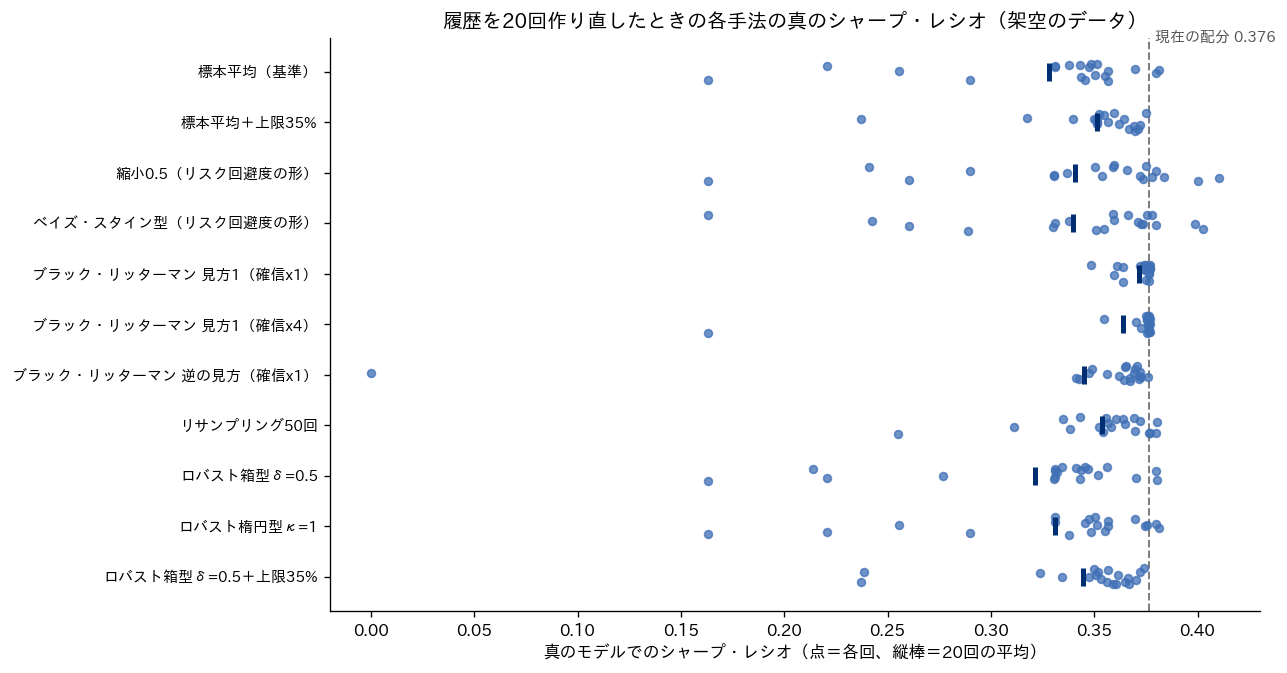
表と図から読み取れることを順に書きます。まず、平均で最も良かったのはブラック・リッターマンの見方1(確信の倍率1)で0.372、最小も0.349と最も高く、ばらつきが最も小さい手法でした。入替率の平均は0.123で、標本平均の0.464の4分の1ほどです。ただし、20回中14回は現在の配分(0.376)をわずかに下回っています。平均0.372と現在の0.376の差は0.004で、20回の多くで「現在の配分とほぼ同じか、ほんの少し下」に落ち着いた、というのが正確な読み方です。見方1は真のモデルに照らして正しい見方ですが、それでも現在の配分を安定して上回ることはできませんでした。この共通データでは現在の配分がもともと真のモデルの最適に近いので、同じリスクの条件のもとでは上回る余地が0.005しかありません。
次に、上限35%の制約は、それだけで平均を0.328から0.351に上げ、最小を0.163から0.237に引き上げました。最も悪い回の損を小さくする効果がはっきり出ています。一方で、20回すべてで現在の配分を下回りました。上限は大きな失敗を防ぎますが、標本平均の見誤りを直すわけではないので、上振れは取れません。ロバスト箱型 δ=0.5 に上限を重ねた場合も同じ傾向で、平均は0.321から0.345に上がりました。
3つ目に、平均の縮小推定(リスク回避度の形)とベイズ・スタイン型は、平均0.341と0.340で基準より少し良く、最大は0.410と0.403で、リスクを現在の配分と同じに抑えるという条件のもとでの真の最適0.381を上回る回がありました。真の最適の0.381はリスク8.30%という条件のもとでの値なので、条件の違うリスクの小さい配分がシャープ・レシオでそれを上回ることは矛盾しません(第6章のリスクパリティも、リスク4.45%でシャープ・レシオ0.388になります)。代わりに真の期待リターンの平均は1.99%と2.16%で、現在の配分の3.62%を大きく下回り、リスクの平均も4.32%と4.78%に下がりました。期待リターンを取りにいく運用の目的からは、別の配分と見るべき結果です。
4つ目に、ロバスト最適化は箱型 δ=0.5 も楕円型 κ=1 も、平均では基準と大差がありませんでした(0.321と0.331)。最大の重みの平均も0.54と0.55で、基準の0.52と同じく集中した配分のままでした。期待リターンの推定値から誤差の分を割り引いても、推定の順位の見誤りを直す働きはありません。ロバスト最適化が守るのは「推定の範囲の中での最悪」で、範囲の中心がずれていることには無力です。
最後に、ブラック・リッターマンの失敗の形を確かめておきます。確信の倍率4と逆の見方で、最小が0.163と0.000という極端な値が出ています。どちらも seed 14 の履歴で、この履歴では現在の配分の推定シャープ・レシオが -0.010 と負になりました。リスク回避度を「推定シャープ÷推定リスク」で置いているので、リスク回避度が負になり、逆算した期待リターンがリスクの大きい資産ほど低くなるという、意味のない値になりました。その結果、国内債券100%や短期資産100%という配分が出ました。20回の推定シャープ・レシオは最小 -0.010・平均0.453・最大1.104と大きくばらついており、この置き方は履歴によっては壊れます。実務でこの置き方を使うなら、推定シャープ・レシオが0以下や極端な値のときは使わず、長期の前提として別に決めた値を置く、という歯止めが要ります。
推定誤差に強い方法が犠牲にしているもの
ここまでの結果を、何を得て何を失ったかの形で整理します。
| 手法 | 何を決める手法か | 得たもの(この章の計算) | 犠牲にしたもの(この章の計算) | 使ってはいけないとき |
|---|---|---|---|---|
| 平均の縮小推定 | 期待リターンの推定値をどこまで割り引くか | リスク回避度の形で、取りすぎたリスクが下がる(seed 0 でリスク8.32%から4.51%) | 期待リターン(同じく3.35%から2.14%)。資産の順位の見誤りは残る。リスク上限を固定した形では効かない | リスクの水準を目標に合わせたいのに、リスク上限の形で使うとき |
| ブラック・リッターマン | 現在の配分をどの見方でどれだけ動かすか | 20回の平均0.372・最小0.349。入替率0.123と小さい | 見方を出さないと改善しない。誤った見方では損をする(平均0.345) | 出発点の配分の推定シャープ・レシオが0以下のとき(逆算が壊れる) |
| リサンプリング | 1本の履歴への依存をどう薄めるか | 6資産に分散し、20回の平均0.354 | 平均した配分はリスクが目標より下がり、期待リターンも下がる(seed 0 で2.94%)。推定の中心のずれは直らない | リスクの水準を厳密に指定したいとき(平均後の調整が要る) |
| ロバスト最適化 | 推定の誤差の範囲で、最悪の場合に備えるか | 見込み違いの最悪の場合の推定値を守る | 範囲を広げると短期資産に逃げる(δ=1 で期待リターン0.50%)。中心のずれには無力 | 範囲の広さを統計の慣習だけで決めるとき |
| 上下限の制約 | 1資産への集中をどこで止めるか | 最悪の回を0.163から0.237に改善 | 上振れは取れない(20回すべて現在の配分を下回った) | 上限を推定の結果を見てから決めるとき(後付けになる) |
共通して言えるのは、推定誤差に強くする手法は、どれも「推定を信じる度合い」を下げる操作で、信じる度合いを下げた分だけ、推定が当たっていた場合の上振れを手放しているということです。この共通データでは、推定(標本平均)が大きく外れているので、信じる度合いを下げるほど結果が良くなりました。推定が当たっている場合には、同じ操作が期待リターンを削ります。どの手法を選ぶかは、自社の推定がどのくらい当たると考えるかの判断と切り離せません。
経営判断としての手法の選び方
この章の結果を、投資委員会の運用に置き換えると、次のような順序が考えられます。まず、現在の配分を出発点に置きます。推定から新しい配分を一から作るのではなく、「現在の配分をどう動かすか」を議題にします。この章の計算では、現在の配分から出発したブラック・リッターマン(見方1、確信の倍率1)が、20回の真のシャープ・レシオの平均(0.372)と最小(0.349)のどちらでも最も高く、入替率の平均も0.123と標本平均の0.464より小さく収まりました。入替率だけを比べると、同じ見方を弱く信じた確信の倍率4のほうが0.088とさらに小さくなります。次に、動かす理由を見方として1つずつ書き出し、それぞれに確信の強さを付けます。見方の根拠(どのデータ、どの分析、誰の判断か)を記録しておくと、後から見方の当たり外れを検証できます。最後に、上下限の制約を安全装置として重ね、どんな見方を入れても1資産への集中が一定以上にならないようにします。
経営指標に翻訳すると、この章の比較は「期待リターンの上積み」ではなく「判断を誤ったときの損の大きさ」の比較でした。第4章の基準(標本平均をそのまま使う最適化)は、20回の最悪で真のシャープ・レシオ0.163、真の期待リターンは最悪の回で1.00%まで下がり、現在の配分の3.62%を2.62pt下回りました(第4章で示した20回の結果)。運用資産100億円(架空)なら、年2億6,200万円の期待収益を失う判断を、推定の上では「改善」と見誤ってしまう計算です。この章の手法は、その最悪を避けるための保険で、保険料は期待リターンの上積みをあきらめることです。保険をどこまで掛けるかは、組織が見込み違いにどこまで耐えられるかで決めるものです。
もう1つ、この章のどの手法にも共通する前提があります。期待リターンと共分散を1つの値(または範囲)で置き、それを使って配分を決めるという前提です。期待リターンを使わずにリスクの情報だけで配分する方法もあり、推定の誤差が特に大きい期待リターンを使わない分、この章の手法とは別の形で推定誤差を避けられます。その方法は第6章で扱います。また、事業投資の案件選択では、期待リターンにあたる NPV の見積りに同じ種類の誤差があり、ブラック・リッターマンの「出発点+見方」の考え方や、上限による安全装置は、案件の予算配分にもそのまま使えると考えています。案件選択の数理は第10章から第12章で扱います。
この章では、推定の誤差を前提に配分を壊れにくくする5つの方法を、同じ条件で解いて真のモデルで比べました。平均の縮小推定とロバスト最適化はリスクを下げる方向に働く一方で資産の順位の見誤りは直せず、現在の配分を出発点にしたブラック・リッターマンが最も安定し、上下限の制約は最悪の回を改善する安全装置として働きました。次の第6章では、期待リターンの推定を使わず、リスクの情報だけで配分を決める方法を扱います。
この章を深めたい方への参考書籍
『標準ベイズ統計学』(ピーター・D・ホフ著、入江薫・菅澤翔之助・橋本真太郎訳、朝倉書店):事前分布とデータから事後分布を作る計算を、正規分布のモデルを中心に基礎から説明した教科書です。ブラック・リッターマンの「逆算した期待リターン(事前)と見方(新しい情報)を確からしさで重みづけして混ぜる」計算が、ベイズ統計の事前と事後の計算と同じ形であることを確かめる足がかりになります。
『ファイナンスのための統計学:統計的アプローチによる評価と意思決定』(T. L. ライ、H. シン著、松原望・山村吉信訳、東京図書):原書(2008年に英語で刊行された、金融市場の統計モデルと手法を題にした本)には、基本的な投資モデルとその統計的分析の章や、パラメトリックモデルとベイズ法の章があり、平均分散の枠組みを統計的推定の側から扱っています。この章で見た「推定の誤差を前提に配分を決める」問題を、統計学の言葉で深めるのに向いています。
第6章 リスクで配分する
第4章と第5章では、期待リターンの推定がどれほど不確かで、その誤りが平均分散最適化によってどう増幅されるか、また推定誤差に強くする工夫が何を犠牲にするかを、第2章で用意したサンプルデータで確かめました。共通データの推定モデルでは、240か月の標本平均が真の期待リターンから大きく外れ、外国株式は真の6.5%に対して標本平均1.95%、外国債券は真の2.5%に対して標本平均 -1.71% でした。一方で、標本の標準偏差と相関は真の値に近いものでした。この章では、この非対称を逆手に取り、推定の難しい期待リターンを使わず、比較的よく推定できるリスク(標準偏差)と相関だけで配分を決める方法を扱います。最小分散、各資産のリスクへの寄与を揃えるリスクパリティ、分散化の度合いを最大にする最大分散化の3つです。あわせて、配分のリスクを資産ごとに分解するリスク寄与度の考え方を説明し、それを事業投資の案件群に当てはめて、どの部門・どの種別が会社全体の NPV のばらつきを占めているかを計算します。なお、本章は資産クラスへの配分の考え方を説明するもので、投資や財務の助言ではありません。個別の判断は専門家に相談してください。
リスク寄与度という見方
配分のリスクを説明するとき、よく使われるのは資産ごとの重み(金額の割合)です。「株式50%、債券50%」と書けば、資産の配分は伝わります。しかし、この書き方からは、配分全体のリスクのうち何割がどの資産から来ているのかは分かりません。株式と債券ではリスク(標準偏差)が何倍も違い、相関の向きも違うので、金額で半々でもリスクは半々になりません。そこで、配分全体のリスクを資産ごとに分け、各資産がリスクの何割を担っているかを表す量を使います。これをリスク寄与度と呼びます。
資産 \( i \) の重みを \( w_i \)、共分散行列を \( \Sigma \)、配分全体のリスクを \( \sigma \) とすると、リスク寄与度は次の式で定義します。
\( RC_i = \dfrac{w_i \times (\Sigma w)_i}{\sigma} \)
分子の \( (\Sigma w)_i \) は、資産 \( i \) のリターンと配分全体のリターンとの共分散です。言葉で言い換えると、リスク寄与度は「その資産の重み」と「その資産が配分全体とどれだけ一緒に動くか」の積を、配分全体のリスクで割ったものです。この量には、全資産について足し合わせると配分全体のリスク \( \sigma \) にちょうど一致するという性質があります。そのため、各資産の寄与度を \( \sigma \) で割った値(以下「リスク寄与の割合」)は合計がちょうど100%になり、「リスクの何割をどの資産が担っているか」を円グラフや棒グラフのように示せます。
もう1つの見方として、\( (\Sigma w)_i \div \sigma \) を限界リスクと呼びます。ある資産の重みをわずかに増やしたとき、配分全体のリスクがどれだけ増えるかを表す量です。リスク寄与度は「重み×限界リスク」で、限界リスクの高い資産を多く持っているほど、その資産の寄与度が大きくなります。限界リスクは配分の見直しを検討するときに役立ちます。限界リスクが高い資産から低い資産へ重みを少し移せば、配分全体のリスクが下がることが一目で分かるからです。
この分解には注意点があります。リスク寄与度は「現在の配分のもとで、その資産が全体のばらつきにどれだけ効いているか」を表すもので、その資産を丸ごと外したときにリスクがその分だけ減る、という意味ではありません。資産を外せば他の資産との相関の関係も変わるからです。また、相関が負の資産は寄与度が負になることがあり、その資産は配分全体のリスクを打ち消す役割を果たしています。寄与度は「小さな変更に対する感応度」として読むのが正確です。
現在の配分では株式がリスクの大半を占める
共通データの現在の配分(架空。国内株式25%・外国株式20%・国内債券35%・外国債券15%・不動産投資信託5%・短期資産0%)について、真のモデルの共分散でリスク寄与度を計算しました。真のモデルでの配分全体のリスクは8.30%です。結果は次の表のとおりです。「推定モデル」の列は、240か月の標本共分散(推定モデル)で同じ計算をした値です。
| 資産クラス | 重み | 真のモデルの寄与度(年率) | 真のモデルのリスク寄与の割合 | 推定モデルのリスク寄与の割合 | 限界リスク(真のモデル) |
|---|---|---|---|---|---|
| 国内株式 | 25% | 3.59% | 43.3% | 42.1% | 0.144 |
| 外国株式 | 20% | 3.28% | 39.6% | 40.6% | 0.164 |
| 国内債券 | 35% | 0.04% | 0.5% | 0.6% | 0.001 |
| 外国債券 | 15% | 0.85% | 10.3% | 9.8% | 0.057 |
| 不動産投資信託 | 5% | 0.54% | 6.5% | 6.8% | 0.107 |
| 短期資産 | 0% | 0.00% | 0.0% | 0.0% | 0.000 |
| 合計 | 100% | 8.30% | 100% | 100% | なし |
重みで見ると、株式系(国内株式・外国株式・不動産投資信託)は合わせて50%、債券(国内債券・外国債券)も50%で、金額の上では半々の配分です。ところがリスク寄与の割合で見ると、株式系が89.3%、うち国内株式と外国株式の2資産だけで82.8%を占め、債券は合わせて10.7%にとどまります。国内債券は重み35%と最大の資産でありながら、リスク寄与の割合は0.5%です。国内債券はリスクが小さいうえに、真のモデルでは株式との相関が負(国内株式との相関 -0.153)なので、配分全体のばらつきにはほとんど効いていません。
表の「重み」の列と「真のモデルのリスク寄与の割合」の列を資産ごとに並べて読むと、「半々の配分」と説明されている配分が、リスクの面では「ほぼ株式の配分」であることが分かります。もう1つ注目したいのは、推定モデルの列と真のモデルの列がほぼ同じであることです。第4章で見たように、標本平均は真の期待リターンから何ポイントも外れていましたが、リスク寄与の割合の差は最大でも1.2ポイントでした。リスク寄与度は共分散だけから計算するので、期待リターンの推定誤差の影響を受けません。この性質が、この章で扱う方法の出発点になります。
限界リスクの列は、重みを1ポイント(1%)動かしたときに配分全体のリスクが何ポイント動くかの目安です。国内株式の0.144に対して国内債券は0.001なので、国内株式から国内債券へ1ポイント移すと、リスクは線形近似で約0.14ポイント下がります。実際に配分を作り直して計算すると、真のモデルでのリスクは8.30%から8.16%へ、0.14ポイント下がりました。資産配分の会議では「株式を何%減らすか」が議論になりますが、その議論の前に、この表のような寄与度の分解を1枚置いておくと、どの資産を動かせばリスクがどれだけ動くかの見当が付きます。
最小分散は短期資産に寄る
期待リターンを使わずに配分を決める最も単純な方法は、配分全体のリスクが最小になる重みを選ぶ最小分散です。必要な入力は共分散行列だけで、期待リターンの推定は一切使いません。第4章で見た効率的フロンティアの左端の点に当たり、平均分散最適化の一種でありながら、推定の最も難しい部分を使わない点が特徴です。基準のスクリプト(第2章で用意した baseline.py)にも min_variance という関数として入っており、この章でもそれを使いました。
ただし、最小分散をそのまま6資産に当てはめると、答えはほとんど役に立ちません。推定モデルの共分散で解いた最小分散は、短期資産98.2%・国内債券1.7%・その他0%で、真のモデルで評価した期待リターンは0.51%、リスクは0.42%、シャープ・レシオは0.025でした。短期資産はリスクが年率0.4%と他の資産より1桁小さいので、リスクを最小にせよと指示すれば、ほぼ全額を短期資産に置くのが正解になります。これは計算の誤りではなく、「リスクを最小にする」という目的が、そのまま「リターンを諦める」ことを意味しているということです。
そこで、短期資産を除いた5資産(国内株式・外国株式・国内債券・外国債券・不動産投資信託)で最小分散を解き直しました。結果は国内債券93.3%・国内株式5.2%・外国株式1.5%で、今度は国内債券にほぼ全額が寄りました。真のモデルでの期待リターンは1.32%、リスクは2.89%です。最小分散は、リスクの最も小さい資産と、それと相関の低い資産の組み合わせに集中する性質があり、資産の数が少ないとその偏りが目立ちます。期待リターンの推定誤差を避けられる代わりに、重みが1つの資産に集中するという、平均分散最適化と同じ型の問題が別の形で現れます。
リスクパリティは寄与度を揃える
最小分散の集中を避けながら、期待リターンを使わずに配分を決める方法として、各資産のリスク寄与度を等しくするリスクパリティがあります。5資産なら、各資産がリスクのちょうど20%ずつを担うように重みを決めます。マイヤール、ロンカリ、テイレッシュの2010年の論文(The Journal of Portfolio Management 第36巻第4号、DOI 10.3905/jpm.2010.36.4.060)は、この配分を「リスク寄与が均等な配分」と呼んで性質を調べています。著者が公開している版の要旨では、この配分のリスクが最小分散の配分と均等配分の間に位置することを理論的に導き、実証でもその順序を確かめたと述べています。同じ論文は、リスク寄与度の定義(重みと限界リスクの積で、合計が配分全体のリスクに一致する)や、リスク寄与度で配分を分析することが機関投資家の間でリスク・バジェッティングと呼ばれていることにも触れています。
リスクパリティの重みは、すべての資産の相関が等しい特別な場合には、各資産のリスクの逆数に比例する重みになります(マイヤールらの論文で導かれています)。リスクの小さい資産ほど多く持ち、大きい資産ほど少なく持つという直観どおりの形です。相関が資産ごとに違う一般の場合は、式で直接は解けないので数値計算で求めます。マイヤールらの論文は、重みの対数の和に下限を付けたうえでリスクを最小にする問題を解き、その解を合計1に直すとリスク寄与が均等な配分になる、という解き方を示しています。この章では、これと同じ考え方を「分散の半分から重みの対数の平均を引いたものを最小にする」形にして、scipy の minimize で解きました。この形は凸な問題(谷が1つしかない問題)なので、初期値によらず同じ答えに収束します。次のコードは、第2章で用意した共通データの補助モジュール port_data.py と同じフォルダに置いて実行すると、下の出力が得られます。
import numpy as np
from scipy.optimize import minimize
from port_data import *

def risk_contrib(w, cov):
    """リスク寄与度 w_i × (Σw)_i ÷ σ。合計がリスク σ に一致する。"""
    sig = np.sqrt(w @ cov @ w)
    return w * (cov @ w) / sig, sig

def risk_parity(cov):
    """0.5 y'Σy − (1/n)Σlog y_i を最小化し、合計1に直す(寄与度が均等になる)。"""
    n = cov.shape[0]
    f = lambda y: 0.5 * y @ cov @ y - np.log(y).sum() / n
    g = lambda y: cov @ y - 1.0 / (n * y)
    r = minimize(f, np.ones(n), jac=g, method="L-BFGS-B", bounds=[(1e-10, None)] * n)
    return r.x / r.x.sum()

rc, sig = risk_contrib(CURRENT.values, TRUE_COV)
print("現在の配分 リスク %.4f / 寄与の割合" % sig, dict(zip(CODES, (rc / sig).round(3).tolist())))

mu_hat, cov_hat = estimate(history())          # 推定モデル(seed 0・240か月)
w5 = risk_parity(cov_hat[:5, :5])              # 短期資産を除く5資産
w = np.append(w5, 0.0)
rc5, s5 = risk_contrib(w5, cov_hat[:5, :5])
print("リスクパリティの重み", dict(zip(CODES, w.round(3).tolist())))
print("推定モデルでの寄与の割合", (rc5 / s5).round(3))
print("真のモデルでの評価", {k: round(v, 4) for k, v in true_stats(w).items()})
# 出力:
# 現在の配分 リスク 0.0830 / 寄与の割合 {'DE': 0.433, 'FE': 0.396, 'DB': 0.005, 'FB': 0.103, 'RE': 0.065, 'CA': 0.0}
# リスクパリティの重み {'DE': 0.083, 'FE': 0.066, 'DB': 0.633, 'FB': 0.138, 'RE': 0.08, 'CA': 0.0}
# 推定モデルでの寄与の割合 [0.2 0.2 0.2 0.2 0.2]
# 真のモデルでの評価 {'mu': 0.0223, 'sig': 0.0445, 'sharpe': 0.3881}
推定モデルの共分散で解いたリスクパリティ(5資産)は、国内株式8.3%・外国株式6.6%・国内債券63.3%・外国債券13.8%・不動産投資信託8.0%でした。推定モデルでのリスク寄与の割合は5資産とも20.0%で、狙いどおり均等になっています。同じ重みを真のモデルの共分散で評価し直すと、寄与の割合は19.0%〜21.0%の範囲に収まりました。共分散の推定誤差は、リスク寄与度をほとんど狂わせていないということです。真のモデルの共分散で解いた場合の重みとの差は、最も大きい資産でも0.9ポイントでした。真のモデルで評価した期待リターンは2.23%、リスクは4.45%、シャープ・レシオは0.388です。
短期資産を含めた6資産でリスクパリティを解くと、短期資産が81.8%を占めました。短期資産のリスクが他の資産より1桁小さいため、リスクの1/6を担わせるには非常に大きな重みが要るからです。真のモデルでの期待リターンは0.81%、リスクは0.89%でした。リスクパリティは「リスクの小さい資産を多く持つ」方法なので、ほとんど値動きのない資産を対象に含めるかどうかで答えが大きく変わります。この章では、以下、短期資産を除いた5資産の結果を主に示します。どの資産を対象に含めるかは、手法の外で決めておく前提です。
最大分散化は分散化比率を最大にする
もう1つの方法として、最大分散化があります。ここでは、各資産のリスクを重みで平均した値(資産どうしの相関が1で、分散の効果がまったく無いと仮定したときのリスク)を、実際の配分全体のリスクで割った比を「分散化比率」と呼び、これを最大にする配分を求めます。分散化比率は、分散投資によってリスクが何分の1に減っているかを表します。1なら分散の効果がまったく無く、大きいほど相関の低い資産を組み合わせてリスクを打ち消し合っている、と読みます。この方法も、入力は各資産のリスクと相関だけで、期待リターンは使いません。最大分散化については、ショエフアティとコワニャールが2008年に The Journal of Portfolio Management(第35巻第1号)に載せた論文があります(書誌は Crossref で確認しました。本文は開けなかったので、論文の主張の中身はこの章では引きません。上の分散化比率の定義は、この章で計算に使った定義です)。この章では、ショートなし・合計100%の条件で、scipy の SLSQP を初期値10通りから解き、最も比の大きい答えを採りました。
推定モデルの共分散で解いた最大分散化(5資産)は、国内株式9.4%・外国株式4.5%・国内債券74.6%・外国債券8.3%・不動産投資信託3.2%でした。真のモデルでの分散化比率は1.612で、現在の配分の1.306、均等配分の1.283より大きくなっています。真のモデルで評価した期待リターンは1.91%、リスクは3.63%、シャープ・レシオは0.388でした。リスクパリティより国内債券に寄り、外国株式と不動産投資信託が少なくなっています。国内債券は他の資産との相関が低い(真のモデルで国内株式と -0.153)ので、分散化比率を上げるには国内債券を厚くするのが効率的だからです。
最小分散・リスクパリティ・最大分散化の3つは、いずれも期待リターンを使わない点で共通していますが、目的は少しずつ違います。最小分散は配分全体のリスクそのものを小さくし、リスクパリティはリスクの担い手を均等に散らし、最大分散化は相関による打ち消し合いを最大にします。共分散の構造によって、3つの答えは近くなることも、大きく離れることもあります。共通データでは、最小分散が国内債券93.3%、最大分散化が74.6%、リスクパリティが63.3%で、国内債券の重みはこの順に小さくなりました。
期待リターンを使わない配分を真のモデルで比べる
ここまでの配分を、現在の配分・均等配分・第4章の平均分散最適化(基準。推定モデルの期待リターンを、現在の配分と同じ推定リスクのもとで最大化した配分)と並べ、真のモデルで評価しました。すべて推定モデル(seed 0・240か月の標本)で解き、評価だけを真のモデルで行っています。「株式系の寄与の割合」は国内株式・外国株式・不動産投資信託のリスク寄与の割合の合計、「寄与の割合の最大」は最も大きい1資産のリスク寄与の割合です。
| 配分 | 期待リターン(真) | リスク(真) | シャープ・レシオ(真) | 重みの最大 | 株式系の寄与の割合 | 寄与の割合の最大 | 分散化比率 |
|---|---|---|---|---|---|---|---|
| 現在の配分 | 3.62% | 8.30% | 0.376 | 35.0% | 89.3% | 43.3% | 1.306 |
| 均等配分(6資産) | 3.42% | 7.98% | 0.365 | 16.7% | 87.9% | 33.9% | 1.283 |
| 平均分散(基準) | 3.35% | 8.32% | 0.343 | 52.3% | 99.6% | 99.6% | 1.187 |
| 最小分散(6資産) | 0.51% | 0.42% | 0.025 | 98.2% | 0.0% | 97.2% | 1.122 |
| 最小分散(5資産) | 1.32% | 2.89% | 0.283 | 93.3% | 7.5% | 92.5% | 1.376 |
| リスクパリティ(5資産) | 2.23% | 4.45% | 0.388 | 63.3% | 60.1% | 21.0% | 1.557 |
| 最大分散化(5資産) | 1.91% | 3.63% | 0.388 | 74.6% | 48.8% | 37.2% | 1.612 |
| リスクの逆数に比例(5資産) | 2.59% | 5.43% | 0.385 | 52.8% | 70.1% | 23.9% | 1.485 |
表から読み取れることは3つあります。1つ目は、期待リターンを使わない配分は、使う配分より真のシャープ・レシオが高くなりうることです。リスクパリティ(5資産)と最大分散化(5資産)の真のシャープ・レシオはどちらも0.388で、平均分散(基準)の0.343、現在の配分の0.376、均等配分の0.365を上回り、第4章の基準で示した真の最適の0.381も上回りました。真の最適が上回られているのは、真の最適が「リスクを現在の配分と同じ8.30%に抑える」という条件のもとでの最適だからで、リスクを4%台まで下げてよいなら、真のモデルではシャープ・レシオのより高い配分が存在する、ということです。
2つ目は、その代わりに期待リターンが大きく下がることです。リスクパリティの真の期待リターンは2.23%で、現在の配分の3.62%より1.39ポイント低く、最大分散化は1.91%で1.71ポイント低くなっています。リスクも半分前後に下がっているので、リスクあたりの効率は良いのですが、運用の目標が「年3%以上の期待リターン」のように期待リターンの水準で決まっている場合、この配分ではその目標に届きません。リスクパリティは債券に寄り、債券は期待リターンの低い資産だからです。
3つ目は、リスクの担い手が散っていることです。現在の配分では株式系がリスクの89.3%を占めていましたが、リスクパリティでは60.1%、最大分散化では48.8%に下がりました。平均分散(基準)は株式系の寄与の割合が99.6%で、国内株式1資産だけでリスクの99.6%を担っています。第4章で見た「推定誤差の増幅」の結果は、リスク寄与度で見ると、リスクが1資産に集中した配分だったということです。
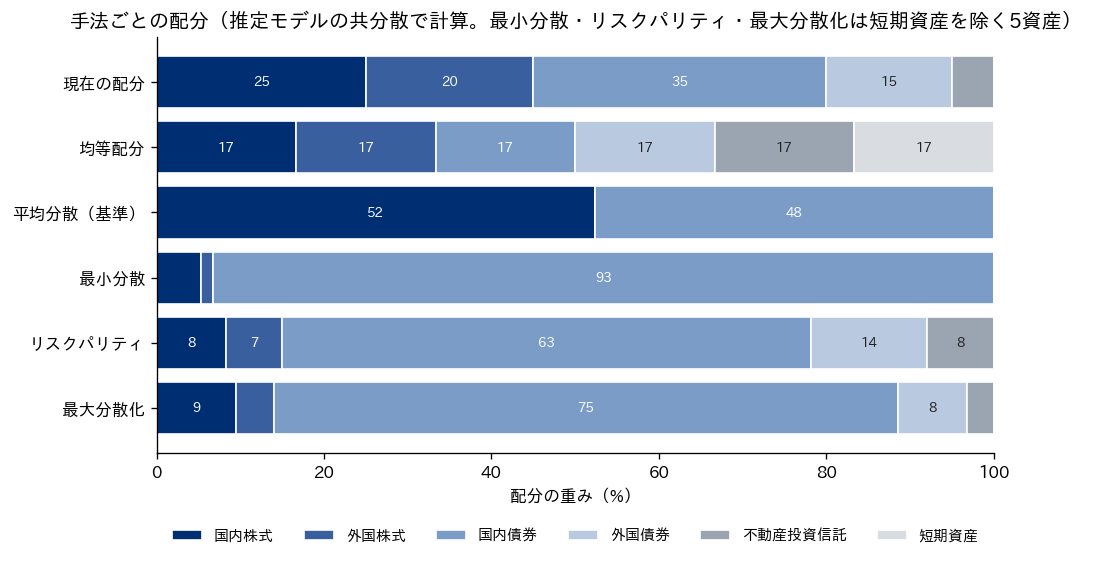
1回の標本の結果だけでは、たまたまの当たり外れと区別できません。第4章と同じく、履歴を作り直した20回(乱数シード1〜20、それぞれ240か月)について、各手法を推定モデルで解き、真のモデルで評価しました。平均分散(基準)は推定モデルの期待リターンと共分散を、他の手法は推定モデルの共分散だけを使います。「現在を下回った回数」は、真のシャープ・レシオが現在の配分の0.376を下回った回数、「重みのぶれ」は、20回の重みの標準偏差を資産について平均した値です。
| 手法 | 真のシャープ・レシオの平均 | 最小 | 最大 | 真の期待リターンの平均 | 真のリスクの平均 | 現在を下回った回数 | 重みのぶれ |
|---|---|---|---|---|---|---|---|
| 平均分散(基準) | 0.328 | 0.163 | 0.381 | 3.17% | 7.99% | 18回 | 20.4ポイント |
| 最小分散(5資産) | 0.272 | 0.247 | 0.296 | 1.29% | 2.90% | 20回 | 0.9ポイント |
| リスクパリティ(5資産) | 0.387 | 0.383 | 0.390 | 2.21% | 4.42% | 0回 | 1.3ポイント |
| 最大分散化(5資産) | 0.388 | 0.372 | 0.405 | 1.87% | 3.52% | 1回 | 2.0ポイント |
| 最小分散(6資産) | 0.029 | 0.000 | 0.068 | 0.51% | 0.42% | 20回 | 0.3ポイント |
| リスクパリティ(6資産) | 0.350 | 0.337 | 0.363 | 0.81% | 0.88% | 20回 | 0.7ポイント |
平均分散(基準)は、20回のうち18回で現在の配分を下回り、真のシャープ・レシオは0.163から0.381まで大きくばらつきました。重みのぶれは20.4ポイントで、標本が変わるたびに配分がまったく違うものになっています。これに対し、リスクパリティ(5資産)は20回すべてで0.383〜0.390に収まり、現在の配分を下回った回は0回でした。重みのぶれは1.3ポイントで、20回の平均は国内株式7.9%・外国株式6.8%・国内債券63.9%・外国債券13.3%・不動産投資信託8.1%、20回の間で最も動いた国内債券でも、重みの標準偏差は3.6ポイントでした。最大分散化(5資産)も平均0.388で、下回ったのは1回です。この共通データ(6資産・240か月)では、共分散の推定の誤差が平均の推定の誤差よりずっと小さかったので、共分散だけで決める配分は標本が変わってもほとんど動きませんでした。資産の数が履歴の月数に比べて多くなると、共分散の推定も不安定になることは第3章で述べたとおりで、この安定は資産の数に比べて履歴が十分に長いことを前提にしています。
一方で、最小分散は5資産でも6資産でも、20回すべてで現在の配分を下回りました。最小分散は推定誤差には強い(重みのぶれが0.9ポイント)ものの、真のモデルでの期待リターンが低すぎて、リスクあたりの効率でも劣ります。期待リターンを使わないことと、良い配分になることは別の話です。リスクパリティと最大分散化がこのデータで良い結果になったのは、共通データの真のモデルで、国内債券・外国債券のリスクあたりの期待リターンが株式と比べて極端に低くはなかったからです。リスクあたりの期待リターンが資産によって大きく違う世界では、期待リターンを無視した配分は、その違いを取りこぼします。この比較は、架空の真のモデル1つでの結果であり、リスクパリティが一般に優れていることを示すものではありません。
期待リターンを使わない方法の長所と短所
ここまでの結果を、手法を選ぶ判断の材料として整理します。長所は、第一に推定誤差に強いことです。期待リターンの推定は第3章で見たとおり誤差が大きく、平均分散最適化はその誤差を増幅しますが、共分散だけを使う方法はその経路を断ち切ります。20回の再生成で、リスクパリティの重みのぶれは平均分散の約16分の1(1.3ポイント対20.4ポイント)でした。第二に、説明しやすいことです。「各資産がリスクの20%ずつを担うように決めた」という説明は、「推定した期待リターンで最適化した」という説明よりも、前提の置き方を問われにくく、毎年の見直しで配分が大きく動くこともありません。第三に、リスクの集中を防ぐことです。リスク寄与の割合の最大が21.0%に抑えられ、1つの資産の不調で配分全体が崩れる事態を避けられます。
短所は、第一に期待リターンが下がることです。共通データでは、リスクパリティの真の期待リターンは2.23%で、現在の配分の3.62%より低くなりました。債券のようにリスクの小さい資産に重みが寄るのは、この方法の構造上避けられません。第二に、低いリターンを補うにはレバレッジ(借入れや先物を使って、配分全体を自己資金より大きく膨らませること)が要ることです。リスクパリティの配分はリスクも低いので、全体を何倍かに膨らませれば、現在の配分と同じリスクでより高い期待リターンを狙える、という使い方が考えられます。ただし、借入れには金利がかかり、先物には証拠金の管理が要り、損失も同じ倍率で膨らみます。借入れが許されない運用方針や、事業会社の余資の運用では、この手段はそもそも使えないことが多いと考えています。本記事ではレバレッジの計算はしません。
第三に、対象に含める資産の選び方に結果が強く依存することです。短期資産を含めるかどうかで、リスクパリティの答えが国内債券63.3%から短期資産81.8%へと変わりました。資産クラスの分け方(外国債券を為替ヘッジの有無で2つに分ける、など)を変えても同じことが起きます。第四に、共分散の推定には依存することです。共分散は平均よりは正確ですが、第3章で見たように荒れた月には株式どうしの相関が上がります。平常時の相関で決めたリスクパリティは、荒れた月には寄与度が株式系に偏ります。荒れた月の左の裾をどう扱うかは、第7章の CVaR で扱います。
これらを踏まえると、使いどころは次のように整理できます。期待リターンの推定に自信が持てない、配分の安定性と説明のしやすさを重視する、リスクの集中を避けたい、という場合はリスクパリティや最大分散化が有力な候補になります。逆に、達成しなければならない期待リターンの水準が決まっていて、借入れが使えない場合は、これらの方法をそのまま採ることはできません。その場合も、リスク寄与度の分解だけは、配分の点検の道具として使えます。期待リターンを使う最適化の答えをリスク寄与度で分解し、1つの資産にリスクが集中していないかを確かめる、という使い方です。
事業領域のリスク予算に読み替える
リスク寄与度の考え方は、金融資産だけのものではありません。事業会社が複数の投資案件を同時に進めるとき、会社全体の NPV 合計のばらつきが、どの部門・どの種別の案件から来ているかを同じ式で分解できます。その分解をもとに、部門や種別ごとに「全体のリスクのうち何割までを担ってよいか」という枠を置く考え方を、この記事ではリスク予算と呼びます。金額の予算が「いくら使ってよいか」を決めるのに対し、リスク予算は「どれだけ全体を揺らしてよいか」を決めるものです。
第2章で用意した共通データB(架空の中堅製造業の投資案件30件)について、基準の選択(NPV 期待値の合計を最大にする整数計画で選んだ14件、NPV 期待値の合計3,155百万円)を、真のモデルのシナリオ1,000本で評価しました。NPV 合計の平均は3,130百万円、標準偏差は2,028百万円です。各案件の「分散への寄与の割合」は、その案件の NPV と NPV 合計との共分散を、NPV 合計の分散で割った値です。資産配分のリスク寄与の割合と同じ定義で、すべての案件について足すとちょうど100%になります(案件を選ぶか選ばないかなので、資産配分の重みに当たる部分はすべて1です)。部門別に集計した結果が次の表です。表の「寄与の割合÷NPV の割合」は、1より大きければ、生む NPV に比べて全体のばらつきを多く担っている部門、1より小さければ、NPV に比べて全体を揺らしていない部門であることを表します。
| 部門 | 件数 | 投資額(百万円) | NPV 期待値(百万円) | NPV の割合 | 分散への寄与の割合 | 寄与の割合÷NPV の割合 | 部門単独の標準偏差(百万円) |
|---|---|---|---|---|---|---|---|
| 第一事業部 | 5 | 2,080 | 1,350 | 42.8% | 52.8% | 1.23 | 1,418 |
| 全社 | 3 | 860 | 520 | 16.5% | 32.3% | 1.96 | 1,142 |
| 生産本部 | 4 | 3,070 | 1,035 | 32.8% | 13.2% | 0.40 | 603 |
| 第二事業部 | 2 | 390 | 250 | 7.9% | 1.7% | 0.22 | 247 |
| 合計 | 14 | 6,400 | 3,155 | 100% | 100% | なし | 2,028 |
第一事業部は NPV 期待値の42.8%を生む一方で、NPV 合計のばらつきの52.8%を担っています。全社の3件(新素材Xの基礎研究・新素材Xの試作ライン・情報セキュリティ強化)は NPV の割合が16.5%なのに、分散への寄与の割合は32.3%で、「寄与の割合÷NPV の割合」が1.96と最も大きくなりました。逆に生産本部は、投資額では最大の3,070百万円を使い、NPV の32.8%を生みながら、分散への寄与の割合は13.2%にとどまります。投資額の大きさとリスクの大きさは一致しないということです。
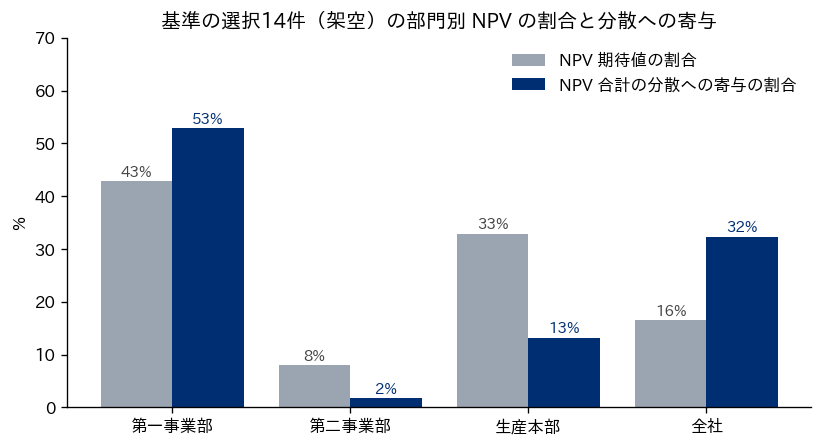
種別で集計すると、偏りはさらにはっきりします。研究開発の5件は NPV の割合43.4%に対して分散への寄与の割合55.9%、新規事業の3件は21.9%に対して30.7%で、この2種別の8件で分散の86.6%を占めました。この8件はちょうど成功確率が1未満の案件で、投資額では全体の46.6%、NPV 期待値では65.3%です。能力増強の3件は NPV の割合35.5%に対して分散への寄与の割合13.3%でした。設備更新(2件)と IT(1件)は、法令対応・取引先要請の必須案件(P02・P11)を含み、NPV がほぼ0か負で寄与の割合もほぼ0なので、比は意味を持ちません。
| 種別 | 件数 | 投資額(百万円) | NPV 期待値(百万円) | NPV の割合 | 分散への寄与の割合 | 種別単独の標準偏差(百万円) |
|---|---|---|---|---|---|---|
| 研究開発 | 5 | 1,760 | 1,370 | 43.4% | 55.9% | 1,473 |
| 新規事業 | 3 | 1,220 | 690 | 21.9% | 30.7% | 1,048 |
| 能力増強 | 3 | 2,850 | 1,120 | 35.5% | 13.3% | 609 |
| 設備更新 | 2 | 370 | 5 | 0.2% | 0.1% | 34 |
| IT | 1 | 200 | -30 | -1.0% | 0.0% | 14 |
案件単位では、新素材Xの基礎研究(P19、成功確率0.25)が22.8%、主力製品の次世代機開発(P15、成功確率0.60)が21.3%、海外販売拠点(X国)(P13、成功確率0.45)が21.2%で、この3件だけで分散の65.3%を占めました(研究開発と新規事業の8件の NPV の割合も65.3%ですが、別の集計で、値が偶然そろったものです)。3件の NPV 期待値の割合は合わせて36.1%です。B工場 新棟建設(P03)は NPV の割合が20.6%と最大ですが、分散への寄与の割合は7.8%でした。成功・失敗の二択がある案件は、失敗すると投資額の7割が損失になる設定なので、NPV の幅が大きくなります。
もう1つ確かめておきたいのが、案件どうしの相関の効き方です。14件の NPV の標準偏差を単純に足すと5,379百万円ですが、NPV 合計の標準偏差は2,028百万円で、単純合計の約2.65分の1でした。案件ごとのばらつきの多くは、互いに打ち消し合っています。NPV 合計の分散のうち、案件どうしの共分散(景気の共通要因と部門の要因で生じる、一緒に動く部分)から来る分は12.5%で、残りの87.5%は案件それぞれのばらつきでした。このデータでは、成功・失敗が案件ごとに独立に決まる設定なので、研究開発と新規事業のリスクは主に「個々の案件の当たり外れ」です。案件の数を増やしたり、1件あたりの規模を小さくしたりすれば、打ち消し合いがさらに効きます。景気要因や部門要因が強い案件群では、共分散の項の割合が大きくなり、件数を増やしてもリスクが減りにくくなります。この違いを無視するとどう誤るかは、第12章で扱います。
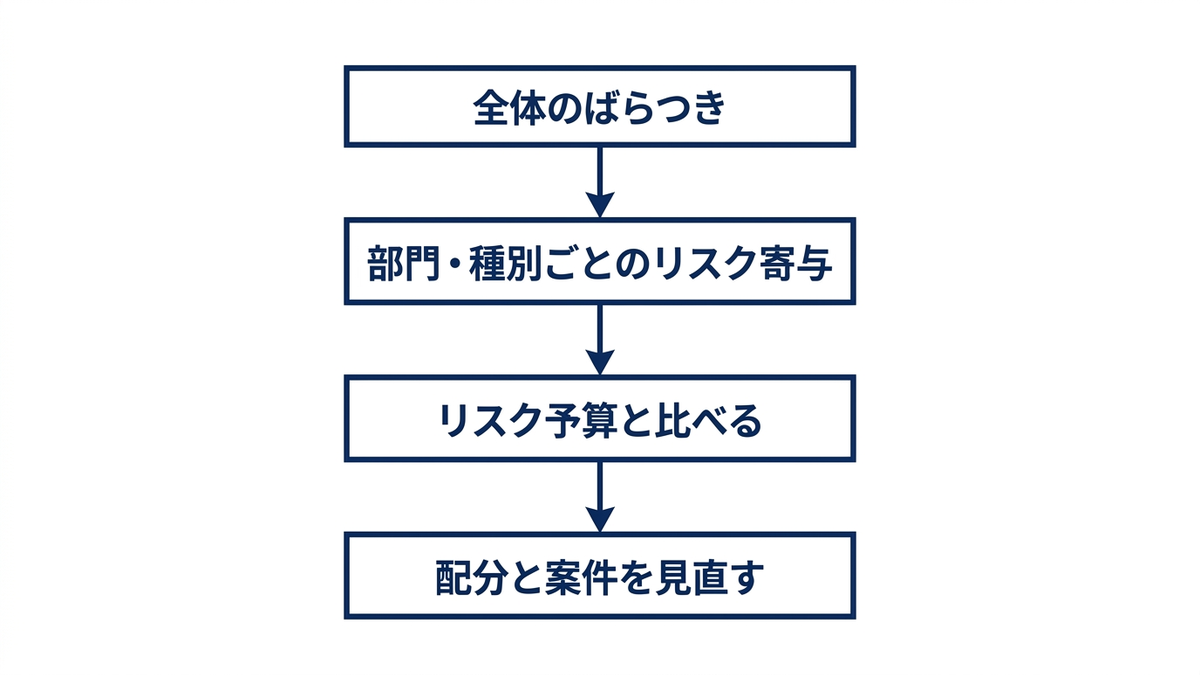
リスク予算を経営判断に落とす
この分解を経営判断に使うときは、次の順で考えるのが有効だと考えています。まず、現在の選択のリスクがどこから来ているかを、部門別・種別・案件別に1枚の表にします。共通データでは「研究開発と新規事業の8件が NPV 合計のばらつきの86.6%を担い、うち3件だけで65.3%」でした。この事実は、NPV 期待値の合計3,155百万円という1つの数字からは見えません。投資委員会や経営会議では、期待値の表の横にこの寄与の表を並べることで、「この計画が下振れするとしたら、どの案件が原因になるか」を事前に共有できます。
次に、寄与の割合と NPV の割合を比べます。寄与の割合が NPV の割合を大きく上回る部門・種別は、期待値に比べて全体を揺らす度合いが大きい部門です。共通データでは全社の3件(比1.96)がそれに当たり、その中心は新素材Xの基礎研究と試作ラインの2件の研究開発です。これは「その部門の案件が悪い」という意味ではありません。基礎研究のような成功確率の低い案件は、全体を揺らすことと引き換えに、大きな成功の可能性を持っています。判断すべきは、会社としてその揺れを許容できるかどうかです。許容できるかどうかは、自己資本の厚み、借入れの条件、株主への説明、他の事業の安定性で決まります。
そのうえで、許容できないと判断したなら、リスク予算を置きます。たとえば「成功確率が1未満の案件群が、NPV 合計の分散に占める割合を一定以下にする」という枠です。具体的な上限の値は、会社の財務体力と方針で決めるもので、数理モデルが決めるものではありません。枠を置いたら、それを守る手段を考えます。成功確率の低い大型案件を段階投資に分け、最初の段階だけを今期の選択に入れる(第11章)、同じ種別の案件を小さく複数に分けて当たり外れを打ち消し合わせる、景気と連動する案件の比重を下げる、といった手段です。NPV 合計の下振れそのものを制約にして案件を選び直す方法は、第12章で CVaR 制約つきの整数計画として扱います。
この判断を誤ったときの損失の型も確認しておきます。リスクの集中に気づかないまま期待値だけで選ぶと、共通データの基準の選択では、NPV 合計が負になる確率が4.5%、下位5%の平均が -572百万円でした(第2章の基準の結果)。リスクの大半が3件に集中しているので、その3件が同時に失敗する年には、計画全体の NPV が大きく沈みます。逆に、リスクを恐れて研究開発と新規事業をすべて外すと、NPV 期待値の65.3%を手放すことになります。リスク予算は、この2つの極端の間のどこに立つかを、数字を見ながら決めるための道具です。
リスク寄与度は、配分全体のリスクを資産や案件ごとに分け、足すとちょうど全体になる量です。共通データの現在の配分は金額では株式と債券が半々でしたが、リスクの89.3%は株式系が担っていました。期待リターンを使わずに配分を決める方法のうち、最小分散はリスクの最も小さい資産に集中し、リスクパリティと最大分散化は推定誤差に強く、20回の再生成でもほとんどぶれませんでした。その代わり、債券に寄るので期待リターンは現在の配分より低くなります。同じ分解を事業投資に当てはめると、共通データの基準の選択では、研究開発と新規事業の8件が NPV 合計のばらつきの86.6%を担っていました。分散と標準偏差は、上振れと下振れを同じ重さで数えます。次の第7章では、下振れの側だけを見る CVaR を使って配分を決める方法を扱います。
この章を深めたい方への参考書籍
『リスクバジェッティング:実務家が語る年金新時代のリスク管理』(レスリー・ラール編、三菱信託銀行受託財産運用部門訳、パンローリング):副題のとおり、年金運用のリスク管理を実務家が論じた編著の翻訳です。この章で事業領域のリスク予算に読み替えた「リスクをどこに割り当てるか」という考え方が、年金運用の文脈でどう議論されてきたかをたどる手がかりになります。
『リスク・バジェッティングのためのVaR:理論と実践の橋渡し』(ニール・D・ピアソン著、竹原均・三菱信託銀行受託財産運用部門監修、山下恵美子訳、パンローリング):書名のとおり、リスク・バジェッティングに使うリスク指標としての VaR を、理論と実務の両面から扱った本の翻訳です。この章では標準偏差でリスクを分解しましたが、下振れの指標で同じ分解を考えるときの手がかりになります。
第7章 下方リスクと CVaR で配分する
第6章では、期待リターンの推定を使わず、リスクの大きさとリスク寄与度だけで配分を決める方法を見ました。そこまでの章で「リスク」と呼んできたのは年率の標準偏差で、上振れと下振れを同じ重さで数える指標です。しかし、投資委員会や取締役会で問われるのは、たいてい「平均からどれだけぶれるか」ではなく「悪いときにどこまで減るか」です。この章では、分布の左の裾(損失の側)だけを測る2つの指標、VaR と CVaR を定義し、なぜ配分の判断には CVaR を使うのかを説明します。次に、CVaR を最小にする配分や、CVaR に上限を置いたうえで期待リターンを最大にする配分を、ロカフェラーとウリャセフが2000年に示した線形計画(目的も制約も一次式だけで書ける最適化問題)の形に直して PuLP で解きます。最後に、分散で決めた配分と何が違うのか、真のモデルで評価すると何が分かるのか、そして月次の CVaR を「最悪の年にいくら減るか」という経営の言葉に直すときの注意を、第2章で用意したサンプルデータで実測します。
この章の計算は、第2章で用意した架空の6資産クラスの月次リターンを使います。実在の市場の記録ではなく、どの資産をどれだけ持つべきかを示すものでもありません。本記事は投資や財務の助言ではなく、個別の判断は専門家に相談してください。
標準偏差では見えない損失がある
第2章で説明したとおり、共通データの真のモデルは「平常の月」と「荒れた月」の2つの分布の混合です。荒れた月は約8%の確率で起き、その月は株式系の資産の平均が負になり、ばらつきが2倍になり、株式系どうしの相関が0.85まで上がります。このような混合分布では、リターンの分布が左右対称になりません。平常の月は小さくプラスに振れ、まれに来る荒れた月だけが大きなマイナスを作るので、分布の左の裾が長く伸びます。
現在の配分(国内株式25%・外国株式20%・国内債券35%・外国債券15%・不動産投資信託5%・短期資産0%)について、真のモデルから12万か月を抽出して月次リターンの分布を描くと、下の図のようになります。平均は月0.29%、標準偏差は2.40%です。左右対称なら平均の左右に同じ形の裾が付くはずですが、実際には左の裾が右より長く、12万か月の中で最も悪い月は -20.8% でした。分布の左右の偏りを表す歪度(左の裾が長いと負になる指標)は -0.71 です。
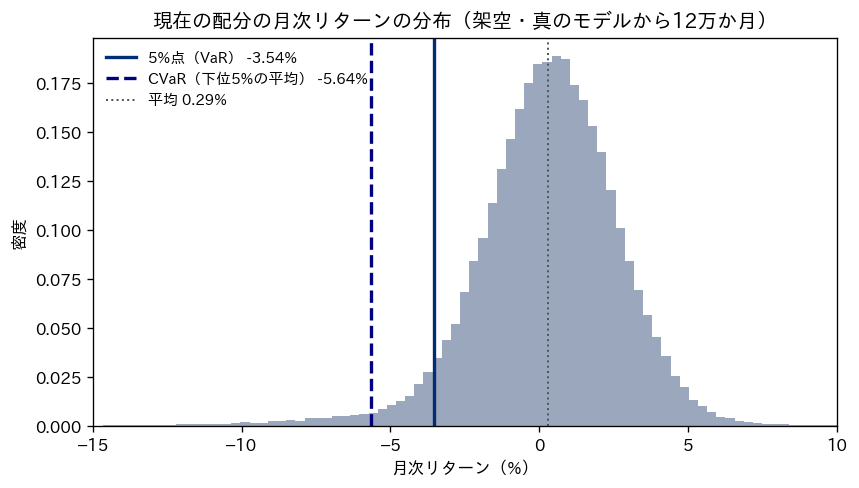
標準偏差は、この非対称を区別できません。左の裾の長い分布と、同じ標準偏差の左右対称な分布は、標準偏差で比べると同じリスクに見えます。実際に、現在の配分の平均と標準偏差がそのまま正規分布に従うと仮定して計算すると、下位5%の月の平均損失は -4.66% になります。真のモデルから抽出した値は -5.64% で、正規分布の仮定は悪い月の損失を約1ポイント小さく見積もります。下位5%に入った月の約6割(59.8%)は荒れた月でした。荒れた月は全体の7.9%しかないので、左の裾は荒れた月にほぼ占められていることになります。
経営の側から見ると、この差は説明の仕方の差になります。「リスク(標準偏差)は年率8.3%です」という説明は、委員の多くには「年に8%程度ぶれる」と受け取られがちです。実際に資金繰りや自己資本の議論で問題になるのは、悪い年にどこまで減るかであり、それは標準偏差の数字からは直接読めません。悪いときの損失を直接測る指標を、配分を決める段階から使うのがこの章の主題です。
VaR と CVaR の定義
悪いときの損失を測る代表的な指標が、バリュー・アット・リスク(VaR)です。信頼水準を95%とすると、95%の確率でこれ以上は悪くならない、という境目の値を VaR と呼びます。信頼水準95%は、悪い側の5%を「悪いとき」として数える、という意味です。月次リターンで言えば、下から数えて5%の位置にある値、つまり5%点です。現在の配分の5%点は -3.54% でした。「20か月に1か月は、-3.54% より悪い月が来る」と読みます。
VaR には、境目より向こう側で何が起きるかを何も語らないという弱点があります。5%点が -3.54% であることは、その5%の月の損失が -4% 程度で収まるのか、-20% に達するのかを区別しません。そこで、境目より悪い月の損失の平均を測るのが条件付きバリュー・アット・リスク(CVaR)です。この記事では第1章の定義のとおり、特に断らない限り「月次リターンの下位5%の平均」(信頼水準95%)を CVaR と呼びます。現在の配分の CVaR は -5.64% でした。「悪い方から20か月に1か月の月だけを集めると、その平均は -5.64%」と読みます。この章で定式化に使うロカフェラーとウリャセフの2000年の論文の冒頭は、CVaR が平均超過損失(Mean Excess Loss)やテール VaR(Tail VaR)とも呼ばれると紹介しています。
ロカフェラーとウリャセフの論文は、損失の分布について、信頼水準 \( \beta \) の VaR を「確率 \( \beta \) で損失がそれを超えない最小の値」、CVaR を「損失がその値以上になるという条件のもとでの損失の期待値」と定義しています。論文の記号は損失(リターンの符号を反転したもの)で書かれているので、損失で言えば VaR も CVaR も正の数になります。この記事では、読みやすさのためにリターンの向き(悪いほど負の数)で書きます。符号の向きが違うだけで、中身は同じです。定義から、CVaR は必ず VaR と同じかそれより悪い値になります。同じ論文は、この性質から、損失の向きで測った CVaR が小さい配分は VaR も小さいと述べています。
この「条件のもとでの期待値」という定義は、損失が飛び飛びの値しか取らない分布では、そのままでは下位5%ちょうどを切り出せません。境目の値ちょうどの損失がまとまった確率を持つことがあるからです。この記事では、境目の損失を、下位5%を埋めるのに必要な確率の分だけ含めて平均したものを CVaR とします。月次リターンの「下位5%の平均」という第1章の定義はこの意味で、後の節で使うロカフェラーとウリャセフの線形計画の式も、同じ値を与えます。
| 指標 | 何を測るか | 現在の配分の値(月次・真のモデル) | 読み方 |
|---|---|---|---|
| リスク(標準偏差) | 平均からのぶれの大きさ。上振れも下振れも同じ重さで数える | 2.40%(年率では8.30%) | 典型的なぶれの幅 |
| VaR(5%点) | 悪い方から5%の境目 | -3.54% | 20か月に1か月はこれより悪い |
| CVaR(下位5%の平均) | 境目より悪い月の平均 | -5.64% | 悪い20か月に1か月の平均的な姿 |
| 最も悪い月 | 12万か月の最小値 | -20.8% | 抽出の数で変わるので、指標には使わない |
最後の行の「最も悪い月」は、抽出する月数を増やすほど悪くなる値で、比較の物差しにはなりません。VaR と CVaR は、分布の一部分を決まった割合で切り取って測るので、抽出の数を十分に取れば値が落ち着きます。どの値も、データを作った側だけが知る真のモデルからの値で、現実の企業はこれを履歴から推定するしかありません。その推定がどれだけ揺れるかは、後の節で測ります。
なぜ VaR ではなく CVaR で配分を決めるのか
VaR は広く使われている指標ですが、配分を決める目的に使うと問題が出ます。ロカフェラーとウリャセフの論文は、Artzner らの研究を引いて、VaR には劣加法性と凸性が欠けていると述べ、2つのポートフォリオを合わせたものの VaR が、それぞれの VaR の和より大きくなりうることを例に挙げています。劣加法性とは、「合わせたもののリスクは、別々に測ったリスクの和を超えない」という性質です。分散投資をすればリスクは増えない、という直感を数式で書いたものと言えます。これが成り立たない指標で配分を決めると、分けて持つほうがリスクが小さく見える、という奇妙な答えが出ることがあります。
劣加法性が崩れる様子は、簡単な架空の例で確かめられます。額面100の貸付が2本あり、それぞれ独立に4%の確率で全額が戻らないとします。1本だけを見ると、損失が出る確率は4%で5%より小さいので、95%の VaR は0です。2本の和も0です。ところが2本をまとめて持つと、少なくとも1本が戻らない確率は約7.8%になり、5%を超えるので、まとめたものの95%の VaR は100になります。別々に測ると0と0なのに、まとめると100になるので、劣加法性が成り立っていません。同じ例で CVaR を計算すると、1本は80、2本の和は160、まとめたものは103.2で、まとめたほうが小さくなります。
| 架空の貸付(各100・独立に確率4%で全損) | 95%の VaR(損失) | 95%の CVaR(損失) |
|---|---|---|
| 1本だけ | 0 | 80.0 |
| 2本を別々に測った和 | 0 | 160.0 |
| 2本をまとめて測る | 100 | 103.2 |
この表の CVaR は、下位5%の確率に入る損失の平均です。1本だけなら、損失100が4%、残りの1%は損失0なので、平均は100×4÷5=80になります。まとめた場合は、損失200が0.16%、損失100が残りの4.84%を占めるので、平均は103.2です。どちらも、境目の損失(1本なら0、まとめたものなら100)は、下位5%を埋めるのに必要な確率の分だけを含めています。この例では、VaR で測ると「2本に分けて別々の部門に持たせればリスクは0」という結論が出てしまいます。VaR は境目の向こう側の損失の大きさを見ないので、まとめたときに裾が重なる効果も、分けたときに裾が隠れる効果も、正しく数えられません。
もう1つの問題は計算です。同じ論文は、シナリオから計算した VaR は配分の関数として性質が悪く、局所的な最小値を複数持ちうるので、最適な配分を探すことが難しいと述べています。これに対して CVaR は、損失が配分の凸関数(線形の場合を含む)であれば配分について凸関数になり、局所的な最小がそのまま全体の最小になります。配分の重みが損失に線形に効く資産配分の問題は、ちょうどこの場合に当たります。指標としての筋の良さと、最適化の解きやすさの両方で、配分の判断には CVaR を使うのが合理的だと考えています。
ロカフェラーとウリャセフの線形計画
CVaR は「VaR より悪い部分の平均」なので、定義どおりに計算しようとすると、先に VaR を求める必要があり、VaR は配分によって変わります。ロカフェラーとウリャセフは、2000年に Journal of Risk 誌(第2巻第3号)に載せた論文で、この循環を断ち切る式を示しました。VaR の候補となる値を \( \alpha \) と置き、次の関数を考えます。
\( F_{\beta}(x, \alpha) = \alpha + \dfrac{1}{1-\beta} \, E\left[ \max(L(x) – \alpha, 0) \right] \)
ここで \( x \) は配分、\( L(x) \) はその配分の損失、\( \beta \) は信頼水準(この章では0.95)、\( E \) は期待値です。言葉で言うと、「VaR の候補 \( \alpha \) に、損失がそれを超えた分の平均を \( 1-\beta \) で割って足したもの」です。論文の定理1は、この関数を \( \alpha \) について最小にした値が CVaR に等しく、そのときの \( \alpha \) が VaR になることを示しています。つまり、VaR を先に求めなくても、\( \alpha \) も一緒に動かして最小化すれば CVaR が出て、VaR は副産物として得られます。定理2は、配分 \( x \) と \( \alpha \) を同時に動かして \( F_{\beta} \) を最小にすることが、CVaR を最小にする配分を求めることと同じだと示しています。
期待値の部分は、シナリオで近似します。シナリオとは、起こりうる月のリターンの組を \( q \) 通り並べたものです。論文の式(9)と式(17)は、シナリオ \( k \) の損失を \( L_k(x) \) として、期待値を \( \frac{1}{q} \sum_k \max(L_k(x) – \alpha, 0) \) で置き換えています。さらに、シナリオごとに「VaR の候補を超えた損失」を表す補助の変数 \( u_k \) を置き、\( u_k \ge 0 \) と \( u_k \ge L_k(x) – \alpha \) の2本の制約を付けると、\( \max \) が消えて、目的も制約もすべて一次式で書ける線形計画になります。論文は、この線形計画への帰着が、シナリオの分布が正規分布でなくても成り立つことを明記しています。
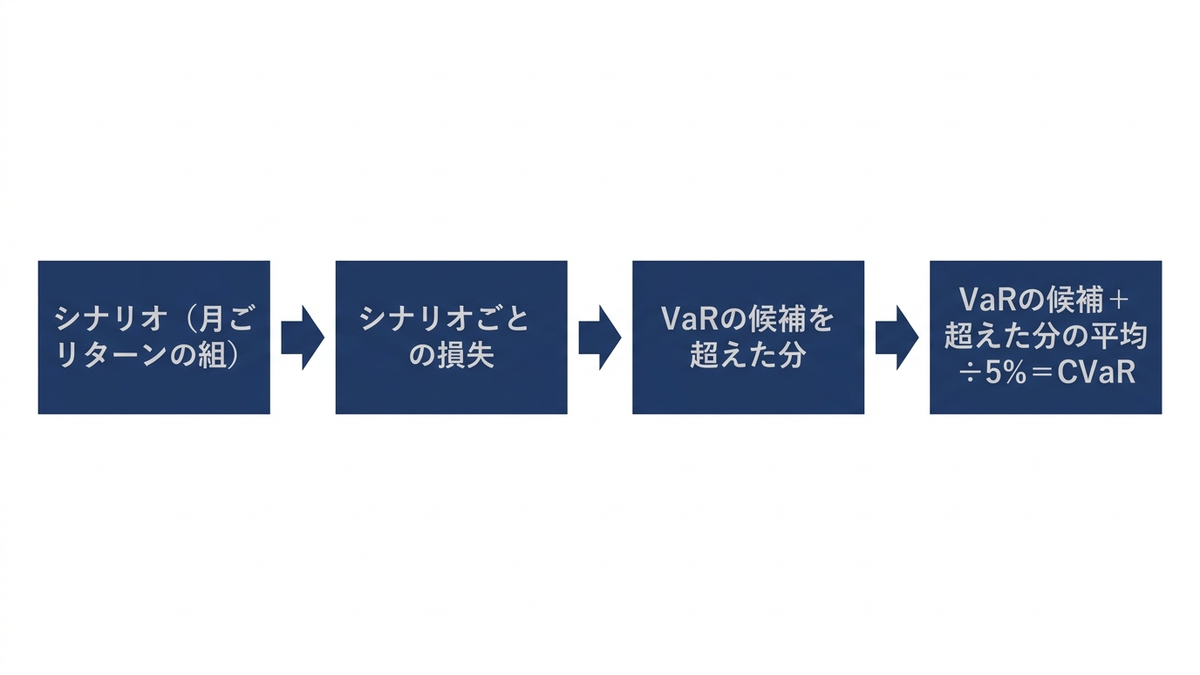
この形の利点は、シナリオの数が増えても問題の種類が変わらないことです。変数は資産の数、VaR の候補1つ、シナリオの数だけの補助変数で、制約はシナリオの数だけ増えます。240か月の履歴なら変数は247個、2万か月なら20,007個です。この記事の実行環境(一般的なノートPC)での実測で、240か月のシナリオは0.07秒、ブートストラップの5,000か月は0.36秒、2万か月は4.40秒で解けました(いずれも CVaR 制約つきの期待リターン最大化。240か月で CVaR 最小化を解いた場合は0.06秒)。本記事の環境の PuLP が扱えるのは線形計画と整数計画だけなので、分散を目的にする平均分散最適化はそのままでは書けませんが、CVaR は PuLP でそのまま解けます。第8章で取引コストや銘柄数の上限を入れるときにも、この線形性が効いてきます。
この定式化には、使う前に押さえておくべき前提が2つあります。1つは、答えの良し悪しがシナリオの質で決まることです。線形計画は与えられたシナリオの中で CVaR を正確に最小にしますが、シナリオに含まれていない種類の悪い月には何の備えもしません。もう1つは、下位5%を測るのに使える月が少ないことです。240か月の履歴なら、下位5%に入るのは12か月だけで、CVaR はその12か月の平均です。配分の答えが、この12か月の顔ぶれに強く左右されます。
シナリオの作り方
シナリオの作り方は大きく3つあります。1つ目は、過去の月をそのまま使う方法で、ヒストリカル法とも呼ばれます。共通データでは240か月の履歴がそのまま240本のシナリオになります。資産どうしの同時の動き、特に荒れた月にそろって下がる動きが、履歴に入っている分だけそのまま反映されるのが長所です。短所は、履歴に無い種類の悪い月は存在しないことになる点と、裾を測る月が少ない点です。
2つ目は、履歴の月を復元抽出(同じ月を何度でも選べる抽出)して並べ直すブートストラップです。これは推定モデルの一種で、「将来の月は、過去240か月のどれかと同じ形で、どれも同じ確率で来る」と仮定しています。月の数は好きなだけ増やせますが、中身は240種類の月の繰り返しなので、新しい情報は増えません。本記事の計算でも、240か月そのものと、ブートストラップで5,000か月に増やしたシナリオとで、配分の答えはほとんど同じでした(後の表)。ブートストラップの本当の使い道は、配分を決めることよりも、推定した CVaR がどれだけ揺れるかを測ることにあります。
3つ目は、分布の形を仮定してそこから大量に抽出する方法です。本記事では、データを作った側だけが知る真のモデルから抽出できます(共通データの simulate_true 関数)。現実の企業には真のモデルが見えないので、この方法は「答え合わせ」としてだけ使います。現実の実務では、推定した分布(正規分布、裾の厚い分布、平常と荒れた月の混合など)から抽出しますが、その分布自体が推定なので、推定モデルのシナリオです。
推定した CVaR がどれだけ揺れるかを、現在の配分で測りました。履歴240か月から計算した CVaR は -5.02% で、真のモデルの -5.64% より0.6ポイント楽観的です。履歴を2,000回ブートストラップすると、CVaR は90%の範囲で -5.88% から -4.08% までばらつきました。さらに、同じ真のモデルから履歴そのものを20回作り直す(乱数の種を1〜20に変える)と、CVaR は最も楽観的な回で -3.99%、最も悲観的な回で -8.47% でした。同じ配分、同じ真のモデルでも、たまたまどの20年を経験したかによって、悪い月の平均の見積りが2倍以上違います。
| 現在の配分の CVaR(月次・下位5%の平均) | 値 |
|---|---|
| 真のモデル(12万か月) | -5.64% |
| 正規分布を仮定した計算(真のモデルの平均と標準偏差を使用) | -4.66% |
| 履歴240か月(推定モデル) | -5.02% |
| 履歴を2,000回ブートストラップしたときの90%の範囲 | -5.88% 〜 -4.08% |
| 履歴を20回作り直したときの最小と最大 | -8.47% 〜 -3.99% |
第3章で、期待リターンの標本平均は240か月あっても真の値から大きく外れることを見ました。CVaR は分布の端の5%だけを使うので、推定の揺れはさらに大きくなります。経営会議で CVaR を報告するときは、1つの数字ではなく、この表の下3行のような幅を添えるのが誠実だと考えています。
PuLP で CVaR を制約に入れて解く
次のコードは、履歴240か月をシナリオにして、「現在の配分の CVaR を超えない範囲で、推定モデルの期待リターンを最大にする」配分を求めます。ショートなし(各資産0〜100%)・合計100%で、信頼水準は95%です。CVaR の上限には、同じ履歴で計算した現在の配分の CVaR(損失の向きで5.02%)を使いました。目的を CVaR そのものに替えれば CVaR 最小化になります。このコードは、共通データAを作る補助モジュール port_data.py と同じフォルダに置いて実行すると、下の出力が得られます。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
import pulp
from port_data import history, estimate, CURRENT, CODES

R = history().values                  # 240か月×6資産の月次リターン(シナリオ)
mu = estimate(history())[0] / 12      # 推定モデルの月次の期待リターン
S, n, beta = R.shape[0], R.shape[1], 0.95
loss_cur = -(R @ CURRENT.values)
cap = np.sort(loss_cur)[::-1][: int(S * (1 - beta))].mean()   # 現在の配分の CVaR(損失の向き)

prob = pulp.LpProblem("cvar_cap", pulp.LpMaximize)
w = [pulp.LpVariable("w_" + c, lowBound=0, upBound=1) for c in CODES]
a = pulp.LpVariable("alpha")                                   # VaR の候補
u = [pulp.LpVariable("u%d" % s, lowBound=0) for s in range(S)] # 超過損失
prob += pulp.lpSum(mu[j] * w[j] for j in range(n))             # 期待リターン最大化
prob += pulp.lpSum(w) == 1                                     # 合計100%
for s in range(S):                                             # u_s >= 損失_s - alpha
    prob += u[s] >= -pulp.lpSum(R[s, j] * w[j] for j in range(n)) - a
prob += a + pulp.lpSum(u) / ((1 - beta) * S) <= cap            # CVaR の上限
prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=60))

print(pulp.LpStatus[prob.status], "CVaR上限 %.4f" % cap)
print({c: round(x.value(), 3) for c, x in zip(CODES, w)})
print("VaR(5%%点の損失) %.4f / 年率の期待リターン %.4f" % (a.value(), 12 * pulp.value(prob.objective)))
# 出力:
# Optimal CVaR上限 0.0502
# {'DE': 0.507, 'FE': 0.0, 'DB': 0.493, 'FB': 0.0, 'RE': 0.0, 'CA': 0.0}
# VaR(5%点の損失) 0.0339 / 年率の期待リターン 0.0209
コードの中心は3か所です。補助変数 \( u_s \) を240個作り、各シナリオで「その月の損失から VaR の候補を引いた値」以上という制約を付けています。\( u_s \) は0以上なので、損失が候補を超えない月は0になり、超えた月だけ超過分が入ります。最後の制約が、ロカフェラーとウリャセフの式の \( F_{\beta} \) を上限で抑える部分です。下位5%は240か月のうち12か月なので、超過分の合計を12で割って候補に足したものが CVaR になります。解き終わったときの \( \alpha \) の値は、得られた配分の VaR の目安として読めます。
答えは国内株式50.7%・国内債券49.3%で、残りの4資産は0%でした。推定モデルの年率の期待リターンは2.09% です。この配分は、第4章の基準(同じ推定モデルで、現在と同じ推定リスクのもとで期待リターンを最大にした配分。国内株式52.3%・国内債券47.7%)とほとんど同じです。リスクの物差しを標準偏差から CVaR に替えても、期待リターンに標本平均を使う限り、標本平均が低く出た外国株式・外国債券・不動産投資信託は選ばれません。CVaR は下方リスクの測り方を改善しますが、期待リターンの推定誤差は直しません。推定誤差への対処は、第5章の方法を組み合わせる必要があります。
推定モデルで決めた配分を真のモデルで評価する
本記事の計算で求めた配分を、すべて真のモデルで評価しました。期待リターンとリスクは真のモデルの年率の値、5%点・CVaR・歪度は真のモデルから抽出した12万か月の月次リターンから計算しています。表の「推定」の行は履歴(推定モデル)のシナリオで解いた配分、「真」の行は真のモデルから別に抽出した2万か月をシナリオにして解いた配分(現実には作れない、答え合わせ用の配分)です。CVaR 制約つきの行は、CVaR の上限をそれぞれのシナリオで計算した現在の配分の CVaR に置いています。
| 配分(解いたシナリオ) | 主な重み | 期待リターン(年率) | リスク(年率) | 5%点(月次) | CVaR(月次) | 歪度 |
|---|---|---|---|---|---|---|
| 現在の配分 | 国内株式25・外国株式20・国内債券35・外国債券15・不動産投資信託5 | 3.62% | 8.30% | -3.54% | -5.64% | -0.71 |
| CVaR 最小(推定・履歴240か月) | 短期資産97.8・国内債券2.0 | 0.52% | 0.42% | -0.16% | -0.21% | 0.00 |
| CVaR 制約つき期待リターン最大(推定・履歴240か月) | 国内株式50.7・国内債券49.3 | 3.28% | 8.07% | -3.50% | -5.27% | -0.52 |
| CVaR 制約つき期待リターン最大(推定・ブートストラップ5,000か月) | 国内株式50.4・国内債券49.6 | 3.27% | 8.02% | -3.48% | -5.24% | -0.52 |
| 平均分散(推定・第4章の基準) | 国内株式52.3・国内債券47.7 | 3.35% | 8.32% | -3.62% | -5.45% | -0.52 |
| CVaR 制約つき期待リターン最大(真・2万か月) | 国内株式18.1・外国株式34.3・国内債券47.6 | 3.70% | 8.44% | -3.65% | -5.65% | -0.62 |
| 平均分散(真のモデル) | 国内株式18.4・外国株式29.3・国内債券45.9・不動産投資信託6.4 | 3.67% | 8.30% | -3.56% | -5.61% | -0.67 |
読み取れることを4つに分けて書きます。第1に、推定モデルで CVaR だけを最小にすると、短期資産が97.8%になりました。基準の計算で、推定モデルの最小分散が短期資産98.2%になったのと同じ構造で、リスクの物差しを替えても、期待リターンを条件に入れない最小化は現金に寄ります。CVaR は月 -0.21% まで小さくなりますが、真の期待リターンは年0.52%しかありません。CVaR 最小化を単独で配分の答えにしてはいけない理由がここにあります。
第2に、推定モデルの CVaR 制約つきの配分は、真のモデルで評価すると期待リターンが現在の配分より0.34ポイント低く(3.62%から3.28%)、CVaR は0.37ポイント改善しています(-5.64% から -5.27%)。推定モデルの中では「現在と同じ CVaR で期待リターンを上げた」つもりの配分が、真のモデルでは「期待リターンを下げて CVaR を下げた」配分になっていました。第4章で見た、推定モデルの見込みと真のモデルでの実際のずれが、CVaR を使っても同じように起きています。履歴の CVaR(-5.02%)が真の値より楽観的だったので、上限そのものが甘く置かれていたことも効いています。
第3に、ブートストラップで5,000か月に増やしても、240か月そのものとほぼ同じ答え(国内株式50.4%・国内債券49.6%)になりました。前の節で書いたとおり、復元抽出では新しい情報が増えないためです。
第4に、真のモデルのシナリオで解いた CVaR 制約つきの配分は、真の平均分散の配分と近い形(国内株式約18%・外国株式約30%・国内債券約46〜48%)になりました。違いは、CVaR 制約つきでは不動産投資信託が0%になり、その分外国株式が増えたことです。共通データの真のモデルの設定では、荒れた月の不動産投資信託の月次の平均は -3.5%(国内株式は -4.0%、外国株式は -4.5%)で、株式系との相関が0.85まで上がるので、左の裾を悪くする資産として外されたと読めます。ただし、真のモデルで評価した CVaR は、CVaR 制約つき -5.65%、平均分散 -5.61% で、CVaR 制約つきの方がわずかに悪くなっています。CVaR 制約は2万か月の抽出で計算した現在の配分の CVaR(-5.52%)を上限にしており、その2万か月の中では制約を満たしていますが、別の12万か月で評価すると上限からはみ出しました。2万か月を使っても CVaR には0.1ポイント程度の抽出の誤差が残り、その中で最適化すると、誤差の有利な側に寄った配分が選ばれます。抽出したシナリオで最適化した配分は、必ず別に抽出したシナリオで評価し直す、という手順が要ります。
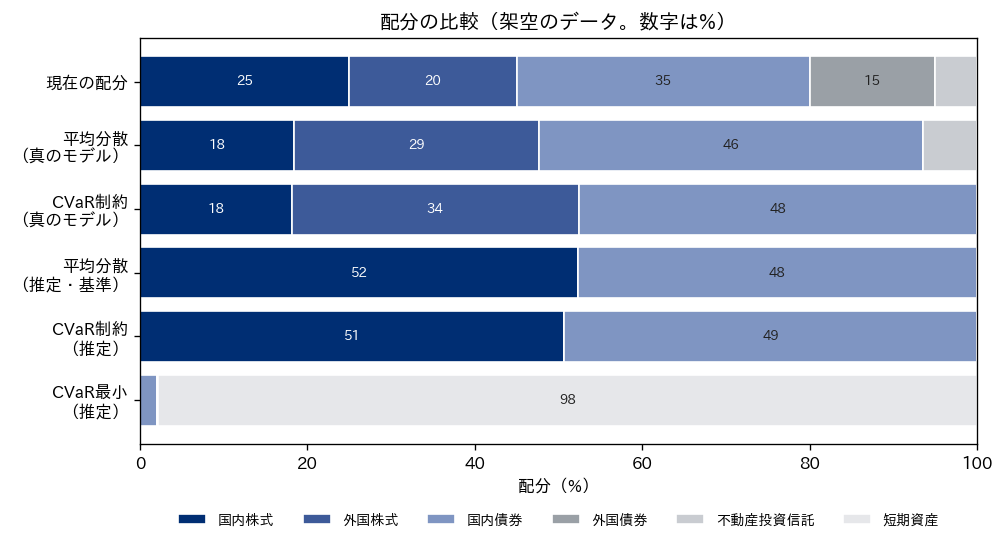
分散で決めた配分と CVaR で決めた配分の違い
前の節の比較は、期待リターンと CVaR の両方が配分ごとに違うので、物差しを替えた効果だけを取り出しにくくなっています。そこで、真のモデルで「期待リターンを現在の配分と同じ年3.62%以上に保ったまま、分散を最小にする配分」と「同じ条件で CVaR を最小にする配分」を求め、左の裾を比べました。CVaR 最小の方は、2万か月をシナリオにした線形計画で、この記事の実行環境(一般的なノートPC)での実測で48.39秒かかりました。
| 真のモデル・期待リターンは現在と同じ | 主な重み | リスク(年率) | 5%点(月次) | CVaR(月次) | 歪度 | 荒れた月の平均(月次) |
|---|---|---|---|---|---|---|
| 分散を最小 | 国内株式18.2・外国株式28.9・国内債券46.7・不動産投資信託6.3 | 8.18% | -3.50% | -5.52% | -0.66 | -2.11% |
| CVaR を最小 | 国内株式17.9・外国株式33.1・国内債券49.0 | 8.21% | -3.55% | -5.48% | -0.61 | -2.06% |
| (参考)現在の配分 | 国内株式25・外国株式20・国内債券35・外国債券15・不動産投資信託5 | 8.30% | -3.54% | -5.64% | -0.71 | -2.13% |
先に結論を書くと、2つの配分の差はごく小さく、CVaR の差(0.04ポイント)は抽出の誤差より小さい値でした。そのうえで差の向きを見ると、CVaR を最小にした配分は、分散を最小にした配分に比べて、リスク(標準偏差)がわずかに大きく(8.18%に対して8.21%)、5%点もわずかに悪い(-3.50% に対して -3.55%)一方で、CVaR はわずかに良く(-5.52% に対して -5.48%)、歪度も左の裾が短い側に動きました(-0.66 から -0.61)。荒れた月の平均も -2.11% から -2.06% に改善しています。CVaR 最小化は、境目付近の月の損失を少し受け入れる代わりに、最も悪い月々の平均を下げる向きに配分を動かしています。中身は、荒れた月に大きく下がる不動産投資信託を外し、外国株式と国内債券に振り替えることでした。
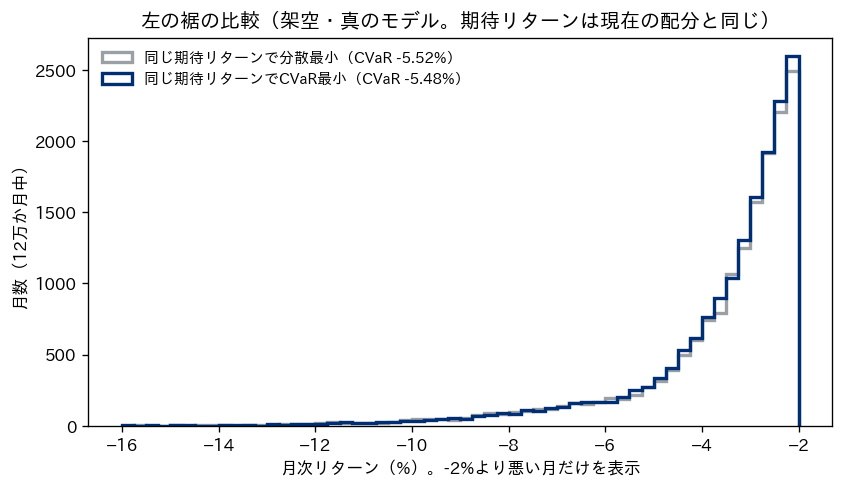
差の小ささを図でも確かめます。上の図は、2つの配分の月次リターンのうち -2% より悪い月だけを12万か月から数えたもので、2本の線はほとんど重なっています。CVaR の差は0.04ポイントで、前の節で見た抽出の誤差(0.1ポイント程度)より小さい値です。共通データの真のモデルは、資産どうしの相関が荒れた月に一斉に上がる構造なので、どの配分も同じ荒れた月に同時に損をし、配分の工夫で左の裾を大きく変える余地が限られています。第4章で、期待リターンとリスクの平面で効率的フロンティアが平らだったのと同じことが、左の裾でも起きています。ロカフェラーとウリャセフの論文も、損失が正規分布に従い期待リターンの制約が効いている場合には、分散最小と CVaR 最小の答えが一致することを命題として示しています。分布の非対称が小さいほど、CVaR で解き直す効果は小さくなります。
差が大きくなるのは、資産ごとに左の裾の形が大きく違う場合です。たとえば、オプションのように損益が非対称な商品を含む場合、信用リスクのように「ほとんどの月は小さくプラス、まれに大きく損をする」資産を含む場合、事業投資の案件のように成功か失敗かの二択で結果が分かれる場合です。第12章では、成功と失敗の二択を含む事業投資の案件選択で、CVaR を制約に入れると期待値をわずかに下げて最悪時を大きく改善できることを実測します。資産配分でも、自社の資産の構成が非対称な損益を含むかどうかを確かめてから、CVaR で解き直す手間をかけるかどうかを決めるのがよいと考えています。
月次の CVaR を「最悪の年にいくら減るか」に直す
経営会議で配分を説明するときは、月次のパーセントではなく、年の金額で話す方が伝わります。ここで間違えやすいのが、月次の CVaR を年に直す計算です。月次の CVaR を12倍すると、毎月が下位5%の悪い月になる年を想定することになり、現在の配分では -67.7% という現実離れした値になります。標準偏差を年率に直すときのように月次の値に \( \sqrt{12} \) を掛けると -19.5% ですが、これは標準偏差の換算をそのまま当てはめただけの値です。分布が正規分布で月どうしが独立という前提を置いても、CVaR には平均の分が含まれているので、平均の分を12倍、平均からの下振れの分を \( \sqrt{12} \) 倍と分けて扱わない限り、正しい換算にはなりません。左の裾が長い分布では、その分け方にも根拠がありません。
確実なのは、年のリターンの分布を直接作ってから、その下位5%の平均を測ることです。真のモデルから抽出した12万か月を12か月ずつ区切って1万年を作り、各年の12か月のリターンを複利で掛け合わせて年のリターンにしました。現在の配分では、年の5%点は -10.59%、年の CVaR(下位5%の年の平均)は -14.33% でした。年がマイナスで終わる確率は34.1%です。12か月を単純に足した年の CVaR は -14.82% で、複利との差は0.5ポイントほどでした。
| 現在の配分(真のモデル) | 値 | 架空の運用資産10,000百万円での金額 |
|---|---|---|
| 月次の CVaR | -5.64% | -564百万円(悪い月の平均) |
| 月次の CVaR を12倍(誤った換算) | -67.7% | 使わない |
| 月次の CVaR に√12を掛ける(標準偏差の換算を当てはめた誤った換算) | -19.5% | 使わない |
| 年の5%点(複利・1万年) | -10.59% | -1,059百万円 |
| 年の CVaR(複利・下位5%の年の平均) | -14.33% | -1,433百万円 |
| 年の平均(複利) | 3.56% | +356百万円 |
| 年がマイナスで終わる確率 | 34.1% | およそ3年に1年 |
運用資産を架空に10,000百万円(100億円)と置くと、現在の配分は「平均的な年には約3.6億円増えるが、3年に1年はマイナスで終わり、20年に1年の悪い年の平均では約14.3億円減る」と説明できます。この数字は架空の真のモデルから抽出したもので、実在の資産の見込みではありません。現実の企業は真のモデルを知らないので、同じ計算を推定モデルのシナリオで行い、前の節で見た推定の幅を添えることになります。
本記事の計算で、真のモデルの CVaR 制約つきの配分と真の平均分散の配分についても同じ換算をすると、年の CVaR はそれぞれ -14.43% と -14.26% で、現在の配分の -14.33% との差は0.2ポイント以内でした。年がマイナスで終わる確率も3つとも約34%です。月次で見た配分の違いは、年に直すとさらに見分けにくくなります。配分の見直しで「最悪の年」を大きく変えられるのは、資産の構成そのもの(株式系の合計の比率など)を変える場合で、株式系の中の配分を入れ替えるだけでは、この共通データでは大きく変わりません。
経営判断としては、次の2点が重要だと考えています。1つは、配分の議論の出発点を「期待リターンとリスク」の組ではなく「平均的な年の増加額と最悪の年の減少額」の組に置くことです。これなら、財務担当者でない取締役にも、その配分を受け入れられるかを判断してもらえます。もう1つは、最悪の年の減少額を、会社が耐えられる額と照らし合わせることです。年の CVaR が自己資本や手元資金の何割に当たるかを示し、その割合に上限を置けば、それがそのまま CVaR 制約の上限値になります。CVaR の上限を経営として決め、その範囲で期待リターンを最大にする、という順序で配分を決めると、委員会の議論が「どの資産が有望か」という推測の比べ合いから、「どこまでの損失なら受け入れるか」という経営の意思決定に移ります。
CVaR で配分を決めてよいとき、決めてはいけないとき
ここまでの結果を、使いどころの判断にまとめます。CVaR で配分を決めてよいのは、損失の分布が左右対称から大きく外れていて、その形をシナリオで表せる場合です。非対称な損益の商品を含む場合、成功か失敗かで結果が分かれる事業投資の案件を扱う場合、そして「最悪の年の減少額」に経営として上限を置きたい場合が当てはまります。上限を置くという使い方は、たとえ分散で決めた配分と答えが近くても、説明の仕方として価値があります。
決めてはいけないのは、次のような場合です。期待リターンの条件を入れずに CVaR だけを最小にする場合は、本記事の計算のとおり現金に寄った配分が出ます。履歴の月数が少なく、下位5%に入る月が数か月しか無い場合は、配分がその数か月の顔ぶれで決まってしまいます。履歴に深刻な下落の局面が含まれていない場合は、CVaR を小さく見積もり、その上限がかえって甘くなります。そして、期待リターンの推定が粗いまま CVaR 制約つきで期待リターンを最大にすると、第4章で見た推定誤差の増幅がそのまま起きます。
| 状況 | CVaR で配分を決めることの適否 | 理由(本章の計算との対応) |
|---|---|---|
| 損益の分布が非対称な資産・案件を含む | 向いている | 分散では区別できない左の裾を測れる |
| 最悪の年の損失額に経営として上限を置きたい | 向いている | 上限値がそのまま制約になり、説明しやすい |
| 期待リターンの条件を入れずに CVaR だけを最小にする | 向いていない | 推定モデルの CVaR 最小は短期資産97.8%になった |
| 履歴が短い、深刻な下落を含まない | そのままでは向いていない | 240か月でも裾の月は12か月。CVaR は履歴によって -3.99% から -8.47% まで揺れた |
| 期待リターンを標本平均で置く | 推定誤差の対処が別に要る | 推定モデルの CVaR 制約つきの配分は真のモデルで期待リターンが0.34ポイント低かった |
| 分布がほぼ対称で、相関が一斉に上がる構造 | 効果は小さい | 分散最小との CVaR の差は0.04ポイントで抽出の誤差より小さかった |
シナリオの不足を補う方法としては、履歴に過去の深刻な局面を意図的に混ぜる、荒れた月の確率を高めた分布から抽出したシナリオでも解いて答えの変化を見る、といった工夫があります。事業投資の文脈で、景気の要因を悪い側に固定するストレステストは第12章で扱います。在庫や発注の文脈で CVaR を使う例は、弊社コラム『在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで』の第9章で扱っています。
この章では、標準偏差では見えない左の裾を測る指標として VaR と CVaR を定義し、劣加法性と最適化の解きやすさの両面から、配分の判断には CVaR を使うのが合理的であることを確認しました。ロカフェラーとウリャセフの式を使うと、CVaR の最小化や CVaR 制約つきの期待リターン最大化は、シナリオの数だけ補助変数を足した線形計画になり、PuLP で解けます。共通データでは、CVaR で解き直すと荒れた月に大きく下がる不動産投資信託が外れて左の裾が少し短くなりましたが、その差は抽出の誤差と同じ桁で、期待リターンの推定誤差は CVaR を使っても直りませんでした。月次の CVaR は12倍や√12倍で年に直さず、年の分布を作ってから測り、「平均的な年にいくら増え、最悪の年にいくら減るか」の金額で説明するのがよいと考えています。第8章では、この線形計画の形を土台に、取引コスト、保有の上下限、銘柄数の上限といった実務の制約を入れていきます。
Anagraftでは、データ活用の構想づくりから、投資配分や予算配分のような業務課題の定式化、見込みの推定と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『定量的リスク管理 基礎概念と数理技法』(アレクサンダー・J・マクニール、リュディガー・フライ、ポール・エンブレヒツ著、塚原英敦 訳者代表、共立出版):リスク尺度の考え方から、損失分布の推定、裾の厚い分布、依存関係のモデルまでを数理的に扱う大部の教科書の日本語訳です。この章で扱った VaR と CVaR の定義、劣加法性をめぐる議論、正規分布の仮定が裾を軽く見積もる問題を、理論の側から確かめたいときに向いています。
『金融工学と最適化』(枇々木規雄著、朝倉書店):経営科学のニューフロンティアのシリーズの1冊で、リスクとリターンの捉え方から、ポートフォリオ選択の様々な数理計画モデル、戦略的資産配分の数理計画、シナリオ・ツリー型やシミュレーション型の多期間確率計画までを扱っています。この章のようにシナリオを並べて線形計画で配分を解く考え方を、多期間の配分や資産と負債の管理へ広げる道筋をたどれます。
第8章 取引コスト・保有制約・銘柄数の上限
第7章では、月次リターンの下位5%の平均であるCVaRを、損失の向き(リターンの符号を反転した値)に直して線形計画に組み込み、その損失の大きさを最小にしたり上限で抑えたりして、分散だけを見て決めた配分と、荒れた月の損失の出方がどう違うかを確かめました。ここまでの章の最適化は、配分をいくらでも自由に、費用をかけずに動かせることを前提にしていました。実際の運用や予算の配分では、配分を動かすたびに売買の費用がかかり、規程で1つの資産クラスに入れてよい割合が決まっており、管理の手間から保有する本数を絞りたいという事情があります。この章では、こうした実務の条件を最適化の目的や制約に組み込む方法と、組み込んだときに答えがどう変わるかを、第2章で用意したサンプルデータ(架空の6資産クラスの月次リターン240か月)で実測します。本章は金融商品の配分の考え方を扱いますが、投資の助言ではなく、個別の判断は専門家に相談してください。複数の時点にまたがる見直し(リバランス)は第9章で扱います。
この章の計算は、特に断らない限り第4章の基準と同じ設定に乗せています。推定モデル(240か月の標本平均と標本共分散)のもとで、現在の配分と同じ推定リスク(年率7.79%)を上限にして、推定の期待リターンを最大にする配分を、ショートなし・合計100%の条件で求めます。条件を何も足さないと、この最適化は国内株式52.3%・国内債券47.7%という基準の配分を返します。ここに、取引コスト、上下限、本数の上限、環境の指標の上限を1つずつ足し、推定モデルでの見込みと、真のモデル(データを作った側だけが知っている本当の分布)での値を並べます。真のモデルは現実の企業には見えませんが、この記事では答え合わせに使えるものとして扱います。ただし、平均絶対偏差モデルの節だけは目的が違い、期待リターンに下限を置いたうえで平均絶対偏差を最小にします(設定はその節で説明します)。
配分を動かすことには費用がかかる
配分を変えるには、比率を下げる資産を売り、上げる資産を買う必要があります。売買には、証券会社などに払う手数料、買値と売値の差(売買の気配の幅)、大きな注文を出したときに自分の注文で価格が不利に動く分(市場への影響)などの費用がかかります。この記事では、これらをまとめて取引コストと呼びます。取引コストの大きさは資産の種類、売買の金額、市場の状況で大きく変わるので、本章では特定の水準を目安として示さず、売買額に対する比率(コスト率)をいくつか仮定して、答えがどう変わるかを見ます。コスト率の値はすべて計算のための仮定で、実在の市場の水準を示すものではありません。
どれだけ売買したかは、回転率で測ります。現在の配分を \( w_0 \)、新しい配分を \( w \) とすると、資産ごとの比率の変化の絶対値を足した \( \sum_i |w_i – w_{0,i}| \) は、売った比率と買った比率の合計です。合計100%を保ったまま配分を変えると、売った比率と買った比率は等しくなるので、その半分を片道の回転率と呼びます。たとえば、ある資産を10%売って別の資産を10%買えば、絶対値の合計は20%、片道の回転率は10%です。第4章の基準の配分は、現在の配分から見ると、国内株式を27.3%分増やし、外国株式20%・外国債券15%・不動産投資信託5%をすべて売り、国内債券を12.7%分増やしているので、片道の回転率は40.0%になります。運用資産の4割を入れ替える提案だということです。
売買の費用が売買額に比例すると仮定すると、費用は \( c \sum_i |w_i – w_{0,i}| \)(\( c \) はコスト率)と書けます。これを目的から差し引いた問題が、取引コストを入れた最適化です。
\( \max_{w} \ \hat{\mu}^{\top} w – c \sum_i |w_i – w_{0,i}| \)
言葉で言うと、「推定の期待リターンから、配分を動かすのにかかる費用を引いた値を最大にする」です。期待リターンは年率で、費用は1回だけかかるので、この式は「売買の費用を1年で回収できるかどうか」で判断していることになります。回収を3年で考えるなら、コスト率を3で割って入れれば同じ形で扱えます。絶対値は線形ではありませんが、買い増す量 \( p_i \ge 0 \) と売り減らす量 \( m_i \ge 0 \) に分けて \( w_i = w_{0,i} + p_i – m_i \) と置き、費用を \( c \sum_i (p_i + m_i) \) と書けば、目的も制約も線形のまま扱えます。最適の点では、同じ資産を買いながら売ることは費用の無駄になるので、\( p_i \) と \( m_i \) の片方は0になります。本章の計算では、リスクの上限が2次の式なので scipy の SLSQP(制約のついた非線形の最適化問題を数値計算で解く方法の名前)で解き、変数をこの \( p \) と \( m \) の12個にしました。
コスト率を上げると「動かさない」解に近づく
コスト率を0%から2%まで6通りに変えて解いた結果が次の表です。「推定の期待リターン」は推定モデルでの見込み(売買の費用を引く前)、「真の期待リターン」は同じ配分を真のモデルで評価した値です。最後の列は、最適化に入れたコスト率とは別に、実際の売買の費用が売買額の0.5%だったと仮定して、その費用を1年目の真の期待リターンから引いた値です。
| 最適化に入れたコスト率 | 国内株式 | 外国株式 | 国内債券 | 外国債券 | 不動産投資信託 | 短期資産 | 片道の回転率 | 推定の期待リターン | 真の期待リターン | 実際のコスト0.5%を引いた真の期待リターン |
|---|---|---|---|---|---|---|---|---|---|---|
| 現在の配分 | 25.0% | 20.0% | 35.0% | 15.0% | 5.0% | 0.0% | 0.0% | 1.21% | 3.62% | 3.62% |
| 0%(第4章の基準) | 52.3% | 0.0% | 47.7% | 0.0% | 0.0% | 0.0% | 40.0% | 2.14% | 3.35% | 2.95% |
| 0.10% | 52.3% | 0.0% | 47.7% | 0.0% | 0.0% | 0.0% | 40.0% | 2.14% | 3.35% | 2.95% |
| 0.25% | 52.3% | 0.0% | 47.7% | 0.0% | 0.0% | 0.0% | 40.0% | 2.14% | 3.35% | 2.95% |
| 0.50% | 51.3% | 1.3% | 47.4% | 0.0% | 0.0% | 0.0% | 38.7% | 2.13% | 3.38% | 2.99% |
| 1.00% | 33.7% | 20.0% | 46.3% | 0.0% | 0.0% | 0.0% | 20.0% | 1.86% | 3.62% | 3.42% |
| 2.00% | 25.0% | 20.0% | 35.0% | 15.0% | 5.0% | 0.0% | 0.0% | 1.21% | 3.63% | 3.63% |
(コスト率2.00%の行は、現在の配分そのものです。現在の配分の真の期待リターンは0.03625で、小数第2位の丸めで3.62%とも3.63%とも表示されます。コスト率を掛ける売買額は、売りと買いの合計なので、表の片道の回転率の2倍です。)
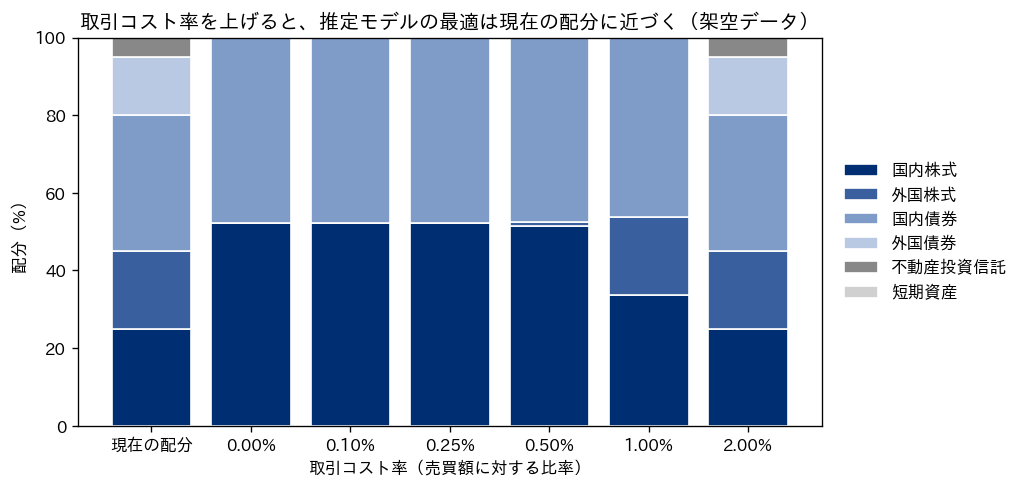
コスト率0.25%までは、答えは第4章の基準とまったく同じです。推定モデルが見込む改善は年0.93ポイントあり、費用は売買額の0.25%×80%=0.20%なので、推定モデルの上では費用を払っても割に合うからです。0.50%でもほぼ変わらず、1.00%で外国株式20%を売らずに残すようになり、片道の回転率は20.0%に半減しました。2.00%では、何も売買しない現在の配分がそのまま答えになりました。コスト率を上げるほど、最適化は「動かさない」方向に寄っていきます。
この表で大事なのは、真の期待リターンの列です。推定モデルは基準の配分で年0.93ポイントの改善を見込みましたが、真のモデルでは現在の配分の3.62%に対して3.35%で、改善どころか0.27ポイントの悪化でした(第4章で確認した結果と同じです)。さらに実際の売買に0.5%の費用がかかったとすると、1年目の正味は2.95%で、現在の配分より0.67ポイント低くなります。コスト率1.00%を入れた解は、売買の量が半分で済み、真の期待リターンは3.62%と現在の配分とほぼ同じで、費用を引いても3.42%に留まります。取引コストの項は、推定モデルが見込む改善のうち「費用に見合わない小さな改善」を切り捨てる働きをしており、その結果、推定の誤りに振り回される売買も一緒に減ります。推定の誤りが大きいときに、コスト率を実際より高めに置いて最適化するのは、売買を抑えるための1つの手段になります。ただし、それは推定の誤りを直す方法ではなく、誤りに乗る量を減らす方法にすぎません。推定そのものを改善する方法は第5章で扱いました。
なお、コスト率を見積もるときは、往復で数えるか片道で数えるかを揃える必要があります。本章の式は、売りと買いの両方に同じ率がかかるとして絶対値の合計(往復)に掛けています。手数料の資料が片道の率で書かれているなら、そのまま入れれば足ります。気配の幅のように「買って売ると1回分の幅を失う」性質の費用は、片道あたりにすると幅の半分になります。どちらで数えたかを資料に明記しないと、費用を2倍か半分に見誤ります。
上下限と資産クラス別の枠
次に、配分そのものに枠をはめる制約を足します。実務でよく使われるのは、1つの資産に入れてよい比率の上限(集中を避ける)、下限(方針として一定量は持つ)、いくつかの資産をまとめたグループの上限です。グループの例として、国内株式・外国株式・不動産投資信託の3つを「株式系」とまとめ、その合計を50%以下にする制約を置きました。現在の配分の株式系は、25%+20%+5%=50%でちょうど上限に当たっています。この枠はいずれも線形の不等式で書けるので、どの解法でもそのまま足せます。
| 制約 | 国内株式 | 外国株式 | 国内債券 | 外国債券 | 不動産投資信託 | 短期資産 | 推定の期待リターン | 真の期待リターン | 真のリスク | 真のシャープ・レシオ |
|---|---|---|---|---|---|---|---|---|---|---|
| 制約なし(第4章の基準) | 52.3% | 0.0% | 47.7% | 0.0% | 0.0% | 0.0% | 2.14% | 3.35% | 8.32% | 0.343 |
| 各資産40%以下 | 40.0% | 14.0% | 40.0% | 0.0% | 0.0% | 6.0% | 1.96% | 3.54% | 8.34% | 0.364 |
| 株式系の合計50%以下 | 50.0% | 0.0% | 50.0% | 0.0% | 0.0% | 0.0% | 2.07% | 3.25% | 7.96% | 0.346 |
| 各資産40%以下+株式系50%以下 | 40.0% | 10.0% | 40.0% | 0.0% | 0.0% | 10.0% | 1.90% | 3.30% | 7.75% | 0.361 |
| 現在の配分 | 25.0% | 20.0% | 35.0% | 15.0% | 5.0% | 0.0% | 1.21% | 3.62% | 8.30% | 0.376 |
「各資産40%以下」は、推定モデルの上では見込みを2.14%から1.96%に下げる制約ですが、真のモデルでは期待リターンが3.35%から3.54%に上がり、シャープ・レシオも0.343から0.364に改善しました。国内株式への集中が抑えられ、推定モデルが過小評価していた外国株式が14.0%入ったためです。第4章で見たとおり、推定モデルの最適は推定の誤りを増幅して少数の資産に集中しやすく、上限の制約はその増幅を機械的に止める役割を果たします。一方、「株式系の合計50%以下」は、この例では真の期待リターンを3.25%に下げ、真のリスクも7.96%に下げました。株式系の枠は国内株式を50%に削るだけで、推定モデルが低く見ている外国株式は相変わらず0%のままだからです。両方を入れると、真のリスクは7.75%まで下がり、シャープ・レシオは0.361になりました。
この表から読み取れるのは、枠の効き方は「推定モデルでの見込み」と「真のモデルでの値」で向きが逆になることがある、ということです。推定モデルの上では、制約を足しても見込みが上がることはなく、制約が効けば下がり、効かなければ同じ値に留まります(この表の3つの制約はいずれも効いており、どの行も2.14%より低くなっています)。真のモデルの上では、推定の誤りによる偏りを止める制約は値を上げ、そうでない制約は下げます。どちらになるかは真のモデルを知らないと分からないので、現実には「推定モデルの見込みが少し下がる代わりに、推定の誤りに対する備えを買う」と理解して枠を決めることになります。枠の水準は、推定の誤りがどの程度ありうるかと、1つの資産が大きく沈んだときに組織が耐えられる損失の大きさから決めるもので、最適化の中からは出てきません。
最小保有単位と本数の上限には0か1の変数が要る
ここまでの制約は、すべて配分の比率についての線形の不等式でした。ところが、実務には線形の不等式だけでは書けない条件があります。1つは「持つなら最低でも5%持つ。持たないなら0%」という最小保有比率です。比率が2%のような半端な保有は、管理や報告の手間に見合わないので避けたい、という条件です。もう1つは「保有する本数を3本以下にする」という本数の上限で、本数に上限を置く制約をカーディナリティ制約と呼びます。カーディナリティは集合の要素の数を指す数学の言葉です。資産クラスの配分では本数の上限はあまり問題になりませんが、個別の銘柄や運用商品、外部の運用委託先の数を絞りたいとき、事業投資で同時に動かす案件の数を絞りたいときには、同じ形の条件が現れます。
この2つの条件は「0か、5%以上か」「0でない資産を数える」という、比率が0かどうかで場合分けが生じる条件です。こうした条件は、資産ごとに「持つなら1、持たないなら0」を取る変数 \( z_i \) を用意して、次のように書きます。
\( 0.05\, z_i \le w_i \le z_i, \quad \sum_i z_i \le K \)
言葉で言い換えると、\( z_i = 0 \) なら比率 \( w_i \) は0に押さえ込まれ、\( z_i = 1 \) なら比率は5%以上100%以下の範囲で自由に動けます。\( z_i \) の合計が持っている本数なので、それを \( K \) 以下にすれば本数の上限になります。0か1しか取らない変数を含む問題は混合整数計画と呼ばれ、連続の変数だけの問題より解くのが難しくなります。資産が6つなら持ち方の組み合わせは \( 2^6 = 64 \) 通りしかありませんが、候補が数百本になると組み合わせは天文学的な数になり、ソルバーの分枝限定法(場合分けをしながら、見込みのない場合を早めに切り捨てる方法)が要ります。
ここで問題になるのが、目的の形です。平均分散最適化のリスクは配分の2次の式(分散)で、本記事の実行環境で使える整数計画のソルバー(PuLP から呼ぶ CBC。PuLP から標準で呼び出せる、線形計画と整数計画を解くソルバーの名前)は、目的や制約に2次の式を書けません。2次の式と0か1の変数を同時に扱えるソルバーは、本記事の実行環境には入っていません。そこで、リスクを線形の式で測る方法に置き換えます。
平均絶対偏差モデルで線形にする
東京工業大学のコンノ(Hiroshi Konno)とヤマザキ(Hiroaki Yamazaki)は、1991年に Management Science 誌(第37巻第5号、519〜531ページ)に発表した論文で、リスクを分散ではなく平均絶対偏差(リターンが平均からどれだけ離れるかの絶対値の平均)で測るポートフォリオ最適化を提案しました。これを平均絶対偏差モデル(MAD モデル)と呼びます。論文の要旨は、このモデルが2次計画ではなく線形計画になるので、1,000銘柄を超える大規模な最適化を実用的な時間で解けること、東京証券市場(日経225の銘柄)の過去のデータで試したところマーコウィッツのモデルと同程度の結果を、はるかに短い計算時間で得たことを述べています。
平均絶対偏差は、シナリオ(ここでは履歴の各月)\( t \) での配分のリターンが平均からどれだけ離れたかを絶対値で測り、それを月数 \( T \) で平均したものです。
\( \mathrm{MAD}(w) = \dfrac{1}{T} \sum_{t=1}^{T} \Bigl| \sum_i (r_{ti} – \bar{r}_i)\, w_i \Bigr| \)
絶対値は、月ごとに補助の変数 \( d_t \) を置き、\( d_t \) が偏差とその符号を反転した値の両方以上になるという2本の不等式で表せます。最小化の問題では \( d_t \) はちょうど偏差の絶対値まで下がるので、目的を \( d_t \) の平均にすれば平均絶対偏差を最小にしたことになります。月数が240なら、補助の変数が240個、不等式が480本増えますが、すべて線形です。リターンが正規分布に従うなら、平均絶対偏差は標準偏差の一定倍(\( \sqrt{2/\pi} \)、約0.8倍)になるので、どちらを小さくしても同じ配分を選びます。リターンの分布が正規分布から外れる場合、たとえば共通データのように荒れた月が混ざる場合には、2つの答えは一致しなくなります。また、平均絶対偏差は損と得の両側の外れを同じ重みで数えるので、損の側だけを測りたいときは、第7章の CVaR を使います。CVaR も、ロカフェラーとウリャセフの定式化で同じように補助の変数と線形の不等式で書けるので、次のコードの平均絶対偏差の部分を CVaR に差し替えれば、本数の上限つきの CVaR 最小化になります。
次のコードは、履歴240か月の各月をシナリオとして、推定の期待リターンが現在の配分の推定値(年率1.21%)以上という条件のもとで平均絶対偏差を最小にし、最小保有比率5%と本数の上限を加えたものです。第7章のコードと同じく、共通データAを作る補助モジュール port_data.py と同じフォルダに置いて実行する形です。
import pulp
from port_data import *

R = history().values                   # 240か月×6資産(架空)をシナリオとして使う
T, rbar = R.shape[0], R.mean(axis=0)   # 月数と標本平均(月次)
r_min = 12 * rbar @ CURRENT.values     # 期待リターンの下限=現在の配分の推定値

def mad_card(K, lmin=0.05):
    prob = pulp.LpProblem("mad", pulp.LpMinimize)
    w = {c: pulp.LpVariable("w_" + c, 0, 1) for c in CODES}
    z = {c: pulp.LpVariable("z_" + c, cat="Binary") for c in CODES}  # 持つなら1
    d = [pulp.LpVariable("d_%d" % t, 0) for t in range(T)]           # 各月の絶対偏差
    prob += pulp.lpSum(d) * (1.0 / T)                                # 平均絶対偏差
    for t in range(T):
        dev = pulp.lpSum((R[t, j] - rbar[j]) * w[c] for j, c in enumerate(CODES))
        prob += d[t] >= dev
        prob += d[t] >= -dev
    prob += pulp.lpSum(w.values()) == 1
    prob += pulp.lpSum(12 * rbar[j] * w[c] for j, c in enumerate(CODES)) >= r_min
    for c in CODES:
        prob += w[c] <= z[c]               # 持たない資産は0
        prob += w[c] >= lmin * z[c]        # 持つなら最低5%
    prob += pulp.lpSum(z.values()) <= K    # 本数の上限
    prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=60))
    return {c: round(100 * w[c].value(), 1) for c in CODES}, pulp.value(prob.objective)

for K in (3, 2):
    wk, mad = mad_card(K)
    print("本数%d以下:" % K, wk, "月次MAD %.5f" % mad)
# 出力:
# 本数3以下: {'DE': 23.3, 'FE': 0.0, 'DB': 35.8, 'FB': 0.0, 'RE': 0.0, 'CA': 41.0} 月次MAD 0.00777
# 本数2以下: {'DE': 24.6, 'FE': 0.0, 'DB': 0.0, 'FB': 0.0, 'RE': 0.0, 'CA': 75.4} 月次MAD 0.00823
(掲載したコードは、標準出力を UTF-8 にする冒頭の2行を省いています。)同じ問題を、本数の条件なし、最小保有比率5%だけ、本数4・3・2以下の5通りで解いた結果が次の表です。月次の平均絶対偏差は、現在の配分では1.764%です。
| 条件 | 国内株式 | 国内債券 | 短期資産 | 本数 | 月次の平均絶対偏差 | 変数の数(うち0か1) | 計算時間 | 真の期待リターン | 真のリスク |
|---|---|---|---|---|---|---|---|---|---|
| 本数の条件なし | 23.3% | 35.8% | 41.0% | 3 | 0.777% | 246(0) | 0.13秒 | 1.84% | 3.74% |
| 最小保有5%のみ | 23.3% | 35.8% | 41.0% | 3 | 0.777% | 252(6) | 0.21秒 | 1.84% | 3.74% |
| 本数4以下+最小5% | 23.3% | 35.8% | 41.0% | 3 | 0.777% | 252(6) | 0.27秒 | 1.84% | 3.74% |
| 本数3以下+最小5% | 23.3% | 35.8% | 41.0% | 3 | 0.777% | 252(6) | 0.22秒 | 1.84% | 3.74% |
| 本数2以下+最小5% | 24.6% | 0.0% | 75.4% | 2 | 0.823% | 252(6) | 0.72秒 | 1.73% | 3.97% |
(外国株式・外国債券・不動産投資信託はすべての行で0.0%なので列を省きました。計算時間は、この記事の実行環境(一般的なノートPC)での実測で、ほかの計算と並行して動かしたため揺れがあります。)
平均絶対偏差を最小にした配分は、本数の条件がなくても国内株式・国内債券・短期資産の3本しか持たないので、本数4以下・3以下の条件は効かず、答えは変わりませんでした。本数2以下にすると国内債券が外れ、平均絶対偏差は0.777%から0.823%に増えました。本数の上限は「効いたときだけ費用が生じる」制約で、効くかどうかは解いてみるまで分かりません。答えが正しいかどうかは、本数3以下の場合について、持つ資産の組み合わせ41通り(1本・2本・3本の選び方の合計)をすべて線形計画で解いて最良を選ぶ全列挙で検算し、同じ「国内株式・国内債券・短期資産」の組み合わせと同じ値0.777%が得られることを確かめました。
この表には、もう1つ注意すべき点があります。平均絶対偏差を最小にした配分は短期資産を41.0%持ち、真のモデルでの期待リターンは1.84%と、現在の配分の3.62%の約半分です。真のシャープ・レシオは0.358で、第4章の基準の0.343よりは高いものの、現在の配分の0.376を下回ります(本数2以下の配分では0.310)。期待リターンの下限を「現在の配分の推定値1.21%」に置いたためで、推定モデルの標本平均では国内株式(3.58%)以外の株式系が低く見積もられているので、推定モデルの上では、リスクの小さい短期資産を増やしても期待リターンの下限を守れてしまいます。リスクの測り方を線形にしても、期待リターンの推定の誤りはそのまま残ります。平均絶対偏差モデルは計算を扱いやすくする道具で、推定の問題を解いてくれるわけではありません。
少ない本数で現在の配分の値動きをなぞる
本数の上限が効く例として、もう1つの使い方を示します。目的を「平均からの偏差」ではなく「現在の配分との月次リターンの差」の平均絶対偏差に変え、少ない本数で現在の配分と同じような値動きをする配分を探す問題です。保有する本数を減らして管理を簡素にしたいが、値動きの性格は変えたくない、という場面に対応します。この問題は期待リターンの推定を使わないので、推定の誤りの影響を受けにくいという利点もあります。
| 本数の上限 | 国内株式 | 外国株式 | 国内債券 | 外国債券 | 不動産投資信託 | 現在の配分との差の月次平均絶対偏差 | 差の年率の標準偏差 | 計算時間 | 真の期待リターン | 真のリスク |
|---|---|---|---|---|---|---|---|---|---|---|
| 5本以下 | 25.0% | 20.0% | 35.0% | 15.0% | 5.0% | 0.000% | 0.00% | 0.22秒 | 3.62% | 8.30% |
| 4本以下 | 27.4% | 21.3% | 37.5% | 13.8% | 0.0% | 0.119% | 0.52% | 0.95秒 | 3.61% | 8.27% |
| 3本以下 | 25.6% | 25.7% | 48.7% | 0.0% | 0.0% | 0.270% | 1.22% | 3.26秒 | 3.56% | 8.04% |
| 2本以下 | 0.0% | 40.8% | 59.2% | 0.0% | 0.0% | 0.723% | 3.29% | 3.78秒 | 3.24% | 7.33% |
(短期資産はすべての行で0.0%です。)現在の配分は短期資産が0%なので5本で、5本以下なら現在の配分そのものが答えです。4本にすると不動産投資信託5%を外し、残りの4資産を少しずつ増やして値動きを合わせます。現在の配分との差は年率の標準偏差で0.52%と小さく、真の期待リターンも3.61%とほとんど変わりません。3本では外国債券も外れ、差は1.22%に広がりました。2本では国内株式まで外れて外国株式と国内債券だけになり、差は3.29%に跳ね上がり、真の期待リターンは3.24%に下がりました。本数を1本減らすごとの「なぞりの誤差」の増え方が、ここでは4本から3本、3本から2本と進むにつれて大きくなっています。計算時間は本数の上限をきつくするほど長くなり、2本以下で3.78秒でした。6資産なら数秒で済みますが、候補の数が増えると、0か1の変数の場合分けが急に増えることは前の節で述べたとおりです。
ESG の指標を制約として置く
環境・社会・企業統治(ESG)への配慮を配分に反映させたいという要請は、運用でも事業投資でも増えています。年金積立金管理運用独立行政法人(GPIF)は、ESG投資のページで、ESG投資を、キャッシュフローや利益率といった財務的な情報に加えて非財務の情報である ESG の要素を考慮する投資と説明し、気候変動に伴うリスクは全ての資産クラス・銘柄に同時に生じ、分散投資を行っても完全には消せないリスクだと述べています。事業会社の開示の側では、金融庁がサステナビリティ情報の開示に関する特集ページで、2023年1月31日に施行された内閣府令の改正により、有価証券報告書に「サステナビリティに関する考え方及び取組」の記載欄が設けられたことを説明しています。本章では、こうした制度の中身には立ち入らず、ESG の指標を最適化にどう組み込むかという「制約の置き方」だけを扱います。
共通データの6資産に、炭素強度(投資額あたりの温室効果ガスの排出の多さを表す指標)のスコアを架空に置きました。国内株式120・外国株式150・国内債券60・外国債券80・不動産投資信託90・短期資産0で、数字の大きいほど排出が多いという設定です。実在の指標の値でも、実在の算定方法でもありません。配分の炭素強度を、保有比率で重み付けしたスコアの平均(加重平均)で測ると、現在の配分は97.5です。加重平均の上限は、スコアと比率の積の和が上限以下という線形の不等式1本で書けるので、上下限と同じようにどの解法にも足せます。
| 加重平均の上限 | 国内株式 | 国内債券 | 短期資産 | 配分の加重平均スコア | 推定の期待リターン | 真の期待リターン | 真のシャープ・レシオ |
|---|---|---|---|---|---|---|---|
| 上限なし(第4章の基準) | 52.3% | 47.7% | 0.0% | 91.4 | 2.14% | 3.35% | 0.343 |
| 90以下 | 52.3% | 45.3% | 2.3% | 90.0 | 2.14% | 3.34% | 0.342 |
| 80以下 | 52.3% | 28.8% | 18.9% | 80.0 | 2.12% | 3.26% | 0.331 |
| 70以下 | 52.0% | 12.7% | 35.3% | 70.0 | 2.09% | 3.16% | 0.320 |
(推定モデルでの最適化。外国株式・外国債券・不動産投資信託はすべての行で0.0%です。)基準の配分は、外国株式を持たないので、もともと加重平均が91.4と現在の配分より低くなっています。上限を80、70と下げると、最適化は国内株式をほとんど減らさず、国内債券を短期資産に置き換えて上限を満たしました。短期資産のスコアを0と置いたので、短期資産を増やせば加重平均は下がり、リスクの上限にも余裕ができるからです。真の期待リターンは上限70で3.16%まで下がりました。
この結果は、指標の定義が答えを決めてしまうことを示しています。短期資産を0と置くかどうか、債券と株式に同じ物差しを当てるかどうかで、「上限を守る最も安上がりな方法」が変わり、最適化はその方法を正確に見つけ出します。この例では、排出の多い資産を減らすのではなく、スコア0の資産を増やして平均を薄めることで上限を満たしました。上限を置く目的が「排出の多い資産への投資を減らすこと」なら、加重平均の上限だけでは目的とずれた答えが出ることがあり、排出の多い資産の合計比率の上限を別に置く、といった補い方が要ります。指標と目的のずれは、最適化を入れる前には見えにくく、入れてみると拡大されて表に出ます。
制約1つあたりの費用を真のモデルで測る
制約は、目的をよくする自由を減らすので、何らかの費用を伴います。その費用を、推定モデルではなく真のモデルで測っておくと、制約の判断の材料になります。ここでは、真のモデルの期待リターンと共分散を使い、真のリスクを現在の配分と同じ8.30%に保ったまま真の期待リターンを最大にする最適化を、制約を1つずつ足して解きました。制約なしの答え(真の最適)は真の期待リターン3.67%で、そこから何ポイント下がるかを制約の費用とみなします。本数の上限は2次のリスクと0か1の変数の組み合わせになるので、持つ資産の組み合わせをすべて列挙し、組み合わせごとに連続の最適化を解いて最良を選びました。経営指標に直すため、架空の運用資産10,000百万円(100億円)に対する年間の期待リターンの差(百万円)も示します。
| 制約 | 真の期待リターン | 真の最適との差 | 架空の運用資産10,000百万円あたりの年間の差 | 現在の配分からの片道の回転率 |
|---|---|---|---|---|
| 制約なし(真の最適) | 3.67% | 0 | 0 | 21.6% |
| 各資産40%以下 | 3.66% | -0.01pt | -1.0百万円 | 13.9% |
| 株式系の合計50%以下 | 3.65% | -0.02pt | -1.6百万円 | 18.6% |
| 本数3以下(最小5%) | 3.66% | -0.01pt | -0.9百万円 | 24.0% |
| 本数2以下(最小5%) | 3.55% | -0.12pt | -11.6百万円 | 45.0% |
| 炭素スコア80以下 | 3.51% | -0.16pt | -16.0百万円 | 41.6% |
| 炭素スコア70以下 | 3.41% | -0.26pt | -25.9百万円 | 57.6% |
| 現在の配分のまま | 3.62% | -0.04pt | -4.0百万円 | 0% |
(最後の列は、それぞれの配分が現在の配分から見て片道でどれだけの売買を要するかです。差の列は、小数第4位まで計算した値を小数第2位に丸めて表示しています。)
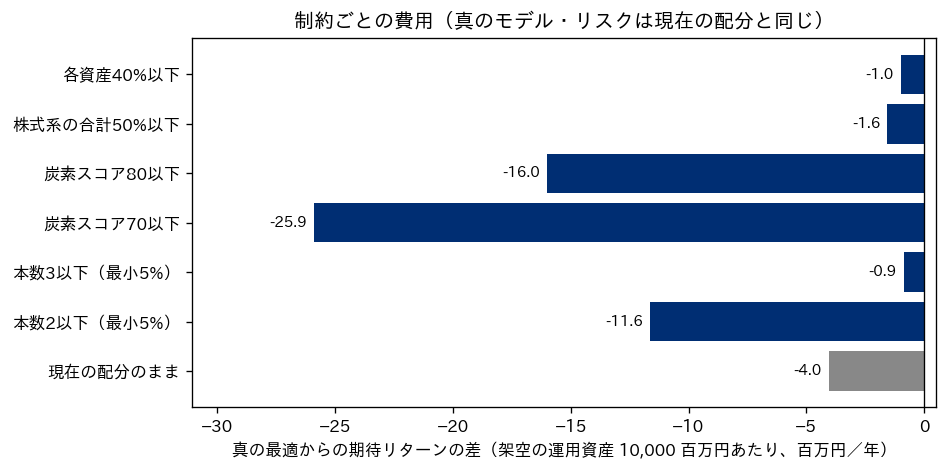
各資産40%以下・株式系50%以下・本数3以下の3つは、真のモデルで測っても年1〜2百万円程度の費用しかかかりません。真の最適は国内株式18.4%・外国株式29.3%・国内債券45.9%・不動産投資信託6.4%で、国内債券は40%の上限を、株式系の合計54.1%は50%の上限を少し超え、持つ資産も4本なので、3つの制約はいずれも効いています。それでも費用が小さいのは、真の最適がこれらの上限を少ししか超えていないうえに、フロンティアが平らで、同じリスクのまま配分の形を少し変えても期待リターンがほとんど落ちないからです。これに対して、本数2以下は年11.6百万円、炭素スコア80以下は年16.0百万円、70以下は年25.9百万円の費用になりました。炭素スコアの上限は、真のモデルでの最適化でも短期資産を28.6%(上限80)、42.7%(上限70)入れて満たしており、前の節で見た「平均を薄める」解き方は、推定の誤りではなく指標の定義から来ていることが分かります。
もう1つ読み取れるのは、現在の配分のままでいることの費用が年4.0百万円にすぎないことです。真の最適に移るには、現在の配分から片道21.6%、売り買いの合計で43.2%の売買が要ります。仮に売買額の0.5%の取引コストがかかるとすると、費用は43.2%×0.5%=0.216%、つまり21.6百万円で、年4.0百万円の改善で回収するには5.4年かかる計算です。しかも、この「改善」は真のモデルを知っている場合の上限で、現実には推定モデルの最適を目指すことになり、第4章で見たとおりそれは現在の配分より悪くなることが多いのです。現在の配分がすでに真の最適に近いときには、動かさないこと自体が合理的な判断になりえます。
経営の判断にどう使うか
この章の計算を経営の言葉に直すと、要点は3つです。1つ目は、配分の見直しの提案は「期待リターンの改善」だけでなく「売買の量と費用」を並べて評価すべきだということです。第4章の基準の配分は、運用資産の4割を入れ替える提案でしたが、推定モデルが見込んだ年0.93ポイントの改善は真のモデルでは0.27ポイントの悪化で、売買の費用を引くと差はさらに広がりました。見直し案には、片道の回転率、その費用の見積り、費用を何年で回収する前提かを必ず添えると、判断を誤りにくくなると考えています。
2つ目は、規程や方針として置く制約には、その費用を金額で示しておくべきだということです。本章の例では、上限や本数の制約の費用は年1〜2百万円(架空の10,000百万円あたり)と小さく、一方で推定の誤りによる集中を止める効果がありました。環境の指標の上限は年16〜26百万円と大きな費用になりましたが、それは方針として受け入れるかどうかを決めるべき費用で、最適化が決めることではありません。費用が見えていれば、「この方針のために年いくらを払っている」と取締役会や加入者に説明でき、方針の水準を変えるときの議論もしやすくなります。逆に、費用を測らずに制約を積み重ねると、どの制約が答えを縛っているのか分からなくなります。
3つ目は、制約の費用の測り方そのものにも推定の誤りが入るということです。本章では答え合わせのために真のモデルで費用を測りましたが、現実には推定モデルで測るしかありません。推定モデルの上で測った費用は、推定の誤りを増幅した最適との差です。本章では推定モデルで制約の費用を測る計算はしていませんが、上下限の表がその危うさを示しています。「各資産40%以下」は、推定モデルの見込みでは期待リターンを2.14%から1.96%に下げる(費用がかかる)制約に見えましたが、真のモデルでは3.35%から3.54%への改善でした。推定モデルの上の費用と真のモデルの上の費用は、向きまで逆になることがあります。制約の費用を推定モデルで示すときは、第3章の推定の幅とあわせて、幅のある数字として扱うのがよいと考えています。事業投資の案件選択で「同時に動かす案件は10件まで」「1部門への配分は予算の4割まで」といった条件を置く場合も、同じ0か1の変数と線形の制約で書け、制約を外したときの NPV の差で費用を測れます。案件選択の整数計画は第10章で扱います。
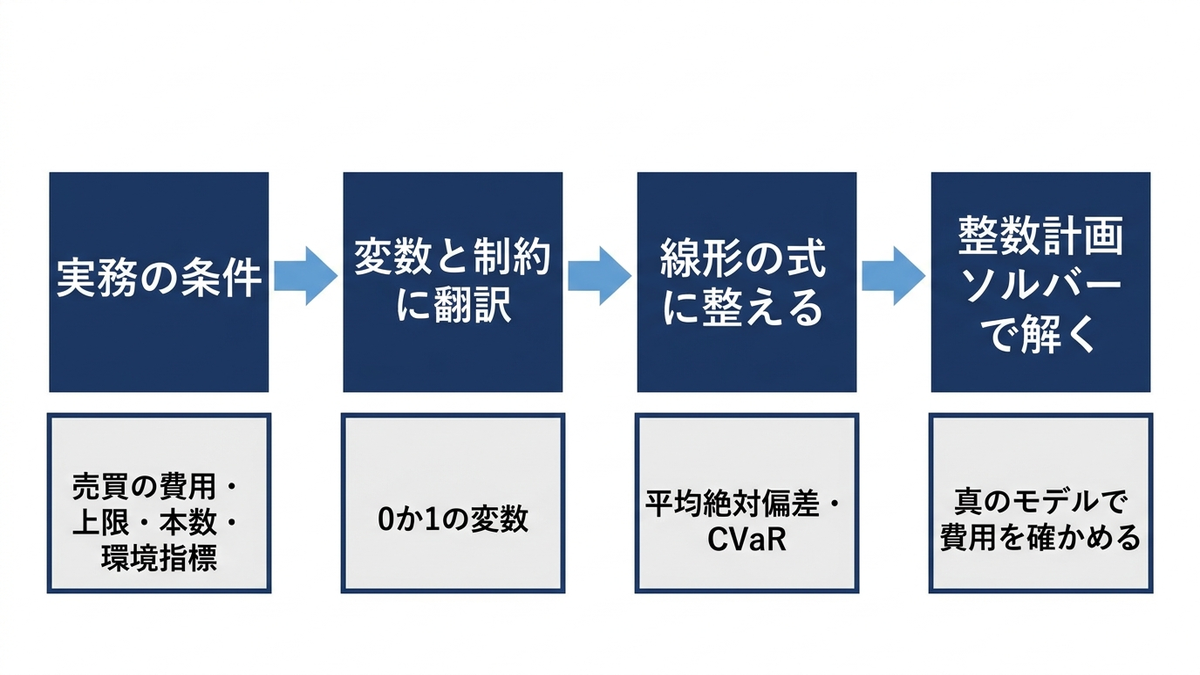
この章の要点をまとめます。取引コストは、現在の配分からの乖離の絶対値にコスト率を掛けて目的から引けば線形のまま扱え、コスト率を上げるほど最適化は「動かさない」答えに近づきました。上下限や資産クラス別の枠は線形の不等式で足せ、推定の誤りによる集中を止める働きがあります。最小保有比率と本数の上限には0か1の変数が要り、2次の目的を扱えない整数計画のソルバーでは、平均絶対偏差モデルや CVaR でリスクを線形にして解きます。どの制約も、真のモデルで費用を測ると大小がはっきり分かれ、方針として受け入れるかどうかを金額で議論できるようになります。第9章では、ここで1回限りとして扱った配分の見直しを、複数の期間にわたるリバランスの問題として扱います。
この章を深めたい方への参考書籍
『理財工学II 数理計画法による資産運用最適化』(今野浩、日科技連出版社):題名のとおり、資産運用の最適化を数理計画法の問題として扱う本です。本章で線形計画や整数計画に置き換えて解いたような、ポートフォリオの選び方を数理計画の側から考える材料になります。1998年の刊行なので、計算機やソフトウェアの事情は現在と異なります。
『市場と取引 実務家のためのマーケット・マイクロストラクチャー』上・下(ラリー・ハリス著、宇佐美洋監訳、東洋経済新報社):売買がどのような仕組みで成立し、売買の費用がどこから生じるかを、市場の制度と参加者の行動から説明する本です。本章では取引コストを売買額に比例する率として置きましたが、その率がどのような要因で決まるかを考えるときの土台になります。
第9章 多期間の配分とリバランス
第8章では、取引コスト・保有の上下限・本数の上限を入れると、最適化の答えが「現在の配分からあまり動かさない」方向に寄ることを確かめました。そこまでの章は、ある1時点で配分を1回決める問題でした。実際の運用方針は、一度決めたら10年、20年と続きます。その間に市場は動き、配分の比率は決めた値から勝手にずれていきます。企業年金であれば掛金の拠出と給付の支払いがあり、余資であれば設備投資への取り崩しがあります。この章では、時間の流れを入れた配分の問題を扱います。配分が放っておくと動くこと、ずれを元に戻す規則(定期・乖離幅・放置)の比較、積立と取り崩しで目標に届く確率、残り期間と資産水準に応じて比率を変える動的計画法の例、そして「長く持てばリスクは小さくなる」という主張をめぐる議論を、第2章で用意したサンプルデータの真のモデルから多数の経路を抽出して確かめます。なお、この章も金融商品の配分の話に踏み込みますが、本記事は投資や財務の助言ではなく、個別の判断は専門家に相談してください。事業投資の予算配分は第10章で扱います。
配分は放っておくと動く
配分の比率は、決めた瞬間から動き始めます。たとえば国内株式を25%、国内債券を35%と決めて買ったあと、株式の価格が上がり債券の価格が変わらなければ、資産全体に占める株式の割合は25%より大きくなります。誰も売買していないのに比率が変わるのは、比率が「各資産の時価÷資産全体の時価」で決まり、時価が資産ごとに違う速さで動くからです。この記事の共通データの真のモデルでは、株式系の資産(国内株式・外国株式・不動産投資信託)は債券系の資産より期待リターンが高いので、平均的には株式系の比率が時間とともに上がっていきます。
比率が動くと、運用方針で決めたはずのリスクも動きます。第4章から第8章で比べた配分は、すべて「その比率を保つ」ことを前提にリスクと期待リターンを計算していました。比率が株式系に寄れば、リスクは方針で想定した値より大きくなります。逆に株式が大きく下がった後は比率が債券系に寄り、リスクは想定より小さくなる一方で、その後の回復の恩恵も小さくなります。ずれた比率を、売買によって方針の比率に戻すことをリバランスと呼びます。リバランスは、値上がりした資産を売り、値下がりした資産を買う操作になります。
この章では、比率の動きを見る単位として「株式系の比率」を使います。共通データの現在の配分(国内株式25%・外国株式20%・国内債券35%・外国債券15%・不動産投資信託5%・短期資産0%。架空)では、国内株式・外国株式・不動産投資信託の合計がちょうど50%です。不動産投資信託を株式系に含めたのは、共通データの真のモデルで、荒れた月に不動産投資信託が株式と同じ向きに大きく下がる(荒れた月の株式系どうしの相関0.85)設定になっているからです。
リバランスの規則を比べる設定
リバランスの規則には、大きく分けて2つの型があります。1つは、年に1回、四半期に1回のように、決めた時期に比率を戻す定期リバランスです。もう1つは、比率が方針からある幅以上ずれたときだけ戻す方法で、この記事ではこの幅を乖離幅と呼びます。運用方針に「各資産の比率が基本の値から±5pt を超えたら戻す」のように書かれる幅です。比較の基準として、一度買ったら一切売買しない「放置」も並べます。
比較は、第2章で用意したサンプルデータの真のモデル(平常の月と荒れた月の混合分布)から、120か月(10年)の月次リターンの経路を2,000本抽出して行いました。2,000本の経路は5つの規則で共通にしたので、規則の差は経路の違いではなく規則の違いだけから生じます。この比較のためにだけ置いた架空の設定は次の表のとおりです。
| 項目 | 設定(すべて架空) |
|---|---|
| 初期の資産 | 1,000百万円(10億円)。余資の運用を想定 |
| 目標の配分 | 共通データの現在の配分(株式系50%) |
| 期間・経路 | 120か月(10年)×2,000本。真のモデルから抽出 |
| 判定のタイミング | 各月末に比率を計算し、規則に当てはまれば目標の配分に全部戻す |
| 規則 | 放置/年1回(12か月ごと)/四半期(3か月ごと)/毎月/乖離幅±5pt(どれか1資産でも目標から5pt を超えてずれた月に戻す) |
| 取引コスト | 売りにも買いにも、売買額の0.1%(片道0.1%)。資産から差し引く |
| 拠出・取り崩し・税 | なし |
表の「取引コスト」の0.1%は、比較のために置いた架空の率で、実在の売買手数料や市場の取引費用を表したものではありません。売買の量を測る指標として、年あたりの回転率も出します。この記事では、1回のリバランスで売った額と買った額の合計の半分(片道の売買額)を、そのときの資産で割った値を回転率とし、10年分を合計して10で割った値を「年あたり回転率」と呼びます。シミュレーションの中心部分を抜き出したものが次のコードです。全体は、これに結果を表にする数行を加えたものです。
import numpy as np
from port_data import *

P, T, COST = 2000, 120, 0.001           # 2,000本 x 120か月、売買額の0.1%(架空)
R = simulate_true(P * T).values.reshape(P, T, 6)   # 真のモデルから抽出して切り分ける
tgt = CURRENT.values                    # 目標配分=現在の配分
eq = [CODES.index(c) for c in ("DE", "FE", "RE")]  # 株式系

def run(rule, cost=COST, w0=1000.0):
    h = np.tile(w0 * tgt, (P, 1))
    traded, paid, eqr, nreb = np.zeros(P), np.zeros(P), np.zeros((P, T)), np.zeros(P)
    for t in range(T):
        h = h * (1 + R[:, t, :])
        W = h.sum(1)
        w = h / W[:, None]
        eqr[:, t] = w[:, eq].sum(1)
        if rule == "放置":
            go = np.zeros(P, bool)
        elif rule == "乖離幅±5pt":
            go = (np.abs(w - tgt) > 0.05).any(1)
        else:
            go = np.full(P, (t + 1) % {"毎月": 1, "四半期": 3, "年1回": 12}[rule] == 0)
        trade = np.abs(W[:, None] * tgt - h).sum(1) * go
        c = cost * trade
        h = np.where(go[:, None], (W - c)[:, None] * tgt, h)
        traded += trade / 2 / W; paid += c; nreb += go
    return h.sum(1), eqr, traded / (T / 12), paid, nreb

WT, eqr, to, paid, nreb = run("年1回")
print("中央値 %.0f / 5%%点 %.0f / 株式系の比率の平均 %.1f%% / 回転率 %.1f%% / コスト %.2f" % (
    np.median(WT), np.quantile(WT, 0.05), 100 * eqr.mean(), 100 * to.mean(), paid.mean()))
# 出力:
# 中央値 1384 / 5%点 876 / 株式系の比率の平均 50.4% / 回転率 3.8% / コスト 0.95
10年×2,000回のシミュレーションの結果
5つの規則の結果をまとめたのが次の表です。金額の単位は百万円で、初期の資産は1,000です。「最終資産」は10年後の資産で、2,000本の経路の中央値・5%点(悪いほうから5%の位置、つまり20本に1本はこれより悪い)・平均を並べました。「株式系の比率の平均」は、全経路・全月の株式系の比率の平均です。「最大の乖離の平均」は、経路ごとに10年間で株式系の比率が50%から最も離れた幅を取り、それを2,000本で平均した値です。「実現リスク」は、経路ごとに月次リターンの標準偏差を年率にして平均した値、「月次 CVaR」は全経路・全月の月次リターンの下位5%の平均です。この2つに使う月次リターンは、その月のリバランスの取引コストを差し引く前の値です。
| 規則 | 最終資産の中央値 | 最終資産の5%点 | 最終資産の平均 | 株式系の比率の平均 | 最大の乖離の平均 | 年あたり回転率 | 取引コストの合計 | リバランス回数 | 実現リスク | 月次 CVaR |
|---|---|---|---|---|---|---|---|---|---|---|
| 放置 | 1,373 | 876 | 1,469 | 53.9% | 15.2pt | 0.0% | 0.00 | 0.0 | 8.92% | -6.15% |
| 年1回 | 1,384 | 876 | 1,436 | 50.4% | 7.8pt | 3.8% | 0.95 | 10.0 | 8.35% | -5.71% |
| 四半期 | 1,389 | 875 | 1,432 | 50.1% | 5.2pt | 7.4% | 1.79 | 40.0 | 8.30% | -5.68% |
| 毎月 | 1,386 | 874 | 1,430 | 50.1% | 4.3pt | 12.5% | 3.00 | 120.0 | 8.29% | -5.67% |
| 乖離幅±5pt | 1,390 | 874 | 1,437 | 50.6% | 7.4pt | 2.7% | 0.66 | 4.1 | 8.37% | -5.73% |
表から読み取れることは3つあります。1つ目は、放置すると比率がはっきり動くことです。放置の「株式系の比率の平均」は53.9%で、目標の50%より高く、「最大の乖離の平均」は15.2pt に達しました。10年後(120か月目)の株式系の比率を放置の2,000本で見ると、中央値は58.3%、5%点は38.0%、95%点は74.5%で、60%を超えていた経路が43.2%ありました。方針では「株式系50%」と決めていても、10年放置すると、半分近くの経路で株式系が6割を超えているということです。その結果、放置の実現リスクは8.92%、月次 CVaR は -6.15% で、リバランスする4つの規則(実現リスク8.29〜8.37%、月次 CVaR -5.67〜-5.73%)より悪くなっています。共通データの真のモデルでの現在の配分のリスクは8.30%なので、リバランスする規則は方針どおりのリスクを保ち、放置は方針より大きなリスクを取っていることになります。なお、毎月リバランスする規則の月次リターンは現在の配分そのものの月次リターンですが、月次 CVaR は -5.67% で、第1章・第7章で示した現在の配分の -5.64% と小数第2位が違います。別に確かめたところ、これは抽出した月数の違い(第1章・第7章は12万か月、この章は2,000本×120か月の24万か月)によるもので、この章の月次リターンは取引コストを引く前の値なので、コストは CVaR に影響していません。
2つ目は、最終資産の中央値と5%点は、規則によってほとんど変わらないことです。中央値は1,373〜1,390、5%点は874〜876の範囲に収まりました。放置の平均(1,469)がほかより大きいのは、株式系の比率が上がった経路で大きく増えた分が平均を押し上げているためで、その代わりにリスクが大きくなっています。平均が大きいことをもって放置が優れているとは読めません。リバランスの規則どうしの中央値の差は最大でも約0.5%で、この程度の差は、真のモデルの設定や経路の本数を変えれば入れ替わりうる大きさです。この結果から「どの頻度が最もよく増える」とは言えません。リバランスの主な効果は、資産を増やすことではなく、方針で決めたリスクの水準を保つことだと読むのが妥当です。
3つ目は、規則によって売買の量と取引コストが大きく違うことです。毎月戻す規則は年あたり回転率12.5%、取引コストの合計は10年で3.00百万円でした。乖離幅±5pt の規則は回転率2.7%、コスト0.66百万円で、毎月の約5分の1です。それでも実現リスク(8.37%)は毎月(8.29%)とほぼ同じ水準に保たれています。乖離幅±5pt の規則で実際にリバランスが起きたのは、10年間で平均4.1回でした。比率がずれていない時期には売買しないので、少ない売買で比率を保てるのが乖離幅による規則の長所です。ただし、この規則の「最大の乖離の平均」は7.4pt で、年1回(7.8pt)と大差ありません。乖離幅は資産ごとに5pt で判定しているので、株式系の3資産がそろって少しずつずれると、合計の株式系の比率は5pt を超えてずれることがあるためです。乖離幅を決めるときは、資産ごとの幅と、株式系の合計のような束ねた単位での幅を分けて考える必要があります。
取引コストの影響も確かめました。同じ経路で取引コストを0にすると、中央値は放置1,373・年1回1,385・四半期1,391・毎月1,390・乖離幅±5pt 1,390で、コストありとの差は0〜4百万円でした。片道0.1%という架空の低いコストのもとでは、頻度の違いが最終資産に与える影響は小さいということです。コストの率が高い資産(流動性の低い資産や、売買のたびに大きな費用がかかる資産)を含む場合は、この差が大きくなります。取引コストを目的関数に入れて最適化する方法は第8章で扱いました。
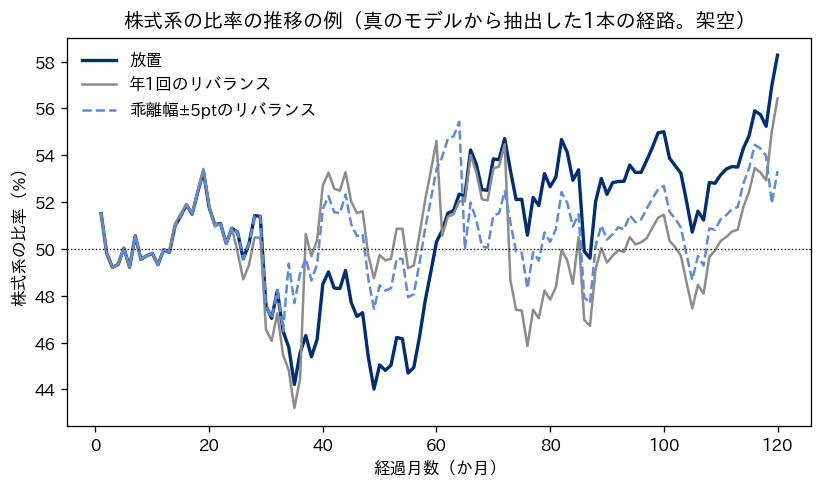
上の図は、2,000本の中から、放置の10年後の株式系の比率が中央値(58.3%)に最も近い経路を1本選び、3つの規則の株式系の比率の推移を描いたものです。放置(濃い線)は、株式が下がった時期には45%を下回り、その後の上昇で58%を超えて終わりました。年1回(灰色の線)は12か月ごとに50%に戻るので、ずれは1年分しか蓄積しません。乖離幅±5pt(破線)は、どれかの資産が5pt を超えてずれた月にだけ戻るので、戻る時期が不規則になっています。どの規則でも、月と月の間の動きは止められず、比率は毎月少しずつずれます。リバランスは「比率を固定する」操作ではなく、「ずれが積み上がるのを止める」操作だということが、この図から分かります。
見直しの頻度と乖離幅をどう決めるか
シミュレーションの結果から、規則の選び方を整理します。リバランスの目的が「方針で決めたリスクの水準を保つこと」だとすると、規則は「どれだけのずれを許すか」と「そのためにどれだけの売買を払うか」の釣り合いで決まります。毎月戻せばずれは最も小さくなりますが、売買は最も多くなります。放置すれば売買は0ですが、10年間で最も離れた時点の幅は平均で15.2pt に達し、方針より大きなリスクを取ることになります。乖離幅による規則は、ずれが小さい時期には売買しないので、この釣り合いを取りやすい規則です。
乖離幅をいくつにするかは、資産ごとの値動きの大きさで考えるのが筋です。値動きの大きい資産(株式)は少しの期間で大きくずれるので、狭い幅にすると頻繁に売買することになります。値動きの小さい資産(短期資産・国内債券)は、ずれること自体が少ないので、幅の影響は小さくなります。幅を広げれば売買は減り、リスクのずれは大きくなります。どの幅が適切かは、この章のようなシミュレーションを自社の方針・資産の構成・取引コストで回し、ずれの大きさと売買の量を並べて決めることになります。公的な年金の運用で使われている実在の乖離許容幅の考え方は、第14章で公式の資料をもとに紹介します。
実務では、定期と乖離幅を組み合わせる方法もよく見られます。たとえば「四半期ごとに比率を点検し、乖離幅を超えていれば戻す」という規則です。点検の頻度を決めることで、毎日比率を監視する手間を避けつつ、大きなずれは放置しないようにできます。もう1つの実務上の工夫は、全部を目標に戻すのではなく、乖離幅の内側まで戻すだけに留める方法と、積立の拠出や取り崩しの支払いを、比率が低くなった資産から先に充てる方法です。後者は、売買をせずに資金の出入りだけで比率を戻すので、取引コストを抑えられます。この章のシミュレーションでは、比較を単純にするために「全部を目標に戻す」規則だけを扱いました。
積立と目標到達確率で考えるゴールベース・アプローチ
ここまでは、拠出も取り崩しもない運用を見てきました。企業年金の掛金や、将来の設備更新に備えて毎年資金を積み立てる場合は、資金の出入りがあります。この場合、「最終資産の中央値」や「リスク」より分かりやすい問いがあります。「必要な時期までに、必要な額に届く確率はどれだけか」という問いです。運用の目的を、将来の具体的な支払い(目標額と時期)から逆算して考え、配分をその目標に届く確率で評価する考え方を、この記事ではゴールベース・アプローチと呼びます。
例として、毎月5百万円を10年間積み立て(拠出の合計600百万円)、10年後に700百万円が必要になる、という架空の設定を置きました。配分は、株式系(国内株式・外国株式・不動産投資信託を25:20:5の比で束ねたもの)と債券系(国内債券・外国債券を35:15の比で束ねたもの)の2つの束の割合だけを動かし、毎月その割合に戻すことにしました。株式系50%が、共通データの現在の配分にあたります。真のモデルから10年分の経路を2,000本抽出した結果が次の表です。
| 株式系の比率 | 目標(700)到達確率 | 最終資産の中央値 | 最終資産の5%点 | 拠出割れ(600未満)の確率 |
|---|---|---|---|---|
| 0% | 13.1% | 645 | 570 | 17.2% |
| 25% | 38.8% | 680 | 577 | 10.4% |
| 50% | 54.2% | 713 | 549 | 13.5% |
| 75% | 60.6% | 742 | 511 | 16.0% |
| 100% | 63.1% | 771 | 472 | 19.2% |
株式系の比率を上げると、目標到達確率は13.1%から63.1%まで上がります。一方で、最終資産の5%点は25%のとき(577)が最も高く、100%では472まで下がります。「拠出割れの確率」、つまり10年間に払い込んだ600百万円を下回って終わる確率は、25%のとき(10.4%)が最も低く、0%(17.2%)でも100%(19.2%)でも高くなりました。株式系0%でも拠出割れの確率が25%のときより高いことは、共通データの真のモデルで債券系の期待リターンが低い(国内債券1.0%・外国債券2.5%)設定と関係している可能性がありますが、原因の切り分けは計算では確かめていません。
この表は、「目標に届く確率」と「悪いときにどこまで下がるか」が同じ向きに動かないことを示しています。目標到達確率だけを見れば株式系100%が最もよく、悪いときの下値だけを見れば25%がよい、という結果です。どちらを優先するかは、目標額に届かなかったときに何が起きるかで決まります。不足分を会社の他の資金で補える場合は、到達確率を重視してよいかもしれません。不足すると事業や給付に直接の支障が出る場合は、5%点や拠出割れの確率を重く見る必要があります。ゴールベース・アプローチの利点は、こうした判断を「リスク何%」という抽象的な数字ではなく、「10年後に700百万円に届く確率」「払い込んだ額を割る確率」という、経営会議で議論できる言葉に置き換えられる点にあります。
取り崩しの率と枯渇の確率
積立の逆が取り崩しです。企業年金の給付期や、運用している余資から毎年一定額を事業に回す場合がこれにあたります。ここでは、初期の資産1,000百万円から、毎年「初期の資産のx%」にあたる一定額を月割りで払い出し、30年間続けたときに、途中で資産が尽きる確率を計算しました。払出額は30年間変えず、物価の変動は考えていません。配分は積立の例と同じ株式系・債券系の2つの束で、毎月その割合に戻しています。真のモデルから30年分の経路を2,000本抽出した結果が次の表です。
| 株式系の比率 | 取り崩し率3% | 取り崩し率4% | 取り崩し率5% | 取り崩し率6% |
|---|---|---|---|---|
| 25% | 0.3% | 16.5% | 68.2% | 95.3% |
| 50% | 1.1% | 14.1% | 43.2% | 73.4% |
| 75% | 3.1% | 15.9% | 35.6% | 57.5% |
表の値は、30年以内に資産が尽きる確率(枯渇の確率)です。取り崩し率が上がると枯渇の確率は急に上がり、株式系50%では、3%のとき1.1%、4%のとき14.1%、5%のとき43.2%、6%のとき73.4%でした。取り崩し率が低いところでは、1pt 上げるだけで枯渇の確率が何倍にもなります(株式系50%で3%から4%にすると、1.1%から14.1%)。取り崩し率が高いところでは倍率こそ小さくなりますが、上がる幅は大きいままです(株式系50%で5%から6%にすると、43.2%から73.4%へ30.2pt 上がります)。配分の影響は取り崩し率によって向きが変わります。3%では株式系の比率を下げたほうが枯渇の確率は低く(25%で0.3%、75%で3.1%)、5%・6%では株式系の比率を上げたほうが低くなります(5%のとき25%で68.2%、75%で35.6%)。取り崩しが少なければ、大きく下がる年を避けることが大事になり、取り崩しが多ければ、増やさないとそもそも30年もたない、ということです。
この結果から言える経営上の要点は、取り崩しの計画では、配分よりも取り崩しの率そのものが枯渇の確率を大きく左右するということです。この例では、株式系の比率を25%から75%まで動かしても、取り崩し率4%の枯渇の確率は14.1〜16.5%の範囲でしか動きませんでした。一方、取り崩し率を4%から3%に下げると、どの配分でも枯渇の確率は3.1%以下になりました。配分の議論に時間をかける前に、毎年いくら払い出す計画なのか、払い出しを市況に応じて減らす余地があるのかを先に決めるほうが、結果への影響が大きいと考えています。なお、ここでの数字は、すべて共通データの架空の真のモデルのもとでの値で、現実の市場での取り崩し率の目安を示すものではありません。
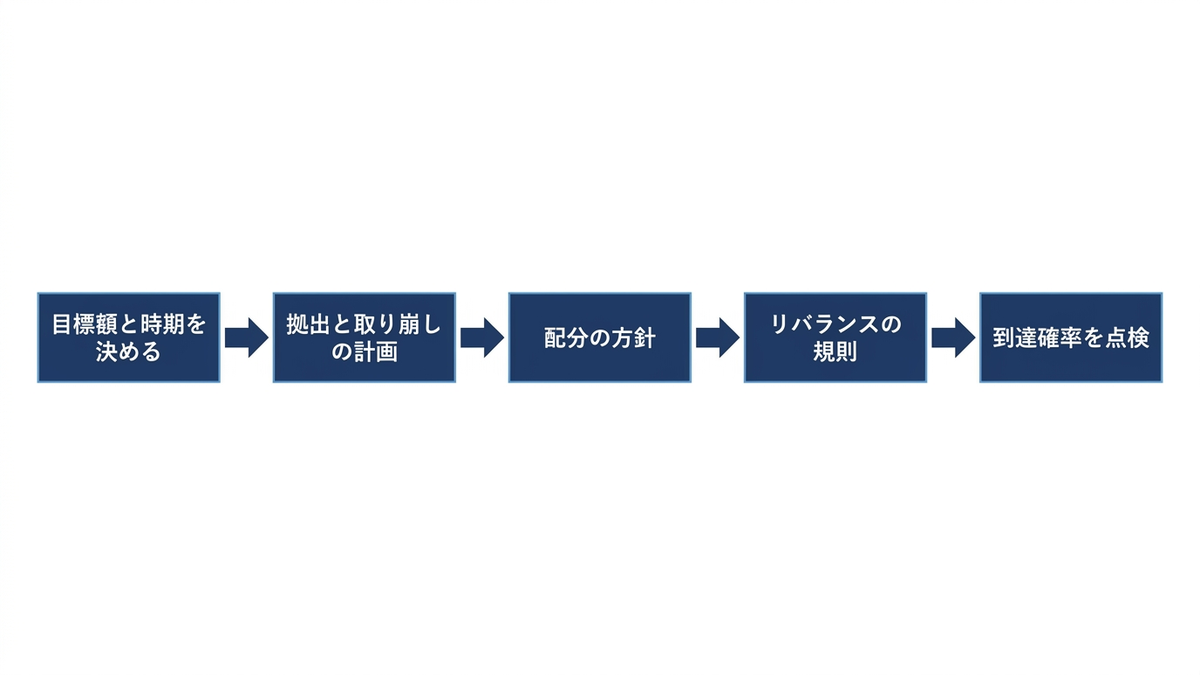
動的計画法で残り期間と資産水準に応じて比率を変える
ここまでの例は、株式系の比率を期間中ずっと同じにしていました。目標額と期限がある場合は、途中の資産の水準を見て比率を変えるほうが、目標に届く確率を上げられることがあります。たとえば、期限が近く、すでに目標額に届いているなら、株式系を減らして守りに入れば、目標を割る確率を下げられます。逆に、期限が近いのに目標から遠い場合は、守っていても届かないので、株式系を増やして賭けるほうが届く確率は上がります。このように「いまの状態(残り年数と資産の水準)に応じて、最もよい行動を選ぶ規則」を求める方法が動的計画法です。最後の年から1年ずつさかのぼって、各状態での最もよい行動と、その行動を取ったときの目標到達確率を順に計算します。
設定は次のとおりです(すべて架空)。初期の資産1,000百万円を10年間運用し、10年後に1,300百万円以上あることを目標とします。拠出と取り崩しはありません。毎年の初めに、株式系の比率を0%から100%まで10%刻みの11通りから選び、1年間は毎月その比率に戻します。状態は「残り年数(1〜10年)」と「資産の水準(0〜2,500百万円を5百万円刻みにした501点の格子。格子は、連続した値を一定の刻みの点に区切って計算する方法で、ここでは資産の水準を501通りの点だけで扱います)」の組で、目的は10年後に目標以上である確率の最大化です。各比率の1年間のリターンの分布は、真のモデルから4,000年分を抽出して作りました。計算の中心部分を抜き出したものが次のコードです。
import numpy as np
from port_data import *

G = np.array([0.25, 0.20, 0, 0, 0.05, 0]) / 0.50   # 株式系の束
S = np.array([0, 0, 0.35, 0.15, 0, 0]) / 0.50      # 債券系の束
SHARES = np.linspace(0, 1, 11)                      # 株式系の比率の候補 0%,10%,...,100%
Y, W0, GOAL, M = 10, 1000.0, 1300.0, 4000           # 10年・初期1,000・目標1,300(架空)

def annual(seed, n):
    """真のモデルから n 年分の年間リターンを、株式系の比率ごとに作る。"""
    R = simulate_true(12 * n, seed=seed).values.reshape(n, 12, 6)
    g, s = R @ G, R @ S
    return np.array([np.prod(1 + a * g + (1 - a) * s, axis=1) - 1 for a in SHARES])

A = annual(seed=3001, n=M)                           # 11 x 4,000
grid = np.linspace(0, 2.5 * W0, 501)                 # 資産水準の格子
V = (grid >= GOAL).astype(float)                     # 残り0年:目標以上なら1
policy = np.zeros((Y, grid.size))
for k in range(1, Y + 1):                            # 残り年数 k
    Q = np.array([np.interp(grid[:, None] * (1 + A[j][None, :]), grid, V).mean(1)
                  for j in range(len(SHARES))])
    policy[k - 1] = SHARES[Q.argmax(0)]
    V = Q.max(0)
print("初期資産での到達確率 %.3f" % np.interp(W0, grid, V))
# 出力:
# 初期資産での到達確率 0.773
計算は、この記事の実行環境(一般的なノートPC)での実測で12.7秒でした。式で書くと、残り \( k \) 年・資産 \( w \) での目標到達確率 \( V_k(w) \) を、\( V_k(w) = \max_a \mathrm{E}\left[ V_{k-1}\left( w (1 + R_a) \right) \right] \) で順に計算しています。言葉で言うと、「いま比率 \( a \) を選んで1年運用し、その結果の資産から先は最もよい規則で運用したときの到達確率」を11通りの比率で計算し、最も高いものを選ぶ、という計算を最後の年からさかのぼって繰り返すということです。得られた方針(各状態で選ぶ株式系の比率)の一部が次の表です。
| 残り年数 | 資産700 | 資産850 | 資産1,000 | 資産1,100 | 資産1,200 | 資産1,250 | 資産1,300 | 資産1,400 | 資産1,600 |
|---|---|---|---|---|---|---|---|---|---|
| 10年 | 100% | 100% | 90% | 60% | 40% | 30% | 20% | 10% | 10% |
| 7年 | 100% | 100% | 100% | 80% | 50% | 40% | 20% | 10% | 10% |
| 5年 | 100% | 100% | 100% | 100% | 60% | 40% | 30% | 10% | 0% |
| 3年 | 100% | 100% | 100% | 100% | 80% | 50% | 30% | 10% | 0% |
| 2年 | 100% | 100% | 100% | 100% | 100% | 60% | 30% | 10% | 0% |
| 1年 | 0% | 100% | 100% | 100% | 100% | 100% | 20% | 0% | 0% |
表の読み方は、行が残り年数、列が資産の水準(百万円)、値がその状態で選ぶ株式系の比率です。資産が目標(1,300)を上回るほど株式系を減らし、下回るほど増やす、という形がはっきり出ています。残り年数が短くなるほど、この切り替えは急になります。残り1年で資産1,250なら株式系100%、1,300なら20%、1,400なら0%です。残り1年で資産700の欄が0%になっているのは、どの比率を選んでも1年で1,300に届く確率が計算上0になり、11通りの比率の到達確率が同じ(0)になったため、計算の手順上、最初の候補である0%が選ばれたものです。届かない状態では、到達確率という目的だけではどの比率も区別できない、ということを表しています。
この方針を、方針を作るのに使った標本とは別に真のモデルから抽出した2,000本の経路で評価し、株式系の比率を固定した場合と比べました。
| 方針 | 目標(1,300)到達確率 | 最終資産の中央値 | 最終資産の5%点 | 初期(1,000)を下回る確率 |
|---|---|---|---|---|
| 動的計画法の方針 | 76.8% | 1,458 | 736 | 12.7% |
| 株式系30%固定 | 49.8% | 1,299 | 941 | 8.8% |
| 株式系50%固定 | 59.0% | 1,382 | 887 | 11.5% |
| 株式系70%固定 | 63.1% | 1,461 | 816 | 14.4% |
| 株式系100%固定 | 65.0% | 1,571 | 692 | 18.1% |
動的計画法の方針は、目標到達確率が76.8%で、固定の比率で最もよい株式系100%(65.0%)を約12pt 上回りました。方針を作った標本での到達確率(77.3%)と、別の標本での評価(76.8%)もほぼ一致しました。別の標本1組での確認ですが、この評価では、方針を作った標本への大きな合わせ込みは見られませんでした。一方で、最終資産の5%点は736で、株式系50%固定(887)や70%固定(816)より低く、100%固定(692)に近い水準です。
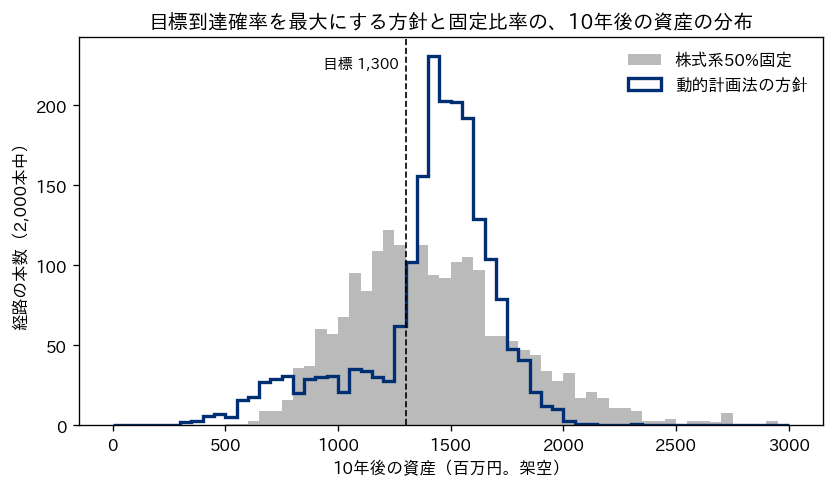
上の図は、10年後の資産の分布を、動的計画法の方針(濃い線)と株式系50%固定(灰色)で重ねたものです。動的計画法の方針は、目標の1,300のすぐ右側に経路が集まっています。目標を超えた経路では株式系を減らして守りに入るので、それ以上は大きく増えず、目標の少し上で止まります。その一方で、左の裾が50%固定より長く伸びています。目標から遠い経路では株式系を100%に上げて賭けるので、うまくいかなかった経路は大きく下がるからです。
これは、目的の置き方がそのまま結果の形に出た例です。「目標以上である確率」だけを最大にすると、目標をどれだけ上回るか、どれだけ下回るかは評価に入りません。届かない経路が700で終わっても900で終わっても、目的の上では同じ「届かなかった1本」です。そのため、届かない可能性が高い経路ほど、下値を気にせずに賭ける方針が選ばれます。経営の文脈で目標到達確率を目的にするときは、この性質を承知したうえで、「最終資産が一定額を下回る確率を何%以下にする」という制約を加えるか、不足額の大きさに応じて罰を重くする目的(不足額の期待値を最小にするなど)を使うことを検討すべきです。この章の例はどちらも入れていない、最も単純な形です。
この例にはほかにも単純化があります。1年ごとにしか比率を変えず、取引コストを入れておらず、真のモデルのリターンの分布を知っている前提で方針を作っています。現実には真のモデルは分からないので、推定モデルから作った方針は、第4章で見た推定誤差の影響を受けます。動的計画法の結果は「状態に応じて比率を変える規則の形」を考える材料として使い、表の数字そのものを運用方針にすることは避けるべきです。
「時間分散」をめぐる議論
多期間の配分では、「株式は長く持つほどリスクが小さくなる」という主張がよく持ち出されます。長期で見れば良い年と悪い年が打ち消し合うので、長く持つ人ほど株式を多く持ってよい、という主張です。このように保有期間を延ばすことでリスクが小さくなるという考え方を、この記事では時間分散と呼びます。この主張は、リスクを何で測るかによって正しくも誤りにもなります。共通データの真のモデルで、株式系100%と短期資産100%を、保有期間ごとに比べました。初期の資産を100とし、30年分の経路2,000本を使っています。
| 保有期間 | 株式系が短期資産を下回る確率 | 下回ったときの平均の不足額 | 不足額の95%点 | 株式系の中央値 | 株式系の5%点 | 短期資産の中央値 |
|---|---|---|---|---|---|---|
| 1年 | 40.0% | 10.4 | 20.9 | 105 | 80 | 101 |
| 5年 | 27.4% | 19.6 | 34.0 | 127 | 69 | 103 |
| 10年 | 20.1% | 23.9 | 35.4 | 161 | 70 | 105 |
| 20年 | 12.2% | 29.3 | 29.4 | 257 | 81 | 111 |
| 30年 | 7.0% | 29.7 | 15.5 | 408 | 100 | 116 |
「株式系が短期資産を下回る確率」は、保有期間1年で40.0%、10年で20.1%、30年で7.0%と、期間が長くなるほど下がります。確率で測れば、長く持つほど株式系が負ける可能性は小さくなる、という主張はこのデータで成り立っています。ところが、「下回ったときの平均の不足額」を見ると、1年で10.4、10年で23.9、30年で29.7と、期間が長くなるほど大きくなっています。負ける確率は下がっても、負けたときの負け方は大きくなるということです。「不足額の95%点」は、全経路の中で不足額(下回らなかった経路は0)が上位5%に入る水準で、20年以降は負ける確率そのものが下がるので小さくなっています。リスクを「負ける確率」で測るか、「負けたときの大きさ」で測るかで、時間分散の主張の見え方が逆になります。
この点を論じた論文に、ボディの1995年の論文(Financial Analysts Journal 第51巻第3号)があります。CFA Institute のページに掲載された要旨によると、この論文は、株式の保有期間が長いほどリスクが小さいという命題が正しいなら、無リスク金利を下回ることに対する保険の費用は保有期間が長くなるほど下がるはずだとしたうえで、実際には逆に上がることを示しています。株式のリターンが長期で平均に回帰する場合でも同じだとしています。要旨はさらに、若い人ほど株式を多く持つべきだという主張の根拠を、株式リターンの長期の性質だけに置くことはできない、と結論しています。上の表で、期間が長いほど負けたときの不足額が大きくなったことは、この論文の議論と同じ向きの結果です(ただし、この章の計算は保険の費用そのものを計算したものではありません)。
多期間の配分を数理的に扱った古典としては、サミュエルソンの1969年の論文(米国の経済学の学術誌、第51巻第3号)があり、題名のとおり、生涯にわたる配分を動的確率計画法で扱っています。この論文の結論は、原文を確認できていないため、この記事では紹介しません。この章の動的計画法の例は、その考え方の最も簡単な形にあたります。
経営の判断に引き直すと、「長期の資金だから株式を多く持ってよい」という説明を受けたときは、リスクを何で測っているのかを確かめる必要があります。負ける確率が下がることは事実でも、負けたときの不足額が大きくなるなら、不足を誰がどう埋めるのかを決めておかなければなりません。企業年金で言えば、運用が予定を下回ったときに会社が追加で拠出する額は、確率ではなく金額で効いてきます。長期の資金で株式の比率を高くするかどうかは、時間分散という言葉ではなく、この章で見た目標到達確率・拠出割れの確率・不足額の分布を並べて判断するのがよいと考えています。
経営判断として、運用方針の見直しをどう決めるか
企業年金や余資の運用方針は、多くの場合、基本となる資産構成の割合と、そこからの乖離の許容幅と、見直しの手続きで構成されます。この章の結果を、方針を決める側の判断に引き直すと、次の4点に整理できます。
- リバランスの規則は、資産を増やす手段ではなく、方針で決めたリスクの水準を保つ手段として決める。この章の例では、10年放置すると、株式系の比率の平均は53.9%(目標50%との差は3.9pt)、10年間で最も離れた時点の幅は2,000本の平均で15.2pt になり、実現リスクは8.30%から8.92%に上がった。一方、リバランスする4つの規則どうしの最終資産の中央値の差は約0.5%に収まった
- 見直しの頻度と乖離幅は、ずれの大きさと売買の量の釣り合いで決める。この章の例では、乖離幅±5pt の規則が、毎月戻す規則の約5分の1の売買で、ほぼ同じリスクの水準を保った。資産ごとの幅と、株式系の合計のような束ねた単位の幅を分けて決める
- 積立・取り崩しがある資金は、目標額と時期から逆算し、目標到達確率と下値(5%点・拠出割れの確率・枯渇の確率)を並べて配分を選ぶ。取り崩しでは、配分より取り崩しの率が結果を大きく左右する
- 状態に応じて比率を変える規則は、目標到達確率を上げる一方で下値を悪くすることがある。目的に下値の制約を入れるかどうかを、方針を決める段階で明示する
判断を誤ったときの損失の型も整理しておきます。リバランスの規則を決めずに放置すると、方針の承認時に説明したリスクと、実際に取っているリスクが離れていきます。荒れた年に想定以上に下がったとき、その下げは「方針どおりの結果」ではなく「方針から外れた結果」になり、説明の責任の所在があいまいになります。逆に、細かすぎる規則で頻繁に売買すると、取引コストが積み上がります。この章の架空の0.1%では10年で3百万円と小さな額でしたが、コストの率が高い資産を含めば無視できない額になります。取り崩しの計画では、取り崩しの率を高く置きすぎると、配分をどう工夫しても資金が尽きる確率を下げられません。
見直しの手続きとしては、比率の点検の頻度(毎月・四半期など)、乖離幅、戻し方(全部戻すか、幅の内側まで戻すか、資金の出入りで戻すか)を方針の文書に書いておくことが基本になります。そのうえで、年に1回程度、この章のようなシミュレーションを自社の資金の出入りと取引コストで回し直し、目標到達確率と下値の指標が方針の想定から外れていないかを確かめるのがよいと考えています。投資委員会での前提の記録や事後評価の仕組みは第13章で扱います。
この章の要点をまとめます。配分の比率は放っておくと動き、この章の例では10年放置すると、株式系の比率の平均は53.9%(目標50%との差は3.9pt)でしたが、10年間で最も離れた時点の幅は2,000本の平均で15.2pt に達し、方針より大きなリスクを取ることになりました。リバランスの規則どうしで最終資産の中央値はほとんど変わらず、規則の役割は資産を増やすことではなくリスクの水準を保つことで、乖離幅による規則は少ない売買でそれを実現しました。積立と取り崩しでは、目標到達確率と下値の指標を並べることで、配分の判断を経営会議で議論できる言葉にでき、動的計画法で状態に応じて比率を変えると到達確率は上がる一方で下値は悪くなりました。次の第10章からは、資産運用から事業投資に話を移し、共通データの投資案件30件から予算内で採る案件を選ぶ問題を扱います。
この章を深めたい方への参考書籍
『戦略的アセットアロケーション 長期投資のための資産配分の考え方』(ジョン・Y・キャンベル、ルイス・M・ビセイラ著、木島正明監訳、野村證券金融経済研究所訳、東洋経済新報社):副題のとおり、長期の投資家にとっての資産配分を主題にした本の翻訳です。この章では1年ごとに比率を選ぶ単純な動的計画法の例しか扱っていませんが、多期間で配分を考えるときの理論的な背景を確かめるのに向いています。
『ゴールベース資産管理入門 顧客志向の新たなアプローチ』(チャック・ウィジャー、ダニエル・クロスビー著、新井聡監訳、野村證券ゴールベース研究会訳、日本経済新聞出版社):運用の目的を将来の目標から逆算して考えるゴールベースの資産管理を、題名のとおり入門として扱った本の翻訳です。主な読者は個人の資産管理に携わる人ですが、この章の積立と取り崩しの例のように、目標額と時期から配分を評価する考え方を、企業の資金の運用方針に読み替える手がかりになります。
第10章 事業投資案件の選択
第9章までは、資産クラスへの配分という「割合を連続的に動かせる」問題を扱い、最後に多期間の配分とリバランスを見ました。この章から、話の舞台を事業会社の投資案件に移します。設備の更新、工場の新棟、基幹システム、研究開発テーマ、新規事業の立ち上げといった案件は、資産クラスの配分と違って「やるか、やらないか」の二択で決まることが多く、年度ごとの予算や案件どうしの前提・排他の関係が答えを大きく左右します。この章では、第2章で用意したサンプルデータ(架空の中堅製造業の、3年間の投資案件30件と年度予算)を使い、限られた予算の中で案件の組み合わせを選ぶ考え方と、その答えが制約・予算・見積りの変化でどう動くかを、実行した結果で確かめます。
この章では、すべての案件を NPV の期待値で評価します。成功確率と段階投資の扱いは第11章、NPV のばらつきと案件どうしの相関、悪い側に外れたときの損失(CVaR。第12章では NPV 合計のシナリオのうち下位5%の平均)を入れた選び方は第12章で扱います。案件選択をナップサック型の整数計画として書く基本(予算枠の中で組み合わせを選ぶこと、依存と排他の書き方、複数年度の扱い)は、弊社コラム『数理最適化の定式化パターン集』第11章で、5件の小さな例を使って説明しています。この章はその基本を前提に、30件の共通データで、制約1つあたりの費用、部分実施、予算の限界価値、見積りの感度、計算量を実測する深掘りに充てます。
資本予算配分という問題
企業が将来の収益を生む案件に資金を割り当てる意思決定を、資本予算配分(キャピタル・バジェッティング)と呼びます。個々の案件について「投資する価値があるか」を判定する作業と、価値のある案件が予算を上回るときに「どれを採るか」を決める作業の2つに分かれます。前者は案件ごとの NPV(正味現在価値。将来の現金の出入りを割引率で今の価値に直し、投資額を差し引いた額)を見れば判定できます。NPV が正なら、その案件は割引率に織り込んだ資金の費用を上回る価値を生む、という読み方です。後者は、使える資金に上限がある状態、つまり資本の割当て(キャピタル・ラショニング)のもとで、価値のある案件の中から組み合わせを選ぶ問題です。この問題は古くから研究されていて、1955年にはローリーとサベージが、資本の割当てに関する3つの問題を題にした論文を The Journal of Business 誌(第28巻第4号)に発表しています。
資金に上限がなく、排他の関係や実行体制のようなほかの制約もなければ、NPV が正の案件は資金の費用を上回る価値を生むので、実施しない理由はなく、選ぶ問題は生じません。実際の企業では、財務の方針(借入の上限や自己資本比率の目標)、経営会議が決めた年度の投資枠、社内の実行体制などで投資額に上限が置かれます。共通データの架空の会社では、30件すべての投資額の合計が1年目6,310・2年目4,890・3年目2,590(3年合計13,790百万円)であるのに対し、年度予算は2,500・2,200・1,800(合計6,500百万円)で、投資額の合計の半分弱しか実施できません。30件の NPV 期待値の合計は5,415百万円ありますが、どの組み合わせを選ぶかで、そのうちいくらを実現できるかが決まります。
この章で使う NPV は、第2章で定義したとおり、案件マスタの npv 列(投資額を差し引いた正味の価値の期待値。割引率は織り込み済みの設定値)です。金額はすべて百万円で、架空の設定値です。共通データは乱数で作った架空のデータなので、データを作った側は NPV の本当の分布(真のモデル)を知っていますが、この章では案件マスタの期待値をそのまま使い、真のモデルのシナリオでの評価は第12章に回します。この章で「最適」と書くときは、すべて「案件マスタの NPV 期待値を正しいとしたときの最適」という意味です。
NPV・内部収益率・収益性指数と、順位づけの限界
案件を比べる指標として、実務でよく使われるのは3つです。1つ目は NPV そのもの、2つ目は内部収益率(IRR。NPV がちょうど0になる割引率で、案件が年何%の利回りを生むかを表す)、3つ目は収益性指数(PI。投資額1円あたりの価値)です。この章では収益性指数を「NPV÷投資額」で計算します。将来の現金の現在価値を投資額で割った比で表すこともでき、その場合は「NPV÷投資額」に1を足した値になるので、案件の順位は同じです。共通データでは投資が3年に分かれているので、ここでの投資額は3年間の投資額の単純な合計(inv_total 列)としました。年度ごとの投資を割り引いて合計する扱いもありえますが、共通データの NPV には割引が織り込み済みなので、この章では単純な合計で統一します。
3つの指標は、予算に上限がない場合の「投資する価値があるか」の判定ではおおむね同じ答えを返しますが、予算の中で順位を付けると食い違います。IRR が NPV と違う順位を付ける典型は、規模の違う案件どうしの比較です。架空の2案件で計算しました。小型案件 X は最初に100を投資し、3年間毎年60を回収します。大型案件 Y は最初に1,000を投資し、3年間毎年450を回収します。割引率8%で計算すると、X の NPV は54.6、IRR は36.3%、Y の NPV は159.7、IRR は16.6%でした。IRR では X が上ですが、生む価値の額は Y が約3倍です。IRR は「率」なので、規模の大きな案件の価値を見落とします。IRR には、現金の出入りの符号が途中で何度も変わる案件では解が1つに決まらないことがあるという性質もあります。たとえば、最初に100を投資し、1年後に230を受け取り、2年後に132を支払う架空の案件は、割引率10%でも20%でも NPV がちょうど0になり、IRR が2つあります。このため、この章では IRR を順位づけの指標としては扱いません。
収益性指数は、規模の違いを「投資額1円あたり」にならして比べる指標で、予算が1本だけで、案件を途中まで実施できる(費用の半分を払えば価値も半分得られる)なら、収益性指数が正の案件を高い順に、予算の範囲で採っていく選び方が最適になります(収益性指数が正の案件の投資額の合計が予算に満たなければ、予算は使い切らずに残します)。この性質と、分割できない案件では成り立たなくなることは、弊社コラム『数理最適化の定式化パターン集』第11章で、5件の例を使って説明しています。共通データBの30件では、第2章で比べたとおり、収益性指数の高い順に、予算・必須・前提・排他の制約を破らない案件だけを採っていく素朴な規則は NPV 合計2,905百万円で、整数計画で解いた基準の3,155百万円より250百万円少なくなりました。NPV の大きい順は2,880百万円(基準より275百万円少ない)、戦略適合スコアの高い順は2,925百万円(230百万円少ない)でした。
次の表は、30件を収益性指数の高い順に並べ、基準(整数計画)で選ばれたかどうかを添えたものです。「選択頻度」の列は、後の節「NPV の見積りが動いたときの選択の変化」で、NPV の見積りを案件ごとに乱数で動かして500回解き直したときに、その案件が選ばれた割合です。
| 案件 | 種別 | 投資額(3年計) | NPV | 収益性指数 | 収益性指数の順位 | NPV の順位 | 基準で選択 | 選択頻度 |
|---|---|---|---|---|---|---|---|---|
| P16 既存製品の原価低減設計 | 研究開発 | 160 | 140 | 0.875 | 1 | 17 | ○ | 0.998 |
| P19 新素材Xの基礎研究 | 研究開発 | 360 | 300 | 0.833 | 2 | 5 | ○ | 1.000 |
| P20 新素材Xの試作ライン | 研究開発 | 300 | 250 | 0.833 | 2 | 8 | ○ | 1.000 |
| P17 保守サービスのサブスクリプション化 | 新規事業 | 220 | 170 | 0.773 | 4 | 13 | ○ | 0.988 |
| P15 主力製品の次世代機開発 | 研究開発 | 700 | 520 | 0.743 | 5 | 2 | ○ | 1.000 |
| P23 製品Zの改良 | 研究開発 | 240 | 160 | 0.667 | 6 | 14 | ○ | 0.928 |
| P22 C工場 増強分の外部委託への切替 | 能力増強 | 150 | 90 | 0.600 | 7 | 22 | ○ | 0.776 |
| P29 大学との共同研究 | 研究開発 | 150 | 80 | 0.533 | 8 | 24 | 0.756 | |
| P13 海外販売拠点(X国) | 新規事業 | 600 | 320 | 0.533 | 8 | 4 | ○ | 0.674 |
| P12 EC・直販チャネル構築 | 新規事業 | 400 | 200 | 0.500 | 10 | 11 | ○ | 0.492 |
| P26 データ分析人材の育成 | IT | 120 | 60 | 0.500 | 10 | 25 | 0.578 | |
| P07 B工場 第2ライン増設(新棟内) | 能力増強 | 800 | 380 | 0.475 | 12 | 3 | ○ | 0.946 |
| P14 海外販売拠点(Y国) | 新規事業 | 550 | 260 | 0.473 | 13 | 7 | 0.232 | |
| P30 省人化ロボット導入 | 設備更新 | 300 | 140 | 0.467 | 14 | 17 | 0.350 | |
| P10 販売データ基盤 | IT | 200 | 90 | 0.450 | 15 | 22 | 0.262 | |
| P25 リサイクル事業の立ち上げ | 新規事業 | 500 | 210 | 0.420 | 16 | 10 | 0.082 | |
| P18 第一事業部 営業支援システム | IT | 120 | 50 | 0.417 | 17 | 26 | 0.132 | |
| P06 検査装置の更新 | 設備更新 | 120 | 45 | 0.375 | 18 | 27 | ○ | 0.866 |
| P09 生産管理システム(MES)導入 | IT | 400 | 150 | 0.375 | 18 | 16 | 0.046 | |
| P24 物流拠点の統合 | 設備更新 | 300 | 110 | 0.367 | 20 | 21 | 0.040 | |
| P21 C工場 設備増強 | 能力増強 | 800 | 280 | 0.350 | 21 | 6 | 0.000 | |
| P03 B工場 新棟建設 | 能力増強 | 1,900 | 650 | 0.342 | 22 | 1 | ○ | 0.946 |
| P04 B工場 自動倉庫 | 能力増強 | 500 | 160 | 0.320 | 23 | 14 | 0.024 | |
| P05 省エネ設備(全工場) | 設備更新 | 450 | 120 | 0.267 | 24 | 20 | 0.050 | |
| P27 D工場 設備更新 | 設備更新 | 500 | 130 | 0.260 | 25 | 19 | 0.000 | |
| P01 A工場 第1ライン更新 | 設備更新 | 800 | 180 | 0.225 | 26 | 12 | 0.000 | |
| P08 基幹システム刷新 | IT | 1,200 | 220 | 0.183 | 27 | 9 | 0.004 | |
| P28 本社ビル改修 | 設備更新 | 500 | 20 | 0.040 | 28 | 28 | 0.000 | |
| P11 情報セキュリティ強化(取引先要請) | IT | 200 | -30 | -0.150 | 29 | 29 | ○(必須) | 1.000 |
| P02 A工場 老朽ボイラー更新(法令対応) | 設備更新 | 250 | -40 | -0.160 | 30 | 30 | ○(必須) | 1.000 |
表の「収益性指数の順位」と「基準で選択」の列を並べると、上位7件はすべて選ばれていますが、そこから先は順位どおりになっていません。収益性指数が8位の P29(0.533)と10位の P26(0.500)は選ばれず、22位の P03(0.342)と18位の P06(0.375)が選ばれています。P03 は NPV が30件で最も大きい(650百万円)うえに、NPV が3位の P07(380百万円)の前提になっている案件です。P03 と P07 を組にすると、投資額2,700百万円・NPV 1,030百万円・収益性指数0.381で、組として見れば中位の効率で大きな価値を生みます。P06 は投資が1年目の120百万円だけなので、1年目の予算の隙間を埋める役を果たしています。どちらも「1件ずつの効率」では見えない理由で選ばれていて、順位表を上から採る方式ではこうした組み合わせを拾えません。
素朴な規則の取りこぼしは、予算の大きさによっても変わります。年度予算を同じ倍率で0.5倍から1.5倍まで動かし、それぞれで整数計画と2つの素朴な規則を解いたのが次の図です。
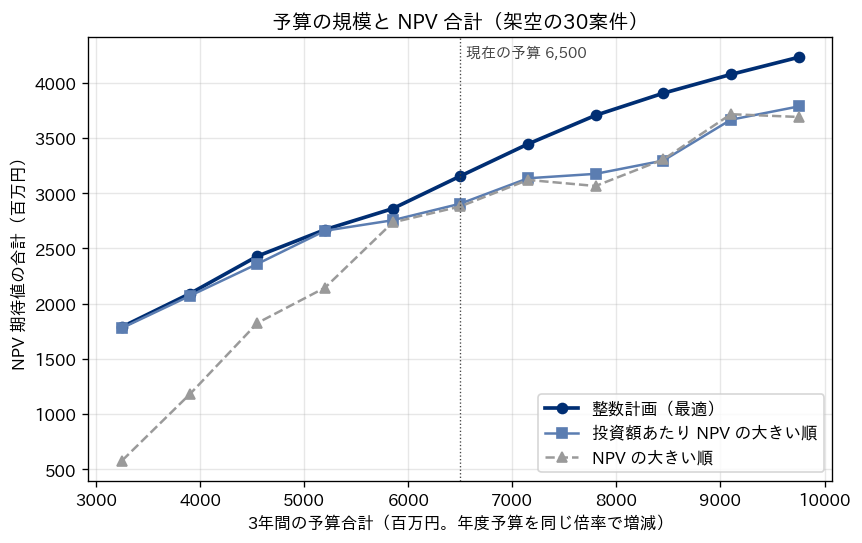
予算が現在の半分(3年合計3,250百万円)のとき、整数計画は1,790百万円、収益性指数の高い順は1,780百万円でほぼ同じでしたが、NPV の大きい順は580百万円にとどまりました。予算が小さいと、NPV の大きい案件(多くは投資額も大きい)が先に枠を埋め、他の案件が入らなくなるからです。予算が現在の1.2倍(7,800百万円)では、整数計画3,705百万円に対し、収益性指数の高い順は3,175百万円(530百万円少ない)、NPV の大きい順は3,065百万円(640百万円少ない)でした。さらに NPV の大きい順は、予算を1.1倍(7,150百万円)から1.2倍に増やしたのに、NPV 合計が3,120百万円から3,065百万円へ下がっています。採用された順をたどると、1.1倍では7件目の P20 の後に P25・P12・P29(NPV 計490百万円)が入っていましたが、1.2倍では予算が増えたことで投資額1,200百万円の P08(基幹システム刷新、NPV 220百万円)が先に入れるようになり、その後は P17・P06(計215百万円)しか入らず、P25・P12・P29 が締め出されました。順位で選ぶ規則は「予算を増やせば成果は必ず増える」という当たり前の性質さえ保証しません。整数計画は、予算を増やして前の組み合わせが実行可能なまま残る限り、NPV 合計が下がることはありません。
ナップサック型の整数計画として書く
案件を選ぶ問題は、ナップサック問題の形をしています。決められた容量の袋に、重さと価値の違う品物を詰めて価値の合計を最大にする問題で、袋の容量が予算、品物が案件、重さが投資額、価値が NPV に当たります。共通データでは年度ごとに予算があるので、袋が3つ(1〜3年目)あり、1つの案件が3つの袋に同時に重さを置く形になります。袋が1つのときと違い、ある年度に余裕があっても別の年度が詰まっていれば案件は入りません。
記事全体の基準(第2章で結果を示したもの)は、この問題を整数計画として、Python で無料で使える最適化のライブラリ PuLP で書き、PuLP に同梱されているソルバー(最適解を計算するプログラム)CBC で解いています。基準の関数 select_projects の構造を、要所だけ言葉で抜き出すと次のとおりです。決定変数は、案件ごとに1つ、選ぶなら1・選ばないなら0を取る変数 \( x_i \) です。目的は、NPV の期待値に \( x_i \) を掛けて足したものの最大化です。制約は4種類で、1つ目は年度ごとの予算(各年度について、その年度の投資額に \( x_i \) を掛けて足したものが年度予算以下)、2つ目は必須案件(P02 と P11 について \( x_i = 1 \))、3つ目は前提(P07 は P03 を選んだときだけ選べるので \( x_{P07} \leq x_{P03} \)、P20 と P19 も同じ)、4つ目は排他(P13 と P14、P21 と P22 はどちらか一方までなので \( x_{P13} + x_{P14} \leq 1 \) など)です。式で書くと、年度 \( t \) の案件 \( i \) の投資額を \( c_{i,t} \)、年度予算を \( B_t \) として、
\( \max \sum_i \mathrm{NPV}_i \, x_i \quad \text{subject to} \quad \sum_i c_{i,t} \, x_i \leq B_t \ (t = 1, 2, 3) \)
に、必須・前提・排他の式を足したものです。言葉で言えば「各年度の予算に収まり、必須を含み、前提と排他を守る組み合わせの中で、NPV の合計が最大のもの」を選んでいます。この関数は、目的の係数(案件ごとの価値)と年度予算を引数で受け取れるので、同じ制約のまま価値や予算を差し替えて解き直せます。この章の計算の多くはこの性質を使っています。
基準の答えは、14件を選んで NPV 合計3,155百万円、投資額は1年目2,470・2年目2,180・3年目1,750(合計6,400百万円)で、各年度の予算の使い残しは30・20・50百万円でした。選ばれたのは P02・P03・P06・P07・P11・P12・P13・P15・P16・P17・P19・P20・P22・P23 で、研究開発6件のうち5件、新規事業5件のうち3件が入り、設備更新8件からは必須の P02 と小口の P06 の2件だけが入っています。この記事の実行環境(一般的なノートPC)での実測で、解くのにかかった時間は0.1秒未満でした。
次のコードは、基準の関数を import して基準の答えを出し、年度予算を1つずつ ±100百万円動かして解き直すものです。第2章で述べたとおり、共通データBを作る補助モジュール project_data.py と基準の計算をまとめた baseline.py を同じフォルダに置いて実行する形で、この2つのモジュール自体は本コラムでは配布していません。
import project_data as pj
from baseline import select_projects

def ids(s):
    return " ".join(sorted(s)) if s else "なし"

npv = pj.PROJECTS["npv"].to_dict()          # 案件ID → NPV の期待値(百万円・架空)
sel0, obj0, sec, status = select_projects(npv)
print("基準: %s / NPV合計 %.0f / %s" % (status, obj0, ids(sel0)))

for year in (1, 2, 3):                       # 年度予算を1つずつ ±100 百万円動かす
    for dv in (-100, 100):
        b = dict(pj.BUDGET)
        b[year] += dv
        sel, obj, _, _ = select_projects(npv, budget=b)
        print("%d年目 %+d: NPV合計 %+.0f / 入る %s / 抜ける %s"
              % (year, dv, obj - obj0, ids(sel - sel0), ids(sel0 - sel)))
# 出力:
# 基準: Optimal / NPV合計 3155 / P02 P03 P06 P07 P11 P12 P13 P15 P16 P17 P19 P20 P22 P23
# 1年目 -100: NPV合計 -45 / 入る なし / 抜ける P06
# 1年目 +100: NPV合計 +30 / 入る P10 P26 P29 / 抜ける P12
# 2年目 -100: NPV合計 -120 / 入る P29 / 抜ける P12
# 2年目 +100: NPV合計 +85 / 入る P29 P30 / 抜ける P06 P22
# 3年目 -100: NPV合計 -25 / 入る P29 P30 / 抜ける P06 P12
# 3年目 +100: NPV合計 +0 / 入る なし / 抜ける なし
出力の読み方は次の節で説明しますが、ここでは1点だけ確認しておきます。予算を100百万円動かしただけで、入る案件と抜ける案件が複数入れ替わる年度があります。2年目を100百万円増やすと、P29 と P30 が入り、P06 と P22 が抜けます。整数計画の答えは、予算の小さな変化で組み合わせごと組み替わることがあるので、「予算が増えたら次点の案件を1件足す」という積み上げの考え方とは違う動き方をします。
制約1つあたりの費用:外して解き直す
必須・前提・排他・年度予算といった制約は、どれも経営上の理由があって置かれていますが、制約を置くたびに選べる組み合わせは狭まり、NPV 合計は下がるか、変わらないかのどちらかです。その下がり幅を、制約を1つずつ外して解き直すことで測りました。外したときに増える NPV 合計が、その制約を守るために払っている費用です。予算の扱いは、年度ごとの予算(基準)に加えて、使い残しを翌年度へ繰り越せる場合(1年目の支出は1年目の予算以下、1〜2年目の累計は1〜2年目の予算の累計以下、のように累計で判定する)と、年度の区切りをなくして3年合計6,500百万円だけを守る場合を比べています。
| 外した制約 | NPV 合計 | 基準との差(制約の費用) | 件数 | 投資額(1年目・2年目・3年目) | 新たに入った案件 | 抜けた案件 |
|---|---|---|---|---|---|---|
| なし(基準) | 3,155 | 0 | 14 | 2,470・2,180・1,750 | なし | なし |
| 必須(P02・P11) | 3,340 | +185 | 15 | 2,470・2,150・1,600 | P18 P25 P26 P29 P30 | P02 P06 P07 P11 |
| 前提(P07←P03、P20←P19) | 3,295 | +140 | 20 | 2,460・2,190・1,740 | P04 P10 P18 P25 P26 P29 P30 | P03 |
| 排他(P13/P14、P21/P22) | 3,155 | 0 | 14 | 2,470・2,180・1,750 | なし | なし |
| 年度予算を繰越可にする | 3,190 | +35 | 15 | 2,390・2,270・1,840 | P14 P26 P29 | P06 P13 |
| 年度予算を3年合計だけにする | 3,205 | +50 | 20 | 2,960・2,140・1,340 | P09 P10 P18 P21 P24 P25 P26 P29 P30 | P03 P07 P22 |
| 必須・前提・排他をすべて | 3,525 | +370 | 18 | 2,180・2,190・1,800 | P10 P14 P24 P25 P26 P29 P30 | P02 P03 P11 |
表の「基準との差(制約の費用)」の列で最も大きいのは必須の+185百万円です。必須の2件(P02 と P11)の NPV は合わせて-70百万円なので、2件を外すだけなら70百万円しか増えないはずですが、実際には185百万円増えました。差の115百万円は、2件の投資額(1年目350百万円、2年目60百万円、3年目40百万円)が予算を占めていたことで締め出されていた案件の価値です。必須案件の費用は、その案件自身の NPV の赤字に、予算を押さえることで他の案件を締め出す費用が加わったものになります。法令対応や取引先の要請で外せない案件であっても、その費用を「赤字の額」ではなく「締め出しまで含めた額」で把握しておくと、たとえば実施時期を予算に余裕のある年度へずらせないか、といった検討の材料になります。
前提を外すと+140百万円でした。このとき P03(新棟)は抜けましたが、P07(新棟内の第2ライン)は残っています。新棟なしに第2ラインは建てられないので、この組み合わせは現実には実行できません。この行は「前提を外した答えを採る」ためのものではなく、P07 の価値を得るために、収益性指数の低い P03 を抱き合わせで実施していることの費用が140百万円に当たる、と読むためのものです。仮に P03 の投資額を抑える設計の見直しや、P07 を新棟以外に置く代替案があれば、最大でこの程度の価値が見込める、という目安になります。
排他は、外しても答えが変わりませんでした。基準ではもともと P13 だけを選び P14 を選んでおらず、P22 だけを選び P21 を選んでいないので、排他の制約が効いていない(基準の答えの選択を妨げていない)ということです。制約が答えに効いているかどうかは、このように外して解き直すと分かります。効いていない制約は、議論の時間を割かなくてよい制約でもあります。
予算の扱いの違いでは、繰越を認めると+35百万円、年度の区切りをなくすと+50百万円でした。年度の区切りをなくした場合は、1年目に2,960百万円を使っていて、1年目の予算2,500百万円を460百万円超えています。資金繰りの上で1年目に前倒しして使える資金がなければ実行できない答えですが、年度の区切りの費用が50百万円にとどまることは、年度予算の配分そのものは大きく外れていないことを示しています。繰越を認めた場合は P13 が P14 に入れ替わるなど、組み合わせは変わりますが、NPV 合計の差は35百万円です。
この表は、経営会議での議論の順番を決めるのに使えます。費用の大きい制約(この例では必須と前提)ほど、その制約が本当に動かせないのかを確かめる価値があり、費用が0の制約(この例では排他)は議論の対象から外せます。なお、制約の費用は単純に足し算になりません。必須・前提・排他をすべて外したときの+370百万円は、1つずつ外したときの+185、+140、0の合計(+325百万円)より大きくなっています。制約どうしが同じ予算を取り合っているので、複数を同時に緩めると、1つずつでは入らなかった組み合わせが入るためです。
部分実施:0か1をやめて0から1の連続にした場合
案件を途中まで実施できる、つまり規模を縮めて実施でき、費用を6割に抑えれば価値も6割得られる、と仮定すると、決定変数は0か1ではなく0から1の間の連続の値を取れるようになります。この問題は整数の条件を外した線形計画で、整数計画の線形計画緩和と呼ばれます。共通データで、必須・前提・排他の制約をそのままにして、決定変数だけを0から1の連続にして解きました。
線形計画緩和の NPV 合計は3,276.6百万円で、整数計画の3,155百万円より121.6百万円(約3.9%)大きくなりました。値が1未満で選ばれたのは4件で、P03 と P07 がともに0.657、P06 が0.482、P10 が0.089でした。前提の制約 \( x_{P07} \leq x_{P03} \) のため、P03 と P07 は同じ割合で縮められています。1で選ばれた(全部実施する)のは15件で、整数計画の基準の14件のうち P03・P06・P07 を除いた11件(P02・P11・P12・P13・P15・P16・P17・P19・P20・P22・P23)に、整数計画では選ばれなかった P25・P26・P29・P30 が加わっています。新棟と第2ラインの規模を約3分の2に縮め、浮いた予算で小さめの案件を4件足す、という答えです。
この121.6百万円の差は、「案件を分割できないこと」の費用の上限の目安です。現実には、新棟を3分の2の規模で建てたときに価値も3分の2になる保証はなく、建物や基幹システムのように縮めると価値がほとんど残らない案件もあります。線形計画緩和の答えをそのまま採ることはできませんが、2つの使い道があります。1つ目は、整数計画の答えがどこまで改善の余地を残しているかを測ることです。整数計画の最適は線形計画緩和の値を超えないので、どんな工夫をしても、この制約のもとでは3,276.6百万円を超える NPV 合計は得られません。2つ目は、規模を変えられる案件の候補を見つけることです。線形計画緩和が縮めたい案件(この例では P03・P07)は、もし段階的に建てる設計や規模を縮めた代替案を作れるなら、価値が出る可能性がある案件です。
反対に、線形計画緩和で1になった案件だけを採る(1未満の案件を切り捨てる)と、NPV 合計は2,570百万円で、整数計画より585百万円少なくなりました。予算・必須・前提・排他の制約は満たしていますが、P03 と P07 がまとめて抜けるので、大きな価値を取りこぼします。連続の答えを丸めて整数の答えを作る方法は、規模の大きな案件ほど大きく外れるので、整数計画で解き直すべきです。
予算の限界価値:どの年度の予算が効いているか
年度予算を少し増やしたら NPV 合計がいくら増えるか、少し減らしたらいくら減るかを、予算の限界価値と呼ぶことにします。予算の追加を財務部門に申請するとき、あるいは予算の削減を求められたときに、その影響を金額で示す指標です。年度予算を1つずつ、また全年度を同時に、±100百万円と±300百万円動かして整数計画を解き直しました。
| 動かした予算 | -300 | -100 | +100 | +300 |
|---|---|---|---|---|
| 1年目(基準 2,500) | -185 | -45 | +30 | +65 |
| 2年目(基準 2,200) | -180 | -120 | +85 | +95 |
| 3年目(基準 1,800) | -155 | -25 | 0 | 0 |
| 全年度を同時に | -315 | -120 | +140 | +400 |
表の数字は、基準の NPV 合計3,155百万円からの差(百万円)です。最も効いているのは2年目の予算で、100百万円増やすと+85百万円、減らすと-120百万円でした。3年目の予算は、増やしても NPV 合計がまったく増えません。基準の答えは3年目の予算を50百万円使い残していて、3年目の予算をさらに増やしても、3年目の投資だけで入れられる案件がないためです。3年目を100百万円減らした場合も、使い残しの50百万円で半分を吸収できるので、減少は-25百万円にとどまりました。1年目は、増やすと+30百万円、減らすと-45百万円です。
同じ問いに、線形計画緩和からも答えが出せます。線形計画には、制約の右辺(ここでは年度予算)を1単位増やしたときに目的の値がいくら増えるかを表す双対価格(シャドウプライス)があり、PuLP では解いた後の制約の pi 属性で読めます。共通データの線形計画緩和では、予算1百万円あたりの双対価格は1年目0.375、2年目0.5625、3年目0.1054でした。100百万円あたりに直すと、37.5、56.3、10.5百万円です。2年目が最も高く、3年目が最も低いという順番は、整数計画で解き直した結果と同じです。ただし、整数計画では予算の変化と NPV 合計の変化が比例せず、2年目の+100百万円で+85百万円(双対価格からの見込みの約1.5倍)、+300百万円でも+95百万円にしかなりません。案件が分割できないので、予算が増えた分を使い切れる組み合わせがあるかどうかで、増え方が階段状になるためです。双対価格は「どの年度が効いているか」の順番を素早く知るのに向き、具体的な金額は整数計画で解き直して確かめるのが確実です。
全年度を同時に動かすと、+100百万円ずつ(合計+300百万円)で+140百万円、+300百万円ずつ(合計+900百万円)で+400百万円でした。全年度+100百万円の+140百万円は、年度ごとに+100百万円したときの+30、+85、0の合計(+115百万円)より大きくなっています。複数年度に投資が分かれる案件は、すべての年度に余裕ができてはじめて入れられるので、予算の効き方も足し算になりません。予算の増額を申請するときは「どの年度に、いくら」の組で示す必要があります。
経営の目線では、この表は2つの判断に使えます。1つ目は予算の年度配分の見直しです。この例では3年目の予算に使い残しがあり、増やしても価値が生まれない一方、2年目の予算は1百万円あたりの価値が最も高くなっています。資金の手当てが許すなら、3年目の枠の一部を2年目へ前倒しすることを検討する根拠になります。2つ目は削減への備えです。業績の悪化で予算の削減を求められたとき、どの年度をいくら削ると NPV がいくら失われるかを、この表であらかじめ示せます。2年目を100百万円削ると120百万円の NPV を失う一方、3年目を100百万円削っても失うのは25百万円です。
NPV の見積りが動いたときの選択の変化
整数計画の答えは、入力した NPV の見積りが正しいことを前提にしています。見積りは将来の予測なので、外れることを前提に、答えがどれだけ見積りに左右されるかを確かめておく必要があります。3通りの動かし方で確かめました。
1つ目は、すべての案件の NPV を一律に±20%動かす場合です。全案件の NPV に0.8を掛けても1.2を掛けても、選ばれる組み合わせは基準と同じで、NPV 合計だけが2,524百万円と3,786百万円に変わりました。目的の係数をすべて同じ倍率で動かしても最適な組み合わせは変わらないので、これは計算するまでもない結果ですが、「見積りを一律に何割か割り引いてから選ぶ」運用が組み合わせを何も変えないことを、共通データでも確かめた形です。
2つ目は、種別ごとに動かす場合です。研究開発と新規事業の見積りは楽観に偏りやすい、という仮定を置いて、この2種別の NPV だけを20%下げると、P12(EC・直販チャネル構築)が抜け、P18・P26・P29 が入りました。40%下げると、P12 に加えて P13(海外販売拠点 X国)も抜け、P10・P18・P26・P29・P30 が入りました。設備更新と能力増強の NPV だけを20%下げた場合は、P22 が抜けて P29 が入りました。一律に動かすと何も変わらない一方、種別ごとに偏りを補正すると組み合わせが変わります。過去の案件で見込みと実績の差を種別ごとに記録しておけば、その差を補正として入れられます。この運用は第13章で扱います。
種別ごとの補正をしたときに、補正後の見積りで最適な組み合わせと、基準の組み合わせを補正後の見積りで評価した値の差は、研究開発と新規事業を20%下げた場合で14百万円、40%下げた場合で76百万円、設備更新と能力増強を20%下げた場合で8百万円でした。つまり、見積りの偏りを補正せずに基準の答えを採っても、損は数十百万円の規模にとどまります。組み合わせは入れ替わっても、入れ替わる案件どうしの価値が近いので、損は小さく収まる、ということです。
3つ目は、案件ごとに独立な乱数で動かす場合です。各案件の NPV に「1+(-0.2から0.2の一様乱数)」を掛けた見積りを500通り作り、それぞれで整数計画を解きました。この記事の実行環境での実測で、500回の求解に合わせて58.8秒かかりました。次の図は、各案件が500回のうち何割で選ばれたかです。
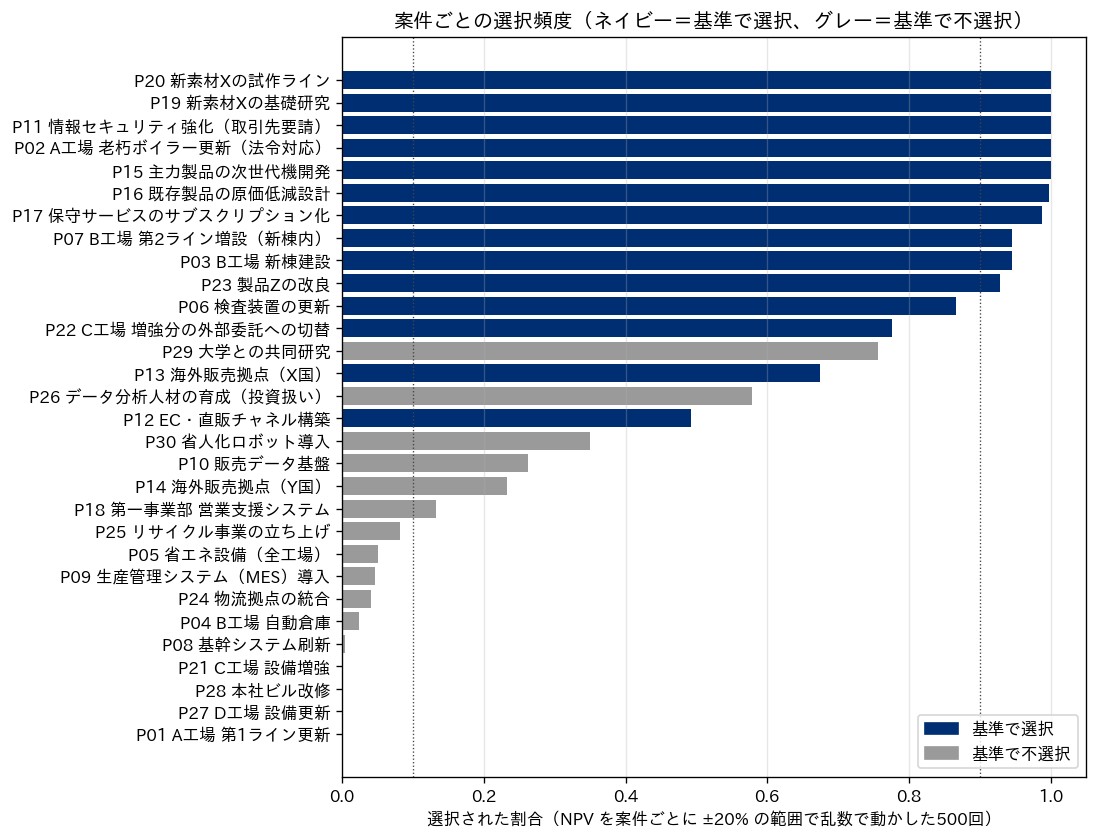
500回のうち、基準とまったく同じ組み合わせになったのは109回(21.8%)でした。基準から入れ替わった案件の数(入った案件と抜けた案件の合計)は平均3.94件、最大13件でした。案件を3つの群に分けて読めます。1つ目は、500回すべてで選ばれた5件(P02・P11・P15・P19・P20)です。P02 と P11 は必須なので当然ですが、P15・P19・P20 は NPV が±20%動いても常に選ばれる、見積りの誤差に強い案件です。0.9を超える P03・P07・P16・P17・P23 もほぼこの群に入ります。2つ目は、一度も選ばれなかった4件(P01・P21・P27・P28)と、0.1未満の6件(P04・P05・P08・P09・P24・P25)で、±20%の範囲の見積りの誤差では答えに入ってこない案件です。3つ目は、選択頻度が0.1から0.9の間にある10件(P06・P10・P12・P13・P14・P18・P22・P26・P29・P30)で、見積りが少し動くだけで入ったり抜けたりする、境界の案件です。基準で選ばれた P12 は0.492と、ほぼ半々でした。基準で選ばれなかった P29 は0.756、P26 は0.578と、半分以上の回で選ばれています。
境界の案件の入れ替わりは、NPV 合計にはあまり響きません。それぞれの見積りのもとで最適な組み合わせの NPV 合計と、基準の組み合わせをその見積りで評価した NPV 合計の差は、500回の平均で23.6百万円、中央値で15.8百万円、95%点(小さい方から数えて95%の位置の値)で72.2百万円、最大で133.7百万円でした。基準の NPV 合計3,155百万円に対して、平均で0.7%程度です。境界の案件どうしは価値が拮抗しているので、どちらを選んでも大差がない、ということです。
境界の案件を見分ける:1件を入れる・外す費用
乱数で何百回も解き直さなくても、境界の案件は別の方法で見分けられます。基準で選ばれた案件を1件ずつ強制的に外し、基準で選ばれなかった案件を1件ずつ強制的に入れて、それぞれ解き直したときの NPV 合計の減少を測る方法です。この減少は、その1件について「モデルの答えと違う判断をする」ときに払う費用に当たります。弊社コラム『数理最適化の定式化パターン集』第11章が「政策的にその施策を通すことの価格」と呼んだものを、30件すべてで計算したことになります。
| 区分 | 案件(入れる・外すときの NPV 合計の減少、百万円) | 選択頻度の範囲 |
|---|---|---|
| 基準で選択、外す費用が大きい | P19(-400)、P20(-250)、P15(-170)、P03(-155)、P07(-155) | 0.946〜1.000 |
| 基準で選択、外す費用が中程度 | P16(-55) | 0.998 |
| 基準で選択、外す費用が30百万円以下 | P13(-30)、P17(-30)、P23(-20)、P06(-15)、P12(-10)、P22(-10) | 0.492〜0.988 |
| 基準で不選択、入れる費用が30百万円以下 | P14(-30)、P10(-15)、P18(-10)、P26(-10)、P29(-10)、P30(-10) | 0.132〜0.756 |
| 基準で不選択、入れる費用が中程度 | P24(-55)、P25(-60)、P05(-80) | 0.040〜0.082 |
| 基準で不選択、入れる費用が大きい | P09(-110)、P27(-125)、P04(-145)、P08(-195)、P21(-215)、P28(-285)、P01(-325) | 0.000〜0.046 |
表の「選択頻度の範囲」の列と並べると、入れる・外す費用が30百万円以下の12件は、乱数で解き直した選択頻度が0.13から0.99の間にあり、前の節の境界の10件はすべてこの12件に含まれます。費用が大きい案件ほど、選択頻度は0か1に寄っています。P19 を外す費用が400百万円と、P19 自身の NPV(300百万円)より大きいのは、前提の制約により P19 を外すと P20 も外れるためです。費用が10百万円の案件は、NPV が5百万円刻みで置かれた共通データの中では、ほぼ同点の扱いです。
この「1件ずつ入れる・外す」計算は、案件数と同じ回数(この例では28回。必須の2件は除く)解き直すだけで済み、乱数の設定も要りません。結果の読み方も直接的で、「P12 を外しても全体の NPV は10百万円しか減らない」「P01 を入れると325百万円減る」という形で、会議の場でそのまま使えます。乱数で動かす方法は、見積りの誤差の大きさを仮定する必要がある代わりに、複数の案件が同時に動いたときの入れ替わりも見られます。2つの方法が同じ案件を境界と判定していることは、共通データでの結果の確かさを裏づけています。
計算量:案件数が増えても解けるか
整数計画は、一般には変数の数が増えると計算時間が急に伸びることがある問題ですが、案件選択の典型的な規模でどうなるかを実測しました。共通データの30件をもとに、投資額と NPV を0.7倍から1.3倍の範囲で乱数で揺らした複製を作り、30件・100件・300件・1,000件・3,000件の仮想の例(架空の設定)を作りました。年度予算は件数に比例させ、必須・前提・排他は30件ごとに共通データと同じ形で付けています。それぞれの規模で乱数を変えた3例を、CBC(制限時間20秒)で解いた実行時間です。
| 案件数 | 実行時間(3例、秒) | 解の状態 |
|---|---|---|
| 30 | 0.07・0.05・0.06 | 3例とも最適 |
| 100 | 0.10・0.11・0.11 | 3例とも最適 |
| 300 | 0.17・0.17・0.18 | 3例とも最適 |
| 1,000 | 0.39・0.27・0.52 | 3例とも最適 |
| 3,000 | 0.41・0.61・0.48 | 3例とも最適 |
この記事の実行環境(一般的なノートPC)での実測で、3,000件でも1秒未満で最適解(ソルバーが最適性を確認した解)が得られました。表の「実行時間」の列は、同じPCで他の計算が並行して動いている中での実測なので、多少揺れます。1年に検討する投資案件が数十件から数百件程度であれば、この構造のもとでは、案件選択の整数計画そのものの計算時間が実務の制約になることは少ないと考えています。
ただし、この結果は「年度予算の制約が3本、前提と排他が少数」という構造での話です。人員の上限や部門別の枠など制約の種類が増えたり、案件どうしの相乗効果を目的に入れたり、シナリオごとの損失を制約に入れたり(第12章で扱う CVaR 制約つきの選び方)すると、計算は重くなりえます。計算量が問題になるかどうかは、案件数よりも、制約と目的の構造で決まります。計算時間を気にするよりも、この章の前の節で見たように、条件を変えて何十回、何百回と解き直せることを活かす使い方のほうが、経営の判断には役立ちます。
経営の判断に翻訳する:境界の案件こそ人が見る
この章の結果を、投資委員会や経営会議での判断の進め方に翻訳します。1つ目は、順位表で決めることの損失です。共通データでは、収益性指数の高い順に採る規則は整数計画より250百万円、NPV の大きい順に採る規則は275百万円少ない NPV 合計にとどまりました。これは基準の NPV 合計3,155百万円の約8〜9%に当たります。予算が現在の1.2倍の場合には、取りこぼしは530百万円と640百万円に広がり、NPV の大きい順の規則では、予算を増やしたのに NPV 合計が減る逆転まで起きました。案件の順位表は議論の材料として有用ですが、順位表の上から線を引く手続きは、予算の枠への収まり方と、前提・排他の関係を見落とします。
2つ目は、制約と予算の値札です。必須の2件は、自身の赤字70百万円に、予算を押さえることによる締め出しの115百万円を加えた185百万円の費用を払っていました。前提の関係は140百万円、排他は0でした。年度予算は2年目が最も効いていて、100百万円の増減で+85百万円から-120百万円の差が出る一方、3年目は増やしても何も生みません。これらの値札は、経営が「どの制約を動かす交渉をするか」「予算をどの年度に厚くするか」を決めるための材料になります。モデルの答えを1案示して終わりにせず、制約の値札と予算の限界価値の表を一緒に示すことが、配分の議論を「どの案件が良いか」から「どの条件を動かすと、いくら増えるか」へ移す方法だと考えています。
3つ目は、境界の案件に人の判断を集中させることです。NPV の見積りが±20%動いても常に選ばれる案件(共通データでは P15・P19・P20 と、ほぼ常に選ばれる P03・P07・P16・P17・P23)と、まず選ばれない案件(P01・P21・P27・P28 など)は、細かな見積りの議論に時間をかけても答えが変わりません。会議の時間を使うべきなのは、入れる・外す費用が数十百万円以下で、見積りしだいで入れ替わる境界の案件(共通データでは P06・P10・P12・P13・P14・P18・P22・P26・P29・P30 など)です。境界の案件どうしは NPV の上では拮抗しているので、どちらを選んでも NPV 合計の差は小さく、だからこそ、戦略との適合、実行する人員の余力、失敗したときの損失の大きさ、見積りの根拠の確かさといった、モデルに入っていない観点で人が決める意味があります。戦略適合スコアや人員の制約を入れた選び方は第11章で、見積りのばらつきと悪い側に外れたときの損失を入れた選び方は第12章で扱います。
判断を誤ったときの損失の型も整理しておきます。境界の案件で判断を誤っても、NPV 合計の損失は数十百万円の規模にとどまります。一方、外す費用が大きい案件(P19 の400百万円、P20 の250百万円、P15 の170百万円)を、戦略上の好みや担当部門の声の大きさで外したり、入れる費用が大きい案件(P01 の325百万円、P28 の285百万円)を押し込んだりすると、損失は一気に数百百万円になります。モデルの答えから外れる判断をするときに、その判断の費用を金額で添えておくことが、誤りの大きさを抑える最も簡単な手段です。
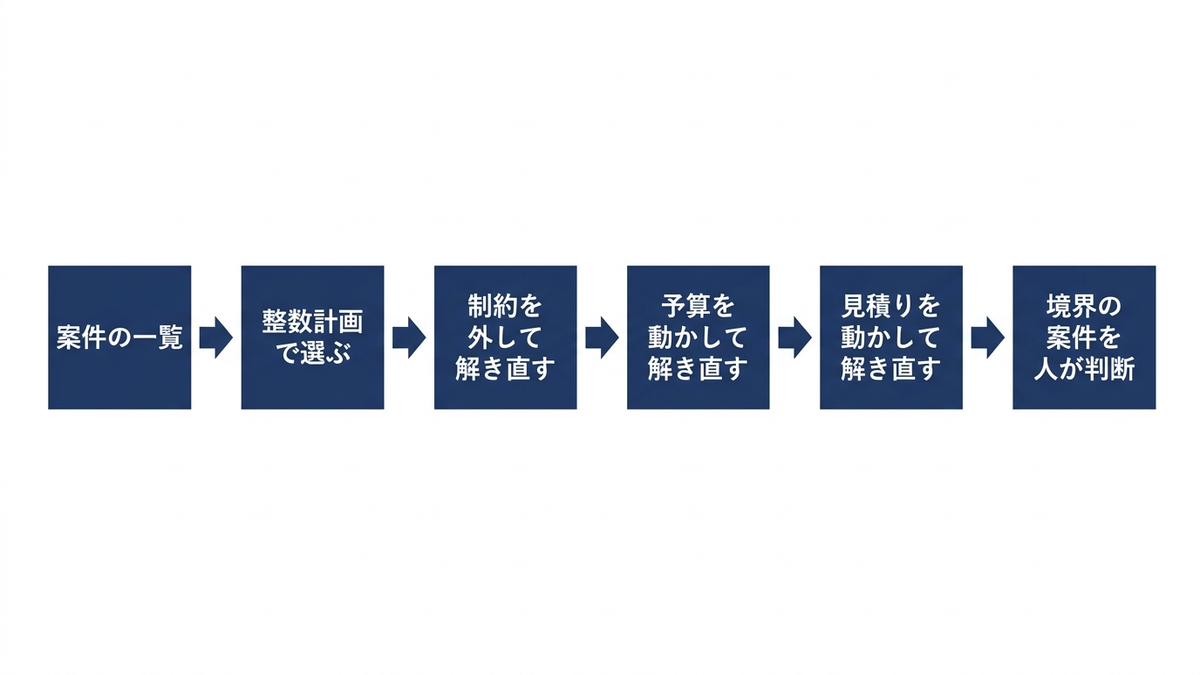
この章の要点は3つです。第一に、予算に上限があるときの案件選択は、ナップサック型の整数計画として書くと、年度予算・必須・前提・排他を守る組み合わせの中で NPV 合計が最大のものを直接求められ、共通データでは、順位で選ぶ規則より多い NPV 合計を得ました(収益性指数の高い順より250百万円、NPV の大きい順より275百万円、戦略適合スコアの高い順より230百万円多い)。第二に、制約を外して解き直す、予算を動かして解き直す、案件を1件ずつ入れる・外して解き直すことで、制約の費用、年度ごとの予算の限界価値、各案件の判断の費用を金額で示せます。第三に、NPV の見積りを動かすと、常に選ばれる案件、まず選ばれない案件、見積りしだいで入れ替わる境界の案件に分かれ、人の判断はこの境界の案件に集中させるのが効率的です。次の第11章では、この章で期待値にまとめていた研究開発と新規事業の成功確率を表に出し、段階投資と、NPV と戦略適合の2つの目的を同時に見る選び方を扱います。
この章を深めたい方への参考書籍
『コーポレート・ファイナンス 第10版 上』(リチャード・A・ブリーリー、スチュワート・C・マイヤーズ、フランクリン・アレン著、藤井眞理子・国枝繁樹監訳、日経BP社):米国のMBAで広く使われているコーポレートファイナンスの教科書の翻訳で、版元の紹介では価値評価・資本コスト・合理的な設備投資の決定などを扱うとされています。この章で前提にした NPV の考え方と、投資の判断基準どうしの関係を、理論の側から体系的に確かめるのに向いています。
『コーポレートファイナンス 戦略と実践』(田中慎一・保田隆明、ダイヤモンド社):会社の一生をたどる形でファイナンスの全体像を示し、会計の読み方から現在価値、DCF法による企業価値の算出までを実務の目線で説明する本です。この章の NPV が、事業の価値の評価とどうつながるかを、日本の実務に近い言葉で押さえるのに役立ちます。
第11章 研究開発テーマと新規事業のポートフォリオ
第10章では、第2章で用意したサンプルデータ(架空の中堅製造業の投資案件30件と3年間の年度予算)を使い、年度予算・必須案件・前提・排他の制約のもとで NPV 期待値の合計を最大にする案件の組み合わせを整数計画で選びました。基準の選択は14件・NPV 期待値の合計 3,155百万円で、そのうち8件が研究開発と新規事業の案件でした。この章では、その8件を含む研究開発・新規事業の11件に焦点を当てます。これらの案件は、成功するか失敗するかの二択を含むので、設備の更新や能力増強とは同じ物差しで並べにくい性質を持っています。成功確率と成功したときの価値の関係、結果を見てから次の投資を決める段階投資の価値、成功件数のばらつき、NPV と戦略適合の2つの目的を同時に扱う方法、人員の余力を制約に足したときの変化を、共通データで実行して確かめます。景気との相関や最悪時の損失を制約に入れた全案件の最適化は第12章で扱います。
研究開発・新規事業の案件は設備投資と何が違うか
共通データの30件のうち、種別が研究開発の6件と新規事業の5件、合わせて11件だけに1未満の成功確率が設定されています。成功確率は0.25から0.80までで、残りの19件(設備更新・能力増強・IT)は成功確率1、つまり NPV が正規分布に従ってばらつくだけで、「全く成果が出ない」という結果はありません。第2章で説明したとおり、このデータは乱数で作った架空のもので、データを作った側は NPV の本当の分布(真のモデル)を知っています。真のモデルでは、成功確率1未満の案件は、成功すれば「成功時の価値」の周りにばらつき、失敗すれば投資額の7割が損失になります。成功・失敗は案件ごとに独立に決まり、景気の要因は成功したときの値だけに効きます。
この違いは、案件の評価に3つの影響を与えます。1つ目は、NPV の期待値が「実際には起きない値」になることです。成功確率0.5の新規事業の NPV 期待値が200百万円だとしても、200百万円前後の結果が出ることはほとんどなく、実際の結果は「大きく当たる」か「投資の大半を失う」かのどちらかに分かれます。2つ目は、ばらつきの大きさです。第2章のシナリオ1,000本で案件ごとの NPV の標準偏差を見ると、成功確率1の案件で最も大きいのは B工場 新棟建設(P03)の424百万円ですが、新素材Xの基礎研究(P19)は985百万円、主力製品の次世代機開発(P15)は900百万円で、期待値に対するばらつきの比(標準偏差÷期待値)は、P03 の0.65(424÷650)に対して P19 は3.3(985÷300)、P15 は1.7(900÷520)で、それぞれ約5倍と約2.7倍です。3つ目は、結果が時間をかけて少しずつ明らかになることです。基礎研究の結果が出れば、その先の試作に進むかどうかを、結果を見てから決められます。設備の更新にはこの「途中で止める」選択肢がほとんどありません。
第10章の整数計画は、こうした違いを NPV の期待値1つに畳み込んで選んでいます。期待値で選ぶこと自体は、多数の案件を長く続けていく会社にとって合理的な出発点ですが、研究開発・新規事業については、期待値の裏にある「成功したときにいくらを見込んでいるのか」「何件が成功しそうか」「途中で止められるか」を合わせて見ないと、期待値の数字を正しく読めません。この章の残りでは、この3点を順に数字にしていきます。
期待値の罠、成功したときにいくらを見込んでいるのか
共通データの真のモデルでは、成功確率 \( q \) の案件の成功時の価値 \( V \) を、NPV の期待値が設定値 npv に一致するように決めています。失敗したときの損失は投資額の7割なので、次の式が成り立ちます。
\( q \times V – (1 – q) \times 0.7 \times \text{投資額} = \text{npv} \)
言葉で言うと、「成功したときの価値に成功確率を掛けたものから、失敗したときの損失に失敗確率を掛けたものを引くと、NPV の期待値になる」という式です。これを \( V \) について解けば、期待値の裏で成功時にいくらを見込んでいるかが分かります。第3章では、この逆算を主力製品の次世代機開発(P15)と基礎研究(P19)について示しました。ここでは11件すべてに広げて、案件どうしを並べて比べます。改めて P19 で計算をたどると、新素材Xの基礎研究(P19)は、成功確率0.25・投資額360百万円・NPV 期待値300百万円です。失敗時の損失は 360×0.7=252百万円、これに失敗確率0.75を掛けると189百万円です。期待値300百万円を出すには、成功時に 300+189=489百万円を成功確率0.25で割った1,956百万円の価値を見込んでいなければなりません。投資額の5.4倍、NPV 期待値の6.5倍です。
同じ計算を11件すべてに行ったのが次の表です。「成功時の価値」は上の式で計算した \( V \)、「失敗時の損失」は投資額の7割、「期待値に対する倍率」は成功時の価値を NPV 期待値で割ったもの、「投資額に対する倍率」は成功時の価値を投資額で割ったものです。「負になる確率」は第2章のシナリオ1,000本で NPV が0を下回った割合で、成功時でも景気が悪ければ負になることがあるので、真のモデルの確率としては失敗確率以上になります。ただし、1,000本という有限の本数で数えているので、失敗が出た本数そのものが設定の失敗確率から少しぶれ、表では P19(失敗確率0.75に対して0.744)のように失敗確率をわずかに下回る行もあります。表は成功確率の低い順に並べました(金額は百万円・すべて架空)。
| 案件 | 種別 | 投資額 | 成功確率 | NPV 期待値 | 成功時の価値 | 失敗時の損失 | 期待値に対する倍率 | 投資額に対する倍率 | 負になる確率 |
|---|---|---|---|---|---|---|---|---|---|
| P19 新素材Xの基礎研究 | 研究開発 | 360 | 0.25 | 300 | 1,956 | 252 | 6.52 | 5.43 | 0.744 |
| P29 大学との共同研究 | 研究開発 | 150 | 0.35 | 80 | 424 | 105 | 5.29 | 2.82 | 0.646 |
| P20 新素材Xの試作ライン | 研究開発 | 300 | 0.40 | 250 | 940 | 210 | 3.76 | 3.13 | 0.605 |
| P13 海外販売拠点(X国) | 新規事業 | 600 | 0.45 | 320 | 1,224 | 420 | 3.83 | 2.04 | 0.558 |
| P25 リサイクル事業の立ち上げ | 新規事業 | 500 | 0.45 | 210 | 894 | 350 | 4.26 | 1.79 | 0.554 |
| P12 EC・直販チャネル構築 | 新規事業 | 400 | 0.50 | 200 | 680 | 280 | 3.40 | 1.70 | 0.497 |
| P14 海外販売拠点(Y国) | 新規事業 | 550 | 0.50 | 260 | 905 | 385 | 3.48 | 1.65 | 0.488 |
| P15 主力製品の次世代機開発 | 研究開発 | 700 | 0.60 | 520 | 1,193 | 490 | 2.29 | 1.70 | 0.408 |
| P17 保守サービスのサブスクリプション化 | 新規事業 | 220 | 0.60 | 170 | 386 | 154 | 2.27 | 1.75 | 0.401 |
| P23 製品Zの改良 | 研究開発 | 240 | 0.70 | 160 | 301 | 168 | 1.88 | 1.25 | 0.313 |
| P16 既存製品の原価低減設計 | 研究開発 | 160 | 0.80 | 140 | 203 | 112 | 1.45 | 1.27 | 0.192 |
表から読み取れることは2つあります。1つ目は、成功確率が低い案件ほど、期待値に対する倍率が大きくなることです。成功確率0.80の原価低減設計(P16)は成功時に期待値の1.45倍を見込めば足りますが、成功確率0.25の基礎研究(P19)は6.52倍、成功確率0.35の共同研究(P29)は5.29倍を見込んでいます。期待値の表だけを見ると P19 の300百万円と P15 の520百万円は同じ列に並んだ数字ですが、その裏で前提にしている成功の大きさはまったく違います。2つ目は、「負になる確率」の列です。P19 はシナリオ1,000本のうち74.4%で NPV が負になり、P29 は64.6%、P20 は60.5%です。基準の選択に入っている8件のうち、P19・P20・P13 の3件は、半分以上の確率で損失を出す案件です。
この表は、案件の起案書の読み方を変えます。起案書に「成功確率25%、NPV 期待値300百万円」と書かれていたら、審査する側は「成功したら約2,000百万円の価値が出るという前提ですね。その根拠は何ですか」と聞き返すことができます。投資額360百万円の基礎研究が、成功すれば投資額の5倍以上の価値を生むという主張は、市場の大きさ・事業化までの期間・競合の状況から裏付けられるかどうかを確かめるべき大きな前提です。逆に、成功時の価値の根拠が弱いのに期待値だけが大きく書かれているなら、その期待値は成功確率か成功時の価値のどちらかが楽観的に置かれている疑いがあります。成功確率と期待値の2つから成功時の価値を逆算する計算は、表計算ソフトでも1行で書けます。審査の資料に「成功時の価値」と「失敗時の損失」の2列を足すだけで、期待値の数字が何を前提にしているかが見えるようになります。
なお、ここでの計算は共通データの設定(失敗時は投資額の7割が損失、成功時は景気要因で上下にばらつく)を前提にしています。現実の案件では、失敗の仕方は一通りではなく、「途中で止めて投資額の一部だけを失う」「部分的に成果が出る」といった中間の結果もあります。その場合でも、「期待値を出すために、うまくいったときにいくらを見込んでいるのか」を逆算して確かめるという考え方はそのまま使えます。案件の NPV 分布を三点見積りやシナリオで置く方法は第3章で扱いました。
段階投資、結果を見てから次を決める価値
共通データには、新素材Xの基礎研究(P19)と新素材Xの試作ライン(P20)という、前提の関係にある2件があります。P20 は P19 を選んだときだけ選べるという制約で、第10章の整数計画にもこの制約が入っています。ただし、共通データの真のモデルでは、成功・失敗は案件ごとに独立に決まります。つまり、P20 の成功確率0.40は P19 の結果によらず、P19 が失敗しても P20 は40%の確率で成功する設定です。整数計画に入っている前提の制約は「P19 をやらずに P20 だけをやることはできない」という選び方の順序を表しているだけで、「P19 の結果が P20 の成否を左右する」という情報のつながりは表していません。
現実の研究開発では、後者のつながりのほうが自然です。基礎研究で新素材の性能が確かめられなければ、試作ラインを作っても事業になりません。そこで、この節だけの架空の設定として、P20 は P19 が成功したときだけ成功しうる(P19 が成功した場合の P20 の成功確率は0.40、P19 が失敗した場合は0)と置き換え、P20 の成功時の価値と失敗時の損失は共通データと同じ値を使って、2通りの決め方を比べました。1つは、P19 の結果を見ずに、最初に P19 と P20 の両方の実施を決めてしまう一括決定です。もう1つは、P19 の結果を見て、成功したときだけ P20 に投資する段階決定です。次の表がその設定と結果です(金額は百万円・架空)。
| 項目 | 値 | 説明 |
|---|---|---|
| P19 の成功確率 | 0.25 | 共通データと同じ |
| P20 の成功時の価値 | 940 | 共通データの式で逆算した値(前節の表) |
| P20 の失敗時の損失 | 210 | 投資額300の7割 |
| P19 成功後の P20 の成功確率 | 0.40 | この節の架空の設定 |
| P19 失敗後の P20 の成功確率 | 0 | この節の架空の設定 |
| P19 成功後に P20 を実施したときの P20 の期待値 | 250.0 | \( 0.40 \times 940 – 0.60 \times 210 \) |
| P19 失敗後に P20 を実施したときの P20 の期待値 | -210.0 | 必ず失敗するので損失だけが残る |
| 一括決定の P20 の期待値 | -95.0 | 0.25×250 + 0.75×(-210) |
| 段階決定の P20 の期待値 | 62.5 | 0.25×250 + 0.75×0(失敗なら投資しない) |
| 段階化の価値 | 157.5 | 段階決定と一括決定の差 |
| P20 への投資額の期待値 | 一括 300・段階 75 | 段階決定では25%の場合だけ投資する |
一括決定では、P20 の期待値は -95.0百万円になり、P20 は採るべきでない案件に見えます。P19 が失敗する75%の場合に、成功の見込みがない試作ラインに300百万円を投じ、その7割を失うからです。段階決定にすると、P20 の期待値は62.5百万円に変わり、採る価値のある案件になります。同じ案件でも、「いつ決めるか」を変えるだけで期待値が157.5百万円変わるということです。P20 に実際に投じる金額の期待値も、一括決定の300百万円から75百万円に下がります。計算の確かめとして、同じ設定で20万回の乱数を振ったところ、一括決定は -95.5百万円、段階決定は62.1百万円で、上の表の計算と一致しました。
この結果は、共通データの数字の読み方にも注意を促します。共通データでは P20 の期待値が250百万円で、P19 の結果によらない設定になっています。もし現実には P20 の成否が P19 に強く依存しているのに、起案書が「P20 の成功確率40%」を P19 と無関係の数字として書いているなら、P19 と同時に P20 の実施を決める予算の組み方は、期待値を過大に見積もっていることになります。前提関係のある案件の組を審査するときは、「後ろの案件の成功確率は、前の案件が成功した場合の値なのか、無条件の値なのか」を起案者に確かめる必要があります。
研究開発や新製品の開発を、いくつかの段階に区切り、段階の切れ目ごとに続行か中止かを判断する進め方は、ステージゲートと呼ばれます。この名前は、クーパー(R. G. Cooper)が1990年に Business Horizons 誌(第33巻第3号)に発表した、ステージゲートの仕組みを新製品の管理の道具として論じた論文の題名に使われています。この章では原論文の本文は確かめていないので、仕組みの細部には立ち入らず、ここでは「段階ごとに続行か中止かを判断する」という一般的な考え方として扱います。上の計算は、この考え方の価値を最も単純な形で数字にしたものです。判断の切れ目で止められることが、失敗の場合の損失を切り詰め、期待値を押し上げます。
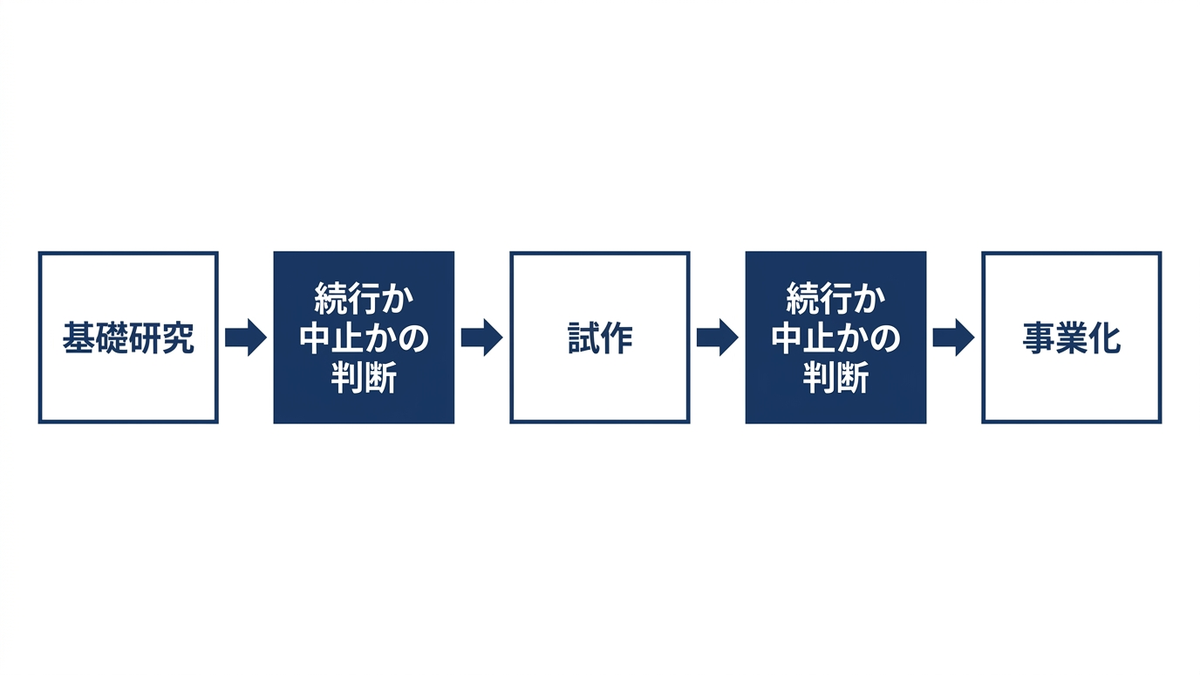
段階投資を予算の計画に落とすには、時間の設計が要ります。共通データでは、P19 は1〜3年目に毎年120百万円を投じ、P20 は3年目に300百万円を投じる設定です。P19 の3年目と P20 が同じ年に重なっているので、P20 の判断を P19 の結果を見てから行うには、P20 の投資が始まる3年目より前、つまり遅くとも2年目の終わりまでに P19 の成否が分かるように研究の計画を組む必要があります。結果が出る時期が投資の判断より後になるなら、段階決定は形だけになり、実質は一括決定と同じです。予算の側では、P20 の300百万円を「3年目に確保済みの予算」ではなく「P19 の結果しだいで使う、条件付きの枠」として扱い、P19 が失敗したときに別の案件へ回せるように候補を用意しておくことが、段階化の価値を実際に取り込む条件になります。条件付きの枠と来年に決定を持ち越す案件の扱いは、第12章で確率計画の考え方として扱います。
段階投資の価値を損なう典型は、止めるべきときに止められないことです。2年間で240百万円を投じた基礎研究が見込みどおりの結果を出さなかったとき、「ここまで投じたのだから」という理由で試作に進むと、上の表の「P19 失敗後に P20 を実施した」行、つまり -210百万円の期待値を選ぶことになります。すでに投じた240百万円は、続けても止めても戻ってきません。判断に使うべきなのは、これから投じる金額と、これから得られる価値だけです。判断の基準を、段階の開始前に「この条件を満たさなければ止める」という形で書いておくことが、止める判断を後から歪めないための実務的な手当てになると考えています。
打率と一発の大きさ、研究開発・新規事業だけの部分ポートフォリオ
次に、研究開発・新規事業の案件をまとめて持ったときに、結果がどれくらいばらつくかを見ます。第10章の基準の選択(NPV 期待値の合計を最大にした14件)には、研究開発・新規事業の8件(P12・P13・P15・P16・P17・P19・P20・P23)が入っています。この8件だけを取り出した部分ポートフォリオについて、第2章のシナリオ1,000本(真のモデルからの抽出)で NPV 合計の分布を計算し、比べる相手として、成功確率0.5以上の5件(P12・P15・P16・P17・P23。排他の関係にある P14 は除く)、成功確率0.5未満の5件(P13・P19・P20・P25・P29)、基準の8件から P19・P20 を外した6件の3つを並べました。成功確率0.5以上と0.5未満の2組は、NPV 期待値の合計がほぼ同じ(1,190と1,160)になるように選んだ比較用の組で、予算の制約は考えていません。「成功0件の確率」は、成功・失敗が案件ごとに独立であることを使って厳密に計算した、全件が失敗する確率です(金額は百万円・架空)。
| 部分ポートフォリオ | 件数 | 投資額 | NPV 期待値の合計 | シナリオの平均 | 標準偏差 | 5%点 | CVaR(下位5%の平均) | 負になる確率 | 成功件数の期待値 | 成功0件の確率 |
|---|---|---|---|---|---|---|---|---|---|---|
| 基準の選択の8件 | 8 | 2,980 | 2,060 | 2,038 | 1,841 | -724 | -1,216 | 12.8% | 4.30 | 0.12% |
| 成功確率0.5以上の5件 | 5 | 1,720 | 1,190 | 1,175 | 1,108 | -530 | -766 | 16.1% | 3.20 | 0.48% |
| 成功確率0.5未満の5件 | 5 | 1,910 | 1,160 | 1,146 | 1,597 | -1,337 | -1,337 | 25.3% | 1.90 | 8.85% |
| 基準の8件から P19・P20 を外した6件 | 6 | 2,320 | 1,510 | 1,489 | 1,431 | -778 | -1,054 | 15.5% | 3.65 | 0.26% |
成功確率0.5以上の5件と0.5未満の5件を比べると、NPV 期待値の合計はほぼ同じですが、標準偏差は1,108と1,597、負になる確率は16.1%と25.3%、全件が失敗する確率は0.48%と8.85%で、打率の低い組のほうがはっきりと危うい結果です。0.5未満の組では、全件が失敗する確率(8.85%)が5%を超えているので、下位5%のシナリオはすべて「全件失敗」になり、5%点と CVaR がどちらも、投資額1,910百万円の7割にあたる -1,337百万円で一致しています。同じ期待値でも、打率が低く一発の大きい案件で組んだポートフォリオは、およそ11回に1回の割合で投資額の7割を失う、という形の分布を持っています。
基準の8件は、期待値の合計が2,060百万円と大きいうえに、負になる確率が12.8%で、比べた4つの組の中で最も低くなりました。件数が多いほど、成功件数がならされるからです。8件の成功件数の分布を厳密に計算すると、0件0.1%・1件1.4%・2件7.1%・3件18.6%・4件28.4%・5件26.0%・6件13.9%・7件4.0%・8件0.5%で、成功件数の期待値は4.30件です。8件のうちおよそ4件が成功し4件弱が失敗する、という見通しが、この部分ポートフォリオの平均的な姿です。
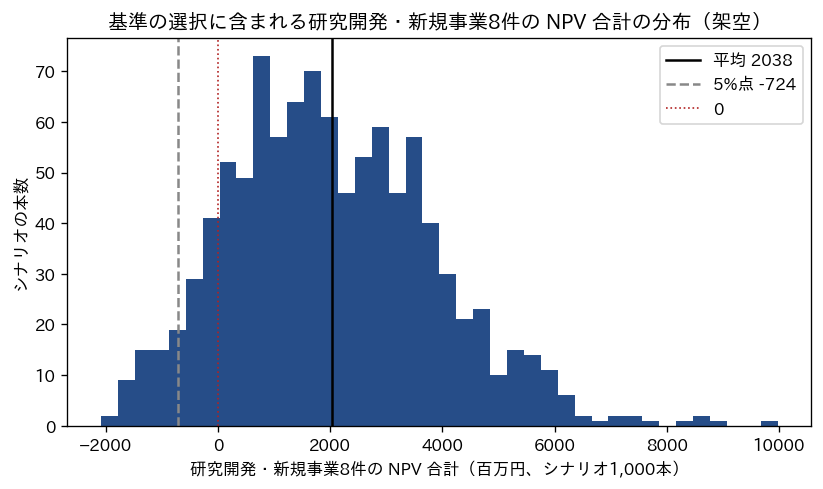
図は、基準の8件の NPV 合計のシナリオ1,000本の分布です。成功件数ごとの分布が重なった形をしていて、左の端は -2,000百万円前後まで、右の端は10,000百万円近くまで伸びています。5%点(-724百万円)は0より左にあり、平均(2,038百万円)の周りに結果が集まっているわけではない、という点が、研究開発・新規事業のポートフォリオを期待値だけで説明してはいけない理由です。
表の最後の行は、基準の8件から成功確率の最も低い P19(0.25)と、それに続く P20(0.40)を外した6件です。直感的には、打率の低い2件を外せば安全になりそうですが、結果はそう単純ではありません。期待値の合計は2,060から1,510に550下がり、負になる確率は12.8%から15.5%へ逆に上がりました。CVaR は -1,216から -1,054に改善しましたが、5%点は -724から -778に悪化しています。P19・P20 は単独では危うい案件ですが、成否が他の案件と独立なので、ポートフォリオの中では成功件数をならす役も果たしています。外すと件数が減り、ならす効果が弱まるので、負になる確率はかえって上がるのです。ばらつきの大きい案件を外せばポートフォリオが安全になるとは限らず、どの指標で安全を測るかによって答えが変わります。最悪時の損失を制約にして全体を選び直す方法は第12章で扱います。
なお、ここで計算した部分ポートフォリオの負になる確率12.8%は、基準の14件全体の負になる確率4.5%より大きくなっています。14件全体では、B工場の新棟建設(P03)や第2ライン増設(P07)のように成功確率1の案件が NPV を下支えしているからです。この共通データのように成功確率1の案件が全体を下支えしている構成で、研究開発・新規事業の予算を設備投資と切り離した別枠で管理すると、その枠の中だけで見たときの「負になる確率」は全社の数字より大きく見えます(この例では12.8%と4.5%)。枠ごとの成績で研究開発部門を評価するなら、この差を前提にしないと、平均的な結果を失敗と取り違えることになります。
多目的最適化、NPV と戦略適合のパレート最適
研究開発・新規事業のテーマを選ぶときには、NPV のような金額の物差しだけでなく、中期の方針に合っているか、将来の事業の柱になりうるかといった、金額にしにくい物差しも使われます。共通データでは、各案件に戦略適合スコア(1〜5。経営が定めた中期方針との合致度。架空)が付いていて、第2章で見たとおり、新規事業(平均4.20)と研究開発(平均3.83)で高めです。NPV 期待値の合計と戦略適合スコアの合計のように、2つ以上の目的を同時に良くしたい問題を多目的最適化と呼びます。2つの目的が対立するとき、両方で最良の答えは一般に存在しません。そこで、「一方の目的を良くするには、もう一方を必ず悪くしなければならない」組み合わせだけを候補として並べます。この状態をパレート最適と呼び、パレート最適な組み合わせを目的の平面に並べたものをパレート前線と呼びます。
パレート前線を求める方法の1つがε制約法です。一方の目的(ここでは戦略適合スコアの合計)を「ε 以上」という制約に移し、もう一方の目的(NPV 期待値の合計)を最大化します。ε を少しずつ上げながら解き直すと、戦略適合を一定以上に保つ条件のもとでの最良の NPV が順に得られます。第10章の基準と同じ整数計画(baseline.py の select_projects)は、追加の制約を受け取る引数 extra を持っているので、そこに戦略適合スコアの制約を足すだけで実装できます。次のコードは、第2章で述べた補助モジュール project_data.py と baseline.py(本コラムでは配布していません)を同じフォルダに置いて実行する形です。
import pulp
import project_data as pj
from baseline import select_projects

P = pj.PROJECTS
npv = P["npv"].astype(float).to_dict()
strat = P["strategic"].astype(float).to_dict()

def at_least(coef, bound):
    """「coef の合計 >= bound」の制約を足す関数を返す。"""
    def extra(prob, x):
        prob += pulp.lpSum(coef[i] * x[i] for i in pj.IDS) >= bound
    return extra

front, eps = [], 0
while True:
    # (1) 戦略スコア合計 >= eps のもとで NPV 期待値の合計を最大化
    sel, best, _, status = select_projects(npv, extra=at_least(strat, eps))
    if status != "Optimal":
        break
    # (2) NPV を best に保ったまま戦略スコア合計を最大化(同点の中で良い方を採る)
    def both(prob, x, eps=eps, best=best):
        at_least(strat, eps)(prob, x)
        at_least(npv, best - 1e-6)(prob, x)
    sel, s, _, _ = select_projects(strat, extra=both)
    front.append((round(s), round(best), len(sel)))
    eps = round(s) + 1          # 次は今より戦略スコアが高い組み合わせを探す

for s, v, n in front:
    print("戦略スコア合計 %d / NPV 期待値の合計 %d / %d件" % (s, v, n))
# 出力:
# 戦略スコア合計 50 / NPV 期待値の合計 3155 / 14件
# 戦略スコア合計 55 / NPV 期待値の合計 3145 / 16件
# 戦略スコア合計 57 / NPV 期待値の合計 3115 / 17件
# 戦略スコア合計 66 / NPV 期待値の合計 3000 / 19件
コードの2つ目の手順(NPV を保ったまま戦略スコア合計を最大化する解き直し)は、NPV が同じで戦略適合だけが低い組み合わせ(どちらの目的でも負けていないが、片方で勝ってもいない組み合わせ)を前線から外すためのものです。ε を「直前に見つかった組み合わせの戦略スコア合計+1」に上げていくので、戦略スコアの合計が取りうる整数の値を飛ばさずにたどれます。戦略スコア合計を66より上げると、予算・必須・前提・排他を満たす組み合わせがなくなり、ループが終わります。前線は4点で、この記事の実行環境(一般的なノートPC)での実測では、詳しい集計を含む同じ計算(前線の1点につき整数計画2回の計8回と、組み合わせがなくなったことを確かめる最後の1回)が0.54秒で終わりました。次の表は4点の中身です(金額は百万円・架空)。「基準との違い」は、NPV 最大の基準の選択(14件)から外れた案件と、新たに入った案件です。
| 前線の点 | 戦略適合スコアの合計 | NPV 期待値の合計 | 基準からの NPV の減少 | 件数 | 人月 | 研究開発・新規事業の件数 | 基準との違い |
|---|---|---|---|---|---|---|---|
| 1(基準) | 50 | 3,155 | 0 | 14 | 1,305 | 8 | なし |
| 2 | 55 | 3,145 | 10 | 16 | 1,325 | 8 | P12 が外れ、P18・P26・P29 が入る |
| 3 | 57 | 3,115 | 40 | 17 | 1,365 | 8 | P13 が外れ、P10・P18・P26・P29 が入る |
| 4 | 66 | 3,000 | 155 | 19 | 1,440 | 10 | P03・P06・P07・P22 が外れ、P05・P09・P10・P18・P24・P25・P26・P29・P30 が入る |
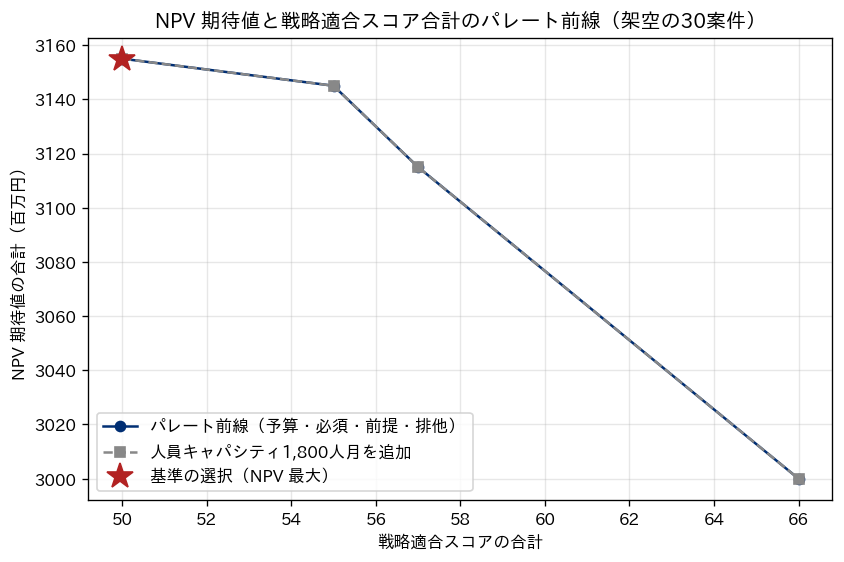
図には、次の節で扱う人員キャパシティ(1,800人月)の制約を足して同じ計算をした前線も灰色の破線で重ねましたが、4点とも制約のない前線と同じ組み合わせになり、線は完全に重なっています。前線上のどの組み合わせも1,440人月以下しか使わないからです。前線の読み方を、経営の言葉に直します。基準(点1)から点2へ動くと、NPV 期待値の合計は3,155から3,145へ10百万円(0.3%)下がるだけで、戦略適合スコアの合計は50から55へ5点上がります。EC・直販チャネル構築(P12)を外し、営業支援システム(P18)・データ分析人材の育成(P26)・大学との共同研究(P29)の小さめの3件を入れる組み替えです。点4まで動くと、戦略適合スコアは66まで上がりますが、NPV は155百万円(4.9%)下がり、B工場の新棟建設(P03)とその前提の上に立つ第2ライン増設(P07)が外れます。会社の生産能力の計画を大きく変える選択で、戦略スコアの数字だけで決めてよい変化ではありません。前線は、「戦略適合を1点上げるのに、NPV をいくら手放すか」という交換の比率を見せてくれます。点1から点2までは1点あたり2百万円、点3から点4までは1点あたり約12.8百万円です。この比率を経営会議で示せば、「戦略に合う案件を優先する」という方針に、いくらの費用がかかっているかを数字で議論できます。
ε制約法とよく比べられるのが、2つの目的に重みを付けて足し合わせ、1つの目的にして解く重み付き和の方法です。重み付き和の方法でパレート前線を求められるかを確かめるため、「NPV + λ×戦略スコア合計」を λ=0〜1,000 の19通りで解きました。見つかったのは、λ=0〜1で点1、λ=2〜10で点2、λ=15以上で点4の3点で、点3(戦略57・NPV 3,115)は一度も現れませんでした。点3は、点2と点4を結んだ線分より下にあるため、どんな重みを付けても、点2か点4のどちらかのほうが重み付きの合計が大きくなるからです。整数計画の前線にはこうした「くぼみ」の点ができることがあり、重み付き和の方法はそれを見落とします。前線の点を漏れなく並べたいときは、ε制約法を使うのが確実です。
この計算には注意点が2つあります。1つ目は、戦略適合スコアの「合計」を目的にすると、件数の多い組み合わせが有利になることです。実際、前線を右へ進むほど件数は14件から19件へ増え、小さめの案件が入っています。戦略適合を「投資額に占める、スコア4以上の案件の割合」のような指標で測れば、別の前線になります。どの指標で戦略適合を測るかは、計算の前に経営が決めることです。2つ目は、戦略適合スコアそのものが、案件を起案した部門や審査する側の主観で付けられやすい数字だということです。スコアを1点上げると前線のどこにいるかが変わるので、スコアの付け方の基準を明文化し、誰が付けたかを記録しておくことが、前線を判断に使う前提になります。前提の記録の仕方は第13章で扱います。
人員キャパシティを制約に足すと選択はどう変わるか
研究開発・新規事業の案件は、お金だけでなく人を食います。共通データでは各案件に社内の実行に要する人員(人月、3年合計)が付いていて、全30件の合計は2,555人月、社内の実行キャパシティ(pj.STAFF_CAP)は1,800人月です。基準の整数計画は、この人員の制約を使っていません。そこで、基準の整数計画に「選んだ案件の人月の合計が1,800以下」という制約を足して解き直しました。
結果は、基準の選択から何も変わりませんでした。基準の14件が使う人月は1,305で、もともと1,800に収まっているからです。この共通データでは、年度予算のほうが先に効いていて、人員は余っています。そこで、キャパシティを1,800から800まで下げていったときに選択がどう変わるかを調べたのが次の表です(金額は百万円・架空)。「外れた案件」と「入った案件」は、基準の選択との違いです。
| 人員キャパシティ(人月) | NPV 期待値の合計 | 件数 | 使う人月 | 投資額 | 研究開発・新規事業の件数 | 外れた案件 | 入った案件 |
|---|---|---|---|---|---|---|---|
| 1,800 | 3,155 | 14 | 1,305 | 6,400 | 8 | なし | なし |
| 1,500 | 3,155 | 14 | 1,305 | 6,400 | 8 | なし | なし |
| 1,300 | 3,145 | 15 | 1,295 | 6,420 | 8 | P12・P22 | P26・P29・P30 |
| 1,200 | 2,965 | 13 | 1,195 | 6,240 | 6 | P17・P23 | P30 |
| 1,100 | 2,745 | 12 | 1,095 | 6,130 | 4 | P12・P16・P17・P23 | P05・P30 |
| 1,000 | 2,495 | 12 | 995 | 5,870 | 4 | P12・P17・P19・P20 | P05・P30 |
| 900 | 2,280 | 9 | 900 | 5,670 | 2 | P06・P12・P16・P17・P19・P20・P22・P23 | P21・P26・P30 |
| 800 | 2,030 | 8 | 800 | 4,900 | 2 | P06・P12・P16・P17・P19・P20・P23 | P30 |
キャパシティを1,300人月まで下げると、NPV の減少は10百万円にとどまりますが、1,200人月では190百万円、1,000人月では660百万円減ります。1,300人月での変化は、新規事業の P12 と能力増強の P22 が外れ、研究開発の P29 などが入る小さな組み替えで、研究開発・新規事業の件数は8件のままです。1,200人月以下になると、外れる案件は主に研究開発・新規事業になり、その件数は1,200では6件、1,100では4件、900では2件に減って、代わりに省エネ設備(P05)や省人化ロボット導入(P30)のような、人月が少なく NPV が確実な設備の案件が入ります。人が減ると予算が余り(キャパシティ800では投資額4,900百万円で、予算6,500百万円の4分の3)、余った予算を使う先がなくなります。人員が足りない会社では、研究開発の予算を増やしても、実行する人がいなければ NPV は増えない、ということです。
逆の方向、つまり予算を増やしたときに人員の制約がいつ効き始めるかも確かめました。年度予算をすべて1.3倍にした場合は、選択が使う人月は1,675で、まだキャパシティに収まります。1.5倍にすると、人員の制約がない場合の最適は1,860人月を使い、キャパシティを超えます。人員の制約を入れると NPV 期待値の合計は4,230から4,175へ55百万円下がります。2.0倍では、人員の制約がない場合は4,820、制約を入れると4,365で、差は455百万円に広がります。予算の制約を外して人員1,800人月だけで縛ると、NPV 期待値の合計は4,365(22件・1,795人月・投資額10,450百万円)が上限です。この共通データでは、予算をおよそ1.5倍にしたあたりから、ボトルネックがお金から人に移ります。
ここでの計算には限界があります。共通データの人員は3年合計の1つの数字だけで、年ごとの繁閑や、研究者・生産技術者・営業といった職種の違いを表していません。現実には、特定の職種の人が特定の年に集中して必要になり、合計では足りていても実行できないことがよくあります。年ごと・職種ごとの人月を制約に足すのは、整数計画では制約の行を増やすだけなので、データさえあれば難しくありません。案件の起案書に、投資額と並べて「年ごと・職種ごとの人月」を書いてもらうことが、この制約を使える状態にする第一歩です。
統計に見る企業の研究費の中身
企業の研究開発の予算が、実際にどのような性格の研究に向いているかを、公的統計で確かめておきます。第1章で紹介した総務省の科学技術研究調査について、2025年(令和7年)科学技術研究調査の結果の要約を開いて確認しました。この調査は2025年6月1日に実施されたもので、2024年度の研究費を集計しています(2026年10月の時点で、これが最新の公表です)。要約によると、企業が自然科学に使用した研究費17兆3,679億円を性格別に分けると、基礎研究費が1兆1,901億円(6.9%)、応用研究費が2兆6,711億円(15.4%)、開発研究費が13兆5,066億円(77.8%)でした。大学等では基礎研究費が最も大きい割合(53.1%)を占めるのと対照的に、企業の研究費の8割近くは開発研究に向いています。
この統計は、企業ごとの成功確率や配分の良し悪しを示すものではありません。ただ、共通データの案件にたとえると、企業の研究費の大部分は、製品Zの改良(P23)や原価低減設計(P16)のような、事業に近く成功確率の比較的高い開発に使われていて、新素材Xの基礎研究(P19)のような成功確率の低いテーマに向く割合は小さい、という構図と整合します。基礎研究の比率をどこまで持つかは、会社の方針と規模によって変わる経営判断で、この記事が答えを出すものではありません。数理モデルが手伝えるのは、その方針を決めるときに、打率の低いテーマを何件持つと全体がどれだけばらつき、全滅の確率がどれだけになるかを、前節のように数字で示すことです。
経営判断、打率と一発の大きさの両方を見る
この章の計算から、研究開発・新規事業の配分の判断に使える点を4つにまとめます。1つ目は、期待値の表に「成功時の価値」と「失敗時の損失」の2列を足すことです。共通データの P19 は、期待値300百万円の裏で、成功時に投資額の5倍以上(1,956百万円)を見込んでいました。期待値だけを並べた表では、この前提の大きさが見えず、審査が期待値の大小の比較で終わってしまいます。成功確率と期待値から成功時の価値を逆算し、その根拠を起案者に聞くことが、楽観的な見積りを見つける最も手軽な方法です。
2つ目は、失敗の損失をあらかじめ予算に織り込むことです。基準の選択の研究開発・新規事業8件では、失敗する件数の期待値は3.70件、失敗による損失の期待値(各案件の失敗確率×投資額の7割の合計)は1,016.4百万円でした。8件の投資額2,980百万円のうち、およそ3分の1にあたる金額が、平均的には失敗で失われる計算です。この損失は、計画が外れた結果ではなく、計画どおりに進んだ場合にも平均的に起きるものです。この数字を研究開発の予算の説明に最初から書いておけば、失敗が出たときに「想定外の損失」として扱われ、ポートフォリオ全体の方針まで揺らぐことを避けられます。失敗した案件の担当者を責める文化のもとでは、成功確率の低いテーマは起案されなくなり、ポートフォリオから打率の低い一発が消えていきます。
3つ目は、打率と一発の大きさの両方を見ることです。期待値がほぼ同じでも、打率の低い5件の組は全件失敗の確率が8.85%、打率の高い5件の組は0.48%でした。どちらを選ぶかは会社の体力、つまり全件が失敗したときの損失(打率の低い組では1,337百万円)に会社が耐えられるかで決まります。耐えられるなら、打率の低い一発を含める組み合わせも候補に残せます。ただし、この章の2組は期待値をほぼそろえて比べたものなので、一発を含めると期待値が上がるとまでは、この数値からは言えません。耐えられないなら、件数を増やして成功件数をならすか、段階投資で失敗の損失を切り詰める必要があります。研究開発の配分を議論するときは、期待値の合計に加えて、成功件数の分布と全件失敗の確率を必ず並べて示すことが有効だと考えています。
4つ目は、段階化と多目的の判断に値段を付けることです。この章の架空の設定では、P19 の結果を見てから P20 を決める段階決定は、一括決定より期待値が157.5百万円大きくなりました。戦略適合スコアを50から55に上げる費用は10百万円、66まで上げる費用は155百万円でした。どちらも、計算しなければ「なんとなく良さそう」で済まされがちな判断です。値段が付けば、判断を誤ったときの損失の大きさも見えます。研究の計画を組み替えて結果が出る時期を早める費用が157.5百万円より小さいなら、組み替える価値がある、という議論ができます。
この章のまとめ
研究開発・新規事業の案件は、成功か失敗かの二択を含むので、NPV の期待値だけでは性質が読めません。成功確率と期待値から成功時の価値を逆算し、部分ポートフォリオの成功件数の分布と全件失敗の確率を示し、前提関係のある案件は結果を見てから次を決める段階投資として予算を組むことで、期待値の裏にある前提とばらつきが見えるようになります。NPV と戦略適合の2つの目的はε制約法でパレート前線として並べ、交換の比率を経営の判断材料にできます。人員の制約は、この共通データでは予算をおよそ1.5倍にしたあたりから効き始め、人員を1,200人月以下まで絞ると研究開発・新規事業の件数が減り始めます。第12章では、研究開発・新規事業を含む全案件について、景気や部門の要因で一緒に動く不確実性と最悪時の損失を制約に入れて、案件の選び方を考えます。
この章を深めたい方への参考書籍
『ステージゲート法 製造業のためのイノベーション・マネジメント』(ロバート・G・クーパー著、浪江一公訳、英治出版):この章で一般的な考え方として紹介したステージゲートについて、その名を論文の題名に掲げたクーパーの著書『Winning at New Products』の原著第4版を翻訳したものです。新製品の開発を段階に区切り、切れ目ごとに続けるか止めるかを決める進め方を、提唱者の説明でたどれます。段階投資の価値を実務の手順に落とすときの参考になります。
『MOT研究開発マネジメント入門』(岡本和也・福代和宏著、上西研監修、朝倉書店):技術経営の考え方を研究開発の管理に当てはめた教科書で、研究開発プロジェクトの選択と評価の手法、ポートフォリオマネジメント、研究開発ファイナンスにそれぞれ章を設けています。この章の計算を、研究開発部門の組織や計画づくりの文脈に置き直して読むのに向いています。
『両利きの経営 「二兎を追う」戦略が未来を切り拓く 増補改訂版』(チャールズ・A・オライリー、マイケル・L・タッシュマン著、入山章栄監訳・解説、冨山和彦解説、渡部典子訳、東洋経済新報社):既存事業を磨くことと新しい事業を探ることを、1つの会社の中でどう両立させるかを論じた本です。この章で扱った、確実な設備投資と打率の低い研究開発・新規事業のあいだの配分を、組織の設計の側から考える手がかりになります。
第12章 不確実性のもとで事業に配分する
第10章では、第2章で用意したサンプルデータ(架空の中堅製造業の投資案件30件と3年間の年度予算)を使い、NPV の期待値の合計を最大にする案件の組み合わせを整数計画で選びました。第11章では、研究開発と新規事業の案件に絞って、成功確率と段階投資、期待値と戦略適合の両立を扱いました。どちらの章も、主に見てきたのは期待値です。ところが、期待値が同じでも、結果のばらつき方が違えば、経営にとっての意味は大きく変わります。この章では、案件の NPV が不確実であることを正面から扱います。期待値だけで選んだ組み合わせが悪い場合にどこまで沈むかを測り、最悪時の損失を抑える選び方を整数計画で解き、景気や部門の要因で案件が一緒に動くことの影響、景気が大きく悪化したときの耐性の確かめ方、予算が途中で削られるかもしれないときに「今決める案件」と「後で決める案件」をどう分けるかを、共通データで実行して確かめます。
期待値だけで選んだ組み合わせは、悪い場合にどこまで沈むか
記事全体で基準としている案件選択(第10章で構造を説明した整数計画)は、年度予算・必須案件・前提・排他の制約の下で、NPV の期待値の合計を最大にする14件を選びました。期待値の合計は3,155百万円です。この期待値は、案件マスタに設定した各案件の NPV の期待値を足したものです。第2章で説明したとおり、共通データは乱数で作った架空のデータなので、データを作った側は NPV が本当に従う確率分布(真のモデル)を知っています。真のモデルでは、各案件の NPV は、景気の共通要因・部門の要因・案件固有の要因の3つで動き、研究開発と新規事業の11件はさらに成功か失敗かの二択で大きく変わります。失敗すると投資額の7割が損失になる設定です。この真のモデルから NPV の組を1,000本抜き出したもの(以下、シナリオ)を使うと、選んだ組み合わせの NPV 合計がどれくらいの幅でばらつくかを数えられます。現実の企業には真のモデルは見えず、シナリオは自社の見積りから作った推定モデルから抜き出すことになります。この章の数字は、真のモデルからのシナリオで答え合わせをしたもの、と読んでください。
基準の14件を1,000本のシナリオで評価すると、NPV 合計の平均は3,130百万円、標準偏差は2,028百万円、5%点(悪い方から数えて5%の位置の値)は63百万円、下位5%のシナリオの平均(CVaR)は -572百万円、合計が負になる確率は4.5%でした。平均の3,130が設定の期待値3,155と少し違うのは、1,000本という有限の本数で数えたときの標本のぶれです。CVaR は第7章で資産配分について定義した指標で、ここでは「悪い方から5%のシナリオだけを集めて平均した NPV 合計」を表します。基準の組み合わせは、平均では3,000百万円を超える価値を生みますが、悪い側の5%に入ったシナリオだけで平均すると、約5.7億円の価値を失う、ということです。
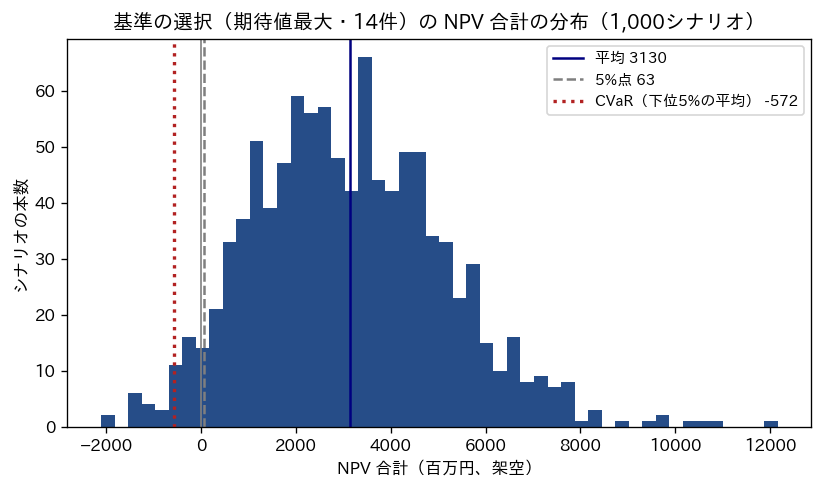
分布の形にも特徴があります。分位点で見ると、1%点は -1,024、10%点は697、中央値は2,979、95%点は6,551、最大は12,155百万円で、右に長い裾があります。研究開発と新規事業の案件は、成功すれば期待値を大きく上回る価値を生み、失敗すれば投資額の7割を失うという二択の形をしているので、組み合わせの分布も「たまに大きく当たる」形になります。平均値だけを報告すると、この形が伝わりません。
悪い側の5%(50本)で何が起きているかを調べました。全体の1,000本では、基準に含まれる成功確率1未満の8件(P12・P13・P15・P16・P17・P19・P20・P23)のうち、平均3.70件が失敗していました。下位5%の50本では、失敗の数の平均が5.52件に増えます。同時に、景気の共通要因(標準正規分布に従う値で、0が平常、負の値が景気の悪化)の平均は、全体で -0.05 だったのに対し、下位5%では -0.99 でした。悪い場合は「研究開発や新規事業の失敗が重なる」ことと「景気が悪い」ことが同時に起きている、ということです。なお、8件が全部失敗した場合の損失の合計は2,086百万円で、基準の選択は研究開発と新規事業に、この大きさの賭けを置いていることになります。
CVaR を目的にした整数計画
最悪時の損失を抑えたいなら、目的を期待値から CVaR に替えて選び直せばよい、と考えられます。CVaR は「下位5%の平均」なので、そのまま目的に書くと、どのシナリオが下位5%に入るかが選択によって変わり、整数計画の式になりません。第7章で、ロカフェラーとウリャセフが2000年に示した線形化を使い、資産配分の CVaR を線形計画で解きました。事業投資の案件選択でも、同じ式がそのまま使えます。式の導き方は第7章と同じなので、ここでは使い方だけを書きます。
シナリオの数を \( n \)、シナリオ \( s \) での NPV 合計を \( V_s \) とすると、NPV 合計の CVaR(下位5%の平均)は次の値に等しくなります。
\( \mathrm{CVaR} = \max_{\zeta} \left\{ \zeta – \dfrac{1}{0.05\,n} \sum_{s} \max(0,\ \zeta – V_s) \right\} \)
言葉で言い換えると、\( \zeta \) は「下位5%の境目」の候補で、各シナリオで NPV 合計がその境目にどれだけ届かなかったか(不足量)を足し、下位5%の本数で割って境目から差し引いたものが、境目の選び方を最も有利にしたときに CVaR と一致する、ということです。不足量を補助変数 \( z_s \)(0以上で、\( \zeta – V_s \) 以上)に置き換えると、すべての式が一次式になり、案件を選ぶかどうかを表す0か1の変数 \( x_i \) と一緒に整数計画として書けます。第7章の記号では、境目の候補が \( \alpha \)、不足量(第7章では損失の超過分)が \( u_s \) に当たります。第7章は損失の向きで書いていましたが、この章は NPV(大きいほどよい)の向きで書いているので、符号が逆になっているだけで中身は同じです。
次のコードは、期待値の合計(設定値)に3,000百万円以上という下限を置いたうえで、CVaR を最大にする組み合わせを選ぶものです。年度予算・必須・前提・排他の制約は基準と同じです。第2章で述べたとおり、共通データBを作る補助モジュール project_data.py と同じフォルダに置いて実行する形で、このモジュール自体は本コラムでは配布していません。
import pulp
import project_data as pj

P, S = pj.PROJECTS, pj.scenarios()      # 案件マスタと 1,000シナリオ(百万円)
alpha, n = 0.05, len(S)
prob = pulp.LpProblem("cvar_selection", pulp.LpMaximize)
x = {i: pulp.LpVariable("x_" + i, cat="Binary") for i in pj.IDS}
zeta = pulp.LpVariable("zeta")                                  # 下位5%の境目の候補
z = [pulp.LpVariable("z_%d" % s, lowBound=0) for s in range(n)]  # 境目からの不足量
prob += zeta - pulp.lpSum(z) / (alpha * n)                      # CVaR を最大化
for s in range(n):
    prob += z[s] >= zeta - pulp.lpSum(S.iloc[s][i] * x[i] for i in pj.IDS)
for y in pj.YEARS:                                              # 年度予算
    prob += pulp.lpSum(int(P.loc[i, "inv%d" % y]) * x[i] for i in pj.IDS) <= pj.BUDGET[y]
for i in pj.IDS:
    r = P.loc[i]
    if r.mandatory:
        prob += x[i] == 1                                       # 必須
    if isinstance(r.requires, str):
        prob += x[i] <= x[r.requires]                           # 前提
    if isinstance(r.excludes, str):
        prob += x[i] + x[r.excludes] <= 1                       # 排他
prob += pulp.lpSum(P.loc[i, "npv"] * x[i] for i in pj.IDS) >= 3000  # 期待値の下限
prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=60))
sel = [i for i in pj.IDS if x[i].value() > 0.5]
print(pulp.LpStatus[prob.status], "CVaR %.0f" % pulp.value(prob.objective))
print("期待値の合計 %d" % P.loc[sel, "npv"].sum(), " ".join(sel))
print({k: round(v, 3) for k, v in pj.summarize_npv(pj.portfolio_npv(sel, S)).items()})
# 出力:
# Optimal CVaR -82
# 期待値の合計 3005 P02 P03 P05 P06 P07 P11 P15 P16 P17 P18 P19 P20 P22 P23 P26 P30
# {'mean': np.float64(2972.569), 'sd': np.float64(1683.523), 'q05': np.float64(524.912), 'cvar05': np.float64(-82.128), 'p_neg': 0.02}
変数は、案件の0か1が30個、境目の候補が1個、不足量が1,000個です。基準の整数計画に、シナリオの数だけ連続変数と制約を足した形になっています。この記事の実行環境(一般的なノートPC)での実測で、CBC は1回あたり4〜7秒で最適解(状態 Optimal)を返しました。シナリオを300本に間引くと1.64秒、500本で2.67秒でした。シナリオの数に比例して変数と制約が増えるので、案件が数百件、シナリオが数万本になると、計算時間は問題になります。その場合は、シナリオを代表的なものに絞る、案件をあらかじめ絞り込む、といった工夫が要ります。
出力の CVaR -82 は、解いた1,000本で測った値で、整数計画の目的値と、選んだ組み合わせを要約の関数で測った値(-82.128)が一致しています。期待値の合計は3,005百万円で、基準の3,155百万円から150百万円下がりました。その代わりに、CVaR は -572 から -82 へ、負になる確率は4.5%から2.0%へ、5%点は63から525百万円へ改善しています。選んだ案件を基準と比べると、新規事業の P12(EC・直販チャネル構築、成功確率0.50)と P13(海外販売拠点 X国、成功確率0.45)を外し、P05(省エネ設備)・P18(営業支援システム)・P26(データ分析人材の育成)・P30(省人化ロボット導入)の4件を加えています。外した2件は、成功すれば大きいが半分以上の確率で失敗する案件で、加えた4件は成功確率1で景気への感応度も小さい案件です。投資額は1年目から順に2,470・2,180・1,740百万円で、予算の消化はほぼ基準と同じです。
期待値を少し下げて、最悪時を大きく改善する
期待値の下限を3,100から2,600まで動かし、それぞれで CVaR を最大にしました。次の表の「設定の期待値」は選んだ案件の期待値の合計(設定値)、「平均」から「負になる確率」までは解いた1,000本のシナリオで測った値、右の2列は、同じ選択を別に抜き出した10,000本のシナリオ(乱数の種を変えたもの)で測り直した値です。下限なしの行は、期待値をまったく問わずに CVaR だけを最大にした結果です。
| 条件 | 件数 | 設定の期待値 | 平均 | 標準偏差 | 5%点 | CVaR | 負になる確率 | 別の10,000本での CVaR | 別の10,000本での負になる確率 |
|---|---|---|---|---|---|---|---|---|---|
| 基準(期待値最大) | 14 | 3,155 | 3,130 | 2,028 | 63 | -572 | 4.5% | -536 | 5.2% |
| 期待値≧3,100 | 17 | 3,115 | 3,101 | 1,794 | 327 | -213 | 3.2% | -257 | 3.3% |
| 期待値≧3,050 | 17 | 3,055 | 3,028 | 1,704 | 463 | -113 | 2.2% | -116 | 2.5% |
| 期待値≧3,000 | 16 | 3,005 | 2,973 | 1,684 | 525 | -82 | 2.0% | -92 | 2.5% |
| 期待値≧2,900 | 16 | 2,985 | 2,962 | 1,675 | 475 | -63 | 2.3% | -115 | 2.7% |
| 期待値≧2,800 | 17 | 2,815 | 2,792 | 1,556 | 437 | -19 | 2.2% | -17 | 2.1% |
| 期待値≧2,600 | 16 | 2,650 | 2,643 | 1,398 | 623 | 232 | 0.9% | 202 | 1.1% |
| 下限なし | 13 | 1,340 | 1,347 | 359 | 770 | 614 | 0.0% | 584 | 0.0% |
表の「設定の期待値」と「CVaR」の列を並べて読むと、期待値を少し下げるだけで CVaR が大きく改善する区間があることが分かります。基準から期待値を40百万円(約1.3%)下げた「期待値≧3,100」の行で、CVaR は -572 から -213 へ359百万円改善しました。150百万円(約4.8%)下げた「期待値≧3,000」の行では490百万円改善し、負になる確率は半分以下になります。一方で、そこから先は改善の割合が鈍り、「期待値≧2,600」で CVaR がようやく正になります。期待値を問わない「下限なし」の行は、CVaR は614と最も良いものの、期待値は1,340百万円と基準の半分以下に落ちます。研究開発と新規事業をほとんど外し、成功確率1の設備更新と IT に寄せた組み合わせで、最悪時は守れても、会社の将来の成長の種をまかない選択です。
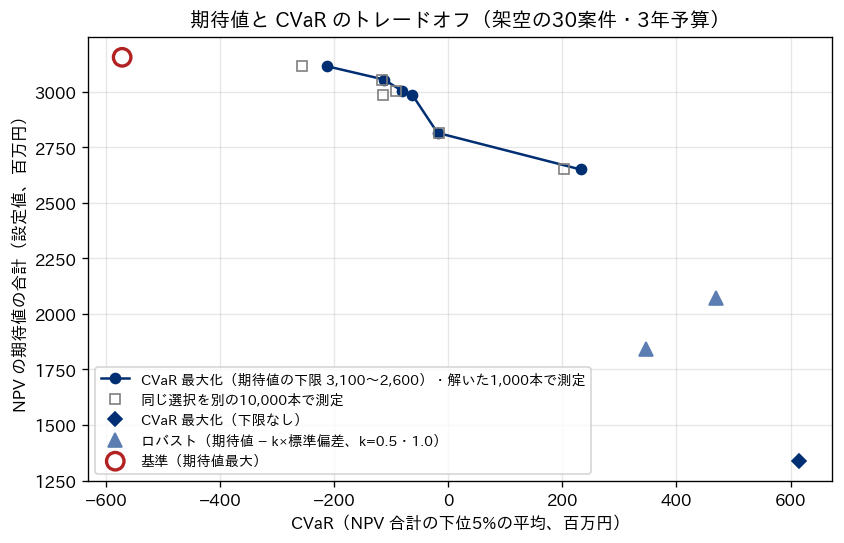
図で見ると、基準の点だけが左上に大きく離れています。基準は期待値を少しでも多く取りにいく選択です。「期待値≧3,100」の行と比べると、期待値の最後の40百万円のために、CVaR を359百万円悪くしています。これは、期待値を最大にする答えがたまたま悪いのではなく、期待値最大化という目的の性質です。期待値の目的は、成功確率が低くても成功時に大きい案件を、期待値が少しでも高ければ選びます。その結果、二択の賭けが組み合わせの中に積み上がり、悪い側の裾が長くなります。
表の右の2列は、この結果を読むときの注意点を示しています。整数計画は、解いた1,000本のシナリオの上で CVaR を最大にしているので、そのシナリオにとって都合のよい組み合わせを選びがちです。選んだ組み合わせを、解くのに使わなかった別のシナリオで測り直すこと(サンプル外評価)をすると、その思い込みの分が見えます。「期待値≧2,900」の行は、解いた1,000本では CVaR -63 で「期待値≧3,000」の行(-82)より良く見えますが、別の10,000本では -115 で、-92 の「期待値≧3,000」より悪くなりました。差が数十百万円の比較は、シナリオの抜き方のぶれの中に入っているということです。シナリオを間引いて解いた場合も同じで、500本で解いた組み合わせは、解いた500本では CVaR 6 と正でしたが、別の10,000本では -115 でした。一方、「期待値≧3,100」と「期待値≧3,000」の行の改善(基準の -536 に対して -257 と -92)は、別の10,000本でもはっきり残っています。大きな改善は信じてよく、小さな差は信じすぎない、という読み方が必要です。ただし、この測り直しも、真のモデルが分かっている前提で、真のモデルから抜いたシナリオで行ったものです。現実のシナリオは自社の見積り(推定モデル)から作るので、見積りが外れている分だけ、改善が表のとおりには実現しない可能性が残ります。
ロバスト最適化を事業投資に使う
シナリオを大量に作らずに、最悪時を意識した選び方をする方法もあります。第5章では、期待リターンの不確実さに備えるロバスト最適化を資産配分で扱いました。事業投資では、各案件の NPV を「期待値から標準偏差の k 倍を引いた値」、つまり控えめに見積もった値に置き換えて、その合計を最大にする、という形が最も簡単です。k は経営がどれだけ慎重に見るかを表すつまみで、k=0 なら基準と同じ期待値最大、k を大きくするほど、ばらつきの大きい案件が不利になります。標準偏差は、各案件について1,000本のシナリオから計算した値を使いました。成功か失敗かの二択まで含めたシナリオ上の標準偏差で、第11章で示した値と同じものです(例えば P15 は約900百万円)。案件マスタに設定したばらつき npv_sd(P15 は450百万円)とは別の量です。式は基準の整数計画の目的の係数を置き換えるだけなので、計算時間は基準と変わりません。
| k | 件数 | 設定の期待値 | 平均 | 標準偏差 | 5%点 | CVaR | 負になる確率 | 別の10,000本での CVaR |
|---|---|---|---|---|---|---|---|---|
| 0(基準) | 14 | 3,155 | 3,130 | 2,028 | 63 | -572 | 4.5% | -536 |
| 0.25 | 16 | 3,005 | 2,973 | 1,684 | 525 | -82 | 2.0% | -92 |
| 0.5 | 14 | 2,070 | 2,061 | 758 | 877 | 470 | 0.9% | 477 |
| 1.0 | 12 | 1,840 | 1,835 | 712 | 675 | 346 | 0.6% | 338 |
k=0.25 の行は、前の節の「期待値≧3,000」の行と、選んだ16件がまったく同じでした。この例では、控えめに見積もる簡単な方法が、シナリオを使う CVaR の整数計画と同じ答えにたどり着いたことになります。ところが k を0.5に上げると、期待値は2,070百万円まで一気に下がり、研究開発と新規事業の大半が外れます。k=1.0 では期待値がさらに下がるのに、CVaR は k=0.5 より悪くなりました。この方法は、案件ごとのばらつきを別々に引いているので、組み合わせたときにばらつきが打ち消し合う効果や、景気で一緒に動く効果を見ていません。k を大きくすると、ばらつきの大きい案件を一律に嫌い、組み合わせ全体の最悪時を良くするとは限らない選択になります。
つまり、期待値から標準偏差の何倍かを引くロバスト最適化は、「つまみ1つで慎重さを調整でき、シナリオを作らなくても使える」点が長所で、「つまみの効き方が急で、組み合わせ全体の最悪時を直接は見ていない」点が短所です。使うときは、k を何段階か変えて解き、そのつど組み合わせ全体の分布(この章で言えば CVaR と負になる確率)で測り直すことが欠かせません。どの k を採るかは数理では決まらず、経営がどれだけの期待値を手放して最悪時を守るかの判断です。
案件を独立とみなすと、ばらつきを過小に見積もる
案件ごとに NPV の見積りの幅(標準偏差)を出している企業でも、組み合わせ全体のばらつきを出すときに、案件どうしを独立とみなして分散を足し合わせることがあります。共通データの真のモデルでは、景気の共通要因に対する感応度(案件マスタの beta)と部門の要因によって、案件どうしの NPV に相関があります。例えば、同じ生産本部で景気への感応度も大きい P03(B工場 新棟建設)と P07(同 第2ライン増設)の相関は0.34です。この相関を無視すると何を見誤るかを、真のモデルから相関の成分を外したシナリオを作って比べました。各案件の NPV の分布(平均と標準偏差、成功確率)は変えず、案件どうしの連動だけを外しています。
| シナリオの作り方(基準の14件・1,000本) | 平均 | 標準偏差 | 5%点 | CVaR | 負になる確率 |
|---|---|---|---|---|---|
| 真のモデル(景気要因・部門要因の両方あり) | 3,130 | 2,028 | 63 | -572 | 4.5% |
| 部門要因だけ残す | 3,180 | 1,937 | 162 | -348 | 3.6% |
| 景気要因だけ残す | 3,118 | 1,977 | 210 | -534 | 4.3% |
| どちらも外す(案件を独立とみなす) | 3,168 | 1,886 | 188 | -327 | 4.0% |
| 真のモデルのシナリオを案件ごとに並べ替えて連動を壊したもの | 3,130 | 1,831 | 154 | -317 | 3.8% |
表の「標準偏差」の列のとおり、案件を独立とみなすと、組み合わせの標準偏差は2,028から1,886百万円に下がり、真のモデルより7.0%小さく見積もられます。案件ごとの分散を単純に足し合わせて計算しても1,898百万円で、6.4%の過小評価です。標準偏差で見ると1割弱の差ですが、悪い側の裾ではもっと大きく効きます。「CVaR」の列では、真のモデルの -572 に対して、独立とみなすと -327 で、最悪時の損失を245百万円、4割以上も甘く見積もることになります。悪い場合に案件が一緒に悪くなるという連動は、平均的なばらつきよりも、裾の深さに表れるということです。
2つの要因の効き方も違いました。景気要因だけを残した行の CVaR は -534 で真のモデルに近く、部門要因だけを残した行は -348 で独立に近い値です。この組み合わせでは、悪い側の裾をつくっているのは主に景気の共通要因です。景気への感応度の大きい P03・P07(1.3と1.4)や新規事業の P12・P13(1.2と1.5)を同時に持っているので、景気が悪化すると、これらが一斉に沈みます。相関を見落とした影響は、選んだ後の評価だけでなく、選び方にも及びます。前の節の「期待値≧3,000」の組み合わせは、真のモデルでは CVaR -82 ですが、独立とみなしたシナリオで測ると CVaR 206、負になる確率1.1%と、実際より安全に見えます。独立を前提にシナリオを作って CVaR の整数計画を解くと、悪い側の裾を短く見た分だけ、リスクを取りすぎた組み合わせを選ぶおそれがあります。
実務では、案件の見積りを部門ごとに集めるので、案件どうしの相関は誰も見積もっていないことが多いように思います。すべての組み合わせの相関を見積もるのは現実的ではありませんが、共通データの真のモデルのように、「景気への感応度」と「同じ部門・同じ市場かどうか」という少数の共通要因で連動を表すと、案件ごとに1〜2個の値を追加で見積もるだけで済みます。案件の起案書に、景気が悪化したときに NPV がどちらへどれだけ動くかの見込みを1行書いてもらうだけでも、組み合わせ全体の最悪時の見積りは大きく変わります。
景気要因を悪い側に固定するストレステスト
CVaR は「シナリオの悪い側5%の平均」なので、シナリオの作り方、特に景気がどれだけ悪くなりうるかの想定に依存します。そこで、確率は問わずに、特定の悪い状況を決め打ちして結果を確かめるストレステストを併用します。ここでは、景気の共通要因 F を -2 に固定し、部門の要因・案件固有の要因・成功か失敗かは乱数のまま1,000本のシナリオを作りました。F は標準正規分布に従う値なので、-2 は「標準偏差2つ分の景気の悪化」に当たり、標準正規分布で -2 以下になる確率は約2.3%です。比較のため、F を -1(同じく約15.9%の確率でそれ以下になる程度の悪化)と0(平常)に固定した結果も並べます。
| 選択 | 設定の期待値 | F=0 の平均 | F=-1 の平均 | F=-2 の平均 | F=-2 の CVaR | F=-2 で負になる確率 |
|---|---|---|---|---|---|---|
| 基準(期待値最大) | 3,155 | 3,175 | 2,317 | 1,458 | -1,296 | 17.0% |
| CVaR 最大・期待値≧3,100 | 3,115 | 3,143 | 2,361 | 1,578 | -917 | 12.6% |
| CVaR 最大・期待値≧3,000 | 3,005 | 3,013 | 2,292 | 1,571 | -746 | 11.0% |
| ロバスト k=0.5 | 2,070 | 2,085 | 1,582 | 1,079 | -137 | 3.5% |
| CVaR 最大・下限なし | 1,340 | 1,354 | 1,198 | 1,041 | 359 | 0.0% |
基準の14件は、景気が平常(F=0)なら平均3,175百万円ですが、F=-2 では平均1,458百万円まで下がり、負になる確率は17.0%、CVaR は -1,296百万円になります。景気の悪化だけで、平均で約17億円の価値が消えることになります。その内訳を案件別に見ると(20,000本で測った、F=-2 と通常の平均の差)、P03 が -438、P07 が -337、P15 が -236、P13 が -216百万円で、14件の合計 -1,725 のうち、この4件(計 -1,227)が約7割を占めていました。14件の合計 -1,725 が前の文の約17億円(1,000本で測った F=0 の平均3,175と F=-2 の平均1,458の差)と少し違うのは、測った本数(20,000本と1,000本)と、比べる相手(景気要因を固定しない通常のシナリオと、F=0 に固定したシナリオ)が違うためです。4件はいずれも景気への感応度が1を超える大型案件です。
前の節で選んだ CVaR 最大の組み合わせは、F=-2 でも基準より平均が高く(1,578 と 1,571)、負になる確率も11〜13%に下がりました。F=0 では基準の3,175より1〜5%低く(3,143 と 3,013)、F=-1 ではほぼ同じか高い、という関係です。景気が悪いときに強く、平常時に少しだけ譲る、という性格がここでも確かめられます。ただし、F=-2 で負になる確率が1割を超えることに変わりはありません。大型の能力増強(P03・P07)を両方含んでいる限り、景気の大きな悪化には弱い組み合わせです。それを受け入れるかどうかは、F=-2 の状況が起きたときに会社の財務がその損失に耐えられるか、で決める必要があります。
ストレステストの長所は、確率の見積りに頼らずに「この状況ではこうなる」と言えることで、経営会議での説明に向いています。短所は、どの状況を想定するかの選び方が恣意的になりうることと、想定しなかった悪い状況には何も言えないことです。この章では景気要因だけを動かしましたが、実務では、主要顧客の喪失、原材料価格の高騰、為替の大きな変動など、自社に固有の悪い状況を数本用意し、それぞれで案件の NPV がどう動くかを起案部門に見積もってもらう形が有効だと考えています。第14章で触れるとおり、公的年金の基本ポートフォリオの策定でも、過去の金融危機の局面を当てはめるストレステストが行われています。
予算の削減に備える、今決める案件と後で決める案件
ここまでの不確実性は、案件の NPV の不確実性でした。事業会社には、もう1つ大きな不確実性があります。翌年度以降の予算そのものが、業績しだいで削られるかもしれないことです。この節では、架空の設定として、2年目と3年目の予算が15%削減される(2年目2,200→1,870、3年目1,800→1,530百万円)可能性があり、その確率を0.3と置きました。削減が決まったときには、1年目に着手済みの案件を中止することもできますが、中止した案件は1年目の投資額が回収できずに損失になる、という簡略な設定です。
最も慎重な対応は、最初から削減後の予算で計画することです。予算が削減されても計画を変えずに済むので、これも一種のロバスト最適化です。これに対して、基準の14件には、1年目の投資額が0の案件が2件あります。P07(B工場 第2ライン増設。2年目から投資)と P20(新素材Xの試作ライン。3年目だけ投資)です。この2件は、1年目の終わりに予算の結果を見てから、実行するかどうかを決められます。今決める案件と、結果を見てから決める案件を分けて、両方を同時に最適化する考え方が確率計画で、ここで解いたのはその最も簡単な形の2段階確率計画です。1段目で1年目に着手する案件を決め、2段目で予算の結果(削減あり・なしの2通り)ごとに、続ける案件と新たに始める案件を決めます。目的は2通りの結果の確率で重みを付けた NPV の期待値です。PuLP で書いて CBC で解き、0.42秒で最適解を得ました。次の表の期待値の列は、削減の確率を0.3と置いて立てた計画を、同じ0.3で評価した値です。確率を変えたときの比べ方は表の後に書きます。
| 計画の立て方 | 削減なしのときの NPV | 削減ありのときの NPV | 期待値(削減の確率0.3) | 削減ありのときの対応 |
|---|---|---|---|---|
| 基準の14件を今すべて確定(2年目以降に始まる P07・P20 の実施も今の時点で約束する) | 3,155 | 2,325 | 2,906 | 着手済みの P12・P17・P23 を中止(1年目の投資300が損失) |
| 常に削減を想定して計画(ロバスト) | 2,965 | 2,965 | 2,965 | 変更なし |
| 2段階確率計画(P07・P20 を後で決める) | 3,155 | 2,775 | 3,041 | P07 を始めない(中止による損失なし) |
2段階確率計画の答えは、1年目に着手する案件が基準の14件のうち1年目に投資のある12件とまったく同じで、削減がなければ P07・P20 を加えて基準どおりの14件、削減があれば P07 だけを見送る、というものでした。期待値は3,041百万円で、3つの計画の中で最も高くなります。同じ14件でも、P07・P20 まで今確定してしまうと、削減があったときに着手済みの新規事業や研究開発の3件を中止せざるを得ず、価値は2,325百万円まで落ちます。2つの計画の差、削減ありのときで450百万円、期待値で135百万円が、「後で決められる」ことの価値です。削減を常に想定した計画は、削減があったときには最も良い(2,965)一方、削減がなければ基準より190百万円低い価値にとどまります。
どの計画が良いかは、削減の確率で変わります。表の値から計算すると、2段階の計画(P07・P20 を後で決める)と常に削減を想定した計画の期待値が並ぶのは削減の確率が0.5のとき、今すべて確定する計画と常に削減を想定した計画が並ぶのは約0.23のときです。削減の確率が0.5を超えると見込むなら、常に削減を想定した計画のほうが期待値が高くなります(その場合に2段階確率計画を解き直せば、削減を想定した計画と同じかそれ以上の答えが出ます。ここでは確率0.3でしか解いていません)。削減の確率は数理では決まらず、経営が業績の見通しから置く値なので、0.3を中心に前後に動かして答えがどう変わるかを示すのがよいと考えています。
この例から言えることは、確率計画の価値の多くは、計算の精密さよりも「どの案件を後で決められるか」を見極める構造の側にある、ということです。2年目以降に投資が始まる案件、段階に分けて投資できる案件、撤退の条件を前もって決められる案件は、それだけで不確実性への備えになります。第11章で扱った段階投資(P19→P20)と同じ考え方で、研究開発に限らず、能力増強や新規事業にも当てはまります。2段階確率計画の定式化の詳細、完全情報の期待価値や確率計画の価値といった指標は、弊社コラム『在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで』の第9章で、在庫の文脈で扱っています。
経営判断に翻訳する、期待値と最悪時の両方を出す
この章の結果を、経営会議に出す形に整理します。案件選択の候補を、期待値だけで並べるのではなく、期待値と最悪時の指標を並べた1枚の表にすることを勧めます。次の表は、この章で比べた候補を、その形にまとめたものです。数字はすべて共通データの架空の値(百万円)で、5%点・CVaR・負になる確率は解いた1,000本のシナリオで測った値です。
| 候補 | 件数 | 設定の期待値 | 20回に1回の悪い場合の水準(5%点) | 悪い5%の平均(CVaR) | 価値が負になる確率 | 景気が大きく悪化したときの平均(F=-2) |
|---|---|---|---|---|---|---|
| 基準(期待値最大) | 14 | 3,155 | 63 | -572 | 4.5% | 1,458 |
| CVaR 最大・期待値≧3,100 | 17 | 3,115 | 327 | -213 | 3.2% | 1,578 |
| CVaR 最大・期待値≧3,000 | 16 | 3,005 | 525 | -82 | 2.0% | 1,571 |
| ロバスト k=0.5 | 14 | 2,070 | 877 | 470 | 0.9% | 1,079 |
| CVaR 最大・下限なし | 13 | 1,340 | 770 | 614 | 0.0% | 1,041 |
この表を前にすると、経営の議論は「期待値が最大の案を採るかどうか」から、「期待値を何百万円手放して、最悪時をどれだけ守るか」に変わります。共通データでは、期待値を40百万円手放すと CVaR が359百万円、150百万円手放すと490百万円改善しました。共通データでは、案件1件の NPV のばらつきも大きく、案件マスタに設定したばらつき(npv_sd。研究開発と新規事業では成功したときの値のばらつき)だけで、P03 は420、P15 は450百万円です。成功か失敗かの二択まで含めたシナリオ上の標準偏差(第11章で示した、シナリオ1,000本から計算した値で、前の節のロバスト最適化で使ったのもこの値です)では、P03 は424、P15 は900百万円になります。成功確率1の P03 では2つの値がほぼ一致し、成功確率0.60の P15 では、失敗の可能性を含めると設定値の2倍になります。期待値の数十百万円の差は、こうした見積りの幅(第3章で扱った NPV の見積り)に比べて小さく、期待値最大の案と期待値を少し下げた案は、事実上同じ期待値と見てよい場合もあります。その場合、最悪時の小さい案を選ぶ理由は十分にあると考えています。
判断を誤ったときの損失の型も整理しておきます。期待値だけで選ぶと、平均的な場合は良くても、20回に1回の悪い場合に、投資全体の価値がマイナスになる確率が高い組み合わせを選びます。その時期に本業の業績も景気で落ちていれば、投資の損失と本業の落ち込みが重なり、翌年度の予算削減や、進行中の案件の中止に追い込まれます。この章の予算削減の例で見たとおり、中止は着手済みの投資額を失うので、損失をさらに大きくします。反対に、最悪時を守りすぎると、研究開発や新規事業を外して期待値を大きく手放し、数年後の成長の種が残りません。下限なしの CVaR 最大の組み合わせは、期待値が基準の半分以下でした。どちらの誤りも、期待値と最悪時の片方しか見ないことから生じます。
施策に落とすときの手順は、次の4つにまとめられます。第一に、案件の起案書に、NPV の期待値だけでなく、悪い場合の値と、景気への感応度、成功確率を書いてもらいます。第二に、それらからシナリオを作り、期待値最大の案と、期待値の下限を何段階か変えた CVaR 最大の案を並べます。第三に、景気の悪化などのストレステストを数本当てて、最悪時の損失が会社の財務の耐えられる範囲にあるかを確かめます。第四に、後で決められる案件を洗い出し、今確定する必要のある案件と分けて承認します。この表を毎年残しておくと、どの程度の最悪時を受け入れて選んだのかが記録に残り、事後の評価にも使えます。投資委員会の運用と事後評価の仕組みは第13章で扱います。
この章の要点は3つです。第一に、期待値だけで選んだ案件の組み合わせは、成功か失敗かの二択の案件と景気に連動する大型案件が重なり、悪い側の裾が長くなります。共通データでは、期待値を数%下げて CVaR を最大にするだけで、最悪時の損失を大きく減らせました。ロカフェラーとウリャセフの線形化を使えば、この選び方は0か1の変数を含む整数計画として PuLP で解けます。第二に、案件どうしの相関を無視すると、組み合わせの最悪時を4割以上甘く見積もることがあり、景気要因を悪い側に固定するストレステストは、その見落としを確かめる簡単な手段です。第三に、予算の削減のような不確実性には、後で決められる案件を見極めて今決める案件と分ける確率計画の考え方が効き、慎重すぎる計画より高い期待値と、何もしない計画より小さい最悪時の損失を両立できます。次の第13章では、ここまでの手法を投資委員会と経営会議の流れに組み込み、前提の記録、ガードレール、事後評価までを含めた運用の形を扱います。
この章を深めたい方への参考書籍
『リアル・オプション:経営戦略の新しいアプローチ』(マーサ・アムラム、ナリン・クラティラカ著、石原雅行ほか訳、東洋経済新報社):投資の「後で決められる」柔軟性を、金融のオプションの考え方で評価するリアル・オプションを、経営戦略の側から解説した本です。この章の予算削減の例で見た「P07 を後で決められることの価値」を、より一般に、延期・段階投資・撤退の選択肢の価値として考えるのに向いています。
『シナリオ・プランニング:戦略的思考と意思決定』(キース・ヴァン・デル・ハイデン著、グロービス監訳、西村行功訳、ダイヤモンド社):将来の不確実性を、確率を当てる代わりに複数のシナリオとして描き、戦略の意思決定に使う方法を扱った本です。この章のストレステストで「どの悪い状況を想定するか」を選ぶ段階、つまりシナリオの作り方そのものを、経営の議論の進め方として学ぶのに向いています。
第13章 現場に入れる
第12章では、第2章で用意したサンプルデータの案件30件について、NPV のシナリオ1,000本を使い、期待値を少し下げて最悪時を大きく改善する選び方と、景気の要因を無視したときの誤りを確かめました。第3章から第12章までで扱ってきたのは、期待リターンやリスク、案件の NPV を推定し、制約のもとで配分や案件の組を計算する方法です。この章では、計算の結果を実際の意思決定の場に載せ、実行した結果を測って次の計算に戻すまでの運用を扱います。投資配分の数理モデルを導入しても成果が出ない理由の多くは、解き方の巧拙よりも、計算に入れた前提を誰がどの根拠で置いたかが残っていないこと、見込みと実績の差を測る仕組みが無いこと、計算の答えを点検する規則が決まっていないことにあると考えています。この章では、投資を決める会議の流れ、前提の決め方と記録、データの精度と見積りの校正、計算の答えを点検する規則、人が最終判断する運用、効果測定、経営報告の指標、導入の順序と失敗の型を順に述べます。仕組みと運用の話が中心ですが、点検の規則の効き方と、完了した案件の見込みと実績を突き合わせて見積りの楽観に気づくまでに要する年数の2つは、共通データと基準の結果で試算して数字で示します。
計算の答えが、会議の途中で止まる道筋
投資配分の計算を業務に入れたときに起きやすい経過には、ある程度決まった型があるように思います。資産運用の側では、推定モデルで最適化した配分を運用の委員会に出すと、「国内株式を半分にする理由は何か」「外国株式を0にしてよいのか」という問いが出て、計算の答えは参考資料の扱いになり、配分は前年の方針のまま据え置かれます。第4章で見たとおり、共通データの基準では推定モデルの最適配分が国内株式52.3%・国内債券47.7%・他の4資産0%になり、推定モデルの見込みでは期待リターンが現在の配分より0.93pt 上がるはずが、真のモデルで評価すると逆に0.27pt 下がりました。会議で出た問いは、この推定誤差の増幅を経験的に嗅ぎ取ったものとも言えます。ただし、問いを出しただけで終わると、計算のどこを直せばよいかは組織に残りません。
事業投資の側では、型が少し違います。案件の NPV は起案した部門が見積もり、投資を決める会議は、その数字を前提に案件を並べて採否を決めます。第10章の整数計画は、この並べ方を予算と前提・排他の条件のもとで最良にする道具でした。しかし、入力の NPV が部門ごとに違う流儀で見積もられていれば、計算は「楽観的に見積もった部門の案件ほど通りやすい」という仕組みを、手間をかけて精密にするだけになります。整数計画は入力の偏りを直しません。偏りを含んだ数字の中で最良の組を選ぶので、偏りの大きい案件ほど選ばれやすくなります。
もう1つの型は、決めっぱなしです。承認した案件が完了した後に、起案時の見込みと実績を突き合わせる工程が無いと、見積りがどれだけ楽観的だったかを組織として知る手段がありません。資産運用でも、配分の方針を決めた後に、方針どおりに運用したことによる結果と、方針から外れたことによる結果を分けて測らないと、方針が良かったのか運用が良かったのかを区別できません。
これらの型を防ぐ手順は、突き詰めると4つです。起案から実績の確認までの流れと各段の責任者を決めること、計算に入れる前提を記録に残し変更の履歴を持つこと、計算の答えを機械的に点検する規則を置き、規則に掛かった配分や案件を中心に人が判断すること、そして見込みと実績の差を測って見積りと推定の方法に戻すことです。以下では、この4つを中心に述べます。
投資委員会の流れ、起案・審査・承認・実行・事後評価
一定額以上の投資を決める場として、多くの企業は経営会議のほかに、投資案件を専門に審査する会議体を置いています。この記事では、名前や構成員は企業によって違うことを前提に、こうした会議体をまとめて投資委員会と呼びます。企業年金や余資の運用では、運用の基本方針と資産の配分を決める委員会が同じ役割を持ちます。事業投資の流れは、おおむね起案・審査・承認・実行・事後評価の5つの段に分かれます。事後評価は、承認した案件について、起案時に見込んだ投資額・売上・NPV と実績を、前もって決めた時点(たとえば稼働の1年後と3年後)で突き合わせる工程です。数理モデルが置き換えるのは、このうち審査の段の一部(案件の並べ方と組の選び方)にすぎません。他の段が決まっていないと、計算の結果は会議の資料で止まるか、承認された後に何も測られないまま次の年度を迎えます。
次の表は、各段で行うこと、使う計算やデータ、担当の例、残すべき記録をまとめたものです。担当の名前は組織によって違うので例として示しました。大切なのは、段ごとに「誰が決めるか」と「何を記録に残すか」を決めておくことです。
| 段 | 行うこと | 使う計算・データ | 担当の例 | 残す記録 |
|---|---|---|---|---|
| 1 起案 | 案件の目的・投資額・期間・NPV の見積りと前提を書く | 投資額の見積り、売上や原価の計画、割引率、成功確率(第3章・第11章) | 起案部門 | 前提の一覧と根拠、見積りの版と日付 |
| 2 審査 | 前提の妥当性を確かめ、全社の基準で見積りをそろえる。案件の組を計算する | 第10章の整数計画、第12章のシナリオと CVaR、点検の規則 | 経営企画・財務の事務局 | 前提の修正とその理由、計算の版、規則に掛かった案件 |
| 3 承認 | 計算の結果と審査の意見を見て、採否と条件を決める | 案件の組ごとの NPV 合計・最悪時・予算の消化・人員の余力 | 投資委員会、経営会議、取締役会(金額による) | 採否・条件・判断の理由。計算の答えと違う判断をした場合はその理由 |
| 4 実行 | 投資を実施し、投資額・工期・稼働を管理する | 予算の消化、工程の計画と実績 | 起案部門、生産本部など | 投資額の実績、工期の遅れ、次の段階に進むかの判定(第11章) |
| 5 事後評価 | 起案時の見込みと実績を、決めた時点で突き合わせる | 実績の売上・原価・投資額、起案時の前提の一覧 | 事務局(起案部門から独立した担当) | 見込みと実績の差、差の理由の分類、次の見積りへの補正 |
表の中で見落とされやすいのは、1番目の段の「前提の一覧と根拠」と、5番目の段の事後評価です。この2つは対になっていて、起案時の前提が記録に残っていなければ、事後評価で差が出ても、どの前提が外れたのかを特定できません。逆に、事後評価が無ければ、前提を丁寧に記録しても誰も読み返しません。事後評価の担当を起案部門から独立させておくのは、起案部門が自分の見積りを評価すると、差の理由が外部の環境の変化に寄りやすいからです。
資産運用の流れも、同じ5つの段に読み替えられます。起案は運用の担当による配分の見直し案、審査は推定の前提とリスクの点検、承認は委員会による基本となる配分(政策として定める資産の配分)の決定、実行は配分に沿った売買とリバランス(第9章)、事後評価は基本となる配分との比較による運用結果の分析です。事業投資と違うのは、資産運用では市場の価格が毎日付くので、事後評価を毎月や四半期ごとに機械的に回せることです。事業投資の NPV は、案件が終わるまで確定しないので、途中の指標(投資額の実績・工期・稼働率・成功の判定)を測る段を設ける必要があります。
前提の決め方と記録、誰がいつどの根拠で置いたか
計算の答えは、入力の前提で決まります。資産運用なら資産ごとの期待リターン・リスク・相関、事業投資なら案件ごとの投資額・売上の計画・成功確率・割引率です。第3章で見たとおり、240か月の履歴から計算した標本平均でさえ、共通データでは外国株式が年1.95%(真の値は6.5%)、不動産投資信託が年-0.22%(真の値は4.5%)と、真の値から大きく外れました。期待リターンは、データから一意に決まる数字ではなく、誰かが根拠を選んで置く数字です。だからこそ、誰が・いつ・どの根拠で置いたかを記録しておく必要があります。
前提の記録は、案件や資産ごとに1行を持つ台帳の形にするのが扱いやすいと考えています。次の表は、台帳に持たせる項目の例です。
| 項目 | 記録する内容の例 | 後で使う目的 |
|---|---|---|
| 前提の名前と値 | 国内株式の期待リターン年5.5%、案件 P15 の成功確率0.60、割引率 | 計算への入力を一意にする |
| 置いた人と日付 | 起案部門の担当者、事務局の担当者、承認した会議と日付 | 誰に問い合わせればよいかを残す |
| 根拠の種類 | 過去の実績の平均、外部の見通し、類似案件の実績、担当者の判断 | 根拠の種類ごとに外れ方を集計する |
| 根拠の出どころ | 参照した資料・期間・計算の版 | 同じ前提を再現できるようにする |
| 幅 | 楽観・標準・悲観の3つの値、または標準誤差(第3章) | 感度分析(第10章)とシナリオ(第12章)に渡す |
| 変更の履歴 | 前の値、変えた日、変えた人、変えた理由 | 前提の変更が答えをどう動かしたかを追う |
表の中で特に大切なのは、変更の履歴です。前提は、審査の途中で何度も変わります。案件の採否が際どいときに、起案部門が売上の計画を少し上げ直すと、整数計画の答えが入れ替わることがあります。第10章では、NPV の見積りを動かしたときに選ばれる案件がどう入れ替わるかを扱いました。前提の変更が、根拠の更新によるものか、採否を通すためのものかは、変更の履歴が無いと後から区別できません。変更の履歴には、前の値と新しい値に加えて、その変更で計算の答え(選ばれる案件の組と NPV 合計)がどう変わったかを一緒に残しておくと、承認の段で「この案件は前提の変更で滑り込んだ」と分かります。
前提をそろえる規則も、審査の段で決めておく必要があります。割引率を案件ごとに起案部門が選ぶと、同じ案件でも部門によって NPV が変わります。割引率・為替・原材料の価格・景気の見通しのように、全社で共通にすべき前提は、事務局が一括して置き、起案部門は案件に固有の前提(投資額・売上の計画・成功確率)だけを置く、という分担にするのが有効だと考えています。共通データの案件マスタでは、NPV の列に割引率を織り込み済みの設定値を置いています。現実の起案では、この「織り込み済み」の中身が部門ごとにそろっているかを確かめることが、審査の最初の仕事になります。
資産運用の期待リターンについても同じことが言えます。過去の標本平均をそのまま使うのか、第5章のように縮小推定やブラック・リッターマンで現在の配分から逆算した値に寄せるのか、外部の見通しを使うのかは、方法の選択そのものが前提です。どの方法を選んだかと、選んだ理由を台帳に残しておけば、数年後に方法を見直すときの材料になります。
データの精度と見積りの校正、楽観に気づくまでに何年かかるか
事業投資の見積りには、楽観に寄る誘因が2つあります。1つは、起案する側が案件を通したい立場にあり、見積りが成功した場合の姿に引き寄せられやすいことです。もう1つは選び方の側にあります。第10章の整数計画のように NPV の見積りが大きい案件から選ぶ仕組みでは、見積りに偏りが無くても、たまたま大きく見積もられた案件が選ばれやすくなるので、選ばれた案件の見積りは、平均すると実績より大きくなります。スミスとウィンクラーは2006年の論文で、この現象をオプティマイザーの呪い(optimizer’s curse)と名付け、推定値に偏りが無くても、推定値で選んだ選択肢の実際の値は平均すると推定値を下回ることを、意思決定分析の立場から示しました。資産運用の側で、推定モデルの最適配分が見込んだ改善(+0.93pt)が真のモデルでは実現しなかった(-0.27pt)のも、同じ性質(推定値が大きく出たものほど選ばれやすい)で説明できると考えています。
- ジェームズ・E・スミス、ロバート・L・ウィンクラー(2006)「The Optimizer’s Curse」(主題のみ。副題は略)、Management Science 第52巻第3号、311〜322ページ
https://doi.org/10.1287/mnsc.1050.0451
この偏りを直す方法は、見込みと実績の差を案件の種別ごとに蓄積し、次の見積りを補正することです。たとえば研究開発の案件で、見込みに対する実績の比が平均して0.8であれば、次の研究開発の案件の見込みを0.8倍して審査に使います。考え方は単純ですが、問題は、比を信頼できる精度で測れるまでに何件の事後評価が要るかです。そこで、共通データで試算しました。
架空の設定として、基準の選択(第10章の整数計画で選んだ14件)のうち、研究開発・新規事業の8件(P12・P13・P15・P16・P17・P19・P20・P23)を取り上げます。この8件の NPV 期待値の合計は真のモデルで2,060百万円、成功件数の期待値は4.30件です。起案部門は NPV を真の期待値より25%高く見積もり(合計2,575百万円)、成功確率を真の値より0.15高く見積もる(上限0.95。成功件数の見込みは5.50件)とします。毎年この8件と同じ性質の案件を承認し、実績は第2章の NPV のシナリオから1本ずつ取るとして、k 年分の事後評価を積み上げたときの「実績÷見込み」の比を、乱数を変えて4,000回計算しました。比が0.9未満と出たら「見積りが楽観的だ」と判断する、という規則を置いたときに、その判断がどれだけ当たるかを見ます。
| 事後評価を積み上げた年数(延べ件数) | NPV の比(見込みが楽観25%)平均と90%の範囲 | NPV の比(偏りなし)平均と90%の範囲 | NPV の比が0.9未満と出た割合(楽観の場合) | NPV の比が0.9未満と出た割合(偏りなしの場合) | 成功件数の比(見込みが楽観)平均と90%の範囲 | 成功件数の比が0.9未満と出た割合(楽観の場合) | 成功件数の比が0.9未満と出た割合(偏りなしの場合) |
|---|---|---|---|---|---|---|---|
| 1年(8件) | 0.80(-0.28〜2.09) | 1.00(-0.35〜2.61) | 57.6% | 48.3% | 0.78(0.36〜1.09) | 53.5% | 27.3% |
| 3年(24件) | 0.78(0.13〜1.48) | 0.98(0.16〜1.85) | 61.8% | 45.4% | 0.78(0.55〜1.03) | 76.4% | 27.4% |
| 5年(40件) | 0.79(0.28〜1.33) | 0.98(0.35〜1.66) | 65.1% | 43.0% | 0.78(0.62〜0.95) | 85.6% | 25.8% |
| 10年(80件) | 0.79(0.43〜1.17) | 0.99(0.53〜1.46) | 69.2% | 39.1% | 0.78(0.65〜0.91) | 94.4% | 13.2% |
| 20年(160件) | 0.79(0.53〜1.06) | 0.99(0.66〜1.33) | 76.7% | 33.9% | 0.78(0.69〜0.86) | 98.6% | 8.1% |
「90%の範囲」は、4,000回の結果の5%点から95%点までです。NPV の比は、平均では0.79前後と楽観の大きさ(1÷1.25=0.8)をおおむね映していますが、範囲が非常に広く、1年分では-0.28から2.09まで散らばりました。見込みに偏りが無い場合の NPV の比は、平均が0.98〜1.00で、楽観の場合の0.79前後より0.2ほど高い位置にありますが、20年分でも90%の範囲は0.66〜1.33で、楽観の場合の範囲(0.53〜1.06)と大きく重なっています。研究開発・新規事業の案件は、成功すれば大きく、失敗すれば投資額の7割を失う二択の性質を持つので、8件の実績の合計は年ごとに大きく振れるからです。0.9未満なら楽観と判断する規則は、見込みが本当に楽観的な場合に20年分を積み上げても76.7%しか当たらず、見込みに偏りが無い場合にも33.9%の割合で「楽観」と誤って判断しました。NPV の実績だけを事後評価の物差しにすると、20年かけても、楽観の見積りと偏りの無い見積りをはっきり見分けられないということです。
一方、成功件数の比は、見分ける力がずっと大きくなりました。見込みが楽観の場合に0.9未満と出た割合は5年分で85.6%、10年分で94.4%で、偏りが無い場合に誤って0.9未満と出た割合は10年分で13.2%でした。成功したか失敗したかは、成功時の価値の大小と違って二択なので、件数を数えるだけで確率の見積りの偏りが見えてきます。
この試算から言えることは、事後評価を NPV の合計だけで行わず、見積りを要素に分けて、要素ごとに見込みと実績を比べるべきだということです。要素とは、投資額、工期(稼働の時期)、成功の判定、成功した場合の売上や原価の水準、といった単位です。要素ごとの比を案件の種別ごとに蓄積すれば、研究開発の成功確率が楽観的なのか、能力増強の投資額が超過しやすいのか、といった偏りの所在が、NPV の合計よりずっと早く分かります。第11章で扱った段階投資の判定(次の段階に進むか)は、成功の判定を早い時点で記録する機会にもなります。なお、この試算は架空の設定で、楽観の大きさも、毎年同じ性質の8件を承認するという想定も、説明のために置いたものです。現実の企業で何年分が要るかは、案件の数と性質によって変わります。
データの精度は、見積りの側だけでなく実績の側にも要ります。事後評価で比べる実績の売上や原価が、案件ごとに切り分けて記録されていないことは多いように思います。新棟の建設で増えた売上と、既存のラインの売上の伸びが、同じ事業部の売上に混ざって記録されていると、案件の実績は事業部の業績から按分して推し量るしかなくなります。案件を承認するときに、事後評価でどの指標を、どの記録から、いつ測るかを決めておくことが、実績の側の精度を保つ前提になります。資産運用の側では、市場の価格が付くので実績の精度の問題は小さい一方、取引コストや売買の時点の違いによる差(第8章・第9章)を、配分の判断の結果と分けて記録しておく必要があります。
ガードレール、計算に入れる制約と計算の後に人が点検する規則
審査と承認の段で、計算の答えを1つずつ人が吟味していくと、資産や案件の数が増えたときに回らなくなります。そこで、計算の答えを機械的に点検する規則を置き、規則に掛かったものだけを人が重点的に見る形にします。この規則を、この記事ではガードレールと呼びます。計算がどれだけ外れても、ここから先には出さないという線を引くものです。ガードレールには、最適化の制約として計算の中に入れるものと、計算の後に点検の規則として掛けるものの2種類があります。
前者は、破った答えがそもそも候補に上がらないものです。第4章のショートなし(どの資産の比率も0以上)と合計100%、第10章の年度予算・必須案件・前提と排他の条件がこれに当たります。後者は、計算の結果を見てから掛ける規則で、掛かったものは自動では止めず、人の判断に回します。どちらに置くかは、規則の出どころと、破ったときの重さで決めるのがよいと考えています。法令や契約、取引先との約束、予算の上限のように、破れば実行できないものは制約として計算に入れます。経営の判断で目安として置いている規則(現在の配分からどこまで動かすか、1つの案件にどこまで集中させるか、最悪時の損失をどこまで許すか)は、まず点検の規則として掛けて人に判断させるのが出発点になります。目安の規則を最初から制約として入れると、その規則がどれだけの期待リターンや NPV を犠牲にしているかが見えなくなるからです。点検の規則として運用し、毎回同じ判断(規則に掛かった答えを必ず退ける)になると分かった規則から、制約に移していきます。制約に移した規則も点検の一覧に残し、計算の後にもう一度確かめます。
点検の規則の効き方を、基準の結果で確かめました。まず資産配分です。基準の推定モデルの最適配分を、現在の配分と並べて乖離(基準の比率から現在の比率を引いた差)を計算しました。
| 資産 | 現在の配分 | 基準(推定モデルの最適) | 乖離 | 乖離幅±10pt の点検 | 乖離幅±20pt の点検 | 1資産の上限40%の点検 |
|---|---|---|---|---|---|---|
| 国内株式 | 25.0% | 52.3% | +27.3pt | 掛かる | 掛かる | 掛かる |
| 外国株式 | 20.0% | 0.0% | -20.0pt | 掛かる | 掛からない | 掛からない |
| 国内債券 | 35.0% | 47.7% | +12.7pt | 掛かる | 掛からない | 掛かる |
| 外国債券 | 15.0% | 0.0% | -15.0pt | 掛かる | 掛からない | 掛からない |
| 不動産投資信託 | 5.0% | 0.0% | -5.0pt | 掛からない | 掛からない | 掛からない |
| 短期資産 | 0.0% | 0.0% | 0.0pt | 掛からない | 掛からない | 掛からない |
乖離幅を±10pt にすると、6資産のうち4資産が掛かります。±20pt に緩めても国内株式が掛かり(外国株式の-20.0pt はちょうど境界で、超えてはいないので掛からないとしました)、1資産の上限を40%にすると国内株式と国内債券の2資産が掛かります。乖離の絶対値を合計して半分にした値、つまり資産の40.0%を売り買いすることになる大きな組み替えでした。第4章で見たとおり、この配分は真のモデルで評価すると現在の配分より期待リターンが0.27pt 低くなります。乖離幅の規則は、推定モデルの答えの正否を判定するものではありませんが、「大きく動く答えほど推定誤差に引きずられている可能性が高い」という経験則を機械的に当てはめ、大きな組み替えを人の吟味に回す役割を果たします。一方で、乖離幅の規則は、真のモデルで見て正しい組み替えまで人の吟味に回すことがあります。このデータの真の最適(国内株式18.4%・外国株式29.3%・国内債券45.9%・外国債券0%・不動産投資信託6.4%・短期資産0%)を同じ規則に掛けると、現在の配分からの乖離は国内債券が+10.9pt、外国債券が-15.0pt で、±10pt の規則には2資産が掛かります(±20pt の規則にはどれも掛かりません)。規則に掛かった答えを人が退ければ、真の改善も止めることになります。ただし、このデータでは真の最適と現在の配分の期待リターンの差が0.04pt しかないので、止めたときに失う価値はわずかです。規則に掛かった答えは自動で退けるのではなく、なぜ大きく動くのかを確かめてから判断する、という運用が要るのはこのためです。
次に案件選択です。基準の14件について、1案件の大きさと部門・種別への集中を計算しました。
| 点検する規則の例 | 基準の選択での値(百万円・構成比) | 規則に掛かるかの読み方 |
|---|---|---|
| 1案件の投資額が3年予算の何%か | P03 B工場 新棟建設 1,900(3年予算6,500の29.2%)、P07 800(12.3%)、P15 700(10.8%) | 上限を20%に置くと P03 が掛かる。P07 は P03 を前提とする案件なので、P03 の判断が2件分の判断になる |
| 部門別の投資額の構成比 | 生産本部 3,070(48.0%)、第一事業部 2,080(32.5%)、全社 860(13.4%)、第二事業部 390(6.1%) | 部門別の枠を置くなら、生産本部への集中と第二事業部の少なさが論点になる |
| 種別の投資額の構成比 | 能力増強 2,850(44.5%)、研究開発 1,760(27.5%)、新規事業 1,220(19.1%)、設備更新 370(5.8%)、IT 200(3.1%) | 研究開発・新規事業の合計は2,980(46.6%)。成功確率が1未満の案件に投資額の半分近くが向かう |
| NPV 合計の最悪時(CVaR、下位5%の平均) | -572(第12章の基準の評価) | CVaR の下限を、たとえば NPV 合計が負にならない水準に置くと掛かる。是正の方法は第12章 |
| NPV 合計が負になる確率 | 4.5% | 許容する確率を前もって決めておけば、機械的に点検できる |
この表から読み取れることが2つあります。1つは、NPV 期待値の合計を最大にする計算は、1案件の大きさにも部門の偏りにも無関心だということです。生産本部に投資額の48.0%が向かい、第二事業部は6.1%にとどまりますが、計算は部門の枠を知らないので、この偏りは計算の誤りではなく、計算に入れていない経営の判断が表に出たものです。部門の人員や設備の余力、事業の戦略上の位置づけから見て偏りが許されないなら、それは点検の規則として掛け、毎回同じ判断になるなら部門別の枠として制約に移します。もう1つは、点検の規則は、計算の答えがどの規則にどれだけ掛かったかを、承認の段で議論すべき論点の一覧に変える働きを持つということです。「P03 は1案件で3年予算の29.2%を占める」「研究開発・新規事業に46.6%が向かう」という2行は、計算の答えを見ただけでは気づきにくい論点を、承認の場の最初に置きます。
規則の一覧には、規則ごとに「制約として計算に入れるか、点検として掛けるか」「出どころは何か」「規則を決めた人は誰か」を書き添えておくのが有効だと考えています。出どころを書いておかないと、慣行として置いた規則がいつの間にか絶対の制約として扱われ、その規則が犠牲にしている NPV を誰も測らないまま払い続けることになります。制約の費用は、制約を外して解き直したときの目的の値の差として測れます。第10章で扱った予算の限界価値は、予算の制約の費用を測ったものでした。
人が最終判断する運用、境界の案件と前提の妥当性
投資配分の計算を入れても、計算の答えを人が見て採否を決める工程は残すべきだと考えています。理由は3つあります。1つ目は、計算に入っていない事情が必ず残っていて、それを知っているのは事業の責任者だからです。取引先との約束、競合の動き、技術の見通し、人材の配置などは、数字に書けても書かれていないことが多くあります。2つ目は、推定モデルには誤差があり、計算の答えの一部は真の最適から外れているからです。第4章の20回の履歴の作り直しでは、推定モデルの最適配分の真のシャープ・レシオは20回中18回で現在の配分を下回りました。3つ目は、投資の判断には、結果について説明する責任を持つ人が要るからです。計算機の答えをそのまま採った判断について、取締役会や投資家に「計算がそう出た」と説明しても、説明の責任を果たしたことにはなりません。
人の判断を集中させる場所は、2つに絞るのが有効だと考えています。1つは境界の案件です。整数計画の答えで、採択と不採択の境目にある案件は、前提を少し動かすだけで入れ替わります。第10章の感度分析で、NPV の見積りを動かしたときに入れ替わる案件を一覧にしておけば、承認の場はその数件の議論に時間を使えます。境界から遠い案件(どの前提でも選ばれる案件、どの前提でも選ばれない案件)は、計算の答えに従っても判断を誤る余地が小さいからです。もう1つは前提の妥当性です。計算の答えそのものより、答えを左右している前提(大型案件の成功確率、売上の計画の伸び率、資産の期待リターン)が妥当かを、根拠の記録と事後評価の実績に照らして確かめることに、人の時間を使います。
判断を記録に残す仕組みも要ります。計算の答えと承認した結果の差を、案件や資産ごとに機械的に取り、差のあるものについて理由を選んでもらう形が、判断する側の負担が小さく、後で集計しやすいと考えています。理由は自由記述にすると集計できないので、選択肢(戦略上の位置づけ、取引先との約束、人員や設備の余力、前提への不信、時期の延期、その他)を用意します。同じ理由の修正が毎回繰り返されるなら、それは計算に書き漏らした制約なので、ガードレールか制約として足します。「前提への不信」が多い案件の種別は、事後評価で見込みと実績の差が大きい種別と重なるかを確かめます。ここで気を付けたいのは、判断の記録を判断した人の評価に使わないことです。記録が評価に使われると、理由の選択が実態からずれ、「その他」に逃げる記録が増えます。
効果測定、基本となる配分との比較と事後評価の制度
計算を入れた効果を測る方法は、資産運用と事業投資で形が違います。資産運用では、委員会が決めた基本となる配分を物差しにするのが一般的な考え方です。運用の結果を、基本となる配分どおりに各資産の市場の平均的な値動き(指数)で運用した場合の結果と比べ、差を、配分を基本からずらしたことによる部分と、各資産の中で指数と違う運用をしたことによる部分に分けます。この分け方は、要因分析(アトリビューション)と呼ばれます。分けておけば、配分の判断が良かったのか、資産の中の運用が良かったのかを区別でき、数理モデルで配分を決めることの効果を、資産の中の運用と混ぜずに測れます。
国内の確定給付企業年金については、厚生労働省のページが、法令で「運用の基本方針」や「政策的資産構成割合」(基本となる資産の構成割合で、この章で「基本となる配分」と呼んできたものに当たります)の策定が義務付けられている等、ガバナンスに関する制度が整備されていると説明しています。同じページに掲載された「確定給付企業年金に係る資産運用関係者の役割及び責任に関するガイドライン」の2025年1月改訂の新旧対照表では、事業主(受託保証型確定給付企業年金を実施する事業主を除く)と基金は自らの判断の下に政策的資産構成割合を定めなければならず、受託保証型確定給付企業年金を実施する事業主は定めるよう努めることとされていること、運用を委託した機関の運用実績は定期的に評価し、評価を踏まえて必要な場合には適当な意思決定の手続きに従って見直すことが望ましいことが記されています。基本となる配分を物差しに置き、運用の結果を定期的に評価して見直しにつなげる流れは、制度の側でも求められている形だと言えます。制度が個々の年金に何を求めるかの解釈には踏み込まないので、実務の判断は専門家に相談してください。
- 厚生労働省「確定給付企業年金の資産運用力向上のための取組」
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/newpage_00055.html - 厚生労働省「確定給付企業年金に係る資産運用関係者の役割及び責任に関するガイドライン」の改訂 新旧対照表(2025年1月9日改訂関係)
https://www.mhlw.go.jp/content/12500000/001417981.pdf
注意したいのは、測る期間の長さです。共通データの現在の配分は、真のモデルで期待リターン3.62%・リスク8.30%で、同じリスクのもとでの真の最適との期待リターンの差は0.04pt でした(第4章。丸める前の値どうしの差で、小数第2位までに丸めた3.62%と3.67%を引くと0.05pt に見えます)。年率リスクが8%前後の配分どうしの期待リターンの差0.04pt を、実際の運用の結果から測り分けるのは、何十年分の記録があっても困難です。第3章で扱った標本平均の標準誤差は、240か月の履歴でも資産ごとに大きく、配分どうしの差も同じ性質を持ちます。資産運用の効果測定は、短い期間の結果で配分の良し悪しを判定する仕組みではなく、方針どおりに運用されているか(基本となる配分からの乖離が規則の範囲に収まっているか)と、リスクが想定どおりか(実際の値動きのばらつきや最悪時の損失が、計算の想定から外れていないか)を確かめる仕組みとして設計するのが現実的だと考えています。リスクは平均より短い期間で精度よく測れるので、こちらは毎月や四半期の点検に向きます。
事業投資では、前の節で述べた事後評価が効果測定の中心になります。事後評価の制度として決めておきたいことは、対象(一定額以上の案件か全件か)、時点(稼働の何年後に測るか)、比べる指標(投資額・工期・成功の判定・売上・原価・NPV の要素)、比べる相手(起案時の前提の台帳の値)、評価の担当(起案部門から独立した担当)、結果の使い道(次の見積りの補正、起案部門への還元)です。最後の使い道を決めておかないと、事後評価は報告書を作って終わる工程になります。前の節の試算で見たように、事後評価の価値は1件ずつの当否ではなく、件数を重ねて見積りの偏りを種別ごとに測ることにあります。1件の大きな失敗を責める場にすると、起案部門は見積りを保守的に寄せて案件を出さなくなるか、事後評価の対象から外れる規模に案件を分けるようになります。
計算を入れたこと自体の効果を測るには、同じ年度の案件について、計算の答えと、計算を使わない従来の決め方(第2章の素朴な規則、たとえば NPV の大きい順)の答えを並べて記録しておく方法が有効だと考えています。共通データでは、基準の整数計画の NPV 期待値の合計3,155百万円に対し、NPV の大きい順は2,880百万円、投資額あたり NPV の大きい順は2,905百万円、戦略適合スコアの高い順は2,925百万円でした。現実には、選ばなかった組の実績は観測できませんが、両方の組の見込みを同じ前提で計算して並べておけば、計算を入れたことで見込みの上でどれだけの差が生まれたか、その差を生んだ案件はどれかが記録に残ります。事後評価でその案件の実績が見込みに届いたかを確かめれば、計算の効果がどこまで実現したかを案件の単位で追えます。
KPI と経営報告、取締役会と投資家への説明
第1章では、投資配分の判断を経営の指標(期待リターン・最悪の年の損失額・NPV・投資回収・予算の消化・案件の成功率・人員の余力・配分を変えるのに要する費用)に翻訳する考え方を述べました。導入の効果を経営に報告するときは、これらを「計算が見込んだ値」と「実際に測った値」の2列で並べるのが基本になります。見込みだけを報告すると、推定モデルの楽観をそのまま経営に伝えることになります。
| 指標 | 見込みの値の出どころ | 実際の値の出どころ | 見込みと実際がずれたときに疑うこと |
|---|---|---|---|
| 承認した案件の NPV 合計 | 起案時の前提での NPV(補正前と補正後の両方) | 事後評価で更新した NPV | 見積りの楽観、選ばれた案件ほど見積りが大きくなる偏り |
| NPV 合計の最悪時(CVaR)と負になる確率 | シナリオでの計算(第12章) | 実績の分布(件数が積み上がってから) | 景気や部門の要因による相関の見落とし |
| 予算の消化率 | 承認した投資額の計画 | 投資額の実績 | 工期の遅れ、投資額の超過 |
| 見込みに対する実績の比(種別ごと・要素ごと) | (計画の段では1) | 事後評価の実績÷起案時の見込み | 前提の置き方そのもの。比が1から離れ続けるなら補正を入れる |
| 計算の答えの採用率 | (計画の段だけで測る) | 計算の答えどおりに承認した案件や資産の割合 | 書き漏らした制約、前提への不信 |
| 資産運用の基本となる配分からの乖離とリスク | 基本となる配分、計算で想定したリスクと最悪時 | 実際の配分、実現した値動きのばらつきと最悪月の損失 | リバランスの遅れ、荒れた月の相関の上昇(第3章) |
表の「見込みに対する実績の比」と「計算の答えの採用率」は、第1章の指標には含めていなかった、導入の段階に特有の指標です。採用率が上がらない状態は、計算の答えがまだ業務に合っておらず、承認の場の判断の手間が導入前と変わっていないことを意味します。見込みに対する実績の比は、前の節の試算のとおり、NPV の合計では測れるまでに長い年数がかかるので、要素ごとの比(投資額・工期・成功の判定)を先に報告に載せるのが現実的です。
取締役会への報告では、個々の案件の採否よりも、配分の方針と、その方針を決めた手続きが適切に回っているかを説明することが中心になると考えています。上場会社の場合、東京証券取引所の「コーポレートガバナンス・コード」(2026年7月21日の改訂版)は、原則4-1で、取締役会が経営戦略や経営計画の策定・公表に当たり、成長投資(設備・研究開発・人的資本・知的財産等の無形資産への投資等)や事業ポートフォリオの見直し等の経営資源の配分等に関し、具体的に何を実行するのかを説明すべきだとしています。同じ原則の解釈指針は、中期経営計画が目標未達に終わった場合には原因と対応を分析して株主に説明し、その分析を次期以降の計画に反映させるべきだとしています。原則4-2は、取締役会が、自社の経営資源の配分が経営戦略や経営計画に照らして適切かを不断に検証すべきだとしています。この章で述べた事後評価と、その結果を次の見積りに戻す流れは、こうした検証と説明の材料を作る仕組みとして位置づけられます。コードが個々の会社に何を求めるか、どう対応するかの判断はこの記事の範囲を超えるので、ここでは記載の紹介に留めます。
- 東京証券取引所「コーポレートガバナンス・コード」の掲載ページ
https://www.jpx.co.jp/equities/listing/cg/index.html - 東京証券取引所「コーポレートガバナンス・コード(2026年7月版)」
https://www.jpx.co.jp/equities/listing/cg/tvdivq0000008jdy-att/nlsgeu000005lnul.pdf
企業年金の運用では、運用の判断に関わる人が加入者や受給者のために注意を尽くす責任(受託者責任と呼ばれます)が一般に求められ、配分を決めた手続きと根拠を説明できることが重要になります。どちらの場合も、説明に使えるのは「計算がそう出た」ではなく、どの前提を誰がどの根拠で置き、どの規則で点検し、どこで人が判断を加え、結果をどう測っているかの記録です。前の節までの台帳・点検の一覧・判断の記録・事後評価は、そのまま説明の材料になります。特定の法令が何を求めるかの解釈は、この記事の範囲を超えるので、制度に照らした判断は専門家に相談してください。
投資家への説明でも、考え方は同じです。事業投資の配分の方針(どの事業領域に、どの程度の規模の投資を、どういう基準で配分するか)と、その方針の結果を測る仕組みを示すことが、配分の結果の数字そのものより説得力を持つことが多いように思います。配分の基準を数理モデルで明示しておけば、方針と実際の配分の対応を説明しやすくなります。
導入の順序と失敗の型
ここまでの内容を、導入の順序としてまとめます。最初の段は、現状を数字にすることです。過去数年の投資案件について、起案時の前提と実績を集め、どの前提がどれだけ外れたかを種別ごとに数えます。資産運用なら、現在の配分の決め方と、置かれている規則(上下限や乖離幅)を書き出します。記録が残っていない案件が多いこと自体が、この段で分かる重要な事実です。2番目の段は、計算の答えを人の判断と並べる並行運用です。1年度分の案件について、従来の決め方で承認を進めながら、同じ案件を整数計画で選び、両方の答えの違いと、計算の答えを採れない理由を集めます。理由の多くは書き漏らした制約か前提のずれなので、規則と台帳に戻して直します。3番目の段で、一部で反映します。たとえば一定額以下の案件や、1つの事業部の案件について、計算の答えを承認の原案として使い、事後評価の時点と指標を決めて始めます。4番目の段で、手順が回ることを確かめたうえで、全社の案件と資産運用の配分に広げ、前提の台帳・点検の規則・判断の記録・事後評価を毎年度の流れに組み込みます。
並行運用の段を飛ばして、いきなり計算の答えで承認することは避けるべきだと考えています。事業の責任者が知っている事情を無視した答えが一度でも承認の原案に出ると、計算そのものへの信頼を失い、その後の改善が進みにくくなります。並行運用は、計算の答えの質を確かめる場であると同時に、承認する側が計算の答えの読み方に慣れる期間でもあります。並行運用をいつ終えるかは、計算の答えの採用率と、採れなかった理由のうち規則や台帳に戻せたものの割合で判断するのが分かりやすい基準です。
導入でよく見られる失敗は、次の表の型に分けられると考えています。どれも、推定の手法や最適化の解き方とは別のところで起きます。
| 失敗の型 | 起きること | 予防する手当て |
|---|---|---|
| 最適化の答えをそのまま採る | 推定誤差に引きずられた集中した配分や、見積りの大きい案件に偏った組が承認される | 乖離幅・1資産や1案件の上限の点検を掛け、掛かったものを人が吟味する(第4章・第5章) |
| 前提を誰も記録していない | 結果が外れても、どの前提が外れたのかを特定できない。前提の変更で案件が滑り込んでも分からない | 前提の台帳に、置いた人・日付・根拠・変更の履歴を残す |
| 事後評価が無い | 見積りの楽観を組織として知る手段が無く、同じ偏りが毎年繰り返される | 承認のときに、事後評価の時点・指標・担当を決める |
| 最悪時を見ない | 期待値だけで選んだ組が、悪い場合に大きく沈む(基準の CVaR は-572百万円) | CVaR と負になる確率を、NPV 合計と同じ表で報告する(第12章) |
| 見積りの楽観を補正しない | 楽観的に見積もる部門の案件ほど選ばれ、整数計画が偏りを増幅する | 要素ごと・種別ごとの見込みに対する実績の比で見積りを補正する |
| 規則の入れすぎ | 慣行まで絶対の制約にして、改善の余地が消える | 規則の出どころを記録し、制約の費用を測って見直す |
| 運用の担い手の不在 | 導入した人が異動すると、台帳・規則・推定の方法を直す人がいなくなる | 台帳・規則・推定の方法の持ち主を業務の役割として決める |
表の最後の型は、見落とされやすいものです。投資配分の計算は、導入した時点で完成するものではなく、事後評価の結果で見積りを補正し、規則と前提を直し続けることで精度を保つ仕組みです。直す作業が特定の個人の頑張りに依存していると、その人がいなくなった時点で仕組みが止まります。台帳・規則・推定の方法の持ち主を業務の役割として決めておくことが、導入の最後の段として必要だと考えています。
経営の判断として最も重要なのは、計算の答えを採るかどうかではなく、計算に入れた前提を記録し、その前提が外れたかどうかを測り続ける仕組みを先に作ることだと考えています。前提と実績の記録が数年分積み上がれば、その記録自体が、次の配分の判断で最も信頼できる入力になります。逆に、記録の無いまま精密な計算を入れても、計算は入力の偏りを精密に増幅するだけで、判断を誤ったときに何を直せばよいかが分かりません。
この章の要点は3つです。第一に、投資配分の計算が業務で使われなくなる原因の多くは、解き方ではなく、前提の記録・点検の規則・事後評価の欠如にあり、計算の答えはガードレールで機械的に点検して、掛かったものと境界の案件を中心に人が判断します。基準の資産配分は乖離幅±10pt の点検で6資産中4資産が掛かり、基準の案件選択では1案件が3年予算の29.2%を占めていました。第二に、事後評価は NPV の合計だけでは見積りの楽観をなかなか見分けられず、この章の試算では20年分を積み上げても判定が安定しませんでした。成功の判定のような要素ごとに比べれば、楽観を正しく「楽観」と判断できた割合は5年分で85.6%、10年分で94.4%に上がり、偏りが無いのに誤って「楽観」と判断した割合は10年分で13.2%まで下がりました。第三に、経営への報告は、見込みと実績を同じ表に並べ、最悪時と見込みに対する実績の比を添えて行います。次の第14章では、公開された一次情報のある事例と研究の動向、生成AIに任せられることと人が決めることを扱います。
この章を深めたい方への参考書籍
『NOISE 組織はなぜ判断を誤るのか?』上・下(ダニエル・カーネマン、オリヴィエ・シボニー、キャス・R・サンスティーン 著、村井章子 訳、早川書房):保険料の見積もりや人事評価、診断や裁判のように、同じ条件なら同じ判断が求められる場面で、判断する人によって結論がばらつく現象を扱っています。この章で述べた、前提を全社でそろえる規則や、判断の理由を選択肢で記録する仕組みは、投資委員会の判断のばらつきを小さくする工夫でもあり、その考え方を組織の意思決定の側から補えます。
『BIG THINGS どデカいことを成し遂げたヤツらはなにをしたのか?』(ベント・フリウビヤ、ダン・ガードナー 著、櫻井祐子 訳、サンマーク出版):大型プロジェクトの研究者が、プロジェクトが予算と期限を守れない理由と、守るための進め方を述べた本です。目次には、人が危険なほど楽観的になること、計画の前の段階に時間をかけることが並んでいます。この章の事後評価の節で扱った見積りの楽観を、設備投資のような大型案件の計画の側から考える材料になります。
第14章 事例と最新動向
第13章では、投資委員会での起案から事後評価までの流れに、この記事で扱った数理モデルをどう組み込むかを整理しました。この章では視点を外に向け、公開された一次情報で中身を確かめられる事例と、研究の動向を紹介します。取り上げるのは、公的年金の基本となる資産構成割合とその乖離の許容幅、企業年金の資産配分の統計、事業会社が公表している資本配分の方針、平均分散の考え方が経済学の賞を受けた経緯、機械学習や強化学習を配分に使う近年の研究、そして大規模言語モデル(大量の文章で学習し、文章を読み書きする生成AI)に任せられる仕事と人が決める仕事の線引きです。いずれも、公式の資料や論文の要旨を開いて確かめた範囲だけを書きます。運用の成績や運用資産の増減額、個別の投資額は、公表されていても書きません。本章で紹介する比率は、それぞれの主体が制度や方針として公表している事実の紹介であり、特定の配分を勧めるものではありません。本記事は投資や財務の助言ではなく、個別の判断は専門家に相談してください。
事例を選ぶときに、弊社コラム『数理最適化の定式化パターン集』の第1章が取り上げた生産・勤務・配送・作業割り当ての事例とは重ならないようにしました。あちらは「計画を作る作業を数理最適化に置き換えた」事例で、この章は「資金をどこにどれだけ振り向けるかの方針を、数理の考え方で組み立てて公表している」事例です。前者は作業時間の短縮が成果として語られやすく、後者は成果より決め方の手続きそのものが公表の中心になります。この違いは、本記事の第13章で述べた「前提と判断の記録を残す」こととそのまま対応しています。
公的年金の基本ポートフォリオと乖離許容幅
資産の配分を数理で決め、その決め方を詳しく公表している国内の代表例が、年金積立金管理運用独立行政法人(以下、GPIF)です。GPIF は、国内債券・外国債券・国内株式・外国株式の4資産について、長期に維持する基本の資産構成割合を基本ポートフォリオとして定めています。公式サイトの「基本ポートフォリオの考え方」のページは、長期の運用では短期的な市場の動きに合わせて構成割合を変えるよりも、基本となる構成割合を決めて長く維持するほうが効率的で良い結果をもたらすことが知られている、と説明しています。この記事の言葉に置き換えると、第1章の4つの層のうち2つ目、資産クラスへの配分の層で「現在の配分」に当たる基準点を、5年ごとの中期目標期間に合わせて決め直している、ということです。
2025年4月1日から適用されている第5期中期目標期間(2025年度からの5か年)の基本ポートフォリオは、公式サイトによれば4資産とも25%です。乖離の許容幅は、国内債券±6%・外国債券±5%・国内株式±6%・外国株式±6%で、これに加えて債券全体と株式全体にそれぞれ±9%の幅が設けられています。第4期(2020〜2024年度)も構成割合は4資産とも25%でしたが、乖離許容幅は各資産で±7%・±6%・±8%・±7%、債券全体と株式全体で±11%でした。第5期の策定では、構成割合は第4期と同じ結果になり、乖離許容幅は新たに想定したリスクをもとに推計し直した結果、第4期より小さくなったと説明されています。
乖離許容幅は、基本ポートフォリオから実際の構成割合がどこまで離れてよいかの範囲です。GPIF の策定資料(「第5期中期目標期間における基本ポートフォリオについて(詳細)」)は、市場は常に変動するため、基本ポートフォリオをベースにしながら合理的に無理のない範囲で機動的な運用を可能とする仕組みとして乖離許容幅を定めている、と書いています。確かめた範囲では、公式サイトと策定資料は、幅の中で実際にどう売買するか、幅を超えたときにどう戻すかまでは書いていません。それでも、基本となる割合と、そこから離れてよい範囲の両方を先に決めて公表している点で、第9章で比べた「乖離幅によるリバランス」(比率がある幅以上ずれたときだけ戻す規則)と同じ考え方に立つ制度と読めます。
債券全体と株式全体の幅を各資産の幅とは別に置いている理由も、公式サイトに書かれています。第4期の説明によると、各資産の幅だけなら株式の保有上限は実質的に50%に内外債券の幅の合計13%を足した値になるところ、株式全体の幅によって50%に11%を足した値までに制限される、という関係です。つまり各資産の幅は資産ごとの上下限の制約、全体の幅は「株式系の合計」に対する上限の制約で、第8章で扱った資産クラス別の枠の考え方と同じ形をしています。個別の上下限を足し合わせると全体としては想定より大きな偏りを許してしまうので、合計にも別の枠を掛ける、という設計です。
基本ポートフォリオの決め方に、この記事の論点がそろっている
GPIF の策定資料(詳細版)は、構成割合の結果だけでなく、目的・制約・推定の方法・検証の手順を順に公表しています。読み進めると、この記事の第3章から第12章で扱った論点が、ほぼ同じ順番で現れます。ここでは策定資料に書かれていることだけを、この記事の章と対応させて整理します。数値は、制度として公表されている運用目標と構成割合に限り、推計の途中で出てくる期待リターンやリスクの値は書きません。
まず目的と制約です。厚生労働大臣が示した第5期中期目標の運用目標は、公式サイトによれば、長期的に年金積立金の実質的な運用利回り(運用利回りから名目賃金上昇率を差し引いたもの)1.9%を最低限のリスクで確保すること、です。策定資料は、リスクの制約として、名目賃金上昇率を下回る確率(下方確率)が全額を国内債券で運用した場合を超えないことを置き、そのうえで、賃金上昇率を下回ったときの平均的な不足率(条件付平均不足率)をリスクの尺度にしたと書いています。この「下回ったときの平均」という考え方は、第7章の CVaR と同じ発想です。分布の下側の、さらに悪いところの平均を見ています。各資産の大小関係などのその他の制約は設定しないとしている点も、明記されています。
次に推定です。策定資料によると、期待リターンは、短期金利にリスクプレミアムを足し上げるビルディングブロック法による推計と、市場の時価総額から逆算した均衡収益率を混ぜ合わせて推計しています。均衡収益率は、策定資料の注記で「各資産のリスク・相関係数及びグローバル市場の時価総額を用いて、市場から示唆されるリターンを逆算したもの」に期待短期金利を加えたもの、と定義されています。第5章で紹介したブラック・リッターマンの出発点(市場の配分から期待リターンを逆算する)と、考え方の骨格が同じです。期待リターンは、財政検証が想定する4つの長期の経済シナリオごとに推計し直しています。リスクと相関は、過去30年間の月次リターンから求め、月次リターンの区切りの開始日を1日から30日まで変えて計算した値の平均をとった、と書かれています。第3章で見たとおり、標本から得た数字は区切り方ひとつで揺れるので、その揺れを平均でならしている工夫と読めます。
最適化の結果の扱いにも、この記事の論点が現れます。策定資料は、厳密な最適構成割合を丸めて5%刻みの構成割合とした、と書いています。丸めた理由は資料に書かれていないので、ここでは丸めたという事実の紹介に留めます。一般に、最適化の答えを丸めて採るときは、丸めた配分と丸める前の配分で、目的とリスクの値がどれだけ違うかを確かめておく必要があります。第4章で、共通データの真のモデルでは効率的フロンティアが平らで、配分を少し変えても期待リターンの差は小さいことを確かめました。フロンティアが平らな範囲であれば、丸めによる差も小さくて済みます。さらに、選んだ配分については、100万回の数値シミュレーションで将来の積立金の分布を調べて財政検証の予定額と比べること、過去の金融危機などの局面を当てはめるストレステスト、正規分布ではなく過去の実現リターンから作った経験分布での試算を行っています。第7章のシナリオによる評価、第12章のストレステストと、手順の並びが一致します。
経営の目線で読むと、この事例から引き出せるのは「数理モデルで出した答え」よりも「決め方を先に公表し、毎年度検証する」という運用の形です。公式サイトは、策定時に想定した運用環境が大きく変わる可能性がないかを毎年度検証し、必要と認めるときは中期目標期間中でも見直しを検討する、と書いています。事業会社の投資配分に置き換えると、中期経営計画の期間ごとに基準の配分を決め、許容する乖離の幅と見直しの条件を合わせて決めておき、毎年の予算編成でその条件に当たっていないかを確かめる、という仕組みに相当します。第13章で述べた投資委員会の運用に、そのまま組み込める形です。
企業年金の政策アセット・ミクスの統計
事業会社にとって、資産配分の判断がいちばん身近に現れるのは企業年金です。確定給付企業年金を持つ会社では、年金の資産をどの資産にどれだけ配分するかの基本方針を定め、その結果が母体企業の財務にも影響します。企業年金連合会は会員の企業年金を対象に毎年「企業年金実態調査」を行っており、2025年12月25日付の「企業年金実態調査結果(2024年度概要版)」が、この章の執筆時点(2026年10月)で連合会の調査ページに掲載されている最新版でした。調査の目的は、企業年金の資産運用と財政・事業運営の実態を把握し、会員が事業運営を検討する際の基礎資料にすることとされています。
この調査には、資産を実際にどう持っているかを示す「資産構成割合」と、基本方針として定めている配分を示す「政策アセット・ミクス」の2つの集計があります。政策アセット・ミクスは、GPIF の基本ポートフォリオと同じ役割の、長期の基本となる配分です。2024年度の会員の確定給付企業年金(会員DB)について、概要版の本文は次のように書いています。数字は概要版の本文の記述をそのまま表にしたもので、本章で計算したものではありません。
| 区分 | 資産構成割合(会員DB・加重平均) | 政策アセット・ミクス(会員DB・単純平均) |
|---|---|---|
| 国内債券 | 19.1% | 25.9% |
| 国内株式 | 9.2% | 10.9% |
| 外国債券 | 17.0% | 12.9% |
| 外国株式 | 13.5% | 12.7% |
| 一般勘定 | 15.4% | 16.6% |
| 短期資産 | 4.9% | 2.7% |
| その他 | 20.7% | 18.3% |
この表を読むときに、注意が2つあります。1つ目は集計の方法の違いです。概要版の注記によると、会員DBの資産構成割合は資産額による加重平均で、政策アセット・ミクスは制度ごとの単純平均で集計されています。加重平均では資産の大きい制度の配分が強く効き、単純平均では小さい制度も大きい制度も同じ重みで数えられます。そのため、2つの列の差を「企業年金は平均して政策アセット・ミクスからこれだけ乖離している」と読むことはできません。表の列名と本文の読み方を一致させる、という第2章で述べた注意は、公的統計を引用するときにも同じように効きます。
2つ目は資産の区分です。この記事の共通データは国内株式・外国株式・国内債券・外国債券・不動産投資信託・短期資産の6つに分けましたが、企業年金の統計には「一般勘定」(生命保険会社の一般勘定を通じた運用)や、オルタナティブ投資を含む「その他」が、それぞれ1割を超える大きさで現れます。概要版の注記は、会員全体の資産構成割合の「その他」の内訳として、不動産・プライベートエクイティ・コモディティなどを挙げています。これらは市場価格が日々つかないものが多く、月次リターンの標本から平均と共分散を推定するという第3章の手順が、そのままでは当てはまりません。GPIF がオルタナティブ資産を独立した区分にせず、リスクとリターンの特性に応じて4資産の中で管理し、資産全体の5%を上限としているのも、同じ問題への1つの対処として読めます。
経営の目線では、企業年金の配分は「運用の専門家が決めるもの」として経営会議の議題から外れがちですが、積立の不足が生じれば母体企業が掛金で埋めることになります。この記事の言葉で言えば、年金資産の配分は、事業投資の予算配分と同じ会社の財布から、最悪の場合に資金を引き出す可能性を持つ配分です。第7章の CVaR や第12章のストレステストの考え方で「最悪の年に、母体企業にいくらの追加負担が来うるか」を年1回確かめておくことは、事業投資の計画を守るためにも意味があると考えています。
事業会社の資本配分方針と、東京証券取引所の要請
事業会社の側で、配分の方針を公表する動きを後押ししているのが、東京証券取引所の「資本コストや株価を意識した経営の実現に向けた対応」です。東証の公式ページによると、東証は2023年3月31日に、プライム市場とスタンダード市場の全上場会社を対象としてこの要請を行いました。要請の趣旨は、自社の資本コストや資本収益性を的確に把握し、取締役会で現状を分析・評価したうえで、改善に向けた計画を策定・開示し、投資者との対話の中で取組みを更新していく、という一連の対応を継続して行うことです。同じページは、研究開発投資・人的資本への投資・設備投資・事業ポートフォリオの見直しなどを進めることで、経営資源の適切な配分を実現していくことが期待される、と書いています。
2026年4月28日には、東証が要請のアップデートを公表しました。その資料(「資本コストや株価を意識した経営」に関する要請のアップデート)は、「経営資源の適切な配分」を中心に、対応のポイントを4つに整理しています。中長期的な経営方針を明確に示せているか、目指す姿に向けた資本の使い方(配分や優先順位)を明確に示せているか、保有する資産が価値創出のために最適な状態か、そしてそれらについて取締役会の水準で実効的な議論と監督を行っているか、の4つです。2つ目のポイントについて資料は、資本配分(キャピタル・アロケーション)の検討では、自社の資本コスト・資本収益性・成長の段階を考慮したうえで、まず中長期的に価値創造の源泉を強化する成長投資を検討し、手元資金の適正な水準も踏まえ、余資があれば機動的に株主還元に振り向けるという「検討の優先順位」が重要だ、と書いています。また、限られた資本をどのような考え方と優先順位で配分していくのか、その方針を投資家に明確に説明することが期待される、としています。
同じ資料には、開示の状況も載っています。同資料が示す2026年3月末時点の状況では、プライム市場の上場会社の93%、スタンダード市場の53%が開示済み(検討中を含む)とされています。さらに、企業と投資家の課題認識のずれとして、株主還元の充実のように着手しやすい取組みが進む一方で、多くの投資家が重要な課題と捉える事業ポートフォリオ・経営資源配分の見直しや最適なバランスシートの検討は十分に進んでいない、と指摘しています。事業会社の投資配分について、方針を「示す」段階は広がった一方で、配分を「決める」中身の検討が次の課題として挙げられている、と読めます。
個別の企業の取組みとしては、同じ資料が過去の事例集から引用する形で、資源配分に関わる例を紹介しています。その中には、独自の ROIC(投下資本利益率)指標と事業ごとに分けたハードルレート(投資の採否を判断する最低限の収益率)を算出し、資産の流動化や新規投資の判断、拠点のモニタリングに活用して、資源配分の最適化を進めている事業会社の例があります。ここで紹介されているのは「事業ごとに異なる基準の収益率を置き、それで投資の採否と見直しを判断する」という方針の形で、金額ではありません。この記事の第10章で扱った資本予算配分に当てはめると、案件ごとの NPV を計算するときの割引率を事業の性格に応じて変える、という設定に当たります。事業ごとにリスクの大きさが違うのに割引率を全社で1つにすると、どの事業の案件も同じ割引率で NPV が計算され、リスクの違いが採否の比較に反映されません。事業別の基準を置くことは、その違いを比較の段階で織り込むための仕組みです。
経営の目線でまとめると、上場会社にとって資本配分の方針は、もはや社内の予算編成の手続きではなく、投資家に説明し、更新し、取締役会で監督する対象になっています。説明を求められるのは「どこにいくら配分したか」の結果よりも、「どういう考え方と優先順位で配分するか」です。第10章から第12章で扱った整数計画やシナリオ分析は、この「考え方と優先順位」を、前提を明示した計算として示す道具になります。たとえば、予算の上限を変えたときに採択される案件がどう変わるか(第10章の予算の限界価値)や、景気が悪い場合に NPV 合計がどこまで沈むか(第12章の CVaR)を添えると、優先順位の根拠を数字で示せます。
事例の一覧と、この記事の章との対応
ここまでの事例と、後の節で紹介する資料を、主体・公開資料・何を決めているか・この記事のどの章に対応するかで一覧にしました。「何を決めているか」の列は、それぞれの公開資料に書かれていることだけを要約したもので、成績や金額は含めていません。
| 主体 | 公開資料 | 何を決めているか | 本記事の対応する章 |
|---|---|---|---|
| 年金積立金管理運用独立行政法人(GPIF) | 基本ポートフォリオの考え方(公式サイト)、第5期中期目標期間における基本ポートフォリオについて(詳細) | 4資産の基本の構成割合、各資産と債券・株式全体の乖離許容幅、運用目標とリスク制約、期待リターンとリスクの推計方法、検証の手順 | 第3章(推定)、第4章(丸めとフロンティアの平らさ)、第5章(均衡収益率)、第7章(下回ったときの平均)、第8章(全体の枠)、第9章(乖離幅)、第12章(ストレステスト) |
| 企業年金連合会 | 企業年金実態調査結果(2024年度概要版) | 会員の企業年金の資産構成割合と政策アセット・ミクスの集計 | 第2章(問題の記述と資産の区分)、第3章(推定の前提)、第13章(基準の配分の管理) |
| 東京証券取引所 | 資本コストや株価を意識した経営の実現に向けた対応(2023年3月31日)、同要請のアップデート(2026年4月28日) | 上場会社に、資本配分の考え方と優先順位を示し、取締役会で議論・監督することを求める | 第10章(資本予算配分)、第12章(不確実性)、第13章(投資委員会と事後評価) |
| 金融庁 | AIディスカッションペーパー(第1.1版、2026年3月3日) | 金融機関がAIを使うときのリスク低減の取組みの整理(設計と事前検証、説明、検証とモニタリング、ガバナンス) | 第13章(人が最終判断する運用)、本章の生成AIの節 |
表の「本記事の対応する章」は、公開資料の記述とこの記事の手法の考え方が同じ形をしている箇所を、筆者の側で対応づけたものです。各主体がこの記事の手法をそのまま使っているという意味ではありません。たとえば GPIF の策定資料に「ブラック・リッターマン」という語は出てきません。均衡収益率を使うという考え方の骨格が、第5章の出発点と同じだということです。
平均分散の考え方が経済学の賞を受けた経緯
この記事の第4章で扱った平均分散最適化は、ハリー・マーコウィッツの1952年の論文に始まります。ノーベル財団の公式サイトによると、1990年のアルフレッド・ノーベル記念スウェーデン国立銀行経済学賞は、ハリー・M・マーコウィッツ、マートン・H・ミラー、ウィリアム・F・シャープの3人に、金融経済学の理論における先駆的な業績を理由として、3分の1ずつ授与されました。同じ年の公式の発表文は、それぞれの授賞理由を、マーコウィッツはポートフォリオ選択の理論を発展させたこと、シャープは資本資産価格モデル(CAPM)と呼ばれる金融資産の価格形成の理論への貢献、ミラーは企業金融(コーポレートファイナンス)の理論への基礎的な貢献、と説明しています。発表文はマーコウィッツの貢献について、一定の条件のもとで投資家のポートフォリオの選択を、期待リターンと分散という2つの次元の釣り合いに帰着させたこと、そして資産のリスクで本質的なのは、その資産単独のリスクではなく、ポートフォリオ全体のリスクへの寄与であることを示したこと、と書いています。後者は、この記事の第6章で計算したリスク寄与度の考え方そのものです。
発表文は、CAPM の実務での使われ方にも触れています。業種に固有のリスクプレミアムをその業種のベータ値(市場全体のリスクに対する感応度)から決められること、そして投資や買収の判断で割引率を求めるための資本コストの計算に、CAPM とベータ値が日常的に使われていることです。前の節で紹介した「事業別のハードルレート」は、この考え方の延長にあります。
この3人の受賞が同じ年にまとまっていることは、この記事の構成と関係があります。発表文の説明に沿って言えば、マーコウィッツは「資産をどう組み合わせるか」、シャープは「市場の均衡で、資産の期待リターンがリスクとどう結びつくか」、ミラーは「企業の資本の構成や配当の方針が企業の市場価値とどう関係するか」を扱いました。資産運用の配分と事業会社の資本の使い方は、同じ金融経済学の枠組みの中で論じられてきた、ということです。この記事が資産の配分と事業投資の予算配分を同じ数理で扱っているのも、この伝統に沿っています。
一方で、理論の答えをそのまま採ることには注意が要ります。第4章で確かめたとおり、推定モデルの最適配分は推定誤差を拡大し、共通データでは履歴を作り直した20回中18回で、真のモデルで評価したシャープ・レシオが現在の配分を下回りました。GPIF の策定資料が、最適化の結果を5%刻みに丸め、複数の推計方法やストレステストで確かめているのも、理論の答えをそのまま採らないための手続きと読めます。理論の価値は「答えを出すこと」よりも「何と何の釣り合いで配分が決まるか」を明らかにしたことにある、と考えています。
研究の動向:機械学習で期待リターンを推定する
この記事で繰り返し確かめたのは、配分の良し悪しを決めるのは最適化の計算よりも入力の推定、とくに期待リターンの推定だということでした。近年の研究で目立つのは、この推定に機械学習を使う流れです。ここでは、論文の要旨を開いて内容を確かめたものだけを紹介します。結論の向きは要旨に書かれているとおりに書き、その結果が自社の配分にもそのまま当てはまるとは書きません。
グ(Gu)、ケリー(Kelly)、シウ(Xiu)の2020年の論文は、The Review of Financial Studies 誌(第33巻第5号)に載った、機械学習による実証資産価格の研究です。要旨によると、資産のリスクプレミアムを測るという資産価格の実証研究の典型的な問題について、機械学習の手法を比較し、機械学習の予測を使うことで投資家に大きな経済的な利得があり、文献にある代表的な回帰に基づく戦略の成績を倍にする場合もあると報告しています。成績の良かった手法は決定木系の手法とニューラルネットワークで、その予測の改善は、他の手法が取りこぼしていた予測変数どうしの非線形の相互作用をとらえたことによる、と分析しています。また、手法によらず、支配的な予測のシグナルはほぼ同じ集合(モメンタム・流動性・ボラティリティの変形を含む)に一致した、と書いています。
この論文の要旨が「予測変数どうしの相互作用」や「支配的なシグナルの集合」を論じていることからも分かるように、多くの予測変数を使える問題設定での研究です。この記事の共通データAは「6つの資産クラスの月次リターンだけで240か月」という小さな問題で、予測に使える情報の量がまったく違います。資産クラスの数が少なく観測期間も限られる配分の問題では、柔軟な手法を持ち込む前に、第3章で見た標本平均の誤差の壁が先に立ちます。事業投資の案件選択はさらに観測が少なく、同じ案件が何百回も繰り返されることはありません。研究の結果を自社に持ち込むときは、データの粒度と量が論文と同じ条件かどうかを最初に確かめる必要があります。
研究の動向:推定と最適化をつなぐ
もう1つの流れは、推定と最適化を別々に行うのではなく、つないで扱う研究です。バン(Ban)、エル・カルイ(El Karoui)、リム(Lim)の2018年の論文は、Management Science 誌(第64巻第3号)に載った、機械学習とポートフォリオ最適化を題にした研究です。要旨は、ポートフォリオ最適化のモデルが実データに適用したときの推定の問題のために実務への影響が限られている、という問題意識から始まります。そのうえで、機械学習の2つの方法である正則化(解が極端にならないよう罰則や制約を加えること)と交差検証(データを分けて、使っていない部分で成績を測ること)を最適化に持ち込み、推定したリスクとリターンの標本分散を制約する「成績に基づく正則化」を、平均分散と平均 CVaR の両方の問題について提案しています。この正則化はロバスト最適化の問題として書き直せることも示しています。実証では、3つのデータセットのうち2つで、提案手法が他の比較対象(正則化の別の方法や均等配分を含む)を上回ったと書いています。
この論文が平均分散と並べて均等配分を比較対象に置いていること、そして3つのうち2つという書き方で結果を報告していることは、読み手にとって重要です。第4章で確かめたとおり、均等配分は推定を一切使わないにもかかわらず、推定モデルの最適配分より真のモデルで良い結果を出すことがあります。新しい手法を評価するときに均等配分や現在の配分を比較対象に入れ、勝てなかったデータも含めて報告するのは、配分の手法を社内に入れるときにも守りたい作法です。
バトラー(Butler)とクォン(Kwon)の論文(arXiv:2102.09287、2021年初出)は、平均分散最適化に予測モデルを統合する枠組みを提案しています。要旨によると、予測モデルは従来、資産配分の意思決定での使われ方とは独立に最適化されてきたという問題を取り上げ、回帰による予測モデルを平均分散最適化の設定に統合する枠組みを示しています。制約がない場合と等式制約の場合には解析的な解を与え、一般の不等式制約の場合にはニューラルネットワークの構成を使って2次計画を効率よく解く方法を使っています。合成データと世界の先物データでの過去のシミュレーションで、統合した方法の利点を示した、と書いています。予測の精度そのものではなく「その予測を使って決めた配分の良さ」で予測モデルを学習させる、という考え方で、第4章の「推定誤差の増幅」に、推定の段階から対処しようとする研究と位置づけられます。
研究の動向:深層学習と強化学習で配分を直接決める
期待リターンの推定を経ずに、配分そのものを学習させる研究もあります。チャン(Zhang)、ゾーレン(Zohren)、ロバーツ(Roberts)の論文(arXiv:2005.13665、2020年初出)は、深層学習のモデルでポートフォリオのシャープ・レシオを直接最適化する枠組みを提案しています。要旨によると、この枠組みは期待リターンを予測する必要を回避し、モデルのパラメータを更新することで配分の重みを直接最適化します。個別の資産を選ぶ代わりに、市場指数に連動する上場投資信託を対象にして、選択肢の数を絞っています。2011年から2020年4月末までの検証期間で、比較した多くの手法の中で最も良い成績を得たと報告し、入力の特徴量の感応度や、取引コストの率とリスク水準を変えた場合の分析も行っています。
強化学習(試行錯誤で報酬を最大にする行動の決め方を学ぶ機械学習の一分野)による配分の研究としては、ジアン(Jiang)、シュー(Xu)、リアン(Liang)の論文(arXiv:1706.10059、2017年初出)があります。要旨によると、資金を複数の金融商品に絶えず配分し直す問題に対して、金融のモデルを前提としない強化学習の枠組みを提示し、畳み込みニューラルネットワーク・再帰型ニューラルネットワーク・LSTM の3種類で実装しています。検証は、30分ごとに取引する暗号資産の市場での3つの過去データの実験で、比較した他の手法を上回ったと報告しています。
これらの研究は、配分の決め方の選択肢を広げるものですが、事業会社の投資配分にそのまま持ち込める段階にはないと考えています。理由は3つあります。1つ目は、検証の対象が流動性の高い市場で高い頻度で取引できる資産であることです。30分ごとに配分を変えられる市場と、年に1回の予算編成で配分を決める事業投資では、学習に使えるデータの量が桁違いです。2つ目は、説明の難しさです。第13章で述べたとおり、投資委員会や取締役会では「なぜこの配分か」を前提とともに説明する責任があり、学習したモデルの重みはその説明になりません。3つ目は、次の節で述べる過剰適合の問題です。
研究の動向:バックテストの過剰適合という警告
機械学習で配分を決める研究を読むときに、併せて押さえておきたい論文があります。ベイリー(Bailey)、ボーウェイン(Borwein)、ロペス・デ・プラド(López de Prado)、ジュー(Zhu)の2014年の論文で、Notices of the American Mathematical Society 誌(第61巻第5号)に載った、バックテストの過剰適合が検証期間外の成績に与える影響を論じたものです。バックテストとは、投資の戦略を過去のデータで動かしたらどうなったかを計算する、過去のシミュレーションです。論文は、比較的少ない試行の回数で、見かけだけ成績の高い戦略が見つかってしまうことを示し、試した回数に応じて必要になるバックテストの最小の長さを計算しています。
論文の例では、データが5年分しかない場合、独立なモデルの設定を45通り試すだけで、学習に使った期間でのシャープ・レシオの最大値の期待値は1になる一方、使っていない期間での期待値は0になる、と書かれています。つまり45通りは安全に試せる回数ではなく、5年分のデータでは、その程度の回数でも見かけだけ良い結果が出てしまう、という警告です。そして、選んだ設定を見つけるまでに何通り試したかを報告しないバックテストでは、過剰適合のリスクを評価できない、と結論づけています。この指摘は、第4章で推定モデルの最適配分が真のモデルで劣ったのと同じ構造を、モデル選びの段階に広げたものと読めます。最適化が推定誤差を拡大するのと同じように、たくさんの候補から最良のものを選ぶ手続きは、偶然の良さを拡大します。
経営の目線では、社内外から「この手法なら過去10年でこれだけ良かった」という提案を受けたときに、何通り試してその結果にたどり着いたのか、検証に使ったデータは設計に使ったデータと分けてあるのか、均等配分や現在の配分と比べたのか、の3点を確かめることが有効だと考えています。これは手法の中身を理解していなくても投げかけられる問いで、投資委員会の審査の項目にそのまま加えられます。
生成AIに任せられることと、人が決めること
投資配分の業務で、生成AI、とくに大規模言語モデルが役に立つ場面は、数理モデルの計算そのものよりも、その前後の文章と情報の扱いにあります。この節では、配分の業務を工程に分け、大規模言語モデルに下書きや整理を任せられる工程と、人が決めなければならない工程を分けて整理します。ここでの整理は、特定の製品の機能に基づくものではなく、この記事で扱った配分の手順に照らした弊社の考えです。
任せやすいのは、次の3種類の仕事です。1つ目は投資委員会資料の下書きです。第13章で整理した起案の段で書く項目(案件の目的・投資額・期間・NPV の見積りと前提)が決まっていれば、担当者のメモや計算結果の表から、型に沿った文章の初稿を作らせることができます。2つ目はシナリオの文章化です。第12章のストレステストで景気要因を下に振った結果を、「どの部門のどの案件が、どういう理由で沈むか」という文章に直す作業は、数字の表を読んで説明文を書く作業で、下書きに向いています。3つ目は情報の整理です。案件ごとに部門から上がってくる書式の違う資料から、投資額・時期・前提・リスクの項目を抜き出して一覧にする作業や、過去の起案書と事後評価を突き合わせて、見込みと実績の差を整理する作業がこれに当たります。
一方、人が決めなければならないのは、次の3つです。1つ目は前提の採否です。期待リターン、成功確率、NPV の見積り、景気のシナリオといった数理モデルの入力は、この記事で何度も見たとおり、配分の結果を大きく動かします。大規模言語モデルに候補を挙げさせることはできても、どの前提を採るかは、根拠を確かめたうえで人が決め、誰がいつどの根拠で置いたかを記録する必要があります。2つ目は最終判断です。数理モデルの答えと文章の下書きは判断の材料で、採択するかどうかは投資委員会や経営会議が決めます。3つ目は説明責任です。取締役会や投資家、年金であれば加入者に対して「なぜこの配分か」を説明する責任は、道具に移せません。
金融庁が2026年3月3日に公表した「AIディスカッションペーパー(第1.1版)金融機関等におけるAIの活用実態と健全な利活用の促進に向けた初期的な論点整理」は、金融機関の顧客向けサービスを念頭に、リスク低減の取組事例を、サービス提供前の「設計と事前検証」、提供時の「顧客への適切な説明・注意喚起」、提供後の「検証・モニタリング」、それら全体を支える「ガバナンス」の4つの局面に分けて整理しています。概要資料には、回答の根拠・情報源の明示、会話の記録を保存して回答を監視すること、推奨の論理を文書にして第三者のレビューを通じて監視すること、といった取組みが挙げられています。顧客向けサービスを想定した整理ですが、社内の投資配分の業務に大規模言語モデルを使うときにも、そのまま点検の項目として使える内容です。
この整理を配分の業務に当てはめると、次のようになります。下書きを作らせるときは、根拠にした資料と計算結果を必ず添えさせ、文中の数字が元の表と一致しているかを人が照合する。前提の候補を挙げさせたときは、採った前提と採らなかった前提の両方を記録に残す。下書きを作った工程と、それを確かめた人を、起案書の履歴に残す。この記事の第13章で述べた「前提と判断の記録」の仕組みがあれば、大規模言語モデルを使っても説明責任の所在は変わりません。逆に、その仕組みがないまま文章の作成だけを速くすると、根拠の追えない資料が増えることになります。
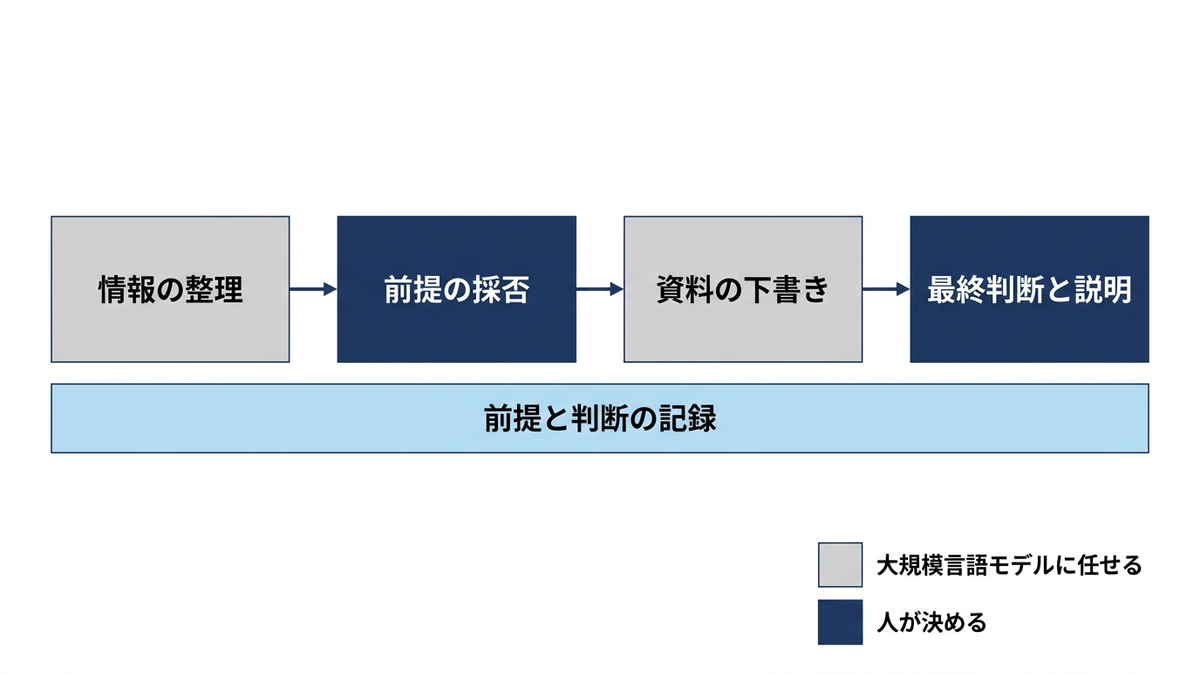
公開されている一次情報を開くと、資産の配分でも事業の資本配分でも、重視されているのは数理モデルが出した答えそのものよりも、決め方を先に定め、公表し、定期的に検証する仕組みでした。GPIF の基本ポートフォリオは、運用目標とリスク制約、推定の方法、丸め方、乖離許容幅、検証の手順までを公表しており、この記事の第3章から第12章の論点がそろって現れます。企業年金の統計は、基本となる配分と実際の配分を別々に集計しており、引用するときは集計の方法と資産の区分を確かめる必要があります。東京証券取引所の要請は、上場会社に資本配分の考え方と優先順位を示し、取締役会で監督することを求めています。
研究の側では、機械学習で期待リターンを推定する研究、推定と最適化をつなぐ研究、配分を直接学習させる研究が進んでいますが、どれも比較の対象と検証の条件を確かめてから読む必要があり、とくにバックテストの過剰適合の警告は、手法の提案を審査する立場の人が押さえておきたい論点です。大規模言語モデルは資料の下書き・シナリオの文章化・情報の整理を速くしますが、前提の採否・最終判断・説明責任は人に残ります。本章で紹介した比率や方針は各主体が公表している事実であり、特定の配分を勧めるものではありません。この記事全体の振り返りと、自社で始めるための順序は、終章でまとめます。
この章を深めたい方への参考書籍
『GPIF 世界最大の機関投資家』(小幡績、東洋経済新報社):公的年金の積立金を運用する GPIF を題材にした本です。2014年の刊行なので、この章で紹介した第5期の基本ポートフォリオより前の時点の本ですが、公式の策定資料と並べて読むと、基本となる配分を決める組織の側から配分の論点を考える手がかりになります。
『ファイナンス機械学習 金融市場分析を変える機械学習アルゴリズムの理論と実践』(マルコス・ロペス・デ・プラド著、長尾慎太郎・鹿子木亨紀監訳、大和アセットマネジメント訳、金融財政事情研究会):この章で紹介したバックテストの過剰適合の論文の著者の1人による本で、副題のとおり、金融市場の分析に機械学習のアルゴリズムを使う理論と実践を扱っています。この章の研究動向の節で紹介した論文を読む前提をそろえ、機械学習による配分の提案を審査する側に立ったときの論点を確かめるのに向いています。
終章 投資配分の判断を、前提を記録して測り直す仕組みにする
本コラムでは、限られた資金をどこにどれだけ振り向けるかという意思決定を、資産クラスへの配分と事業投資の案件選択の両方について、同じ数理の言葉で扱いました。記録から期待リターンやリスクを推定するところから始めて、平均分散最適化とその弱点、推定誤差への対処、リスクや最悪時の損失で配分する方法、取引コストと保有制約、多期間の見直し、予算のもとでの案件選択、研究開発テーマの選び方、不確実性のもとでの配分、現場への導入へと、論点を1つずつ足しながら進めました。終章では、各章で実際に計算した結果から言えることを振り返り、投資配分の判断を仕組みにするための考え方をまとめます。
各章の結果から言えること
はじめに、各章の結論を1行ずつ表にまとめます。数字はいずれも架空の設定による例題の値です。表の「真のモデル」は、データを作った側だけが知る本当の分布のことで、「推定モデル」は過去の記録から推定した見込みのことです。「真の最適」は、真のモデルのもとで、空売りをせず、リスクを現在の配分と同じ8.30%以下に抑えるという条件で期待リターンを最大にした配分で、第4章で計算しました。資産配分の章の数字は年率、事業投資の章の数字は百万円で、3年間に選んだ案件の正味現在価値(NPV)の合計です。続く段落で、条件と根拠を章ごとに補います。
| 章 | 一言の結論 | 根拠の数字(例題) |
|---|---|---|
| 第1章・第2章 | 配分は見込みの上で決める変数で、素朴な規則は見込みの外れをそのまま持ち込む | 標本平均が最も高い1資産に寄せる規則の真のシャープ・レシオは0.311、現在の配分は0.376 |
| 第3章 | 期待リターンの見込みは、記録を長くしても精度が上がりにくい | 240か月の記録でも国内株式の標本平均の標準誤差は3.60ポイント。1ポイントに縮めるには約259年分が要る |
| 第4章 | 最適化は見込みの誤差を配分の偏りに増幅する | 推定モデルの最適は見込み+0.93ポイント、真のモデルで-0.27ポイント。20回の作り直しで18回が現在の配分を下回る |
| 第5章 | 見込みを「現在の配分」に寄せる方法は、答えを安定させる代わりに大きな改善を諦める | ブラック・リッターマンの真のシャープ・レシオは20回の平均0.372・最小0.349で、基準の平均0.328より安定だが現在の配分0.376を14回下回る |
| 第6章 | 見込みを使わずリスクの大きさで配分すると、答えは安定するが期待リターンは下がる | リスクパリティは20回とも真のシャープ・レシオ0.383〜0.390、期待リターンは2.23%(現在の配分3.62%) |
| 第7章 | この例題では、分散で決めても最悪時の損失で決めても配分はほぼ同じ | 同じ期待リターンでの月次CVaRの差は0.04ポイント。年の分布で見た下位5%の平均は-14.33% |
| 第8章 | 配分を動かす費用を入れると、動かさないことが答えになる | 取引コスト率2.00%で推定モデルの最適は現在の配分そのもの。取引コスト率0.5%でも、真の最適へ移る費用の回収に5.4年 |
| 第9章 | 見直しの規則の違いは資産の増え方をほとんど変えず、リスクと費用を変える | 10年後の資産の中央値は放置1,373・規則1,384〜1,390。放置は株式系が60%を超える経路が43.2% |
| 第10章 | 案件は順位表の上から選ぶのではなく、組み合わせで選ぶ | 整数計画のNPV合計3,155に対し、NPVの大きい順は2,880 |
| 第11章 | 成功確率のある案件は、期待値の中身と失敗の重なり方まで見る | 成功確率0.25の案件は成功時に1,956を見込んでいる。成功確率0.5未満の5件では全件失敗の確率8.85% |
| 第12章 | 期待値を少し下げると最悪時を大きく改善できる | 期待値3,155→3,005で、下位5%の平均は-572→-82、負になる確率は4.5%→2.0% |
| 第13章 | 事後評価は、何を比べるかで見分ける力が決まる | 見積りの楽観をNPVの合計で見分けるのは20年分でも難しく、成功件数なら10年分で94.4%を検出 |
| 第14章 | 公開された制度は、配分比率より「決め方と乖離の管理」を見る | 公的年金を運用するGPIFの基本ポートフォリオは4資産25%ずつと乖離許容幅を公表 |
第1章では、架空の6資産について、1つの資産だけを持つ場合と組み合わせた場合のリスクを真のモデルで計算しました。現在の配分のリスク8.30%は、各資産のリスクを配分比率で平均した10.84%より23.4%低く、架空の運用資産100億円で見ると、悪い方の5%に入った年の平均の損失は国内株式だけなら27億1,900万円、現在の配分なら14億3,300万円でした。分散の効果は確かにありますが、第2章で試した素朴な規則は、その効果を見込みの外れで食いつぶします。240か月の記録で標本平均が最も高かった資産に寄せる規則は真のシャープ・レシオが0.311、上位3資産に均等に置く規則は0.366で、記録を20回作り直すとどちらも20回すべてで現在の配分の0.376を下回りました。事業投資でも、NPVの大きい順に予算が許す限り選ぶ規則は2,880百万円、投資額あたりのNPVの大きい順は2,905百万円で、組み合わせを整数計画で選んだ3,155百万円に届きません。
第3章では、見込みの精度そのものを測りました。月次リターンの標本平均の標準誤差は、240か月の記録でも国内株式で3.60ポイント、外国株式で4.05ポイントあり、真の期待リターンが5.5%や6.5%であることを考えると、記録から期待リターンの差を見分けるのは難しいことが分かります。標準誤差を1ポイントに縮めるには約259年分の記録が要ります。一方でリスク(標準偏差)の推定は240か月で相対誤差5〜8.5%と安定しており、相関も平常の月では設定に近い値が出ます。ただし荒れた月だけを取り出すと国内株式と外国株式の相関は0.823に上がり、分散の効果が最も欲しいときに弱くなることも、同じデータで確かめました。第4章では、この見込みの誤差が最適化でどう増幅されるかを示しました。推定モデルの最適は国内株式52%・国内債券48%という偏った配分で、見込みでは現在の配分より0.93ポイント高い期待リターンが、真のモデルでは0.27ポイント低くなりました。外国株式の標本平均を2ポイント変えるだけで配分が0%から21.5%へ跳ぶ一方、真の最適の付近では国内株式を10%から30%まで動かしても期待リターンの差は0.03ポイント以内という平らさがあります。答えが大きく動く割に、動かしたことで得られるものは小さいのです。
第5章と第6章では、この弱点への対処を比べました。ブラック・リッターマンのように「現在の配分」を出発点にして見方を加える方法や、見込みを縮小する方法、ロバスト最適化は、いずれも答えのぶれを抑えます。20回の作り直しでブラック・リッターマンの真のシャープ・レシオは平均0.372・最小0.349と、基準の平均0.328・最小0.163より明らかに安定でした。ただし現在の配分の0.376を上回ったのは20回中6回で、見込みを現在の配分に寄せるほど、現在の配分から離れた大きな改善は得られなくなります。期待リターンの見込みを使わないリスクパリティは20回とも0.383から0.390で、真の最適の0.381を上回りました。真の最適はリスクを8.30%以下に抑えるという条件のもとで期待リターンを最大にした配分で、リスクパリティはリスクを4%台まで下げた別の配分なので、シャープ・レシオで上回っても矛盾はありません。その代わり、共通データの記録で解いたリスクパリティは期待リターンが2.23%と現在の配分の3.62%より低く、国内債券に63%が寄ります。見込みを使わない方法は「どの資産がどれだけ増えるか」の判断を放棄しているので、目標の収益が決まっている運用では、その目標に届くかを別に確かめる必要があります。第6章ではこの考え方を事業に読み替え、基準で選んだ14件のNPV合計のばらつきの52.8%を第一事業部が、86.6%を研究開発と新規事業の8件が占めていることも示しました。
第7章では、分散ではなく最悪時の損失(CVaR、下位5%の平均)で配分を決める方法を扱いました。この例題では、同じ期待リターンのもとで分散を最小にした配分とCVaRを最小にした配分の差は月次で0.04ポイントと、抽出の誤差より小さいものでした。この結果は誇張せずそのまま書き、差が出るのは損益が非対称な資産や、成功か失敗かで分かれる案件を扱うときだと第12章へ送りました。一方で、月次のCVaRを12倍や12の平方根倍して年に直す近似はどちらも使えず、年の分布から直接測ると下位5%の平均は-14.33%、架空の運用資産10,000百万円なら年に1,433百万円の損失でした。第8章では、現在の配分から動かす費用を目的に入れると、取引コスト率2.00%で推定モデルの最適が現在の配分そのものになること、売買額の0.5%の取引コストを仮定すると、真の最適へ移るための売買費用21.6百万円を年4.0百万円の改善で回収するには5.4年かかることを示しました。架空の炭素スコアに上限を置くと、最適化は排出の多い資産を減らすのではなくスコア0の短期資産を増やして平均を薄めました。指標の定義が答えを決める例です。第9章では、見直しの規則の違いは10年後の資産の中央値をほとんど変えず(放置1,373に対し規則1,384〜1,390)、変えるのはリスクと取引コスト、そして放置すれば株式系の比率が60%を超える経路が43.2%あるという配分の漂流であることを示しました。
第10章から第12章では、同じ数理を事業投資に当てはめました。整数計画は、各年度の予算を300百万円ずつ(3年で合計900百万円)増やしたときの効果(+400百万円)や、前提や排他の制約を外したときの費用(前提で140百万円)を数字で出せます。500回の見積りの揺らぎのもとで常に選ばれた案件は5件、境界にある案件は10件あり、人が見るべき案件はこの境界に集中します。第11章では、成功確率0.25で期待NPV300百万円の案件が成功時に1,956百万円を見込んでいることを示し、期待値がほぼ同じでも成功確率の低い5件の組では全件失敗の確率が8.85%と、高い5件の組の0.48%より大きいことを確かめました。第12章では、期待値を最大にする基準の14件が1,000通りの将来のうち下位5%の平均で572百万円の損失、負になる確率4.5%であるのに対し、期待値を3,005百万円に下げるだけで下位5%の平均は-82百万円、負になる確率は2.0%に改善することを示しました。また、基準の14件について案件を独立とみなして相関を無視すると、下位5%の平均の損失を572百万円ではなく327百万円と、4割以上甘く見積もります。
第13章では、こうした計算を投資委員会の運用に乗せるための前提の台帳、ガードレール、事後評価を扱いました。起案時の見積りが楽観に偏っているかを事後評価で見分けようとしても、NPVの合計で比べるのでは20年分を積み上げても難しく、成功件数で比べれば10年分で94.4%を検出できるという架空の試算は、何を記録し何を比べるかを先に決めることの意味を示しています。第14章では、公的年金の積立金を運用するGPIF(年金積立金管理運用独立行政法人)が基本ポートフォリオとして4資産25%ずつの配分と乖離許容幅、その決め方の手順を公表していること、東京証券取引所が2023年にプライム市場とスタンダード市場の上場会社を対象に資本コストや株価を意識した経営を要請し、2026年のアップデートで資本をどのような考え方と優先順位で配分するかを投資家に説明することを期待していること、期待リターンの推定に機械学習を使う研究やバックテストの過剰適合への警告があることを、公開一次情報の範囲で紹介しました。
投資配分の判断を仕組みにするための5つの考え方
各章の結果を踏まえて、投資配分の判断を測って直す仕組みにするための考え方を5つにまとめます。
- 最初に、前提と記録が残るようにする。資産ならリターンの履歴、案件なら起案時の見積りと誰がどの根拠で置いたかの記録が無ければ、見込みの精度は測れず、事後評価もできません。記録の整備は、どの手法よりも先に来ます(第2章・第3章・第13章)。
- 最適化の答えは、幅をもった候補として扱う。期待リターンの見込みには記録を長くしても縮まない幅があり、最適化はその幅を配分の偏りに増幅します。答えを出したら、記録を作り直して答えの揺れを測り、現在の配分と均等配分に勝てるかを確かめ、上下限と変更幅の上限を付けてから採用します(第3章・第4章・第5章)。
- 期待値と最悪時の両方で測る。期待値を最大にする配分や組み合わせは、成功確率の低い案件に寄りやすく、悪い将来で大きく沈みます。期待値を少し下げる代わりに最悪時の損失をどれだけ減らせるかを、トレードオフの表として経営会議に出します。案件どうしの相関と景気との連動を無視すると、最悪時を甘く見積もります(第7章・第11章・第12章)。
- 動かす費用と守るべき制約を計算に入れ、「動かさない」も答えに含める。取引コストや本数の上限を式に入れると、答えは現在の配分に近づき、人員の余力や前提と排他の関係を入れると、実行できない組み合わせが答えから外れます。制約1つあたりの費用を数字で出しておけば、制約を緩めるべきか守るべきかを判断できます(第8章・第9章・第10章)。
- 見込みと実績の差を測り、前提に戻す。本コラムの例題では、推定モデルで最適化した配分の期待リターンの改善幅(現在の配分比・年率)は、見込みの+0.93ポイントに対して真のモデルでは-0.27ポイントで、最適化で見込んだ改善は実際より大きく出ました。配分を決める前に、比べる相手・期間・測る指標を決めておき、結果で見込みの置き方を直します。何を比べるかで、偏りを見分けられるかどうかが決まります(序章・第13章)。
ポートフォリオの理論には、1952年の論文から数えて70年を超える研究の蓄積があり、本コラムで使った推定や最適化は、無償のライブラリで動かせるものばかりです。例題の6資産の配分は1秒足らずで、30件の案件の組み合わせは0.1秒ほどで決まりました。それでも投資配分が前年の踏襲や順位表の上から選ぶ慣習で決められがちな背景には、道具の不足だけでなく、見込みの幅を前提に判断する手順と、見込みと実績の差を測る仕組みの不足があると考えています。本コラムが、自社の投資配分をどこから見直すかを考える材料になれば幸いです。
予算のもとで案件を選ぶ整数計画の基本は弊社コラム『数理最適化の定式化パターン集』の第11章で、確率計画とロバスト最適化を在庫の文脈で扱った内容は弊社コラム『在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで』の第9章で、推定モデルと真のモデルを書き分けて需要の推定と価格の最適化を扱った内容は弊社コラム『価格を決める数理モデル、需要曲線の推定からダイナミックプライシングまで』で扱っています。見込みの推定と最適化の2段で判断を組み立てる考え方は共通ですので、あわせて参考にしていただければと思います。
なお、本コラムは投資や財務の助言ではありません。特定の金融商品や銘柄、特定の配分比率を勧めるものではなく、本文の数値はすべて架空の設定による例題の値です。実際の判断は、自社の状況を踏まえて専門家にご相談ください。
Anagraftでは、データ活用の構想づくりから、投資配分や予算配分のような業務課題の定式化、見込みの推定と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 投資配分はなぜ経営の問題なのか
『ROIC経営 稼ぐ力の創造と戦略的対話』(KPMG FAS、あずさ監査法人、日本経済新聞出版社):投下資本利益率(ROIC)を軸に、事業ごとに資本をどう使い、その成果を投資家とどう対話するかを扱う本です。この章で整理した4つの層のうち、いちばん上の資本配分の方針と、事業領域への配分の考え方を経営の言葉で確かめるのに向いています。
『戦略的コーポレートファイナンス』(中野誠、日本経済新聞出版社):企業価値と財務の意思決定を、経営戦略と結びつけて論じる教科書です。投資の判断を NPV や資本コストで評価する考え方の土台を固めておくと、第10章以降の事業投資の予算配分を読むときの前提がそろいます。
第2章 投資配分の問題を記述する
『意思決定のための「分析の技術」 最大の経営成果をあげる問題発見・解決の思考法』(後正武、ダイヤモンド社):経営の意思決定に向けて、問題を正しく捉え、実行できる施策を立てるための分析の進め方を扱った本です。この章で行った、決めること・縛る条件・良しとする基準を書き出す作業を、数式を使わない側から考えるときの手がかりになります。
『道具としてのファイナンス 増補改訂版』(石野雄一、日本実業出版社):現場の意思決定に使うファイナンスの基本を、難しい数式は表計算ソフトに任せる方針で説明した本です。共通データBの案件に付けた NPV のような、投資判断に使う数字の背後にある考え方を確かめたいときに役立ちます。
『ファイナンス思考 日本企業を蝕む病と、再生の戦略論』(朝倉祐介、ダイヤモンド社):前年比の売上や利益の増減にとらわれる考え方と、将来の価値を見て判断する考え方を対比し、後者を経営の判断に生かすことを論じた本です。この章で扱った「何を目的に置くか」という問題の記述が、経営の考え方そのものに左右されることを確かめられます。
第3章 リターンとリスクを推定する
『経済・ファイナンスデータの計量時系列分析』(沖本竜義、朝倉書店):定常性と自己相関の基礎からARMA・VAR・単位根・共和分を経て、GARCHモデル、多変量GARCHと相関が時間とともに変わるモデル、状態の変化を伴うモデルまでを扱う教科書です。この章で見た、荒れた月にばらつきと相関が変わる現象を、統計モデルとして推定する方法を学べます。
『ファイナンスへの計量分析』(小暮厚之、朝倉書店):金融のデータの整理、収益率の確率モデル、標本分布と推定・検定、条件つき分散のモデルを順に扱う、ファイナンス講座の1冊です。標本平均や標本の標準偏差がどれだけ揺れるかという、この章の標準誤差の話の土台を、ファイナンスの文脈で確かめられます。
『金融データ解析の基礎』(金明哲 編、高柳慎一・井口亮・水木栄 著、共立出版):Rを使って金融のデータを取得し、変化率の計算、リスク(標準偏差)と相関係数の算出、外れ値の扱い、可視化、時系列解析までを手を動かして進める本です。この章の計算を、自社のデータで再現するときの手順の参考になります。
第4章 平均分散最適化とその弱点
『新・証券投資論 I 理論篇』(小林孝雄・芹田敏夫 著、日本証券アナリスト協会 編、日本経済新聞出版社):証券投資の理論を体系立てて学ぶための教科書です。この章で扱った期待リターンとリスクによる配分の考え方を、資産価格の理論やリスクの測り方と合わせて位置づけ直すのに向いています。
『金融工学入門 第2版』(David G. Luenberger著、今野浩・鈴木賢一・枇々木規雄訳、日本経済新聞出版社):金融工学の入門書の翻訳で、2015年に第2版が出ています。この章で使った期待リターンと共分散の計算の背景を、教科書の体系の中で数式を追って確かめたい方に向いています。
第5章 推定誤差に強くする
『標準ベイズ統計学』(ピーター・D・ホフ著、入江薫・菅澤翔之助・橋本真太郎訳、朝倉書店):事前分布とデータから事後分布を作る計算を、正規分布のモデルを中心に基礎から説明した教科書です。ブラック・リッターマンの「逆算した期待リターン(事前)と見方(新しい情報)を確からしさで重みづけして混ぜる」計算が、ベイズ統計の事前と事後の計算と同じ形であることを確かめる足がかりになります。
『ファイナンスのための統計学:統計的アプローチによる評価と意思決定』(T. L. ライ、H. シン著、松原望・山村吉信訳、東京図書):原書(2008年に英語で刊行された、金融市場の統計モデルと手法を題にした本)には、基本的な投資モデルとその統計的分析の章や、パラメトリックモデルとベイズ法の章があり、平均分散の枠組みを統計的推定の側から扱っています。この章で見た「推定の誤差を前提に配分を決める」問題を、統計学の言葉で深めるのに向いています。
第6章 リスクで配分する
『リスクバジェッティング:実務家が語る年金新時代のリスク管理』(レスリー・ラール編、三菱信託銀行受託財産運用部門訳、パンローリング):副題のとおり、年金運用のリスク管理を実務家が論じた編著の翻訳です。この章で事業領域のリスク予算に読み替えた「リスクをどこに割り当てるか」という考え方が、年金運用の文脈でどう議論されてきたかをたどる手がかりになります。
『リスク・バジェッティングのためのVaR:理論と実践の橋渡し』(ニール・D・ピアソン著、竹原均・三菱信託銀行受託財産運用部門監修、山下恵美子訳、パンローリング):書名のとおり、リスク・バジェッティングに使うリスク指標としての VaR を、理論と実務の両面から扱った本の翻訳です。この章では標準偏差でリスクを分解しましたが、下振れの指標で同じ分解を考えるときの手がかりになります。
第7章 下方リスクと CVaR で配分する
『定量的リスク管理 基礎概念と数理技法』(アレクサンダー・J・マクニール、リュディガー・フライ、ポール・エンブレヒツ著、塚原英敦 訳者代表、共立出版):リスク尺度の考え方から、損失分布の推定、裾の厚い分布、依存関係のモデルまでを数理的に扱う大部の教科書の日本語訳です。この章で扱った VaR と CVaR の定義、劣加法性をめぐる議論、正規分布の仮定が裾を軽く見積もる問題を、理論の側から確かめたいときに向いています。
『金融工学と最適化』(枇々木規雄著、朝倉書店):経営科学のニューフロンティアのシリーズの1冊で、リスクとリターンの捉え方から、ポートフォリオ選択の様々な数理計画モデル、戦略的資産配分の数理計画、シナリオ・ツリー型やシミュレーション型の多期間確率計画までを扱っています。この章のようにシナリオを並べて線形計画で配分を解く考え方を、多期間の配分や資産と負債の管理へ広げる道筋をたどれます。
第8章 取引コスト・保有制約・銘柄数の上限
『理財工学II 数理計画法による資産運用最適化』(今野浩、日科技連出版社):題名のとおり、資産運用の最適化を数理計画法の問題として扱う本です。本章で線形計画や整数計画に置き換えて解いたような、ポートフォリオの選び方を数理計画の側から考える材料になります。1998年の刊行なので、計算機やソフトウェアの事情は現在と異なります。
『市場と取引 実務家のためのマーケット・マイクロストラクチャー』上・下(ラリー・ハリス著、宇佐美洋監訳、東洋経済新報社):売買がどのような仕組みで成立し、売買の費用がどこから生じるかを、市場の制度と参加者の行動から説明する本です。本章では取引コストを売買額に比例する率として置きましたが、その率がどのような要因で決まるかを考えるときの土台になります。
第9章 多期間の配分とリバランス
『戦略的アセットアロケーション 長期投資のための資産配分の考え方』(ジョン・Y・キャンベル、ルイス・M・ビセイラ著、木島正明監訳、野村證券金融経済研究所訳、東洋経済新報社):副題のとおり、長期の投資家にとっての資産配分を主題にした本の翻訳です。この章では1年ごとに比率を選ぶ単純な動的計画法の例しか扱っていませんが、多期間で配分を考えるときの理論的な背景を確かめるのに向いています。
『ゴールベース資産管理入門 顧客志向の新たなアプローチ』(チャック・ウィジャー、ダニエル・クロスビー著、新井聡監訳、野村證券ゴールベース研究会訳、日本経済新聞出版社):運用の目的を将来の目標から逆算して考えるゴールベースの資産管理を、題名のとおり入門として扱った本の翻訳です。主な読者は個人の資産管理に携わる人ですが、この章の積立と取り崩しの例のように、目標額と時期から配分を評価する考え方を、企業の資金の運用方針に読み替える手がかりになります。
第10章 事業投資案件の選択
『コーポレート・ファイナンス 第10版 上』(リチャード・A・ブリーリー、スチュワート・C・マイヤーズ、フランクリン・アレン著、藤井眞理子・国枝繁樹監訳、日経BP社):米国のMBAで広く使われているコーポレートファイナンスの教科書の翻訳で、版元の紹介では価値評価・資本コスト・合理的な設備投資の決定などを扱うとされています。この章で前提にした NPV の考え方と、投資の判断基準どうしの関係を、理論の側から体系的に確かめるのに向いています。
『コーポレートファイナンス 戦略と実践』(田中慎一・保田隆明、ダイヤモンド社):会社の一生をたどる形でファイナンスの全体像を示し、会計の読み方から現在価値、DCF法による企業価値の算出までを実務の目線で説明する本です。この章の NPV が、事業の価値の評価とどうつながるかを、日本の実務に近い言葉で押さえるのに役立ちます。
第11章 研究開発テーマと新規事業のポートフォリオ
『ステージゲート法 製造業のためのイノベーション・マネジメント』(ロバート・G・クーパー著、浪江一公訳、英治出版):この章で一般的な考え方として紹介したステージゲートについて、その名を論文の題名に掲げたクーパーの著書『Winning at New Products』の原著第4版を翻訳したものです。新製品の開発を段階に区切り、切れ目ごとに続けるか止めるかを決める進め方を、提唱者の説明でたどれます。段階投資の価値を実務の手順に落とすときの参考になります。
『MOT研究開発マネジメント入門』(岡本和也・福代和宏著、上西研監修、朝倉書店):技術経営の考え方を研究開発の管理に当てはめた教科書で、研究開発プロジェクトの選択と評価の手法、ポートフォリオマネジメント、研究開発ファイナンスにそれぞれ章を設けています。この章の計算を、研究開発部門の組織や計画づくりの文脈に置き直して読むのに向いています。
『両利きの経営 「二兎を追う」戦略が未来を切り拓く 増補改訂版』(チャールズ・A・オライリー、マイケル・L・タッシュマン著、入山章栄監訳・解説、冨山和彦解説、渡部典子訳、東洋経済新報社):既存事業を磨くことと新しい事業を探ることを、1つの会社の中でどう両立させるかを論じた本です。この章で扱った、確実な設備投資と打率の低い研究開発・新規事業のあいだの配分を、組織の設計の側から考える手がかりになります。
第12章 不確実性のもとで事業に配分する
『リアル・オプション:経営戦略の新しいアプローチ』(マーサ・アムラム、ナリン・クラティラカ著、石原雅行ほか訳、東洋経済新報社):投資の「後で決められる」柔軟性を、金融のオプションの考え方で評価するリアル・オプションを、経営戦略の側から解説した本です。この章の予算削減の例で見た「P07 を後で決められることの価値」を、より一般に、延期・段階投資・撤退の選択肢の価値として考えるのに向いています。
『シナリオ・プランニング:戦略的思考と意思決定』(キース・ヴァン・デル・ハイデン著、グロービス監訳、西村行功訳、ダイヤモンド社):将来の不確実性を、確率を当てる代わりに複数のシナリオとして描き、戦略の意思決定に使う方法を扱った本です。この章のストレステストで「どの悪い状況を想定するか」を選ぶ段階、つまりシナリオの作り方そのものを、経営の議論の進め方として学ぶのに向いています。
第13章 現場に入れる
『NOISE 組織はなぜ判断を誤るのか?』上・下(ダニエル・カーネマン、オリヴィエ・シボニー、キャス・R・サンスティーン 著、村井章子 訳、早川書房):保険料の見積もりや人事評価、診断や裁判のように、同じ条件なら同じ判断が求められる場面で、判断する人によって結論がばらつく現象を扱っています。この章で述べた、前提を全社でそろえる規則や、判断の理由を選択肢で記録する仕組みは、投資委員会の判断のばらつきを小さくする工夫でもあり、その考え方を組織の意思決定の側から補えます。
『BIG THINGS どデカいことを成し遂げたヤツらはなにをしたのか?』(ベント・フリウビヤ、ダン・ガードナー 著、櫻井祐子 訳、サンマーク出版):大型プロジェクトの研究者が、プロジェクトが予算と期限を守れない理由と、守るための進め方を述べた本です。目次には、人が危険なほど楽観的になること、計画の前の段階に時間をかけることが並んでいます。この章の事後評価の節で扱った見積りの楽観を、設備投資のような大型案件の計画の側から考える材料になります。
第14章 事例と最新動向
『GPIF 世界最大の機関投資家』(小幡績、東洋経済新報社):公的年金の積立金を運用する GPIF を題材にした本です。2014年の刊行なので、この章で紹介した第5期の基本ポートフォリオより前の時点の本ですが、公式の策定資料と並べて読むと、基本となる配分を決める組織の側から配分の論点を考える手がかりになります。
『ファイナンス機械学習 金融市場分析を変える機械学習アルゴリズムの理論と実践』(マルコス・ロペス・デ・プラド著、長尾慎太郎・鹿子木亨紀監訳、大和アセットマネジメント訳、金融財政事情研究会):この章で紹介したバックテストの過剰適合の論文の著者の1人による本で、副題のとおり、金融市場の分析に機械学習のアルゴリズムを使う理論と実践を扱っています。この章の研究動向の節で紹介した論文を読む前提をそろえ、機械学習による配分の提案を審査する側に立ったときの論点を確かめるのに向いています。
参考情報
本コラムの記述は、次の資料を2026年10月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 財務省 年次別法人企業統計調査(令和7年度)の設備投資はソフトウェアを含み金融業・保険業を除く全産業で57兆8,999億円、前年度比4.3%増、製造業18兆4,924億円、非製造業39兆4,075億円、平成13年度以降で最大
https://www.mof.go.jp/pri/reference/ssc/results/data.htm - 財務省 年次別法人企業統計調査(令和7年度)の設備投資はソフトウェアを含み金融業・保険業を除く全産業で57兆8,999億円、前年度比4.3%増、製造業18兆4,924億円、非製造業39兆4,075億円、平成13年度以降で最大
https://www.mof.go.jp/pri/reference/ssc/results/r7.pdf - 総務省 2025年科学技術研究調査 結果の概要(2025年12月12日公表)で2024年度の科学技術研究費は23兆7,925億円、企業が17兆4,303億円で全体の73.3%、企業の研究費は前年度比8.1%増、研究を実施している企業の売上高に対する研究費の比率は3.24%
https://www.stat.go.jp/data/kagaku/kekka/index.html - 総務省 2025年科学技術研究調査 結果の概要(2025年12月12日公表)で2024年度の科学技術研究費は23兆7,925億円、企業が17兆4,303億円で全体の73.3%、企業の研究費は前年度比8.1%増、研究を実施している企業の売上高に対する研究費の比率は3.24%
https://www.stat.go.jp/data/kagaku/kekka/kekkagai/pdf/2025ke_gai.pdf - 年金積立金管理運用独立行政法人の運用資産額は317兆7,596億円で2026年度第1四半期末現在
https://www.gpif.go.jp/operation/the-latest-results.html - マーコウィッツの1952年の論文はポートフォリオ選択を題にし The Journal of Finance 誌第7巻第1号に掲載
https://doi.org/10.2307/2975974 - 参考書籍 ROIC経営 稼ぐ力の創造と戦略的対話 KPMG FAS とあずさ監査法人 日本経済新聞出版社 2017年
https://ndlsearch.ndl.go.jp/books/R100000002-I028624253 - 参考書籍 戦略的コーポレートファイナンス 中野誠 日本経済新聞出版社 2016年
https://ndlsearch.ndl.go.jp/books/R100000002-I027514110
第2章
- 『意思決定のための「分析の技術」 最大の経営成果をあげる問題発見・解決の思考法』後正武、ダイヤモンド社、1998年
https://ndlsearch.ndl.go.jp/books/R100000002-I000002744902 - 『道具としてのファイナンス 増補改訂版』石野雄一、日本実業出版社、2022年
https://ndlsearch.ndl.go.jp/books/R100000002-I032290509 - 『道具としてのファイナンス 増補改訂版』石野雄一、日本実業出版社、2022年
https://www.njg.co.jp/book/9784534059352/ - 『ファイナンス思考 日本企業を蝕む病と、再生の戦略論』朝倉祐介、ダイヤモンド社、2018年
https://ndlsearch.ndl.go.jp/books/R100000002-I029070983
第3章
- マートンが1980年に Journal of Financial Economics 誌第8巻第4号に発表した市場の期待リターンの推定の論文
https://doi.org/10.1016/0304-405x(80 - 期待リターンの推定量の精度は観測期間の全長だけで決まり観測の回数に依存しない、分散の推定は観測の頻度に大きく依存する、分散は期待リターンより精度よく推定できる
https://www.nber.org/papers/w0444 - 期待リターンの推定量の精度は観測期間の全長だけで決まり観測の回数に依存しない、分散の推定は観測の頻度に大きく依存する、分散は期待リターンより精度よく推定できる
https://www.nber.org/system/files/working_papers/w0444/w0444.pdf - ルドワとヴォルフが2004年に Journal of Multivariate Analysis 誌第88巻第2号に発表した共分散行列の推定量の論文
https://doi.org/10.1016/s0047-259x(03 - 大きな次元の標本共分散は条件が悪く逆行列が取れないこともある、標本共分散と単位行列の凸結合で漸近的に最適な推定量、2乗の損失で観測の本数と変数の数がともに大きくなる極限での最適性、分布を仮定しない
https://ideas.repec.org/a/eee/jmvana/v88y2004i2p365-411.html - scikit-learn の LedoitWolf の縮小の式(1から縮小の強さを引いた値×標本共分散+縮小の強さ×対角成分の平均×単位行列)、属性 shrinkage_ と covariance_
https://scikit-learn.org/stable/modules/generated/sklearn.covariance.LedoitWolf.html - scikit-learn の LedoitWolf の縮小の式(1から縮小の強さを引いた値×標本共分散+縮小の強さ×対角成分の平均×単位行列)、属性 shrinkage_ と covariance_
https://scikit-learn.org/stable/modules/covariance.html - マルコムらが1959年に Operations Research 誌第7巻第5号に発表した研究開発計画の評価技法の論文、時間の見積りを技術の担当者から得て確率の言葉で表す
https://doi.org/10.1287/opre.7.5.646 - 英国財務省グリーンブックの補足ガイダンス 楽観バイアス、2013年4月掲載、評価者の体系的な楽観の傾向と過去データに基づく明示的な補正、資本支出の上振れ率の上限 標準的な建物24%・標準的でない建物51%・設備と開発200%、上限は構想段階の平均的な楽観
https://www.gov.uk/government/publications/green-book-supplementary-guidance-optimism-bias - 英国財務省グリーンブックの補足ガイダンス 楽観バイアス、2013年4月掲載、評価者の体系的な楽観の傾向と過去データに基づく明示的な補正、資本支出の上振れ率の上限 標準的な建物24%・標準的でない建物51%・設備と開発200%、上限は構想段階の平均的な楽観
https://assets.publishing.service.gov.uk/media/5a74dae740f0b65f61322c72/Optimism_bias.pdf - カーネマンとロバロの1993年の論文、過度に楽観的な予測は内側からの見方から生じ過去の統計を無視する
https://doi.org/10.1287/mnsc.39.1.17 - 参考書籍『経済・ファイナンスデータの計量時系列分析』沖本竜義、朝倉書店、統計ライブラリー、2010年2月、ISBN 978-4-254-12792-8
https://ndlsearch.ndl.go.jp/books/R100000002-I000010689145 - 参考書籍『経済・ファイナンスデータの計量時系列分析』沖本竜義、朝倉書店、統計ライブラリー、2010年2月、ISBN 978-4-254-12792-8
https://www.asakura.co.jp/detail.php?book_code=12792 - 参考書籍『ファイナンスへの計量分析』小暮厚之、朝倉書店、ファイナンス講座1、1996年12月、ISBN 978-4-254-54551-7
https://ndlsearch.ndl.go.jp/books/R100000002-I000002560356 - 参考書籍『ファイナンスへの計量分析』小暮厚之、朝倉書店、ファイナンス講座1、1996年12月、ISBN 978-4-254-54551-7
https://www.asakura.co.jp/detail.php?book_code=54551 - 参考書籍『金融データ解析の基礎』金明哲 編、高柳慎一・井口亮・水木栄 著、共立出版、2014年8月、ISBN 9784320123717
https://ndlsearch.ndl.go.jp/books/R100000136-I1970586434793377710 - 参考書籍『金融データ解析の基礎』金明哲 編、高柳慎一・井口亮・水木栄 著、共立出版、2014年8月、ISBN 9784320123717
https://www.kyoritsu-pub.co.jp/book/b10004502.html
第4章
- マーコウィッツ、ポートフォリオ選択の論文、The Journal of Finance 第7巻第1号、1952年
https://doi.org/10.1111/j.1540-6261.1952.tb01525.x - 1990年ノーベル経済学賞の発表文、マーコウィッツはポートフォリオ選択の理論で受賞
https://www.nobelprize.org/prizes/economic-sciences/1990/press-release/ - ジャガナサンとマ、2003年、The Journal of Finance 第58巻第4号、1651〜1683ページ、非負制約が推定した最適配分のリスクを下げうる
https://doi.org/10.1111/1540-6261.00580 - デミゲル、ガルラッピ、ウッパル、Review of Financial Studies 第22巻第5号、1915〜1953ページ、2009年、14のモデルが一貫して1/Nを上回らない
https://doi.org/10.1093/rfs/hhm075 - デミゲル、ガルラッピ、ウッパル、Review of Financial Studies 第22巻第5号、1915〜1953ページ、2009年、14のモデルが一貫して1/Nを上回らない
https://api.openalex.org/works/https://doi.org/10.1093/rfs/hhm075 - 書籍 新・証券投資論 I 理論篇、小林孝雄・芹田敏夫、日本証券アナリスト協会、日本経済新聞出版社、2009年
https://ndlsearch.ndl.go.jp/books/R100000002-I000010331054 - 書籍 金融工学入門 第2版、Luenberger著、今野浩・鈴木賢一・枇々木規雄訳、日本経済新聞出版社、2015年
https://ndlsearch.ndl.go.jp/books/R100000002-I026251362
第5章
- ジョリオンの1986年の論文(JFQA 誌 第21巻第3号、ポートフォリオ分析のためのベイズ・スタイン推定を題にした論文)
https://doi.org/10.2307/2331042 - ブラックとリッターマンの1992年の論文(Financial Analysts Journal 第48巻第5号、世界の資産への配分の最適化を題にした論文)
https://doi.org/10.2469/faj.v48.n5.28 - 書籍『標準ベイズ統計学』ピーター・D・ホフ著、入江薫・菅澤翔之助・橋本真太郎訳、朝倉書店、2022年
https://ndlsearch.ndl.go.jp/books/R100000002-I032167945 - 書籍『ファイナンスのための統計学 統計的アプローチによる評価と意思決定』T. L. ライ、H. シン著、松原望・山村吉信訳、東京図書、2016年
https://ndlsearch.ndl.go.jp/books/R100000002-I027225503 - 上記の原書は2008年刊行で、基本的な投資モデルとその統計的分析の章、パラメトリックモデルとベイズ法の章がある
https://link.springer.com/book/10.1007/978-0-387-77827-3
第6章
- マイヤール、ロンカリ、テイレッシュの2010年の論文はリスク寄与が均等な配分の性質を調べている
https://doi.org/10.3905/jpm.2010.36.4.060 - マイヤール、ロンカリ、テイレッシュの2010年の論文はリスク寄与が均等な配分の性質を調べている
http://www.thierry-roncalli.com/download/erc.pdf - 書籍 リスクバジェッティング 実務家が語る年金新時代のリスク管理 レスリー・ラール編 パンローリング 2002年
https://ndlsearch.ndl.go.jp/books/R100000002-I000003628556 - 書籍 リスク・バジェッティングのためのVaR 理論と実践の橋渡し ニール・D・ピアソン著 パンローリング 2003年
https://ndlsearch.ndl.go.jp/books/R100000002-I000003980686
第7章
- ロカフェラーとウリャセフの2000年の論文は Journal of Risk 誌の第2巻第3号に載った
https://doi.org/10.21314/JOR.2000.038 - 同論文の VaR と CVaR の定義、CVaR は VaR 以上であり CVaR の小さい配分は VaR も小さいこと、CVaR の別名
https://sites.math.washington.edu/~rtr/papers/rtr179-CVaR1.pdf - Artzner らの研究の書誌
https://doi.org/10.1111/1467-9965.00068 - 『定量的リスク管理 基礎概念と数理技法』マクニール、フライ、エンブレヒツ著、塚原英敦 訳者代表、共立出版、2008年7月、627ページ
https://ndlsearch.ndl.go.jp/books/R100000002-I000009427981 - 『金融工学と最適化』枇々木規雄著、朝倉書店、2001年3月、経営科学のニューフロンティアのシリーズ
https://www.asakura.co.jp/detail.php?book_code=27515
第8章
- 平均絶対偏差モデルはコンノとヤマザキが1991年に Management Science 誌で提案した
https://doi.org/10.1287/mnsc.37.5.519 - 年金積立金管理運用独立行政法人はESG投資を財務情報に加えて非財務のESG要素を考慮する投資と説明し、気候変動リスクは分散投資でも完全には消せないとしている
https://www.gpif.go.jp/esg-stw/esginvestments/ - 金融庁の特集ページによれば、2023年1月31日施行の内閣府令改正で有価証券報告書にサステナビリティに関する考え方及び取組の記載欄が設けられた
https://www.fsa.go.jp/policy/kaiji/sustainability-kaiji.html - 参考書籍 理財工学II 数理計画法による資産運用最適化
https://ndlsearch.ndl.go.jp/books/R100000002-I000002746999 - 参考書籍 市場と取引 実務家のためのマーケット・マイクロストラクチャー 上下
https://ndlsearch.ndl.go.jp/books/R100000002-I000008146616
第9章
- ボディの1995年の論文 Financial Analysts Journal 第51巻第3号 18から22ページ
https://doi.org/10.2469/faj.v51.n3.1901 - ボディの論文の要旨 長期ほど保険の費用が上がる 平均回帰でも同じ 若い人ほど株式を多くという主張の根拠を長期の性質だけに置けない
https://rpc.cfainstitute.org/research/financial-analysts-journal/1995/on-the-risk-of-stocks-in-the-long-run - サミュエルソンの1969年の論文 米国の経済学の学術誌 第51巻第3号 239から246ページ 題名は動的確率計画法による生涯のポートフォリオ選択
https://doi.org/10.2307/1926559 - 参考書籍 戦略的アセットアロケーション 長期投資のための資産配分の考え方 キャンベルとビセイラ著 木島正明監訳 野村證券金融経済研究所訳 東洋経済新報社 2005年
https://ndlsearch.ndl.go.jp/books/R100000002-I000007645802 - 参考書籍 ゴールベース資産管理入門 顧客志向の新たなアプローチ ウィジャーとクロスビー著 新井聡監訳 野村證券ゴールベース研究会訳 日本経済新聞出版社 2016年
https://ndlsearch.ndl.go.jp/books/R100000002-I027299229
第10章
- 1955年にローリーとサベージが資本の割当てに関する3つの問題を題にした論文を The Journal of Business 誌 第28巻第4号に発表
https://doi.org/10.1086/294081 - 参考書籍 コーポレート・ファイナンス 第10版 上 ブリーリー マイヤーズ アレン 藤井眞理子と国枝繁樹の監訳 日経BP社 2014年
https://ndlsearch.ndl.go.jp/books/R100000002-I025500425 - 参考書籍 コーポレート・ファイナンス 第10版 上 ブリーリー マイヤーズ アレン 藤井眞理子と国枝繁樹の監訳 日経BP社 2014年
https://bookplus.nikkei.com/atcl/catalog/14/P48600/ - 参考書籍 コーポレートファイナンス戦略と実践 田中慎一と保田隆明 ダイヤモンド社 2019年
https://ndlsearch.ndl.go.jp/books/R100000002-I029596034
第11章
- ステージゲートの名はクーパーの1990年の論文の題名に使われている(Business Horizons 第33巻第3号)
https://doi.org/10.1016/0007-6813(90 - 2025年科学技術研究調査は2025年6月1日実施、2024年度の研究費を集計
https://www.stat.go.jp/data/kagaku/kekka/youyaku/pdf/2025youyak.pdf - 2025年科学技術研究調査は2025年6月1日実施、2024年度の研究費を集計
https://www.stat.go.jp/data/kagaku/kekka/index.html - 参考書籍 ステージゲート法 製造業のためのイノベーション・マネジメント
https://ndlsearch.ndl.go.jp/books/R100000002-I024111737 - 参考書籍 MOT研究開発マネジメント入門
https://ndlsearch.ndl.go.jp/books/R100000002-I030329964 - 参考書籍 MOT研究開発マネジメント入門
https://www.asakura.co.jp/detail.php?book_code=20167 - 参考書籍 両利きの経営 増補改訂版
https://ndlsearch.ndl.go.jp/books/R100000002-I032207047 - 参考書籍 両利きの経営 増補改訂版の責任表示に冨山和彦の解説を追加(2026-10-08 Codex指摘対応)
https://str.toyokeizai.net/books/9784492534519/
第12章
第13章
- スミスとウィンクラーの2006年の論文はオプティマイザーの呪いを名付け、偏りの無い推定値でも選んだ選択肢の実際の値は平均して推定値を下回ると示した
https://doi.org/10.1287/mnsc.1050.0451 - コーポレートガバナンス・コード原則4-1は成長投資や事業ポートフォリオの見直し等の経営資源の配分等について具体的に何を実行するかを説明すべきとし、解釈指針は中期経営計画が未達の場合に原因を分析して説明し次期以降の計画に反映させるべきとする
https://www.jpx.co.jp/equities/listing/cg/tvdivq0000008jdy-att/nlsgeu000005lnul.pdf - 東京証券取引所 コーポレートガバナンス・コードの掲載ページ
https://www.jpx.co.jp/equities/listing/cg/index.html - 確定給付企業年金は法令で運用の基本方針や政策的資産構成割合の策定が義務付けられている等、ガバナンスに関する制度が整備されている
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/newpage_00055.html - ガイドラインは事業主(受託保証型確定給付企業年金を実施する事業主を除く)と基金が政策的資産構成割合を自らの判断の下に定めなければならないとし、受託保証型を実施する事業主には定める努力義務を置き、運用受託機関の運用実績を定期的に評価し必要な場合は見直すことが望ましいとする
https://www.mhlw.go.jp/content/12500000/001417981.pdf - 書籍 NOISE 組織はなぜ判断を誤るのか? 上・下
https://ndlsearch.ndl.go.jp/books/R100000002-I031823678 - 書籍 BIG THINGS どデカいことを成し遂げたヤツらはなにをしたのか?
https://ndlsearch.ndl.go.jp/books/R100000002-I033432978
第14章
- 年金積立金管理運用独立行政法人「基本ポートフォリオの考え方」
https://www.gpif.go.jp/gpif/portfolio.html - 年金積立金管理運用独立行政法人「第5期中期目標期間における基本ポートフォリオについて(詳細)」
https://www.gpif.go.jp/gpif/15324685gpif/5th_policy_asset_mix_details_jp.pdf - 企業年金連合会「企業年金実態調査結果(2024年度概要版)」
https://www.pfa.or.jp/activity/tokei/j-chosa/files/jittaichosa_gaiyou_2024.pdf - 東京証券取引所「資本コストや株価を意識した経営の実現に向けた対応」
https://www.jpx.co.jp/equities/follow-up/02.html - 東京証券取引所「資本コストや株価を意識した経営に関する要請のアップデート」
https://www.jpx.co.jp/equities/follow-up/jr4eth0000004vj2-att/t13vrt000001ung0.pdf - 1990年の経済学賞はマーコウィッツ、ミラー、シャープの3人に3分の1ずつ
https://www.nobelprize.org/prizes/economic-sciences/1990/summary/ - 1990年の経済学賞の発表文
https://www.nobelprize.org/prizes/economic-sciences/1990/press-release/ - グとケリーとシウの2020年の機械学習による実証資産価格の論文
https://doi.org/10.1093/rfs/hhaa009 - バンとエル・カルイとリムの2018年の機械学習とポートフォリオ最適化の論文
https://doi.org/10.1287/mnsc.2016.2644 - バトラーとクォンの予測を平均分散最適化に統合する論文
https://arxiv.org/abs/2102.09287 - チャンとゾーレンとロバーツの深層学習でシャープ・レシオを直接最適化する論文
https://arxiv.org/abs/2005.13665 - ジアンとシューとリアンの深層強化学習による配分の論文
https://arxiv.org/abs/1706.10059 - ベイリーらの2014年のバックテストの過剰適合の論文
https://doi.org/10.1090/noti1105 - ベイリーらの2014年のバックテストの過剰適合の論文
https://www.ams.org/notices/201405/rnoti-p458.pdf - 金融庁 AIディスカッションペーパー第1.1版
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp.html - 金融庁 AIディスカッションペーパー第1.1版の概要資料
https://www.fsa.go.jp/news/r7/sonota/20260303/aidp_version1.1_summary.pdf - 書籍 GPIF 世界最大の機関投資家
https://ndlsearch.ndl.go.jp/books/R100000002-I025534318 - 書籍 ファイナンス機械学習 金融市場分析を変える機械学習アルゴリズムの理論と実践
https://ndlsearch.ndl.go.jp/books/R100000002-I030095820