こんにちは、Anagraftの伊藤です。
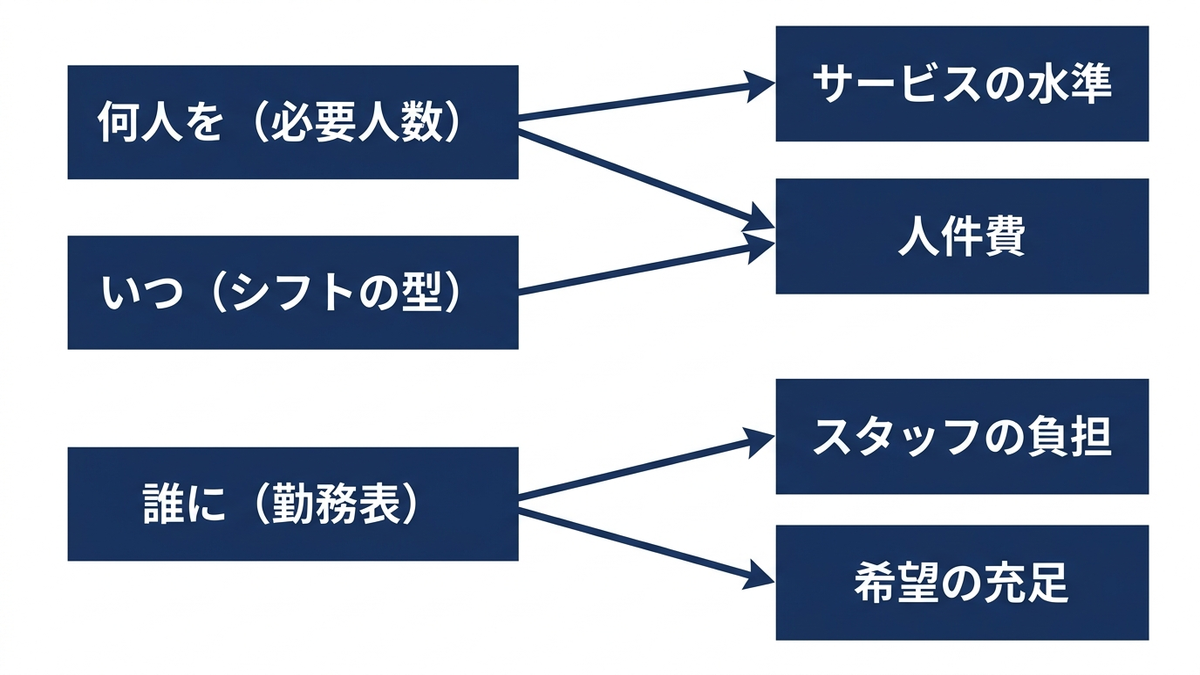
今回は、店舗やコンタクトセンター、物流センター、病院や介護施設のように、時間帯ごとに必要な人数が変わる職場で「何人を、いつ、誰に働いてもらうか」を決める人員配置とシフト作成を、数理最適化の立場から整理しました。需要から時間帯ごとの必要人数を見積もるところから始めて、早番や遅番といったシフトの型の設計、スタッフ一人ひとりへの勤務の割り当て、労働法令と就業規則の組み込み、希望休と公平性の扱い、スキルと多能工化、長い期間と大きな組織への対処、当日の欠勤への対応、需要のばらつきへの備え、そして現場への導入と最新の動向までを扱います。ここに挙げた用語は、それぞれの章で最初に出るときに平易な言葉で説明していますので、ここで分からなくても差し支えありません。
この題材を選んだ理由は、シフトが人件費、サービスの水準、スタッフの残業と連勤、希望の通り方といった経営の数字を直接左右する意思決定でありながら、その作成が店長や管理者の手作業に委ねられていることが多いためです。人手が足りない職場ほど、同じ人数でどう回すかという問いは、費用の問題であると同時に、サービスを保てるかどうか、スタッフが働き続けられるかどうかの問題にもなっています。スタッフと日付と勤務の型の組合せは人数と日数とともに急速に増えるため、人が頭の中ですべてを比べることはできません。どこまでを計算機に任せ、どこから先を人が判断するかを見極める道具として、数理最適化の手法を紹介します。
各章では、架空のコンタクトセンターのデータを共通の題材にして、実際にコードを動かした結果を載せています。営業時間は7時から24時まで、30分ごとの入電の予測があり、4週間の勤務表を正社員18名とパート12名の計30名で組むという設定です。スタッフごとに入れる勤務の型、リーダーや英語対応といったスキル、希望休の日が決まっています。データは乱数で生成したもので、実在の企業や拠点の記録ではありません。あわせて、研究の世界で使われている看護師の勤務表の公開ベンチマーク問題も解き、既に知られている最良の値と比べています。同じデータに対して、手作業に近い素朴な作り方と、無償で使える最適化ソルバーを順に当てることで、手法どうしの関係と、それぞれの得意と不得意が横に比べられるようにしました。
想定している読者は、店舗やセンターでシフト作成や要員計画を任された実務者の方、勤務表の自動作成の仕組みの導入を検討している方、そして人件費やサービスの水準、スタッフの負担を経営指標として見る立場の方です。オペレーションズ・リサーチの専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にして言葉で言い換えています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各手法について「何を決める手法か」「どういう前提で使えるか」「使ってはいけないのはどういうときか」「結果を経営指標にどう翻訳するか」を書くようにしました。シフト作成の手法の多くは教科書に載っていますが、実務で難しいのは、自社のシフトがどの段階の問題に当たるのか、管理者が守っている暗黙のルールをどこまで制約として書くのか、スタッフの希望と職場の必要をどこで折り合わせるのか、計算時間と勤務表の良さをどこで折り合わせるのかを見極めるところだと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムの記述は2026年9月時点で確認したものです。労働法令や公的統計は改正や更新がありますので、実務で使う際は所管官庁のページで最新の内容をご確認ください。本コラムは法律上の助言ではありません。ライブラリの関数名や引数も版によって変わります。計算時間は本コラムの実行環境で測った値であり、計算機が変われば変わります。
目的別の読み方の目安を挙げておきます。シフトの良し悪しを経営指標としてどう見るかを整理したい場合は、第1章と第13章が入口になります。自社のシフト作成がどの段階の問題に当たるかを見極めたい場合は、第2章の分類をご覧ください。時間帯ごとに何人いればよいかを決めたい場合は第3章、早番や遅番といったシフトの型そのものを見直したい場合は第4章、スタッフ一人ひとりの勤務表を作りたい場合は第5章が中心になります。無償のソルバーで実際に勤務表を組みたい場合は、第6章で書き方と設定の選び方を整理しました。
労働時間や休日、勤務間の休息の扱いを確かめたい場合は第7章、希望休の通し方や勤務の偏りが課題の場合は第8章、リーダーや特定のスキルを持つ人が足りない場合は第9章をご覧ください。スタッフが百人を超える場合や、数か月から1年の要員計画と採用を考えたい場合は第10章、当日の欠勤で勤務表がすぐ崩れる場合は第11章、予測が外れて人が余ったり足りなくなったりする場合は第12章が入口です。機械学習や生成AIをシフト作成にどう位置づけるかは第14章で扱っています。

目次
- 序章 シフト作成は「何人を・いつ・誰に」を決める問題である
- 全体の地図
- 第1章 シフト作成はなぜ経営の問題なのか
- 第2章 シフト作成の問題を記述する
- 第3章 必要人数を見積もる
- 第4章 シフトの型を設計する
- 第5章 勤務表を作る
- 第6章 CP-SAT を使いこなす
- 第7章 労働法令と就業規則を制約に入れる
- 第8章 希望と公平性を扱う
- 第9章 スキルと多能工化
- 第10章 大規模化と長期の要員計画
- 第11章 当日の欠勤と勤務表の組み直し
- 第12章 需要のばらつきに備える
- 第13章 現場に入れる
- 第14章 事例と最新動向、公開された成果をどう読み、何を自社に持ち帰るか
- 終章 勤務表を、毎月回る仕組みにする
- 本コラムで紹介した書籍一覧
- 参考情報
序章 シフト作成は「何人を・いつ・誰に」を決める問題である
人手不足への対策というと、採用の強化や賃金の見直し、機械による省力化のような話が思い浮かぶことが多いように思います。いずれも目に見えやすく、効果も説明しやすいためです。ところが、同じ人数のスタッフを抱えていても、勤務表の組み方によって、忙しい時間帯に足りない人数、暇な時間帯に余る人数、スタッフの連勤や遅番の偏り、希望休が通らない件数は大きく変わります。時間帯ごとに何人が必要かを見積もり、どの型の勤務を何人ずつ置くかを決め、それを誰に割り当てるかを決める仕事、すなわち人員配置とシフト作成が、本コラムの主題です。
この問題は、数理最適化の歴史の早い時期から研究されてきました。1954年には、料金所での待ちを扱ったエディの研究に対してダンツィグが論評を寄せ、どの時刻に始まる勤務を何人ずつ置けば全時間帯の必要人数を満たせるかという問題を、数理計画の形で書いています(第4章で扱います)。看護師の勤務表の作成についても、研究者が共通の問題で手法を比べるための公開ベンチマークや国際的な競技会が作られ、厳密に最適な答えを求める方法と、実用的な時間で十分に良い答えを出す方法の両方が工夫されてきました(第10章と第14章で扱います)。本コラムの実行環境では、無償で使えるソルバーが、30名・4週間の勤務表について、後述の条件のもとで最適であることの証明までを2.6秒で終えました(本コラムの実行環境での実測)。本コラムでは、どの手法がいつ効くかを、実際に解いた結果で示すことを方針にしました。
シフトの良し悪しは、経営の数字に直結する
シフトの良し悪しは、人件費とサービスの水準にそのまま現れます。忙しい時間帯に人が足りなければ、お客様を待たせ、電話がつながらず、スタッフは休憩を削って対応することになります。その状態が続けば、残業が増え、疲れがたまり、辞める人が出て、さらに人が足りなくなります。反対に、暇な時間帯に人が余れば、その時間の人件費は売上やサービスに結びつきません。不足と過剰は同じ勤務表の中に同時に現れることが多く、合計の人数が足りていても、時間帯の配り方が合っていなければ両方の損失を抱えます。
これらの損失は、互いに引っ張り合う関係にあります。不足を減らそうとして人を増やせば人件費が増えます。人件費を抑えようとして勤務の型を細かくすれば、管理が複雑になり、スタッフの生活の予定が立てにくくなります。希望休をすべて通せば、特定の日に人が足りなくなることがあります。どの損失をどこまで許すかは経営の判断であり、シフト作成の手法は、その判断を目的と制約という形で書き下し、判断に沿った最良の勤務表を計算する道具です。
管理者の頭の中にある判断を、書き出す
多くの職場では、勤務表は店長や管理者が組んでいます。管理者は、どのスタッフがどの曜日に入れないか、誰と誰を同じ時間帯に置くと仕事が回るか、新人には誰を付けるべきか、誰が最近遅番ばかりで疲れているかを知っており、その判断は多くの場合に的確です。問題は、その判断が管理者の頭の中にだけあり、書き出されていないことです。管理者が休めば勤務表が組めず、スタッフが増えれば手作業が追いつかず、なぜその勤務表にしたのかを後から説明できません。
数理最適化で勤務表を組む作業は、この頭の中の判断を、制約と目的として一つずつ書き出す作業でもあります。書き出してみると、管理者が当然のように守っている条件が、実は誰も明文化していない職場のルールだったと分かることが少なくありません。第13章では、この書き出しの手順を、ヒアリングの設問と制約の優先順位の付け方として整理しました。計算機に任せる前に、現場の判断を言葉にすることが、導入の成否を分けると考えています。
同じコンタクトセンターのデータで、手法を横に比べる
本コラムでは、架空のコンタクトセンターを共通の題材にしました。営業時間は7時から24時までで、30分ごとに入電の件数を予測しています。4週間の予測入電は合計16,802件で、月曜が最も多く、日曜が最も少なくなっています。予測から時間帯ごとの必要人数を計算すると、最も忙しい時間帯で10名、4週間の合計で2,935人時が必要です。これを正社員18名とパート12名で受け持ちます。正社員は早番・日勤・中番・遅番の4つの型で4週間に20日、パートは午前か夕方の短時間の型を中心に週3日か4日まで働けます。リーダーの役割を担える人は7名、英語で対応できる人は4名です。
このデータは乱数で生成したもので、実在の企業や拠点の記録ではありません。その代わり、同じ問題に素朴な作り方とソルバーを順に当てて、結果と計算時間を横に比べることができます。参考までに、無償のソルバーで勤務表を組むと、時間帯ごとの必要人数に対して不足が合計221.0人時、過剰が合計641.0人時になり、希望休88件のうち3件が通りませんでした。不足と過剰が同時に大きいのは、ソルバーの力不足ではなく、9時間拘束の固定の型では需要の山と谷に合わせきれないためです。この勤務表は、与えた条件と重みのもとでは最適であることが証明されています。つまり、同じ型と条件のままでは、不足・希望休・人件費を重みで足した値をこれ以上小さくする組み方はありません。パートを増やせば不足は減らせますが、その分だけ過剰と人件費が増えます(第2章の手作りの勤務表がこの形です)。不足と過剰を同時に大きく減らすには、シフトの型や条件そのものを見直す必要があります。こうした結果の読み方は、第4章と第5章で扱います。
もう一点、各章の数字を読むうえでの注意があります。上の勤務表と重みの合計がまったく同じで、中身だけが違う勤務表が複数あります。同じ条件で解き直すと、重みの合計は変わらないまま、不足が216.0人時から221.0人時の間で、過剰が641.0人時から656.0人時の間で、パートの勤務が475時間から495時間の間で動くことがあります。この勤務表では、不足1人×30分を3,000円、パートの勤務1時間を架空の時給1,500円として重みを足しています。そのため、1人分の不足を30分減らすこと(3,000円分)と、パートの勤務を2時間増やすこと(1,500円×2時間=3,000円分)が、重みの上ではちょうど釣り合います。本コラムでは、「基準の勤務表」として引く数字は上の221.0人時・641.0人時にそろえ、各章で条件を変えて比べるときは、同じ章の中で解き直した勤務表どうしを、重みの合計の差で比べています。この現象は第5章と第13章で詳しく扱います。
最適解より、毎月同じ手順で出せる納得できる勤務表
本コラムを通じてお伝えしたいことが一つあります。シフト作成で大事なのは、一度きりの最適解ではなく、毎月決まった手順で出せる十分に良い勤務表と、それをスタッフが納得して受け入れられる仕組みだということです。勤務表は欠勤や急な予定の変更、予測の外れで崩れます。崩れるたびに組み直すには、計算が決まった時間で終わり、すでに伝えた予定を大きく変えず、なぜその勤務になったのかを管理者が説明できることが要ります。厳密な最適性は、そのための手段の一つにすぎません。
経営判断に関わる方にとって、この点は導入の目標の置き方に直結します。勤務表の自動作成の仕組みを入れれば最適な勤務表が出るという期待で始めると、職場のルールが入っていない勤務表が出て使われなくなることが多いように思います。まず現状の勤務表の作り方を書き出し、不足人時・過剰人時・希望の充足・勤務の偏りを測り、計算機に任せる範囲を小さく始めて、結果を見ながら制約を足していくという順序であれば、投資の効果を数字で確かめながら進められます。
Anagraftでは、データ活用の構想づくりから、人員配置やシフト作成のような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムの本編は第1章から第14章までの14の章で、その後に終章を置いています。第1章と第2章で、シフト作成を経営の問題として位置づけ、問題を記述する言葉をそろえます。第3章から第5章では、計画の順番に沿って解き方を扱います。需要から時間帯ごとの必要人数を見積もる工程、早番や遅番といったシフトの型とその人数を決める工程、スタッフ一人ひとりに勤務を割り当てて勤務表にする工程の順です。第6章では、無償で使えるソルバーでの書き方と、設定の選び方を整理します。
第7章から第9章は、現実の職場で勤務表の問題に加わる要素を扱います。労働法令と就業規則、スタッフの希望と勤務の公平性、そしてリーダーや英語対応のようなスキルの配置です。第10章では、スタッフが百人を超えるときや、数か月から1年の要員計画を立てるときの対処を扱います。第11章では、当日の欠勤で勤務表を直すときの対処を扱います。第12章では、予測の外れにどう備えるかを扱います。第13章で現場への導入と運用を、第14章で公開された事例と研究の動向をまとめ、終章で全体を振り返ります。
| 章 | 題 | 主に扱う手法と題材 |
|---|---|---|
| 第1章 | シフト作成はなぜ経営の問題なのか | 人件費と人手不足、シフトの経営指標、計画の階層、損失の型 |
| 第2章 | シフト作成の問題を記述する | 問題の分類、決めることと制約と目的、組合せの数、共通データの紹介、手作りの勤務表 |
| 第3章 | 必要人数を見積もる | 作業量による見積り、待ち行列とアーランC、サービスレベル、規模の効果、シュリンケージ |
| 第4章 | シフトの型を設計する | 集合被覆問題、開始時刻と長さの選び方、休憩の置き方、不足人時と過剰人時 |
| 第5章 | 勤務表を作る | 個人への割り当て、ハード制約とソフト制約、基準の勤務表の読み方 |
| 第6章 | CP-SAT を使いこなす | 変数と制約の書き方、並びの制約、重みと段階的な解き方、時間制限と品質、解なしの原因探し、公開ベンチマーク |
| 第7章 | 労働法令と就業規則を制約に入れる | 法定労働時間、休憩と休日、時間外労働の上限、変形労働時間制、勤務間インターバル、年次有給休暇 |
| 第8章 | 希望と公平性を扱う | 希望休と希望シフト、公平性の測り方、重みの決め方 |
| 第9章 | スキルと多能工化 | スキル要件、リーダーの配置、多能工化の効果の試算、応援 |
| 第10章 | 大規模化と長期の要員計画 | 公開ベンチマークでの時間と品質、分解、列生成と大近傍探索、採用計画 |
| 第11章 | 当日の欠勤と勤務表の組み直し | 変更を最小にする再作成、待機要員、欠勤のシミュレーション |
| 第12章 | 需要のばらつきに備える | 予測誤差とサービスレベル、余裕人員、複数のシナリオ、柔軟な勤務の枠 |
| 第13章 | 現場に入れる | 暗黙のルールの書き出し、システム連携、人が直す運用、説明できる勤務表、導入の順序、失敗の型 |
| 第14章 | 事例と最新動向 | 公開一次情報のある事例、国際競技会、機械学習、生成AIとの分担、ソルバーの動向 |
読者の立場ごとに、問いから章を引けるように対応表も置きました。一つの問いに複数の章が関わる場合は、入口になる章を先に書いています。
| 問い | 入口になる章 | あわせて読む章 |
|---|---|---|
| シフトの良し悪しを経営の数字でどう測るか | 第1章 | 第2章、第13章 |
| 自社のシフト作成はどの段階の問題に当たるか | 第2章 | 第3章、第4章、第5章 |
| 手で組んだ勤務表にはどれくらい改善の余地があるか | 第2章 | 第5章、第14章 |
| 時間帯ごとに何人いればよいか | 第3章 | 第12章 |
| 人数は足りているのに忙しい時間帯に人がいない | 第4章 | 第3章、第5章 |
| 無償のソルバーで勤務表を組みたい | 第6章 | 第5章、第10章 |
| 労働時間や休日の決まりを勤務表に反映したい | 第7章 | 第1章、第13章 |
| 希望休が通らない、勤務が特定の人に偏る | 第8章 | 第13章 |
| リーダーや特定のスキルを持つ人が足りない | 第9章 | 第10章 |
| スタッフが多く計算が終わらない、採用計画を立てたい | 第10章 | 第6章 |
| 当日の欠勤で勤務表がすぐ崩れる | 第11章 | 第12章 |
| 予測が外れて人が余る、足りない | 第12章 | 第3章、第11章 |
| 自動作成の仕組みを入れても現場で使われない | 第13章 | 第14章 |
各章の末尾には、その章の主題を深めるための参考書籍を挙げ、巻末に一覧としてまとめました。本文で引いた論文や公式ドキュメント、官公庁の資料は、巻末の参考情報に章ごとに載せています。
第1章 シフト作成はなぜ経営の問題なのか
シフト作成は、店長・センター長・看護管理者といった現場の責任者が、毎月の締切に合わせて手作業で担っていることが多い仕事です。表計算ソフトに名前と日付を並べ、希望休を書き込み、足りない日に誰かを入れ、入れすぎた日から誰かを外す。この作業は現場の段取りの問題として扱われ、経営会議の議題に上ることは少ないように思います。しかし勤務表は、会社が支払う人件費の配分そのものであり、同時に顧客へのサービスの水準と、働く人の負担の配分を決めるものでもあります。この章では、なぜシフト作成が経営の問題なのかを、公的統計で確かめた人件費の比重と人手不足の状況から説明します。そのうえで、勤務表の良し悪しを経営の言葉で測るための指標を定義し、年間の要員計画から当日の欠勤対応までの計画の階層と、この記事が扱う範囲を整理します。最後に、判断を誤ったときの損失の型を示し、架空の時給を使った小さな計算で「過剰を減らす」と「不足を減らす」の効き目を比べます。
人がサービスを提供する業種では人件費が収益の過半を占め、勤務表がその配分を決める
最初に、人件費が企業の費用の中でどれほどの重みを持つかを、公的統計で確かめます。財務省の法人企業統計調査は、金融業・保険業を除く全産業の法人企業について、売上高・付加価値・人件費などを毎年集計しています。2026年9月1日に公表された「年次別法人企業統計調査(令和7年度)」の報道発表資料を開くと、2025年度の売上高は1,720兆2,560億円、付加価値は373兆6,701億円、人件費は235兆2,869億円でした。ここでいう人件費は、役員給与・役員賞与・従業員給与・従業員賞与・福利厚生費の合計です。付加価値に占める人件費の割合(いわゆる労働分配率)は63.0%で、同じ資料の付加価値の構成の表では、人件費は支払利息・賃借料・租税公課・営業純益を合わせたよりも大きい項目です。売上高に対する人件費の割合を資料の数字から計算すると、13.7%になります。
全産業を平均した13.7%という数字は、製造業や卸売業のように材料や商品の仕入れを伴う業種も含めた平均です。人がサービスを直接提供する業種では、人件費の比重はずっと大きくなります。厚生労働省が公表している業種別の経営調査から、収益に対する給与費の割合を拾ったのが次の表です。調査ごとに分母(売上高・医業収益・介護事業の収入)と分子(人件費・給与費)の定義が違うので、数字を横に並べて厳密に比べることはできませんが、桁の違いを見るには十分です。
| 対象 | 収益に対する人件費・給与費の割合 | 年度 | 出典 |
|---|---|---|---|
| 全産業(金融業・保険業を除く)の法人企業 | 付加価値に対して63.0%、売上高に対して13.7%(売上高に対する割合は公表値から計算) | 2025年度 | 財務省 年次別法人企業統計調査(令和7年度) |
| 一般病院 | 医業・介護収益に対して55.3% | 2024年度 | 第25回医療経済実態調査の分析(厚生労働省保険局医療課) |
| 精神科病院 | 医業・介護収益に対して69.3% | 2024年度 | 同上 |
| 介護老人福祉施設 | 収入に対して63.5% | 2024年度決算 | 令和7年度介護事業経営概況調査結果(厚生労働省老健局老人保健課) |
| 訪問介護 | 収入に対して67.8% | 2024年度決算 | 同上 |
| 通所介護 | 収入に対して60.9% | 2024年度決算 | 同上 |
病院の数字は、厚生労働省保険局医療課の「第25回医療経済実態調査の分析」(2025年11月26日の中央社会保険医療協議会の資料)の、病院類型別の収支構造の表から取りました。同じ資料は、どの病院類型でも材料費と給与費の比率を合わせると70%を超え、療養型病院や精神科病院は相対的に給与費の比率が高いと説明しています。介護の数字は、厚生労働省老健局老人保健課の「令和7年度介護事業経営概況調査結果」の1施設・事業所あたりの収支の表で、2024年度決算の給与費が「収入」に占める割合です。
この表が示しているのは、人がサービスを提供する業種では、収益の半分から7割近くが人件費として出ていくということです。売上高に対する人件費の割合が60%の事業で、勤務表の組み方を変えて人件費を1%削れれば、売上高に対して0.6%分の利益が生まれます。逆に、同じ人件費を払っていても、配置が需要の山とずれていれば、払った人件費の一部はサービスに変わりません。勤務表は、この最大の費用を「どの日の、どの時間帯に、誰の時間として使うか」を決める文書です。その意味で、シフト作成は現場の段取りであると同時に、最大の費用項目の配分を毎月決め直す経営の意思決定だと考えています。
人手不足は「採れば埋まる」段階を過ぎている
人件費の比重が大きいことに加えて、人を採ること自体が難しくなっています。厚生労働省の「一般職業紹介状況(令和8年7月分)」によると、2026年7月の有効求人倍率(季節調整値)は1.18倍、正社員の有効求人倍率(同)は1.00倍でした。有効求人倍率は、ハローワークに出ている求人の数を求職者の数で割ったもので、1倍を超えると求職者1人あたり1件を超える求人があることを表します。この記事を書いた2026年9月30日に確認した時点では、令和8年7月分がこの統計の最新の公表分でした。
全体の倍率が1倍台前半でも、シフトを組む職種に限ると状況はまったく違います。同じ公表の参考統計表から、常用(パートタイムを含む)の職業別の有効求人倍率を拾ったのが次の図の左側です。介護サービス職業従事者は3.82倍、自動車運転従事者は2.53倍、接客・給仕職業従事者は2.30倍、飲食物調理従事者は2.18倍、保健師・助産師・看護師は1.94倍、商品販売従事者は1.73倍でした。一方で一般事務従事者は0.29倍です。職業別の数字は季節調整をしていない実数で、見出しの1.18倍(季節調整値)とは作り方が違うので直接は比べられず、職業どうしの差として見るのが適切です。交替制の勤務表を組む職種ほど、求人に対して求職者が少ないことが分かります。
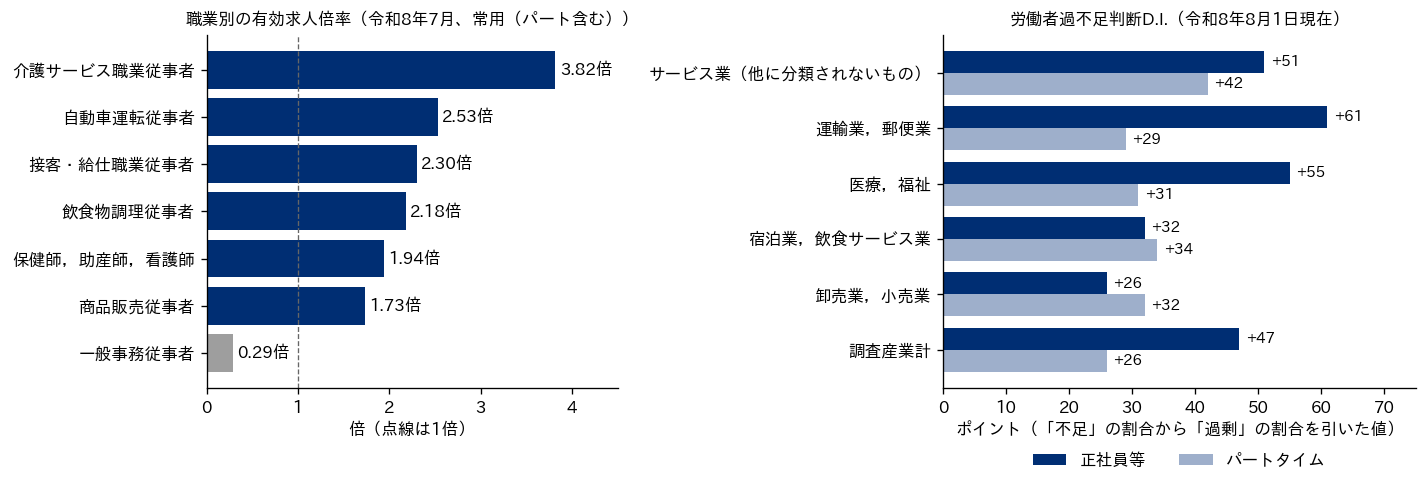
図の右側は、厚生労働省の「労働経済動向調査(令和8年8月)の概況」から取った労働者過不足判断D.I.です。これは、労働者が「不足」と答えた事業所の割合から「過剰」と答えた事業所の割合を引いた値で、プラスであれば人手不足と感じている事業所が多いことを表します。2026年8月1日現在で、調査産業計は正社員等が+47ポイント、パートタイムが+26ポイントでした。産業別には、正社員等では運輸業・郵便業の+61ポイント、医療・福祉の+55ポイント、パートタイムではサービス業(他に分類されないもの)の+42ポイント、宿泊業・飲食サービス業の+34ポイント、卸売業・小売業の+32ポイントが目立ちます。この調査は主要産業の規模30人以上の民営事業所から抽出した事業所を対象にしたもので、2026年9月29日に公表されています。
人が辞めることも、勤務表の問題に直結します。厚生労働省の「令和7年雇用動向調査結果の概要」によると、2025年1年間の離職率(年初の常用労働者数に対する離職者の割合)は産業計で13.7%でした。前の節の「売上高に対する人件費の割合」も13.7%でしたが、数字が同じだけで、別の指標です。産業別では、宿泊業・飲食サービス業が23.7%、サービス業(他に分類されないもの)が21.2%、医療・福祉が14.3%、卸売業・小売業が11.9%です。同じ調査で、転職して入職した人が前の職場を辞めた理由を見ると、「労働時間、休日等の労働条件が悪かった」は女性で12.9%、男性で8.5%でした。女性ではこの理由が、「その他の個人的理由」を除くと最も多い理由です。この数字は勤務表が離職の原因だと示すものではありませんが、働く時間と休日の条件が、辞める理由として一定の割合を占めていることは確かめられます。
これらの統計から言えるのは、不足を「人を採って埋める」ことが、以前より高くつき、時間もかかるようになっているということです。求人を出しても応募が来ない職種では、今いる人の時間をどう配るかが、事業を回せるかどうかを直接左右します。勤務表の組み方で同じ人数からより多くのサービスを引き出せるなら、不足する枠を埋めるという点に限れば、採用に近い効果を採用より早く生む手段になりえます。これが、この記事でシフト作成を数理最適化の対象として取り上げる理由です。
勤務表の良し悪しを経営の言葉で測る指標
勤務表が経営の意思決定であるなら、その良し悪しも経営の言葉で測る必要があります。現場では「今月のシフトは回った」「きつかった」という感覚で振り返ることが多いのですが、感覚では、2つの勤務表のどちらが良いかを比べたり、改善の効果を人件費に換算したりできません。この記事では、勤務表を評価する指標を次のように定義し、すべての章で同じ定義を使います。前半の4つは数え方をこの記事全体で固定する指標で、後半の4つは章ごとに扱い方を詳しく述べる指標です。
| 指標 | この記事での定義 | 経営上の意味 | 主に扱う章 |
|---|---|---|---|
| 不足人時 | 30分の枠ごとに「必要在席人数から在席人数を引いた値」の正の部分を全枠で足し、30分を0.5時間として換算したもの | サービスが落ちる時間の量。応答の遅れ・待ち・放棄、残っている人の負荷の増加 | 全章 |
| 過剰人時 | 同じく「在席人数から必要在席人数を引いた値」の正の部分を足したもの | 払ったのにサービスに変わらない人件費の量 | 全章 |
| 希望休の違反 | 希望休の日に勤務が入った件数(共通データでは88件中の件数)。裏返すと希望の充足率 | 働く人の満足と定着。約束を守れる職場かどうか | 第5章・第8章 |
| サービスレベル | その枠で20秒以内に応答できる入電の割合(アーランCの式による推定値) | 顧客が受けるサービスの水準 | 第3章・第12章 |
| 人件費 | 勤務した時間に時給を掛けた合計(共通データでは架空の時給) | 損益計算書に直接出る費用 | 第4章・第5章 |
| 残業時間 | 所定の労働時間を超えた時間 | 割増賃金と法令上の上限。疲弊の兆候 | 第7章・第11章 |
| 連勤 | 休みをはさまずに続けて勤務した日数 | 疲労の蓄積と、健康・安全上の問題 | 第5章・第7章 |
| 公平性の偏り | 土日勤務・遅番などの回数の、スタッフ間の最大と最小の差など | 不満の集中と、特定の人の離職 | 第8章 |
このうち、この記事の中心になるのは不足人時と過剰人時の2つです。1日を30分の枠に区切り、枠ごとに「この枠に何人いれば目標のサービスを出せるか」(必要在席人数)と「勤務表の上で実際に何人が席にいるか」(在席人数)を比べます。必要より少ない枠では、その差を不足として数え、多い枠ではその差を過剰として数えます。2人足りない枠が1つあれば、不足は2人×30分=1人時です。ここで大事なのは、不足と過剰を1日や1か月の合計で相殺しないことです。朝に3人足りず、夕方に3人余っている日は、1日の合計では過不足ゼロに見えますが、朝の顧客は待たされ、夕方の人件費は無駄になっています。枠ごとに正の部分だけを足すのは、この打ち消し合いを防ぐためです。
サービスレベルは、コンタクトセンターでよく使われる「入電のうち何%を何秒以内に応答できたか」という指標です。この記事の共通データは架空のコンタクトセンターなので、この指標を使います。必要在席人数は、各枠でこのサービスレベルの目標を満たす最小の人数として計算しています。このため、在席が必要在席人数に届かない枠は、目標のサービスレベルを下回る枠になります(入電が少なく、運用ルールで最低2名を置いている枠は例外になりえます)。この章の後半の計算例で使う基準の勤務表では、不足のある枠と目標を下回る枠は、どちらも952枠中181枠で一致します。計算の方法(アーランCの式)と目標の決め方は第3章で扱います。小売店なら「レジの待ち時間」、病院の病棟なら「看護師1人あたりの患者数」のように、業種ごとにサービスの水準を測る指標は違いますが、「必要な人数を決める根拠になる指標」を1つ持つという考え方は共通です。
指標を読むときに注意したいことが2つあります。1つ目は、1つの指標だけを見て勤務表を評価しないことです。不足人時だけを見れば、全員を毎日出勤させる勤務表が最良になりますが、過剰人時と人件費が膨らみます。過剰人時だけを見れば、人を減らすほど良くなりますが、不足が増えます。希望休を全部通した勤務表は、不足の日を作りやすくなります。指標どうしはトレードオフの関係にあり、どこで釣り合わせるかは経営の判断です。2つ目は、指標の値が勤務表だけで決まるわけではないことです。必要在席人数は需要の予測から計算した値なので、予測が外れれば、勤務表どおりに人が出勤しても実際の不足と過剰は変わります。当日の欠勤でも変わります。この記事では、勤務表を作る段階の指標(計画値)を主に扱い、予測の誤差は第12章、当日の欠勤は第11章で、計画値と実際の差として扱います。
計画の階層と、この記事が扱う範囲
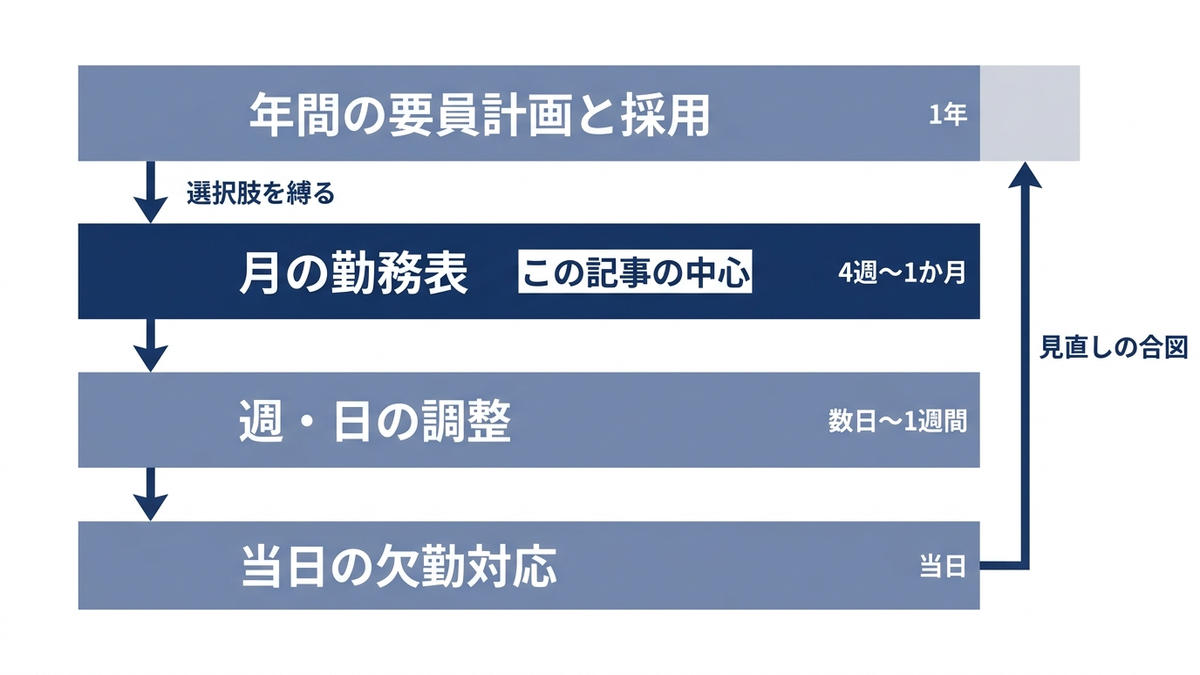
「シフトを決める」と一口に言っても、実際には時間の長さの違う複数の計画が重なっています。何年も先を見て人を採る計画と、明日の朝の欠勤に対応する判断では、決めることも、使える手段も、判断にかけられる時間も違います。この記事では、人員配置の計画を次の4つの層に分けて考えます。
| 計画の層 | 時間の幅と頻度 | 決めること | 動かせる手段 | この記事の章 |
|---|---|---|---|---|
| 年間の要員計画と採用 | 1年先まで。年に1〜数回 | 何人を、どの雇用形態で、どのスキルで抱えるか | 採用、異動、研修、雇用形態の組合せ、営業時間 | 第10章(スキルの研修の効果は第9章) |
| 月の勤務表 | 4週〜1か月。月に1回 | 誰が、どの日に、どの勤務の型で働くか | 勤務の型の割当、休日の配置、希望の反映 | 第2章〜第9章 |
| 週・日の調整 | 数日〜1週間。随時 | 勤務表の一部の入れ替え | 勤務の交代、パートの追加・短縮、他部署からの応援 | 第11章・第12章 |
| 当日の欠勤対応 | 当日。発生のつど | 欠けた人の穴をどう埋めるか | 待機要員の呼び出し、延長の依頼、業務の優先順位の変更 | 第11章 |
上の層ほど長い時間をかけて大きな手段を動かせますが、先の需要ほど予測が外れやすくなります。下の層ほど状況ははっきりしていますが、使える手段は限られます。重要なのは、上の層の決定が下の層の選択肢を縛ることです。年間の計画で採用した人数とスキルの構成が、月の勤務表で組める組合せの上限を決め、月の勤務表の組み方が、当日に欠勤が出たときに動かせる人の余地を決めます。たとえば、英語対応ができる人を2人しか採用していなければ、月の勤務表でどれだけ工夫しても、英語対応が要る時間帯を毎日すべて埋めることはできません。反対に、当日の欠勤対応がいつも同じ時間帯で行き詰まるなら、それは月の勤務表や年間の要員計画を見直す合図です。
この記事の中心は、2段目の「月の勤務表」です。第2章で問題を記述し、第3章で需要から必要人数を見積もり、第4章で勤務の型(何時から何時までの勤務を何人置くか)を設計し、第5章から第9章で個人への割当と、法令・希望・公平性・スキルの扱いを述べます。そのうえで、第10章で規模の大きな問題と年間の要員計画へ、第11章と第12章で当日の欠勤と需要のばらつきへと、上下の層に広げます。第13章は現場への導入、第14章は事例と動向です。
判断を誤ったときの損失の型
勤務表の判断を誤ったときの損失は、過剰の側と不足の側で性質がまったく違います。過剰の損失は単純です。必要以上に人を置けば、その時間の人件費がそのまま余分な費用になります。この損失は給与の支払いとして損益計算書に現れるので、金額で把握しやすく、経営の目にも留まりやすいという特徴があります。そのため、人件費の削減を求められた現場では、過剰を減らすことに意識が向きがちです。
不足の損失は、形を変えて複数の場所に現れます。1つ目は顧客へのサービスの低下です。コンタクトセンターなら応答までの待ち時間が延び、待ちきれずに切れる電話(放棄呼)が増えます。店舗ならレジの行列が延び、購入をやめる客が出ます。病棟なら、ナースコールへの対応が遅れるおそれがあります。2つ目は売上の機会の損失で、受けられなかった注文や予約は、後から取り戻せないこともあります。3つ目は、その場にいる人への負荷の集中です。不足の枠では、残っている人が休憩を削ったり、終業後に残って対応したりすることで穴を埋めることが多く、それが残業時間になります。4つ目は、その負荷が続いたときの疲弊と離職です。離職が出れば不足はさらに大きくなり、採用と教育の費用がかかります。
この非対称性が、勤務表の判断を難しくしています。過剰の損失は目に見えて、すぐに金額になりますが、不足の損失は目に見えにくく、遅れて、別の勘定科目に現れます。残業代は人件費に入りますが、それが「勤務表の不足」から生じたことは帳簿からは分かりません。離職による採用費は採用の予算から出ていきます。サービスの低下による売上の減少は、他の要因と区別できないことが多いでしょう。その結果、過剰を削る方向の判断は数字で正当化しやすく、不足を減らすための投資は数字で説明しにくい、という偏りが生まれやすいと考えています。
この偏りを正すには、不足にも値段を付ける必要があります。この記事の共通データでは、不足1人×30分を3,000円相当とみなす重みを置いています(1人時あたり6,000円)。これは架空の値で、実在の企業の損失を推計したものではありません。実務では、不足1人時あたりの損失を、放棄呼1件あたりの逸失利益、残業の割増賃金、離職1人あたりの採用・教育費などから、自社のデータで見積もることになります。見積もりには不確かさが残りますが、値段をゼロのままにしておくよりは、幅を持たせた値を置いて感度を確かめるほうが、判断を誤りにくいと考えています。不足の値段の決め方と、それが勤務表をどう変えるかは、第5章と第8章で重みの問題として扱います。
小さな計算例、過剰を1割減らすか不足を1割減らすか
損失の非対称性を、数字で確かめてみます。ここでは、この記事の第2章で用意する共通のサンプルデータ(架空のコンタクトセンター、スタッフ30名、4週間28日、営業は7時から24時まで)と、第5章で扱う基準の勤務表を使います。どちらも実在の企業・拠点の記録ではなく、乱数の種を固定して作った架空のデータです。基準の勤務表は、不足・希望休の違反・リーダーや英語対応の人の不在・パートの人件費を、円に換算した重みで足し合わせた1つの値を最小にするように、数理最適化のソルバーで作ったものです。作り方は第5章で説明するので、ここでは結果の数字だけを使います。
費用の計算には、共通データに用意した架空の時給(正社員2,600円、パート1,500円)を使います。これも実在の企業の賃金ではなく、例題のために置いた値です。基準の勤務表では、正社員18名が4週間でちょうど20日ずつ、1日の実働8時間で勤務するので、正社員の実働は2,880時間、人件費は748万8,000円です。パートの勤務は475時間で、人件費は71万2,500円です。合計の820万500円が、この架空のセンターの4週間の人件費になります。
この勤務表の在席人時は3,355.0人時で、必要在席人数から計算した必要人時の2,935.0人時より420人時多くなっています。それにもかかわらず、不足人時は221.0人時あります。過剰人時は641.0人時で、在席人時の19.1%にあたります。不足人時は必要人時の7.5%です。人数の合計では足りているのに、時間帯によっては足りず、別の時間帯では余っているということです。4週間の予測入電16,802件のうち、20秒以内に応答できるのは78.3%(アーランCの式による推定)で、目標の80%を全体で下回っています。20秒以内に応答できない入電は、推定で3,649件です。
ここで、2つの改善を仮定して比べます。1つは「過剰を1割減らす」で、過剰の大きい枠から順に1人×30分ずつ、過剰の合計1,282人×30分の1割にあたる128人×30分(64.0人時)を取り除きます。もう1つは「不足を1割減らす」で、不足の大きい枠から順に1人×30分ずつ、不足の合計442人×30分の1割にあたる44人×30分(22.0人時)を足します。どちらも、30分単位で人を自由に足し引きできるという仮の計算で、実際の勤務の型(9時間や5時間の固定の枠)には縛られていません。この計算をする Python のコードが次のものです(共通データの関数と、基準の勤務表の在席人数を保存したファイルを読み込んでいます)。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
from shift_data import *

req, calls = required_staff(), call_forecast()
cover = np.load("../_out/baseline_cover.npy")         # 基準の勤務表の在席人数(28日×34枠)

def report(cv, label):
    short = np.clip(req - cv, 0, None).sum() / 2         # 不足人時
    over = np.clip(cv - req, 0, None).sum() / 2          # 過剰人時
    sl = np.array([[service_level(int(cv[d, s]), calls[d, s]) for s in range(N_SLOTS)]
                   for d in range(N_DAYS)])
    miss = ((1 - sl) * calls).sum()                      # 20秒以内に応答できない入電(推定)
    print("%s 不足 %.1f 人時 過剰 %.1f 人時 20秒超 %.0f 件" % (label, short, over, miss))

def shift_one(cv, sign, k):                              # 差の大きい枠から1人×30分ずつ動かす
    cv = cv.copy()
    for _ in range(k):
        gap = (cv - req) if sign < 0 else (req - cv)
        d, s = np.unravel_index(np.argmax(gap), gap.shape)
        cv[d, s] += sign
    return cv

report(cover, "基準")
report(shift_one(cover, -1, 128), "過剰を1割減らす")      # 過剰 1,282 人×30分の1割
report(shift_one(cover, +1, 44), "不足を1割減らす")       # 不足 442 人×30分の1割
# 出力: 基準 不足 221.0 人時 過剰 641.0 人時 20秒超 3649 件
# 出力: 過剰を1割減らす 不足 221.0 人時 過剰 577.0 人時 20秒超 3651 件
# 出力: 不足を1割減らす 不足 199.0 人時 過剰 641.0 人時 20秒超 3418 件
required_staff() は枠ごとの必要在席人数、call_forecast() は枠ごとの予測入電件数、service_level(n, calls) は在席 n 人のときに20秒以内に応答できる入電の割合の推定値を返す、共通データの関数です。np.clip(req - cv, 0, None) が「必要から在席を引いた値の正の部分」で、その合計を2で割ると不足人時になります。人件費の増減と1年への換算は、同じ計算を広げて出しました。結果をまとめたのが次の表です。
| 案 | 動かした時間 | 不足人時 | 過剰人時 | 20秒以内に応答できない入電(4週、推定) | 20秒以内に応答できる割合 | 4週の人件費の増減(パート時給で換算) | 4週の人件費の増減(正社員時給で換算) |
|---|---|---|---|---|---|---|---|
| 基準 | なし | 221.0 | 641.0 | 3,649件 | 78.3% | 0円 | 0円 |
| 過剰を1割減らす | 64.0人時を減らす | 221.0 | 577.0 | 3,651件 | 78.3% | 96,000円の減少 | 166,400円の減少 |
| 不足を1割減らす | 22.0人時を足す | 199.0 | 641.0 | 3,418件 | 79.7% | 33,000円の増加 | 57,200円の増加 |
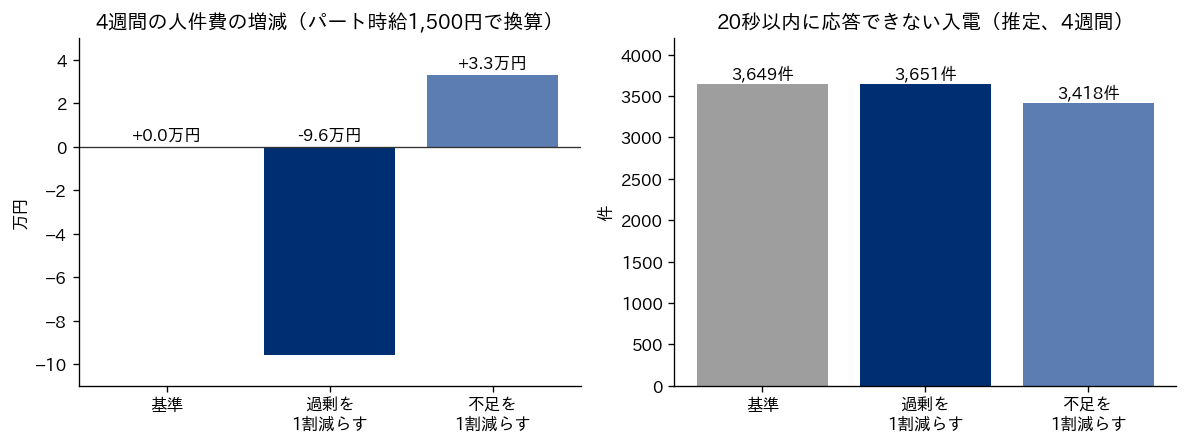
表の「過剰を1割減らす」の行を見ると、64.0人時を減らしても、20秒以内に応答できない入電は3,649件から3,651件へ2件増えただけで、20秒以内に応答できる割合は78.3%のまま変わりません。過剰の大きい枠は、もともと必要人数より何人も多く席にいる枠なので、1人減らしてもサービスはほとんど落ちないからです。人件費は、減らした時間をパートの時給で数えると4週で96,000円、正社員の時給で数えると166,400円減ります。4週間を13回で1年(52週)とみなすと、年間ではそれぞれ124万8,000円と216万3,200円です。
「不足を1割減らす」の行では、22.0人時を足すだけで、20秒以内に応答できない入電が3,649件から3,418件へ231件減り、20秒以内に応答できる割合は78.3%から79.7%へ1.4ポイント上がりました。人件費の増加は、パートの時給なら4週で33,000円、正社員の時給なら57,200円です。1人時あたりに直すと、不足の枠に1人時を足すことで、20秒以内に応答できない入電がおよそ10件減っています。これに対して、過剰の枠から1人時を減らしても、応答できない入電はほとんど増えません。同じ1人時でも、どの枠に置くかによって、サービスに対する効き目がまったく違うということです。
この比較から言えることは3つあります。第一に、「過剰を減らす」と「不足を減らす」は、どちらか一方を選ぶ話ではありません。過剰の枠から時間を削り、その一部を不足の枠に回せれば、人件費を増やさずにサービスを上げられます。この例なら、過剰から削る64.0人時は、不足を1割減らすのに足す22.0人時の3倍近くあります。第二に、共通データに置いた不足の重み(1人時あたり6,000円、架空)で換算すると、不足を22.0人時減らす価値は132,000円相当で、足すのにかかる人件費(33,000円から57,200円)を上回ります。この重みを自社でどう見積もるかによって、どこまで人を足すべきかの答えが変わります。第三に、この計算は30分単位で人を自由に足し引きできるという仮定の上に成り立っています。実際には、人は9時間や5時間のまとまった勤務で働くので、朝の不足の枠に30分だけ人を足すことはできません。表の「不足を1割減らす」でも、目標のサービスレベルを下回る枠の数は、基準と同じ181枠のまま変わっていません。不足の大きい枠に1人ずつ足しても、その枠の不足が解消しきらないからです。
過剰と不足が同時に大きいのは、この基準の勤務表の出来が悪いからではありません。基準の勤務表は、与えた重みのもとで最適であることがソルバーによって証明されています。それでも過剰と不足が残るのは、勤務の型(7時からの早番、9時からの日勤など、固定の時間帯の勤務)と、1日の中の需要の山の形が合っていないためです。つまり、同じ人数と同じ勤務の型のままでは、勤務表の組み方を工夫しても、不足と過剰を同時には消せません。パートの勤務を増やせば不足は減らせますが、その分だけ過剰と人件費が増えます(第2章で、規則で作った手作りの勤務表を例に確かめます)。不足と過剰を同時に減らすには、勤務の型そのもの(開始時刻や長さ)を見直す必要があり、これが第4章の主題です。経営の判断として言い換えると、「誰をどの日に入れるか」の改善で取れる効果と、「どんな勤務の型を用意するか」の改善で取れる効果は別のもので、後者は就業規則や雇用契約の見直しを伴う、より上の層の判断になります。
数字を経営の判断に使うときの注意
勤務表の指標を経営の報告に載せるときに、よく起きる読み違いがいくつかあります。1つ目は、合計や平均で報告してしまうことです。前の節で見たとおり、この架空のセンターは在席人時の合計では必要人時を420人時上回っていますが、不足人時は221.0人時あります。「必要人時に対する在席人時の比率」は114%で、これだけを見れば人は足りているように見えます。枠ごとの正の部分を足すという不足人時・過剰人時の定義は、この読み違いを防ぐためのものです。報告には、少なくとも不足人時と過剰人時を別々に載せ、どの曜日・どの時間帯に偏っているかを添えることが有効だと考えています。
2つ目は、サービスレベルを全体の1つの数字で見ることです。この例の4週間全体で20秒以内に応答できる割合は78.3%ですが、これは入電件数で重みをつけた平均で、枠ごとに見れば目標を大きく上回る枠と大きく下回る枠が混ざっています。顧客にとっては、自分が電話をかけた時間帯のサービスがすべてです。全体の平均が目標に近くても、特定の時間帯に待ちが集中していれば、その時間帯の顧客は不満を持ちます。目標を下回った枠の数(この例では952枠中181枠)を併せて見ると、偏りが分かります。
3つ目は、勤務表の作成で使った重みを、そのまま経営の損益として読んでしまうことです。この記事の基準の勤務表は、不足1人×30分を3,000円、希望休の違反1件を5,000円といった架空の重みで足し合わせた値を最小にしています。この重みは「どちらをどれだけ優先するか」を表す調整の目盛りであって、実際の損失額ではありません。重みを変えれば勤務表が変わり、不足人時と希望休の違反の釣り合いも変わります。経営の報告では、重みを掛けた合計の値ではなく、不足人時・過剰人時・人件費・希望休の違反といった個々の指標を並べ、重みを変えたときにそれぞれがどう動くかを示すほうが、判断の材料として使いやすいでしょう。
4つ目は、1か月の勤務表の結果だけで判断することです。勤務表の指標は月ごとに揺れます。祝日の数、希望休の集中、需要の季節変動によって、同じ人数でも不足人時は変わります。ある月の不足が大きかったからといって、すぐに採用を決めるのではなく、数か月分の不足人時がどの曜日・時間帯に、どのくらいの頻度で出ているかを見てから、勤務の型の見直しで済むのか、採用が要るのかを判断するのが確実です。この判断の枠組みは、計画の階層で見たとおり、月の勤務表の結果を年間の要員計画へ返す流れそのものです。
この章の要点は3つです。第一に、人件費は人がサービスを提供する業種で収益の半分から7割近くを占め、人手不足の統計(職業別の有効求人倍率、労働者過不足判断D.I.、離職率)は、人を採って不足を埋めることが難しくなっていることを示しています。勤務表は、この最大の費用の配分を毎月決める経営の意思決定です。第二に、勤務表の良し悪しは、不足人時・過剰人時・人件費・サービスレベル・希望の充足・残業・連勤・公平性で測り、特に不足人時と過剰人時は枠ごとに正の部分を足して、合計で相殺しないことが要点です。第三に、過剰の損失は目に見えやすく、不足の損失は見えにくいという非対称性があり、架空のデータの計算では、同じ1人時でも不足の枠に置くか過剰の枠から外すかで、サービスへの効き目がまったく違いました。次の第2章では、シフト作成の問題を「決めること」「守るべき条件」「目的」に分けて記述し、この章で使った共通のサンプルデータを詳しく紹介します。
この章を深めたい方への参考書籍
『人手不足なのになぜ賃金が上がらないのか』(玄田有史 編、慶應義塾大学出版会):人手不足が続いているのに賃金が伸びにくいという現象を、労働経済学の研究者らが需給・行動経済学・制度・規制・正規雇用・能力開発・年齢などの複数の視点から分析した論集です。この章では人手不足を統計で確かめ、今いる人の時間の配り方の重要性を述べましたが、その背景にある労働市場の仕組みを経済学の側から押さえるのに向いています。
『改訂2版 看護管理者が知っておきたい「様式9」の基礎講座』(福井トシ子 監修、日本施設基準管理士協会 編著、メディカ出版):病院の施設基準に関わる書類である「様式9」について、2024年度の診療報酬改定に対応して、看護管理者向けに基本と見落としやすい点を解説した本で、副題は「施設基準を遵守した勤務表を作成するために」です。セミナーでの質疑をもとにしたQ&Aを含みます。病棟の勤務表が書類の作成や勤務管理を通じて病院の経営に結び付いていることを、看護管理の実務の側から確かめる材料になります。
第2章 シフト作成の問題を記述する
第1章では、シフト作成が人件費とサービスの両方に効く経営の問題であることを確かめ、不足人時・過剰人時・希望休の違反・サービスレベルといった指標で結果を測る考え方を整理しました。この章では、その問題を解く前の段階として、シフト作成とは何を決め、何を守り、何を良しとする問題なのかを言葉で書き下します。まず、ひとまとめに「シフト作成」と呼ばれている仕事を性格の違う5つの問題に分け、この記事でどの章がどれを扱うかを示します。次に、決めること・守ること・望ましいこと・目的の4つを区別し、勤務表の並べ方の数がどれほど大きいかを実際に数えます。そのうえで、この記事の全章で使う共通のサンプルデータを紹介し、人が規則で作る「手作りの勤務表」を実際に作って、第5章で詳しく読む最適化の基準の結果と同じ物差しで比べます。
シフト作成を5つの問題に分ける
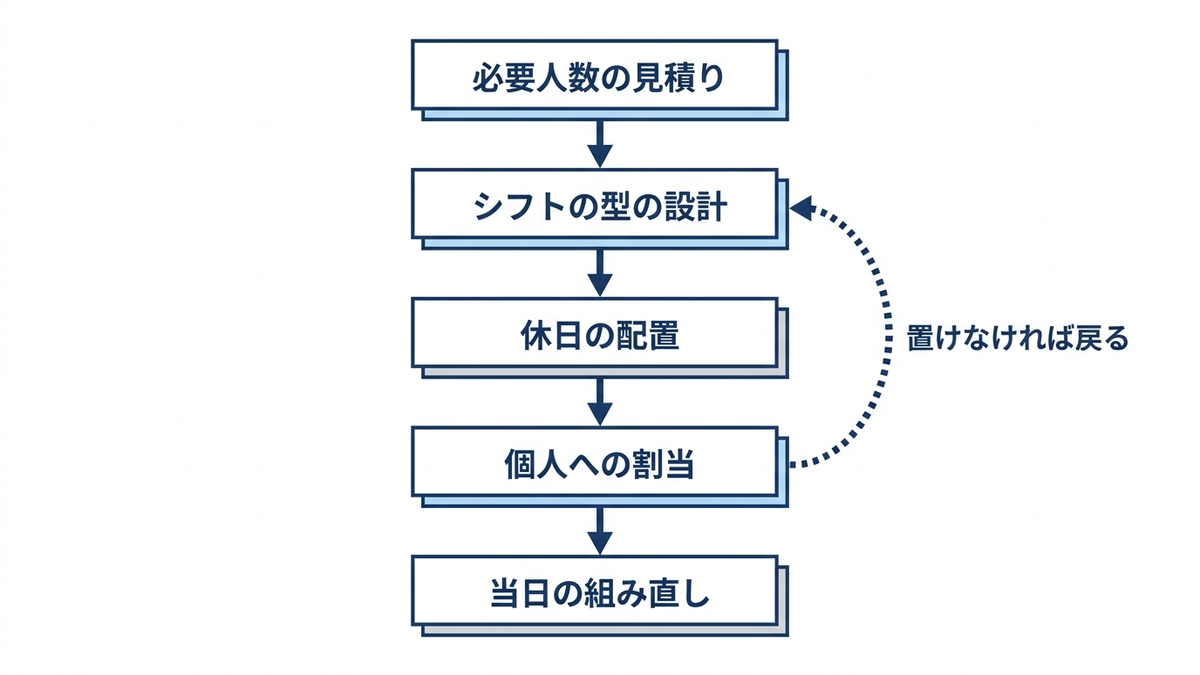
「来月のシフトを作る」という一言には、実際には性格の違う判断がいくつも含まれています。どの時間帯に何人が席にいれば目標のサービスを出せるのかという見積り、何時から何時までの勤務を何種類用意するかという勤務の型の設計、誰がいつ休むかという休日の配置、誰にどの日のどの勤務を割り当てるかという個人への割当、そして当日の欠勤や需要の急な変化に合わせた組み直しです。これらを1人の担当者が一度に頭の中で処理していると、どこで判断を誤ったのかが外から見えにくくなります。数理最適化で扱うときは、まずこれを分けて考えます。
| 問題 | 決めること | 主な入力 | 主な出力 | この記事で扱う章 |
|---|---|---|---|---|
| 必要人数の見積り | 時間帯ごとに席にいるべき人数 | 予測入電件数・平均処理時間・サービス目標 | 必要在席人数(日×時間帯の表) | 第3章 |
| シフトの型の設計(シフトスケジューリング) | どの開始時刻・長さの勤務を何人ずつ置くか | 必要在席人数・勤務の長さや休憩の規則 | 勤務の型ごとの人数 | 第4章 |
| 休日の配置(デイオフスケジューリング) | 各人が何曜日(何日目)に休むか | 日ごとの必要人数・休日の規則・連勤の上限 | 出勤日と休日の並び | 第5章・第7章 |
| 個人への割当(ロスタリング) | 誰がどの日にどの型で働くか | 上の3つの結果・スキル・雇用契約・希望 | 勤務表(スタッフ×日付の表) | 第5章〜第10章 |
| 当日の組み直し | 欠勤や需要の変化に合わせて誰を動かすか | 確定した勤務表・欠勤の連絡・当日の実績 | 変更した勤務表 | 第11章・第12章 |
表の2行目のシフトスケジューリングは、個人を区別せずに「どういう勤務の型を何人置くか」だけを決める問題です。必要在席人数という需要の山に対して、長さの決まった勤務の帯を何本重ねれば覆えるかを考えるので、個人の事情は入りません。3行目のデイオフスケジューリングは、1日の中の時間帯ではなく、日の単位で出勤と休みの並びを決める問題です。週休2日を曜日で固定するのか、4週で8日の休みを自由に置くのかで、答えの形が大きく変わります。4行目のロスタリングは、これらを個人の名前に落とす工程です。病院の看護師の勤務表を作る問題はナース・スケジューリング問題と呼ばれ、国内でも研究が重ねられてきました(次の節で1998年の論文に触れます)。その本格的な扱いは第5章で行います。
この5つは、上から順に解くのが基本の流れです。ただし独立ではありません。第4章で型の人数を決めても、個人の休日や希望を入れた第5章の割当ではその人数どおりに置けないことがあり、そうなると型の設計まで戻って考え直す必要が出てきます。逆に、第5章のように型と休日と個人の割当を1つのモデルでまとめて解けば、この行き戻りは不要になりますが、そのぶんモデルは大きくなります。分けて解くか、まとめて解くかは、問題の規模と、どれだけ良い答えが要るかで決める設計上の判断です。この記事の共通データでは、勤務の型を6つに固定したうえで、休日の配置と個人への割当をまとめて解いています。
現場でこの分け方が役に立つのは、改善の手をどこに打つかを判断するときです。不足が出ている原因が、需要の見積りの誤りなのか、勤務の型が需要の山に合っていないのか、人数は足りているのに休みの並べ方が悪いのか、特定のスキルを持つ人が足りないのかで、打つべき手はまったく違います。見積りの誤りなら予測を直し、型の不一致なら勤務時間の設計を変え、休みの並びなら勤務表の作り方を変え、スキル不足なら研修や採用を考えます。原因が混ざったまま「シフトがうまく組めない」と議論していると、採用を増やせば解決する問題だと誤って判断し、実際には勤務の型を変えるだけで減らせた不足に人件費を払い続けることになりかねません。
決めること・守ること・望ましいこと・目的
問題を分けたら、次はその中身を4つの要素に書き分けます。数理最適化では、決めることを決定変数、守らなければならない条件を制約、何を良しとするかを目的関数と呼びます。シフト作成ではこれに加えて、守れれば望ましいが守れないこともある条件、つまり希望や努力目標の扱いが大きな比重を占めます。この記事では、必ず守る条件をハード制約、破ってもよいが破ると目的の値が悪くなる条件をソフト制約と呼び分けます。
決めることは、この記事の共通データでは「スタッフ \(s\) が日 \(d\) に勤務の型 \(t\) で働くかどうか」の1つだけです。スタッフが30名、日が28日、勤務の型が6つなので、1人1日ごとに「6つの型のどれか、または休み」の7通りから1つを選ぶことになります。勤務表はスタッフを縦に、日付を横に並べた表で、そのマス目1つひとつに7通りのどれかを書き込む作業だと言い換えられます。個人と日と型の3つの添字で変数を置く定式化の考え方は、弊社コラム『数理最適化の定式化パターン集』の第7章で詳しく扱っているので、この記事では式の細部はそちらに送り、ここでは言葉で整理します。
守ることは、大きく2つの方向から書けます。1つはスタッフの側から見た条件です。1人が1日に入れる勤務は1つまで、正社員は4週で20日勤務、週に5日まで、連続勤務は5日まで、遅番の翌朝に早番を入れないといった勤務の並びの条件、パートは契約した型しか入れない、といったものがこれに当たります。もう1つは時間帯の側から見た条件で、各時間帯に必要な人数がいる、リーダーが1人以上いる、平日の日中は英語対応ができる人が1人以上いる、といったものです。ただし、この記事の基準では、時間帯の側の条件は必ず守る条件にはせず、満たせなかった分を不足や不在の枠数として数え、重みをかけて目的に入れています(後の表のソフト制約)。Ikegami と Niwa による看護師の勤務表の研究(1998年、日本オペレーションズ・リサーチ学会の英文誌 Journal of the Operations Research Society of Japan 第41巻に掲載)は、この構造を、看護師1人ごとの条件の塊と、各勤務帯の構成に関わる条件(複数の看護師を結びつける条件)に分けて捉え、1人ずつ順に勤務を組み直していく解き方を示しました。同じ論文は、要求をすべて満たす勤務表を作ることは、時間と手間をかけても通常は不可能だと述べています。
この2方向の区別は、手作業で勤務表を作るときの難しさそのものを表しています。1人ずつ横に見ていけば連勤や休日の数は確かめられますが、そのときには各時間帯の人数は見えていません。日付ごとに縦に見れば人数は数えられますが、今度は各人の連勤や翌日への続き方が見えません。表計算ソフトで勤務表を作ると、横の合計と縦の合計を交互に見ながら何度も直す作業になりやすいのはこのためです。数理最適化のソルバーは、この縦と横の条件を同時に扱います。
望ましいことは、共通データでは希望休を通すこと、不足をなくすことの2つが中心です。不足をソフト制約に置くのは意外に見えるかもしれませんが、「必要人数を必ず満たす」をハード制約にすると、人数が足りない月には勤務表そのものが作れず、ソルバーは解なしと答えるだけになります。不足を「1人×30分あたりいくら」の重みつきで目的に入れておけば、足りない月でも「どこがどれだけ足りないか」が分かる勤務表が返ってきます。これは第6章で扱う、解なしのときの原因探しの考え方ともつながります。
目的は、この記事の基準では、不足・希望休の違反・リーダー不在・英語対応の不在・パートの人件費を円換算の重みで足した1つの値を小さくすることです。重みはすべて架空で、不足1人×30分を3,000円相当、希望休の違反1件を5,000円相当、リーダー不在1枠を5,000円相当、英語対応の不在1枠を2,000円相当とし、パートの人件費は時給どおりに数えています。重みの値を変えれば答えも変わります。重みをどう決めるか、重みを変えると何が起きるかは第5章と第8章で扱います。ここで押さえておきたいのは、目的が1つの値にまとめられている以上、「不足だけ」「人件費だけ」を別々に最小にしているのではない、ということです。
| 要素 | 共通データでの中身 | 扱い |
|---|---|---|
| 決めること | スタッフ30名×28日の各マスに、6つの勤務の型か休みのどれを入れるか | 決定変数 |
| スタッフの側の条件 | 1日1勤務まで・正社員は4週20日・週の上限日数・連勤5日まで・続けてはいけない型の組・入れる型の制限 | ハード制約 |
| 時間帯の側の条件 | 必要在席人数を満たす・リーダーが1人以上・平日9〜18時は英語対応が1人以上 | ソフト制約(不足・不在の枠数に重み) |
| 希望 | 希望休88件 | ソフト制約(違反1件に重み) |
| 目的 | 不足・希望休の違反・リーダー不在・英語対応の不在・パートの人件費の重みづけの和 | 最小化 |
どの条件をハード制約に置き、どれをソフト制約に置くかは、分析の側が勝手に決めてよいものではありません。法令にもとづく条件はハード制約に置くのが原則で、その条件は第7章で条文にあたって確かめます。この記事の共通データにある勤務間インターバル11時間は、法令上は努力義務の制度を参考にした架空の社内ルールとして置いており、共通データではハード制約として扱っています。社内ルールをハードに置くかソフトに置くかは、そのルールを緩めたときにどれだけ人員に余裕が生まれるかを見せたうえで、現場と経営が決める事柄です。
勤務表の並べ方はどれだけあるか
勤務表を手で作るのが難しいことは経験的によく知られていますが、その難しさを数で見ておきます。共通データの勤務表は30名×28日=840マスで、各マスに7通り(6つの勤務の型か休み)のどれかが入ります。条件を何も考えずに並べ方を数えると、7を840回掛けた数になります。これを計算すると、およそ10の709.9乗、つまり710桁の数です(Python で計算。以下の数も同じ)。実際にはスタッフごとに入れる型が決まっているので、正社員は4つの型か休みの5通り、パートは契約した型か休みの2〜4通りに絞れます。それでも並べ方の数はおよそ10の499.9乗で、500桁ほどの数であることに変わりはありません。
規則を守るものだけに絞ると、どれだけ減るかも数えました。正社員1人ぶんについて、4週で20日勤務・週5日まで・連勤5日まで・続けてはいけない型の組を避ける、という条件をすべて満たす28日の並べ方を、動的計画法(前の日までの状態を記録しながら1日ずつ数を積み上げる数え方)で数えると、5,972,248,574,777,296通り、約6,000兆通りでした。1人ぶんでこの数なので、正社員18名がそれぞれ独立に並べ方を選ぶと、各時間帯の人数をまだ一切考えていない段階で、およそ10の284.0乗通りになります。1秒に10億通りを調べられる計算機があっても、正社員18名ぶんを全部調べるにはおよそ10の275乗秒かかります。すべての並べ方を試して一番良いものを選ぶ、という方法はこの規模では使えないということです。
| スタッフ数 | 7日 | 14日 | 28日 |
|---|---|---|---|
| 5名 | 10の30乗 | 10の59乗 | 10の118乗 |
| 10名 | 10の59乗 | 10の118乗 | 10の237乗 |
| 20名 | 10の118乗 | 10の237乗 | 10の473乗 |
| 30名 | 10の177乗 | 10の355乗 | 10の710乗 |
| 60名 | 10の355乗 | 10の710乗 | 10の1420乗 |
表は、1マスに7通りを入れる場合の並べ方の数を、スタッフ数と日数を変えて桁で示したものです(指数は小数点以下を四捨五入)。「規模とともに急に重くなる」という言い方は、この表の読み方を指しています。スタッフが1人増えるたびに、並べ方の数は7の28乗倍、つまり約10の23.7乗倍になります。スタッフを30名から60名に倍にすると、並べ方の数は2倍になるのではなく、桁数が2倍(数としては2乗)になります。計画期間を2週間から4週間に延ばしたときも同じです。人数や日数を少し増やしただけで、全部を調べ尽くす方法の所要時間は掛け算で膨らんでいきます。
ただし、並べ方の数が多いことは、それだけで問題が解けないことを意味しません。条件が「各マスに何か1つを入れる」だけなら、1マスずつ好きに決めれば済みます。弊社コラム『数理最適化の定式化パターン集』の第7章でも触れているとおり、2つの集合を1対1で結ぶ割当問題のように、並べ方が膨大でも短い時間で最適な答えが求まる構造の問題もあります。勤務表を難しくしているのは数の多さそのものではなく、前の節で見た縦の条件(時間帯ごとの人数・スキル)と横の条件(1人ごとの日数・連勤・並び)が同じマスを取り合うことです。ある人の休みを1日動かすと、その日の人数も、その人の連勤も、前後の日の並びも同時に変わります。第5章以降で使う CP-SAT(Google が Apache 2.0 ライセンスで無償公開している最適化ライブラリ OR-Tools に含まれるソルバー)のような汎用のソルバーは、並べ方を1つずつ全部試すのではなく、条件どうしの関係を使って調べる範囲を絞り込みながら解を探します。その使い方と、どこまでの規模なら実用的な時間で解けるかは、第6章と第10章で実測します。
共通データ:架空のコンタクトセンター
この記事の第2章以降は、同じサンプルデータを使って説明を進めます。このデータは実在の企業・拠点の記録ではなく、乱数のシード(乱数の出発点)を固定して生成した架空のサンプルです。入電件数・平均処理時間・サービスの目標・スタッフの人数とスキル・希望休・勤務の型・社内ルールのすべてが、この記事のために置いた架空の設定です。題材にコンタクトセンターを選んだのは、30分ごとの需要が入電件数として数えやすく、必要人数を待ち行列の式から求められるので、需要から勤務表までの流れを一続きで示せるためです。小売の店舗、物流センター、病院の病棟、介護施設でも、需要の測り方と必要人数の出し方が違うだけで、勤務表を作る部分の構造は共通しています。
営業時間は7時から24時で、これを30分刻みの34枠に分けます。枠0が7時から7時30分、枠33が23時30分から24時です。計画期間は4週間28日で、第1日は月曜です。予測入電件数は28日×34枠の表で、4週の合計は16,802件、1日平均600件です。曜日による違いが大きく、月曜が最も多く、土曜と日曜が少なくなるように置いています。
次の表は、曜日ごとに4週分を平均した1日の入電の形を、30分あたりの件数で示したものです。3つの山の欄には、それぞれの時間帯の中で件数が最も多い30分の枠の開始時刻と、その枠の30分あたりの件数を書きました。最も少ない枠の欄も同じ形で、1日の合計は4週の平均を整数に丸めた値です。
| 曜日 | 1つ目の山(10時台) | 2つ目の山(13時台) | 3つ目の山(18時30分〜19時台) | 最も少ない枠 | 1日の合計 |
|---|---|---|---|---|---|
| 月 | 10:30 33.7件 | 13:30 30.7件 | 19:00 29.1件 | 23:30 4.2件 | 760件 |
| 火 | 10:30 29.3件 | 13:30 26.2件 | 18:30 25.1件 | 23:30 3.5件 | 642件 |
| 水 | 10:00 26.2件 | 13:30 23.9件 | 18:30 23.5件 | 23:30 3.3件 | 609件 |
| 木 | 10:30 26.4件 | 13:30 23.9件 | 18:30 22.9件 | 23:30 3.4件 | 607件 |
| 金 | 10:30 29.4件 | 13:30 26.7件 | 19:00 26.1件 | 23:30 3.7件 | 669件 |
| 土 | 10:30 21.6件 | 13:30 19.7件 | 19:00 18.7件 | 23:30 2.7件 | 487件 |
| 日 | 10:30 19.0件 | 13:30 16.9件 | 19:00 16.2件 | 23:30 2.3件 | 426件 |
どの曜日も、目立つ山は10時台・13時台・18時30分から19時台の3つです(月曜だけは17時30分の枠にも前後の枠より少し多い小さな山があります)。最も高い山は10時台(水曜は10時の枠、それ以外の曜日は10時30分の枠が最大)、次が13時台、3つ目が18時30分から19時台です。最も高い枠の件数は、月曜で33.7件、日曜で19.0件でした。一方、最も少ないのはどの曜日も23時30分の枠で、2〜4件台にとどまります。1日の中で件数が数倍に変わること、曜日によっても山の高さが変わることが、勤務表を難しくする需要側の要因です。次の節で示すとおり、正社員の勤務の型は9時間拘束の帯なので、その帯を何本か重ねるだけでは、表で示した3つの時間帯の山の形にぴったり合わせることはできません。
各枠で必要な在席人数は、入電件数から求めます。平均処理時間(通話と後処理を合わせた時間)を6分、サービスの目標を「入電の80%を20秒以内に応答する」と置き、待ち行列の理論にもとづくアーランCの式で、その目標を満たす最小の在席人数を枠ごとに計算しました。さらに、入電が少ない時間帯でも最低2名は席にいる、という架空の運用ルールを加えています。計算の中身と、目標の値を変えたときの違いは第3章で扱います。この章では、結果として出てくる「必要在席人数」の表を、勤務表の需要として使います。
| 曜日 | 1日の予測入電の平均 | 必要在席の人×時間(1日平均) | 必要在席人数の最大 |
|---|---|---|---|
| 月 | 760件 | 125.0 | 10名 |
| 火 | 642件 | 110.1 | 9名 |
| 水 | 609件 | 105.8 | 8名 |
| 木 | 607件 | 106.2 | 9名 |
| 金 | 669件 | 112.9 | 9名 |
| 土 | 487件 | 90.5 | 7名 |
| 日 | 426件 | 83.2 | 7名 |
表の値は、サンプルデータから実際に集計したものです。必要在席人数を4週の全枠で足すと5,870人×30分、時間に直すと2,935人×時間になります。ここで「人×時間」は、1人が1時間席にいることを1と数える量で、人時とも呼びます。必要在席人数は「席にいて電話を取れる人数」なので、休憩や研修で席を外している人は数えません。休憩は勤務の型の側で、在席の枠から外して扱っています。休憩・研修・欠勤などで席にいない割合(シュリンケージ)をどう見込むかは、第3章で扱います。
スタッフ30名と6つの勤務の型
供給の側は、スタッフ30名と6つの勤務の型です。スタッフは実名ではなく S01 から S30 の記号で呼びます。S01 から S18 の18名が正社員、S19 から S30 の12名がパートです。勤務の型は、正社員が入る9時間拘束の4つと、パートが入る5時間の2つです。9時間拘束の型は休憩60分を含み、実働は8時間です。休憩は勤務の中ほどの2枠(60分)に固定し、その間は在席に数えません。たとえば早番の休憩は11時から12時です。
| 勤務の型 | 時間 | 実働 | 休憩(在席に数えない枠) | 入れるスタッフ |
|---|---|---|---|---|
| 早番 | 7時〜16時 | 8時間 | 11時〜12時 | 正社員 |
| 日勤 | 9時〜18時 | 8時間 | 13時〜14時 | 正社員、一部のパート |
| 中番 | 12時〜21時 | 8時間 | 16時〜17時 | 正社員 |
| 遅番 | 15時〜24時 | 8時間 | 19時〜20時 | 正社員 |
| 短時間(午前) | 9時〜14時 | 5時間 | なし | パート |
| 短時間(夕方) | 17時〜22時 | 5時間 | なし | パート |
正社員18名は早番・日勤・中番・遅番のどれにも入れ、4週でちょうど20日勤務、週5日までと置きました。パート12名は人によって入れる型が違い、午前の短時間だけの人、夕方の短時間だけの人、両方に入れる人がいて、うち6名(S19〜S24)は日勤にも入れます。パートは週3日または4日までで、4週の日数の下限はありません。12名の週の上限日数を足すと44日です。スキルは2種類で、リーダー(SV)が7名(S01〜S07、すべて正社員)、英語対応が4名(S03・S09・S12 の正社員3名とパートの S21)です。S03 は両方を持っています。希望休は30名で合計88件あり、1人2件から4件です。
| 区分 | 人数 | 入れる型 | 日数の条件 | スキルを持つ人 |
|---|---|---|---|---|
| 正社員 | 18名(S01〜S18) | 早番・日勤・中番・遅番 | 4週でちょうど20日・週5日まで | リーダー7名(S01〜S07)、英語対応3名(S03・S09・S12) |
| パート | 12名(S19〜S30) | 短時間(午前)か短時間(夕方)、またはその両方。S19〜S24 は日勤にも入れる | 週3日または4日まで。4週の下限なし | 英語対応1名(S21) |
社内ルールとして、連続勤務は5日まで、終業から次の始業まで11時間を空ける(勤務間インターバル)、の2つを置きました。11時間の休息から、前日と翌日に続けてはいけない型の組が決まります。中番(21時終業)の翌日の早番(7時始業)は休息が10時間、遅番(24時終業)の翌日の早番・日勤・短時間(午前)は休息がそれぞれ7時間・9時間・9時間、短時間(夕方)(22時終業)の翌日の早番は9時間で、いずれも11時間に届かないので入れられません。時間帯の側の条件は、各枠にリーダーが1名以上、平日の9時から18時は英語対応が1名以上です。英語対応の条件がかかるのは、平日20日×18枠で360枠です。
費用も架空です。人件費は時給で正社員2,600円、パート1,500円と置き、不足1人×30分を3,000円相当とみなします。正社員は4週20日×8時間で勤務時間が決まっているので、正社員の人件費はどの勤務表でも同じになります。勤務表によって変わる人件費はパートの分だけです。基準の目的にパートの人件費だけが入っているのはこのためです。
供給と需要の総量も比べておきます。9時間拘束の型は、休憩を除いて1回あたり8時間(16枠)在席します。正社員18名×20日×8時間で、正社員だけの在席は4週で2,880人×時間です。必要在席の合計は2,935人×時間なので、総量では正社員だけでほぼ足りている計算です。それでも不足が出るのは、在席の時間帯の形が必要の形に合わないためです。ここから、この章の後半で繰り返し使う関係が1つ出てきます。在席の総量から必要の総量を引いた値は、過剰人時から不足人時を引いた値に必ず等しくなります。枠ごとに「在席人数から必要在席人数を引いた値」を足すと、正の部分が過剰、負の部分が不足になるからです。したがって、パートを増やして在席の総量を増やせば、不足が減らなくても過剰はその分だけ増えます。
手作りの勤務表を規則で作る
最適化の結果と比べる相手として、人が規則にしたがって作る勤務表を用意しました。表計算ソフトで勤務表を作る担当者が使いそうな、説明しやすい規則です。実在の職場の作り方を再現したものではなく、この記事で置いた1つの例です。
- 正社員の休みは曜日で固定する。S01 は月曜と火曜、S02 は火曜と水曜、というように、連続する2日の曜日を1人ずつずらして割り振る(S08 で月曜と火曜に戻る)
- 正社員の勤務の型は週替わりで回す。人ごとに開始をずらし、早番→遅番→中番→日勤→早番の順で1週ごとに次の型へ進む
- パートは、正社員を置いたあとで不足が大きい日と時間帯(短時間(午前)か短時間(夕方)の枠)から順に、入れる人がいれば入れる。1回の勤務(10枠)で不足を5枠以上埋められる所にだけ入れ、週の上限日数・連勤5日・続けてはいけない組は守る
型を回す順番を「早番→遅番→中番→日勤」にしたのは、続けてはいけない組を避けるためです。「早番→日勤→中番→遅番」の順に回すと、遅番の週の最終日と早番の週の初日が続いたとき、遅番の翌日に早番が入ってしまいます。この順番では、前の週の型から次の週の型への移り方(早番→遅番、遅番→中番、中番→日勤、日勤→早番)がどれも11時間以上の休息を確保できます。休みを連続する2日に固定しているので、連勤は最長5日で、週5日・4週20日の条件も自動的に満たされます。
この規則で作った勤務表を2通り用意しました。手作りAは、上の規則だけで作り、希望休は見ません。手作りBは、正社員について、規則で作ったあとに希望休の日を見て、その日に勤務が入っていたら同じ週の固定の休みの日(希望休でない日)と入れ替えます。入れ替えは、連勤5日と続けてはいけない組を破らない場合だけ行います。パートは希望休の日を避けて入れます。手作りBは、担当者が希望休の一覧を見ながら手で直した勤務表にあたります。次のコードは、手作りの勤務表を作るプログラムから、正社員の部分を作る関数を抜き出したものです(この部分だけでは動きません)。
# 抜き出し:手作りの勤務表の正社員の部分。R[i, d] は勤務の型(None は休み)
ROT = ["E", "L", "M", "D"]          # 週替わりの順番。遅番→早番を作らない並び

def full_time_part(use_requests):
    R = {}
    for i in range(18):
        off_wd = {i % 7, (i + 1) % 7}                  # 連続2日の曜日を休みに固定
        for d in range(N_DAYS):
            R[i, d] = None if weekday(d) in off_wd else ROT[(i + d // 7) % 4]
    if use_requests:                                     # 手作りB:希望休を見て入れ替える
        for i in range(18):
            for d in ps[i]["off_req"]:
                if R[i, d] is None:
                    continue
                wk = d // 7
                for d2 in range(wk * 7, wk * 7 + 7):     # 同じ週の休みの日と入れ替える
                    if (R[i, d2] is not None) | (d2 in ps[i]["off_req"]):
                        continue
                    trial = dict(R)
                    trial[i, d2] = R[i, d]
                    trial[i, d] = None
                    if len(hard_violations(trial, i)) == 0:   # 連勤・続けてはいけない組を確かめる
                        R = trial
                        break
    return R
評価は、第1章と同じ定義で行います。不足人時は、各枠で必要在席人数から在席人数を引いた値の正の部分を全枠で足し、30分を0.5時間として換算したものです。過剰人時は、在席人数から必要在席人数を引いた値の正の部分を同じように足したものです。希望休の違反は、希望休の日に勤務が入った件数(88件中)です。これに、リーダーが1人もいない枠の数、英語対応が必要な枠で英語対応の人がいない枠の数、パートの勤務時間と人件費を加えました。基準と同じ重みで目的の値も計算しています。
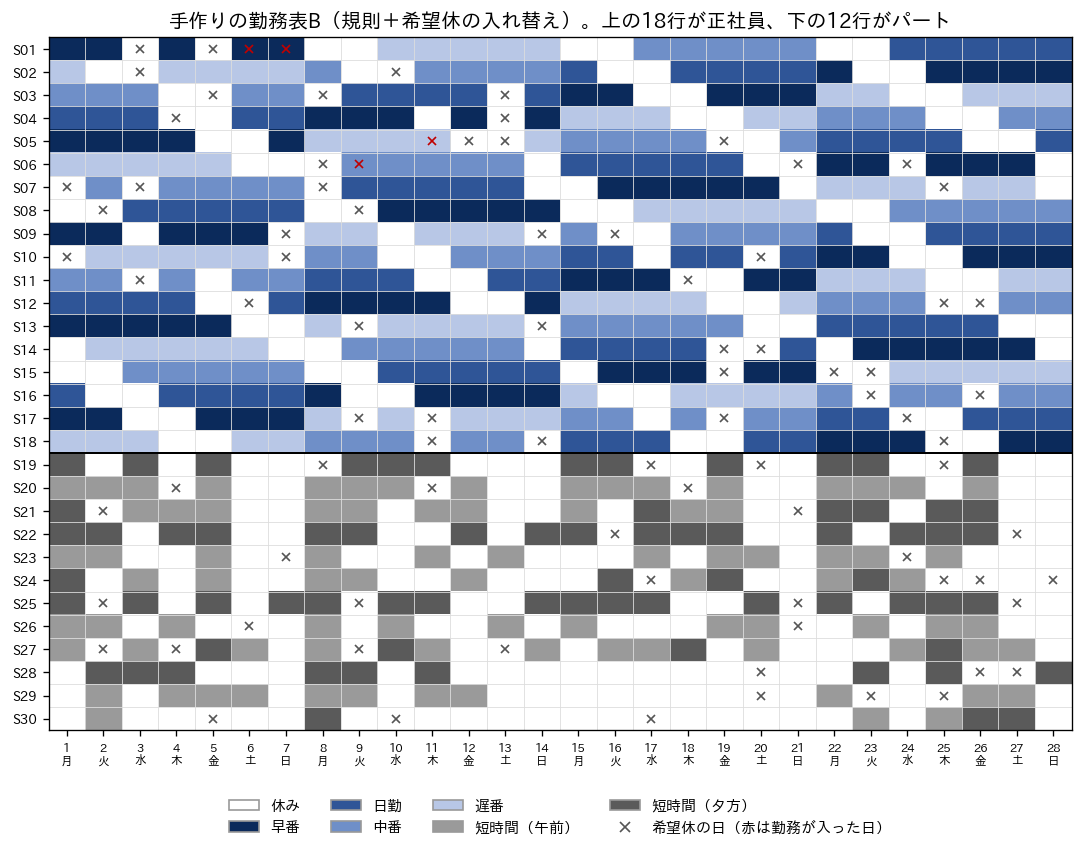
図は手作りBの勤務表です。上の18行が正社員で、同じ色が週ごとにまとまって横に続き、休みの白いマスが人ごとに1日ずつずれて斜めに並んでいます。規則で作った勤務表は、このように形がそろっていて、誰がいつ何番なのかを覚えやすいという長所があります。希望休の日には×を付け、それでも勤務が入った日を赤い×にしました。正社員の入れ替えで通せなかった希望休は、S01 の第6日(土曜)と第7日(日曜)、S05 の第11日、S06 の第9日の4件でした。S01 は第1週に4日の希望休(第3日・第5日・第6日・第7日)を出しており、同じ週で入れ替えに使える固定の休みは2日しかないため、2件は通せませんでした。
手作りの勤務表と基準を同じ物差しで比べる
手作りA・手作りBと、第5章で詳しく読む基準の勤務表を、同じ指標で並べたのが次の表です。基準は、この記事の全章で共通に使う CP-SAT の勤務表で、不足・希望休の違反・リーダー不在・英語対応の不在・パートの人件費の重みづけの和を最小にしたものです。この記事の実行環境(一般的なノートPC)で、30秒の時間制限・num_workers=8(8本の探索を並列に走らせる設定)で解き、2.6秒で OPTIMAL(この重みづけの目的について最適であることの証明つき)になっています。基準の数字は、この1回の実行の結果をそのまま引用しており、この章で解き直してはいません。
| 指標 | 手作りA(規則だけ) | 手作りB(規則+希望休の入れ替え) | 基準(CP-SAT) |
|---|---|---|---|
| 不足人時 | 197.5人×時間 | 203.5人×時間 | 221.0人×時間 |
| 不足がある枠(952枠中) | 229枠 | 239枠 | 181枠 |
| 過剰人時 | 887.5人×時間 | 918.5人×時間 | 641.0人×時間 |
| 希望休の違反(88件中) | 45件 | 4件 | 3件 |
| リーダー不在の枠(952枠中) | 28枠 | 52枠 | 0枠 |
| 英語対応の不在の枠(360枠中) | 40枠 | 38枠 | 0枠 |
| パートの勤務時間 | 745時間 | 770時間 | 475時間 |
| パートの人件費(架空の時給) | 1,117,500円 | 1,155,000円 | 712,500円 |
| 重みづけの和(基準の目的と同じ数え方) | 2,747,500 | 2,732,000 | 2,053,500 |
表の「重みづけの和」の行を見ると、基準の2,053,500に対して、手作りAは2,747,500、手作りBは2,732,000です。基準はこの値について最適性が証明されているので、同じスタッフ・同じ6つの勤務の型・同じハード制約・同じ重みの範囲では、これより小さい値の勤務表は作れません(第4章で勤務の型そのものを変えると、この範囲の外に出ます)。手作りとの差はこの重みのもとでの損失を表しています。手作りBと基準の差は678,500で、その内訳は次の表のとおりです。
| 項目 | 手作りBと基準の違い | 重み | 重みづけの和で見た手作りBの差 |
|---|---|---|---|
| パートの人件費 | 1,155,000円と712,500円 | 支払う金額そのもの | 442,500多い |
| リーダー不在 | 52枠と0枠 | 1枠5,000 | 260,000多い |
| 英語対応の不在 | 38枠と0枠 | 1枠2,000 | 76,000多い |
| 希望休の違反 | 4件と3件 | 1件5,000 | 5,000多い |
| 不足 | 407人×30分と442人×30分 | 1人×30分3,000 | 105,000少ない |
| 合計 | 678,500多い |
手作りBは不足が35人×30分少ない分だけ基準より有利ですが、ほかの4項目の不利(合計783,500)がそれを上回ります。重みのうち実際に支払うお金はパートの人件費だけで、残りは不足や不在を円に換算した架空の重みである点に注意してください。
この表で最も注意したいのは、不足人時の行だけを見ると手作りのほうが少ないことです。不足人時は手作りAが197.5、手作りBが203.5で、基準の221.0より小さくなっています。これを見て「手作りのほうが不足が少ないのだから良い勤務表だ」と判断すると、表のほかの行を見落とします。手作りはパートを270〜295時間多く入れて在席の総量を増やしており、その結果、過剰人時が基準より246.5〜277.5人×時間多くなっています。先に述べた関係のとおり、過剰人時から不足人時を引いた値は在席の総量から必要の総量を引いた値に等しく、手作りBでは \(2880 + 770 – 2935 = 715\)、基準では \(2880 + 475 – 2935 = 420\) です(単位は人×時間。2,880は正社員の在席、770と475はパートの勤務時間)。手作りBはパートを295時間多く入れて、不足を17.5人×時間減らし、過剰を277.5人×時間増やしたことになります。入れた時間の大半は、必要のない時間帯を埋める形になりました。
不足のある枠の数は逆の結果で、手作りBの239枠に対して基準は181枠です。不足の合計は基準のほうが多く、不足のある枠の数は手作りのほうが多いということは、基準の不足は少ない枠に深く、手作りの不足は多くの枠に浅く散らばっていることを意味します。どちらが望ましいかは、この記事の基準の重みのように不足を「1人×30分あたりいくら」と一律に数える限りは区別されません。1つの枠で2人足りないことを、2つの枠で1人ずつ足りないことより重く見たいなら、不足の数え方そのものを変える必要があり、これは重みの設計の問題として第5章と第8章で扱います。
希望休とスキルの行は、手で直すことの難しさを示しています。規則だけの手作りAは希望休を45件(88件中)破っており、希望の充足率に直すと48.9%です。担当者が希望休を見て休みを入れ替えた手作りBでは違反が4件(充足率95.5%)まで減り、基準の3件(96.6%)に近づきました。ところが、リーダー不在の枠は28枠から52枠に増えています。休みの日を入れ替えたことで、リーダーの7名が同じ日に休む組合せが新たに生まれたためです。担当者は希望休の一覧を見て入れ替えを判断しており、そのときリーダーの配置は見ていません。1つの条件を手で直すと、見ていない別の条件が崩れるという現象は、前の節で見た縦と横の条件が同じマスを取り合う構造の直接の帰結です。基準の勤務表は、希望休の違反を3件にとどめながら、リーダー不在と英語対応の不在をどちらも0枠にしています。
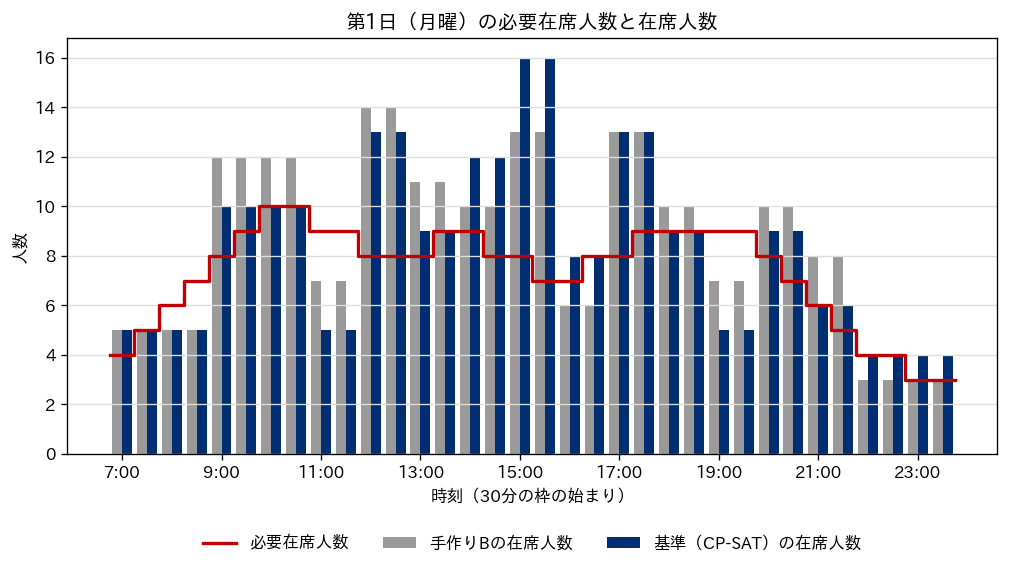
図は第1日(月曜)について、必要在席人数と2つの勤務表の在席人数を重ねたものです。この日の不足は手作りBが16人×30分、基準が19人×30分、過剰は手作りBが64人×30分、基準が55人×30分でした。2つの勤務表の形はよく似ていて、どちらも12時から18時にかけて必要を大きく上回り、11時台と19時台に在席が落ち込んでいます。11時台は早番の休憩、19時台は遅番の休憩の時間帯で、休憩の位置が勤務の型で固定されているために、入電の山の時間帯にまとめて席が空きます。昼過ぎの過剰は、4つの型のうち3つ以上が重なる時間帯だからです。この形は、個人への割当を工夫しても不足と過剰を同時には消せない部分で、勤務の型の設計の問題です。第4章で、開始時刻や長さ、休憩の位置を変えた型を選ばせたときに、この過不足がどれだけ減るかを測ります。
| 時間帯(4週合計) | 必要在席(人×30分) | 手作りBの不足 | 手作りBの過剰 | 基準の不足 | 基準の過剰 |
|---|---|---|---|---|---|
| 7〜9時 | 492 | 146 | 14 | 81 | 17 |
| 9〜12時 | 1,296 | 94 | 202 | 172 | 114 |
| 12〜15時 | 1,204 | 5 | 577 | 0 | 398 |
| 15〜18時 | 1,092 | 27 | 695 | 2 | 606 |
| 18〜21時 | 1,185 | 97 | 232 | 173 | 84 |
| 21〜24時 | 601 | 38 | 117 | 14 | 63 |
4週全体を時間帯に分けて集計すると、違いがもう少しはっきりします(単位はいずれも人×30分)。手作りBの不足は朝の7〜9時に146と集中しています。規則で作ると、早番の人数は日によって2名から5名までばらつき、そのばらつきが曜日の需要とは無関係に決まるためです。手作りBの朝の不足を曜日別に見ると、月曜29・水曜32に対して日曜は7で、需要の多い平日の朝に早番が少ない日が重なっています。基準は早番を4週で107回(手作りは90回)置いて朝の不足を81まで抑え、その代わりに9〜12時と18〜21時の山で172と173の不足を残しています。どちらの勤務表も、12〜18時の過剰が全体の過剰の大半を占めています(手作りBは1,837のうち1,272、基準は1,282のうち1,004)。過剰の多くが勤務の型の重なりから来ているという読み方は、第1日の図と一致します。
サービスレベルに直して読む
不足人時は人数の指標なので、顧客から見た影響に翻訳しておきます。各枠の在席人数と予測入電件数から、アーランCの式で「20秒以内に応答できる入電の割合」(サービスレベル)を推定し、入電件数で重みをつけて4週全体の平均を取りました。結果は、手作りA・手作りBがともに0.844(小数第3位まで同じ値でした)、基準が0.783でした。サービスレベルが目標の80%を下回った枠の数は、手作りBが239枠、基準が181枠で、今回のデータでは不足のある枠の数と一致しました。必要在席人数は「目標を満たす最小の人数」と「最低2名」の大きいほうとして定義しているので、目標を満たす最小の人数で決まる枠では、1人でも足りなければ目標を下回ります。一方、最低2名の決まりで引き上げた枠では、1人足りなくても目標を満たすことがありえます。今回の2つの勤務表では、そうした枠は数に表れませんでした。
入電で重みをつけた平均では、手作りのほうがサービスレベルが高く出ています。これは、手作りがパートを多く入れて在席の総量を増やしていること、基準の不足が入電の多い9〜12時と18〜21時の山に集まっていることの両方の結果です。基準の重みは不足1人×30分を3,000円相当と数えており、パートを1回(5時間、架空の時給で7,500円)入れても不足を2人×30分以下しか埋められない場所では、入れると目的の値が悪くなります(3人×30分以上埋められれば、9,000相当以上の不足が減るので良くなります)。この判断が経営として妥当かどうかは、不足1人×30分の重みが本当に3,000円相当なのかにかかっています。電話がつながらないことで失う売上や信用を重く見るなら重みを上げることになり、そうするとパートを1回入れて元が取れる境目(埋めるべき不足の枠数)が下がります。重みを変えたときに勤務表と人件費とサービスレベルがどう動くかは、第5章で実際に解いて確かめます。ここで言えるのは、手作りの勤務表はその釣り合いを誰も決めないまま結果として出てきたもので、最適化の勤務表は重みという形で釣り合いを明示したうえで出てきたもの、という違いです。
経営の目で読む、手作りの勤務表の損失はどこに出るか
この比較を経営の判断に翻訳すると、手作りの勤務表の損失は3つの形で出ています。1つ目は人件費です。手作りBは基準よりパートを295時間多く使い、架空の時給で4週あたり442,500円多く払っています。そのうち不足の削減に使われたのは17.5人×時間ぶんで、残りは過剰として席にいるだけの時間になりました。この差が毎月の勤務表で繰り返されるなら、4週を13回繰り返す1年で、同じ時給の前提では5,752,500円になります。例題の金額そのものに意味はありませんが、「在席の総量を増やして不足を埋める」という手作りの典型的な対処が、どれだけ効率の悪い買い方になりうるかは、この比で読み取れます。
2つ目は、数字に表れにくい運営上の危険です。手作りBでは、リーダーが1人もいない枠が52枠(26時間)、英語対応が必要な時間帯に英語対応の人がいない枠が38枠(19時間)ありました。これらは不足人時の集計には表れません。人数は足りていても、判断を仰ぐ相手がいない時間帯や、英語の問い合わせを受けられない時間帯が勤務表の中に残っているということです。勤務表を人数の合計だけで点検していると、この種の穴は当日になって初めて気づくことになります。
3つ目は希望の扱いです。規則だけの手作りAは希望休の半分を破っていました。担当者が手で直した手作りBでは4件まで減りましたが、その代わりにリーダーの配置が崩れています。希望を通すために他の条件を犠牲にしたことは、勤務表を見ただけでは分かりません。希望の充足率と、それを通したことで失ったものを同時に示せないと、希望を出したスタッフにも、配置の穴を受け止める現場にも説明がつきません。希望と公平性を離職の問題と結びつけて扱う話は、第8章で出典のある範囲に絞って扱います。
自分の職場でこの比較を行うなら、最初の一歩は最適化ではなく、いま使っている勤務表を同じ物差しで測ることだと考えています。時間帯ごとの必要人数、勤務の型、スタッフの一覧(雇用区分・入れる型・スキル・希望)があれば、現行の勤務表の不足人時・過剰人時・希望休の違反・スキルの不在を、この章と同じ定義で数えられます。数えてみると、不足と過剰が同時に大きい、スキルの穴が特定の曜日に集まっている、といった形が見えることが多いように思います。そこで初めて、原因が必要人数の見積りにあるのか、勤務の型にあるのか、割当にあるのかを、この章の最初の表の5つの問題に照らして切り分けられます。現行の勤務表を測るためのデータの整え方と導入の順序は、第13章で扱います。
最後に、手作りの勤務表にも長所があることを書いておきます。図で見たように、規則で作った勤務表は同じ型が週ごとにまとまり、休みの曜日が固定されていて、スタッフが自分の予定を立てやすい形をしています。最適化の勤務表は、目的や制約に書かれていない規則性を守る理由を持ちません。基準の勤務表の先頭7日を見ると、S01 は中番・日勤・日勤・中番・日勤と日ごとに型が変わっています。基準の勤務表全体のヒートマップは第5章で読みます。規則性に価値があるなら、それを「同じ型が続く」「休みの曜日をそろえる」といった条件として目的や制約に書き込む必要があります。手作りの勤務表が暗黙に持っていた良さを言葉にして条件に落とす作業は、第13章で扱うヒアリングの中心になります。
この章の要点は3つです。第一に、シフト作成は、必要人数の見積り・シフトの型の設計・休日の配置・個人への割当・当日の組み直しという性格の違う問題の集まりで、不足や過剰の原因がどこにあるかを切り分けてから手を打つ必要があります。第二に、勤務表の並べ方は30名×28日で710桁にのぼり、全部を調べる方法は使えませんが、難しさの本質は数の多さよりも、スタッフの側の条件と時間帯の側の条件が同じマスを取り合うことにあります。第三に、規則で作った手作りの勤務表は、不足人時だけを見ると基準より小さく見えても、パートの人件費・過剰人時・リーダーや英語対応の穴・希望休の扱いを合わせて見ると、この記事の重みで678,500だけ基準より悪くなりました。次の第3章では、この章で需要として使った必要在席人数を、入電件数とサービスの目標からどう求めるかを扱います。
この章を深めたい方への参考書籍
『Pythonによる実務で役立つ最適化問題100+(3)配送計画・パッキング・スケジューリング』(久保幹雄、朝倉書店):同じ題名のシリーズのうち、スケジューリングを扱う巻です。目次にシフトスケジューリング問題の章があり、シフト最適化問題の定式化、ナーススケジューリング問題、業務割当を考慮したシフトスケジューリング問題が並んでいます。この章で5つに分けた問題のうち、型の設計と個人への割当を、Python のコードを追いながら確かめたいときの手引きになります。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画から整数計画と組合せ最適化までを、モデルの作り方とアルゴリズムの両面から解説した教科書です。整数計画と組合せ最適化の章で、アルゴリズムの計算量の評価や、近似解法・局所探索法・メタヒューリスティクスを扱っています。この章で並べ方の数を数えて「全部を調べる方法は使えない」と述べた部分を、計算の手間の理論と、それでも解を得るための方法の側から理解するのに向いています。
第3章 必要人数を見積もる
第2章では、シフト作成の問題を「誰が・どの日に・どの勤務の型で働くか」を決める問題として記述し、この記事で使う架空のコンタクトセンターのサンプルデータを紹介しました。どの解き方を使うにしても、その出発点には「各時間帯に何人が席にいればよいか」という数字が必要です。この数字を誤ると、後の章でどれほど精密に勤務表を組んでも、不足や過剰は減らせません。この章では、必要人数を見積もる2つの考え方、作業量から割り戻す方法と待ち行列の式を使う方法を並べ、サンプルデータの予測入電から30分ごとの必要在席人数を実際に計算します。そのうえで、サービス目標を1段上げると人件費がどれだけ増えるか、入電が増えると必要人数がどう増えるか、休憩や研修で席を離れる時間をどう上乗せするかを、実行結果で確かめます。
必要人数を決める2つの考え方
必要人数の見積り方は、仕事の性質によって大きく2つに分かれます。1つ目は、仕事の量を処理にかかる時間の合計に直し、1人が働ける時間で割る方法です。この記事では作業量基準と呼びます。倉庫でのピッキング、店舗の品出し、書類の入力のように、仕事が溜めておけるもので、多少遅れても後でまとめて片付けられる業務に向いています。たとえば1日に3,000行のピッキングがあり、1行に1分かかるなら、処理時間の合計は50時間です。1人の実働が8時間なら、50÷8で6.25人、切り上げて7人という計算になります。
2つ目は、客の到着がばらつくことを前提に、待ち行列の理論で「待ち時間を一定以下に抑えるには何人が必要か」を計算する方法です。電話の受付、店舗のレジ、窓口、救急外来のように、仕事を溜めておけず、来たときにすぐ対応しないとサービスの質が落ちる業務では、こちらを使う必要があります。この種の業務では、平均の仕事量を処理できるだけの人数を置いても、到着が一時的に重なった時間帯に待ちが急に伸びます。待ちを抑えるには、平均の仕事量より多めの人数を置いておかなければなりません。この「多めに置く分」を計算で決めるのが、待ち行列の方法です。
2つの方法の違いは、どこまでの待ちを許すかにあります。作業量基準は、仕事が1日のうちに終わればよいという前提で、途中の待ちを問いません。待ち行列の方法は、1件ごとの待ちの長さを目標に入れます。同じ量の仕事でも、どちらの前提を置くかで必要人数は大きく変わります。次の表に、2つの方法の違いを整理しました。
| 観点 | 作業量基準 | 待ち行列による方法(アーランC) |
|---|---|---|
| 向いている業務 | 仕事を溜めておける業務(倉庫の作業、品出し、事務処理) | 来た客にすぐ応える必要がある業務(電話の受付、窓口、レジ) |
| 入力 | 作業の件数、1件あたりの標準時間、1人の稼働時間 | 時間帯ごとの到着件数、1件あたりの平均処理時間、待ち時間の目標 |
| 計算の考え方 | 処理時間の合計を1人の稼働時間で割る | 人数を1人ずつ増やし、待ち時間の目標を満たす最小の人数を探す |
| 出てくる数字 | 1日(または1週)に必要な延べの人数 | 30分や15分の枠ごとに必要な在席人数 |
| 苦手なこと | 到着のばらつきによる待ちを表せない | 客が待ちきれずに切る(放棄する)こと、予測の外れ、枠と枠のつながり |
作業量基準で見積もると何が足りないか
サンプルデータの第1日(月曜)で、作業量基準の計算をしてみます。この日の予測入電は751.4件で、1件あたりの平均処理時間(通話と後処理を合わせた時間。以下 AHT と書きます)は、第2章で紹介したとおり架空の設定で6分です。751.4件×6分を時間に直すと、処理時間の合計は75.1時間になります。1人の実働を8時間とすると、75.1÷8で9.39人です。1日を通した延べの仕事量で見れば、10人弱で電話を処理しきれる計算になります。
ただし、この計算は入電が1日のうちに均等に来ることを暗に仮定しています。サンプルデータの入電には10時台・13時台・19時台に山があり、23時台には30分あたり4件ほどしかありません。そこで、30分の枠ごとに「その枠の処理時間の合計÷30分」を計算して切り上げ、枠ごとの人数を足し合わせました。この値を人×時間に直すと83.0人×時間になり、1日の平均で割った9.39人×8時間(75.1人×時間)より大きくなります。時間帯の山と谷を考えるだけで、必要な時間は1割ほど増えるということです。
それでも、この83.0人×時間は電話の受付には足りません。後で示すとおり、「80%の入電に20秒以内に応答する」という目標を置いてアーランCの式で計算すると、同じ日の必要在席は125.0人×時間になります。作業量基準で求めた83.0人×時間のおよそ1.5倍です。作業量基準の人数は、係員が1秒の休みもなく次々に電話を取り続けて、ようやく仕事量に追いつく人数です。電話は好きな時刻に掛かってくるので、ある瞬間に5件がまとめて鳴り、次の3分間は1件も鳴らない、ということが普通に起こります。まとめて鳴った瞬間に席が空いていなければ、客は待たされます。この差が、次の節で扱う待ち行列の考え方の出発点です。
作業量基準が役に立たないという意味ではありません。倉庫や事務のように仕事を溜めておける業務では、作業量基準が素直で説明しやすい方法です。コンタクトセンターでも、メールや書面の返信のように当日中に処理すればよい仕事は、作業量基準で見積もるほうが実態に合います。大切なのは、自社の業務が「溜めておける仕事」か「すぐ応える仕事」かを先に見分けることです。すぐ応える仕事に作業量基準を当てはめると、紙の上では人数が足りているのに、現場では毎日のように待ちが発生する、という状態になります。
待ち行列で見積もる、アーランCの考え方
電話の受付のように、客がランダムに到着し、係員が空いていれば応対し、空いていなければ順番に待つ仕組みは、待ち行列のモデルで表せます。コンタクトセンターの必要人数の計算で広く使われているのが、アーランCと呼ばれる式です。デンマークの電話技術者アーラン(A. K. Erlang)の名前が付いています。待ち行列の分類記号では M/M/c と書かれるモデルで、最初の M は到着の間隔がランダム(ポアソン到着)、2番目の M は処理時間が指数分布に従うこと、c は窓口(係員)の数を表します。Koole と Li がコンタクトセンターの要員計画の実務を概観した論文(arXiv 2101.10122)も、この M/M/c のモデル、すなわちアーランCが実務で最も多く使われていると書いています。
アーランCで待たされる確率を計算するのに必要な入力は3つだけです。枠ごとの入電件数、AHT、そして係員の人数です。そこから必要人数を決めるときは、これに加えてサービス目標の割合と秒数(この記事では80%・20秒)を固定し、それを満たす最小の人数を探します。まず、入電件数×AHT÷枠の長さでトラフィック量を求めます。単位はアーランで、「その枠の仕事量を処理しきるのに、休みなく働く係員が平均で何人分要るか」を表します。サンプルデータの第1日10時30分の枠は、30分に33.9件、AHT 6分なので、33.9×6÷30で6.78アーランです。前の節の作業量基準の人数は、このトラフィック量を切り上げた値(この枠では7人)に当たります。
アーランCの式は、トラフィック量 \( a \) と人数 \( n \) から、到着した客が待たされる確率 \( C(n, a) \) を計算します。人数がトラフィック量以下(\( n \le a \))だと待ち行列は際限なく伸びるので、式が意味を持つのは \( n \gt a \) のときだけです。待たされる確率が分かれば、コンタクトセンターで使われる代表的な指標が計算できます。1つ目はサービスレベルで、「一定の秒数以内に応答できた入電の割合」です。20秒以内に応答できた割合なら、次の式の t を20秒として求めます。
\( SL = 1 – C(n, a)\, e^{-(n – a)\, t / \mathrm{AHT}} \)
t と AHT は同じ単位(この記事では秒。AHT 6分なら360秒)にそろえて入れます。言葉で言い換えると、「待たされた客のうち、待ちが t 秒を超える客の割合」は、人数がトラフィック量をどれだけ上回っているか(\( n – a \))に応じて指数的に小さくなり、それに待たされる確率を掛けたものが「t 秒を超えて待つ客の割合」になる、ということです。2つ目の指標は平均応答時間(ASA)で、全入電の待ち時間の平均です。アーランCでは \( C(n, a) \times \mathrm{AHT} / (n – a) \) で計算できます。3つ目は稼働率で、トラフィック量を人数で割った値です。係員が電話の処理に使っている時間の割合を表します。
この記事の共通データに入っているアーランCの関数(erlang_c・service_level・agents_needed)が正しく計算できているかを、公開されている計算例で確かめました。Koole の『Call Center Optimization』1.2節には、15分に100件、AHT 3分30秒の枠で、トラフィック量23.33に対して24人ではおよそ21%の入電しか20秒以内に応答できず、80%以上にするには28人が必要で、そのときのサービスレベルは83%、という例が載っています。共通データの関数で同じ条件を計算すると、24人で20.6%、28人で83.0%、目標を満たす最小の人数は28人で、書籍の数字と一致しました。
アーランCで必要人数を求める手順は単純です。人数をトラフィック量のすぐ上の整数から始めて1人ずつ増やし、サービスレベルが目標(この記事では80%)に届いた最初の人数を答えにします。共通データの agents_needed は、この手順をそのまま実装したものです。答えが「その枠に席にいる人数」であることに注意が要ります。休憩中の人、研修中の人、欠勤した人は含みません。この点は、後のシュリンケージの節で扱います。
サンプルデータで1日の必要在席人数を出す
第2章で用意したサンプルデータの予測入電から、第1日の必要在席人数を計算します。次のコードは、代表的な5つの枠について、入電件数・トラフィック量・目標を満たす最小の人数・そのときのサービスレベル・1人少ないときのサービスレベルを表示し、最後に共通データの required_staff で1日と4週の合計を出します。共通データの読み込みは import の1行で済みます。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from shift_data import *

f = call_forecast()                       # 予測入電(28日×34枠、30分あたり)
day = 0                                   # 第1日(月曜)
for s in [0, 7, 12, 25, 33]:              # 7時・10時30分・13時・19時30分・23時30分
    calls = f[day, s]
    a = calls * AHT_SEC / 1800            # トラフィック量(アーラン)
    n = agents_needed(calls)              # 80%を20秒以内に応答できる最小の在席人数
    print("%5s 入電%5.1f件 トラフィック量%5.2f 必要%2d人 SL %.3f 1人少ないと %.3f" % (
        slot_label(s), calls, a, n, service_level(n, calls), service_level(n - 1, calls)))
r = required_staff(f)                     # 最低2名を加えた必要在席人数
print("第1日の必要在席 %.1f 人×時間 / 4週の合計 %.1f 人×時間" % (r[day].sum() / 2, r.sum() / 2))
# 出力:  7:00 入電  8.3件 トラフィック量 1.66 必要 4人 SL 0.911 1人少ないと 0.724
# 出力: 10:30 入電 33.9件 トラフィック量 6.78 必要10人 SL 0.841 1人少ないと 0.702
# 出力: 13:00 入電 26.9件 トラフィック量 5.38 必要 8人 SL 0.802 1人少ないと 0.614
# 出力: 19:30 入電 27.6件 トラフィック量 5.52 必要 9人 SL 0.891 1人少ないと 0.778
# 出力: 23:30 入電  4.2件 トラフィック量 0.84 必要 3人 SL 0.948 1人少ないと 0.767
# 出力: 第1日の必要在席 125.0 人×時間 / 4週の合計 2935.0 人×時間
出力の1行目を読むと、7時の枠は入電8.3件、トラフィック量1.66で、目標を満たすには4人が必要です。4人ならサービスレベルは91.1%ですが、3人にすると72.4%に落ちて目標の80%を下回ります。トラフィック量1.66に対して4人ですから、係員が電話の処理に使う時間の割合(稼働率)は4割ほどにとどまります。入電の少ない時間帯ほど、トラフィック量に対して多めの人数が要るということです。これは後の「規模の経済」の節で詳しく扱います。
もう1つ目を引くのは、必要人数ちょうどのときのサービスレベルが枠によって違うことです。13時の枠は80.2%で目標ぎりぎり、23時30分の枠は94.8%で目標を大きく上回っています。人数は整数でしか置けないので、目標をわずかに超える人数を置くと、枠によってはかなり余裕のある状態になります。「必要人数」は、その枠で目標を下回らないための最小の整数であり、目標ちょうどのサービスレベルを実現する人数ではありません。
第1日の34枠すべてについて、計算の中身を表にまとめました。紙面の都合で、2時間おきの枠と、入電の山にあたる10時30分・13時30分・19時の枠を抜き出しています。表の「必要在席」は共通データの required_staff の値で、「作業量だけで割った人数」はトラフィック量の切り上げです。
| 枠 | 予測入電(件) | トラフィック量(アーラン) | 作業量だけで割った人数 | 必要在席 | サービスレベル(20秒) | 平均応答時間(秒) | 待たされる確率 | 稼働率 |
|---|---|---|---|---|---|---|---|---|
| 7時 | 8.3 | 1.66 | 2 | 4 | 91.1% | 15.6 | 10.1% | 41.5% |
| 9時 | 24.4 | 4.88 | 5 | 8 | 87.4% | 17.3 | 15.0% | 61.0% |
| 10時30分 | 33.9 | 6.78 | 7 | 10 | 84.1% | 21.2 | 19.0% | 67.8% |
| 11時 | 31.0 | 6.20 | 7 | 9 | 80.5% | 29.3 | 22.8% | 68.9% |
| 13時 | 26.9 | 5.38 | 6 | 8 | 80.2% | 31.5 | 22.9% | 67.2% |
| 13時30分 | 30.1 | 6.02 | 7 | 9 | 83.1% | 24.0 | 19.9% | 66.9% |
| 15時 | 23.0 | 4.60 | 5 | 8 | 90.5% | 12.2 | 11.5% | 57.5% |
| 17時 | 24.7 | 4.94 | 5 | 8 | 86.6% | 18.7 | 15.9% | 61.8% |
| 19時 | 29.7 | 5.94 | 6 | 9 | 84.2% | 22.0 | 18.7% | 66.0% |
| 21時 | 16.3 | 3.26 | 4 | 6 | 88.3% | 17.9 | 13.6% | 54.3% |
| 23時 | 6.0 | 1.20 | 2 | 3 | 87.2% | 28.2 | 14.1% | 40.0% |
表の「平均応答時間」列は全入電の待ち時間の平均で、待たずにつながった入電の0秒も含めて平均したものです。13時の枠は、サービスレベルが80.2%で目標を満たしていながら、平均応答時間は31.5秒で、20秒を超えています。「80%を20秒以内」という目標は、残りの20%がどれだけ長く待つかを問わないので、平均応答時間の目標とは別物です。どちらを目標にするかで必要人数は変わりうるので、自社の目標がどちらの指標で書かれているかを確かめてから計算する必要があります。Koole の書籍も、サービスレベルと平均応答時間はどちらも1つの数字にまとめた指標で、待ち時間の分布の全体は表さないと注意しています。
「稼働率」列を見ると、必要在席を置いたときの稼働率は、入電の多い10時30分の枠で67.8%、入電の少ない7時の枠で41.5%です。1日を通すと、処理時間の合計75.1時間に対して必要在席は125.0人×時間なので、係員は席にいる時間のおよそ6割を電話の処理に使い、残りの4割は次の電話を待っている計算になります。この4割は無駄ではなく、ランダムに鳴る電話にすぐ応えるための待機です。経営の側から見ると、この待機の時間こそがサービスレベルの対価であり、削れば待ち時間として客に跳ね返ります。
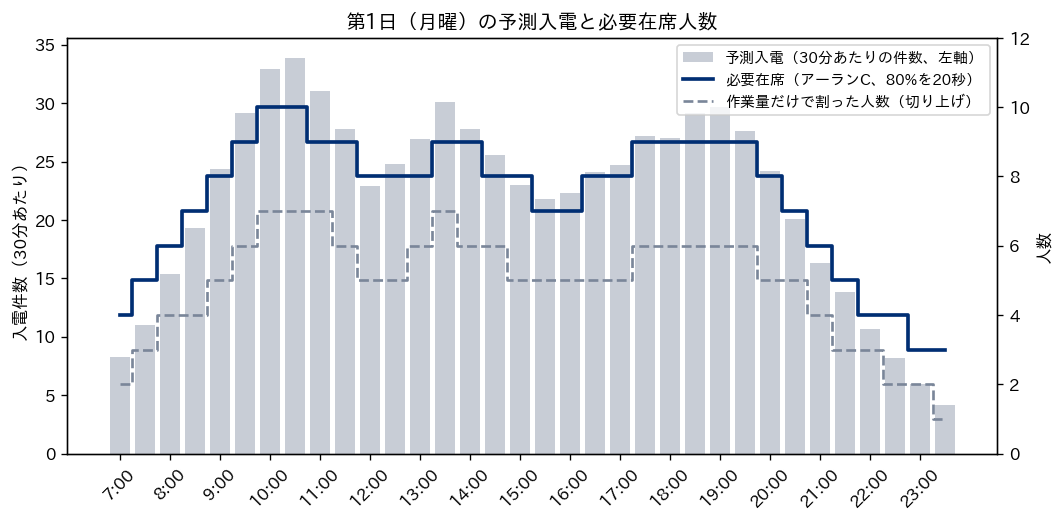
図は、第1日の予測入電(棒、左軸)と、アーランCで求めた必要在席(実線、右軸)、作業量だけで割った人数(破線、右軸)を重ねたものです。必要在席は入電の山に沿って上下し、10時から11時の枠で最大の10人になります。実線と破線の差が、到着のばらつきに備えて置く上乗せの人数です。第1日の34枠で数えると、この差は3人の枠が18、2人の枠が14、1人の枠が2でした。10時30分の枠の入電(33.9件)は7時の枠(8.3件)の約4倍ありますが、上乗せの人数は10時30分が3人、7時が2人で、入電ほどには増えていません。入電に対する上乗せの割合は、入電の多い枠ほど小さくなるということです。この曲線が、第4章でシフトの型を設計し、第5章で勤務表を作るときの需要の側の入力になります。
必要人数の計算でもう1つ押さえておきたいのは、人数とサービスレベルの関係が直線ではないことです。第1日の10時30分の枠(入電33.9件、トラフィック量6.78アーラン)で、在席人数を7人から14人まで1人ずつ変えて計算しました。
| 在席人数 | サービスレベル(20秒) | 平均応答時間(秒) | 待たされる確率 | 稼働率 |
|---|---|---|---|---|
| 7人 | 10.4% | 1,484.6 | 90.7% | 96.9% |
| 8人 | 47.1% | 167.2 | 56.6% | 84.8% |
| 9人 | 70.2% | 54.6 | 33.7% | 75.3% |
| 10人 | 84.1% | 21.2 | 19.0% | 67.8% |
| 11人 | 92.0% | 8.6 | 10.1% | 61.6% |
| 12人 | 96.2% | 3.5 | 5.1% | 56.5% |
| 13人 | 98.3% | 1.4 | 2.4% | 52.2% |
| 14人 | 99.3% | 0.5 | 1.1% | 48.4% |
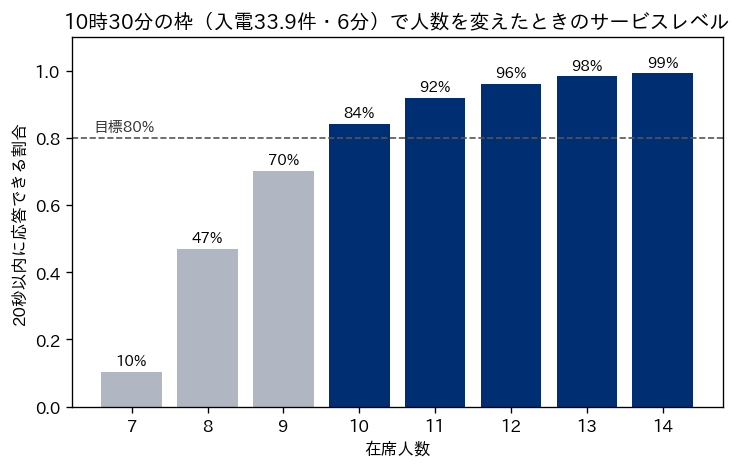
トラフィック量のすぐ上の7人では、稼働率は96.9%で係員はほぼ休みなく電話を取り続けますが、サービスレベルは10.4%で、平均応答時間は1,484.6秒、25分近くになります。ここから1人増やして8人にすると平均応答時間は167.2秒、9人で54.6秒、10人で21.2秒と、1人ごとに劇的に短くなります。反対に、目標を満たした10人から先は、1人増やしたときの改善が小さくなります。10人から11人でサービスレベルは84.1%から92.0%へ7.9ポイント上がりますが、13人から14人では98.3%から99.3%へ1.0ポイントです。
この形から、2つのことが言えます。1つ目は、人数が目標の近くにあるとき、1人の欠勤や1人の休憩の重なりがサービスレベルを大きく動かすことです。10人が必要な枠で1人欠けて9人になると、サービスレベルは84.1%から70.2%へ下がり、平均応答時間は2.5倍以上に延びます。第11章で扱う当日の欠勤の影響が大きいのは、この急な傾きのためです。2つ目は、目標を高くするほど、目標を1段上げるために要る人数の割に得られる改善が小さくなることです。次の節では、この性質が人件費にどう表れるかを確かめます。
サービス目標を変えると必要人時はどう変わるか
この記事の共通データは、サービスレベルの目標を「80%の入電に20秒以内に応答する」と置いています。この組合せは、コンタクトセンターの目標としてよく使われる目安です。Koole の『Call Center Optimization』は2章で、80%を20秒以内という値を「業界標準」と引用符つきで紹介し、ほかの値もありうると添えています。前に挙げた Koole と Li の論文も、サービスレベルはしばしば80%を20秒以内に取られる、と書いています。ただし、これはあくまで広く使われている値であって、自社の客にとって適切な値であることを保証するものではありません。この記事の80%・20秒も、例として置いた架空の設定です。
目標を変えると、必要人数はどれだけ変わるのでしょうか。4週28日の全952枠について、目標を6通りに変えて必要在席を計算し直しました。最低2名の在席(共通データの架空の運用ルール)は、どの目標でも同じく入れています。
| 目標(割合/秒数) | 4週の必要在席(人×時間) | 80%・20秒との差(人×時間) | 最大の在席人数 | 差を正社員の時給2,600円で換算 | 参考:別の数え方(席を離れる時間を0.30と仮定して割り戻した概算) |
|---|---|---|---|---|---|
| 70%/20秒 | 2,697.0 | 238.0減 | 10人 | 618,800円減 | 884,000円減 |
| 80%/20秒(基準) | 2,935.0 | 0 | 10人 | 0円 | 0円 |
| 90%/20秒 | 3,324.0 | 389.0増 | 11人 | 1,011,400円増 | 1,444,857円増 |
| 95%/20秒 | 3,652.0 | 717.0増 | 12人 | 1,864,200円増 | 2,663,143円増 |
| 80%/30秒 | 2,911.0 | 24.0減 | 10人 | 62,400円減 | 89,143円減 |
| 90%/30秒 | 3,281.0 | 346.0増 | 11人 | 899,600円増 | 1,285,143円増 |
表の「4週の必要在席」列を見ると、80%・20秒の2,935.0人×時間に対して、90%・20秒は3,324.0人×時間で389.0人×時間(13.3%)多く、95%・20秒は3,652.0人×時間で717.0人×時間(24.4%)多くなります。80%から90%への10ポイントで389.0人×時間、90%から95%への5ポイントで328.0人×時間増えるので、目標を上げるほど1ポイントあたりの費用が大きくなっています。前の節で見た「目標を満たした後は1人あたりの改善が小さくなる」性質が、4週の合計にそのまま表れた結果です。
一方で、秒数の側を20秒から30秒に緩めても、80%の目標では24.0人×時間しか減りませんでした。90%の目標でも、20秒から30秒に緩めて減るのは43.0人×時間です。この例題の条件(AHT 6分、30分あたり数件から30件台の入電)では、待ち時間の上限の秒数より、何割の入電をその秒数以内に応答するかという割合のほうが、必要人数を大きく左右しています。AHT 6分に比べて20秒と30秒の差は小さく、待たされる確率そのものを下げないとサービスレベルが上がらないためです。目標を見直すときは、秒数と割合のどちらを動かすかで費用の出方が違うことを知っておく必要があります。
表の右の2列は、この差を架空の時給で円に換算したものです。第1章で説明したとおり、この記事の時給(正社員2,600円、パート1,500円)は架空の値で、ここでは正社員の時給で換算しました。90%・20秒に上げると、席にいる時間が4週で389.0人×時間増え、これを正社員の時給で換算すると4週あたり約101万円の人件費が増えます。この記事の共通データは、休憩を勤務の型の側で在席から外し、人件費も実働の時間だけで数えているので、共通データの勤務表の人件費(第1章の820万500円など)と同じ数え方で並べられるのは、この約101万円のほうです。右端の列は参考として置いた別の数え方です。後の節で説明するシュリンケージ(休憩・研修・欠勤などで席を離れる時間の割合)を0.30と仮定し、席にいる時間の増分を \( 1 – 0.30 \) で割り戻して時給を掛けたもので、90%・20秒では約144万円になります。ただし、この0.30には休憩も含まれているので、休憩を勤務の型で扱っているこの記事の共通データにそのまま当てはめると、休憩を2度数えることになります。右端の列は、休憩を型で扱わず、休憩・研修・欠勤をひとまとめにして雇う時間を見積もる職場で使う場合の目安です。どちらの列も時給を一律に掛けた概算で、実際の増分は、増えた時間を正社員とパートのどちらで埋めるか、第4章・第5章で扱うシフトの型にどれだけ無駄なく収まるかで変わります。
規模の経済、入電が2倍でも人数は2倍にならない
アーランCの計算には、入電が多いほど効率が上がるという性質があります。AHT 6分、80%・20秒の目標のまま、30分あたりの入電を5件から320件まで倍々に増やし、必要人数を計算しました。
| 30分あたりの入電(件) | トラフィック量(アーラン) | 必要在席(人) | 1人あたりの入電(件) | 稼働率 | 必要在席÷トラフィック量 |
|---|---|---|---|---|---|
| 5 | 1.0 | 3 | 1.67 | 33.3% | 3.000 |
| 10 | 2.0 | 4 | 2.50 | 50.0% | 2.000 |
| 20 | 4.0 | 7 | 2.86 | 57.1% | 1.750 |
| 40 | 8.0 | 12 | 3.33 | 66.7% | 1.500 |
| 80 | 16.0 | 21 | 3.81 | 76.2% | 1.312 |
| 160 | 32.0 | 38 | 4.21 | 84.2% | 1.188 |
| 320 | 64.0 | 71 | 4.51 | 90.1% | 1.109 |
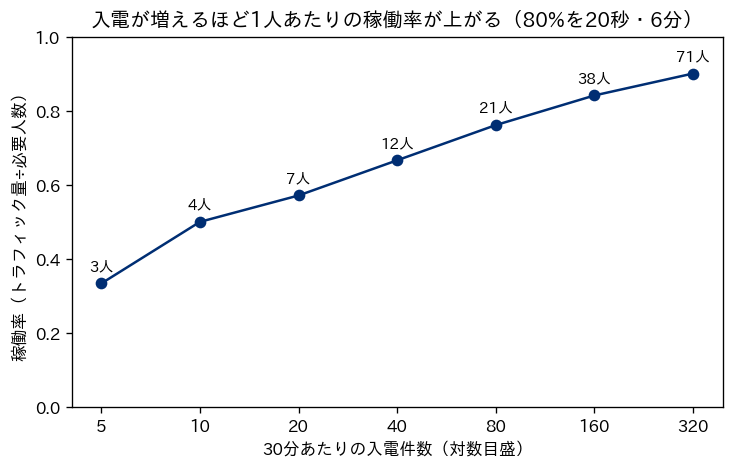
入電が5件のときは、トラフィック量1.0に対して3人が必要で、稼働率は33.3%です。入電が320件になると、トラフィック量64.0に対して71人で足り、稼働率は90.1%まで上がります。表の右端の列は、必要在席がトラフィック量の何倍かを示しており、入電が増えるにつれて3.000倍から1.109倍まで下がります。ばらつきに備えて上乗せする人数は、入電の量に比例しては増えず、それよりゆっくり増えるということです。Koole と Li の論文は、この性質を「平方根則による人員配置」(必要人数をトラフィック量にその平方根の定数倍を足した値で近似する考え方)で説明し、これが規模の経済を示すとしています。独立なばらつきを2つ足すと標準偏差は2倍ではなく √2 倍になるのと同じ理屈で、上乗せの人数もトラフィック量の平方根に比例して増えると考えるのです。
サンプルデータでも確かめました。第1日の予測入電を全枠で2倍にして必要在席を計算すると、125.0人×時間が212.5人×時間になり、比は1.700倍でした。入電が2倍になっても、必要な在席時間は1.7倍で済むということです。反対に、同じ入電を2つの拠点に半分ずつ分けて、それぞれで80%・20秒を満たすように人を置くと、2拠点の合計は154.0人×時間になり、1拠点にまとめた125.0人×時間より29.0人×時間(23.2%)多くなりました。どちらの計算も最低2名のルールを外して、アーランCの人数だけで比べています。
この性質は、組織の設計に直接効きます。受付の窓口を商品別・地域別・言語別に細かく分けると、1つ1つの窓口の入電が少なくなり、窓口ごとに上乗せの人数が要るので、全体の人件費は上がります。窓口をまとめて誰でも応対できるようにすると上乗せが共有され、同じサービスレベルを少ない人数で実現できます。ただし、まとめるには係員が複数の業務に対応できる必要があり、研修の費用がかかります。どこまでまとめるか、何人を多能工にするかの試算は第9章で扱います。Koole と Li の論文も、平方根則の曲線は凹型なので効きが次第に鈍り、全員を多能工にする必要はないことが読み取れる、と述べています。
シュリンケージの意味と掛け方
アーランCで求めた人数は、その枠に席にいて電話を取れる人数です。係員は、休憩、研修、面談、会議、事務作業、欠勤、休暇などで、給与の対象になっている時間のすべてを席で過ごすわけではありません。この「雇っているが電話を取れない時間」の割合を、コンタクトセンターではシュリンケージと呼びます。Koole の書籍は、シュリンケージを、病気などの予期しない欠勤、休暇、研修やコーチング、有給の休憩など、係員が電話を取れない時間の割合と説明し、40%のシュリンケージは珍しくないと書いています。一方で、研修やコーチングは品質のために必要なので、ある程度のシュリンケージは避けられないとも述べています。
シュリンケージの掛け方は単純で、席にいる必要のある時間を、シュリンケージを \( s \) として \( 1 – s \) で割ります。サンプルデータの4週の必要在席2,935.0人×時間に対して、シュリンケージが0.20なら3,668.8時間、0.30なら4,192.9時間、0.35なら4,515.4時間の勤務時間を用意する必要があります。シュリンケージが0.30のとき、必要在席の約1.43倍の時間を雇うことになります。
| シュリンケージ | 4週の必要在席(人×時間) | 用意すべき勤務時間(時間) | 必要在席に対する倍率 |
|---|---|---|---|
| 0(掛けない) | 2,935.0 | 2,935.0 | 1.00倍 |
| 0.20 | 2,935.0 | 3,668.8 | 1.25倍 |
| 0.30(この記事で置いた架空の値。必要在席人数には掛けていない) | 2,935.0 | 4,192.9 | 1.43倍 |
| 0.35 | 2,935.0 | 4,515.4 | 1.54倍 |
ここで注意が要るのは、同じ時間を2度数えないことです。この記事の共通データでは、勤務の型の側で休憩を在席の枠から外しています。第2章で紹介したとおり、早番・日勤・中番・遅番はいずれも拘束9時間のうち60分が休憩で、休憩中の2枠は在席に数えません。拘束時間に対する休憩の割合は9分の1、約11%です。したがって、勤務表を組む段階(第5章)で必要在席をそのまま満たすように人を割り当てれば、休憩の分はすでに織り込まれています。この状態でさらに休憩を含むシュリンケージを必要在席に掛けると、休憩を2度数えることになり、人数を多く見積もりすぎます。共通データの required_staff にシュリンケージを掛けていないのは、このためです。
では、シュリンケージの残りの部分、つまり欠勤・休暇・研修・会議はどこで扱うのでしょうか。1つの整理の仕方は、計画の階層で分けることです。研修や会議のように予定が決まっているものは、勤務表の中で「その時間は電話を取らない」と明示して割り当てます。年次有給休暇や公休は、何人を雇えば4週の勤務表が組めるかという要員計画の段階で、1人あたりの勤務可能日数を減らす形で入れます。病欠のように予測できないものは、第11章で扱う待機要員や、第12章で扱う余裕人員で吸収します。シュリンケージを1つの係数で一律に掛けるのは、年間の採用人数を大づかみに決めるときには便利ですが、勤務表を作る段階では、何が席を離れる理由なのかを分けて扱うほうが、過剰や不足の原因をたどりやすくなります。
Koole の書籍は、稼働率の数え方にも同じ問題があることを例で示しています。週36時間契約の係員について、短い休憩を分母に入れるかどうか、職場にいる時間すべてを分母にするかで、稼働率が82%・72%・58%と大きく変わる例です。シュリンケージの相場を他社の数字と比べるときは、休憩を含めた値か、欠勤や休暇を含めた値かを確かめないと、比べる意味がありません。この記事の0.30は、休憩・研修・欠勤などをひとまとめにした架空の仮定で、特定の業界の実測値ではありません。
ここまでの計算を、予測から勤務表までの流れの中に置き直しておきます。出発点は第2章で紹介した30分ごとの予測入電で、これに AHT を掛けて枠の長さで割るとトラフィック量になります。トラフィック量とサービス目標をアーランCに入れると、枠ごとの必要在席人数が出ます。共通データでは、ここに最低2名の在席という運用のルールを重ねて required_staff としています。この必要在席を、休憩を外した勤務の型で覆うのが第4章のシフトの型の設計で、個人に割り当てるのが第5章の勤務表の作成です。欠勤・休暇・研修などのシュリンケージは、要員計画の段階で雇う人数を決めるときに上乗せします。
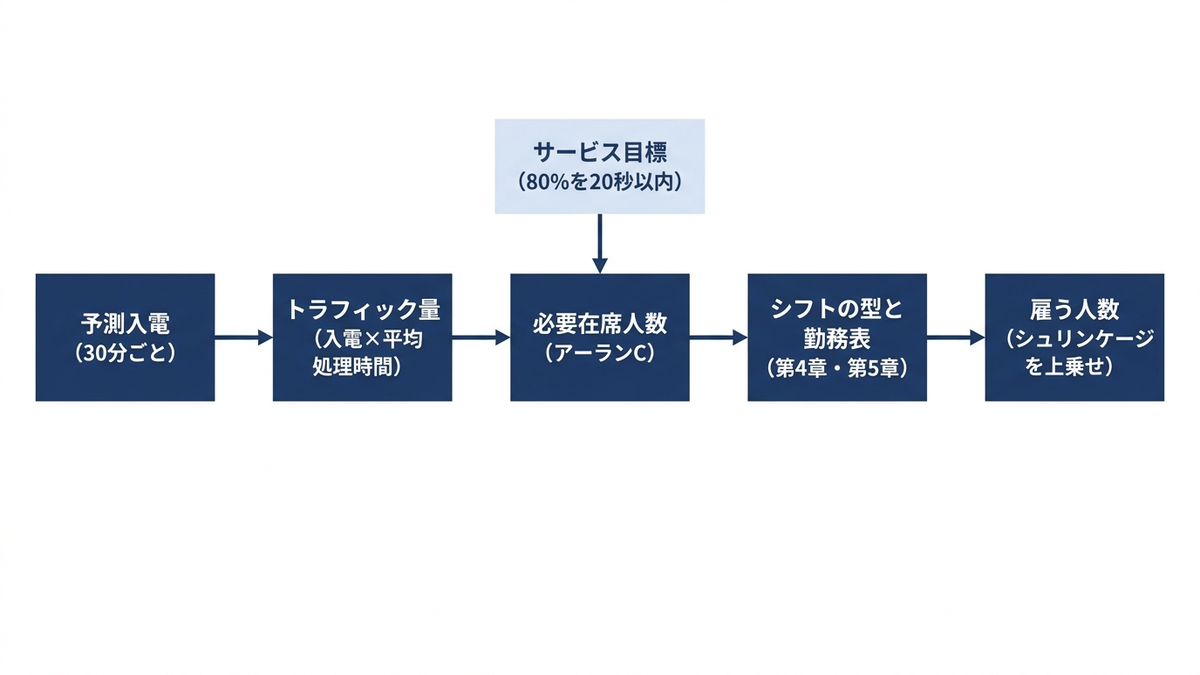
この流れで気をつけたいのは、各段階の入力がそれぞれ別の部署や担当者の持ち物になりやすいことです。予測入電はマーケティングや需要予測の担当、AHT は品質管理や業務改善の担当、サービス目標は経営や顧客との契約、シュリンケージは人事と労務、という具合です。どれか1つが古い値のまま放置されると、ほかの段階をどれほど精密に計算しても必要人数は外れます。見積りの前提を1枚の表にまとめて、誰がいつ更新するかを決めておくことが有効だと考えています。
処理時間を短くすると必要人数はどれだけ減るか
トラフィック量は入電件数と AHT の積なので、AHT を短くすると必要人数は減ります。第1日の予測入電のまま、AHT を5分から7分まで30秒刻みで変えて、80%・20秒を満たす必要在席(最低2名を含む)を計算しました。
| 平均処理時間(AHT) | 第1日の必要在席(人×時間) | 6分との差(人×時間) |
|---|---|---|
| 5分(300秒) | 108.5 | 16.5減 |
| 5分30秒(330秒) | 114.5 | 10.5減 |
| 6分(360秒、共通データ) | 125.0 | 0 |
| 6分30秒(390秒) | 131.5 | 6.5増 |
| 7分(420秒) | 139.0 | 14.0増 |
AHT を6分から5分30秒へ30秒(8.3%)短くすると、第1日の必要在席は125.0人×時間から114.5人×時間へ10.5人×時間(8.4%)減りました。1分短くして5分にすると16.5人×時間(13.2%)減ります。この例題では、AHT の短縮の割合と必要在席の減少の割合がほぼ同じ大きさになっています。逆に AHT が1分延びて7分になると、14.0人×時間(11.2%)増えます。
この表は、需要予測と同じくらい AHT の見積りが重要であることを示しています。新しい商品の発売、料金体系の変更、システムの切り替えなどで問い合わせの中身が変わると、件数が同じでも AHT が延び、必要人数が増えます。新人が多い時期も AHT は延びやすいと考えられます。AHT を時間帯や曜日ごとに実績から測り直し、予測入電と同じ頻度で見直すことが、必要人数の見積りの精度を保つうえで欠かせません。また、よくある質問の案内の改善や、後処理の入力の簡素化で AHT を短くする施策は、この表を使えば人件費の削減額に翻訳できます。
アーランCの前提が崩れる場面
アーランCの計算は、いくつかの前提の上に成り立っています。入電がポアソン到着であること(互いに無関係な多数の客が、ばらばらに電話を掛けてくる状態)、処理時間が指数分布に従うこと、待っている客は応対されるまで電話を切らない(放棄しない)こと、待ち行列の長さに上限がないこと、そして同じ入電の率と人数がずっと続いたときの平均の状態(定常状態)を計算していることです。実際のコンタクトセンターでは、これらの前提はどれも厳密には成り立ちません。
この節の結論を先に書いておきます。処理時間のばらつき方の仮定を変えても、20秒以内に応答できる割合はほとんど変わりませんでした。大きく変わったのは、待ちきれずに電話を切る客(放棄)を入れたときです。以下に出てくる指数分布・対数正規分布・変動係数(ばらつきの大きさを平均との比で表した値)は、処理時間のばらつき方の仮定を表す用語で、細部を追わなくても表の読み方は変わりません。
前提が崩れたときに結果がどれだけ変わるかを、乱数で窓口の動きを再現して確かめました。第1日の10時30分の枠(30分に33.9件、AHT 6分)の条件で20万件の入電を発生させ、先着順に係員へ割り当てる計算です。放棄を入れた条件では、客ごとに「待てる時間」を指数分布で与え、待ちがそれを超えた客は電話を切るとしました。待てる時間の平均(60秒と180秒)は、この記事で置いた架空の値です。サービスレベルは、放棄した入電も分母に含めた「全入電のうち20秒以内に応答できた割合」で数えています。
| 在席人数 | アーランCの式 | 乱数(アーランCと同じ前提) | 処理時間のばらつきが小さい場合 | 放棄あり(平均で180秒待てる) | 放棄あり(平均で60秒待てる) |
|---|---|---|---|---|---|
| 7人 | 10.4% | 未計算 | 未計算 | 61.0%(放棄16.3%) | 70.9%(放棄19.6%) |
| 8人 | 47.1% | 46.0% | 48.2% | 73.0%(放棄10.4%) | 79.8%(放棄13.2%) |
| 9人 | 70.2% | 69.7% | 71.2% | 82.8%(放棄6.1%) | 86.9%(放棄8.3%) |
| 10人 | 84.1% | 84.0% | 84.6% | 89.9%(放棄3.4%) | 92.1%(放棄4.9%) |
| 11人 | 92.0% | 92.0% | 92.1% | 94.4%(放棄1.8%) | 95.6%(放棄2.7%) |
表の数字は、すべて20秒以内に応答できた割合です。「乱数(アーランCと同じ前提)」列は、ポアソン到着・指数分布の処理時間・放棄なしで再現したもので、式の値とほぼ一致しました(10人で式84.1%に対して84.0%)。平均応答時間も、10人で式の21.2秒に対して乱数では21.0秒でした。共通データの関数が、前提どおりの窓口の動きを正しく計算していることの確認になります。「処理時間のばらつきが小さい場合」列は、処理時間の平均を6分のまま、ばらつきを指数分布より小さくした(対数正規分布で変動係数0.5)ものです。サービスレベルはわずかに上がり、10人で84.6%、平均応答時間は15.6秒に縮みました。処理時間のばらつきが指数分布より小さい職場では、アーランCはやや控えめ(人数を多め)に見積もることになります。
影響が大きいのは放棄です。放棄を入れると、待ち行列が長くなる前に客が抜けていくので、残った客の待ちは短くなり、20秒以内に応答できる割合は上がります。10人の枠では、平均で180秒待てる条件で89.9%、60秒の条件で92.1%になり、アーランCの84.1%を上回りました。その代わり、放棄率はそれぞれ3.4%と4.9%です。8人の枠では違いがさらに大きく、アーランCでは47.1%と出るところが、平均で180秒待てる条件では73.0%で、放棄率は10.4%に達しました。アーランCは、待ちきれずに切った客も待ち続けると仮定するので、人数が足りない枠ほど、実際より悪いサービスレベルを予測します。その一方で、放棄という損失は計算に現れません。
放棄を入れたモデルは、待てる時間が指数分布のときアーランAと呼ばれます。Koole と Li の論文は、アーランCとアーランAの関係をこう整理したうえで、待てる時間の平均を5分や10分と置くだけでも、アーランCをそのまま使うよりずっと良い近似になると述べています。同じ論文は、待てる時間を放棄した客のデータだけから推定すると短く見積もりすぎることにも注意しています。つながった客は、待てる時間より早く応答されたので、その客が本当は何秒まで待てたかは記録に残らないためです。Koole の書籍は、放棄率に3%や5%程度の上限を置く職場が多いと書いています。放棄率を目標に入れたい場合や、人数の足りない時間帯の見込みを正しく出したい場合は、アーランAか、乱数で窓口を再現するシミュレーションを使う必要があります。
もう1つの前提、定常状態も実務ではずれます。アーランCは、同じ入電の率と人数が長く続いたときの平均を計算しますが、実際には30分ごとに入電も人数も変わり、前の枠で溜まった待ち行列が次の枠に持ち越されます。Koole の書籍は、アーランCの答えが1つの数字で、誤差の大きさを示さないことを指摘し、同じ条件の30分でも実現するサービスレベルはばらつくと説明しています。Koole と Li の論文は、枠ごとの平均が目標ちょうどになるように人を置くと、1日単位で目標を達成できない日がおよそ半分になると書いています。予測の外れと実績のばらつきにどう備えるかは第12章で、窓口の動きを時間に沿って再現するシミュレーションの考え方は弊社コラム『シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで』で扱っています。
ここまでの結果をまとめると、アーランCは「人数がやや足りない時間帯のサービスレベルを悪く見積もり、放棄という損失を表さない」「予測が当たっても実績のサービスレベルはばらつく」という2つの弱点を持ちます。それでも、計算が一瞬で終わり、入力が3つだけで、公開の計算例で正しさを確かめられるという利点は大きく、必要人数の最初の見積りには十分に使えます。放棄の多い職場や、放棄率を契約上の目標にしている職場では、アーランCの結果を出発点にしてアーランAやシミュレーションで点検する、という順序が扱いやすいと考えています。
経営判断に翻訳する、サービス目標と組織の形
必要人数の見積りは、技術的な計算に見えて、実は経営の判断の置き場所です。この章の計算から、経営の側で決めるべきことが3つ読み取れます。
1つ目は、サービス目標の水準です。表で見たとおり、この例題では80%・20秒から90%・20秒に上げると、席にいる時間が4週で389.0人×時間増え、架空の正社員の時給で換算すると4週あたり約101万円の人件費になります。これは席にいる時間だけの換算で、休憩・研修・欠勤で席を離れる時間をどう上乗せするかは、シュリンケージの節で述べたとおり、休憩を勤務の型で扱っているかどうかで変わります。この費用に見合う効果があるかは、待ち時間が短くなることで客の満足や解約、売上がどれだけ変わるかで決まり、その関係は業種や客層によって違います。目標を決めずに「できるだけ待たせない」とだけ言うと、現場は人を増やす方向にしか動けません。目標の水準と、それを1段上げる費用を並べて示し、経営が水準を選ぶ形にすることが有効だと考えています。
2つ目は、目標をどの指標で書くかです。サービスレベル(何割を何秒以内)、平均応答時間、放棄率は、それぞれ別のものを測っています。13時の枠のように、サービスレベルは目標を満たしているのに平均応答時間は20秒を超える、ということが起こります。放棄を無視したアーランCで人数を決めると、人数の足りない時間帯の放棄が経営指標に表れません。顧客との契約や社内の目標にどの指標を書くかで、必要人数も、現場の改善の方向も変わります。
3つ目は、組織の形です。規模の経済の節で見たとおり、この例題では入電を2つの拠点に半分ずつ分けると、同じ目標を満たすのに必要な在席は1拠点にまとめた場合より23.2%増えました。窓口を商品別・言語別に分ける判断や、拠点を分散させる判断には、この上乗せの費用が付いてきます。事業継続のために拠点を分ける、専門性の高い問い合わせを分ける、といった理由があれば分けるべきですが、その判断をするときに上乗せの費用を数字で示すことはできます。反対に、窓口をまとめるための研修や、第9章で扱う多能工化の投資は、この上乗せの減少で効果を示せます。
判断を誤ったときの損失の型も整理しておきます。必要人数を少なく見積もると、10時30分の枠の表で見たとおり、1人の不足でサービスレベルが大きく落ち、待ち時間と放棄が急に増えます。放棄した客の一部は掛け直すので入電がさらに増え、係員の負担も重くなります。反対に多く見積もると、係員が電話を待つ時間が増え、人件費がそのまま過剰になります。どちらの損失も、需要予測・AHT・サービス目標・シュリンケージという4つの入力の精度で決まるので、見積りの前提を定期的に実績と照らし合わせる仕組みが要ります。
この章の要点は3つです。第一に、仕事を溜めておけない電話の受付では、作業量だけで割った人数では足りず、アーランCで「80%を20秒以内」のようなサービス目標を満たす最小の在席人数を求めます。サンプルデータの第1日では、作業量基準の83.0人×時間に対してアーランCでは125.0人×時間で、4週の合計は2,935.0人×時間になりました。第二に、目標を上げるほど1ポイントあたりの費用が大きくなり、入電が多いほど1人あたりの効率が上がる(入電が2倍でも必要在席は1.7倍)という性質があり、どちらもサービス目標や組織の形の判断に直結します。第三に、シュリンケージは休憩を勤務の型の側で扱っているかどうかで掛け方が変わり、アーランCの前提(放棄なし・定常状態)が崩れる場面ではアーランAやシミュレーションで点検します。次の第4章では、この章で求めた必要在席の曲線を、開始時刻と長さの決まった勤務の型でどう覆うかを、集合被覆の考え方で扱います。
この章を深めたい方への参考書籍
『基礎から学ぶトラヒック理論』(稲井寛、森北出版):通信ネットワークの設計と運用を待ち行列理論で解析するトラヒック理論の入門書で、確率の基礎から出生死滅過程、即時式・待時式の交換線群までを丁寧な式変形で説明しています。この章で使ったアーランCは待時式の交換線群のモデルにあたり、版元の紹介ではコールセンターなどの身近な例も交えているとされています。式の導出を自分で追いたい方に向いています。
『Call Center Optimization』(Ger Koole、MG books):コンタクトセンターの運営を数理の側から解説した英語の本で、この章で引いたサービスレベルの目安、シュリンケージと稼働率の定義、放棄の扱い、アーランCとシミュレーションの関係を、技術的な細部に入らずに計算の結果で示しています。著者のサイトで冒頭の章を読むことができ、この章の出典の多くもそこから確かめました。
第4章 シフトの型を設計する
第3章では、アーランCの式を使って、30分の枠ごとに何人が席にいればサービスレベルの目標を満たせるかを見積もりました。第2章で用意したサンプルデータでは、その必要在席人数は月曜の10時台に10名まで膨らみ、23時台には3名まで下がります。ところが、実際に人を置くときには、30分ごとに人数を上げ下げすることはできません。人は「7時から16時まで」「17時から22時まで」といった決まった時間のまとまりで勤務し、その途中で休憩を取ります。この時間のまとまりを、この章では勤務の型と呼びます。この章では、必要在席人数の山と谷に対して、どの開始時刻・どの長さの型を何人ずつ置けばよいかを数理最適化で決める方法を示し、型の選び方によって不足人時と過剰人時がどれだけ変わるかを、サンプルデータで実測します。誰をどの日のどの型に割り当てるかは第5章で扱うので、この章で決めるのは型ごとの「人数」までです。
型の設計は、勤務表を作る前の段階の意思決定
勤務表を作る仕事は、2つの段階に分けて考えると整理しやすくなります。1つ目は、1日の中にどのような型を用意し、各日に各型を何人置くかを決める段階です。2つ目は、その人数の枠に、スタッフ1人ひとりを日ごとに割り当てる段階です。前者は研究の分野ではシフトデザイン(勤務の型の設計)やシフトスケジューリングと呼ばれ、後者はロスタリング(勤務表の作成)と呼ばれます。第2章の問題の分類表で見たとおり、この2つは別の問題として研究されてきましたが、現場では多くの場合、型は就業規則や過去の慣行で固定されたまま、2つ目の段階だけが毎月繰り返されています。
型を固定したまま勤務表だけを工夫しても、取り除けない過不足が残ります。例えば共通データの早番(7時〜16時、休憩は11時〜12時)は、月曜の需要の山の頂上(10時台の10名)をまたいで働く型ですが、休憩の1時間は、その直後でまだ9名が必要な11時台に置かれています。この型を何人置いても、11時台には早番の全員が席を外します。こうした型そのものに由来する過不足は、誰をどこに割り当てるかを工夫しても、不足と過剰を同時に消すことはできません。型の設計は、勤務表の品質の上限を決める意思決定だと言えます。
記事全体の基準の結果(第2章で紹介した、CP-SAT で個人まで割り当てた勤務表)では、不足が221.0人×時間、過剰が641.0人×時間でした。必要在席の4週合計が2,935人×時間なので、過剰はその2割を超えます。不足と過剰が同時に大きいのは、9時間の固定の型と需要の山が合っていないためです。この章では、この見立てを数字で確かめます。
集合被覆問題として書く
型の設計を数理最適化で解く考え方は古く、1954年までさかのぼります。ニューヨーク港湾公社のエディ(L. C. Edie)は、同公社のトンネルと橋の料金所の要員配置を論じた論文を、Journal of the Operations Research Society of America の第2巻第2号(1954年)に発表しました。要旨によると、料金所の要員は、利用者へのサービスを一定に保ちつつ、収受員の休憩を適切な間隔で挟みながら、最少の人数で交通をさばくように配置する必要がありました。それまでは経験に基づく判断で人数を決めていたところを、確率論を使って交通量・ブースの数・サービスの水準の関係を求め、1日の各時刻に必要なブースの数を事前に決められるようにした、というのが論文の内容です。第3章のアーランCと同じく、待ち行列の考え方で時間帯ごとの必要人数を出す仕事だったと言えます。
この論文に対して、ランド研究所のダンツィグ(G. B. Dantzig)が同誌の第2巻第3号(1954年、339〜341ページ)に短い論評を寄せました。後の研究は、この論評を、人員のスケジューリングを集合被覆問題として定式化した最初のものとして引用しています。例えばアッケルマンスらの論文(Annals of Operations Research 第302巻、2021年)は、人員のスケジューリングはエディ(1954)が導入し、ダンツィグ(1954)が集合被覆問題として定式化したと整理しています。時間帯ごとの必要人数を出すところまでがエディ、その必要人数を勤務の型の組合せで覆うところがダンツィグ、という分担は、この記事の第3章と第4章の分担と同じです。
ダンツィグの論評の本文は、この記事の執筆では開けていません(版元のページを開けなかったため)。内容は、上の論文と次に挙げる論文の記述によっています。
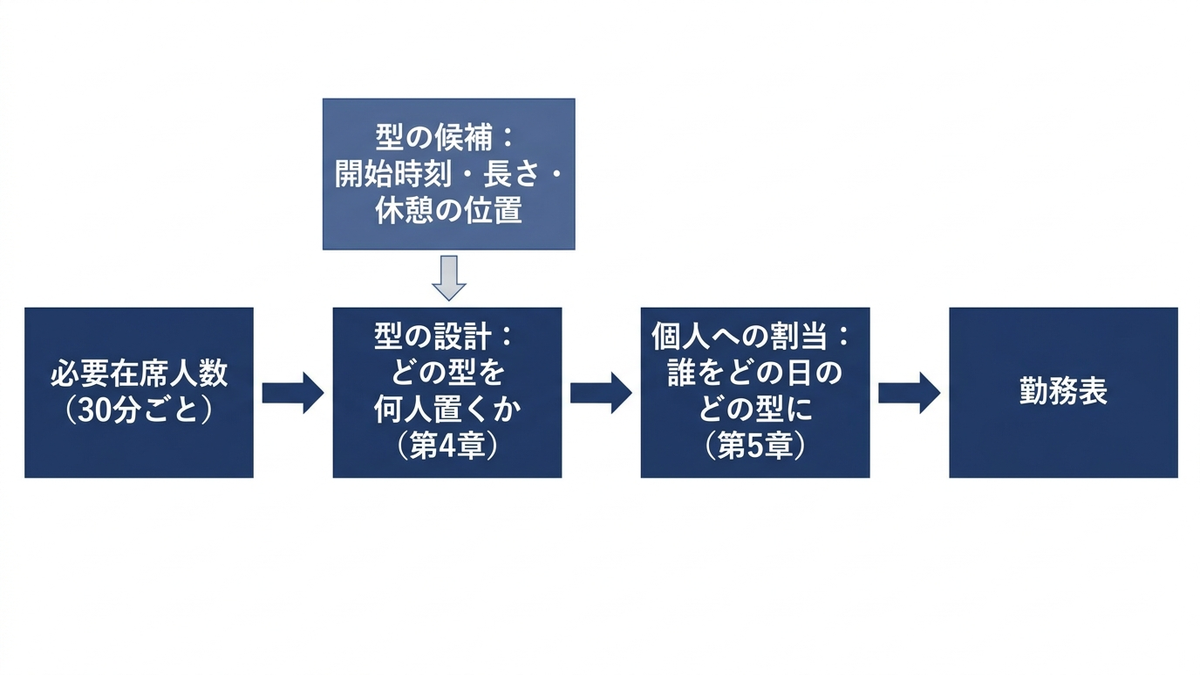
集合被覆問題とは、「覆わなければならない要素」と「要素のまとまり(集合)」が与えられたとき、すべての要素を覆うようにまとまりを選び、選んだまとまりの費用の合計を最小にする問題です。シフトの型の設計に当てはめると、覆わなければならない要素は「各30分の枠で必要な在席人数」で、まとまりは「1つの勤務の型が在席している枠の集まり」です。ただし、1つの枠に何人も必要なので、正確には各まとまりを何個ずつ選ぶか(型ごとに何人置くか)を決める、集合被覆の一般化した形になります。
式で書くと次のとおりです。型 \( j \) に置く人数を \( x_j \)、型 \( j \) が枠 \( s \) に在席していれば1、いなければ0になる値を \( a_{sj} \)、枠 \( s \) の必要在席人数を \( r_s \)、型 \( j \) の費用(ここでは実働の時間)を \( c_j \) とします。
\( \min \sum_j c_j x_j \quad \text{subject to} \quad \sum_j a_{sj} x_j \ge r_s \ \ (\text{すべての枠 } s), \quad x_j \in \{0, 1, 2, \dots\} \)
言葉にすると、「どの30分の枠でも、その枠に在席している型の人数の合計が必要在席人数以上になるようにしながら、全員の実働時間の合計を最小にする」という問題です。変数は型ごとの人数だけで、スタッフの名前は出てきません。この点が、第5章の個人への割当との違いです。
この定式化の特徴は、型の候補を列として並べておき、その中から選ばせることです。候補の型を増やせば需要の形に合わせやすくなりますが、変数の数も増えます。ルスビーらの論文(2015年、南デンマーク大学のディスカッションペーパー)は、ダンツィグの方法は開始時刻・長さ・休憩の位置の組合せをすべて別の型として数え上げるもので、根本的な難しさは変数の数が急に増えることだと述べています。この章のサンプルデータは30分刻みで34枠しかないので、候補を全部数え上げても、多い場合で110個でした。ルスビーらの計算実験では、型の候補が1,241種類や2,145種類ある問題を扱っています。
1日分を解く、現行の型と開始時刻を自由にした型
まず、第1日(月曜)の1日だけを取り出して解きます。月曜はサンプルデータの中で入電が最も多い曜日で、必要在席人数の合計は250人×30分、すなわち125.0人×時間、最大は10名です。この1日について、「すべての枠で必要在席人数を満たす」ことを条件に、実働の人時が最小になる型の人数の組合せを求めました。すべての枠を満たす条件なので不足人時は0で、実働の人時から必要在席の125.0人×時間を引いた差が、そのまま過剰人時になります。
比べたのは、型の候補の集合です。1つ目は共通データの現行の6つの型(早番・日勤・中番・遅番の実働8時間の4つと、短時間の午前・夕方の実働5時間の2つ)です。2つ目は、実働8時間(拘束9時間、勤務の中ほどに休憩60分)の型の開始時刻を7時から15時まで30分刻みで自由にし、短時間は現行の2つのままにした集合です。3つ目は、実働8時間に加えて実働5時間(休憩なし)の型も、7時から19時まで30分刻みで開始を自由にした集合です。短時間の型の休憩の扱いは共通データの就業規則に合わせ、実働6時間以下の型には休憩を置いていません。休憩の法令上の条件は第7章で確かめます。
次のコードは、1つ目と3つ目を解いて比べる最小の例です。共通データの shift_slots で現行の型の在席枠を取り出し、自由にした型は開始枠・拘束の枠数・休憩の位置から在席枠を作っています。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from ortools.sat.python import cp_model
from shift_data import *

req = required_staff()[0]                      # 第1日(月曜)の必要在席人数、34枠


def column(start, span, brk=None):             # 型の在席枠。brk は休憩が始まる枠(開始から数える)
    slots = list(range(start, start + span))
    if brk is not None:
        del slots[brk:brk + 2]                 # 休憩60分=2枠は在席しない
    return slots


cands = {"現行の6つの型": [shift_slots(sid) for sid in SHIFT_IDS],
         "開始を30分刻みで自由に": [column(s, 18, 8) for s in range(0, N_SLOTS - 17)]
                                  + [column(s, 10) for s in range(0, N_SLOTS - 9)]}
for label, cols in cands.items():
    m = cp_model.CpModel()
    x = [m.new_int_var(0, 20, "x%d" % j) for j in range(len(cols))]
    for s in range(N_SLOTS):                   # どの枠も必要在席人数以上
        m.add(sum(x[j] for j, c in enumerate(cols) if s in c) >= int(req[s]))
    m.minimize(sum(len(c) * x[j] for j, c in enumerate(cols)))   # 実働の枠の合計
    sv = cp_model.CpSolver()
    sv.parameters.num_workers = 8
    sv.parameters.max_time_in_seconds = 30
    st = sv.solve(m)
    work = sv.objective_value / 2
    print("%s 候補%d 状態 %s 実働 %.1f 人時 過剰 %.1f 人時" %
          (label, len(cols), sv.status_name(st), work, work - req.sum() / 2))
# 出力: 現行の6つの型 候補6 状態 OPTIMAL 実働 190.0 人時 過剰 65.0 人時
# 出力: 開始を30分刻みで自由に 候補42 状態 OPTIMAL 実働 128.0 人時 過剰 3.0 人時
変数 x[j] が型 j に置く人数で、制約は「枠 s に在席している型の人数の合計が必要在席人数以上」の1種類だけです。目的は在席する枠の数の合計で、休憩の枠は在席に数えないので、これは実働の時間を30分単位で数えたものと同じになります。前の節の式を、ほぼそのまま書き写した形です。
コードに載せた2つを含む、候補の集合ごとの結果が次の表です(いずれも CP-SAT が最適性を証明した値で、1回あたり1秒未満でした)。
| 型の候補 | 候補の数 | 8時間の型の人数 | 短時間の型の人数 | 実働の人時 | 過剰人時 |
|---|---|---|---|---|---|
| A 現行の6つの型 | 6 | 15人 | 14人 | 190.0 | 65.0 |
| B 8時間の型の開始を自由に、短時間は現行の2つ | 19 | 15人 | 7人 | 155.0 | 30.0 |
| C 8時間と5時間の型の開始を自由に | 42 | 6人 | 16人 | 128.0 | 3.0 |
| C2 Cに人数の構成の条件を足す(8時間13人以上・短時間12人以下) | 42 | 13人 | 7人 | 139.0 | 14.0 |
| D Cに実働4時間と6時間の型も加える | 92 | 1人 | 24人(4時間10人・5時間6人・6時間8人) | 126.0 | 1.0 |
現行の6つの型で月曜の全枠を満たすには、実働190.0人時が必要で、そのうち65.0人時が過剰でした。必要在席の125.0人×時間に対して5割を超える上乗せです。8時間の型の開始時刻を30分刻みで自由にするだけで(B)、過剰は30.0人時に半減します。短時間の型の開始も自由にすると(C)、過剰は3.0人時まで下がり、需要の形にほぼぴったり沿う組合せになります。
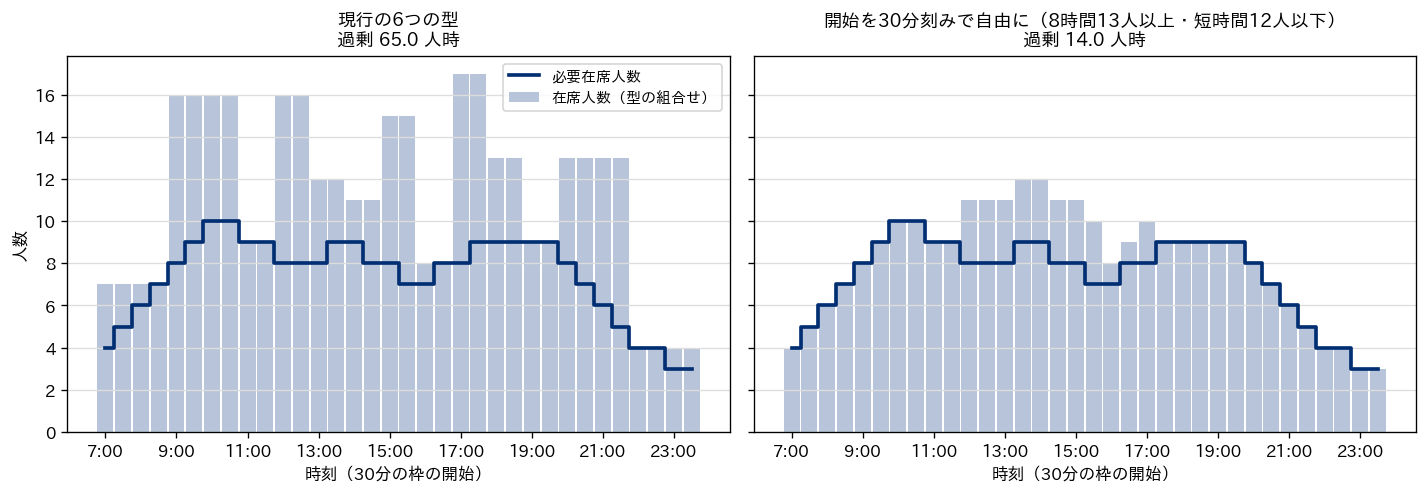
図の左が現行の型、右が開始を自由にしたうえで人数の構成の条件(後の節で説明します)を付けた C2 の組合せです。左の図で棒が線を大きく超えている時間帯には、はっきりした理由があります。現行の型での最適な組合せは、早番7人・日勤4人・遅番4人・短時間(午前)5人・短時間(夕方)9人で、中番は0人でした。早番の7人は、8時30分の枠の必要在席7名を満たすために要る人数です。その7人が11時〜12時に一斉に休憩に入るので、11時台の必要在席9名は、日勤4人と短時間(午前)5人の計9人で埋めるしかありません。その結果、3つの型が全員そろう9時から10時台と、早番が休憩から戻る12時台には16名が在席し、必要(8〜10名)を大きく超えます。夕方も同じ構造です。遅番の休憩は19時〜20時で、その間の必要在席9名は短時間(夕方)の9人だけで埋めています。この9人が17時から在席するので、日勤と遅番が重なる17時台は17名、遅番が休憩から戻る20時台は13名になります。現行の型は、開始時刻が2〜3時間おきにしかなく、休憩の位置も型ごとに1つに決まっているため、ある時間帯の谷を埋めるために置いた人が、別の時間帯の山の前後で余る、という構造になっています。
右の図の C2 では、在席が必要を超えるのは12時から15時台(各枠3名)と16時・17時の枠(1〜2名)だけで、朝と夜は必要在席人数に一致しています。人数の構成の条件を付けない C の過剰は3.0人時だったので、C2 との差の11.0人時は、8時間の型に13人以上を置く条件から来ています。拘束9時間の勤務を13本、7時から24時の17時間の中に並べると、開始時刻をどう散らしても昼過ぎには多くの勤務が重なります。
人時だけを目的にすると、型は短時間に偏る
表の C の行には、見落としやすい点があります。過剰が3.0人時まで下がった C の組合せは、8時間の型が6人、短時間(5時間)の型が16人でした。実働4時間と6時間の型も候補に加えた D では、過剰は1.0人時まで下がりますが、8時間の型は1人だけで、残りの24人は短時間の型です。実働の人時だけを目的にすると、ソルバーは短い型を細かく積み上げて需要の形をなぞろうとします。短い型ほど需要の山と谷に沿わせやすいので、これは計算としては正しい答えです。しかし、サンプルデータのセンターには正社員が18名いて、4週で20日ずつ、つまり1日平均で約12.9人(18名×20日÷28日)が実働8時間で出勤します。パートは12名です。正社員を6人しか出勤させず、パートを16人並べる組合せは、この職場では実行できません。
そこで、8時間の型に就く人数を13人以上、短時間の型に就く人数を12人以下とする条件を足して解き直したのが表の C2 です。実働は139.0人時、過剰は14.0人時になりました。C の3.0人時よりは増えますが、現行の型の65.0人時と比べれば5分の1近くまで下がっています。ここから読み取れるのは、型の設計の効果の大部分は、型の長さを短くすることではなく、開始時刻を需要に合わせて散らすことから来ているということです。実際、8時間の型だけで開始時刻を自由にした場合(次の節の表の F)でも、過剰は51.0人時で、現行の型の65.0人時より14.0人時少なくなりました。
この結果は、集合被覆のモデルを使うときの注意点を示しています。モデルの目的が職場の雇用の構造を映していないと、ソルバーはその職場では実行できない答えを「最適」として返します。サンプルデータでは、正社員は4週でちょうど20日勤務することが決まっていて、その人件費は勤務表の作り方では変わりません(記事全体の基準の目的にも、正社員の人件費は入っていません)。これに対してパートの人件費は、入った時間に比例します。したがって「実働の人時を最小にする」は、正社員の人数が決まっている職場では目的として不正確で、「決まった正社員の労働力を前提に、不足とパートの人件費を最小にする」ほうが実態に近くなります。後の節の4週間のモデルは、この形で解きます。
短時間の型を増やす案そのものが間違っているわけではありません。D の結果は、4時間や6時間で働ける人を確保できるなら、過剰をほぼなくせることを示しています。ただし、それは採用の問題で、型の設計だけでは実現しません。短時間で働きたい人がどの時間帯にどれだけいるかは地域や職種で違うので、型の候補に短い型を入れるかどうかは、採用の見込みと一緒に決める必要があります。
休憩の置き方で、過剰はどれだけ変わるか
現行の型では、休憩の位置が型ごとに1つに決まっていました。早番なら全員が11時〜12時に休憩します。休憩の位置を、勤務開始から3時間後・3時間30分後・4時間後・4時間30分後・5時間後の5通りから人ごとに選べるようにすると、同じ開始時刻の型でも在席の形が5通りになり、休憩による在席の落ち込みを時間帯に散らせます。候補の列は、8時間の型1つにつき5列になります。ただし、管理の上ではどれも「同じ開始時刻・同じ長さの型」で、休憩の時刻を当日に割り振るだけの違いです。
月曜の1日で、休憩の位置を固定した場合と選べる場合を比べました(F・G は8時間の型だけの候補、C・E は前の表と同じ候補です)。
| 型の候補 | 休憩の位置 | 候補の数 | 実働の人時 | 過剰人時 |
|---|---|---|---|---|
| 8時間の型だけ、開始は30分刻みで自由(F) | 中ほどに固定 | 17 | 176.0 | 51.0 |
| 8時間の型だけ、開始は30分刻みで自由(G) | 5通りから選べる | 85 | 160.0 | 35.0 |
| 8時間と5時間の型、開始は30分刻みで自由(C) | 中ほどに固定 | 42 | 128.0 | 3.0 |
| 8時間と5時間の型、開始は30分刻みで自由(E) | 5通りから選べる | 110 | 126.0 | 1.0 |
8時間の型だけで回す場合、休憩の位置を選べるようにすると、月曜の過剰は51.0人時から35.0人時へ16.0人時減りました。これに対して、5時間の短い型が使える場合は、3.0人時から1.0人時へ2.0人時しか減りません。短い型が多ければ、休憩の落ち込みを短い型の人で埋められるので、休憩を動かす効果は小さくなります。反対に、正社員の8時間勤務が中心の職場ほど、休憩の置き方の効果が大きく出ます。
休憩を動かす方法には、経営の上で見逃せない利点があります。型の種類を増やさずに過剰を減らせることです。後の節で見るとおり、開始時刻の異なる型を増やすことには管理の手間という費用が伴いますが、休憩の時刻の割り振りは、当日の運営の中で決められます。コンタクトセンターのように全員が同じ業務をしている職場なら、「休憩は11時から13時の間に、班ごとに30分ずらして取る」という運用の決めごとで、この効果に近づけられると考えています。
計算の面では、休憩を動かせるようにすると問題の性質が少し変わります。アッケルマンスらの論文は、休憩がなく、1日をまたがない型だけからなる場合、ダンツィグの定式化の制約の行列は、各列の1が連続して並ぶ形(連続1の性質)になり、整数の条件を外した線形計画として解いても整数の答えが得られると述べています。今回の実行でも、休憩を5通りから選べる G では、整数の条件を外して解いた値(線形緩和の値)が309.33で、整数で解いた320(人×30分)と一致しませんでした。休憩の位置を固定した A・B・C・F では、線形緩和の値と整数の答えが一致しました。休憩を柔軟にすると候補の列が増え、整数の答えを探す手間も増えますが、この例題の規模では、どの場合も1秒未満で最適性まで証明できています。休憩を型の列として数え上げず、別の変数として扱う定式化(アイキン(Aykin)の1996年の論文など)も提案されていることが、ルスビーらの論文で紹介されています。
4週間分を、基準と同じ人数の枠で解く
1日分の実験は、型の形の効き目を見るには分かりやすいのですが、「全枠を満たす」という条件は現実の人数を無視しています。そこで次に、4週間28日分を、記事全体の基準と同じ労働力と同じ重みで解きました。この章ではこれを「人数だけのモデル」と呼びます。決めるのは、日ごと・型ごとの人数だけです。
人数だけのモデルに入れた条件は次のとおりです。正社員18名が4週で20日ずつ働くので、実働8時間の勤務は4週で合計360回、各週90回、1日18回までとしました。パート12名は短時間の型(実働5時間)に就き、1日12回まで、各週44回まで(12名の週の上限日数の合計)としました。目的は基準と同じく、不足1人×30分あたり3,000と、パートの人件費(時給1,500円×時間)の重みづけの和です。どちらも第2章で断ったとおり架空の値です。
基準の結果と比べる前に、条件の違いを明記しておきます。基準は30名の1人ひとりに勤務を割り当てるモデルで、希望休(違反1件5,000の重み)、連続勤務の上限5日、勤務間インターバル11時間から来る続けてはいけない勤務の組、SV と英語対応の配置(不在1枠5,000・2,000の重み)、パートごとの週の上限日数と就ける型(午前だけ・夕方だけの人がいる、一部のパートは日勤にも就ける)を入れています。人数だけのモデルは、これらをすべて外し、正社員とパートの延べ回数の上限だけを残した模型です。
| モデル・型の候補 | 重みづけの和 | 不足人時 | 不足のある枠 | 過剰人時 | パートの勤務 | 使った型の種類 |
|---|---|---|---|---|---|---|
| 基準(個人まで割当・現行の6つの型) | 2,053,500 | 221.0 | 181/952 | 641.0 | 475時間 | 6 |
| 人数だけ・A 現行の6つの型 | 2,038,500 | 218.5 | 179/952 | 648.5 | 485時間 | 6 |
| 人数だけ・B 8時間の型の開始を自由に、短時間は現行の2つ | 1,129,500 | 19.5 | 35/952 | 639.5 | 675時間 | 15 |
| 人数だけ・C 8時間と5時間の型の開始を自由に | 808,500 | 6.0 | 12/952 | 466.0 | 515時間 | 23 |
| 人数だけ・E Cで休憩を5通りから選べる | 676,500 | 11.5 | 23/952 | 361.5 | 405時間 | 30 |
人数だけのモデルの4行は、いずれも CP-SAT が60秒の制限の中で最適性を証明した値です(num_workers=8、この記事の実行環境(一般的なノートPC)での実測で0.6秒から28.8秒)。同じ設定で2回解き、重みづけの和・不足人時・過剰人時・パートの勤務時間は2回とも同じでした。ただし、同じ重みづけの和になる答えが複数あるため、使った型の種類や曜日別の不足の内訳は2回で違いました(C の使った型は1回目22種、2回目23種)。表の値は2回目の実行のものです。
最初に注目したいのは、表の1行目と2行目です。現行の6つの型のままでは、個人の条件をすべて外した人数だけのモデルでも、不足は218.5人時残りました。基準の221.0人時との差は2.5人時です。重みづけの和で見ると、基準の2,053,500から希望休の違反3件分(3件×5,000=15,000)を除くと2,038,500で、人数だけのモデルの値と一致しました。つまりこの例題では、目的関数の合計で見ると、個人ごとの条件が基準の重みづけの和を押し上げた分は希望休の違反3件の15,000だけで、不足とパートの人件費を足した部分は、個人の条件を外しても合計の値はまったく下がりませんでした(内訳では、不足の分が15,000小さく、パートの人件費が15,000大きくなって打ち消し合っています)。基準の不足のほぼすべては、現行の型の形から来ていたことになります。言い換えると、この記事の重み(不足1人×30分あたり3,000)とパートの人件費の釣り合いのもとでは、基準に見られる不足と過剰を同時に大きく減らす余地は、誰をどこに割り当てるかの工夫にはほとんど残っておらず、型の見直しが要るということです。同じ型のままでも、パートの勤務を増やして在席の総量を増やせば不足は減らせますが、その分だけ過剰とパートの人件費が増えます。第2章の手作りの勤務表は、パートを基準より270〜295時間多く入れて不足を197.5〜203.5人時に下げた代わりに、過剰が887.5〜918.5人時に増えていました。
次に、型の候補を広げた行を見ます。8時間の型の開始時刻を30分刻みで自由にすると(B)、不足は218.5人時から19.5人時へ、9割以上減りました。正社員の勤務は同じ18名・360回のまま、8時間の型の開始時刻を自由にした結果です。ただし、この答えではパートの勤務も485時間から675時間へ190時間増えているので、開始時刻をずらしただけの効果ではありません(次の段落で述べます)。短時間の型の開始も自由にすると(C)、不足は6.0人時、過剰は466.0人時になり、重みづけの和は現行の型の4割程度(808,500)まで下がります。休憩の位置も選べるようにすると(E)、パートの勤務を515時間から405時間へ110時間減らしながら、不足を11.5人時に抑えています。不足が C より5.5人時増えたのは、パートの人件費の節約との釣り合いで、ソルバーが不足をわずかに残すほうを選んだためです。重みづけの和は E が最も小さくなっています。
B の行の過剰人時が639.5で、現行の型の648.5とほとんど変わらないことにも注意が要ります。正社員の360回の勤務(2,880時間)は必ず使う条件なので、不足を減らすためにパートを増やすと、その分だけ在席の合計が増えます。B ではパートの勤務が485時間から675時間に増え、不足は減ったものの、過剰は減っていません。過剰人時は、型の形だけでなく、正社員の労働力を全部使うという前提からも生まれています。過剰を減らすには、開始時刻に加えて短時間の型の開始も動かす(C)か、休憩の位置を動かす(E)必要がありました。
全枠を満たすには、何人分の勤務が要るか
同じ模型を使って、逆向きの問いにも答えられます。「不足を1枠も出さないためには、正社員の8時間の勤務が延べ何回要るか」です。パートの上限(1日12回・週44回)は同じままにし、8時間の勤務の回数は自由にして、全枠を満たしながら実働の人時が最小になる組合せを解きました(いずれも最適性を証明)。
現行の6つの型では、全枠を満たすのに8時間の勤務が4週で527回、パートの短時間の勤務が上限いっぱいの176回(880時間)必要で、過剰人時は2,161.0になりました。527回は、1人4週20日で割ると26.4人分です。今の正社員18名より8名以上多い人数を置かないと、この型のままでは全枠を満たせません。これに対して、8時間と5時間の開始を自由にした候補(C)では、8時間の勤務は294回(14.7人分)、過剰人時は297.0で済みました。休憩の位置も選べる候補(E)では283回(14.2人分)、過剰人時は209.0です。この2つの答えは、正社員の勤務を1日18回まで・週90回までとする条件を足して解き直しても、実働の人時が変わらないことを確かめました。
この比較は、型の設計が「何人採用すべきか」という判断を大きく動かすことを示しています。現行の型のまま不足をなくそうとすれば、正社員を約8名増やす計画になります。型を見直せば、個人の条件を外した模型の上では、今の人数で全枠を満たせる計算になります。もちろん、個人の条件(希望休・連勤・勤務間インターバル・スキル)を入れると必要な人数は増えるので、採用の計画は第5章以降の個人割当のモデルで確かめる必要があります。それでも、採用を決める前に型の見直しで何人分が浮くかを測っておくことは、採用の費用に比べて小さな手間で済む確認だと考えています。
型の種類に上限を付けて解く
開始時刻を自由にした C の答えは、4週間で23種類の型を使っていました。7時開始、7時30分開始、8時開始……と、30分違いの型が並びます。計算の上では最も良い答えですが、23種類の型を運用するのは簡単ではありません。型が増えるほど、勤務表は読みにくくなり、引き継ぎの時刻がばらばらになり、朝礼や研修の時間を全員に合わせることが難しくなります。前出のアッケルマンスらの論文も、型の種類が少ない勤務表は管理がしやすく、職員にも受け入れられやすいので、型の数を少なくすることはシフトデザインの重要な目標だと述べています。ルスビーらの論文は、使える型の種類に上限を付けた問題を「型の数に制約のあるシフトデザイン問題」として定式化しています。
そこで、4週間の人数だけのモデル(同じ人数の枠)に「使う型(開始時刻と長さの組)の種類は K 個まで」という条件を足しました。型ごとに「使うか使わないか」を表す0か1の変数を置き、使わない型の人数を0に縛り、使う型の数の合計を K 以下にします。休憩の位置の違いは同じ型として数えます。最初に、この条件をそのまま CP-SAT に入れて、候補42個(8時間と5時間の開始を自由にした C の候補)から K 個を選ばせました(時間制限60秒・num_workers=8)。次の表の「状態」の FEASIBLE は、答えは見つかったが、それが最良であることは時間内に証明できていない状態を表します(証明できた場合は OPTIMAL です)。「下界」は、これより良い値はあり得ないとソルバーが証明できた値で、最適値は下界と見つかった答えの間のどこかにあります。OPTIMAL のときは両者が一致します。
| 型の種類の上限 K | 状態 | 重みづけの和 | 下界 | 不足人時 | 過剰人時 |
|---|---|---|---|---|---|
| 3 | FEASIBLE | 2,494,500 | 879,000 | 254.5 | 844.5 |
| 4 | FEASIBLE | 1,531,500 | 811,500 | 69.0 | 759.0 |
| 5 | FEASIBLE | 1,390,500 | 811,500 | 33.0 | 773.0 |
| 6 | FEASIBLE | 1,536,000 | 807,000 | 36.0 | 861.0 |
| 8 | FEASIBLE | 1,228,500 | 807,000 | 31.0 | 671.0 |
| 10 | FEASIBLE | 1,095,000 | 807,000 | 35.0 | 570.0 |
| 12 | FEASIBLE | 979,500 | 807,000 | 22.0 | 532.0 |
結果は、この章のほかの実験と様子が違いました。どの K でも60秒では最適性を証明できず(状態 FEASIBLE)、下界は807,000〜879,000にとどまりました。下界は、上限を付けない C の最適値808,500とほぼ同じ水準で、「上限を付けたことでどれだけ悪くなるか」について、ソルバーはほとんど何も証明できていません。例えば K=6なら、最適値は下界の807,000と見つかった答えの1,536,000の間のどこかにある、ということしか言えません。さらに、K=6の重みづけの和1,536,000は、K=5の1,390,500より大きくなっています。K=6の条件は K=5の答えも満たすので、最適解どうしなら K=6が K=5より悪くなることはありません。これは探索が60秒で打ち切られ、良い組合せにたどり着けていないことを示しています。型の数に上限を付けると、「どの型を使うか」という0か1の選択が28日分の人数の決定すべてに効くようになり、問題が急に難しくなります。同じ問題を PuLP と CBC の混合整数計画に書き直し、60秒の制限で K=6について解いた試行でも、得られた値は1,680,000で、CP-SAT より悪い結果でした(PuLP の表示する状態は Optimal でしたが、実測は88.9秒で60秒の制限を超えており、CP-SAT がこれより良い答えを見つけているので、最適の証明とは読めません)。
そこで、問題を2段に分けました。「どの型の組を使うか」を外側で探し、型の組を1つ決めたら、残りの「日ごと・型ごとの人数」を CP-SAT で最適性まで解きます。型の組が決まれば、この内側の問題は現行の6つの型を解いたときと同じ形で、この例題では1回あたり平均1秒ほどで解けました。外側は、上限が1つ少ないときの組に最も効く型を1つ足し、そのあと、組の中の型を開始時刻が前後1時間以内の同じ長さの型に入れ替えて、良くなる限り入れ替えを続けました。外側の探索は最適性を保証しない近似の方法です。
| 型の種類の上限 K | 選ばれた型(開始時刻と実働時間) | 重みづけの和 | 不足人時 | 過剰人時 | パートの勤務 |
|---|---|---|---|---|---|
| 3 | 7時〜5時間、11時30分〜8時間、15時〜8時間 | 2,139,000 | 136.5 | 961.5 | 880時間 |
| 4 | 7時〜5時間、7時30分〜8時間、11時30分〜8時間、15時〜8時間 | 1,639,500 | 62.0 | 852.0 | 845時間 |
| 5 | K=4に14時〜8時間を追加 | 1,345,500 | 43.0 | 713.0 | 725時間 |
| 6 | K=5に9時〜5時間を追加 | 1,206,000 | 18.5 | 693.5 | 730時間 |
| 7 | 7時〜5時間、9時〜5時間、7時〜8時間、11時〜8時間、13時〜8時間、14時〜8時間、15時〜8時間 | 1,119,000 | 16.5 | 641.5 | 680時間 |
| 8 | K=7に9時〜8時間を追加 | 1,075,500 | 28.0 | 578.0 | 605時間 |
| 9 | K=8に19時〜5時間を追加 | 1,005,000 | 12.5 | 577.5 | 620時間 |
| 10 | 7時・8時・19時〜5時間、7時・9時・10時・11時・13時・14時・15時〜8時間 | 972,000 | 12.0 | 557.0 | 600時間 |
| (比較)現行の6つの型 | 7時・9時・12時・15時〜8時間、9時・17時〜5時間 | 2,038,500 | 218.5 | 648.5 | 485時間 |
| (比較)上限なし(C) | 23種 | 808,500 | 6.0 | 466.0 | 515時間 |
この2段の方法で評価した型の組は537通り、内側はすべて最適性を証明し、全体の実測は547秒でした(この記事の実行環境での実測)。K=1と2は8時間の型しか選ばれず、不足が1,326.0人時と710.0人時と桁が違うので、表と図から外しています。外側の探索は近似なので、表の値が各 K の最適値である保証はありません。実際、K=4では、最初に CP-SAT へ直接入れて解いた値(1,531,500)のほうが、この探索の値(1,639,500)より小さくなっています。反対に、K=3・5・6・8・10では、この探索の値が CP-SAT の直接の値を下回りました。重みづけの和は K を増やすごとに下がっていて、K=6と K=5の逆転のような矛盾は出ていません。
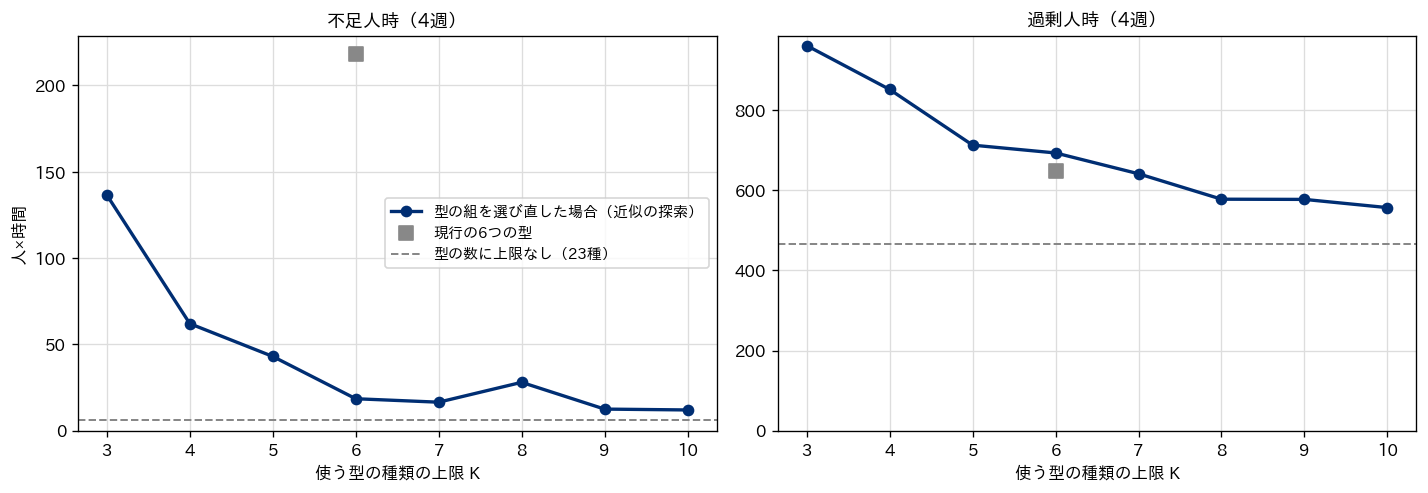
最も重要な行は K=6です。現行と同じ6種類という上限でも、開始時刻と長さを選び直すと、不足は218.5人時から18.5人時に、重みづけの和は2,038,500から1,206,000に下がりました。選ばれた6種類は、8時間の型が7時30分・11時30分・14時・15時開始の4つ、5時間の型が7時・9時開始の2つです。現行の型と比べると、早番の開始を30分遅らせ、日勤(9時開始)と中番(12時開始)の代わりに11時30分と14時の開始を置き、短時間(午前)の9時開始は残したまま、短時間(夕方)の代わりに7時開始の短時間を置いた形です。型の種類を増やさなくても、どの時刻に置くかを変え、パートの勤務の量を選び直せば、不足の大半は消えるということです(パートの勤務が増える点は次の段落で述べます)。
一方で、K=6の過剰人時は693.5で、現行の型の648.5より45.0人時多くなっています。パートの勤務が485時間から730時間に増えたためです。不足1人×30分の重み3,000に対して、パートの5時間勤務1回の人件費は7,500なので、3枠以上の不足を埋められるならパートを入れたほうが重みづけの和は下がります。そうして入れたパートの勤務は、不足の枠を埋める一方で、ほかの枠では過剰にもなります。過剰人時だけを見て「型を変えたら悪くなった」と読むのは誤りで、この表は、パートの人件費を払って不足を買い戻した結果として読む必要があります。不足と過剰のどちらを重く見るかは重みで決まり、その重みを決めるのは経営の判断です。
図の左の不足人時は、K=3から6までで急に下がり、6を超えると10〜30人時の間で横ばいになります(K=8で28.0人時に戻っているのは、重みづけの和を下げる代わりにパートを減らした結果で、重みづけの和は K=7より小さくなっています)。右の過剰人時は K=10まで緩やかに下がり続けますが、上限なしの466.0人時にはまだ届きません。この例題に限って言えば、不足を減らす目的なら型は6種類前後で十分で、それ以上の種類は主に過剰(パートの人件費)を削る効果になる、という読み方ができます。型を1種類増やすたびに管理の手間が増えることを考えると、効きが鈍る点を探し、そこで止めるのが実務的です。この点がどこにあるかは需要の形で変わるので、自社の必要在席人数で同じ曲線を描いて確かめる必要があります。
経営の判断に翻訳する、営業時間・パートの勤務の長さ・型の数
この章の結果を、経営の判断に使える形に整理します。型の設計で決まるのは、同じ人数を雇ったときに、その労働時間のうちどれだけが需要に当たり、どれだけが余るかの割合です。サンプルデータでは、正社員18名とパート12名の同じ労働力のまま、現行の型では不足218.5人時・過剰648.5人時だったものが、8時間と5時間の開始を30分刻みで動かすと不足6.0人時・過剰466.0人時になりました(いずれも個人の条件を外した人数だけのモデル)。この間、パートの勤務は485時間から515時間へ30時間増えただけです。人件費をほとんど増やさずにサービスレベルを上げる手段として、型の見直しは採用や残業より先に検討すべきものだと考えています。
判断を誤ったときの損失の型は、第1章で整理した2つに分かれます。型が需要に合っていないと、不足の側では、必要在席を割り込む枠でサービスレベルが目標を下回り、待たされる入電や放棄が増えます。過剰の側では、需要の谷の時間帯に席にいる人の人件費が、そのまま成果に結びつかない費用になります。サンプルデータの架空の時給で換算すると、過剰648.5人時のうち、例えば182.5人時を削れた場合(現行の型の648.5から C の466.0を引いた差)、正社員の時給2,600円なら約47万円、パートの時給1,500円なら約27万円の労働時間が、4週ごとに需要のある時間帯へ移せる計算になります。ただし、正社員の人件費は勤務表では変わらないので、これは「支払いが減る」のではなく「同じ支払いで需要に当たる時間が増える」という意味です。この違いを取り違えると、型の見直しの効果を人件費の削減として報告してしまい、翌月の人件費が下がらないことで信頼を失います。
型の設計から、経営の打ち手がいくつか導かれます。1つ目は、正社員の出勤時刻を30分刻みで散らすことです。表の B では、正社員の勤務回数を変えずに8時間の型の開始時刻を自由にし、短時間は現行の2つの型のまま使える条件で、不足が9割以上減りました。ただし、この答えではパートの勤務も190時間増えているので、正社員の開始時刻だけで得た効果ではありません。2つ目は、パートの勤務の長さと開始時刻を、需要の山に合わせて設計し直すことです。現行の短時間(午前)9時〜14時と短時間(夕方)17時〜22時は、需要の山を外しているわけではありませんが、C の答えでは7時開始の5時間勤務と、18時30分〜19時開始の5時間勤務が多く選ばれました。朝の立ち上がりと、遅番の休憩(19時〜20時)を含む夜の時間帯です。3つ目は、休憩の時刻を型に固定せず、当日の需要に合わせて割り振ることで、E のとおり、パートの勤務を減らしながら不足を低く抑えられました。
営業時間そのものも、型の設計と一緒に考える対象です。サンプルデータの月曜の必要在席は、23時台に3名、7時台に4〜5名です。営業時間の端の時間帯を誰が覆うかは、型の開始時刻と長さの選び方を縛る条件になっていて、例えば24時まで覆うには、15時開始の8時間の型か19時開始の5時間の型のような、終わりが24時になる型が要ります。営業時間を30分縮めたときに、不足人時と過剰人時、そして応答できなくなる入電の件数がどう変わるかは、この章のモデルの必要在席人数の枠を減らして解き直せば測れます。営業時間の変更は顧客への影響が大きい判断なので、この記事では試算していませんが、型の設計のモデルは、そうした判断の材料を出す道具としても使えます。
最後に、このモデルを使ってはいけない場面を挙げておきます。第1に、必要在席人数そのものが大きく外れている場合です。型の設計は必要在席人数を正しいものとして組み立てるので、第3章の見積りや需要予測が外れていれば、型も外れます。需要のばらつきへの備えは第12章で扱います。第2に、スタッフごとの事情(家庭の事情による時間帯の制約、通勤、育成の組合せ)が強い職場で、個人の条件を確かめずに人数だけのモデルの答えを採用する場合です。人数だけのモデルは、個人の条件を外した分だけ楽観的な答えを出します。型を見直したら、必ず第5章の個人割当のモデルで、その型の組を使って勤務表が組めるかを確かめてください。第3に、型の変更には、労働契約や就業規則の変更、労使の協議が伴うことがある点です。どの変更にどの手続きが要るかは、第7章と第13章で扱います。
この章の要点は3つです。第一に、どの開始時刻・長さ・休憩の位置の型を何人置くかは、ダンツィグ(1954)以来の集合被覆問題として書け、型の種類に上限を付けなければ、この例題の規模では CP-SAT で1秒未満から数十秒で最適性まで証明できます。第二に、この記事の重みのもとでは、記事全体の基準の不足221.0人時は個人の条件ではなく型の形からほぼすべて来ており、個人の条件を外した人数だけのモデルでは、同じスタッフ数の枠の中で開始時刻を30分刻みで動かし、パートの勤務の量もあわせて選び直すと、不足は大きく減ります(C ではパートの勤務が485時間から515時間)。型を変えずにパートを増やしても不足は減りますが、過剰とパートの人件費が増えるので、不足と過剰を同時に減らすには型の見直しが要ります。第三に、型の種類を増やすほど過不足は減りますが、管理の手間が増えるので、型の数に上限を付けて解き、効きが鈍る点を探して決めるのが実務的です。この例題では、現行と同じ6種類という上限のまま型を選び直すと、不足は18.5人時まで下がりました(パートの勤務は730時間に増えます)。上限を付けると問題が急に難しくなるので、型の組を外側で探し、人数を内側で解く2段の方法が扱いやすくなります。次の第5章では、この章で「人数」として扱った勤務を、30名のスタッフ1人ひとりに割り当て、勤務表として組み立てます。
この章を深めたい方への参考書籍
『Pythonによる数理最適化入門』(並木誠 著、久保幹雄 監修、朝倉書店):実践Pythonライブラリーの1冊で、Python の基礎から、線形最適化・整数線形最適化問題・グラフ最適化・非線形最適化までを、手を動かしながら学ぶ構成です。この章の集合被覆は整数線形最適化の典型なので、型の人数を変数にして制約と目的を書き下す練習の土台になります。
『組合せ最適化 理論とアルゴリズム』(B.コルテ、J.フィーゲン 著、浅野孝夫・浅野泰仁・平田富夫 訳、丸善出版):原著第6版の翻訳で、組合せ最適化の理論を網羅的に扱う専門書です。第5章「整数計画法」に完全ユニモジュラー行列の節があり、第16章「近似アルゴリズム」は集合カバーの節から始まります。この章で触れた「休憩の無い型だけなら線形計画でも整数の答えが出る」理由や、集合被覆の難しさを、数理の側から確かめたい方に向いています。
第5章 勤務表を作る
第4章では、シフトの型(開始時刻と長さの決まった勤務の枠)を設計し、どの型を何人ずつ置けば必要在席人数を過不足少なく満たせるかを、人数の問題として解きました。そこで決まるのは「月曜の早番に何人」という数で、「誰が」入るかはまだ決まっていません。実際に現場へ配る勤務表は、スタッフ一人ひとりについて、4週間の毎日を「どの型で働くか、休むか」で埋めた表です。この章では、第2章で用意したサンプルデータ(架空のコンタクトセンター、スタッフ30名・4週間)を使って、個人への割当を数理最適化で解き、記事全体の基準としている勤務表の結果を、表と図で読み解きます。あわせて、重みを変えると勤務表の中身がどう変わるかを実行して確かめ、最後に、できあがった勤務表を現場に出すときの形を整理します。
個人への割当を「ナース・スケジューリング問題」として書く
スタッフ一人ひとりに、計画期間の各日の勤務を割り当てる問題は、研究の世界ではナース・スケジューリング問題(英語では nurse rostering)と呼ばれてきました。病院の看護師の勤務表が代表的な対象だったためにこの名前が付いていますが、コンタクトセンター・小売店・介護施設・工場の交替勤務など、人を日と勤務の型に割り当てる問題は同じ形をしています。看護師の勤務表の研究を総覧した Burke らの論文(Journal of Scheduling、2004年)は、この問題を「数週間にわたって、看護師を勤務の時間帯に割り当てること」と説明し、計画期間の典型的な長さを4週間としています。この記事の共通データも4週間28日なので、ちょうどこの典型に当たります。
同じ論文は、問題を構成する条件を2種類に分けています。1つは被覆の条件で、計画期間のすべての日・すべての勤務の型について、スキルの区分ごとに何人が必要かを表すものです。論文は、この必要人数がしばしば業務量の測定や予測の方法で決められていると述べています。この記事で言えば、第3章でアーランCの式から出した必要在席人数がこれに当たります。もう1つは、個人の勤務表にかかる時間の条件で、個人の希望、勤務の負担の偏りをならす条件、雇用契約で決まる勤務の日数や回数などがここに入ります。
もう1つの分け方が、ハード制約とソフト制約です。Burke らは、ハード制約を「どんな代償を払っても満たさなければならないもの」、ソフト制約を「満たすことが望ましいが、実行できる解を作るためには破る必要が出うるもの」と定義しています。注意したいのは、同じ論文の例では被覆の条件をハード制約として扱っている一方で、どの条件をハードにするかは問題ごとに決めることだ、という点です。この章の基準のモデルでは、あとで見るとおり、必要人数を満たすこと自体をソフト制約にしています。30名で全枠の必要人数を満たすことができない場合でも、ソルバーが解なしで止まらず、不足を重みつきで目的に入れて評価した勤務表を返せるようにするためです。返ってくるのは、不足だけを最小にした勤務表ではなく、不足・希望休の違反・スキルの不在・パートの人件費の重みづけの和が最も小さい勤務表です。
公開されている研究用の問題集もあります。Curtois と Qu が公開している看護師勤務表のベンチマーク(Nurse Rostering Benchmark Instances)には24問が載っていて、ページの表によると、最も小さい Instance1 は2週間・8名・勤務の型1種類、最も大きい Instance24 は52週間・150名・勤務の型32種類です。4週間・30名・勤務の型4種類の Instance8 は、この記事の共通データと規模が近い問題です。これらのベンチマークを実際に読み込んで解き、既知の最良解と比べる作業は第6章と第10章で扱います。
決めることと、守る条件・できれば守る条件
この章のモデルが決めるのは、「スタッフ i が d 日目に勤務の型 s で働くかどうか」という、はい・いいえの値だけです。30名×28日×(その人が入れる型の数)の組合せについて、この値を1つずつ決めます。正社員18名は早番・日勤・中番・遅番の4つ、パート12名は人によって短時間(午前)・短時間(夕方)・日勤のうち1〜3つに入れるので、決める値の数は全部で2,632個になります(正社員が18名×28日×4=2,016個、パートが616個)。値を決めれば、その日のその時刻に誰が席にいるかが決まり、必要在席人数との過不足、希望休が守れたか、SV(リーダー)や英語対応の人がいるかが、すべて計算で出てきます。
基準のモデルに入れた条件を、ハード制約とソフト制約に分けて並べたのが次の表です。「重み」の列は、ソフト制約を破ったときに目的関数に足す値で、すべて第2章で用意した架空の値です。円で書いていますが、実在の企業の賃金や費用ではありません。
| 区分 | 条件 | 基準のモデルでの扱い | 重み(架空) |
|---|---|---|---|
| ハード制約 | 1日に入る勤務は1つまで | 各人・各日で、入れる型の値の合計を1以下にする | 破れない |
| ハード制約 | 正社員は4週でちょうど20日勤務 | 正社員ごとに、28日の勤務日数の合計を20にする | 破れない |
| ハード制約 | 1週間の勤務日数の上限(正社員5日、パートは人により3日か4日) | 第1週〜第4週それぞれで勤務日数の合計を上限以下にする | 破れない |
| ハード制約 | 連続勤務は5日まで | どの連続した6日間をとっても、勤務日数を5以下にする | 破れない |
| ハード制約 | 続けてはいけない勤務の組(勤務間インターバル11時間、架空の社内ルール) | 中番の翌日の早番、遅番の翌日の早番・日勤・短時間(午前)、短時間(夕方)の翌日の早番を禁止する | 破れない |
| ソフト制約 | 各枠の必要在席人数を満たす | 足りない人数を表す変数を置き、在席+不足が必要人数以上になるようにする | 不足1人×30分あたり3,000円 |
| ソフト制約 | 希望休の日に勤務を入れない | 希望休の日に勤務が入った件数を数える(88件中) | 1件あたり5,000円 |
| ソフト制約 | 各枠にSVを1名以上 | SVがいない枠を数える(952枠中) | 1枠あたり5,000円 |
| ソフト制約 | 平日9時〜18時に英語対応を1名以上 | 英語対応がいない枠を数える(360枠中) | 1枠あたり2,000円 |
| 費用 | パートの人件費 | 勤務の実働時間×時給1,500円を足す | 時給どおり |
表の下半分にある重みを足し合わせた1つの値を最小にする、というのが基準のモデルの目的です。数式で書くと次のようになります。
\( \min \; 3000 \times (\text{不足}) + 5000 \times (\text{希望休の違反}) + 5000 \times (\text{SV不在}) + 2000 \times (\text{英語不在}) + (\text{パートの人件費}) \)
言葉で言い換えると、「不足1人×30分を3,000円、希望休を1件破ることを5,000円、SVのいない30分を5,000円、英語対応のいない30分を2,000円と見なし、パートに払う人件費と合わせた総額が最も小さくなる勤務表を選ぶ」ということです。ここで大事なのは、この目的は重みづけの和であって、「不足を最優先で減らす」という順番を決めたものではないことです。たとえば、不足を1人×30分減らすためにパートを追加で何時間入れてよいかは、3,000円という重みとパートの時給の比で決まります。この点は、あとの節で重みを変えて確かめます。
正社員の人件費が目的に入っていないことにも理由があります。正社員は4週でちょうど20日、1日8時間の実働と決まっているので、誰をどの型に入れても正社員の人件費の総額は変わりません。変えられないものを目的に入れても答えは変わらないので、基準のモデルは、動かせるパートの人件費だけを目的に入れています。これは同時に、この勤務表で経営が動かせる費用はパートの時間だけだということも意味しています。
モデルの要所をコードで読む
基準の勤務表は記事全体で共通のスクリプトで作っていますが、この章ではそれを再実行せず、同じモデルをこの章のスクリプトに組み直して解きました。基準の数字は、記事全体で揺れないように、基準のスクリプトを1回実行した記録(以下、基準の記録)からだけ引用するためです。ソルバーは OR-Tools の CP-SAT(版 9.15.6755)で、書き方の詳細は第6章で扱います。ここでは、表の条件がコードのどこに当たるかだけを読みます。次のコードはこの章のスクリプトから、変数とハード制約の部分を抜き出したものです(単独では動きません)。
# 抜き出し:req は必要在席人数(28日×34枠)、ps はスタッフ30名、fb は続けてはいけない組
m = cp_model.CpModel()
# x[i, d, sid] = 1 ならスタッフ i は d 日目に勤務 sid に入る
x = {(i, d, sid): m.new_bool_var("x_%d_%d_%s" % (i, d, sid))
     for i, p in enumerate(ps) for d in range(N_DAYS) for sid in p["allowed"]}
work = {}
for i, p in enumerate(ps):
    for d in range(N_DAYS):
        w = m.new_bool_var("w_%d_%d" % (i, d))
        m.add(sum(x[i, d, sid] for sid in p["allowed"]) == w)      # 1日1勤務まで
        work[i, d] = w
    if p["days_4w"] is not None:
        m.add(sum(work[i, d] for d in range(N_DAYS)) == p["days_4w"])   # 正社員は4週で20日
    for wk in range(4):
        m.add(sum(work[i, d] for d in range(wk * 7, wk * 7 + 7)) <= p["max_days_week"])
    for d in range(N_DAYS - MAX_CONSEC_WORK):                    # どの6日間にも休みが1日以上
        m.add(sum(work[i, d + k] for k in range(MAX_CONSEC_WORK + 1)) <= MAX_CONSEC_WORK)
    for d in range(N_DAYS - 1):                                  # 続けてはいけない組
        for a in p["allowed"]:
            for b in fb[a]:
                if b in p["allowed"]:
                    m.add_bool_or([x[i, d, a].Not(), x[i, d + 1, b].Not()])
要点は3つあります。1つ目は、勤務日かどうかを表す値 work を別に作り、「その日に入る型の値の合計=勤務日かどうか」と結んでいることです。勤務日の値は0か1なので、この1行で「1日に入る勤務は1つまで」が表せます。以降の日数の条件はすべてこの work の和で書けるので、コードが短くなります。2つ目は、連続勤務の上限を「どの連続した6日間をとっても勤務は5日以下」という窓の和で書いていることです。6日連続で働く並びは、ちょうどこの窓のどれかに引っかかります。3つ目は、続けてはいけない組を add_bool_or で「前日のaに入らない、または翌日のbに入らない、の少なくとも一方が成り立つ」と書いていることです。この書き方と、並びの条件を自動機械(add_automaton)で書く方法の比較は第6章で扱います。
続いて、ソフト制約と目的の部分です。同じくこの章のスクリプトから抜き出したもので、英語対応の部分を1行のコメントに省略し、引数で渡している重みを数字で書き直しています(単独では動きません)。
# 抜き出し(続き):各枠の在席人数と、不足・SV不在・英語不在を表す変数
short, sv_miss, en_miss = {}, {}, {}
for d in range(N_DAYS):
    for s in range(N_SLOTS):
        terms = [x[i, d, sid] for i, p in enumerate(ps) for sid in p["allowed"] if s in shift_slots(sid)]
        sv_t = [x[i, d, sid] for i, p in enumerate(ps) if "SV" in p["skills"]
                for sid in p["allowed"] if s in shift_slots(sid)]
        sh = m.new_int_var(0, int(req[d, s]), "sh_%d_%d" % (d, s))
        m.add(sum(terms) + sh >= int(req[d, s]))                 # 足りない分を sh で受ける
        short[d, s] = sh
        sv = m.new_bool_var("sv_%d_%d" % (d, s))
        m.add(sum(sv_t) + sv >= 1)                               # SVがいなければ sv=1
        sv_miss[d, s] = sv
        # 英語対応(平日9〜18時)も sv と同じ形で en_miss に入れる
off_viol = [work[i, d] for i, p in enumerate(ps) for d in p["off_req"]]
part_cost = [x[i, d, sid] * int(HOURLY_COST["パート"] * shift_work_min(sid) / 60)
             for (i, d, sid) in x if ps[i]["kind"] == "パート"]
m.minimize(3000 * sum(short.values()) + 5000 * sum(off_viol)
           + 5000 * sum(sv_miss.values()) + 2000 * sum(en_miss.values()) + sum(part_cost))
必要人数をソフト制約にする書き方が、このコードの中心です。各枠に「足りない人数」を表す整数の変数 sh を置き、「在席人数+足りない人数が必要人数以上」という条件にします。sh を大きくすればどんな勤務表でもこの条件は満たせますが、sh には1あたり3,000の重みが掛かっているので、ソルバーはなるべく sh を小さくしようとします。こうしておくと、全枠を満たすことができない場合でも、ソルバーが「解なし」で止まらずに、ほかの項(希望休の違反・スキルの不在・パートの人件費)との兼ね合いの中で不足を抑えた勤務表を返します。不足だけを最小にしているわけではないので、不足の重みを上げれば不足はさらに減ります(後の節の案3)。在席人数は、その枠に在席している型の値を全員分足したもので、休憩の1時間は型の側で在席の枠から外してあります(第2章で説明した shift_slots の働きです)。
もう1つ読み取ってほしいのは、希望休の違反を work[i, d]、つまり「希望休の日に勤務日になったかどうか」そのもので数えていることです。希望休の日に早番でも遅番でも、入れば1件と数えます。希望休の日に「どの型なら入ってもよい」という区別をしたい職場では、ここを型ごとの値に置き換えます。希望の通し方の設計は第8章で扱います。
基準の結果を読む(1)目的関数の内訳と経営指標
基準のモデルを CP-SAT で、時間制限30秒・num_workers=8・乱数種0で解いた結果が、基準の記録に残っています。この記事の実行環境(一般的なノートPC)での実測で2.6秒で終わり、状態は OPTIMAL、目的関数の値2,053,500と下界2,053,500が一致しています。下界は「これより良い勤務表は存在しない」ことをソルバーが証明した値なので、両者が一致したことは、この重みづけの目的について、これ以上良い勤務表がないことが証明されたことを意味します。記録の数字を、経営指標の言葉に置き換えて並べたのが次の表です。
| 指標 | 基準の結果 | 目的関数への寄与(架空の重み) |
|---|---|---|
| 不足人時 | 221.0 人×時間(442 人×30分)。不足のある枠は952枠中181枠 | 442×3,000=1,326,000 |
| 過剰人時 | 641.0 人×時間 | 目的に入れていない |
| 希望休の違反 | 88件中3件 | 3×5,000=15,000 |
| SV 不在の枠 | 952枠中0枠 | 0 |
| 英語不在の枠 | 平日9時〜18時の360枠中0枠 | 0 |
| パートの勤務 | 475時間、人件費712,500円(架空の時給) | 712,500 |
| 目的関数の合計 | 2,053,500(下界も2,053,500、OPTIMAL) | 1,326,000+15,000+712,500 |
表の「目的関数への寄与」の列を足すと、1,326,000+15,000+712,500=2,053,500 で、記録された目的関数の値と一致します。内訳を見ると、目的関数の約65%が不足の重みで、残りのほとんどがパートの人件費です。SV と英語対応はどの枠でも1名以上いて、希望休は88件中85件が守られています。
読み方で注意したいのは、過剰人時の641.0 人×時間が目的関数に入っていないことです。先に述べたとおり正社員の勤務時間は4週で固定なので、正社員が必要以上に席にいても目的関数は変わりません。在席の総量を計算すると、正社員18名×20日×8時間=2,880 人×時間、パートが475時間で、合わせて3,355 人×時間です。必要在席人数の4週合計は2,935 人×時間なので、在席の総量は必要を420 人×時間上回っています。それでも221.0 人×時間の不足が残るのは、在席の総量が足りないからではなく、在席している時刻と必要な時刻が合っていないからです。必要2,935から不足221.0を引き、過剰641.0を足すと3,355になり、在席の総量と一致します。
経営の言葉にすると、この勤務表は「人は足りているのに、足りない時間がある」状態です。不足の221.0 人×時間は、必要在席人数に届かない30分が4週間で181回あるということです。この181枠はどれも、必要人数が第3章のアーランCの式で決まっている枠(最低2名の規則で決まった枠ではない)なので、どの枠でもサービスレベルの目標(80%を20秒以内に応答)を下回ります。実際に在席人数でサービスレベルを推定し直すと、181枠の中央値は20.8%、最も良い枠でも78.4%で、在席人数が入電の量(トラフィック量)以下になって推定値が0%になる枠もありました。1人か2人足りないだけで、その30分の応答の質は大きく落ちるということです。過剰の641.0 人×時間は、仮に正社員の架空の時給2,600円で換算すると1,666,600円分の勤務時間が、必要人数を超えて席にいることに当たります。ただしこの過剰は、正社員の4週20日という雇用の条件から生まれているので、勤務表の組み方だけでは減らせません。どこで不足し、どこで余っているかを次の節で図にして確かめます。
基準の結果を読む(2)勤務表のヒートマップ
勤務表そのものを見るには、縦にスタッフ、横に日付を並べ、セルの色で勤務の型を表すヒートマップが向いています。ここで1つ断っておくことがあります。基準の記録に残っている勤務表は先頭7日分だけで、28日分の全体は記録されていません。また、後の節で示すとおり、同じ目的関数の値になる勤務表は何通りもあり、同じ設定で解き直しても同じ勤務表が返るとは限りません。そこで、この章のスクリプトで、同じモデルに「先頭7日は記録どおり」「各日・各枠の在席人数は基準の記録どおり」「目的関数の値は2,053,500」という条件を足して解き、基準の記録と矛盾しない28日分の勤務表を1つ求めました。結果は OPTIMAL で、不足221.0 人×時間・過剰641.0 人×時間・希望休の違反3件・パート475時間・型ごとの延べ回数(早番107・日勤92・中番70・遅番91・短時間(午前)43・短時間(夕方)52)まで、基準の記録とすべて一致しました。以下、この勤務表を「基準の記録に合わせた勤務表」と呼びます。ただし、8日目以降の個人の割当が基準の実行と同じであることまでは確かめられません。この章の図は、この勤務表で描いています。
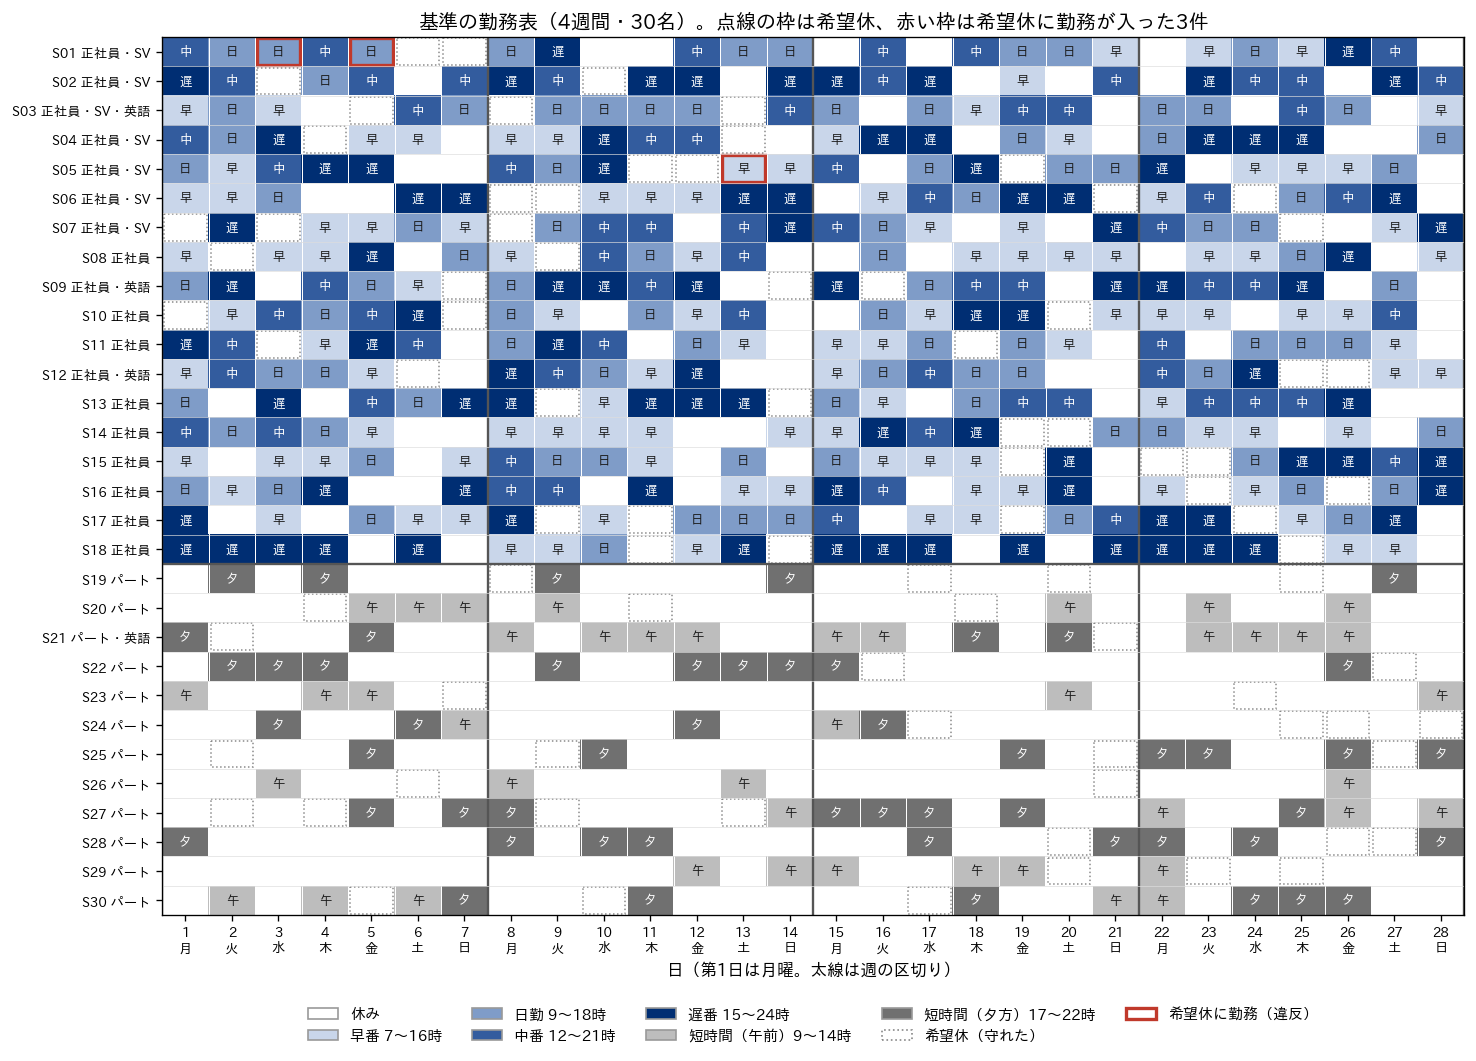
図の上18行が正社員、下12行がパートです。正社員の行は20日ずつ色が付き、パートの行は色の付いた日が少なく、入っているのはすべて短時間(午前)か短時間(夕方)で、パートの日勤は1回も使われていません。点線の枠は希望休の日で、ほとんどは白(休み)になっています。赤い枠の3件が、希望休に勤務が入った日です。
この3件がどこにあるかを見ると、原因が読み取れます。S01 は第1週に4日(第3日・第5日・第6日・第7日)の希望休を出していて、希望を全部守ると第1週に働ける日は3日です。第2週以降を週の上限5日ずつ働いても3+5+5+5=18日で、4週20日という正社員の条件に2日足りません。S05 も第2週に3日の希望休を出していて、全部守ると4+5+5+5=19日で1日足りません。つまり、この2人の希望休は、雇用の条件(4週20日・週5日まで)と両立しないので、少なくとも S01 で2件、S05 で1件、合わせて3件は必ず破られます。基準の勤務表の違反3件は、この避けられない最小の件数とちょうど一致していました。3件という下限は重みによらず条件の組合せから決まりますが、基準の重みのもとで違反がその下限にとどまったということで、希望休の違反の重みを極端に小さくすれば、ほかの項との兼ね合いで違反がこれより増える答えが選ばれることもありえます。
このことは、希望休の違反を減らしたいときに、何に手を入れればよいかを示しています。ソルバーの重みを上げても3件は減りません。減らすには、希望休の出し方の規則(1週に出せる日数の上限など)を決めるか、その月だけ週の上限や4週の日数を調整するか、本人と相談して希望日をずらすか、のいずれかが必要です。どれも勤務表を作る人ではなく、就業規則や運用を決める人の判断です。
ヒートマップからは、1人ずつの負担の偏りも読めます。基準の記録に合わせた勤務表で正社員18名を数えると、遅番の回数は最も少ない人で0回(S03)、最も多い人で14回(S18)、早番は1回から12回、土日の勤務は2日から7日まで開いています。ただし、この偏りは基準の勤務表に固有の値ではありません。第8章で同じ設定を解き直した勤務表は、不足・過剰・希望休の違反・パートの時間がこの勤務表とまったく同じなのに、同じ正社員18名の遅番は1回から7回、土日は3日から7日でした。基準のモデルには公平性の条件を入れていないので、目的関数が同じなら、誰に遅番が集まっても区別されず、偏りは返ってきた勤務表しだいで大きく変わります。最長の連勤は全員5日以下で、ハード制約は守られています。パート12名の勤務日数は4日から14日までで、4週で1日も入らない人はいませんでした。偏りの測り方と、偏りに上限を付けたときに不足人時がどれだけ増えるかは第8章で扱います。
基準の結果を読む(3)必要と在席の重ね合わせ
不足と過剰がどこにあるかは、横に時刻、縦に人数をとり、必要在席人数を線で、在席人数を棒で重ねた図で見るのが分かりやすいと考えています。次の図は、入電の最も多い月曜の第1日と、少ない土曜の第6日を並べたものです。
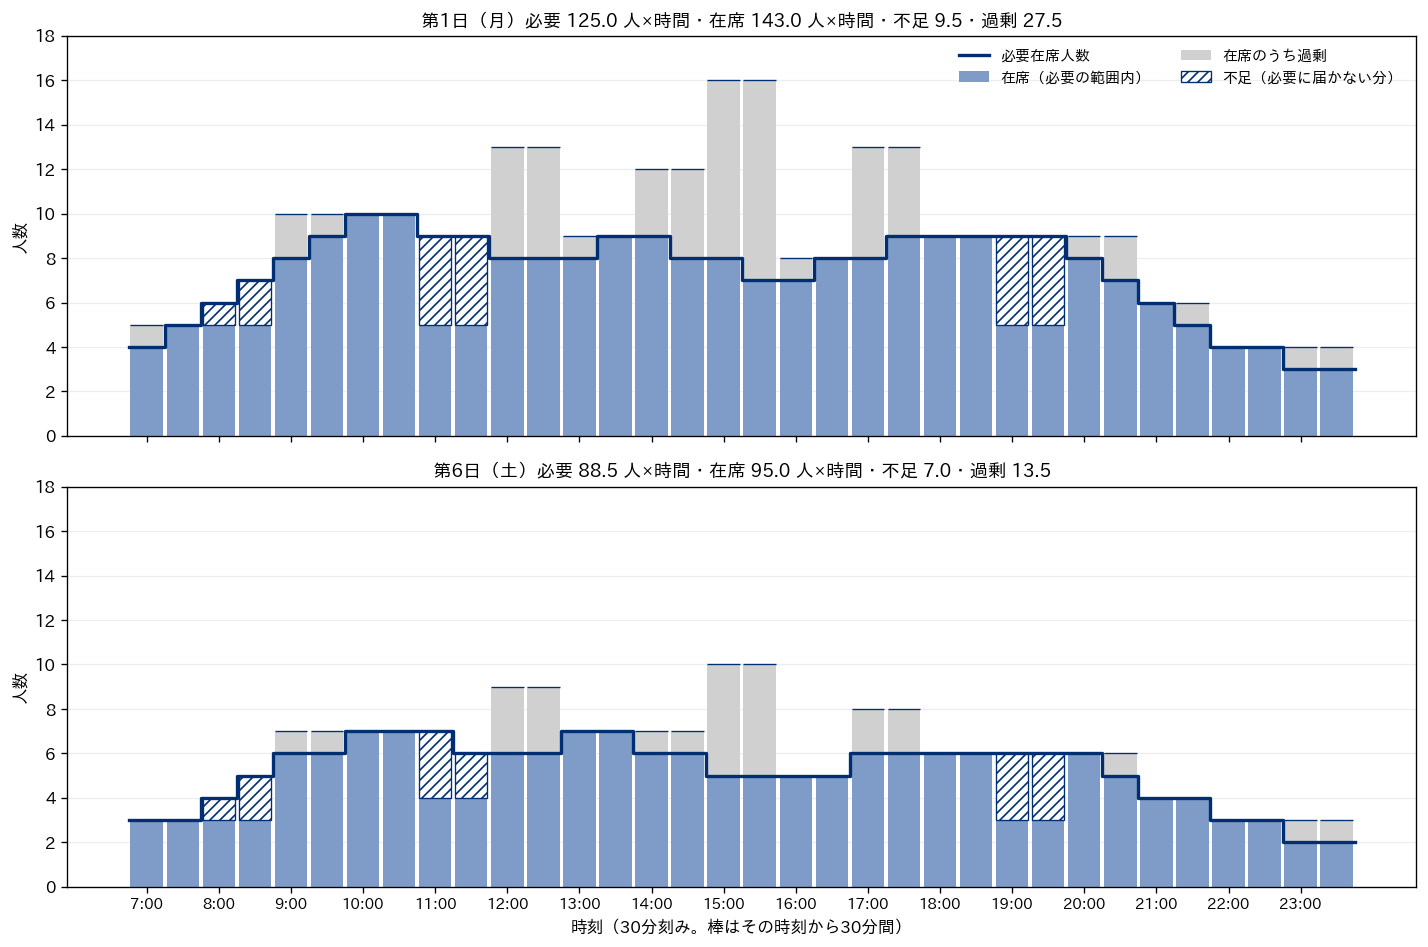
月曜の第1日は、必要125.0 人×時間に対して在席143.0 人×時間で、不足9.5・過剰27.5 人×時間です。土曜の第6日は必要88.5・在席95.0・不足7.0・過剰13.5 人×時間でした。両日とも、不足が出ているのは8時台・11時台・19時台の6枠で、同じ時刻に集中しています。月曜の11時台は必要9名に対して在席5名、19時台も必要9名に対して在席5名です。反対に15時台は必要8名に対して16名が在席していて、倍の人数が席にいます。
この形が28日のすべてで起きているかどうかを、時刻ごとに不足と過剰を28日分足して確かめたのが次の図です。
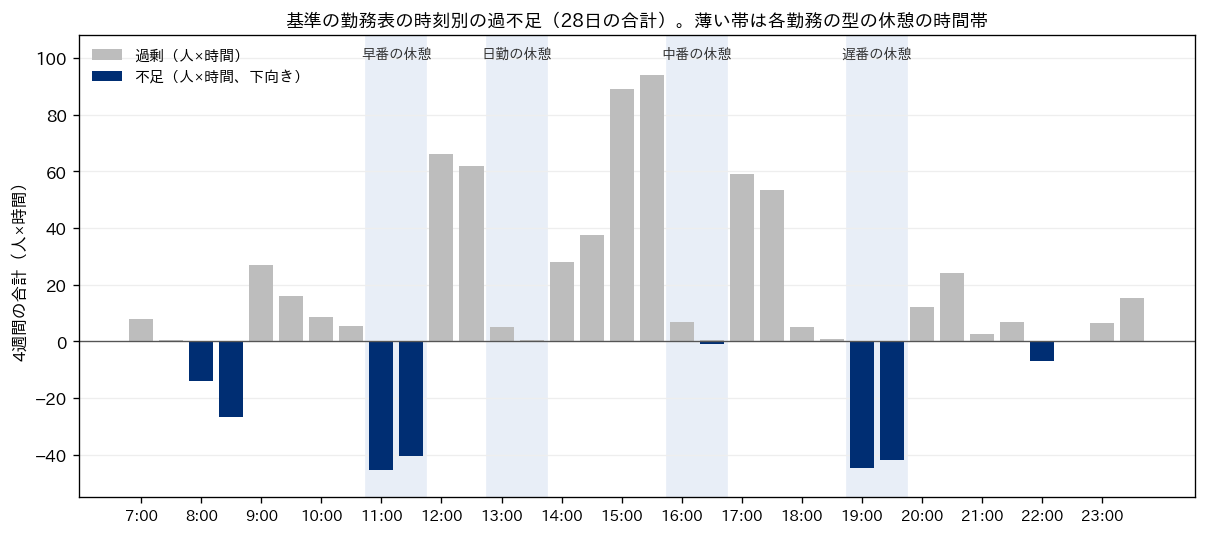
28日の合計で見ると、不足221.0 人×時間のうち、11時台が86.0、19時台が86.5 人×時間で、この2つの時間帯だけで172.5 人×時間、不足全体の78%を占めます。次に多いのが8時台の40.5 人×時間です。過剰は15時台の2枠が最も大きく、15時30分からの30分だけで28日合計94.0 人×時間ありました。不足と過剰が同じ日に両方ある日は、28日中28日です。
図の薄い帯が、原因を示しています。共通データの勤務の型は、休憩60分の位置が型ごとに決まっていて、早番は11時〜12時、日勤は13時〜14時、中番は16時〜17時、遅番は19時〜20時です。11時台の不足は早番の全員が同時に休憩に入る時間、19時台の不足は遅番の全員が同時に休憩に入る時間と重なっています。8時台の不足は、7時始まりの早番しかいない時間に入電が増えていく時間帯で、9時始まりの日勤がまだ来ていないためです。15時台の過剰は、遅番が始まる15時から早番が終わる16時までの1時間に、早番・日勤・中番・遅番の4つの型が休憩なしで同時に席にいるためです。
つまり、基準の勤務表の不足の大半は「誰をどの日に入れるか」ではなく「型の休憩の位置と開始時刻」から来ています。個人への割当をどれだけ工夫しても、早番の人が全員11時に休憩に入る限り、11時台の穴は埋まりません。この記事の基準の結果で「不足と過剰が同時に大きい」理由がこれで、休憩の位置を動かせる場合の効果や、開始時刻の違う型を増やした場合の効果は、第4章で集合被覆の問題として扱っています。勤務表の結果を見て不足が特定の時刻に偏っていたら、割当の問題ではなく、型の設計の問題を疑うのが順序だと考えています。
SV と英語対応についても、同じ勤務表で余裕を見ておきます。SV の在席人数はどの枠でも1名以上でしたが、ちょうど1名しかいない枠が952枠中312枠ありました。英語対応が必要な平日9時〜18時の360枠のうち、英語対応がちょうど1名の枠は118枠です。これらの枠では、その1名が欠勤すると SV 不在・英語不在になります。基準の結果の「SV 不在0枠」は、計画の時点で0というだけで、当日の欠勤に強いという意味ではありません。欠勤への備えは第11章、スキルを持つ人を増やす効果は第9章で扱います。
同じ最適値の勤務表は何通りもある
この章で基準のモデルを組み直して最初に解いたとき、状態は OPTIMAL で目的関数の値も2,053,500と基準に一致しましたが、内訳は基準の記録と違っていました。不足は216.0 人×時間(基準は221.0)、パートの勤務は495時間(基準は475時間)、過剰は656.0 人×時間(基準は641.0)です。そこで、同じ設定のまま乱数種を変えて解き直し、内訳がどれだけ動くかを確かめました。
| 実行 | 状態 | 目的関数 | 不足人時 | 過剰人時 | 希望休の違反 | パートの勤務 |
|---|---|---|---|---|---|---|
| 基準の記録(乱数種0) | OPTIMAL | 2,053,500 | 221.0 | 641.0 | 3件 | 475時間 |
| 第5章 乱数種0(1回目) | OPTIMAL | 2,053,500 | 216.0 | 656.0 | 3件 | 495時間 |
| 第5章 乱数種0(2回目) | OPTIMAL | 2,053,500 | 216.0 | 656.0 | 3件 | 495時間 |
| 第5章 乱数種1 | OPTIMAL | 2,053,500 | 218.5 | 648.5 | 3件 | 485時間 |
| 第5章 乱数種2 | OPTIMAL | 2,053,500 | 221.0 | 641.0 | 3件 | 475時間 |
| 第5章 乱数種3 | OPTIMAL | 2,053,500 | 218.5 | 648.5 | 3件 | 485時間 |
表の「目的関数」の列はすべて2,053,500で、どれも最適性が証明された勤務表です。それでも「不足人時」の列は216.0から221.0まで、「パートの勤務」の列は475時間から495時間まで動いています。このように、目的関数の値が同じで中身の違う最適解を代替最適解と呼びます。この表の中で、乱数種0の2回の実行(第5章のスクリプト)は同じ結果でしたが、基準の記録は同じ乱数種0で221.0でした。同じ乱数種でも、実行が違えば別の最適解が返ることがある、ということです。OR-Tools のパラメータ定義(sat_parameters.proto)には、実験的な設定 interleave_search を有効にすると探索が num_workers によらず決定的になる、という説明があります。この記事の実行はすべてこの設定を使わない既定の状態なので、最適解が複数ある問題では、どの解が返るかは実行ごとに変わりうるものとして扱っています。時間制限と乱数種による揺れの測り方は第6章で扱います。
内訳が動く理由は、重みの比で説明できます。基準の記録と乱数種0の結果を比べると、不足は5.0 人×時間(10 人×30分)少なく、パートは20時間多くなっています。不足10 人×30分の重みは10×3,000=30,000、パート20時間の人件費は20×1,500円=30,000円で、ちょうど等しくなります。つまり、この2つの勤務表は「パートを20時間増やして不足を5 人×時間減らす」という取引が、重みの上では損も得もない関係にあるということです。重みづけの和を目的にすると、重みの上で等しい取引は区別されず、ソルバーはどちらを返してもよいことになります。
この揺れは、この章だけのものではありません。第6章から第9章でも、それぞれの章のスクリプトで基準と同じ設定を解き直しており、目的関数はどれも2,053,500(OPTIMAL)でしたが、返ってきた勤務表の不足人時は章によって違います。序章でも触れたこの点を、ここでまとめて示します。
| 基準と同じ設定を解いた実行 | 目的関数 | 不足人時 | パートの勤務 |
|---|---|---|---|
| 基準の記録(記事全体の基準の数字) | 2,053,500 | 221.0 | 475時間 |
| 第5章(上の表の5回) | 2,053,500 | 216.0〜221.0 | 475〜495時間 |
| 第6章(並びの制約を窓の和で書いたモデル、2回) | 2,053,500 | 218.5 | 485時間 |
| 第7章(最初の計算) | 2,053,500 | 218.5 | 485時間 |
| 第7章(目的関数を最適値に保ったまま、不足を最小にした2段目の計算) | 2,053,500 | 216.0 | 495時間 |
| 第8章 | 2,053,500 | 221.0 | 475時間 |
| 第9章(乱数種0と乱数種1) | 2,053,500 | 216.0と218.5 | 495時間と485時間 |
表のどの行も、基準の記録の勤務表とは「不足5 人×30分とパート10時間」(重みではどちらも15,000)を単位にした入れ替えの関係にあります。第7章の2段目の計算は、目的関数が2,053,500のままの勤務表の中で不足を最も小さくすると216.0 人×時間になることを、OPTIMAL として証明しています。つまり、この設定の同点の勤務表の不足人時は216.0が下限で、各章の解き直しで出てきた値は216.0〜221.0の範囲に収まっています。この記事では、基準の数字は基準の記録の221.0 人×時間・過剰641.0 人×時間にそろえ、各章の中の比較は、その章で解き直した勤務表どうしを、目的関数(重みの合計)の差で比べることにしています。不足人時の数 人×時間の違いは、同点の解の選ばれ方による揺れを含みます。
計算時間も揺れます。基準の記録は2.6秒でしたが、この章で同じ設定を解いた実行は、最初の1回が2.5秒、上の表の5回が10.5〜18.4秒でした(いずれもこの記事の実行環境での実測)。この記事の各章の計算は同じPCで並行して動かしているので、他の計算の負荷で時間が変わります。2.6秒は1回の実測値で、いつも同じ時間で解けることを保証する値ではありません。
実務では、この性質を2つの意味で意識しておく必要があります。1つは、毎月同じ設定で勤務表を作り直すと、条件が同じでも違う勤務表が出てくることがある、という点です。前月と比べて誰かの勤務が変わったとき、それが条件の変化によるものか、同点の解の入れ替わりによるものかを区別できるようにしておかないと、現場への説明に困ります。もう1つは、同点の解の中から選びたい基準(たとえば「同じ費用ならパートの時間は少ないほうがよい」「同じなら不足が少ないほうがよい」)があるなら、それを重みか、目的の順番として明示的にモデルに書く必要がある、という点です。書かなければ、ソルバーはその好みを知りません。1つ目の目的で最適値を出し、その値を保ったまま2つ目の目的で解き直す段階的な解き方は第6章で扱います。
重みを変えると何が起きるか
次に、基準の重みを変えて解いたときに、勤務表の中身がどう変わるかを確かめました。基準は再実行せず基準の記録の数字を使い、新しい設定はこの章の別のスクリプトで、時間制限60秒・num_workers=8 で2回ずつ解いています。試したのは次の3つです。案1は、希望休を必ず守る(ハード制約にする)場合です。案2は、不足1人×30分あたりの重みを3,000から1,000に下げる場合で、不足を軽く見積もった運用に当たります。案3は、逆に不足1人×30分あたりの重みを6,000に上げる場合です。以下、この節で「不足の重み」と書くときは、すべて不足1人×30分あたりの値です。
| 設定 | 状態 | 不足人時 | 不足のある枠 | 過剰人時 | 希望休の違反 | パートの勤務 | パートの人件費(架空) |
|---|---|---|---|---|---|---|---|
| 基準(不足の重み 1人×30分あたり3,000) | OPTIMAL | 221.0 | 181 | 641.0 | 3件 | 475時間 | 712,500円 |
| 案1 希望休を必ず守る | INFEASIBLE(2回とも) | なし | なし | なし | なし | なし | なし |
| 案2 不足の重み1,000 | OPTIMAL(2回とも同じ) | 476.0 | 391 | 421.0 | 3件 | 0時間 | 0円 |
| 案3 不足の重み6,000 | OPTIMAL(2回とも同じ値) | 139.0 | 153と152 | 964.0 | 3件 | 880時間 | 1,320,000円 |
案1は、2回とも(実測2.6秒と2.0秒)INFEASIBLE(実行可能な解が存在しない)と判定されました。理由は、ヒートマップの節で見たとおりです。S01 と S05 の希望休は、4週20日・週5日までという条件と両立しないので、希望休をハード制約にした瞬間に、条件をすべて満たす勤務表が1つも存在しなくなります。この通常の解き方では、ソルバーは「解がない」と答えるだけで、どの条件がぶつかっているかまでは分かりません。この例では手で原因を特定できましたが、条件が多くなると難しくなります。解なしのときに原因の条件を絞り込む方法は第6章で扱います。この結果から言えるのは、希望や努力目標をむやみにハード制約にすると、勤務表そのものが作れなくなる危険がある、ということです。基準のモデルが希望休をソフト制約にしているのは、この事態を避けるためです。
案2では、パートが1時間も使われなくなりました。不足人時は221.0から476.0 人×時間に倍以上に増え、必要在席人数を下回る枠も181から391枠に増えています。パートを入れなくなったぶん、正社員の型の使い方も変わり、早番129回・遅番106回と、朝と夜の端の型が増えています(基準は早番107回・遅番91回)。この振る舞いは、パートの時給と不足の重みの比で説明できます。パートの短時間勤務は実働5時間(10枠)で7,500円、1枠あたり750円です。不足の重みが1枠1,000円なら、パートを1回入れて得をするのは、その10枠のうち8枠以上(7.5枠を超える)で不足を埋められるときだけです。結果として、この例題ではパートを入れて元が取れる入れ方が1つも選ばれず、パートの勤務は0時間になりました。基準の重み3,000なら、10枠のうち3枠(2.5枠を超える)で不足を埋められれば元が取れます。
案3では逆に、パートの勤務が880時間に増え、不足人時は139.0 人×時間まで減りました。ただし、パートを405時間増やして減った不足は82.0 人×時間で、過剰人時は641.0から964.0に増えています。不足の重みを倍にしても不足は0にならず、3つの結果を並べると、パートを0時間(案2)から475時間(基準)に増やしたときは、パート1時間あたり約0.54 人×時間(255.0÷475)の不足が減りましたが、475時間から880時間(案3)に増やしたときは約0.20 人×時間(82.0÷405)しか減っていません。パートを足すほど、1時間あたりに埋まる不足は小さくなっています。パートは週3〜4日までという上限があり、型も短時間(午前)・短時間(夕方)・日勤に限られるので、埋められる時刻にも限りがあります。2回の実行で不足人時・過剰人時・パートの時間は同じでしたが、不足のある枠の数は153と152、型ごとの延べ回数も少し違っていて、ここでも代替最適解が現れています。
3つの結果を経営の言葉で並べると、不足の重みは「不足1 人×時間を減らすために、いくらまで払ってよいか」という値付けそのものです。基準から案3へ移ると、パートの人件費が607,500円増えて不足が82.0 人×時間減るので、不足1 人×時間あたり約7,400円を払ったことになります。第6章では、不足をどれだけ費用がかかっても最小にする段階的な解き方で、同じ139.0 人×時間まで不足を減らします。そこで必要になるパートの最小も、この案3の勤務表と突き合わせると880時間(基準から405時間・607,500円の増加)で、同じ取引を別の方向から見たものになっています。基準から案2へ移ると、パートの人件費712,500円が浮く代わりに不足が255.0 人×時間増えるので、不足1 人×時間あたり約2,800円の人件費を節約したことになります。どちらが正しいかはソルバーでは決まらず、不足がサービスレベルの低下を通じて売上や顧客満足をどれだけ損なうかという経営の判断で決まります。第3章で見たサービスレベルと必要人数の関係を、不足1 人×時間の値段に翻訳してから重みを決めるのが筋だと考えています。
勤務表を現場に出すときの形
ソルバーが返すのは、スタッフ×日の表に型の記号が並んだデータです。これをそのまま配っても、現場で使える勤務表にはなりません。見る人ごとに必要な切り口が違うからです。基準の勤務表を例に、少なくとも次の4つの形に作り分けることが有効だと考えています。
| 形 | 見る人 | 中身 | 基準の勤務表での例 |
|---|---|---|---|
| 個人別の表 | スタッフ本人 | その人の4週間の勤務の型と休み、始業・終業の時刻 | S01 は第1週が中番・日勤・日勤・中番・日勤・休み・休み。4週で20日 |
| 日別の表 | その日の責任者 | 型ごとに誰が入るか、SV と英語対応が誰か | 第1日(月)は早番5名(SV は S03・S06)、日勤4名、中番3名、遅番4名、短時間(午前)1名、短時間(夕方)2名 |
| 時刻別の在席表 | センター長・運営管理 | 30分ごとの必要在席人数と在席人数、SV と英語対応の人数 | 第1日の11時台は必要9名に在席5名、SV は1名、英語対応は1名 |
| 例外の一覧 | シフト作成者・管理者 | 通らなかった希望休と理由、不足の残る枠、SV が1名だけの枠 | 希望休の違反3件(S01 の第3日・第5日、S05 の第13日)と、雇用の条件と両立しないという理由 |
表の「基準の勤務表での例」の列は、基準の記録に合わせた勤務表の第1日から取りました。日別の表と時刻別の在席表は、同じデータを別の向きから見たものです。日別の表は「今日は誰が来るか」を確かめるためのもので、時刻別の在席表は「今日はどの時間が薄いか」を事前に知るためのものです。第1日の時刻別の在席表を見れば、11時台と19時台に在席が必要を4名下回ることが朝の時点で分かるので、休憩の時刻を当日だけずらす、応援を頼むといった手を前もって打てます。
4つ目の例外の一覧は、自動作成の勤務表を現場が受け入れるかどうかを左右すると考えています。自動で作った勤務表では、なぜ自分の希望休が通らなかったのかが本人に見えません。基準の勤務表の3件は、雇用の条件(4週20日・週5日まで)と希望休の出し方がぶつかったことが原因で、誰が勤務表を作っても避けられなかったものです。この理由を一覧に添えておけば、本人への説明が「ソルバーがそう決めた」ではなく「この週に4日の希望休を出すと、週5日までの規則の下では4週20日に届かない」という、規則にもとづいた説明になります。説明できる勤務表の作り方と、人が最後に手で直す運用は第13章で扱います。
もう1点、勤務表と一緒に、この章の最初の表にある経営指標(不足人時・過剰人時・希望休の違反・SV 不在・パートの時間)を1枚にまとめて添えることも有効です。毎月同じ指標を並べておけば、前月と比べて何が良くなり何が悪くなったかが、勤務表の細部を見なくても分かります。ただし、前の節で見たとおり、同じ条件でも代替最適解の入れ替わりで内訳が少し動くことがあるので、月ごとの比較では、指標の小さな動きを条件の変化と取り違えないように注意が要ります。
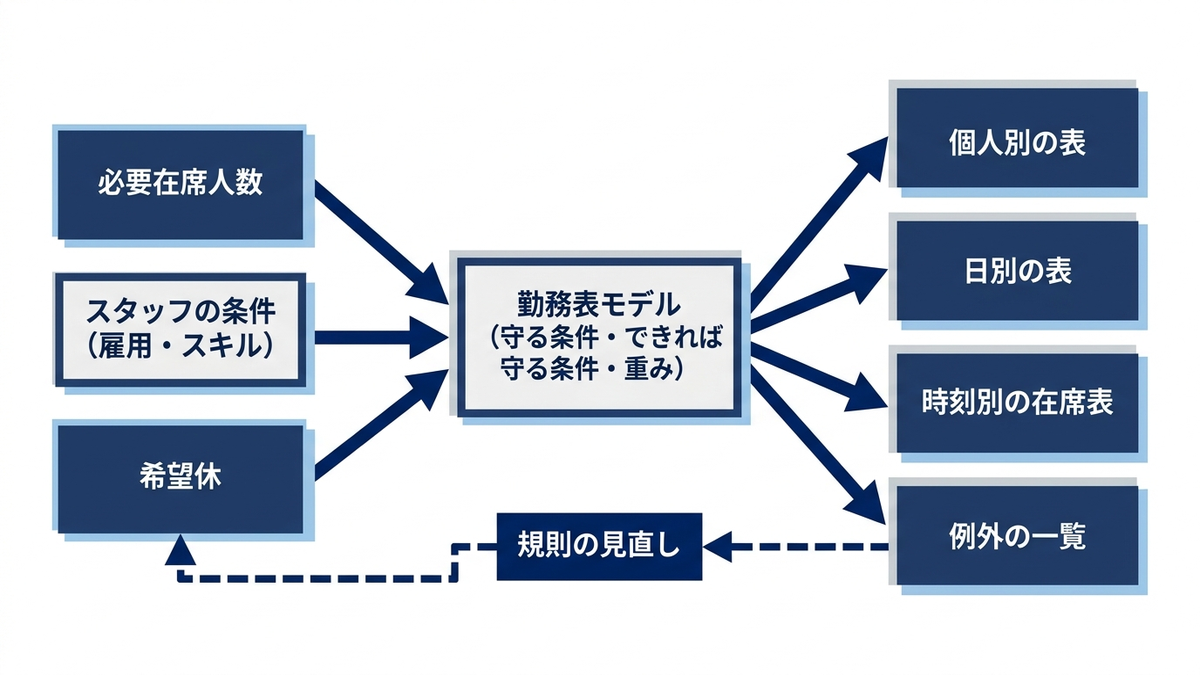
経営の判断に翻訳する
この章の結果を、経営の判断に使える形に整理します。1つ目は、勤務表の不足の原因を3つに分けて見ることです。基準の勤務表の不足221.0 人×時間のうち78%は、早番と遅番の休憩の時間帯(11時台と19時台)に重なっていました。休憩の位置と型の開始時刻は型の設計の問題で、第4章の範囲です。希望休の違反3件は、雇用の条件と希望休の出し方の衝突から来ていて、就業規則と運用の問題です。個人への割当の工夫が効く余地があるのは、多くてもこの2つを除いた残りの部分です。勤務表の出来が悪いとき、割当のソルバーを取り替えても直らない不足があることを知っておくと、投資の向け先を誤りにくくなります。
2つ目は、重みの決め方が、そのまま人件費とサービスの取引の値決めになることです。この章の例題では、不足1 人×30分の重みを1,000・3,000・6,000と変えると、パートの時間は0・475・880時間、不足人時は476.0・221.0・139.0 人×時間と大きく動きました。重みを決めるのは技術者ではなく、「不足1 人×時間を減らすのに何円まで払うか」を決められる立場の人です。重みを決めずに担当者の感覚で置くと、会社として意図しない水準のサービスと人件費の組合せが、毎月の勤務表に黙って組み込まれます。
3つ目は、判断を誤ったときの損失の型です。不足の重みを低く置きすぎると、案2のように人件費は浮きますが、必要在席人数を下回る30分が4週間で391回に増え、そのたびにサービスレベルが目標を大きく下回ります。反対に、希望や努力目標をハード制約に積み上げすぎると、案1のように勤務表そのものが作れなくなり、締切の直前に手作業に戻ることになります。どちらも、ソルバーの性能ではなく、モデルに何をどの重さで書いたかで決まる損失です。
この章の要点は3つです。第一に、個人への割当はナース・スケジューリング問題として、日数や並びの規則をハード制約、必要人数と希望休をソフト制約にし、重みづけの和を最小にする形で解けます。基準の勤務表は2.6秒で最適性まで証明されました。第二に、基準の結果を図にすると、不足の大半は型の休憩の位置から、希望休の違反は雇用の条件との衝突から来ていて、割当だけでは減らせない部分がはっきり分かれます。第三に、目的関数が同じでも内訳の違う代替最適解があり、重みを変えるとパートの時間と不足人時が大きく入れ替わるので、重みは経営の値決めとして決める必要があります。次の第6章では、この章で使った CP-SAT の書き方を詳しく見て、並びの条件の別の書き方、段階的な解き方、解なしのときの原因の探し方を扱います。
この章を深めたい方への参考書籍
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):数理最適化の代表的な問題を Python で定式化して解く本で、多目的最適化の章の中にスタッフスケジューリングの節があります。この章で扱った「複数の目的を重みでまとめて1つの勤務表を選ぶ」ことを、多目的最適化の問題として読み直すのに向いています。ソルバーには商用の Gurobi を使っているので、この記事の CP-SAT のコードとは書き方が違いますが、定式化の考え方はそのまま比べられます。
『数理最適化の実践ガイド』(穴井宏和、講談社):最適化の基礎概念とアルゴリズムを整理したうえで、多目的最適化の章と、実問題を解くときの心得を扱う章を置いた本です。この章で見た「重みづけの和で複数の目的をまとめる」ことの意味と限界を、多目的最適化の考え方から見直すのに役立ちます。
第6章 CP-SAT を使いこなす
第5章では、第2章で用意したサンプルデータ(架空のコンタクトセンター、スタッフ30名・4週間)に対して、CP-SAT で作った基準の勤務表を読み、どこが不足し、どこが過剰になっているかを確かめました。基準の勤務表は、不足・希望休の違反・SV 不在・英語不在・パートの人件費を円換算の重みで足した1つの値を最小にしたもので、30秒の時間制限に対して実測2.6秒で最適性まで証明されています(第5章で説明した基準の記録)。この章では、その勤務表を作った道具である CP-SAT そのものに焦点を移します。制約の書き方には同じ意味でも複数の選択肢があり、目的の立て方にも重みづけと段階的な解き方の2通りがあります。時間制限で打ち切った解をどう読むか、解が無いと言われたときに原因をどう探すか、別のソルバーで解くと何が変わるか、そして自分のモデルが正しいかを公開ベンチマークでどう検算するか。いずれも、勤務表の自動作成を業務に入れたあとで必ず出会う問題です。この章では、それぞれを共通データで実際に解いて確かめます。
以下の計算は、すべてこの記事の実行環境(一般的なノートPC、OR-Tools 9.15.6755、Python 3.14.3)での実測です。この記事の各章の計算は同じPCで並行して走っているため、計算時間は他の計算の負荷で揺れます。時間の数字は同じ条件で2回以上測った値を並べ、揺れが大きいものはそのまま書きました。
CP-SAT は何を受け取り、何を返すのか
CP-SAT は、Google が公開している最適化ライブラリ OR-Tools に含まれるソルバーで、名前の CP は制約プログラミング(変数の取りうる値の範囲を制約で絞り込んでいく方法)、SAT は真か偽かの変数の組合せが論理式を満たすかを判定する問題を指します。内部の仕組みの詳細はこの章では扱わず、使う側から見て押さえるべき性質に絞ります。最も大事なのは、扱える数が整数だけという点です。OR-Tools の公式ガイド「CP-SAT Solver」は、計算を速くするために CP-SAT は整数の上で動くので、問題は整数だけで定義する必要があり、整数でない項を含む制約は十分大きな整数を掛けて整数にそろえるよう説明しています。第5章の基準のモデルでも、費用を円の整数で書いていました。時給の端数や割合を使いたいときは、100倍するなどして整数にそろえてから渡します。
勤務表のモデルで使う変数のほとんどは、ブール変数(0か1の値をとる変数)です。基準のモデルでは「スタッフ i が d 日目に勤務の型 t に入るなら1、入らないなら0」という変数を、スタッフが入れる型の数だけ作りました。30名×28日×(正社員は4通り、パートは1〜3通り)で、この変数は2,632個になり、勤務の有無や不足を表す補助の変数を合わせると5,736個、制約は5,390本です。制約は、この変数を足し合わせた式に上限や下限を付ける線形制約が中心です。たとえば「1日に1つの勤務まで」は、その日のその人の変数の和が1以下という式で、「在席人数が必要人数に届かない分を不足とする」は、在席している人の変数の和に不足の変数を足したものが必要人数以上という式で書いています。
ソルバーが返すのは、変数の値(つまり勤務表)と、解の状態です。状態のうち実務で見るのは4つで、OPTIMAL(最適な解が見つかり、それより良い解が無いことまで証明できた)、FEASIBLE(制約を満たす解は見つかったが、最適かどうかは時間内に証明できなかった)、INFEASIBLE(制約を満たす解が存在しないことが証明された)、UNKNOWN(時間内に解も見つからず、解が無いことの証明もできなかった)です。最適化の問題では、状態と一緒に目的の値と下界も返ります。下界は「これより良い値の解は存在しない」と証明できた値で、最小化の問題なら、目的の値と下界の差が、見つかった解がどれだけ最適から離れている可能性があるかの上限になります。OPTIMAL は、この差が0になった状態です。
| 状態 | 意味 | 勤務表を使ってよいか | 次にすること |
|---|---|---|---|
| OPTIMAL | 最適な解が見つかり、最適性まで証明できた | 使ってよい。ただし最適なのはモデルに書いた目的と制約について | 同じ値の別の解があることがあるので、運用上の好みは目的か制約に書き足す |
| FEASIBLE | 制約を満たす解は見つかったが、最適性は証明できていない | ハード制約は満たしているので使える。どれだけ改善の余地があるかは目的と下界の差で読む | 差が大きければ時間制限を延ばす、モデルを締める、ヒントを与える |
| INFEASIBLE | ハード制約をすべて満たす勤務表は存在しない | 勤務表は返らない | どの制約の組合せが矛盾しているかを探す(後の節) |
| UNKNOWN | 時間内に解が見つからず、解が無いことの証明もできなかった | 勤務表は返らない | 時間制限を延ばす、制約の一部をソフトにして解を見つけやすくする |
表の「使ってよい」は、モデルに書いたことについてだけ正しい、という点に注意が要ります。基準のモデルは希望休を破ると1件5,000の罰則、不足は1人×30分あたり3,000と置いていますが(どちらも第5章で説明した架空の重み)、ソルバーはこの重みのもとで最適な勤務表を返すだけで、重みが現場の感覚に合っているかは判断しません。OPTIMAL という表示は、「モデルが現場を正しく表しているなら、これ以上の勤務表は無い」という条件つきの保証です。
よく使う部品、add_exactly_one・add_bool_or・含意
勤務表のモデルは、少数の部品の組合せでほとんど書けます。OR-Tools 9.15 の Python の API は小文字のスネークケースの名前(new_bool_var、add_exactly_one など)になっていて、この記事ではこちらを使います。次のコードは、共通データのスタッフ S01〜S08 の最初の1週間だけを取り出し、早番・日勤・中番・遅番と休みを割り当てる小さな例です。必要人数は使わず、「各型に1名以上」という簡単な条件に置き換えています。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from ortools.sat.python import cp_model
from shift_data import staff, forbidden_next, WEEKDAY_NAMES
ps = staff()[:8]                      # S01〜S08、先頭の1週間だけ
T = ["E", "D", "M", "L", "休"]
fb = forbidden_next()
m = cp_model.CpModel()
x = {(i, d, t): m.new_bool_var(f"x{i}_{d}_{t}") for i in range(8) for d in range(7) for t in T}
for i in range(8):
    for d in range(7):
        m.add_exactly_one(x[i, d, t] for t in T)                  # 1日に1つだけ(休みも1つの型)
    m.add(sum(x[i, d, "休"] for d in range(7)) == 2)             # 週2日休む
    for d in range(6):
        for a in ["M", "L"]:
            for b in [c for c in fb[a] if c in T]:
                m.add_bool_or([x[i, d, a].Not(), x[i, d + 1, b].Not()])   # 続けてはいけない組
    m.add_implication(x[i, 5, "休"].Not(), x[i, 6, "休"].Not())   # 土曜に出たら日曜も出る
for d in range(7):
    for t in ["E", "D", "M", "L"]:
        m.add(sum(x[i, d, t] for i in range(8)) >= 1)            # 各型に1名以上
    late = sum(x[i, d, "L"] for i in range(8))
    for i in range(3):                                           # S01〜S03 が遅番の日は遅番を2名以上に
        m.add(late >= 2).only_enforce_if(x[i, d, "L"])
viol = [x[i, d, "休"].Not() for i in range(8) for d in ps[i]["off_req"] if d < 7]
m.minimize(sum(viol))                                            # 希望休の違反を最小に
solver = cp_model.CpSolver()
solver.parameters.num_workers = 8
solver.parameters.random_seed = 0
st = solver.solve(m)
print(solver.status_name(st), "希望休の違反", int(solver.objective_value), "/", len(viol))
print("    ", " ".join(WEEKDAY_NAMES))
for i in range(8):
    print(ps[i]["id"], " ".join(next(t for t in T if solver.value(x[i, d, t])) for d in range(7)))
# 出力: OPTIMAL 希望休の違反 2 / 10
# 出力:      月 火 水 木 金 土 日
# 出力: S01 E L 休 D 休 M D
# 出力: S02 D M 休 E 休 L M
# 出力: S03 M D 休 M 休 L L
# 出力: S04 E L M 休 L 休 L
# 出力: S05 L 休 D L 休 D E
# 出力: S06 休 E E E D 休 E
# 出力: S07 休 E 休 E E E E
# 出力: S08 E 休 L L M 休 E
使った部品を順に説明します。add_exactly_one は、渡したブール変数のうちちょうど1つが1になる、という制約です。ここでは休みも1つの型として扱ったので、「その日は5つのうちどれか1つ」と書けます。休みを型に含めない基準のモデルでは、同じことを「変数の和が勤務の有無を表す変数と等しい」という線形制約で書いていました。どちらでも意味は同じで、休みを型に含めると勤務表を表として読むときに扱いやすく、含めないと変数の数が少し減ります。
add_bool_or は、渡したものの少なくとも1つが真になる、という制約です。.Not() は変数の否定で、「中番の日の翌日は早番でない」を「今日が中番でない、あるいは翌日が早番でない」の少なくとも一方が成り立つ、と書き換えています。続けてはいけない組(第2章で説明した勤務間インターバル11時間から導いたもの)は、すべてこの形で入ります。add_implication(a, b) は「a が真なら b も真」という含意で、ここでは「土曜が休みでないなら日曜も休みでない」、つまり土曜に出たら日曜も出るという規則を書きました。この1本で禁じられるのは「土曜に勤務して日曜に休む」並びだけで、「土曜に休んで日曜に勤務する」並びは禁じていません。出力でも S04・S06・S08 は土曜が休みで日曜が勤務です。土日を必ずそろえて休ませたいなら、逆向きの含意(日曜に出たら土曜も出る)も足すか、土曜の休みと日曜の休みの2つの変数を等しいとする制約を1本置きます。
only_enforce_if は、制約に「この変数が真のときだけ効く」という条件を付けるものです。上のコードでは、S01〜S03 のだれかが遅番に入る日だけ、その日の遅番の人数を2名以上にしています。たとえば新しく SV になった人が遅番に入る日はもう1人付ける、といった規則はこの形で書けます。条件付きの制約は、大きな定数を使った書き方(いわゆる Big-M)で線形制約に直すこともできますが、CP-SAT では only_enforce_if をそのまま渡せます。出力の勤務表で S01〜S03 が遅番(L)に入っている日(S01 の火曜、S02 の土曜、S03 の土曜と日曜)を見ると、いずれもその日の遅番が2名以上になっています。
この例の希望休は8名の1週間分で10件あり、2件が守られませんでした。状態は OPTIMAL なので、この条件のもとでは2件より少なくできないことまで証明されています。出力の表と共通データの希望休を突き合わせると、破られたのは S01 の土曜と日曜です。S01 はこの週に水・金・土・日の4日の希望休を出していますが、モデルには「週2日休む」という規則があるので、4日のうち2日は必ず勤務になります。この小さな例なら理由は目で追えますが、30名・4週間のモデルで同じことを目で追うのは難しくなります。後の「解なしのときに原因を探す」の節では、この種の理由をソルバーに探させる方法を扱います。
並びの制約を窓の和で書くか、オートマトンで書くか
勤務表に特有なのが、日の並びに関する規則です。「連続勤務は5日まで」「中番の翌日に早番を入れない」「休むなら2日以上続けて休む」のように、1日だけを見ても守れているか分からず、前後の日と合わせて初めて判定できる規則をここでは並びの制約と呼びます。書き方は大きく2通りあります。1つは窓の和で書く方法で、「どの連続6日を取っても勤務は5日以下」のように、決まった長さの区間(窓)ごとに線形制約を置きます。基準のモデルの連勤の上限はこの書き方で、1人あたり23本(28日から5を引いた数の窓)の制約になります。「中番の翌日に早番を入れない」は長さ2の窓に対する add_bool_or で、これも窓の書き方の一種です。
もう1つが オートマトン(状態と、状態の移り方の表で規則を表したもの)を使う方法です。CP-SAT の add_automaton は、変数の列と、開始の状態、終わってよい状態の一覧、そして「状態 a のときに値 v が来たら状態 b に移る」という遷移の組の一覧を受け取り、列の値をこの表に沿って読んでいったとき、開始の状態から終わってよい状態のどれかに行き着けることを制約にします(OR-Tools 9.15 に付属する add_automaton の説明文で確認)。表に無い遷移は起こせないので、「してはいけない並び」を、遷移を置かないことで表します。連勤の上限なら、状態を「いま何日続けて勤務しているか」とし、5日目の状態からは勤務の遷移を置かなければ、6日連続の勤務は作れなくなります。
# 抜き出し(この章のモデルの部品、説明文は省略)。ws はその人の28日分の「勤務なら1」の変数
# 状態0=休み(か期間の始め)、状態k=k日続けて勤務、状態 kmax+1=休みの1日目
def add_seq_automaton(m, ws, kmax, no_single_off):
    first_off = kmax + 1
    tr = [(0, 0, 0), (0, 1, 1)]              # 休みが続く/休みのあと勤務に入る
    for k in range(1, kmax):                 # 勤務を続ける(kmax 日目からは続けられない)
        tr.append((k, 1, k + 1))
    for k in range(1, kmax + 1):             # 勤務のあと休む
        tr.append((k, 0, first_off if no_single_off else 0))
    if no_single_off:
        tr.append((first_off, 0, 0))         # 休みの2日目。休み1日目から勤務へ戻る遷移は置かない
    finals = list(range(0, first_off + 1))   # 期間の終わりはどの状態でもよい
    m.add_automaton(ws, 0, finals, tr)

# 同じ規則を窓の和で書く場合
def add_max_consec_window(m, ws, kmax):
    # 連勤の上限:どの kmax+1 日の窓でも勤務は kmax 日まで
    for d in range(len(ws) - kmax):
        m.add(sum(ws[d:d + kmax + 1]) <= kmax)

def add_no_single_off_window(m, ws):
    # 勤務・休み・勤務の並びを禁じる(1日だけの休みを作らない)。期間の端の休みは許す
    for d in range(len(ws) - 2):
        m.add_bool_or([ws[d].Not(), ws[d + 1], ws[d + 2].Not()])
2つの規則を同時に表すとき、オートマトンの利点が見えます。「連勤5日まで」に「1日だけの休みを作らない(休むなら2日以上続ける)」を重ねる場合、窓の書き方では規則ごとに別の制約の群を足しますが、オートマトンでは状態を1つ(休みの1日目)増やし、そこから勤務へ戻る遷移を置かないだけで済みます。規則が状態の表として1か所にまとまるので、現場のルールとの突き合わせもしやすくなります。一方で、状態の数は規則の組合せとともに増えるので、多くの規則を1つのオートマトンに詰め込むと表が読みにくくなります。
では、どちらが速いのか。共通データの基準のモデルで、連勤の上限だけの場合と、正社員に「1日だけの休みを作らない」を足した場合の2通りについて、2つの書き方を30秒の時間制限(num_workers=8、random_seed=0)で2回ずつ解きました。
| 並びの規則 | 書き方 | 制約の本数 | 1回目の状態と実測時間 | 1回目の目的/下界 | 2回目の状態と実測時間 | 2回目の目的/下界 |
|---|---|---|---|---|---|---|
| 連勤5日まで | 窓の和 | 5,390 | OPTIMAL 13.1秒 | 2,053,500/2,053,500 | OPTIMAL 17.9秒 | 2,053,500/2,053,500 |
| 連勤5日まで | オートマトン | 4,730 | OPTIMAL 29.7秒 | 2,053,500/2,053,500 | FEASIBLE 30.5秒 | 2,828,500/2,053,500 |
| 連勤5日まで+1日だけの休みを作らない | 窓の和 | 5,858 | FEASIBLE 30.1秒 | 2,136,500/2,103,500 | FEASIBLE 30.1秒 | 2,154,000/2,103,500 |
| 連勤5日まで+1日だけの休みを作らない | オートマトン | 4,730 | FEASIBLE 30.2秒 | 2,601,500/2,118,000 | FEASIBLE 30.3秒 | 2,689,500/2,096,000 |
表から読めることが3つあります。1つ目は、窓の和で書いた連勤5日までのモデルが、目的2,053,500で OPTIMAL になったことです。これは基準の記録の目的と同じ値で、この章で自分で組み直したモデルが基準と同じ問題を表していることの確認になります。ただし中身は少し違い、基準の勤務表の不足は442人×30分でしたが、ここで得た勤務表の不足は437人×30分で、そのぶんパートの人件費が15,000円多くなっています。不足5人×30分の重み(3,000×5=15,000)とパートの人件費の差がちょうど釣り合い、重みづけの目的では同じ値になる別の勤務表が見つかったということです。OPTIMAL の勤務表は1つとは限らず、同じ最適値の中でどれが返るかは実行ごとに変わりえます(各章の解き直しの値は第5章の表にまとめました)。
2つ目は、この例題ではオートマトンの書き方のほうが遅かったことです。制約の本数はオートマトンのほうが少ない(連勤の23本の窓が1本のオートマトンに置き換わる)のに、連勤だけのモデルでは2回目が30秒で最適に届かず、目的2,828,500という大きく劣る解で打ち切られました。「1日だけの休みを作らない」を足したモデルでも、30秒の時点の目的は窓の和のほうが良い値でした。制約の本数が少ないことは、速く解けることを意味しません。どちらの書き方が速いかは問題によって変わるので、自分のモデルで両方を試してから決めるのが確実だと考えています。なお、基準の記録では同じ問題が2.6秒で最適になっていましたが、この表の計算は他の章の計算と同じPCで並行して走ったため13秒から18秒かかりました。表の時間の差は、書き方の差と負荷の揺れの両方を含んでいます。
3つ目は、規則を1つ足すだけで問題が急に難しくなることです。「1日だけの休みを作らない」を足すと、どちらの書き方でも30秒では最適性を証明できませんでした。ここで下界が役に立ちます。4回の実行で得た下界のうち最も大きいのは2,118,000で、どの実行の下界も「これより良い解は無い」ことの証明なので、この規則を足したモデルの最適値は2,118,000以上です。見つかった最も良い解は2,136,500なので、最適値はこの間にあります。規則を足す前の最適値2,053,500と比べると、「1日だけの休みを作らない」という規則の費用は、重みづけの目的で少なくとも64,500、多くとも83,000と読めます。この幅は時間制限を延ばせば縮みます。規則を足す前の最適な勤務表では、正社員18名に「勤務・休み・勤務」の1日だけの休みが80回ありました。飛び石の休みを減らすという現場の要望にどれだけの費用がかかるかを、このように下界つきで示せるのが、最適性の証明まで扱えるソルバーの強みです。
重みづけの和と辞書式、目的の立て方で勤務表が変わる
基準のモデルの目的は、不足・希望休の違反・SV 不在・英語不在・パートの人件費を、円換算の重みで足した1つの値です。重みは交換の比率を表していて、たとえば不足1人×30分の重み3,000と、パートの時給1,500円から、「パートを1時間余分に入れて不足が1人×30分減るなら、目的は1,500だけ良くなる」という計算をソルバーはしています。これに対し、目標に優先順位を付け、上の目標を最も良くしたうえで、その値を悪化させない範囲で次の目標を良くする、という解き方があります。これを辞書式の最適化(段階的に解く方法)と呼びます。辞書で単語を1文字目から順に比べるのと同じ順序の付け方だからです。
CP-SAT では、辞書式は段階ごとに解き直して書きます。1段目の目的で解き、得られた値を「これより悪くしない」という制約としてモデルに足し、目的を次の目標に取り替えて解き直します。前の段の解をヒント(add_hint)として渡すと、次の段の探索でその解を最初の解の手がかりとして使いやすくなります。OR-Tools の cp_model.proto(9.15版)の説明によれば、ヒントはソルバーが最初の実行可能な解を作るときに使おうとする情報で、必ず使われる保証は無く、渡したほうが常に速いとも限りません。
# 抜き出し(この章の辞書式のスクリプト、表示と時間計測の行は省略)。exprs は目標ごとの式、order は優先順位
for key in order:
    m.clear_objective()
    m.minimize(exprs[key])
    solver = cp_model.CpSolver()
    solver.parameters.max_time_in_seconds = 30.0
    solver.parameters.num_workers = 8
    solver.parameters.random_seed = 0
    st = solver.solve(m)
    val = int(round(solver.objective_value))
    m.add(exprs[key] <= val)          # この段の値を悪化させない
    m.clear_hints()
    for v in b["x"].values():
        m.add_hint(v, solver.value(v))  # この段の解を次の段の出発点にする
基準と同じ制約のもとで、2通りの優先順位で解いた結果が次の表です。順番Aは「不足→SV・英語の不在→希望休の違反→パートの人件費」、順番Bは「希望休の違反→不足→SV・英語の不在→パートの人件費」です。表の数字は最後の段を解き終えた時点(打ち切りを含む)の勤務表のもので、重みづけの和の行は基準の記録からの引用です。
| 目的の立て方 | 不足人時 | 過剰人時 | 希望休の違反 | SV・英語の不在 | パートの勤務 | 重みづけの目的に換算 | 最後の段の状態 |
|---|---|---|---|---|---|---|---|
| 重みづけの和(基準) | 221.0人×時間 | 641.0人×時間 | 3件 | 0枠 | 475時間 | 2,053,500 | OPTIMAL |
| 辞書式 順番A(不足が先) | 139.0人×時間 | 997.0人×時間 | 3件 | 0枠 | 913時間 | 2,218,500 | FEASIBLE(パートの人件費 1,369,500円、下界 1,320,000円) |
| 辞書式 順番B(希望休が先) | 142.5人×時間 | 1,010.5人×時間 | 3件 | 0枠 | 923時間 | 2,254,500 | FEASIBLE(パートの人件費 1,384,500円、下界 1,294,500円) |
順番Aでは、1段目で不足を最小にした結果、不足は278人×30分(139.0人×時間)まで下がり、これは最適値であることまで証明されました(1段目の状態は OPTIMAL)。重みづけの和の基準の221.0人×時間より82.0人×時間少ない値です。その代わり、この実行ではパートの勤務が475時間から913時間へ438時間増え、過剰人時も641.0から997.0へ増えました。不足を1人×30分でも減らせるなら、パートの人件費がいくらかかっても入れる、というのが辞書式で不足を先頭に置いた意味だからです。
ただし、913時間は「必要な最小」ではありません。最後の段(パートの人件費の最小化)は30秒で打ち切られた FEASIBLE で、下界は1,320,000円、つまりパート880時間分でした。一方、第5章の案3(不足1人×30分あたりの重みを6,000にした計算)は、不足139.0人×時間・SV と英語の不在0枠・希望休の違反3件という、順番Aの1〜3段目と同じ条件を満たす勤務表を、パート880時間で OPTIMAL として返しています。下界と同じ値の勤務表が実際にあるので、順番Aで本当に必要なパートの最小は880時間ちょうどで、基準から405時間の増加です。表の「重みづけの目的に換算」の2,218,500は打ち切り時点の勤務表の値で、880時間の勤務表なら2,169,000(基準より115,500悪い値)になります。重みづけの和は、不足82.0人×時間(重みでは164枠×3,000=492,000)を減らすのにパートの人件費405時間分(1,500円×405=607,500円)を払うのは割に合わない、と判断していたことになります。不足1人×時間あたりに直すと約7,400円で、第5章で「案3へ移ると不足1人×時間あたり約7,400円を払ったことになる」と読んだのと同じ取引です。
順番Bでは、1段目で希望休の違反を最小にし、3件になりました(OPTIMAL)。この3件は基準の3件と同じ件数で、後の「解なしのときに原因を探す」の節で見るとおり、ハードの規則だけから見て避けられない最小の件数です。2段目の不足の最小化は30秒で最適性を証明できず、285人×30分(下界278)で打ち切られました。順番Aの1段目で不足の最適値が278だと分かっているので、この差は打ち切りによるものです。辞書式は段の数だけ解き直すので、各段に時間制限を付けると、どこかの段で最適に届かず、その段の値が後の段の制約として固定されてしまいます。順番Aは4段の合計で実測74.4秒、順番Bは75.8秒かかり、最後の段はどちらも FEASIBLE でした。
実務での使い分けは、次のように考えています。辞書式は「不足はどんな費用を払っても最小に」「希望休は絶対に最優先」のように、目標の間に交換の比率を認めない場合の書き方で、説明がしやすい半面、下位の目標がどれだけ犠牲になっても止まりません。上の例では、不足を82.0人×時間減らすためにパートの勤務がほぼ2倍(最小でも475時間から880時間)になっています。重みづけの和は、「不足1人×30分はいくらに相当するか」という比率を決める必要がありますが、その比率のもとで全体の釣り合いを取ります。経営の判断として使いやすいのは、両方を並べることだと考えています。辞書式の1段目で「最大限頑張ると不足はどこまで減らせるか」(ここでは139.0人×時間)という限界を示し、重みづけの和で「今の重みのもとで費用と釣り合う点」(221.0人×時間)を示せば、その差の82.0人×時間を埋めるのにパートの勤務が405時間(架空の時給で607,500円)要る、という形で、追加の人件費と不足の削減を並べて議論できます。重みの決め方そのものは第8章でも扱います。
時間制限と解の質、状態と下界を必ず読む
実務では、勤務表の計算に使える時間は限られます。毎月の作成なら数分でも待てますが、欠勤が出た当日の組み直しなら数十秒で答えが欲しい場面もあります。CP-SAT は max_time_in_seconds で時間制限を付けると、その時点で見つかっている最良の解と下界を返します。時間制限をどこに置けばよいかは、時間を変えて解いてみないと分かりません。そこで、並びの制約の節で最適性を証明できなかった「1日だけの休みを作らない」を足したモデルを、時間制限を5秒から80秒まで変えて解きました(num_workers=8、random_seed=0)。
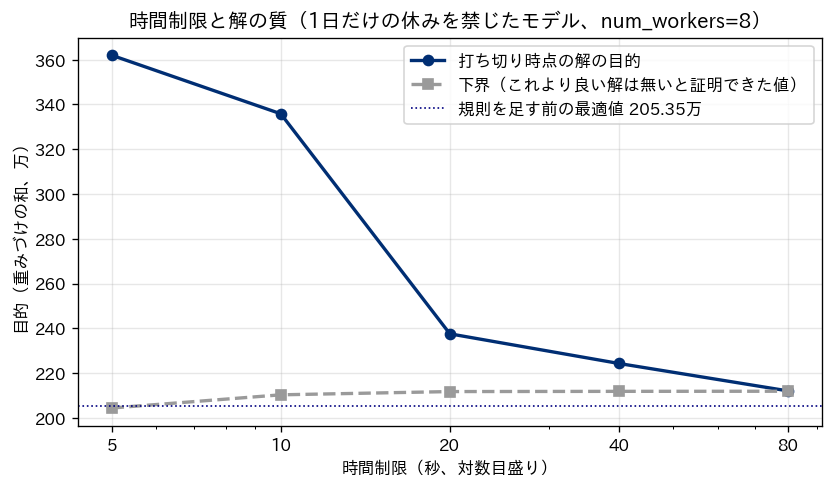
| 時間制限 | 状態 | 打ち切り時点の目的 | 下界 | 目的と下界の差(目的に対する割合) | 不足(人×30分) | 希望休の違反 |
|---|---|---|---|---|---|---|
| 5秒 | FEASIBLE | 3,620,000 | 2,044,000 | 43.54% | 1,030 | 29件 |
| 10秒 | FEASIBLE | 3,358,500 | 2,103,000 | 37.38% | 700 | 37件 |
| 20秒 | FEASIBLE | 2,375,500 | 2,117,500 | 10.86% | 499 | 19件 |
| 40秒 | FEASIBLE | 2,243,000 | 2,118,500 | 5.55% | 433 | 16件 |
| 80秒 | FEASIBLE | 2,120,500 | 2,119,000 | 0.07% | 436 | 14件 |
時間制限を延ばすほど、打ち切り時点の目的は良くなり、下界は少しずつ上がって、80秒では両者の差が0.07%まで縮みました。状態はどれも FEASIBLE で、最適性の証明までは届いていません。それでも80秒の結果からは、「最適値は2,119,000以上で、手元の勤務表は2,120,500なので、最適との差は多くても1,500」と言えます。並びの制約の節の30秒の実験では、この規則の費用を「少なくとも64,500、多くとも83,000」と見積もりましたが、80秒の結果を使うと、規則を足す前の最適値2,053,500との差は「少なくとも65,500、多くとも67,000」まで絞れます。80秒の勤務表の中身を見ると、不足は436人×30分で規則を足す前とほぼ同じ一方、希望休の違反が14件と、基準の3件から増えています。この例題では、飛び石の休みを無くす費用の多くが、希望休を守れなくなる形で表れているということです。
一方、5秒や10秒で打ち切った勤務表は、目的が下界より40%前後も悪く、不足も700〜1,030人×30分と、80秒の436人×30分の1.6〜2.4倍でした。同じモデルでも、計算を途中で止めた勤務表は、最適に近い勤務表とは別物になりえます。状態が FEASIBLE の勤務表を使うときは、必ず目的と下界の差を見るのが基本です。差が数%以内なら使い、数十%なら時間を延ばすかモデルを見直す、という線引きが一案だと考えています。どこで線を引くかは、差を重みづけの目的のまま読むのではなく、不足人時や人件費に換算して決めるのが確実です。
次に、揺れを確かめました。CP-SAT は並列に複数の探索を走らせるので、同じ設定でも結果が変わることがあります。OR-Tools の sat_parameters.proto(9.15版)は、乱数種 random_seed を変えるとソルバーが探索の途中で異なる選択をしうること、問題によっては小さな違いで実行時間が大きく変わることを説明し、num_workers については、0なら使えるコアをすべて使い、1なら並列化しないと説明しています。同じモデルを20秒で、乱数種と num_workers を変えて解いた結果が次の表です。
| 設定(時間制限20秒) | 状態 | 打ち切り時点の目的 | 下界 | 目的と下界の差 |
|---|---|---|---|---|
| num_workers=8、random_seed=0 | FEASIBLE | 2,335,500 | 2,114,000 | 9.48% |
| num_workers=8、random_seed=1 | FEASIBLE | 2,179,500 | 2,103,500 | 3.49% |
| num_workers=8、random_seed=2 | FEASIBLE | 2,294,000 | 2,103,500 | 8.30% |
| num_workers=8、random_seed=3 | FEASIBLE | 2,343,500 | 2,114,000 | 9.79% |
| num_workers=8、random_seed=4 | FEASIBLE | 2,222,000 | 2,112,500 | 4.93% |
| num_workers=1、random_seed=0 | UNKNOWN(解が見つからなかった) | なし | 2,053,500 | なし |
| num_workers=2、random_seed=0 | FEASIBLE | 2,622,500 | 2,053,500 | 21.70% |
| num_workers=4、random_seed=0 | FEASIBLE | 3,261,500 | 2,053,500 | 37.04% |
| num_workers=8、random_seed=0(同じ設定の再実行) | FEASIBLE | 2,809,500 | 2,114,500 | 24.74% |
乱数種を0から4に変えると、20秒の時点の目的は2,179,500から2,343,500まで、約16万の幅で揺れました。さらに注意したいのは、num_workers=8・random_seed=0 という同じ設定の20秒の実行が、この記事の中で3回あり、2,375,500(時間制限の表)、2,335,500、2,809,500と、3回とも違う値になったことです。乱数種を固定しても、並列で探索する設定では同じ結果が再現するとは限らない、ということです。この章の計算は他の章の計算と同じPCで並行して走っていたので、揺れには負荷の影響も含まれている可能性がありますが、その内訳はこの実験では切り分けていません。同じ設定で結果を再現したい場合について、前記の sat_parameters.proto は、実験的な機能としている interleave_search を有効にすると、探索が num_workers に関係なく決定的になると説明しています。この章ではこの設定は試していないので、効果は確かめていません。
num_workers を減らすと、20秒の時点の結果ははっきり悪くなりました。1では解が1つも見つからず(UNKNOWN)、2と4でも目的と下界の差は20〜40%台で、下界は規則を足す前の最適値2,053,500から動いていません。8では下界が2,114,500まで上がっています。なぜ並列数でここまで差が出るのかは、この実験では確かめていません。実務での教訓は2つです。時間制限つきの結果を比べるときは同じ条件で複数回解き、揺れの幅を知ったうえで差を読むこと。そして、勤務表を作る計算機の並列数を減らす(たとえば共用のサーバーで1スレッドに制限する)と、同じ時間制限でも品質が大きく落ちうることです。
解なしのときに原因を探す、仮定を使った切り分け
勤務表のモデルを業務に入れると、ある月だけ INFEASIBLE(解なし)が返ってくる、ということが起こります。ハード制約を増やしたとき、人が減ったとき、希望休を「必ず守る」扱いにしたときなどです。解なしのときソルバーは勤務表を返さないので、作成者は何を緩めればよいか分からないまま手作業に戻ることになりがちです。数百本の制約のどれとどれが矛盾しているかを人が探すのは難しいので、ソルバーに探させます。CP-SAT には、そのための仕組みとして仮定(assumptions)があります。
やり方は次のとおりです。制約をまとまりごとに分け、まとまりごとに1つのブール変数(ここでは札と呼びます)を作って、そのまとまりの制約すべてに only_enforce_if(札) を付けます。そして add_assumptions で「札はすべて真であると仮定して解け」と指示します。解なしになった場合は、sufficient_assumptions_for_infeasibility が、矛盾を説明するのに足りる札の組を返します。OR-Tools の cp_model.proto(9.15版)の説明は、この仕組みを、関係の深い制約のまとまりを1つの札の下にまとめることで解釈しやすい説明が得られるもの、と位置づけています。同じ説明は、返る組が最小である保証は無いこと、そして現状では、組を小さくする処理は1スレッドで最適化でない(目的の無い)問題のときだけ行われ、それ以外では仮定がすべて含まれる、とも書いています。そのため、下のモデルには目的を置きませんでした。
# 抜き出し(この章の切り分けのスクリプト、ループと結果の表示は省略)。tag(名前) はその名前の札(ブール変数)を1つだけ作って返す
m.add(sum(work[i, d] for d in range(N_DAYS)) == p["days_4w"]).only_enforce_if(tag("正社員は4週で20日"))
m.add(sum(work[i, d] for d in range(wk * 7, wk * 7 + 7)) <= p["max_days_week"]).only_enforce_if(tag("週の日数の上限"))
m.add(work[i, d] == 0).only_enforce_if(tag("希望休 %s %d日目(%s)" % (p["id"], d + 1, WEEKDAY_NAMES[weekday(d)])))
m.add(sum(en_terms) >= 1).only_enforce_if(tag("英語対応を平日9〜18時の全枠に1名以上"))
# ……連勤・インターバル・SV も同様に札を付ける
m.add_assumptions([lit[nm] for nm in names])      # 札はすべて真と仮定する
st = solver.solve(m)
if st == cp_model.INFEASIBLE:
    idx = solver.sufficient_assumptions_for_infeasibility()
    core = [m.proto.variables[k].name for k in idx]  # 矛盾を説明するのに足りる札の名前
場面として、英語対応の S12 が別部署へ移り、英語対応が S03・S09・S21 の3名になった月を想定しました。そのうえで、英語対応の配置(平日9〜18時の全枠に1名以上)と SV の配置(全枠に1名以上)を必ず守るハード制約にし、希望休88件もすべて必ず守る扱いにしました。必要人数の不足はこの実験では扱わず、ハードの規則だけで勤務表が作れるかを問います。札は、正社員の4週20日、週の日数の上限、連勤5日まで、勤務間インターバル11時間、SV の配置、英語の配置の6つと、希望休1件ごとに1つの88個、合わせて94個です。
結果は INFEASIBLE で、返った札は7個でした(実測0.8秒)。中身は、S05 の希望休4件(11日目の木曜、12日目の金曜、13日目の土曜、19日目の金曜)と、正社員の4週20日、連勤5日まで、週の日数の上限です。予想していた英語の配置は含まれていませんでした。この1回目は num_workers=8 で解いたもので、前記の説明からは94個すべてが返ることもありうると考えていましたが、実際には7個に絞られて返り、num_workers=1 で解き直しても同じ7個でした。前記の説明のとおり、この組が最小とは限らないので、返った札を1つずつ外して解き直し、外しても解なしのままの札を捨てる、という点検(削除による絞り込み)をしました。19日目の希望休と連勤5日までは、外しても解なしのままだったので捨てられ、最小の組は5個になりました。
| 手順 | ソルバーが返した札の数 | 絞り込んだ最小の組 | 読み方 | 緩めた札 |
|---|---|---|---|---|
| 1 | 7個 | S05 の希望休(11・12・13日目)、正社員は4週で20日、週の日数の上限 | 2週目(8〜14日目)に希望休が3日あり、勤務できるのは4日。4週で20日を週5日以内で満たすには毎週5日勤務が必要なので、1日足りない | S05 の13日目の希望休 |
| 2 | 7個 | S01 の希望休(5・6・7日目)、正社員は4週で20日、週の日数の上限 | S01 は1週目に4日の希望休(3・5・6・7日目)を出しており、同じ理由で足りない | S01 の7日目の希望休 |
| 3 | 6個 | S01 の希望休(3・5・6日目)、正社員は4週で20日、週の日数の上限 | 1週目に希望休がまだ3日残っていて、まだ1日足りない | S01 の6日目の希望休 |
| 4 | (解あり) | なし | 残りの91個の札をすべて守る勤務表が存在する | 計3個 |
この切り分けから分かったことは2つあります。1つ目は、共通データの希望休のうち3件は、英語や SV の配置とは関係なく、正社員の「4週で20日」と「週5日まで」の2つの規則だけで守れなくなっていることです。4週で20日を週5日以内で勤務するには、毎週ちょうど5日勤務するしかありません。S01 は1週目に4日、S05 は2週目に3日の希望休を出しているので、それぞれ2件と1件は必ず破られます。第5章で読んだ基準の勤務表の「希望休の違反3件」は、この下限と同じ件数でした。つまり基準の勤務表は、希望休について規則の範囲で守れるものはすべて守っていたことになります。なお、表で緩めた希望休(S05 の13日目、S01 の7日目と6日目)は、第5章の基準の記録に合わせた勤務表で破られていた日(S01 の3日目と5日目、S05 の13日目)と一部違います。S01 は1週目の4日の希望休のうち2日が破られればよく、その2日の選び方は1通りではありません(この章の切り分けでは6日目と7日目、第5章の勤務表では3日目と5日目)。どの日が選ばれるかは、切り分けで札を外した順番や、同点の勤務表のどれが返ったかで変わります。食い違いではなく、同じ件数(S01 が2件、S05 が1件)の別の選び方です。
2つ目は、想定した「英語対応が1人減った」ことは、ハードの規則の上では矛盾を生んでいなかったことです。3個の札を緩めたあとの手順4では、英語の配置と SV の配置をハードにしたまま解が見つかりました。人が原因を推測すると、直前に起きた変化(ここでは S12 の異動)を疑いがちですが、ソルバーが返した矛盾は別の場所にありました。解なしの原因を推測で探さず、札を付けて機械に切り分けさせることの価値はここにあります。
実務で使うときの注意も書いておきます。札の粒度は、緩め方の単位に合わせて決めます。希望休を1件ごとに札にしたので「S05 の13日目」という形で答えが返りましたが、希望休全体を1つの札にすると、「希望休」という答えしか返りません。また、この方法が使えるのは解なしの判定が速い場合で、判定そのものに時間がかかるモデルでは、時間切れ(UNKNOWN)になることがあります。そのときは、ハード制約を罰則つきのソフト制約に置き換え、「どの規則を何件破れば解が作れるか」を最小化する形で解くのが実用的です。基準のモデルのように希望休や SV の配置をソフト制約にしておけば、残りのハード制約が矛盾しない限り勤務表は必ず返り、どの規則を何件破ったかが結果に数字として出ます。
PuLP と CBC で同じ問題を解く
CP-SAT 以外のソルバーで解くと何が変わるかも確かめました。PuLP は Python で数理最適化のモデルを書くためのライブラリで、この記事の実行環境では、PuLP 3.3.2 に同梱された CBC(COIN-OR の混合整数計画ソルバー、版は2.10.3)を呼び出して解きます。混合整数計画(MIP)のソルバーは、一般に、整数の条件を外した線形計画(連続緩和)の値を下界として使いながら整数の解を探します。CBC のログにも、最初に連続緩和の値が表示されます。基準と同じモデル(同じ変数・同じ制約・同じ重み)を PuLP で書き直しました。ブール変数は cat="Binary" の変数になり、続けてはいけない組は add_bool_or の代わりに「2つの変数の和が1以下」という線形制約で書きます。only_enforce_if や add_automaton に当たる部品は無いので、条件付きの制約や並びの規則を足すときは、線形制約への書き換えが要ります。
| ソルバー | 状態 | 目的 | 不足(人×30分) | 希望休の違反 | 計算時間(この記事の実行環境での実測) | どの実行か |
|---|---|---|---|---|---|---|
| CP-SAT(num_workers=8、30秒制限) | OPTIMAL | 2,053,500 | 442 | 3件 | 2.6秒 | 基準の記録 |
| CBC(threads=8、120秒制限) | Optimal | 2,053,500 | 442 | 3件 | CBC の計測 4.17秒(PuLP の呼び出し全体 7.4秒) | この章の CBC の1回目の呼び出し |
| CBC(threads=1、120秒制限) | Optimal | 2,053,500 | 442 | 3件 | CBC の計測 3.05秒(PuLP の呼び出し全体 3.7秒) | この章の CBC の3回目の呼び出し |
CBC も同じ最適値2,053,500にたどり着き、最適性まで証明しました。この例題では、CBC のログに「Continuous objective value is 2.0535e+06」とあり、整数の条件を外した連続緩和の値が、すでに整数の最適値と同じ値でした(ログの表示は有効数字5桁)。分枝の節点の数(Enumerated nodes)は0で、分枝をせずに最適性が証明されています。分枝とは、整数でない値をとった変数について「0にする場合」「1にする場合」のように場合分けして探す手順のことで、節点が0というのは、場合分けを1度もせずに解けたという意味です。基準のモデルは、連続緩和が強い(整数の最適値と緩和の値の差が小さい)種類の問題だったということで、このような問題では MIP のソルバーでも速く解けます。ただし、「1日だけの休みを作らない」を足したモデルのように、規則を足して最適値が緩和の値から離れる問題でも同じように速いかは、この章では CBC で確かめていません。
一方で、CBC には運用上の注意も見つかりました。この章では PuLP から CBC を7回呼び出しましたが、上の表の2回を除く5回は、CBC の処理が CPU をほとんど使わないまま止まり、120秒の時間制限を過ぎても終わりませんでした(長いものは13分後にこちらで停止させました)。止まった原因は確かめられていません。ソルバーの時間制限は、ソルバーが計算を進めている間の打ち切りで、ソルバーの外で止まった処理には効かないことがある、というのがこの経験から言えることです。業務で勤務表を自動作成する仕組みでは、ソルバーを呼び出す側にも、壁時計の時間での打ち切りと、失敗したときの再実行の手順を用意しておくべきだと考えています。
どちらのソルバーを使うべきかについて、この例題から言えることは限られます。基準のモデルはどちらでも数秒で最適性まで解けたので、速さの比較にはなりません。違いが出るのは書き方の側で、CP-SAT は only_enforce_if やオートマトンのような論理の部品をそのまま渡せ、CBC などの MIP のソルバーは線形制約に書き換えたモデルを受け取り、連続緩和の値を下界として使います。CP-SAT はこの章の実験のとおり整数しか扱えないので、係数に小数を多く含むモデル(連続量の配分が主体の計画など)では MIP のソルバーのほうが書きやすいことがあります。規模が大きくなったときの計算時間と品質は、第10章でベンチマークを使って扱います。
公開ベンチマークで自分のモデルを検算する
自分で組んだモデルが正しいかどうかは、自社のデータだけでは確かめにくいものです。制約の書き間違いがあっても、ソルバーはその間違ったモデルの最適解を OPTIMAL として返すからです。そこで役に立つのが、定義と既知最良解が公開されているベンチマークです。この記事では、Curtois と Qu が公開している看護師勤務表のベンチマーク Instance1〜24 を使います。Nurse Rostering Benchmark Instances のページには、各インスタンスの週数・職員数・勤務の型の数と、既知の最良の下界と最良の解の値が表で載っています(2026年9月30日に確認)。Instance1〜3 はいずれも2週間で、職員は8名・14名・20名、勤務の型は1・2・3種類です。既知最良解はそれぞれ607・828・1001で、どれも下界と一致しているので、最適値が証明済みです。大きなインスタンスでの計算時間と品質は第10章で扱い、この章では小さい3つで、自分の目的関数の実装が公開の定義と一致するかを確かめます。
定義は同じサイトの Nurse Rostering Instances 1..24 のページで確かめました。ハード制約は、1日1勤務、続けてはいけない勤務の組、勤務の型ごとの回数の上限、合計の勤務時間(分)の上限と下限、連続勤務の上限と下限、連続休みの下限、週末(土曜か日曜に勤務があれば1回と数える)の勤務回数の上限、指定された休みの日です。ソフト制約は、入りたい勤務の希望(入らなかったら重み分の罰則)、入りたくない勤務の希望(入ったら重み分の罰則)、日と勤務の型ごとの必要人数(不足1人ごとに不足の重み、過剰1人ごとに過剰の重み)の3つで、罰則の合計が目的です。共通データの基準のモデルと違い、必要人数は30分の枠ではなく「日と勤務の型」ごとに与えられます。
読み違えやすいのが、計画期間の端の扱いです。定義のページは、連続勤務の上限については前の期間の最終日と次の期間の初日を休みとみなす一方、連続勤務の下限と連続休みの下限については、期間の前後に勤務(あるいは休み)が無限に続いているとみなす、と書いています。つまり、期間の初日から2日だけ勤務して休む、という並びは「前の期間から勤務が続いている」とみなされるので、連続勤務の下限(多くの職員で2日)に違反しません。この扱いを落として、期間の外を一律に休みとみなすと、端の短い連勤まで禁じる、定義より厳しいモデルになります。
そこで、定義どおりのモデルと、端を厳しく読んだ誤りのモデルの両方を作り、さらにモデルとは別に書いた採点関数(解を受け取り、ハード制約の違反と罰則を定義どおりに数え直す関数)で検算しました。時間制限は60秒、num_workers=8、random_seed=0 です。
| インスタンス | 職員/勤務の型 | 既知最良解 | 定義どおりのモデル(状態・実測時間) | 目的/下界 | 採点関数の罰則合計(ハード違反) | 端を厳しく読んだ誤りのモデル |
|---|---|---|---|---|---|---|
| Instance1 | 8名/1種類 | 607 | OPTIMAL 0.8秒 | 607/607 | 607(0件) | OPTIMAL 607 |
| Instance2 | 14名/2種類 | 828 | OPTIMAL 7.2秒 | 828/828 | 828(0件) | OPTIMAL 833 |
| Instance3 | 20名/3種類 | 1001 | OPTIMAL 10.3秒 | 1001/1001 | 1001(0件) | OPTIMAL 1005 |
定義どおりのモデルは、3つとも既知最良解と同じ値で OPTIMAL になり、採点関数で数え直した罰則の合計もソルバーの目的と一致し、ハード制約の違反は0件でした。既知最良解は下界と一致している(最適値が証明済み)ので、自分のモデルの最適値がそれと一致したことは、目的関数と制約の実装が公開の定義と同じ問題を表していることの強い裏付けになります。罰則の内訳を見ると、Instance1 は必要人数の不足が600で、希望の違反が7(入りたい希望4、入りたくない希望3)でした。Instance2 と Instance3 でも不足の罰則が800と1000を占めています。不足1人の重みは100なので、3つのインスタンスとも、最適な勤務表でも必要人数に届かない枠が延べ6〜10人分残る、ということです。
一方、端を厳しく読んだ誤りのモデルは、Instance1 では同じ607になりましたが、Instance2 では833、Instance3 では1005と、既知最良解より悪い値を OPTIMAL として返しました。ソルバーから見れば、誤ったモデルの最適解を正しく求めているので、状態は OPTIMAL です。このずれは、公開の最適値という答え合わせの相手がいたから見つかったもので、自社のデータだけで解いていたら気づけません。しかも Instance1 のように、読み違いが結果に表れない小さな例もあります。検算には複数のインスタンスを使い、既知最良解との一致と、独立に書いた採点関数との一致の両方を確かめるのがよいと考えています。
実務への翻訳としては、勤務表のモデルを導入するときに「期間の境目をどう扱うか」を必ず決めておく必要がある、ということです。月をまたぐ連勤や、月初の短い勤務の並びは、前月の勤務表を読み込んでつなぐのか、前月の最終日を休みとみなすのかで、許される勤務表が変わります。上の Instance3 では、境目を厳しく扱っただけで罰則が1001から1005に増えました。自社のモデルでも、前月末の勤務の実績を入力に含める設計にしておくと、月の境目で規則が破られたり、逆に必要以上に厳しくなったりすることを防げます。
経営の判断に翻訳する、ソルバーの出力をどう報告するか
ここまでの実験は、ソルバーの使い方の話に見えますが、どれも経営の判断に直結しています。最初に効いてくるのは、下界を使った「規則の値段」の見積りです。「1日だけの休みを作らない」という規則は、飛び石の休みによる疲れを減らすための規則として考えられるものですが、この章の例題では、重みづけの目的で少なくとも65,500、多くとも67,000の悪化と見積もれました(時間制限の節の80秒の結果。状態は FEASIBLE)。下限の65,500は下界から出した値なので、「ソルバーの腕が悪くて高く見えている」のではなく、「どんな勤務表を作っても、この規則を入れる限り65,500より小さい悪化では済まない」という意味を持ちます。上限の67,000は、その悪化で済む勤務表が手元に実在するという意味です。要望を通すかどうかを判断する人に、「この規則を入れると、不足や希望休の違反に換算して少なくともこれだけの費用がかかり、現時点でこれ以内に収まる勤務表がある」と幅で言えることは、話し合いの土台として重要だと考えています。
2つ目は、状態の報告の仕方です。勤務表を配布する担当者が、ソルバーの状態を見ずに「最適な勤務表です」と説明してしまうと、FEASIBLE で打ち切られた勤務表でも最適であるかのように扱われます。時間制限の節で見たとおり、5秒で打ち切った勤務表は、80秒の勤務表より重みづけの目的で約150万悪く、不足は1,030人×30分と、80秒の436人×30分の2倍以上でした。この差は不足人時の差です。サービスレベルへの影響は、不足がどの時間帯に出ているかで変わるので、時間帯別の入電と在席人数から第3章の方法で別に見積もる必要があります。勤務表を出すときには、少なくとも「状態(OPTIMAL か FEASIBLE か)」「目的と下界の差(%)」「計算に使った時間」の3つを一緒に記録し、FEASIBLE で差が大きいときは時間を延ばして作り直す、という運用の規則を決めておくのがよいと考えています。
3つ目は、解なしの原因の切り分けを、人の推測より先に行うことです。この章の例では、直前の異動を原因だと思い込んで英語対応の採用や研修を検討し始めても、解なしは解消しませんでした。実際の原因は、特定の週に希望休が集中していたことでした。この種の取り違えは、採用や配置転換のような費用の大きな判断を誤らせます。札を付けた切り分けは数秒で終わるので、解なしが出たら必ず先に回す手順にしておく価値があります。同じ切り分けは、「希望休は1週間に2日まで」のような受付の規則を作るときの根拠にもなります。4週でちょうど20日・週5日までの規則で働く正社員では、1週間に3日以上の希望休は必ず1件以上破られることが、この章の計算で確かめられたからです。4週の勤務日数に下限がなく、週の上限も3〜4日のパートには、この理屈は当てはまりません。
4つ目は、ソルバーの選定と検算の考え方です。この章の例題程度の大きさなら、無償のソルバーで最適性まで証明できました。この章の例題では、CP-SAT と CBC は同じ最適値を返した一方、期間の端の読み違いはベンチマークの最適値を1001から1005に変えました。結果を左右したのは、ソルバーの違いよりもモデルの側の誤りでした。ベンチマークでの検算は、ソルバーを選ぶためではなく、自分たちのモデルの読み違いを見つけるために使うものだと考えています。
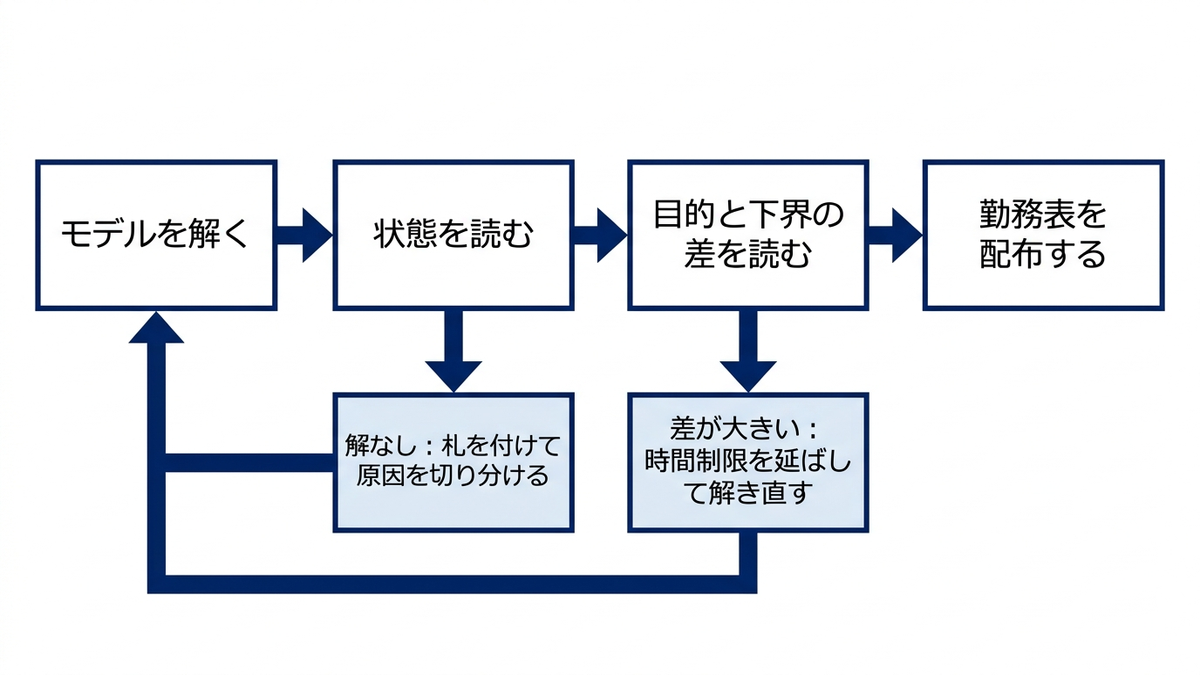
この章の要点は4つです。第一に、CP-SAT はブール変数と線形制約を中心に、add_exactly_one・add_bool_or・add_implication・only_enforce_if の少数の部品で勤務表の規則をほとんど書けます。並びの制約は窓の和でもオートマトンでも書けますが、どちらが速いかは問題によって変わり、この例題では窓の和のほうが速く解けました。第二に、目的の立て方は結果を大きく変えます。辞書式で不足を先頭に置くと不足は139.0人×時間まで減る一方、パートの勤務がほぼ2倍になり、重みづけの和はその交換を割に合わないと判断していました。第三に、時間制限で打ち切った解は、状態と下界を必ず併記して読みます。下界があれば、規則を足したときの費用の幅を示せます。第四に、解なしのときは仮定を使ってソルバーに原因を切り分けさせ、公開ベンチマークと独立の採点関数で自分のモデルを検算します。次の第7章では、ここで使った部品を使って、労働基準法などの法令と就業規則を制約として入れる方法を扱います。
この章を深めたい方への参考書籍
『今日から使える!組合せ最適化 離散問題ガイドブック』(穴井宏和・斉藤努、講談社):副題のとおり、組合せ最適化(離散的な選択肢の組合せから最も良いものを選ぶ問題)の基礎から始めて、離散的な問題の扱い方を整理したガイドブックです。この章では勤務表という1つの問題で CP-SAT の部品を試しましたが、勤務表を組合せ最適化の問題の1つとして一般的な言葉で捉え直すと、制約の書き方や解き方の選択肢を比べやすくなります。
『Pythonではじめる数理最適化 ケーススタディでモデリングのスキルを身につけよう 第2版』(岩永二郎・石原響太・西村直樹・田中一樹、オーム社):数理モデルの考え方と Python による最適化のチュートリアルに続いて、学校のクラス編成などのケーススタディでモデルを組み立てていく本です。この章の PuLP と CP-SAT の比較のように、同じ問題を自分の手でモデルに書き下ろし、結果を読んで直す練習の題材になります。
第7章 労働法令と就業規則を制約に入れる
第6章では、CP-SAT で勤務表の制約を書く部品(ブール変数、add_exactly_one、窓の和、add_automaton)と、時間制限・下界・解なしの原因探しを確かめました。そこで扱った制約のうち、連続勤務の上限や続けてはいけない勤務の組は、この記事では「架空の社内ルール」として置いてきました。しかし実際の勤務表には、社内で決めたルールの外側に、国が定めたルールがかかっています。1日と1週の労働時間の上限、休憩、休日、時間外労働の上限、年次有給休暇の取得です。この章では、労働基準法とその関連法令の条文を、原則と例外まで e-Gov 法令検索と厚生労働省のページで確かめたうえで、共通データの勤務の型がそれぞれのルールのどこに当たるかを照合し、CP-SAT のモデルにどう書くかを示します。あわせて、勤務間インターバルを11時間から9時間に縮めたとき、残業の上限を変えたとき、年次有給休暇の取得日を勤務表に入れたときに、不足人時がどう動くかを実行結果で測ります。
最初にお断りしておきます。この章は、勤務表の自動作成に法令の条件をどう組み込むかという技術の説明であり、法律の助言ではありません。条文は2026年9月30日に e-Gov 法令検索で開いた現行の版を引用していますが、個々の事業場にどの規定がどう適用されるかは、業種・規模・労使協定・就業規則の内容で変わります。実際の運用では、就業規則と36協定の現物を確かめ、必要に応じて社会保険労務士・弁護士や所轄の労働基準監督署に確認してください。
法令は動かせない制約、社内ルールは議論できる制約
勤務表の制約を整理するとき、この記事では3つの層に分けて考えています。1つ目は法令の層で、労働基準法の労働時間・休憩・休日の規定や、36協定で定めた時間外労働の上限です。これは勤務表の作成者が判断で緩めてよいものではないので、モデルでは必ず守るハード制約として書きます。違反しそうな場合でも、ソルバーの目的関数に罰則を足して「なるべく守る」形にはしません。2つ目は労使の合意と就業規則の層で、変形労働時間制の定め、所定の勤務の型(就業規則や雇用契約であらかじめ決めた勤務の型。以下「所定」はこの意味で使います)、36協定で協定した時間数などです。これも作成者の一存では変えられませんが、労使で見直すことはできます。3つ目は職場の運用ルールの層で、連勤の上限、勤務間インターバルの長さ(法令上は努力義務なので、何時間にするかは各社が決めます)、希望休の扱いなどです。
この3つの層を分けておく理由は、勤務表が組めないとき、あるいは不足が大きいときに「どこを動かす議論をしてよいか」をはっきりさせるためです。第6章で見たように、ハード制約を足しすぎるとモデルは解なしになり、その原因を探す作業が必要になります。そのとき、原因として見つかった制約が法令の層であれば、動かすのは制約ではなく人員の数や勤務の型の側です。運用ルールの層であれば、そのルールを緩めた場合に不足人時がどれだけ減るかを測り、減る量と、緩めることで生じる負担(休息が短くなる、連勤が長くなる)を並べて労使で判断できます。この章の後半の実験は、この「運用ルールを緩めると何がどれだけ変わるか」を数字で出すためのものです。
もう1つ、法令の層にも「絶対の上限」と「条件つきの上限」が混ざっている点に注意が要ります。たとえば1日8時間の上限は、36協定を結んで届け出れば延長でき、変形労働時間制を定めれば特定の日に超えることができます。こうした例外は、使える条件(協定・届出・就業規則の定め)がそろっているときにだけ使えるので、モデルに書くときは「この事業場では、どの例外の条件がそろっているか」を先に決め、それに応じた上限を入れる必要があります。条件がそろっていない例外を前提にした勤務表は、ソルバーが解を返しても使えません。
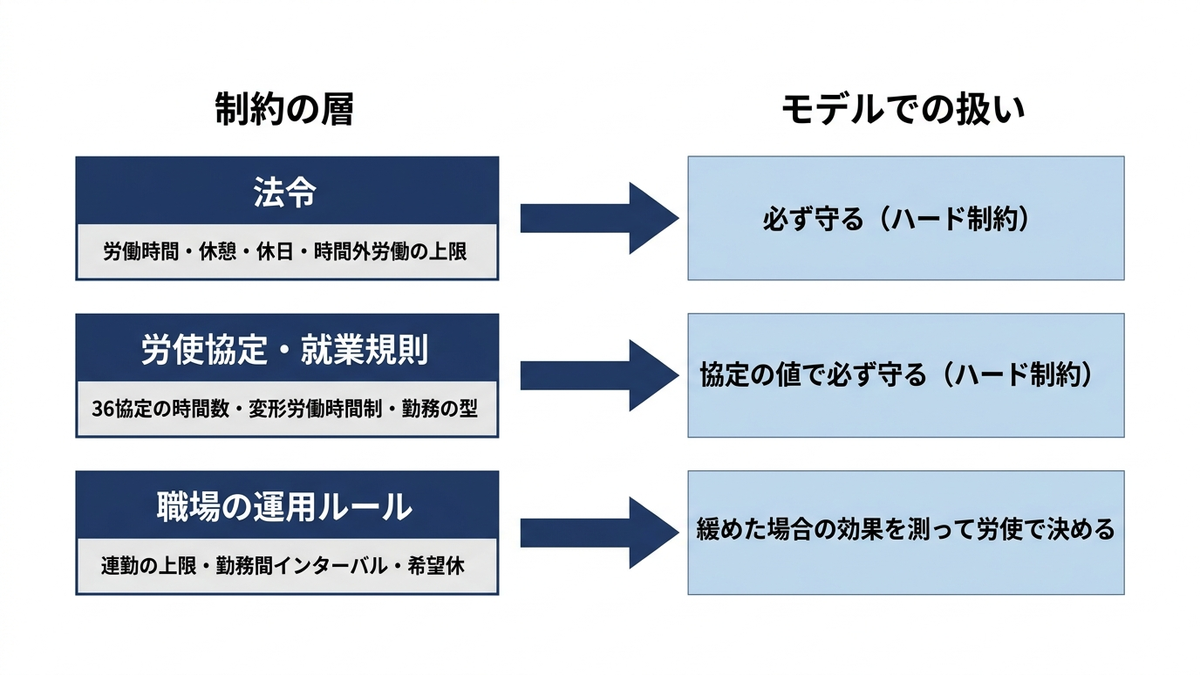
労働時間・休憩・休日と変形労働時間制の条文を確かめる
労働基準法(e-Gov 法令検索。2026年9月30日時点の現行の版は、令和8年7月17日施行の改正を反映したもの)と、労働基準法施行規則を開いて、勤務表に直接かかわる条文を確かめました。あわせて e-Gov の改正履歴で、施行日が先の改正(令和9年4月1日施行と令和10年12月23日施行の2件)が登録されていることを確かめ、それぞれの施行後の版の第32条から第41条までを現行の版と突き合わせ、文言に違いがないことを確認しました。したがって、この章で引く労働時間・休憩・休日・時間外労働・年次有給休暇の条文は、2026年9月30日時点で e-Gov に登録されている範囲では、当面そのまま続く前提で読めます。
| 条文 | 原則 | 例外・条件 | 勤務表のモデルでの扱い |
|---|---|---|---|
| 第32条(労働時間) | 休憩時間を除き1週40時間、1日8時間を超えて労働させてはならない | 変形労働時間制(第32条の2〜第32条の5)、36協定による延長(第36条)、災害等の臨時の必要(第33条)。施行規則第25条の2は、法の別表第一(労働基準法の末尾に置かれた、事業の種類の一覧)の第8号(物品の販売・保管などの事業)・第10号(映画の製作を除く興行の事業)・第13号(保健衛生の事業)・第14号(旅館・飲食店・接客娯楽の事業)のうち常時10人未満の労働者を使用するものについて、1週44時間とする特例を置いている | 勤務の型の実働時間の上限と、週の労働時間の合計の上限(ハード) |
| 第34条(休憩) | 労働時間が6時間を超える場合は少なくとも45分、8時間を超える場合は少なくとも1時間を、労働時間の途中に与える。一斉に与え、自由に利用させる | 一斉に与える原則は、労使協定がある場合(第34条第2項ただし書)と、施行規則第31条が定める事業(法の別表第一の第4号・第8号・第9号・第10号・第11号・第13号・第14号の事業、つまり運送・物品の販売など・金融や保険など・興行・郵便や電気通信・保健衛生・接客娯楽の事業と、官公署の事業)には適用しない | 勤務の型の設計で休憩を組み込む。残業で労働時間が8時間を超える日は、休憩が1時間あるかを点検する |
| 第35条(休日) | 毎週少なくとも1回の休日 | 4週間を通じ4日以上の休日を与える場合は適用しない(第2項)。この場合、就業規則などで4週間の起算日を明らかにする(施行規則第12条の2第2項) | 週(または起算日から数えた4週)ごとの休日の数の下限(ハード) |
| 第41条(適用の除外) | 別表第一の第6号(林業を除く農林の事業)・第7号(畜産・養蚕・水産の事業)に従事する者、監督もしくは管理の地位にある者または機密の事務を取り扱う者、許可を受けた監視・断続的労働に従事する者には、労働時間・休憩・休日の規定を適用しない | 対象の範囲は条文の各号に限られる | この記事では、SV(リーダー)を含む全員に労働時間の規定がかかるものとして扱う |
表の「勤務表のモデルでの扱い」の列が、この章で CP-SAT に書く内容の見取り図です。第32条の1日8時間と1週40時間は、勤務の型の実働時間と、週に何日・どの型に入るかの組合せで決まるので、型の設計(第4章)と個人への割当(第5章)の両方にかかわります。第34条の休憩は、勤務の型の中に休憩の時間を組み込むことで満たすのが普通で、共通データの早番・日勤・中番・遅番は、どれも拘束9時間(始業から終業までの、休憩を含む時間)の中ほどに60分の休憩を置いています。共通データでは早番の休憩が11時から、遅番の休憩が19時からというように、型によって休憩の時刻がずれており、休憩を一斉に取らせない運用を前提にしています。条文上は一斉付与が原則で、ずらすには労使協定があるか、施行規則第31条に挙げられた事業に当たる必要があります。どちらに当たるかは事業場ごとに確かめる事項なので、この記事の例題では「休憩をずらす前提が満たされている」と置いています。
第35条の休日は、読み違えやすい条文です。原則は「毎週少なくとも1回」ですが、第2項により「4週間を通じ4日以上」の休日を与えれば第1項は適用されません。この4週4休の定めを使う場合、4週間の起算日を就業規則などで明らかにする必要があります。勤務表の計画期間を4週間にしている職場では、計画期間の初日と4週4休の起算日をそろえておくと、1枚の勤務表の中で休日の数を点検できます。ずれていると、前月の勤務表の後半と今月の前半をつないだ4週間でも休日が足りているかを確かめる必要が出てきます。なお、法定の休日(週1日または4週4日)と、就業規則で定めた所定の休日(週休2日制の2日目など)は別のもので、時間外・休日労働の扱いも変わります。この記事の例題では、正社員は4週で20日勤務・週5日までなので、毎週少なくとも2日の休みがあり、どちらの数え方でも法定の休日の条件は満たします。
第41条は、管理監督者などに労働時間・休憩・休日の規定を適用しないとするものです。条文の文言は「監督若しくは管理の地位にある者」で、リーダー・主任といった役職名を要件にしてはいません。勤務表のモデルでリーダー役の人だけ時間の上限を外したくなったときは、その人が条文の各号に当たるかどうかを、モデルの外で先に確かめる必要があります。この記事の共通データの SV は、各枠に1名以上いてほしいスキルを持つ人という意味で置いたもので、管理監督者として扱う前提は置いていません。
シフト制の職場で1日8時間を超える勤務の型(たとえば拘束11時間・実働10時間の長日勤)を置く場合に使える制度の1つが、変形労働時間制です。1か月単位の変形労働時間制(第32条の2)は、労使協定または就業規則その他これに準ずるものにより、1か月以内の一定の期間を平均して1週あたりの労働時間が40時間を超えない定めをしたときに、特定された週に40時間、特定された日に8時間を超えて労働させることができる、という制度です。協定で定めた場合は行政官庁への届出が要り(同条第2項)、どちらで定める場合も期間の起算日を明らかにします(施行規則第12条の2第1項)。
数理最適化の立場から見ると、この制度は「1日8時間・1週40時間」という日ごと・週ごとの上限を、「期間を平均して週40時間」という期間の合計の上限に置き換えるものです。4週間(28日)を期間とすると、期間の労働時間の合計の上限は \( 40 \times 28 \div 7 = 160 \) 時間になります。言い換えると、4週間で160時間を超えなければ、ある日は10時間、別の日は6時間という組み方ができるということです。ただし、条文の文言は「特定された週」「特定された日」で、あらかじめ勤務表や就業規則で各日・各週の労働時間を特定しておくことが前提になっています。ソルバーが解いた勤務表を確定させた時点で各日の時間が特定される、という運用にするなら、確定した勤務表を後から変更するときの扱いを就業規則で確かめておく必要があります。変更の扱いは、この記事では確かめていないので、ここでは前提の指摘にとどめます。
1年単位の変形労働時間制(第32条の4)は、1か月を超え1年以内の期間を平均して週40時間とする制度で、労使協定と届出が必要です。こちらは施行規則第12条の4で上限が細かく決まっています。1日の労働時間の限度は10時間、1週の限度は52時間です。対象期間が3か月を超える場合は、労働日数の限度が1年あたり280日で、週48時間を超える週は連続3週以下、3か月ごとに区切った各期間で48時間を超える週の初日の数は3以下でなければなりません。連続して労働させる日数の限度は6日で、協定で特定期間として定めた繁忙期でも1週間に1日の休日が確保できる日数までです。これらはいずれも、CP-SAT では窓の和(連続日数)と期間の合計(労働日数・週の時間)で書ける形の制約です。
変形労働時間制を使うかどうかは、勤務表の作成者ではなく会社と労働者の側で決めることです。モデルの側でできるのは、「変形労働時間制を使わない場合(1日8時間・1週40時間)」と「1か月単位の変形労働時間制を使う場合(4週160時間)」の2通りで解いて、不足人時と人件費がどれだけ違うかを示すことです。その差が大きければ、制度を導入する価値を労使で検討する材料になります。この記事の共通データは、正社員の型がすべて実働8時間なので、1日8時間・1週40時間の上限の中に収まっており、変形労働時間制を使わずに成り立つ設定になっています。勤務の型の長さそのものを変える検討は、第4章で扱いました。
時間外労働の上限と36協定、2024年4月から変わった業種
第32条の上限を超えて働かせる、あるいは法定の休日に働かせるには、第36条にもとづく労使の書面の協定を結び、行政官庁に届け出る必要があります。これが36協定です。協定では、延長できる労働者の範囲、対象期間(1年間に限る)、延長できる場合、対象期間の1日・1か月・1年それぞれについて延長できる時間などを定めます(第36条第2項)。延長できる時間は限度時間を超えない範囲に限られ、限度時間は1か月45時間・1年360時間です(同条第3項・第4項。3か月を超える期間の1年単位の変形労働時間制をとる場合は1か月42時間・1年320時間)。
通常予見できない業務量の大幅な増加などに伴い臨時的に限度時間を超える必要がある場合には、協定に特別の条項を付けることができます(第36条第5項)。この場合、1か月の時間外労働と休日労働の合計は100時間未満、1年の時間外労働は720時間以内の範囲で定め、1か月45時間を超えることができる月数(1年に6か月以内)も定めなければなりません。さらに第36条第6項は、協定の範囲内であっても、実際の労働時間について次の要件を満たすよう使用者に求めています。1か月の時間外労働と休日労働の合計が100時間未満であること、そして対象期間の各月について、直前の2か月から6か月までの各期間の時間外労働と休日労働の1か月あたりの平均が80時間を超えないことです。第6項に違反した場合の罰則は、第119条で6か月以下の拘禁刑または30万円以下の罰金と定められています。
ここで勤務表のモデルに効いてくるのは、上限が「協定で定める値」と「法律が定める天井」の二重になっていることです。法律の天井(原則の月45時間・年360時間、特別条項でも年720時間など)は、その事業場の協定の値の外側にあるもので、実際の上限は協定に書いた時間数です。協定に月30時間と書いた事業場では、月30時間が勤務表の上限になります。さらに第36条第6項の「2か月から6か月の平均80時間以内」は、今月の勤務表だけでは点検できず、過去5か月の実績を入力として持つ必要があります。この章の後半のモデルでは、この「月の上限」を1人あたりの残業時間の上限として入れます。
割増賃金も費用として効きます。第37条第1項は、時間外労働と休日労働に割増賃金を支払うことを定め、率は政令で定める率以上とし、1か月の時間外労働が60時間を超えた部分は5割以上とします。割増賃金の率の最低限度を定める政令は、時間外労働を2割5分、休日労働を3割5分としています。第37条第4項は、午後10時から午前5時までの深夜の労働に2割5分以上の割増賃金を求めています。共通データの遅番(15時〜24時)は22時から24時までの2時間が深夜にあたるので、遅番を何回組むかは深夜の割増賃金の額に直結します。
業種による違いも確かめました。厚生労働省の「建設業・ドライバー・医師等の時間外労働の上限規制」のページによると、時間外労働の上限規制は2019年4月(中小企業は2020年4月)から適用されましたが、工作物の建設の事業・自動車運転の業務・医業に従事する医師・鹿児島県と沖縄県の砂糖製造業は適用が5年間猶予され、2024年4月から適用されています(一部に特例があります)。猶予と特例は、労働基準法の附則第139条から第142条が定めています。2024年4月以降も続く特例は、第139条(工作物の建設の事業のうち災害時の復旧・復興の事業)、第140条(自動車運転の業務)、第141条(医業に従事する医師)です。第142条(鹿児島県と沖縄県の砂糖製造業)は、2024年3月31日まで(その日をまたぐ36協定では、協定の期間の初日から1年を経過する日まで)の猶予を定めた規定です。
| 事業・業務 | 2024年4月以降の取扱い(厚生労働省のページの記載) | 勤務表への影響 |
|---|---|---|
| 工作物の建設の事業 | 災害時における復旧・復興の事業を除き、上限規制がすべて適用される。災害時の復旧・復興の事業には、時間外労働と休日労働の合計の月100時間未満・2〜6か月平均80時間以内の規制は適用されない | 災害時の復旧・復興の事業を除けば、一般の業種と同じ上限を入れる。その事業に当たる期間は、月100時間未満・2〜6か月平均80時間以内の制約を外す(年720時間などは附則第139条第1項の読み替えの対象外で残る) |
| 自動車運転の業務 | 特別条項付き36協定を結ぶ場合の年間の時間外労働の上限が年960時間。月100時間未満・2〜6か月平均80時間以内の規制と、月45時間を超えられるのは年6か月までとする規制は適用されない。別途「改善基準告示」を守る必要がある | 年960時間の天井に加え、改善基準告示の拘束時間・休息期間を入れる(弊社コラム「配送ルートと配車計画の数理最適化、巡回セールスマン問題から当日の再配車まで」第7章) |
| 医業に従事する医師 | 特別条項付き36協定を結ぶ場合の年間の時間外・休日労働の上限は最大1,860時間。A水準・連携B水準は年960時間、B水準・C水準は年1,860時間(いずれも休日労働を含む)。36協定の上限としては、時間外・休日労働の合計の月100時間未満・2〜6か月平均80時間以内の規制と、月45時間を超えられるのは年6か月までとする規制は適用されない。ただし個人に対する時間外・休日労働の上限として、副業・兼業先の労働時間も通算して、A水準は年960時間・月100時間未満、B・連携B・C水準は年1,860時間・月100時間未満とする必要がある(いずれも月100時間未満が例外的に適用されない場合がある)。医療法等に追加的健康確保措置の定めがある | 水準ごとの年の上限に加え、個人の月100時間未満(例外の扱いは別に確認する)と、連続勤務時間の制限・勤務間インターバルを入れる |
| 鹿児島県・沖縄県の砂糖製造業 | 上限規制がすべて適用される | 一般の業種と同じ |
医師については、医療機関の勤務表に直接かかわる規定がもう1つあります。厚生労働省の医師の働き方改革の制度解説ページに掲載された資料「医師の勤務間インターバルの仕組みについて」(厚生労働省医政局、2021年4月1日)によると、勤務間インターバルは B・C 水準の医師について義務、A 水準の医師について努力義務で、基本のルールは2種類です。1つは始業から24時間以内に9時間の継続した休息時間を確保すること(15時間の連続勤務時間制限にあたる。通常の日勤の場合)、もう1つは始業から46時間以内に18時間の継続した休息時間を確保すること(28時間の連続勤務時間制限にあたる。宿日直許可のない宿日直に従事する場合)です。同じ資料は、A 水準の医師のうち実際に定める36協定の上限時間数が一般則を超えない場合は対象外であることや、臨床研修医には別途のルールがあることも示しています。この2つのルールは「始業から一定時間の窓の中に、一定の長さの連続した休みがあること」という形をしているので、第6章の窓の和や add_automaton で書ける種類の制約です。
看護職員の夜勤については、労働法令ではなく診療報酬の施設基準に数字があります。厚生労働省の「令和8年度診療報酬改定について」のページに掲載された通知「基本診療料の施設基準等及びその届出に関する手続きの取扱いについて」(令和8年3月5日保医発0305第7号)を開いて確かめました。入院基本料の施設基準では、夜勤を行う看護職員の1人あたりの月平均夜勤時間数が72時間以下であることが求められています。この「夜勤」は、各保険医療機関が定める午後10時から翌日の午前5時までを含む連続する16時間(夜勤時間帯)に勤務することを指します。月平均夜勤時間数は、同一の入院基本料を算定する病棟全体で、1か月または4週間の延べ夜勤時間数を夜勤時間帯に従事した実人員数で割って求め、病棟(看護単位)ごとに72時間以下である必要はないとされています。夜勤専従者は計算に含めず、急性期一般入院基本料などの病棟では月の夜勤時間数が16時間未満の者も含めない、といった数え方の規定もあります。個人ごとの上限ではなく病棟全体の平均の上限なので、勤務表のモデルでは「全員の夜勤時間の合計 ≤ 72 × 夜勤に入る人数」という形の、集計の制約になります。数え方の除外規定まで含めてモデルに書く場合は、通知の本文の該当箇所を一つずつ制約に置き換える必要があります。
勤務間インターバルと年次有給休暇の取得
勤務間インターバルは、終業から次の始業までの間に一定時間以上の休息を確保する仕組みです。労働時間等の設定の改善に関する特別措置法の第2条第1項は、事業主が「健康及び福祉を確保するために必要な終業から始業までの時間の設定」などの措置を講ずるように努めなければならない、と定めています。厚生労働省の働き方・休み方改善ポータルサイトの「勤務間インターバル制度とは」は、この法律の改正により2019年4月1日から勤務間インターバル制度の導入が事業主の努力義務になったと説明しています。つまり一般の労働者について、法律は何時間という数字を定めておらず、制度を置くかどうか、置くなら何時間にするかは各社の就業規則や労使の取り決めで決めることになります。この記事の共通データが11時間を「架空の社内ルール」と呼んでいるのはこのためで、医師(前の節)やトラック運転者(改善基準告示)のように数字が決まっている職種とは位置づけが違います。この章の後半で、11時間を9時間に縮めると何が変わるかを測ります。
年次有給休暇は、勤務表の中で「休みだが勤務日数に数える日」として扱う必要があります。第39条第1項は、雇入れの日から6か月継続勤務し全労働日の8割以上出勤した労働者に10労働日の有給休暇を与えることを定め、第2項で継続勤務年数に応じて加算されます。第7項は、使用者が与えなければならない有給休暇の日数が10労働日以上である労働者について、そのうち5日を、基準日から1年以内の期間に、労働者ごとに時季を定めることにより与えなければならないと定めています。使用者が取得の日を指定して取らせるこの仕組みを、以下では「時季指定」と呼びます。ただし第8項により、労働者が自分で請求して取った日や計画的付与(第6項)で与えた日は、その日数分(5日を上限)を時季指定の5日から差し引けます。時季を指定するときは、あらかじめ時季指定で年休を与えることを労働者に明らかにしたうえで、その時季について意見を聴かなければならず、聴いた意見を尊重するよう努めなければなりません(施行規則第24条の6)。第39条第7項に違反した場合の罰則は、第120条で30万円以下の罰金と定められています。
パートタイムの労働者も対象になりえます。第39条第3項と施行規則第24条の3により、週の所定労働時間が30時間未満で、週の所定労働日数が4日以下(週以外の期間で定める場合は1年間の所定労働日数が216日以下)の労働者には、所定労働日数に比例した日数が付与されます。施行規則の表によると、週4日(1年169日から216日)の労働者は、継続勤務3年6か月で10日、6年6か月以上で15日です。週3日の労働者は5年6か月で10日になります。10日以上付与される時点から、第39条第7項の年5日の対象になるということです。共通データのパート(週3〜4日まで)も、勤続年数によっては年5日の対象に入ります。
勤務表のモデルから見ると、年5日の時季指定は「計画期間のどこかに、決まった人数分の年休の日を置く」という制約です。年休の日は勤務しないので在席を減らしますが、労働日として扱う日なので、正社員の「4週で20日勤務」を「勤務日と年休の日の合計が20日」と読み替える必要があります。どの人をどの日に休ませるかをソルバーに選ばせれば、不足への影響が最も小さい日に年休を置く勤務表が得られます。ただし、それは時季指定の候補であって、本人の意見を聴いて尊重するという手続きを飛ばしてよいということではありません。
共通データの勤務の型を法令と照合し、CP-SAT に書く
ここまで確かめた条文を、第2章で用意したサンプルデータの勤務の型に当てはめます。共通データは架空のコンタクトセンターで、正社員は早番・日勤・中番・遅番の4つの型(いずれも拘束9時間・休憩60分・実働8時間)、パートは短時間(午前)・短時間(夕方)の2つの型(実働5時間・休憩なし)と一部が日勤に入ります。休息時間は、前日の型の終業から翌日の型の始業までを数えました。表の「実働」は、拘束の時間(始業から終業まで)から休憩を除いた時間のことです。
| 勤務の型 | 時間帯 | 実働 | 休憩 | 第34条で必要な休憩 | 1日8時間(第32条第2項) | 22時以降の深夜の労働(第37条第4項) | 翌日に続けると休息が11時間未満になる型 |
|---|---|---|---|---|---|---|---|
| 早番 | 7時〜16時 | 8時間 | 60分 | 45分以上(6時間超8時間以下) | 上限ちょうど | なし | なし |
| 日勤 | 9時〜18時 | 8時間 | 60分 | 45分以上 | 上限ちょうど | なし | なし |
| 中番 | 12時〜21時 | 8時間 | 60分 | 45分以上 | 上限ちょうど | なし | 早番(休息10時間) |
| 遅番 | 15時〜24時 | 8時間 | 60分 | 45分以上 | 上限ちょうど | 2時間 | 早番(7時間)・日勤(9時間)・短時間(午前)(9時間) |
| 短時間(午前) | 9時〜14時 | 5時間 | なし | 不要(6時間以下) | 内側 | なし | なし |
| 短時間(夕方) | 17時〜22時 | 5時間 | なし | 不要 | 内側 | なし | 早番(9時間) |
表から分かることを3つ挙げます。1つ目は、正社員の4つの型がどれも1日8時間の上限ちょうどに作られていることです。これは所定の勤務だけなら第32条第2項に収まる一方で、終業後に1分でも延長すればその分は時間外労働になり、36協定が必要になることを意味します。また休憩は60分なので、延長して実働が8時間を超えても第34条の「8時間を超える場合は少なくとも1時間」を満たします。休憩を45分にした型であれば、延長した日だけ休憩が足りなくなるので、残業を入れるモデルでは型ごとの休憩の長さを確かめる必要があります。
2つ目は、週の労働時間です。正社員は4週で20日・週5日までなので、どの週も5日×8時間=40時間ちょうどで、第32条第1項に収まります。週5日の上限を6日に緩めると、所定の勤務だけで週48時間になり、その週は時間外労働が8時間生じます。共通データの「週5日まで」は、法令の側から見ると「所定の勤務では時間外労働を生まない」ための制約になっているということです。パートは週3〜4日までで、日勤に4日入る週でも32時間です。
3つ目は、深夜の労働が遅番にだけ生じることです。基準の結果(第5章で説明した基準の記録)の勤務の型ごとの延べ回数では遅番が91回なので、4週で延べ182時間の深夜の労働があり、第37条第4項の割増賃金の対象になります。仮に架空の時給2,600円に2割5分を掛けると、1時間あたり650円の割増で、4週で118,300円です。この金額は目的関数には入っていません。基準の目的関数は正社員の人件費を含んでいない(正社員の勤務日数が20日に固定されているため)ので、遅番と中番のどちらに入れるかで人件費が変わることは、今のモデルでは見えていません。深夜の割増まで含めて比べたいときは、遅番の1回あたりの割増額を目的関数に足す必要があります。
休息時間の列は、前日の型の終業から翌日の型の始業までを並べたものです。11時間を下回る組は5つあり、共通データの forbidden_next() が「続けてはいけない組」として返す組と一致します。このうち遅番から早番への7時間は、24時に退勤して7時に出勤する組合せで、通勤や睡眠の時間を考えると最も厳しい組です。9時間に縮めると、中番→早番(10時間)・遅番→日勤(9時間)・遅番→短時間(午前)(9時間)・短時間(夕方)→早番(9時間)の4つが許され、遅番→早番だけが残ります。なお、共通データでは遅番に入るのは正社員だけ、短時間の型に入るのはパートだけなので、遅番→短時間(午前)と短時間(夕方)→早番の組は、同じ人の前日と翌日には現れません。実際に効くのは、中番→早番・遅番→早番・遅番→日勤の3つの組です。
次のコードは、正社員1人の4週間の勤務について、法令と協定の枠だけを制約に入れ、その枠の中で最も長く働かせる勤務表を CP-SAT で求めたものです。勤務表を作る目的としては不自然ですが、「制約が本当に上限として効いているか」を確かめるときに役に立つ形です。上限を正しく書けていれば、最大化の答えは上限どおりの値になります。書き間違えていれば、上限を超える答えが返ってきます。36協定で定めた4週の残業の上限は、ここでは例として20時間と置きました(4週を1か月とみなした仮の値で、実在の協定の値ではありません)。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from ortools.sat.python import cp_model
from shift_data import SHIFT_TYPES, shift_work_min, N_DAYS
T = ["E", "D", "M", "L"]                              # 正社員の型(実働8時間)
OT_OK = ["E", "D", "M"]                               # 終業後に1時間延ばせる型
CAP_OT_H, WEEK_H, REST_H = 20, 40, 11                 # 36協定で定めた4週の上限(仮)・第32条・社内のインターバル
m = cp_model.CpModel()
x = {(d, t): m.new_bool_var("") for d in range(N_DAYS) for t in T}
ot = {(d, t): m.new_bool_var("") for d in range(N_DAYS) for t in OT_OK}
for d in range(N_DAYS):
    m.add_at_most_one(x[d, t] for t in T)             # 1日1勤務まで
    for t in OT_OK:
        m.add_implication(ot[d, t], x[d, t])          # 延長はその型の日だけ
def end(t, e=0): return SHIFT_TYPES[t]["end"] + 60 * e
for d in range(N_DAYS - 1):                           # 勤務間インターバル(延長した日は終業が1時間遅い)
    for a in T:
        for b in T:
            for e in ([0, 1] if a in OT_OK else [0]):
                if 24 * 60 - end(a, e) + SHIFT_TYPES[b]["start"] < REST_H * 60:
                    lits = [x[d, a].Not(), x[d + 1, b].Not()] + ([ot[d, a].Not()] if e else [])
                    m.add_bool_or(lits)
for w in range(4):
    days = range(7 * w, 7 * w + 7)
    m.add(sum(shift_work_min(t) * x[d, t] for d in days for t in T) <= WEEK_H * 60)   # 第32条(法定内)
    m.add(sum(x[d, t] for d in days for t in T) <= 6)                              # 第35条(毎週1日の休日)
m.add(sum(ot.values()) <= CAP_OT_H)                   # 36協定の上限(1時間単位)
hours = sum(8 * x[k] for k in x) + sum(ot.values())
m.maximize(hours)                                     # 法令と協定の枠の中で、最も長く働かせる勤務表
s = cp_model.CpSolver(); s.parameters.num_workers = 8; s.parameters.max_time_in_seconds = 10
print(s.status_name(s.solve(m)), "4週の労働時間の最大 =", int(s.objective_value), "時間")
print("残業 =", sum(s.value(v) for v in ot.values()), "時間 / 勤務日 =", sum(s.value(v) for v in x.values()), "日")
# 出力: OPTIMAL 4週の労働時間の最大 = 180 時間
# 出力: 残業 = 20 時間 / 勤務日 = 20 日
出力は、4週の労働時間の最大が180時間(所定の勤務20日×8時間=160時間と、残業の上限20時間の和)で、状態は OPTIMAL でした。週の法定内の労働時間を40時間以下にした制約で、勤務日は各週5日・4週で20日に抑えられています。第35条の「毎週1日の休日」は各週の勤務日を6日以下にする制約として書きましたが、この例では第32条の40時間のほうが先に効くので、休日は各週2日になっています。
コードの要点を順に説明します。勤務間インターバルは、第6章と同じく「前日に型 a、翌日に型 b は同時に選べない」という add_bool_or で書き、延長した日は終業が1時間遅れるので、延長の変数も否定のリテラルに加えた3項の節にしています。こうしておくと、中番を延長して22時に終わった翌日の日勤(休息11時間)は許され、翌日の早番(休息9時間)は延長の有無にかかわらず禁止される、という区別が正しく入ります。第32条の週40時間は「法定内の労働時間」の上限として書き、延長の時間は別の変数に分けて36協定の上限で縛りました。時間外労働を1つの変数にまとめず、所定・法定内・時間外を分けて持っておくと、第37条の割増賃金を費用として足すときにも、第36条第6項の月100時間未満のような実績の点検をするときにも、そのまま使えます。
実際の勤務表のモデルでは、これを全員に対して置き、目的関数を第5章の重みづけの和にします。この章の実験に使ったモデルは、基準と同じ変数・制約・重みをこの章のスクリプトで組み直し、インターバルの時間・残業の上限・年休の日数を引数で変えられるようにしたものです。インターバル11時間・残業なし・年休なしの設定では、目的関数の値が基準と同じ 2,053,500 になり、OPTIMAL であることを確かめてから比較に使いました。
勤務間インターバルを11時間から9時間にすると何が変わるか
勤務間インターバルは法令上は努力義務なので、「11時間では勤務表が組みにくいから9時間にしたい」という議論は、職場によっては実際に起こりえます。その議論の材料として、インターバルの時間だけを変え、ほかはすべて基準と同じ設定(同じ重み、時間制限30秒、num_workers=8、random_seed=0)で解き比べました。比べたのは、インターバルなし・9時間・11時間(基準と同じ)・12時間・13時間の5通りと、時間制限を90秒にした14時間・15時間の2通りです。
比べる前に、読み方の注意が1つあります。この問題には、重みづけの目的の値が同じ最適値になる勤務表が複数あります。基準の目的は、不足1人×30分を3,000、パートの勤務1時間を1,500(架空の時給)と数えているので、不足を10人×30分減らしてパートを20時間増やした勤務表は、目的の値がちょうど同じ(どちらも30,000)になります。実際、この章のスクリプトで基準と同じ11時間の設定を解くと、目的の値は基準の記録と同じ 2,053,500(OPTIMAL)でしたが、不足は437人×30分で、基準の結果(442人×30分=221.0人時)とは別の勤務表になりました(各章の解き直しの値は第5章の表にまとめています)。したがって、条件を変えたときの比較は、まず目的の値で行い、不足人時の差は「同点の勤務表のどれが選ばれたか」という揺れを含みうるものとして読む必要があります。そのうえで不足人時を公平に比べるために、各設定で「目的の値を最適値に保ったまま、不足を最小にする」2段目の計算も行いました(第6章の辞書式の考え方です)。
| 勤務間インターバル | 続けてはいけない組の数 | 状態 | 重みづけの目的の値 | 同点の勤務表の中での最小の不足人時 | 11時間なら禁止される組が勤務表に現れた回数 |
|---|---|---|---|---|---|
| なし | 0 | OPTIMAL | 2,053,500 | 216.0人時(2段目も OPTIMAL) | 47回(うち遅番→早番14回) |
| 9時間 | 1(遅番→早番) | OPTIMAL | 2,053,500 | 216.0人時 | 38回(遅番→早番は0回) |
| 11時間(基準と同じ設定で解き直し) | 5 | OPTIMAL | 2,053,500 | 216.0人時 | 0回 |
| 12時間 | 7 | OPTIMAL | 2,053,500 | 216.0人時 | 0回 |
| 13時間 | 10 | OPTIMAL | 2,053,500 | 216.0人時 | 0回 |
| 14時間(90秒) | 11 | OPTIMAL | 2,053,500 | 216.0人時 | 0回 |
| 15時間(90秒) | 12 | OPTIMAL | 2,053,500 | 216.0人時 | 0回 |
結果は、インターバルなしから15時間まで、重みづけの目的の値がすべて 2,053,500 で、どれも OPTIMAL(最適性の証明つき)でした。同点の勤務表の中で不足を最小にした値も、7通りすべてで432人×30分(216.0人時)で、2段目も OPTIMAL です。9時間と11時間は同じ設定で2回ずつ解き、2回とも同じ目的の値と同じ最小の不足でした。計算時間は、この記事の実行環境(一般的なノートPC)での実測で、どの設定も1段目が15秒以内に終わっています(ほかの章の計算と同時に動かしているので、時間そのものは揺れます)。つまりこの例題では、勤務間インターバルを11時間から9時間に縮めても、なくしても、不足人時は1人×30分も減りません。反対に15時間まで延ばしても増えません。
理由は、このデータの正社員の勤務表に、型の並べ方の自由度が十分にあることです。11時間で禁止される組は、実際に効くものでは中番→早番・遅番→早番・遅番→日勤の3つですが、遅番の翌日を遅番・中番・休みにし、早番の前日を早番・日勤・休みにするといった並べ方で、禁止の組を避けながら同じ目的の値に届く勤務表が見つかりました。11時間の勤務表には禁止の組が1回も現れず、目的の値はインターバルなしの場合と同じです。不足が残るのは、後の節で見るように、勤務の型(9時間の固定の枠)の始業の時刻や休憩の時間帯と、需要の山がずれている枠です。
この結果から、経営の判断として2つのことが言えます。1つ目は、少なくともこの例題の条件では、インターバルを縮める提案には不足を減らす効果がないので、縮める理由がないということです。インターバルを縮めると、休息が短くなる負担はスタッフに確実に生じる一方、この例題では得るものがありません。2つ目は、表の右の列が示すことで、インターバルの制約を外すと、ソルバーは不要なのに短い休息の組を使う、ということです。インターバルなしの勤務表には、11時間なら禁止される組が47回現れ、そのうち14回は24時に退勤して翌朝7時に出勤する遅番→早番でした。目的の値にとって得にも損にもならない並べ方は、ソルバーにとってはどれでもよいので、制約で禁じていない限り、負担の大きい並べ方も普通に選ばれます。費用がかからないことが分かったルールは、ハード制約として残しておくのが合理的だと考えています。
人手がもっと少ない職場でも同じかを確かめるため、正社員のうち S16・S17・S18 の3名を除いた27名の模型でも解きました(時間制限は90秒)。この模型では目的の値が 2,613,000 に上がり、パートの勤務が880時間に増えますが、インターバルなし・9時間・11時間の3通りで目的の値はすべて 2,613,000(OPTIMAL)、同点の中での最小の不足も3通りとも426人×30分(213.0人時)で同じでした。ここでも、インターバルなしの勤務表には遅番→早番が16回現れています。
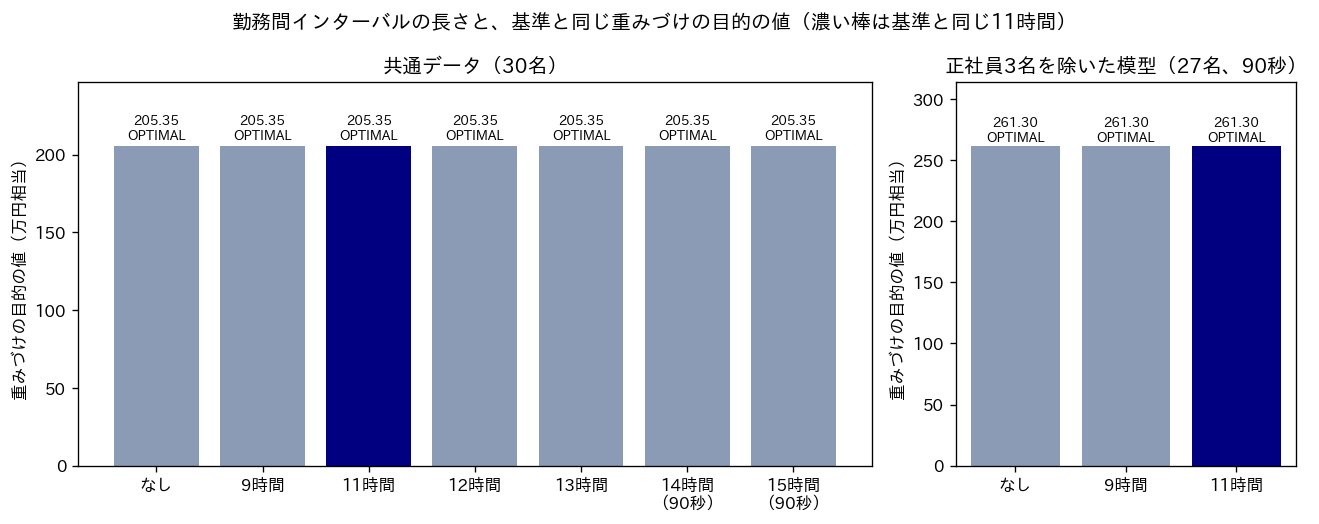
15時間という長さは、正社員の4つの型について見ると、日勤→早番・中番→早番・中番→日勤・遅番→早番・遅番→日勤・遅番→中番の6つの組をすべて禁じることに当たります。言い換えると、勤務の日が続くときは、早番→日勤→中番→遅番の順に始業が同じか遅くなる向きにしか並べられない、という強い制約です。それでもこの例題では目的の値が変わりませんでした。正社員は週5日・連勤5日までで、週に2日の休みが入ります。休みの日を挟めば型を早い側に戻せるので、並べ方の制約が強くなっても、目的の値を悪くしない勤務表が見つかった、ということです。
ただし、これは「インターバルはいつでも費用がかからない」ことを示すものではありません。休みの日が少ない勤務形態や、型の種類が少なく夜勤を含む職場では、並べ方の自由度が小さく、インターバルが目的の値を押し上げる可能性があります。この例題で「効かない」と言えるのは、正社員に週2日の休みがあり、型が4つあって、需要の穴が勤務の順番ではなく型の時間帯から生じているという条件のもとでの話です。
ここで測ったのは「このデータでは効かなかった」という事実で、自社の職場で同じかどうかは、自社のデータで同じ比較をしてみないと分かりません。とくに、型が少なく人数に余裕のない職場、夜勤明けの翌日の扱いが絡む職場では、インターバルが効き始める長さがずっと短い可能性があります。重要なのは、インターバルを何時間にするかを労使で議論するときに、「11時間だと勤務表が組めない」という感覚ではなく、「11時間と9時間で目的の値(不足・希望休・人件費)がどれだけ違うか」という数字を出せることです。差がなければ、長いほうを選ぶのに迷う理由はありません。
時間外労働の上限を変えると不足はどう変わるか
次に、36協定で定める時間外労働の上限を、勤務表のモデルに入れて測りました。モデルには、正社員が1日に1時間だけ時間外労働をする選択肢を足しました。向きは2つで、始業を1時間早める早出(日勤・中番・遅番)と、終業を1時間遅らせる残業(早番・日勤・中番)です。営業時間の外には延ばさないので、早番の早出と遅番の残業はありません。時間外1時間の費用は、架空の時給2,600円に第37条の最低の割増率2割5分を掛けた3,250円とし、基準の目的関数に足しました。この費用の項が加わる点が基準との違いで、ほかの重みは同じです。上限は正社員1人あたり4週で0・4・8・16・24・45時間の6通りにしました。4週間を1か月とみなした仮の上限で、45時間は第36条の限度時間の1か月45時間に合わせた値です。勤務間インターバルは11時間のままで、早出や残業で休息が11時間を切る組合せは禁止しています。
結果は次の表のとおりです(30秒・num_workers=8)。0時間と4時間は OPTIMAL、8時間以上は30秒で FEASIBLE に止まり、下界は 1,759,000 でした。不足人時の列は、OPTIMAL の設定では同点の勤務表の中で不足を最小にする2段目の値、FEASIBLE の設定では打ち切り時点の勤務表の値です。ただし4時間の2段目は30秒で FEASIBLE に止まったので(不足の下界は288人×30分=144.0人時)、146.5人時が同点の中の最小であることまでは示せていません。
| 1人4週の時間外労働の上限 | 状態 | 重みづけの目的の値 | 不足人時 | 時間外労働の延べ時間 | 時間外の費用(架空) | 1人の最大 | 内訳 |
|---|---|---|---|---|---|---|---|
| 0時間(基準と同じ設定で解き直し) | OPTIMAL | 2,053,500 | 216.0人時 | 0時間 | 0円 | 0時間 | なし |
| 4時間 | OPTIMAL | 1,855,500 | 146.5人時 | 72時間 | 234,000円 | 4時間 | 中番の早出44・日勤の早出28 |
| 8時間 | FEASIBLE(下界 1,759,000) | 1,767,000 | 114.0人時 | 114時間 | 370,500円 | 8時間 | 中番の早出79・日勤の早出34・早番の残業1 |
| 16時間 | FEASIBLE(同) | 1,764,250 | 115.5人時 | 115時間 | 373,750円 | 12時間 | 中番の早出81・日勤の早出33・早番の残業1 |
| 24時間 | FEASIBLE(同) | 1,765,750 | 114.5人時 | 115時間 | 373,750円 | 11時間 | 中番の早出80・日勤の早出34・早番の残業1 |
| 45時間 | FEASIBLE(同) | 1,767,250 | 113.5人時 | 115時間 | 373,750円 | 13時間 | 中番の早出80・日勤の早出34・早番の残業1 |
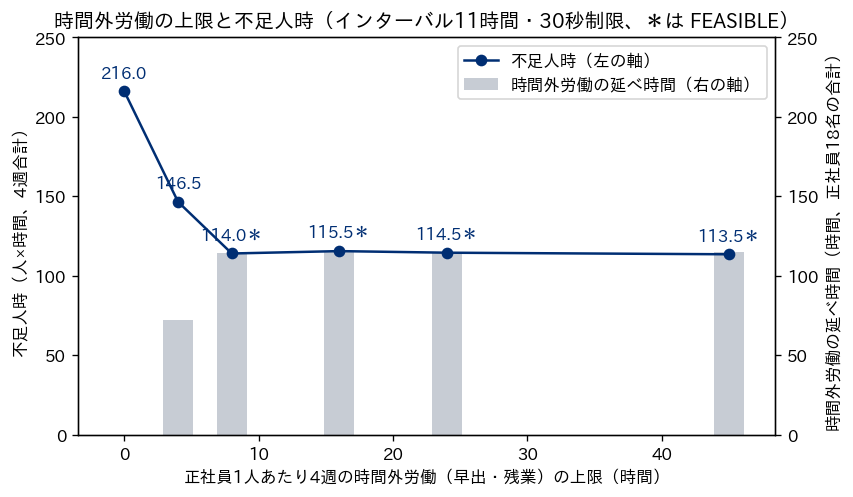
30秒で FEASIBLE に止まった上限8・16・45時間は、時間制限を90秒に延ばしてもう一度解きました。目的の値は順に 1,763,000・1,762,750・1,761,500 で、いずれも FEASIBLE、下界は 1,759,000 のままでした。最適値との差は最大でも4,000以内(目的の値の0.3%以内)に収まっていることになります。時間外の延べ時間は115〜116時間で、18名全員が時間外をしており、1人の最大は8〜13時間でした。30秒の結果と同じく、上限を8時間から45時間まで広げても目的の値はほとんど変わりません。
この表から読めることは3つあります。1つ目は、時間外労働を少し認めるだけで不足が大きく減ることです。1人4週で4時間まで認めると、正社員18名で延べ72時間の時間外労働が使われ、不足人時は216.0人時から146.5人時に減りました。重みづけの目的の値は、時間外の費用234,000円を払ったうえで 2,053,500 から 1,855,500 へ198,000 下がっています。2つ目は、効きがすぐに頭打ちになることです。8時間以上では、表の30秒の実行で時間外の延べ時間は114〜115時間、不足人時は113.5〜115.5人時でほぼ横ばいになり(前の段落の90秒の実行では延べ115〜116時間)、上限を16時間・24時間・45時間と広げても、1人が実際に使う時間外は最大でも13時間でした。1日1時間まで、型は4つに固定、という条件のもとでは、時間外で埋められる不足の枠が尽きるからです。
3つ目が最も重要で、時間外がどこで使われたかです。内訳のほとんどは中番の早出(11時開始)と日勤の早出(8時開始)でした。共通データの不足は、朝の8時から9時(日勤が始まる前)と、11時から12時(早番の休憩の時間帯)、19時から20時(遅番の休憩の時間帯)に集中しています(基準の記録の在席人数を時刻の枠ごとに集計した値。4週合計の不足442人×30分のうち、8時台が81、11時台が172、19時台が173人×30分)。中番を1時間早く始めれば11時台の穴が、日勤を1時間早く始めれば8時台の穴が埋まる、ということです。つまりソルバーは、時間外労働を「勤務の型と需要の山のずれ」を毎日埋めるための道具として使っています。
経営の判断としては、これを時間外労働で埋め続けるのか、勤務の型を変えるのかが分かれ目になります。毎日同じ時刻に同じ向きの時間外が発生するなら、それは突発的な需要ではなく、型の設計の問題です。時間外で埋め続けると、割増賃金の分だけ人件費が高くつくうえに、協定で定めた時間数の枠を毎月の決まった穴で使ってしまい、欠勤や需要の急な増加(第11章・第12章)に使える余地が小さくなります。この例題でいえば、11時開始や8時開始の型を置けば、同じ時間帯を所定の勤務の中で埋められる可能性があります。型の設計は第4章で扱いました。時間外の上限を変えて解いてみることは、どこに型の設計の穴があるかを見つける手段にもなる、と考えています。
点検の結果も確かめました(解いた勤務表を、法令の条件ごとに別のスクリプトで集計し直したもの)。時間外を認めた勤務表では、1日の労働が最大9時間、1週(月曜から日曜)の労働が最大43〜45時間になり、第32条の1日8時間・1週40時間を超える日と週が生じます。これは36協定を結んで届け出ていることが前提の勤務表で、協定がない事業場では使えません。休憩は60分なので、9時間の日も第34条の1時間を満たしていました。勤務間の休息は最短11時間で、早出によって休息が11時間を切る組合せが正しく禁止されていることも確かめました。22時以降の深夜の労働は、延べ176〜182時間でした。
インターバルを9時間にして同じ比較もしました。時間外の上限16時間で 1,762,750、45時間で 1,763,000 と、11時間の場合(1,764,250・1,767,250)と近い値でしたが、いずれも30秒で FEASIBLE(下界 1,759,000)なので、この差がインターバルの効果なのか探索の打ち切りによるものなのかは、この実験からは区別できません。9時間の勤務表では、休息が9時間ちょうどの組合せが使われていました。
年次有給休暇の取得日を勤務表の中で決める
最後に、年次有給休暇の年5日の取得を勤務表に入れた場合を測りました。正社員は「勤務日と年休の日の合計が4週で20日」とし、この4週間に正社員全体で取る年休の日数の合計を決めて、誰がどの日に取るかはソルバーに選ばせました(1人この4週で3日まで)。日数は、正社員18名が年5日を1年365日に均等に取るとした場合の4週あたり6.9人日を丸めた7人日と、年10日の場合の13.8人日を丸めた14人日の2通りです。重み・インターバル11時間・30秒は基準と同じで、年休の日そのものには費用を付けていません(基準の目的関数はもともと正社員の人件費を含んでいないので、それに合わせた扱いです)。
| この4週に取る年休の合計 | 状態 | 重みづけの目的の値 | 基準の設定からの増加 | 不足人時 | パートの勤務 | 希望休の違反 |
|---|---|---|---|---|---|---|
| 0人日(基準と同じ設定で解き直し) | OPTIMAL | 2,053,500 | 0 | 218.5人時(1段目のみ。同点の中で不足を最小にする2段目は解いていない) | 485時間 | 3件 |
| 7人日 | OPTIMAL | 2,097,000 | 43,500 | 222.0人時(2回目は224.5人時) | 510時間(2回目は500時間) | 0件 |
| 14人日 | OPTIMAL | 2,160,000 | 106,500 | 217.5人時(2回目も同じ) | 570時間(2回目も同じ) | 0件 |
3通りとも OPTIMAL で、7人日と14人日は2回ずつ解いて目的の値が2回とも同じでした。年休を7人日入れると目的の値は43,500、14人日では106,500増えます。これは最適値どうしの差なので、年休をこの4週に入れることの費用として読める値です。この表の比較は、どの行も最初の計算(1段目)の勤務表で、インターバルや時間外の表のような「同点の中で不足を最小にする2段目」は解いていません。そのため0人日の行の不足は218.5人時で、インターバルの表の11時間の行(2段目の216.0人時)とは違う値になっています。どちらも目的の値は同じ 2,053,500 で、同点の勤務表の選ばれ方の違いです。
不足人時とパートの勤務時間は同点の勤務表の選び方で揺れ、7人日の2回の実行では不足が222.0人時と224.5人時、パートが510時間と500時間でした。内訳の揺れを除いて傾向を読むと、年休で空いた正社員の勤務は、不足を大きく増やすのではなく、過剰の削減とパートの勤務の追加で吸収されています。7人日の年休で正社員の在席は56時間(7日×8時間)減りますが、0人日の行と比べた内訳は、1回目の実行では過剰人時の減少27.5時間(648.5人時から621.0人時へ)、パートの勤務の増加25時間(485時間から510時間へ)、不足人時の増加3.5時間(218.5人時から222.0人時へ)、2回目の実行では過剰の減少35.0時間(613.5人時へ)、パートの増加15時間(500時間へ)、不足の増加6.0時間(224.5人時へ)で、どちらも合計が56時間になります。不足の増加は2回とも数人×時間で、基準と同じ設定を各章で解き直したときの揺れの幅(216.0〜221.0人時、第5章の表)と同じくらいの大きさです。「年休を入れても不足はほとんど増えない」と読めるのは、この程度の揺れを含んだうえでのことです。
もう1つ目を引くのは、希望休の違反が3件から0件になったことです。ソルバーは年休の日を、スタッフが休みを希望していた日に重ねて置きました。7人日の1回目の実行では S01 に2日、S05・S08・S10・S14・S18 に1日ずつ年休が入っています。このモデルでは年休の日を勤務日数に数えるので、希望休の日を年休にすれば、4週20日の条件を保ったまま、その日を休みにできます。施行規則第24条の6は、時季を指定するときに、あらかじめ年休を与えることを本人に明らかにしたうえで時季について意見を聴くことを義務とし、聴いた意見を尊重するよう努めることを求めています。希望休を受け付けるときに、その日を年休に充ててよいかも本人に確かめておけば、希望休のデータを年休の日の候補として使いやすくなり、この手続きとも向きが合うと考えています。希望休の申請がそのまま年休の時季についての意見を兼ねるとは限らないので、その確認を受付の手順に入れておくことが前提です。
経営の判断としては、年5日の取得を「勤務表を作ったあとで空いた日に差し込むもの」ではなく、「勤務表を作るときに一緒に決めるもの」として扱うことが有効だと考えています。後から差し込むと、たまたま不足の大きい日に年休が重なる可能性があり、その日の穴を時間外やパートの追加で埋めることになります。勤務表の中で決めれば、この例題では7人日あたり43,500(架空の重みの単位)という費用が最初から見え、どの月に何人日を取らせるかを、年間の取得義務と月ごとの繁閑を並べて計画できます。年間の要員計画との関係は第10章で扱います。
法令の条件を経営の判断に翻訳する
ここまでの実験を、経営の判断の形にまとめ直します。勤務表に法令の条件を入れる目的は、違反を防ぐことだけではありません。条件ごとに「それを動かしたら何がどれだけ変わるか」を測れるようにしておくと、労使の協議や制度の選択を数字で行えるようになります。この章の例題で得た数字を並べると、次のようになります。
- 勤務間インターバル:なし・9時間・11時間から15時間までの7通りで、重みづけの目的の値は同じ(OPTIMAL)。縮めても不足は減らず、外すと遅番→早番のような短い休息の組が不要なのに現れる
- 時間外労働:1人4週4時間まで認めると不足人時は216.0から146.5へ減り、延べ72時間・架空の費用234,000円。8時間より上では効きが頭打ちになり、時間外のほとんどが中番と日勤の早出という決まった時刻に集中する
- 年次有給休暇:この4週に正社員全体で7人日の年休を入れると目的の値は43,500、14人日で106,500増える(いずれも OPTIMAL どうしの差)。ソルバーは年休を希望休の日に重ね、希望休の違反は3件から0件になる
判断を誤ったときの損失の型も、この3つから読み取れます。1つ目は、効かないルールを緩めてしまう損失です。インターバルを縮めても不足が減らない職場でそれを縮めれば、経営の指標は何も改善せず、スタッフの休息時間だけが短くなります。2つ目は、構造の穴を時間外で埋め続ける損失です。毎日同じ時刻に生じる不足を早出や残業で埋めると、割増賃金の分だけ人件費が高くつき、協定の枠も決まった穴に使われて、突発的な欠勤に回せる余地が減ります。3つ目は、年次有給休暇を勤務表の外で扱う損失です。年5日の取得を勤務表と別に後から差し込むと、不足が大きい日に休みが重なる可能性があり、その日の穴を時間外で埋めることになります。どの損失も、法令の条件をモデルの中に入れ、条件を変えて解いた結果を並べることで、事前に見積もることができます。
もう1つ付け加えると、ここで示した数字はすべて、架空のコンタクトセンターの例題で、架空の重みと費用を使って測ったものです。自社で同じ判断をするときは、自社の必要人数・勤務の型・協定の時間数で同じ比較を行う必要があります。そのとき、条件を変えた比較は同じ時間制限で解き、状態(OPTIMAL か FEASIBLE か)と下界を併記し、同点の勤務表による内訳の揺れを区別する、という読み方の手順を守ることが、数字を判断の根拠として使うための前提になります。
この章の要点は3つです。第一に、労働基準法の労働時間・休憩・休日・時間外労働・年次有給休暇の規定は、原則と例外の条件(協定・届出・就業規則の定め・業種)がセットになっており、勤務表のモデルには「この事業場でどの例外の条件がそろっているか」を決めてから上限を書く必要があります。第二に、法令と協定の値は必ず守るハード制約として書き、勤務間インターバルのような社内ルールは、緩めた場合の効果を測って労使で決める対象として扱うと整理しやすくなります。第三に、例題では、インターバルを緩めても不足は減らず、時間外労働は少量で大きく効くもののすぐに頭打ちになり、その使われ方が勤務の型の穴を示していました。次の第8章では、希望休や希望シフトの通し方と、土日や遅番の偏りといった公平性の扱いを考えます。
Anagraftでは、データ活用の構想づくりから、勤務表の作成のような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『詳解 労働法』第4版(水町勇一郎、東京大学出版会、2025年):版元の紹介によると、法令や告示・通達などの制度の枠組みと、実際の紛争事例を数多く扱った労働法制の概説書で、目次には労働時間と年次有給休暇の章があります。この章では条文を勤務表の制約に置き換える側から読みましたが、条文の解釈や例外の適用範囲を確かめたいときの手引きになります。
『36協定締結の手引』改訂8版(労働調査会 編、労働調査会、2023年):版元の紹介によると、36協定が必要な場合、締結の方法、協定で定める内容、有効期間、届出の手続き、法的効力などを、労働基準法と行政解釈に沿ってQ&A形式で解説した本です。勤務表のモデルに入れる残業の上限は「協定に書いた時間数」なので、その値がどう決まり、どこまでが協定で動かせるのかを押さえるのに向いています。
第8章 希望と公平性を扱う
第7章では、労働基準法の労働時間・休憩・休日の条件や時間外労働の上限を確かめ、法令は必ず守る側(ハード制約)、社内ルールは緩め方を議論できる側として勤務表のモデルに入れる方法を扱いました。法令と就業規則を満たした勤務表は「作ってよい勤務表」ですが、それだけでは「現場が受け入れる勤務表」にはなりません。受け入れられるかどうかを左右するのは、多くの場合、スタッフ一人ひとりの希望がどれだけ通ったか、そして土日や遅い時間帯の勤務のような負担の重い仕事が一部の人に偏っていないか、の2点です。この章では、希望休と希望シフトをモデルでどう扱うか、希望の受け付け方をどう設計するか、公平性を何で測るかを整理したうえで、第2章で用意したサンプルデータ(架空のコンタクトセンター、30名・4週間)を使い、公平性の条件を入れたときに不足人時がどう変わるかを実測します。
希望には種類があり、扱い方が違う
勤務表に対する希望と一口に言っても、中身はいくつかに分かれます。最も多いのは「この日は休みたい」という希望休です。次に、「この日はこの型の勤務に入りたい」「この型には入りたくない」という希望で、この章ではこれを希望シフトと呼びます。夜の遅い時間帯を避けたい、朝の早い時間帯なら入れる、といった希望がこれに当たります。このほかに、月の勤務日数や連休の取り方、一緒に組みたい人や組みたくない人のように、日をまたいだり人をまたいだりする希望もあります。
これらの希望は、勤務表のモデルの中では2通りの扱い方があります。1つは「必ず守る条件」(ハード制約)として入れる方法で、希望した日には勤務を入れないという条件を加えます。もう1つは「破ってもよいが、破ると罰点がつく条件」(ソフト制約)として入れる方法で、希望を破った件数に重みを掛けて目的関数に足します。第5章で見た基準の勤務表は後者で、希望休の違反1件に5,000(架空の重み)を置き、不足1人×30分の3,000、SV 不在1枠の5,000、英語対応の不在1枠の2,000、パートの人件費と合わせた重みづけの和を最小にしています。
公開ベンチマークも同じ2通りを使い分けています。第6章と第10章で使う Curtois と Qu の看護師勤務表ベンチマークの書式説明を開いて確かめると、指定した日に勤務を入れてはいけない「Days off」はハード制約で、特定の日に特定の型に入りたい「Shift on requests」と入りたくない「Shift off requests」はソフト制約として定義され、満たされなかったときの罰点(重み)が1件ずつ指定されています。同じページでは、1人が勤務してよい週末の数の上限(Maximum Number of Weekends、土曜か日曜のどちらかに勤務があればその週末は勤務したと数える)もハード制約として置かれています。Instance1・Instance12・Instance24 のデータを読んで数えると、希望の重みは1〜3の3段階で、人員の不足1人あたりの重みは3つとも100、過剰1人あたりの重みは1でした。希望は、優先度に差をつけたうえで、人員の不足よりずっと軽く扱われているということです。
どちらの扱いを選ぶかは、希望の性質で決まります。通院や学校行事、家族の介護のように、休めなければその日は出勤できない事情がある希望は、実態としては勤務できない日です。これはソフトにしても意味がなく、ハード制約として入れるべきです。一方で、「できれば休みたい」「できれば早い時間がいい」という希望は、人員が足りない日には調整してもらう余地がある希望です。これをすべてハードにすると、人員の不足が増えるか、そもそも条件を満たす勤務表が存在しなくなります。希望を受け付ける段階で、この2つを区別して出してもらうことが、モデルに入れる前の最も大事な設計だと考えています。
希望の受け付け方を設計する
希望の扱いはモデルの書き方だけでは決まらず、希望をどう集めるかという運用の設計と組になっています。設計の要素は、件数の上限、優先度、締切の3つに整理できます。
件数の上限は、1人が1か月に出せる希望休や希望シフトの件数に上限を置くものです。上限がないと、多く出した人ほど希望が通る件数が増え、少ししか出さない人との間で差が開きます。重みづけの和を最小にするモデルは、希望の件数を人ごとに区別せずに数えるので、10件出した人の希望を2件破るのも、2件出した人の希望を2件破るのも、同じ罰点になります。件数に上限を置くと、希望の出し方による差が小さくなり、モデルの結果も説明しやすくなります。
優先度は、希望に「必ず」「できれば」のような段階をつけるものです。前の節で述べたとおり、「必ず」はハード制約、「できれば」は重みつきのソフト制約に対応させます。ベンチマークの重み1〜3のように、ソフト制約の中でもさらに段階を分けることもできます。ただし、「必ず」を無制限に受け付けると実質的にすべての希望がハードになるので、「必ず」の件数には、件数の上限とは別に、より小さい上限を置くのが扱いやすいと考えています。この章の後半では、1人1件だけを「必ず」として扱う設定を実際に解いて比べます。
締切は、希望をいつまでに出してもらうかです。勤務表をソルバーで作る場合、希望はモデルの入力なので、締切の後に出た希望は、作り直しか手直しで対応することになります。締切を勤務表の公開日のどれだけ前に置くかは、作り直しにかかる手間と、スタッフが予定を決められる時期の釣り合いで決まります。ソルバーで作ると作り直し自体は短時間で済むので、締切を遅めに置ける余地があります。ただし、公開済みの勤務表を作り直すと、希望と関係のない人の勤務まで動くことがあります。公開後の変更を小さく抑える作り直しの方法は、第11章で扱います。
| 設計の要素 | 決めること | モデルでの扱い | 決めないと起きること |
|---|---|---|---|
| 件数の上限 | 1人が1か月に出せる希望休・希望シフトの件数 | 入力の段階で件数を制限する。モデルは変えない | 多く出した人ほど希望が多く通り、出し方の差が結果の差になる |
| 優先度 | 「必ず」「できれば」の区別と、「必ず」の件数の上限 | 「必ず」はハード制約、「できれば」は重みつきのソフト制約 | すべてハードにすると不足が増えるか解がなくなる。すべてソフトにすると通院などの予定が崩れる |
| 締切 | 勤務表の公開日の何日前までに出すか | 締切までの希望をモデルの入力にする。締切後は作り直しか手直し | 締切後の希望への対応が作成者の裁量になり、説明できなくなる |
| 破られた希望の記録 | 誰の希望が何件破られたかを月ごとに残すか | 翌月以降の重みや上限に反映できる | 同じ人の希望が毎月破られても気づけない |
表の最後の行は、希望の扱いを1か月の中だけで閉じないための要素です。1回の勤務表の中で公平にしても、毎月同じ人の希望が破られていれば、長い目で見ると不公平です。これは次の節から扱う公平性の問題と同じ構造をしています。
公平性を何で測るか
勤務表の公平性を議論するには、まず何の偏りを測るのかを決める必要があります。測る対象は、多くの職場で負担が重いと受け止められている勤務の回数です。この記事のサンプルデータでは、土曜・日曜の勤務日数と、15時から24時までの遅番の回数の2つを測ります。どちらも、家庭の予定や生活のリズムとぶつかりやすい勤務です。対象は正社員18名(S01〜S18)に限りました。正社員は全員が4週でちょうど20日勤務する同じ契約なので、回数をそのまま比べられます。パートは週の上限日数や入れる勤務の型が人ごとに違うため、回数を並べても契約の違いと偏りを区別できません。パートの公平性を測るなら、契約の日数に対する割合のように、契約の違いをそろえた指標が要ります。
偏りの測り方には、主に3通りあります。1つ目は、回数の最大と最小の差です。18名のうち土日に最も多く勤務した人と最も少なく勤務した人の日数の差で、「差が2日以内」のように上限を置く形でモデルに入れやすく、現場にも説明しやすい指標です。2つ目は、ばらつき(標準偏差)です。全員の回数が平均からどれだけ散らばっているかを表し、最大と最小以外の人の状態も反映します。ただし、モデルに入れると2乗の項が出てくるので、この記事で使っている線形の形のままでは書けません。3つ目は、最も不利な人に注目する考え方で、マックスミン(最小値の最大化)と呼ばれます。満足度で言えば「最も満足度の低い人の満足度を、できるだけ高くする」、負担で言えば「最も負担の重い人の負担を、できるだけ軽くする」という目的です。
差の上限は、次のように書けます。正社員 \( i \) の土日の勤務日数を \( w_i \) とすると、
\( \max_i w_i – \min_i w_i \le g \)
で、言葉にすると「土日の勤務日数が最も多い人と最も少ない人の差を \( g \) 日以下にする」という条件です。CP-SAT では、最大値と最小値を表す整数の変数を作り、add_max_equality と add_min_equality で18名の回数と結び付けたうえで、その差に上限を置きます。マックスミンは、負担の側から見ると「最大値の最小化」になるので、同じ最大値の変数を目的関数に入れて小さくすることで表せます。次のコードは、この章の共通部品(後のコードで ch08_model として読み込むモジュール)から、土日の勤務日数の差を制約にする部分を抜き出したものです(単独では動きません)。遅番の回数も同じ形で書いています。
# 抜き出し:work[i, d] は「人 i が日 d に勤務するか」を表すブール変数(基準のモデルと同じ)
FT = list(range(18))                                     # 正社員 S01〜S18
WEEKEND_DAYS = [d for d in range(N_DAYS) if is_weekend(d)]
wk_cnt = {i: sum(work[i, d] for d in WEEKEND_DAYS) for i in FT}      # 土日の勤務日数
wk_max = m.new_int_var(0, 8, "wk_max")
wk_min = m.new_int_var(0, 8, "wk_min")
m.add_max_equality(wk_max, list(wk_cnt.values()))        # wk_max = 18名の最大
m.add_min_equality(wk_min, list(wk_cnt.values()))        # wk_min = 18名の最小
if fair_weekend_gap is not None:
    m.add(wk_max - wk_min <= fair_weekend_gap)          # 差の上限
部品を使って解く側のコードは、次のように短く書けます。これは単独で実行でき、出力はこの記事の実行環境(一般的なノートPC)で実行したものです。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from ch08_model import build, solve, metrics

# 正社員18名の「土日の勤務日数の差」と「遅番の回数の差」をそれぞれ1以下にする
m, V = build(fair_weekend_gap=1, fair_late_gap=1)
solver, st, sec = solve(m, time_limit=90, workers=8, seed=0)
r = metrics(solver, V)
print("状態", solver.status_name(st), "目的 %.0f 下界 %.0f" % (solver.objective_value, solver.best_objective_bound))
print("不足 %.1f 人×時間 / 希望休の違反 %d 件" % (r["short"] / 2, r["off"]))
print("土日の勤務日数", r["wk"])
print("遅番の回数", r["lt"])
# 出力: 状態 OPTIMAL 目的 2053500 下界 2053500
# 出力: 不足 221.0 人×時間 / 希望休の違反 3 件
# 出力: 土日の勤務日数 [5, 5, 5, 5, 4, 5, 5, 4, 4, 4, 5, 4, 5, 4, 5, 5, 5, 5]
# 出力: 遅番の回数 [5, 5, 5, 5, 5, 6, 5, 5, 5, 5, 5, 5, 5, 5, 5, 5, 5, 5]
build の引数 fair_weekend_gap=1 と fair_late_gap=1 が、土日の勤務日数の差と遅番の回数の差の上限です。時間制限を90秒にしたこの実行では、状態は OPTIMAL で、重みづけの和は偏りの条件がないときと同じ2,053,500でした。出力の2つのリストは正社員18名の回数で、土日は4日か5日、遅番は1名だけ6回で残りは5回にそろっています。この結果の意味は、後の節で表にまとめて読みます。
3つの測り方は、同じ勤務表でも違う答えを出すことがあります。差だけを見ると、全員の回数が1回ずつそろっていれば差は0ですが、その1回が全員にとって負担の重い回数かどうかは分かりません。反対に、差が大きくても、それが1人だけ極端に少ない人がいるためなら、多くの人にとっては問題になりません。マックスミンは最も不利な1人に注目するので、その1人以外の人の状態が悪くなっても気づきにくいという弱点があります。どれか1つで判断するのではなく、差・ばらつき・最大の人の値を並べて見るのが確実だと考えています。この章の実験では、3つの指標をすべて記録しました。
基準の勤務表の偏りを測る
第5章で示した基準の勤務表(基準の記録)は、重みづけの和について最適性まで証明された計画で、不足は221.0人×時間、希望休の違反は88件中3件でした。この勤務表の公平性を測ろうとしたところ、1つ問題がありました。基準の記録には先頭7日分の勤務表しか残っていないので、4週間の土日勤務や遅番の回数を数えられないのです。そこで、基準のスクリプトは再実行せず、同じ変数・同じ制約・同じ重みのモデルをこの章の共通部品で組み立て、同じ条件(時間制限30秒、num_workers=8、random_seed=0)で解きました。
結果は、状態 OPTIMAL、目的関数の値 2,053,500 で、基準の値と同じでした。この実行では、不足221.0人×時間・過剰641.0人×時間・希望休の違反3件・SV 不在0枠・英語不在0枠・パートの勤務475時間も、基準と同じ値になりました。ただし、内訳まで一致したのはこの実行でたまたまそうなったもので、第5章や第9章で同じ設定を解き直した実行では、同じ目的関数の値で不足216.0人×時間・パート495時間の勤務表が返っています(各章の値は第5章の表にまとめました)。さらに、返ってきた勤務表を基準の記録の先頭7日と比べると、30名×7日の210マスのうち119マスで勤務の型が違っていました。目的関数の値が同じまま中身の違う勤務表が返ってきたということは、この問題には重みづけの和が同じ最適解が複数あるということです。このような最適解どうしを代替最適解と呼びます。ソルバーはそのうちの1つを返すだけで、どれを返すかは実行ごとの探索の経路で決まります。
この章で解き直した勤務表で、正社員18名の土日勤務と遅番の回数を数えた結果が次のとおりです。土日の勤務日数は最小3日・最大7日で、差は4日、標準偏差は1.05日でした。遅番の回数は最小1回・最大7回で、差は6回、標準偏差は2.04回です。4週間の土日は8日あるので、7日勤務した人(S07)は土日のうち1日しか休めていません。遅番は、7回の人が6名いる一方で、1回の人が2名(S10・S17)いました。希望休の違反3件の内訳は、S01が2件、S05が1件で、違反は2人に集まっていました。
ここで注意したいのは、この偏りは「重みづけの和を最小にした結果として生まれた」のではなく、「重みづけの和が偏りについて何も言っていないために、たまたまこうなった」ということです。目的関数には土日や遅番の回数が入っていないので、ソルバーにとっては、遅番7回の人がいる勤務表も、全員5回の勤務表も、重みづけの和が同じなら同じ価値です。基準の記録の勤務表そのものの4週間の偏りは、上に書いたとおり記録から数えられないので、この章の数字は解き直した勤務表のものです。
第5章では、これとは別に、基準の記録の先頭7日と各枠の在席人数に合わせた28日分の勤務表(基準の記録に合わせた勤務表)を求めて偏りを数えています。同じ正社員18名で、遅番は0〜14回(差14回)、土日は2〜7日(差5日)でした。この章の勤務表(遅番の差6回、土日の差4日)と第5章の勤務表は、どちらも不足221.0人×時間・過剰641.0人×時間・希望休の違反3件・パート475時間の同点の解ですが、偏りはこれだけ違います。つまり「基準の勤務表の偏り」は1つの値ではなく、同点の解のどれが返るかで、この例題では少なくとも遅番の差6〜14回、土日の差4〜5日の幅で動く値です。以下の比較では、この章で解き直した勤務表(差4日・6回)を出発点として書きます。
目的を変えずに偏りを減らす
代替最適解が多いということは、裏を返せば、重みづけの和を少しも悪くせずに偏りを減らせる余地があるかもしれない、ということです。これを確かめるために、2段階で解きました。1段階目は基準と同じ重みづけの和の最小化で、最適値は2,053,500です。2段階目では、「重みづけの和が2,053,500以下である」という条件を加えたうえで、目的を「土日の勤務日数の差+遅番の回数の差」の最小化に取り替えて解き直します。このように、優先する目的から順に解き、前の段階の最適値を条件として残して次の目的を最小にするやり方は、辞書式の最適化(段階的に解く方法)と呼ばれます。CP-SAT での書き方と、重みづけの和との違いの詳細は第6章で扱います。
2段階目の結果は、時間制限30秒で状態 FEASIBLE、差の和2(下界1)でした。土日の勤務日数は最小4日・最大5日で差1日、標準偏差0.42日、遅番の回数は最小5回・最大6回で差1回、標準偏差0.23回です。この章で解き直した1段階目の勤務表(差4日・6回)と比べて、偏りは大きく縮みました。第5章の勤務表(差5日・14回)と比べれば、縮み方はさらに大きくなります。2段階目は「重みづけの和が最適値のまま、差の和が2になる勤務表がある」ことを示したもので、この事実はどちらの勤務表を出発点に考えても変わりません。それでいて、重みづけの和は2,053,500のまま、不足221.0人×時間・過剰641.0人×時間・希望休の違反3件・パートの勤務475時間も変わっていません。次の図は、2つの勤務表について、正社員18名の土日勤務と遅番の回数を並べたものです。
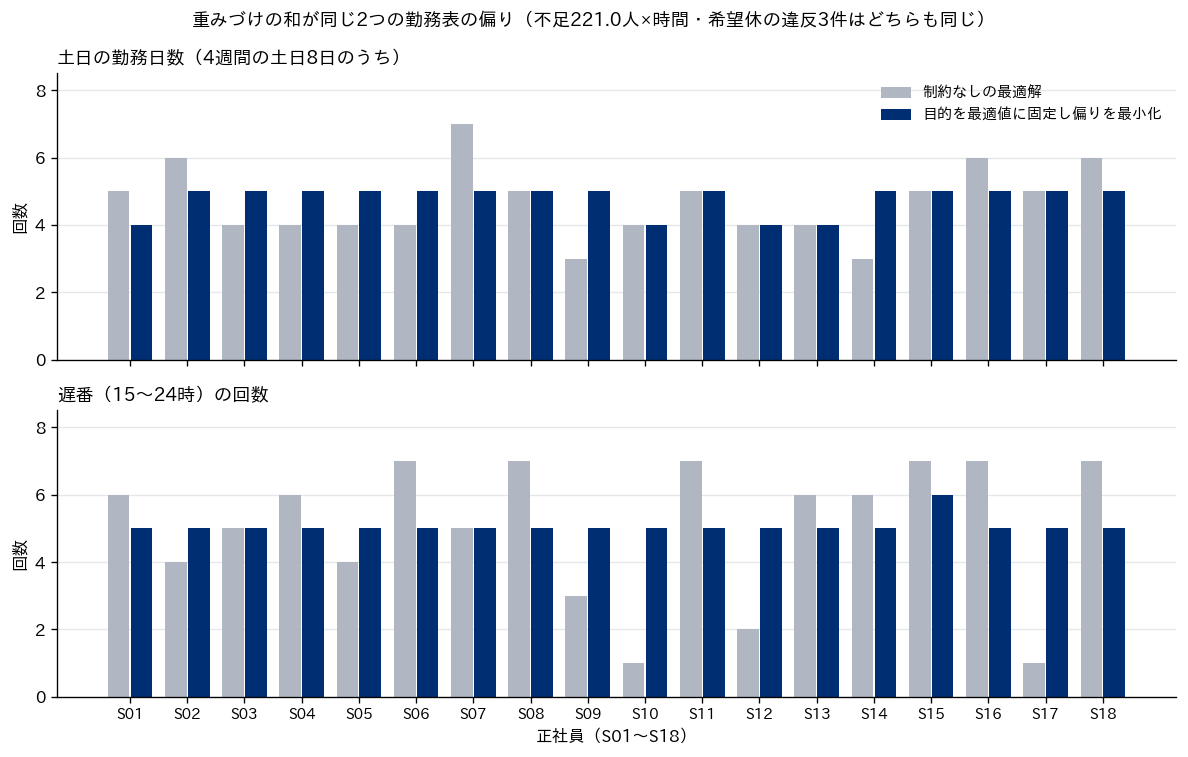
差の和の下界が1で、見つかった解が2なので、時間制限の中では「差の和を1にできるかどうか」までは決着していません。そこで時間制限を90秒に延ばして同じ2段階目を解き直しましたが、やはり FEASIBLE で差の和2(下界1)でした。後で示すとおり、遅番の差を0にしても重みづけの和は最適値のままにできる一方、土日の差を0にすると重みづけの和が悪くなることが別の実験で証明されているので、差の和の最小は1か2のどちらかです。どちらであっても、現場にとっての違いは「土日か遅番のどちらかで、1人だけ1回多い」かどうかにとどまります。
この結果は、公平性の議論の順番について1つの示唆を与えます。公平性の条件を入れると不足が増える、という心配から公平性を後回しにしがちですが、少なくともこの例題では、偏りの大部分は不足と引き換えにしなくても取り除けました。偏りの大部分は、需要や制約から必然的に生まれたものではなく、目的関数が偏りを気にしていなかったために残っていた、探索の経路で偶然決まったものだったということです。勤務表をソルバーで作るなら、まず重みづけの和を最小にし、その値を保ったまま偏りを最小にする2段階目を回す運用を標準にすることが、重みづけの和を悪化させずに公平性を上げるために、まず検討すべき打ち手になると考えています。2段階目の計算時間が取れない場合は、1段階目の時間制限との配分を決めておきます。
偏りの上限を入れると不足人時はどう変わるか
次に、偏りの差に上限を置いた条件を基準のモデルに加え、目的は基準と同じ重みづけの和のままで解きました。重み・時間制限30秒・num_workers=8・random_seed=0 は基準と同じです。30秒で OPTIMAL にならなかった条件は、時間制限を90秒に延ばして解き直しました。偏りの差の条件は、正社員18名の土日の勤務日数と遅番の回数についてのものです。
| 条件 | 時間制限 | 状態 | 重みづけの和 | 下界 | 不足人時 | 過剰人時 | 希望休の違反 | 土日の差 | 遅番の差 |
|---|---|---|---|---|---|---|---|---|---|
| 偏りの条件なし(基準と同じ設定) | 30秒 | OPTIMAL | 2,053,500 | 2,053,500 | 221.0 | 641.0 | 3件 | 4日 | 6回 |
| 土日の差2日以下 | 30秒 | OPTIMAL | 2,053,500 | 2,053,500 | 221.0 | 641.0 | 3件 | 2日 | 6回 |
| 土日の差1日以下 | 30秒 | OPTIMAL | 2,053,500 | 2,053,500 | 223.5 | 633.5 | 3件 | 1日 | 7回 |
| 土日の差0日 | 30秒 | FEASIBLE | 2,062,500 | 2,054,500 | 222.5 | 642.5 | 3件 | 0日 | 6回 |
| 土日の差0日 | 90秒 | OPTIMAL | 2,059,500 | 2,059,500 | 222.0 | 642.0 | 3件 | 0日 | 8回 |
| 遅番の差2回以下 | 30秒 | OPTIMAL | 2,053,500 | 2,053,500 | 216.0 | 656.0 | 3件 | 5日 | 2回 |
| 遅番の差1回以下 | 30秒 | FEASIBLE | 2,058,000 | 2,053,500 | 218.0 | 653.0 | 3件 | 3日 | 1回 |
| 遅番の差0回 | 30秒 | FEASIBLE | 2,074,500 | 2,053,500 | 219.5 | 659.5 | 3件 | 6日 | 0回 |
| 遅番の差0回 | 90秒 | OPTIMAL | 2,053,500 | 2,053,500 | 221.0 | 641.0 | 3件 | 4日 | 0回 |
| 土日の差1日以下・遅番の差1回以下 | 30秒 | FEASIBLE | 2,058,000 | 2,053,500 | 220.5 | 645.5 | 3件 | 1日 | 0回 |
| 土日の差1日以下・遅番の差1回以下 | 90秒 | OPTIMAL | 2,053,500 | 2,053,500 | 221.0 | 641.0 | 3件 | 1日 | 1回 |
| 土日の差0日・遅番の差0回 | 30秒 | FEASIBLE | 3,007,000 | 2,054,500 | 257.0 | 932.0 | 24件 | 0日 | 0回 |
| 土日の差0日・遅番の差0回 | 90秒 | FEASIBLE | 2,065,500 | 2,054,500 | 220.5 | 650.5 | 3件 | 0日 | 0回 |
表の「重みづけの和」列と「下界」列が同じ行は、その条件のもとで最適性が証明された結果です。これらの行を見ると、土日の差を2日以下や1日以下にしても、遅番の差を2回以下や0回にしても、両方を1以下にしても、重みづけの和は偏りの条件なしのときと同じ2,053,500のままでした。偏りの条件が重みづけの和を悪くしたのは、土日の差を0日にした行だけで、90秒で OPTIMAL の2,059,500、つまり6,000(不足1人×30分の3,000で2枠分)だけ悪くなりました。不足人時は221.0から222.0へ1.0人×時間増えています。土日の差を0日にするには、正社員18名全員の土日の勤務日数をそろえる必要があり、全員が同じ日数になる組み合わせが需要の形とかみ合わないために、わずかな不足が生じたということです。
表を読むときに注意したいのは、「不足人時」「過剰人時」の列の違いを、そのまま偏りの条件の効果として読まないことです。たとえば土日の差1日以下の行は、重みづけの和が2,053,500で OPTIMAL なのに、不足人時は223.5で、条件なしの221.0より2.5人×時間多くなっています。一方でパートの勤務は465時間で、条件なしの475時間より10時間少なくなっています。基準の重みでは、不足1人×30分が3,000、パート1時間が1,500なので、不足5枠分(15,000)とパート10時間分(15,000)がちょうど相殺し、重みづけの和は変わりません。重みづけの和が同じ最適解の中で、不足とパートの勤務時間の内訳が入れ替わっただけです。同じことは遅番の差2回以下の行(不足216.0人×時間・パート495時間)にも表れています。このため、この表で偏りの条件の効果として読むべきなのは「重みづけの和」列の差で、不足人時や偏りの列の小さな違いは、代替最適解の間の揺れを含んでいます。なお、表の1行目の偏り(土日の差4日・遅番の差6回)は、前の節で述べたとおり、基準の記録の勤務表ではなく、この章で同じ設定を解き直した勤務表の値です(第5章の勤務表では差5日・14回)。
土日の差0日・遅番の差0回の両方を課した最後の2行は、90秒でも FEASIBLE でした。重みづけの和2,065,500に対して下界が2,054,500です。ただし、この条件は「土日の差0日」を含んでいるので、土日の差0日だけの条件(90秒で OPTIMAL の2,059,500)より良くなることはありません。したがって最適な値は2,059,500から2,065,500の間にあり、偏りの条件なしと比べて少なくとも6,000、多くとも12,000悪くなることまでは言えます。
時間制限で打ち切った解を「公平性の費用」と読まない
表には、同じ条件を30秒と90秒で解いた行を並べました。この比較から、実務上とても大事な注意点が読み取れます。遅番の差0回の条件は、30秒では重みづけの和2,074,500の FEASIBLE でした。偏りの条件なしの2,053,500と比べると21,000悪く、不足1人×30分の3,000で割ると7枠分です。この数字だけを見ると「遅番をそろえるには、不足7枠分に相当する費用がかかる」と読みたくなります。ところが同じ条件を90秒で解くと OPTIMAL の2,053,500で、費用は0でした。30秒の結果に現れた21,000は、公平性の費用ではなく、探索が打ち切られたために良い解に届いていなかった分です。
もっと極端なのが、土日と遅番の両方の差を0にした条件です。30秒の結果は重みづけの和3,007,000で、不足257.0人×時間、希望休の違反24件、SV 不在50枠という、とても現場に出せない勤務表でした。90秒では2,065,500まで改善し、不足220.5人×時間・希望休の違反3件・SV 不在0枠になっています。30秒の結果だけを見て「完全に公平にすると SV が50枠不在になる」と結論していたら、根拠のない理由で公平性をあきらめることになっていました。
公平性の条件は、条件を満たす勤務表の数を大きく減らすので、ソルバーにとっては良い解を見つけにくい問題になります。そのため、同じ時間制限で解くと、条件を足した側だけが探索の打ち切りの影響を強く受けます。条件を足した計画と足す前の計画を比べるときは、状態と下界を必ず並べて見て、FEASIBLE の結果の差を費用として読まないことが必要です。下界と見つかった解の間が開いているなら、時間制限を延ばして差が縮むかを確かめてから判断します。
揺れの大きさも確かめました。この節の実験と同じ10通りの条件(偏りの条件なし、前の節の2段階目、偏りの上限8通り)を、乱数種だけを random_seed=1 に変えて30秒ずつ解き直したところ、今度は偏りの条件なし(基準と同じ設定)ですら30秒で OPTIMAL に届かず、FEASIBLE の2,184,000(不足226.5人×時間、希望休の違反9件)でした。目的を最適値に固定して偏りを最小にする2段階目は、30秒の間に条件を満たす勤務表を1つも見つけられず、状態は UNKNOWN(解も非存在の証明も得られていない)でした。ほかの8条件もすべて FEASIBLE で、たとえば遅番の差2回以下の条件は重みづけの和2,595,000、SV 不在14枠という結果です。この2回目の実行は、同じ PC でほかの計算が多く動いていた時間帯に行ったもので、1回目(random_seed=0)で基準と同じ設定が7.2秒で OPTIMAL になったのとは条件が違います。乱数種と計算機の混み具合だけで、30秒の結果はこれだけ変わるということです。
一方で、OPTIMAL と証明された結果は、乱数種や計算機の混み具合によらず正しい値です。この章の結論のうち、「土日の差1日以下・遅番の差1回以下でも重みづけの和は2,053,500のまま」「土日の差0日にすると6,000悪くなる」は、どちらも90秒で最適性が証明された結果に基づいています。勤務表を毎月の運用で作るなら、時間制限の中で OPTIMAL に届いたかどうかを毎回記録し、届かなかった月は時間を延ばすか、前月の勤務表を初期解として与えるなどの手当てを決めておくことが必要です。時間制限と品質の関係は第6章、大きな問題を決まった時間で解く工夫は第10章で扱います。
希望休の違反3件は、なぜ避けられないのか
ここからは希望の側を扱います。基準の勤務表では、希望休88件のうち3件が破られていました。この3件を0にできないかを確かめるために、希望休をすべてハード制約にして(88件すべての日を必ず休みにして)解いたところ、ソルバーは3.6秒で INFEASIBLE(条件を満たす勤務表は存在しない)と答えました。1人あたりの違反を1件までに制限した条件でも、8.1秒で INFEASIBLE でした。どちらも、時間が足りなかったのではなく、解が存在しないことが証明されたという結果です。
理由は、希望休の出し方と雇用契約の組み合わせにあります。正社員は4週でちょうど20日勤務し、1週間に勤務できるのは5日までです。S01は第1週の水曜・金曜・土曜・日曜(第3日・第5日・第6日・第7日)の4日に希望休を出しています。これをすべて休みにすると、第1週に勤務できるのは3日だけになり、残りの3週間で5日ずつ勤務しても合計18日で、20日に届きません。したがって、S01の希望休は少なくとも2件破らざるをえません。S05も同じで、第2週に3日(第11日・第12日・第13日)の希望休が集まっているため、第2週は4日までしか勤務できず、合計19日にしかならないので、少なくとも1件は破られます。この数え上げはソルバーを使わずにできるもので、スクリプトで全員分を数えると、契約から見て避けられない違反は合計3件でした。基準の勤務表の違反3件は、この最低件数とちょうど一致しています。
この結果は、ソルバーの性能の問題ではなく、希望の受け付け方の問題です。S01とS05の希望は、勤務表を作る前の段階で、契約と両立しないことが分かります。受け付けた時点で「この週に4日の希望休を出すと、4週20日の契約では2件は通りません」と本人に返せば、本人がどの日を優先するかを選べます。ソルバーに任せると、どの日の希望を破るかはソルバーが重みづけの和だけを見て決めることになり、本人にとって最も大事な日が破られる可能性があります。前に述べた件数の上限の設計には、1か月の合計件数だけでなく、1週間に集中してよい件数の上限も含めるべきだということが、この例から分かります。
優先度の効果も確かめました。全員について希望休のうち1件を「必ず」(ハード制約)とし、残りは基準と同じ重み5,000のソフト制約とした条件です。どの1件を「必ず」にするかは、乱数種を固定して選んだ架空の設定で、S01は第7日、S05は第12日が選ばれました。結果は OPTIMAL で、重みづけの和・不足・希望休の違反3件(S01が2件、S05が1件)とも基準と同じでした。S01とS05の「必ず」の日は守られたうえで、別の日の希望が破られたということです。優先度を付けても違反の件数は変わりませんが、どの希望が破られるかを本人の意思に沿わせることができます。件数が同じなら、本人が選んだ優先順位どおりに破られるほうが、納得を得やすいと考えています。
希望を通すと、負担はほかの人に移る
希望を通すことの費用を、2つの実験で測りました。1つ目は、希望休の重みを0にして(希望休を一切考えずに)解いた場合です。時間制限90秒で OPTIMAL、重みづけの和は2,038,500でした。基準の2,053,500との差15,000は、基準の希望休の違反3件×5,000とちょうど等しく、不足221.0人×時間・過剰641.0人×時間・パートの勤務475時間は基準と同じです。つまりこのサンプルデータでは、希望休88件のうち85件を通すことに、不足人時と人件費の面での費用は0でした。重みを0にした勤務表では違反が43件ありましたが、これはソルバーが希望休を区別しなかったために、たまたま43件が勤務日に当たったというだけです。希望休の重みは、希望を守るための費用を払わせるためではなく、同じ費用の勤務表の中から希望を守るものを選ばせるために働いていたことになります。
2つ目は希望シフトです。共通データには希望シフトがないので、正社員18名のうち6名(S01・S03・S07・S08・S12・S16。乱数種を固定して選んだ架空の設定)が「遅番に入りたくない」という希望を出したとし、遅番に入った1回につき5,000の重みを目的に足して解きました。時間制限90秒で OPTIMAL、重みづけの和(遅番の希望の罰点を含む)は2,053,500で、6名の遅番は全員0回になりました。この希望も、不足人時の面では費用0で通ったということです。ところが、この実験の勤務表では遅番の合計が91回のままだったので、6名が抜けた分はほかの12名に回りました。ほかの12名の遅番は最小3回・最大10回で、10回の人が5名いました。希望を入れない設定でこの章が解き直した勤務表では、18名の遅番は最大7回だったので、それと比べると、希望を通したことで、希望を出さなかった人の負担が最大で10回まで増えたことになります(第5章の勤務表のように、希望を入れなくても最大14回の人が出る同点の解もあります)。
そこで、希望を通したうえで、ほかの12名の遅番の回数の差を1回以下にする条件を加えました。結果は同じく90秒で OPTIMAL、重みづけの和は2,053,500のままで、ほかの12名の遅番は7回か8回にそろいました。不足221.0人×時間・希望休の違反3件も基準と同じです。次の図は、3つの勤務表の遅番の回数を人別に並べたものです。
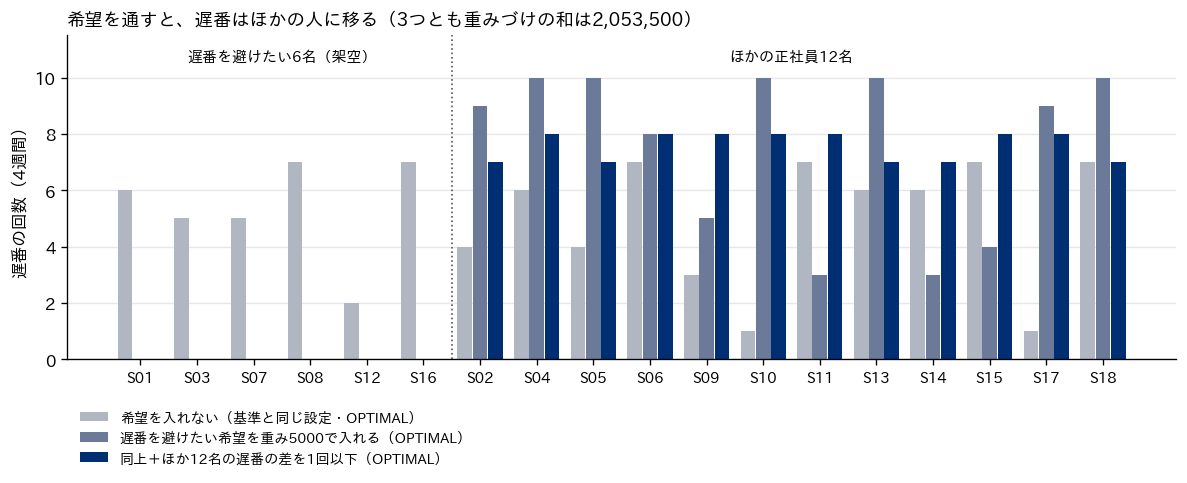
| 条件 | 時間制限 | 状態 | 重みづけの和 | 不足人時 | 希望休の違反 | 遅番を避けたい6名の遅番 | ほかの12名の遅番 |
|---|---|---|---|---|---|---|---|
| 希望シフトを入れない(基準と同じ設定。偏りを測った再現の勤務表) | 30秒 | OPTIMAL | 2,053,500 | 221.0 | 3件 | 2〜7回(合計32回) | 1〜7回(合計59回) |
| 遅番を避けたい希望を重み5,000で入れる | 90秒 | OPTIMAL | 2,053,500 | 218.5 | 3件 | 全員0回 | 3〜10回(合計91回) |
| 同上+ほかの12名の遅番の差を1回以下 | 90秒 | OPTIMAL | 2,053,500 | 221.0 | 3件 | 全員0回 | 7〜8回(合計91回) |
表の2行目で不足人時が218.5になっているのは、重みづけの和が同じまま、不足と過剰・パートの勤務時間の内訳が入れ替わったためです(過剰648.5人×時間、パートの勤務485時間)。重みづけの和で見れば、3つの勤務表は同じ価値です。
この実験から言えるのは、希望を通すことの費用は、不足人時や人件費ではなく、ほかの人の負担として現れることがある、ということです。遅番を避けたい6名の希望を通したあとの、ほかの12名の平均は91÷12で約7.6回で、希望を通す前の18名の平均(91÷18で約5.1回)より2.5回ほど多くなります。この増加は、差の上限を置いても消えません。差の上限が防げるのは「12名のうち誰か1人に10回が集中すること」までで、遅番の総数がほぼ変わらない限り、12名全体の負担が増えることは、総数と希望者の数から決まります。遅番の総数そのものは必然の値ではなく、勤務表によって少し動きます(たとえば遅番の差を0回にした30秒の実行では、18名全員が5回で合計90回でした)が、この実験の3つの勤務表ではどれも91回でした。ここでマックスミンの考え方が役に立ちます。ほかの12名の中で最も負担の重い人の回数は、何も条件を置かないと10回、差の上限を置くと8回で、最も不利な人の状態を基準にすると後者のほうが明らかに良い勤務表です。
運用の面では、この結果は2つの設計を示唆しています。1つは、希望シフトを受け付けるときに、希望を通すとほかの人の負担がどれだけ増えるかを、希望を出した人と出さなかった人の両方に見える形にすることです。遅番の総数がほぼ変わらない以上、6名の希望は12名の負担の上に成り立っています。もう1つは、希望を通した人に別の形で負担を分けてもらう設計です。たとえば、遅番を避けたい人には土日の勤務を多めに受けてもらう、希望を通す人数に上限を置いて毎月入れ替える、といった取り決めが考えられます。どの取り決めが納得されるかは職場で決めることですが、モデルの側では、負担の種類ごとの回数を人別に数え、それぞれに差の上限や重みを置くことで、どの取り決めでも表せます。
重みは「交換の比率」として決める
希望や公平性をソフト制約で入れるときに、最も議論になるのが重みの値です。重みの値そのものには意味がなく、意味を持つのは重みどうしの比です。基準のモデルでは、希望休の違反1件の重みが5,000、不足1人×30分の重みが3,000でした。比にすると、希望休の違反1件は不足1人×30分の約1.67枠分に当たります。言い換えると、ほかの項目(パートの勤務時間・SV 不在・英語不在)が変わらないなら、このモデルは「希望休を1件破ることで不足が2枠(1人×1時間)以上減るなら破る、1枠しか減らないなら破らない」という交換の比率で判断しています。重みを決めるということは、この交換の比率を決めるということです。
比率で考えると、現場に確かめるべき問いが具体的になります。「希望休を1件破ってよいのは、不足が何時間減るときか」「遅番が1人に1回偏ることは、不足の何時間分と同じくらい避けたいか」という問いです。前に見たベンチマークでは、人員の不足1人の重みが100、希望1件の重みが1〜3だったので、希望は不足の数十分の1から百分の1の重さで扱われています。この比率が現場に合うかどうかは職場ごとに違い、どちらが正しいということはありません。ただ、比率を言葉にしておくと、「なぜこの人の希望が破られたのか」を「このモデルは、希望1件を不足1時間より軽く扱うと決めているから」と説明できるようになります。
重みを決めるときに注意したいのは、重みを大きくすれば必ずその項目が守られるわけではないことです。この章の実験で見たとおり、希望休の違反3件は契約上避けられない最低件数だったので、重みをいくら大きくしても3件より減りません。反対に、重みを大きくしすぎると、希望1件を守るためなら大きな不足を受け入れてよい、という比率をモデルに与えることになり、希望を守る代わりに不足の多い勤務表が選ばれうる設定になります。重みは、何通りかの値で解いて結果の表を並べ、比率を変えたときに不足人時と希望の違反がどう入れ替わるかを見てから決めるのが確実です。
交換の比率は、項目どうしの間だけでなく、同じ項目の中にもあります。基準のモデルは不足を「1人×30分あたり3,000」と一定の重みで数えているので、1つの枠で2人足りないことと、2つの枠で1人ずつ足りないことを同じ重さに扱います。コンタクトセンターでは、1つの枠で2人足りると応答率が大きく落ちるので、前者をより重く見たいことがあります。その場合は、各枠の不足を「1人目の不足」と「2人目以降の不足」の2つの変数に分け、後者に大きな重みを置くと、不足を多くの枠に薄く散らす勤務表が選ばれやすくなります。公平性も同じで、遅番の回数の差に上限を置く代わりに、1人の遅番が一定の回数を超えた分にだけ重みを置けば、「月に6回までは問題にしないが、7回目からは避けたい」という現場の感覚に近い形で表せます。どちらも、この章では実験していない書き方なので、使うときは第6章の手順で小さな例を解いて確かめてから本番のモデルに入れるのが安全です。
重みを現場と合意する手順は、次のように整理できると考えています。
- 守る項目を「ハード(必ず守る)」と「ソフト(重みで比べる)」に分ける。法令と雇用契約はハード、希望と公平性は原則ソフトにし、ハードにする希望の件数には上限を置く
- ソフトの項目どうしの交換の比率を、「不足1時間を減らすためなら、希望休を何件破ってよいか」のような問いの形で現場の責任者に聞く
- 聞いた比率の前後で重みを3通りほど置いて解き、不足人時・過剰人時・希望の違反・偏りの差を1枚の表に並べて見せる。時間制限で打ち切った結果は状態と下界を添え、FEASIBLE の差を比率の効果として見せない
- 表の中から採用する行を現場と一緒に選び、その重みと理由を記録する
- 毎月の勤務表で、破られた希望と偏りを人別に記録し、同じ人に偏っていれば、翌月の重みや上限を見直す
3番目の手順で結果を表にして見せることが大事なのは、重みの値を直接議論しても合意しにくいからです。「希望休の重みを5,000にするか10,000にするか」は現場にとって判断の材料になりにくい問いですが、前の表の行を使って「土日の勤務日数の差が1日で不足が221.0人×時間の勤務表と、差が0日で不足が222.0人×時間の勤務表のどちらを選ぶか」と聞けば判断できます。モデルの中の重みは、現場が選んだ結果を再現するための道具として扱うのがよいと考えています。
ここまでの内容を、希望の受け付けから勤務表の公開までの流れとしてまとめると、次の図のようになります。
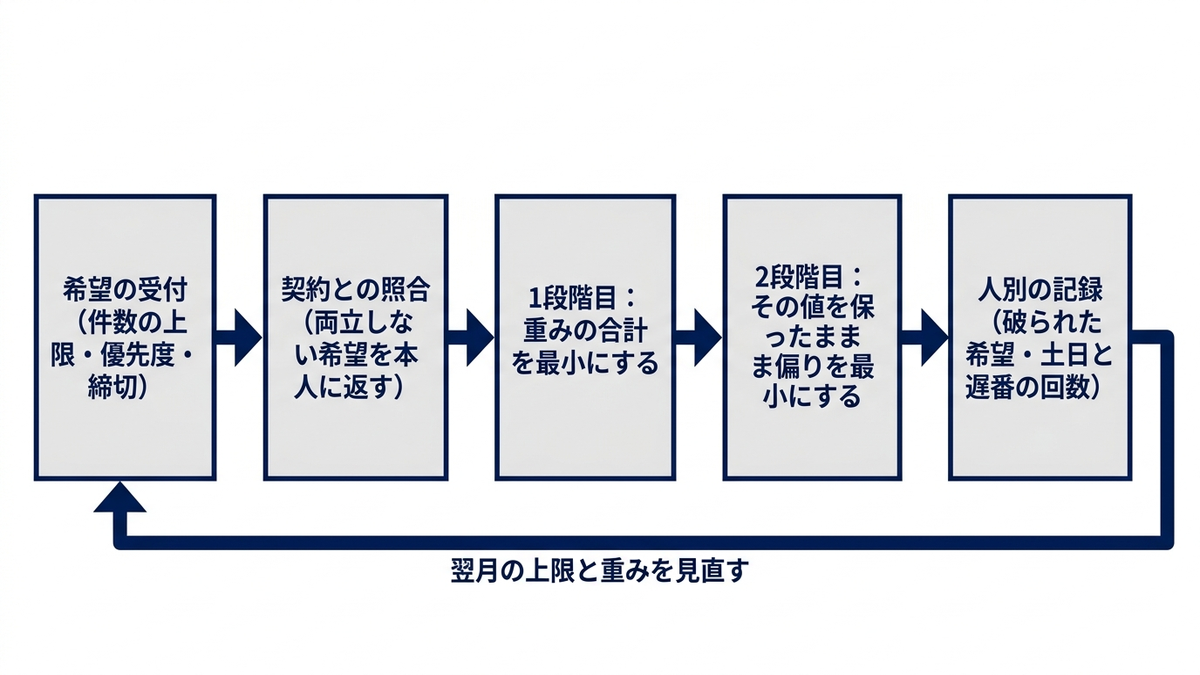
経営の判断に翻訳する
この章の実験を経営の言葉に置き換えると、3つのことが言えます。1つ目は、このサンプルデータでは、公平性のかなりの部分を重みづけの和を悪化させずに改善できたということです。どの職場でも同じになるとは限らないので、自社のデータで同じ2段階の計算をして確かめる必要があります。サンプルデータでは、この章で解き直した勤務表(土日の勤務日数の差4日・遅番の回数の差6回)から、2段階目の計算で差1日・1回の勤務表を求めると、不足人時・過剰人時・希望休の違反・パートの勤務時間はまったく変わりませんでした(2段階目の計算は1段階目の勤務表を初期解として使わずに解き直しているので、第5章の勤務表の差5日・14回から見ても、差1日・1回の勤務表が同じ費用で手に入ることは変わりません)。同点の勤務表の中に、不足を変えずに偏りを縮められるものがあった、ということです。偏りの上限を入れた表には、重みづけの和が同じまま不足人時が数人×時間動いた行もありますが、それは同点の解の揺れで、偏りの条件の費用ではありません。重みづけの和で見れば、差1日・1回までの改善の費用は0円です。費用がかかったのは土日の勤務日数を全員完全にそろえた場合で、重みづけの和で6,000(不足1人×30分を3,000円相当とみなす架空の重みで、不足2枠分)でした。偏りを「差1日」まで縮めるのと「差0日」まで縮めるのとでは、費用の性質がまったく違うということです。
2つ目は、希望の違反の件数には、勤務表の作り方では下げられない下限があるということです。サンプルデータの違反3件は、希望休の出し方と4週20日・週5日の契約の組み合わせから、どう作っても避けられない件数でした。この3件を減らす手段は、ソルバーの時間を延ばすことでも重みを変えることでもなく、希望を受け付ける段階で、契約と両立しない出し方を本人に返すことです。勤務表の品質の指標として「希望の充足率」を経営報告に載せるなら、避けられない違反と、勤務表の作り方で減らせる違反を分けて数える必要があります。前者は受け付けの運用の指標で、後者は勤務表の作り方の指標です。
3つ目は、希望を通すことには、ほかの人の負担という形の費用があるということです。遅番を避けたい人の希望を通すと、その分の遅番はほかの人に回ります。この章の実験では、6名の希望を通しても重みづけの和と不足人時の水準は変わらなかった一方で、希望を出さなかった12名の遅番が最大10回まで増えました。経営の指標として不足人時と人件費だけを見ていると、この負担の移動は見えません。人別の土日勤務・遅番の回数と、その最大と最小の差を、不足人時と並べて毎月の報告に載せることが、負担の偏りを見逃さない方法だと考えています。
公平性の欠如が離職にどれだけつながるかについて、勤務表の偏りと離職の関係を直接測った公的統計は、この章の範囲では確認できませんでした。関連する統計として、厚生労働省の「令和7年雇用動向調査結果の概要(転職入職者の状況)」によると、令和7年の1年間の転職入職者のうち女性が前職を辞めた理由は、「その他の個人的理由」23.8%を除くと「労働時間、休日等の労働条件が悪かった」12.9%が最も多く、次いで「職場の人間関係が好ましくなかった」11.5%でした。同じ表で男性の「労働時間、休日等の労働条件が悪かった」は8.5%です。この調査は、労働時間や休日の条件の中で勤務の割り振りの公平性がどれだけの比重を占めるかまでは分けていないので、ここから「偏りを減らせば離職がこれだけ減る」とは言えません。言えるのは、労働時間や休日の条件が転職の理由として上位に挙がっており、土日や遅番の割り振りはその条件の一部だ、ということまでです。自社で判断するなら、退職者への聞き取りや社内の調査で、勤務の割り振りへの不満が理由に含まれていたかを記録し、人別の偏りの記録と突き合わせるのが確実です。
判断を誤ったときの損失の型も整理しておきます。公平性をモデルに入れずに勤務表を作り続けると、偏りはソルバーの探索の経路で決まり、毎月違う人に偏るとは限りません。同じ人に土日や遅番が重なり続けても、不足人時の指標には現れないので気づけません。反対に、公平性を完全にそろえる条件を短い時間制限のまま入れると、この章の30秒の実験のように、不足や SV の不在が大きく増えた勤務表が返り、それを見て「公平性は高くつく」と誤って判断し、2段階目の最小化のような費用のかからない改善まで捨ててしまうことが起こりえます。どちらの損失も、モデルに何を書き、結果をどう読むかで決まります。
この章の要点は3つです。第一に、希望は「必ず」と「できれば」に分けて受け付け、「必ず」はハード制約、「できれば」は重みつきのソフト制約として入れ、件数の上限は1か月の合計だけでなく1週間への集中にも置きます。契約と両立しない希望は、勤務表を作る前に本人に返せます。第二に、公平性は土日勤務や遅番の回数の最大と最小の差・ばらつき・最も不利な人の値で測り、重みづけの和を最小にしたあと、その値を保ったまま偏りを最小にする2段階目を回すと、この例題では不足人時を変えずに偏りを大きく縮められました。第三に、公平性の条件を足した結果は状態と下界を添えて読み、時間制限で打ち切った FEASIBLE の差を公平性の費用と読まないことが必要です。次の第9章では、SV や英語対応のようなスキルを持つ人の少なさが不足にどう効くかと、多能工化の効果を試算します。
この章を深めたい方への参考書籍
『社会的選択理論への招待 投票と多数決の科学』(坂井豊貴、日本評論社):多くの人の意見を1つの決定にまとめる方法を扱う社会的選択理論の入門書で、2025年に新版が出ています。勤務表の重みづけの和も、スタッフ一人ひとりの希望をまとめて1つの勤務表を選ぶ仕組みの1つです。まとめ方によって選ばれる結果が変わることを押さえておくと、重みや公平性の条件を現場と議論するときの足場になります。
『公正としての正義 再説』(ジョン・ロールズ著、エリン・ケリー編、田中成明・亀本洋・平井亮輔訳、岩波書店):社会を公正な協働のシステムとみなす立場から、正義の構想を著者自身がまとめ直した本で、岩波現代文庫に入っています。この章のマックスミンは勤務表の目的関数の書き方の話で、ロールズの議論そのものではありませんが、「誰の状態を基準に公平を判断するか」を政治哲学の側から考える材料になります。
『Who Gets What マッチメイキングとマーケットデザインの経済学』(アルビン・E・ロス著、櫻井祐子訳、日本経済新聞出版社):安定配分の理論とマーケットデザインの実践で2012年にノーベル経済学賞を受けた著者が、誰が何を得るかを決める仕組み(マッチメイキング)の設計を一般向けに解説した本で、日経ビジネス人文庫に入っています。参加者の希望をどう集め、どう割り当てに反映するかという問いは、この章で扱った希望の受け付け方の設計と重なります。
第9章 スキルと多能工化
第8章では、希望休と、土日勤務や遅番の回数の偏りといった公平性を、勤務表の目的と制約に入れる方法を扱いました。ここまでの章では、スタッフを「在席している人数」として数えてきましたが、実際の職場では人は同じではありません。リーダーとして判断できる人、英語で応対できる人、特定の商品や手続きに詳しい人がいて、その人が席にいるかどうかで、同じ人数でも回せる仕事が変わります。この章では、第2章で用意したサンプルデータのスキル(SV と英語対応)を例に、スキル要件を勤務表のモデルに書く方法を示し、スキルを持つ人の人数を増減させたときに勤務表の質がどう変わるかを実行結果で測ります。そのうえで、複数のスキルを持つ人を増やす多能工化の効果を試算し、何人目から効きが鈍るのかを確かめ、研修への投資を経営指標に翻訳する方法を考えます。
スキル要件は「その枠に誰がいるか」の条件である
第2章で用意したサンプルデータには、2種類のスキルがあります。1つは SV(リーダー)で、オペレーターからの相談を受けたり、難しい入電を引き取ったりするリーダー役です。SV を持つのは正社員の S01〜S07 の7名で、営業時間の全枠(1日34枠×28日=952枠)に1名以上いることを求めています。もう1つは英語対応で、S03・S09・S12(正社員)と S21(パート)の4名が持ち、平日の9時〜18時(1日18枠×平日20日=360枠)に1名以上いることを求めています。どちらの人数も、どの枠に何人を求めるかも、この記事で置いた架空の設定です。
第5章で説明したとおり、この記事の基準の勤務表では、決める変数は「スタッフ i が日 d に勤務の型 t で入るかどうか」の0か1です。勤務の型ごとに在席している枠が決まっているので、ある日のある枠に在席している人は、この変数の和で表せます。スキル要件は、この和を「スキルを持つ人だけ」に絞ったものです。SV の要件を式で書くと次のようになります。
\( \sum_{i \in \mathrm{SV}} \sum_{t \ni s} x_{i,d,t} + u_{d,s} \ge 1 \)
言葉で言い換えると、「日 d の枠 s に在席している SV の人数に、SV 不在を表す0か1の変数 u を足すと1以上になる」という条件です。SV が1人でもいれば u は0でよく、誰もいなければ u が1になります。u には目的関数で1枠あたり5,000(円相当、架空の重み)の罰則を掛けています。英語対応も同じ形で、罰則は1枠あたり2,000です。このように不在を罰則つきで許す書き方(柔らかい制約)にしたのは、スキルを持つ人が足りない条件でも勤務表が返ってきて、「どこで何枠足りないか」が数えられるようにするためです。絶対に守る条件(硬い制約)にすると、足りない条件では解なしで止まり、足りない場所が分かりません。
コードでは、第5章で示した基準のモデルの在席の和を作る箇所に、スキルで絞った和と、不在を表す変数を数行足すだけです。次は、この章の共通部品(この章の計算すべてで使うモデルの組み立て部分)から該当部分を抜き出したものです(単独では動きません)。
# 抜き出し:d は日、s は30分の枠、ps はスタッフの一覧、x[i, d, sid] は勤務の0/1変数
terms = [x[i, d, sid] for i, p in enumerate(ps) for sid in p["allowed"] if s in shift_slots(sid)]
sv_terms = [x[i, d, sid] for i, p in enumerate(ps) if "SV" in p["skills"]
            for sid in p["allowed"] if s in shift_slots(sid)]
en_terms = [x[i, d, sid] for i, p in enumerate(ps) if "EN" in p["skills"]
            for sid in p["allowed"] if s in shift_slots(sid)]
sv = m.new_bool_var("sv_%d_%d" % (d, s))          # SV 不在なら 1
m.add(sum(sv_terms) + sv >= 1)
sv_miss[d, s] = sv
if (not is_weekend(d)) & (EN_SLOTS_WEEKDAY[0] <= s < EN_SLOTS_WEEKDAY[1]):
    en = m.new_bool_var("en_%d_%d" % (d, s))      # 英語対応が不在なら 1
    m.add(sum(en_terms) + en >= 1)
    en_miss[d, s] = en
# 目的:3000*不足 + 5000*希望休の違反 + 5000*SV 不在 + 2000*英語不在 + パートの人件費
スキルを「持つか持たないか」の2値で扱っているのは、この記事の例題を簡単にするためです。実際の職場では、1人で任せられる水準と、誰かの補助があれば対応できる水準を分けることが多いように思います。その場合は、スキルの水準ごとに別の集合を作り、「独り立ちの水準の人が1名以上」「補助付きの水準の人は、独り立ちの人と同じ枠にいるときだけ数える」のように条件を分けて書きます。どの書き方をするにしても、モデルの側に必要なのは「誰がどのスキルをどの水準で持つか」という一覧(スキルマップ)で、その一覧が古いと、勤務表は正しく解けても現場では回りません。スキルマップを誰がいつ更新するかは、第13章で扱うマスタの精度の問題でもあります。
基準の勤務表で、スキル要件はどれだけ効いているか
まず、基準の勤務表でスキル要件がどれだけ効いているかを測りました。この章のスクリプトでは、基準と同じモデルをこの章の部品で組み直し、同じ重み、同じ時間制限30秒、num_workers=8、random_seed=0 で解いています。基準の数字は再実行せず、第5章で説明した基準の記録の値を引用します。
SV の要件を外して解くと(参考のための設定です)、状態は OPTIMAL(重みづけの目的について最適性を証明)で、目的関数の値は 2,053,500 でした。これは基準の目的関数の値 2,053,500 と同じです。つまり SV が7名いるこのデータでは、SV の要件を入れても、不足・希望休の違反・パートの人件費を合わせた重みづけの和は少しも悪くなっていません。ところが、要件を外した勤務表では SV 不在の枠が58枠ありました。乱数種を random_seed=1 に変えて同じ条件を解き直すと、目的関数は同じ 2,053,500 のまま、SV 不在は80枠でした。要件を書かなければ、SV 不在の枠数は解ごとに偶然で決まるということです。ソルバーは目的関数に書かれていないことには何の配慮もしないので、「満たすのに費用がかからない要件」であっても、書かなければ守られません。スキル要件は、費用がかかるかどうかにかかわらずモデルに書いておく必要がある、ということです。
もう1つ、この章の数字を読むうえで押さえておきたい点があります。同じモデルを自分のスクリプトで組み直して解いたところ、状態は OPTIMAL、目的関数の値は基準と同じ 2,053,500 でしたが、中身は基準と違いました。基準の不足は 221.0 人×時間・過剰は 641.0 人×時間・パートの勤務は 475時間ですが、組み直したモデルの解では不足 216.0 人×時間・過剰 656.0 人×時間・パートの勤務 495時間でした。不足が10人×30分減る代わりに、パートの勤務が20時間増えています。この記事の架空の重みでは、不足1人×30分が3,000、パートの人件費が1時間1,500なので、不足10人×30分(30,000)とパート20時間(30,000)はちょうど同じ重さです。第5章で見た代替最適解(重みづけの和が同じ最適解が複数あること。各章の解き直しの値は第5章の表にまとめました)が、不足人時とパートの勤務時間の内訳にも表れているということです。ソルバーがどれを返すかは実行ごとに変わりえます。この章の比較でも、目的関数の値が同じなのに不足人時が 216.0〜223.5 人×時間の範囲で動く例が繰り返し出てきます。この章では、目的関数の値と、SV・英語対応の不在の枠数で比べ、不足人時の数人×時間の差は「同点の解の選ばれ方の違い」として読みます。
SV を減らす・増やす、何人目から効きが鈍るか
次に、SV を持つ人の人数を3名から12名まで変えて解きました。SV を持つ人は S01 から番号順に k 名とし(共通データの7名は S01〜S07)、それ以外の設定は基準と同じです。結果が次の表です。「目的関数の増分」は、基準の目的関数の値 2,053,500 との差です。
| SV を持つ人の人数 | 状態 | 目的関数 | 目的関数の増分 | SV 不在の枠(952枠中) | 計算上の下限 | 不足人時 | 希望休の違反 |
|---|---|---|---|---|---|---|---|
| 3名(S01〜S03) | OPTIMAL | 2,573,500 | 520,000 | 104枠 | 104枠 | 221.0 人×時間 | 3/88件 |
| 4名(S01〜S04) | OPTIMAL | 2,373,500 | 320,000 | 64枠 | 64枠 | 218.5 人×時間 | 3/88件 |
| 5名(S01〜S05) | OPTIMAL | 2,175,000 | 121,500 | 24枠 | 24枠 | 220.0 人×時間 | 3/88件 |
| 6名(S01〜S06) | OPTIMAL | 2,053,500 | 0 | 0枠 | 0枠 | 223.5 人×時間 | 3/88件 |
| 7名(共通データの設定。組み直したモデルの解で、基準の値は不足 221.0 人×時間) | OPTIMAL | 2,053,500 | 0 | 0枠 | 0枠 | 216.0 人×時間 | 3/88件 |
| 8名(S01〜S08) | OPTIMAL | 2,053,500 | 0 | 0枠 | 0枠 | 218.5 人×時間 | 3/88件 |
| 10名(S01〜S10) | OPTIMAL | 2,053,500 | 0 | 0枠 | 0枠 | 221.0 人×時間 | 3/88件 |
| 12名(S01〜S12) | OPTIMAL | 2,053,500 | 0 | 0枠 | 0枠 | 221.0 人×時間 | 3/88件 |
表には載せていませんが、9名の場合も OPTIMAL・目的関数 2,053,500・SV 不在0枠でした。いずれの条件も30秒の制限の中で最適性まで証明できており、表の各行の計算は1回あたり10〜24秒でした(この記事の実行環境での実測。他の章の計算と同じ PC で並行して動かしたので、時間は負荷で揺れます)。「不足人時」の列は前の節で述べたとおり同点の解の選ばれ方で動いており、SV の人数とは関係なく 216.0〜223.5 人×時間の範囲に収まっています。SV を減らしたときに悪くなったのは、不足人時ではなく SV 不在の枠でした。揺れを確かめるため、同じ比較を乱数種 random_seed=1 でもう一度回しました。4名の条件だけ30秒で最適性を証明できず FEASIBLE(目的関数 2,375,000、下界 2,373,500)でしたが、ほかの行は OPTIMAL で、目的関数と SV 不在の枠数は表とすべて同じでした。4名の条件も SV 不在は64枠で表と同じです。
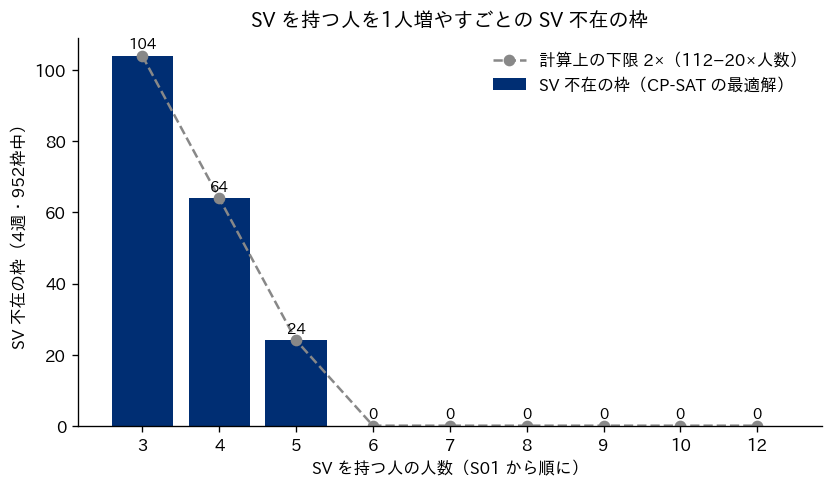
表の「計算上の下限」の列は、ソルバーを使わずに数えた値です。このデータの勤務の型では、早番(7時〜16時)と遅番(15時〜24時)の2人で営業時間の大半を覆えますが、早番の休憩の11時〜12時と、遅番の休憩の19時〜20時の2時間が空きます。この空きを埋められるのは、11時〜12時に在席している日勤と、19時〜20時に在席している中番です。したがって全枠に SV を置くには、1日に早番・日勤・中番・遅番の SV が1名ずつ、4名が要ります。28日では112人日です。正社員は4週でちょうど20日勤務するので、SV が k 名いれば SV の勤務は20k 人日あります。足りない1人日ごとに、どこかの日の休憩の1時間(2枠)が SV 不在になるので、SV 不在の枠は少なくとも \( 2 \times (112 – 20k) \) 枠です。言葉で言い換えると、「必要な SV の勤務の日数から、SV が勤務できる日数を引いた差の2倍」が下限になります。
3名・4名・5名の場合、ソルバーが返した SV 不在の枠は、この下限とぴったり一致しました。SV 5名の勤務表の中身を見ると(別の実行で同じ条件を解き直したもの。状態 OPTIMAL、目的関数 2,175,000 で、表と同じ値)、SV が4名出勤している日が18日、3名の日が8日、2名の日が2日で、SV 不在の枠は19時と19時30分が9枠ずつ、11時と11時30分が3枠ずつでした。SV が足りない日は日勤か中番の SV を抜き、休憩の1時間だけ SV 不在にするという、下限どおりの作り方をソルバーが見つけています。
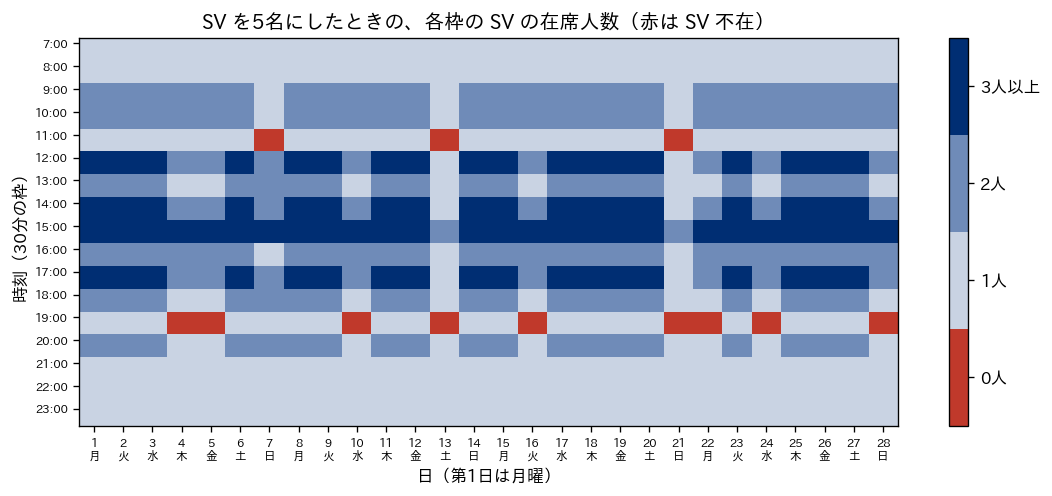
この結果から、SV を1人増やす効果の形が読み取れます。3名から4名、4名から5名に増やすと、SV 不在はそれぞれ40枠(20時間)ずつ減ります。5名から6名では24枠(12時間)減って0になり、6名から先は何人増やしても SV 不在は0のままで、目的関数も変わりません。効きは「なだらかに鈍る」のではなく、必要な人日(このデータでは112人日)を満たしたところで急に0になります。何人目から効きが鈍るかは、必要な人日を1人あたりの勤務日数で割った値(112÷20=5.6)で、ほぼ決まるということです。
ただし、6名で足りるから7名目が無駄だ、とは言えません。6名の SV の勤務は120人日で、必要な112人日に対する余裕は8人日しかありません。SV の1人が2週間(10日)休めば、勤務は110人日になり、下限の式から少なくとも4枠の SV 不在が出ます。7名なら余裕は28人日あり、1人が4週間まるごと休んでも6名の状態に戻るだけで、6名の実験のとおり SV 不在は0枠で済みます。7名目の価値は、この4週間の計画の中ではなく、欠勤や休職が起きたときの備えにあります。欠勤が出たときの組み直しは第11章で扱います。
英語対応を1人減らす・1人増やす
英語対応についても同じ比較をしました。共通データの英語対応は S03・S09・S12(正社員)と S21(パート)の4名です。減らすときは S21→S12→S09 の順に外し、増やすときは正社員の S13→S14→S15→S16 の順に足しました。それ以外の設定は基準と同じです。
| 英語対応を持つ人 | 状態 | 目的関数 | 目的関数の増分 | 英語不在の枠(360枠中) | 希望休の違反 | 不足人時 |
|---|---|---|---|---|---|---|
| 1名(S03) | OPTIMAL | 2,143,500 | 90,000 | 40枠 | 5/88件 | 221.0 人×時間 |
| 2名(S03・S09) | OPTIMAL | 2,066,500 | 13,000 | 4枠 | 4/88件 | 218.5 人×時間 |
| 3名(S03・S09・S12) | OPTIMAL | 2,053,500 | 0 | 0枠 | 3/88件 | 218.5 人×時間 |
| 4名(共通データの設定。組み直したモデルの解で、基準の値は不足 221.0 人×時間) | OPTIMAL | 2,053,500 | 0 | 0枠 | 3/88件 | 216.0 人×時間 |
| 5名(+S13) | FEASIBLE(下界 2,053,500) | 2,058,000 | 4,500 | 0枠 | 3/88件 | 218.0 人×時間 |
| 6名(+S13・S14) | OPTIMAL | 2,053,500 | 0 | 0枠 | 3/88件 | 221.0 人×時間 |
| 8名(+S13〜S16) | OPTIMAL | 2,053,500 | 0 | 0枠 | 3/88件 | 221.0 人×時間 |
SV の表と同じく、この表の右端の「不足人時」の列は、目的関数が同じでも同点の解の選ばれ方で動く値で、英語対応の人数の効果を表すものではありません。英語対応を1人減らして3名にしても、目的関数も英語不在も基準と変わりませんでした。4人目の S21 は、この4週間の計画の上では余裕の1人だったということです。S21 の代わりに正社員の S13 を英語対応にした4名の条件も解きましたが、目的関数は 2,053,500 で同じでした。1人増やして5名にした条件だけは、30秒で最適性を証明できず、FEASIBLE(目的関数 2,058,000、下界 2,053,500)で打ち切られました。下界が基準と同じ値なので、最適解が基準より悪いことは示されていません。6名・8名では OPTIMAL で基準と同じ値でした。乱数種を random_seed=1 に変えた2回目では、5名の条件も OPTIMAL で目的関数 2,053,500 になり、ほかの行も状態 OPTIMAL で目的関数・英語不在・希望休の違反が表と同じでした。英語対応を増やしても、この要件(平日9時〜18時に1名以上)の下では勤務表は良くならない、というのがこの表の読み方です。
減らしたときの悪くなり方は、SV とは違う形で出ました。2名にすると英語不在が4枠、1名にすると40枠になり、同時に希望休の違反が3件から4件、5件へと増えています。目的関数の増分は、1名の場合で英語不在40枠×2,000+希望休の違反の増加2件×5,000=90,000、2名の場合で4枠×2,000+1件×5,000=13,000で、どちらも増分がそのまま説明できます。1名の場合の勤務表を見ると(同じ条件を別の実行で解き直したもの。状態 OPTIMAL、目的関数 2,143,500)、S03 は4週間の平日20日すべてに日勤で入り、土日はすべて休みでした。正社員は4週で20日勤務で、平日はちょうど20日なので、英語対応を平日に切らさないためには S03 を平日に全部入れるしかありません。S03 の希望休3件のうち平日の2件(第5日の金曜と第8日の月曜)はそのために破られています。英語不在の40枠は、すべて日勤の休憩の13時〜13時30分と13時30分〜14時(20日×2枠)でした。1人で覆える時間には、休憩の分だけ必ず穴が空きます。
ここから分かるのは、スキルを持つ人が少ないときの損失が、不在の枠だけでなくスキル保有者への負担の集中として現れることです。英語対応が1人しかいない職場では、その人の希望休は通らず、勤務の型も曜日も固定されます。第8章で扱った希望の充足率と公平性の指標で見ると、全体の平均は小さく動くだけでも、特定の1人に偏りが集まります。スキル保有者が少ないことの費用は、欠員が出たときのサービスの低下と、その人の離職につながりかねない負担の両方で見る必要があると考えています。
窓口を分けたときの多能工化の効果
ここまでの結果では、SV も英語対応も、要件を満たす人数を超えると勤務表はそれ以上良くなりませんでした。これは、共通データのスキル要件が「その枠に1名以上いればよい」という形だからです。SV や英語対応の人は、要件を満たしたうえで、ほかの人と同じように日本語の入電も受けられる前提になっています。言い換えると、共通データのスキル保有者は、はじめから多能工(複数の仕事をこなせる人)として扱われています。
多能工化の効果を測るには、スキルを持つ人にしかできない仕事の量が、需要として別にある設定が必要です。そこで、共通データを次のように変えた設定を作りました。平日9時〜18時の予測入電のうち8%(架空の割合)を英語の窓口に分け、英語と日本語の必要席数を、それぞれの入電件数からアーランCで別々に出します。英語の席には英語対応を持つ人しか座れません。そのうえで、英語対応を持つ人を k 名にし、2つの方式を比べました。1つは「多能工」で、英語対応を持つ人は英語・日本語のどちらの席にも座れます。もう1つは「専任」で、英語対応を持つ人は、英語の窓口が開いている平日9時〜18時には英語の席にしか座れません(それ以外の時間は日本語の席に座れます)。英語対応を持つ人は、S03・S09・S12・S21 のあとに S13〜S18・S10・S11 の順に足しました。不足は「英語の席の不足+日本語の席の不足」で数え、重み・時間制限30秒・num_workers=8・random_seed=0 は基準と同じです。この節の設定は必要席数が基準と違うので、数字は基準と直接は比べられません。
窓口を分けた時点で、必要な席は増えます。英語の窓口が開く360枠では、英語の入電は30分あたり平均1.87件(1.34〜2.78件)しかありませんが、アーランCで計算すると、どの枠でも英語に2席が要りました。1席ではサービスレベルが45.8%〜74.3%で、80%を20秒以内に応答する目標に届かず、2席にすると88.9%〜97.1%になります。2席を置いたときの1席あたりの稼働率(通話と後処理に使っている時間の割合)は平均19%で、英語の席は大半の時間、入電を待っていることになります。この360枠の必要席数は、窓口が1つのままなら 2,747 人×30分ですが、分けると英語 720+日本語 2,582=3,302 人×30分になり、555 人×30分(277.5 人×時間)増えます。4週間の合計では 5,870 から 6,425 人×30分への増加です。小さな窓口を切り出すと待ち行列の規模の経済(第3章)が失われるので、窓口を分けること自体に費用がかかる、という点は先に押さえておく必要があります。
まず、基準と同じ時間制限30秒で16通りを解いたところ、10通りが FEASIBLE(最適性を証明できないまま打ち切り)でした。そこで同じ16通りを、時間制限だけ90秒に延ばして解き直しました(ほかの設定は同じ)。90秒では16通りすべてが OPTIMAL になったので、比較は90秒の結果で行います。次の表には両方を載せました。
| 英語対応を持つ人 | 方式 | 30秒の状態 | 30秒の目的関数(下界) | 90秒の状態 | 90秒の目的関数 | 不足人時(90秒の解、英語+日本語) |
|---|---|---|---|---|---|---|
| 2名 | 多能工 | OPTIMAL | 2,526,000(2,526,000) | OPTIMAL | 2,526,000 | 253.5(71.0+182.5) |
| 2名 | 専任 | OPTIMAL | 2,526,000(2,526,000) | OPTIMAL | 2,526,000 | 253.5(40.0+213.5) |
| 3名 | 多能工 | OPTIMAL | 2,417,000(2,417,000) | OPTIMAL | 2,417,000 | 232.0(52.5+179.5) |
| 3名 | 専任 | FEASIBLE | 2,421,500(2,420,000) | OPTIMAL | 2,421,000 | 231.0(40.0+191.0) |
| 4名 | 多能工 | OPTIMAL | 2,358,500(2,358,500) | OPTIMAL | 2,358,500 | 203.5(17.5+186.0) |
| 4名 | 専任 | FEASIBLE | 2,360,000(2,358,500) | OPTIMAL | 2,358,500 | 201.0(12.0+189.0) |
| 5名 | 多能工 | FEASIBLE | 2,588,500(2,329,500) | OPTIMAL | 2,329,500 | 179.5(15.5+164.0) |
| 5名 | 専任 | FEASIBLE | 2,332,500(2,329,500) | OPTIMAL | 2,329,500 | 182.0(4.0+178.0) |
| 6名 | 多能工 | FEASIBLE | 2,334,000(2,329,500) | OPTIMAL | 2,329,500 | 179.5(20.0+159.5) |
| 6名 | 専任 | FEASIBLE | 2,337,000(2,334,000) | OPTIMAL | 2,334,000 | 184.5(15.0+169.5) |
| 8名 | 多能工 | OPTIMAL | 2,329,500(2,329,500) | OPTIMAL | 2,329,500 | 177.0(11.5+165.5) |
| 8名 | 専任 | FEASIBLE | 2,426,500(2,405,000) | OPTIMAL | 2,418,500 | 206.5(28.0+178.5) |
| 10名 | 多能工 | FEASIBLE | 2,335,500(2,329,500) | OPTIMAL | 2,329,500 | 179.5(16.5+163.0) |
| 10名 | 専任 | FEASIBLE | 2,607,000(2,578,500) | OPTIMAL | 2,589,000 | 200.5(27.0+173.5) |
| 12名 | 多能工 | FEASIBLE | 2,551,500(2,329,500) | OPTIMAL | 2,329,500 | 179.5(10.0+169.5) |
| 12名 | 専任 | FEASIBLE | 2,808,000(2,805,000) | OPTIMAL | 2,806,500 | 221.5(28.0+193.5) |
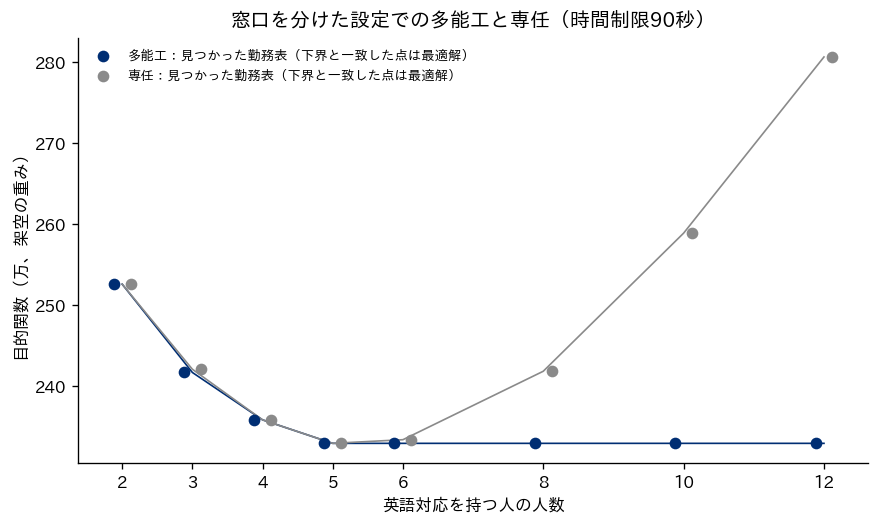
多能工の方式では、英語対応を2名から3名にすると目的関数が 109,000 下がり、3名から4名で 58,500、4名から5名で 29,000 下がって、5名から先は12名まで 2,329,500 のまま変わりませんでした。1人増やすごとの効果が、この設定ではおよそ半分ずつに鈍り、5人目で出きっています。英語の席は常に2席なので、2名では2人とも出勤している時間は英語の席に座り続けるしかなく、勤務表を工夫する余地がありません。3名・4名と増えると、誰かが休む日や休憩の時間にも英語の席を埋められるようになり、英語の席の不足は2名の 71.0 人×時間から4名の 17.5 人×時間に減りました。希望休の違反は2名の6件から5名の3件に減っています(3名では7件で、途中の人数では増えることもありました)。不足人時の内訳は、前に見たとおり同点の解の選ばれ方で数人×時間動くので、目的関数の差を主に比べるという読み方は、ここでも同じです。
専任の方式は、人数を増やしたときの振る舞いが違います。2名から5名までは多能工とほぼ同じ値で下がり(3名だけ 4,000 悪い)、5名では多能工と同じ 2,329,500 に届きます。ところがその先は、6名で 2,334,000、8名で 2,418,500、10名で 2,589,000、12名で 2,806,500 と、増やすほど悪くなりました。12名の専任は、同じ12名の多能工より 477,000 悪い値です。専任の人は平日9時〜18時に英語の席にしか座れないので、英語の席が2つしかない時間に3人目以降が在席すると、その人は日本語の入電を受けられず、席を持て余します。英語対応ができる人を増やしても、仕事の割り振りを専任のままにしておくと、増やすほど勤務表が悪くなる場合があるということです。
この悪化は、研修の効果が逆向きに出たという意味ではありません。この設定では「専任に指定された人は、平日9時〜18時に日本語の席に座れない」と置いているので、専任に指定された人は、同じ人数の多能工より座れる席が必ず少なくなります。そのため専任の目的関数は、同じ人数の多能工の値(5名以上では 2,329,500)より良くなることがなく、英語の席が足りたあとで専任の指定を増やすことは、日本語の席の担い手を減らすことにしかなりません。6人目以降の悪化は、このモデルの置き方の帰結です。実務に引き直すと、スキルを身に付けた人を増やすこと自体ではなく、「スキルを持つ人はその仕事だけをする」という配置のルールが費用を生んでいる、ということです。
30秒の結果には、もう1つ注意点が表れています。多能工の方式の5名と12名では、30秒で見つかった勤務表の目的関数(2,588,500 と 2,551,500)が、4名の最適解 2,358,500 より悪くなっていました。多能工の方式では、英語対応を持つ人を1人足しても足す前の勤務表がそのまま使えるので、最適解が悪くなることはありません。これは人数を増やした効果ではなく、30秒で探索を打ち切ったために良い解に届かなかったことを表しています(90秒ではどちらも 2,329,500 でした)。スキルを持つ人を増やすと、ソルバーが選べる組合せが増え、同じ時間制限での探索が難しくなることがあります。「スキルを増やしたら勤務表が悪くなった」という結果が出たときは、状態が OPTIMAL か、下界と目的関数の差がどれだけあるかを確かめてから読む必要があります。30秒の結果でも、下界の列は90秒の最適値を下回るか等しく、下界と見つかった値の間に最適値があるという読み方は正しく働いています。時間制限と品質の関係は第6章で扱いました。計算時間は90秒の条件で1通りあたり12〜75秒でした(この記事の実行環境での実測。他の章の計算と並行して動かしたので、負荷で揺れます)。
この結果の向きは、公開されている研究とも合っています。Jordan と Graves の1995年の論文(Management Science 誌)は、製品と工場の割当を扱う計画モデルから、各工場が一部の製品だけを作れる限られた柔軟性でも、正しく組めば、全工場が全製品を作れる場合の便益の大半が得られ、その便益は製品と工場を鎖のようにつなぐ組み方(チェイニング)で最も大きくなる、という原則を示しました。コールセンターについては、Wallace と Whitt の2005年の論文(Manufacturing & Service Operations Management 誌)が、スキルごとにルーティングする窓口の人員配置を扱い、処理時間の分布が入電の種類や人によらない場合には、各オペレーターが適切な組合せの2つのスキルを持つだけで、全員が全スキルを持つ場合とほぼ同じ性能になることをシミュレーションで示しています。ただし、この章の実験は「席を何人で埋めるか」の勤務表のモデルで、入電をどのオペレーターに回すかというルーティングの効果は含んでいません。多能工のオペレーターが、そのとき空いている窓口の入電を受けることで得られる待ち行列の効果は、この実験の数字の外側にあります。
新人とベテランの組合せを制約にする
スキルの話のもう1つの側面は、スキルを持たない人、特に新人の置き方です。新人を1人で遅い時間帯に置かない、新人が入る日には指導できる人を同じ時間に置く、新人どうしを同じ時間に固めない、といった決まりは、多くの職場で勤務表の作成者が経験で守っているものだと思います。これらはスキル要件と同じく「その枠に誰がいるか」の条件なので、同じ変数で書けます。ここでは、正社員18名のうち S15〜S18 の4名を新人とみなす架空の設定を置き(4名ともスキルなし)、組合せの決まりを3通りの書き方で入れて解きました。
- 書き方A:各枠に在席する新人は1名まで(新人どうしを同じ時間に置かない)
- 書き方B:新人が入る日・勤務の型には、同じ日・同じ勤務の型の SV が1名以上いる(指導役と同じ時間帯に働く)
- 書き方C:日・勤務の型ごとに、新人の人数は同じ型の SV の人数以下(指導役1人が新人1人を受け持つ)
書き方Bは、「新人がこの型に入るなら、同じ型の SV の人数は1以上」という条件付きの制約で、CP-SAT では only_enforce_if で書けます(第6章で触れた OR-Tools 9.15 の Python の書き方です)。次はこの章の共通部品の該当部分を抜き出し、字下げを整えたものです(単独では動きません)。
# 抜き出し:nb は新人の番号の一覧、svp は SV の番号の一覧
for d in range(N_DAYS):
    for sid in SHIFT_IDS:
        nterm = [x[i, d, sid] for i in nb if sid in ps[i]["allowed"]]
        sterm = [x[j, d, sid] for j in svp if sid in ps[j]["allowed"]]
        if not nterm:
            continue
        if newbie_rule == "one_to_one":                 # 書き方C
            m.add(sum(nterm) <= sum(sterm))
        else:                                           # 書き方B
            for v in nterm:
                m.add(sum(sterm) >= 1).only_enforce_if(v)
いずれも硬い制約として入れ、それ以外の設定は基準と同じにしました(30秒、num_workers=8、random_seed=0)。SV は共通データの7名の場合と、S07 を外した6名の場合の2通りです。
| SV の人数 | 新人の組合せの決まり | 状態(30秒) | 目的関数 | 下界 |
|---|---|---|---|---|
| 7名 | 決まりなし | OPTIMAL | 2,053,500 | 2,053,500 |
| 7名 | 書き方A(各枠の新人は1名まで) | INFEASIBLE(4.9秒) | 解なし | 解なし |
| 7名 | 書き方B(同じ型に SV が1名以上) | OPTIMAL | 2,053,500 | 2,053,500 |
| 7名 | 書き方C(新人の人数は同じ型の SV 以下) | FEASIBLE | 2,077,500 | 2,053,500 |
| 6名 | 決まりなし | OPTIMAL | 2,053,500 | 2,053,500 |
| 6名 | 書き方A | INFEASIBLE(4.0秒) | 解なし | 解なし |
| 6名 | 書き方B | FEASIBLE | 2,055,000 | 2,053,500 |
| 6名 | 書き方C | FEASIBLE | 2,059,500 | 2,053,500 |
最も穏やかに見える書き方Aが、SV の人数にかかわらず解なし(INFEASIBLE)になりました。ソルバーは4〜5秒で「この条件を満たす勤務表は存在しない」と証明しています。理由は勤務の型の重なりにあります。このデータの4つの勤務の型は、どの2つを取っても在席の時間が重なります(早番と遅番は15時〜16時、日勤と遅番は15時〜18時が重なり、ほかの組はもっと長く重なります)。したがって「各枠の新人は1名まで」は、実質的に「1日に出勤できる新人は1名まで」という意味になり、28日で28人日しか新人を入れられません。一方、新人4名は正社員として4週で20日ずつ、合わせて80人日勤務する決まりなので、両立しません。言葉の上では小さな配慮に見える決まりが、ほかの決まりと組み合わさると不可能になる例です。解なしになったときに原因の制約を探す方法は第6章で扱いました。こうした決まりは硬い制約にせず、「同じ枠の新人が2名以上になったら罰則」という柔らかい制約にするか、新人の人数に合わせて「同じ勤務の型の新人は1名まで」のように緩めた形で現場と合意し直す必要があります。
書き方Bは、SV 7名では OPTIMAL で目的関数が 2,053,500 のままでした。新人を SV と同じ型に入れるという決まりは、この条件では無償で守れるということです。SV 6名では30秒で最適性を証明できず、見つかった勤務表は 2,055,000、下界は 2,053,500 でした。書き方Cは SV 7名・6名とも FEASIBLE で、見つかった勤務表は決まりなしより 24,000 と 6,000 悪く、下界は決まりなしと同じでした。30秒の結果からは、書き方B・Cの費用が0なのか、見つかった勤務表との差の分だけかかるのかを区別できません。
そこで、書き方B・Cの4通りを、時間制限だけ90秒に延ばして解き直しました。4通りとも OPTIMAL で、目的関数はいずれも決まりなしと同じ 2,053,500 でした(計算は14〜36秒)。30秒で打ち切られた条件も、90秒の条件では30秒より短い時間で最適性まで証明できたものがあり、同じ設定でも実行ごとの探索の経路と PC の負荷で結果が揺れることが分かります。このデータでは、SV が6名以上いれば、新人を SV と同じ型に入れる決まりも、指導役1人が新人1人を受け持つ決まりも、重みづけの和を少しも悪くせずに守れるということです。
SV をさらに減らすと費用が出るかも確かめました。時間制限90秒で、SV 5名・4名のそれぞれについて、決まりなし・書き方B・書き方Cの3通りを解くと、6通りすべてが OPTIMAL でした。SV 5名では3通りとも目的関数 2,175,000 で、決まりの費用は0でした。SV 4名では、決まりなしと書き方Bが 2,373,500 で同じ、書き方Cだけが 2,378,000 で、4,500 だけ高くなりました(SV 不在はどれも64枠で同じ)。指導役1人が新人1人を受け持つ決まりは、SV が4名まで減ったときに初めて費用が表れ、その大きさはこの重みの下では不足1人×30分の1.5倍程度にとどまった、ということです。新人の育成の決まりが勤務表を悪くするかどうかは、指導役になれる人の人数との釣り合いで決まります。このデータでは、SV が5名までは費用が0で、4名でもわずかでした。ただし、これは新人が4名で、勤務の型が4つしかない例題での結果です。新人の割合が高い職場や、勤務の型が多く指導役が分散しやすい職場では、同じ決まりの費用が大きくなりえます。
経営の目線で言い換えると、新人の育成の決まりを無理なく守れるかどうかは、指導役になれる人の人数と深く関わります。新人を増やす採用計画を立てるときは、同時に「指導役になれる人の勤務の人日が足りているか」を割り算で確かめ、足りなければ新人の受け入れの時期をずらすか、指導役の研修を先に進める、という順序で考えるのが有効だと考えています。
複数の職種・拠点をまたぐ応援の考え方
ここまでは1つの拠点の中でスキルを扱いましたが、実務では、別の部署や別の拠点から人を借りる「応援」も同じ構造の問題になります。応援に来る人は、応援先の仕事のうち一部しかこなせないことが多く、モデルの上では「応援先の拠点で使えるスキルが限られた人」として扱えます。つまり応援は、拠点という単位で見た多能工化です。
モデルに入れる方法は、大きく2つあります。1つは、複数の拠点を1つのモデルにまとめ、変数を「スタッフ i が日 d に拠点 k で勤務の型 t に入るか」に広げる方法です。1日に1つの拠点にしか行けないこと、移動時間を含めて勤務間の休息を守ること、応援先で数えてよいスキル(応援先の手順やシステムを知らない人は、在席の人数には数えても SV や特定業務の要件には数えない、など)、1人あたりの応援の回数の上限を制約として書きます。拠点をまたいで最も良い勤務表が得られますが、拠点ごとの勤務表の作成者が1つのモデルを共有する必要があり、運用の負担は大きくなります。
もう1つは、各拠点がまず自分の勤務表を作り、その結果として出た不足の枠と過剰の枠を持ち寄って、応援の割当だけを後から決める方法です。後段は「どの拠点の過剰を、どの拠点の不足に回すか」という小さな割当問題になり、各拠点の勤務表の作り方を変えずに済みます。その代わり、各拠点の勤務表は応援を前提にせずに作られるので、1つのモデルにまとめた場合より不足と過剰が多めに残ります。どちらを選ぶかは、応援の頻度と、拠点どうしで勤務表を作る時期や担当者をそろえられるかで決めるのが現実的だと考えています。
応援がどれだけ効くかは、拠点どうしの需要の山がずれているかどうかに左右されます。一方の拠点が忙しい時間に他方が空いていれば、一方の過剰を他方の不足に回せますが、両方が同じ時間に忙しければ、回せる人はいません。前に紹介した工場の柔軟性の研究(Jordan と Graves、1995年)も、各工場が一部の製品だけを作れる柔軟性で全部を作れる場合の便益の大半が得られるという結論を、需要が不確かな状況での計画モデルから導いています。同じ論文は柔軟性の尺度として、ある製品の群に満たせない需要が残る一方で、ほかの製品を作る工場に余った能力がある、という状態が起きる確率を使っています。柔軟性が役に立つのは、ある場所の不足と別の場所の余りが同時に起きるときだ、ということです。応援の仕組みを作る前に、拠点ごとの不足の枠と過剰の枠を同じ時間軸に並べて、重なりがどれだけあるかを確かめるのが先だと考えています。
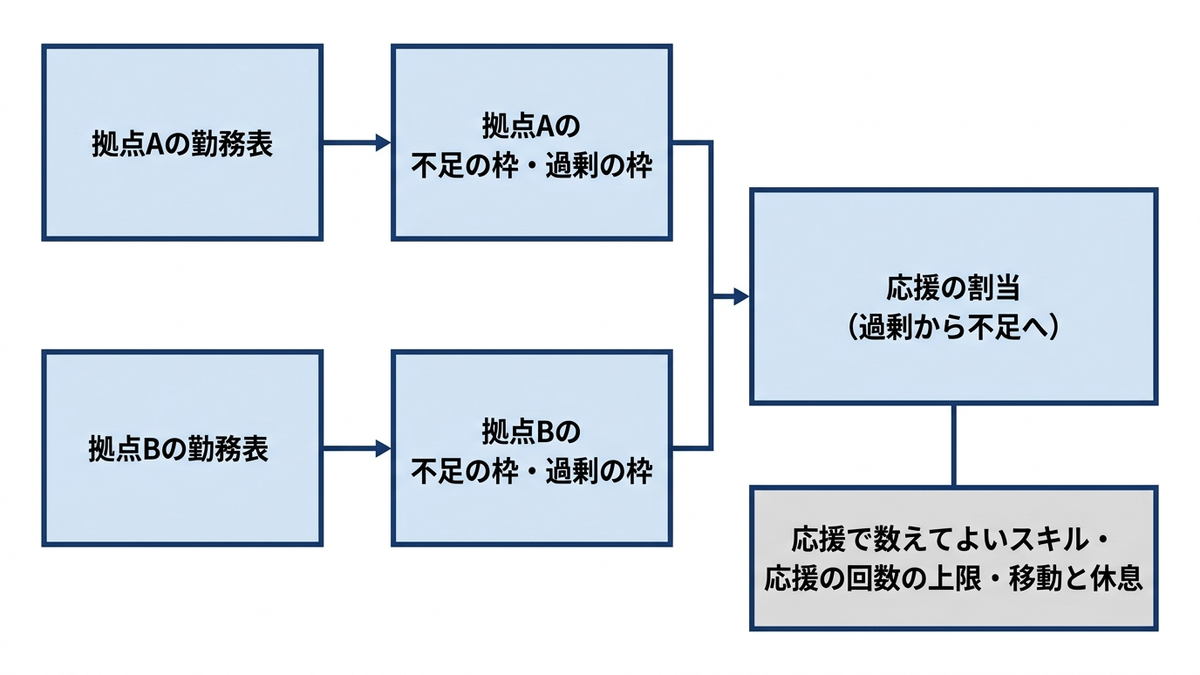
研修への投資を、不在の枠と不足人時で示す
スキルを持つ人を増やす手段は、採用と研修です。どちらも費用と時間がかかるので、経営の判断としては「あと何人に、どのスキルを身に付けてもらうと、何がどれだけ良くなるか」を先に数字で示す必要があります。この章の実験は、その数字の出し方の例になっています。次の表は、この章で測った結果から、スキルを持つ人を1人(または数人)増やしたときの4週間あたりの効果を並べたものです。「目的関数の減少」は、この記事の架空の重み(不足1人×30分=3,000、希望休の違反1件=5,000、SV 不在1枠=5,000、英語不在1枠=2,000、パートの人件費)で換算した値です。
| 増やすスキル保有者 | 4週間あたりの効果(勤務表の上の量) | 目的関数の減少(架空の重みで換算) | 出典の実験 |
|---|---|---|---|
| SV を5名から6名に | SV 不在が24枠(12時間)から0枠に | 121,500 | SV の人数の比較 |
| SV を6名から7名に | 変化なし(SV の勤務の余裕が8人日から28人日に) | 0 | SV の人数の比較 |
| 英語対応を1名から2名に | 英語不在が40枠から4枠に、希望休の違反が5件から4件に | 77,000 | 英語対応の人数の比較 |
| 英語対応を2名から3名に | 英語不在が4枠から0枠に、希望休の違反が4件から3件に | 13,000 | 英語対応の人数の比較 |
| 窓口を分けた設定で、多能工を2名から3名に | 英語の席の不足・希望休の違反などの合計が減る | 109,000 | 窓口を分けた設定 |
| 同じ設定で、多能工を4名から5名に | 同上 | 29,000 | 窓口を分けた設定 |
| 同じ設定で、多能工を5名から12名に | 変化なし | 0 | 窓口を分けた設定 |
表から言えることは3つあります。1つ目は、研修の効果が人数に比例しないことです。SV の例では5人目から6人目で効果が出きり、7人目の効果は4週間の計画の上では0でした。必要なスキル保有者の人数は「必要な人日÷1人あたりの勤務日数」でおおよそ見積もれるので(SV の例では112÷20=5.6)、研修の計画を立てる前にこの割り算をしておくと、どこまでが勤務表の穴を埋める投資で、どこからが欠勤への備えの投資かを分けて議論できます。2つ目は、必要な人数を超えた分の価値は、この章のような1つの計画の比較では測れないことです。7人目の SV の価値は、誰かが休んだときに SV 不在を出さないことにあるので、欠勤の起き方をばらつかせた試算(第11章)で測る必要があります。3つ目は、同じ人数を育てても、仕事の割り振り方で効果が変わることです。窓口を分けた設定では、英語対応の人を専任にしたまま増やすと、12名で同じ人数の多能工より 477,000 悪くなりました。研修で身に付けたスキルを活かせるかどうかは、勤務表と仕事の割り振りの設計に左右されます。
表の右の列の円換算は、あくまでこの記事の架空の重みによるものです。SV が不在の1枠を何円と見るかは、SV がいない時間に起きうること(難しい入電を引き取れない、判断が遅れる、新人が相談できない)を、それぞれの職場で評価して決めるものです。勤務表のモデルが出せるのは「SV 不在が何枠減るか」「英語対応の人の希望休の違反が何件減るか」という勤務表の上の量で、それを円に直す重みは経営が決める値だと考えています。重みを決めかねるときは、逆向きに「研修費と手当の合計が、4週間で SV 不在を24枠減らすことに見合うか」と問う形にすると、議論しやすくなります。
研修には、効果が出るまでの時間と、研修中の費用もあります。研修を受けている時間はその人が席を外すので、第3章で扱ったシュリンケージ(席にいない時間の割合)が一時的に増えます。研修を終えた直後の人は、新人の組合せを扱った節と同じように、独り立ちの水準に達するまでは補助付きの扱いにするのが自然です。研修の計画を勤務表のモデルに載せるなら、「研修の日は勤務の型を研修にして在席には数えない」「研修を終えた日からスキル集合に加える」という2つの変更で表せます。研修の日程を需要の少ない曜日(このデータでは土日)に寄せると不足人時がどう変わるかも、同じモデルで比べられます。
判断を誤ったときの損失の型も整理しておきます。スキル保有者が足りないまま勤務表を作り続けると、表に出る損失はスキル不在の枠ですが、表に出にくい損失として、少ないスキル保有者に勤務の型と曜日が固定され、その人の希望が通らなくなります。英語対応が1人だけの例では、その人の平日の希望休はすべて破られました。こうした負担が特定の人に続くと、その人が辞めたときにスキル不在の枠が一度に増えるという、より大きな損失につながりかねません。反対に、必要な人数を大きく超えて育成し、専任の配置のまま抱えると、席を持て余す時間が人件費として残ります。どちらの損失も、スキル保有者の人数と配置のルールを変えて勤務表を解き比べれば、事前に大きさを見積もれます。
この章の要点は3つです。第一に、スキル要件は「その枠にスキルを持つ人が何人いるか」の条件として書き、不在を罰則つきで許す形にすると、不足する枠の数を測れます。費用のかからない要件でも、書かなければ守られません。第二に、スキル保有者を増やす効果は、必要な人日を満たすところまでは一定で、満たした先では急に0になりました。必要な人数は「必要な人日÷1人の勤務日数」でおおよそ見積もれ、それを超えた分の価値は欠勤への備えとして別に測る必要があります。第三に、スキルを持つ人にしかできない仕事が別にある場合、多能工として両方の仕事をこなせるようにすると、1人増やすごとの効果はおよそ半分ずつに鈍って5人目で出きり、専任のまま増やすと6人目からかえって悪くなりました。次の第10章では、スタッフの人数や計画の期間が大きくなったときに、勤務表をどう解くか、年間の要員計画と採用をどう考えるかを扱います。
この章を深めたい方への参考書籍
『研修開発入門「研修評価」の教科書 「数字」と「物語」で経営・現場を変える』(中原淳・関根雅泰・島村公俊・林博之、ダイヤモンド社):研修の評価を、「数字」と「物語」という2つの視点を組み合わせて行い、経営と現場を変えていく方法を扱った、研修・教育の担当者向けの教科書です。この章ではスキル保有者を増やす効果を勤務表の上の量で示しましたが、研修そのものの効果をどう測り、投資の判断にどうつなげるかを考えるときの手がかりになります。
『職場学習論 仕事の学びを科学する 新装版』(中原淳、東京大学出版会):職場で人が他者とつながり、コミュニケーションをとり、支援を受けながら学ぶ過程を科学的に解き明かそうとした研究書です。この章で扱った新人とベテランの組合せの制約は、勤務表の上で「誰と同じ時間に働くか」を決めるものなので、職場での学びがどのような関係の中で起きるかを考える材料になります。
第10章 大規模化と長期の要員計画
第9章では、SV や英語対応のようなスキルを持つ人の数が不足人時にどう効くかを試算し、多能工化の効果を経営指標に置き換えました。ここまでの章で扱ってきた共通データは、30名・4週間のコンタクトセンターで、CP-SAT は数秒から数十秒で最適性まで示せる規模でした。しかし実際の職場では、100名を超える病棟群や複数拠点のセンター、半年から1年の計画期間といった、もっと大きな問題を扱うことがあります。また、勤務表を毎月作る仕事の手前には、「来年度に何人を採用するか」という、勤務表よりも長い時間軸の判断があります。この章では、まず公開ベンチマークを使って、規模が大きくなると計算時間と勤務表の品質がどう変わるかを実測します。次に、大きな問題を扱うための3つの考え方(問題を分けて解く、勤務パターンを列として足していく列生成、一部を壊して解き直す大近傍探索)を小さな実装で確かめ、最後に共通データを1年に延ばした模型で、採用人数と不足人時の関係を測ります。
規模が大きくなると何が重くなるのか
勤務表の問題の大きさは、おおまかに「スタッフの人数×計画期間の日数×勤務の型の種類」で決まります。第5章で組んだ共通データのモデルでは、スタッフ1人・1日・1つの勤務の型ごとに「その勤務に入るかどうか」を表す0か1の変数を1つ置きました。30名・28日で、1人が入れる型は1〜4種類なので、この変数は2,632個です。後で使う公開ベンチマークのうち最も大きい問題(150名・52週間・勤務の型32種類)では、同じ書き方で1,039,432個になります。変数が増えると、ソルバーが探す範囲が広がるだけでなく、モデルを作るための時間とメモリも増えます。
もう1つ重くなるのは、制約が互いにつながる範囲です。連勤の上限や「遅番の翌日に早番を入れない」といった並びの制約は、同じ人の隣り合う日をつなぎます。必要人数の制約は、同じ日の全員をつなぎます。1人の勤務を1日動かすと、その人の前後の日の並びと、その日の全員の在席人数の両方に影響が出るので、大きな問題ほど「どこか1か所を直すと別の場所が崩れる」連鎖が長くなります。規模が大きくなったときに解の品質が落ちる理由の1つは、この連鎖だと考えています。
実務の立場から見ると、問題が大きいこと自体は避けられないことが多いと考えています。病棟をまたいだ応援や、拠点をまたいだ人の融通を計画に入れたいのであれば、問題はその分だけ大きくなります。大きな問題を分けて解けば計算は軽くなりますが、分けた境目で融通の効果が失われます。この章の前半では、その損失がどれくらいかを実測で示します。
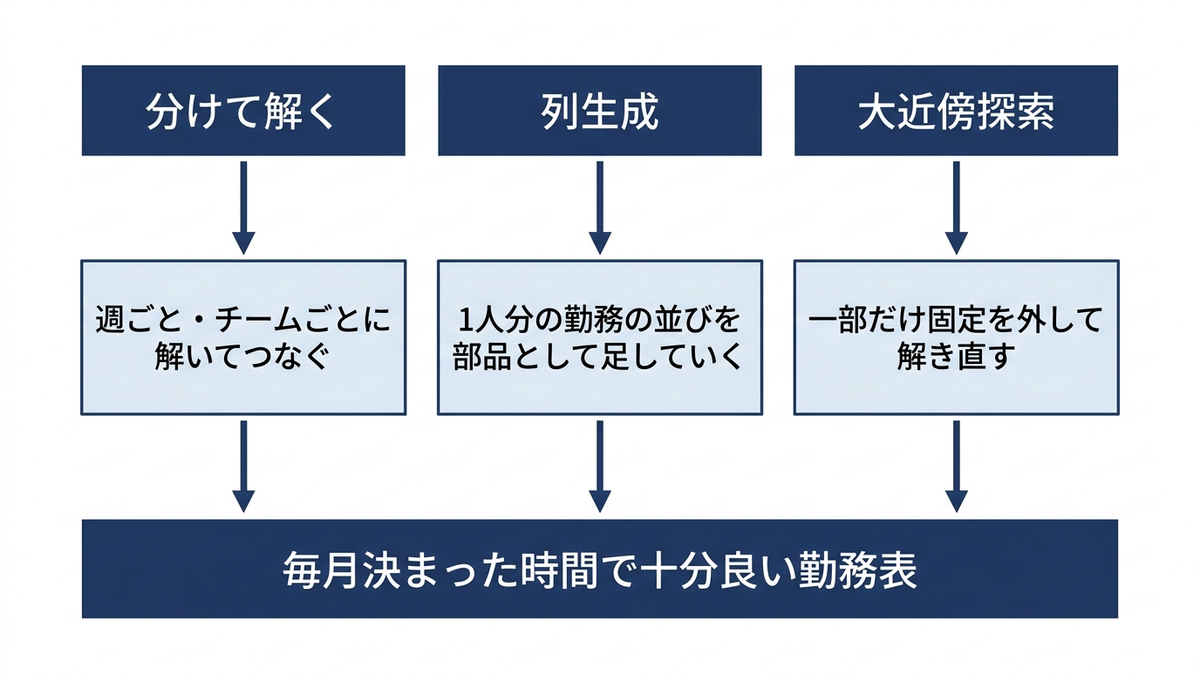
公開ベンチマークで時間と品質を測る
共通データは30名・4週間で、規模を変えて比べるには小さすぎます。そこで、第6章でも使った Curtois と Qu のベンチマーク(英国ノッティンガム大学の研究者が2014年に技術報告とともに公開した看護師勤務表の問題集)を使います。公開ページ「Nurse Rostering Benchmark Instances」には Instance1〜24 の24問が並び、それぞれの週数・人数・勤務の型の数と、これまでに見つかった最も良い解の罰点(既知最良解)と、その問題の罰点がこれより小さくならないことが示された値(下界)が表になっています。最も小さい Instance1 は2週間・8名・勤務の型1種類、最も大きい Instance24 は52週間・150名・勤務の型32種類です。表の既知最良解と下界は Instance24 を除く23問で一致していて、公開ページではこの23問の既知最良解が、最適と示された解として太字で示されています。Instance24 だけは下界40,438と既知最良解40,439が1だけ離れています(2026年9月30日に閲覧)。なお同じページは、掲載する解は掲載前に検証しているが、下界は検証できないと断っています。この章では、既知最良解を「実在する勤務表の罰点」、下界を「報告された値」として扱います。
ベンチマークを使う利点は、答え合わせの相手があることです。自分で作った勤務表の罰点が既知最良解から何%離れているかを見れば、手法や時間制限の良し悪しを、他人の結果と同じ物差しで比べられます。ただし、比べる前に「罰点の数え方が公式の定義と同じか」を確かめる必要があります。定義が少しでも違えば、既知最良解より良い値が出たように見えたり、逆に悪く見えたりします。
公式の書式の説明ページ「Nurse Rostering Instances 1..24」を開いて、制約と罰点の定義を確かめました。ハード制約(必ず守る条件)は、1日1勤務まで、続けてはいけない勤務の組、勤務の型ごとの回数の上限、総勤務時間(分)の上限と下限、連続勤務の上限と下限、連続休みの下限、週末(土曜か日曜のどちらかに勤務がある週)の回数の上限、勤務できない指定日の9種類です。ソフト制約(破ると罰点になる条件)は、「この日にこの勤務に入りたい」という希望が通らなかったときの罰点、「この日にこの勤務に入りたくない」という希望に反したときの罰点、必要人数に対する不足と過剰に人数あたりの重みを掛けた罰点の3種類です。目的は、これらの罰点の合計を最小にすることです。
定義の中で取り違えやすいのは、計画期間の端の扱いです。同じページは、連続勤務の上限と続けてはいけない組については「計画期間の前日と翌日は休み」とみなし、連続勤務の下限と連続休みの下限については「期間の前後に勤務(または休み)が無限に続いている」とみなすと定めています。つまり、期間の初日から始まる短い連勤や、最終日で終わる短い連休は、下限の違反に数えません。ここを「期間の外は休み」と一律に置くと、初日から2日だけ働く並びが違反になり、公式より厳しいモデルになります。
この定義に従って、Python で2つの部品を作りました。1つは CP-SAT のモデルで、もう1つはソルバーとは独立に勤務表を採点する関数です。採点の関数が正しいかは、公式サイトが配布している解の zip(Instance1〜24 の解50件。ファイル名に罰点が書いてある)で確かめました。50件すべてについて、自分の採点がファイル名の罰点と一致し、ハード制約の違反は0件でした。逆向きの確認として、Instance1〜19 の解39件を CP-SAT のモデルに固定して入れたところ、39件すべてが実行可能と判定され、ソルバーの目的値が公式の罰点と一致しました。前者は「採点が公式と同じ」ことを、後者は「モデルが公式より厳しすぎない」ことを示しています。そのうえで Instance1 を CP-SAT(60秒制限・num_workers=8・乱数種0)で解くと、1.0秒で OPTIMAL(最適性の証明まで完了)となり、目的値607は既知最良解607と一致しました。以下の数値は、いずれもこの記事の実行環境(一般的なノートPC)での実測です。同じPCで別の計算が並行して動いている条件で測ったので、時間制限つきの結果には、その分の揺れが含まれます。
規模の異なる5問を時間制限つきで解いた結果
第6章は Instance1〜3 のような小さい問題を扱うので、この章では規模の離れた Instance1・5・10・15・20 の5問を選びました。2週間・8名から、26週間・50名までです。それぞれを CP-SAT で、時間制限10秒と60秒、num_workers=8、乱数種0と1の2回ずつ解き、得られた勤務表を採点の関数で採点して、既知最良解との差を百分率で出しました。差は、採点から既知最良解を引き、既知最良解で割った値で、0%なら既知最良解と同じ品質、100%なら罰点が2倍という意味です。
| 問題 | 週数・人数・型の数 | 変数の数 | 既知最良解 | 10秒制限の結果(乱数種0/1) | 60秒制限の結果(乱数種0/1) | 60秒制限の下界(乱数種0/1) |
|---|---|---|---|---|---|---|
| Instance1 | 2週・8名・1種 | 260 | 607 | 607/607(OPTIMAL、約1秒) | 607/607(OPTIMAL、約1秒) | 607/607 |
| Instance5 | 4週・16名・2種 | 1,300 | 1,143 | 1,649/1,345(差 +44.3%/+17.7%) | 1,246/1,239(差 +9.0%/+8.4%) | 873/794 |
| Instance10 | 4週・40名・5種 | 5,044 | 4,631 | 11,276/14,635(差 +143.5%/+216.0%) | 5,368/5,264(差 +15.9%/+13.7%) | 4,626/4,625 |
| Instance15 | 6週・45名・6種 | 9,390 | 3,828 | 解なし/解なし(UNKNOWN) | 14,626/10,246(差 +282.1%/+167.7%) | 3,752/3,752 |
| Instance20 | 26週・50名・6種 | 47,844 | 4,769 | 解なし/解なし(UNKNOWN) | 解なし/解なし(UNKNOWN) | なし |
表の「変数の数」は、CP-SAT のモデルに作った変数の総数(勤務の割当、1日に勤務があるかどうか、週末、不足と過剰の補助の変数を含む)です。章の冒頭で挙げた変数の数(共通データの2,632個、Instance24 の1,039,432個)は「誰がどの日にどの勤務か」を表す0か1の変数だけを数えたもので、数え方が違います。この数え方では、Instance20 は表の47,844個ではなく35,260個になります。60秒制限の列で解が得られたものは、OPTIMAL 以外すべて FEASIBLE(実行可能な解はあるが最適とは示せていない)でした。Instance20 だけは60秒でも2回とも UNKNOWN(時間内に実行可能な解が見つからず、解が無いことも示せていない状態)でした。同じ結果を、既知最良解との差の棒グラフにしたのが次の図です。棒は2回の平均、縦の線は2回の結果の幅です。
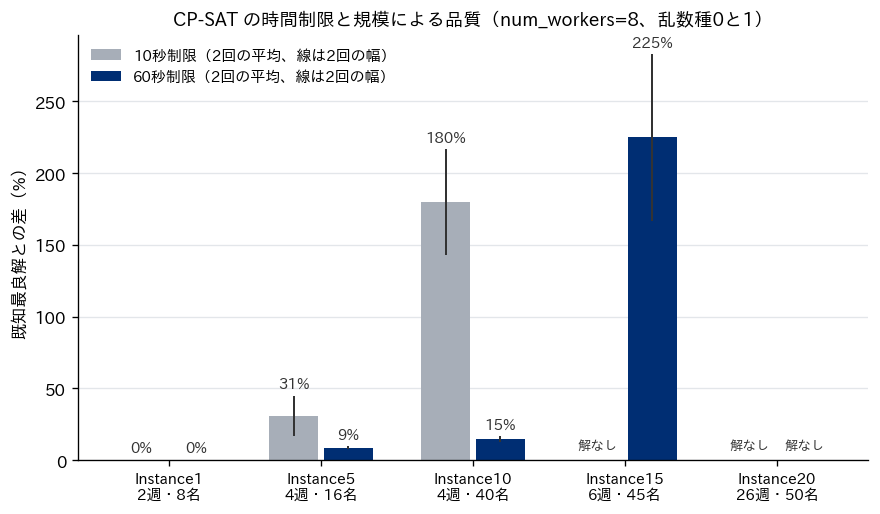
結果から読み取れることは3つあります。1つ目は、規模に対する品質の落ち方が急なことです。Instance1 は1秒ほどで最適性まで示せたのに対し、変数が5倍の Instance5 では60秒かけても既知最良解から8〜9%離れ、Instance15 では60秒で既知最良解の2.7〜3.8倍の罰点の勤務表しか得られず、Instance20 では60秒の間にハード制約をすべて満たす勤務表が1つも見つかりませんでした。Instance20 は時間制限を120秒に延ばして2回(乱数種0と1)解き直しましたが、どちらも解なし(UNKNOWN)のままでした。この状態は「解が存在しない」ことの証明ではなく、「時間内に見つけられなかった」という意味です。既知最良解4,769が公開されているので、実行可能な勤務表は存在します。
2つ目は、時間制限が短いときの揺れの大きさです。Instance10 の10秒制限では、乱数種によって罰点が11,276と14,635に分かれました。同じ問題・同じ時間でも、ソルバー内部の探索の順序が変わると結果が大きく変わります。60秒にすると揺れは5,368と5,264に縮みました。毎月の勤務表を短い時間制限で作る運用では、1回の結果だけを見て「このモデルでは不足が出る」と判断するのは危ういということです。
3つ目は、下界の読み方です。Instance10 の60秒制限の下界は4,626と4,625で、既知最良解4,631のすぐ下まで来ています。下界は「これより良い勤務表は存在しない」という保証なので、手元の解5,264と下界4,625の差(約14%)が、この時点で分かっている改善の余地の上限になります。Instance5 は反対に、60秒でも下界が873と794にとどまり、既知最良解1,143よりかなり低いままです。このように下界が伸びない問題では、解の品質の評価を下界だけに頼れません。なお、時間切れで止まった解では、ソルバーが報告する目的値が採点より大きいことがありました(Instance10 の10秒・乱数種0で、目的値11,680に対して採点11,276)。モデルでは不足と過剰を2つの補助の変数で表しているため、途中の解では両方が正のまま残ることがあるためです。報告値ではなく、別に書いた採点の関数で勤務表そのものを採点し直すのが確実です。
参考として、ベンチマークの作成者による技術報告(Curtois と Qu、2014年、Computational results on new staff scheduling benchmark instances)は、同じ24問に3つの方法を当てた結果を載せています。整数計画ソルバー Gurobi 5.6.3 を1スレッド・1時間で回した結果は、Instance1 が1.62秒で最適、Instance5 が1,520秒で最適、Instance15 が1時間で罰点4,964(下界3,806)、Instance20 は1時間で解なし(下界4,743)でした。分枝価格法(後で説明する列生成を使う厳密解法)は小さい問題から中規模の一部で強く、Instance10 では113.44秒で既知最良解と同じ4,631に達していますが、Instance13 以降の多くの大きい問題ではメモリ不足で止まったと報告されています。計算機も年代も違うので時間を直接比べることはできませんが、「中規模を超えると、汎用のソルバーを1回回すだけでは既知最良解に届かない」という傾向は、この章の実測と同じ向きです。
分けて解くと何を失うか
大きな問題を扱う最も素朴な方法は、問題を分けて解くことです。分け方は大きく2つあります。1つは時間で分ける方法で、4週間の勤務表を1週ずつ解き、前の週の結果を固定して次の週に進みます。もう1つは人で分ける方法で、部署やチームごとに別々に勤務表を作ります。どちらも1回に解く問題が小さくなるので速く解けますが、分けた境目をまたぐ融通が失われます。その損失の大きさは、境目をまたぐ制約がどれだけ強いかで決まります。
第2章で用意したサンプルデータで、この損失を測りました。第5章の基準と同じ制約・同じ重み(不足1人×30分あたり3,000、希望休の違反1件5,000、SV 不在1枠5,000、英語不在1枠2,000、パートの人件費。いずれも架空)のモデルを、この章のプログラムの中で組み直し、次の3通りで解きました。いずれも CP-SAT、1回30秒制限、num_workers=8 で、乱数種0と1の2回です。週ごとに解くときは、前の週の勤務を連勤の上限と続けてはいけない組の判定に引き継ぎ、4週で20日という正社員の条件は「残りの週で達成できる範囲」に収まるように各週の日数を制約しました。チームに分けるときは、スタッフを番号の奇数と偶数で15名ずつに分け、必要在席人数を半分ずつ(奇数の人数は奇数番号のチームが1名多く)受け持たせ、SV と英語対応もチームごとに置くことにしました。採点は、分けて作った勤務表をつなぎ合わせてから、4週分をまとめて基準と同じ物差しで行いました。
| 解き方(乱数種0/1) | 重みづけの目的 | 不足人時(人×時間) | 過剰人時(人×時間) | 希望休の違反(88件中) | SV 不在の枠 | ソルバーの実測時間の合計 |
|---|---|---|---|---|---|---|
| 4週を一度に | 2,053,500/2,053,500 | 216.0/218.5 | 656.0/648.5 | 3/3 | 0/0 | 7.9秒/7.4秒(OPTIMAL) |
| 1週ずつ解いてつなぐ | 2,058,500/2,053,500 | 218.5/223.5 | 648.5/633.5 | 4/3 | 0/0 | 3.7秒/2.1秒(各週 OPTIMAL) |
| 2チームに分けて解く | 2,368,500/2,378,500 | 211.0/211.0 | 681.0/681.0 | 5/5 | 58/60 | 9.1秒/5.1秒(各チーム OPTIMAL) |
| 週の上限を6日に緩めて4週を一度に | 2,034,000/2,034,000 | 219.0/219.0 | 644.0/644.0 | 0/0 | 0/0 | 12.3秒/6.3秒(OPTIMAL) |
| 週の上限を6日に緩めて1週ずつ | 2,703,000/2,669,000 | 281.0/277.0 | 764.0/760.0 | 22/20 | 20/20 | 3.6秒/2.2秒(各週 OPTIMAL) |
1行目の「4週を一度に」は、基準(第5章)と同じ目的値2,053,500で OPTIMAL になりました。ただし不足人時は216.0と218.5で、基準の結果の221.0と一致していません。序章で触れたとおり、同じ条件で解き直すと不足人時は216.0〜221.0人時の間で動きます。重みづけの目的の値が同じで、不足人時・過剰人時・パートの勤務時間の内訳が違う勤務表が複数あるためです。目的の値だけを最小にしている以上、同じ値の勤務表のどれが出てくるかは乱数種や計算の順序で変わります。基準の数字を引用するときは、この揺れがあることを前提に、目的の値と内訳を組で見る必要があります。
2行目の「1週ずつ解いてつなぐ」は、乱数種0で目的が5,000(希望休の違反1件分)悪くなり、乱数種1では差がありませんでした。この共通データでは週をまたぐ損失はほとんど出なかったということです。理由は、正社員が「週5日まで、4週で20日」という条件で働いていて、結果として毎週ちょうど5日勤務することが最初から決まっているからです。週をまたぐ制約は、連勤の上限と続けてはいけない組だけで、どちらも週の境目の1〜2日にしか効きません。
5行目は、同じ分け方でも境目をまたぐ制約が強いと損失が大きくなることを示すために作った設定です。正社員の週の上限を6日に緩めると(4週で20日は同じ)、忙しい週に勤務を寄せる余地が生まれます。4週を一度に解いた4行目では、目的が2,034,000まで下がり、希望休の違反も0件になりました。ところが1週ずつ解くと、目的は2,703,000と2,669,000に悪化し、不足人時は58〜62人×時間、希望休の違反は20〜22件増えました。正社員18名の週ごとの勤務日数の合計を見ると、4週を一度に解いた勤務表では89・91・88・92日とほぼ均等なのに対し、1週ずつ解いた勤務表では107・105・102・46日(乱数種0)でした。最初の週は「今週の不足を減らす」ことだけを見て勤務を詰め込み、最後の週には入れる日数が残っていなかったのです。月の総枠のように期間全体で効く条件がある職場で、週ごとや日ごとに順番に決めていくと、同じ形の失敗が起きると考えています。
3行目の「2チームに分けて解く」は、不足人時がむしろわずかに減った(211.0)一方で、SV 不在の枠が58と60に増え、重みづけの目的は31万〜32万5千悪化しました。SV は7名で、奇数と偶数で分けるとチームAに4名、チームBに3名になります。チームごとの計画は自分のチームの SV の配置しか見ないので、両方のチームの計画が同じ枠で SV を置けなかった58〜60枠が、つなぎ合わせた勤務表で SV 不在として残りました。1つのセンターとして組んだ1行目では、同じ7名で SV 不在は0枠です。人で分けたときに失われるのは、このように人数の少ないスキルの融通であり、第9章で扱ったスキルを持つ人の少なさが効く職場ほど、この損失に注意が要ると考えています。分けるなら、人数の少ないスキルを持つ人だけは分けずに全体で配置を決める、といった工夫が要ります。
経営の目線で言い換えると、分けて解くことの損失は「計算を速くするために払う費用」です。この共通データの週ごとの分解のように損失がほとんど無い分け方なら、使ってよいでしょう。月の総枠のように期間全体で効く条件や、人数の少ないスキルの融通がある場合は、分けた計画の不足人時・希望休の違反を、一度に解いた計画と一度は並べて比べ、差が許容できるかを確かめてから運用に入れるのが安全です。
列生成:勤務パターンを列として足していく
大きな勤務表の問題に対して研究で長く使われてきた方法の1つが列生成です。ここまでの章のモデルは「スタッフ i が日 d に勤務 t に入るか」という細かい変数で勤務表を表していました。列生成では見方を変えて、1人分の計画期間の勤務の並び(たとえば4週間28日分の「早番・早番・休み・遅番…」)を1つの部品として扱います。この部品を勤務パターンと呼ぶことにします。この節で確かめたのは、列生成は強い下界(これより良い勤務表は無いという線)を出せる一方、この章の小さな実装では整数の勤務表を良い品質で作れなかった、という2点です。勤務表は「各スタッフに勤務パターンを1つずつ選んで割り当てたもの」になり、各枠の在席人数は、選ばれたパターンを足し合わせたものになります。
この見方の利点は、1人の中で閉じている制約(4週で20日、週5日まで、連勤5日まで、続けてはいけない組、その人が入れる型)を、すべて「パターンを作る段階」で片づけられることです。パターンを選ぶ側の問題(主問題と呼びます)に残るのは、在席人数と必要人数の関係、SV や英語対応の配置のように、人と人をまたぐ条件だけになります。その代わり、1人がとりうるパターンの数は膨大です。共通データの正社員1人でも、28日のうち20日を選び、その各日に4種類の型を当てる並べ方は天文学的な数になり、全部を列挙することはできません。
そこで、パターンを必要な分だけ少しずつ足していきます。手順は次のとおりです。まず、各人に1つずつ、とりあえずのパターンを用意します。次に、手元にあるパターンだけを使って、どのパターンを使うかを線形計画(0か1ではなく、0から1の割合で選んでよいとした緩い問題)で解きます。線形計画を解くと、各枠の必要人数の制約に双対価格という値が付きます。これは「その枠に在席が1人増えると目的がどれだけ下がるか」を表す値で、不足している枠ほど高くなります。そして各人について、「双対価格で測った貢献から、その人の費用(希望休の違反やパートの人件費)を引いた得が最も大きいパターン」を探します。この得がプラスになるパターン、言い換えると今の組合せより目的を下げうるパターンが見つかれば、それを手元に足して線形計画を解き直します。どの人についてもそのようなパターンが見つからなくなったら終わりです。この「得をするパターンを探す」問題は価格付け問題と呼ばれ、1人分の勤務表を作る小さな問題なので速く解けます。
Burke と Curtois の論文(2014年、New approaches to nurse rostering benchmark instances)は、看護師勤務表に使われてきた列生成の構造をこう説明しています。主問題は集合被覆問題として立て、単体法などの線形計画の方法で解く。価格付け問題は、双対価格による費用を加えたうえで個々の職員の最適な勤務予定を求める問題であり、資源制約つき最短路問題(1日ずつ勤務を選んで進む経路のうち、勤務日数や連勤の上限といった「資源」の制限を守りながら費用が最小のものを探す問題)として動的計画法で解く。枝分かれの木は完全に探索するには大きすぎるので、勤務の割当に対して発見的な枝分かれを行う。列生成を枝分かれ限定法の各節点で繰り返す方法は分枝価格法と呼ばれます。
列生成の考え方を確かめるために、第2章のサンプルデータで小さな実装を作りました。列は1人の4週間28日分の勤務パターンで、主問題は scipy(版は1.16.3)の線形計画(linprog)で解き、価格付け問題は1人ずつ CP-SAT で解きました(1人分の制約は、4週で20日、週の上限、連勤5日まで、続けてはいけない組、その人が入れる型)。目的と重みは基準と同じです。価格付けでは、双対価格を10倍して整数に丸めてから CP-SAT に渡し、見つかったパターンの得は丸めない値で計算し直しました。最初の列は、双対価格を0として各人に1本ずつ作りました。
結果は次のとおりです。反復1回目の主問題の値は10,245,000でしたが、パターンを足すごとに下がり、10回目で2,137,019、20回目で2,064,426となり、26回目に、どの人についても得をするパターンが見つからなくなって止まりました。このときの線形計画の値は2,053,500で、手元のパターンは756本、経過時間は74.2秒でした。この値は線形計画の緩和(0か1の選択を割合に緩めた問題)の最適値なので、整数で解いた勤務表の目的はこれより小さくなりません。そして基準の最適値も2,053,500なので、この共通データでは、列生成で得た下界が最適値とぴったり一致しました。反復の途中でも、主問題の値と価格付けの結果から計算できる下界(ラグランジュ下界と呼ばれる値。主問題の値から、各人について価格付けで見つかった得を合計して差し引いたもの)があり、10回目で992,860、20回目で1,722,299と、上から下りてくる主問題の値に下から近づいていきました。
一方で、下界が良いことと、良い勤務表が手に入ることは別の話です。線形計画の解を見ると、30名全員が、複数のパターンを割合で混ぜて使っていました。「Aさんは、このパターンを0.4、あのパターンを0.6」という答えは、勤務表としては使えません。そこで、集めた756本のパターンだけを使って、各人にパターンを1本ずつ選ぶ整数計画を解きました。scipy の milp(60秒制限)では、時間切れの時点の勤務表の目的は3,791,500で、最適値より84.64%悪いものでした。同じ問題を CP-SAT(60秒制限・num_workers=8)で解くと2,982,500(+45.24%、状態 FEASIBLE)で、SV 不在が104枠残りました。線形計画の答えを作るのに役立ったパターンの寄せ集めからは、整数の良い組合せが作れなかったということです。
研究で使われる分枝価格法は、この弱点を、枝分かれの途中でも価格付けを続けて新しいパターンを足すことで埋めています。この章の小さな実装はそこまで作っていないので、勤務表を作る道具としては、同じ共通データを10秒足らずで最適まで解ける(この章の実測で7.4〜7.9秒) CP-SAT の直接のモデルに遠く及びません。列生成の価値はむしろ2つの点にあると考えています。1つは、この例のように強い下界が得られることで、ソルバーが下界を伸ばせない大きな問題でも「これ以上は良くならない」という線を引けます。もう1つは、1人の中で閉じた複雑な就業ルールを、価格付けの側(1人分の勤務予定を作る部品)に閉じ込められることです。就業ルールの種類が多い職場ほど、この分担は効いてきます。一方で、実装と調整に必要な手間は、ソルバーに直接モデルを渡す方法よりはるかに大きいので、まず直接のモデルで時間と品質を測り、足りないと分かってから検討する順番が現実的です。
大近傍探索:一部を壊して解き直す
列生成が「問題の書き方を変える」方法だとすると、大近傍探索は「今ある勤務表を少しずつ直していく」方法です。手順は単純で、まず何らかの方法で勤務表を1つ作り、その一部(たとえば特定の2週間の全員、あるいは一部のスタッフの全期間)だけを未定に戻し、残りを今の値に固定したまま、未定に戻した部分をソルバーで解き直します。解き直した結果が前より良ければ採用し、悪ければ捨てて、別の部分を壊して同じことを繰り返します。固定した部分がある分だけ1回の問題は小さくなり、短い時間でも最適に近い答えが出やすくなります。この方法は、Shaw が1998年に配送計画の問題に対して提案したもので、関連する訪問先をいくつか計画から取り除き、制約に基づく探索で入れ直すという形でした(制約プログラミングの国際会議 CP98 の論文)。
ベンチマークの Instance15(6週間・45名・勤務の型6種類)で、小さな実装を試しました。最初の勤務表は、CP-SAT に「実行可能な解が1つ見つかったら止める」という設定(stop_after_first_solution)を付けて作りました。そのあと、奇数回目は連続した14日間の全員を、偶数回目はランダムに選んだ9名(45名の5分の1)の全期間を未定に戻し、1回5秒の時間制限で解き直しました。固定するには、固定する変数の取りうる値の範囲を今の値1つに狭めます。次のコードは、実装のうち固定と解き直しの部分を抜き出したものです(全体は、ベンチマークの読み込みと採点の関数を含む別のファイルに分けています)。
for (i, d, t) in keys:                  # 壊さない部分は今の値に固定する
    if not free(i, d):
        v = 1 if cur.get((i, d)) == t else 0
        dom = m.proto.variables[idx[i, d, t]].domain
        saved[i, d, t] = True
        dom[0] = v
        dom[1] = v
m.clear_hints()
for (i, d, t) in keys:                  # 今の勤務表をヒントとして渡す
    m.add_hint(x[i, d, t], 1 if cur.get((i, d)) == t else 0)
s = cp_model.CpSolver()
s.parameters.max_time_in_seconds = SUB  # 1回5秒
s.parameters.num_workers = 8
s.parameters.random_seed = seed + it
st = s.solve(m)
for k2 in saved:                        # 固定を元に戻す
    dom = m.proto.variables[idx[k2]].domain
    dom[0] = 0
    dom[1] = 1
if st in (cp_model.OPTIMAL, cp_model.FEASIBLE):
    a = nm.extract(inst, s, x)
    pen, viol = nm.evaluate(inst, a)    # ソルバーと独立に採点する
    if (pen < best) & (len(viol) == 0):
        best, cur = pen, a              # 良くなったときだけ採用する
比べる相手は、同じ合計120秒を CP-SAT の1回の実行に使ったものです。どちらも num_workers=8 で、乱数種0と1の2回ずつ回しました。
| 方法(合計120秒) | 乱数種0の罰点 | 乱数種1の罰点 | 既知最良解3,828との差(乱数種0/1) | 補足 |
|---|---|---|---|---|
| CP-SAT を1回 | 8,596 | 7,749 | +124.6%/+102.4% | 状態はどちらも FEASIBLE、下界3,752 |
| 大近傍探索 | 7,464 | 6,899 | +95.0%/+80.2% | 最初の解は13.3秒で26,087/2.2秒で28,658。解き直し19回/21回で、すべての回で改善を採用 |
2回とも、大近傍探索のほうが CP-SAT を1回回すより罰点が小さくなりました(乱数種0で8,596に対して7,464、乱数種1で7,749に対して6,899)。ただし、どちらの方法も既知最良解3,828からはまだ80〜125%離れています。大近傍探索の経過を見ると、解き直しのたびに罰点が下がり続けていて、120秒の時点で下げ止まっていません。この問題の規模では、120秒という時間の予算そのものが足りていないということです。実務でこの規模の勤務表を作るなら、時間の予算を数十分に広げるか、手法をさらに作り込む必要があります。
大近傍探索を使うときの注意は3つあります。1つ目は、壊し方の設計が結果を左右することです。この実装では「連続した14日間」と「ランダムな9名」の2通りを交互に使いましたが、たとえば不足が集中している日や、希望休の違反が残っている人を優先して壊すなど、問題の構造に合わせた壊し方のほうが効くことが多いと考えています。2つ目は、最初の勤務表が必要なことです。Instance20 のように、ソルバーが120秒で実行可能な解を1つも見つけられない問題では、この方法をそのままでは始められません。人が作った勤務表や前月の勤務表から出発する、あるいはハード制約の一部をいったん罰点つきの柔らかい制約に置き換えて出発点を作る、といった工夫が要ります。3つ目は、大近傍探索は最適性の証明を出さないことです。下界は別の方法(CP-SAT の下界や、列生成の線形計画の値)で持っておき、解との差を記録しておきます。
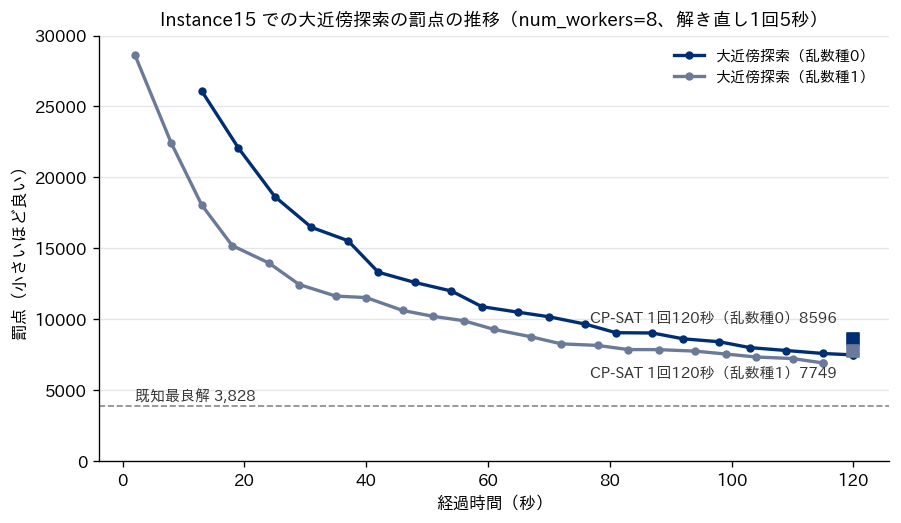
年間の要員計画:何人採れば不足人時がどれだけ減るか
ここからは時間軸を延ばします。勤務表は、今いるスタッフで何ができるかを決める道具です。今いるスタッフで足りないなら、採用するか、パートの契約時間を増やすか、勤務の型を見直す必要があります。要員計画は、この「何人をいつまでに確保するか」を、数か月から1年の単位で決める計画です。要員計画でよく使われる計算は、必要な人時の合計を1人あたりの勤務時間で割って必要人数を出すものですが、第4章で見たとおり、勤務の型と需要の山が合っていなければ、人時の合計が足りていても不足は残ります。そこで、勤務表のモデルそのものを使って「正社員を1人増やすと、4週の勤務表の不足人時・過剰人時・パートの勤務時間がどう変わるか」を測り、その結果を年間の計画の入力にしました。
設定は次のとおりで、すべて架空です。入電の水準は、第2章の予測入電に0.9倍・1.0倍・1.1倍・1.2倍を掛けた4通りとし、季節による波を表します。正社員の人数は16名から24名まで変え、18名より少ない場合は S18・S17 を外し、多い場合はスキルと希望休の無い正社員を足しました。パート12名はそのままです。重みは基準と同じで、CP-SAT、1回30秒制限、num_workers=8、乱数種0で解きました。36通りのうち34通りは OPTIMAL、2通り(1.1倍で16名、1.2倍で23名)は30秒の時点で FEASIBLE で、目的と下界の差は目的の0.5%未満でした。正社員1人の4週の人件費は、架空の時給2,600円×160時間=416,000円としました。
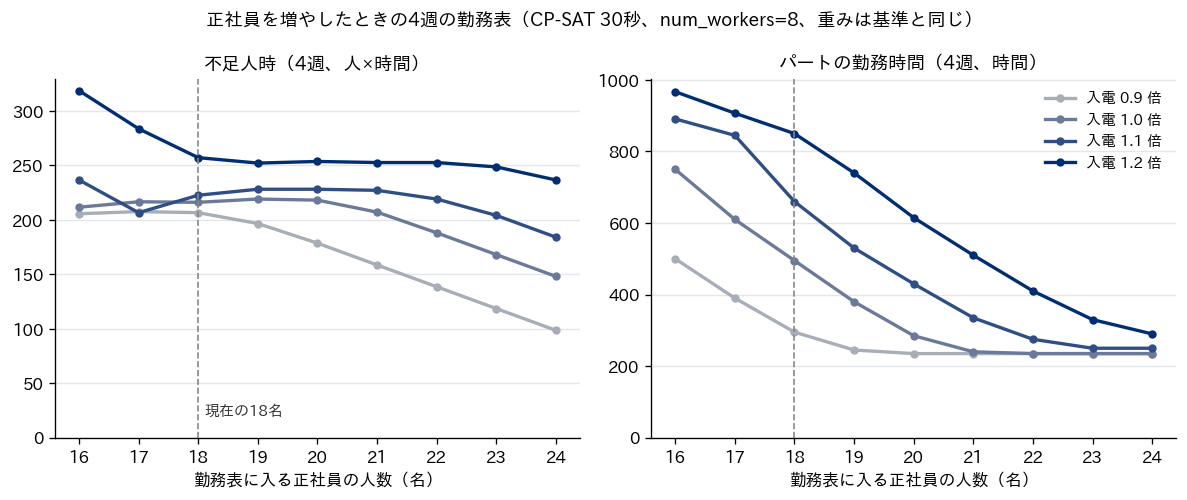
図の左は不足人時、右はパートの勤務時間です。正社員を増やしても不足人時はあまり減らず、入電1.0倍では16名で211.5、18名で216.0、24名でも148.0人×時間でした。代わりに大きく動いたのはパートの勤務時間で、1.0倍では16名の750時間から、21名以上では235〜240時間まで下がりました。この重みの下では、正社員が増えると、ソルバーはパートの勤務を正社員の勤務に置き換えて人件費を減らす方向に使い、増えた正社員は不足の解消にはあまり回りませんでした。9時間の固定の勤務の型を持つ正社員は、需要の山に合わせて置く自由度が小さいので、増やした分の多くは過剰人時(1.0倍で18名の656.0から24名の1,288.0へ)になりました。
この表を入力にして、1年(4週を1期とした12期)の採用計画を作りました。入電の水準は期ごとに1.0・1.0・1.1・1.2・1.1・1.0・0.9・0.9・1.0・1.1・1.2・1.1倍とし、正社員は期3と期8の終わりに1名ずつ退職すると置きました。採用した人は採用した期は研修(人件費は掛かるが勤務表には入らない)で、翌期から勤務表に入ります。各期の費用は、勤務表の重みづけの目的(不足・希望休・SV・英語の重みとパートの人件費)に正社員の人件費を足したもので、各期の初めに何人採るかを動的計画法(期を1つずつ進めながら、人数ごとに最小の費用を覚えておく方法)で決めました。
| 不足の重み(不足1人×30分あたり。かっこ内は1時間あたりに換算した値) | 採用の方針 | 1年の採用人数 | 1年の不足人時(人×時間) | 1年の過剰人時(人×時間) | 1年の人件費(正社員+パート) | 「採用しない」に比べて、減った不足1人×時間あたりに増えた人件費 |
|---|---|---|---|---|---|---|
| 3,000円(基準。1時間あたり6,000円) | 採用しない | 0名 | 2,779.0 | 7,081.0 | 96,884,500円 | 比較の基準 |
| 3,000円(基準。1時間あたり6,000円) | 欠員を同じ期に補充 | 2名(期3・期8) | 2,681.0 | 7,682.0 | 101,053,000円 | 42,536円 |
| 3,000円(基準。1時間あたり6,000円) | 動的計画法 | 0名 | 2,779.0 | 7,081.0 | 96,884,500円 | 差なし(採用しないと同じ) |
| 9,000円(基準の3倍。1時間あたり18,000円) | 採用しない | 0名 | 2,222.5 | 9,309.5 | 101,062,000円 | 比較の基準 |
| 9,000円(基準の3倍。1時間あたり18,000円) | 欠員を同じ期に補充 | 2名(期3・期8) | 1,928.0 | 10,735.0 | 106,762,000円 | 19,355円 |
| 9,000円(基準の3倍。1時間あたり18,000円) | 動的計画法 | 1名(期9) | 2,142.5 | 9,487.5 | 102,393,000円 | 16,638円 |
基準の重み(不足1人×30分あたり3,000円、1時間あたり6,000円)では、動的計画法の答えは「1年を通じて採用しない」でした。欠員を補充すると不足人時は1年で98.0人×時間減りますが、人件費は4,168,500円増え、減った不足1時間あたり42,536円かかります。不足1人×1時間の値打ちを6,000円(30分あたり3,000円)と見ている以上、この採用は割に合わないという判定です。不足の重みを3倍(1人×30分あたり9,000円、1時間あたりに換算すると18,000円)にして同じ計算をやり直すと、パートの勤務時間はどの人数・どの入電の水準でも840〜1,045時間になり(基準の重みでは235〜967時間)、正社員を1人増やすごとの不足の減り方も大きくなりました(入電1.0倍で18名の139.0から19名の119.0、20名の99.0へ)。このときの動的計画法の答えは「期9に1名採用する」で、2度目の退職で16名に減った直後、入電が1.1倍・1.2倍に上がる期10・期11の前に研修を終えさせる時期でした。減った不足1人×1時間あたりの人件費は16,638円で、不足の重みを1時間あたりに換算した18,000円を下回ります。
この模型から言えることは3つあります。1つ目は、採用の判断は「不足1時間をいくらと見るか」でほぼ決まることです。不足の重みが1人×30分あたり3,000円(1時間あたり6,000円、基準)なら採用しない、9,000円(1時間あたり18,000円)なら1名採る、という結論の差は、ソルバーの性能ではなく経営の判断から来ています。不足1時間の値打ちは、コンタクトセンターなら応答率の低下による機会損失や、サービス水準の契約上の罰則、残業での穴埋めの費用などから見積もることになり、そこは現場と経営が合意して決める数字です。2つ目は、人時の割り算だけで採用人数を決めると、この模型のように「採っても不足が減らず、過剰とパートの削減に消える」ことを見落とすことです。勤務表のモデルで1人増やしたときの効果を測ってから決めると、この見落としを防げます。不足が勤務の型と需要の山の不一致から来ているなら、採用よりも型の見直し(第4章)やパートの時間帯の設計のほうが効く可能性があります。3つ目は、採用には研修の期間があるので、繁忙期の前に採る時期を決める必要があることです。この模型では、期9に採用すると研修が期9のうちに終わり、入電の多い期10・期11から勤務表に入ります。
この模型は、退職の時期を確定したものとして置き、欠勤や需要の予測誤差を入れていません。実際には、退職も需要も不確かなので、第11章の欠勤のシミュレーションや第12章の需要のばらつきと組み合わせ、いくつかのシナリオで同じ計算を回して、どのシナリオでも大きく外さない採用人数を選ぶのが現実的だと考えています。また、正社員を採る以外に、パートの契約時間を延ばす、短時間の型を増やすといった選択肢も同じ表の上で比べられます。
毎月決まった時間で「十分良い勤務表」を作る設計
ここまでの結果を、毎月の勤務表の作成という運用に落とすと、設計の要点は4つあると考えています。1つ目は、時間の予算を先に決めることです。勤務表の作成は、希望休の締切から公開日までの間に、確認と手直しを含めて終える必要があります。ソルバーに使える時間を「1回あたり何分」と先に決め、その時間で解いた結果を、状態(OPTIMAL か FEASIBLE か)と下界と一緒に毎月記録します。同じ時間で下界との差が毎月どう推移するかを見ていれば、職場の規模や制約が増えて問題が重くなってきたことに、手遅れになる前に気づけます。
2つ目は、「十分良い」の基準を経営指標で決めることです。下界との差が何%以内なら公開してよいか、という基準は罰点の単位では現場に伝わりません。不足人時・希望休の違反・連勤の上限に当たった人数のように、第1章で定義した指標に翻訳し、「不足人時が前月の実績を超えない」「希望休の違反は0件」のように書いておくと、時間内に基準を満たせなかった月に、誰が何を判断するかも決めやすくなります。基準を満たせなかったときの手段(時間を延ばす、制約を1つ緩める候補を出す、人が手直しする)も、あらかじめ順番を決めておくのが良いと考えています。
3つ目は、前月の勤務表や、同じ月の途中の案を出発点として渡すことです。CP-SAT には、解の候補を「ヒント」として渡す仕組み(add_hint)があり、この章の大近傍探索の実装でも、今の勤務表をヒントとして渡してから解き直させました。毎月の運用では、前月の勤務表を曜日をそろえてずらしたものや、人が手で作った案をヒントにすると、最初の解を探す時間を短くできる場合があります。ただし、ヒントは解の品質を保証するものではないので、結果は必ず採点し直します。
4つ目は、1回の結果で判断しないことです。この章の表で見たように、中規模を超える問題では、乱数種を変えるだけで結果が大きく揺れます。時間の予算の中で乱数種を変えて2〜3回解き、最も良いものを採る運用にすると、揺れの影響を小さくできます。num_workers を増やすと1回の中で複数の探索が並列に走りますが、この記事の実行環境では8を上限にしました。どれだけの計算機を使えば毎月の時間の予算に収まるかも、下界との差の推移を見ながら判断することになります。
この章では、公開ベンチマークで規模と時間と品質の関係を測り、2週間・8名の問題なら1秒ほどで最適まで解ける CP-SAT でも、6週間・45名では120秒で既知最良解の2倍前後、26週間・50名では120秒で実行可能な勤務表すら見つからないことを確かめました。大きな問題に対しては、分けて解く(境目をまたぐ条件が弱いときだけ損失が小さい)、列生成(強い下界が得られるが、整数の勤務表を作るには作り込みが要る)、大近傍探索(同じ時間で直接解くより良い勤務表が得られたが、出発点が要る)という3つの考え方を、それぞれの長所と限界とともに示しました。また、勤務表のモデルを年間の採用計画の入力に使うと、採用の効果が不足人時の減少として測れる一方で、結論は不足1時間の値打ちという経営の判断に強く依存することを示しました。次の第11章では、時間軸を反対側に縮め、当日に欠勤が出たときに勤務表をどう組み直すかを扱います。
この章を深めたい方への参考書籍
『メタヒューリスティクスの数理』(久保幹雄、J.P.ペドロソ、共立出版):局所探索法から模擬焼なまし法・禁断探索法・遺伝的アルゴリズムまで代表的なメタヒューリスティクスを並べ、なぜその工夫がうまく働くのかを数理の面から説明した本です。目次には大近傍探索法の節と、変数固定法・MIP近傍局所探索法など「数理計画とメタヒューリスティクスの融合」の章があり、この章で行った「一部を固定してソルバーで解き直す」方法の位置づけを確かめるのに向いています。
『Column Generation』(Guy Desaulniers、Jacques Desrosiers、Marius M. Solomon 編、Springer):列生成を主題にした論文集で、冒頭の章 A Primer in Column Generation が、大規模な実務の問題を列生成で解くための理論と考え方を例とともに解説しています。ほかに、この章で触れた価格付けの資源制約つき最短路問題の章、分枝価格法の発見的解法の章、航空業界の大規模モデルの章、実装上の論点(初期化・安定化・列の管理)をまとめた最終章があります。この章の列生成の小さな実装から先へ、分枝価格法まで進めたいときの原典になります。
第11章 当日の欠勤と勤務表の組み直し
第10章では、規模の大きい勤務表を決まった時間の中で十分に良く解く方法と、年間の要員計画への延ばし方を扱いました。そこまでの章が作ってきたのは、計画期間が始まる前に確定させる勤務表です。しかし勤務表は、公開した翌日から崩れ始めます。体調不良、家族の看病、交通機関の乱れなどで、予定していた人が来られない日は必ず出てきます。この章では、勤務表の期間の途中で欠勤が出たときに、何をどこまで変えて穴を埋めるかを扱います。第2章で用意したサンプルデータの勤務表に2名の欠勤を起こし、穴を空けたままにする場合、当日だけで手当てする場合、変更の件数を最小にしながら残りの期間を組み直す場合、変更の件数を気にせずに全体を組み直す場合を実際に解いて比べます。そのうえで、欠勤を乱数で繰り返し発生させ、待機要員を何人置けば不足人時がどれだけ減るかを測り、変更がスタッフに与える負担を経営の指標としてどう扱うかを考えます。
欠勤が出たときの対応の型
欠勤への対応は、大きく4つの型に分けられます。1つ目は、何もせずに穴を空けたまま営業する型です。欠けた人の勤務の時間帯は在席人数が1人減り、そこがもともと人数に余裕のある時間帯なら影響は小さく、ぎりぎりの時間帯なら不足がそのまま増えます。2つ目は、あらかじめ決めておいた待機要員を呼ぶ型です。待機要員はその日の勤務表には入っていませんが、連絡があれば出勤できるように待機している人で、医療や保守の現場ではオンコールとも呼ばれます。3つ目は、当日すでに出勤する人の勤務を動かす型で、パートの勤務を1時間延ばしてもらう、日勤の人に早番へ回ってもらう、といった手当てです。4つ目は、欠勤の日から先の勤務表全体を組み直す型です。
4つの型は、決めることの範囲と、それに伴う負担が違います。次の表に整理しました。
| 対応の型 | 変えるもの | 前提になる準備 | 主な費用と負担 | 向かない場面 |
|---|---|---|---|---|
| そのまま(穴を空けたまま) | 何も変えない | なし | 不足人時の増加、サービスレベルの低下、残った人の負荷 | 欠けた人が SV(リーダー)や英語対応など、代わりの少ない役割を持つとき |
| 待機要員を呼ぶ | 待機している人を1人出勤させる | 待機の当番表、待機手当、連絡の手順 | 待機手当と呼び出したときの賃金。到着までの時間は穴が残る | 欠勤が待機の人数を超えて重なる日、待機の人が欠けた役割を持たないとき |
| 当日の勤務を動かす | 当日出勤する人の勤務の型、休みの人の呼び出し、パートの延長 | 延長や型の変更に応じてもらえる取り決め | 変更を頼まれる人の負担。延長分の賃金 | 当日の人員にもともと余裕がないとき |
| 勤務表を組み直す | 欠勤の日から先の勤務表全体 | 勤務表を作ったときのモデルと、元の勤務表のデータ | 変更の件数と通知の手間。変更の罰則を入れないと、必要のない変更が大量に出る | 変更を最小にする仕組みがないまま、ソルバーをそのまま回し直すとき |
表の最後の列は、それぞれの型が失敗する典型の場面です。とくに4つ目の型は、第5章で作った勤務表のモデルがあればすぐに試せるため、手軽に見えます。しかし、勤務表を作ったときと同じモデルをそのまま解き直すと、欠勤とは関係のない人の勤務まで大きく入れ替わることがあります。これは後の節で実測します。組み直しで大事なのは、穴を埋めることと同じくらい、元の勤務表をできるだけ変えないことです。
実務では、4つの型を組み合わせて使うことが多いと考えています。当日の朝に欠勤の連絡が来たら、まず当日の勤務を動かすか待機要員を呼んで当日の穴をふさぎ、翌日以降に影響が残る場合(欠けた人の勤務日数をどこかで調整する必要がある場合や、欠勤が数日続く場合)は、翌日以降の勤務表を変更最小で組み直す、という順番です。この章の比較も、この順番に沿って進めます。
例題の設定、第8日に2名が欠勤する
比較の土台になる元の勤務表から作ります。本コラムでは、第5章の基準の勤務表は一度解いた結果をそのまま引用し、解き直していません。そこでこの章では、基準と同じモデル(同じ制約・同じ重み)をこの章のプログラムの中で組み立て直し、同じ条件(CP-SAT、30秒の時間制限、num_workers=8、random_seed=0)で解きました。結果は OPTIMAL で、目的関数は 2,053,500、下界も 2,053,500 となり、基準の目的関数 2,053,500 と一致しました。
ただし、目的関数が同じでも勤務表の中身は基準と同じではありませんでした。この章の元の勤務表は、不足が 216.0 人×時間(432 人×30分)、過剰が 656.0 人×時間、パートの勤務が 495 時間で、基準の 221.0 人×時間・641.0 人×時間・475 時間とは少し違います。基準の目的は、不足1人×30分を3,000円、パートの人件費を時給1,500円として足した重みづけの和です(いずれも架空の値)。この勤務表は基準に比べて不足が10人×30分少なく、その分パートの勤務が20時間多いので、不足の側で 10×3,000=30,000、パートの側で 20×1,500=30,000 だけ動き、和は変わりません。つまり、重みづけの和が同じ値になる勤務表が複数あり、ソルバーはそのうちの1つを返したということです。序章で触れた、同じ条件で解き直すと不足が216.0〜221.0人時、パートの勤務が475〜495時間の間で動く現象の一例です。この章では、この同じ目的値の別の最適解を元の勤務表として使います。第5章などで「基準の結果」として引かれる数字(不足221.0人×時間など)は第5章で示した基準の勤務表のもので、この章の数字とは内訳が少し違う点に注意してください。基準の勤務表の先頭7日(30名×7日=210件)と照らし合わせると、208件が一致しました。希望休の違反3件、SV 不在0枠、英語不在0枠は基準と同じです。この章の数字は、すべてこの勤務表(ファイルに保存し、後のコードで読み込みます)を元にしています。
欠勤は、第8日(2週目の月曜)に起きたものとしました。月曜は入電が最も多い曜日です。欠勤するのは、SV の資格を持ち早番(7時〜16時)に入っていた S01 と、遅番(15時〜24時)に入っていた S13 の2名です。この日の元の勤務表では、SV は S01(早番)・S02(中番)・S04(日勤)・S05(遅番)の4名で、7時から9時の間の SV は S01 だけでした。S01 が欠けると、この時間帯に SV がいなくなります。
欠勤の扱いについて、モデルに置いた仮定を先に書いておきます。欠勤した日は、その人の勤務がない日として扱います。正社員の「4週でちょうど20日勤務」と「週5日まで」の数え方では、欠勤の日を勤務した日として数えました。欠勤を年次有給休暇などに振り替えて、勤務日数を後から取り戻さない運用を想定しています。反対に、連続勤務の上限(5日)の数え方では、欠勤の日を休みとして数えました。欠勤を勤務日数に数えない運用(後日に1日多く勤務してもらう運用)なら、組み直しの変更は増えます。どちらの運用にするかは就業規則と労使の取り決めで決まることなので、実際に使うときは自社の規則に合わせて設定を変える必要があります。
組み直しでは、欠勤の日より前の7日間(第1日〜第7日)は過去の日として元のまま固定しました。当日の手当てとして、パートの短時間の型を1時間延ばす型を2つ足しています。短時間(午前)9時〜14時を15時まで延ばした型と、短時間(夕方)17時〜22時を16時からに早めた型で、どちらも実働6時間、休憩なしです。労働基準法第34条は、労働時間が6時間を超える場合に少なくとも45分、8時間を超える場合に少なくとも1時間の休憩を労働時間の途中に与えることを定めています(e-Gov 法令検索で条文を確認しました)。延長後の実働を6時間ちょうどにしたのは、休憩を入れずに済む範囲にとどめるためです。休憩を含む法令の条件の詳しい扱いは第7章で扱います。延長の型は欠勤の当日だけ使えることにしました。
4つの対応を解き比べる
この設定で、4つの対応を比べました。A は穴を空けたままにする対応です。B は当日だけで手当てする対応で、第8日の中だけで、出勤する人の勤務の型の変更、休みの人の呼び出し、パートの1時間延長を認め、第9日以降は元のまま固定しました。C は変更最小の組み直しで、第8日から第28日までを組み直してよいことにし、目的に「元の勤務表からの変更1件につき2,000」の罰則を足しました。D は第8日から第28日までを、変更の罰則なしで組み直す対応です。変更1件は、ある人のある日の勤務が元と違うこと(休み→勤務、勤務→休み、勤務の型の変更)を1件と数えます。欠勤そのものは変更に数えていません。B から D は CP-SAT で60秒の時間制限・num_workers=8・random_seed=0 で解き、いずれも時間内に OPTIMAL(下界と一致)になりました。変更の罰則2,000は、ほかの重みと同じく架空の値です。
| 対応 | 第8日の不足(人×30分) | 第8日の SV 不在(枠) | 第8〜28日の不足(人×時間) | 第8〜28日の希望休の違反 | 第8〜28日のパートの勤務 | 変更件数(うち当日) | 変更を受けた人 | 計算時間 |
|---|---|---|---|---|---|---|---|---|
| 欠勤が無かった場合(元の勤務表) | 21 | 0 | 165.0 | 1件 | 370時間 | 0件 | 0名 | (なし) |
| A そのまま | 35 | 4 | 172.0 | 1件 | 370時間 | 0件 | 0名 | (なし) |
| B 当日だけで手当て | 21 | 2 | 165.0 | 1件 | 381時間 | 4件(4件) | 4名 | 0.5秒 |
| C 変更最小の組み直し | 21 | 0 | 166.5 | 2件 | 376時間 | 3件(2件) | 2名 | 2.8秒 |
| D 全体の組み直し(変更の罰則なし) | 21 | 0 | 167.5 | 2件 | 371時間 | 347件(19件) | 30名 | 27.6秒 |
計算時間はこの記事の実行環境(一般的なノートPC)での実測で、ほかの章の計算と同時に動かしているため揺れがあります。まず A の行を見ると、2名の欠勤で第8日の不足は21人×30分から35人×30分に増え、7時から9時までの4枠で SV がいなくなりました。第8日から第28日までの不足は165.0人×時間から172.0人×時間に増えています。増えた7.0人×時間は第8日の14人×30分の増加そのものです。欠けた2名は1人あたり16枠(8時間)在席する予定だったので、在席は合わせて32人×30分減ったことになりますが、不足が増えたのはそのうち14人×30分でした。残りの18人×30分は、もともと必要人数を上回って在席していた時間帯(過剰のあった時間帯)に当たり、欠けても不足にはなりませんでした。第8日の過剰が48人×30分から30人×30分に減っているのはこのためです。欠勤の影響は、欠けた人の勤務時間ではなく、欠けた時間帯に余裕があったかどうかで決まります。
B の当日だけの手当ては、4件の変更で第8日の不足を元の21人×30分まで戻しました。中身は、日勤の S04 を早番に、中番の S16 を遅番に回し、休みだったパート S24 に短時間(夕方)を1時間延ばした型で、同じく休みだったパート S29 に短時間(午前)で入ってもらう、というものです。ただし SV 不在は2枠残りました。S04 は SV なので、早番に回すと7時から9時の SV は埋まりますが、早番の休憩の11時から12時に SV がいなくなります。当日だけで手当てする範囲では、正社員の休みの人を呼び出せません。正社員は4週でちょうど20日勤務するので、休みの日に1日出勤してもらうなら、どこか別の日を休みにする必要があり、それは当日の外の変更になるからです。
C の変更最小の組み直しは、変更3件で第8日の不足を21人×30分に戻し、SV 不在も0枠にしました。中身は、第8日に休みだった SV の S03 に早番で出てもらい、その代わりに S03 の第11日(木曜)の日勤を休みにする、というもので、これで2件です。残りの1件は、B と同じく S24 に延長した短時間(夕方)で入ってもらう変更です。正社員の休みの日と勤務の日を1日入れ替えることで、当日の外の変更を1件だけ使って SV を確保したことになります。
ここで、C の希望休の違反が1件から2件に増えていることに注意が要ります。S03 は第8日を希望休として出していました。モデルは希望休の違反に1件5,000の罰則を置いているだけなので、希望休の違反も、ほかの損失と足し引きできる候補の1つにすぎません。S01 の欠勤で朝の SV 不在が4枠生じ、当日だけの手当て(B)でも2枠(1枠5,000)残ります。C は、S03 の希望休の違反1件を受け入れて SV 不在を0枠にする方が、不足・パートの勤務時間・変更件数の罰則まで足した重みづけの目的の合計で B より5,500小さくなる(B は2,088,000、C は2,082,500)と判断して、希望休の日に呼び出す方を選んだのです。現実には、希望休の日に出勤を命じられるかどうかは、就業規則と本人の同意に左右されます。組み直しの結果は「この人に頼めば最も良くなる」という候補として扱い、本人に打診して断られたら、その人の第8日を勤務不可にして解き直す、という手順が現実的だと考えています。解き直しは数秒で済むので、打診と解き直しを何回か繰り返しても当日の朝の運用に収まります。
D の全体の組み直しは、第8日の不足と SV 不在については C と同じ結果になりました。しかし変更は347件で、30名全員の勤務表が変わり、1人で最も多い人は18件変わっています。当日の変更だけでも19件です。第8日から第28日までの21日間の勤務の延べは元の勤務表で344件なので、変更の件数はそれを上回ります。休みの日に勤務を入れる変更と、勤務の日を休みにする変更が両方数えられるためで、実質的には勤務表を作り直したのと同じです。それでいて、第8〜28日の不足は167.5人×時間で、C の166.5人×時間より多くなっています。D の目的には変更の罰則がないので、ソルバーにとっては「元の勤務表に近いか」はどうでもよく、重みづけの和が同じなら、どの勤務表を返しても同じ評価になります。その結果、欠勤とは関係のない人の勤務が大量に入れ替わりました。
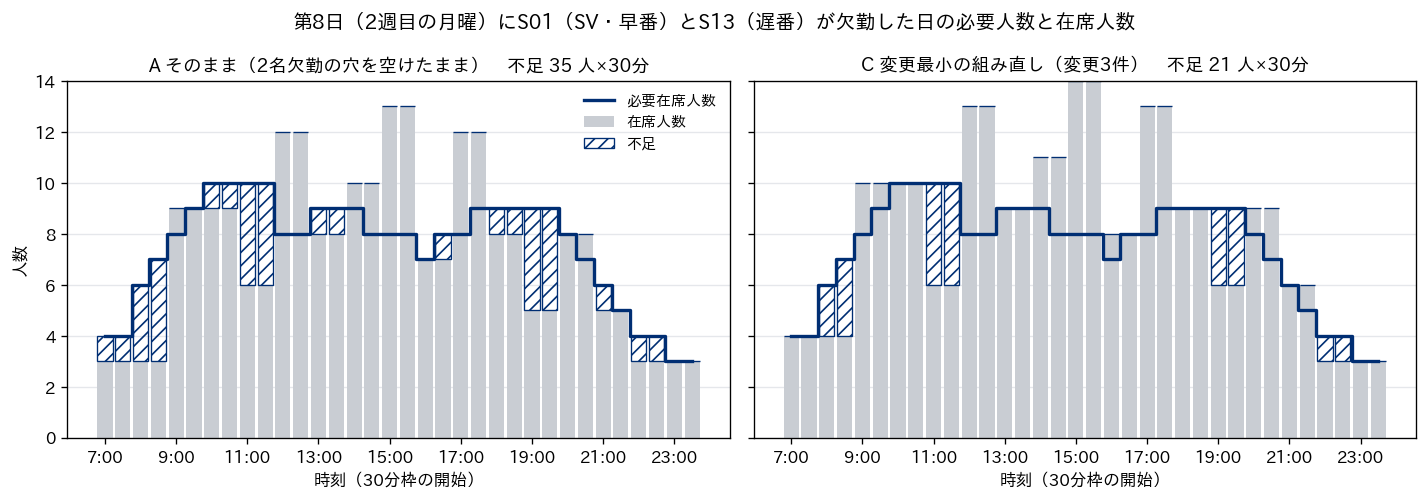
図は、第8日の30分ごとの必要在席人数(線)と在席人数(灰色の棒)、不足(斜線)を、A と C で並べたものです。A では早番の欠けた朝の時間帯と、遅番の欠けた夕方から夜の時間帯に不足が出ています。C では7時台の不足と夕方の不足が消えています。枠ごとの不足を書き出すと、C に残っている不足は8時から9時(2人・3人)、11時から12時(4人ずつ)、19時から20時(3人ずつ)、22時から23時(1人ずつ)です。このうち前の3つの時間帯は欠勤の前からあった不足で、19時台は元の4人ずつから1人ずつ減っています。22時台の1人ずつは、24時まで入る予定だった遅番の穴を、22時で終わる延長の型で埋めたために残った不足です。この例題の勤務表には、第4章で扱ったとおり、勤務の型(9時間の固定の枠)と需要の山が合っていないことによる不足と過剰がもともとあり、組み直しでそれを解消することはできません。
変更を最小にする再作成の書き方
C の組み直しは、勤務表を作ったときのモデルに3つの部品を足しただけで作れます。1つ目は、過去の日(欠勤の日より前)の勤務を元の値に固定する制約です。2つ目は、欠勤した人のその日の勤務をなしに固定し、勤務日数の数え方を調整する制約です。3つ目が、元の勤務表からの変更件数を数えて目的に足す部品です。こうして元の計画からのずれを小さく保ったまま計画を作り直すことを、勤務表の分野ではリロスタリング(再作成)と呼びます。
看護師の勤務表について、この問題を早くから扱った研究に、ポルトガルの Moz と Pato による2003年の論文があります(Annals of Operations Research 第119巻)。要旨を開いて確かめると、1人以上の職員が予定の勤務に就けなくなったとき、その仕事はほかの職員の勤務表を変えることで埋める必要があり、その変更は管理側の規則と雇用契約に反してはならず、元の勤務表への影響をできるだけ小さくすべきだ、と問題が説明されています。論文はこれを整数の多品種流れ問題(種類の違う複数のものを、網の目の経路に整数の量で流す問題の型)として定式化し、リスボンの公立病院の実データで、整数計画のソルバーでもヒューリスティクスでも、許容できる計算時間で満足な勤務表が得られたと報告しています。この章の C は、同じ考え方を CP-SAT の目的に書いたものです。
変更件数を数える部品の考え方は単純です。元の勤務表で人 \( i \) の日 \( d \) の勤務が型 \( o \) なら、新しい勤務表でも型 \( o \) に入っているかを表す変数 \( x_{i,d,o} \) を見て、それが0なら変更1件と数えます。元が休みなら、新しい勤務表で勤務が入ったら変更1件です。式で書くと、変更件数は \( \sum_{i,d} (1 – x_{i,d,o(i,d)}) \) のようになります。言葉で言えば、「元の勤務と同じ勤務に入っていない人×日の数」です。次のコードは、この章で基準と同じモデルを組み立てる部品からこの部分を抜き出し、組み直す日を限る引数などを省いて書き直したものです(単独では動きません)。
# 抜き出し:orig は元の勤務表 {(人, 日): 型}、休みはキーなし。work[i, d] はその日に勤務があるかのブール変数
changes = []
for i, p in enumerate(ps):
    for d in range(N_DAYS):
        o = orig.get((i, d))
        if (d < fixed_days) & ((i, d) not in absent):          # 過去の日は元のまま固定
            for sid in types_of[i, d]:
                m.add(x[i, d, sid] == (1 if sid == o else 0))
            continue
        if (i, d) in absent:                                     # 欠勤は変更に数えない
            continue
        same = x[i, d, o] if o is not None else work[i, d].Not() # 元と同じ勤務(元が休みなら休み)
        changes.append(same.Not())                               # 元と違えば変更1件
obj = obj + change_w * sum(changes)                              # 変更1件あたり change_w の罰則
same.Not() は、ブール変数の否定(元と同じでないこと)を表します。CP-SAT ではブール変数の否定をそのまま線形の和に入れられるので、変更件数を新しい変数を作らずに目的へ足せます。欠勤した人の4週20日の数え方は、4週の勤務日数の制約の右辺から欠勤の日数を引くことで調整しました(p["days_4w"] - n_abs)。
この部品を使って、変更の罰則0と2,000で組み直す全体のコードが次です。共通データ、この章の部品(基準と同じモデルを組み立てて解く関数 build_and_solve など。全体が長いので本文には載せていません)、元の勤務表のファイルの3つがそろえば動きます。元の勤務表は、スクリプトを置いたフォルダ(この記事では _code)から見て1つ上の _out フォルダにある前提の相対パスで読んでいるので、そのフォルダから実行する想定です。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import json
from ch11_model import *                     # 第2章の共通データ+この章の部品
orig = {tuple(map(int, k.split(","))): v for k, v in json.load(open("../_out/ch11_roster.json", encoding="utf-8")).items()}
req, ps = required_staff(), staff()
D0, ABS = 7, {(0, 7), (12, 7)}               # 第8日に S01 と S13 が欠勤
for W in [0, 2000]:                          # 変更1件の罰則(架空)
    r = build_and_solve(req, ps, orig=orig, fixed_days=D0, absent=ABS,
                        change_w=W, ext_days={D0}, time_limit=60.0)
    ro = r["roster"]
    chg = [(ps[i]["id"], d + 1, orig.get((i, d), "-"), ro.get((i, d), "-"))
           for i in range(30) for d in range(D0, N_DAYS)
           if ((i, d) not in ABS) & (orig.get((i, d)) != ro.get((i, d)))]
    print("W=%d %s 変更 %d 件" % (W, r["status"], len(chg)), chg if len(chg) < 10 else "")
# 出力: W=0 OPTIMAL 変更 349 件
# 出力: W=2000 OPTIMAL 変更 3 件 [('S03', 8, '-', 'E'), ('S03', 11, 'D', '-'), ('S24', 8, '-', 'P2x')]
出力の2行目が、前の表の C と同じ3件の変更です(P2x は短時間(夕方)を1時間延ばした型)。1行目の変更の罰則0では、変更は349件になりました。前の表の D(347件)と同じ設定なのに件数が違うのは、罰則がない場合、重みづけの和が最小になる勤務表が無数にあり、複数のスレッドで並列に探索する CP-SAT がどれにたどり着くかが実行のたびに変わるからです。この章の中だけでも、罰則0の組み直しは346件・347件・349件と3通りの結果になりました。どれも OPTIMAL で、重みづけの和は同じです。変更件数を目的に入れないと、変更の件数は「たまたま返ってきた解」で決まるということを、この揺れがよく表しています。
変更の罰則の重さを決める
変更1件の罰則を2,000と置いたのは、例題のための仮の値です。この値を変えると、組み直しの結果がどう変わるかを測りました。欠勤の設定は前の節と同じで、第8日から第28日までを組み直し、変更の罰則を0から50,000まで9通りに変えて、それぞれ60秒の時間制限で解きました。9通りとも OPTIMAL です。表の「重みづけの目的」は、基準と同じ重みづけの和(不足・希望休の違反・SV 不在・英語不在・パートの人件費)を28日全体で数えた値で、変更の罰則は含めていません。欠勤が無かった場合の元の勤務表では 2,053,500、穴を空けたままの A では 2,115,500 です。
| 変更1件の罰則 | 変更件数 | うち当日 | 変更を受けた人 | 重みづけの目的(変更の罰則を除く) | 第8〜28日の不足(人×時間) | 第8〜28日の SV 不在(枠) |
|---|---|---|---|---|---|---|
| 0 | 346件 | 18件 | 30名 | 2,075,000 | 170.0 | 0 |
| 10・100 | 8件 | 6件 | 6名 | 2,075,000 | 165.0 | 0 |
| 500・1,000・2,000・5,000 | 3件 | 2件 | 2名 | 2,076,500 | 166.5 | 0 |
| 10,000 | 2件 | 1件 | 1名 | 2,085,500 | 169.5 | 0 |
| 50,000 | 0件 | 0件 | 0名 | 2,115,500 | 172.0 | 4 |
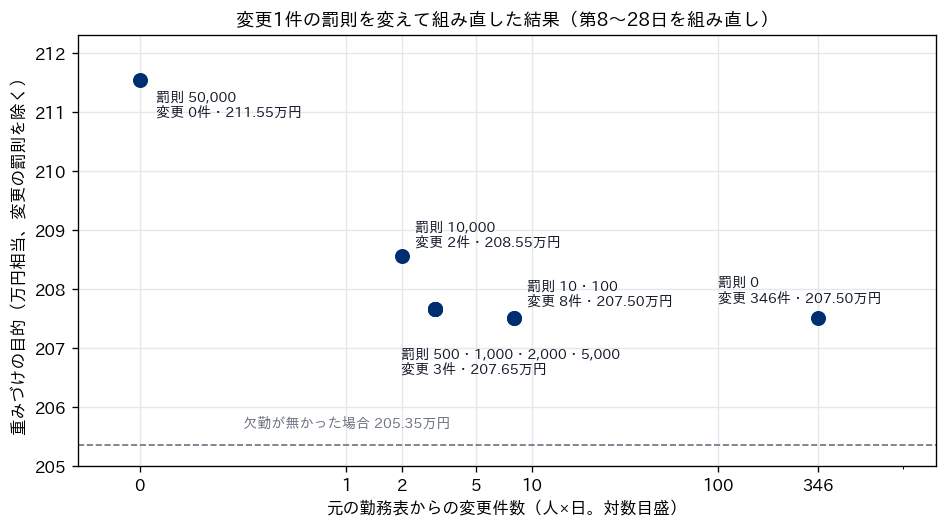
表と図から、3つのことが読み取れます。1つ目は、変更の罰則をごく小さく(10や100)置くだけで、変更は346件から8件に減り、しかも重みづけの目的は罰則0のときと同じ 2,075,000 のままだったことです。罰則0の組み直しは、重みづけの和を最小にする勤務表の中から1つを勝手に選んでいたので、同じ最小値を保ったまま変更を8件に抑えた勤務表が存在していたということです。罰則を小さく置くと、ソルバーは「重みづけの和を最小にする勤務表のうち、変更の少ないもの」を選ぶようになります。これは第6章で扱った辞書式(段階的に解く)の考え方に近い使い方で、重みづけの和を先に確定させて、その範囲で変更を減らす、という順番を1回の求解で近似しています。
2つ目は、罰則を500から5,000の範囲に置くと、変更は3件まで減り、その代わりに重みづけの目的が 1,500 だけ悪くなったことです。罰則10や100のときと比べると、第8〜28日の不足は165.0人×時間から166.5人×時間に1.5人×時間(3人×30分、重みで9,000)増え、ほかの項目が減った分と差し引きして、重みづけの和が1,500だけ悪くなりました。5件の変更を頼まずに済ませる代わりに、3人×30分の不足を受け入れた、という釣り合いです。この範囲では、罰則を500から5,000まで10倍に変えても結果が同じでした。変更の罰則の値は、狭い範囲で細かく決めなくても、結果が変わる境目がいくつかあるだけだということです。
3つ目は、罰則を10,000以上に上げると、今度は勤務表の質が目に見えて落ちることです。10,000では変更2件になり、重みづけの目的は 2,085,500 と、罰則2,000のときより 9,000 悪くなりました。50,000では変更が0件になり、A の穴を空けたままと同じ結果(SV 不在4枠)に戻ります。変更1件の罰則が、SV 不在1枠の重み(5,000)や不足1人×30分の重み(3,000)よりずっと大きいと、ソルバーは不足や SV 不在を受け入れてでも変更を避けるようになるからです。
この比較から、変更の罰則の決め方について、実務的な手順が見えてきます。まず、ほかの重みより十分に小さい値(この例題では10や100)で解き、重みづけの和を損なわずにどこまで変更を減らせるかを見ます。次に、ほかの重みと同じ桁の値(この例題では1,000から5,000)で解き、変更をさらに減らす代わりに何を受け入れるかを見ます。この2つの結果を並べて、現場の責任者が「5件の変更を頼むか、パートの1時間の延長で済ませるか」を選ぶ、という使い方が扱いやすいと考えています。罰則の値そのものを事前に正しく決めようとするより、2〜3通りの値で解いた候補を比べる方が、判断の根拠を説明しやすくなります。
12通りの欠勤の場面で確かめる
ここまでの比較は、第8日に2名が欠ける1つの場面だけの結果です。結論が場面に依存していないかを確かめるため、欠勤の場面を乱数で12通り作り、同じ比較を繰り返しました(乱数の種は0で固定)。欠勤の日は第2日から第21日の中から選び、欠勤する人はその日に勤務のある人から1〜3名を選んでいます。B と C は変更1件の罰則2,000、C’ は罰則10、D は罰則なしで、いずれも30秒の時間制限で解きました。C’ は前の節で見た「重みづけの和を保ったまま変更を減らす」小さな罰則の設定です。表の「重みづけの目的の悪化」は、欠勤が無かった場合の元の勤務表(2,053,500)からの増分で、変更の罰則は含めていません。
| 対応 | 重みづけの目的の悪化(12場面の平均) | 変更件数(12場面の平均) | 変更件数(12場面の最大) |
|---|---|---|---|
| A そのまま | 49,875 | 0.0件 | 0件 |
| B 当日だけで手当て(変更1件2,000) | 20,208 | 3.2件 | 6件 |
| C 変更最小の組み直し(変更1件2,000) | 19,958 | 3.2件 | 6件 |
| C’ 変更最小の組み直し(変更1件10) | 17,750 | 5.7件 | 9件 |
| D 全体の組み直し(変更の罰則なし) | 17,875 | 342.1件 | 435件 |
12場面の平均で見ると、穴を空けたままの A は重みづけの目的を 49,875 悪くし、B・C・C’・D はいずれもその半分以下に抑えました。B と C の差は小さく、平均の悪化は 20,208 と 19,958、変更件数はどちらも平均3.2件です。12場面のうち C が B より良くなったのは1場面(第2日に3名が欠けた場面)だけで、残りの11場面では B と C は同じ悪化の値でした。この例題では、当日の中だけで手当てしても、翌日以降まで組み直しても、多くの場合に結果は変わらないということです。第8日の場面で C が B より良かったのは、SV の休みと勤務を入れ替えるという、当日の外に及ぶ変更がたまたま効いたからでした。
C’ は平均で変更5.7件(最大9件)を使って、悪化を 17,750 まで抑えました。D の平均 17,875 より良い値になっているのは、D が30秒の時間制限の中で最適性を証明できなかった場面が2つあったからです(12場面のうち2場面で FEASIBLE。そのうち1場面では D の悪化が C’ より 1,500 大きく、もう1場面では同じ値でした)。D の変更件数は平均342.1件、最大435件で、最も少ない場面(第19日に2名が欠けた場面)でも168件でした。前の節の結論、つまり「変更の罰則を入れないと必要のない変更が大量に出るが、ごく小さな罰則を入れるだけで同じ質の勤務表を数件の変更で得られる」は、12場面のどれでも成り立っていました。
もう1つ、場面によっては罰則2,000では何も変えない方が良いと判断されることも分かりました。第2日に S01(日勤)が1名だけ欠けた場面では、A・B・C の悪化はどれも 12,000 で、B と C は変更0件を返しました。C’ は3件の変更で悪化を 7,500 に減らしています。3件の変更で 4,500 の改善、1件あたり 1,500 なので、変更1件に2,000の罰則を置いた設定では割に合わないと判断されたわけです。1名の欠勤で、しかもその時間帯に余裕がある場合は、何もしないことが合理的な選択になりうるということで、これは現場の感覚とも合う結果だと考えています。
待機要員を何人置くか、欠勤を乱数で繰り返し発生させて測る
組み直しは、欠勤が起きたあとの手当てです。これに対して待機要員は、欠勤が起きる前に用意しておく備えで、何人置くかは勤務表を作る段階で決める必要があります。待機要員の人数は、欠勤がいつ・何人出るかという偶然に左右されるので、1つの場面を解くだけでは決められません。そこで、元の勤務表に欠勤を乱数で発生させる計算を4週間分×1,000回繰り返し、待機要員の人数ごとに、欠勤で増えた不足人時の平均と散らばりを測りました。
模型の仮定は次のとおりで、欠勤率・待機手当・到着の遅れは、いずれもこの記事で置いた架空の値です。
- 元の勤務表に入っている勤務(4週で延べ459件)の1件1件が、独立に一定の確率で欠勤になる。欠勤率は3%と5%の2通り
- 待機要員は毎日決まった人数(0〜4人)がいて、欠勤の連絡が来た順に1人ずつ呼び出す。待機要員は、30名とは別に用意した、6つの勤務の型のどれにでも入れる人とする。SV・英語対応の資格は持たない
- 呼び出した待機要員が入る型は、「欠けた人と同じ型」と「その時点で不足が最も減る型」の2通りの決め方を比べる。呼んでも不足が1枠も減らない欠勤には呼ばない
- 待機要員の到着は、勤務の開始に間に合う場合(遅れなし)と、開始から60分遅れる場合の2通り。遅れる場合、最初の2枠は在席に数えない
- 待機手当は1人1日3,000円、呼び出したときの賃金は時給2,600円×8時間とする
この計算は、SimPy のような離散イベントシミュレーションの道具を使わず、NumPy の乱数を繰り返すだけで書きました。この模型では1日の中の出来事の順番(何時に連絡が来て、何時に誰が着くか)を「到着の遅れ」という1つの値に畳み込んでいるので、時刻を進める仕組みが要らないからです。欠勤の連絡が時刻ごとにばらばらに届き、待機要員の移動時間や複数の職場からの取り合いが結果を左右する場合は、時刻の順に出来事を処理する離散イベントシミュレーションが向いています。その考え方は、弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」で扱っています。
比べる設定どうしで乱数の出方をそろえるため、どの設定でも乱数の種を同じ(0)にしました。これにより、同じ回の同じ日には、どの設定でも同じ人が欠勤します。設定の違いによる差を、乱数の偶然による差と混ぜずに測るための工夫で、共通乱数法と呼ばれます。
| 1日あたりの待機要員 | 欠勤で増えた不足(人×時間、平均) | 同(上位10%点) | 呼び出し(回、平均) | 到着が60分遅れる場合の不足(平均) | 欠勤率5%の場合の不足(平均) |
|---|---|---|---|---|---|
| 0人 | 39.4 | 55.0 | 0.0 | 39.4 | 67.9 |
| 1人 | 6.6 | 13.5 | 10.9 | 8.7 | 17.5 |
| 2人 | 1.0 | 3.0 | 13.2 | 3.3 | 3.6 |
| 3人 | 0.2 | 0.5 | 13.6 | 2.6 | 0.8 |
| 4人 | 0.1 | 0.5 | 13.6 | 2.5 | 0.3 |
表は、待機要員が「その時点で不足が最も減る型」に入る決め方の結果で、2〜4列目は欠勤率3%・遅れなし、5列目は欠勤率3%・60分の遅れ、6列目は欠勤率5%・遅れなしです。「欠勤で増えた不足」は、4週間の不足人時から元の勤務表の不足(216.0人×時間)を引いた値で、1,000回の平均と、1,000回を大きい順に並べたときの上位10%の位置の値(上位10%点)を示しました。
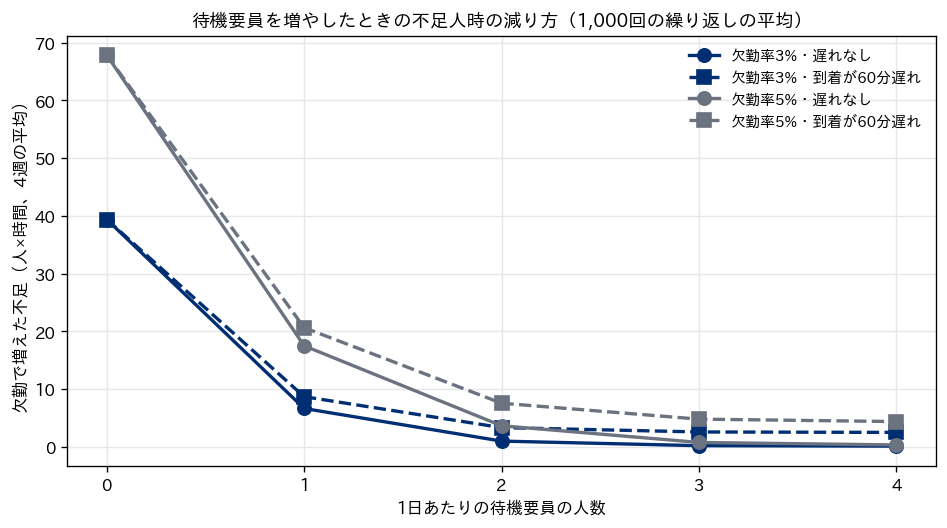
欠勤率3%で待機要員がいない場合、欠勤による不足の増加は4週で平均39.4人×時間、上位10%点で55.0人×時間でした。延べ459件の勤務の3%は約13.8件なので、4週で平均14件近い欠勤が出る計算です。待機要員を1人置くと、不足の増加は平均6.6人×時間まで減ります。欠勤が1日に1件なら待機1人で埋められるので、1人目の効果が最も大きく出ます。2人目で1.0人×時間、3人目で0.2人×時間と、そこから先の減り方は急に小さくなります。呼び出しの回数も、待機1人で平均10.9回、2人で13.2回、3人以上で13.6回と頭打ちになりました。3人目以降の待機要員は、ほとんど呼ばれないまま待機手当だけがかかる、ということです。
到着が60分遅れる場合は、待機を何人増やしても不足の増加が2.5人×時間前後から下がらなくなりました。待機要員が来るまでの穴は、人数では埋められないからです。この下げ止まりを減らすのは、待機要員の人数ではなく、欠勤の連絡を早く受ける仕組み(前日の夕方までに体調を申告してもらう、当日の連絡の締切を勤務開始の2時間前にする、など)や、職場の近くに住む人を待機に充てる工夫です。欠勤率が5%になると、待機0人の不足の増加は67.9人×時間、待機1人でも17.5人×時間残り、2人目の効果(17.5から3.6へ)が大きくなります。欠勤率によって2人目の待機の効き方が大きく変わるということで、自社の欠勤率を測ってから人数を決める必要があります。
待機要員が入る型の決め方も比べました。「欠けた人と同じ型」に入る決め方だと、欠勤率3%・遅れなしで待機1人のときの不足の増加は7.4人×時間で、「不足が最も減る型」の6.6人×時間より少し大きくなりました。欠けた人の時間帯にもともと余裕があれば、同じ型で埋めても不足は減らず、余裕のない別の時間帯に入れた方が効くからです。ただし差は大きくなく、待機3人では逆に「同じ型」の方が0.1人×時間、「最も減る型」が0.2人×時間でした。この模型の「最も減る型」は、欠勤の連絡が来た順にその場で最も良い型を選ぶだけの近視眼的な決め方で、あとから来る欠勤のことを考えていないためです。
表のどの設定でも、SV 不在の枠は待機要員の人数によって変わりませんでした(欠勤率3%で平均8.9枠、5%で15.6枠)。この模型の待機要員は SV の資格を持たないので、SV が欠けた時間帯の穴は埋められません。待機の当番に SV の資格を持つ人を入れるかどうかは、第9章で扱ったスキルの配置の問題そのものです。待機要員を人数だけで決めると、最も代わりの利かない役割の穴が残ります。
待機の費用と不足の釣り合いを経営の数字にする
待機要員を何人置くかは、待機にかかる費用と、減らせる不足の価値の釣り合いで決まります。シミュレーションの結果から、待機を1人増やすごとの不足の減少と、追加の費用を計算しました。待機手当は1人を4週置くと3,000円×28日=84,000円、呼び出し1回の賃金は2,600円×8時間=20,800円です(いずれも架空)。
| 待機の人数(欠勤率3%・遅れなし) | 不足の減少(人×時間) | 追加の待機手当 | 追加の呼び出し(回)と賃金 | 元が取れる不足1人×時間の価値(待機手当だけ) | 同(呼び出しの賃金込み) |
|---|---|---|---|---|---|
| 0人→1人 | 32.7 | 84,000円 | 10.9回・227,282円 | 2,565円 | 9,507円 |
| 1人→2人 | 5.7 | 84,000円 | 2.3回・48,173円 | 14,857円 | 23,377円 |
| 2人→3人 | 0.8 | 84,000円 | 0.4回・7,592円 | 105,927円 | 115,501円 |
表の右の2列は、「不足1人×時間をいくらと評価すれば、その待機要員の費用に見合うか」という分岐点です。待機手当だけを数える列は、欠けた人の賃金がかからず、呼び出した人の賃金と相殺される場合(欠勤が無給の場合など)の見方で、呼び出しの賃金込みの列は、欠けた人の賃金も払う場合(年次有給休暇に振り替える場合など)の見方です。共通データでは不足1人×30分を3,000円相当と置いているので、不足1人×時間は6,000円相当になります。この重みで評価すると、1人目の待機は、待機手当だけで見れば分岐点2,565円を大きく上回って元が取れ、呼び出しの賃金込みで見ると分岐点9,507円に届かず、元が取れません。2人目は、待機手当だけで見ても分岐点が14,857円で、6,000円の評価では元が取れません。
この表から分かるのは、待機の人数の判断が、不足1人×時間をいくらと評価するかと、欠勤した人の賃金をどう扱うかの2つで入れ替わるということです。どちらも経営の判断で決める値で、ソルバーやシミュレーションが決めてくれるものではありません。不足の評価は、コンタクトセンターなら放棄された入電1件あたりの機会損失や、サービスレベルの目標を割ったときの契約上の扱いから、店舗なら待ち時間による売上の取りこぼしから見積もることになります。評価の根拠がはっきりしない場合でも、この表のように分岐点を示しておけば、判断の分かれ目を経営会議に出せます。分岐点は欠勤した人の賃金の扱いで読む列が変わるので、1人目と2人目を同じ列で読みます。欠勤した人の賃金も払う運用(呼び出しの賃金込みの列)なら、「不足1人×時間を9,507円以上と見るなら1人目を置く」「23,377円以上と見るなら2人目も置く」となります。欠勤が無給で、追加の費用が待機手当だけになる運用(待機手当だけの列)なら、「2,565円以上で1人目」「14,857円以上で2人目」です。3人目は、どちらの列でも10万円を超えます。
判断を誤ったときの損失の型も整理しておきます。待機を置かずに欠勤をそのままにすると、この例題では4週で平均39.4人×時間、多い月(上位10%点)で55.0人×時間の不足が増えます。これは元の勤務表の不足216.0人×時間の約2割にあたり、勤務表の作り方をいくら工夫しても、当日の欠勤で失う分がその改善を食いつぶしうる大きさです。反対に、必要以上に待機を置くと、3人目以降はほとんど呼ばれないまま、1人あたり4週で84,000円の待機手当がかかり続けます。待機の人数は、欠勤率と不足の評価を入力にして、1人ずつ足したときの効果を並べて決めるのが確実だと考えています。
変更の負担を経営の指標として扱う
ここまで「変更件数」を組み直しの目的に入れてきましたが、変更は数理モデルの都合の数字ではなく、スタッフが実際に負う負担です。休みの日に呼び出される、勤務の時間帯が前日に変わる、予定していた休みが別の日に動く、といった変更は、育児や介護、通院、別の仕事など、勤務の外の予定を持つ人ほど重くのしかかります。変更を頼まれる人が特定の人に偏ると、その人の負担が積み重なり、勤務表そのものへの信頼も下がります。変更の負担が離職にどの程度つながるかを数字で示した公的統計は、この章の範囲では確認できませんでした。そのため離職率への影響は数字で書きませんが、変更の負担を測って管理すること自体は、経営の側でできることです。
測り方としては、次の指標を月ごとに集計することが有効だと考えています。1つ目は変更件数で、この章で目的に入れたものです。2つ目は、変更の通知から勤務までの日数の分布です。この章の計算では変更を「当日」「翌日から6日以内」「7日以上先」の3つに分けて数えていて、C の3件は当日2件・翌日から6日以内1件、D の347件は当日19件・6日以内100件・7日以上先228件でした。同じ1件でも、当日の変更と3週間先の変更では重さが違うので、通知までの日数で重みを変えて目的に入れる(当日の変更を重く、先の変更を軽くする)こともできます。3つ目は、変更を受けた人数と、1人あたりの最大件数です。D の組み直しでは1人で18件変わった人がいました。4つ目は、希望休の日の呼び出しの件数で、C で S03 に起きたものです。
これらの指標は、第8章で扱った公平性の指標と同じ形で扱えます。変更を頼まれた回数の多い人と少ない人の差を、月をまたいで記録しておき、次の月の組み直しでは、変更の罰則を人ごとに変えて(その月にすでに変更を受けた人ほど罰則を重くして)偏りを抑えることができます。変更の罰則を人ごとに変える書き方は、この章のコードの change_w * sum(changes) を、人ごとの重みを掛けた和に置き換えるだけです。
もう1つ、組み直しの運用を決めるときに見落とされやすいのが、変更を決める権限と手順です。ソルバーが数秒で候補を出せても、その候補を本人に打診し、承諾を得て、勤務表を更新し、関係者に知らせるまでの手順が決まっていなければ、当日の朝には使えません。この章の例では、C の候補は「S03 に第8日の出勤を頼み、第11日を休みにする」「S24 に第8日の夕方の出勤を頼む」の2人への打診でした。打診の順番(誰から聞くか)、断られたときの扱い、承諾の記録の残し方を、あらかじめ現場と決めておく必要があります。現場への導入の手順は第13章で扱います。
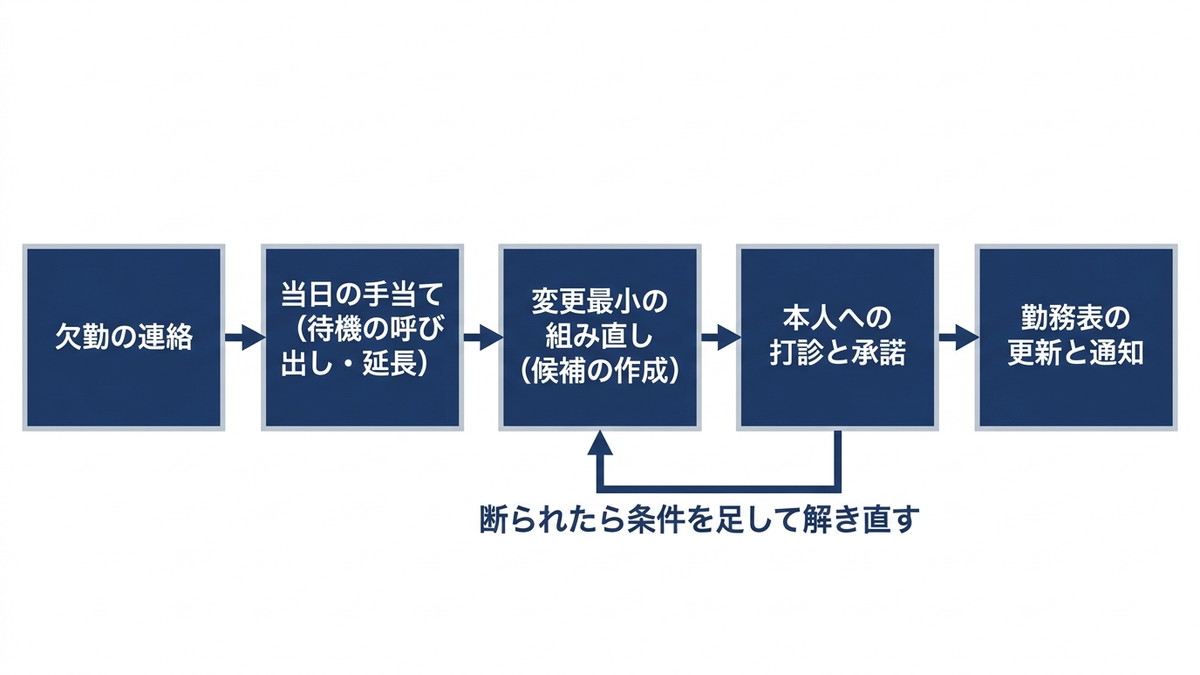
この章の模型の限界と、次に確かめること
この章の数字は、架空のコンタクトセンターの1つの勤務表と、架空の欠勤率・待機手当から得たものです。結論を自社に当てはめる前に、模型の限界を確かめておく必要があります。1つ目は、欠勤を勤務1件ごとに独立に起こしたことです。実際の欠勤は、感染症の流行や悪天候、学校行事などで同じ日に重なりやすく、独立を仮定すると、欠勤が重なる日の頻度を少なく見積もります。重なりやすさを入れるには、日ごとに欠勤率そのものを乱数で揺らす(流行の日は欠勤率を上げる)模型にする方法があります。2つ目は、欠勤が1日で終わるとしたことです。数日続く欠勤では、当日の手当てだけでは済まず、組み直しの役割が大きくなります。3つ目は、待機要員を30名とは別の人として置いたことです。待機要員を30名の中から当番で出す場合は、待機の日も勤務日数や連勤の数え方に関わるので、待機の当番そのものを勤務表のモデルの中で決める必要があります。
4つ目は、需要のばらつきを入れていないことです。この章では予測どおりに入電がある前提で、欠勤だけを乱数にしました。実際には、入電が予測より多い日と欠勤が重なることも、少ない日に欠勤が出て影響が小さく済むこともあります。予測の誤差を入れたサービスレベルの分布と余裕人員の決め方は、第12章で扱います。欠勤の乱数と需要の乱数を同時に動かす場合も、この章と同じ繰り返しの計算の中で、日ごとに入電の実績を乱数で作れば扱えます。
最後に、組み直しの計算時間について補足します。この章の組み直しは、変更の罰則を入れた場合(B・C・C’)は、12通りの欠勤の場面のすべてで30秒の制限の中で OPTIMAL になりました。罰則なしの全体の組み直し(D)は、第8日の主例では27.6秒で OPTIMAL になりましたが、12通りの場面のうち2つでは30秒の制限までに最適性を証明できず、FEASIBLE で止まりました。当日の朝に使う仕組みでは、時間制限を短く(例えば10秒から30秒)置き、状態(OPTIMAL か FEASIBLE か)と下界を必ず画面に出すことが有効だと考えています。変更の罰則を入れると、元の勤務表の近くを探すことになるので、探索が速く終わる傾向がこの章の実行でも見られました(前の表の C は2.8秒、D は27.6秒)。
この章の要点は3つです。第一に、欠勤への対応には、そのまま・待機要員・当日の勤務を動かす・組み直すの4つの型があり、欠勤の影響は欠けた人の勤務時間ではなく、その時間帯に余裕があったかどうかと、欠けた人の役割(SV など)で決まります。第二に、組み直しでは元の勤務表からの変更件数を目的に入れることが欠かせず、罰則を入れないと同じ質の勤務表のために数百件の変更が出る一方、ごく小さな罰則を入れるだけで数件に収まります。第三に、待機要員の人数は、欠勤を乱数で繰り返し発生させて1人ずつ足したときの効果を測り、不足1人×時間の評価と欠勤した人の賃金の扱いという経営の判断と突き合わせて決めます。次の第12章では、欠勤ではなく需要そのものが予測からずれる場合に、余裕人員をどれだけ持つかを扱います。
この章を深めたい方への参考書籍
『ガイダンスPythonによる確率統計 基礎から学ぶモンテカルロ法』(石谷謙介、サイエンス社):確率変数と分布、大数の法則と中心極限定理、推定と検定までを、Python による乱数の実験(モンテカルロ法)と組み合わせて学ぶ教科書です。この章では欠勤を乱数で1,000回発生させ、平均と上位10%点で待機要員の効果を読みましたが、繰り返しの回数で推定の精度がどう決まるか、平均の差をどこまで信じてよいかを確かめる土台になります。
『オンラインアルゴリズムとストリームアルゴリズム』(徳山豪、共立出版):先の入力を知らないまま、その場で決定を下していくアルゴリズムの基礎と、さまざまなオンライン問題、確率的な最適化の手法を扱った本です(アルゴリズム・サイエンスシリーズ)。この章の待機要員の割り当ては、あとから来る欠勤を知らずに連絡が来た順に決める近視眼的な決め方でした。当日の判断を、将来を知っていた場合と比べてどれだけ損をするかという物差しで考える見方を得るのに向いています。
第12章 需要のばらつきに備える
第11章では、スタッフの当日の欠勤という「供給の側のばらつき」に対して、待機要員の置き方と、変更を最小にする勤務表の組み直しを扱いました。この章では反対側の、需要の側のばらつきを扱います。ここまでの章は、第3章で予測入電件数から出した必要在席人数を「正解」として扱い、それに合う勤務表を作ってきました。しかし予測入電件数は予測であり、実際の入電は予測より多い日も少ない日もあります。勤務表は通常、数週間前に確定して公表するので、当日になって入電が予測より多いと分かっても、席に座る人数はすぐには増やせません。この章では、予測誤差があるときに予測どおりの人数でサービスレベルがどれだけ下がるのかを測り、そのうえで、予測に余裕人員を上乗せする方法、複数のシナリオを置いて人数を決める方法、当日に動かせる柔軟な枠を持つ方法、月の途中で見直す方法を、第2章で用意したサンプルデータで比べます。
予測は外れる前提で人数を決める
需要のばらつきには、性格の違う2つの成分があります。1つは、ある日の入電の水準そのものが予測からずれる成分です。月曜の予測が760件でも、実際には700件の月曜もあれば820件の月曜もあります。これを予測誤差と呼びます。もう1つは、その日の水準が正しく分かっていたとしても、30分ごとの件数が偶然に上下する成分です。アーランC式のモデルでは電話が1件ずつ独立にかかってくると仮定するので、平均22件の枠でも20件の枠と25件の枠が生じます。第3章で扱ったとおり、アーランC式は後者の偶然のばらつき(到着がポアソン過程に従うこと)を前提に組み込んだうえで、平均の入電件数が分かっているときに必要な人数を出す式です。前者の予測誤差は、式の外にあります。
第2章で用意したサンプルデータには、この2つの成分を足した架空の実績を作る関数 call_actual(seed, cv) があります。中身は、予測入電件数に日ごとの誤差(平均1、標準偏差 cv の正規分布に従う係数)を掛けてその日の実際の水準を作り、各枠の件数をその水準を平均とするポアソン分布から引く、という2段階です。この章で使う誤差の大きさ cv=0.12(日の水準が予測から標準偏差12%でずれる)は、この記事で置いた架空の設定です。実在のコンタクトセンターの予測精度を表すものではありません。予測誤差の大きさは業種・予測の手法・予測してから当日までの期間で大きく変わるので、自社で使うときは、過去の予測と実績を並べて誤差の分布を測るところから始める必要があります。予測の手法と誤差の測り方そのものは、弊社コラム『ビジネスデータの予測に効く時系列分析、基礎から実務まで』で扱っています。
この章で決めたいことは、予測誤差の大きさが分かっているとき、勤務表を作る段階で何人を置くか、という1点です。予測より多めに置けば、入電が多い日のサービスレベルは守れますが、入電が予測どおりか少ない日には過剰人時として人件費が出ていきます。少なめに置けば、その逆です。この釣り合いを、経営指標(サービスレベルを下回る日の割合、不足人時と過剰人時、人件費)で比べるのがこの章の目的です。当日の欠勤は第11章の範囲なので、この章では全員が勤務表どおりに出勤する前提を置きます。
予測どおりの人数で実績を受けるとサービスレベルはどうなるか
まず、予測誤差の影響だけを取り出して測りました。第3章で出した必要在席人数(28日×34枠、4週合計5,870人×30分)を、そのまま各枠に置いたとします。この人数は、予測どおりの入電なら全枠でサービスレベル80%を満たすように決めたものです。これに、call_actual と同じ手順で作った「その日の実際の水準」を当て、各枠のサービスレベルをアーランC式で推定しました。乱数種を1から200まで変えて200通りの4週間を作り、28日×200通り=5,600日分の1日のサービスレベル(各枠のサービスレベルを入電件数で重みづけて平均したもの)を数えています。この測り方では、日の水準のずれ(予測誤差)だけが効き、30分ごとの偶然のばらつきはアーランC式の中の前提として扱われます。偶然のばらつきまで含めた確認は、次の節で1件ずつの模擬によって行います。
読者が手元で再現できるよう、この計算を短くまとめたコードを載せます。共通データの関数だけで動きます。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
import numpy as np
from shift_data import *

fc = call_forecast()
plan = required_staff()                      # 予測から出した必要在席(28日×34枠)
day_sl = []
for seed in range(1, 201):                   # 架空の実績を200通り
    rng = np.random.default_rng(seed)        # call_actual と同じ手順で「その日の実際の水準」を作る
    lam = fc * rng.normal(1.0, 0.12, (N_DAYS, 1))
    for d in range(N_DAYS):
        s = [service_level(int(plan[d, k]), lam[d, k]) for k in range(N_SLOTS)]
        day_sl.append(np.dot(s, lam[d]) / lam[d].sum())   # 入電で重みづけた1日のサービスレベル
day_sl = np.array(day_sl)
print("日数", len(day_sl))
print("1日のSLの平均 %.3f / 5%%点 %.3f" % (day_sl.mean(), np.percentile(day_sl, 5)))
print("80%%を下回った日の割合 %.1f%%" % ((day_sl < 0.80).mean() * 100))
# 出力: 日数 5600
# 出力: 1日のSLの平均 0.853 / 5%点 0.721
# 出力: 80%を下回った日の割合 20.5%
rng.normal(1.0, 0.12, (N_DAYS, 1)) は28日それぞれに1つずつ誤差の係数を引き、その日の34枠すべてに同じ係数を掛けます。call_actual の中でも、同じ乱数種から最初に引かれるのがこの係数なので、ここで作る水準は call_actual(seed=seed, cv=0.12) がポアソン分布で件数を引く直前の値と一致します。
結果は、1日のサービスレベルの平均が85.3%、下から5%の日(5%点)が72.1%、80%を下回った日が全体の20.5%でした。予測どおりの入電なら全枠で目標を満たす人数を置いても、予測誤差が標準偏差12%あると、およそ5日に1日は1日を通したサービスレベルが目標を割るということです。平均の85.3%は目標を上回っていますが、これは入電が予測より少ない日に目標を大きく上回る分が、平均を押し上げているためです。
日の誤差の大きさごとに分けると、この仕組みがはっきりします。同じ5,600日を、その日の水準が予測からどれだけずれたかで6つに分けた結果が次の表です(表の「1日のSLの平均」と「80%を下回った日の割合」は、必要人数どおりに置いた場合の値です)。
| その日の水準の予測からのずれ | 日数 | 1日のSLの平均 | 80%を下回った日の割合 |
|---|---|---|---|
| 12%超 少ない | 899日 | 94.1% | 0.0% |
| 5%超〜12% 少ない | 1,020日 | 90.5% | 0.0% |
| 0〜5% 少ない | 855日 | 87.7% | 0.0% |
| 0〜5% 多い | 927日 | 84.9% | 0.0% |
| 5%超〜12% 多い | 1,030日 | 81.1% | 29.8% |
| 12%超 多い | 869日 | 73.2% | 96.8% |
入電が予測より5%以内で多い日までは、目標を下回る日はありませんでした。第3章で見たとおり、必要在席人数は人数の整数に切り上げて決めるので、どの枠にも少しずつ余裕があり、5%程度の上振れはその余裕で吸収されています。ところが上振れが5%を超えると目標を割る日が出始め、12%を超える日では96.8%の日で目標を割りました。目標を割る日は、入電が多い日にまとめて起きます。入電が多い日は、目標を割るだけでなく、目標を割った状態で受ける入電の件数も多いので、顧客から見た影響は日数の割合より大きくなります。
誤差の大きさを変えると、目標を割る日の割合は次のように変わりました(必要人数どおりに置いた場合、同じ推定の方法で各200通り)。誤差なし(cv=0)では0%、cv=0.06で5.1%、cv=0.12で20.5%、cv=0.18で28.9%です。1日のサービスレベルの5%点は、それぞれ85.4%、79.9%、72.1%、62.4%でした。誤差が倍になると、悪い日の悪さが大きく深くなります。予測の精度を上げることは、人を増やさずに悪い日を減らす手段だということが、この数字から読めます。
基準の勤務表(第5章)の在席人数でも同じ測り方をしました。基準の勤務表は勤務の型が9時間の固定の枠であるため、予測どおりの入電に対しても不足人時が221.0人×時間あり、予測どおりの入電でも目標を下回る枠が19.0%ありました。これに予測誤差が加わると、目標を下回る日の割合は61.8%に上がりました。基準の勤務表は在席の合計(6,710人×30分)が必要在席の合計(5,870人×30分)より多いものの、その多い分は需要の山から外れた時間帯に積み上がっているので、上振れの日の山を支える力は必要人数どおりに置いた場合より弱いということです。
1件ずつの模擬で、偶然のばらつきまで含めて確かめる
前の節の推定は、各枠のサービスレベルを、その日の水準を平均とする定常状態のアーランC式で出しています。実際の運用では、30分の枠の中で入電が偶然に固まって来ることもあり、前の枠で待たされていた電話が次の枠に持ち越されることもあります。そこで、入電を1件ずつ再現する簡単な模擬(シミュレーション)を作って確かめました。call_actual(seed, cv=0.12) が返す各枠の件数を、その枠の30分の中にランダムに置き、到着した順に空いている席で受けます。処理時間は平均6分の指数分布、途中で電話を切る人(放棄)はいないとし、どちらもアーランC式と同じ前提にそろえました。枠が変わって席の数が減るときは、通話中の人はその通話を終えてから席を離れるとしています。20秒以内に応答できた件数の割合が、模擬で数えたサービスレベルです。計算の量が多いので、実績は50通り(1,400日)にしました。
| 置いた人数 | 入電 | 1日のSLの平均 | 1日のSLの5%点 | 80%を下回った日の割合 |
|---|---|---|---|---|
| 必要人数どおり | 予測どおりの水準(cv=0、偶然のばらつきだけ) | 86.9% | 78.9% | 7.8% |
| 必要人数どおり | 予測誤差あり(cv=0.12) | 86.1% | 70.9% | 19.4% |
| 基準の勤務表 | 予測どおりの水準(cv=0、偶然のばらつきだけ) | 81.6% | 72.8% | 37.6% |
| 基準の勤務表 | 予測誤差あり(cv=0.12) | 81.4% | 68.7% | 39.4% |
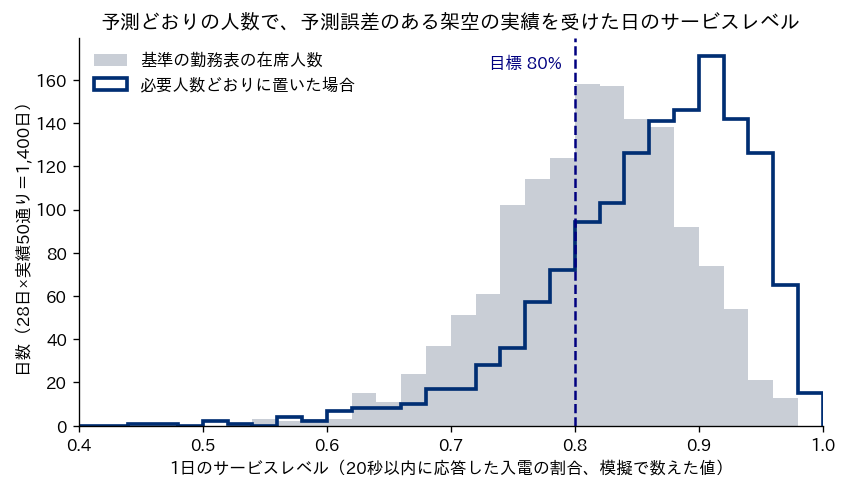
必要人数どおりに置いた場合、模擬でも80%を下回った日は19.4%で、前の節の式による推定(20.5%)と近い値になりました。予測誤差がない場合でも7.8%の日で目標を割っています。これは30分ごとの件数の偶然のばらつきによるもので、式による推定では、その日の水準が予測どおりなら目標を割る日は0%でした。式は「平均としての」サービスレベルを出しているので、偶然に入電が固まった日の悪さは模擬で見て初めて分かります。予測誤差を加えると、目標を割る日は7.8%から19.4%に増え、5%点は78.9%から70.9%に下がりました。この例題では、目標を割る日の多くを予測誤差が生んでいることになります。
基準の勤務表では、模擬で目標を割った日が39.4%で、式による推定の61.8%より少なく出ました。1日のサービスレベルの平均も、模擬は81.4%、式は78.4%です。2つの測り方は作りが違います。式の側は枠ごとに独立に計算し、在席人数が入電の負荷(アーラン)以下の枠ではサービスレベルを0として数えます(共通データの関数 service_level がそう実装しています)。模擬の側は枠をまたいで待ちが続き、前後の枠の席も持ち越しの電話を受けます。どちらの違いがこの差をどれだけ生んでいるのかは、この記事では切り分けていません。確かに言えるのは、どちらの測り方でも、基準の勤務表は必要人数どおりに置いた場合より目標を割る日がはっきり多いということです。
2つの測り方の使い分けについて整理しておきます。アーランC式による推定は速く、200通りの4週間でも数十秒で終わるので、多くの案を比べるのに向いています。模擬は遅いものの、偶然のばらつき・枠をまたぐ待ち・席の数の切り替わりをそのまま再現できます。この章の以降の比較は、案の数が多いので式による推定で行い、方向が模擬でも変わらないことを要所で確かめる、という手順にしました。模擬の考え方と、放棄や処理時間の分布を実態に近づけた作り方は、弊社コラム『シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで』で扱っています。
余裕人員をどれだけ上乗せするか
予測誤差に備える最も単純な方法は、予測入電件数に一定の割合を上乗せしてから必要人数を出し直すことです。こうして上乗せした分の人数を、この章では余裕人員と呼びます。予測入電件数を m% 増やしてから第3章の手順で各枠の必要在席人数を出し直し、その人数を置いたときに、前の節と同じ200通りの実績の水準で目標を下回る日がどれだけ減るかを測りました。人数は必要在席人数をそのまま置いたものとして比べています(勤務の型に当てはめたときに生じる過不足は、この比較には入れていません)。
費用の比較には、この記事の架空の値を使います。追加した在席の人時は、正社員の時給2,600円(架空)で買うものとして人件費に換算しました。不足人時は、第2章で置いた「不足1人×30分を3,000円相当とみなす重み」(架空)で円に換算しています。ここでの不足人時は、不足人時の定義に使う「必要在席人数」を、第3章で予測から出したものではなく、実績の水準から逆算した必要在席人数に置き換えて数えたものです。予測から出した人数に対して実際にどれだけ足りなかったかを表します。
| 予測への上乗せ | 4週の必要在席(人×時間) | 追加の人件費 | 80%を下回った日の割合 | 1日のSLの5%点 | 不足人時(実績の水準に対して) | 過剰人時(実績の水準に対して) | 不足の円換算 | 追加の人件費と不足の円換算の合計 |
|---|---|---|---|---|---|---|---|---|
| 0% | 2,935.0 | 0円 | 20.5% | 72.1% | 100.1 | 97.4 | 600,855円 | 600,855円 |
| 5% | 3,037.5 | 266,500円 | 10.4% | 76.5% | 56.0 | 155.8 | 336,135円 | 602,635円 |
| 10% | 3,140.0 | 533,000円 | 4.7% | 80.2% | 28.1 | 230.4 | 168,690円 | 701,690円 |
| 15% | 3,246.5 | 809,900円 | 1.7% | 83.6% | 12.4 | 321.2 | 74,145円 | 884,045円 |
| 20% | 3,364.5 | 1,116,700円 | 0.4% | 86.7% | 4.0 | 430.8 | 24,150円 | 1,140,850円 |
| 25% | 3,464.0 | 1,375,400円 | 0.1% | 88.9% | 1.2 | 527.5 | 7,080円 | 1,382,480円 |
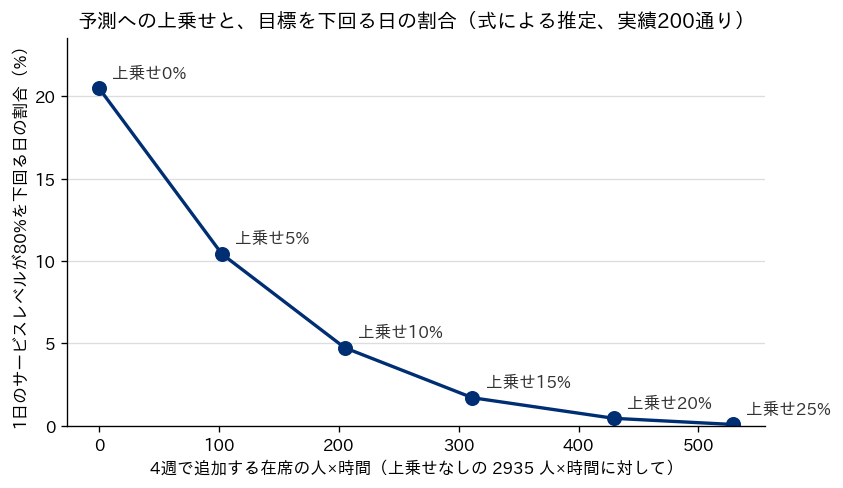
上乗せを増やすと、目標を下回る日は急速に減ります。表の「80%を下回った日の割合」列で、上乗せ0%の20.5%が、5%で10.4%、10%で4.7%になりました。一方、必要在席の人時は上乗せの割合ほどは増えません。上乗せ10%で追加の人時は205.0人×時間、元の2,935.0人×時間の7.0%です。第3章で見た規模の経済(入電が増えても必要人数は比例しては増えない)がここでも効いています。
ただし、減り方は途中から鈍ります。図の折れ線は、上乗せ0%から5%で10.1ポイント、5%から10%で5.7ポイント減ったあと、10%から15%では3.0ポイント、15%から20%では1.3ポイントしか減っていません。追加の人時は5%ごとにほぼ100人×時間ずつ増えるので、1ポイント減らすための人時は上乗せが大きいほど高くつきます。表の「過剰人時」列も、上乗せ0%の97.4から25%の527.5まで増えています。入電が予測より少ない日には、上乗せした分がそのまま余ります。
この架空の重みで費用を合計すると、表の最後の列は上乗せ0%の600,855円と5%の602,635円がほぼ同じで、10%より先は上乗せするほど高くなりました。つまり「不足1人×30分=3,000円」という重みのもとでは、5%を超える上乗せは費用に見合いません。これは、この重みが目標を割ることをどれだけ重く見るかを表しているからです。サービスレベルを割ったときの損失(顧客の離反・苦情・契約上の違約)が大きい事業では、重みを大きくすると、費用の合計が最小になる上乗せの割合は大きい側へ動きます。上乗せの割合は、統計の問題として1つに決まるものではなく、目標を割ることの損失をいくらと見るかという経営の判断で決まる、というのがこの表の読み方です。
上乗せの配り方も比べました。一律10%のほかに、各日の入電の多い半分の枠だけに20%を上乗せする方法と、全枠に1名ずつ足す方法を、同じ200通りで測っています(追加の人時は配り方ごとに異なります)。入電の多い半分の枠だけに20%を上乗せすると、追加は264.0人×時間で、80%を下回った日は2.4%でした。一律10%(追加205.0人×時間、4.7%)より日の割合は小さい一方、目標を下回る枠の割合は、一律10%の5.8%に対して8.5%と大きくなりました。1日を通したサービスレベルは入電の多い枠で決まるので、山に厚く置くと日の単位では効きますが、入電の少ない枠の取りこぼしは残ります。全枠に1名ずつ足す方法は、追加が476.0人×時間と最も多く、80%を下回った日は0.7%でした。目標を「1日の単位で守る」のか「30分の枠ごとに守る」のかで、効く配り方が変わるということです。
シナリオを複数置いて解く
上乗せは、予測を一律に割り増すだけなので、勤務の型の制約とは切り離されています。実際には人数は勤務の型の単位でしか置けず、正社員の勤務日数は決まっています。そこで、予測誤差を人数を決めるモデルの中に入れる方法を試しました。将来の需要を1つの予測値ではなく、起こりうる複数の筋書き(シナリオ)として並べ、「シナリオ全体で平均した費用が最も小さくなる人数」を選ぶ方法です。不確実性を最適化のモデルに直接組み込む手法は確率計画法と呼ばれ、章末で紹介する専門書は、扱う問題の1つとして、リコースを有する問題を挙げています。この章では、先に決める変数と、不確実な値が分かったあとに調整する変数を分けて考え、後者をリコースと呼びます。ここではその考え方を、共通データで小さく試します。
モデルの設定は次のとおりです。対象は第1週の7日間で、決めるのは「どの日に、どの勤務の型を何人置くか」という人数です。誰を割り当てるかは第5章の範囲なので、この節では人数の段階で止め、個人ごとの連勤や続けてはいけない組の制約は入れていません。正社員18名は週5日ずつ、合計90勤務を必ず置きます。基準(第5章)と同じく、正社員の人件費は固定なので目的には入れません。パート12名は、週の勤務日数の上限の合計が44日で、1日に置けるのは午前に入れる8名・夕方に入れる8名・日勤に入れる6名、合わせて12名までです(共通データの staff() の条件を人数に集計したもの)。目的は、パートの人件費(時給1,500円、架空)と、不足1人×30分あたり3,000円の重みの和です。
シナリオは、この章の前の節と同じ手順で作った「その日の実際の水準」50通り(乱数種1〜50)から、それぞれ必要在席人数を逆算したものです。モデルは50通りすべての不足を平均した値を目的に入れます。式で書くと次のとおりです。
\( \min_{x} \; C(x) + \frac{1}{K}\sum_{k=1}^{K} p \, U_k(x) \)
ここで \( x \) は日ごと・型ごとの人数、\( C(x) \) はパートの人件費、\( U_k(x) \) はシナリオ \( k \) で生じる不足(人×30分)、\( p \) は不足1人×30分の重み(3,000円)、\( K \) はシナリオの数(50)です。言葉で言えば、「人件費」と「50通りの筋書きで平均した不足の円換算」の和を最小にする人数を選ぶ、ということです。比べる相手は、予測値1つだけを使って同じ目的で解いた人数(表では「予測値1つで解いた人数」)と、予測を10%割り増した1つの値で解いた人数(表では「10%上乗せした値1つで解いた人数」)です。前の節までの「必要人数どおりに置いた場合」は各枠に必要在席人数をちょうど置いたもので、ここでの「予測値1つで解いた人数」は、それを勤務の型の単位に当てはめて解いたものなので、別物です。評価は、解くときに使っていない別の200通り(乱数種101〜300)で行いました。解くときに使ったシナリオで評価すると、そのシナリオにたまたま合わせた分だけ良く見えるためです。
モデルの中心部分を、この節の計算のプログラムから抜き出して示します(抜き出したものなので単独では動きません)。
# 抜き出し:reqs はシナリオごとの必要在席(K×7日×34枠)、TYPES は E D M L P1 P2 PD
K = len(reqs)
m = cp_model.CpModel()
n = {(d, t): m.new_int_var(0, 18, "n_%d_%s" % (d, t)) for d in DAYS for t in TYPES}
m.add(sum(n[d, t] for d in DAYS for t in FT) == FT_WEEK_TOTAL)      # 正社員は週90勤務
m.add(sum(n[d, t] for d in DAYS for t in PT) <= PT_WEEK_TOTAL)      # パートは週44日まで
for d in DAYS:
    m.add(sum(n[d, t] for t in FT) <= 18)                     # 正社員は1日18名まで
    m.add(sum(n[d, t] for t in PT) <= PT_DAY_TOTAL)
    for t in PT:
        m.add(n[d, t] <= PT_DAY_MAX[t])
obj = [K * PT_COST[t] * n[d, t] for d in DAYS for t in PT]         # 人件費はK倍して平均に合わせる
for k in range(K):
    for d in DAYS:
        for s in range(N_SLOTS):
            r = int(reqs[k][d][s])
            cov = sum(n[d, t] for t in TYPES if s in SLOTS[t])       # その枠の在席
            sh = m.new_int_var(0, r, "sh_%d_%d_%d" % (k, d, s))       # シナリオkの不足
            m.add(cov + sh >= r)
            obj.append(PEN * sh)
m.minimize(sum(obj))
人数 n はすべてのシナリオで共通の1組で、不足 sh はシナリオごとに別の変数になっています。人数は「どの筋書きになるか分かる前に」決め、不足はその結果として筋書きごとに決まる、という関係をこの形で表しています。目的の人件費をシナリオの数 K 倍しているのは、不足の側が K 通りの合計になっているので、両者の尺度を平均にそろえるためです(整数のまま扱うための工夫です)。CP-SAT は60秒制限・num_workers=8・random_seed=0 で、この記事の実行環境(一般的なノートPC)で7.4秒で OPTIMAL(この目的について最適性を証明)になりました。
| 人数の決め方 | パートの人件費(週) | 期待不足人時(週) | 期待費用(週) | 1日のSLの平均 | 80%を下回った日の割合 |
|---|---|---|---|---|---|
| 予測値1つで解いた人数 | 187,500円 | 58.5 | 538,770円 | 79.5% | 52.1% |
| 10%上乗せした値1つで解いた人数 | 232,500円 | 49.3 | 528,330円 | 81.5% | 40.8% |
| シナリオ50通りで解いた人数 | 240,000円 | 47.4 | 524,385円 | 82.7% | 32.4% |
表の「期待費用(週)」は、パートの人件費と、評価用200通りで平均した不足の円換算の和で、正社員の人件費は含みません。予測値1つで解いた人数は、予測値に対しては最も安い人数ですが、実績の200通りで評価すると期待費用は538,770円で、3つのうち最も高くなりました。シナリオ50通りで決めた人数は524,385円で、予測値1つで解いた人数より14,385円(2.7%)安く、10%上乗せした値1つで解いた人数より3,945円安くなっています。パートの人件費は予測値1つで解いた人数より52,500円多く払っていますが、期待不足人時が58.5から47.4に減り、その円換算の減り方が人件費の増加を上回りました。80%を下回った日の割合は、52.1%・40.8%・32.4%の順に下がっています。
予測値1つで解いた人数の52.1%は、前の節で見た20.5%(4週の各枠に必要在席人数をちょうど置いた場合)とは条件の違う別の実験の値です。ここでは人数を勤務の型の単位でしか置けないため、予測どおりの入電に対しても、この人数では第1週にすでに51.0人×時間の不足があります(解いたときの目的の値493,500円からパートの人件費187,500円を引き、不足1人×30分の重み3,000円で割って求めた値)。また、対象は入電の最も多い月曜を含む第1週の7日間だけです。2つの割合を並べて比べることはできず、比べてよいのは同じ表の行どうしです。
この比較の数字は、どれも「人数の段階」の値です。勤務の型が固定で、個人の制約を入れていないので、第5章の基準の勤務表とは不足人時の水準が違います(基準は4週で221.0人×時間、この節は第1週だけで予測値1つで解いた人数でも期待値58.5人×時間)。比べてよいのは、同じ表の中の行どうしです。また、式による推定の方向を模擬でも確かめました。同じ人数を、1件ずつの模擬(評価用のうち50通り、350日)で受けると、80%を下回った日の割合は、予測値1つで解いた人数34.9%、10%上乗せした値1つで解いた人数23.1%、シナリオ50通りで解いた人数17.1%で、順序は式による推定と同じでした。
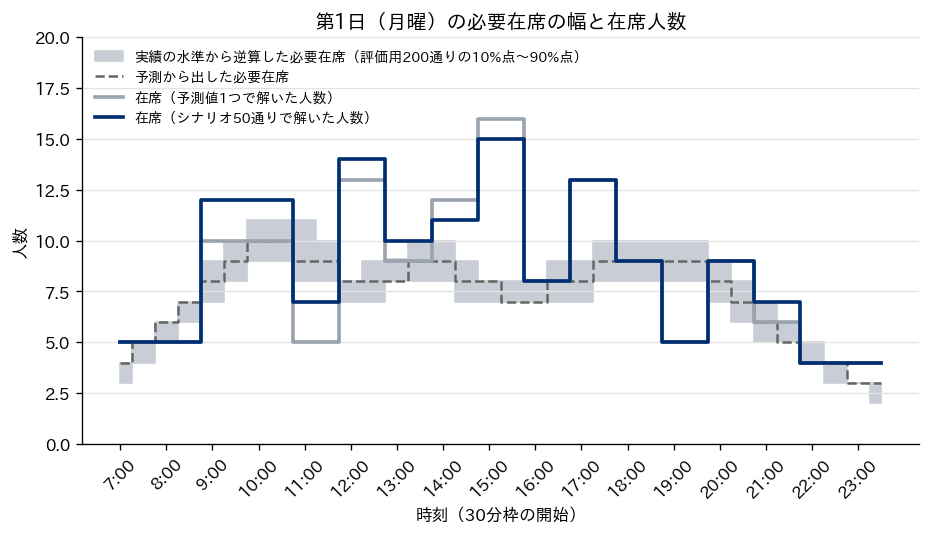
第1日(月曜)の在席を並べた図を見ると、シナリオで決めた人数(ネイビーの線)は、予測値1つで解いた人数(グレーの線)より9時から10時台にかけて厚く、時間帯によっては薄い枠もあります。在席の合計は、予測値1つで解いた人数の143.0人×時間に対して150.0人×時間でした。週全体では、火曜(127.0に対して137.0)・木曜(124.0に対して127.0)・土曜(95.0に対して111.0)で厚く、水曜はわずかに薄く(130.0に対して129.0)、金曜と日曜は同じでした。グレーの帯は、実績の水準から逆算した必要在席の10%点から90%点までで、予測の破線より上に1〜2名分広がっています。どちらの線も、勤務の型の休憩の位置で在席が落ち込む枠があり、型の固定による過不足は残ったままです。これは第4章で扱った、型の設計の側で解く問題です。
不足の重み(不足1人×30分あたり)を基準の倍の6,000円(1時間あたりに換算すると12,000円)にして同じ比較をすると、差はさらに開きました。期待費用は、予測値1つで解いた人数800,070円、10%上乗せした値1つで解いた人数766,980円、シナリオ50通りで解いた人数740,670円で、シナリオで決めた人数は予測値1つで解いた人数より59,400円(7.4%)安く、80%を下回った日の割合は25.1%・16.9%・9.2%でした。不足を重く見るほど、ばらつきを考えて人数を決める価値が大きくなります。
シナリオを置く方法の使いどころを整理します。使えるのは、予測誤差の分布を過去の実績から見積もれる場合です。誤差の大きさを見積もらずにシナリオを作ると、結果の人数はその想定をそのまま映すだけになります。また、この節のように人数の段階で解いたあと、個人への割当(第5章)に渡す二段構えにすると、割当の段階で人数が再現できないことがあります。シナリオを勤務表のモデルに直接入れることもできますが、変数の数はシナリオの数に比例して増えます。この節の7日間・50通りのモデルで不足の変数は11,900個(50通り×7日×34枠)で、4週間・30名の勤務表モデルに同じ数のシナリオを入れると、不足の変数だけで47,600個になります。時間制限の中で解けるかどうかは、第10章の大規模化の議論と同じく、自社の規模で実測して確かめる必要があります。
柔軟な枠の価値を測る
予測誤差に備えるもう1つの方法は、当日になって入電の水準が分かってから動かせる人手を持っておくことです。確率計画法の言葉でいえば、先に決める人数とは別に、当日の調整(リコース)の手段を用意することにあたります。コンタクトセンターでは、ふだんはメール対応や事務処理をしているスタッフを入電の多い時間帯だけ電話に回す兼務、パートの勤務の延長や短縮、他の部署からの応援などがこれにあたります。ここでは兼務を例に、その価値を測りました。
設定は次のとおりです。電話以外の業務をしている兼務のスタッフが毎日2名いて、日勤の在席枠(9時から18時のうち休憩を除く枠)に限り、当日の朝に入電の水準が分かった時点で、足りない枠に最大2名まで電話に回せるとします。兼務の2名の給与は電話以外の業務の側で払われているので、ここでの費用は、電話に回したことで本来の業務が遅れる損失だけです。この損失を30分あたり1,300円とする場合と2,600円とする場合の2通りを置きました。いずれも架空の値で、1,300円は正社員の時給2,600円の30分ぶん、2,600円はその倍です。モデルには、シナリオごとに「兼務から回す人数」の変数を足し、その費用を目的に加えています。
| 人数の決め方(不足1人×30分の重み3,000円) | パートの人件費(週) | 期待不足人時(週) | 兼務の期待利用(人×時間、週) | 期待費用(週) | 80%を下回った日の割合 |
|---|---|---|---|---|---|
| シナリオ50通り(兼務なし) | 240,000円 | 47.4 | 0.0 | 524,385円 | 32.4% |
| シナリオ50通り+兼務2名(30分1,300円) | 202,500円 | 37.4 | 18.1 | 473,814円 | 17.6% |
| シナリオ50通り+兼務2名(30分2,600円) | 240,000円 | 33.2 | 14.4 | 514,093円 | 10.5% |
兼務の費用が30分1,300円のとき、期待費用は兼務なしの524,385円から473,814円へ、週に50,571円下がりました。注目したいのは、パートの人件費が240,000円から202,500円に減っていることです。当日に動かせる人手があると、モデルは「念のために先に置いておくパート」を減らし、入電が多い日だけ兼務で埋めるほうを選びました。柔軟な枠は、不足を減らすだけでなく、ばらつきに備えて先に置いていた余裕人員を置き換えます。兼務の費用が30分2,600円になると、パートは減らさず、期待費用の下がり方は週に10,292円に縮みました。この場合も80%を下回った日の割合は32.4%から10.5%に下がっています。同じ兼務の2名でも、電話に回したときの損失をいくらと見るかで、先に置く人数の決め方が変わるということです。不足の重みを1人×30分あたり6,000円にした場合は、兼務なし740,670円に対して、30分1,300円で614,066円、30分2,600円で655,330円でした。
1件ずつの模擬(評価用のうち50通り、350日)でも、兼務(30分1,300円)を持った場合の80%を下回った日の割合は10.9%で、兼務なしの17.1%より小さくなりました。模擬では、兼務から回す人数は、その日の実際の水準から逆算した必要在席に足りない枠だけに足しています。
この結果は、柔軟な枠の価値を金額で示す方法として使えます。兼務の体制を作るには、電話対応の研修や、電話以外の業務の締切に余裕を持たせる調整が要ります。その費用が、ここで測った期待費用の差(この例題では週に1万円から5万円程度)を下回るなら、柔軟な枠を持つ価値があると判断できます。スキルを持つ人を増やす効果(多能工化)は第9章で扱っているので、兼務できる人を何人育てるかは、第9章の試算と合わせて判断することになります。パートの勤務の延長や短縮も、同じ形(シナリオごとに延長する時間の変数を足し、延長の費用を目的に入れる)で表せますが、この記事では計算していません。延長を頼める人数と時間帯、本人の同意の取り方が職場ごとに違うためです。
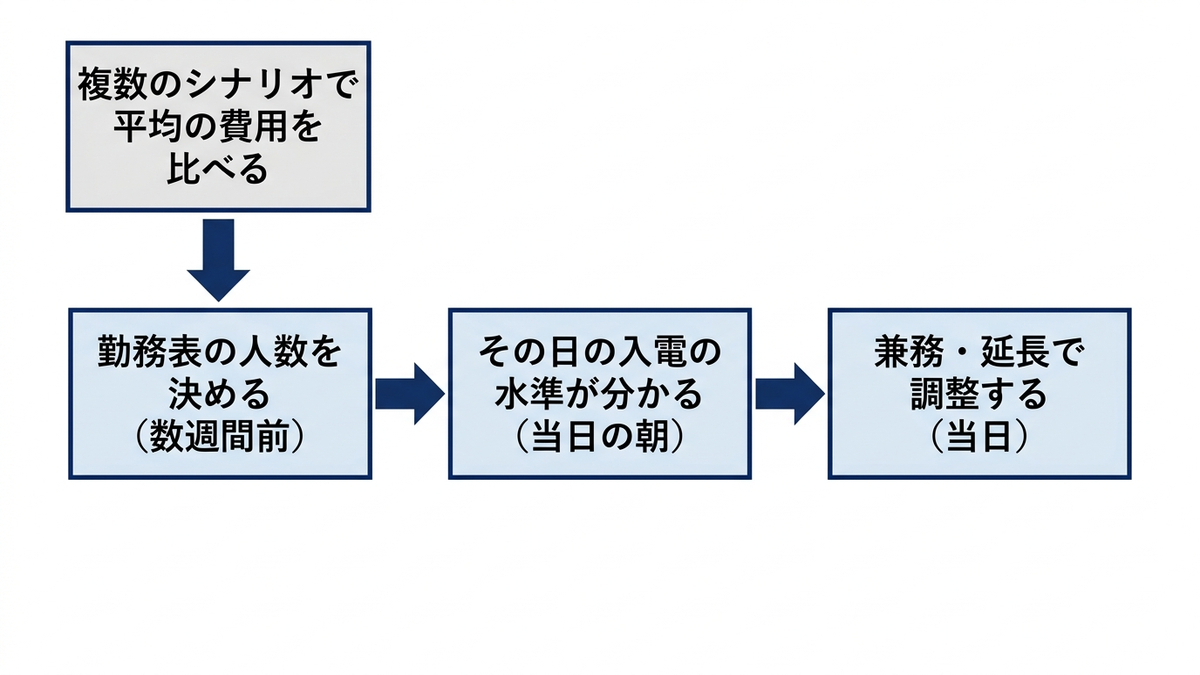
月の途中で見直す
勤務表を4週間分まとめて作っても、2週間が過ぎれば前半の実績が手に入ります。前半の実績が予測より一貫して多いなら、後半の人数を増やす手を打てます。この「月の途中での見直し」が効くかどうかは、予測誤差の性質で決まります。共通データの call_actual は、日ごとの誤差を互いに独立に引いています。この場合、前半の実績が多かったことは後半について何の手がかりにもなりません。
そこで、共通データの誤差に「月全体に共通のずれ」を追加で仮定した場合(架空)を作り、見直しの効果を測りました。その日の実際の水準は、予測×(1+月全体のずれ)×日の誤差(標準偏差12%)とし、月全体のずれは平均0、標準偏差が0・0.05・0.10の3通りの正規分布から引きます。見直しの方法は、前半2週(14日)の実績の件数の合計を予測の合計で割った比を求め、後半2週の予測にその比を掛けてから必要在席人数を出し直す、という単純なものです。評価は後半2週について、実績の水準から逆算した必要在席に対する不足人時と過剰人時、80%を下回った日の割合で行い、200通りで平均しました。
| 月全体のずれの標準偏差(架空の仮定) | 方法 | 後半2週の不足人時 | 後半2週の過剰人時 | 80%を下回った日の割合 |
|---|---|---|---|---|
| 0(ずれなし) | 見直さない | 51.5 | 46.2 | 20.8% |
| 0(ずれなし) | 前半2週の実績で後半を出し直す | 50.6 | 49.8 | 20.6% |
| 0.05 | 見直さない | 56.8 | 50.0 | 23.6% |
| 0.05 | 前半2週の実績で後半を出し直す | 50.7 | 50.4 | 21.2% |
| 0.10 | 見直さない | 69.7 | 61.3 | 27.2% |
| 0.10 | 前半2週の実績で後半を出し直す | 51.0 | 51.5 | 20.8% |
月全体のずれがない場合、見直しはほとんど何も変えませんでした。不足人時は51.5から50.6へわずかに減った一方、過剰人時は46.2から49.8へ増えています。前半の実績から出した比は、日ごとの誤差の平均を拾っているだけなので、後半を当て直す力はありません。月全体のずれの標準偏差が0.10の場合は、見直しによって後半2週の不足人時が69.7から51.0に、過剰人時が61.3から51.5に、80%を下回った日が27.2%から20.8%に減りました。見直しの効果は、ずれがない場合の水準(不足人時50前後、20%前後)まで戻すところにあります。前半2週の比と真のずれとの差は、標準偏差0.032程度でした。日の誤差の標準偏差12%を14日で平均すると、おおむね12%÷\( \sqrt{14} \)(約3.2%)に縮むことと合っています。
この結果から、見直しを制度にするかどうかは、自社の予測誤差に「後まで続くずれ」がどれだけ含まれているかで決まると言えます。過去の予測と実績を並べ、誤差が日ごとにばらばらか、週や月の単位で同じ向きに続くかを確かめれば判断できます。続くずれが大きい職場では、月の途中に見直しの日を決めておく価値があります。ただし、見直して後半の人数を変えるには、すでに公表した勤務表を変更する必要があり、変更はスタッフの負担になります。変更の件数を最小にして勤務表を組み直す方法は第11章で扱ったので、見直しで増やす人数が決まったら、その方法で変更の件数と合わせて判断することになります。
経営の判断に翻訳する
この章の数字を、経営の判断に使える形にまとめます。第一に、予測どおりの人数は「予測が当たれば最も安い人数」であって、「平均して最も安い人数」ではありません。この例題では、予測誤差が標準偏差12%あると、4週の各枠に必要在席人数どおりに置いても、5日に1日(式による推定で20.5%)は1日のサービスレベルが目標を割りました。これとは別に、第1週の人数を勤務の型の単位で決めた実験では、予測値1つで解いた人数の期待費用が、シナリオ50通りで決めた人数より週に14,385円(不足1人×30分の重みが基準の3,000円のとき)から59,400円(6,000円のとき)高くなりました。第1週の差を単純に4倍すると、それぞれ約5.8万円と約23.8万円です。予測どおりの人数で勤務表を作り続けることの損失は、勤務表の上には現れず、実績のサービスレベルと、目標を割った日の対応(残業・応援・苦情の処理)の側に現れます。
第二に、余裕人員をどれだけ置くかは、目標を割ることの損失をいくらと見るかで決まります。この例題の重み(不足1人×30分=3,000円)では、追加の人件費と不足の円換算の合計が上乗せ0%と5%でほぼ同じ(600,855円と602,635円)になり、それを超えると人件費の増加が不足の減少を上回りました。目標を割ったときの損失を大きく見る事業なら、上乗せの割合は大きくなります。重みをいくらに置くかは、ソルバーではなく経営が決める値です。第8章で扱った重みの決め方の手順(現場と合意する手順)は、この重みにもそのまま使えます。
第三に、柔軟な枠は、余裕人員を先に置く費用を減らします。この例題では兼務2名(電話に回したときの損失が30分1,300円)で、期待費用が週に50,571円下がり、先に置くパートの人件費も週に37,500円減りました。予測の精度を上げること、柔軟な枠を持つこと、余裕人員を置くことは、どれも需要のばらつきへの備えで、互いに代わりになります。予測の精度を上げる投資(弊社コラム『ビジネスデータの予測に効く時系列分析、基礎から実務まで』)と、兼務の体制を作る投資と、人を多めに置く人件費を、同じ期待費用の尺度で並べて比べることが有効だと考えています。
判断を誤ったときの損失の型も整理しておきます。予測誤差を無視すると、勤務表の上では不足が小さく見えるのに、実績では目標を割る日が続き、原因が「人が足りない」のか「予測が外れた」のかを切り分けられないまま、採用を増やすという判断に進むことがあります。反対に、誤差を大きく見積もりすぎて一律の上乗せを重ねると、この例題の上乗せ25%の行のように、過剰人時が527.5人×時間まで積み上がります。どちらも、過去の予測と実績から誤差の大きさを測っておけば避けられる損失です。
この章の要点は3つです。第一に、予測どおりの人数で勤務表を作ると、予測誤差(この例題では架空の標準偏差12%)によって、目標を割る日が入電の多い日にまとまって起き、偶然のばらつきまで含めた模擬でも約2割の日で目標を割りました。第二に、予測への上乗せ・シナリオを複数置いた人数の決め方・当日に動かせる柔軟な枠は、いずれも目標を割る日を減らしますが、どれがどこまで見合うかは、目標を割る損失の重みと柔軟な枠の費用で決まります。第三に、月の途中での見直しが効くのは、予測誤差に後まで続くずれが含まれている場合で、効くかどうかは過去の予測と実績から確かめられます。次の第13章では、ここまでの章で作った仕組みを、現場の運用に入れる手順を扱います。
この章を深めたい方への参考書籍
『確率計画法』(椎名孝之、朝倉書店):不確実性を数理モデルに直接組み込む最適化手法の専門書で、版元の紹介によると、一般の定式化、リコースを有する問題、確率的制約を持つ問題、多段階の問題、モンテカルロ法の応用、リスクを考慮したモデルまでを扱っています。この章のシナリオを置いた人数の決め方と、兼務のような当日の調整を先に決める変数と分けて表す考え方の、理論の側を押さえるのに向いています。
『この1冊ですべてわかる 新版 需要予測の基本』(山口雄大、日本実業出版社):2021年11月に新版として出た需要予測の入門書で、版元の紹介では、サプライチェーンとマーケティングでの需要予測の活用、デマンドプランナーの育成までを事例とともに体系的にまとめた本とされています。この章で前提にした「予測誤差の大きさを測る」ことを、予測を業務として回す側から考えるのに役立ちます。
第13章 現場に入れる
第12章では、需要の予測が外れることを前提に、余裕人員の置き方や柔軟な勤務の枠の価値を扱いました。第3章からそこまでの章で扱ってきたのは、どれも「問題が正しく書けていれば、良い勤務表を計算で出せる」という話です。この章では、その前提そのもの、つまり問題を正しく書くための情報をどう集め、計算した勤務表をどう職場の運用に載せるかを扱います。勤務表の自動作成を入れても使われなくなる理由の多くは、ソルバーの性能ではなく、勤務表を作ってきた人の頭の中にある書かれていない決まりと、マスタ(スタッフごとのスキル・雇用契約・希望といった基礎データ)の粗さにあると考えています。この章では、シフト作成者の暗黙のルールを聞き出して制約に落とす手順、ルールごとの費用を測って優先順位を付ける方法、マスタの精度、勤怠管理・給与・需要予測のシステムとのデータの流れ、人が最後に直す運用と手直しの記録の活かし方、なぜこの人がこの日に入ったのかを説明する方法、労使で決めておくこと、経営への報告の指標、導入の順序と失敗の型を順に述べます。仕組みと運用の話が中心ですが、ルールごとの費用と割当の理由の説明は、第2章で用意したサンプルデータで実際に解いて数字で示します。
計算上は良い勤務表が、職場で使われなくなる道筋
勤務表の自動作成を導入した職場で起きやすい経過には、ある程度決まった型があるように思います。最初に出てきた勤務表を見たシフト作成者やスタッフから、「この2人は同じ時間帯に入れないようにしてきた」「この人は終電の都合で遅番に入れない」「この人は保育園の送りがあるので早番は無理」「新人の週は必ず面倒を見る人と同じ時間帯にしている」といった指摘が出ます。どれも計算機に渡したデータには書かれていなかった決まりです。作成者は出てきた勤務表を手で直して使いますが、直す量が多いと、最初から自分で組むのと手間が変わらなくなり、やがて計算の出力は参考として眺めるだけのものになります。
この道筋で起きていることは、書き漏らした制約はソルバーにとって存在しない、ということの現れです。ソルバーは書かれた条件の中で目的の値が最も小さい勤務表を探すので、書かれていない決まりが多いほど、計算上の勤務表は現実には回せない勤務表に近づきます。しかも、決まりを書かずに解くと、ソルバーが選べる勤務表が増えるので、目的の値(重みづけの和)は決まりを入れた場合より悪くなることがなく、不足人時などの指標も良く見えやすくなります。そのため、導入前の試算では効果が大きく出て、職場に入れた後で縮む、という順序になりやすくなります。ただし、良く見えるのは必ずではありません。この章の後半の表のように、決まりを入れても目的の値が変わらないことがあり、個々の指標は他の指標との交換で上下するので、不足人時だけを比べると決まりの影響を読み違えます。導入の前後で効果の見積りが食い違うときは、試算に使ったモデルが職場の決まりをどれだけ含んでいたかを最初に疑うのが筋です。
もう1つの型は、マスタの誤りです。スキルの登録が古く、英語対応ができるようになった人が登録されていない、パートの雇用契約で決めた週の日数の上限が入っていない、希望休が紙で出されて入力が漏れている、といった状態です。条件は正しく書けていても、条件に入れる数字が現実とずれていれば、勤務表は同じように職場で崩れます。
勤務表には、配車や生産の計画と違う事情がもう1つあります。計画の対象が人そのものであることです。配送の計画が悪ければ費用が増えますが、勤務表が悪ければ、特定の人に遅番や土日が偏る、希望休が通らない、家庭の事情が無視される、といった形で、スタッフ1人ひとりの生活に直接響きます。そのため、計算機の勤務表が職場で受け入れられるかどうかは、不足人時の小ささだけでは決まらず、スタッフが「なぜ自分がこの日に入ったのか」に納得できるかどうかにも左右されます。この章の後半で、説明できる勤務表と労使の合意を扱うのはこのためです。
これらの型を防ぐ手順は、突き詰めると4つです。職場の決まりを漏れなく聞き出して書くこと、書いた決まりごとにどれだけの費用がかかっているかを測って、守るべきものと見直すべきものを分けること、勤務表を人が直したときにその理由を記録して次の制約やマスタに戻すこと、そして割当の理由を説明できるようにしておくことです。以下では、この順に述べます。
暗黙のルールを聞き出す、ヒアリングの設問と制約の型
シフト作成者が毎月の勤務表で使っている決まりの多くは、文書になっていません。長く担当している人ほど、決まりを決まりとして意識せずに使っているので、「何か制約はありますか」と聞いても出てこないことがよくあります。聞き出すときは、抽象的に聞くのではなく、人・日・勤務の型・スキルの切り口ごとに、具体的な場面を示して聞くほうが漏れが減ると考えています。たとえば「先月の勤務表を見ながら、この人をこの日の遅番にした理由を教えてください」「この2人を同じ日の同じ型にしなかったのはなぜですか」と、実際の勤務表の1マスずつについて理由を尋ねる方法です。理由を聞いていくと、必要人数や希望休だけでは説明できない判断が出てきて、それが書き漏らしている制約の候補になります。
聞き出す相手は、シフト作成者だけでは足りません。作成者が把握している事情は、スタッフから申し出があったものに限られることが多く、申し出ずに我慢している事情は勤務表にも作成者の頭にも入っていないからです。スタッフ本人への聞き取りでは、「入れない日や時間帯と、その理由」「入りたくない勤務の型と、その程度(絶対に無理か、できれば避けたいか)」を分けて聞くと、後でハードとソフトに振り分けやすくなります。家庭の事情や健康に関わる情報は個人の事情に深く立ち入るので、理由の詳細まで記録する必要はなく、「その条件がいつまで続くか」と「どの程度守る必要があるか」を記録すれば、制約としては足ります。
聞き出した決まりは、ソルバーに渡せる形に翻訳します。勤務表の決まりの大半は、第5章から第9章で扱った道具のどれかで書けます。次の表は、ヒアリングの切り口ごとに、設問の例と、聞き出した決まりがどの型の制約になるか、その値をどこに持っておくかをまとめたものです。
| 切り口 | 設問の例 | 出てくる決まりの例 | 制約の型 | 値の置き場所 |
|---|---|---|---|---|
| 人どうしの組合せ | 同じ日や同じ時間帯に入れないようにしている2人はいますか。逆に必ず一緒にしている組はありますか | 折り合いの悪い2人を同じ型にしない、新人の週は指導役と同じ型にする | 2人の割当の組に対する禁止、含意(第6章) | 組合せの表 |
| 通勤 | 始発や終電の都合で入れない勤務の型はありますか | 終電の都合で遅番に入れない、始発の都合で早番に入れない | その人に許す勤務の型の限定 | スタッフのマスタ |
| 家庭の事情 | 入れない曜日や時間帯はありますか。それはいつまで続きますか | 保育園の送りで早番に入れない、土日は入れない | 勤務の型・曜日の限定(期限つき) | スタッフのマスタ(有効期限つき) |
| 育成 | 新人や異動してきた人に、最初の数週間で決まった入れ方はありますか | 最初の2週は日勤だけ、指導役と同じ型 | 期間を区切った型の限定、組合せ(第9章) | 育成の計画表 |
| 体調・負担 | 続けて入れたくない並びはありますか。月に何回までにしている勤務の型はありますか | 遅番の翌日は早番にしない、遅番は月8回まで | 並びの制約、回数の上限(第6章・第8章) | 就業規則・社内の運用ルール |
| 雇用契約 | 契約で決めた日数・時間・時間帯の範囲はどうなっていますか | 週3日まで、午前だけ、月の目安は12日程度 | 日数・時間の上下限 | 雇用契約のマスタ |
| スキル | この時間帯に必ず1人は要る人はいますか。その人たちは誰ですか | リーダーを全時間帯に1人、英語対応を平日の日中に1人 | スキルの被覆(第9章) | スキルのマスタ |
| 例外の扱い | できあがった勤務表を手で直すのはどういうときですか。直した後のほうが良い理由は何ですか | 月末は事務処理があるので特定の人を日勤にする、繁忙期は短時間勤務を延ばす | 時期によって変わるマスタの値 | 手直しの記録 |
表の最後の行は、ほかの行と性質が違います。前の7行は「決まりを聞く」設問ですが、最後の行は「決まりを聞き漏らしたことを見つける」設問です。作成者が手で直す場面には、まだ書かれていない決まりが必ず含まれています。最初のヒアリングで決まりを出し切ることはできないので、手直しの理由を聞く設問を運用の中に残しておくことが、後の節で述べる手直しの記録につながります。
聞き出した決まりには、出どころを書き添えておくのが有効だと考えています。「法令や就業規則で決まっている」「雇用契約で本人と合意している」「本人から申し出があった」「過去に一度トラブルがあったので避けている」「作成者の慣行で、理由ははっきりしない」では、同じ決まりでも重みがまったく違います。最初の2つは守るしかありませんが、3番目は期限や程度を確かめる余地があり、4番目は今も生きているかを確かめる余地があり、5番目は勤務表の自由度を上げる候補です。出どころを書いておかないと、すべてが同じ重さの制約としてソルバーに入り、次の節で述べる優先順位が付けられなくなります。
ハード制約とソフト制約、決まり1つずつの費用で優先順位を付ける
聞き出した決まりは、2つに分けて書きます。1つは、破った勤務表はそもそも使えない、あるいは使ってはいけない決まりで、ハード制約と呼びます。法令、就業規則、雇用契約で決まった日数や時間、本人が物理的に来られない時間帯などです。もう1つは、破ることはできるが、破るたびに何らかの損が出る決まりで、ソフト制約と呼びます。ソルバーには、破った量に応じた罰の費用(重み)を目的に足す形で渡します。基準の勤務表(第5章)では、希望休がこちらに入っていて、1件破るごとに5,000(架空の重み)を目的に足しています。第5章から第9章で扱ったとおり、ハードとソフトのどちらに置くかで、勤務表の出方は大きく変わります。
ハードかソフトかの判断は、技術の問題ではなく、決まりの出どころで決まります。前の節で決まりに出どころを書き添えるよう述べたのは、このためです。法令・就業規則・雇用契約・本人が来られない時間帯はハードに、過去の経緯や作成者の慣行はソフトに置くのが出発点になります。迷う決まりは、まずソフトにして重みを大きめに置き、計算した勤務表でその決まりがどれだけ破られるかを見てから決めるのが安全だと考えています。すべてをハードにすると、決まりどうしがぶつかったときにソルバーは「解なし」しか返せず、どの決まりを緩めればよいかの手がかりが得られないからです。ソフトにしておけば、勤務表が出たうえで、破られた決まりとその量を一覧にできます。「解なし」のときに原因の決まりを探す方法は第6章で扱いました。
ソフト制約の重みは、互いの比で意味を持ちます。基準の勤務表では、不足1人×30分が3,000、希望休の違反1件が5,000と置いているので、ソルバーから見ると「希望休を1件守るためなら、不足を1人×30分と少し(5,000÷3,000)まで増やしてもよい」という交換比率になっています。重みを決めることは、この交換比率を決めることであり、それはシフト作成者や管理者が暗黙に持っている価値判断を数字にすることです。重みをどう現場と合意するかは第8章で扱いましたが、導入の場面では、重みの値そのものより先に、「どの決まりとどの決まりを天秤にかけているのか」を関係者が理解していることが大切だと考えています。
もう1つ、ソフト制約には「破られた件数を必ず報告する」という運用がついて回ります。ソフトにした決まりは、計算機が黙って破ることがあるからです。希望休の違反が0件の月もあれば、需要の多い月に数件出る月もあります。破られた決まりを勤務表と一緒に一覧で出し、作成者が1件ずつ確かめてから公開する流れにしておけば、ソフトにしたことで職場の信頼を損なうことを避けられます。
決まりに優先順位を付けるための最も直接的な材料は、その決まりを入れたときに勤務表がどれだけ悪くなるか、つまり決まり1つあたりの費用です。試算した月の条件で費用がほぼゼロの決まりは、ハード制約として入れても影響が小さい候補です。ただし、需要・欠勤・希望休が違う月には費用が出たり、ほかの決まりとぶつかって解が無くなったりすることがあるので、本番に入れる前に数か月分の条件で費用を確かめておくのが安全です。費用の大きい決まりは、本当に守る必要があるのかを出どころに戻って確かめ、関係者と話し合う価値があります。話し合いの順番を費用の大きさで決められるのが、この測り方の利点です。
第2章で用意したサンプルデータに、ヒアリングで出てきたという想定の決まりを1つずつ足して解きました。決まりはすべて架空で、この実験のために置いたものです。A は人どうしの組合せで、S04 と S11 を同じ日の同じ勤務の型に入れません。B は通勤で、S14 を遅番に入れません。C は家庭の事情で、S08 を早番に入れません。D も家庭の事情で、パートの S20 を土日に入れません。E は作成者の慣行で、SV のうち S01・S02・S03 を遅番に入れません。F は育成で、S16 と S17 を新人とみなし、最初の2週(第1日〜第14日)は日勤だけにします。さらに範囲の広い慣行の例として、G は SV の7名(S01〜S07)を全員遅番に入れない、H はパートの12名(S19〜S30)を全員土日に入れない、という決まりを置きました。
モデルは第5章の基準と同じ構造を、この章のプログラムの中で組み直したものです。解き方は CP-SAT で、num_workers=8・random_seed=0 に固定し、時間制限は A〜D が30秒、E・F・G・H が60秒です。計算時間はいずれもこの記事の実行環境(一般的なノートPC)での実測で、ほかの章の計算と同時に走らせています。基準の結果(第5章)は同じモデルを2.6秒で解いていますが、ここで組み直した基準は19.7秒かかりました。差の理由は確かめていないので、この章では計算時間どうしを比べる材料にはしていません。
| 決まり(すべて架空) | 出どころの想定 | 状態 | 目的の値 | 組み直した基準との目的の差 | 不足(人×時間) | SV 不在の枠 |
|---|---|---|---|---|---|---|
| 組み直した基準 | (なし) | OPTIMAL | 2,053,500 | 0 | 216.0 | 0 |
| A 組合せ(S04 と S11 を同じ日の同じ型にしない) | 過去のトラブル | OPTIMAL | 2,053,500 | 0 | 221.0 | 0 |
| B 通勤(S14 は遅番に入れない) | 本人の申し出 | OPTIMAL | 2,053,500 | 0 | 221.0 | 0 |
| C 家庭の事情(S08 は早番に入れない) | 本人の申し出 | OPTIMAL | 2,053,500 | 0 | 216.0 | 0 |
| D 家庭の事情(S20 は土日に入れない) | 本人の申し出 | OPTIMAL | 2,053,500 | 0 | 218.5 | 0 |
| E 慣行(S01・S02・S03 は遅番に入れない) | 作成者の慣行 | OPTIMAL | 2,053,500 | 0 | 221.0 | 0 |
| F 育成(S16・S17 は最初の2週は日勤だけ) | 育成の計画 | OPTIMAL | 2,053,500 | 0 | 218.5 | 0 |
| A〜D を全部(90秒で解き直し) | (上の組合せ) | OPTIMAL | 2,053,500 | 0 | 221.0 | 0 |
| G 慣行(SV は全員、遅番に入れない) | 作成者の慣行 | OPTIMAL | 2,893,500 | +840,000 | 216.0 | 168 |
| H 慣行(パートは全員、土日に入れない) | 作成者の慣行 | OPTIMAL | 2,128,500 | +75,000 | 228.5 | 0 |
目的の値は、基準と同じ重みづけの和(不足1人×30分あたり3,000、希望休の違反1件5,000、SV 不在1枠5,000、英語不在1枠2,000、パートの人件費。いずれも架空)です。表の状態がすべて OPTIMAL なので、目的の値はその決まりのもとでの最小値であることが証明されています。
結果は、決まりの費用に大きな差があることを示しています。A から F までの6つは、1つずつ入れても、A〜D を全部入れても、E と F を両方入れても、目的の値が基準と同じ2,053,500のままでした。これらの決まりは、このサンプルデータの4週では費用がゼロで、ハード制約として入れても影響が小さい決まりです。本人の申し出による通勤や家庭の事情を守っても勤務表が悪くならないのであれば、守らない理由はありません。ただし、これは1つの月の条件で測った結果なので、別の月の需要や希望休でも費用がゼロのままかは、数か月分で解いて確かめる必要があります。導入の前に、こうした決まりの多くが実は費用ゼロであることを示せると、スタッフの事情を制約として登録してもらう動機にもなると考えています。
一方、範囲の広い慣行の2つには、はっきりした費用が出ました。G(SV を全員遅番に入れない)では、SV 不在の枠が168になりました。サンプルデータの勤務の型で21時以降を受け持つのは遅番(15時〜24時)と短時間(夕方、17時〜22時)だけで、SV は全員正社員なので、SV が遅番に入らなければ21時〜24時の6枠は毎日 SV 不在になり、6枠×28日で168枠です。この決まりをそのまま守ると夜の時間帯のリーダーが常にいなくなるので、このサンプルでは見直しの候補の筆頭で、出どころを確かめたうえで、見直すか、夜のリーダーを別の形で置く(SV の育成、第9章)ことを検討すべき決まりです。H(パートを全員土日に入れない)では、目的の値が75,000増えました。組み直した基準と比べると、パートの勤務時間は同じ495時間のまま、不足が216.0人×時間から228.5人×時間へ12.5人×時間(25人×30分)増えていて、その3,000×25=75,000がそのまま目的の差です。4週で12.5人×時間の不足は、4週を1年に13回繰り返すと考えれば、年に約160人×時間の不足にあたります。この量が、パートを土日に入れないという慣行に見合うかどうかは経営の判断で、見合わないなら、土日に入れるパートを募集する、土日だけ入れる人に手当を付ける、といった施策の材料になります。
表の「不足(人×時間)」の列には、注意が要ります。目的の値が同じ行どうしでも、不足は216.0・218.5・221.0とばらついています。これは、基準の重みでは、不足5人×時間(10人×30分、3,000×10=30,000)とパートの勤務20時間(1,500円×20=30,000円)がちょうど同じ値になり、不足を少し減らしてパートを増やした勤務表と、その逆の勤務表が、同じ目的の値で並ぶからです。実際、この表の「組み直した基準」も、基準の結果(第5章。不足221.0人×時間、パートの勤務475時間)とは違う勤務表で、目的の値だけが同じです。したがって、この表で決まりの費用として読んでよいのは「目的の差」の列だけで、不足の列の差を決まりの費用と読むと誤ります。決まりの費用を測るときは、1つの指標の差ではなく、ソルバーが最小にしている値の差で読むのが安全です。
時間制限の効き方にも注意が要りました。A〜D を全部入れた場合を30秒で解くと、状態は FEASIBLE(実行可能な勤務表は見つかったが最適とは証明できていない)で、目的の値は2,058,000、下界は2,053,500でした。この結果だけを見ると「4つの決まりを全部入れると4,500の費用がかかる」ように見えますが、90秒の制限で解き直すと29.3秒で OPTIMAL になり、目的の値は2,053,500で費用はゼロでした。A をハードではなくソフト(破ると1回5,000)にした場合も、30秒では FEASIBLE の2,056,500で、ハードにした A(OPTIMAL の2,053,500)より悪い値でした。ソフトにすれば選べる勤務表が増えるので、最適な値がハードより悪くなることはありえず、これは探索が時間内に最適まで届かなかっただけです。90秒では43.8秒で OPTIMAL の2,053,500になりました。現場と話し合う材料にする数字ほど、状態が OPTIMAL であることを確かめるか、FEASIBLE なら下界との差を併記して「費用は最大でいくら」と幅で示す必要があります。時間制限と品質の関係は第6章で扱いました。
マスタの精度、スキル・雇用契約・希望
勤務表の計算に入る数字のうち、スタッフごとに持つ基礎データを、ここではマスタと呼びます。勤務表で特に効くのは、スキル(リーダーを務められるか、英語に対応できるか、どの業務の研修を終えたか)、雇用契約(正社員かパートか、週や月の日数・時間の上限と下限、入れる時間帯)、希望(希望休、入りたい・入りたくない勤務の型)の3つです。第2章のサンプルデータでは、この3つを staff() の中に持たせました。スキルが違えば SV 不在や英語不在の枠が変わり、雇用契約が違えば置ける人の数が変わり、希望が違えば希望休の違反の件数が変わります。
スキルのマスタは、古くなりやすい項目です。研修を終えて新しい業務に入れるようになった、異動してきた人が前の職場で身に付けたスキルを持っている、逆に長く離れていた業務の手順が変わってすぐには入れない、といった変化が、登録に反映されないまま残ります。スキルを持つ人が登録上少ないと、ソルバーはその少ない人に負担を寄せた勤務表を作ります。スキルを持つ人の数が不足人時や SV 不在・英語不在の枠にどう効くかは第9章で扱いました。登録上のスキルが実態より少なければ、その効き方がそのまま、特定の人の負担の偏りと、実際には無い不足として勤務表に現れます。スキルごとに「誰が、いつ、何をもって登録するか」(研修の修了、指導役の判定など)を決めておくのが有効だと考えています。
雇用契約のマスタは、法令や契約との関係で、誤りが許されない項目です。厚生労働省は、パートやアルバイトを中心に、労働契約の時点では労働日や労働時間を確定的に定めず、一定期間ごとに作る勤務シフトで初めて具体的な労働日や労働時間が決まる働き方を「シフト制」と呼び、使用者が留意すべき事項をまとめています(2022年1月作成、2026年6月改正)。そこでは、労働契約の締結時に「始業及び終業の時刻」や「休日」に関する事項を明示しなければならず、労働条件通知書に単に「シフトによる」と書くだけでは足りないことが示されています。また、一定の期間に労働する可能性がある最大の日数・時間数・時間帯や、目安となる労働日数・労働時間数を、あらかじめ話し合って合意しておくことが考えられる、とされています。勤務表の計算から見ると、これらはそのまま、スタッフごとの日数・時間の上限・下限と、入れる時間帯のマスタになります。契約で合意した内容とマスタの値が食い違えば、計算機は契約を超えた、あるいは契約を大きく下回る勤務を組むことになるので、契約書とマスタを突き合わせる作業は導入の最初に一度、その後は契約の更新のたびに行う必要があります。
- 厚生労働省「いわゆる『シフト制』により就業する労働者の適切な雇用管理を行うための留意事項」(2022年1月7日、2026年6月19日改正)
https://www.mhlw.go.jp/content/11200000/001713615.pdf - 厚生労働省「いわゆる『シフト制』について」
https://www.mhlw.go.jp/stf/newpage_22954.html
同じ留意事項は、所定労働日数の考え方にも触れています。所定労働日数は、その日数のとおりに働くことを使用者と労働者で約束するものなので、実際に働く日数と乖離しないようにすることが望まれ、使用者の都合で一方的に所定労働日数を増減させることは認められない、とされています。第2章のサンプルデータでは、パートの4週の日数に下限を置いていません(週の上限だけ)。この設定のまま計算すると、需要の少ない月には特定のパートの勤務が極端に少なくなることがありえます。実際の職場で使うときは、契約で合意した目安の日数を、下限の制約か、目安から外れた日数への罰の費用として入れておくのが、契約の趣旨に沿った書き方になると考えています。
希望のマスタは、集め方で精度が決まります。希望休を紙やチャットで受け付けて作成者が転記する形では、転記の漏れや、締切の後に出た希望の扱いがあいまいになりがちです。希望を入力する画面をスタッフ本人に用意し、締切・1人あたりの件数の上限・優先度の付け方(第8章)を画面の上で決めておくと、計算機に渡す希望のデータと、スタッフが出したつもりの希望が一致します。留意事項も、シフト表の作成にあたって事前に労働者の意見を聴取すること、確定したシフト表を通知する期限や方法を、あらかじめ使用者と労働者で話し合って定めておくことが考えられる、としています。希望の締切と勤務表の公開日は、計算の都合だけでなく、この通知の期限との関係で決める必要があります。
マスタは、一度作れば終わりではありません。研修の修了、契約の更新、家庭の事情の変化、新しいスタッフの採用といった変化は、毎月のように起きます。マスタの項目ごとに「誰が、何を見て、いつ直すか」を決め、家庭の事情のように期限のある決まりには有効期限を持たせておくことが、次の節以降で述べる運用の土台になります。期限を持たせないと、事情が解消した後も制約だけが残り、勤務表の自由度を理由もなく狭め続けることになります。
勤怠管理・給与・需要予測、データの流れを決める
勤務表は、単独では動きません。前には需要の予測と必要人数の見積り(第3章)があり、スタッフの希望の受け付けがあり、後ろには実際の出退勤の記録と、それをもとにした給与の計算があります。多くの職場では、需要予測は表計算や専用の仕組みが、出退勤の記録は勤怠管理システム(タイムカードや ICカード、パソコンの記録などで始業・終業の時刻を集め、労働時間を集計する仕組み)が、給与の計算は給与計算の仕組みが受け持っています。勤務表の自動作成は、この流れの中の1つの段にすぎず、前後の段とのデータの受け渡しが決まっていないと、毎月の勤務表の入力と出力を人が打ち直すことになります。
勤怠の記録には、法令上の位置づけがあります。厚生労働省の「労働時間の適正な把握のために使用者が講ずべき措置に関するガイドライン」(2017年1月20日策定)は、使用者は労働日ごとの始業・終業時刻を確認して記録すること、その方法は原則として、使用者が自ら現認するか、タイムカード・ICカード・パソコンの使用時間の記録等の客観的な記録を基礎として確認し記録することを求めています。自己申告制による場合は、申告した労働時間と事業場内にいた時間の記録との間に著しい乖離があれば、実態調査をして補正することなどが求められています。記録の保存について、労働基準法第109条は労働者名簿・賃金台帳・その他労働関係に関する重要な書類を5年間保存することを定めていますが、同法の附則第143条により、当分の間は3年間と読み替えられています。勤務表の予定と勤怠の実績を突き合わせる仕組みを作るときは、実績の側がこのように法令にもとづいて記録され、一定期間残るデータであることを前提にできます。
- 厚生労働省「労働時間の適正な把握のために使用者が講ずべき措置に関するガイドライン」
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/koyou_roudou/roudoukijun/roudouzikan/070614-2.html - e-Gov 法令検索「労働基準法」(昭和22年法律第49号)
https://laws.e-gov.go.jp/law/322AC0000000049
次の表は、勤務表の自動作成と前後の段の間で受け渡すデータと、受け渡しが崩れたときに勤務表で起きることをまとめたものです。システムの名前や製品ではなく、「何をいつ渡すか」を決めることが、導入の設計の中心になります。
| 段 | 勤務表に渡すもの | 勤務表から受け取るもの | 受け渡しが崩れたときに起きること |
|---|---|---|---|
| 需要予測・必要人数 | 日・時間帯ごとの必要在席人数(第3章)、予測の更新日 | 在席の予定人数(過不足の見込み) | 古い予測で勤務表を作る、必要人数の数え方(シュリンケージを掛けたか)が段ごとに違う |
| スタッフのマスタ | スキル、雇用契約の上下限、入れる時間帯、期限つきの事情 | (受け取るものは無い) | 登録の古いスキルや契約で勤務表を作る |
| 希望の受け付け | 希望休、入りたい・入りたくない勤務の型、優先度 | 通った希望と通らなかった希望の一覧 | 転記の漏れ、締切後の希望の扱いがあいまいになる |
| 勤務表の作成 | (この段で勤務表を作る) | (前後の段へ渡す) | 勤務表の版が複数でき、どれが確定版か分からない |
| 勤怠管理 | 日ごとの始業・終業の実績、欠勤・遅刻・早退、休暇の取得 | 確定した勤務表(予定の始業・終業) | 予定と実績の比較ができず、欠勤率や残業の実態が勤務表に戻らない。当日の組み直し(第11章)の起点が分からない |
| 給与計算 | (勤怠の実績を経由して受け取る) | 勤務の型ごとの手当の区分(深夜・休日など) | 勤務の型の区分が勤務表と給与で違い、手当の計算を人が直す |
表の中で、この章で最も重要なのは、勤怠管理との受け渡しです。勤怠の実績には、日ごとの出退勤と欠勤が入るので、予定どおりに勤務が行われたかどうか、どの勤務の型で残業が多いか、欠勤がどの曜日に多いかが、毎日たまっていきます。これを勤務表の側に戻す流れがあれば、第3章で仮定として置いたシュリンケージ(休憩・研修・欠勤などで席にいない割合)を実績から見直せますし、第11章で扱った待機要員の人数も、実際の欠勤率から決められます。戻す流れがなければ、仮定の値は導入時に一度置いたまま古くなっていきます。
需要予測との受け渡しでは、必要人数の数え方をそろえることが大切です。第2章のサンプルデータでは、必要在席人数にシュリンケージを掛けず、休憩は勤務の型の側で在席の枠から外しました。予測の担当が「シュリンケージを掛けた後の人数」を渡し、勤務表の側でもう一度休憩を差し引くと、同じ休憩を二重に数えて過剰人時が膨らみます。逆に、どちらの段でも差し引かなければ不足が見えなくなります。必要人数の表には、どこまでの差し引きを済ませた値なのかを必ず書き添えておくのが有効だと考えています。
予定と実績の比較は、経営への報告でもそのまま使えます。第1章で定義した不足人時・過剰人時は、計画の段階では「必要在席人数と予定の在席人数」から計算しますが、実績の段階では「実際の入電から計算し直した必要人数と、勤怠の記録から数えた実際の在席人数」から計算し直せます。計画の値だけを報告すると、計算上の効果を報告することになり、当日の欠勤や予測の外れで失われた分が見えません。
人が最後に直す運用、手直しの記録を次の制約にする
勤務表の自動作成を入れても、勤務表を人が最後に見て直す工程は残すべきだと考えています。理由は2つあります。1つ目は、前の節までで述べたとおり、書かれていない決まりは必ず残っていて、それを知っているのはシフト作成者とスタッフだからです。2つ目は、その月にしか分からない事情(急な休職や復職、研修の日程、行事への対応)があるからです。計算機の勤務表をそのまま公開する運用を目指すより、人が直すことを前提に、直す作業を短くし、直した理由を次の計算に戻す運用を設計するほうが、職場に定着しやすくなります。
そのためには、手直しを記録に残す仕組みが要ります。計算した勤務表と人が確定した勤務表の差分を機械的に取り、差分ごとに理由を選んでもらう形が、作成者の負担が小さく、後で集計しやすいと考えています。勤務表の差分は「スタッフ×日」のマスのうち、勤務の型が変わったマスとして機械的に取り出せます。理由を自由記述にすると集計できないので、選択肢を用意し、どれにも当てはまらないときだけ自由記述にします。記録の項目の例を次の表に示します。
| 項目 | 記録する内容の例 | 後で使う目的 |
|---|---|---|
| 対象の月・勤務表の版 | 計算した版の番号と、確定した版の番号 | どの勤務表をどう直したかを追う |
| 手直しの種類 | 勤務の型を替えた、勤務と休みを入れ替えた、2人の勤務を交換した、人を足した | 手直しの量を種類別に数える |
| 対象 | スタッフの記号、日付、直す前と後の勤務の型 | 同じ人・同じ曜日で繰り返されていないかを見る |
| 理由(選択肢) | 人どうしの組合せ、通勤、家庭の事情、育成、体調・負担、契約、スキル、その月だけの事情、その他 | 制約の書き漏らしか、マスタの誤りか、その月だけの事情かを分ける |
| 手直しによる変化 | 不足人時・過剰人時・希望休の違反の、直す前と後の値 | 手直しの費用を測る |
この記録を月に一度集計すると、手直しは3種類に分かれます。同じ人・同じ理由の手直しが毎月繰り返されているなら、それは書き漏らした制約か、マスタの誤りです。前者なら制約として足し、後者ならマスタを直します。これが「手直しの記録を次の制約にする」ということです。一方、その月だけの事情による手直しは、繰り返しの少ないものが大半なので、制約にするのではなく、マスタの期限つきの項目か、確定後の組み直しの手順(第11章)の側で扱います。
手直しによる不足人時や希望休の違反の変化も記録しておくと、手直しそのものの良し悪しが見えてきます。人の手直しで不足人時が増えている場合、その増分は職場の決まりを守るための費用か、作成者の慣れや好みによる費用かのどちらかです。前者なら制約として書けば計算機が最初から守れるようになり、後者なら計算機の勤務表のほうが良い可能性があります。どちらなのかを作成者と一緒に確かめる材料として、手直しの記録は役に立ちます。手直しの量(件数、あるいは直したマスの割合)が月ごとに減っていくことは、モデルが職場に近づいていることの目安になります。
ここで気を付けたいのは、手直しの記録を作成者の評価に使わないことです。記録が評価に使われると、理由の選択が実態からずれ、「その月だけの事情」や「その他」に逃げる記録が増えます。記録の目的は、モデルとマスタを直すことに限ると、最初に決めて伝えておくのが有効だと考えています。また、確定した後に勤務表を変える場面は、計算する前の手直しとは扱いが違います。厚生労働省の留意事項は、一旦確定したシフト上の労働日や労働時間を変更することは労働条件の変更に該当し、使用者と労働者の双方が合意したうえで行うよう求めています。計算機の出力を人が直すのは確定の前の作業ですが、公開した後の変更は本人との合意が要る変更だと、運用の手順の上で区別しておく必要があります。
説明できる勤務表、なぜこの人がこの日に入ったのか
計算機の勤務表を公開すると、スタッフから「なぜ自分の希望休が通らなかったのか」「なぜ自分がこの日の遅番なのか」と尋ねられる場面が必ず出てきます。人が作っていた頃は、作成者が理由を覚えていて答えられましたが、計算機の勤務表では、作成者自身も理由を知りません。ここで答えられないと、勤務表への不信は計算機ではなく作成者に向かいます。説明の方法は、大きく2つあると考えています。1つは、ハード制約から必然的に決まっていることを、制約の数字で示す方法です。もう1つは、その割当を禁じて解き直し、目的の値がどれだけ悪くなるかで示す方法です。
1つ目の方法の例として、基準の勤務表の希望休の違反3件を見ます。第2章のサンプルデータでは、正社員は4週でちょうど20日勤務し、1週(7日)に5日までしか勤務できません。4週で20日を5日×4週で割り振るしかないので、正社員は毎週ちょうど5日勤務し、毎週の休みはちょうど2日になります。S01 の希望休は第3日・第5日・第6日・第7日の4件で、すべて第1週に入っています。第1週の休みは2日しか取れないので、4件のうち少なくとも2件は必ず破られます。S05 の希望休は第11日・第12日・第13日・第19日で、第2週(第8日〜第14日)に3件あるので、少なくとも1件は必ず破られます。ほかの正社員の希望休は、どの週にも2件以下しか入っていません。したがって、この条件のもとでは希望休の違反は少なくとも3件で、基準の勤務表の3件はこの下限そのものです。S01 に「なぜ通らなかったのか」と聞かれたら、「週5日・4週20日の決まりのもとでは、1週に4日の休みは取れない」と、制約の数字で答えられます。この種の説明は、計算をしなくても、希望の締切の時点で「通らないことが確定している希望」として本人に返せるので、希望の受け付けの画面で先に知らせる運用にもつなげられます。
ただし、この説明で言えるのは「4件のうち2件は破られる」までです。どの2件が破られるかは、制約からは決まりません。ここで2つ目の方法が要ります。この章の実験では、第5章の基準と同じモデルをこの章のプログラムの中で組み直して解きました(CP-SAT、30秒制限・num_workers=8・random_seed=0。この記事の実行環境(一般的なノートPC)で、ほかの章の計算と同時に実行)。状態は OPTIMAL で、目的の値は2,053,500と、基準の結果(第5章)と同じ値になりました。ところが、不足は216.0人×時間、過剰は656.0人×時間、パートの勤務は495時間で、基準の結果(不足221.0人×時間、過剰641.0人×時間、パートの勤務475時間)とは違う勤務表でした。不足が5.0人×時間(10人×30分、重みで30,000)少ない代わりに、パートの勤務が20時間(時給1,500円で30,000円)多く、重みづけの和がちょうど同じになっています。同じ目的の値を持つ最適な勤務表が複数ある状態を、代替最適解と呼びます。
代替最適解があると、「なぜこの割当か」への答えが変わります。この組み直した勤務表で破られた希望休は、S01 の第3日・第5日と、S05 の第13日でした。そのうち S01 の第5日の勤務を禁じて解き直すと、状態は OPTIMAL で目的の値は同じ2,053,500のまま、代わりに S01 の第7日の希望休が破られました。S05 の第13日の勤務を禁じても、目的の値は同じで、代わりに第11日が破られました。第1日(月)の S18 の遅番を禁じても、同じ日の S01 の中番を禁じても、目的の値は変わりませんでした。つまり、これらの割当はどれも「そうしなければ勤務表が悪くなる」から選ばれたのではなく、同じ値の勤務表がいくつもある中から、探索の途中でたまたま選ばれたものです。
S01 の第3日の勤務を禁じた場合には、注意の要る結果が出ました。30秒の制限では状態が FEASIBLE(実行可能な勤務表は見つかったが、最適かどうかは証明できていない)で、目的の値は2,055,000でした。下界は2,053,500だったので、「目的の値は最大で1,500悪くなる」までしか言えません。これを90秒の制限で解き直すと、実測38.5秒で OPTIMAL になり、目的の値は2,053,500と同じで、S01 は第6日と第7日の希望休が破られる勤務表でした。30秒の結果だけを見て「S01 の第3日を休みにすると1,500悪くなるので、第3日に入ってもらった」と説明していたら、誤った説明になっていたことになります。割当を禁じて解き直す方法で理由を説明するときは、状態が OPTIMAL になるまで解くか、FEASIBLE なら悪化の量を「下界との差の範囲で最大いくら」と幅で示す必要があります。
この結果は、説明の運用に2つのことを示していると考えています。1つは、「なぜ自分なのか」と聞かれたときに、「計算機が最適と判断したから」と答えるのは正確ではない場合が多いということです。正確な答えは、「同じくらい良い勤務表が複数あり、そのうちの1つが選ばれた」です。もう1つは、そうであれば、同じ値の勤務表の中から何を基準に選ぶかを、あらかじめ決めておく必要があるということです。たとえば、前月に希望休が破られた人の希望を優先する、前月の勤務表からの変更を少なくする、遅番や土日の回数の偏りを小さくする、といった基準を、重みの小さな2番目の目的として足しておけば、選ばれ方に理由が付きます。偏りの測り方は第8章、目的を段階的に最適化する書き方は第6章で扱いました。こうした基準を決めずに計算機に任せると、この章の実験で基準の結果と組み直した勤務表が違ったように、同じ条件で解き直しただけで勤務表が変わることがあり、それ自体がスタッフの不信を招きます。
説明のために、勤務表の公開と一緒に出しておくとよいものを挙げておきます。破られた希望休の一覧とそれぞれの理由(制約から必然か、同じ値の中からの選択か)、ソフト制約ごとの破られた件数、不足が残った時間帯とその量です。スタッフ全員に同じ一覧を示せば、特定の人だけが損をしているのではないことを示す材料にもなります。
労使で決めておくこと、協定・就業規則・シフトのルール
勤務表の自動作成は、勤務のさせ方そのものを変えるものではありませんが、導入の機会に、勤務のさせ方の前提になっている労使の取り決めを確かめておく必要があります。法令の条件の詳細は第7章で扱ったので、ここでは、導入の場面で確かめるべき取り決めの種類を、労働基準法の条文で確かめた範囲に限って整理します。以下は法律の助言ではなく、個別の判断は社会保険労務士などの専門家や労働基準監督署に確認することを前提にしています。
労働基準法には、事業場の労働者の過半数で組織する労働組合があればその労働組合、無ければ労働者の過半数を代表する者(以下、過半数代表)との書面による協定(労使協定)を要件にしている規定が複数あります。勤務表に関わるものとして、時間外・休日の労働(第36条。協定を結び、労働基準監督署に届け出た場合に、協定の範囲で時間外・休日に労働させることができる)、1か月単位の変形労働時間制(第32条の2。労使協定または就業規則その他これに準ずるもので定める。協定による場合は届出が要る)、休憩の一斉付与の例外(第34条第2項。休憩は一斉に与えるのが原則で、労使協定があるときはこの限りでない)があります。休憩の一斉付与については、労働基準法施行規則第31条により、運輸・商業・金融・保健衛生・接客娯楽などの事業には一斉付与の規定そのものが適用されません。第2章のサンプルデータのように、休憩の位置を人ごとにずらして在席を保つ勤務表は、事業の種類によっては休憩の一斉付与の例外にあたるので、その職場がどの扱いになるかを導入の前に確かめておく必要があります。
- e-Gov 法令検索「労働基準法施行規則」(昭和22年厚生省令第23号)
https://laws.e-gov.go.jp/law/322M40000100023
就業規則にも手続があります。常時10人以上の労働者を使用する使用者は、始業・終業の時刻、休憩時間、休日、休暇、交替制の場合の就業時転換に関する事項などを就業規則に定めて届け出なければならず(第89条)、就業規則の作成・変更にあたっては、過半数代表の意見を聴かなければなりません(第90条)。勤務表の自動作成にあわせて勤務の型(始業・終業の時刻)を新しく設計する場合、たとえば第4章で扱ったように開始時刻や長さの違う型を増やす場合は、就業規則に定めた始業・終業の時刻との関係を確かめる必要があります。厚生労働省の留意事項は、就業規則に「シフトによる」とだけ書くのでは作成義務を果たしたことにならず、基本となる始業・終業の時刻や休日を定めたうえで「具体的にはシフトによる」と定めるのは差し支えない、としています。また、シフト制の労働者に1か月単位の変形労働時間制を導入する場合には、就業規則で、すべての始業・終業時刻のパターンとその組合せの考え方、シフト表の作成手続と周知方法などを定めておかなければならない、としています。勤務表の自動作成で使う勤務の型の一覧は、この「始業・終業時刻のパターン」と一致させておくのが、法令との関係でも、運用の分かりやすさでも有効だと考えています。
協定や就業規則は、労働者に周知しなければなりません(第106条。作業場の見やすい場所への掲示・備え付け、書面の交付などの方法による)。勤務表の自動作成の側から見ると、協定で定めた時間外労働の上限や、就業規則に定めた勤務の型は、ソルバーに渡すハード制約の出どころそのものです。協定の内容が変わったときに制約の値も直す流れを作っておかないと、協定と勤務表が食い違ったまま運用が続くことになります。
法令で求められる手続とは別に、勤務表の作り方そのものを労使で話し合っておくことにも意味があると考えています。厚生労働省の留意事項は、シフト制の労働者について、使用者が一方的にシフトを決めることは望ましくなく、シフトの作成(事前の意見聴取、確定したシフトの通知の期限と方法)と変更(期間の開始前・開始後に変更を申し出る場合の期限や手続)に関するルールを、あらかじめ話し合って定めておくことが考えられる、としています。勤務表を計算機で作るようになると、スタッフからは「誰がどういう基準で決めているのか」が見えにくくなります。ソフト制約の重み(希望休と不足の交換比率)や、公平性の測り方(第8章)を、スタッフの代表を交えて決めておくことは、計算機の勤務表が受け入れられるための土台になります。
KPI と経営報告、計画と実績を同じ物差しで並べる
第1章では、シフトの経営指標として、不足人時・過剰人時・人件費・サービスレベル・希望の充足率・残業・連勤・公平性を定義しました。導入の効果を報告するときは、これらを「計画の値」と「実績の値」の2列で並べるのが基本になります。計画の値は計算機が出した(あるいは人が確定した)勤務表から、実績の値は勤怠管理の記録と実際の入電の記録から取ります。
| 指標 | 計画の値の出どころ | 実績の値の出どころ | 計画と実績がずれたときに疑うこと |
|---|---|---|---|
| 不足人時・過剰人時 | 必要在席人数と、確定した勤務表の在席人数 | 実際の入電から計算し直した必要人数と、勤怠の記録から数えた在席人数 | 需要予測の外れ(第12章)、当日の欠勤(第11章)、必要人数の数え方の食い違い |
| 人件費 | 確定した勤務表の勤務時間×時給 | 給与計算の実額 | 残業、当日の呼び出し、手当の区分 |
| サービスレベル | 計画の在席人数と予測の入電によるアーランCの推定値(第3章) | 電話の仕組みの記録(20秒以内に応答した割合) | 予測の外れ、処理時間の変化、席にいない時間(シュリンケージ) |
| 希望休の違反・希望の充足率 | 確定した勤務表と希望の突き合わせ | 確定後の変更を反映した実績 | 確定後の変更、希望の転記の漏れ |
| 残業・連勤 | 勤務表では原則0(残業を計画に入れない場合)、連勤は勤務表から数える | 勤怠の記録 | 欠勤の穴埋め、当日の業務量 |
| 公平性(土日・遅番の偏り) | 確定した勤務表から数える(第8章) | 確定後の変更を反映した実績 | 穴埋めが特定の人に集中していないか |
| 手直しの量 | 計算した勤務表と確定した勤務表の差分 | (計画の段だけで測る) | 書き漏らした制約、マスタの誤り |
表の最後の行の手直しの量は、第1章の指標には含めていなかった、導入の段階に特有の指標です。経営への報告には、費用の指標と並べて、この手直しの量を載せておくのが有効だと考えています。不足人時や人件費が下がっていても手直しの量が減らない状態は、計算機の勤務表がまだ職場に合っておらず、シフト作成者の手間が導入前と変わっていないことを意味するからです。勤務表の作成にかかる時間そのもの(希望の締切から公開までの日数、作成者の作業時間)も、導入の効果として並べておく価値があります。
もう1つ、報告で分けておきたいのは、計算機の勤務表の改善と、前提の変更による改善です。導入と同時に、勤務の型を増やした(第4章)、パートを採用した、希望休の件数に上限を設けた、といった変更があると、改善のどこまでが最適化の効果で、どこからが前提の変更の効果なのかが混ざります。同じ前提で計算した勤務表と人の勤務表を並べる比較(前提を固定した比較)と、前提を変えたときの勤務表の比較(この章の前半の、ルールごとの費用)を分けて報告すると、次にどこへ投資するかの判断に使えます。
経営の判断として最も重要なのは、スタッフの負担の指標を、費用の指標と同じ表に載せ続けることだと考えています。不足人時と人件費だけを報告の中心にすると、次の改善はそれを下げる方向にだけ進み、希望休の違反や連勤、遅番の偏りといった負担が、報告に出ないまま積み上がります。負担の積み上がりは、欠勤や離職として後から人件費と不足人時に跳ね返ってくるので、同じ表で両方を見ていないと、原因と結果のつながりが経営の側から見えなくなります。
導入の順序と失敗の型
ここまでの内容を、導入の順序としてまとめます。最初の段は、現状の勤務表を数字にすることです。過去数か月の勤務表と勤怠の記録、提出された希望休の記録から、不足人時・過剰人時・希望休の違反・連勤・偏りの現状値を出し、同時にスタッフのマスタ(スキル・雇用契約・希望)を集め、契約書と突き合わせます。2番目の段は、ヒアリングで決まりを聞き出し、出どころと優先順位を付けて書くことです。この段で、協定や就業規則に定めた内容との関係も確かめます。3番目の段は、過去の同じ月の条件で計算機の勤務表を作り、人の勤務表と並べる並行運用です。ここでは計算機の勤務表を公開せず、シフト作成者に見てもらって、使えない理由を集めます。理由の多くは書き漏らした決まりかマスタの誤りなので、2番目の段に戻して直します。4番目の段で、計算機の勤務表を人が直して確定する運用を始め、手直しの記録を取ります。5番目の段で、手直しの記録と勤怠の実績を定期的に集計し、制約とマスタを直す仕組みを回し続けます。
並行運用の段を飛ばして、いきなり計算機の勤務表を公開することは避けるべきだと考えています。公開した勤務表に、通勤や家庭の事情を無視した割当が一度でも入ると、スタッフとシフト作成者の信頼を失い、その後の改善が進みにくくなります。しかも、公開後の変更は本人との合意が要る労働条件の変更になるので、確定前の手直しよりはるかに手間がかかります。並行運用は、計算機の勤務表の品質を確かめる場であると同時に、作成者が計算機の勤務表を見慣れる期間でもあります。並行運用をいつ終えるかは、手直しの量が一定の水準まで下がったかで判断するのが分かりやすい基準です。
導入でよく見られる失敗は、次の表の型に分けられると考えています。どれも、ソルバーの選び方や計算の速さとは別のところで起きます。
| 失敗の型 | 起きること | 予防する手当て |
|---|---|---|
| 決まりの書き漏らし | 勤務表が職場で使えず、手直しが多くなり、やがて使われなくなる | 具体的な勤務表を見ながらのヒアリング、スタッフ本人への聞き取り、並行運用で使えない理由を集める |
| 決まりの入れすぎ | 作成者の慣行まで絶対の制約にして、改善の余地が消える。解が見つからなくなる | 決まりの出どころを記録し、決まりごとの費用を測って優先順位を付ける |
| マスタの放置 | 導入時のスキル・契約・事情が古くなり、勤務表の精度が月を追って落ちる | マスタの項目ごとに直す人と時期を決め、期限つきの事情には有効期限を持たせる |
| 試算の効果の過大評価 | 職場の決まりを入れない試算で効果を見積り、導入後に効果が縮む | 試算の段階から主要な決まりを入れ、前提を固定した比較で報告する |
| 説明できない勤務表 | 「なぜ自分がこの日なのか」に答えられず、スタッフの不信が作成者に向かう | 破った希望と理由の一覧を添える、同じ値の勤務表から選ぶ基準を決めておく |
| 費用の指標だけの報告 | 負担の指標が報告に出ず、偏りや連勤が積み上がって欠勤・離職として跳ね返る | 負担の指標を費用の指標と同じ表で報告し続ける |
| 運用の担い手の不在 | 導入した人が異動すると、決まりやマスタを直す人がいなくなる | 決まりの一覧とマスタの持ち主を業務の役割として決める |
表の最後の型は、見落とされやすいものです。勤務表の自動作成は、導入した時点で完成するものではなく、決まりとマスタを直し続けることで精度を保つ仕組みです。直す作業が特定の個人の頑張りに依存していると、その人がいなくなった時点で仕組みが止まります。決まりの一覧とマスタの持ち主を業務の役割として決めておくことが、導入の最後の段として必要だと考えています。
この章の要点は3つです。第一に、勤務表の自動作成が職場で使われなくなる原因の多くは、ソルバーではなく、書かれていない決まりとマスタの粗さにあり、決まりは具体的な勤務表を見ながら理由を尋ね、スタッフ本人にも聞いて聞き出すのが確実です。第二に、聞き出した決まりは出どころと費用を添えて優先順位を付け、守るべき決まりと見直すべき決まりを分けます。決まりの費用も割当の理由も、同じ値の勤務表が複数ありうることを踏まえて、目的の値と下界で読みます。第三に、勤務表は人が最後に直すことを前提に運用し、手直しの理由と勤怠の実績を記録して、制約とマスタに戻し続けます。その前提として、協定・就業規則・シフトの作成と変更のルールを労使で確かめておきます。次の第14章では、公開された一次情報のある事例と研究の動向、機械学習や生成AIと勤務表作成の関係を扱います。
この章を深めたい方への参考書籍
『ナース・スケジューリング:問題把握とモデリング』(池上敦子、近代科学社):日本オペレーションズ・リサーチ学会が監修するシリーズ「最適化モデリング」の1冊で、病棟の看護師の勤務表作成を題材にしています。第1章は現場調査とシフト制約条件・ナース制約条件の整理から始まり、最終章は「現実問題を最適化はどう支援するか」を扱っています。人間の暗黙的な評価や制約をどう把握してモデルにするかという、この章の前半の主題を、研究の側から深く追えます。
『AI・データ分析プロジェクトのすべて[ビジネス力×技術力=価値創出]』(大城信晃・マスクド・アナライズ・伊藤徹郎・小西哲平・西原成輝・油井志郎、技術評論社):データ分析のプロジェクトを、準備・入口・実行・出口の4部に分けて、組織の立ち上げから実務の進め方、成果の活かし方までを解説しています。勤務表の自動作成に限らず、分析や最適化の成果を業務に組み込んで使い続けるための段取りを、この章の「導入の順序と失敗の型」を補う視点から学べます。
第14章 事例と最新動向、公開された成果をどう読み、何を自社に持ち帰るか
第13章では、シフト作成者が頭の中に持っている暗黙のルールをヒアリングで書き出し、ハード制約とソフト制約に分け、人が最後に直した記録を次の制約に戻すという、最適化を現場に入れる手順を整理しました。この最後の章では視野を外に広げ、他の組織がどこまで進んでいるのか、研究とソフトウェアがどちらに動いているのかを確認します。扱うのは5つです。1つ目は、公開された一次情報で成果の中身をたどれる国内外の事例です。2つ目は、勤務表作成の国際競技会です。3つ目は、機械学習を勤務表づくりにどう使うかという研究の位置づけと限界です。4つ目は、生成AI(大規模言語モデル)に任せられることと人が決めなければならないことの線引きです。5つ目は、ソルバーの動向です。
この章では、企業名・病院名と数字は、企業の公式発表・学術誌や国際会議の論文・競技会の公式ページを開いて中身を確かめたものだけを書きました。見つからなかったものは書いていません。事例の数字には「実際に運用して測った値」と「導入前に見込んだ値や試算」が混ざりやすいので、どちらなのかを原文の表現に沿って書き分けます。なお、弊社コラム「数理最適化の定式化パターン集」の第1章で取り上げた国内の事例(大阪ガスの当直シフトの編成など)は、ここでは重ねて扱いません。
事例を読むための物差し、何が減ったのかを分ける
勤務表の自動作成の事例には「作成時間が8割減」「数十時間が1時間未満に」といった数字が並びます。自社の判断に使うには、その数字が何を測ったもので、どういう条件で出たものかを確かめる必要があります。この章では、事例の数字を次の4つの観点で読みました。
1つ目は、数字の種類です。実際に運用している部署で測った実績なのか、試行(期間や対象を限った導入)の結果なのか、導入前の見込みや社内の試算なのかを分けます。2つ目は、減ったものの種類です。この章で集めた事例では、公表されていた数字の多くが作成にかかる人の作業時間で、第1章で定義した不足人時・過剰人時・サービスレベル・希望の充足率のような「勤務表そのものの質」の数字は、トロント市の希望の充足率を除いて見当たりませんでした。作成時間の削減は、主にシフト作成者(店長・看護師長・センター長)の人件費と負担の効果で、不足人時や過剰人時の削減は、現場全体の人件費とサービスの効果です。この2つは金額の桁が違うことが多いので、同じ「〇割削減」として並べられません。3つ目は、比べている相手です。「手作業のときの作成時間」と比べたのか、「以前使っていた別の仕組み」と比べたのかで意味が変わります。4つ目は、範囲です。全店・全病棟の話なのか、一部の部門・一部の病棟の話なのかを確かめます。
2つ目の観点は、この記事の共通データでも確かめられます。第5章の基準の勤務表は、CP-SAT が 2.6 秒で解き終え、重みづけの目的について最適であることを証明しています(第5章で読み方を説明した基準の結果。この記事の実行環境での実測)。2.6秒は1回の実測で、同じモデルを第10・11・13章で解き直したときは、ほかの計算と同時に動かした条件で7.4〜19.7秒かかりました。それでも、不足は 221.0 人×時間、過剰は 641.0 人×時間残っています。計算にかかる時間が数秒から数十秒に収まっても、勤務の型と需要の山が合っていなければ(第4章)、勤務表の質の数字は良くなりません。反対に、作成時間の数字には、計算の時間だけでなく、希望を集める手間、出てきた勤務表を確認して直す手間が含まれます。事例の「作成時間の削減」がどこからどこまでを数えたものかは、公表資料に書かれていないことが多く、書かれていない場合は「公表資料からは分からない」と読むのが安全です。
以下の事例は、この4点が分かるように書き、分からない点は分からないと書きました。先に一覧を示します。
| 事例 | 対象 | 公表された主な数字 | 数字の種類 | 出典の種類 |
|---|---|---|---|---|
| Taco Bell(米国) | 店舗の従業員の人員計画と勤務の割り振り | 1997年までに人件費を5,300万ドル超節約 | 著者が報告した累計の節約額 | 学術誌 Interfaces の論文(1998年) |
| L.L.Bean(米国) | 電話受付の要員数 | 年50万ドル超の節約 | 推定(estimated) | 学術誌 Interfaces の論文(1993年) |
| イオンリテール | 店舗の時間帯ごとの作業割り当て(ワークスケジュール) | 作成時間が半減から8割減/年約200万人時 | 前者は先行した部門で出た効果、後者は同社の試算で複数のシステムの合計 | 同社のニュースリリース(2024年4月5日) |
| トロント市の長期療養施設(カナダ) | 看護職員の勤務表 | 数十時間かかりうる作業が1時間未満に/割り当てた勤務の平均94%超が最も希望の高い勤務 | 391床の施設に導入した結果 | 学術誌 INFORMS Journal on Applied Analytics の論文(2023年。初稿は arXiv、2021年) |
| 山梨大学医学部附属病院 | 病棟の看護師の勤務表 | 作成時間の数字は公表なし。約1年の改良の繰り返しと、6病棟での試行を報告 | 試行中の報告 | 国際会議 ICLP 2025 の論文 |
| Swissgrid(スイス) | 従業員の勤務表 | 市販ソルバーだけで解く場合より1桁速く、最適に近い解 | 計算実験の結果。ツールは試行中 | 論文(arXiv、2021年) |
表の「数字の種類」の列が、この章で最も気をつけて書いた部分です。同じ列に並んでいても、実績・推定・試算・計算実験は、自社の効果の見込みに使うときの重みがまったく違います。以下、1件ずつ中身を見ます。
海外の古典的な事例、Taco Bell と L.L.Bean
勤務表と要員数の最適化は、OR(オペレーションズ・リサーチ)の実務の中でも歴史の長い分野で、成果を学術誌に報告した事例が1990年代からあります。ここでは、この記事の2つの工程(必要人数を見積もる工程と、勤務に割り当てる工程)にそれぞれ対応する2件を取り上げます。いずれも、実務での成果を報告する学術誌 Interfaces(Crossref の雑誌情報では、同じ ISSN の誌名は現在 INFORMS Journal on Applied Analytics)に掲載された論文で、要旨は出版社が Crossref に登録したものを開いて確かめました。
1件目は、米国のファストフードチェーン Taco Bell の人員管理の仕組みを報告した Hueter と Swart の論文「An Integrated Labor-Management System for Taco Bell」(Interfaces、1998年)です。要旨によれば、同社は値下げを軸にした新しい戦略のもとで事業をより効率的な形に組み直す必要があり、そのために互いにつながったORのモデルの組を使いました。来店客の到着を予測するモデル、望むサービス水準を出すのに必要な人員をシミュレーションで決めるモデル、そして人件費を最小にするように従業員を勤務に割り当てる最適化のモデルです。要旨は、1997年までにこれらのモデルで人件費を5,300万ドル超節約したと書いています。要旨の表現は「have saved」で、見込みではなく、著者が報告した累計の実績として書かれています。ただし、何と比べた節約か、どの期間の何店舗分かは、要旨からは分かりません。
この事例がこの記事の構成とよく対応しているのは、予測・必要人数の算出・割り当ての3つを別々のモデルにして順につないでいる点です。第3章で扱った必要人数の見積り(Taco Bell ではシミュレーション)と、第4章・第5章で扱った型の設計と割り当て(最適化)を分け、その前に需要の予測を置いています。3つを1つの巨大なモデルにするのではなく、工程ごとに適した道具を使い、前の工程の出力を次の工程の入力にするという分け方は、30年近く前の事例でも今の実務でも同じです。
2件目は、アウトドア用品の通信販売の L.L.Bean で、電話受付の要員数を決めた Andrews と Parsons の論文「Establishing Telephone-Agent Staffing Levels through Economic Optimization」(Interfaces、1993年)です。要旨によれば、著者らは待ち行列の理論を使い、期待される費用の合計を目的にした経済的な最適化のモデルを作って導入しました。その結果得られた要員数は、同社が以前使っていた「サービスレベルの基準で要員数を決める」方法の要員数とは大きく違ったとされています。モデルには、電話がつながらずにかけ直す客や、途中で切ってしまう客(放棄)も、放棄率とサービス率(決められた時間内に応答できた電話の割合)の関係を回帰で表す形で入れています。節約額は年50万ドル超と推定されています(原文は「estimated」)。
この事例は、第3章で扱った「サービスレベルの目標を先に決めて必要人数を出す」やり方に対して、「待たせることの費用と人件費を足した合計を最小にする人数」を出すやり方があることを示しています。サービスレベルの目標(この記事の共通データでは80%を20秒以内に応答)は、それ自体が経営判断で、目標を1段上げたときの人件費の増え方と、待たせたことで失う売上や顧客の不満とを比べて決めるべきものです。L.L.Bean の事例は、その比較を式にした例として読めます。一方で、待たせることの費用を円で置くには、放棄された電話がどれだけの売上を失ったかという推定が必要で、その推定の確からしさが結果を左右します。自社で同じことをするなら、推定に使ったデータと仮定を、要員数の結果と一緒に経営に示す必要があります。
国内の小売の事例、イオンリテールのワークスケジュール自動作成
国内で公式発表から中身をたどれる例として、イオンリテールの取り組みを取り上げます。同社の2024年4月5日のニュースリリースによれば、同社は2024年4月21日から、AI による「ワークスケジュール自動作成機能」を店舗の全部門で実装しました(食品の部門は2023年8月から先行して実装)。展開する店舗は「イオン」「イオンスタイル」など約360店舗です。この機能は、2022年に実装した「AIワーク」(リリースの表記は全角の「AIワーク」)の機能拡張で、従業員の勤務シフト、スキル、時間帯ごとに必要な業務内容などに基づいて、各従業員の時間帯ごとの作業割り当てを自動で行うとされています。
この事例で注目したいのは、自動化の対象が「誰がどの日に出勤するか」の勤務表ではなく、出勤が決まった人に「何時から何時まで何の作業をするか」を割り当てる工程だという点です。第2章で整理した問題の分類でいえば、勤務の割り当ての後にある、日の中の作業の割り当てに当たります。小売の店舗では、品出し・レジ・売場づくり・発注のように作業の種類が多く、時間帯ごとに必要な作業が変わるので、勤務表を作ったあとの作業の割り当てにも手間がかかります。この記事の共通データのコンタクトセンターでは作業が「電話を受ける」1種類なので、この工程は出てきませんが、第9章のスキルの話を時間帯の単位に細かくしたものと考えると、同じ枠組みで書けます。
数字は2つあります。1つ目は、リリースの「既に導入している一部の部門では、ワークスケジュールの作成時間について半減~8割減の効果が出ています」という記述です(リリースの表記のまま引用しました)。先行した部門での作成時間の効果で、全部門・全店の数字ではありません。また、比べている相手(以前の作り方)と測り方は、リリースには書かれていません。2つ目は「年間約200万人時(当社試算)」で、リリースの注記によれば、同社が2020年以降に実装した各種の AI システムと「新・販売計画支援システム」の試算を合計した数値です。つまり、ワークスケジュールの自動作成だけの効果ではなく、発注や値引きなどの仕組みも含めた合計の試算です。この2つの数字を「シフト作成の AI で年200万人時」とまとめて読むのは、原文の範囲を越えています。
リリースはもう1つ、同社の考え方として、システムで生まれた時間を接客や売場での工夫に回すこと、AI の提案をもとにもう一段精度を高める考え方が生まれたことを挙げています。作成時間の削減を人員の削減ではなく、別の仕事への時間の付け替えとして説明している点は、第13章で扱った現場の受け入れの観点からも参考になります。なお、同社の2025年5月15日のリリースでは、「AIワーク」を柱に、1人ひとりのシフトや時間帯ごとのワークスケジュールを示す従業員アプリの実証運用を2025年6月から始めるとしています。勤務表と作業の割り当てを、作る側の道具から、働く側が毎日見る画面へ広げる方向です。
病院と介護などの事例、暗黙知の取り込みと人による手直し
看護師の勤務表は、第5章で扱ったナース・スケジューリング問題の名前の由来でもあり、長く研究されてきた領域です。一方で、後で紹介する日本の論文の要旨は、多くの病院で勤務表がまだ手作業で作られていると書いています。ここでは、実際の病院・施設で使われたことが論文に書かれている事例を3件見ます。
1件目は、山梨大学医学部附属病院の看護師の勤務表作成の仕組みです。Nabeshima・Banbara・Schaub・Soh の論文「The ASP-based Nurse Scheduling System at the University of Yamanashi Hospital」(国際会議 ICLP 2025 の論文集 EPTCS 439 に収録、2026年)によれば、同院は病床約620、医師約400名、看護師約760名で、19の病棟がそれぞれ看護師の勤務表を持ち、勤務表は看護師長の手作業で作られていました。著者らは解集合プログラミング(ASP。守るべき条件を論理の規則として書き並べ、それを満たす答えをソルバーに探させる、制約プログラミングに近い技術)で勤務表の問題を書き、自動で作成する仕組みを作りました。
この論文で最も参考になるのは、モデルの作り方の手順です。著者らはまず、日本の病院に典型的な勤務表の問題の定式化を看護師長に示し、意見を受けて足りない条件を足し、不要な条件を外して基本のモデルを作りました。次に、条件が特に厳しい産科・婦人科の病棟に絞り、自動で作った勤務表を看護師長に評価してもらい、受け入れられない点や不自然な点の指摘を受けて定式化を直すことを繰り返しました。論文はこれを「反復的なモデル改良のサイクル」と呼び、勤務表の作成と評価を4週ごとに、約1年繰り返したと書いています。明示的な知識は最初の定式化の段階で多くが見つかる一方、暗黙の知識は自動で作った勤務表を評価する段階で表に出てくるので、このサイクルが暗黙知を引き出すのに欠かせないとしています。第13章で扱った「人が最後に直した記録を次の制約にする」運用を、1年かけて実際に回した記録として読めます。
論文は、暗黙知を完全に取り込むことは難しいと認めたうえで、定式化は本質的に不完全であるという前提に立ち、自動で作った勤務表を看護師長が手で直すことを支援する仕組みを用意したと書いています。ウェブの画面で特定のマスを直す・固定する、入りたい勤務と入りたくない勤務を追加する、といった操作をしてから解き直します。論文は、このときに元の勤務表からの変更を少なくしたいという課題を、最小摂動問題(元の答えをできるだけ変えずに、新しい条件に合わせる問題)として位置づけています。ただし、実装で使っているのは、変更の少なさを目的に入れて解く方法ではなく、元の割当を優先して選びながら探索し直す LNPS(大近傍優先探索)という方法です。論文の実験では、LNPS のほうが解の改善が速く、対話的な手直しに向いていたとしており、一方でこの方法では変更が最小になることは保証されないとも書いています。第11章で扱った「変更を最小にする再作成」(変更の件数を目的に入れる方法)と目指すところは近いものの、変更の最小化までは保証しない点が違います。モデルの規則は約100で、規則の全体と匿名化した実データのインスタンスは公開のリポジトリにあるとされています。論文の時点で、この仕組みは同院の6つの病棟で試行中です。作成時間がどれだけ減ったかの数字は、論文には書かれていません。利用者の声としては、看護師長から勤務表作成の負担が減ったという声、看護師から休みの希望を看護師長の手間を気にせず出しやすくなったという声がある一方、否定的な声の多くはモデルの不足(特にきつい勤務の並びを避けてほしい、連休と夜勤の配分を均等にしてほしい)に関するもので、それを受けて条件を追加したと報告しています。
関連して、共著者の番原睦則氏(名古屋大学)が2023年10月26日に名古屋大学のウェブサイト「情報玉手箱」の記事「看護師の勤務表作成 ー解集合プログラミングの応用ー」で、ある国立大学の附属病院(記事では大学名を伏せています)の1つの病棟で、32名×28日、休みを含む6種類の勤務の勤務表を自動作成し、実際に使ったことを紹介しています。記事は、自動作成で勤務表を作る時間は減ったが、看護師長の確認作業の時間が逆に増えたことを最大の懸念として挙げ、最優先で解決すべき課題としています。勤務表の作成時間の事例を読むときに、確認と手直しの時間が数えられているかを確かめるべき理由が、ここにあります。なお、この記事の病院と上の論文の病院が同じかどうかは、記事の記述からは確かめていません。
2件目は、カナダのトロント市の長期療養施設の事例です。Anderson・Bodur・Rathwell・Sarhangian の論文「Optimization Helps Scheduling Nursing Staff at the Long-Term Care Homes of the City of Toronto」(INFORMS Journal on Applied Analytics 第53巻第2号、2023年。査読を経て掲載された論文で、初稿は2021年に arXiv で公開)によれば、トロント市の長期療養施設の部局は市内10か所で2,640人の入居者にケアを提供しており、看護職員の勤務表作成が難しくなっていることと、パートタイムの看護職員の欠勤率の高さが共同研究のきっかけでした。著者らは表計算ソフトをもとにした勤務表の作成ツールを作り、看護職員の勤務の希望を勤務表に取り込めるようにしました。中心にあるのは、満たせる需要を最大にしたうえで希望の点数の合計を最大にする、段階的(階層的)な最適化のモデルで、勤続年数の長い看護職員を優先して勤務を割り当てるという複雑な先任順の規則も守らせています。このツールは391床の施設に導入され、手作業では数十時間かかりうる作業が1時間未満で実行可能な勤務表を作れるようになり、割り当てた勤務の平均94%超が本人にとって最も希望の高い勤務だったと報告されています。
この事例は、第8章の希望と公平性の話と、第6章の「重みづけの和」と「段階的に解く」の違いの話を、実地で示しています。需要を満たすことを先に決め、その範囲で希望を最大にするという段階の付け方は、この記事の基準(不足・希望休の違反・人件費などを円換算の重みで足した1つの値を最小にする)とは違う設計です。どちらが良いかは職場のルールで決まります。この施設では、勤続年数の長い人を優先するという守らなければならない規則があり、その規則と希望の点数を1つの重みづけの和にまとめるより、段階に分けたほうが扱いやすかったと考えられます。作成時間だけでなく希望の充足率を成果の数字として出している点も、第1章で定義した経営指標に沿った報告の仕方です。
3件目は日本の急性期と慢性期の病院で、Nakashima・Furuike・Inoue の論文(arXiv、2025年。看護師の勤務表作成のための2段階スケジューリング法と、その実用化を扱ったもので、本文は日本語)です。要旨によれば、今の整数計画ソルバーは実用的な時間で勤務表を作れるにもかかわらず、多くの病院で勤務表がまだ手作業で作られている理由は、看護師長が無意識に考慮していること(暗黙知)を明示的な制約として書き切れず、自動で作った勤務表が実用にならないことが多いからだとしています。そこで著者らは、夜勤の段階と日勤の段階の2段階に分けて勤務表を作り、1段階目のあとに看護師長が手で調整できるようにする「2段階スケジューリング法」を提案し、この方法に基づくシステムを急性期と慢性期の病院に導入した事例と、導入で出会った課題とその対処を報告しています。2段階に分けると、全体を一度に解く場合の最適性は失われますが、人が口を挟める場所を設計として作っています。これは第10章で扱った分解の考え方を、計算のためではなく人の判断を入れるために使った例です。
この3件に共通するのは、ソルバーの性能よりも、暗黙のルールを取り込む手順と、人が手で直す仕組みに多くの記述が割かれていることです。どの論文も、成果として書いているのは「解けた」ことではなく「使われる形にした」ことでした。第13章の導入の手順は、この部分を自社の規模で進めるためのものです。
病院以外で、従業員の勤務表を扱った論文の事例として、スイスの Swissgrid を取り上げます。Park と Vrettos の論文(arXiv、2021年)によれば、同社の従業員の勤務表作成は大部分が手作業でした。著者らは混合整数線形計画(MILP。第6章で PuLP と CBC を使って扱った種類のモデル)と、進化計算の一種であるスキャッターサーチ(良い解をいくつか手元に集め、それらを組み合わせて新しい解を作ることを繰り返す探索)を組み合わせた方法を作り、労働法令を守ること、従業員の希望の充足を最大にすること、負担をできるだけ均等に配ることを同時に扱っています。要旨によれば、現実的な規模の問題を最適に近い解まで、市販の最新ソルバーで MILP だけを解く場合より1桁速く解けたとされ、この方法を組み込んだソフトウェアのツールが同社で試行中(pilot use)とされています。
この事例の数字は計算実験の結果で、同社の勤務表の質や作成時間が実際にどう変わったかの数字ではありません。持ち帰れるのは「法令を守る」「希望を満たす」「負担を均等にする」の3つを同時に扱った設計と、計算時間の問題を、厳密な解法と発見的な解法の組み合わせで乗り越えたという点です。第10章で扱った大近傍探索のように、厳密に解ける部分と探索で広げる部分を組み合わせる考え方は、規模が大きくなったときの選択肢になります。
勤務表作成の国際競技会、INRC-I と INRC-II
勤務表作成の研究を実務に近づけるために、研究者どうしが同じ問題を解いて競う国際競技会が開かれてきました。代表的なものが国際看護師勤務表競技会(International Nurse Rostering Competition。略して INRC)で、これまでに2回開かれています。以下は、2つの競技会の公式ページで確かめた内容です。
1回目の INRC(2回目と区別して INRC-I と呼ばれます)は2010年に開かれました。公式ページによれば、運営はベルギーのルーヴェン・カトリック大学の CODeS 研究グループ、ノルウェーの SINTEF、イタリアのウーディネ大学です。競技は2010年3月1日に始まり、最終的な解の提出期限は2010年6月20日で、公式ページは、各部門の順位と勝者をベルファストで開かれる時間割・勤務表の国際会議 PATAT 2010 で発表するとしています。競技は、陸上競技の種目にならって短距離(sprint)・中距離・長距離と名付けた3つの部門に分かれており、公式ページはその理由を、部門ごとに実務での問題の設定が違い、アルゴリズムの性能は使える計算時間に合わせて調整されることが多いためだと説明しています。問題には初期・後期・非公開の3種類のデータがあり、非公開のデータは最終候補のアルゴリズムを試すために取っておかれました。公式ページの順位表では、3部門とも Valouxis・Gogos・Goulas・Alefragis・Housos のチームが1位で、短距離の部門では K. Nonobe 氏が2位に入っています。公式ページは競技会の目的として、実世界の制約を多く含む問題のモデルを研究者に提供すること、そしてこの分野に今ある研究と実務の間の差を縮めることを挙げています。
2回目の INRC-II は2014年から2015年に開かれました。公式ページによれば、運営はルーヴェン・カトリック大学(コルトレイク校)の CODeS、ウーディネ大学、ベルギーの VIVES 大学カレッジの研究者です。INRC-I との大きな違いは、問題が「段階」に分かれている点です。4週または8週の計画期間を1週ずつ順に解き、1週を解き終えるたびに次の週の情報が明らかになります。公式ページは、先の週で人員を使いすぎると後の週で困るので、前の週までのデータに基づく予測が必要になることがあると説明しています。つまり、4週分をまとめて解けるこの記事の共通データとは違い、先が見えないまま週ごとに決めていく設定です。競技は2014年10月17日に始まり、解法と最良の結果の提出期限は2015年6月1日、勝者の発表の場はプラハでの国際会議 MISTA 2015 とされていました。公式ページによれば、提出は15件あり、7チームが最終候補に残りました。非公開のデータでの最終順位は、1位がドイツのマルティン・ルター大学ハレ・ヴィッテンベルクのチーム(NurseOptimizers)、2位がカナダのモントリオール理工科大学のチーム、3位が英国のエクセター大学のチームで、企業の ORTEC のチーム(公式ページの所属の表記も ORTEC)が5位に入っています。
競技会の結果を実務の目で読むときに大事なのは、順位そのものより、問題の設定です。INRC-II が「1週ずつ、先が見えないまま解く」設定を選んだのは、実際の病棟では翌月の欠勤や入院患者の数が分からないまま勤務表を確定させるからで、第11章(当日の欠勤)と第12章(需要のばらつき)で扱った問題を、競技の形にしたものといえます。一方で、山梨大学医学部附属病院の論文は、実際の病院の勤務表には、典型的なベンチマーク問題や競技会を越える独自の難しさがあると書いています。勤務の種類の多さ、看護師のグループの重なり、手で直すことへの対応などです。競技会の問題は研究の共通の土台として役立ちますが、自社の問題がそのまま競技会の問題の形をしているとは限りません。
この記事では、競技会とは別の公開ベンチマークである Curtois と Qu の看護師勤務表のインスタンス(Instance1〜24)を、第6章と第10章で CP-SAT を使って解き、既知最良解と比べています。ベンチマークで良い成績が出ることは、ソルバーと定式化が一定の水準にあることの確認になりますが、自社の勤務表で使えるかどうかは、第13章の手順で自社の条件を書き出して解いてみるまで分かりません。
機械学習と勤務表、予測と制約の発見に使う
勤務表の世界で機械学習(データから規則を学ぶ技術)が担う役割は、大きく2つに分けて考えると整理しやすくなります。1つ目は、勤務表の入力になる数字の予測です。第3章と第12章で扱った入電件数などの需要の予測に加えて、欠勤の予測があります。2つ目は、勤務表の条件そのものを過去のデータから見つけることです。どちらも、勤務表を作る計算そのものはソルバーに任せ、機械学習はその前段を受け持つ形です。
1つ目の例として、Doneda・Smet・Carello・Lanzarone・Vanden Berghe の論文「Robust personnel rostering: how accurate should absenteeism predictions be?」(arXiv、2024年)を取り上げます。題名を訳せば「頑健な勤務表:欠勤の予測はどれほど正確であるべきか」です。要旨によれば、欠勤による勤務表の乱れを和らげる一般的な方法は、欠勤者の代わりに呼び出せる待機の勤務(第11章でいうオンコール)を割り当てておくことで、著者らは機械学習のモデルで欠勤を予測し、その予測に基づいて待機の勤務の数を決める予測してから最適化する(predict-then-optimize)方法を想定しています。この論文の工夫は、実際に予測モデルを作る代わりに、「予測がこの程度の性能だったら」という前提で予測を模擬し、データに基づかない単純な方針(たとえば待機を一律に何人置く)より良くなるには、予測がどれだけの性能を持つ必要があるかの下限を調べる方法を示した点です。看護師の勤務表の計算実験では、妥当な性能の要件のもとで予測に基づく方法が単純な方針を上回り、とくに従業員のスキルが互いに代わりの利く場合に上回ったとしています。
この結論は、第9章の多能工化の話と第11章の待機要員の話をつなぎます。欠勤を予測できても、代わりに入れる人のスキルが合わなければ、待機を置く場所を予測どおりに決めても不足は埋まりません。予測への投資と多能工化への投資は、別々に評価するより、組み合わせて評価したほうがよいということです。また、「予測の精度がどれだけあれば元が取れるか」を先に調べるという考え方は、機械学習の導入を検討するときの順序として参考になります。精度の高い予測を作ってから使い道を考えるのではなく、使い道の側から必要な精度を決めるということです。
2つ目の例は、Kumar・Teso・De Raedt の論文「Automating Personnel Rostering by Learning Constraints Using Tensors」(arXiv、2018年)です。要旨によれば、OR の多くの問題ではモデルに制約を書く必要があり、正しい制約を決めるのは難しく手間のかかる作業です。著者らは、勤務表の問題では過去の勤務表が手元にあることが多い点に着目し、過去の勤務表の例から制約を自動で学習する方法を提案しました。評価では、INRC の制約を満たす勤務表を作ってそれを例として与え、人が読める形の制約を取り出せたとしています。第13章で扱ったヒアリングでは、シフト作成者本人も気づいていないルール(暗黙知)が漏れやすいので、過去の勤務表から「いつも守られている並び」を候補として取り出し、それを人に確かめてもらうという使い方が考えられます。
ただし、限界もはっきりしています。過去の勤務表から学んだ規則には、守るべき理由のある規則と、たまたまそうなっていただけの習慣が区別なく入ります。特定の人がいつも遅番に入っていたという並びは、本人の希望かもしれませんし、作成者の偏りかもしれません。第8章で扱った公平性の観点からは、過去の偏りを学習して再現することは避けなければなりません。学習した規則は、そのまま制約に入れるのではなく、第13章の手順でハード制約・ソフト制約・捨てるものに人が振り分ける前提で使うのが安全だと考えています。また、この論文の評価は、競技会の制約から人工的に作った勤務表を使ったもので、実際の病院の勤務表で試した結果ではありません。
生成AIに任せられること、人が決めること
大規模言語モデル(大量の文章で学習し、文章を読んで文章を書く AI。生成AI の中核の技術)を最適化のモデルづくりに使う研究も出てきています。勤務表に関係するものを3件、要旨を開いて確かめました。
1件目は、Li・Zhang・Mak-Hau の論文(arXiv、2025年)で、勤務のスケジューリングを対象に、専門家の知識に導かれた MILP のモデルづくりの仕組み SMILO を提案しています。要旨によれば、大規模言語モデルでモデルづくりを自動化する試みには、モデルづくりの専門知識の不足、大量の学習データへの依存、もっともらしい誤り(ハルシネーション)といった課題があります。SMILO は、使い回せるモデルの部品と、専門家が定義した式のひな形を用意しておき、大規模言語モデルには「どの部品が関係するか」と「その事例に固有の情報」を文章から取り出させ、式そのものはひな形から組み立てるという3段階の構成です。情報の取り出しと式の生成を分けることで、正確さ・透明性・再現性を高めたとしています。製造・物流・サービスの勤務のスケジューリングの問題で試し、5回の試行を通じて90%のテスト事例で正しいモデルを作り、大規模言語モデルに一度に式まで作らせる方法を少なくとも35%上回ったとしています。
2件目は、Sharma と Sharma の論文「SCHEDBench」(arXiv、2026年。コメント欄によれば自然言語処理の国際会議 EMNLP 2026 の Findings)で、こちらは限界を測った研究です。要旨によれば、ジョブショップ・資源制約つきのプロジェクトスケジューリング・看護師の勤務表・授業の時間割にまたがる1,132の問題を自然な文章で与え、同じ意味の問題を言い回しだけ変えて与えたときに、大規模言語モデルが制約を守った答えを同じように出せるかを調べました。13の大規模言語モデルを試した結果、意味が同じでも言い回しが変わると結果が安定せず、実行可能な答えを出す割合が下がり、ハード制約の違反が増えたとしています。調べた変化の中では、制約を書く順番を入れ替えることの影響が最もはっきりしていたと書いています。
3件目は、Chen・Hu・Luo の MAPLE(arXiv、2026年9月)で、一度作った最適化の問題を、自然な言葉での変更の依頼に合わせて保守し続けるエージェント(道具を使いながら複数の手順を自分で進める AI の仕組み)を提案しています。要旨は、実際の業務では需要・資源・優先順位が変わるので、データ・制約・目的を更新し続ける必要があり、1回ごとの依頼を別々に扱う方法ではそれまでの決定を保った素早い対応が難しいと指摘しています。評価用の問題集には、選択・スケジューリング・勤務表・配送・計算資源の配置にまたがる15の系列と180回の更新を用意したとされています。毎月の勤務表の条件が少しずつ変わっていくという実務の姿に近い設定です。
これらの研究の数字は、公開された問題集での評価で、実際の職場の勤務表に使ったときの成果ではありません。そのうえで、この記事の各章で扱った作業に当てはめると、任せやすい作業と人が決めるべきことは、次のように分かれると考えています。
| 作業 | 生成AIに任せやすいこと | 人が決めること・確かめること |
|---|---|---|
| ヒアリングの整理(第13章) | 聞き取りの記録から条件の候補を抜き出し、ハード制約とソフト制約の案に分けて一覧にする。似た条件の重複をまとめる | どの条件を守るべき制約とし、どれを緩められる条件とするか。法令に当たる条件の確認(第7章) |
| 制約の下書き(第5章・第6章) | 条件の一覧から CP-SAT のコードの下書きを作る。窓の和で書くか並びの制約で書くかの候補を出す | コードが条件どおりかの確認。小さな勤務表で違反が0件か、わざと違反させた勤務表で違反が検出されるかを試すこと |
| 結果の説明(第13章) | 勤務表と経営指標の表から、スタッフ向け・管理者向けの説明文の下書きを作る。「なぜこの日にこの人か」を制約の言葉で説明する | 説明の数字が実行結果と一致しているかの確認。個人の事情に触れる説明を出してよいかの判断 |
| 重みと優先順位の設定(第5章・第8章) | 重みを変えたときに何が変わるかの選択肢の整理 | 不足・希望・公平性・人件費の優先順位と重み。これは経営と労使の合意そのもの |
| 毎月の勤務表の計算 | 任せない。計算はソルバーに行わせる | 時間制限、解が出ないときの手順、最後に作成者が確認して確定すること |
表の最後の行が要点です。SCHEDBench の結果が示すとおり、大規模言語モデルに勤務表そのものを作らせると、言い回しの違いだけで制約を守れる割合が変わります。この記事の共通データ(30名×28日)程度の規模でも、制約をすべて守った勤務表を毎回出すことは保証されません。制約を守った勤務表を出し、どれだけ良いかを下界と比べて測れるのはソルバーの側です。生成AI の役割は、ソルバーに渡すまでの「言葉を式にする」工程と、ソルバーから返った結果を「言葉にして伝える」工程を速くすることにあります。SMILO が情報の取り出しと式の組み立てを分けたのも、同じ考え方に立っています。表の中央の列の作業はいずれも、出てきたものを人が照合できる性質の作業で、照合できない作業(重みと優先順位)は人が決める側に置きました。
勤務表に特有の注意点がもう1つあります。勤務表の条件には、健康状態・家庭の事情・相性といった個人の事情が含まれます。ヒアリングの記録を外部の生成AI のサービスに入れる場合は、個人情報の扱いについての社内の規程と、サービスの利用条件を先に確かめる必要があります。
ソルバーの動向、公式ページで確かめたこと
最後に、勤務表の計算に使えるソフトウェアの動きを、公式のリポジトリと競技会の公式ページで確かめられた範囲で整理します。
この記事で使った OR-Tools は、GitHub の公開リリースによれば v9.15 が2026年1月12日に公開されており、この記事の実行環境の版(9.15.6755)はこの系列です。OR-Tools の CP-SAT は、制約プログラミングのソルバーの国際競技会である MiniZinc Challenge で好成績を続けています。同競技会の公式の結果ページによれば、2024年・2025年・2026年のいずれの年も、固定の探索(Fixed)・自由な探索(Free)・並列(Parallel)の3部門で OR-Tools CP-SAT が金メダルでした。ただし、MiniZinc Challenge の問題は勤務表に限らない様々な組合せ問題の集まりで、勤務表の問題での順位を示すものではありません。第6章で CP-SAT を主な道具にしたのは、この記事の実行環境で無償で使え、勤務表で必要な並びの制約を書く手段がそろっているからで、競技会の順位だけが理由ではありません。
整数計画(MILP)のソルバーでは、オープンソースの HiGHS が、GitHub のリリースによれば v1.15.1 を2026年7月2日に公開しており、ライセンスは MIT です。MiniZinc Challenge 2026 の結果ページにも、HiGHS 1.14.0 を使う形で参加が記載されています(賞の対象外の参考出場の扱い)。この記事の実行環境には HiGHS を入れていないので、第6章の PuLP と CBC の比較には含めていません。
勤務表の用途を明示しているソフトウェアとして、Java と Kotlin 向けのオープンソースの Timefold Solver があります。GitHub のリポジトリの説明文は、配送計画・従業員の勤務表・作業の割り当て・保守の計画などの計画問題を最適化するソルバーと書いており、リリースによれば v2.7.0 が2026年9月24日に公開され、ライセンスは Apache-2.0 です。社内のシステムが Java で作られている場合の選択肢になりますが、この記事では試していません。
山梨大学医学部附属病院の事例で使われた解集合プログラミングのソルバー clingo(ポツダム大学のグループによるもの)は、GitHub のリリースによれば v5.8.2 が2026年8月14日に公開されており、ライセンスは MIT です。論文の著者らは、勤務表の規則と匿名化したインスタンスを公開のリポジトリ(nabesima/yamanashi-nsp)に置いており、実際の病院の勤務表の問題を研究者が試せる数少ない公開例になっています。
ソルバーを選ぶときに大切なのは、新しさよりも、自社の制約を書けるかどうかです。第13章で書き出した制約(連勤・続けてはいけない組・スキルの配置・希望休・公平性の上限など)の一覧を手元に置き、それぞれのソルバーの公式ドキュメントで書き方があるかを確かめるのが、比較の出発点になります。速さの比較は、そのあとに自社のデータで行うべきもので、公開のベンチマークや競技会の順位は参考にとどまります。
経営の側から見る、事例と動向を自社の判断に落とす
この章の内容を経営判断に翻訳すると、3つの問いになります。1つ目は「他社の事例の数字を自社の効果の見込みに使ってよいか」です。答えは、そのままでは使えない、です。この章で見た数字の多くは作成時間の削減で、しかも先行した部門の効果(イオンリテール)、推定(L.L.Bean)、計算実験(Swissgrid)と種類が混ざっています。複数のシステムの合計の試算を1つの仕組みの効果として読むと、見込みは実際より大きくなります。事例の数字は「その種類の取り組みで効果が出うる方向」を示すものとして読み、大きさは自社のデータで、現状の勤務表を比べる相手にして測るのが確実です。測るべき数字は、作成時間だけでなく、第1章で定義した不足人時・過剰人時・希望の充足率・連勤や遅番の偏りです。作成時間しか測らずに導入を評価すると、勤務表の質が下がっていても気づけません。
2つ目は「どこに投資すると効果が大きいか」です。事例を並べると、成果を左右していたのはソルバーの性能より、暗黙のルールを取り込む手順と、人が手で直す仕組みでした。山梨大学医学部附属病院は約1年かけてモデルを直し続け、名古屋大学の記事は確認作業の時間が増えたことを最大の課題に挙げ、日本の2段階スケジューリング法の論文は看護師長が途中で手を入れられる設計にしていました。ソルバーやシステムへの投資と同じ重さで、条件を書き出して直し続ける体制(担当者の時間、看護師長や店長との定期的な見直し)に投資する必要があると考えています。この体制の費用を見積りに入れずに導入を決めると、導入後に確認と手直しの時間が膨らみ、作成時間の削減が相殺されます。
3つ目は「新しい技術にどう備えるか」です。機械学習は欠勤や需要の予測、過去の勤務表からの条件の候補の発見に、生成AI はヒアリングの整理・制約の下書き・結果の説明に使える段階に来ています。ただし、どちらも勤務表を作る計算をソルバーから置き換えるものではありません。導入の順序としては、まず第13章の手順でソルバーによる勤務表の作成を回し、条件の一覧と手直しの記録がたまってから、その記録を材料に機械学習や生成AI で前後の工程を速くする、という順番が扱いやすいと考えています。条件の一覧が無いまま生成AI に勤務表を作らせると、制約の違反を見つける手段がありません。
この章の要点は3つです。第一に、事例の数字は、実績か見込みか、何が減ったか(作成時間か勤務表の質か)、何と比べたか、どの範囲かの4点で読み分ける必要があり、公表される数字の多くは作成時間の削減でした。第二に、Taco Bell・L.L.Bean から山梨大学医学部附属病院・トロント市の長期療養施設まで、成果を支えていたのは、工程を分けて適した道具を使う設計と、暗黙のルールを取り込み人が手で直す仕組みで、INRC のような競技会は研究の共通の土台になる一方、実際の職場の問題はそれを越える難しさを持つと、実地の論文自身が書いています。第三に、機械学習と生成AI は予測・条件の発見・定式化の下書き・結果の説明で勤務表の仕事を速くしますが、勤務表を作る計算はソルバーに、重みと優先順位の判断は人に残ります。この記事で扱った手法と事例を、自社の職場で何人を・いつ・誰に配置するかを決める判断に使っていただければ幸いです。
この章を深めたい方への参考書籍
『大規模言語モデルは新たな知能か ChatGPTが変えた世界』(岡野原大輔、岩波書店):大規模言語モデルで何ができるようになるかと、幻覚(もっともらしい誤り)をはじめとするリスクと課題、そして仕組みを、数式を使わずに一般向けに解説した本です。この章で生成AI に任せる作業と人が確かめる作業を分けた理由を、技術の側から理解するのに向いています。
『AI開発力を鍛える!機械学習と最適化による問題解決講座』(沓掛健太朗、翔泳社):機械学習と最適化の違い、問題への落とし込み方、両者を組み合わせる考え方を、開発の現場で起こる問題への答えの形で解説した本です。この章で扱った「予測は機械学習、決めるのは最適化」という分担を、自社の課題に当てはめて考えるときの手がかりになります。
終章 勤務表を、毎月回る仕組みにする
本コラムでは、時間帯ごとに必要な人数が変わる職場の人員配置とシフト作成を、必要人数の見積りから始めて、シフトの型の設計、個人への割り当て、労働法令、希望と公平性、スキル、規模と長期の計画、当日の欠勤、需要のばらつき、現場への導入へと、論点を1つずつ足しながら扱いました。終章では、各章で実際に解いた結果から言えることを振り返り、勤務表の作成を毎月回る仕組みにするための考え方をまとめます。
各章の結果から言えること
第2章では、規則に沿って手で組んだ勤務表を作り、ソルバーで組んだ基準の勤務表と比べました。手作りの勤務表(希望休を見ない案)は、不足が197.5人時で基準の221.0人時より少なく見えますが、過剰は887.5人時で基準の641.0人時より246.5人時多く、パートの勤務は745時間で基準の475時間より270時間多くなっていました。リーダー役の不在は28枠、希望休の違反は88件中45件です。不足だけを見ると手作りのほうが良く見えるのは、人を多めに入れて得た結果であり、勤務表の良し悪しは不足・過剰・人件費・希望・スキルの配置を同時に見なければ判断できないというのが、第1章と第2章を通した結論です。なお、序章で断ったとおり、基準の勤務表には重みの合計が同じで中身だけが違う勤務表が複数あり、各章で解き直すと不足は216.0〜221.0人時の間で動きます。以下で「基準」と書く数字は221.0人時にそろえ、章の中で条件を変えた比較は、その章で解き直した勤務表どうしの値で書いています。
第3章では、需要から必要人数を見積もる方法を比べました。架空の月曜の入電を、処理にかかる時間の合計だけで割って枠ごとに切り上げると83.0人時ですが、待ち行列の式(アーランC)で「80%の入電に20秒以内に応答する」という目標を置くと125.0人時が必要になりました。待たせずに応答するための余裕は、作業量の計算には現れません。また、応答の目標を90%に上げると4週間の必要在席が389.0人時増え、月曜の入電が2倍になっても必要人数は2倍にはならない(1.700倍)ことも確かめました。サービスの目標は、必要人数を通じて人件費に直結する経営の判断です。
第4章と第5章では、基準の勤務表に残る不足と過剰の出どころを調べました。スタッフ一人ひとりの条件を外し、現行の6つの型を何人ずつ置くかだけを決めても、不足は218.5人時残りました。基準の不足221.0人時のほとんどは、勤務表の組み方ではなく、9時間拘束の型が需要の山と谷に合っていないことから来ています。8時間の型の開始時刻を30分刻みで選べるようにすると(短時間の型は現行の2つのまま)、同じ人数の枠の中で不足は19.5人時まで減りました。ただしこのときパートの勤務も485時間から675時間に増えており、不足の減少のすべてが型の工夫によるものではありません。それでも、正社員の勤務の回数を変えずに不足が1割未満まで下がったことは、型の見直しの効き目の大きさを示しています。第5章では、基準の不足221.0人時のうち78%が、早番の休憩(11時台)と遅番の休憩(19時台)の時間帯に集まっていることを示しました。人数が足りないように見える職場でも、先に見直すべきは型と休憩の置き方である場合があります。
第5章から第8章では、重みと条件の決め方が勤務表をどう変えるかを測りました。不足の重み(不足1人×30分あたり。基準は3,000)を1,000にすると、不足は476.0人時に増える代わりにパートの勤務は0時間になり、6,000にすると不足は139.0人時に減る代わりにパートの勤務は880時間に増えました。重みは技術的な設定ではなく、不足1人時と人件費1円をどう交換するかという経営の判断そのものです。第7章では、勤務間の休息を11時間から9時間に縮めても、この例題では不足が減らないことを確かめました。一方、1人4週間に4時間までの時間外労働を認めると、第7章で解き直した基準(不足216.0人時)から不足は146.5人時に減りました。8時間まで認めると114人時前後まで減りますが、それより上限を上げても横ばいで、効きは頭打ちになりました(8時間以上の設定は時間制限内に最適性までは証明できていません)。第8章では、土日の勤務日数と遅番の回数の偏りを、最も多い人と少ない人の差1以内に抑えても、重みづけの目的は変わらないことを示しました(90秒まで解いて最適性を確かめた結果で、30秒で打ち切ると同点までは示せませんでした)。このサンプルデータでは、差1以内までの公平性は費用をかけずに入れられました(差を0にすると重みの合計が6,000増えました)。ただしそれは、同じ目的の値を持つ勤務表が複数あることを利用した結果であり、同点の勤務表の中からどれを選ぶかを決めておかなければ、偏りは偶然に任されます。
第9章では、リーダー役(SV)の人数と不在の枠の関係を測りました。SVが5名では24枠で不在になり、6名以上で不在は0になりました。スキルを持つ人の人数は、勤務表の工夫では埋められない下限を決めます。研修や採用の投資は、この下限を動かす施策として評価できます。第10章では、公開ベンチマークで規模の限界を測りました。小さい問題はソルバーがすぐに最適性まで証明しますが、既知最良解との差は、Instance10 で60秒後に14〜16%、Instance15 で168〜282%と開き、Instance20 は120秒でも解が見つかりませんでした。規模が大きい職場では、問題の分け方や一部を壊して解き直す探索を組み合わせる設計が要ります。
第11章と第12章では、計画が崩れる場面を扱いました。欠勤が2名出た日に、変更の件数を気にせず全体を組み直すと、346〜349件の変更が30名全員に及びました。変更1件に小さな罰則を置いて組み直すと、変更は3件で、リーダー役の不在も解消できました。欠勤率3%の架空の設定では、待機要員を1日1名置き、不足が最も減る型で呼ぶと、欠勤で増える不足の平均が39.4人時から6.6人時に減りました。ただしこれは呼んですぐに来られる前提の値で、到着が60分遅れると8.7人時にとどまり、リーダー役の資格を持たない待機要員ではリーダー役の不在は減りません。第12章では、予測の外れ(架空の誤差12%)があると、必要人数どおりに置いても1日のサービスレベルが80%を下回る日が20.5%あり、予測に5%上乗せすると10.4%、10%上乗せすると4.7%に減ることを示しました。架空の重みでは、5%の上乗せまでは費用の合計がほぼ変わらず、それより上は人件費の増加が上回りました。
勤務表を仕組みにするための5つの考え方
各章の結果を踏まえて、勤務表の作成を毎月回る仕組みにするための考え方を5つにまとめます。
- 最初に測るのは、今の勤務表の不足人時・過剰人時・人件費・希望の充足・偏り。改善の効果は、現状を同じ指標で測っておかなければ示せません。不足だけ、人件費だけで評価すると、第2章の手作りの勤務表のように読み違えます(第1章・第2章)。
- 人数を増やす前に、型と休憩を疑う。例題では、不足のほとんどが型の形から来ていました。型の開始時刻や長さ、休憩の置き方を変えるほうが、採用より早く効く場合があります(第4章)。
- 重みは経営が決める。不足1人時をいくらと見るか、希望休の違反1件をどれだけ重く見るかで、勤務表は大きく変わります。重みを現場任せにせず、サービスの目標と人件費の交換条件として経営が決め、記録しておくことが要ります(第5章・第8章)。
- 法令は守る側、社内ルールは測ってから決める側に置く。法令と協定の値は必ず守る制約として書き、勤務間の休息のような社内ルールは、緩めた場合に何がどれだけ変わるかを測ってから労使で決めると、議論を数字で進められます(第7章)。
- 崩れたときの直し方を、先に決めておく。欠勤や予測の外れは毎月起きます。組み直しで変えてよい範囲、待機の置き方、上乗せの幅をあらかじめ決めておくことで、管理者が当日に一から組み直す負担と、スタッフが受ける変更の負担を小さくできます(第11章・第12章・第13章)。
シフト作成の数理最適化には、待ち行列と整数計画の長い研究の蓄積があり、無償で使えるソルバーも充実しています。本コラムの例題でも、30名・4週間の勤務表について、与えた条件と重みのもとでの最適性の証明までを、最短で2.6秒で得られました。ただし同じモデルでも、解き直すと数秒から数十秒かかり、条件を足したり乱数の種を変えたりすると、時間制限の中で最適性まで届かない場合もありました(第6章・第8章)。それでも勤務表が管理者の手作業に委ねられがちな背景には、道具の不足だけでなく、管理者の判断を制約と重みに書き出し、結果を指標で測り、スタッフが納得できる形で説明し、崩れたときに直す仕組みの不足もあると考えています。本コラムが、自社の勤務表をどこから見直すかを考える材料になれば幸いです。
在庫と発注量の決め方は弊社コラム『在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで』で、工場の中の作業の順番と時刻の決め方は弊社コラム『生産スケジューリングの数理最適化、ディスパッチングルールからジョブショップまで』で、配送の車の割り当てと回る順番の決め方は弊社コラム『配送ルートと配車計画の数理最適化、巡回セールスマン問題から当日の再配車まで』で扱っています。本コラムとあわせて、モノの計画とヒトの計画を数理最適化で見直す際の参考にしていただければと思います。
Anagraftでは、データ活用の構想づくりから、人員配置やシフト作成のような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 シフト作成はなぜ経営の問題なのか
『人手不足なのになぜ賃金が上がらないのか』(玄田有史 編、慶應義塾大学出版会):人手不足が続いているのに賃金が伸びにくいという現象を、労働経済学の研究者らが需給・行動経済学・制度・規制・正規雇用・能力開発・年齢などの複数の視点から分析した論集です。この章では人手不足を統計で確かめ、今いる人の時間の配り方の重要性を述べましたが、その背景にある労働市場の仕組みを経済学の側から押さえるのに向いています。
『改訂2版 看護管理者が知っておきたい「様式9」の基礎講座』(福井トシ子 監修、日本施設基準管理士協会 編著、メディカ出版):病院の施設基準に関わる書類である「様式9」について、2024年度の診療報酬改定に対応して、看護管理者向けに基本と見落としやすい点を解説した本で、副題は「施設基準を遵守した勤務表を作成するために」です。セミナーでの質疑をもとにしたQ&Aを含みます。病棟の勤務表が書類の作成や勤務管理を通じて病院の経営に結び付いていることを、看護管理の実務の側から確かめる材料になります。
第2章 シフト作成の問題を記述する
『Pythonによる実務で役立つ最適化問題100+(3)配送計画・パッキング・スケジューリング』(久保幹雄、朝倉書店):同じ題名のシリーズのうち、スケジューリングを扱う巻です。目次にシフトスケジューリング問題の章があり、シフト最適化問題の定式化、ナーススケジューリング問題、業務割当を考慮したシフトスケジューリング問題が並んでいます。この章で5つに分けた問題のうち、型の設計と個人への割当を、Python のコードを追いながら確かめたいときの手引きになります。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画から整数計画と組合せ最適化までを、モデルの作り方とアルゴリズムの両面から解説した教科書です。整数計画と組合せ最適化の章で、アルゴリズムの計算量の評価や、近似解法・局所探索法・メタヒューリスティクスを扱っています。この章で並べ方の数を数えて「全部を調べる方法は使えない」と述べた部分を、計算の手間の理論と、それでも解を得るための方法の側から理解するのに向いています。
第3章 必要人数を見積もる
『基礎から学ぶトラヒック理論』(稲井寛、森北出版):通信ネットワークの設計と運用を待ち行列理論で解析するトラヒック理論の入門書で、確率の基礎から出生死滅過程、即時式・待時式の交換線群までを丁寧な式変形で説明しています。この章で使ったアーランCは待時式の交換線群のモデルにあたり、版元の紹介ではコールセンターなどの身近な例も交えているとされています。式の導出を自分で追いたい方に向いています。
『Call Center Optimization』(Ger Koole、MG books):コンタクトセンターの運営を数理の側から解説した英語の本で、この章で引いたサービスレベルの目安、シュリンケージと稼働率の定義、放棄の扱い、アーランCとシミュレーションの関係を、技術的な細部に入らずに計算の結果で示しています。著者のサイトで冒頭の章を読むことができ、この章の出典の多くもそこから確かめました。
第4章 シフトの型を設計する
『Pythonによる数理最適化入門』(並木誠 著、久保幹雄 監修、朝倉書店):実践Pythonライブラリーの1冊で、Python の基礎から、線形最適化・整数線形最適化問題・グラフ最適化・非線形最適化までを、手を動かしながら学ぶ構成です。この章の集合被覆は整数線形最適化の典型なので、型の人数を変数にして制約と目的を書き下す練習の土台になります。
『組合せ最適化 理論とアルゴリズム』(B.コルテ、J.フィーゲン 著、浅野孝夫・浅野泰仁・平田富夫 訳、丸善出版):原著第6版の翻訳で、組合せ最適化の理論を網羅的に扱う専門書です。第5章「整数計画法」に完全ユニモジュラー行列の節があり、第16章「近似アルゴリズム」は集合カバーの節から始まります。この章で触れた「休憩の無い型だけなら線形計画でも整数の答えが出る」理由や、集合被覆の難しさを、数理の側から確かめたい方に向いています。
第5章 勤務表を作る
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):数理最適化の代表的な問題を Python で定式化して解く本で、多目的最適化の章の中にスタッフスケジューリングの節があります。この章で扱った「複数の目的を重みでまとめて1つの勤務表を選ぶ」ことを、多目的最適化の問題として読み直すのに向いています。ソルバーには商用の Gurobi を使っているので、この記事の CP-SAT のコードとは書き方が違いますが、定式化の考え方はそのまま比べられます。
『数理最適化の実践ガイド』(穴井宏和、講談社):最適化の基礎概念とアルゴリズムを整理したうえで、多目的最適化の章と、実問題を解くときの心得を扱う章を置いた本です。この章で見た「重みづけの和で複数の目的をまとめる」ことの意味と限界を、多目的最適化の考え方から見直すのに役立ちます。
第6章 CP-SAT を使いこなす
『今日から使える!組合せ最適化 離散問題ガイドブック』(穴井宏和・斉藤努、講談社):副題のとおり、組合せ最適化(離散的な選択肢の組合せから最も良いものを選ぶ問題)の基礎から始めて、離散的な問題の扱い方を整理したガイドブックです。この章では勤務表という1つの問題で CP-SAT の部品を試しましたが、勤務表を組合せ最適化の問題の1つとして一般的な言葉で捉え直すと、制約の書き方や解き方の選択肢を比べやすくなります。
『Pythonではじめる数理最適化 ケーススタディでモデリングのスキルを身につけよう 第2版』(岩永二郎・石原響太・西村直樹・田中一樹、オーム社):数理モデルの考え方と Python による最適化のチュートリアルに続いて、学校のクラス編成などのケーススタディでモデルを組み立てていく本です。この章の PuLP と CP-SAT の比較のように、同じ問題を自分の手でモデルに書き下ろし、結果を読んで直す練習の題材になります。
第7章 労働法令と就業規則を制約に入れる
『詳解 労働法』第4版(水町勇一郎、東京大学出版会、2025年):版元の紹介によると、法令や告示・通達などの制度の枠組みと、実際の紛争事例を数多く扱った労働法制の概説書で、目次には労働時間と年次有給休暇の章があります。この章では条文を勤務表の制約に置き換える側から読みましたが、条文の解釈や例外の適用範囲を確かめたいときの手引きになります。
『36協定締結の手引』改訂8版(労働調査会 編、労働調査会、2023年):版元の紹介によると、36協定が必要な場合、締結の方法、協定で定める内容、有効期間、届出の手続き、法的効力などを、労働基準法と行政解釈に沿ってQ&A形式で解説した本です。勤務表のモデルに入れる残業の上限は「協定に書いた時間数」なので、その値がどう決まり、どこまでが協定で動かせるのかを押さえるのに向いています。
第8章 希望と公平性を扱う
『社会的選択理論への招待 投票と多数決の科学』(坂井豊貴、日本評論社):多くの人の意見を1つの決定にまとめる方法を扱う社会的選択理論の入門書で、2025年に新版が出ています。勤務表の重みづけの和も、スタッフ一人ひとりの希望をまとめて1つの勤務表を選ぶ仕組みの1つです。まとめ方によって選ばれる結果が変わることを押さえておくと、重みや公平性の条件を現場と議論するときの足場になります。
『公正としての正義 再説』(ジョン・ロールズ著、エリン・ケリー編、田中成明・亀本洋・平井亮輔訳、岩波書店):社会を公正な協働のシステムとみなす立場から、正義の構想を著者自身がまとめ直した本で、岩波現代文庫に入っています。この章のマックスミンは勤務表の目的関数の書き方の話で、ロールズの議論そのものではありませんが、「誰の状態を基準に公平を判断するか」を政治哲学の側から考える材料になります。
『Who Gets What マッチメイキングとマーケットデザインの経済学』(アルビン・E・ロス著、櫻井祐子訳、日本経済新聞出版社):安定配分の理論とマーケットデザインの実践で2012年にノーベル経済学賞を受けた著者が、誰が何を得るかを決める仕組み(マッチメイキング)の設計を一般向けに解説した本で、日経ビジネス人文庫に入っています。参加者の希望をどう集め、どう割り当てに反映するかという問いは、この章で扱った希望の受け付け方の設計と重なります。
第9章 スキルと多能工化
『研修開発入門「研修評価」の教科書 「数字」と「物語」で経営・現場を変える』(中原淳・関根雅泰・島村公俊・林博之、ダイヤモンド社):研修の評価を、「数字」と「物語」という2つの視点を組み合わせて行い、経営と現場を変えていく方法を扱った、研修・教育の担当者向けの教科書です。この章ではスキル保有者を増やす効果を勤務表の上の量で示しましたが、研修そのものの効果をどう測り、投資の判断にどうつなげるかを考えるときの手がかりになります。
『職場学習論 仕事の学びを科学する 新装版』(中原淳、東京大学出版会):職場で人が他者とつながり、コミュニケーションをとり、支援を受けながら学ぶ過程を科学的に解き明かそうとした研究書です。この章で扱った新人とベテランの組合せの制約は、勤務表の上で「誰と同じ時間に働くか」を決めるものなので、職場での学びがどのような関係の中で起きるかを考える材料になります。
第10章 大規模化と長期の要員計画
『メタヒューリスティクスの数理』(久保幹雄、J.P.ペドロソ、共立出版):局所探索法から模擬焼なまし法・禁断探索法・遺伝的アルゴリズムまで代表的なメタヒューリスティクスを並べ、なぜその工夫がうまく働くのかを数理の面から説明した本です。目次には大近傍探索法の節と、変数固定法・MIP近傍局所探索法など「数理計画とメタヒューリスティクスの融合」の章があり、この章で行った「一部を固定してソルバーで解き直す」方法の位置づけを確かめるのに向いています。
『Column Generation』(Guy Desaulniers、Jacques Desrosiers、Marius M. Solomon 編、Springer):列生成を主題にした論文集で、冒頭の章 A Primer in Column Generation が、大規模な実務の問題を列生成で解くための理論と考え方を例とともに解説しています。ほかに、この章で触れた価格付けの資源制約つき最短路問題の章、分枝価格法の発見的解法の章、航空業界の大規模モデルの章、実装上の論点(初期化・安定化・列の管理)をまとめた最終章があります。この章の列生成の小さな実装から先へ、分枝価格法まで進めたいときの原典になります。
第11章 当日の欠勤と勤務表の組み直し
『ガイダンスPythonによる確率統計 基礎から学ぶモンテカルロ法』(石谷謙介、サイエンス社):確率変数と分布、大数の法則と中心極限定理、推定と検定までを、Python による乱数の実験(モンテカルロ法)と組み合わせて学ぶ教科書です。この章では欠勤を乱数で1,000回発生させ、平均と上位10%点で待機要員の効果を読みましたが、繰り返しの回数で推定の精度がどう決まるか、平均の差をどこまで信じてよいかを確かめる土台になります。
『オンラインアルゴリズムとストリームアルゴリズム』(徳山豪、共立出版):先の入力を知らないまま、その場で決定を下していくアルゴリズムの基礎と、さまざまなオンライン問題、確率的な最適化の手法を扱った本です(アルゴリズム・サイエンスシリーズ)。この章の待機要員の割り当ては、あとから来る欠勤を知らずに連絡が来た順に決める近視眼的な決め方でした。当日の判断を、将来を知っていた場合と比べてどれだけ損をするかという物差しで考える見方を得るのに向いています。
第12章 需要のばらつきに備える
『確率計画法』(椎名孝之、朝倉書店):不確実性を数理モデルに直接組み込む最適化手法の専門書で、版元の紹介によると、一般の定式化、リコースを有する問題、確率的制約を持つ問題、多段階の問題、モンテカルロ法の応用、リスクを考慮したモデルまでを扱っています。この章のシナリオを置いた人数の決め方と、兼務のような当日の調整を先に決める変数と分けて表す考え方の、理論の側を押さえるのに向いています。
『この1冊ですべてわかる 新版 需要予測の基本』(山口雄大、日本実業出版社):2021年11月に新版として出た需要予測の入門書で、版元の紹介では、サプライチェーンとマーケティングでの需要予測の活用、デマンドプランナーの育成までを事例とともに体系的にまとめた本とされています。この章で前提にした「予測誤差の大きさを測る」ことを、予測を業務として回す側から考えるのに役立ちます。
第13章 現場に入れる
『ナース・スケジューリング:問題把握とモデリング』(池上敦子、近代科学社):日本オペレーションズ・リサーチ学会が監修するシリーズ「最適化モデリング」の1冊で、病棟の看護師の勤務表作成を題材にしています。第1章は現場調査とシフト制約条件・ナース制約条件の整理から始まり、最終章は「現実問題を最適化はどう支援するか」を扱っています。人間の暗黙的な評価や制約をどう把握してモデルにするかという、この章の前半の主題を、研究の側から深く追えます。
『AI・データ分析プロジェクトのすべて[ビジネス力×技術力=価値創出]』(大城信晃・マスクド・アナライズ・伊藤徹郎・小西哲平・西原成輝・油井志郎、技術評論社):データ分析のプロジェクトを、準備・入口・実行・出口の4部に分けて、組織の立ち上げから実務の進め方、成果の活かし方までを解説しています。勤務表の自動作成に限らず、分析や最適化の成果を業務に組み込んで使い続けるための段取りを、この章の「導入の順序と失敗の型」を補う視点から学べます。
第14章 事例と最新動向、公開された成果をどう読み、何を自社に持ち帰るか
『大規模言語モデルは新たな知能か ChatGPTが変えた世界』(岡野原大輔、岩波書店):大規模言語モデルで何ができるようになるかと、幻覚(もっともらしい誤り)をはじめとするリスクと課題、そして仕組みを、数式を使わずに一般向けに解説した本です。この章で生成AI に任せる作業と人が確かめる作業を分けた理由を、技術の側から理解するのに向いています。
『AI開発力を鍛える!機械学習と最適化による問題解決講座』(沓掛健太朗、翔泳社):機械学習と最適化の違い、問題への落とし込み方、両者を組み合わせる考え方を、開発の現場で起こる問題への答えの形で解説した本です。この章で扱った「予測は機械学習、決めるのは最適化」という分担を、自社の課題に当てはめて考えるときの手がかりになります。
参考情報
本コラムの記述は、次の資料を2026年9月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 法人企業統計調査の2025年度の売上高・付加価値・人件費
https://www.mof.go.jp/pri/reference/ssc/results/r7.pdf - 一般病院の給与費比率 55.3%、精神科病院 69.3%、材料費と給与費で70%超
https://www.mhlw.go.jp/content/10808000/001599548.pdf - 介護老人福祉施設 63.5%・訪問介護 67.8%・通所介護 60.9%
https://www.mhlw.go.jp/toukei/list/dl/153-1/r07_gaikyoukekka.pdf - 有効求人倍率1.18倍・正社員有効求人倍率1.00倍(令和8年7月、季節調整値)
https://www.mhlw.go.jp/stf/newpage_75707.html - 職業別の有効求人倍率(介護サービス3.82倍など7職業)
https://www.mhlw.go.jp/content/11602000/001741200.pdf - 労働者過不足判断D.I.の定義と値(正社員等+47、パート+26、産業別の値)
https://www.mhlw.go.jp/toukei/itiran/roudou/koyou/keizai/2608/ - 離職率 産業計13.7%、宿泊業・飲食サービス業23.7%、サービス業(他に分類されないもの)21.2%、医療・福祉14.3%、卸売業・小売業11.9%
https://www.mhlw.go.jp/toukei/itiran/roudou/koyou/doukou/26-2/index.html - 前職を辞めた理由「労働時間、休日等の労働条件が悪かった」女性12.9%・男性8.5%、女性では「その他の個人的理由」を除き最多
https://www.mhlw.go.jp/toukei/itiran/roudou/koyou/doukou/26-2/dl/kekka_gaiyo-03.pdf - 参考書籍『人手不足なのになぜ賃金が上がらないのか』玄田有史 編 慶應義塾大学出版会 2017年4月
https://ndlsearch.ndl.go.jp/books/R100000002-I028083880 - 参考書籍『人手不足なのになぜ賃金が上がらないのか』玄田有史 編 慶應義塾大学出版会 2017年4月
https://www.keio-up.co.jp/np/isbn/9784766424072/ - 参考書籍『改訂2版 看護管理者が知っておきたい「様式9」の基礎講座』福井トシ子 監修 日本施設基準管理士協会 編著 メディカ出版 2024年11月
https://ndlsearch.ndl.go.jp/books/R100000002-I033771423 - 参考書籍『改訂2版 看護管理者が知っておきたい「様式9」の基礎講座』福井トシ子 監修 日本施設基準管理士協会 編著 メディカ出版 2024年11月
https://store.medica.co.jp/item/301050601
第2章
- 看護師の勤務表の問題を、看護師1人ごとの条件の塊と、各勤務帯の構成に関わる結合の条件に分けて捉え、1人ずつ順に組み直す解き方を示した研究
https://doi.org/10.15807/jorsj.41.572 - 勤務間インターバルは法令上は努力義務
https://jsite.mhlw.go.jp/tokyo-roudoukyoku/hourei_seido_tetsuzuki/interval01.html - 書籍 Pythonによる実務で役立つ最適化問題100+(3)配送計画・パッキング・スケジューリング
https://www.asakura.co.jp/detail.php?book_code=12275 - 書籍 しっかり学ぶ数理最適化 モデルからアルゴリズムまで
https://ndlsearch.ndl.go.jp/books/R100000002-I030691339 - 書籍 しっかり学ぶ数理最適化 モデルからアルゴリズムまで
https://www.kspub.co.jp/book/detail/5212707.html
第3章
- アーランCは待ち行列の M/M/c のモデルで、コンタクトセンターの必要人数の計算で実務に最も多く使われている
https://arxiv.org/abs/2101.10122 - アーランCの式の前提はポアソン到着・指数分布の処理時間・待ち行列の長さに上限なし・待っている客が切らないこと
https://en.wikipedia.org/wiki/Erlang_(unit - アーランCは待たされる確率を人数とトラフィック量から計算する式で、トラフィック量の単位はアーラン
https://ja.wikipedia.org/wiki/アーラン - Koole の書籍1.2節の計算例(15分に100件・AHT 3分30秒で24人なら約21%、28人で80%以上・83%)
https://www.gerkoole.com/CCO/downloads/CCO_Koole_first_chapters.pdf - 参考書籍 基礎から学ぶトラヒック理論
https://ndlsearch.ndl.go.jp/books/R100000002-I025479242 - 参考書籍 基礎から学ぶトラヒック理論
https://www.morikita.co.jp/books/mid/085221 - 参考書籍 Call Center Optimization
https://www.gerkoole.com/CCO
第4章
- エディの1954年の論文は、ニューヨーク港湾公社のトンネルと橋の料金所の要員配置を論じ、確率論で時刻ごとに必要なブースの数を事前に決められるようにした
https://doi.org/10.1287/opre.2.2.107 - ダンツィグの論評はエディの論文への論評で、同誌2巻3号339〜341ページ、1954年
https://doi.org/10.1287/opre.2.3.339 - 人員のスケジューリングはエディが導入し、ダンツィグが集合被覆問題として定式化したと後の研究が整理している
https://doi.org/10.1007/s10479-019-03487-6 - 人員のスケジューリングはエディが導入し、ダンツィグが集合被覆問題として定式化したと後の研究が整理している
https://link.springer.com/content/pdf/10.1007/s10479-019-03487-6.pdf - ダンツィグの方法は開始時刻・長さ・休憩の位置の組合せをすべて別の型として数え上げ、変数の数が急に増えることが根本的な難しさである
https://backend.orbit.dtu.dk/ws/files/108130538/A_Benders_decomposition.pdf - 参考書籍『Pythonによる数理最適化入門』並木誠 著、久保幹雄 監修、朝倉書店、2018年、実践Pythonライブラリー
https://ndlsearch.ndl.go.jp/books/R100000002-I028905968 - 参考書籍『Pythonによる数理最適化入門』並木誠 著、久保幹雄 監修、朝倉書店、2018年、実践Pythonライブラリー
https://www.asakura.co.jp/detail.php?book_code=12895 - 参考書籍『組合せ最適化 理論とアルゴリズム』B.コルテ、J.フィーゲン 著、浅野孝夫・浅野泰仁・平田富夫 訳、丸善出版、2022年11月、原著第6版の翻訳
https://ndlsearch.ndl.go.jp/books/R100000002-I032497427
第5章
- 看護師の勤務表の研究の総覧は、この問題を数週間にわたって看護師を勤務の時間帯に割り当てることと説明し、計画期間の典型を4週間としている
https://doi.org/10.1023/B:JOSH.0000046076.75950.0b - 看護師の勤務表の研究の総覧は、この問題を数週間にわたって看護師を勤務の時間帯に割り当てることと説明し、計画期間の典型を4週間としている
https://lirias.kuleuven.be/retrieve/df8f1e47-2dd9-4f30-844d-3ea6dd15a96d - Curtois と Qu の看護師勤務表ベンチマークは24問で、最小の Instance1 は2週間・8名・勤務の型1種類、最大の Instance24 は52週間・150名・勤務の型32種類、Instance8 は4週間・30名・勤務の型4種類
https://www.schedulingbenchmarks.org/nrp/ - OR-Tools のパラメータ定義には、実験的な設定 interleave_search を有効にすると探索が num_workers によらず決定的になるという説明がある
https://github.com/google/or-tools/blob/v9.15/ortools/sat/sat_parameters.proto - 参考書籍 あたらしい数理最適化 Python言語とGurobiで解く(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社、2012年、ISBN 978-4-7649-0433-0)
https://www.kindaikagaku.co.jp/book_list/detail/9784764904330/ - 参考書籍 数理最適化の実践ガイド(穴井宏和、講談社、2013年、ISBN 978-4-06-156510-4)
https://www.kspub.co.jp/book/detail/1565104.html
第6章
- CP-SAT は整数の上で動くので、問題は整数だけで定義し、整数でない項は大きな整数を掛けてそろえる
https://developers.google.com/optimization/cp/cp_solver - 仮定は関係の深い制約のまとまりを1つの札の下にまとめ、解なしの説明を得る仕組みである
https://github.com/google/or-tools/blob/v9.15/ortools/sat/cp_model.proto - random_seed を変えると探索中の選択が変わり、問題によっては実行時間が大きく変わる
https://github.com/google/or-tools/blob/v9.15/ortools/sat/sat_parameters.proto - Curtois と Qu の看護師勤務表ベンチマーク
https://www.schedulingbenchmarks.org/nrp/ - ベンチマークのハード制約・ソフト制約・罰則の定義、期間の端の扱い(連続勤務の上限は前後を休みとみなし、連続勤務の下限と連続休みの下限は前後に同じ状態が無限に続くとみなす)
https://www.schedulingbenchmarks.org/nrp/instances1_24.html - 今日から使える!組合せ最適化 離散問題ガイドブック(穴井宏和・斉藤努、講談社、2015年)
https://ndlsearch.ndl.go.jp/books/R100000002-I026447126 - Pythonではじめる数理最適化 ケーススタディでモデリングのスキルを身につけよう 第2版(岩永二郎・石原響太・西村直樹・田中一樹、オーム社、2024年)
https://ndlsearch.ndl.go.jp/books/R100000002-I033374307
第7章
- 労働基準法の現行の版は令和8年7月17日施行の改正を反映したもので、施行日が先の改正が2件登録されているが、第32条から第41条までの文言は変わらない
https://laws.e-gov.go.jp/law/322AC0000000049 - 施行規則第25条の2の1週44時間の特例は、別表第一の第8号・第10号(映画の製作を除く)・第13号・第14号の事業のうち常時10人未満の労働者を使用するもの
https://laws.e-gov.go.jp/law/322M40000100023 - 割増賃金の率の最低限度は時間外2割5分、休日3割5分
https://laws.e-gov.go.jp/law/406CO0000000005 - 時間外労働の上限規制は2019年4月(中小企業は2020年4月)から適用、建設・自動車運転・医師・鹿児島県と沖縄県の砂糖製造業は5年猶予され2024年4月から適用(一部特例)
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/koyou_roudou/roudoukijun/gyosyu/topics/01.html - 医師の勤務間インターバルはB・C水準で義務、A水準で努力義務
https://iryou-kinmukankyou.mhlw.go.jp/information/explanation - 看護職員の月平均夜勤時間数72時間以下、夜勤時間帯は22時〜5時を含む連続16時間、病棟全体で計算、夜勤専従者と月16時間未満の者を除く
https://www.mhlw.go.jp/stf/newpage_67729.html - 労働時間等設定改善法第2条第1項は、終業から始業までの時間の設定などの措置を講ずる努力義務を定める
https://laws.e-gov.go.jp/law/404AC0000000090 - 2019年4月1日から勤務間インターバル制度の導入が事業主の努力義務
https://work-holiday.mhlw.go.jp/interval/ - 書籍『詳解 労働法』第4版(水町勇一郎、東京大学出版会、2025年)
https://www.utp.or.jp/book/b10140193.html - 書籍『36協定締結の手引』改訂8版(労働調査会 編、労働調査会、2023年)
https://www.chosakai.co.jp/publications/30499/
第8章
- Curtois と Qu の看護師勤務表ベンチマークでは、指定日に勤務を入れない Days off と週末の勤務数の上限はハード制約、Shift on requests と Shift off requests は重みつきのソフト制約である
https://www.schedulingbenchmarks.org/nrp/instances1_24.html - ベンチマークの Instance1・Instance12・Instance24 では、希望の重みは1から3の3段階、人員の不足1人の重みは100、過剰1人の重みは1
https://www.schedulingbenchmarks.org/nrp/ - 令和7年雇用動向調査で、女性の転職入職者が前職を辞めた理由は、その他の個人的理由23.8%を除くと労働時間・休日等の労働条件が悪かった12.9%が最も多く、次いで職場の人間関係が好ましくなかった11.5%
https://www.mhlw.go.jp/toukei/itiran/roudou/koyou/doukou/26-2/dl/kekka_gaiyo-03.pdf - 令和7年雇用動向調査結果の概要が最新版であること
https://www.mhlw.go.jp/toukei/list/9-23-1c.html - 『社会的選択理論への招待 投票と多数決の科学』新版(坂井豊貴、日本評論社、2025年)は多くの人の意見をまとめる方法を扱う
https://ndlsearch.ndl.go.jp/books/R100000002-I034005714 - 『公正としての正義 再説』(ジョン・ロールズ著、エリン・ケリー編、田中成明・亀本洋・平井亮輔訳、岩波書店、岩波現代文庫)
https://ndlsearch.ndl.go.jp/books/R100000002-I030253820 - 『Who Gets What マッチメイキングとマーケットデザインの経済学』(アルビン・E・ロス著、櫻井祐子訳、日本経済新聞出版社、日経ビジネス人文庫)、著者は安定配分の理論とマーケットデザインの実践で2012年にノーベル経済学賞
https://ndlsearch.ndl.go.jp/books/R100000002-I029171821
第9章
- Jordan と Graves の1995年の論文は、限られた柔軟性でも正しく組めば完全な柔軟性の便益の大半が得られ、製品と工場を鎖状につなぐ組み方で便益が最大になるという原則を、需要が不確かな状況の計画モデルから示した
https://doi.org/10.1287/mnsc.41.4.577 - Wallace と Whitt の2005年の論文は、処理時間の分布が入電の種類や人によらない場合、各オペレーターが適切な組合せの2つのスキルを持つだけで全員が全スキルを持つ場合とほぼ同じ性能になることをシミュレーションで示した
https://doi.org/10.1287/msom.1050.0086 - 参考書籍 研修開発入門「研修評価」の教科書 「数字」と「物語」で経営・現場を変える、中原淳・関根雅泰・島村公俊・林博之、ダイヤモンド社、2022年
https://ndlsearch.ndl.go.jp/books/R100000002-I032160291 - 参考書籍 職場学習論 仕事の学びを科学する 新装版、中原淳、東京大学出版会、2021年
https://ndlsearch.ndl.go.jp/books/R100000002-I031365580
第10章
- Curtois と Qu の看護師勤務表ベンチマーク Instance1〜24 の週数・人数・勤務の型の数・既知最良解・下界
https://www.schedulingbenchmarks.org/nrp/ - ベンチマークのハード制約9種とソフト制約3種、計画期間の端の扱い
https://www.schedulingbenchmarks.org/nrp/instances1_24.html - Curtois と Qu の技術報告の Gurobi 5.6.3(1スレッド・1時間)と分枝価格法の結果
https://www.schedulingbenchmarks.org/papers/computational_results_on_new_staff_scheduling_benchmark_instances.pdf - 列生成の構造の説明
https://www.schedulingbenchmarks.org/papers/new_approaches_to_nurse_rostering_benchmark_instances.pdf - 大近傍探索は Shaw が1998年に配送計画の問題に対して提案した
https://doi.org/10.1007/3-540-49481-2_30 - 書籍 メタヒューリスティクスの数理(久保幹雄、J.P.ペドロソ、共立出版、2009年、ISBN 978-4-320-12235-2)
https://www.kyoritsu-pub.co.jp/book/b10010761.html - 書籍 メタヒューリスティクスの数理(久保幹雄、J.P.ペドロソ、共立出版、2009年、ISBN 978-4-320-12235-2)
https://ci.nii.ac.jp/ncid/BA89986066 - 書籍 Column Generation(Guy Desaulniers、Jacques Desrosiers、Marius M. Solomon 編、Springer、2005年、Hardcover ISBN 978-0-387-25485-2)
https://link.springer.com/book/10.1007/b135457 - 書籍 Column Generation(Guy Desaulniers、Jacques Desrosiers、Marius M. Solomon 編、Springer、2005年、Hardcover ISBN 978-0-387-25485-2)
https://ci.nii.ac.jp/ncid/BA75513088
第11章
- 労働基準法第34条は、労働時間が6時間を超える場合は少なくとも45分、8時間を超える場合は少なくとも1時間の休憩を労働時間の途中に与えることを定める
https://laws.e-gov.go.jp/law/322AC0000000049 - 看護師の勤務表の組み直しを扱った Moz と Pato の2003年の論文の要旨
https://link.springer.com/article/10.1023/A:1022907212477 - 書籍 ガイダンスPythonによる確率統計 基礎から学ぶモンテカルロ法
https://ndlsearch.ndl.go.jp/books/R100000002-I034710569 - 書籍 オンラインアルゴリズムとストリームアルゴリズム
https://ndlsearch.ndl.go.jp/books/R100000002-I000008961748
第12章
- 確率計画法は不確実性を数理モデルに直接組み込む最適化手法で、リコースを有する問題などを扱う
https://www.asakura.co.jp/detail.php?book_code=11790 - 書籍『確率計画法』椎名孝之、朝倉書店、2015年、シリーズ応用最適化5
https://ndlsearch.ndl.go.jp/books/R100000002-I026246307 - 書籍『この1冊ですべてわかる 新版 需要予測の基本』山口雄大、日本実業出版社、2021年11月
https://ndlsearch.ndl.go.jp/books/R100000002-I031804112
第13章
- 厚生労働省はシフト制を、労働契約の時点では労働日や労働時間を確定的に定めず、一定期間ごとに作る勤務シフトで初めて具体的な労働日や労働時間が決まる働き方として、使用者の留意事項をまとめている
https://www.mhlw.go.jp/content/11200000/001713615.pdf - 厚生労働省「いわゆるシフト制について」のページ
https://www.mhlw.go.jp/stf/newpage_22954.html - 労働時間の適正な把握のためのガイドライン(2017年1月20日策定)は、始業終業時刻の確認と記録、原則として現認かタイムカード・ICカード・パソコンの使用時間の記録等の客観的な記録を基礎とすること、自己申告制では事業場内にいた時間との著しい乖離があれば実態調査と補正を求める
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/koyou_roudou/roudoukijun/roudouzikan/070614-2.html - 労働基準法第109条は労働関係の重要な書類を5年間保存すると定め、附則第143条により当分の間は3年間と読み替える
https://laws.e-gov.go.jp/law/322AC0000000049 - 労働基準法施行規則第31条により、運輸・商業・金融・保健衛生・接客娯楽などの事業には休憩の一斉付与の規定が適用されない
https://laws.e-gov.go.jp/law/322M40000100023 - 参考書籍『ナース・スケジューリング:問題把握とモデリング』池上敦子、近代科学社、2018年
https://ndlsearch.ndl.go.jp/books/R100000002-I028822127 - 参考書籍『ナース・スケジューリング:問題把握とモデリング』池上敦子、近代科学社、2018年
https://www.kindaikagaku.co.jp/book_list/detail/9784764905580/ - 参考書籍『AI・データ分析プロジェクトのすべて[ビジネス力×技術力=価値創出]』大城信晃ほか、技術評論社、2020年12月
https://ndlsearch.ndl.go.jp/books/R100000002-I030807431 - 参考書籍『AI・データ分析プロジェクトのすべて[ビジネス力×技術力=価値創出]』大城信晃ほか、技術評論社、2020年12月
https://gihyo.jp/book/2021/978-4-297-11758-0
第14章
- Taco Bell の人員管理システムの論文
https://doi.org/10.1287/inte.28.1.75 - L.L.Bean の電話受付の要員数を経済的な最適化で決め、以前のサービスレベル基準の要員数と大きく違った
https://doi.org/10.1287/inte.23.2.14 - Interfaces の ISSN の誌名は現在 INFORMS Journal on Applied Analytics
https://api.crossref.org/journals/0092-2102 - イオンリテールは2024年4月21日から店舗の全部門でワークスケジュール自動作成機能を実装、食品の部門は2023年8月から先行、約360店舗
https://www.aeonretail.jp/pdf/230405R_1.pdf - イオンリテールは2024年4月21日から店舗の全部門でワークスケジュール自動作成機能を実装、食品の部門は2023年8月から先行、約360店舗
https://www.aeonretail.jp/company/news.html - 2025年6月から従業員アプリの実証運用
https://www.aeonretail.jp/pdf/250515R_2.pdf - 山梨大学医学部附属病院は病床約620・医師約400名・看護師約760名・19病棟、勤務表は看護師長の手作業
https://arxiv.org/abs/2506.13600 - 定式化は本質的に不完全という前提で手直しの支援を用意、変更を少なくする課題を最小摂動問題として位置づけ、実装は LNPS で変更の最小化は保証しない、規則は約100、規則と匿名化した実データを公開
https://github.com/nabesima/yamanashi-nsp - 名古屋大学の記事で、ある国立大学附属病院の1病棟、32名×28日・休みを含む6種類の勤務の勤務表を自動作成して実際に使った
https://tamatebako.i.nagoya-u.ac.jp/8671/ - トロント市の長期療養施設の部局は10か所で2,640人の入居者、パートの看護職員の欠勤率の高さがきっかけ
https://doi.org/10.1287/inte.2022.1132 - トロント市の長期療養施設の部局は10か所で2,640人の入居者、パートの看護職員の欠勤率の高さがきっかけ
https://arxiv.org/abs/2102.09461 - 日本の急性期と慢性期の病院に、夜勤と日勤の2段階に分けて途中で看護師長が手直しできる方法のシステムを導入した事例を報告
https://arxiv.org/abs/2507.05182 - Swissgrid の勤務表作成は大部分が手作業
https://arxiv.org/abs/2111.10845 - INRC-I は2010年、運営は KU Leuven の CODeS・SINTEF・ウーディネ大学、3部門、PATAT 2010 で発表する予定、研究と実務の差を縮めることが目的
https://nrpcompetition.kuleuven-kulak.be/ - INRC-I は2010年3月1日開始、最終提出2010年6月20日、初期・後期・非公開のデータ
https://nrpcompetition.kuleuven-kulak.be/dates/ - INRC-I の3部門とも Valouxis らのチームが1位、短距離部門で K. Nonobe 氏が2位
https://nrpcompetition.kuleuven-kulak.be/competitor-ranking/ - INRC-II は段階制で4週または8週を1週ずつ解き、予測が要ることがある
https://mobiz.vives.be/inrc2/ - INRC-II は段階制で4週または8週を1週ずつ解き、予測が要ることがある
https://mobiz.vives.be/inrc2/?page_id=23 - INRC-II の運営は KU Leuven Kulak の CODeS・ウーディネ大学・VIVES
https://mobiz.vives.be/inrc2/?page_id=49 - INRC-II は提出15件、最終候補7チーム
https://mobiz.vives.be/inrc2/?page_id=226 - INRC-II の最終順位は1位 NurseOptimizers(マルティン・ルター大学ハレ・ヴィッテンベルク)、2位モントリオール理工科大学、3位エクセター大学、ORTEC は5位
https://mobiz.vives.be/inrc2/?page_id=241 - INRC-II の問題記述の論文
https://arxiv.org/abs/1501.04177 - Curtois と Qu のベンチマークは第6章と第10章で解く
https://www.schedulingbenchmarks.org/nrp/ - 欠勤予測に基づき待機の勤務を割り当てる予測してから最適化する方法
https://arxiv.org/abs/2406.18119 - 過去の勤務表から制約を学習する方法
https://arxiv.org/abs/1805.11375 - SMILO は勤務のスケジューリングの MILP を作る仕組み
https://arxiv.org/abs/2511.02364 - SCHEDBench は1,132問、13の大規模言語モデル、言い回しの違いで実行可能な割合が下がりハード制約違反が増える
https://arxiv.org/abs/2608.00991 - MAPLE は変更の依頼に合わせて最適化の問題を保守し続けるエージェント
https://arxiv.org/abs/2609.11636 - OR-Tools v9.15 は2026年1月12日公開
https://github.com/google/or-tools/releases - MiniZinc Challenge 2024・2025・2026 で OR-Tools CP-SAT が Fixed・Free・Parallel の3部門で金
https://www.minizinc.org/challenge/2024/results/ - MiniZinc Challenge 2024・2025・2026 で OR-Tools CP-SAT が Fixed・Free・Parallel の3部門で金
https://www.minizinc.org/challenge/2025/results/ - MiniZinc Challenge 2024・2025・2026 で OR-Tools CP-SAT が Fixed・Free・Parallel の3部門で金
https://www.minizinc.org/challenge/2026/results/ - HiGHS v1.15.1 は2026年7月2日公開、ライセンス MIT
https://github.com/ERGO-Code/HiGHS/releases - Timefold Solver は Java と Kotlin 向けで従業員の勤務表などを対象、v2.7.0 は2026年9月24日公開、Apache-2.0
https://github.com/TimefoldAI/timefold-solver - clingo はポツダム大学のグループの解集合プログラミングのソルバー、v5.8.2 は2026年8月14日公開、MIT
https://potassco.org/ - clingo はポツダム大学のグループの解集合プログラミングのソルバー、v5.8.2 は2026年8月14日公開、MIT
https://github.com/potassco/clingo/releases - 書籍 大規模言語モデルは新たな知能か ChatGPTが変えた世界、岡野原大輔、岩波書店、2023年6月、岩波科学ライブラリー319
https://ndlsearch.ndl.go.jp/books/R100000002-I032831989 - 書籍 大規模言語モデルは新たな知能か ChatGPTが変えた世界、岡野原大輔、岩波書店、2023年6月、岩波科学ライブラリー319
https://www.hanmoto.com/bd/isbn/9784000297196 - 書籍 AI開発力を鍛える!機械学習と最適化による問題解決講座、沓掛健太朗、翔泳社、2025年4月
https://ndlsearch.ndl.go.jp/books/R100000002-I034032359 - 書籍 AI開発力を鍛える!機械学習と最適化による問題解決講座、沓掛健太朗、翔泳社、2025年4月
https://www.hanmoto.com/bd/isbn/9784798185651