こんにちは、Anagraftの伊藤です。
今回は、配送センターから納品先へトラックを走らせるときに「どの車に、どの納品先を、どの順番で、何時に回らせるか」を決める配車計画を、数理最適化の立場から整理しました。1台の車が全件を回る巡回セールスマン問題から始めて、車の積載量を守る配車、納品先の時間指定を守る配車、ドライバーの労働時間を守る配車へと進み、車種の使い分け、複数の配送センター、集荷と配送の組み合わせ、距離と所要時間の作り方、大規模な問題への対処、当日の追加注文や遅れに合わせた再配車、配送エリアと配送頻度の設計、そして現場への導入と最新の動向までを扱います。ここに挙げた用語は、それぞれの章で最初に出るときに平易な言葉で説明していますので、ここで分からなくても差し支えありません。
この題材を選んだ理由は、配車計画が使用する車両の台数、総走行距離、ドライバーの拘束時間と残業、時間指定の遵守率といった経営の数字を直接左右する意思決定でありながら、その作成が経験を積んだ配車担当者の手作業に委ねられていることが多いためです。トラックドライバーの時間外労働に上限が設けられた現在、同じ荷物を同じ台数でどう運ぶかという問いは、費用の問題であると同時に、運べるかどうかの問題にもなっています。納品先の並べ方の組合せは件数とともに急速に増えるため、人が頭の中ですべてを比べることはできません。どこまでを計算機に任せ、どこから先を人が判断するかを見極める道具として、数理最適化の手法を紹介します。
各章では、架空の配送センターのデータを共通の題材にして、実際にコードを動かした結果を載せています。30km四方のエリアに40件の納品先があり、積載量150ケースの2トン車で配送するという設定です。納品先ごとに荷物の量、荷下ろしにかかる時間、午前・午後・終日の時間指定が決まっています。データは乱数で生成したもので、実在の企業や地域の記録ではありません。あわせて、研究の世界で長く使われてきた公開のベンチマーク問題も解き、既に知られている最良の値と比べています。同じデータに対して、手作業に近い素朴な割り振り、古典的な構築法と改善法、無償で使える最適化ソルバーを順に当てることで、手法どうしの関係と、それぞれの得意と不得意が横に比べられるようにしました。
想定している読者は、物流部門や営業所で配車計画の改善を任された実務者の方、配車システムの導入を検討している方、そして配送費や積載率、時間指定の遵守率を経営指標として見る立場の方です。オペレーションズ・リサーチの専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にして言葉で言い換えています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各手法について「何を決める手法か」「どういう前提で使えるか」「使ってはいけないのはどういうときか」「結果を経営指標にどう翻訳するか」を書くようにしました。配送計画の手法の多くは教科書に載っていますが、実務で難しいのは、自社の配送がどの型の問題に当てはまるのか、配車担当者が守っている暗黙の条件をどこまで制約として書くのか、距離や所要時間の見積りの誤差をどこまで許すのか、計算時間と解の良さをどこで折り合わせるのかを見極めるところだと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムの記述は2026年9月時点で確認したものです。法令や公的統計は改正や更新がありますので、実務で使う際は所管官庁のページで最新の内容をご確認ください。ライブラリの関数名や引数も版によって変わります。計算時間は本コラムの実行環境で測った値であり、計算機が変われば変わります。
目的別の読み方の目安を挙げておきます。配車計画を経営指標としてどう見るかを整理したい場合は、第1章と第13章が入口になります。自社の配送がどの型の問題に当たるかを見極めたい場合は、第2章の分類をご覧ください。1台の車の回る順番を決めたい場合は第3章、積載量が詰まりどころの場合は第4章、納品先の時間指定が厳しい場合は第5章が中心になります。無償のソルバーを実際に使って配車を組みたい場合は、第6章で使い方と設定の選び方を整理しました。
ドライバーの拘束時間や残業が課題の場合は第7章、車種の構成や配送センターの数、集荷と配送の組み合わせを検討している場合は第8章をご覧ください。計画どおりに車が走らない原因が距離や所要時間の見積りにありそうな場合は第9章、納品先が数百件から千件を超える場合は第10章で扱っています。当日の追加注文や遅れで計画がすぐ崩れる場合は第11章、担当エリアの決め方や曜日ごとの配送の割り振り、共同配送を検討している場合は第12章が入口です。機械学習や生成AIを配車計画にどう位置づけるかは第14章で扱っています。

目次
- 序章 配車計画は「どの車が・どの順に・何時に回るか」を決める問題である
- 全体の地図
- 第1章 配車計画はなぜ経営の問題なのか
- 第2章 配送計画問題を記述する、決めること・守ること・目指すことを言葉と行列にする
- 第3章 1台の巡回を決める、巡回セールスマン問題の構築法と改善法
- 第4章 積載制約付きの配車、何台で・どう分けて・どの順に回るかを決める
- 第5章 時間指定を守る配車、時間枠と待ち時間、指定の厳しさの費用
- 第6章 OR-Toolsのルーティングソルバーを使いこなす
- 第7章 ドライバーの労働時間を制約に入れる
- 第8章 車種・複数拠点・集荷と配送、配車の前提そのものを変える判断
- 第9章 距離と時間をどう作るか、見積りの誤差が計画を壊す
- 第10章 大規模化への対処、数百件から千件の配送先を決まった時間で解く
- 第11章 当日の変化と再配車、走行中の車を固定して計画を直す
- 第12章 配送エリアと配送頻度を設計する、担当地区と曜日割りと共同配送
- 第13章 現場に入れる、配車担当の暗黙知を制約に落とし、人が直す運用で育てる
- 第14章 事例と最新動向、公開された成果をどう読み、何を自社に持ち帰るか
- 終章 配車計画を、毎朝回る仕組みにする
- 本コラムで紹介した書籍一覧
- 第1章 配車計画はなぜ経営の問題なのか
- 第2章 配送計画問題を記述する、決めること・守ること・目指すことを言葉と行列にする
- 第3章 1台の巡回を決める、巡回セールスマン問題の構築法と改善法
- 第4章 積載制約付きの配車、何台で・どう分けて・どの順に回るかを決める
- 第5章 時間指定を守る配車、時間枠と待ち時間、指定の厳しさの費用
- 第6章 OR-Toolsのルーティングソルバーを使いこなす
- 第7章 ドライバーの労働時間を制約に入れる
- 第8章 車種・複数拠点・集荷と配送、配車の前提そのものを変える判断
- 第9章 距離と時間をどう作るか、見積りの誤差が計画を壊す
- 第10章 大規模化への対処、数百件から千件の配送先を決まった時間で解く
- 第11章 当日の変化と再配車、走行中の車を固定して計画を直す
- 第12章 配送エリアと配送頻度を設計する、担当地区と曜日割りと共同配送
- 第13章 現場に入れる、配車担当の暗黙知を制約に落とし、人が直す運用で育てる
- 第14章 事例と最新動向、公開された成果をどう読み、何を自社に持ち帰るか
- 参考情報
序章 配車計画は「どの車が・どの順に・何時に回るか」を決める問題である
物流の改善というと、倉庫の自動化や車両の入れ替えのような設備の話が思い浮かぶことが多いように思います。設備の投資は目に見えやすく、効果も説明しやすいためです。ところが、同じ倉庫と同じ車両を使っていても、毎朝の配車の組み方によって、使う車の台数、走る距離、ドライバーが拘束される時間、時間指定に遅れる件数は大きく変わります。どの納品先をどの車に割り当て、その車にどの順番で回らせ、各納品先に何時に着くかを決める仕事、すなわち配車計画が、本コラムの主題です。
この問題の研究は古く、1959年にはダンツィクとラムサーが、1つの油槽所から多数のガソリンスタンドへ燃料を運ぶトラックの配車を数理計画の問題として定式化しています。1964年には、クラークとライトが、2つの納品先を別々の車で往復させる代わりに1台で続けて回ると距離がどれだけ節約できるかを手掛かりにルートをつないでいく方法を発表しました(第4章で扱うセービング法)。それから60年以上、納品先の数が増えると並べ方の組合せが爆発的に増えるという難しさと向き合いながら、厳密に最適な答えを求める方法と、実用的な時間で十分に良い答えを出す方法の両方が工夫されてきました。本コラムの実行環境では、無償で使えるソルバーを20秒動かしただけで、40件の配車について台数の下限どおりの6台で回る計画が得られました(後述)。ただし20秒は探索を打ち切った時間で、その計画が最短であることまでは示していません。本コラムでは、どの手法がいつ効くかを、実際に解いた結果で示すことを方針にしました。
配車の良し悪しは、経営の数字に直結する
配車の良し悪しは、配送費の内訳にそのまま現れます。車を1台多く出せば、その車の固定費とドライバー1人分の人件費がかかります。ルートが長ければ、燃料費と車両の摩耗が増え、ドライバーの拘束時間も延びます。時間指定に遅れれば、納品先の信用を損ない、場合によっては再配達や特別便の手配が必要になります。反対に、時間指定を確実に守ろうとして余裕を持たせすぎれば、1台で回れる件数が減り、台数が増えます。
これらの損失は、互いに引っ張り合う関係にあります。台数を減らせば1台あたりの担当件数が増え、拘束時間と遅れの危険が増します。距離を縮めようとして近い納品先から順に回れば、時間指定の厳しい納品先に間に合わなくなることがあります。どの損失をどこまで許すかは経営の判断であり、配車計画の手法は、その判断を目的と制約という形で書き下し、判断に沿った最良の配車を計算する道具です。
配車担当者の頭の中にある判断を、書き出す
多くの営業所では、配車は経験を積んだ担当者が組んでいます。担当者は、どの納品先の荷受けが何時から始まるか、どの道が夕方に混むか、どの納品先には大きな車が入れないか、どのドライバーがどの地区に慣れているかを知っており、その判断は多くの場合に的確です。問題は、その判断が担当者の頭の中にだけあり、書き出されていないことです。担当者が休めば配車が組めず、納品先が増えれば手作業が追いつかず、なぜその配車にしたのかを後から検証できません。
数理最適化で配車を組む作業は、この頭の中の判断を、制約と目的として一つずつ書き出す作業でもあります。書き出してみると、担当者が当然のように守っている条件が、実は誰も明文化していない例外ルールだったと分かることが少なくありません。第13章では、この書き出しの手順を、ヒアリングの設問と制約の優先順位の付け方として整理しました。計算機に任せる前に、現場の判断を言葉にすることが、導入の成否を分けると考えています。
同じ配送センターのデータで、手法を横に比べる
本コラムでは、架空の配送センターを共通の題材にしました。30km四方のエリアの中ほどに配送センターがあり、40件の納品先に合計868ケースの荷物を届けます。車は積載量150ケースの2トン車で、総ケース数を積載量で割ると、どう組んでも最低6台が必要になります。納品先のうち11件は午前、7件は午後の時間指定があり、残りの22件は終日受け取れます。このほかに、車種の違う3種類の車、2つ目の配送センター、集荷と配送の組、当日の追加注文、週に何度か届ける定期配送の納品先を用意し、章ごとに使い分けています。
このデータは乱数で生成したもので、実在の企業や地域の記録ではありません。その代わり、同じ問題に素朴な割り振り、古典的な構築法と改善法、ソルバーを順に当てて、結果と計算時間を横に比べることができます。参考までに、無償のソルバーを20秒動かして得た計画は、積載だけを制約にした場合で6台・総距離296.3km、時間指定も守る場合で6台・総距離293.2kmでした。時間指定を加えたほうが短くなっているのは、20秒で打ち切った探索が、制約の少ない問題で最良の答えまで届いていないためで、この2つの差を「時間指定の費用」と読んではいけません。こうした読み違いを避ける方法も、第5章と第6章で扱います。
最適解より、毎朝同じ時間で出せる良い計画
本コラムを通じてお伝えしたいことが一つあります。配車計画で大事なのは、一度きりの最適解ではなく、毎朝決まった時間で出せる十分に良い計画と、それを配車担当者とドライバーが信頼して使い続けられる仕組みだということです。配車は当日の追加注文や渋滞、荷待ちで崩れます。崩れるたびに組み直すには、計算が決まった時間で終わり、走行中の車の予定を大きく変えず、担当者が結果を読んで納得できることが要ります。厳密な最適性は、そのための手段の一つにすぎません。
経営判断に関わる方にとって、この点は導入の目標の置き方に直結します。配車システムを導入すれば最適な配車が自動で出るという期待で始めると、現場の例外ルールが入っていない計画が出て使われなくなることが多いように思います。まず現状の配車の組み方を書き出し、台数・距離・拘束時間・時間指定の遵守率を測り、計算機に任せる範囲を小さく始めて、結果を見ながら制約を足していくという順序であれば、投資の効果を数字で確かめながら進められます。
Anagraftでは、データ活用の構想づくりから、配車計画のような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムの本編は第1章から第14章までの14の章で、その後に終章を置いています。第1章と第2章で、配車計画を経営の問題として位置づけ、問題を記述する言葉をそろえます。第3章から第5章では、制約を1つずつ足しながら解き方を扱います。1台の車が回る順番を決める巡回セールスマン問題、車の積載量を守る配車、納品先の時間指定を守る配車の順です。第6章では、無償で使えるソルバーの使い方と、設定の選び方を整理します。
第7章から第9章は、現実の配送で配車の問題に加わる要素を扱います。ドライバーの労働時間、車種の構成と配送センターの数と集荷の組み合わせ、そして計画の土台になる距離と所要時間の見積りです。第10章と第11章は、納品先が数百件から千件を超えるときと、当日の追加注文や遅れで計画を直すときの対処です。第12章では、日々の配車の一段上にある担当地区と曜日割りと共同配送の設計を扱います。第13章で現場への導入と運用を、第14章で公開された事例と研究の動向をまとめ、終章で全体を振り返ります。
| 章 | 題 | 主に扱う手法と題材 |
|---|---|---|
| 第1章 | 配車計画はなぜ経営の問題なのか | 物流コストの構造、トラックドライバーの労働時間規制、積載効率、配車の経営指標、計画の階層 |
| 第2章 | 配送計画問題を記述する | 問題の分類、距離行列と時間行列、組合せの数、共通データの紹介、方面別の手割り |
| 第3章 | 1台の巡回を決める | 最近傍法・挿入法、2-opt・Or-opt、厳密解との比較 |
| 第4章 | 積載制約付きの配車 | セービング法、スイープ法、クラスター先・ルート後、公開ベンチマーク |
| 第5章 | 時間指定を守る配車 | 時間枠と待ち時間、ハードとソフトの時間枠、Solomon のベンチマーク、指定の厳しさの費用 |
| 第6章 | ルーティングソルバーを使いこなす | 次元とコールバック、初期解と改善の戦略、時間制限と品質、訪問の省略、MIP と CP-SAT との比較 |
| 第7章 | ドライバーの労働時間を制約に入れる | 改善基準告示、時間外労働の上限、休憩、2回転、台数と残業の釣り合い |
| 第8章 | 車種・複数拠点・集荷と配送 | 車種の構成、複数の配送センター、集荷と配送の組、帰り荷 |
| 第9章 | 距離と時間をどう作るか | 直線距離と道路距離、道路網の模型、時間帯による所要時間、見積りの誤差と余裕 |
| 第10章 | 大規模化への対処 | 大近傍探索、遺伝的アルゴリズム系の解法、大規模ベンチマーク、分割統治 |
| 第11章 | 当日の変化と再配車 | 追加注文の挿入と再計算、走行中の車の固定、受付締切、計画の変更量 |
| 第12章 | 配送エリアと配送頻度を設計する | 担当地区の固定と毎日の最適化、曜日割り、共同配送の試算 |
| 第13章 | 現場に入れる | 暗黙知の書き出し、ハード制約とソフト制約、システム連携、人が直す運用、導入の順序、失敗の型 |
| 第14章 | 事例と最新動向 | 公開一次情報のある事例、物流政策の動き、機械学習、生成AIとの分担、ソルバーの動向 |
読者の立場ごとに、問いから章を引けるように対応表も置きました。一つの問いに複数の章が関わる場合は、入口になる章を先に書いています。
| 問い | 入口になる章 | あわせて読む章 |
|---|---|---|
| 配車の良し悪しを経営の数字でどう測るか | 第1章 | 第2章、第13章 |
| 自社の配送はどの型の問題に当たるか | 第2章 | 第3章、第4章、第5章 |
| 手で組んだ配車はどれくらい改善の余地があるか | 第2章 | 第4章、第14章 |
| 時間指定を受けることの費用を知りたい | 第5章 | 第7章 |
| 無償のソルバーで配車を組みたい | 第6章 | 第4章、第10章 |
| ドライバーの拘束時間と残業を減らしたい | 第7章 | 第5章、第12章 |
| 車種や配送センターの数を見直したい | 第8章 | 第12章 |
| 計画どおりに車が走らない | 第9章 | 第11章 |
| 納品先が多く計算が終わらない | 第10章 | 第6章 |
| 当日の追加注文で配車がすぐ崩れる | 第11章 | 第9章 |
| 担当地区や共同配送を見直したい | 第12章 | 第8章、第14章 |
| 配車システムを入れても現場で使われない | 第13章 | 第14章 |
各章の末尾には、その章の主題を深めるための参考書籍を挙げ、巻末に一覧としてまとめました。本文で引いた論文や公式ドキュメント、官公庁の資料は、巻末の参考情報に章ごとに載せています。
第1章 配車計画はなぜ経営の問題なのか
配車計画とは、その日に届ける荷物を、どの車に積み、どの順番で回り、何時に着くかを決める仕事です。多くの配送センターでは、経験を積んだ配車担当者が前日の夕方から当日の朝にかけて、この計画を手作業か表計算ソフトで組み立てています。計画は毎日作り直されるので1回あたりの判断は小さく見えますが、使う車の台数・走る距離・ドライバーが働く時間は、すべてこの計画で決まります。つまり配車計画は、物流費の中で大きな比重を占める輸送費、とくに納品先へ届ける費用を毎日左右している意思決定です。
この章では、手法の説明に入る前に、配車計画がなぜ経営の問題として扱われるべきなのかを整理します。まず公的な調査と統計で、物流費の中で輸送費が占める重さ、トラックドライバーの労働時間規制が配送に与えた影響、トラックの荷台がどれだけ埋まっているかを確認します。次に、配車の良し悪しを測る経営指標を定義し、この記事の共通サンプルデータで組んだ計画をその指標で読んでみます。最後に「車を1台減らす」と「走行距離を10km減らす」の効き目を費用で比べ、配車の判断を誤ったときにどういう損失が出るかを型に分けて示します。配送計画問題の分類や解き方は第2章以降で扱い、この章では数理モデルには踏み込みません。
物流コストの半分以上は輸送費である
企業の物流費の大きさを測る代表的な指標に、売上高物流コスト比率(売上高に対して物流費が何%かを示す比率)があります。公益社団法人日本ロジスティクスシステム協会(JILS)は、通商産業省(現在の経済産業省)の「物流コスト算定活用マニュアル」に準拠した物流コスト調査を毎年行っています。2026年4月30日に公表された2025年度調査の概要によると、有効回答205社の売上高物流コスト比率は全業種平均で5.32%で、前年度から0.12ポイント下がったものの、過去20年間の調査結果の中では4番目に高い水準でした。同じ公表文は、物流事業者からの運賃・料金の値上げ要請や、労働力不足による人件費の高騰を背景に、この比率が長期的な上昇傾向にあると述べています。なお2025年度調査は、主に回答企業の2024年度の実績を集計したものです。
物流費の中身を機能別に見ると、輸送費の重さが分かります。機能別の構成比は、本文の図表を確認できた1年前の2024年度調査の概要版(有効回答191社、売上高物流コスト比率5.44%)から、全業種の値を示します。
| 機能 | 内訳 | 物流コストに占める割合(%) |
|---|---|---|
| 輸送費 | 調達輸送費6.34・社内輸送費15.19・販売輸送費34.36 | 55.89 |
| 保管費 | 資材保管費3.75・製品保管費15.91 | 19.66 |
| 荷役費 | (内訳なし) | 15.52 |
| 物流管理費 | (内訳なし) | 4.93 |
| 包装費 | (内訳なし) | 4.00 |
表の出典は JILS「2024年度 物流コスト調査報告書【概要版】」の図表4-1(全業種、191社)です。輸送費は物流コストの55.89%を占め、そのうち顧客へ届ける販売輸送費だけで34.36%あります。この記事が扱う配車計画は、主にこの販売輸送費、つまり配送センターから納品先へ届ける費用を左右します。販売輸送費は物流コストの3分の1余りにあたるので、配車計画の改善は物流費の中でも大きな費目に直接効きます。
2025年度調査の速報(2025年10月31日公表)は、機能別に見て輸送費の上昇が特に目立ち、回答企業177社のうち88.1%で輸送費の単価が「増加」したと報告しています。「横ばい」は9.1%、「減少」は2.8%でした。同じ速報は、荷主企業が物流コストの上昇に対して輸配送費の削減を主軸とした施策を展開していることも伝えています。運賃の単価は荷主の側だけでは下げにくいので、単価が上がる局面で荷主に残る打ち手は、使う量、つまり台数と距離と時間を減らすことです。ここに配車計画の出番があります。
ただし、JILS 自身が注意を促しているように、この調査は回答が約200社に限られ、近年は数値が乱高下しやすい傾向があります。上の比率は「日本企業の平均的な姿」の目安であり、自社の物流費を評価するときは、自社の輸送費を実際に集計して比べるのが確実です。
いわゆる2024年問題で、運べる量に上限がかかった
配車計画が経営の議題に上がるようになった直接のきっかけは、いわゆる物流の「2024年問題」です。2018年6月に改正された働き方改革関連法に基づき、自動車の運転業務にも2024年4月から時間外労働の上限規制が適用されました。厚生労働省の「自動車運転者の長時間労働改善に向けたポータルサイト」は、自動車運転者の時間外労働の上限を、2024年4月から原則として月45時間・年360時間、臨時的な特別の事情がある場合でも年960時間、と説明しています。国土交通省の資料は、この年960時間に休日労働が含まれないことを明記しています。
同じ時期に、トラックドライバーの拘束時間(始業から終業までの、労働時間と休憩時間を合わせた時間)や休息期間(勤務と勤務の間の、使用者に拘束されない時間)の基準を定めた厚生労働大臣告示「自動車運転者の労働時間等の改善のための基準」(改善基準告示)も改正され、2024年4月1日から適用されています。同ポータルサイトによると、改正後の拘束時間の上限は、原則として1年3,300時間・1か月284時間で、労使協定を結べば一定の条件のもとで延長が認められます。1日の拘束時間や休息期間、運転時間、連続運転の中断にも原則と例外が細かく定められています。条件の詳細と、それを配車の制約としてどう入れるかは第7章で扱います。
国土交通省の資料「物流の2024年問題について」は、トラックドライバーの労働時間の削減について具体的な対応を行わなかった場合、2024年度には輸送能力が約14%(4億トン相当)、2030年度には約34%(9億トン相当)不足する可能性があるという試算を示しています。2026年3月31日に閣議決定された「総合物流施策大綱(2026年度~2030年度)」は、この試算が2023年8月の「持続可能な物流の実現に向けた検討会」の最終とりまとめで示されたものであること(株式会社NX総合研究所の試算)を記したうえで、官民の取組の成果などにより2024年度に見込まれた約14%の不足はおおむね克服でき、2030年度に想定された約34%の不足のうち約14%は克服できた、と整理しています。一方で同じ大綱は、一部で輸送の制限が見られるなど輸送力は依然として逼迫しており、残りの不足の克服に向けて取組を続ける必要があると述べています。
経営の側から見ると、この変化は「ドライバーに頼めば今日中に何とかしてもらえる」という前提が崩れたことを意味します。1人のドライバーが1日に働ける時間と1か月に働ける時間に上限があるので、車を増やさずに運ぶ量を増やすには、同じ時間でより多く運べるようにする必要があります。そのための手段は、荷待ち・荷役の時間の短縮や積載効率の向上、他社との共同輸配送など複数ありますが、配車計画の質も、限られたドライバーの時間で運べる量を左右する要因の1つになったと言えます。
トラックの積載効率は4割程度にとどまっている
運べる量を増やす手段として国が目標を立てているのが、トラックの積載効率です。総合物流施策大綱(2026年度~2030年度)は、自動車輸送統計年報をもとに国土交通省が「輸送トンキロ÷能力トンキロ(空車時のデータを含む)」として算出した値を指標にしています。輸送トンキロは実際に運んだ重さに運んだ距離を掛けたもの、能力トンキロは積めた重さの上限に走った距離を掛けたものなので、この比率は「走っている荷台のうち、実際に荷物で埋まっていた割合」を距離で重みづけした値です。帰りの空車の区間も分母に入ります。
同じ大綱によると、この積載効率は2019年度の37.7%から2024年度には41.3%まで上がりましたが、前の大綱(2021年度~2025年度)が掲げた50%の目標には届いていません。新しい大綱は2030年度の目標を44%としています。大綱は、積載効率の向上に向けてトラック運送事業者が進めるべき取組として、他の事業者と連携した共同輸配送や帰り荷の確保と並んで「配車・運行計画の最適化」を挙げています。
法律の面でも、荷主に求められることが増えました。大綱によると、2024年4月に成立した「流通業務の総合化及び効率化の促進に関する法律及び貨物自動車運送事業法の一部を改正する法律」(大綱の中での略称は改正物流法)により、荷主・物流事業者に物流効率化の取組の努力義務が課され、改正後の物流効率化法に基づく積載効率の向上や荷待ち・荷役等の時間の短縮の努力義務は2025年4月に施行されました。大綱はさらに、大手の荷主・物流事業者を対象とした中長期計画の作成や定期報告などの義務付けが2026年4月に施行されることにも触れています。積載効率は、物流部門の内部の指標から、社外に説明を求められる指標へと性格が変わりつつあります。
ここで注意したいのは、統計の積載効率と、配送センターで配車担当者が見ている「積載率」は同じものではないことです。統計の値は重さと距離で測り、帰りの空車も含めた全国の平均です。一方、1つの配送センターの配送便では、荷物の量をケースや容積で数え、1便の荷台がどれだけ埋まったかを見ることが多いでしょう。配送センターから出て納品先を回り、空になって戻るルート配送では、荷物は納品先を回るたびに減り、最後の納品先から戻る区間は空車です。後の節で使う共通サンプルデータの計画で、統計と同じく「積んでいた量×走った距離」の合計を「積める上限×走った距離」の合計で割ってみると、出庫時の積載率が6台合計で96.4%の計画でも、この距離で重みづけした値は45.1%(積載だけの計画)と47.9%(時間指定も守る計画)でした。自社の数字を全国の41.3%と並べて一喜一憂するのではなく、次の節で定義するように、何を分子と分母に取ったかを明示して、自社の中で時系列に比べるのが実務的だと考えています。
配車の成績を測る6つの経営指標
配車計画の良し悪しを経営の言葉で語るには、指標を先に決めておく必要があります。この記事では、各章の計算結果を次の6つの指標に翻訳して示します。
| 指標 | 定義(この記事での計り方) | 主に効く費用 | 読むときの注意 |
|---|---|---|---|
| 使用台数 | その日に1回以上出庫した車の台数 | 車両とドライバーの固定費 | 1台が2回転する計画では、台数と便数を分けて数える |
| 総走行距離 | 全車が出庫してから帰庫するまでに走った道路距離の合計(km) | 燃料費・車両の摩耗などの変動費 | 距離の作り方(直線距離に係数を掛けるか、道路網で測るか)で値が変わる(第9章) |
| 1件あたり配送費 | (台数×1台1日の固定費+総走行距離×km単価)÷配送件数 | 配送費の全体 | 件数の多い日ほど下がるので、同じ曜日・同じ物量の日どうしで比べる |
| 積載率 | 総積載量÷(使用台数×1台の積載上限)。単位はケース・重さ・容積のどれかに決めて固定する | 台数 | 高すぎると需要の小さな増加で台数が1台増える(後述) |
| 時間指定の遵守率 | 納品先の指定時間の枠の終わりまでに荷下ろしを始められた件数÷配送件数。枠の開始より早く着いたときは、開始まで待ってから荷下ろしを始めるとして数える | 顧客との取引条件、再配達・待機 | この記事では早着を違反に数えず、待った時間を「時間枠を待つ時間」として別に数える。早着そのものを嫌う納品先もあるので、どちらで数えるかを社内で決めて固定する |
| 拘束時間・運行時間 | ドライバーの始業から終業まで(拘束時間)。この記事の計算では、その一部である出庫から帰庫までの時間(運行時間)を測る | 残業代、改善基準告示の遵守 | 出庫前の積込み・点検や帰庫後の作業は運行時間に入らないので、拘束時間はこれより長くなる。全車を同じ時刻に出庫させるか、便ごとに出庫をずらすかで運行時間と待ち時間が大きく変わるので、どちらで数えたかを添える |
6つの指標は互いに引っ張り合います。台数を減らせば1台あたりの受け持ちが増え、運行時間が延びます。時間指定を厳しく守ろうとすると、同じ地区の納品先を1便でまとめて回れなくなり、距離と台数が増えます。積載率を上げようとすると、便に余裕がなくなり、当日の追加注文を受け止めにくくなります。どれか1つの指標だけを最適にする計画は、たいてい別の指標を悪くします。どの指標をどれだけ優先するかは、ソルバーではなく経営が決めることで、数理最適化はその判断の結果を数字で示す道具です。
指標の定義は、社内で一度決めたら変えないことが大切です。積載率をケースで測るか重さで測るか、運行時間に荷待ちを含めるかどうかで、同じ計画でも数字が変わります。改善の効果を測るときに定義が途中で変わると、計画が良くなったのか、測り方が変わっただけなのかが区別できなくなります。
共通サンプルデータの計画を指標で読む
この記事では、全章を通して同じサンプルデータを使います。架空の配送センター1か所と納品先40件で、乱数のシードを固定して作ったものです。実在の企業や地域の記録ではありません。データの中身は第2章で詳しく紹介しますが、ここでは指標の読み方を示すために、2トン車(積載150ケース、架空)で40件・総計868ケースを届ける問題を、この記事の基準の解き方(OR-Tools の誘導局所探索を20秒で打ち切る方法。最適性は証明していません)で解いた2つの計画を使います。1つは積載量だけを制約にした計画、もう1つは納品先ごとの時間指定(午前9時〜12時・午後13時〜17時・終日8時〜18時の3種類)も守るように解いた計画です。費用の計算には、1台1日の固定費20,000円、1kmあたり40円という単価を使います。いずれもこの記事のために置いた架空の値です。
基準の結果の2つの計画について、ルートを変えずに指標だけを計算し直したのが次の表です(ch01_kpi.py と ch01b_kpi.py の出力)。2つの計画には同じ物差しを当てました。枠の開始より早く着いたら開始まで待って荷下ろしを始め、枠の終わりを過ぎて着いたときだけを「遅れ」として数えます。運行時間と待ち時間は出庫の時刻の置き方で変わるので、「便ごとに出庫を遅らせた場合」と「全車8時に出庫した場合」の2通りを載せています。
| 指標 | 積載だけの計画 | 積載+時間指定の計画 |
|---|---|---|
| 使用台数 | 6台 | 6台 |
| 総走行距離 | 296.3km | 293.2km |
| 1日の配送費(固定費+走行費) | 131,850円 | 131,730円 |
| 1件あたり配送費 | 3,296円 | 3,293円 |
| 積載率(868ケース÷(6台×150ケース)) | 96.4% | 96.4% |
| 時間指定の遵守率(早着は待ち、遅れだけを数える) | 95.0%(遅れ2件) | 100%(遅れ0件) |
| 運行時間の平均・最長(便ごとに出庫を遅らせた場合) | 243分・309分 | 259分・293分 |
| 時間枠を待つ時間の合計(便ごとに出庫を遅らせた場合) | 60分 | 164分 |
| 運行時間の平均・最長(全車8時に出庫した場合) | 405分・504分 | 400分・475分 |
| 時間枠を待つ時間の合計(全車8時に出庫した場合) | 1,035分 | 1,012分 |
表の「積載だけの計画」の列は、費用の指標だけを見ると問題がないように見えます。台数は6台、1件あたり配送費は3,296円です。ところがこの計画は時間指定を考えずに作られているので、8時に出庫して待たずに走ると、40件のうち11件で枠の開始より前に着きます。内訳は午後指定の納品先に午前中に着く7件と、午前指定の納品先に9時前に着く4件で、午後指定の7件は枠の始まりまで156分から232分早い到着です。この早着を枠の開始まで待ってから荷下ろしすると、待った分だけ後ろの納品先への到着が遅れ、午前指定の C37 と C40 の2件が、枠の終わりの12時からそれぞれ94分と132分遅れて着きます。これが表の遵守率95.0%です。待つ前提で数えると8時に出庫したときが最も早く着くので、同じ回り順のままでは、出庫の時刻をどう置いてもこの2件の遅れは残ります。この計画を現場に渡すと、ドライバーは納品先の前で2〜4時間待って午前指定の2件に遅れるか、順番を勝手に入れ替えるかを迫られます。費用の指標が良い計画でも、サービスの指標で見ると使えない計画があるということです。
「積載+時間指定の計画」の列は、遵守率100%で、しかも総走行距離が3.1km短くなっています。時間指定を加えたほうが距離が短いのは直感に反しますが、これは基準の解き方が20秒で探索を打ち切っていて、積載だけの問題で最良の計画を見つけきれていないためです。この2つの差を「時間指定を守るための費用」として読んではいけません。時間指定の費用を正しく測る方法は第5章で扱います。
運行時間と待ち時間は、出庫の時刻をどう置くかで大きく変わります。表の「便ごとに出庫を遅らせた場合」は、便ごとに、帰庫の時刻と遅れを悪くしない範囲で出庫をできるだけ遅らせたものです。時間指定の計画では、6台の出庫が9時24分から11時2分に分かれ、運行時間は220分から293分、時間枠を待つ時間は6台合計で164分になりました。同じ計画を全車8時にそろって出庫させると、待ち時間は1,012分、運行時間の平均は400分に延びます。ルートも帰庫の時刻も変わらず、違うのは出庫前の時間を配送センターで過ごすか、納品先の前で待って過ごすかだけです。第2章の比較表は全車8時に出庫する置き方で数えているので、同じ計画の待ち時間が1,012分として出てきます。次の図は便ごとに出庫を遅らせた場合で、左は便ごとの積載率、右は便ごとの運行時間、灰色の部分が時間枠を待っている時間です。
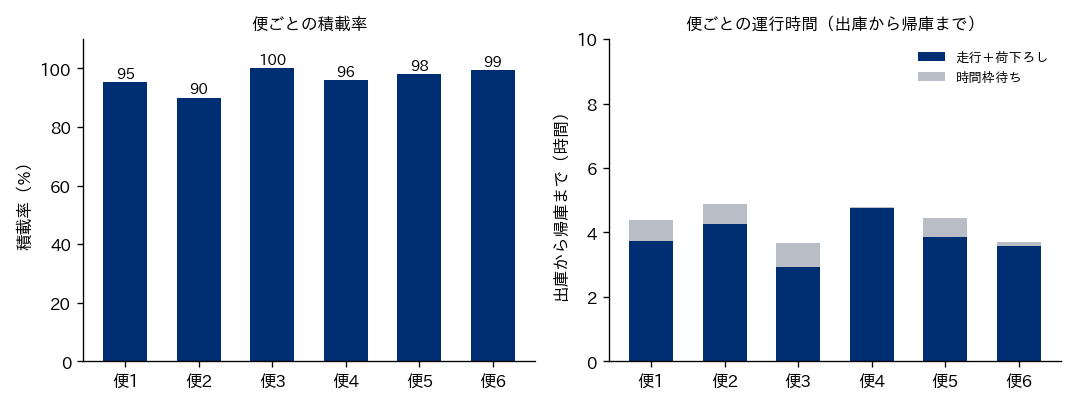
左の図では、6便のうち5便の積載率が95%以上で、荷台はほぼ埋まっています。一方で右の図を見ると、どの便も運行時間は5時間未満です。1日の終業を18時とすれば、ドライバーの時間にはまだ余裕があり、この計画で台数を決めているのは時間ではなく荷台の大きさです。こうした状況では、1台が配送センターに戻って積み直し、2回目の配送に出る「2回転」の計画を検討する余地があります。反対に、荷台に余裕があって時間が足りない計画では、打ち手は積込みの前倒しや時間指定の見直しになります。どちらの制約が台数を決めているのかを見分けるのが、指標を読むときの最初の仕事です。2回転の計画と労働時間の制約は第7章で扱います。
1台減らすか、10km減らすか
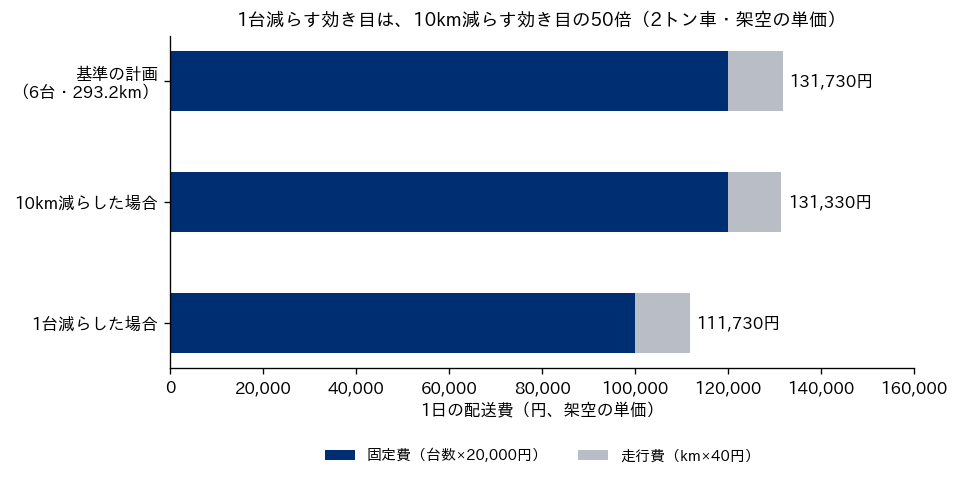
配車の改善というと、走行距離の短縮が真っ先に思い浮かびます。しかし費用の構造を見ると、距離より台数のほうがはるかに効くことが多くあります。前の節の時間指定の計画(6台・293.2km)を基準にして、架空の単価で2つの打ち手を比べました。
FIX, PER_KM = 20000, 40          # 2トン車の固定費(円/台・日)と走行費(円/km)。架空
n_veh, km = 6, 293.2              # 積載+時間指定の計画(基準の結果)
base = n_veh * FIX + km * PER_KM
print("基準", round(base))
print("1台減らす", round(base - FIX), "差", FIX, "(%.1f%%)" % (100 * FIX / base))
print("10km減らす", round(base - 10 * PER_KM), "差", 10 * PER_KM, "(%.1f%%)" % (100 * 10 * PER_KM / base))
print("1台の固定費を距離に換算", FIX / PER_KM, "km")
# 出力: 基準 131728
# 出力: 1台減らす 111728 差 20000 (15.2%)
# 出力: 10km減らす 131328 差 400 (0.3%)
# 出力: 1台の固定費を距離に換算 500.0 km
上のコードは、計算の考え方を示すために距離を小数第1位の293.2kmで入れたものです。本文と表の金額は、ルートの距離を丸めずに計算した ch01_kpi.py の出力(131,730円)に合わせているので、1〜2円ずれます。
1台減らすと1日の配送費は20,000円、率にして15.2%下がります。10km減らした場合は400円、0.3%です。この単価では、1台の固定費は500km分の走行費に相当します。基準の計画の総走行距離は293.2kmなので、全車の走行距離をすべて消しても1台分の固定費に届きません。総走行距離を1割(29.3km)縮めても1日1,173円で、年250日稼働と仮定すると年29万円余りですが、1台減らせば同じ仮定で年500万円です。
もちろん、実際の比率は単価しだいです。固定費には車両のリース料や減価償却、保険、ドライバーの人件費のうち日々の走行距離に比例しない部分が入り、自社便か委託か、委託なら車建て(1台1日いくら)か個建て(1ケースいくら)かで構造がまったく変わります。自社の単価で同じ計算をすると、「1台の固定費は何km分の走行費か」という換算値が出ます。この値が大きいほど、配車の目的は距離より台数を優先すべきだということになります。この記事の基準の解き方が、車両の固定費を100km相当と置いて台数が増えにくいようにしているのも同じ考え方で、固定費と距離の重みの付け方は第6章と第8章で詳しく扱います。
逆に、委託先に個建てで払っている場合は、台数を減らしても自社の支払いは直接には減りません。その場合でも、運送事業者の側の台数と時間が減れば、次の運賃の交渉や、繁忙期に車を確保できるかどうかに効いてきます。配車の改善の効果が、自社の損益に直接出るのか、取引条件を通じて間接に出るのかを、先に確かめておく必要があります。
積載率96.4%の意味、需要が4%増えると7台目が要る
積載率は高いほど良い指標として扱われがちですが、高すぎる積載率は台数の余裕がないことの裏返しでもあります。サンプルデータの総ケース数は868で、2トン車1台の積載は150ケースなので、どう組んでも最低 \( \lceil 868 / 150 \rceil = 6 \) 台は要ります。この式は「総ケース数を1台の積載で割り、小数点以下を切り上げた数」が台数の下限になる、という意味です。基準の計画はこの下限の6台で組めているので、台数の面ではこれ以上良くなりません。
6台で運べるのは900ケースまでで、現在の868ケースとの差は32ケース、需要の3.7%しかありません。需要を増減させて台数の下限を計算し直したのが次の表です。
| 需要(現在を100%) | 総ケース数 | 台数の下限 | 下限の台数で走ったときの積載率 |
|---|---|---|---|
| 90% | 781 | 6台 | 86.8% |
| 95% | 825 | 6台 | 91.6% |
| 100% | 868 | 6台 | 96.4% |
| 103% | 894 | 6台 | 99.3% |
| 104% | 903 | 7台 | 86.0% |
| 110% | 955 | 7台 | 90.9% |
表の総ケース数は868に倍率を掛けた値を整数に四捨五入して示し、積載率は四捨五入する前の値で計算しました。たとえば95%の行は824.6ケースで、900ケースに対して91.6%です(四捨五入後の825ケースで割ると91.7%)。需要が4%増えただけで下限は7台になり、積載率は86.0%に下がります。固定費は1台分、この単価で1日20,000円増えますが、運ぶ量は4%しか増えていません。これは台数が整数でしか増減できないことから来る段差で、積載率が高い状態で運用している配送センターほど、この段差の手前にいます。また、下限は荷物を自由に分けて積める場合の値です。実際には納品先の荷物を2台に分けて積むことはふつう避けるので、組める台数は下限より多くなることがあります。
経営の判断としては、この段差をどう扱うかが問われます。繁忙日だけ7台目を傭車(外部の車を1日単位で借りること)で手当てするのか、4トン車を1台混ぜて段差をならすのか、追加注文の受付を締め切って翌日に回すのか、といった選択肢があり、どれが安いかは単価と頻度で決まります。車種を混ぜる判断は第8章、当日の追加注文と受付締切は第11章で扱います。積載率の数字を見るときは、平均値だけでなく「あと何ケースで次の1台が要るか」を一緒に見ておくと、台数の計画を立てやすくなります。
計画の階層、どの時間軸で何を決めるか
配送に関わる判断は、配車計画だけではありません。決める頻度と、一度決めたら変えにくい度合いによって、少なくとも4つの段に分けて考えると整理しやすくなります。
| 段 | 決めること | 見直す頻度の目安 | この記事で扱う章 |
|---|---|---|---|
| 拠点網の設計 | 配送センターをどこに何か所置くか、どの地域をどの拠点から出すか | 数年に1回 | 第8章で複数拠点の比較に触れる。立地の定式化は弊社コラム「数理最適化の定式化パターン集」へ |
| 配送エリアと曜日の設計 | 担当地区を固定するか、定期配送の納品先を何曜日に回るか、配送頻度をどうするか | 数か月に1回 | 第12章 |
| 日々の配車 | その日の荷物を、どの車に、どの順番で、何時に届けるか | 毎日 | 第2章〜第10章 |
| 当日の再配車 | 追加注文・キャンセル・遅れが出たときに、走行中の計画をどう直すか | 1日に何度も | 第11章 |
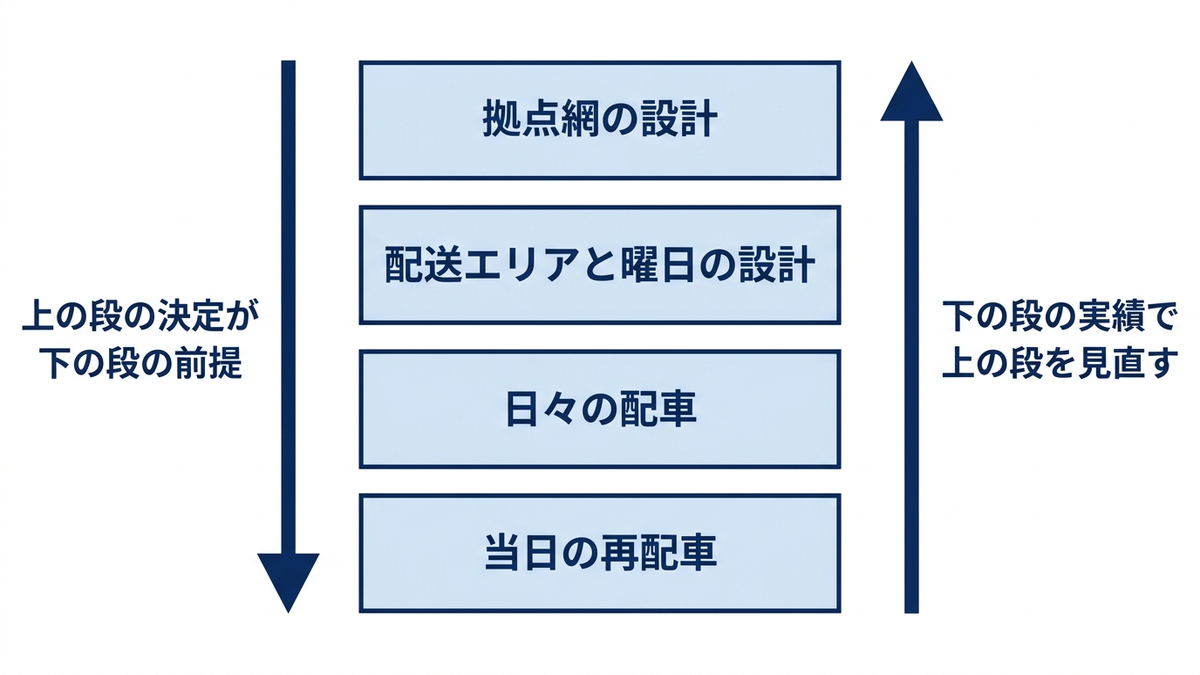
上の段の決定は、下の段の前提になります。拠点の位置が決まれば、その日の配車で回れる範囲も決まります。担当地区を固定すれば、日々の配車で入れ替えられる納品先が限られます。逆に、下の段の実績は上の段を見直す材料になります。毎日の配車で特定の地区の便だけ積載率が低い、あるいは時間が足りないという状況が続くなら、それは日々の配車の腕前の問題ではなく、エリアの分け方や拠点の位置の問題かもしれません。
この記事の中心は3段目の日々の配車で、第2章から第10章までを使って、1台の巡回、積載、時間指定、労働時間、車種と拠点、距離の作り方、規模への対処を順に扱います。そのうえで第11章で4段目の当日の再配車、第12章で2段目のエリアと曜日の設計を扱い、第13章で現場への導入、第14章で事例と最新動向をまとめます。1段目の拠点網の設計は、この記事では第8章で拠点を1か所足したときの効果を測るところまでにとどめます。
段を分けて考えることには、もう1つ実務上の意味があります。数理最適化の道具は段ごとに違い、日々の配車には数秒から数分で良い解を返す探索の手法が向き、拠点網の設計には時間をかけて最適性を確かめる整数計画が向きます。「配送を最適化したい」という相談の多くは、どの段の話なのかを切り分けるところから始めると、必要なデータと道具が見えてきます。
判断を誤ったときの損失の型
配車計画の判断を誤ったときの損失は、いくつかの型に分けられます。型を知っておくと、自社の配送でどの損失が起きているかを当てはめて考えやすくなります。
| 損失の型 | 起きること | 表に出る経営指標 | 関係する章 |
|---|---|---|---|
| 台数の過剰 | 下限より多い台数で回し、積載率の低い便が毎日出る | 使用台数、積載率、1件あたり配送費 | 第4章・第8章 |
| 時間指定の見落とし | 費用だけを見た計画が現場で守れず、早着の待機や遅着が出る | 時間指定の遵守率、運行時間 | 第5章 |
| 労働時間の超過 | 計画上は回るが、拘束時間の上限を超える便が出る | 拘束時間、残業時間 | 第7章 |
| 見積りの誤差 | 距離・所要時間・荷下ろし時間の見積りが甘く、計画どおりに走れない | 遵守率、残業時間 | 第9章 |
| 当日の変化への弱さ | 追加注文や遅れのたびに計画が崩れ、臨時の車を手配する | 使用台数(臨時分)、遵守率 | 第11章 |
| 段の取り違え | エリアや拠点の問題を日々の配車で解こうとして、効果が出ない | 特定の地区の積載率・運行時間が改善しない | 第12章 |
前の節までの数字をこの型に当てはめると、「積載だけの計画」は時間指定の見落としの型にあたり、1件あたり配送費は良くても、早着を待つと午前指定の2件が1時間半以上遅れ、遵守率は95.0%でした。需要が4%増えると7台目が要るという話は、台数の段差の手前で運用していることの危うさで、当日の変化への弱さの型につながります。
損失の型の中で見落とされやすいのは、計画の上では問題がなく、現場で初めて表に出るものです。時間指定の見落とし・労働時間の超過・見積りの誤差の3つは、いずれも「モデルに書いていない制約はソルバーにとって存在しない」ことから生まれます。配車システムが出した計画を現場が手で直している場合、その手直しの中身こそが、モデルに足りない制約の一覧です。手直しの記録を残して次の制約に加える運用は第13章で扱います。
経営の側から見て押さえておきたい数字は3つあると考えています。1つ目は「1台の固定費は何km分の走行費か」という換算値で、配車の目的を台数優先にするか距離優先にするかを決めます。2つ目は「あと何ケースで次の1台が要るか」で、台数の段差にどれだけ近いところで運用しているかを示します。3つ目は時間指定の遵守率と、便ごとの運行時間の余裕です。この2つは費用の指標には現れませんが、ここが崩れると、顧客との取引条件と、ドライバーの労働時間の上限という、お金では簡単に取り戻せないものを失います。
この章の要点は3つです。第一に、公的な調査で見ると物流コストの半分以上は輸送費で、単価が上がる中で荷主に残る打ち手は、台数・距離・時間という使う量を減らすことであり、それを毎日決めているのが配車計画です。第二に、2024年4月からの時間外労働の上限規制と改善基準告示の改正で、ドライバーの時間に上限がかかり、積載効率の向上と配車・運行計画の最適化は国の大綱でも取組として挙げられています。第三に、配車の成績は使用台数・総走行距離・1件あたり配送費・積載率・時間指定の遵守率・拘束時間の6つで測り、架空の単価で見ると1台減らす効き目は10km減らす効き目の50倍でした。次の第2章では、配車計画を数理最適化の問題として書き表し、問題の種類と組合せの数、この記事の共通サンプルデータを紹介します。
この章を深めたい方への参考書籍
『間違いだらけの日本の物流』(矢野裕児・首藤若菜、ウェッジ):2025年3月刊行。版元の紹介によると、物流の「2024年問題」で「物が運べなくなる」事態は起きなかったものの、業界の構造は変わっておらず、その現状を物流の専門家2名が分析した本です。目次には「2024年問題」とは何だったのか、商慣行が深刻化させるドライバー不足、荷主・消費者にとっての「当たり前」は持続可能か、といった章が並びます。この章で見た規制と輸送力の話を、荷主の立場から考え直すのに向いています。
『物流危機は終わらない:暮らしを支える労働のゆくえ』(首藤若菜、岩波書店):岩波新書の1冊で、2018年12月刊行。著者は労使関係論を専門とする研究者で、副題のとおり、暮らしを支える物流の労働に焦点を当てた本です。2024年4月の規制強化より前に書かれていますが、配車計画が前提としている「ドライバーの時間」がなぜ希少になったのかを、背景から理解するのに役立ちます。
第2章 配送計画問題を記述する、決めること・守ること・目指すことを言葉と行列にする
第1章では、配車計画が使用台数・総走行距離・積載率・時間指定の遵守率・ドライバーの拘束時間といった経営指標を直接動かすこと、そして計画には拠点網の設計から当日の再配車までの階層があることを確かめました。この章では、その階層のうち「日々の配車」を、コンピュータに渡せる形に書き下ろします。数理最適化の道具は、問題を正確に書けて初めて役に立ちます。逆に言えば、配車計画のシステムを入れても期待した効果が出ない原因の多くは、ソルバーの性能より手前の、問題の書き方にあると考えています。この章では、配車計画で決めること・守ること・目指すことを整理し、問題の型を分類表にまとめ、距離と時間を行列として用意し、組合せの数がどれほど大きくなるかを数えます。そのうえで、この記事の全章で使う架空のサンプルデータを紹介し、配車担当者が地図を見て方面ごとに手で割ったような素朴な計画を作って、第3章以降で使う最適化の結果と並べます。
配車計画で決めることは「どの車に・どの順に・何時に」の3つ
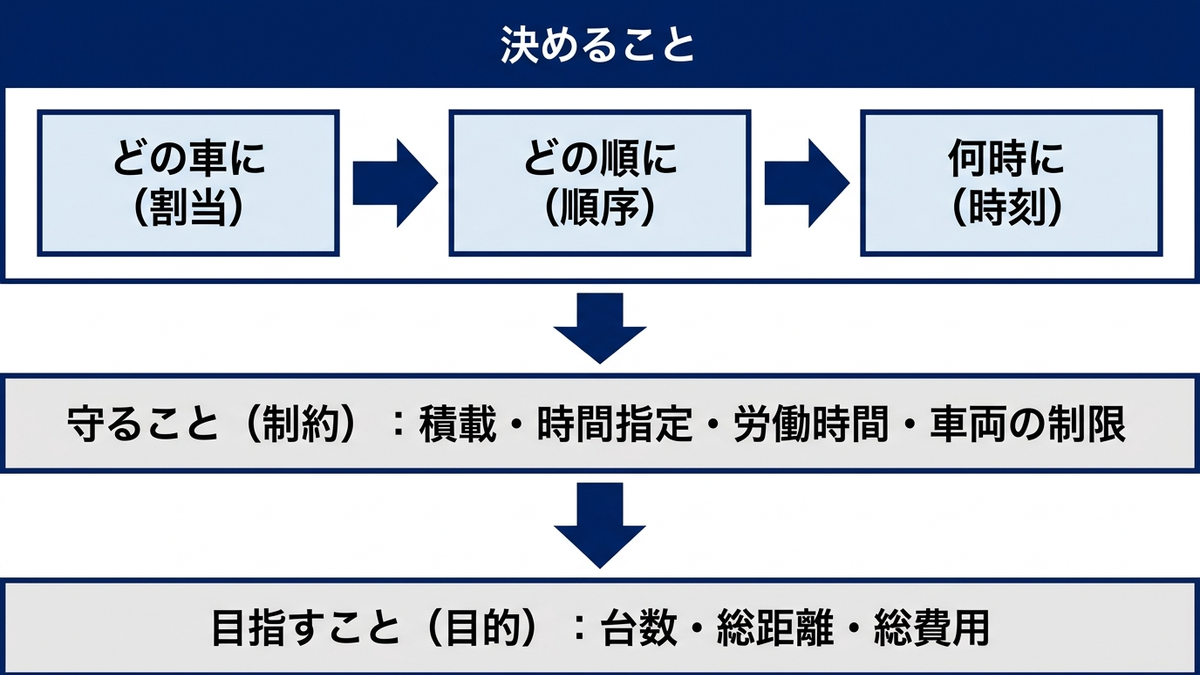
配送センターから複数の納品先へ荷物を届ける日々の計画を、数理最適化では配送計画問題(英語の Vehicle Routing Problem の頭文字で VRP。車両経路問題とも訳されます)と呼びます。この問題で決めることは、突き詰めると3つです。1つ目は、どの納品先をどの車に割り当てるか(割当)。2つ目は、各車がその納品先をどの順番で回るか(順序)。3つ目は、各納品先に何時に着き、何時に荷下ろしを始めるか(時刻)です。
3つは互いに独立ではありません。割当を変えれば、その車が回る順番の最善も変わります。順番を変えれば各納品先への到着時刻が変わり、時間指定を守れるかどうかが変わります。時間指定を守れなければ、別の車に割り当て直す必要が出てきます。配車担当者が頭の中で行っているのは、この3つを行き来しながら全体として辻褄の合う計画を探す作業で、数理最適化はこの行き来を計算機に肩代わりさせる道具です。
この3つのうち、どれを決める対象にし、どれを与えられた条件として扱うかで、問題の型が変わります。たとえば、ドライバーごとの担当地区が固定されていて、その日の納品先の割当が最初から決まっているなら、決めるのは各車の順番と時刻だけです。これは1台ずつの巡回の問題(第3章で扱う巡回セールスマン問題)に分解できます。反対に、割当から決める必要があるなら、複数の車にまたがる配送計画問題として一度に解くことになります。自社の配車で本当に決めているのはどれか、を最初に確かめることが、道具を選ぶ出発点になります。
決める対象の外側には、日々の配車では動かさない前提があります。拠点の位置、保有する車両の台数と車種、納品先ごとの配送の曜日、受注の締切時刻などです。これらは第1章で整理した計画の階層の上の段で決まるもので、この章の問題では与えられた条件として扱います。ただし、前提を動かせば日々の配車の結果も変わるので、第8章(車種と拠点)や第12章(エリアと曜日)で、前提そのものを変えたときの効果を測ります。
守ること(制約)と目指すこと(目的)を分けて書く
決めることが分かったら、次に「守らなければならない条件」と「できるだけ良くしたい量」を分けて書き出します。前者を制約、後者を目的と呼びます。この区別は、配車の議論で混乱が起きやすいところです。たとえば「時間指定は守りたい」という要望が、絶対に破ってはいけない条件なのか、破ってもよいが破るたびに損が出る量なのかで、ソルバーの答えはまったく変わります。
配送計画問題でよく現れる制約は、次のようなものです。各納品先には、ちょうど1回、どれか1台の車が訪問すること。各車の積荷の合計が、その車の積載量を超えないこと。各車はデポ(配送センター)を出発してデポに戻ること。納品先ごとの時間指定の範囲内に到着すること。ドライバーの拘束時間・運転時間が法令と社内規程の範囲に収まること。車両の大きさによっては入れない納品先があること。荷下ろしの順番に決まりがあること(後から積んだ荷を先に下ろす等)。どれを入れるかは会社ごとに違い、書き漏らした制約はソルバーにとって存在しないものとして扱われます。
目的には、使用台数の最小化、総走行距離の最小化、総費用(車両の固定費と距離に比例する費用、残業代の合計)の最小化、全車の帰着時刻のうち最も遅いものの最小化(仕事の平準化)などがあります。目的は1つに絞るのが原則で、複数の量を同時に良くしたいときは、重みを付けて足し合わせるか、優先順位を付けて順に最適化します。この記事の基準の結果(後の節で紹介します)では、車両1台に100km相当の固定費を掛けて距離に足すことで、台数が増えにくい目的にしています。これは重みを付けて足し合わせる方式で、厳密に「台数が第1、距離が第2」という優先順位ではありません。1台増やすことで距離が100kmより多く縮むなら、ソルバーは台数の多い計画を選びえます。台数を厳密に先に決めたいときは、台数を固定して解くか、台数を最小にしてから、その台数のもとで距離を最小にする、と段階に分けて解きます。
目的を何にするかは、技術の問題ではなく経営の判断です。台数を1台減らすことと、総距離を10km減らすことのどちらに価値があるかは、自社の車両の固定費と距離あたりの費用、ドライバーの確保のしやすさで決まります。第1章の費用の計算例がこの判断の材料になります。業務の側で目的を決めないまま、実装の都合で総距離だけを目的に置いてソルバーを回すと、台数が1台多い計画が「最適」として出てくることがあります。
配送計画問題の分類表、条件を1つ足すごとに別の型になる
1959年に Management Science 誌に載った Dantzig と Ramser の論文「The Truck Dispatching Problem」は、この問題を扱った早い時期の論文です。要旨によれば、この論文が扱ったのは、1か所の油槽所から多数のガソリンスタンドへ燃料を運ぶタンクローリーの経路で、各スタンドの需要を満たしながら車隊の総走行距離を最小にするようにスタンドを車に割り当てる、という問題でした。線形計画に基づく手順で最適に近い解を求める方法を示し、手計算でも計算機でも実行できること、ただし実務への適用はまだ行われていないことも要旨に書かれています。燃料の配送という具体的な業務から、この問題の研究が始まったことになります。
その後の半世紀あまりで、現実の条件を1つ足すたびに別の名前の問題が作られてきました。配送計画問題を総合的に扱った Toth と Vigo の編著『Vehicle Routing』の第2版(SIAM、2014年)は、第1章を配送計画問題の「一族」の整理にあて、以降の章で積載制約付きの問題の厳密解法、近似解法、時間枠付きの問題、荷物の集荷と配送の問題、確率的な要素を含む問題、動的な問題などを章ごとに扱っています。この記事で扱う型を、追加される条件と決めることで整理したのが次の表です。
| 問題の型(略称) | 基本形に追加される条件 | 決めること | 身近な例 | この記事で扱う章 |
|---|---|---|---|---|
| 巡回セールスマン問題(TSP) | 車は1台。積載も時刻も問わない | 回る順番 | 担当が決まったドライバー1人の回り方 | 第3章 |
| 積載制約付き配送計画問題(CVRP) | 複数台。各車の積荷の合計が積載量以内 | 割当と順番 | 2トン車を何台出し、どこを受け持たせるか | 第4章 |
| 時間枠付き配送計画問題(VRPTW) | 納品先ごとの到着時刻の範囲と荷下ろし時間 | 割当・順番・到着時刻 | 午前指定・午後指定の納品 | 第5章 |
| 労働時間の制約付き | 拘束時間・運転時間・休憩 | 割当・順番・時刻・休憩の位置 | ドライバーの拘束時間の上限を守る計画 | 第7章 |
| 集荷配送問題(PDP) | 集荷先と配送先の組を同じ車で、集荷を先に回る | 割当と順番(組の前後関係つき) | 取引先で引き取った返品を別の拠点へ届ける | 第8章 |
| 複数拠点の配送計画問題(MDVRP) | 出発する拠点が複数 | 拠点の割当・車の割当・順番 | 2つの配送センターから出す | 第8章 |
| 車種混在の配送計画問題 | 積載量と費用が違う車種が混在 | 車種の選択・割当・順番 | 4トン車・2トン車・軽バンの使い分け | 第8章 |
| 周期的な配送計画問題(PVRP) | 1週間などの期間内に、納品先ごとに決まった回数だけ訪問 | 訪問する曜日・曜日ごとの割当と順番 | 週2回の納品先を月木にするか火金にするか | 第12章 |
| 動的な配送計画問題(DVRP) | 計画の実行中に注文の追加や遅れが起きる | 走行中の車の計画の組み直し | 当日の追加注文への対応 | 第11章 |
表の上から下へ進むほど、条件が増えて問題は現実に近づきます。ただし、下の型は上の型を含んでいるので、下の型を解ける道具は上の型も解けますが、その逆は成り立ちません。巡回セールスマン問題の解き方だけを知っていても、積載や時間指定がある配車は解けません。反対に、時間枠付きの問題を解ける道具(この記事では主に Google の OR-Tools のルーティングソルバーを使います)は、時間枠を全部「終日」にすれば積載制約付きの問題としても使えます。
現実の配車は、この表の型のどれか1つにきれいに収まることはまれで、多くの場合は複数の型の組み合わせです。たとえば「時間指定があり、ドライバーの拘束時間に上限があり、車種が2種類ある」配車は、時間枠付き・労働時間の制約付き・車種混在の3つを同時に持ちます。自社の配車がどの型の組み合わせなのかを表で確かめておくと、必要な道具と、この記事のどの章を参照すればよいかが決まります。逆に、表のどの型にも当てはまらない条件(特定の納品先には特定のドライバーしか行けない、などの現場の決まりごと)は、第13章で扱うように、ヒアリングで拾って制約として書き足す必要があります。
表のどの型を選ぶかで計算の重さも大きく変わります。条件を1つ足すと、解の候補を絞り込む手がかりが増える場合もありますが、多くの場合は探す手間が増え、同じ時間で見つかる解の質が下がります。「念のため」全部の条件を入れて解くより、効いている条件を見極めて入れるほうが、良い計画が早く出ることがあります。どの条件が効いているかを確かめる方法は、第5章(時間指定の緩め方)と第7章(労働時間)で実例を示します。
距離行列と時間行列、ソルバーが見る地図はこの2枚の表だけ
配送計画問題を計算機で解くとき、ソルバーは地図そのものを見ません。見るのは、地点のあらゆる組について「AからBまで何km・何分か」を並べた表です。これを距離行列・時間行列と呼びます。行と列にデポと納品先を並べ、i行j列に地点 i から地点 j までの距離(または所要時間)を書いた正方形の表で、この記事ではデポを0番、納品先を1番から順に並べます。
この記事のサンプルデータ(次の節で紹介します)では、道路距離を「2地点の直線距離×1.3」、移動時間を「道路距離÷時速25km」と置いて行列を作りました。係数1.3と時速25kmは、この記事のための仮定です。実際の道路網では、川や線路を渡る橋の位置、一方通行、時間帯による渋滞で、直線距離との比は地点の組ごとに違います。その違いが計画をどれだけ狂わせるかは第9章で実験します。次の表は、実際に作った行列の左上の一部(デポと納品先 C01〜C05)です。
| 道路距離(km) | デポ | C01 | C02 | C03 | C04 | C05 |
|---|---|---|---|---|---|---|
| デポ | 0.0 | 16.0 | 13.5 | 18.3 | 20.0 | 15.7 |
| C01 | 16.0 | 0.0 | 17.1 | 28.2 | 35.9 | 20.7 |
| C02 | 13.5 | 17.1 | 0.0 | 31.8 | 29.2 | 3.6 |
| C03 | 18.3 | 28.2 | 31.8 | 0.0 | 19.1 | 33.9 |
| C04 | 20.0 | 35.9 | 29.2 | 19.1 | 0.0 | 29.2 |
| C05 | 15.7 | 20.7 | 3.6 | 33.9 | 29.2 | 0.0 |
時間行列は、この表の各値を時速25kmで割って分に直したもので、たとえばデポから C01 までの16.0kmは38.5分、C02 から C05 までの3.6kmは8.5分になります。この2枚の表と、納品先ごとのケース数・荷下ろし時間・時間指定、車の積載量と台数があれば、配送計画問題の入力はそろいます。
行列について、実務で押さえておきたい点が3つあります。1つ目は大きさです。デポと納品先40件なら41行41列で1,681個の値ですが、100件なら10,201個、1,000件なら100万個を超えます。地図サービスや経路探索のエンジンで道路距離を1組ずつ求める場合、この個数がそのまま問い合わせの回数と時間になります。2つ目は向きです。この記事の行列は直線距離から作ったので、AからBとBからAが同じ値(対称)になっています。実際の道路では、一方通行や右折の可否で往復の距離が違うことがあり、その場合は非対称の行列を使います。OR-Tools のルーティングソルバーは行列の値を1組ずつ問い合わせる作りなので、非対称の行列もそのまま渡せます。3つ目は単位と丸めです。この記事の実行環境(OR-Tools 9.15.6755)で、3地点の小さな問題を作り、距離を問い合わせる関数が小数(1.7)を返すようにして解かせたところ、エラーで止まりました。同じ関数が整数(2)を返すようにすると解けます。そのためこの記事では、km をメートルに直して整数に丸めた行列を渡しています。丸めの扱いと、単位の選び方で結果がどう変わるかは第6章で説明します。
行列の精度は、最適化の精度の上限を決めます。ソルバーは与えられた行列の上で最良の計画を探すので、行列が現実とずれていれば、ソルバーが「最適」と言った計画は現実の最適からずれます。計画の品質を上げたいとき、ソルバーの設定を調整するより先に、距離と時間の元データを見直すほうが効くことが少なくありません。この点は第9章で数字を示します。
組合せの数を数える、40件の順番は10の47乗通りを超える
配送計画問題が難しいと言われる理由は、候補の数の多さにあります。1台の車が n 件の納品先を回る順番は、1件目の選び方が n 通り、2件目が残りの \( n-1 \) 通り、と続くので、全部で \( n! \)(n の階乗、つまり 1×2×…×n)通りあります。デポから出て戻るので、同じ巡回を逆向きに回るものを同じとみなせば、その半分です。実際に数えた値が次の表です。
| 納品先の数 | 1台で回る順番の数(n!) | 逆向きを同じとみなした数(n!÷2) |
|---|---|---|
| 5件 | 120 | 60 |
| 10件 | 約363万(3,628,800) | 約181万 |
| 15件 | 約1.3×10の12乗 | 約6.5×10の11乗 |
| 20件 | 約2.4×10の18乗 | 約1.2×10の18乗 |
| 30件 | 約2.7×10の32乗 | 約1.3×10の32乗 |
| 40件 | 約8.2×10の47乗 | 約4.1×10の47乗 |
40件の階乗は48桁の数です。複数の車に分ける場合はさらに増えます。40件を、区別しない6台に1件以上ずつ分け、各車の回る順番まで決める方法の数は、組合せ論でラー数(区別できるものを、区別しないいくつかの空でない列に分ける方法の数)と呼ばれる数で、\( \binom{39}{5} \times 40! \div 6! \) と計算できます。言葉にすれば「40件を1列に並べる並べ方に、その列を6つの区間に切る切り方(39か所の切れ目から5か所を選ぶ)を掛け、車の番号の付け替えで重複した分を割る」という計算で、値は約6.5×10の50乗になりました。このうち積載や時間指定を満たすものはごく一部ですが、どれが満たすかは調べてみないと分かりません。
候補を全部試す方法(全列挙)がどれくらいの時間で行き詰まるかを、この記事の実行環境(一般的なノートPC)で実測しました。サンプルデータの納品先 C01 から順に n 件を取り、1台で全部回る最短の順番を、順番を1つずつ全部試して求めるプログラムを Python で書いて走らせています。
| 件数 | 試した順番の数 | 計算時間(実測) | 1順番あたりの時間 |
|---|---|---|---|
| 6件 | 720 | 0.00秒 | 2.00マイクロ秒 |
| 7件 | 5,040 | 0.01秒 | 2.29マイクロ秒 |
| 8件 | 40,320 | 0.19秒 | 4.63マイクロ秒 |
| 9件 | 362,880 | 1.61秒 | 4.45マイクロ秒 |
| 10件 | 3,628,800 | 17.56秒 | 4.84マイクロ秒 |
1件増えるごとに計算時間はおよそ件数倍になり、10件で17.56秒かかりました。1順番あたりの時間は、6件の2.00マイクロ秒から10件の4.84マイクロ秒まで揺れました。揺れの原因は確かめていません。同じPCで他の計算が並行して動いている環境での実測なので、この表の時間は目安として読む必要があります。10件のときの1順番あたり4.84マイクロ秒がそのまま続くと仮定して単純に掛け算すると、15件の全列挙には約630万秒(約73日)、20件には約1.2×10の13乗秒(約37万年)かかる計算になります。計算機を1,000倍速くしても、20件で数百年です。配車担当者が日々扱う規模(数十件から数百件)では、全部を試す方法は最初から選択肢にならない、ということがこの表から読み取れます。
NP困難の意味、「解けない」ではなく「規模とともに急に重くなる」
巡回セールスマン問題や配送計画問題は、計算量の理論でNP困難と呼ばれる問題の仲間です。Lenstra と Rinnooy Kan が1981年に Networks 誌に発表した、配送計画とスケジューリングの問題の計算量を論じた論文は、配送計画とスケジューリングの一群の問題について、それまでに知られていたNP困難性の結果を整理し、近似解法の最悪の場合の性能に関する結果をまとめています。NP困難とは、大まかに言えば「どんな大きさの問題でも、規模の多項式で表せる時間で必ず最適解を出す方法」が見つかっておらず、見つかる見込みも薄いと考えられている問題の型のことです。
この言葉は、ときに「配送計画問題は解けない」と誤解されます。実際には2つの点で違います。1つ目は、NP困難は「最悪の場合に、規模とともに計算時間が急に増える」ことを言っているのであって、個々の問題が解けないという意味ではないことです。巡回セールスマン問題では、専用の厳密解法で非常に大きな問題が最適性の証明つきで解かれてきました。ウォータールー大学の巡回セールスマン問題のページ(2022年8月更新)によれば、TSPLIB という公開問題集の pla85900(85,900点の巡回)は Concorde というプログラムで 2005年から2006年にかけて最短であることが証明され、同ページはこれを解かれた最大の問題と記しています。2つ目は、実務で必要なのは多くの場合「証明つきの最適解」ではなく「決まった時間内に出る十分良い解」だという点です。第3章以降で扱う構築法・改善法・メタヒューリスティクス(局所探索を工夫して悪い解から抜け出す汎用の枠組み)は、最適性の保証を手放す代わりに、数十件から数千件の問題で短時間に良い解を出すための方法です。
経営の側から見ると、NP困難という性質は2つのことを意味します。1つは、配車の規模が大きくなったとき、同じ計算時間で得られる計画の質が下がりうることです。納品先が2倍になったとき、計算時間を2倍にすれば同じ質が得られる、という保証はありません。もう1つは、得られた計画が最適かどうかを多くの場合は確かめられないことです。この記事の基準の結果も、OR-Tools に20秒の制限を付けて打ち切ったもので、最適性は証明していません。計画の良し悪しを評価するには、公開ベンチマークの既知最良値との比較(第4章・第5章・第10章)や、同じ問題を時間制限を変えて解いたときの改善の頭打ち具合(第6章)を見る必要があります。
この記事の共通サンプルデータ、架空の配送センターと納品先40件
第3章以降の実行例は、すべて同じサンプルデータの上で行います。このデータは実在の企業・地域の配送記録ではありません。乱数のシードを固定して、この記事のために生成した架空のデータです。地名や取引先名も付けていません。架空のデータにしたのは、守秘の問題を避けるためと、読者が同じコードを手元で動かして同じ数字を再現できるようにするためです。データを作るプログラム(vrp_data.py)は、この記事の全章で共通に読み込みます。
舞台は30km四方のエリアで、配送センター(デポ)は座標 (12, 14) にあります。座標の単位は km です。納品先は40件(C01〜C40)で、住宅や商業施設が集まる3つの地区に10件ずつ、郊外に散らばる形で10件を置きました。3つの地区の中心は、デポから見て北西 (6, 22)・北東 (20, 24)・南東 (22, 8) です。各納品先には、届けるケース数、荷下ろしと検品にかかる時間、時間指定(到着してよい時刻の範囲)を持たせています。時刻は8時を0分として分で数え、車は8時にデポを出て、18時までに戻る前提です。
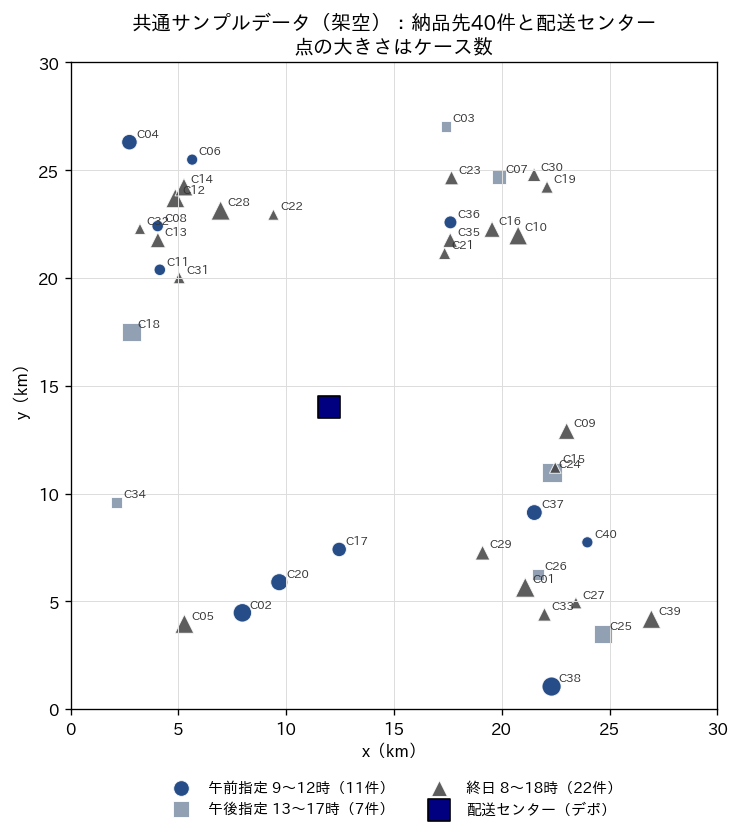
上の図がサンプルデータの地図です。丸が午前指定、四角が午後指定、三角が終日の納品先で、点の大きさはケース数を表します。納品先の中身を集計したのが次の表です。
| 時間指定の種類 | 到着してよい時刻 | 件数 | ケース数の合計 | 荷下ろし時間の合計(分) |
|---|---|---|---|---|
| 午前指定 | 9時〜12時 | 11件 | 220 | 140 |
| 午後指定 | 13時〜17時 | 7件 | 155 | 145 |
| 終日 | 8時〜18時 | 22件 | 493 | 400 |
| 合計 | 40件 | 868 | 685 |
1件あたりのケース数は最小7、中央値20、最大40です。荷下ろし時間は1件10分・15分・20分・25分のいずれかで、合計685分になります。デポから各納品先までの道路距離は最短8.6km、平均15.5km、最長23.2kmで、移動時間にすると最短20.6分、平均37.1分、最長55.8分です。
車は、2トン車(架空)で積載量150ケースとしました。総ケース数868を150で割ると5.79なので、どう積み合わせても6台は要ります。これが台数の下限です。6台で運べば、平均の積載率は868÷900で96.4%になり、6台の枠の余りは合計32ケースしかありません。この数字は、次の節の手割りの計画で効いてきます。なお、第8章で使う車種ごとの固定費と km あたりの費用(4トン車・2トン車・軽バン)も、この記事のために置いた架空の値です。
このデータは、実在の配送センターの典型を表したものではありません。件数・ケース数・時間指定の割合は、手法の違いが結果に表れるように置いた値です。自社のデータで同じ計算をするときは、納品先の位置・ケース数・荷下ろし時間・時間指定をマスタから取り出し、同じ形に整えれば、この記事のコードがそのまま使えます。マスタの精度をどう確保するかは第13章で扱います。
各章の結果を比べる物差しとして、このデータを OR-Tools のルーティングソルバーで解いた「基準の結果」を用意しました。初期解を PATH_CHEAPEST_ARC(今いる地点から一番安く行ける地点へ順につなぐ方法)で作り、誘導局所探索(局所探索が行き詰まった特徴に罰点を付けて抜け出す方法)で20秒改善したものです。車両1台に100km相当の固定費を掛け、台数が増えにくいようにしています(前の節で書いたとおり、厳密な優先順位ではなく重みです。今回はどちらの計画も台数の下限の6台になりました)。20秒で打ち切っているので、最適性は証明していません。
結果は、積載の制約だけで解いた場合(時間指定なし、18時までに帰着)が6台・総距離296.3km、積載と時間指定の両方を入れた場合が6台・総距離293.2kmでした。時間指定を加えたほうが総距離が短くなっていますが、これは時間指定を入れると距離が縮むという意味ではありません。制約を加えれば、とりうる計画の範囲は狭まるので、最適な計画の距離が短くなることはありません。打ち切りの探索が、積載だけの問題で同じ時間内に最良の計画を見つけていないことの現れです。この2つの差を「時間指定の費用」として読んではいけません。時間指定にかかる費用を同じ探索条件で測る方法は、第5章で扱います。
方面別に手で割った計画を作る
最適化の効果を測るには、比べる相手が要ります。配車担当者が地図を見て「北西方面」「南東方面」のように方面を決め、方面ごとに車を1台割り当て、ドライバーが近い順に回る、という計画の立て方は、広く見られるように思います。この素朴な計画をサンプルデータで再現しました。デポから見た各納品先の方角を、真東を0度として反時計回りに測り、方角で6つの方面に分けます。各車は、デポを出て、まだ回っていない納品先のうち一番近いところへ進む、を繰り返します(近い順)。
評価は、全部の計画に同じ物差しを当てました。8時にデポを出て、行列どおりの時間で走り、時間指定の開始より早く着いたら開始まで待ち、荷下ろしをして次へ向かいます。時間指定の終わりを過ぎて着いたら「遅れ」として数えます。計画を立てるときに時間指定を考えていない計画にも、同じ物差しを当てて遅れを数えています。早着は待って吸収し、遅れだけを数えるという点は第1章の遵守率と同じ数え方です。ただしこの章では、どの計画も全車が8時にそろって出庫するとして数えており、第1章の表の一部のように便ごとに出庫を遅らせてはいません。そのぶん、待ち時間と帰着までの時間は第1章の「便ごとに出庫を遅らせた場合」の値より大きく出ます。次のコードは、最も素朴な「方角を60度ずつ6つに区切る」案(下の表の案A)を評価するものです。
import math
from vrp_data import DEPOT, customers, points, dist_km, time_min, TRUCK_CAPACITY

cs = customers()
D, T = dist_km(points(cs)), time_min(points(cs))   # 距離(km)と時間(分)の行列。0番がデポ
ang = {i: math.degrees(math.atan2(c["y"] - DEPOT[1], c["x"] - DEPOT[0])) % 360
       for i, c in enumerate(cs, start=1)}           # デポから見た方角(真東が0度)
sectors = [[i for i in ang if s * 60 <= ang[i] < (s + 1) * 60] for s in range(6)]

km_all, late_all, over_all = 0.0, 0, 0
for g in sectors:
    cur, t, rest = 0, 0.0, set(g)                   # 8時にデポを出る
    while rest:
        nx = min(rest, key=lambda j: D[cur][j])      # まだ回っていない中で一番近い納品先へ
        km_all += D[cur][nx]; t += T[cur][nx]
        lo, hi = cs[nx - 1]["tw"]
        late_all += int(t > hi)                      # 時間指定の終わりを過ぎて着いた
        t = max(t, lo) + cs[nx - 1]["service"]       # 早く着いたら待ち、荷下ろしする
        rest.remove(nx); cur = nx
    km_all += D[cur][0]
    over_all += max(0, sum(cs[j - 1]["demand"] for j in g) - TRUCK_CAPACITY)
print("総距離 %.1f km  積載超過 %d ケース  時間指定の遅れ %d件" % (km_all, over_all, late_all))
# 出力: 総距離 290.0 km  積載超過 208 ケース  時間指定の遅れ 3件
案Aの総距離は290.0kmで、基準の結果より短く見えます。しかし6つの方面のうち3つで積載量150ケースを超え、超過の合計は208ケースでした。南東の方面には13件・313ケースが入り、2トン車2台分を超えています。反対に南西の方面は2件・46ケースしかありません。納品先は3つの地区に偏っているので、方角を均等に区切ると、荷物の量は均等になりません。積めない計画は計画になっていないので、この290.0kmは比べる対象になりません。
そこで、方角の順に並べた納品先を、件数が7・7・7・7・6・6件になるように区切り直しました(案B)。区切りの起点は、方角の隙間が最も大きいところ(C09 と C10 の間の48.0度)にしています。これでも1つの方面が203ケースで積載量を超えました。区切りの起点を40通りすべてずらしてみても、件数をそろえた区切りで6台とも積載量に収まる案は1つもありませんでした。さらに、積載量を超えた方面の端の納品先を隣の方面へ移す手直しを試みましたが、隣の2つの方面にも移せるだけの空きがなく、6台のままでは解消できませんでした。6台の枠の余りが32ケースしかないので、方面の境目を少し動かす程度では収まらないわけです。
現場でこうなったときの素直な対応は、積みきれない方面に車をもう1台出すことです。案Bで積載量を超えた方面を、方角の順に4件と3件に分けて2台で回る7台の計画を作りました(案D)。さらに、近い順に回ると時間指定に遅れる納品先が出るので、同じ割当のまま「午前指定を先に、終日を次に、午後指定を最後に、それぞれの中では近い順」に回る順番に直しました(案E)。配車担当者が時間指定を見て回る順を調整する、という手直しにあたります。結果をまとめたのが次の表です。
| 計画 | 使用台数 | 総距離(km) | 積載超過(ケース) | 時間指定の遅れ(40件中) | 最も遅い帰着 | 待ち時間の合計(分) |
|---|---|---|---|---|---|---|
| 案A 方角を60度ずつ6方面、近い順 | 6 | 290.0 | 208 | 3件 | 17時59分 | 862 |
| 案B 方角順に件数をそろえて6方面、近い順 | 6 | 332.3 | 53 | 3件 | 16時26分 | 911 |
| 案D 案Bの超過した方面を2台に分けて7台、近い順 | 7 | 340.0 | 0 | 3件 | 15時31分 | 1,036 |
| 案E 案Dと同じ割当、午前指定から先に回る | 7 | 361.3 | 0 | 0件 | 14時36分 | 760 |
| 基準の結果1 OR-Tools、積載のみ | 6 | 296.3 | 0 | 2件 | 16時24分 | 1,035 |
| 基準の結果2 OR-Tools、積載+時間指定 | 6 | 293.2 | 0 | 0件 | 15時55分 | 1,012 |
表の「最も遅い帰着」と「待ち時間の合計」は、上に書いた同じ物差しで評価し直した値です。基準の結果1は時間指定を考えずに作った計画なので、時間指定の開始まで待つ前提で評価し直すと、帰着が OR-Tools の出力(待ちを含まない)より遅くなり、2件で時間指定に遅れます。この2件は第1章の表の遵守率95.0%の遅れ2件(午前指定の C37 と C40)と同じものです。時間指定を制約に入れていない計画は、時間指定を守る保証が無い、ということがこの行から分かります。
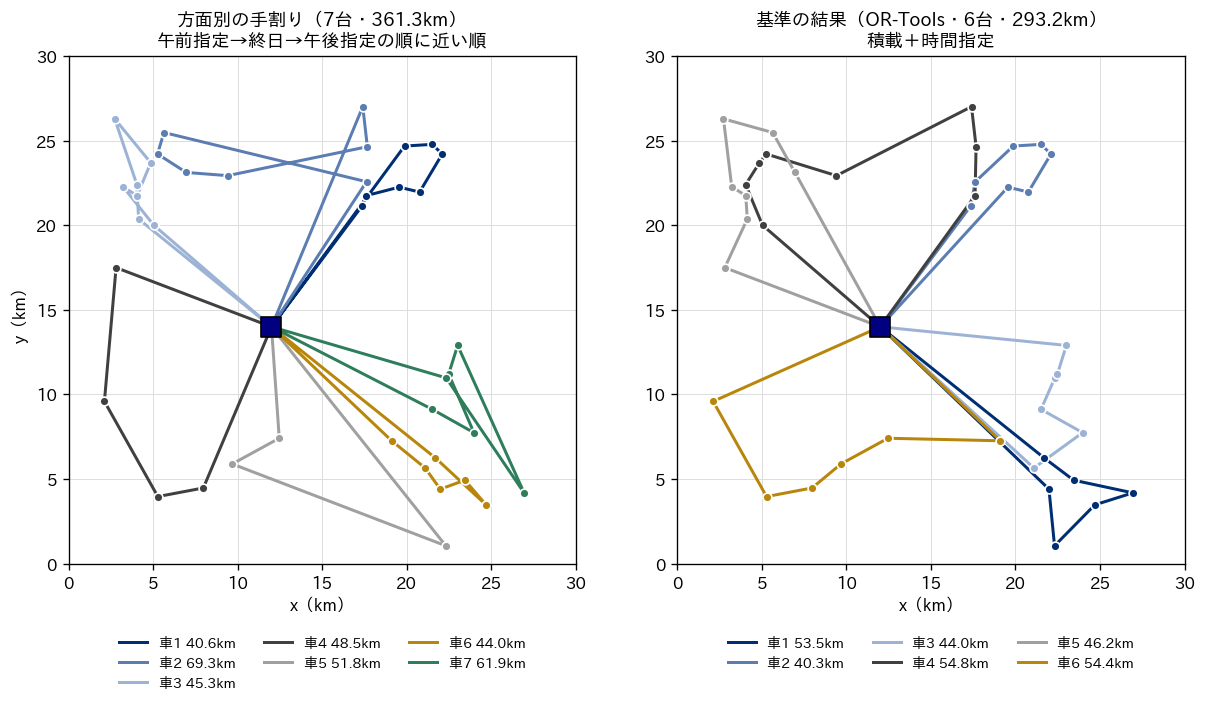
上の図の左が案E、右が基準の結果2のルートです。右の図の車番号は、使われた車を1から順に振り直しています。案Eの車2は、北東の C36(午前指定)から北西の地区へ渡り、また北東の C23・C03(午後指定)へ戻るため、長い横移動が2回生まれています。南東の地区に入る車は、左の案Eが車5・車6・車7の3台、右の基準の結果2が車1と車3の2台(ほかに南側を回る車6が C29 に寄ります)です。左の図では、方角で区切った方面の境目が地区の途中を通るため、1つの地区を複数の車が分け合う形になっています。
手割りの計画と基準の結果を経営指標で比べる
時間指定を全部守れる手割りの計画(案E)と、同じく全部守る基準の結果2を比べると、案Eは台数が1台多く(7台と6台)、総距離が68.1km長く(361.3kmと293.2km)なりました。サンプルデータの仮定(時速25km)で68.1kmは約163分の運転に相当します。第8章で使う架空の単価(2トン車の固定費1日20,000円、km あたり40円)で換算すると、1台分の固定費20,000円と距離の費用2,724円で、1日あたり22,724円の差になります。この単価は例題のために置いた値なので、自社の固定費と km 単価に置き換えて計算する必要があります。
ただし、この差をそのまま「最適化で削減できる額」と読むのは早計です。案Eは、この章で機械的に作った素朴な手割りで、経験を積んだ配車担当者の計画はこれより良い可能性があります。実際、区切りの件数を固定せず、方角の順に積めるだけ積んで次の車に移る区切り方にすると、積載の上では起点40通りのうち6通りで6台に収まりました(時間指定は考えていない集計です)。この考え方は第4章で扱うスイープ法そのものです。手割りと最適化の比較で意味があるのは金額そのものより、「手割りでは6台に収めるのが難しいほど積載に余裕が無い日がある」「時間指定を守るために回る順を直すと、距離が延びる」という構造の方です。
この構造は、積載率が高い日ほど強く出ます。今回のデータは平均積載率96.4%で、6台の余りが32ケースしかありません。こうした日は、方面の決め方を少し変えただけで積みきれない車が出て、1台追加か、翌日回しかの判断を迫られます。反対に、荷物が少ない日は手割りでも最適化でも台数は同じになりやすく、差は距離の数%にとどまることがあります。最適化の効果を見積もるときは、平均的な1日だけでなく、積載率が高い日・時間指定が多い日を選んで比べることが大切です。
もう1つ、表の待ち時間の合計に注目しておきます。どの計画でも待ち時間は760分から1,036分あり、基準の結果2でも1,012分です。第1章で同じ計画の待ち時間を164分と書いたのは、便ごとに出庫を遅らせた場合の値で、この表は全車8時出庫の値です。帰着の時刻はどちらも同じなので、8時にそろって出庫すると、その差の848分を配送センターではなく納品先の前で待って過ごすことになります。待った納品先の時間指定の種類で分けると、基準の結果2では1,012分のうち1,001分(98.9%)、案Eでも760分のうち609分(80.2%)が、午後指定の納品先に13時より前に着いて開始を待つ時間でした。待っている分だけ帰着は遅くなるので、総距離が短い計画でもドライバーが車と一緒にいる時間が短いとは限りません。この記事の基準の結果は距離と台数を目的にしており、待ち時間は目的に入っていません。待ち時間を減らす方法(出発時刻をずらす、時間指定の幅を交渉する)は第5章と第7章で扱います。何を目的に入れたかによって、「最適な計画」の中身が変わることの一例です。
問題の書き方を誤ったときに起きる損失
この章で見てきたことを、判断を誤ったときの損失の型としてまとめておきます。1つ目は、制約の書き漏らしです。基準の結果1のように時間指定を制約に入れずに計画を作ると、計画の上では台数も距離も良く見えるのに、実行すると時間指定に遅れる納品先が出ます。遅れは納品先との取引条件に響き、現場では当日の組み直しや臨時便で埋めることになります。計画担当者から見れば「現場が計画どおりに動かない」、現場から見れば「計画が現実を見ていない」という対立になりやすく、実際には書くべき制約が書かれていない、という情報の問題です。
2つ目は、目的の取り違えです。距離だけを目的にすると台数が増えることがあり、台数だけを目的にすると距離や拘束時間が延びることがあります。今回の基準の結果が6台になっているのは、1台に100km相当の固定費を掛けて台数が増えにくいように目的を書いたからです。どちらを優先するか、どれだけの重みを付けるかは、自社の固定費・km 単価・ドライバーの確保のしやすさで決まる経営の判断で、実装の都合に任せる事柄ではありません。
3つ目は、入力データの精度の過信です。距離行列を直線距離×1.3で作れば、橋の位置や一方通行は無視されます。荷下ろし時間をマスタの標準値で置けば、実際にかかる時間とのずれは計画に反映されません。ソルバーは与えられた行列の上で最良の計画を出すので、行列がずれていれば、その「最良」は現実の最良からずれます。第9章で、見積りの誤差が時間指定の遅れにどう化けるかを測ります。
4つ目は、最適性の過信です。NP困難な問題を時間制限つきで解いた結果は、最適である保証がありません。基準の結果で、時間指定を加えたほうが距離が短くなったのはその現れです。ソルバーの出力を「これ以上は良くならない」と読んで設備投資や車両の増減を判断すると、判断の前提がずれます。重要な判断に使う数字は、時間制限を変えて解き直したり、別の方法で解いたりして、揺れの幅を確かめてから使う必要があります。
この章の要点は3つです。第一に、配送計画問題は「どの車に・どの順に・何時に」を決める問題で、守ること(制約)と目指すこと(目的)を分けて書くことで、計算機に渡せる形になります。条件を1つ足すごとに問題の型が変わり、自社の配車がどの型の組み合わせかで使う道具が決まります。第二に、候補の数は40件の順番だけで10の47乗通りを超え、全部を試す方法は10件で17.56秒、20件では現実的な時間に収まらない計算になります。NP困難は「解けない」ではなく「規模とともに急に重くなる」という意味で、実務では決まった時間で十分良い解を出す方法を使います。第三に、架空のサンプルデータで方面別に手で割った計画を作ると、積載に余裕が無いために6台に収まらず、時間指定を守るように回る順を直すと、基準の結果より1台多く68.1km長い計画になりました。次の第3章では、まず1台の車が回る順番を決める巡回セールスマン問題を取り上げ、近い順に回る方法がどれだけ最短から離れているか、どう改善できるかを測ります。
この章を深めたい方への参考書籍
『Vehicle Routing』第2版(Paolo Toth・Daniele Vigo 編、SIAM):配送計画問題を総合的に扱った編著で、第1章が配送計画問題の一族の整理、以降の章が積載制約付きの問題の厳密解法と近似解法、時間枠付きの問題、集荷と配送の問題、確率的な問題、動的な問題などにあてられています。この章の分類表に挙げた型のそれぞれを、研究の側から深く知るための入口になります。英語の専門書です。
『ロジスティクス工学』(久保幹雄、朝倉書店):日本オペレーションズ・リサーチ学会の40周年記念シリーズ「経営科学のニューフロンティア」の1冊で、目次によれば経済発注量・在庫・ロットサイズのモデルと並んで、配送計画モデル(構築法、ルート先・クラスター後法、クラスター先・ルート後法など)と運搬スケジューリングモデルの章があります。配送計画を、在庫や拠点配置と同じロジスティクスの意思決定の1つとして位置づけて見るのに向いています。
第3章 1台の巡回を決める、巡回セールスマン問題の構築法と改善法
第2章では、配送計画の問題を「どの車に・どの順に・何時に」を決める問題として書き下し、共通のサンプルデータと、方面別に手で割った素朴な計画を用意しました。この章では、その中で最も小さな部品にあたる「1台の車が、決まった納品先を、どの順番で回るか」だけを取り出して扱います。積載も時間指定も外し、配送センターを出て全部の納品先を1回ずつ訪ね、配送センターに戻る道のりを最短にする問題です。この問題は巡回セールスマン問題(英語の頭文字で TSP)と呼ばれ、配車計画のほとんどの手法の内側で、部品として繰り返し使われています。
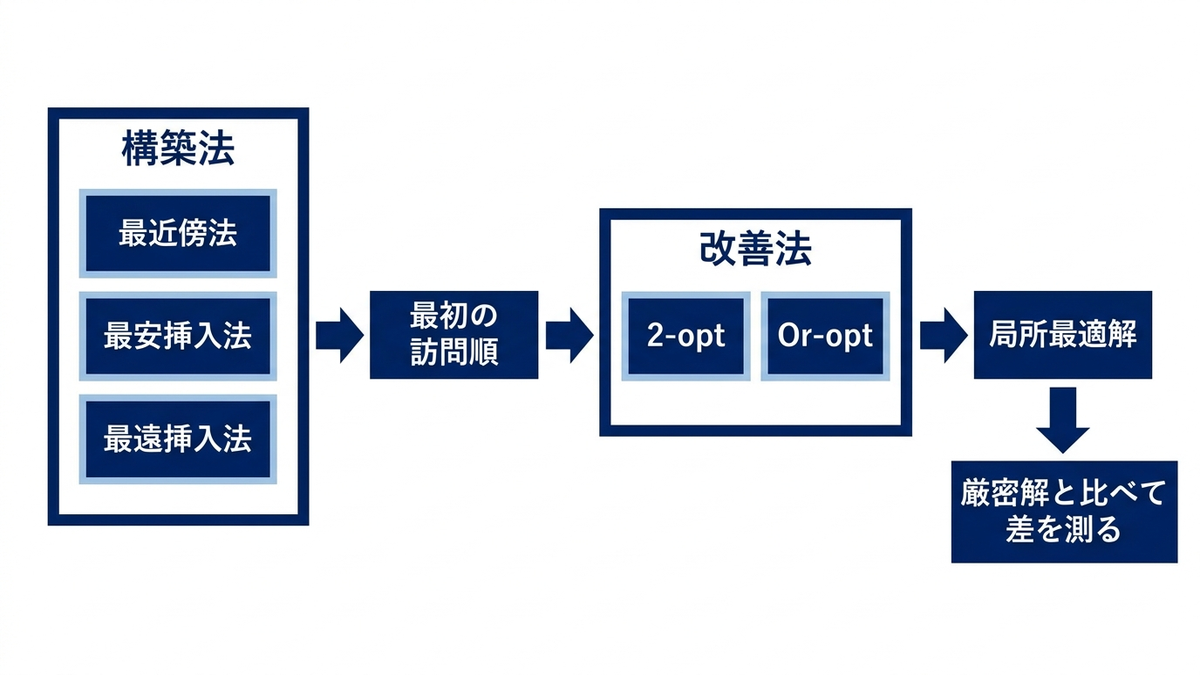
章の前半では、訪問順を一気に作る構築法(最近傍法・最安挿入法・最遠挿入法)と、できた訪問順を少しずつ直す改善法(2-opt・Or-opt)の仕組みを説明し、第2章の納品先40件を1台で回る問題に当てはめて、距離と計算時間を実測します。後半では、CP-SAT という整数の最適化ソルバーで最短であることを証明した訪問順と比べて、簡単な方法がどれだけ最適から離れるかを示し、担当先が決まった車の訪問順を直す場面と、件数が増えたときの計算時間を測ります。
1台の訪問順を決める問題、何を決めて何を決めないか
巡回セールスマン問題で決めるものは、訪問の順番だけです。どの納品先を回るかは最初から決まっていて、すべてを1回ずつ回ります。車が1台なので、どの車に積むかという判断はありません。目的は総距離(あるいは総移動時間)の最小化で、制約は「全部の納品先をちょうど1回ずつ訪ね、出発地に戻る」ことだけです。順番を決めるには、地点どうしの距離を並べた距離行列があれば足ります。この章では第2章と同じく、道路距離を直線距離の1.3倍と置いた距離行列を使います(1.3という係数は仮定で、その危うさは第9章で扱います)。
配車の実務で、この問題がそのまま出てくる場面は2つあります。1つは、担当の車と担当の納品先がすでに決まっていて、その日の訪問順だけを決める場面です。ルート配送で「このコースはこのドライバー」と固定している事業所や、第4章以降の方法で車への割り当てを決めたあとの仕上げがこれにあたります。もう1つは、第4章以降で扱う複数台の問題を解くときの内部です。多くの配車の手法は、納品先を車に割り当てる判断と、各車の中の順番を決める判断を行き来しながら解を良くしていきます。その後半の判断が、1台ずつの巡回セールスマン問題です。
反対に、この問題の形のまま使ってはいけない場面もはっきりしています。1台で積み切れない量がある、時間指定がある、ドライバーの拘束時間に上限がある、といった条件があれば、訪問順だけを最短にした計画は現場で成り立ちません。後で示すとおり、この章の40件を1台で回る最短の道のりは157.0kmですが、時速25kmの仮定で走行に377分、荷下ろしに685分かかり、合わせて1,062分、つまり17.7時間になります。積載は868ケースで、2トン車(150ケース)の5倍を超えます。この章の「40件を1台で」は、方法の性質を比べるための思考実験であり、実際の配車計画ではありません。積載は第4章、時間指定は第5章、労働時間は第7章で足していきます。
部分巡回(全体を1周せず、いくつかの小さな輪に分かれてしまう答え)を禁じる制約をどう書くかといった、整数計画としての定式化の詳細は、弊社コラム「数理最適化の定式化パターン集」の第12章で扱いました。この章ではそこには重ねず、実務で訪問順を決めるときに使われる近似の方法と、その結果の読み方に絞ります。並べ方の数が件数とともにどれだけ急に増えるかは、第2章で示したとおりです。40件の並べ方を全部試すことはできないので、何らかの近道を使うことになります。
構築法、訪問順を一気に作る3つの方法
構築法は、何もない状態から訪問順を1本作る方法です。代表的な3つを、ここでは次のように実装しました。
最近傍法は、配送センターを出発し、「いまいる地点から最も近い、まだ訪ねていない納品先」へ進むことを繰り返します。配車担当者が地図を見て「次はここが近い」と順に指でたどるやり方に近く、手順が単純で最も速い方法です。弱点は、序盤に近い先を拾い尽くしたあと、終盤に遠くに取り残された先を回収するために長い移動が生じやすいことです。最後の先から配送センターへ戻る距離も、途中では一度も考慮されません。
最安挿入法は、配送センターだけの小さな輪から始め、「どの納品先を、輪のどの2点の間に差し込むと、距離の増え方が最も小さいか」を全部の組み合わせで調べ、最も小さいものから1件ずつ差し込んでいきます。差し込むたびに輪全体の形を見て判断するので、最近傍法のような「最後に遠くへ取りに行く」形にはなりにくい代わりに、1件ごとに全部の組み合わせを調べるぶん計算が重くなります。
最遠挿入法は、差し込む納品先の選び方を逆にします。いまの輪から「最も遠い」納品先を先に選び、それを輪の中で距離の増え方が最も小さい位置に差し込みます。遠い先を先に輪に入れることで、最初の数件で配送エリア全体の外形がおおまかに決まり、あとから近い先がその外形の中に差し込まれていきます。
これらの方法がどれだけ最適から離れうるかは、理論的にも調べられています。Rosenkrantz・Stearns・Lewis の1977年の論文(SIAM Journal on Computing)は、得られた訪問順の長さと最短の長さの比で近さを測り、最近傍法ではその比の上限が地点数の対数で増える関数で抑えられ、最悪の場合にその程度まで悪くなる例もあることを示しています。同じ論文は挿入法の一群にも対数の上限があること、そのうち最近挿入法と最安挿入法では比の上限が2で、2にいくらでも近づく例があることを要旨で述べています。つまり理論上の保証は、最安挿入法のように「最悪でも最短の2倍以内」が示される方法でも、最近傍法のように件数とともに緩む対数の上限しかない方法でも、実務の目安としては粗いもので、実際のデータでどの程度になるかは、測ってみないと分かりません。
改善法、2-opt と Or-opt で訪問順を少しずつ直す
改善法は、すでにある訪問順を少しだけ変えて、短くなれば採用することを、短くならなくなるまで繰り返す方法です。どういう変え方を試すかで名前が付いています。
2-optは、訪問順の中の区間(道のり)を2本外し、残った2本の鎖を別の向きでつなぎ直す操作です。地図の上で言えば、道のりが交差している箇所を見つけて、交差をほどく操作にあたります。実装上は、訪問順の中のある範囲をそっくり逆順にすることと同じです。2-opt の源流としては、Croes の1958年の論文(Operations Research 誌)がよく引かれます。この論文の要旨は、提案する方法が対称な問題にも非対称な問題にも使えること、主観的な判断を使わないので完全に機械化できること、得られた解が十分だと判断した時点でいつでも打ち切れることを挙げています。いつでも打ち切れるという性質は、現在の改善法にも共通する実務上の利点です。
Or-opt は、連続する1〜3件の納品先をひとかたまりとして抜き出し、訪問順の別の場所に差し込み直す操作です。2-opt が区間の向きを逆にするのに対し、Or-opt は途中の数件を引っ越させるだけで、残りの順番の向きは変えません。「この1件だけ別の場所で寄ったほうが近い」という、配車担当者が手作業でもよく行う直し方を、全部の組み合わせで機械的に試すものと考えると分かりやすいと思います。この操作の出典としては、Or(Ilhan Or)の1976年の博士論文(ノースウェスタン大学。地域の血液センターの配送を題材に、巡回セールスマン型の問題を扱ったもの)が挙げられることが多いようです。この章の実装では、差し込むときにかたまりの向きは逆にしていません。
次のコードは、最近傍法で作った訪問順に 2-opt をかける部分を、単独で実行できる形にしたものです。
from vrp_data import customers, points, dist_km
D = dist_km(points(customers()))          # デポ+40件の道路距離(km)
n = len(D)

def length(t):                             # デポに戻る区間まで含めた総距離
    return sum(D[t[k], t[(k + 1) % n]] for k in range(n))

t, left = [0], set(range(1, n))            # 最近傍法:いまいる地点から最も近い未訪問先へ
while left:
    j = min(left, key=lambda v: D[t[-1], v])
    t.append(j)
    left.remove(j)
print("最近傍法 %.2f km" % length(t))

improved = True                            # 2-opt:辺を2本外して掛け替え、短くなる限り続ける
while improved:
    improved = False
    for i in range(1, n - 1):
        for j in range(i + 1, n):
            a, b, c, d = t[i - 1], t[i], t[j], t[(j + 1) % n]
            if D[a, c] + D[b, d] - D[a, b] - D[c, d] < -1e-9:
                t[i:j + 1] = reversed(t[i:j + 1])
                improved = True
print("2-opt後 %.2f km" % length(t))
# 出力: 最近傍法 176.02 km
# 出力: 2-opt後 157.52 km
判定の式は、外す2本(a から b、c から d)の長さの合計と、つなぎ直す2本(a から c、b から d)の長さの合計を比べ、つなぎ直したほうが短ければ間の区間を逆順にする、という意味です。最後の -1e-9 は、小数の計算誤差で「ほとんど同じ長さ」の掛け替えを延々と繰り返さないための小さな余裕です。改善法は、どの改善を試しても短くならない訪問順にたどり着いたところで止まります。この状態の訪問順を局所最適解と呼びます。「その操作の範囲では、もう直せない」という意味で、最短であることは保証しません。
40件を1台で回る、各方法の距離と計算時間
第2章で用意したサンプルデータ(乱数で作った架空の納品先40件と配送センター)を、1台で全部回る問題として解きました。積載と時間指定は無視し、距離は道路距離(直線距離の1.3倍)です。3つの構築法それぞれに、改善なし・2-opt だけ・Or-opt だけ・両方(2-opt と Or-opt をどちらも改善しなくなるまで交互にかける)の4通りを組み合わせ、12通りの距離と計算時間を測りました。比べる相手は、後の節で CP-SAT によって最短であると証明した訪問順の157.0kmです。計算時間は、この記事の実行環境(一般的なノートPC)での実測で、同じ計算を7回繰り返した中央値です。構築と改善の時間の合計で、Python で素朴に書いた実装の値です。
| 構築法 | 改善 | 総距離(km) | 厳密解との差 | 計算時間(ミリ秒) |
|---|---|---|---|---|
| 最近傍法 | なし | 176.0 | 12.14% | 0.1 |
| 最近傍法 | 2-opt | 157.5 | 0.35% | 1.0 |
| 最近傍法 | Or-opt | 158.6 | 1.01% | 7.0 |
| 最近傍法 | 2-opt+Or-opt | 157.0 | 0.00% | 5.5 |
| 最安挿入法 | なし | 167.6 | 6.79% | 4.8 |
| 最安挿入法 | 2-opt | 159.6 | 1.69% | 6.4 |
| 最安挿入法 | Or-opt | 158.3 | 0.87% | 7.7 |
| 最安挿入法 | 2-opt+Or-opt | 158.3 | 0.87% | 11.6 |
| 最遠挿入法 | なし | 161.7 | 3.04% | 1.7 |
| 最遠挿入法 | 2-opt | 161.7 | 3.04% | 2.1 |
| 最遠挿入法 | Or-opt | 161.7 | 3.04% | 3.8 |
| 最遠挿入法 | 2-opt+Or-opt | 161.7 | 3.04% | 4.1 |
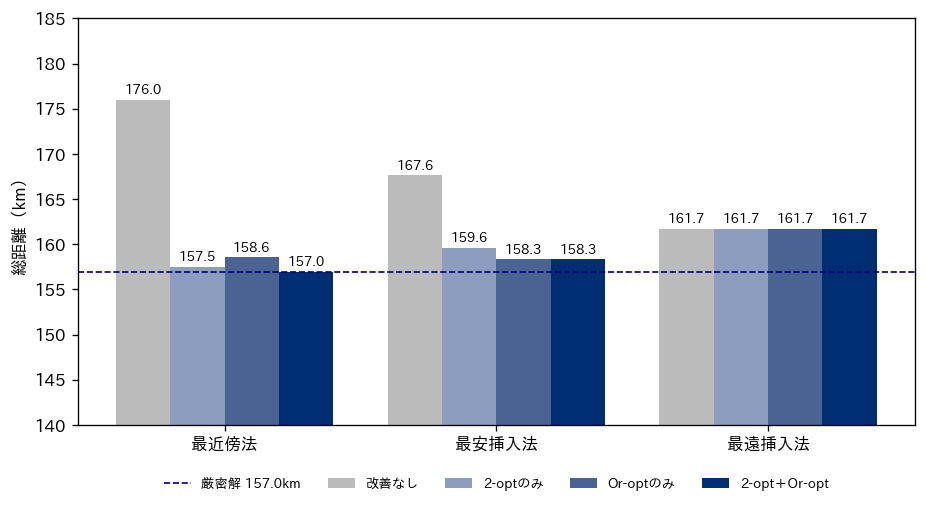
構築法だけで比べると(表の改善「なし」の行)、最遠挿入法が161.7km(厳密解との差3.04%)、最安挿入法が167.6km(6.79%)、最近傍法が176.0km(12.14%)で、最近傍法が最も長くなりました。ところが改善法をかけたあとの順位は逆転します。最近傍法は 2-opt だけで157.5km(0.35%)まで縮み、2-opt と Or-opt を両方かけると157.0kmで厳密解と一致しました。最安挿入法は両方かけて158.3km(0.87%)、最遠挿入法はどの改善をかけても、実行ログの小数第2位まで161.74kmのまま縮みませんでした。
最遠挿入法の結果が動かなかったのは、その訪問順がすでに 2-opt でも Or-opt でも直せない局所最適解になっていたからです。構築法だけで見れば最も良かった訪問順が、改善法で直す余地を残していなかったわけです。一方、最近傍法の訪問順は、下の図の左のように交差や遠回りが多く、2-opt が直せる箇所がたくさん残っていました。この結果は、構築法の良し悪しを構築法だけの距離で選ぶと判断を誤りうることを示しています。改善法と組み合わせて使う前提なら、「改善をかけたあとにどこへたどり着くか」で比べる必要があります。ただし、どの構築法が改善後に有利になるかはデータによって変わり、今回の40件の結果を一般化はできません。この順位の入れ替わりは、次の節で見るように、出発点によって行き着く局所最適解が変わることの一例です。
計算時間は、どの組み合わせでも12ミリ秒以内でした。40件の1台分であれば、方法の選択によって待ち時間が問題になることはありません。問題になるのは、後の節で見るように件数が数百件に増えたときや、第4章以降で複数台の割り当てを変えるたびに各車の訪問順を直す処理を何万回も呼び出すときです。
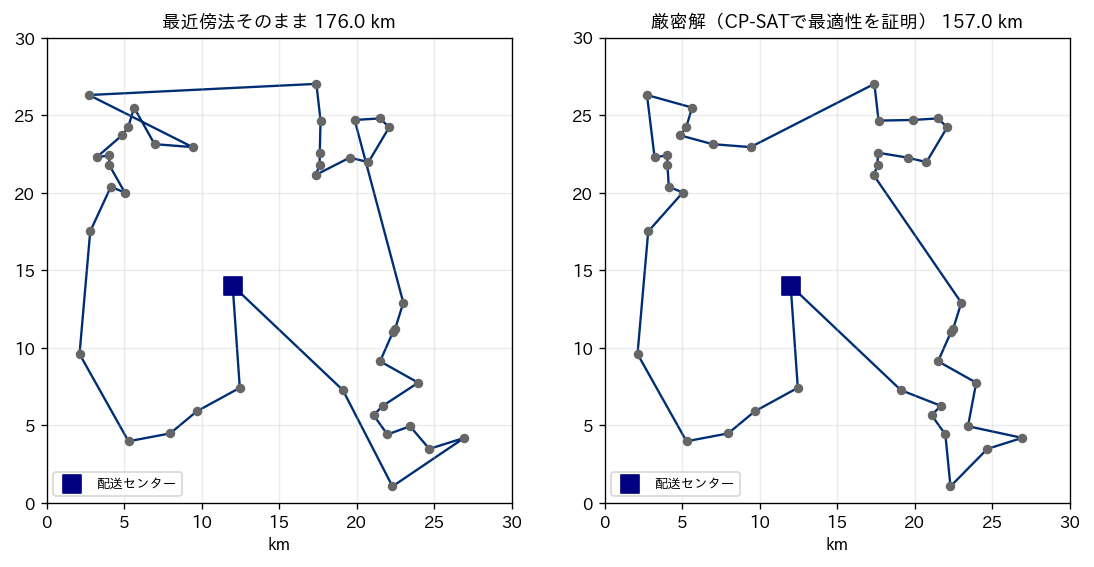
図の左が最近傍法そのままの訪問順、右が厳密解です。四角が配送センター、点が納品先です。最近傍法は配送センターの南の納品先から回り始め、南西を経て西側の地区を北へ進みますが、地区の中で近い先を順に拾ううちに地区の北端(左上の点)で近い先が尽き、そこから北東の地区の入口まで横に長く移動しています。厳密解は同じ西側の地区を別の順で回り、地区を出る位置を東寄りにして、北東の地区への移動を短くしています。2つの訪問順は、最初の6件(C17・C20・C02・C05・C34・C18)がまったく同じで、違いは地区の中の順番と、地区から地区へ移る位置にあります。距離の差は19.0kmで、図で見て取れる最も大きな違いは、この「地区の出口」の選び方です。
厳密解を CP-SAT で証明する、add_circuit の使い方
ここまで「厳密解」と呼んできた157.0kmは、Google の OR-Tools に含まれる CP-SAT というソルバー(整数の変数に条件を課して最適な値を探し、最適であることの証明まで行う道具)で求めました。CP-SAT には、選んだ矢印(地点から地点への移動)がちょうど1周の輪になることを1行で課せる add_circuit という制約があります。OR-Tools 9.15.6755 の説明文では、この制約は「全体のグラフの一部分の中にある、ただ1つのハミルトン閉路(全部の地点をちょうど1回ずつ通る輪)」を表し、輪に含めない地点がある場合はその地点から自分自身への矢印を真にする、と書かれています。部分巡回を禁じる制約を自分で書く必要はありません。
from ortools.sat.python import cp_model
from vrp_data import customers, points, dist_km, int_matrix
Dm = int_matrix(dist_km(points(customers())), 1000)   # km を m の整数に
n = len(Dm)

m = cp_model.CpModel()
x = {(i, j): m.new_bool_var(f"x{i}_{j}") for i in range(n) for j in range(n) if i != j}
m.add_circuit([(i, j, v) for (i, j), v in x.items()])   # 選んだ矢印が1周の輪になる
m.minimize(sum(Dm[i][j] * v for (i, j), v in x.items()))

s = cp_model.CpSolver()
s.parameters.max_time_in_seconds = 60                   # 時間制限
s.parameters.num_workers = 8
st = s.solve(m)
print(s.status_name(st), s.objective_value / 1000, s.best_objective_bound / 1000)
# 出力: OPTIMAL 156.97 156.97
変数 x[i, j] は「地点 i の次に地点 j へ行くなら1」を表す0か1の変数で、地点が41(配送センターと40件)あるので1,640個あります。CP-SAT は整数の変数を扱うソルバーです。目的の係数には小数も渡せますが(この記事の実行環境の OR-Tools 9.15.6755 で、係数1.7と2.3の小さな問題を解けることを確かめました)、ここでは距離の丸め方をはっきりさせ、結果を再現しやすくするため、km の距離を1,000倍して m 単位の整数に丸めています。丸めた距離で求めた最短の訪問順を小数の距離で測り直しても156.97kmで、丸めによる違いはこの例では出ませんでした。並列で探索する作業の数(num_workers)は8に固定し、時間制限は60秒にしました。
出力の OPTIMAL は「最適であることを証明した」という意味で、同時に出している目的値(見つけた訪問順の長さ)と下界(これより短い訪問順は存在しないことが保証された値)が一致しています。この問題で証明までにかかった時間は、この記事の実行環境で0.24秒でした。時間制限で打ち切られたときの状態は FEASIBLE(条件を満たす訪問順は見つかったが、最適かどうかは未証明)になり、目的値と下界の間に差が残ります。その差を下界で割ったものが、「見つけた訪問順は、最悪でも最適よりこれだけ長いかもしれない」という幅になります。最適な長さは下界以上なので、下界を分母にしておけば幅を小さく見積もることがありません(この章で最適との差を百分率で示すときは、すべて最適な長さか下界を分母にしています)。最適性を証明できない規模で結果を報告するときは、この幅を添えることが大切です。
ここで使った CP-SAT は汎用の整数最適化の道具で、巡回セールスマン問題専用ではありません。専用の厳密解法としては Concorde というプログラムが知られており、ウォータールー大学の巡回セールスマン問題の解説ページによれば、85,900地点の問題の最短の訪問順が Concorde を用いて求められ、その計算は2005年から2006年にかけて行われました。汎用のソルバーと専用のプログラムでは解ける規模が桁違いに異なるので、「巡回セールスマン問題は何件まで厳密に解けるか」という問いには、道具を決めないと答えられません。この章の測定は、あくまで CP-SAT を素直に使った場合の値です。
出発点で行き着く先が変わる、ランダムな訪問順100通りから改善する
改善法の結果が出発点に左右されることを確かめるため、40件の訪問順をランダムに100通り作り(乱数のシードは0に固定)、それぞれに 2-opt だけ、または 2-opt と Or-opt の両方をかけました。ランダムな訪問順そのものの総距離は641.2〜939.4km(中央値781.1km)で、厳密解の4〜6倍です。
| 改善 | 最小(km) | 中央値(km) | 最大(km) | 中央値の厳密解との差 | 厳密解に一致した回数 |
|---|---|---|---|---|---|
| 2-opt | 157.0 | 161.2 | 175.6 | 2.7% | 100回中1回 |
| 2-opt+Or-opt | 157.0 | 158.0 | 169.5 | 0.6% | 100回中6回 |
2-opt だけの場合、100回の結果は157.0〜175.6kmに散らばり、中央値は161.2km(厳密解との差2.7%)、厳密解にたどり着いたのは1回だけでした。Or-opt を加えると中央値は158.0km(0.6%)に縮み、厳密解に一致したのは6回になりましたが、最大は169.5kmで、出発点が悪ければ8%ほど長い訪問順で止まることもあります。改善法は、どこから始めても似たような長さの局所最適解に落ち着くものの、同じ最短の訪問順に必ず行き着くわけではありません。
この性質から、実務で改善法を使うときの工夫が2つ出てきます。1つは、出発点を変えて何度か改善し、最も短いものを採用すること(多スタート)です。40件なら1回の改善が数ミリ秒なので、100回繰り返しても1秒かかりません。もう1つは、局所最適解で止まらずに、いったん少し長くなる変更も受け入れて別の谷へ移る工夫で、焼きなまし法やタブー探索、誘導局所探索といったメタヒューリスティクスがこれにあたります。OR-Tools のルーティングソルバーが使う誘導局所探索は第6章、規模が大きい問題での大近傍探索や遺伝的アルゴリズム系の方法は第10章で扱います。
担当が決まった車の訪問順を直す
次に、巡回セールスマン問題がそのまま役に立つ場面として、担当先がすでに決まっている車の訪問順だけを決める場面を試しました。担当先には、この記事の基準の結果(OR-Tools で積載だけを制約にして解いた6台の計画、総距離296.3km)の各車の担当先をそのまま使い、各車について、訪問先を番号順(C01、C02、…の順)に回る場合、最近傍法で回る場合、最近傍法に 2-opt と Or-opt をかけた場合、CP-SAT の厳密解を比べました。番号順は、受注の順や伝票の順に回るような、順番を考えていない計画の代わりとして置いたものです。
| 車 | 件数 | 番号順(km) | 最近傍法(km) | 2-opt+Or-opt(km) | 厳密解(km) | 基準の結果の訪問順(km) |
|---|---|---|---|---|---|---|
| 車2 | 8 | 61.3 | 49.4 | 43.2 | 43.2 | 43.2 |
| 車3 | 7 | 98.2 | 55.2 | 52.9 | 52.9 | 52.9 |
| 車4 | 8 | 92.0 | 53.2 | 53.2 | 53.2 | 53.2 |
| 車5 | 6 | 58.3 | 42.4 | 40.9 | 40.9 | 40.9 |
| 車6 | 5 | 77.4 | 48.9 | 48.9 | 48.9 | 48.9 |
| 車7 | 6 | 63.9 | 65.3 | 57.2 | 57.2 | 57.2 |
| 合計 | 40 | 451.2 | 314.4 | 296.3 | 296.3 | 296.3 |
1台あたり5〜8件の規模では、最近傍法に 2-opt と Or-opt をかけるだけで、6台すべてが厳密解と一致しました。厳密解はどの車も CP-SAT が最適性を証明しています。基準の結果の訪問順も6台とも厳密解と同じ長さで、基準の結果を作った OR-Tools の探索は、各車の中の順番については最短を見つけていたことが分かります(基準の結果全体が最適かどうか、つまり納品先の車への割り当てまで含めて最短かどうかは、証明していません)。
番号順の合計451.2kmは、最短の296.3kmより154.9km(52%)長くなりました。最近傍法の合計314.4kmは最短より18.1km(6.1%)長く、しかも車7では最近傍法(65.3km)が番号順(63.9km)より長くなっています。車7の担当は南東の地区を中心とする6件です。最近傍法は近い先を順に拾った結果、最後に南端の C38 へ9.0km引き返して寄り、そこから配送センターへ21.5km戻る形になり、最後の2区間だけで30.5kmかかっていました。最短の訪問順では C38 を2件目に回し、最後の2区間は合わせて21.3kmです。最近傍法は「たいていは番号順よりずっと良いが、いつも良いとは限らない」方法で、改善法と組み合わせて初めて安定します。
この表から読み取れる実務上の結論は、担当先が決まっていて1台あたりの件数が十数件以下なら、訪問順は改善法、あるいは厳密解で決めてしまってよい、ということです。この表の6台はすべて、CP-SAT が60秒の時間制限の内側で最適性を証明しています。配車担当者の経験で決めた訪問順がある場合も、それを出発点に改善法をかけ、短くなるかどうかを確かめる使い方ができます。短くならなければ、その訪問順は少なくとも 2-opt と Or-opt の範囲では直す余地が無い、という裏付けになります。
件数が増えると、改善法と厳密解の計算時間はどう伸びるか
最後に、件数を増やしたときの計算時間を測りました。30km 四方に一様な乱数で n 件の地点を置き(シード0。配送センターは中央、道路係数1.3)、n を20・40・80・160・320と倍々に増やして、最近傍法に 2-opt と Or-opt をかけた改善法と、CP-SAT(num_workers は8、時間制限60秒)を比べました。この実験だけは第2章のサンプルデータではなく、規模を変えるために作った別の乱数の地点です。14章分の計算が同じ PC で並行して動いている状態で測ったため、同じスクリプトを2回実行して揺れを確かめました。
| 件数 n | 改善法の総距離(km) | 改善法の時間(秒、1回目/2回目) | CP-SAT の状態 | CP-SAT の目的値(km、1回目/2回目) | CP-SAT の下界(km、1回目/2回目) | CP-SAT の時間(秒、1回目/2回目) |
|---|---|---|---|---|---|---|
| 20 | 177.4 | 0.00/0.00 | 最適を証明 | 177.4/177.4 | 177.4/177.4 | 0.1/0.3 |
| 40 | 198.3 | 0.01/0.01 | 最適を証明 | 198.3/198.3 | 198.3/198.3 | 0.4/0.9 |
| 80 | 301.8 | 0.04/0.07 | 最適を証明 | 286.2/286.2 | 286.2/286.2 | 5.8/5.7 |
| 160 | 397.9 | 0.39/0.40 | 60秒で未証明 | 386.4/392.4 | 380.4/380.5 | 60.3/60.4 |
| 320 | 542.6 | 2.50/3.00 | 回していない | なし | なし | なし |
CP-SAT は80件まで最適性を証明し、その時間は20件で0.1〜0.3秒、40件で0.4〜0.9秒、80件で5.7〜5.8秒でした。160件では60秒の時間制限の中で証明できず、1回目は目的値386.4km・下界380.4km、2回目は目的値392.4km・下界380.5kmで打ち切られました。見つけた訪問順の長さが2回で6.0km違い、同じ問題・同じ設定でも、並列探索の打ち切り時点の結果は実行ごとに揺れます。下界から見ると、1回目の訪問順は最適より最大で1.6%、2回目は最大で3.1%長い可能性がある、という読み方になります。320件は変数が約10万個になるため、CP-SAT は回していません。
改善法の時間は、80件から先では件数が2倍になるごとに約6〜10倍に伸び、320件で2.5〜3.0秒でした。Python で素朴に書いた実装なので、専用の実装ならずっと速くなりますが、2-opt は1回の見直しで全部の2本の組み合わせを調べるため、件数の2乗以上で重くなる性質は変わりません。距離の質は、40件では厳密解と一致した一方、80件では最適より5.5%長い局所最適解で止まりました。改善法1回の結果は、規模が大きくなるほど出発点の運に左右されやすくなります。160件では、改善法の397.9kmは CP-SAT が60秒で見つけた訪問順より長く、1回目の下界380.4kmを分母にすると、最適より最大で約4.6%長い可能性があります。
この表は、1台あたりの件数が数十件程度の配送では、この記事の実行環境でも厳密解の証明まで数秒以内(80件で約6秒)に終わり、方法の選択が経営上の論点になることは少ない、ということを示しています。1台で数百件を回る宅配型の配送になると、厳密解の証明は汎用のソルバーでは難しくなり、改善法やメタヒューリスティクスで「時間内に十分良い解」を作る設計が必要になります。その設計は第10章で扱います。
経営の側から見る、訪問順の差を距離と時間に翻訳する
この章の数字を経営指標に置き換えます。担当が決まった6台の例で、訪問先を番号順に回る計画と最短の訪問順の差は、6台合計で1日154.9kmでした。第2章のサンプルデータの仮定(時速25km)で走行時間に直すと約372分、つまり1日に6時間強の走行が、訪問順の決め方だけで余分に生じる計算です。最近傍法だけで決めた場合でも、差は1日18.1km、走行時間にして約43分です。費用に直すため、この記事で車種の例として置いた2トン車の km 単価40円(架空の値です)を掛けると、番号順との差は1日6,196円、最近傍法との差は1日724円になります。年間の稼働日を250日と置けば、それぞれ年間約155万円と約18万円です。
ただし、この金額の差をそのまま「訪問順の最適化で得られる効果」と読むのは危険です。第1に、実際の配車担当者は番号順で回らせてはおらず、地図と経験で相当に良い訪問順を組んでいることが多いと考えられます。比べるべき相手は番号順ではなく、今の現場の訪問順です。第2に、距離に比例する費用(燃料費やタイヤの摩耗など)は、車両の固定費やドライバーの人件費に比べて小さいことが多く、訪問順の改善だけでは使用台数は減りません。台数が変わるのは、第4章で扱う「どの車にどの納品先を割り当てるか」を変えたときです。
それでも訪問順の最適化が経営上意味を持つのは、走行時間が労働時間に直結するからです。1台あたり1日数十分の走行の短縮は、時間指定に間に合わなかった納品を間に合わせる余裕、あるいはドライバーの拘束時間を法令の上限の内側に収める余裕になります。労働時間の制約は第7章で扱います。また、訪問順を人の経験で決めている事業所では、担当ドライバーが休んだ日や担当が替わった日に訪問順の質が大きく落ちることがあります。改善法で訪問順を機械的に作れるようにしておくことは、特定の人に依存しない配送の体制を作ることでもあります。
判断を誤ったときの損失の型も整理しておきます。訪問順だけを最短にする計算を、積載や時間指定を無視したまま使えば、この章の思考実験のように1日17.7時間かかる計画が「最短」として出てきます。巡回セールスマン問題は、担当先と1台あたりの件数が決まったあとの仕上げとしては強力ですが、配車計画全体の代わりにはなりません。どの制約を式に入れずに解いたのかを、計算結果と一緒に必ず確かめることが大切です。
この章の要点は3つです。第一に、1台の訪問順を決める巡回セールスマン問題には、訪問順を一気に作る構築法と、少しずつ直す改善法があり、40件の例では最近傍法に 2-opt と Or-opt をかけるだけで厳密解の157.0kmに届きました。第二に、改善法は局所最適解で止まり、どこに止まるかは出発点で変わります。構築法だけの距離で方法を選ぶと判断を誤りうるので、改善後の結果で比べ、必要なら多スタートにします。第三に、今回の測定では、CP-SAT の add_circuit で40件なら1秒以内、80件でも6秒ほどで最短であることまで証明できました。担当先が決まった車の訪問順は、少なくともこの章で試した1台5〜8件や、80件程度までの規模なら、厳密に決める選択肢が現実的です。次の第4章では、積載の制約を加えて、納品先をどの車に割り当てるかという判断を扱います。
この章を深めたい方への参考書籍
『巡回セールスマン問題への招待』(山本芳嗣・久保幹雄、朝倉書店):シリーズ〈現代人の数理〉の1冊で、巡回セールスマン問題の歴史、計算量の理論と NP 完全問題、精度保証のある近似算法などを章立てて解説しています。この章で実行結果として示した構築法と改善法の性質や、最悪の場合の保証の考え方を、理論の側から確かめるのに向いています。
『驚きの数学 巡回セールスマン問題』(ウィリアム・J・クック著、松浦俊輔訳、青土社):原題は In Pursuit of the Traveling Salesman です。見かけの単純さからは想像できないほど奥の深い、巡回セールスマン問題の数学の世界を一般向けに紹介した本で、この章で触れた「汎用のソルバーと専用の厳密解法では解ける規模が桁違いに異なる」背景を知るのに役立ちます。
第4章 積載制約付きの配車、何台で・どう分けて・どの順に回るかを決める
第3章では、担当する納品先が決まっている1台の車について、回る順番を構築法と改善法で決めました。そこでは積載を無視し、40件すべてを1台で回る問題として扱っていました。実際の配送センターでは、1台の荷台に積める量には上限があるので、納品先を何台かに分けて受け持たせる必要があります。この章では、車ごとの積載の上限を守りながら、使う台数と総走行距離を小さくする積載制約付き配送計画問題(英語の頭文字で CVRP)を扱います。決めることは「何台使うか」「どの納品先をどの車に割り当てるか」「各車がどの順に回るか」の3つで、第3章の問題に「分け方」の判断が加わった形です。
この章では、古くから使われてきた3つの考え方、つまり近い納品先どうしを1台にまとめていくセービング法、デポから見た方角で扇形に区切るスイープ法、先に車ごとの担当を割り当ててから順番を決めるクラスター先・ルート後の方法を、第2章で用意したサンプルデータで実際に動かします。そのうえで、同じデータを OR-Tools のルーティングソルバーで解いた結果と並べ、さらに研究の世界で共通に使われている公開ベンチマーク(CVRPLIB)で、既知の最良値からどれだけ離れるかを測ります。最後に、台数の下限と積載率の読み方、結果を経営指標に翻訳する方法を述べます。時間指定(時間枠)は第5章で扱うので、この章では入れません。
積載制約付きの配車を、第2章のサンプルデータに当てはめて書き直すと次のようになります。配送センター(デポ)から2トン車が出発し、40件の納品先に合計868ケースを届けて、デポに戻ります。2トン車1台に積めるのは150ケースまでで、1件の納品先の荷物は1台でまとめて届けます(1件の荷物を2台に分けて運ぶことはしない、という前提です)。どの車も、デポを出てから担当の納品先を順に回り、デポに帰ってきます。この条件を守る計画のうち、費用が最も小さいものを探すのが問題です。
費用の中身は2つあります。1つは使う台数で、車両の償却費やリース料、ドライバーの人件費など、1台動かすごとにほぼ決まった額がかかる固定的な費用です。もう1つは総走行距離で、燃料費やタイヤ・整備の費用など、走った距離に比例してかかる変動的な費用です。第1章で見たように、この2つは桁が違うことが多く、1台減らす効果は数十km減らす効果より大きくなりがちです。そこでこの章では、結果を読むときに、まず台数を見て、同じ台数の中で距離を比べます。OR-Tools で解くときは、第2章の基準の結果と同じく、1台使うごとに100km相当の固定費を距離に足した値を目的関数にしました。これは台数が増えにくくなるように付けた重みで、厳密に「台数が第1、距離が第2」という優先順位ではありません。1台増やして100kmより多く距離が縮むなら、台数の多い計画が選ばれうる置き方です(第2章で説明しました)。
第3章の巡回セールスマン問題と比べると、判断が1段増えています。巡回セールスマン問題では「どの順に回るか」だけを決めればよかったのに対し、ここでは「どの納品先を同じ車に乗せるか」という分け方を決め、そのうえで各車の順番を決めます。分け方と順番は互いに影響します。遠い2件を同じ車に入れると、その車の順番をどう工夫しても距離は伸びますし、逆に順番を先に決めてしまうと、積載の都合で分け方の選択肢が狭まります。この章で紹介する3つの方法は、この2つの判断をどういう順番で、どういう手がかりで決めるかの違いとして読むことができます。
台数の下限と積載率を先に計算する
解き始める前に、紙の上で計算できる数字が2つあります。1つ目は台数の下限です。総ケース数868を1台の積載150で割ると5.79なので、切り上げて6台が、どんな計画でも下回れない台数になります。第2章でも示したこの値は、問題を解かなくても分かる下限で、実際に6台で回れるかどうかは解いてみないと分かりません。1件の荷物を分割できないため、荷物の大きさの組み合わせによっては、下限より1台多く必要になることがあるからです。積み荷の大きさの組み合わせで何台(何箱)必要かを決める問題はビンパッキング問題と呼ばれ、それ自体が組合せ最適化の問題です。今回のデータでは、後で示すように6台で回る計画が見つかったので、下限の6台が実際の最小台数です。
2つ目は積載率です。この章では積載率を「積んだケース数÷(使った台数×1台の積載)」と定義します。6台で運べば、平均の積載率は868÷900で96.4%になります。数字だけを見ると余裕が小さく、6台の空きを全部足しても32ケースしかありません。今回のデータで最も大きい納品先は40ケースなので、当日に33ケース以上の注文が1件増えただけで、どう組み替えても6台には収まらず、7台目が要ることになります。積載率が高いことは効率の良さを示す一方で、変動を吸収する余地が小さいことも意味します。この読み方は、この章の後半で経営指標に翻訳するときにもう一度扱います。
なお、積載率の分子をケース数で数えられるのは、この例がケースという1つの単位だけで荷物を表しているからです。実際の荷物は重さと容積の両方で制約され、軽くてかさばる荷物は容積で、重い荷物は重さで先に満杯になります。積載率を指標にするときは、どの単位で数えた値かを必ず添える必要があります。複数の単位を同時に守る計画は、OR-Tools では積載の次元を2つ並べることで表せますが、この章では単位を1つに絞って話を進めます。
| 項目 | 値 | 計算 |
|---|---|---|
| 納品先の数 | 40件 | 第2章のサンプルデータ |
| 総ケース数 | 868ケース | 納品先ごとのケース数の合計 |
| 2トン車1台の積載 | 150ケース | 架空の値 |
| 台数の下限 | 6台 | 868÷150=5.79 を切り上げ |
| 6台で運ぶときの平均積載率 | 96.4% | 868÷(6×150) |
| 6台の空きの合計 | 32ケース | 900から868を引いた値 |
| 最も大きい納品先 | 40ケース | C01・C24 |
セービング法、近い2件を1台にまとめると何km節約できるか
最初に紹介するセービング法は、Clarke と Wright が1964年に Operations Research 誌で発表した方法で、配車の実務で最もよく知られた手順の1つです。原論文の要旨は、中央のデポから多数の納品先へ向かうトラックの経路を、最適か最適に近い形で素早く選ぶ反復的な手順を示したもので、計算機向けに組んであるが手計算にも向いている、と述べています。
考え方は単純です。出発点として、納品先1件ごとに1台の車を割り当て、デポとその納品先を往復させる計画を置きます。40件なら40台が往復する、極端に効率の悪い計画です。ここで、納品先 \( i \) と \( j \) を別々の車で往復する代わりに、1台の車で「デポ→ \( i \) → \( j \) →デポ」と回ることにすると、走行距離は \( s(i,j) = d(0,i) + d(0,j) – d(i,j) \) だけ短くなります。\( d(0,i) \) はデポから \( i \) までの距離、\( d(i,j) \) は \( i \) と \( j \) の間の距離です。言葉にすれば、「\( i \) からデポへ戻る道と、デポから \( j \) へ出る道を使わずに済む代わりに、\( i \) から \( j \) へ直接移る道が1本増える」ので、その差が節約になります。この節約の大きさを節約値(セービング)と呼び、方法の名前もここから来ています。
手順は次のとおりです。すべての納品先の組について節約値を計算し、大きい順に並べます。上から順に見ていき、「2件が別々の車に乗っている」「2件とも、それぞれの車のルートの端(デポのすぐ隣)にある」「2台の荷物を合わせても積載の上限を超えない」の3つを満たすときだけ、2台のルートを1本につなぎます。節約値が正の組を全部見終わったら終わりです。デポから遠く、互いに近い2件ほど節約値が大きくなるので、遠方の近い納品先どうしが先にまとまり、ルートは外側から内側へ向かって伸びていきます。
共通データで実行したコードが次のものです。距離行列の作り方は第2章と同じで、道路距離を直線距離の1.3倍と置いています。
from vrp_data import customers, points, dist_km, TRUCK_CAPACITY
cs = customers(); D = dist_km(points(cs)); dem = [0] + [c["demand"] for c in cs]
n = len(D)
route = {i: [i] for i in range(1, n)}          # 最初は1件ごとに1台(デポと往復)
owner = {i: i for i in range(1, n)}            # 納品先 -> 担当ルートの番号
load = {i: dem[i] for i in range(1, n)}
pairs = sorted(((D[0, i] + D[0, j] - D[i, j], i, j)
                for i in range(1, n) for j in range(i + 1, n)), reverse=True)
for s, i, j in pairs:                          # 節約値の大きい順に見る
    a, b = owner[i], owner[j]
    if s <= 0: break
    if a == b: continue                        # 既に同じ車
    if load[a] + load[b] > TRUCK_CAPACITY: continue   # 積み切れない
    ra, rb = route[a], route[b]
    if ra[0] == i: ra = ra[::-1]               # i を ra の末尾に向ける
    if rb[-1] == j: rb = rb[::-1]              # j を rb の先頭に向ける
    if ra[-1] != i: continue                   # i がルートの途中にある
    if rb[0] != j: continue                    # j がルートの途中にある
    route[a] = ra + rb; load[a] += load.pop(b); del route[b]
    for k in route[a]: owner[k] = a
km = sum(D[0, r[0]] + sum(D[p, q] for p, q in zip(r, r[1:])) + D[r[-1], 0] for r in route.values())
print("台数", len(route), "総距離 %.1f km" % km, "積載", sorted(load.values(), reverse=True))
# 出力: 台数 7 総距離 303.8 km 積載 [148, 142, 142, 136, 129, 94, 77]
結果は7台・総距離303.8kmでした。計算時間は、この記事の実行環境(一般的なノートPC)での実測で1ミリ秒未満でした。距離だけを見ると悪くない値ですが、台数が下限の6台より1台多くなっています。7台の積載を見ると、148・142・142・136・129ケースと満杯に近い車が5台ある一方で、残りの2台は94ケース(積載率63%)と77ケース(51%)しか積んでいません。平均の積載率は82.7%です。
こうなる理由は、セービング法が距離の節約だけを手がかりに貪欲に(その時点で最も得な選択を1つずつ確定させながら)ルートをつなぐからです。つなげる候補は「ルートの端どうし」に限られ、一度つないだものはほどきません。早い段階で遠方の納品先どうしが満杯に近いルートを作ってしまうと、最後にデポの近くに残った納品先は、どのルートにも入れられずに少ない荷物で独立した車になります。今回の7台目は、デポの東側にある C09・C15・C24 の3件だけを回る31.0kmのルートでした。セービング法は台数を直接減らそうとはしていないので、台数の下限に届くかどうかはデータ次第です。
ルートの中の順番については、つないだ順がそのまま回る順になるので、改善の余地が残ることがあります。各車の担当は変えずに、回る順だけを第3章の考え方で厳密に最適化し直したところ(1台あたり最大8件なので、全部の順番を動的計画で調べられます)、303.8kmが302.7kmになりました。縮んだのは1.1kmで、セービング法の弱点は順番ではなく分け方の側にあることが分かります。
スイープ法、デポから見た方角で扇形に区切る
2つ目のスイープ法は、Gillett と Miller が1974年に Operations Research 誌で発表した方法です。原論文の要旨によれば、各ルートに入れる地点を、それぞれの地点の極座標の角度、つまりデポから見た方角に従って決め、その後で反復的な手順により全ルートの総距離を改善します。要旨はさらに、1ルートあたりの平均の地点数がほぼ一定なら、計算量は地点数に比例して増えるという特徴を挙げています。
基本の手順は、時計の針でデポの周りを掃くような操作です。デポを中心に、すべての納品先の方角(角度)を計算して並べます。ある納品先を起点に、反時計回り(または時計回り)に順に1台目の車へ積んでいき、次の納品先を積むと積載の上限を超えるところで、その車を締めて2台目に切り替えます。これを全件がどれかの車に入るまで繰り返し、最後に各車の中で回る順番を決めます。方角の近い納品先が同じ車に入るので、ルートは扇形の区域になります。
この章では、原論文の反復的な改善の手順は入れず、方角で区切る部分だけを実装しました。区切ったあとの各車の順番は、セービング法と同じく厳密に最適化しています。つまりここで比べているのは「方角で区切る」という分け方そのものの良し悪しです。起点の納品先を40通り、回る向きを2通りに変えた80通りを試したところ、6台に収まったのは12通りだけで、残りの68通りは7台になりました。6台になった12通りは総距離がすべて304.5kmで、同じ区切りに落ち着いていました。7台になった68通りの総距離は310.8〜349.9kmで、中央の値は328.9kmです。
スイープ法は、起点をどこに置くかで台数まで変わる、ということがこの結果から読み取れます。積載が満杯に近づいたところで区切るので、区切りの位置が1件ずれると、その先の全部の車の区切りがずれ、最後の車に少量の荷物が余って1台増えることがあるからです。今回のデータは平均積載率96.4%と余裕が小さいので、この影響が強く出ています。実務でスイープ法を使うなら、起点を全部試して最良のものを選ぶのが前提になります。1回の実行は軽いので、80通りを試しても実測で0.2秒程度でした。
最良の区切り(6台・304.5km)は、台数ではセービング法より1台少なく、距離ではセービング法より0.7km長い計画です。ルート図で見ると、扇形の性質がよく表れています。一方で、デポの南側では、方角が近いという理由で南西の C02・C20 と南東の C38・C33 が同じ車に入り、デポの南を横切って走る57.1kmのルートになっていました。方角が近くても、デポからの距離が違えば地点どうしは離れています。スイープ法の苦手な形がこれで、デポを中心に放射状に納品先が並んでいる地域ほど向き、デポを挟んで両側に遠い納品先がある地域や、デポが区域の端にある地域では、扇形の区切りが不自然になりやすくなります。
クラスター先・ルート後、担当を割り当ててから順番を決める
3つ目は、分け方と順番を2段階に分けて決めるクラスター先・ルート後の考え方です。スイープ法も「方角で分けてから順番を決める」のでこの仲間に入りますが、ここでは分け方そのものを最適化問題として解く方法を取り上げます。代表的なものが、Fisher と Jaikumar が1981年に Networks 誌で発表した一般化割当による方法です。原論文の要旨は、納品先を車に割り当てる判断を、配送費用を近似した目的関数を持つ一般化割当問題(各仕事を容量のある担当者のどれか1人に割り当て、容量を守りながら費用を最小にする問題)として解くと述べ、実行可能な解があれば必ず見つけること、車の台数を変えながら解くことで、需要を運べる最小の台数を求められることを特徴に挙げています。
手順は次のとおりです。まず台数 \( K \) を決め、車ごとに「種」と呼ぶ代表の納品先を1件ずつ選びます。種は、その車が受け持つ区域のおおよその位置を表す目印です。次に、納品先 \( i \) を種 \( k \) の車に割り当てる費用を、「デポ→種→デポ」という往復に \( i \) を立ち寄らせたときに増える距離 \( d(0,i) + d(i,k) – d(0,k) \) で近似します。この近似費用の合計を最小にし、各車の積載の合計が150ケース以下になるように、各納品先をどれか1台に割り当てます。これは0か1の変数を持つ整数計画なので、PuLP と CBC で解きました。最後に、車ごとに回る順番を決めます。
この方法の長所は、積載を守る割り当てが必ず整数計画の制約として保証されることです。セービング法やスイープ法は、手順の途中で積載が満杯に近づいた車を締めていくので、最後に少量の荷物が余って台数が増えることがありましたが、一般化割当は、ソルバーが時間内に解き切れる規模であれば、「6台で積載を守る割り当て」が存在するならそれを必ず返します(規模が大きく時間制限で打ち切った場合は、割り当てが見つからないまま止まることもあります)。実際、6台で解いたところ CBC は最適解を返し、どの設定でも台数は6台になりました。
一方で、結果は種の選び方に強く左右されます。種として、デポから見た方角を6等分した扇形ごとにデポから最も遠い納品先を選んだところ、総距離は345.0kmで、ここまでで最も長くなりました。ルート図を見ると、北の C03 と東の C24 が同じ車に入るなど、方向の違う納品先を1台に抱える車ができています。割当の費用は「種へ向かう往復に立ち寄る費用」という近似なので、種どうしの間にある納品先を、実際の回り方とは合わない車に振り分けることがあるためです。
種の選び方がどれだけ効くかを確かめるため、種を乱数で50通り選んで同じ計算をしました。総距離は最小299.5km、中央値329.6km、最大384.1kmと、同じ手順でも85km近い幅がありました。最小の299.5kmはセービング法より台数が1台少なく、距離もスイープ法より短い計画です。つまりクラスター先・ルート後は、良い種を選べれば強い方法ですが、種の選び方という新しい判断を人に任せる方法でもあります。なお最良だった種(C15・C25・C08・C36・C04・C38)の計画にも、南西の C02・C20 と南東の C38・C33 を1台で回る、スイープ法と同じ形のルートが残っていました。現場の配車担当者が「この方面はこの車」という感覚を持っている場合には、その感覚を種として与える使い方が考えられます。
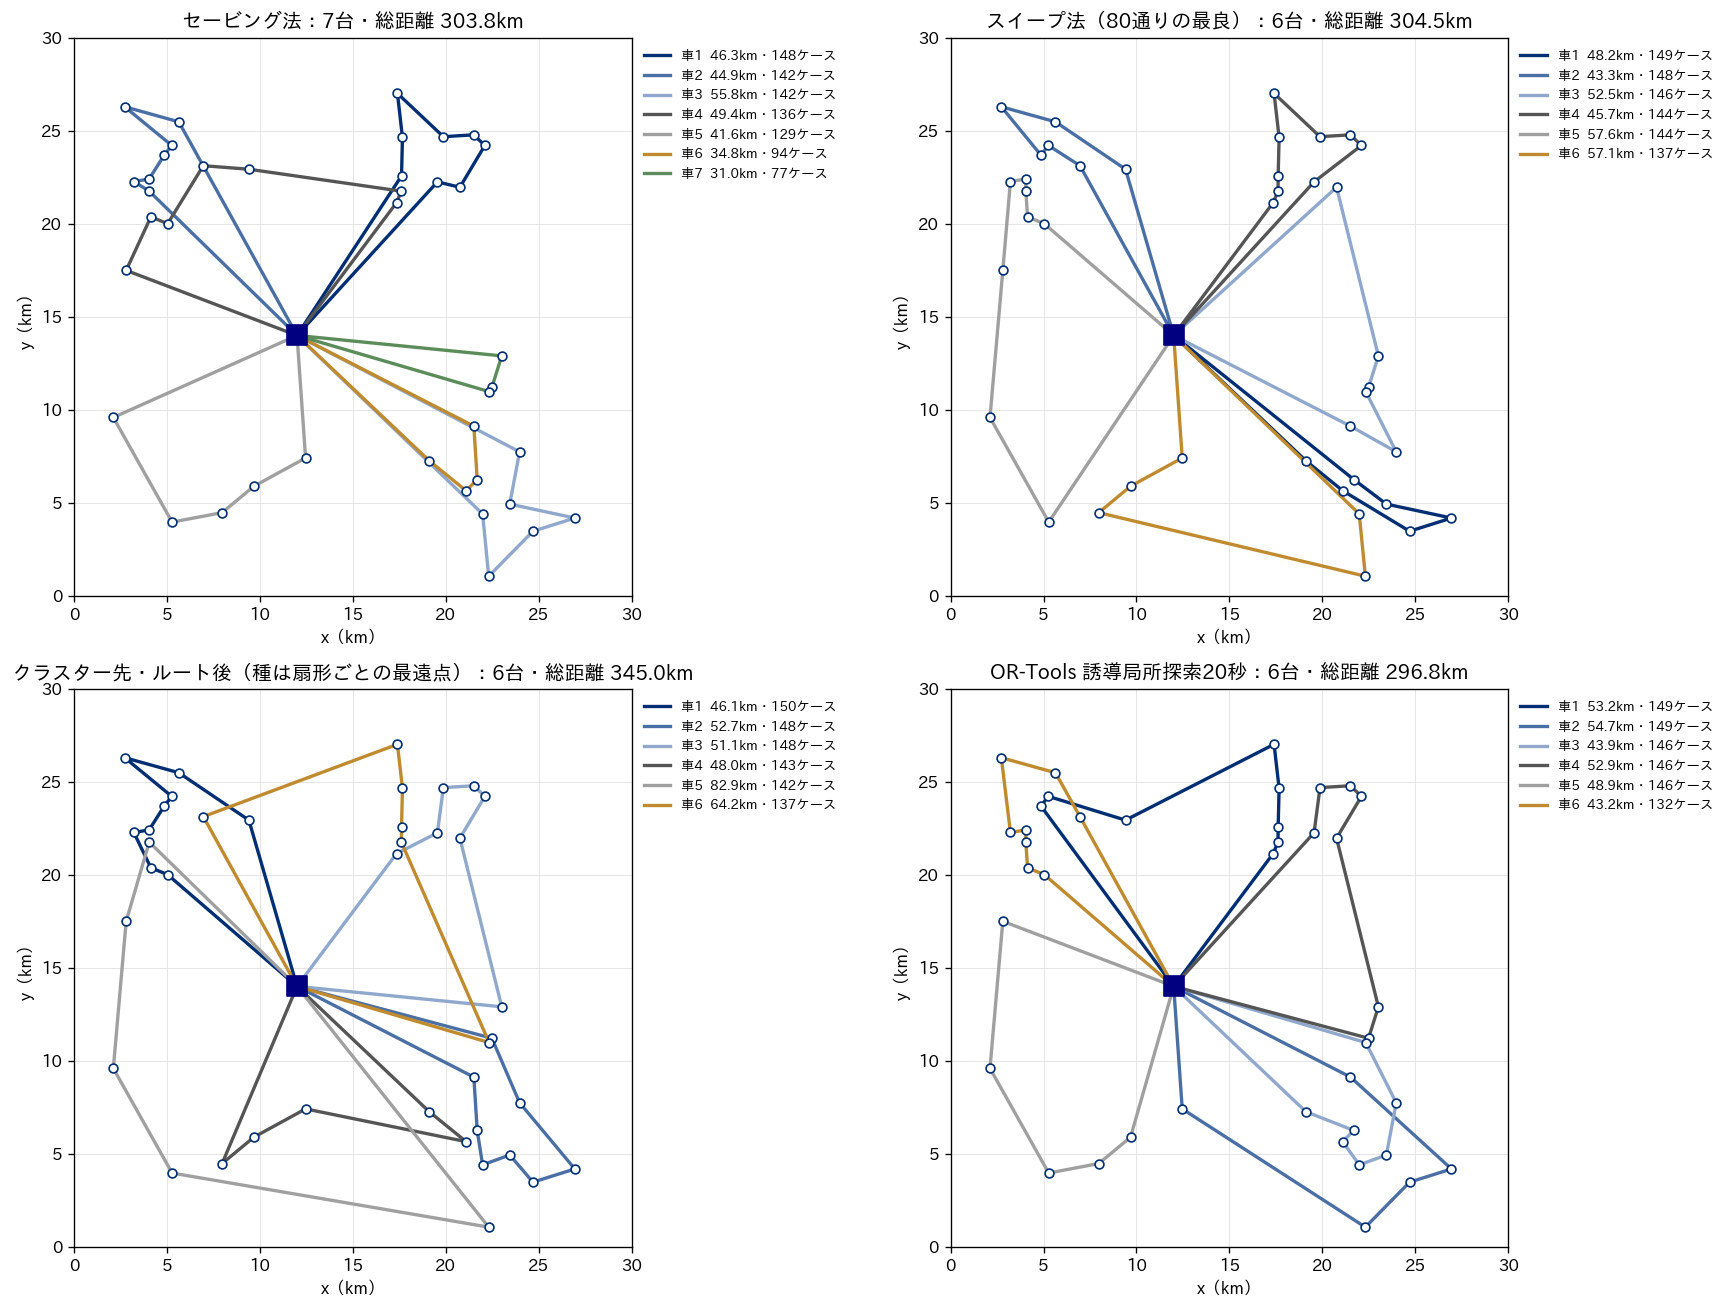
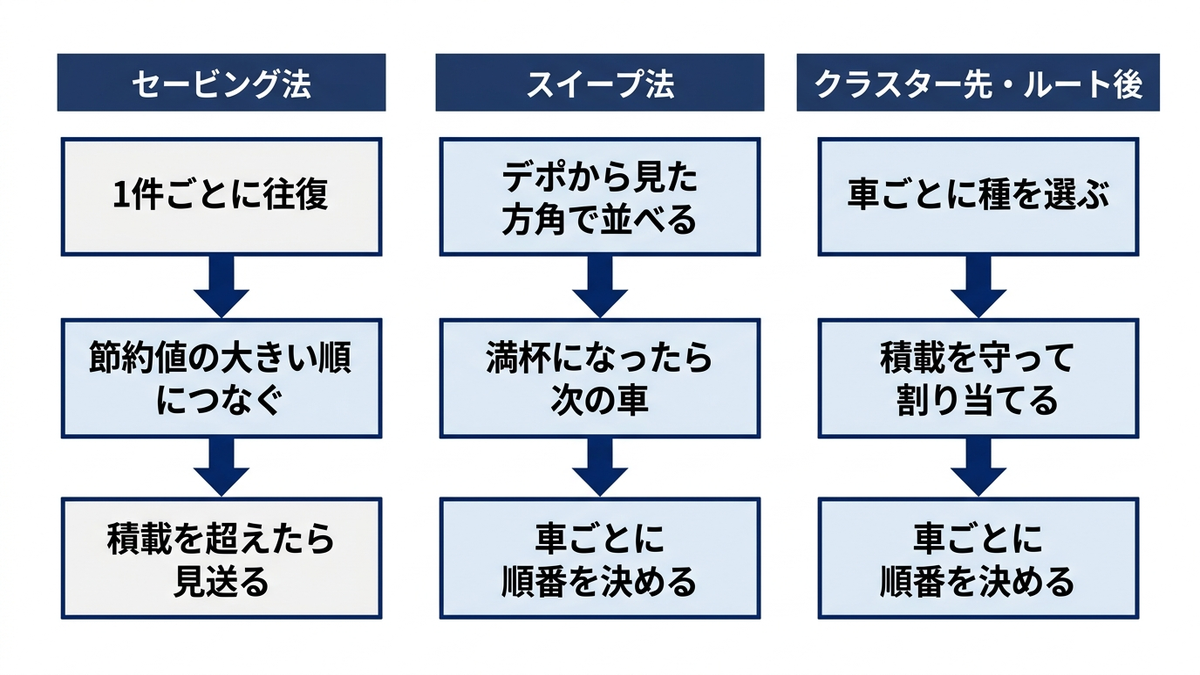
上の図は、共通データで4つの方法が作ったルートを並べたものです。四角がデポ、白丸が納品先で、線の色が車を表し、凡例に車ごとの距離とケース数を入れています。セービング法は北西・北東・南東の地区をそれぞれまとまりよく回っていますが、デポ東側の3件だけを回る短い車(凡例の車7)が独立しています。スイープ法は扇形の区切りがはっきり出ており、南側の車6がデポの南を東西に横切っています。クラスター先・ルート後は、ほかの方法に比べて線が交差し、方向の違う納品先を抱える車が目立ちます。
OR-Tools で解く、分け方と順番を同時に探す
ここまでの3つは、分け方と順番のどちらかを先に決めて固定する方法でした。これに対して、Google が公開している OR-Tools のルーティングソルバーは、まず簡単な規則で初期解を作り、そこから納品先を別の車に移す・2台の間で入れ替える・順番を入れ替える、といった変更を繰り返して、分け方と順番を同時に改善していきます。改善の途中で行き詰まらないように工夫した探索の方法(メタヒューリスティクス)として、ここでは第2章の基準の結果と同じ誘導局所探索を使い、20秒で打ち切りました。探索の仕組みや初期解・改善方法の選び方は第6章で詳しく扱うので、この章では積載の制約を入れる部分に絞ります。
OR-Tools の公式ドキュメントの「Capacity Constraints」のページは、積載の制約を AddDimensionWithVehicleCapacity で入れる例を示しています。次元(ディメンション)とは、ルートに沿って積み上がる量(ここでは積んだケース数)を追跡する仕組みで、引数には、各地点の需要を返す関数、余裕(スラック)の上限、車ごとの積載の上限の並び、出発時点の値を0にするかどうか、次元の名前を渡します。今回のデータで書いたコードが次のものです。版は OR-Tools 9.15.6755 です。
from ortools.constraint_solver import pywrapcp, routing_enums_pb2
from vrp_data import customers, points, dist_km, int_matrix, TRUCK_CAPACITY
cs = customers(); D = int_matrix(dist_km(points(cs)), 1000)   # km を m の整数に
dem = [0] + [c["demand"] for c in cs]
N_VEH = 10                                                     # 使ってよい台数の上限
man = pywrapcp.RoutingIndexManager(len(D), N_VEH, 0)          # 地点数・台数・デポの番号
rt = pywrapcp.RoutingModel(man)
dist_cb = rt.RegisterTransitCallback(lambda a, b: D[man.IndexToNode(a)][man.IndexToNode(b)])
rt.SetArcCostEvaluatorOfAllVehicles(dist_cb)                   # 費用は走行距離
rt.SetFixedCostOfAllVehicles(100000)                           # 1台使うごとに100km相当を足す
dem_cb = rt.RegisterUnaryTransitCallback(lambda a: dem[man.IndexToNode(a)])
rt.AddDimensionWithVehicleCapacity(dem_cb, 0, [TRUCK_CAPACITY] * N_VEH, True, "Cap")
prm = pywrapcp.DefaultRoutingSearchParameters()
prm.first_solution_strategy = routing_enums_pb2.FirstSolutionStrategy.PATH_CHEAPEST_ARC
prm.local_search_metaheuristic = routing_enums_pb2.LocalSearchMetaheuristic.GUIDED_LOCAL_SEARCH
prm.time_limit.seconds = 20                                    # 誘導局所探索は時間で打ち切る
sol = rt.SolveWithParameters(prm)
used, km = 0, 0
for v in range(N_VEH):
    i = rt.Start(v)
    if rt.IsEnd(sol.Value(rt.NextVar(i))): continue            # この車は使わない
    used += 1
    while not rt.IsEnd(i):
        j = sol.Value(rt.NextVar(i))
        km += D[man.IndexToNode(i)][man.IndexToNode(j)]; i = j
print("台数", used, "総距離 %.1f km" % (km / 1000))
# 出力: 台数 6 総距離 296.8 km
使ってよい台数の上限を10台にしておき、1台使うごとに100km相当の固定費を足すことで、ソルバーは使わない車をデポに置いたままにし、台数を減らす方向に探索します。結果は6台・296.8kmで、同じ設定で2回実行しても同じ値でした。平均積載率は96.4%、6台の積載は149・149・146・146・146・132ケースで、最も少ない車でも132ケース(88%)を積んでいます。初期解を作って既定の局所探索をかけただけの段階(0.17秒で打ち切り)では6台・301.3kmだったので、20秒の誘導局所探索で4.5km縮んだことになります。
第2章の基準の結果(積載のみで6台・296.3km)とは0.5kmの差があります。これは設定の違いによるものです。基準の結果は、同じ誘導局所探索20秒でも、荷下ろし時間を含む時間の次元を入れ、18時までに帰着する制約を付けて解いています。この章のコードは時間の次元を持たず、積載だけを入れています。各車の所要時間は長い車でも298分(8時に出れば12時58分に帰着)なので、18時の制約は実質的に効いていませんが、次元が1つ増えると探索の道筋が変わり、20秒で行き着く解が変わります。この章の設定で60秒まで延ばすと6台・296.3kmとなり、基準の結果と同じ総距離になりました。どちらも時間で打ち切った探索の結果で、最適であることは証明されていません。
ここまでの結果を、共通データでの比較として1つの表にまとめます。「各車の順を最適化」とある行は、分け方を変えずに各車の回る順だけを厳密に最適化し直した値です。計算時間はこの記事の実行環境での実測です。
| 方法 | 台数 | 総距離(km) | 平均積載率 | 最も少ない車の積載(ケース) | 計算時間 |
|---|---|---|---|---|---|
| セービング法 | 7 | 303.8 | 82.7% | 77 | 1ミリ秒未満 |
| セービング法+各車の順を最適化 | 7 | 302.7 | 82.7% | 77 | 0.003秒 |
| スイープ法(80通りの最良)+各車の順を最適化 | 6 | 304.5 | 96.4% | 137 | 0.2秒(80通り) |
| クラスター先・ルート後(扇形ごとの最遠点が種)+各車の順を最適化 | 6 | 345.0 | 96.4% | 137 | 1.0秒 |
| クラスター先・ルート後(乱数の種50通りの最良)+各車の順を最適化 | 6 | 299.5 | 96.4% | 137 | 50通りで75.9秒 |
| OR-Tools 初期解+既定の局所探索 | 6 | 301.3 | 96.4% | 136 | 0.17秒 |
| OR-Tools 誘導局所探索20秒(2回とも同じ) | 6 | 296.8 | 96.4% | 132 | 20秒 |
表から読み取れることは3つあります。1つ目は、台数の差が最も大きな違いだということです。セービング法は距離では OR-Tools との差が7.0km(2.4%)しかありませんが、台数が1台多く、費用に換算するとこの差が支配的になります(後の節で計算します)。2つ目は、距離の差は小さく見えても、同じ6台どうしの比較で OR-Tools はスイープ法より7.7km、扇形の種を使ったクラスター先・ルート後より48.2km短いことです。3つ目は、簡単な方法の成績は設定しだいで大きく揺れることです。スイープ法は起点で台数が変わり、クラスター先・ルート後は種で距離が85km近く変わりました。OR-Tools は20秒の探索を2回回して同じ値になり、今回のデータでは揺れが見られませんでした。
公開ベンチマークで、既知の最良値からの差を測る
共通データの結果だけでは、OR-Tools の296.8kmが最適にどれだけ近いのかは分かりません。40件の積載制約付き配車は、手元の整数計画ソルバーで最適性まで証明するには重い規模です。そこで、研究の世界で解法の比較に共通して使われている公開ベンチマークを使い、最適値が分かっている問題で差を測りました。使ったのは CVRPLIB で、積載制約付き配送計画問題の問題集と既知の最良解を集めたサイトです。サイトの見出しには、ブラジルのリオデジャネイロ・カトリカ大学(PUC-Rio)の研究グループ Galgos などの名前が並んでいます。サイトの一覧ページでは、問題ごとに納品先の数・台数・積載・既知の最良値(UB)と、その値が最適と証明されているかどうか(Opt)が示されています。
選んだのは、一覧で Augerat ほか(1995)の A 系列とされている A-n32-k5・A-n45-k7 と、Christofides ほか(1969)の E 系列とされている E-n51-k5 の3問題です。名前の n の後の数字はデポを含む地点の数、k の後の数字は台数を表します。3問題とも一覧で最適と証明済みで、既知の最良値は A-n32-k5 が784、A-n45-k7 が1,146、E-n51-k5 が521です。距離は、座標のユークリッド距離を四捨五入した整数(TSPLIB の EUC_2D という決まり)で数えます。念のため、配布されている最良解のファイル(.sol)に書かれたルートを読み込んで自分で距離を計算し直し、3問題とも一覧の値と一致することを確かめました。
各方法の設定は共通データのときと同じです。ただし CVRPLIB の既知最良値は総距離で示されているので、OR-Tools には車両の固定費を入れず、台数の上限を名前の k より3台多くして解きました。一方で、配布されている問題のファイルには台数(A-n32-k5 なら5台、E-n51-k5 なら最小5台)も書かれていて、配布されている最良解はどれもその台数のルートでできています。そのため、下の表で台数が既知最良より多い行は、距離の差だけでなく台数の超過も含む結果として読む必要があります。セービング法とスイープ法の後の順番の最適化は、1台10件までは厳密に、それを超える車は第3章の 2-opt で行っています。結果が次の表です。「差」は、総距離から既知最良を引いた値を既知最良で割ったものです。
| 方法 | A-n32-k5 の台数 | A-n32-k5 の総距離(差) | A-n45-k7 の台数 | A-n45-k7 の総距離(差) | E-n51-k5 の台数 | E-n51-k5 の総距離(差) |
|---|---|---|---|---|---|---|
| 既知最良(最適) | 5 | 784 | 7 | 1,146 | 5 | 521 |
| セービング法 | 5 | 842(+7.4%) | 7 | 1,198(+4.5%) | 6 | 582(+11.7%) |
| セービング法+各車の順を最適化 | 5 | 829(+5.7%) | 7 | 1,198(+4.5%) | 6 | 582(+11.7%) |
| スイープ法(起点×2方向の最良)+各車の順を最適化 | 5 | 860(+9.7%) | 7 | 1,302(+13.6%) | 5 | 528(+1.3%) |
| OR-Tools 誘導局所探索1秒 | 5 | 796(+1.5%) | 7 | 1,164(+1.6%) | 5 | 600(+15.2%) |
| OR-Tools 誘導局所探索10秒 | 5 | 796(+1.5%) | 7 | 1,152(+0.5%) | 5 | 527(+1.2%) |
| OR-Tools 誘導局所探索30秒(2回とも同じ) | 5 | 784(0.0%) | 7 | 1,152(+0.5%) | 5 | 521(0.0%) |
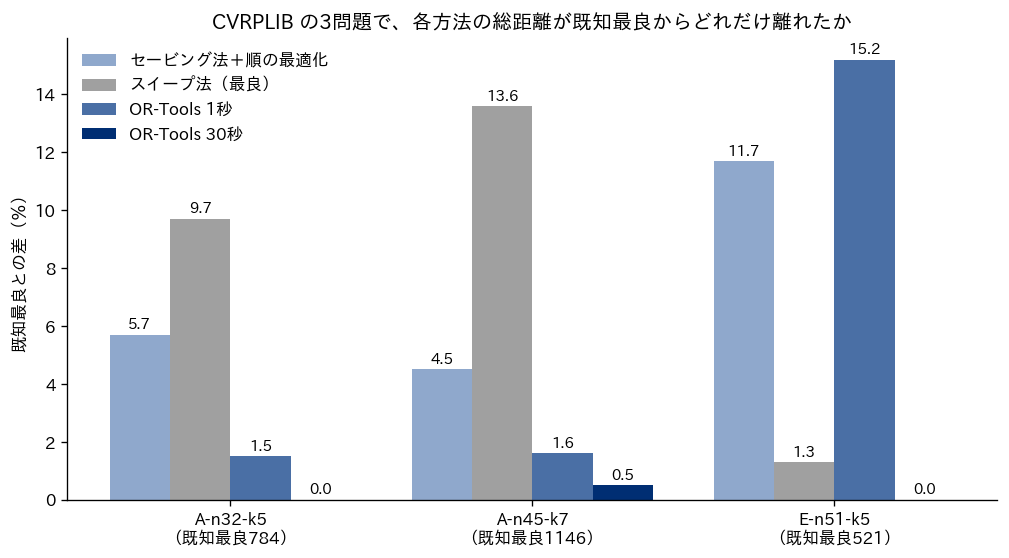
OR-Tools は30秒の誘導局所探索で、A-n32-k5 と E-n51-k5 では最適値そのもの(784と521)に到達し、A-n45-k7 でも差は0.5%でした。2回実行しても同じ値です。A-n32-k5 の最適値784は、配布ファイルの値を引き写したものではなく、自分で解いた OR-Tools の解がこの値に一致したことを確かめています。ただし、OR-Tools が返したのは「784の解」であって、「784が最適である」という証明ではありません。最適であることは CVRPLIB の一覧(Opt の欄)が示しているもので、OR-Tools だけを見ている限り、自分の問題で得た解が最適かどうかは分かりません。
時間制限の効き方は問題によって違いました。A-n32-k5 は1秒でも10秒でも796で、30秒で784に届きました。E-n51-k5 は1秒では600(差15.2%)とスイープ法より悪く、10秒で527、30秒で521です。短い時間制限は、問題によっては簡単な方法に負けるということです。毎朝の配車で探索に何秒使えるかは、この差を見て決めることになります。時間制限と品質の関係は、第6章で曲線として詳しく扱います。
簡単な方法どうしの比較は、問題によって順位が入れ替わりました。スイープ法は E-n51-k5 では1.3%と OR-Tools の10秒並みでしたが、A-n45-k7 では13.6%と最も悪い成績です。セービング法は A-n45-k7 で4.5%とスイープ法に大差をつけましたが、E-n51-k5 では6台を使い、最適解より1台多くなりました。Gillett と Miller の原論文の要旨は、スイープ法は一般に、Gaskell のセービング法の結果より大幅に良いと述べていますが、ここで実装したスイープ法は原論文の反復的な改善を入れていない基本形で、セービング法も最も素朴な形です。今回の3問題の結果からどちらが優れているとは言えず、言えるのは「簡単な方法の成績はデータの形に強く依存する」ということです。
台数と積載率の読み方、平均の数字に隠れるもの
配車の結果を評価するとき、最初に見るべきは台数と下限の差です。今回の共通データでは下限が6台で、OR-Tools・スイープ法(最良)・クラスター先・ルート後が6台、セービング法が7台でした。下限と同じ台数の計画が見つかっていれば、少なくとも台数の面ではこれ以上減らせません。下限より多い計画しか見つからないときは、手法の問題か、荷物の大きさの組み合わせで下限が達成できないのかを区別する必要があります。後者なら、どんな手法を使っても台数は減らず、減らすには積載の大きい車に替えるか、大口の納品先の荷物を分割して運べるようにするかといった、問題の条件そのものを変える判断になります。車種の組み合わせを変える検討は第8章で扱います。
次に積載率です。平均の積載率は「台数×積載」に対する総ケース数の比なので、この章のように1車種(2トン車)だけを使う場合は、同じ台数の計画どうしでは必ず同じ値になります(積載の違う車種を混ぜると、どの車種を何台使うかで値が変わります)。今回、6台の計画はどれも96.4%で、平均の積載率では計画の良し悪しは区別できません。区別できるのは、車ごとの積載の散らばりと、1台あたりの距離です。例えばセービング法の7台の計画は平均82.7%ですが、5台は86〜99%で、残る2台が63%と51%と低く、この2台が平均を下げています。平均だけを報告すると「どの車も8割程度積んでいる」ように読めてしまうので、車ごとの積載を並べるか、最も少ない車の積載を併記するのが良いと考えています。
積載率を上げようとすると、距離や拘束時間が伸びることがあります。台数を1台減らせば平均の積載率は上がりますが、そのために遠回りして荷物を積み合わせれば、総距離は増えます。今回の結果でも、セービング法の7台の計画は、6台のスイープ法(最良)より距離が1.8km短くなっていました(各車の順を最適化したもので比べると302.7kmと304.5km)。積載率を単独の目標にすると、台数は減っても走行距離が伸び、ドライバーの拘束時間が長くなることがあります。積載率・台数・距離は、組にして読む指標です。
もう1つ、積載だけで計画を立てたときの時間の余りにも注意が必要です。OR-Tools の6台の計画では、各車の所要時間(移動と荷下ろしの合計)は192〜298分で、8時に出発すれば全車が13時前に帰着します。つまりこのデータでは、制約として効いているのは積載で、時間には大きな余りがあります。午後の空いた時間に2回目の配送(2回転)を組めば、台数をさらに減らせる可能性がありますが、それにはドライバーの労働時間の制約を入れて計画する必要があり、第7章で扱います。また、実際の納品先の多くには時間指定があり、時間指定を入れると車ごとの帰着時刻は大きく変わります。第2章の基準の結果でも、時間指定を入れた計画では帰着が13時51分〜15時55分になっていました。時間指定の扱いは第5章に送ります。
経営指標に翻訳する、1台と500kmが釣り合う
ここまでの結果を費用に置き換えます。共通データの車種表にある2トン車の費用、つまり1日1台あたりの固定費20,000円と、1kmあたりの変動費40円を使います。これはこの記事のために置いた架空の値で、実在の運賃や契約条件ではありません。この単価では、1台の固定費は500km分の変動費に相当します。言い換えると、1台減らせるなら、総距離が500km延びるまでは費用の上で得になります。今回の計画の総距離は300km前後なので、台数を1台減らすことは、距離をゼロにするよりも大きな効果を持つ計算です。
| 方法 | 台数 | 総距離(km) | 1日の配送費(円) | 1件あたり配送費(円) | 1ケースあたり配送費(円) |
|---|---|---|---|---|---|
| セービング法 | 7 | 303.8 | 152,152 | 3,804 | 175.3 |
| スイープ法(80通りの最良) | 6 | 304.5 | 132,180 | 3,305 | 152.3 |
| クラスター先・ルート後(扇形ごとの最遠点が種) | 6 | 345.0 | 133,800 | 3,345 | 154.1 |
| OR-Tools 誘導局所探索20秒 | 6 | 296.8 | 131,872 | 3,297 | 151.9 |
表の1日の配送費は「台数×20,000円+総距離×40円」、1件あたりはそれを納品先の40件で割って1円未満を四捨五入した値、1ケースあたりは868ケースで割って小数第2位を四捨五入した値です。セービング法と OR-Tools の差は1日20,280円で、その大半(20,000円)が1台分の固定費です。距離の差7.0kmが生む差は280円にすぎません。反対に、扇形の種を使ったクラスター先・ルート後は、OR-Tools より48.2km長く走るのに、費用の差は1,928円にとどまります。台数が同じだからです。仮に年間の稼働日を250日とすると、1日20,280円の差は年間で約507万円になります。自社の単価と稼働日に置き換えれば、同じ計算で「配車の方法を変えたときに年間いくら違うか」が出ます。
この比較から言えるのは、配車の改善を評価するときは、まず台数が下限に届いているかを見て、次に同じ台数の中で距離を見る、という順番が経営の数字に合っているということです。距離だけを成果指標にすると、「距離は2%しか違わない」という理由で、1台多い計画を見逃すことになります。逆に、台数を減らすことだけを目標にすると、1台あたりの距離と拘束時間が伸び、残業代や安全面の負担として別の費用が出てきます。ここで使った費用には残業代もドライバーの拘束時間も入っていないので、それらを入れた比較は第7章で行います。
判断を誤ったときの損失は、大きく2つの型に分かれると考えています。1つ目は、台数を多く見積もる損失です。セービング法の結果をそのまま採用すれば、6台で回れる日に毎日7台を手配することになり、固定費がそのまま上乗せされます。傭車(外部の運送会社から借りる車)で調整している配送センターなら、手配する台数の見積もりが1台違うだけで、その日の傭車費が変わります。2つ目は、余裕を見ずに下限ぎりぎりの台数で固定する損失です。今回のデータでは6台の空きの合計が32ケースしかないので、当日に大口の注文が1件入るだけで6台では回れなくなります。そのとき急に7台目を手配できなければ、翌日回しか、既にいる車の2回転か、時間外の配送になります。
2つの型のどちらに寄せるかは、台数の手配をいつまでに確定させる必要があるかで決まります。前日に台数を確定させる必要があるなら、下限の台数に対してどれだけ空きがあるか(今回なら32ケース)を毎日記録し、空きが少ない日の予備車の手配基準を決めておくのが実務的です。当日の追加注文をどう組み込むかは第11章で扱います。いずれの場合も、毎日の「総ケース数・台数の下限・実際の台数・最も少ない車の積載」を記録しておけば、下限と実際の台数の差が何日続いているかという形で、配車の改善余地が経営の報告に載る数字になります。
どの方法を、どういうときに使うか
セービング法は、計算が非常に軽く、手順を人に説明しやすいのが強みです。原論文が手計算にも向いていると述べているとおり、節約値の表を作れば紙の上でも同じ結果を再現できます。距離は今回のデータでも公開ベンチマークでも既知最良から数%〜12%程度の範囲に収まっており、初期解や、手作業の配車の妥当性を確かめる目安として使えます。一方で、台数を直接減らそうとはしないので、積載に余裕が小さいデータでは下限より1台多くなることがあります。台数が費用を支配する配送センターでは、セービング法の結果を最終案にせず、改善をかける前提で使うのが安全です。
スイープ法は、方角で区切るので、ルートが扇形の区域になり、ドライバーの担当地区として分かりやすいのが特徴です。デポが区域の中央にあり、納品先がデポの周りに散らばっている地域に向いています。反対に、デポが区域の端にある地域や、デポを挟んで両側に遠い納品先がある地域では、方角が近いだけで離れた納品先を1台にまとめてしまいます。今回のデータのように積載に余裕が小さいと、起点しだいで台数が変わるので、起点を全部試すことが前提になります。
クラスター先・ルート後は、積載を守る割り当てを整数計画で保証できるので、決まった台数で回れるかどうかを確かめたいとき、あるいは担当地区の骨格を人が種として与え、細部を計算に任せたいときに向いています。ただし、種の選び方で距離が大きく変わり、今回は同じ台数で85km近い幅がありました。種を自動で選ぶ場合は、複数の選び方を試して最良のものを取る必要があります。
OR-Tools のような改善型のソルバーは、今回の共通データでも公開ベンチマークでも、簡単な方法より短い距離を、下限の台数で出しました。20〜30秒の時間制限で、最適値が分かっている50件規模の問題では最適値に届くか0.5%以内でした。毎日の配車に使う第一の候補はこちらで、3つの簡単な方法は、ソルバーの結果が妥当かどうかを確かめる物差しとして、あるいは現場に計画の考え方を説明する言葉として使うのが良いと考えています。ただし、ソルバーは書いた制約しか守りません。時間指定、ドライバーの労働時間、車両の進入制限など、この章で入れなかった条件がある現場では、この章の結果はそのままでは使えません。それぞれ第5章・第7章・第13章で扱います。
この章の要点は3つです。第一に、積載制約付きの配車では、解く前に台数の下限(総ケース÷積載の切り上げ)と平均の積載率を計算しておき、結果の台数が下限に届いているかを最初に見ます。今回のデータでは下限6台・平均96.4%で、空きは32ケースしかありませんでした。第二に、セービング法・スイープ法・クラスター先・ルート後は、分け方と順番を決める順序が違う方法で、成績はデータの形と設定(起点・種)に強く依存します。共通データでは、セービング法が7台、ほかが6台でした。第三に、OR-Tools の誘導局所探索は、共通データで6台・296.8km(20秒)、公開ベンチマークでは30秒で3問題とも既知最良から0.5%以内でしたが、最適であることの証明は出しません。費用に換算すると、1台の差は距離の差よりはるかに大きく、今回の架空の単価では1台が500km分に相当しました。次の第5章では、納品先ごとの時間指定を加え、時間枠を守る配車を扱います。
この章を深めたい方への参考書籍
『Pythonではじめる数理最適化 ケーススタディでモデリングのスキルを身につけよう 第2版』(岩永二郎・石原響太・西村直樹・田中一樹、オーム社):数理最適化のモデルを Python で組み立てるケーススタディ集で、第5章が「最小コストで行う輸送車両の配送計画」です。この章ではヒューリスティクスとソルバーの比較を中心にしましたが、配送計画を数理モデルとして書き下し、コードで解くまでの流れを手元で追うのに向いています。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画・整数計画から近似解法・局所探索法・メタヒューリスティクスまでを体系的に解説した教科書で、近似解法の章でビンパッキング問題を扱っています。この章の台数の下限(荷物を何台に詰められるか)の考え方や、OR-Tools が内部で行っている局所探索の基礎を、数理の側から理解するのに役立ちます。
第5章 時間指定を守る配車、時間枠と待ち時間、指定の厳しさの費用
第4章では、車の積載量だけを制約に入れた配車を扱い、総ケース数を1台の積載量で割って切り上げた値が台数の下限になること、第2章で用意したサンプルデータでは2トン車(150ケース)6台がその下限であることを確かめました。そこで決めたのは「どの車にどの納品先を載せ、どの順に回るか」で、何時に着くかは問いませんでした。しかし実際の納品先の多くは、受け取れる時間帯を指定しています。スーパーの店舗なら開店前の品出しに間に合う時間、飲食店なら仕込みの前、事業所なら受付に人がいる時間です。この章では、納品先ごとの受け入れ可能な時間帯を制約に入れた配車、つまり時間枠付きの配送計画問題(英語の頭文字で VRPTW)を扱います。時間枠を入れると、問題は「どの順に回るか」から「何時にどこにいるか」を決める問題に変わり、待ち時間という新しい無駄が生まれます。時間枠の守り方には、破れば計画が成り立たない扱い(ハード)と、破ってもよいが罰金を払う扱い(ソフト)の2つがあり、どちらを選ぶかは技術の問題である以上に、顧客とどう約束するかという経営の問題です。この章の後半では、時間指定を厳しくしたり緩めたりしたときに、台数・総走行距離・待ち時間・ドライバーの拘束時間がどう動くかを、同じ探索条件で複数回解いて測り、「時間指定サービスの費用」を経営指標に置き換えます。
時間枠とは何か、配車が「時刻」を決める問題に変わる
納品先が受け入れ可能な時間帯を、配送計画の分野では時間枠(タイムウィンドウ)と呼びます。時間枠は「この時刻より前には受け取れない」という開始時刻と、「この時刻までには作業を始めてほしい」という終了時刻の組で表します。第2章のサンプルデータでは、40件の納品先のうち11件が午前(9時〜12時)、7件が午後(13時〜17時)の指定を持ち、残りの22件は終日(8時〜18時)受け取れる、としていました。配送センターを出られるのは8時、戻らなければならないのは18時で、これも車の側の時間枠と見ることができます。
時間枠が入ると、ルートの評価に必要な情報が増えます。積載の制約だけなら、ルートに載せた納品先のケース数を足して150以下かどうかを見れば済みました。足し算の順番は結果に影響しません。時間枠の制約は違います。同じ5件を回るのでも、回る順番によって各納品先に着く時刻が変わり、ある順番では全件が枠内に収まるのに、別の順番では1件だけ枠を過ぎる、ということが起こります。つまり時間枠は、ルートの「中身」だけでなく「順番」に掛かる制約です。このため、第4章で扱ったセービング法のように2つのルートを端でつなぐ操作や、第3章で扱った 2-opt のようにルートの一部を逆向きにする操作は、そのたびに後ろの納品先の時刻を計算し直して枠を確かめる必要があります。とくに逆向きにした区間では到着の順番がそっくり入れ替わるので、午前指定と午後指定が混ざった区間を逆向きにすれば、それまで守れていた枠はまず破れます。
時間枠の終了時刻を「到着の締切」と読むか「作業開始の締切」と読むか「作業完了の締切」と読むかは、定義によって違います。この記事の共通データと、後で使う公開ベンチマークでは、いずれも「作業(荷下ろし)を始める時刻が枠の中に入っていればよい」という定義を使っています。枠の終了時刻の直前に着いて作業を始め、作業の終わりが枠の外にはみ出すことは許される、という読み方です。自社の納品先の「11時まで」が「11時までに着けばよい」のか「11時までに検品まで終えてほしい」のかは、同じ「11時まで」でも計画に与える影響がまるで違います。システムに入れる前に、この読み方を納品先ごとに確かめておく必要があります。
到着・待ち・荷下ろし、1台のルートの時刻表を計算する
時間枠付きの問題では、ルートの順番が決まると、各納品先での時刻が次の規則で順に決まります。まず、前の地点の作業を終えた時刻に、そこから次の納品先までの移動時間を足したものが到着時刻です。到着時刻が枠の開始時刻より早ければ、開始時刻まで待ってから作業を始めます。遅ければ、枠の終了時刻を過ぎていない限り、着いてすぐ作業を始めます。作業を始めた時刻に荷下ろし時間を足したものが作業の終わる時刻で、そこから次の納品先へ向かいます。式で書くと、納品先 \( j \) での作業開始時刻 \( s_j \) は \( s_j = \max(a_j,\; s_i + p_i + t_{ij}) \) です。言葉にすれば「直前の納品先 \( i \) で作業を始めた時刻に、そこでの荷下ろし時間 \( p_i \) と移動時間 \( t_{ij} \) を足したものと、自分の枠の開始時刻 \( a_j \) の、遅いほう」となります。この \( s_j \) が枠の終了時刻 \( b_j \) 以下であることが、時間枠を守るという条件です。
この規則から、時間枠の問題に特有の無駄である待ち時間が生まれます。午前指定の納品先に8時40分に着いてしまえば、9時まで20分待つことになります。待っている間、車は走らないので走行距離は増えませんが、ドライバーの拘束時間は増えます。待ち時間は距離の数字には表れないので、総走行距離だけを見ていると見落とします。逆に、待ち時間を減らそうとして出発時刻を遅らせると、後ろの納品先で枠の終了時刻に間に合わなくなることがあります。ルートの順番を固定したとき、出発時刻をどこまで遅らせられるかは、ルート上のすべての納品先について「枠の終了時刻まであと何分余裕があるか」の最小値で決まります。
この章の計算では、待ち時間と拘束時間を次のように数えました。ソルバーが返したルートの順番をそのまま使い、デポを出る時刻を8時から18時まで1分刻みに動かして、すべての枠を守れる出発時刻のうち、デポを出てから戻るまでの時間が最も短くなるものを選びます。その出発時刻で計算した待ち時間の合計と、出発から帰着までの時間の合計を、それぞれ「待ち合計」「拘束合計」と呼びます。ソルバーは総走行距離(と台数)を最小にしているだけで、待ち時間や拘束時間を目的に入れていないので、出発時刻を後から選び直さないと、計算上の待ち時間が実際よりずっと大きく出るためです。ここでいう拘束合計は、配送センターを出てから戻るまでの時間だけで、出庫前の積み込みや帰着後の作業を含みません。法令上の拘束時間との関係は第7章で扱います。
具体例で確かめます。後の節で解く「現行の時間指定」の計画のうち1台は、C29・C01・C33(いずれも終日)、C40・C37(午前)、C24(午後)の順に6件を回ります。このルートの時刻表を、8時に出発した場合と10時に出発した場合の2通りで計算するコードが次のものです。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from vrp_data import customers, points, time_min, hhmm

cs = customers()
T = time_min(points(cs))                       # 移動時間(分)。行列の0番はデポ
pos = {c["id"]: k + 1 for k, c in enumerate(cs)}
route = ["C29", "C01", "C33", "C40", "C37", "C24"]


def timetable(depart):
    t, prev, rows = depart, 0, []
    for cid in route:
        c = cs[pos[cid] - 1]
        arr = t + round(T[prev][pos[cid]])     # 到着 = 前の地点を出た時刻 + 移動
        start = max(arr, c["tw"][0])           # 枠の開始より早ければ待つ
        rows.append((cid, c["tw_kind"], arr, start - arr, start, c["tw"][1] - start))
        t, prev = start + c["service"], pos[cid]   # 荷下ろしを終えて出発
    return rows, t + round(T[prev][0])


for depart in (0, 120):                        # 8時に出る案と10時に出る案
    rows, back = timetable(depart)
    print("出発 %s" % hhmm(depart))
    for cid, kind, arr, wait, start, slack in rows:
        print("  %s %s 到着%s 待ち%3d分 作業開始%s 枠の終了まで%4d分" % (cid, kind, hhmm(arr), wait, hhmm(start), slack))
    print("  帰着 %s  待ち合計 %d分  出発から帰着まで %d分" % (hhmm(back), sum(r[3] for r in rows), back - depart))
# 出力(抜粋): 出発 8:00 … C24 午後 到着10:16 待ち164分 作業開始13:00 … 帰着 13:44  待ち合計 164分  出発から帰着まで 344分
# 出力(抜粋): 出発 10:00 … C37 午前 到着12:00 待ち  0分 作業開始12:00 枠の終了まで   0分 … 待ち合計 44分  出発から帰着まで 224分
移動時間は、第2章で置いた仮定(道路距離=直線距離×1.3、時速25km)で計算し、分に丸めています。結果を表にまとめました。
| 納品先 | 時間指定 | 8時出発の到着 | 8時出発の待ち(分) | 10時出発の到着 | 10時出発の待ち(分) | 10時出発で枠の終了まで(分) |
|---|---|---|---|---|---|---|
| C29 | 終日 | 8時31分 | 0 | 10時31分 | 0 | 449 |
| C01 | 終日 | 8時54分 | 0 | 10時54分 | 0 | 426 |
| C33 | 終日 | 9時14分 | 0 | 11時14分 | 0 | 406 |
| C40 | 午前 | 9時41分 | 0 | 11時41分 | 0 | 19 |
| C37 | 午前 | 10時00分 | 0 | 12時00分 | 0 | 0 |
| C24 | 午後 | 10時16分 | 164 | 12時16分 | 44 | 240 |
8時に出発すると、午前指定の2件を10時台に終えたあと、午後指定の C24 に10時16分に着いてしまい、13時まで164分待ちます。帰着は13時44分で、出発から帰着までは344分です。10時に出発すると、同じ順番のまま待ちは44分に減り、出発から帰着までは224分になります。帰着時刻はどちらも13時44分で変わりません。待ちが減った120分は、配送センターでの2時間の出発遅れと入れ替わっただけで、その2時間を別の仕事(別の便の積み込みや、午前の別ルート)に使えるかどうかで価値が決まります。
10時より遅くは出られません。表の右端の列「10時出発で枠の終了まで」を見ると、午前指定の C37 がちょうど12時に作業を始めており、余裕が0分です。この1件が出発時刻の上限を決めています。そして10時に出ても、C24 の前の44分の待ちは消えません。午前指定の納品先を終えてから午後指定の納品先に向かう順番そのものが、昼の待ちを生んでいるからです。この待ちを消すには、ルートの組み方を変える(C24 を午後に回る別の車に移す)必要があります。時間枠の問題で待ち時間を減らす手段は、出発時刻をずらすことと、ルートの組み方を変えることの2つです。前者で減らせるのは、ルートの順番を固定したまま、どこかの納品先で枠の終了時刻に当たるまで出発を遅らせて減る分に限られます(この例では C24 の前の待ちが164分から44分に減りました)。その先に残る待ちは順番が生んでいるもので、後者でなければ減りません。
ハードな時間枠とソフトな時間枠、破れない約束か罰金つきの約束か
ここまでは、枠の終了時刻を1分でも過ぎた計画は成り立たない、として扱いました。これをハードな時間枠と呼びます。これに対して、枠を過ぎることを許し、その代わり遅れた分に応じた罰金(ペナルティ)を目的関数に足す扱いをソフトな時間枠と呼びます。罰金は実際に支払うお金とは限りません。「遅れ1分を何円の損失とみなすか」という重みで、顧客の不満や再配達の手間、取引を失うおそれを、走行距離や台数と同じ物差しで比べるための換算値です。
どちらを使うべきかは、遅れたときに何が起きるかで決まります。荷受けの担当者が決まった時刻にしかいない、倉庫の搬入口の予約時刻を過ぎると受け付けてもらえない、生鮮品の売場の開店に間に合わないと売り逃しになる、といった納品先では、遅れは許されないのでハードに置くのが自然です。一方、「午前中」のような指定が多少の遅れなら実際には受け入れられている納品先や、遅れても翌日の納品で埋め合わせがきく取引では、ソフトに置くことで、後で見るように台数を減らせる場合があります。ハードとソフトは納品先ごとに混ぜて設定できます。重要な納品先だけハードにし、それ以外はソフトにする、という使い分けが有効だと考えています。
ソフトな時間枠の研究として、Ibaraki・Imahori・Kubo・Masuda・Uno・Yagiura の6名が2005年に Transportation Science 誌(39巻2号)に発表した論文があります。この論文の要旨は、各納品先の時間枠の制約を罰金の関数として扱い、その関数は区分的に線形であれば凸でなくても不連続でもよい、という一般的な形を認めています。そのうえで、局所探索で「どの車に、どの順に」を決め、順番を固定したあとで罰金の合計が最小になる作業開始時刻を動的計画法(大きな問題を、前から順に小さな部分問題の最良の答えを積み上げて解く方法)で効率よく求める、という2段の構造で解いています。この章で待ち時間を数えるときに「順番を固定して出発時刻を選び直した」のは、この2段目の考え方をごく単純にしたものです。罰金の関数を自由に置けるので、「30分までの遅れは軽く、それを超えると急に重くなる」「早すぎる到着にも罰金を付ける」といった現場の感覚を、そのまま式に写せます。
ソフトな時間枠を使うときの注意は、罰金の単価が計画を決めてしまうことです。単価が小さすぎれば、遅れを多く含む距離の短い計画が選ばれやすくなります。単価が大きすぎれば、実質的にハードと同じになります。単価をいくらにするかは技術の問題ではなく、「1台分の費用を払ってでも遅れを避けたいか」という経営の判断です。後の節で、単価を変えたときに台数と遅れがどう入れ替わるかを実際に測ります。
この記事で使っている OR-Tools のルーティングソルバーでは、時刻を「時間の次元」として持たせます。ハードな時間枠は、各納品先の時刻の変数に CumulVar(index).SetRange(開始, 終了) で範囲を与えて入れ、待ち時間は次元を作る AddDimension の2つ目の引数(スラック、つまり各地点で時刻が移動時間の分より余分に進んでよい量の上限)で許します。OR-Tools の公式ガイドの時間枠付きの例も、時間枠のために正の待ち時間を許す必要があるとして、この引数に正の値を入れています。ソフトな時間枠は、範囲の上限を1日の終わりまで広げたうえで SetCumulVarSoftUpperBound(index, 終了, 1分あたりの罰金) を足して入れました。いずれもこの章のスクリプトで実行して確かめた書き方です。次元・スラック・コールバックの仕組みと細かな使い方は第6章で扱います。
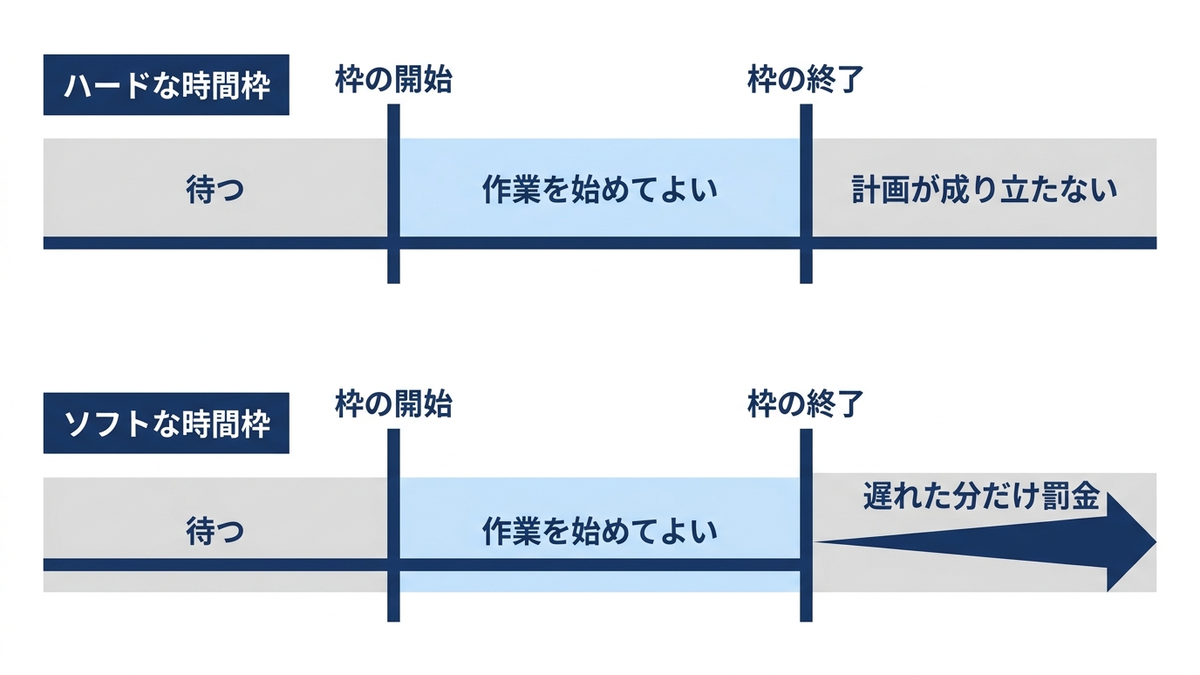
公開ベンチマークで腕前を測る、Solomon の問題と既知最良
共通データの結果はこの記事の中でしか比べられないので、先に公開ベンチマークでソルバーの腕前を測っておきます。時間枠付きの配車で最も広く使われてきたSolomon のベンチマークは、Solomon が1987年に Operations Research 誌(35巻2号、254〜265ページ)に発表した論文で使われた問題群です。この論文の要旨は、この種の問題は本質的に難しいので実用規模では近似解法(最適とは限らないが速く良い解を出す方法)が有望だとし、いろいろな近似解法を計算実験で比べています。問題群は、データの作り方、時間枠を持つ納品先の割合、時間枠の幅と位置、計画期間の長さが異なるように作られており、比べた方法の中では挿入型の方法(ルートに納品先を1件ずつ、最も費用の増えない位置に差し込んでいく方法)が一貫して非常に良い結果を出した、と要旨は報告しています。
既知最良値(これまでに報告された最も良い解の値)の比べ方には注意が要ります。ノルウェーの研究機関 SINTEF が公開している一覧は、目的を2段階の優先順位で定義しています。第1に車両の台数を最小にし、第2に総距離を最小にする、というものです。距離と時間は倍精度(小数を丸めない計算)で扱い、表の総距離は小数第2位に丸めて載せる、と明記されています。同じページは、厳密解法(最適であることを証明する解法)の研究では総距離だけを目的にし、整数や低い精度で距離を計算するのが一般的なので、結果を直接には比べられない、とも注意しています。また、SINTEF のドキュメントのページは、各納品先の「Ready time」を作業を始めてよい最も早い時刻、「Due date」を作業を始めてよい最も遅い時刻と定義し、移動時間の値は距離の値に等しい、としています。この章の共通データの定義(作業開始の時刻が枠に入っていればよい)はこれに合わせてあります。
納品先100件の問題群から C101・R101・RC101 の3つを選び、OR-Tools で解きました。OR-Tools のルーティングソルバーは距離や時刻を返す関数の値を整数で受け取るので、距離を100倍して整数にし、費用の距離は四捨五入、時間は切り上げ(枠を破らない側に丸める)にしました。台数を第1の目的にするため、車1台に、距離に換算して1,000万(100倍した単位。元の距離で10万)という固定費を掛けています。3問題とも座標が0〜95の範囲に収まり、1区間の距離は最長でも126に満たないので、どんな計画でも総距離は2万に届きません。したがって、1台減らせる計画は距離がどれだけ伸びても必ず有利になり、目的は厳密に「台数が第1、距離が第2」になります。第2章以降の共通データで使っている「1台100km相当」の固定費は台数が増えにくくなるように付けた重みで、この置き方とは違います。解いたあと、得られたルートを倍精度で計算し直し、時間枠・積載・デポへの帰着の締切を全部守っていることを検査しました。改善の方法は誘導局所探索(第6章で扱います)で、初期解(探索の出発点になる最初の解)の作り方を2通り試しています。
| 問題 | 既知最良(台数・総距離) | 初期解の作り方 | 5秒(1回) | 30秒(2回) | 30秒の既知最良との差 |
|---|---|---|---|---|---|
| C101 | 10台・828.94 | 最安の辺をつなぐ方法 | 10台・828.94 | 10台・828.94(2回とも) | 台数同じ・距離同じ |
| C101 | 10台・828.94 | 並列の最安挿入 | 10台・828.94 | 10台・828.94(2回とも) | 台数同じ・距離同じ |
| R101 | 19台・1,650.80 | 最安の辺をつなぐ方法 | 解なし | 解なし(2回とも) | 比較できない |
| R101 | 19台・1,650.80 | 並列の最安挿入 | 19台・1,682.26 | 19台・1,653.53(2回とも) | 台数同じ・距離+0.17% |
| RC101 | 14台・1,696.95 | 最安の辺をつなぐ方法 | 解なし | 解なし(2回とも) | 比較できない |
| RC101 | 14台・1,696.95 | 並列の最安挿入 | 16台・1,740.02 | 16台・1,682.13(2回とも) | 台数2台多い・距離0.87%短い |
表の「最安の辺をつなぐ方法」は OR-Tools の初期解の戦略 PATH_CHEAPEST_ARC、「並列の最安挿入」は PARALLEL_CHEAPEST_INSERTION です。「解なし」は、時間制限の中で時間枠を満たす解が1つも見つからなかったことを表し、ソルバーの状態は ROUTING_FAIL_TIMEOUT(時間切れ)でした。既知最良の解が公開されているので、時間枠を満たす解は存在します。見つけられなかったのはソルバーの側です。計算時間はこの記事の実行環境(一般的なノートPC)での実測で、ほかの章の計算と同じPCで並行して動かしています。
C101 では、どちらの初期解からでも5秒で既知最良と同じ10台・828.94に達しました。R101 と RC101 では結果が分かれ、最安の辺をつなぐ方法は30秒でも時間枠を満たす最初の解を作れませんでした。OR-Tools の公式ガイドの説明では、この方法はルートの出発点から、最も安い区間になる地点へつなぎ、そのあとは最後に加えた地点から同じように1本ずつ伸ばしていく作り方です。並列の最安挿入は、差し込む費用が最も安い地点を、最も安い位置に1件ずつ差し込んでいく作り方で、Solomon の論文が良い結果の方法として挙げた挿入型と同じ系統です。今回の3問では、R101 と RC101 で前者が最初の解を作れず、後者は作れました。なぜ前者が失敗したのかまでは、この実験では確かめていません。この章の後半の共通データでは基準の結果と同じ最安の辺をつなぐ方法を使いますが、共通データの現行の時間枠は3時間以上と広く、この章で1時間枠まで狭めた設定を含め、どの設定でも解が見つかっています。初期解の戦略の比較は第6章で詳しく扱います。
R101 は台数が既知最良と同じ19台で、総距離が0.17%長い解でした。RC101 の30秒の解は総距離が1,682.13で、既知最良の1,696.95より0.87%短くなっています。ただしこれは既知最良を上回ったことを意味しません。台数が既知最良の14台より2台多い16台だからです。SINTEF の一覧は台数を第1の目的にしているので、16台の解は、距離がいくら短くても14台の解より悪い解です。台数を2台増やせば1台あたりの受け持ちが減り、総距離は短くしやすくなります。既知最良と比べるときは、まずその値がどういう目的で測られたものかを確かめ、同じ物差しで比べる必要があります。前の表で「差」の列を台数と距離に分けて書いたのはこのためです。
この比較から実務に持ち帰れることは3つあります。第一に、時間枠が狭い問題では、初期解を作る段階で失敗することがあり、その場合は出てくる結果が「悪い解」ではなく「解なし」になります。解なしが出たときは、時間枠を本当に満たせないのか、初期解の作り方が合っていないのかを区別する必要があります。第二に、同じ30秒でも問題によって既知最良との差は0%から台数2台分まで開きます。自社のデータで「この解がどれくらい良いか」を知るには、同じ時間制限で何回か解いて揺れを見るか、公開ベンチマークのように基準のある問題で先に腕前を測っておくのが確実です。第三に、比べる相手の定義を確かめずに「既知最良より良い」と書くと、台数という経営上いちばん重い数字を見落とします。
共通データで時間指定を厳しくする、同じ探索条件で3回ずつ解く
ここから共通データに戻ります。時間指定の厳しさを5段階に変え、それぞれを同じ探索条件で3回ずつ解きました。探索条件は第2章以降の基準の結果とほぼ同じで(違いは車の上限で、基準の結果の10台に対してここでは15台)、2トン車(150ケース)を最大15台まで使ってよく、OR-Tools の最安の辺をつなぐ方法で初期解を作り、誘導局所探索で20秒改善します。車1台に100km 相当の固定費を掛けて、台数が増えにくくなるようにしてあります(前の節の Solomon の問題とは違い、厳密に台数を第1にする置き方ではなく重みです)。全車8時以降に出発し、18時までに戻ります。5つの設定は次のとおりです。
- A 時間指定なし:40件すべてを終日(8時〜18時)受け取れるものとする
- B 現行:午前11件・午後7件・終日22件(第2章で紹介したサンプルデータのまま)
- C 指定のある18件だけ2時間枠:午前・午後の指定を持つ18件の枠を、元の枠の内側で2時間に狭める。終日の22件はそのまま
- D 全件を2時間枠:40件すべての枠を、元の枠の内側で2時間に狭める
- E 全件を1時間枠:40件すべての枠を、元の枠の内側で1時間に狭める
狭めた枠は、元の枠の内側に収まる開始時刻を30分刻みで並べ、その中から乱数(シードを固定)で1つ選んで作りました。たとえば午前(9時〜12時)の納品先の2時間枠は、9時〜11時・9時30分〜11時30分・10時〜12時のどれかになります。終日の納品先の2時間枠は、8時〜10時から16時〜18時までのどれかです。宅配便の時間帯指定のように、納品先が受け取りやすい時間帯を細かく指定するようになった状況を想定しています。
| 設定 | 台数(3回) | 総距離 km(回1/回2/回3) | 待ち合計 分(回1/回2/回3) | 拘束合計 時間(回1/回2/回3) | 最終帰着(最良の回) |
|---|---|---|---|---|---|
| A 時間指定なし | 6・6・6 | 298.1/298.1/298.1 | 0/0/0 | 23.4/23.4/23.4 | 13時18分 |
| B 現行 | 6・6・6 | 296.5/305.5/305.5 | 101/6/6 | 25.0/23.8/23.8 | 15時52分 |
| C 指定のある18件だけ2時間枠 | 6・6・6 | 301.3/301.3/301.3 | 442/442/442 | 30.8/30.8/30.8 | 16時59分 |
| D 全件を2時間枠 | 6・6・6 | 328.6/328.6/328.6 | 904/904/904 | 39.7/39.7/39.7 | 17時35分 |
| E 全件を1時間枠 | 6・6・6 | 359.8/357.8/359.8 | 959/1,062/959 | 41.9/43.5/41.9 | 17時55分 |
表の「最良の回」は、台数が最も少なく、その中で総距離が最も短い回です(B は回1、E は回2)。待ち合計と拘束合計は、前の節で説明したとおり、順番を固定して出発時刻を選び直した値で、拘束合計は6台の出発から帰着までの時間の合計です。計算時間は1回20秒(時間制限いっぱい)で、この記事の実行環境での実測です。
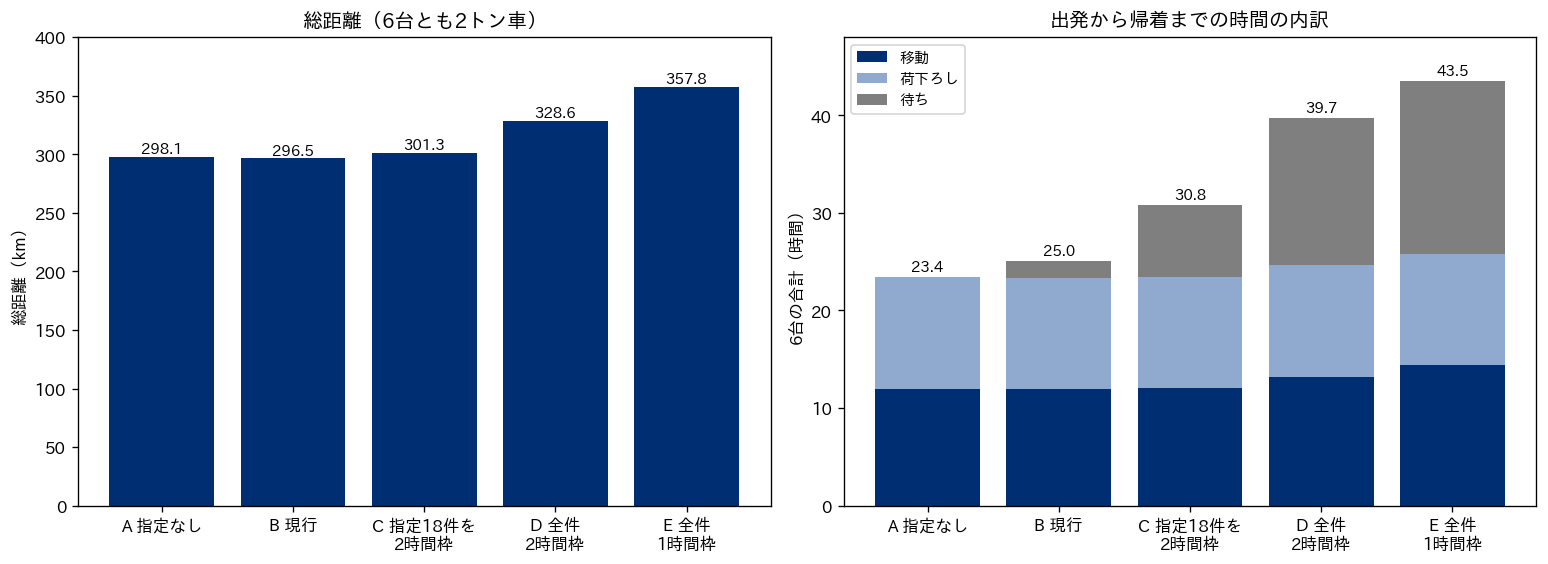
まず台数です。5つの設定のすべてで、3回とも6台でした。2トン車の積載150ケースでは、総ケース868を運ぶのに少なくとも6台が要ります。この6台で、全件を1時間枠に狭めた設定まで回り切れています。このデータでは、台数を決めているのは時間枠ではなく積載です。
総距離は、A から C まではほぼ横ばいで、D で328.6km、E で357.8km に伸びました。時間指定の無い A(298.1km)に比べて、D は30.5km(10.2%)、E は59.7km(20.0%)長くなっています。上の図の左がこの比較です。時間枠を狭めると、近くにある納品先どうしでも指定の時間帯が違えば同じ車で続けて回れなくなり、エリアの中を行き来するルートが増えます。その様子は、この後に示すルート図で確かめられます。
距離より大きく動いたのは時間です。上の図の右は、6台の出発から帰着までの時間の合計を、移動・荷下ろし・待ちに分けて積み上げたものです。荷下ろしは40件で685分(11.4時間)と、どの設定でも同じです。移動は A の12.0時間から E の14.4時間へ2.4時間増えただけですが、待ちは0から17.7時間に増え、合計は23.4時間から43.5時間とほぼ倍になりました。全件を2時間枠にした D では、待ちが15.1時間(904分)で、荷下ろしの時間を上回っています。枠を狭めると、ドライバーは走っている時間より待っている時間のほうが長くなる、というのがこのデータの結果です。
最終帰着も遅くなります。A では最も遅い車でも13時18分に戻るのに対し、D では17時35分、E では17時55分と、18時の終業ぎりぎりまで使っています。帰着が早ければ、午後に2回目の配送(第7章で扱う2回転)や、当日の追加注文への対応(第11章)に車を回せます。枠を狭めると、その余力が消えます。
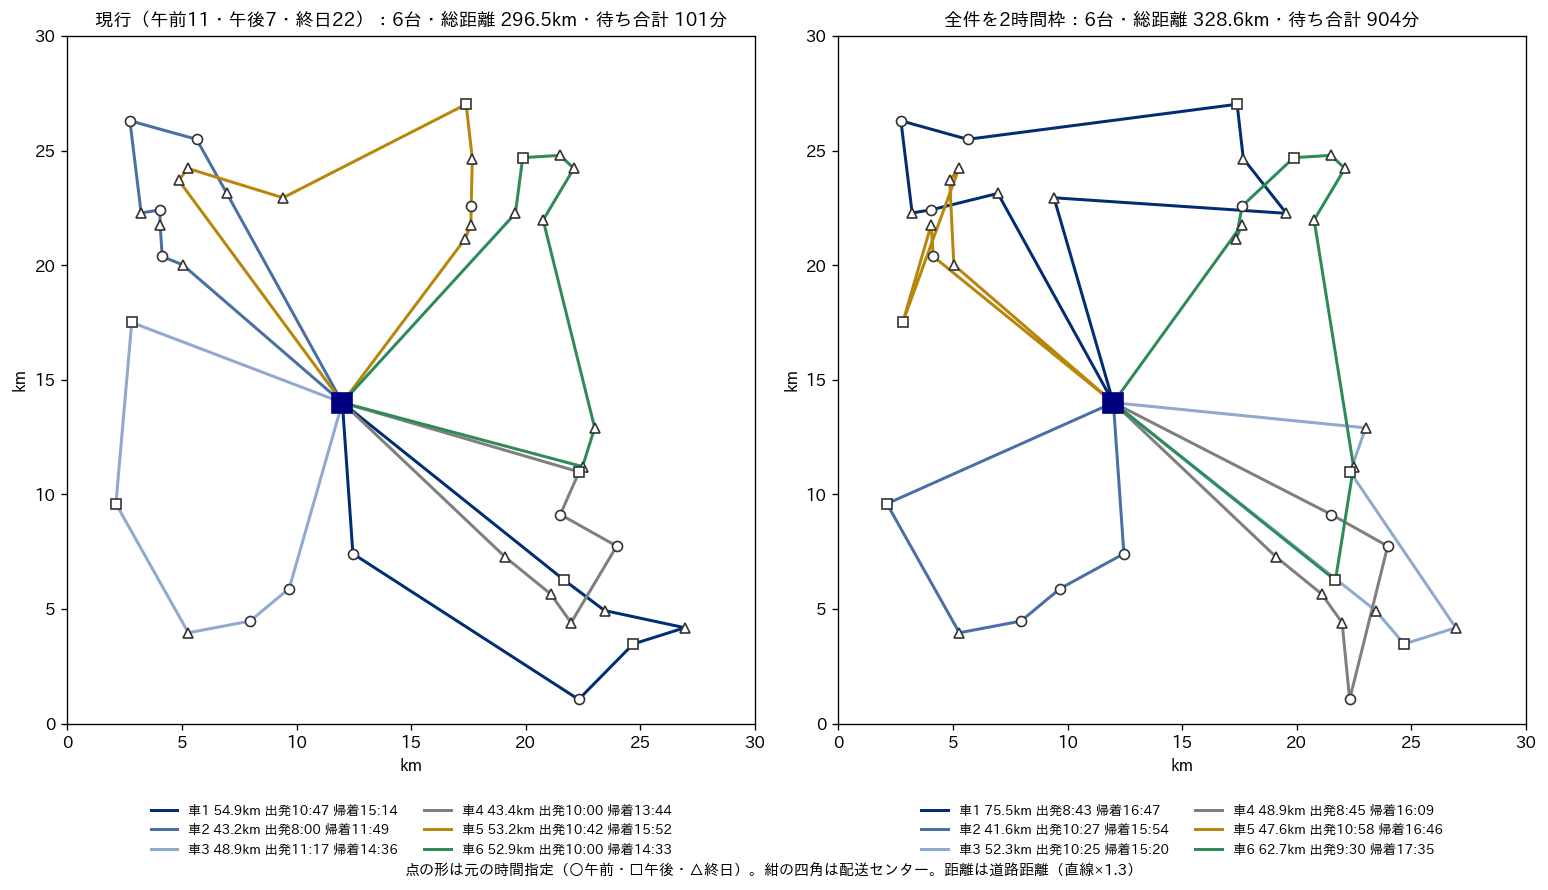
ルート図の左は B(現行)の最良の回、右は D(全件2時間枠)です。点の形は元の時間指定(丸が午前、四角が午後、三角が終日)を表し、凡例に各車の距離と出発・帰着時刻を入れました。左では、各車がおおむね1つの方面にまとまって回っています。右では、北西の地区の納品先が車1と車5に分かれ、車1は北西から北東の地区まで横断しています。同じ地区の納品先でも指定の2時間帯が違えば、1台で続けて回ると枠と枠の間で待つことになります。右の図では、そうした納品先が別々の車に分かれています。
時間指定を足したほうが短い、という結果の読み方
表をよく見ると、A(時間指定なし)の298.1km が、B(現行)の回1の296.5km より長くなっています。第2章以降の基準の結果(同じ設定で別に解いた値)でも、積載だけの6台・296.3km に対し、時間指定を加えると6台・293.2km と短くなっていました。制約を足した問題のほうが短い、というのは最適解どうしでは起こりえません。時間指定のある問題で許される計画は、時間指定の無い問題でも必ず許されるからです。B の293.2km の計画は A の計画としてもそのまま使えるので、A の最適値は293.2km 以下であることが、この記録から確かめられます。したがって A の298.1km は、少なくとも4.9km(1.6%)改善の余地が残っている解です。
原因はソルバーの探索が20秒で打ち切られていることで、最適性は証明していません。時間指定の有無で探索の出発点も経路も変わるので、同じ20秒で行き着く先の良し悪しは設定ごとにばらつきます。同じ B の設定でも、3回の総距離は296.5km と305.5km に分かれ、その差は9.0km(3.0%)ありました。基準の結果の293.2km とも違います。時間で打ち切る探索は、同じ設定・同じ時間制限でも、実行のたびに結果が揺れることがあります。この記事では14の章の計算が同じPCで並行して動いており、その影響も含めた値です。
このことから、「時間指定の費用」を測るときの規則が2つ出てきます。1つ目は、同じ探索条件で複数回解き、設定の間の差が回ごとの揺れより大きいかを見ることです。B と A の距離の差(B が1.6km 短い回から7.4km 長い回まで)は、B の回ごとの揺れ(9.0km)の中に収まっているので、このデータでは「現行の時間指定は距離をほとんど増やしていない」としか言えません。D と E の差(+30.5km・+59.7km)は揺れより十分に大きいので、枠を狭めた費用として読んでよいと判断しました。2つ目は、距離だけでなく待ちと拘束時間を並べることです。B の回1と回2を比べると、回1は距離が9.0km 短い代わりに待ちが95分長く、どちらが良い計画かは距離と時間のどちらを重く見るかで変わります。ソルバーに渡した目的は総距離と台数だけなので、待ち時間の少なさは偶然に任されています。拘束時間を減らしたいなら、それを目的に入れる必要があります(OR-Tools では時間の次元の長さに費用を掛ける方法があり、第6章と第7章で扱います)。
車が大きいと、時間枠が台数を決める
2トン車では積載が台数を決めていたので、時間枠を狭めても台数は変わりませんでした。そこで同じ5つの設定を、積載300ケースの車(第2章で紹介した車種のうち4トン車の積載)で解きました。積載だけなら3台で足ります。探索条件は前の節と同じで、1設定あたり2回ずつです。費用は、第2章で紹介した架空の車種の値(4トン車は1台1日28,000円・1km 60円、2トン車は20,000円・40円)で、各設定の最良の回から計算しました。
| 設定 | 4トン車の台数(2回) | 4トン車の総距離 km(回1/回2) | 4トン車の拘束合計 時間(最良の回) | 4トン車の費用(円) | 2トン車の費用(円) | 2トン車の1件あたり(円) |
|---|---|---|---|---|---|---|
| A 時間指定なし | 3・3 | 213.3/213.3 | 20.0 | 96,798 | 131,924 | 3,298 |
| B 現行 | 3・3 | 225.9/238.2 | 21.3 | 97,553 | 131,860 | 3,297 |
| C 指定のある18件だけ2時間枠 | 3・3 | 237.2/237.2 | 23.0 | 98,232 | 132,052 | 3,301 |
| D 全件を2時間枠 | 4・4 | 255.9/255.9 | 31.4 | 127,353 | 133,146 | 3,329 |
| E 全件を1時間枠 | 4・4 | 315.0/315.0 | 34.0 | 130,901 | 134,312 | 3,358 |
4トン車では、D と E で台数が3台から4台に増えました。D の4台の積載は199・207・176・286ケースで、積載だけなら3台に収まる量で、4台目は積載のために出ているのではありません(それが本当に必要な台数かどうかは、この節の最後で述べるように、まだ分かりません)。費用で見ると、A から C までは96,798〜98,232円とほとんど差が無いのに対し、D で127,353円と3万円近く跳ね上がります。1台分の固定費28,000円がそのまま乗るからです。2トン車の費用は、台数が6台のまま動かないので、A の131,924円から E の134,312円まで、距離の増えた分の2,388円しか増えません。
この表から読み取れるのは、時間指定の費用が「距離が少しずつ増える」形ではなく、「ある厳しさを超えたところで台数が1台増える」階段の形で現れることです。このデータでは、A〜C で1台が11〜17件を回っていた4トン車で台数に効き、1台が5〜9件を回る2トン車では台数に効きませんでした。1台が多くの納品先を受け持つほど、その全員の時間帯を1日の中に並べるのが難しくなるので、積載に余裕のある車ほど時間枠が台数に効きやすいと考えています。反対に、積載がぎりぎりの車では台数が積載で決まるので、時間枠の費用は待ちと拘束時間に出ます。自社の車両が積載と時間のどちらで台数を決められているかを先に確かめておくと、時間指定を変える話の効き方を見積もれます。
ただし、D の「4台」がこのデータの本当の必要台数かどうかは、この表だけでは分かりません。この値も20秒で打ち切った探索の結果だからです。次の節で、遅れを許すソフトな時間枠で解き直したときに、この点を確かめます。
遅れを許すと台数はどう変わるか、罰金の単価を振って解く
4トン車で全件を2時間枠にした設定(D)を、ソフトな時間枠で解き直しました。枠の開始時刻より早く作業を始めることは許さず(早く着いたら待つ)、枠の終了時刻を過ぎて作業を始めることは18時まで許して、遅れ1分ごとに罰金を目的に足します。罰金の単価は、遅れ1分あたり500円・100円・50円・20円・10円の5通りです。目的関数は円にそろえ、4トン車の固定費28,000円と1km 60円(いずれも架空)に罰金を足した額を最小にしました。前の節の表では台数が増えにくくなるように固定費を100km 相当と置いていましたが、ここでは固定費を28,000円(60円/km で約467km 相当)にしているので、ハードに解いた行の結果も前の節と少し違います。探索条件(初期解の作り方・誘導局所探索・20秒)は同じで、各2回解いて2回とも同じ結果でした。遅れは、得られたルートを8時に出発させ、着いたら枠の開始まで待つ最も早い時刻表で数えています。
| 遅れ1分の罰金(円、架空) | 台数 | 総距離 km | 遅れた件数 | 遅れの合計(分) | 最大の遅れ(分) | 固定費+走行費(円) | 罰金(円) |
|---|---|---|---|---|---|---|---|
| ハード(遅れ不可) | 4 | 258.9 | 0 | 0 | 0 | 127,537 | 0 |
| 500 | 4 | 258.9 | 0 | 0 | 0 | 127,531 | 0 |
| 100 | 3 | 301.0 | 3 | 52 | 24 | 102,061 | 5,200 |
| 50 | 3 | 330.4 | 0 | 0 | 0 | 103,824 | 0 |
| 20 | 3 | 299.9 | 4 | 53 | 24 | 101,995 | 1,060 |
| 10 | 3 | 293.9 | 3 | 133 | 113 | 101,633 | 1,330 |
最も重要なのは、単価50円の行です。3台で、遅れた件数が0件の計画が見つかっています。遅れが0件なので、これはハードな時間枠のもとでもそのまま使える計画です。つまり、この設定は3台で回れます。ハードのまま解いた探索は、20秒でも、時間制限を90秒に延ばして2回解いても、4台(90秒では2回とも4台・255.9km)から抜け出せませんでした。単価50円のソフトな時間枠は、90秒で2回解いても2回とも同じ3台・330.4km・遅れ0件の計画を返しています。前の節の表の「D は4台」は、時間枠が必要とした台数ではなく、ハードな時間枠のもとでの探索が3台の計画にたどり着けなかった結果だったことになります。固定費+走行費で比べると、ハードの探索の127,537円に対して3台の計画は103,824円で、1日23,713円の差です。
なぜソフトにすると見つかったのかは、この実験では確かめていません。言えるのは、ソフトな時間枠では遅れのある3台の計画も「許される計画」に含まれるので、探索がそうした計画の間も動けるようになる、ということだけです。ハードな時間枠では、遅れのある計画は1つも許されません。一方、2トン車で同じ実験をしたところ(どの単価でも6台)、単価200円の行は遅れ0件のまま総距離が351.2km と、ハードの328.6km より長い計画で止まりました。ソフトにすれば探索が良くなる、とは限らないので、ハードとソフトの両方で解き、遅れ0件の計画のうち安いほうを採るのが確実です。
表の単価100円の行にも注意が要ります。この行は3台で52分遅れ、固定費+走行費102,061円に罰金5,200円を足して107,261円です。ところが単価50円の行で見つかった遅れ0件の計画は、単価が100円でも103,824円のままなので、こちらのほうが安いはずです。単価100円の探索は、より良い計画を見逃しています。表を上から下へ読むと単価と遅れの関係が単調でないのはこのためで、この表は「単価ごとの最適解」ではなく「単価ごとに20秒で見つかった解」の一覧として読む必要があります。
そのうえで、単価を下げたときに何が起きるかは読み取れます。単価10円まで下げると、ソルバーは1件を113分遅らせてまで総距離を293.9km に縮めました。遅れ0件の3台の計画(330.4km)より36.5km 短く、走行費で2,191円安くなる代わりに、遅れの合計が133分になります。遅れ1分を10円と置くことは、「2時間近い遅れを1件出しても、2千円ほど安ければそれでよい」と宣言するのと同じです。罰金の単価は、このように計画の性格を丸ごと変えます。単価は顧客との約束の重さを表す経営の値として、営業や顧客窓口と合意して決めるものだと考えています。
全件を1時間枠にした設定(E)でも同じ実験をしました。こちらはどの単価でも4台のままで、3台の計画は見つかりませんでした。ハードに解いた4台・315.0km に対し、単価100円と50円では遅れ3件・合計8分(最大5分)で298.5km、単価20円では遅れ4件・34分で285.6km、単価10円では遅れ4件・66分で279.0km でした。合計8分の遅れを認めるだけで16.5km(走行費990円)短くなる、という結果は、狭い時間枠のわずかな遅れの許容が、距離を縮めるのに効くことを示しています。
時間指定サービスの費用を経営指標に翻訳する
この章の結果を、第1章で整理した経営指標(使用台数・総走行距離・1件あたり配送費・拘束時間)に置き換えます。費用の単価は第2章で紹介した架空の値なので、ここで示せるのは金額そのものではなく、どの指標がどれだけ動くかの形です。自社の単価に置き換えれば、同じ計算で自社の数字が出ます。
2トン車(積載で台数が決まる場合)では、全件を2時間枠にしても台数は6台のまま、総距離は時間指定なしの298.1km から328.6km へ30.5km 増え、費用の増加は1日1,222円、1件あたり約31円でした。これだけを見ると、時間指定を細かくする費用は小さく見えます。しかし拘束時間の合計は23.4時間から39.7時間へ16.3時間増え、1台あたり平均3.9時間から6.6時間になりました。増えた分の大半は待ちです。この待ちは、ドライバーの人件費や残業、第7章で扱う労働時間の上限に直接効きます。距離の費用だけで時間指定の費用を見積もると、最も大きい部分を見落とします。
4トン車(積載に余裕があり、時間枠が台数に効く場合)では、全件を2時間枠にしたときの費用は、ハードの探索が出した4台の計画なら時間指定なしより1日30,556円高く、ソフトの探索で見つかった3台の計画なら7,026円高い、という結果でした。同じ時間指定の費用が、探索の出来しだいで4倍以上違って見えます。時間指定の料金やオプションの設計、納品先との条件交渉の材料に使う数字は、1回解いた値ではなく、複数回・複数の方法で解いて確かめた値を使う必要があります。3台の計画で見れば、時間指定なしとの差7,026円を40件で割って、全件を2時間枠にする費用は1件あたり約176円です。
時間指定を緩める交渉の効き目も数字にできます。2トン車で全件2時間枠(D)から現行(B)の午前・午後・終日に戻すと、総距離は328.6km から296.5〜305.5km に、拘束時間の合計は39.7時間から23.8〜25.0時間に、最終帰着は17時35分から15時39分〜15時52分に戻ります。すべての納品先に一律に緩めてもらう必要はありません。この章の結果では、指定のある18件だけを2時間枠にした設定(C)は、全件を2時間枠にした設定(D)より総距離で27.3km、拘束時間で8.9時間少なく済んでいます。どの納品先の指定が費用を押し上げているかを突き止め、そこに絞って時間帯の幅を相談する、あるいは遅れを数分認めてもらう(ソフトな時間枠)ほうが、交渉の相手も手間も少なくて済むと考えています。
判断を誤ったときの損失の型は3つあります。1つ目は、距離だけを見て時間指定の拡大を受け入れ、拘束時間と残業が膨らむ型です。2つ目は、探索の打ち切りで出た「台数が1台増える」結果を真に受け、不要な車両やドライバーを手配する型です。この章の4トン車の例では、その差は1日23,713円でした。3つ目は、遅れの罰金の単価をシステムの既定値のまま使い、顧客との約束より距離の短さを優先した計画が毎日出てくる型です。いずれも、ソルバーの出力をそのまま結論にせず、揺れの幅・別の解き方・目的に入れていない指標を並べて確かめることで防げます。
この章の要点は3つです。第一に、時間枠を入れると配車は「何時にどこにいるか」を決める問題になり、待ち時間という距離に表れない無駄が生まれます。待ちは出発時刻をずらすだけでは消えず、ルートの組み方を変えないと減りません。第二に、時間指定の費用は、積載で台数が決まる車では待ちと拘束時間に、積載に余裕のある車では台数の階段として現れます。共通データでは、全件を2時間枠にすると2トン車の拘束時間の合計が16.3時間増え、4トン車では台数が3台から4台に増えたように見えました。第三に、その「4台」は探索の限界で、ソフトな時間枠で解き直すと遅れ0件の3台の計画が見つかりました。時間で打ち切る探索の結果は同じ条件でも揺れ、既知最良と比べるときも台数と距離の定義を確かめる必要があります。次の第6章では、この章で使った OR-Tools のルーティングソルバーの部品(次元・スラック・罰金つきの訪問省略)と、初期解・改善の方法・時間制限の選び方を詳しく扱います。
この章を深めたい方への参考書籍
『Pythonによる実務で役立つ最適化問題100+(3)配送計画・パッキング・スケジューリング』(久保幹雄、朝倉書店):版元の目次によると、配送計画問題の章に、容量制約付き・時間枠付きの配送計画問題と、時間枠付き配送計画問題に対するメタヒューリスティクスの設計方法の基本原理を扱う節があります。この章で扱った時間枠の入れ方と探索の工夫を、Python のコードを動かしながら確かめたい方に向いています。
『組合せ最適化 メタ戦略を中心として』(柳浦睦憲・茨木俊秀、朝倉書店):日本オペレーションズ・リサーチ学会の40周年を記念したシリーズ「経営科学のニューフロンティア」の1冊で、書名のとおりメタ戦略(メタヒューリスティクス)を中心に組合せ最適化を扱う本です。この章では誘導局所探索を時間で打ち切って使い、探索の出来しだいで台数の見え方が変わることを見ました。そうした近似解法がどういう考え方で作られているかを学ぶ入口として挙げました。
第6章 OR-Toolsのルーティングソルバーを使いこなす
第5章では、納品先ごとの時間指定を守る配車を扱い、時間指定を厳しくしたり緩めたりすると台数・距離・待ち時間がどう動くかを測りました。そこまでの章で使ってきた計算の道具は、Google が公開しているオープンソースの最適化ライブラリ OR-Tools のルーティングソルバーです。この章では道具そのものに焦点を移し、ルーティングソルバーがどういう部品で組み立てられているか、探索の設定を変えると結果がどう変わるか、どの問題には別の道具を使うべきかを、実行結果で確かめます。使う版は OR-Tools 9.15.6755 で、この記事の実行環境で確認したものです。
ルーティングソルバーは、数行のコードで配車の答えを返してくれる手軽さがある一方で、設定の意味を知らずに使うと「なぜか解が出ない」「毎回ちがう答えが出る」「思ったより悪い答えで止まっている」といった壁に当たります。この章の目的は、そうした壁の正体を知り、配車の担当者や情報システムの担当者が、計算結果を業務の判断に使ってよいかどうかを自分で見極められるようにすることです。
ルーティングソルバーは4つの部品でできている
OR-Tools は、公式ドキュメントが組合せ最適化のためのオープンソースのソフトウェアと説明しているライブラリで、ルーティング(配車)のほかに制約プログラミング、線形計画・混合整数計画、グラフのアルゴリズムなどの解き方を含んでいます。このうちルーティングソルバーは、配送計画問題に特化した部品の集まりです。第2章から第5章までのコードはすべてこの部品の組み合わせで書かれていて、組み合わせ方を理解すると、第7章以降で労働時間・車種・集荷配送・当日の再配車を足していくときにも同じ考え方で読めます。
部品は大きく4つに分けて考えると整理しやすくなります。1つ目はインデックスの対応で、納品先の番号(ノード)とソルバーの内部の番号(インデックス)を読み替える表です。2つ目はコールバックで、「地点 a から地点 b へ行くと、距離や時間がいくら増えるか」をソルバーに教える関数です。3つ目は次元(ディメンション)で、積載や時刻のように、ルートに沿って足し上げていく量を管理します。4つ目は探索の設定で、最初の解をどう作るか、それをどう改善するか、いつ止めるかを決めます。この章の後半で扱うペナルティつきの訪問の省略は、2つ目と3つ目の間に置かれる「制約をゆるめる部品」と見ることができます。
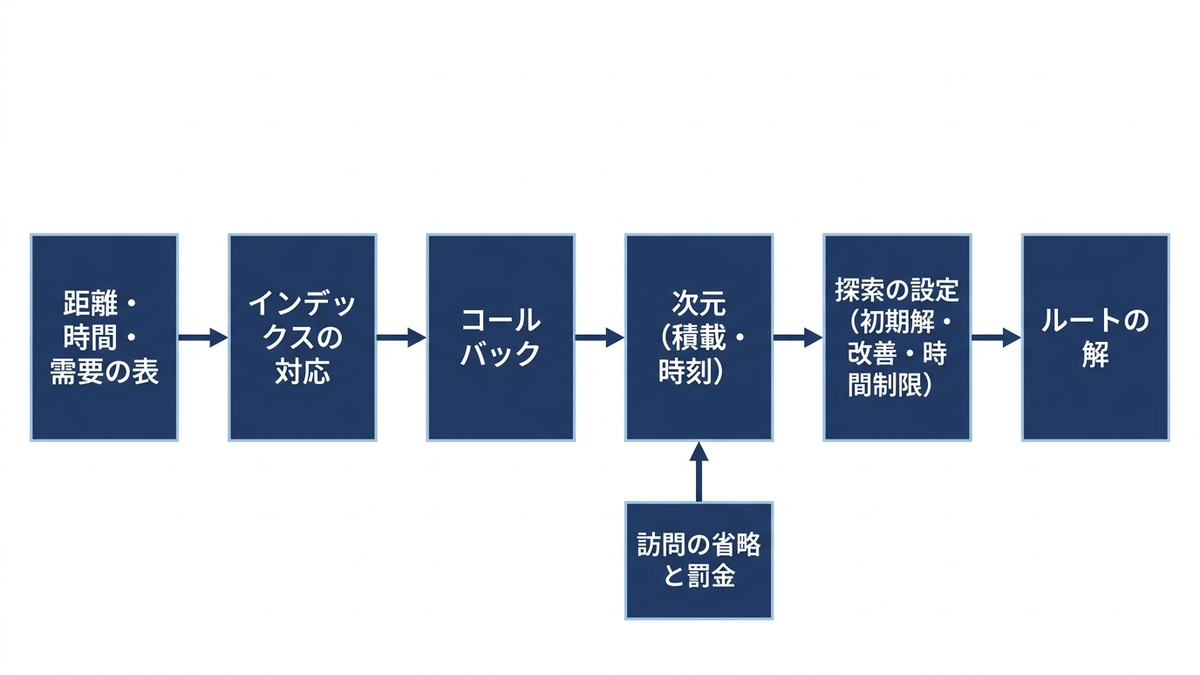
第2章で用意したサンプルデータ(40件の納品先、2トン車150ケース、時間指定あり)を、この4つの部品で書いたのが次のコードです。第2章で示した基準の結果と同じ設定(初期解は PATH_CHEAPEST_ARC、改善は誘導局所探索、車両の固定費は100km相当)で、時間制限だけを10秒にしています。
from ortools.constraint_solver import pywrapcp, routing_enums_pb2
from vrp_data import customers, points, dist_km, time_min, int_matrix, TRUCK_CAPACITY

cs = customers(); pts = points(cs); n, V = len(pts), 10
D = int_matrix(dist_km(pts), 1000)                        # 距離はメートルの整数
svc = [0] + [c["service"] for c in cs]
T = [[int(round(t)) + svc[i] for t in row] for i, row in enumerate(time_min(pts))]  # 移動+出発地の荷下ろし(分)
dem = [0] + [c["demand"] for c in cs]

man = pywrapcp.RoutingIndexManager(n, V, 0)               # ノード41・車10台・デポはノード0
r = pywrapcp.RoutingModel(man)
dist_cb = r.RegisterTransitCallback(lambda a, b: D[man.IndexToNode(a)][man.IndexToNode(b)])
r.SetArcCostEvaluatorOfAllVehicles(dist_cb)               # 費用=距離
r.SetFixedCostOfAllVehicles(100000)                       # 1台使うと100km相当の費用
dem_cb = r.RegisterUnaryTransitCallback(lambda a: dem[man.IndexToNode(a)])
r.AddDimensionWithVehicleCapacity(dem_cb, 0, [TRUCK_CAPACITY] * V, True, "Cap")
time_cb = r.RegisterTransitCallback(lambda a, b: T[man.IndexToNode(a)][man.IndexToNode(b)])
r.AddDimension(time_cb, 600, 600, False, "Time")          # 待ちの上限600分・18時まで・出発時刻は自由
td = r.GetDimensionOrDie("Time")
for i, c in enumerate(cs, start=1):
    td.CumulVar(man.NodeToIndex(i)).SetRange(*c["tw"])    # 時間枠(8時からの分)

p = pywrapcp.DefaultRoutingSearchParameters()
p.first_solution_strategy = routing_enums_pb2.FirstSolutionStrategy.PATH_CHEAPEST_ARC
p.local_search_metaheuristic = routing_enums_pb2.LocalSearchMetaheuristic.GUIDED_LOCAL_SEARCH
p.time_limit.seconds = 10                                 # 必ず時間制限を付ける
s = r.SolveWithParameters(p)
print("インデックス数", man.GetNumberOfIndices(), "状態", r.status())
used = [v for v in range(V) if not r.IsEnd(s.Value(r.NextVar(r.Start(v))))]
tot = 0
for v in used:
    i = r.Start(v)
    while not r.IsEnd(i):
        j = s.Value(r.NextVar(i)); tot += D[man.IndexToNode(i)][man.IndexToNode(j)]; i = j
print("使用台数", len(used), "総距離 %.1f km" % (tot / 1000))
# 出力: インデックス数 60 状態 1
# 出力: 使用台数 6 総距離 310.5 km
掲載したコードは、実行ログ(ch06_minimal.txt)を取ったスクリプトから、標準出力の文字コードを整える冒頭の2行だけを省いたものです。出力の「状態 1」は、公式ドキュメントの状態コードの表で「問題が解けた」(ROUTING_SUCCESS)を意味します。総距離310.5kmは、同じ設定で20秒回した基準の結果(6台・293.2km)より長くなっています。この章の後半で時間と品質の関係を曲線にして示すとおり、同じ設定でも打ち切る時点で総距離は大きく変わり、同じ20秒でも実行によって293.2kmに届いた回と309.1kmにとどまった回があります。
最初のつまずきは、番号の読み替えです。RoutingIndexManager(n, V, 0) は、デポを含む地点の数 n、車両の台数 V、デポの番号を受け取り、ソルバーの内部で使う番号の表を作ります。コードの出力にあるとおり、ノードが41(デポ1+納品先40)で車両10台のとき、インデックスは60個になりました。納品先の40個に、車両ごとの「出発」と「帰着」が10台ぶんずつ、計20個加わるからです。デポは1か所でも、ソルバーの中では車両ごとに別々の出発点と帰着点として扱われます。
小さな例で確かめると、ノード5(デポ+納品先4)・車両2台では、インデックスは8個で、納品先1〜4はインデックス1〜4、車1の出発はインデックス0、車2の出発はインデックス5、帰着は車1が6、車2が7でした。帰着のインデックスは、納品先と出発のインデックスの後ろにまとめて置かれます。サンプルデータ(ノード41・車両10台)でも同じ並びで、車1の出発は0、車10の出発は49、帰着は車1が50、車10が59でした(ch06_pitfalls.txt)。つまり「インデックス=ノード番号」が成り立つのは一部の番号だけで、成り立つかどうかは車両の台数やデポの置き方で変わります。
このため、距離や需要を返すコールバックの中では、受け取ったインデックスを必ず IndexToNode でノード番号に直してから、距離行列や需要の表を引きます。反対に、特定の納品先に時間枠を付けるときは NodeToIndex でノード番号をインデックスに直します。取り違えが見つけにくいのは、上の例のように納品先のインデックスがノード番号とたまたま同じになる場合が多いからです。デポをノード3に置いた例(ノード5・車両2台)でも、納品先のノード0・1・2・4のインデックスはそれぞれ0・1・2・4で、車2の出発(インデックス5)と帰着(6・7)だけがデポのノード3に対応していました(ch06_probe2.txt)。ずれるのは出発と帰着の番号で、サンプルデータでは41〜59番が、41行しかない距離行列に存在しない行を指します。実際にコールバックで IndexToNode を通さずに距離行列を引いてみると、解き始めた時点で Python の例外(SystemError)が出て止まりました(ch06_probe3.txt)。この形なら気づけますが、距離行列を車両ごとの出発地・帰着地の分まで大きく作っている場合などは、例外が出ないまま誤った距離を引く書き方も作れてしまいます。結果が「動くが、なぜか答えがおかしい」ときは、最初にここを疑うのが近道です。
コールバックと次元、足し上げる量をどう教えるか
コールバックは2種類あります。RegisterTransitCallback は「地点 a から b へ移るときに増える量」を返す関数で、距離や移動時間に使います。RegisterUnaryTransitCallback は「地点 a を訪れると増える量」を返す関数で、需要(積むケース数)のように行き先に関係なく決まる量に使います。どちらも登録すると整数の番号が返り、その番号を目的関数や次元に渡します。SetArcCostEvaluatorOfAllVehicles に距離のコールバックを渡すと、ソルバーはその合計を費用として最小化します。
次元は、ルートに沿って量を足し上げる仕組みです。公式ドキュメントは、次元が内部に2種類の変数を持つと説明しています。ルートの1歩ごとの増減(トランジット)と、各地点での累積値(キュムル)です。そのうえで、地点 i から j へ1歩進むとき、j の累積値から i の累積値と i から j へのトランジットを引いた残りを、i でのスラックと定義しています。式にすると \( \mathrm{slack}(i) = \mathrm{cumul}(j) – \mathrm{cumul}(i) – \mathrm{transit}(i, j) \) で、時刻の次元なら「着いた時刻の差のうち、移動と荷下ろしで説明できない残り」、つまり待ち時間です。積載の次元なら、累積値は「その地点に着くまでに回った納品先の需要の合計」です。上のコードのように RegisterUnaryTransitCallback で需要を返す書き方では、地点 i の需要は i から次の地点へ進むときに加わるので、i の累積値には i 自身の需要は入らず、帰着したときの累積値がそのルートの需要の総計になります。小さな例(需要10・20・30の3件を回る車1台)で確かめると、累積値は順に0・10・30で、帰着時に60でした(ch06_cap_cumul.txt)。累積値の上限を2トン車の150ケースにすれば、各車の需要の総計が150ケースを超えないという積載制約になります。配送の車が物理的に積んでいる残りの荷物の量とは別のものです。時刻の次元なら、累積値は「その地点に着いた時刻」で、各地点の累積値に範囲を付ければ時間枠になります。
AddDimension の引数は、コールバックの番号、スラックの上限、累積値の上限、出発時の累積値を0に固定するかどうか、次元の名前の5つです。公式ドキュメントによれば、スラックはその地点での待ち時間を表す変数で、時間枠がある問題では車両が時間枠の開始まで待つ必要があるため正の値を許す必要があり、積載のようにトランジットが需要と常に等しい量では0にしてよい、とされています。出発時の累積値を0に固定するかについては、多くの場合は固定してよいが、時間枠がある問題では時間枠のために時刻0より後に出発しなければならない車両があるので固定しない、と書かれています。上のコードの時刻の次元は、スラックの上限600分、累積値の上限600分(8時から18時まで)、出発時刻は固定しない、という設定です。
コールバックに渡す時間の行列は、移動時間に「出発する地点の荷下ろし時間」を足したものにしています。納品先 a で荷下ろしをしてから b へ向かうので、a を出る時刻は a に着いた時刻より荷下ろしの分だけ遅れます。この足し方は第5章と同じで、基準の結果とも同じです。到着する地点の荷下ろし時間を足す書き方にすると、時間枠が「荷下ろしを終える時刻」に対する制約に変わってしまうので、どちらの意味で時間枠を約束しているかを先に決めてから書きます。
スラックと出発時刻の設定は、待ち時間と拘束時間を変える
スラックの上限をどう置くかで、同じデータの解がどう変わるかを測りました。共通データの積載+時間指定の問題を、初期解 PATH_CHEAPEST_ARC、誘導局所探索10秒で、スラックの上限だけを変えて解いた結果です(ch06_settings.txt)。待ち時間の合計は、各地点で時間枠の開始を待った時間を全車両で足したもの、稼働時間の合計は各車両の出発から帰着までの時間を全車両で足したものです。
| 設定 | 使用台数 | 総距離(km) | 待ち時間の合計(分) | 稼働時間の合計(分) | 最も遅い帰着 |
|---|---|---|---|---|---|
| スラックの上限0分 | 6 | 329.4 | 0 | 1,480 | 16時02分 |
| スラックの上限10分 | 6 | 295.3 | 270 | 1,667 | 16時31分 |
| スラックの上限30分 | 6 | 293.6 | 612 | 2,004 | 16時31分 |
| スラックの上限60分 | 6 | 310.5 | 805 | 2,237 | 16時41分 |
| スラックの上限600分 | 6 | 310.5 | 845 | 2,277 | 16時41分 |
| 上限600分+稼働時間の係数10 | 6 | 328.2 | 75 | 1,553 | 16時04分 |
| 上限600分+稼働時間の係数100 | 6 | 313.2 | 34 | 1,472 | 16時31分 |
| 全車8時出発+稼働時間の係数10 | 6 | 292.7 | 878 | 2,270 | 16時31分 |
読み取れることは2つあります。1つ目は、スラックの上限を0にすると「どこでも待たない」ルートしか許されなくなり、総距離が329.4kmに延びたことです。待ってよい上限を10分・30分と少しでも与えると、総距離は300kmを切りました(60分以上では310.5kmで、次の段落で述べるとおり、この差には探索の止まり方の違いも混ざっています)。上限を0に置くのは、積載のような待ちの無い量の次元に限るべきで、時刻の次元で0にすると、到着が早すぎる順番がすべて禁止され、選べるルートが大きく狭まります。
2つ目は、この表の待ち時間と稼働時間の数字は、目的関数に入れない限りソルバーが気にかけていない数字だということです。スラックの上限600分の行では、待ち時間の合計が845分、稼働時間の合計が2,277分と出ていますが、ソルバーが最小化したのは距離と台数だけで、各車両が何時に出発するかは、時間枠を満たす範囲のどれかが選ばれているにすぎません。そこで SetSpanCostCoefficientForAllVehicles を使い、各車両の「帰着時刻から出発時刻を引いた時間」に係数を掛けて目的関数に足しました。係数10は「稼働時間1分を距離10メートルと同じ重さで数える」という意味です。係数10で待ち時間の合計は845分から75分に、稼働時間の合計は2,277分から1,553分に減りました。
ここで距離の列を比べるときは注意が要ります。係数10の行の距離(328.2km)は係数0の行(310.5km)より長く、係数100の行(313.2km)は係数10の行より短くなっていて、係数を大きくするほど距離が延びる、という単純な関係にはなっていません。誘導局所探索は、モデルが少し変わるだけで探索の道筋が変わり、10秒で打ち切った時点でたどり着いている解も変わります。この後の節で示すように、打ち切りの時点を変えただけで総距離は十数km動きます。表の距離の差のうち数km〜十数kmは、設定そのものの効果というより、探索がどこで止まったかの違いとして読むのが安全です。これに対して待ち時間と稼働時間の変化は数百分の単位で、探索の止まり方による差よりはっきり大きく、設定の効果として読めます。最後の行のように全車両の出発を8時に固定すると、9時からの時間枠を待つ時間が発生して、係数10を付けていても待ち時間は878分に戻りました。
経営の側から見ると、この設定は「ドライバーの拘束時間を費用として数えるか」という判断です。距離と台数だけを目的にした計画は、帳票上の稼働時間が長く出ても、ソルバーにとっては無関係です。拘束時間を管理指標にしている事業所では、稼働時間に係数を付けるか、第7章で扱う労働時間の制約として上限を入れる必要があります。係数の値は「稼働時間1分の人件費」と「1mの走行費」の比で決めるのが筋で、たとえば架空の値として、人件費を1分あたり40円、走行費を1kmあたり40円と置けば、1分=1kmとなり係数は1,000です。係数を実際の単価から逆算しておけば、結果の総費用をそのまま円で読めます。
訪問の省略を許す、AddDisjunctionと罰金の大きさ
配車の計算では、全件を回れる答えが存在しないことがあります。車両が故障して台数が足りない日、注文が積載の合計を超えた日、物理的に間に合わない時間指定が入った日などです。このときルーティングソルバーは、制約を満たす解を見つけられず、何も返しません。これを避けるのが AddDisjunction で、納品先のインデックスと罰金を渡すと、「その納品先を回らなくてもよい。ただし回らなければ罰金を費用に足す」という扱いになります。公式ドキュメントは、制約のために解が無い問題で、どの訪問を落とすかを決める方法として、落とした地点の罰金を総距離に足し、その合計を最小にする考え方を説明しています。
サンプルデータで、車両を5台に減らしました。2トン車5台の積載の合計は750ケースで、総ケース868に118ケース足りません。訪問の省略を許さずに解くと、10秒の時間制限いっぱい探したうえで解なしとなり、状態コードは4(時間制限までに解が見つからなかった、ROUTING_FAIL_TIMEOUT)でした。解が存在しないことを証明したのではなく、見つからないまま時間切れになった、という返り方です。そこで全納品先に同じ罰金を付けて解き直し、罰金の大きさを変えました。
| 車両の上限 | 罰金(1件あたり、距離換算) | 使用台数 | 総距離(km) | 省略した件数 | 省略したケース |
|---|---|---|---|---|---|
| 5台 | 10km | 0 | 0.0 | 40 | 868 |
| 5台 | 30km | 3 | 164.0 | 12 | 428 |
| 5台 | 100km | 5 | 253.6 | 4 | 136 |
| 5台 | 1,000km | 5 | 255.3 | 4 | 143 |
| 10台 | 20km | 0 | 0.0 | 40 | 868 |
| 10台 | 50km | 6 | 314.4 | 0 | 0 |
| 10台 | 200km | 6 | 316.4 | 0 | 0 |
罰金が10kmの行では、ソルバーは1台も出さず、40件すべてを省略しました。計算の誤りではありません。このモデルでは車両1台に100km相当の固定費を付けているので、1台出して数件を回るより、罰金10kmを払って回らないほうが安い、という計算になるためです。車両を10台まで許した場合でも、罰金20kmでは全件省略になりました。40件の罰金の合計は800km相当で、6台出して約310km走る費用(固定費600km相当+距離)より小さいからです。罰金を50kmに上げると、全件を回る解に戻りました。罰金は、固定費や距離と同じ物差しで「1件を届けないことの損失」を表す数字なので、ほかの費用と桁を合わせて置かないと、ソルバーは平然と配送そのものを放棄します。
罰金を100km・1,000kmと十分大きくすると、省略は4件になりました。ただし、どの4件が落ちるかには注意が要ります。全件に同じ罰金を付けると、ソルバーが減らそうとするのは「省略した件数」で、「届かなかったケース数」ではありません。そこで同じ5台の条件で、罰金をケース数に比例させる置き方を試しました(ch06_disj2.txt)。
| 罰金の置き方 | 総距離(km) | 省略した件数 | 省略したケース | 配送できたケース |
|---|---|---|---|---|
| 1件一律 1,000km相当 | 255.8 | 4 | 137 | 731 |
| 1ケースあたり 10km相当 | 280.1 | 5 | 120 | 748 |
| 1ケースあたり 3km相当 | 276.4 | 12 | 123 | 745 |
積載の合計から計算すると、省略しなければならないケース数の下限は118です。1件一律の罰金では、24〜40ケースの納品先が4件落ち、届かなかったのは137ケースでした(1つ前の表の1,000kmの行とは別の実行で、落ちた納品先の組み合わせと距離が少し違います)。1ケースあたり10kmの罰金では、省略は5件・120ケースで、下限の118ケースに近づきました。1ケースあたり3kmまで下げると、届かなかったケースは123とほぼ同じでも、省略は5〜16ケースの小口の納品先12件に広がりました。ケース比例の罰金では小口の納品先ほど罰金が小さく(5ケースなら15km相当)、そこへ寄るための距離のほうが高くつく納品先は、回らないほうが費用が小さいと計算されます。
どれが正しいかは、事業の約束で決まります。「1件でも多くの取引先に届ける」なら件数を減らす一律の罰金、「1ケースでも多く届ける」ならケース比例の罰金、「この取引先は絶対に落とせない」なら、その納品先だけ省略を許さない(AddDisjunction を付けない)か、桁違いの罰金を置きます。罰金の置き方は、欠品や翌日回しを誰に負担してもらうかという営業上の判断をソルバーに渡す窓口であり、配車担当者だけで決めてよい数字ではないと考えています。
初期解の戦略を比べる
ルーティングソルバーの探索は2段階です。まず初期解の戦略(first_solution_strategy)で、制約を満たす最初のルートを1つ作ります。次に改善の方法(local_search_metaheuristic)で、そのルートを少しずつ組み替えて費用を下げていきます。公式ドキュメントの一覧には、初期解の戦略として、デポから出て一番近い地点へ順につないでいく PATH_CHEAPEST_ARC、クラークとライトのセービング法による SAVINGS、レンとホリデーのスイープ法による SWEEP、クリストフィデスの方法の変種である CHRISTOFIDES、最も安い位置へ1件ずつ挿入していく挿入法の系統などが並んでいます。セービング法とスイープ法の中身は第4章で扱いました。
サンプルデータで、初期解だけを作って止めた場合(探索の上限を解1つにした場合)の結果を、戦略ごとに並べました(ch06_first.txt)。計算時間はどれも0.1秒未満で、差はありません。
| 初期解の戦略 | 積載のみ 台数 | 積載のみ 総距離(km) | 積載+時間指定 台数 | 積載+時間指定 総距離(km) |
|---|---|---|---|---|
| PATH_CHEAPEST_ARC | 6 | 324.2 | 7 | 395.0 |
| SAVINGS | 6 | 336.2 | 7 | 346.3 |
| PARALLEL_SAVINGS | 7 | 308.4 | 7 | 307.7 |
| CHRISTOFIDES | 6 | 321.4 | 6 | 340.3 |
| PARALLEL_CHEAPEST_INSERTION | 6 | 340.9 | 6 | 362.2 |
| LOCAL_CHEAPEST_INSERTION | 6 | 446.5 | 6 | 479.0 |
| GLOBAL_CHEAPEST_ARC | 7 | 334.0 | 7 | 341.2 |
| LOCAL_CHEAPEST_ARC | 8 | 397.6 | 8 | 423.2 |
| FIRST_UNBOUND_MIN_VALUE | 6 | 761.2 | 解なし | 解なし |
| SWEEP | 解なし | 解なし | 解なし | 解なし |
| BEST_INSERTION | 解なし | 解なし | 解なし | 解なし |
AUTOMATIC と PATH_MOST_CONSTRAINED_ARC は、どちらの問題でも PATH_CHEAPEST_ARC と同じ台数・距離になったので表から省きました。SEQUENTIAL_CHEAPEST_INSERTION は PARALLEL_CHEAPEST_INSERTION と、LOCAL_CHEAPEST_COST_INSERTION は LOCAL_CHEAPEST_INSERTION と同じ結果でした。初期解だけを比べると、戦略によって台数が6〜8台、距離が300km台から700km台まで開きます。時間指定を加えると、PATH_CHEAPEST_ARC は7台・395.0kmまで悪くなり、6台で済む初期解を作れたのは CHRISTOFIDES と挿入法の系統だけでした。
「解なし」の3つは、理由がそれぞれ違います。SWEEP は状態コード5(モデルや設定が不正、ROUTING_INVALID)で、実行ログには「スイープのための配置(sweep arranger)が定義されていない」という趣旨のエラーが出ました。スイープ法は地点をデポから見た角度で並べる方法で、エラーの文面から、そのための配置をモデルに設定しないとこの戦略は使えないことが分かります。BEST_INSERTION は状態コード3(解が見つからない、ROUTING_FAIL)で、公式ドキュメントには、この戦略は省略可能な地点(罰金つきの AddDisjunction を付けた地点)のあるモデルでしか動かない、と書かれています。FIRST_UNBOUND_MIN_VALUE は時間指定つきの問題で30秒の上限まで探して見つからず、状態コード4(時間切れ)でした。どれも例外は出ず、解が空で返るだけなので、状態コードを確かめずに結果を読もうとすると、原因の分からない不具合に見えます。
初期解の良し悪しが最終結果にどこまで残るかを見るため、時間指定つきの問題で、6つの戦略それぞれから誘導局所探索を10秒回しました。
| 初期解の戦略 | 初期解の総距離(km) | 誘導局所探索10秒後の台数 | 誘導局所探索10秒後の総距離(km) |
|---|---|---|---|
| PATH_CHEAPEST_ARC | 395.0(7台) | 6 | 309.1 |
| SAVINGS | 346.3(7台) | 6 | 297.2 |
| PARALLEL_CHEAPEST_INSERTION | 362.2(6台) | 6 | 297.8 |
| LOCAL_CHEAPEST_INSERTION | 479.0(6台) | 6 | 297.8 |
| GLOBAL_CHEAPEST_ARC | 341.2(7台) | 6 | 306.5 |
| CHRISTOFIDES | 340.3(6台) | 6 | 304.1 |
10秒の改善のあとでは、どの戦略から始めても6台になり、総距離は297.2〜309.1kmの範囲に収まりました。初期解で最も距離の長かった LOCAL_CHEAPEST_INSERTION(479.0km)が、改善後は297.8kmと SAVINGS に次ぐ短さになり、初期解の距離の順位は改善後の順位を予言しません。一方で、同じ10秒でも初期解によって最終結果に12km近い差がつきました(PATH_CHEAPEST_ARC の309.1kmと、最初に掲載したコードの出力310.5kmは同じ設定の別の実行で、差は打ち切りの時点のずれによるものと考えています。これは後の節で扱います)。短い時間で打ち切る運用では、初期解の戦略が結果に効きます。この実験では基準の結果に使った PATH_CHEAPEST_ARC が10秒後の距離で最も長く、SAVINGS と挿入法の系統が短くなりました。ただしこれはこのデータと10秒という条件での1回の結果で、一般則ではありません。自社のデータで使うときは、主な戦略を数個、本番と同じ時間制限で試して選ぶのが確実です。
改善の方法を比べる、誘導局所探索・焼きなまし・タブー探索
初期解を組み替えて費用を下げる段階では、ルートの一部を入れ替える・区間を反転する・納品先を別の車両へ移すといった小さな変更(近傍)を次々に試します。費用が下がる変更だけを受け入れていくと、どの小さな変更でも改善しない解(局所最適解)で止まります。そこから抜け出す工夫がメタヒューリスティクスで、ルーティングソルバーには、改善しなくなったら止まる GREEDY_DESCENT(貪欲な降下)のほかに、誘導局所探索(GUIDED_LOCAL_SEARCH)、焼きなまし(SIMULATED_ANNEALING)、タブー探索(TABU_SEARCH)、目的関数の値に対するタブー探索(GENERIC_TABU_SEARCH)が用意されています。
考え方を一言ずつ補います。誘導局所探索は、ボードリスとツァン(Voudouris と Tsang)が巡回セールスマン問題への適用を1999年に論文にまとめた方法で、その解説(ハンドブックの章の要旨)によれば、罰則(ペナルティ)を使って局所的な改善の手続きに働きかけ、局所最適から抜け出せるようにする仕組みです。焼きなましは、カークパトリックらが1983年に、固体の焼きなまし(高温からゆっくり冷やす操作)との対応として示した方法です。改善しない変更もある程度受け入れ、その許容の度合いを単調に絞っていく、という制御の仕方が特徴です。タブー探索は、グローバーが1989年と1990年の2部構成の論文で体系化した方法で、直前の探索の記憶(短期記憶)を使って一部の動きを一時的に禁止(タブー)にしながら、局所最適の限界を越えて探索を導きます。公式ドキュメントは、誘導局所探索が配送計画では一般に最も効率のよいメタヒューリスティクスであるとしています。また、誘導局所探索などのメタヒューリスティクスを使うときは時間制限を設定する必要があり、設定しないと探索が終わらない、と注記しています。探索の上限(時間・解の数)の既定値はどちらも整数の最大値なので、上限を付けずに実行すると、実質的に止まりません。
2つの問題で5つの方法を比べました。1つはサンプルデータの積載+時間指定の問題、もう1つは公開ベンチマーク CVRPLIB の E-n51-k5(納品先50件、積載160、車両5台、既知最良521。既知最良は公開されている解の値で、この例では最適値です)です。初期解はどちらも PATH_CHEAPEST_ARC、時間制限は各30秒で、全体を2回実行しました(ch06_meta.txt・ch06_meta_run2.txt)。
| 改善の方法 | サンプルデータ 総距離(km)1回目 | サンプルデータ 総距離(km)2回目 | E-n51-k5 総距離 1回目 | E-n51-k5 総距離 2回目 | 探索を終えた時刻(秒)1回目 |
|---|---|---|---|---|---|
| GREEDY_DESCENT | 333.4 | 333.4 | 625(+20.0%) | 625(+20.0%) | 0.3・0.2 |
| GUIDED_LOCAL_SEARCH | 304.0 | 308.2 | 548(+5.2%) | 541(+3.8%) | 30.0・30.0 |
| SIMULATED_ANNEALING | 315.3 | 315.3 | 625(+20.0%) | 625(+20.0%) | 30.0・30.0 |
| TABU_SEARCH | 321.8 | 321.8 | 565(+8.4%) | 565(+8.4%) | 3.8・7.2 |
| GENERIC_TABU_SEARCH | 333.4 | 333.4 | 625(+20.0%) | 625(+20.0%) | 30.0・30.1 |
サンプルデータはどの方法でも6台で、差は距離に出ています。E-n51-k5 のかっこ内は既知最良との差で、最後の列はサンプルデータ・E-n51-k5 の順に、探索が終わった時刻を1回目の実行で示しています。どちらの問題でも誘導局所探索が最も短く、既知最良との差は30秒で3.8〜5.2%でした(E-n51-k5 は車両の上限を5台ちょうどにした条件です。上限を変えると結果が変わることを、後の節で示します)。焼きなましと目的関数値のタブー探索は、E-n51-k5 では30秒回しても貪欲な降下と同じ625から改善しませんでした。タブー探索は、どちらの問題でも30秒の上限より前(3〜7秒)に自分から探索を終え、改善の途中で止まっています。なぜこの時点で終わるのかは、公式ドキュメントの記述からは確認できませんでした。確かめられたのは「時間制限を30秒にしても30秒使うとは限らない」という挙動です。
この結果は、公式ドキュメントの「誘導局所探索が一般に最も効率がよい」という記述と整合します。ただし、2つの問題・30秒・初期解1種類での比較なので、焼きなましやタブー探索が劣る方法だという意味ではありません。焼きなましの温度の下げ方のように、方法ごとに調整できる設定があり、今回は既定のまま使っています。実務で最初に選ぶなら誘導局所探索、というところまでが、この実験から言えることです。
時間制限と品質の曲線、実行ごとの揺れ
改善の方法を選んだら、次に決めるのは「何秒回すか」です。探索の途中で解が更新されるたびに経過時間と総距離を記録し(AddAtSolutionCallback で、解が見つかるたびに呼ばれる関数を登録できます)、その時点までの最良の総距離を描いたのが次の図です。横軸は経過時間を対数目盛で、左はサンプルデータ(6台の解だけを描いています)、右は E-n51-k5 です。
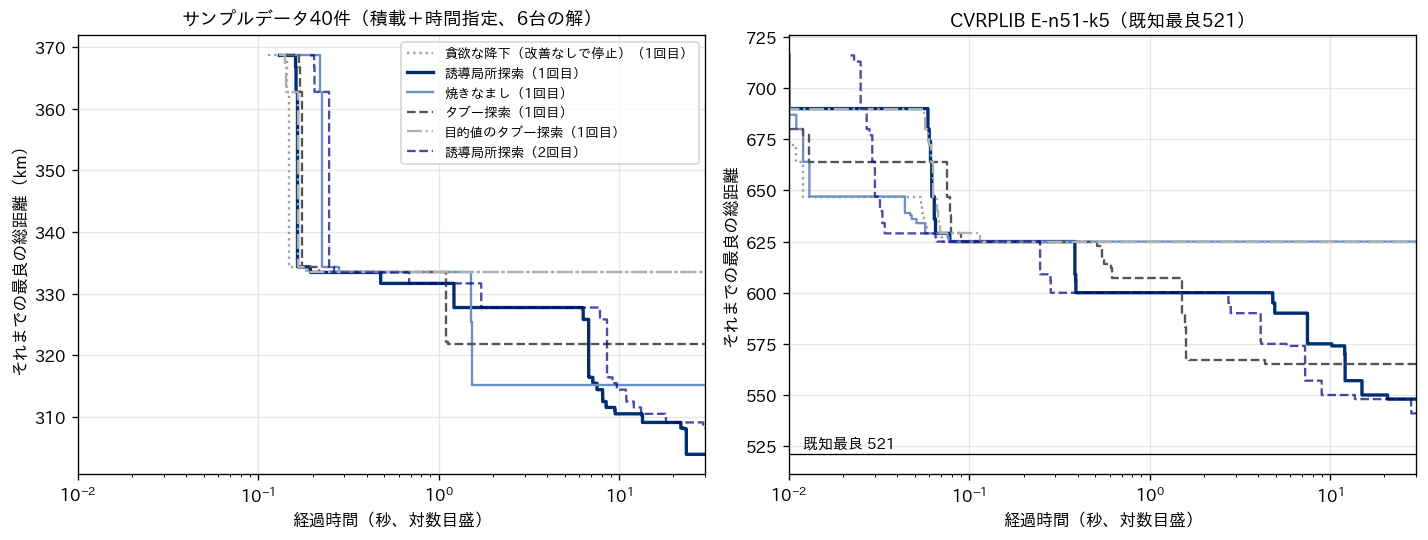
誘導局所探索の「それまでの最良」を、時点ごとに2回の実行で並べると次のとおりです(サンプルデータは km)。
| 経過時間 | サンプルデータ 1回目 | サンプルデータ 2回目 | E-n51-k5 1回目 | E-n51-k5 2回目 |
|---|---|---|---|---|
| 1秒 | 331.7 | 331.7 | 600(+15.2%) | 600(+15.2%) |
| 2秒 | 327.8 | 327.8 | 600(+15.2%) | 600(+15.2%) |
| 5秒 | 327.8 | 327.8 | 590(+13.2%) | 575(+10.4%) |
| 10秒 | 310.5 | 314.4 | 575(+10.4%) | 550(+5.6%) |
| 20秒 | 309.1 | 309.1 | 550(+5.6%) | 548(+5.2%) |
| 30秒 | 304.0 | 308.2 | 548(+5.2%) | 541(+3.8%) |
曲線は階段状で、しばらく平らになってから急に下がる区間を繰り返します。サンプルデータでは2秒から5秒まで327.8kmで止まり、5秒から10秒の間に17km以上下がりました。この形は、時間制限を「何秒で十分か」と一律に決めにくいことを示しています。5秒で打ち切れば327.8km、10秒なら310〜314km、30秒なら304〜308kmで、この範囲では時間を延ばすほど良くなる一方、延ばした分の改善がいつ来るかは読めません。比較のために、時間ではなく解の数で打ち切る設定(誘導局所探索で解3,000個)を3回回したところ、3回とも296.5kmで、かかった時間は59.5秒・62.7秒・69.0秒でした(ch06_pitfalls.txt)。このデータでは1分前後回すと300kmを切る水準に入ります。なお、第2章で示した基準の結果(同じモデル・同じ探索の設定で20秒、293.2km)は、この表の20秒時点(309.1km)より短く、解の数3,000で打ち切った296.5kmよりも短い値です。モデルと探索の設定は同じで、確かめられた違いは、この表の実行が解の更新を記録する関数(AddAtSolutionCallback)を登録していたことと、実行した時刻が違うこと(それぞれの時点でほかの章の計算がどれだけ並行していたかは記録していません)です。記録用の関数を登録していない解の数3,000の実行でも296.5kmだったので、記録用の関数だけでは説明がつきません。この差の原因は切り分けておらず、確定していません。基準の結果も時間で打ち切った1回の実行の値で、最適であることは証明されていません。
E-n51-k5 では、既知最良との差が10秒で5.6〜10.4%、30秒で3.8〜5.2%でした。規模がさらに大きい問題での時間と品質の関係は、第10章で X 系列のベンチマークを使って扱います。
上の表では、同じ設定の2回の実行で、30秒後の距離が1回目304.0km、2回目308.2kmと違いました。E-n51-k5 でも548と541です。この実験の範囲では、揺れは乱数から来ているようには見えません。同じ設定で時間制限5秒を5回続けて回したときは、5回とも327.8kmで完全に一致しました。解の数3,000で打ち切った3回も296.5kmで一致しています。探索そのものは同じ道筋をたどっており、違うのは「決まった秒数のあいだに、道筋のどこまで進めたか」です。
実際、30秒のあいだに解が更新された回数は、サンプルデータの誘導局所探索で1回目1,689回、2回目1,265回で、同じ30秒でこなせた探索の量が2回目は1回目の4分の3ほどでした。この記事の実行は、ほかの章の計算と同じPCで並行して動いていたので、そのときどきの負荷の差が表れたものと考えています。道筋の途中にある「急に下がる段」を時間内に越えたかどうかで、最終結果が数km違ってきます。同じことは、配車システムを本番で動かすときにも起こりえます。朝の配車計算をほかの処理と同じサーバーで動かしていると、日によってこなせる計算量が変わり、同じ注文でも別のルートが出ることがあります。
対策は2つです。1つは、解の数(solution_limit)で打ち切ることです。結果は再現しますが、計算時間が負荷で延びます(上の3回では59.5〜69.0秒)。朝の締切が厳しい運用では、解の数と時間の両方に上限を付け、先に来たほうで止めるのが現実的です。もう1つは、結果が揺れる前提で、揺れの幅を経営指標で把握しておくことです。サンプルデータで30秒の揺れは約4km、1日の総距離の1.4%程度でした。この幅が、配車計画の見直しで狙っている改善幅より小さいかどうかを確かめておけば、「今日の計算結果が昨日より悪い」ことに一喜一憂せずに済みます。ドライバーにとっては、毎日ルートが変わること自体が負担になるので、前日のルートとの差を目的に入れる考え方を第11章で扱います。
つまずきやすい点、整数化・単位・到達不能
ルーティングソルバーで結果がおかしいとき、原因の多くはソルバーの能力ではなく、データの渡し方にあります。よく当たるものを3つ、実行結果とあわせて示します(ch06_pitfalls.txt)。
1つ目は整数化です。公式ドキュメントは、ルーティングソルバーはすべての計算を整数で行うので、距離のコールバックは整数を返す必要があり、行列が整数でなければ丸める必要がある、と注記しています。問題は丸める単位です。サンプルデータの道路距離を km 単位で整数に丸めると、近い納品先どうしの距離が0になる区間が2つ生まれました。積載のみの問題を誘導局所探索10秒で解くと、ソルバーが見ている総距離は297.0kmでしたが、同じルートを丸める前の距離で測り直すと298.7kmでした。100m単位とm単位で丸めた場合は、どちらもソルバーの見た距離と実際の距離が298.1kmで一致し、km 単位で丸めた解より0.6km短いルートが選ばれています。1区間あたり最大0.5kmの丸め誤差が、区間の数だけ積み重なり、ソルバーは実際には長いルートを短いと誤認します。距離はm単位、時間は分より秒を単位にして整数にするのが安全です。
時間の行列は、この記事では分の整数に丸めています。移動時間を分に丸めると1区間あたり最大30秒の誤差が生じ、10件回るルートなら数分ずれうることになります。時間枠が1時間単位の約束であれば問題になりにくい一方、到着時刻を分単位で約束する業務では秒の単位で持つほうが安全です。単位をそろえることも重要で、距離をm、時間を分、積載をケースで持つなら、固定費や罰金や稼働時間の係数も「m換算でいくらか」を決めてから置きます。前の節の罰金の実験で見たとおり、桁を1つ間違えると、ソルバーは配送そのものを放棄する解を平然と返します。
2つ目は到達不能です。デポから最も遠い納品先 C39(道路距離23.2km、移動55.8分)に、8時から8時30分までに着けという時間枠を付けました。デポを8時に出ても間に合わない、物理的に守れない約束です。そのまま解くと、10秒の時間制限いっぱい探したうえで解なし(状態コード4、時間切れ)になりました。「解が無いことを証明した」ではなく「見つからないまま時間が来た」という返り方です。問題そのものに解が無いので、時間制限を延ばしても、計算を待つ時間が延びるだけです。一方、C01 の注文を2トン車の積載を超える160ケースにした場合は、0.00秒で解なし(状態コード6、実行不可能と証明された)になりました。積載のような単純な矛盾はすぐに検出される一方、時間枠の矛盾は探索してみないと分からず、時間切れの形で返ってくることがあります。
到達不能の原因を探すのに役立つのが、前の節の AddDisjunction です。全納品先に大きな罰金(1,000km相当)を付けて解き直すと、6台・270.8kmの解が状態コード1(成功)で返り、省略された納品先は C39 の1件だけでした。どの約束が守れないのかを、ソルバー自身に指し示させたことになります。本番の配車システムでは、全件に大きな罰金を付けた設定を標準にしておき、省略が出たら配車担当者に知らせる作りにすると、「計算が返ってこない朝」を避けられます。
3つ目は、Python のコールバックの速さです。距離を返す関数を Python で書くと、ソルバーは距離が必要になるたびに Python の関数を呼び出します。OR-Tools 9.15 の RoutingModel には、行列をそのまま登録する RegisterTransitMatrix があり、同じ積載のみの問題を誘導局所探索10秒で解いたところ、10秒のあいだに解が更新された回数は、コールバックで808回、行列の登録で1,390回と、行列のほうが約1.7倍多くなりました。目的関数の値は、コールバックが898,097、行列が896,225です。行列で表せる量は行列で登録し、Python の関数は、時間帯によって所要時間が変わるといった行列にできない場合に使うのがよいと考えています。
小さな問題でMIP・CP-SATと比べる、どの道具をいつ使うか
ルーティングソルバーの状態コードには「最適に解けた」を表す値(ROUTING_OPTIMAL、7)も用意されていますが、この章のように誘導局所探索を時間制限で打ち切る使い方では、返ってきた解が最適とは限りません。状態コード1(ROUTING_SUCCESS)は解が見つかったことを表すだけで、最適であることの証明ではありません。最適であることを証明できる道具として、混合整数計画(MIP。変数の一部を整数に限った線形の最適化)のソルバーと、OR-Tools に同梱の制約プログラミングのソルバー CP-SAT があります。3つを同じ問題で比べるため、サンプルデータの先頭から n 件だけを取り出した小さな問題(時間指定なし、2トン車150ケース、台数は自由、目的は「固定費100km相当×台数+総距離」)を作り、件数を6件から30件まで増やしました(ch06_exact.txt)。
MIP は PuLP 3.3.2 と同梱の CBC で、車両ごとの区別を持たない2添字の定式化に、積載の順序で部分巡回(デポを通らない小さな輪)を防ぐ制約(MTZ 型と呼ばれる形)を足して、上限60秒で解きました。部分巡回を禁じる制約の書き方と強さの違いは、弊社コラム「数理最適化の定式化パターン集」の第12章で扱っているので、ここでは重ねません。CP-SAT は、複数の巡回を1つの制約で表す add_multiple_circuit に、積載の順序の制約を足し、並列の作業数 num_workers=8、上限60秒としました。ルーティングソルバーは、PATH_CHEAPEST_ARC から誘導局所探索5秒です。
| 納品先の件数 | MIP(CBC)の結果 | MIP(CBC)の時間(秒) | CP-SAT の結果 | CP-SAT の時間(秒) | ルーティング5秒の結果 |
|---|---|---|---|---|---|
| 6 | 2台 110.1km(最適を証明) | 4.6 | 2台 110.1km(最適を証明) | 0.2 | 2台 110.1km |
| 8 | 2台 113.8km(時間切れ) | 60.8 | 2台 113.8km(最適を証明) | 0.5 | 2台 113.8km |
| 10 | 2台 131.8km(時間切れ) | 61.2 | 2台 123.8km(最適を証明) | 0.2 | 2台 123.8km |
| 12 | 2台 150.8km(時間切れ) | 61.0 | 2台 143.7km(最適を証明) | 1.7 | 2台 143.7km |
| 15 | 3台 170.3km(時間切れ) | 66.5 | 3台 140.4km(最適を証明) | 0.3 | 3台 140.4km |
| 20 | 4台 243.4km(時間切れ) | 60.1 | 4台 179.7km(最適を証明) | 1.1 | 4台 179.7km |
| 25 | 5台 337.0km(時間切れ) | 60.4 | 4台 207.4km(最適を証明) | 53.5 | 4台 211.6km |
| 30 | 6台 347.9km(時間切れ) | 59.0 | 5台 235.3km(時間切れ、下界との差0.73%) | 60.1 | 5台 235.1km |
時間はこの記事の実行環境(一般的なノートPC)での実測で、ほかの章の計算と並行して動かしています。「時間切れ」は、上限60秒までに最適であることを証明できずに止まり、その時点の最良の解を返したことを意味します。納品先10件の MIP を上限10秒で解き直して確かめたところ、PuLP の LpStatus は時間切れでも「Optimal」と表示し、解の状態を表す sol_status のほうは「Solution Found」(解はあるが最適とは限らない)と表示しました(ch06_pulp_status.txt)。表の最適性は sol_status で見分けています。
この定式化の MIP は、6件でしか最適を証明できず、8件以上では60秒で打ち切られ、10件以上では返した解そのものが最適値より悪くなりました。20件では同じ4台でも243.4km(最適は179.7km)、25件と30件では台数も1台多い解です。これはこの素朴な定式化と CBC の組み合わせでの結果で、MIP という方法一般の限界を示すものではありません。部分巡回を禁じる制約の書き方と、必要な制約だけを後から足していく解き方は、前記の弊社コラムの第12章で扱っています。一方、CP-SAT は20件まで2秒以内に最適を証明し、25件では53.5秒かかり、30件では60秒で証明に届かず、下界との差0.73%の解で止まりました。下界とは、ソルバーが「目的の値(ここでは固定費100km相当×台数+総距離)はこれより小さくならない」と証明できた値のことです。下界との差0.73%は、見つけた解の目的の値と下界の差を解の目的の値で割ったもので、最適値がまだ分からなくても、この解が最適より悪いとしてもその差は0.73%以内に収まる、という保証を表します(ch06_exact.txt の30件の行)。
ルーティングソルバーは、5秒の探索で20件までは CP-SAT が証明した最適値とまったく同じ値を出しました。25件では最適値より4.2km(目的関数で0.7%)長い解でしたが、30件では60秒回した CP-SAT よりわずかに良い解(235.1km)を5秒で出しています。証明はできないものの、実務の規模で良い解を速く出すことにかけては、ルーティングソルバーが最も安定していました。
ここから、道具の使い分けを次のように整理しています。
| 道具 | 得意なこと | 向いている場面 | 向かない場面 |
|---|---|---|---|
| ルーティングソルバー(誘導局所探索) | 数十件以上の配車で、決まった時間内に良い解を出す(さらに大きな規模は第10章)。時間枠・積載・訪問の省略などの部品がそろっている | 毎日の配車計画、当日の再計算、実務の規模の試算 | 最適であることの証明が要る場面。配車の型に収まらない独自の制約が中心の問題 |
| CP-SAT | 数十件までの配車で最適を証明する。「この区間を通るなら積載の条件を課す」のような条件つきの制約も書ける | ルーティングソルバーの解の品質の検証、小さな問題の厳密解、複雑な業務ルールの試作 | 数十件を超える毎日の配車(今回は30件で60秒以内に証明できなかった) |
| MIP(PuLP+CBC) | 線形の式で書ける問題を汎用に解く。拠点の配置や車種構成のような、ルートより上の段の意思決定 | 配送エリアの割り当て、車種の台数の決定、計画の上位の問題 | ルートそのものの決定(今回の定式化では8件で証明が止まった) |
実務では、ルーティングソルバーを主に使い、導入の初期や設定を変えたときに、小さく切り出した問題で CP-SAT の最適値と比べて、ルーティングソルバーの解がどれくらい最適に近いかを確かめる、という組み合わせが有効だと考えています。今回の比較のように20件程度の部分問題で差が0%なら、実務の規模でも設定の誤りによる大きな取りこぼしは少ないと判断する材料になります。
なお、E-n51-k5 の誘導局所探索30秒は、第4章では既知最良の521に届いており、この章の548・541と食い違って見えます。設定を突き合わせると、初期解(PATH_CHEAPEST_ARC)・改善の方法・固定費なし・距離の計算は同じで、違いは車両の上限でした。第4章は必要台数5台に3台を足した8台を上限にし、この章は5台ちょうどにしていました。そこで、上の表とは別に、E-n51-k5 だけを取り出して車両の上限5台と8台を30秒ずつ2回回す追加の実験を行いました(ch06_e51_vehicles.txt)。この追加の実験では、上限5台は2回とも548、上限8台は2回とも521(使った車両はどちらも5台)で、30秒間の解の更新回数は5台の713回・782回に対し8台では1,788回・1,854回でした。上限5台の結果は、上の表(ch06_meta.txt・ch06_meta_run2.txt の2回、548と541)とは別の実行で、上の表の2回目の541はこの追加の実験では出ませんでした。同じ設定でも、決まった秒数のあいだに探索がどこまで進むかで結果が揺れることは、前の節で見たとおりです。上限5台では4回の実行が548・541・548・548、上限8台では2回とも521で、揺れの幅を含めても8台のほうが良い解に届いています。車両の上限が探索の内部でどう効いているのかまでは切り分けていません。確かめられたのは、このベンチマークでは、車両の上限を必要台数ちょうどにするより余裕を持たせたほうが、同じ30秒で良い解に届いたという事実です。台数を抑えたい場合は、上限で縛るより、上限に余裕を持たせたうえで固定費で台数を抑える置き方を、自社のデータでも試す価値があります。
経営の側から見る、設定値は業務の約束である
この章で扱った設定は、どれも技術的な調整値に見えますが、中身は業務の約束です。時間制限は「配車計算にいつまでに答えを出すか」という締切、罰金は「届けられない注文を誰にどう負担してもらうか」という営業上の判断、稼働時間の係数は「ドライバーの拘束時間を距離とどう釣り合わせるか」という人件費の判断、固定費は「車両を1台増やすことの重さ」です。設定値を情報システムの担当者だけが決め、配車や営業の責任者が知らない状態は、判断の権限が知らないうちに移っている状態だと考えています。
数字に直すと、重みの違いが見えます。サンプルデータで、誘導局所探索を5秒で打ち切った解(327.8km)と30秒回した解(304.0〜308.2km)の差は1日19.6〜23.8kmでした。サンプルデータの車種の設定(第8章で使います)にある2トン車の走行費(架空の値で1kmあたり40円)を掛けると、1日784〜952円です。年250日稼働と置くと(これも架空の置き方です)、年19.6万〜23.8万円になります。解の数3,000(約1分)まで回した296.5kmなら、5秒との差は1日31.3km、年31.3万円です。計算時間を数十秒延ばすだけでこの差が得られるなら、朝の配車計算に1分を確保する価値はあると考えます。
一方で、台数の差はこれより1桁大きくなります。2トン車1台の固定費(架空の値で1日2万円)は、年250日で500万円です。この章の実験では、どの設定でも共通データは6台に収まりましたが、罰金や固定費の置き方を誤ると、ソルバーは台数を減らす代わりに配送を落とす、あるいは配送を全部放棄するといった解を返しました。時間制限の数秒より、費用の桁を正しく置くことのほうが経営への影響は大きく、設定の見直しでは先に費用の桁を点検するのが効果的です。
計算結果の揺れも、経営指標で読むと扱い方が決まります。サンプルデータの30秒の揺れは約4km、走行費にして1日170円程度でした。ソルバーの結果が日によって数km違っても、それ自体は損失として小さく、むしろドライバーに毎日違う順番を渡すことによる現場の混乱のほうが大きな損失になりえます。前日のルートとの差を抑える工夫は第11章で、担当地区を固定するか毎日最適化するかの判断は第12章で扱います。
この章の要点は3つです。第一に、ルーティングソルバーは、インデックスの対応・コールバック・次元・探索の設定という部品の組み合わせで、スラックや出発時刻、稼働時間の係数、訪問の省略の罰金といった設定の1つ1つが、待ち時間・拘束時間・届けない注文の選び方を直接変えます。第二に、探索は初期解の戦略と改善の方法の2段階で、誘導局所探索は2つの問題で最も良い結果を出しましたが、時間制限で打ち切るかぎり結果は階段状に改善し、負荷によって実行ごとに揺れます。第三に、解なしの返り方には時間切れと実行不可能の証明があり、罰金つきの省略を標準にしておけば、守れない約束をソルバー自身に指し示させることができます。次の第7章では、この章で触れた稼働時間の扱いを、ドライバーの労働時間の規制に沿った制約として組み込みます。
この章を深めたい方への参考書籍
『今日から使える!組合せ最適化 離散問題ガイドブック』(穴井宏和・斉藤努、講談社):版元の内容紹介は、問題の分類・アルゴリズム・具体的な課題のつながりを双方向から整理し、根拠なくソルバーを選んでしまう前に俯瞰するための本としています。目次には経路問題を含む標準問題の体系、局所探索法とメタヒューリスティックス、列生成法、実問題に臨む考え方が並びます。この章の「どの道具をいつ使うか」を、配送計画以外の問題も含めて考えるのに向いています。
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):Python で数理最適化のモデルを書いて解く本で、目次には巡回路問題の章があり、巡回セールスマン問題・時間枠付き巡回セールスマン問題・容量制約付き配送計画問題の定式化が並びます。付録には、数理最適化ソルバー Gurobi に加えて、制約最適化ソルバーとスケジューリング最適化ソルバーの概説もあります。この章で比べた MIP と制約プログラミングの違いを、定式化の側から確かめるのに向いています。本の中で使うソルバーは OR-Tools ではなく Gurobi です。
第7章 ドライバーの労働時間を制約に入れる
第6章では、OR-Tools のルーティングソルバーの構造を整理し、次元(時間や積載のように、ルートに沿って積み上がる量)とスラック(待ち時間のように、次元の値を調整する余地)を使って制約を表す方法を確かめました。ここまでの章で扱った制約は、車の積載と納品先の時間指定でした。しかし配車計画を現場で回すときに最後に効いてくるのは、多くの場合、車ではなく運転する人の側の制約です。1台の車は1日に何回でも走れますが、ドライバーには始業から終業までの時間の上限があり、休憩を取る必要があり、翌日の勤務までに休息を取る必要があります。この章では、トラックドライバーの労働時間に関する国のルールを原則と例外まで確かめたうえで、それを OR-Tools の配車モデルに制約として入れる方法を示し、1台が配送センターに戻って積み直してもう一度出る「2回転」の計画と、台数と残業の釣り合いを実行結果で測ります。
ドライバーの時間を縛る2つのルール
トラックドライバーの労働時間には、性格の違う2つのルールがかかっています。1つは労働基準法の時間外労働の上限で、労使で結ぶ協定(いわゆる36協定)によって延ばせる残業時間の上限を定めたものです。もう1つは、厚生労働大臣の告示である「自動車運転者の労働時間等の改善のための基準」で、一般に改善基準告示と呼ばれます。こちらは残業時間ではなく、始業から終業までの時間、勤務と勤務の間の休息、運転している時間の長さに上限を置いたものです。
厚生労働省の「自動車運転者の長時間労働改善に向けたポータルサイト」によると、改善基準告示は平成9年以降改正されていませんでしたが、令和4年12月に見直され、令和6年4月1日から改正後の基準が適用されています。同じページは、自動車運転者の時間外労働の上限が令和6年4月から原則月45時間・年360時間、臨時的な特別の事情がある場合でも年960時間になったことを受けて、改善基準告示の見直しが行われたと説明しています。いわゆる物流の2024年問題の法令面の中身は、この2つの変更です。背景と経営への影響は第1章で扱ったので、この章では配車計画に制約として入れるために必要な数字と条件に絞ります。
配車計画の立場から見ると、2つのルールは効き方が違います。時間外労働の上限は年や月の単位で積み上がる量の上限で、1日の配車計画だけを見ても守れているかどうかは分かりません。これに対して改善基準告示の1日の拘束時間や連続運転時間は、1日のルートを作る段階で守れるかどうかが決まります。したがって、1日の配車モデルに直接書き込むのは改善基準告示の1日単位の条件で、月や年の上限は「1日あたりに使ってよい時間の予算」に割り戻してモデルに渡す、という分担になります。この割り戻しの計算は、この章の後半で示します。
改善基準告示の数字を原則と例外まで確かめる
改善基準告示の本文と、厚生労働省のポータルサイトにあるトラック運転者向けの解説を開いて、貨物自動車運送事業に従事する運転者の条件を確かめました。用語を先に整理しておきます。拘束時間は始業から終業までの時間で、労働時間と休憩時間を合わせたものです。厚生労働省労働基準局の「改善基準告示(令和6年4月1日適用)に関するQ&A」は、点呼や会議などの運転以外の労働時間はもちろん、休憩時間も拘束時間に該当すると説明しています。休息期間は、勤務が終わってから次の勤務が始まるまでの、使用者の拘束を受けない時間です。
| 項目 | 原則 | 例外・延長の条件 |
|---|---|---|
| 1年の拘束時間 | 3,300時間以内 | 労使協定により3,400時間まで |
| 1か月の拘束時間 | 284時間以内 | 労使協定により年6か月まで310時間まで。284時間を超える月は連続3か月まで。1か月の時間外・休日労働が100時間未満となるよう努める |
| 1日の拘束時間 | 13時間以内 | 延長しても最大15時間。14時間を超える回数はできるだけ少なくするよう努める(週2回までが目安)。1週間の運行がすべて長距離貨物運送(一の運行の走行距離が450km以上)で、休息期間が住所地以外の場所である場合は週2回まで16時間 |
| 休息期間 | 継続11時間以上与えるよう努めることを基本とし、継続9時間を下回らない | 上の長距離の条件に当たる場合は週2回まで継続8時間。この場合、一の運行の終了後に継続12時間以上の休息期間を与える |
| 運転時間 | 2日を平均し1日あたり9時間以内、2週間を平均し1週間あたり44時間以内 | 予期し得ない事象(事故・故障・災害など)への対応時間は、客観的な記録がある場合に限り除くことができる |
| 連続運転時間 | 4時間以内(1回がおおむね連続10分以上、合計30分以上の運転の中断をせずに運転する時間) | 高速道路等のサービスエリア・パーキングエリア等に駐停車できず、やむを得ず4時間を超える場合は4時間30分まで |
表のほかに、休息期間を勤務の途中と直後に分けて与える分割休息の特例(一定期間における全勤務回数の2分の1が限度で、分割した1回は継続3時間以上、2分割なら合計10時間以上、3分割なら合計12時間以上)、2人乗務の特例、隔日勤務の特例、フェリーに乗船している時間の扱いが定められています。いずれも長距離の運行や特殊な勤務形態のための規定で、この記事の例題のような日帰りの地域配送では使わないので、ここでは存在を示すにとどめます。
連続運転時間については、実務で誤解されやすい点が2つあります。1つ目は、運転の中断に何を数えてよいかです。改善基準告示は「運転の中断については、原則として休憩を与える」と定めています。前記のQ&Aはこの趣旨を、中断のときに荷積み・荷卸しの作業をして十分な休憩が取れていない実態を踏まえたものと説明し、休憩を与えられない実態なら運行計画を見直すよう使用者に求めています。そのうえで、短期的に見直しが難しいなどの特段の事情がある場合には、中断のときに荷積み・荷卸しや荷待ちをしても告示違反にはならない、とも答えています。つまり荷下ろしの時間を中断として数えることは直ちに違反ではないものの、それを前提に計画を組むことは告示の趣旨に沿わない、というのが原則と例外の関係です。
2つ目は、中断を数える単位です。同じQ&Aは、「おおむね連続10分以上」とは中断を原則30分以上とする趣旨で、10分未満の中断が3回以上連続するような場合は認められないと説明しています。また、渋滞で止まっている時間やサービスエリアの駐車待ちで少しずつ進む時間は、運転の中断ではなく連続運転時間に数えるとしています。配車計画で連続運転を管理するなら、「止まっている時間」ではなく「運転から離れている時間」で区切る必要があるということです。
休憩の長さそのものは、改善基準告示ではなく労働基準法34条が決めています。前記のQ&Aは、運転の中断のときに休憩を与えるかどうかにかかわらず、法34条の休憩(労働時間が6時間を超える場合は少なくとも45分、8時間を超える場合は少なくとも1時間)を適切に与える必要があると注意しています。この章の例題では、所定の労働時間を8時間とし、休憩を1時間取る前提で計画します。
なお、改善基準告示でいうトラック運転者は運送会社の運転者に限りません。Q&Aによると、製造業などの配達部門の運転者でも、主として人以外を運ぶ自動車の運転業務に従事していれば該当します。自社便で配送している荷主企業の配車計画にも、同じ条件がかかるということです。
時間外労働の上限、年960時間の読み方
厚生労働省の「建設業・ドライバー・医師等の時間外労働の上限規制」のページは、自動車運転の業務について、令和6年4月から特別条項付き36協定を締結する場合の年間の時間外労働の上限が年960時間になったと説明しています。同じページは、一般の労働者と異なり、時間外労働と休日労働の合計を月100時間未満・2〜6か月平均80時間以内とする規制と、時間外労働が月45時間を超えられるのは年6か月までとする規制は、自動車運転の業務には適用されないとしています。そのうえで、自動車運転の業務に従事する労働者は、別途、改善基準告示を守る必要があると明記しています。
この数字には条件が付いていることに注意が要ります。年960時間は特別条項付きの協定を結んだ場合の上限で、原則は月45時間・年360時間です。また、一般則で適用される月100時間未満などの規制がドライバーには適用されないからといって、月の残業に歯止めがないわけではありません。改善基準告示の1か月の拘束時間の上限(原則284時間、労使協定で延長しても310時間)が歯止めになり、延長したときには「時間外・休日労働を100時間未満とするよう努める」という努力の条件も付いています。配車計画の側から言えば、年960時間は「特別条項を結んだときの天井」であって、毎日の計画で使い切ってよい目標値ではありません。
ルールを配車モデルの部品に置き換える
法令の条件をそのままソルバーに渡すことはできないので、1日の配車モデルが扱える形に置き換えます。置き換えの前に、1日の拘束時間が何でできているかを決めておく必要があります。配送センターを出発してから帰着するまでのルートの時間には、走行・荷下ろし・時間指定の待ちが含まれますが、拘束時間はそれより長く、出発前の点呼と積み込み、帰着後の片付け・日報・点呼も含みます。Q&Aが述べているとおり、点呼や休憩も拘束時間に入ります。この章の例題では、出発前に30分、帰着後に30分の作業があると置き、拘束時間を「帰着時刻から出発時刻を引いた時間に60分を足したもの」として計算します。この式は休憩がルートの途中に入る場合の数え方で、休憩が帰着後に置かれた車では、その休憩の時間を別に足します(後の節の車5・車6)。30分という値はこの記事で置いた仮定で、実際の値は営業所ごとに点呼記録や運行記録から測る必要があります。
そのうえで、ルールごとに次の表のように置き換えました。
| ルール | 1日の配車モデルでの扱い | OR-Tools で使った部品 |
|---|---|---|
| 1日の拘束時間の上限(原則13時間) | 出発から帰着までの時間の上限=上限の拘束時間から出発前・帰着後の60分を引いた値 | 時間の次元の上限(AddDimension の容量)と、帰着の時刻の上限(CumulVar(End).SetMax) |
| 所定の労働時間(8時間)を超えた分の残業 | 拘束時間が所定の9時間(労働8時間+休憩1時間)を超えた分に、1分あたりの残業単価を掛けて費用に足す | 帰着の時刻に対する柔らかい上限(SetCumulVarSoftUpperBound) |
| 休憩(労働基準法34条、8時間超で少なくとも1時間) | 60分の休憩を、決めた時間帯のどこかで必ず取る。荷下ろしの最中には取らない | 休憩の区間(FixedDurationIntervalVar)と SetBreakIntervalsOfVehicle |
| 1日の運転時間(2日平均9時間) | 計画の結果から走行時間を集計して確かめる。この例題では上限に遠いので制約にしない | 計画後の点検 |
| 連続運転時間(4時間) | 計画の結果から、中断と中断の間の走行時間の最大を集計して確かめる | 計画後の点検 |
| 休息期間・1か月と1年の拘束時間・年の時間外労働 | 1日の計画には直接書かず、1日あたりに使ってよい拘束時間と残業の予算に割り戻して渡す | 時間の次元の上限と残業単価の設定 |
表の下の3行を「計画後の点検」や「予算への割り戻し」にしたのには理由があります。運転時間の2日平均や休息期間は、今日の計画だけでなく前日と翌日の勤務に依存します。1日ずつ計画を立てる仕組みでは、今日の計画を作る時点で前日の終業時刻と運転時間が分かっていれば、今日使ってよい上限を計算してモデルに渡せます。反対に、1日のモデルの中で2日平均を完全に扱おうとすると、複数日をまとめて計画する必要があり、問題の規模が大きく変わります。ドライバーごとの前日の実績から当日の上限を計算する部分は、配車ソルバーの外に置くほうが扱いやすいと考えています。
もう1つ、この表には「ドライバー」という変数がありません。この章の例題では、1台の車を1人のドライバーが1日担当する前提を置き、車の時間の上限をそのままドライバーの時間の上限として扱います。交替制で1台の車を2人が使う場合や、ドライバーごとに勤務の上限が違う場合(前日の終業が遅かった人、短時間勤務の人など)は、車ごとに上限を変える(SetMax を車ごとに設定する)ことで表せます。
月と年の上限を1日の予算に割り戻す
1日の上限13時間は、毎日使ってよい値ではありません。月と年の上限を1日あたりに割り戻すと、1日の計画に渡すべき上限はもっと小さくなります。出勤日数を仮に1か月22日と置いて割り算した結果が次の表です(出勤日数は事業所の勤務体系で変わるので、20日の場合も併記しました)。
| 上限の種類 | 上限の値 | 1か月22日で割った1日あたり | 1か月20日で割った1日あたり |
|---|---|---|---|
| 1か月の拘束時間(原則) | 284時間 | 12時間55分 | 14時間12分 |
| 1年の拘束時間(原則)を12か月で割った値 | 3,300時間÷12=275時間 | 12時間30分 | 13時間45分 |
| 時間外労働(原則) | 年360時間=月30時間 | 82分 | 90分 |
| 時間外労働(特別条項を結んだ場合の上限) | 年960時間=月80時間 | 218分 | 240分 |
1か月22日勤務の場合、1日の上限いっぱいの13時間を毎日続けると1か月の拘束時間は286時間になり、原則の284時間を超えます。年の原則3,300時間を月平均にならすと275時間で、1日あたりでは12時間30分です。つまり、22日勤務を続ける事業所では、毎日の計画に渡す拘束の上限は13時間ではなく12時間30分前後が実質的な天井になり、これを超える日を作るなら、ほかの日で取り戻す計画が要ります。時間外労働も同じで、特別条項の年960時間を均等に割っても1日あたり218分、原則の年360時間なら82分です。
この割り戻しは、配車計画の入力をどう設計するかに直結します。1日の配車ソルバーには「今日このドライバーが使ってよい拘束時間と残業時間」を渡し、その値は月の累計と残りの勤務日数から毎日計算し直す、という形が扱いやすいと考えています。月の前半に残業を使い切ったドライバーには、後半の上限を小さく渡すことになります。このとき年960時間は、ここで割り戻した数字のさらに外側にある天井です。事業所の36協定で定めた時間数がこれより小さい場合は、その時間数を使って割り戻す必要があります。協定の時間数は事業所ごとに違うので、この記事では例として扱いません。
OR-Tools で拘束時間の上限と休憩を入れる
ここからは第2章で用意したサンプルデータ(架空の配送センターと納品先40件、2トン車150ケース)を使います。時間の単位は分で、時刻0は8時です。まず、1台1回転の配車に、拘束時間の上限・所定時間を超えた分の罰則・60分の休憩を入れた最小の例を示します。記事全体の基準の設定(積載・時間指定と、車両1台に100km 相当の固定費を置いて台数が増えにくくなるようにした重み)に、次の3点を足しました。1つ目は、時間の次元の上限を「拘束13時間から出発前・帰着後の60分を引いた720分」にしたことです。2つ目は、帰着の時刻に柔らかい上限を置き、帰着が16時(出発前・帰着後の60分を足すと拘束9時間)を超えた分に1分あたりの罰則を課したことです。3つ目は、11時から13時30分までの間に始まる60分の休憩を、車ごとに区間として置いたことです。あわせて、全車が8時に出発するよう出発時刻を固定しました。基準の設定では出発時刻が0分から600分の範囲で動けたので、ここは設定が違います。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from ortools.constraint_solver import pywrapcp, routing_enums_pb2
from vrp_data import customers, points, dist_km, time_min, int_matrix, TRUCK_CAPACITY, hhmm
cs = customers(); pts = points(cs); n, V = len(pts), 8
D = int_matrix(dist_km(pts), 1000)                                   # m
svc = [0] + [c["service"] for c in cs]                               # 荷下ろし(分)
TT = [[int(round(t)) + svc[i] for t in row] for i, row in enumerate(time_min(pts))]
man = pywrapcp.RoutingIndexManager(n, V, 0); r = pywrapcp.RoutingModel(man)
r.SetArcCostEvaluatorOfAllVehicles(r.RegisterTransitCallback(lambda a, b: D[man.IndexToNode(a)][man.IndexToNode(b)]))
r.SetFixedCostOfAllVehicles(100000)                                  # 1台=100km 相当
dem = [0] + [c["demand"] for c in cs]
r.AddDimensionWithVehicleCapacity(r.RegisterUnaryTransitCallback(lambda a: dem[man.IndexToNode(a)]),
                                  0, [TRUCK_CAPACITY] * V, True, "Load")
MAX_ROUTE = 780 - 60                                                 # 拘束13時間から出発前・帰着後の60分を引く
r.AddDimension(r.RegisterTransitCallback(lambda a, b: TT[man.IndexToNode(a)][man.IndexToNode(b)]),
               MAX_ROUTE, MAX_ROUTE, False, "Time")                  # 待ちの上限, ルートの時間の上限
td = r.GetDimensionOrDie("Time")
for i, c in enumerate(cs, start=1):
    td.CumulVar(man.NodeToIndex(i)).SetRange(*c["tw"])               # 時間指定
visit = [svc[man.IndexToNode(i)] for i in range(r.Size())]          # 荷下ろし中は休憩にしない
for v in range(V):
    td.CumulVar(r.Start(v)).SetValue(0)                              # 8時に出発
    td.SetCumulVarSoftUpperBound(r.End(v), 480, 40)                  # 16時(拘束9時間)を超えたら1分40の罰則
    brk = r.solver().FixedDurationIntervalVar(180, 330, 60, False, "break%d" % v)  # 11時〜13時30分に開始する60分
    td.SetBreakIntervalsOfVehicle([brk], v, visit)
td.SetSpanCostCoefficientForAllVehicles(1)
p = pywrapcp.DefaultRoutingSearchParameters()
p.first_solution_strategy = routing_enums_pb2.FirstSolutionStrategy.PATH_CHEAPEST_ARC
p.local_search_metaheuristic = routing_enums_pb2.LocalSearchMetaheuristic.GUIDED_LOCAL_SEARCH
p.time_limit.seconds = 20
s = r.SolveWithParameters(p)
iv, total, used = s.IntervalVarContainer(), 0.0, 0
for v in range(V):
    i, km = r.Start(v), 0.0
    while not r.IsEnd(i):
        j = s.Value(r.NextVar(i)); km += D[man.IndexToNode(i)][man.IndexToNode(j)] / 1000; i = j
    if km > 0:
        used += 1; total += km
        print("車%d %5.1fkm 帰着%s 休憩%s〜" % (v + 1, km, hhmm(s.Value(td.CumulVar(r.End(v)))),
                                          hhmm(iv.Element(v).StartValue())))
print("台数 %d 総距離 %.1fkm" % (used, total))
# 出力: 車1  58.3km 帰着14:45 休憩11:06〜
# 出力: 車2  49.7km 帰着15:45 休憩11:00〜
# 出力: 車5  48.9km 帰着11:14 休憩11:14〜
# 出力: 車6  34.8km 帰着11:09 休憩11:09〜
# 出力: 車7  61.3km 帰着14:17 休憩11:38〜
# 出力: 車8  53.6km 帰着14:38 休憩11:00〜
# 出力: 台数 6 総距離 306.6km
要点になる行を順に説明します。AddDimension の2番目と3番目の引数は、それぞれ「1か所で待ってよい時間の上限」と「ルートの累計時間の上限」で、ここではどちらも720分にしています。後者が、拘束時間の上限をルートに翻訳したものです。SetCumulVarSoftUpperBound は、帰着の時刻が480分(16時)を超えたとき、超えた分に係数を掛けた値を目的関数に足します。ここでは距離の単位(メートル)と同じ尺度で1分あたり40を置いたので、残業1分を40mの走行と同じ重さで評価していることになります。費用の単位をそろえて残業の単価を円で入れる形は、次の節で使います。
休憩は FixedDurationIntervalVar(180, 330, 60, False, 名前) で「180分から330分の間に始まる、長さ60分の、省略できない区間」を作り、SetBreakIntervalsOfVehicle でその車の時間の次元に結び付けます。3番目の引数 visit は各地点での作業時間の一覧で、休憩が荷下ろしの最中に重ならないようにするために渡します。休憩は走行の途中や、時間指定の待ちの時間に入ることができます。
出力を見ると、この条件で6台・総距離306.6km の計画が得られました(この記事の実行環境での実測、誘導局所探索20秒で打ち切り)。注意したいのは車5と車6で、帰着時刻と休憩の開始時刻が同じです。つまりこの2台は午前中に配送を終えて帰着し、休憩は帰着の後に置かれています。休憩の区間を置いただけでは、休憩がルートの途中に入ることまでは保証されない、ということがこの実行結果から分かります。この2台の労働時間は、出発前と帰着後の30分ずつを足しても4時間余り(車5は7時30分から11時44分までの4時間14分、車6は4時間09分)で、6時間を超えないので法34条の休憩は要りません。ただし、このモデルでは全車に60分の休憩を必ず置く設定にしたため、この2台にも休憩が帰着後に置かれています。帰着後に置かれた休憩60分も拘束時間に含めると、拘束時間は車5が5時間14分、車6が5時間09分になります。長いルートでも同じことが起きうるので、帰着後に置かれた休憩は拘束時間に含めて数え直す必要があります。この章の以降の集計では、休憩が帰着後に置かれた車は、帰着後に休憩を取ってから終業すると数えました。
休憩を入れると総距離はどれだけ延びるのかも測りました。費用を円にそろえた共通部品(次の節で説明します)で、1台1回転・車6台の条件を、休憩ありと休憩なしで解き比べた結果が次の表です。
| 時間制限(誘導局所探索) | 休憩なしの総距離 | 休憩60分ありの総距離 | 差 |
|---|---|---|---|
| 30秒 | 300.0km | 340.3km | 40.3km |
| 120秒 | 297.3km | 318.8km | 21.5km |
どちらの条件でも台数は6台で、休憩を入れた計画のほうが総距離が長くなりました。ただし、時間制限を30秒から120秒に延ばすと差は40.3km から21.5km に縮んでいます。30秒の条件は同じ設定で2回解いて2回とも同じ距離でしたが、それは同じ30秒で同じ解にたどり着いたというだけで、休憩を入れた問題のほうが探索に時間がかかり、打ち切りの時点で良い解に届いていないことを表しています。先ほどの最小例(目的の尺度が違い、車8台まで使える設定)では、休憩ありで306.6km でした。どちらの計画も最適性は証明していないので、休憩そのものが距離をどれだけ増やすのかは、この実験からは確定できません。言えるのは、30秒の条件で見えた40.3km の差のうち、少なくとも半分近くは探索の打ち切りによるものだった、ということです。実務で注意すべきなのは、制約を1つ足すたびに同じ時間制限での解の質が変わりうることです。制約を足した計画と足す前の計画を比べるときは、時間制限を延ばして差が縮むかどうかを確かめてから、差を「制約の費用」として読むべきです。
1台が2回転する計画をモデルにする
ここまでの計画では、どの車も朝に積んだ荷物だけを配り、昼過ぎには帰着していました。記事全体で基準にしている OR-Tools の計画(積載+時間指定、6台・総距離293.2km)でも、6台の帰着は13時51分から15時55分の間で、終業の18時まで時間が余っています。2トン車の積載150ケースに対して、この例題の総ケースは868なので、1回転なら6台が要ります。しかし、午前中に1便目を配って配送センターに戻り、積み直して午後に2便目を出せば、同じ荷物を少ない台数で運べる可能性があります。これが2回転(1台が1日に2便を運行すること)の計画です。台数を減らせば車両の固定費は下がりますが、1人のドライバーの拘束時間は長くなり、残業が増えます。台数と労働時間の釣り合いが、この章の中心の問いです。
OR-Tools で2回転を表す方法はいくつかありますが、ここでは配送センターの「複製」を置く方法を使いました。配送センターと同じ座標に「積み直しの点」を車の台数分だけ追加し、積み直しの点 k は車 k だけが訪問でき、訪問するかどうかは任意(訪問しなくても罰則なし)とします。積み直しの点では30分の積み込み時間がかかり、そこで荷台が空に戻ります。荷台が空に戻る仕組みは、積載の次元で積み直しの点の需要を「マイナス150ケース」とし、その点に限ってスラック(次元の値を調整する余地)を許すことで作りました。次のコードは、共通部品 ch07_labor.py の該当部分を抜き出したものです(単独では動きません)。
# 抜き出し:pts_all は [デポ, 納品先40件, 積み直しの点 n_rel 個]、dem の積み直しの点は -TRUCK_CAPACITY
dcb = r.RegisterUnaryTransitCallback(lambda a: dem[man.IndexToNode(a)])
r.AddDimension(dcb, TRUCK_CAPACITY, TRUCK_CAPACITY, True, "Load")    # スラックの上限を積載と同じにする
ld = r.GetDimensionOrDie("Load")
for i in range(1, nc + 1):
    ld.SlackVar(man.NodeToIndex(i)).SetValue(0)      # 納品先では荷台は空かない
for i in range(1, nc + 1):                           # 積み残しは1件1,000万円の罰則(実質禁止。初期解を作りやすくする)
    r.AddDisjunction([man.NodeToIndex(i)], drop_yen * 100)
for j in range(n_rel):                               # n_rel = 台数×(最大の便数-1)
    k = j % n_veh                                    # 積み直しの点 j は車 k のもの
    idx = man.NodeToIndex(nc + 1 + j)
    r.AddDisjunction([idx], 0)                       # 積み直しは任意
    r.VehicleVar(idx).SetValues([-1, k])             # 車 k だけが訪問できる
    r.NextVar(r.Start(k)).RemoveValue(idx)           # 出発直後の積み直しは無意味なので禁じる
    r.NextVar(idx).RemoveValue(r.End(k))             # 積み直してそのまま帰着も禁じる
    for j2 in range(k, n_rel, n_veh):                # 積み直しの連続も禁じる
        if j2 != j:
            r.NextVar(idx).RemoveValue(man.NodeToIndex(nc + 1 + j2))
1台の便の数の上限は、車ごとに用意する積み直しの点の数で決まります。積み直しの点が1つなら最大2便、2つなら最大3便です。VehicleVar(idx).SetValues([-1, k]) は「この点は訪問しない(-1)か、車 k が訪問する」という意味です。出発直後の積み直し、積み直してすぐ帰着する経路、積み直しの連続を禁じたのは、試しに解いたときに、出発してすぐ積み直しの点に立ち寄る(距離は0で30分を失うだけの)ルートが返ってきたためです。意味のない訪問を先に禁じておくと、拘束時間の集計が実態に近くなり、探索の無駄も減ります。
納品先にも AddDisjunction で訪問の省略を許し、省略には1件1,000万円(架空)の罰則を付けました。全件を必ず回る制約にすると、台数が足りない条件で初期解が作れず、ソルバーが何も返さないまま時間切れになったためです。罰則つきの省略を許しておくと、台数が足りない条件でも「何件積み残すか」という答えが返ってくるので、足りないことがはっきり分かります。この扱いは第6章で扱った訪問の省略と同じ部品です。
費用はすべて円にそろえました。2トン車の固定費を1台1日20,000円、距離の費用を1kmあたり40円(どちらも共通データに用意した架空の値)、残業の単価を1分40円(1時間2,400円、この記事で置いた架空の値)とし、ソルバーには0.01円単位の整数で渡しています。所定の拘束時間は9時間(労働8時間+休憩1時間)で、拘束が9時間を超えた分を残業として数えます。休憩は全員に60分、11時から13時30分の間に始まる区間として置きました。
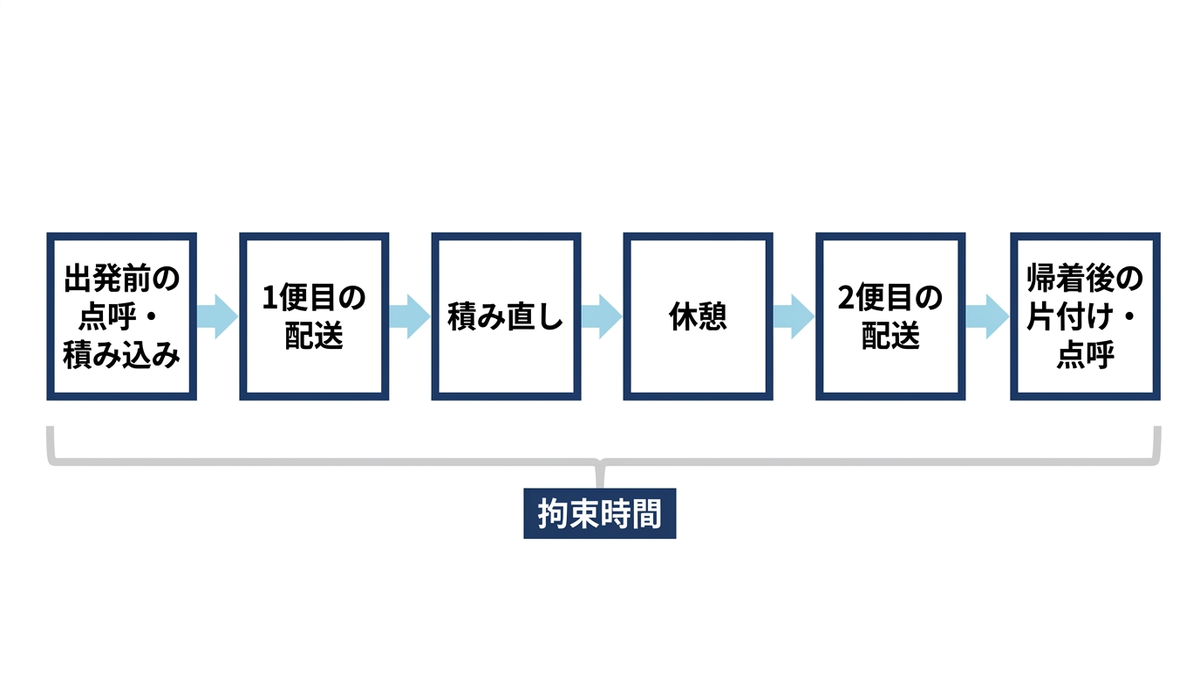
台数と残業の釣り合い、6台・4台・3台を比べる
この部品を使って、使える台数と1台の便の上限を変えた3つの計画を解きました。6台で1回転、4台で2回転まで、3台で3回転まで、の3つです。いずれも休憩60分と時間指定を入れ、拘束の上限は13時間、残業単価は1分40円、誘導局所探索は90秒で打ち切りました(この記事の実行環境での実測)。同じ条件を2回ずつ解き、3つの計画とも2回とも同じ結果になりました。
| 計画 | 使用台数 | 便の数 | 総距離 | 拘束の最大 | 拘束の平均 | 残業の合計 | 固定費 | 距離の費用 | 残業の費用 | 1日の費用の合計 |
|---|---|---|---|---|---|---|---|---|---|---|
| 6台・1回転 | 6台 | 6便 | 318.8km | 8時間34分 | 7時間24分 | 0分 | 120,000円 | 12,751円 | 0円 | 132,751円 |
| 4台・2回転まで | 4台 | 7便 | 326.5km | 9時間03分 | 8時間38分 | 3分 | 80,000円 | 13,061円 | 120円 | 93,181円 |
| 3台・3回転まで | 3台 | 7便 | 313.2km | 11時間27分 | 10時間49分 | 326分 | 60,000円 | 12,526円 | 13,040円 | 85,566円 |
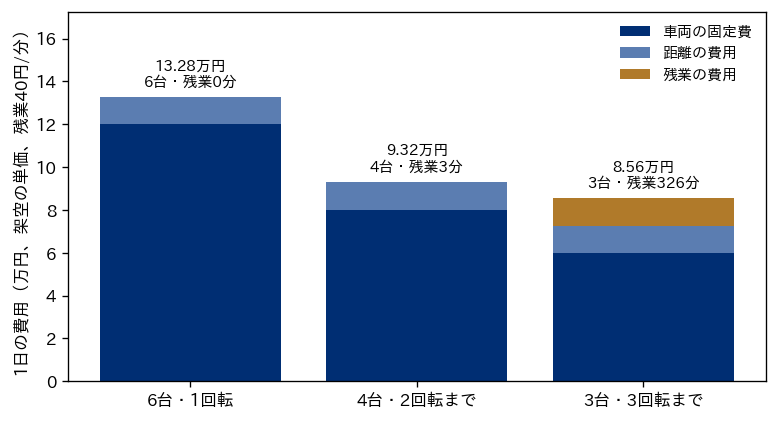
表の「1日の費用の合計」列を見ると、6台・1回転の132,751円に対し、4台・2回転までの計画は93,181円で、差は39,570円です。総距離は318.8km と326.5km でほとんど変わらず、差のほぼすべては2台分の固定費40,000円から来ています。4台の計画は7便のうち3台が2便を走り、1台は1便だけで、拘束の最大は9時間03分、残業は合計3分でした。この例題では、午前の配送を終えて戻る時間帯に積み直せば、ドライバーの所定の時間の中で2回転がほぼ収まるということです。
3台・3回転までの計画は85,566円で、4台の計画よりさらに7,615円安くなりました。ただし中身が違います。固定費は20,000円減りましたが、残業が326分に増え、残業の費用が13,040円かかっています。拘束の最大は11時間27分、3人の平均は10時間49分です。次のルート図と1日の時間割がこの計画で、車1は3便、車2と車3は2便を走っています。
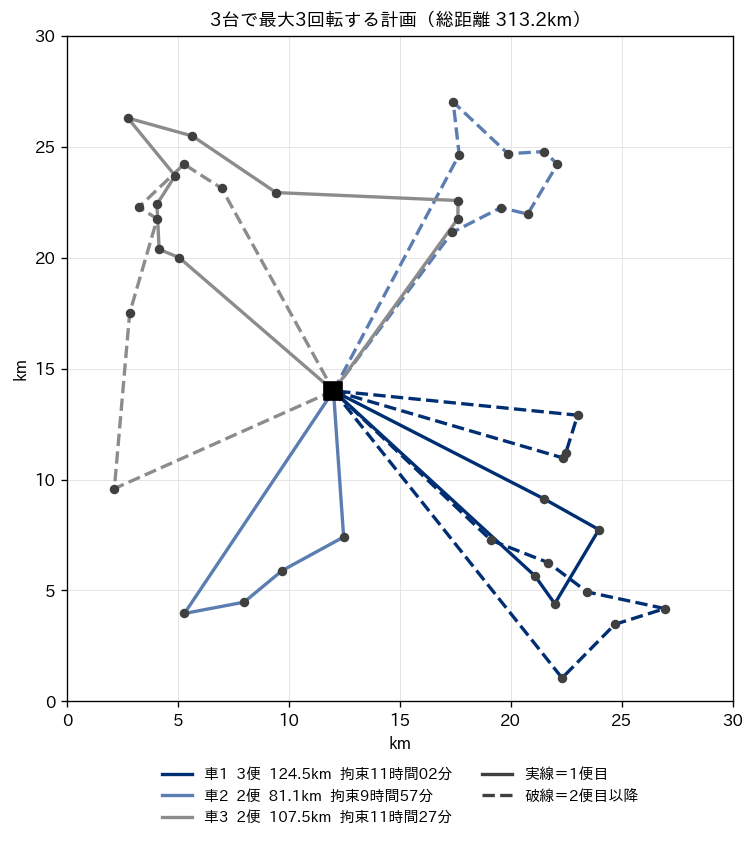
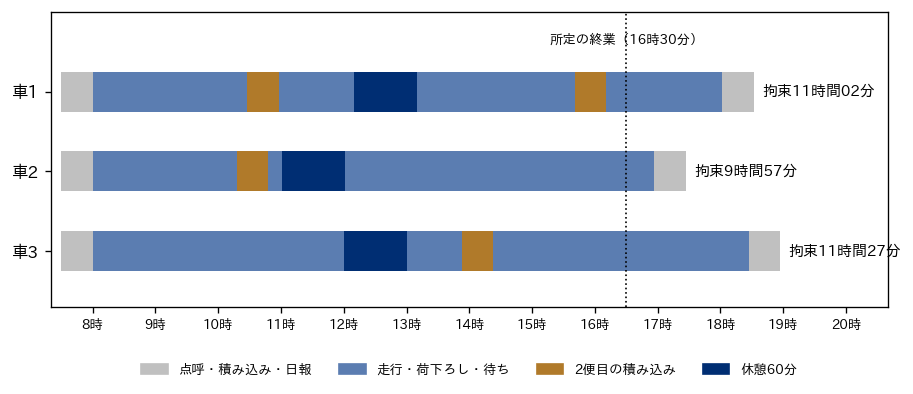
時間割を見ると、3台とも休憩は11時台から12時台に始まっており、車1と車3は18時を過ぎてから終業しています。点線は所定の終業の16時30分(7時30分に始業して9時間後)で、これより右に伸びた部分が残業です。3台・3回転の計画は、1台あたりの荷物を増やす代わりに、ドライバーの1日を長くして成り立っています。
この比較で注意したいのは、「台数を減らすほど安い」という結論が残業単価に依存していることです。3台の計画と4台の計画の費用の差は、固定費の20,000円と、残業の差(326分と3分)に単価を掛けた額との綱引きで決まります。上の2つの計画をそのまま使って、固定費と距離の費用の合計(3台は72,526円、4台は93,061円)に残業の費用を足した額が等しくなる単価を求めると、1分63.6円(1時間3,815円)でした。残業単価がこれより安ければ3台、高ければ4台のほうが安い、という分かれ目です。実際に残業単価を1分100円に上げて3台・3回転までの条件で解き直すと、ソルバーは残業を314分までしか減らせず、残業の費用を含めた合計は104,094円で、同じ単価で数えた4台の計画(93,361円)より高くなりました。使える台数を3台に固定している限り、単価を上げても残業はほとんど減らないので、台数の判断はソルバーの中ではなく、台数を変えて解いた結果を並べて外側で行うのが確実です。
「台数もソルバーに選ばせればよい」と考えたくなりますが、この例題ではうまくいきませんでした。2回転までの条件で使える台数を4・5・6台と変えて30秒ずつ解いた実験では、5台や6台を使えるようにしてもソルバーが使ったのは4台で、そこまでは良かったものの、総距離は321.5km から379.8km まで揺れ、6台を使える設定では残業95分の計画が返りました。拘束の上限を9時間(残業を認めない)に下げた条件では、使える台数4台の設定で90秒・2回とも1件の積み残しが出た一方、使える台数5台の30秒の実験では4台で全件を回る計画(337.6km)が見つかっています。車を多めに用意すると探索の自由度が増えて良い解が見つかることもあれば、探索が散って悪くなることもあり、打ち切りの探索では結果が安定しません。台数の候補が数通りに限られるなら、台数ごとに解いて比べるほうが、結果を説明しやすいと考えています。
計画を法令の目で点検する
ソルバーが返した計画は、モデルに書いた制約しか守っていません。表の「ルールを配車モデルの部品に置き換える」で計画後の点検に回した項目を、この章で90秒ずつ解いた計画(上の3つと、残業単価や拘束の上限を変えた計画)について確かめました。1日の運転時間は最大308分(5時間08分)で、2日平均9時間の上限に対して十分に小さい値でした。連続運転時間は、納品先や積み直しでの停車(荷下ろしは短いもので10分)で運転が区切られるとみなして数えると、最大52分でした。この例題は30km 四方の地域配送なので、4時間の連続運転の上限に近づく場面はありません。ただし、ここで荷下ろしの時間を運転の中断として数えていることには注意が要ります。前に見たとおり、Q&Aは荷下ろしを中断とすることを直ちに違反とはしない一方、中断には原則として休憩を与えるよう求めています。長距離の幹線輸送のように1回の走行が長い計画では、連続運転の上限は計画の後の点検ではなく、制約として入れる必要があります。
点検で引っかかるのは、むしろ月と年の予算です。3台・3回転の計画は、1日の拘束の最大が11時間27分で1日の上限13時間には収まっていますが、残業はドライバー1人あたり平均で約109分(3人合計326分)です。前の表で割り戻したとおり、1か月22日勤務なら原則の年360時間は1日82分、特別条項の年960時間は1日218分にあたります。この計画を毎日続けると、特別条項付きの協定を結んでいない事業所では時間外労働の原則の枠を超え、結んでいる事業所でも年960時間の枠の半分近くを毎日使い続けることになります。拘束の平均10時間49分に22日を掛けると約238時間で、1か月の拘束284時間には収まります。1日単位の制約をすべて満たした計画でも、月と年で見ると続けられるかどうかは別の問題だということが、この点検から分かります。
経営の判断に翻訳する、台数・時間指定・荷下ろし
台数と残業の釣り合いが見えたら、次は「どうすれば少ない台数で残業を減らせるか」という打ち手の比較です。3台・3回転までの計画を基準に、条件を1つずつ変えて解き直しました(90秒・2回ずつ、2回とも同じ結果)。
| 条件(3台・3回転まで) | 総距離 | 拘束の最大 | 残業の合計 | 1日の費用の合計(残業40円/分) |
|---|---|---|---|---|
| そのまま | 313.2km | 11時間27分 | 326分 | 85,566円 |
| 午前指定(9時〜12時)の11件を終日に緩めてもらう | 303.6km | 11時間09分 | 275分 | 83,144円 |
| 午前・午後の指定18件をすべて終日に緩めてもらう | 302.3km | 11時間35分 | 274分 | 83,053円 |
| 荷下ろしを1件あたり5分短くする | 311.3km | 9時間53分 | 95分 | 76,253円 |
時間指定を緩めてもらう打ち手は、この例題では効果が小さく出ました。午前指定の11件を終日にすると残業は326分から275分へ51分減りましたが、午後指定まで含めて18件すべてを終日にしても274分で、ほとんど変わりません。総距離は約10km 短くなっています。これに対して、荷下ろしを1件あたり5分短くすると、残業は95分まで231分減り、拘束の最大は9時間53分になりました。40件で5分ずつなので、荷下ろしの合計は685分から485分へ200分減っています。この例題の3台の計画では、1日の時間の中で荷下ろしが占める割合が大きく、時間指定よりも荷下ろしの時間のほうが残業を左右していたということです。
この結果から、経営の打ち手は3つの型に整理できます。1つ目は台数を増やすことで、この例題では4台に戻せば残業はほぼなくなり、費用は1日7,615円増えます(残業単価40円のとき)。2つ目は時間指定を緩めてもらうことで、納品先との交渉が必要なわりに、この例題では残業の削減が51分にとどまりました。3つ目は荷下ろしや検品の時間を短くすることで、納品先での待ち時間の削減や検品の簡素化、荷姿の工夫など、納品先と一緒に取り組む必要がありますが、この例題では最も効きました。どの打ち手が効くかは、各納品先の時間指定と荷下ろし時間の分布で決まるので、自社のデータで同じ比較をしてから交渉の優先順位を決めることが有効だと考えています。
判断を誤ったときの損失の型も、表から読み取れます。労働時間を制約に入れずに台数を決めると、紙の上では3台で回る計画が、実際には毎日326分の残業を前提にしていることに気づかず、月の途中で残業の枠が尽きて車を借りる、という形の損失が起こりえます。反対に、1回転の前提のまま6台を持ち続けると、2回転で4台に減らせる余地に気づかず、この例題の単価では、表の「1日の費用の合計」の差で1日約4万円、月22日で約87万円を余分に払い続けることになります。この差の中身はほぼ固定費で、2台分の固定費40,000円から、4台・2回転で増える距離の費用310円と残業の費用120円を差し引いた額です。どちらの損失も、ソルバーの性能ではなく、モデルに何を書いたかで決まります。
この章の要点は3つです。第一に、トラックドライバーの労働時間には、改善基準告示(1日の拘束13時間・最大15時間、休息期間、運転時間、連続運転4時間など)と時間外労働の上限(特別条項を結んだ場合で年960時間)がかかり、どちらも原則と例外の条件つきで読む必要があります。第二に、1日の配車モデルには拘束時間の上限・休憩の区間・残業の罰則を入れ、月と年の上限は1日の予算に割り戻して渡すのが扱いやすく、運転時間や連続運転は計画後に点検します。第三に、2回転・3回転を許すと台数は6台から4台・3台に減りますが、その先は残業との釣り合いになり、残業単価や荷下ろしの時間で答えが入れ替わります。次の第8章では、車種の混在・複数の拠点・集荷と配送の組を扱い、車そのものの構成を費用の面から考えます。
Anagraftでは、データ活用の構想づくりから、配車計画やドライバーの労働時間のような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『中小企業のためのトラック運送業の時間外労働削減の実務 売上・利益を維持し、ドライバーを定着させる 補訂版』(石原清美、第一法規):社会保険労務士の著者が、トラック運送事業の時間外労働を減らすために、法規制と罰則を整理したうえで労働時間の短縮策を解説した本で、よくある相談への回答や、長距離輸送の時間を実際に数えた事例を含みます。この章では拘束時間と残業を配車モデルの制約と費用として扱いましたが、運送事業者の労務管理の側からそれをどう数え、どう減らすかを押さえるのに向いています。
『エッセンシャルワーカー 社会に不可欠な仕事なのに、なぜ安く使われるのか』(田中洋子 編著、旬報社):社会に不可欠な仕事の働き方を職種ごとに比べた本で、トラックドライバーの章(首藤若菜)に加えて、ドイツの労働時間法制を扱う章を含んでいます。ドライバーの労働時間を、日本の他の職種や海外の制度と並べて考える材料になります。
第8章 車種・複数拠点・集荷と配送、配車の前提そのものを変える判断
第7章では、ドライバーの拘束時間と休憩を制約に入れ、台数を増やすか残業で吸収するかの釣り合いを数字にしました。そこまでの章は、同じ2トン車が同じ配送センターから出発し、積んだ荷物を納品先に降ろして戻る、という前提を置いてきました。実際の配車では、この前提そのものが判断の対象になります。4トン車と軽バンをどう組み合わせるか、第2の拠点から出す車を用意するか、納品の帰りに別の荷物を引き取るか、といった判断です。この章では、共通データに車種・第2デポ・集荷と配送の組を加え、前提を変えると使用台数・総走行距離・総費用がどう動くかを実行結果で示します。
日々の配車と、前提を決める判断は時間の長さが違う
第1章で整理した計画の階層では、拠点網の設計が最も上にあり、その下に配送エリアと曜日、日々の配車、当日の再配車が続きました。この章が扱う3つの話題は、その階層の間にまたがっています。どの車種を何台持つかは、車両のリースや購入を通じて、年単位で固定されることの多い判断です。第2の拠点を置くかどうかは、さらに長い期間を縛ります。一方で、手持ちの車の中からその日に何トン車を何台出すか、どの納品先をどちらの拠点から出すか、集荷をどの車の帰り道に組み込むかは、毎日の配車で決めることです。
この違いは、最適化の使い方の違いになります。毎日の配車では、車種と拠点は与えられたものとして、その中で最も安い計画を探します。車種の構成や拠点の配置を決める段階では、「この車種構成なら毎日の配車はいくらになるか」を、代表的な日の注文で何通りも解いて比べます。つまり、上の段の判断は下の段の最適化を何度も呼び出して作ります。この章の実験もその形で、車種の構成や拠点の数を変えながら、同じ共通データを同じ探索の条件で解き直しています。
なお、どこに拠点を置くかそのもの、つまり候補地の中から拠点の場所と数を選ぶ施設配置の問題は、弊社コラム「数理最適化の定式化パターン集」の第8章で扱っています。この章は、拠点の場所が決まっている、あるいは候補が1つに絞られている段階で、「その拠点を配車に加えると日々の距離と台数がどう変わるか」を測る側に立ちます。
| 前提の変え方 | 配送計画問題の呼び名 | 毎日の配車で決めること | 数年単位で決めること | OR-Tools での書き方(この章で実行したもの) |
|---|---|---|---|---|
| 車種を混ぜる | 車種混在の配送計画(台数と車種構成を同時に決める型を含む) | その日にどの車種を何台出すか | 車種ごとに何台持つか | 車ごとの積載上限、車ごとの固定費と距離の費用 |
| 拠点を増やす | 複数デポの配送計画 | どの納品先をどの拠点から出すか | 拠点を置くか、在庫をどう分けるか | 車ごとの出発地と帰着地 |
| 集荷と配送を組にする | 集荷配送問題 | どの車が、どの順で集荷して届けるか | 集荷を自社便で引き受けるか | 組の宣言、同じ車の制約、集荷が先の制約 |
| 納品の帰りに回収する | 帰り荷・回収つきの配送計画 | 回収をどの車の帰り道に入れるか | 回収を別便にするか、納品便に載せるか | 積み降ろしの両方を数える積載の次元 |
表の右端の列は、この章で実際に書いて実行したものです。OR-Tools のルーティングソルバーの基本構造(インデックスの対応、コールバック、次元)は第6章で説明しているので、ここでは基本構造からの差分だけを示します。
車種混在の配車を式に書く、車ごとに積載と費用を変える
共通データの VEHICLE_TYPES には、3つの車種が用意してあります。4トン車は積載300ケース・固定費1日1台28,000円・距離1kmあたり60円、2トン車は150ケース・20,000円・40円、軽バンは60ケース・12,000円・25円です。これらの費用はいずれもこの記事のために置いた架空の値で、実在の運賃や車両費を表すものではありません。固定費は、その車を1日動かすと距離に関係なくかかる費用(車両の償却やリース料、ドライバー1人分の日当など)をまとめたもの、距離の費用は燃料やタイヤ・整備など走った距離に比例する費用をまとめたもの、と読んでください。
車種が混ざる配車では、決めることが1つ増えます。どの車がどの順に回るかに加えて、「どの車種を何台出すか」、つまりフリートミックス(車種構成)を同時に決めることになります。車種の構成と台数を配車と同時に決める問題は、配送計画の研究では「車両の台数と構成」の問題として扱われ、この問題そのものを題名に掲げた論文として Golden・Assad・Levy・Gheysens の1984年の論文があります。目的は、使った車の固定費の合計と、車ごとの距離の単価に走行距離を掛けたものの合計を足した総費用の最小化です。式で書けば \( \min \sum_{v} (F_v\, u_v + c_v\, d_v) \) で、\( u_v \) は車 \( v \) を使うかどうか(0か1)、\( F_v \) はその車の固定費、\( c_v \) は1kmあたりの費用、\( d_v \) はその車の走行距離です。言葉にすれば「使った車の固定費と、車ごとの単価で数えた距離の費用を全部足して、その総額を最小にする」となります。
OR-Tools では、この目的を「車ごとに別の費用の関数を登録する」ことで書きます。SetArcCostEvaluatorOfVehicle で車ごとに距離の費用のコールバックを渡し、SetFixedCostOfVehicle で車ごとに固定費を設定します。積載は AddDimensionWithVehicleCapacity に車ごとの上限の並びを渡します。次のコードは、4トン車3台と2トン車2台を用意して、時間指定を守りながら総費用が最小になる計画を探すものです。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from ortools.constraint_solver import pywrapcp, routing_enums_pb2
from vrp_data import customers, points, dist_km, time_min, VEHICLE_TYPES

cs = customers(); pts = points(cs); n = len(pts)
D = (dist_km(pts) * 1000).round().astype(int).tolist()                  # m
svc = [0] + [c["service"] for c in cs]
T = [[int(round(t)) + svc[i] for t in row] for i, row in enumerate(time_min(pts))]
dem = [0] + [c["demand"] for c in cs]
fleet = [VEHICLE_TYPES[0]] * 3 + [VEHICLE_TYPES[1]] * 2                # 4トン車3台・2トン車2台
man = pywrapcp.RoutingIndexManager(n, len(fleet), 0)
r = pywrapcp.RoutingModel(man)
for v, f in enumerate(fleet):                                          # 車ごとに費用を変える
    cb = r.RegisterTransitCallback(
        lambda a, b, k=f["yen_per_km"]: D[man.IndexToNode(a)][man.IndexToNode(b)] * k // 1000)
    r.SetArcCostEvaluatorOfVehicle(cb, v)
    r.SetFixedCostOfVehicle(f["fixed_yen"], v)
qcb = r.RegisterUnaryTransitCallback(lambda a: dem[man.IndexToNode(a)])
r.AddDimensionWithVehicleCapacity(qcb, 0, [f["capacity"] for f in fleet], True, "Load")
tcb = r.RegisterTransitCallback(lambda a, b: T[man.IndexToNode(a)][man.IndexToNode(b)])
r.AddDimension(tcb, 600, 600, False, "Time")                           # 18時までに帰着
td = r.GetDimensionOrDie("Time")
for i, c in enumerate(cs, start=1):
    td.CumulVar(man.NodeToIndex(i)).SetRange(*c["tw"])                 # 時間指定
p = pywrapcp.DefaultRoutingSearchParameters()
p.first_solution_strategy = routing_enums_pb2.FirstSolutionStrategy.PATH_CHEAPEST_ARC
p.local_search_metaheuristic = routing_enums_pb2.LocalSearchMetaheuristic.GUIDED_LOCAL_SEARCH
p.time_limit.seconds = 10
s = r.SolveWithParameters(p)
print("総費用(円)", s.ObjectiveValue() if s else "初期解が作れなかった")
# 出力: 総費用(円) 98285
ポイントは2つあります。1つ目は、距離の費用を車ごとに登録していることです。同じ道を走っても、4トン車なら60円、2トン車なら40円が距離1kmごとにかかるので、ソルバーは遠い納品先をどの車に回すかを費用の差まで含めて選びます。コールバックの中で k=f["yen_per_km"] と既定値の引数に単価を固定しているのは、Python の無名関数がループの変数を後から参照してしまい、全部の車が最後の単価になるのを避けるためです。2つ目は、固定費を車ごとに設定していることで、ソルバーは車を1台減らすと固定費がまるごと浮くことを知ったうえで計画を組みます。使わない車の固定費はかからないので、手持ちの車を多めに用意しておいても、使う台数はソルバーが決めます。このコードを誘導局所探索10秒で実行した結果は、出力の行のとおり総費用98,285円でした。
1車種だけで組むと、総費用は車種で大きく変わる
まず、1つの車種だけで40件を回る計画を3通り作りました。条件はすべて同じで、積載と時間指定を守り、18時までに帰着し、総費用(固定費+距離の費用)を最小にします。初期解は PATH_CHEAPEST_ARC(今いる点から最も安い辺を順につなぐ作り方)、改善は誘導局所探索で、20秒で打ち切りました。手持ちの台数は、2トン車10台・4トン車6台・軽バン20台と、足りなくならない数を用意しています。
| 車種の構成 | 使用台数 | 総距離(km) | 総費用(円/日) | 1件あたり配送費(円) | 最も遅い帰着 |
|---|---|---|---|---|---|
| 2トン車のみ | 6 | 295.7 | 131,827 | 3,296 | 15時28分 |
| 4トン車のみ | 3 | 234.3 | 98,059 | 2,451 | 16時57分 |
| 軽バンのみ | 15 | 598.6 | 194,965 | 4,874 | 15時39分 |
1件あたり配送費は、総費用を納品先の40件で割った値です。この架空の費用のもとでは、4トン車だけで組んだ計画が最も安く、2トン車だけの計画より1日あたり33,768円安くなりました。4トン車は1台あたりの固定費も距離の単価も2トン車より高いのに、全体では安くなっています。理由は積載1ケースあたりの固定費で、4トン車は28,000円で300ケース、2トン車は20,000円で150ケース、軽バンは12,000円で60ケースを運べるので、1ケースぶんの積載枠にかかる固定費はそれぞれ約93円、約133円、200円です。台数が積載で決まる条件では、大きい車ほど台数が減り、固定費の合計が小さくなります。距離も、少ない台数で回るぶんデポとの往復が減り、234.3kmと最も短くなりました。
一方で、4トン車の計画は1台あたりの仕事が長くなります。3台の帰着は15時45分から16時57分で、2トン車だけの計画(13時51分から15時28分)より遅く、1台が回る件数も2トン車の6〜8件から12〜14件に増えます。ドライバーの拘束時間の上限に近づくほど、この差は効いてきます。拘束時間や休憩を制約に入れたときの扱いは第7章で示したとおりで、この章の実験では18時までの帰着だけを条件にしています。軽バンだけの計画は、固定費が安くても積載が小さいので15台が必要になり、総費用は最も高くなりました。軽バンは、1件あたりの荷物が小さく件数の多い配送や、大きな車が入れない場所で力を発揮する車種で、この共通データのように1件あたり5〜40ケースの納品を大量に運ぶ場面では割高になります。
なお、3つの計画の積載率(デポから積んだ量を、使った車の積載の合計で割った値)は、どれも96.4%で同じでした。総ケース868に対して、使った車の積載の合計がどの計画でも900ケースになったためです。積載率は「車の枠をどれだけ使い切ったか」を示す指標で、車種の選び方の良し悪しは映しません。車種の判断には、積載率ではなく1件あたり配送費や総費用を並べて見る必要があります。
3車種を自由に選ばせても、良い構成が見つかるとは限らない
次に、4トン車4台・2トン車8台・軽バン8台を手持ちとして、どれを使うかをソルバーに任せました。選択肢が増えるので、4トン車だけの計画(98,059円)と同じかそれより安い計画が出てくるはずです。ところが、同じ設定で3回解いた結果は、1回目と2回目が4トン車2台と2トン車2台で総費用109,632円、3回目が4トン車1台と2トン車4台で120,699円でした。どちらも4トン車だけの計画より1万円以上高く、しかも実行ごとに結果が変わっています。同じ条件を別のスクリプトで下調べした際には、4トン車3台で98,155円の計画が出たこともありました(実行ログ ch08_probe.txt)。
同じ設定で結果が変わるのは、誘導局所探索を回数ではなく時間で打ち切っているためです。20秒の間に試せる改善の回数は、同じPCで並列に動いている他の計算の負荷で変わります。そのうえで、車種混在の問題で揺れが大きく出る理由としては、車種の構成を変える改善が1歩では届かないことが考えられます。例えば2トン車2台を4トン車1台に置き換えるには、2台が回っていた十数件を別の車へ移し替える必要があり、1件ずつ移す局所的な改善では、途中の段階で費用がいったん上がります。この説明はソルバーの内部の動きを追って確かめたものではありませんが、実務上の結論は変わりません。「車種を自由に選ばせれば最良の構成が出てくる」とは期待できない、ということです。
対策として有効なのは、車種の構成を外側で列挙し、構成ごとに配車を解いて比べるやり方です。構成を固定すれば、ソルバーは「その車で最も安く回る順番」だけを探せばよくなり、構成の比較は人が表で行えます。積載の合計が総ケース868以上になる組み合わせを10通り選び、それぞれ15秒で解きました。
このとき、もう1つつまずきました。2トン車を6台ちょうどにして解くと、15秒の間に初期解が作れず、ソルバーは「解なし」を返しました。6台で回れる計画は基準の結果で見つかっているので、これは「解が存在しない」という意味ではありません。初期解の作り方(PATH_CHEAPEST_ARC)が、15秒の間に40件全部を6台に収める計画を作れなかった、ということです。このときの積載の余裕は、900ケースに対して32ケースしかありませんでした。そこで、納品先の訪問を省略することを1件あたり1,000万円のペナルティつきで許しました(第6章で扱った AddDisjunction を使う書き方です)。ペナルティは総費用に比べて十分大きいので、全件を回れる計画があれば省略は選ばれず、省略が残ればその構成では回りきれなかったと読めます。
| 用意した4トン車 | 用意した2トン車 | 用意した軽バン | 積載の合計(ケース) | 使用台数 | 総距離(km) | 総費用(円/日) | 1件あたり配送費(円) | 省略した納品先 |
|---|---|---|---|---|---|---|---|---|
| 3 | 0 | 0 | 900 | 3 | 224.1 | 97,447 | 2,436 | 0件 |
| 2 | 2 | 0 | 900 | 4 | 247.7 | 108,512 | 2,713 | 0件 |
| 2 | 1 | 2 | 870 | 5 | 311.4 | 114,383 | 2,860 | 0件 |
| 1 | 4 | 0 | 900 | 5 | 261.6 | 119,796 | 2,995 | 0件 |
| 2 | 0 | 5 | 900 | 7 | 347.0 | 129,313 | 3,233 | 0件 |
| 0 | 6 | 0 | 900 | 6 | 291.4 | 131,656 | 3,291 | 0件 |
| 1 | 3 | 2 | 870 | 6 | 388.7 | 127,206 | 3,180 | 0件 |
| 1 | 2 | 5 | 900 | 8 | 353.6 | 140,755 | 3,519 | 0件 |
| 0 | 5 | 2 | 870 | 7 | 308.6 | 135,079 | (参考) | 1件(C38) |
| 0 | 4 | 5 | 900 | 9 | 369.9 | 152,067 | 3,802 | 0件 |
表の総費用は、使った車の固定費と距離の費用の合計で、省略のペナルティは含めていません。省略が1件残った「2トン車5台・軽バン2台」の行は、C38 を回っていない計画の費用なので、他の行とは比べられません。1件あたり配送費も参考として空欄にしました。
最も安いのは4トン車3台の構成で、総費用97,447円、総距離224.1kmでした。前の節で4トン車だけを6台まで用意して解いた計画(98,059円)より612円安く、同じ構成でも解き方しだいでこの程度の差が出ることが分かります。4トン車を1台減らして2トン車2台に置き換えると108,512円、4トン車を1台にすると119,796円で、4トン車を1台減らすごとにおよそ1万1,000円ずつ高くなります。2トン車だけの6台は131,656円で、4トン車3台との差は1日34,209円です。この131,656円(291.4km)も、前の節の表の2トン車だけの計画(131,827円、295.7km)とは別の実行の結果です。前の節は2トン車を10台まで用意して訪問の省略を許さず20秒で解いたもの、この表は6台ちょうどにして省略をペナルティつきで許し15秒で解いたもので、どちらも使ったのは2トン車6台です。4トン車の612円と同じく、同じ構成でも解き方しだいで171円の差が出ました。以下、2つの構成を比べるときは、同じ実験の中の値どうしを並べます。
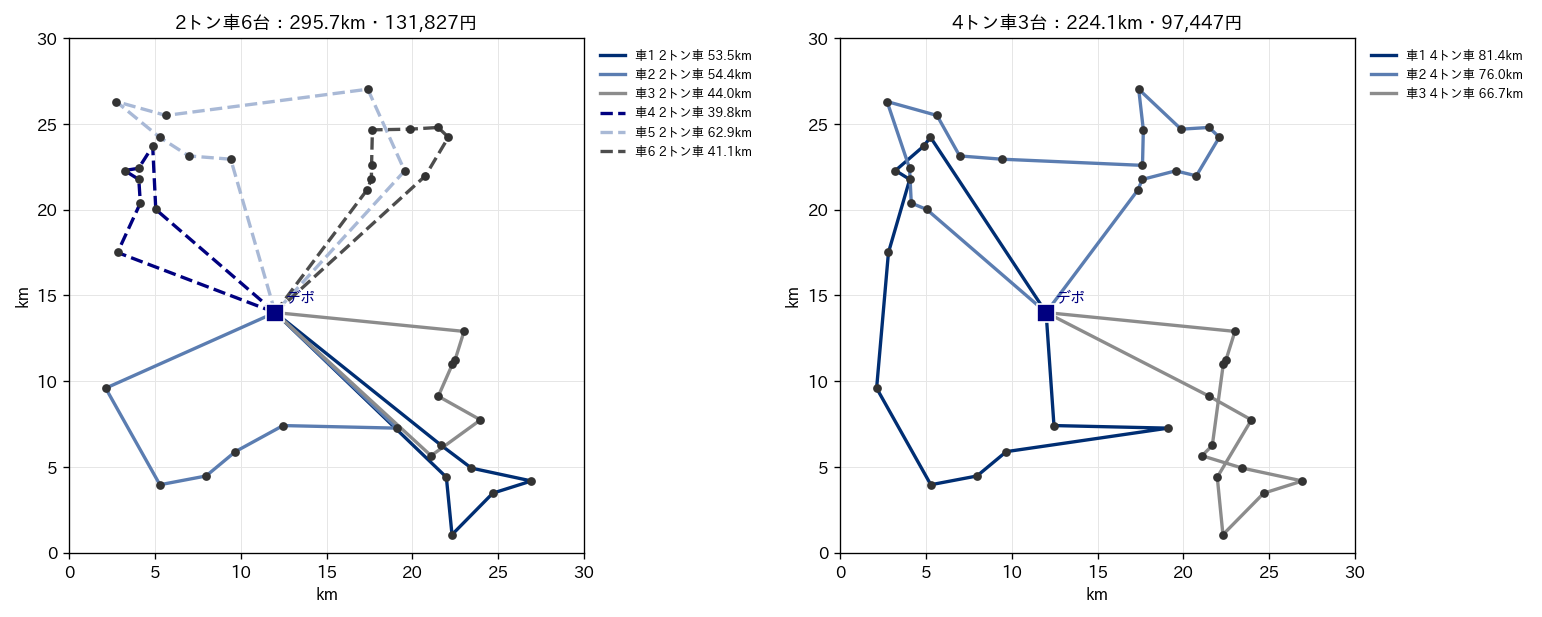
上の図の左が2トン車だけの計画、右が4トン車3台の計画のルート図です(凡例の車の番号は図の中での通し番号です)。左は前の節の表の計画(295.7km、131,827円)、右はこの節の表の計画(224.1km、97,447円)を描いています。図はルートの形を見るためのもので、2つの構成の費用の差は、上の表の同じ実験の中の値(2トン車6台の131,656円と4トン車3台の97,447円)で比べます。2トン車の計画では、北側の2つの地区に向けて3台がデポから出ていき、デポから地区までの往復の線が何本も重なっています。4トン車の計画では、1台が北西の地区から北東の地区までを1本の巡回でつないでおり、往復の線が減っています。大きい車で台数を減らすと、固定費だけでなく、この往復の距離も減ります。
4トン車が入れない地区があると、最適な構成が変わる
ここまでの結果だけを見ると、全部を4トン車にすればよいことになります。しかし実際の配車では、住宅地の細い道や、納品先の駐車場所の広さ、建物の高さ制限などで、大きい車が入れない納品先があります。こうした制約は、配車担当者の頭の中にだけあることが多い情報で、ヒアリングで制約に落とす手順は第13章で扱います。ここでは例として、北西の住宅地区(座標で x が8km未満かつ y が18kmを超える範囲)の10件(C04・C06・C08・C11・C12・C13・C14・C28・C31・C32、合計201ケース)に4トン車が入れない、という架空の条件を置きました。
OR-Tools で「この納品先にはこの車は行けない」を書くには、納品先ごとに訪問できる車の集合を絞ります。公式の関数としては SetAllowedVehiclesForIndex がありますが、この記事の実行環境(OR-Tools 9.15.6755)で Python から車の番号のリストを渡すと、引数の型が合わないという TypeError になり、タプルで渡しても同じでした。そこで、納品先ごとの「担当する車」を表す変数 VehicleVar から、4トン車の番号を RemoveValues で取り除く書き方にしました。こちらは同じ版で動くことを確かめています。
| 用意した4トン車 | 用意した2トン車 | 用意した軽バン | 使用台数 | 総距離(km) | 総費用(円/日) | 省略した納品先 |
|---|---|---|---|---|---|---|
| 3 | 0 | 0 | 3 | 181.8 | (参考)94,906 | 10件(北西の住宅地区の全件) |
| 2 | 3 | 0 | 4(4トン車2・2トン車2) | 246.7 | 108,783 | 0件 |
| 2 | 2 | 0 | 4 | 250.4 | 109,004 | 0件 |
| 2 | 1 | 2 | 5 | 309.8 | 114,393 | 0件 |
| 1 | 5 | 0 | 5 | 260.2 | 119,730 | 0件 |
| 1 | 4 | 0 | 5 | 262.2 | 119,822 | 0件 |
| 0 | 6 | 0 | 6 | 291.4 | 131,656 | 0件 |
表は、試した10通りの構成のうち、省略の無い計画と、比較のために4トン車3台の行を抜き出したものです(全行は実行ログ ch08_fleet.txt にあります)。4トン車3台では、北西の住宅地区の10件を誰も回れず、全件が省略されました。費用の94,906円は10件を回っていない計画の値で、比較の対象にはなりません。省略なしで最も安いのは、4トン車2台と2トン車2台で回る計画で、総費用は108,783円(2トン車を3台用意して2台を使った行)と109,004円(2トン車を2台だけ用意した行)でした。2つは同じ構成を使っており、差の221円は探索の揺れの範囲です。2トン車2台が北西の住宅地区の10件に西側の数件(C05・C18・C22・C34)を加えて受け持ち、4トン車2台が残りの地区を回っています。
立ち入りの制限が無い場合の最良(4トン車3台、97,447円)と比べると、制限があるときの最良は1日あたり11,336円、率にして11.6%高くなりました。この差は「4トン車が入れない地区がある」ことの費用で、仮に年250日稼働とすれば年283万4,000円になります。制限のある納品先がエリアの一角に集まっているので、その地区を小さい車にまとめて任せ、残りを大きい車で回す、という構成が最も安くなりました。もし制限のある納品先がエリア全体に散らばっていれば、どの車も大きい車と小さい車の両方の役割を持てず、差はさらに開きやすくなります。
ここから読み取れるのは、車種構成の判断は「どの車種が安いか」ではなく「どの制約がどの車種を必要としているか」で決まるということです。費用の構造だけを見れば大きい車がいつも有利でも、立ち入りの制限、納品先の荷受けの設備、ドライバーの拘束時間の上限といった制約が、小さい車を何台か持つ理由になります。構成を決める前に、制約のある納品先が何件あり、合計で何ケースあり、エリアのどこに集まっているかを数えておくと、必要な小型車の台数の見当がつきます。
複数デポ、第2の拠点を足すと距離と台数はどう変わるか
共通データには、配送センター(以下デポ1、座標 (12, 14))に加えて、第2のデポ(以下デポ2、座標 (24, 20))が用意してあります。デポ2はエリアの東寄りで、北東の地区と東の地区の間にあります。まず位置関係を数字で確かめました。40件の納品先までの道路距離(直線距離の1.3倍。第2章で置いた仮定)の平均は、デポ1から15.5km、デポ2から18.8kmです。それぞれの納品先について近いほうのデポまでの距離をとると、平均は13.3kmに下がり、40件のうち15件はデポ2のほうが近くにあります。
OR-Tools では、複数デポ(車ごとに出発する拠点が違う配車)は「車ごとに出発地と帰着地を指定する」ことで書きます。公式ガイドの「Common Routing Tasks」には、RoutingIndexManager に出発地の番号の並びと帰着地の番号の並びを渡すと、車ごとに違う出発地と帰着地を設定できることが書かれています。この章では、各車は出発したデポへ戻ることにし、デポ1の車10台とデポ2の車10台を用意して、どの車を使うかはソルバーに選ばせました。車は2トン車(積載150ケース)で、費用は共通データの VEHICLE_TYPES の値(固定費1日1台20,000円、距離1kmあたり40円)を使います。この費用はいずれも、この記事のために置いた架空の値です。時間指定を守り、18時までに自分のデポへ戻る条件で、誘導局所探索を20秒で打ち切りました。
ここで大事な仮定が1つあります。デポ2にも、40件の納品先に届ける全品目の在庫があるとしています。実際には、第2の拠点に何を置くか(全品目を置くのか、よく出る品目だけを置くのか)で、デポ2から出せる納品先が変わります。在庫の置き方は拠点を増やす判断と一体で、この仮定が崩れると以下の数字は成り立ちません。
| 拠点の条件 | 使用台数 | デポ1の台数(件数) | デポ2の台数(件数) | 総距離(km) | 総費用(円/日) |
|---|---|---|---|---|---|
| デポ1だけ | 6 | 6(40件) | なし | 295.7 | 131,827 |
| デポ1とデポ2(1回目) | 6 | 4(27件) | 2(13件) | 278.9 | 131,158 |
| デポ1とデポ2(2回目) | 6 | 4(26件) | 2(14件) | 284.1 | 131,364 |
| デポ2だけに移す | 6 | なし | 6(40件) | 324.4 | 132,976 |
表の「デポ1だけ」の行の総距離は295.7kmで、基準の結果(積載+時間指定、6台・293.2km)と少し違います。基準の結果は距離の最小化に台数の固定費を100km相当で足した目的で解いていますが、この章は円の総費用(固定費20,000円は距離500km相当)を最小化しています。目的の重みが違うので、同じ20秒でも行き着く計画が変わりました。どちらも最適性は証明していません。デポ1だけの計画は2回解いて2回とも同じ結果でした。
第2のデポを加えると、総距離は295.7kmから278.9km(1回目)、284.1km(2回目)に減りました。減った量は16.8kmと11.6kmで、割合にすると5.7%と3.9%です。同じ設定で2回の結果が違ったのは、車種を自由に選ばせた節と同じく、時間で打ち切る探索の揺れです。デポ1だけの問題では2回とも同じ計画に行き着いたのに対し、デポが2つになると揺れが出ました。デポ2から出た2台は、北東の地区(C03・C07・C10・C16・C19・C23・C30)と東の地区(C09・C15・C24・C37・C39・C40)を受け持ち、デポ1の4台が残りを回っています。デポ2から北東の地区を回る車は、1回目の計画で27.2kmを走って7件を回っています。デポ1だけの計画で走行距離が最も短い車(39.8km・7件)と比べても、10km以上短い巡回です。
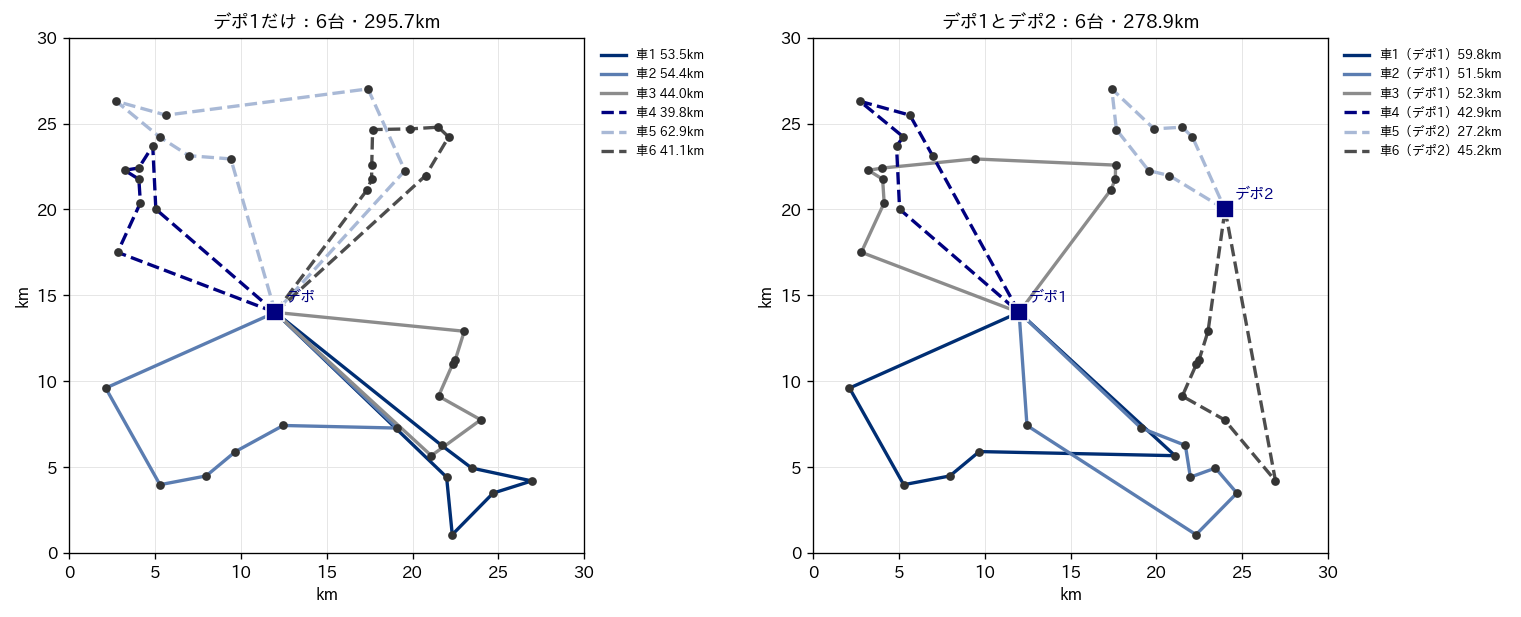
上の図の左がデポ1だけ、右がデポ1とデポ2を使った1回目の計画です。右の図では、デポ2から出た2台(破線)が北東の地区と東の地区を受け持ち、デポ1から北東の地区の奥へ向かう線が減っています。
一方で、使用台数は6台のまま変わりませんでした。この共通データでは、台数を決めているのは積載です。総ケース868を150ケースの車で運ぶには6台が下限で(第2章・第4章で確かめた下限)、拠点を増やしても荷物の量は減らないので、台数の下限は動きません。拠点を足して減るのは距離の費用だけで、1日あたりの総費用の差は669円(1回目)と463円(2回目)にとどまりました。
「デポ2だけに移す」行は、拠点を増やすのではなく移転した場合です。納品先までの平均の道路距離はデポ2から18.8kmで、デポ1からの15.5kmより長く、総距離は324.4kmに増え、総費用も1日1,149円増えました。デポ2のほうが近い納品先が15件あっても、残りの25件はデポ1のほうが近いので、全部をデポ2から出すと損になります。
この結果を経営の判断に翻訳すると、第2の拠点が日々の配車にもたらす効果は、この条件では1日あたり数百円の距離の費用です。仮に年間250日稼働するとして(この日数も例として置いた値です)、1回目の差額669円なら年16万7,250円、2回目の463円なら年11万5,750円になります。拠点を1つ持つには、賃料・人件費・在庫の二重持ちといった費用がかかり、その額は拠点ごとに大きく違うのでここでは置きませんが、配車の距離の節約だけで拠点の費用をまかなえる場面は、この規模では想定しにくいと考えています。
ただし、これは台数が変わらなかった場合の読み方です。第2の拠点で台数が減りうるのは、積載ではなく時間が台数を決めている場合です。遠い納品先へ往復する時間が長く、1台が回れる件数が時間の上限で頭打ちになっているなら、近い拠点から出すことで1台あたりの件数が増え、台数が減りえます。今回の共通データでは、デポ1だけの計画でも各車が13時51分から15時28分の間に帰着しており、18時までの時間にまだ余裕があったので、時間ではなく積載が台数を決めていました。自社のデータで試すときは、まず「台数を決めているのは積載か時間か」を確かめ、積載が決めているなら拠点の効果は距離の費用に限られる、と見当をつけてから詳細な試算に入るのが効率的です。
拠点を増やす判断には、配車以外の効果もあります。デポ2から出た車は、デポに戻る時刻が早くなれば、その日のうちに2回目の積み込みができるかもしれません。デポ2に在庫を置けば、東側の納品先への当日の追加注文に応えやすくなります(当日の追加注文の扱いは第11章で扱います)。反対に、在庫を2か所に分けると、どちらかで欠品が起きる確率は上がり、拠点間の在庫の移動(横持ち)が必要になることもあります。どの段階・どの拠点に在庫を置くかの考え方は、弊社コラム「在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで」の第10章で扱いました。配車の最適化が答えられるのは、このうち「配送の距離と台数がどう変わるか」の部分だけで、その数字を拠点の費用と在庫の費用に並べて判断することになります。
集荷と配送の組、同じ車で・集荷を先に
ここまでの配車は、荷物はすべてデポで積み、納品先で降ろすだけでした。実際の配送では、ある取引先で引き取った荷物(返品、部材、預かり品など)を別の取引先へ届ける仕事が混ざることがあります。この「A で積んで B で降ろす」仕事を配車に組み込む問題を集荷配送問題と呼びます。Savelsbergh と Sol の1995年の総説は、要旨で、集荷配送問題を「車が途中で積み替えをせずに荷を出発地から目的地へ運ぶ問題」と説明し、標準的な配送計画問題と区別するいくつかの特徴と、問題の型と解法を概観したと述べています。
集荷配送の組には、2つの条件が付きます。1つ目は、集荷と配送を同じ車が行うことです。A で積んだ荷物を別の車が B へ届けることはできません(途中で積み替える拠点を設けるなら話は別ですが、それは別の問題になります)。2つ目は、集荷が配送より先であることです。積んでいない荷物は降ろせません。この2つは人間にとっては当然すぎて、配車担当者が口に出すことはまずありませんが、ソルバーには書かなければ伝わりません。
共通データの pickup_delivery_pairs() には、集荷と配送の組が8件用意してあります(合計95ケース)。例えば「C20 で20ケースを引き取り、C39 へ届ける」といった組で、集荷先・配送先はいずれも40件の納品先のどれかです。集荷先と配送先での作業は、それぞれ10分と仮定し、時間指定はその納品先と同じ枠にしました。車は2トン車10台まで、条件はこれまでと同じです。OR-Tools の公式ガイドの集荷配送のページの例では、AddPickupAndDelivery で組を宣言したうえで、同じ車であることを VehicleVar の等式で、集荷が先であることを累積の値(この章では時間の次元)の不等式で、それぞれ明示的に加えています。この章の実装も同じ形にしました。次は、共通の関数から該当する部分を抜き出したものです。
# ch08_common.py から抜き出したもの(a は集荷点、b は配送点のインデックス)
r.AddPickupAndDelivery(a, b)                                  # 組の宣言
r.solver().Add(r.VehicleVar(a) == r.VehicleVar(b))            # 同じ車
r.solver().Add(td.CumulVar(a) <= td.CumulVar(b))             # 集荷が先(td は時間の次元)
| 計画の作り方 | 使用台数 | 総距離(km) | 総費用(円/日) | 組の検査 |
|---|---|---|---|---|
| 納品40件だけ(組なし) | 6 | 295.7 | 131,827 | 対象外 |
| 納品+組8件を同じ計画で(宣言+同じ車+集荷が先) | 6 | 392.1 | 135,682 | 8組とも同じ車・集荷が先 |
| 同上、組の宣言だけ | 6 | 392.1 | 135,682 | 8組とも同じ車・集荷が先 |
| 組の制約を何も書かない(積載は簡略な数え方) | 6 | 296.8 | 131,872 | 7組が別の車に分かれ、1組は配送が先 |
| 納品40件の計画+組8件だけの別便 | 8 | 509.0 | 180,361 | 8組とも同じ車・集荷が先 |
組8件を納品の計画に組み込むと、台数は6台のまま、総距離は295.7kmから392.1kmへ96.4km増え、総費用は1日3,855円増えました。同じ設定で2回解き、2回とも同じ結果です。距離が大きく増えたのは、組の中に遠い2点を結ぶものがあるからで、例えば南の C20 で積んで南東の C39 へ、北西の C08 で積んで南東の C40 へ運ぶ組が、1台の車の巡回に入っています。一方で、組8件を納品とは別の車で運ぶと、組だけで2台・213.3km・48,534円がかかり、納品の計画と合わせて8台・509.0km・180,361円になりました。納品の車に組み込んだほうが1日44,679円安く、台数も2台少なく済みます。
組の宣言だけ(AddPickupAndDelivery だけで、同じ車と集荷が先の制約を足さない)で解いた計画は、この版の OR-Tools では宣言に加えて制約を書いた場合とまったく同じ計画になり、検査でも8組すべてが同じ車・集荷が先でした。ただし、公式の例は2つの制約を明示しており、宣言だけで同じ結果になることを保証する記述は、今回開いたガイドのページには見当たりませんでした。実装では制約を明示しておき、この章のように解いた後に「同じ車か」「集荷が先か」を検査するのが安全です。
組の制約を何も書かずに解くと、総距離は296.8kmで、組なしの計画とほとんど変わりません。一見すると「組を入れても費用はほぼ増えない」ように見えますが、検査すると8組のうち7組で集荷と配送が別の車に分かれ、残る1組は同じ車で配送が集荷より先になっていました。集荷と配送の点を、ばらばらの納品先としてそれぞれ近い車に割り振っただけの計画で、現場では実行できません。なお、この行は、組の制約を書かないまま積載を正しく数えるモデル(次の節で説明します)では20秒の間に初期解が作れなかったので、積載を簡略に数えるモデルで解いたものです。組を入れた計画の費用を見積もるときに、この行の数字(1日45円増)を使うと、実際の増分(1日3,855円)を大きく読み違えます。
帰り荷と回収、途中で積む荷物は積載の数え方を変える
集荷配送の組の特別な場合として、納品先で引き取った荷物をデポへ持ち帰る仕事があります。通い箱(繰り返し使う配送用の箱)やパレットの回収、返品の引き取りがその例です。納品で荷台が空いていくので、その空きを使って帰り道に回収する、というのが帰り荷の基本的な考え方です。ここでは、40件のうち15件で合計300ケースの回収がある、という架空の条件を乱数で作りました(1件あたり10〜36ケース)。
回収を配車に入れるとき、積載の数え方で大きな落とし穴があります。最初に書いたモデルでは、積載を1本の累積(次元)で数え、納品先で降ろす量を引き、回収する量を足し、デポを出る時点の積載は「最初に積んだ量」として自由な値にしていました。回収が無い場合はこれで正しく、出発時の積載は自然に「その車が降ろす量の合計」以上になります。ところが回収があると、途中で積んだ回収品が、その後の納品先で「降ろす荷物」として数えられてしまいます。このモデルで解くと、2トン車4台・243.5km・89,741円という計画が出てきました。1台がデポから積むべき量を数えると188・247・257・176ケースで、4台とも150ケースの積載を超えています。回収した通い箱を次の店に納品することはできないので、この計画は実行できません。
正しく数えるには、デポで積む荷物と途中で積む荷物を区別する必要があります。この章では、各納品先の荷物を「デポでの積み込み」と「納品先での荷下ろし」の組として表し、積み込みは出発時刻に行う(時間の枠を0分に固定する。このため各車は8時に出発する扱いになります)ことにしました。前の節の集荷配送の組を入れた計画も、この数え方で解いています。前の節の集荷配送の組と同じ書き方で、積載の次元は出発時0から始め、積み込みで増え、荷下ろしで減り、回収で増えます。こうすると、各時点の積載は「まだ降ろしていない納品の荷物+すでに積んだ回収品」になり、150ケースの上限がどの時点でも守られます。
| 計画の作り方 | 使用台数 | 総距離(km) | 総費用(円/日) | 実行できるか |
|---|---|---|---|---|
| 納品40件だけ(回収なし) | 6 | 295.7 | 131,827 | できる |
| 納品+回収(誤った数え方) | 4 | 243.5 | 89,741 | できない(4台とも出発時に150ケースを超える) |
| 納品+回収(正しい数え方) | 6 | 296.9 | 131,877 | できる |
| 納品40件の計画+回収だけの別便 | 8 | 465.1 | 178,602 | できる |
正しい数え方で解いた計画は、6台・296.9km・131,877円で、回収なしの計画と比べて距離は1.2km、費用は50円しか増えませんでした(2回解いて2回とも同じ結果)。回収を納品とは別の便で行うと、回収だけで2台・169.4km・46,775円かかり、合計で8台・465.1km・178,602円になります。回収を納品の車の帰り道に載せると、別便より1日46,725円安く、2台少なく済みます。
この例で回収がほぼ無料で入ったのは、回収の量が、空いていく荷台に収まったからです。実際、回収を考えずに作った納品だけの計画に回収を後から足しても、途中で150ケースを超える車は1台もありませんでした。この計算では、同じ納品先では先に降ろしてから回収品を積むとしています。回収のある納品先では、その場での荷下ろしと、それまでの納品先での荷下ろしで、回収量を上回る空きが荷台にできていました。ただし、これはこのデータでの結果です。最初の数件で回収量の多い納品先を回る順番になっていたり、回収量が納品量より大きい納品先が多かったりすれば、途中で積載を超え、納品だけの計画に回収を後から足すことはできなくなります。回収量が増えてきたら、回収を積載の条件に入れて計画し直すことが必要になります。
この節の落とし穴は、モデルの数え方の誤りが、もっともらしい数字として出てくる例です。ソルバーはエラーを出さず、実行ログの上では正常に解けています。回収の誤った数え方は台数を6台から4台に減らし、1日4万円以上安い計画を示しました。こうした「良すぎる結果」が出たときは、まず各車の積み込み量や積載の推移を、表に書き出して手で確かめるのが有効だと考えています。
帰り荷という言葉は、もっと広い意味でも使われます。自社の納品を終えて空で戻る車に、別の荷主の荷物を載せて帰る、という使い方です。考え方はこの節と同じで、行きの荷台の空き方と帰り道の空き時間に、別の荷物が収まるかどうかを積載と時間の条件で確かめることになります。ただし、別の荷主の荷物を運ぶには、荷主どうしの取り決めや運賃の分担、積み替えの場所といった配車の外側の条件が加わります。別の荷主と納品先を合わせる共同配送の効果の試算は第12章で、共同配送や中継輸送をめぐる政策の動きは第14章で扱います。
経営の判断に使う、車種と拠点と帰り荷の数字
この章の結果を経営指標に置き換えて並べると、判断の大きさの順序が見えてきます。以下の金額はいずれも架空の費用のもとでの1日あたりの差で、傾向を読むためのものです。
| 判断 | 比べたもの | 使用台数の差 | 総距離の差(km) | 総費用の差(円/日) | この章での読み方 |
|---|---|---|---|---|---|
| 車種構成を変える | 2トン車6台(131,656円)と4トン車3台(97,447円) | 3台減 | 67.3減 | 34,209減 | 固定費が効く。最も大きい |
| 大きい車の立ち入り制限 | 制限なしの最良(97,447円)と制限ありの最良(108,783円) | 1台増 | 22.6増 | 11,336増 | 制約が小さい車を持つ理由になる |
| 第2の拠点を足す | デポ1だけ(131,827円)とデポ1とデポ2(1回目131,158円) | 変わらず | 16.8減 | 669減 | 積載が台数を決めている間は小さい |
| 集荷配送の組を納品便に載せる | 別便(180,361円)と同じ計画(135,682円) | 2台減 | 116.9減 | 44,679減 | 別便を仕立てるより大幅に安い |
| 回収を納品便の帰り道に載せる | 別便(178,602円)と同じ計画(131,877円) | 2台減 | 168.2減 | 46,725減 | 荷台の空きに収まる限りほぼ無料 |
表の差は、「判断」の列に書いた方向へ計画を変えたときの増減です。例えば1行目は、2トン車6台の構成から4トン車3台の構成に変えると、台数が3台減り、距離が67.3km減り、総費用が1日34,209円減る、という意味です。1行目と3行目の「2トン車6台」の総費用が131,656円と131,827円で違うのは、1行目が構成を固定して比べた実験(15秒、省略をペナルティつきで許す)、3行目が拠点を比べた実験(2トン車を10台まで用意して20秒)の値で、それぞれの行を同じ実験の中の値どうしで比べているためです。どちらの値も2トン車6台で全40件を回った計画です。
この表から読み取れることは3つあります。1つ目は、台数が変わる判断は、距離しか変わらない判断より一桁大きい効果を持つことです。この架空の費用では、2トン車1台の固定費20,000円は、距離にして500km分の距離の費用にあたります。第2の拠点で減った距離は16.8kmで、固定費に換算すれば1台の3%あまりにすぎません。拠点や経路の工夫で距離を削るより先に、台数を決めている条件(積載か、時間か、立ち入りのような車種の条件か)を突き止めるほうが、経営上の効果は大きくなりやすいと考えています。
2つ目は、車種構成の判断は、費用の構造と制約の両方を見ないと誤るということです。費用だけを見れば4トン車だけの構成が最も安くなりますが、4トン車の入れない納品先が201ケース分あるだけで、2トン車2台が必要になり、最良の費用は1日11,336円上がりました。車両の入れ替えは数年単位の契約になるので、「制約を入れずに最適化した構成」で車両を発注すると、その後の数年間、現場は入れない納品先を無理に回るか、臨時の車を手配するかの対応を毎日迫られます。構成を決める前に、立ち入りの制限、荷受けの設備、ドライバーの拘束時間の上限といった条件を、車種ごとに洗い出しておくことが欠かせません。また、この章の固定費には、大きい車を運転できるドライバーの確保のしやすさや、車両の調達にかかる時間は入っていません。これらは数字にしにくいものの、構成の判断を左右しうる条件です。
3つ目は、集荷や回収のように「別便で行っていた仕事」を納品の便に組み込むと、台数が減る可能性があることです。この章の例では、組8件を納品便に載せると別便より2台少なく、回収を帰り道に載せるとやはり2台少なく済みました。一方で、集荷配送の組は総距離を96.4km増やしており、組み込んだぶん1台の仕事は長くなります。組み込めるかどうかは、荷台の空きと時間の余裕で決まるので、別便で回している仕事があれば、まずそれを納品の計画に入れて解き直し、台数と帰着時刻がどう変わるかを見るのが手軽な試算になります。
拠点を増やす判断については、配車の最適化が出せるのは距離と台数の変化だけで、拠点そのものの費用や在庫の費用とは別に比べる必要があります。拠点の場所と数を候補の中から選ぶ問題は、先に述べたとおり弊社コラム「数理最適化の定式化パターン集」の第8章で扱っています。この章の方法は、候補の拠点を1つずつ配車に加えてみて、距離と台数の変化を測る、という使い方になります。
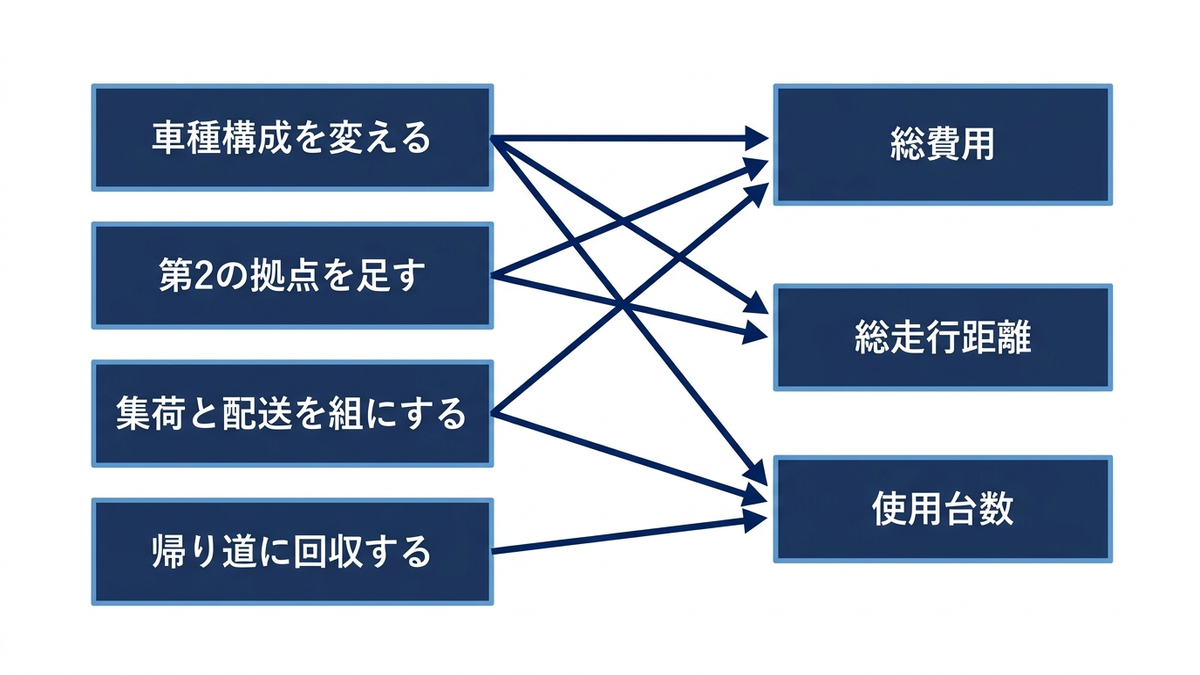
この章の要点は3つです。第一に、車種・拠点・集荷配送は、OR-Tools では車ごとの積載と費用、車ごとの出発地と帰着地、組の宣言と同じ車・集荷が先の制約として書け、前提を変えた配車を同じ枠組みで比べられます。ただし車種混在の問題は時間で打ち切る探索の揺れが大きく、車種の構成は外側で列挙して構成ごとに解くほうが確実でした。第二に、この共通データでは台数を決めているのが積載だったので、大きい車で台数を減らす判断の効果が最も大きく、第2の拠点の効果は距離の費用にとどまりました。立ち入りの制限のような車種の条件は、最適な構成を変えます。第三に、途中で積む荷物がある配車では、積載の数え方を誤ると実行できない「良すぎる計画」が出ます。集荷と回収を納品の便に正しく組み込めば、別便より台数を減らせます。次の第9章では、ここまで全章で仮定として置いてきた「直線距離の1.3倍」「時速25km」という距離と時間の作り方そのものを検討します。
この章を深めたい方への参考書籍
『Pythonによる実務で役立つ最適化問題100+(2)割当・施設配置・在庫最適化・巡回セールスマン』(久保幹雄、朝倉書店):版元の目次では、連続施設配置問題、k-メディアン問題、k-センター問題がそれぞれ章として立っています。この章では拠点の場所を与えられたものとして配車への効果を測りましたが、拠点の候補地そのものを選ぶ問題を、Python のコードを動かしながら確かめたい方に向いています。
『サプライ・チェイン最適化ハンドブック』(久保幹雄、朝倉書店):版元の目次には、「施設配置モデル」「ロジスティクス・ネットワーク設計モデル」「配送計画モデル」「運搬スケジューリングモデル」の章が並んでいます。この章で扱った「拠点を置くか」「どの車で運ぶか」の判断を、在庫や生産を含むサプライチェーン全体のモデルの中で位置づけたい方に向いています。
第9章 距離と時間をどう作るか、見積りの誤差が計画を壊す
第8章では、車種の混在・複数の拠点・集荷と配送の組を配車の問題に入れ、車両の構成や拠点の置き方を判断する材料を最適化で作りました。第2章からここまでの計算は、どれも2地点の間の距離と所要時間が分かっているものとして進めてきました。共通データでは、道路距離を「直線距離の1.3倍」、移動時間を「その道路距離を時速25kmで割ったもの」と置いています。第2章で断ったとおり、1.3と25はどちらも仮定です。この章では、この仮定そのものを取り上げます。配車の最適化は、与えられた距離と時間を疑いません。入力の距離と時間が現実とずれていれば、ソルバーはずれた前提のもとでの最適を正確に返し、その計画は実際の道路の上で約束の時刻を破ります。この章では、道路網の模型を作って直線距離に係数を掛ける方法と比べ、時間帯による所要時間の違い、納品先の位置の精度、荷下ろし時間の見積りを順に扱ったうえで、見積りの誤差が計画をどれだけ壊すかを実験で測り、余裕の持たせ方を比べます。
距離行列と時間行列は、ソルバーにとって現実そのものである
第2章で説明したように、配送計画問題の入力の中心は、すべての地点の組について距離と移動時間を並べた表、つまり距離行列と時間行列です。納品先が40件で配送センターを含めると41地点なので、行列は41行41列で、同じ地点どうしの41個を除き、向きを区別すれば組は1,640通りあります。ソルバーはこの表の値を使って、どの車がどの順に回るかを探し、時間枠を守れるかを判定します。表の値が正しいかどうかをソルバーが確かめることはありません。表に「C11からC18まで10分」と書いてあれば、実際には橋まで回って20分以上かかる区間でも、ソルバーは10分で着く前提で計画を組みます。
このため、配車の最適化の品質は、探索の上手さだけでは決まらず、距離と時間の表の品質に強く左右されます。この章の後半で示すように、共通データの基準の計画(6台・総距離293.2km)を、同じ順番のまま道路網の模型の上で走らせると331.1kmになり、計画上の距離より12.9%長くなりました。探索の設定を変えて得られる差より、入力の表のずれのほうが大きいことは十分に起こりえます。探索を磨く前に入力を確かめる、というのがこの章の出発点です。
距離と時間の作り方には、大きく分けて3つの段階があります。1つ目は、座標から直線距離を計算し、係数を掛けて道路距離の代わりにする方法です。計算が一瞬で済み、地図データも要りませんが、個々の区間の誤差は大きくなります。2つ目は、道路網のデータの上で最短経路を計算する方法です。道路の形や川・線路・一方通行を反映できますが、道路網のデータと経路の計算が必要になります。3つ目は、時間帯ごとの所要時間の実績(走行の記録や交通情報)を使い、出発する時刻によって所要時間を変える方法です。最も現実に近い一方で、データを集めて維持する手間は最も大きくなります。この章では、1つ目と2つ目の差を模型で測り、3つ目の効き目を約束の時刻に対する遅れとして測ります。
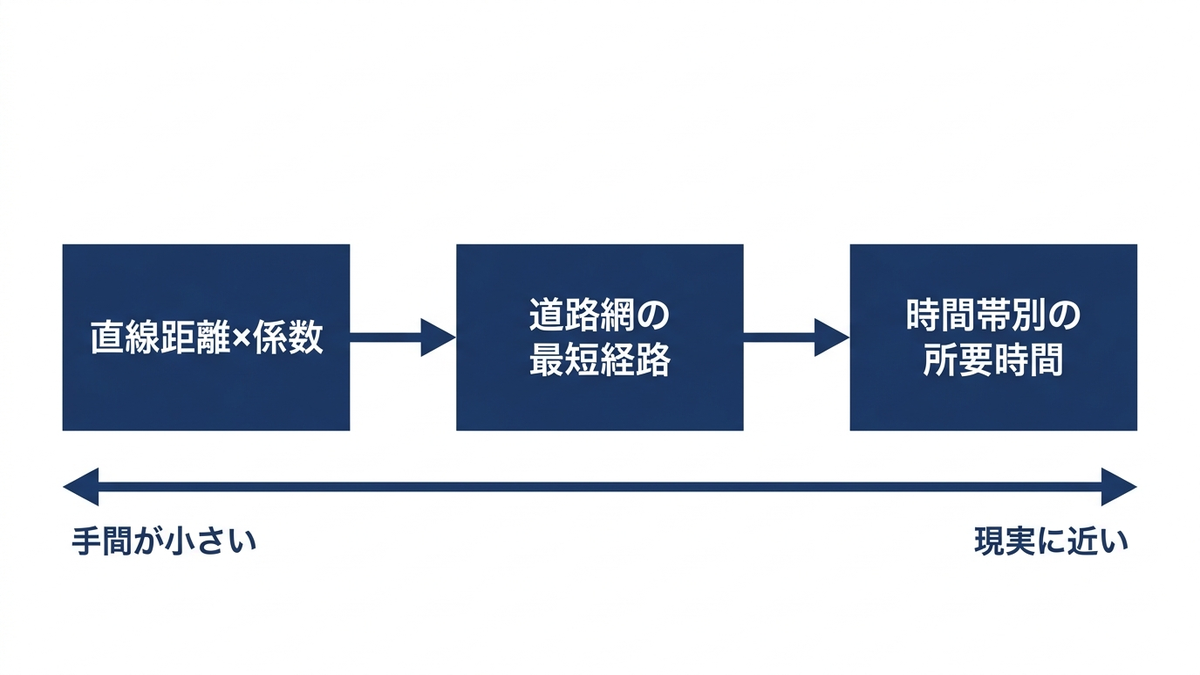
直線距離に係数を掛ける方法と、その危うさ
直線距離に掛ける係数は、道路の曲がり具合を表すもので、迂回係数(英語では circuity factor などと呼ばれます)と呼ばれます。道路が碁盤の目になっている地域では、2点の間を縦と横の道だけで結ぶので、道路距離は直線距離より長くなります。碁盤の目の上で進む向きがあらゆる方向に均等に散らばっているなら、縦横の移動距離の合計と直線距離の比の平均は \( 4/\pi \approx 1.273 \) になります。言葉にすれば「碁盤の目の道路では、平均すると直線の約1.27倍を走る」ということです。乱数で向きを100万本作って数値で確かめたところ、平均は1.2730で、理論値の1.2732と一致しました。真北や真東へ向かうときの比は1.0、斜め45度のときの比は最大の約1.414です。共通データの1.3は、この平均に近い仮定です。
この係数には2つの危うさがあります。1つ目は、係数が平均でしかないことです。同じ1.3を全部の区間に掛けると、真北や真東に向かう区間は長めに、斜めの区間は短めに見積もられます。平均が合っていても、個々の区間は上下にずれます。2つ目は、川・線路・山・幹線道路の中央分離帯のように、横切れる場所が限られた障害物を係数では表せないことです。川の向こう岸にある納品先は、直線では目と鼻の先でも、橋まで回れば何倍もの距離になります。この2つ目のずれは平均の係数を調整しても直らず、特定の区間に集中して現れます。そして配送のルートは、近い納品先どうしを続けて回るように組まれるので、係数の誤差が大きい短い区間ほど、ルートの中に多く含まれます。
道路網の模型を作り、最短経路の距離と比べる
係数の危うさを数字で見るため、共通データの30km四方の地域に、架空の道路網の模型を作りました。0.5km間隔の碁盤の目を生活道路とし、4kmごと(x または y が 2・6・10…km の線)を幹線とします。速度は幹線が時速30km、生活道路が時速15kmと置きました(いずれも仮定です)。さらに、y=18.25km の位置に東西に流れる川を置き、渡れるのは x=6・14・22km の3本の橋だけとしました。共通データの納品先が集まる3つの地区のうち、北西と北東の地区は川の北側に、配送センターと南東の地区は川の南側にあります。各地点は最寄りの交差点へ直線でつなぎ(川の向こう側の交差点にはつながない)、Python のネットワーク解析ライブラリ networkx 3.6.1 で、所要時間が最小になる経路を全地点の組について求めました。模型は交差点3,721か所の道路網で、次のコードはその作り方と、1つの組の最短経路の求め方です(実験に使ったスクリプトから1組の計算だけを抜き出したもので、第2章の共通データのプログラム vrp_data.py を読み込めば、このコードだけで動きます)。
import math
import networkx as nx
from vrp_data import customers, points

STEP, N, RIVER_Y, BRIDGES = 0.5, 61, 18.25, {6.0, 14.0, 22.0}
def speed(v):                                   # 4km ごとの幹線は時速30km、ほかは15km(仮定)
    return 30.0 if (v - 2.0) % 4.0 == 0 else 15.0
g = nx.Graph()
for i in range(N):
    for j in range(N):
        x, y = i * STEP, j * STEP
        if i + 1 < N:
            g.add_edge((x, y), (x + STEP, y), km=STEP, minutes=STEP / speed(y) * 60)
        crossing = (y < RIVER_Y) & (y + STEP > RIVER_Y)
        if (j + 1 < N) & ((not crossing) | (x in BRIDGES)):   # 川は橋でしか渡れない
            g.add_edge((x, y), (x, y + STEP), km=STEP, minutes=STEP / speed(x) * 60)
pts = points(customers())
for k, (x, y) in enumerate(pts):                # 各地点を最寄りの交差点へつなぐ(川の同じ側)
    gy = round(y / STEP) * STEP
    gy = gy - STEP if (y < RIVER_Y) & (gy > RIVER_Y) else gy
    gy = gy + STEP if (y > RIVER_Y) & (gy < RIVER_Y) else gy
    gx = round(x / STEP) * STEP
    d = math.hypot(x - gx, y - gy)
    g.add_edge(("P", k), (gx, gy), km=d, minutes=d / 15.0 * 60)
t, path = nx.single_source_dijkstra(g, ("P", 11), weight="minutes")   # C11 から最短時間で
p = path[("P", 18)]                                                   # C18 まで
km = sum(g[p[a]][p[a + 1]]["km"] for a in range(len(p) - 1))
straight = math.dist(pts[11], pts[18])
print("C11→C18 直線 %.1f km  直線×1.3 %.1f km  道路網 %.1f km  %.1f 分" % (straight, straight * 1.3, km, t[("P", 18)]))
# 出力: C11→C18 直線 3.2 km  直線×1.3 4.1 km  道路網 8.4 km  22.5 分
C11とC18は、北西の地区の南端と、川をはさんだ南側にある納品先です。直線では3.2kmしか離れておらず、係数1.3を掛けた見積りは4.1km・9.9分ですが、道路網では x=6km の橋まで回るので8.4km・22.5分かかります。この1区間だけで、時間の見積りは12分以上短すぎます。
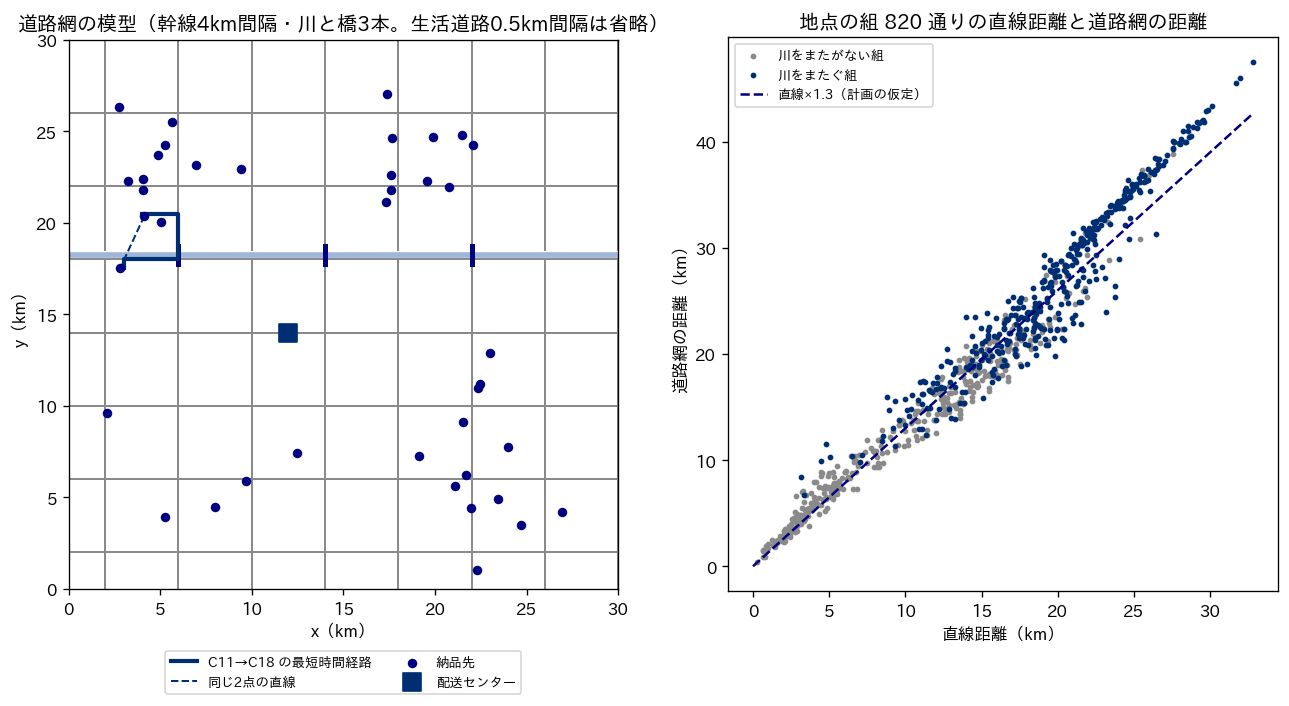
41地点の組820通り(向きは区別しない)について、道路網の距離と直線距離の比をまとめたのが次の表です。左の図が模型、右の図が全組の散布図で、破線が計画で仮定した「直線×1.3」です。
| 項目 | 値 |
|---|---|
| 道路網の距離÷直線距離の平均(820組) | 1.360 |
| 同じ比の中央値 | 1.367 |
| 同じ比の最小〜最大 | 1.001〜2.640 |
| 比が1.3を超える組の割合 | 64.5% |
| 比が1.5を超える組の割合 | 11.1% |
| 比が2.0を超える組の割合 | 1.5% |
| 直線3km未満の組(63組)の比の平均 | 1.532 |
| 道路網の距離と直線×1.3の差の絶対値の平均 | 1.73km |
| 道路網の所要時間÷直線×1.3を時速25kmで割った所要時間の平均 | 1.019 |
| 同じ時間の比の最小〜最大 | 0.653〜3.068 |
比の平均は1.360で、仮定の1.3とそれほど違いません。所要時間の比の平均も1.019で、平均だけを見れば「直線×1.3・時速25km」はこの模型をよく近似しているように見えます。ところが個々の組を見ると、時間の比は0.653から3.068まで散らばっています。幹線を長く走れる組は見積りより速く、川を渡る短い組や生活道路だけで結ばれる組は見積りより大幅に遅くなります。直線3km未満の近い組63組では比の平均が1.532に上がり、最大は2.393でした。近い組ほど、最寄りの交差点までの寄り道や、碁盤の目に沿った曲がりが距離の中で占める割合が大きくなるためです。
ここで注意したいのは、平均が合っていても計画は守られない、という点です。配車の最適化は、近い納品先どうしを続けて回るルートを作ります。そのため計画に含まれる区間は、全組の平均より近い組に偏ります。実際、基準の計画の区間だけで比べると、計画上の総距離293.2kmに対して道路網での距離は331.1kmで、比は1.129倍、つまり全体に12.9%長くなりました。全組で見た距離の差(道路網の距離から直線×1.3を引いた値の平均)は0.50kmにすぎないのに、ルートに入る区間では差が積み上がります。係数を全組の平均で決めても、計画の距離の見積りとしては甘くなりやすいということです。
この模型の数字は、架空の地域の架空の道路網から出したもので、実在の地域の迂回係数を示すものではありません。実際の係数は、道路の密度や地形、川や鉄道の配置によって地域ごとに違います。自社の配送エリアで係数を使うなら、過去の運行記録(走行距離計やデジタルタコグラフの記録)から、実際に走った距離と直線距離の比を区間ごとに集計し、平均だけでなくばらつきと、比の大きい区間がどこに集中しているかを確かめるのが確実です。
時間帯によって所要時間は変わる、公的な調査の数字で確かめる
道路網の距離が正しくても、所要時間は時間帯によって変わります。朝夕の通勤時間帯には道路が混み、同じ区間でも昼間より時間がかかります。この差がどの程度かは、国土交通省の「令和3年度全国道路・街路交通情勢調査」(いわゆる道路交通センサス)の旅行速度整理表で確かめられます。2026年9月時点で国土交通省の道路関係データのページに掲載されている調査は令和3年度のものが最新でした。調査の説明資料によると、朝夕旅行速度(混雑時旅行速度)は混雑する方向(上りと下りのうち、朝夕の速度が低い方向)だけを集計したもので、昼間12時間の平均を出す際には7・8・17・18時台を混雑時の速度、9〜16時台を非混雑時の速度として扱っています。
| 沿道の区分(全国・一般道路計) | 混雑時旅行速度(km/h) | 非混雑時旅行速度(km/h) | 所要時間の比(混雑時÷非混雑時) |
|---|---|---|---|
| DID(人口集中地区)の商業地域 | 15.5 | 19.2 | 約1.24倍 |
| DID(商業地域を除く) | 17.3 | 22.0 | 約1.27倍 |
| その他市街部 | 25.8 | 29.7 | 約1.15倍 |
| 合計 | 30.8 | 33.8 | 約1.10倍 |
表の速度は、令和3年度調査の旅行速度整理表(都道府県別・道路種別別)の CSV の「合計」の行、道路種別「一般道路計」の値です。所要時間の比は、速度の逆数の比として計算しました。市街地では、混雑時の所要時間は非混雑時の1.2倍台になっています。なお共通データの時速25kmは、市街地の非混雑時の速度(DID の19.2〜22.0km/h)と、その他市街部の速度(29.7km/h)の間にある値です。配送センターの周りが都心の商業地域なのか、郊外の市街部なのかで、平均の速度そのものが大きく変わることも、この表から読み取れます。
この調査の数字を目安に、この章の実験では、実際の所要時間に次の時間帯の倍率を掛けることにしました。朝8時から9時30分までに出発する区間は1.3倍、16時30分以降に出発する区間は1.2倍、それ以外は1.0倍です。倍率の値そのものは仮定で、調査の市街地の比(1.24〜1.27倍)に近い値として置きました。倍率は区間ごとに、その区間を出発する時刻で決めます。朝の倍率が掛かるのは、8時から9時30分までに出発するすべての区間です。多くの車が8時に一斉に出発するので、全ルートの最初の区間がこの影響を受け、9時30分より前に次の納品先へ向けて出発する区間も同じ倍率を受けます。
時間帯によって所要時間が変わる問題は、時間依存の配送計画問題と呼ばれます。この記事で使っている OR-Tools のルーティングソルバーでは、この記事のコードのように、移動時間を「どの地点からどの地点へ」だけで決まる値として登録しており、出発時刻によらない1つの表として扱っています。時間依存を正面から入れるには、出発時刻ごとに表を持つ専用の実装が要ります。実務では、時間帯ごとに別の表を使って計画を分ける、朝の区間だけに倍率を掛けておく、といった近似が使われることが多いように思います。この章の実験は、計画側でどこまで近似すれば約束が守れるかを測るものです。
納品先の位置の精度、ジオコーディングの誤差
距離と時間を計算する前に、納品先の位置(緯度・経度)が正しく入っている必要があります。住所の文字列から緯度・経度を求める処理をジオコーディングと呼びます。日本の住所では、国土交通省が「位置参照情報」を整備しています。国土交通省の位置参照情報ダウンロードサービスの説明によると、街区レベル位置参照情報は、全国の都市計画区域相当範囲を対象に「○○町△丁目□番」の街区単位で代表点の緯度・経度を整備したデータで、平成15年度から毎年1回更新されています。大字・町丁目レベル位置参照情報は、都市計画区域外も含めた全国で大字・町丁目の住所代表点を整備したもので、街区レベルを補完する位置づけです。同じ説明には、特に住居表示が実施されていない区域では、代表点が代表する領域が広い場合があるという注意も書かれています。
つまり、住所から求めた位置は、建物の入口の位置ではなく、街区や町丁目の代表点になることがあります。代表点と実際の建物の位置の差は、代表点が受け持つ範囲(街区や町丁目)が広いほど大きくなりえます。さらに配送で問題になるのは、トラックを停められる場所や荷受けの入口の位置で、これは住所の位置とは別の情報です。敷地の広い施設では、搬入口が住所の代表点とは別の道路に面していることもありえます。
位置の誤差がどれだけ計画を狂わせるかを測りました。納品先の真の位置に、東西・南北それぞれ標準偏差 σ の正規分布の誤差を加えた「誤った位置」で道路網の時間行列を作り直し、基準の計画のルートの区間について、真の位置での所要時間と比べます。σ ごとに誤差の与え方を20通り試しました。
| 位置の誤差 σ | 区間の所要時間の誤差の平均(分) | 同じ誤差の90%点(分) | 同じ誤差の最大(分) | 川の反対側に置かれた納品先(平均件数) | 計画の総距離の見積りの差の平均(km) |
|---|---|---|---|---|---|
| 0.1km | 0.8 | 2.0 | 4.0 | 0.00 | 1.1短い(絶対値の平均2.1) |
| 0.3km | 1.6 | 3.4 | 6.3 | 0.00 | 0.3長い(絶対値の平均2.9) |
| 1.0km | 3.7 | 7.5 | 15.5 | 0.35 | 18.3長い(絶対値の平均18.5) |
σ が0.1〜0.3km、つまり街区の代表点程度の誤差なら、区間の所要時間の誤差は平均で1〜2分で、計画への影響は小さいといえます。σ が1kmになると誤差の平均は3.7分、最大で15.5分になり、20通りの平均で0.35件の納品先が川の反対側に置かれました。川の反対側に置かれた納品先は、計画上は橋を渡らずに行けることになり、前節のC11とC18のように所要時間が大きく狂います。総距離の見積りも、1kmの誤差では平均18.3km長く出ました。位置がばらつくと、ルートの区間が平均して長くなるためです。一方、この誤った位置で作った到着予定を次の節と同じ条件(前後30分の約束、200日)で評価すると、約束に遅れる納品の割合は誤差なしの0.9%に対して、σ=0.1kmで1.0%、0.3kmで1.3%、1.0kmで1.1%(20通りのうち最大3.1%)で、平均ではほとんど変わりませんでした。位置の誤差は、多くの場合は小さく、まれに特定の納品先で大きく効く、という形をとります。
位置の誤差のうち、ばらつきのように均等に効くものは計画を大きく壊しませんが、川や線路の反対側に置かれるような誤りは、特定の納品先で決まって約束を破る原因になります。マスタの位置を点検するときは、全件の精度を一様に上げるより、道路網の障害物の近くにある納品先と、ドライバーから「地図の位置と実際の入口が違う」と報告のある納品先を優先して直すのが効率的だと考えています。
荷下ろし時間の見積り、1件ごとの値を持つ
所要時間のうち、移動と並んで大きいのが荷下ろし・検品の時間です。共通データの荷下ろし時間は納品先ごとに10〜25分で、合計は685分あります。6台で回れば1台あたり100分を超え、移動の時間と同じ程度の重みを持ちます。ところが実務のマスタでは、荷下ろし時間が納品先ごとに入っておらず、全件一律の値で計画を立てていることがあります。納品先ごとの値の平均がおよそ17分(685分÷40件)なので、一律15分と置くのは、それほど乱暴な近似には見えません。
しかし一律の値は、長くかかる納品先の後に続く全部の到着予定を早めにずらし、短い納品先の後では遅めにずらします。そのずれは同じルートの後ろの納品先に次々と引き継がれます。次の節の実験では、この一律15分の見積りが、約束の時刻を守る割合をどれだけ下げるかを測ります。荷下ろし時間は、ケース数、検品の有無、納品先の受け入れの体制(荷受けの担当者がすぐ出てくるか)で決まることが多いので、運行記録から納品先ごとの実績を集めてマスタに持たせるのが基本になります。マスタの整備の手順は第13章で扱います。
見積りの誤差が計画を壊す実験、到着予定を前後30分で約束する
ここからが、この章の中心の実験です。計画は、共通データの基準の結果(積載と時間指定を入れた6台・293.2kmのルート)を使い、ルートと訪問の順番は固定します。各車は8時に配送センターを出発し、時間枠の開始より早く着いたら開始まで待ちます。この計画をもとに、各納品先に到着予定時刻を計算し、「予定の前後30分の間に着く」と約束したとします。配送の現場では、納品先へ到着予定を知らせ、その幅の中で着くことが求められる場面が多くあります。
実際の所要時間は、道路網の模型の最短時間の所要時間に、前節の時間帯の倍率を掛け、さらに区間ごとの偶然のばらつきを掛けたものとしました。ばらつきは対数正規分布(中央値が1倍で、長くかかる側に裾が伸びる分布)で、区間の移動は σ=0.2、荷下ろしは σ=0.25 と置きました(いずれも仮定です)。この「実際」の中で1,000日分の運行を乱数で作り、約束の幅より遅れて着いた件数を数えます。約束の幅より早く着いた場合は、幅の始まりまで待つとします。比べたのは、到着予定を作るときの見積りの作り方です。
| 見積りの作り方 | 遅れた件数(1日平均) | 遅れた納品の割合 | 遅れが0件だった日の割合 | 早く着いて待った時間(1日・6台合計) |
|---|---|---|---|---|
| A 直線×1.3・時速25km(共通データの仮定) | 6.08件 | 15.2% | 1.3% | 0.0分 |
| B A の荷下ろしを一律15分と置いた見積り | 8.93件 | 22.3% | 0.0% | 0.0分 |
| C 道路網の所要時間 | 2.63件 | 6.6% | 27.2% | 0.0分 |
| D 道路網+時間帯の倍率 | 0.42件 | 1.0% | 79.5% | 0.0分 |
| E D の移動時間を1.1倍 | 0.12件 | 0.3% | 93.5% | 0.4分 |
| F D の移動時間を1.2倍 | 0.05件 | 0.1% | 97.1% | 2.9分 |
| G D に1件ごと5分を足す | 0.03件 | 0.1% | 98.2% | 7.7分 |
| H A の移動時間を1.2倍 | 2.54件 | 6.3% | 24.7% | 0.0分 |
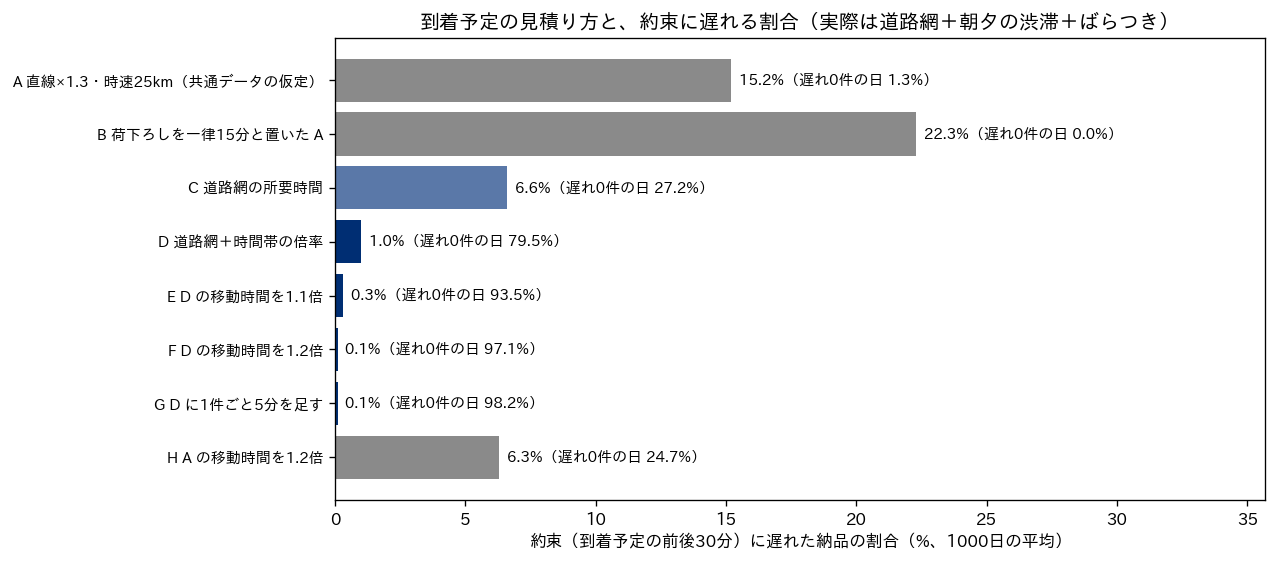
共通データの仮定(A)で到着予定を作ると、40件のうち1日平均6.08件、割合にして15.2%で約束に遅れ、遅れが1件も出なかった日は1,000日のうち1.3%しかありませんでした。荷下ろし時間を一律15分と置くと(B)、遅れは22.3%に増え、遅れ0件の日は1日もありません。見積りを道路網の所要時間に替えると(C)6.6%まで下がり、さらに時間帯の倍率を入れると(D)1.0%になり、79.5%の日は遅れ0件で終わります。
訪問の順番ごとに「実際に荷下ろしを始められた時刻から到着予定を引いた値」を見ると、見積りの違いの中身が分かります。A では1件目の平均が10.8分の遅れ、5件目が20.2分の遅れで、どの順番でも平均が遅れ側に偏り、前後30分に収まる割合は5件目で71.7%まで下がりました。D では1件目から8件目まで平均の遅れが0.9〜2.9分に収まり、前後30分に収まる割合は98.1〜99.6%でした。A の遅れの主な原因は、ばらつきではなく見積りの偏りです。朝の混雑と川の迂回を見積りが含んでいないので、予定が系統的に早すぎるのです。なお、この計画では昼の時間枠(13時開始)で待つ車が多く、そこで遅れがいったん吸収されるため、順番が後になるほど遅れが単純に積み上がる形にはなっていません。
余裕の持たせ方として、移動時間に倍率を掛ける方法(E・F・H)と、1件ごとに一定の時間を足す方法(G)を比べました。D に1.1倍の余裕を掛けると遅れは0.3%、1.2倍では0.1%まで下がります。代わりに、予定より早く着いて約束の幅の始まりまで待つ時間が増えますが、前後30分の幅では1日6台合計で数分にとどまりました。ここで大事なのは H の行です。共通データの仮定(A)に1.2倍の余裕を掛けても、遅れは6.3%にしか下がりません。見積りの偏り(朝の混雑と川の迂回)がある区間では、全体に一律の倍率を掛けても、偏りの大きい区間の遅れは消えないからです。余裕を足すより先に、見積りの偏りを取り除くことのほうが効きます。
この実験の「実際」の時間帯の倍率は、D の見積りに使った倍率と同じ値です。つまり D は、時間帯の傾向を正確に知っている場合の結果で、実務で時間帯の傾向を推定すれば、その推定の誤差のぶんだけ遅れは D より増えます。表の D〜G の遅れの割合は、見積りの作り方の上限に近い性能と読むのが適切です。
約束の幅を変えると、必要な余裕の大きさも変わります。D(道路網+時間帯の倍率)と F(その移動時間を1.2倍)について、約束の幅を前後15分・30分・60分にして同じ1,000日で測りました。
| 約束の幅 | D の遅れた納品の割合 | D の遅れ0件の日 | D の待ち時間(1日) | F の遅れた納品の割合 | F の遅れ0件の日 | F の待ち時間(1日) |
|---|---|---|---|---|---|---|
| 前後15分 | 9.3% | 14.3% | 2.2分 | 1.8% | 65.5% | 31.9分 |
| 前後30分 | 1.0% | 79.5% | 0.0分 | 0.1% | 97.1% | 2.9分 |
| 前後60分 | 0.0% | 99.9% | 0.0分 | 0.0% | 100.0% | 0.0分 |
約束の幅を前後15分に狭めると、見積りの偏りを取り除いた D でも遅れは9.3%に増え、遅れ0件の日は14.3%しかありません。1.2倍の余裕を持たせた F でも遅れは1.8%残り、代わりに1日6台合計で31.9分、早く着いて待つ時間が生じます。前後60分にすれば、D でも遅れはほぼ0になります。約束の幅が狭いほど、見積りの精度と余裕の両方が必要になり、余裕の代償としての待ち時間も増えます。到着予定を細かく約束するサービスを始めるなら、その幅を守れる見積りの精度があるかを、先にこの種の計算で確かめておくのが安全です。
道路網で計画し直す、正確な見積りほど余裕を削る
ここまでは、ルートを基準の計画のまま固定して、到着予定の作り方だけを変えてきました。次に、道路網の距離と時間を入力にして、ルートそのものを OR-Tools で計画し直しました。探索の条件は第2章以降の基準の結果と同じで、最寄りの弧をつなぐ初期解(PATH_CHEAPEST_ARC)から誘導局所探索を20秒、車両の固定費は100km相当です。約束の幅ではなく、元の時間指定(午前・午後・終日の時間枠)を守れるかを、同じ「実際」の1,000日で数えました。
道路網で計画し直すと、6台のまま、道路網の上で走る総距離は326.1kmになり、基準の計画を道路網で走らせた331.1kmより5.0km短くなりました(同じ条件で2回解いて、2回とも同じ結果でした)。ところが、元の時間枠に遅れた日の割合は、基準の計画の0.1%に対して、道路網で計画し直したルートでは17.2%に増えました。道路網の時間は模型の上では正確なので、ソルバーは時間枠の締切ぎりぎりまで使ってルートを詰めます。正確な見積りで最適化するほど、計画から余裕が消え、実際のばらつきに弱くなるのです。基準の計画は、見積りが粗かったために偶然余裕が残っていたにすぎません。
そこで、道路網で計画するときに余裕を入れる方法を比べました。計画に使う移動時間に倍率を掛ける方法、時間枠の終わりを前倒しする方法、荷下ろし時間を1件ごとに長く見積もる方法です。この比較は同じ PC で他の計算が並行して動いている中で実行したため、同じ条件でも探索の到達点が揺れました。そこで表の全行を2回ずつ解き、2回の結果を並べています(この記事の実行環境、一般的なノートPCでの実測です)。
| 計画に入れた余裕 | 台数 | 道路網の総距離(1回目/2回目) | 元の時間枠に遅れた日の割合(1回目/2回目) | 遅れの多かった納品先 |
|---|---|---|---|---|
| 余裕なし | 6台 | 324.1km/322.1km | 47.6%/42.6% | C11(午前)・C08(午前) |
| 移動時間を1.1倍 | 6台 | 329.1km/329.1km | 0.0%/0.0% | なし |
| 移動時間を1.2倍 | 6台 | 329.1km/329.1km | 0.4%/0.4% | C11(午前) |
| 時間枠の終わりを15分前倒し | 6台 | 339.1km/330.1km | 49.5%/47.8% | C11(午前)・C08(午前) |
| 時間枠の終わりを30分前倒し | 6台 | 330.1km/330.1km | 0.0%/0.1% | C11(午前、1日だけ) |
| 荷下ろしを1件5分長く見積もる | 6台 | 332.1km/332.1km | 20.5%/20.5% | C36(午前)・C37(午前) |
余裕なしの行は、前の段落の計画し直し(326.1km・17.2%)と同じ条件ですが、この実行では324.1kmと322.1km、遅れた日は47.6%と42.6%になりました。前の段落の2回と表の2回、合わせて4回の実行で、総距離は322.1〜326.1km、遅れた日の割合は17.2〜47.6%の幅で揺れたことになります。総距離の違いは4km程度でも、どの納品先をどの車の何番目に置くかが変わると、時間枠の締切との余裕が変わり、遅れやすさは大きく変わります。遅れはどの実行でも午前の時間枠の C11 に集中していました。朝の混雑の倍率が計画に入っていないので、朝の区間の多いルートの後ろにある午前の納品先が締切を越えやすいのです。
余裕を入れた計画では、移動時間を1.1倍にする方法と、時間枠の終わりを30分前倒しする方法が、2回とも遅れた日をほぼ0%にしました。その代償は、道路網の総距離で余裕なしより数km(329.1〜330.1km)長くなる程度で、台数は6台のまま変わりませんでした。ただし総距離の差は、上に書いた探索の揺れ(4km程度)と同じ大きさなので、この例で余裕の費用を km 単位で正確に言うことはできません。言えるのは「この例では、余裕を入れても台数は増えず、距離の増加は探索の揺れと同程度だった」ということです。
時間枠の終わりを15分前倒しする方法は、ほとんど効きませんでした。ソルバーは前倒しした新しい締切に対しても、またぎりぎりまでルートを詰めるからです。実際のずれ(朝の混雑で9時30分までに出発する区間が3割長くなる、など)より前倒しの幅が小さいと、遅れはそのまま残ります。荷下ろしを1件5分長く見積もる方法は、遅れの多い納品先が C36・C37 に移っただけで、20.5%の日に遅れが残りました。余裕の入れ方は、どこで時間がずれるかに合わせる必要がある、ということです。この例では、ずれの主因が移動(とくに朝の区間)にあるので、移動時間に掛ける余裕がよく効き、荷下ろしに足す余裕は効きが弱くなりました。
地図データの選択肢、公式の説明で確かめられること
道路網で距離と時間を作るには、道路網のデータと経路の計算の道具が要ります。選択肢はいくつかあり、ここでは公式のページで確かめられたことだけを整理します。料金は契約や利用量で変わるので書いていません。
| 選択肢 | 公式のページで確かめた内容 | 配車計画で使うときの注意 |
|---|---|---|
| OpenStreetMap | Open Data Commons Open Database License(ODbL)のもとで公開されたオープンデータで、OpenStreetMap とその貢献者の表示をすれば複製・配布・改変ができる。改変したデータを配布する場合は同じライセンスで配布する | 道路の形は地域によって更新の頻度が違う。大型車の通行規制や搬入口の位置は、自社で補う必要がある |
| OSRM | 道路網の最短経路を計算する C++ の経路探索エンジンで、OpenStreetMap のデータを取り込める。2条項 BSD ライセンス。table という機能が、与えた座標のすべての組について最速経路の所要時間や距離を返す | 自社のサーバーで動かす形になり、道路網のデータの更新も自社で行う。時間帯による所要時間の違いは、別に用意する必要がある |
| Google Maps Platform の Routes API | computeRouteMatrix が出発地と目的地の組ごとに距離と所要時間を返す。1回の要求の要素数は、公共交通以外で625まで、交通状況を最適に考慮する設定(TRAFFIC_AWARE_OPTIMAL)では100まで | 41地点×41地点の1,681要素は1回の要求の上限を超えるので、分けて要求する。この記事では有料・要キーの API は呼んでいない |
| 国土地理院の基盤地図情報 | 測量の基準点・海岸線・道路縁(道路の縁の線)・建築物の外周線など13の項目を整備している | 13の項目の中に、経路の計算にそのまま使える道路のつながり(ネットワーク)の項目は無い |
| 国土交通省の位置参照情報 | 街区レベルと大字・町丁目レベルの代表点の緯度・経度(前述) | 住所から位置を求める材料で、道路網ではない |
公式のページは次のとおりです。OpenStreetMap の著作権とライセンス、OSRM、OSRM の API 説明、Routes API の computeRouteMatrix、基盤地図情報とは(国土地理院)、位置参照情報ダウンロードサービス(国土交通省)、令和3年度全国道路・街路交通情勢調査(国土交通省)。
どれを選ぶかは、地点数と、時間帯の違いをどこまで入れたいかで決まります。地点が数十件で、毎朝1回だけ計画するなら、外部のサービスで行列を作る方法でも足ります。地点が数百件を超え、1日に何度も計画し直す(第11章で扱う当日の再配車など)なら、行列の要素数は地点数の2乗で増えるので、自社で経路探索のエンジンを動かすほうが扱いやすくなります。どの方法でも、トラックが通れない道・搬入口の位置・右折できない交差点のような、配送に固有の条件は地図データだけでは入りません。運行記録とドライバーの報告で補う仕組みが要ります。
経営の側から見る、見積りの精度はサービス水準と距離の両方に効く
この章の数字を経営指標に置き換えると、次のようになります。1つ目は総走行距離です。直線×1.3で立てた計画は、計画上293.2kmでしたが、同じルートを道路網の模型で走ると331.1kmでした。共通データで架空に置いた2トン車の km 単価(40円)で換算すると、1日あたり37.9km、約1,500円の走行費が計画に表れていないことになります。燃料費や車両の維持費の予算を計画上の距離から作っていると、実績が毎日1割強上振れし、その理由を現場の運転の問題と取り違えるおそれがあります。
2つ目は時間指定の遵守率です。同じ計画でも、到着予定を前後30分で約束すると、見積りの作り方しだいで遅れる納品の割合は22.3%から0.1%まで変わりました。荷下ろし時間を一律で持っているだけで、遅れは15.2%から22.3%に増えました。遅れは納品先からの苦情や再配達、取引の条件の見直しにつながり、その費用は走行費よりはるかに大きくなりえます。到着予定の精度は、ソルバーの性能ではなく、距離と時間のマスタの品質で決まります。
3つ目は、正確な見積りで最適化すると余裕が消える、という点です。道路網で計画し直すと総距離は数km短くなりましたが、元の時間枠に遅れる日は0.1%から17.2〜47.6%に増えました。計画の精度を上げる投資(地図データの導入など)をするときは、同時に余裕の入れ方を決めておかないと、距離が減った代わりにサービス水準が下がる、という結果になりかねません。この例では移動時間を1.1倍にするだけで遅れはほぼ消え、台数は増えませんでした。判断の手順としては、まず見積りの偏り(道路網・時間帯・荷下ろし時間)を取り除き、そのうえで残ったばらつきに見合う余裕を、実績の到着時刻の記録から決めるのがよいと考えています。
この章の要点は3つです。第一に、直線距離に係数を掛ける方法は、全組の平均では道路網とよく合っていても、配送のルートに多く含まれる近い区間や、川のような障害物をまたぐ区間で大きくずれ、この例では計画の距離を12.9%短く見積もりました。第二に、到着予定の遅れの主因は、偶然のばらつきより見積りの偏り(朝の混雑・迂回・荷下ろし時間の一律化)で、偏りを取り除かずに余裕の倍率を掛けても遅れは残ります。第三に、正確な見積りで最適化するとソルバーは余裕を削るので、余裕はずれの生じる場所(この例では移動、とくに朝の区間)に合わせて計画に入れる必要があります。次の第10章では、納品先が数百件から千件に増えたときに、計算時間の制約の中で良い解を得る方法を扱います。当日に起きた遅れや追加注文への対応は、第11章で扱います。
この章を深めたい方への参考書籍
『地理情報科学 GISスタンダード』(浅見泰司・矢野桂司・貞広幸雄・湯田ミノリ編、古今書院):地理情報科学(GIS)の教科書として2015年に刊行された本で、空間分析におけるスケールの章なども収めています。この章では、住所から位置を求める処理と位置の誤差、道路網のデータを配車の入力として扱いましたが、それらを地理情報の側から体系的に学び直す入口として挙げました。
『最短経路の本 レナのふしぎな数学の旅』(P. Gritzmann・R. Brandenberg 著、石田基広 訳、丸善出版):書名のとおり最短経路を主題にした本で、国立国会図書館の書誌ではグラフ理論に分類されています。この章で networkx に計算させた最短経路の探索が、距離行列を作る処理の中で何をしているのかを理解する助けになります。2007年にシュプリンガー・ジャパンから刊行され、2012年に丸善出版から再刊されています。
第10章 大規模化への対処、数百件から千件の配送先を決まった時間で解く
第9章では、距離と時間の行列をどう作るか、見積りの誤差が計画をどう壊すかを確かめました。ここまでの章は、第2章で用意した納品先40件のサンプルデータを中心に、数十秒で答えが出る規模の問題を扱ってきました。この章では、それより1桁から2桁大きい、数百件から千件以上の納品先を1日に計画する場面を扱います。後の節の実測で見るように、件数に対して一様にではありませんが、規模が大きくなると、同じソルバーに同じ時間を与えても答えの質を保ちにくくなります。この章では、規模が大きくなると何が難しくなるのかを整理し、大規模な配車で使われる代表的な考え方である大近傍探索(壊して直す探索)、遺伝的アルゴリズム系の探索、タブー探索を紹介します。そのうえで、公開ベンチマークの大きな問題と、件数を変えて作った架空のデータで、時間制限と答えの質の関係を実測し、エリアで分けてから解く分割統治の得失と、「毎朝決まった時間で十分良い解を出す」ための設計を考えます。
規模が大きくなると、何が重くなるのか
納品先の数を \( n \) とすると、配車の問題で重くなるものは大きく3つあります。1つ目は距離と時間の行列です。すべての地点の組の距離を持つので、要素の数は地点数の2乗で増えます。デポを含めて101地点なら約1万、1,001地点なら約100万、1万地点なら約1億の要素になり、道路網から最短路を計算して行列を作る場合(第9章)は、その計算自体が重い処理になります。2つ目は、局所探索(今の解を少しずつ変えて良くなる変更を探す方法。第3章・第6章)が1回に調べる「近くの解」の数です。2つの納品先を入れ替える、1つを別の車に移す、といった基本の操作は、組の数だけ候補があるので、これも \( n \) の2乗の程度で増えます。3つ目は、良い解にたどり着くまでに必要な改善の回数そのものです。納品先が増えれば、直すべき箇所も増えます。
1回の改善が重くなり、しかも必要な改善の回数も増えるので、この2つが掛け合わさって効きます。しかも実務の計画では、計算に使える時間は規模によらずほぼ一定です。受注の締切から出発までの間に、配車を計算し、担当者が確かめ、積込みの指示を出す必要があり、計算に割ける時間は数分から十数分程度に限られることが多いように思います。つまり大規模化の問題は「大きな問題を解けるか」ではなく、「決まった時間の中で、どこまで良い解を出せるか」という問題として現れます。この章では一貫して、時間制限を固定したときの答えの質で手法と設計を比べます。
もう1つ、規模が大きくなると厳密解(最適であることの証明つきの答え)は現実的でなくなります。第4章で扱った CVRPLIB(配送計画問題の公開ベンチマーク集)の X 系列は、Uchoa らが2017年に発表した納品先100件から1,000件の100問で、この章で使う CVRPLIB の一覧(2026年9月25日に取得)では、100問のうち最適性が証明済みの印が付いているのは61問です。問題名の数字(地点の数)が500以上の32問に限ると、証明済みは5問しかありません。研究の最前線でも、千件規模の問題は「既知最良値」(これまでに誰かが見つけた最も良い解の値)と比べるしかない、ということです。この章でも、X 系列の答えは既知最良値とのギャップ(何%長いか)で評価します。
| 規模が大きくなると重くなるもの | 増え方の目安 | 実務での現れ方 | この章での対処 |
|---|---|---|---|
| 距離と時間の行列 | 地点数の2乗 | 行列を作る時間とメモリ、地図の経路計算の回数 | 行列は前日に作り置く、近い地点だけを候補にする |
| 局所探索で1回に調べる候補 | おおむね地点数の2乗 | 改善1回あたりの時間が伸びる | 近い納品先どうしの変更だけを調べる、壊して直す |
| 良い解までの改善の回数 | 地点数とともに増える | 同じ時間では質を保ちにくい | 強い探索法を選ぶ、分割統治、時間の設計 |
| 最適性の証明 | 数百件を超えると現実的でない | 「最適か」ではなく「どれだけ良いか」でしか測れない | 既知最良値や下限とのギャップで評価する |
局所探索が大きな問題で止まる理由、壊して直す大近傍探索
第3章の2-opt や第6章の誘導局所探索は、今の解から「1〜2か所だけ変えた解」を近くの解として調べ、良くなるものがあれば移る、という方法でした。この方法は、1か所変えるだけでは良くならないが、数か所を同時に変えれば大きく良くなる、という状況に弱い性質があります。たとえば、ある地区の納品先8件が3台の車にばらばらに割り当てられているとき、1件ずつ別の車へ移すと、途中の段階ではかえって距離が伸びるので、局所探索はその変更を選びません。規模が大きくなるほど、このような「まとめて組み替えないと良くならない箇所」が解の中に増えていきます。
これに対する代表的な考え方が、大近傍探索(Large Neighborhood Search、略して LNS)です。Shaw が1998年の制約プログラミングの国際会議(CP98)の論文で配送計画問題に用いたもので、今の解から訪問をいくつかまとめて取り外し(壊す)、取り外した訪問を入れ直す(直す)、という操作を繰り返します。取り外す件数を増やせば一度に大きく組み替えられるので、1〜2か所の変更では抜け出せない状態から抜け出せます。同じ発想は、Schrimpf らが2000年の論文の題名で「ルーイン・アンド・リクリエイト」(壊して作り直す原理)と呼んだものとも共通しています。
大近傍探索には、決めることが3つあります。1つ目は「何件を、どう選んで外すか」です。Shaw の論文の要旨は、互いに「関連のある」訪問をいくつか選んで外すと述べています。無関係な納品先をばらばらに外しても、入れ直すときに元の位置へ戻るだけになりやすい、という考え方です。2つ目は「どう入れ直すか」で、Shaw は制約プログラミングの木探索で入れ直しましたが、増える距離が最も小さい位置へ1件ずつ戻す貪欲な方法(最安挿入)も広く使われます。3つ目は「入れ直した解を受け入れるか」で、良くなったときだけ受け入れる方法のほか、少し悪くなっても受け入れる方法があります。Ropke と Pisinger は2006年の論文で、壊し方と直し方を複数用意し、過去の成績に応じて使う頻度を変える方式を適応型大近傍探索(ALNS)と名付けました。要旨によれば、集荷と配送を組にした時間枠付きの問題で、500件の依頼までの350問以上のベンチマークを解き、半数を超える問題で文献上の既知最良解を更新しています。1つの壊し方だけを使うより、複数を競わせるほうが有利だったという実験結果も要旨に書かれています。
壊して直す探索を小さく作って確かめる
大近傍探索の骨組みは、短いコードで書けます。第2章で用意した納品先40件のサンプルデータを、2トン車(150ケース)の積載制約だけで解く例を作りました。車1台を100km相当の費用とみなして台数が増えにくくなる重みを置く点は、第2章で示した基準の結果(OR-Tools の誘導局所探索20秒で、積載のみ6台・総距離296.3km)と同じ設定です。距離は第2章と同じく直線距離の1.3倍です。まず、外した納品先を入れ直す部分です。
import numpy as np
from vrp_data import customers, points, dist_km, TRUCK_CAPACITY

cs = customers()
D = dist_km(points(cs))
q = [0] + [c["demand"] for c in cs]
CAP = TRUCK_CAPACITY
FIXED_KM = 100                                                   # 基準の結果と同じく、車1台を100km相当とみなす


def total(routes):
    return sum(D[0, r[0]] + sum(D[a, b] for a, b in zip(r, r[1:])) + D[r[-1], 0] for r in routes)


def obj(routes):
    return total(routes) + FIXED_KM * len(routes)               # 台数が増えにくくなる重み


def insert_all(routes, removed, rng):
    """外した納品先を、増える距離が最小の位置へ1件ずつ戻す(入らなければ新しい車)"""
    for c in rng.permutation(removed):
        best = None
        for k, r in enumerate(routes):
            if sum(q[i] for i in r) + q[c] > CAP:
                continue
            path = [0] + r + [0]
            for p in range(len(path) - 1):
                d = D[path[p], c] + D[c, path[p + 1]] - D[path[p], path[p + 1]]
                if best is None:
                    best = (d, k, p)
                elif d < best[0]:
                    best = (d, k, p)
        if best is None:
            routes.append([int(c)])
        else:
            routes[best[1]].insert(best[2], int(c))
    return routes
次が、壊して直す繰り返しの本体です。初期解も「全員を外した状態から入れ直す」ことで作っています。外し方は、納品先を無作為に選ぶ方法と、無作為に選んだ1件とその近くの納品先をまとめて外す方法(コードの related)の2つを用意しました。入れ直した解は、目的の値(総距離に台数×100km を足したもの)が悪くならなければ受け入れます。
def lns(iters, n_remove, related, seed):
    rng = np.random.default_rng(seed)
    cur = insert_all([], list(range(1, len(q))), rng)            # 初期解も「全部外した状態から戻す」で作る
    log = {0: (total(cur), len(cur))}
    for it in range(1, iters + 1):
        if related:                                              # 関連の強い(近い)納品先をまとめて外す
            s = int(rng.integers(1, len(q)))
            removed = [int(i) for i in np.argsort(D[s, 1:])[:n_remove] + 1]
        else:                                                    # でたらめに外す
            removed = [int(i) for i in rng.choice(np.arange(1, len(q)), n_remove, replace=False)]
        cand = [[i for i in r if i not in removed] for r in cur]
        cand = insert_all([r for r in cand if r], removed, rng)
        if obj(cand) <= obj(cur):                                # 悪くならなければ受け入れる
            cur = cand
        if it in (100, 500, 1000, 3000):
            log[it] = (total(cur), len(cur))
    return cur, log


cur, log = lns(3000, 8, False, 0)                               # 無作為に8件ずつ外す・種0
for it, (km, nv) in log.items():
    print(it, "回", round(km, 1), "km", nv, "台")
# 出力: 0 回 524.0 km 6 台
# 出力: 100 回 338.1 km 6 台
# 出力: 500 回 306.4 km 6 台
# 出力: 1000 回 293.6 km 6 台
# 出力: 3000 回 291.8 km 6 台
2つのブロックを続けて1つのファイルにし、共通データの vrp_data.py と同じフォルダで実行すると、上の出力が得られます。初期解は6台・524.0kmで、無作為に8件ずつ外して入れ直すことを3,000回繰り返すと、6台・291.8kmまで下がりました。外す件数・外し方・乱数の種を変えて、同じ3,000回で比べたのが次の表です。
| 外し方 | 1回に外す件数 | 初期解の総距離(km) | 3,000回後の総距離、種0(km) | 3,000回後の総距離、種1(km) | 3,000回後の台数 | 3,000回の所要時間(秒) |
|---|---|---|---|---|---|---|
| 無作為 | 4 | 524.0/547.9 | 334.4 | 324.9 | 6 | 0.5〜0.8 |
| 無作為 | 8 | 524.0/547.9 | 291.8 | 301.2 | 6 | 1.2 |
| 無作為 | 12 | 524.0/547.9 | 298.4 | 291.8 | 6 | 1.5〜1.8 |
| 近い順 | 4 | 524.0/547.9 | 402.4 | 431.5 | 6 | 0.6 |
| 近い順 | 8 | 524.0/547.9 | 364.5 | 391.9 | 6 | 1.0 |
| 近い順 | 12 | 524.0/547.9 | 299.6 | 303.2 | 6 | 1.1〜1.2 |
「初期解の総距離」の列は、種0と種1の初期解の値を並べたものです。所要時間は、この記事の実行環境(一般的なノートPC)での実測で、ほかの章の計算と同時に動かしていたため目安です。表から読み取れることは3つあります。1つ目は、1回に外す件数が少なすぎると改善が早く止まることです。無作為に4件ずつ外す場合は324.9〜334.4kmで止まり、8件・12件では291.8〜301.2kmまで下がりました。2つ目は、外し方に偏りがあると探索が止まりやすいことです。この実装の「近い順」は、起点の1件を決めると外す組が1通りに決まるので、壊し方が40通りしかありません。そのため4件・8件では同じ組み替えを繰り返すだけになり、無作為に外すよりはるかに悪い値で止まりました。Shaw の論文の考え方である「関連のある訪問をまとめて外す」こと自体を否定する結果ではありません。この実験で分かるのは、壊し方の種類が少ないと、関連の強い組を外しても同じところを回り続ける、ということです。3つ目は、同じ設定でも乱数の種で結果が数%変わることです。
最も良かった6台・291.8kmは、第2章の基準の結果(6台・296.3km)より4.5km短い値です。基準の結果には18時までに帰着する条件が入っていましたが、この解の各車の帰着は、時速25kmと荷下ろし時間で計算すると最も遅い車でも12時51分で、その条件も満たしています。距離の丸め方(基準の結果は m 単位の整数、ここは小数)がわずかに違う点を除けば、同じ条件で基準の結果より短い解が見つかったことになります。基準の結果は最適性を証明していないので、これは矛盾ではありません。20秒の探索で得た答えにもまだ数km縮む余地があったこと、そして50行あまりの素朴な大近傍探索でもそこに届くことを示しています。ただし、40件の小さな問題で素朴な実装がうまくいったことは、数百件以上の問題でも通用することを意味しません。入れ直しのたびに全ルートの全位置を調べるこの実装は、件数が増えると1回の繰り返しが急に重くなります。実用のソルバーには、調べる候補を絞る仕組みがあります。たとえば PyVRP の探索の設定には、近い納品先の候補を決める近傍の設定(NeighbourhoodParams)が含まれていることを、この章で使った版で確認しました。
遺伝的アルゴリズム系の探索、反復局所探索、タブー探索
もう1つの大きな流れが、遺伝的アルゴリズム系の探索です。遺伝的アルゴリズムは、解の集団を持ち、2つの解を組み合わせて(交叉)新しい解を作り、良いものを残す、という操作を繰り返す方法です。組み合わせた直後の解を局所探索で磨く「ハイブリッド」型の代表が、Vidal らが2012年に Operations Research 誌で発表したハイブリッド遺伝的探索(Hybrid Genetic Search、略して HGS)です。論文の要旨は、集団による探索の幅広さと、近傍を使った改善の強さ、そして集団の多様性を管理する仕組みを組み合わせた方法だと説明しています。複数デポ・周期配送などの3種類の問題について、当時のベンチマークのすべてで既知最良解に並ぶか更新したと報告しており、積載制約付きの配車(CVRP)でも非常に競争力があるとしています。
Vidal は2022年に、HGS を CVRP に特化して公開したオープンソースの実装を Computers & Operations Research 誌で発表しました。要旨によれば、2012年の方法と同じ枠組みに、その後10年の改良を加えたもので、SWAP* と名付けた近傍(異なるルートの2つの納品先を、互いの元の位置にこだわらずに入れ替える操作)を新たに含みます。要旨は、Uchoa らの X 系列での比較で、HGS が解の質、収束の速さ、考え方の簡潔さの点で今も有力なメタヒューリスティクス(特定の問題に依存しない探索の枠組み)だと述べています。
この HGS を Python から使えるようにしたのが、Wouda・Lan・Kool が2024年に INFORMS Journal on Computing 誌で発表した PyVRP です。論文の要旨によれば、PyVRP は HGS を実装した配車ソルバーのパッケージで、性能が必要な部分だけを C++ で書き、Python の側から細かく設定を変えられるように作られています。2021年の DIMACS の時間枠付き配車の競技会で1位になったアルゴリズムを磨き上げた実装であり、改良を加えて2022年の EURO meets NeurIPS の配車競技会の静的な部門でも1位になったと書かれています。ライセンスは MIT です。
ここで注意が要るのは、PyVRP の中身がその後変わったことです。GitHub で公開されている PyVRP の v0.13.0 のリリースノートは、基盤のアルゴリズムを「ハイブリッド遺伝的探索から反復局所探索へ」全面的に作り替えたと書き、数分までの計算時間や、500件程度からの大きな問題で解の質が良くなったことを変更の理由に挙げています。PyPI の記録では 0.13.1 が2026年1月15日に、この章で使った 0.14.0 が2026年8月20日に公開されています。反復局所探索(Iterated Local Search)は、PyVRP の説明ページによれば、局所最適から抜け出すのに足りる程度だけ今の解を崩し、局所探索で新しい局所最適まで磨き、受け入れるかどうかを判定する、という手順を繰り返す方法です。崩し方の程度を小さく保つ点を除けば、前の節の「壊して直す」と同じ骨格を持っています。この章の実験は PyVRP 0.14.0 で行っていますので、結果は HGS ではなく反復局所探索のものです。論文や解説記事で「PyVRP は HGS」と書かれていても、手元の版によって中身が違う、ということは道具を選ぶときの注意点になります。
3つ目の流れがタブー探索です。局所探索で直前に行った変更を一定の回数だけ元に戻せないようにし(タブーにし)、そのあいだは悪くなる方向へも動くことを許して、局所最適から抜け出す方法です。Taillard の1993年の論文は、車の台数が多い問題を領域に分けてタブー探索を並列に動かし、当時の古典的なベンチマークの既知最良解をすべて見つけたと要旨で報告しています。この論文は、後の節で扱う分割統治の先駆けでもあります。
OR-Tools のルーティングソルバーでも、改善の方法としてタブー探索(TABU_SEARCH)・焼きなまし(SIMULATED_ANNEALING)・誘導局所探索(GUIDED_LOCAL_SEARCH)を選べます。OR-Tools の公式ドキュメントは、誘導局所探索が配車では一般に最も効率が良いと書いています。これらの方法を同じ問題で比べた結果は第6章で扱いましたので、この章では重ねません。この章では OR-Tools を誘導局所探索に固定し、別の系統の探索である PyVRP と、規模を変えながら比べます。
X 系列で測る、時間制限と既知最良値とのギャップ
ここからは実測です。CVRPLIB の X 系列から、納品先100件(X-n101-k25)、199件(X-n200-k36)、501件(X-n502-k39)、1,000件(X-n1001-k43)の4問を選びました。問題名の n の後の数字はデポを含む地点の数、k の後の数字は CVRPLIB の一覧で台数の欄に載っている値です。距離は CVRPLIB の定義どおり、座標間の直線距離を四捨五入した整数で、目的は総距離の最小化です。台数は固定されていません。実際、X-n101-k25 の既知最良解のファイル(.sol)は26本のルートでできています。
比べたのは次の2つです。1つは第6章までと同じ OR-Tools 9.15.6755 のルーティングソルバーで、初期解の戦略は PATH_CHEAPEST_ARC、改善は誘導局所探索です。もう1つは PyVRP 0.14.0(反復局所探索)で、乱数の種は0です。PyVRP は PyPI の公式配布物を python -m pip install pyvrp で入れました。どちらにも同じ整数の距離行列を渡し、X-n101 と X-n200 は60秒、X-n502 と X-n1001 は120秒の時間制限で1回ずつ解き、解が更新されるたびに経過時間と総距離を記録しました。1回の実行の途中経過を読むので、表の「5秒」の値は「5秒で打ち切っていたら得られた値」にあたります。時間はこの記事の実行環境(一般的なノートPC)での実測で、ほかの章の計算と同じPCで並行して動かしたため、単独で動かした場合より遅く出ている可能性があります。
| 問題(納品先の数) | 既知最良値(最適性の証明) | 解き方 | 1秒 | 5秒 | 10秒 | 30秒 | 60秒 | 120秒 | 最終の台数 |
|---|---|---|---|---|---|---|---|---|---|
| X-n101-k25(100件) | 27,591(証明済み) | OR-Tools | 9.31% | 5.68% | 5.68% | 5.49% | 5.49% | 対象外 | 27 |
| X-n101-k25(100件) | 27,591(証明済み) | PyVRP | 1.90% | 0.25% | 0.02% | 0.00% | 0.00% | 対象外 | 26 |
| X-n200-k36(199件) | 58,578(証明済み) | OR-Tools | 5.16% | 3.92% | 3.90% | 3.77% | 3.58% | 対象外 | 37 |
| X-n200-k36(199件) | 58,578(証明済み) | PyVRP | 2.91% | 2.66% | 2.50% | 1.77% | 0.69% | 対象外 | 36 |
| X-n502-k39(501件) | 69,226(未証明) | OR-Tools | 3.67% | 1.72% | 1.55% | 1.54% | 1.54% | 1.45% | 39 |
| X-n502-k39(501件) | 69,226(未証明) | PyVRP | 1.69% | 1.21% | 0.98% | 0.53% | 0.25% | 0.20% | 39 |
| X-n1001-k43(1,000件) | 72,346(未証明) | OR-Tools | 18.85% | 13.19% | 11.05% | 9.80% | 9.75% | 9.75% | 43 |
| X-n1001-k43(1,000件) | 72,346(未証明) | PyVRP | 8.58% | 5.58% | 4.62% | 4.18% | 2.93% | 1.97% | 43 |
表の「1秒」から「120秒」の列は、その時点までに見つかった最良の解が、既知最良値より何%長いか(ギャップ)です。「対象外」はその問題では時間制限がそこまで無かったことを表します。「既知最良値」の列は、2026年9月25日に取得した CVRPLIB の一覧の値と最適性の印です。
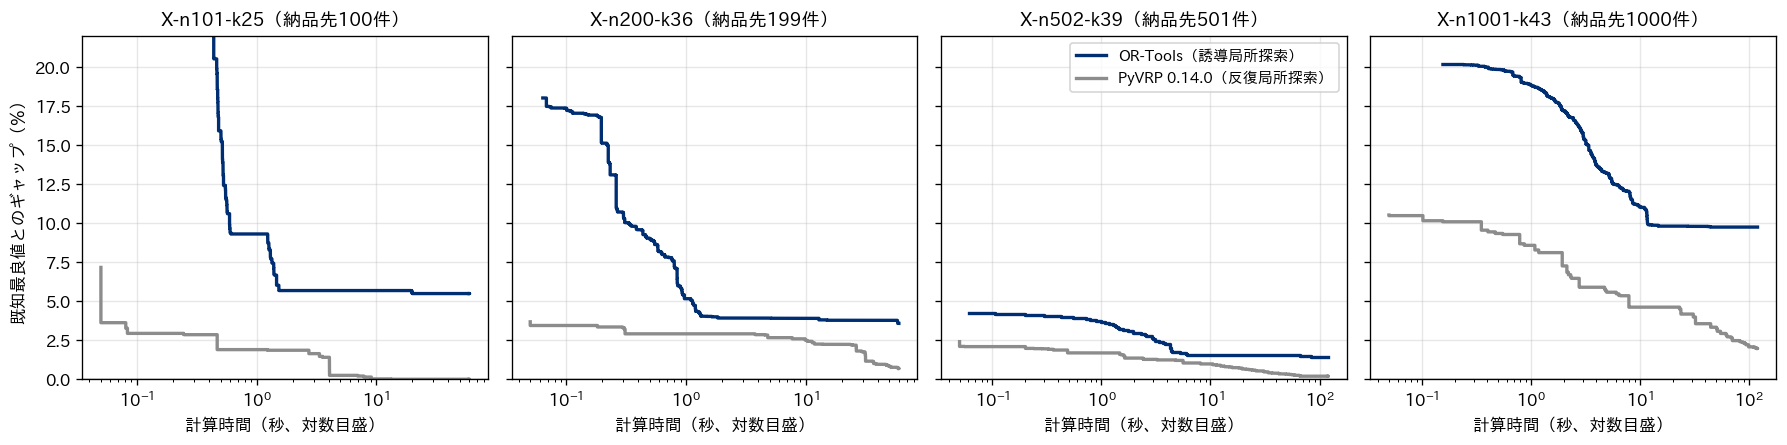
図は同じ記録を、横軸を対数目盛の計算時間にして描いたものです。読み取れることを4つ挙げます。1つ目は、100件の問題では、PyVRP は5秒でギャップ0.25%、30秒で既知最良値(最適値)そのものに到達したのに対し、OR-Tools は60秒でも5.49%に留まったことです。最終の台数は、OR-Tools が27台、PyVRP が既知最良解と同じ26台でした。2つ目は、OR-Tools の曲線が早い段階で平らになることです。X-n1001 では10秒から30秒の間はまだ下がっていますが、30秒の9.80%から120秒の9.75%までほとんど動いていません。時間制限を延ばしても、この設定の誘導局所探索は1,000件の問題で約10%の差を埋められませんでした。3つ目は、PyVRP は時間を与えるほど着実に下がり続けたことです。X-n1001 では30秒の4.18%から120秒の1.97%まで下がっています。4つ目は、問題の性質によって差の大きさが変わることです。X-n502-k39 は車1台の積載が13で、1台あたりの訪問数が少なく、OR-Tools の初期解ですでにギャップ4.2%でした。こうした問題では、2つの道具の差は1.45%と0.20%で、X-n1001 ほど開きません。
揺れも確かめました。PyVRP は乱数の種で結果が変わるので、X-n200-k36 を種1で同じ60秒だけ解き直したところ、最終のギャップは2.01%(種0では0.69%)、10秒時点で2.57%、30秒時点で2.08%でした。60秒時点の差は1ポイント以上あり、1回の実行の値を道具の実力として読むのは危険です。OR-Tools でも、X-n200-k36 を同じ条件(60秒)でもう一度解いたところ、最終のギャップは3.42%(1回目は3.58%)、1秒時点では4.03%(同5.16%)でした。解が更新された回数も1回目の639回に対して808回で、同じ設定でも、計算機の負荷などで同じ時間内に進む探索の量が変わると、途中と最終の値が変わります。60秒時点のギャップは、OR-Tools が2回で3.42〜3.58%、PyVRP が2つの種で0.69〜2.01%で、幅は重なっていません。この問題では、2回ずつの範囲で見ても差の向きは変わりませんでした。重要な判断に使う比較では、種を変えて複数回解き、幅で読むことが必要です。
この表は「PyVRP のほうが優れた道具だ」という意味に読むべきではありません。今回の比較は、積載制約だけの CVRP という、PyVRP の論文が最先端の結果を示したと述べている問題の型での比較です。OR-Tools は、第5章〜第8章で見たように、時間枠・休憩・集荷と配送の組・訪問の省略など、実務の制約を1つの枠組みに足していけます。そのうえ今回の設定(PATH_CHEAPEST_ARC+誘導局所探索、そのほかは既定値)も、大規模向けに調整したものではありません。PyVRP で扱える問題は、公開ページが挙げている範囲(時間枠、車種混在、複数デポ、集荷と配送、積み直し、任意訪問など)で、それ以外の制約が要る場合は道具の選び方が変わります。この表から読むべきなのは、「同じ時間制限でも、探索法の違いで千件規模では距離に数%から10%の差が出うる」ことと、「規模が大きいほど、道具の選択と時間の与え方が答えの質を左右する」ことです。
件数を増やすと、30秒で得られる答えはどう変わるか
ベンチマークは問題ごとに性質が違うので、件数だけを変えた比較も行いました。共通データの large_customers(n) は、規模の実験用に納品先 n 件を作る関数で、エリアは60km四方、デポは中央の (30, 30)、各納品先の荷量は5〜40ケースです。第2章の40件と同じく乱数の種を固定した架空のデータで、エリアの広さを変えずに件数だけを増やすので、件数が多いほど納品先は密になります。2トン車(150ケース)の積載制約だけを入れ、距離は直線距離の1.3倍を m 単位の整数にしました。目的は X 系列と同じく総距離の最小化で、台数に費用は付けていません。時間制限は30秒で、OR-Tools と PyVRP(種0)を1回ずつ解きました。
| 納品先の件数 | 台数の下限 | 距離行列の作成(秒) | OR-Tools 初期解まで(秒) | OR-Tools 初期解(km) | OR-Tools 5秒(km) | OR-Tools 30秒(km) | PyVRP 5秒(km) | PyVRP 30秒(km) | 30秒の台数 OR-Tools/PyVRP | 30秒の差(OR-Tools が長い%) |
|---|---|---|---|---|---|---|---|---|---|---|
| 100 | 16 | 0.00 | 0.08 | 1,737.4 | 1,584.7 | 1,412.8 | 1,368.1 | 1,363.4 | 16/16 | 3.6 |
| 200 | 31 | 0.01 | 0.02 | 3,067.7 | 2,606.6 | 2,606.6 | 2,414.4 | 2,356.3 | 31/31 | 10.6 |
| 400 | 59 | 0.06 | 0.14 | 5,301.0 | 4,609.7 | 4,596.9 | 4,412.3 | 4,319.7 | 60/60 | 6.4 |
| 800 | 119 | 0.19 | 0.19 | 9,760.7 | 9,228.7 | 8,673.2 | 8,515.3 | 8,427.3 | 121/122 | 2.9 |
| 1,600 | 238 | 0.88 | 1.20 | 18,975.6 | 18,562.3 | 18,047.9 | 16,430.9 | 16,259.8 | 241/243 | 11.0 |
「台数の下限」は総ケース数を150で割って切り上げた値、「30秒の差」は OR-Tools の30秒の総距離が PyVRP の30秒の総距離より何%長いかです。距離行列は numpy で直線距離から作っているので、1,600件でも0.88秒で済んでいます。道路網から最短路を計算して行列を作る場合(第9章)は、この部分がはるかに重くなります。
この表から読み取れることは3つあります。1つ目は、初期解(PATH_CHEAPEST_ARC)はどの規模でも1秒前後で出る一方、その質は低く、OR-Tools 自身の30秒の値より5〜23%、PyVRP の30秒の値より16〜30%長いことです。初期解の戦略だけで配車を決めるのは、規模によらず損が大きいということです。2つ目は、同じ30秒で得られる答えの差が、件数とともに一様に広がるわけではないことです。差は100件で3.6%、200件で10.6%、800件で2.9%、1,600件で11.0%と上下しました。200件の OR-Tools は5秒の値と30秒の値が同じ2,606.6kmで、5秒から先は改善できていません。探索がどこで行き詰まるかは問題ごとに違い、件数だけで「何件までなら大丈夫」とは言えない、ということです。3つ目は、台数です。400件以上では、どちらの道具も台数を下限より1〜5台多く使っています。この実験は総距離だけを目的にしているので、ソルバーは距離が縮むなら車を増やします。第8章で使う架空の費用(2トン車の固定費が1日1台20,000円、走行費が1kmあたり40円)で換算すると、車1台の固定費は500km分の走行費に相当します。台数の判断が要る場面では、第4章や第8章のように台数に費用を付けて解く必要があります。この表の数字は探索の強さを見るためのもので、台数の判断にはそのまま使えません。
もう1つ付け加えると、PyVRP の30秒間の反復回数は、100件で19,344回、200件で12,004回、400件で9,483回、800件で5,226回と、件数とともに減っていきました(1,600件では6,889回と800件より多く、件数だけでは説明できない値でした。ほかの章の計算と同じPCで並行して動かしていたので、この比較には負荷の違いが含まれています)。1回の反復が重くなるので、同じ30秒で試せる組み替えの数が減る、ということです。規模が大きくなると同じ時間で答えの質を保ちにくくなることは、この反復回数の減り方と整合しています。
エリアで分けてから解く分割統治、得になる場合と損になる場合
大きな問題を扱う古くからの方法が、分割統治です。納品先をエリアに分け、エリアごとに独立した小さな問題として解き、答えを並べて全体の計画にします。前に挙げた Taillard の1993年の論文は、デポの周りを極座標の領域(扇形)に分ける方法と、各地点からデポへの最短路の木で分ける方法を示し、台数の多い問題でタブー探索を速くする手段として使っています。実務でも、方面や営業所ごとに配車を分けて計画するのは自然なやり方で、担当者が方面ごとに確認でき、計算も並列に回せます。代わりに、エリアの境界をまたぐ組み合わせは最初から捨てることになります。
その得失を測るため、large_customers(n) の200件と800件を、デポからの角度で件数がほぼ等しい4つ、または8つの扇形に分け、扇形ごとに解いて合計しました。公平に比べるため、合計の計算時間を30秒にそろえ、4分割なら1つの扇形に7.5秒、8分割なら3.75秒を与えています。そのほかの条件は前の節と同じです(2トン車150ケース、総距離の最小化、PyVRP の種は0)。
| 件数 | 解き方 | 分割数 | 総距離(km) | 台数 | 台数の下限 | 分割しない場合との距離の差 |
|---|---|---|---|---|---|---|
| 200 | OR-Tools | 1(分割しない) | 2,606.6 | 31 | 31 | 0 |
| 200 | OR-Tools | 4 | 2,452.0 | 33 | 31 | 5.9%短い |
| 200 | OR-Tools | 8 | 2,517.8 | 34 | 31 | 3.4%短い |
| 200 | PyVRP | 1(分割しない) | 2,350.4 | 31 | 31 | 0 |
| 200 | PyVRP | 4 | 2,409.0 | 33 | 31 | 2.5%長い |
| 200 | PyVRP | 8 | 2,499.3 | 34 | 31 | 6.3%長い |
| 800 | OR-Tools | 1(分割しない) | 8,672.4 | 121 | 119 | 0 |
| 800 | OR-Tools | 4 | 8,692.7 | 122 | 119 | 0.2%長い |
| 800 | OR-Tools | 8 | 8,727.2 | 123 | 119 | 0.6%長い |
| 800 | PyVRP | 1(分割しない) | 8,385.0 | 121 | 119 | 0 |
| 800 | PyVRP | 4 | 8,350.6 | 122 | 119 | 0.4%短い |
| 800 | PyVRP | 8 | 8,393.0 | 123 | 119 | 0.1%長い |
「分割しない場合との距離の差」は、同じ件数・同じ解き方で分割しなかった行の総距離との差で、「短い」は分割したほうが総距離が短かったことを表します。距離だけを見ると、結果は道具と規模で分かれました。200件の OR-Tools では、分割したほうが3.4〜5.9%短くなりました。前の節で見たように、この問題の OR-Tools は分割しないと5秒以降に改善が止まっていました。分割した場合は、その止まった値より短い答えに届いています。一方、200件の PyVRP では、分割すると2.5〜6.3%長くなりました。全体を30秒で十分に探索できる道具にとって、境界をまたぐ組み合わせを捨てることは純粋な損になります。800件では、どちらの道具でも差は「0.4%短い」から「0.6%長い」の範囲に収まり、距離の面では分割の得失はほとんどありませんでした。
ここで注意したいのは、同じ条件の値の揺れです。800件の PyVRP を分割せずに30秒で解いた値は、前の節の表では8,427.3km、この表では8,385.0kmで、同じ種・同じ時間制限でも0.5%ほど違いました。時間制限で打ち切る探索では、同じ種でも、打ち切りまでに進んだ反復の数が実行ごとに違えば、最終の値も変わります。800件の行の差(0.4%短い〜0.6%長い)はこの揺れと同じ大きさなので、「800件では分割が有利」「不利」のどちらとも言えない、と読むのが妥当です。
一方、台数ははっきりしています。分割した場合はすべての行で台数が増え、200件では2〜3台、800件では1〜2台多くなりました。扇形ごとに台数の下限(その扇形の総ケース数を150で割って切り上げた値)が決まるので、扇形ごとの端数が積み上がり、合計の下限は全体の下限以上になります。境界をまたいで1台の空きを埋め合わせることができないためです。前の節の架空の費用では1台の固定費が500km分の走行費に相当するので、距離が5.9%縮んだ200件の OR-Tools の4分割でも、短くなった154.6km(6,184円)より、2台増えた固定費(40,000円)のほうが大きく、1日の総費用では分割しないほうが安くなります。
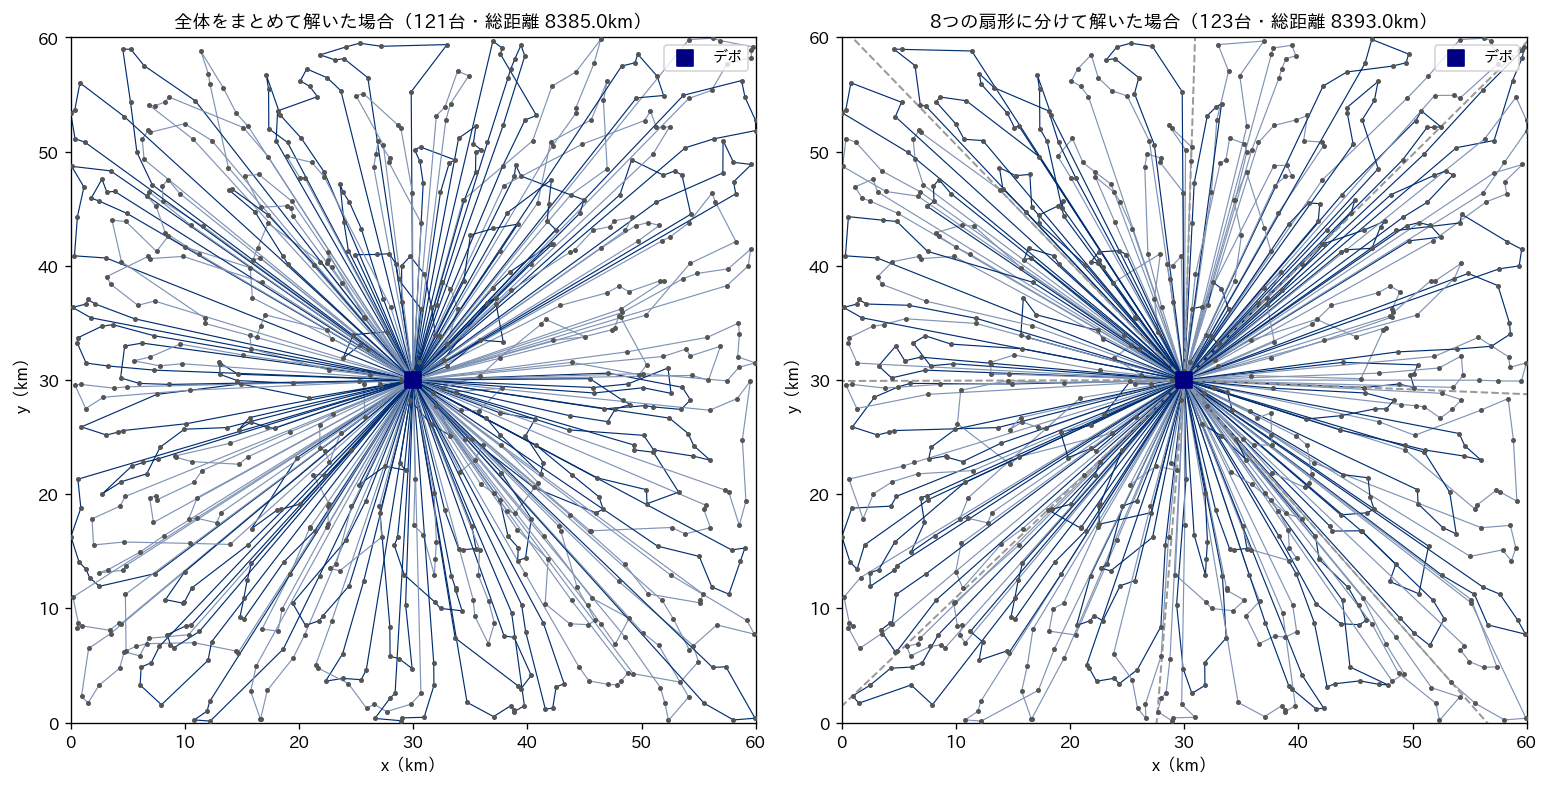
図は800件を PyVRP で解いたルートで、左が分割しない場合、右が8分割の場合です。右の図の灰色の破線が扇形の境界で、ルートは破線を越えません。境界の両側にある近い納品先どうしは、同じ車に乗せられないということです。総距離の差は0.1%でも、台数は左の121台に対して右は123台です。
分割統治を使う場面は、3つに整理できると考えています。1つ目は、使える道具の探索が弱く、全体を一度に渡すと改善が止まってしまう場合です。200件の OR-Tools の結果がこれにあたります。ただし、このときも台数の増加を費用に入れて比べる必要があります。2つ目は、業務の上で分ける理由がある場合です。営業所が別々、車両の所属が別々、方面ごとに締切が違う、といった場合は、分割は制約そのものであり、損ではありません。3つ目は、計算を並列に回して時間を縮めたい場合です。分けた問題は互いに独立しているので、コア数の分だけ同時に解けます。反対に、探索の強い道具で全体を解ける規模なら、分割は台数を増やす方向に働くので、安易に分けないほうがよい、というのがこの実験の結果です。分割するなら、扇形の数を増やすほど境界が増えることを踏まえて最小限にし、境界付近の納品先を隣の扇形にも入れられるようにする、分けて解いた後に全体で改善をかけ直す、といった工夫で損を減らすのが有効だと考えています。
「毎朝決まった時間で十分良い解」を設計する
ここまでの実測を、毎朝の配車業務の設計に置き換えます。出発点は、計算に使える時間を先に決めることです。受注の締切、倉庫のピッキングと積込みの開始、担当者の確認の時間から逆算して、配車の計算に割ける時間を「何時何分から何分間」と決めます。そのうえで、その時間の中で答えの質を最大にする、という順番で考えます。前の節までの表は、どれも「時間を固定したときの質」を測ったもので、この設計にそのまま使えます。
1つ目の設計項目は、時間制限の値です。自社の実際のデータ(あるいはそれに近い規模の過去の1日分)で、時間ごとの最良値を記録しておけば、どこで曲線が平らになるかが分かります。この章の X-n1001 では、OR-Tools は30秒以降ほとんど改善せず、PyVRP は120秒まで改善を続けました。前者なら時間制限を延ばしても得るものは小さく、後者なら延ばす価値があります。どちらになるかは道具と問題の組み合わせで決まるので、自社のデータで一度測るのが確実です。OR-Tools では、この章のコードのように AddAtSolutionCallback で解が更新されるたびに値を記録でき、PyVRP では solve の戻り値の統計に反復ごとの値が残ります。
2つ目は、探索の出発点です。前の日と今日の納品先の多くが同じなら、前の日のルートを初期解として渡し、そこから改善を始める、という使い方ができます。PyVRP の solve には初期解を渡す引数 initial_solution があり、OR-Tools にも既存のルートから解を読み込む ReadAssignmentFromRoutes と、その解から探索を始める SolveFromAssignmentWithParameters があります(いずれもこの章で使った版に存在することは確認しましたが、ゼロから始める場合と比べた効果はこの章では測っていません)。前の日のルートを出発点にすることには、ドライバーの担当が大きく変わりにくいという副次的な利点もあります。ルートの変更量を目的に入れる考え方は第11章、担当エリアを固定するか毎日最適化するかの比較は第12章で扱います。
3つ目は、揺れへの備えです。X-n200-k36 の PyVRP は、乱数の種を変えただけで60秒後のギャップが0.69%と2.01%に分かれました。計算機のコア数に余裕があれば、種を変えた複数の探索を同時に動かし、時間制限の時点で最も良い解を採用する、という運用が考えられます。1本の探索に時間を足すことと、本数を増やすことのどちらが得かは、この章では測っていません。これも自社のデータで確かめるべき項目です。
4つ目は、計算の前処理を朝の時間から外すことです。距離と時間の行列は、納品先のマスタが変わらない限り作り直す必要はありません。前日の夜に行列を作り置き、朝は当日の注文に含まれる納品先の分を取り出すだけにすれば、朝の時間をすべて探索に使えます。この章の実験では行列を直線距離から作ったので1,600件でも1秒未満でしたが、道路網の最短路から作る場合(第9章)は、この部分の計算が別に必要になるので、作り置きの効果が大きくなります。
最後に、答えの質を毎日測る仕組みです。実務のデータには既知最良値がありません。そのため、答えが良いのかどうかを判断する手がかりを別に用意します。台数については、総ケース数を1台の積載で割った下限と比べられます。距離については、休日の夜などに同じ日のデータを長い時間制限で解き直し、朝の答えとの差を記録しておけば、「朝の10分でどれだけ取りこぼしているか」を継続的に把握できます。この差が広がってきたら、件数の増加に探索が追いついていない兆候として、時間制限・道具・分割の方法を見直すきっかけになります。
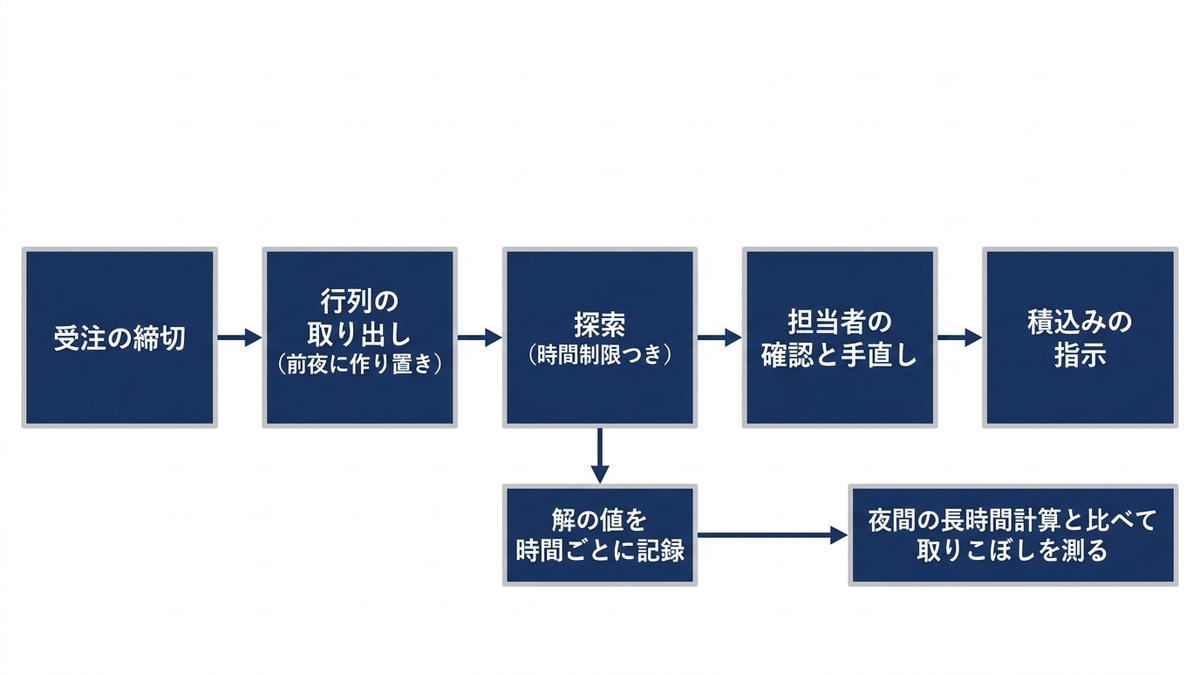
経営の側から見る、計算の数分と距離の数%
大規模な配車で探索の質が数%違うことを、経営指標に置き換えてみます。件数を変えた実験の800件の行では、30秒で OR-Tools が121台・8,673.2km、PyVRP が122台・8,427.3kmでした。総距離の差は245.9kmで、第8章の架空の走行費(2トン車で1kmあたり40円)を掛けると1日9,836円になります。仮に年250日稼働するなら、年間で約246万円です。距離の数%は、規模が大きいほど金額として無視できない大きさになります。
ただし、同じ行を台数まで含めて換算すると、結論が逆になります。架空の固定費(1日1台20,000円)を足した1日の総費用は、OR-Tools の答えが2,766,928円、PyVRP の答えが2,777,092円で、PyVRP のほうが10,164円高くなります。距離では PyVRP が良くても、1台多く使っているからです。この実験は総距離だけを目的にしていたので、どちらのソルバーも台数を重く見ていません。「どちらの道具が良いか」の答えは、ソルバーに渡した目的が経営の目的と一致しているときにだけ意味を持ちます。大規模化の検討で道具や設定を比べるときも、比べる指標は総距離ではなく、固定費と変動費を合わせた1日の総費用、あるいは1件あたりの配送費にそろえる必要があります。
判断を誤ったときの損失の型は、3つに分けられると考えています。1つ目は、規模の拡大に探索が追いついていないことに気づかない損失です。件数が増えても計算時間を据え置いたままだと、答えの質を保ちにくくなり、走行距離と台数の増加として毎日の費用に表れます。前の節の「夜間の長時間計算との差」を記録していれば、この損失は数字で見えます。2つ目は、計算時間に見合わない投資の損失です。X-n1001 の OR-Tools のように、時間を延ばしても改善しない設定では、計算機を増強しても答えは良くなりません。先に時間ごとの曲線を測ることで、この投資の要否を判断できます。3つ目は、分割のしかたが生む損失です。エリアごとに別々に解く運用は、次の日の計画が分かりやすく、担当者の確認もしやすい一方で、境界付近の納品先の組み合わせを捨てています。前の節の比較のように、分割が得になるか損になるかは道具と規模で変わるので、分割を決める前に、全体を一括で解いた答えと比べて差を数字で示しておくことが大切です。
この章の要点は3つです。第一に、規模が大きくなると、距離の行列・1回の局所探索で調べる候補・必要な改善の回数がそろって増え、同じ時間制限で得られる答えの質を保ちにくくなります(件数に対して一様に悪くなるわけではないことは、この章の実測のとおりです)。千件規模の問題では、最適性の証明ではなく、既知最良値や下限とのギャップで質を測ることになります。第二に、壊して直す大近傍探索、遺伝的アルゴリズム系の探索、反復局所探索といった方法は、この規模で良い解を速く出すための工夫で、X 系列の実測では、同じ時間制限でも道具によって千件の問題で約2%と約10%の差が出ました。ただし、どちらが良いかは制約の種類・目的の置き方・乱数の種で変わるので、自社のデータで測ることが欠かせません。第三に、分割統治は探索の弱い道具では得になり、強い道具では損になりえます。毎朝の配車は、計算時間を先に決め、時間ごとの曲線・出発点・揺れ・前処理・答えの質の記録を設計項目として組み立てるものです。次の第11章では、こうして朝に作った計画が、当日の追加注文や遅れでどう崩れ、走行中の車両を固定したまま再配車するにはどうするかを扱います。
この章を深めたい方への参考書籍
『メタヒューリスティクスの数理』(久保幹雄・J.P.ペドロソ、共立出版):局所探索法から、反復局所探索法、禁断探索法(タブー探索)、誘導局所探索法、大近傍探索法、遺伝的アルゴリズムまで、この章で名前を挙げた探索法を1冊の中で並べて解説し、数理計画とメタヒューリスティクスの融合、巡回セールスマン問題などへの応用、Python の概説の付録まで収めた本です。この章では道具として外から使った探索法の中身を、自分で組み立てられる水準で理解したいときに向いています。
『メタヒューリスティクスとナチュラルコンピューティング』(古川正志・川上敬・渡辺美知子・木下正博・山本雅人・鈴木育男、コロナ社):山登り法、シミュレーテッドアニーリング、タブーサーチ、遺伝的アルゴリズム、粒子群最適化法、アントコロニー最適化法などを章ごとに取り上げ、版元の紹介によれば各章に問題の表現、アルゴリズム、実装例、演習問題を含めています。探索法ごとの考え方の違いを、手を動かしながら比べたい読者に向いています。
第11章 当日の変化と再配車、走行中の車を固定して計画を直す
第10章では、納品先が数百件から千件に増えたときに、決まった計算時間で十分良い計画を出す方法を扱いました。ここまでの章はすべて、朝の出発前に注文がそろっていて、計画どおりに一日が進む、という前提で計画を作ってきました。実際の配送センターでは、車が出たあとに追加の注文が入り、渋滞や荷受けの待ちで車が遅れます。計画の実行中に新しい情報が入り、それに合わせて計画を直していく問題を、動的な配送計画問題と呼びます(第2章の分類表の最後の行です)。この章では、一日の途中で入ってくる変化に対して、どの車の、どの部分なら計画を直せるのかを整理し、第2章で用意したサンプルデータの当日の追加注文8件を受付時刻の順に入れながら、走行中の車の済んだ部分を固定して計算し直す実験を行います。対応の型(空いている車に差し込む・全体を計算し直す・予備の車を出す・翌日に回す)の比較、何時までの注文を当日に回すかという受付締切の決め方、計画を直したときにドライバーと納品先に及ぶ変更の量、車が遅れたときの直し方を、実行結果の数字で示します。
当日に変わるもの、動かせるもの、動かせないもの
一日の途中で起きる変化は、大きく2種類に分かれます。1つ目は仕事が増える、あるいは変わる変化で、追加の注文、注文の取り消し、数量の変更、時間指定の変更がこれにあたります。2つ目は計画の前提が崩れる変化で、事故や渋滞による遅れ、荷受けでの待ち、車両の故障、ドライバーの急な欠勤がこれにあたります。どちらの場合も、朝に作った計画のうち、すでに実行した部分は取り消せません。直せるのは、まだ実行していない部分だけです。
配送の再計画で見落とされやすいのは、「まだ実行していない部分」の中にも動かせないものがあることです。配送の車は朝に荷物を積んで出発しているので、車に積んである荷物は、その車でしか届けられません。朝の計算では納品先をどの車に割り当ててもよかったのに対し、出発後の再計算では、まだ届けていない納品先であっても、その荷物を積んでいる車に縛られます。別の車に回すには、途中で落ち合って荷物を積み替えるか、いったんセンターに戻して積み直す必要があり、どちらも時間と手間がかかります。この章の実験では積み替えは扱わず、積んだ荷物はその車が届ける、という条件を守ったまま計画を直します。
追加の注文にも同じ事情があります。追加の注文の荷物は配送センターにあるので、すでに出発した車がそれを届けるには、どこかで一度センターに戻って積み込む必要があります。センターの近くを通る車なら戻る手間は小さく、遠くを回っている車なら大きくなります。まだ出発していない車や、予備の車があれば、センターから直接出せます。このため、当日の追加注文をどの車に回すかは、単に「追加の納品先に一番近い車」では決まらず、「センターに寄り道できて、積載に空きがあり、残りの時間指定を守れる車」を探す問題になります。
動かせるものと動かせないものを整理すると、次の表のようになります。この章の実験は、この表の条件をそのままモデルに入れています。
| 対象 | 再計算で動かせるか | この章のモデルでの扱い |
|---|---|---|
| 納品を済ませた納品先 | 動かせない | 計算から外す |
| いま向かっている納品先、いま荷下ろし中の納品先 | 動かせない | その納品先を車の出発点とし、荷下ろしを終えて出発できる時刻を出発時刻として固定する |
| まだ届けていない納品先の荷物 | 別の車には移せない。同じ車の中で回る順番は変えられる | その荷物を積んでいる車だけが訪問できるように縛る |
| 当日の追加注文の荷物 | センターで積めばどの車でも届けられる | 「センターで積む」「納品先で降ろす」の組にして、同じ車が積んでから降ろすことを条件にする |
| 予備の車 | 使うかどうかを決められる | 受付時刻以降にセンターから出発できる7台目として置き、使えば固定費がかかる |
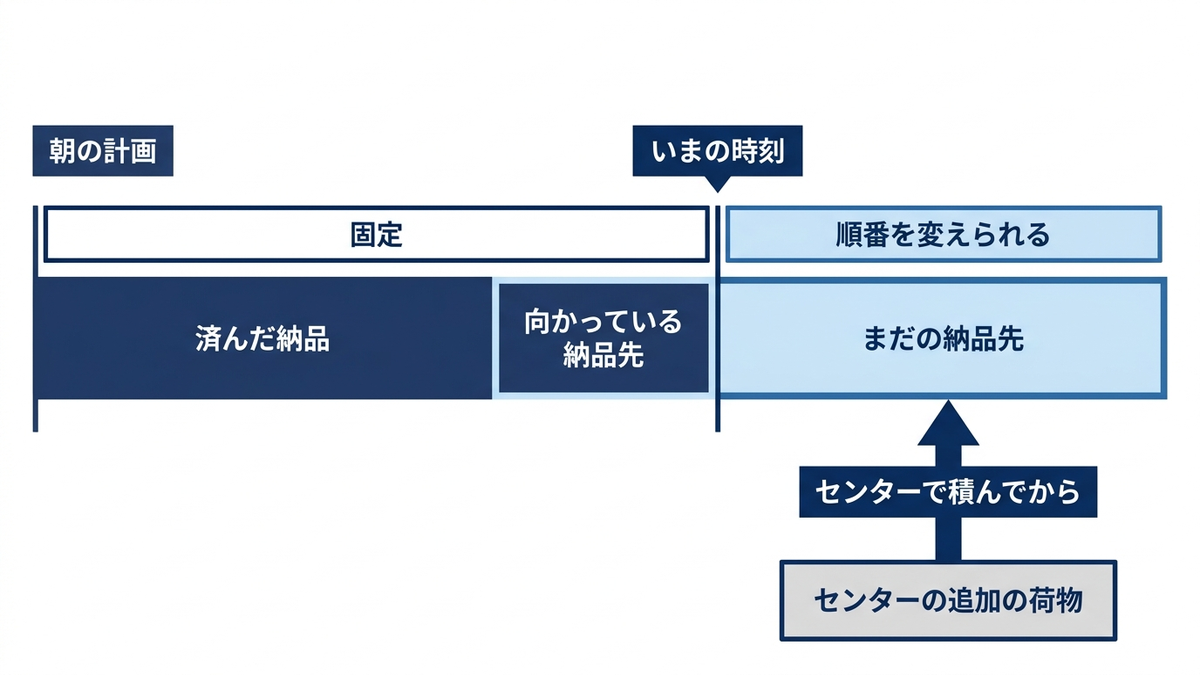
実験の設定、朝の計画と8件の追加注文
朝の計画には、共通データの基準の結果のうち「積載+時間指定」の計画(6台・総距離293.2km)をそのまま使いました。この章では6台を車1〜車6と呼びます。朝の計画では、最も早く戻る車5が13時51分、最も遅く戻る車2が15時55分に帰着し、6台の稼働時間(出発から帰着まで)の合計は40.0時間です。午後に時間指定のある納品先を持つ車は、午前の納品を終えたあと13時の枠の開始まで待つ時間があり、たとえば車1は9時9分に2件目の納品を始めたあと、3件目の納品は13時からです。この待ち時間と、午後の早い時刻に戻ってくる車の空き時間が、当日の追加の仕事を吸収する余地になります。一方で、2トン車6台の積載の上限の合計は900ケース、朝の荷物は868ケースなので、朝の時点で積める余地は合計32ケースしかありません。追加注文を届けるには、多くの場合センターに戻って積み直すことになります。
当日の追加注文は、共通データの extra_orders() の8件です。受付時刻とケース数は次の表のとおりで、どれも荷下ろしは15分、受付時刻から18時までのどの時刻に届けてもよい注文として扱いました。8件の合計は78ケースです。受付時刻は午前に1件ずつ3件、12時30分にまとめて5件で、後者は午前の受付分を昼にまとめて伝えられた場面にあたります。
| 注文 | 受付時刻 | ケース数 | 荷下ろし | 届けてよい時間 |
|---|---|---|---|---|
| X01 | 9時 | 10 | 15分 | 受付から18時まで |
| X05 | 9時30分 | 8 | 15分 | 受付から18時まで |
| X08 | 10時 | 6 | 15分 | 受付から18時まで |
| X02・X03・X04・X06・X07 | 12時30分 | 16・7・6・5・20 | 各15分 | 受付から18時まで |
モデルに入れた仮定は次のとおりです。センターに戻って追加の荷物を積む時間は1回15分と置きました(この章で置いた仮定です)。続けて複数の注文を積むときは、立ち寄りは1回として数えます。車の終業は18時で、それまでにセンターへ戻ることを条件にしました。予備の車は1台で、使うと固定費がかかります。固定費は基準の結果と同じく、100km 走るのと同じ重さに置きました。再計算には OR-Tools のルーティングソルバーを使い、受付のたびに、いまの時刻での各車の状態を切り出して、残りの部分を計算し直します。探索はいまの順番を初期解として読み込み(ReadAssignmentFromRoutes)、そこから誘導局所探索を10秒で打ち切りました。1回の再計算は10.0〜10.1秒で、これはこの記事の実行環境(一般的なノートPC)での実測です。
前の節の表の条件を、ソルバーの言葉に直した部分を抜き出すと次のようになります。記事フォルダの _code\ch11_engine.py の関数 reoptimize から、説明に必要な行だけを抜き出してコメントを書き足したもので、単独では動きません。
# ch11_engine.py の reoptimize から抜き出したもの(単独では動かない)
for vi, (n_fix, loc, ready, load, keep) in enumerate(info):
    td.CumulVar(r.Start(vi)).SetRange(ready, ready)   # 向かっている停車を終えた時刻から出発する
    ld.CumulVar(r.Start(vi)).SetRange(load, load)     # その時点で積んでいるケース数から始める
for node, vi in locked:
    r.VehicleVar(man.NodeToIndex(node)).SetValue(vi)  # 積んだ荷物はその車だけが届ける
for p, d in pairs:                                     # 追加注文は「センターで積む」「納品先で降ろす」の組
    pi, di = man.NodeToIndex(p), man.NodeToIndex(d)
    r.AddPickupAndDelivery(pi, di)
    r.solver().Add(r.VehicleVar(pi) == r.VehicleVar(di))
    r.solver().Add(td.CumulVar(pi) <= td.CumulVar(di))
    r.AddDisjunction([pi], BIG_PEN)                    # 落とすことも許すが、罰金を非常に大きくする
    r.AddDisjunction([di], BIG_PEN)
各車の出発点は、配送センターではなく「いま向かっている納品先」で、出発の時刻はその納品先の荷下ろしを終える時刻に固定しています。積んでいる荷物の納品先には VehicleVar で車を1台に固定し、ほかの車が訪問できないようにしました。追加注文は、センターでの積み込みを集荷、納品先を配送とする組として第8章と同じ AddPickupAndDelivery で入れ、同じ車が積んでから降ろすことを条件にしています。時間内に入れる車が無い場合に計算が止まらないよう、追加注文を落とすことも許しましたが、罰金を1万 km 相当と非常に大きくし、入れられる注文を優先して入れるようにしました。時間で打ち切る探索なので、入れられる注文が必ず入るとまでは言えませんが、この章の実験では、どの型でも8件すべてが当日に届けられ、落ちた注文はありませんでした。
対応の型を比べる、翌日回し・差し込み・全体再計算・予備車
当日の追加注文への対応の型として、次の4つを同じ条件で比べました。結果の表には、この4つに加えて、次の節で説明する「全体再計算+変更量の罰金」も参考として並べます。1つ目は翌日回しで、当日は追加注文を受けず、朝の計画のまま走ります。2つ目は差し込みで、注文を受け付けるたびに、その1件だけを、追加の距離が最も小さくなる車と位置に入れます。センターに寄って積む位置と、納品する位置の組をすべて試し、時間指定・積載・18時の帰着を守れる中で最も安いものを選びます。ほかの納品先の順番は変えません。すでに予定しているセンターへの立ち寄りがあれば、そこに相乗りして積むことも候補に入れました。3つ目は全体再計算で、受付のたびに、前の節のモデルで残りの部分全体を計算し直します。4つ目は予備車の別便で、朝の6台には手を付けず、追加注文はすべて予備の車1台で運びます。予備車の割り当ても受付のたびに計算し直します。
結果は次の表のとおりです。表の「約束より30分超遅れた納品先」は、朝の計画で決めた納品の開始時刻を納品先への約束とみなし、それより30分を超えて遅れた納品先の数です。時間指定の枠を破ったかどうかとは別の指標で、枠の中であっても、朝に伝えた到着予定から大きく外れれば、荷受けの段取りを組み直してもらうことになります。「朝の順番から変わった納品先」は、同じ車の中で、直前に回る納品先が朝の計画と変わった納品先の数で、ドライバーから見た順番の変更の量を表します。全体再計算と、次の節で扱う罰金つきの全体再計算は2回ずつ実行し、2回とも同じ結果になりました。
| 対応の型 | 使用台数 | 総距離 | 最遅帰着 | 稼働時間の合計 | センター立ち寄り | 約束より30分超遅れた納品先 | 朝の順番から変わった納品先 |
|---|---|---|---|---|---|---|---|
| 翌日回し(朝の計画のまま) | 6台 | 293.2km | 15時55分 | 40.0時間 | 0回 | 0件 | 0件 |
| 差し込み | 6台 | 462.9km | 17時53分 | 47.7時間 | 5回 | 6件 | 0件 |
| 全体再計算 | 6台 | 431.8km | 17時50分 | 46.2時間 | 4回 | 6件 | 0件 |
| 全体再計算+変更量の罰金 | 6台 | 425.1km | 17時57分 | 46.1時間 | 3回 | 0件 | 3件 |
| 予備車の別便 | 7台 | 431.6km | 17時33分 | 48.6時間 | 4回 | 0件 | 0件 |
翌日回し以外の4つの型は、いずれも8件すべてを当日に届け、時間指定の枠を破った納品先は0件でした。違いは、そのために何を使ったかに出ています。差し込みは総距離が462.9kmで、朝の計画より169.7km増えました。全体再計算は431.8kmで、差し込みより31.1km短く、センターへの立ち寄りも1回少なくなっています。
差し込みと全体再計算の差がどこで生まれたかを実行ログで追うと、9時の X01 の扱いは両者で同じでした。9時の時点で見えている追加注文は X01 の1件だけで、積んだ荷物は車を移れないので、全体を計算し直しても、差し込みと同じく車6をいったんセンターに戻す案が選ばれています。差が出たのは12時30分に5件がまとめて入った場面です。差し込みは5件を1件ずつ順に入れ、車1・車2・車4の3台に分けてそれぞれセンターへ戻らせました。全体再計算は5件をまとめて見て、朝の計画で14時17分に帰着する予定だった車3に、C15 の納品のあとでセンターへ寄らせ、X02・X03・X07 の3件を1回の立ち寄りで積ませています。1件ずつ最安の位置を選ぶと、後から来る注文との組み合わせが考慮されません。このデータでは、同時に複数の注文が入った12時30分の場面で、全体再計算の効果が大きく出ました。反対に、1件ずつ入った9時の場面では、全体を計算し直しても差し込みと同じ答えになりました。1日分の結果なので、どの程度一般に言えるかは、自社の注文の入り方で確かめる必要があります。
ただし、全体再計算も、約束より30分を超えて遅れた納品先は差し込みと同じ6件でした。差し込みでは車1の C39・C27・C26 が136〜156分、全体再計算では車3の C09 と車4の C22・C35 が88〜104分遅れています。どちらの型でも、9時に X01 のために車6をセンターへ戻したことで、車6の C20・C02・C05 が52分ずつ遅れました。距離だけを目的にしたソルバーは、時間指定の枠の中に収まる限り、朝に伝えた到着予定を動かすことを何とも思いません。この点を扱うのが次の節です。
予備車の別便は、朝の6台の計画に一切手を付けないので、遅れも順番の変更も0件です。その代わりに7台目を9時から17時33分まで走らせ、予備車だけで138.4km を走りました。総距離は431.6kmで全体再計算とほぼ同じですが、1台分の固定費と、ドライバー1人分の拘束がかかります。朝の6台の稼働時間は変わらないので、6台の合計に予備車の8.6時間が加わり、稼働時間の合計は48.6時間と最も長くなりました。
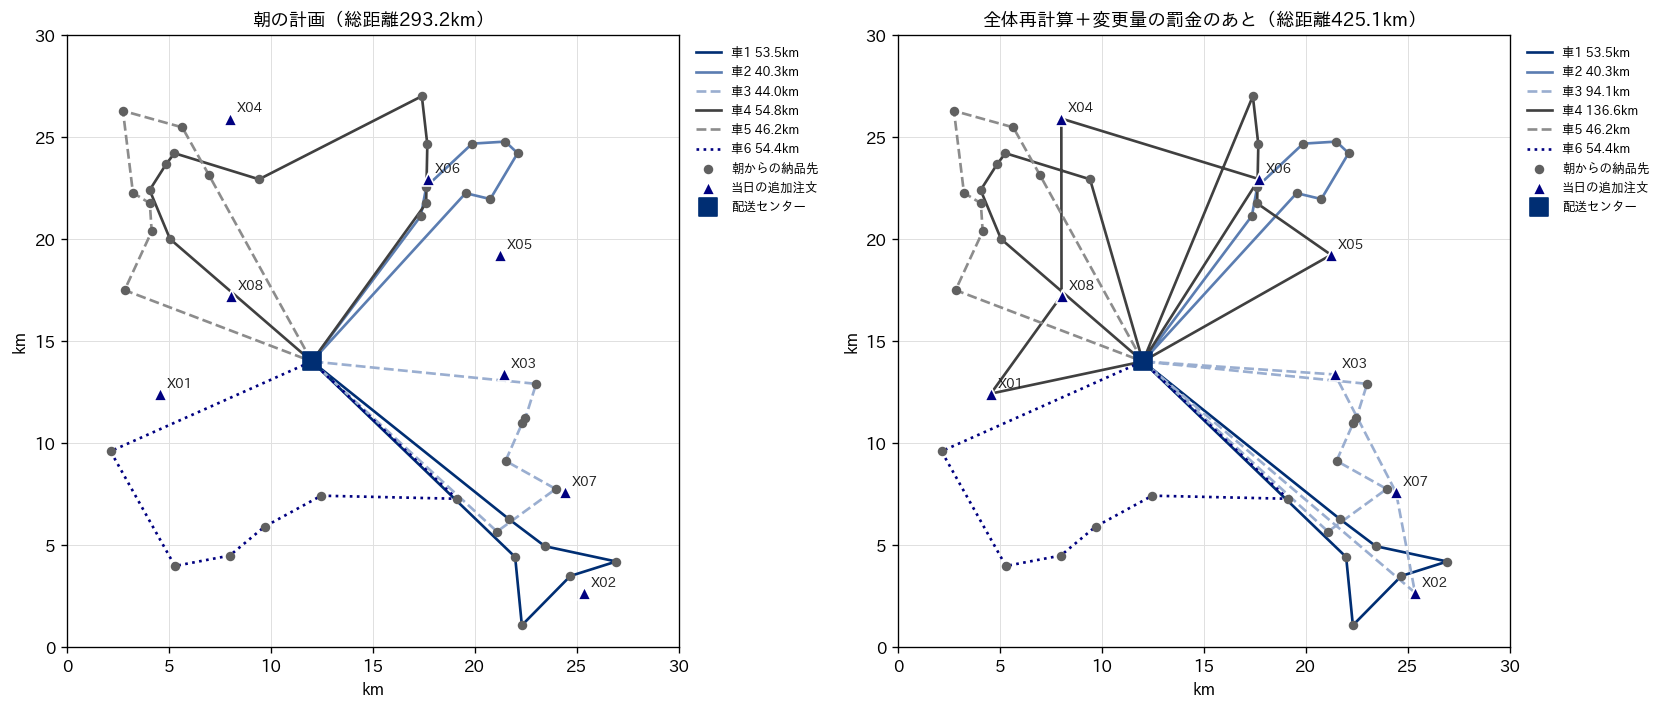
計画の変更量を目的に入れる
再配車で直したいのは距離だけではありません。すでに到着予定を伝えている納品先の予定を大きく動かすこと、ドライバーが頭に入れている回る順番を変えることは、どちらも現場の負担になります。そこで、全体再計算の目的に、朝の約束からの遅れに対する罰金を足しました。各納品先について、朝の計画の納品開始時刻に30分を足した時刻を柔らかい上限とし、それを超えた1分ごとに1km 相当の罰金を距離に加えます。OR-Tools では、時間の次元に SetCumulVarSoftUpperBound で上限と係数を与える形で入れました。第7章で帰着の時刻に使ったのと同じ仕組みです。
結果は前の節の表の「全体再計算+変更量の罰金」の行です。約束より30分を超えて遅れた納品先は6件から0件になり、総距離は425.1kmで、罰金なしの全体再計算(431.8km)より6.7km短くなりました。罰金を足したのに距離が短くなったのは、再計算がその時点で見えている注文だけで良い計画を探しているためです。罰金なしの計算では、9時に X01 のために車6をセンターへ戻す案を選び、後から来た注文にとってはそれが不利な先約になりました。罰金を入れた計算では、車6は朝の計画のまま走り、X01 は車4が11時5分にセンターに寄るときに X05・X08 と一緒に積む形になりました。車6の3件を52分遅らせると、約束の30分を超えた22分ずつに罰金がかかるためです。その時点で得られた良い計画を積み重ねても一日を通した良い計画になるとは限らず、約束を守らせる条件が、結果として先の注文に備える余裕を残す方向に働いた例です。
代わりに増えたのは、順番の変更と1台への負担の集中です。車4は朝の C03・C23・C35 の順番を C35・C23・C03 に入れ替え、センターに2回寄って追加注文を5件運び、総距離136.6km、帰着17時57分になりました。18時の終業まで3分しかありません。順番の変更は3件で、C35 と C23 は約束より早く、C03 は約束より18分遅く着く変更です。約束の幅の中に収まってはいますが、ドライバーと納品先には伝え直す必要があります。車4の帰着が終業ぎりぎりになったことは、次の遅れが起きたときに吸収する余地が車4に残っていないことを意味します。第7章で扱った拘束時間の制約は、朝の計画だけでなく再計算にも同じように入れておく必要があります。
変更量の測り方と罰金の重さは、運用で決める設計項目です。この章では「約束より30分を超えた遅れ」を1分1km 相当で数えましたが、納品先ごとに重さを変える(荷受けの人手が限られる納品先は重くする)、順番の変更そのものに罰金を掛ける、変更してよい車を限る、といった置き方もできます。第6章で触れた、毎朝の計画と前の日のルートとの差を目的に入れる考え方も、同じ柔らかい上限と罰金の仕組みで表せます。ただし、前の日のルートとの差を入れた計画はこの章では測っていないので、効果の大きさは自社のデータで確かめる必要があります。
何回計算し直すか、先を知っていたらどうなるか
全体再計算は受付のたびに行いましたが、計算し直す回数を減らす運用も考えられます。そこで、9時・9時30分・10時・12時30分の4回ではなく、10時と12時30分の2回だけ、その時点までに受け付けた注文をまとめて入れる計算を行いました(罰金なし、各10秒)。総距離は413.3kmで、受付のたびに計算し直した場合(431.8km)より18.5km短くなり、センターへの立ち寄りも3回に減りました。10時に X01・X05・X08 の3件をまとめて見られるので、車4が1回の立ち寄りで3件を積めたためです。
その代わり、約束より30分を超えて遅れた納品先は5件で、遅れの幅は114〜161分と、受付のたびに計算し直した場合(88〜104分)より大きくなりました。まとめて計算すると、受付から配車が決まるまでの待ちが長くなり、その間に車は朝の計画どおりに走り続けるので、追加の仕事を後ろにまとめて押し込む形になりやすいからです。計算の回数を減らすと距離は減ることがあり、約束の遅れは増えることがある、という関係で、どちらを取るかは約束をどれだけ重く見るかで決まります。この例では罰金を入れていないので、まとめて計算する運用に罰金を組み合わせた場合の結果は測っていません。
比較の物差しとして、8件の追加注文の中身と受付時刻を朝8時の時点で全部知っていた場合の計画も解きました。受付時刻より前には荷物を積めない、という条件はそのまま残し、30秒の探索で1回だけ計算しています。総距離は385.2kmで、受付のたびに計算し直した場合(431.8km)より46.6km短くなりました。この差が、注文が前もって分からないことの費用の目安です。ただし、この計画は約束の遅れを気にせずに作っているので、約束より30分を超えて遅れた納品先は6件、最大で240分ありました。先を知っていれば、追加注文の荷物を積むために2台が12時30分にセンターへ戻り、その前後の納品の順番を大きく入れ替える計画が選ばれます。
この「後知恵の計画」は実際には作れませんが、先を知っていた場合にどの程度変わりうるかを見る参考値になります。30秒の探索で1回だけ解いた値なので、先を知っていた場合の最善の値ではなく、改善の余地の上限とは言えません。当日の追加注文の一部でも前日のうちに予告してもらえれば、この46.6kmの一部を取り戻せる、ということです。取引先に前日の予告を依頼するか、受付の時刻をまとめてもらうかといった交渉の材料として、この差を数字で示せます。
受付締切を何時にするか、500日分のシミュレーションで比べる
ここまでの実験は、8件の追加注文が決まった時刻に入る1日だけの結果です。追加注文の件数・場所・時刻は日によって変わるので、何時までの注文を当日に届けるかという受付締切は、1日の結果では決められません。そこで、追加注文の入り方を乱数で作った日を500日分用意し、締切を9時から15時まで1時間刻みで変えて、同じ500日を締切ごとに流しました。締切ごとに同じ乱数の日を使ったのは、締切の違いによる差と、日ごとの偶然の差を混ぜないためです。
1日の流れは、SimPy(版4.1.1)で書いた離散イベントシミュレーションで進めました。離散イベントシミュレーションは、「注文を受け付ける」のような出来事が起きる時刻だけを順に追って、時計を次の出来事まで飛ばしながら状態を更新していく方法です。受付の処理は次のように書いています。記事フォルダの _code\ch11_sim.py の関数 one_day から抜き出したもので、単独では動きません。
# ch11_sim.py の one_day から抜き出したもの(単独では動かない)
env = simpy.Environment()

def reception(env):
    for o in orders:
        yield env.timeout(o["t_call"] - env.now)       # 次の注文の受付時刻まで進める
        if env.now > cutoff:
            log["late_call"] += 1                      # 締切後の受付は翌日回し
        elif not insert_order(fleet, o["id"], env.now):
            log["rejected"] += 1                       # 当日に入る車が無い

env.process(reception(env))
env.run(until=600)
設定は次のとおりです。朝の計画は毎日同じ6台の計画(基準の結果)で、予備車を1台置きました。追加注文の件数は1日平均8件と平均16件の2通りをポアソン分布(決まった平均のまわりで、独立に起きる出来事の件数がばらつく様子を表す分布)で作り、受付時刻は9時から15時まで5分刻みで一様に、場所はエリアの中で一様に、ケース数は5〜25ケース、荷下ろしは15分としました。締切までに受け付けた注文は、前の節の差し込みで入れます。どの車にも入らなければ予備車を使い、予備車にも入らなければ翌日回しです。締切後に受け付けた注文も翌日回しです。受付時刻を15時までとしたので、締切15時は締切なしと同じです。
500日を回すのに全体再計算ではなく差し込みを使ったのは、計算時間のためです。全体再計算は1回10秒かかるので、500日・7通りの締切・2通りの件数では数日かかります。差し込みなら、全部で139.6秒でした(この記事の実行環境での実測)。前の節の1日の実験では、差し込みは全体再計算より総距離が31.1km長かったので、このシミュレーションの追加距離は、全体再計算を使った場合より多めに出ていると考えられます。締切の違いによる傾向を見るための計算で、金額の水準をそのまま使うための計算ではありません。
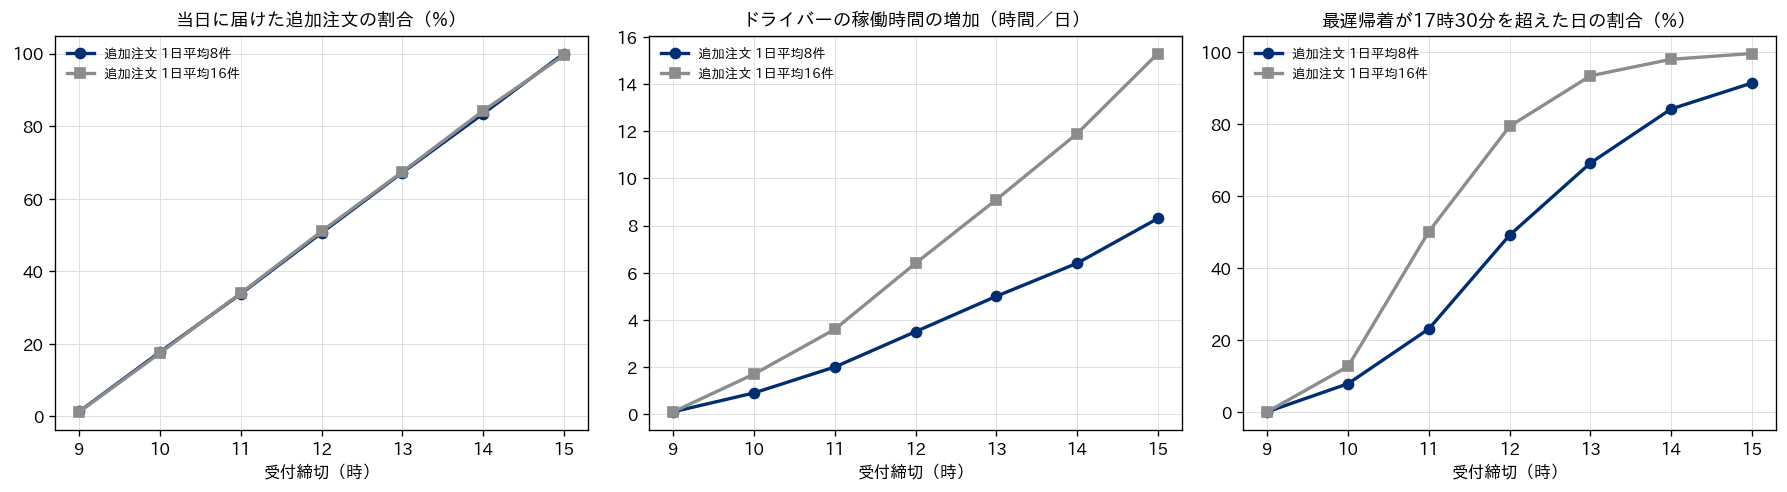
1日平均8件の場合の結果を表にまとめます。「追加費用」は、追加の距離に共通データの2トン車の km 単価(40円、架空の値)を、稼働時間の増加に第7章で置いた架空の残業単価(1分40円)を掛けて足した額で、予備車を使った日はその割合に固定費(20,000円、架空の値)を掛けて足しました。増えた稼働時間がすべて残業になるとは限らないので、時間の費用は多めに見積もった額です。
| 受付締切 | 当日に届けた割合 | 追加距離(1日平均) | 稼働時間の増加(1日平均) | 最遅帰着が17時30分を超えた日 | 約束より30分超遅れた納品先(1日平均) | 追加費用(1日平均) | 当日に届けた1件あたりの追加費用 |
|---|---|---|---|---|---|---|---|
| 9時 | 1.4% | 2.5km | 0.1時間 | 0.2% | 0.08件 | 340円 | 3,091円 |
| 10時 | 17.8% | 28.0km | 0.9時間 | 8.0% | 0.55件 | 3,280円 | 2,307円 |
| 11時 | 33.8% | 48.6km | 2.0時間 | 23.2% | 1.00件 | 6,744円 | 2,503円 |
| 12時 | 50.6% | 74.4km | 3.5時間 | 49.2% | 1.35件 | 11,376円 | 2,814円 |
| 13時 | 67.2% | 100.2km | 5.0時間 | 69.2% | 1.55件 | 16,008円 | 2,984円 |
| 14時 | 83.4% | 123.4km | 6.4時間 | 84.2% | 1.62件 | 20,296円 | 3,049円 |
| 15時(締切なし) | 100.0% | 150.3km | 8.3時間 | 91.4% | 1.63件 | 25,972円 | 3,254円 |
当日に届けた割合は、締切を1時間遅らせるごとにほぼ一定の幅(16〜17ポイント)で増えています。これは受付時刻を9時から15時まで一様に作ったためで、実際の締切の効き目は、注文が何時ごろに集中するかで決まります。自社の受注の記録から、受付時刻の分布を先に集計しておく必要があります。9時締切で1.4%になっているのは、ちょうど9時に受け付けた注文だけが当日に回っているためです。
費用の側は、締切を遅らせるほど増えますが、増え方は一様ではありません。当日に届けた1件あたりの追加費用は、10時締切の2,307円から15時の3,254円まで、締切を遅らせるほど高くなりました(9時締切は1日0.11件と件数が少ないので、この比較から除いています)。遅い時刻の注文ほど、午後の空き時間が減った車に押し込むことになり、1件あたりの寄り道が長くなるためです。最遅帰着が17時30分を超えた日の割合は、11時締切の23.2%から12時締切の49.2%へと大きく跳ね、締切なしでは91.4%でした。18時の終業の手前まで働く日がほぼ毎日になると、その日に次の遅れが起きたときの逃げ場がありません。
追加注文が1日平均16件に増えると、同じ締切でも負担は大きくなります。最遅帰着が17時30分を超えた日は、11時締切で50.2%、12時締切で79.4%でした。締切なしでは、予備車を使った日が23.0%、予備車にも入らず翌日に回った注文が500日で42件出ました。当日に届けた1件あたりの追加費用は、10時から14時の締切では平均8件の場合より安く(10時締切で2,143円、14時締切で2,799円)、締切なしでは3,264円と平均8件の場合(3,254円)とほぼ同じでした。件数が多いほど、同じセンターへの立ち寄りで運べる注文が増える一方、締切なしでは予備車の固定費が加わるためです。同じ締切でも、追加注文の量によって、どこで負担が急に重くなるかが変わります。
車が遅れたとき、残りの順番を変えて取り戻せる分
次に、事故や渋滞で1台が遅れた場合を扱います。積んだ荷物は別の車に移せないので、積み替えを考えない限り、直せるのはその車の残りの順番だけです。そこで、6台のうち1台だけが、いま向かっている納品先での作業の終わりを一定の時間だけ後ろにずらされる場面を作り、残りの順番をそのまま走る場合と、残りの順番を変える場合を比べました。残りの納品先は多くても7件なので、並べ方をすべて試して(7件なら5,040通り)、時間指定の枠の遅れの合計が最も小さく、その中で約束より30分を超えて遅れる納品先が最も少なく、さらにその中で距離が最も短い順番を選んでいます。遅れる車を1台ずつ入れ替えて6通りの場面を作り、下の表はその6通りの合計です。
| 遅れが起きた時刻と遅れの長さ | 6通りの場面の残りの納品先(合計) | 約束より30分超遅れた納品先(順番そのまま) | 約束より30分超遅れた納品先(順番を変える) | 時間指定の枠の遅れ(順番そのまま) | 時間指定の枠の遅れ(順番を変える) |
|---|---|---|---|---|---|
| 8時30分に30分 | 34件 | 0件 | 0件 | 0件 | 0件 |
| 8時30分に60分 | 34件 | 17件 | 11件 | 0件 | 0件 |
| 8時30分に90分 | 34件 | 17件 | 14件 | 1件(5分) | 0件 |
| 8時30分に120分 | 34件 | 17件 | 17件 | 1件(35分) | 1件(4分) |
| 10時に60分 | 18件 | 13件 | 10件 | 0件 | 0件 |
| 10時に120分 | 18件 | 13件 | 13件 | 1件(35分) | 1件(25分) |
| 13時に60分 | 11件 | 11件 | 8件 | 0件 | 0件 |
| 13時に120分 | 11件 | 11件 | 11件 | 0件 | 0件 |
まず、30分の遅れはどの場面でも約束の遅れとして数えられていません。これは約束の幅を30分と置いたためで、30分ちょうどの遅れは定義上この指標に表れません。60分以上の遅れでは、残りの納品先の多くが約束を破ります。一方、時間指定の枠そのものを破ったのは、どの場面でも車5の C11 の1件だけでした。朝の計画には午後の枠の開始まで待つ時間が組み込まれているので、午前の遅れの多くは待ち時間に吸収され、枠は守れます。守れないのは、朝に伝えた到着予定のほうです。
順番を変えると、60分の遅れでは約束を破る納品先が減りました(8時30分の場面で17件から11件、10時の場面で13件から10件、13時の場面で11件から8件)。遅れた車の中で、枠に余裕のある納品先を後ろに回し、約束の近い納品先を先に回すことで、一部を取り戻せます。ただし距離は増えます。8時30分に60分遅れた場面では、車4の残りの距離は42.8kmから56.3kmに、車6は41.7kmから56.9kmに増えました。120分の遅れでは、順番を変えても約束を破る件数は減らず、減らせたのは C11 の枠の遅れの分数(35分から4分、あるいは25分)だけでした。
この結果から言えるのは、このデータと積み替えなしの条件では、1台の中の順番の入れ替えで取り戻せるのは1時間前後の遅れまでで、それより大きな遅れは、ほかの車に仕事を移さない限り取り戻せなかった、ということです。ほかの車に移すには、途中で落ち合って荷物を積み替えるか、遅れた車の後半の納品先をあきらめて翌日に回すか、納品先に連絡して時刻をずらしてもらうかのどれかになります。この章のモデルは積み替えを扱っていないので、積み替えの効果は測っていません。実務では、遅れの長さに応じて「順番の入れ替えで吸収する」「納品先に連絡する」「応援の車を出す」の境目を先に決めておき、その境目を決める材料としてこの種の計算を使うのがよいと考えています。
運用に落とすときの設計項目
再配車をシステムとして回すには、計算の方法より先に、いくつかの運用上の設計が要ります。1つ目は、いまどの車がどこまで回ったかという情報です。この章の実験では、各車が朝の計画どおりに走っていると仮定して、ある時刻の状態を計算で切り出しました。実際には、動態管理(車載端末やスマートフォンで車の位置と納品の完了を記録する仕組み)の記録が再計算の出発点になります。この情報が遅れて入る、あるいは入らない車があると、固定すべき部分を誤り、もう済んだ納品先を計画に残すことになります。動態管理を含むシステムの間のデータの流れは第13章で扱います。
2つ目は、計算にかける時間と計算する時点です。この章では1回の再計算に10秒をかけましたが、車が数十台になれば、同じ時間での答えの質を保ちにくくなります(第10章)。受付のたびに計算し直すか、決まった時刻にまとめて計算するかは、前の節で見たように距離と約束の遅れのトレードオフで、計算時間の制約とも絡みます。3つ目は、変わった計画をドライバーにどう伝えるかです。変更の量を目的に入れても、変更がゼロになるわけではありません。変更は、センターに戻ったとき、あるいは次の納品先に着いたときにまとめて伝える、といった伝え方の決まりを作り、伝え方に合わせて「変更してよいのは次の次の納品先から」といった条件を計算に入れる、という順に考えるのが現実的です。
4つ目は、計算の前提になる距離と時間の精度です。第9章で見たように、見積りの誤差は計画を壊し、計画を直すたびに同じ誤差が入り込みます。再計算の結果がすぐに現実とずれるなら、ソルバーの設定より先に、距離と時間の表を見直す必要があります。5つ目は、ここまでに見た締切・予備車・変更量の罰金といった設計項目を、実際に運用する前に試す手段です。この章の締切の比較のように、注文の入り方と車の動きを模擬して多くの日を流せば、運用を変える前に効果の見当を付けられます。シミュレーションの組み立て方と使いどころ、結果の読み方の注意は、弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」で扱っています。
経営の側から見る、当日対応は1件ごとに費用がかかるサービスである
この章の数字を経営指標に翻訳します。まず、8件の追加注文の1日の実験で、朝の計画との差を費用に直しました。距離は共通データの2トン車の km 単価(40円)、稼働時間の増加は第7章の残業単価(1分40円)、予備車は固定費(20,000円)で数えています(いずれも架空の値)。全体再計算に変更量の罰金を入れた型は、追加距離131.9km・稼働時間366分の増加で、合計19,916円、当日に届けた1件あたり2,490円でした。差し込みは25,268円(1件あたり3,159円)、罰金なしの全体再計算は20,424円(同2,553円)、予備車の別便は固定費を含めて46,176円(同5,772円)です。後知恵の計画でも15,440円(同1,930円)かかっており、当日の追加注文は、先に分かっていたとしてもそれなりの費用がかかるサービスだということが分かります。
この1件あたりの費用を、当日配送で得られる粗利や、取引先から受け取る当日配送の料金と比べることが、受付締切を決める出発点になります。500日のシミュレーションでは、1日平均8件のとき、締切を12時にすると当日に届けられる注文は約半分(50.6%)、1日の追加費用は平均11,376円で、最遅帰着が17時30分を超える日が約半分(49.2%)でした。締切を11時に早めると、当日に届けられる割合は33.8%に下がる一方、17時30分を超える日は23.2%に減ります。どちらが良いかは、当日に届けられなかった注文を翌日に回したときに失うもの(取引の機会や取引先の満足)をどう見るかで決まり、この損失はこの章の計算には入っていません。締切の判断は、この表のような曲線を自社の受注の記録から作り、失うものの見積りと並べて行う必要があります。
次に、ドライバーの時間です。締切を遅らせるほど、当日に届けた1件あたりの稼働時間の増加は長くなり、平均8件のとき10時締切で38分、15時締切で62分でした(_out\ch11b_cost.txt)。第7章で扱ったように、ドライバーの労働時間には上限があるので、当日対応で毎日の拘束が延びることは、残業の費用だけでなく、翌日以降の人の手配にも響きます。帰着が終業の間際になる日が続けば、遅れへの備えもなくなります。最後に予備車です。予備車の別便は、朝の計画に手を付けずに済み、約束の遅れも0件でしたが、1日の追加注文が8件程度では、1件あたりの費用が最も高くなりました。予備車が見合うのは、追加注文が多く、既存の車に押し込むと約束の遅れや終業の超過が増える日です。16件の場合に締切なしで予備車を使った日が23.0%あったことは、件数が増えるとその境目に近づくことを示しています。
当日対応の水準は、配車の技術だけでは決まらず、営業(何時まで受けるか)と物流(何台で待ち構えるか)の間の取り決めです。受付締切・予備車の台数・約束の幅を、1件あたりの費用とサービス水準の組として表にしておけば、営業と物流が同じ数字を見て話せるようになります。
この章の要点は3つです。第一に、当日の再配車では、済んだ部分と向かっている納品先を固定し、積んだ荷物をその車に縛ったうえで残りを計算し直します。追加注文は「センターで積んでから届ける」組として扱い、このデータでは、同時に複数の注文が入る場面で全体再計算が差し込みより距離を短くしました。第二に、距離だけを目的にした再計算は、枠の中で朝の約束を大きく動かします。約束からの遅れに罰金を掛けると、このデータでは約束より30分を超える遅れが6件から0件になり、罰金なしの全体再計算より距離も増えませんでしたが、負担が1台に集中しました。第三に、受付締切は、当日に届ける割合と、1件あたりの費用・ドライバーの時間・終業間際の日の割合との取引で決まり、この関係は受注の時刻の分布と件数で変わります。車の遅れは、このデータでは1台の中の順番の入れ替えで取り戻せるのは1時間前後までで、それを超える遅れには運用上の手当てを先に決めておく必要があります。次の第12章では、毎朝の配車より1つ上の段で決める、配送エリアと配送の頻度の設計を扱います。
この章を深めたい方への参考書籍
『オンラインアルゴリズムとストリームアルゴリズム』(徳山豪 著、共立出版):アルゴリズム・サイエンスシリーズの1冊で、先の入力を知らないまま順に決めていく問題(オンライン問題)を、後から全部を知っていた場合の最善と比べる競合比という物差しで解析する方法から始まり、確率的最適化によるオンライン問題までを扱います。この章で比べた「受付のたびに決める計画」と「後知恵の計画」の差を、理論の側から考えるための本です。
『マルコフ決定過程 理論とアルゴリズム』(中出康一 著、コロナ社):シリーズ情報科学における確率モデルの1冊で、状態を観測しながら各期に決定を行う問題を、動的計画法・値反復法・政策反復法などで解く方法を解説しています。当日の再配車を「その時点の状態を見て次の手を決める」問題として捉え直し、先の注文の入り方まで考えに入れた決め方を学ぶための土台になります。
第12章 配送エリアと配送頻度を設計する、担当地区と曜日割りと共同配送
第11章では、当日の追加注文や遅れに対して、走行中の車両がすでに回った部分を固定したまま残りの計画を直す方法を扱いました。そこで前提にしていたのは、「今日どの納品先を回るか」は朝の時点で決まっている、ということです。しかし、その前提そのものも誰かが決めています。どの納品先をどのドライバーが担当するのか、週に何回、何曜日に届けるのか、他社の荷物と一緒に運ぶのか。これらは毎朝の配車より1つ上の段、数週間から数か月単位で見直す設計の問題で、毎朝の配車の結果(台数と距離)の上限と下限を先に決めてしまいます。この章では、担当地区を固定する運用と毎日最適化する運用の比較、定期配送の曜日割り、配送頻度とサービス水準の関係、共同配送の効果の試算を、架空のデータで実行して数字で示します。
第1章で整理した計画の階層では、拠点網の設計の下に「配送エリアと曜日」の段があり、その下に日々の配車、さらにその下に当日の再配車がありました。この章が扱うのは2段目です。拠点をどこに置くかという1段目は、弊社コラム「数理最適化の定式化パターン集」の第8章で施設配置の問題として扱っているので、ここでは拠点は第2章のサンプルデータの配送センター1か所に固定します。
2段目で決めるものは大きく3つあります。1つ目は担当の割り振りで、納品先ごとに「ふだん誰が届けるか」を決めるかどうか、決めるならどう分けるかです。2つ目は配送の曜日と頻度で、週に2回届ける納品先を月曜と木曜にするのか火曜と金曜にするのか、そもそも週2回でよいのかです。3つ目は荷主の組み方で、自社の荷物だけで車を仕立てるのか、同じ地域に納品する別の荷主と荷物を合わせるのかです。どれも毎朝の配車ソルバーには「与えられた条件」として入り、ソルバーはその枠の中でしか良い計画を探せません。曜日割りが偏っていれば、月曜に7台、水曜に4台という計画を毎週繰り返すことになり、ピークの曜日に合わせて車両とドライバーを抱える費用は、毎朝どれだけ上手に配車しても取り戻せません。
この段の判断は、毎日の配車と比べて見直しの頻度が低く、いったん決めると取引先への案内やドライバーの勤務表にまで波及します。一方で、決める材料となる数字(担当を固定したら距離が何%増えるか、曜日を組み替えたら最も忙しい曜日の台数が何台減るか)は、日々の配車と同じソルバーを繰り返し回せば作れます。この章の実験は、どれもその「繰り返し回して並べる」作業です。
担当地区を固定するか、毎日組み直すか
配送の現場では、ドライバーごとに担当の地区やコースを決め、毎日ほぼ同じ納品先を同じ順番で回る運用が広く見られます。担当が決まっていると、ドライバーは納品先の駐車位置、荷受けの窓口、検品のやり方、店の担当者の顔を覚え、同じ荷物でも短い時間で下ろせるようになります。納品先の側も、毎日同じ人が同じような時刻に来ることを前提に受け入れの段取りを組めます。これに対して、配車計画のソルバーを毎朝回すと、その日の注文だけを見て最も短い組み合わせを作るので、昨日 A さんが回った店を今日は B さんが回る、ということが普通に起きます。
この2つの運用の釣り合いは、研究でも正面から扱われてきました。Zhong・Hall・Dessouky の2007年の論文(Transportation Science 誌41巻)は、小口荷物の地域配送を題材に、納品先の場所と量が日々変わるなかで、ドライバーが担当地域に慣れていること(担当の一貫性)を保ちながら配車を最適化するモデルを扱っています。要旨によれば、担当への習熟を高めようとすれば担当地域は固定に近づき、日々の変動に合わせるには毎日ドライバーと地域を割り当て直すほうが有利で、この2つの目的の釣り合いをとるために、中核の区域を戦略的に設計する段と、日々の配車の段からなる2段階のモデルを作り、習熟と忘却の曲線を使って習熟の効果を明示的に評価しています。Groër・Golden・Wasil の2009年の論文(Manufacturing & Service Operations Management 誌11巻)は、小口の荷物の配送会社の要請として「同じドライバーが、同じ納品先を、毎回ほぼ同じ時刻に訪れる」ことを制約に加えた問題を一貫性のある配送計画問題(Consistent VRP、略して ConVRP)と名付け、混合整数計画として定式化し、1,000件規模の模擬データと3,700件を超える実データに解法を適用しています。
ここで押さえておきたいのは、担当の固定は「距離が長くなる代わりに何かを得る」取引だということです。何を失うかは、日々の注文のばらつきと、車両の積載にどれだけ余裕があるかで決まります。何を得るかは、習熟による荷下ろし時間の短縮や誤配の減少、納品先の満足で、これはデータから測りにくい量です。そこでこの章では、失うほうを実行して測り、得るほうは「どれだけあれば元が取れるか」という損益分岐の形で示します。
20営業日で比べる、固定と毎日最適化とその中間
第2章で用意したサンプルデータの納品先40件を使い、20営業日分の注文を作りました。各納品先は毎日80%の確率で注文し、注文するときの量は共通データのケース数の0.7〜1.3倍(一様乱数、シード固定)とします。これはこの章で置いた架空の変動で、実在の注文の記録ではありません。結果として1日の注文は平均31.9件(23〜37件)、1日のケース数は平均697.5(551〜855)になりました。時間指定は外し、積載150ケースと終業18時だけを制約にしています。共通データの基準の結果のうち「積載のみ」と同じ条件です。
担当地区は、基準の結果の「積載のみ」の6ルート(全件が注文した日の計画)を、そのまま6人のドライバー(以下 A〜F)の担当にしました。全件の注文を前提に地区を切り、日々は注文のあった納品先だけを回る、という多くの現場に近い作り方です。比べた運用は次のとおりです。
- 担当地区を固定:各ドライバーはその日に注文のあった自分の地区の納品先だけを、最も短い順番で回る。地区の荷がその日150ケースを超えたら、あふれた分は応援の車が回る
- 毎日最適化:その日の注文全体を OR-Tools で解き、できたルートを、担当地区の納品先を最も多く含むドライバーに当てはめる(当てはめは割当問題として解く)
- 中間:毎日最適化と同じく全体を解くが、ドライバーが自分の担当地区の外の納品先へ行くときだけ、距離に一定の値(2km・5km・10km・20km)を上乗せして評価する。ドライバーに割り当てのない予備の車は、どの納品先へ行っても上乗せがかかる
OR-Tools の設定は基準の結果と同じく、初期解が PATH_CHEAPEST_ARC、改善が誘導局所探索で、1日あたり3秒で打ち切り、車両1台に距離100km 相当の固定費を加えて、台数が増えにくくなる重みを置いています。担当地区を固定する運用では、地区ごとの巡回を1秒で解きました。費用は共通データの車種表(第8章で車種の比較に使う架空の値)の2トン車の単価で、その日に使った台数×20,000円と、距離×40円の合計です。
| 運用 | 1日の台数(平均) | 1日の台数(最大) | 20日の総距離(km) | 1日の距離(平均、km) | 担当者が届けた割合 | 1件あたりの担当者数(平均) | 20日の費用(円) |
|---|---|---|---|---|---|---|---|
| 担当地区を固定 | 6.75 | 8 | 5,963.2 | 298.2 | 91.7% | 2.33 | 2,938,526 |
| 担当外に20km上乗せ | 5.15 | 6 | 5,488.4 | 274.4 | 84.1% | 2.62 | 2,279,535 |
| 担当外に10km上乗せ | 5.10 | 6 | 5,257.7 | 262.9 | 80.2% | 2.45 | 2,250,306 |
| 担当外に5km上乗せ | 5.10 | 6 | 5,251.6 | 262.6 | 78.3% | 2.50 | 2,250,063 |
| 担当外に2km上乗せ | 5.10 | 6 | 5,127.3 | 256.4 | 73.3% | 2.62 | 2,245,092 |
| 毎日最適化 | 5.10 | 6 | 5,015.7 | 250.8 | 63.0% | 2.88 | 2,240,626 |
「担当者が届けた割合」は、20日間の延べ訪問のうち、その納品先の担当ドライバーが届けた訪問の割合です。「1件あたりの担当者数」は、1つの納品先を20日間で何人が訪れたかの平均で、応援の車はその日限りの別の人として数えています。
担当地区を固定した運用は、1日平均6.75台、多い日は8台を使い、20日の総距離は5,963.2km でした。毎日最適化は1日平均5.10台、最大6台、総距離5,015.7km です。台数の差は1日あたり1.65台、距離の差は20日で947.5km(固定のほうが18.9%長い)、費用の差は20日で69万7,900円、1日あたり3万4,895円になりました。一方、担当者が届けた割合は、固定の91.7%に対して毎日最適化は63.0%で、納品先から見ると3回に1回以上は担当でない人が来ることになります。
固定の運用で台数が多い理由は2つあります。1つは、注文が8割の日でも6人全員が出るので、各車の荷が軽いまま走ることです。もう1つは、地区の荷のばらつきを他の地区で吸収できないことで、担当地区ごとの1日のケース数の最大は、6地区のうち4地区で150ケースを超えました(最大169ケース)。その日は応援の車が要り、応援を含めた20日の延べ台数は135台(1日平均6.75台)、最も多い日は8台でした。毎日最適化は、軽い日には5台に減らし、重い日には荷を地区の境をまたいで詰め直すことで、この2つを同時に避けています。1日のケース数の平均697.5を150で割ると4.65なので、1日平均5.10台は、積載で決まる下限に近い値です。
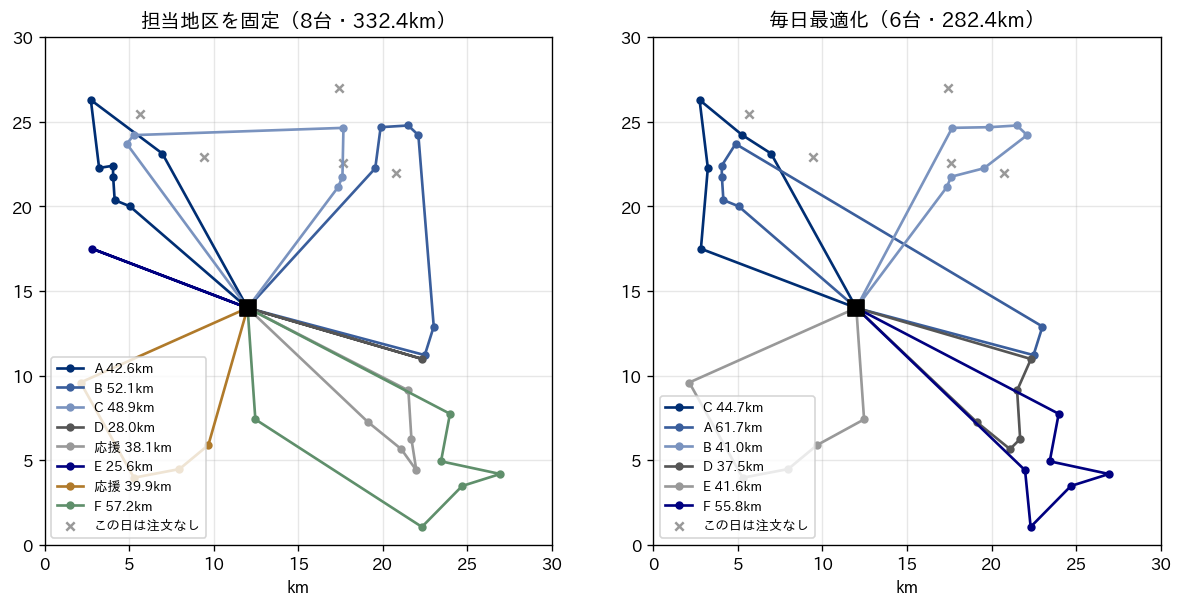
上の図は、20日のうち注文のケース数が最も多かった13日目(855ケース)のルートです。左の固定の運用は、6人のルートに応援の車2台が加わって8台・332.4km、右の毎日最適化は6台・282.4km でした(数値は図の題に入れたもので、同じ実行で出力したものです)。右の図では、いくつかのルートが担当地区の境をまたいで組まれています。
中間の運用は、この両極端のあいだを埋めます。担当外に2km を上乗せしただけで、担当者が届けた割合は63.0%から73.3%に上がり、20日の費用の増加は4,466円(0.2%)にとどまりました。5km では78.3%で9,437円増、10km では80.2%で9,680円増です。20km まで上げると、台数が1日平均5.15台に増え、費用は3万8,909円増(1.7%)になります。担当者が届けた割合を10ポイント上げるのに要る費用は、上乗せが小さいうちは非常に安く、大きくなるにつれて急に高くなる、という形です。20km の行の「1件あたりの担当者数」が10km の行より大きいのは、台数が増えた日に予備の車(応援)が出て、その分が別の人として数えられたためです。
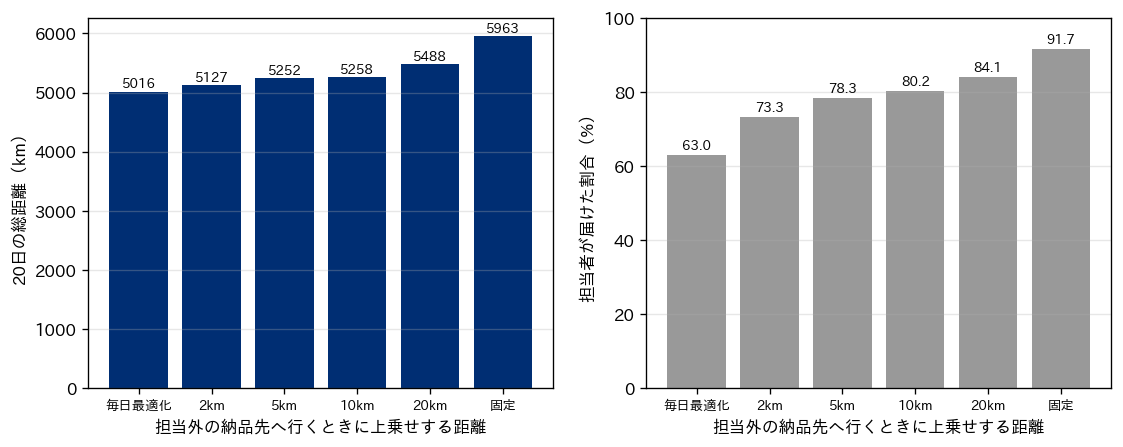
中間の運用の作り方は、OR-Tools では車両ごとに別の費用の関数を登録するだけです。次のコードは、全件の注文がある日について、担当外へ行くと5km を上乗せする設定で解いたものです。積載だけを制約にした簡略版で、上の表の実験(終業18時の制約あり、20日分)とは条件が違います。
import sys, io
sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8")
from ortools.constraint_solver import pywrapcp, routing_enums_pb2
from vrp_data import customers, points, dist_km, int_matrix, TRUCK_CAPACITY
cs = customers()
TERR = ["C31 C11 C13 C08 C32 C04 C06 C28", "C16 C07 C30 C19 C10 C09 C15", "C21 C35 C36 C23 C03 C22 C14 C12",
        "C29 C01 C33 C26 C37 C24", "C20 C02 C05 C34 C18", "C17 C38 C25 C39 C27 C40"]   # 担当者0〜5の地区
home = {cid: v for v, s in enumerate(TERR) for cid in s.split()}
D = int_matrix(dist_km(points(cs)), 1000)                      # m
dem = [0] + [c["demand"] for c in cs]
PEN = 5000                                                     # 担当外の納品先へ行くと5km上乗せ
man = pywrapcp.RoutingIndexManager(len(D), 6, 0)
r = pywrapcp.RoutingModel(man)
for v in range(6):                                             # 車両(担当者)ごとに別の費用を登録する
    pen = [0] + [0 if home[c["id"]] == v else PEN for c in cs]
    cb = r.RegisterTransitCallback(lambda a, b, pen=pen: D[man.IndexToNode(a)][man.IndexToNode(b)]
                                   + pen[man.IndexToNode(b)])
    r.SetArcCostEvaluatorOfVehicle(cb, v)
dcb = r.RegisterUnaryTransitCallback(lambda a: dem[man.IndexToNode(a)])
r.AddDimensionWithVehicleCapacity(dcb, 0, [TRUCK_CAPACITY] * 6, True, "Cap")
p = pywrapcp.DefaultRoutingSearchParameters()
p.first_solution_strategy = routing_enums_pb2.FirstSolutionStrategy.PATH_CHEAPEST_ARC
p.local_search_metaheuristic = routing_enums_pb2.LocalSearchMetaheuristic.GUIDED_LOCAL_SEARCH
p.time_limit.seconds = 5
s = r.SolveWithParameters(p)
km, same = 0, 0
for v in range(6):
    i = r.Start(v)
    while not r.IsEnd(i):
        j = s.Value(r.NextVar(i))
        km += D[man.IndexToNode(i)][man.IndexToNode(j)] / 1000
        nd = man.IndexToNode(j)
        if nd:
            same += home[cs[nd - 1]["id"]] == v
        i = j
print("総距離 %.1fkm  担当者が届けた件数 %d/40" % (km, same))
# 出力: 総距離 292.5km  担当者が届けた件数 29/40
ポイントは SetArcCostEvaluatorOfVehicle で、車両 v が地点 b へ向かう費用を「距離+(担当外なら上乗せ)」にしています。上乗せは費用の評価にだけ入り、実際に走る距離には入りません。出力では、全件の日なのに40件のうち11件が担当外になり、総距離は292.5km でした。実際に走る距離は、担当地区の元になった基準の結果(296.3km)より短くなっています。ただし、上乗せを含めた評価値で比べると、292.5kmに5km×11件=55kmを足した347.5km相当で、基準の計画をそのまま使って全件を担当者が届ける場合(上乗せは0で、総距離は約296.3km)より大きい値です。つまりこの5秒の探索は、上乗せを含めた評価で最も良い計画には届いていません。担当を守らせたい場合は、探索時間を延ばすか、上乗せを大きくする必要があります。一方で、担当を外れてもよければ基準より短い計画が存在することも分かります。担当地区を「ある日の最適解」から切り出しても、その地区割り自体が最善とは限りません。地区を設計するときにも、この上乗せの仕組みで「どの納品先を境界で入れ替えると距離が大きく縮むか」を洗い出すことができます。
習熟の効果は、どれだけあれば元が取れるか
固定の運用を支持する根拠は、習熟による時間の短縮や品質の向上です。この章のデータには習熟の効果が入っていないので、上の比較は固定の運用に不利な条件で測ったものです。では、習熟でどれだけ時間が縮めば、固定と毎日最適化の差が埋まるのでしょうか。
差は1日あたり1.65台です。このデータでは台数を決めているのは主に積載(150ケース)で、終業18時の時間の制約ではありません。1日平均5.10台という毎日最適化の台数が積載の下限4.65に近いことがその裏付けです。荷下ろしが速くなっても、トラックに積めるケース数は変わらないので、習熟でいくら時間が縮んでも固定の運用の台数は減りません。つまりこのデータでは、習熟の効果は台数の差をまったく埋めません。埋められるのは、ドライバーの拘束時間と残業、そして時間指定を守る余裕です。
反対に、1台が回れる件数が時間で決まっている現場(小口で件数の多い宅配、1件の荷下ろしが長い業態)では話が変わります。時間が台数を決めている場合、1日あたり1.65台分の稼働時間(1台600分として990分)を、1日平均31.9件の納品で割ると、1件あたり約31分の短縮に相当します。この章のデータの荷下ろし時間は1件10〜25分なので、1件あたり31分は荷下ろし時間そのものより長く、習熟だけで取り戻せる量ではありません。この計算は、差の大きさを時間に置き換えて見当をつけるためのものです。自社の現場で固定の運用を続けるかどうかを判断するなら、担当の人と応援の人が同じ納品先で要した荷下ろし時間を実績から比べ、その差をこの損益分岐と並べるのが筋道になります。
ここから言えるのは、全面的に固定するか、全面的に毎日最適化するかの二択にしないほうがよい、ということです。上の表では、担当外に数km の上乗せをするだけで、費用をほとんど増やさずに担当者が届けた割合を10〜15ポイント上げられました。習熟の効果が特に大きい納品先(荷受けの手順が複雑な店、夜間の搬入口がある施設など)だけを担当に固定し、残りを毎日最適化に回す、あるいは納品先ごとに上乗せの大きさを変える、といった設計も同じ仕組みで作れます。
定期配送の曜日割り、週2回の納品先を月木にするか火金にするか
次に、曜日を決める問題に移ります。スーパーやドラッグストアの店舗、飲食店、事業所への定期配送では、納品先ごとに「週に何回届けるか」が契約や取り決めで決まっていて、配送センターはそれを満たす曜日の組み合わせを選びます。週2回の納品先なら月曜と木曜、あるいは火曜と金曜というように、間隔がほぼ等しくなる組が選ばれることが多いと考えられます。どの納品先にどの組を当てるかで、各曜日に回る納品先の集合が決まり、その日の台数と距離が決まります。この「曜日の組を選んでから、各曜日の配車を解く」問題は、周期配送計画問題(英語で Periodic Vehicle Routing Problem、略して PVRP)と呼ばれます。Campbell と Wilson の2014年の総説(Networks 誌63巻)は、この問題が文献に初めて現れたのは1974年のごみ収集に関する Beltrami と Bodin の論文だとしています。
解き方の骨格は古くからあります。Christofides と Beasley の1984年の論文は、まず各納品先について訪問回数の条件を満たす曜日の組を初期値として選び、その後で組を入れ替えて配送費を下げる、という2段の方法を示しています。入れ替えのたびに毎日の配車を厳密に解き直すのは重いので、この論文では各曜日の配車の費用を、より簡単な問題(施設配置に近い問題と、巡回セールスマン問題)で見積もって代用しています。この章の実験も同じ骨格にしました。曜日の組を入れ替えるたびの評価には、計算の軽いセービング法(第4章で扱った、2つのルートをつなぐと距離がどれだけ浮くかの大きい順に結合していく方法)を使い、最後に確定した曜日割りだけを OR-Tools で解き直して台数と距離を測っています。
データは第2章で用意したサンプルデータの定期配送60件(weekly_customers())です。週の訪問回数は週1回が18件、週2回が29件、週3回が13件で、元の週のケース数の合計は3,220、週の訪問は延べ115件です。1回の納品量は、週のケース数を訪問回数で割り、整数に丸めた値にしました。丸めのため、配車で運ぶケース数の合計は3,211で、元の合計より9ケース少なくなります(下の表の曜日別のケース数を足した値)。1回の納品量は、納品先ごとの値を60件で単純に平均すると32.6ケース、延べ訪問1回あたりでは約27.9ケース(3,211÷115)です。2つの平均が違うのは、訪問回数の多い納品先ほど1回の量が小さく、延べ訪問で平均するとその小さい値が回数の分だけ多く数えられるためです。荷下ろしはどの納品先も1件15分と置いています(このデータには荷下ろし時間が無いので、この章で置いた仮定です)。配送センターは共通データと同じ位置、車は2トン車(150ケース)、終業は18時で、時間指定は入れていません。曜日は月曜から金曜の5日で、選べる組は、週1回なら5つの曜日のどれか、週2回なら月木か火金、週3回なら月水金の1通りとしました。
比べたのは4つの曜日割りです。A は番号順に機械的に割り振った案で、週1回の納品先を番号順に月・火・水・木・金へ順に、週2回の納品先を番号順に月木・火金へ交互に当てます。B は各曜日のケース数の最大値を最小にするように PuLP と CBC で曜日を選んだ案で、場所は見ていません。C は場所だけを見た案で、配送センターから見た方角の順に納品先を並べ、週2回の納品先を方角で半分に分けて月木と火金に当て、週1回の納品先を方角で5つに分けて曜日に当てます。D は B を出発点に、納品先1件ずつ曜日の組を入れ替えては評価し、良くなる入れ替えだけを受け入れることを、改善が無くなるまで繰り返した案です。評価の尺度は「最も台数が多い曜日の台数×5日×固定費」と「週の総距離×km 単価」の合計にしました。車両とドライバーは最も忙しい曜日に合わせて抱える必要があるので、固定費は延べ台数ではなく最大台数で効く、という考え方です。費用の単価は共通データの車種表にある架空の2トン車の値(固定費1台1日20,000円、1km 40円)です。
| 曜日割り | 曜日別のケース数(月/火/水/木/金) | 曜日別の台数(月/火/水/木/金) | 週の総距離(km) | 延べ台数 | 最大台数 | 週の費用(円) |
|---|---|---|---|---|---|---|
| A 番号順に交互 | 917/546/496/519/733 | 7/4/4/4/5 | 1,062.3 | 24 | 7 | 742,493 |
| B 量だけ平準化 | 644/643/641/640/643 | 5/5/5/5/5 | 1,056.3 | 25 | 5 | 542,252 |
| C 方面でまとめる | 787/580/447/587/810 | 6/4/3/4/6 | 1,016.4 | 23 | 6 | 640,656 |
| D 量と方面を両方 | 711/563/532/685/720 | 5/4/4/5/5 | 1,001.5 | 23 | 5 | 540,060 |
表の「週の費用」は、最大台数×5日×20,000円と、週の総距離×40円の合計です。OR-Tools の誘導局所探索は各曜日5秒で打ち切っており、最適性は証明していません。
A の番号順の割り振りは、月曜に917ケース、金曜に733ケースが集まり、月曜だけ7台が必要になりました。月木と火金に交互に当てても、週3回の納品先13件が月水金に固定で乗るので、月曜と金曜が重くなるためです。水曜は週2回の納品先が来ない曜日で、496ケースしかありません。最大台数が7台なので、この案の車両とドライバーは7台分を抱えることになり、火曜から木曜は3台が遊びます。B はケース数を5つの曜日でほぼ均等(640〜644ケース)にし、毎日5台で回るようにしました。最大台数は A より2台少なく、週の費用は74万2,493円から54万2,252円へ20万241円下がります。この差はほぼ固定費2台×5日の20万円で、曜日割りの最初の効き目は距離より台数に出ることが分かります。
C の方面でまとめた案は、週の総距離が1,016.4km と B より短くなりましたが、月曜787ケース・金曜810ケースと偏りが残り、最大台数は6台でした。方面だけでまとめると、週3回の納品先が乗る月曜と金曜の重さを打ち消せないためです。D は B のケース数の平準化から出発して、14件の納品先の曜日を入れ替えました。曜日別のケース数は532〜720ケースと B より幅が広がりましたが、最大台数は5台のまま、週の総距離は1,001.5km で4案の中で最も短くなりました。延べ台数も B の25台から23台に減り、火曜と水曜は4台で回ります。量をそろえることと、同じ曜日に回る納品先を近くに集めることを同時に見ると、台数と距離の両方で A から C のどれより良い案が得られた、ということです。
ただし、D と B の週の費用の差は2,192円で、これは距離の差(54.8km)から来ています。一方で、同じ D の曜日割りを別の時刻にもう一度 OR-Tools で解き直したところ(次の節の表の「現状」の行)、週の総距離は1,012.7km になりました。同じ曜日割りでも、打ち切りの探索は並行して動いている他の計算の負荷で結果が1%程度揺れます。B と D の距離の差は5%あるので揺れより大きいものの、数千円の差を決め手にするときは、何回か解いて揺れの幅を確かめてから判断するのが安全です。
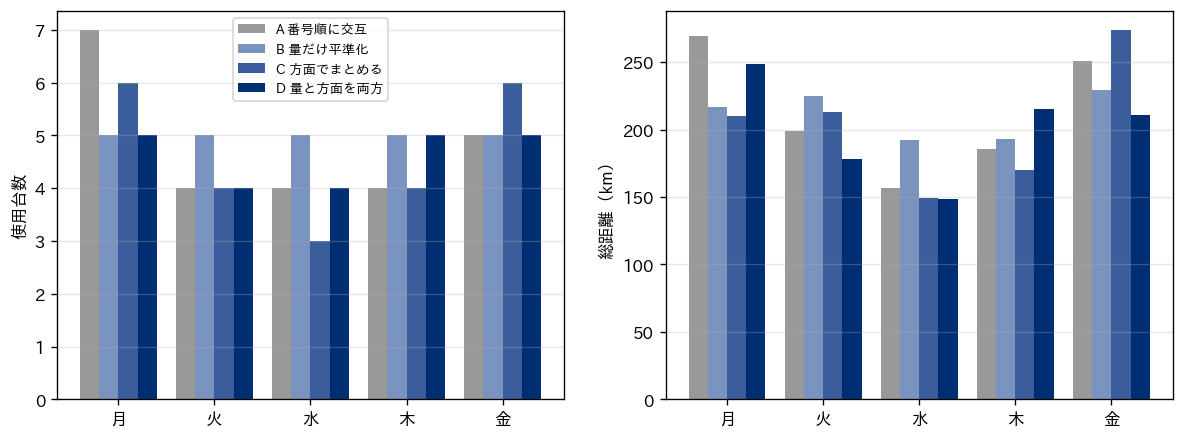
曜日割りを地図に描いたのが次の図です。左が A、右が D で、四角が週2回の納品先(濃い色が月木、灰色が火金)、三角が週3回、白抜きの丸が週1回(色が曜日)です。A では月木と火金の納品先がエリア全体に混ざっています。D でも混ざり方は残っていて、はっきりした境界で2つに分かれているわけではありません。それでも、エリアの左下の隅では月木が、中央の下側では火金が多いなど、同じ組どうしが近くに寄っている場所が増えています。D は台数を増やさない範囲で距離を削る入れ替えだけを受け入れたので、地図の上でのまとまりは、量の釣り合いを崩さない程度にとどまっています。
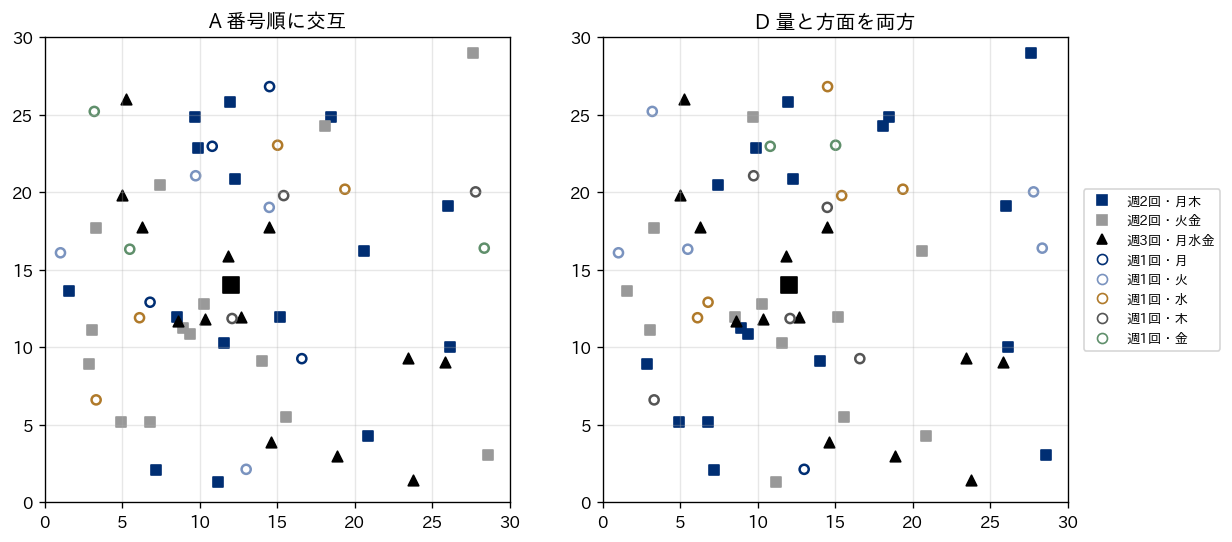
曜日割りを見直すときには、配送センターの都合だけで決められない点に注意が要ります。納品先の側にも「月曜は棚卸しで受け取れない」「週末前の金曜に厚く欲しい」といった事情があり、曜日を変えるには納品先との合意が要ります。ソルバーに渡すときは、動かしてよい納品先と動かせない納品先を分け、動かせない納品先は今の曜日の組に固定して解くのが実務的です。D が B から入れ替えたのは14件でしたが、入れ替えの候補を「交渉してよい納品先」に絞れば、交渉の件数と効果の釣り合いを事前に測れます。
配送頻度とサービス水準、回数を減らすと何が起きるか
曜日割りの前提になっている訪問回数そのものも、設計の対象です。納品の回数を増やせば、納品先は1回に受け取る量が減り、店の在庫や保管場所が小さくて済みます。生鮮品や日持ちの短い品では、回数が品質そのものになります。反対に回数を減らせば、配送センターは訪問の件数が減り、1回の納品量が増えて積載が効率的になります。どちらの側に寄せるかは、配送費と納品先のサービス水準の取引になります。
定期配送60件の訪問回数を5通りに変え、それぞれで D と同じ方法(量の平準化から出発して入れ替える)で曜日割りを作り直し、各曜日を OR-Tools で解きました。元の週のケース数(合計3,220)は変えていません。ただし1回の納品量を整数に丸めるので、配車で運ぶケース数の合計は設定ごとに数ケース違います(全件週1回で3,220、週3回を週2回にして3,208、現状で3,211、週1回を週2回にして3,207、全件週3回で3,225)。納品先の側の指標としては、「1回の納品量の半分」を60件分足した値を、納品先が抱える平均在庫の目安として並べました。納品と納品の間に在庫が一定の速さで減っていくなら、平均在庫は1回の納品量のおよそ半分になる、という単純な見積もりです。この目安は、整数に丸める前の1回の納品量(週のケース数÷訪問回数)で計算しているので、丸めた値から検算すると数ケースずれます。曜日によって間隔が違う(月木なら3日と4日)ことや、売れ方の曜日差は入れていないので、比べるための目安です。
| 訪問回数の設定 | 週の訪問(件) | 曜日別の台数(月/火/水/木/金) | 週の総距離(km) | 最大台数 | 週の費用(円) | 納品先の平均在庫の目安(ケース) |
|---|---|---|---|---|---|---|
| 全件 週1回 | 60 | 5/5/5/4/5 | 744.6 | 5 | 529,785 | 1,610 |
| 週3回を週2回に | 102 | 5/5/3/5/5 | 963.4 | 5 | 538,537 | 1,048 |
| 現状(週1回18件・週2回29件・週3回13件) | 115 | 5/4/4/5/5 | 1,012.7 | 5 | 540,506 | 982 |
| 週1回を週2回に | 133 | 6/5/2/5/6 | 1,089.6 | 6 | 643,582 | 739 |
| 全件 週3回 | 180 | 8/0/8/0/8 | 1,083.3 | 8 | 843,331 | 537 |
全件を週1回にすると、週の訪問は115件から60件に、週の総距離は1,012.7km から744.6km へ26%減ります。ところが週の費用は54万506円から52万9,785円へ2%しか下がりません。最大台数が5台のまま変わらないからです。週1回にすると1回の納品量が増え、1台に積める件数が減るので、台数は荷の量(週3,220ケースを5日で割って1日644ケース、150ケースの車で5台)で決まり、訪問回数を減らしても台数は減りません。一方で納品先の平均在庫の目安は982ケースから1,610ケースへ64%増えます。配送センターから見た節約は小さく、納品先の負担の増え方は大きい、という釣り合いです。
反対方向に、週1回の18件を週2回に上げると、週の訪問は133件に増え、月曜と金曜の台数が6台になって最大台数が1台増え、週の費用は64万3,582円と10万円あまり上がります。平均在庫の目安は982ケースから739ケースに下がります。このとき水曜の台数は2台しかありません。週2回の組を月木と火金に限ったため、週2回の納品先が増えるほど水曜が空き、月曜と金曜に荷が集まります。全件を週3回にした行はその極端な形で、選べる組が月水金しかないので火曜と木曜は0台、月水金は8台です。回数を増やすと費用が上がるのは当然として、その上がり方の大部分は「選べる曜日の組が曜日の偏りを生む」ことから来ています。
訪問パターンの選択肢を増やす、間隔の均等さと台数の取引
前の表で見えた曜日の偏りは、「週2回なら月木か火金」という選択肢の狭さから来ています。そこで、週2回の組に月水・水金・火木の3つを加え、5通りから選べるようにして曜日割りを作り直しました。月木と火金は納品の間隔が3日と4日でほぼ均等ですが、加えた3つは間隔が2日と5日で、均等ではありません。つまり、納品先の側から見ると「間隔の均等さ」をいくらか譲る代わりに、配送センターの側では曜日を選ぶ自由が増える、という取引です。
| 訪問回数の設定 | 週2回の組の選択肢 | 曜日別の台数(月/火/水/木/金) | 週の総距離(km) | 最大台数 | 週の費用(円) | 週2回の納品先の組の内訳 |
|---|---|---|---|---|---|---|
| 現状 | 月木・火金 | 5/4/4/5/5 | 1,016.1 | 5 | 540,644 | 月木17・火金12 |
| 現状 | 5通り | 5/4/4/5/5 | 944.5 | 5 | 537,778 | 火木18・月水5・水金3・月木2・火金1 |
| 週1回を週2回に | 月木・火金 | 6/5/2/5/6 | 1,089.6 | 6 | 643,582 | 火金24・月木23 |
| 週1回を週2回に | 5通り | 5/4/5/4/5 | 999.7 | 5 | 539,986 | 火木12・水金12・月木9・火金7・月水7 |
この表は前の2つの表とは別の実行で、「現状・月木と火金」の行は曜日割りの表の D と同じ曜日割りを解き直したものです。週の総距離は、曜日割りの表では1,001.5km、配送頻度の表では1,012.7km、この表では1,016.1km と、同じ曜日割りでも実行ごとに1.5%ほどの幅で揺れています。以下の比較は、同じ実行の中の行どうしで行っています。
現状の訪問回数のまま選択肢を5通りにすると、最大台数は5台で変わらず、週の総距離が1,016.1km から944.5km へ71.6km(7.0%)縮みました。週の費用の差は2,866円で、台数が変わらないので効き目は距離の分だけです。選ばれた組の内訳を見ると、週2回の29件のうち18件が火木になり、均等な間隔の組(月木・火金)は3件しか残りませんでした。距離だけを見るソルバーは、間隔の均等さを何とも思わないので、許せば迷わず不均等な組を選びます。
効き目が大きいのは、週1回の納品先を週2回に上げた場合です。選択肢が月木と火金だけなら、水曜が2台に空く一方で月曜と金曜が6台になり、週の費用は64万3,582円でした。5通りから選べるようにすると、曜日別の台数は5・4・5・4・5台にならし込まれ、最大台数は5台、週の費用は53万9,986円と10万3,596円下がりました。これは、訪問回数を上げる前の現状(同じ実行で54万644円)とほぼ同じ費用です。この架空のデータの条件では、週1回の18件を週2回に上げても、曜日の組を柔軟にすれば配送費をほとんど増やさずに済み、納品先の平均在庫の目安は前の表のとおり982ケースから739ケースに下がる、という結果になりました。
ここで判断が要るのは、間隔が2日と5日に偏ることを納品先が受け入れられるかどうかです。日持ちのしない品や、店の保管場所が小さい納品先では、5日空くことが欠品や廃棄につながります。反対に、日持ちのする品で、店の側でも受け取る曜日がまとまっているほうが楽な納品先なら、不均等な組のほうが喜ばれることもありえます。ソルバーに渡すときは、納品先ごとに「認める組」を列挙しておき、その範囲の中で選ばせるのが実務的です。この章のコードでも、訪問回数ごとに選べる組の一覧を持たせ、そこから1つを選ぶ形にしています。
共同配送の効果を試算する、どういう荷主どうしなら効くのか
ここまでは自社の荷物だけで車を仕立てる前提でした。同じ地域の同じ店に、別の荷主も毎日トラックを出していることはよくあります。荷主どうしが荷物を合わせて1台の車で運べば、車の数と走る距離が減る可能性があります。このように、同じ段階にいる企業(荷主どうし、運送会社どうし)が物流の一部を共同で行うことを、水平協業(horizontal collaboration)と呼びます。Gansterer と Hartl の2018年の総説(European Journal of Operational Research 誌268巻)は、共同で配送を計画する研究を3つの流れ(情報を集めて全体を1つの計画として解く集中型、競り(オークション)を使わない分散型、オークションを使う分散型)に整理し、集中型の共同計画については、多くの研究が協力しない場合の解に比べて20〜30%程度の改善を報告している、とまとめています。ただし同じ総説は、その範囲の外の値を報告する研究もあることを付け加えています。改善の幅は、組む相手と条件しだいです。
どういう条件で効くのかを、架空のデータで試算しました。荷主 A は第2章で用意したサンプルデータの納品先40件(868ケース)です。荷主 B はこの章のコードで乱数(シード固定)から作った架空の荷主で、納品先40件のうち20件は荷主 A と同じ店、残り20件は別の場所にあり、1件のケース数は5〜40、荷下ろしは10〜25分です。同じ配送センターから、同じ2トン車(150ケース、終業18時、時間指定なし)で出すとします。共同配送では、同じ店への納品は1回の停車にまとめ、荷下ろし時間は2社のうち長いほうに5分を足した値としました(2社分を続けて下ろす手間の仮定です)。OR-Tools の誘導局所探索は1回10秒で打ち切り、同じ計算を2回繰り返して同じ結果になることを確かめています。
比べた条件は3つです。1つ目は上のとおりの基本の条件、2つ目は荷主 B の納品先が荷主 A と1件も重ならない条件、3つ目は重なりが20件のまま、両社とも1件あたりのケース数を基本の30%に減らした条件(小口の荷主どうしの組み合わせ)です。
| 条件 | 配送の仕方 | 停車(件) | ケース | 台数 | 距離(km) | 積載率 | 費用(円) |
|---|---|---|---|---|---|---|---|
| 同じ店20件・量は基本 | 別々(A6台+B7台) | 80 | 1,824 | 13 | 645.9 | 93.5% | 285,838 |
| 同じ店20件・量は基本 | 共同配送 | 60 | 1,824 | 13 | 537.9 | 93.5% | 281,514 |
| 同じ店20件・量は基本 | 削減 | 20 | 0 | 0 | 108.1(16.7%) | 0 | 4,323(1.5%) |
| 同じ店0件・量は基本 | 別々(A6台+B7台) | 80 | 1,812 | 13 | 609.4 | 92.9% | 284,374 |
| 同じ店0件・量は基本 | 共同配送 | 80 | 1,812 | 13 | 559.8 | 92.9% | 282,392 |
| 同じ店0件・量は基本 | 削減 | 0 | 0 | 0 | 49.5(8.1%) | 0 | 1,982(0.7%) |
| 同じ店20件・量は30% | 別々(A2台+B3台) | 80 | 550 | 5 | 395.4 | 73.3% | 115,814 |
| 同じ店20件・量は30% | 共同配送 | 60 | 550 | 4 | 280.0 | 91.7% | 91,199 |
| 同じ店20件・量は30% | 削減 | 20 | 0 | 1 | 115.4(29.2%) | 18.4ポイント上昇 | 24,616(21.3%) |
積載率は、運んだケースの合計を「台数×150ケース」で割った値です。費用は使った台数×20,000円と距離×40円の合計(架空の単価)です。
基本の条件では、共同配送で停車が80件から60件に減り、距離は645.9km から537.9km へ108.1km(16.7%)縮みました。ところが台数は13台のままで、費用の削減は4,323円(1.5%)にとどまります。荷主 A は単独で積載率96.4%、荷主 B は91.0%と、どちらもすでに車をほぼ満杯にして走っているからです。2社の合計1,824ケースを150で割ると12.16で、13台は積載で決まる下限そのものです。車を減らす余地が最初から無いので、共同化の効き目は距離にしか出ません。このデータの単価では固定費が費用の大半を占めるので、距離が2割近く縮んでも費用はほとんど動きません。
同じ店が1件も無い条件では、距離の削減も49.5km(8.1%)に下がりました。同じ店への納品を1回の停車にまとめられることが、共同配送の距離の効き目の半分以上を占めていたことになります。2社の納品先が地理的に近くても、停車そのものが減らなければ、ルートを組み替えて稼げる距離は限られます。
小口の荷主どうしの条件では、結果が大きく変わります。荷主 A は262ケースを2台で運び(積載率87.3%)、荷主 B は288ケースに3台を使っていました(積載率64.0%)。288ケースは150ケースの車2台に積めるので、荷主 B の3台目は荷物の量ではなく、40件を回る時間が終業までに足りないために出ている車です。共同配送にすると、同じ店の停車がまとまって回る時間が減り、4台(積載率91.7%)で回れるようになりました。台数が1台減り、距離は115.4km(29.2%)縮み、費用は2万4,616円(21.3%)下がります。Gansterer と Hartl の総説がまとめた20〜30%という幅に入るのは、この条件でした。
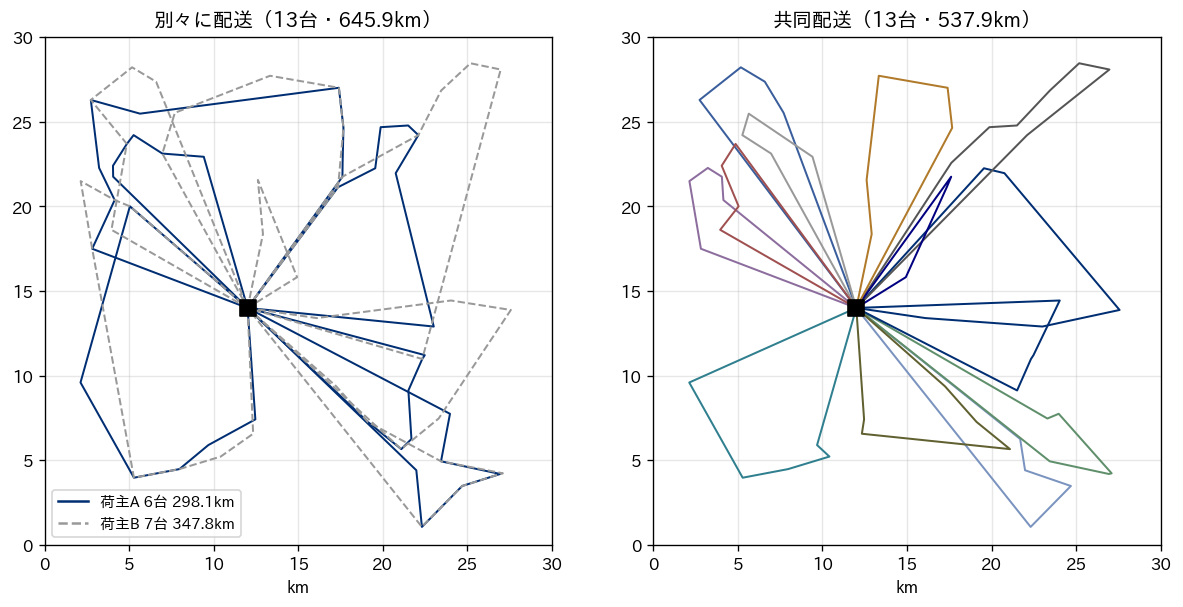
上の図は基本の条件のルートです。左の別々の配送では、荷主 A(実線)と荷主 B(破線)のルートが同じ地域に重なって走っています。右の共同配送は同じ13台ですが、1台ごとの受け持ちの範囲が狭くなっています。ここから読み取れる共同配送の効き目の条件は2つです。1つは、少なくとも片方の荷主の車に空きがあること(積載率が低い、あるいは件数が多くて時間で台数が決まっている)。もう1つは、納品先が重なっていて停車そのものをまとめられることです。両社とも満載に近く、納品先も重ならない組み合わせでは、共同化の手間に見合う効果が出にくいと考えられます。
削減分をどう分けるか、分け方しだいで協業は崩れる
共同配送で浮いた費用を2社でどう分けるかは、協業が続くかどうかを左右します。Gansterer と Hartl の総説は、共同輸送の研究で使われる利益の分け方には40を超える方法があるとする Guajardo と Rönnqvist の2016年の研究を引き、大多数の研究はシャープレイ値・比例による按分・仁(nucleolus)の3つのどれかを使っており、シャープレイ値が最もよく使われていると整理しています。シャープレイ値は協力ゲーム理論の配分の考え方で、各社が協業に加わる順番をすべて考え、その社が加わったことで全体の費用がいくら変わったかを平均したものです。2社の場合は加わる順番が2通りしかないので、計算すると「単独のときの費用から、削減分の半分を引いた額」、つまり削減分の折半と一致します。
この章の試算で、削減分の折半と、共同配送の費用をケース数の比で按分する方法を比べました。
| 条件 | 荷主 | 単独の費用(円) | 削減分を折半(円) | ケース数で按分(円) |
|---|---|---|---|---|
| 同じ店20件・量は基本 | A(868ケース) | 131,924 | 129,762 | 133,966 |
| 同じ店20件・量は基本 | B(956ケース) | 153,914 | 151,752 | 147,548 |
| 同じ店0件・量は基本 | A(868ケース) | 131,924 | 130,933 | 135,274 |
| 同じ店0件・量は基本 | B(944ケース) | 152,450 | 151,459 | 147,118 |
| 同じ店20件・量は30% | A(262ケース) | 47,269 | 34,962 | 43,444 |
| 同じ店20件・量は30% | B(288ケース) | 68,545 | 56,237 | 47,755 |
ケース数で按分すると、量が基本の2つの条件では、荷主 A の負担が単独で運んだときより大きくなりました(13万1,924円に対して13万3,966円、13万5,274円)。荷主 A は満載に近い車を効率よく走らせていたのに、共同化で浮いた分の大半が荷主 B の側に回り、A は損をする計算です。これでは荷主 A が協業に加わる理由がありません。削減分の折半なら、どの条件でも両社とも単独より負担が小さくなります。小口の条件では、ケース数の按分でも両社とも単独より安くなりますが、削減の配分は大きく偏り、荷主 A の削減は3,825円、荷主 B は2万790円です。どちらの分け方が公平かは、量の多寡を重く見るか、協業に持ち込んだ効率を重く見るかという考え方の問題で、正解は1つではありません。ただ、少なくとも「どの参加者も単独より損をしない」ことは、分け方を決める最低条件として確かめておく必要があります。
共同配送の実務には、この計算の外にある論点も多くあります。荷物の形や温度帯がそろうか、伝票や検品の方式を合わせられるか、納品の時刻や曜日を2社で合わせられるか、競合する荷主どうしで出荷の情報をどこまで共有するか、といった点です。国の政策として進められている共同配送や中継輸送の動きは第14章で扱います。この章で示したかったのは、共同化の効果は「組む相手の積載率」と「納品先の重なり」で大きく変わり、試算しないまま一律に何割減ると見込むのは危うい、ということです。
経営の側から見る、設計の段の判断が毎日の費用を決める
この章の3つの設計を、経営指標に翻訳して並べます。
担当地区の固定は、このデータでは1日あたり1.65台、20日で69万7,900円(1日3万4,895円)の費用と引き換えに、担当者が届ける割合を63.0%から91.7%に上げる運用でした。この差の大部分は台数、つまり車両とドライバーの人数の差です。ドライバーの確保が難しい状況では、1日1.65台分の人手は費用以上の重みを持ちます。一方で、担当外に数km を上乗せする中間の運用なら、費用の増加を0.2〜0.4%に抑えながら担当者が届ける割合を73〜78%に上げられました。全面固定か全面最適化かを決める前に、この中間の曲線を自社のデータで描いてみることが、判断の材料として有効だと考えています。
曜日割りは、最大台数で効きます。番号順に機械的に割り振った案(最大7台)を、量と方面の両方を見た案(最大5台)に変えるだけで、週の費用は約20万円、1年を50週とすれば約1,000万円の差になります。ここで効いているのは距離ではなく、最も忙しい曜日に合わせて抱える車両と人の数です。毎朝の配車をどれだけ磨いても、曜日の偏りから来るピークは消せません。配車のシステムを入れる前に、まず曜日ごとのケース数と台数の表を作り、ピークの曜日がどこにあるかを見ておくのが、効果の大きい最初の一手になります。
配送頻度は、配送センターと納品先の間で費用を付け替える判断です。訪問回数を減らしても、積載で台数が決まっている限り配送費はあまり下がらず(全件週1回で2%減)、納品先の在庫は大きく増えます(目安で64%増)。反対に、訪問回数を上げる要望には、曜日の組の選択肢を広げれば、配送費をほとんど増やさずに応えられる場合があります。取引先との交渉では、頻度そのものより「どの曜日の組を認めてもらえるか」を材料にすることが有効だと考えています。
共同配送は、組む相手の条件で費用の削減が0.7%から21.3%まで変わりました。自社の車の積載率が高いなら、共同化は自社にとっては距離が縮む程度の効果しか生まず、分け方によっては相手が得をするだけの取引になりやすいことを、交渉の前に数字で押さえておく必要があります。反対に、自社が小口で件数の多い荷主なら、共同化で台数そのものを減らせる可能性があります。
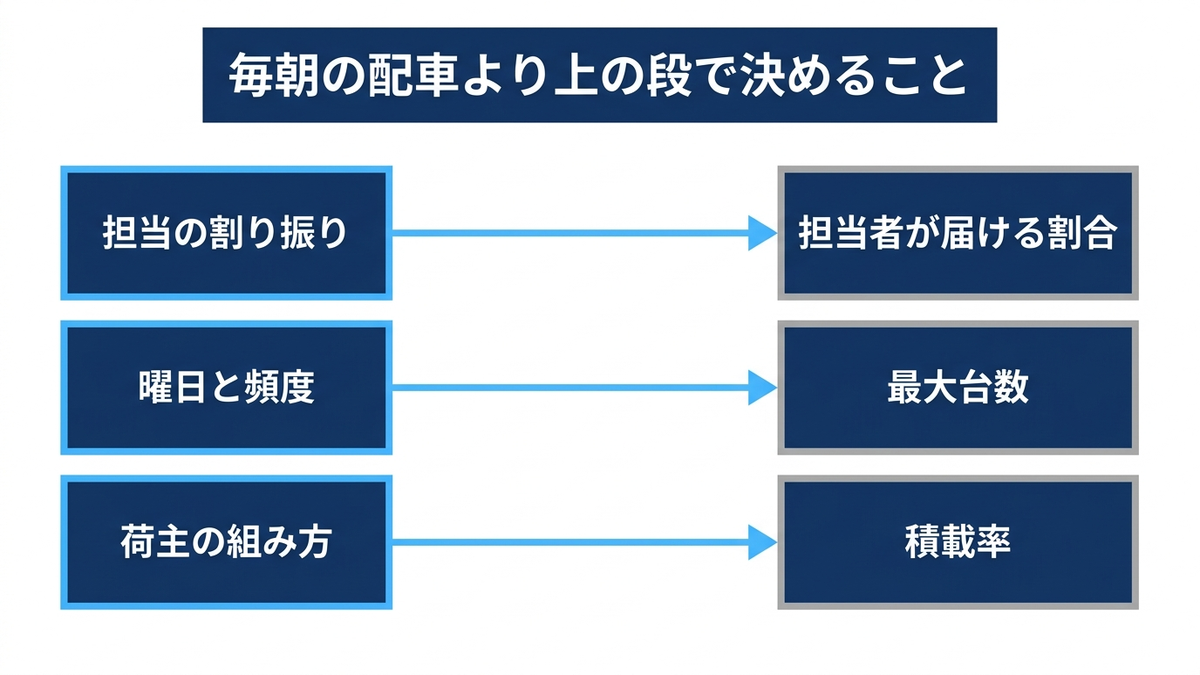
この章の要点は3つです。第一に、担当地区の固定と毎日最適化は二択ではなく、担当外へ行くときの上乗せの大きさで連続的につながっています。このデータでは固定の運用が1日1.65台多く、その差は積載から来るので習熟では埋まりませんでした。数km の上乗せで、費用をほぼそのままに担当の一貫性を高められます。第二に、定期配送の曜日割りは最大台数を決め、量と方面を両方見て曜日を選ぶと、機械的な割り振りより最大台数が2台少なくなりました。訪問回数を変えるときは、選べる曜日の組の広さが費用を大きく左右します。第三に、共同配送の効果は相手の積載率と納品先の重なりで大きく変わり、削減分の分け方によっては片方が単独より損をします。次の第13章では、ここまでの章で扱ってきた計画の仕組みを、配車担当の知恵やシステムと組み合わせて現場に入れる手順を扱います。
この章を深めたい方への参考書籍
『空間解析入門:都市を測る・都市がわかる』(貞広幸雄・山田育穂・石井儀光 編、朝倉書店):版元ドットコムの紹介と目次によると、データの可視化や集計単位の変換から、空間的自己相関、施設配置問題、最短経路問題、配送計画までを扱う空間解析の入門書です。担当地区を切る、納品先の分布を曜日ごとに見る、といったこの章の作業を、地図の上のデータ分析として体系的に学ぶのに向いています。
『協力ゲーム理論』(中山幹夫・船木由喜彦・武藤滋夫、勁草書房):版元ドットコムの目次では、第1章が特性関数と配分を扱う TU ゲーム、続いて NTU ゲームとコア、整合性公理と解の特徴付け、戦略形協力ゲームという構成です。この章で触れた「共同配送で浮いた費用を参加者でどう分けるか」は、協力ゲーム理論でいう配分の問題そのもので、2社を超える協業で分け方を設計するときの理論的な土台になります。
第13章 現場に入れる、配車担当の暗黙知を制約に落とし、人が直す運用で育てる
第12章では、配送エリアを固定するか毎日最適化するか、週に何回どの曜日に届けるかといった、日々の配車の一段上にある前提を設計しました。第3章からそこまでの章で扱ってきたのは、どれも「問題が正しく書けていれば、良い計画を計算で出せる」という話です。この章では、その前提そのもの、つまり問題を正しく書くための情報をどう集め、計算した計画をどう現場の運用に載せるかを扱います。配車計画のシステムを入れても使われなくなる理由の多くは、ソルバーの性能ではなく、計画に書かれていない現場の条件と、マスタ(納品先ごとの住所・荷下ろし時間・積載の換算といった基礎データ)の粗さにあると考えています。この章では、配車担当者の頭の中にある条件を聞き出して制約に落とす手順、条件ごとの費用を測って優先順位を付ける方法、マスタの精度の上げ方、関係するシステムとデータの流れ、人が最後に直す運用と手直しの記録の活かし方、経営への報告の指標、導入の順序と失敗の型を順に述べます。この章は仕組みと運用の話が中心ですが、条件ごとの費用とマスタの誤差の影響は、第2章で用意したサンプルデータで実際に解いて数字で示します。
計算上は良い計画が、現場で使われなくなる道筋
配車の最適化を導入した現場で起きやすい経過には、ある程度決まった型があるように思います。最初の計画を見た配車担当者やドライバーから「この店は午前中は荷受けしない」「この道は2トン車では曲がれない」「この納品先は店の前に停められないので、台車で運ぶと倍の時間がかかる」といった指摘が出ます。どれも計算機に渡したデータには書かれていなかった条件です。担当者は計画を手で直して使いますが、直す量が多いと、最初から自分で組むのと手間が変わらなくなり、やがて計画の出力は参考として眺めるだけのものになります。
この道筋で起きていることは、第2章で述べた「書き漏らした制約はソルバーにとって存在しない」ということの現れです。ソルバーは書かれた条件の中で距離の短い計画を探すので、書かれていない条件が多いほど、計算上の計画は現実には走れない計画に近づきます。しかも、書かれていない条件を破る計画ほど距離が短く見えるので、導入前の試算では効果が大きく出て、現場に入れた後で縮む、という順序になりやすくなります。導入の前後で効果の見積りが食い違うときは、試算に使ったモデルが現場の条件をどれだけ含んでいたかを最初に疑うのが筋です。
もう1つの型は、マスタの誤りです。納品先の位置が町名の代表点になっている、荷下ろし時間が全件一律の15分になっている、積載の換算がケース数だけで、かさばる品目も小さな品目も同じ1ケースとして数えている、といった状態です。条件は正しく書けていても、条件に入れる数字が現実とずれていれば、計画は同じように現場で崩れます。距離や移動時間の作り方そのもの(道路距離の係数や時間帯による渋滞)は第9章で扱ったので、この章では納品先ごとのマスタに絞ります。
この2つの型を防ぐ手順は、突き詰めると3つです。現場の条件を漏れなく聞き出して書くこと、書いた条件ごとにどれだけの費用がかかっているかを測って、守るべきものと交渉すべきものを分けること、そして計画を人が直したときにその理由を記録し、次の計画の条件やマスタに戻すことです。以下では、この順に述べます。
暗黙知を聞き出す、ヒアリングの設問と制約の型
配車担当者が毎朝の配車で使っている条件の多くは、文書になっていません。長く担当している人ほど、条件を条件として意識せずに使っているので、「何か制約はありますか」と聞いても出てこないことがよくあります。聞き出すときは、抽象的に聞くのではなく、納品先・車両・ドライバー・時間の切り口ごとに、具体的な場面を示して聞くほうが漏れが減ると考えています。たとえば「過去1か月の配車表を見ながら、この納品先をこの車に割り当てた理由を教えてください」「この2件を同じ便にしなかったのはなぜですか」と、実際の計画の1件ずつについて理由を尋ねる方法です。理由を聞いていくと、距離の短さだけでは説明できない判断が出てきて、それが書き漏らしている条件の候補になります。
聞き出した条件は、ソルバーに渡せる形に翻訳します。配車の条件の大半は、第5章から第8章で扱った道具のどれかで書けます。次の表は、ヒアリングの切り口ごとに、設問の例と、聞き出した条件がどの型の制約になるか、その値をどこに持っておくかをまとめたものです。
| 切り口 | 設問の例 | 出てくる条件の例 | 制約の型 | 値の置き場所 |
|---|---|---|---|---|
| 納品先の荷受け | 何時から何時まで荷を受けますか。昼休みや品出しの時間帯に受けない時間はありますか | 午前は受けない、12時から13時は受けない | 時間枠(第5章) | 納品先マスタ |
| 納品先の駐車・搬入 | 車はどこに停めますか。店の前に停められない日や時間帯はありますか | 近くの駐車場から台車で運ぶ、搬入口が1つで待ちが出る | 荷下ろし時間の加算、時間枠 | 納品先マスタ |
| 納品先への道 | 入れない車の大きさはありますか。高さや重さの制限のある道はありますか | 狭い道で小型の車しか入れない | 訪問できる車の限定 | 納品先マスタと車両マスタ |
| 担当の固定 | 決まったドライバーが行く納品先はありますか。その理由は何ですか | 検品の手順が独特で慣れた人しか行けない、同じチェーンの店は同じ人 | 同じ車への割当 | 納品先のグループ |
| 積み方と順番 | 積み込みの順番に決まりはありますか。一緒に積めない荷はありますか | 後で下ろす荷を奥に積む、冷蔵品と常温品を分ける | 訪問順の制約、車種の限定 | 品目マスタ |
| 積載の換算 | ケース数が同じでも積めない日はありますか。かさばる品目はどれですか | 特定の品目は1ケースが通常の1.5倍の場所を取る | 積載量の換算 | 品目マスタ |
| ドライバーと車両 | 出発時刻・帰着時刻・休憩の決まりは何ですか。2回転する車はありますか | 帰着は17時まで、昼に決まった長さの休憩を取る | ルートの最大時間、休憩(第7章) | 車両マスタ、勤務の規程 |
| 例外の扱い | 計画を手で直すのはどういうときですか。直した後の計画のほうが良い理由は何ですか | 雨の日は荷下ろしが遅い、月末は量が多い | 日によって変わるマスタの値 | 手直しの記録 |
表の最後の行は、ほかの行と性質が違います。前の7行は「条件を聞く」設問ですが、最後の行は「条件を聞き漏らしたことを見つける」設問です。担当者が手で直す場面には、まだ書かれていない条件が必ず含まれています。最初のヒアリングで条件を出し切ることはできないので、手直しの理由を聞く設問を運用の中に残しておくことが、後の節で述べる「手直しの記録」につながります。
聞き出した条件には、出どころを書き添えておくのが有効だと考えています。「納品先から書面で指定されている」「過去に一度苦情があったので避けている」「担当者の好みで、理由ははっきりしない」では、同じ条件でも重みがまったく違います。最初の型は守るしかありませんが、2番目は条件が今も生きているかを確かめる余地があり、3番目は計画の自由度を上げる候補です。出どころを書いておかないと、すべてが同じ重さの制約としてソルバーに入り、次の節で述べる優先順位が付けられなくなります。
ハード制約とソフト制約、条件に優先順位を付ける
聞き出した条件は、2つに分けて書きます。1つは、破った計画はそもそも走れない、あるいは走らせてはいけない条件で、ハード制約と呼びます。法令と社内規程で決まった労働時間、物理的に車が入れない道、納品先から書面で指定された荷受けの時間帯などです。もう1つは、破ることはできるが、破るたびに何らかの損が出る条件で、ソフト制約と呼びます。ソルバーには、破った量に応じた罰の費用(ペナルティ)を目的に足す形で渡します。「なるべく同じドライバーが行く」「なるべく午前中に届ける」といった条件がこちらに入ります。時間枠をソフトにする具体的な書き方は第5章、訪問そのものを罰の費用つきで省略できるようにする書き方は第6章で扱いました。
ハードかソフトかの判断は、技術の問題ではなく、条件の出どころで決まります。前の節で条件に出どころを書き添えるよう述べたのは、このためです。書面の指定や法令はハードに、過去の経緯や担当者の好みはソフトに置くのが出発点になります。迷う条件は、まずソフトにして罰の費用を大きめに置き、計算した計画でその条件がどれだけ破られるかを見てから決めるのが安全だと考えています。すべてをハードにすると、条件どうしがぶつかったときにソルバーは「解なし」しか返せず、どの条件を緩めればよいかの手がかりが得られないからです。ソフトにしておけば、残したハード制約どうしがぶつからず、探索が計画を見つけられる限り、計画が出たうえで、破られた条件とその量を一覧にできます。
ここで1つ注意が要ります。ソルバーが「解なし」を返したとき、それが「条件を満たす計画が存在しない」という意味なのか、「探索の途中で見つけられなかった」という意味なのかは、別のことです。この章の実験でも、後で述べる「同じチェーンの3店は同じ車」という条件を、3店の車の変数が等しいという式で OR-Tools に渡したところ、5秒の探索で「解なし」が返りました。条件を満たす計画は明らかに存在します(その3店だけを回る車を1台出せばよい)。最初の計画を作る段階の手順が、この形の条件を満たす計画を組み立てられなかったのです。そこで、3店を特定の1台に割り当てる形に書き換えると、計画が出ました。この条件だけを入れる場合は、車はすべて同じ2トン車なので、どの1台に固定しても同じことです。ただし、この章で試した条件を全部同時に入れる場合(後の表の F)は事情が違います。そこには狭い道の4件を車1だけに回らせる条件(同じ表の C)も入っており、3店まで車1に固定すると、3回とも「解なし」が返りました。なぜ車1への固定だけが解けなかったのかは確かめていません。表の F の行には、3店を車2に固定して解いた結果を載せています。現場の条件を足していって「解なし」が出たら、まず条件を1つずつ外して、どの条件が原因かを確かめ、次にその条件の書き方を変えて試すのが、手戻りの少ない順序です。
条件1つずつの費用を測る、守る条件と交渉する条件を分ける
条件に優先順位を付けるための最も直接的な材料は、その条件を入れたときに計画がどれだけ悪くなるか、つまり条件1つあたりの費用です。費用がほぼゼロの条件は、迷わずハード制約として入れてよく、交渉の対象にする必要もありません。費用の大きい条件は、本当に守る必要があるのかを出どころに戻って確かめ、納品先や社内の関係者と交渉する価値があります。交渉の順番を費用の大きさで決められるのが、この測り方の利点です。
第2章で用意したサンプルデータ(積載と時間指定のある40件)に、ヒアリングで出てきたという想定の条件を5つ、1つずつ足して解きました。5つの条件はすべて架空で、この実験のために置いたものです。A は駐車位置の条件で、C12 と C28 の2件は店の前に停められず台車で運ぶため、荷下ろし時間を15分ずつ延ばします。B は荷受けの時間帯の条件で、終日指定だった C10 と C16 が午前は荷受けしないことにして、時間枠を13時から17時にします。C は車両の制限で、道が狭い C04・C06・C08・C11 の4件には小型の車1しか入れないことにします。D は担当の固定で、同じチェーンの3店 C01・C09・C10 は同じ車(同じドライバー)が回ることにします。E は積載の換算の補正で、C05 と C18 の荷はかさばる品目なので、ケース数を1.5倍に換算します。最後に F として、AからEを全部同時に入れました。
探索の設定には注意が要りました。探索の手順は基準の結果(第2章)と同じ OR-Tools の誘導局所探索ですが、打ち切りの時間で決まる探索は、同じ条件でも実行するたびに結果が変わります。この記事の実行環境(一般的なノートPC)では、ほかの計算と同時に走らせていたため、時間内に探索が進む量も実行ごとに違いました。実際、打ち切りを30秒にして各条件を3回ずつ解いたところ、基準の条件の3回は295.0km から304.0km までばらつき、条件を足した C の3回(いずれも292.2km)のほうが短いという、条件を足したほうが得をするように見える結果になりました。そこで、この30秒×3回を第1段とし、次に、第1段の計画のうち、その条件でも走れるものを初期解にして20秒ずつ解き直しました(第1段の自分の最良と、ほかの条件の上位3つまで)。さらに、条件を足した問題の計画は条件の少ない問題でもそのまま走れる(条件は計画の選択肢を絞る方向にしか働かない)ので、条件を多く含む問題で見つかった計画のほうが良ければ、それに置き換えました。どの値も、最適であることは証明していない「見つかった中で最良の計画」です。
| 条件 | 使用台数 | 総距離(km) | 基準との距離の差(km) | 1日の費用(円、架空) | 基準との費用の差(円/日) | 最初の3回の総距離の幅(km) |
|---|---|---|---|---|---|---|
| 基準(積載+時間指定) | 6 | 291.8 | 0 | 131,671 | 0 | 295.0〜304.0 |
| A 駐車位置(荷下ろし+15分) | 6 | 292.2 | +0.4 | 131,688 | +18 | 304.0〜309.1 |
| B 荷受け時間帯(午前は受けない) | 6 | 292.2 | +0.4 | 131,688 | +18 | 296.5〜300.1 |
| C 車両の制限(狭い道は車1だけ) | 6 | 291.8 | 0 | 131,671 | 0 | 292.2〜292.2 |
| D 担当の固定(同じチェーンは同じ車) | 6 | 304.6 | +12.8 | 132,185 | +514 | 305.0〜305.0 |
| E 積載換算の補正(2件を1.5倍) | 7 | 301.6 | +9.8 | 152,063 | +20,392 | 301.9〜301.9 |
| F AからEを全部 | 7 | 308.4 | +16.6 | 152,335 | +20,664 | 308.4〜308.4 |
1日の費用は、第8章で使った2トン車の値(固定費20,000円/台、40円/km。どちらも架空)で、使用台数と総距離を換算したものです。基準の行の総距離291.8kmは、第2章の基準の結果(293.2km)より短くなっています。これは探索の時間と初期解を変えたためで、同じ問題に対して、より良い計画が見つかったということです。
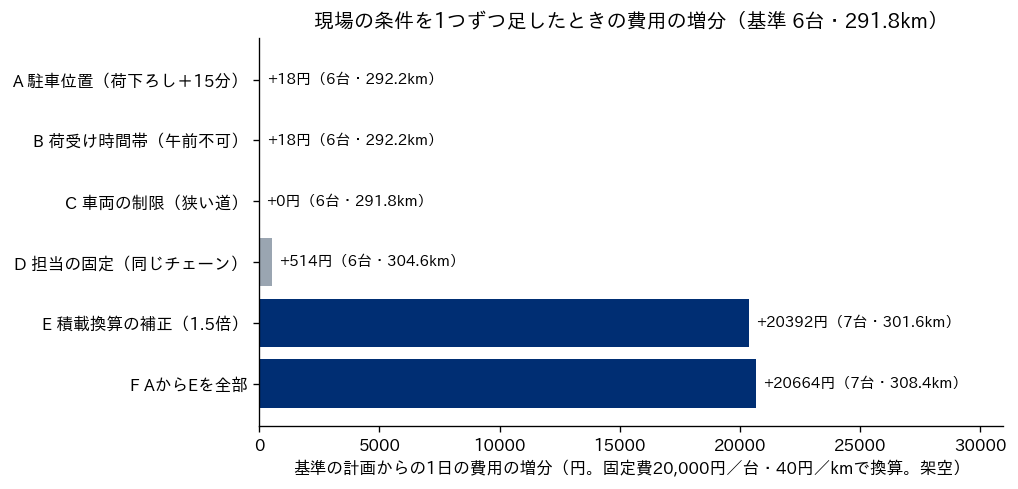
結果は、条件の費用に大きな差があることを示しています。A・B・C の3つは、費用がほぼゼロでした。基準の行の計画(6台・291.8km)は、もともと狭い道の4件を1台(車1)にまとめていました。また次の節で示すとおり、この計画は訪問順を変えずに A や B の条件で評価し直しても、時間指定の遅れが出ません。A と B の行の0.4kmの差は、探索がこの計画にたどり着かなかった分で、条件そのものの費用はほぼゼロと読むのが妥当です。こうした条件は、ヒアリングで出てきたらそのままハード制約として入れてよく、納品先と交渉する意味もほとんどありません。一方、D の担当の固定は1日あたり12.8km、514円(架空の単価)の費用がかかりました。年間の稼働日を250日と仮定すると、年に約12.8万円です。この金額が、同じドライバーが行くことの価値(検品の手間が少ない、納品先との関係が保てる)に見合うかどうかは経営の判断で、見合わないならソフト制約に変える、あるいは3店のうち遠い1店だけ固定を外す、といった交渉の材料になります。
E の積載換算の補正は、ほかの条件と性質が違います。C05 は37ケースが56ケース相当に、C18 は36ケースが54ケース相当になり、総需要は868ケースから905ケース相当に増えます。905を積載量150で割ると6.03なので、7台がどうしても必要になります。E の費用の増分20,392円のうち20,000円は、この1台の固定費です。ただし、これは「条件を入れたことによる損」ではありません。後の節で見るとおり、補正前の6台の計画は、実際には積めない計画だったので、補正によって隠れていた費用が表に出ただけです。条件の費用を読むときは、それが選べる条件なのか、現実そのものなのかを区別する必要があります。
もう1つ、表の右端の列が示しているのは、探索の揺れの大きさです。基準の条件でも、最初の3回の総距離は295.0kmから304.0kmまで、9km の幅がありました。A の最初の3回(304.0〜309.1km)だけを見て基準の最良と比べると、駐車位置の条件に10km 以上の費用がかかるように見えてしまいます。条件の費用を測るときは、1回の実行の値で判断せず、繰り返して揺れの幅を確かめ、揺れより大きい差だけを読むのが安全です。打ち切りの探索の性質や時間と品質の関係は第6章で扱いました。現場との交渉の材料にする数字ほど、この確かめが欠かせません。
実装の上で2つ、つまずいた点を記録しておきます。1つ目は、特定の納品先に入れる車を限る関数 SetAllowedVehiclesForIndex が、この記事の実行環境(OR-Tools 9.15.6755 の Python)で、車の番号のリストと納品先の番号を渡す呼び出し方では、引数の型の誤り(TypeError)になったことです。関数そのものは Python から見えており、合わなかったのは引数の型です。ほかの版やほかの渡し方では試していません。代わりに、納品先ごとの「訪問する車の番号」を表す変数(VehicleVar)に、車1であるという条件を直接課しました。2つ目は、前の節で述べた「同じ車」の条件で「解なし」が返ったことです。どちらも、条件を書いたら小さな例で実際に解いて、意図どおりの計画が出るかを確かめる必要があることを示しています。
マスタの精度、住所・荷下ろし時間・積載換算
配車の計算に入る数字のうち、納品先ごと・品目ごとに持つ基礎データを、ここではマスタと呼びます。配車で特に効くのは、納品先の位置、荷下ろしにかかる時間、荷の積載への換算の3つです。位置が違えば距離と時間が違い、荷下ろし時間が違えば後ろの納品先の到着時刻がずれ、換算が違えば積めない計画ができます。
換算の誤りがどう効くかを、前の節の基準の計画で確かめました。基準の計画(6台・291.8km)の訪問順を変えずに、補正後のマスタで評価し直したのです。荷下ろし時間を15分延ばす補正(A)と、午前の荷受けをなくす補正(B)では、時間指定の遅れは0件でした。この計画はたまたまこれらの条件に余裕を残していたので、補正しても崩れませんでした。一方、積載換算の補正(E)では、6台のうち2台が積載量150を超え、それぞれ155ケース相当と168ケース相当になりました。計画の上では全車が150以内に収まっていたのに、実際には2台の荷が積み切れず、当日の朝に積み残しか車の追加が起きる計画だった、ということです。前の節で E の費用を「隠れていた費用」と呼んだのはこのためで、マスタを直さないまま6台で計画を回し続けると、その費用は毎朝の積み残しや臨時の車として現場で払われ、計画の数字には現れません。
換算の誤りが見つけにくいのは、ケース数という単位そのものは正しいからです。受注のデータはケース数で正しく入っていて、積載量もケース数で正しく定義されているのに、品目によって1ケースの大きさが違うことだけが抜けています。積載をケース数・重さ・容積のどれで数えるか、品目ごとにどの換算を持つかは、ヒアリングの表の「積載の換算」の行で聞き出しておくべき項目です。ケース数と容積の両方が効く荷であれば、積載の条件を2つ置きます。OR-Tools では、積載を数える次元(第6章で扱った、経路に沿って量を積み上げる仕組み)をケース数と容積の2つ登録すれば書けます。サンプルデータの先頭10件に架空の容積を付けた小さな例で確かめたところ、ケース数だけで解いた計画では2台のうち1台の容積が上限1,500を超えて1,575になりましたが、容積の次元を足して解き直すと、2台の容積は1,435と1,305で、どちらも上限に収まりました。
荷下ろし時間は、納品先の事情で日によってばらつきやすい一方で、実績を取りやすい項目です。動態管理の仕組みがあれば、納品先ごとの到着と完了の時刻から毎日の実績がたまります。運送事業者の側にも、法令で定められた記録があります。国土交通省のリーフレットによると、貨物自動車運送事業輸送安全規則の改正(2024年10月1日公布、2025年4月1日施行)により、荷待ち時間と荷役作業等を業務記録に記録する義務の対象が、それまでの「車両総重量8トン以上または最大積載量5トン以上の車両」から全車両に広がりました。記録の対象になるのは、荷主の都合で30分以上待機したときの荷待ち時間と、荷役作業等(荷主との契約書に実施した作業がすべて明記されている場合は、要した時間の合計が1時間以上のとき)で、記録は最低1年間保存することとされています。国土交通省のページでは、荷待ち時間の記録には到着と出発の時刻、積込みと取卸しの開始と終了の時刻が含まれるとしています。対象は条件を満たした場合に限られるので、すべての納品先の荷下ろし時間がこの記録から取れるわけではありませんが、記録が残るのは待ちや荷役が長かった場面なので、計画で見込んだ時間と実際の時間の差が大きくなりやすい納品先を見つける手がかりの1つになると考えています。
- 国土交通省「令和7年4月1日から、全車両が記載対象になります 荷待時間や荷役作業・附帯業務の『業務記録』への記録義務の対象が、全車両に拡大」(リーフレット)
https://www.mlit.go.jp/jidosha/content/001865382.pdf - 国土交通省「乗務記録の記載対象となる荷待時間・荷役作業等について」
https://www.mlit.go.jp/jidosha/jidosha_fr4_000026.html
実績から荷下ろし時間のマスタを作るときは、平均ではなく、分布の上のほうの値を使うのが有効だと考えています。平均で計画すると、半分近くの日は計画より遅くなり、その遅れが後ろの納品先に積み重なるからです。どの程度の余裕を持たせるかの考え方と、見積りの誤差が時間指定の遅れにどう効くかの実験は、第9章で扱いました。位置の精度も同じで、住所から座標を作るときに町名や番地の代表点になっていないか、実際に車を停める場所(搬入口)と住所の点がずれていないかを、ドライバーの知っている情報で直していきます。第9章で扱った距離の作り方がどれほど精密でも、出発点と到着点の座標がずれていれば、その精度は活きません。
マスタは、一度作れば終わりではありません。納品先の改装で搬入口が変わる、品目の荷姿が変わる、新しい納品先が増える、といった変化は日常的に起きます。マスタの項目ごとに「誰が、何を見て、いつ直すか」を決めておくことが、次の節以降で述べる運用の土台になります。
受注・倉庫管理・配車・動態管理、データの流れを決める
配車の計画は、単独では動きません。前には受注があり、倉庫での出荷の準備があり、後ろには実際の運行と、その記録があります。多くの会社では、受注は販売管理や受注管理のシステムが、倉庫の作業は倉庫管理システム(英語の頭文字で WMS。入荷・保管・ピッキング・出荷を管理する仕組み)が、配車は輸配送管理システム(同じく TMS)や表計算が、走行中の車両の位置や到着の記録は動態管理の仕組み(車載の端末やスマートフォンで位置と作業の状態を集める仕組み)が受け持っています。配車の最適化は、この流れの中の1つの段にすぎず、前後の段とのデータの受け渡しが決まっていないと、毎朝の計画の入力を人が打ち直すことになります。
次の表は、4つの段の間で受け渡すデータと、受け渡しが崩れたときに配車で起きることをまとめたものです。システムの名前や製品ではなく、「何をいつ渡すか」を決めることが、導入の設計の中心になります。
| 段 | 配車に渡すもの | 配車から受け取るもの | 受け渡しが崩れたときに起きること |
|---|---|---|---|
| 受注 | 納品先・品目・数量・希望の時間帯。受注の締切時刻 | 納品予定時刻(取引先への回答) | 締切後の注文が計画に入らない、数量の単位が品目ごとに違い積載に換算できない |
| 倉庫管理 | 出荷できる時刻(ピッキングの完了見込み)、荷姿(ケース・パレット・かご車) | 車ごとの積込順と出発時刻 | 計画上の出発時刻に荷がそろわない、積込順と下ろす順が合わない |
| 配車 | (この段で計画を作る) | (前後の段へ渡す) | 計画の版が複数でき、どれが確定版か分からない |
| 動態管理 | 走行中の位置、到着・荷下ろし開始・完了の時刻 | 確定した計画(訪問順と予定時刻) | 予定と実績の比較ができず、マスタが直らない。当日の再配車の起点が分からない |
表の最後の行の「予定と実績の比較」が、この章で最も重要な受け渡しです。動態管理の記録には、納品先ごとの到着時刻と荷下ろしの完了時刻が入るので、荷下ろし時間の実績が納品先ごとに毎日たまっていきます。これを配車のマスタに戻す流れがあれば、次の節で述べるマスタの精度は運用の中で自然に上がります。戻す流れがなければ、マスタは導入時に一度作ったまま古くなっていきます。当日の変化に応じて計画を直す再配車(第11章)も、今どの車がどこまで回ったかという動態管理の情報を起点にするので、この受け渡しが無い状態では成り立ちません。
会社をまたぐ受け渡しでは、データの形式そのものが問題になります。荷主・倉庫・運送会社で、同じ「納品予定日」や「数量」をそれぞれ別の形式・単位で持っていると、会社の境目ごとに変換の手間が生じます。この問題に対して、内閣府の戦略的イノベーション創造プログラム(SIP)の「スマート物流サービス」では、運送計画や出荷の情報などを標準化する「物流情報標準ガイドライン」が作られています。国土交通省の報道発表によると、2025年2月7日にガイドラインを ver.3.00 に改訂したことが公表され、ガイドラインの管理は一般社団法人フィジカルインターネットセンターが担っています。ガイドラインの専用サイトは、物流業務プロセス標準・物流情報標準メッセージ・物流共通マスタの3つを掲げています。自社だけで閉じた配車であれば必須ではありませんが、取引先との間でデータ項目を新しく決めるときに、ゼロから決めるより先に参照する価値があると考えています。
- 国土交通省「『物流情報標準ガイドライン』をver3.00に改訂しました」(報道発表資料、2025年2月7日)
https://www.mlit.go.jp/report/press/tokatsu01_hh_000853.html - 物流情報標準ガイドライン(専用サイト)
https://www.lisc.or.jp/
人が最後に直す運用、手直しの記録を次の制約にする
配車の最適化を入れても、計画を人が最後に見て直す工程は残すべきだと考えています。理由は2つあります。1つ目は、前の節までで述べたとおり、書かれていない条件は必ず残っていて、それを知っているのは配車担当者とドライバーだからです。2つ目は、その日にしか分からない事情(車両の故障、ドライバーの急な休み、納品先からの電話での依頼)があるからです。計算機の計画をそのまま出す運用を目指すより、人が直すことを前提に、直す作業を短くし、直した理由を次の計画に戻す運用を設計するほうが、現場に定着しやすくなります。
そのためには、手直しを記録に残す仕組みが要ります。計算した計画と人が確定した計画の差分を機械的に取り、差分ごとに理由を選んでもらう形が、担当者の負担が小さく、後で集計しやすいと考えています。理由を自由記述にすると集計できないので、選択肢を用意し、どれにも当てはまらないときだけ自由記述にします。記録の項目の例を次の表に示します。
| 項目 | 記録する内容の例 | 後で使う目的 |
|---|---|---|
| 日付・計画の版 | 計算した版の番号と、確定した版の番号 | どの計画をどう直したかを追う |
| 手直しの種類 | 別の車へ移した、同じ車の中で順番を入れ替えた、翌日に回した、車を1台足した | 手直しの量を種類別に数える |
| 対象 | 納品先の ID、車番号 | 同じ納品先で繰り返されていないかを見る |
| 理由(選択肢) | 荷受けの時間、駐車・搬入、車の大きさ、担当の固定、積み方、当日の事情、その他 | 制約の書き漏らしか、マスタの誤りか、当日の事情かを分ける |
| 手直しによる変化 | 総距離・台数・最も遅い帰着時刻の、直す前と後の値 | 手直しの費用を測る |
この記録を月に一度集計すると、手直しは3種類に分かれます。同じ納品先で同じ理由の手直しが繰り返されているなら、それは書き漏らした制約か、マスタの誤りです。前者なら制約として足し、後者ならマスタを直します。これが「手直しの記録を次の制約にする」ということです。一方、当日の事情による手直しは、繰り返しの少ないものが大半なので、制約にするのではなく、当日の再配車の手順(第11章)の側で扱います。
手直しによる距離や台数の変化も記録しておくと、手直しそのものの良し悪しが見えてきます。人の手直しで距離が増えている場合、その増分は現場の条件を守るための費用か、担当者の慣れや好みによる費用かのどちらかです。前者なら制約として書けば計算機が最初から守れるようになり、後者なら計算機の計画のほうが良い可能性があります。どちらなのかを担当者と一緒に確かめる材料として、手直しの記録は役に立ちます。手直しの量(件数、あるいは直した納品先の割合)が月ごとに減っていくことは、モデルが現場に近づいていることの目安になります。
ここで気を付けたいのは、手直しの記録を担当者の評価に使わないことです。記録が評価に使われると、理由の選択が実態からずれ、「当日の事情」や「その他」に逃げる記録が増えます。記録の目的は、モデルとマスタを直すことに限ると、最初に決めて伝えておくのが有効だと考えています。
KPI と経営報告、計画と実績を同じ物差しで並べる
第1章では、配車の経営指標として、使用台数・総走行距離・1件あたり配送費・積載率・時間指定の遵守率・ドライバーの拘束時間を定義しました。導入の効果を報告するときは、これらを「計画の値」と「実績の値」の2列で並べるのが基本になります。計画の値は計算機が出した(あるいは人が確定した)計画から、実績の値は動態管理の記録から取ります。計画の値だけを報告すると、計算上の効果を報告することになり、現場で守れなかった分が見えません。
| 指標 | 計画の値の出どころ | 実績の値の出どころ | 計画と実績がずれたときに疑うこと |
|---|---|---|---|
| 使用台数 | 確定した計画 | 運行の記録 | 当日の車の追加、手直しで足した車 |
| 総走行距離 | 計画の距離行列 | 動態管理の走行距離 | 距離の作り方(第9章)、ルートの逸脱 |
| 1件あたり配送費 | 計画の台数と距離に単価を掛けたもの | 実際の費用を件数で割ったもの | 残業、追加の車、単価の前提 |
| 積載率 | 計画の積載の合計÷使った車の積載量の合計 | 出荷の実績の積載の合計÷使った車の積載量の合計 | 積載の換算の誤り、当日の数量の変更 |
| 時間指定の遵守率 | 時間枠をハード制約にした計画では原則100%(ソフトにした時間枠は、計画の段階でも100%を下回りうる) | 到着時刻の記録 | 荷下ろし時間のマスタ、移動時間の見積り |
| 拘束時間 | 計画の出発から帰着まで | 運行の記録 | 荷待ち、荷下ろし時間のマスタ |
| 手直しの量 | 計算した計画と確定した計画の差分 | (計画の段だけで測る) | 書き漏らした制約、マスタの誤り |
表の最後の行の手直しの量は、第1章の指標には含めていなかった、導入の段階に特有の指標です。経営への報告には、費用の指標と並べて、この手直しの量を載せておくのが有効だと考えています。費用が下がっていても手直しの量が減らない状態は、計算機の計画がまだ現場に合っておらず、配車担当者の手間が導入前と変わっていないことを意味するからです。
もう1つ、報告で分けておきたいのは、計算機の計画の改善と、前提の変更による改善です。導入と同時に、納品先と交渉して時間指定を緩めてもらった、車種を入れ替えた、といった変更があると、費用の改善のどこまでが最適化の効果で、どこからが前提の変更の効果なのかが混ざります。同じ前提で計算した計画と人の計画を並べる比較(前提を固定した比較)と、前提を変えたときの計画の比較(前の節の条件ごとの費用)を分けて報告すると、次にどこへ投資するかの判断に使えます。
導入の順序と失敗の型
ここまでの内容を、導入の順序としてまとめます。最初の段は、現状の計画を数字にすることです。過去の配車表と運行の記録から、台数・距離・時間指定の遵守率・拘束時間の現状値を出し、同時に納品先・車両・品目のマスタを集めます。2番目の段は、ヒアリングで条件を聞き出し、出どころと優先順位を付けて書くことです。3番目の段は、過去の同じ日の受注を使って計算機の計画を作り、人の計画と並べる「並行運用」です。ここでは計算機の計画を実際には走らせず、担当者に見てもらって、走れない理由を集めます。理由の多くは書き漏らした条件かマスタの誤りなので、2番目の段に戻して直します。4番目の段で、計算機の計画を人が直して確定する運用を始め、手直しの記録を取ります。5番目の段で、手直しの記録と動態管理の実績を定期的に集計し、制約とマスタを直す仕組みを回し続けます。
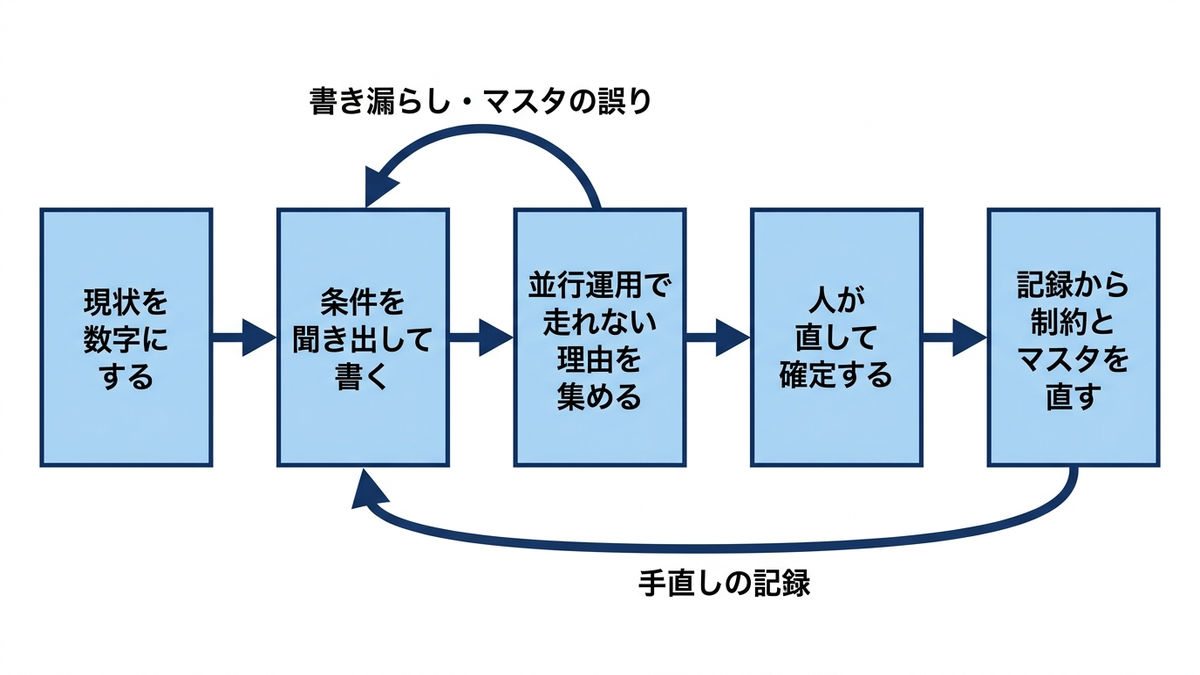
並行運用の段を飛ばして、いきなり計算機の計画で走らせることは避けるべきだと考えています。走れない計画が一度でも現場に出ると、ドライバーと配車担当者の信頼を失い、その後の改善が進みにくくなります。並行運用は、計算機の計画の品質を確かめる場であると同時に、担当者が計算機の計画を見慣れる期間でもあります。並行運用をいつ終えるかは、手直しの量が一定の水準まで下がったか、で判断するのが分かりやすい基準です。
導入でよく見られる失敗は、次の表の型に分けられると考えています。どれも、ソルバーの選び方や計算の速さとは別のところで起きます。
| 失敗の型 | 起きること | 予防する手当て |
|---|---|---|
| 条件の書き漏らし | 計画が現場で走れず、手直しが多くなり、やがて使われなくなる | 具体的な配車表を見ながらのヒアリング、並行運用で走れない理由を集める |
| 条件の入れすぎ | 担当者の好みまで絶対の制約にして、改善の余地が消える。解が見つからなくなる | 条件の出どころを記録し、条件ごとの費用を測って優先順位を付ける |
| マスタの放置 | 導入時のマスタが古くなり、計画の精度が月を追って落ちる | 動態管理の実績でマスタを定期的に直す流れを作る |
| 試算の効果の過大評価 | 現場の条件を入れない試算で効果を見積り、導入後に効果が縮む | 試算の段階から主要な条件を入れ、前提を固定した比較で報告する |
| 計画の版の混乱 | 計算機の計画と人の計画が並存し、どれが確定版か分からない | 確定の手順と確定版の置き場所を1つに決める |
| 運用の担い手の不在 | 導入した人が異動すると、条件やマスタを直す人がいなくなる | 条件とマスタの持ち主(誰が直すか)を業務として決める |
表の最後の型は、見落とされやすいものです。配車の最適化は、導入した時点で完成するものではなく、条件とマスタを直し続けることで精度を保つ仕組みです。直す作業が特定の個人の頑張りに依存していると、その人がいなくなった時点で仕組みが止まります。条件の一覧とマスタの持ち主を業務の役割として決めておくことが、導入の最後の段として必要だと考えています。
この章の要点は3つです。第一に、配車の最適化が現場で使われなくなる原因の多くは、ソルバーではなく、書かれていない現場の条件とマスタの粗さにあり、条件は具体的な配車表を見ながら理由を尋ねて聞き出すのが確実です。第二に、聞き出した条件は出どころと費用を添えて優先順位を付け、守るべき条件と交渉すべき条件を分けます。条件ごとの費用は、同じ探索条件で繰り返し解き、揺れより大きい差だけを読みます。第三に、計画は人が最後に直すことを前提に運用し、手直しの理由と動態管理の実績を記録して、制約とマスタに戻し続けます。次の第14章では、公開された一次情報のある事例と、共同配送などの政策の動き、機械学習や生成AIと配送計画の関係を扱います。
この章を深めたい方への参考書籍
『輸配送DX』(検崎朴郎・渡邉安彦・山本広高、日本橋出版):副題は「数理技術を活かした輸送を“つなぐ”ことの実現」で、日本パレットレンタルの取り組みを題材に、共同輸送の候補探索や輸送ルート決定業務の省力化などを、物流の戦略・企画部門の読者に向けて解説しています。数理の手法を1つの会社の業務にどう組み込んでいったかという、この章の「現場に入れる」過程を具体的な事例で追えます。
『崖っぷちの物流DX導入マニュアル』(鈴木邦成・中村康久、NTT出版):副題は「ロジスティクスの最適化を急げ!」で、中小企業やスタートアップの経営者・担当者が物流のデジタル化を導入する前に知っておくべき事項を、企業の事例を交えて解説しています。レガシーシステムからの移行や導入前の準備を扱う章があり、この章の「システムとデータの流れ」「導入の順序と失敗の型」を、配車に限らない物流全体の視点から補えます。
第14章 事例と最新動向、公開された成果をどう読み、何を自社に持ち帰るか
第13章では、配車担当が頭の中に持っている条件をヒアリングで書き出し、ハード制約とソフト制約に分け、人が最後に直した記録を次の制約に戻す運用として、最適化を現場に入れる手順を整理しました。この最後の章では視野を外に広げ、他社がどこまで進んでいるのか、政策と研究がどちらに動いているのかを確認します。扱うのは4つです。1つ目は、公開された一次情報で成果の中身をたどれる国内外の事例です。2つ目は、共同配送や中継輸送のように、1社の配車計画の外側で国が進めている取り組みです。3つ目は、機械学習で配送計画を解く研究の位置づけと限界です。4つ目は、生成AI(大規模言語モデル)に任せられることと人が決めなければならないことの線引き、そしてソルバーの動向です。
この章では、企業名と数字は、公式発表・官公庁の資料・論文を開いて中身を確かめたものだけを書きました。見つからなかったものは書いていません。また、事例の数字には「実際に運用して測った値」と「試験や試算で見込んだ値」が混ざりやすいので、どちらなのかを本文で書き分けます。なお、弊社コラム「数理最適化の定式化パターン集」の第1章で取り上げた国内の事例(ソフトバンクの LP ガス配送のサービス、東京ガスの開栓業務の割り振りなど)は、ここでは重ねて扱いません。
事例を読むための物差し、見込み値と実測値を分ける
配送計画の事例には「走行距離を20%削減」「配車業務を半分に」といった数字が並びます。自社の判断に使うには、その数字が何を分母にし、どういう条件で測られたものかを確かめる必要があります。この章では、事例の数字を次の4つの観点で読みました。
1つ目は、数字の種類です。実際の運用期間に測った実績値なのか、実証実験(期間と対象を限った試験)の値なのか、シミュレーションや計画上の試算なのかを分けます。この記事の第9章で見たとおり、計画の段階の所要時間と、実際に走ったときの所要時間は一致しません。計画上の削減率は、実走での削減率の上限に近いものとして読むのが安全です。2つ目は、比べている相手です。「人が組んだ計画」と比べたのか、「導入前の年の実績」と比べたのかで意味が変わります。導入前の年と比べた場合、物量や納品先の数、道路事情の変化も差に入ります。3つ目は、指標の種類です。走行距離・使用台数・配車の作業時間・時間指定の遵守率のどれが動いたのかを見ます。配車の作業時間の削減は主に人件費の効果で、走行距離や台数の削減は輸送費の効果です。この2つは金額の桁が違うことが多く、第1章で示した費用の構造に当てはめて換算し直す必要があります。4つ目は、範囲です。全社の全車両なのか、1つの営業所の一部の車両なのかを確かめます。
この4つの観点で読むと、同じ「20%削減」でも、自社の投資判断に使える数字とそうでない数字が分かれます。以下の事例では、この4点が分かるように書き、分からない点は「公表資料からは分からない」と書きました。
削減率は比べる相手で変わる、共通データで確かめる
2つ目の観点「比べている相手」がどれほど数字を動かすかを、第2章で用意したサンプルデータ(架空の配送センターと納品先40件)で測りました。条件は基準の結果と同じ積載制約のみ(2トン車150ケース、時間指定なし、18時までに帰着)で、OR-Tools 9.15 のルーティングソルバーに、第6章で説明した初期解の作り方(最安の辺を延ばす構築法)と改善の方法の組み合わせを変えて解かせています。「各納品先へ1件ずつ往復」は、1台が納品先ごとにデポとの間を往復した場合の距離の合計で、比べる相手としては最も素朴なものです。計算時間は、この記事の実行環境(一般的なノートPC)での実測です。
| 計画の作り方 | 使用台数 | 総距離(km) | 計算時間(秒) | 誘導局所探索20秒の計画の削減率 |
|---|---|---|---|---|
| 各納品先へ1件ずつ往復 | 40 | 1,236.3 | 0.0 | 76.0% |
| 初期解のみ(最安の辺を延ばす構築法) | 6 | 324.2 | 0.0 | 8.5% |
| 初期解+貪欲な局所探索(改善が止まるまで) | 6 | 301.3 | 0.1 | 1.5% |
| 誘導局所探索 1秒 | 6 | 300.7 | 1.0 | 1.3% |
| 誘導局所探索 5秒 | 6 | 298.1 | 5.0 | 0.4% |
| 誘導局所探索 20秒 | 6 | 296.8 | 20.0 | (比べる基準) |
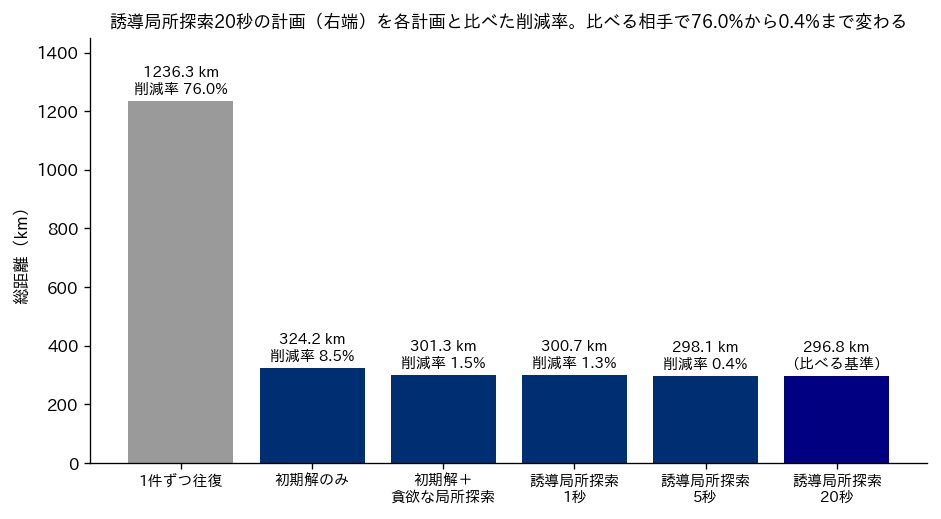
表の右端の列は、同じ1つの計画(誘導局所探索20秒、総距離296.8km)を、左の列の計画と比べたときの削減率です。「1件ずつ往復」と比べれば76.0%の削減、「初期解のみ」と比べれば8.5%、「誘導局所探索5秒」と比べれば0.4%になります。計画そのものは1つなのに、削減率は比べる相手しだいで2桁の幅で動きます。事例の「〇〇%削減」を読むときに、比べた相手の計画がどの程度作り込まれたものだったかを確かめる理由はここにあります。人が長年かけて磨いてきた配車表と比べた削減率と、整理されていない状態の配車と比べた削減率は、同じ尺度では並べられません。
もう1点、この表の最下行の296.8kmは、この記事の基準の結果(同じ設定・同じ20秒で296.3km)と0.5km違います(第4章にも296.8kmという値が出てきますが、そちらはこの章とは別の実行です)。誘導局所探索は時間で打ち切る探索で、同じ PC でも他の処理の負荷で探索できる量が変わり、結果が揺れます。この実行は他の章の計算と同時に走っていました。つまり「最適化した計画」自体にも実行ごとの揺れがあり、1回の比較で出た1%前後の差は、揺れの中に埋もれうるということです。事例の数字が小さな改善幅を主張している場合は、何回測った値か、期間を通じた平均かを確かめる必要があります。
国内外の事例、UPS の ORION と国内の配達ルート自動作成・予測に基づく配車
海外で最も詳しく公開されている事例の1つが、米国の物流大手 UPS のORION(UPS が開発したルート最適化の仕組みの名称)です。Holland ほかが2017年に学術誌 Interfaces に発表した論文「UPS Optimizes Delivery Routes」の要旨によれば、UPS は2003年に集荷と配達の業務の刷新に着手し、その成果としてメタヒューリスティクス(第10章で扱った、厳密な最適性を保証しない代わりに大きな問題で良い解を探す方法)による最適化の仕組みを作りました。要旨は、ORION が毎日、米国の5万5,000人のドライバー1人ひとりに、その日に集荷・配達する荷物に基づいて最適化したルートを出していること、そのルートは日々の一貫性を望ましい水準に保つように作られていることを述べています。
この要旨には、この章で読み分けたい2種類の数字が並んでいます。1つは構築と展開にかかった費用で、2億9,500万ドルを超えたとされています。もう1つは効果で、要旨の表現は「年3億〜4億ドルの節約が見込まれる」、さらに「CO2 の排出を年10万トン減らしている」です。前者は実際にかかった額、後者のうち節約額は見込み(expected)として書かれています。投資額と効果を同じ資料の中で並べて読むときは、片方が実績、片方が見込みであることを押さえておく必要があります。
ORION の事例から配車計画の実務に持ち帰れる点は、数字よりも2つの記述のほうにあると考えています。1つ目は「日々の一貫性」です。第12章で扱ったとおり、毎日ゼロから最適化すると、前日と大きく違うルートが出て、ドライバーの習熟が生きなくなります。UPS は一貫性を最適化の条件として持ち込んでいました。2つ目は、要旨が「利用者と経営陣の双方が受け入れるように、UPS は管理の実務を大規模に変えた」と書いている点です。技術的な仕組みを作ることと、それを現場と経営が受け入れることが、同じ重さで扱われています。第13章で整理した導入の手順は、この部分を自社の規模で進めるためのものです。
国内に目を移すと、日本郵便が2020年6月15日の発表で、AI による配達ルート自動作成などを活用した配達業務支援システムの試行導入を公表しています。発表の別紙によれば、CBcloud の宅配業務支援システムと、オプティマインドの配達ルート自動作成システムを連携させたもので、試行期間は2020年6月から2021年3月(予定)、対象は全国約200局の郵便局(予定)の一部エリアで、ゆうパックとゆうパケットの配達に使うとされています。この発表で目を引くのは目的の書き方です。別紙は、業務負荷の軽減と「業務経験の浅い人でも簡単に配達できる仕組み作り」を目的に掲げ、ルートの自動計算を「これまで配達経験のない方も熟練者と遜色なく業務を行えるよう支援する」技術と説明しています。走行距離の削減ではなく、担い手の確保を主な狙いとして置いている点が特徴です。一方、この発表には、試行の結果として距離や時間がどれだけ変わったかの数字は書かれていません。効果の大きさは、この公表資料からは分かりません。
もう1つは、ヤマト運輸と医薬品卸のアルフレッサの取り組みです。ヤマトホールディングスの2021年8月3日の発表によれば、両社はビッグデータと AI を活用した配送業務量の予測システムと、その予測を基に配車計画を自動的に作成するシステムを開発し、2021年8月からアルフレッサの首都圏の支店を対象に導入を始め、全国の支店へ順次広げる予定としています。予測するのは顧客ごとの注文数・配送の発生確率・納品時の滞在時間などで、第9章で扱った「荷下ろし時間の見積り」を予測で置き換える発想です。発表は、配送生産性の最大20%向上、CO2 排出量の最大25%削減、医療機関での対面作業時間の最大20%削減という数字を挙げていますが、これらには「現在との比較。両社予想値」と注記されています。つまり導入前に見込んだ値で、運用して測った実績ではありません。
この2つの事例は、配車の最適化を「距離を短くする道具」としてだけでなく、「経験の浅い人でも回せるようにする道具」「予測と組み合わせて計画の前提を正確にする道具」として位置づけている点で共通しています。第1章で整理した経営指標でいえば、前者は配車担当とドライバーの育成期間、後者は時間指定の遵守率と拘束時間に効く取り組みです。自社で同じ種類の投資を検討するときは、どちらの指標を主な効果として説明するかを先に決めておくと、導入後の評価がぶれません。
共同配送の実証、コンビニ3社の実績とシミュレーションの差
1社の配車計画の外側に踏み出す取り組みとして、競合する事業者どうしが同じトラックで配送する共同配送があります。公開資料で実績値とシミュレーション値が並べて示されている例として、セブン-イレブン・ジャパン、ファミリーマート、ローソンの3社による実証実験を取り上げます。いずれも内閣府の戦略的イノベーション創造プログラム(SIP)「スマート物流サービス」の一環で、研究代表機関は公益財団法人流通経済研究所です。
2020年7月22日の発表によれば、1回目の実証は都内湾岸エリアで、3社の近接した店舗(セブン-イレブン13店舗、ファミリーマート13店舗、ローソン14店舗、計40店舗)に同じトラックで商品を納めるもので、2020年8月1日から7日の1週間の実施予定とされ、江東区の物流倉庫に共同物流センターを置いて常温の商品を配送する計画でした。2021年2月26日に公表された結果(チェーン横断で配送した20店舗の結果)が次の表です。
| 評価指標(チェーンごとに別々に配送する場合との比較) | 実証期間中の実績 | 納品時間を調整した場合の効果(シミュレーション) |
|---|---|---|
| 配送距離の短縮率 | 13.8%短縮 | 32.3%短縮 |
| 納品1店舗あたり CO2 排出量 | 295g 削減 | 780g 削減 |
| 納品1店舗あたり燃料消費量 | 115ml 削減 | 304ml 削減 |
| トラック回転率 | 0.8回転/日 向上 | 0.9回転/日 向上 |
| トラック生産性(トラック1台あたりの納品店舗数) | 0.2店舗/台 低下 | 3.0店舗/台 向上 |
| 積載率(容積ベース) | 7.8% 改善 | 36.1% 改善 |
表は流通経済研究所の2021年2月26日の発表資料の表を、列名もそのまま写したものです。発表資料は、実績では多くの指標で改善を確認した一方、トラック生産性だけは「店舗の納品時間を調整できずに納品店舗数が低下したため」改善を確認できなかったとしています。そのうえで、納品時間を調整して最も効率の良いルートで配送する場合をシミュレーションで評価したのが右の列です。配送距離の短縮率は、実績の13.8%に対してシミュレーションでは32.3%で、2倍以上の開きがあります。資料の注記によれば、CO2 排出量は積載率60%の4トン車で試算した値です。
この実証は、この記事で扱ってきた制約の話をそのまま実地で示しています。共同配送で納品先が近くにまとまっても、各店舗の納品時間(第5章でいう時間枠)が各チェーンの都合で決まったままだと、ルートは時間枠に縛られ、共同化の効果の半分以上が出ません。第5章では時間指定の厳しさが台数と距離にどう効くかを扱いましたが、この実証では、時間枠を緩めることが共同化の効果を引き出す鍵になっています。そして右の列はあくまでシミュレーションの値なので、実際に納品時間を動かしたときに同じ効果が出るかは、この資料からは分かりません。
2回目の実証は地方部で行われました。流通経済研究所と3社の2022年10月17日の発表によれば、2022年2月21日から1週間、北海道の函館エリアで、配送センター間の横持ち(拠点間の商品移動)の共同化と、遠隔地の店舗への配送の共同化を実証しています。札幌近郊の基幹センターから函館のサテライトセンターまでの横持ちを共同化した結果は、1便あたり車両台数1台減、走行距離275km(48%)減、CO2 排出量176kg(45%)減、走行時間2.5時間(23%)減でした。函館南西エリアでセブン-イレブンとローソンの店舗配送を共同化した実証では、2社合計で走行時間11.5時間・走行距離280.8kmだったものが、共同配送のルートで9.2時間・218.9kmになり、2.3時間(20%)、61.9km(22%)短くなったとされています。2社の配送を別々に数える場合と比べた値で、実証期間の実走に基づく数字です。
共同配送の効果を自社のデータで試算する方法は、第12章で扱いました。ここで事例から持ち帰りたいのは、共同化の効果は「誰と組むか」より先に「時間枠と納品条件をそろえられるか」で上限が決まる、という点です。交渉の相手は物流部門の外、つまり営業部門と納品先にいます。
政策の動き、物流効率化法・中継輸送・総合物流施策大綱
共同配送や積載効率の向上は、2025年以降、企業の自主的な取り組みから法律上の努力義務へと位置づけが変わりました。国土交通省の「物流効率化法」理解促進ポータルサイトによれば、改正された物資の流通の効率化に関する法律(物流効率化法)は、2025年4月から荷主・物流事業者の努力義務を施行し、2026年4月から一定規模以上の特定事業者に中長期計画の作成と定期報告を義務づけています。努力義務の中身は、積載効率の向上(1回の運送でトラックに積む貨物量を増やす取組)、荷待ち時間の短縮、荷役等時間の短縮などです。特定事業者の指定基準は、荷主(発荷主・着荷主)と連鎖化事業者(フランチャイズチェーンの本部)が取扱貨物の重量9万トン以上、貨物自動車運送事業者等が保有車両台数150台以上、倉庫業者が保管量70万トン以上で、特定荷主と特定連鎖化事業者には物流統括管理者(CLO。物流の効率化を全社で統括する責任者)の選任も求められます。同じポータルサイトの質問集は、積載効率を「積載率×実車率」と定義し、基本方針の目標を「日本全体で積載効率44%を目指す」としています。
配車計画の数理最適化は、この努力義務のうち積載効率の向上に直接かかわります。制度の積載効率は、前の段落のとおり積載率に実車率を掛けたものですが、そのうち積載率については、第4章で見た「台数の下限は総需要÷積載の切り上げ」という考え方が使えます。この記事のサンプルデータのように、車種が1つで1日の総需要が決まっている場合、積載率を上げるとは、台数を下限に近づけることです。特定事業者に指定される規模の荷主では、配車の結果が定期報告の数字として経営に上がってくるようになります。第1章で「配車計画は経営の問題」と書いた理由の1つが、ここで制度の形をとっています。
もう1つの動きが中継輸送(1つの長距離の輸送を、途中の拠点でドライバーや荷物を引き継いで複数のドライバーで分担する運び方)です。2026年3月6日に閣議決定された「物資の流通の効率化に関する法律の一部を改正する法律案」は、衆議院の議案情報によれば2026年5月13日に参議院で可決・成立し、5月20日に令和8年法律第21号として公布されました。国土交通省の法律案の概要によれば、中継輸送の実施に関する基本方針を国土交通大臣が定め、国・地方公共団体・事業者に中継輸送の促進に必要な助言・協力等の責務(努力義務)を規定すること(施行期日は公布の日から6月以内)、事業者が共同で「貨物自動車中継輸送実施計画」を作って国土交通大臣の認定を受けられる制度を設け、認定事業には中継輸送施設の課税の特例や運行経費の支援などを用意することが柱です。概要資料は、中継輸送のねらいとして、ドライバーの負担軽減と、帰り荷の確保によるトラックの運行効率の向上を挙げています。
中継輸送は、配車の問題としては「どの拠点で誰と引き継ぐか」を決める問題で、この記事で扱った集荷と配送の組(第8章)と、ドライバーの労働時間(第7章)の両方の制約を持ちます。日帰りできる範囲に運行を区切る設計なので、第7章の拘束時間の制約を満たすための手段の1つとして読むことができます。
政府全体の計画では、令和8年3月31日付の「総合物流施策大綱(2026年度~2030年度)」が、トラック運送事業者に「他の事業者と連携した共同輸配送や復荷(帰り荷)の確保、配車・運行計画の最適化などの取組」を積極的に進める必要があると書いています。同じ大綱は、生成 AI をはじめとする新技術の開発と実用化を踏まえ、多数の荷主・物流事業者がかかわる集配送のマッチングや、配車・運行計画の最適化などの先進的なユースケースの創出を支援するとしています。配車・運行計画の最適化が、政府の中期計画の文面に施策として書かれていることになります。
機械学習で配送計画を解く研究、位置づけと限界
近年、深層学習(多層のニューラルネットワークによる機械学習)で巡回セールスマン問題や配送計画問題を解く研究が盛んになりました。代表的な論文の1つが、Kool・van Hoof・Welling が2019年の国際会議 ICLR で発表した「Attention, Learn to Solve Routing Problems!」です。要旨によれば、注意機構(入力のどこに重みを置くかを学習する仕組み)に基づくモデルを強化学習で訓練し、巡回セールスマン問題で「100地点までの問題で最適に近い結果」を得て、同じ設定のまま配送計画問題の2つの変形などにも強い構築法を学習できたとしています。ここでの「学習した構築法」は、第3章で扱った最近傍法のような構築法を、人が規則を書く代わりにデータから学ばせたものと考えると分かりやすいでしょう。
この研究の流れの位置づけを整理するうえで参考になるのが、Bengio・Lodi・Prouvost が2021年に European Journal of Operational Research に発表した総説「Machine learning for combinatorial optimization: A methodological tour d’horizon」です。要旨は、組合せ最適化の最先端のアルゴリズムが、計算するには重すぎる判断や数学的にきちんと定義できない判断を、人が作った経験則に頼っていることを指摘し、機械学習はそうした判断をより系統立てて行う自然な候補だと述べています。そして、個々の最適化問題をデータの点と見なし、学習に使う問題の分布をどう選ぶかが重要だとしています。自社の配車に当てはめれば、「毎日の配車の問題は、よく似た問題が繰り返し出てくる分布から来ている」ので、その分布に合わせて探索の判断を学習させる余地がある、という見方です。
一方、限界もはっきり書かれています。ORTEC(配車ソフトウェアの提供企業)の実データを使って2022年に行われた配送計画のコンペティション「EURO Meets NeurIPS 2022 Vehicle Routing Competition」の報告論文(Kool ほか、NeurIPS 2022 の競技部門の論文集に収録)は、要旨で、OR(オペレーションズ・リサーチ)の側は主に単純な機械学習の手法を取り入れ、機械学習の側は一般に深層学習を使うが「OR のベースラインを上回れていない」と書いています。このコンペティションでは時間枠付きの配送計画と、1日の中で新しい注文が届く動的な版の2つが出題され、50を超えるチームが参加しました。報告は、上位の提出物のいくつかで OR と機械学習の両方の最先端の技術が大きな役割を果たしたとまとめています。また、第10章で考え方を扱った遺伝的アルゴリズム系の解法(Vidal ほかの HGS)は、PyVRP という名前でオープンソースとして公開されました(Wouda・Lan・Kool、INFORMS Journal on Computing、2024年)。同論文の要旨は、PyVRP が2021年の DIMACS の VRPTW チャレンジで1位になったアルゴリズムの実装であり、改良後に上記コンペティションの静的な部門でも1位になったとしています。ただし、この説明は論文の時点の PyVRP についてのものです。第10章で確かめたとおり、PyVRP は 0.13.0 で探索の仕組みを反復局所探索に作り替えており、第10章で使った 0.14.0 は HGS ではありません。
学習の使い方には別の方向もあります。Amazon のラストマイル研究チームが主催し、マサチューセッツ工科大学の交通・物流センター(MIT CTL)が支援した「Amazon Last Mile Routing Research Challenge」(2021年)です。公式サイトの説明によれば、この課題は距離や時間を最小にするのではなく、経験を積んだ実際のドライバーが走ったルートから学習して、良い経路の順序を作ることを求めました。説明文は、熟練ドライバーは通りにくい道、渋滞する時間帯、駐車しやすい場所、まとめて回りやすい納品先などについて、最適化のモデルに書き表すのが難しい暗黙知を持っていると述べています。評価には、実際の質の高いルートにどれだけ近いか、ルートの総所要時間、計算時間の3つを組み合わせたとされています。公開されたデータについては、Merchán ほかの論文(Transportation Science、2024年)が、2018年に米国の5つの都市圏で Amazon のドライバーが走った9,184本のルートを含み、個人を特定できる情報を除いたうえで、実際の運用のデータに基づく初めての大規模な公開データだとしています。
この課題の考え方は、第13章で扱った「人が最後に直した記録を次の制約にする」運用を、データの量で置き換えようとするものです。ただし、学習した順序が熟練者の順序に近いことは、それが費用の面で良いことを保証しません。熟練者のルートには、暗黙知と一緒に、理由の分からない習慣も入っているからです。現時点の実務では、距離・時間・台数を最適化する従来の方法を土台にし、学習は荷下ろし時間や所要時間の予測、あるいは制約の候補の発見に使う、という組み合わせが扱いやすいと考えています。
生成AIに任せられること、人が決めること
2022年以降は、大規模言語モデル(大量の文章で学習し、文章を読んで文章を書く AI。生成AI の中核の技術)を最適化に使う研究も出てきました。方向は大きく2つあります。1つ目は、文章で書かれた業務の問題を数式のモデルに翻訳する方向です。NeurIPS 2022 の競技部門で行われた NL4Opt コンペティション(Ramamonjison ほか)は、線形計画の文章題を対象に、文章から問題の要素を見つける課題と、ソルバーに渡せる形の中間表現を作る課題を設け、最適化ソルバーを専門家でない人でも自然な言葉で使えるようにすることを目的に掲げました。2024年に公開された OptiMUS(AhmadiTeshnizi・Gao・Udell)は、大規模言語モデルを使って、自然な言葉の説明から混合整数線形計画のモデルを作り、ソルバーのコードを書いて誤りを直し、解を評価して改良するエージェント(道具を使いながら複数の手順を自分で進める AI の仕組み)で、要旨では既存の手法を簡単なデータセットで20%超、難しいデータセットで30%超上回ったとしています。2つ目は、ヒューリスティクスそのものを大規模言語モデルに考えさせる方向で、Liu ほかの Evolution of Heuristics(2024年)は、大規模言語モデルと進化計算を組み合わせ、経験則の考え方を自然な言葉で表したうえでコードに翻訳し、世代を重ねて改良する枠組みを提案しています。
これらの研究の数字は、公開された問題集(ベンチマーク)での正答率や比較の結果で、実際の配送センターの配車に使ったときの成果ではありません。そのうえで、この記事の各章で扱った作業に当てはめると、任せやすい作業と人が決めるべきことは次のように分かれると考えています。
| 作業 | 生成AIに任せやすいこと | 人が決めること・確かめること |
|---|---|---|
| ヒアリングの整理(第13章) | 聞き取りの記録から条件の候補を抜き出し、ハード制約とソフト制約の案に分けて一覧にする | どの条件を守るべき制約とし、どれを交渉の余地がある条件とするか。優先順位 |
| 定式化の下書き(第4章から第8章) | 条件の一覧から OR-Tools や PuLP のコードの下書きを作る。単位や整数化の漏れを点検する観点を挙げる | コードが条件どおりかの確認。小さな問題で手計算と照合すること |
| 結果の説明 | ルート表や経営指標の表から、配車担当や営業所長向けの説明文の下書きを作る | 説明の数字が実行結果と一致しているかの確認 |
| 費用と目的の設定(第1章・第7章) | 設定の選択肢と、それぞれで何が変わるかの整理 | 車両の固定費・km 単価・残業単価・台数と時間指定の優先順位。これらは経営判断そのもの |
| 毎日の配車の計算 | 任せない。計算はソルバーに行わせる | 時間制限・異常時の手順。最後に配車担当が確認して確定する |
表の最後の行が要点です。大規模言語モデルは、この記事で扱ったような40件・6台の問題でも、実行できる計画を毎回出すことを保証しません。制約を守った計画を出し、どれだけ良い解かを測れるのは、第6章で扱ったソルバーのほうです。生成AI の役割は、ソルバーに渡すまでの「言葉を式にする」工程と、ソルバーから返った結果を「言葉にして伝える」工程を速くすることにあります。表の中央の列の作業はいずれも、出てきたものを人が照合できる性質の作業で、照合できない作業(費用の設定や優先順位)は人が決める側に置きました。
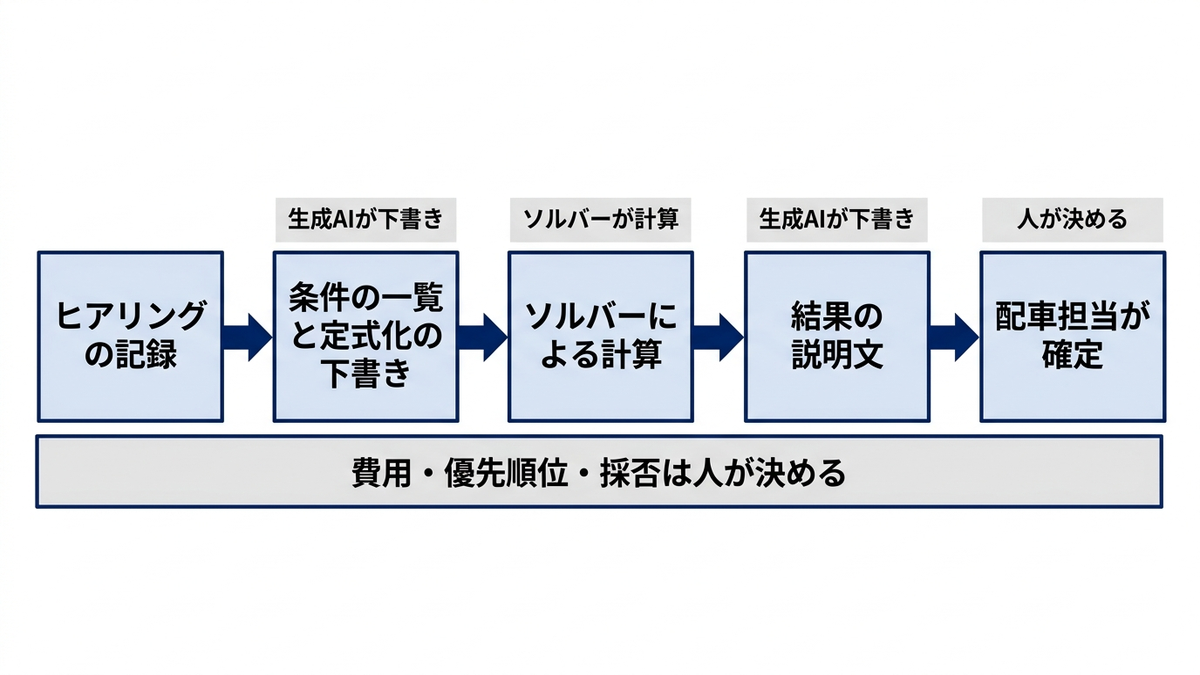
ソルバーの動向、公式ページで確かめたこと
最後に、配送計画に使えるソフトウェアの動きを、公式のリポジトリや論文で確かめられた範囲で整理します。この記事で使った OR-Tools は、GitHub の公開リリースによれば v9.15 が2026年1月12日に公開されており、この記事の実行環境の版(9.15.6755)はこの系列です。ルーティングソルバーと CP-SAT を同じパッケージで使える点は変わっていません。
PyVRP は、GitHub のリリースによれば v0.14.0 が2026年8月20日に公開されています。公式の README は、集荷と配送、車両ごとに異なる積載量・費用・勤務時間、時間枠、複数デポ、複数回転(途中の拠点での積み直し)、訪問を省略できる納品先などの変形に対応していると書いています。同じ README には、EU と米国の運転時間規制に沿った休憩の自動計画などを有償版(Enterprise)の機能として挙げており、オープンソース版と有償版で使える機能が分かれている点には注意が要ります。日本の改善基準告示(第7章)に合わせた制約を入れる場合は、どちらの版でも自分で条件を書くことになります。
もう1つの動きは、GPU(画像処理用の演算装置を計算に使うもの)で最適化を速くする試みです。NVIDIA の cuOpt は、GitHub のリポジトリが2025年4月に作られ、Apache-2.0 のライセンスで公開されています。README によれば、Python の API で巡回セールスマン問題・配送計画問題・集荷配送問題を扱え、線形計画にも対応し、混合整数計画はベータ版で、見つけた解の最適性を証明する機能は開発中とされています。GPU で計算を速くする仕組みなので、GPU を使っていないこの記事の実行環境では試していません。
ソルバーを選ぶときに大切なのは、新しさよりも、自社の制約を書けるかどうかです。第13章で書き出した制約(駐車位置・荷受けの時間帯・車両の制限・担当の固定など)の一覧を手元に置き、それぞれのソルバーの公式ドキュメントで書き方があるかを確かめるのが、比較の出発点になります。速さの比較は、そのあとに自社のデータで行うべきもので、公開のベンチマークの順位は参考にとどまります。この章の実験でも、同じソルバーで探索時間が1秒か20秒かによって総距離が3.9km違いました。時間制限の置き方ひとつで比較の結果は動きます。
経営の側から見る、事例と動向を自社の判断に落とす
この章の内容を経営判断に翻訳すると、3つの問いになります。1つ目は「他社の事例の数字を自社の効果の見込みに使ってよいか」です。答えは、そのままでは使えない、です。この章の実験で見たとおり、削減率は比べる相手で76.0%から0.4%まで動きます。コンビニ3社の実証でも、同じ取り組みの配送距離の短縮が、実績13.8%とシミュレーション32.3%で2倍以上違いました。事例の数字は「その種類の取り組みで効果が出うる方向」を示すものとして読み、大きさは自社のデータで、現状の配車表を比べる相手にして測るのが確実です。誤った比べ方をした数字で投資を決めると、導入後に「効果が出ない」という評価になり、仕組みそのものが使われなくなります。
2つ目は「どこに投資すると効果が大きいか」です。事例を並べると、効果の上限を決めているのはソルバーの性能より、時間枠・納品条件・一貫性といった制約の側でした。コンビニ3社の実証では納品時間を調整できないことが効果の半分以上を止め、UPS は日々の一貫性を条件に入れ、日本郵便は経験の浅い人が回せることを目的に置きました。ソルバーへの投資と同じ重さで、納品先との時間枠の交渉、営業部門との納品条件の整理、現場の受け入れに投資する必要があると考えています。
3つ目は「制度の変化にどう備えるか」です。物流効率化法の特定事業者の基準(荷主は取扱貨物9万トン以上、運送事業者は保有車両150台以上など)に当たる企業では、積載効率などの取り組みを中長期計画と定期報告で示すことになります。配車の最適化は、報告の数字を作るための道具であると同時に、「台数を増やす・時間指定を緩めてもらう・中継輸送や共同配送に参加する」といった選択肢の費用を比べる道具でもあります。第7章の台数と残業のトレードオフの表や、第12章の共同配送の試算は、こうした判断の材料になります。
この章の要点は3つです。第一に、事例の数字は、実績か見込みか、何と比べたか、どの指標か、どの範囲かの4点で読み分ける必要があり、共通データの実験では、同じ計画の削減率が比べる相手で76.0%から0.4%まで変わりました。第二に、国内外の事例と共同配送の実証は、効果の上限が時間枠・納品条件・一貫性・現場の受け入れで決まることを示しており、政策も物流効率化法の努力義務と特定事業者の報告、中継輸送の認定制度、総合物流施策大綱の「配車・運行計画の最適化」へと、同じ方向を向いています。第三に、機械学習と生成AI は、予測・制約の発見・定式化の下書き・結果の説明で配車の仕事を速くしますが、計画を作る計算はソルバーに、費用と優先順位の判断は人に残ります。この記事で扱った手法と事例を、自社の配送センターで何をどう決めるかの判断に使っていただければ幸いです。
この章を深めたい方への参考書籍
『フィジカルインターネット 企業間の壁崩す物流革命』(エリック・バロー、ブノア・モントルイユ、ラッセル・D・メラー著、荒木勉訳、日経BP):企業ごとに閉じた物流網を、インターネットのように共有する網に組み替えるという構想を、提唱者自身が解説した本の日本語訳です。この章で扱った共同配送や中継輸送が、どういう将来像の一部として語られているのかをつかむのに向いています。
『数理最適化の実践ガイド』(穴井宏和、講談社):開発や制御でよく使われる最適化の手法に絞り、使い方・特徴・留意点を解説した入門書で、最終章は実問題を解決するための心得にあてられています。事例の数字を読み、自社の問題に最適化を当てはめるときに何に気をつけるべきかを、手法の側から整理するのに役立ちます。
終章 配車計画を、毎朝回る仕組みにする
本コラムでは、配送センターから納品先へ車を走らせる配車計画を、1台の巡回から始めて、積載、時間指定、労働時間、車種と拠点、距離の見積り、規模、当日の変化、エリアと頻度の設計、現場への導入へと、制約と論点を1つずつ足しながら扱いました。終章では、各章で実際に解いた結果から言えることを振り返り、配車計画を毎朝回る仕組みにするための考え方をまとめます。
各章の結果から言えること
第2章では、方面別に手で割り振った配車を作りました。方角だけで区切ると積載量を超える車が出るため、積載と時間指定を守るように手直しした案は7台・361.3kmになり、同じく積載と時間指定を入れてソルバーを20秒動かした基準の計画(6台・293.2km)より1台多く、68.1km長くなりました。第1章で示したとおり、共通データの架空の単価では車1台の固定費が500km分の走行費に相当します。配車の改善で最初に効くのは距離の短縮より台数の削減であり、台数は積載と時間指定と労働時間の組み合わせで決まるというのが、第1章から第7章を通した結論です。
第3章と第4章では、古典的な構築法と改善法の実力を測りました。1台で40件を回る問題では、最近傍法で作った順番を2-optとOr-optで改善すると、CP-SATが0.24秒で証明した最短距離157.0kmに一致しました。複数台の配車では、セービング法が7台・303.8km、スイープ法が6台・304.5kmで、ソルバーの誘導局所探索は20秒で6台・296.8kmでした(いずれも積載の制約だけで解いた値)。公開ベンチマークのA-n32-k5では、ソルバーが30秒で既知最良の784に届いています。古典的な方法は、ソルバーの初期解や結果の検算として今も役に立ちますが、毎日の配車を任せるにはソルバーとの差が残ります。
第5章では、時間指定の厳しさの費用を測りました。2トン車では時間指定を5段階に変えても台数は6台のままでしたが、全件を2時間枠にすると総距離が298.1kmから328.6kmへ、拘束時間の合計が23.4時間から39.7時間へ増えました。時間指定は台数を変えなくても、距離と拘束時間を通じて費用に効きます。第7章では、同じ荷物を6台の1回転、4台の2回転、3台の3回転で運ぶ計画を比べ、架空の単価では3台の計画が最も安い一方で、残業が326分に達することを示しました。どの計画を選ぶかは、費用だけでなく、ドライバーの拘束時間の上限と、残業に頼る計画をどこまで許すかという経営の判断で決まります。
第6章と第10章では、ソルバーの使い方と規模の限界を測りました。第6章では、同じ問題でも時間制限と初期解の選び方で結果が数%動きました。50件規模の公開ベンチマーク(E-n51-k5)では、渡す車両の台数の上限を5台から8台に変えただけで、既知最良との差が3.8〜5.2%から0%になりました。第10章の千件規模のベンチマークでは、OR-Toolsが120秒で既知最良から9.75%離れたのに対し、PyVRPは1.97%まで近づきました。どの道具が良いかは規模と時間制限で変わるため、自社の規模の問題で、毎朝使える時間の中で比べてから選ぶ必要があります。
第9章では、計画の土台になる距離と所要時間の見積りを扱いました。基準の計画を同じ順番のまま道路網の模型で走らせると、総距離は12.9%長くなりました。到着予定を前後30分で約束したときの遅れ率は、直線距離に係数を掛けた見積りで15.2%、道路網と時間帯の違いを入れた見積りで1.0%でした。計画の精度は、ソルバーの性能より先に、距離と時間の見積りで決まることがあります。
第11章では、当日の追加注文と遅れに合わせた再配車を扱いました。追加注文8件をすべて当日に届ける場合、空いている車に後から差し込む方法では総距離が462.9km、走行中の車の訪問済みの部分を固定して全体を計算し直す方法では431.8kmでした。約束の時刻からの遅れに罰金を掛けて計算し直すと、30分を超える遅れは6件から0件になりました。当日に届けられる注文の割合と、ドライバーの帰着時刻は、差し込むか計算し直すかという手法の選択だけでなく、何時までの注文を当日に回すかという受付締切の設計でも大きく変わります。
第12章では、担当地区の固定と毎日の最適化、曜日割り、共同配送を比べました。担当地区を固定すると、20営業日の平均で台数が1日6.75台、毎日最適化すると5.10台になる一方、担当のドライバーが届けた割合は91.7%から63.0%に下がりました。距離と台数だけを見れば毎日最適化が有利ですが、ドライバーの習熟や納品先との関係を失う費用は計算に入っていません。どちらを取るかは、その費用をどう見るかという判断です。
配車計画を仕組みにするための5つの考え方
各章の結果を踏まえて、配車計画を毎朝回る仕組みにするための考え方を5つにまとめます。
- 最初に測るのは、今の配車の台数・距離・拘束時間・時間指定の遵守率。改善の効果は、現状を同じ指標で測っておかなければ示せません。第1章の指標の定義をそろえることが出発点です。
- 台数を先に、距離を後に。共通データの単価では1台の固定費が500km分の走行費に相当しました。台数を決めている制約(積載・時間指定・労働時間)のどれが効いているかを見極めることが、最も大きな改善につながります。
- 距離と時間の見積りに投資する。見積りが粗いと、どれほど良いソルバーを使っても、計画どおりに車が走りません(第9章)。
- 毎朝決まった時間で出せる解を、揺れを含めて評価する。時間で打ち切る探索は、実行ごとに結果が揺れます。本コラムの各章でも、同じ設定で数kmの揺れが出ました。比較するときは複数回解いて幅で見る必要があります(第6章)。
- 配車担当者が直した記録を、次の制約にする。計算機が出した計画を人が直すのは失敗ではありません。直した理由を記録し、制約や見積りに戻すことで、計画は現場に合っていきます(第13章)。
配車計画の数理最適化は、60年以上の研究の蓄積があり、無償で使えるソルバーも充実しています。それでも、多くの配送の現場で配車が経験を積んだ担当者の手作業に委ねられているのは、道具が足りないからではなく、現場の判断を制約と目的に書き出し、見積りを整え、結果を読んで直す仕組みが無いためだと考えています。本コラムが、自社の配車をどこから見直すかを考える材料になれば幸いです。
在庫と発注量の決め方は弊社コラム『在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで』で、工場の中の順番と時刻の決め方は弊社コラム『生産スケジューリングの数理最適化、ディスパッチングルールからジョブショップまで』で扱っています。本コラムとあわせて、サプライチェーンの3つの意思決定、すなわち在庫・生産・配送を数理最適化で見直す際の参考にしていただければと思います。
Anagraftでは、データ活用の構想づくりから、配車計画のような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着まで一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 配車計画はなぜ経営の問題なのか
『間違いだらけの日本の物流』(矢野裕児・首藤若菜、ウェッジ):2025年3月刊行。版元の紹介によると、物流の「2024年問題」で「物が運べなくなる」事態は起きなかったものの、業界の構造は変わっておらず、その現状を物流の専門家2名が分析した本です。目次には「2024年問題」とは何だったのか、商慣行が深刻化させるドライバー不足、荷主・消費者にとっての「当たり前」は持続可能か、といった章が並びます。この章で見た規制と輸送力の話を、荷主の立場から考え直すのに向いています。
『物流危機は終わらない:暮らしを支える労働のゆくえ』(首藤若菜、岩波書店):岩波新書の1冊で、2018年12月刊行。著者は労使関係論を専門とする研究者で、副題のとおり、暮らしを支える物流の労働に焦点を当てた本です。2024年4月の規制強化より前に書かれていますが、配車計画が前提としている「ドライバーの時間」がなぜ希少になったのかを、背景から理解するのに役立ちます。
第2章 配送計画問題を記述する、決めること・守ること・目指すことを言葉と行列にする
『Vehicle Routing』第2版(Paolo Toth・Daniele Vigo 編、SIAM):配送計画問題を総合的に扱った編著で、第1章が配送計画問題の一族の整理、以降の章が積載制約付きの問題の厳密解法と近似解法、時間枠付きの問題、集荷と配送の問題、確率的な問題、動的な問題などにあてられています。この章の分類表に挙げた型のそれぞれを、研究の側から深く知るための入口になります。英語の専門書です。
『ロジスティクス工学』(久保幹雄、朝倉書店):日本オペレーションズ・リサーチ学会の40周年記念シリーズ「経営科学のニューフロンティア」の1冊で、目次によれば経済発注量・在庫・ロットサイズのモデルと並んで、配送計画モデル(構築法、ルート先・クラスター後法、クラスター先・ルート後法など)と運搬スケジューリングモデルの章があります。配送計画を、在庫や拠点配置と同じロジスティクスの意思決定の1つとして位置づけて見るのに向いています。
第3章 1台の巡回を決める、巡回セールスマン問題の構築法と改善法
『巡回セールスマン問題への招待』(山本芳嗣・久保幹雄、朝倉書店):シリーズ〈現代人の数理〉の1冊で、巡回セールスマン問題の歴史、計算量の理論と NP 完全問題、精度保証のある近似算法などを章立てて解説しています。この章で実行結果として示した構築法と改善法の性質や、最悪の場合の保証の考え方を、理論の側から確かめるのに向いています。
『驚きの数学 巡回セールスマン問題』(ウィリアム・J・クック著、松浦俊輔訳、青土社):原題は In Pursuit of the Traveling Salesman です。見かけの単純さからは想像できないほど奥の深い、巡回セールスマン問題の数学の世界を一般向けに紹介した本で、この章で触れた「汎用のソルバーと専用の厳密解法では解ける規模が桁違いに異なる」背景を知るのに役立ちます。
第4章 積載制約付きの配車、何台で・どう分けて・どの順に回るかを決める
『Pythonではじめる数理最適化 ケーススタディでモデリングのスキルを身につけよう 第2版』(岩永二郎・石原響太・西村直樹・田中一樹、オーム社):数理最適化のモデルを Python で組み立てるケーススタディ集で、第5章が「最小コストで行う輸送車両の配送計画」です。この章ではヒューリスティクスとソルバーの比較を中心にしましたが、配送計画を数理モデルとして書き下し、コードで解くまでの流れを手元で追うのに向いています。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画・整数計画から近似解法・局所探索法・メタヒューリスティクスまでを体系的に解説した教科書で、近似解法の章でビンパッキング問題を扱っています。この章の台数の下限(荷物を何台に詰められるか)の考え方や、OR-Tools が内部で行っている局所探索の基礎を、数理の側から理解するのに役立ちます。
第5章 時間指定を守る配車、時間枠と待ち時間、指定の厳しさの費用
『Pythonによる実務で役立つ最適化問題100+(3)配送計画・パッキング・スケジューリング』(久保幹雄、朝倉書店):版元の目次によると、配送計画問題の章に、容量制約付き・時間枠付きの配送計画問題と、時間枠付き配送計画問題に対するメタヒューリスティクスの設計方法の基本原理を扱う節があります。この章で扱った時間枠の入れ方と探索の工夫を、Python のコードを動かしながら確かめたい方に向いています。
『組合せ最適化 メタ戦略を中心として』(柳浦睦憲・茨木俊秀、朝倉書店):日本オペレーションズ・リサーチ学会の40周年を記念したシリーズ「経営科学のニューフロンティア」の1冊で、書名のとおりメタ戦略(メタヒューリスティクス)を中心に組合せ最適化を扱う本です。この章では誘導局所探索を時間で打ち切って使い、探索の出来しだいで台数の見え方が変わることを見ました。そうした近似解法がどういう考え方で作られているかを学ぶ入口として挙げました。
第6章 OR-Toolsのルーティングソルバーを使いこなす
『今日から使える!組合せ最適化 離散問題ガイドブック』(穴井宏和・斉藤努、講談社):版元の内容紹介は、問題の分類・アルゴリズム・具体的な課題のつながりを双方向から整理し、根拠なくソルバーを選んでしまう前に俯瞰するための本としています。目次には経路問題を含む標準問題の体系、局所探索法とメタヒューリスティックス、列生成法、実問題に臨む考え方が並びます。この章の「どの道具をいつ使うか」を、配送計画以外の問題も含めて考えるのに向いています。
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):Python で数理最適化のモデルを書いて解く本で、目次には巡回路問題の章があり、巡回セールスマン問題・時間枠付き巡回セールスマン問題・容量制約付き配送計画問題の定式化が並びます。付録には、数理最適化ソルバー Gurobi に加えて、制約最適化ソルバーとスケジューリング最適化ソルバーの概説もあります。この章で比べた MIP と制約プログラミングの違いを、定式化の側から確かめるのに向いています。本の中で使うソルバーは OR-Tools ではなく Gurobi です。
第7章 ドライバーの労働時間を制約に入れる
『中小企業のためのトラック運送業の時間外労働削減の実務 売上・利益を維持し、ドライバーを定着させる 補訂版』(石原清美、第一法規):社会保険労務士の著者が、トラック運送事業の時間外労働を減らすために、法規制と罰則を整理したうえで労働時間の短縮策を解説した本で、よくある相談への回答や、長距離輸送の時間を実際に数えた事例を含みます。この章では拘束時間と残業を配車モデルの制約と費用として扱いましたが、運送事業者の労務管理の側からそれをどう数え、どう減らすかを押さえるのに向いています。
『エッセンシャルワーカー 社会に不可欠な仕事なのに、なぜ安く使われるのか』(田中洋子 編著、旬報社):社会に不可欠な仕事の働き方を職種ごとに比べた本で、トラックドライバーの章(首藤若菜)に加えて、ドイツの労働時間法制を扱う章を含んでいます。ドライバーの労働時間を、日本の他の職種や海外の制度と並べて考える材料になります。
第8章 車種・複数拠点・集荷と配送、配車の前提そのものを変える判断
『Pythonによる実務で役立つ最適化問題100+(2)割当・施設配置・在庫最適化・巡回セールスマン』(久保幹雄、朝倉書店):版元の目次では、連続施設配置問題、k-メディアン問題、k-センター問題がそれぞれ章として立っています。この章では拠点の場所を与えられたものとして配車への効果を測りましたが、拠点の候補地そのものを選ぶ問題を、Python のコードを動かしながら確かめたい方に向いています。
『サプライ・チェイン最適化ハンドブック』(久保幹雄、朝倉書店):版元の目次には、「施設配置モデル」「ロジスティクス・ネットワーク設計モデル」「配送計画モデル」「運搬スケジューリングモデル」の章が並んでいます。この章で扱った「拠点を置くか」「どの車で運ぶか」の判断を、在庫や生産を含むサプライチェーン全体のモデルの中で位置づけたい方に向いています。
第9章 距離と時間をどう作るか、見積りの誤差が計画を壊す
『地理情報科学 GISスタンダード』(浅見泰司・矢野桂司・貞広幸雄・湯田ミノリ編、古今書院):地理情報科学(GIS)の教科書として2015年に刊行された本で、空間分析におけるスケールの章なども収めています。この章では、住所から位置を求める処理と位置の誤差、道路網のデータを配車の入力として扱いましたが、それらを地理情報の側から体系的に学び直す入口として挙げました。
『最短経路の本 レナのふしぎな数学の旅』(P. Gritzmann・R. Brandenberg 著、石田基広 訳、丸善出版):書名のとおり最短経路を主題にした本で、国立国会図書館の書誌ではグラフ理論に分類されています。この章で networkx に計算させた最短経路の探索が、距離行列を作る処理の中で何をしているのかを理解する助けになります。2007年にシュプリンガー・ジャパンから刊行され、2012年に丸善出版から再刊されています。
第10章 大規模化への対処、数百件から千件の配送先を決まった時間で解く
『メタヒューリスティクスの数理』(久保幹雄・J.P.ペドロソ、共立出版):局所探索法から、反復局所探索法、禁断探索法(タブー探索)、誘導局所探索法、大近傍探索法、遺伝的アルゴリズムまで、この章で名前を挙げた探索法を1冊の中で並べて解説し、数理計画とメタヒューリスティクスの融合、巡回セールスマン問題などへの応用、Python の概説の付録まで収めた本です。この章では道具として外から使った探索法の中身を、自分で組み立てられる水準で理解したいときに向いています。
『メタヒューリスティクスとナチュラルコンピューティング』(古川正志・川上敬・渡辺美知子・木下正博・山本雅人・鈴木育男、コロナ社):山登り法、シミュレーテッドアニーリング、タブーサーチ、遺伝的アルゴリズム、粒子群最適化法、アントコロニー最適化法などを章ごとに取り上げ、版元の紹介によれば各章に問題の表現、アルゴリズム、実装例、演習問題を含めています。探索法ごとの考え方の違いを、手を動かしながら比べたい読者に向いています。
第11章 当日の変化と再配車、走行中の車を固定して計画を直す
『オンラインアルゴリズムとストリームアルゴリズム』(徳山豪 著、共立出版):アルゴリズム・サイエンスシリーズの1冊で、先の入力を知らないまま順に決めていく問題(オンライン問題)を、後から全部を知っていた場合の最善と比べる競合比という物差しで解析する方法から始まり、確率的最適化によるオンライン問題までを扱います。この章で比べた「受付のたびに決める計画」と「後知恵の計画」の差を、理論の側から考えるための本です。
『マルコフ決定過程 理論とアルゴリズム』(中出康一 著、コロナ社):シリーズ情報科学における確率モデルの1冊で、状態を観測しながら各期に決定を行う問題を、動的計画法・値反復法・政策反復法などで解く方法を解説しています。当日の再配車を「その時点の状態を見て次の手を決める」問題として捉え直し、先の注文の入り方まで考えに入れた決め方を学ぶための土台になります。
第12章 配送エリアと配送頻度を設計する、担当地区と曜日割りと共同配送
『空間解析入門:都市を測る・都市がわかる』(貞広幸雄・山田育穂・石井儀光 編、朝倉書店):版元ドットコムの紹介と目次によると、データの可視化や集計単位の変換から、空間的自己相関、施設配置問題、最短経路問題、配送計画までを扱う空間解析の入門書です。担当地区を切る、納品先の分布を曜日ごとに見る、といったこの章の作業を、地図の上のデータ分析として体系的に学ぶのに向いています。
『協力ゲーム理論』(中山幹夫・船木由喜彦・武藤滋夫、勁草書房):版元ドットコムの目次では、第1章が特性関数と配分を扱う TU ゲーム、続いて NTU ゲームとコア、整合性公理と解の特徴付け、戦略形協力ゲームという構成です。この章で触れた「共同配送で浮いた費用を参加者でどう分けるか」は、協力ゲーム理論でいう配分の問題そのもので、2社を超える協業で分け方を設計するときの理論的な土台になります。
第13章 現場に入れる、配車担当の暗黙知を制約に落とし、人が直す運用で育てる
『輸配送DX』(検崎朴郎・渡邉安彦・山本広高、日本橋出版):副題は「数理技術を活かした輸送を“つなぐ”ことの実現」で、日本パレットレンタルの取り組みを題材に、共同輸送の候補探索や輸送ルート決定業務の省力化などを、物流の戦略・企画部門の読者に向けて解説しています。数理の手法を1つの会社の業務にどう組み込んでいったかという、この章の「現場に入れる」過程を具体的な事例で追えます。
『崖っぷちの物流DX導入マニュアル』(鈴木邦成・中村康久、NTT出版):副題は「ロジスティクスの最適化を急げ!」で、中小企業やスタートアップの経営者・担当者が物流のデジタル化を導入する前に知っておくべき事項を、企業の事例を交えて解説しています。レガシーシステムからの移行や導入前の準備を扱う章があり、この章の「システムとデータの流れ」「導入の順序と失敗の型」を、配車に限らない物流全体の視点から補えます。
第14章 事例と最新動向、公開された成果をどう読み、何を自社に持ち帰るか
『フィジカルインターネット 企業間の壁崩す物流革命』(エリック・バロー、ブノア・モントルイユ、ラッセル・D・メラー著、荒木勉訳、日経BP):企業ごとに閉じた物流網を、インターネットのように共有する網に組み替えるという構想を、提唱者自身が解説した本の日本語訳です。この章で扱った共同配送や中継輸送が、どういう将来像の一部として語られているのかをつかむのに向いています。
『数理最適化の実践ガイド』(穴井宏和、講談社):開発や制御でよく使われる最適化の手法に絞り、使い方・特徴・留意点を解説した入門書で、最終章は実問題を解決するための心得にあてられています。事例の数字を読み、自社の問題に最適化を当てはめるときに何に気をつけるべきかを、手法の側から整理するのに役立ちます。
参考情報
本コラムの記述は、次の資料を2026年9月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 2025年度物流コスト調査の売上高物流コスト比率は全業種平均5.32%、有効回答205社、前年度から0.12ポイント低下、過去20年で4番目に高い水準
https://www1.logistics.or.jp/news/news-12744/ - 2024年度調査の物流コスト構成比は輸送費55.89%(調達6.34・社内15.19・販売34.36)、保管費19.66%、荷役費15.52%、物流管理費4.93%、包装費4.00%、有効回答191社、比率5.44%
https://www1.logistics.or.jp/wp-content/uploads/2025/04/cost_report_20250428.pdf - 車を増やさずに運ぶ量を増やす手段は、荷待ち・荷役の時間の短縮、積載効率の向上、他社との共同輸配送など複数あり、配車計画はその1つ
https://www.mlit.go.jp/seisakutokatsu/freight/content/001993236.pdf - 2025年度調査の速報で、回答企業177社のうち輸送費単価が増加した企業は88.1%、横ばい9.1%、減少2.8%
https://www1.logistics.or.jp/news/news-10535/ - 自動車運転者の時間外労働の上限は2024年4月から原則月45時間・年360時間、臨時的な特別の事情がある場合でも年960時間
https://driver-roudou-jikan.mhlw.go.jp/truck/notice - 働き方改革関連法は2018年6月改正、年960時間は休日労働を含まない
https://www.mlit.go.jp/policy/shingikai/content/001620626.pdf - 総合物流施策大綱(2026年度~2030年度)は2026年3月31日に閣議決定
https://www.mlit.go.jp/report/press/content/001991949.pdf - 大綱の公式ページ
https://www.mlit.go.jp/seisakutokatsu/freight/butsuryu03100.html - 書籍『間違いだらけの日本の物流』矢野裕児・首藤若菜、ウェッジ、2025年3月
https://wedge.ismedia.jp/ud/books/isbn/978-4-86310-292-7 - 書籍『物流危機は終わらない:暮らしを支える労働のゆくえ』首藤若菜、岩波書店、岩波新書 新赤版1753、2018年12月
https://ndlsearch.ndl.go.jp/books/R100000002-I029341626
第2章
- Dantzig と Ramser の1959年の論文は、油槽所からガソリンスタンドへ燃料を運ぶ車隊の総走行距離を最小にする割当を扱った
https://doi.org/10.1287/mnsc.6.1.80 - Toth と Vigo の編著 Vehicle Routing 第2版は2014年に SIAM から出た
https://doi.org/10.1137/1.9781611973594 - Toth と Vigo の編著 Vehicle Routing 第2版は2014年に SIAM から出た
https://doi.org/10.1137/1.9781611973594.ch1 - Lenstra と Rinnooy Kan の1981年の論文は、配送計画とスケジューリングの問題群について既知のNP困難性の結果を整理し、近似解法の最悪の場合の性能をまとめた
https://doi.org/10.1002/net.3230110211 - TSPLIB の pla85900 は85,900点の巡回で、Concorde により2005年から2006年に最短が証明され、ページは解かれた最大の問題と記している
https://www.math.uwaterloo.ca/tsp/pla85900/index.html - OR-Tools は Google のソフトウェアで、ルーティングソルバーを持つ
https://developers.google.com/optimization/routing/vrp - ラー数は区別できるものを区別しない空でない列に分ける方法の数で、C(n-1,k-1)×n!÷k!
https://oeis.org/A008297 - 参考書籍『ロジスティクス工学』久保幹雄、朝倉書店
https://ndlsearch.ndl.go.jp/books/R100000002-I000002998828 - 参考書籍『ロジスティクス工学』久保幹雄、朝倉書店
https://www.asakura.co.jp/detail.php?book_code=27518
第3章
- 最近傍法の近似比の上限は地点数の対数で増える関数で抑えられ、対数の下限の例もある
https://doi.org/10.1137/0206041 - Croes の1958年の論文の要旨は、対称・非対称の問題に使えること、完全に機械化できること、いつでも打ち切れることを挙げている
https://doi.org/10.1287/opre.6.6.791 - Or の1976年の博士論文、ノースウェスタン大学、血液センターの配送を題材にした巡回セールスマン型の問題
https://books.google.co.jp/books/about/Traveling_Salesman_type_Combinatorial_Pr.html?id=u7kkYgEACAAJ - 85,900地点の問題の最短の訪問順が Concorde で求められ、計算は2005年から2006年
https://www.math.uwaterloo.ca/tsp/pla85900/index.html - 書籍 巡回セールスマン問題への招待
https://ndlsearch.ndl.go.jp/books/R100000002-I000002576349 - 書籍 驚きの数学 巡回セールスマン問題
https://ndlsearch.ndl.go.jp/books/R100000002-I024432921
第4章
- セービング法は Clarke と Wright が1964年に Operations Research 誌で発表した
https://doi.org/10.1287/opre.12.4.568 - スイープ法は Gillett と Miller が1974年に Operations Research 誌で発表
https://doi.org/10.1287/opre.22.2.340 - 一般化割当による方法は Fisher と Jaikumar が1981年に Networks 誌で発表
https://doi.org/10.1002/net.3230110205 - CVRPLIB の一覧に問題ごとの既知の最良値と最適性の証明の有無が示され、A 系列は Augerat ほか 1995、E 系列は Christofides ほか 1969 とされている
https://galgos.inf.puc-rio.br/cvrplib/ - OR-Tools の公式ドキュメントは積載の制約を AddDimensionWithVehicleCapacity で入れる例を示し、引数は需要の関数・スラック・車ごとの積載・出発時を0にするか・次元の名前
https://developers.google.com/optimization/routing/cvrp - 書籍 Pythonではじめる数理最適化 第2版
https://ndlsearch.ndl.go.jp/books/R100000002-I033374307 - 書籍 しっかり学ぶ数理最適化 モデルからアルゴリズムまで
https://ndlsearch.ndl.go.jp/books/R100000002-I030691339
第5章
- Solomon のベンチマークは Solomon が1987年に Operations Research 誌35巻2号254〜265ページに発表した論文の問題群
https://doi.org/10.1287/opre.35.2.254 - Solomon の論文の要旨は、実用規模では近似解法が有望とし、問題群はデータの作り方・時間枠を持つ納品先の割合・枠の幅と位置・計画期間が異なり、挿入型の方法が一貫して非常に良い結果を出したと報告
https://api.openalex.org/works/doi:10.1287/opre.35.2.254 - SINTEF の既知最良の一覧は第1目的が車両台数、第2目的が総距離
https://www.sintef.no/projectweb/top/vrptw/100-customers/ - Ready time は作業を始めてよい最も早い時刻、Due date は作業を始めてよい最も遅い時刻、移動時間の値は距離の値に等しい
https://www.sintef.no/projectweb/top/vrptw/documentation/ - Solomon のベンチマークの距離はユークリッド距離で、移動時間は距離に等しい
https://www.sintef.no/projectweb/top/vrptw/solomon-benchmark/ - ソフトな時間枠の研究として Ibaraki・Imahori・Kubo・Masuda・Uno・Yagiura が2005年に Transportation Science 誌39巻2号に発表した論文
https://doi.org/10.1287/trsc.1030.0085 - OR-Tools の時間枠付きの例は、時間枠のために正の待ち時間を許す必要があるとして AddDimension のスラックに正の値を入れ、CumulVar の SetRange で枠を入れている
https://developers.google.com/optimization/routing/vrptw - PATH_CHEAPEST_ARC は出発点から最も安い区間になる地点へつなぎ最後に加えた地点から伸ばす作り方、PARALLEL_CHEAPEST_INSERTION は最も安い地点を最も安い位置に差し込む作り方
https://developers.google.com/optimization/routing/routing_options - 書籍 Pythonによる実務で役立つ最適化問題100+ 第3巻 配送計画・パッキング・スケジューリング、久保幹雄、朝倉書店、2022年
https://www.asakura.co.jp/detail.php?book_code=12275 - 書籍 組合せ最適化 メタ戦略を中心として、柳浦睦憲・茨木俊秀、朝倉書店、2001年
https://ndlsearch.ndl.go.jp/books/R100000002-I000002953684 - OR-Tools のルーティングソルバーは距離や時刻を返す関数の値を整数で受け取る
https://developers.google.com/optimization/routing/tsp
第6章
- OR-Tools は組合せ最適化のためのオープンソースのソフトウェアで、制約プログラミング・線形計画と混合整数計画・ルーティング・グラフのアルゴリズムを含む
https://developers.google.com/optimization/introduction - OR-Tools は Google が公開している
https://github.com/google/or-tools - OR-Tools は Google が公開している
https://pypi.org/project/ortools/9.15.6755/ - 次元は内部にトランジットと累積値の2種類の変数を持ち、スラックは j の累積値から i の累積値と i から j へのトランジットを引いた残りと定義される
https://developers.google.com/optimization/routing/dimensions - AddDisjunction で省略した地点の罰金を総距離に足し、その合計を最小にする
https://developers.google.com/optimization/routing/penalties - 状態コード 0〜6 の意味(1=ROUTING_SUCCESS、4=ROUTING_FAIL_TIMEOUT、5=ROUTING_INVALID、6=ROUTING_INFEASIBLE 等)
https://developers.google.com/optimization/routing/routing_options - 誘導局所探索などのメタヒューリスティクスを使うときは時間制限を設定しないと終わらない
https://developers.google.com/optimization/routing/tsp - 誘導局所探索は罰則を使って局所改善の手続きに働きかけ局所最適から抜け出す方法
https://link.springer.com/rwe/10.1007/978-3-319-07124-4_2 - 誘導局所探索はボードリスとツァンが1999年に巡回セールスマン問題への適用を論文にまとめた
https://doi.org/10.1016/S0377-2217(98 - 焼きなましはカークパトリックらが1983年に固体の焼きなましとの対応として示した
https://pubmed.ncbi.nlm.nih.gov/17813860/ - 焼きなましは改善しない変更の許容度を単調に絞っていく制御をする
https://doi.org/10.1287/ijoc.7.4.426 - タブー探索はグローバーが1989年と1990年の2部構成の論文で体系化し、短期記憶でタブーの条件を管理して局所最適の限界を越える
https://doi.org/10.1287/ijoc.1.3.190 - タブー探索はグローバーが1989年と1990年の2部構成の論文で体系化し、短期記憶でタブーの条件を管理して局所最適の限界を越える
https://doi.org/10.1287/ijoc.2.1.4 - CVRPLIB の E-n51-k5 は納品先50件・車両5台・積載160で、既知最良 521 は最適値
https://galgos.inf.puc-rio.br/cvrplib/ - 参考書籍『今日から使える!組合せ最適化 離散問題ガイドブック』穴井宏和・斉藤努、講談社、2015年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I026447126 - 参考書籍『今日から使える!組合せ最適化 離散問題ガイドブック』穴井宏和・斉藤努、講談社、2015年6月
https://www.kspub.co.jp/book/detail/1565449.html - 参考書籍『あたらしい数理最適化 Python言語とGurobiで解く』久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社、2012年11月
https://ndlsearch.ndl.go.jp/books/R100000002-I024082844 - 参考書籍『あたらしい数理最適化 Python言語とGurobiで解く』久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社、2012年11月
https://www.kindaikagaku.co.jp/book_list/detail/9784764904330/
第7章
- 改善基準告示は平成9年以降改正されず、令和4年12月に見直され令和6年4月1日から適用されている
https://driver-roudou-jikan.mhlw.go.jp/truck/notice - 1年の拘束時間は原則3,300時間、労使協定により3,400時間まで
https://www.mhlw.go.jp/content/001035032.pdf - 拘束時間には点呼・会議などの運転以外の労働時間も休憩時間も含まれる
https://www.mhlw.go.jp/content/001441923.pdf - 特別条項付き36協定を締結する場合の年間の時間外労働の上限が年960時間
https://www.mhlw.go.jp/stf/seisakunitsuite/bunya/koyou_roudou/roudoukijun/gyosyu/topics/01.html - 参考書籍 中小企業のためのトラック運送業の時間外労働削減の実務 売上・利益を維持し、ドライバーを定着させる 補訂版
https://ndlsearch.ndl.go.jp/books/R100000002-I032829313 - 参考書籍 中小企業のためのトラック運送業の時間外労働削減の実務 売上・利益を維持し、ドライバーを定着させる 補訂版
https://www.daiichihoki.co.jp/store/products/detail/104680.html - 参考書籍 エッセンシャルワーカー 社会に不可欠な仕事なのに、なぜ安く使われるのか
https://ndlsearch.ndl.go.jp/books/R100000002-I033113863
第8章
- OR-Tools では車ごとに出発地と帰着地を指定して複数デポを書ける
https://developers.google.com/optimization/routing/routing_tasks - OR-Tools の集荷配送の公式例は、組の宣言に加えて同じ車の制約と集荷が先の制約を明示している
https://developers.google.com/optimization/routing/pickup_delivery - 車両の台数と構成を題名に掲げた論文 Golden・Assad・Levy・Gheysens 1984
https://doi.org/10.1016/0305-0548(84 - 集荷配送問題の総説 Savelsbergh と Sol 1995
https://doi.org/10.1287/trsc.29.1.17 - 参考書籍 Pythonによる実務で役立つ最適化問題100+(2)割当・施設配置・在庫最適化・巡回セールスマン 久保幹雄 朝倉書店 2022年
https://www.asakura.co.jp/detail.php?book_code=12274 - 参考書籍 Pythonによる実務で役立つ最適化問題100+(2)の書誌
https://ndlsearch.ndl.go.jp/books/R100000002-I032507119 - 参考書籍 サプライ・チェイン最適化ハンドブック 久保幹雄 朝倉書店 2007年
https://www.asakura.co.jp/detail.php?book_code=27015 - 参考書籍 サプライ・チェイン最適化ハンドブックの書誌
https://ndlsearch.ndl.go.jp/books/R100000002-I000009135148
第9章
- 令和3年度全国道路・街路交通情勢調査の旅行速度整理表 全国合計の一般道路計で混雑時30.8、非混雑時33.8、DID商業地域15.5と19.2、DID商業地域を除く17.3と22.0、その他市街部25.8と29.7 km/h
https://www.mlit.go.jp/road/census/r3/index.html - 混雑時旅行速度は混雑方向だけを集計し、昼間12時間平均では7・8・17・18時台を混雑時、9〜16時台を非混雑時として扱う
https://www.mlit.go.jp/road/census/r3/data/pdf/syuukeirep.pdf - 2026年9月時点で国土交通省の道路関係データのページに掲載の調査は令和3年度が最新
https://www.mlit.go.jp/road/ir/ir-data/ir-data.html - 位置参照情報 街区レベルは都市計画区域相当範囲の街区単位の代表点、平成15年度から毎年1回更新
https://nlftp.mlit.go.jp/isj/ - OpenStreetMapはODbLのもとで公開され、表示をすれば複製・改変でき、改変したデータは同じライセンスで配布する
https://www.openstreetmap.org/copyright - OSRMはC++の道路網の最短経路エンジンでOpenStreetMapを取り込み、2条項BSDライセンス
https://project-osrm.org/ - OSRMのtableは与えた座標の全組について最速経路の所要時間や距離を返す
https://project-osrm.org/docs/v5.24.0/api/ - Routes APIのcomputeRouteMatrixは組ごとに距離と所要時間を返し、要素数は公共交通以外で625まで、TRAFFIC_AWARE_OPTIMALでは100まで
https://developers.google.com/maps/documentation/routes/compute_route_matrix - 基盤地図情報は道路縁を含む13項目で、道路のつながりの項目は無い
https://www.gsi.go.jp/kiban/towa.html - 地理情報科学 GISスタンダード(浅見泰司・矢野桂司・貞広幸雄・湯田ミノリ編、古今書院、2015年)
https://ndlsearch.ndl.go.jp/books/R100000002-I026277029 - 最短経路の本 レナのふしぎな数学の旅(P. Gritzmann・R. Brandenberg著、石田基広訳、丸善出版、2012年
https://ndlsearch.ndl.go.jp/books/R100000136-I1970867909912129441
第10章
- X 系列は Uchoa らが2017年に発表した納品先100件から1,000件の100問
https://galgos.inf.puc-rio.br/cvrplib/ - X 系列は Uchoa らが2017年に発表した納品先100件から1,000件の100問
https://doi.org/10.1016/j.ejor.2016.08.012 - Shaw は1998年の CP98 の論文で大近傍探索を配送計画問題に用い、関連のある訪問をまとめて外して制約に基づく木探索で入れ直した
https://doi.org/10.1007/3-540-49481-2_30 - Schrimpf らの2000年の論文は題名でルーイン・アンド・リクリエイトの原理を名乗る
https://doi.org/10.1006/jcph.1999.6413 - Ropke と Pisinger は2006年に適応型大近傍探索を示し、500件の依頼までの350問以上で半数超の既知最良を更新、複数の部分ヒューリスティクスを競わせるほうが有利
https://doi.org/10.1287/trsc.1050.0135 - Vidal らの2012年の HGS は集団探索・近傍による改善・多様性管理を組み合わせ、3種の問題のベンチマークで既知最良に並ぶか更新、CVRP でも競争力がある
https://doi.org/10.1287/opre.1120.1048 - Vidal の2022年の論文は CVRP 特化の HGS のオープンソース実装で SWAP 近傍を含み、X 系列の比較で有力と述べる
https://arxiv.org/abs/2012.10384 - Vidal の2022年の論文は CVRP 特化の HGS のオープンソース実装で SWAP 近傍を含み、X 系列の比較で有力と述べる
https://doi.org/10.1016/j.cor.2021.105643 - PyVRP の論文(Wouda・Lan・Kool 2024年)は HGS を実装、2021年 DIMACS の VRPTW 競技会で1位、EURO meets NeurIPS 2022 の静的部門で1位、MIT ライセンス
https://doi.org/10.1287/ijoc.2023.0055 - PyVRP は v0.13.0 でハイブリッド遺伝的探索から反復局所探索へ作り替え、数分までの計算時間と500件程度以上で質が良くなったと説明
https://github.com/PyVRP/PyVRP/releases/tag/v0.13.0 - PyVRP 0.13.1 は2026年1月15日、0.14.0 は2026年8月20日に公開
https://pypi.org/project/pyvrp/ - 反復局所探索は、局所最適から抜け出すのに足りる程度だけ解を崩し、局所探索で磨き、受け入れを判定する
https://pyvrp.org/dev/algorithm.html - PyVRP が扱える問題の範囲(時間枠・車種混在・複数デポ・集荷と配送・積み直し・任意訪問など)
https://pyvrp.org/ - Taillard の1993年の論文は、台数の多い問題を極座標の領域に分けてタブー探索を並列に動かし、古典的な問題の既知最良解をすべて見つけた
https://doi.org/10.1002/net.3230230804 - タブー探索は Glover が1986年の論文で名付けた
https://doi.org/10.1016/0305-0548(86 - OR-Tools の改善の方法に GUIDED_LOCAL_SEARCH・SIMULATED_ANNEALING・TABU_SEARCH があり、誘導局所探索が配車では一般に最も効率が良い
https://developers.google.com/optimization/routing/routing_options - 参考書籍『メタヒューリスティクスの数理』久保幹雄・J.P.ペドロソ、共立出版、2009年、ISBN 978-4-320-12235-2
https://ndlsearch.ndl.go.jp/books/R100000002-I000010151169 - 参考書籍『メタヒューリスティクスとナチュラルコンピューティング』古川正志・川上敬・渡辺美知子・木下正博・山本雅人・鈴木育男、コロナ社、2012年1月、ISBN 978-4-339-02461-6
https://ndlsearch.ndl.go.jp/books/R100000002-I023180135 - 参考書籍『メタヒューリスティクスとナチュラルコンピューティング』古川正志・川上敬・渡辺美知子・木下正博・山本雅人・鈴木育男、コロナ社、2012年1月、ISBN 978-4-339-02461-6
https://www.coronasha.co.jp/np/isbn/9784339024616/
第11章
- 書籍 オンラインアルゴリズムとストリームアルゴリズム、徳山豪 著、共立出版、2007年8月、ISBN 978-4-320-12171-3、アルゴリズム・サイエンスシリーズ 数理技法編5
https://ndlsearch.ndl.go.jp/books/R100000002-I000008961748 - 書籍 オンラインアルゴリズムとストリームアルゴリズム、徳山豪 著、共立出版、2007年8月、ISBN 978-4-320-12171-3、アルゴリズム・サイエンスシリーズ 数理技法編5
https://www.kyoritsu-pub.co.jp/bookdetail/9784320121713 - 書籍 マルコフ決定過程 理論とアルゴリズム、中出康一 著、コロナ社、2019年4月、ISBN 978-4-339-02834-8、シリーズ情報科学における確率モデル4
https://ndlsearch.ndl.go.jp/books/R100000002-I029544933 - 書籍 マルコフ決定過程 理論とアルゴリズム、中出康一 著、コロナ社、2019年4月、ISBN 978-4-339-02834-8、シリーズ情報科学における確率モデル4
https://www.coronasha.co.jp/np/isbn/9784339028348/
第12章
- Zhong、Hall、Dessouky の2007年の論文は、小口荷物の地域配送で納品先の場所と量が日々変わるなか、担当への習熟を保ちながら配車を最適化するモデルを扱い、担当地域を固定に近づける目的と日々割り当て直す目的の釣り合いをとるため
https://doi.org/10.1287/trsc.1060.0167 - Groër、Golden、Wasil の2009年の論文は、小口の荷物の配送会社の要請として同じドライバーが同じ納品先をほぼ同じ時刻に訪れることを加えた問題を ConVRP と名付け、混合整数計画として定式化し、1,000件の模擬データ5つと3,700件を超える実データに適用した
https://doi.org/10.1287/msom.1080.0243 - 周期配送計画問題が文献に初めて現れたのは1974年のごみ収集に関する Beltrami と Bodin の論文であると Campbell と Wilson の総説が述べている
https://doi.org/10.1002/net.21527 - Christofides と Beasley の1984年の論文は、訪問回数の条件を満たす曜日の組を初期値として選び、組を入れ替えて配送費を下げる2段の方法を示し、各曜日の配車の費用を施設配置に近い問題と巡回セールスマン問題で置き換えて見積もる
https://doi.org/10.1002/net.3230140205 - 空間解析入門、都市を測る・都市がわかる
https://ndlsearch.ndl.go.jp/books/R100000002-I029120139 - 空間解析入門、都市を測る・都市がわかる
https://www.hanmoto.com/bd/isbn/9784254163568 - 協力ゲーム理論
https://ndlsearch.ndl.go.jp/books/R100000002-I000009427918 - 協力ゲーム理論
https://www.hanmoto.com/bd/isbn/9784326503049
第13章
- 物流情報標準ガイドラインは内閣府SIPスマート物流サービスで作られ、2025年2月7日にver.3.00への改訂が公表された
https://www.mlit.go.jp/report/press/tokatsu01_hh_000853.html - 物流情報標準ガイドラインの専用サイトは物流業務プロセス標準・物流情報標準メッセージ・物流共通マスタの3つを掲げている
https://www.lisc.or.jp/ - 荷待時間・荷役作業等の業務記録への記録義務の対象が、2025年4月1日から全車両に拡大された
https://www.mlit.go.jp/jidosha/content/001865382.pdf - 荷待時間の記録には集貨地点等、到着と出発の時刻、積込みと取卸しの開始と終了の時刻が含まれる
https://www.mlit.go.jp/jidosha/jidosha_fr4_000026.html - 参考書籍『輸配送DX』検崎朴郎・渡邉安彦・山本広高、日本橋出版、2025年
https://ndlsearch.ndl.go.jp/books/R100000002-I034199716 - 参考書籍『輸配送DX』検崎朴郎・渡邉安彦・山本広高、日本橋出版、2025年
https://nihonbashi-pub.co.jp/news/323 - 参考書籍『崖っぷちの物流DX導入マニュアル』鈴木邦成・中村康久、NTT出版、2023年
https://ndlsearch.ndl.go.jp/books/R100000002-I033155864 - 参考書籍『崖っぷちの物流DX導入マニュアル』鈴木邦成・中村康久、NTT出版、2023年
https://www.hanmoto.com/bd/isbn/9784757123892
第14章
- UPS の ORION は毎日5万5,000人の米国ドライバーにルートを出し、日々の一貫性を保つ
https://doi.org/10.1287/inte.2016.0875 - 日本郵便が AI による配達ルート自動作成を活用した配達業務支援システムを試行導入
https://www.post.japanpost.jp/notification/pressrelease/2020/00_honsha/0615_02.html - 日本郵便が AI による配達ルート自動作成を活用した配達業務支援システムを試行導入
https://www.post.japanpost.jp/notification/pressrelease/2020/00_honsha/0615_02_02.pdf - ヤマト運輸とアルフレッサが配送業務量予測と配車計画の自動作成を2021年8月に首都圏の支店で導入開始
https://www.yamato-hd.co.jp/news/2021/newsrelease_20210803_1.html - コンビニ3社の都内湾岸エリアの共同配送実証の計画
https://www.dei.or.jp/aboutdei/pdf/press/press_200722_01.pdf - コンビニ3社の共同配送の実績と、納品時間を調整した場合のシミュレーションの表
https://www.dei.or.jp/aboutdei/pdf/press/press_210226_01.pdf - コンビニ3社の共同配送の実績と、納品時間を調整した場合のシミュレーションの表
https://prtimes.jp/main/html/rd/p/000000031.000036006.html - 北海道函館エリアの共同配送実証
https://www.family.co.jp/company/news_releases/2022/20221017_03.html - 北海道函館エリアの共同配送実証
https://www.family.co.jp/content/dam/family/company/news_releases/2022/20221017_newsrelease_03.pdf - 物流効率化法は2025年4月から努力義務、2026年4月から特定事業者の中長期計画と定期報告
https://www.revised-logistics-act-portal.mlit.go.jp/5minutes/ - 物流効率化法は2025年4月から努力義務、2026年4月から特定事業者の中長期計画と定期報告
https://www.mlit.go.jp/seisakutokatsu/freight/seisakutokatsu_freight_mn1_000034.html - 積載効率は積載率×実車率
https://www.revised-logistics-act-portal.mlit.go.jp/faq/ - 中継輸送の改正法案は2026年3月6日閣議決定、2026年5月13日に参議院で可決・成立、5月20日に令和8年法律第21号として公布
https://www.shugiin.go.jp/internet/itdb_gian.nsf/html/gian/keika/1DE164E.htm - 中継輸送の改正法案は2026年3月6日閣議決定、2026年5月13日に参議院で可決・成立、5月20日に令和8年法律第21号として公布
https://www.mlit.go.jp/report/press/jidosha04_hh_000351.html - 改正法の中身 中継輸送の基本方針と努力義務、施行期日は公布の日から6月以内、貨物自動車中継輸送実施計画の認定制度と支援、ねらいはドライバーの負担軽減と帰り荷の確保による運行効率
https://www.mlit.go.jp/report/press/content/001985394.pdf - 総合物流施策大綱 2026年度から2030年度 は、共同輸配送や復荷の確保、配車・運行計画の最適化などの取組を進める必要があるとし、生成 AI などを踏まえた配車・運行計画の最適化などのユースケース創出を支援するとしている
https://www.mlit.go.jp/seisakutokatsu/freight/content/001993236.pdf - 総合物流施策大綱 2026年度から2030年度 は、共同輸配送や復荷の確保、配車・運行計画の最適化などの取組を進める必要があるとし、生成 AI などを踏まえた配車・運行計画の最適化などのユースケース創出を支援するとしている
https://www.mlit.go.jp/seisakutokatsu/freight/butsuryu03100.html - 注意機構に基づくモデルを強化学習で訓練し、100地点までの巡回セールスマン問題で最適に近い結果
https://arxiv.org/abs/1803.08475 - 機械学習による組合せ最適化の総説
https://arxiv.org/abs/1811.06128 - 機械学習による組合せ最適化の総説
https://doi.org/10.1016/j.ejor.2020.07.063 - EURO Meets NeurIPS 2022 のコンペティション
https://proceedings.mlr.press/v220/kool23a.html - PyVRP は2021年 DIMACS の VRPTW チャレンジで1位のアルゴリズムの実装で、改良後に EURO Meets NeurIPS 2022 の静的部門で1位
https://doi.org/10.1287/ijoc.2023.0055 - HGS の実装論文
https://doi.org/10.1016/j.cor.2021.105643 - Amazon Last Mile Routing Research Challenge は熟練ドライバーの実際のルートから学習して経路の順序を作る課題
https://routingchallenge.mit.edu/about-the-challenge/ - Amazon Last Mile Routing Research Challenge は熟練ドライバーの実際のルートから学習して経路の順序を作る課題
https://routingchallenge.mit.edu/ - 公開データは2018年に米国5都市圏で走った9,184本のルート
https://doi.org/10.1287/trsc.2022.1173 - NL4Opt コンペティションは線形計画の文章題を対象に、要素の認識と中間表現の生成の2課題
https://proceedings.mlr.press/v220/ramamonjison23a.html - OptiMUS は大規模言語モデルで混合整数線形計画を定式化し、コードを書き、誤りを直し、評価して改良するエージェント
https://arxiv.org/abs/2402.10172 - Evolution of Heuristics は大規模言語モデルと進化計算を組み合わせ、経験則の考え方を自然な言葉で表してコードに翻訳する
https://arxiv.org/abs/2401.02051 - OR-Tools v9.15 は2026年1月12日公開
https://github.com/google/or-tools/releases/tag/v9.15 - PyVRP v0.14.0 は2026年8月20日公開
https://github.com/PyVRP/PyVRP/releases/tag/v0.14.0 - PyVRP v0.14.0 は2026年8月20日公開
https://github.com/PyVRP/PyVRP - NVIDIA cuOpt はリポジトリ作成2025年4月、Apache-2.0
https://github.com/NVIDIA/cuopt - 参考書籍『フィジカルインターネット 企業間の壁崩す物流革命』エリック・バロー、ブノア・モントルイユ、ラッセル・D・メラー著、荒木勉訳、日経BP、2020年6月
https://ndlsearch.ndl.go.jp/books/R100000002-I030458654 - 参考書籍『数理最適化の実践ガイド』穴井宏和、講談社、2013年3月
https://ndlsearch.ndl.go.jp/books/R100000002-I024244241