こんにちは、Anagraftの伊藤です。
今回は、工場の中で「どの仕事を、どの機械で、どの順番に、何時から始めるか」を決める生産スケジューリングを、数理最適化の立場から整理しました。1台の機械に並ぶ仕事の順番を決める単一機械の問題から始めて、すべての仕事が同じ順路で流れるフローショップ、仕事ごとに順路が違うジョブショップへと進み、段取り替え、ロットサイジング、並列機械と組立ラインのバランシング、作業者や炉のような資源の制約、大規模な問題への対処、故障や飛び込み注文への再スケジューリング、そして現場への導入と最新の動向までを扱います。ここに挙げた用語は、それぞれの章で最初に出るときに平易な言葉で説明していますので、ここで分からなくても差し支えありません。
この題材を選んだ理由は、生産スケジュールが納期、リードタイム、設備の稼働率、残業、仕掛品といった経営の数字を直接左右する意思決定でありながら、その作成が特定の担当者の経験と手作業に委ねられていることが多いためです。同じ受注と同じ設備でも、仕事の順番を変えるだけで納期に遅れる件数や、段取り替えで失う時間は大きく変わります。順番の組合せの数は仕事の数とともに急速に増えるため、人が頭の中ですべてを比べることはできません。どこまでを計算機に任せ、どこから先を人が判断するかを見極める道具として、数理最適化の手法を紹介します。
各章では、架空の部品加工工場のデータを共通の題材にして、実際にコードを動かした結果を載せています。旋盤、マシニングセンタ、研削盤、熱処理炉、検査の5工程を持ち、4つの製品系列の受注を抱えた工場という設定です。データは乱数で生成したもので、実在の企業の記録ではありません。あわせて、研究の世界で60年以上使われてきた公開のベンチマーク問題も解いています。同じデータに対して、ディスパッチングルール、混合整数計画、制約プログラミング、メタヒューリスティクスを順に当てることで、手法どうしの関係と、それぞれの得意と不得意が横に比べられるようにしました。
想定している読者は、生産計画や工程管理の改善を任された実務者の方、生産スケジューラの導入を検討している方、そして納期遵守率や設備稼働率を経営指標として見る立場の方です。オペレーションズ・リサーチの専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にして言葉で言い換えています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各手法について「何を決める手法か」「どういう前提で使えるか」「使ってはいけないのはどういうときか」「結果を経営指標にどう翻訳するか」を書くようにしました。スケジューリングの手法の多くは教科書に載っていますが、実務で難しいのは、自分の工場の問題がどの型に当てはまるのか、現場の例外ルールをどこまで制約として書くのか、計算時間と解の良さをどこで折り合わせるのかを見極めるところだと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムの記述は2026年9月時点で確認したものです。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。計算時間は、本コラムの実行環境で測った値であり、計算機が変われば変わります。
目的別の読み方の目安を挙げておきます。スケジューリングを経営指標としてどう見るかを整理したい場合は、第1章と第13章が入口になります。自社の問題がどの型に当たるかを見極めたい場合は、第2章の分類をご覧ください。現場で使われている優先順位のルールの根拠を確かめたい場合は第3章、ライン生産に近い工場では第4章、多品種少量の加工工場では第5章が中心になります。どの解き方を選ぶかに迷っている場合は、第6章の計算時間の比較が判断の材料になります。
段取り替えの時間が大きい工場は第7章、週単位の生産計画と日々の順番をどうつなぐかを整理したい場合は第8章をご覧ください。同じ工程に複数の設備がある場合や組立ラインの編成は第9章、作業者の人数や炉の容量が詰まりどころになっている場合は第10章で扱っています。問題が大きく計算が終わらない場合は第11章、故障や飛び込み注文でスケジュールがすぐに崩れる場合は第12章が入口です。機械学習や生成AIをスケジューリングにどう位置づけるかは第14章で扱っています。

目次
- 序章 スケジューリングは、順番と時刻を決める問題である
- 全体の地図
- 第1章 生産スケジューリングはなぜ経営の問題なのか、計画の階層と経営指標から考える
- 第2章 スケジューリング問題を記述する、機械環境・制約・目的とガントチャート
- 第3章 単一機械とディスパッチングルール、並べる順番の決め方で何が変わるか
- 第4章 フローショップ、全ジョブが同じ順に機械を通る工程の順序づけ
- 第5章 ジョブショップ、品目ごとに工程の道順が違う工場の順序を解く
- 第6章 MIP と CP の使い分け、同じジョブショップを3つの定式化で解き比べる
- 第7章 段取り替えを減らす、順序依存の段取りと納期の釣り合いを最適化で決める
- 第8章 ロットサイジングと生産計画、週の計画に容量と段取り時間を入れる
- 第9章 並列機械とラインバランシング、仕事を複数の機械と工程に配る
- 第10章 人・治具・炉を制約に入れる、資源制約と稼働カレンダーとバッチ処理
- 第11章 大規模化への対処、局所探索と分解で十分良い解を毎日同じ時間で出す
- 第12章 不確実性と再スケジューリング、故障と飛び込み注文にどう組み直すか
- 第13章 現場に入れる、暗黙知を制約に落とし運用を回し続けるまで
- 第14章 事例と最新動向、学習する手法と生成AIの時代のスケジューリング
- 終章 順番を書き出し、解き、結果で直す
- 本コラムで紹介した書籍一覧
- 第1章 生産スケジューリングはなぜ経営の問題なのか、計画の階層と経営指標から考える
- 第2章 スケジューリング問題を記述する、機械環境・制約・目的とガントチャート
- 第3章 単一機械とディスパッチングルール、並べる順番の決め方で何が変わるか
- 第4章 フローショップ、全ジョブが同じ順に機械を通る工程の順序づけ
- 第5章 ジョブショップ、品目ごとに工程の道順が違う工場の順序を解く
- 第6章 MIP と CP の使い分け、同じジョブショップを3つの定式化で解き比べる
- 第7章 段取り替えを減らす、順序依存の段取りと納期の釣り合いを最適化で決める
- 第8章 ロットサイジングと生産計画、週の計画に容量と段取り時間を入れる
- 第9章 並列機械とラインバランシング、仕事を複数の機械と工程に配る
- 第10章 人・治具・炉を制約に入れる、資源制約と稼働カレンダーとバッチ処理
- 第11章 大規模化への対処、局所探索と分解で十分良い解を毎日同じ時間で出す
- 第12章 不確実性と再スケジューリング、故障と飛び込み注文にどう組み直すか
- 第13章 現場に入れる、暗黙知を制約に落とし運用を回し続けるまで
- 第14章 事例と最新動向、学習する手法と生成AIの時代のスケジューリング
- 参考情報
序章 スケジューリングは、順番と時刻を決める問題である
工場の生産計画というと、今月は何をいくつ作るかという量の計画が思い浮かぶことが多いように思います。量の計画は、需要と設備の能力の釣り合いを取る仕事で、表計算ソフトで組める範囲のものも多くあります。ところが、量が決まったあとにも、どの仕事をどの機械で、どの順番に、何時から始めるかを決める仕事が残ります。同じ量を作る計画でも、順番の決め方によって、納期に遅れる受注の件数、機械が止まって待つ時間、段取り替えで失う時間、工程の間に積み上がる仕掛品の量が大きく変わります。本コラムが扱うのは、この順番と時刻を決める仕事、すなわち生産スケジューリングです。
スケジューリングの研究は古く、1954年には2台の機械を順に通る仕事の最適な順番を求める規則が発表されています(第4章で扱うジョンソン則)。1963年に発表された6件の仕事と6台の機械からなる小さな問題は、今も公開のベンチマークとして配布されています。その一方で、仕事と機械が少し増えるだけで組合せの数が爆発的に増えることも早くから知られており、厳密に最適な答えを求めることと、実用的な時間で十分に良い答えを出すことのあいだで、多くの手法が工夫されてきました。本コラムの実行環境では、無償で使える制約プログラミングのソルバーで、10件の仕事と10台の機械からなる公開ベンチマークの最適解が数秒で得られました(第2章・第5章)。一方で、同じソルバーでも、目的の種類や件数によっては短い時間では最適に届かず、単純な並べ方の規則に負けることもありました(第3章)。どの手法がいつ効くかを、実際に解いた結果で示すことが本コラムの方針です。
順番の良し悪しは、経営の数字に直結する
スケジュールの良し悪しは、工場の外から見える数字に現れます。納期に遅れれば取引先の信用を損ない、場合によっては特急の輸送費や違約の負担が生じます。遅れを取り戻すために残業や休日出勤を組めば、人件費が膨らみます。反対に、納期を守るために早め早めに着手すれば、工程の間に仕掛品が積み上がり、資金が寝て、保管の場所も要ります。段取り替えの回数が多ければ、その分だけ設備が生産に使える時間が減り、設備投資で能力を買い足す判断を早めることになります。
これらの損失は、互いに引っ張り合う関係にあります。段取り替えを減らすために同じ系列の仕事をまとめれば、その系列以外の受注は待たされて納期に遅れやすくなります。設備の稼働率を上げようとして仕事を詰め込めば、待ち時間が延びてリードタイムが長くなります。どの損失をどこまで許すかは経営の判断であり、スケジューリングの手法は、その判断を目的関数と制約という形で書き下し、判断に沿った最良の順番を計算する道具です。
現場の担当者の頭の中にある判断を、書き出す
多くの工場では、スケジュールは経験を積んだ担当者が作っています。担当者は、どの機械が詰まりやすいか、どの製品を続けて流すと段取りが軽いか、どの取引先の納期を最優先にすべきかを知っており、その判断は多くの場合に的確です。問題は、その判断が担当者の頭の中にだけあり、書き出されていないことです。担当者が休めば計画が止まり、受注が増えれば手作業が追いつかず、なぜその順番にしたのかを後から検証できません。
数理最適化でスケジュールを作る作業は、この頭の中の判断を、制約と目的として一つずつ書き出す作業でもあります。書き出してみると、担当者が当然のように守っている条件が、実は誰も明文化していない例外ルールだったと分かることが少なくありません。第13章では、この書き出しの手順を、ヒアリングの設問と制約の優先順位の付け方として整理しました。計算機に任せる前に、現場の判断を言葉にすることが、導入の成否を分けると考えています。
同じ工場のデータで、手法を横に比べる
本コラムでは、架空の部品加工工場を共通の題材にしました。旋盤、マシニングセンタ、研削盤、熱処理炉、検査の5工程を持ち、4つの製品系列の受注を抱えた工場です。受注ごとに通る工程の順番が違い、着手できる時刻と納期と重要度が決まっています。このほかに、1台の機械に並ぶ15件の仕事、全件が同じ順路で流れる10件の仕事、速度の違う3台の機械に割り当てる20件の仕事、4製品の12週分の需要、組立ラインの20個の作業を用意し、章ごとに使い分けています。
このデータは乱数で生成したもので、実在の企業の記録ではありません。その代わり、同じ問題にディスパッチングルール、混合整数計画、制約プログラミング、メタヒューリスティクスを順に当てて、結果と計算時間を横に比べることができます。手法の説明だけを読むと、どれも万能に見えることがありますが、同じ問題に当てると、得意と不得意がはっきり分かれます。その差を実際の数字で示すことが、架空データを使う利点だと考えています。
最適解より、毎日同じ時間で出せる良い解
本コラムを通じてお伝えしたいことが一つあります。生産スケジューリングで大事なのは、一度きりの最適解ではなく、毎日同じ時間で出せる十分に良い解と、それを現場が信頼して使い続けられる仕組みだということです。スケジュールは翌日には受注の追加や設備の故障で崩れます。崩れるたびに作り直すには、計算が決まった時間で終わり、前のスケジュールから大きく変わらず、現場の担当者が結果を読んで納得できることが要ります。厳密な最適性は、そのための手段の一つにすぎません。
経営判断に関わる方にとって、この点は導入の目標の置き方に直結します。スケジューラを導入すれば最適な計画が自動で出るという期待で始めると、現場の例外ルールが入っていない計画が出て使われなくなることが多いように思います。まず現状の順番の決め方を書き出し、納期遅れや段取り時間を測り、計算機に任せる範囲を小さく始めて、結果を見ながら制約を足していくという順序であれば、投資の効果を数字で確かめながら進められます。
Anagraftでは、データ活用の構想づくりから、生産計画やスケジューリングのような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章からなります。第1章と第2章で、スケジューリングを経営の問題として位置づけ、問題を記述する言葉をそろえます。第3章から第5章では、工場の形に沿って、1台の機械、全件が同じ順路で流れるフローショップ、仕事ごとに順路が違うジョブショップの順に解き方を扱います。第6章では、同じ問題を混合整数計画と制約プログラミングで解き比べ、どちらをどう選ぶかを整理します。
第7章から第10章は、現実の工場で順番の問題に加わる要素を一つずつ扱います。段取り替え、週単位の生産量の計画、同じ工程に複数ある機械と組立ライン、作業者や治具や炉のような資源です。第11章と第12章は、問題が大きくなったときと、計画が故障や飛び込み注文で崩れたときの対処です。第13章で現場への導入と運用を、第14章で公開された事例と研究の動向をまとめ、終章で全体を振り返ります。
| 章 | 題 | 主に扱う手法と題材 |
|---|---|---|
| 第1章 | 生産スケジューリングはなぜ経営の問題なのか | 計画の階層、経営指標の定義、リトルの法則、稼働率と待ち時間 |
| 第2章 | スケジューリング問題を記述する | 機械環境・制約・目的の3項記法、ガントチャート、組合せの数、共通データの紹介 |
| 第3章 | 単一機械とディスパッチングルール | 加工時間順・納期順・重み付きの並べ方、ムーア法、合成ルール、厳密解との比較 |
| 第4章 | フローショップ | ジョンソン則、NEH法、ボトルネックの見極め |
| 第5章 | ジョブショップ | ディスジャンクティブグラフ、クリティカルパス、制約プログラミング、公開ベンチマーク |
| 第6章 | MIP と CP の使い分け | 3つの定式化、計算時間と下界の比較、使い分けの基準 |
| 第7章 | 段取り替えを減らす | 順序依存の段取り、巡回セールスマン問題との対応、段取りと納期の釣り合い |
| 第8章 | ロットサイジングと生産計画 | 容量制約付きロットサイジング、段取り時間、残業、計画とスケジュールの整合、ローリング |
| 第9章 | 並列機械とラインバランシング | LPT、非同一の並列機械、組立ラインの工程編成 |
| 第10章 | 人・治具・炉を制約に入れる | 資源制約付きスケジューリング、作業者のスキル、稼働カレンダー、バッチ処理 |
| 第11章 | 大規模化への対処 | 局所探索、焼きなまし、タブー探索、遺伝的アルゴリズム、分解、時間制限とギャップ |
| 第12章 | 不確実性と再スケジューリング | 故障と飛び込み注文、右シフト修復と再最適化、安定性、凍結区間 |
| 第13章 | 現場に入れる | 例外ルールの書き出し、標準時間の精度、システム連携、導入の順序、失敗の型 |
| 第14章 | 事例と最新動向 | 公開一次情報のある事例、学習による手法、生成AIと数理最適化の分担 |
読者の立場ごとに、問いから章を引けるように対応表も置きました。一つの問いに複数の章が関わる場合は、入口になる章を先に書いています。
| 問い | 入口になる章 | あわせて読む章 |
|---|---|---|
| スケジュールの良し悪しを経営の数字でどう測るか | 第1章 | 第2章、第13章 |
| 自社の工場の問題はどの型に当たるか | 第2章 | 第3章、第4章、第5章 |
| 現場の優先順位のルールは正しいのか | 第3章 | 第11章 |
| どの解き方、どのソルバーを選ぶか | 第6章 | 第5章、第11章 |
| 段取り替えで失う時間を減らしたい | 第7章 | 第8章 |
| 週の生産計画と日々の順番が合わない | 第8章 | 第12章 |
| 設備や作業者の割り当てを決めたい | 第9章 | 第10章 |
| 計算が終わらない、規模が大きい | 第11章 | 第6章 |
| 故障や飛び込み注文ですぐ計画が崩れる | 第12章 | 第13章 |
| 導入しても現場で使われない | 第13章 | 第14章 |
各章の末尾には、その章の主題を深めるための参考書籍を挙げ、巻末に一覧としてまとめました。本文で引いた論文や公式ドキュメントは、巻末の参考情報に章ごとに載せています。
第1章 生産スケジューリングはなぜ経営の問題なのか、計画の階層と経営指標から考える
生産スケジューリングは、工場の中で「どの注文を、どの機械で、どの順番に、何時から何時まで加工するか」を決める仕事です。現場の係長や計画担当者が表計算ソフトやホワイトボードで毎日組んでいることが多く、経営の議題に上がることはあまりありません。しかし、順番の決め方ひとつで、同じ設備・同じ人員・同じ受注のままでも、納期に遅れる注文の数、工場の中に積み上がる仕掛品の量、残業の時間、段取り替えで止まる時間が変わります。これらはいずれも、顧客の信用、運転資金、人件費、設備投資の判断に直結する経営の数字です。この章では、後の章で個々の手法に入る前に、スケジューリングが生産管理の計画の中でどこに位置するのか、その良し悪しをどの経営指標で測るのか、そして判断を誤るとどういう形で損失が出るのかを整理します。
生産管理の計画は階層になっている
工場の計画は、1枚の計画表で完結しているわけではありません。長い期間を粗い単位で決める計画から、短い期間を細かい単位で決める計画へと、段階を追って具体化していく階層になっています。日本の生産管理用語を定めた日本産業規格 JIS Z 8141(生産管理用語)の2001年版は、生産計画を「生産量と生産時期に関する計画」と定義し、備考で大日程計画・中日程計画・小日程計画の3つに分けています。大日程計画は日程に関してマスターとなる長期の生産計画で月別の生産量を決め、中日程計画はそれに基づいて部門別の生産予定を決め、小日程計画は日々の作業予定を決める、という説明です。なお、この規格は2022年に改正されています(2022年版)。この章の定義の引用は、全文を開いて確認できた2001年版によるものです。
同じ規格には、資材所要量計画(MRP)の用語群も収められています。基準生産計画(MPS)は「独立需要品目を対象品目とし、品目ごとにタイムバケット単位で設定した生産予定」と定義されています。独立需要品目とは、受注や予測から直接必要な時期と量が決まる品目、つまり最終製品やサービスパーツのことで、タイムバケットとは週や日のように区切った計画の小期間のことです。資材所要量計画は、生産計画の情報・部品構成表の情報・在庫の情報に基づいて資材の必要量と時期を求める仕組みとされ、基準生産計画を部品構成表で展開して、部品や材料をいつ、いくつ用意するかを計算します。
この階層を、上から順に並べると次のようになります。最上位は、販売・生産・在庫の計画を月単位で突き合わせ、何をどれだけ売り、どれだけ作るかを経営として決める段階で、JIS の大日程計画に近い位置づけです。その下に、最終製品ごとに週や日の単位で生産量を決める基準生産計画があります。さらにその下で、資材所要量計画が部品と材料の必要量と時期を計算し、製造オーダ(何を、いつまでに、いくつ作るかの指示)を出します。この製造オーダを、個々の機械と作業者に、分や時間の単位で割り付けるのが日程計画、すなわちスケジューリングです。最後に、現場の各機械に「次にどの仕事に着手するか」を指示する差立てが続きます。
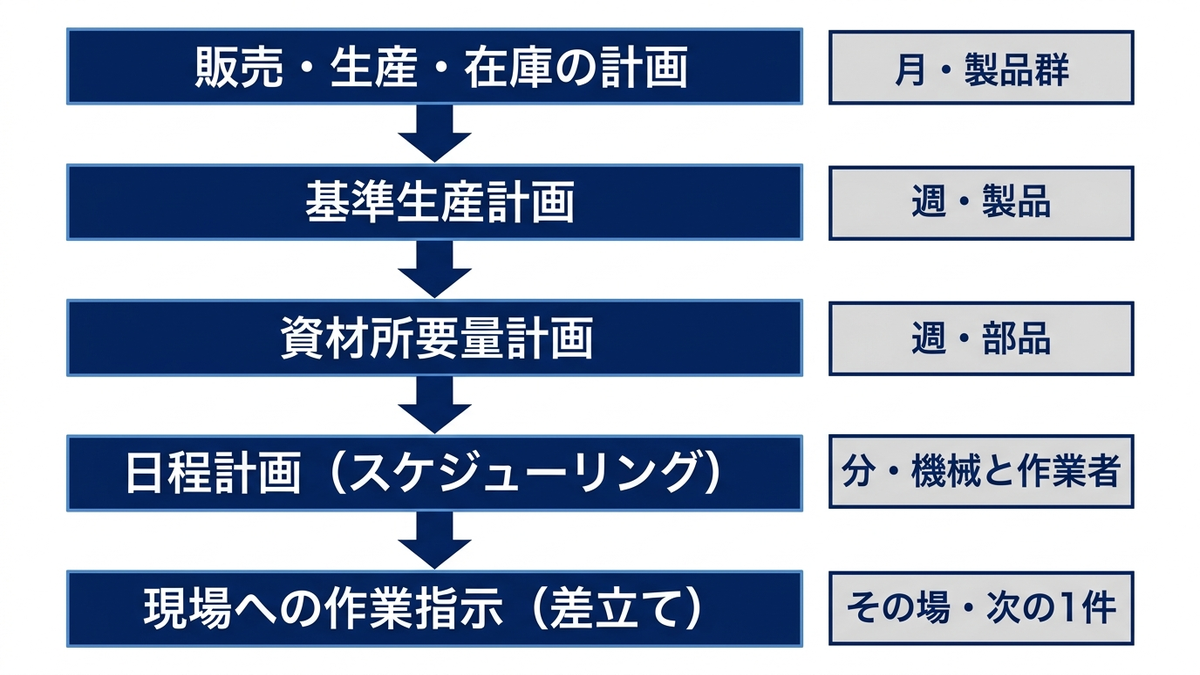
JIS Z 8141 の2001年版は、スケジューリングそのものについても定義を置いています。生産スケジューリングは「製品又は部品の製造を行うにあたって、使用可能な資源の制約下で、製品又は部品それぞれの工程ごとの着手時期・終了時期・着手順序、使用設備を決める活動」です。備考では、設備の構成によって単一機械・並列機械・フローショップ・ジョブショップなどに分類すると書かれており、この記事の第3章から第9章の章立ては、おおむねこの分類に沿っています。差立ては、ある機械で1つのジョブの加工が終わったときに次に加工すべきジョブを決定して指示することで、そのための規則がディスパッチングルールです。規格は、待ちジョブの中から次に優先して加工するジョブを決めるための規則と定義し、代表例として先着順規則、最小作業時間規則、最早納期規則、最小スラック規則を挙げています。これらは第3章で1つずつ扱います。
スケジューリングが決めること、上の計画から受け取ること
階層のなかでスケジューリングが担うのは、上から渡された製造オーダを、限られた機械・人・時間の中で実際に実行できる順番と時刻に直すことです。受け取る側から見ると、何を・いくつ・いつまでに作るかは、基準生産計画と資材所要量計画でおおむね決まっています。スケジューリングが自由に動かせるのは、同じ機械に並んだ仕事の順番、どの機械で加工するか(同じ加工ができる機械が複数あるとき)、そして各工程の着手時刻です。量と納期を決める権限はありませんが、順番と時刻の決め方で、納期を守れるかどうか、途中で何がどれだけ滞留するかが決まります。
ここで注意したいのは、上の計画の多くが能力に無限の余裕があるとみなして作られることです。資材所要量計画は、部品構成表を展開して必要量と時期を計算しますが、計算の段階ではその時期に機械が空いているかどうかを見ていません。JIS Z 8141 の2001年版も、資材所要量計画の用語群の中で、計画したオーダを実行するのに必要な製造能力を算出する活動(キャパシティプランニング)や、各ワークセンタへの投入量を調整して負荷変動を少なくし仕掛量を管理する活動(キャパシティコントロール)を別の用語として定義しています。能力の突き合わせは、所要量の計算とは別の段階で行う設計になっているということです。その結果、スケジューリングの段階で初めて「この週の熱処理炉は計画どおりに流すと能力が足りない」といった矛盾が見つかることが少なくありません。
そのため、スケジューリングは下流の作業であると同時に、上の計画の実行可能性を検査する役割も持っています。スケジュールを組んでみて納期に間に合わない注文が出たら、その情報は上へ戻して、納期の再交渉、残業や休日出勤の手配、外注、あるいは基準生産計画の見直しにつなげる必要があります。JIS Z 8141 の2001年版の余力管理の定義(各工程や作業者の負荷と能力を把握し、余力または不足を検討して作業を再配分し、能力と負荷を均衡させる活動)は、まさにこの往復のことを指しています。スケジューリングを現場の段取りの問題として閉じてしまうと、この往復が途切れ、上の計画は実行できない前提のまま次の月へ進みます。
計画の単位が変わることも、階層の境目で問題が起きやすい理由です。基準生産計画や資材所要量計画は週や日のタイムバケットで量を数えますが、スケジューリングは分単位の時刻と順番を扱います。週単位では能力の範囲内に収まっていても、分単位で並べると、同じ機械を必要とする仕事が同じ時間帯に集中して待ちが生じることがあります。週の計画とその週の中の順番の整合は、第8章でロットサイジングを扱う際に改めて取り上げます。
スケジュールの良し悪しを測る経営指標
スケジュールの良し悪しを議論するには、測る物差しを先に決めておく必要があります。学術的なスケジューリング理論は、最後の仕事が終わる時刻(メイクスパン)や納期遅れの合計などの目的関数で解を評価します。これらは第2章で整理しますが、経営の報告に載るのは、それを翻訳した指標です。この記事では、次の6つを経営指標として使います。定義は JIS Z 8141 の2001年版にある語はそれに従い、規格に定義が無いものはこの記事での定義として明記しました。
| 経営指標 | この記事での定義 | 良い方向 | 読むときの注意 |
|---|---|---|---|
| 製造リードタイム | 生産の着手時期から完了時期に至るまでの期間(JIS Z 8141 の生産リードタイムの定義)。注文ごとに測り、平均とばらつきを見る | 短い | 平均だけを見ると、一部の注文が極端に長く待っていても見えない。上位1割の長さも併せて見る |
| 納期遵守率 | 期間内に完了した注文のうち、納期までに完了した件数の割合(この記事での定義) | 高い | 件数の割合なので、重要顧客の大口の遅れも小口の遅れも1件と数える。遅れの日数と注文の重みを別に見る |
| 設備稼働率 | 利用可能時間に対する有効稼働時間の比率(JIS Z 8141 の稼働率の定義。有効稼働時間は生産に直接役立っている時間) | ボトルネックでは高く、それ以外は目標にしない | 規格の備考にあるとおり、解釈に広義と狭義があり、何を分母・分子にするかで値が変わる。段取り時間を含めるかどうかを社内で固定する |
| 仕掛品 | 原材料が払い出されてから完成品として入庫(または出荷)の手続きが済むまでのすべての段階にある品物(JIS Z 8141 の定義)。件数か金額で測る | 少ない | ある時点の在庫ではなく、期間の平均で見る。後述のリトルの法則で製造リードタイムと結びつく |
| 段取りで失う時間 | 機械を止めて行う段取り替え(内段取)に費やした時間の合計(この記事での定義) | 少ない | 段取り回数を減らすと同じ系列をまとめることになり、納期の早い注文が後回しになりやすい。第7章で両者の釣り合いを扱う |
| 残業時間 | 所定の稼働時間を超えて設備や作業者を動かした時間(この記事での定義) | 少ない | 残業で納期遵守率を支えている場合、残業時間が減った月に遅れが増える。2つを並べて読む |
表の6つの指標は、互いに独立ではありません。とくに、設備稼働率を高く保とうとすると仕事を多めに投入することになり、仕掛品が増え、製造リードタイムが伸び、納期遵守率が下がる、という連鎖が起きます。逆に、仕掛品を絞りすぎるとボトルネックの機械が仕事を待って止まり、スループット(単位時間に処理される仕事量)が落ちます。この連鎖の中心にあるのが、次に扱うリトルの法則と、待ち行列の理論が示す稼働率と待ち時間の関係です。どちらも個別のスケジューリング手法より前にある、工場全体の流れについての性質です。
段取りで失う時間について補足します。JIS Z 8141 の2001年版は、段取りを、機械やラインを停止しないで行う外段取と、停止して行う内段取に大別しています。スケジュールの順番で変わるのは主に内段取の回数と長さで、たとえば旋盤で製品系列を切り替えるたびに治具や刃物を替える時間がこれにあたります。段取りの時間そのものを短くする改善と、段取りの回数を順番の工夫で減らす最適化は役割が違い、その分担は第7章で整理します。
リトルの法則、仕掛品を減らすとリードタイムが縮む
工場の流れを考えるうえで最も基本的な関係が、リトルの法則です。John D. C. Little が1961年に学術誌 Operations Research(第9巻第3号)で証明を発表した待ち行列の定理で、「系の中にいる平均の個数は、平均の到着率と、1個が系の中にいる平均時間の積に等しい」という内容です。式では \( L = \lambda W \) と書き、\( L \) が系内の平均個数、\( \lambda \) が単位時間あたりの平均到着数、\( W \) が1個あたりの平均滞在時間です。Little と Graves が2008年に教科書の1章として書いた解説は、この関係が成り立つために、機械の台数、待ち行列の並び方、加工時間や到着間隔の分布、処理の順番を問わないことを強調しています。必要なのは、長い期間で平均をとったときに系が安定している、という前提だけです。
工場に当てはめると、系は工場またはある工程、個数は仕掛品、到着率は投入量(安定していれば出荷量と等しい)、滞在時間は製造リードタイムです。同じ解説は、生産管理の教科書である Hopp と Spearman の『Factory Physics』がこの法則をスループット・仕掛品・サイクルタイムの関係として書き直していることを紹介し、この形では「出力を増やすには、仕掛品を増やすか、サイクルタイムを短くするか、その両方が要る」と読めると述べています。これは式の上での関係で、サイクルタイムが変わらないと仮定したときに限って、仕掛品が多いほど出力が大きいと読めるという意味です。実際の工場では、仕掛品を増やすと待ちが増えてサイクルタイムも伸びるので、仕掛品を積み増せば出力が増えるとは限りません(この点は次の節の待ち行列の結果で確かめます)。同じ式を並べ替えると、製造リードタイムは仕掛品をスループットで割ったものになります。つまり、スループットを保ったまま仕掛品を減らせば、平均の製造リードタイムはそれに比例して縮みます。
解説には半導体工場の例が載っています。1日あたり平均1,000枚のウエハを投入し、仕掛品が平均45,000枚ある工場では、平均のフロータイム(投入から完成までの時間)は45日になります。個々のウエハの記録を追わなくても、投入量と仕掛品の平均という2つの数字だけで、リードタイムの平均が分かるということです。同じ計算を、架空の数字で工場の意思決定に当てはめてみます。週に60件の注文を出荷している工場で、工場の中に平均240件の仕掛品があれば、平均の製造リードタイムは4.0週です。出荷量を変えずに仕掛品を180件に減らせば3.0週、120件なら2.0週、90件なら1.5週になります(実行ログ ch01_queue.txt の4節)。
この計算が経営にとって意味を持つのは、リードタイムを縮める手段が「作業を速くする」だけではないことを示すからです。加工時間そのものが同じでも、工場の中に待っている仕事が多ければ、1件の注文は長く待たされます。投入を絞り、流れている仕事の量を管理するだけで、製造リードタイムは縮み得ます。仕掛品は棚卸資産として貸借対照表に計上され、その分の運転資金を拘束しているので、減らせば資金が浮きます。さらに、リードタイムが短くなれば受注から出荷までの約束を短く提示でき、需要予測に頼る範囲も狭まります。
ただし、リトルの法則を使ってはいけない場面もあります。Little と Graves の解説は、工場で使うときの条件として、投入と出力の平均が釣り合っていること、投入した仕事がいずれ完了して出ていくこと、観測期間の最初と最後で仕掛品の量がおおむね同じであること、仕掛品の平均の年齢が伸び続けたり縮み続けたりしていないことを挙げています。立ち上げ直後で仕掛品が増え続けている時期や、売れ残りの仕掛品が棚の奥に溜まって動かない状態では、法則から計算したリードタイムは実際と一致しません。また、法則が示すのは平均の関係だけで、個々の注文が納期に間に合うかどうかは教えてくれません。平均のリードタイムが縮んでも、順番の決め方が悪ければ特定の注文だけが遅れます。平均を決めるのが投入量の管理で、個々の注文の遅れを決めるのが順番の管理だと整理すると、スケジューリングの役割が見えやすくなります。
稼働率を上げすぎると待ち時間が急に伸びる
もう1つの基本的な関係は、機械の稼働率と待ち時間の関係です。待ち行列の理論の標準的な結果によれば、仕事が互いに無関係なばらばらの間隔で到着し、加工時間もばらつく1台の機械では、稼働率を1に近づけると待ち時間が際限なく伸びます。アイントホーフェン工科大学の Adan と Resing の講義ノート『Queueing Systems』は、最も基本的なモデル(到着の間隔も加工時間も指数分布に従う1台の機械。記号で M/M/1)について、1件あたりの平均滞在時間(待ち+加工)が平均加工時間の \( 1/(1-\rho) \) 倍になること(\( \rho \) は稼働率)、系内の平均個数とともに \( \rho \) が1に近づくと無限大に発散することを示し、その原因は到着と加工のばらつきにあると述べています。
加工時間の分布を問わない形もあります。同じノートが示す Pollaczek-Khinchin の平均値公式によると、到着がポアソン到着とみなせる1台の機械での平均待ち時間は \( \frac{\rho}{1-\rho} \cdot \frac{1+c^2}{2} \cdot E(B) \) です。ポアソン到着とは、仕事が互いに無関係に届き、到着の間隔が指数分布に従う到着の仕方のことで、ノートはこの到着を前提にした1台の機械のモデル(記号で M/G/1)としてこの式を示しています。到着の間隔が一定に近い、あるいは計画的に投入している工程では、この前提は成り立ちません。言葉にすると、平均の待ち時間は「稼働率を1から稼働率を引いた値で割ったもの」と「加工時間のばらつきの大きさで決まる係数」と「平均の加工時間」の積になります。ここで \( c \) は加工時間の標準偏差を平均で割った変動係数で、加工時間が毎回同じなら0、指数分布なら1です。ノートは、平均待ち時間が加工時間の平均と標準偏差だけで決まり、分布の細かい形には依らないことを指摘しています。
この式で、稼働率ごとの平均待ち時間を計算しました。単位は平均加工時間の何倍かで、加工時間が指数分布の場合と一定の場合を並べています。あわせて、同じ条件で40万件の到着を乱数で模擬し(先頭の1割は立ち上がりとして捨て、乱数のシードは固定)、模擬の値が式とほぼ一致すること、系内の時間平均の個数が到着率と滞在時間の積に一致すること、つまりリトルの法則が模擬の上でも成り立つことを確かめました。稼働率0.95の加工時間一定のケースでは模擬の値が式より大きく出ました(式9.50に対して模擬10.62。実行ログ ch01_queue.txt の2節)。この差の原因は確かめていません(観測を延ばす、乱数のシードを変えるといった追加の模擬はしていません)。その他のケースは式とよく合っています。
def wait_mg1(rho, cv2):
    """平均待ち時間を、平均加工時間の何倍かで返す(PK 平均値公式)
    rho: 稼働率 / cv2: 加工時間の変動係数の2乗(指数分布=1、一定=0)"""
    return rho / (1.0 - rho) * (1.0 + cv2) / 2.0

from sched_data import load_orders
m4 = [p for o in load_orders() for m, p in o["route"] if m == "M4"]
pm = sum(m4) / len(m4)                       # 熱処理炉 M4 の1件平均の加工時間(分)
for r in [0.70, 0.80, 0.90, 0.95]:
    wq = wait_mg1(r, 1.0) * pm               # 加工時間のばらつきを指数分布と仮定
    print("%.2f  待ち%5.0f分  待ち+加工%5.1f時間" % (r, wq, (wq + pm) / 60))
# 出力:
# 0.70  待ち  357分  待ち+加工  8.5時間
# 0.80  待ち  612分  待ち+加工 12.8時間
# 0.90  待ち 1377分  待ち+加工 25.5時間
# 0.95  待ち 2907分  待ち+加工 51.0時間
このコードでは、第2章で紹介する共通のサンプルデータ(架空の部品加工工場)から、熱処理炉 M4 の数字だけを借りています。受注12件のうち10件が熱処理炉を通り、その加工時間の合計は1,530分、1件あたりの平均は153.0分です。この平均加工時間を持つ熱処理炉に、仕事がポアソン到着で1件ずつ届き、加工時間が指数分布に従うと仮定して、稼働率ごとに1件あたりの「待ち+加工」の時間を計算したのが次の表と図です。受注12件を実際に並べたスケジュールではなく、到着と加工のばらつきを確率で表したモデルの計算であることに注意してください。
| 熱処理炉の稼働率 | 平均待ち時間(加工時間が指数分布、分) | 待ち+加工(加工時間が指数分布、時間) | 平均待ち時間の倍率(加工時間が一定、平均加工時間の何倍か) |
|---|---|---|---|
| 50% | 153 | 5.1 | 0.50 |
| 70% | 357 | 8.5 | 1.17 |
| 80% | 612 | 12.8 | 2.00 |
| 85% | 867 | 17.0 | 2.83 |
| 90% | 1,377 | 25.5 | 4.50 |
| 95% | 2,907 | 51.0 | 9.50 |
| 98% | 7,497 | 127.5 | 24.50 |
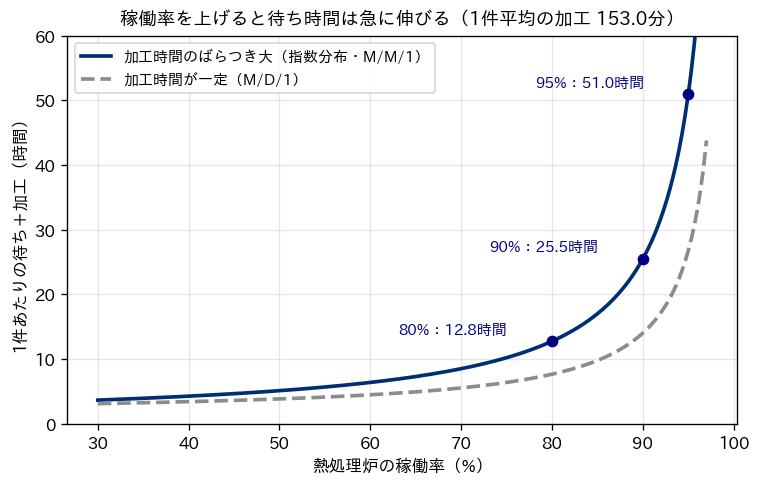
表の「待ち+加工(加工時間が指数分布、時間)」の列を見ると、稼働率50%では1件あたり5.1時間で済んでいたものが、80%で12.8時間、90%で25.5時間、95%で51.0時間になります。稼働率を80%から90%へ10ポイント上げると待ち+加工は2倍になり、90%から95%へ5ポイント上げるとさらに2倍になります。稼働率が高い領域では、わずかな上積みが大きな待ちを生みます。表の右端の列は加工時間が毎回一定の場合で、同じ稼働率でも待ち時間は指数分布の場合のちょうど半分です。加工時間のばらつきを小さくすることは、稼働率を下げるのと同じく待ちを減らす手段になります。
この結果は、設備稼働率を一律に高く保つことを目標にする管理と衝突します。高価な設備ほど遊ばせたくないのは自然ですが、ばらつきのある工場で稼働率を95%に上げれば、その設備の前には長い行列ができ、リトルの法則を通じて仕掛品と製造リードタイムが増えます。稼働率は、ボトルネックの設備では高く保つべき指標ですが、それ以外の設備では目標にしない方がよい指標です。ボトルネック以外の設備がボトルネックの前に仕事を積み上げても、工場全体の出荷量は増えず、仕掛品が増えるだけだからです。稼働率の目標は、設備ごとに、その設備が工場全体の流れの中でどこにあるかを見て決めるものだと考えています。
スケジューリングの役割は、この曲線を動かすことにあります。待ち行列のモデルは仕事がポアソン到着で届くと仮定していますが、実際の工場では、投入の時刻と順番をこちらで決められます。同じ稼働率でも、ボトルネックの前に仕事が途切れず、しかし積み上がりすぎないように投入と順番を組めば、モデルが示すよりも短い待ちで流せる余地があります。後の章で扱う最適化は、突き詰めれば、ばらつきを前提とした平均の曲線よりも良い点を、個々の注文の組み合わせの中から探す作業です。
指標どうしの釣り合いと、どれを優先するかという経営判断
ここまでの2つの関係から、経営指標の間には避けられない釣り合いがあることが分かります。設備稼働率を上げれば製造リードタイムが伸び、製造リードタイムを縮めるために仕掛品を絞ればボトルネックが止まるリスクが生じます。段取りで失う時間を減らすために同じ系列の注文をまとめれば、納期の早い注文が系列の順番待ちで遅れます。納期遵守率を上げるために残業を増やせば、人件費が増えます。すべての指標を同時に最良にするスケジュールは、ほとんどの場合存在しません。
したがって、スケジューリングを始める前に決めるべきことは、どの指標をどれだけ優先するかです。これは現場の計画担当者が1人で決められることではなく、経営の判断です。たとえば、重要顧客への納期遅れを1件でも出さないことを最優先にするなら、目的は「重み付きの納期遅れの最小化」になり、段取りの回数は多少増えても許容します。受注が安定していて設備投資を回収したい時期なら、ボトルネックの稼働率を目的に置き、非ボトルネックの稼働率は問わない、という決め方もあります。目的が変わればスケジュールが変わることは、第5章で同じ受注12件をメイクスパン最小と重み付き納期遅れ最小の2通りで解いて示します。
この優先順位を決めないままスケジューリングの仕組みを導入すると、現場の担当者は暗黙のうちに自分なりの目的で順番を組み続けることになります。その目的は、担当者が最も責められやすい指標、たとえば直近の納期遅れの件数に寄りやすく、段取りの時間や仕掛品は後回しになりがちです。数理最適化の手法を入れる価値の半分は、この暗黙の目的を明示的な式として書き出し、経営として合意することにあると考えています。第13章で、現場の暗黙知と例外ルールを制約と目的に落とす手順を扱います。
判断を誤ったときの損失の型
スケジューリングにかかわる判断の誤りは、多くの場合すぐには目に見えず、後から別の費用として現れます。どの誤りがどの経営指標に現れるかを整理しておくと、指標の悪化を見たときに原因の見当をつけやすくなります。次の表は、この記事で扱う判断の誤りを型に分け、表面に出る症状と経営指標での現れ方を並べたものです。
| 判断の誤りの型 | 表面に出る症状 | 経営指標での現れ方 | 主に扱う章 |
|---|---|---|---|
| 能力を見ずに計画を確定する | 計画どおりに流すと特定の設備に仕事が集中し、後半の週に遅れがまとめて出る | 納期遵守率の低下、残業時間の増加、外注費の発生 | 第8章・第10章 |
| 全設備の稼働率を一律に追う | 非ボトルネックの設備が先へ先へと加工し、ボトルネックの前に仕掛品が積み上がる | 仕掛品の増加、製造リードタイムの延長 | 第4章・第5章 |
| 段取りを減らすことだけを追う | 同じ系列をまとめすぎて、納期の早い注文が系列の順番待ちになる | 段取りで失う時間は減るが納期遵守率が下がる | 第7章 |
| 納期だけを追って段取りを無視する | 系列の切り替えが頻発し、段取りの合計で設備の実効能力が削られる | 設備稼働率の低下、残業時間の増加 | 第3章・第7章 |
| 計画を作りっぱなしで直さない | 故障や飛び込み注文のあと、現場が計画を無視して独自に順番を組む | 計画と実績の乖離、どの指標も説明できなくなる | 第12章・第13章 |
| 標準時間のマスタを更新しない | 計算上は間に合うはずの注文が毎回遅れる | 納期遵守率の慢性的な低下、計画への不信 | 第13章 |
表の上の2行は、この章で扱ったリトルの法則と稼働率の関係から直接導かれる型です。能力を見ずに確定した計画は、スケジューリングの段階で実行不可能であることが露見し、その差を残業と外注で埋めることになります。全設備の稼働率を一律に追う管理は、仕掛品を増やし、リトルの法則を通じて製造リードタイムを伸ばします。3行目と4行目は段取りと納期の釣り合いで、どちらか一方だけを追うと、もう一方の指標が悪化します。下の2行は、スケジュールの作り方ではなく運用の問題で、どれほど精緻な最適化を入れても、入力の標準時間が実態とずれていれば結果は現場で使われなくなります。
これらの損失を金額にするときは、指標ごとに換算の単価を決めておくと比較しやすくなります。残業は時間あたりの割増賃金、外注は外注単価と品質確認の手間、仕掛品は保有する金額に資本コストを掛けたもの、納期遅れは値引きや違約金に加えて失注の可能性で見積もります。単価そのものは会社ごとに違うため、この記事では例題の費用を架空の値として置きますが、実務ではこれらの単価を経理部門と合わせて決めておくことが、スケジューリングの目的関数を経営の数字につなぐ第一歩になります。費用の置き方は、第7章の段取り費や第8章の保管費の例題で具体的に扱います。
公的統計から見る、いま生産スケジューリングを見直す理由
スケジューリングを経営の問題として取り上げる背景には、製造業の人手の制約があります。『2026年版ものづくり白書』(経済産業省・厚生労働省・文部科学省の3省が共同で作成し、2026年5月29日に閣議決定)について厚生労働省が公表した資料によると、製造業の就業者数は2023年の1,055万人から、2024年の1,046万人、2025年の1,033万人へと減少しました。同じ資料の概要(厚生労働省担当パート)は、中小企業庁の中小企業景況調査をもとに、中小企業の製造業の従業員数過不足DI(従業員が「過剰」と答えた企業の割合から「不足」と答えた企業の割合を引いた値)が2025年にマイナス17.9で、感染症の拡大前の2019年に近い水準にあることを示しています。数字が負であるほど、人が足りないと答える企業が多いという意味です。
1年前の『2025年版ものづくり白書』の概要は、事業環境に影響を及ぼす社会情勢の変化として、原材料価格とエネルギー価格の高騰に加えて労働力不足を挙げる事業者が多いこと(民間の委託調査による)、製造業が日本の GDP の約2割を占めることも記しています。この2点は2026年版では確認できていないため、2025年版の記述として紹介します。人を増やして能力を足すことが難しい状況では、同じ人員と設備から引き出せる出荷量と、約束できる納期が競争力を左右します。スケジューリングの改善は、設備投資や採用に比べて小さな検証から始められる場合があり、既存の能力の使い方を変えることで効果を出せる余地がある点で、この状況に合った打ち手だと考えています。ただし、仕組みとして定着させるには、データの整備やシステムの導入に費用がかかることもあります。
一方で、統計が示すのは業界全体の傾向で、個々の工場で順番の工夫がどれだけの効果を生むかは、その工場の受注の組み合わせ、設備の構成、段取りの重さによって大きく変わります。導入の効果を見積もるときは、自社の過去数か月の受注と実績を使って、現行の順番の決め方と最適化した順番を同じ指標で比べるのが確実です。この記事の各章で共通のサンプルデータに対して行う比較は、その比べ方の手本として読める形にしています。
この記事の進め方
第2章では、スケジューリング問題を記述するための言葉(機械の環境・制約・目的)と、この記事全体で使う架空の工場のサンプルデータを紹介します。第3章から第5章は、単一機械、フローショップ、ジョブショップと、設備の構成が複雑になる順に、順番を決める手法とその限界を扱います。第6章は数理最適化の2つの道具である混合整数計画と制約プログラミングの使い分け、第7章から第10章は段取り・ロットの量・並列機械とライン・人や治具の制約といった実務の条件の入れ方、第11章と第12章は大規模化と不確実性への対処、第13章と第14章は現場への導入と事例です。
各章では、手法の説明に加えて、その手法が何を決めるのか、どういう前提で使えるのか、使ってはいけないのはどういうときか、結果を経営指標にどう翻訳するかを書きました。この章で定義した6つの経営指標と損失の型の表は、各章で結果を読むときの共通の物差しとして使います。
この章の要点は3つです。第一に、スケジューリングは生産管理の計画の階層の最下層に近い位置で、上から渡された製造オーダを実行できる順番と時刻に直すと同時に、上の計画が実行可能かどうかを検査する役割を持っています。第二に、リトルの法則によって仕掛品と製造リードタイムは比例して結びついており、待ち行列の理論によって稼働率を1に近づけると待ち時間は急に伸びます。したがって、設備稼働率を一律に追う管理は、仕掛品と製造リードタイムの悪化という形で損失を生みます。第三に、どの経営指標を優先するかはスケジューリングの前に経営が決めるべき判断で、その判断が最適化の目的関数になります。次の第2章では、その目的関数と制約を書き表すための言葉を整理します。
この章を深めたい方への参考書籍
『ザ・ゴール 企業の究極の目的とは何か』(エリヤフ・ゴールドラット著、三本木亮訳、ダイヤモンド社):工場長を主人公にした小説の形で、制約条件の理論(工場全体の出力はボトルネックで決まるという考え方)を説明した本です。この章で扱った稼働率・仕掛品・スループットの関係を、数式を使わずに工場の場面の中で考えられるため、経営層と現場で考え方をそろえる題材になると考えています。
『生産マネジメント入門 1 生産システム編』(藤本隆宏、日本経済新聞社):生産システムを競争力の観点から整理した教科書で、目次にはコスト・生産性、納期と工程管理、品質、フレキシビリティ、生産戦略の章が並びます。この章で扱った経営指標を、コスト・品質・納期・柔軟性という競争力の要素の中に位置づけて理解するのに向いています。
『Factory Physics』(Wallace J. Hopp、Mark L. Spearman、Waveland Press、第3版):リトルの法則を工場のスループット・仕掛品・サイクルタイムの関係として整理し、ばらつきが工場の性能をどう悪化させるかを体系的に論じた教科書です。この章で紹介した稼働率と待ち時間の関係を、工場全体の流れの設計にどう生かすかを、第2部の章(基本的な工場の動き、ばらつきの基礎など)で学べます。洋書ですが、この章の考え方の原典にあたります。
第2章 スケジューリング問題を記述する、機械環境・制約・目的とガントチャート
第1章では、生産スケジューリングが計画の階層の最も下で「どの仕事を、どの機械で、どの順番に、何時から」を決める工程であり、その出来がリードタイム・納期遵守率・仕掛品・残業といった経営指標に直接表れることを確認しました。この章では、解き方に入る前の準備として、スケジューリング問題を「誰が読んでも同じ問題だと分かる形」で書き表す方法を整理します。工場の現実は複雑ですが、研究の世界では問題を機械の並び方・制約・目的の3つの要素に分けて記述する共通の型が確立しており、その型に当てはめると、自社の問題がどの既知の問題に近いか、どの程度の手間で解けそうかの見当が付くようになります。あわせて、第3章以降で使う共通のサンプルデータを紹介し、受注12件に素朴な先着順を当てたガントチャートを描いて、スケジュールの良し悪しをどう読むかを示します。
ジョブ・機械・工程、問題を書くための最小限の言葉
スケジューリングの教科書や論文では、加工の対象となる受注や製造指図をジョブと呼びます。ジョブは1つ以上の工程(オペレーション)からなり、各工程は決まった機械で決まった時間だけ加工されます。この加工時間は記号で \( p_j \)(ジョブ \( j \) の加工時間)と書くのが慣例です。工場の言葉に置き換えると、ジョブは製造指図書1枚、工程は工程表の1行、機械は設備や作業場、加工時間は標準時間にあたります。この記事では、機械は同時に1つの工程しか加工できず、1つのジョブは同時に2台の機械で加工されない、という前提を置きます。これはスケジューリング理論の標準的な前提で、Graham・Lawler・Lenstra・Rinnooy Kan の1979年の概説論文も、問題の分類を始める前にこの2つを全体の前提として置いています。
ジョブには加工時間のほかに、時刻と重要度に関する3つの情報が付くことがよくあります。1つ目は着手可能時刻 \( r_j \) で、材料が届く、前工程の外注から戻るといった理由で、それより前には加工を始められない時刻です。2つ目は納期 \( d_j \) で、それまでに加工を終えたい時刻です。3つ目は重み \( w_j \) で、そのジョブが遅れたときの痛みの大きさを表す係数です。同じ論文は重みを「ジョブの相対的な重要度」と定義しています。実務では、顧客の重要度、違約金の有無、後工程や組立ラインへの影響の大きさなどを1つの数字にまとめたものと考えると扱いやすく、同じ1時間の遅れでも重みが3のジョブは重みが1のジョブの3倍の損失と数えます。
スケジュールを決めると、各ジョブの完了時刻 \( C_j \) が決まります。完了時刻から納期を引いた値を遅れ(ラテネス)と呼び、\( L_j = C_j – d_j \) と書きます。納期より早く終わった場合は負の値になります。遅れのうち正の部分だけを取り出したものが納期遅れ(ターディネス)で、\( T_j = \max(0, C_j – d_j) \) と書きます。言葉にすれば「納期に間に合ったジョブは0、遅れたジョブは遅れた分の時間」です。さらに、納期に遅れたかどうかだけを0か1で表したものを \( U_j \) と書きます。これら4つの定義は1979年の論文の第2.5節にそのまま載っているもので、後の節で説明する目的関数は、すべてこの完了時刻・遅れ・納期遅れ・遅れの有無を、全ジョブについて足し合わせるか、最大値を取るかして作ります。
もう1つ、ジョブが工場に入ってから出るまでの時間を流れ時間(フロータイム)と呼び、完了時刻から着手可能時刻を引いた \( C_j – r_j \) で測ります。第1章で扱った製造リードタイムを、ジョブ1件ずつについて測ったものがこれにあたります。流れ時間は「加工している時間」と「機械の前で待っている時間」の和で、前者は標準時間でほぼ決まってしまうため、スケジューリングで縮められるのは主に後者です。後の節で先着順のスケジュールを測ると、この待ちの割合がどれほど大きいかが数字で見えます。
機械環境の5つの型、単一・並列・フローショップ・ジョブショップ・オープンショップ
スケジューリング問題の性格を最も大きく左右するのは、機械がどう並び、ジョブがどの順番で機械を回るかです。これを機械環境と呼びます。最も単純なのは機械が1台だけの単一機械で、ジョブは1つの工程しか持たず、決めることは「どの順に並べるか」だけです。工場全体が1台で済むことは少ないものの、全体の出来を決めているボトルネック設備(最も負荷の高い設備)だけを取り出して考えるときに、この型がそのまま使えます。第3章はこの型を扱います。
同じ役割の機械が複数台あり、ジョブはどれか1台で加工されればよい、というのが並列機械です。1979年の論文は並列機械を3つに分けています。どの機械でも加工時間が同じ「同一並列機械」、ジョブごとの標準の加工時間に機械ごとの係数(論文の用語では速度係数)を掛けたものがその機械での加工時間になる「一様並列機械」(係数が大きい機械ほど加工に時間がかかる、つまり遅い)、ジョブと機械の組み合わせごとに加工時間がばらばらな「無関係並列機械」です。同じ型式の旋盤が3台並んでいれば同一、新旧の機械で速さが違えば一様、得意・不得意が品目ごとに違えば無関係と考えるとよいでしょう。並列機械では「どの機械に割り当てるか」と「各機械でどの順に並べるか」の2つを同時に決めることになり、第9章で扱います。
ジョブが複数の工程を持つ場合は、工程の回り方で3つの型に分かれます。すべてのジョブが同じ順番で機械を回るのがフローショップで、機械1、機械2、機械3の順に全ジョブが流れる加工ラインや連続工程がこれにあたります。ジョブごとに回る順番が決まっていて、その順番がジョブによって違うのがジョブショップで、多品種の部品加工工場や試作工場のように、品目ごとに工程表が違う現場がこれにあたります。回るべき機械は決まっているものの、回る順番は問わないのがオープンショップで、検査や試験のように「全部の項目を済ませればどの順でもよい」作業がこれに近い形です。フローショップは第4章、ジョブショップは第5章と第6章で扱います。
| 機械環境 | ジョブの回り方 | 工場での例 | 記号 | この記事で扱う章 |
|---|---|---|---|---|
| 単一機械 | 1台の機械で1工程 | ボトルネック設備1台の前の順番待ち | 1 | 第3章・第7章 |
| 同一並列機械 | 同じ能力の複数台のどれか1台で1工程 | 同じ型式の成形機が並ぶ職場 | P | 第9章 |
| 一様並列機械 | 速度の違う複数台のどれか1台で1工程 | 新旧の機械が混在する職場 | Q | 第9章 |
| 無関係並列機械 | 組み合わせごとに加工時間が違う複数台のどれか1台 | 品目ごとに得意な機械が違う職場 | R | 第9章 |
| フローショップ | 全ジョブが同じ順番で複数の機械を回る | 加工ライン・連続工程 | F | 第4章・第11章 |
| ジョブショップ | ジョブごとに決まった、ジョブによって違う順番で回る | 多品種の部品加工・試作 | J | 第5章・第6章 |
| オープンショップ | 回る機械は決まっているが順番は自由 | 順不同でよい検査・試験の項目 | O | この記事では扱わない |
表の「記号」の列は、後の節で説明する3項記法で機械環境を表す文字で、1979年の論文の定義に合わせました。自社の工場をこの表に当てはめるときの注意が1つあります。現実の工場は1つの型にきれいに収まらないことが多く、たとえば大半の品目は旋盤、マシニングセンタ、検査の順に流れるが一部の品目だけ研削盤を経由する、という工場はフローショップともジョブショップとも言い切れません。この場合は、より一般的な型(この例ならジョブショップ)で書いておくのが安全です。一般的な型で書いたモデルは特殊な場合も含むので、あとで「実はほとんどフローショップだった」と分かっても、モデルを書き直さずに済みます。逆に、特殊な型で書いてしまうと、例外の品目が現れたときに手法ごと差し替えることになります。
制約、着手可能時刻・先行関係・段取り・中断
機械環境が同じでも、ジョブに付く条件によって問題の性格は大きく変わります。1979年の論文は、この条件を「ジョブの特性」として6つの欄で分類しています。中断(加工の途中で止めて後で再開してよいか)、資源(機械以外の限られた資源を使うか)、先行関係(あるジョブが終わるまで別のジョブを始められないか)、着手可能時刻(ジョブごとに違う着手可能時刻があるか)、ジョブあたりの工程数の上限、加工時間の条件(すべて1単位時間であるか等)の6つです。何も書かなければ、中断なし・資源制約なし・先行関係なし・全ジョブの着手可能時刻が0、という最も単純な設定を意味します。
実務で最もよく現れるのは、着手可能時刻と先行関係です。着手可能時刻は材料の入荷予定や前工程の完了予定から決まり、これを無視したスケジュールは「材料が無いのに加工を始める」計画になります。先行関係は、組立品の子部品がそろわないと組立を始められない、といったジョブ間の順序の縛りです。ジョブショップの「1つのジョブの中の工程の順番」も先行関係の一種ですが、こちらは機械環境の定義に含まれているので、改めて書く必要はありません。
中断の可否は、現場の設備の性質で決まります。熱処理炉のように一度入れたら規定時間まで取り出せない工程や、切削の途中で段取りを崩すと精度が出ない工程は中断できません。一方で、手作業の組立や検査は昼休みで区切って再開できることが多いでしょう。中断を許すと問題が易しくなる場合があることが知られていますが、この記事では断らない限り中断なしで扱います。稼働カレンダー(昼休み・夜間停止)と中断の関係は第10章で扱います。
段取りは、1979年の論文の6つの欄には含まれていません。しかし実務のスケジューリングでは最も重要な制約の1つで、前に加工した品目と次に加工する品目の組み合わせによって段取り時間が変わる「順序依存の段取り」は、並べる順番そのものが加工能力を左右します。この記事では、段取りを制約の欄に書き足して扱い、第7章で順序依存の段取りを詳しく扱います。資源制約(作業者の人数、治具の数、炉の容量)は第10章で扱います。
目的関数とその経営上の意味
スケジュールの良し悪しを1つの数字で測るのが目的関数です。何を目的にするかで最適なスケジュールは変わるため、目的の選択は技術の問題ではなく経営の判断です。1979年の論文は、よく使われる目的を2つの系統に整理しています。1つは全ジョブの中で最も悪い値を小さくする「最大値」の系統で、最後のジョブの完了時刻であるメイクスパン \( C_{\max} \) と、最大遅れ \( L_{\max} \) がこれにあたります。もう1つは全ジョブの値を足し合わせる「総和」の系統で、総完了時間 \( \sum C_j \)、総納期遅れ \( \sum T_j \)、遅れ件数 \( \sum U_j \) と、それぞれに重みを掛けた \( \sum w_j C_j \)、\( \sum w_j T_j \)、\( \sum w_j U_j \) がこれにあたります。
| 目的関数 | 記号 | 言葉での意味 | 経営指標への翻訳 | この目的が向く場面 |
|---|---|---|---|---|
| メイクスパン最小 | \( C_{\max} \) | 最後のジョブが終わる時刻を早める | 受注の束を捌き切る時間、設備の稼働率、残業の要否 | 今週分をいつまでに終えられるかを知りたい、繁忙期の山を早く崩したい |
| 総完了時間最小 | \( \sum C_j \) | 全ジョブの完了時刻の合計を小さくする | 平均の製造リードタイムと平均の仕掛品(全ジョブの着手可能時刻が同じ場合。ばらつく場合は流れ時間の合計 \( \sum (C_j – r_j) \) のほうが直接対応する) | 仕掛品と工場内の滞留を減らしたい |
| 最大遅れ最小 | \( L_{\max} \) | 最も遅れたジョブの遅れを小さくする | 最悪の顧客への遅延時間 | 1件でも大きく遅れると取引に響く |
| 総納期遅れ最小 | \( \sum T_j \) | 遅れた時間の合計を小さくする | 遅延時間の総量 | 遅れの長さに比例して損失が増える |
| 遅れ件数最小 | \( \sum U_j \) | 納期に遅れる件数を減らす | 納期遵守率 | 遅れの長さより件数が評価される(遵守率が契約指標) |
| 重み付き総納期遅れ最小 | \( \sum w_j T_j \) | 重要なジョブほど重く数えた遅れの合計を小さくする | 遅延による損失額の近似 | 顧客や品目ごとに遅れの痛みが違う |
表のうち、どれを選ぶかで結論が大きく変わる組み合わせがあります。メイクスパンを最小にするスケジュールは、最後の1件が早く終わりさえすれば途中の順番を問わないので、納期の近いジョブを後回しにする解も同じ値として扱います。反対に総納期遅れを最小にするスケジュールは、納期に余裕のあるジョブを後ろに回すため、メイクスパンはかえって延びることがあります。遅れ件数の最小化はさらに極端で、間に合わないと分かったジョブを最後まで後回しにする解を返すことがあり、件数は減っても1件の遅れが非常に長くなります。第5章では、受注12件をメイクスパン最小と重み付き納期遅れ最小の2通りで解き、スケジュールがどう変わるかをガントチャートで比べます。
目的を1つに絞れない場合は、複数の目的に重みを付けて足すか、1つを目的にして残りを制約に回す(たとえば「遅れ件数は2件以下」という条件のもとでメイクスパンを最小にする)のが一般的です。どちらの場合も、重みや上限の値は経営が決める数字です。遅れ1時間の損失と残業1時間の費用のどちらが重いかは、ソルバーではなく経営が答えるべき問いで、その答えがないまま最適化を回すと、技術者が暗黙に決めた重みで工場が動くことになります。
3項記法で問題を1行に書く
ここまでの3つの要素、つまり機械環境・制約・目的関数を縦線で区切って1行に書くのが、スケジューリング理論の共通語である3項記法です。1979年の Graham らの論文が導入したもので、α|β|γ の形で書きます。α が機械環境、β がジョブの特性(制約)、γ が目的関数です。β が空なら縦線を2本続けて書きます。たとえば 1||ΣwjTj は「単一機械で、特別な制約はなく、重み付き総納期遅れを最小にする」問題、F2||Cmax は「2台のフローショップでメイクスパンを最小にする」問題、Jm||Cmax は「m台のジョブショップでメイクスパンを最小にする」問題です。β に rj と書けば着手可能時刻あり、prec と書けば先行関係あり、pmtn と書けば中断を許すという意味になります。
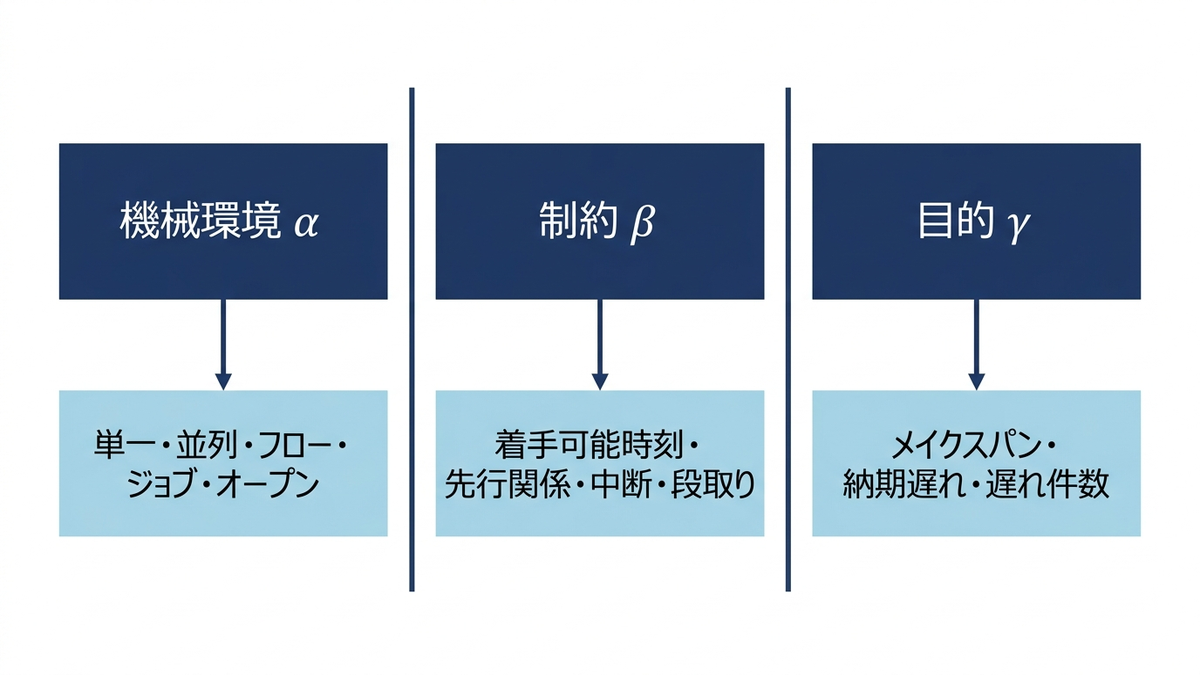
この記法の価値は、問題を1行で書けることそのものより、書いた1行から「既知の結果」を引けることにあります。スケジューリングの研究は数十年にわたってこの記法の組み合わせごとに結果を積み上げており、自社の問題を1行に書ければ、同じ行について何が分かっているかを文献で探せます。次の表は、1979年の論文に載っている結果のうち、この記事の各章に関わるものを抜き出したものです。「易しい」は、ジョブ数が増えても計算時間が穏やかにしか増えない解き方(多項式時間の解法)が知られていること、「難しい」は、後の節で説明する NP 困難であることが示されていることを意味します。
| 問題(3項記法) | 言葉での意味 | 1979年の論文での位置づけ | 詳しく扱う章 |
|---|---|---|---|
1||ΣwjCj | 単一機械、重み付き総完了時間 | 易しい(加工時間あたりの重みの大きい順に並べる Smith の規則、1956年) | 第3章 |
1||Lmax | 単一機械、最大遅れ | 易しい(納期の早い順に並べる Jackson の規則、1955年) | 第3章 |
1|rj|Lmax | 単一機械、着手可能時刻あり、最大遅れ | 難しい(着手可能時刻を入れただけで NP 困難になる) | 第3章 |
1||ΣUj | 単一機械、遅れ件数 | 易しい(Moore の方法、1968年) | 第3章 |
1||ΣwjUj | 単一機械、重み付き遅れ件数 | 難しい(ただし加工時間の合計に比例する時間の動的計画で解ける) | 第3章 |
1||ΣwjTj | 単一機械、重み付き総納期遅れ | 難しい | 第3章 |
F2||Cmax | 2台のフローショップ、メイクスパン | 易しい(Johnson の規則、1954年) | 第4章 |
F3||Cmax | 3台のフローショップ、メイクスパン | 難しい | 第4章 |
J2||Cmax | 2台のジョブショップ、メイクスパン | 各ジョブの工程が2つまでなら易しい。3工程以上のジョブがあると難しい | 第5章 |
この表から読み取れるのは、問題の設定がわずかに変わるだけで、易しい問題が難しい問題に変わることです。単一機械の最大遅れは納期順に並べるだけで最適になるのに、ジョブごとの着手可能時刻が加わると NP 困難になります。遅れ件数は重みがなければ易しいのに、重みを付けると難しくなります。フローショップは機械2台なら規則1つで最適解が出るのに、3台になると難しくなります。現場の言葉で言えば、「材料の入荷日がばらばら」「顧客ごとに重要度が違う」「工程が1つ増えた」といった、ごく普通の条件の追加で、手計算で最適解を出せる世界の外に出てしまう、ということです。
なお、表の各規則が「どういう前提で最適になるか」「前提が崩れたときにどれほど悪くなるか」は第3章と第4章で実際に計算して確かめます。この章では、3項記法が自社の問題を既知の結果と照らし合わせる索引として使える、という点を押さえておけば十分です。工場の問題を1行に書こうとすると、「うちの工場で本当に守らなければならない制約は何か」「本当に小さくしたい指標は何か」を言葉にせざるを得なくなります。この言語化の作業そのものが、スケジューリングを導入するときの最初の成果物になると考えています。
第2章で用意したサンプルデータ、架空の部品加工工場
この記事の第3章以降では、手法を横に比べられるように、同じ1つの工場のデータを使い回します。このデータは実在の企業の記録ではありません。乱数の種(シード)を固定して生成した架空のサンプルで、誰が何度実行しても同じ値が出るようにしてあります。数値の規模は部品加工工場を想定して決めましたが、特定の業種・企業の実績を写したものではないので、この記事で出てくる計算結果(遅れの件数、稼働率、計算時間など)も、あくまでこの架空の工場についての値として読んでください。データを作るコードは記事フォルダの sched_data.py にまとめ、各章のコードは冒頭の1行でこれを読み込みます。
工場には5種類の機械があります。M1 旋盤、M2 マシニングセンタ、M3 研削盤、M4 熱処理炉、M5 検査です。製品は F1 から F4 の4つの系列に分かれ、系列が変わるときに段取り替えが発生します。時間の単位はすべて分で、時刻0を月曜の8時とし、稼働は途切れずに続くものとみなします。夜間停止や昼休みといったシフトの扱いは第10章で改めて入れます。このデータから、章の主題に合わせて7種類の問題を切り出しました。
| データ | 中身 | 規模の目安 | 主に使う章 |
|---|---|---|---|
| 受注12件(ジョブショップ) | 受注 J01〜J12。各受注に系列・工程順(3〜5工程、最後は必ず M5 検査)・着手可能時刻・納期・重み(1〜3) | 総加工時間 5,850分。機械別の負荷は M1 1,210分、M2 1,330分、M3 1,430分、M4 1,530分、M5 350分 | 第2章・第5章・第6章・第10章・第11章・第12章 |
| 単一機械15件 | M2 マシニングセンタに並ぶ15件 S01〜S15。加工時間・納期・重み・系列 | 総加工時間 1,300分 | 第3章・第7章 |
| 系列間の段取り時間 | 系列 F1〜F4 の間の段取り時間の4行4列の表。同じ系列の連続は0分で、行き帰りで時間が違う(非対称) | 20分から70分 | 第7章 |
| フローショップ | 10ジョブが4台の機械を同じ順番で回る。ジョブと機械ごとの加工時間 | 機械別の合計 780分、660分、800分、660分 | 第4章・第11章 |
| 並列機械 | 20ジョブを速度の違う3台に割り当てる。標準加工時間と、それに掛ける機械ごとの速度係数(1.0、1.25、1.6。値が大きい機械ほど遅い) | 標準加工時間の合計 3,080分 | 第9章 |
| ロットサイジング | 4製品の12週分の需要、1個あたり加工時間、段取り時間、段取り費、保管費、週の稼働時間 | 週の稼働時間 4,800分。段取りを除いた必要時間が最大で容量の111.8%になる週がある | 第8章 |
| 組立ラインの作業 | 20個の作業の作業時間(秒)と先行作業 | 作業時間の合計 458秒 | 第9章 |
| 公開ベンチマーク ft06 ほか | OR-Library の jobshop1.txt に収録された問題。ft06 は6ジョブ×6機械 | ft10 は10ジョブ×10機械 | 第5章・第6章・第11章 |
表の最後の行だけは架空のデータではなく、研究で広く使われている公開ベンチマークです。J. E. Beasley が作成・運営する OR-Library(ブルネル大学のサーバーで公開されている、オペレーションズ・リサーチの試験問題集)に、ジョブショップの試験問題82問を収めたファイル jobshop1.txt があり、ft06・ft10・ft20 の3問は Fisher と Thompson が1963年に Muth と Thompson の編著『Industrial Scheduling』に発表したものだと、同じファイルの冒頭に出典が記されています。架空のデータだけで手法を比べると、データの作り方がたまたまある手法に有利だった可能性を消せません。公開ベンチマークは、世界中の研究者が同じ問題を解いて結果を報告しているので、自分の実装が正しく動いているかを確かめる物差しとして使えます。
受注12件の中身を少し見ておきます。最も加工時間の長い受注は J02 の730分(5工程)、最も短いのは J08 の200分(4工程)です。着手可能時刻は0分(月曜8時から着手可)の受注が4件、60分・120分・240分の受注がそれぞれ2件・2件・4件あり、材料の届き方がばらばらな状況を表しています。納期は最も早い J08 が630分(月曜18時30分)、最も遅い J02 が2,520分(水曜の午前2時)です。重みが3の受注は J04 と J05 の2件で、この2件は遅れたときの痛みが最も大きい受注として扱います。機械の負荷を見ると M4 熱処理炉が1,530分で最も重く、12件すべてを捌くには、ほかの機械がどれだけ速くても M4 だけで1,530分、つまり25時間30分はかかります。この「最も重い機械の負荷」は、どんなスケジュールでもメイクスパンがこれより短くならないという下界(これより良くはならないという限界の値)になります。
費用のパラメータ(ロットサイジングの段取り費・保管費など)も同じく架空の値です。第8章で使うときに改めて断ります。
ガントチャートを読む、受注12件を先着順で流す
スケジュールを目で確かめる道具がガントチャートです。横軸に時刻、縦軸に機械を取り、各工程を開始から終了までの横棒で描きます。棒の色でジョブや系列を見分けられるようにすると、どの機械がいつ何を加工し、いつ空いているかが一目で分かります。ここでは、受注12件に最も素朴な決め方である先着順を当てて、ガントチャートを描きます。先着順とは、機械が空いたときに、その機械の前で待っている工程のうち先に着いたものから加工する決め方です。同時に着いたものは受注番号の小さい順にしました。多くの現場で、特にルールを決めずに回していると、結果的にこれに近い動き方になっていることが多いように思います。
コードの骨格は次のとおりです。すべての工程について「始められる最も早い時刻」を計算し、その時刻が最も早い工程を1つずつ確定させていきます。機械の前での待ちの順番は、工程がその機械に着いた時刻で決めます。
from sched_data import MACHINES, load_orders
orders = load_orders()
route = {o["id"]: o["route"] for o in orders}
nxt = {o["id"]: 0 for o in orders}               # 次に加工する工程の番号
ready = {o["id"]: o["release"] for o in orders}  # 次の工程が機械の前に着く時刻
free = {m: 0 for m in MACHINES}                  # 機械が空く時刻
sched = []
for _ in range(sum(len(r) for r in route.values())):
    cand = []
    for jid, k in nxt.items():
        if k < len(route[jid]):
            m, p = route[jid][k]
            cand.append((max(ready[jid], free[m]), ready[jid], jid, m, p))
    t = min(c[0] for c in cand)
    start, _, jid, m, p = min([c for c in cand if c[0] == t], key=lambda c: (c[1], c[2]))
    sched.append((jid, m, start, start + p))
    free[m] = ready[jid] = start + p
    nxt[jid] += 1
C = {o["id"]: max(e for j, _, _, e in sched if j == o["id"]) for o in orders}
print("メイクスパン", max(C.values()))
print("遅れ件数", sum(1 for o in orders if C[o["id"]] > o["due"]))
print("重み付き総納期遅れ", sum(o["weight"] * max(0, C[o["id"]] - o["due"]) for o in orders))
# 出力:
# メイクスパン 1870
# 遅れ件数 6
# 重み付き総納期遅れ 5730
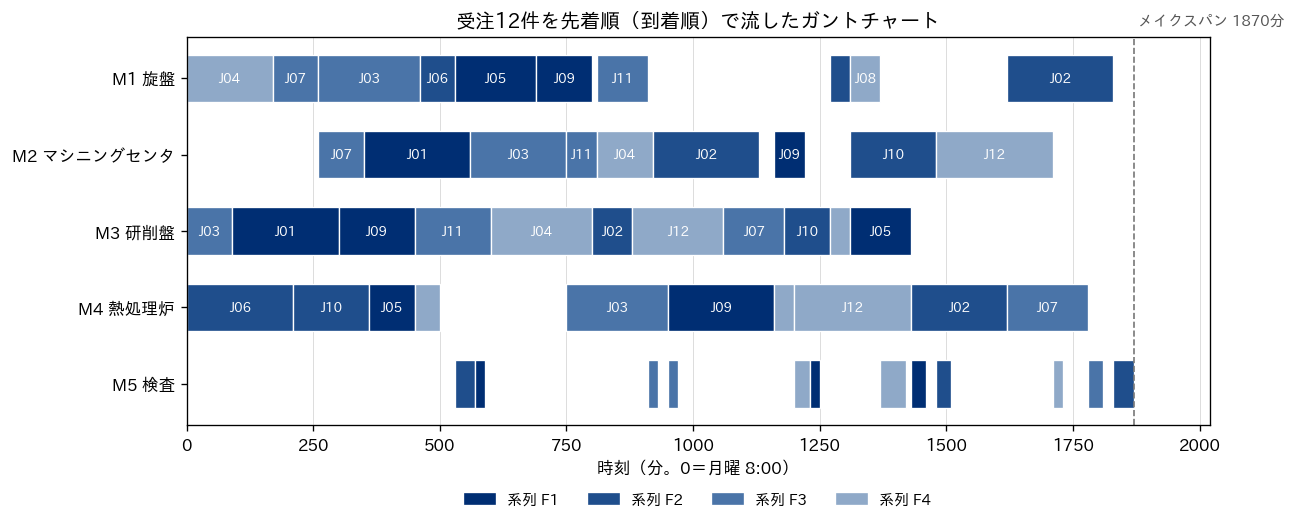
ガントチャートを読むときは、3つの点を見ます。第一に、右端がメイクスパンです。この先着順のスケジュールでは、最後の工程(J02 の検査)が1,870分に終わります。月曜8時に始めて、火曜の15時10分に全件が終わる計算です。前の節で求めた下界は M4 熱処理炉の負荷1,530分でしたから、このスケジュールは下界より340分、比率で22.2%長いことになります。最適なスケジュールのメイクスパンは1,530分から1,870分の間のどこかにあり、どこにあるかは第5章で実際に解いて確かめます。
第二に、機械ごとの空きを見ます。最も負荷の重い M4 熱処理炉には、500分から750分のあたりに約250分の空きがあります。この時間帯、このあと M4 を通る6件(J02、J03、J04、J07、J09、J12)は、いずれも前の工程で加工中か、前の工程の機械の前で順番を待っていました。とくに M3 研削盤は0分から1,430分まで一度も止まらずに加工を続けており、M3 が最初の工程である J12 は、240分に着手可能になってから880分まで、640分も M3 の前で待ちました。最も負荷の重い機械が、上流の渋滞のせいで手待ちになっている状態です。ボトルネックで失った1時間は工場全体で失った1時間になるので、この空きは経営上最も高くつく空きです。先着順は各機械が目の前の工程だけを見て順番を決めるため、下流のボトルネックに仕事を途切れなく送る、という工場全体の視点を持てません。
第三に、ジョブごとの流れを見ます。ガントチャートは機械の視点の図なので、ジョブの視点で見るには、ジョブごとに着手可能時刻から完了までを並べた図のほうが読みやすくなります。次の図は、各受注の着手可能時刻から完了までを横棒で、納期を灰色の縦線で描いたものです。棒の右端が縦線より右にある受注が、納期に遅れた受注です。
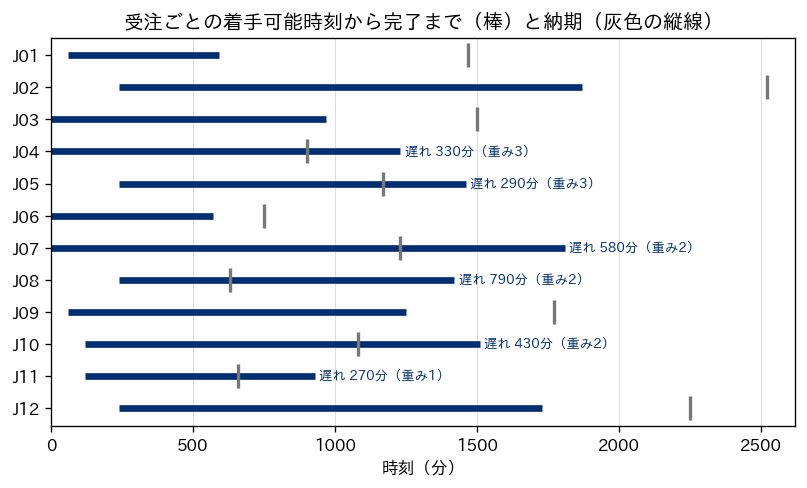
実行ログから、先着順のスケジュールの指標を1つの表にまとめます。「流れ時間」は完了時刻から着手可能時刻を引いた値、「待ち」は流れ時間から加工時間の合計を引いた値です。
| 受注 | 着手可能時刻(分) | 納期(分) | 重み | 完了時刻(分) | 流れ時間(分) | 加工時間の合計(分) | 待ち(分) | 納期遅れ(分) |
|---|---|---|---|---|---|---|---|---|
| J01 | 60 | 1,470 | 1 | 590 | 530 | 440 | 90 | 0 |
| J02 | 240 | 2,520 | 1 | 1,870 | 1,630 | 730 | 900 | 0 |
| J03 | 0 | 1,500 | 1 | 970 | 970 | 700 | 270 | 0 |
| J04 | 0 | 900 | 3 | 1,230 | 1,230 | 550 | 680 | 330 |
| J05 | 240 | 1,170 | 3 | 1,460 | 1,220 | 400 | 820 | 290 |
| J06 | 0 | 750 | 1 | 570 | 570 | 320 | 250 | 0 |
| J07 | 0 | 1,230 | 2 | 1,810 | 1,810 | 490 | 1,320 | 580 |
| J08 | 240 | 630 | 2 | 1,420 | 1,180 | 200 | 980 | 790 |
| J09 | 60 | 1,770 | 1 | 1,250 | 1,190 | 550 | 640 | 0 |
| J10 | 120 | 1,080 | 2 | 1,510 | 1,390 | 480 | 910 | 430 |
| J11 | 120 | 660 | 1 | 930 | 810 | 330 | 480 | 270 |
| J12 | 240 | 2,250 | 2 | 1,730 | 1,490 | 660 | 830 | 0 |
全体の指標は次のとおりです。メイクスパンは1,870分、総完了時間は15,340分、平均の流れ時間は1,168.3分です。納期に遅れたのは12件中6件(J04、J05、J07、J08、J10、J11)で、納期遵守率は50%です。総納期遅れは2,690分、重み付き総納期遅れは5,730分、最大遅れは J08 の790分(13時間10分)です。重みが3の2件(J04 と J05)はどちらも遅れており、それぞれ330分と290分遅れています。
流れ時間の内訳は、さらに示唆に富んでいます。12件の流れ時間を合計すると14,020分で、そのうち加工している時間は5,850分、待っている時間は8,170分です。ジョブが工場にいる時間のうち58.3%は、機械の前で順番を待っている時間だということになります。また、流れ時間の合計をメイクスパンで割ると7.50で、これは月曜8時から全件が終わるまでの間に、平均して7.5件の受注が工場の中にある(仕掛品として滞留している)ことを意味します。第1章のリトルの法則のとおり、待ちを減らして流れ時間を縮めれば、この仕掛品の件数も同じ比率で減ります。
機械ごとの稼働率(0分からメイクスパンまでの間に加工していた時間の割合)は、M1 旋盤が64.7%、M2 マシニングセンタが71.1%、M3 研削盤が76.5%、M4 熱処理炉が81.8%、M5 検査が18.7%でした。M4 の稼働率が81.8%にとどまっているのは、先ほどガントチャートで見た手待ちのためです。M4 の負荷1,530分をメイクスパンの1,870分で割った値がこの81.8%なので、メイクスパンを下界の1,530分まで縮められれば、M4 の稼働率は100%に近づきます。
組合せの数と NP 困難の意味、「解けない」ではなく「規模とともに急に重くなる」
先着順のスケジュールが最適でないなら、すべての順番を試して一番良いものを選べばよい、と考えるのは自然です。しかし、順番の数は驚くほど速く増えます。単一機械で \( n \) 件のジョブを並べる方法は \( n! \)(\( n \) の階乗、つまり \( n \times (n-1) \times \cdots \times 1 \))通りあり、10件で3,628,800通り、12件で479,001,600通り、15件で1,307,674,368,000通り(約1.3兆通り)、20件では約2.4×10の18乗通りになります。ジョブショップでは機械ごとに並べ方を決めるので、並べ方の数は機械ごとの階乗の積になります。受注12件では、機械ごとの工程数が M1 10、M2 9、M3 11、M4 10、M5 12 なので、その積は約9.1×10の34乗です。この数には、工程の順番と矛盾して実行できない組み合わせも含まれているので実際の候補はこれより少なくなりますが、桁の感覚としては、総当たりが問題外であることが分かります。
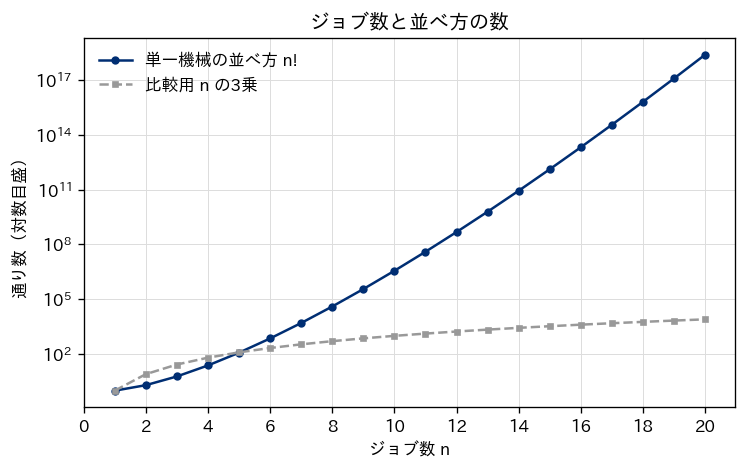
実際に総当たりの時間を測りました。単一機械15件のデータを納期の早い順に並べ、先頭の \( n \) 件について、重み付き総納期遅れを最小にする並べ方をすべて列挙して探します。この記事の実行環境(一般的なノートPC、Python 3.14 で素直に書いた列挙)での実測は次の表のとおりです。10件の総当たりは362万8,800通りを調べて23.25秒かかりました。この回の評価速度(1秒あたり約15万6千通り)で割り算すると、12件は約51分、15件は約97日、20件は約49万年かかる計算になります。12件以上は実行しておらず、あくまで同じ速度が続くと仮定した換算です。なお、同じスクリプトを別の時刻にもう1回実行したところ、10件は11.85秒で終わりました。評価速度はPCのほかの負荷によって2倍程度揺れますが、桁の話としての結論は変わりません。
| ジョブ数 | 並べ方の数 | 総当たりの時間(実測または換算) | 最小の重み付き総納期遅れ |
|---|---|---|---|
| 6 | 720 | 0.00秒(実測) | 0 |
| 7 | 5,040 | 0.01秒(実測) | 20 |
| 8 | 40,320 | 0.18秒(実測) | 20 |
| 9 | 362,880 | 2.48秒(実測) | 20 |
| 10 | 3,628,800 | 23.25秒(実測) | 140 |
| 12 | 479,001,600 | 約51分(換算) | 実行していない |
| 15 | 約1.3兆 | 約97日(換算) | 実行していない |
| 20 | 約2.4×10の18乗 | 約49万年(換算) | 実行していない |
ここで効いてくるのが、計算の難しさを分類する理論です。問題の規模(ジョブ数)が増えたときに、計算時間が規模の何乗かの割合でしか増えない解き方があれば、その問題は「易しい」と呼ばれます。前の節の表の Smith の規則や Jackson の規則は、並べ替え1回で済むのでこの意味で易しい解き方です。これに対してNP 困難と呼ばれる問題には、そのような解き方が見つかっていません。もし1つでも NP 困難な問題に対して、規模の何乗かの時間で必ず最適解を出す解き方が見つかれば、「答えを確かめるのが易しい問題は、答えを見つけるのも易しいか」という計算機科学の未解決問題(P 対 NP 問題)が肯定的に解けたことになります。この問題はクレイ数学研究所がミレニアム懸賞問題の1つに挙げており、同研究所のページでは現在も未解決と表示されています。前の節の表で「難しい」とした 1||ΣwjTj、F3||Cmax、J2||Cmax(3工程以上のジョブがある場合)は、すべてこの意味で NP 困難であることが示されています。
ただし、NP 困難は「解けない」という意味ではありません。意味するのは、どんな入力に対しても規模の何乗かの時間で最適解を保証する解き方が知られておらず、規模が大きくなると最適解を保証するための計算時間が急に重くなる場合がある、ということです。実際の問題が最悪の場合になるとは限らず、問題の構造をうまく使う解き方(分枝限定法、動的計画法、制約プログラミングなど)は、総当たりよりはるかに大きな問題を最適に解きます。象徴的な例が、この記事で使う公開ベンチマーク ft10 です。1979年の Graham らの論文は、ジョブショップの一般形は最適に解くのが極めて難しく、1963年に示された10ジョブ×10機械の問題が当時まだ解かれていない、と書いています。OR-Library によれば ft10 はその1963年の編著に収められた10×10の問題です。この問題を、この記事の実行環境で OR-Tools 9.15 の CP-SAT(並列ワーカー数8、時間制限60秒)に解かせたところ、メイクスパン930で最適であることの証明(下界も930)まで、5.95秒で終わりました。もう1回実行したときは8.68秒で、計算時間は実行ごとに揺れますが、どちらも1分以内です。ft06 は0.10秒でメイクスパン55の最適解が出ました。並べ方の数で言えば ft06 は \( (6!)^6 \) で約1.4×10の17乗、ft10 は \( (10!)^{10} \) で約4.0×10の65乗の組み合わせを持つ問題です。
この結果の読み方は2つあります。1つは、NP 困難であっても、実務の規模の問題が現在のソルバーで実用的な時間に解けることは珍しくない、ということです。もう1つは、その「解ける」は問題の大きさと構造に強く依存し、規模を少し大きくしただけで、同じソルバーが時間制限内に最適性を証明できなくなることがある、ということです。どこまでが解ける範囲かは、手法ごとの実測を第5章・第6章で、大規模化への対処を第11章で扱います。この章の段階で押さえておきたいのは、「NP 困難だから最適化は無理」でも「ソルバーを使えば何でも解ける」でもなく、自社の問題の規模で実際に測って確かめる必要がある、という点です。
問題の書き方を誤ると、どういう損失になるか
経営の側から見ると、この章で扱ったことはすべて「解く前に、何を解くかを決める」作業です。ここでの誤りは、どれほど優れたソルバーを使っても後から取り返せません。典型的な誤りは3つあると考えています。
1つ目は、目的関数の選び誤りです。先着順の結果で言えば、メイクスパンの1,870分だけを見て「下界の1,530分から22.2%の差なので悪くない」と判断すると、重みが3の2件を含む6件が遅れているという事実が見えなくなります。反対に遅れ件数だけを追えば、1件の遅れが極端に長くなる解を選ぶことがあります。この架空の工場で経営が気にしているのが重要顧客の納期なら、目的は重み付き総納期遅れで、メイクスパンは「残業なしで今週を捌き切れるか」を見る補助の指標、という位置づけになります。どの指標を目的にし、どの指標を制約や監視に回すかを経営の言葉で決めてから、技術の側に渡すのが順序です。
2つ目は、制約の書き漏れです。着手可能時刻を書き漏らしたモデルは、材料が届く前の加工を前提にした計画を返します。紙の上では納期遵守率が上がって見えても、現場では実行できないので、結局は人が手で直すことになり、最適化に投資した意味が薄れます。3つ目は、機械環境の単純化しすぎです。一部の品目だけが別の経路を通る工場をフローショップとして書くと、その品目が現れるたびにモデルの外で調整が必要になります。第13章で扱うように、現場に入れたモデルが使われなくなる原因の多くは、この「書き漏らした例外」の積み重ねにあると考えています。
先着順の結果を経営指標に翻訳しておきます。受注12件の半分が遅れ、納期遵守率は50%です。重み付きで数えた遅れの合計は5,730(重み×分)で、重み1あたり1分の遅れにいくらの損失が出るかを経営が決めれば、そのまま損失額の見積もりになります。ジョブが工場にいる時間の58.3%は待ち時間で、平均7.5件の仕掛品が滞留しています。ボトルネックの M4 熱処理炉は約250分の手待ちを抱え、稼働率は81.8%です。そして、この結果は「特にルールを決めずに回した」場合の出発点にすぎません。第3章以降の手法がこの数字をどこまで動かせるかが、スケジューリングへの投資の価値を測る基準になります。
この章の要点は3つです。第一に、スケジューリング問題は機械環境・制約・目的関数の3つに分けて記述でき、3項記法 α|β|γ で1行に書くと、既知の結果を引く索引になります。第二に、目的関数の選択は経営の判断で、メイクスパン・総完了時間・納期遅れ・遅れ件数のどれを選ぶかで最適なスケジュールは変わります。第三に、組合せの数は規模とともに爆発的に増え、多くの問題は NP 困難ですが、それは「解けない」ではなく「規模とともに急に重くなる」という意味で、実際に解けるかは測って確かめるしかありません。受注12件を先着順で流すと、12件中6件が遅れ、ボトルネックには手待ちが生じました。次の第3章では、まず機械1台の問題に絞り、SPT・EDD などのディスパッチングルールがどの目的で最適になるのかを、単一機械15件のデータで確かめます。
この章を深めたい方への参考書籍
『生産スケジューリング』(黒田充・村松健児 編、朝倉書店):シリーズ「経営科学のニューフロンティア」の第11巻です。第1章で生産管理の中でのスケジューリングの位置づけと基本用語を、第2章で物的システムの構造による分類や静的問題と動的問題の区別を扱っており、この章で整理した「問題をどう記述するか」を日本語でより詳しく学べます。後半にはディスパッチングルール、メタヒューリスティクス、ラグランジュ緩和など、この記事の後の章につながる手法も収められています。
『Scheduling: Theory, Algorithms, and Systems』(Michael L. Pinedo、Springer):スケジューリング理論の代表的な教科書で、第2章「Deterministic Models: Preliminaries」は、確定的なスケジューリングのモデルの構造を簡潔に表す記法を扱う章として始まり、この章で紹介した問題の書き方を原典に近い形で確かめられます。確定的なモデル、確率的なモデル、実務でのシステム設計の3部構成で、この記事全体の理論的な背景を1冊で追えます。版元の Springer のページでは2022年刊の第6版が現行で、第7版が2026年12月に刊行予定と案内されています。洋書ですが、記法と用語の原典として手元に置く価値があると考えています。
第3章 単一機械とディスパッチングルール、並べる順番の決め方で何が変わるか
第2章では、スケジューリング問題を「機械環境」「制約」「目的」の3つで書き分け、目的関数によって同じ受注から良いとされる並べ方が変わることを確かめました。この章では、その中で最も単純な型である単一機械の問題を扱います。機械が1台しかなく、そこに並んだ仕事の順番だけを決める問題です。単純ですが、工場全体の流れを決めているのは多くの場合ボトルネックの1台で、その1台の前に並んだ仕事をどの順で流すかは、納期遅れの件数やリードタイムに直接効きます。現場で「急ぎの順」「短いものから」「納期の早い順」と呼ばれている並べ方は、どれもディスパッチングルール(機械が空いた時点で、待っている仕事の中から次の1件を決める規則)の一種です。この章では代表的なルールが何を最小にするのかを整理し、第2章で用意したサンプルデータで実際に比べ、厳密に解いた最適解との差を測ります。
単一機械の問題は何を決める問題か
単一機械の問題では、仕事(ジョブ)ごとに加工時間と納期、そして遅れたときの痛みの大きさを表す重みが与えられ、決めるのは加工する順番だけです。この章では、すべての仕事が時刻0の時点で揃っていて、途中で加工を中断せず、段取り替えの時間は考えない、という最も基本的な前提を置きます。この前提のもとでは、機械は仕事の間に遊ばせる理由がないので、順番が決まれば各仕事の完了時刻がすべて決まります。1件目の完了時刻はその加工時間、2件目の完了時刻は1件目と2件目の加工時間の和、という具合に、完了時刻は前に並んだ仕事の加工時間の累積になります。
この前提では、最後の仕事が終わる時刻(メイクスパン)はどの順番でも加工時間の合計に等しく、順番では変わりません。変わるのは、各仕事が「いつ終わるか」の分布です。短い仕事を先に流せば、多くの仕事が早く終わり、平均の完了時刻が下がります。納期の早い仕事を先に流せば、納期に対する遅れの最大値が下がります。どちらを優先するかは目的関数の選び方の問題で、第2章で整理した総完了時間・最大遅れ・遅れ件数・納期遅れの合計といった指標のどれを重く見るかによって、最適な並べ方が変わります。この章では、指標ごとに「それを最小にする並べ方の規則」が知られているものと、知られていないものとを区別して見ていきます。
段取り替えのある単一機械、つまり前に何を加工したかで次の準備時間が変わる問題は、この章の前提から外れます。段取り時間が順番に依存すると、メイクスパン自体が順番で変わり、問題の性格が大きく変わるためです。この型は第7章で、同じ15件のデータに系列間の段取り時間を入れて扱います。
この章で使うのは、第2章で用意したサンプルデータのうち single_machine() の15件です。架空の部品加工工場のマシニングセンタ(M2)の前に並んだ仕事という設定で、加工時間は30分から170分、合計は1,300分です。納期は360分から1,370分まで散らばっており、重みは1から3です。時刻0は月曜の8時で、稼働は連続とみなします。総加工時間が1,300分ですから、どう並べても最後の仕事は月曜8時から1,300分後、つまり火曜の5時40分に終わります。この章の比較は、すべてこの1,300分の中での並べ方の違いです。
目的ごとに最適な並べ方が決まっている4つの規則
単一機械の問題には、並べ替えるだけで最適解が得られる有名な結果がいくつかあります。1つ目は SPT(Shortest Processing Time、加工時間の短い順)で、総完了時間、つまり全仕事の完了時刻の合計を最小にします。理由は完了時刻の足し算の構造にあります。\( n \) 件を順に並べると、1番目の仕事の加工時間は自分を含めて \( n \) 件すべての完了時刻に足し込まれ、2番目の加工時間は \( n-1 \) 件に足し込まれます。先頭に置いた仕事ほど多くの完了時刻を押し下げるので、短いものを先頭から並べれば合計が最も小さくなります。Pinedo の教科書 Scheduling の支援サイトで公開されている単一機械問題の講義資料が、この導出を1ページで示しています。
2つ目は WSPT(Weighted Shortest Processing Time、重み付きの加工時間の短い順)で、重み付き総完了時間を最小にします。各仕事について「重み÷加工時間」を計算し、その値の大きい順に並べる規則です。1956年に Smith が示した結果で、Smith の規則とも呼ばれます。証明の考え方は隣接交換の議論と呼ばれるもので、「この規則に反する並びがあれば、隣り合う2件を入れ替えると必ず目的関数が下がる(悪くならない)」ことを示します。隣り合う2件 \( i \) と \( k \) を入れ替えても、その前後の仕事の完了時刻は変わりません。変わるのは2件の完了時刻だけで、入れ替えによる目的関数の変化は \( w_i p_k – w_k p_i \) になります。言葉で言えば「後ろに回された仕事の重み×前に出た仕事の加工時間」と「前に出た仕事の重み×後ろに回された仕事の加工時間」の差で、比 \( w/p \) の大きい方を前に置けばこの差は必ず0以下になります。先の講義資料は、重み付き総完了時間が「在庫の保有費用の合計」を表す指標だと説明しています。重みを1個あたりの保有費用と読めば、仕掛品の金額を時間で積み上げたものになる、という意味です。
3つ目は EDD(Earliest Due Date、納期の早い順)で、最大遅れ(各仕事の完了時刻から納期を引いた値の最大値。納期より早く終われば負の値になります)を最小にします。1955年に Jackson がカリフォルニア大学ロサンゼルス校の研究報告で示した結果で、Jackson の規則とも呼ばれます。これも隣接交換の議論で証明でき、納期の遅い仕事が早い仕事の直前にある並びを入れ替えても、どちらの遅れも入れ替え前の最大値を超えないことを示します。最大遅れの最小化は「一番ひどい遅れをどこまで抑えられるか」を問う目的で、顧客ごとの約束を1件も大きく破りたくない場面に向きます。
4つ目は遅れ件数(納期を過ぎて終わる仕事の数)の最小化で、Moore が1968年の論文で示した算法が最適解を与えます。手順は短く、仕事を納期の早い順に1件ずつ積んでいき、積んだ仕事が納期に遅れたら、それまでに積んだ中で最も加工時間の長い仕事を1件外して「遅れ確定」の側に回し、最後まで繰り返します。外した仕事は、間に合う仕事をすべて流した後にまとめて流します。長い仕事を外すのは、1件を諦める代わりに、後ろに続く仕事に使える時間を最も多く取り戻すためです。英語版のウィキペディアでは Hodgson-Moore algorithm の名で紹介されていますが、この記事では提示者の論文に合わせて「ムーア法」と呼びます。
これら4つの結果をまとめたのが次の表です。「3項記法」の列は第2章で紹介した書き方で、左から機械環境(1は単一機械)、制約(空欄は制約なし)、目的関数を表します。「計算量」は件数 \( n \) に対して手間がどう増えるかで、\( n \log n \) は並べ替え1回分の手間です。
| 目的(何を最小にするか) | 3項記法 | 最適な並べ方 | 提示者 | 計算量 | 経営上の意味 |
|---|---|---|---|---|---|
| 総完了時間 | 1||ΣCj | SPT(加工時間の短い順) | 教科書の基本結果 | \( n \log n \) | 平均リードタイムと平均の仕掛件数 |
| 重み付き総完了時間 | 1||ΣwjCj | WSPT(重み÷加工時間の大きい順) | Smith(1956) | \( n \log n \) | 仕掛品の保有費用 |
| 最大遅れ | 1||Lmax | EDD(納期の早い順) | Jackson(1955) | \( n \log n \) | 最悪の約束破りの大きさ |
| 遅れ件数 | 1||ΣUj | ムーア法 | Moore(1968) | \( n \log n \)(効率よく実装した場合) | 納期遵守率 |
| 納期遅れの合計 | 1||ΣTj | 並べ替えの規則では解けない | Du と Leung(1990)が NP 困難を証明 | 擬多項式時間の解法あり(Lawler 1977) | 遅れ分数の総量 |
| 重み付き納期遅れの合計 | 1||ΣwjTj | 並べ替えの規則では解けない | 強い意味で NP 困難(Lawler 1977、Lenstra ほか 1977) | 厳密解は分枝限定法・動的計画・整数計画など | 遅延の罰金・値引き・信用の損失 |
| 重み付き遅れ件数 | 1||ΣwjUj | 並べ替えの規則では解けない | NP 困難(Karp 1972 ほか) | 擬多項式時間の解法あり | 重要顧客の納期遵守 |
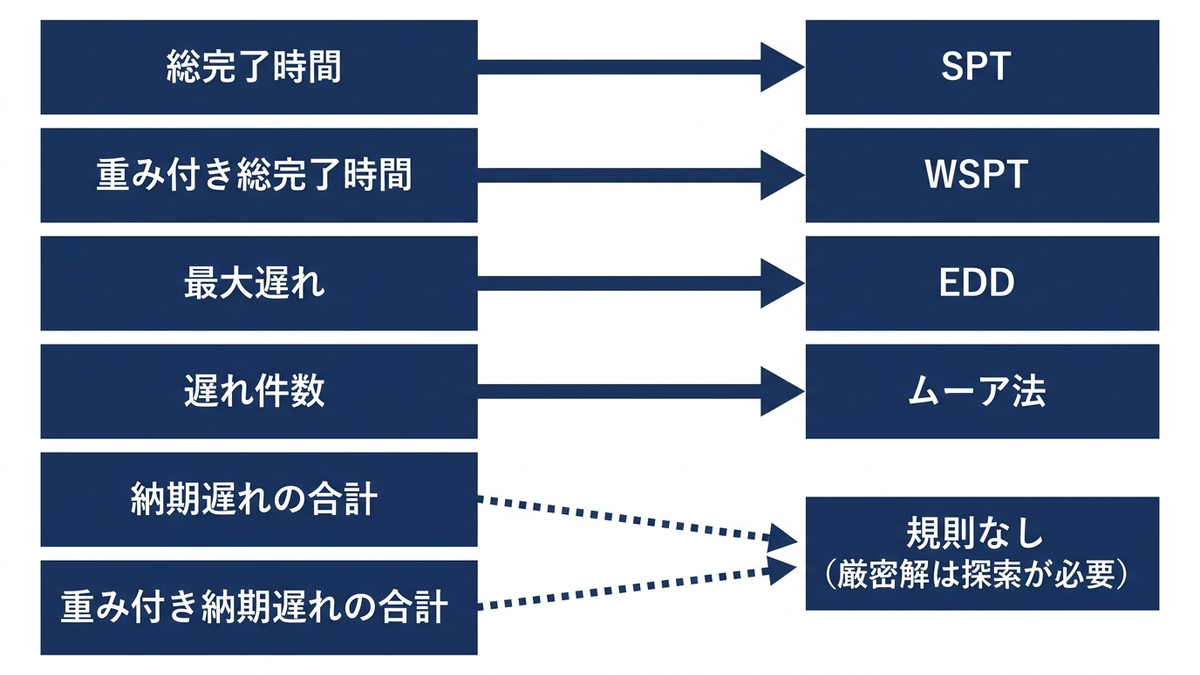
表の下3行が、この章の後半の主題です。遅れの「件数」や「最大値」には並べ替えの規則が存在するのに、遅れの「合計」になると、重みの無い場合でも NP 困難(件数が増えると厳密解を求める手間が急激に増える型)であることを Du と Leung が1990年に証明しました。重み付きになると、Lawler と Lenstra らの1977年の研究により「強い意味で NP 困難」、つまり加工時間や納期の数値が小さな整数に限られていても難しいことが分かっています。ドイツのオスナブリュック大学の Brucker と Knust が公開しているスケジューリング問題の計算量の分類表でも、1||ΣwjTj は強い意味で NP 困難な問題として、1||ΣTj は擬多項式時間(数値の大きさに比例する手間)で解ける NP 困難な問題として載っています。
実務で最も知りたいのは、多くの場合この「重み付き納期遅れの合計」です。遅れ1分あたりの損失が顧客や案件で違い、遅れた分だけ損失が積み上がる、という構造を最も素直に表すからです。その目的に対しては並べ替えの規則で最適解が出ない、というのがこの表の要点で、ここから先はルールがどこまで最適に近づけるか、厳密に解くとどうなるかを実測で見ていきます。
納期遅れの合計に向けた合成ルール、スラック順と ATC
最適な並べ方の規則が無い目的に対して、実務と研究で使われてきたのが、単純な規則を組み合わせた合成ルールです。出発点になるのはスラック順です。スラックは「その仕事の開始を、納期に遅れずにあと何分遅らせられるか」を表す量で、現在時刻を \( t \) とすると \( d_j – p_j – t \)(納期から加工時間と現在時刻を引いた値)です。スラックの小さい、つまり余裕の少ない仕事から流すのがスラック順です。この章の前提(全件が時刻0に揃う)では、どの仕事にも同じ \( t \) が引かれるので、スラック順は「納期から加工時間を引いた値」の小さい順に並べるのと同じになります。
スラック順と EDD は納期に敏感ですが、重みも加工時間の効率も見ません。逆に WSPT は重みと加工時間の効率だけを見て、納期を見ません。この両方を1つの優先度にまとめたのが ATC(Apparent Tardiness Cost)ルールです。重み付き納期遅れの単一機械問題向けに Rachamadugu と Morton が1982年の研究報告で提案し、Vepsalainen と Morton が1987年の論文でジョブショップ向けに拡張したものとして知られています。機械が空くたびに、待っている各仕事について次の優先度を計算し、最も大きい仕事を選びます。
\( I_j(t) = \dfrac{w_j}{p_j} \exp\left( -\dfrac{\max(d_j – p_j – t,\ 0)}{k\, \bar{p}} \right) \)
言葉にすると、「WSPT の値(重み÷加工時間)に、スラックが大きいほど小さくなる割引を掛けたもの」です。\( \bar{p} \) は平均加工時間、\( k \) は割引の効き方を決める調整の係数(先読みの係数)です。スラックが0以下の仕事、つまり今すぐ始めても納期ちょうどに終わるのがやっと(スラックが0)か、すでに遅れが避けられない(スラックが負)仕事には割引が掛からず、優先度は WSPT の値そのものになります。余裕の無くなった仕事の間では「遅れ1分あたりの損失が大きく、短く片付くもの」を先に流すのが得だからです。スラックの大きい仕事は割引が強く効いて後回しになり、納期が迫るにつれて割引が弱まって順位が上がってきます。
係数 \( k \) を大きくすると割引が弱くなり、ATC は WSPT に近づきます。\( k \) を小さくすると、スラックが少しでもある仕事は大きく割り引かれ、遅れの迫った仕事だけが上位に来るので、スラック順に近い振る舞いになります。2012年の生産・オペレーション管理学会(POMS)の年次大会で発表された Xi と Jang の論文は、ATC の優先度を上の式で紹介し、静的な単一機械の問題では \( k \) を2とする設定が推奨されていると述べています。ただしこれは多くの問題に対する平均的な目安で、個々の問題で最も良い \( k \) は納期の厳しさによって変わります。この点は後の実験で確かめます。
ATC の分母の \( \bar{p} \) について、Xi と Jang の論文は「平均加工時間」と書くだけで、どの仕事の平均を取るかまでは述べていません。この記事では「最初に並んだ15件全体の平均加工時間(86.67分)」で固定しました。仕事が次々に到着する現場で使うなら、機械が空くたびに、その時点で待っている仕事の平均で計算し直す作り方も考えられます。どちらを採るかは実装の選択で、結果が変わりうるので、比較するときは同じ定義にそろえる必要があります。
15件で比べる、ルールごとの指標
ここまでの規則を、15件のデータにそのまま当てはめました。ルールの本体は並べ替えか、機械が空くたびに1件を選ぶ繰り返しで、次の数十行に収まります。全件が時刻0に揃い段取りが無いので、順番が決まれば各仕事の完了時刻は加工時間の累積として決まり、そこから各指標を計算できます。
from sched_data import single_machine
import math
jobs = single_machine()          # p: 加工時間, d: 納期, w: 重み(時間の単位は分)
pbar = sum(j["p"] for j in jobs) / len(jobs)

spt  = sorted(jobs, key=lambda j: j["p"])                 # 加工時間の短い順
wspt = sorted(jobs, key=lambda j: -j["w"] / j["p"])       # 重み÷加工時間の大きい順
edd  = sorted(jobs, key=lambda j: j["d"])                 # 納期の早い順

def moore(jobs):                                          # 遅れ件数を最小にする
    kept, late, t = [], [], 0
    for j in sorted(jobs, key=lambda j: j["d"]):
        kept.append(j); t += j["p"]
        if t > j["d"]:                                    # 遅れたら、積んだ中で最長の仕事を外す
            x = max(kept, key=lambda k: (k["p"], k["id"]))
            kept.remove(x); late.append(x); t -= x["p"]
    return kept + sorted(late, key=lambda j: j["d"])

def atc(jobs, k):                                         # 機械が空くたびに優先度最大を選ぶ
    rest, t, seq = list(jobs), 0, []
    while rest:
        j = max(rest, key=lambda x: x["w"] / x["p"]
                * math.exp(-max(x["d"] - x["p"] - t, 0) / (k * pbar)))
        rest.remove(j); seq.append(j); t += j["p"]
    return seq

def weighted_tardiness(seq):
    t, total = 0, 0
    for j in seq:
        t += j["p"]; total += j["w"] * max(0, t - j["d"])
    return total

print(weighted_tardiness(edd), weighted_tardiness(atc(jobs, 2)))
# 出力: 220 420
各ルールの並べ方で計算した指標が次の表です。「平均仕掛件数」は、機械の前で待っている仕事と加工中の仕事の件数を、0分から1,300分までの時間で平均したものです。全件が時刻0に揃う場合、この値は総完了時間を1,300分で割ったものに等しくなります(各仕事は完了するまで件数に数えられるので、件数を時間で積み上げた面積がちょうど完了時刻の合計になるためです)。「重み付き納期遅れ」は、各仕事の遅れた分数に重みを掛けて足したもので、単位は「重み×分」です。最下行の「厳密解」は、後の節で CP-SAT を使って各列の指標をそれぞれ単独で最小にした値で、行全体が1つの並べ方を表すのではない点にご注意ください。
| ルール | 総完了時間(分) | 重み付き総完了時間 | 平均仕掛件数 | 最大遅れ(分) | 遅れ件数 | 納期遅れの合計(分) | 重み付き納期遅れ |
|---|---|---|---|---|---|---|---|
| 受付順(番号順) | 10,140 | 18,650 | 7.80 | 910 | 6 | 3,540 | 6,230 |
| SPT | 7,710 | 13,510 | 5.93 | 720 | 4 | 1,420 | 2,400 |
| WSPT | 8,390 | 12,140 | 6.45 | 770 | 4 | 2,220 | 2,650 |
| EDD | 10,080 | 19,220 | 7.75 | 70 | 3 | 140 | 220 |
| スラック順 | 10,470 | 20,020 | 8.05 | 110 | 4 | 260 | 340 |
| ムーア法 | 9,450 | 18,220 | 7.27 | 890 | 1 | 890 | 1,780 |
| ATC(k=2) | 9,470 | 16,980 | 7.28 | 380 | 2 | 420 | 420 |
| 厳密解(列ごとに単独で最小化) | 7,710 | 12,140 | 算出せず | 70 | 1 | 110 | 210 |
表の読み方を順に確認します。総完了時間の列では SPT の7,710分が最小で、厳密解の7,710分と一致しています。重み付き総完了時間の列では WSPT の12,140が厳密解と一致し、最大遅れの列では EDD の70分が厳密解と一致し、遅れ件数の列ではムーア法の1件が厳密解と一致しました。前の節の表の4つの結果が、このデータでもそのとおりに再現されたことになります。一方で、どの規則もほかの列では最良ではありません。SPT は総完了時間を最小にする代わりに最大遅れが720分に達し、ムーア法は遅れ件数を1件に抑える代わりに、その1件(S12)を最後に回して890分遅らせています。
納期遅れの合計と重み付き納期遅れの列には、最適を保証する規則がありません。この15件では EDD が納期遅れの合計140分、重み付き納期遅れ220で、厳密解の110分と210にかなり近い値になりました。ATC(k=2)は重み付き納期遅れが420で、EDD より悪くなっています。スラック順は340です。受付順は重み付き納期遅れが6,230で、厳密解の約30倍でした。受付順は並べ方について特別な判断をしない場合の順番ですが、この15件のように納期と受付の順が揃っていない場合、何も考えずに流すことの損失が最も大きく出ます。
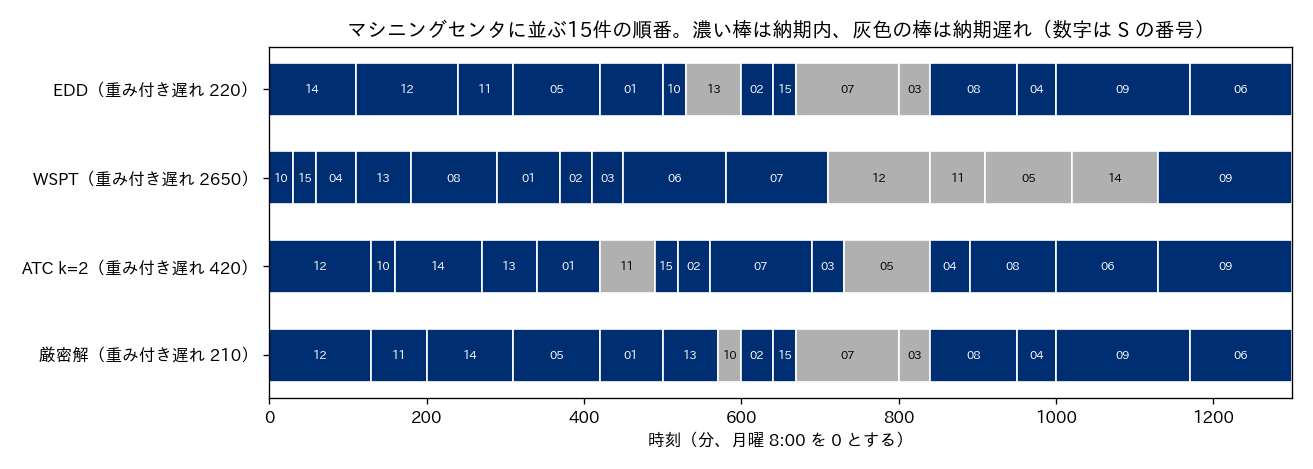
上の図は、EDD・WSPT・ATC(k=2)・厳密解の4通りの並びをガントチャートにしたものです。ここでの「厳密解」は、重み付き納期遅れを最小にする1つの並びです(表の最下行は、列ごとに別々に最小化した値を並べたもので、1つの並びではありません)。濃い棒は納期内に終わる仕事、灰色の棒は納期に遅れる仕事で、棒の中の数字は仕事の番号です。WSPT は短くて重みの大きい仕事を前に集めるため、納期の早い S12・S11・S05・S14 が後半に押し出され、4件がまとめて遅れています。EDD と厳密解の並びはよく似ています。違いは先頭3件の順序と、6番目・7番目の2件です。先頭の3件(S12・S11・S14)はどちらの順序でもすべて納期内に終わるので、指標には影響しません。S10(加工30分・重み2)と S13(加工70分・重み3)はどちらも納期が590分で、EDD はこの同着を番号の若い S10 から流し、厳密解は重みの大きい S13 を先に流しています。その結果、厳密解では S13 が納期に間に合い、S10 が10分遅れます。重み付き納期遅れは EDD の220に対して厳密解が210で、差の10はこの入れ替えから生まれています。納期の同じ仕事の並べ方を重みで決めるという小さな工夫が、この15件ではそのまま最適解につながっていたことになります。
厳密解を求める、CP-SAT と動的計画で確かめる
表の最下行の厳密解は、Google が公開している最適化ライブラリ OR-Tools(この記事では 9.15.6755)に含まれるCP-SAT(制約プログラミングと充足可能性判定の技術を組み合わせたソルバー)で求めました。単一機械の問題は、各仕事の「開始時刻・加工時間・終了時刻」をひとまとまりにしたインターバル変数を作り、それらが時間軸上で重ならないという制約を1行置くだけで書けます。納期遅れは「終了時刻から納期を引いた値」以上、かつ0以上の変数として置き、重みを掛けた合計を最小にします。ジョブショップでも同じ書き方を機械ごとに繰り返すことになり、その詳細は第5章で扱います。
from ortools.sat.python import cp_model
from sched_data import single_machine
jobs = single_machine()                           # 前のコードと同じ15件
H = sum(j["p"] for j in jobs)                     # 時間軸の上限(総加工時間 1,300分)
m = cp_model.CpModel()
start = [m.new_int_var(0, H, "s") for j in jobs]
end   = [m.new_int_var(0, H, "e") for j in jobs]
iv    = [m.new_interval_var(start[i], j["p"], end[i], "i") for i, j in enumerate(jobs)]
m.add_no_overlap(iv)                              # 1台なので同時に2件は加工しない
tard = [m.new_int_var(0, H, "t") for j in jobs]
for i, j in enumerate(jobs):
    m.add(tard[i] >= end[i] - j["d"])             # 納期遅れは max(0, 完了 - 納期) 以上
m.minimize(sum(j["w"] * tard[i] for i, j in enumerate(jobs)))
solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 20
solver.parameters.num_workers = 8
solver.parameters.random_seed = 0
status = solver.solve(m)
print(solver.status_name(status), solver.objective_value)
# 出力: OPTIMAL 210.0
出力の OPTIMAL は、210より小さい値が存在しないことをソルバーが証明した、という意味です。目的関数を総完了時間・重み付き総完了時間・最大遅れ・遅れ件数・納期遅れの合計に差し替えて同じように解くと、それぞれ7,710・12,140・70・1・110が最適値として得られ、どれも OPTIMAL でした。計算時間は6つの目的とも0.4秒以内です(この記事の実行環境である一般的なノートPCでの実測。並列ワーカー数は8に固定)。前の節の表で SPT・WSPT・EDD・ムーア法の値が厳密解の列と一致していたのは、この計算との照合です。
ソルバーの答えを別の方法でも検算しました。全件が時刻0に揃う単一機械では、「先に加工し終えた仕事の集合」が決まれば、その集合の加工時間の合計、つまり次の仕事の開始時刻が決まります。そこで、仕事の集合ごとに「その集合を先に済ませたときの重み付き納期遅れの最小値」を、集合を1件ずつ大きくしながら表に書き込んでいく動的計画(部分集合の動的計画)で解くことができます。15件なら集合の数は2の15乗で32,768通りなので、表を埋めるのは一瞬です。この方法で求めた重み付き納期遅れの最小値は210、納期遅れの合計の最小値は110で、CP-SAT の答えと一致しました。計算時間は2つ合わせて0.04秒でした。
ただし、部分集合の動的計画は件数が1つ増えるごとに表の大きさが2倍になります。20件なら約100万通り、30件なら約10億通りです。この記事の実装は表の1マスを8バイトの整数で持つので、30件では表だけで約8.6ギガバイトになります。件数が少ないうちは強力でも、規模とともに急に使えなくなる、という NP 困難な問題の典型的な姿です。CP-SAT のような汎用のソルバーは、この爆発を探索の工夫と下界(最適値がこれ以上は良くならないという保証の値)で抑えようとしますが、それでも限界はあります。件数を増やしたときの様子は後の節で測ります。
ATC の係数 k で結果はどれだけ変わるか
15件の問題で、ATC の係数 \( k \) を0.1から10まで振ったところ、重み付き納期遅れは次のように変わりました。\( k \)=0.1 と0.25で290、0.5で210、1.0で220、1.5と2.0で420、3.0で630、4.0で960、5.0で1,070、10で1,330です。\( k \)=0.5 のとき ATC は厳密解と同じ210に達しました。推奨値とされる \( k \)=2 では420で、厳密解の2倍です。
この15件は、総加工時間1,300分に対して納期が360分から1,370分に散らばっていて、EDD の順に流しても15件中12件は納期内に終わります。遅れが出るのは中盤の数件だけで、その数件の順序を正しく決められるかが勝負になります。\( k \) が小さいと ATC はスラック順に近づいて「納期の迫った仕事だけを見る」ようになり、この問題の構造に合います。\( k \) が大きいと WSPT に近づき、短くて重みの大きい仕事を前に出すため、納期の早い長い仕事が押し出されて遅れます。\( k \)=10 の1,330は、WSPT そのものの2,650に向かって近づいていく途中の値です。
この結果から言えるのは、ATC は係数1つで振る舞いが大きく変わるルールだ、ということです。推奨値をそのまま使うのではなく、自分の工場の過去の受注データで \( k \) を何通りか試し、最も成績の良い値を選ぶのが実務的な使い方だと考えています。ルールの計算は一瞬なので、候補の \( k \) を数個から十数個試すことは、毎回の計画の中でも十分に可能です。
納期の厳しさでルールの優劣は入れ替わる
15件の問題1つだけでは、どのルールが良いかを判断するには材料が足りません。そこで、第2章のデータと同じ作り方で15件の問題を乱数で300個作り、納期の厳しさを3段階に変えて、各ルールの重み付き納期遅れを厳密解と比べました。加工時間は30分から180分の10分刻み、重みは1・1・2・3から等確率で選び、納期は「総加工時間×一様乱数」として乱数の幅を変えています。「厳しい」は幅が0.1から0.6(すべての仕事が総加工時間の6割より前に納期を迎える)、「標準」は第2章のデータと同じ0.2から1.1、「ゆるい」は0.4から1.2です。厳密解は前の節の部分集合の動的計画で求め、300問すべてを解くのにルールの評価を含めて4.6秒でした。
次の表の「最適と一致」は、100問のうちルールの値が厳密解と同じだった問題の数です。「合計の超過率」は、100問ぶんのルールの値の合計が、100問ぶんの厳密解の合計を何%上回ったかです。1問ずつの超過率を平均すると、最適値が0や小さな値の問題で割り算が暴れるので、合計どうしで比べました。「ATC(k 最良)」は、\( k \) を0.25・0.5・1・2・3・5の6通り試して、問題ごとに最も良かった値を採ったものです。
| ルール | 厳しい:最適と一致 | 厳しい:合計の超過率 | 標準:最適と一致 | 標準:合計の超過率 | ゆるい:最適と一致 | ゆるい:合計の超過率 |
|---|---|---|---|---|---|---|
| EDD | 0問 | 96.4% | 67問 | 73.5% | 94問 | 35.9% |
| WSPT | 0問 | 34.1% | 0問 | 1,309.6% | 2問 | 4,031.2% |
| スラック順 | 0問 | 115.5% | 52問 | 124.7% | 87問 | 104.7% |
| ムーア法 | 0問 | 56.3% | 55問 | 365.5% | 91問 | 268.5% |
| ATC(k=2) | 4問 | 5.2% | 35問 | 71.8% | 85問 | 71.7% |
| ATC(k 最良) | 27問 | 2.1% | 77問 | 7.5% | 96問 | 12.0% |
厳密解の平均は、「厳しい」で4,062.4、「標準」で155.2、「ゆるい」で27.6でした。「標準」では100問中55問、「ゆるい」では100問中90問で、厳密解の重み付き納期遅れが0、つまり並べ方しだいで全件を納期内に収められる問題でした。「ゆるい」の超過率が大きく見えるルールがあるのは、分母の厳密解の合計が小さいためで、わずかな遅れでも率は大きく出ます。
この表から読み取れることは3つあります。第一に、納期が厳しいか、ゆるいかで、単純なルールの優劣が入れ替わります。納期が厳しく、ほぼ全件が遅れる状況では、WSPT の超過率が34.1%で、EDD(96.4%)やスラック順(115.5%)より良い成績です。どうせ遅れるなら「遅れ1分あたりの損失が大きく短いもの」から片付けるのが得、という ATC の説明と同じ理屈です。逆に納期がゆるい状況では EDD が100問中94問で最適と一致し、WSPT は2問しか一致しません。納期に間に合うかどうかが勝負の状況では、納期を見ないルールは大きく外れます。
第二に、ATC は両方の状況に対応できますが、\( k \) の選び方に強く依存します。\( k \)=2 に固定すると、「厳しい」では超過率5.2%と最良のルールでしたが、「標準」と「ゆるい」では約72%で、EDD と同程度か劣ります。問題ごとに6通りの \( k \) から最良を選ぶと、3つの状況すべてで超過率が12%以下に収まり、「標準」では77問、「ゆるい」では96問で最適と一致しました。前の節で見た「k を試して選ぶ」運用の効果が、ここでも数字に出ています。第三に、ムーア法は遅れ件数を最小にする規則であって、遅れの総量には向きません。「標準」の超過率は365.5%で、遅れ件数を減らすために1件を大きく遅らせる性質が、重み付き納期遅れでは不利に働いています。
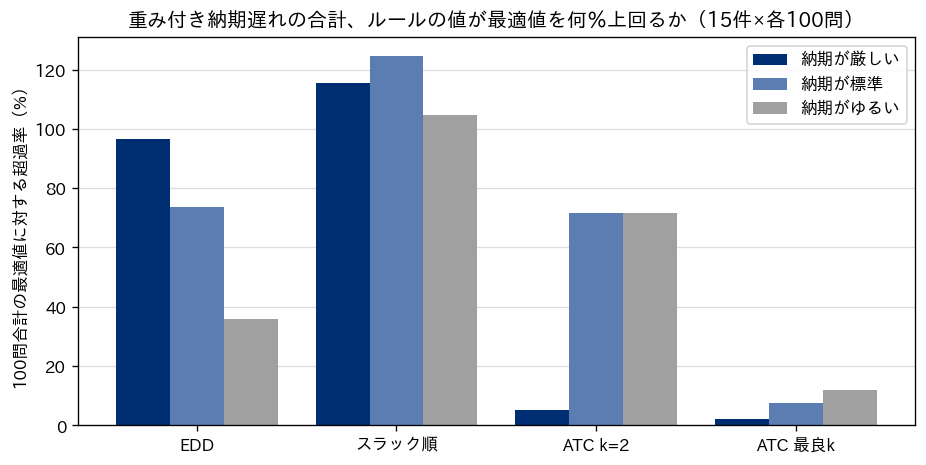
上の図は、表のうち EDD・スラック順・ATC(k=2)・ATC(k 最良)の「合計の超過率」を棒グラフにしたものです。WSPT とムーア法は「標準」と「ゆるい」で値が桁違いに大きいので、図からは外しました。EDD の棒は納期が厳しいほど高く、ATC(k=2)は厳しいときだけ低く、ATC(k 最良)はどの状況でも低い、という関係が読み取れます。自分の工場がどの状況に近いかは、過去の受注データで「総加工時間に対して納期がどれだけ手前に来ているか」を見れば見当がつきます。ボトルネックの前に仕事が溜まって、多くの受注がすでに遅れている時期と、余裕がある時期とで、同じルールを使い続けることが得策とは限らない、ということです。
件数が増えると厳密解はどうなるか
15件の問題では、CP-SAT も部分集合の動的計画も一瞬で最適解を返しました。件数を増やすとどうなるかを見るため、納期の厳しい条件(納期=総加工時間×0.1から0.6の一様乱数)で15件・25件・40件・60件・100件の問題を2問ずつ作り、CP-SAT に上限10秒で解かせました。前の節の実験で、納期が厳しいほど最適値が大きく、ルールとの差も大きかったため、難しい側の条件で測っています。比較のため、ATC を6通りの \( k \) で試した最良値も並べます。さらに、ATC の最良の並びを CP-SAT に「初期解のヒント」として渡した場合も測りました。CP-SAT はヒントの解から探索を始められるので、ルールの答えを出発点にして改善させる使い方になります。
| 件数 | 問 | ATC(k 最良) | CP-SAT 10秒の値 | CP-SAT 10秒の下界 | ギャップ | ヒントあり 10秒の値 | ヒントありのギャップ |
|---|---|---|---|---|---|---|---|
| 15 | 1 | 4,970 | 4,870 | 4,143 | 14.9% | 4,870(最適を証明) | 0% |
| 15 | 2 | 4,190 | 4,190(最適を証明) | 4,190 | 0% | 4,190 | 19.0% |
| 25 | 1 | 14,810 | 15,130 | 12,634 | 16.5% | 14,440 | 12.5% |
| 25 | 2 | 9,850 | 9,620 | 7,632 | 20.7% | 9,620 | 20.7% |
| 40 | 1 | 26,100 | 29,990 | 19,227 | 35.9% | 25,380 | 24.2% |
| 40 | 2 | 19,440 | 24,030 | 16,662 | 30.7% | 19,290 | 11.5% |
| 60 | 1 | 46,120 | 65,490 | 33,904 | 48.2% | 45,570 | 25.0% |
| 60 | 2 | 65,940 | 97,960 | 50,653 | 48.3% | 65,660 | 22.8% |
| 100 | 1 | 143,280 | 199,630 | 99,164 | 50.3% | 142,690 | 28.1% |
| 100 | 2 | 118,300 | 176,710 | 91,057 | 48.5% | 118,010 | 20.9% |
「ギャップ」は、見つかった解の値と下界の差を、解の値で割ったものです。ギャップが0%なら最適であることが証明されています。15件の2問については、部分集合の動的計画で求めた最適値(4,870と4,190)も確認しました。値はいずれも重み付き納期遅れ(重み×分)です。計算は一般的なノートPCで、並列ワーカー数は8に固定しました。上限は10秒ですが、ヒントありの15件の問2だけは、終了処理を含めて13.6秒かかりました。
読み取れることは4つあります。第一に、納期が厳しい条件では、15件でも CP-SAT が10秒で最適性を証明できないことがありました(問1)。ところが同じ問題を部分集合の動的計画は一瞬で解きます。単一機械の問題に特化した解き方と、汎用のソルバーとでは、得意な規模が違います。第二に、25件の問1で早くも10秒の CP-SAT の値が ATC の最良値を下回れず(15,130対14,810)、40件以上ではすべての問題で ATC の最良値より悪くなりました。60件の問1では ATC が46,120なのに対し、CP-SAT は65,490です。汎用のソルバーを短い時間で打ち切ると、よく調整したルールに負けることがある、ということです。
第三に、この実験では、ATC の答えをヒントとして渡すと、10問すべてで ATC の最良値と同じか、それより良い値になりました。25件の問1では ATC の14,810に対して14,440、40件の問1では26,100に対して25,380です。100件でも、改善幅は小さいものの ATC を下回っています。ルールで作った並びをソルバーに渡して磨く、という組み合わせは、この10問では、ルールだけ、ソルバーだけのどちらよりも安定した結果を出しました。第四に、下界は弱く、ギャップは解の悪さを過大に見せます。ヒントありの15件の問2は、実際には最適値4,190に到達しているのに、下界が3,395にとどまったためギャップは19.0%と表示されました。ギャップが大きいとき、それが「解が悪い」のか「下界が弱い」のかは、この数字だけでは区別できません。
なお、CP-SAT を8並列で時間制限つきで動かすと、同じ設定でも実行するたびに値が少し変わることがあります。この記事でも、同じスクリプトを2回実行したところ、25件の問1の値が15,010と15,130で異なりました。表はすべて最後に実行したときのログの値です。比較実験で順位をつけるときは、何回か実行して揺れの幅を確かめる必要があります。時間制限とギャップの読み方、局所探索による改善は第11章で詳しく扱います。
ルールの差を経営指標に翻訳する
ここまでの数字を、経営の言葉に置き換えてみます。まず平均仕掛件数です。15件の表で、受付順の平均仕掛件数は7.80件、SPT は5.93件でした。同じ15件を同じ1台で同じ1,300分かけて加工しているのに、並べ方だけで機械の前に滞留する仕事の数が約24%減っています。平均の完了時刻も、受付順の676分から SPT の514分に短くなります。第1章で見たリトルの法則(仕掛品=スループット×リードタイム)どおり、処理の速さが同じなら、仕掛件数が減った分だけ平均リードタイムも縮みます。仕掛品が減れば、置き場所、運搬、管理の手間、そして仕掛品に寝ている資金が減ります。
次に重み付き納期遅れです。重みを「遅れ1分あたりの損失」と読めば、この指標はそのまま納期遅れの損失額の見積もりになります。例として、重み1を遅れ1分あたり100円と置いてみます(この金額は説明のための架空の値です)。すると15件の重み付き納期遅れは、受付順の6,230が約62万円、WSPT の2,650が約27万円、ATC(k=2)の420が4万2,000円、EDD の220が2万2,000円、厳密解の210が2万1,000円に相当します。受付順と厳密解の差の約60万円は、1台の機械の1回分の並べ方だけで生まれる差です。遅れ1分あたりの損失は、実際には遅延の違約金、値引き、特急輸送費、顧客の信用の低下などから見積もることになり、その見積もり自体が経営の判断です。
3つ目は、目的の選び方そのものの損失です。15件の表で、ムーア法は遅れ件数を1件に抑えましたが、その1件(S12)は890分、約15時間遅れます。重み付き納期遅れは1,780で、EDD の220の8倍です。「納期遵守率」だけを KPI に置くと、遅れが確定した仕事を後回しにし続ける並べ方が最も良く見え、特定の顧客に大きな遅れが集中します。逆に遅れの総量だけを見ると、小さな遅れが多数の顧客に散らばる並べ方が選ばれることがあります。どちらの損失が大きいかは、顧客との契約と関係によって違います。スケジューリングの目的関数を決めることは、どの顧客にどの種類の不便を寄せるかを決めることと同じで、現場のルールに任せずに経営が決めるべき事柄だと考えています。
最後に、ルールを「どれか1つに決め打ちする」ことの損失です。乱数の300問の実験では、同じ EDD でも、納期がゆるい状況では100問中94問で最適だったのに、納期が厳しい状況では最適の約2倍の損失(超過率96.4%)を出しました。繁忙期と閑散期で受注の状況が変われば、最適なルールも変わります。ルールの選択を年に一度の見直し事項ではなく、受注の状況を見て切り替える運用の変数として扱うことが、損失を小さくする近道になると考えています。
ルールを現場で使う条件と、使ってはいけない場面
この章の結果はすべて「全件が時刻0に揃い、中断せず、段取りが無い1台の機械」という前提の上に成り立っています。現場でルールを使う前に、この前提がどこまで成り立つかを確かめる必要があります。とくに注意が要るのは、仕事が時間をずらして到着する場合です。着手可能時刻(その仕事を始められる最も早い時刻)が仕事ごとに違うと、最大遅れを最小にする問題も、総完了時間を最小にする問題も、強い意味で NP 困難になることが Lenstra らの1977年の研究で示されており、先のオスナブリュック大学の分類表にも載っています。EDD や SPT が最適であるという保証は、全件が揃っている場合に限られます。
到着がずれる場合に単純なルールがつまずく典型は、「機械が空いたら、いま待っている中から選ぶ」ことの副作用です。たとえば、納期の迫った重要な仕事が10分後に届くと分かっていても、ルールは待っている長い仕事を先に始めてしまい、重要な仕事はその長い仕事が終わるまで待たされます。Righini の講義資料は、着手可能時刻がある最大遅れの問題では、最適なスケジュールが「機械を遊ばせる時間を含む」ことがあると説明しています。意図的に機械を空けて待つ判断は、目の前の待ち行列だけを見るディスパッチングルールには原理的にできません。到着予定が分かっているなら、その情報を使える厳密解法やソルバーのほうが有利になります。
段取り替えがある場合も、ルールの成績は大きく変わります。同じ系列の仕事を続けて流せば段取りが省けるのに、EDD は系列を見ずに納期順に並べるので、段取り替えの回数が増え、その分だけ機械の実質的な能力が減ります。段取りを入れた単一機械の問題と、そこでの段取りと納期の釣り合いは第7章で扱います。複数の工程を経る仕事では、1台の前の並べ方が次の工程の待ち方を変えるので、単一機械の最適性はそのままは引き継がれません。フローショップは第4章、ジョブショップは第5章で扱います。
逆に、ディスパッチングルールが威力を発揮するのは次のような場面です。1つ目は、計画を立てる時間がほとんど無く、機械が空くたびにその場で次を決める必要がある場面です。ルールの計算は一瞬で、データが揃っていなくても、納期と加工時間さえ分かれば動きます。2つ目は、明確なボトルネックが1台あり、その前の並べ方が工場全体の成績を決めている場面です。単一機械の理論がそのまま使えます。3つ目は、ソルバーの初期解を作る場面で、前の節の10問では、ルールの答えを出発点にするとソルバーの成績が安定しました。4つ目は、スケジューラ(生産スケジューラ)を入れる前の現状把握です。今の並べ方が受付順なのか、納期順なのかを確かめ、同じ受注データに各ルールを当てて指標を比べるだけで、改善の余地の大きさが見えます。
使う側の注意として、ルールの成績は入力の精度に依存します。加工時間の見積もりが実際と大きく違えば、SPT も ATC も誤った順番を返します。とくに ATC は加工時間で割り算をし、スラックの計算にも加工時間を使うので、標準時間(マスタ)の誤差がそのまま優先度に入ります。標準時間の精度と、それを維持する仕組みについては第13章で扱います。また、重みは経営の判断で決めるべき値ですが、現場では「声の大きい顧客の重みが大きい」ように暗黙に運用されていることが少なくないように思います。重みを明示して文書に残すことは、ルールの導入以前に、並べ方の判断を説明可能にするための第一歩です。
ルールを選ぶ手順をまとめると、次のようになります。
- 目的を1つに決める(平均リードタイム、最悪の遅れ、遅れ件数、重み付きの遅れの総量のどれか)。決められない場合は、重みの付け方を経営で決める
- 前提を確かめる(全件が揃っているか、段取りがあるか、工程が1つか)
- 目的に対して最適な規則があり、前提が成り立つなら、その規則を使う(SPT・WSPT・EDD・ムーア法)
- 最適な規則が無い目的なら、ATC のような合成ルールを使い、係数を過去データで試して選ぶ
- 余裕があれば、ルールの答えをソルバーの初期解にして改善し、ギャップと下界で改善余地を確かめる
この章の要点をまとめます。単一機械の問題では、総完了時間には SPT、重み付き総完了時間には WSPT、最大遅れには EDD、遅れ件数にはムーア法という、並べ替えだけで最適解が出る規則が知られています。15件のサンプルデータでも、それぞれの規則の値は CP-SAT の厳密解と一致しました。一方で、実務で最も知りたいことの多い重み付き納期遅れの合計には最適な規則が無く、合成ルールの ATC も係数 \( k \) と納期の厳しさによって成績が大きく変わります。件数が増えると厳密解は急に重くなり、短い時間で打ち切ったソルバーはよく調整したルールに負けることもありますが、この章の実験(15件から100件までの10問)では、ルールの答えを初期解として渡すと、すべての問題でルールと同じか、それより良い値が得られました。目的の選び方は、どの顧客にどの種類の不便を寄せるかを決める経営の判断です。次の第4章では、仕事が複数の機械を同じ順に流れるフローショップに進み、2機械の Johnson の規則と、3機械以上での解き方を扱います。
この章を深めたい方への参考書籍
『アルゴリズムデザイン』(Jon Kleinberg・Éva Tardos 著、浅野孝夫・浅野泰仁・小野孝男・平田富夫 訳、共立出版):第4章「グリーディアルゴリズム」の4.2節「遅延最小化スケジューリング:交換議論」が、この章で EDD の最適性の根拠として紹介した隣接交換の議論を、丁寧な証明つきで説明しています。並べ替えの規則が「なぜ最適なのか」を自分で確かめたいときに、最初に開く本として適していると考えています。
『Heuristic Scheduling Systems』(Thomas E. Morton・David W. Pentico、Wiley):副題は生産システムとプロジェクト管理への応用です。ATC ルールの提案者の一人である Morton らによる、ディスパッチングを中心とした発見的スケジューリングの原典です。単一機械からフローショップ、ジョブショップ、プロジェクトスケジューリングまで、優先度ルールの考え方と計算実験が扱われています。1993年刊の洋書で、合成ルールの設計の考え方を提案者の側からたどれる本です。
第4章 フローショップ、全ジョブが同じ順に機械を通る工程の順序づけ
第3章では、1台の機械の前に並んだ仕事の順番を、目的に合ったディスパッチングルールで決める方法を見ました。機械が1台なら、どの順に並べても最後の仕事が終わる時刻は加工時間の合計で決まり、順番が効くのは納期遅れや完了時間の合計でした。この章では機械が複数になり、しかもすべての仕事が同じ順序で機械を通る工場を扱います。この形をフローショップと呼びます。機械が2台以上直列に並ぶと、仕事の順番を変えるだけで、同じ仕事量を終えるまでの時間(メイクスパン)が変わります。前の機械で早く終わった仕事が次の機械の前で待たされたり、後ろの機械が仕事を待って止まったりするためです。
この章で決めるのは「10件の仕事を、4台の機械に同じ順番で流すとき、どの順番にすれば全部が最も早く終わるか」です。2台の機械なら、1954年に Johnson が示した簡単な手順で最適な順番が求まります。3台以上では、一般の場合にはそのような手順は知られておらず、ヒューリスティクス(最適の保証はないが短時間で良い解を出す手順)と厳密解法を使い分けます。第2章で用意したサンプルデータの flow_shop()(10件×4台)を使い、Johnson 則の拡張、NEH 法、制約プログラミングによる厳密解を実際に計算して、メイクスパンの差と、それが工場の稼働時間や仕掛品でどれだけの差になるかを示します。
フローショップとは何か、どこに現れるか
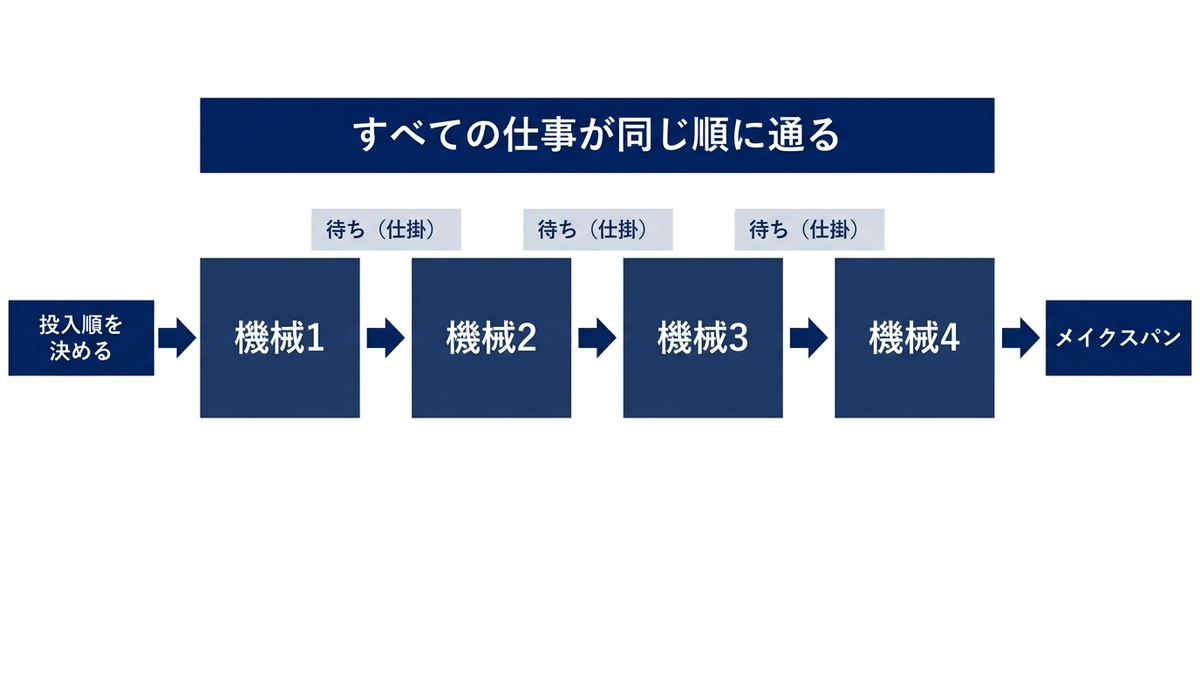
フローショップは、第2章の機械環境の分類でいう「すべてのジョブが同じ機械の列を同じ順に通る」工場です。旋盤で削ってから研削し、熱処理をして検査に回す、という工程順が品目によらず共通なら、その工場はフローショップとして書けます。組立ラインや塗装ライン、食品や化学品の連続工程のように、設備が工程順に並べられた職場の多くがこの形に近いと考えられます。一方で、品目ごとに通る機械の順番が違う職場はジョブショップと呼ばれ、第5章で扱います。
フローショップで決めるのは、原則として「どの仕事を何番目に流すか」という1本の順番です。1台目の機械に投入する順番を決め、後ろの機械もその順番のまま処理する形を置換フローショップと呼びます。置換(パーミュテーション)は「並べ替え」の意味で、答えが10件の並べ方の1つとして表せることを指しています。実際の工場で、機械と機械の間の置き場がベルトコンベヤや一列のシュートになっていて途中で追い越しができない場合は、自然に置換フローショップになります。置き場に余裕があって、2台目以降で順番を入れ替えられる場合は、機械ごとに順番を変えてよい問題になります。両者の違いがメイクスパンに効くかどうかは、後の節で実例を示します。
この章で使うデータは、第2章で用意した架空の部品加工工場の flow_shop() です。10件の仕事 F01〜F10 が、機械1から機械4までを必ずこの順に通ります。加工時間は10分から150分の10分刻みで、機械ごとの合計は機械1が780分、機械2が660分、機械3が800分、機械4が660分、全体で2,900分です。仕事1件あたりの合計は250分から410分で、最も重い F09 は4台の合計が410分あります。
| 仕事 | 機械1(分) | 機械2(分) | 機械3(分) | 機械4(分) | 合計(分) |
|---|---|---|---|---|---|
| F01 | 120 | 40 | 100 | 40 | 300 |
| F02 | 70 | 80 | 80 | 70 | 300 |
| F03 | 60 | 90 | 40 | 60 | 250 |
| F04 | 30 | 40 | 30 | 150 | 250 |
| F05 | 40 | 80 | 150 | 20 | 290 |
| F06 | 20 | 80 | 100 | 50 | 250 |
| F07 | 120 | 50 | 40 | 40 | 250 |
| F08 | 80 | 40 | 140 | 20 | 280 |
| F09 | 100 | 140 | 70 | 100 | 410 |
| F10 | 140 | 20 | 50 | 110 | 320 |
| 機械別合計 | 780 | 660 | 800 | 660 | 2,900 |
メイクスパンがどこまで短くなり得るかは、計算する前にある程度見積もれます。どの機械も、自分の加工時間の合計より早くは仕事を終えられません。さらに機械1は、最初の仕事が始まるまでは空きがありませんが、最後の仕事を終えた後に、その仕事の機械2〜4の加工が残ります。そこで「機械1の合計780分に、機械2〜4の合計が最も短い仕事の分を足した値」は、どんな順番でも下回れない下限(下界)になります。10件の中で機械2〜4の合計が最も短いのは F07 の130分なので、機械1からの下界は910分です。同じ考え方で機械2は760分、機械3は890分、機械4は760分となり、最も大きい910分がこのデータのメイクスパンの下界です。後で見るとおり、実際の最適値は940分で、この簡単な下界との差は30分でした。
2台の機械なら Johnson 則で最適な順番が決まる
機械が2台のフローショップでメイクスパンを最小にする問題は、Johnson が1954年に Naval Research Logistics Quarterly に発表した論文で、簡単な並べ替えの手順で最適に解けることが示されています。この論文は、スケジューリング理論の最初の成果として扱われることが多いものです。Johnson 則の手順は次のとおりです。
- 仕事を2つの組に分ける。機械1の時間が機械2の時間より短い仕事を「前の組」、それ以外(機械1の時間が機械2の時間以上)を「後ろの組」にする
- 前の組は、機械1の時間の短い順に並べる
- 後ろの組は、機械2の時間の長い順に並べ、前の組の後ろにつなげる
この手順の意味は、言葉にすると分かりやすくなります。前の機械が短く後ろの機械が長い仕事を先に流すと、後ろの機械にすぐ仕事が届き、しかも後ろの機械の作業が長いので、その間に前の機械が次の仕事を準備できます。逆に、前の機械が長く後ろの機械が短い仕事を最後に回すと、最後に後ろの機械だけが動いている時間が短くて済みます。最初に後ろの機械を早く動かし始め、最後に後ろの機械を早く止める、という2つの要求を同時に満たすのが Johnson 則です。ニューヨーク大学の Pinedo の教材ページに掲載されているフローショップの講義資料では、2台の場合には機械ごとに順番を変えても得をせず、両方の機械で同じ順番にする最適解が必ず存在することも示されています。
サンプルデータの機械1と機械2だけを取り出して、2台の問題として確かめました。Johnson 則の順番は F06、F04、F05、F03、F02、F09、F07、F01、F08、F10 で、メイクスパンは800分です。機械ごとに順番を変えてよい条件で CP-SAT(Google の OR-Tools に含まれる制約プログラミングのソルバー)に解かせても最適値は800分で、Johnson 則の答えが最適であることを確認しました。この800分は、機械1の合計780分に、機械2の時間が最も短い F10 の20分を足した値に一致しています。前の節の下界がそのまま達成された例です。なお、この2台の問題では、F01 から順に流した場合でも810分で、差は10分しかありません。2台の問題は、仕事のばらつき方によっては順番の効き目が小さいこともあります。順番の差が大きく開くのは、機械が増えたときです。
Johnson の論文は3台の場合も扱っており、一定の条件を満たせば3台でも同じ考え方で最適解が得られます。条件は「機械1の最短時間が機械2の最長時間以上である」か「機械3の最短時間が機械2の最長時間以上である」ことです。言い換えると、真ん中の機械のどの加工時間も、両端の機械のうち少なくとも一方のどの加工時間より長くない場合で、真ん中の機械が少なくとも片側の機械より速く、行列の原因にならない場合です。このときは機械1と機械2の時間の和、機械2と機械3の時間の和を2台分の時間とみなして Johnson 則を当てます。サンプルデータの機械1〜3では、機械1の最短時間は20分、機械3の最短時間は30分、機械2の最長時間は140分で、条件は成り立ちません。真ん中の機械が少なくとも片側の機械より一律に速いという条件は、実務の工程ではそれほど当たり前には成り立たないと考えています。
機械が3台以上になると何が難しくなるか
機械が3台以上になると、一般の場合には Johnson 則のような簡単な手順は知られていません。Garey・Johnson・Sethi の1976年の論文は、機械が3台以上のフローショップで「メイクスパンが指定した値以下になる順番があるか」を判定する問題が NP 完全であることを示しました。NP 完全は「はい・いいえ」で答える判定問題についての言葉で、メイクスパン最小の順番を求める問題そのものは、第2章で説明した NP 困難にあたります。どちらも、問題が大きくなると、厳密に解くのに要する時間が急激に伸びる型の問題です。同じ論文は、ジョブショップでは機械が2台でもすでに対応する判定問題が NP 完全であること、フローショップで完了時間の合計を最小にする問題も機械が2台で同じく NP 困難になることを示しています。第2章で説明したとおり、これは「解けない」という意味ではありません。小さな問題なら厳密に解けますし、大きな問題でも良い解は短時間で作れます。規模とともに、最適であることを証明する手間が急に重くなる、という意味です。
組合せの数を数えると、この重さの感覚がつかめます。10件の並べ方は \( 10! = 3{,}628{,}800 \) 通りで、全部を試すことは現在のパソコンなら可能な範囲です。しかし20件なら約 \( 2.4 \times 10^{18} \) 通り、50件なら65桁の数になり、全部を試すことは現実的ではありません。そこで、良い順番を短時間で組み立てるヒューリスティクスと、探索の途中で見込みのない枝を切り捨てながら最適を証明するソルバーを組み合わせて使います。
もう1つ、機械が4台以上になると、全機械で同じ順番にする置換フローショップの答えが、機械ごとに順番を変えてよい場合の答えより悪くなることがあります。講義資料に載っている2件×4台の例題(仕事Aは機械1から順に4分・1分・1分・4分、仕事Bは1分・4分・4分・1分)を実際に解いて確かめました。全機械でAを先にしてもBを先にしてもメイクスパンは14分ですが、機械1と機械2ではBを先に、機械3と機械4ではAを先にすると12分で終わり、CP-SAT でもこの12分が最適と確認できました。前の機械ではBの短い作業を先に済ませて後ろへ送り、後ろの機械ではAの短い作業を先に通す、という追い越しが効いている例です。ただし、サンプルデータの10件×4台では、機械ごとに順番を変えてよい条件で解いても最適値は置換の場合と同じ940分でした。追い越しの余地があるかどうかは、置き場の構造と、データによって確かめる必要があります。
Johnson 則を広げる、CDS 法と Palmer の傾斜指数
3台以上のフローショップに対しては、Johnson 則を借りて順番を組み立てるヒューリスティクスがいくつも提案されています。代表的なものが、Campbell・Dudek・Smith が1970年に Management Science に発表した方法で、頭文字を取って CDS 法と呼ばれます。CDS 法は、4台の機械を「前のかたまり」と「後ろのかたまり」の2台に見立てた仮想の2台問題を、機械の台数より1つ少ない数だけ作り、それぞれを Johnson 則で解いて、元の4台の問題で最もメイクスパンが短かった順番を採ります。この記事の実装では、k 通り目の仮想問題として、前の k 台の時間の合計と後ろの k 台の時間の合計を2台分の時間にしました。
サンプルデータに CDS 法を当てると、3つの仮想問題の答えのメイクスパンは、前後1台ずつ(機械1と機械4)で1,100分、前後2台ずつで1,030分、前後3台ずつで1,080分でした。採用されるのは1,030分の順番で、最適値940分より90分(9.6%)長い答えです。Palmer が1965年に発表したもう1つの古典的な方法は、仕事ごとに「後ろの機械ほど時間が長いほど大きくなる」傾斜指数を計算し、その大きい順に並べます。後ろの機械で時間がかかる仕事を先に流し、前の機械で時間がかかる仕事を後ろに回す、という Johnson 則と同じ発想を、1本の指数にまとめたものです。この記事の実装では、4台の機械に順に \( -3, -1, 1, 3 \) の重み(前の機械ほど負、後ろの機械ほど正)を掛けて足した値を傾斜指数にしました。結果は990分で、最適値より50分(5.3%)長い答えでした。
この2つの方法は、どちらも計算がほとんど要らないことが長所です。その一方で、機械の間の待ちを実際に計算して確かめる手順を持たないため、データによっては最適から離れた答えを出します。Gupta と Chauhan の2015年の論文は、これまでの研究で CDS 法が Palmer の方法より良い結果を出すと整理していますが、このサンプルデータでは逆に Palmer の方法の方が短い答えになりました。ヒューリスティクスの優劣は多数の問題での平均の話であり、手元の1件でどちらが良いかは、計算してみないと分かりません。
NEH 法、長い仕事から1件ずつ最良の位置へ差し込む
Nawaz・Enscore・Ham が1983年に Omega に発表した方法は、3人の頭文字を取って NEH 法と呼ばれ、置換フローショップのメイクスパン最小化で最もよく使われる構築型のヒューリスティクスです。Xu らの2026年の論文でも、構築型のヒューリスティクスの中で最も影響力のある代表として挙げられ、より強力な探索法(反復貪欲法と呼ばれる、壊して作り直すことを繰り返す方法)の初期解を作る手順として使われています。Baker と Altheimer の2011年の論文も、過去の比較研究の結果として、CDS 法と NEH 法を最も良く頑健な構築型の手順として紹介しています。
手順は次のとおりです。まず、4台の合計時間が長い順に仕事を並べた候補の列を作ります。次に、候補の列の先頭の仕事を取り出して、それまでに作った部分的な順番のあらゆる位置に差し込んでみて、部分的な順番のメイクスパンが最も短くなる位置に入れます。これを候補の列が空になるまで繰り返します。長い仕事ほど全体の骨格に効くので先に位置を決め、短い仕事は後から隙間に差し込む、という考え方です。差し込むたびに実際のメイクスパンを計算して比べるので、CDS 法や Palmer の方法と違って、機械の間の待ちが結果に反映されます。
import numpy as np
from sched_data import flow_shop

P = flow_shop()          # 行=仕事 F01..F10、列=機械1..4、値=分

def makespan(seq, p=P):
    """全機械で同じ順(置換)に流したときの、最後の仕事の完了時刻"""
    m = p.shape[1]
    C = np.zeros((len(seq), m), dtype=int)
    for a, j in enumerate(seq):
        for k in range(m):
            prev_job = C[a - 1, k] if a > 0 else 0     # 同じ機械の前の仕事
            prev_mc = C[a, k - 1] if k > 0 else 0      # 同じ仕事の前の機械
            C[a, k] = max(prev_job, prev_mc) + p[j, k]
    return int(C[-1, -1])

def neh(p=P):
    order = sorted(range(p.shape[0]), key=lambda j: -p[j].sum())   # 合計の長い順
    seq = [order[0]]
    for j in order[1:]:
        cands = [seq[:i] + [j] + seq[i:] for i in range(len(seq) + 1)]
        seq = min(cands, key=lambda c: makespan(c, p))              # 最良の位置へ差し込む
    return seq

s = neh()
print(["F%02d" % (j + 1) for j in s], makespan(s))
# 出力: ['F06', 'F04', 'F05', 'F02', 'F09', 'F10', 'F08', 'F03', 'F01', 'F07'] 940
サンプルデータでは、NEH 法の答えは F06、F04、F05、F02、F09、F10、F08、F03、F01、F07 の順で、メイクスパンは940分でした。次の節で示すとおり、これは CP-SAT が証明した最適値と同じです。上のコードは差し込むたびにメイクスパンを最初から計算し直す素朴な実装で、仕事が n 件なら計算の手間はおよそ n の3乗に比例します。Baker と Altheimer は NEH 法の計算量を n の2乗に機械数を掛けたオーダーと整理しており、実装の際には、差し込みの評価を効率よく行う工夫として Taillard が1990年に示した高速化の手順が広く使われています。この記事の実行環境(一般的なノートPC)での実測では、素朴な実装のままでも50件×10台で0.31秒でした。
CP-SAT で最適な順番を求め、最適であることを確かめる
ヒューリスティクスの答えがどれほど良いかは、最適値と比べないと分かりません。そこで、同じ問題を CP-SAT で厳密に解きました。OR-Tools の公式ドキュメントは、CP-SAT を、充足可能性判定(論理式を満たす値の組を探す技術)の手法を使う制約プログラミングのソルバーと説明しています。変数は整数に限られ、時刻を分単位の整数で表すスケジューリングとは相性の良い道具です。中心になるのはインターバル変数で、1つの作業の開始時刻・長さ・終了時刻をひとまとめにした変数です。1台の機械で作業が重ならないことは add_no_overlap という1つの制約で書けます。定式化の考え方とジョブショップへの使い方は第5章で、整数計画との比較は第6章で詳しく扱いますので、ここでは置換フローショップに必要な部分だけを示します。加工時間の配列 P は、前の NEH 法のコードで読み込んだものをそのまま使います。
from ortools.sat.python import cp_model

n, m = P.shape
H = int(P.sum())                                    # 時刻の上限(全作業を直列にした長さ)
md = cp_model.CpModel()
S = [[md.new_int_var(0, H, "") for k in range(m)] for j in range(n)]   # 開始
E = [[md.new_int_var(0, H, "") for k in range(m)] for j in range(n)]   # 終了
I = [[md.new_interval_var(S[j][k], int(P[j, k]), E[j][k], "") for k in range(m)] for j in range(n)]
for j in range(n):
    for k in range(1, m):
        md.add(S[j][k] >= E[j][k - 1])              # 前の機械が終わってから次の機械へ
for k in range(m):
    md.add_no_overlap([I[j][k] for j in range(n)])  # 1台の機械は同時に1件
for i in range(n):                                  # 置換:どの機械でも同じ前後関係
    for j in range(i + 1, n):
        b = md.new_bool_var("")                     # b が真なら i が j より前
        for k in range(m):
            md.add(E[i][k] <= S[j][k]).only_enforce_if(b)
            md.add(E[j][k] <= S[i][k]).only_enforce_if(~b)
cmax = md.new_int_var(0, H, "")
md.add_max_equality(cmax, [E[j][m - 1] for j in range(n)])
md.minimize(cmax)
sv = cp_model.CpSolver()
sv.parameters.max_time_in_seconds = 60
sv.parameters.num_workers = 8
sv.parameters.random_seed = 0
st = sv.solve(md)
print(sv.status_name(st), sv.objective_value, sv.best_objective_bound)
# 出力: OPTIMAL 940.0 940.0
最後の行の OPTIMAL は、ソルバーが最適であることを証明できたという意味です。objective_value は見つけた最良の答え、best_objective_bound はソルバーが証明した「これより良い答えは存在しない」という下界で、両者が一致していれば最適です。サンプルデータでは、並列のワーカー数を8に固定した条件で、この記事の実行環境での実測0.2秒ほどで940分が最適と証明されました。置換の制約(2件ずつの前後関係を表す真偽の変数 b の部分)を外し、機械ごとに順番を変えてよい条件で解き直しても最適値は同じ940分でした。つまり、このデータでは追い越しを許しても得はなく、置換フローショップとして順番を1本決めれば十分です。
ここで1つ注意があります。最適なメイクスパン940分を達成する順番は1つではありません。この記事の実行では、CP-SAT が返した順番(F06、F04、F08、F02、F09、F10、F05、F03、F01、F07)と NEH 法の順番は異なり、どちらも940分でした。CP-SAT は並列で探索するため、同じ設定でも実行するたびに、同じ940分の別の順番を返すことがあります。最適値は変わりませんが、どの順番が返るかは保証されません。メイクスパンが同じ順番の中から、別の指標で良いものを選ぶ方法は、後の「経営指標に翻訳する」の節で示します。
10件×4台で各手法を比べる
ここまでの手法に、現場でよく使われる素朴な決め方を加えて、10件×4台のサンプルデータで比べたのが次の表です。「入力順」は F01 から番号順に流す場合で、受付順に流すことに相当します。SPT と LPT は、第3章のディスパッチングルールを4台の合計時間に当てはめたものです。「機械間の待ち」は、各仕事が2台目以降の機械の前で待たされた時間を10件分足したもので、工程の間に滞留する仕掛品の量の目安になります。各作業はできるだけ早く始める前提で計算しています。「無作為な順でこれ以下の割合」は、10件の順番を乱数(シード0)で1万通り作り、その手法のメイクスパン以下になった順番の割合です。
| 決め方 | メイクスパン(分) | 最適値との差 | 機械4が動き始める時刻(分) | 機械4の遊休(分) | 機械間の待ち(分) | 無作為な順でこれ以下の割合 |
|---|---|---|---|---|---|---|
| 入力順(F01から番号順) | 1,190 | +250分(26.6%) | 260 | 270 | 1,240 | 71.2% |
| SPT(合計時間の短い順) | 1,160 | +220分(23.4%) | 190 | 310 | 1,150 | 58.0% |
| LPT(合計時間の長い順) | 1,220 | +280分(29.8%) | 310 | 250 | 1,360 | 82.5% |
| CDS 法(Johnson 則の拡張) | 1,030 | +90分(9.6%) | 100 | 270 | 1,240 | 4.0% |
| Palmer の傾斜指数 | 990 | +50分(5.3%) | 100 | 230 | 980 | 0.5% |
| NEH 法 | 940 | 0分(0.0%) | 200 | 80 | 830 | 0.0% |
| CP-SAT(置換・最適を証明) | 940 | 0分(0.0%) | 200 | 80 | 630 | 0.0% |
表の「機械4の遊休」は、機械4が最初の作業を始めてから最後の作業を終えるまでの間に、仕事が届かずに止まっていた時間です。入力順では270分、NEH 法と CP-SAT の順では80分でした。メイクスパンは、「機械4が動き始める時刻」「機械4の加工時間の合計660分」「機械4の遊休」の3つを足した値になります(入力順なら260+660+270=1,190分)。660分は順番によらないので、順番の良し悪しは、動き始める時刻と遊休の和に表れます。遊休だけを見ても良し悪しは決まりません。SPT は遊休が310分と入力順より多いのに、機械4が190分に動き始めるのでメイクスパンは入力順より短く、LPT は遊休が250分と入力順より少ないのに、動き始めが310分と遅いのでメイクスパンは入力順より長くなっています。CDS 法は遊休が入力順と同じ270分で、メイクスパンの短縮は、機械4が動き始める時刻が入力順の260分から100分に早まったことから来ています。最初に後ろの機械を早く動かし始めるという Johnson 則の半分の効果だけが出ている形です。NEH 法と CP-SAT の順は、動き始める時刻は200分と CDS 法より遅いものの、遊休が80分と小さく、両者の和が280分で表の中で最も小さくなっています。
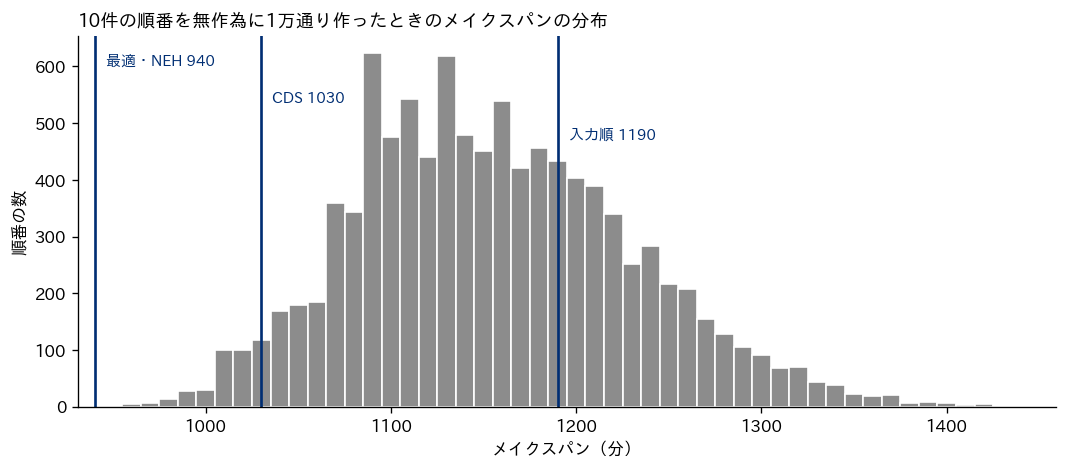
「無作為な順でこれ以下の割合」の列を見ると、入力順の1,190分は、1万通りの無作為な順番のうち71.2%がこれ以下、つまり順番を適当に決めた場合より悪い側にいます。1万通りの中で最も良かった順番でも960分で、940分に届いた順番は1つもありませんでした。最適値の5%以内(987分以下)に入った順番は0.2%です。順番を「だいたい良さそうに」決めても、最適に近い答えに偶然当たることはほとんどない、ということです。次の図は、無作為な1万通りのメイクスパンの分布と、主な手法の位置を示したものです。無作為な順番の平均は1,155.2分、最大は1,430分でした。
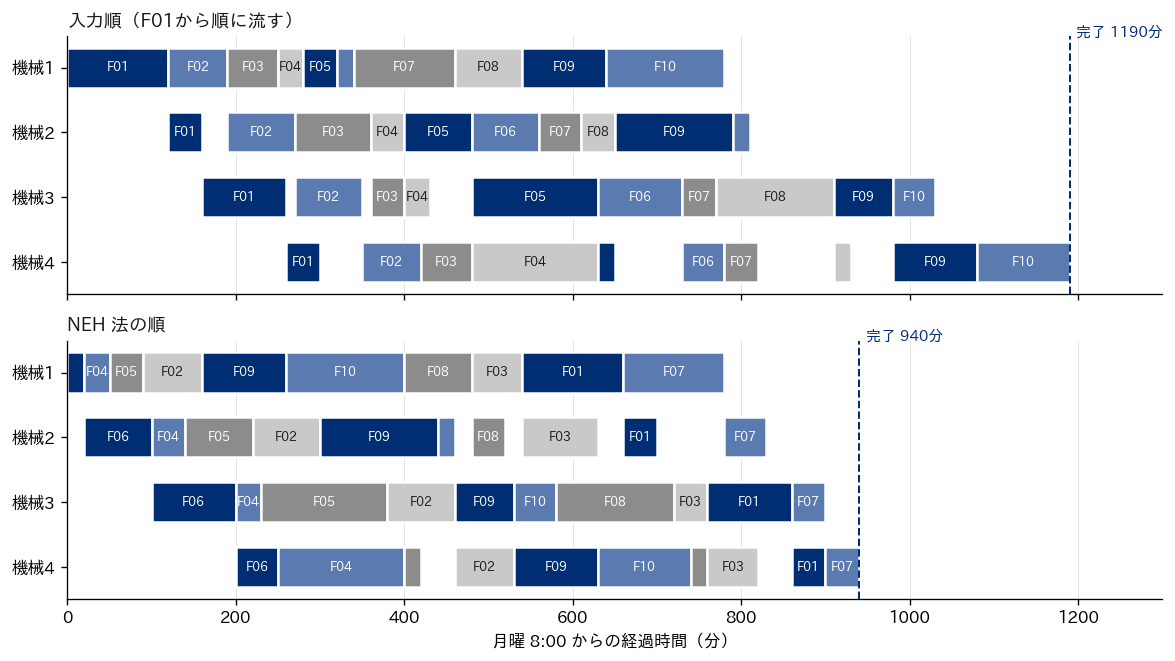
次の図は、入力順と NEH 法の順のガントチャートです。横軸は月曜8:00からの経過時間(分)で、機械ごとに作業の帯を並べています。入力順(上段)では、機械1の最初に120分の F01 が入るため、機械2〜4は長く待たされてから動き始め、機械4は途中にも大きな空きがあります。NEH 法(下段)では、機械1の時間が短い F06 と F04 を先頭に置くことで、機械2〜4が早く動き始め、機械4は200分の時点で F06 の作業を始め、続けて F04 の150分の作業に入ります(入力順では機械4が動き始めるのは260分でした)。最後には機械1の時間が長く機械4の時間が短い F01 と F07 が来るので、機械3が900分に作業を終えた後、機械4だけが動いている時間は F07 の40分で済んでいます。Johnson 則が2台で行っていた「後ろを早く動かし始め、後ろを早く止める」ことが、4台で実現されているのが読み取れます。
規模を増やすと、ヒューリスティクスと厳密解法の関係はどう変わるか
10件×4台なら CP-SAT が0.2秒ほどで最適を証明しましたが、実務の規模ではどうでしょうか。flow_shop() と同じ作り方(10〜150分の10分刻みの一様乱数、シード0)で、仕事の件数と機械の台数を増やした問題を作り、NEH 法と CP-SAT を比べました。CP-SAT の時間制限は1問あたり15秒、並列のワーカー数は8です。さらに、NEH 法の答えを CP-SAT に初期解の手がかり(ヒント)として渡す方法も試しました。表の「下界」は、ソルバーが証明した下界と、前に説明した機械ごとの簡単な下界のうち大きい方で、「下界との差」はその下界から見た答えの長さの割合です。計算時間はこの記事の実行環境(一般的なノートPC)での実測です。
| 件数×台数 | NEH 法(分) | NEH の時間(秒) | CP-SAT 単独(分) | CP-SAT に NEH をヒント(分) | 下界(分) | NEH の下界との差 | CP-SAT の状態 |
|---|---|---|---|---|---|---|---|
| 10×5 | 1,190 | 0.00 | 1,180 | (省略) | 1,180 | 0.8% | 最適(0.2秒) |
| 20×5 | 2,330 | 0.01 | 2,250 | 2,250 | 2,250 | 3.6% | 最適(単独2.3秒、ヒントつき2.6秒) |
| 20×10 | 2,710 | 0.02 | 2,670 | 2,700 | 2,551 | 6.2% | 15秒で打ち切り |
| 50×5 | 4,800 | 0.14 | 4,930 | 4,800 | 4,800 | 0.0% | 単独は打ち切り、ヒントつきは最適(1.7秒) |
| 50×10 | 5,410 | 0.31 | 5,870 | 5,370 | 5,220 | 3.6% | 15秒で打ち切り |
この表から読み取れることは3つあります。第一に、20件×5台までは CP-SAT が数秒で最適を証明し、NEH 法の答えは最適より0.8%から3.6%長いだけでした。第二に、50件になると CP-SAT 単独では15秒の間に NEH 法より良い答えを見つけられず、50件×5台では4,930分(NEH 法は4,800分)、50件×10台では5,870分(NEH 法は5,410分)と、ヒューリスティクスより悪い答えで止まりました。探索の出発点が悪いと、限られた時間では良い答えにたどり着けないということです。第三に、NEH 法の答えをヒントとして渡すと、50件×5台では1.7秒で4,800分が最適と証明され、NEH 法の答えがもともと最適だったことが分かりました。50件×10台ではヒントから40分縮めた5,370分まで進み、下界5,220分との差は2.9%です。20件×10台では、ヒントつき(2,700分)が単独(2,670分)より悪い答えで止まっており、ヒントが常に有利とは限りません。CP-SAT は並列の探索なので、打ち切りのときの答えは実行ごとに揺れることにも注意が必要です。
この実験は1問ずつの結果で、傾向を言い切れるほどの数ではありません。研究の世界では、Taillard が作った公開ベンチマーク問題集が、置換フローショップの手法を比べるための最も広く使われているデータの1つです。Alejandro-Soto らの2025年の論文は、手法の研究が進んだ現在でも、最良の既知解と最良の既知下界の間に大きな差が残っていると述べています。実務では「最適を証明すること」より、「決まった時間の中で、良い答えと、それがどれだけ良いかの目安(下界との差)を毎回出すこと」を目標にするのが現実的だと考えています。大規模な問題で局所探索や焼きなまし法を使って答えを磨く方法は、第11章で扱います。
ボトルネックはどこか、どの機械を速くするとメイクスパンが縮むか
フローショップでは、どの機械の能力を上げれば全体が早く終わるかが、順番の決め方と同じくらい重要な経営判断になります。機械ごとの合計時間が最も大きいのは機械3の800分で、素朴にはここがボトルネック(全体の流れを律速する工程)です。しかし前に計算した下界では、機械1からの下界910分が機械3からの下界890分より大きく、メイクスパンを決めている機械は負荷の合計だけでは決まりません。機械1は先頭にあるため、最後の仕事を終えた後に後ろの3台の加工が必ず残るからです。
そこで、4台の機械のうち1台ずつ、その機械の加工時間をすべて2割短くした問題を作り、CP-SAT で最適値を求め直しました。改善の投資をどの機械に向けるべきかを、最適化で確かめる実験です。結果は次の表のとおりです。
| 2割短くした機械 | その機械の合計(分) | 最適メイクスパン(分) | 基準940分からの短縮(分) |
|---|---|---|---|
| 機械1 | 780→624 | 916 | 24 |
| 機械2 | 660→528 | 924 | 16 |
| 機械3 | 800→640 | 902 | 38 |
| 機械4 | 660→528 | 932 | 8 |
最も効いたのは機械3の改善で、メイクスパンは38分縮みました。ただし機械3の合計は160分減っているのに、全体の短縮は38分にとどまります。機械3を速くすると、今度は機械1からの下界(改善後は902分)が効いてきて、最適値はその下界にぴったり張り付いたためです。ボトルネックを解消すると、次のボトルネックが現れます。機械2と機械4の改善は、それぞれ132分ずつ加工時間を減らしたのに、全体の短縮は16分と8分でした。ボトルネックでない機械の能力を上げても、全体の完了時刻はほとんど変わりません。どの改善案でも、NEH 法の答えは最適値と一致していました。
制約理論(TOC)は、制約になっている工程の改善に集中すれば組織全体のアウトプットが向上するとし、制約を解消したら次の制約を探す、という手順を定めています。この実験の結果は、その考え方と同じ向きを数字で示しています。実務で設備投資や段取り改善、人員の配置を検討するときは、候補ごとに加工時間を書き換えて最適化を解き直し、全体の完了時刻がどれだけ縮むかを比べると、効果の小さい投資を避けられます。1回の最適化が数秒で終わる規模なら、改善案が数十あっても一通り試せます。
経営指標に翻訳する、同じ940分でも仕掛品は変わる
10件×4台の比較を経営指標に直すと、入力順の1,190分と最適の940分の差は250分、つまり4時間10分です。同じ10件の仕事を終えるのに、順番を変えるだけで半日分の稼働時間が要らなくなる計算です。4台の機械の平均稼働率(加工時間の合計2,900分を、4台×メイクスパンで割った値)は、入力順で60.9%、最適な順で77.1%になります。設備も人も同じで、順番だけで稼働率が16ポイント変わるということです。夜勤や休日出勤で遅れを取り戻している工場なら、この差はそのまま残業時間の差として現れます。順番の決め方を属人的な経験や受付順に任せていることは、見えない形で毎日この差を払い続けていることを意味すると考えています。
もう1つの経営指標は仕掛品です。前の表で、NEH 法と CP-SAT の順番は同じ940分なのに、機械間の待ちは830分と630分で違っていました。機械間の待ちが長いほど、工程の間に部品が置かれている時間が長く、置き場と運転資金を使います。第1章のリトルの法則のとおり、仕掛品が多ければ1件あたりのリードタイムも延びます。そこで、メイクスパンを940分以下に保つ条件をつけたまま、機械間の待ちの合計を最小にする問題を CP-SAT で解きました。この計算では、機械1への投入を必要なときまで遅らせることを許しています。結果は、順番が F06、F02、F03、F01、F04、F05、F09、F10、F08、F07 となり、メイクスパンは940分のまま、機械間の待ちの合計は290分まで減りました(最適であることを証明済み、実測0.8秒)。10件の仕事が機械1に入ってから機械4を出るまでの滞在時間の合計は3,190分で、加工時間の合計2,900分との差がこの290分です。
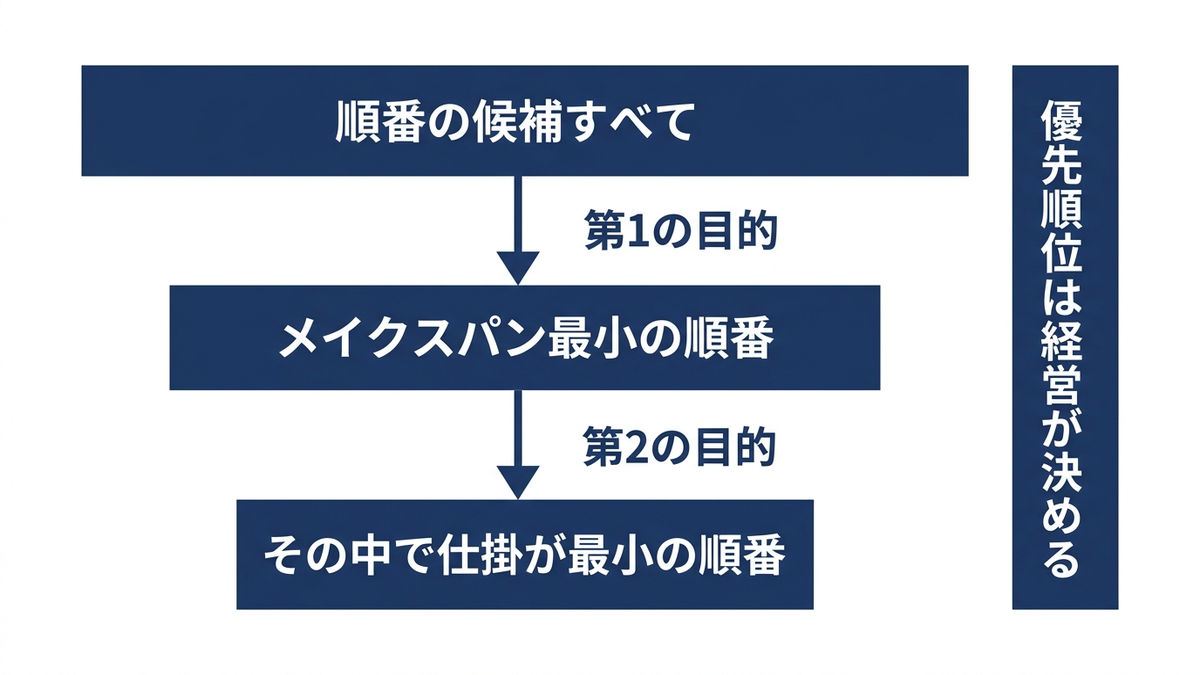
ここから言えるのは、最適化の目的を1つに決めて終わりにしないことの大切さです。メイクスパンだけを目的にすると、ソルバーは同じ940分の答えの中からどれを返してもよく、仕掛品が多い答えが返ってくることがあります。「まずメイクスパンを最小にし、その値を守ったまま次の指標(仕掛品・納期遅れ・段取り回数など)を最小にする」という順に目的を重ねると、経営として望ましい答えに絞り込めます。目的の優先順位を決めることは、ソルバーではなく経営側の仕事です。なお、この問題の納期は扱っていません。納期つきのフローショップは、重み付き納期遅れを目的にして同じ CP-SAT のモデルで解けますので、目的関数の書き方は第5章の受注12件の例で扱います。
フローショップの手法を使ってよいとき、使ってはいけないとき
この章の手法が前提にしているのは、すべての仕事が同じ機械の列を同じ順に通ること、加工時間が事前に分かっていること、機械の間の置き場に制限がないこと、段取り時間が順番によって変わらないこと、の4つです。どれかが崩れると、答えの意味が変わります。品目によって工程を飛ばすだけなら、その機械の加工時間を0分とみなしてフローショップのまま扱えますが、品目によって工程の順序そのものが違うなら、それはジョブショップで、第5章の方法を使います。
機械の間の置き場が小さく、前の機械で終わった仕事を置けないときは、前の機械が仕事を抱えたまま止まる「詰まり」が起きます。この章のメイクスパンの計算は、終わった仕事はいくらでも置き場で待てる前提なので、詰まりのある工程に当てはめると、実際より短いメイクスパンを約束してしまいます。熱処理のように、前の工程から間を空けずに次の工程に入らなければならない場合も同じです。CP-SAT のモデルなら、置き場の数を資源として加える、前の工程の終了と次の工程の開始を等式で結ぶ、といった形で制約を足せます。資源の制約の書き方は第10章で扱います。
段取り時間が前の品目によって変わる場合(旋盤の治具の付け替えが品目の組み合わせで違う、など)は、順番の良し悪しが段取りの合計でも決まるようになり、Johnson 則や NEH 法の前提が崩れます。この場合の考え方は第7章で扱います。また、加工時間が日によってばらつく工程では、計画上のメイクスパンと実績がずれます。ばらつきを入れたシミュレーションで計画の頑健さを確かめる方法は第12章で扱います。最後に、NEH 法や CDS 法は置換フローショップのメイクスパン最小を目的に作られた手順で、納期遅れの最小化にそのまま使うと良い答えになる保証はありません。目的が納期なら、目的に合わせた手順かソルバーを使うべきです。
この章の要点は3つです。第一に、全仕事が同じ順に機械を通るフローショップでは、順番を変えるだけでメイクスパンが大きく変わり、サンプルデータでは入力順の1,190分に対して最適は940分でした。2台なら Johnson 則で最適が求まり、3台以上では NEH 法が短時間で最適に近い答えを出し、CP-SAT がその答えの良さを下界との差で保証します。第二に、規模が大きくなると厳密解法だけでは限られた時間で良い答えに届かず、NEH 法の答えをソルバーに渡すような組み合わせが効きます。第三に、同じメイクスパンでも仕掛品は変わり、どの機械を改善すべきかも最適化で確かめられます。目的の優先順位を決め、改善の候補を数字で比べることが、経営として最適化を使う意味だと考えています。次の第5章では、品目ごとに通る機械の順番が違うジョブショップに進み、ディスジャンクティブグラフとクリティカルパスの考え方で問題を捉え直します。
この章を深めたい方への参考書籍
『流れ生産と1個流し 生産流れ学と究極のムダ表面化』(平野裕之、日刊工業新聞社):「新IE」入門シリーズの第4巻で、書名のとおり、工程をつないで仕事を流す流れ生産と、仕事を1個ずつ次の工程へ送る1個流しを主題にした本です。この章では順番を変えることで機械間の待ち(仕掛品)が減ることを計算で示しましたが、この本は工程の並べ方や流し方そのものを変えて滞留をなくす側の考え方にあたります。最適化で順番を決める前に、流れの形を見直す余地がないかを考える材料になります。2001年の刊行です。
『Flow Shop Scheduling』(Hamilton Emmons・George Vairaktarakis、Springer):フローショップのスケジューリングだけを主題にした専門書で、2台のフローショップ、機械間の置き場に制限がある場合、待ちを許さない場合、工程ごとに複数の機械を持つ場合、加工時間が確率的な場合、同じ工程に戻ってくる場合などを章ごとに扱っています。この章で「使ってはいけないとき」として触れた条件が、それぞれどのような問題になるかを深く学べます。洋書ですが、自社の工程がどの型の問題にあたるかを調べる参照先として価値があると考えています。
第5章 ジョブショップ、品目ごとに工程の道順が違う工場の順序を解く
第4章では、すべての品目が同じ順番で機械を通るフローショップを扱い、2機械なら Johnson の方法で最適な順序が簡単に決まること、3機械以上では NEH のような発見的な方法と厳密解を比べる必要があることを見ました。この章では、その前提を外します。品目ごとに通る機械の順番が違い、ある品目は旋盤から研削盤へ、別の品目は熱処理炉から旋盤へ、というように道順がばらばらな工場です。多品種少量の部品加工、金型、試作、修理工場の多くはこの形をしています。この型の問題をジョブショップと呼びます。この章では、問題の定義と、順序の決め方を図で表すディスジャンクティブグラフ、メイクスパンを決めるクリティカルパスの読み方を説明したうえで、制約プログラミングのソルバーで実際に解きます。公開ベンチマークで最適値が知られた結果と一致することを確かめ、次に第2章で用意した受注12件を、目的を変えて解き比べます。
ジョブショップ問題とは何を決める問題か
ジョブショップ問題の入力は、ジョブ(受注や製造指図のこと)ごとの工程の列です。各工程は「どの機械で」「何分かかるか」が決まっていて、同じジョブの工程は決められた順番どおりにしか進めません。前の工程が終わるまで次の工程には着手できない、という制約を先行関係と呼びます。もう1つの制約は機械の側にあり、1台の機械は同時に1つの工程しか加工できません。決めたいのは、各機械の上で工程をどの順番に並べるか、そしてその結果として各工程を何時何分に始めるかです。第2章の3項記法でいえば、目的をメイクスパン(最後の工程が終わる時刻)にした基本形は Jm||Cmax と書かれます。
フローショップとの違いは、道順が品目ごとに違うことだけですが、この違いが順序の決め方を大きく変えます。フローショップでは全機械で同じ順番に流す(置換フローショップ)という割り切りがよく効き、ジョブの並べ方を1本の順列として探せば済みました。ジョブショップでは、機械ごとに独立に並び順を決める必要があります。機械が5台なら、5本の順列を同時に決めることになり、しかもある機械の並べ方が別の機械の空き時間を通じて影響し合います。旋盤で J04 を先にするかどうかが、その先の研削盤やマシニングセンタの待ちを変え、それがまた別のジョブの熱処理炉への到着時刻を変える、という連鎖です。
この章の基本形では、次の前提を置きます。工程は一度始めたら途中で止めない(中断なし)、段取り時間は加工時間に含めるか無視する(順序によって変わる段取りは第7章で扱います)、機械は常に使える(故障や休憩は第10章と第12章で扱います)、1つの工程を加工できる機械は1台に決まっている(代替機の選択は扱わない)、ジョブは着手可能時刻より前には始められない。現実の工場はこれよりずっと複雑ですが、ここで作る骨格はそのまま残り、後の章で制約を足していく土台になります。
計算の難しさについては、Garey・Johnson・Sethi の1976年の論文が、ジョブショップで「メイクスパンが指定した値以下になるスケジュールがあるか」を判定する問題は、一般の形では機械が2台以上で NP 完全であることを示しています。NP 完全は「はい・いいえ」で答える判定問題についての言葉で、それに対応する「最短のスケジュールを求める」問題は、第2章で説明した NP 困難にあたります。どちらも、知られているどの厳密解法でも最悪の場合の計算時間が規模とともに急激に伸びる、という意味では同じです。しかもこの結果は、加工時間の数値を大きくしなくても(問題の大きさを加工時間の合計で測っても)難しさが変わらない、という強い意味のものです(第2章の表のとおり、2台でも各ジョブの工程が2つまでなら易しい特別な場合があります)。同じ論文は、フローショップについても、機械3台以上で対応する判定問題が NP 完全になることを示しており、第4章で見た「2機械なら Johnson の方法で解ける」こととの境目がここにあります。第2章で説明したとおり、これは「解けない」という意味ではなく、「規模とともに急に重くなる」という意味です。実際、この章で扱う6ジョブ×6機械や12ジョブ×5機械の大きさなら、ノートPCで1秒もかからずに最適性の証明まで終わります。どのくらいの規模から重くなるかは第6章と第11章で測ります。
ディスジャンクティブグラフ、決めなければならない「対」を数える
ジョブショップの構造を見通すには、ディスジャンクティブグラフという図が便利です。工程を1つずつ点(ノード)で表し、開始と終了の2つの点を足します。同じジョブの工程どうしは、決められた順番に向きのある矢印で結びます。これは先行関係そのもので、向きは最初から決まっています。一方、同じ機械を使う2つの工程は、どちらが先になるかがまだ決まっていないので、向きのない線で結びます。「ディスジャンクティブ」は「どちらか一方」という意味で、この線は「A が B より先か、B が A より先か、のどちらか一方が成り立つ」という選択を表しています。Balas の1969年の論文は、機械の順序づけ問題を、このグラフの上で最長路が最小になるように線の向きを選ぶ問題として定式化し、その上で探索する方法を示しました。
次の図は、OR-Tools の公式ドキュメントでジョブショップの例題として使われている3ジョブ×3機械の問題を、この形に描いたものです。ノードの上段の「J0-1」はジョブ0の1番目の工程、下段の「M0・3」は機械0で3の時間がかかることを表します(ドキュメントに合わせ、この例と後の ft06 では機械とジョブの番号を0から数えています)。左の図の実線の矢印が先行関係、灰色の点線が同じ機械を使う工程の対です。
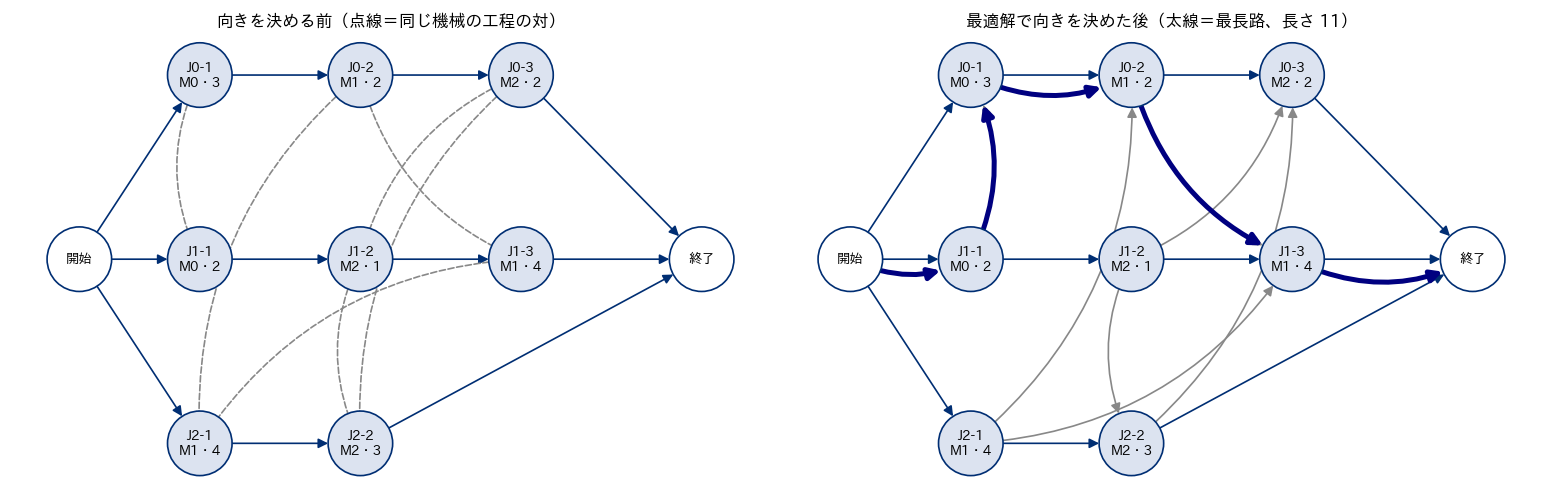
この小さな例では、同じ機械を使う工程の対が7組あります(実行ログ ch05_disjunctive.txt)。それぞれの向きを2通りずつ選べるので、組み合わせは \( 2^7 = 128 \) 通りです。ただし、そのすべてがスケジュールになるわけではありません。向きの選び方によっては「A は B より先、B は C より先、C は A より先」という循環ができ、どの時刻を割り当てても満たせなくなります。循環のない向きの選び方だけが実行可能なスケジュールに対応し、そのとき各工程の最も早い開始時刻は、開始の点からその工程までの最長路の長さとして決まります。右の図は、最適解の並び順に合わせて点線に向きを付けたもので、循環がないことをプログラムで確かめたうえで最長路を求めると長さ11になり、ドキュメントに書かれた最適値11と一致しました。
対の数は、ジョブと機械が増えると急速に増えます。公開ベンチマークの ft06(6ジョブ×6機械、各ジョブが6台の機械をすべて1回ずつ通る)では、1台の機械に6つの工程が載るので、機械1台あたりの対は \( \binom{6}{2} = 15 \) 組、6台で90組です。向きの組み合わせは \( 2^{90} \)、およそ \( 1.2 \times 10^{27} \) 通りになります。機械ごとの並び順として数え直すと、6工程の並べ方が720通りで、それが6台分なので \( 720^6 \)、およそ \( 1.4 \times 10^{17} \) 通りです。後者のほうが小さいのは、機械の上の並び順が決まれば対の向きがすべて決まり、しかも並び順どうしの矛盾(循環)を起こす組み合わせが前者には大量に含まれているためです。いずれにしても、1秒に1億通りを調べても \( 1.4 \times 10^{17} \) 通りの総当たりには40年以上かかります。ソルバーは総当たりをせず、後で説明する制約の推論と下界の計算で、調べなくてよい組み合わせを大きく切り捨てています。
クリティカルパス、メイクスパンを決めている工程の列
向きを決めたグラフの上で、開始から終了までの最長路をクリティカルパスと呼びます。メイクスパンはこの最長路の長さに等しくなります。クリティカルパスの上に並ぶ工程は、どれも「直前の工程(同じジョブの前工程か、同じ機械で直前に加工した工程)が終わった瞬間に始まっている」工程で、どれか1つでも遅れればメイクスパンがそのまま延び、逆にメイクスパンを縮めるには、この経路の上のどこかを縮めるか、経路そのものを組み替えるしかありません。プロジェクト管理のクリティカルパスと同じ考え方ですが、ジョブショップでは経路の一部が「機械の上での並び順」でできている点が違います。Balas の1969年の論文は、改善の候補として向きを入れ替える価値があるのはクリティカルパス上の対だけである、という性質を使って探索を大きく絞り込めることを示しています。
ft06 の最適スケジュールでクリティカルパスをたどると、次の9つの工程が並びました(番号は0から数えるジョブの番号に1を足して J1〜J6 と書いています)。機械1で J2(8)、J4(5)、J6(3)と続けて加工し、そのまま J6 が機械3(3)、機械5(9)、機械0(10)、機械4(4)と進み、機械4で J3(7)、J1(6)が続いて時刻55に終わります。括弧内は加工時間で、合計がちょうど55です(ch05_ft06.txt)。経路の前半は機械1の上での並び順、中盤は J6 というジョブの道順、終盤は機械4の上での並び順でできています。この経路の上の工程で、たとえば J6 の機械5の加工9を短くできればメイクスパンは縮む可能性がありますが、この並び順を固定する限り、経路の外の工程を短くしても、このスケジュールのメイクスパン55は変わりません。
クリティカルパスの考え方は、最適値の見積もりにも使えます。ft06 では、最も負荷の大きい機械(機械5)の加工時間の合計が43、最も長いジョブの加工時間の合計が47です。どの機械も同時に1工程しか加工できず、どのジョブも工程を順にしか進められないので、メイクスパンは43と47のどちらも下回れません。つまり47は、計算しなくても言える下界(最適値がこれより小さくならない保証のある値)です。実際の最適値55はこれより8大きく、その差は、機械の待ちとジョブの待ちが組み合わさって生じる避けられない空き時間です。現場で「一番忙しい設備の負荷」だけを見て納期を答えると、この差の分だけ楽観的な答えになります。
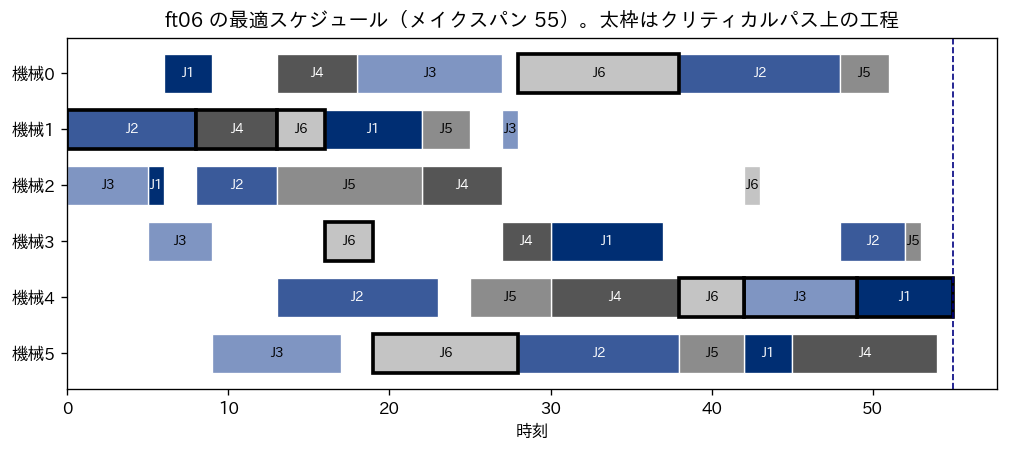
上の図は ft06 の最適スケジュールのガントチャートで、太枠がクリティカルパス上の工程です。機械1の最初の3工程から J6 の道順を経て機械4の最後の3工程へつながる階段状の経路が、メイクスパン55を決めていることが読み取れます。一方で、機械2には時刻27から42まで、機械3には時刻37から48まで大きな空きがありますが、これらはクリティカルパスの外にあるので、この空き時間に収まる作業なら、既存の並び順を変えずに、メイクスパンを延ばさずに入れられます。飛び込みの仕事を入れる余地がどこにあるかも、クリティカルパスとの関係で判断できます。
CP-SAT のインターバル変数と重なり禁止制約で書く
ジョブショップを解く道具として、この記事では Google の OR-Tools に含まれる制約プログラミングのソルバー CP-SAT を使います。制約プログラミングは、変数の取りうる値の範囲を制約から推論して狭めていき、狭めきれないところで場合分けをして探索する解き方で、順序と時刻を決める問題を自然に書けるのが特徴です。OR-Tools の公式ドキュメントでは、CP-SAT は整数の変数だけで書かれた問題を扱うソルバーとして説明されており、時刻や時間は整数(この記事では分)で表します。MIP(混合整数計画)との使い分けは第6章で実測して比べますので、この章ではジョブショップの書き方に絞ります。
CP-SAT でジョブショップを書く中心は、インターバル変数と重なり禁止制約の2つです。インターバル変数は「開始時刻・長さ・終了時刻」をひとまとめにした変数で、各工程に1つ作ります。重なり禁止制約(add_no_overlap)は、インターバル変数のリストを受け取り、その中のどの2つも時間が重ならないことを要求します。同じ機械の工程のインターバル変数をまとめてこの制約に渡すだけで、「1台の機械は同時に1工程」という条件が書けます。ディスジャンクティブグラフの対を1つずつ「A が先か B が先か」の0か1の変数で書く必要はありません。先行関係は「後の工程の開始時刻は前の工程の終了時刻以上」という不等式で書き、メイクスパンは全ジョブの最後の工程の終了時刻の最大値として置きます。この書き方は OR-Tools の公式ドキュメントのジョブショップの例と同じ構成です。
次のコードは、ft06 を解く最小のモデルです。OR-Tools 9.15.6755、Python 3.14.3 で実行しました。load_orlib("ft06") は第2章で用意した読み込み関数で、OR-Library の公開ファイルから各ジョブの工程の列を読みます。
from ortools.sat.python import cp_model
from sched_data import load_orlib

jobs = load_orlib("ft06")                      # [[(機械, 加工時間), ...], ...]
horizon = sum(p for job in jobs for _, p in job)
model = cp_model.CpModel()
start, end, on_machine = {}, {}, {}
for j, job in enumerate(jobs):
    for k, (m, p) in enumerate(job):
        s = model.new_int_var(0, horizon, f"s{j}_{k}")
        e = model.new_int_var(0, horizon, f"e{j}_{k}")
        iv = model.new_interval_var(s, p, e, f"iv{j}_{k}")   # 開始・長さ・終了をひとまとめにした変数
        start[j, k], end[j, k] = s, e
        on_machine.setdefault(m, []).append(iv)
        if k > 0:
            model.add(s >= end[j, k - 1])        # 前の工程が終わってから始める
for m, ivs in on_machine.items():
    model.add_no_overlap(ivs)                    # 同じ機械の工程は時間が重ならない
cmax = model.new_int_var(0, horizon, "cmax")
model.add_max_equality(cmax, [end[j, len(job) - 1] for j, job in enumerate(jobs)])
model.minimize(cmax)                             # 最後の工程の終了時刻を最小にする
solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 60
solver.parameters.num_workers = 8
solver.parameters.random_seed = 0
status = solver.solve(model)
print(solver.status_name(status), solver.objective_value, solver.best_objective_bound)
# 出力: OPTIMAL 55.0 55.0
変数の範囲の上限 horizon には、全工程の加工時間の合計を入れました。すべての工程を1列に並べても必ずこの時刻までに終わるので、最適解を取りこぼさない上限になります。実務では「計画期間の終わり」のような意味のある値を入れておくと、結果の読み違いが起きにくくなります。max_time_in_seconds は計算の打ち切り時間、num_workers は並列に動かす探索の数です。計算時間は並列の数で変わるため、この記事では比較のときに8に固定しています。並列で探索すると、同じ設定でも返るスケジュールが実行ごとに変わることがある点は、後の受注12件の節で実測を示します。
出力の3つの値は、状態・見つかった最良の目的関数値・下界です。状態の OPTIMAL は、最良の値と下界が一致し、これより良い解が無いことが証明されたことを意味します。打ち切り時間で止まった場合は FEASIBLE(実行可能な解はあるが最適性は未証明)が返り、そのときは最良の値と下界の差が、解の質を測る物差しになります。この2つを区別して読むことが、ソルバーの結果を業務に使ううえで最初の注意点です。
ft06 を解いて最適値55を確かめる
ft06 は、Fisher と Thompson が1963年に発表した6ジョブ×6機械の問題で、OR-Library の jobshop1.txt に収録されています(収録ファイルの冒頭に、Muth と Thompson が編集した論文集『Industrial Scheduling』に載ったことが記されています。この論文集には1966年に竹内書店から日本語訳『インダストリアルスケジューリング』が出ています)。最適なメイクスパンは55として知られており、公開されているベンチマーク一覧でも最適値は55とされています。上のコードで解くと、状態 OPTIMAL、メイクスパン55、下界55が返り、最適値55を自分の計算で確かめられました。計算時間は、この記事の実行環境(一般的なノートPC)での実測で、並列8で0.074秒、並列1で0.012秒でした。この大きさでは並列化の準備の手間のほうが大きく、並列1のほうが速く終わっています。
同じ論文の10ジョブ×10機械の問題 ft10 は、長く最適値が確定しなかったことで知られています。Carlier と Pinson の1989年の論文は、この問題を分枝限定法で初めて解いたと報告しており、Applegate と Cook の1991年の論文は、同じ問題を当時のワークステーションで7分弱で解いたと報告しています。同じモデルで ft10 を解くと、この記事の実行環境では並列8で5.43秒で状態 OPTIMAL、メイクスパン930に達しました(ch05_ft10.txt)。計算機とソルバーの進歩により、数十年前に難問とされた大きさは、いまはノートPCで数秒の問題になっています。ただし、これは機械10台・工程100個の話で、工程が数千になる実務の規模では事情が違います。その規模での振る舞いは第6章と第11章で扱います。
比較のため、同じ ft06 と ft10 を、第3章で扱った考え方のディスパッチングルールで組みました。ジョブショップにルールを当てるには「どの機械の前で、どの工程とどの工程が順番を争っているか」を決める手順が要ります。ここでは Giffler と Thompson の1960年の論文の手順(以下、GT法)を使いました。GT法は次の操作の繰り返しです。まず、各ジョブの次の工程のうち、今の状態で最も早く終えられる工程を1つ探します。次に、その工程が使う機械の上で、その終了時刻より前に始められる他の工程を集めます。これらは同じ機械を取り合っているので「衝突している工程」と呼びます。最後に、衝突している工程の中からルールで1つを選んで機械に載せ、その機械が空く時刻を更新して、最初に戻ります。同論文は、この手順で作られるスケジュールの集まり(能動的スケジュールと呼ばれます)の中に必ず最適なスケジュールが含まれること、そしてこの基本の手順でよく知られた機械への割り付けルールによるスケジュールも作れることを示しています。
ルールは3つです。1つ目は、衝突している工程の中で最も早く始められる工程を選び、同時に始められる工程どうしはジョブの番号の小さい順にする規則で、この記事では「早く始められる順(GT法)」と呼びます。機械の前で既に待っている工程は、どれも機械が空いた時刻に同時に始められるので、待っている工程どうしの順番はジョブの番号で決まり、機械に先に着いた順にはなりません。先着順(FIFO)に近い考え方ですが、同じ規則ではありません。2つ目は加工時間の短い工程を優先する SPT、3つ目は残りの加工時間が長いジョブを優先する MWKR です。
| 方法 | ft06 のメイクスパン | 最適値との差(ft06) | ft10 のメイクスパン | 最適値との差(ft10) |
|---|---|---|---|---|
| 早く始められる順(GT法) | 68 | 23.6% | 1,262 | 35.7% |
| 加工時間の短い順(SPT) | 94 | 70.9% | 1,429 | 53.7% |
| 残り加工時間の長い順(MWKR) | 67 | 21.8% | 1,178 | 26.7% |
| CP-SAT(最適) | 55 | 0% | 930 | 0% |
表の「最適値との差」は、ルールで得たメイクスパンが最適値を何%上回ったかです。3つのルールの中では MWKR が最も良く、ft06 で21.8%、ft10 で26.7%の上振れでした。SPT は総完了時間を減らすルールで、メイクスパンを縮める目的とは合っておらず、ft06 で70.9%上回っています。第3章で見たとおり、ルールには「その目的で良い結果を出す」相性があり、目的と合わないルールを使うと大きく外れます。仮に ft10 の時間の単位を分とすると、MWKR の1,178分と最適の930分の差は248分、4時間強です。1日2交替の工場で、同じ仕事量を終えるのに半交替分の時間を余計に使っている計算になります。
受注12件を2つの目的で解き比べる
ここからは第2章で用意したサンプルデータの受注12件(J01〜J12)を解きます。5台の機械(M1 旋盤、M2 マシニングセンタ、M3 研削盤、M4 熱処理炉、M5 検査)を、ジョブごとに3〜5工程で通り、最後は必ず M5 検査です。各ジョブには着手可能時刻(材料が揃う時刻)と納期、重み(1〜3。大きいほど遅れたときの痛みが大きい)が付いています。時間の単位は分、時刻0は月曜8:00です。機械別の負荷は M4 熱処理炉が1,530分で最も大きく、ここがボトルネックです。ft06 のモデルに、着手可能時刻の制約(最初の工程の開始時刻が着手可能時刻以上)を足しました。
目的は2つ用意しました。1つはこれまでと同じメイクスパン最小、もう1つは重み付き納期遅れの合計の最小です。ジョブ \( j \) の完了時刻を \( C_j \)、納期を \( d_j \)、重みを \( w_j \) とすると、後者は \( \sum_j w_j \max(0, C_j – d_j) \) で、言葉にすれば「各ジョブが納期を何分過ぎたか(間に合えば0)に重みを掛けて全ジョブで足したもの」です。CP-SAT では、ジョブごとに納期遅れの変数を0以上で作り、「完了時刻から納期を引いた値以上」という制約を置いて、重みを掛けた和を最小化します。納期遅れの変数は0以上に限っているので、間に合ったジョブでは0になり、遅れたジョブでは遅れた分数になります。次のコードは、重み付き納期遅れを最小にするモデルの全体です。着手可能時刻は、各工程の開始時刻の変数の下限として与えました。最初の工程だけに付ければ十分ですが、後の工程は前の工程より必ず後になるので、全部に付けても答えは変わりません。
from ortools.sat.python import cp_model
from sched_data import load_orders

orders = load_orders()                          # route=[("M3", 210), ...], release, due, weight
horizon = max(o["release"] for o in orders) + sum(p for o in orders for _, p in o["route"])
model = cp_model.CpModel()
on_machine, tard = {}, []
for o in orders:
    prev_end = None
    for k, (m, p) in enumerate(o["route"]):
        s = model.new_int_var(o["release"], horizon, f"s_{o['id']}_{k}")   # 着手可能時刻より前には始めない
        e = model.new_int_var(0, horizon, f"e_{o['id']}_{k}")
        on_machine.setdefault(m, []).append(model.new_interval_var(s, p, e, f"iv_{o['id']}_{k}"))
        if prev_end is not None:
            model.add(s >= prev_end)             # 工程の順番
        prev_end = e
    t = model.new_int_var(0, horizon, f"T_{o['id']}")
    model.add(t >= prev_end - o["due"])          # 納期遅れ(間に合えば 0)
    tard.append(o["weight"] * t)
for ivs in on_machine.values():
    model.add_no_overlap(ivs)
model.minimize(sum(tard))                        # 重み付き納期遅れの合計を最小にする
solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 60
solver.parameters.num_workers = 8
solver.parameters.random_seed = 0
status = solver.solve(model)
print(solver.status_name(status), solver.objective_value, solver.best_objective_bound)
# 出力: OPTIMAL 0.0 0.0
出力の目的関数値0は、12件すべてを納期までに終えるスケジュールが存在し、それをソルバーが見つけたことを意味します。下界も0なので、これ以上は改善しようがありません。一方、同じデータでメイクスパンを最小にすると最適値は1,560分で、ボトルネックの M4 熱処理炉の負荷1,530分にわずか30分を足しただけの長さです。つまり、メイクスパンの面では熱処理炉をほぼ休みなく動かすのが最良で、納期の面では全件を間に合わせることができます。問題は、この2つが同じスケジュールで両立しないことです。
目的によってスケジュールはどう変わるか
目的を変えたときの結果を、ディスパッチングルールと並べたのが次の表です。ルールは ft06 と同じ Giffler と Thompson の手順で組み、ft06 で使った3つに、納期の早い順(EDD)を加えました。CP-SAT は4通りに解いています。「メイクスパン最小」と「重み付き納期遅れ最小」は、それぞれの目的だけを最小にしたもの、残りの2行は、一方の目的を最適値に固定したうえで、もう一方を最小にしたもの(目的に優先順位を付けて順に解く方法)です。すべて CP-SAT の状態は OPTIMAL で、計算時間は、この記事の実行環境での実測でいずれも0.2秒未満でした(ch05_orders.txt)。
| 方法 | メイクスパン(分) | 重み付き納期遅れ | 遅れ件数 | 納期遅れの合計(分) | 平均リードタイム(分) | M4 稼働率 |
|---|---|---|---|---|---|---|
| 早く始められる順(GT法) | 2,000 | 3,150 | 5 | 1,750 | 1,050.0 | 76.5% |
| 加工時間の短い順(SPT) | 2,230 | 4,190 | 6 | 2,430 | 1,201.7 | 68.6% |
| 納期の早い順(EDD) | 2,450 | 200 | 3 | 190 | 1,070.0 | 62.4% |
| 残り加工時間の長い順(MWKR) | 1,720 | 7,740 | 7 | 3,930 | 1,314.2 | 89.0% |
| CP-SAT メイクスパン最小 | 1,560 | 4,670 | 8 | 2,230 | 1,149.2 | 98.1% |
| CP-SAT 重み付き納期遅れ最小 | 2,160 | 0 | 0 | 0 | 1,059.2 | 70.8% |
| CP-SAT メイクスパン優先、次に納期遅れ | 1,560 | 4,290 | 6 | 1,820 | 1,078.3 | 98.1% |
| CP-SAT 納期遅れ優先、次にメイクスパン | 2,080 | 0 | 0 | 0 | 986.7 | 73.6% |
表の「早く始められる順(GT法)」の行は、第2章で受注12件に当てた素朴な先着順(メイクスパン1,870分、重み付き納期遅れ5,730、遅れ6件)とは数字が違います。第2章の先着順は、機械の前で待っている工程のうち先に着いたものから加工する手順で、この章の規則は、前の節で説明したとおり、待っている工程どうしをジョブの番号順に選びます。この章の GT法の手順のまま、同時に始められる工程どうしを「機械の前に着いた時刻の早い順」に選ぶように変えて計算し直すと、メイクスパン1,870分、重み付き納期遅れ5,730、遅れ6件となり、第2章の先着順の結果と一致しました(ch05_fifo_compare.txt)。同じ受注でも、待っている仕事どうしの順番の付け方1つで、メイクスパンが130分、遅れる受注が1件変わるということです。
表の列の意味を確認しておきます。「重み付き納期遅れ」は、各ジョブの納期遅れ(分)に重みを掛けた合計です。「平均リードタイム」は、各ジョブの着手可能時刻から完了時刻までの時間の12件平均で、材料が揃ってから検査を終えるまでに何分かかったかを表します。「M4 稼働率」は、M4 熱処理炉の加工時間の合計1,530分をメイクスパンで割ったもので、計画の始まりから最後の完了までの間に、ボトルネックが何割の時間動いていたかを表します。
最も大きな違いは、下の2行の比較に現れます。メイクスパンを優先したスケジュールは1,560分(月曜8:00から26時間後)ですべてを終え、M4 熱処理炉の稼働率は98.1%です。しかし12件のうち6件が納期に遅れ、その中には重み3の J04 の460分遅れと J05 の320分遅れ、重み2の J08 の820分遅れが含まれます。J08 は納期が630分(月曜18:30)の急ぎの仕事ですが、完了は1,450分です。一方、納期遅れを優先したスケジュールは12件すべてを納期までに終え、最後の完了は2,080分(34時間40分後)です。全体が終わるのは520分、8時間40分遅くなり、M4 の稼働率は73.6%に下がります。どちらも「最適」ですが、何に対して最適かが違うので、工場の姿がまるで違います。
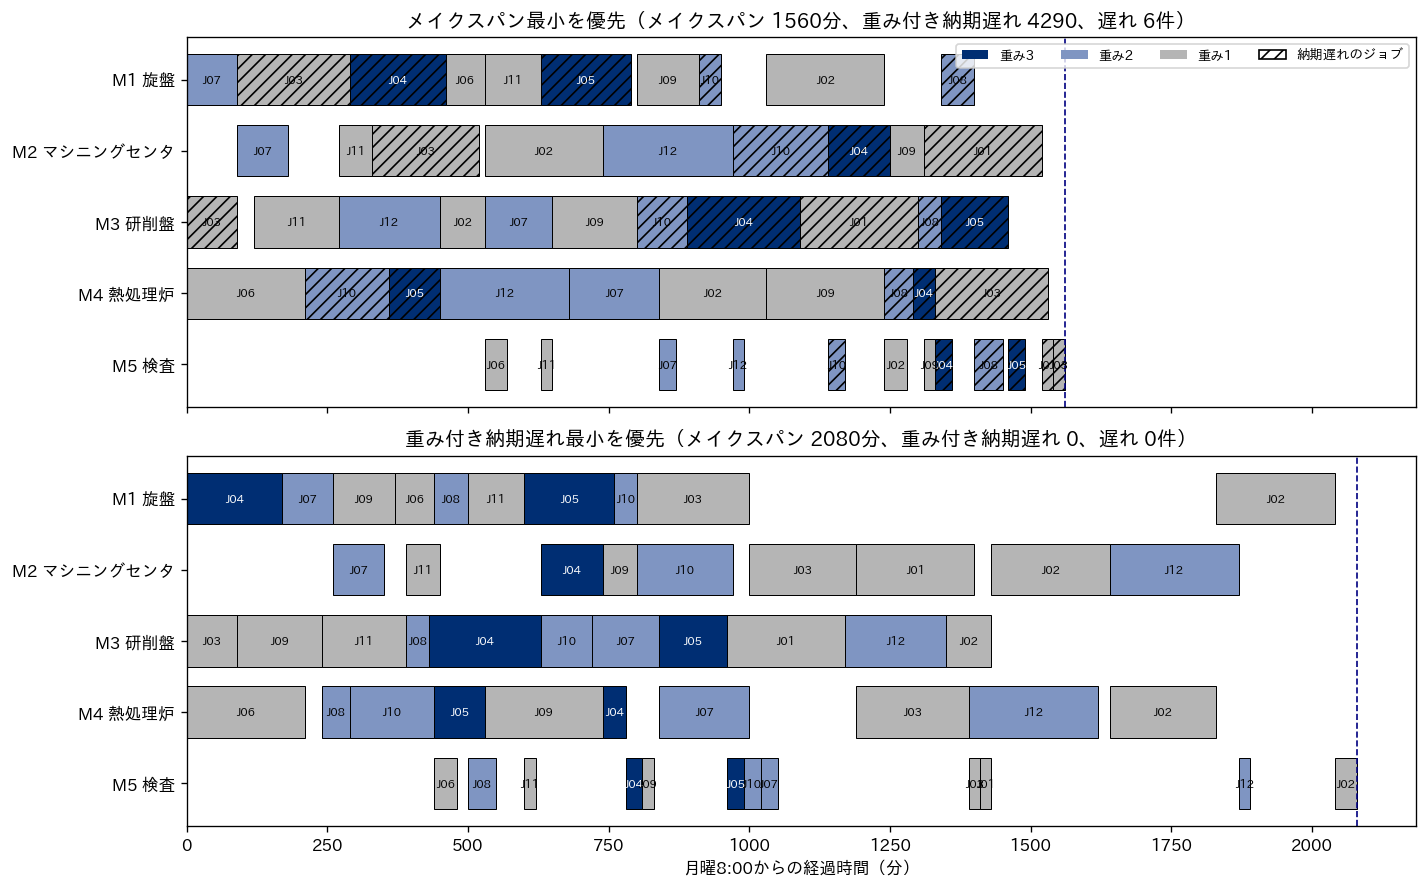
上のガントチャートの上段がメイクスパン優先、下段が納期遅れ優先で、色は重み(濃いネイビーが重み3、薄い青が重み2、灰色が重み1)、斜線は納期に遅れたジョブです。上段では M4 熱処理炉の帯が時刻0から1,530分まで一度も途切れず、ボトルネックを休ませない並べ方になっています。その代わり、重み3の J04 は M1 旋盤で3番目、J05 は6番目に回され、斜線が目立ちます。下段では、重み3の J04 を M1 旋盤の先頭に置き、納期630分の J08 を材料が揃う240分の直後に M4 熱処理炉へ入れています。その結果、M4 には210分から240分、780分から840分、1,000分から1,190分などの待ちの隙間ができ、納期に余裕のある J02 と J12 を最後に回したことで全体の完了が延びています(機械ごとの並び順と隙間は ch05_orders.txt に出力しました)。
目的に入れなかった指標は保証されない
表の中で見落としやすいのが、目的を1つだけにした2行です。「CP-SAT メイクスパン最小」は、メイクスパン1,560分という点では最適ですが、重み付き納期遅れは4,670で、メイクスパンを1,560分に保ったまま納期遅れを最小にした行の4,290より悪くなっています。メイクスパンが同じ1,560分のスケジュールは多数あり、ソルバーはその中の1つを返しただけで、納期遅れの良し悪しは考慮していないからです。実際に、同じ設定でメイクスパン最小をさらに3回解き直すと、メイクスパンは3回とも1,560分でしたが、重み付き納期遅れは4,440、5,010、4,440と表の4,670とは違う値になり、遅れ件数は7件でした(ch05_orders.txt)。この記事の執筆中に同じスクリプトを何度か実行した際も、この値は実行のたびに変わっていました。並列で探索するソルバーでは、目的関数の値が同じ解のうちどれが返るかは実行ごとに変わりうる、と考えておくのが安全です。同じく「CP-SAT 重み付き納期遅れ最小」も、全件を間に合わせるという点では最適ですが、最後の完了は2,160分で、納期遅れ0のまま最短にした2,080分より80分長くなっています。
この現象は、ソルバーの不具合ではなく、目的関数の書き方の問題です。ソルバーは目的に書いた指標だけを見ており、目的に入れていない指標については何も約束しません。ここから、実務で最適化を使うときの原則が1つ出てきます。気にする指標が複数あるなら、優先順位を決めて順に解く(上の表の下2行のやり方)か、重みを付けて1つの式にまとめるかのどちらかで、必ず目的に入れることです。前者は「まず納期遅れを最小にし、その値を守ったうえで全体を早く終える」のように説明しやすく、後者は重みの決め方に経営判断が入ります。重みを振ったときに解がどう動くかは、第7章で段取りと納期の組み合わせを題材に表とグラフで示します。
ディスパッチングルールとの差をどう読むか
受注12件の表でディスパッチングルールの行を見ると、目的とルールの相性がはっきり表れています。納期の早い順(EDD)は重み付き納期遅れが200で、ルールの中では断然良く、遅れは3件(J03 が90分、J09 が90分、J12 が10分)です。ただしメイクスパンは2,450分と最も長くなりました。残り加工時間の長い順(MWKR)はメイクスパンが1,720分で、最適の1,560分より10.3%長いだけですが、重み付き納期遅れは7,740と最も悪く、7件が遅れます。早く始められる順(GT法)は、どちらの指標でも中ほどです。
CP-SAT と比べると、EDD の重み付き納期遅れ200に対して最適は0で、EDD で遅れた3件は、並べ方を変えれば全部間に合うことが分かります。一方、EDD の200という値は、早く始められる順の3,150や SPT の4,190と比べれば桁違いに小さく、「納期で並べる」という単純な方針だけで、最適との差のかなりの部分を埋められていることも読み取れます。ルールには、計算が一瞬で終わる、現場の作業者が理由を理解できる、機械が空くたびにその場で次の仕事を選び直せる、という利点があります。故障や飛び込みで計画が崩れたときに、その場で次を決める手段として、ルールは最適化と競合するものではなく補い合うものです。崩れたときの対応は第12章で扱います。
逆に、ルールだけに任せてはいけないのは、ボトルネックが明確で、しかも納期と稼働率のどちらを優先するかで結果が大きく変わる場合です。この受注12件はまさにその例で、EDD の M4 稼働率62.4%、MWKR の89.0%、最適化の98.1%や73.6%という数字は、同じ仕事を同じ機械で処理しているのに、並べ方だけで大きく違っています。ルールを選ぶことは、暗黙のうちに目的を選ぶことです。どの目的を選んだのかを自覚しないままルールを使い続けると、工場の実績が「なぜかいつも急ぎの仕事が遅れる」「なぜか熱処理炉が空いている」といった形で現れます。
このモデルを使えるとき、使ってはいけないとき
この章のモデルが前提にしているのは、工程の道順と加工時間が確定していること、各工程を加工できる機械が1台に決まっていること、機械が常に使えること、工程を途中で止めないこと、段取りが順序に依存しないことです。このうち、実務で最も結果を左右するのは加工時間の精度です。モデルが正確でも、入力の標準時間が実際より2割短ければ、最適と称するスケジュールは毎日2割遅れて崩れます。標準時間(マスタ)の精度をどう上げ、どう運用するかは第13章で扱います。
前提が崩れる場合には、モデルを拡張します。同じ工程を複数の機械のどれでも加工できる場合(代替機がある場合)は、工程ごとに「どの機械を使うか」の選択を加えた拡張が必要になり、並列機械の割当の考え方は第9章で扱います。品目の切り替えで段取り時間が変わる場合は第7章、作業者や治具の数、稼働カレンダーの制約は第10章、故障や飛び込み注文への対応は第12章です。CP-SAT のインターバル変数と重なり禁止制約という骨格は、これらの拡張でもそのまま使えます。
もう1つの注意は、目的関数の選び方です。この章で見たとおり、メイクスパン最小は「全体を早く終える」ことだけを目指し、個々の納期には無関心です。メイクスパンが意味を持つのは、ある期間の仕事の塊をまとめて終えたい場合、たとえば週末までに今週の受注を全部終えて設備を止める、出荷便がまとめて出る、といった状況です。受注ごとに納期が違い、顧客との約束が重要な工場では、納期遅れを目的に入れないと、最適化がむしろ納期遵守を悪化させます。
経営指標に翻訳する、稼働率と納期遵守のどちらを買うか
受注12件の2つのスケジュールを経営の言葉に直すと、次のようになります。メイクスパン優先は、熱処理炉の稼働率98.1%、全体の完了は26時間後で、設備の面では理想に近い計画です。その代償は、6件の納期遅れで、重み3の顧客2件への遅れ(7時間40分と5時間20分)と、急ぎの J08 の13時間40分の遅れを含みます。納期遅れ優先は、12件すべてを約束どおりに届け、平均リードタイムも986.7分と表の中で最も短くなります。代償は、熱処理炉の稼働率が73.6%に下がり、全体の完了が8時間40分遅れることです。
この比較から言えるのは、稼働率そのものを経営目標にすると判断を誤りやすい、ということです。稼働率98.1%の計画は、ボトルネックの熱処理炉を休ませない代わりに、その前後の工程で急ぎの仕事を待たせています。第1章で見た「稼働率を上げすぎると待ち時間が急増する」関係が、スケジュールの中でも同じ形で現れています。どちらを選ぶべきかは工場の事情で決まり、納期遅れの違約金や信用の損失が大きい受注生産なら納期優先、ボトルネックの設備の1時間が高価で後ろに十分な余裕がある見込み生産なら稼働率優先が合理的です。重要なのは、この選択をスケジュール担当者の暗黙の癖に任せず、経営として目的の優先順位を決め、それをモデルの目的関数として書くことだと考えています。
報告の形としては、スケジュールを1本だけ示すのではなく、この章の表のように「目的の優先順位を変えたときの指標の組」を並べて見せるのが有効です。全件を間に合わせると全体の完了が何時間延びるか、熱処理炉の稼働率が何ポイント下がるか、逆に全体を早く終えると誰の納期がどれだけ遅れるか、という引き換えの関係が数字で見えれば、営業と製造の議論が「どちらが正しいか」から「どの組を選ぶか」に変わります。
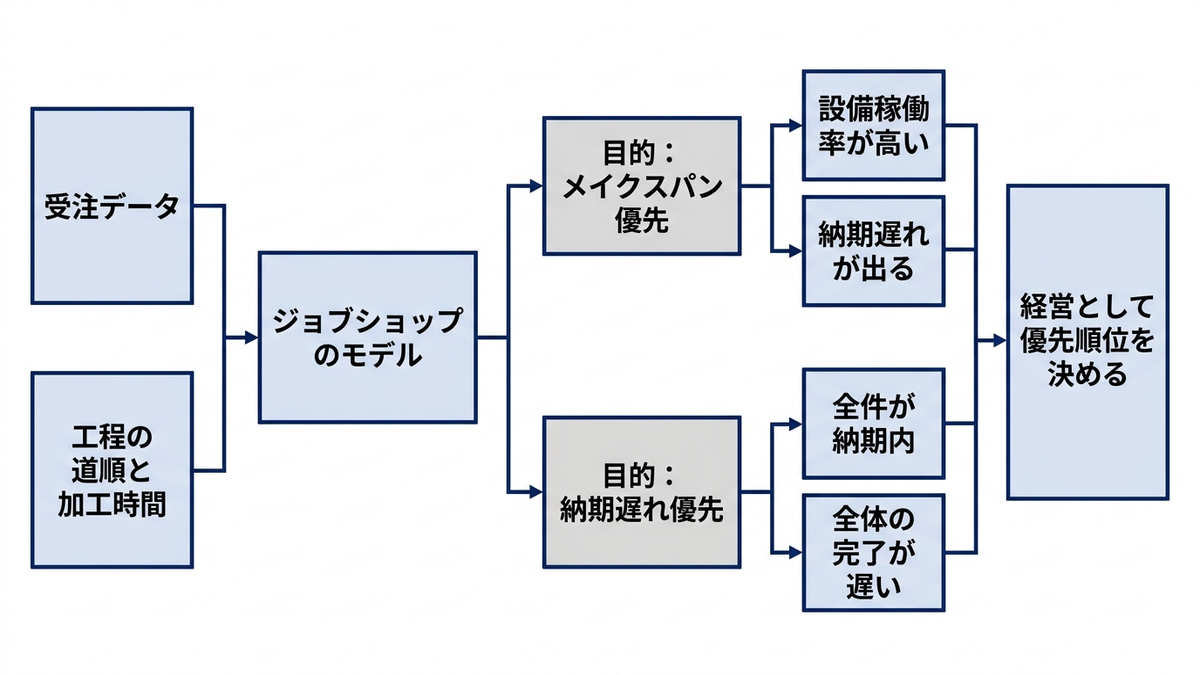
この章の要点は3つです。第一に、ジョブショップは機械ごとの並び順を同時に決める問題で、ディスジャンクティブグラフの対の向きの選び方として表せ、メイクスパンはその上の最長路(クリティカルパス)で決まります。第二に、CP-SAT のインターバル変数と重なり禁止制約を使えば、この問題を30行ほどで書くことができ、公開ベンチマーク ft06 の最適値55と ft10 の最適値930を、この記事の実行環境で数秒以内に再現できました。第三に、同じ受注12件でも、メイクスパン最小と重み付き納期遅れ最小ではスケジュールがまるで違い、目的に入れなかった指標は何も保証されません。目的の優先順位は経営判断そのものです。この章では CP-SAT だけを使いましたが、同じ問題は MIP(混合整数計画)でも書けます。次の第6章では、ジョブショップを3通りの式で書き、MIP のソルバーと CP-SAT の計算時間と下界を同じ問題で比べます。
この章を深めたい方への参考書籍
『Pythonによる実務で役立つ最適化問題100+ 3 配送計画・パッキング・スケジューリング』(久保幹雄、朝倉書店):第29章「スケジューリング問題」で、1機械問題や順列フローショップ問題と並んでジョブショップスケジューリング問題を取り上げ、OR-Tools を用いた求解の節を設けています。資源制約付きプロジェクトスケジューリング問題の節もあり、この章のモデルを後の章の制約へ広げていく道筋を、Python のコードとともに追えます。
『Constraint-Based Scheduling』(Philippe Baptiste、Claude Le Pape、Wim Nuijten、Springer):制約プログラミングでスケジューリング問題を解くための推論の技法をまとめた専門書で、1台の機械の資源制約の推論、累積的な資源制約の推論、ディスジャンクティブな問題の解き方などに章が割かれています。この章で「重なり禁止制約を渡すだけで書ける」と済ませた部分の内側で、ソルバーが何をしているかを知る手がかりになります。洋書です。
第6章 MIP と CP の使い分け、同じジョブショップを3つの定式化で解き比べる
第5章では、ジョブショップ(仕事ごとに機械を回る順番が違う工場)を CP-SAT のインターバル変数と重なり禁止制約で書き、公開ベンチマークの ft06 で最適値55を確かめ、受注12件をメイクスパン最小と重み付き納期遅れ最小で解きました。同じ問題は、混合整数計画(連続の量と0か1の判断を同時に決める最適化の型。英語の頭文字で MIP と呼びます)でも書けます。この記事で使う無償の道具は、MIP なら PuLP と CBC、制約プログラミング(変数の取りうる値の組み合わせを制約から絞り込みながら探索する解き方)なら OR-Tools の CP-SAT です。この章では、同じジョブショップを3つの書き方で定式化し、同じ時間制限で解いて、計算時間と「解の質の保証」がどれほど違うかを実測します。そのうえで、どういう問題なら MIP を選び、どういう問題なら CP を選ぶか、両方をどう組み合わせるかを整理します。定式化の一般的な作法(決定変数・目的関数・制約の3点セット、big-M 法、論理条件の書き方)は弊社コラム「数理最適化の定式化パターン集」で扱っていますので、ここではスケジューリングに固有の書き方と、実際に解いたときに何が起きるかに絞ります。
同じ問題を3通りに書く、ディスジャンクティブ・時間インデックス・インターバル
ジョブショップで決めたいのは「各工程を何時に始めるか」です。制約は2種類しかありません。1つは工程順で、同じ仕事の中では前の工程が終わるまで次の工程を始められません。もう1つは機械の排他で、1台の機械は同時に1つの工程しか加工できません。第5章で見たとおり、前者は「開始時刻の差が加工時間以上」という素直な不等式で書けます。難しいのは後者です。同じ機械を使う2つの工程AとBについて、「Aが終わってからBを始める」か「Bが終わってからAを始める」かのどちらか一方が成り立てばよく、この「どちらか一方」という条件は、そのままでは線形の不等式になりません。3つの定式化は、この「どちらか一方」をどう表すかの違いです。
1つ目はディスジャンクティブ定式化(選言的定式化。「どちらか一方」を0か1の変数で選ぶ書き方)です。同じ機械を使う工程の組ごとに、Aが先なら1、Bが先なら0を取る変数 \( y_{AB} \) を1つ置き、十分大きな定数 \( M \) を使って2本の不等式を書きます。\( y_{AB} = 1 \) のときは「Bの開始 ≧ Aの開始+Aの加工時間」が効き、もう1本は \( M \) で打ち消されて何も縛りません。\( y_{AB} = 0 \) のときはその逆です。Ku と Beck の2016年の論文は、この形を Manne の1960年の論文に由来するものとして紹介しています。変数の数は「機械ごとに、その機械を使う工程の組の数」だけで、6仕事×6機械の ft06 なら0-1変数は90個です。
2つ目は時間インデックス定式化です。時間を1単位ずつの格子に区切り、「工程 \( i \) を時刻 \( t \) に始めるなら1」という0-1変数 \( x_{it} \) を、工程と時刻の組み合わせの数だけ置きます。各工程はどこか1つの時刻に始まり(\( \sum_t x_{it} = 1 \))、各機械・各時刻について「その時刻に加工中の工程は1つまで」という不等式を並べます。機械の排他が「時刻ごとの容量が1」という線形の制約になるので、「どちらか一方」を考えずに済みます。同じ論文によれば、時間で添字を付ける発想は Bowman の1959年の論文にさかのぼり、論文の実験では Kondili らの形(この章のコードと同じ形)を使っています。代わりに変数の数は計画期間の長さに比例し、後で示すとおり ft06 でも0-1変数は1,302個になります。
3つ目は第5章で使った CP-SAT のインターバル変数です。工程を「開始・長さ・終了」の3つ組として1つの変数にまとめ、機械ごとに「これらの区間は重ならない」という1本の制約(add_no_overlap)を置きます。「どちらか一方」を0-1変数に展開せず、重なり禁止をソルバーが理解できる形のまま渡すのが特徴です。Google の OR-Tools の公式ガイドは、ジョブショップをこの形(インターバル変数・重なり禁止・工程順の不等式・メイクスパンの最小化)で解く例を載せています。3つの書き方は、同じ最適値を持つ同じ問題を表しています。違うのは、ソルバーに渡る情報の形と、その結果としての解きやすさです。
| 定式化 | 「どちらか一方」の表し方 | 0-1変数の数の目安 | 強み | 弱み |
|---|---|---|---|---|
| ディスジャンクティブ(big-M) | 工程の組ごとの順序変数と、定数 M で打ち消す2本の不等式 | 機械ごとの工程の組の数 | 変数が少ない。時刻を連続値のまま扱える | 0-1変数を連続値に緩めると機械の排他がほとんど効かず、下界が弱い |
| 時間インデックス | 時刻ごとの機械容量(1台なら1) | 工程数 × 計画期間の時刻数 | 緩めても機械容量の情報が残り、下界が強くなりやすい | 時間の刻みを細かくすると変数が膨れる。時刻は格子の上に限られる |
| インターバル(CP-SAT) | 重なり禁止の制約をそのまま渡す | 展開しない(工程ごとの区間変数) | 順序と時刻の推論が速い。大規模でも良い解を早く出す | 整数しか扱えない。連続量や小数の係数は整数に直して渡す必要がある |
表の「弱み」の列にある「下界が弱い」は、この章の中心になる論点なので、後の節で実測値を使って説明します。ここでは、定式化の違いが「問題の違い」ではなく「同じ問題をソルバーにどう見せるか」の違いであることだけ押さえておけば十分です。
PuLP と CBC、CP-SAT で書くとどうなるか
実装は PuLP 3.3.2 と、それに同梱されている CBC 2.10.3(COIN-OR の無償の混合整数計画ソルバー。公式リポジトリは「C++ で書かれたオープンソースの混合整数線形計画ソルバー」と説明しています)、そして OR-Tools 9.15 の CP-SAT で行いました。ジョブショップのデータは、各仕事を「(機械番号, 加工時間)の並び」で表したリスト jobs と、仕事ごとの着手可能時刻 rel です。公開ベンチマークは第2章で用意した load_orlib で読み、受注12件は10分を1単位に直して同じ形にしました。まずディスジャンクティブ定式化の骨格です。
import pulp
from sched_data import load_orlib
jobs = load_orlib("ft06"); rel = [0] * len(jobs)
H = max(rel) + sum(p for j in jobs for _, p in j)      # big-M は全工程の加工時間の合計
prob = pulp.LpProblem("js_bigm", pulp.LpMinimize)
s = {(j, o): pulp.LpVariable("s_%d_%d" % (j, o), lowBound=0)
     for j, ops in enumerate(jobs) for o in range(len(ops))}
cmax = pulp.LpVariable("cmax", lowBound=0)
prob += cmax
for j, ops in enumerate(jobs):
    prob += s[j, 0] >= rel[j]
    for o in range(len(ops) - 1):
        prob += s[j, o + 1] >= s[j, o] + ops[o][1]         # 工程順
    prob += cmax >= s[j, len(ops) - 1] + ops[-1][1]
by_m = {}
for j, ops in enumerate(jobs):
    for o, (m, p) in enumerate(ops):
        by_m.setdefault(m, []).append((j, o, p))
for m, lst in by_m.items():
    for a in range(len(lst)):
        for b in range(a + 1, len(lst)):
            (ja, oa, pa), (jb, ob, pb) = lst[a], lst[b]
            y = pulp.LpVariable("y_%d_%d_%d_%d" % (ja, oa, jb, ob), cat="Binary")  # 1 なら a が先
            prob += s[jb, ob] >= s[ja, oa] + pa - H * (1 - y)
            prob += s[ja, oa] >= s[jb, ob] + pb - H * y
prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=60, logPath="cbc.log"))
print(pulp.LpStatus[prob.status], pulp.LpSolution[prob.sol_status], pulp.value(prob.objective))
# 出力: Optimal Optimal Solution Found 55.0
時間インデックス定式化では、計画期間 H を先に決める必要があります。期間が長いほど変数が増えるので、なるべく短く、しかし最適解を切り落とさない長さにします。ここでは、各工程を「その時点で最も早く始められるもの」から順に置いていく単純な貪欲法で実行可能なスケジュールを1つ作り、そのメイクスパンを計画期間にしました。さらに工程ごとに「これより早くは始められない時刻」(着手可能時刻と前の工程の加工時間の合計)と「これより遅く始めると期間に収まらない時刻」を計算し、その窓の中だけに変数を置いています。次のコードは、変数と制約を作る中心部分だけの抜粋です。prob と cmax は前のコードと同じ作り方で用意し、greedy_ub は上で説明した貪欲法でメイクスパンを返す関数、n_machines は機械の台数です。
H = greedy_ub(jobs, rel)          # 貪欲法で作った実行可能解のメイクスパン
x, win = {}, {}
for j, ops in enumerate(jobs):
    for o, (m, p) in enumerate(ops):
        es = rel[j] + sum(q for _, q in ops[:o])     # 最早開始
        ls = H - sum(q for _, q in ops[o:])          # 最遅開始
        win[j, o] = range(es, ls + 1)
        for t in win[j, o]:
            x[j, o, t] = pulp.LpVariable("x_%d_%d_%d" % (j, o, t), cat="Binary")
st = lambda j, o: pulp.lpSum(t * x[j, o, t] for t in win[j, o])   # 開始時刻
for j, ops in enumerate(jobs):
    for o, (m, p) in enumerate(ops):
        prob += pulp.lpSum(x[j, o, t] for t in win[j, o]) == 1   # 1回だけ始める
        if o + 1 < len(ops):
            prob += st(j, o + 1) >= st(j, o) + p                 # 工程順
    prob += cmax >= st(j, len(ops) - 1) + ops[-1][1]
for m in range(n_machines):
    for t in range(H):
        busy = [x[j, o, u] for j, ops in enumerate(jobs) for o, (mm, p) in enumerate(ops)
                if mm == m for u in range(t - p + 1, t + 1) if (j, o, u) in x]
        if len(busy) > 1:
            prob += pulp.lpSum(busy) <= 1                        # 時刻 t に加工中は1つまで
CP-SAT の書き方は第5章と同じです。比較のために、ソルバーの並列ワーカー数(同時に走らせる探索の数)を8と1の2通りで測りました。CBC はスレッド数を指定せず、PuLP から呼ぶ既定の設定のまま動かしています。この記事の実行環境では、PuLP の threads=1 を明示した実行が2回とも、CPU をほとんど使わない状態のまま60秒の制限を過ぎても終わらなかったため、指定を外しました。原因は突き止めていません。ソルバーに時間制限を付けていても、それが守られるとは限らないということで、実務で定期的に回すときは、ソルバーの外側にも締切(一定時間で子プロセスごと止める仕組み)を置いておくと安全です。この章の実験も、1回ごとに別のプロセスで動かし、外側に115秒の締切を置いて回しました。
from ortools.sat.python import cp_model
model = cp_model.CpModel()
H = max(rel) + sum(p for j in jobs for _, p in j)
iv = {m: [] for m in range(n_machines)}
ends = []
for j, ops in enumerate(jobs):
    prev = None
    for o, (m, p) in enumerate(ops):
        s = model.new_int_var(rel[j], H, "s%d_%d" % (j, o))
        e = model.new_int_var(0, H, "e%d_%d" % (j, o))
        iv[m].append(model.new_interval_var(s, p, e, "i%d_%d" % (j, o)))
        if prev is not None:
            model.add(s >= prev)                      # 工程順
        prev = e
    ends.append(prev)
for m in iv:
    model.add_no_overlap(iv[m])                       # 機械の排他
cmax = model.new_int_var(0, H, "cmax")
model.add_max_equality(cmax, ends)
model.minimize(cmax)
solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 60
solver.parameters.num_workers = 8
solver.parameters.random_seed = 0
st = solver.solve(model)
print(solver.status_name(st), solver.objective_value, solver.best_objective_bound)
# 出力: OPTIMAL 55.0 55.0
行数で比べると、CP-SAT の定式化が最も短く、ディスジャンクティブ定式化は工程の組を二重ループで列挙する分だけ長くなります。時間インデックス定式化は、計画期間と時刻の窓の計算が要るぶん、コードも前準備も最も重くなります。書きやすさの差は、そのまま保守のしやすさの差になります。新しい制約(段取りや作業者)を後から足すとき、工程の組や時刻の格子を意識せずに済む書き方ほど、手戻りが少なく済みます。
3つの問題で実測する、時間制限・下界・ギャップの読み方
計算時間を比べるときに最も大事なのは、「解けた」の意味をそろえることです。ソルバーの出力には2つの数字があります。1つは上界で、これまでに見つけた最良のスケジュールのメイクスパンです。実際に実行できる計画があるので、最適値はこれ以下です。もう1つは下界で、「どう並べてもこれより短くはならない」ことをソルバーが証明できた値です。最適値は下界と上界の間にあり、両者が一致したとき、はじめて「最適であることが証明された」と言えます。両者の差を上界で割った値がギャップで、たとえばギャップ5%なら「手元の計画と最善の計画の差は、手元の計画の長さの5%以内」という保証になります。
この章の実験では、すべての実行に60秒の時間制限を付けました。時間切れで止まったものは「最適」と書かず、その時点の上界・下界・ギャップを表に書きます。CBC の下界は、PuLP の戻り値からは取れないため、CBC のログの最終行(Objective value と Lower bound)から読み取りました。CP-SAT の下界は solver.best_objective_bound で取れます。PuLP の LpStatus は、時間切れで止まっても実行可能な解があれば Optimal を返すので、最適性が証明されたかどうかは LpSolution[prob.sol_status] が Optimal Solution Found か Solution Found かで見分けています。弊社コラム「在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで」の第11章でも同じ注意を書きましたが、ここを取り違えると、時間切れの暫定解を最適解として報告することになります。
比べた問題は3種類です。1つ目は第5章でも解いた ft06(Fisher と Thompson が1963年に示した6仕事×6機械の問題)、2つ目は同じ OR-Library に収められている la01(Lawrence が1984年に示した10仕事×5機械の問題)、3つ目は第2章で用意したサンプルデータの受注12件(12仕事・5機械・52工程。着手可能時刻つき)です。受注12件は加工時間がすべて10分の倍数なので、10分を1単位にして解きました。そのうえで、規模を増やしたときの伸びを見るために、OR-Library の la06(15×5)・la11(20×5)・la16(10×10)・la21(15×10)・la26(20×10)・la31(30×10)と ft10(10×10)を加えています。目的はすべてメイクスパン(最後の仕事が終わる時刻)の最小化です。
計算時間は、この記事の実行環境(一般的なノートPC。Intel Core Ultra 7 258V、8コア)での実測です。記事の制作中は同じPCで他の処理も動いていたため、秒数には揺れがあります。表の秒数は、桁と傾向を読むための数字です。CBC はスレッド数を指定せず、CP-SAT は並列ワーカー数を8と1の2通りにし、乱数の種は0に固定しました。
まず小さな3問題で、3つの定式化を同じ60秒の制限で解いた結果が次の表です。受注12件の値は10分単位で解いた結果を分に戻して書いています。「下界」はソルバーが時間内に証明できた「これより短くはならない」値、「ギャップ」は上界から下界を引いた差を上界で割った値です。「0-1変数」はソルバーに渡したモデルの0か1の変数の数で、CP-SAT はこの形に展開しないため空欄にしました。
| 問題 | 定式化・ソルバー | 0-1変数 | 結果 | 上界(最良の解) | 下界 | ギャップ | 時間(秒) |
|---|---|---|---|---|---|---|---|
| ft06(6×6) | ディスジャンクティブ・CBC | 90 | 最適を証明 | 55 | 55 | 0 | 3.8 |
| ft06(6×6) | 時間インデックス・CBC | 1,302 | 時間切れ | 62 | 47.7 | 23.0% | 60.5 |
| ft06(6×6) | CP-SAT(8ワーカー) | 最適を証明 | 55 | 55 | 0 | 0.02 | |
| ft06(6×6) | CP-SAT(1ワーカー) | 最適を証明 | 55 | 55 | 0 | 0.01 | |
| la01(10×5) | ディスジャンクティブ・CBC | 225 | 時間切れ | 666 | 499.3 | 25.0% | 61.3 |
| la01(10×5) | 時間インデックス・CBC | 27,305 | 時間切れ・解なし | なし | 517.2 | 算出不可 | 67.2 |
| la01(10×5) | CP-SAT(8ワーカー) | 最適を証明 | 666 | 666 | 0 | 0.27 | |
| la01(10×5) | CP-SAT(1ワーカー) | 最適を証明 | 666 | 666 | 0 | 0.13 | |
| 受注12件(12仕事・5機械) | ディスジャンクティブ・CBC | 247 | 時間切れ | 1,750分 | 1,143分 | 34.7% | 60.3 |
| 受注12件(12仕事・5機械) | 時間インデックス・CBC | 7,274 | 時間切れ・解なし | なし | 1,132分 | 算出不可 | 60.8 |
| 受注12件(12仕事・5機械) | CP-SAT(8ワーカー) | 最適を証明 | 1,560分 | 1,560分 | 0 | 0.05 | |
| 受注12件(12仕事・5機械) | CP-SAT(1ワーカー) | 最適を証明 | 1,560分 | 1,560分 | 0 | 0.20 |
この表から読み取れることは3つあります。第一に、CP-SAT は3問題とも1秒未満で最適値を出し、最適であることの証明まで終えました。ft06 の55は第5章の結果と同じで、受注12件の1,560分も第5章でメイクスパン最小として求めた値と一致しています。la01 の最適値は666で、CP-SAT が証明した値です。第二に、ディスジャンクティブ定式化の CBC は、ft06 なら3.8秒で最適性の証明まで終えましたが、10仕事×5機械の la01 では60秒で証明が終わりませんでした。注目したいのは、la01 の上界の666が CP-SAT の最適値と同じだという点です。CBC は最適なスケジュールを手にしていながら、それが最適だと証明できないまま時間切れになっています。受注12件では上界も1,750分にとどまり、最適値より190分(約12%)長い計画しか出せませんでした。第三に、時間インデックス定式化は ft06 ですら60秒で最適値に届かず、la01 と受注12件では実行可能なスケジュールを1つも見つけられませんでした。0-1変数は la01 で27,305個と、ディスジャンクティブ定式化の120倍を超えています。
「時間切れ・解なし」は、スケジュールが存在しないという意味ではありません。計画期間を決めるために貪欲法で作った実行可能なスケジュールが既にあるので、解は必ず存在します。ソルバーが60秒の中でそれを見つけられなかった、というだけです。この区別は実務で重要です。ソルバーを毎日の計画に組み込むなら、ディスパッチングルールや貪欲法で作った実行可能な計画を別に用意しておき、ソルバーが時間内に何も返さなかった日にはそれを使う、という二段構えにしておくのが安全です。大規模な問題での時間制限の使い方は第11章で扱います。
LP 緩和が弱いとはどういうことか、紙と鉛筆の下界に負ける
CBC が la01 で最適解を持ちながら証明できなかった理由は、下界の弱さにあります。混合整数計画のソルバーは、0か1の変数を「0から1の間の任意の値」に緩めた線形計画(LP 緩和)を解いて下界を作り、そこから変数を1つずつ0か1に固定して枝分かれさせながら下界を押し上げていきます(分枝限定法)。LP 緩和の値が最初から最適値に近ければ、少ない枝分かれで証明が終わります。遠ければ、膨大な枝を調べないと下界が上がりません。
ディスジャンクティブ定式化の LP 緩和がどうなるかは、式を見ると分かります。LP 緩和では、順序変数 \( y_{AB} \) が0から1の間の任意の値を取れます。たとえば0.5なら、2本の不等式の右辺からはどちらも \( M/2 \) が引かれます。この章では \( M \) を全工程の加工時間の合計にしているので、\( M/2 \) は1つの工程の加工時間よりずっと大きく、AとBを同じ時刻に始める(つまり重ねる)開始時刻の組でも、2本の不等式はどちらも満たされます。LP 緩和は、2つの工程が重なる開始時刻の組にも、それに見合う分数の \( y_{AB} \) を選べてしまうので、機械の排他を表す制約が下界にほとんど効かなくなります。残る強い制約は工程順だけなので、LP 緩和の値は「最も長い仕事の加工時間の合計(着手可能時刻を含む)」に近い値にとどまると考えられます。実測の CBC のログに出る LP 緩和の値(Continuous objective value)を、紙と鉛筆で出せる2つの下界と並べたのが次の表です。
| 問題 | 最長の仕事(工程順だけから出る下界) | 最も混む機械の負荷(機械の排他だけから出る下界) | ディスジャンクティブの LP 緩和 | 時間インデックスの LP 緩和 | ディスジャンクティブで60秒後の下界 | 最適値(CP-SAT) |
|---|---|---|---|---|---|---|
| ft06 | 47 | 43 | 47 | 47 | 55(証明済み) | 55 |
| la01 | 413 | 666 | 413 | 517.2 | 499.3 | 666 |
| 受注12件 | 970分 | 1,530分 | 970分 | 1,117分 | 1,143分 | 1,560分 |
ディスジャンクティブ定式化の LP 緩和は、3問題とも「最長の仕事」の値に一致しました。機械の混み具合をまったく見ていない下界です。la01 では、最も混む機械の負荷がちょうど666で、これは最適値と同じです。「この機械だけで666単位の加工があるのだから、全体が666より早く終わることはない」という、紙と鉛筆で出せる下界が最適値そのものなのに、CBC は4,312個の枝(分枝限定法で一部の0-1変数を0か1に固定して作った部分問題。CBC のログではノードと呼ばれます)を調べた60秒後でも下界を499.3までしか上げられませんでした。受注12件でも、最も混む M4(熱処理炉)の負荷1,530分という自明な下界に対して、60秒後の CBC の下界は1,143分です。これが「LP 緩和が弱い」ということの中身で、ディスジャンクティブ定式化の弱さは、big-M が大きいほど緩和で制約が効きにくくなる、という構造から来ています。
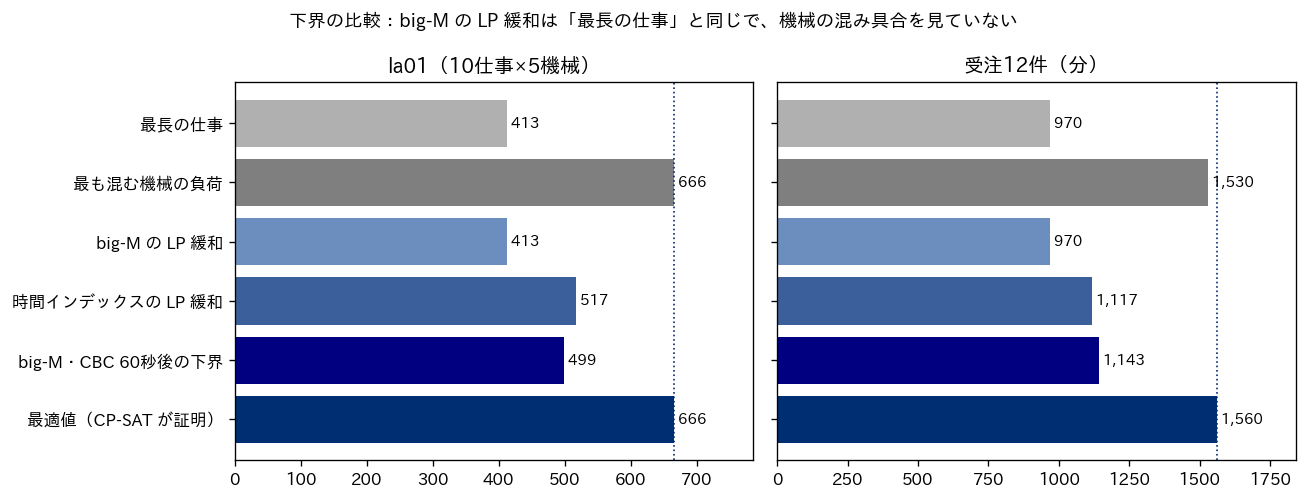
上の図は、表の la01 と受注12件の行を横棒で並べたものです。点線が最適値です。big-M の LP 緩和の棒は、どちらの問題でも一番上の「最長の仕事」とまったく同じ長さで、2本目の「最も混む機械の負荷」にも届いていません。60秒探索した後の下界(下から2本目)も、紙と鉛筆で出せる2本目の棒より短いままです。
時間インデックス定式化の LP 緩和は、機械ごと・時刻ごとの容量の制約が緩めても残るため、ft06 では同じ47でしたが、la01 では517.2、受注12件では1,117分と、ディスジャンクティブ定式化より強い下界になりました。ただし、ここでも最も混む機械の負荷には届いていません。しかも変数が多すぎて、la01 と受注12件では CBC のログの探索ノード数が0のまま、つまり枝分かれを1つも始めないうちに60秒を使い切り、実行可能なスケジュールすら見つけられませんでした。la01 では LP 緩和が解けたのが開始から38秒後で、その先に進まないまま時間切れになりました。受注12件では LP 緩和は開始から0.6秒で解け、その後、枝分かれの前に不等式(切除平面)を525本追加して下界を補強し、下界が1,117分から1,132分に上がりましたが、枝分かれを始めないまま時間切れになりました。3問題の実測の表にある受注12件の時間インデックスの下界1,132分と、LP 緩和を比べた表の1,117分の差15分は、同じ1回の実行の中で、この補強によって上がった分です(ch06_cbc_orders_timeidx.log)。la01 では補強の段階まで進まなかったので、2つの表の値はどちらも517.2で同じです。緩和が強くても、モデルが重すぎれば探索が進みません。この章の実験では、時間インデックス定式化がディスジャンクティブ定式化より良い結果を出した問題は1つもありませんでした。Ku と Beck の2016年の論文も、CPLEX と Gurobi ではディスジャンクティブ定式化が全体として最も速く、時間インデックス定式化は15仕事×15機械で8GB のメモリに収まらなかったと報告しています。
一方の CP-SAT は、同じ la01 で0.13秒(1ワーカー)のうちに下界を666まで上げ、証明を終えました。モデルの違いは、機械の排他を0-1変数の組に分解せず、「この機械に載る工程の区間は重ならない」という1本の制約のまま渡したことだけです。ソルバーの内部で何が起きているかをこの章の実験だけで言い当てることはできませんが、最も混む機械の負荷という自明な下界の666に、CP-SAT は1秒未満で到達し、big-M に分解した MIP は60秒かけても届かなかった、という差は数字に出ています。制約プログラミングがスケジューリングの制約から何を推論するのかを詳しく知りたい方は、第5章の参考書籍に挙げた『Constraint-Based Scheduling』が手がかりになります。
規模を増やすと差はどう開くか
次に、OR-Library の問題で仕事と機械の数を増やし、ディスジャンクティブ定式化の CBC と CP-SAT の差がどう変わるかを測りました。時間インデックス定式化は la01 で既に実行可能解を出せなかったため、ここでは外しています。表の「上界」と「下界」はいずれも60秒の制限の中で得た値で、ギャップが0のものは最適であることを証明できたものです。
| 問題(仕事×機械) | 工程数 | CBC の順序変数 | CBC 上界 | CBC 下界 | CBC ギャップ | CP-SAT(8ワーカー)上界 | CP-SAT(8ワーカー)下界 | CP-SAT(8ワーカー)時間(秒) | CP-SAT(1ワーカー)時間(秒) |
|---|---|---|---|---|---|---|---|---|---|
| la01(10×5) | 50 | 225 | 666 | 499.3 | 25.0% | 666 | 666 | 0.27 | 0.13 |
| la06(15×5) | 75 | 525 | 970 | 487.8 | 49.7% | 926 | 926 | 0.05 | 0.02 |
| la11(20×5) | 100 | 950 | 1,630 | 492.0 | 69.8% | 1,222 | 1,222 | 0.23 | 0.28 |
| la16(10×10) | 100 | 450 | 1,048 | 771.4 | 26.4% | 945 | 945 | 0.60 | 0.87 |
| ft10(10×10) | 100 | 450 | 1,155 | 722.7 | 37.4% | 930 | 930 | 3.21 | 38.14 |
| la21(15×10) | 150 | 1,050 | 1,528 | 736.2 | 51.8% | 1,046 | 1,037 | 60.06(時間切れ) | 60.01(時間切れ) |
| la26(20×10) | 200 | 1,900 | 1,568 | 770.2 | 50.9% | 1,218 | 1,218 | 1.13 | 43.70 |
| la31(30×10) | 300 | 4,350 | 8,034 | 770.0 | 90.4% | 1,784 | 1,784 | 2.38 | 5.49 |
CBC は8問題すべてで60秒の時間切れになり、ギャップは25.0%から90.4%でした。順序変数(0-1変数)の数は、機械ごとの工程の組の数なので、1台の機械に載る工程の数の2乗に比例して増えます。5機械の問題を10仕事から20仕事にすると(la01 から la11)、順序変数は225個から950個に増え、ギャップは25.0%から69.8%に広がりました。30仕事×10機械の la31 では、60秒で調べられた枝は83個にとどまり、上界は8,034と CP-SAT の最適値1,784の4.5倍でした。これは計画として使えない水準です。
CP-SAT(8ワーカー)は、la21 を除く7問題で最適性を証明しました。la21 だけは60秒で証明が終わらず、上界1,046に対して下界1,037、ギャップは0.9%でした。1ワーカーの la21 はギャップ4.1%(上界1,047、下界1,004)です。規模が大きいほど必ず時間がかかるわけではなく、300工程の la31 が2.38秒で証明できた一方で、150工程の la21 は60秒で終わりませんでした。表の問題のうち la06・la11・la26・la31 は、最適値が「最も混む機械の負荷」と一致しています(各問題のデータから機械ごとの加工時間を合計した最大値は、la06 が926、la11 が1,222、la26 が1,218、la31 が1,784でした)。この場合、最も混む機械を休みなく動かすスケジュールが見つかった時点で、自明な下界と一致して証明が終わります。la21 は最も混む機械の負荷が935で、60秒で得た下界の1,037はそれより大きい値です。つまり la21 の最適値は自明な下界より大きく、証明には下界を押し上げる探索が要ります。問題の難しさは工程数だけでは決まらず、「機械の負荷が1台に偏っているか」にも左右されます。
並列ワーカーの効果も問題によって違いました。ft10 では8ワーカーが3.21秒、1ワーカーが38.14秒、la26 では8ワーカーが1.13秒、1ワーカーが43.70秒と、並列化が大きく効いています。一方で la01・la06 では1ワーカーのほうが短い時間で終わりました。いずれも1秒未満で終わる問題です。実務で CP-SAT を使うときは、ワーカー数を固定した上で、自社の代表的な問題で両方を測ってから決めるのが確実です。
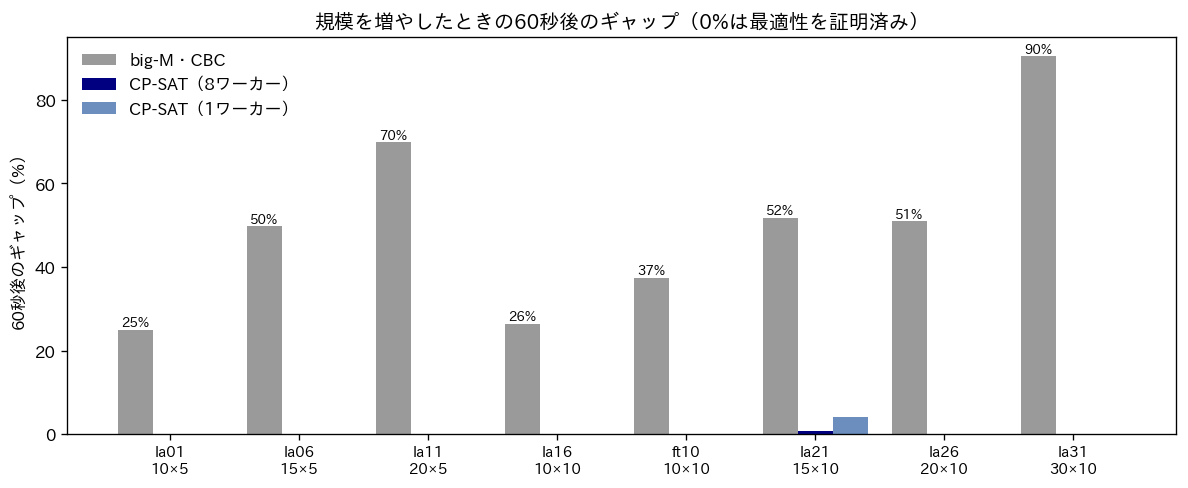
上の図は、表のギャップを問題ごとに並べたものです。灰色の棒が CBC、濃紺と淡い紺の棒が CP-SAT の8ワーカーと1ワーカーで、CP-SAT の棒が見えない問題は、最適性を証明できた(ギャップ0%)ことを表しています。Ku と Beck の論文は商用の CPLEX と3,600秒という条件で、15×15 でも MIP で8割の問題の最適性を証明できたと報告しており、CBC と60秒のこの実験はそれよりずっと MIP に厳しい条件です。それでも、規模が大きくなるほど CP が有利になるという向きは、同論文の結論と一致しています。
目的を納期遅れに変えると、CP-SAT でも証明は難しくなる
ここまでの比較は、すべてメイクスパン最小でした。実務でより重要なのは納期です。そこで受注12件を、第5章と同じ重み付き納期遅れ(仕事ごとに、納期より遅れた分数に重みを掛け、全件で合計した値)の最小化で、ディスジャンクティブ定式化の CBC と CP-SAT で解き比べました。MIP では、仕事ごとに遅れを表す0以上の変数を置き、「遅れ ≧ 最終工程の終了時刻から納期を引いた値」という不等式を足して、遅れに重みを掛けた合計を最小にします。CP-SAT では、add_max_equality で「0と、終了時刻から納期を引いた値の大きい方」を遅れとして定義します。さらに、納期が厳しい場合を見るために、各仕事の着手可能時刻から納期までの長さを6割に縮めた設定でも解きました。
| 納期の設定 | 定式化・ソルバー | 結果 | 上界(重み付き納期遅れ) | 下界 | ギャップ | 時間(秒) |
|---|---|---|---|---|---|---|
| 元の納期 | ディスジャンクティブ・CBC | 最適を証明 | 0 | 0 | 0 | 9.2 |
| 元の納期 | CP-SAT(8ワーカー) | 最適を証明 | 0 | 0 | 0 | 0.03 |
| 元の納期 | CP-SAT(1ワーカー) | 最適を証明 | 0 | 0 | 0 | 0.01 |
| 納期までの長さを6割に | ディスジャンクティブ・CBC | 時間切れ | 6,030 | 1,446 | 76.0% | 60.2 |
| 納期までの長さを6割に | CP-SAT(8ワーカー) | 時間切れ | 3,960 | 2,900 | 26.8% | 60.1 |
| 納期までの長さを6割に | CP-SAT(1ワーカー) | 時間切れ | 4,110 | 60 | 98.5% | 60.0 |
元の納期では、全件を納期内に収める計画が存在し(第5章の結果と同じく重み付き納期遅れ0)、どのソルバーも最適を証明しました。ただし CBC は、下界が最初から0なのに、遅れ0の計画を見つけるまでに13,606個の枝を調べて9.2秒かかっています。下界が自明な0で済んでいる分、この問題では MIP の弱点が表に出にくく、「全件間に合う計画を探す」という実行可能解の探索の重さだけが時間に表れています。
納期を厳しくすると様子が変わります。CP-SAT も60秒で証明を終えられず、8ワーカーで上界3,960・下界2,900、ギャップ26.8%でした。1ワーカーでは上界4,110に対して下界は60にとどまり、ギャップは98.5%です。CBC の上界は6,030で、CP-SAT(8ワーカー)より2,070大きく、LP 緩和の値は40、60秒後の下界は1,446でした。メイクスパンでは一瞬で最適を証明した CP-SAT も、納期遅れの合計を目的にすると、12件でも時間内に証明が終わらないことがある、ということです。理由をこの実験だけで切り分けることはできませんが、メイクスパンには「最も混む機械の負荷」という紙と鉛筆で出せる強い下界があるのに対し、納期遅れの合計にはそれに相当する簡単な下界が見当たらない、という違いはあります。それでも、同じ60秒で得た計画の質(上界)は CP-SAT のほうが良く、順序と時刻の問題では CP を第一候補にするという結論は変わりません。変わるのは、「最適の証明」を期待せず、時間制限の中で得た最良の計画とギャップを受け入れる運用が前提になる点です。
MIP が向く問題、CP が向く問題
ここまでの結果だけを見ると、「スケジューリングは CP-SAT で解けばよい」という結論になりそうです。順序と時刻を決める問題に限れば、その理解でほぼ差し支えありません。しかし生産計画の全体を見ると、MIP のほうが自然に書ける問題も多くあります。使い分けの基準は、問題の中心にある決定が「量」なのか「順序と時刻」なのか、そして制約が「線形の足し算」なのか「重なり・前後関係」なのか、の2点に整理できると考えています。
MIP が向くのは、決めるものが量で、制約と目的が量の一次式で書ける問題です。第8章で扱う容量制約付きロットサイジング(週ごとに何個作るか、段取りをするか)がその典型で、「週の生産量×1個あたりの加工時間+段取り時間≦週の稼働時間」「前週の在庫に生産量を足して需要を引いたものが今週の在庫」のように、制約がすべて足し算と掛け算の一次式になります。費用も「段取り費×段取り回数+保管費×在庫量」の一次式です。この形の問題でも big-M の締め方で解時間が大きく変わることは、弊社コラム「在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで」の第11章で実測しましたが、量と費用をそのまま一次式で書けること自体が MIP の強みです。量が連続値(キログラム、リットル、時間)の場合は、整数しか扱えない CP-SAT では係数を整数に直す手間がかかります。OR-Tools の公式ガイドも、CP-SAT は整数だけを扱うので、整数でない係数を持つ制約は十分大きな整数を掛けて整数にしてから渡すよう求めています。複数の工場への生産量の割り振り、原料の配合、設備投資の選択のように、量と費用の釣り合いを決める問題は MIP の領分です。
CP が向くのは、決めるものが順序と時刻で、制約が「重ならない」「この後に来る」「同時に使えるのはここまで」という形の問題です。ジョブショップ、段取り替えを含む順序付け(第7章)、作業者や治具の数の上限(第10章)がこれにあたります。これらを MIP で書くと、この章で見たように big-M と0-1変数の組に分解することになり、この章で実測したのと同じ LP 緩和の弱さを抱えやすくなります。CP-SAT には、重なり禁止(add_no_overlap)や累積資源(add_cumulative。同時に使える数に上限のある作業者や治具のような資源を表す制約で、第10章で扱います)のように、スケジューリングの構造をそのまま表す制約が用意されています。目的が納期遅れやメイクスパンのように「最大値」や「0以上に切り上げた差」を含む場合も、CP-SAT は add_max_equality で素直に書けます。
| 観点 | MIP(PuLP+CBC など)が向く | CP(CP-SAT)が向く |
|---|---|---|
| 中心の決定 | 量(何個・何キロ・何時間)、選ぶか選ばないか | 順序と開始時刻 |
| 制約の形 | 容量・在庫バランス・配合のような一次式の足し算 | 重なり禁止・前後関係・同時使用数の上限 |
| 変数の種類 | 連続値と整数の混在をそのまま扱える | 整数だけ(連続量は整数に直して渡す) |
| 時間の粒度 | 週・日の単位の計画 | 分・秒の単位の順序 |
| この記事の章 | 第8章(ロットサイジング)、第9章(並列機械の割当の一部) | 第5章・第7章・第10章 |
| 下界の読み方 | LP 緩和が強い問題では、ギャップで品質を保証しやすい | 順序の問題でも下界を早く押し上げやすい(この章の実測) |
表の「下界の読み方」の行は、この章の実測と Ku と Beck の報告の範囲で言えることに限っています。同じ論文は、10仕事×10機械までは MIP も CP もすぐに最適性を証明でき、12×12 も MIP で妥当な時間で解けたが、15×15 になると MIP は8割の問題しか証明できず CP は全部を証明し、20×15 では CP が6割を証明した、と報告しています。この論文の MIP は商用の CPLEX で、CPU 時間の上限は1回3,600秒です。この章の CBC と60秒という条件とは違うので、どの規模まで MIP で解けるかという境目の数字は、そのまま持ち込めません。持ち込めるのは「小さいうちは差が小さく、大きくなるほど CP が有利になる」という向きです。
組み合わせて使う、上位を MIP・下位を CP
実務では、MIP と CP のどちらか一方を選ぶより、計画の階層ごとに使い分けるほうが自然です。第1章で整理した計画の階層に当てはめると、上位の「週ごとに何をどれだけ作るか」は量の問題なので MIP で解き、その結果を受けて下位の「今日の各機械で、どの順に、何時から加工するか」を CP で解く、という分担になります。上位の MIP は稼働時間の合計を容量として扱うだけで、機械の上での順序や段取りの細部は見ていません。下位の CP は、上位が決めた今週分の仕事を所与として、順序と時刻だけを決めます。
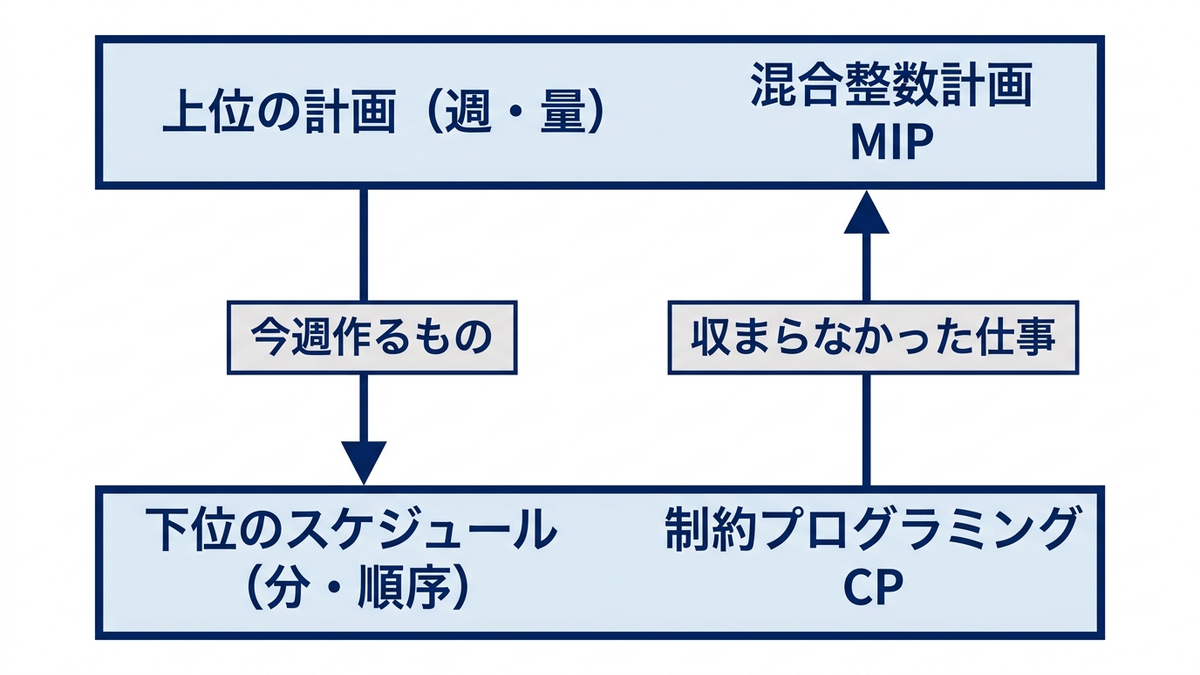
この分担で気をつけるべきことは、上位の計画が下位で実行できない場合があることです。週の稼働時間の合計に収まっていても、工程順の待ちや段取りのせいで、実際に機械の上に並べると週の中に収まらないことがあります。その場合は、下位の CP で「今週に収まらなかった仕事」を上位に返し、上位の容量の係数(1個あたりの加工時間に掛ける余裕率など)を見直して解き直します。計画(週・量)とスケジュール(分・順序)の整合の取り方は第8章で具体例を扱いますので、ここでは「上位を MIP、下位を CP」という役割分担と、下位から上位へ実行できなかった分を戻す流れがあることだけを押さえておきます。
同じ階層の中で両者を組み合わせる方法もあります。たとえば、CP-SAT で短時間に良い順序を見つけ、その順序を固定したうえで、MIP で残業時間や外注量のような連続量を最適化する、という2段階の解き方です。逆に、MIP で機械への割当(どの仕事をどの機械に載せるか)だけを決め、割当が決まった後の各機械の順序を CP で解く、という分け方もあります。どちらも、問題を「量の部分」と「順序の部分」に切り分け、それぞれを得意なソルバーに任せるという考え方で、分解による大規模化の工夫は第11章で改めて扱います。
商用のソルバー(Gurobi・CPLEX など)は、この記事の実行環境に入っていないため、CBC との差を測っていません。ここでは考え方だけを書きます。商用ソルバーを使っても、変わるのは同じ定式化を解く速さであって、この章で見た「big-M の LP 緩和では機械の排他がほとんど効かない」という定式化そのものの性質は変わりません。ソルバーは探索の途中で不等式を追加して下界を補強しようとしますが、出発点になる LP 緩和は同じです。Ku と Beck の論文は CPLEX の設定の効果として、8スレッドで1スレッドの約3倍速くなったことを報告しています。同じ論文の脚注には、CP を8スレッドで動かすと逆に実行時間が約1.6倍に延びたとも書かれています。この章の CP-SAT でも、ft06 と la01 では8ワーカーより1ワーカーのほうが短い時間で終わりました。並列化は常に速くなるわけではないので、実際の問題で両方を測ってから設定を決めるのが確実です。商用ソルバーの導入を検討する場合も、まず無償の CBC と CP-SAT で定式化と時間制限の感覚をつかみ、それでも足りないことを実測で確かめてから費用を比べる、という順序が手戻りの少ない進め方だと考えています。
ソルバー選びの誤りは、残業と納期回答の甘さに化ける
経営の側から見ると、この章の結果は「道具の選び方を誤ると、同じ工場・同じ受注でも計画の質が変わる」ことを示しています。受注12件のメイクスパン最小化で、CP-SAT は1,560分の計画を0.05秒で出し、それが最適であることも証明しました。同じ問題を big-M の MIP と CBC で60秒解いた計画は1,750分で、差は190分です。時刻0を月曜8:00とし連続稼働とみなすこの記事の前提では、全件の完了が火曜の10:00から13:10へ、3時間10分遅れることになります。現実の工場では、この差は残業時間、休日出勤、あるいは顧客への納期回答の後ろ倒しとして現れます。
もう1つの損失は、ギャップを読まないことから生じます。CBC が la01 で返した666は、実は最適解でした。しかしソルバーの出力は「時間切れ・ギャップ25.0%」で、これだけを見た担当者は「最善の計画との差が、この計画の長さの最大25%あるかもしれない」と受け取ります。その結果、計画の見直しに余計な工数をかけたり、余裕を見て納期回答を長めに出したりすれば、人件費を余分に払い、受注の機会を逃すことになります。この場合、最も混む機械の負荷という紙と鉛筆の下界(666)と並べるだけで、手元の計画が最適だと分かりました。逆に、ギャップを確認せずに時間切れの暫定解を「最適」と報告すれば、受注12件の1,750分の計画のように、改善の余地がある計画をそのまま現場に流すことになります。どちらも、上界と下界を分けて読み、自明な下界とも突き合わせる習慣があれば避けられる損失です。
この判断を施策に落とすと、次の3点になると考えています。第一に、順序と時刻を決める日々のスケジューリングには CP 系のソルバーを第一候補にし、MIP を使うのは量と費用を決める上位の計画に絞ります。第二に、ソルバーの結果を報告するときは、計画の値(上界)だけでなく、下界とギャップ、打ち切りかどうかを必ず並べて報告します。経営会議の資料でいえば「この計画のメイクスパンは1,560分で、最適であることが証明済み」なのか「1,750分で、最善の計画との差がこの計画の長さの最大34.7%に達する可能性がある」なのかは、まったく別の情報です。第三に、ソルバーを定期的に回す運用では、ソルバー内の時間制限に加えて外側の締切と、時間内に解が出なかった日の代替の計画(ディスパッチングルールによる計画など)を用意します。この章の実験でも、時間制限を付けたはずの実行が止まらなくなる現象が起きました。
この章の要点は3つです。第一に、ジョブショップはディスジャンクティブ(big-M)・時間インデックス・CP のインターバルの3通りに書け、同じ問題でも書き方によって解ける規模が大きく変わります。第二に、big-M の定式化は LP 緩和で機械の排他がほとんど効かないため、下界が「最長の仕事」にとどまり、最適解を持っていても証明できないまま時間切れになりやすく、時間インデックスは下界が強くなる代わりにモデルが重くなります。第三に、順序と時刻を決める問題は CP-SAT、量と費用を決める問題は MIP を第一候補とし、計画の階層ごとに組み合わせて使うのが実務的な分担です。どちらを使う場合も、結果は上界・下界・ギャップの3つを並べて読みます。次の第7章では、この章で CP-SAT の得意分野とした順序付けに、系列の切り替えで生じる段取り時間を加え、段取りを減らす順序と納期を守る順序の釣り合いを扱います。
この章を深めたい方への参考書籍
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画・非線形計画・整数計画を1冊で扱う教科書で、整数計画と組合せ最適化の章に、分枝限定法と切除平面法、整数計画ソルバーの利用の節があります。この章で「LP 緩和が弱いと下界が上がらず、証明が終わらない」と説明した現象を、緩和問題と分枝限定法の仕組みから理解できます。
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):Python で数理最適化のモデルを書く例を問題の種類ごとに集めた本で、第6章「スケジューリング問題」では、1機械のリリース時刻付き重み付き完了時刻和問題、1機械の総納期遅れ最小化問題、順列フローショップ問題、資源制約付きスケジューリング問題を取り上げています。ソルバーは商用の Gurobi ですが、スケジューリングを数理最適化のモデルとしてどう書くかを、この章のジョブショップ以外の問題の型で確かめられます。
第7章 段取り替えを減らす、順序依存の段取りと納期の釣り合いを最適化で決める
第6章では、同じジョブショップの問題を混合整数計画と制約プログラミングで解き比べ、順序と時刻を決める問題では制約プログラミングの書き方が素直に効くことを確かめました。ここまでの章では、ある仕事から次の仕事へ切り替えるときの準備の時間を、加工時間に含めるか無視してきました。しかし多品種を1台の設備で流す工場では、この切り替えの時間が品種の組み合わせによって大きく変わり、並べ方しだいで1日の稼働時間の相当部分が失われます。この章では、切り替えの時間が「前に何を流したか」と「次に何を流すか」の両方で決まる場合を扱い、段取りの合計を減らすことと納期を守ることの釣り合いを、最適化で数字にして示します。
段取り替えの時間は「順序」で決まる
設備で次の品種の加工を始めるには、治具や刃物の交換、プログラムの切り替え、試し削りと寸法の確認、清掃といった準備が要ります。日本産業規格の生産管理用語(JIS Z 8141:2001)は、段取を「作業開始前の材料,機械,治工具,図面などの準備及び試し加工」と定義しています。品種を切り替えるための段取りを、この章では段取り替えと呼びます。段取りの間、設備は製品を1つも生み出しません。設備が動いていても稼ぎを生まない時間であり、第1章で経営指標として挙げた「段取りで失う時間」がこれにあたります。
段取りの時間が品種ごとに一定なら、並べ方を変えても合計は変わらず、順序を工夫する意味はありません。実際の工場では、段取りの時間は前後の品種の組み合わせで変わることが多いように思います。同じ材質で寸法だけが違う品種の間なら刃物を替えずに済み、材質が違えば清掃と刃物交換が要り、熱処理の条件が違えば炉の温度を上げ下げする時間がかかります。このように、切り替えの時間が「直前に加工していた品種」と「次に加工する品種」の組で決まる段取りを順序依存段取りと呼びます。順序依存段取りがあると、同じ仕事の集合でも並べ方によって段取りの合計が変わるので、順序そのものが最適化の対象になります。
この記事の共通データでは、製品を4つの系列 F1〜F4 に分け、系列から系列への段取り時間を分単位の4行4列の表(SETUP)で与えています。行が直前の系列、列が次の系列で、同じ系列が続くときの段取りは0分です。
| 直前の系列\次の系列 | F1 | F2 | F3 | F4 |
|---|---|---|---|---|
| F1 | 0 | 20 | 45 | 60 |
| F2 | 30 | 0 | 25 | 50 |
| F3 | 55 | 35 | 0 | 20 |
| F4 | 70 | 60 | 30 | 0 |
表の値は分です。この表には2つの性質を持たせました。第一に、系列の番号が近いほど段取りが短く、F1 と F4 のように離れた系列の間は長くなっています。第二に、行き帰りで時間が違う、つまり非対称です。F1 から F2 へは20分ですが、F2 から F1 へは30分かかります。F1 から F4 は60分、F4 から F1 は70分です。現場でいえば、軽い仕上げから重い加工へ移るときは刃物の追加で済むのに、逆向きは清掃と精度の出し直しが要る、といった状況を想定しています。この表も第2章で用意したサンプルデータの一部で、実在の工場の値ではありません。
表をもう1つの観点から確かめておきます。F2 から F4 へ直接切り替えると50分かかりますが、間に F3 を挟んで F2、F3、F4 と進めば25分と20分で合計45分です。直接行くより寄り道したほうが短い組があるということで、数学の言葉では「三角不等式が成り立たない」と言います。全24通りの3系列の組を実行して調べたところ、この性質を持つのは F2 から F4 への1組だけでした(_out\ch07_setup.txt)。現実の段取り表でも、系列の間に「つなぎ」の品種を入れると合計が短くなる組はあり得ます。最適化は表の値をそのまま比べて順序を選ぶので、こうした組があっても扱いは変わりません。人が経験で並べる場合は、直接の切り替えが最短だと思い込みやすい点に注意が要ります。
段取りの合計を最小にする問題は、巡回セールスマン問題と同じ形をしている
納期を考えず、段取りの合計だけを最小にする場合を考えます。全部の仕事を1台で加工し終えるまでの時間(メイクスパン)は、加工時間の合計と段取り時間の合計の和です。加工時間の合計は並べ方によらず一定なので、メイクスパンを最小にすることと、段取りの合計を最小にすることは同じ問題になります。
この問題は巡回セールスマン問題と同じ形をしています。巡回セールスマン問題は、いくつかの都市を1回ずつ訪れて出発点に戻る経路のうち、移動距離の合計が最も短いものを求める問題です。仕事を都市、段取り時間を都市の間の距離と読み替えると、「すべての仕事を1回ずつ並べ、隣り合う仕事の間の段取りの合計を最小にする」ことは「すべての都市を1回ずつ訪れ、隣り合う都市の間の距離の合計を最小にする」ことにそのまま対応します。距離の表が非対称なので、行きと帰りで距離が違う非対称な巡回セールスマン問題です。1964年に Gilmore と Gomory は、機械の状態を変えるための費用がかかる順序付けの問題を扱った論文で、この問題が巡回セールスマン問題の特殊な場合であると要旨に明記しています。
| 段取りつきの順序付け | 巡回セールスマン問題 |
|---|---|
| 加工する仕事 | 訪れる都市 |
| 仕事 i の直後に仕事 k を加工するときの段取り時間 | 都市 i から都市 k への距離 |
| 加工の順序 | 訪問の経路 |
| 段取り時間の合計(メイクスパンから加工時間の合計を引いた値) | 移動距離の合計 |
| 計画の開始時点の機械の段取り状態 | 出発する都市 |
違いが1つあります。巡回セールスマン問題は出発点に戻るまでを数えますが、スケジューリングでは最後の仕事の後に段取りを戻す必要がないことが普通です。この差は「計画の始まりと終わりを表す仮の仕事」を1つ加え、そこから各仕事への距離を初期状態からの段取り時間、各仕事からそこへの距離を0分とすれば吸収できます。後で使う CP-SAT のコードも、この仮の仕事を節点0として置いています。
対応が分かると、2つのことが言えます。第一に、巡回セールスマン問題は規模とともに急に重くなる問題の代表例で、第2章で触れた NP 困難の性質をそのまま引き継ぎます。仕事の数が増えると、厳密に最適であることを証明するための計算は急に重くなります。第二に、巡回セールスマン問題のために蓄積された解法、たとえば近い都市から順に回る貪欲法や、経路の一部を入れ替えて改善する局所探索が、そのまま段取りの問題に使えます。局所探索とその発展は第11章で扱います。
ただし、実務の段取りの問題は、多くの場合「系列」という構造を持っていて、純粋な巡回セールスマン問題より易しくなります。この記事のデータでは15件の仕事が4系列に分かれ、同じ系列の中の段取りは0分です。同じ系列の仕事は続けて流せば段取りが要らないので、段取りの合計だけを考えるなら、まず「4つの系列をどの順で回るか」を調べれば見当が付きます。行き帰りで時間が違い、寄り道のほうが短い組もある段取り表では、1つの系列を2回に分けて回る順序が有利になる可能性も一般にはありますが、この段取り表では、後で CP-SAT が最適と証明した段取り合計最小の解も、4つの系列を1回ずつ回る形でした。初期状態を F1 として、残りの3系列の回り方6通りを全部数えると、次のようになりました。
| 系列を回る順 | 段取り合計(分) |
|---|---|
| F1、F2、F3、F4 | 65 |
| F1、F2、F4、F3 | 100 |
| F1、F3、F4、F2 | 125 |
| F1、F4、F3、F2 | 125 |
| F1、F3、F2、F4 | 130 |
| F1、F4、F2、F3 | 145 |
系列の番号の順に回る F1、F2、F3、F4 が65分で最短です。最長の145分との差は80分で、同じ15件を同じ台数で加工しても、系列を回る順だけで段取りの合計が2倍以上違います。系列が4つなら全部数えれば済みますが、系列の数が10なら残り9系列の並べ方は約36万通り、15なら約870億通りで、全部数える方法はすぐに使えなくなります。
15件の単一機械に段取りを入れる、ルールとキャンペーンの成績
ここからは第3章で使った単一機械の15件(ボトルネックの M2 マシニングセンタに並ぶ S01〜S15)に、系列ごとの段取りを入れて解きます。15件の内訳は F1 が4件(加工時間の合計410分)、F2 が4件(390分)、F3 が4件(400分)、F4 が3件(100分)で、加工時間の総計は1,300分です。すべて時刻0から着手でき、納期と重み(1〜3。大きいほど遅れの痛みが大きい)が付いています。時刻0の時点で機械は F1 の段取りになっている、という前提を置きました。
まず、段取りを考えずに作った順序が、段取りのある世界でどういう成績になるかを測りました。到着順(S01 から番号順)と、第3章で扱った EDD(納期の早い順)・WSPT(加工時間を重みで割った値の小さい順)の3つに、同じ系列をまとめて流す運用を2通り加えています。同じ系列をまとめて続けて流す運用を、この章ではキャンペーンと呼びます。1つ目のキャンペーンは系列を段取り最短の F1、F2、F3、F4 の順に回し、系列の中は納期の早い順に並べたもの、2つ目は各系列の中で最も早い納期の順(F3、F2、F1、F4)に系列を回したものです。
| 順序の作り方 | 段取り合計(分) | 切り替え回数 | 完了時刻(分) | 重み付き納期遅れ | 遅れ件数 | 最大の遅れ(分) |
|---|---|---|---|---|---|---|
| 到着順 | 415 | 12 | 1,715 | 10,510 | 8 | 1,305 |
| EDD(納期の早い順) | 510 | 12 | 1,810 | 6,270 | 12 | 480 |
| WSPT(加工時間÷重みの小さい順) | 390 | 9 | 1,690 | 5,005 | 6 | 1,160 |
| キャンペーン(F1、F2、F3、F4の順、系列内は納期順) | 65 | 3 | 1,365 | 5,405 | 8 | 705 |
| キャンペーン(系列の最早納期順、F3、F2、F1、F4) | 170 | 4 | 1,470 | 6,870 | 9 | 810 |
「重み付き納期遅れ」は、各仕事の遅れ(納期を過ぎた分数。間に合えば0)に重みを掛けて足した値で、単位は「重み×分」です。「完了時刻」は最後の仕事が終わる時刻で、加工時間の総計1,300分に段取り合計を足した値になっています。
表から読み取れることは3つあります。第一に、段取りを考えないルールは段取りの合計が大きくなります。EDD は510分、到着順は415分で、加工時間の総計1,300分に対して3割から4割にあたる時間を段取りに使っています。EDD は納期の早いものを先に出そうとして系列を細かく行き来するため、15件の間で12回も切り替えています。第二に、段取りで失った時間は全員の完了を遅らせるので、納期を守るためのルールであるはずの EDD が、遅れ件数では12件と最も悪くなりました。EDD は第3章で扱う最大の遅れを小さくするためのルールで、この15件でも段取りを0とみなして計算すると、EDD の最大の遅れ(納期との差)70分は、全部の並べ方の中の最小値と一致しました(_out\ch07_edd_check.txt)。しかし段取りが順序で変わる世界では、この性質を当てにできません。この表の中では最大の遅れ480分は最も小さいものの、遅れた件数は15件中12件です。第三に、キャンペーンは段取りを65分まで減らし、完了時刻を1,365分まで前に出しますが、重み付き納期遅れは5,405で、WSPT の5,005より悪くなっています。系列の順番を納期に合わせた2つ目のキャンペーンは、段取りが170分に増えたうえに重み付き納期遅れも6,870と悪化しました。段取りだけ、あるいは納期だけを見た素朴な並べ方では、両方を同時に良くすることはできていません。
CP-SAT で解く、段取りを順序の制約として書く
段取りと納期を同時に扱うには、最適化のモデルに「i の直後に k を加工するなら、k の開始は i の終了に段取り時間を足した時刻以降」という条件を書く必要があります。第5章・第6章で使った CP-SAT(Google の OR-Tools に含まれる制約プログラミングのソルバー)では、これを回路制約で書くのが素直です。回路制約(add_circuit)は、節点の間の矢印それぞれに「その矢印を使うかどうか」の0か1の変数を付け、使う矢印がすべての節点を1回ずつ通る1本の輪になることを求める制約です。この記事の実行環境の OR-Tools 9.15.6755 で関数の説明文を表示すると、矢印は(出発の節点、到着の節点、真偽の変数)の組で与え、変数が真の矢印が輪に選ばれる、と書かれています。仕事を節点、「i の直後に k」を矢印とみなせば、前の節で見た巡回セールスマン問題の形そのものになります。
次のコードは、15件について重み付き納期遅れを最小にするモデルです。節点0は計画の始まりと終わりを表す仮の仕事で、節点0から仕事 i への矢印を使うと i が最初の仕事になり、初期状態の F1 からの段取りが掛かります。矢印の変数が真のときだけ時刻の条件を効かせる書き方が only_enforce_if です。目的関数の行を段取りの合計に差し替えれば、段取り合計の最小化になります。
from ortools.sat.python import cp_model
from sched_data import SETUP, FAMILIES, single_machine

jobs = single_machine()
n, fam = len(jobs), {f: k for k, f in enumerate(FAMILIES)}
H = sum(j["p"] for j in jobs) + int(SETUP.max()) * n
m = cp_model.CpModel()
st = [m.new_int_var(0, H, "s%d" % i) for i in range(n)]
en = [m.new_int_var(0, H, "e%d" % i) for i in range(n)]
m.add_no_overlap([m.new_interval_var(st[i], jobs[i]["p"], en[i], "") for i in range(n)])
arcs, setup = [], []
for i in range(n):
    fi = fam[jobs[i]["family"]]
    first = m.new_bool_var("")               # 節点0(計画の始まり)から i へ
    arcs += [(0, i + 1, first), (i + 1, 0, m.new_bool_var(""))]
    m.add(st[i] >= int(SETUP[fam["F1"], fi])).only_enforce_if(first)   # 機械は F1 の段取りで始まる
    setup.append(int(SETUP[fam["F1"], fi]) * first)
    for k in range(n):
        if k != i:
            s = int(SETUP[fi, fam[jobs[k]["family"]]])
            lit = m.new_bool_var("")         # i の直後に k を加工するなら真
            arcs.append((i + 1, k + 1, lit))
            m.add(st[k] >= en[i] + s).only_enforce_if(lit)
            setup.append(s * lit)
m.add_circuit(arcs)                          # 全ジョブを1本の順序につなぐ
tard = [m.new_int_var(0, H, "") for i in range(n)]
for i in range(n):
    m.add_max_equality(tard[i], [0, en[i] - jobs[i]["d"]])
m.minimize(sum(jobs[i]["w"] * tard[i] for i in range(n)))   # 段取り合計なら m.minimize(sum(setup))
solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 20
solver.parameters.num_workers = 8
solver.parameters.random_seed = 0
status = solver.solve(m)
order = sorted(range(n), key=lambda i: solver.value(st[i]))
print(solver.status_name(status), solver.objective_value, solver.best_objective_bound)
print(" ".join(jobs[i]["id"] for i in order), "段取り合計", solver.value(sum(setup)))
# 出力: FEASIBLE 1155.0 156.0
# 出力: S01 S12 S13 S14 S11 S10 S02 S15 S03 S07 S05 S08 S04 S06 S09 段取り合計 280
時間の上限は20秒、並列ワーカーは8に固定しました。段取り合計の最小化は、この記事の実行環境(一般的なノートPC)での実測で0.39秒のうちに65分の解を見つけ、最適であることの証明(状態 OPTIMAL)まで終わりました。65分は前の節で数えた系列の最短の回り方と同じ値で、切り替えは3回、完了時刻は1,365分です。一方、重み付き納期遅れの最小化は様子が違います。上の出力のとおり、20秒の上限で止まった時点の状態は FEASIBLE(実行可能な解は見つかったが、最適かどうかは証明できていない)で、見つかった解の重み付き納期遅れは1,155、ソルバーが証明できた下界(これより良い解は無いと保証できる値)は156でした。
見つかった順序は、F2 の3件(S01・S12・S13)を先に流し、次に F3 の2件、F4 の3件、F1 の3件と進み、最後に残りの4件(F2 の S08、F3 の S04、F1 の S06、F3 の S09)を系列をまたいで処理する形です。段取りの合計は280分、切り替えは8回、完了時刻は1,580分で、遅れは15件中5件になりました。段取り合計最小の解と比べると、段取りに215分多く使う代わりに、重み付き納期遅れを大きく減らしています。重みの大きい仕事と納期の早い仕事を先に出すために、あえて系列を分割しているのが読み取れます。
良い解は早く見つかるが、最適の証明には時間がかかる
重み付き納期遅れの最小化で、ソルバーの途中経過を記録しました(_out\ch07_setup.txt。コードは上のものと同じ考え方で、途中の改善解を記録する処理を足した版)。最初の解は0.19秒で見つかり、重み付き納期遅れは9,050でした。0.75秒で1,965、2.31秒で1,565、3.48秒で1,265と改善が続き、4.64秒で1,155に到達した後は、上限の20秒まで新しい解は出ませんでした。一方、下界は20秒の時点で153にとどまり、見つかった解との差は大きいままです。この版の実行と上のコードの実行とでは下界が153と156でわずかに違いましたが、見つかった解の値1,155はどちらも同じでした。
この状況では「1,155は最適なのか、まだ良い解があるのか」がソルバーの出力からは分かりません。そこで、この小さな問題に限って、別の方法で厳密に確かめました。使ったのは動的計画法で、「加工し終えた仕事の集合」と「最後に加工した系列」の組を状態とし、各状態に「現在の時刻」と「そこまでの重み付き納期遅れ」の組を記録していく方法です。時刻も遅れも小さい記録は、どちらも大きい記録より必ず有利なので(後に続く仕事の遅れは時刻が遅いほど増えるため)、有利な記録だけを残して先へ進めます。15件なら状態の数は最大で2の15乗に4系列を掛けた約13万で、この記事の実行環境では4.5秒で全部の計算が終わりました(_out\ch07_dp.txt)。この方法は仕事の数が1つ増えるごとに状態が倍になるので、15件を大きく超える規模には使えません。
動的計画法の結果、重み付き納期遅れの最小値は1,155で、CP-SAT が4.64秒で見つけた値が実は最適だったことが分かりました。動的計画法の実装が正しいことは、先頭9件だけの小さな問題で、9件の並べ方36万2,880通りをすべて評価した結果と突き合わせて確かめています。段取り合計と重み付き納期遅れの組として最適なもの(後で説明する「どちらかを改善するにはもう一方を悪くするしかない解」)が4つ見つかり、両者は完全に一致しました(_out\ch07_plot.txt)。
ここから実務への教訓が2つ引き出せます。第一に、この種の問題では、ソルバーは良い解を数秒で見つけることが多い一方、それが最適であることの証明には時間がかかります。上限時間で止めた解をそのまま使う運用は十分に現実的で、そのときに見るべきなのは状態が OPTIMAL かどうかだけでなく、「どれだけの時間で解の改善が止まったか」と「下界との差」です。第二に、下界との差が大きく残っていても、それが解の悪さを意味するとは限りません。今回のように、解は最適なのに下界が追いついていないだけ、ということがあります。小さな問題であれば、この章のように別の方法で厳密解を求めて、ソルバーの打ち切り解の質を一度確かめておくと、その後の運用で上限時間を決める根拠になります。上限時間とギャップの読み方は、大規模化を扱う第11章で改めて扱います。
段取りと納期の釣り合いを一覧にする
段取り合計最小の解は段取り65分・重み付き納期遅れ5,035(同じ65分の解の中で遅れが最も小さいもの。系列の回り方は第3節の表の1つ目のキャンペーンと同じ F1、F2、F3、F4 ですが、系列の中の順序が違うため、納期順に並べたキャンペーンの5,405より小さくなっています)、重み付き納期遅れ最小の解は段取り280分・重み付き納期遅れ1,155でした。この2つの間には、段取りを少し増やすと遅れが減る、という中間の解が並んでいます。どちらかの指標を改善するにはもう一方を悪くするしかない解の集まりをパレート最適な解の集合(パレート前線)と呼びます。先の動的計画法は、記録を最後まで残すと、この集合をまるごと厳密に求められます。段取り合計は「現在の時刻から加工時間の合計を引いた値」として記録の中に含まれているからです。結果は14個の解で、主なものを次の表に抜き出しました。
| 段取り合計(分) | 重み付き納期遅れ | 完了時刻(分) | 系列の並び(仕事の順に系列の番号) |
|---|---|---|---|
| 65 | 5,035 | 1,365 | 111122223333444 |
| 95 | 3,610 | 1,395 | 111122223444333 |
| 100 | 3,450 | 1,400 | 111122224443333 |
| 135 | 3,245 | 1,435 | 111122244433332 |
| 150 | 2,225 | 1,450 | 111222234443331 |
| 160 | 1,630 | 1,460 | 112223444333211 |
| 180 | 1,310 | 1,480 | 222334441111233 |
| 235 | 1,255 | 1,535 | 222334441112331 |
| 280 | 1,155 | 1,580 | 222334441112313 |
表の最後の列は、15件を加工する順に系列の番号を並べたものです。たとえば「111122223333444」は F1 を4件、F2 を4件、F3 を4件、F4 を3件の順に流すキャンペーンを表します。表に載せなかった5つの解(段取り130分・140分・155分・165分・230分)も含めた14個の全体は _out\ch07_dp.txt にあり、次の図の濃い線がそれを結んだものです。
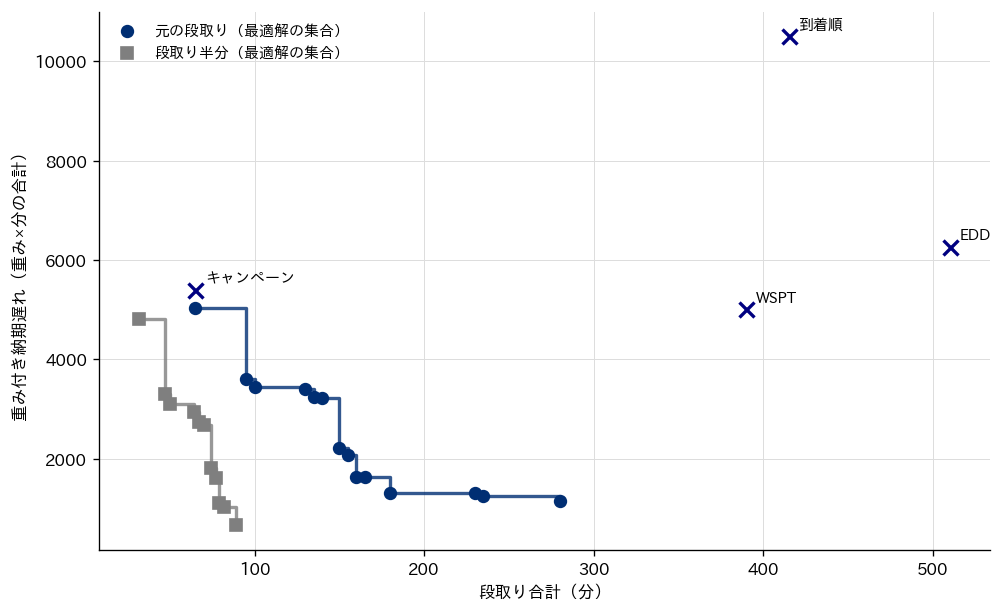
図と表から読み取れることは3つあります。第一に、段取りを少し許すだけで遅れが大きく減る区間があります。段取りを65分から95分へ30分増やすと、重み付き納期遅れは5,035から3,610へ約3割減ります。これは F3 の4件のうち S11 だけを F4 の前に残し、残りの3件(S14・S04・S09)を F4 の後ろに回した解で、系列を1つだけ分割しています。65分から160分への95分の追加で、遅れは5,035から1,630へ約3分の1になります。第二に、ある点を超えると効果が細ります。180分から280分へさらに100分の段取りを足しても、重み付き納期遅れは1,310から1,155へ155しか減りません。第三に、第3節の表の到着順・EDD・WSPT・キャンペーンは、どれも図の階段より右上にあります。EDD の段取り510分・重み付き納期遅れ6,270に対して、段取り95分の解は段取りでも遅れでも上回っています。段取りを考えない並べ方は、段取りと納期のどちらを重視するかという選び方の問題以前に、両方で損をしています。
図の階段のどの点を選ぶかは、数理最適化ではなく経営の判断です。その判断を数字で行う方法として、2つの目的を1つにまとめる重み付き和があります。「段取り1分の損失は、重み付き納期遅れ \( \lambda \) 単位の損失に相当する」と決め、\( \lambda \times \) 段取り合計 \( + \) 重み付き納期遅れ を最小にします。\( \lambda \) は段取りの痛みと遅れの痛みの交換比率で、たとえば段取りで設備が1分止まる損失を200円、重み1の仕事が1分遅れる損失を100円と見積もるなら、\( \lambda = 2 \) です(どちらも説明のための架空の値です)。パレート前線の14個の解のうち、\( \lambda \) ごとに重み付き和が最も小さくなる解を選ぶと、次のようになりました。
| 交換比率 λ | 選ばれる解の段取り合計(分) | 重み付き納期遅れ |
|---|---|---|
| 0〜1 | 280 | 1,155 |
| 2〜10 | 180 | 1,310 |
| 20 | 160 | 1,630 |
| 50 | 65 | 5,035 |
表の λ は、0・0.5・1・2・3・5・10・20・50の9通りを試した結果で、「0〜1」「2〜10」はその範囲の試した値すべてで同じ解が選ばれたことを表します。交換比率を2から10まで5倍に動かしても、選ばれる解は段取り180分・重み付き納期遅れ1,310のまま変わりません。この解は、図の階段で遅れの減り方が細り始める角にあたります。交換比率を正確に見積もれなくても、おおよその桁が合っていれば選ぶべき解は同じになることが多く、この性質が重み付き和を実務で使いやすくしています。逆に、交換比率を1から2に変えただけで解が切り替わる境目もあるので、見積もりに自信がない場合は、隣の解の段取りと遅れも並べて示すのがよいと考えています。
もう1つの方法は、段取り合計に上限を置き、その範囲で重み付き納期遅れを最小にするやり方です。「段取りは1日180分まで」のように現場の運用ルールとして決まっているなら、こちらのほうが素直です。CP-SAT のモデルに段取り合計の上限180分を1行足して解くと、20秒の上限で重み付き納期遅れ1,310の解を見つけました(14.12秒で到達。状態は FEASIBLE)。動的計画法の結果と照らすと、これは上限180分での最適値です。一方、重み付き和を CP-SAT で直接解いた場合(\( \lambda = 2 \)、上限20秒)は、段取り210分・重み付き納期遅れ1,370の解で止まりました。重み付き和の値は1,790で、動的計画法による最適値1,670(段取り180分・重み付き納期遅れ1,310)に届いていません。同じ問題でも、目的関数の形によってソルバーの効き方が変わるということで、重要な判断に使う場合は、書き方を変えて解き比べることを勧めます。
ガントチャートで、4つの順序を並べたのが次の図です。斜線の箱が段取り、色の濃淡が系列です。
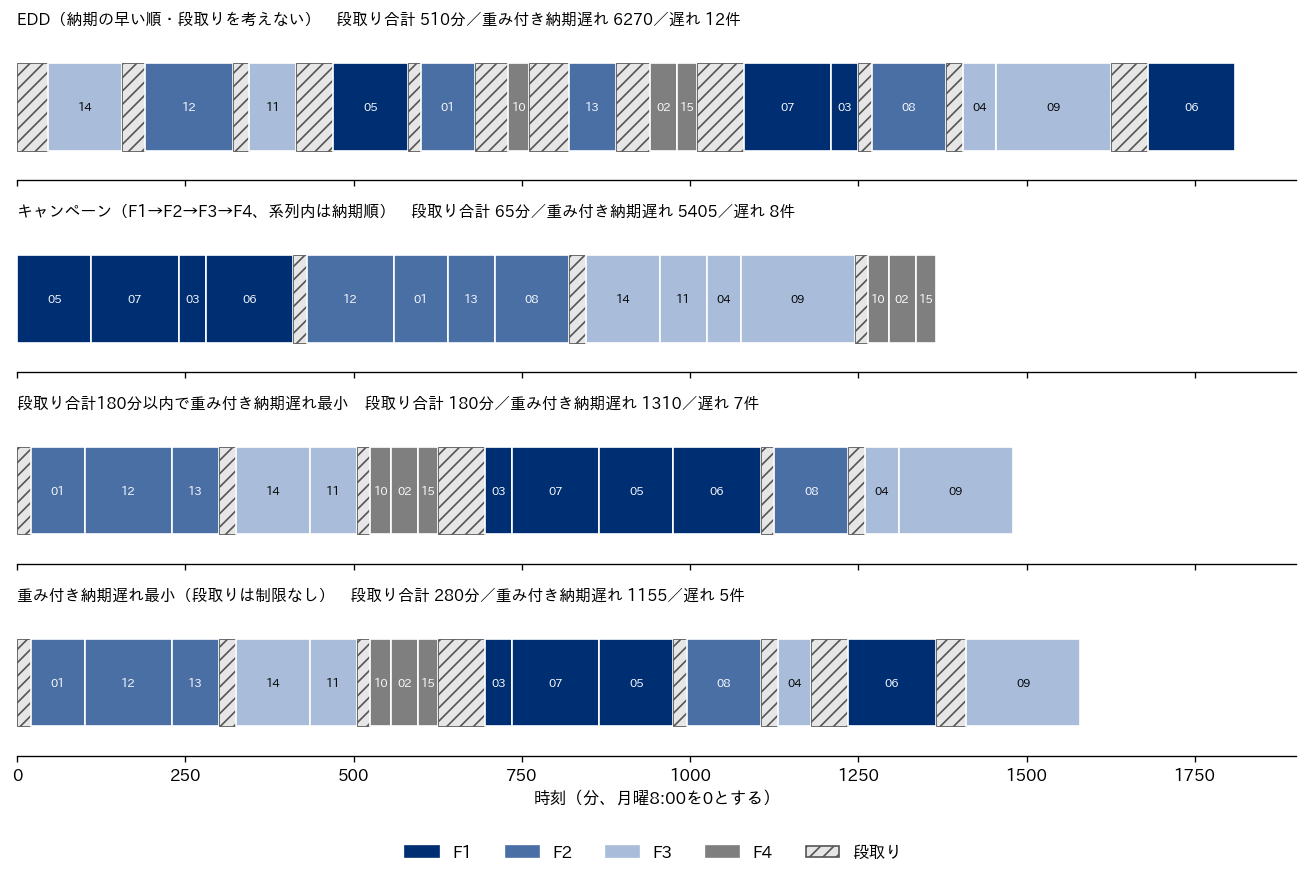
EDD の段は、斜線の段取りが12回挟まり、最後の仕事が1,810分に終わります。キャンペーンの段は段取りが3回しかなく1,365分に終わりますが、納期の早い F3 の仕事(S14・S11)が F1・F2 の後ろに回るため遅れます。段取り180分以内の解は、F2 の S01・S12・S13、F3 の S14・S11、F4 の3件を先に流してから F1 の4件へ移り、残った F2 の S08 と F3 の S04・S09 を最後に回しています。重み付き納期遅れ最小の解は、そこからさらに F1 の S06 を分割して S04 と S09 の間に挟み、段取りを100分増やして遅れを155減らしています。
段取り時間そのものを減らす改善と、最適化の役割分担
ここまでの最適化は、段取り時間の表を与えられたものとして、順序を工夫して段取りの合計を減らしてきました。段取りで失う時間を減らすもう1つの道は、表の数字そのものを小さくすることです。JIS Z 8141:2001 の段取の備考は、段取を「機械又はラインを停止しないで行う外段取と,機械又はラインを停止して行う内段取」に大別し、10分未満の内段取をシングル段取と呼ぶとしています。機械を止めて行う内段取りのうち、治具の準備や工具の予熱のように止めなくてもできる作業を外段取りに移せば、機械が止まる時間は短くなります。段取り時間の短縮を主題とする新郷重夫の著書『シングル段取への原点的志向』は1983年に日本能率協会から出ており、同じ著者の英語の著書『A Revolution in Manufacturing』も1985年に Productivity Press から出ています(いずれも国立国会図書館の書誌で確認)。
段取り時間の短縮と、順序の最適化は、どちらが効くかを比べられます。この章のデータで、段取り表の値をすべて半分(端数は切り捨て)にした場合を計算しました。最適な順序を求め直さず、元の表で作った順序をそのまま使った場合と、半分の表で最適化し直した場合の両方です。
| 段取り表 | 順序 | 段取り合計(分) | 重み付き納期遅れ | 遅れ件数 |
|---|---|---|---|---|
| 元の表 | EDD | 510 | 6,270 | 12 |
| 半分 | EDD のまま | 252 | 2,321 | 10 |
| 元の表 | 重み付き納期遅れ最小 | 280 | 1,155 | 5 |
| 半分 | 元の表での重み付き納期遅れ最小の順序のまま | 138 | 763 | 5 |
| 半分 | 半分の表で重み付き納期遅れ最小に解き直し | 89 | 661 | 未集計 |
| 元の表 | 段取り合計最小(F1からF4の順に回る65分の順序のうち、重み付き納期遅れが最小のもの) | 65 | 5,035 | 未集計 |
| 半分 | 半分の表で段取り合計最小 | 32 | 4,804 | 未集計 |
「未集計」の欄は、動的計画法の記録に遅れ件数を残していないため空けています。重み付き納期遅れの数字は _out\ch07_setup.txt と _out\ch07_dp.txt の値です。
表の上2行を比べると、EDD の順序のまま段取り時間を半分にするだけで、重み付き納期遅れは6,270から2,321へ6割以上減ります。これは段取りの改善の効果として大きな数字です。一方、元の段取り表のまま順序を最適化した3行目は1,155で、段取りを半分にした EDD の2,321より小さくなっています。この例では、設備と作業の改善で段取りを半減させるより、順序を変えるほうが重み付き納期遅れを減らす効果が大きかった、ということです。そして両方を組み合わせると661まで下がり、どちらか片方だけの場合より良くなります。先の図の灰色の階段が、段取りを半分にしたときのパレート前線で、元の階段より全体が左下に移っています。
この比較から、段取り時間の短縮と順序の最適化は代わりにはならず、補い合う関係だと考えています。段取り時間の短縮は、段取り表のすべての値を下げるので、どんな順序に対しても効きます。ただし治具の追加や作業手順の見直しといった投資と時間が要り、効果が出るのは改善した設備と品種の組だけです。順序の最適化は投資なしで明日から効きますが、段取り表の値そのものは変えられません。また、半分の表で重み付き納期遅れを最小にした順序は、系列の並びが元の表での段取り180分の解と同じ(222334441111233)で、切り替えは開始時の F1 からの1回を含めて6回です。元の表での重み付き納期遅れ最小の解は8回でした(_out\ch07_transitions.txt)。段取り表が変わると、最適な順序の形そのものが変わるということです。段取り改善の後は、同じ順序を使い続けるのではなく、新しい段取り表で解き直す必要があります。
段取り改善の優先順位を決めるときにも、最適化の結果が使えます。パレート前線の上で、どの系列の間の切り替えが何回選ばれているかを数えれば、「最適な順序が頻繁に使う切り替え」が分かります。回数の多い切り替えの段取り時間を縮めれば、最適化と改善の両方の効果が重なります。この章のデータで元の表のパレート前線14個の解を数えると、開始時の F1 からの切り替えを含めて、F1 から F2 への切り替え(20分)が14個すべての解に現れて合計18回、F2 から F3(25分)が12回使われていました。反対に F4 から F2 への切り替え(60分)は1回も使われていません(_out\ch07_transitions.txt)。最適な順序が使わない切り替えをいくら改善しても、その順序では段取りの合計は変わりません。改善の対象は、段取り表の数字の大きさではなく、最適な順序が使う回数と掛け合わせて選ぶのが筋だと考えています。
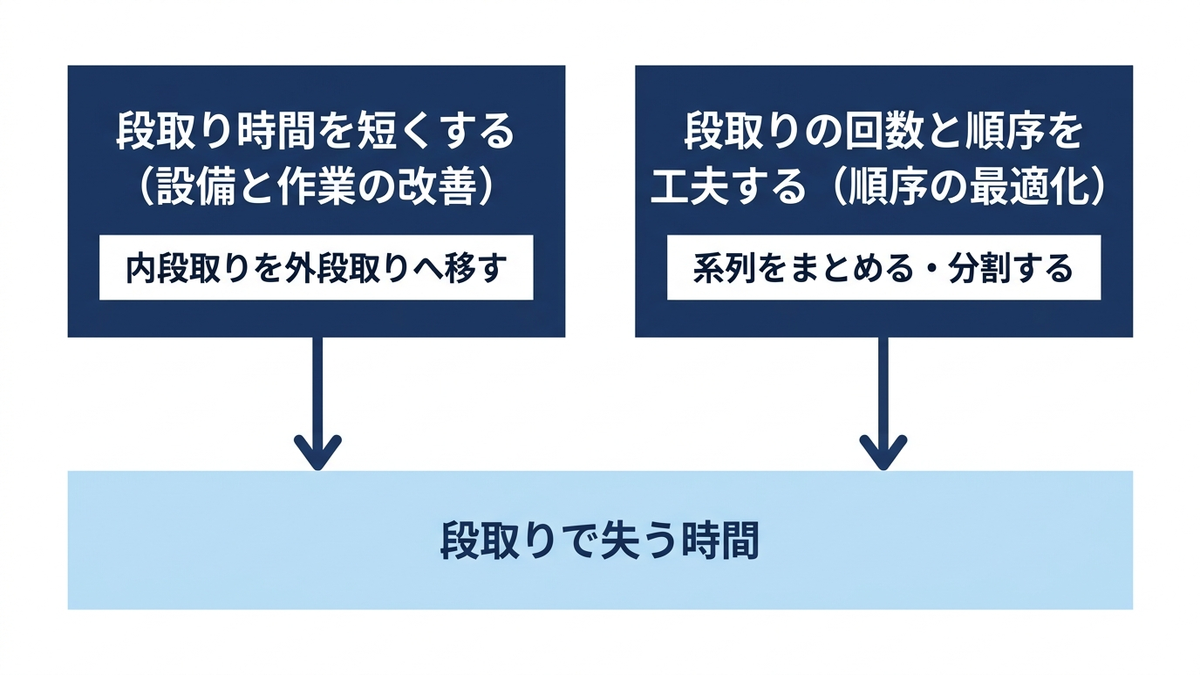
経営の判断にどう使うか、段取りの時間と納期遅れを同じ物差しで測る
段取りの問題を経営の側から見ると、この章の結果は3つの判断に翻訳できます。
第一は、設備の時間の損失です。段取り合計最小の解(65分)と重み付き納期遅れ最小の解(280分)の差215分は、ボトルネックの M2 マシニングセンタが製品を生まない時間です。仮に1日2交替で16時間(960分)稼働する設備なら、その約2割にあたります。ボトルネックで失った時間は工場全体の出来高の損失に直結するので、段取りの215分は「納期遅れを減らすために払った、ボトルネックの能力の2割」と言い換えられます。一方、段取りを考えない EDD は510分を失っており、1日の稼働の半分以上に相当します。段取りを考慮しない並べ方を続けている現場では、「設備が足りない」「残業が要る」という問題の一部が、実は順序の問題である可能性があります。
第二は、納期遅れの量と重みです。重み付き納期遅れは技術的な指標ですが、重みを「その顧客の仕事が1分遅れたときの痛み」と読めば、遅れの費用に置き換えられます。前の節で使った架空の単価(重み1の仕事の1分の遅れを100円)で換算すると、EDD の6,270は62万7,000円、段取り180分の解の1,310は13万1,000円に相当します。単価は工場によって違いますが、同じ物差しで並べれば、どの順序を選ぶかは金額の比較になります。ここで大事なのは、遅れの件数と重み付きの遅れが別のものだという点です。EDD は最大の遅れが小さい一方で遅れ件数が12件と多く、「1件でも遅れれば顧客の評価が下がる」取引では最悪の選択になります。何を遅れとして数えるかを先に決めないと、どのルールが良いかも決まりません。
第三は、段取り改善への投資の判断です。前の節の表のとおり、段取り表を半分にすると、EDD のまま使っても重み付き納期遅れは6,270から2,321に減り、最適化と組み合わせれば661まで下がります。改善に要る投資と、この差を上の単価で換算した金額を比べれば、投資の回収の目安が立ちます。同時に、段取りを減らさずに順序だけを最適化した場合の1,155も並べておくと、「投資の前にまず順序を変える」という安い打ち手が見えます。順序の最適化で済む分は、投資で買う必要がありません。
判断を誤ったときの損失の型も整理しておきます。段取りだけを見て大きなキャンペーンを組むと、段取りの時間は減りますが、系列の後ろに回された仕事の納期が犠牲になり、その仕事の仕掛品が工程の前で待ち続けます。納期だけを見て EDD を守らせると、段取りで能力を失って全体が遅れ、結果として納期も守れません。どちらの失敗も、片方の指標しか見ていないことから起きます。パレート前線を一度描いておけば、「段取りをあと30分許せば遅れがどれだけ減るか」「段取りをあと30分減らせと言われたら遅れがどれだけ増えるか」を、現場と経営が同じ図の上で議論できます。
現場で使うときの注意、系列の粒度と段取り表の精度
この章の方法を実際の工場に当てはめるときに、結果を左右する準備が3つあります。
第一は、系列の粒度です。この章では段取り時間が系列だけで決まり、同じ系列の中は0分としました。実際には、同じ系列でも寸法が違えば数分の調整が要るといった「系列内の小さな段取り」がよくあります。系列の中の段取りを0とみなすと、最適化は系列内の順序を納期だけで決めてしまい、実際の段取りを過小評価します。系列内の段取りが無視できない大きさなら、系列を細かく分けるか、仕事ごとの段取り表を作ります。CP-SAT のモデルは仕事の組ごとに段取り時間を与える形なので、表を細かくしてもコードは変わりません。
第二は、段取り表の精度です。最適化は、表の数字を信じて順序を決めます。表の F2 から F4 が実際より10分短く書かれていれば、最適化はその切り替えを実際より多く選びます。段取り時間は作業者の熟練や治具の状態でばらつくので、表の値は実績の記録から作り、定期的に見直す必要があります。表を作る作業そのものが、どの切り替えが重いかを現場と共有するきっかけになります。標準時間の精度が結果を決めることは、第13章で導入の観点から改めて扱います。
第三は、この章が単一機械の問題に絞っている点です。実際の工場では、ボトルネックの順序が決まれば、前後の工程はそれに合わせて動くことが多いので、まずボトルネックの設備に段取りつきの最適化を当てるのが現実的です。複数の設備にまたがる段取りつきのジョブショップも、CP-SAT では各機械の回路制約を並べれば同じ書き方で表せますが、規模が大きくなるほど証明が難しくなります。作業者や治具の数の制約を加える方法は第10章、大規模な問題の扱いは第11章で扱います。また、段取りの回数を減らすために同じ品種をまとめて作る量、つまりロットの大きさをどう決めるかは、週と個数の単位の計画として次の第8章で扱います。この章は、量が決まった後の順序の問題を扱ったことになります。
この章の要点は3つです。第一に、段取り時間が前後の品種の組で決まるとき、段取りの合計を最小にする問題は巡回セールスマン問題と同じ形になり、CP-SAT の回路制約で素直に書けます。第二に、段取りを考えない EDD や到着順は、段取りでも納期でも最適な解の集合より悪く、段取りと納期の釣り合いはパレート前線として描けば、どこを選ぶかを交換比率や段取りの上限という経営の言葉で決められます。第三に、段取り時間そのものの短縮と順序の最適化は補い合う関係で、この章のデータでは、重み付き納期遅れで比べると、順序の最適化だけで段取り半減より大きな効果が出て、両方を組み合わせるとさらに改善しました。次の第8章では、段取りの回数と在庫の釣り合いを、どの週に何個作るかというロットサイジングの問題として扱います。
Anagraftでは、データ活用の構想づくりから、生産計画やスケジューリングのような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『シングル段取への原点的志向 段取時間の革命』(新郷重夫、日本能率協会):書名のとおり、段取り時間の短縮(シングル段取)を主題とした本です。1983年の刊行で、この章が最適化で扱った「順序」とは別の、段取りの作業そのものを変える側の考え方を知るための古典にあたります。この章の「段取り時間そのものを減らす改善」の節と対にして読めます。
『驚きの数学 巡回セールスマン問題』(ウィリアム・J・クック著、松浦俊輔訳、青土社):原書『In Pursuit of the Traveling Salesman』の翻訳で、2013年に刊行されています。この章で段取りの問題と同じ形だと示した巡回セールスマン問題を、単純に見えて数学的な奥行きを持つ問題として取り上げた一般向けの本です。段取りの順序付けの裏側にある問題そのものについて知りたい方に向いています。
第8章 ロットサイジングと生産計画、週の計画に容量と段取り時間を入れる
第7章では、同じ機械に並ぶ仕事の順番を変えることで段取り替えの時間を減らし、段取りと納期の釣り合いを最適化で決めました。そこで決めたのは「今ある仕事をどの順に流すか」で、流す仕事の量そのものは与えられたものとして扱っていました。しかし工場の計画担当者が毎週決めているのは、順番より前に「今週どの製品をいくつ作るか」です。来週の需要を今週まとめて作れば段取りの回数は減りますが、作った分は在庫として倉庫に寝かせることになります。反対に毎週その週の分だけ作れば在庫は減りますが、段取りのたびに機械が止まり、その時間は生産に使えません。この章では、この「まとめて作るか、小分けに作るか」を週単位で決めるロットサイジング(生産ロットの大きさと時期を決める問題)を、工場の能力と段取り時間を制約に入れた混合整数計画として解きます。あわせて、週の量を決める計画と、分の単位で順番を決めるスケジュールがどうつながるか、つながらないと何が起きるかを実行結果で示します。
計画とスケジュールは、決める単位が違う
第1章で整理した計画の階層では、基準生産計画(どの製品を、どの週に、いくつ作るかを決めた表)の下に日程計画があり、その下に現場への作業指示がありました。この記事の第3章から第7章までが扱ってきたのは、階層の下のほう、つまり分の単位で「どの仕事をどの機械でいつ始めるか」を決めるスケジューリングです。この章が扱うロットサイジングは、それより1つ上の段にあたり、時間の単位は週や日、決めるものは生産する量です。順番は決めません。
単位が違うことには理由があります。数週間から数か月先を見通して量を決める段階では、個々の注文の細かな時刻や機械の割付を決めても、需要の見込みが変われば全部やり直しになります。そこで計画の段階では時間を週のような「バケット」(まとまった時間の区切り)に丸め、各バケットの中では順番を問わず、能力の合計だけを見る扱いにします。週の稼働時間が4,800分なら、その週に割り当てる加工時間と段取り時間の合計が4,800分以内に収まっていれば計画としては成り立っている、とみなすわけです。この単純化があるので、計画の問題は数週から数十週の長さで解けます。
一方で、この単純化は現場の実行可能性を保証しません。週の合計が4,800分に収まっていても、週の途中に納期がある注文を後回しにすれば遅れが出ますし、段取り時間が順番によって変わる工場(第7章で扱った順序依存の段取り)では、計画で見込んだ段取り時間と実際の段取り時間がずれます。計画とスケジュールの整合とは、上の段で決めた量が下の段で実際に流せるかどうかを確かめ、流せないなら上の段の前提を直すことです。この章では、まず計画の段で容量と段取り時間を正しく扱う方法を示し、その後で、計画の前提が外れたときに現場で何分の残業に化けるかを測ります。
ロットサイジングは在庫の問題として語られることも多く、1品目で容量の制約が無い場合の厳密解法(Wagner と Whitin の動的計画)や、倉庫の受入能力を複数品目で分け合う発注計画は、弊社コラム「在庫と発注量を決める数理モデル、安全在庫の計算から多段階在庫の最適化まで」の第7章と第11章で扱いました。この章は同じ型の問題を工場の側から見て、「機械の時間」という容量と、「段取りで機械が止まる時間」を中心に据えます。在庫の理論はそちらに譲り、ここでは重ねません。
容量制約付きロットサイジングを式に書く、段取り時間を容量に入れる
工場の週次計画でよく使われるのが、容量制約付きロットサイジング(英語の頭文字で CLSP)と呼ばれる型です。製品を \( i \)、週を \( t \) とし、各週の需要 \( d_{it} \) を欠品なしで満たしながら、各週の生産量 \( x_{it} \)、週末在庫 \( s_{it} \)、その週にその製品の段取りをするかどうか \( y_{it} \)(0か1)を決めます。目的は段取り費と保管費の合計を最小にすることで、式にすると \( \min \sum_{i,t} (S_i\, y_{it} + h_i\, s_{it}) \) です。言葉にすれば「段取りした回数に1回あたりの段取り費を掛けたものと、週末に残った在庫に1個1週あたりの保管費を掛けたものを全部足し、その総額を最小にする」となります。
制約は3種類です。1つ目は在庫バランスで、「前の週末の在庫に今週の生産を足し、今週の需要を引いたものが今週末の在庫」という等式です。2つ目は段取りと生産の連動で、「段取りをしていない週には、その製品は作れない」という条件を、生産量が「段取りの有無に十分大きな数を掛けたもの」以下である、という不等式で書きます。十分大きな数には、その週から計画の終わりまでの需要の合計を使いました。それ以上作っても使い道が無いので、これで解の正しさは変わらず、しかも数が小さいぶん計算が軽くなります。3つ目が週の能力の制約です。
能力の制約をどう書くかが、この章の中心です。Drexl と Kimms が1997年の総説で CLSP の標準形として示している式では、能力の制約は「各製品の1個あたりの所要時間に生産量を掛けた合計が、その週の能力以下」で、段取りは費用としてだけ目的関数に入り、時間は食わない扱いになっています。これに対して工場では、段取り替えの間は機械が止まるので、段取りは時間も食います。そこで能力の制約を \( \sum_i (p_i\, x_{it} + \tau_i\, y_{it}) \le C_t \) と書きます。\( p_i \) は1個あたりの加工時間、\( \tau_i \) は段取り時間、\( C_t \) は週の稼働時間です。言葉にすれば「その週に作る量の加工時間と、その週に行う段取りの時間を足したものが、その週の稼働時間を超えない」という条件です。
段取り時間を入れた形は、Trigeiro・Thomas・McClain の1989年の論文が主題として扱っています。同じ論文の要旨は、能力の制約が極端にきつい問題は想定よりはるかに解きにくく、残業なしの計画が常に見つかったわけではないこと、段取り時間のある問題では能力の制約のきつさが難しさのよい指標になることを報告しています。この後の実行結果は、この2点をそのままの形でなぞることになります。
サンプルデータ、4製品×12週の工場
ここからは第2章で用意したサンプルデータのうち、ロットサイジング用の lot_sizing() を使います。乱数のシードを固定して作った架空の工場で、4製品(以下 P1〜P4 と呼びます)を1つの共通の工程で作り、週の稼働時間は2交替×8時間×5日の4,800分です。段取り費・保管費の円の値も、この記事のために置いた架空の値です。製品ごとの条件と12週の需要は次の表のとおりです。
| 製品 | 12週の需要合計(個) | 週平均(個) | 週の最小〜最大(個) | 1個の加工時間(分) | 段取り時間(分) | 段取り費(円/回) | 保管費(円/個/週) |
|---|---|---|---|---|---|---|---|
| P1 | 4,871 | 405.9 | 252〜619 | 3.0 | 120 | 30,000 | 40 |
| P2 | 3,167 | 263.9 | 157〜360 | 4.5 | 90 | 24,000 | 70 |
| P3 | 1,643 | 136.9 | 98〜184 | 6.0 | 150 | 36,000 | 110 |
| P4 | 1,075 | 89.6 | 55〜136 | 9.0 | 180 | 45,000 | 160 |
12週の加工時間の合計は48,397.5分、稼働時間の合計は57,600分で、期間全体の平均負荷率は84.0%です。数字だけを見ると余裕がありますが、週ごとに見ると様子が違います。段取りを除いた加工時間だけでも、第4週は5,367分で稼働時間の111.8%、第6週は105.2%と、その週の稼働時間を超えています。さらに毎週4製品とも段取りをすると1週あたり540分が段取りに消え、負荷率は第2週110.6%、第4週123.1%、第5週108.5%、第6週116.5%になります。
まず比較の基準として、毎週その週の需要だけを作る「ロット・フォー・ロット」(ロットをまとめない作り方)を評価しました。在庫は持たないので保管費は0ですが、段取りは12週で48回、段取り費は162万円、段取りに消える時間は6,480分です。稼働時間を超える週は第2・4・5・6週の4つで、超過の合計は2,815.5分になります。この超過分は残業か休日出勤で埋めるしかありません。まとめて作らない計画は、在庫が少ない代わりに段取りと残業が重くなる、というのが出発点です。
段取り時間を容量に入れない計画は、現場で何分はみ出すか
次に、段取りを費用としてだけ数え、時間は食わないとみなした CLSP(前の節の標準形)を PuLP 3.3.2 と同梱の CBC で解きました。上限時間は60秒に設定し、実際には1秒前後で最適解が出ています。結果は段取り34回、段取り費111万3,000円、保管費23万120円、総費用134万3,120円です。ロット・フォー・ロットより段取りを14回減らし、その代わりに在庫を持つ計画で、紙の上では大きく安くなっています。
ところが、この計画をそのまま現場に渡すと、段取り時間のぶんだけ週の所要時間がはみ出します。解いた計画の加工時間は第2週から第5週まで4,800分ちょうどで、稼働時間を加工だけで使い切っています。そこに実際の段取り時間を足し直すと、第1週から第7週までの7週がすべて稼働時間を超え、超過は第1週441分、第2週540分、第3週540分、第4週360分、第5週540分、第6週333分、第7週96分、合計2,850分でした。ロット・フォー・ロットの超過(2,815.5分)より多く、しかも計画の段階では「残業0分」と表示されていた計画です。
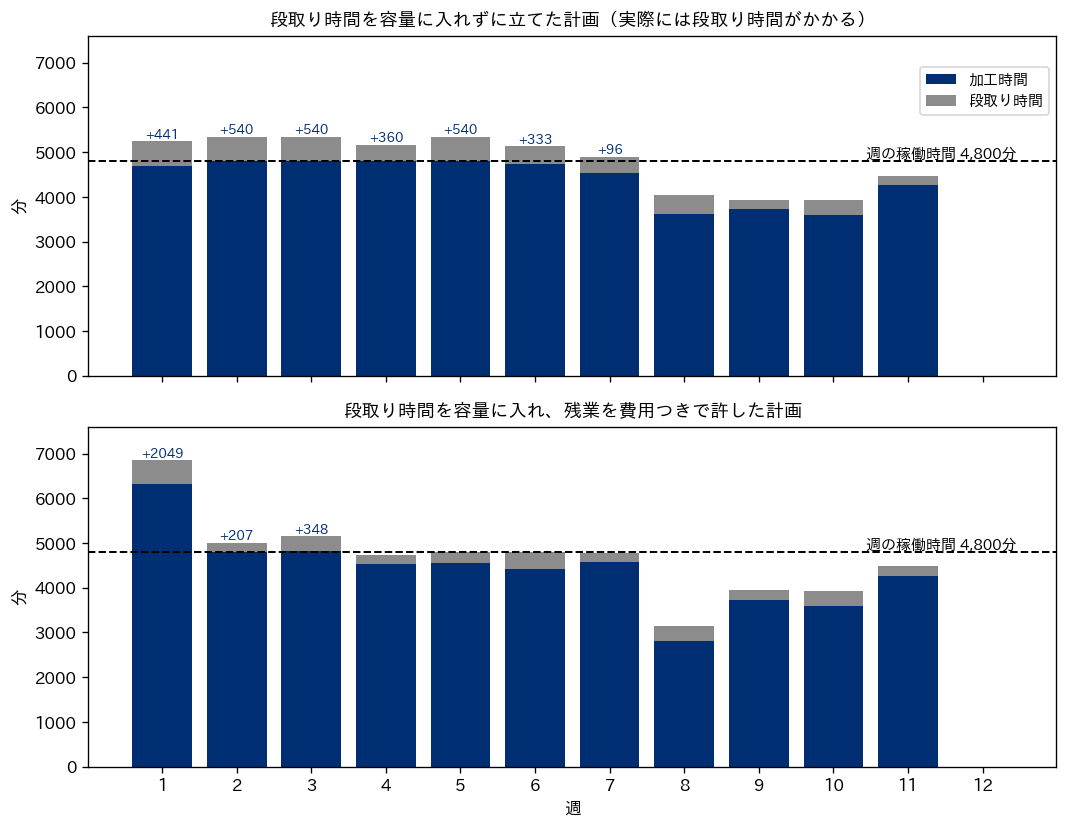
上の図の上段がこの計画です。濃い棒が加工時間、灰色が段取り時間で、破線が週の稼働時間4,800分です。加工時間だけで破線に張り付いている週に、灰色の段取りが上乗せされています。これは計算の誤りではなく、モデルに書いていない制約はソルバーにとって存在しない、ということの現れです。段取りを時間として書かなかったので、ソルバーは「段取りに時間はかからない」前提で能力をぎりぎりまで使う計画を返しました。生産計画のシステムが段取り時間を持っていない、あるいは標準時間のマスタに段取りが入っていない工場では、同様のずれが繰り返し起きやすくなります。
段取り時間を入れると「解なし」になる、実行可能性を先に確かめる
そこで能力の制約に段取り時間を入れ、残業を認めずに解き直しました。CBC の答えは「解なし」(実行不可能)で、判定までの時間は0.2秒前後でした。欠品を許さない前提では、この工場の12週の需要を稼働時間内で作り切る計画は、段取りの回数をどう工夫しても存在しない、という意味です。整数の条件を外し、段取りの有無を0から1の間の連続値に緩めた問題(LP 緩和)は解けてしまうので、この「解なし」は整数の条件と組み合わさって初めて出てくるものです。
なぜ解が無いのかは、累積で見ると分かります。第 \( t \) 週までに作り終えていなければならない加工時間の累積と、第 \( t \) 週までの稼働時間の累積を並べ、その差が段取りに使える時間の上限になります。
| 週 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 加工時間の累積(分) | 4,200 | 8,968 | 12,936 | 18,303 | 22,971 | 28,023 | 32,169 | 35,440 |
| 稼働時間の累積(分) | 4,800 | 9,600 | 14,400 | 19,200 | 24,000 | 28,800 | 33,600 | 38,400 |
| 段取りに使える時間の上限(分) | 600 | 632 | 1,464 | 897 | 1,029 | 777 | 1,431 | 2,960 |
期首在庫がゼロなので、第1週には4製品とも少なくとも1回は段取りが要り、それだけで540分を使います。第6週までに段取りに使える時間は777分しかないので、第2週から第6週の5週間で追加できる段取りは237分ぶん、たとえば P1(120分)と P2(90分)を1回ずつ程度です。そうすると P3 と P4 は第1週に6週分をまとめて作るしかありませんが、第1週の稼働時間には第1週の需要を作ったあと60分しか残りません。この例の組み合わせでは成り立たないことが、累積の表から手で確かめられます。追加の237分をほかの製品の段取りに振り向けた場合も含め、どの組み合わせでも成り立たないことは、上の CBC の「解なし」の判定が示しています。
この「解なし」には2つの教訓があります。1つ目は、段取り時間を入れた CLSP では、費用の最小化より前に「そもそも実行可能な計画があるか」が問題になることです。Drexl と Kimms の総説は、段取り時間を入れると実行可能な計画があるかどうかを判定する問題そのものが NP 完全(規模が大きくなると、条件を満たす答えを見つける手間が急激に増えるおそれのある問題の型)になることを、Maes・McClain・Van Wassenhove の1991年の論文を引いて述べています。今回は12週・4製品と小さく、CBC は一瞬で「解なし」を返しましたが、規模が大きくなると、実行不可能な問題に対してソルバーが解を探し続けて時間切れになることがあります。上限時間を必ず付け、打ち切りで止まったときは「解が見つからなかった」のか「解が無いと証明された」のかを区別して読む必要があります。
2つ目は、実行可能性が計画の境界条件に強く左右されることです。同じ問題で、期首在庫として第1週の需要ちょうど1週分(P1 303個、P2 286個、P3 184個、P4 100個、加工時間にして4,200分)を持って始めると、残業なしで最適解が出ました。段取り23回、段取り費75万3,000円、保管費39万2,673円です。期首在庫の分は費用に入っていないので、次に示す残業つきの計画とは総費用を直接比べられませんが、「計画の最初の週にどれだけの在庫と仕掛りがあるか」を正しく入れないと、実際には回る工場が計算上は回らない、あるいはその逆が起こります。計画を回す前にまず累積の表を作り、どの週で能力が足りなくなるかを見ておくのが、ソルバーに渡す前の点検として有効です。
残業を費用つきで許す、先行生産の読み方
現実の工場では、能力が足りなければ残業や休日出勤で埋めます。そこで各週の残業時間 \( o_t \)(分、0以上)を変数として足し、能力の制約を「加工時間と段取り時間の合計が、稼働時間と残業時間の合計以下」にゆるめ、目的関数に残業1分あたりの費用を掛けた項を足しました。単価は例として1分100円(架空)と置いています。コードは次のとおりです。
import pulp
from sched_data import lot_sizing
D = lot_sizing()
dem, P, ST = D["demand"], D["proc_min"], D["setup_min"]      # 需要・1個の分・段取りの分
SC, HC, CAP = D["setup_cost"], D["hold_cost"], D["cap_min"]  # 段取り費・保管費・週の稼働分
I, T = range(4), range(12)
OT_RATE = 100                                                # 残業1分の費用(円、架空)

prob = pulp.LpProblem("clsp", pulp.LpMinimize)
x = {(i, t): pulp.LpVariable(f"x_{i}_{t}", lowBound=0) for i in I for t in T}   # 生産量
s = {(i, t): pulp.LpVariable(f"s_{i}_{t}", lowBound=0) for i in I for t in T}   # 週末在庫
y = {(i, t): pulp.LpVariable(f"y_{i}_{t}", cat="Binary") for i in I for t in T}  # 段取りの有無
o = {t: pulp.LpVariable(f"o_{t}", lowBound=0) for t in T}                        # 残業(分)
prob += (pulp.lpSum(SC[i] * y[i, t] + HC[i] * s[i, t] for i in I for t in T)
         + pulp.lpSum(OT_RATE * o[t] for t in T))
for i in I:
    for t in T:
        prev = s[i, t - 1] if t > 0 else 0                          # 期首在庫は0
        prob += prev + x[i, t] == int(dem[i, t]) + s[i, t]           # 在庫バランス
        prob += x[i, t] <= float(dem[i, t:].sum()) * y[i, t]         # 段取りしなければ作れない
for t in T:
    prob += pulp.lpSum(P[i] * x[i, t] + ST[i] * y[i, t] for i in I) <= CAP + o[t]  # 加工+段取り≦稼働+残業
prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=60))
print(pulp.LpSolution[prob.sol_status], round(pulp.value(prob.objective)))
print("残業(分)", [round(o[t].value()) for t in T])
# 出力: Optimal Solution Found 1451070
# 出力: 残業(分) [2049, 207, 348, 0, 0, 0, 0, 0, 0, 0, 0, 0]
生産量 x は連続値のままにしてあります。個数を整数にしたい場合でも、整数変数を等式で結ぶ書き方(ある量をロット単位の整数倍に固定するなど)は、組み合わせによっては整数の解が1つも無い問題を作り、ソルバーが長時間探し続ける原因になります。整数化が必要なら、まず連続値で解いて規模感を確かめ、上限時間を付けてから足すのが安全です。
結果は最適解で、総費用145万1,070円、内訳は段取り費80万7,000円(段取り25回)、保管費38万3,670円、残業費26万400円(残業2,604分)です。残業は第1週2,049分、第2週207分、第3週348分と計画の最初の3週に集まり、第4週以降は0です。前の図の下段がこの計画で、第1週の棒が大きく伸びているのが分かります。期首在庫がゼロの状態から、第4週と第6週の山に備えて最初の週に先回りして作る(先行生産、いわゆる作りだめ)ために、残業を使っているわけです。第4週から第7週は加工と段取りの合計が4,740〜4,800分に収まり、第5週と第6週はちょうど4,800分で、能力を使い切っています。
段取り時間の合計は3,210分で、ロット・フォー・ロットの6,480分からほぼ半分になりました。段取りを減らして浮いた時間を生産に回し、その分を在庫として先に持つ、というのが先行生産の中身です。4製品合計の週末在庫は平均381.7個、最大797個で、この在庫が保管費38万3,670円の正体です。
残業の単価を変えると、計画の組み立て方が変わります。単価を振って解き直した結果が次の表です。
| 残業単価(円/分、架空) | 総費用(円) | 段取り回数 | 段取り費(円) | 保管費(円) | 残業(分) | 残業した週の数 |
|---|---|---|---|---|---|---|
| 25 | 1,255,545 | 25 | 807,000 | 380,070 | 2,739 | 4 |
| 50 | 1,320,870 | 25 | 807,000 | 383,670 | 2,604 | 3 |
| 100 | 1,451,070 | 25 | 807,000 | 383,670 | 2,604 | 3 |
| 200 | 1,663,550 | 32 | 1,038,000 | 251,150 | 1,872 | 3 |
| 400 | 2,037,950 | 32 | 1,038,000 | 251,150 | 1,872 | 3 |
| 1,000 | 3,159,820 | 35 | 1,143,000 | 213,820 | 1,803 | 4 |
今回試した単価(25・50・100・200・400・1,000円)のうち、25〜100円では、段取りを25回に絞り、残業で先行生産して在庫を持つ計画が選ばれます。200円の行からは、段取りを32回に増やして残業を1,872分に減らす計画が選ばれ、保管費も25万1,150円に下がります。残業で作りだめするより、段取りの回数を増やしてこまめに作るほうが安くなるためです。単価を1,000円まで上げても残業は1,803分より減りません。残業の合計だけを最小にするように目的関数を差し替えて解いたところ、最小値は1,803分(第1週1,119分、第4週684分)でした。この工場のこの需要は、どう計画しても少なくとも1,803分の残業がないと欠品なしでは作れない、ということです。能力を何分足せば回るのかが、この形で数字になります。
計画とスケジュールの整合、週の計画を現場で流せるか
ここまでで決めたのは、週ごとに何をいくつ作るかです。その週の中でどの順番に流すかは決めていません。Drexl と Kimms の総説は、CLSP には順番の判断が組み込まれておらず、通常はまず CLSP を解き、その後で期ごとに別々にスケジューリングの問題を解く、と整理しています。同じ総説は、市販の生産計画システムの多くが実装している MRP II(製造資源計画)の論理を3段階で説明しています。第1段階で能力を無視してロットの大きさを決め、第2段階で能力を超えた期のロットをずらし、第3段階で順番を決めて現場に指示を出す、という流れで、段階をまたぐたびに前の段階で無視した条件が問題になりうることを、小さな例で示しています。この章の前半で見た「段取り時間を入れない計画が現場で2,850分はみ出す」現象は、この段階の切れ目で起きることの一例です。
計画の段とスケジュールの段をつなぐときに、ずれが生じやすいところが3つあります。1つ目は段取り時間の見積もりです。CLSP は製品ごとに決まった段取り時間を置きますが、第7章で扱ったように、実際の段取り時間は直前に何を作っていたかで変わります。2つ目は週をまたぐ段取りの扱いです。CLSP は「その週にその製品を作るなら段取り1回」と数えますが、前の週の最後に作った製品を今週の最初に続けて作れば、段取りは要りません。3つ目は週の中の納期で、週末にまとめて出荷する前提なら週の合計だけ見れば足りますが、週の途中に出荷日があれば、順番しだいで遅れが出ます。
2つ目の週をまたぐ段取りについては、1つ下の段で順番を工夫するだけでどれだけ取り戻せるかを測りました。残業つきの計画(段取り25回)を固定したまま、各週の最初と最後にどの製品を置くかだけを動的計画で選び、前の週の最後と今週の最初が同じ製品になる回数を最大にしました。結果は3回の段取りが不要になり、段取り費にして8万4,000円、段取り時間にして330分です。ただし、これは計画を固定したあとで順番だけを工夫した値です。この段取りの持ち越し(前の期の段取り状態を次の期に引き継ぐこと)を計画の式の中に最初から入れれば、持ち越しを前提にロットの時期そのものを組み替えられるので、効果はこれ以上になりえます。Drexl と Kimms の総説は、週より細かい時間の区切りで順番まで同時に決める「スモールバケット」型のモデル(1つの区切りで作れる製品の数を限る型)では、同じ製品のロットの間に空き時間があっても段取り費が追加でかからない扱いになることを示しています。時間の区切りを細かくすると順番と持ち越しを式の中で扱える代わりに、区切りの数が増えて問題が大きくなります。
1つ目の段取り時間の見積もりのずれについては、計画に使う能力に余裕を持たせる効果を測りました。計画を立てるときの能力を4,800分の100%・95%・90%にした3つの計画を作り(計画上の能力を超えた分は残業として費用に数えます)、それぞれを「実際の段取り時間が標準の1.25倍・1.5倍・2倍だった」「加工時間が5%長かった」といった条件で評価し直して、実際の稼働時間4,800分を超えた分を残業として数えました。
| 実際の条件 | 計画能力100%の残業(分) | 計画能力100%の総費用(円) | 計画能力95%の残業(分) | 計画能力95%の総費用(円) | 計画能力90%の残業(分) | 計画能力90%の総費用(円) |
|---|---|---|---|---|---|---|
| 計画どおり | 2,604 | 1,451,070 | 2,604 | 1,481,253 | 2,604 | 1,480,297 |
| 段取り時間1.25倍 | 3,064 | 1,497,120 | 2,874 | 1,508,253 | 2,874 | 1,507,297 |
| 段取り時間1.5倍 | 3,590 | 1,549,620 | 3,144 | 1,535,253 | 3,253 | 1,545,247 |
| 段取り時間2倍 | 4,654 | 1,656,120 | 3,969 | 1,617,753 | 4,183 | 1,638,247 |
| 加工時間1.05倍 | 4,224 | 1,613,093 | 3,425 | 1,563,348 | 3,589 | 1,578,764 |
| 段取り1.5倍かつ加工1.05倍 | 5,289 | 1,719,593 | 4,453 | 1,666,121 | 4,609 | 1,680,764 |
計画どおりに進めば、能力100%で立てた計画が最も安く、95%の計画より3万183円安くなります。余裕を持たせた計画は、段取りを27回に増やして週の負荷を平らにするため、その分の段取り費と保管費がかかるからです。ところが段取り時間が1.5倍になると順位が逆転し、100%の計画の残業は3,590分(7週)に増えるのに対し、95%の計画は3,144分(3週)にとどまり、総費用も95%の計画が1万4,367円安くなります。段取り時間が2倍、加工時間が5%長い、といった条件でも95%の計画が安くなりました。90%まで余裕を取ると、段取り時間1.5倍・2倍や加工時間1.05倍の条件では95%の計画より残業が多くなり、余裕を増やすほど良くなるわけではありませんでした。残業が発生する週の数も大事で、100%の計画は前提が少し外れただけで残業する週が3週から6〜7週に増えます。残業の予定が立たない週が増えることは、費用以上に現場の負担になります。
なお、どの計画でも最初の3週の残業2,604分は消えません。これは期首在庫がゼロという境界条件から来る残業で、余裕率では減らせない部分です。余裕率が効くのは、能力を使い切っている第4週から第7週のような週です。
ローリング、先をどこまで見て計画するか
実務の生産計画は、12週分を一度決めて終わりにはしません。毎週、最新の需要見込みで先の数週を計画し直し、今週の分だけを確定して現場に渡し、翌週にまた1週ずらして計画する、というローリング(転がし計画)で回します。Baker の1977年の論文は、有限の期間を持つ多期間モデルを最適化して、その決定を転がしながら実行する方式の効率を実験で調べ、転がし方式はかなり効率的であること、そしてモデルの作り方について重要な設計上の論点があることを報告しています。その論点の1つが、先を何週まで見るかです。
この工場のデータで、先を見る週数を1・2・3・4・6・8・12週と変えて測りました。毎週、その時点の在庫から先の \( W \) 週だけを対象に残業つきの CLSP を解き、最初の1週の生産と段取りだけを確定して1週進める、を12回繰り返します。需要は確定値として与え、見込みの外れは入れていません。「先をどこまで見るか」だけの効果を切り出すためです。
| 先を見る週数 | 総費用(円) | 段取り回数 | 段取り費(円) | 保管費(円) | 残業(分) | 12週一括との差 |
|---|---|---|---|---|---|---|
| 1週 | 1,901,550 | 48 | 1,620,000 | 0 | 2,815.5 | +31.0% |
| 2週 | 1,645,110 | 39 | 1,293,000 | 116,310 | 2,358 | +13.4% |
| 3週 | 1,587,990 | 37 | 1,197,000 | 188,190 | 2,028 | +9.4% |
| 4週 | 1,503,230 | 32 | 1,017,000 | 267,980 | 2,182.5 | +3.6% |
| 6週 | 1,466,237 | 30 | 978,000 | 269,837 | 2,184 | +1.0% |
| 8週 | 1,462,237 | 25 | 813,000 | 397,237 | 2,520 | +0.8% |
| 12週 | 1,451,070 | 25 | 807,000 | 383,670 | 2,604 | 0 |
表の総費用は、段取り費と保管費に、残業(分)に単価100円を掛けた残業費を足した値です。生産量を連続値のまま解いているので、残業の分数は整数になるとは限りません。1週と4週の行は、実行ログ(ch08_rolling.txt)の残業費281,550円と218,250円に合わせ、残業を小数第1位まで書いています。
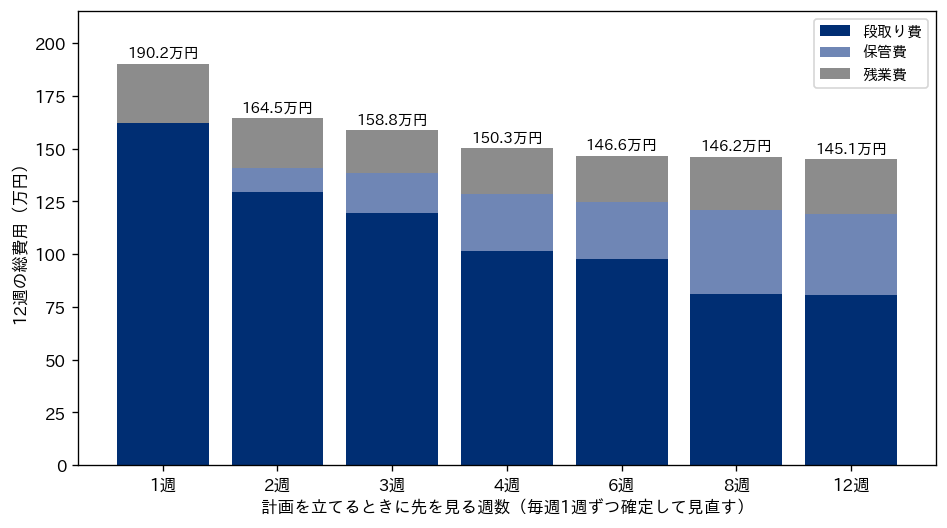
1週しか見ない計画は、ロット・フォー・ロットと同じになります。来週の需要が見えないので、まとめて作る理由が無いからです。総費用は190万1,550円で、12週一括の計画より31.0%高くなりました。先を見る週数を増やすと、段取り費が減って保管費が増え、4週で差は3.6%、6週で1.0%、8週で0.8%まで縮みます。図を見ると、濃い段取り費の部分が先を見る週数とともに小さくなり、中間色の保管費がそれに代わっているのが分かります。残業は先を見る週数に対して単調ではなく、3週で2,028分と最も少なくなっています。短い見通しの計画は第4週の山を直前で残業して乗り切り、長い見通しの計画は第1週に残業して先行生産するというように、残業の使いどころが変わるためです。
この結果の読み方には注意が要ります。ここでは需要を確定値として与えたので、先を長く見るほど得になるのは当然です。実務では先の需要ほど見込みが外れやすく、遠い週の需要に合わせて作りだめした在庫は、見込みが外れれば売れ残ります。この工場の条件では、6週先まで見れば12週一括との差は1.0%で、残り6週を見ることの上積みは小さいという結果でした。需要の山が来る何週前から先行生産を始める必要があるか、つまり能力が足りなくなる週と、それを埋めるのに必要な先行生産の長さが、先を見る週数の下限を決めます。前の節の累積の表で、能力が足りなくなる週を先に確かめておくのはこのためでもあります。計画を確定する範囲(凍結する範囲)の決め方や、確定後に飛び込みの注文や設備の故障が起きたときの直し方は、第12章で扱います。
経営の側から見る、段取り・在庫・残業の釣り合い
この章の数字を経営指標に置き換えると、次のようになります。毎週その週の分だけを作る計画(ロット・フォー・ロット)は、在庫がゼロで一見身軽ですが、段取りが48回、段取りで機械が止まる時間が12週で6,480分、つまり週の稼働時間の1.35週ぶんに達し、残業も2,815.5分発生します。12週一括で最適化した計画は、段取りを25回に減らして段取り時間を3,210分に半減させ、その代わりに平均381.7個の在庫を持ちます。今回の架空の単価では、総費用の差は45万480円でした。単価を実際の値に置き換えれば、同じ計算で自社の工場の差額が出ます。
判断を誤ったときの損失は、どの制約を式に入れなかったかで型が決まります。段取り時間を入れなかった計画は、計画の上では残業ゼロなのに、現場では7週連続で稼働時間をはみ出しました。この差は、計画担当者から見れば「現場が計画どおりに動かない」、現場から見れば「計画が現実を見ていない」という対立として現れやすく、実際には標準時間のマスタに段取りが入っていない、という情報の問題です。能力を100%使い切る計画は、前提どおりなら最も安いものの、段取り時間が1.5倍になっただけで残業する週が3週から7週に増えます。残業時間に上限を設けている工場では、この増え方がそのまま納期遅れにつながります。
意思決定に使うときに押さえておきたい数字は3つあると考えています。1つ目は、欠品なしに必要な残業の最小値です。この工場では1,803分で、これより少ない能力では、どう計画しても欠品が出ます。設備の増設や交替勤務の追加を検討するときの下限の目安になります。2つ目は、残業単価と段取り回数の関係です。単価がある水準を超えると、残業で作りだめするより段取りを増やしてこまめに作るほうが安くなり、計画の型そのものが切り替わります(今回試した単価では、100円の行と200円の行の間で切り替わりました)。残業単価や段取り費の見積もりが粗いと、切り替わる点を読み違えます。3つ目は、計画に使う能力の余裕率です。余裕を取れば前提どおりの週には損をし、前提が外れた週には得をします。この工場の条件では、段取り時間の見積もりが1.5倍程度外れうるなら95%で計画するほうが総費用も残業の週数も小さくなりました。自社の段取り時間の実績のばらつきを測り、それに見合う余裕率を決めるのが、計画の精度を上げる近道だと考えています。
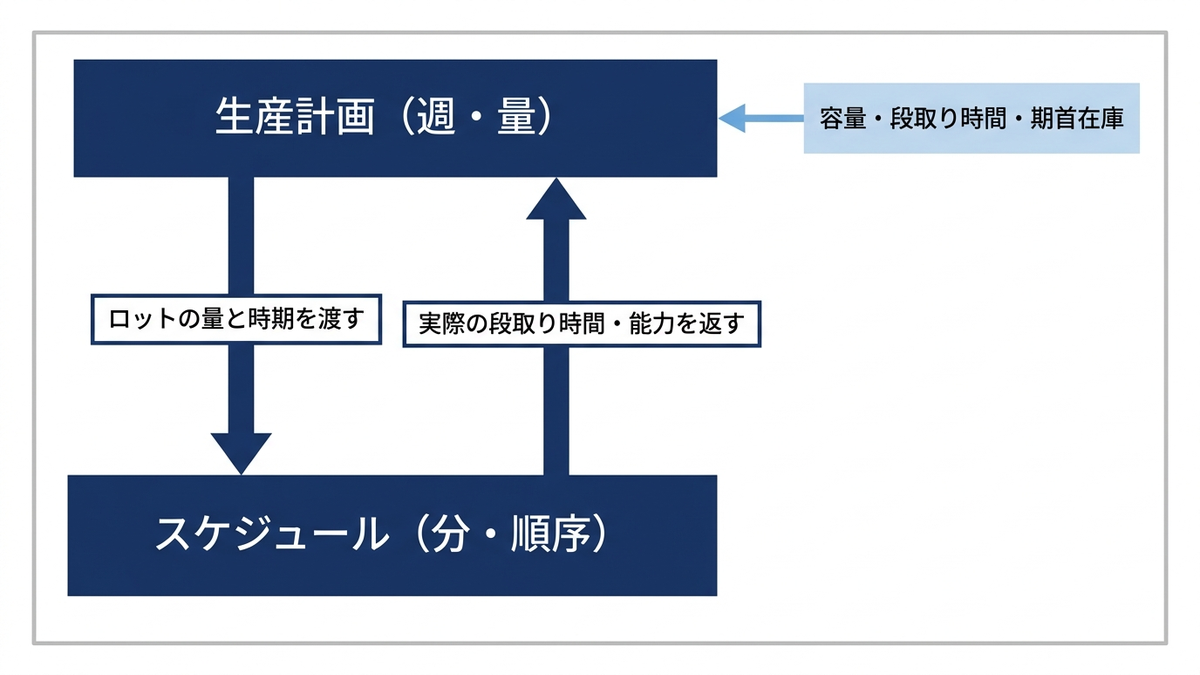
この章の要点は3つです。第一に、週単位の生産計画は、容量制約付きロットサイジングとして混合整数計画で書け、段取り時間を能力の制約に入れることで、現場で実際に流せる計画になります。段取り時間を入れない計画は、紙の上では安く見えても、現場で段取りの分だけはみ出します。第二に、段取り時間を入れると「解なし」になることがあり、その原因は累積の能力の表で確かめられます。残業を費用つきで許せば、欠品なしに必要な残業の最小値や、残業と段取りのどちらで能力不足を埋めるべきかが数字になります。第三に、計画は週の合計しか見ていないので、スケジュールの段との間で段取り時間・段取りの持ち越し・週の中の納期がずれます。余裕率とローリングの見通しの長さは、そのずれを吸収するための設計変数です。次の第9章では、仕事を複数の機械や工程に配る問題として、並列機械への割り当てと組立ラインのバランシングを扱います。
この章を深めたい方への参考書籍
『生産計画』(本間峰一・北島貴三夫・葉恒二、日本能率協会マネジメントセンター):シリーズ「図解でわかる生産の実務」の1冊で、版元の内容紹介は「利益が上がる生産計画の立て方」と知っておきたい計画手法を平易に解説した本としています。この章では数理モデルの側から週の計画を扱いましたが、計画担当者が実際にどういう順序で計画を立てているかを、実務の言葉で押さえるのに向いています。
『生産管理システム構築のすべて』(北村友博、日本実業出版社):生産計画が複数の計画で成り立っていること、基準生産計画(MPS)とタイムバケットの考え方、MRP(資材所要量計画)の論理を、システムを作る側の視点で解説しています。この章の「計画とスケジュールの整合」で触れた、段階ごとに計画を積み上げる仕組みが、情報システムの中でどう実装されているかを知るのに役立ちます。
第9章 並列機械とラインバランシング、仕事を複数の機械と工程に配る
第8章では、週ごとに何をどれだけ作るかというロットの量を、容量の制約のもとで決めました。量が決まると、次に問題になるのは「その仕事をどの機械、どの作業者に割り当てるか」です。同じ加工ができる機械が複数台ある職場では、仕事の順番より先に、仕事をどの機械に載せるかという割当が結果を大きく左右します。組立ラインでは、1台の製品を仕上げるための作業を何人の作業者(工程)にどう分けるかで、ラインから製品が出てくる間隔と、作業者の手待ちの量が決まります。この章では、この2つの「配る」問題を扱います。前半は複数の機械に仕事を配る並列機械のスケジューリング、後半は組立作業を工程に配るラインバランシングです。
並列機械とラインバランシングは、何を決める問題か
並列機械の問題は、同じ種類の加工ができる機械が \( m \) 台あり、どの仕事もそのうちの1台で1回加工すれば終わる、という状況を扱います。決めるのは、各仕事をどの機械に割り当てるかと、各機械の上での仕事の順番です。目的を「すべての仕事が終わる時刻(メイクスパン)を最小にする」とした場合、機械の上での順番は完了時刻に影響しないので、問題は実質的に割当だけになります。各機械が抱える加工時間の合計(機械の負荷)のうち最も大きいものがメイクスパンになるため、負荷をできるだけ均等に配ることが目的と一致します。
並列機械は、機械どうしの関係によって3つの型に分けて呼ばれます。第2章で紹介した3項記法の原典である Graham・Lawler・Lenstra・Rinnooy Kan の1979年のサーベイは、どの機械で加工しても同じ時間がかかる場合を同一並列機械(記号 P)、機械ごとに速度係数があり、加工時間が「仕事の加工時間 × 機械の速度係数」で決まる場合を一様並列機械(記号 Q)、仕事と機械の組合せごとに加工時間が自由に違う場合を非関連並列機械(記号 R)と定義しています。同じ型番の NC 旋盤を3台並べた職場は同一並列機械、新旧の世代が混ざって新しい機械ほど速い職場は一様並列機械、機械ごとに得意な加工が違う(ある仕事は治具の都合で2号機では時間がかかる)職場は非関連並列機械に近くなります。
ラインバランシングは、1つの製品を組み立てるための作業の集合を、流れ作業の工程(ステーション)に割り振る問題です。各作業には作業時間があり、「この作業はあの作業が終わってからでないとできない」という先行関係があります。1つの工程に割り振った作業時間の合計は、ラインが製品を1台送り出す間隔であるサイクルタイムを超えてはいけません。このとき、サイクルタイムを与えて工程数を最小にする問題と、工程数を与えてサイクルタイムを最小にする問題の2種類が区別され、研究の世界ではそれぞれタイプ1、タイプ2と呼ばれています。前者は新しいラインを設計するときの「必要な生産速度を出すのに何人要るか」、後者は既存のラインで「今の人数で最大どれだけの速度が出るか」という問いに対応します。
2つの問題は、見た目は違いますが構造がよく似ています。並列機械は「仕事を機械に配り、最も重い機械の負荷を小さくする」問題で、ラインバランシングは「作業を工程に配り、最も重い工程の負荷(それがサイクルタイムを決める)を小さくする」問題です。違いは先行関係の有無で、ラインバランシングでは後の工程に置いた作業の先行作業を、それより後ろの工程に置くことができません。Ritt と Costa の論文は、先行関係を取り除くとタイプ1はビンパッキング問題(決まった大きさの箱に品物を詰め、使う箱の数を最小にする問題)に、タイプ2は同一並列機械のメイクスパン最小化に帰着すると述べています。この章では両者を同じ道具(負荷の下界、貪欲な割当ルール、混合整数計画)で解き、どこで差が出るかを実測で示します。
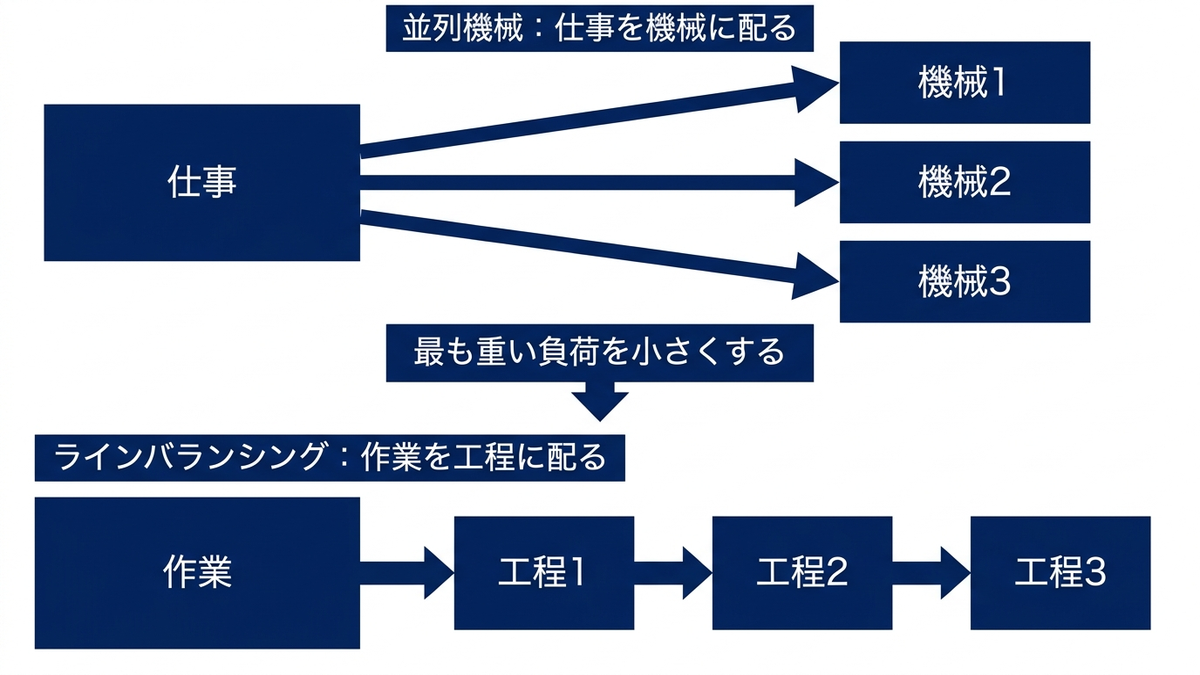
同一並列機械のメイクスパン、負荷の下界と割当ルール
まず、同一並列機械でメイクスパンを最小にする問題(3項記法で P||Cmax)から始めます。この問題は機械が2台でも NP 困難(規模が大きくなると厳密解を求める時間が急激に伸びる型)であることが知られており、Graham らの1979年のサーベイにも P2||Cmax が NP 困難であると整理されています。ただし、NP 困難であることは「解けない」ことを意味しません。後で示すように、20件や200件の規模なら、この記事の環境で数秒から10秒程度のうちに最適解が見つかることが多くあります。
厳密に解く前に、どんな割当をしても下回れない値、つまり下界を押さえておくと、解の良し悪しを判断しやすくなります。同一並列機械の下界は2つあります。1つは加工時間の合計を台数で割った値で、全部の機械が一瞬も休まずに同時に終わる理想の状態に相当します。もう1つは最も長い仕事の加工時間で、1つの仕事は分割できないので、それより早く全部が終わることはありません。この2つの大きい方が下界です。式で書くと \( LB = \max(\sum_j p_j / m,\ \max_j p_j) \) で、言葉にすれば「平均の負荷と最長の仕事の大きい方」です。この下界と実際の割当のメイクスパンの差が、その割当に残っている改善の余地の上限になります。
割当を作る最も簡単なルールは、仕事を何かの順番に並べ、先頭から順に「その時点で負荷が最も小さい機械」へ載せていく方法で、リストスケジューリングと呼ばれます。受付順に並べれば、空いた機械に次の仕事を回すという現場の自然な運用そのものです。このルールに加えて、仕事を加工時間の長い順に並べてから同じことをするのがLPT(Longest Processing Time first、長い仕事から先に配るルール)です。長い仕事を先に配っておき、最後に短い仕事で凹凸を埋める、という考え方で、第3章で扱った SPT(短い順)とは目的も並べ方も逆になります。
LPT と Graham の性能保証、実測で見る最適解との差
リストスケジューリングと LPT には、どんなデータに対しても最適値の何倍を超えないかという性能保証が証明されています。Graham らの1979年のサーベイによれば、並べる順番が任意のリストスケジューリングは、Graham が1966年に示したとおりメイクスパンが最適値の \( 2 – 1/m \) 倍以下になり、LPT の順に並べると、Graham の1969年の結果により \( 4/3 – 1/(3m) \) 倍以下に改善されます。3台なら、任意の順番で約1.67倍以内、LPT なら約1.22倍以内です。これは最悪の場合の保証で、実際のデータではもっと最適に近いことがほとんどですが、「どんなに運が悪くても、最適より22%以上悪くはならない」という保証がある点が、経験則の割当ルールとの違いです。
第2章で用意したサンプルデータの並列機械20件(parallel_jobs())の標準加工時間を使い、台数を2台から6台まで変えて、受付順のリストスケジューリング、LPT、最適解を比べました。標準加工時間は40分から240分、合計3,080分です。最適解は PuLP 3.3.2 と CBC で混合整数計画として解き、あわせて OR-Tools 9.15 の CP-SAT(制約プログラミングのソルバー。第5章・第6章で使ったもの)でも解いて、最適であることの証明を確かめました。CP-SAT の並列ワーカー数は8に固定しています。解時間はこの記事の実行環境(一般的なノートPC)での実測です。
| 台数 | 下界(分) | 受付順のリスト(分) | LPT(分) | 最適(分) | LPT÷最適 | LPTの保証 | 任意の順番の保証 | CP-SATの解時間(秒) |
|---|---|---|---|---|---|---|---|---|
| 2 | 1,540 | 1,610 | 1,540 | 1,540 | 1.000 | 1.167 | 1.500 | 0.20 |
| 3 | 1,027 | 1,090 | 1,040 | 1,030 | 1.010 | 1.222 | 1.667 | 0.90 |
| 4 | 770 | 820 | 780 | 770 | 1.013 | 1.250 | 1.750 | 0.29 |
| 5 | 616 | 690 | 630 | 620 | 1.016 | 1.267 | 1.800 | 0.40 |
| 6 | 514 | 600 | 530 | 520 | 1.019 | 1.278 | 1.833 | 5.58 |
表の「LPT÷最適」の列は、5つの台数すべてで1.02以下でした。保証の1.17から1.28に比べてずっと小さく、このサンプルでは LPT が最適から2%以内に収まりました。一方、「受付順のリスト」の列は、3台で1,090分(最適の1.058倍)、6台で600分(最適の1.154倍)と、台数が増えるほど最適から離れます。受付順に空いた機械へ回すだけの運用と、長い順に並べ替えてから回す運用とでは、6台の場合で70分(600分と530分)の差がつきます。並べ替えは表計算ソフトでも1回の操作で済むので、並列機械の割当を人が決めている職場で最初に試す価値のある改善です。
「下界」の列には端数が出ていますが、このデータの加工時間はすべて10分単位なので、どの機械の負荷も、したがってメイクスパンも10分単位になります。3台の下界1,027分は、10分単位に切り上げると1,030分で、最適値と一致します。5台の616分は620分、6台の514分は520分に切り上がり、いずれも最適値と一致しました。つまりこの3つの台数では、ソルバーに頼らなくても「平均の負荷を10分単位に切り上げた値」に到達した時点で最適だと言えます。実際、CBC は3台・5台・6台では上限の15秒以内に最適性の証明を終えられませんでしたが、見つけていた解は上の理由で最適でした。データの性質(時間の刻み)を使った下界の締め直しは、ソルバーの証明より強いことがある、という例です。
規模を増やしたときの目安も測りました。parallel_jobs() と同じ40分から240分の範囲で加工時間を乱数で作り(乱数のシードは0)、仕事の数を20件・50件・100件・200件、台数を3台と10台にして、LPT と CP-SAT(上限10秒)を比べた結果が次の表です。下界は上と同じく10分単位に切り上げています。
| 仕事数 | 台数 | 下界(分) | LPT(分) | LPT÷下界 | CP-SATの結果 | CP-SATの解(分) | CP-SATの解時間(秒) |
|---|---|---|---|---|---|---|---|
| 20 | 3 | 990 | 990 | 1.0000 | 最適を証明 | 990 | 0.37 |
| 20 | 10 | 300 | 320 | 1.0667 | 最適を証明 | 320 | 0.05 |
| 50 | 3 | 2,380 | 2,390 | 1.0042 | 最適を証明 | 2,380 | 0.03 |
| 50 | 10 | 720 | 720 | 1.0000 | 最適を証明 | 720 | 5.97 |
| 100 | 3 | 4,810 | 4,830 | 1.0042 | 最適を証明 | 4,810 | 0.49 |
| 100 | 10 | 1,450 | 1,450 | 1.0000 | 10秒で打ち切り | 1,450 | 10.07 |
| 200 | 3 | 9,670 | 9,680 | 1.0010 | 最適を証明 | 9,670 | 0.06 |
| 200 | 10 | 2,910 | 2,910 | 1.0000 | 10秒で打ち切り | 2,910 | 10.15 |
仕事の数が増えるほど、LPT は下界にほぼ張り付きます。200件・3台では LPT が9,680分、下界が9,670分で、差は10分(0.1%)です。仕事が多いと、最後に配る短い仕事で凹凸をならす余地が大きくなるためです。逆に仕事が少なく台数が多い20件・10台では、LPT も最適解も320分で、下界の300分には届きません。1台あたり2件しか載らないので、平均どおりにならす余地がそもそも無いからです。CP-SAT は100件・10台と200件・10台で10秒の上限に達しましたが、見つけた解は10分単位の下界と一致しているので最適です(CP-SAT 自身が示した下界は1,445分と2,902分で、時間の刻みを使っていない分だけ弱くなっています)。同一並列機械のメイクスパン最小化に限れば、今回の乱数実験の範囲(仕事20〜200件、3台と10台)では、LPT は下界から7%以内、仕事が50件以上の4つの組み合わせでは0.5%以内に収まりました。これは1つの乱数の組での結果で、どの工場のデータでも同じになるとは限りません。
速度の違う3台に配る、混合整数計画と LPT 系の比較
次に、機械の速さが違う場合です。parallel_jobs() は、同じ20件を速度係数1.0・1.25・1.6の3台(ここでの速度係数は標準加工時間に掛ける倍率で、値が小さいほど速い機械です)(以下、A・B・C と呼びます。A が最も速い新しい機械、C が最も遅い古い機械です)で加工する問題で、機械ごとの加工時間は「標準加工時間 × 速度係数」を10分単位に丸めた値です。全部を A でやれば合計3,080分、B なら3,850分、C なら4,940分かかります。丸めているため厳密には一様並列機械の定義から少しずれるので、混合整数計画では加工時間の表をそのまま使い、非関連並列機械として書きました。
速度が違うと、同一並列機械の「負荷の小さい機械へ回す」という発想はそのままでは使えません。同じ仕事でも C に載せると A の1.6倍の時間を食うからです。Graham らのサーベイは、Gonzalez・Ibarra・Sahni の1977年の研究として、LPT を「長い順に、その仕事が最も早く終わる機械へ割り当てる」形に一般化した方法(LPT’ と表記されます)を紹介し、一般の一様並列機械で最適値の \( 2 – 2/(m+1) \) 倍以下(3台なら1.5倍以下)になることを示しています。この章ではこれを LPT’ と呼び、速度を無視して標準時間だけで LPT をした場合、混合整数計画の最適解と比べました。混合整数計画のモデルは次のとおりです。
import pulp
from sched_data import parallel_jobs
pj = parallel_jobs()
P = pj["p"]                      # 20件 x 3台の加工時間(分)
n, m = P.shape
prob = pulp.LpProblem("parallel_cmax", pulp.LpMinimize)
x = {(j, k): pulp.LpVariable("x_%d_%d" % (j, k), cat="Binary") for j in range(n) for k in range(m)}
C = pulp.LpVariable("Cmax", lowBound=0)       # メイクスパン
prob += C                                      # 目的関数: メイクスパン最小
for j in range(n):                             # どの仕事もちょうど1台に載せる
    prob += pulp.lpSum(x[j, k] for k in range(m)) == 1
for k in range(m):                             # どの機械の負荷もメイクスパン以下
    prob += pulp.lpSum(int(P[j][k]) * x[j, k] for j in range(n)) <= C
prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=30))
print(pulp.value(C))
# 出力: 1270.0
0か1の変数 \( x_{jk} \) は「仕事 \( j \) を機械 \( k \) に載せるなら1」を表し、制約は「どの仕事もちょうど1台に載る」と「どの機械の負荷もメイクスパン以下」の2種類だけです。LPT’ のほうは数行で書けます。
base = [int(v) for v in pj["base"]]
order = sorted(range(n), key=lambda j: (-base[j], j))   # 標準時間の長い順
load = [0] * m
assign = {}
for j in order:
    k = min(range(m), key=lambda i: (load[i] + P[j][i], i))   # 載せたら最も早く終わる機械
    assign[j] = k
    load[k] += int(P[j][k])
print(max(load), load)
# 出力: 1300 [1280, 1300, 1220]
結果をまとめたのが次の表です。「平均完了時刻」は、各機械で短い順に流したときの20件の完了時刻(時刻0からの分)の平均で、仕事が出来上がるまでの平均の待ち時間、つまり平均のリードタイムに相当します。「総完了時間の最小」の行は次の節で説明します。
| 割当の方式 | メイクスパン(分) | 機械別の負荷 A/B/C(分) | 機械別の件数 A/B/C | 平均完了時刻(分) |
|---|---|---|---|---|
| 速度を無視した均等割り(標準時間で LPT) | 1,670 | 1,010/1,290/1,670 | 6/7/7 | 616.0 |
| LPT’(最も早く終わる機械へ) | 1,300 | 1,280/1,300/1,220 | 8/7/5 | 586.0 |
| 混合整数計画(メイクスパン最小) | 1,270 | 1,270/1,260/1,250 | 8/7/5 | 586.0 |
| 総完了時間の最小(割当問題) | 1,320 | 1,230/1,320/1,240 | 8/7/5 | 581.5 |
| 参考:全部を A に載せる | 3,080 | 3,080/0/0 | 20/0/0 | 1,260.0 |
速度を無視して台数だけで均等に割ると、件数は6件・7件・7件と揃いますが、遅い C に載った仕事が長引き、メイクスパンは1,670分になります。このとき A は1,010分で仕事がなくなり、C が終わるまでの660分を遊んでいます。LPT’ は速さの違いを見て、速い A に8件、遅い C に5件を載せ、メイクスパンを1,300分まで縮めました。混合整数計画の最適解は1,270分で、3台の負荷が1,250分から1,270分の20分の幅に収まっています。LPT’ と最適解の差は30分(2.4%)でした。一様並列機械であれば3台での LPT’ の保証は1.5倍ですが、ここでは10分単位の丸めのため厳密には非関連並列機械として扱っているので、この1.5倍はこの表に対する保証そのものではなく、目安として見るものです。
この1,270分が最適であることは、CBC では安定して確かめられませんでした。上のモデルを上限30秒で4回解いたところ、3回は PuLP の LpSolution[prob.sol_status] が Solution Found(実行可能な解は見つかったが、最適とは証明されていない)を返し、1回だけ30.48秒で Optimal Solution Found を返しました。ログを出した回では、CBC は「Stopped on time limit」で止まり、その時点の最良解が1,270分、最適値の下限が1,260.5分、探索した節点は111万個余りでした。同じモデル・同じ上限でも、証明が間に合うかどうかは実行ごとに揺れます。一方、同じ問題を CP-SAT(並列ワーカー8)に解かせると、8.5秒で最適(下界も1,270分)と証明されました。0と1を連続値に緩めた線形計画の値は1,258.13分で、10分単位に切り上げても1,260分にしかならないため、同一並列機械の場合のような下界の締め直しでは証明できない例です。最適性を判断の根拠に使う場合は、解の値だけでなく、状態の表示とソルバーのログ(msg=1)で最適値の下限を確かめておくのが安全です。
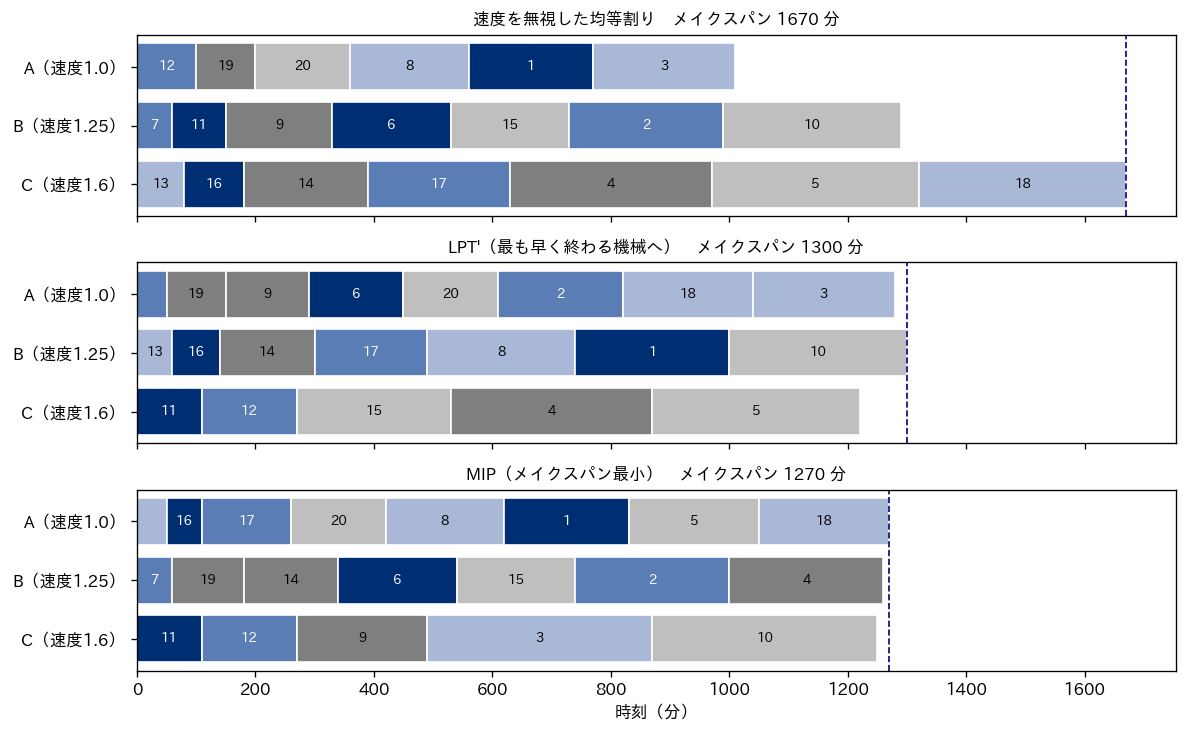
上の図は3つの割当のガントチャートです(各機械の上では短い順に流しています。棒の中の数字は仕事の番号)。上段の均等割りでは C の棒だけが突き出ており、中段と下段では3台の終わりがほぼ揃っています。速度の違う設備が混ざった職場で「台数で割る」「件数で割る」配り方をすると、上段のように最も遅い設備が全体の終わりを決めてしまいます。
負荷の偏りと平均完了時刻、目的が変われば割当も変わる
メイクスパンは「最後の仕事がいつ終わるか」だけを見る指標で、途中の仕事がいつ終わるかは問いません。受注ごとの納期やリードタイムを気にするなら、各仕事の完了時刻の合計(総完了時間。20件で割れば平均完了時刻)を小さくしたい場面も多くあります。Graham らのサーベイによれば、同一並列機械で総完了時間を最小にする問題は、Conway・Maxwell・Miller の1967年の方法(短い仕事から順に各機械へ1件ずつ配り、各機械の上では短い順に流す)で解けます。非関連並列機械でも、Horn の1973年の研究などにより、「どの仕事を、どの機械の後ろから何番目に流すか」を決める割当問題(輸送問題)として多項式時間で解けることが示されています。機械 \( i \) で後ろから \( k \) 番目に流す仕事は、自分を含めて \( k \) 件の完了時刻に加工時間を足し込むので、総完了時間への寄与は \( k \times p_{ij} \) になる、という見方です。
この割当問題を SciPy の linear_sum_assignment(割当問題を解く関数)で解いた結果が、前の表の「総完了時間の最小」の行です。平均完了時刻は581.5分で、メイクスパン最小の586.0分より4.5分短くなっています。その代わりにメイクスパンは1,320分で、最適の1,270分より50分長くなりました。総完了時間を小さくするには、短い仕事を速い機械の早い位置に集めるのが有利で、そのぶん長い仕事の置き場所が偏るためです。逆に、メイクスパン最小の解は平均完了時刻586.0分で、LPT’ と同じ値でした。
この差は小さく見えますが、目的の選び方が割当を変えることをはっきり示しています。「全部の仕事を今日の定時までに終わらせたい」のならメイクスパン、「受注1件あたりの待ち時間を短くしたい」のなら総完了時間、「納期に遅れる件数や重みを減らしたい」のなら第3章で扱った納期遅れの指標が目的になります。納期つきの並列機械は、上の混合整数計画に各仕事の完了時刻の変数を足し、機械ごとの順番を決める変数(第5章・第6章のジョブショップと同じ書き方)を加えれば同じ枠組みで解けます。このときは順番が結果に効くので、問題は割当だけの場合より重くなります。サンプルデータの parallel_jobs() には納期を持たせていないため、この章では納期遅れの実測までは行っていません。
もう1点、表の最後の行「全部を A に載せる」は、最も速い機械だけを使った場合の参考値です。メイクスパン3,080分、平均完了時刻1,260.0分で、遅い機械を使わないことの損失は明らかです。古い機械を「遅いから」という理由で遊ばせるより、速度の違いを織り込んで短い仕事を回すほうが、全体の終わりも平均のリードタイムも縮みます。速度の違いを数字(速度係数、あるいは機械ごとの標準時間)としてマスタに持っていることが、この計算の前提になります。
組立ラインのバランシング、編成効率と位置重み法
ここから後半のラインバランシングに移ります。Salveson が1955年に組立ラインのバランシング問題を初めて解析的に定式化し、その後 Baybars が1986年に基本形(単純組立ラインバランシング問題、SALBP)と一般化した形を区別した、と El Machouti らの2024年のサーベイ論文は整理しています。基本形は、1種類の製品を流す直線のラインで、作業時間は一定、先行関係以外に制約がない、という最も単純な設定です。
日本 IE 協会の解説は、JIS Z 8141 の定義として、ラインバランシングを「生産ラインの各作業ステーションに割り付ける作業量を均等化する方法」と紹介しています。同じ解説では、目標サイクルタイムを「1日の実質稼働時間 ÷ その日の必要生産数」で求め、ラインの出来を編成効率(作業編成効率)で評価するとしています。編成効率は「すべての作業ステーションの所要時間の合計 ÷(サイクルタイム × 作業ステーション数)× 100」で、100から編成効率を引いたものがバランス・ロス率です。式で書けば \( E = \sum_i t_i / (m \times c) \) で、言葉にすれば「作業者全員が1サイクルのうち実際に作業している時間の割合」です。残りは手待ち(その工程は仕事を終えたが、次の製品がまだ来ない時間)になります。なお、同じ解説は式のサイクルタイムを「ボトルネック工程の所要時間」と注記しています。この章の表では、与えた目標サイクルタイムで割った値を編成効率として示しました。工程の最大の負荷が目標より短い編成では、ボトルネック工程の所要時間で割った値のほうが少し高くなります。
第2章で用意したサンプルデータの line_tasks() は、組立作業20個からなる架空の製品で、作業時間は8秒から43秒、合計458秒です。先行関係を図にすると次のようになります。作業1が起点で、作業17・19・20が終点です。
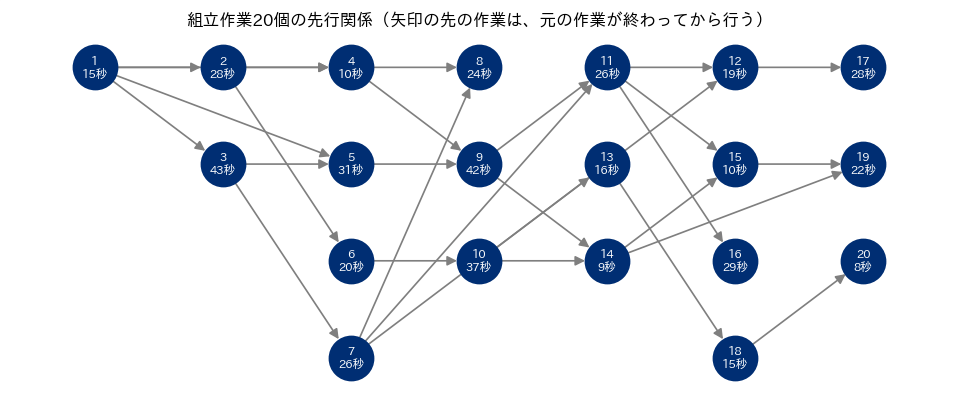
サイクルタイムを \( c \) 秒とすると、工程数の下界は作業時間の合計を \( c \) で割って切り上げた値です。日本 IE 協会の解説でも、最小作業ステーション数を「総所要時間 ÷ 目標サイクルタイム」で求めるとしています。458秒を60秒で割ると7.63なので、60秒のラインには少なくとも8工程が要ります。また、1つの作業は分割できないので、サイクルタイムは最長の作業である43秒(作業3)より短くできません。並列機械の下界と同じく、「平均の負荷」と「最大の1個」の2つが下界を作る、という構造です。
ラインバランシングの代表的な割付ルールが位置重み法です。El Machouti らのサーベイは、これを Helgeson と Birnie が1961年に示した最初期の発見的解法の1つとして紹介し、作業時間と、その作業の後に続くすべての作業の作業時間の合計を位置重みとして、位置重みの大きい順に作業を並べる方法だと説明しています。後ろにたくさんの作業を抱えている作業ほど早く片付けないとラインが詰まる、という考え方で、並列機械の LPT が「長い仕事を先に」配ったのと同じく、「重いものから先に」配るルールです。
この記事では、位置重みの大きい順に優先順位を付け、工程を1つ開いたら「先行作業がすべて済んでいて、今の工程に入れてもサイクルタイムを超えない作業」のうち優先順位の最も高いものを入れ、入れられる作業がなくなったら次の工程を開く、という手順で実装しました。サンプルデータの位置重みは、作業1が458秒(全作業が作業1の後に続くため合計と同じ)、作業2が343秒、作業3が309秒と続き、最後の作業20は8秒です。
サイクルタイム60秒で位置重み法を当てた結果は9工程でした。工程ごとの作業時間は53・43・57・42・46・56・59・57・45秒で、2番目の工程は作業3(43秒)だけ、4番目の工程は作業9(42秒)だけが入って、それぞれ17秒と18秒の手待ちが出ています。作業3の後に続けたい作業5・7・6はどれも入れると60秒を超え、他の作業はまだ先行作業が済んでいない、という状態で工程を閉じざるを得なかったためです。9工程の編成効率は458 ÷(60 × 9)で84.8%です。
混合整数計画で工程数とサイクルタイムを最小にする
同じ問題を混合整数計画で解きます。0か1の変数 \( x_{is} \) で「作業 \( i \) を工程 \( s \) に置くなら1」を表し、各作業をちょうど1つの工程に置くこと、各工程の作業時間の合計がサイクルタイム以下であること、先行関係を守ることを制約にします。先行関係は、作業を置いた工程の番号 \( \sum_s s\, x_{is} \) が、後に続く作業の工程番号以下になる、という不等式で書きました。工程を使うかどうかの変数 \( y_s \) を足し、その合計を最小にすればタイプ1(工程数最小)、工程数を固定してサイクルタイムの変数を最小にすればタイプ2になります。Ritt と Costa の論文は、Bowman が1960年に提案した定式化以来、このような0か1の割付変数を使う書き方が文献で最も一般的だと述べています。
import pulp
from sched_data import line_tasks
tasks = line_tasks()
T = {d["task"]: d["time"] for d in tasks}         # 作業時間(秒)
PRED = {d["task"]: d["pred"] for d in tasks}      # 直前の先行作業
N, S, c = sorted(T), range(1, 10), 60             # 工程は9個まで用意、サイクルタイム60秒
prob = pulp.LpProblem("line_type1", pulp.LpMinimize)
x = {(i, s): pulp.LpVariable("x_%d_%d" % (i, s), cat="Binary") for i in N for s in S}
y = {s: pulp.LpVariable("y_%d" % s, cat="Binary") for s in S}   # 工程 s を使うか
prob += pulp.lpSum(y[s] for s in S)                             # 目的関数: 工程数
for s in S:
    if s > 1:
        prob += y[s] <= y[s - 1]                                   # 前から詰めて使う
    prob += pulp.lpSum(T[i] * x[i, s] for i in N) <= c * y[s]    # サイクルタイム
for i in N:
    prob += pulp.lpSum(x[i, s] for s in S) == 1                 # 各作業はちょうど1工程
for j in N:
    for i in PRED[j]:                                           # 先行作業は同じか前の工程
        prob += pulp.lpSum(s * x[i, s] for s in S) <= pulp.lpSum(s * x[j, s] for s in S)
prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=30))
print(pulp.value(prob.objective))
# 出力: 8.0
サイクルタイム60秒では、混合整数計画の答えは8工程で、下界の8に一致しました。工程ごとの作業時間は53・57・59・57・57・58・57・60秒で、手待ちの合計は22秒、編成効率は95.4%です。位置重み法の9工程(手待ちの合計82秒)より1工程少なく、同じ1時間60台の生産速度を作業者8人で出せる、という結果です。サイクルタイムを変えて同じ比較をしたのが次の表です。「1時間の生産台数」は3,600秒をサイクルタイムで割った値です。
| サイクルタイム(秒) | 1時間の生産台数 | 工程数の下界 | 位置重み法の工程数 | 混合整数計画の工程数 | 編成効率 位置重み法 | 編成効率 混合整数計画 | 解時間(秒) |
|---|---|---|---|---|---|---|---|
| 43 | 83.7 | 11 | 13 | 12 | 81.9% | 88.8% | 2.72 |
| 50 | 72.0 | 10 | 11 | 10 | 83.3% | 91.6% | 0.62 |
| 60 | 60.0 | 8 | 9 | 8 | 84.8% | 95.4% | 0.85 |
| 70 | 51.4 | 7 | 8 | 7 | 81.8% | 93.5% | 0.65 |
| 80 | 45.0 | 6 | 7 | 6 | 81.8% | 95.4% | 0.95 |
| 90 | 40.0 | 6 | 6 | 6 | 84.8% | 84.8% | 1.78 |
| 100 | 36.0 | 5 | 5 | 5 | 91.6% | 91.6% | 0.21 |
| 120 | 30.0 | 4 | 5 | 4 | 76.3% | 95.4% | 0.32 |
| 150 | 24.0 | 4 | 4 | 4 | 76.3% | 76.3% | 0.24 |
9つのサイクルタイムのうち6つで、位置重み法は最適より1工程多くなりました。混合整数計画の解時間はすべて3秒未満で、CBC は最適性の証明まで終えています。表で注目したいのは2点です。第一に、サイクルタイム43秒では下界が11工程なのに、最適は12工程で、下界に届きません。43秒は最長の作業3と同じ長さなので、作業3の工程には他の作業が一切入らず、ほかにも詰め合わせにくい作業が残るためです。サイクルタイムを最長の作業ぎりぎりまで縮めると、編成効率は88.8%まで落ちます。第二に、サイクルタイム90秒と150秒では、最適解でも編成効率が84.8%と76.3%にとどまります。458秒を90秒で割ると5.09で、5工程にはわずかに入りきらず6工程が必要になるからです。編成効率は「割付の上手下手」だけでなく、「作業時間の合計とサイクルタイムの割り切れ方」にも左右されます。
次は工程数を固定し、サイクルタイムを最小にするタイプ2です。位置重み法には工程数を指定する形がないので、サイクルタイムを下界から1秒ずつ伸ばし、位置重み法で指定の工程数に収まった最初の値を位置重み法の答えとしました。8時間の生産台数は、28,800秒をサイクルタイムで割って端数を切り捨てた値です。
| 工程数 | サイクルタイムの下界(秒) | 位置重み法(秒) | 混合整数計画(秒) | 8時間の生産台数 位置重み法 | 8時間の生産台数 混合整数計画 | 編成効率 位置重み法 | 編成効率 混合整数計画 | 解時間(秒) |
|---|---|---|---|---|---|---|---|---|
| 3 | 153 | 153 | 153 | 188 | 188 | 99.8% | 99.8% | 0.34 |
| 4 | 115 | 122 | 116 | 236 | 248 | 93.9% | 98.7% | 0.76 |
| 5 | 92 | 97 | 95 | 296 | 303 | 94.4% | 96.4% | 1.44 |
| 6 | 77 | 82 | 79 | 351 | 364 | 93.1% | 96.6% | 12.47 |
| 7 | 66 | 73 | 69 | 394 | 417 | 89.6% | 94.8% | 9.71 |
| 8 | 58 | 66 | 59 | 436 | 488 | 86.7% | 97.0% | 5.17 |
| 9 | 51 | 57 | 53 | 505 | 543 | 89.3% | 96.0% | 9.97 |
| 10 | 46 | 52 | 49 | 553 | 587 | 88.1% | 93.5% | 4.13 |
8工程の行を見ると、位置重み法のサイクルタイムは66秒、混合整数計画は59秒で、8時間の生産台数は436台と488台です。同じ8人のラインで、割付を変えるだけで1シフトあたり52台(約12%)多く作れる計算になります。工程数が増えるほど位置重み法と最適解の差は開く傾向があり、3工程では両者とも153秒(編成効率99.8%)で差がありません。混合整数計画の解時間は最長で12.47秒(6工程)で、タイプ1より長くかかりました。タイプ2はサイクルタイムという整数の変数を最小にするため、工程数を数えるタイプ1より探索が重くなりやすいようです。
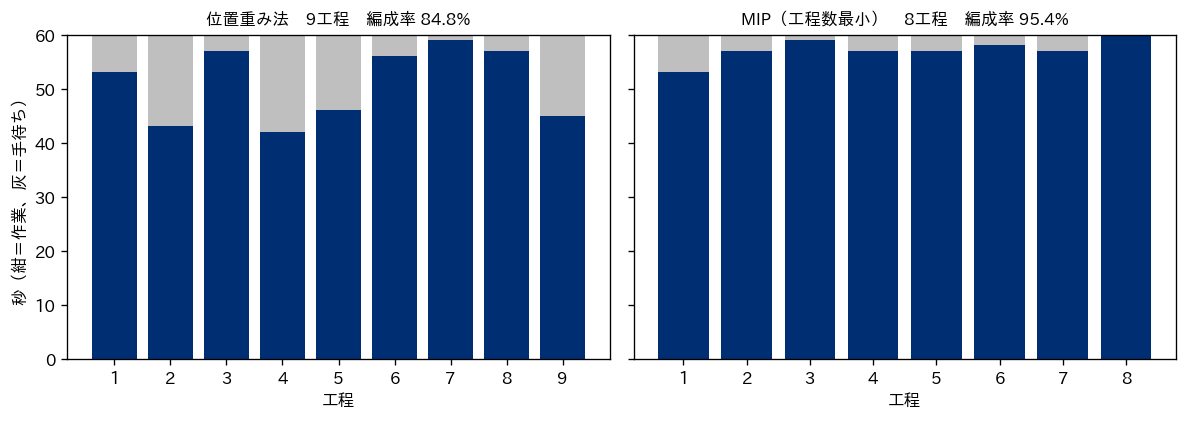
上の図は、サイクルタイム60秒での工程別の作業時間です(紺が作業、灰色が手待ち、点線がサイクルタイム)。日本 IE 協会の解説でピッチ・ダイヤグラムと呼ばれている図と同じ見方で、灰色の面積の合計がバランス・ロスです。位置重み法では2番目・4番目・5番目・9番目の工程に大きな灰色が残り、混合整数計画ではほとんど消えています。
経営の指標に翻訳する、台数・人数・残業
並列機械の割当とラインバランシングは、どちらも「同じ設備と人で、どれだけ作れるか」を決める問題なので、経営指標への翻訳が直接的です。並列機械では、その日のうちに全部を終わらせる前提なら、メイクスパンの差は残業か翌日への持ち越しの差として表れます。速度の違う3台の例で、速度を無視した均等割りの1,670分と最適の1,270分の差は400分、つまり6時間40分です。この差は最も遅い C の稼働時間の延長として現れ、C に作業者が張り付く職場なら、その人の残業か、翌日への持ち越しになります。同時に A は660分遊んでいるので、設備稼働率の数字で見ると「設備は余っているのに残業が出る」という状態になります。稼働率が低いまま残業が出ている職場では、設備の追加より先に割当を疑う価値があります。
ラインバランシングでは、編成効率の差が人数か生産台数の差になります。1工程に1人を配置するとすれば、タイプ1の60秒の例では、位置重み法の9人と最適の8人の差が1人分の人件費です。タイプ2の8工程の例では、同じ8人で1シフト436台と488台の差があり、需要が488台あるなら、位置重み法の編成のままでは52台分を残業か休日出勤で埋めることになります。どちらの場合も、差を生んでいるのは作業の割り振り方だけで、設備投資も作業改善も要りません。ラインの編成替えは、機種切替や増産の際に行われることが多いので、そのたびに下界と比べて編成効率を確認する習慣を付けておくと、この種の損失を見落としにくくなります。
もう1つの経営上の論点は、下界の使い方です。この章の実測では、並列機械でもラインでも「平均の負荷」と「最大の1個」から作る下界が、最適解とかなり近い位置にありました。下界は電卓で計算できるので、現場の編成案や割当案が下界からどれだけ離れているかを見れば、最適化に投資する価値があるかどうかを事前に判断できます。現行案が下界から1〜2%以内なら、最適化で取れる余地はそれ以下です。逆に10%以上離れていれば、割当を見直すだけで改善できる可能性が高い、と考えています。
使い分けと、現場で使うときの注意
並列機械の割当については、この章の実測を踏まえると次のように使い分けるのが実務的だと考えています。機械が同一で目的がメイクスパンなら、まず LPT を当て、下界と比べて差が小さければそれで十分です。機械の速さが違う場合は、速度を織り込んだ LPT’ を使い、最適との差が気になるなら、この章程度の規模(数十件・数台)は CP-SAT で数秒から十数秒で最適まで解けます。納期・段取り・着手可能時刻が絡むと割当と順番を同時に決める必要が出るので、第5章・第6章のインターバル変数を使った定式化に機械の選択を加える形になります。
ラインバランシングについては、この章のサンプル(20作業)なら混合整数計画で十数秒以内に最適が出ました。Ritt と Costa の論文は、汎用ソルバーで解く数理モデルは最先端の専用解法には及ばないが、ベンチマークや新しい問題の試作には有用だと述べています。作業数が数百になる大きなラインでは、位置重み法のような優先順位ルールで初期案を作り、第11章で扱う局所探索で改善する、あるいは上限時間付きで混合整数計画を回して下界との差を見る、という組み合わせが現実的です。
この章のモデルには、現場で必ず確認すべき前提がいくつかあります。第一に、作業時間を一定と見ています。実際の組立作業には作業者や個体によるばらつきがあり、サイクルタイムぎりぎりまで詰めた編成(この章の混合整数計画の解は、工程8が60秒ちょうどでした)は、ばらつきが出るたびにラインを止めます。編成効率を上げることと、ばらつきへの余裕を残すことは引き換えの関係にあり、その評価は第12章のシミュレーションの領分です。第二に、1種類の製品だけを流す前提です。複数の機種を同じラインに流す混流ラインでは、機種ごとの作業時間の違いと投入順序の問題が加わります。第三に、作業をどの工程にも置けるとしています。実際には、治具や工具の置き場所、作業姿勢、安全上の理由で「この作業はこの工程でしかできない」という制約があり、Ritt と Costa の論文も、割付の制約を持つ問題やU字ラインなどの一般化された問題を、この基本形を核とする問題群として挙げています。こうした制約は、混合整数計画なら該当する \( x_{is} \) を0に固定するだけで入れられるので、位置重み法より混合整数計画のほうが扱いやすい領域です。
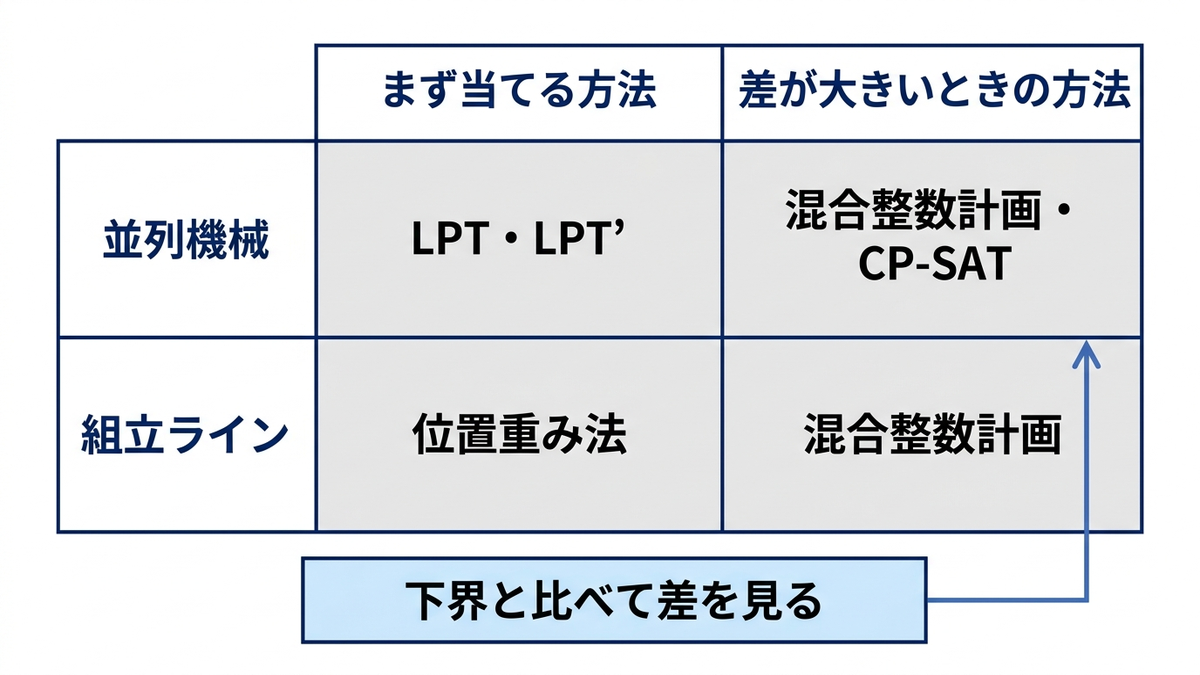
この章の要点は3つです。第一に、並列機械の割当とラインバランシングは、どちらも「最も重い負荷を小さくする」配分の問題で、「平均の負荷」と「最大の1個」から作る下界が、解の良し悪しを測る物差しとして強く働きます。第二に、LPT や位置重み法のような「重いものから先に配る」ルールは簡単で、この章の同一並列機械のサンプルでは最適から2%以内に収まった一方、速度の違う機械や先行関係のあるラインでは差が開き、混合整数計画や CP-SAT で最適を求める価値が出ます。この章の例では、速度を無視した割当は最適より400分長く、ラインの8工程では1シフトあたり52台の差になりました。第三に、目的をメイクスパンにするか平均完了時刻にするかで最適な割当は変わるので、何を経営指標にするかを先に決めることが必要です。次の第10章では、機械だけでなく、作業者・治具・熱処理炉といった資源を制約に入れたスケジューリングを扱います。
この章を深めたい方への参考書籍
『近似アルゴリズムデザイン』(David P. Williamson・David B. Shmoys 著、浅野孝夫 訳、共立出版):第2章と第3章に「同一並列マシーン上でのジョブのスケジューリング」の節があり、この章で紹介したリストスケジューリングや LPT のような貪欲な割当が、なぜ最適値の一定倍以内に収まるのかを証明とともに学べます。ビンパッキング問題の節もあり、ラインバランシングのタイプ1が先行関係を外すとこの問題に帰着する、という話ともつながります。
『新人IErと学ぶ 実践 IEの強化書』(日本インダストリアル・エンジニアリング協会 編、日刊工業新聞社):IE(インダストリアル・エンジニアリング、作業と工程を分析して生産性を上げる技術)の実践を、ライン・工程・経営などの段階ごとに解説した本で、作業編成効率による作業編成の評価や、ラインバランシングが分析手法として取り上げられています。この章の数理モデルを現場に持ち込む際の、編成効率の測り方や改善の進め方を補う1冊です。
第10章 人・治具・炉を制約に入れる、資源制約と稼働カレンダーとバッチ処理
第9章では、仕事を複数の機械や工程に配る並列機械とラインバランシングを扱いました。ここまでの章は、機械が1台ずつ空いていれば工程を始められる、という前提で解いてきました。しかし実際の工場では、機械が空いていても、その機械を扱える作業者が別の機械に付いていれば工程は始まりません。昼休みや夜間は機械も人も止まり、熱処理炉は1ロットずつではなく複数のロットをまとめて入れて加熱します。この章では、機械以外の資源(作業者・治具)、稼働の時間帯(カレンダー)、まとめて処理する設備(バッチ処理の炉)を制約としてモデルに入れる方法を扱い、第2章で用意したサンプルデータの受注12件に作業者の制約を加えると、スケジュールと納期遅れがどう変わるかを実測で示します。
機械以外の資源が効くとき、資源制約付きスケジューリングという考え方
第5章のジョブショップでは、各機械は同時に1つの工程しか処理できない、という制約だけで工程の重なりを禁じました。これは「機械という資源の容量が1」という制約だと読み替えられます。この読み替えを一般化し、容量が1より大きい資源、たとえば「作業者が3人いるので、人の付く工程は同時に3つまで」「治具が2組しかないので、この治具を使う工程は同時に2つまで」を扱えるようにしたものが資源制約付きスケジューリングです。英語の略称で RCPSP(Resource-Constrained Project Scheduling Problem、資源制約付きプロジェクトスケジューリング問題)と呼ばれ、もともとは建設や開発のプロジェクトで、作業の先行関係と人員・機材の上限を守りながら工期を最短にする問題として研究されてきました。
この型の問題を決めるものは3つです。1つ目は作業(工程)で、それぞれ所要時間と、終わってからでないと始められない先行作業を持ちます。2つ目は資源で、それぞれ「同時に使える量の上限」を持ちます。3つ目は、各作業がどの資源をいくつ使うかの対応です。旋盤で加工する工程なら「旋盤を1台、旋盤を扱える作業者を1人」、熱処理炉に入れる工程なら「炉の容量のうち自分の占める分」を使う、というように書きます。そのうえで、どの時刻を取っても、その時刻に進行中の作業が使う量の合計が資源の上限を超えないように、各作業の開始時刻を決めます。この「どの時刻でも合計が上限以下」という条件を累積制約(cumulative 制約)と呼び、後の節で CP-SAT の書き方を示します。
ジョブショップとの違いは、資源の上限が1とは限らないことと、1つの作業が複数の資源を同時に使うことの2点です。旋盤の工程は「旋盤」と「作業者」の両方が同時に空いていなければ始められません。機械の空きだけを見て組んだ計画は、人の空きを見ていないため、現場で「機械は空いているのに人がいない」待ちを生みます。逆に、人の空きだけを見て機械を見ない計画も成り立ちません。資源制約付きスケジューリングは、この2種類以上の資源の空きを同時に満たす開始時刻を探す問題だと言えます。
この一般化には代償があります。資源制約付きスケジューリングのベンチマーク問題集 PSPLIB を公開した Kolisch と Sprecher の1996年の報告書は、この問題の枠組みにフローショップ・ジョブショップ・オープンショップが含まれることを指摘し、そのためこの問題は NP 困難(規模が大きくなると厳密解を求める時間が急激に伸びる問題の型)の仲間になると述べています。第2章で見たとおり、NP 困難は「解けない」という意味ではなく、規模とともに急に重くなるという意味です。受注12件の規模なら、この章で示すとおり数秒から数十秒で最適解か、それに近い解が得られます。一方で、同じ報告書は、作業数30の問題集(480問)には厳密解法で最適値が求められているのに対し、作業数60の問題集(480問)は当時の厳密解法では解けず、発見的な方法(厳密さを保証しない代わりに速く良い解を探す方法)で得た最良値を載せている、と記しています。作業数が30から60に増えただけで厳密に解けなくなったという記録は、資源の制約が入った問題の重さをよく表しています。ソルバーは1996年から大きく進歩していますので、この記録を今の計算時間の目安として読むことはできませんが、NP 困難という問題の性質そのものは変わりません。
CP-SAT の累積制約で「同時に使える人数」を書く
第5章で使った CP-SAT(Google の OR-Tools に含まれる制約プログラミングのソルバー)には、この累積制約がそのまま用意されています。OR-Tools の公式ドキュメント(CP-SAT のスケジューリングの手引き)は、累積制約を「区間の一覧と、それぞれの使用量と、容量を受け取り、どの時点でも、その時点で進行中の区間の使用量の合計が容量を超えないようにする制約」と説明しています。Python では model.add_cumulative(区間のリスト, 使用量のリスト, 容量) と書きます。第5章で機械ごとに書いた add_no_overlap(重なり禁止)は、使用量がすべて1で容量が1の累積制約と同じ意味になります。
ここで、この章の実験のために架空の条件を足します。第2章のサンプルデータには作業者の情報がありませんので、次のように決めました。旋盤(M1)・マシニングセンタ(M2)・研削盤(M3)・検査(M5)の4つの工程には、加工の始めから終わりまで作業者が1人付きます。熱処理炉(M4)は材料を入れれば無人で加熱するので、作業者は付かないものとします。人の付く工程の加工時間は、受注12件の合計で M1 が1,210分、M2 が1,330分、M3 が1,430分、M5 が350分、足して4,320分です。この条件で、作業者の人数に上限を置いたときに最短の完了時刻(メイクスパン)がどう変わるかを解いたのが次のコードです。
from ortools.sat.python import cp_model
from sched_data import load_orders

def solve_with_people(n_people):
    orders, m = load_orders(), cp_model.CpModel()
    H = 6200
    per_machine, manned, ends = {}, [], []
    for o in orders:
        prev = None
        for mc, p in o["route"]:
            s = m.new_int_var(o["release"], H, "s")
            iv = m.new_fixed_size_interval_var(s, p, "iv")   # 開始 s から p 分
            per_machine.setdefault(mc, []).append(iv)
            if mc != "M4":                     # 熱処理炉以外は作業者が1人付く
                manned.append(iv)
            if prev is not None:
                m.add(s >= prev)               # 工程の順番
            prev = s + p
        ends.append(prev)
    for ivs in per_machine.values():
        m.add_no_overlap(ivs)                  # 機械は同時に1工程
    m.add_cumulative(manned, [1] * len(manned), n_people)   # 人は同時に n_people 工程まで
    cmax = m.new_int_var(0, H, "cmax")
    m.add_max_equality(cmax, ends)
    m.minimize(cmax)
    solver = cp_model.CpSolver()
    solver.parameters.max_time_in_seconds = 30
    solver.parameters.num_workers = 8
    solver.parameters.random_seed = 0
    st = solver.solve(m)
    print(n_people, "人", solver.status_name(st), solver.value(cmax), "下界", solver.best_objective_bound)

for n in (4, 3, 2):
    solve_with_people(n)
# 出力:
# 4 人 OPTIMAL 1560 下界 1560.0
# 3 人 OPTIMAL 1560 下界 1560.0
# 2 人 OPTIMAL 2170 下界 2170.0
機械ごとの重なり禁止に、人の付く工程すべてを対象にした累積制約を1行足しただけです。結果は、作業者が4人でも3人でもメイクスパンの最小値は1,560分で変わらず、2人にすると2,170分に延びました。いずれも OPTIMAL(最適であることが証明された解)で、計算時間の上限30秒の中で終わっています。3人で変わらないのは、人の付く機械が4台あっても、最短の1,560分を保ったまま、同時に動く人の付く機械を3台以下に抑える並べ方が存在するからです。この場合、人数は足かせ(制約として効いている状態)になっていません。2人にすると、人の付く工程の合計4,320分を2人で分けるので、どう並べても完了は4,320÷2=2,160分より前にはなりません。実際の最小値2,170分はこの下限とほぼ同じで、2人体制の工場では、機械ではなく人が生産量を決める資源(ボトルネック)になることが分かります。
この比較は、経営の判断に直接つながります。3人から4人に増やしても最短の完了時刻は1分も縮まりませんが、3人から2人に減らすと610分、つまり約10時間延びます。人員計画を「機械の台数に合わせて人を置く」で決めると、この例では4人目の人件費が完了時刻に何も効かないことになります。逆に「平均の稼働率で見れば2人で足りる」と考えて減らすと、完了が1,560分から2,170分へ約4割延びます。必要な人数は平均の負荷ではなく、スケジュールを組んでみて初めて分かる「同時に何人要る時間帯があるか」で決まります。累積制約を入れたモデルは、この問いに人数を振って答えを出すための道具になります。
誰がどの機械を扱えるか、スキル表と任意の区間
前の節では、作業者を「誰でもどの機械も扱える」人数として扱いました。実際には旋盤を扱えるのは誰と誰、研削盤は誰、という技能の違いがあり、多能工化の進み具合によって同じ人数でも組める計画が変わります。この違いは、人数の上限ではなく「作業者1人ひとりを容量1の資源とし、各工程をそれを扱える作業者の誰か1人に割り当てる」形で書きます。CP-SAT では、この割り当てを任意の区間(optional interval。実行するかどうかを0か1の変数で切り替えられる区間)で表します。公式ドキュメントは、重なり禁止制約と累積制約はこの有無の変数を理解し、実行しない区間を正しく無視する、と説明しています。
架空のスキル表を次のように置きました。3人の作業者 A・B・C は、それぞれ2台か3台の機械を扱えます。どの機械も、扱える人が2人ずつになるようにしてあります。表の「○」はその機械を担当できることを表します。
| 作業者(架空) | M1 旋盤 | M2 マシニングセンタ | M3 研削盤 | M4 熱処理炉 | M5 検査 |
|---|---|---|---|---|---|
| A | ○ | ○ | 人は付かない | ||
| B | ○ | ○ | 人は付かない | ○ | |
| C | ○ | ○ | 人は付かない | ○ | |
| その機械を扱える人数 | 2人(A・C) | 2人(A・B) | 2人(B・C) | 0人 | 2人(B・C) |
次のコードは、前のコードを書き換えた関数の全体で、このまま単独で実行できます。前のコードからの変更は2か所です。1つ目は、人の付く工程を区間ではなく、機械・開始時刻・加工時間の組で manned に入れておく点です。2つ目は、累積制約の1行をスキル表のブロックに置き換えた点です。そのブロックでは、人の付く工程ごとに、それを扱える作業者の数だけ任意の区間を作り、そのうちちょうど1つが実行されるようにします。そのうえで、作業者ごとに重なり禁止を掛けます。
from ortools.sat.python import cp_model
from sched_data import load_orders

def solve_with_skills(people):
    orders, m = load_orders(), cp_model.CpModel()
    H = 6200
    per_machine, manned, ends = {}, [], []
    for o in orders:
        prev = None
        for mc, p in o["route"]:
            s = m.new_int_var(o["release"], H, "s")
            iv = m.new_fixed_size_interval_var(s, p, "iv")   # 開始 s から p 分
            per_machine.setdefault(mc, []).append(iv)
            if mc != "M4":                     # 熱処理炉以外は作業者が1人付く
                manned.append((mc, s, p))      # 変更点1:区間ではなく組で持つ
            if prev is not None:
                m.add(s >= prev)               # 工程の順番
            prev = s + p
        ends.append(prev)
    for ivs in per_machine.values():
        m.add_no_overlap(ivs)                  # 機械は同時に1工程
    # 変更点2:累積制約の1行を、次のスキル表のブロックに置き換える
    SKILL = {"A": ["M1", "M2"], "B": ["M2", "M3", "M5"], "C": ["M1", "M3", "M5"]}
    per_person = {w: [] for w in people}
    for mc, s, p in manned:
        lits = []
        for w in people:
            if mc in SKILL[w]:                 # 扱える人の分だけ「任意の区間」を作る
                x = m.new_bool_var("x")
                per_person[w].append(m.new_optional_fixed_size_interval_var(s, p, x, "w"))
                lits.append(x)
        m.add_exactly_one(lits)                # 誰か1人がちょうど担当する
    for ivs in per_person.values():
        m.add_no_overlap(ivs)                  # 1人は同時に1工程
    cmax = m.new_int_var(0, H, "cmax")
    m.add_max_equality(cmax, ends)
    m.minimize(cmax)
    solver = cp_model.CpSolver()
    solver.parameters.max_time_in_seconds = 30
    solver.parameters.num_workers = 8
    solver.parameters.random_seed = 0
    st = solver.solve(m)
    print("".join(people), solver.status_name(st), solver.value(cmax), "下界", solver.best_objective_bound)

for people in (["A", "B", "C"], ["A", "B"], ["B", "C"]):
    solve_with_skills(people)
# 出力:
# ABC OPTIMAL 1560 下界 1560.0
# AB OPTIMAL 2170 下界 2170.0
# BC FEASIBLE 2170 下界 2160.0
3人がそろっていれば、スキル表があってもメイクスパンの最小値は1,560分で、人数だけで考えたときと同じでした。作業者 C が休んで A と B の2人になると2,170分で、これも最適であることが証明されています。A が休んで B と C の2人になった場合は、30秒の上限では2,170分の解と2,160分の下界が得られ、最適性の証明までは届きませんでした(FEASIBLE は「実行可能な解は見つかったが、最適であるとはまだ証明されていない」状態を表します)。下界とは「どんな並べ方をしてもこれより短くはならない」ことが証明された値で、解との差10分が、残っている不確かさの幅です。
A と B の2人の場合、旋盤(M1)を扱えるのは A だけ、研削盤(M3)と検査(M5)を扱えるのは B だけになります。B は研削盤1,430分と検査350分の合計1,780分を1人で抱え、マシニングセンタ(M2)の1,330分を A と分け合うことになります。スキル表に空白が多いと、人数が同じでも仕事を移せる先が限られ、特定の人に負荷が偏ります。この例では、人数だけで見た2人体制と同じ2,170分に収まりましたが、マシニングセンタを2人とも扱えるので、負荷を調整する余地が残っていたためと考えられます。
受注12件に作業者の制約を入れると、納期遅れはどう変わるか
メイクスパンは「全部がいつ終わるか」の指標で、個々の受注の納期は見ていません。第5章では、同じ受注12件を重み付き納期遅れ(各受注の納期からの遅れ時間に重みを掛けて合計したもの。重みは1〜3で、大きいほど遅れたときの痛みが大きい受注)の最小化でも解き、目的によってスケジュールが変わることを確かめました。この節では、作業者の条件を1つずつ変えながら、重み付き納期遅れの最小化とメイクスパンの最小化の両方を解きました。条件は次の7通りです。S0 は第5章と同じ機械だけの問題、S1 と S2 は前の節の人数の上限、S3 から S6 はスキル表を使う場合です。S5 では、さらに系列 F4 の旋盤・マシニングセンタ工程が専用の治具を1組しか持たない、という架空の条件を足しました(治具が1組なので、その治具を使う工程は旋盤とマシニングセンタにまたがって同時に1つしか進められません。容量1の資源として重なり禁止で書けます)。
計算の条件をそろえておきます。CP-SAT の並列ワーカー数は8に固定し、乱数の種は0、1回の求解の上限時間は、S0・S1・S3・S5 が25秒、残りが50秒です。サンプルデータの加工時間・着手可能時刻・納期はすべて10分の倍数なので、モデルの中の時間は10分刻みにして解きました。刻みを粗くすると変数の取り得る値の数が10分の1になり、計算が軽くなります。同じ条件を1分刻みでも解き、両方で最適性が証明された値(S0・S1・S3・S4・S5 の各値と、後の節の K1 の2つの値、K2 のメイクスパン)が一致することを確かめています。計算時間はこの記事の実行環境(一般的なノートPC)での実測です。
| 条件 | 重み付き納期遅れの最小値(重み×分) | その状態 | メイクスパンの最小値(分) | その状態 |
|---|---|---|---|---|
| S0 機械だけ | 0 | 最適 | 1,560 | 最適 |
| S1 人数3人(誰でもどの機械も可) | 0 | 最適 | 1,560 | 最適 |
| S2 人数2人(誰でもどの機械も可) | 580 | 暫定解(下界120) | 2,170 | 最適 |
| S3 3人+スキル表 | 0 | 最適 | 1,560 | 最適 |
| S4 スキル表でCが休み(A・Bの2人) | 880 | 最適 | 2,170 | 最適 |
| S5 3人+スキル表+F4の治具1組 | 0 | 最適 | 1,560 | 最適 |
| S6 スキル表でAが休み(B・Cの2人) | 660 | 暫定解(下界430) | 2,170 | 暫定解(下界2,160) |
表の読み方を補足します。「最適」は最適であることが証明された値、「暫定解」は上限時間の中で見つかった最良の解で、括弧の中の下界は「どう並べてもこれより小さくはならない」ことが証明された値です。たとえば S2 の重み付き納期遅れは、580まで下げた解が見つかっていて、真の最小値は120以上580以下のどこかにある、という意味になります。
3人がそろっている S1・S3・S5 では、重み付き納期遅れの最小値は0、つまり12件すべてを納期内に収めるスケジュールが存在し、メイクスパンの最小値も機械だけの S0 と同じ1,560分でした。この架空の工場では、3人いれば人も治具も制約として効いていません。効き始めるのは2人になったときで、S4(A と B の2人)では重み付き納期遅れの最小値が880になり、それ以上は下げられないことが証明されました。実行ログで中身を見ると、J01 が310分、J03 が300分、J07 が50分、J09 が70分、J10 が20分、J12 が30分、合わせて6件が納期に遅れています。S2 は人数だけの上限で、S4 の条件を緩めた問題です(S4 で成り立つスケジュールは、必ず S2 でも成り立ちます)。S2 で580の解が見つかっているので、スキル表の制約は、少なくとも300(880と580の差)だけ重み付き納期遅れを押し上げていることが、証明済みの数字だけから言えます。
同じ2人でも、誰が休むかで結果が変わります。C が休んだ S4 の最小値は880で、A が休んだ S6 では660の解が見つかっています。S6 の真の最小値は660以下なので、この工場では C が休む日のほうが A が休む日より納期への影響が大きい、と言えます。C は旋盤・研削盤・検査の3台を扱え、A は旋盤とマシニングセンタの2台です。C が抜けると、研削盤と検査を扱えるのは B だけになり、B に負荷が集中します。人数の表だけでは見えないこの差が、スキル表をモデルに入れると数字で出てきます。
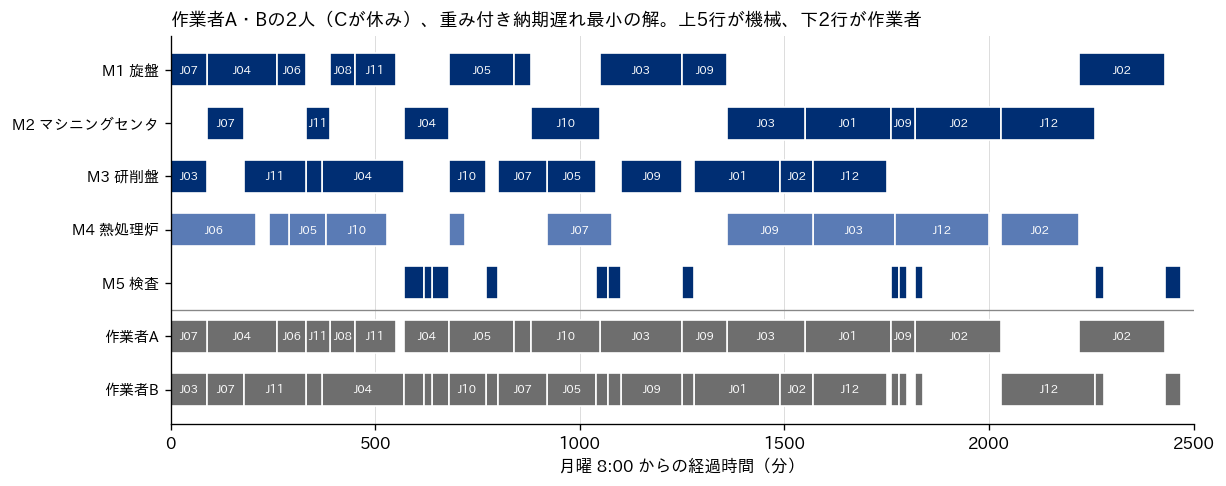
上の図は S4 の解を、機械の行(上5行)と作業者の行(下2行)で描いたものです。機械の行だけを見ると、旋盤やマシニングセンタに空きの時間帯があり、「機械は空いているのに進めていない」ように見えます。下の作業者の行を見ると、その時間帯に A か B が別の機械に付いていることが分かります。人の制約が効いている計画では、機械の稼働率は下がって見えますが、それは段取りや故障のせいではなく、人がいないためです。機械の稼働率だけで工場の余力を判断すると、この区別がつきません。
稼働カレンダー、昼休み・夜間停止・週末をどう表すか
ここまでは第2章の約束どおり、工場が24時間止まらずに動くとみなしてきました。実際の工場には、昼休み、交替の間の休憩、夜間の停止、週末があります。この章では架空のカレンダーとして、平日は8:00〜12:00、13:00〜17:00、17:30〜20:00 の3つの稼働枠(1日630分)を持ち、20:00〜翌8:00 と土日は止まる、と置きました。熱処理炉は、投入と取り出しに人が要るものの、加熱そのものは夜間も無人で続けてよい、という条件を後で比べます。
カレンダーをモデルに入れるとき、最初に決めなければならないのは、工程を休憩で中断してよいかどうかです。中断できない工程は、稼働枠の1つの中に丸ごと収まらなければなりません。これは、開始時刻に取り得る値を「枠の始まりから、枠の終わりまでに加工時間が収まる時刻まで」に限ることで書けます。中断できる工程は、休憩をまたぐと、加工時間は同じでも、開始から終了までの長さが休憩の分だけ延びます。OR-Tools の公式ドキュメントも「休憩をまたぐ区間」の書き方として、作業の長さを開始時刻の関数にする方法を示しています。次のコードは、加工時間200分の工程1つについて、この2つの書き方を示したものです。
from ortools.sat.python import cp_model

# 月曜の稼働枠(8:00 からの分):8:00-12:00 / 13:00-17:00 / 17:30-20:00
WIN = [(0, 240), (300, 540), (570, 720)]
p = 200                                   # 加工時間200分の工程
m = cp_model.CpModel()
# 中断できない工程:開始は「枠の終わりまでに p 分が収まる時刻」だけに限る
dom = cp_model.Domain.from_intervals([(a, b - p) for a, b in WIN if b - a >= p])
s = m.new_int_var_from_domain(dom, "s")
iv = m.new_fixed_size_interval_var(s, p, "iv")
print("開始できる時刻(分):", dom)

# 中断できる工程:終了は開始の関数。休憩をまたげば休憩の長さだけ延びる
def end_of(start):
    left = p
    for a, b in WIN:
        if b <= start:
            continue
        st = max(a, start)
        if st + left <= b:
            return st + left
        left -= b - st
    return None
table = [(t, end_of(t)) for a, b in WIN for t in range(a, b) if end_of(t) is not None]
s2, e2 = m.new_int_var(0, 720, "s2"), m.new_int_var(0, 720, "e2")
m.add_allowed_assignments([s2, e2], table)   # (開始, 終了) の組を表で許す
print("例: 開始100分 -> 終了", end_of(100), "/ 開始400分 -> 終了", end_of(400))
# 出力:
# 開始できる時刻(分): [0,40][300,340]
# 例: 開始100分 -> 終了 360 / 開始400分 -> 終了 630
中断できない200分の工程は、8:00〜8:40 か 13:00〜13:40 に始めるしかありません。17:30〜20:00 の夕方の枠は150分しかないので、200分の工程はそもそも入りません。受注12件の人の付く工程42件のうち、150分を超えるものが12件あり、この12件は夕方の枠では加工できません。中断できる場合は、たとえば 9:40(開始100分)に始めた工程は昼休みの60分をまたいで 14:00(終了360分)に終わり、14:40(開始400分)に始めた工程は夕休憩の30分をまたいで 18:30(終了630分)に終わります。中断できる工程の書き方では、開始と終了の組を表で許す add_allowed_assignments を使いました。公式ドキュメントの例は、休憩をまたぐかどうかを0か1の変数で切り替える形ですが、休憩が1日に何度もある場合は、組の表にしたほうが書き漏らしが少ないと考えています。
夜間の熱処理炉は、第3の書き方の例になります。投入と取り出しにだけ人が要るなら、開始時刻と終了時刻がそれぞれ稼働枠の中にあればよく、その間の加熱は夜間にかかっても構いません。ただし、加熱が夜中に終わっても、取り出しは翌朝の稼働開始まで待つことになります。モデルでは、炉の区間の長さを「加工時間以上」の変数にし、終了時刻を稼働枠の中に限ることで、この待ちを表しました。下の図の上段で、J02 の熱処理が火曜の夕方から水曜 8:00 まで炉を占有しているのはこのためです。
カレンダーを入れた受注12件を、作業者3人+スキル表(S3)の条件で解いた結果が次の表です。比べたのは3通りで、K1 はすべての工程が稼働枠の内側で中断不可、K2 は人の付く工程は中断不可で炉だけ夜間の加熱を許す場合、K3 は人の付く工程も休憩・夜間で中断して次の枠で再開できる場合です。上限時間は50秒、ワーカー数は8です。時刻は月曜 8:00 を起点とした曜日と時刻で書きました。メイクスパンの列と重み付き納期遅れの列は、それぞれを目的にして別々に解いた値で、同じ1つのスケジュールの値ではありません。たとえば K1 で重み付き納期遅れを最小にした解は、メイクスパンが4,910分(木曜 17:50)でした。
| 条件 | メイクスパンの最小値 | その状態 | 重み付き納期遅れの最小値(重み×分) | その状態 |
|---|---|---|---|---|
| S3 連続稼働(カレンダーなし) | 1,560分(火曜 10:00) | 最適 | 0 | 最適 |
| K1 カレンダー・中断不可・炉も枠の内側 | 4,540分(木曜 11:40) | 最適 | 20,800 | 最適 |
| K2 カレンダー・中断不可・炉は夜間も加熱可 | 4,520分(木曜 11:20) | 最適 | 18,890 | 最適 |
| K3 カレンダー・休憩で中断可・炉は夜間も加熱可 | 3,220分(水曜 13:40) | 最適 | 10,910 | 暫定解(下界7,100) |
連続稼働なら火曜 10:00 に終わる仕事が、カレンダーを入れると木曜の昼前までかかります。1日が1,440分から630分に減るので、延びること自体は当然ですが、延び方は中断の扱いで大きく変わります。人の付く工程を中断できない K2 の最短は木曜 11:20、中断できる K3 は水曜 13:40 で、差は約1日です。中断できない場合は、長い工程が入らない夕方の枠や、昼休みの前の半端な時間が使いにくくなります。これが差の主な理由だと考えています。炉の夜間加熱を許すかどうか(K1 と K2 の差)は、メイクスパンでは20分、重み付き納期遅れでは20,800から18,890への改善にとどまりました。この例では、炉の運用より、人の付く工程の中断の扱いのほうが結果を大きく動かしています。
重み付き納期遅れは、カレンダーを入れた3通りとも大きな値になりました。K1 では12件すべてが遅れます。これは、第2章のサンプルデータの納期が、24時間の連続稼働を前提に、着手可能時刻に「加工時間の合計の1.6〜3.2倍を30分単位に丸めた時間」を足して作られているためです。この結果は、連続稼働を前提にした計算で納期を回答し、実際には昼休みと夜間停止のある工場で作ると、ほぼすべての受注が遅れる、という形で読むことができます。カレンダーは、スケジュールを組む段階だけでなく、納期を回答する段階から入れておく必要があります。
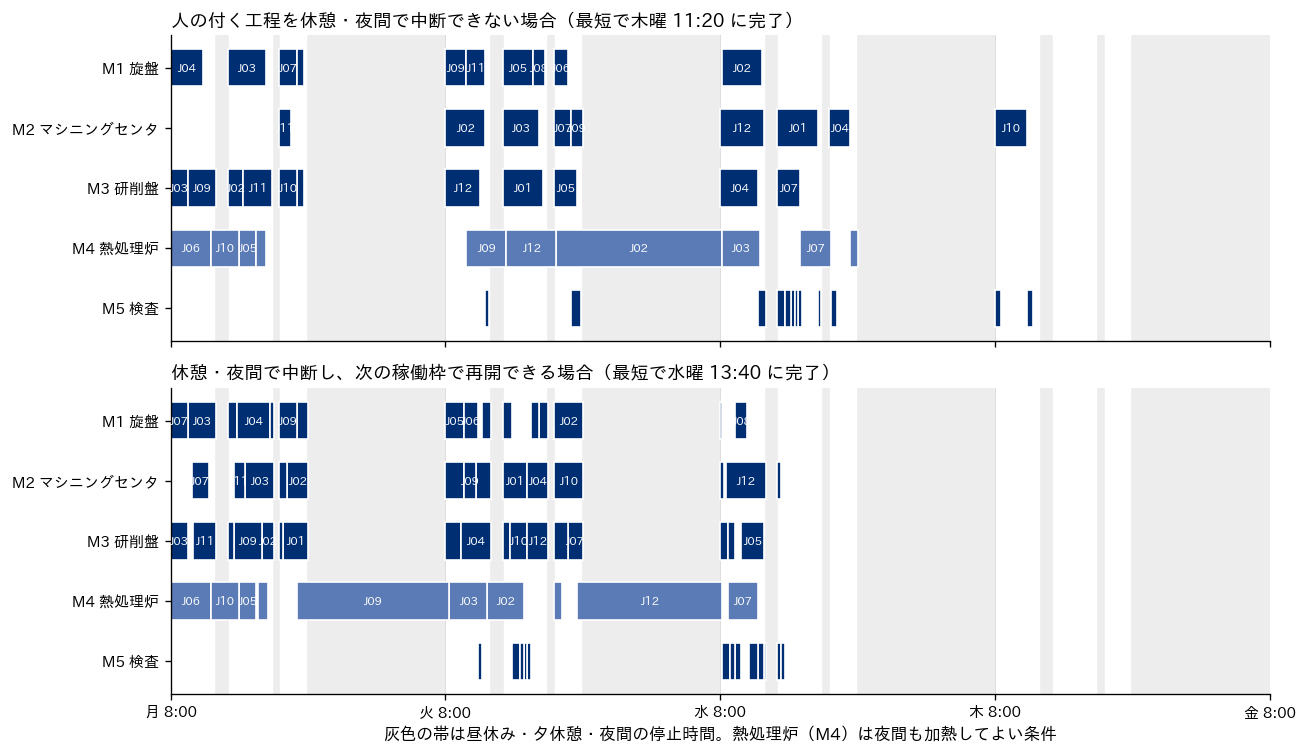
中断してよいかどうかは、モデルの都合ではなく工程の性質と品質の約束事で決まります。途中で止めると品質に影響する工程や、止めた後に再開の段取りが要る工程は中断不可として扱い、区切りのよいところで止めてよい工程だけを中断可とします。同じ工場の中に中断してよい工程とよくない工程が混ざっていても、上のモデルなら、工程ごとに開始時刻の範囲の書き方を変えるだけで扱えます。現場への聞き取りでは「この工程は昼休みに止めてよいか」「夜間に機械を止めた状態で翌朝続きから加工してよいか」を工程ごとに確かめ、その答えを表にしておくのが確実です。聞き取りの進め方は第13章で扱います。
カレンダーの書き方には、もう1つ、モデルの時間軸そのものを「稼働している分だけ」に詰める方法があります。すべての機械と人が同じカレンダーで動き、すべての工程を中断してよいなら、休憩と夜間を取り除いた稼働時間の軸で普通のジョブショップとして解き、答えを後から時計の時刻に戻せば済みます。ただし、この章の例のように炉だけは夜間も動く、という資源ごとのカレンダーの違いがあると、この詰め方は使えません。どの書き方を選ぶかは、カレンダーが資源ごとに違うかどうかで決まります。
熱処理炉のバッチ処理、まとめて入れて容量を守る
熱処理炉や乾燥炉、洗浄槽のような設備は、1ロットずつではなく、容量の範囲で複数のロットをまとめて入れて処理します。このような設備の順序づけをバッチ処理機械のスケジューリングと呼びます。同じバッチに入ったロットは同時に入れて同時に出すので、バッチの処理時間は、入れたロットの中で最も長い加工時間になります。短いロットを長いロットと一緒に入れると、短いロットは本来より長く炉にいることになりますが、加熱の回数は減ります。Uzsoy の1994年の論文は、大きさの異なるロットを容量のある1台のバッチ処理機械でまとめる問題を扱い、メイクスパンの最小化と総完了時間の最小化のどちらも NP 困難であることを証明しています。1台の炉の問題でも、まとめ方の組み合わせで難しくなるということです。
ここでも架空の条件を置きます。熱処理炉には1回に最大3ロット(比較のため2ロットの場合も)まで入れられ、熱処理の条件が系列ごとに違うので、同じ系列のロットしか一緒に入れられないものとします。受注12件のうち熱処理のある受注は10件で、系列ごとに F1 が2件、F2 が3件、F3 が2件、F4 が3件です。まず、炉だけを取り出して、加熱時間の合計を最小にするまとめ方を解いたのが次のコードです。
from ortools.sat.python import cp_model
from sched_data import load_orders

lots = [(o["id"], o["family"], p) for o in load_orders() for mc, p in o["route"] if mc == "M4"]
CAP, n = 3, len(lots)                    # 1回に入れられるのは3ロットまで
m = cp_model.CpModel()
use = [m.new_bool_var("use") for b in range(n)]           # b 回目の加熱を行うか
dur = [m.new_int_var(0, 300, "dur") for b in range(n)]    # b 回目の加熱時間
x = [[m.new_bool_var("x") for b in range(n)] for i in range(n)]   # ロット i を b 回目に入れるか
for i, (lot, fam, p) in enumerate(lots):
    m.add_exactly_one(x[i])                                # どれか1回の加熱に入る
    for b in range(n):
        m.add(dur[b] >= p).only_enforce_if(x[i][b])        # 加熱時間は入れたロットの最長
        m.add_implication(x[i][b], use[b])
        for k, (lot2, fam2, p2) in enumerate(lots):
            if (k > i) & (fam2 != fam):
                m.add_bool_or([~x[i][b], ~x[k][b]])       # 系列が違えば同じ加熱に入れない
for b in range(n):
    m.add(sum(x[i][b] for i in range(n)) <= CAP)
    m.add(sum(x[i][b] for i in range(n)) >= use[b])       # 空の加熱は数えない
m.minimize(sum(dur))                                       # 加熱時間の合計を最小に
solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 30
solver.parameters.random_seed = 0
print(solver.status_name(solver.solve(m)), "加熱時間の合計", solver.objective_value,
      "加熱回数", sum(solver.value(u) for u in use))
# 出力: OPTIMAL 加熱時間の合計 850.0 加熱回数 4
1ロットずつ加熱すると10回・合計1,530分かかるところを、系列ごとにまとめれば4回・合計850分で済みます。加熱時間は44%減り、加熱の回数は6割減ります。ただし、これは炉だけを見た計算で、受注の着手可能時刻も前後の工程も納期も見ていません。同じ系列のロットは、前工程が終わる時刻がばらばらなので、全部そろうまで待ってからまとめて入れると、その待ちの分だけ後工程と納期が遅れます。
そこで、受注12件のジョブショップ全体(作業者3人+スキル表、連続稼働)の中に炉のバッチを組み込んで解き直しました。全体モデルでは、ロットごとに「どの回の加熱に入るか」を0か1の変数で選び、同じ回に入ったロットは炉への投入時刻と取り出し時刻がそろう、という制約を足しています。加熱の回どうしは炉の上で重なり禁止です。求めたのは、納期を問わない場合の加熱回数の最小値、納期遅れを0に保ったままの加熱回数と加熱時間の合計それぞれの最小値、そしてメイクスパンの最小値です。上限時間は、加熱回数・加熱時間の計算が20秒、メイクスパンが50秒で、ワーカー数は8です。次の表の各列は、それぞれを目的にして別々に解いた値です。同じ行の値が1つのスケジュールで同時に成り立つとは限りません。たとえば B2 で納期遅れ0のまま加熱回数を最小にした解(8回)は加熱時間の合計が1,440分で、1,220分は加熱時間の合計を目的にして解き直した値です。メイクスパンの列は納期を問わずに解いた値で、その解では納期遅れが出ています。
| 炉の条件(架空) | 納期を問わない場合の最少加熱回数 | 納期遅れ0での最少加熱回数 | 納期遅れ0での加熱時間の合計の最小値 | メイクスパンの最小値 |
|---|---|---|---|---|
| 1ロットずつ(ここまでの章と同じ) | 10回 | 10回 | 1,530分 | 1,560分(最適) |
| B1 最大2ロット・同じ系列のみ | 6回 | 8回 | 1,220分 | 1,550分(暫定解、下界1,540) |
| B2 最大3ロット・同じ系列のみ | 4回 | 8回 | 1,220分 | 1,550分(暫定解、下界1,540) |
| B3 最大3ロット・系列を問わない | 4回 | 5回 | 840分 | 1,540分(最適) |
加熱回数と加熱時間の列は、この表のどの値も最適であることが証明されています。表から読み取れることは3つあります。第一に、納期を守る条件を入れると、まとめられる量が大きく減ります。最大3ロット・同じ系列のみ(B2)では、納期を問わなければ4回で済む加熱が、納期遅れを0に保つと8回必要になりました。前工程の終わる時刻がそろわないので、待たずに入れるしかないロットが出るためです。第二に、炉の容量を2ロットから3ロットに増やしても(B1 と B2)、納期遅れ0の条件では加熱回数も加熱時間の合計も変わりませんでした。容量を大きくした炉を入れても、同じ系列のロットが同じ時期にそろわなければ、容量は使われません。第三に、系列の制約を外すと(B3)、納期遅れ0のまま加熱は5回・合計840分まで減ります。熱処理の条件をそろえる(たとえば複数の系列で共通に使える熱処理条件を開発する)ことが、炉を大きくするより効く場合がある、ということです。
一方で、メイクスパンの最小値は1,560分から1,540分へ、最大でも20分しか縮まりませんでした。炉の加熱時間を半分近くにしても、全部の受注が終わる時刻はほとんど変わりません。炉以外の機械の負荷と、工程のつながりが完了時刻を決めていると考えられます。炉のバッチ化の効果は、この例ではメイクスパンではなく、加熱の回数(燃料や電力、炉の立ち上げの手間)に現れます。バッチ化の投資を評価するときは、効果がどの指標に出るのかを、全体のモデルで先に確かめておく必要があります。
この節のモデルには注意点があります。炉の容量をロットの数で数えましたが、実際の炉では重量や容積、治具の段数で容量が決まることが多く、ロットごとに大きさが違います。その場合は、各ロットの大きさを係数にして「同じ回に入れたロットの大きさの合計が容量以下」と書き換えます。Uzsoy が NP 困難であることを示したのは、まさにこの大きさの違うロットの場合です。また、熱処理のように加熱後の冷却に時間がかかる設備では、取り出してから次に入れるまでの時間も炉を占有します。その時間は、加熱の回の区間を冷却の分だけ長く取ることで表せます。
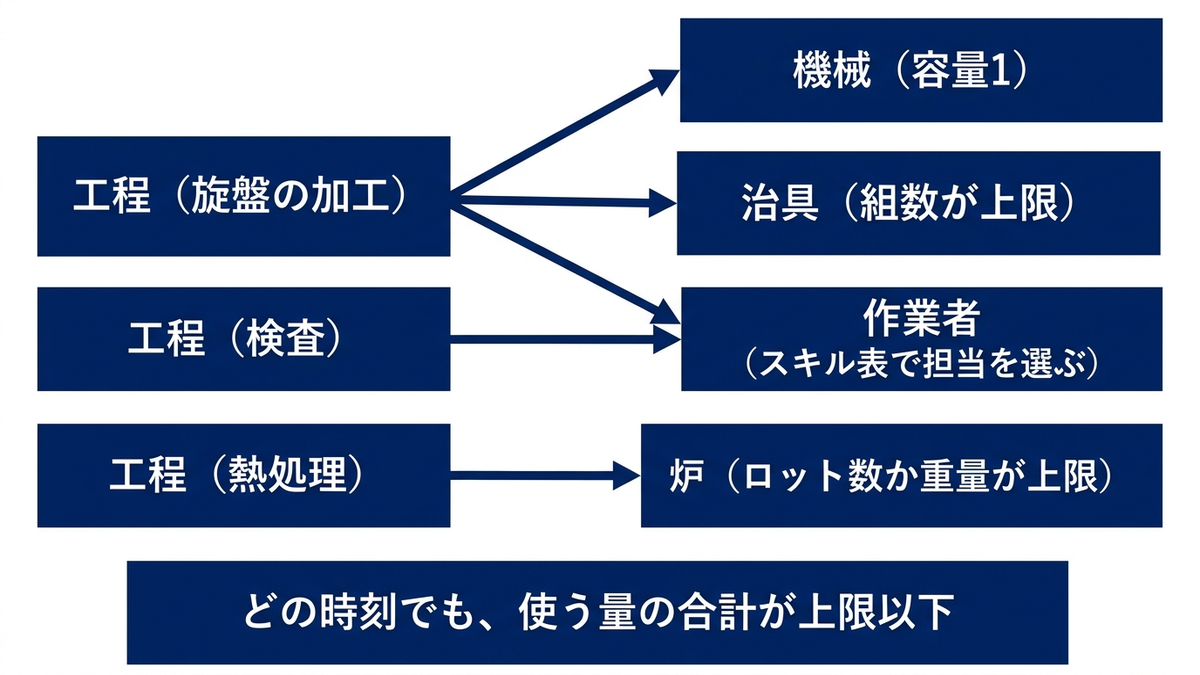
人の制約を無視した計画は、何に化けるか
経営の側から見ると、この章で最も重要なのは「機械だけを見て組んだ計画が、現場で何に化けるか」です。機械だけの計画(S0)は、受注12件をすべて納期内に収められると答えます。しかし作業者が C を欠いて2人の日には、同じ受注に対して重み付き納期遅れ880が避けられず、6件が遅れます。この差は計画の上では見えず、現場では「予定どおりに進まない」「機械が空いているのに着手できない」という形で現れ、残業か、納期遅れの連絡か、協力会社への外注で埋めることになります。計画が人の空きを見ていない限り、その手当ての費用はどこにも計上されません。
人の制約をモデルに入れると、教育の投資を数字で比べられるようになります。C が休む日(A と B の2人)を想定して、A か B が機械を1台だけ新しく扱えるようになった場合の重み付き納期遅れの最小値を解きました。上限時間は50秒、ワーカー数は8です。
| スキルの追加(架空、C が休む日) | 重み付き納期遅れの最小値(重み×分) | その状態 | 遅れ件数(見つかった解) |
|---|---|---|---|
| 追加なし(今のスキル表) | 880 | 最適 | 6件 |
| A が検査(M5)も扱える | 600 | 最適 | 5件 |
| A が研削盤(M3)も扱える | 670 | 暫定解(下界560) | 5件 |
| B が旋盤(M1)も扱える | 840 | 最適 | 5件 |
最も効いたのは、A が検査を扱えるようにする場合で、880から600へ3割以上下がりました。検査の加工時間は受注12件の合計で350分と、機械の中で最も小さい負荷です。負荷の大きい研削盤(1,430分)を A が覚える場合は670の解が見つかっていて、真の最小値は560以上670以下です。B が旋盤を覚える場合は840で、ほとんど改善しません。C が休むと検査と研削盤を扱えるのが B だけになり、B が最終工程である検査を抱えて詰まりやすいので、B の仕事を引き取れる人を増やすことが効く、と読めます。教育の対象を「負荷の大きい機械」から順に選ぶと、この例では最も効く選択を外します。どの技能を誰に教えるかは、人の制約を入れたモデルでスキル表を1マスずつ変えて比べるのが確実だと考えています。
カレンダーについても同じ見方ができます。この章の例では、人の付く工程を休憩・夜間で中断できるかどうかで、全部が終わる時刻に約1日(木曜 11:20 と水曜 13:40)の差が出ました。これは、中断を許すように作業手順や品質の取り決めを見直すことに、1日分の設備能力に相当する価値があり得る、ということです。一方で、炉の夜間加熱を許すかどうかの差は、メイクスパンでは20分でした。夜間の無人運転の設備投資を検討するなら、その前に、どの設備の夜間運転が全体の完了時刻に効くのかを、この章のようなモデルで確かめておくと、効かない設備への投資を避けられます。
数字を経営指標に翻訳するときの注意も書いておきます。重み付き納期遅れは「重み×分」という単位を持たない合成の値で、そのまま金額にはなりません。報告するときは、遅れた件数、最大の遅れ時間、重み3の受注(最も痛い受注)が遅れたかどうか、の3つに分けて示すほうが伝わります。第1章で整理したように、納期遅れの損失は、遅延の違約金だけでなく、特急の輸送費、顧客への説明の手間、次の受注への影響に広がります。この章のモデルは、その損失の手前にある「どれだけ遅れるか」を、人員とスキルとカレンダーの前提ごとに数字で出す役割を担います。
モデルを重くしないための工夫と、結果の読み方
資源の制約を足すほど、ソルバーの仕事は重くなります。この章の実験でも、機械だけの問題は1秒未満で最適性まで証明されたのに対し、作業者を2人に絞った問題の一部は50秒で証明が終わりませんでした。目を引くのは、重み付き納期遅れの最小化で、人数だけの上限(S2)のほうが、スキル表つき(S4)より条件が緩いのに、証明が終わらなかったことです。S4 は担当できる人が限られるので割り当ての組み合わせが少なく、そのぶん探す範囲が狭くなった可能性がありますが、原因は実験で切り分けていません。この例のように、条件を足すと必ず重くなるとは限らず、選択肢を絞る制約がかえって計算を軽くすることがあります。
計算を軽くするために、この章では3つの工夫をしました。1つ目は時間の刻みで、データがすべて10分の倍数なので10分刻みにしました。刻みを粗くすると、取り得る開始時刻の数が減ります。ただし、実データの加工時間が1分単位でばらついているのに10分に丸めると、丸めの誤差が工程数だけ積み上がります。刻みを粗くするなら、丸めた後の計画が現場で成り立つか(丸めで加工時間を短く見積もっていないか)を確かめる必要があります。2つ目は、中断できる工程の終了時刻を、開始時刻からの表引きで与えたことです。3つ目は、炉のバッチで「ある回の加熱を使うなら、それより番号の小さい回も使う」という順序の制約を足し、同じ組み合わせを番号の付け替えだけで何通りも探さないようにしたことです。
結果を読むときは、ソルバーが返す状態を必ず確かめます。OPTIMAL なら最適性が証明されており、FEASIBLE なら実行可能な解と下界の間に真の最適値があります。この章の表では、FEASIBLE の値には必ず下界を併記しました。たとえば「A が研削盤を覚えた場合は670」とだけ書くと、それが本当の最小値なのか、計算を打ち切った時点の値なのかが分かりません。人員や投資の判断に使う数字は、どこまでが証明済みで、どこからが暫定なのかを分けて報告することが大切です。大規模な問題で上限時間とギャップ(解と下界の差)をどう扱うかは、第11章で扱います。
もう1つ、目的関数を1つだけ最小化した解は、ほかの指標については偶然の値になることにも注意が要ります。この章の実験で、重み付き納期遅れを最小化した解のメイクスパンは、条件によって2,150分から2,510分まで散らばりました。これは、納期遅れの最小値が同じになる解が多数あり、ソルバーがその中の1つを返しているだけだからです。「納期遅れを最小にしたうえで、次にメイクスパンも短く」と望むなら、1段目で納期遅れの最小値を求め、2段目でその値を上限の制約として固定してメイクスパンを最小化する、という2段階の解き方にします。
この章の要点は3つです。第一に、作業者・治具・炉の容量といった機械以外の資源は、CP-SAT の累積制約と任意の区間で、機械の重なり禁止に数行足すだけでモデルに入れられます。第二に、人の制約が効くかどうかは人数の平均では決まらず、この架空の工場では3人なら効かず、2人で初めて効き、誰が休むか・誰が何を扱えるかで納期遅れが大きく変わりました。スキル表を1マスずつ変えて比べると、教育の優先順位が数字で決まります。第三に、稼働カレンダーでは工程を中断してよいかどうかが結果を大きく動かし、炉のバッチ化は完了時刻よりも加熱の回数に効きました。どの制約がどの指標に効くのかは、全体のモデルで確かめて初めて分かります。ここまでの章は、受注12件という小さな規模で最適解か、それに近い解を求めてきました。規模が大きくなり、上限時間の中で証明が終わらなくなったときにどう対処するかを、次の第11章で扱います。
この章を深めたい方への参考書籍
『Python言語によるビジネスアナリティクス 実務家のための最適化・統計解析・機械学習』(久保幹雄・小林和博・斉藤努・並木誠・橋本英樹、近代科学社):第14章が資源制約付きスケジューリング問題にあてられ、スケジューリング最適化モジュール OptSeq を使って、作業・資源・先行関係をどう書くかを例題とともに示しています。この章では CP-SAT で書いた人員や設備の制約を、別のソルバーでどう表すかを比べながら読めます。
『Complex Scheduling』第2版(Peter Brucker・Sigrid Knust、Springer):スケジューリングのモデルと計算量の整理から始まり、資源制約付きプロジェクトスケジューリングと、複雑なジョブショップ(複数の機械から選べる工程、搬送、置き場の容量の制限を含むもの)に章をあてた専門書です。整数計画・制約伝播・分枝限定法・局所探索などの解法と、下界の計算方法が説明されており、この章で扱った累積制約や下界の考え方を、解法の側から体系的に学べます。洋書ですが、資源制約付きの問題を正面から扱った教科書として参照する価値があると考えています。
第11章 大規模化への対処、局所探索と分解で十分良い解を毎日同じ時間で出す
第10章では、作業者・治具・熱処理炉といった機械以外の資源を制約に加え、現実の工場に近い形でスケジュールを解きました。制約を足すほどモデルは現場に近づきますが、同時に、ジョブの件数や工程の数が増えると計算時間が急に伸びるという問題が表に出てきます。第2章で見たとおり、ジョブショップのような問題は NP 困難で、規模が大きくなると「最適であることを証明するまで解く」ことが現実的な時間では終わらなくなります。この章では、そうした規模の問題を毎日の計画業務で回すための考え方として、局所探索とメタヒューリスティクス、時間制限つきで解いたときの結果の読み方、問題を小さく分けて解く分解の手法を扱います。
この章で伝えたいことは、生産スケジューリングの実務では「最適解」よりも「十分良い解を、毎日決まった時間の中で、安定して出す」ことのほうが価値を持つ場面が多い、という点です。そのために、手法の考え方を説明したうえで、第2章で用意したサンプルデータと公開ベンチマークを使い、焼きなまし法などの近似解法と CP-SAT(Google の OR-Tools に含まれる制約プログラミングのソルバー)を同じ時間制限のもとで比べた実測結果を示します。
規模が増えると何が起きるか、公開ベンチマークで測る
まず、第5章で使った CP-SAT のジョブショップのモデル(工程ごとのインターバル変数と、機械ごとの重なり禁止制約)をそのまま使い、大きさの違う公開ベンチマークを時間制限つきで解きました。問題はすべて OR-Library の jobshop1.txt(ジョブショップの標準的な試験問題を集めたファイル)から取り、第5章で最適値 55 を確かめた ft06(6ジョブ×6機械)に加えて、ft10(10×10)、Lawrence の la26(20×10)と la31(30×10)、Adams・Balas・Zawack の abz7(20ジョブ×15機械)、Storer・Wu・Vaccari の swv01(20×10)と swv11(50×10)、Yamada と Nakano の yn1(20×20)を選びました。swv の2つは、ファイルの説明行に hard(難しい)と記されている問題です。OR-Library の問題は時間の単位を持たないので、この節では「単位時間」と書きます。時間制限は1秒・10秒・60秒の3通りで、CP-SAT の並列ワーカー数は8に固定し、各時間制限は別々の実行です(10秒の結果は、1秒の実行を続けたものではありません)。最適性が証明できた時点で、長い時間制限の実行は省きました。計算時間は、この記事の実行環境(一般的なノートPC)での実測です。
from ortools.sat.python import cp_model
from sched_data import load_orlib

jobs = load_orlib("swv01")                      # [(機械番号, 加工時間), ...] のジョブのリスト
horizon = sum(p for job in jobs for _, p in job)
model = cp_model.CpModel()
ends, per_machine = [], {}
for j, job in enumerate(jobs):
    prev = None
    for o, (m, p) in enumerate(job):
        s = model.new_int_var(0, horizon, "s")
        e = model.new_int_var(0, horizon, "e")
        per_machine.setdefault(m, []).append(model.new_interval_var(s, p, e, "i"))
        if prev is not None:
            model.add(s >= prev)                # ジョブの工程順
        prev = e
    ends.append(prev)
for m in per_machine:
    model.add_no_overlap(per_machine[m])        # 1台の機械は同時に1工程だけ
cmax = model.new_int_var(0, horizon, "cmax")
model.add_max_equality(cmax, ends)
model.minimize(cmax)
solver = cp_model.CpSolver()
solver.parameters.max_time_in_seconds = 10      # 時間制限(秒)
solver.parameters.num_workers = 8
solver.parameters.random_seed = 0
st = solver.solve(model)
print(solver.status_name(st), solver.objective_value, solver.best_objective_bound)
# 出力: FEASIBLE 1527.0 1395.0
このコードを単独で実行したときの出力は上のとおりで、次の表の swv01 の10秒の行(1,477/1,396)とは値が違います。乱数の種もワーカー数も同じ設定で、別々に2回実行しただけでこれだけの差が出ました。この揺れについては後の節で詳しく扱います。最後の行の objective_value は見つかった中で最良のスケジュールのメイクスパン、best_objective_bound はソルバーが証明した下界(どんなスケジュールでもメイクスパンはこれより短くならない、という値)です。状態 FEASIBLE は「実行可能な解は見つかったが、最適かどうかは証明できていない」、OPTIMAL は「最適であることを証明した」を意味します。8つのベンチマークの結果をまとめたのが次の表です。ギャップは、解のメイクスパンから下界を引いた差を、解のメイクスパンで割って計算しています。
| 問題 | ジョブ×機械 | 工程数 | 1秒:解/下界(ギャップ) | 10秒:解/下界(ギャップ) | 60秒:解/下界(ギャップ) | 最適性の証明 |
|---|---|---|---|---|---|---|
| ft06 | 6×6 | 36 | 55/55(0%) | 省略 | 省略 | 0.06秒で証明 |
| ft10 | 10×10 | 100 | 962/863(10.29%) | 930/930(0%) | 省略 | 7.72秒で証明 |
| la26 | 20×10 | 200 | 1,275/1,218(4.47%) | 1,218/1,218(0%) | 省略 | 4.71秒で証明 |
| la31 | 30×10 | 300 | 1,859/1,784(4.03%) | 1,784/1,784(0%) | 省略 | 6.12秒で証明 |
| swv01 | 20×10 | 200 | 1,585/1,373(13.38%) | 1,477/1,396(5.48%) | 1,422/1,399(1.62%) | 60秒では証明できず |
| abz7 | 20×15 | 300 | 734/650(11.44%) | 688/651(5.38%) | 667/653(2.10%) | 60秒では証明できず |
| yn1 | 20×20 | 400 | 1,000/763(23.70%) | 947/764(19.32%) | 903/812(10.08%) | 60秒では証明できず |
| swv11 | 50×10 | 500 | 4,277/2,983(30.25%) | 3,440/2,983(13.28%) | 3,372/2,983(11.54%) | 60秒では証明できず |
表から読み取れることは3つあります。第一に、ft10(jobshop1.txt の説明行では別名 mt10)は、Applegate と Cook の1991年の論文が Muth と Thompson の「よく知られた 10×10 問題」として取り上げ、当時のワークステーション(Sun Sparcstation 1)で7分弱かけて最適性まで解いたと報告している問題です。同じ問題が、今回の環境の CP-SAT では7.72秒で最適性の証明まで終わりました。今回試した中では、100〜300工程の ft10・la26・la31 が10秒以内に最適性の証明まで終わりました。第二に、難しさは工程数だけでは決まりません。300工程の la31 は6.12秒で最適性を証明できたのに、200工程の swv01 は60秒たってもギャップが1.62%残りました。何が難しさを分けているのかはこの実験では調べていませんが、同じ大きさでも解きやすさが大きく違うことは、規模だけで計算時間を見積もれないことを意味します。第三に、400〜500工程になると、60秒の時間制限では yn1 で10.08%、swv11 で11.54% のギャップが残ります。swv11 の下界は3回とも2,983から動いておらず、ソルバーが下界を締める手がかりを見つけられていないことが分かります。
実際の工場では、受注数十件、機械十数台、1件あたり数工程から十数工程という規模は珍しくないと考えています。第10章で扱った作業者や治具の制約、第7章の段取り替えが加わると、同じ工程数でも問題はさらに重くなります。つまり、実務のスケジューリングでは「最適性の証明が時間内に終わらない」ことを前提に仕組みを作る必要があり、それが次の節の時間制限とギャップの読み方につながります。
時間制限つきの解とギャップ、上界と下界の読み方
時間制限で打ち切ったソルバーは、2つの数字を返します。以下は、この章のようにメイクスパンを小さくする最小化問題の場合の説明です。1つは見つかった最良の解の値で、これを上界と呼びます。最適値はこれ以下であることが分かっているからです。もう1つは下界で、最適値はこれ以上であることが証明されています。最適値は必ず下界と上界の間にあり、両者の差がギャップです。ギャップが0になったとき、上界の解が最適であることが証明されます。
ギャップは「今の解が最適解からどれだけ離れているか」ではなく、「最大でどれだけ離れている可能性があるか」を表す点に注意が必要です。前節の swv01 を60秒で解いた結果は、解のメイクスパンが1,422単位時間、下界が1,399で、ギャップ1.62%でした。これは「最適解はこの解より最大で23単位時間短い可能性がある。実際にはもっと差が小さいかもしれないし、この解が既に最適かもしれない」という意味です。一方、swv11 の11.54%は、解が悪いのか下界が甘いのかを区別できない状態で、「改善の余地がどれだけあるか分からない」ことを示しています。ギャップが大きいとき、時間を延ばして上界が下がるのか、下界が上がるのかは、実際に走らせてみるまで分かりません。
ギャップを経営の言葉に直すと、「この計画を採用することで、理論上取りこぼしている可能性がある最大の損失」になります。仮に時間の単位を分と読めば、メイクスパン1,422分の計画でギャップ1.62%は、取りこぼしが最大23分、つまり約24時間の計画で30分に満たない差です。この程度なら、残り時間を使って最適性の証明を目指すより、その時間で飛び込みの受注や設備の状況を反映して計画を作り直すほうが価値がある、と判断できます。逆にギャップが10%を超えるなら、同じ設備でもっと早く終わる計画がある可能性を否定できず、時間制限の延長、定式化の見直し、次の節以降で扱う近似解法や分解の併用を検討する価値があります。ギャップの許容値は、この「取りこぼしてよい時間や費用」を先に決めておくことで、技術的な数字から経営判断の基準に変わります。
下界にはもう1つの使い道があります。ソルバーを使わない近似解法(次の節から扱う局所探索や焼きなまし法)は解を返すだけで、下界を返しません。解の質を保証する数字が無いので、「この近似解法の結果はどれくらい良いのか」を判断するには、別の方法で求めた下界と比べるしかありません。機械ごとの加工時間の合計(その機械の負荷)は、どんなスケジュールでもメイクスパンがそれより短くならないという単純な下界になり、計算も一瞬です。CP-SAT で求めた下界、あるいはこの単純な下界と並べて近似解を評価する、というのが、この章の実験での評価の型です。
局所探索、今の解を少しずつ直していく考え方
局所探索は、ひとまず1つのスケジュールを作り、それを少しだけ変えた候補を試して、良くなれば置き換える、という手順を繰り返す解き方です。最初のスケジュールには、第3章のディスパッチングルールや第4章の NEH 法のような、速く作れて質もそこそこ良い解を使うことが多いです。ここで「少しだけ変える」ときの変え方の決まりを近傍と呼びます。今の解から近傍の操作で1回に届く解の集まりが「近所」で、局所探索はその近所の中で今より良い解を探しては移る、ということを近所に良い解がなくなるまで続けます。近所に今より良い解が1つもない状態を局所最適と呼び、ここで探索は止まります。
生産スケジューリングで使われる近傍は、問題の型によって違います。全ジョブが同じ順に機械を通る置換フローショップ(第4章)では、解は「ジョブを流す順番」という1本の並びで表せるので、並びの中の2件を入れ替える交換近傍と、1件を抜いて別の位置へ入れ直す挿入近傍がよく使われます。10件の並びなら、交換の候補は \( 10 \times 9 / 2 = 45 \) 通り、挿入の候補は1件を抜いて元の位置以外の9か所へ入れ直すので、1件あたり9通り、合計90通りです(隣どうしの挿入は交換と同じ並びになるので、異なる並びの数はこれより少し減ります)。この程度なら1回の探索で全部を試しても一瞬で終わります。この章の実験でも挿入近傍を使いました。
ジョブショップ(第5章)では、解は「機械ごとの工程の並び」の組で表されます。ここで同じ機械の任意の2工程を入れ替えると、ジョブの工程順と矛盾して実行できないスケジュール(ある工程がそれ自身の後工程を待つ、という循環)になることがあります。また、メイクスパンは第5章で説明したクリティカルパス(メイクスパンを決めている、途切れなく続く工程の鎖)の長さで決まるので、クリティカルパスに乗っていない工程の順序をいくら入れ替えても、その鎖が残っている限りメイクスパンは縮みません。そこで、クリティカルパスの上の工程に的を絞った近傍が工夫されてきました。van Laarhoven・Aarts・Lenstra の1992年の論文は、ジョブショップに焼きなまし法を当てはめ、コストが増える移動も0でない確率で受け入れることで局所最適を避ける手法を示し、当時の他の近似解法より短いメイクスパンを見つけられる一方で計算時間が長くなると報告しています。Nowicki と Smutnicki の1996年の論文は、クリティカルパスと、同じ機械で連続する工程のまとまり(ブロック)という考え方で近傍を定義したタブー探索を示し、よく知られた 10×10 の難しいベンチマークをパソコンで30秒以内に解いたと報告しています。近傍を「効きそうな場所だけに絞る」ことが、ジョブショップの近似解法の性能を大きく左右します。
局所探索の弱点は、局所最適で止まってしまうことです。スケジュールの良し悪しの地形は起伏が多く、近所の中では一番良くても、少し離れたところにもっと良い解があることが多くあります。どの初期解から始めたかで行き着く局所最適が変わり、その質もばらつきます。次の節で扱うメタヒューリスティクスは、この「局所最適で止まる」問題を回避するための枠組みの総称です。
焼きなまし・タブー探索・遺伝的アルゴリズム、局所最適から抜け出す3つの考え方
メタヒューリスティクスは、個々の問題に特化した解き方(ヒューリスティクス)の上に被せて使う、探索の進め方の枠組みです。問題ごとの知識は近傍と評価関数に入れ、枠組みそのものは問題を選ばない、という分業になっています。生産スケジューリングで名前が挙がることの多い3つについて、何を工夫しているかを整理します。
焼きなまし法(シミュレーテッドアニーリング)は、Kirkpatrick・Gelatt・Vecchi が1983年の論文で、固体を高温から徐々に冷やして安定な結晶を得る「焼きなまし」との類推から組合せ最適化に持ち込んだ方法です。近傍からランダムに1つ候補を選び、良くなるなら必ず移り、悪くなる場合でも「温度」と呼ぶパラメータに応じた確率で移ります。温度が高いうちは悪化もよく受け入れて広く動き回り、温度を下げるにつれて改善しか受け入れない局所探索に近づきます。置換フローショップへの適用は Osman と Potts の1989年の論文が早い例です。仕組みが単純で実装しやすい一方、温度の初期値と下げ方の設計で結果が変わり、そこに試行錯誤が要ります。
タブー探索は、Glover が1989年と1990年の2部作の論文で基本原理を体系的に示した方法です。毎回、近傍の中で最も良い候補へ移ります。今より悪くなる場合でも移るので局所最適で止まりませんが、そのままでは直前の解へすぐ戻ってしまうため、最近行った操作を「タブーリスト」に記録してしばらく禁止します。ただし禁止された操作でも、それによってこれまでの最良解を更新できるなら許す、という例外規則(Glover の論文では aspiration criteria と呼ばれます)を置くのが一般的です。近傍を全部評価するので1歩が重く、近傍を小さく絞る工夫と相性が良い方法で、前節で触れた Nowicki と Smutnicki のジョブショップの手法はこの型です。
遺伝的アルゴリズムは、生物の進化になぞらえて、たくさんの解(集団)を同時に持ち、良い解どうしを組み合わせて(交叉)新しい解を作り、ときどき一部を変え(突然変異)、良い解ほど次の世代に残りやすくする、という手順を繰り返す方法です。Reeves の1995年の論文は、フローショップの順序づけに遺伝的アルゴリズムを当てはめた例です。集団を持つので多様な解を並行して探せる一方、交叉で並びが壊れないように(同じジョブが2回現れたり、あるジョブが消えたりしないように)演算を設計する必要があり、生産スケジューリングでは局所探索と組み合わせて使われることが多い方法です。
もう1つ、置換フローショップで実績のある単純な方法に、Ruiz と Stützle が2007年の論文で提案した反復貪欲法(iterated greedy)があります。この章の実験では、焼きなまし法とこの反復貪欲法の2つを実装しました。反復貪欲法は、今の並びから4件を抜き取り、NEH 法と同じ要領で1件ずつ最良の位置に入れ直し、挿入近傍の局所探索で磨く、という「壊して作り直す」操作を繰り返す形で組んでいます。
| 手法 | 局所最適から抜け出す仕掛け | 調整が要るパラメータ | 向いている場面 | 注意点 |
|---|---|---|---|---|
| 局所探索(山登り) | なし(局所最適で止まる) | 近傍の種類 | 既存の計画を短時間で手直しする | 初期解によって結果が変わる |
| 焼きなまし法 | 悪化する移動を温度に応じた確率で受け入れる | 初期温度・冷却の速さ・時間 | 評価が速く、近傍が単純な問題 | 温度設計の試行錯誤が要る。乱数で結果がばらつく |
| タブー探索 | 最良の候補へ必ず移り、戻る操作を一定期間禁止する | タブーリストの長さ・近傍の絞り方 | ジョブショップのように近傍を小さく絞れる問題 | 近傍を全部評価するので1歩が重い |
| 遺伝的アルゴリズム | 複数の解を持ち、組み合わせて新しい解を作る | 集団の大きさ・交叉と突然変異の方法 | 多様な候補を並行して探したいとき | 並びを壊さない交叉の設計が要る。局所探索との併用が多い |
| 反復貪欲法 | 一部を壊して貪欲に作り直す | 抜き取る件数・受け入れの温度 | 置換フローショップ | 作り直しの手順を問題ごとに用意する必要がある |
表の「注意点」の列のうち、経営の側から見て最も重要なのは、乱数を使う手法では同じデータでも実行のたびに結果が少しずつ変わる点です。毎朝の計画で、同じ受注なのに昨日と今日で並びが違う、という事態は現場の信頼を損ないます。乱数の種(シード)を固定すれば再現はできますが、データが1件変わっただけで結果が大きく動くこともあります。この点は後の節で、実験の結果とあわせて扱います。
置換フローショップで焼きなまし法を実装し、CP-SAT と比べる
ここからは実際に手を動かします。題材は第4章と同じ置換フローショップで、2つの大きさを用意しました。1つは第2章で用意したサンプルデータの flow_shop()(10件×4台、加工時間の合計2,900分)、もう1つは、この章で同じ作り方(加工時間を20分から150分まで10分刻みの一様乱数で作る)を使い、乱数の種を0に固定して生成した50件×10台の問題(加工時間の合計44,150分)です。後者も架空のデータです。
比べた手法は5つです。NEH 法(第4章)、NEH 法の結果を初期解にした挿入近傍の局所探索、焼きなまし法、反復貪欲法、そして CP-SAT です。焼きなまし法と反復貪欲法は乱数を使うので、乱数の種を0から4まで変えて5回ずつ走らせました。時間制限は、10件×4台では各手法2秒、50件×10台では各手法20秒です。焼きなまし法と反復貪欲法は Python だけで書いた素朴な実装で、評価の高速化の工夫は入れていません。CP-SAT は、ジョブの対ごとに「どちらが先か」を表す0か1の変数を置き、その変数をすべての機械で共有して、どの機械でも同じ順序になるようにしたモデルで解きました(並列ワーカー数8)。焼きなまし法の中心部分は次のとおりです。
import math, random, time

def makespan(perm, P):
    """並び perm の順に流したときの最後の機械の完了時刻"""
    c = [0] * len(P[0])
    for j in perm:
        c[0] += P[j][0]
        for k in range(1, len(c)):
            c[k] = max(c[k], c[k - 1]) + P[j][k]
    return c[-1]

def simulated_annealing(P, limit, seed):
    rng = random.Random(seed)
    seq = neh(P)                                 # 第4章の NEH 法で初期解を作る
    cur = makespan(seq, P)
    best, best_seq = cur, seq[:]
    n = len(seq)
    T0 = 0.05 * cur / n                          # 初期温度
    T1 = T0 / 100.0                              # 終わりの温度
    t0 = time.perf_counter()
    while time.perf_counter() - t0 < limit:
        el = time.perf_counter() - t0
        T = T0 * (T1 / T0) ** (el / limit)       # 残り時間に応じて温度を下げる
        a, b = rng.randrange(n), rng.randrange(n)
        cand = seq[:]
        cand.insert(b, cand.pop(a))              # 挿入近傍:a 番目を b 番目へ移す
        v = makespan(cand, P)
        accept = v <= cur
        if not accept:                           # 悪くなる手も確率的に受け入れる
            accept = rng.random() < math.exp(-(v - cur) / T)
        if accept:
            seq, cur = cand, v
            if cur < best:
                best, best_seq = cur, seq[:]
    return best_seq, best
温度の式は、残り時間の割合に応じて初期温度から終わりの温度へ指数的に下げる形にしました。時間制限そのものを冷却の予定に組み込んでいるので、「20秒で必ず止まり、止まるときには改善しか受け入れない状態になっている」ように動きます。実行結果をまとめたのが次の表です。下界の列は、前の節で説明した機械ごとの負荷から作った単純な下界(どの機械についても、その機械の加工時間の合計に、前の機械群で最も短い待ちと後ろの機械群で最も短い残りを足したものの最大)で、ギャップはこの下界に対する値です。
| 手法 | 10件×4台:メイクスパン(分) | 10件×4台:計算時間 | 50件×10台:メイクスパン(分) | 50件×10台:計算時間 | 50件×10台:単純な下界 5,250 分に対するギャップ |
|---|---|---|---|---|---|
| NEH 法 | 940 | 0.001秒未満 | 5,570 | 0.07秒 | 5.7% |
| NEH 法+挿入近傍の局所探索 | 940 | 0.001秒未満 | 5,510 | 0.51秒 | 4.7% |
| 焼きなまし法(5回の最良/平均/最悪) | 940/940/940 | 各2秒 | 5,390/5,410/5,420 | 各20秒 | 2.6%〜3.1% |
| 反復貪欲法(5回の最良/平均/最悪) | 940/940/940 | 各2秒 | 5,400/5,414/5,420 | 各20秒 | 2.8%〜3.1% |
| CP-SAT(短い時間制限:10件は2秒、50件は20秒) | 940 | 2秒で打ち切り | 5,830 | 20秒で打ち切り | 9.9% |
| CP-SAT(時間制限60秒) | 940(最適性を証明) | 7.00秒 | 5,680 | 60秒で打ち切り | 7.6% |
10件×4台では、どの手法も同じ940分に達しました。CP-SAT は60秒の時間制限のうち7.00秒で940分が最適であることを証明したので、NEH 法の時点で既に最適解だったことになります。この大きさでは、近似解法を持ち出す必要はなく、厳密に解いて「最適である」という保証まで付けるのが最善の選択です。一方、単純な下界は910分で、CP-SAT が2秒で打ち切ったときに報告した下界は、実行した2回でそれぞれ651と613でした。単純な下界のほうがはるかに締まっており、ソルバーの下界がいつも良いとは限らないことが分かります。同じ設定で2回走らせて下界が違ったことは、後の節で扱う「実行のたびに結果が揺れる」性質の一例でもあります。
50件×10台では、様子が大きく変わりました。焼きなまし法と反復貪欲法は、20秒で5,390分から5,420分の解を出し、単純な下界5,250分に対して3%程度の差まで詰めています。NEH 法の5,570分と比べると150分から180分、つまり連続稼働で2時間半から3時間ほど早く全件が終わる計画です。これに対して、この章の CP-SAT のモデルは60秒かけても5,680分で、NEH 法の解より悪い結果でした。報告された下界は1,642で、単純な下界5,250に遠く及ばず、ギャップは71.09%と、解の質について何も言えない状態です。最初の実行可能解が見つかるまでにも2.4秒から3.0秒かかっています。
ここから言えるのは、CP-SAT が置換フローショップに弱いということではなく、この章で使った「対ごとの順序変数を全機械で共有する」書き方が、50件では変数が1,225個、条件つきの制約が24,500本になり、下界を締める手がかりが乏しいということです。定式化の強さで計算時間が桁で変わる話は第6章で扱いました。実務的な教訓は、ソルバーに渡す前に、NEH 法のような速い近似解法で一度解を作り、その値と単純な下界とを並べておくことです。ソルバーの結果がその近似解より悪ければ、モデルの書き方か時間制限に問題があると分かります。
近似解法とソルバーは対立するものではなく、組み合わせて使えます。CP-SAT には、変数の値の手がかり(ヒント)を渡す add_hint という機能があります。NEH 法と局所探索で作った5,510分の並びをヒントとして渡し、同じモデルを60秒で解き直したところ、CP-SAT は3.16秒の時点で5,510分の解を最初の解として採用し、60秒で5,490分まで改善しました。ヒントなしの5,680分より190分良くなりましたが、20秒の焼きなまし法の5,390分には届いていません。下界は1,582のままで、ギャップの改善にはつながっていません。この大きさの置換フローショップでは、この章のモデルのままなら、近似解法の結果をそのまま使うほうが良い、というのが今回の実測の結論です。
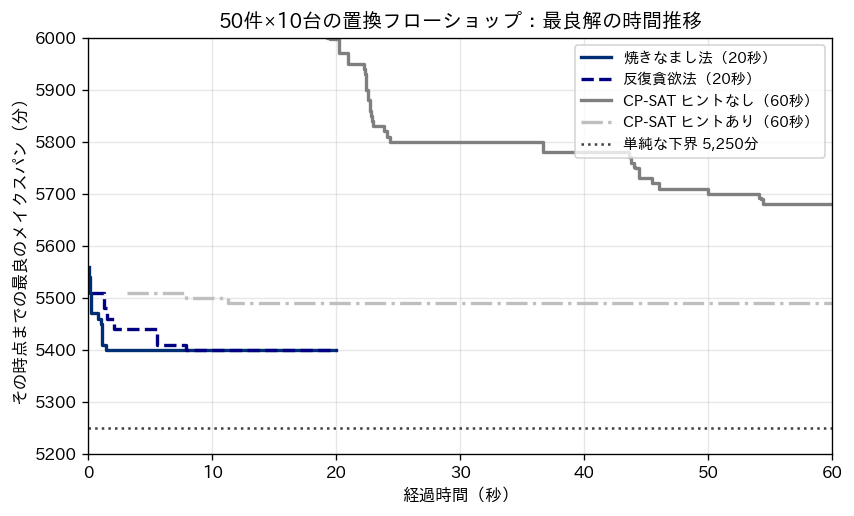
上の図は、50件×10台の問題で、焼きなまし法と反復貪欲法(どちらも乱数の種0の回)、ヒントなしとヒントつきの CP-SAT(時間制限60秒)が見つけた最良の解が時間とともにどう下がったかを示したものです。横軸は経過時間、縦軸はその時点までの最良のメイクスパンで、点線が単純な下界です。焼きなまし法は0.18秒で5,500分を下回り、1.44秒で5,400分に達したあとは、20秒の終わりまで更新がありませんでした。反復貪欲法は7.85秒で同じ5,400分に達しています。ヒントなしの CP-SAT は最初の解(6,470分)を3.03秒で見つけ、6,000分を下回ったのは19.47秒の時点で、60秒の時点でも5,680分でした。近似解法は最初の数秒で大きく改善し、その後はほとんど下がりません。どこで止めても、その時点の最良の解がすぐに使える、という性質は近似解法とソルバーに共通で、実務の時間制限を決めるときには、この曲線の「伸びが鈍る時点」が1つの目安になります。
分解という考え方、シフティングボトルネック法
近似解法とは別の方向の対処として、問題を小さく分けて順に解く分解があります。大きな問題を一度に解く代わりに、解きやすい大きさの部分問題を繰り返し解き、その答えをつないで全体の解にします。部分問題は厳密に解けても、つなぎ方の段階で全体としての最適性は失われるので、分解もまた近似解法の一種です。その代わり、1回あたりの計算時間が読みやすくなり、規模が倍になっても計算時間が倍程度で済む、という性質を持たせやすくなります。
ジョブショップの分解の代表例が、Adams・Balas・Zawack が1988年の論文で示したシフティングボトルネック法です。論文の要旨によれば、この方法は機械を1台ずつ順に順序づけていき、そのたびに、まだ順序を決めていない機械の中からボトルネック(最も苦しい機械)と判定された1台を選びます。新しい機械の順序を決めるたびに、それまでに決めた機械の順序も局所的に最適化し直します。ボトルネックの判定と再最適化は、どちらも1台の機械だけの部分問題を繰り返し解くことで行います。要旨はまた、部分的な探索木と組み合わせた版が、多くの解法が何時間走っても最適解を見つけられなかった悪名高い 10×10 問題の最適解を5分余りで見つけたことを伝えています。
1台の機械の部分問題は、次のように作ります。すでに順序を決めた機械の並びとジョブの工程順を固定したまま、第5章のディスジャンクティブグラフで最長経路を計算すると、各工程について「それより前に必ず済ませる仕事の長さ」(頭と呼びます。その工程の最早の着手時刻になります)と、「その工程の後に必ず続く仕事の長さ」(尻尾と呼びます)が求まります。着目する機械の工程を、頭を着手可能時刻、尻尾を完了後の配送時間とみなして1台の機械に並べ、「完了時刻に尻尾を足した値の最大」を最小にする問題を解きます。この値が大きい機械ほど、その機械の並べ方が全体のメイクスパンを押し上げている、つまりボトルネックだと判定します。1台ぶんの工程だけを並べる問題なので、全体を一度に解くよりはるかに小さな問題になります。
この章では、この考え方を簡略化して実装しました。1台の部分問題は CP-SAT で解き(1回の時間制限は2秒)、新しい機械を決めるたびの再最適化は、決めた機械を1台ずつ外して解き直す操作を1巡だけ行います。論文の探索木と組み合わせた版は実装していません。部分問題の中心は次のとおりです。
def one_machine(ops, head, tail, p, limit=2.0):
    """1台の機械で、max(完了時刻+尻尾) を最小にする順序を CP-SAT で求める"""
    H = max(head[v] for v in ops) + sum(p[v] for v in ops) + max(tail[v] for v in ops)
    md = cp_model.CpModel()
    S, ivs = {}, []
    for v in ops:
        S[v] = md.new_int_var(head[v], H, "s")          # 頭より前には始められない
        ivs.append(md.new_fixed_size_interval_var(S[v], p[v], "i"))
    md.add_no_overlap(ivs)
    L = md.new_int_var(0, 2 * H, "L")
    for v in ops:
        md.add(L >= S[v] + p[v] + tail[v])               # 完了時刻+尻尾
    md.minimize(L)
    sv = cp_model.CpSolver()
    sv.parameters.max_time_in_seconds = limit
    sv.parameters.num_workers = 8
    sv.parameters.random_seed = 0
    sv.solve(md)
    return int(sv.objective_value), sorted(ops, key=lambda v: sv.value(S[v]))
このコードは実験で使った関数そのままで、解が見つかったかどうかの確認を省いています。この部分問題には必ず実行可能な並べ方があり(どの工程も頭の最大値より後に順に並べれば、上の H の範囲に収まります)、1台ぶんの小さな問題です。ただし、手元で制約を足して使う場合は、sv.solve(md) の戻り値が cp_model.OPTIMAL か cp_model.FEASIBLE であることを確かめてから、値を読む形にしておくのが安全です。
この章の最初の実験で使った8つのベンチマークに、この簡略版のシフティングボトルネック法を当てた結果が次の表です。再最適化を1巡だけ行う版と、3巡行う版の2通りを走らせました。比較の相手は、この章の最初の実験で CP-SAT を10秒と60秒で解いた結果です(最適性を証明できた問題は最適値)。
| 問題 | ジョブ×機械 | CP-SAT 10秒の解 | CP-SAT 60秒の解(最適なら最適値) | シフティングボトルネック 再最適化1巡(計算時間) | シフティングボトルネック 再最適化3巡(計算時間) |
|---|---|---|---|---|---|
| ft06 | 6×6 | 55(最適) | 55(最適) | 58(4.60秒) | 59(4.09秒) |
| ft10 | 10×10 | 930(最適) | 930(最適) | 991(10.52秒) | 1,071(8.33秒) |
| la26 | 20×10 | 1,218(最適) | 1,218(最適) | 1,525(4.64秒) | 1,343(11.02秒) |
| la31 | 30×10 | 1,784(最適) | 1,784(最適) | 1,784(6.47秒) | 1,784(3.66秒) |
| swv01 | 20×10 | 1,477 | 1,422 | 1,634(2.73秒) | 1,608(3.53秒) |
| abz7 | 20×15 | 688 | 667 | 830(10.27秒) | 747(10.07秒) |
| yn1 | 20×20 | 947 | 903 | 1,069(32.20秒) | 995(14.12秒) |
| swv11 | 50×10 | 3,440 | 3,372 | 3,522(10.68秒) | 3,418(7.07秒) |
この簡略版は、多くの問題で CP-SAT を全体に10秒かけた解に及びませんでした。la26 では再最適化1巡で1,525と、最適値1,218より25%長い計画になっています。一方で、30×10 の la31 では1巡でも3巡でも最適値1,784に一致し、最も大きい50×10 の swv11 では、3巡の版が7.07秒で3,418を出し、CP-SAT の10秒の解(3,440)を上回りました。再最適化を3巡に増やすと多くの問題で良くなりましたが、ft10 と ft06 では逆に悪くなっており、巡回を増やせば必ず良くなるわけではありません。1台の部分問題を並列の CP-SAT で解いているので、この結果自体にも実行ごとの揺れが含まれます。
この結果から、次の2つを読み取っています。第一に、今日の CP-SAT のように強力な汎用ソルバーが手元にあるなら、数百工程までのジョブショップでは、全体をそのまま時間制限つきで解くほうが、素朴に実装した分解より良い結果になることが多い、ということです。1988年の論文の時代と今とでは、全体を一度に解く道具の力が大きく違います。第二に、分解の価値は解の質よりも構造の側にあります。シフティングボトルネック法は「どの機械がボトルネックか」を順番に明らかにしながら解くので、途中経過そのものが工場の診断になります。swv11 では、最初に選ばれた機械(機械番号2)を順序づけた時点で部分的なメイクスパンが2,983になりました。これは CP-SAT が60秒かけても動かせなかった下界2,983と同じ値です。確かめると、機械番号2の加工時間の合計は2,782で、どのジョブもこの機械を通った後に少なくとも201単位時間の加工を残しているので、最後にこの機械を使うジョブが終わった後にも201以上の時間がかかります。したがって、2,782に201を足した2,983より短いスケジュールはあり得ません。この機械の負荷が全体の下限を決めているということです。能力増強や外注を検討するときに「どの機械に手を打てば全体が縮むか」を説明する材料として、分解の途中経過は解そのものと同じくらい役に立つと考えています。
ローリングホライズン、時間の方向に分けて解く
もう1つの分解の型がローリングホライズンです。計画の対象期間全体を一度に解くのではなく、手前の一定期間(窓)だけを詳しく解いて確定させ、窓を先へずらしながら、次の期間を、確定済みの部分を固定したうえで解く、という手順を繰り返します。ロットサイジングの計画を週ごとに回し直す運用(第8章)も、同じ考え方の上に立っています。スケジューリングでは、窓を時間で区切る方法のほかに、受注を着手可能時刻や納期の順に並べ、一定件数ずつ区切って順に積んでいく方法もあります。
ローリングホライズンが実務で扱いやすい理由は、問題の大きさが窓の大きさで決まり、計画期間や受注の総数が増えても1回の計算の重さが変わらないことです。受注が1日に数十件ずつ入る工場なら、毎日「明日と明後日の分だけを詳しく解き、それより先は粗い見込みにとどめる」という運用にすれば、計算時間は毎日ほぼ一定になります。遠い先の予定は、どうせ飛び込みの受注や設備の都合で変わるので、今の時点で細かく最適化しても価値は小さい、という事情もあります。飛び込みや故障が起きたときにどこまで計画を組み直すか、直近の何時間を固定するか(凍結区間)という話は、第12章で扱います。
弱点は、窓の境目で近視眼的な判断が起きることです。窓の中だけを見て最適化すると、窓の外にある受注のために機械を空けておく、といった判断ができません。境目の影響を和らげるには、窓を確定させる部分より少し長めに取り(確定するのは手前の半分だけ、など)、窓の後ろ側は次の回で解き直す、という重ねしろを持たせる工夫が考えられます。この章の実験では、最も単純な形として、受注を加工時間の合計が短い順に並べて10件ずつ区切り、確定済みの工程を機械の上に固定したまま次の10件を CP-SAT で差し込む、という「受注の塊ごとに順に積む」分解を実装し、全体を一度に解く場合と同じ合計時間で比べました。
題材は2つです。1つは最初の実験で使った swv11(50ジョブ×10機械)、もう1つは、この章で乱数の種を0に固定して生成した100ジョブ×10機械のジョブショップ(各ジョブが10台の機械をランダムな順に1回ずつ通り、加工時間は1から99の一様乱数。架空のデータです)です。どちらも、1回の窓で解くときの目的は「新しく入れる10件の最大完了時刻を主、完了時刻の合計を従として最小化」とし、全体を一度に解く場合も同じ目的にそろえました。窓1つあたりの時間制限は、合計の時間制限を窓の数で割った値です。
| 問題 | 機械ごとの負荷の最大(単純な下界) | 全体を一度に CP-SAT で解く:メイクスパン(時間制限) | 10件ずつ順に積む分解:メイクスパン | 分解の実際の計算時間(窓ごと) |
|---|---|---|---|---|
| swv11(50×10) | 2,808 | 3,489(30秒で打ち切り) | 3,360 | 合計19.32秒(3.90/2.53/6.03/0.83/6.03秒) |
| 生成した100×10 | 5,548 | 5,548(40秒で打ち切り) | 6,173 | 合計3.10秒(10の窓はいずれも0.16〜0.48秒) |
2つの問題で、結果は正反対になりました。swv11 では、10件ずつ積む分解が合計19.32秒で3,360を出し、全体を30秒で解いた3,489より129短く、最初の実験で60秒かけた結果(3,372)も下回りました。窓の中の問題は小さいので、5つの窓のうち3つは最適性を証明して終わっています。一方、生成した100×10 の問題では、全体を一度に解いた CP-SAT が単純な下界と同じ5,548に達しました。下界と一致したので、この値はメイクスパンとして最適です(状態が OPTIMAL にならないのは、従の目的である完了時刻の合計の最適性まで証明できていないためです)。分解は3.10秒で終わったものの6,173で、最適値より11%長い計画でした。この分解は、加工時間の合計が短い受注から順に10件ずつ積み、先に積んだ窓の工程を後から動かさない作りです。先に決めた窓の配置が後の窓の自由度を奪うことはこの作りに固有の弱点ですが、この問題で11%の差のうちどれだけがそのためかは、この実験では切り分けていません。
この対照から言えるのは、分解が良いか悪いかは問題によって変わるということです。分解の本当の利点は、計算時間が窓の数に比例して読めることと、窓の中の問題が小さいので最適性まで解けることが多いことです。その代わり、窓の区切り方(どの受注を先に積むか)が結果を大きく左右します。実務で使うなら、窓の区切り方を納期の順や着手可能時刻の順など何通りか試し、全体を一度に解いた結果とも並べて、自社の受注の形に合う方法を選ぶ手順を踏むべきだと考えています。
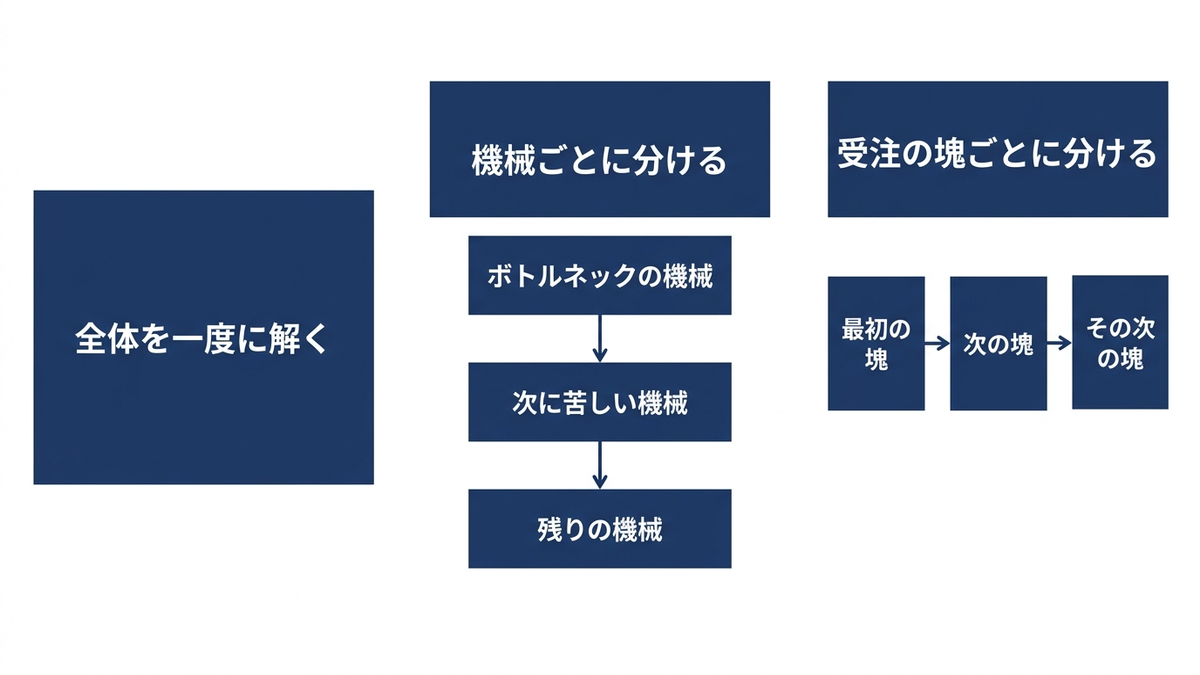
「最適」より「十分良い解を毎日同じ時間で」、運用の設計
ここまでの実験を、毎日の計画業務の側から見直します。生産計画の担当者にとって重要なのは、ある日たまたま最適解が出ることではなく、毎日決まった時刻までに、一定以上の質の計画が、同じ手順で出てくることです。そのために決めておくべきことは、時間制限、結果の再現性、そして質の下限の3つだと考えています。
1つ目の時間制限は、計画を使う側の業務の時刻から逆算して決めます。たとえば、前日の夕方に受注と設備の状況を締め、翌朝の始業前に現場へ作業指示を出す運用なら、計算に使える時間は数分から数十分あります。一方、飛び込みの受注が入るたびに組み直すなら、使える時間は数十秒程度かもしれません。置換フローショップの実験の図のように、改善の大部分は最初の数秒から数十秒で起き、その後は伸びが鈍るので、実データで何度か走らせて「この時間を超えてもほとんど良くならない」という点を見つけ、そこを時間制限にするのが実務的な決め方です。
2つ目の再現性は、見落とされやすい論点です。swv01 を CP-SAT で10秒解く同じ設定(並列ワーカー数8、乱数の種0)を別々に5回実行したところ、得られたメイクスパンは1,450、1,465、1,477、1,509、1,527で、最良と最悪の差は77、最悪の値に対して5%ほどでした。この5回のうち2回は、この章でここまでに示した結果です。1,527は章の冒頭のコードを単独で実行した回、1,477はベンチマークの表の swv01 の10秒の行で、残りの3回(1,450、1,465、1,509)は同じ定式化と同じ設定で続けて実行しました。下界は5回とも1,395か1,396でほぼ動いていません。乱数の種を1と2に変えた回はそれぞれ1,471と1,488(下界は1,396と1,397)でした。乱数の種を固定しても、壁時計の秒数で打ち切る限り結果は再現しない、というのが実測の結論です。焼きなまし法と反復貪欲法でも、前の節の表のとおり、乱数の種を変えると50件×10台で最大30分の差が出ています。
では、結果を毎回同じにするにはどうすればよいか。ここからの説明では「決定的」という言葉を使います。同じ入力と同じ設定を与えれば、何度実行しても同じ手順で計算が進み、同じ結果が返ることを指す用語です。反対に、実行のたびに結果が変わり得る動き方を非決定的と呼びます。前の段落の実験のように壁時計の秒数で打ち切る設定は、同じ10秒でも結果が変わったので、決定的ではありません。CP-SAT の設定項目を定義した sat_parameters.proto(OR-Tools 9.15 のソース)には、壁時計の秒数で打ち切る max_time_in_seconds とは別に、計算の手数から見積もった「決定的時間」で打ち切る max_deterministic_time があり、また試験的な機能として、探索の戦略を交互に実行して並列ワーカー数によらず決定的に動かす interleave_search がある、と説明されています。決定的時間は、壁時計の秒数ではなく、ソルバーが自分の計算の手数から見積もる時間です。同じファイルの説明では、実際にかかった時間とおおむね連動し、単位はできるだけ1秒に近づけてあるとされています。interleave_search は、複数の探索のやり方をひとまとまりの作業ごとに各ワーカーへ割り振り、そのまとまりが全部終わるのを待って足並みをそろえてから次へ進む設定だと説明されています。swv01 でこれらを試した結果が次の表です。
| 設定(乱数の種は0) | 1回目:解/下界 | 2回目:解/下界 | 1回目と2回目の壁時計の計算時間 | 結果が一致したか |
|---|---|---|---|---|
| ワーカー1、壁時計10秒で打ち切り | 1,567/1,366 | 1,513/1,366 | 10.01秒/10.01秒 | 一致しない |
| ワーカー8、決定的時間10で打ち切り(安全弁として壁時計40秒) | 1,433/1,398 | 1,436/1,399 | 40.04秒/40.05秒 | 一致しない |
ワーカー8、interleave_search を有効にして決定的時間10で打ち切り | 1,466/1,397 | 1,466/1,397 | 30.97秒/18.17秒 | 一致した |
ワーカーを1つにしても、壁時計で打ち切る限り、その10秒の間にどこまで計算が進むかが実行のたびに違うので、結果は一致しませんでした。ワーカー8つで決定的時間の上限を10にした設定は、報告された決定的時間が28.12と31.50に達しても止まらず、安全弁として付けた壁時計40秒で打ち切られ、結果も一致しませんでした。少なくとも swv01 をこの版(OR-Tools 9.15)のワーカー8つで解いたこの設定では、決定的時間の上限だけでは期待どおりに打ち切れませんでした。ほかの問題や版で同じことが起きるかは確かめていません。interleave_search を有効にした設定だけが、2回とも1,466/1,397という同じ結果を返し、報告された決定的時間も2回とも12.16で一致しました。ただし壁時計の計算時間は30.97秒と18.17秒で大きく違い、解の質も、同じ8ワーカーで40秒走った2行目の設定より少し劣ります。再現性と引き換えに、終わる時刻の読みやすさと解の質を少し手放す、というのが実測から見たこの設定の性格です。試験的な機能とされているので、使うなら版を上げるたびに挙動を確かめる必要があります。
実務での落としどころは、用途によって分けることだと考えています。毎朝の本計画のように「同じ入力なら同じ計画が出る」ことが重要な場面では、決定的に動く設定を使い、壁時計の時間制限は安全弁として別に持たせます。飛び込み対応のように時間が最優先の場面では、壁時計で打ち切って、そのとき得られた最良の解を使います。どちらの場合も、採用した計画と、そのときの設定・下界・計算時間を記録しておけば、後から「なぜこの計画になったか」を説明できます。
3つ目の質の下限は、ギャップと単純な下界で監視します。毎日の計算結果について、ソルバーが返した下界、機械ごとの負荷から作る単純な下界、前日までの同規模の結果を並べて記録しておけば、「今日の計画は下界から何%離れているか」「いつもより悪くないか」が数字で分かります。置換フローショップの実験で見たように、ソルバーの下界はいつも締まっているとは限らないので、単純な下界を併記しておくことに意味があります。ギャップが普段より大きい日は、受注の構成が変わったか、データに誤りがある(加工時間の桁違いなど)可能性があるので、計画を現場に出す前に人が確認する、という運用の分岐点にもなります。
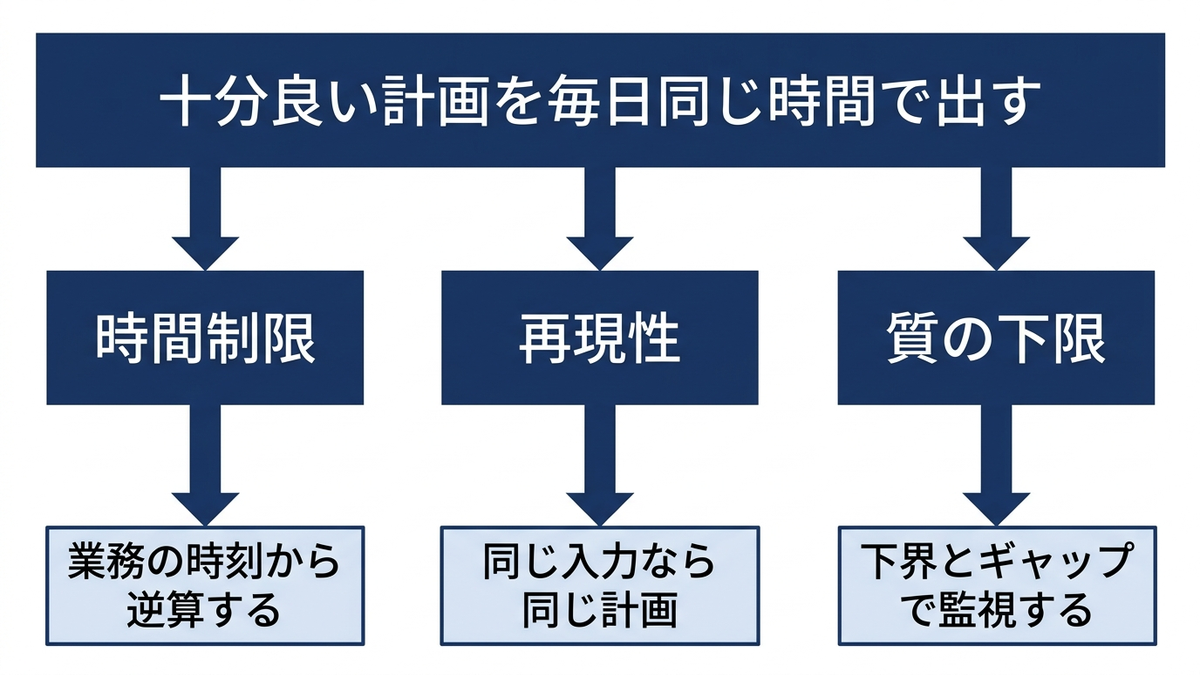
規模への対処を誤ったときの経営上の損失
この章の実験を経営の言葉に直すと、規模の大きい問題への対処の誤り方には3つの型があります。1つ目は、最適解にこだわって計算を待ちすぎることです。ギャップが数%の解が数秒で出ているのに、最適性の証明まで待つ運用にすると、計画が現場に届くのが遅れ、その間に受注や設備の状況が変わって、計画そのものが古くなります。計画の遅れは、朝の段取りの準備や材料の払い出しの遅れとして、毎日少しずつ稼働時間を削ります。
2つ目は、ソルバーの出力を検証せずに使うことです。50件×10台の置換フローショップの実験では、この章のモデルのまま CP-SAT を60秒走らせた結果(5,680分)は、20秒の焼きなまし法の結果(5,390分)より290分遅く全件が終わる計画でした。仮に1日16時間稼働(2交替)の工場なら、290分は1日の稼働時間960分のおよそ3割に当たり、週末までに全件を終える必要があるなら、その分は残業か休日出勤で埋めることになります。ソルバーを使っているから良い計画のはずだ、という思い込みが、見えない残業代として現れる例です。NEH 法の結果や単純な下界と並べて検証していれば、この差には気づけます。
3つ目は、計画の揺れを放置することです。同じ受注なのに日によって並びが大きく変わる計画は、現場から見ると理由の分からない指示の変更です。段取りの準備や治具の手配をやり直す手間が生じ、指示への信頼が下がると、最終的には現場が計画を使わずに自分たちの判断で順番を決めるようになります。そうなると、スケジューリングの仕組みに投じた費用は回収できません。再現性の設定と、前日の計画からの変更量を抑える工夫(第12章で扱う安定性の考え方)は、計画の質と同じ重さで設計すべき項目だと考えています。
逆に、これらを押さえた運用からは、経営指標として読める数字が毎日得られます。その日の計画のメイクスパンと下界の差(取りこぼしている可能性の上限)、計算にかかった時間、前日からの変更件数を記録していけば、「計画の質は安定しているか」「受注の増加に計算が追いついているか」「どの時点で分解や近似解法への切り替えが必要か」を、担当者の感覚ではなく数字で判断できます。
この章の要点は3つです。第一に、規模の大きいスケジューリングでは、時間制限つきで解いて上界と下界の差(ギャップ)を読むことが基本で、ギャップは「取りこぼしている可能性がある最大の損失」として経営の言葉に直せます。第二に、局所探索と焼きなまし法・反復貪欲法のようなメタヒューリスティクスは、ソルバーのモデルが弱い問題では短時間でソルバーより良い解を出すことがあり、シフティングボトルネック法や受注の塊ごとに積む分解は、計算時間を読みやすくし、ボトルネックの所在を明らかにしますが、どれが良いかは問題によって変わるので、単純な下界と並べて実測で選ぶ必要があります。第三に、毎日の運用では、最適性より、時間制限・再現性・質の下限を先に決めることが、計画を現場で使い続けてもらうための条件になります。ただし、この章の実験はすべて、加工時間が計画どおりで、設備も止まらない前提に立っています。次の第12章では、故障や飛び込みの受注、加工時間のばらつきが起きたときに、計画をどう直し、どう評価するかを扱います。
この章を深めたい方への参考書籍
『組合せ最適化 メタ戦略を中心として』(柳浦睦憲・茨木俊秀、朝倉書店):経営科学のニューフロンティアのシリーズの1冊で、目次は近似解法の基本戦略、メタ戦略の基礎と実現、高性能アルゴリズムの設計、手軽なツールとしてのメタ戦略、近似解法の理論と進みます。この章で扱った局所探索・焼きなまし法・タブー探索・遺伝的アルゴリズムを、近傍の設計と探索の戦略という共通の枠組みで整理して学べます。
『メタヒューリスティクスとナチュラルコンピューティング』(古川正志・川上敬・渡辺美知子・木下正博・山本雅人・鈴木育男、コロナ社):山登り法、シミュレーテッドアニーリング、タブーサーチ、遺伝的アルゴリズムと、手法ごとに章が分かれています。この章では考え方の紹介にとどめた各手法の手順を、1つずつ追って確かめたいときに向いています。
『メタヒューリスティクスの数理』(久保幹雄・J.P.ペドロソ、共立出版):代表的なメタヒューリスティクスの解説に加えて、数理計画とメタヒューリスティクスの融合を1つの章として扱っています。この章で見た「ソルバーに近似解をヒントとして渡す」「問題を分けてソルバーで解く」といった、厳密解法と近似解法を組み合わせる考え方を深めるのに向いています。版元のページでは品切れ・重版未定と表示されています。
第12章 不確実性と再スケジューリング、故障と飛び込み注文にどう組み直すか
第11章では、問題が大きくなったときに局所探索や時間制限つきのソルバーで「十分に良い解を、毎日同じ時間で」出す考え方を扱いました。ここまでの章はすべて、加工時間も納期も機械の稼働も計画どおりに進むという前提でスケジュールを作ってきました。しかし工場の1日は、機械の故障、急ぎの飛び込み注文、見込みより長くかかった加工といった出来事で、朝に配ったスケジュールから少しずつずれていきます。この章では、そうしたずれが起きたときにスケジュールをどう組み直すか(再スケジューリング)を扱います。組み直し方の型を整理したうえで、第2章で用意した受注12件に架空の故障と飛び込み注文、加工時間のばらつきを起こし、組み直し方ごとに納期遅れと「前のスケジュールからどれだけ変わったか」を実測で比べます。
計画どおりに進まない3つの原因と、その性質の違い
スケジュールを狂わせる出来事は、大きく3つに分けて考えると整理しやすくなります。1つ目は機械の故障や停止です。ある機械が一定の時間使えなくなり、その機械に予定されていた工程と、その工程の後に続く別の機械の工程が連鎖的に遅れます。2つ目は飛び込み注文(急ぎの追加受注)です。計画を作った時点では存在しなかったジョブが途中で加わり、既存のジョブと機械を取り合います。3つ目は加工時間のばらつきです。標準時間(マスタに登録された1工程あたりの予定時間)どおりに終わる工程は実際には少なく、材料のロット差、作業者の習熟、治具の状態によって毎回少しずつ長くも短くもなります。
この3つは、起きる頻度と1回あたりの影響の大きさが違います。故障と飛び込みは「たまに起きて、起きると大きく崩れる」型で、起きた瞬間がはっきりしているので、その時点で組み直すかどうかを判断できます。加工時間のばらつきは「毎回少しずつずれる」型で、1つ1つは小さくても積み重なり、どの時点で組み直すべきかがはっきりしません。前者には起きたときに対応する仕組み、後者には最初から余裕を織り込んだスケジュールが向いており、対策の置き場所が違います。この章では両方を扱い、最後に組み合わせて評価します。
もう1つ区別しておきたいのは、不確実性が「計画の前に分かっているか」です。故障の平均的な頻度や加工時間のばらつきの幅は、過去の実績から統計的に見積もれます。これは「どれくらいずれるか」の分布が分かっている不確実性で、余裕の大きさを決める材料になります。一方で、特定の顧客から明日どんな急ぎの注文が来るかは、分布すら当てにならないことが多く、起きてから対応するしかありません。前者は計画の段階で手当てし、後者は運用の段階で手当てする、という役割分担が考え方の出発点になります。
組み直しの枠組み、いつ直すかと、どう直すか
再スケジューリングの研究は、扱う工場も手法も論文ごとにばらばらで、同じ言葉が別の意味で使われてきました。Vieira・Herrmann・Lin の2003年の論文は、その用語を整理し、再スケジューリングを「環境」「戦略」「方針」「方法」の4段で捉える枠組みを示しています。この章の実験もこの枠組みに沿って組み立てたので、先に要点を紹介します。論文では、再スケジューリングを「乱れやその他の変化に応じて、既存の生産スケジュールを更新すること」と定義し、その引き金になる代表的な出来事として、機械の故障、急ぎの注文の到着、注文の取消し、納期の変更、材料の遅れ、優先度の変更、手直し、加工時間の見積り違い、作業者の欠勤を挙げています。この章で扱う故障・飛び込み・加工時間のばらつきは、いずれもこの一覧に含まれています。
戦略は、スケジュールをそもそも作るかどうかの選択です。スケジュールを作らず、機械が空いた時点で待っているジョブからディスパッチングルール(第3章)で次を選ぶやり方を、論文は動的スケジューリングと呼んでいます。もう1つは、先にスケジュールを作り、乱れが起きたら更新する予測反応型(predictive-reactive)のスケジューリングで、論文は実務で最もよく使われる戦略だと述べています。第5章以降で CP-SAT を使って作ってきたスケジュールは、予測反応型の「予測」の側にあたります。この章は、その「反応」の側を扱います。
方針は、いつ組み直すかの決め方です。論文は3つに分けています。1つ目は定期型で、たとえばシフトの始めや毎朝など決まった間隔で組み直し、次の組み直しまでは原則として変えません。論文はこの方式について、頻繁に組み直すより安定するが、大きな変化が起きても計画に従い続けるため成績を損ねうると書いています。2つ目は事象駆動型で、故障や飛び込みが起きるたびに組み直します。論文は、事象が次々と起きる大きな工場では常に組み直している状態になり、計画の変更が多すぎて計算負荷も大きくなりうると指摘しています。3つ目は両者を組み合わせた併用型で、定期的に組み直しつつ、大きな事象が起きたときだけ臨時に組み直します。
方法は、どう組み直すかです。論文は代表的な修復の方法として3つを挙げています。右シフトによる修復は、残りの工程の順序はそのままに、成り立たせるのに必要な分だけ後ろへずらす方法です(ガントチャートの上で右へずれるので、この名が付いています)。部分再計算は、乱れの影響を直接または間接に受けた工程だけを組み直す方法で、影響工程の再スケジューリングとも呼ばれます。全体再計算は、組み直しの時点でまだ加工していないすべての工程を、影響の有無にかかわらず組み直す方法です。論文の結びでは、全体再計算は計算の手間が最も大きい代わりに良いスケジュールを作れるが計画の変更も最も大きく、右シフトは変更が最も小さく、部分再計算はその中間に位置づけられると整理されています。この章の実験では、この3つに「全体再計算に変更量の小ささを加えたもの」と「凍結区間つきの再計算」を足した5通りを比べます。
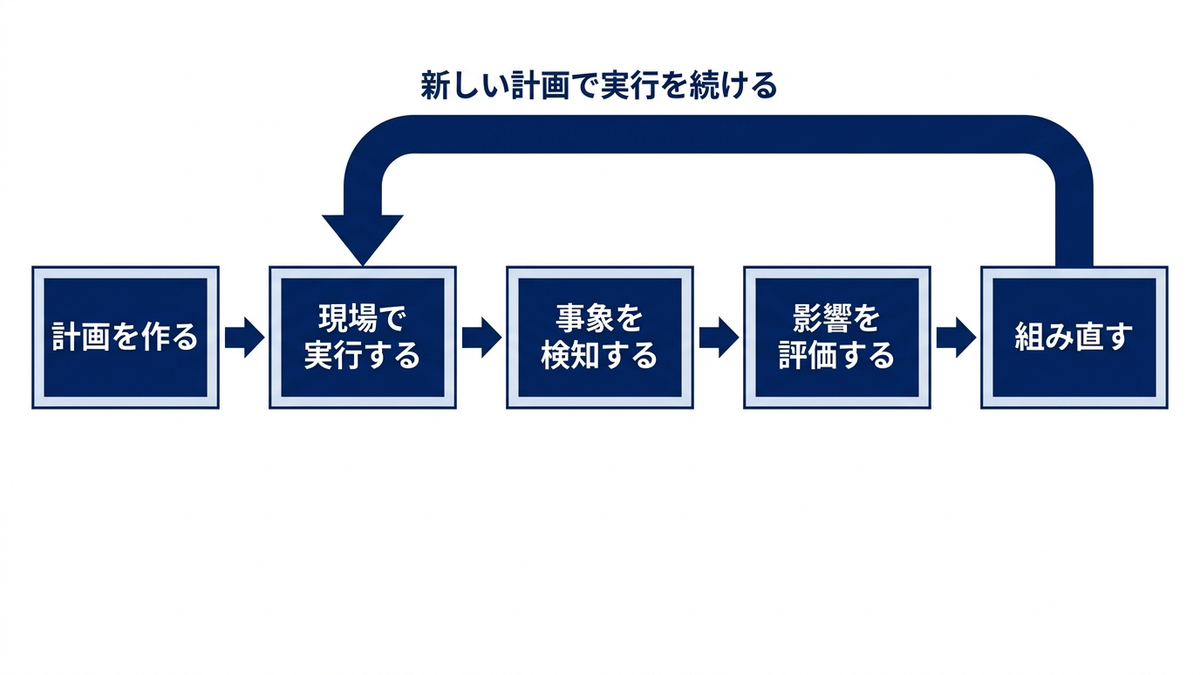
安定性という物差し、前のスケジュールからどれだけ変わったか
組み直した結果を納期遅れの大きさだけで評価すると、すべてを組み直す全体再計算が最善の候補に見えやすくなります。しかし現場から見ると、朝に配った作業指示の半分以上が昼に書き換わる計画は、それだけで損失を生みます。段取りの準備、材料の払い出し、作業者の割り当て、外注先や後工程への連絡は、いずれも計画の時刻と順序に合わせて手配されているからです。この「前の計画からどれだけ変わったか」を測る物差しが、スケジュールの安定性です。
Vieira らの論文は、安定性を「実行中にスケジュールが受ける改訂や変更の数」を測るものと定義し、その反対の状態、つまり計画が絶えず変わって先が読めない状態を、資材所要量計画(MRP)の分野で使われてきた言葉を借りて「ナーバスネス」と呼んでいます。あわせて、Wu・Storer・Chang の1993年の研究が、変更の大きさを「新旧のスケジュールの開始時刻のずれ」と「新旧のスケジュールの順序の違い」の2通りで定義したことを紹介しています。また、安定性やナーバスネスが「計画がどれだけ変わったか」を測るのに対し、ロバスト性(頑健さ)は「乱れが起きたときに工場全体の成績がどれだけ落ちるか」を測るもので、両者は別の物差しだと区別しています。
この章では、Wu らの2通りの定義に沿って、変更の大きさを3つの数字で測りました。1つ目は「開始時刻が元の計画から1時間以上動いた工程の数」です。数分のずれは現場で吸収されますが、1時間を超えると段取りや材料の手配をやり直す必要が出る、という想定で線を引きました(1時間という線は例として置いたもので、工場ごとに決める値です)。2つ目は「開始時刻のずれの合計(分)」で、ずれの総量を表します。3つ目は「機械の上で直前の工程が変わった工程の数」で、順序の入れ替えの多さを表します。直前の工程が変わると、段取り替えの内容(第7章)や治具の準備も変わるためです。いずれも、組み直しの時点でまだ始まっていない工程だけを数え、飛び込み注文で新しく加わったジョブは数えません。
実験の設定、受注12件に故障と飛び込み注文を起こす
実験の土台には、第2章で用意したサンプルデータの受注12件(5台の機械、合計52工程、着手可能時刻と納期と重みつき)を使いました。まず CP-SAT(OR-Tools 9.15)で重み付き納期遅れを最小にする元の計画を作ります。第5章と同じインターバル変数と重なり禁止制約の定式化で、重み付き納期遅れの最小値を求めたあと、その値を保ったまま各工程の開始時刻の合計を最小にして、できるだけ前に詰めた計画を選んでいます。並列ワーカー数は8、乱数シードは0に固定しました。結果は最適性が証明された解(OPTIMAL)で、計算時間は1.51秒、重み付き納期遅れは0(12件すべて納期内)、最後の工程が終わる時刻(メイクスパン)は2,080分、つまり月曜8時に始めて火曜18時40分に終わる計画です。時刻は第2章の約束どおり連続稼働とみなしています。
この計画に、次の2つの架空の出来事を1つずつ起こしました。シナリオAは故障で、月曜12時(時刻240分)に M4 熱処理炉が止まり、修理に240分かかって16時に復旧します。M4 は受注12件の負荷が最も大きい機械(1,530分)です。止まった時点で加工中だった工程は中断し、修理後に残りを加工する、という扱いにしました。シナリオBは飛び込み注文で、月曜13時(時刻300分)に新しいジョブ J13 が入ります。道順は M1 旋盤60分、M2 マシニングセンタ80分、M5 検査20分の3工程で、納期は到着から300分後の18時、重みは最大の3です。いずれも起きた時点で修理時間や J13 の内容が分かっており、組み直しはその時点で1回だけ行うものとしました。
組み直しの時点で既に始まっている工程は動かしません。シナリオAでは52工程のうち6工程が着手済みで残り46工程、シナリオBでは11工程が着手済みで残り41工程が組み直しの対象です。比べた5通りの対応は次のとおりです。
- 右シフト:機械ごとの順序を元の計画のまま保ち、遅れた分だけ後ろへずらす。飛び込みのジョブは各機械の待ち行列の先頭に割り込ませる
- 部分再計算:右シフトしたときに開始時刻が変わる工程(影響を受ける工程)と飛び込みのジョブだけを CP-SAT で組み直し、影響を受けない工程は元の開始時刻に固定する
- 全体再計算:未着手の全工程を、重み付き納期遅れ最小で組み直す
- 全体再計算+変更量最小:全体再計算の最小の納期遅れを保ったまま、元の計画からの開始時刻のずれの合計を最小にする
- 凍結:元の計画で組み直しの時点から120分以内に始まる予定だった工程は、各機械で元の順序のまま先頭に並べ(凍結)、それ以外を納期遅れ最小で組み直す
計画の実行は、どの対応でも同じ規則で模擬しました。規則は2つで、「機械の上の順序は計画どおりに守る」と「予定の開始時刻より前には始めない」です。後者は、材料や作業者が計画の時刻に合わせて手配されている、という想定を表しています。前工程や機械が空くのが遅れた場合は、空いた時点で始めます。これがそのまま右シフトの修復になっています。次のコードは、その中心部分の考え方を抜き出したものです。条件の書き方を一部変えてあるので、実際のファイルの行とは完全には一致しません。seq は機械ごとの工程の並び、plan は予定の開始時刻、dur は加工時間、downs は機械の停止の一覧です。
# 右シフトで計画を実行する(ch12_common.py の execute から考え方を抜き出したもの)
while remaining:
    for mc, lst in seq.items():                 # 機械ごとに、計画の順で先頭の工程を見る
        while ptr[mc] < len(lst):
            j, i = lst[ptr[mc]]
            if i > 0:
                if (j, i - 1) not in res:        # 前工程が終わっていなければ、この機械は待つ
                    break
            ready = res[(j, i - 1)][1] if i > 0 else jobs[j]["release"]
            st = max(plan[(j, i)], ready, mfree.get(mc, 0))   # 予定より前には始めない
            for (dm, b, e) in downs:             # 停止中なら復旧を待つ
                if dm == mc:
                    if b <= st < e:
                        st = e
            en = st + dur[(j, i)]
            for (dm, b, e) in downs:             # 加工中に止まったら、止まった時間だけ延びる
                if dm == mc:
                    if st < b < en:
                        en += e - b
            res[(j, i)] = (st, en)
            mfree[mc] = en
            ptr[mc] += 1
            remaining -= 1
組み直しの計算は、どれも時間制限20秒・並列ワーカー8・乱数シード0で CP-SAT に解かせました。組み直しの時刻より前には始められないこと、着手済みの工程が機械を使い終わる時刻と故障の復旧時刻より前にはその機械を使えないことを、各工程の開始時刻の下限として入れています。計算時間は、この記事の実行環境(一般的なノートPC)での実測です。
故障への対応を比べる、右シフトの遅れと全体再計算の変更量
シナリオA(M4 熱処理炉の240分停止)の結果が次の表です。「重み付き納期遅れ」は、各ジョブの納期遅れ(分)に重みを掛けて合計したもので、元の計画では0でした。「1時間以上動いた工程」は、組み直しの対象46工程のうち、実際の開始時刻が元の計画から1時間以上ずれた工程の数です。
| 対応 | 重み付き納期遅れ | 遅れ件数 | メイクスパン(分) | 1時間以上動いた工程(46工程中) | 開始時刻のずれの合計(分) | 直前の工程が変わった工程 | 計算時間(秒) |
|---|---|---|---|---|---|---|---|
| 右シフト | 720 | 7 | 2,260 | 39 | 7,210 | 0 | 0.00 |
| 部分再計算 | 220 | 1 | 2,080 | 24 | 5,580 | 26 | 0.11 |
| 全体再計算 | 100 | 1 | 2,250 | 37 | 10,760 | 36 | 0.13 |
| 全体再計算+変更量最小 | 100 | 1 | 2,250 | 31 | 9,870 | 35 | 0.38 |
| 凍結(120分) | 480 | 7 | 2,450 | 39 | 10,450 | 6 | 0.23 |
右シフトは順序を1つも変えない(直前の工程が変わった工程が0)ので、現場の手順書は書き換えずに済みます。その代わり、重み付き納期遅れは720、遅れるジョブは7件に増えました。M4 はこの工場で最も負荷の高い機械で、240分の停止がそのまま M4 の後ろの工程へ波及し、そのジョブの次の工程を通じて M1 や M3 の工程も後ろへずれるためです。注目したいのは「開始時刻のずれの合計」で、右シフトでも7,210分あり、46工程中39工程が1時間以上動いています。順序を守ることと、時刻を守ることは別のことで、右シフトは前者を守る代わりに後者を大きく崩します。
全体再計算は重み付き納期遅れを100まで下げ、遅れを1件に抑えました。一方で開始時刻のずれの合計は10,760分と5通りの中で最も大きく、36工程で直前の工程が入れ替わっています。納期遅れだけを目的にしたので、ソルバーにとって前の計画との違いはどうでもよく、遅れの最小値を達成する多くの解の中から、たまたま大きく動かす解を返しても区別されないからです。全体再計算+変更量最小は同じ重み付き納期遅れ100のまま、ずれの合計を9,870分、1時間以上動いた工程を31に減らしました。改善は1割弱ですが、納期の成績を1つも損なわずに得られた改善です。
部分再計算は、影響を受けない工程を元の時刻に固定したまま、影響を受けた工程だけを組み直しています。重み付き納期遅れは220で全体再計算には届きませんが、右シフトの720から大きく下がり、1時間以上動いた工程は24と5通りで最も少なくなりました。Abumaizar と Svestka の1997年の論文は、影響を受けた工程だけを組み直す方法を全体再計算および右シフトと比べ、効率(納期やメイクスパン)と安定性の両面で他の2つの欠点を補えると報告しており、この実験の結果もその報告と同じ向きです。ただし、この実験の部分再計算は直前の工程が変わった工程が26あり、「時刻はあまり動かさないが、順序はそれなりに入れ替える」性格の解になっています。
凍結(120分)は、この故障のシナリオでは良い結果になりませんでした。凍結した工程には、M4 で故障の直後に予定されていた J08 と J05 も含まれ、この2つは修理明けに元の順序のまま先頭で流すことになります。遅れ件数は右シフトと同じ7件、メイクスパンは2,450分と5通りで最も長くなりました。凍結した工程は修理明けに並べ替えられないので、全体再計算に比べて並べ替えの自由が狭くなっています。凍結は「現場が準備を始めている工程を守る」ための道具で、故障した機械の直後の工程に当てると、守る価値の薄い順序を守ることになります。凍結区間の長さによる違いは次の節で見ます。
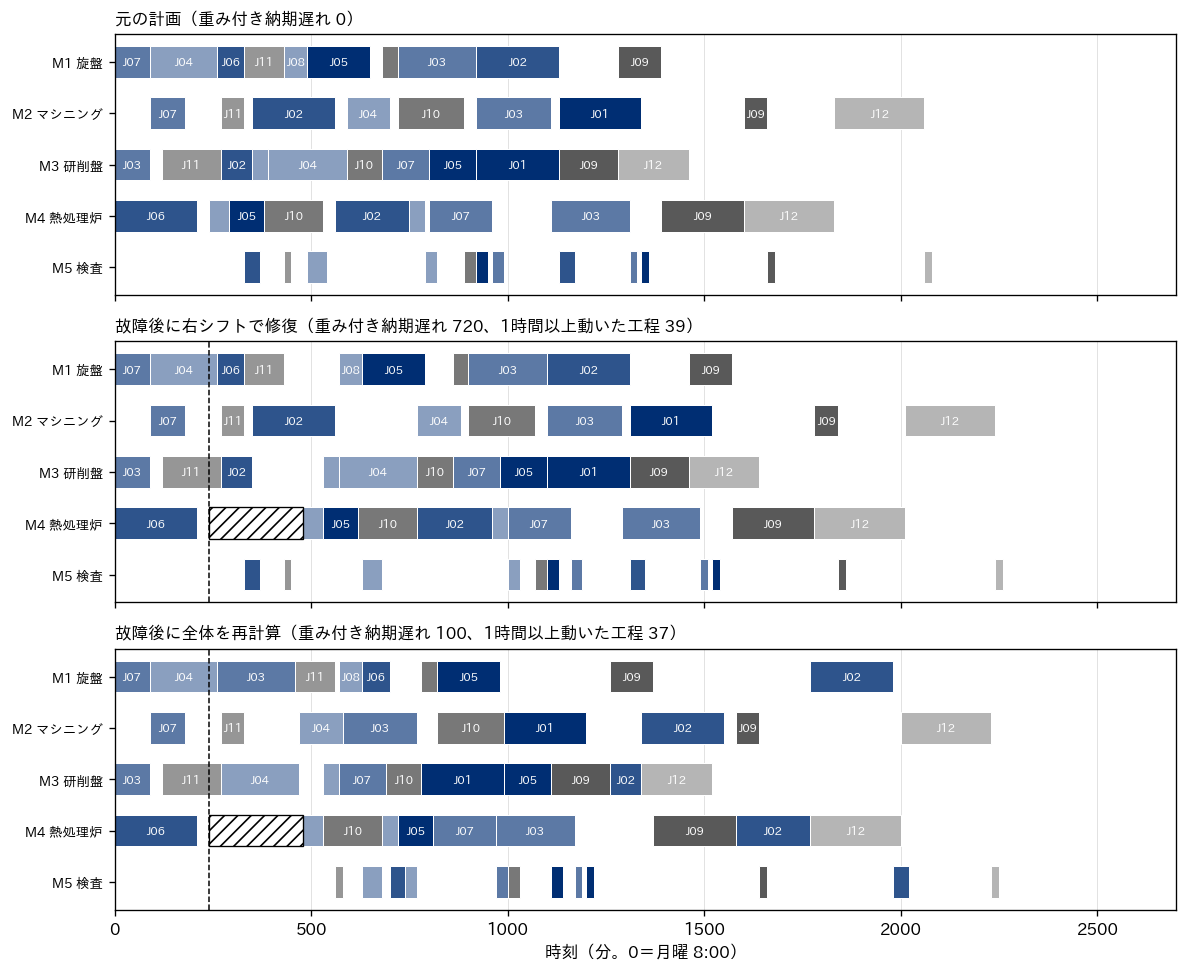
上の図は、元の計画(上段)と、故障後の右シフト(中段)と全体再計算(下段)のガントチャートです。斜線の帯が M4 の停止、縦の点線が故障の時刻です。中段では M4 の列の工程が修理明けから順に後ろへずれ、その影響が M1 や M3 の列の後半まで広がっています。下段では M1 の列の J03 と J06、M4 の列の J05 と J10 のように順序そのものが入れ替わっていることが読み取れます。
飛び込み注文への対応と、凍結区間の長さの効き方
シナリオB(月曜13時に J13 が到着、納期18時、重み3)の結果が次の表です。「J13 の遅れ」は飛び込んだジョブ自身の納期遅れ(分)です。組み直しの対象は41工程です。
| 対応 | 重み付き納期遅れ | 遅れ件数 | J13 の遅れ(分) | メイクスパン(分) | 1時間以上動いた工程(41工程中) | 開始時刻のずれの合計(分) | 直前の工程が変わった工程 |
|---|---|---|---|---|---|---|---|
| 右シフト(J13 を先頭に割り込み) | 120 | 1 | 0 | 2,080 | 16 | 1,790 | 0 |
| 部分再計算 | 0 | 0 | 0 | 2,270 | 8 | 5,220 | 17 |
| 全体再計算 | 0 | 0 | 0 | 2,090 | 27 | 4,230 | 20 |
| 全体再計算+変更量最小 | 0 | 0 | 0 | 2,080 | 16 | 1,920 | 9 |
| 凍結(120分) | 180 | 1 | 60 | 2,080 | 1 | 460 | 0 |
飛び込みは故障より影響が小さく、J13 の加工時間は合計160分、納期まで300分の余裕があります。右シフトで J13 を各機械の先頭に割り込ませると J13 自身は間に合いますが、押し出された既存の工程のうち1件の受注が納期に遅れ、重み付き納期遅れは120になりました。全体再計算は遅れを0にしましたが、41工程中27工程を1時間以上動かしています。ここで効いたのが全体再計算+変更量最小で、遅れ0を保ったまま、1時間以上動いた工程を16、ずれの合計を1,920分、直前の工程が変わった工程を9に抑えました。全体再計算と比べると、同じ納期の成績で、1時間以上動かす工程を27から16へ、ずれの合計を半分以下にできたことになります。故障のシナリオAでは改善が1割弱でしたが、飛び込みのように「どこかを少し空ければ入る」種類の乱れでは、変更量を目的に入れる効果が大きく出ました。
部分再計算は、1時間以上動いた工程が8と、凍結を除く4通りの中で最も少ない一方で、ずれの合計は5,220分と大きく、メイクスパンも2,270分に延びました。影響を受けた工程だけを動かす制約の中で納期遅れを0にするため、動かせる少数の工程を大きく後ろへ送る解になっています。「動かす工程の数」と「動かす量」のどちらを重く見るかで評価が変わる例で、この章で物差しを3つ並べた理由でもあります。
凍結(120分)は、1時間以上動いた工程が1、ずれの合計が460分と、変更量では5通りの中で最小でした。その代わり、凍結した工程が M1 の列の先頭を占めるため、J13 は60分遅れて重み付き納期遅れは180になっています。凍結区間とは、計画のうち直近の一定期間を「もう変えない」と決めた範囲のことで、現場が既に準備を始めている工程を守るための仕組みです。凍結区間の長さを変えたときの結果が次の表です。凍結0分は全体再計算と同じ条件です。
| 凍結区間の長さ(分) | シナリオA 重み付き納期遅れ | シナリオA ずれの合計(分) | シナリオB 重み付き納期遅れ | シナリオB J13 の遅れ(分) | シナリオB ずれの合計(分) |
|---|---|---|---|---|---|
| 0 | 100 | 10,760 | 0 | 0 | 4,230 |
| 60 | 260 | 4,730 | 180 | 60 | 460 |
| 120 | 480 | 10,450 | 180 | 60 | 460 |
| 240 | 480 | 10,450 | 630 | 210 | 480 |
| 480 | 720 | 7,210 | 1,450 | 480 | 1,170 |
| 960 | 720 | 7,210 | 2,520 | 840 | 0 |
飛び込みのシナリオBでは、凍結区間を長くするほど J13 は後回しになり、960分(16時間)凍結すると J13 は840分遅れて重み付き納期遅れは2,520まで増えます。一方で、ずれの合計は凍結60分の時点で460分まで下がり、120分と240分でもほぼ同じ(460分と480分)で、480分の凍結ではかえって1,170分に増えます。960分凍結すると残りの工程がすべて元の計画のまま動かないのでずれは0になりますが、その代償が J13 の840分の遅れです。この条件では、60分の凍結で変更量を大きく減らし、それより長い凍結は飛び込みの受け入れを遅らせるだけ、という形でした。故障のシナリオAでは、凍結を長くすると重み付き納期遅れが右シフトの720に近づき、480分以上ではちょうど右シフトと同じ結果になりました。凍結区間の外側だけを組み直す方法は、凍結を長くするほど右シフトに近づく、ということがこの表から確かめられます。なおシナリオAの「ずれの合計」は凍結の長さに対して単調ではなく、120分と240分の凍結では右シフトより大きくなっています。凍結の外側の工程は納期遅れだけを目的に組み直しており、変更量は目的に入っていません。次の節で見るとおり、この故障のシナリオには右シフトより納期遅れも変更量も小さい解が存在するので、凍結を使うときも、外側の組み直しに変更量を目的として入れる意味があります。
凍結区間は、もともと基準生産計画(MPS)の分野で研究されてきた考え方です。Sridharan・Berry・Udayabhanu の1987年の論文は、ローリング(計画を一定間隔で作り直す)のもとで基準生産計画を凍結する方法を、凍結の方式・凍結区間の長さ・計画期間の長さの3つの決定変数についてシミュレーションで調べ、凍結によって計画の変更は減らせるが生産費用や在庫費用が増えうること、幅広い条件で計画期間の50%までの凍結は費用への影響がわずかだったことを報告しています。対象は週単位の基準生産計画で、この章の分単位の現場スケジュールとは時間の刻みが違いますが、「凍結の長さは、変更の少なさと成績の悪化のあいだで決める設計変数である」という捉え方は共通しています。この章の実験では、飛び込み注文を受ける工場ほど凍結を短くする必要があることが、J13 の遅れの列にはっきり表れました。
変更量を目的に入れる、納期遅れとのトレードオフを数字で見る
全体再計算+変更量最小は、2段階で解いています。1段目で重み付き納期遅れの最小値を求め、2段目では「重み付き納期遅れはその最小値以下」という制約を足したうえで、元の計画からの開始時刻のずれ(絶対値)の合計を最小にします。ずれの絶対値は、CP-SAT の add_abs_equality で補助の変数に結びつけると線形の目的関数に入れられます。凍結は、凍結する工程を機械ごとに元の順序で並べ、それ以外の工程をその後ろに置く制約で表しました。考え方を抜き出すと、中心部分は次のようになります。実際のファイルとは書き方が一部違い、2段目の目的関数も次の段落で補うとおり少し複雑です。
# 前計画からのずれ(絶対値)を変数にする(ch12_common.py の solve から考え方を抜き出したもの)
devs = []
for k in keys:                                   # keys は未着手の工程
    if k in plan_prev:                           # 飛び込みのジョブは前計画に無いので数えない
        d = m.new_int_var(0, H, "d%s_%d" % k)
        m.add_abs_equality(d, S[k] - plan_prev[k])
        devs.append(d)

# 凍結:凍結する工程を前計画の順で先頭に並べ、残りはその後ろ
fz = sorted([k for k in keys if M[k] == mc if k in frozen], key=lambda k: plan_prev[k])
for a, b in zip(fz, fz[1:]):
    m.add(S[b] >= E[a])
if fz:
    for k in keys:
        if M[k] == mc:
            if k not in frozen:
                m.add(S[k] >= E[fz[-1]])

# 2段目:納期遅れは1段目の最小値 wt1 以下に保ち、ずれの合計を最小にする
m.add(WT <= wt1)
m.minimize(sum(devs))
実際のスクリプトでは、2段目の目的関数を sum(devs) * 100000 + sum(new2)(new2 は飛び込みのジョブの工程の開始時刻)とし、ずれの合計を最優先にしたうえで、飛び込みのジョブを必要以上に後ろへ置かないようにしています(_code\ch12_common.py)。1段目の上限 wt1 を最小値ではなく、それより大きな値にすると、「納期遅れをこれだけ許すなら、変更量はどこまで減らせるか」を順に調べられます。シナリオAで上限を全体再計算の100から右シフトの720まで7段階に変えて解いた結果が次の図です。
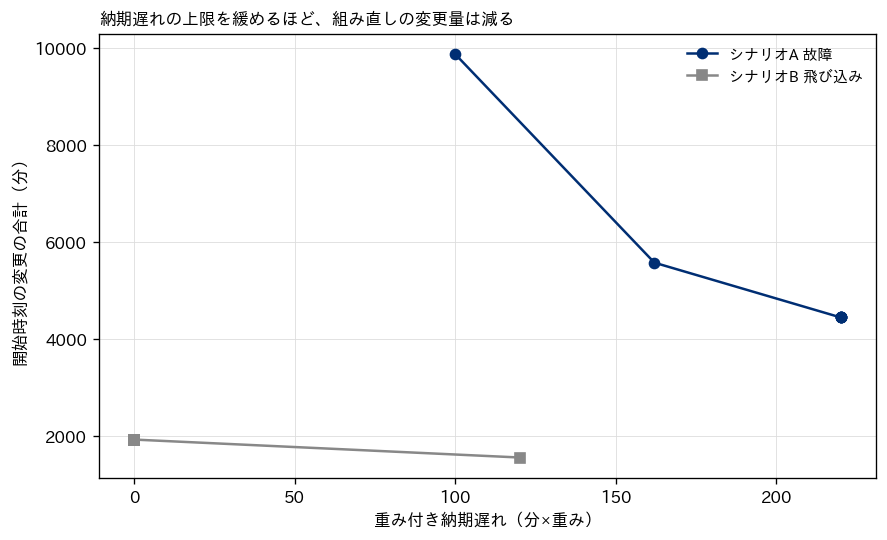
シナリオAでは、重み付き納期遅れ100のときにずれの合計が9,870分、上限を162に緩めると5,570分、224に緩めると重み付き納期遅れ220でずれの合計4,440分になり、上限をそれ以上(317・410・565・720)に緩めても220と4,440分のまま変わりませんでした(上限720の回は20秒の時間制限で打ち切られ、最適性は証明されていません)。つまり、納期遅れを100から220へ120だけ許すと、変更量を半分以下にできます。さらに目を引くのは、右シフト(重み付き納期遅れ720、ずれの合計7,210分)が、この曲線より右上にあることです。重み付き納期遅れ220・ずれの合計4,440分の解は、右シフトより納期遅れが小さく、変更量も小さい解で、右シフトは「計画をなるべく変えない」つもりの対応でありながら、どちらの物差しでも改善の余地がある、という結果になりました。順序を変えないことと、時刻を変えないことは違う、という前の節の観察が、ここで数字として確かめられます。シナリオBでは、上限0から90までずれの合計1,920分で変わらず、上限120で1,550分に下がるだけでした。飛び込みのような小さな乱れでは、納期遅れを許しても変更量はそれほど減らない、ということです。
2つの物差しを1本の目的関数にまとめるなら、重み付き納期遅れに「変更1分あたりの費用」を掛けたずれの合計を足す形になります。この重みは、変更1回あたりに現場で何が起きるか(段取りのやり直し、材料の再払い出し、外注先への連絡)を金額や工数に直して決めるのが筋ですが、その値を最初から正確に決めるのは難しいことが多いように思います。上のように上限を段階的に変えて一覧を作り、「この納期遅れの差で、この変更量の差なら、どちらを選ぶか」を計画担当者と現場の責任者が一覧を見て決めるほうが、重みを推測で置くより合意を取りやすいと考えています。
余裕を織り込んだロバストなスケジュール、加工時間のばらつきへの備え
ここまでは、起きた出来事にどう反応するかを見てきました。次は、ばらつきを見込んで最初から余裕を持たせておく方法です。乱れが起きても大きく崩れないように作ったスケジュールをロバストなスケジュールと呼びます。Leon・Wu・Storer の1994年の論文は、乱れが起きたら右シフトで修復するという運用を前提に、乱れの後のメイクスパンとそのばらつきの2つでロバスト性を定義し、その代わりになる指標を遺伝的アルゴリズムに組み込んで作ったスケジュールが、メイクスパンだけで作ったスケジュールを大きく上回ったと報告しています。Vieira らの論文は、Mehta と Uzsoy の研究を、工程の順序を決めたあとで意図的に空き時間(挿入アイドル時間)を差し込み、乱れの影響を減らす方法として紹介し、その研究では、成績をあまり落とさずに乱れに強いスケジュールを作れたとされる一方で、故障が起きなかったときに早く終わりすぎる影響は考慮していなかった、と付記しています。
この章では、最も単純な余裕の持たせ方を試しました。計画を作るときに、各工程の標準時間に一律の倍率を掛けた時間を使うのです。実際の加工時間は「標準時間×係数」とし、係数は最小0.9・最頻1.0・最大1.4の三角分布に従う、と仮定しました。標準時間どおりに終わることが最も多く、1割早く終わることもあるが、遅れるときは最大で4割長くかかる、という右に裾の長い形で、係数の平均は1.1です(この分布は例として置いた架空の仮定です)。計画の倍率を1.0(余裕なし)・1.1・1.2・1.3の4通りにして、それぞれ CP-SAT で重み付き納期遅れ最小の計画を作り、同じ乱数で1,000回、加工時間を振って右シフトで実行しました。乱数シードは12、全工程の係数の標本平均は1.1001でした。スクリプト全体の実行時間は約1分です。
| 計画の倍率 | 計画上の重み付き納期遅れ | 計画上のメイクスパン(分) | 実績の重み付き納期遅れ 平均 | 同 90%点 | 遅れ件数 平均 | 実績のメイクスパン 平均(分) | 予定開始からの遅れ 平均(分) | 予定の10分以内に始まった工程(%) |
|---|---|---|---|---|---|---|---|---|
| 1.0 | 0 | 2,080 | 240.3 | 493 | 3.12 | 2,280.4 | 70.4 | 17.6 |
| 1.1 | 0 | 2,407 | 102.8 | 247 | 2.17 | 2,456.0 | 23.3 | 46.2 |
| 1.2 | 684 | 2,616 | 698.1 | 744 | 5.12 | 2,616.0 | 3.0 | 89.3 |
| 1.3 | 1,501 | 2,587 | 1,461.0 | 1,476 | 6.25 | 2,583.3 | 0.2 | 99.4 |
余裕なし(倍率1.0)の計画は、紙の上では12件すべて納期内ですが、加工時間がばらつくと、実績の重み付き納期遅れは平均240.3、遅れ件数は平均3.12件になりました。1,000回のうち遅れが1件も出なかった回は3.1%しかありません。予定の開始時刻から10分以内に始まった工程は17.6%で、残りの8割強は予定より遅れて始まっています。朝に配った計画の時刻が、ほとんど当てにならないということです。
倍率1.1、つまり加工時間の平均どおりの時間で計画すると、実績の重み付き納期遅れは平均102.8と、余裕なしの半分以下に下がりました。90%点(1,000回を悪い順に並べて上から1割の境目)も493から247に下がっています。計画上のメイクスパンは2,407分に延びますが、実績のメイクスパンの平均は2,456.0分で、余裕なしの2,280.4分との差は計画上の差より小さくなっています。予定の10分以内に始まった工程は46.2%に増えました。
倍率を1.2・1.3と大きくすると、様子が変わります。計画の時点で既に納期に間に合わない(計画上の重み付き納期遅れが684、1,501)ため、実績の重み付き納期遅れも698.1、1,461.0と大きく悪化しました。「予定の開始時刻より前には始めない」という規則のもとでは、余裕を取りすぎると、早く終わった工程の後に空き時間ができ、その空き時間がそのまま納期遅れになります。その代わり、予定の10分以内に始まった工程は89.3%、99.4%で、計画の時刻はほぼ守られます。余裕は、納期の成績と計画の当たりやすさを交換する道具で、取りすぎると納期の成績を失う、という関係がこの表の読み方です。この条件では、ばらつきの平均に合わせた1.1倍が納期の面では最も良い結果でした。なお、計画上のメイクスパンは1.3倍(2,587分)のほうが1.2倍(2,616分)より短くなっています。計画は、重み付き納期遅れを最小にしたあとで開始時刻の合計を小さくする2段階で作っており、メイクスパンそのものは目的関数に入れていません。そのため、倍率を大きくしても計画上のメイクスパンが順に長くなるとは限りません。
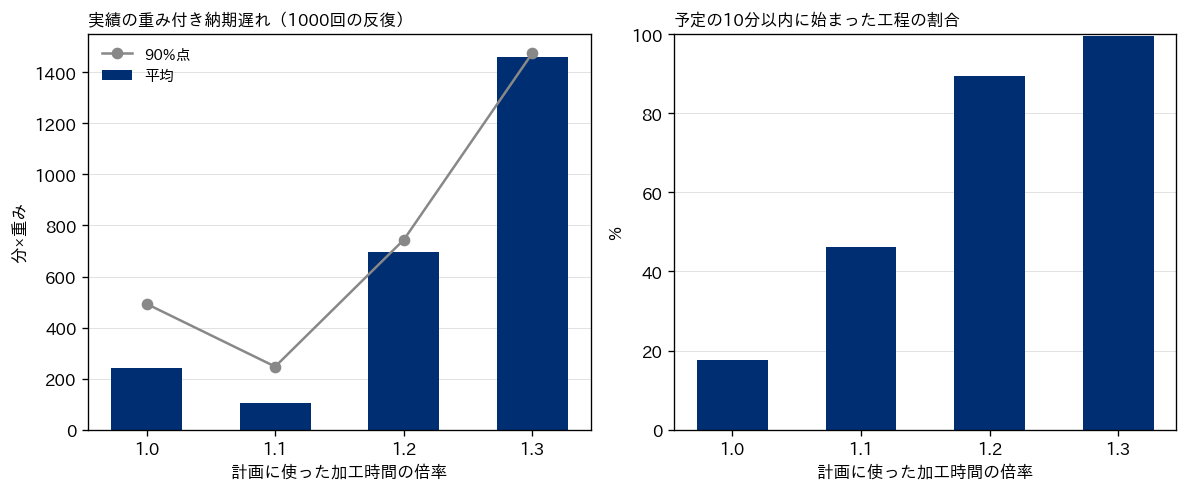
この実験の余裕は、全工程に一律で掛けた最も単純なものです。実務では、ばらつきの大きい工程(新しい製品、熟練者が限られる工程、故障の多い設備)にだけ余裕を厚く取る、ボトルネックの手前にまとめて余裕を置く、といった配分の工夫が考えられます。プロジェクト管理の分野では、ゴールドラットの『クリティカルチェーン』が、作業時間を必要以上に見積もることをプロジェクトが予定どおりに進まない原因の1つとして取り上げています(章末の参考書籍で紹介します)。どこに、どれだけ余裕を置くかは、過去の実績(標準時間に対する実績時間の比)の分布を工程ごとに集計してから決める値で、その集計が無いまま一律の倍率を掛けると、この表の1.2倍・1.3倍のように、余裕が納期遅れに化けることがあります。
故障・飛び込み・ばらつきを同時に起こす反復シミュレーション
最後に、3種類の乱れを同時に起こして、組み直し方の違いが平均的にどう出るかを反復シミュレーションで調べました。1回の反復では、次の3つを起こします(いずれも架空の仮定です)。加工時間は前の節と同じ三角分布の係数で振ります。故障は、M1〜M4 のどれか1台(等確率)が時刻60〜1,200分のどこかで止まり、修理に60〜240分(10分刻み、等確率)かかります。飛び込みは、J13 が時刻120〜1,200分のどこかで到着します(道順・納期・重みはシナリオBと同じ)。故障と飛び込みが起きるたびに、その時点で組み直します。組み直しの計算には標準時間を使い、実際の加工時間は組み直しの時点では分からないものとしました。加工中の工程の終わりは「標準時間どおりに終わる、ただし既に標準時間を過ぎていればもう少しかかる」と見込んでいます。
反復は200回、乱数シードは12で、各反復ではすべての対応に同じ乱数(同じ加工時間・同じ故障・同じ到着時刻)を使いました。こうすると、対応の違いだけが結果の違いになります。組み直しの計算は1回あたり時間制限5秒・並列ワーカー8にしました。比べたのは前の節までの5通りに、倍率1.1の余裕つき計画を右シフトで実行するものを加えた6通りです。200回の反復全体の実行時間は83.7秒でした。「朝の計画から1時間以上ずれた工程」は、受注12件の46工程ではなく全52工程のうち、実際の開始時刻が朝の計画(余裕つきの対応では余裕つきの計画)から1時間以上ずれた工程の数です。
| 対応 | 重み付き納期遅れ 平均 | 同 90%点 | 遅れ件数 平均 | J13 の遅れ 平均(分) | J13 が遅れた回(%) | 朝の計画から1時間以上ずれた工程 平均(52工程中) | 組み直しの計算 平均(秒/反復) | 右シフトより納期遅れが小さかった回(200回中) |
|---|---|---|---|---|---|---|---|---|
| 右シフト | 2,384.3 | 4,271 | 8.44 | 106.2 | 76 | 33.0 | 0.00 | 基準 |
| 部分再計算 | 1,219.6 | 2,174 | 6.71 | 38.7 | 62 | 31.5 | 0.05 | 183 |
| 全体再計算 | 1,206.1 | 2,170 | 6.55 | 40.8 | 61 | 31.4 | 0.14 | 182 |
| 全体再計算+変更量最小 | 1,168.3 | 2,161 | 6.60 | 39.2 | 61 | 31.6 | 0.12 | 187 |
| 凍結(120分) | 1,759.1 | 2,886 | 7.15 | 167.5 | 97 | 31.6 | 0.10 | 147 |
| 余裕1.1倍+右シフト | 1,432.4 | 3,348 | 7.30 | 45.1 | 50 | 26.0 | 0.00 | 173 |
読み取れることは4つあります。第一に、組み直しをするかしないかの差は大きく、右シフトだけで済ませると重み付き納期遅れの平均は2,384.3で、組み直す3通り(部分再計算・全体再計算・全体再計算+変更量最小)の約2倍でした。この3通りは、200回のうち182〜187回で右シフトより納期遅れが小さくなっています。第二に、組み直す3通りのあいだの差は小さく、平均で1,168.3〜1,219.6の範囲に収まりました。同じ乱数で同じスクリプトをもう一度走らせたところ、部分再計算の平均は1,198.4になり、全体再計算(1,207.0)との順位が入れ替わりました。乱数シードを固定していても、並列ワーカー8・時間制限つきの CP-SAT は同じ入力に対して実行ごとに違う解を返すことがあり、この2回の実行でそれが確かめられました。3通りの間の数十程度の差は、この実験では実行ごとのぶれと区別できません。また、組み直しの計算は標準時間で行い、実行は実際の加工時間で進むので、組み直しの時点で最適な計画が、実行した後にも最適であるとは限りません。組み直す3通りの差が小さいことにこの食い違いがどれだけ効いているかは、この実験では切り分けていません。
第三に、凍結(120分)は J13 の遅れの平均が167.5分、J13 が遅れた回が97%と、飛び込みの受け入れで明らかに不利でした。シナリオBで見たのと同じ傾向が、到着時刻をばらつかせても現れています。第四に、余裕1.1倍+右シフトは、組み直しを一切しないのに重み付き納期遅れの平均が1,432.4で、右シフトの2,384.3から4割ほど下がりました。朝の計画から1時間以上ずれた工程も平均26.0と、6通りの中で最も少なくなっています。ただし90%点は3,348と組み直す3通りより大きく、故障や飛び込みが重なった悪い回では余裕だけでは吸収しきれません。余裕で日々の小さなばらつきを吸収し、大きな事象には組み直しで対応する、という組み合わせが、この結果から読み取れる方向です(この組み合わせそのものは、この実験では試していません)。
一方で、安定性の物差しは、確定的なシナリオのときほどはっきりした差を示しませんでした。朝の計画から1時間以上ずれた工程は、組み直す3通りでいずれも平均31前後で、右シフトの33.0とも大きくは違いません。前の節の余裕なしの実験では、故障も飛び込みも起こさずに加工時間を振るだけで、予定の10分以内に始まった工程が17.6%にとどまりました。ばらつきだけでも朝の計画の時刻は大きくずれる、ということで、この表の安定性の数字にもその分が含まれています。組み直しのたびに計画の上で1時間以上動かした工程の数(2回の組み直しの延べ)は、全体再計算が平均31.2、全体再計算+変更量最小が平均29.7で、変更量を目的に入れた効果はこの条件では小さなものでした。この2つの数字は上の表には載せていない別の集計です。表の「朝の計画から1時間以上ずれた工程」は、実際に動いた開始時刻を朝の計画と比べて数えたもので、加工時間のばらつきによるずれも含みます。こちらは、組み直しの前後の計画どうしを比べて1時間以上書き換えた工程を数え、1回の反復で起きる2回の組み直しの分を足し合わせたものです。値は近いですが、同じものを言い換えた数字ではありません。変更量を目的に入れる価値は、飛び込みのシナリオBのように「どこかを少し空ければ済む」乱れで大きく、ばらつきが支配的な状況では小さい、というのがこの章の実験の範囲での結論です。
この実験は、受注12件・機械5台という小さな工場で、乱れの分布もすべて架空の仮定です。数字そのものを自社の工場に当てはめることはできませんが、「自社の受注と機械のデータに、自社の故障記録と実績時間の分布を与えて同じ比較をする」という比較の考え方は、そのまま応用できます。実際に使うときは、この章では入れていない勤務カレンダー・段取り・作業者の制約や、途中で中断してよいかどうかを、第7章・第10章の方法でモデルに足す必要があります。離散イベントシミュレーション(出来事が起きる時刻ごとに状態を更新していく模擬の方法)の一般的な組み立て方、乱数の扱い、反復回数の決め方と結果のばらつきの読み方は、弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」で扱っています。
経営指標への翻訳と、組み直しの決まりごとの作り方
この章の数字を経営の言葉に直すと、次のようになります。重み付き納期遅れは、重みを顧客への影響の大きさとみなせば、遅延の罰金や信用の損失の総量の代わりの指標です。故障のシナリオAで、右シフトだけで済ませると7件の受注が遅れ、全体再計算なら1件で済みました。この差の6件が、組み直しの仕組みを持たないことの代償です。一方、全体再計算は46工程中37工程の開始を1時間以上動かしました。これは、現場の段取り・材料・人の手配を37回やり直すことに相当し、残業や手待ち、指示の取り違えといった形で費用になります。どちらの損失も、納期遅れの件数だけを見る管理指標には現れません。
| 経営の問い | この章で見た数字 | 自社で測るもの |
|---|---|---|
| 組み直しの仕組みを持つ価値はあるか | 反復シミュレーションで、右シフトだけの重み付き納期遅れ平均2,384.3に対し、組み直す3通りは1,168.3〜1,219.6 | 乱れが起きた日の納期遅れの件数と重みを、組み直した場合と組み直さなかった場合で比べる |
| 組み直しで現場をどれだけ振り回しているか | シナリオAの全体再計算で46工程中37工程が1時間以上移動 | 1回の組み直しで開始時刻が1時間以上動いた工程の数、順序が入れ替わった工程の数 |
| 変更を抑えるとどれだけ納期を失うか | シナリオAで重み付き納期遅れを100から220に許すと、ずれの合計は9,870分から4,440分へ | 納期遅れの上限を変えたときの変更量の一覧(上限を段階的に変えて解く) |
| 飛び込みをどこまで受けられるか | 凍結60分で J13 は60分遅れ、凍結960分で840分遅れ | 凍結区間の長さと、飛び込み注文の受け入れまでの時間 |
| 余裕はどれだけ持つべきか | 加工時間の平均に合わせた1.1倍で重み付き納期遅れが最小。1.2倍以上では計画の時点で納期に遅れる | 工程ごとの「実績時間÷標準時間」の分布 |
この一覧から、組み直しの運用として決めておくべきことが3つ見えてきます。1つ目は、いつ組み直すかの決まりです。Vieira らの整理に沿えば、毎朝などの定期的な組み直しに、大きな事象(ボトルネック設備の故障、重みの大きい飛び込み)のときだけの臨時の組み直しを加える併用型が出発点になると考えています。どの事象を「大きい」とみなすかは、右シフトで済ませたときの納期遅れの増分を見て決められます。この章の実験の範囲では、右シフトで吸収できない事象が起きたときに組み直す、という線の引き方が素直です。2つ目は、どう組み直すかの決まりで、全体を組み直すにしても、変更量を目的に入れる(少なくとも同じ納期遅れのなかでは変更の少ない解を選ぶ)ことを標準にしておくと、同じ納期の成績のまま現場の手配のやり直しを減らせる場合があります。シナリオBでは、1時間以上動かす工程が27から16に減りました。3つ目は、凍結区間の長さで、これは段取りや材料の準備に実際にかかる時間から決め、飛び込みの多い工場ほど短くします。
これらの決まりの前提になるのは、実績のデータです。加工時間の実績と標準時間の比、故障の頻度と修理時間、飛び込み注文の頻度と重みが記録されていなければ、余裕の倍率も凍結区間の長さも決められず、この章のシミュレーションも自社の条件では回せません。標準時間の精度が結果を決めることと、現場の実績をどう集めて計画に戻すかは、次の第13章で扱います。
次の図は、この章の冒頭で紹介した Vieira らの論文の整理に沿って、組み直しの3つの方法の性格を一般論として並べたもので、この章の実測値を大・中・小に直したものではありません。論文は、全体再計算は組み直す工程が多いので計算の手間が大きく、右シフトは残りの工程を後ろへずらすだけなので変更が最も小さい、と説明しています。この章の受注12件の規模では、組み直し1回の計算時間はシナリオAの表で右シフト0.00秒、部分再計算0.11秒、全体再計算0.13秒(変更量最小つきは0.38秒)、反復シミュレーションの平均でも0.14秒以下で、どの方法も1秒未満でした。この規模では、計算の手間の差は方法を選ぶ理由になりません。
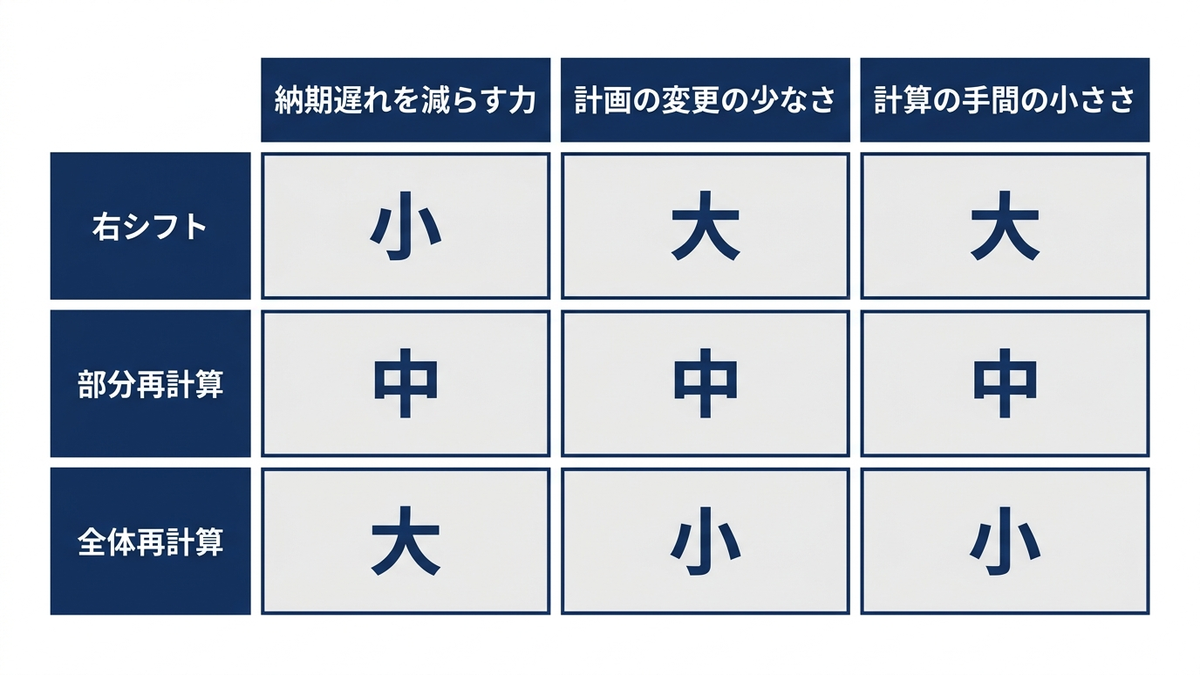
この章の要点は3つです。第一に、乱れへの対応は「いつ組み直すか(方針)」と「どう組み直すか(方法)」に分けて決めるもので、方法には右シフト・部分再計算・全体再計算があり、納期の成績と計画の変更量が逆向きに動きます。第二に、変更量(安定性)は目的関数に入れて測れる量で、同じ納期遅れのまま変更を減らせる場合があり、納期遅れの上限を段階的に変えれば両者の交換条件を一覧にできます。右シフトは順序を守りますが時刻は大きく崩し、この章の故障のシナリオでは納期遅れと変更量の両方で上回る解が存在しました。第三に、加工時間のばらつきには、平均に合わせた余裕を最初から織り込むことが効き、余裕を取りすぎると納期遅れに化けます。組み直しの仕組みと余裕の持ち方は、自社の実績データを与えたシミュレーションで比べてから決めるのが確実です。次の第13章では、こうした仕組みを実際の工場に入れるときの手順、つまり暗黙知を制約に落とす方法、標準時間の精度、システムの連携と運用を扱います。
この章を深めたい方への参考書籍
『システムシミュレーション』(森戸晋・逆瀬川浩孝、朝倉書店):経営工学ライブラリーの1冊で、簡単な待ち行列モデルのシミュレーションから始めて、より複雑なモデルの組み立て、ランダムな要因の決め方、擬似乱数の作り方、シミュレーション結果のまとめ方までを扱っています。この章の反復シミュレーションで乱数シードを固定し、共通乱数で対応を比べた部分の背景にある、乱数と結果の統計的な読み方を体系的に学べます。
『「ザ・ゴール」シリーズ クリティカルチェーン なぜ、プロジェクトは予定どおりに進まないのか?』(エリヤフ・ゴールドラット著、三本木亮訳、ダイヤモンド社):制約理論に基づくプロジェクト管理の手法を小説の形で描いた本で、2026年3月に新装版が出ています。所要時間が延びる、必要以上に時間を見積もる、ぎりぎりまで手を付けない、というプロジェクトが遅れる構造を扱っており、この章の「余裕の取りすぎが納期遅れに化ける」という結果を、計画の見積りと人の行動の側から考える手がかりになります。
第13章 現場に入れる、暗黙知を制約に落とし運用を回し続けるまで
第12章では、故障や飛び込み注文、加工時間のばらつきが起きたときに、スケジュールを右にずらして修復するのか、一部だけ計算し直すのか、全体を解き直すのかを比べ、前のスケジュールからの変更量を抑えることや、直近の区間を凍結することの意味を確認しました。この章はその続きで、ここまでの章で組み立てたモデルを、実際の工場で毎日使われる仕組みにするための手順を扱います。数理モデルの話はここで一段落し、対象はヒアリングの仕方、データの整え方、システムの役割分担、運用と報告の設計に移ります。
生産スケジューリングの最適化が現場で使われなくなる原因は、ソルバーの性能やモデルの式の誤りではないことが多いように思います。現場のベテランが頭の中で守っている決まりごとがモデルに入っていない、標準時間のマスタが実態とずれていて計算上の完了時刻が当たらない、計画担当者が出力を毎日手で直していてその理由が残らない、経営には「稼働率が何パーセント」としか報告されず何が良くなったのか分からない、といった運用側の理由で止まります。この章では、暗黙知と例外ルールを制約に落とす手順、ハード制約とソフト制約の分け方、標準時間の精度、APS・MES・ERP の役割分担とデータの流れ、人が最後に直す運用、KPI と経営報告、導入の順序、失敗の型を、この順に扱います。コードは載せません。代わりに、ヒアリングで何を聞くか、どの制約を守らせどの制約を目的に回すか、どこから手を付けるか、という設計の判断を書きます。
暗黙知を制約に落とす、ヒアリングで聞くこと
第2章から第12章までのモデルは、機械・工程・加工時間・着手可能時刻・納期・段取り時間・作業者といった「表に書けるもの」で組み立てました。ところが実際の工場の日程は、表に書かれていない決まりごとで大きく動いています。たとえば「この研削盤は午前中に精度の要る品物を流す」「熱処理炉は同じ温度条件の品物がそろうまで火を入れない」「この顧客の品物は検査を2人で行う」「金曜の夕方に段取り替えをしない」「新人は M2 を一人で扱わない」といったものです。こうした決まりごとはベテランの計画担当者の頭の中にあり、文書になっていないことが多いように思います。モデルにこれが入っていないと、計算結果は数字の上では良くても現場から見ると「使えない」スケジュールになり、担当者は出力を無視して手で組み直します。導入の最初の仕事は、この暗黙の決まりごとを1つずつ言葉にして、制約か目的のどちらかに落とすことです。
ヒアリングは、抽象的に「どんなルールがありますか」と聞いても、ほとんど出てきません。本人にとって当たり前すぎて、ルールだと認識していないからです。有効だと考えているのは、具体的な過去のスケジュールを題材にして聞く方法です。先週の実績のガントチャート(第2章で読み方を確認したもの)を印刷して担当者の前に置き、「このジョブをなぜこの順番にしたのか」「このジョブをここに入れなかったのはなぜか」「この空き時間は何のためか」を1本ずつ聞きます。順番の理由を説明してもらうと、その説明の中にルールが現れます。「この2つは同じ治具を使うので続けた」なら段取りの制約(第7章)、「午後は検査員が1人になるので検査の多い品物を午前に寄せた」なら人の制約(第10章)、「この顧客は納期の前日に電話が来るので前倒しにした」なら納期の重み(第3章)の話です。
ヒアリングの設問は、次の5つの系統に分けて用意しておくと漏れが減ります。第一に資源についての設問で、機械ごとに「扱える品物と扱えない品物」「同時に動かせない機械の組み合わせ」「担当できる作業者」「止まる時間帯」を聞きます。第二に順序についての設問で、「続けて流したい品物の組」「続けて流してはいけない品物の組」「必ず朝一番か最後に流す品物」を聞きます。第三に時間についての設問で、「標準時間どおりに終わらない工程」「工程と工程の間に必要な待ち時間(冷却・乾燥・検査待ち)」「逆に、間を空けてはいけない工程」を聞きます。第四に優先についての設問で、「遅れたときに一番困る顧客や品物」「遅れても許される品物」「急ぎの注文が来たときに後回しにしてよい品物」を聞きます。第五に例外についての設問で、「年に数回しか起きないが、起きたら必ずこうする」という決まりを聞きます。最後の系統は、モデルに入れるかどうかを後で決めるとしても、記録だけは残しておきます。
聞き取った決まりごとは、その場で1行ずつ台帳に書きます。台帳の列は「決まりごとの文言(担当者の言葉のまま)」「関係する資源・品物・時間帯」「破ったら何が起きるか」「誰が言ったか」「いつから・なぜあるのか」の5つを最低限にします。「破ったら何が起きるか」の列が次の節の分類の材料になり、「いつから・なぜあるのか」の列が後で見直すときの材料になります。昔の設備の不具合を避けるために作った決まりが、設備を入れ替えた後も残っている、ということは珍しくないように思います。理由が分かっていれば、その決まりを外す判断ができます。
ハード制約とソフト制約、決まりごとを2つの箱に分ける
台帳に集めた決まりごとは、モデルの中で2通りの扱い方があります。1つは、破ったスケジュールを最初から候補に入れない扱いで、この記事ではハード制約と呼びます。第5章で CP-SAT に入れた「同じ機械で2つの工程が重ならない」「工程の順番を守る」「着手可能時刻より前に始めない」はこれにあたります。もう1つは、破ることを許すが、破った分だけ罰を目的関数に足す扱いで、ソフト制約と呼びます。第3章以降で目的にした「納期遅れ」は、まさに納期をソフト制約として扱ったものです。納期を守れない注文が1件でもあるときに納期をハード制約にすると、解が1つも無い(実行不可能)という答えしか返ってこず、どの注文をどれだけ遅らせるのが一番ましかという、現場が本当に知りたいことが分かりません。
どちらの箱に入れるかは、台帳の「破ったら何が起きるか」の列で決めます。物理的にできないこと(その機械では加工できない、炉の容量を超える、資格の無い人は扱えない)と、安全・法令・品質保証に関わること(冷却時間を取らずに次工程に送ると割れる、検査を飛ばす)はハード制約にします。破ると損はするが工場は動くこと(段取りが増える、残業になる、顧客への約束より遅れる、好ましくない順番になる)はソフト制約にして、破った量に重みを付けて目的関数に足します。迷ったときはソフト制約にしておくのが安全だと考えています。ハード制約を増やしすぎると、少し条件が厳しい週に解が無くなり、計画担当者はシステムを使うのをやめて手で組み直すことになるからです。ソフト制約にしておけば、少なくとも「どの決まりをどれだけ破れば計画が成り立つか」が数字で出ます。
ソフト制約の重みは、優先順位の表明です。重みの付け方には2つの流儀があります。1つは、すべてを円に換算して足す流儀で、納期遅れ1分あたりの損失、段取り1回あたりの費用、残業1時間あたりの費用をそれぞれ円で置き、合計の費用を最小にします。経営指標とつながりやすい反面、「顧客の信用を失う損失は何円か」のように換算の根拠を作れない項目が必ず出ます。もう1つは、優先順位をつけて上から順に最適化する流儀(辞書式の最適化)で、たとえば「まず重み付き納期遅れを最小にし、その値を悪化させない範囲で段取りの合計を最小にし、さらにその範囲で残業を最小にする」と段階的に解きます。CP-SAT では、1段目を解いて得た最適値を制約として追加してから2段目の目的で解き直す、という手順で実現できます。円に換算できない項目が多い工場では、後者のほうが現場の感覚に合うことが多いように思います。
次の表は、ヒアリングで集まりやすい決まりごとを、弊社の考えで2つの箱に振り分けた例です。同じ決まりでも工場によって箱が変わることがあるので、最終的には「破ったら何が起きるか」を現場で確かめて決めます。
| 決まりごとの例(台帳の文言) | 分類 | モデルでの表し方 | 関係する章 |
|---|---|---|---|
| この品物は M2 でしか削れない | ハード制約 | 工程に使える機械を限定する(代替機があれば選択肢として持たせる) | 第5章・第9章 |
| 熱処理の後、最低60分は冷やしてから研削に回す | ハード制約 | 前工程の終了から次工程の開始までに最小の間隔を入れる | 第5章 |
| 炉には同じ温度条件の品物しか一緒に入れられない | ハード制約 | バッチの組み合わせに条件を付ける | 第10章 |
| M2 を扱えるのは3人だけ | ハード制約 | 作業者を資源として持ち、同時に使える人数の上限を置く | 第10章 |
| 同じ系列はなるべく続けて流す | ソフト制約 | 順序依存の段取り時間を目的に足す | 第7章 |
| A 社の品物は絶対に遅らせない | ソフト制約(重みを大きく) | 納期遅れの重みを大きくする。本当に破れないなら、その注文だけ納期をハード制約にする | 第3章・第5章 |
| 金曜の夕方に段取り替えをしない | ソフト制約か、稼働カレンダー | その時間帯に段取りが入ったら罰を足すか、段取りができない時間帯として表す | 第7章・第10章 |
| 残業はなるべく避けたい | ソフト制約 | 定時を超えて使った時間に費用を付ける | 第10章 |
| 明日の朝の分は今さら動かさないでほしい | ハード制約(凍結区間) | 直近の時間帯の割り付けを前回の結果に固定する | 第12章 |
表の最後の行のように、決まりごとには「計画の作り方」に関するものも混ざっています。第12章で扱った凍結区間や、前回のスケジュールからの変更量を抑えるという考え方は、現場の「今さら動かさないでほしい」という声を制約と目的に翻訳したものです。ヒアリングでは、品物や機械の決まりごとだけでなく、「どのくらい前に決まっていれば困らないか」「計画が変わるとき、誰に何を連絡しているか」も聞いておくと、凍結区間の長さや再計算の頻度を決める材料になります。
ハード制約とソフト制約の振り分けで、もう1つ注意したいのは、ハード制約の中に「本当は破れるもの」が混ざっていないかを、導入後に確かめることです。ヒアリングで「絶対に無理」と言われた決まりが、実績を見ると月に数回は破られている、ということはよくあるように思います。そういう決まりは、実態としてはソフト制約で、重みの大きいソフト制約に移すほうが、厳しい週に解が消える事故を防げます。逆に、ソフト制約にした決まりが一度も破られない計画しか出てこないなら、その重みは実質的にハード制約として働いています。どちらも、実績と計画を並べて見れば分かります。
標準時間のマスタが結果を決める
スケジューリングのモデルに入れる加工時間は、ほとんどの工場で「標準時間」としてマスタに登録された値です。JIS Z 8141(生産管理用語)は2022年に改正されていますが、この章の定義の引用は、第1章と同じく全文を開いて確認できた2001年版によるものです。以下、この章で JIS Z 8141 と書くときは2001年版を指します。この規格は標準時間を「その仕事に適性をもち,習熟した作業者が,所定の作業条件のもとで,必要な余裕をもち,正常な作業ペースによって仕事を遂行するために必要とされる時間」と定義し、正味時間と余裕時間から構成されるとしています。同じ規格は標準時間の設定法として、ストップウォッチ法、PTS 法、標準時間資料法、実績資料法、経験見積り法を挙げ、経験見積り法を「現場経験の豊富な管理者が作業時間を見積もる方法」と説明しています。実際の工場のマスタには、きちんと測った値と、立ち上げのときに経験で見積もったまま更新されていない値が混ざっていることが多いように思います。
最適化は、与えられた加工時間を正しいものとして、その上で最も良い順序と時刻を計算します。加工時間が実態とずれていれば、計算は正しくても答えは外れます。それがどの程度の影響になるかを、第2章で用意したサンプルデータの受注12件で確かめました。まず、標準時間どおりの加工時間で重み付き納期遅れを最小にする計画を CP-SAT で解きました(8ワーカー・乱数シード0・時間制限30秒。この記事の実行環境での実測で、最適性が証明されています)。この計画は重み付き納期遅れ0分、つまり全件が納期に間に合う計画です。次に、機械ごとの加工の順番をこの計画のまま固定し、実際の加工時間がマスタと違っていたら完了時刻がどうなるかを計算しました。各工程は、機械が空き、前の工程が終わり、着手可能時刻を過ぎた時点で始まるとしています。比べたのは、マスタが研削盤 M3 の加工時間を2割短く見積もっていた場合(実際は標準時間の1.2倍)、熱処理炉 M4 で同じことが起きていた場合、すべての機械で1割短く見積もっていた場合の3つです。
| 実際の加工時間 | 標準時間で組んだ計画を実際の時間で実行 | 2段目で完了時刻の合計も詰めた計画を実際の時間で実行 | 実際の時間を知っていた場合の最適な計画 |
|---|---|---|---|
| 標準時間どおり | 重み付き納期遅れ 0分・遅れ 0件 | 重み付き納期遅れ 0分・遅れ 0件 | 重み付き納期遅れ 0分・遅れ 0件(2列目の計画そのもの) |
| M3 研削盤だけ1.2倍 | 重み付き納期遅れ 966分・遅れ 7件 | 重み付き納期遅れ 438分・遅れ 4件 | 重み付き納期遅れ 46分・遅れ 1件 |
| M4 熱処理炉だけ1.2倍 | 重み付き納期遅れ 574分・遅れ 3件 | 重み付き納期遅れ 0分・遅れ 0件 | 重み付き納期遅れ 0分・遅れ 0件 |
| 全機械1.1倍 | 重み付き納期遅れ 664分・遅れ 5件 | 重み付き納期遅れ 132分・遅れ 3件 | 重み付き納期遅れ 0分・遅れ 0件 |
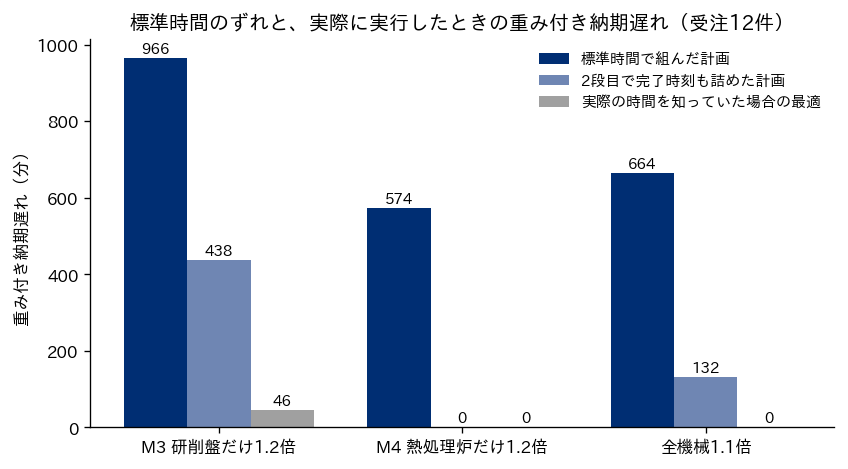
表の2列目「標準時間で組んだ計画を実際の時間で実行」を見ると、研削盤1台の見積もりが2割甘いだけで、全件が間に合うはずだった計画は、12件中7件が遅れ、重み付き納期遅れが966分になりました。一方、4列目「実際の時間を知っていた場合の最適な計画」は、同じ条件でも遅れを1件・46分に抑えられています。研削盤の実際の総負荷は1,430分から1,716分に増えます。このシナリオでは、実際の時間を知ったうえで CP-SAT が最適性を証明した計画でも重み付き納期遅れ46分・遅れ1件が残ったので(最適値と下界がともに46分)、全件を間に合わせる計画はこの条件では存在しません。それでも、正しい時間を知っていれば被害を1件に絞れた、ということです。熱処理炉で1.2倍、全機械で1.1倍の場合は、正しい時間を知っていれば遅れ0件の計画が作れたのに、マスタの誤りのせいで3件と5件の遅れが出ています。この差は、ソルバーの性能ではなく、マスタの精度だけで生まれています。
3列目は、前の節で触れた辞書式の最適化を使った計画です。1段目で重み付き納期遅れを最小にし(最適値0分)、その値を保ったまま2段目で重み付き完了時刻の合計を最小にしました。1段目だけで止めた計画は、「全件が納期に間に合う」という条件を満たす無数の計画のうち、ソルバーがたまたま返した1つで、納期ぎりぎりに完了する注文を多く含んでいても区別されません。2段目で完了時刻を前に詰めた計画は、同じ「遅れ0」の計画でも納期までの余裕が大きく、加工時間が延びたときの被害が小さくなりました(M3 が1.2倍で7件から4件、M4 が1.2倍で3件から0件)。第12章で扱った、余裕を持たせたスケジュールの考え方が、目的関数の2段目という形でも実現できることを示しています。ただし、この比較は1つのデータと3つのシナリオでの結果で、2段目を足せば必ず頑健になるという一般的な主張ではありません。
この実験から導かれる運用上の結論は、最適化の導入より前に、あるいは導入と同時に、標準時間のマスタを実績と照合する仕組みを作る必要があるということです。照合の材料は、JIS Z 8141 が作業日報(1日の作業実績として品名・作業名・生産数・直接作業時間・間接作業時間などを記録する伝票)と呼んでいるものや、後述する MES が集める実績です。工程ごとに「標準時間」「実績の中央値」「実績のばらつき」「実績の件数」を並べた表を月に1回作り、実績の中央値が標準時間から一定の割合以上ずれている工程を洗い出します。ずれの原因が段取りの含め方の違い(標準時間には段取りが入っていないのに、実績には入っている、あるいはその逆)であることも多いので、段取りを別の項目として記録できるようにしておくと、第7章の段取り時間の行列もあわせて更新できます。
照合で見つけたずれを、そのまま実績の平均で置き換えればよいとは限りません。実績の中には、材料待ちや段取り待ちで機械が止まっていた時間、作業者が別の機械を掛け持ちしていた時間、不良の手直しの時間が混ざっていることがあり、それを含めた平均をマスタにすると、今度は計画が甘くなりすぎて、機械の空き時間が増えます。JIS の定義が「習熟した作業者が,所定の作業条件のもとで」「正常な作業ペース」と条件を付けているのは、標準時間が理想的な実績の平均ではなく、決められた条件のもとでの基準であることを示しています。弊社としては、スケジューリングに使う加工時間は、標準時間そのものではなく「計画用の時間」として別に持ち、標準時間に工程ごとの実績の比率を掛けた値を使うのがよいと考えています。標準時間は原価計算や能率の評価にも使われるので、スケジューリングの都合だけで書き換えると別の部門の数字が狂うからです。
マスタの精度が経営に与える影響は、表の数字で説明できます。研削盤の見積もりが2割甘いだけで、全件が間に合うはずの計画から7件の遅れが出ました。これが毎週起きれば、営業は納期回答のたびに「システムの予定より何日か余裕を見て」回答するようになり、見かけの納期遵守率を保つために、顧客に答える納期までの期間を長く答えることになります。回答する期間が長いと受注を取り逃がします。余裕を見た分だけ早めに投入する運用になれば仕掛品も増えます(第1章で見たリトルの法則は、生産量が安定している期間について、平均の仕掛品と平均のリードタイムが比例することを示しています)。逆に、マスタが実態より長すぎれば、機械が空いているのに計画上は満杯に見え、受けられる注文を断るか、不要な設備投資や外注の判断につながります。マスタの精度は、スケジューリングの品質である以前に、納期回答と設備投資の判断の品質です。マスタの精度を KPI の1つにして経営に報告するのがよいと考えているのは、このためです。
APS・MES・ERP の役割分担とデータの流れ
ここまでの内容を毎日回すには、スケジュールを計算する仕組みを、工場の他の情報システムとつなぐ必要があります。関係するシステムは大きく3つです。最初に、それぞれが何をするものかを、確かめられた定義に沿って整理します。
ERP について、JIS Z 8141 は「ERP システム」を、販売・在庫管理・物流、生産管理または購買管理、管理会計または財務会計、人事管理などの基幹業務プロセスに必要な機能を、あらかじめ備えたソフトウェア群である統合業務パッケージを利用して、相互に関係づけながら実行を支援する総合情報システム、と定義しています。受注、品目、部品構成、在庫、原価といった、会社全体で1つであるべき記録の正本を持つのが ERP です。生産の文脈では、第8章で扱った週単位・量単位の計画や、資材所要量計画(MRP)の結果を持つのもここであることが多いと考えています。
MES について、日本の JIS Z 8141 には項目がありません(この記事で確認した JIS Z 8141 の本文には「製造実行システム」の項が見当たりませんでした)。業界団体の MESA International(当時の名称は Manufacturing Execution Systems Association)が1997年9月に公表した白書『MES Explained: A High Level Vision』は、MES を、受注の投入から完成品に至るまでの生産活動の最適化を可能にする情報を提供するもので、最新で正確なデータを使って工場の活動を、起きたその時に導き、開始し、応答し、報告するもの、と定義しています。同じ白書は MES の機能を11に分けており、その中には工程の詳細な順序づけ(Operations/Detail Scheduling。有限の能力を前提に、交代勤務のパターンに合わせて詳細な時刻を計算するもの)と、差立て(Dispatching Production Units。作業を行うべき順に指示を示し、現場で事象が起きると即時に変わるもの)が含まれています。JIS Z 8141 の用語でいえば、差立て(ある機械で1つのジョブの加工が終わったとき、次に加工すべきジョブを決定し指示する活動)と、生産時点情報管理(生産活動で発生する情報を発生場所で即時に収集し、必要な指示を提供する情報管理システム)にあたる働きを担うのが MES だと整理できます。
本記事では、第2章から第12章で扱ってきた計算、つまり JIS Z 8141 が生産スケジューリングと呼んでいる「使用可能な資源の制約下で,製品又は部品それぞれの工程ごとの着手時期・終了時期・着手順序,使用設備を決める活動」を計算機で行うソフトウェアを、APS(生産スケジューラ)と呼びます。JIS Z 8141 には APS という項目は無く、サプライチェーンマネジメントの項の備考に、制約理論などと並ぶサプライチェーン計画の管理技術として名前が出てくるだけです。製品としての APS には、MES の一部として提供されるもの、ERP の計画機能の一部として提供されるもの、単独の製品として両者の間に置かれるものがあり、名前だけでは中身が決まりません。前述の MESA の白書も、ERP と MES のどちらも現場に作業を差し立てることができ、サプライチェーンのシステムと MES のどちらも有限能力のスケジューリングを含む、と重なりを認めています。導入の検討では、製品の分類名ではなく、どの計算をどこで行うかで役割を決めるほうが混乱が少ないと考えています。
システムの階層については、国際標準の ISA-95(IEC 62264 としても知られます)が、企業の業務システムと製造の制御システムの間の情報交換の抽象モデルを定めています。ISA の公式ページは、レベル0を物理的な工程、レベル1をセンサなどの機器、レベル2を PLC や DCS による監視と制御、レベル3を MES など製造の運用を管理するシステム、レベル4を ERP を含む事業の運営に関わる活動としており、この標準は主にレベル3とレベル4の間のつなぎ目を扱うと説明しています。この記事では、APS を、レベル4の受注・計画の情報とレベル3の現場の情報をつなぐ位置に置いて整理します。ERP から来る「何を・いつまでに・いくつ」という注文の情報を、MES の現場の状態(機械が動いているか、作業者がいるか、材料が来ているか)と突き合わせて、「どの機械で・何時から・どの順で」に変換するのがスケジューリングの仕事だからです。これは ISA-95 がスケジューリングの置き場所を決めているという意味ではなく、この記事の整理の仕方です。前述の MESA の白書が工程の詳細な順序づけを MES の機能に含めているように、スケジューリングをレベル3の側に置く整理もあります。
| システム | 持つもの(正本) | スケジューリングへの入力 | スケジューリングからの出力を受けて行うこと |
|---|---|---|---|
| ERP(レベル4) | 受注・品目・部品構成・在庫・原価・週単位の生産計画 | 注文(品目・数量・納期・顧客の重み)、材料の入荷予定 | 納期回答、資材の手配時期の見直し、原価の見積もり |
| APS(この記事ではレベル3と4をつなぐ位置に置く) | 工程の手順と使える機械、計画用の加工時間、段取りの行列、ハード制約とソフト制約の台帳、重み | ERP の注文、MES の現場の状態と実績 | 工程ごとの着手時刻・終了時刻・順序・使用設備を計算し、ERP と MES へ渡す |
| MES(レベル3) | 作業の実績(開始・終了時刻、数量、不良、停止の理由)、作業者と設備の状態 | 機械の稼働状態、仕掛品の位置、実績の加工時間(マスタの照合に使う) | 差立て(次に何を加工するかの指示)、進捗の把握、計画と実績の差の記録 |
データの流れで最も手間がかかるのは、表の3列目「スケジューリングへの入力」をそろえることです。ERP の品目コードと MES の作業の単位が一致していない、ERP の工程手順は設計時のままで実際の工程と違う、MES の実績には開始時刻しか無く終了時刻は次の作業の開始時刻で代用している、といったずれは、システムを見ただけでは分からず、現場の手順を確かめる必要があります。前の節で述べたマスタの照合も、MES の実績の開始時刻と終了時刻が工程単位で正しく取れていることが前提です。弊社としては、最適化のモデルを作り込む前に、実績が工程単位で取れているかを確かめ、取れていなければそこから整えるのがよいと考えています。
もう1つ決めておくことは、計算を行う場所を1か所にすることです。ERP の計画機能が出す日程と、APS が出すスケジュールと、計画担当者が表計算で持っている予定表が並存すると、どれが正なのか分からなくなり、現場は一番よく知っている表計算に戻ります。計算は1か所で行い、その結果を他のシステムに書き戻し、他のシステムは結果を表示するだけにする、という取り決めを、導入の最初に置くのがよいと考えています。
人が最後に直す運用、手直しの記録を次の制約にする
どれだけ丁寧にヒアリングしても、最初のモデルに全部の決まりごとが入ることはありません。したがって、導入後しばらくは、計画担当者が計算結果を見て手で直してから現場に出す運用になります。これは失敗ではなく、モデルを育てる過程の一部だと考えています。問題は、手直しが記録されずに消えることです。計画担当者が画面上でジョブを動かし、その理由を誰にも伝えずに現場へ出すと、翌日も同じ手直しが必要になり、モデルはいつまでも現場に追いつきません。
弊社が妥当だと考えている運用は、「手直しは自由、ただし理由を1行残す」です。計画担当者がスケジュールを変えたら、どのジョブをどこからどこへ動かしたか(これはシステムが自動で記録できます)と、なぜ動かしたか(これは人が書くしかありません)を残します。理由は自由記述でもよいのですが、「材料が来ていない」「作業者が休み」「機械の調子が悪い」「顧客から催促」「順番の決まりがモデルに無い」「計算結果が現場の感覚と合わない」のような選択肢を用意しておくと、後で集計しやすくなります。
この記録を月に1回集計すると、手直しの理由は大きく3つに分かれます。1つ目は、モデルに入っていない決まりごとが原因の手直しで、同じ理由が何度も出てくるなら、それは台帳に追加してハード制約かソフト制約としてモデルに入れるべきものです。2つ目は、入力データの誤りが原因の手直しで、材料の入荷予定が ERP で更新されていなかった、機械の停止が MES に入っていなかった、というものです。これはモデルではなくデータの流れを直す対象です。3つ目は、その日かぎりの事情による手直しで、急な休みや顧客からの特別な依頼です。これはモデルに入れる必要はなく、第12章で扱った再スケジューリングの仕組みで対応するものです。手直しを3つに分けて数えることで、「モデルの改善」「データの改善」「再計算の運用の改善」のどこに手を入れるべきかが分かります。
手直しの件数そのものも、導入が進んでいるかを示す指標になります。導入直後は手直しが多く、モデルに決まりごとを足していくにつれて減っていくのが順調な姿です。件数が減らない場合は、同じ理由の手直しが繰り返されていないかを見ます。繰り返されているのに台帳に追加されていないなら、記録が集計されていないか、集計しても誰もモデルを直していないかのどちらかです。逆に、件数が急にゼロになった場合は、計画担当者が手直しをやめたのではなく、計算結果を使うのをやめて別の表で計画を立てている可能性も疑う必要があります。手直しの件数と、計算結果がそのまま現場に出た割合を並べて見ると、この区別がつきます。
人が直す余地を残しておくことには、もう1つの意味があります。計画担当者が「最後は自分が決める」と思えることは、現場がシステムを受け入れる条件の1つだと考えています。計算結果を変えられない仕組みにすると、担当者はシステムの外で計画を立て始めます。変えられるが、変えた理由が残り、その理由が次の月のモデルに反映される、という循環が回ると、担当者の知識がモデルに移っていき、担当者が異動しても計画の品質が保たれます。これは、ベテランの計画担当者に依存した属人的な計画を、会社の資産に変える過程でもあります。
KPI の設計と経営報告
スケジューリングの仕組みが効いているかどうかを測る指標を決めます。第2章以降で目的関数にしてきたメイクスパンや重み付き納期遅れは、1回の計算の良し悪しを測る指標でした。運用の KPI はそれより広く、計画と実績の差、計画の作り方そのものの健全さ、経営指標への翻訳を含めます。弊社が月次で見るとよいと考えている指標を、次の表にまとめます。定義のうち JIS Z 8141 に項目があるものはその定義に沿い、無いものは弊社の定義として書いています。
| 指標 | 定義 | 読み方 | 誤読しやすい点 |
|---|---|---|---|
| 納期遵守率 | 期間中に納期を迎えた注文のうち、納期までに完了した件数の割合(弊社の定義)。納期を過ぎてまだ完了していない注文も分母に入れる | 顧客から見た約束の守り方。経営の共通語 | 納期を後から延ばした注文を「遵守」と数えると高く出る。当初の納期と変更後の納期を分けて持つ |
| 重み付き納期遅れ | 遅れた注文の遅れ時間に重みを掛けて合計したもの(第2章・第3章の目的関数) | 遅れの深さと重要度。件数では見えない大口の遅れが分かる | 重みの付け方で値が変わる。重みの表を経営が承認しておく |
| 製造リードタイム | JIS Z 8141 の生産リードタイム「生産の着手時期から完了時期に至るまでの期間」。注文ごとの平均に加えて、中央値と上位の値で見る | 生産に着手してから完了するまでの速さ。受注から出荷までの期間は、着手前の待ちや出荷の手続きを含む別の指標として分けて定義する | 平均だけ見ると、長く滞留した少数の注文が埋もれる |
| 仕掛品 | 着手して完了していない注文の数量または金額 | 工場の中に溜まっているもの。リードタイムと連動する(第1章) | 月末の1点だけで見ると、月末に投入を止める操作で下がる |
| ボトルネック設備の稼働率 | JIS Z 8141 の稼働率「人又は機械における就業時間若しくは利用可能時間に対する有効稼働時間との比率」を、あい路となる設備について見る | 工場全体の出来高を決める設備が、どれだけ有効に使われたか | JIS も解釈に広義と狭義があるとしている。分母(就業時間か利用可能時間か)を固定する。全設備の平均は意味が薄い |
| 段取り時間の合計 | 期間中の段取り替えに使った時間の合計(第7章) | 段取りで失った能力 | 回数だけ数えると、長い段取りと短い段取りが同じに見える |
| 残業時間 | 定時を超えて稼働した時間の合計 | 計画で吸収できなかった負荷 | 残業で納期を守っていると、納期遵守率だけ見て問題に気づかない |
| 計画どおりに出た割合 | 計算結果が手直しなしで現場に出た件数の割合(弊社の定義) | モデルが現場に追いついているか | 急にゼロや100%になったら、計算結果が使われていない可能性を疑う |
| マスタの精度 | 工程ごとの実績の加工時間の中央値を、計画用の加工時間で割った比(弊社の定義) | 計画の前提が当たっているか | 待ちや手直しの時間が実績に混ざると比が大きく出る |
表の指標は、いくつかの組で読みます。納期遵守率と残業時間は、表と裏の関係にあります。納期遵守率が高くても、残業で無理に間に合わせているなら、計画は負荷を読み違えていて、その費用は人件費に回っています。製造リードタイムの平均と仕掛品の平均は、生産量(スループット)が安定している期間では、第1章で見たリトルの法則で結びつきます。生産量が変わらないのに平均の片方だけが改善して見えるなら、測り方がずれていないか(仕掛品を月末の1点で測っている、リードタイムの起点と終点が仕掛品の数え方と合っていない等)を疑います。リトルの法則が結びつけるのは平均どうしなので、中央値や上位の値は別に見ます。ボトルネック設備の稼働率と段取り時間の合計は、ボトルネックの能力をどこで失っているかを示す組で、稼働率が低い原因が段取りなら第7章、材料待ちなら ERP の手配、故障なら保全の問題と、打ち手が分かれます。計画どおりに出た割合とマスタの精度は、スケジューリングの仕組みそのものの健康状態を示す組で、ほかの指標が悪化したとき、原因がモデルの外(需要や故障)にあるのか、モデルの中(決まりごとの漏れや時間の誤り)にあるのかを切り分けるのに使います。
経営への報告は、このうち経営指標に翻訳できるものを軸にします。弊社が妥当だと考えている月次の報告は、1枚目に納期遵守率・製造リードタイム・仕掛品・残業時間の12か月の推移、2枚目にボトルネック設備の稼働率と段取り時間と、それを能力に換算した値(段取りで失った時間が、ボトルネックで何件分の注文にあたるか)、3枚目に遅れた注文の一覧を重み付き納期遅れの大きい順に並べ、それぞれの遅れの原因(負荷超過・マスタの誤り・材料・故障・飛び込み)を1語で付けたもの、という構成です。3枚目の原因の内訳は、次の月の打ち手を決める材料になります。原因がマスタの誤りに偏っていればマスタの照合に、負荷超過に偏っていれば受注の平準化か能力の増強に、材料に偏っていれば調達の見直しに手を入れる、という判断です。
経営目線で注意したいのは、稼働率を単独の目標にしないことです。稼働率は分かりやすく、設備投資の回収とも結びつくので、目標にしやすい指標です。しかし、第1章で見たとおり、稼働率を上げていくと待ち時間は急激に増えます。稼働率だけを目標にすると、機械を止めないために先の注文まで前倒しで投入するようになり、仕掛品が増え、製造リードタイムが延び、急ぎの注文が割り込めなくなります。稼働率はボトルネック設備に限って見ること、そして納期遵守率と製造リードタイムを同時に目標にすることで、この行動を防げると考えています。ボトルネックでない設備は、ボトルネックより能力に余裕があるのが正常な姿で、その稼働率が低いことは問題ではありません。
導入の順序、実績の見える化から範囲の拡大まで
ここまでの内容を、どの順に進めるかを整理します。弊社が妥当だと考えている順序は、実績の見える化、決まりごとの台帳づくり、ボトルネック工程での並行運用、本番運用、範囲の拡大と評価、の5段階です。この順序の要点は、「最適化の計算を現場に出すのは4段階目」であることと、「最初に取り組むのはデータ」であることです。
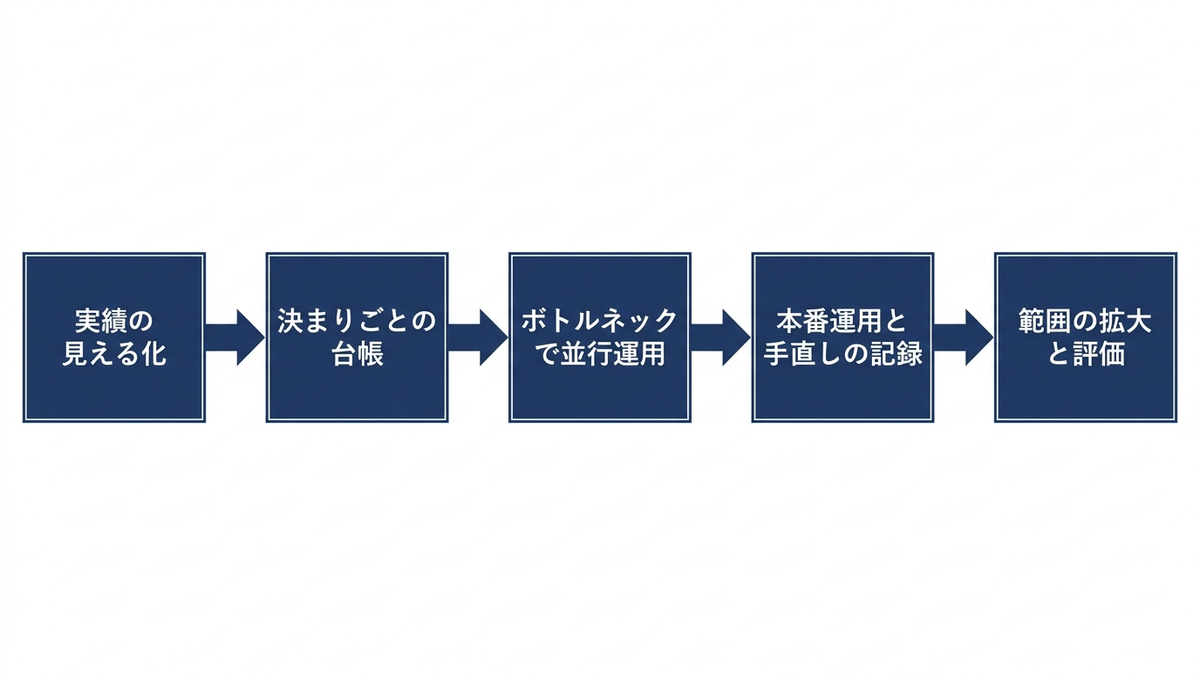
1段階目の実績の見える化では、工程ごとの実績の開始時刻と終了時刻が取れているかを確かめ、取れていれば標準時間と並べてマスタの精度を測ります。あわせて、注文ごとの製造リードタイム、仕掛品、ボトルネック設備の稼働率、段取り時間を、今のやり方のまま測ります。この段階の目的は改善ではなく、改善の前の基準値を持つことです。基準値が無いと、導入後に「良くなったのか」を誰も答えられません。実績が工程単位で取れていない工場では、この段階で作業日報の様式や MES の入力を整えることになり、ここに最も時間がかかることが多いように思います。
2段階目の決まりごとの台帳づくりでは、最初の節で述べたヒアリングを行い、ハード制約とソフト制約に振り分け、優先順位(重み、または辞書式の順番)を決めます。優先順位は、計画担当者だけでなく、営業と工場長を交えて決めるのがよいと考えています。どの顧客のどの注文を優先するかは、製造だけで決められる問題ではないからです。
3段階目のボトルネック工程での並行運用では、対象を1つのボトルネック工程(第4章で見た、工場全体の出来高を決める工程)に絞ってモデルを作り、計算結果を現場には出さずに、計画担当者が作った計画と毎日並べて比べます。比べる物差しは、KPI の表の指標のうち、その工程で測れるもの(重み付き納期遅れ、段取り時間、稼働率)です。計算結果が担当者の計画より悪い日があれば、その差の原因を担当者と一緒に調べます。多くの場合、原因はモデルに入っていない決まりごとか、入力データの誤りで、それを直していくうちに、計算結果が担当者の計画に並び、やがて上回るようになります。この段階を飛ばして本番に入ると、最初の数日で「使えない」という評価が固まり、その後で直しても信用が戻りにくいように思います。
4段階目の本番運用で、計算結果を計画担当者が確認し、必要なら直して現場に出す運用に切り替えます。前の節で述べた手直しの記録は、ここから始めます。5段階目の範囲の拡大と評価で、対象をボトルネックの前後の工程、さらに工場全体へ広げ、1段階目で取った基準値と比べて KPI の改善を経営に報告します。範囲を広げるたびに、2段階目の台帳づくりに戻って、その工程の決まりごとを足します。5段階は一方向に進むだけではなく、範囲を広げるたびに2段階目と3段階目を小さく繰り返すことになります。
この順序を崩す典型は、ソフトウェアの選定を最初に置くことです。どの APS を入れるかを先に決めると、その製品が表せる制約の範囲に決まりごとを合わせることになり、表せない決まりごとは台帳に載らないまま、手直しとして残り続けます。台帳を先に作っておけば、製品を比べるときに「この台帳の決まりごとのうち、何割をハード制約かソフト制約として表せるか」という具体的な物差しで比べられます。第5章から第10章で CP-SAT を使って示したように、インターバル変数、重なりの禁止、累積の制約、段取りの行列が表せれば、多くの決まりごとは表現できます。表せない決まりごとがどれだけ残るかは、製品ごとに台帳を使って確かめるしかありません。
失敗の型、6つの型と見つけ方
最後に、スケジューリングの導入と運用でよく見られる失敗の型を6つに整理します。どれも数理モデルの誤りではなく、モデルの使い方の誤りです。
1つ目は、決まりごとの漏れです。ヒアリングで拾いきれなかった決まりごとがあると、計算結果は現場から見て「ありえない」スケジュールになります。一度「ありえない」と言われると、その後の計算結果も疑われます。見つけ方は、手直しの理由の集計で、同じ理由が繰り返し出ているかを見ます。対処は、並行運用の期間を十分に取り、計算結果と担当者の計画の差を1件ずつ調べることです。
2つ目は、ハード制約の入れすぎです。ヒアリングで「絶対」と言われた決まりをすべてハード制約にすると、注文が集中した週に解が無くなり、システムは「実行不可能」としか答えなくなります。現場が最も助けを必要とする週に、システムが役に立たなくなるということです。見つけ方は、実行不可能になった日の記録と、実績でその決まりが破られている頻度です。対処は、破られている決まりを重みの大きいソフト制約に移すことです。
3つ目は、マスタの放置です。標準時間を立ち上げのときの見積もりのまま使い続けると、この章の実験のように、計画上は全件間に合うはずが実際には半数以上遅れる、ということが起きます。見つけ方は、マスタの精度(実績と計画用の加工時間の比)の月次の推移です。対処は、マスタの照合を月次の定常業務にし、計画用の加工時間を標準時間とは別に持つことです。
4つ目は、目的の置き違いです。メイクスパンの最小化は計算しやすく、第5章でも最初に扱いましたが、受注生産の工場で本当に問題になるのは多くの場合、納期遅れです。第5章で受注12件をメイクスパン最小と重み付き納期遅れ最小で解いたとき、目的によってスケジュールが変わることを確かめました。目的を「分かりやすいから」という理由で選ぶと、全体は早く終わるが大事な注文が遅れる計画が出ます。見つけ方は、計算上の目的の値が良くなっているのに、経営が見ている KPI(納期遵守率や重み付き納期遅れ)が良くならないことです。対処は、目的関数を KPI と同じ言葉で定義し直すことです。
5つ目は、計算の二重化です。ERP の計画機能、APS、担当者の表計算がそれぞれ別の予定を持ち、現場がどれに従っているのか分からなくなる型です。見つけ方は、現場の掲示やタブレットに出ている予定と、APS の出力を突き合わせることです。対処は、計算を行う場所を1か所に決め、他のシステムは結果を表示するだけにすることです。
6つ目は、再計算の頻度と凍結の不一致です。飛び込み注文のたびに全体を解き直すと、スケジュールが毎回大きく変わり、現場は段取りや材料の準備が追いつかず、計算結果を無視するようになります。逆に、週に1回しか計算しないと、週の途中の変化に追いつけず、手直しが増えます。見つけ方は、前回のスケジュールからの変更量(第12章の安定性の指標)と、手直しの件数の推移です。対処は、現場が準備に必要な時間を聞いて凍結区間の長さを決め、変更量を目的関数に入れることです。
| 失敗の型 | 現れ方 | 見つける指標 | 対処 |
|---|---|---|---|
| 決まりごとの漏れ | 計算結果が現場から「ありえない」と言われる | 手直しの理由の集計で同じ理由が繰り返し出る | 並行運用で差を1件ずつ調べ、台帳に足す |
| ハード制約の入れすぎ | 注文が集中した週に解が無くなる | 実行不可能になった日の記録、実績で決まりが破られている頻度 | 破られている決まりを重みの大きいソフト制約に移す |
| マスタの放置 | 計画上は間に合うはずの注文が実際には遅れる | マスタの精度の月次推移 | マスタの照合を定常業務にし、計画用の加工時間を別に持つ |
| 目的の置き違い | 全体は早く終わるが大事な注文が遅れる | 目的の値は良くなるのに KPI が良くならない | 目的関数を KPI と同じ言葉で定義し直す |
| 計算の二重化 | 現場がどの予定に従っているか分からない | 現場の掲示と APS の出力の不一致 | 計算を1か所に決め、他は表示だけにする |
| 再計算の頻度と凍結の不一致 | スケジュールが毎回大きく変わるか、変化に追いつかない | 前回からの変更量、手直しの件数 | 準備に必要な時間から凍結区間を決め、変更量を目的に入れる |
この6つの型のうち、経営が直接防げるものは、目的の置き違いと計算の二重化です。目的関数は、工場が何を大事にするかの表明であり、重みの表や辞書式の順番は経営が承認すべきものです。計算の二重化は、部門ごとに別のシステムや表を持つことを許した結果として起きるので、どのシステムの予定を正とするかを経営が決めて宣言することで防げます。残りの4つは、現場と情報システムの担当が、この章で述べた台帳・手直しの記録・マスタの照合・凍結区間の運用で防ぐものです。
この章の要点をまとめます。暗黙の決まりごとは、過去のガントチャートを題材に理由を聞いて台帳に書き出し、「破ったら何が起きるか」でハード制約とソフト制約に振り分けます。標準時間のマスタが2割ずれるだけで、全件間に合うはずの計画から半数以上の遅れが出ることを、受注12件で確かめました。APS・MES・ERP は製品の分類名ではなく、どの計算をどこで行うかで役割を決め、計算の場所は1か所にします。手直しは理由とともに記録し、月次で集計してモデル・データ・再計算の運用のどれを直すかを決めます。導入は実績の見える化から始め、ボトルネック工程での並行運用を経て本番に移り、KPI を組で読んで経営に報告します。次の第14章では、公開された一次情報のある事例と、機械学習や生成AIがスケジューリングのどこに入り、何が人の判断として残るかを扱います。
この章を深めたい方への参考書籍
『実践的MES導入ガイド 製造実行システムが工場を強くする』(一般財団法人エンジニアリング協会「次世代スマート工場」研究会、近代科学社):MES を、今なぜ必要か、何であるか、会社をどう変えるか、何ができるか、業界別の特徴、導入の進め方、工場のハードウェアとの関係、データドリブン製造との関係の順に解説した本で、同協会が公開した「MES/MOM導入のための標準業務一覧」をもとに書かれています。この章で扱った APS・MES・ERP の役割分担や、実績を工程単位で取るためのデータの流れを、MES の側から具体的に確かめたい方に向いています。2026年9月発売の新刊です。
『Asprova解体新書 生産スケジューラ使いこなし再入門』(高橋邦芳、日刊工業新聞社):生産スケジューラの導入がうまく運ばない根本原因を利用者の目線で考察し、失敗を避ける工夫や設定、運用を工程順に解説した本です。特定の製品を題材にしていますが、この章の導入の順序や失敗の型、人が計算結果を直す運用を、実際の生産スケジューラの画面と設定に落として考えるときの参考になります。
『納期見積りと生産スケジューリング』(黒田充、朝倉書店):サプライチェーンマネジメント講座の第1巻で、個別生産・受注生産を対象に、納期バッファを用いた納期見積り、資材の引当てを同時に行う納期見積り、顧客の要求納期とメーカーの理想納期などを扱っています。この章で、標準時間のずれが納期回答とリードタイムの判断を狂わせると述べた点を、受注生産の納期見積りの理論から深めたい方に向いています。
第14章 事例と最新動向、学習する手法と生成AIの時代のスケジューリング
第13章では、暗黙知を制約に落とす手順、標準時間の精度、APS・MES・ERP との連携、人が最後に直す運用という、スケジューリングを現場に入れるための段取りを確認しました。この第14章では視点を外に向けます。公開された一次情報から読み取れる生産スケジューリングの事例、機械学習と強化学習によるスケジューリング研究の位置づけ、生成AI(大規模言語モデル)に任せられることと人が決めること、そしてソルバーの動向を、2026年9月時点で確認できる範囲で整理します。
この章で取り上げる企業名と数字は、企業・官公庁・研究機関が自ら公表した資料と、査読を経た論文に書かれているものだけに限りました。報道や第三者の解説記事に載っている数字は、出典の一次資料を開いて確認できなかったものは採用していません。世の中で語られている「AI でスケジュール作成が何割速くなった」という話の多くがここに出てこないのは、それが事実でないという意味ではなく、公開された資料で裏を取れる範囲がまだ狭いという意味です。また、弊社コラム「数理最適化の定式化パターン集」の第1章で紹介した国内の導入事例は、この章では繰り返しません。
事例を選んだ基準と、公開事例の読み方
生産計画やスケジューリングの導入事例は、ソフトウェアを提供する企業の導入事例ページやニュースリリースに数多く載っています。その中からこの章で取り上げたのは、次の3つの条件をすべて満たすものです。第一に、発表の主体が当事者(導入企業、または導入企業と連名の提供企業)であること。第二に、何を決める仕組みなのか(何の計画か、どの工程か)が本文に書かれていること。第三に、成果の数字がどの業務のどの量について述べたものかを本文から読み取れることです。第三の条件を置いたのは、「効率が何割上がった」という数字が、計画を作る担当者の作業時間の話なのか、工場の設備稼働率の話なのかで、経営上の意味がまったく違うからです。
公開事例を読むときに、弊社が特に注意すべきだと考えている点が3つあります。一つ目は、数字の時制です。「短縮した」と「短縮することが可能になります」と「見込んでいる」は、同じ段落に並んでいても意味が違います。前者は測定済みの結果で、後の2つは見込みです。二つ目は、比べている相手です。熟練者が作った計画と比べたのか、過去の実績と比べたのか、導入前の同じ工場と比べたのかで、数字の信頼度が変わります。三つ目は、公開事例が成功した例に偏りやすいという点です。この章で取り上げる事例も「うまくいった」報告であり、同じ時期に同じ手法を試して断念した例は、公開されにくいと考えられます。したがって、事例の数字は「この条件がそろえばここまで届いた例がある」という上限側の参考値として読み、自社で同じ数字が出る根拠としては使わないのが安全です。
この基準で残った事例は、どれも国内の製造業のものになりました。海外の企業の事例は、この章の執筆の範囲では、企業名と数字を当事者の一次資料で確かめられたものが無かったため採用していません。研究の動向については、後半で論文を開いて確かめた範囲で海外の成果を扱います。
段取りと順序を決める事例、NECプラットフォームズの表面実装ライン
最初の事例は、第7章で扱った順序依存の段取りそのものを対象にしたものです。日本電気株式会社(NEC)は2023年3月31日付の導入事例で、グループ会社の NECプラットフォームズ株式会社が、プリント基板に電子部品を実装する表面実装(SMT)工程の生産計画立案を自動化した取り組みを公表しています(NEC 導入事例 NECプラットフォームズ)。この工程では1本のラインで複数の品種を流す混流生産を行っており、品種が変わるたびに数百種類ある部品や設備設定を変える段取りを、ラインを止めて行います。事例ページは、段取りにかかる時間が「いつ」「どの順番で」その日に必要な品種を生産するかの組み合わせで大きく変わること、そして段取りは付加価値を生まないためその時間を短くすることが競争力につながることを、背景として挙げています。
事例ページによれば、2019年9月から2020年2月まで福島事業所の SMT ラインで実証実験を行い、熟練作業者が立案した生産計画とシステムが導き出した生産計画を過去データで比較しました。熟練作業者が毎日1〜2時間かけて立案していた生産計画は、計算時間が数秒、データの準備や人による結果確認などの付帯作業を入れても10分程度になったとあります。その後、白石・大月・掛川の各事業所にも展開して計4事業所で実証とチューニングを重ね、2023年3月から4事業所の SMT 工程で本格導入を決めました。成果の数字としては、段取り工数の50%削減、設備稼働率の15%向上、生産計画立案工数の90%削減が「見込まれるまでのレベルに達しています」と書かれています。つまり、1〜2時間から10分程度という立案時間の短縮は実証で測った結果で、50%・15%・90%は見込みの値です。
この事例から読み取れることを、この記事の章立てに沿って整理します。まず、問題の構造です。NEC の技術者のコメントとして、難しいのは数百のオーダーの中から「当日加工すべき製品を選択する問題」と、どの順番で加工するかを求める「順番決め問題」の2つだと説明されています。前者は第8章で扱った計画(何をどれだけ作るか)に、後者は第7章の順序依存段取りに対応します。この2つを一度に解いている点が、単純な順序づけとの違いです。次に、複数ラインの扱いです。事例では、ライン間の作業者や治工具といった資源まで考慮し、人手が要る段取り時間の重なりを短くしたり、ライン同士の段取り時間をずらして作業者の負担を減らしたりできたとあります。これは第10章で扱った、作業者を累積資源として制約に入れる考え方と同じ形です。段取りそのものは機械の問題に見えますが、段取りをするのは人であり、同じ時刻に2本のラインが段取りに入れば作業者が足りなくなります。
もう一つ注目したいのは、機械学習を先に検討して断念した経緯が書かれている点です。事例ページによれば、同社は以前に機械学習の導入を検討したものの、学習に欠かせない教師データがそろわず、断念しました。担当者は、熟練作業者が立案した計画のデータはあるものの、生産メニューのパターンが大きく変わると精度が悪化し、再学習が必要になると考えたと述べています。これは後半で述べる学習型スケジューリングの限界と同じ論点で、「過去の計画を真似る」方式は、品種構成が変わる現場では前提が崩れやすいということです。最適化の方式は、再学習を必要とせず、新しい品種の工程・加工時間・段取り時間といったマスタと、制約と目的を更新して検証すれば、新しい品種構成に対応しやすい作りです。なお、この事例で使われた「NEC Vector Annealingサービス」は、量子コンピュータの手法の一つであるアニーリング方式の技術をスーパーコンピュータに適用したものと説明されています。量子アニーリングという名前がついていますが、事例で解いているのは第7章と同じ組合せ最適化問題であり、手法の選択は解きたい問題の構造とは別の話です。
経営目線で読むと、この事例の数字は2種類に分かれます。1〜2時間から10分程度への短縮は、計画担当者の作業時間であり、人件費と属人化の解消に効きます。事例ページが「スキルフリー化」と呼び、離職率の高い海外拠点での人材不足にも触れているのはこの側面です。一方で、段取り工数50%減と設備稼働率15%向上の見込みは、工場の生産能力そのものに効く数字です。第1章で述べたように、ボトルネック工程の稼働率が上がれば、設備を増やさずに出荷量を増やせます。どちらの効果を主に狙うかで、投資の説明の仕方が変わります。
生産計画と要員計画を同時に決める事例、ニチレイフーズの食品工場
二つ目の事例は、機械の計画と人の計画を一緒に立てるものです。株式会社日立製作所は2020年2月4日のニュースリリースで、株式会社ニチレイフーズと協創した「最適生産・要員計画自動立案システム」を、国内4拠点の食品工場に導入し、2020年1月から順次本格運用を開始したと発表しました(日立製作所 ニュースリリース 2020年2月4日)。システムが立案するのは、日別・ライン別の生産商品や生産量といった生産計画と、作業者のシフトスケジュールといった要員計画で、リリースは1工場で最大16兆通りの組み合わせがある中から最適解を自動立案すると説明しています。
リリースは、従来の立案の仕方も具体的に書いています。熟練者が工場別・ライン別・生産品目別に、ノウハウや経験則に基づく勘、設備・納期・コスト、作業者のスキルを考慮した配置(勤務シフト)などの複雑な制約条件、過去の膨大な計画履歴などを基に、長時間かけて立案していたとあります。新しいシステムは、機械学習と数理最適化技術を組み合わせた技術で熟練者独自の計画パターンを数値化・重みづけしたうえで、最適な計画を立案する仕組みです。成果の「1/10程度」は、リリースの中に2通りの書き方で出てきます。1つは、2018年8月から1年にわたってニチレイフーズの事業所へ試験的に導入し効果を検証した結果として、生産計画と要員計画の最適解を「従来の1/10程度の時間に短縮して自動立案することが可能となりました」という記述で、これは試験導入で確かめた、計画を自動で作る時間についての結果です。もう1つは、本システムの導入によりニチレイフーズの当該業務時間を従来の1/10程度に短縮することが「可能になります」という記述で、本格運用を始めた時点で業務全体の時間について述べた、これから先の効果の表現です。本格運用の後に業務時間を実際に測った数字は、このリリースには書かれていません。
この事例は、第10章で扱った「人を制約に入れる」の実例です。生産計画だけを先に決めて、あとから人を割り当てると、ある日のあるラインに必要なスキルを持つ作業者がいない、という矛盾が後工程で見つかります。生産と要員を同時に決めれば、その矛盾は計画の段階で消えます。また、機械学習の使い方にも注目したいところです。ここでの機械学習は、計画そのものを出力するのではなく、熟練者の計画パターンを重みとして数値化し、最適化の目的関数に反映させる役割を担っています。第13章で述べた、暗黙知をソフト制約(破ってもよいが破ると罰則がかかる条件)に落とす作業を、過去の計画履歴から半自動で行っていると読めます。前節の NECプラットフォームズが「過去の計画を真似る」機械学習を断念した話と並べると、機械学習を最適化の部品として使うか、最適化の代わりに使うかで、品種構成の変化への強さが変わることが分かります。
拠点をまたぐ計画の事例、サントリー食品インターナショナル
三つ目の事例は、スケジューリングより一段上の生産計画です。日立製作所の計画最適化ソリューションの導入事例ページは、サントリー食品インターナショナル株式会社と日立が協創を通じて AI を活用した生産計画立案システムを開発し、2019年1月から実運用を開始したと紹介しています(日立製作所 計画最適化ソリューション 導入事例 サントリー食品インターナショナル)。飲料メーカーには、消費者ニーズの多様化や天候による需要変動に迅速かつ柔軟に対応することが求められ、納期、生産能力、生産・輸送コストといった複雑な制約条件を考慮した計画が必要です。従来は担当者が経験に基づいて計画を立てており、エリア単位で立案していたために、エリアごとの個別最適になっていたと書かれています。成果として、複数の熟練者が平均毎週約40時間かけて立案していた生産計画を、約1時間で自動立案することを可能にしたとあります。
この事例が教えてくれるのは、第1章で述べた計画の階層の中で、どの階層に手を入れたかを見分ける必要があるということです。ここで決めているのは、どの工場でどの製品をどれだけ作り、どこへ運ぶかという計画であり、機械ごとの分単位の順序ではありません。第8章で扱ったロットサイジングや、弊社コラム「数理最適化の定式化パターン集」で扱った生産計画の線形計画に近い問題です。エリアごとの個別最適を全体最適に変えたという効果は、スケジューリングの改善では得られない種類のものです。工場の中の順序をどれほど良くしても、その工場に割り当てられた生産量そのものが偏っていれば、偏りは解消しません。逆に、計画の階層で全体最適を取っても、各工場の中で順序と段取りが悪ければ、計画どおりの量は作れません。自社の課題が計画の階層にあるのか、スケジュールの階層にあるのかを先に確かめることが、どの事例を参考にするかを決める前提になります。
エネルギーを目的に入れる事例、住友化学の実工場での検証
四つ目は、まだ検証の段階にある事例です。日立製作所と住友化学株式会社は2025年3月27日、エネルギー消費の低減・最適化を図る生産計画の自動立案システムの実用化に向けて、住友化学の千葉工場・袖ケ浦地区で実工場での検証を2025年3月から開始したと発表しました(日立製作所 ニュースリリース 2025年3月27日)。リリースによれば、合成樹脂の生産計画の策定と変更に伴う調整は、熟練者が経験とノウハウを基に手作業で行っており、業務負荷の大きさや脱属人化が課題でした。検証では、生産計画を自動立案するシステムと、エネルギー消費量の低減を支援するシステムの2つを連携させ、エネルギー効率を考慮した生産計画の自動立案を目指します。事前の検証で、過去1年分の生産量とエネルギー消費量の実績データを使い、エネルギー消費量を一定量削減できることを確認したとあり、検証の後は住友化学の国内6工場への展開を検討するとしています。
この事例は、成果の数字がまだ出ていないので、数字ではなく目的関数の変化として読むべきものです。第2章で整理した目的関数は、メイクスパン、納期遅れ、段取り時間など、時間に関するものが中心でした。ここに、エネルギー消費量や電力の使い方という別の軸が加わります。同じ量を作るにしても、どの設備をどの順でいつ動かすかで、エネルギーの使い方が変わるということです。目的が2つになれば、第7章で段取りと納期について行ったのと同じように、重みを振って両者のトレードオフを並べ、どこを採るかを経営が決めることになります。脱炭素の要請が強まるほど、スケジューリングの目的関数に何を入れるかは、技術者だけで決められる話ではなくなっていきます。
| 事例 | 公表主体と時期 | 決めていること | 公表されている数字 | 数字の性格 | この記事の対応章 |
|---|---|---|---|---|---|
| 表面実装ラインの品種選択と順序 | NEC(グループ会社の事例)、2023年3月 | 当日加工する製品の選択と加工順序、複数ラインの段取りの時刻 | 立案が毎日1〜2時間から10分程度。段取り工数50%減、設備稼働率15%向上、立案工数90%減 | 前者は実証の結果、後の3つは見込み | 第7章・第8章・第10章 |
| 食品工場の生産計画と要員計画 | 日立製作所(ニチレイフーズと協創)、2020年2月 | 日別・ライン別の生産商品と生産量、作業者のシフト | 1工場で最大16兆通りの組み合わせ。自動立案の時間が従来の1/10程度、業務時間も従来の1/10程度に | 前者は1年の試験導入で検証した結果、後者は本格運用の開始時点で「可能になります」と述べた見込み | 第8章・第10章・第13章 |
| 飲料の拠点をまたぐ生産計画 | 日立製作所の導入事例(サントリー食品インターナショナル) | 納期・生産能力・生産と輸送のコストを考慮した全体の生産計画 | 複数の熟練者が毎週約40時間かけていた立案が約1時間に | 実運用後の記述 | 第1章・第8章 |
| エネルギーを考慮した合成樹脂の生産計画 | 日立製作所・住友化学、2025年3月 | エネルギー効率を考慮した生産計画 | 成果の数値は未公表。事前検証で一定量の削減を確認 | 実工場での検証を開始した段階 | 第2章・第7章 |
4つの事例を並べると、共通点が見えます。どの事例でも、最初に語られている課題は「熟練者でなければ計画を作れない」ことで、最初に報告されている成果は「計画を作る時間の短縮」です。設備稼働率や段取り時間のような工場の指標が数字で出ているのは NECプラットフォームズの見込み値だけで、それも見込みです。これは、スケジューリングの導入効果が、まず計画担当者の時間と属人化の解消として現れ、工場の生産性への効果は時間をかけて測るものだということを示していると考えています。第13章で述べたように、導入の前に「何で効果を測るか」を決めておかなければ、工場の指標への効果は測られないまま終わります。
スケジュールを学習で作る研究、強化学習・グラフニューラルネットワーク・大規模言語モデル
ここからは研究の動向です。第3章で見たように、ディスパッチングルールは「次にどの仕事を機械に載せるか」を優先度で決める規則で、計算が速く、現場で説明しやすい代わりに、目的によっては最適解から大きく離れます。どのルールがどの目的に効くかは問題の性質によって変わり、良いルールを人が設計するには経験と試行錯誤が要ります。そこで、ルールそのものを機械学習で作ろうという研究が2020年前後から増えました。使われる道具は2つで、試行錯誤の結果から良い行動を学ぶ強化学習と、機械と工程のつながりをグラフのまま扱うグラフニューラルネットワーク(GNN)です。GNN は、第5章で扱ったディスジャンクティブグラフ(工程を点、先行関係と同一機械上の順序の候補を線で表した図)をそのまま入力にできるので、ジョブショップと相性が良いと考えられています。
代表的な研究が、Zhang らが2020年の NeurIPS(機械学習の主要な国際会議)で発表したものです(Zhang ほか 2020、ジョブショップのディスパッチングを深層強化学習で学ぶ、NeurIPS 2020)。要旨は、ディスパッチングルールは実務のジョブショップで広く使われているが、効果的なルールの設計は専門知識の要る面倒な作業で、性能も限られることが多い、と問題を置きます。そのうえで、ディスジャンクティブグラフを GNN で埋め込み、深層強化学習でルールを端から端まで学習する方法を提案しました。方策のネットワークは問題の大きさに依存しない作りになっており、学習時より大きな問題にもそのまま適用できるとしています。翌2021年には、Park らも GNN と強化学習を組み合わせた枠組みを発表し、よく使われるディスパッチングルールや既存の強化学習の手法を、さまざまなベンチマークで上回ったと報告しています(Park ほか 2021、International Journal of Production Research)。
ここで大事なのは、「既存のルールを上回った」が「最適解に近い」を意味しないことです。Zhang らの論文本文の表を開くと、そのことがはっきり分かります。公開ベンチマークの Taillard の問題(ジョブ数×機械数の大きさ別に10問ずつ)で、文献上の最良解に対する差(ギャップ)を、既存のルールと学習したルールで比べた結果が次の表です。表の数字は論文の Table 3 からそのまま写しました。
| 問題の大きさ(ジョブ数×機械数) | SPT(加工時間の短い順) | MOPNR(残り工程数の多い順) | 学習したルール | 学習したルールの計算時間(秒) |
|---|---|---|---|---|
| 15×15 | 54.8% | 45.0% | 26.0% | 0.447 |
| 20×20 | 64.2% | 42.8% | 31.6% | 0.937 |
| 30×20 | 66.0% | 48.2% | 33.6% | 1.799 |
| 100×20 | 41.0% | 20.2% | 13.6% | 28.328 |
表の読み方を説明します。各列の百分率は、そのルールで作ったスケジュールのメイクスパン(全部の仕事が終わるまでの時間)が、文献上の最良解より平均で何%長いかを表します。15×15の行で、学習したルールは26.0%、既存のルールで最も良かった MOPNR は45.0%でした。学習したルールは既存のルールより明らかに良いのですが、最良解と比べると約4分の1(26.0%)長いスケジュールです。最良解なら100時間で終わる仕事に、約126時間かかる計算になります。30×20の行でも33.6%で、差は縮まっていません。100×20の行(学習に使ったより大きい問題。30×20で学習した方策を適用)では13.6%まで縮みますが、論文は、ジョブ数が機械数に比べて多い問題はもともと解きやすい傾向があると注記しており、既存のルールも同じく差が小さくなっています。一方で計算時間は、最大の100×20でも約28秒です。論文は、比較に使った OR-Tools(制約プログラミングのソルバー)には1問あたり3,600秒の制限時間を与えており、自分たちで生成した100×20の問題では、その時間内に最適解が得られたのは2%だったとしています。
その後の研究も、同じ方向で改善を重ねています。Tassel らは、第5章・第6章で使った制約プログラミングの定式化をそのまま強化学習の環境に使う方法を提案し、7つのジョブショップのデータセットで、非常に大きな問題では、固定のディスパッチングルールよりも、また同じ制限時間を与えた制約プログラミングのソルバーよりも、質の高い解を見つけたと報告しています(Tassel ほか 2023、ICAPS 2023)。この要旨は、制約プログラミングのソルバーは小さい問題では最適解か最適に近い解を見つけるが、大きい問題には拡張しにくい、とも書いています。Corsini らは、複数の解を生成して最も良いものを正解の代わりに使う自己教師ありの学習法を提案し、構築型のヒューリスティックと、それまでの学習型の手法を上回ったと報告しています(Corsini ほか 2024、NeurIPS 2024)。
この記事の立場から、学習型の手法の位置づけを整理します。まず、比べている相手を確かめる必要があります。これらの研究の多くは、ディスパッチングルールを主な比較相手にしており、「ルールよりどれだけ良いか」を示しています。第11章で扱ったように、実務の選択肢にはルールのほかに、時間制限つきの CP-SAT や局所探索があります。学習型の手法が意味を持つのは、「1秒以内に答えが要るのでソルバーを回す時間が無い」「問題が非常に大きく、ソルバーが制限時間内に良い解を出せない」という条件がそろうときです。第12章で扱った飛び込み注文や故障への即時対応は、この条件に近い場面です。逆に、毎朝1回、数分かけて翌日のスケジュールを作る運用であれば、第5章と第6章のようにソルバーを回すほうが、最良解との差をはるかに小さくできます。
次に、学習に使うデータの問題があります。これらの研究は、同じ分布から乱数で作った大量の問題で学習し、同じ種類の問題で評価しています。前半の NECプラットフォームズの事例で、品種構成が変わると過去の計画から学んだモデルの精度が落ちると考えて機械学習を断念した話は、この前提が現場では崩れやすいことを示しています。さらに、学習したルールは、なぜその順序になったかを説明しにくいという性質があります。第13章で述べた「人が最後に直す運用」では、スケジュールの理由を担当者が理解できることが手直しの前提になります。現時点では、学習型の手法は研究の段階にあり、ソルバーを置き換えるものではなく、即時性が要る場面の選択肢の一つとして見るのが妥当だと考えています。
同じ流れの延長で、2024年以降は、大規模言語モデル(大量の文章で学習し、文章を生成するモデル。以下 LLM)にジョブショップを直接解かせる研究も現れました。Abgaryan らは、ジョブショップの問題とその解を文章の形にした12万件の教師データを作り、LLM を学習させたところ、LLM によるスケジューリングが他のニューラルネットワークによる手法に匹敵する性能に達した、と報告しています(Abgaryan ほか 2024、arXiv)。同じグループは続報で、13万件のデータセットで80億パラメータの LLM を追加学習し、従来のディスパッチングルールと前節の Zhang らの手法を上回り、Taillard の問題で平均7.85%、別のベンチマーク(DMU)で平均15.36%の改善を得たとしています(Abgaryan ほか 2025、Starjob、arXiv)。
これらの結果の向きを正しく読むことが大切です。比較の相手は、ディスパッチングルールと、前節の学習したルールです。前節の表で見たとおり、学習したルールそのものが、学習した大きさの問題では最良解から26〜34%程度離れているので、そこから数%から十数%改善しても、最良解や時間制限つきのソルバーの解に届いたことにはなりません。また、2本とも arXiv(査読前の論文を公開するサイト)に置かれた論文で、この記事の執筆時点で要旨から査読の有無は確認できませんでした。LLM がスケジュールの計算そのものを担う段階には、まだ来ていないと考えています。LLM が生産スケジューリングで価値を持つのは、次節で述べるように、計算の前後にある言葉の作業です。
生成AIは定式化と説明の側で効く
LLM を最適化と組み合わせる研究のうち、実務に近いのは、計算をソルバーに任せ、LLM には定式化と説明を担わせる方向です。2022年には、文章で書かれた最適化問題から決定変数・制約・目的を抜き出して定式化する技術を競う NL4Opt コンペティションが NeurIPS の競技部門として開かれました(Ramamonjison ほか 2023、NL4Opt コンペティション、arXiv)。AhmadiTeshnizi らの OptiMUS は、LLM を使って数理モデルを作り、ソルバーのコードを書き、エラーを直し、解を評価して改善する一連の作業を自動化するエージェントで、既存の手法に比べて易しいデータセットで20%以上、難しいデータセットで30%以上良い成績だったとしています(AhmadiTeshnizi ほか 2024、OptiMUS、arXiv)。ここでの「成績」は、正しく定式化して解けた問題の割合を競うもので、スケジュールの質を競うものではありません。
結果の説明については、Li らの OptiGuide が参考になります(Li ほか 2023、サプライチェーン最適化のための大規模言語モデル、arXiv)。要旨は、サプライチェーンでは計算による最適化が進んだ一方で、担当者は最適化の結果を関係者に説明し解釈するために大きな労力を費やしている、と課題を置きます。OptiGuide は、平文の質問を受けて最適化の結果について洞察を返し、「もしこの条件を変えたら」という問いに答える枠組みで、最適化の計算自体はソルバーに残し、企業の固有データを LLM に送らない設計にしたとしています。Microsoft のクラウドのサーバー配置という実際の事例で検証したと書かれています。
国内でも、生成AIと数理最適化の役割を分けた研究成果が出ています。日立製作所は2026年8月4日、ハンガリーの研究機関 HUN-REN SZTAKI と共同で、生成AIと数理最適化技術で生産ラインの構成を自動立案する技術を開発したと発表しました(日立製作所 研究開発 2026年8月4日)。「生産量を20%増やしたい」といった現場の要請を数理最適化モデルで扱うパラメータへ変換する作業は、従来人手で行われており、製造現場の知識と数理最適化の知識の両方を持つ熟練者は限られている、というのが出発点です。生成AIの処理を「生産ラインの運用・改修方針決定」「パラメータ項目決定」「パラメータ値決定」の3段階に分け、数理最適化が工程分割や設備割り付けなどの複数のライン構成案を現場で実行可能な範囲で導きます。電池製造ラインの構成見直し業務での検証で、熟練者が検討した案と同等のライン構成品質を保ちながら、見直し業務の工数を従来の手作業と比べて最大87.3%削減できることを確認したとしています。この発表は研究開発のトピックスとして公開されたもので、製品として導入された事例ではありません。また87.3%は「最大」の値です。
この研究の構図は、この章の結論と重なります。生成AIが担うのは、人の言葉で書かれた要請を、最適化モデルが受け取れる形(どの制約を動かし、どのパラメータをどの値にするか)に翻訳する作業で、実行可能な案を作るのは数理最適化です。第13章で述べたヒアリングの整理と、ハード制約とソフト制約の書き分けは、まさにこの翻訳の作業です。そしてこの発表は、複数の案を比較できることで、各案の違いや選定理由を確認しやすくし、現場でのレビューや上位層への提案を進めやすくする、と述べています。案を選ぶのは人だという前提が、設計の中に置かれています。
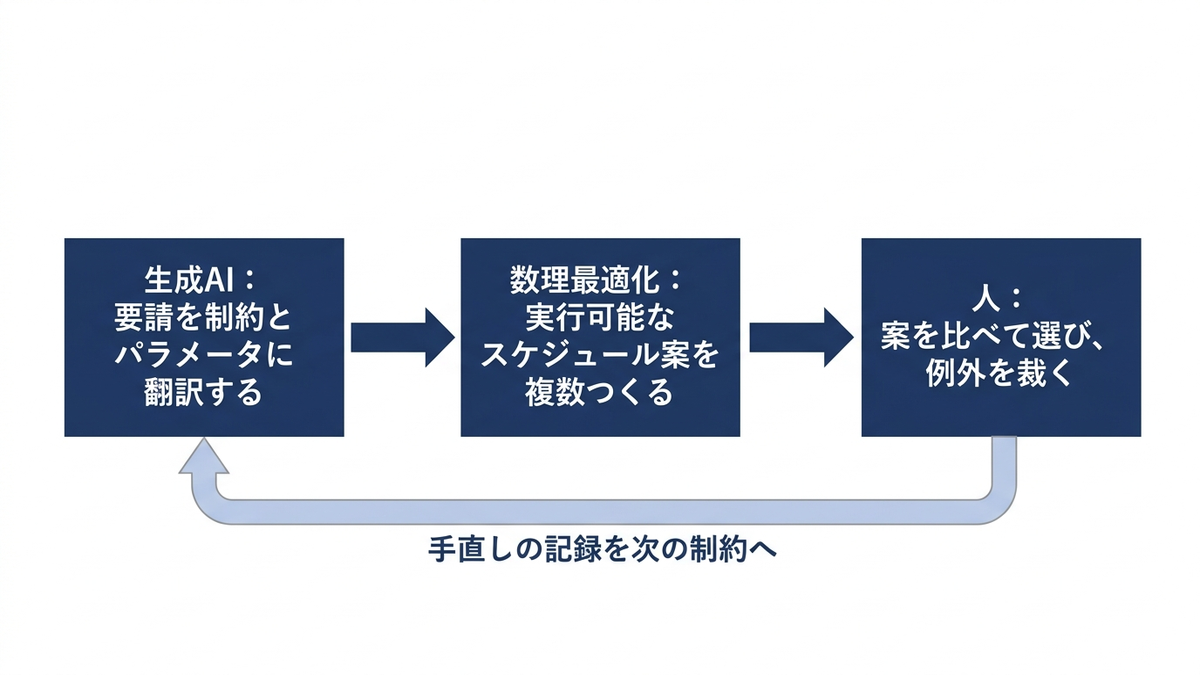
生成AIに任せられることと、人が決めること
ここまでの研究と事例を踏まえて、生産スケジューリングの仕事のどこを生成AIに任せられ、どこを人が決めるべきかを整理します。整理の軸は、第13章で述べた導入の流れ(ヒアリングで条件を集め、制約と目的に書き、ソルバーで解き、結果を人が確かめて直し、その記録を次に生かす)です。
生成AIに任せやすいのは、言葉を扱う作業です。一つ目は、ヒアリングの整理です。現場の担当者に聞き取った「この機械は午前中に熱処理品を先にやる」「この治具は2台で共有している」といった話を、ハード制約(必ず守る条件)、ソフト制約(守りたいが破ることもある条件)、目的(何を良いとするか)に振り分け、重複や矛盾の候補を挙げる作業は、LLM の得意な領域です。二つ目は、定式化の下書きです。OptiMUS の研究が示すように、LLM は数理モデルとソルバーのコードの下書きを作れます。ただし、下書きが正しいかどうかは、小さな例で解いて確かめる必要があります。第5章で ft06 を解いて最適値55を確かめたように、答えの分かっている問題で検算することが、下書きを採用する条件です。三つ目は、結果の説明です。「なぜこの受注が後回しになったか」「この段取りの順番の理由は何か」を、ソルバーの出力(各工程の開始時刻、どの制約が効いているか)を入力にして文章にする作業は、OptiGuide の研究が狙っている領域で、第13章の経営報告の下書きにも使えます。
一方で、人が決めることは3つあります。第一に、目的の重みです。納期遅れを1件減らすために段取りを何分増やしてよいか、エネルギー消費を減らすために納期をどこまで緩めてよいかは、第7章で見たトレードオフの上のどこを採るかという経営判断で、データからは出てきません。第二に、例外の裁定です。飛び込み注文を受けるかどうか、得意先の優先順位をどうするかは、取引関係と契約に関わる判断で、計算の外にあります。第三に、制約そのものの変更です。段取り時間を短くする改善、治具を1台増やす投資、稼働カレンダーの変更は、最適化の入力を変える判断であり、最適化の中で決めるものではありません。第7章で述べたように、段取り時間そのものを減らす改善は、スケジュールの工夫とは別の効果を持ちます。
| 作業 | 主に担うもの | 理由 | 関連する章 |
|---|---|---|---|
| ヒアリング内容の整理、ハード制約・ソフト制約・目的への振り分け、矛盾の候補の提示 | 生成AI(最終確認は人) | 言葉の分類と要約が中心で、量が多い | 第13章 |
| 定式化とソルバーのコードの下書き | 生成AI(検算は人とソルバー) | 下書きは速いが、正しさは答えの分かっている小さな例で確かめる必要がある | 第5章・第6章 |
| スケジュールの計算 | ソルバー、ディスパッチングルール | どちらも制約を守った実行可能な解を作れる。最良解との差(ギャップ)を下界とあわせて示せるのはソルバーで、ディスパッチングルールの解の差を知るには、別に下界を求めるかベンチマークと比べる必要がある | 第3章〜第11章 |
| 即時の再スケジューリング(秒単位の応答が要る場面) | ディスパッチングルール、将来は学習したルールも候補 | ソルバーを回す時間が無い場面では速さが優先される | 第3章・第12章 |
| スケジュールの理由の説明、経営報告の文章の下書き | 生成AI(ソルバーの出力を入力にして) | 数値はソルバーから、文章は言語モデルからという分担が成り立つ | 第13章 |
| 目的の重み(納期・段取り・エネルギーのどれをどれだけ重視するか) | 人(経営) | トレードオフのどこを採るかは経営判断 | 第2章・第7章 |
| 例外の裁定と、手直しの記録 | 人(計画担当者・管理者) | 取引関係や契約など、計算の外の事情を持ち込むのは人。記録が次の制約になる | 第12章・第13章 |
| 制約そのものの変更(段取り改善・治具の追加・稼働カレンダー) | 人(投資と改善の判断) | 最適化の入力を変える判断で、最適化の対象ではない | 第7章・第10章 |
表のスケジュールの計算の行には、生成AIを入れていません。これは生成AIの能力を低く見ているからではなく、スケジュールには「制約をすべて守っていること」と「最良解からどれだけ離れているかが分かること」の2つが求められ、現時点ではソルバーがその両方を示せる道具だからです。LLM が出したスケジュールは、見た目が整っていても、機械の重なりや先行関係の違反が無いかを別に検査しなければ使えません。検査の仕組みを作るのであれば、最初からソルバーに解かせるほうが確実です。
ソルバーの動向、公式に確認できたこと
この記事の第5章から第11章で使ってきた CP-SAT(Google が開発する OR-Tools に含まれる制約プログラミングのソルバー)について、公式の情報で確認できた動向を記録しておきます。OR-Tools の最新版は、この記事の執筆時点で2026年1月12日に公開された v9.15 で、この記事の実行環境でも同じ版(9.15.6755)を使いました(OR-Tools v9.15 リリースノート)。リリースノートの CP-SAT の項には、2次元の重なり禁止(たとえば時間と置き場所の平面の上で、長方形どうしが重ならないようにする)の no_overlap_2d 制約の前処理・伝播・カット(解の探索範囲を狭める追加の不等式)の改善、先行関係を検出して前処理・伝播・カットに使う改良、スケジューリング用のカットの改善、ソフト制約の例の追加などが並んでいます。先行関係とスケジューリング用のカットの改善は、第5章と第6章で扱ったジョブショップの下界(これより良い解は存在しないという保証の値)を引き上げる方向の改良で、同じ制限時間でもギャップを小さく示せる可能性がある種類の変更です。ただし、この版で自社の問題がどれだけ速くなるかは、リリースノートからは分かりません。版を上げたら、第6章と同じ手順で自社の問題の計算時間とギャップを測り直す必要があります。
ソルバーの性能を横並びで比べる公開の場として、制約プログラミングの分野では MiniZinc Challenge が毎年開かれています。2025年の結果のページによれば、OR-Tools CP-SAT は Fixed・Free・Parallel の3部門で金メダルを、局所探索版の OR-Tools CP-SAT LS は Local Search 部門で金メダルを獲得しました(MiniZinc Challenge 2025 Results)。このページには、主催者が参考として参加させた混合整数計画のソルバー(CBC、CPLEX、Gurobi、HiGHS、SCIP)や IBM の CP Optimizer も載っており、これらは規定により賞の対象外で、得点の計算には影響すると書かれています。MiniZinc Challenge の問題には、スケジューリング以外の問題も多く含まれます。したがって、この結果は「制約プログラミングの汎用ソルバーとして、公開の比較で上位にある」ことを示すもので、「自社のスケジューリング問題で最も速い」ことを示すものではありません。第6章で述べたように、どのソルバーが速いかは問題の構造で変わり、自社のデータで測るほかありません。
OR-Tools v9.15 のリリースノートには、同梱する依存関係として、オープンソースの混合整数計画ソルバー HiGHS v1.12.0 と SCIP v10.0.0 が挙げられています。この記事の実行環境では HiGHS の Python 版(highspy)は導入していないため、第6章の MIP の比較は PuLP と CBC で行いました。商用ソルバーについては、第6章と同じく概念の紹介に留め、この章でも性能の比較は行いません。ソルバーの選択は、ライセンス費用と保守体制を含めた経営判断であり、公開ベンチマークの順位だけで決めるものではないと考えています。
学習型の手法と生成AIに投資する前に確かめること
経営目線でこの章を締めくくります。「AI でスケジューリングを自動化する」という提案を受けたときに、判断の材料として確かめるべきことを、この章の事例と研究から5つに整理します。
第一に、何を比較の基準にしているかです。研究の多くはディスパッチングルールを基準にしており、前半の表で見たとおり、ルールより良くても最良解から26〜34%程度離れている手法があります。メイクスパンが26%長いということは、同じ設備で同じ仕事を終えるのに約4分の1(26%)余計に時間がかかるということで、設備稼働率や残業時間に直接響きます。提案の数字が「従来のルール比」なのか「最良解比」なのか「熟練者の計画比」なのかを、最初に確かめるべきです。
第二に、その数字が測った結果か見込みかです。この章で取り上げた4つの企業の事例でも、測定済みの数字と見込みの数字が同じページに並んでいました。投資判断に使えるのは測定済みの数字で、見込みの数字は自社で測るための仮説として扱います。
第三に、どの階層の問題に効くのかです。サントリー食品インターナショナルの事例は拠点をまたぐ計画の階層、NECプラットフォームズの事例は1つの工程の中の順序と段取りの階層でした。自社の課題が計画の階層にあるのにスケジューラを入れても、効果は出ません。第1章の計画の階層の図のどこに手を入れる提案なのかを、提案書の上で特定することが出発点になります。
第四に、品種構成や設備が変わったときに何が起きるかです。過去の計画から学ぶ方式は、変化のたびに再学習が要り、その間は精度が落ちます。制約と目的を書き直せば済む方式は、変化への追従を担当者の書き換え作業として見積もれます。どちらの方式でも保守の費用はかかりますが、その費用の出方が違います。導入時の効果だけでなく、3年後に品種が入れ替わったときの保守の手間まで含めて比べることが、投資の判断として妥当だと考えています。
第五に、人が何を決めるのかが設計に書かれているかです。この章で見たどの事例と研究も、計算を機械に任せる一方で、目的の重み、例外の裁定、案の選択を人に残していました。第13章で述べた「人が最後に直す運用」と、手直しの記録を次の制約にする仕組みが提案の中に無ければ、導入後にスケジュールが現場で上書きされ、上書きの理由も残らず、改善が止まります。
この5つは、いずれもこの記事の第1章から第13章で扱った内容です。裏返せば、学習型の手法も生成AIも、生産スケジューリングに新しい問題を持ち込むものではありません。何を決めるのか(どの仕事を、どの機械で、どの順番で、いつ始めるか)と、何を良いとするのか(納期、段取り、稼働率、エネルギー)は変わらず、その周りの作業の速さと、計算の選択肢が増えるだけです。スケジューリングは順番と時刻を決める問題である、という序章の主張は、AI の時代でも変わりません。
この章では、公開一次情報で確かめられる国内の4つの事例から、スケジューリング導入の効果がまず計画担当者の時間と属人化の解消として現れること、工場の指標への効果は測り方を先に決めて時間をかけて確かめるものであることを見ました。学習型の手法は即時性が要る場面の選択肢として研究が進んでいるものの、最良解との差はまだ大きく、生成AIは計算そのものではなく、定式化の下書きと結果の説明で効きます。終章では、この記事全体の要点を並べ、自社のどこから手を付けるかを整理します。
この章を深めたい方への参考書籍
『強化学習』(森村哲郎、講談社):機械学習プロフェッショナルシリーズの1冊で、マルコフ決定過程とプランニングから、モデルフリー型・モデルベース型の強化学習、関数近似を使う方法までを数理的に整理した本です。この章で紹介した、ディスパッチングルールを強化学習で作る研究が、どのような枠組みの上に立っているかを確かめるのに向いています。
『グラフニューラルネットワーク』(佐藤竜馬、講談社):同じシリーズから2024年に出た本で、グラフニューラルネットワークの定式化、さまざまなタスクへの応用、高速化、表現能力の限界までを扱っています。第5章のディスジャンクティブグラフを入力にしてスケジュールを学習する研究が、グラフの何を捉えようとしているのかを理解する助けになります。
『大規模言語モデル入門』(山田育矢 監修・著、鈴木正敏、山田康輔、李凌寒 著、技術評論社):Transformer の仕組みから大規模言語モデルの基礎と進展、追加学習(ファインチューニング)、要約や質問応答への応用までを解説した本です。この章で述べた、LLM を定式化の下書きや結果の説明に使うときに、何が得意で何が苦手かを判断する土台になります。
終章 順番を書き出し、解き、結果で直す
本コラムでは、生産スケジューリングを、工場の形と現実の条件に沿って14の章で整理しました。最後に、各章で実際に解いて分かったことを振り返り、導入の順序として何から始めるかをまとめます。
同じ工場でも、目的を変えると答えが変わる
第2章では、架空の部品加工工場の受注12件を到着順に流すと、全体の完了まで1,870分かかり、12件中6件が納期に遅れることを確かめました。第5章で同じ受注を制約プログラミングで解くと、全体の完了時刻を最小にする目的では1,560分まで縮みますが、その1,560分を保ったまま納期遅れをできるだけ減らしても6件が遅れました。反対に、納期遅れを優先して全件を間に合わせ、そのうえで全体の完了時刻をできるだけ早めても、全体の完了は2,080分になりました。どちらが良い計画かは、計算では決まりません。設備を早く空けたいのか、取引先との約束を守りたいのかという経営の判断が先にあり、その判断を目的関数として書いたときに初めて、計算機はその判断に沿った最良の順番を返します。
第4章では、同じ順路を流れる10件の仕事について、番号順に流すと1,190分かかるところを、最適な順番では940分に縮められることを示しました。第7章では、系列ごとの段取り替えを含む15件の順番で、段取りの合計と納期遅れの釣り合いを示す候補を厳密に列挙しました。第8章では、段取り時間を容量に入れずに立てた週の生産計画が、実際の段取りを足すと稼働時間を大きくはみ出すことを確かめました。いずれも、順番と時刻の決め方が、納期遅れ、リードタイム、残業という経営の数字を直接動かすことを示しています。
解き方は、規模と目的で選ぶ
解き方については、万能の手法は無いというのが本コラムの実測の結論です。第3章では、1台の機械の問題で、加工時間の短い順や納期の早い順といった単純な並べ方の規則が、目的によっては厳密に最適になることを確かめました。その一方で、重み付きの納期遅れのように規則だけでは最適にならない目的もあり、件数が40件以上の問題では、試したすべての問題で、10秒で打ち切った制約プログラミングのソルバーが規則(合成ルールの ATC)の最良値に負け、規則の答えを初期解として渡すと逆転しました。第11章では、大きなフローショップで、焼きなまし法や反復貪欲法のようなメタヒューリスティクスが20秒で出した答えが、60秒回したソルバーの答えより良くなりました。
第6章では、同じ問題を混合整数計画と制約プログラミングで解き比べ、順番と時刻を決める問題では制約プログラミングが、量と費用を決める問題では混合整数計画が向くことを整理しました。第9章と第10章では、並列機械、組立ライン、作業者や炉といった資源の制約を加えても、同じ考え方で定式化できることを示しました。選ぶ基準は、手法の名前ではなく、問題の規模、目的の種類、計算に使える時間、そして答えの良さを下界と比べて確かめられるかどうかです。
計画は崩れる前提で作る
第12章では、熱処理炉の故障と飛び込み注文を起こして、組み直し方を比べました。故障の時間だけ後ろにずらす修復は順番を保てる一方で納期遅れが増え、全体を組み直すと納期遅れは減る一方で、現場から見た変更量が増えます。変更量そのものを目的に入れると、納期を守ったまま大きく動かす工程を減らせました。加工時間のばらつきに対しては、計画に持たせる余裕が大きすぎても小さすぎても納期遅れが増えることを、1,000回の模擬で確かめました。スケジュールは翌日には崩れるものとして、組み直しの手順と、どこまで変えてよいかの決まりを先に作っておくことが要ります。
第13章では、標準時間のマスタが実際より短いと、最適化した計画ほど遅れが出やすいことを、研削盤の加工時間が2割長い場合の計算で示しました。最適化の答えの良さは、入力の正しさを超えません。計算の手法より先に、実績を記録し、標準時間を実績に合わせて直す仕組みを作ることが、導入の土台になります。
導入の順序
本コラムの内容を、導入の順序としてまとめます。第一に、現状のスケジュールがどう作られ、納期遅れ、段取り時間、待ち時間がどれだけあるかを実績で測ります。第二に、担当者が守っている決まりごとを書き出し、守らなければならない制約と、できれば守りたい条件とに分けます。第三に、ボトルネックの工程など範囲を絞って、計算機の計画と担当者の計画を並べて運用し、差がどこから来るかを確かめます。第四に、本番で使い始めたら、担当者が手で直した箇所を記録し、次の制約の追加に使います。第五に、範囲を広げながら、納期遵守率、リードタイム、残業時間を導入前と比べて評価します。
この順序で進めると、どこかの段階で「計算機の計画が使われない」という壁に当たることが多いように思います。その多くは、手法の問題ではなく、書き出されていない例外ルールか、実際と合っていない標準時間が原因です。壁に当たったときに、手法を取り替えるのではなく、制約と入力を見直すという判断ができるかどうかが、投資を回収できるかどうかを分けると考えています。第14章で見たように、生成AIは、要望を制約の形に翻訳したり、計算結果を説明したりする場面で助けになりますが、どの損失をどこまで許すかを決めるのは、引き続き人の役割です。
スケジューリングの手法は60年以上の研究の蓄積があり、無償で使える優れたソルバーも手に入る時代になりました。残っている仕事は、自社の工場の判断を言葉と式に書き出し、解き、結果を見て直すことです。本コラムが、その最初の一歩を踏み出す材料になれば幸いです。
Anagraftでは、データ活用の構想づくりから、生産計画やスケジューリングのような業務課題の定式化、分析と最適化の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 生産スケジューリングはなぜ経営の問題なのか、計画の階層と経営指標から考える
『ザ・ゴール 企業の究極の目的とは何か』(エリヤフ・ゴールドラット著、三本木亮訳、ダイヤモンド社):工場長を主人公にした小説の形で、制約条件の理論(工場全体の出力はボトルネックで決まるという考え方)を説明した本です。この章で扱った稼働率・仕掛品・スループットの関係を、数式を使わずに工場の場面の中で考えられるため、経営層と現場で考え方をそろえる題材になると考えています。
『生産マネジメント入門 1 生産システム編』(藤本隆宏、日本経済新聞社):生産システムを競争力の観点から整理した教科書で、目次にはコスト・生産性、納期と工程管理、品質、フレキシビリティ、生産戦略の章が並びます。この章で扱った経営指標を、コスト・品質・納期・柔軟性という競争力の要素の中に位置づけて理解するのに向いています。
『Factory Physics』(Wallace J. Hopp、Mark L. Spearman、Waveland Press、第3版):リトルの法則を工場のスループット・仕掛品・サイクルタイムの関係として整理し、ばらつきが工場の性能をどう悪化させるかを体系的に論じた教科書です。この章で紹介した稼働率と待ち時間の関係を、工場全体の流れの設計にどう生かすかを、第2部の章(基本的な工場の動き、ばらつきの基礎など)で学べます。洋書ですが、この章の考え方の原典にあたります。
第2章 スケジューリング問題を記述する、機械環境・制約・目的とガントチャート
『生産スケジューリング』(黒田充・村松健児 編、朝倉書店):シリーズ「経営科学のニューフロンティア」の第11巻です。第1章で生産管理の中でのスケジューリングの位置づけと基本用語を、第2章で物的システムの構造による分類や静的問題と動的問題の区別を扱っており、この章で整理した「問題をどう記述するか」を日本語でより詳しく学べます。後半にはディスパッチングルール、メタヒューリスティクス、ラグランジュ緩和など、この記事の後の章につながる手法も収められています。
『Scheduling: Theory, Algorithms, and Systems』(Michael L. Pinedo、Springer):スケジューリング理論の代表的な教科書で、第2章「Deterministic Models: Preliminaries」は、確定的なスケジューリングのモデルの構造を簡潔に表す記法を扱う章として始まり、この章で紹介した問題の書き方を原典に近い形で確かめられます。確定的なモデル、確率的なモデル、実務でのシステム設計の3部構成で、この記事全体の理論的な背景を1冊で追えます。版元の Springer のページでは2022年刊の第6版が現行で、第7版が2026年12月に刊行予定と案内されています。洋書ですが、記法と用語の原典として手元に置く価値があると考えています。
第3章 単一機械とディスパッチングルール、並べる順番の決め方で何が変わるか
『アルゴリズムデザイン』(Jon Kleinberg・Éva Tardos 著、浅野孝夫・浅野泰仁・小野孝男・平田富夫 訳、共立出版):第4章「グリーディアルゴリズム」の4.2節「遅延最小化スケジューリング:交換議論」が、この章で EDD の最適性の根拠として紹介した隣接交換の議論を、丁寧な証明つきで説明しています。並べ替えの規則が「なぜ最適なのか」を自分で確かめたいときに、最初に開く本として適していると考えています。
『Heuristic Scheduling Systems』(Thomas E. Morton・David W. Pentico、Wiley):副題は生産システムとプロジェクト管理への応用です。ATC ルールの提案者の一人である Morton らによる、ディスパッチングを中心とした発見的スケジューリングの原典です。単一機械からフローショップ、ジョブショップ、プロジェクトスケジューリングまで、優先度ルールの考え方と計算実験が扱われています。1993年刊の洋書で、合成ルールの設計の考え方を提案者の側からたどれる本です。
第4章 フローショップ、全ジョブが同じ順に機械を通る工程の順序づけ
『流れ生産と1個流し 生産流れ学と究極のムダ表面化』(平野裕之、日刊工業新聞社):「新IE」入門シリーズの第4巻で、書名のとおり、工程をつないで仕事を流す流れ生産と、仕事を1個ずつ次の工程へ送る1個流しを主題にした本です。この章では順番を変えることで機械間の待ち(仕掛品)が減ることを計算で示しましたが、この本は工程の並べ方や流し方そのものを変えて滞留をなくす側の考え方にあたります。最適化で順番を決める前に、流れの形を見直す余地がないかを考える材料になります。2001年の刊行です。
『Flow Shop Scheduling』(Hamilton Emmons・George Vairaktarakis、Springer):フローショップのスケジューリングだけを主題にした専門書で、2台のフローショップ、機械間の置き場に制限がある場合、待ちを許さない場合、工程ごとに複数の機械を持つ場合、加工時間が確率的な場合、同じ工程に戻ってくる場合などを章ごとに扱っています。この章で「使ってはいけないとき」として触れた条件が、それぞれどのような問題になるかを深く学べます。洋書ですが、自社の工程がどの型の問題にあたるかを調べる参照先として価値があると考えています。
第5章 ジョブショップ、品目ごとに工程の道順が違う工場の順序を解く
『Pythonによる実務で役立つ最適化問題100+ 3 配送計画・パッキング・スケジューリング』(久保幹雄、朝倉書店):第29章「スケジューリング問題」で、1機械問題や順列フローショップ問題と並んでジョブショップスケジューリング問題を取り上げ、OR-Tools を用いた求解の節を設けています。資源制約付きプロジェクトスケジューリング問題の節もあり、この章のモデルを後の章の制約へ広げていく道筋を、Python のコードとともに追えます。
『Constraint-Based Scheduling』(Philippe Baptiste、Claude Le Pape、Wim Nuijten、Springer):制約プログラミングでスケジューリング問題を解くための推論の技法をまとめた専門書で、1台の機械の資源制約の推論、累積的な資源制約の推論、ディスジャンクティブな問題の解き方などに章が割かれています。この章で「重なり禁止制約を渡すだけで書ける」と済ませた部分の内側で、ソルバーが何をしているかを知る手がかりになります。洋書です。
第6章 MIP と CP の使い分け、同じジョブショップを3つの定式化で解き比べる
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):線形計画・非線形計画・整数計画を1冊で扱う教科書で、整数計画と組合せ最適化の章に、分枝限定法と切除平面法、整数計画ソルバーの利用の節があります。この章で「LP 緩和が弱いと下界が上がらず、証明が終わらない」と説明した現象を、緩和問題と分枝限定法の仕組みから理解できます。
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):Python で数理最適化のモデルを書く例を問題の種類ごとに集めた本で、第6章「スケジューリング問題」では、1機械のリリース時刻付き重み付き完了時刻和問題、1機械の総納期遅れ最小化問題、順列フローショップ問題、資源制約付きスケジューリング問題を取り上げています。ソルバーは商用の Gurobi ですが、スケジューリングを数理最適化のモデルとしてどう書くかを、この章のジョブショップ以外の問題の型で確かめられます。
第7章 段取り替えを減らす、順序依存の段取りと納期の釣り合いを最適化で決める
『シングル段取への原点的志向 段取時間の革命』(新郷重夫、日本能率協会):書名のとおり、段取り時間の短縮(シングル段取)を主題とした本です。1983年の刊行で、この章が最適化で扱った「順序」とは別の、段取りの作業そのものを変える側の考え方を知るための古典にあたります。この章の「段取り時間そのものを減らす改善」の節と対にして読めます。
『驚きの数学 巡回セールスマン問題』(ウィリアム・J・クック著、松浦俊輔訳、青土社):原書『In Pursuit of the Traveling Salesman』の翻訳で、2013年に刊行されています。この章で段取りの問題と同じ形だと示した巡回セールスマン問題を、単純に見えて数学的な奥行きを持つ問題として取り上げた一般向けの本です。段取りの順序付けの裏側にある問題そのものについて知りたい方に向いています。
第8章 ロットサイジングと生産計画、週の計画に容量と段取り時間を入れる
『生産計画』(本間峰一・北島貴三夫・葉恒二、日本能率協会マネジメントセンター):シリーズ「図解でわかる生産の実務」の1冊で、版元の内容紹介は「利益が上がる生産計画の立て方」と知っておきたい計画手法を平易に解説した本としています。この章では数理モデルの側から週の計画を扱いましたが、計画担当者が実際にどういう順序で計画を立てているかを、実務の言葉で押さえるのに向いています。
『生産管理システム構築のすべて』(北村友博、日本実業出版社):生産計画が複数の計画で成り立っていること、基準生産計画(MPS)とタイムバケットの考え方、MRP(資材所要量計画)の論理を、システムを作る側の視点で解説しています。この章の「計画とスケジュールの整合」で触れた、段階ごとに計画を積み上げる仕組みが、情報システムの中でどう実装されているかを知るのに役立ちます。
第9章 並列機械とラインバランシング、仕事を複数の機械と工程に配る
『近似アルゴリズムデザイン』(David P. Williamson・David B. Shmoys 著、浅野孝夫 訳、共立出版):第2章と第3章に「同一並列マシーン上でのジョブのスケジューリング」の節があり、この章で紹介したリストスケジューリングや LPT のような貪欲な割当が、なぜ最適値の一定倍以内に収まるのかを証明とともに学べます。ビンパッキング問題の節もあり、ラインバランシングのタイプ1が先行関係を外すとこの問題に帰着する、という話ともつながります。
『新人IErと学ぶ 実践 IEの強化書』(日本インダストリアル・エンジニアリング協会 編、日刊工業新聞社):IE(インダストリアル・エンジニアリング、作業と工程を分析して生産性を上げる技術)の実践を、ライン・工程・経営などの段階ごとに解説した本で、作業編成効率による作業編成の評価や、ラインバランシングが分析手法として取り上げられています。この章の数理モデルを現場に持ち込む際の、編成効率の測り方や改善の進め方を補う1冊です。
第10章 人・治具・炉を制約に入れる、資源制約と稼働カレンダーとバッチ処理
『Python言語によるビジネスアナリティクス 実務家のための最適化・統計解析・機械学習』(久保幹雄・小林和博・斉藤努・並木誠・橋本英樹、近代科学社):第14章が資源制約付きスケジューリング問題にあてられ、スケジューリング最適化モジュール OptSeq を使って、作業・資源・先行関係をどう書くかを例題とともに示しています。この章では CP-SAT で書いた人員や設備の制約を、別のソルバーでどう表すかを比べながら読めます。
『Complex Scheduling』第2版(Peter Brucker・Sigrid Knust、Springer):スケジューリングのモデルと計算量の整理から始まり、資源制約付きプロジェクトスケジューリングと、複雑なジョブショップ(複数の機械から選べる工程、搬送、置き場の容量の制限を含むもの)に章をあてた専門書です。整数計画・制約伝播・分枝限定法・局所探索などの解法と、下界の計算方法が説明されており、この章で扱った累積制約や下界の考え方を、解法の側から体系的に学べます。洋書ですが、資源制約付きの問題を正面から扱った教科書として参照する価値があると考えています。
第11章 大規模化への対処、局所探索と分解で十分良い解を毎日同じ時間で出す
『組合せ最適化 メタ戦略を中心として』(柳浦睦憲・茨木俊秀、朝倉書店):経営科学のニューフロンティアのシリーズの1冊で、目次は近似解法の基本戦略、メタ戦略の基礎と実現、高性能アルゴリズムの設計、手軽なツールとしてのメタ戦略、近似解法の理論と進みます。この章で扱った局所探索・焼きなまし法・タブー探索・遺伝的アルゴリズムを、近傍の設計と探索の戦略という共通の枠組みで整理して学べます。
『メタヒューリスティクスとナチュラルコンピューティング』(古川正志・川上敬・渡辺美知子・木下正博・山本雅人・鈴木育男、コロナ社):山登り法、シミュレーテッドアニーリング、タブーサーチ、遺伝的アルゴリズムと、手法ごとに章が分かれています。この章では考え方の紹介にとどめた各手法の手順を、1つずつ追って確かめたいときに向いています。
『メタヒューリスティクスの数理』(久保幹雄・J.P.ペドロソ、共立出版):代表的なメタヒューリスティクスの解説に加えて、数理計画とメタヒューリスティクスの融合を1つの章として扱っています。この章で見た「ソルバーに近似解をヒントとして渡す」「問題を分けてソルバーで解く」といった、厳密解法と近似解法を組み合わせる考え方を深めるのに向いています。版元のページでは品切れ・重版未定と表示されています。
第12章 不確実性と再スケジューリング、故障と飛び込み注文にどう組み直すか
『システムシミュレーション』(森戸晋・逆瀬川浩孝、朝倉書店):経営工学ライブラリーの1冊で、簡単な待ち行列モデルのシミュレーションから始めて、より複雑なモデルの組み立て、ランダムな要因の決め方、擬似乱数の作り方、シミュレーション結果のまとめ方までを扱っています。この章の反復シミュレーションで乱数シードを固定し、共通乱数で対応を比べた部分の背景にある、乱数と結果の統計的な読み方を体系的に学べます。
『「ザ・ゴール」シリーズ クリティカルチェーン なぜ、プロジェクトは予定どおりに進まないのか?』(エリヤフ・ゴールドラット著、三本木亮訳、ダイヤモンド社):制約理論に基づくプロジェクト管理の手法を小説の形で描いた本で、2026年3月に新装版が出ています。所要時間が延びる、必要以上に時間を見積もる、ぎりぎりまで手を付けない、というプロジェクトが遅れる構造を扱っており、この章の「余裕の取りすぎが納期遅れに化ける」という結果を、計画の見積りと人の行動の側から考える手がかりになります。
第13章 現場に入れる、暗黙知を制約に落とし運用を回し続けるまで
『実践的MES導入ガイド 製造実行システムが工場を強くする』(一般財団法人エンジニアリング協会「次世代スマート工場」研究会、近代科学社):MES を、今なぜ必要か、何であるか、会社をどう変えるか、何ができるか、業界別の特徴、導入の進め方、工場のハードウェアとの関係、データドリブン製造との関係の順に解説した本で、同協会が公開した「MES/MOM導入のための標準業務一覧」をもとに書かれています。この章で扱った APS・MES・ERP の役割分担や、実績を工程単位で取るためのデータの流れを、MES の側から具体的に確かめたい方に向いています。2026年9月発売の新刊です。
『Asprova解体新書 生産スケジューラ使いこなし再入門』(高橋邦芳、日刊工業新聞社):生産スケジューラの導入がうまく運ばない根本原因を利用者の目線で考察し、失敗を避ける工夫や設定、運用を工程順に解説した本です。特定の製品を題材にしていますが、この章の導入の順序や失敗の型、人が計算結果を直す運用を、実際の生産スケジューラの画面と設定に落として考えるときの参考になります。
『納期見積りと生産スケジューリング』(黒田充、朝倉書店):サプライチェーンマネジメント講座の第1巻で、個別生産・受注生産を対象に、納期バッファを用いた納期見積り、資材の引当てを同時に行う納期見積り、顧客の要求納期とメーカーの理想納期などを扱っています。この章で、標準時間のずれが納期回答とリードタイムの判断を狂わせると述べた点を、受注生産の納期見積りの理論から深めたい方に向いています。
第14章 事例と最新動向、学習する手法と生成AIの時代のスケジューリング
『強化学習』(森村哲郎、講談社):機械学習プロフェッショナルシリーズの1冊で、マルコフ決定過程とプランニングから、モデルフリー型・モデルベース型の強化学習、関数近似を使う方法までを数理的に整理した本です。この章で紹介した、ディスパッチングルールを強化学習で作る研究が、どのような枠組みの上に立っているかを確かめるのに向いています。
『グラフニューラルネットワーク』(佐藤竜馬、講談社):同じシリーズから2024年に出た本で、グラフニューラルネットワークの定式化、さまざまなタスクへの応用、高速化、表現能力の限界までを扱っています。第5章のディスジャンクティブグラフを入力にしてスケジュールを学習する研究が、グラフの何を捉えようとしているのかを理解する助けになります。
『大規模言語モデル入門』(山田育矢 監修・著、鈴木正敏、山田康輔、李凌寒 著、技術評論社):Transformer の仕組みから大規模言語モデルの基礎と進展、追加学習(ファインチューニング)、要約や質問応答への応用までを解説した本です。この章で述べた、LLM を定式化の下書きや結果の説明に使うときに、何が得意で何が苦手かを判断する土台になります。
参考情報
本コラムの記述は、次の資料を2026年9月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- JIS Z 8141 の2001年版は生産計画を生産量と生産時期に関する計画と定義し大日程計画・中日程計画・小日程計画に分けている
https://kikakurui.com/z8/Z8141-2001-01.html - JIS Z 8141 は2022年に改正されている
https://webdesk.jsa.or.jp/books/W11M0090/index/?bunsyo_id=JIS%20Z%208141:2022 - リトルの法則は1961年に Operations Research 第9巻第3号で証明が発表された
https://people.cs.umass.edu/~emery/classes/cmpsci691st/readings/OS/Littles-Law-50-Years-Later.pdf - リトルの法則の内容と、機械の台数・待ち行列の並び方・加工時間や到着間隔の分布・処理順を問わないこと、定常性の前提
https://web.eng.ucsd.edu/~massimo/ECE158A/Handouts_files/Little.pdf - 到着間隔も加工時間も指数分布に従う1台の機械では、平均滞在時間は平均加工時間を1から稼働率を引いた値で割ったものになり、稼働率が1に近づくと系内の平均個数とともに発散し、原因は到着と加工のばらつき
https://www.win.tue.nl/~iadan/queueing.pdf - 2026年版ものづくり白書は3省が共同で作成し2026年5月29日に閣議決定
https://www.mhlw.go.jp/stf/houdou/newpage_00229.html - 製造業の就業者数は2023年1,055万人、2024年1,046万人、2025年1,033万人
https://www.mhlw.go.jp/content/11801500/001704747.pdf - 2025年版ものづくり白書は2025年5月30日に経済産業省・厚生労働省・文部科学省が公表
https://www.meti.go.jp/report/whitepaper/mono/2025/index.html - 2025年版ものづくり白書の概要で、労働力不足を挙げる事業者が多い
https://www.meti.go.jp/report/whitepaper/mono/2025/pdf/gaiyo.pdf - 参考書籍 ザ・ゴール 企業の究極の目的とは何か
https://ndlsearch.ndl.go.jp/books/R100000002-I000002989607 - 参考書籍 生産マネジメント入門 1 生産システム編
https://ndlsearch.ndl.go.jp/books/R100000002-I000003018132 - 参考書籍 生産マネジメント入門 1 生産システム編
https://www.rieti.go.jp/jp/publications/summary/01060004.html - 参考書籍 Factory Physics 第3版
https://www.waveland.com/browse.php?t=587
第2章
- 機械は同時に1つのジョブしか加工できず、ジョブは同時に1台の機械でしか加工されないという前提
https://ir.cwi.nl/pub/18052/18052A.pdf - NP 困難な問題には、どんな入力に対しても規模の何乗かの時間で最適解を保証する解き方が知られていない
https://www.claymath.org/millennium/p-vs-np/ - OR-Library は J. E. Beasley が作成・運営する試験問題集
http://people.brunel.ac.uk/~mastjjb/jeb/info.html - jobshop1.txt はジョブショップの試験問題82問を収録し、ft06・ft10・ft20 は Fisher と Thompson が1963年に Muth と Thompson の編著 Industrial Scheduling に発表したもの
http://people.brunel.ac.uk/~mastjjb/jeb/orlib/files/jobshop1.txt - 参考書籍 生産スケジューリング
https://www.asakura.co.jp/detail.php?book_code=27521 - 参考書籍 Scheduling Theory, Algorithms, Systems
https://link.springer.com/book/10.1007/978-3-031-05921-6 - 参考書籍 Scheduling Theory, Algorithms, Systems
https://link.springer.com/book/9783032365347 - 参考書籍 Scheduling Theory, Algorithms, Systems
https://link.springer.com/chapter/10.1007/978-3-031-05921-6_2
第3章
- 総完了時間は加工時間の短い順で最小になる
https://web-static.stern.nyu.edu/om/faculty/pinedo/scheduling/shakhlevich/handout02.pdf - Smith の論文の書誌
https://doi.org/10.1002/nav.3800030106 - 最大遅れは納期の早い順で最小になる
https://web-static.stern.nyu.edu/om/faculty/pinedo/scheduling/shakhlevich/handout04.pdf - Jackson の研究報告は1955年のカリフォルニア大学ロサンゼルス校のもの
https://ntrl.ntis.gov/NTRL/dashboard/searchResults/titleDetail/AD152722.xhtml - 遅れ件数はムーア法で最小になり、手順は納期順に積んで遅れたら最長の仕事を外す
https://homes.di.unimi.it/righini/Didattica/Logistica/MaterialeLog/S8b%20-%20Scheduling%20single%20machine.pdf - Moore の1968年の論文
https://doi.org/10.1287/mnsc.15.1.102 - 英語版ウィキペディアでは Hodgson-Moore algorithm の名で紹介
https://en.wikipedia.org/wiki/Single-machine_scheduling - 納期遅れの合計の最小化は NP 困難で、1990年に Du と Leung が証明
https://doi.org/10.1287/moor.15.3.483 - 重み付き納期遅れの合計は強い意味で NP 困難
http://www2.informatik.uni-osnabrueck.de/knust/class/ - 重み付き納期遅れの合計は強い意味で NP 困難
http://www2.informatik.uni-osnabrueck.de/knust/class/dateien/classes/ein_ma/ein_ma/ - Lawler と Lenstra らの1977年の論文の書誌
https://doi.org/10.1016/S0167-5060(08 - スラックは納期に遅れずに開始を遅らせられる最大の時間
https://www.pomsmeetings.org/confpapers/025/025-0010.pdf - Vepsalainen と Morton の1987年の論文
https://doi.org/10.1287/mnsc.33.8.1035 - CP-SAT は制約プログラミングと SAT の技術を組み合わせたソルバーで OR-Tools に含まれる
https://developers.google.com/optimization/cp - CP-SAT は制約プログラミングと SAT の技術を組み合わせたソルバーで OR-Tools に含まれる
https://developers.google.com/optimization/cp/cp_solver - 参考書籍 アルゴリズムデザイン
https://www.kyoritsu-pub.co.jp/book/b10010675.html - 参考書籍 Heuristic Scheduling Systems
https://books.google.co.jp/books/about/Heuristic_Scheduling_Systems.html?id=6ORuBRNk_Z8C
第4章
- 2台のフローショップのメイクスパン最小化は Johnson が1954年に示した手順で最適に解ける
https://doi.org/10.1002/nav.3800010110 - Johnson の論文はスケジューリング理論の最初の成果として扱われることが多い
https://web-static.stern.nyu.edu/om/faculty/pinedo/scheduling/shakhlevich/handout08.pdf - 3台の場合に Johnson 則が使える条件(機械1か機械3の最短時間が機械2の最長時間以上)
https://en.wikipedia.org/wiki/Johnson%27s_rule - 機械が3台以上のフローショップのメイクスパン最小化は NP 完全
https://doi.org/10.1287/moor.1.2.117 - CDS 法は Campbell・Dudek・Smith が1970年に Management Science に発表
https://doi.org/10.1287/mnsc.16.10.B630 - CDS 法は機械を2台に見立てた仮想問題を機械の台数より1つ少ない数だけ作り、Johnson 則で解いて最良を採る
https://www.growingscience.com/ijiec/Vol6/IJIEC_2014_43.pdf - Palmer が1965年に傾斜指数の方法を発表
https://doi.org/10.1057/jors.1965.8 - NEH 法は Nawaz・Enscore・Ham が1983年に Omega に発表
https://doi.org/10.1016/0305-0483(83 - NEH 法の手順(合計時間の長い順に並べ、1件ずつ最良の位置へ差し込む)
https://arxiv.org/abs/2606.15334 - Baker と Altheimer は CDS 法と NEH 法を最も良く頑健な構築型の手順と紹介し、計算量を CDS は mn log n、NEH は mn の2乗と整理
https://faculty.tuck.dartmouth.edu/images/uploads/faculty/principles-sequencing-scheduling/HeuristicsForFlowShops.pdf - Taillard のベンチマークは置換フローショップの研究で最も広く使われるデータの1つで、最良の既知解と既知下界の間に大きな差が残っている
https://arxiv.org/abs/2509.23512 - CP-SAT は充足可能性判定の手法を使う制約プログラミングのソルバーで、整数で動く
https://developers.google.com/optimization/cp - CP-SAT は整数だけで動く
https://developers.google.com/optimization/cp/cp_solver - 制約理論は制約工程の改善に集中すれば全体のアウトプットが向上するとし、制約を解消したら次の制約を探す手順を定めている
https://ja.wikipedia.org/wiki/%E5%88%B6%E7%B4%84%E7%90%86%E8%AB%96 - 参考書籍『流れ生産と1個流し 生産流れ学と究極のムダ表面化』平野裕之、日刊工業新聞社、2001年7月、ISBN 4-526-04792-9、171頁、「新IE」入門シリーズ4
https://ndlsearch.ndl.go.jp/books/R100000002-I000003009467 - 参考書籍『Flow Shop Scheduling』Hamilton Emmons・George Vairaktarakis、Springer、2013年、International Series in Operations Research の叢書
https://link.springer.com/book/10.1007/978-1-4614-5152-5
第5章
- ジョブショップのメイクスパン最小化は一般の形では機械2台以上で NP 完全、強い意味での結果
https://api.openalex.org/works/doi:10.1287/moor.1.2.117 - Balas 1969 がディスジャンクティブグラフ上の最長路の問題として定式化し、向きを入れ替える候補はクリティカルパス上の対だけでよいことを使って探索を絞った
https://api.openalex.org/works/doi:10.1287/opre.17.6.941 - Giffler と Thompson 1960 の手順で能動的スケジュールを作る
https://api.openalex.org/works/doi:10.1287/opre.8.4.487 - ft10 を初めて解いたのは Carlier と Pinson の1989年の論文
https://api.openalex.org/works/doi:10.1287/mnsc.35.2.164 - Applegate と Cook 1991 は同じ問題を7分弱で解いた
https://api.openalex.org/works/doi:10.1287/ijoc.3.2.149 - ft06 は Fisher と Thompson 1963、OR-Library の jobshop1.txt に収録、Muth と Thompson 編の Industrial Scheduling に掲載
http://people.brunel.ac.uk/~mastjjb/jeb/orlib/jobshopinfo.html - Industrial Scheduling には1966年に竹内書店から日本語訳『インダストリアルスケジューリング』が出ている
https://ndlsearch.ndl.go.jp/books/R100000002-I000001076662 - ft06 の最適値は55、ft10 は930として公開ベンチマーク一覧に記載
https://raw.githubusercontent.com/tamy0612/JSPLIB/master/instances.json - 3ジョブ×3機械の例の対は7組、128通り、最長路11、ドキュメントの最適値11と一致
https://developers.google.com/optimization/scheduling/job_shop - CP-SAT は整数の変数で書かれた問題を扱うソルバー
https://developers.google.com/optimization/cp/cp_solver - 参考書籍『Pythonによる実務で役立つ最適化問題100+ 3 配送計画・パッキング・スケジューリング』久保幹雄、朝倉書店、2022年12月
https://www.asakura.co.jp/detail.php?book_code=12275 - 参考書籍『Pythonによる実務で役立つ最適化問題100+ 3 配送計画・パッキング・スケジューリング』久保幹雄、朝倉書店、2022年12月
https://ndlsearch.ndl.go.jp/books/R100000002-I032507121 - 参考書籍『Constraint-Based Scheduling』Baptiste、Le Pape、Nuijten、Springer、2001
https://doi.org/10.1007/978-1-4615-1479-4
第6章
- ジョブショップの混合整数計画には、ディスジャンクティブ型・時間インデックス型・順位型などがあり、ディスジャンクティブ型は Manne 1960 に由来する
https://tidel.mie.utoronto.ca/pubs/JSP_CandOR_2016.pdf - ジョブショップの混合整数計画には、ディスジャンクティブ型・時間インデックス型・順位型などがあり、ディスジャンクティブ型は Manne 1960 に由来する
https://doi.org/10.1016/j.cor.2016.04.006 - Ku と Beck は CPLEX・Gurobi・SCIP で4つの定式化を比べ、Manne のディスジャンクティブ型が最も良かった
https://api.semanticscholar.org/graph/v1/paper/DOI:10.1016/j.cor.2016.04.006?fields=title,abstract - OR-Tools の公式ガイドはジョブショップをインターバル変数・重なり禁止・工程順・メイクスパン最小で解く例を載せている
https://developers.google.com/optimization/scheduling/job_shop - CP-SAT は整数だけを扱うソルバーである
https://developers.google.com/optimization/cp/cp_solver - CBC は C++ で書かれたオープンソースの混合整数線形計画ソルバーである
https://github.com/coin-or/Cbc - ft06 は Fisher と Thompson 1963、la01 などは Lawrence 1984 の問題で OR-Library に収められている
http://people.brunel.ac.uk/~mastjjb/jeb/orlib/jobshopinfo.html - 参考書籍『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』梅谷俊治、講談社、2020年
https://ndlsearch.ndl.go.jp/books/R100000002-I030691339 - 参考書籍『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』梅谷俊治、講談社、2020年
https://www.kspub.co.jp/book/detail/5212707.html - 参考書籍『あたらしい数理最適化 Python言語とGurobiで解く』久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社、2012年
https://www.kindaikagaku.co.jp/book_list/detail/9784764904330/
第7章
- JIS Z 8141 生産管理用語の2001年版は、段取を作業開始前の材料・機械・治工具・図面などの準備と試し加工と定義している
https://kikakurui.com/z8/Z8141-2001-01.html - Gilmore と Gomory の1964年の論文は、機械の状態を変える費用のかかる順序付けが巡回セールスマン問題の特殊な場合であると要旨に書いている
https://doi.org/10.1287/opre.12.5.655 - 新郷重夫『シングル段取への原点的志向 段取時間の革命』日本能率協会 1983年 373ページ
https://ndlsearch.ndl.go.jp/books/R100000002-I000001646825 - 新郷重夫『A Revolution in Manufacturing』Productivity Press 1985年
https://ndlsearch.ndl.go.jp/books/R100000136-I1970304959889485084 - ウィリアム・J・クック『驚きの数学 巡回セールスマン問題』松浦俊輔訳 青土社 2013年
https://ndlsearch.ndl.go.jp/books/R100000002-I024432921
第8章
- CLSP の標準形では能力の制約は加工時間の合計だけで、段取りは費用として目的関数に入る
https://prolog.univie.ac.at/teaching/LVAs/Production_Analysis/SS_09/DK97.pdf - Trigeiro・Thomas・McClain の1989年の論文は段取り時間を主題とし、能力の制約が極端にきつい問題は想定より解きにくく残業なしの解が常に見つかったわけではなく、能力の制約のきつさが難しさのよい指標になると報告
https://api.openalex.org/works/doi:10.1287/mnsc.35.3.353 - 『生産計画』本間峰一・北島貴三夫・葉恒二、日本能率協会マネジメントセンター、2004年7月、シリーズ図解でわかる生産の実務、ISBN 9784820742357
https://ndlsearch.ndl.go.jp/books/R100000002-I000007398457 - 『生産計画』本間峰一・北島貴三夫・葉恒二、日本能率協会マネジメントセンター、2004年7月、シリーズ図解でわかる生産の実務、ISBN 9784820742357
https://www.books.or.jp/book-details/9784820742357 - 『生産管理システム構築のすべて』北村友博、日本実業出版社、2010年2月、ISBN 9784534046741
https://www.njg.co.jp/book/9784534046741/
第9章
- 並列機械の同一・一様・非関連の3つの型と記号 P・Q・R の定義
https://ir.cwi.nl/pub/18052/18052A.pdf - ラインバランシングのタイプ1は工程数最小、タイプ2はサイクルタイム最小
https://arxiv.org/abs/1111.0934 - Salveson 1955 が最初の定式化、Baybars 1986 が基本形と一般化した形を区別
https://www.jiem.org/index.php/jiem/article/download/7390/1109 - 位置重みの定義(自分の時間+間接の後続を含む全後続の時間)
https://arxiv.org/abs/1003.3676 - ラインバランシングの JIS Z 8141 の定義「生産ラインの各作業ステーションに割り付ける作業量を均等化する方法」
https://www.j-ie.com/about_ie/methods/06/ - 参考書籍『近似アルゴリズムデザイン』Williamson・Shmoys 著、浅野孝夫 訳、共立出版、2015年9月
https://www.kyoritsu-pub.co.jp/book/b10003664.html - 参考書籍『近似アルゴリズムデザイン』Williamson・Shmoys 著、浅野孝夫 訳、共立出版、2015年9月
https://ndlsearch.ndl.go.jp/books/R100000002-I026729697 - 参考書籍『新人IErと学ぶ 実践 IEの強化書』日本インダストリアル・エンジニアリング協会 編、日刊工業新聞社、2021年3月
https://pub.nikkan.co.jp/book/b10021920.html - 参考書籍『新人IErと学ぶ 実践 IEの強化書』日本インダストリアル・エンジニアリング協会 編、日刊工業新聞社、2021年3月
https://ndlsearch.ndl.go.jp/books/R100000002-I031333950
第10章
- PSPLIB の報告書は、資源制約付きスケジューリングの枠組みにフローショップ・ジョブショップ・オープンショップが含まれ、NP 困難の仲間になると述べている
https://www.econstor.eu/bitstream/10419/149843/1/manuskript_396.pdf - PSPLIB の報告書は、資源制約付きスケジューリングの枠組みにフローショップ・ジョブショップ・オープンショップが含まれ、NP 困難の仲間になると述べている
https://hdl.handle.net/10419/149843 - PSPLIB の報告書は学術誌にも掲載されている
https://doi.org/10.1016/S0377-2217(96 - 累積制約は区間の一覧と使用量と容量を受け取り、どの時点でも進行中の区間の使用量の合計が容量を超えないようにする制約
https://github.com/google/or-tools/blob/stable/ortools/sat/docs/scheduling.md - Uzsoy の1994年の論文は、大きさの異なるロットを容量のある1台のバッチ処理機械でまとめる問題で、メイクスパンと総完了時間の最小化がともに NP 困難であることを示した
https://doi.org/10.1080/00207549408957026 - Uzsoy の1994年の論文は、大きさの異なるロットを容量のある1台のバッチ処理機械でまとめる問題で、メイクスパンと総完了時間の最小化がともに NP 困難であることを示した
https://api.openalex.org/works/doi:10.1080/00207549408957026 - 『Python言語によるビジネスアナリティクス 実務家のための最適化・統計解析・機械学習』久保幹雄・小林和博・斉藤努・並木誠・橋本英樹、近代科学社
https://www.kindaikagaku.co.jp/book_list/detail/9784764905160/ - 『Python言語によるビジネスアナリティクス 実務家のための最適化・統計解析・機械学習』久保幹雄・小林和博・斉藤努・並木誠・橋本英樹、近代科学社
https://ndlsearch.ndl.go.jp/books/R100000002-I027548722 - 『Complex Scheduling』第2版、Peter Brucker・Sigrid Knust、Springer
https://link.springer.com/book/10.1007/978-3-642-23929-8 - 『Complex Scheduling』第2版、Peter Brucker・Sigrid Knust、Springer
https://ndlsearch.ndl.go.jp/books/R100000136-I1970023484875061793
第11章
- 公開ベンチマーク ft06・ft10・la26・la31・abz7・swv01・swv11・yn1 の問題データと説明行
http://people.brunel.ac.uk/~mastjjb/jeb/orlib/jobshopinfo.html - Applegate と Cook の1991年の論文は Muth と Thompson の 10×10 問題を Sun Sparcstation 1 で7分弱で最適性まで解いた
https://doi.org/10.1287/ijoc.3.2.149 - Adams・Balas・Zawack の1988年の論文によるシフティングボトルネック法は、機械を1台ずつボトルネックから順序づけ、そのたびに既に決めた順序を局所的に再最適化し、どちらも単一機械の部分問題を繰り返し解く
https://doi.org/10.1287/mnsc.34.3.391 - 焼きなまし法は Kirkpatrick・Gelatt・Vecchi の1983年の論文が固体の焼きなましとの類推で組合せ最適化に持ち込んだ
https://doi.org/10.1126/science.220.4598.671 - タブー探索は Glover が1989年と1990年の2部作で基本原理を示した
https://doi.org/10.1287/ijoc.1.3.190 - タブー探索の2部作の後半
https://doi.org/10.1287/ijoc.2.1.4 - van Laarhoven・Aarts・Lenstra の1992年の論文はジョブショップに焼きなまし法を適用し、コストが増える移動も確率的に受け入れて局所最適を避けた
https://doi.org/10.1287/opre.40.1.113 - Nowicki と Smutnicki の1996年の論文は、クリティカルパスとブロックに基づく近傍のタブー探索で、10×10 の難問をパソコンで30秒以内に解いた
https://doi.org/10.1287/mnsc.42.6.797 - Osman と Potts の1989年の論文は置換フローショップへの焼きなまし法の適用
https://doi.org/10.1016/0305-0483%2889%2990059-5 - Reeves の1995年の論文はフローショップの順序づけへの遺伝的アルゴリズムの適用
https://doi.org/10.1016/0305-0548%2893%29E0014-K - Ruiz と Stützle の2007年の論文は置換フローショップの反復貪欲法
https://doi.org/10.1016/j.ejor.2005.12.009 - NEH 法の原論文
https://doi.org/10.1016/0305-0483%2883%2990088-9 - max_time_in_seconds と max_deterministic_time と interleave_search の説明
https://raw.githubusercontent.com/google/or-tools/v9.15/ortools/sat/sat_parameters.proto - 参考書籍『組合せ最適化 メタ戦略を中心として』柳浦睦憲・茨木俊秀、朝倉書店、経営科学のニューフロンティア2、2001年初版、ISBN 978-4-254-27512-4
https://www.asakura.co.jp/detail.php?book_code=27512 - 参考書籍『組合せ最適化 メタ戦略を中心として』の国立国会図書館の書誌
https://ndlsearch.ndl.go.jp/books/R100000002-I000002953684 - 参考書籍『メタヒューリスティクスとナチュラルコンピューティング』古川正志ほか、コロナ社、2012年、ISBN 978-4-339-02461-6
https://www.coronasha.co.jp/np/isbn/9784339024616/ - 参考書籍『メタヒューリスティクスの数理』久保幹雄・J.P.ペドロソ、共立出版、2009年、ISBN 978-4-320-12235-2
https://www.kyoritsu-pub.co.jp/bookdetail/9784320122352
第12章
- 再スケジューリングを環境・戦略・方針・方法で捉える枠組みと定義
https://isr.umd.edu/Labs/CIM/projects/jos-rescheduling.pdf - Wu・Storer・Chang の研究が変更の大きさを開始時刻のずれと順序の違いの2通りで定義
https://api.openalex.org/works/doi:10.1016/0305-0548%2893%2990091-V - Abumaizar と Svestka の影響工程の再スケジューリングが他の2方法の欠点を補う
https://api.openalex.org/works/doi:10.1080/002075497195074 - Leon・Wu・Storer のロバスト性の定義と、ロバストなスケジュールがメイクスパンだけのスケジュールを上回った
https://api.openalex.org/works/doi:10.1080/07408179408966626 - Sridharan・Berry・Udayabhanu の基準生産計画の凍結、凍結方式・凍結区間・計画期間の3変数、計画期間の50%までの凍結は費用への影響がわずか
https://api.openalex.org/works/doi:10.1287/mnsc.33.9.1137 - 参考書籍 システムシミュレーション
https://www.asakura.co.jp/detail.php?book_code=20955 - 参考書籍 クリティカルチェーン 新装版
https://www.diamond.co.jp/book/9784478124079.html
第13章
- 2026-09-24 追記: 日本規格協会の Webdesk( WebFetch で開き、JIS Z 8141:2022(生産管理用語、発行日 2022-03-22、状態 有効)が現行であることを確認した
https://webdesk.jsa.or.jp/books/W11M0090/index/?bunsyo_id=JIS+Z+8141%3A2022 - JIS Z 8141 は標準時間を、その仕事に適性をもち習熟した作業者が所定の作業条件のもとで必要な余裕をもち正常な作業ペースによって仕事を遂行するために必要とされる時間と定義し、正味時間と余裕時間から構成されるとしている
https://kikakurui.com/z8/Z8141-2001-01.html - MESA International が1997年9月に公表した白書 MES Explained A High Level Vision は、MES を、受注の投入から完成品に至るまでの生産活動の最適化を可能にする情報を提供するもので
http://www.cpdee.ufmg.br/~luizt/seixas/PaginaII/Download/DownloadFiles/pap6.pdf - ISA-95 は IEC 62264 としても知られ、企業の業務システムと製造の制御システムの間の情報交換の抽象モデルを定めている
https://www.isa.org/standards-and-publications/isa-standards/isa-95-standard - 『実践的MES導入ガイド 製造実行システムが工場を強くする』一般財団法人エンジニアリング協会「次世代スマート工場」研究会、近代科学社
https://www.kindaikagaku.co.jp/book_list/detail/9784764961494/ - 『実践的MES導入ガイド 製造実行システムが工場を強くする』一般財団法人エンジニアリング協会「次世代スマート工場」研究会、近代科学社
https://www.enaa.or.jp/seminar/82878 - 『Asprova解体新書 生産スケジューラ使いこなし再入門』高橋邦芳、日刊工業新聞社
https://www.hanmoto.com/bd/isbn/9784526079849 - 『納期見積りと生産スケジューリング』黒田充、朝倉書店
https://www.asakura.co.jp/detail.php?book_code=27541 - 『納期見積りと生産スケジューリング』黒田充、朝倉書店
https://www.hanmoto.com/bd/isbn/9784254275414
第14章
- NECプラットフォームズの表面実装工程における生産計画立案の自動化の事例
https://jpn.nec.com/quantum_annealing/case/necplatforms/index.html - ニチレイフーズの食品工場における最適生産・要員計画自動立案システム
https://www.hitachi.com/ja-jp/press/articles/2020/02/0204/ - サントリー食品インターナショナルの生産計画立案システム
https://www.hitachi.co.jp/products/infrastructure/portal/industry/optimization/casestudies/lv1004.html - 住友化学の千葉工場・袖ケ浦地区でのエネルギーを考慮した生産計画の実工場検証
https://www.hitachi.com/ja-jp/press/articles/2025/03/0327/ - 生成AIと数理最適化で生産ラインの構成を自動立案する日立製作所の研究成果
https://rd.hitachi.co.jp/_ct/17855383 - 深層強化学習とグラフニューラルネットワークでディスパッチングルールを学習する研究
https://proceedings.neurips.cc/paper/2020/hash/11958dfee29b6709f48a9ba0387a2431-Abstract.html - グラフニューラルネットワークと強化学習によるジョブショップの学習型スケジューラ
https://arxiv.org/abs/2106.01086 - 制約プログラミングの定式化を使う強化学習でディスパッチングルールを学ぶ研究
https://arxiv.org/abs/2306.05747 - 複数の解から最良のものを疑似正解にする自己教師ありの学習法
https://arxiv.org/abs/2401.11849 - 大規模言語モデルにジョブショップを解かせる研究
https://arxiv.org/abs/2408.06993 - 大規模言語モデルのジョブショップ用データセットの続報
https://arxiv.org/abs/2503.01877 - 文章から最適化問題を定式化する技術を競うコンペティション
https://arxiv.org/abs/2303.08233 - 大規模言語モデルで定式化からソルバーのコード作成・修正までを行うエージェント
https://arxiv.org/abs/2402.10172 - 最適化の結果を説明する大規模言語モデルの枠組み
https://arxiv.org/abs/2307.03875 - OR-Tools v9.15 のリリースと CP-SAT の改良点
https://github.com/google/or-tools/releases/tag/v9.15 - MiniZinc Challenge 2025 で OR-Tools CP-SAT が3部門で金メダル
https://www.minizinc.org/challenge/2025/results/ - ft06 の最適値55
http://people.brunel.ac.uk/~mastjjb/jeb/orlib/jobshopinfo.html - 参考書籍『強化学習』森村哲郎、講談社、機械学習プロフェッショナルシリーズ、2019年5月
https://www.kspub.co.jp/book/detail/5155912.html - 参考書籍『グラフニューラルネットワーク』佐藤竜馬、講談社、機械学習プロフェッショナルシリーズ、2024年4月
https://www.kspub.co.jp/book/detail/5347829.html - 参考書籍『大規模言語モデル入門』山田育矢 監修・著、鈴木正敏・山田康輔・李凌寒 著、技術評論社、2023年
https://gihyo.jp/book/2023/978-4-297-13633-8