こんにちは、Anagraftの伊藤です。
今回は、在庫と発注量を決めるための数理モデルを、「いくつずつ買うか」「どれだけ余分に持つか」「いつ買うか」「一度しか買えないときはいくつか」「どこに置くか」「決めた方針をどう評価し、どう運用するか」という問いの順に整理しました。経済的発注量、安全在庫とサービスレベル、定量発注方式と定期発注方式、ニューズベンダー問題、多期間の在庫方策と動的ロットサイジング、需要予測との接続、確率計画とロバスト最適化、多段階在庫とブルウィップ効果、混合整数計画による発注計画、シミュレーションによる方策の評価、そして運用と経営報告までを扱います。ここに挙げた用語は、それぞれの章で最初に出るときに平易な言葉で説明していますので、ここで分からなくても差し支えありません。
この題材を選んだ理由は、在庫が経営の数字に直結する意思決定でありながら、その決め方が担当者の経験則に委ねられていることが多いためです。在庫は貸借対照表の棚卸資産そのもので、持ちすぎれば運転資金が固定され、陳腐化や廃棄の損失が出ます。持たなければ欠品で売上の機会を失い、納期を守れず信用を損ないます。この両側の損失のあいだで、どこに線を引くかを決める道具が在庫の数理モデルです。需要予測の精度を上げれば在庫の問題が解けると考えられがちですが、予測はあくまで入力であり、発注量と発注時期を決める工程が別に要ります。本コラムは、その「決める」工程を扱います。
各章では、架空の日次需要データを共通の題材にして、実際にコードを動かした結果を載せています。データは乱数で生成したもので、実在の企業の記録ではありませんが、定番品、季節品、間欠需要品、成長品という4つの型を持つ代表品目と、ABC分析のための56品目を含めてあります。同じデータに対して、経済的発注量、安全在庫、各発注方式、確率計画、シミュレーションを順に当てることで、手法どうしの関係と、それぞれが何を決めて何を決めないかが横に比べられるようにしました。費用の設定も架空のもので、業種によって桁が変わりますので、数値そのものではなく計算の構造をご覧ください。
想定している読者は、在庫や発注の改善を任された実務者の方、需要予測や在庫管理のシステム導入を検討している方、そして在庫の水準を経営指標として見る立場の方です。オペレーションズ・リサーチの専門家でなくても読めるように、専門用語には平易な補足を添え、数式は最小限にして言葉で言い換えています。Pythonのコードも載せていますが、コードを読まなくても結果の読み方は分かるように書きました。
本コラムでは、各手法について「何を決める手法か」「どういう前提で使えるか」「使ってはいけないのはどういうときか」「結果を経営指標にどう翻訳するか」を必ず書くようにしました。手法の式そのものは教科書に載っていますが、実務で困るのは、自分の品目にどの式が当てはまり、その式の前提が自分の現場で崩れていないかを見極めるところだと考えているためです。各章には、その判断を誤ったときに経営上どういう損失になるかを示す段落を置いています。
本コラムの記述は2026年9月時点で確認したものです。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
目的別の読み方の目安を挙げておきます。在庫の水準を経営指標としてどう見るかを整理したい場合は、第1章と第13章が入口になります。発注量と安全在庫の計算の根拠を確かめたい場合は、第2章で需要の記述を整えたうえで、第3章から第5章をご覧ください。生鮮品や季節品のように一度しか買えない品目を扱う場合は第6章のニューズベンダー問題が中心です。需要予測を導入したのに欠品や過剰在庫が減らないという場合は、第8章の予測誤差と安全在庫の関係を先にご覧いただくと、原因の切り分けに役立ちます。
複数の拠点や倉庫を持ち、どこに在庫を置くかを決めたい場合は第10章の多段階在庫が入口です。品目数が多く、容量や予算の制約の下で発注計画を組みたい場合は第9章の確率計画と第11章の混合整数計画をご覧ください。決めた方針が実際にどれだけのサービス率と在庫金額になるかを確かめる方法は第12章にまとめています。機械学習や生成AIを在庫管理にどう位置づけるかは第14章で扱っています。

目次
- 序章 在庫は予測の問題ではなく、決める問題である
- 全体の地図
- 第1章 在庫はなぜ経営の問題なのか、費用の構造と経営指標
- 第2章 需要とリードタイムの不確実性を記述する
- 第3章 経済的発注量、いくつずつ買うか
- 第4章 安全在庫、どれだけ余分に持つか
- 第5章 発注方式の体系、いつ買うか
- 第6章 ニューズベンダー問題、一度しか買えないときの最適量
- 第7章 多期間の在庫問題、(s,S)方策と動的ロットサイジング
- 第8章 需要予測と発注をつなぐ、予測誤差を在庫に翻訳する
- 第9章 確率計画とロバスト最適化、不確実性を式に入れる
- 第10章 多段階在庫、どこに在庫を置くか
- 第11章 数理最適化としての発注計画、複数品目と容量制約を混合整数計画で解く
- 第12章 シミュレーションで方策を評価する
- 第13章 在庫方策を運用する、パラメータの更新から経営報告まで
- 第14章 事例と最新動向、機械学習と生成AIの時代の在庫管理
- 終章 式で決めて、結果で直す
- 本コラムで紹介した書籍一覧
- 第1章 在庫はなぜ経営の問題なのか、費用の構造と経営指標
- 第2章 需要とリードタイムの不確実性を記述する
- 第3章 経済的発注量、いくつずつ買うか
- 第4章 安全在庫、どれだけ余分に持つか
- 第5章 発注方式の体系、いつ買うか
- 第6章 ニューズベンダー問題、一度しか買えないときの最適量
- 第7章 多期間の在庫問題、(s,S)方策と動的ロットサイジング
- 第8章 需要予測と発注をつなぐ、予測誤差を在庫に翻訳する
- 第9章 確率計画とロバスト最適化、不確実性を式に入れる
- 第10章 多段階在庫、どこに在庫を置くか
- 第11章 数理最適化としての発注計画、複数品目と容量制約を混合整数計画で解く
- 第12章 シミュレーションで方策を評価する
- 第13章 在庫方策を運用する、パラメータの更新から経営報告まで
- 第14章 事例と最新動向、機械学習と生成AIの時代の在庫管理
- 参考情報
序章 在庫は予測の問題ではなく、決める問題である
在庫の話題になると、まず需要予測の精度が問われることが多いように思います。予測が当たれば在庫は減り、欠品も無くなるという見立てです。ところが、予測がどれだけ精緻になっても、需要は予測どおりには来ません。予測と実績のあいだには必ず誤差があり、その誤差に備えて余分に持つのが安全在庫です。さらに、発注してから届くまでのリードタイムがあり、まとめて買えば発注の手間は減るが在庫は増えるという釣り合いがあり、一度しか買えない品目もあれば、複数の倉庫のどこに置くかを決めなければならない品目もあります。予測は入力の一つにすぎず、そこから発注量と発注時期を決める工程が別に要ります。本コラムが扱うのは、この「決める」工程です。
在庫理論は、この決め方を費用の釣り合いとして定式化してきた分野です。1913年に発表された経済的発注量の式に始まり、確率的な需要の下での安全在庫、多期間の最適方策、多段階のサプライチェーン全体の在庫配置へと広がってきました。手法の多くは古典ですが、古いから使えないのではなく、前提を満たす場面では今も簡潔で頑健な答えを返します。問題は、自分の品目にどの前提が当てはまり、どこで崩れているかを見極めることにあります。
在庫は損益計算書と貸借対照表の両方に現れる
在庫の意思決定が経営の問題である理由は、その結果が財務諸表の両方に現れることにあります。持ちすぎた在庫は貸借対照表の棚卸資産として運転資金を固定し、保管費や資本コストとして損益を圧迫し、売れ残れば評価損や廃棄損になります。持たなかった在庫は、欠品による売上の機会損失として損益計算書には現れにくい形で利益を削り、納期遅延として取引先からの信用を損ないます。どちらの損失も、発注量と発注時期をどう決めたかの結果です。
この両側の損失は、片方を減らそうとするともう片方が増える関係にあります。欠品をゼロにしようとすれば在庫は際限なく増え、在庫を減らそうとすれば欠品が増えます。在庫の数理モデルは、この釣り合いを費用の式で表し、総費用が最も小さくなる点、あるいは目標とするサービス水準を最も少ない在庫で達成する点を計算するものです。担当者の経験則が間違っているとは限りませんが、経験則には根拠が残らず、担当者が変われば水準も変わります。式で決めれば、なぜその量なのかを説明でき、前提が変わったときにどこを直せばよいかも分かります。
五つの問いに沿って手法を並べる
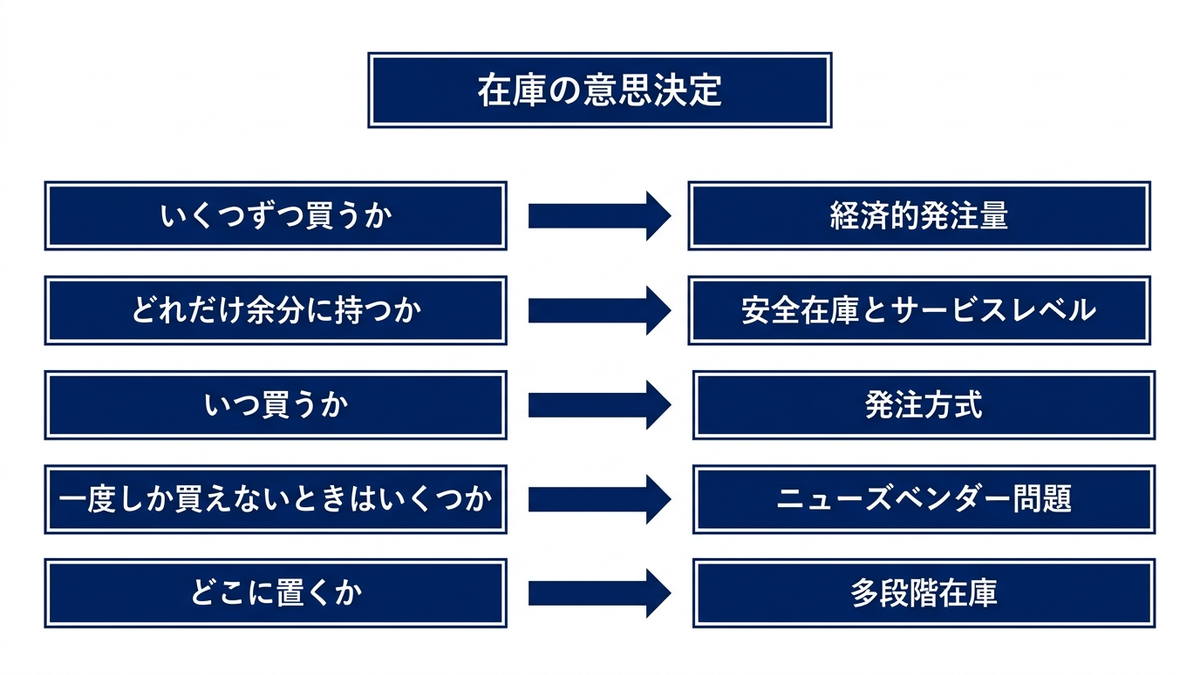
本コラムは、在庫の意思決定を五つの問いに分けて章を並べました。「いくつずつ買うか」は経済的発注量の問題で、発注の手間と在庫の保有費用の釣り合いを扱います。「どれだけ余分に持つか」は安全在庫の問題で、需要とリードタイムのばらつきに対して、どの程度の欠品を許容するかを決めます。「いつ買うか」は発注方式の問題で、在庫を常に監視して発注点を切ったら買うのか、決まった間隔で買うのかを選びます。「一度しか買えないときはいくつか」はニューズベンダー問題で、生鮮品や季節品のように売れ残りが損失になる品目を扱います。「どこに置くか」は多段階在庫の問題で、工場、物流拠点、店舗のどこに在庫を集めるかを決めます。
これらの問いに答える手法の前に、需要とリードタイムの不確実性をどう記述するかを第2章で扱い、後には、需要予測との接続、不確実性を式の中に入れる確率計画、複数品目と容量制約を扱う混合整数計画、決めた方策をシミュレーションで評価する方法、そして運用と経営報告までを置きました。最後の章では、公開された一次情報のある事例と、機械学習や生成AIをどこに位置づけるかを扱います。
同じデータで、手法を横に比べる
手法の解説では、手法ごとに別の例題を使うことが多く、その結果、手法どうしの関係が見えにくくなります。本コラムでは、架空の日次需要データを共通の題材にしました。3年分の日次需要を持つ60品目で、そのうち4品目を代表品目として全章で使い回します。需要が安定している定番品、夏に山がある季節品、ほとんどの日に需要が無く時々まとまって出る間欠需要品、日次の需要水準が3年で2倍になるように生成した成長品(年間合計では約1.5倍)の4つです。同じ品目に経済的発注量、安全在庫、各発注方式、確率計画、シミュレーションを順に当てることで、手法ごとに何が決まり、何が決まらないかを横に比べられるようにしました。
このデータは乱数で生成したもので、実在の企業の記録ではありません。費用の設定も架空です。その代わり、生成時に需要の型を仕込んであるため、たとえば正規分布を前提にした安全在庫の式が定番品ではよく働き、間欠需要品では働かないことを、同じ計算で確かめられます。手法の限界を隠さず示せることが、架空データを使う利点だと考えています。
式で決めて、結果で直す
本コラムを通じてお伝えしたいことが一つあります。在庫の水準は、式で決めて、結果で直すということです。式で決めるとは、発注量と安全在庫を費用とサービス水準の釣り合いから計算し、その根拠を残すことです。結果で直すとは、決めた方策を実際の需要に当てて、フィルレートや在庫日数といった指標を測り、前提が崩れていれば式の入力を直すことです。どちらか片方だけでは足りません。式だけでは前提の崩れに気づけず、結果だけでは何を直せばよいかが分かりません。
経営判断に関わる方にとって、この点は在庫削減の目標の置き方に直結します。回転率や在庫金額の目標だけを置くと、現場は欠品を増やして在庫を減らすか、目標に合わせて発注を先送りするかしかできません。目標とするサービス水準を決め、その水準を達成するのに必要な在庫を式で出し、実績との差を毎月見るという順序であれば、在庫の削減と欠品の抑制を、同じ指標の上で両立させる余地を探れます。本コラムの第13章では、この順序を運用の手順として整理しました。
Anagraftでは、データ活用の構想づくりから分析の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。章の並びは、在庫の意思決定を五つの問いに分け、その問いの順に手法を配置する形にしました。最初の2つの章で在庫を経営の問題として捉える視点と、需要とリードタイムの不確実性の記述を扱い、第3章から第7章で「いくつずつ買うか」「どれだけ余分に持つか」「いつ買うか」「一度しか買えないときはいくつか」「多期間ではどう決めるか」を順に扱います。第8章と第9章は、需要予測と不確実性を発注の式にどう入れるかを扱い、第10章と第11章で「どこに置くか」と「複数品目・容量制約の下でどう組むか」へ進みます。最後の3つの章は、決めた方策の評価、運用と経営報告、事例と最新動向です。
必要な章だけを拾って読む使い方も想定しています。その場合も、第2章で紹介する共通のサンプルデータは第3章以降のすべての章で使いますので、第2章の「共通データ」の節だけは先にご覧いただくと、各章の結果が読みやすくなります。費用の設定も第3章で説明していますので、第4章以降の金額の意味を確かめたい場合は第3章の冒頭をご覧ください。
| 章 | 扱う内容 | この章で答えたいこと |
|---|---|---|
| 第1章 在庫はなぜ経営の問題なのか、費用の構造と経営指標 | 在庫の役割、保有費用と欠品費用の内訳、棚卸資産回転率と在庫日数、資金繰りへの影響、判断を誤ったときの損失の型 | 在庫の水準は、経営の数字のどこにどう現れるか |
| 第2章 需要とリードタイムの不確実性を記述する | 需要分布、間欠需要、季節とトレンド、リードタイムのばらつき、ABC分析とXYZ分析、共通データの紹介 | 自分の品目の需要は、どの型に属し、どう記述すべきか |
| 第3章 経済的発注量、いくつずつ買うか | 発注費用と保有費用の釣り合い、総費用曲線、平方根の頑健性、数量割引、生産ロット、複数品目の制約 | まとめ買いの量を、費用の根拠をもって決めるには |
| 第4章 安全在庫、どれだけ余分に持つか | サービスレベルの2つの定義、安全係数、需要とリードタイムのばらつきの合成、発注点、正規近似の限界 | どの程度の欠品を許し、そのためにどれだけ余分に持つか |
| 第5章 発注方式の体系、いつ買うか | 定量発注方式、定期発注方式、(s,S)方策、ベースストック方策、方式ごとの情報要件と安全在庫の違い | 常に監視して買うのか、決まった間隔で買うのか、品目ごとにどう選ぶか |
| 第6章 ニューズベンダー問題、一度しか買えないときの最適量 | 過小費用と過大費用、臨界比、最適発注量、粗利率とサービス率の関係、推定誤差の影響 | 売れ残りが損失になる品目を、いくつ仕入れるか |
第7章 多期間の在庫問題、(s,S)方策と動的ロットサイジング | 動的計画、一定の条件のもとでの(s,S)方策の最適性、ベースストック方策、Wagner-Whitin法、近似法、MRPとの関係 | 需要が期によって違うとき、何期分をいつ買うか |
| 第8章 需要予測と発注をつなぐ、予測誤差を在庫に翻訳する | 予測誤差の分布、バイアスの害、更新頻度と発注周期、間欠需要の予測、分位点予測 | 予測の精度は、安全在庫と発注量にどう効くか |
| 第9章 確率計画とロバスト最適化、不確実性を式に入れる | シナリオ型の2段階確率計画、サンプル平均近似、CVaR、ロバスト最適化、平均需要で解くことの誤り | 需要が分からないまま、いま決めなければならない量をどう決めるか |
| 第10章 多段階在庫、どこに在庫を置くか | エシェロン在庫、直列系の最適方策の分解、ブルウィップ効果、保証サービス時間モデル、リスクプーリング | 工場、物流拠点、店舗のどこに在庫を集め、どこを薄くするか |
| 第11章 数理最適化としての発注計画、複数品目と容量制約を混合整数計画で解く | 動的ロットサイジングの定式化、段取り変数、容量制約、安全在庫の制約化、計算時間 | 品目が多く制約がある発注計画を、一度に解くには |
| 第12章 シミュレーションで方策を評価する | 離散イベントシミュレーション、ヒストリカルシミュレーション、KPI、反復回数、パラメータ格子、感度分析 | 式で決めた方策は、実際にどれだけのサービス率と在庫になるか |
| 第13章 在庫方策を運用する、パラメータの更新から経営報告まで | ABC別の自動化、例外管理、KPI設計、システム連携、導入の順序、失敗の型 | 決めた方策を、担当者が変わっても回り続ける仕組みにするには |
| 第14章 事例と最新動向、機械学習と生成AIの時代の在庫管理 | 公開一次情報のある事例、食品ロスと商慣習の制度動向、確率的な需要予測との接続、予測と最適化の一体化、生成AIの位置づけ | 在庫管理の考え方は、機械学習と生成AIの時代にどう生きるか |
五つの問いと、その周りにある補助的な問い(不確実性の扱い・制約・評価)を合わせて、手法との対応を一覧にしておきます。同じ品目でも、問いが違えば入口の章が変わります。
| 問い | 典型的な場面 | 主な手法 | 章 |
|---|---|---|---|
| いくつずつ買うか | 発注の手間と在庫の保有費用を釣り合わせたい | 経済的発注量、生産ロット、数量割引の扱い | 第3章 |
| どれだけ余分に持つか | 需要とリードタイムのばらつきに備えたい | 安全在庫、サービスレベル、発注点 | 第4章、第8章 |
| いつ買うか | 在庫を常に監視するか、決まった間隔で見るかを決めたい | 定量発注方式、定期発注方式、(s,S)方策、ベースストック方策 | 第5章、第7章 |
| 一度しか買えないときはいくつか | 生鮮品、季節品、イベント用の商品を仕入れたい | ニューズベンダー問題 | 第6章 |
| 不確実なまま、いま決めるには | 需要のシナリオが複数あり、悪いときの損失も抑えたい | 確率計画、CVaR、ロバスト最適化 | 第9章 |
| どこに置くか | 工場、物流拠点、店舗のあいだで在庫を配分したい | エシェロン在庫、保証サービス時間モデル、リスクプーリング | 第10章 |
| 制約の下で一度に組むには | 品目が多く、倉庫の容量や予算の上限がある | 混合整数計画によるロットサイジング | 第11章 |
| 決めた方策をどう確かめるか | 式で出した安全在庫が本当に効いているか知りたい | シミュレーション、KPI | 第12章、第13章 |
第1章 在庫はなぜ経営の問題なのか、費用の構造と経営指標
在庫は、貸借対照表の上では棚卸資産という流動資産の一項目にすぎません。しかし経営の実態としては、売れるはずだった商品が無くて失った売上、売れずに残って値下げや廃棄に回った商品、倉庫と資金を占有し続ける仕掛品といった形で、損益と資金繰りの両方に影響します。本コラムは在庫と発注量を数理モデルで決める方法を14章かけて扱いますが、その入口となる本章では、個々の手法に入る前に、在庫のどこで費用が発生し、それが経営指標のどこに現れるのかを整理します。
具体的には、在庫が果たしている4つの役割、在庫を持つことの費用の内訳とそれを年率で表す考え方、欠品の費用、棚卸資産回転率と在庫日数とキャッシュ・コンバージョン・サイクルの定義と読み方、在庫の増減が利益と資金繰りに与える影響、公的統計で見た日本企業の在庫水準、そして判断を誤ったときの損失の型を順に述べます。第2章以降で扱う各手法は、すべて本章の費用と指標の言葉に翻訳して読めるように書いています。手法の名前より先に、自社の在庫がどの費用を発生させ、どの指標を動かしているのかを押さえておくことが、後の章で「自分の在庫で何を決めるか」を判断する土台になると考えています。
在庫が果たしている4つの役割
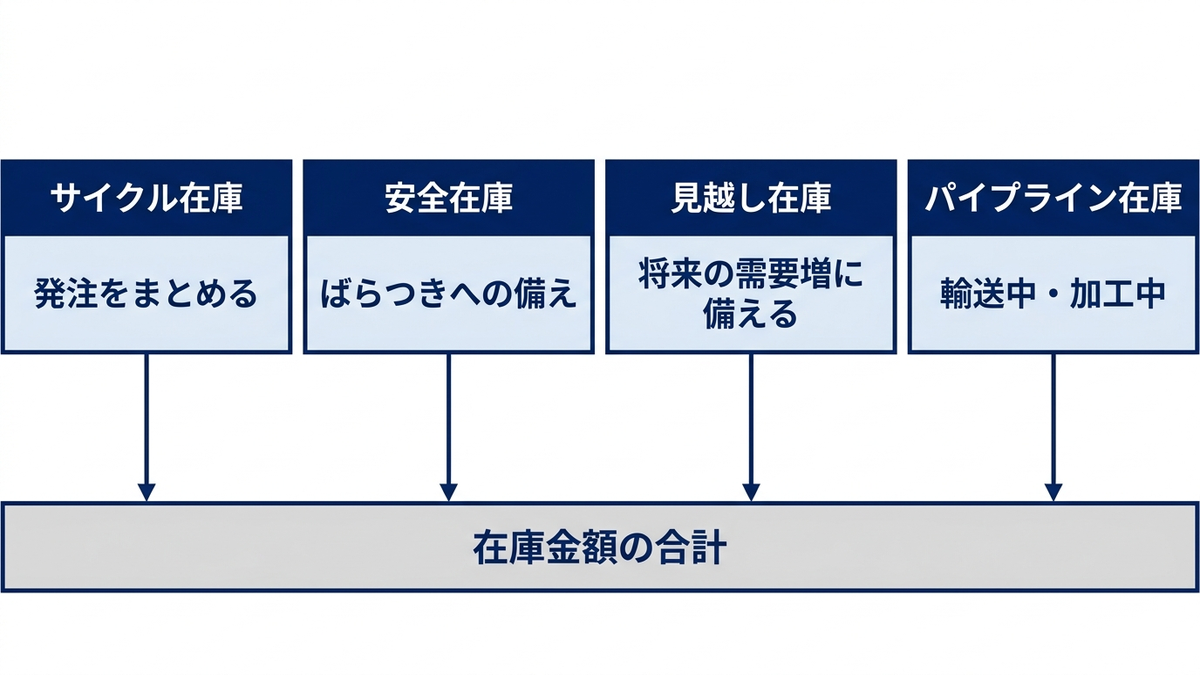
在庫を「なぜ持っているのか」で分けると、役割ごとに減らす手段が違うことが見えてきます。在庫管理の教科書や講義ノートでは、在庫をパイプライン在庫、サイクル在庫、安全在庫、季節在庫、熟成在庫、投機在庫などに分類しています。本コラムでは、このうち季節在庫と投機在庫をまとめて見越し在庫と呼び、サイクル在庫、安全在庫、見越し在庫、パイプライン在庫の4つに整理して以降の章を組み立てます。熟成在庫は本コラムでは扱いません。
サイクル在庫は、発注や生産をある程度まとめて行うことで生じる在庫です。1回に \( Q \) 個ずつ発注して、それが次の入荷までに一定の速さで消費されていくなら、手元の在庫は \( Q \) から0まで直線的に減り、平均すると \( Q/2 \) の在庫を常に抱えていることになります。年間需要を \( D \)、発注の間隔を年単位で \( T \) とすれば、サイクル在庫の平均は \( D T / 2 \) と書けます。減らす手段は発注ロットを小さくすることですが、その分だけ発注回数が増えて発注費用がかさみます。このつり合いを式で決めるのが第3章の経済的発注量です。
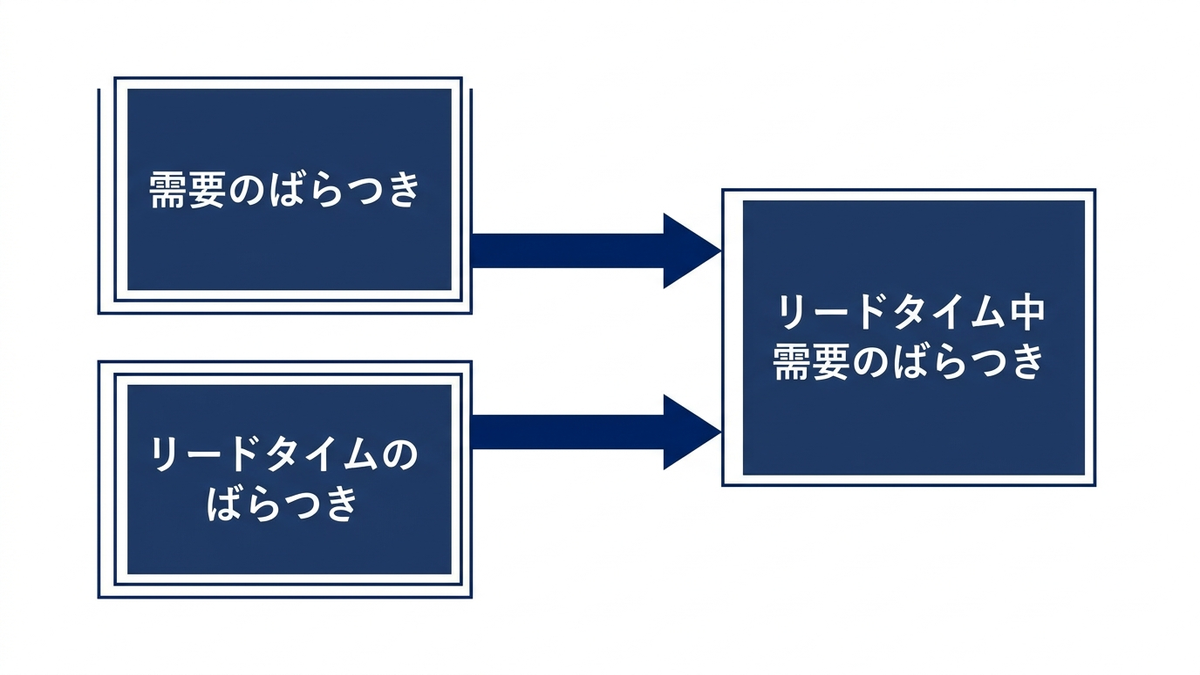
安全在庫は、需要とリードタイム(発注してから入荷するまでの期間)のばらつきに備えて、平均的に必要な量より余分に持つ在庫です。需要が予想より多かった、入荷が遅れた、という事態が起きても欠品しないための保険にあたります。減らす手段は、ばらつきそのものを小さくすること、リードタイムを短くすること、そして許容する欠品の水準を見直すことの3つで、どれも「在庫を減らせ」と号令をかけるだけでは動きません。安全在庫の量をサービスレベルから逆算する方法は第4章で扱います。
見越し在庫は、季節の繁忙期、販売促進、値上げや供給の途絶の予告といった、将来の需要増や供給減を見越して先に積んでおく在庫です。季節在庫の場合、需要の少ない時期に作り溜めて繁忙期に売ることで、生産能力をピークに合わせて増強しなくて済む代わりに、溜めている期間の保有費用を払うことになります。減らすには生産能力の側を柔軟にするか、ピークの需要を平準化するかのどちらかが要ります。
パイプライン在庫は、輸送中や加工中で、まだ使える状態になっていない在庫です。1日あたりの需要率を \( d \)、輸送や加工にかかる日数を \( L \) とすれば、常に \( d L \) だけの在庫が途中にあることになります。海外からの調達で船便に30日かかるなら、30日分の需要に相当する在庫が常に輸送中にあるわけです。この在庫はリードタイムを短くしない限り減らせず、発注の仕方をどう工夫しても動きません。
この4分類が経営上重要なのは、役割ごとに、減らす手段と、減らしすぎたときに失うものが違うからです。「在庫を全体で1割減らす」という一律の指示は、いちばん減らしやすい安全在庫が削られて欠品が増え、サイクル在庫とパイプライン在庫はそのまま、という結果に落ち着きやすいと考えています。まず自社の在庫金額を4つの役割に振り分け、どの役割の在庫が大きいのかを見ることが、施策を選ぶ前の最初の作業になります。
| 役割 | 生じる理由 | 減らす手段 | 減らしすぎたときの損失 | 扱う章 |
|---|---|---|---|---|
| サイクル在庫 | 発注や生産をまとめて行う | ロットを小さくする(発注回数は増える) | 発注費・段取り費の増加 | 第3章・第7章 |
| 安全在庫 | 需要とリードタイムのばらつき | ばらつきの縮小、リードタイム短縮、欠品許容水準の見直し | 欠品による機会損失と信用の低下 | 第4章・第8章 |
| 見越し在庫 | 季節、販促、値上げや供給途絶の予告 | 生産能力の柔軟化、需要の平準化 | 繁忙期の欠品、能力増強の投資 | 第6章・第7章 |
| パイプライン在庫 | 輸送中・加工中の時間 | リードタイムの短縮 | 減らせない(リードタイムを変えない限り) | 第10章 |
在庫を持つ費用の内訳と、年率で表す考え方
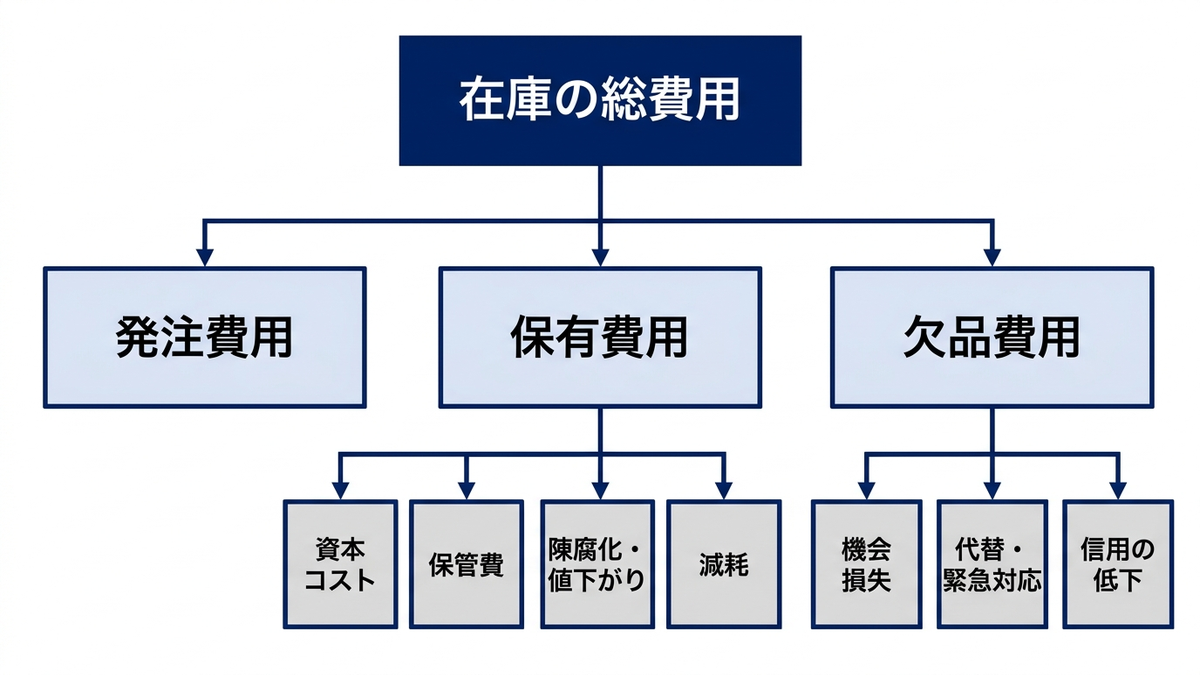
在庫を持つことの費用は、まとめて保有費用(保管費用、在庫維持費用とも呼ばれます)と呼ばれます。内訳は大きく4つあります。1つ目は資本コストで、在庫に形を変えて寝ている資金を別の用途に回せば得られたはずの収益、あるいは在庫を借入で賄っているなら支払利息にあたります。2つ目は保管費で、倉庫の賃料や減価償却、光熱費、ハンドリングの人件費、保険料、在庫にかかる税金などです。3つ目は陳腐化と値下がりで、モデルチェンジや流行の変化、賞味期限で売れなくなった分の損失です。4つ目は減耗で、破損、紛失、盗難によって帳簿上の数量と実際の数量がずれる分です。Georgia Tech の Goetschalckx による講義ノート「Logistics Systems Design」の在庫の章でも、保有費用に含まれるものとして保管設備、ハンドリング、保険、盗難、陳腐化、資本の機会費用が挙げられています。
これらは性質がばらばらで、倉庫の賃料は面積に、資本コストは金額に、陳腐化は品目の性格に比例します。実務ではこれを1つにまとめて、保有費率という年率で表します。保有費率とは、ある品目を1年間持ち続けたときにかかる保有費用を、その品目の価値(原価)で割ったものです。たとえば原価1,200円の品目を1年間持つのに240円かかるなら、保有費率は年20%です。同じ講義ノートには、米国の産業では単位価値の年25%が保有費率の平均として広く引用されている、という記述があります。本コラムの例題では年20%という値を共通の費用パラメータとして使いますが、これは架空の設定で、金利の水準、倉庫の性格、品目の陳腐化の速さで大きく変わります。詳しくは費用パラメータを最初に使う第3章で述べます。
| 内訳 | 何に比例するか | 損益計算書での見え方 | 大きくなる業種・品目 |
|---|---|---|---|
| 資本コスト | 在庫金額と金利(または期待収益率) | 借入なら支払利息。自己資金なら機会費用として現れない | 高額品、金利が高い局面 |
| 保管費 | 保管する体積・面積・期間 | 賃料、減価償却費、人件費、保険料などに分散 | かさばる品、温度管理が要る品 |
| 陳腐化・値下がり | 品目の寿命、モデルチェンジの頻度 | 値引き、評価損、廃棄損として遅れて現れる | 季節品、ファッション、電子機器、生鮮 |
| 減耗 | 取り扱いの回数、保管の条件 | 棚卸差損、廃棄損 | 破損しやすい品、小さく高価な品 |
経営目線で重要なのは、この4つの費用のうち、損益計算書に「在庫の費用」という科目で現れるものが1つも無いことです。資本コストは自己資金で賄っていれば会計上どこにも出てきませんし、保管費は倉庫や人件費の中に溶け込んでいます。陳腐化の損失は、評価損を計上するか、実際に値引きや廃棄をした期になって初めて損益に現れます。税務の面でも、法人税基本通達では、棚卸資産の評価損を計上できる「著しい陳腐化」を、季節商品の売れ残りで今後通常の価額では販売できないことが明らかな場合や、型式・性能・品質が著しく異なる新製品の発売で通常の方法で販売できなくなった場合と例示し、破損、型崩れ、たなざらし、品質変化もこれに準ずるとしている一方で、物価変動、過剰生産、建値の変更だけで時価が下がった場合は該当しないとしています。つまり、過剰に持った在庫の損失は、帳簿に現れるまでに時間差があります。在庫金額が減っていないことと、在庫が健全であることは別の話で、この時間差が在庫の問題を見えにくくしていると考えています。
欠品の費用は推定しにくいが、無視すると判断が偏る
在庫が足りないときの費用は、欠品費用(品切れ費用)と呼ばれます。内訳は3つに分けられます。1つ目は機会損失で、その注文が他社に流れて売上と粗利を失う分です。2つ目は代替と緊急対応の費用で、納期遅れを埋めるための緊急輸送、代替品を値引きして納めること、契約上のペナルティ、納期遅れの間の事務対応などです。3つ目は信用の低下で、その顧客からの将来の注文が減ることや、同じ注文に含まれていた他の品目まで失注することです。前述の講義ノートも、欠品費用には緊急輸送、ペナルティ、顧客の信用の喪失が含まれ、3つの在庫費用の中で最も正確に見積もることが難しく、とくに信用の喪失と同一注文内の他品目の失注は推定が困難だと述べています。
欠品の費用は業態によって型が違います。納期を遅らせて後から納品できる取引(バックオーダー)では、失うのは信用と緊急対応の費用で、売上そのものは残ります。店頭の小売や、競合が同じ品を持っている場合は、その売上は消えます(失注)。後の章で安全在庫やニューズベンダー問題を扱うとき、欠品を「バックオーダー」と「失注」のどちらで置くかによって最適な在庫量が変わりますので、自社の欠品がどちらの型かを先に決めておく必要があります。
欠品費用を金額で置けないときは、代わりに「欠品を許容する水準」をサービスレベルとして制約に置く方法が使われます。これは費用を推定できないときの実務上の逃げ道であると同時に、経営としてどの程度の欠品を受け入れるかを明示的に決める行為でもあります。第4章では、サービスレベルの2つの定義と、それを保有費用と欠品費用のつり合いから決める考え方を扱います。本コラムの例題では、欠品1個あたりの費用を原価の50%(粗利相当)と置いていますが、これも架空の設定です。
経営目線で言えば、欠品費用のうち機会損失と信用の低下が損益計算書に現れないという点が最大の問題です。緊急輸送費やペナルティは費用として計上されますが、欠品が原因だと紐づけて集計しない限り、やはり在庫の判断の結果としては見えません。売れなかった売上は記録されず、失った顧客がどれだけいたかも、意識して数えない限り記録に残りません。一方で過剰在庫は棚卸資産として毎期の貸借対照表に載ります。この非対称のため、在庫削減の施策は過剰の側にだけ目が向きやすく、欠品の損失が見積もられないまま在庫を減らして、翌期の売上減として跳ね返ることが起きやすいと考えています。欠品の費用を推定できないなら、せめて欠品の回数と量を計測しておくこと、それが在庫を減らす前に必要な準備です。
発注費用と、費用のつり合いとしての在庫問題
在庫の費用にはもう1つ、発注費用があります。1回発注するたびにかかる固定的な費用で、発注書の作成、検収、支払処理、輸送の固定分、生産なら段取り替えの費用がこれにあたります。発注量に比例しない点が保有費用との違いで、ロットを大きくすれば発注回数が減って発注費用は下がりますが、サイクル在庫が増えて保有費用が上がります。本コラムの例題では1回あたり4,000円と置いています。
したがって在庫の問題は、発注費用、保有費用、欠品費用という3つの費用の合計を最小にする問題として書けます。前述の講義ノートも、在庫システムの総費用は伝統的に在庫の保有、補充の発注、満たされなかった需要の3つに関する費用から成り、満たされなかった需要の費用の代わりに最低サービスレベルを制約として使うこともある、と整理しています。この記事の第3章以降は、この3つの費用のどれとどれのつり合いを取っているのかで読むと見通しがよくなります。発注量を決める第3章は発注費用と保有費用のつり合い、安全在庫を決める第4章は保有費用と欠品費用のつり合い、一度しか買えないときの量を決める第6章は売れ残りの損失と欠品の損失のつり合いです。多期間の第7章、確率計画の第9章、多段階の第10章は、この3つの費用を時間や拠点にまたがって合計したものを扱います。
棚卸資産回転率と在庫日数
在庫の水準を経営指標として見るとき、最も広く使われるのが棚卸資産回転率です。定義は、一定期間の売上原価を、その期間の平均棚卸資産で割ったもので、単位は「回」です。年間の売上原価が8億4,000万円、平均の棚卸資産が1億5,000万円なら、回転率は5.6回で、在庫が1年に5.6回入れ替わっている、と読みます。これを日数に直したものが在庫日数(在庫回転日数)で、365日を回転率で割ります。5.6回なら65.2日で、今ある在庫を売り切るのに65日分の売上原価に相当する量を持っている、という意味になります。
分子に売上原価ではなく売上高を使う流儀もあります。財務省の法人企業統計では、棚卸資産回転期間を「棚卸資産(期首・期末平均)を、売上高を12で割ったもので割る」と定義しており、単位は月です。売上高を使うと粗利の分だけ分母が大きくなるので、同じ在庫でも回転率は高く、日数は短く出ます。同業他社や統計と比べるときは、分子が原価なのか売上高なのか、分母が平均なのか期末なのかを必ず揃える必要があります。もう1つの注意点は季節性で、期末が繁忙期の直前にあたる会社は期末在庫が年間平均より多く、期末残高で計算すると在庫日数が過大に出ます。
次のコードは、架空の会社の決算数値(単位は百万円)から、これらの指標を一通り計算するものです。売上高1,200、売上原価840、棚卸資産は期首140と期末160、売上債権は期首200と期末220、買入債務は期首100と期末110としています。
sales, cogs = 1200.0, 840.0                  # 売上高、売上原価(百万円)
inv_begin, inv_end = 140.0, 160.0            # 棚卸資産(期首・期末)
ar_begin, ar_end = 200.0, 220.0              # 売上債権(受取手形+売掛金)
ap_begin, ap_end = 100.0, 110.0              # 買入債務(支払手形+買掛金)
holding_rate = 0.20                          # 年間保有費率(原価比、架空)

inv_avg = (inv_begin + inv_end) / 2
ar_avg = (ar_begin + ar_end) / 2
ap_avg = (ap_begin + ap_end) / 2

turnover_cogs = cogs / inv_avg               # 棚卸資産回転率(回/年)
days_inv_cogs = 365 / turnover_cogs          # 在庫日数
period_inv_month = inv_avg / (sales / 12)    # 棚卸資産回転期間(月)。財務省の算式
wc_month = (ar_avg + inv_avg - ap_avg) / (sales / 12)   # 営業運転資本回転期間(月)

dio = days_inv_cogs                          # 在庫日数(原価ベース)
dso = ar_avg / sales * 365                   # 売上債権回転日数(売上高ベース)
dpo = ap_avg / cogs * 365                    # 買入債務回転日数(原価ベース)
ccc = dio + dso - dpo
print(f"回転率 {turnover_cogs:.2f} 回/年, 在庫日数 {days_inv_cogs:.1f} 日, 回転期間 {period_inv_month:.2f} か月")
print(f"営業運転資本回転期間 {wc_month:.2f} か月, CCC {ccc:.1f} 日")
print(f"年間保有費用 {inv_avg * holding_rate:.1f} 百万円")
for cut in (5, 10, 20):
    freed = cogs / 365 * cut
    print(f"在庫日数を {cut} 日短縮: 解放資金 {freed:.1f}, 保有費用の減少 {freed * holding_rate:.2f} 百万円/年")
# 出力:
# 回転率 5.60 回/年, 在庫日数 65.2 日, 回転期間 1.50 か月
# 営業運転資本回転期間 2.55 か月, CCC 83.4 日
# 年間保有費用 30.0 百万円
# 在庫日数を 5 日短縮: 解放資金 11.5, 保有費用の減少 2.30 百万円/年
# 在庫日数を 10 日短縮: 解放資金 23.0, 保有費用の減少 4.60 百万円/年
# 在庫日数を 20 日短縮: 解放資金 46.0, 保有費用の減少 9.21 百万円/年
| 指標 | 算式 | 計算例の値 |
|---|---|---|
| 棚卸資産回転率(原価ベース) | 売上原価 ÷ 平均棚卸資産 | 5.60回 |
| 在庫日数 | 365 ÷ 回転率 | 65.2日 |
| 売上高ベースの回転率 | 売上高 ÷ 平均棚卸資産 | 8.00回 |
| 棚卸資産回転期間(財務省の定義) | 平均棚卸資産 ÷(売上高 ÷ 12) | 1.50か月 |
| 年間の保有費用(保有費率20%) | 平均棚卸資産 × 0.20 | 3,000万円 |
同じ在庫でも、原価ベースなら5.6回、売上高ベースなら8.0回と、基準の取り方で数字が変わることが計算例からも分かります。回転率の水準そのものは業種で桁が違い、生鮮食品と重機を同じ物差しで比べることはできません。読み方としては、同業他社との比較か、自社の時系列での変化のどちらかに絞るのが安全です。とくに時系列で在庫日数が伸びているときは、売上が落ちているのに発注が減っていないか、特定の品目に売れ残りが溜まっていないかを、品目別に分解して確かめる必要があります。全社の回転率は平均であって、その中には回転率が50回の品目と1回に満たない品目が混ざっていることがあります。品目ごとの分解は第2章の ABC 分析で扱います。
キャッシュ・コンバージョン・サイクルと営業運転資本回転期間
在庫日数を、売上債権と買入債務の回転日数と組み合わせたものがキャッシュ・コンバージョン・サイクル(CCC)です。仕入代金を支払ってから、その仕入が商品として売れ、売上代金を回収するまでの日数を表します。在庫日数に売上債権の回転日数を足し、買入債務の回転日数を引いて求めます。計算例では、在庫日数65.2日に売上債権回転日数63.9日を足し、買入債務回転日数45.6日を引いて83.4日でした。これは、仕入の支払いから売上の回収までに平均83日かかり、その間の運転資金を会社が立て替えている、という意味です。CCC が長いほど、同じ売上を支えるのに多くの運転資金が要ります。
日本の公的な経営診断の枠組みでも、同じ発想の指標が使われています。経済産業省のローカルベンチマーク(ロカベン)は、企業の経営状態を把握する「健康診断」のツールとして、売上増加率、営業利益率、労働生産性、EBITDA 有利子負債倍率(ロカベンでは健全性の指標に分類されています)、営業運転資本回転期間、自己資本比率の6つの財務指標を定めています。このうち営業運転資本回転期間は効率性の指標で、売上債権と棚卸資産の合計から買入債務を引いた額を、売上高を12で割ったもので割って、月数で表します。上の計算例では2.55か月でした(この計算例は期首と期末の平均を使った簡易な例で、期末残高だけで計算すると2.70か月になります)。上の計算例の CCC と違って分母をすべて売上高で揃えているので、決算書の数字からそのまま計算できる点が実務向きです。
ロカベンのシート(2022年度版)には、帝国データバンクが保有する2019年4月から2022年2月の間に3期連続の決算書が収録されている約37,000社を対象にした、業種別・規模別の基準値が入っています。営業運転資本回転期間の中規模事業者の中央値をいくつか抜き出すと、次のようになります。
| 業種(ロカベンの区分) | 営業運転資本回転期間の中央値(か月) |
|---|---|
| 一般・電気機械器具製造業 | 2.48 |
| 化学工業・関連製品製造業 | 2.46 |
| 金属製品製造業 | 2.15 |
| 食料品・飼料・飲料製造業 | 1.83 |
| 建設業 | 1.23 |
| その他の卸売業 | 0.99 |
| 小売業 | 0.86 |
| 飲食業 | 0.08 |
製造業は2か月を超え、小売業や飲食業は現金商売で売上債権が小さく在庫も短いため1か月を切っています。この表の読み方で注意したいのは、営業運転資本を構成する3つの要素のうち、売上債権と買入債務は取引先との契約条件で決まる部分が大きく、自社の意思決定だけで動かしにくいのに対して、棚卸資産は発注と生産の判断で直接動かせる、という点です。運転資金を減らしたいとき、支払条件の交渉より先に在庫の判断を見直すほうが手戻りが少ないことが多いと考えています。もう1つは、中央値を目標にしないことです。中央値は「その業種の真ん中の会社」の値であって、良い状態の値ではありません。
在庫の増減が利益と資金繰りに与える影響
在庫が経営指標の中でとくに注意を要するのは、利益への現れ方と資金への現れ方がずれるからです。商品を仕入れた時点では、支出した現金は棚卸資産という資産に形を変えるだけで、費用にはなりません。売上原価として費用に計上されるのは、その商品が売れたときです。したがって、売れる見込みより多く仕入れても、その期の利益は減りません。減るのは現金です。金融庁のサイトに掲載されている連結キャッシュ・フロー計算書等の作成基準の様式でも、間接法の営業活動によるキャッシュ・フローの区分に、たな卸資産の増減額、売上債権の増減額、仕入債務の増減額が、税金等調整前当期純利益に加減する項目として並んでいます。在庫が増えた分だけ、利益とキャッシュ・フローの間に差が開きます。
この仕組みから、在庫を減らしたときの効果は2種類に分けて考える必要があります。1つは一度きりの効果で、在庫を減らした分の運転資金が解放されることです。もう1つは毎年続く効果で、減らした在庫にかかっていた保有費用が翌年以降かからなくなることです。計算例の会社で在庫日数を10日短縮すると、解放される資金は売上原価の10日分にあたる2,300万円で、保有費率20%を掛けた年間の保有費用の減少は460万円です。20日なら4,600万円と921万円になります。
| 在庫日数の短縮 | 解放される資金(一度きり) | 年間の保有費用の減少(毎年) |
|---|---|---|
| 5日 | 1,150万円 | 230万円 |
| 10日 | 2,300万円 | 460万円 |
| 20日 | 4,600万円 | 921万円 |
経営への報告では、この2つを混ぜないことが大切です。「在庫削減で2,300万円の効果」と書くと、それが資金なのか利益なのか、一度きりなのか毎年なのかが伝わりません。資金の効果は運転資金の借入を減らせるか、投資に回せるかという資金繰りの話であり、費用の効果は利益の話です。もう1つ、在庫を減らして欠品が増えれば、失った粗利が保有費用の減少を上回ることがあります。在庫削減の報告には、必ず同じ期間の欠品の指標(欠品回数、フィルレート)を並べる必要があります。この報告の設計は第13章で扱います。
逆方向の注意もあります。前節で述べたとおり、陳腐化の損失は評価損の計上や値引き、廃棄をした期になって初めて損益に現れます。在庫を多く持っている期は利益が高く見え、それを処分する期に利益が落ちる、という時間差が生じるので、在庫日数が伸びている会社の利益は、将来の処分損を織り込んで読む必要があります。
公的統計で見る日本企業の在庫水準
日本企業全体の在庫水準は、財務省の年次別法人企業統計調査で見ることができます。2026年9月1日に公表された令和7年度の報道発表によると、金融業・保険業を除く全産業の売上高は1,720兆2,560億円で前年度比1.6%の増加でした。同じ資料の第9表には、期末の棚卸資産を売上高で割った在庫率が載っており、2021年度から2025年度にかけて9.2%、9.5%、9.5%、9.6%、9.9%と推移しています。売上高に在庫率を掛けると、期末の棚卸資産はおおよそ170兆円という規模になります(報道発表に棚卸資産の残高そのものは載っていないため、2つの公表値からの概算です)。在庫率9.9%を日数に直すと、売上高ベースで36日分の在庫を期末に持っていることになります。
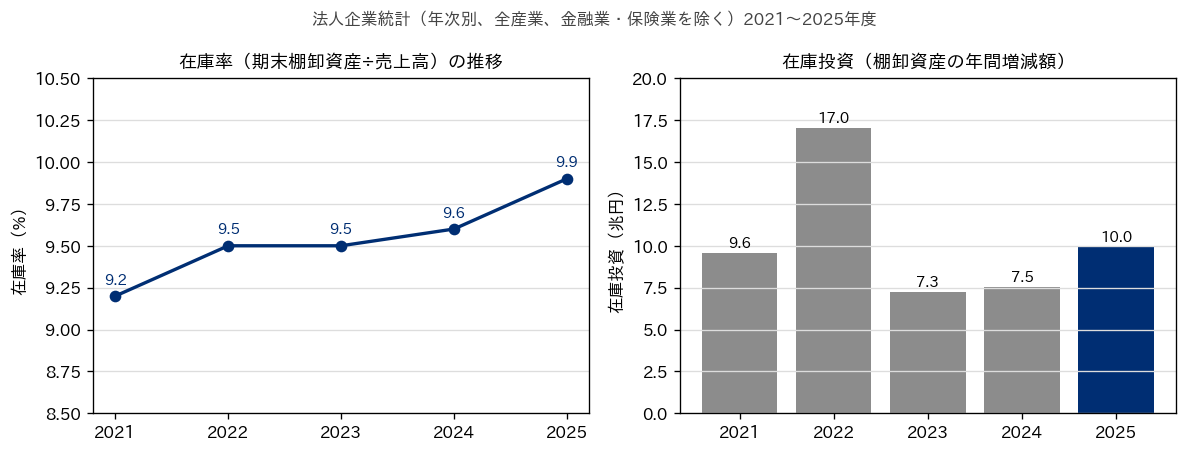
同じ第9表の在庫投資(調査対象年度中の棚卸資産の増減額)は、2025年度に全産業で9兆9,632億円の増加でした。内訳は製品・商品が4兆6,447億円、仕掛品が3兆6,217億円、原材料・貯蔵品が1兆6,967億円で、割合にすると47%、36%、17%です。製造業が3兆187億円、非製造業が6兆9,445億円で、非製造業の内訳のうち大きい業種を挙げると、不動産業が3兆1,584億円、卸売業・小売業が1兆4,827億円、建設業が1兆1,901億円で、この3業種で非製造業の8割強を占めます。5年間で最も増加額が大きかったのは2022年度の17兆206億円で、2025年度はその6割弱にあたります。在庫率が4年で0.7ポイント上がった意味を概算すると、もし2025年度の在庫率が2021年度の9.2%のままだったなら、期末の棚卸資産は約12兆円少なかった計算になります。
売上債権と買入債務も同じ報道発表の第10表に載っています。2025年度末の受取手形・売掛金は262兆96億円、支払手形・買掛金は173兆4,042億円です。売上高で割って日数に直すと、売上債権が55.6日、買入債務が36.8日になります。これに在庫の36.1日を合わせると、売上高ベースで揃えた営業運転資本の回転日数は54.9日、月数にして約1.8か月という概算になります。分母をすべて売上高にしていること、在庫は期末残高で売上債権と買入債務も期末残高であること、金融業・保険業を除く全産業の合計であることから、あくまで大きさの感覚をつかむための概算です。日本企業全体では、売上債権と在庫を合わせて売上の約3か月分が固定されており、そのうち在庫が約4割を占め、買入債務で約1.2か月分を賄った残りの約1.8か月分を企業側が立て替えている、という程度に読んでおくのがよいと考えています。
マクロの平均は自社の目標にはなりません。業種によって在庫率も回転期間も桁が違いますし、同じ業種でも取扱品目と取引条件で変わります。統計の使いどころは、自社の水準が業種の分布のどのあたりにあるかを知ることと、在庫が全体として積み上がる局面か減る局面かを知ることの2つです。前者にはロカベンの業種別基準値が、後者には法人企業統計の時系列が向いています。
判断を誤ったときの損失の型
本章の締めくくりとして、在庫の判断を誤ったときに経営上どういう損失が出るかを、型として整理します。第2章以降の各手法は、このどれかの型を防ぐために使うものだと位置づけられます。
1つ目は過剰の型です。需要より多く持ち続けた結果、資金が固定され、保有費用がかかり、最後に陳腐化の損失が出ます。経営指標では在庫日数の上昇、営業運転資本回転期間の長期化、そして遅れて評価損や廃棄損として現れます。2つ目は欠品の型です。持たなすぎた結果、機会損失と信用の低下が起きます。損益計算書には現れないため、欠品回数やフィルレート(需要のうち在庫から即納できた割合)を別に計測しない限り見えません。この2つは対立するので、片方だけを追うともう片方が悪化します。
3つ目は偏在の型です。全社の在庫金額は足りているのに、売れる拠点に無くて売れない拠点にある、売れる品目が欠品して売れない品目が余っている、という状態です。全社の回転率を見ているだけでは見つからず、拠点別・品目別に在庫日数の分布を見て初めて分かります。拠点間の配置は第10章、品目の分類は第2章で扱います。4つ目は一律の型で、すべての品目に同じサービス率や同じ在庫日数を課すことです。売上の大半を占める少数の品目と、めったに売れない多数の品目では、持つべき在庫の考え方が違います。第2章の ABC 分析と XYZ 分析、第5章の発注方式の使い分けがこれに対応します。5つ目は二重取りの型で、需要予測に上乗せし、さらに安全在庫を持ち、さらに担当者が手元で余分に発注する、というように、同じ不確実性に対して何重にも備えてしまうことです。予測誤差と安全在庫の関係を整理する第8章と、運用の失敗の型を扱う第13章で述べます。
| 損失の型 | 経営指標への現れ方 | 対応する施策 | 扱う章 |
|---|---|---|---|
| 過剰 | 在庫日数の上昇、運転資金の固定、遅れて評価損・廃棄損 | 発注量と発注点の根拠づけ、陳腐化の早期検知 | 第3章・第4章・第13章 |
| 欠品 | 機会損失と信用の低下は損益計算書に出ない。欠品回数・フィルレートの悪化 | サービスレベルの設定と安全在庫、欠品の計測 | 第4章・第12章 |
| 偏在 | 全社の回転率は正常、拠点別・品目別の在庫日数がばらつく | 拠点間の配置、品目別の分解 | 第2章・第10章 |
| 一律 | 重要品目の欠品と、末端品目の過剰が同時に起きる | ABC・XYZ 分析による方式の使い分け | 第2章・第5章 |
| 二重取り | 安全在庫の設定値より実在庫が恒常的に多い | 予測・安全在庫・現場判断の役割分担 | 第8章・第13章 |
どの型の損失も、最終的には在庫金額、欠品による粗利の損失、運転資金、在庫日数のいずれかの数字に翻訳できます。数理モデルの結果を経営に報告するときは、安全係数やサービス率といった技術指標のままではなく、この4つの経営指標に置き換えて示すことを、本コラム全体を通じて意識しています。
本章では、在庫を4つの役割に分け、在庫の費用を発注費用、保有費用、欠品費用の3つに整理して、それぞれが損益計算書と貸借対照表のどこに現れ、どこに現れないかを確かめました。そのうえで棚卸資産回転率、在庫日数、キャッシュ・コンバージョン・サイクル、営業運転資本回転期間の定義と読み方を計算例と公的統計で見て、判断を誤ったときの損失を5つの型にまとめました。次の第2章では、在庫の判断の前提になる需要とリードタイムの不確実性をどう記述するかを扱い、あわせて本コラムの全章で使う架空のサンプルデータを紹介します。
この章を深めたい方への参考書籍
『手にとるようにわかる在庫管理入門:ムダのない在庫管理で利益を生み出す』(芝田稔子、かんき出版):副題に「ムダのない在庫管理で利益を生み出す」とあるとおり、在庫管理を利益と結びつけて説く2023年刊の入門書です。本章で述べた在庫の役割や費用の考え方を、実務の入門書の言葉でもう一度たどりたい方に向いていると考えています。第13章の運用の話に入る前の準備としても使えます。
『新版 財務3表一体理解法』(國貞克則、朝日新聞出版):書名のとおり、損益計算書、貸借対照表、キャッシュ・フロー計算書の3表を一体のものとして理解する方法を説く朝日新書の1冊で、2021年の新版です。本章で扱った「在庫を仕入れてもただちに費用にはならず、棚卸資産として計上され、支払いの時点で現金か買掛金に影響する」という仕組みを、会計の側から確かめたい方に向いています。在庫の判断を経営指標に翻訳して報告する立場の方に、本章と併せて読むことを勧めます。
『サプライ・チェインの設計と管理:コンセプト・戦略・事例(普及版)』(D. スミチ-レビ、P. カミンスキー、E. スミチ-レビ、久保幹雄監修、朝倉書店):サプライ・チェイン・マネジメントの教科書の日本語版で、副題のとおりコンセプト、戦略、事例を扱う構成です。本章で触れた在庫の役割を、企業の内側の問題ではなく調達から販売までの連鎖の中で位置づけ直して読むのに向いていると考えています。2017年の普及版で入手しやすくなっています。
第2章 需要とリードタイムの不確実性を記述する
第1章では、在庫が貸借対照表の棚卸資産そのものであり、欠品は売上の機会損失、過剰在庫は運転資金の固定と陳腐化の損失として経営数字に現れることを確認しました。在庫を数理モデルで決めるとき、その入力になるのは「需要がどれだけ、どのようにばらつくか」と「発注してから届くまでの日数(リードタイム)がどれだけばらつくか」の2つです。この2つを数字で記述できていなければ、第3章以降のどの式に入れても、出てくる発注量や安全在庫は根拠を持ちません。この章では、需要とリードタイムの不確実性を記述するための道具を、実際に動かしながら確認します。
あわせて、この記事の第3章以降で繰り返し使う共通のサンプルデータをこの章で用意します。手法ごとに別のデータを持ち出すと、手法の違いなのかデータの違いなのかが読み分けにくくなるためです。同じ60品目の3年分の需要を、経済的発注量・安全在庫・発注方式・シミュレーションと順に通していくことで、各手法が同じ需要の何を見て何を決めているかを比べられるようにしました。
この記事で使う共通データ:架空の60品目・3年分の日次需要
最初に断っておきます。この記事で使う需要データは、実在の企業の販売記録ではありません。乱数のシード(種)を固定して生成した架空のサンプルで、60品目(SKU)の3年分(2023年1月1日から2025年12月31日までの1,096日)の日次需要という体裁にしています。実在の企業・商品・取引先とは一切関係がなく、生成のコードは記事フォルダの inv_data.py に置いてあります。同じコードを実行すれば、誰の環境でも同じ1,096日×60品目の表が再現されます。原価やリードタイムの平均・標準偏差も同じファイルに入れた架空の値で、第3章以降で使う発注費や保管費率も同様に架空です(費用の桁が業種でどれだけ違うかは第3章で述べます)。
架空のデータを使う理由は2つあります。1つは守秘の問題で、実務の販売データをそのまま公開することはできません。もう1つは教材としての都合で、需要の「型」をあらかじめ仕込んでおけば、各手法がその型をどう扱えるか、扱えないかを検証できます。生成のときに仕込んだ型は、安定した定番品、夏に山がある季節品、需要が発生する日がまばらな間欠需要品、3年で日次平均が約2倍に伸びる成長品の4つです。60品目のうち4つを「代表品目」として全章で使い回し、残り56品目は ABC 分析や XYZ 分析のように品目群を扱う場面で使います。
| 代表品目 | 型 | 日次需要の平均 | 標準偏差 | 最小・中央値・最大 | ゼロ需要日の割合 | 原価(円) | リードタイム(日) |
|---|---|---|---|---|---|---|---|
| A001 | 定番品 | 39.62 | 9.73 | 15・39・89 | 0.0% | 1,200 | 平均7・標準偏差2 |
| B001 | 季節品 | 25.08 | 14.74 | 1・22・105 | 0.0% | 3,500 | 平均14・標準偏差4 |
| C001 | 間欠需要品 | 1.27 | 3.41 | 0・0・27 | 81.2% | 8,000 | 平均21・標準偏差5 |
| D001 | 成長品 | 17.66 | 6.44 | 5・17・46 | 0.0% | 2,400 | 平均10・標準偏差3 |
表の数値は、記事フォルダの _out\ch02_overview.txt に残した実行結果から転記しています。年別の合計を見ると、A001 は14,621・14,385・14,416個とほぼ横ばい、B001 は9,439・9,027・9,020個で横ばいですが月ごとの山谷が大きく、C001 は453・463・471個と少なく、D001 は5,106・6,443・7,803個と毎年2割以上伸びています。この4つは、実務の品目構成を極端に単純化したものですが、後の章で「この手法はどの型に効いて、どの型には効かないか」を示す物差しとして使います。
from inv_data import load_demand, load_skus, FOCUS, FOCUS_LABELS

dem = load_demand()     # 1,096日 × 60 SKU の日次需要。index は日付
skus = load_skus()      # SKU マスタ: kind, base_daily_mean, unit_cost, lt_mean, lt_sd
print(dem.shape)

summ = dem[FOCUS].describe().T[["mean", "std", "min", "50%", "max"]].round(2)
summ["ゼロ需要日の割合"] = (dem[FOCUS] == 0).mean().round(3)
summ["分散/平均"] = (dem[FOCUS].var() / dem[FOCUS].mean()).round(2)
summ.insert(0, "型", [FOCUS_LABELS[s] for s in FOCUS])
print(summ.to_string())
print(dem[FOCUS].groupby(dem.index.year).sum().astype(int))
# 出力:
# (1096, 60)
#          型   mean    std   min   50%    max  ゼロ需要日の割合  分散/平均
# A001    定番品  39.62   9.73  15.0  39.0   89.0     0.000   2.39
# B001    季節品  25.08  14.74   1.0  22.0  105.0     0.000   8.66
# C001  間欠需要品   1.27   3.41   0.0   0.0   27.0     0.812   9.22
# D001    成長品  17.66   6.44   5.0  17.0   46.0     0.000   2.35
#        A001  B001  C001  D001
# date
# 2023  14621  9439   453  5106
# 2024  14385  9027   463  6443
# 2025  14416  9020   471  7803
4つの代表品目に見る需要の姿
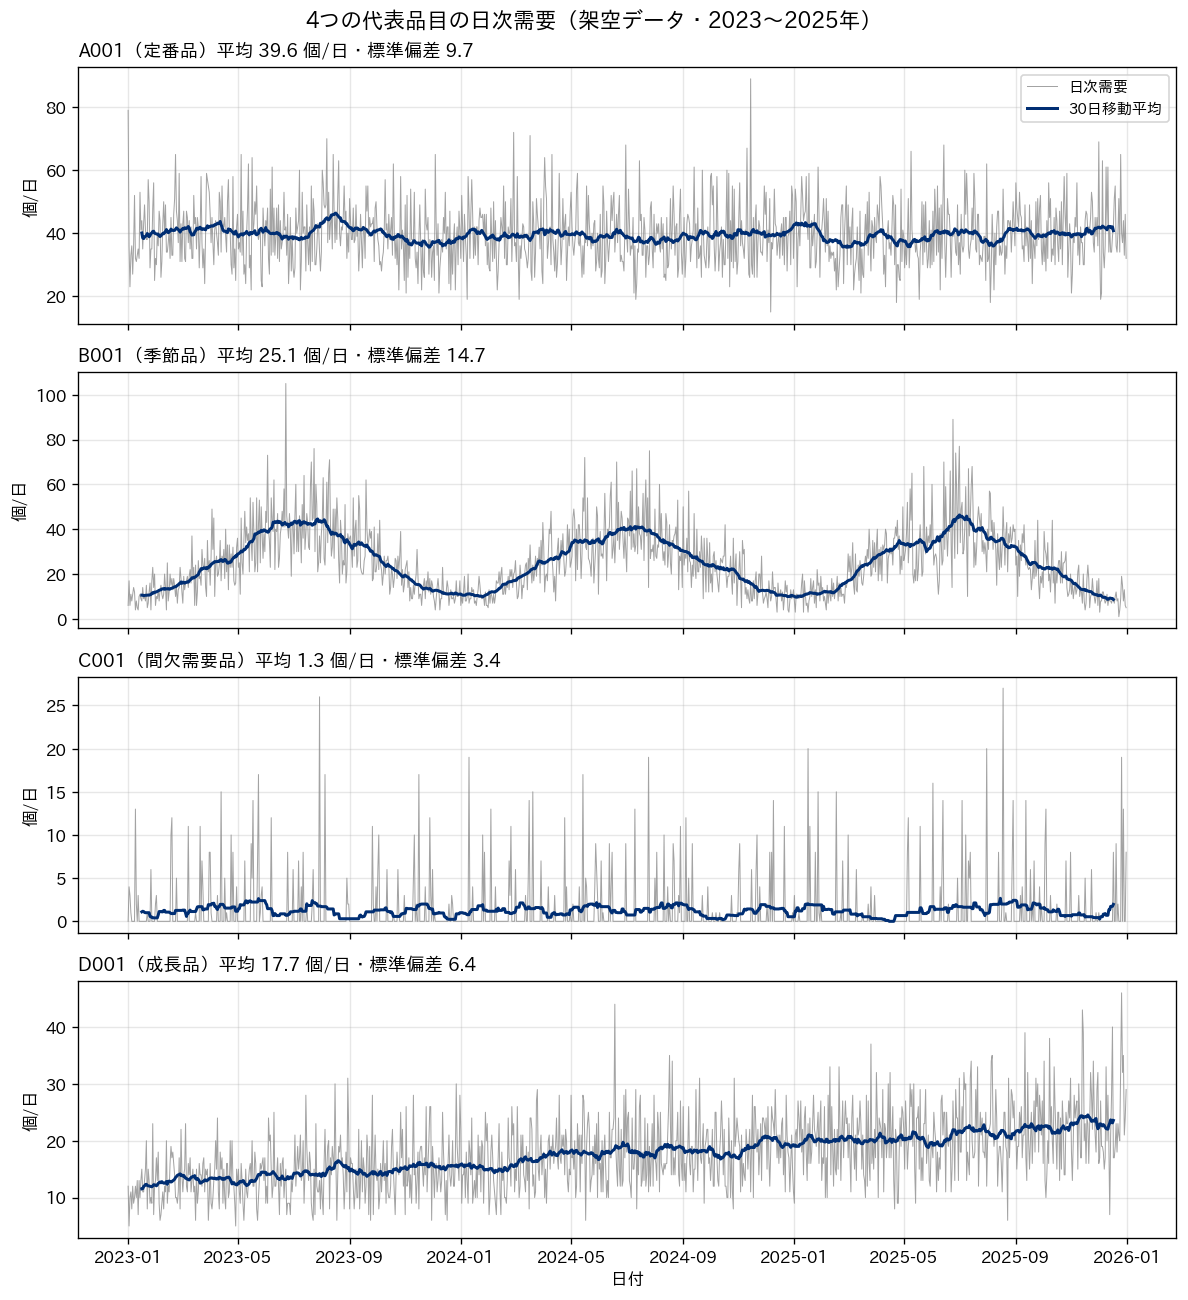
上の図は4つの代表品目の日次需要を3年分並べ、30日移動平均を重ねたものです。A001(定番品)は平均39.6個の周りに標準偏差9.7個で散らばっていて、移動平均はほぼ水平です。曜日による差も設計上入れておらず、曜日別の平均は38.8個から40.7個の範囲に収まります(実務の小売データでは曜日効果が大きいことが多いので、その場合は曜日を分けて記述する必要があります)。このような品目は、需要のばらつきを「平均と標準偏差」の2つで表せば、後の章の式にそのまま入れられます。
B001(季節品)は、月別平均が1月の10.6個から7月の41.0個まで動きます。最も低い12月の10.3個と7月の比は3.98倍です。全期間をひとまとめにした標準偏差は14.74個ですが、この数字には「夏は多く冬は少ない」という予測できる動きが混ざっています。C001(間欠需要品)は、1,096日のうち需要があった日が206日しかなく、ゼロ需要日の割合は81.2%です。需要があった日だけを見ると平均6.73個・最大27個で、全日の平均1.27個とはかけ離れています。D001(成長品)は年間合計が毎年2割以上伸びていて、直近90日の平均23.0個に対し全期間の平均は17.7個です。3年分をまとめて平均すると、今の需要を23%過小に見積もることになります。
この4つの姿は、それぞれ別の落とし穴を示しています。A001 だけを見て「需要は平均と標準偏差で表せる」と考えると、B001 では季節の動きをばらつきと取り違え、C001 では存在しない負の需要を予言し、D001 では過去の平均が今の水準を下回ります。この章の残りは、この4つの落とし穴を順に扱います。まず需要のばらつきを確率分布で表す方法から始めます。
需要のばらつきを確率分布で表す:正規・ポアソン・負の二項
安全在庫や発注点の計算では、「需要が x 個を超える確率」を求める場面が繰り返し出てきます。この確率を出すために、需要の散らばり方を確率分布で表します。在庫の教科書や実務で使われる分布は主に3つで、正規分布、ポアソン分布、負の二項分布です。3つの違いは「平均に対して分散がどれだけ大きいか」と「整数か連続か」で整理できます。
正規分布は、平均と標準偏差の2つのパラメータで形が決まる連続分布です。左右対称の釣鐘型で、安全係数の表や第4章の合成式はこの分布を前提にしています。連続分布なので需要が小数や負の値をとることを許してしまいますが、平均が標準偏差に比べて十分大きい品目では、負の値の確率は無視できます。A001 に正規分布を当てたとき、需要が負になる確率は約0.00002(10万日に2日程度)で、実用上ゼロです。
ポアソン分布は、「一定の割合でぽつぽつ起きる出来事の回数」を表す整数の分布で、パラメータは平均の1つだけです。この分布の特徴は分散が平均に等しいことで、scipy.stats.poisson.stats(40, moments="mv") を実行すると平均40.00・分散40.00が返ります。パラメータが1つで済むぶん、当てはめは簡単ですが、実務の需要データは分散が平均より大きいことが多く、その場合はポアソン分布では散らばりを過小に見積もります。分散を平均で割った値(分散平均比)が1を大きく超えている品目には向きません。
負の二項分布は、ポアソン分布の「分散=平均」という制約を外した整数の分布です。平均 \( \mu \) と形状パラメータ \( r \) の2つで決まり、分散は \( \mu + \mu^2 / r \) になります。言葉で言えば「ポアソン分布の分散に、平均の2乗を r で割った分だけ上乗せした分布」で、r が小さいほど散らばりが大きく、r を大きくしていくとポアソン分布に近づきます。scipy では scipy.stats.nbinom(n=r, p=r/(r+mu)) という書き方で、この平均と形状の組を指定できます(公式ドキュメントに、平均 \( \mu \) を使う場合は \( p = n/(n+\mu) \) とする旨の記載があります)。実際に平均40・r=10 で分散を計算させると200.00が返り、式の \( 40 + 40^2/10 = 200 \) と一致します。r を1・5・30・1000と変えると分散平均比は41.0・9.0・2.33・1.04と動き、r が大きいほどポアソン分布に近づくことが確かめられます。
| 分布 | パラメータ | 値の範囲 | 分散と平均の関係 | 向いている品目 | 向かない品目 |
|---|---|---|---|---|---|
| 正規分布 | 平均・標準偏差 | 連続(負も含む) | 独立に決められる | 平均が標準偏差に比べて十分大きい定番品 | 需要が小さい品目、ゼロが多い品目(負の需要を予言する) |
| ポアソン分布 | 平均の1つ | 0以上の整数 | 分散=平均 | 需要が小さく、散らばりが平均程度の品目 | 分散平均比が1を大きく超える品目(散らばりを過小に見る) |
| 負の二項分布 | 平均・形状 r | 0以上の整数 | 分散=平均+平均²÷r | 分散が平均より大きい整数の需要全般。間欠需要も含む | パラメータが2つ要るので、履歴が極端に短い品目では推定が不安定 |
どの分布を使うかは、まず分散平均比を見ると当たりが付きます。共通データでは A001 が2.39、D001 が2.35、B001 が8.66、C001 が9.22で、いずれも1を大きく超えています。したがってポアソン分布は4品目のどれにも向いておらず、候補は正規分布か負の二項分布に絞られます。次に、両者のどちらが実際のデータに合うかを、当てはめて比べます。
分布の当てはまりを比べる:A001 と C001 の実験
A001 と C001 の日次需要に3つの分布を最尤法(観測されたデータが最も出やすくなるようにパラメータを選ぶ方法)で当てはめ、対数尤度(そのパラメータの下でデータが出る確からしさの対数。大きいほど当てはまりがよい)・AIC(小さいほど良い)・累積分布の実測との最大乖離・分布から計算した95%点と99%点を並べました。正規分布は連続なので、整数 k の確率を「k の前後0.5の範囲の面積」で近似して同じ土俵に乗せています。負の二項分布は平均を標本平均に固定し、形状 r を数値最適化で求めました。
import numpy as np
from scipy import stats, optimize

x = dem["A001"].values.astype(float)
mu = x.mean()
m, s = stats.norm.fit(x)                          # 正規: 平均と標準偏差
lam = mu                                          # ポアソン: 平均だけ

def nll(log_r):                                   # 負の二項: 形状 r を最尤で
    r = np.exp(log_r)
    return -np.sum(stats.nbinom.logpmf(x, r, r / (r + mu)))
opt = optimize.minimize_scalar(nll, bounds=(np.log(0.01), np.log(1e4)), method="bounded")
r = float(np.exp(opt.x))
nb = stats.nbinom(r, r / (r + mu))

print("分散/平均 %.2f, 負の二項の r %.2f" % (x.var(ddof=1) / mu, r))
print("95%点: 実測 %.0f / 正規 %.1f / ポアソン %.0f / 負の二項 %.0f"
      % (np.quantile(x, 0.95), stats.norm.ppf(0.95, m, s), stats.poisson.ppf(0.95, lam), nb.ppf(0.95)))
# 出力:
# 分散/平均 2.39, 負の二項の r 29.48
# 95%点: 実測 57 / 正規 55.6 / ポアソン 50 / 負の二項 56
| 品目 | 分布 | 推定したパラメータ | AIC | 累積分布の最大乖離 | 95%点 | 99%点 | 実測の95%点・99%点 |
|---|---|---|---|---|---|---|---|
| A001 | 正規 | 平均39.62・標準偏差9.72 | 8,099.9 | 0.046 | 55.6 | 62.2 | 57・65 |
| A001 | ポアソン | 平均39.62 | 8,591.6 | 0.124 | 50 | 55 | 57・65 |
| A001 | 負の二項 | 平均39.62・r 29.48 | 8,046.2 | 0.023 | 56 | 65 | 57・65 |
| C001 | 正規 | 平均1.27・標準偏差3.41 | 3,438.2 | 0.401 | 6.9 | 9.2 | 9・16 |
| C001 | ポアソン | 平均1.27 | 6,083.2 | 0.530 | 3 | 4 | 9・16 |
| C001 | 負の二項 | 平均1.27・r 0.07 | 2,300.8 | 0.039 | 7 | 24 | 9・16 |
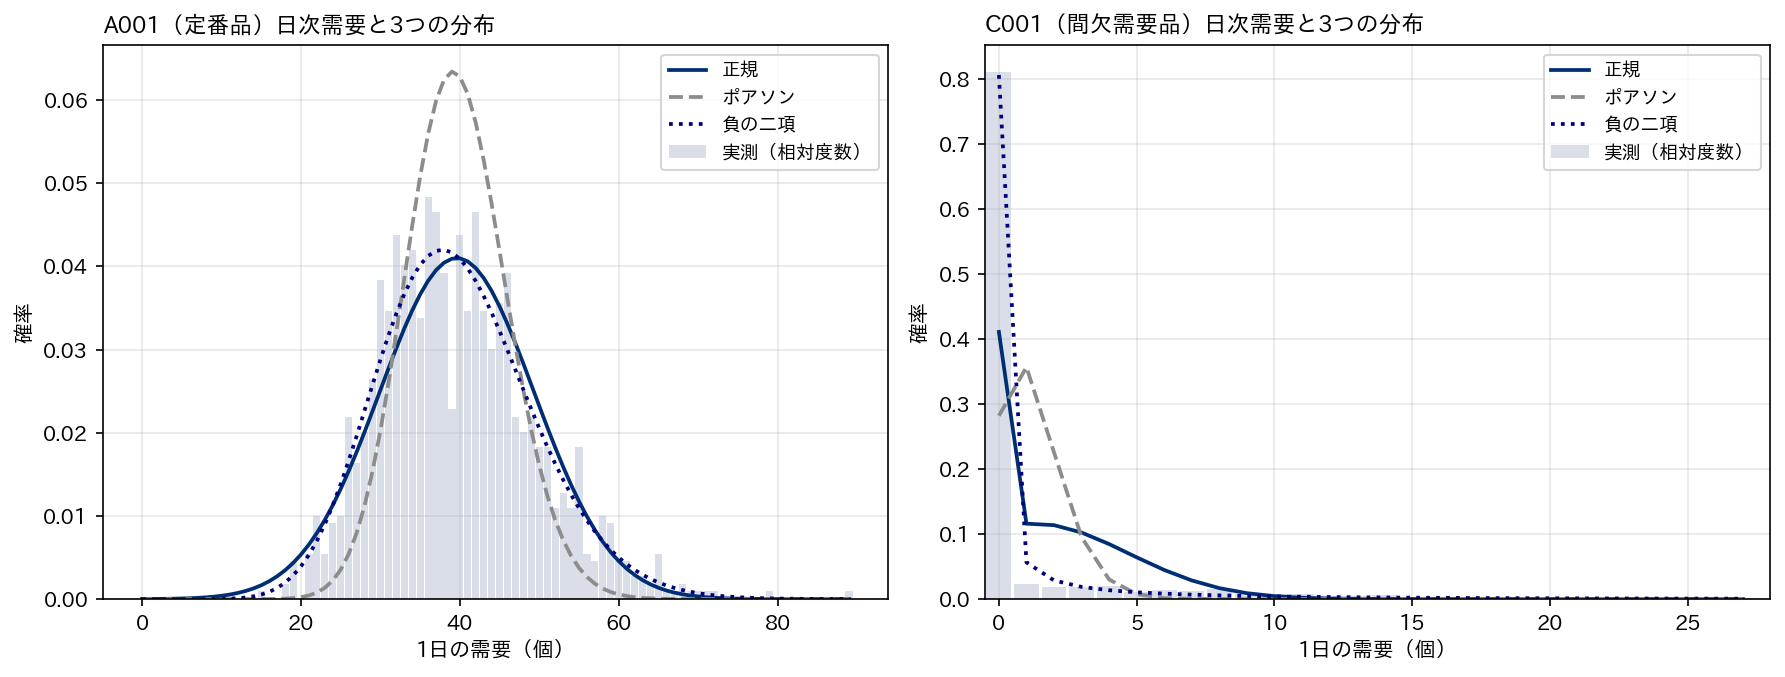
A001 では、負の二項分布の AIC が8,046.2で最も小さく、正規分布が8,099.9で続き、ポアソン分布は8,591.6と大きく離れます。累積分布の最大乖離も負の二項0.023、正規0.046、ポアソン0.124の順です。ただし実務で効くのは上側の分位点で、95%点は実測57個に対して正規55.6・負の二項56、99%点は実測65個に対して正規62.2・負の二項65です。ポアソン分布の95%点50個を実測が超えた日の割合は13.1%で、「5%しか超えないはず」の水準を実際には2.6倍の頻度で超えています。正規分布と負の二項分布はそれぞれ6.0%・5.5%で、想定どおりに近い値です。定番品では正規分布で実用上十分であり、整数の分布を使うなら負の二項分布が一段良い、というのがこの実験の読み方です。
C001 では様相が変わります。正規分布を当てると、需要が負になる確率が0.355、5%点がマイナス4.35個と、意味のない値が出ます。ゼロ需要日の確率は実測81.2%に対し、正規分布は41.1%、ポアソン分布は28.2%と大きく外し、負の二項分布だけが80.7%と実測に沿います。AIC も負の二項2,300.8に対して正規3,438.2、ポアソン6,083.2で、差は A001 とは桁が違います。上側を見ると、99%点は実測16個に対して正規9.2個、ポアソン4個、負の二項24個です。正規分布とポアソン分布は「めったに来ない大きな需要」を小さく見積もり、負の二項分布は逆に大きめに見ます。どちらの誤りが高くつくかは、C001 の原価が8,000円で、欠品したときに何が止まるかによって変わります。この判断は第4章と第6章に送りますが、少なくとも「正規分布を当てて安全係数の表を引く」やり方が C001 では成立しないことは、この表だけで分かります。
成長品の D001 でも同じ当てはめを行い、AIC は負の二項7,109.1・正規7,194.6・ポアソン7,627.2の順でした。ただし D001 の場合、分布の形より先に「平均が動いている」ことが問題で、3年分をまとめて分布を当てること自体が誤りです。この点は季節とトレンドの節で扱います。
間欠需要を見分ける:ゼロの割合、ADI と CV²
C001 のように需要がある日とない日が混在し、需要のない期間が挟まる品目を間欠需要(intermittent demand)と呼びます。補修部品、業務用の消耗品、ロングテールの品揃えの末端、店舗別に見た低回転の商品などがこの型になりやすく、品目数で見るとこの型が多数を占める企業も多いように思います。間欠需要をふつうの品目と同じ式で扱うと、前節で見たとおり分布の当てはめが崩れ、第8章で扱う予測の方法も変わります。したがって、どの品目が間欠需要なのかを機械的に見分ける物差しが要ります。
最も単純な物差しはゼロ需要日の割合です。C001 は81.2%で、これだけでも「ふつうの品目ではない」と分かります。ただしゼロの割合だけでは、「ゼロでない日の需要が毎回同じくらいなのか、ばらばらなのか」が分かりません。この2つを分けて測る物差しとして、Syntetos、Boylan、Croston の3人が2005年に Journal of the Operational Research Society 誌の論文(56巻5号、495〜503ページ)で提案した分類が広く使われています。使う指標は2つで、1つは平均需要間隔(ADI。総期間数を需要のあった期間数で割った値。毎日需要があれば1.0、5日に1回なら5.0)、もう1つは需要があった期間だけのサイズの変動係数の2乗(CV²。標準偏差を平均で割って2乗した値)です。
この分類では、ADI の境界を1.32、CV² の境界を0.49に置き、平面を4つに分けます。ADI も CV² も小さい品目は平滑(smooth)、ADI が小さく CV² が大きい品目は不規則(erratic)、ADI が大きく CV² が小さい品目は間欠(intermittent)、両方大きい品目は塊状(lumpy)です。境界の値は「Croston 法とその修正版(SBA)のどちらの予測誤差が小さいか」が入れ替わる点から導かれたもので、Kostenko と Hyndman が2006年に同じ誌に寄せた短報(著者版)は、厳密な境界は ADI で 4/3、CV² で 0.5 であること、そして境界を直線で近似する別の規則を示しています。つまり1.32・0.49という数字は絶対の閾値ではなく、「この2つの予測法の使い分け」から出た目安です。それでも、ゼロの割合だけで見るより2つの軸で見るほうが、品目の性格をよく捉えます。
| 区分 | ADI(平均需要間隔) | CV²(需要サイズの変動係数の2乗) | 需要の姿 | 共通データでの品目数(日次) |
|---|---|---|---|---|
| 平滑(smooth) | 1.32未満 | 0.49未満 | ほぼ毎日需要があり、量も安定 | 44 |
| 不規則(erratic) | 1.32未満 | 0.49以上 | ほぼ毎日需要があるが、量が大きくばらつく | 0 |
| 間欠(intermittent) | 1.32以上 | 0.49未満 | 需要のない期間が挟まるが、あるときの量は安定 | 8 |
| 塊状(lumpy) | 1.32以上 | 0.49以上 | 需要のない期間が挟まり、あるときの量もばらつく | 8 |
def adi_cv2(x):
    x = np.asarray(x, dtype=float)
    nz = x[x > 0]
    adi = len(x) / len(nz)                    # 総期間数 ÷ 需要のあった期間数
    cv2 = (nz.std(ddof=1) / nz.mean()) ** 2   # 需要のあった日のサイズだけで計算
    return adi, cv2

def category(adi, cv2):
    if adi < 1.32:
        return "smooth" if cv2 < 0.49 else "erratic"
    return "intermittent" if cv2 < 0.49 else "lumpy"

for s in FOCUS:
    adi, cv2 = adi_cv2(dem[s].values)
    print(s, round(adi, 2), round(cv2, 3), category(adi, cv2))
# 出力:
# A001 1.0 0.06 smooth
# B001 1.0 0.345 smooth
# C001 5.32 0.558 lumpy
# D001 1.0 0.133 smooth
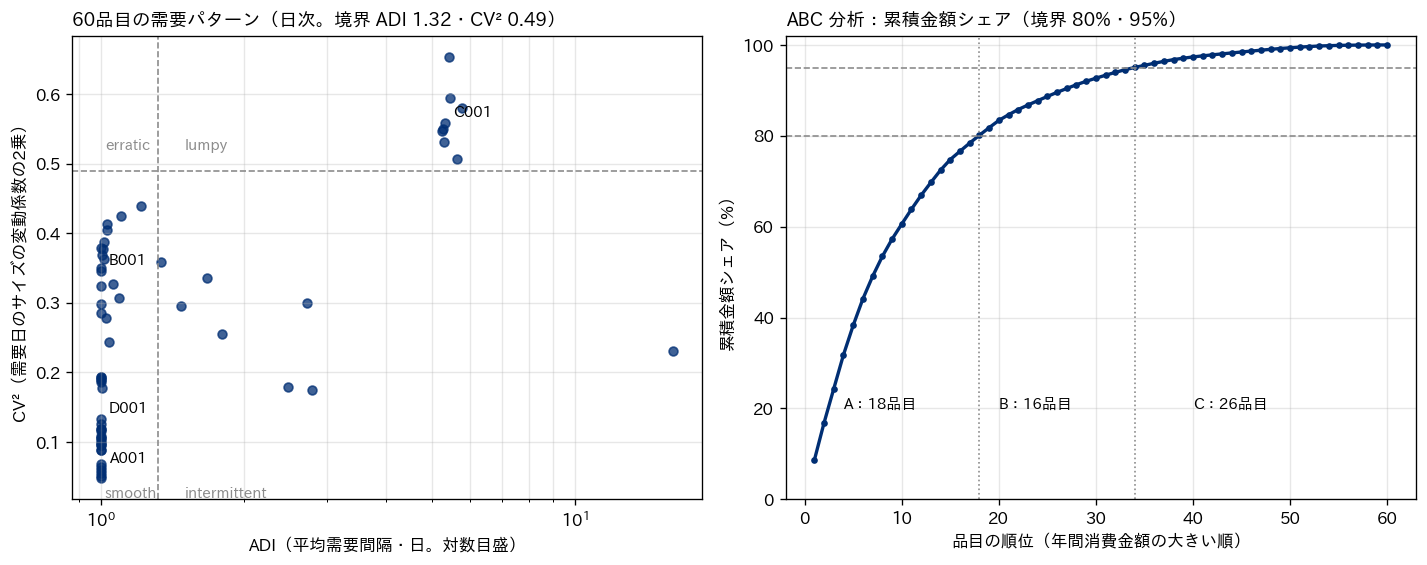
共通データの60品目を日次で分類すると、平滑44・間欠8・塊状8・不規則0でした。C001 は ADI 5.32(平均して5.3日に1回需要がある)、CV² 0.558 で塊状に入ります。需要があった206日のサイズは平均6.73個・標準偏差5.03個・最大27個、需要と需要の間隔は平均5.34日・中央値4日・最大36日です。全日の平均1.27個は「需要日の平均サイズ6.73個×需要が発生する日の割合0.188」と分解でき、間欠需要の予測法(第8章の Croston 法)がこの2つを別々に推定するのは、まさにこの分解に基づいています。
見落としやすい点が2つあります。1つは、生成時の型が「安定」や「季節」の品目でも、日次の平均が1個に満たないほど小さければ日次では間欠に分類されることです。共通データでも、安定型20品目のうち3品目、季節型18品目のうち4品目が日次では間欠に入りました。間欠かどうかは品目の性質だけでなく、需要の大きさと観測の粒度で決まります。もう1つは、その裏返しで、集計の粒度を粗くすると分類が変わることです。同じ60品目を暦の週で集計し直す(158週。両端の週は日数が足りません)と、C001 は ADI 1.35・CV² 0.475 で塊状から間欠に移り、日次で間欠か塊状だった16品目のうち10品目が平滑か不規則に移りました。週次発注の品目を日次の分類で「間欠だから特別扱い」と決めるのは、実態より複雑にしている可能性があります。分類は、発注や補充を判断する粒度に合わせて行うのが原則です。
季節とトレンドを「ばらつき」と混同しない
安全在庫は需要の「予測できないばらつき」に備えるものです。ところが、需要の履歴からそのまま標準偏差を計算すると、季節の山谷やトレンドのような「予測できる動き」まで、ばらつきとして数えてしまいます。B001 と D001 で、その大きさを確かめます。
B001 の月別平均は、1月10.6個、2月13.4個、3月21.4個、4月28.0個、5月34.2個、6月40.3個、7月41.0個、8月35.8個、9月28.4個、10月22.3個、11月14.5個、12月10.3個です。全期間をひとまとめにした標準偏差は14.74個ですが、月別平均を引いた残差の標準偏差は10.01個、月ごとに計算した標準偏差の平均は9.30個です。つまり標準偏差の値で見ると、14.74個のうち3分の1ほどは季節の動きであって、備えるべき不確実性ではありません。もし全期間の平均25.1個と標準偏差14.74個で「平均±2σ」の帯(マイナス4.4個から54.6個)を作って在庫を管理すると、1月には需要が平均25.1個を超える日が1日もなく(実測0%)、帯の中心そのものが実態の2.4倍の位置にあります。逆に7月には需要が25.1個を超える日が89.2%あり、上限54.6個を超える日も18.3%あります。同じ帯が冬には過剰、夏には不足を生みます。
D001 は年別の平均が13.99個・17.60個・21.38個と伸びていて、前年比は26.2%・21.1%です。日付に対する直線を当てると傾きは1日あたり0.0102個(年あたり3.73個)で、全期間の標準偏差6.44個は、直線を引いた残差では5.57個に下がります。それ以上に大きいのは平均の問題で、直近90日の平均23.03個に対し3年平均は17.66個です。3年平均で発注していれば、需要の23%を恒常的に取りこぼします。成長品は伸びているからこそ利益の源泉であり、その品目で恒常的に欠品することの損失は、売上機会の逸失だけでなく、伸びている市場での顧客の離反にもつながります。
このように、需要の記述は「平均の動き(水準・季節・トレンド)」と「その周りのばらつき」に分けて行う必要があります。平均の動きを追いかけるのが需要予測であり、その周りのばらつきが安全在庫の入力です。第8章では、安全在庫の計算に使う標準偏差は「需要そのもの」ではなく「予測誤差」から求めるべきであることを、この B001 と D001 を使って示します。予測の手法そのものは弊社コラム「ビジネスデータの予測に効く時系列分析、基礎から実務まで」に送ります。この章では、標準偏差を計算する前に「その中に予測できる動きが混ざっていないか」を必ず確かめる、という原則だけ押さえてください。
リードタイムのばらつきを記述する
不確実性のもう1つの源はリードタイム(発注してから入荷するまでの日数)です。需要が完全に一定でも、リードタイムがばらつけば、発注してから届くまでに消費される量はばらつきます。実務ではリードタイムを「7日」のような1つの数で扱うことが多いのですが、その7日が「平均7日で標準偏差2日」なのか「常に7日」なのかで、必要な安全在庫は大きく変わります。
共通データでは、品目ごとにリードタイムの平均と標準偏差を持たせ、実際の入荷日を正規乱数(下限1日、整数に丸め)で決めます。4つの代表品目について10,000回ずつサンプルした結果が次の表です。
| 品目 | 設計(平均・標準偏差) | サンプルの平均・標準偏差 | 最小・中央値・最大 | 95%点 | 平均より2日以上遅れた割合 |
|---|---|---|---|---|---|
| A001 | 7日・2日 | 7.02・2.02 | 1・7・14 | 10日 | 23.2% |
| B001 | 14日・4日 | 14.01・3.98 | 1・14・30 | 20日 | 35.6% |
| C001 | 21日・5日 | 21.02・5.01 | 1・21・41 | 29日 | 38.3% |
| D001 | 10日・3日 | 9.99・3.06 | 1・10・24 | 15日 | 30.6% |
A001 のリードタイムは平均7日ですが、4回に1回近く(23.2%)は9日以上かかり、95%点は10日、最長では14日でした。この「遅れ」がどれだけ効くかを、実データで確かめます。A001 の3年分の需要から起点を無作為に選び、リードタイム中の需要(起点からリードタイムの日数分の需要の合計)を10,000回計算しました。リードタイムを7日に固定すると、リードタイム中需要は平均276.8個・標準偏差25.4個・95%点319個です。リードタイムを表のとおりサンプルすると、平均は278.2個とほぼ同じですが、標準偏差は84.2個、95%点は417個に跳ね上がります。標準偏差の比は3.31倍です。
この結果は、需要のばらつきだけを見ていると安全在庫を3分の1以下に見積もってしまうことを意味します。A001 は原価1,200円の定番品ですから、リードタイムのばらつきを無視した安全在庫では、A 品目でありながら欠品が頻発する状態になります。安全在庫はリードタイム中需要の標準偏差に比例して決まるので(第4章)、標準偏差が3.3倍なら、安全在庫の量とその分の在庫金額も3.3倍になります。需要とリードタイムの両方のばらつきを1つの式に合成する方法は第4章で扱いますが、この章で押さえるべきは、リードタイムも「平均と標準偏差」で記述し、その実績を発注データから継続的に測る、ということです。入荷日の実績は発注システムに残っているはずで、需要データより取りやすいことが多いにもかかわらず、「仕入先の標準納期」という1つの数で代用されている例が多いように思います。
ABC 分析:金額で品目を分ける
ここまでは1品目ずつの記述でしたが、実務では数百から数万の品目を同時に扱います。すべての品目に同じ手間をかけることはできないので、品目を分けて手間の配分を決める必要があります。その最も基本的な道具がABC 分析です。品目ごとの年間消費金額(年間の数量×単価)を大きい順に並べ、累積の金額シェアで上位から A・B・C に分けます。境界の置き方は慣行によりますが、累積シェア80%までを A、95%までを B、残りを C とする分け方が広く使われています。Stojanović と Regodić が2017年に Acta Polytechnica Hungarica 誌に発表した論文もこの境界を採用しています。同論文は、ABC 分析が1950年代に General Electric で開発され、以来在庫管理に使われてきたと述べ、その出典として Dickie が1951年に発表した記事を挙げています。また、パレートの法則に基づく「約20%の品目が金額の80%を占める」という区分は恣意的なもので、企業の必要に応じて決めるものだとも述べています。
共通データでは、単価に原価を使いました。在庫の保有費用は原価に対してかかるため、在庫の管理という目的では販売価格より原価が適しています(品目の重要度を「利益への貢献」で測りたいなら粗利を使う、という選択もあり、目的で使い分けます)。60品目の年間消費金額の合計は約9億6,373万円で、上位18品目(品目数の30.0%)で80.1%、次の16品目(26.7%)で14.9%、残り26品目(43.3%)で5.0%です。「上位20%の品目が80%を占める」と言われることが多いパレートの法則に照らすと、このデータでは上位20%(12品目)の占める割合は66.9%で、80%に届くには30%の品目が要ります。80対20はあくまで目安で、実際の偏り方はデータごとに違う、という例です。
annual_qty = dem.sum() / 3.0                        # 3年平均の年間数量
annual_value = annual_qty * skus["unit_cost"]      # 年間消費金額(原価ベース)
abc = annual_value.sort_values(ascending=False).to_frame("value")
abc["cum_share"] = abc["value"].cumsum() / abc["value"].sum()
abc["rank"] = np.arange(1, len(abc) + 1)
first_a = (abc["cum_share"] >= 0.80).values.argmax() + 1   # 80% を初めて超える順位
first_b = (abc["cum_share"] >= 0.95).values.argmax() + 1
abc["ABC"] = "C"
abc.loc[abc["rank"] <= first_a, "ABC"] = "A"
abc.loc[(abc["rank"] > first_a) & (abc["rank"] <= first_b), "ABC"] = "B"
print(abc.groupby("ABC")["value"].agg(["count", "sum"]))
print(abc.loc[FOCUS])
# 出力:
#      count          sum
# ABC
# A       18  772159820.0
# B       16  143745269.0
# C       26   47821594.0
#            value  cum_share  rank ABC
# A001  17368800.0      0.784    17   A
# B001  32067000.0      0.606    10   A
# C001   3698667.0      0.968    38   C
# D001  15481600.0      0.834    20   B
| 区分 | 品目数 | 品目の割合 | 年間消費金額(円) | 金額の割合 | 代表品目 |
|---|---|---|---|---|---|
| A | 18 | 30.0% | 772,159,820 | 80.1% | B001(10位)、A001(17位) |
| B | 16 | 26.7% | 143,745,269 | 14.9% | D001(20位) |
| C | 26 | 43.3% | 47,821,594 | 5.0% | C001(38位) |
代表品目の位置を見ると、B001 は原価3,500円で年間9,162個のため10位の A、A001 は数量では年間14,474個と多いものの原価1,200円のため17位で A の末尾、D001 は20位で B、C001 は原価8,000円と最も高いにもかかわらず年間462個しか動かないため38位の C です。数量で並べたときと金額で並べたときの違いも見ておくと、金額では A なのに数量の順位では18位より下の品目が4つありました。たとえば S054 は原価10,010円で年間4,765個、金額では7位です。数量だけで「よく動く品目」を管理していると、こうした高単価で数量の少ない品目が視野から外れます。
ABC 分析が決めるのは「どの品目にどれだけ手間と注意を配分するか」です。A 品目は金額が大きいので、需要の記述を丁寧に行い、発注の頻度を上げ、在庫水準を頻繁に見直す価値があります。C 品目は金額が小さいので、多少多めに持っても在庫金額への影響は小さく、むしろ発注や検収の手間を減らす単純なルール(第5章の2ビン方式など)が向きます。ただし ABC 分析が測っているのは金額だけで、「欠品したときの影響の大きさ」は測っていません。C001 のような補修部品的な品目は、金額では C でも、欠品すれば設備や販売が止まるなら管理上の重要度は高くなります。Stojanović と Regodić の論文も、金額だけの ABC 分析の限界を指摘し、リードタイムや重要度を加えた多基準の分類を扱っています。金額の ABC を出発点にしつつ、重要度の軸を別に持つのが実務的です。どの区分にどの発注方式を当てるかは第5章、区分ごとの運用の設計は第13章に送ります。
XYZ 分析と ABC との組み合わせ:9つの箱に方策を割り当てる
ABC 分析は金額の軸だけで品目を分けます。これに「需要の予測しやすさ」の軸を足したのがXYZ 分析です。品目ごとに需要の変動係数(標準偏差を平均で割った値)を計算し、小さい品目を X(安定・予測しやすい)、中程度を Y、大きい品目を Z(不安定・予測しにくい)に分けます。境界は文献や企業によって異なり、前掲の Stojanović と Regodić の論文では、変動係数0.5未満を X、0.5から1までを Y、1を超えるものを Z としています(同論文は Sommerer の1998年の書籍を出典に挙げています)。この記事でもこの境界を使います。
変動係数は「どの粒度で集計した需要」で計算するかによって大きく変わります。共通データの60品目について、日次・週次(7日ごとの区切り、156区切り)・月次(暦月、36か月)の3つの粒度で変動係数を計算し、同じ境界で分けた結果は次のとおりです。日次では X 26・Y 20・Z 14、週次では X 45・Y 7・Z 8、月次では X 55・Y 5・Z 0でした。変動係数の中央値も日次0.563、週次0.336、月次0.239と、粗く集計するほど小さくなります。同じ品目でも、日次で見れば Z、月次で見れば X ということが普通に起きるので、XYZ 分析の結果を読むときは必ず粒度を添える必要があります。この記事では、共通の費用パラメータで定期発注の間隔を7日としていることに合わせ、週次の変動係数を採用しました。
週次で見た代表品目の変動係数は、A001 が0.089で X、B001 が0.463で X、C001 が1.001で Z、D001 が0.215で X です。ここで注意したいのは B001 です。季節品で月別平均が4倍近く動くにもかかわらず、変動係数は0.463で X に入りました。変動係数は「予測できる動き」と「予測できないばらつき」を区別しないので、季節性の強い品目が X になることも、逆に季節性がはっきりしていて予測しやすい品目が変動係数の大きさだけで Z になることもあります。XYZ 分析を「予測しやすさ」の物差しとして使いたいなら、需要そのものではなく予測誤差の変動係数で分けるほうが目的に合います。この考え方は第8章で扱います。
ABC と XYZ を掛け合わせると、品目は9つの箱に分かれます。共通データの60品目を週次の XYZ で分けた結果は、AX 17品目、AZ 1品目、BX 16品目、CX 12品目、CY 7品目、CZ 7品目で、AY・BY・BZ は0品目でした。年間消費金額の割合で見ると AX が78.3%、BX が14.9%で、この2つの箱で金額の93%を占めます。AZ は S017 の1品目だけですが、金額シェア1.8%を持ちながら需要が読みにくい、最も扱いの難しい箱です。CZ には C001 を含む7品目が入り、金額シェアは合計1.4%です。
| 箱 | 品目数(金額シェア) | 需要の性格 | 方策の考え方(弊社の整理) |
|---|---|---|---|
| AX | 17(78.3%) | 金額が大きく、需要が安定 | 統計的な安全在庫と発注点で自動化し、在庫水準を頻繁に見直す。在庫金額を削る余地が最も大きい箱 |
| AY・AZ | 1(1.8%。AZ のみ) | 金額が大きく、需要が読みにくい | 需要の記述に最も手間をかける。予測の改善、リードタイムの短縮、仕入先との情報共有で不確実性そのものを減らす。安全在庫だけで対処すると在庫金額が膨らむ |
| BX | 16(14.9%) | 金額が中程度で、需要が安定 | 統計的な方式で自動化し、見直しの頻度は AX より下げる |
| BY・BZ | 0 | 金額が中程度で、需要が読みにくい | 安全在庫を厚めにするか、発注間隔を短くする。品目数が多ければ、AZ に準じた扱いを一部に限る |
| CX | 12(2.9%) | 金額が小さく、需要が安定 | まとめ買いと単純なルール(2ビン方式など)で手間を最小にする。多少の過剰は許容する |
| CY・CZ | 14(2.1%) | 金額が小さく、需要が読みにくい | そもそも在庫を持つか、受注後に手配するかを問う。持つなら定量の少量在庫で、欠品時の影響(重要度)で例外を決める |
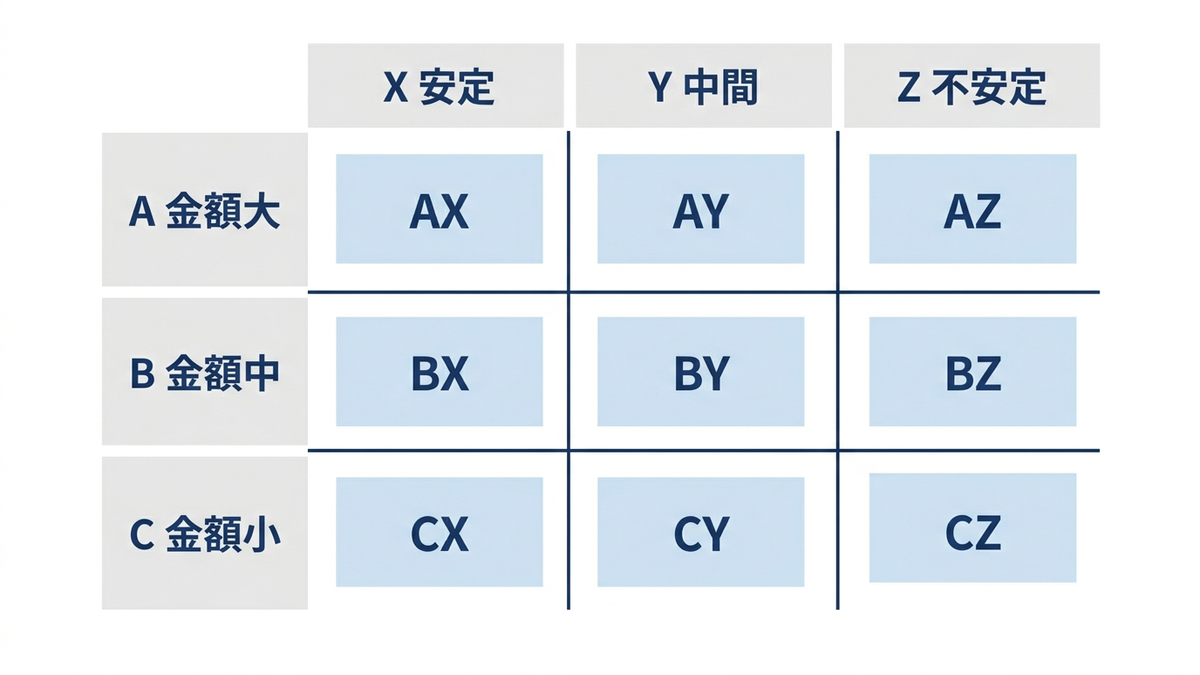
この9つの箱は、品目ごとに方策を決める出発点であって、最終的な答えではありません。共通データのように箱によっては品目が0だったり1つだったりすることは実務でも起き、そのときは箱ごとに方策を作り込む意味は薄く、AX と BX をまとめて「統計的に自動化する群」、C 群をまとめて「単純なルールの群」、AZ を「個別に見る群」と3つ程度に束ねるほうが運用しやすくなります。分類は運用の粒度に合わせて粗くしてよく、大切なのは「金額の大きい品目に手間をかけ、読みにくい品目には不確実性を減らす手を打ち、金額の小さい品目には手間をかけない」という配分の原則です。
経営の目線で言えば、この分類を行わずに全品目を同じルールで管理すると、2つの損失が同時に起きます。1つは手間の配分の誤りで、品目数の43%を占める C 品目に担当者の時間の43%を使えば、金額の5%のために時間の4割を費やすことになります。もう1つは在庫金額の誤りで、A 品目に C 品目と同じ「多めに持って手間を省く」ルールを当てると、金額の80%を占める品目群で過剰在庫が積み上がり、運転資金を固定します。逆に C 品目に A 品目並みの細かい管理を当てても、削れる在庫金額は全体の5%が上限です。第1章で見た棚卸資産回転率や在庫日数を改善するとき、効くのは AX と BX の箱であり、そこに統計的な方式を入れることが第3章以降の主題になります。
この章で確認したことをまとめます。需要の不確実性は「平均の動き」と「その周りのばらつき」に分けて記述し、ばらつきは分散平均比を見てから分布を選びます。定番品は正規分布で実用上足り、整数の需要には負の二項分布が一段良く、ゼロの多い品目は ADI と CV² で見分けて別扱いにします。季節とトレンドはばらつきではなく平均の動きとして扱い、リードタイムも平均と標準偏差で記述して、その実績を継続的に測ります。品目群は金額の ABC と変動の XYZ で分け、手間と在庫金額の配分を決めます。次の第3章では、この章で得た「平均需要」を入力にして、いくつずつ買うかを決める経済的発注量を扱います。ばらつきの側の入力(標準偏差)は第4章の安全在庫で使います。
この章を深めたい方への参考書籍
『統計分布ハンドブック 増補第3版』(蓑谷千凰彦、朝倉書店):正規分布・ポアソン分布・負の二項分布を含む54の確率分布について、性質・グラフ・乱数の生成法をまとめた事典です。この章で「どの分布を需要に当てるか」を迷ったとき、候補の分布の平均・分散・形の関係を確かめるのに使えます。
『データ解析のための統計モデリング入門:一般化線形モデル・階層ベイズモデル・MCMC』(久保拓弥、岩波書店):章ごとに異なる例題を解きながら、確率分布と最尤推定から一般化線形モデル、モデル選択、階層ベイズへと進む入門書です。この章で行った「データに分布を最尤法で当てはめ、AIC で比べる」という作業の背後にある考え方を、丁寧に追うことができます。
『カウントデータの統計解析』(岩崎学、朝倉書店):個数のデータを扱う統計の教科書で、確率統計の基礎から二項分布、ベータ二項分布、ポアソン分布、負の二項分布へと進みます。日次の需要は「その日に売れた個数」というカウントデータそのものなので、この章でポアソン分布より負の二項分布のほうが当てはまった理由を、分布の性質の側から確かめたい方に向いています。
第3章 経済的発注量、いくつずつ買うか
第2章では、需要とリードタイムがどうばらつくかを記述し、架空のサンプルデータ(60品目・3年分の日次需要)と、4つの代表SKUを用意しました。本章からは、そのデータを使って発注の意思決定を1つずつ扱います。最初の問いは「1回にいくつ買うか」です。発注のたびに固定の手間がかかるなら、まとめて買えば回数は減りますが、在庫が増えて保管の費用がかさみます。この2つの費用の釣り合いで発注量を決める考え方が経済的発注量(EOQ、Economic Order Quantity)で、在庫理論の中で最も古い式の1つでありながら、今も広く使われています。
本章では、まず式を1本だけ導き、代表SKU A001(定番品。平均39.6個/日、原価1,200円)で総費用曲線を描きます。次に、この式の「答えを外してもあまり損をしない」という性質を数値で確かめ、それが実務でどう効くかを見ます。後半では、数量割引・自社生産のロット・複数品目に共通する予算やスペースの制約といった拡張を扱い、最後に式の前提が崩れる場面(需要の変動・賞味期限・最小発注量・発注単位)を整理します。「いつ買うか」「どれだけ余分に持つか」は本章では決めません。需要のばらつきに備える安全在庫は第4章、発注のタイミングを決める方式は第5章、需要が期ごとに変わるときのロットの決め方は第7章で扱います。
発注量を決めるのは2つの費用の釣り合い
年間の需要が \( D \) 個で一定、1回の発注に固定費 \( K \) 円、在庫1個を1年持つと \( h \) 円かかるとします。需要は途切れなく一定の速さで減り、注文した分は一度にまとめて届き、欠品はさせないとします。このとき、1回に \( Q \) 個ずつ発注すると、年間の発注回数は \( D/Q \) 回、在庫は \( Q \) 個から0個まで直線的に減ってまた \( Q \) 個に戻るので、平均在庫は \( Q/2 \) 個です。年間の費用は発注費 \( KD/Q \) と保管費 \( hQ/2 \) の和になります。式で書くと次の1本です。
\( TRC(Q) = \dfrac{KD}{Q} + \dfrac{hQ}{2}, \qquad Q^{*} = \sqrt{\dfrac{2KD}{h}} \)
左の式が発注量 \( Q \) を決めたときの年間の総関連費用(Total Relevant Cost。購入代金 \( cD \) は \( Q \) に依らないので除きます)で、右の式がそれを最小にする発注量です。発注費は \( Q \) が大きいほど減り、保管費は \( Q \) に比例して増えるので、総費用はどこかで底を打ちます。その底は、発注費と保管費がちょうど等しくなる点に来ます。言葉にすると「発注1回の手間と、在庫1個を1年持つ費用の比が大きいほど、まとめて買う。ただし比が4倍になっても発注量は2倍にしかならない」となります。平方根が付いているのがこの式の要点で、後で見る頑健性はここから来ます。
この式は Ford W. Harris が1913年に発表したものです。原論文は長く忘れられ、式の出所は数十年にわたって曖昧なままでしたが、Erlenkotter(1990)がその経緯を整理し、Operations Research 誌に原論文の再録とあわせて掲載しています。式そのものは100年以上前のものですが、扱っている問いは今の購買や店舗運営でそのまま生きています。なお、本章の式では保管費を「原価に保管費率を掛けた値」\( h = rc \) として扱います。第1章で見たとおり、保管費率 \( r \) は資本コスト・倉庫費・陳腐化・減耗の合計を原価に対する年率で表したものです。
費用パラメータは架空であり、業種で桁が違う
本記事で使う費用パラメータは、第2章のサンプルデータと同じく架空の設定です。発注固定費 \( K \) は4,000円/回、保管費率 \( r \) は年20%(原価比)、欠品1個あたりの機会損失は原価の50%、定期発注の間隔は7日と置いています。これらは説明のための仮置きで、どの業種の実測値でもありません。実際の値は業種と業務のやり方で桁が変わります。発注固定費は、担当者が見積を取り、発注書を起こし、入荷を検収し、伝票を処理する手間の合計ですが、EDIで自動発注している品目ならその大半が消えるでしょうし、逆に輸入品で通関や検査が要るなら一桁大きくなりえます。保管費率も、金利と倉庫費だけなら小さく、季節商品や電子部品のように陳腐化が速い品目では資本コストより陳腐化の損失のほうが大きくなることがあります。
パラメータの違いが発注量にどう効くかは、A001の需要と原価を固定して \( K \) と \( r \) だけを動かすと分かります。次の表は、本章のコード(ch03_assumptions.py)で計算した値です。
| 設定(架空) | 発注固定費 K | 保管費率 r | 最適発注量 Q* | 発注間隔 | 年間の総関連費用 |
|---|---|---|---|---|---|
| 本記事の設定 | 4,000円 | 20% | 695個 | 17.5日 | 166,704円 |
| EDI自動発注で手間が小さい | 500円 | 20% | 246個 | 6.2日 | 58,939円 |
| 輸入品で検収に手間がかかる | 20,000円 | 20% | 1,553個 | 39.2日 | 372,761円 |
| 陳腐化が速い | 4,000円 | 50% | 439個 | 11.1日 | 263,581円 |
| 資本コストが低く保管も安い | 4,000円 | 8% | 1,098個 | 27.7日 | 105,433円 |
発注固定費が500円から20,000円へ40倍になると、発注量は246個から1,553個へ約6.3倍(40の平方根)になり、発注間隔は6日から39日へ延びます。保管費率が8%から50%へ6.25倍になると、発注量は1,098個から439個へ0.4倍(6.25の平方根の逆数)に縮みます。つまり、自社の費用パラメータを一桁取り違えると、発注量は3倍ほど狂います。ただし、後で見るように、発注量が3倍狂っても総費用は1.67倍にしかなりません。この「パラメータは大きく外れやすいが、費用への影響は小さい」という性質を知っておくと、費用の推定に過剰な労力をかけずに済みます。自社の \( K \) と \( r \) を決めるときは、まず桁を合わせることに集中し、細かい精度は求めない、というのが実務上の落としどころだと考えています。
A001で総費用曲線を描く
A001の年間需要は、3年分の実績(14,621・14,385・14,416個)の平均で14,474個です。原価1,200円に保管費率20%を掛けた保管費は240円/個/年、発注固定費は4,000円/回です。次のコードで最適発注量と総費用曲線を出します。
import numpy as np
from inv_data import load_demand, load_skus, COST

dem, skus = load_demand(), load_skus()
K = COST["order_cost"]                      # 発注固定費 4,000 円/回
r = COST["holding_rate"]                    # 保管費率 0.20
c = float(skus.loc["A001", "unit_cost"])    # 原価 1,200 円
h = r * c                                   # 保管費 240 円/個/年
D = float(dem["A001"].groupby(dem.index.year).sum().mean())   # 年間需要 14,474

def trc(Q):
    return K * D / Q + h * Q / 2            # 発注費 + 保管費

Qs = np.sqrt(2 * K * D / h)
print(round(Qs, 1), round(Qs / D * 365, 1), round(D / Qs, 1))
print(round(trc(Qs)), round(K * D / Qs), round(h * Qs / 2))
print(round(Qs / 2 * c))                    # 平均サイクル在庫の金額
grid = np.arange(1, 5001)                   # 総当たりで検算
print(grid[trc(grid).argmin()], round(trc(grid).min()))
# 出力:
# 694.6 17.5 20.8
# 166704 83352 83352
# 416759
# 695 166704
最適発注量は694.6個、発注間隔は17.5日、年間の発注回数は20.8回です。総関連費用は年166,704円で、その内訳は発注費83,352円と保管費83,352円、つまり2つの費用がちょうど等しくなっています。整数の発注量を1個から5,000個まで総当たりで調べた最小値も695個・166,704円で、式の答えと一致しました。平均サイクル在庫は347個、金額にして416,759円です。なお、この品目の年間の購入代金は17,368,800円で、総関連費用の100倍以上あります。発注量の決め方で動かせるのは、購入代金ではなく、その1%程度の周辺費用だという規模感も押さえておくとよいと思います。
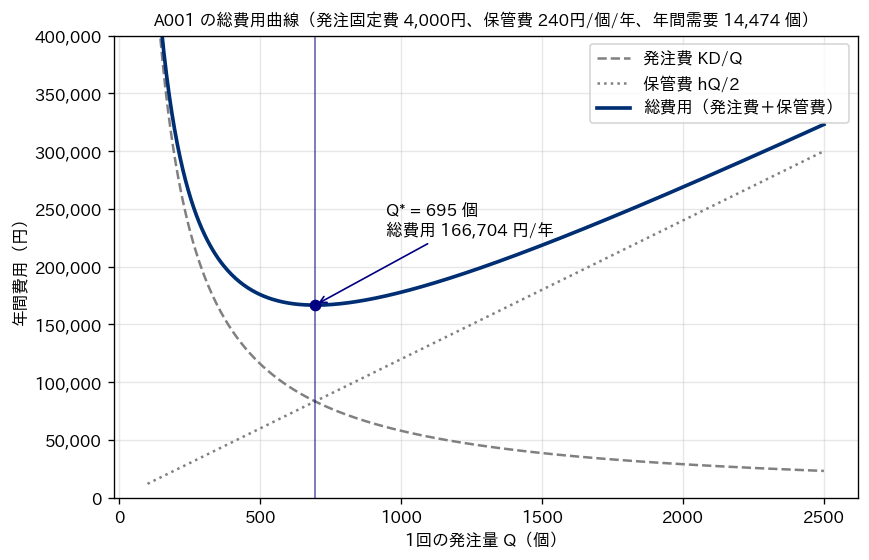
図を見ると、総費用の曲線は最小点の付近で平らです。600個でも800個でも、総費用は最小値からほとんど離れていません。一方、200個まで減らすと発注費が急に膨らみ、2,000個まで増やすと保管費が直線的に伸びます。曲線の形が左右で違う(左は急、右は緩やか)ことも見て取れます。次の節で、この平らさと非対称を式で確かめます。
平方根の頑健性、発注量を外しても費用は少ししか増えない
発注量を最適値の \( k \) 倍にしたとき、総関連費用は最適値の何倍になるでしょうか。\( Q = kQ^{*} \) を総費用の式に入れて整理すると、発注費は \( 1/k \) 倍、保管費は \( k \) 倍になり、最適点では両者が等しいので、費用の比は次の形になります。
\( \dfrac{TRC(kQ^{*})}{TRC(Q^{*})} = \dfrac{1}{2}\left(k + \dfrac{1}{k}\right) \)
この式には需要も費用パラメータも入っていません。どの品目でも、どの業種でも、発注量を2倍にすれば費用は \( (2 + 0.5)/2 = 1.25 \) 倍、半分にしても \( (0.5 + 2)/2 = 1.25 \) 倍です。MIT OpenCourseWare の物流システムの講義資料(Caplice、2006年)も同じ式を示し、発注量を最適値の5倍にすると費用は2.6倍、最適値の5%まで減らすと約10倍になるという例を載せています。次の表は、A001でこの式を数値で検算したもので、式の値と総費用を直接計算した値は小数第4位まで一致しました。
| 倍率 k | 発注量 Q | 費用比(式) | 年間の追加費用 | 平均サイクル在庫金額 | 年間発注回数 |
|---|---|---|---|---|---|
| 0.5 | 347個 | 1.2500 | 41,676円 | 208,379円 | 41.7回 |
| 0.8 | 556個 | 1.0250 | 4,168円 | 333,407円 | 26.0回 |
| 0.9 | 625個 | 1.0056 | 926円 | 375,083円 | 23.2回 |
| 1.0(最適) | 695個 | 1.0000 | 0円 | 416,759円 | 20.8回 |
| 1.25 | 868個 | 1.0250 | 4,168円 | 520,949円 | 16.7回 |
| 1.5 | 1,042個 | 1.0833 | 13,892円 | 625,138円 | 13.9回 |
| 2.0 | 1,389個 | 1.2500 | 41,676円 | 833,518円 | 10.4回 |
| 3.0 | 2,084個 | 1.6667 | 111,136円 | 1,250,277円 | 6.9回 |
| 4.0 | 2,778個 | 2.1250 | 187,542円 | 1,667,036円 | 5.2回 |
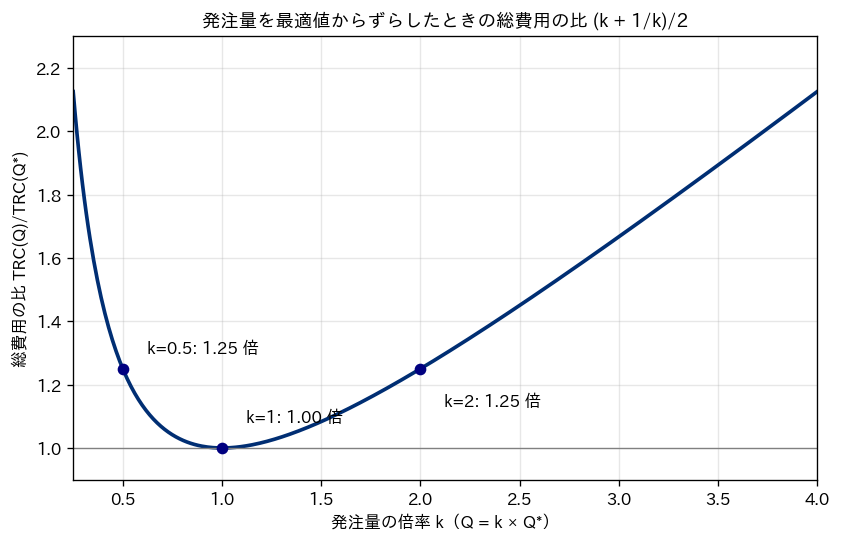
読み方は3つあります。第一に、最適値の0.8倍から1.25倍の範囲なら費用の増分は2.5%以内で、A001では年4,000円程度です。発注量の細かい精度を追う意味はほとんどありません。第二に、曲線は倍率で見れば対称で、半分にする(k=0.5)と2倍にする(k=2)はどちらも費用比1.25ですが、個数で見れば非対称です。最適値より347個少ない発注(k=0.5)は費用比1.25、347個多い発注(k=1.5)は1.0833で、同じ個数だけ外すなら少ない側のほうが損が大きくなります。費用の面だけなら、迷ったときは多めに発注するほうが安全です。第三に、表の右から2列目を見てください。費用比は平らでも、平均サイクル在庫の金額は発注量に比例して直線的に増えます。発注量を2倍にしたときの追加費用は年41,676円ですが、在庫に寝る金額は416,759円から833,518円へ、41万円以上増えます。「費用は平ら、在庫金額は直線」というこの2つの見え方の違いは、本章の最後で経営指標に翻訳し直します。
需要の見込み違いにも同じ式が使えます。見込みの需要で発注量を決め、実際の需要がその \( E \) 倍だった場合、費用比は \( (\sqrt{E} + 1/\sqrt{E})/2 \) です。A001で実測すると、需要を半分に見誤っても2倍に見誤っても費用比は1.0607、つまり6%の損にとどまります。需要が見込みの4分の1、あるいは4倍という大外れでようやく1.25倍です。費用パラメータの誤りも同じで、発注固定費 \( K \) を2倍に見積もると発注量は1.41倍(2の平方根)になり、真の費用で評価した費用比はやはり1.0607です。保管費 \( h \) を半分に見積もった場合も同じ1.41倍・1.0607です。前の節で「パラメータは桁を合わせれば十分」と書いた根拠はここにあります。MIT の講義資料も、EOQは発注量の丸め・需要予測の誤り・費用パラメータの誤りに対して総費用が鈍感であり、だからこそ前提が厳しいにもかかわらず広く使われている、とまとめています。
この性質は、実務で発注量を切りのよい値に丸めるときの安心材料になります。次の表は、A001の発注量を実務でありがちな形に置き換えたときの費用です。
| 発注の仕方 | 発注量 | 年間発注回数 | 費用比 | 年間の追加費用 | 平均サイクル在庫金額 |
|---|---|---|---|---|---|
| 最適値 | 695個 | 20.8回 | 1.0000 | 0円 | 416,759円 |
| 週1回 | 278個 | 52.0回 | 1.4481 | 74,698円 | 167,008円 |
| 2週に1回 | 557個 | 26.0回 | 1.0246 | 4,100円 | 334,015円 |
| 月1回 | 1,206個 | 12.0回 | 1.1562 | 26,036円 | 723,700円 |
| ケース50個単位に切り上げ | 700個 | 20.7回 | 1.0000 | 5円 | 420,000円 |
| パレット600個単位 | 600個 | 24.1回 | 1.0107 | 1,790円 | 360,000円 |
| パレット2枚 1,200個 | 1,200個 | 12.1回 | 1.1532 | 25,543円 | 720,000円 |
ケース単位への切り上げ(700個)は年5円の差しかなく、パレット1枚(600個)でも1,790円です。2週に1回の定期発注(557個)も2.5%の増加で済みます。一方、週1回では45%、月1回では16%の増加になります。発注間隔を1日・2日・4日・8日・16日・32日のような2のべき乗の日数に丸める方策では、最適間隔に最も近いものを選べば費用比は最悪でも \( (\sqrt{2} + 1/\sqrt{2})/2 = 1.0607 \) に収まることが知られており、MIT の講義資料も「2のべき乗の間隔は最適な間隔の費用の6%以内に入ることが保証される」と述べています。A001の最適間隔は17.5日で、16日ごとに634個ずつ発注すると費用比は1.0041でした。複数の品目を同じ日にまとめて発注したいときに、この考え方が使えます。
数量割引、まとめ買いの値引きを取るべきか
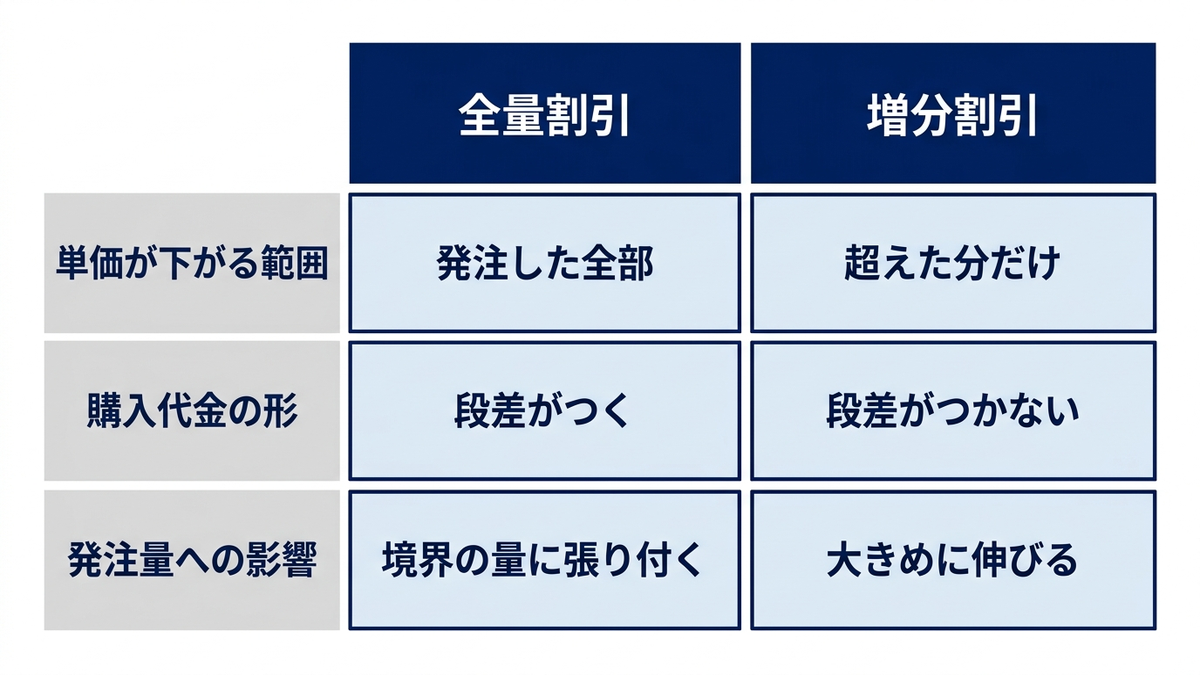
ここまでの式では、単価は発注量に関係なく一定でした。実際には「1,000個以上なら単価2%引き」のような価格表が付いてくることが多く、このとき購入代金も発注量に依存するので、総費用に購入代金 \( cD \) を含めて比べる必要があります。保管費も単価に比例するので、割引を受けると \( h = rc \) がわずかに下がります。割引の形には2種類あります。全量割引(all-units discount)は、発注量が境界を超えると発注した全部の単価が下がる方式で、増分割引(incremental discount)は境界を超えた分にだけ低い単価が適用される方式です。実務で目にする価格表は前者の形が多いように思います。
全量割引の解き方は、MIT の講義資料(EOQ の拡張)が示す手順がそのまま使えます。まず各単価で EOQ を計算し、その EOQ がその単価の適用範囲に入っていればそれが候補です。入っていなければ(EOQ が下限より小さければ)、その価格帯の下限の量を候補にします。最後に候補ごとの総費用(購入代金+発注費+保管費)を比べて最小のものを選びます。A001に「1,000個以上で2%引き(1,176円)、2,000個以上で4%引き(1,152円)」という架空の価格表を当てて計算します。
breaks = [(0, 1200.0), (1000, 1176.0), (2000, 1152.0)]   # (下限の量, 単価)

def total_cost(Q, price):
    return price * D + K * D / Q + r * price * Q / 2   # 購入代金 + 発注費 + 保管費

cands = []
for i, (qmin, p) in enumerate(breaks):
    qmax = breaks[i + 1][0] if i + 1 < len(breaks) else np.inf
    Qp = np.sqrt(2 * K * D / (r * p))          # その単価での EOQ
    if qmin <= Qp < qmax:
        cands.append((Qp, p))                  # 価格帯の中なら候補
    elif Qp < qmin:
        cands.append((qmin, p))                # 下限未満なら下限で評価
for Q, p in cands:
    print(round(Q), p, round(total_cost(Q, p)), round(Q / 2 * p))
# 出力:
# 695 1200.0 17535504 416759
# 1000 1176.0 17196920 588000
# 2000 1152.0 16933396 1152000
各単価での EOQ は694.6個・701.7個・708.9個で、割引後の単価でもほとんど変わりません(保管費が2%か4%下がるだけなので、平方根の中で効いてもわずかです)。したがって1,176円と1,152円の EOQ はどちらも価格帯の下限に届かず、候補は695個(1,200円)・1,000個(1,176円)・2,000個(1,152円)の3つになります。総費用はそれぞれ17,535,504円・17,196,920円・16,933,396円で、2,000個ずつ買って4%引きを取るのが最も安く、割引なしの EOQ より年602,108円安くなります。1個から6,000個まで総当たりで確かめた最小値も2,000個・16,933,396円でした。
ただし、内訳を見ると注意点が見えます。2,000個では発注費が28,948円に減る一方で保管費は230,400円に増え、周辺費用だけなら EOQ の166,704円より92,644円多くなっています。それを購入代金の削減694,752円が上回るので割引を取る判断になるのですが、平均サイクル在庫の金額は416,759円から1,152,000円へ2.8倍になります。2,000個は約50日分の需要にあたり、賞味期限や仕様変更の可能性がある品目では、この50日の間に陳腐化する損失が保管費率20%に織り込まれているかを確かめる必要があります。割引率を変えて試すと、2,000個以上の割引が2%なら1,000個が最良で、3%以上になって初めて2,000個が最良になりました。境界の値引き率が1ポイント違うだけで答えが変わるので、価格表を受け取ったら必ずこの計算を一度通すことをお勧めします。
増分割引は、境界を超えた分にだけ低い単価が適用されるため、購入代金が発注量の連続な区分線形関数になります。MIT の講義資料の手順では、各価格帯について「その価格帯に入るまでに払う割引前との差額」を固定分 \( F_i \) として発注固定費に加え、\( \sqrt{2(K+F_i)D/(rc_i)} \) で EOQ を計算し、価格帯の中にあるものだけを候補として実効単価で総費用を比べます。A001の同じ境界で実測すると、固定分は0円・24,000円・72,000円、各帯の EOQ は694.6個・1,856.4個・3,090.1個で3つとも価格帯の中にあり、総費用は17,535,504円・17,460,447円・17,393,211円で3,090個が最良でした。全量割引の2,000個と比べると、増分割引では発注量が価格表の境界に張り付かず、大きめの量に伸びるのが特徴です。総当たりの結果も3,090個で一致しています。
生産ロット、作りながら使うときの EPQ
外部から買うのではなく自社で作る場合、ロットは一度に届くのではなく、生産速度 \( P \)(個/日)で少しずつ在庫に積み上がり、その間も1日あたりの需要 \( d \)(年間需要 \( D \) を365で割ったもの)の速さで減っていきます。在庫の山の高さは \( Q \) ではなく \( Q(1 – d/P) \) になるので、保管費がその分だけ軽くなり、最適なロットは EOQ より大きくなります。これを経済的生産ロット(EPQ、Economic Production Quantity)と呼び、式は \( Q^{*} = \sqrt{2KD/(h(1-d/P))} \) です。ここでの \( K \) は発注費ではなく段取り費(機械の切り替え・洗浄・立ち上げ損の合計)と読み替えます。MIT の講義資料は、この式を「EOQ に \( 1/(1-d/P) \) の平方根を掛けたもの」として示しています。
A001を自社で作ると仮定し、生産速度を変えてロットを計算した結果が次の表です。年間需要14,474個は1日あたり39.7個で、生産速度が50個/日なら設備の8割が A001 の生産で埋まる計算になります。数値解は scipy.optimize.minimize_scalar で総費用を直接最小化した値で、式の値と一致しています。
| 生産速度 P | 需要/生産速度 d/P | EPQ | EOQ との比 | 在庫の最大値 | 1ロットの生産日数 | 年間の総関連費用 |
|---|---|---|---|---|---|---|
| 50個/日 | 0.793 | 1,527個 | 2.198 | 316個 | 30.5日 | 75,828円 |
| 80個/日 | 0.496 | 978個 | 1.408 | 493個 | 12.2日 | 118,385円 |
| 100個/日 | 0.397 | 894個 | 1.287 | 540個 | 8.9日 | 129,499円 |
| 200個/日 | 0.198 | 776個 | 1.117 | 622個 | 3.9日 | 149,265円 |
| 400個/日 | 0.099 | 732個 | 1.054 | 659個 | 1.8日 | 158,225円 |
| 1,000個/日 | 0.040 | 709個 | 1.020 | 681個 | 0.7日 | 163,365円 |
| 瞬時補充(EOQ) | 0 | 695個 | 1.000 | 695個 | 0日 | 166,704円 |
生産速度が需要に近い(d/P が1に近い)ほど、ロットは大きく、在庫の山は低く、総費用は小さくなります。50個/日では1,527個のロットを30日かけて作り続けることになり、在庫の山は316個までしか上がりません。生産速度が需要の10倍以上あれば、EPQ は EOQ とほとんど変わらず、瞬時補充として扱って差し支えありません。実務で EPQ を使うときの注意は、\( d/P \) が1以上(需要が生産能力以上)の品目にはこの式が成り立たないこと、そして複数の品目が同じ設備を取り合う場合には、各品目のロットを独立に決めると設備の稼働が重なって成り立たなくなることです。後者は品目ごとの EOQ ではなく、設備を共有する品目の生産順序と周期を同時に決める問題(経済的ロットスケジューリング)になり、本記事の範囲を超えます。段取り費が高い設備でロットが大きくなりがちなときは、式でロットを大きくする前に、段取り時間そのものを短縮して \( K \) を下げる余地を先に見るほうが、在庫を増やさずに済みます。
複数品目に共通の制約、予算とスペースをラグランジュ乗数で配る
品目ごとに EOQ を計算すると、その合計が会社の在庫予算や倉庫の容量に収まらないことがあります。第2章の60品目全部について EOQ を出すと、平均サイクル在庫の金額は合計19,379,470円、年間の発注回数は合計969回、総関連費用は年7,751,788円(発注費と保管費が3,875,894円ずつ)になりました。ここで「サイクル在庫の合計を13,565,629円(70%)以内に抑えたい」という予算の制約が付いたとします。各品目の発注量をどう縮めるのが最も損が小さいでしょうか。
この問題はラグランジュ乗数で解けます。制約 \( \sum_i c_i Q_i / 2 \le B \) に乗数 \( \theta \) を掛けて目的関数に足し、品目ごとに微分してゼロと置くと、各品目の発注量は \( Q_i = \sqrt{2KD_i/((r+\theta)c_i)} \) になります。式の形を見ると、保管費率が \( r \) から \( r + \theta \) に上がった EOQ にほかなりません。乗数 \( \theta \) は「予算が1円きつくなるごとに年間費用がいくら増えるか」を表す影の価格で、予算の制約が効いていなければ0です。あとは、\( \theta \) を動かして在庫金額の合計がちょうど予算に等しくなる値を二分法で探すだけです。
from scipy.optimize import brentq

Dv = (dem.sum() / 3).values                     # 60 品目の年間需要
cv = skus.loc[dem.columns, "unit_cost"].values  # 60 品目の原価

def q_lagrange(theta):
    return np.sqrt(2 * K * Dv / ((r + theta) * cv))

def invest(Q):
    return float((cv * Q / 2).sum())            # 平均サイクル在庫金額の合計

def cost(Q):
    return float((K * Dv / Q + r * cv * Q / 2).sum())

Q0 = q_lagrange(0.0)                            # 制約なしの EOQ
B = 0.7 * invest(Q0)                            # 予算を 70% に
theta = brentq(lambda t: invest(q_lagrange(t)) - B, 0.0, 10.0)
Qb = q_lagrange(theta)
print(round(theta, 4), round(np.sqrt(r / (r + theta)), 4))
print(round(cost(Q0)), round(cost(Qb)), round((Dv / Q0).sum()), round((Dv / Qb).sum()))
# 出力:
# 0.2082 0.7
# 7751788 8250117 969 1384
乗数は0.2082になりました。予算を70%に絞ることは、保管費率を20%から40.8%に上げて EOQ を計算するのと同じです。発注固定費と保管費率が全品目で共通なら、各品目の発注量は同じ比率 \( \sqrt{r/(r+\theta)} \)、ここでは0.70倍に縮みます。年間の発注回数は969回から1,384回へ1.43倍に増え、総費用は8,250,117円へ年498,329円(6.4%)増えます。浮いた在庫金額は5,813,841円です。scipy.optimize.minimize(SLSQP)で制約付き最小化を直接解いた数値解と比べると、総費用は同じ8,250,117円で、各品目の発注量の相対差は最大でも100万分の2でした。
比較のために、同じ予算を「全品目を同じ在庫日数にする」という素朴な配り方で使うとどうなるかも計算しました。予算13,565,629円を全品目10.3日分の発注量で使い切る配分です。在庫金額は同じなのに、年間の発注回数は2,131回、総費用は11,238,142円で、ラグランジュ乗数による配分より36.2%高くなります。ラグランジュ解では品目ごとの在庫日数が5.6日から370.8日まで大きく違い、需要が多く原価が安い品目ほど日数が短く、需要が少なく原価が高い品目ほど長くなります。「全品目を一律で何日分」という基準は分かりやすい反面、費用の面では大きな損を伴います。代表SKUで見ると、A001は制約なしの695個が486個に、C001(間欠需要品、原価8,000円)は48個が34個になり、一律日数の配分ではC001が13個まで削られて発注回数が跳ね上がります。
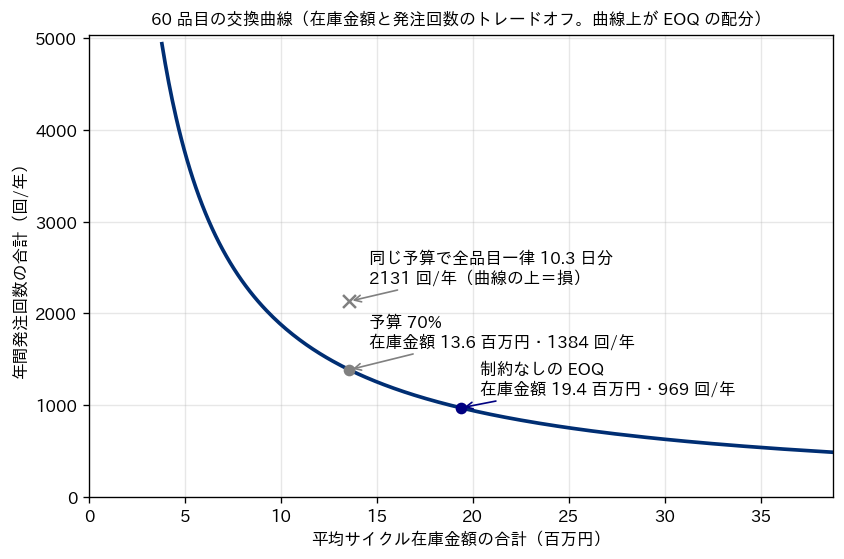
上の図は、乗数 \( \theta \) を動かして描いた交換曲線です。横軸がサイクル在庫の金額の合計、縦軸が年間の発注回数の合計で、曲線上の点はすべて「その在庫金額で達成できる最少の発注回数」を表します。この予算制約の例では在庫金額と発注回数の積は一定(双曲線)で、在庫を半分にすれば発注回数は2倍になります。経営として在庫金額を減らしたいなら、この曲線に沿って左上へ動くことになり、そのときの発注回数の増加、つまり購買と検収の業務量の増加を同時に引き受ける必要があります。曲線の上に外れている点(一律日数の配分)は、同じ在庫金額でより多くの発注をしている、つまり損をしている状態です。現状の在庫金額と発注回数を実測してこの図に打点すると、自社が曲線の上にどれだけ外れているか、つまり配分の見直しだけで取れる改善の余地が見えます。
倉庫のスペースが制約になる場合も式の形は同じで、制約 \( \sum_i v_i Q_i \le S \)(\( v_i \) は1個の体積)に乗数 \( \lambda \) を付けると \( Q_i = \sqrt{2KD_i/(rc_i + 2\lambda v_i)} \) になります。こちらは体積と原価の比が品目ごとに違うので、縮小率も品目ごとに変わります。60品目に架空の体積を割り当ててスペースを70%に絞ると、縮小率は品目により0.318倍から0.989倍まで開き、総費用は4.0%増えました。予算とスペースの両方が効く場合は乗数を2つ持てば同じ手順で解けます。
EOQ の前提が崩れるとき
EOQ の式は、需要が一定で既知、補充は一度に届く、単価は発注量に依らない、品目どうしは独立、期限や最小発注量はない、という前提の上に立っています。数量割引・生産ロット・共通制約は、それぞれ第3・第2・第4の前提を外した拡張でした。残りの前提が崩れる場面を整理します。
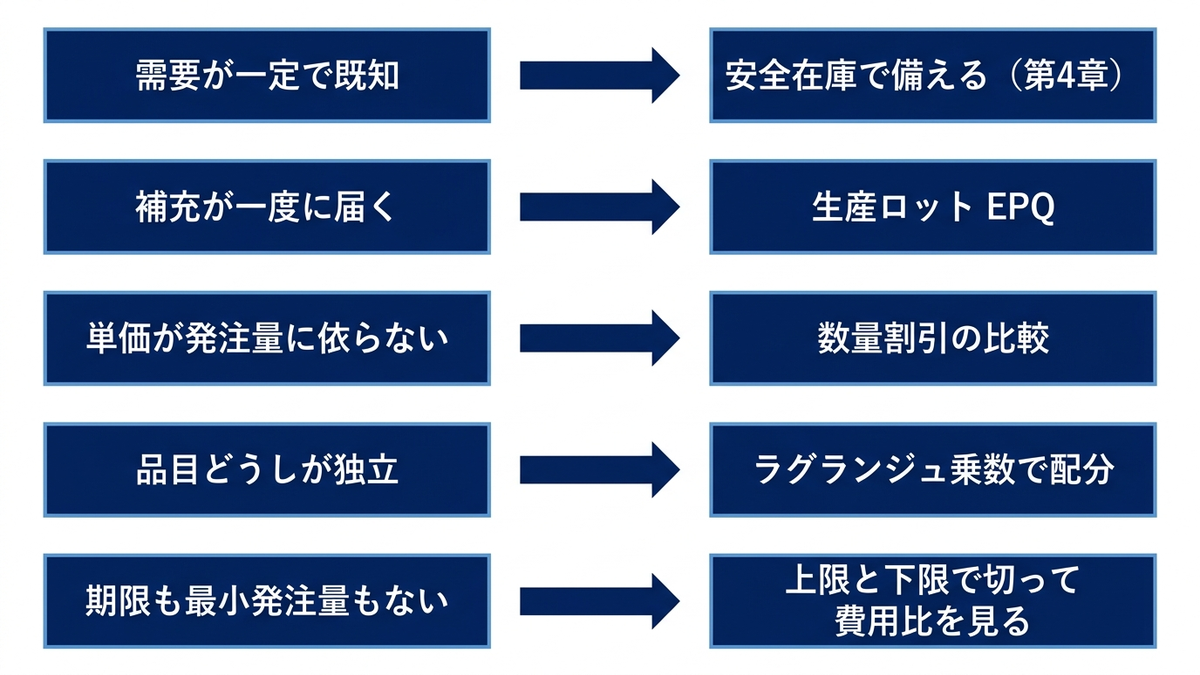
第一に、需要は一定ではありません。ただし、需要のばらつきそのものは EOQ の値を変えないことに注意してください。式に入るのは年間の合計 \( D \) だけで、日々の標準偏差は入りません。A001の日次需要は平均39.6個・標準偏差9.7個・最小15個・最大89個とばらついていますが、年ごとの合計は14,621・14,385・14,416個とほぼ同じなので、年ごとに EOQ を出し直しても698・692・693個と変わらず、3年平均で決めた695個に対する費用比は1.0000です。日々のばらつきが効くのは「いつ発注するか」と「どれだけ余分に持つか」で、これは安全在庫(第4章)の仕事です。EOQ は発注量、安全在庫は発注のタイミング、と役割を分けて考えると整理しやすくなります。
需要の水準そのものが動く場合は事情が違います。季節品 B001 は月別の日次平均が1月の10.6個から7月の41.0個まで3.86倍動きます。年平均で決めた発注量324個をそのまま使うと、1月には15.2日分の在庫を抱え、7月には3.9日分しか持たない発注を繰り返すことになります。月ごとの需要速度で EOQ を出し直すと1月は211個、7月は414個で、その比は需要の比の平方根の1.96倍です。年平均の324個を使い続けたときの費用比は、1月で1.0936、12月で1.0999と最大10%の損で、7月でも1.0303です。季節や成長で需要の水準が動く品目では、四半期か月ごとに \( D \) を更新して発注量を出し直せば足ります。成長品 D001 も年ごとの EOQ は292・328・361個と伸びますが、平均で決めた328個との費用比は最大1.0068でした。ただし、需要が期ごとに大きく変わり、その予定が分かっているなら、EOQ ではなく期ごとの需要に合わせてロットを組む動的ロットサイジングのほうが適しています。これは第7章で扱います。
第二に、賞味期限や使用期限がある品目では、1回に買った分を期限内に使い切る必要があるため、発注量に上限(1日の需要に期限の日数を掛けた量)が付きます。A001 の EOQ の695個は17.5日分なので、期限が18日以上ならそのまま使えます。期限が14日なら上限555個(EOQ の0.80倍)で費用比1.0252、10日なら397個(0.57倍)で1.1613、7日なら278個(0.40倍)で1.4510です。期限が EOQ の日数より短いほど損は急に増えますが、それでも「期限で切った量」が最良で、上限より少なく買う理由はありません。なお、期限切れの廃棄損失が保管費率に入っていない場合は、まず \( r \) を上げるか、廃棄が起きる確率を考慮する別のモデル(第6章のニューズベンダー問題に近い考え方)が要ります。
第三に、最小発注量(MOQ)や発注単位です。仕入先から MOQ を指定されたら、それが EOQ より大きい場合は MOQ で発注するしかなく、損失は費用比の式で読めます。A001 で MOQ が1,000個なら1.44倍で費用比1.0671(年11,192円の損)、1,500個なら2.16倍で1.3113(年51,894円)、2,000個なら2.88倍で1.6133(年102,244円)です。ここでも費用より在庫金額の増え方に注意が要ります。MOQ 2,000個では平均サイクル在庫の金額が416,759円から1,200,000円へ増えます。MOQ が EOQ の2倍を超える品目は、費用比が1.25を超え在庫金額も2倍以上になるので、仕入先との MOQ の交渉か、代替の仕入先の検討に値します。発注単位(ケース・パレット)で丸める場合は、切り捨てと切り上げの両方の費用比を出して小さい側を選びます。A001 では50個単位なら700個、200個単位なら800個(1.0100)と600個(1.0107)のどちらでもほぼ同じ、500個単位なら500個(1.0545)のほうが1,000個(1.0671)より良い、という結果でした。
経営目線、発注量の誤りを在庫金額と運転資金に翻訳する
本章の結果を経営指標に翻訳します。EOQ の総費用曲線が平らだという事実は、「発注量を多少外しても損は小さい」という安心をくれる一方で、経営の側から見ると危うい面があります。費用の曲線が平らでも、在庫金額は発注量に比例して直線的に増えるからです。A001 を月1回まとめて発注すると(1,206個)、総関連費用の増加は年26,036円、15.6%の悪化にすぎません。しかし平均サイクル在庫の金額は416,759円から723,700円へ306,941円増え、サイクル在庫の在庫日数は8.8日から15.2日へ延びます。この30万円は、費用の計算では保管費率20%を掛けた6万円ほどの差にしかなりませんが、貸借対照表の棚卸資産と運転資金には全額が現れます。60品目すべてを月1回の発注に切り替えると、サイクル在庫の金額は EOQ の19,379,470円から40,155,278円へ2,078万円増え、総費用は年7,751,788円から10,911,056円へ316万円増えます。費用の増分は在庫の増分の15%で、残りの85%は損益には出ずに運転資金だけを固定します。
逆の方向にも同じ翻訳ができます。60品目の交換曲線で、サイクル在庫の予算を30%(5,813,841円)減らすと、年間の総費用は498,329円増えました。浮かせた在庫金額に対する追加費用の比は年8.6%です。もし会社の資金調達の金利や、その資金で得られる投資の収益率が年8.6%より高ければ、在庫を減らして発注回数を増やす判断は正しいことになり、低ければ現状の EOQ のままが正しいことになります。ここで注意したいのは、保管費率 \( r \) にはすでに資本コストが入っているはずだという点です。それでも予算の制約が効くなら、\( r \) に織り込んだ資本コストが実態より低いか、金額とは別の理由(資金繰りの上限)が働いていることになります。乗数 \( \theta = 0.208 \) は、その「見えていない資本コスト」の大きさを数字にしたものと読めます。予算の制約が強く効いている会社は、EOQ の \( r \) を見直すところから始めるのが筋です。
数量割引の判断も同じ物差しで見ます。A001 で4%引きを取る発注(2,000個)は、年602,108円の費用削減と引き換えに、平均サイクル在庫の金額を416,759円から1,152,000円へ73万円増やします。利益の面では正しい判断ですが、資金の面では73万円の運転資金と、50日分の在庫が陳腐化する危険を引き受けています。値引きの提案を受けたときは、年間の削減額だけでなく「在庫金額が何円増え、在庫日数が何日延び、その間に仕様や需要が変わる確率はどれほどか」まで並べて判断することをお勧めします。逆に、費用比が1.25を超えるほど発注量を最適値から外している品目(週1回の小刻みな発注、MOQ が EOQ の2倍以上の品目)は、改善の余地が金額で見える品目です。発注固定費 \( K \) の削減(EDI 化・検収の簡素化)と MOQ の交渉は、在庫を増やさずに費用を下げる数少ない打ち手なので、EOQ の計算はその優先順位付けに使えます。
本章の要点は3つです。経済的発注量は発注固定費と保管費の釣り合いで「いくつずつ買うか」を決める式で、平方根の形をしているため、需要や費用パラメータを2倍に見誤っても総費用は6%しか増えません。その頑健性のおかげで、数量割引・生産ロット・予算やスペースの共通制約・期限や最小発注量といった実務の条件は、基本の式を少し変えるか、上限と下限で切って費用比を見るだけで扱えます。ただし総費用が平らでも在庫金額は発注量に比例して増えるので、経営の判断では費用比と在庫金額の両方を並べて見る必要があります。本章では需要を一定として扱いましたが、実際の需要は日々ばらつき、リードタイムの間に欠品が起きます。それに備えて「どれだけ余分に持つか」を決めるのが安全在庫で、第4章で扱います。
この章を深めたい方への参考書籍
『ロジスティクス工学』(久保幹雄、朝倉書店):日本オペレーションズ・リサーチ学会の40周年記念シリーズ「経営科学のニューフロンティア」の第8巻で、2001年刊。第2章が「経済発注量モデル」で、Harris の基本モデルから多段階への拡張までを扱い、以降の章で確率的在庫モデル・安全在庫の配置・動的ロットサイズ決定へ進む構成です。本章の EOQ を、後の章で扱う多段階在庫や動的ロットサイジングと同じ土台で見直したい方に向いています。
『Excelによる生産管理:需要予測、在庫管理からJITまで』(大野勝久、朝倉書店):2011年刊。実務家と文科系の学生に向けて、生産と在庫の管理の問題を Excel で解く手順を示した本で、目次の「確実環境下の在庫管理」が、需要を確定として扱う本章の範囲に近い部分です。Python ではなく Excel で同じ計算を手元の品目に当ててみたい方の最初の1冊として挙げます。
『Inventory Control』(Sven Axsäter、Springer):2015年刊の洋書で、Springer のオペレーションズ・リサーチと経営科学の国際叢書の1冊です。第4章「Single-Echelon Systems: Deterministic Lot Sizing」(45〜63ページ)が本章の範囲にあたり、確定需要のもとでのロットサイズの決め方を扱います。本章で言葉に言い換えた導出を、数式の側から確かめたい方向けです。
第4章 安全在庫、どれだけ余分に持つか
第3章では、発注1回の固定費と在庫の保管費の釣り合いから「1回にいくつ買うか」を決める経済的発注量を確認しました。定番品 A001 では、発注固定費 4,000円、年間保管費率 20%(原価 1,200円の品目なので1個あたり年 240円)、年間需要 14,474個という架空の条件のもとで、1回の発注量は約 695個、年に約 21回の発注になります。ただし経済的発注量は「平均的にどれだけ売れるか」だけを見ており、需要が平均より多い日が続いたり、仕入先からの納品が遅れたりする場面には備えていません。その備えが本章の主題である安全在庫です。
安全在庫は、発注してから品物が届くまでの期間(リードタイム)に、平均を超えて出た需要を吸収するために余分に持つ在庫です。本章では、まず「どれだけ欠品を許すか」を表すサービスレベルに2つの異なる定義があることを整理し、次に安全在庫を「リードタイム中需要の標準偏差の何倍にするか」で決める標準的な手順を、需要とリードタイムの両方がばらつく場合の合成式まで含めて実行結果つきで追います。後半では、正規分布の近似が通用しない間欠需要品での扱い、サービスレベルを上げるほど安全在庫が加速度的に増える性質、そして欠品費と保管費の釣り合いからサービスレベルそのものを決める考え方を扱います。定量発注と定期発注で安全在庫の置き方がどう変わるかは第5章で、需要予測の誤差から安全在庫を決める実務の手順は第8章で扱います。
サービスレベルには2つの定義がある、サイクルサービス率とフィルレート
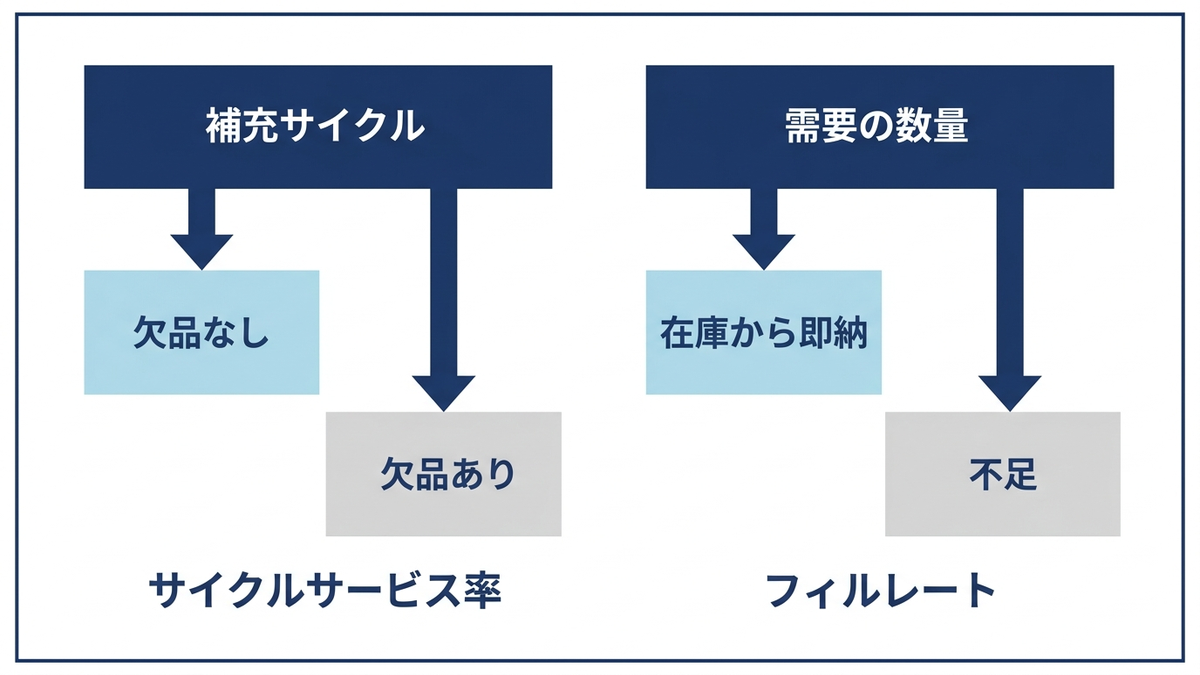
「サービス率95%」という言葉は、在庫の議論で最もよく使われ、最もよく取り違えられる言葉です。同じ95%でも、何を分母にした95%なのかが2通りあり、それぞれで必要な安全在庫がまったく違うからです。1つ目は サイクルサービス率(Cycle Service Level。CSL、教科書によっては P1 とも書かれます)で、「補充の1サイクルの間に欠品が起きない確率」です。発注点を切って発注し、品物が届くまでの間に在庫が尽きなければそのサイクルは成功、1個でも足りなければ失敗と数えます。分母は補充サイクルの回数で、欠品が1個だったか100個だったかは問いません。
2つ目は フィルレート(Item Fill Rate。IFR、P2 とも書かれます)で、「需要のうち在庫から即納できた数量の割合」です。分母は需要の数量で、欠品が起きたサイクルでも、足りなかった分が需要全体に比べて小さければフィルレートはあまり下がりません。MIT の公開講義資料(Caplice、ESD.260 Logistics Systems 第11講)は、この2つを P1「補充サイクルあたりに欠品が起きない確率」、P2「手持ち在庫から充足した需要の割合」と定義し、同じ安全在庫に対してフィルレートは通常サイクルサービス率よりずっと高くなること、フィルレートは発注点だけでなく発注量にも依存するがサイクルサービス率は発注量に依存しないことを指摘しています。
取り違えの害は具体的です。顧客に約束しているのは通常「注文の何%を即納できるか」、つまりフィルレートに近い指標です。ところが安全在庫の計算式に入れるのはサイクルサービス率であることが多く、両者を同じ数字として扱うと、後の数値例で示すとおり、フィルレート 99% で足りる品目に安全在庫を 83個で済むところ 194個持つ、といった過剰が起きます。逆に「サイクルサービス率90%でよい」と決めたつもりで、営業部門がフィルレート90%と受け取ると、実際には需要の99%以上が即納できているのに「サービス率が低い」と不満が出る、といったすれ違いも起きます。どちらの定義を使うかを、計算の前に文書で決めておく必要があります。
| 定義 | 分母 | 問うこと | 発注量 Q への依存 | 計算に使うもの |
|---|---|---|---|---|
| サイクルサービス率(P1) | 補充サイクルの回数 | 1サイクルの間に欠品が起きない確率 | しない | 正規分布の分位点(安全係数 k) |
| フィルレート(P2) | 需要の数量 | 需要のうち在庫から即納できた割合 | する(Q が大きいほど高い) | 標準正規の損失関数 \( G(k) \) |
安全係数と正規分布、安全在庫は標準偏差の何倍で決める
安全在庫の標準的な決め方は、リードタイム中の需要が正規分布に従うと近似し、その平均と標準偏差を求めて、「平均+標準偏差の k 倍」を発注点にする、というものです。この k を 安全係数と呼び、安全在庫は \( SS = k \sigma_{L} \)、発注点は \( s = \mu_{L} + k \sigma_{L} \) と書きます。\( \mu_L \) と \( \sigma_L \) はリードタイム中需要の平均と標準偏差です。言葉にすると、「リードタイムの間に平均的に売れる量を基本の備えとし、そこにばらつきの大きさに比例した上乗せを加える。上乗せの比例定数が安全係数」ということです。
サイクルサービス率は「リードタイム中需要が発注点を超えない確率」なので、正規分布の近似のもとでは、安全係数はサイクルサービス率の分位点そのものになります。サイクルサービス率を 95% にしたければ、標準正規分布の上側 5% 点である 1.645 が k です。Python では scipy.stats.norm.ppf(0.95) がこの値を返します(ppf は percent point function、累積分布関数の逆関数のことです。scipy.stats.norm の公式ドキュメント)。実行して確かめた値を並べると、サイクルサービス率 80% で k は 0.842、90% で 1.282、95% で 1.645、98% で 2.054、99% で 2.326、99.9% で 3.090 です。ここで重要なのは、安全係数がサービス率に比例して増えるのではなく、100% に近づくほど急に増えることです。95% から 99% へ4ポイント上げるだけで k は 1.41 倍、99% から 99.9% へ0.9ポイント上げるだけで 1.33 倍になります。この性質は後の節でグラフと金額で確認します。
この手順の前提は3つあります。第一に、リードタイム中需要の平均と標準偏差が正しく見積もれていること。第二に、その分布が正規分布で近似できること。第三に、在庫の状態を常に把握していて、発注点を切った時点で発注できること(定量発注方式)。第一の前提は次の節の合成式で、第二の前提は間欠需要の節で、第三の前提は第5章で扱います。前提が崩れたときに何が起きるかを知らずに式だけ使うと、計算上の 95% と実際の 95% が離れていきます。
リードタイム中需要の平均と標準偏差、需要とリードタイムの両方がばらつくときの合成式
需要の記録は日次で取れますが、安全在庫の計算に要るのは「リードタイムの間に合計でいくつ売れるか」の分布です。日次需要の平均を \( \mu_D \)、標準偏差を \( \sigma_D \)、リードタイムの平均を \( L \) 日、標準偏差を \( \sigma_{LT} \) 日とすると、日ごとの需要が互いに独立で、需要とリードタイムも独立なとき、リードタイム中需要の平均と標準偏差は次のように合成されます。
\( \mu_L = \mu_D L, \quad \sigma_L = \sqrt{L \sigma_D^2 + \mu_D^2 \sigma_{LT}^2} \)
平均は「1日の平均需要×平均リードタイム」です。標準偏差の中身は2つの項の和で、第1項 \( L\sigma_D^2 \) は「日々の需要のばらつきが L 日分積み上がった分散」、第2項 \( \mu_D^2 \sigma_{LT}^2 \) は「リードタイムが1日ずれると平均需要1日分だけ合計が変わる、そのずれの分散」です。リードタイムが一定なら第2項が消えて \( \sigma_L = \sqrt{L}\,\sigma_D \) になります。日次のばらつきは日数の平方根でしか増えないのに対し、リードタイムのばらつきは平均需要に比例して効くので、需要が大きい品目ほどリードタイムのぶれが安全在庫を支配します。この式は在庫管理の教科書で標準的に使われているもので、Chopra らの論文(The Effect of Lead Time Uncertainty on Safety Stocks、Decision Sciences、2004年)は、正規近似のもとでのリードタイム中需要の標準偏差をこの形で示し、その出典として Silver と Peterson の教科書(1985年)を挙げています。
第2章で用意した架空のサンプルデータの定番品 A001 に当てはめます。日次需要は平均 39.62個、標準偏差 9.73個、リードタイムは平均 7日、標準偏差 2日です。
import numpy as np
from scipy.stats import norm
from inv_data import load_demand, load_skus

dem, skus = load_demand(), load_skus()
d, s = dem["A001"], skus.loc["A001"]
mu_d, sd_d = d.mean(), d.std(ddof=1)          # 日次需要の平均・標準偏差
L, sd_lt = float(s["lt_mean"]), float(s["lt_sd"])  # リードタイムの平均・標準偏差

mu_ltd = mu_d * L
sd_ltd = np.sqrt(L * sd_d**2 + mu_d**2 * sd_lt**2)
print(round(mu_ltd, 1), round(sd_ltd, 1), round(np.sqrt(L) * sd_d, 1))
for csl in (0.90, 0.95, 0.99):
    k = norm.ppf(csl)
    print(csl, round(k, 3), round(k * sd_ltd, 1), round(mu_ltd + k * sd_ltd, 1))
# 出力:
# 277.3 83.3 25.7
# 0.9 1.282 106.8 384.1
# 0.95 1.645 137.0 414.4
# 0.99 2.326 193.8 471.1
リードタイム中需要の平均は 39.62×7 で 277.3個です。標準偏差の第1項は 7×9.73² で 662.3、第2項は 39.62²×2² で 6,278.5、合計の平方根を取って 83.3個になります。もしリードタイムを「7日で一定」と扱っていたら標準偏差は 25.7個で、実際の3分の1以下に見積もることになります。この品目では分散の 90.5% がリードタイムのばらつきから来ており、需要のばらつきは1割に満たないのです。安全在庫を減らしたいなら、需要予測の精度より先に、納期のぶれを減らす(あるいは正しく測る)ほうが効く、というのがこの数字の意味です。ただし Chopra らの同じ論文は、正規近似が「リードタイムのばらつきを減らせば必ず安全在庫が減る」と示唆するのに対し、リードタイム中需要の厳密な分布で計算し直すとサイクルサービス率が 50% から 70% 程度の範囲ではその処方が逆転しうることも示しています。高いサービス率(同論文の例では 95%)では正規近似の処方どおりです。
合成式が本当に合っているかを、同じデータでブートストラップ(復元抽出のシミュレーション)で確かめました。リードタイムを平均 7日・標準偏差 2日の正規乱数から整数に丸めて(下限1日)サンプルし、その日数分の日次需要を実データから復元抽出して合計する、という操作を 20万回繰り返します。結果はリードタイム中需要の平均 277.5個、標準偏差 84.2個で、合成式の 277.3個・83.3個とほぼ一致しました(丸めによってリードタイムの標準偏差がわずかに 2.021 に増えたぶんを補正すると 84.1 です)。分位点で見ると、ブートストラップの 95% 点は 418個、正規近似は 414個、99% 点は 479個に対して 471個と、上側の裾で正規近似がやや小さめに出ます。日次需要が負の二項分布で右に裾を引いているためですが、この品目ではその差は安全在庫の 2〜4% 程度です。
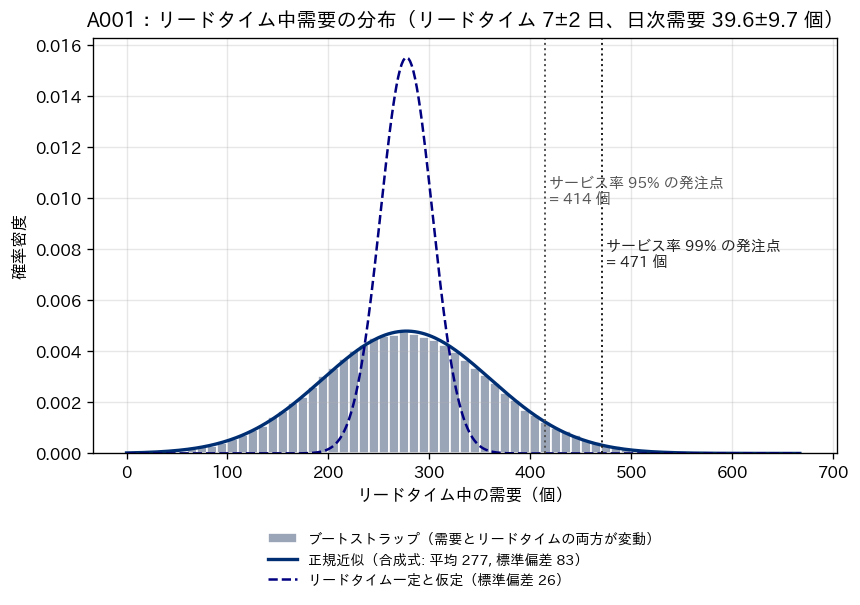
グラフの実線が合成式による正規近似、破線がリードタイムを一定と仮定した場合の分布です。破線の分布で発注点を決めていたら、サイクルサービス率 95% のつもりの発注点は 277.3+1.645×25.7 で約 320個になり、実際の分布ではその値を超える確率が3割を超えます。「計算上は 95% のはずなのに欠品が多い」という状態の原因の一つが、このリードタイムのばらつきの見落としです。
発注点を決める、A001 の数値例と実測のサービス率
安全係数を決めれば、安全在庫と発注点は掛け算と足し算で出ます。A001 について、サイクルサービス率を変えたときの安全係数・安全在庫・発注点と、原価 1,200円を掛けた安全在庫の金額、年間保管費率 20% を掛けた年間の保管費、そしてブートストラップ分布でその発注点が実際に達成するサイクルサービス率を表にまとめました。
| サイクルサービス率 | 安全係数 k | 安全在庫(個) | 発注点(個) | 安全在庫の金額(円) | 年間保管費(円) | 実測の達成率 |
|---|---|---|---|---|---|---|
| 50% | 0.000 | 0 | 277 | 0 | 0 | 50.6% |
| 80% | 0.842 | 70 | 347 | 84,140 | 16,828 | 79.8% |
| 90% | 1.282 | 107 | 384 | 128,122 | 25,624 | 89.7% |
| 95% | 1.645 | 137 | 414 | 164,443 | 32,889 | 94.6% |
| 98% | 2.054 | 171 | 448 | 205,322 | 41,064 | 97.7% |
| 99% | 2.326 | 194 | 471 | 232,574 | 46,515 | 98.8% |
| 99.9% | 3.090 | 258 | 535 | 308,943 | 61,789 | 99.85% |
サイクルサービス率 50% は安全在庫ゼロ、つまり発注点が平均需要ちょうどの状態で、2回に1回は品物が届く前に在庫が尽きます。95% にするには 137個、原価にして約 16万円の安全在庫を積み、その保管費は年 3.3万円です。99.9% にするとその 1.88 倍の 258個、約 31万円になります。右端の実測の達成率を見ると、正規近似で決めた発注点は、この品目ではほぼ狙いどおりの確率を達成しています。99% の発注点で 98.8% と、上側の裾がやや重いぶんだけ 0.2 ポイント下回りますが、実務上は無視できる差です。なお安全在庫の金額は、貸借対照表の棚卸資産を押し上げる金額の目安で、その 20% が毎年の費用(資本コストと倉庫費と陳腐化の合計。第1章)として消えていきます。サービス率の数字を1つ動かすことは、この2つの経営数値を同時に動かすことです。
フィルレートから安全係数を決める、標準正規の損失関数
顧客への約束がフィルレートで表されているなら、安全係数もフィルレートから逆算する必要があります。そのために要るのが、1サイクルの間に「発注点を超えた需要の量」の期待値です。リードタイム中需要が発注点 \( s \) を超えた分の期待値を、正規近似のもとで \( \sigma_L G(k) \) と書きます。ここで \( G(k) = \phi(k) – k\{1 – \Phi(k)\} \) は 標準正規の損失関数で、\( \phi \) と \( \Phi \) は標準正規分布の密度関数と累積分布関数です。言葉にすると「安全係数 k のとき、標準化した需要が k をどれだけ超えるかの平均」です。前掲の MIT の講義資料は、この量を1サイクルあたりの期待欠品数と呼び、フィルレートを \( \beta = 1 – \sigma_L G(k) / Q \) と定義しています。1サイクルの需要はおおむね発注量 Q に等しいので、「1サイクルの期待欠品数を発注量で割ったものが欠品の割合」というのが式の読み方です。
この式には安全係数だけでなく発注量 Q が入っています。発注量が大きいほど1サイクルが長く、同じ安全在庫でも欠品にさらされる回数が減るので、フィルレートは上がります。逆に言えば、フィルレートを目標にするなら、第3章で決めた発注量と本章の安全在庫は独立には決められません。A001 の経済的発注量 695個を Q として計算します。
from scipy.optimize import brentq

def G(k):
    """標準正規の損失関数 phi(k) - k * (1 - Phi(k))"""
    return norm.pdf(k) - k * (1.0 - norm.cdf(k))

D = d.sum() / 3                          # 年間需要(3年平均)14,474 個
Q = np.sqrt(2 * 4000 * D / 240)          # 第3章の EOQ。694.6 個(約 695 個)
for csl in (0.90, 0.95, 0.99):          # CSL で決めた k のフィルレート
    k = norm.ppf(csl)
    print(csl, round(sd_ltd * G(k), 2), round(1 - sd_ltd * G(k) / Q, 4))
for beta in (0.95, 0.99, 0.999):        # 目標フィルレートから k を逆算
    k = brentq(lambda kk: G(kk) - (1 - beta) * Q / sd_ltd, -4, 6)
    print(beta, round(k, 3), round(norm.cdf(k), 4), round(k * sd_ltd, 1))
# 出力:
# 0.9 3.94 0.9943
# 0.95 1.74 0.9975
# 0.99 0.28 0.9996
# 0.95 -0.035 0.4859 -2.9
# 0.99 1.0 0.8413 83.3
# 0.999 2.007 0.9776 167.2
結果は、サービスレベルの2つの定義がどれほど違うかをはっきり示します。サイクルサービス率 90% の安全係数 1.282 では、1サイクルの期待欠品数は 3.94個、フィルレートは 99.43% です。サイクルサービス率 95% ならフィルレートは 99.75%、99% なら 99.96% になります。「10回に1回は欠品する」発注点でも、数量で見れば需要の 99.4% は即納できているのです。逆に、フィルレート 95% を目標にすると、必要な安全係数は 0 をわずかに下回り(マイナス0.035)、安全在庫は不要という答えになります(数式上は発注点が平均をわずかに下回りますが、運用では安全在庫を0個に丸めます)。発注量 695個に対して欠品を 5%、つまり1サイクルに 35個まで許すなら、平均需要ちょうどの発注点で足りるからです。フィルレート 99% でも安全係数は 1.000(サイクルサービス率にして 84.1%)、安全在庫は 83個で、サイクルサービス率 95% として計算した 137個の6割です。フィルレート 99.9% でようやく安全係数 2.007、安全在庫 167個になります。
| 目標の置き方 | 安全係数 k | 安全在庫(個) | 安全在庫の金額(円) | 対応するもう一方の指標 |
|---|---|---|---|---|
| サイクルサービス率 95% | 1.645 | 137 | 164,443 | フィルレート 99.75% |
| サイクルサービス率 99% | 2.326 | 194 | 232,574 | フィルレート 99.96% |
| フィルレート 99% | 1.000 | 83 | 99,938 | サイクルサービス率 84.1% |
| フィルレート 99.5% | 1.341 | 112 | 134,081 | サイクルサービス率 91.0% |
| フィルレート 99.9% | 2.007 | 167 | 200,627 | サイクルサービス率 97.8% |
発注量を変えると同じ話が別の形で現れます。安全係数を 1.645 に固定したまま発注量を 100個まで小さくすると(年に 145回発注)、フィルレートは 98.26% まで下がり、1,389個(年 10回)にすると 99.87% まで上がります。フィルレート 99% を守るために要る安全在庫は、発注量 100個なら 156個、695個なら 83個、1,389個なら 51個です。発注量を大きくすれば安全在庫は減りますが、サイクル在庫(発注量の半分)が増えるので、合計の在庫が減るとは限りません。この釣り合いは第5章の発注方式の比較と第12章のシミュレーションで扱います。なお、ブートストラップ分布でサイクルサービス率 95% の発注点 414個を検算すると、欠品が起きたサイクルの割合は 5.44%、1サイクルの平均欠品数は 2.07個、フィルレートは 99.70% で、損失関数による 1.74個・99.75% とほぼ一致しました。
Chopra らの前掲論文は、実務では多くの企業がサイクルサービス率ではなくフィルレートを目標にしており、その目標値は 97% から 99% の間に置かれることが多く、それは同論文の例ではサイクルサービス率にして 50% から 70% に相当する、と述べています。サービス率の目標を決めるときは、その数字がどちらの定義か、そして相手方(営業・顧客・仕入先)がどちらで受け取るかを、必ず確かめてから式に入れることです。
正規近似の限界、間欠需要と小さい需要ではポアソン・負の二項を使う
ここまでの計算は、リードタイム中需要が正規分布で近似できることを前提にしていました。A001 のように1日に数十個売れる品目では、リードタイム中の合計は多数の日次需要の和になり、中心極限定理が働いて正規分布に近づきます。しかし、需要がある日のほうが珍しい間欠需要品や、1日に1個売れるか売れないかの小さい需要では、この前提が崩れます。Eppen と Martin は 1988年の論文(Management Science 34巻11号)で、この正規性の仮定は一般には正当化できず、欠品確率の見積もりに大きな誤りを生みうると指摘しました。何が起きるかを、間欠需要品 C001 で確かめます。
C001 は日次需要の平均 1.27個、標準偏差 3.41個で、需要がゼロの日が 81.2% を占め、需要が出た日の平均は 6.73個、最大 27個です。分散を平均で割った値は 9.22 で、ポアソン分布なら 1 になるはずの比を大きく超えています(過分散)。リードタイムは平均 21日・標準偏差 5日、原価は 8,000円です。合成式を当てはめると、リードタイム中需要の平均は 26.6個、標準偏差は 16.9個になります。ここまでは A001 と同じ手順ですが、その先の「正規分布で分位点を出す」ところで無理が出ます。平均 26.6・標準偏差 16.9 の正規分布は、需要が負になる確率に 5.77% を割り当てています。分布の形が左右対称ではなく、右に長く裾を引いているのに、対称な釣鐘型を当てはめているからです。次のコードでは、比較のために負の二項分布も当てています。第2章では最尤法で当てましたが、ここではブートストラップで得たリードタイム中需要の平均と分散から、負の二項分布のパラメータを直接逆算する簡便な方法(モーメント法)を使っています。
from scipy.stats import nbinom

rng = np.random.default_rng(0)
d, s = dem["C001"], skus.loc["C001"]
mu_d, sd_d = d.mean(), d.std(ddof=1)
L, sd_lt = float(s["lt_mean"]), float(s["lt_sd"])
mu_ltd = mu_d * L
sd_ltd = np.sqrt(L * sd_d**2 + mu_d**2 * sd_lt**2)

N = 200000                                      # ブートストラップ
lt = np.maximum(1, np.round(rng.normal(L, sd_lt, N))).astype(int)
draws = rng.choice(d.values, size=(N, lt.max()), replace=True)
ltd = (draws * (np.arange(lt.max())[None, :] < lt[:, None])).sum(axis=1)

m, v = ltd.mean(), ltd.var(ddof=1)              # 負の二項をモーメント法で当てる
n_nb = m**2 / (v - m)
nb = nbinom(n_nb, n_nb / (n_nb + m))
for csl in (0.95, 0.99):
    r_norm = mu_ltd + norm.ppf(csl) * sd_ltd
    print(csl, round(np.quantile(ltd, csl)), round(r_norm, 1), nb.ppf(csl),
          round((ltd <= r_norm).mean(), 3), round((ltd <= nb.ppf(csl)).mean(), 3))
# 出力:
# 0.95 58 54.3 59.0 0.934 0.957
# 0.99 75 65.8 80.0 0.975 0.994
ブートストラップで求めた実際の分布では、リードタイム中需要の 95% 点は 58個、99% 点は 75個です。正規近似はそれぞれ 54.3個、65.8個と小さく見積もり、その発注点で実際に達成するサイクルサービス率は 93.4% と 97.5% にとどまります。99% を狙って 97.5% しか出ない、というのは、欠品の起きるサイクルが計算の 2.5倍になるということです。一方、平均と分散を合わせた負の二項分布は 95% 点を 59個、99% 点を 80個と見積もり、達成率は 95.7% と 99.4% になります。ポアソン分布は平均と分散が等しいという前提なので、この品目には合いません。同じ平均のポアソン分布で 99% 点を出すと 39個で、実際の 75個の半分にしかならず、その発注点で達成できるサイクルサービス率は 79.4% にとどまります。
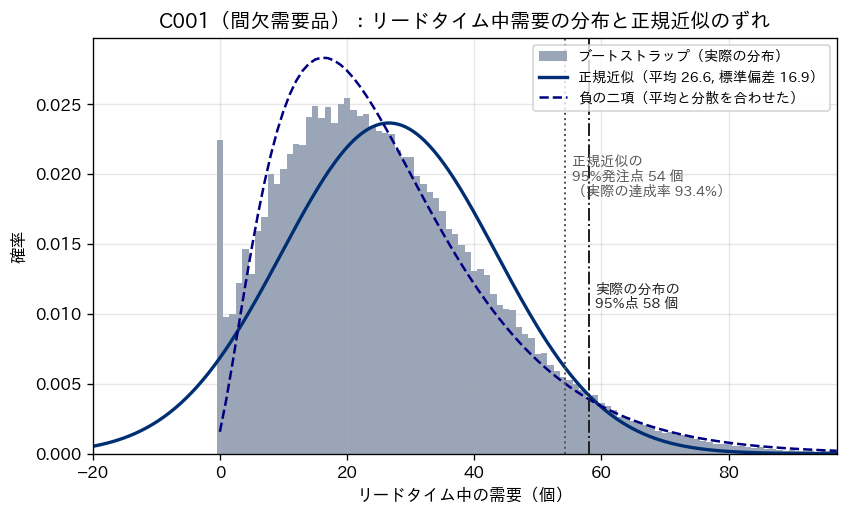
| サイクルサービス率の目標 | 実際の分布の分位点(個) | 正規近似(個) | ポアソン(個) | 負の二項(個) | 正規近似の発注点の達成率 | 負の二項の発注点の達成率 |
|---|---|---|---|---|---|---|
| 90% | 49 | 48.2 | 33 | 49 | 89.4% | 90.2% |
| 95% | 58 | 54.3 | 35 | 59 | 93.4% | 95.7% |
| 98% | 68 | 61.2 | 38 | 71 | 96.4% | 98.5% |
| 99% | 75 | 65.8 | 39 | 80 | 97.5% | 99.4% |
負の二項分布が万能というわけではありません。グラフを見ると、実際の分布は需要ゼロの山(リードタイム中に一度も需要が出ない確率 2.24%)と 20個前後の山を持ち、負の二項分布はその形を完全には再現していません。99% 点では 80個と、実際の 75個より大きめに見積もっています。ただ、正規近似が「足りない側」に外すのに対して、負の二項は「多め側」に外すので、欠品の面では安全側です。原価 8,000円のこの品目で 95% を狙う場合、正規近似の安全在庫は 27.8個(約 22万円)、負の二項では 32.4個(約 26万円)で、4万円の差で達成率が 93.4% から 95.7% へ変わります。Syntetos らは 7,000系列を超える間欠需要データの実証研究(Journal of Business Research、2015年)で、需要の発生がポアソン過程かベルヌーイ過程に従い需要量の分布を任意とすると、リードタイム中の合計需要は複合ポアソン分布か複合ベルヌーイ分布になること、そして負の二項分布(需要の発生回数がポアソン、1回の量が対数分布の複合分布)で需要をモデル化して在庫水準を決めていることを述べています。第2章で紹介した需要の型の見分け方(ゼロの割合、需要間隔)で間欠と判定した品目は、正規近似ではなく、負の二項分布か、あるいは本節のように実データからのブートストラップで分位点を直接取るほうが安全です。
需要が小さいだけで間欠ではない品目でも、離散性が効きます。サンプルデータの中で最も需要の小さい安定品 S029 は、日次需要の平均 0.518個、分散と平均の比 1.00 で、ポアソン分布そのものに近い品目です(年間需要 189個)。リードタイムは平均 9日・標準偏差 2日で、リードタイム中需要の平均は 4.66個、標準偏差 2.39個になります。正規近似の 95% 点は 8.6個ですが、品物は整数なので、8個までしか持たないなら達成率は 93.4%、9個に切り上げれば 96.6% になります。負の二項分布の 95% 点は 9個で、達成率は同じ 96.6% です。需要が1桁の品目では、分布の選び方と同じくらい「端数をどちらに丸めるか」が達成率を左右します。安全在庫を小数のまま報告して、現場が切り捨てて運用している、というずれは珍しくないように思います。
サービスレベルを上げると安全在庫は加速度的に増える
安全係数がサービス率に対して直線的に増えないことは、正規分布の形から来る性質で、品目に関係なく成り立ちます。左のグラフは安全係数 k をサイクルサービス率に対して描いたもので、90% から 95% への5ポイントで k は 0.363 増え、95% から 99% への4ポイントで 0.681、99% から 99.9% へのわずか 0.9ポイントで 0.764 増えます。右のグラフは、サンプルデータの 60品目すべてに同じサイクルサービス率を適用し、合成式で求めた安全在庫を原価で金額に直して合計したものです。曲線の形は左とまったく同じで、金額の軸に置き換わっただけです。
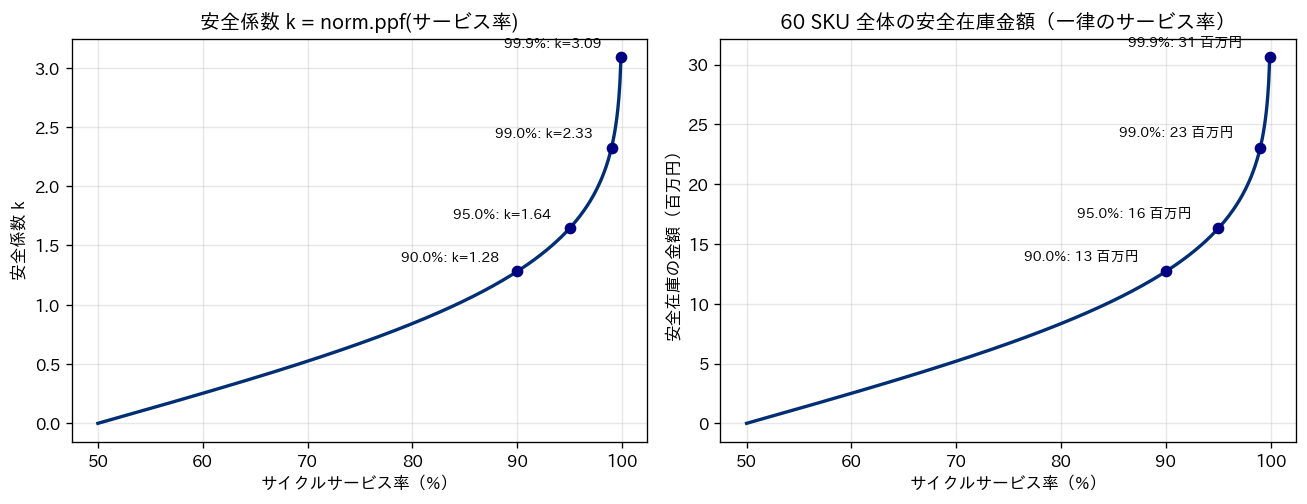
60品目の年間消費金額(原価ベース)は合計 9億6,373万円です。サイクルサービス率を一律 90% にしたときの安全在庫の合計は 1,271万円、95% で 1,631万円、99% で 2,307万円、99.9% で 3,064万円になります。95% を基準にすると 99% は 1.41 倍、99.9% は 1.88 倍です。増分に直すと、95% から 99% へ上げるのに 676万円、99% から 99.9% へ上げるのにさらに 757万円の在庫が要ります。4ポイントの改善より、0.9ポイントの改善のほうが高くつくのです。「あと少し」の欠品をなくすための最後の数ポイントが、最も高くつきます。
| 一律のサイクルサービス率 | 安全係数 k | 安全在庫の合計(万円) | 年間保管費(万円) | 在庫日数への換算(日) | 95% 比 |
|---|---|---|---|---|---|
| 80% | 0.842 | 834 | 167 | 3.2 | 0.51 倍 |
| 90% | 1.282 | 1,271 | 254 | 4.8 | 0.78 倍 |
| 95% | 1.645 | 1,631 | 326 | 6.2 | 1.00 倍 |
| 98% | 2.054 | 2,036 | 407 | 7.7 | 1.25 倍 |
| 99% | 2.326 | 2,307 | 461 | 8.7 | 1.41 倍 |
| 99.5% | 2.576 | 2,554 | 511 | 9.7 | 1.57 倍 |
| 99.9% | 3.090 | 3,064 | 613 | 11.6 | 1.88 倍 |
表の「在庫日数への換算」は、安全在庫の金額を年間消費金額の1日分(9億6,373万円÷365日)で割ったもので、安全在庫だけで何日分の売上原価に相当するかを表します。第1章で見た在庫日数の指標に、安全在庫がどれだけ寄与するかを示す数字です。一律 95% なら 6.2日、一律 99.9% なら 11.6日で、サイクル在庫や見越し在庫を足す前の段階で、サービス率の決め方だけで在庫日数が5日以上動きます。この表には需要が「平均値のまわりで安定している」前提が入っています。季節品や成長品では、年間を通した標準偏差にはトレンドや季節の変動が混ざるので、この計算は安全在庫を過大に見積もります。その扱いは第8章で、予測誤差の標準偏差を使う形に置き換えます。
サービスレベルを費用で決める、欠品費と保管費の釣り合い
ここまでサービスレベルは「与えられるもの」として扱ってきましたが、欠品1個あたりの費用を見積もれるなら、サービスレベルそのものを費用の釣り合いから決められます。定量発注方式で、安全在庫の年間保管費と、年間の欠品費(1サイクルの期待欠品数×サイクル数×欠品1個あたりの費用)の和を最小にする安全係数を探します。年間需要を D、発注量を Q、1個あたりの年間保管費を h、欠品1個あたりの費用を p とすると、年間の関連費用は \( h k \sigma_L + p (D/Q) \sigma_L G(k) \) です。損失関数の微分が \( G'(k) = -\{1-\Phi(k)\} \) であることを使ってこれを k で微分し、ゼロと置くと、最適な安全係数は次の条件を満たします。
\( 1 – \Phi(k^*) = \dfrac{Q h}{p D} \)
左辺は1サイクルに欠品する確率、つまり「1からサイクルサービス率を引いたもの」です。言葉にすると、「最適な欠品確率は、発注量あたりの保管費を、年間需要あたりの欠品費で割ったもの」になります。欠品費が高い、需要が多い、発注量が小さい(サイクルが多く欠品にさらされる回数が多い)、保管費が安い、のどれかであれば、最適なサービス率は上がります。前掲の MIT の講義資料は、この形の決定則を「1個あたりの欠品費(B2)」による規則として、Silver らの教科書の式番号つきで紹介しています。
from scipy.optimize import minimize_scalar
from inv_data import COST

d, s = dem["A001"], skus.loc["A001"]
mu_d, sd_d = d.mean(), d.std(ddof=1)
L, sd_lt, cost = float(s["lt_mean"]), float(s["lt_sd"]), float(s["unit_cost"])
sd_ltd = np.sqrt(L * sd_d**2 + mu_d**2 * sd_lt**2)
D = d.sum() / 3                                  # 年間需要(3年平均)
h = COST["holding_rate"] * cost                  # 1個あたり年間保管費 240円
p = COST["shortage_cost_ratio"] * cost           # 欠品1個あたり 600円
Q = np.sqrt(2 * COST["order_cost"] * D / h)      # EOQ

annual = lambda k: h * k * sd_ltd + p * (D / Q) * sd_ltd * G(k)
res = minimize_scalar(annual, bounds=(-1, 5), method="bounded")
csl_star = 1 - Q * h / (p * D)
print(round(res.x, 3), round(norm.cdf(res.x), 4), round(res.fun))
print(round(csl_star, 4), round(norm.ppf(csl_star), 3))
# 出力:
# 2.071 0.9808 48706
# 0.9808 2.071
A001 では、年間需要 14,474個、発注量 695個、保管費 240円、欠品費を原価の 50%(粗利相当)として 600円と置くと、最適な欠品確率は 695×240÷(600×14,474)で 0.0192、サイクルサービス率にして 98.08%、安全係数 2.071 になります。数値最適化で年間費用を直接最小化しても同じ 2.071 に落ち着き、そのときの年間費用は 48,706円です。サービス率別に費用を分解すると、サービス率 80% では保管費 16,828円に対して欠品費が 116,285円と欠品側が圧倒し、95% で保管費 32,889円・欠品費 21,763円、98% で 41,064円・7,649円と拮抗し、99.9% では保管費 61,789円に対して欠品費は 288円しか残りません。合計は 98% 付近で最小になり、そこから上げても下げても増えます。
| サイクルサービス率 | 安全係数 k | 安全在庫の年間保管費(円) | 年間欠品費(円) | 合計(円) |
|---|---|---|---|---|
| 80% | 0.842 | 16,828 | 116,285 | 133,113 |
| 90% | 1.282 | 25,624 | 49,314 | 74,938 |
| 95% | 1.645 | 32,889 | 21,763 | 54,651 |
| 98% | 2.054 | 41,064 | 7,649 | 48,713 |
| 98.08%(最適) | 2.071 | 41,402 | 7,304 | 48,706 |
| 99% | 2.326 | 46,515 | 3,530 | 50,045 |
| 99.9% | 3.090 | 61,789 | 288 | 62,077 |
この答えは欠品費の見積もりに強く依存します。欠品費を原価の 10%(120円)にすると最適なサービス率は 90.40% に下がり、原価と同額(1,200円)なら 99.04%、原価の5倍(6,000円。欠品が取引の打ち切りにつながるような品目)なら 99.81% まで上がります。欠品費は、失った粗利だけでなく、代替品の調達費、納期遅れの違約、顧客の信用の低下(第1章)を含む数字で、正確には測れません。それでも「原価の10%か、50%か、5倍か」という桁の見積もりだけで、サービス率の答えは 90% 台前半か、98%か、99.8% かに分かれます。桁を決める議論を営業や経営と共有することが、サービス率を「なんとなく 95%」で決めるより、はるかに実のある作業だと考えています。代表4品目にそれぞれの経済的発注量と原価を当てはめると、最適なサイクルサービス率は A001 で 98.08%、季節品 B001 で 98.59%、間欠需要品 C001 で 95.84%、成長品 D001 で 97.97% と、同じ費用の比率でも発注量と需要の大きさで違う値になります。なお、C001 の値は正規近似のもとでの計算であり、前節の理由で実際には負の二項分布で分位点を取り直す必要があります。
経営目線、一律 99% のサービス率が在庫金額と運転資金をどう動かすか
「全品目サービス率 99%」は、欠品を出したくない経営者にも、責められたくない担当者にも受け入れやすい方針で、それだけに多くの現場で採用されているように思います。サンプルデータでこの方針の値段を見積もります。一律 95% から一律 99% に上げると、安全在庫の合計は 1,631万円から 2,307万円へ 676万円増えます。年間消費金額 9億6,373万円の会社にとって、これは棚卸資産が 676万円増え、運転資金がそれだけ長く固定されることを意味します。年間保管費率 20% で毎年 135万円の費用が新たに発生し、在庫日数は 6.2日から 8.7日へ 2.5日延びます。この 2.5日は、第1章で見たキャッシュ・コンバージョン・サイクルを、売上原価と支払・回収の条件が変わらない前提で、そのまま 2.5日延ばします。
その 676万円が何を買っているかも数字にできます。一律 99% の安全在庫 2,307万円の内訳を ABC 区分(年間消費金額の累積 80% までを A、95% までを B、残りを C)で見ると、A の 18品目に 1,778万円(77.1%)、B の 16品目に 349万円、C の 26品目に 179万円(7.8%)です。サービス率を一律に上げるとき、増える金額のほぼ8割は A 品目に積まれます。A 品目は需要が大きく、リードタイムのばらつきが平均需要に比例して効くので、安全在庫の金額も大きくなるからです。裏を返せば、C 品目のサービス率を 99% にしても金額はほとんど増えません。A を 95%、B を 98%、C を 99% にする組み合わせは合計 1,745万円で、一律 99% より 562万円少なく、一律 95% より 114万円多いだけです。反対に「重要な A 品目ほど高いサービス率」という直観で A を 99%、B を 95%、C を 90% にすると 2,124万円で、一律 99% とあまり変わりません。
どちらが正しいかは、前節の費用の釣り合いが答えます。欠品費が原価に比例するなら、最適なサービス率は品目の重要度ではなく、発注量と需要の大きさと欠品費の比率で決まります。A 品目は需要が大きく発注回数も多いので最適なサービス率は高めに出ますが、それは「重要だから」ではなく「欠品にさらされる回数が多いから」です。C 品目は在庫金額が小さいので、サービス率を高くする費用が安く、その品目の欠品が客先の生産ラインを止めるような場合には、むしろ C 品目こそ高いサービス率を持つのが合理的です。経営として決めるべきは、品目ごとのサービス率の数字ではなく、「欠品1個の費用を原価の何倍と見るか」という1つの方針で、あとは式が品目ごとの答えを出します。第13章では、この方針を品目群ごとのルールに落とし、毎月更新する運用の形を扱います。
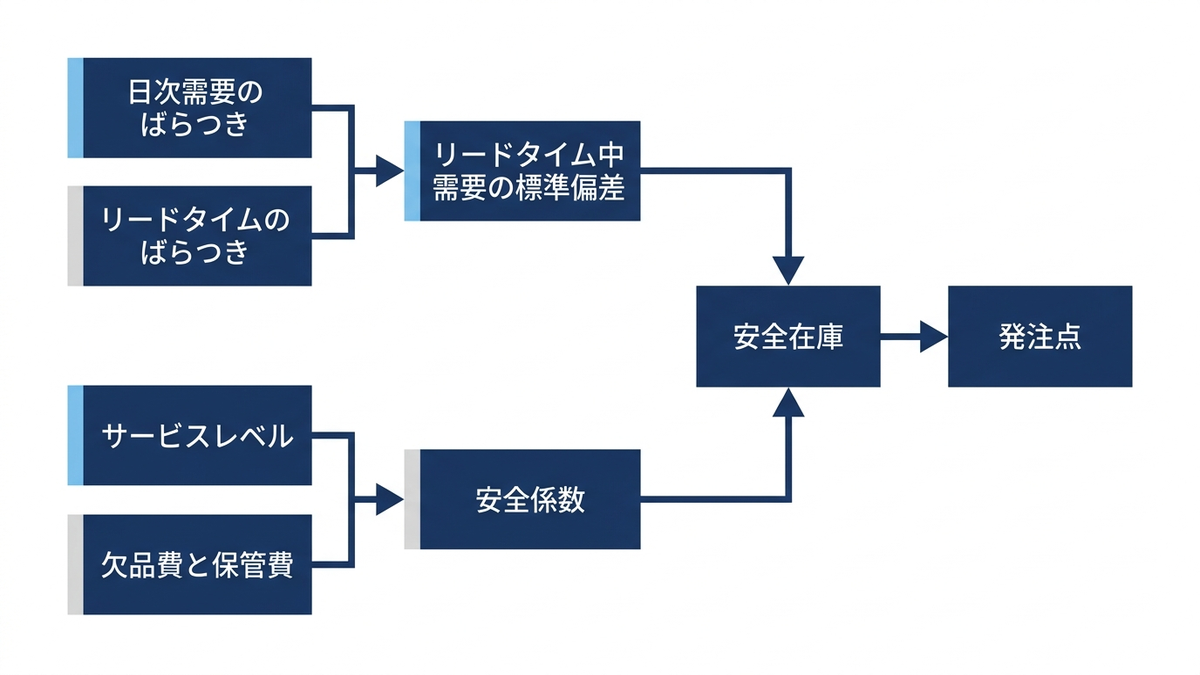
本章の要点は3つです。第一に、サービスレベルにはサイクルサービス率とフィルレートの2つの定義があり、同じ 95% でも必要な安全在庫は大きく違います。どちらの定義を使うかを先に決め、フィルレートなら損失関数で発注量と一緒に安全係数を求めます。第二に、安全在庫はリードタイム中需要の標準偏差に安全係数を掛けたもので、その標準偏差は需要のばらつきとリードタイムのばらつきの合成で決まり、需要の大きい品目ではリードタイムのばらつきが支配的です。間欠需要や小さい需要では正規近似が外れるので、ポアソン分布・負の二項分布かブートストラップで分位点を取ります。第三に、サービスレベルを上げるほど安全在庫は加速度的に増え、最後の数ポイントが最も高くつきます。サービス率は一律に決めるものではなく、欠品費と保管費の釣り合いから品目ごとに導くものです。次の第5章では、ここで求めた発注点と発注量を、定量発注・定期発注・\( (s, S) \) 方策といった発注方式の体系の中に位置づけ、方式によって安全在庫がカバーすべき期間がどう変わるかを、同じ需要系列に各方式を当てた在庫推移で確認します。
この章を深めたい方への参考書籍
『適正在庫の考え方・求め方』(勝呂隆男、日刊工業新聞社):「在庫はゼロにできない」という立場から、定量発注と定期発注における安全在庫の求め方を、需要とリードタイムの変動、安全係数と正規分布、間欠需要や正規分布に従わない場合の扱いまで含めて解説した実務書です。本章で扱った合成式と正規近似の限界を、現場のデータで計算する手順として学び直したい方に向いています。
『適正在庫のテクニック』(勝呂隆男、日刊工業新聞社):同じ著者による続編で、第3章「安全在庫の求め方」と第7章「リードタイムのかぞえかた」を含む10章構成です。安全在庫の計算に入れるリードタイムをどこからどこまで数えるかは、本章の合成式の入力そのものであり、その実務的な扱いを補ってくれる1冊です。
『サプライチェーンサイエンス』(Wallace J. Hopp 著、松川弘明・佐藤知一 監訳、近代科学社):工場物理学の考え方でサプライチェーンの振る舞いの原理を説明する教科書で、第7章「在庫」がサイクル在庫、安全在庫、定期発注方式、随時発注方式、複数品目管理を扱います。本章の安全在庫の式を、ばらつきと緩衝の一般原理の中に位置づけて理解したい方に向いています。
第5章 発注方式の体系、いつ買うか
第3章では「いくつずつ買うか」を経済的発注量で決め、第4章では「どれだけ余分に持つか」を安全在庫とサービスレベルの関係で決めました。この2つが決まっても、発注の業務はまだ動きません。残っているのは「いつ買うか」、つまり在庫をいつ確認し、どの条件で発注を出すかという手順の設計です。本章はこの手順を発注方式と呼び、代表的な方式を体系として整理します。
発注方式の選び方は、在庫の水準そのものと同じくらい経営に効きます。在庫を毎日確認して発注する方式と、週に一度まとめて発注する方式とでは、同じサービスレベルを狙っても必要な安全在庫が変わり、発注の回数、つまり購買や検収の工数も変わります。本章では、定量発注方式、定期発注方式、発注点と補充点を組み合わせる方式、ベースストック方策、2ビン方式を、それぞれ「何を決めるか」「どんな情報が要るか」「安全在庫と発注費がどう違うか」の観点で並べ、第2章で用意したサンプルデータの定番品A001に同じ条件で当てはめて在庫の推移を比べます。方式の最適性の理論は第7章に、方策の本格的な評価は第12章に送ります。
発注方式を分ける2つの軸、いつ在庫を見るか、いくつ頼むか
発注方式は多くの名前で呼ばれますが、整理すると2つの軸に分解できます。1つ目は「在庫をいつ確認するか」です。取引のたびに在庫を把握して、条件を満たした瞬間に発注するのが連続監視で、週に一度、月に一度と決めた日にだけ在庫を見るのが定期監視です。2つ目は「発注量をどう決めるか」です。毎回同じ量を頼むのが固定量で、あらかじめ決めた水準まで補充するように毎回の量を変えるのが補充量です。JIS Z 8141(生産管理用語)は在庫管理の方式を「定量発注方式と定期発注方式に大別される」としており、これは前者が連続監視と固定量、後者が定期監視と補充量の組み合わせにあたります。
どの方式でも判断の基準になるのは、手元にある在庫ではなく在庫ポジションです。JIS Z 8141 は有効在庫を「手持在庫に加えて発注残及び引当済みの量(引当量)を考慮した、実質的に利用可能な在庫量」と定義し、手持在庫から引当量を引いて発注残を足す式で表しています。発注済みでまだ届いていない分を数えに入れないと、リードタイムの間に同じ品目を二重に発注してしまいます。逆に、受注済みで出荷待ちの分を数えに入れると、実際には使えない在庫を当てにして発注が遅れます。本章のシミュレーションでは引当を扱わないので、在庫ポジションは手持在庫と発注残の和です。
| 固定量を頼む | 決めた水準まで補充する | |
|---|---|---|
| 連続監視(取引のたびに在庫を見る) | 定量発注方式。発注点 s を割ったら Q を頼む。JIS の発注点方式、(s,Q) 方式 | 発注点補充点方式。s を割ったら補充点 S までの差を頼む。(s,S) 方式。S と s の差を1にした極端な形がベースストック方策 |
| 定期監視(決めた間隔 R でだけ在庫を見る) | 実務ではあまり使われない。固定量を定期に頼むと需要の変動を吸収できない | 定期発注方式。R ごとに基準在庫 S まで補充する。(R,S) 方式。発注点も併用するのが定期発注点補充点方式、(R,s,S) 方式 |
表の右上と左下が空欄に近いことからも分かるように、実務で使われる方式は「連続監視なら固定量か補充量」「定期監視なら補充量」の3つの組み合わせに集約され、そこに情報システムを使わない簡便法として2ビン方式が加わります。以下、この順に見ていきます。
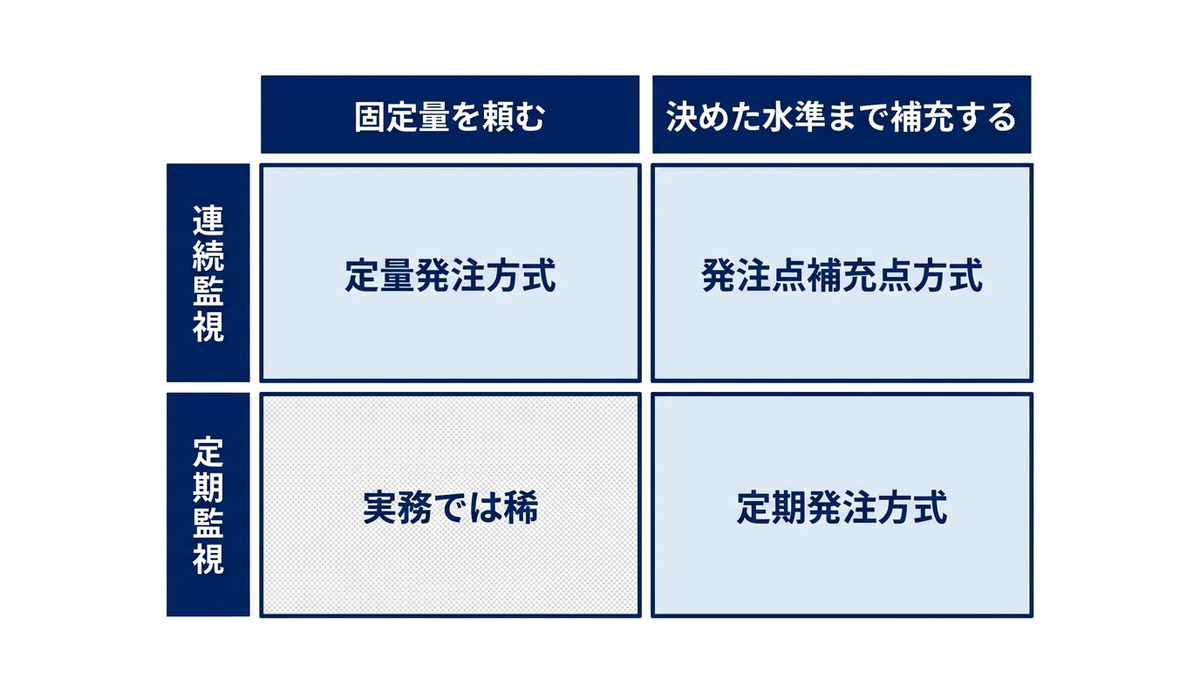
定量発注方式、発注点と発注量の2つの数で動かす
定量発注方式は、在庫ポジションがあらかじめ決めた発注点まで下がったときに、あらかじめ決めた一定量を発注する方式です。JIS Z 8141 は発注点方式を「在庫量があらかじめ定められた発注点よりも減少したとき、あらかじめ定められた量だけ発注する在庫管理方式」と定義し、発注点を s、発注量を Q として (s,Q) 方式とも呼ぶとしています。決める数は2つだけです。発注量 Q は第3章の経済的発注量から決め、発注点 s は第4章の式で決めます。JIS の発注点の定義は「調達期間中の推定需要量と安全在庫の和」であり、式で書けば \( s = \mu_L + z\sigma_L \) です。\( \mu_L \) はリードタイム中の需要の平均、\( \sigma_L \) はその標準偏差、z は狙うサービスレベルに対応する安全係数です。
この方式で在庫が欠品にさらされる期間、すなわち保護期間は、発注を出してから届くまでのリードタイム L だけです。発注点を割った瞬間に発注が出るので、次の入荷までに売れる分を発注点が受け持てばよく、安全在庫はリードタイム中の需要のばらつきに対してだけ持てば済みます。この「保護期間が短い」ことが、次に見る定期発注方式との最も大きな違いになります。
A001 で数字を入れてみます。日次需要は平均39.6個(3年分の日次実績の平均。年間需要14,474個を365日で割ると39.7個になり、表示の丸めで末尾が違います)、標準偏差9.73個、リードタイムは平均7日、標準偏差2日、原価1,200円です。第3章の費用パラメータ(発注費4,000円/回、保管費率は年20%なので保管費は240円/個/年)を使うと、年間需要は14,474個(3年分の合計を3で割った値で、第3章と同じ)、経済的発注量は694.6個なので Q は695個です。リードタイム中の需要は平均277.3個、需要とリードタイムの両方のばらつきを合成した標準偏差(第4章の式 \( \sigma_L = \sqrt{L\sigma_D^2 + \mu_D^2\sigma_{LT}^2} \) )は83.3個で、サイクルサービス率95%に対応する安全係数1.645を掛けた安全在庫は137.0個、発注点 s は414個になります。在庫ポジションが414個以下になった日の夕方に695個を発注する、というのがこの品目の定量発注方式です。
定量発注方式が必要とする情報は「在庫ポジションを常に把握できること」です。出庫のたびに在庫を引き落とす仕組み、つまり取引記録がそろっていないと発注点を割った瞬間が分かりません。販売時点情報管理や倉庫管理システムが入っている品目では自然に満たせますが、記録が月次の棚卸しにしか無い品目では成り立ちません。逆に言えば、この情報さえあれば発注のタイミングは機械的に決まるので、担当者の判断が要らず、品目数が多くても自動化しやすい方式です。
2ビン方式は、この情報要件を物理的な仕掛けで代替した簡便法です。JIS Z 8141 はダブルビン法を「同容量の在庫が入った二つのビン(箱、容器)を用意しておき、一方のビンが空になり、他方の在庫を使用しはじめたときに一つのビンの容量を発注する方法」と定義し、備考で「一つのビンの容量を発注点と発注量とする発注点方式の簡易版」であり、複棚法、二棚法、ツービン法とも呼ぶとしています。在庫の記録を取らなくても、箱が空になったという事実が発注点の到達を知らせてくれるので、ねじやラベルのような安価で数の多い品目に向きます。ただし2つのビンが同じ容量である以上、発注量は発注点と同じ量に縛られ、経済的発注量とは別の量になります。この制約がどう効くかは後の比較で数字として出ます。
定期発注方式、発注間隔と基準在庫で動かす
定期発注方式は、決めた間隔で在庫を確認し、そのたびに発注量を計算して発注する方式です。JIS Z 8141 の定義は「あらかじめ定めた発注間隔で、発注量を発注ごとに決めて発注する在庫管理方式」で、備考では発注量を、発注間隔と調達期間を足した期間の需要推定量から発注残と手持在庫量を引き、安全在庫量を足す式で示しています。決める数は発注間隔 R と、補充の目標になる基準在庫 S の2つです。基準在庫まで補充する形に書き直すと、発注量は S から在庫ポジションを引いた値であり、S は \( S = \mu_{R+L} + z\sigma_{R+L} \) で決まります。
ここで重要なのは、JIS の式が需要推定量の期間を発注間隔と調達期間の和にしているとおり、保護期間が R+L になることです。理由は発注の機会が R ごとにしか無いことにあります。ある発注日に出した注文は L 日後に届きますが、その次に発注できるのは R 日後で、その注文が届くのはさらに L 日後です。つまり、今日の発注は「次の発注が届くまで」、すなわち R+L 日先までの需要を受け持たなければなりません。発注日の直後に需要が急に増えても、次の発注日まで何もできないので、その分を基準在庫に含めておく必要があります。定量発注方式なら発注点を割った瞬間に反応できたのに対し、定期発注方式は反応が最大で R 日遅れる、と言い換えることもできます。
MIT OpenCourseWare の物流システムの講義資料は、定量発注方式の決め方をそのまま定期発注方式に流用する変換を示しています。発注点 s を基準在庫 S に、発注量 Q を1間隔分の需要 D×R に、保護期間 L を R+L に置き換えるという対応で、第4章までに決めた安全係数や損失関数の計算をそのまま使い回せます。A001 で発注間隔を第3章の費用パラメータにある7日にすると、保護期間は14日、その間の需要の平均は554.7個(丸める前の日次平均39.62個の14日分)、標準偏差は87.2個、安全在庫は143.4個、基準在庫 S は698個になります。7日ごとの発注日に、698個から在庫ポジションを引いた量を発注します。
保護期間が伸びると安全在庫がどれだけ増えるかを、A001 で発注間隔を変えて計算した結果が次の表です。右端の列は、比較のためにリードタイムのばらつきを0にして需要のばらつきだけで計算した値です。
| 保護期間 | 日数 | 需要の標準偏差(個) | 安全在庫(個、95%) | リードタイムのばらつきが0なら(個) |
|---|---|---|---|---|
| L(定量発注) | 7 | 83.3 | 137.0 | 42.3 |
| 1+L(毎日発注のベースストック) | 8 | 83.9 | 138.0 | 45.3 |
| R+L(定期発注、R=7) | 14 | 87.2 | 143.4 | 59.9 |
| R+L(定期発注、R=14) | 21 | 90.9 | 149.5 | 73.3 |
| R+L(定期発注、R=28) | 35 | 97.9 | 161.1 | 94.7 |
読み方に注意が要ります。右端の列では保護期間が7日から14日に倍になると安全在庫は42.3個から59.9個へ、およそ1.41倍(2の平方根)に増えています。これが「安全在庫は保護期間の平方根に比例する」という教科書どおりの動きです。ところが左の列では137.0個から143.4個へ、5%しか増えていません。A001 はリードタイムの標準偏差が2日あり、その2日間に売れる約80個分のばらつきが安全在庫の大半を占めているため、保護期間を伸ばしても需要のばらつきの寄与が相対的に小さいのです。この品目で定期発注方式の安全在庫が定量発注方式とあまり変わらないのは、方式の差が小さいからではなく、リードタイムのばらつきが両方に等しく効いているからです。リードタイムが安定している仕入先なら右端の列に近づき、方式の差がはっきり出ます。
発注間隔 R をどう決めるかは、理論と実務で答えが分かれます。理論の側では、経済的発注量を1回頼むごとの間隔 \( T^* = Q^*/D \) が目安になり、A001 では694.6個を1日あたりの需要(年間需要14,474個を365日で割った39.7個)で割った約17.5日です。実務の側では、仕入先の配送曜日、締め日、担当者の業務サイクルで R が先に決まっていることが多く、その場合は R を所与として S を計算します。どちらの場合も、R を短くすれば保護期間が縮んで安全在庫とサイクル在庫が減る一方で発注回数が増える、というトレードオフは同じで、これは後のシミュレーションで数字にして確かめます。
発注点補充点方式とベースストック方策、2つの方式のあいだにあるもの
定量発注方式で発注量を固定せず、発注点を割ったときに決めた水準まで補充する形にしたのが発注点補充点方式です。JIS Z 8141 は「在庫量があらかじめ定められた水準に減少したときに、補充点と現在の有効在庫との差を発注する(発注点)方式」と定義し、発注点を s、補充点を S として (s,S) 方式とも呼ぶとしています。MIT の講義資料はこれを Min-Max システムとも呼んでおり、在庫管理システムで「最小在庫」と「最大在庫」を設定する形の運用は、この方式にあたることが多いようです。需要が1個ずつ出る品目では、発注点を割った瞬間の在庫ポジションはほぼ s に等しく、S と s の差を Q に取れば定量発注方式と同じ動きになります。差が出るのは需要がまとまった量で出る品目で、発注点を大きく割り込んだ分だけ発注量が自動的に増えるため、次のサイクルの欠品を防ぎやすくなります。
この方式の S をどう決めるかには、素朴な方法と理論的な方法があります。素朴な方法は本章で使う S=s+Q で、定量発注方式のパラメータをそのまま流用します。理論的な方法は第7章の主題で、そこでは発注に固定費がかかる多期間の問題で (s,S) 方策が最適になる条件と、最適な s と S を動的計画で求める手順を扱います。本章では「定量発注方式の自然な拡張であり、ERP の Min-Max 設定はこの方式である」という位置づけにとどめます。定期監視と組み合わせた (R,s,S) 方式は、JIS では定期発注点補充点方式として、在庫調査間隔、発注点、最大在庫量(補充点)をあらかじめ定めておき、定期的な在庫調査の結果、有効在庫量が発注点を下回っている場合に、補充点と有効在庫量の差を発注する方式と定義されています。定期に在庫を見るが、減っていなければ発注しないという運用で、多くの方式を包含する一般形です。
ベースストック方策は、発注点補充点方式の s を S から1を引いた値にした極端な形で、需要があるたびに売れた分と同じ量を発注し、在庫ポジションを常に S に保ちます。MIT の供給連鎖の講座資料は「ベースストック方策は1対1の補充であり、4個売れたら4個発注する」と説明し、基準在庫 S を「リードタイム中の期待需要に、リードタイム中の予測誤差の二乗平均平方根に安全係数 k を掛けたものを足した値」としています。発注に固定費がかからない、または固定費に比べて品目の価値がきわめて高い場合に向く方式で、修理部品や高額な医療材料、後の第10章で扱う多段階在庫の各段の方策としてよく使われます。日次で在庫を見る運用では、毎日 S まで補充する定期発注方式(R=1)と同じ動きになり、保護期間は 1+L です。A001 では保護期間8日の需要の平均316.9個に安全在庫138.0個を足した455個が S になります。
ベースストック方策の弱点は発注回数です。需要があるたびに発注するので、A001 のように毎日需要がある品目では毎日発注になり、発注1回あたりの固定費が少しでもあれば費用が跳ね上がります。逆に、需要が月に数回しか無い間欠需要品では発注回数も自然に少なくなるので、C001 のような品目には合理的な選択になり得ます。この違いも次の比較で数字にします。
5つの方式の比較、情報要件と発注費と安全在庫
ここまでの方式を、決めるパラメータ、在庫を見るタイミング、保護期間、必要な情報、発注回数の傾向で並べたのが次の表です。安全在庫の列は「同じサービスレベルを狙ったときの相対的な傾向」であり、絶対量は品目のばらつきの構造で変わります。
| 方式 | 決めるもの | 在庫を見る時期と発注量 | 保護期間 | 必要な情報 | 発注回数と発注費 | 安全在庫の傾向 | 別名、向く場面 |
|---|---|---|---|---|---|---|---|
定量発注方式 (s,Q) | 発注点 s、発注量 Q | 常時。s を割ったら固定量 Q | L | 取引ごとの在庫ポジション | Q で決まる。Q を経済的発注量にすれば発注費と保管費の釣り合いが取れる | 最も少ない部類。保護期間が L だけ | 発注点方式。取引記録がある定番品 |
| 2ビン方式 | ビンの容量(発注点と発注量を兼ねる) | ビンが空になった時点。固定量 | L | 不要。箱が空になったという現物の事実だけ | ビン容量で決まる。経済的発注量とは一致しない | 定量発注方式と同じ理屈だが、ビン容量に縛られる | ダブルビン法。安価で数の多い消耗品や部品 |
定期発注方式 (R,S) | 発注間隔 R、基準在庫 S | R ごと。S までの差を発注 | R+L | 発注日の在庫ポジションだけ | R で決まる。1年の日数を R で割った回数 | 多い部類。保護期間に R が上乗せされる | 補充サイクル方式。仕入先ごとにまとめて頼む品目、棚卸しが定期の品目 |
発注点補充点方式 (s,S) | 発注点 s、補充点 S | 常時。s を割ったら S までの差 | L | 取引ごとの在庫ポジション | おおむね S と s の差で決まる | 定量発注方式と同程度。まとまった需要に強い | Min-Max。ERP の最小在庫と最大在庫の設定 |
| ベースストック方策 | 基準在庫 S | 需要のたび。売れた分を発注 | 1+L(日次なら) | 取引ごとの在庫ポジション | 需要の発生回数と同じ。固定費があると最も高い | 少ない。ただし固定費を無視した前提 | 1対1補充。固定費が無視できる高額品、修理部品、多段階の各段 |
安全在庫の列について、一般には「連続監視のほうが同じサービスレベルを少ない安全在庫で達成できる」とされ、MIT の講義資料も連続監視の利点としてこの点を挙げています。保護期間が L と R+L で違うのですから、需要のばらつきだけを見ればこれは自明です。ただし、この結論には条件が付きます。日本経営工学会誌に1975年に載った村松林太郎らの研究は、両方式に同じ品切率を与えたときの安全在庫の水準を比較し、予測誤差の水準が小さい場合には定期発注方式のほうが、大きい場合には定量発注方式のほうが安全在庫を低く抑えられ、その切り替え点が納入リードタイムと需要の変動係数の関係で表せると結論づけています。定期発注方式は発注のたびに需要予測を更新して発注量に反映できるため、予測が当たる品目ではその分が効く、という理屈だと弊社は理解しています。「定量発注のほうが安全在庫が少ない」を無条件の法則として覚えるのではなく、自社の品目のリードタイムのばらつきと予測精度で確かめる必要があります。
もう1つ、表の「必要な情報」の列は、方式を選ぶときに最初に見るべき列です。取引ごとの在庫ポジションが取れない品目に定量発注方式を設定しても、発注点を割った瞬間が分からないので運用は定期発注方式に退化します。逆に、取引記録が整っている品目にわざわざ月1回の定期発注を当てるのは、R+L の保護期間分の安全在庫を余計に持つことになります。情報の整備状況が方式を決め、方式が安全在庫を決める、という順序です。
同じ需要系列に5つの方式を当てて在庫の推移を比べる
方式の違いを言葉で並べるだけでは、どれがどれだけ違うのかが分かりません。そこで A001 の3年分の日次需要(1,096日)に、ここまでで決めたパラメータを使って5つの方式を当て、在庫の推移と年あたりの費用を比べます。シミュレーションは離散イベントの道具を使わず、1日を1ステップとする素朴なループで書きました。方式の本格的な評価(乱数のばらつき、反復回数、パラメータの格子探索)は第12章の主題なので、ここでは「同じ需要に同じ条件で当てたときの差」を見ることに絞ります。
条件は次のとおりです。欠品した分は失注として数え、バックオーダーにはしません。発注は日末に判断し、発注から L 日後の日末に入荷して翌日から使えるようにしたので、発注後 L 日分の需要にさらされる、つまり保護期間が L になる設定です。リードタイムは第2章の sample_lead_times で乱数列を1本作り、k 回目の発注にはどの方式でも同じ k 番目の値を使いました。方式ごとにリードタイムの引きが違うと比較が不公平になるためです。安全係数はサイクルサービス率95%に対応する1.645で統一し、発注点補充点方式の S は s+Q の1,109個、2ビン方式のビン容量は発注点と同じ414個にしました。次のコードは、そのループの要点を抜き出したものです(全体は ch05_policies.py)。
import numpy as np
from inv_data import load_demand, sample_lead_times

dem = load_demand()["A001"].values                        # 1,096 日の日次需要
lt = sample_lead_times(np.random.default_rng(0), "A001", 5000)  # 全方式で共通の列

def simulate(policy, s=414, Q=695, R=7, S=698, start=698):
    on_hand, pipeline, k, lost, hist = start, [], 0, 0.0, []
    for t in range(len(dem)):
        sold = min(dem[t], on_hand)                       # 欠品分は失注
        lost += dem[t] - sold
        on_hand -= sold
        on_hand += sum(q for (a, q) in pipeline if a == t)   # 日末に入荷
        pipeline = [(a, q) for (a, q) in pipeline if a != t]
        ip = on_hand + sum(q for (_, q) in pipeline)      # 在庫ポジション
        qty = 0
        if policy == "sQ":
            qty = Q if ip <= s else 0                     # 定量発注
        elif policy == "RS":
            qty = max(0, S - ip) if t % R == 0 else 0     # 定期発注
        elif policy == "sS":
            qty = S - ip if ip <= s else 0                # 発注点補充点
        elif policy == "BS":
            qty = max(0, S - ip)                          # ベースストック
        if qty > 0:
            pipeline.append((t + int(lt[k]), qty)); k += 1
        hist.append(on_hand)
    return k / (len(dem) / 365), np.mean(hist), lost      # 発注回数/年、平均在庫、失注

print(simulate("sQ", start=414 + 695))   # 初期在庫は s+Q。表の定量発注の行と同じ条件
# 出力: (20.6478102189781, np.float64(477.9653284671533), np.float64(151.0))
# つまり定量発注 (s,Q) は 20.6 回/年、平均在庫 478.0 個、失注 151 個(3年計)
最初の180日の在庫推移を4つの方式で並べたのが次の図です。実線が手持在庫、破線が在庫ポジション、三角が発注のタイミングです。
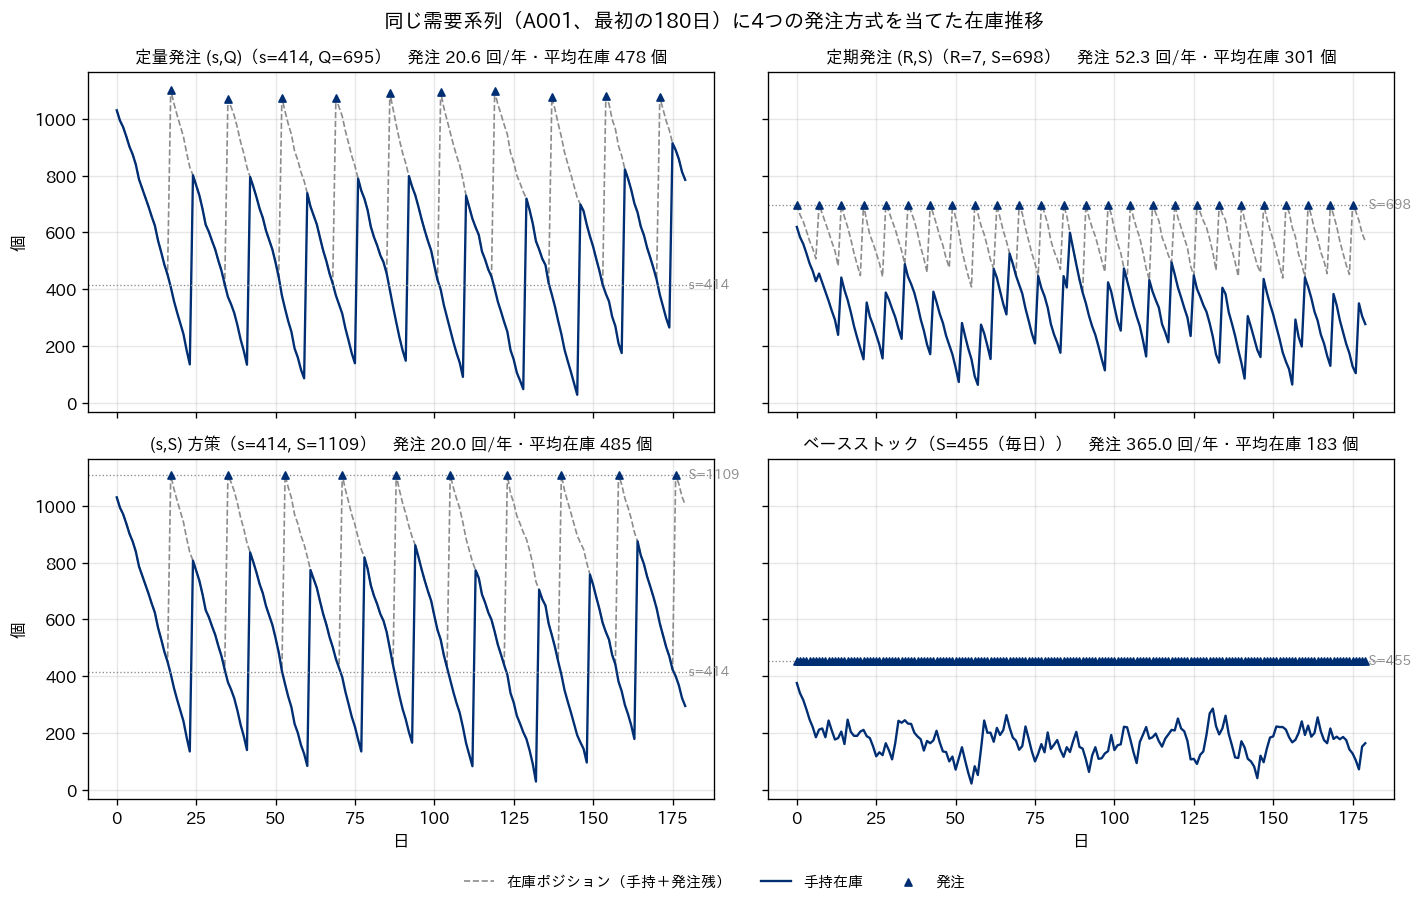
図の形が方式の性格をそのまま表しています。左上の定量発注方式は、在庫ポジションが発注点414個以下になるたびに695個を頼むので、のこぎりの歯のような大きな山と谷を約17日周期で繰り返します。右上の定期発注方式は、7日ごとに698個まで補充するので山が低く周期が短く、手持在庫はおおむね100個から500個の帯に収まります。左下の発注点補充点方式は定量発注方式とほぼ同じ形で、発注量が毎回わずかに違う(平均717個)ところだけが異なります。右下のベースストック方策は毎日売れた分を頼むので、手持在庫は200個前後で平らに推移し、発注の三角が毎日並びます。3年間の集計は次の表のとおりです。
| 方式 | パラメータ | 発注回数(回/年) | 平均発注量(個) | 平均手持在庫(個) | 在庫金額(円、原価) | 失注(個、3年計) | 欠品が起きた入荷区間(入荷で区切った回数) | 発注費(円/年) | 保管費(円/年) | 欠品費(円/年) | 総費用(円/年) |
|---|---|---|---|---|---|---|---|---|---|---|---|
定量発注 (s,Q) | s=414、Q=695 | 20.6 | 695 | 478.0 | 573,558 | 151 | 61回中4回 | 82,591 | 114,712 | 30,172 | 227,475 |
定期発注 (R,S) | R=7、S=698 | 52.3 | 276 | 300.6 | 360,685 | 3 | 154回中2回 | 209,142 | 72,137 | 599 | 281,879 |
発注点補充点 (s,S) | s=414、S=1,109 | 20.0 | 717 | 485.5 | 582,586 | 234 | 59回中7回 | 79,927 | 116,517 | 46,757 | 243,201 |
| ベースストック | S=455、毎日 | 365.0 | 40 | 182.8 | 219,314 | 82 | 713回中3回 | 1,460,000 | 43,863 | 16,385 | 1,520,248 |
| 2ビン | ビン容量414個×2 | 34.6 | 414 | 344.3 | 413,176 | 330 | 103回中10回 | 138,540 | 82,635 | 65,940 | 287,115 |
表からいくつかのことが読み取れます。第一に、平均手持在庫の差はほぼサイクル在庫の差です。定量発注方式の平均在庫478個は、発注量の半分348個に安全在庫137個を足した485個とほぼ一致し、定期発注方式の301個は、1間隔分の需要の半分139個に安全在庫143個を足した282個に近い値です。方式で在庫金額が21万円ほど違うのは、安全在庫の差(6個)ではなく、1回に頼む量の差から来ています。第二に、その代わりに定期発注方式は発注回数が2.5倍になり、発注費が12.7万円増えて総費用では定量発注方式に負けています。A001 の経済的発注量に対応する間隔が約17.5日なのに対し、7日という間隔は短すぎるからです。第三に、欠品が起きたサイクルの割合は、定量発注方式で61回中4回(約7%)、発注点補充点方式で59回中7回(約12%)と、狙った5%より多めに出ています。需要の分布を正規分布で近似したこと、リードタイムを整数に丸めたこと、そして3年という短さで割合の推定自体がぶれること(発注量を1個変えただけで欠品の回数が動く程度のぶれです)が理由で、この「式で決めた値と実際の差」を測るのが第12章の仕事です。第四に、2ビン方式は発注量がビン容量414個に縛られて経済的発注量より小さいため、発注回数が増え、サイクル数が増えたぶん欠品にさらされる回数も増えて、失注が330個と最も多くなりました。同じ発注点でも、1年に何回発注点を通過するかで欠品の回数が変わる、という構造です。
発注回数と在庫金額の関係を1枚にまとめたのが次の図です。横軸は対数目盛にしてあります。
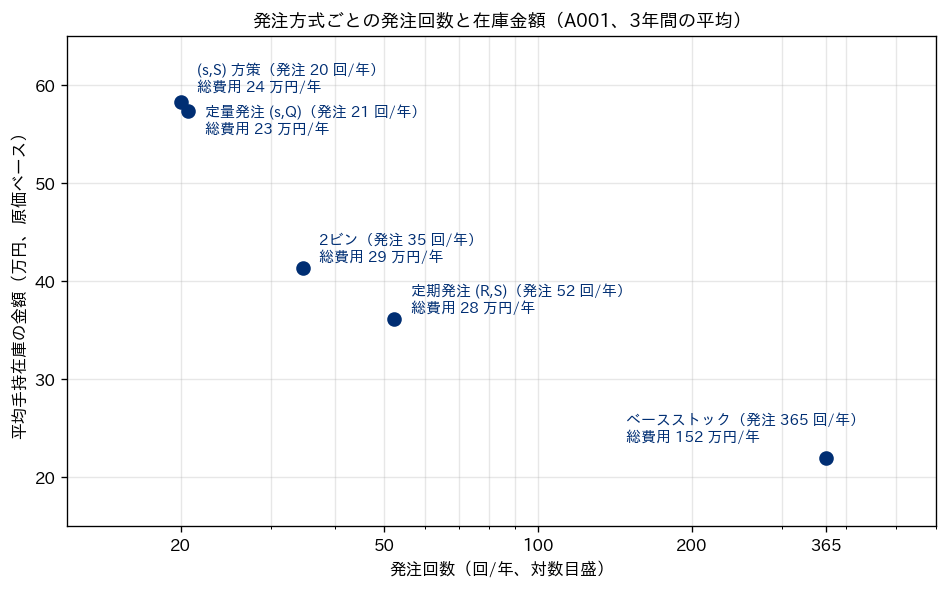
点は左上から右下へ並び、発注回数を増やすほど在庫金額が下がるという、第3章で見た発注費と保管費のトレードオフがそのまま現れています。ただし総費用は単調ではなく、両端で高くなります。ベースストック方策は在庫金額を22万円まで下げましたが、毎日4,000円の発注費を払うので総費用が年152万円と桁違いになり、この品目には合いません。逆に、定期発注方式の間隔を伸ばしていくとどうなるかを、R を変えて S を計算し直したのが次の表です。
| 発注間隔 R(日) | 基準在庫 S(個) | 発注回数(回/年) | 平均手持在庫(個) | 在庫金額(円) | フィルレート | 総費用(円/年) |
|---|---|---|---|---|---|---|
| 1 | 455 | 365.0 | 182.8 | 219,314 | 0.9981 | 1,520,248 |
| 3 | 536 | 121.9 | 221.7 | 265,993 | 0.9941 | 591,707 |
| 7 | 698 | 52.3 | 300.6 | 360,685 | 0.9999 | 281,879 |
| 14 | 982 | 26.3 | 440.6 | 528,768 | 0.9976 | 231,572 |
| 28 | 1,548 | 13.3 | 746.1 | 895,284 | 1.0000 | 232,342 |
総費用は R=14 の23.2万円で底を打ち、R=28 でもほぼ同じで、経済的発注量から導いた約17.5日の間隔と整合しています。一方で在庫金額は R に比例して増え続け、R=28 では90万円近くになります。総費用がほぼ同じ R=14 と R=28 でも、運転資金として寝る金額は37万円違います。費用の式に資本コストを年20%の保管費率として織り込んでいるので理屈の上では総費用に反映済みですが、資金繰りを重視する局面では、総費用が同じなら在庫金額の少ない短い間隔を選ぶ、という判断が加わります。
どの品目にどの方式か、ABC 分析と組み合わせる
方式は品目ごとに選ぶものであり、全品目を1つの方式に揃える必要はありません。むしろ、品目の重要度に応じて方式の手間を変えるのが定石です。JIS Z 8141 は ABC 分析を「多くの在庫品目を取り扱うときそれを品目の取り扱い金額又は量の大きい順に並べて、A、B、Cの3種類に区分し、管理の重点を決めるのに用いる分析」と定義しており、第2章で見たサンプルデータでは、年間消費金額の上位18品目で全体の80%、34品目で95%を占めていました。MIT の講義資料は「厳密な規則は無いが目安はある」と断ったうえで、A品目には (s,S) または (R,s,S)、B品目には (s,Q) または (R,S)、C品目には手作業に近い (R,S) を挙げています。同じ資料は A品目を「数は少ないが影響が大きく、最も経営の注意と見直しを要し、多くの例外が出る」、B品目を「例外管理つきの自動制御」、C品目を「制御の仕組みはできるだけ単純にし、管理の時間と注意の浪費を減らす」と性格づけています。
この目安を、本章の比較表と結びつけて整理すると次のようになります。A品目は在庫金額が大きいので、安全在庫を最小にできる連続監視と、まとまった需要にも対応できる補充点の組み合わせが合います。取引ごとの在庫記録を整える投資も、在庫金額の削減額で回収しやすい品目です。B品目は数が多いので、方式は自動で回る定量発注方式か定期発注方式にし、パラメータの更新だけを定期に行います。C品目は金額が小さいので、安全在庫を多めに持つ損失より、発注の手間を減らす利益のほうが大きく、2ビン方式や長い間隔の定期発注、あるいは仕入先に補充を任せる形が合理的です。C品目に「精緻な方式」を当てるのは、在庫金額の削減効果が小さいのに発注業務の手間だけが増える典型的な失敗です。
| 区分 | 品目の性格 | 合う方式 | 理由 | 先に整えるもの |
|---|---|---|---|---|
| A品目(金額の上位、品目数は少ない) | 在庫金額が大きく、欠品の損失も大きい | 発注点補充点方式 (s,S)。定期にしか在庫を見られないなら (R,s,S) | 保護期間を L に抑えて安全在庫を最小にし、まとまった需要にも対応する | 取引ごとの在庫記録、リードタイムの実績 |
| B品目(中間) | 数が多く、1品目あたりの金額は中程度 | 定量発注方式 (s,Q)、または仕入先単位でまとめる定期発注方式 (R,S) | 自動で回し、例外だけ人が見る | パラメータの定期更新の仕組み |
| C品目(金額の下位、品目数は多い) | 安価で数が多い。欠品しても代替が利きやすい | 2ビン方式、長い間隔の定期発注、仕入先への委託 | 在庫を多めに持つ費用より発注の手間を減らす利益が大きい | ビンや棚の物理的な仕掛け |
ABC は金額の軸だけの区分なので、需要の型の軸を足す必要があります。第2章の XYZ 分析で需要が安定している X 品目は本章の方式がそのまま使えますが、ばらつきが大きい Z 品目や、C001 のような間欠需要品は、正規分布を前提にした発注点や基準在庫の式が当てにならず、第8章で扱う間欠需要の予測と組み合わせるか、需要の発生に合わせて1対1で補充するベースストック方策に寄せることになります。B001 のような季節品は、基準在庫 S を季節ごとに引き直す運用が要り、固定した s と Q のままでは夏に欠品し冬に過剰になります。方式の選択は「金額の区分で手間の水準を決め、需要の型でパラメータの決め方を変える」という2段階で考えると整理しやすいと思います。
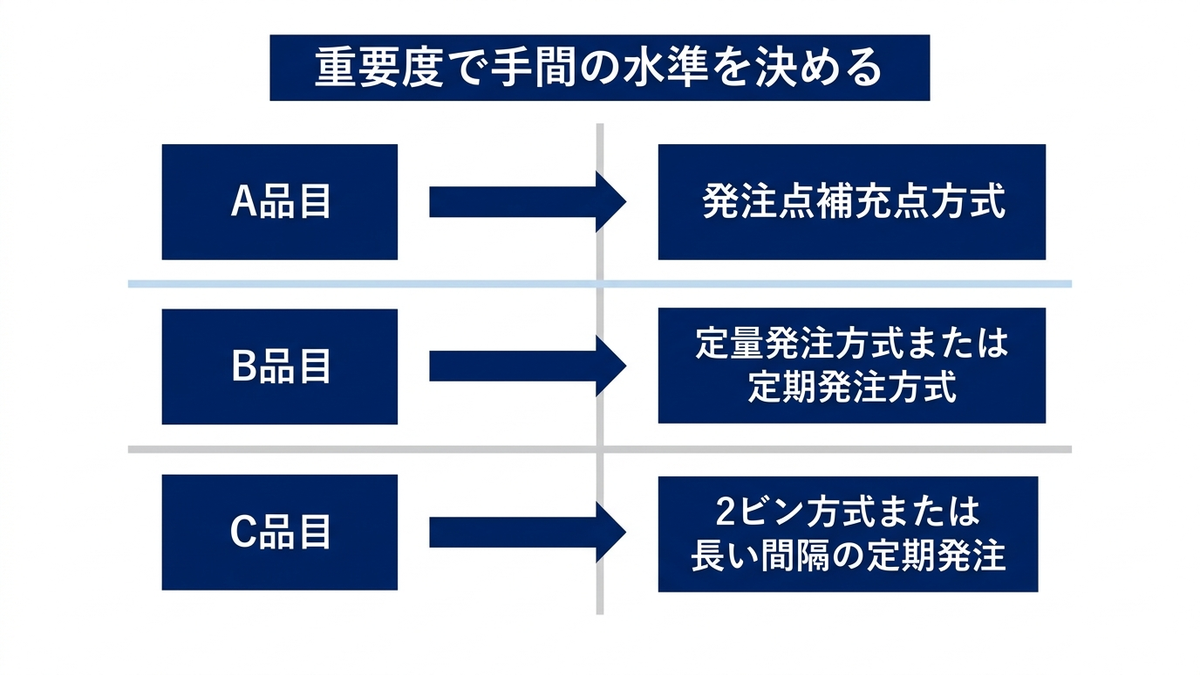
実務の運用ルール、発注単位と最小発注量と発注日の固定
式で決めた s、Q、R、S は、そのままでは発注書に書けないことがあります。仕入先との取り決めや物流の都合で、発注量や発注日に制約が付くからです。代表的な制約と、それを方式のどのパラメータに反映するかを整理します。
発注単位はケース、パレット、コンテナといった荷姿の単位で、発注量はこの整数倍に丸めます。A001 の Q は695個ですが、1ケース50個なら700個(14ケース)に切り上げる、というように扱います。第3章で見たとおり、経済的発注量の総費用曲線は最適点の近くで平らなので、多少の丸めで総費用はほとんど変わりません。最小発注量は仕入先が受け付ける下限で、Q がこれを下回るときは最小発注量を Q にします。この場合、発注1回あたりの量が経済的発注量より大きくなるので、サイクル在庫が増え、発注回数が減ります。最小発注量が経済的発注量の何倍にもなる品目では、その仕入先から買うこと自体の妥当性、あるいは複数品目をまとめて最小発注量を満たす運用(第3章の複数品目の共通制約、第10章の共同補充に関係します)を検討する場面です。
発注日の固定は、実務で最も多い制約です。仕入先が週に1回しか配送しない、社内の発注承認が毎週月曜にまとめて行われる、といった事情があると、在庫ポジションが発注点を割った瞬間に発注する定量発注方式は成り立たず、実質的に定期発注方式になります。この場合は R を配送や承認の周期に合わせ、基準在庫 S を R+L の保護期間で計算し直します。ここを見落として、定量発注方式の発注点(保護期間 L)のまま週1回の発注日運用にすると、発注日から発注日までの R 日分の需要を受け持つ在庫が無く、欠品が周期的に起きます。逆に、発注日が固定されているのに発注点も併用したい場合は、JIS の定期発注点補充点方式 (R,s,S) にして、発注日に在庫ポジションが s を上回っていれば発注を見送る、という形にすると発注回数を抑えられます。
複数品目を同じ仕入先から買っている場合、品目ごとに発注日がばらばらだと配送の回数と送料が増えます。同じ仕入先の品目は R を揃えて定期発注方式にまとめる、あるいは A品目の発注点到達をきっかけにして同じ仕入先の他の品目も一緒に補充点まで頼む、といった運用が取られます。後者は発注費の一部が品目ではなく発注書の単位で発生する場合に効き、これも第10章の共同補充で扱う考え方の実務版です。
| 実務の制約 | 反映するパラメータ | 反映の仕方 | 在庫と費用への影響 |
|---|---|---|---|
| 発注単位(ケース、パレット) | Q または S | 単位の整数倍に切り上げる | サイクル在庫が少し増える。総費用への影響は小さい |
| 最小発注量 | Q | Q が下限を下回れば下限に置き換える | サイクル在庫が増え、発注回数が減る。下限が大きすぎれば仕入先や品目のまとめ方を見直す |
| 発注日の固定、配送曜日 | R、S | 定期発注方式として扱い、S を R+L で計算し直す | 安全在庫が R の分だけ増える。発注点のまま運用すると周期的に欠品する |
| 同一仕入先の複数品目 | R | 品目間で R を揃える、または一方の発注をきっかけに他方も補充する | 配送回数と送料が減る。品目単位の発注費の前提が変わる |
| 取引記録が無い品目 | 方式そのもの | 定期発注方式か2ビン方式にする | 連続監視の方式を設定しても機能しない |
最後に、これらのパラメータは決めたら終わりではありません。需要の平均やばらつき、リードタイムは変わるので、s や S は定期的に計算し直す必要があります。更新の頻度と仕組み、品目数が多いときの自動化は第13章で扱います。本章の範囲で言えるのは、方式の選択(連続か定期か、固定量か補充量か)は年に一度見直せば十分なことが多い一方で、パラメータの値は月次程度で見直す品目が多い、ということです。
経営から見た方式の選択、発注業務の工数と在庫金額のどちらを取るか
方式の選択を経営の言葉に翻訳すると、「発注業務の工数」と「在庫に寝る運転資金」の配分の問題です。発注回数は購買担当の起票、承認、仕入先とのやり取り、入荷検収、支払処理の回数そのもので、本章の費用パラメータではこれを発注1回4,000円と置いています。A001 の1品目だけで見ても、定量発注方式なら年20.6回、7日ごとの定期発注方式なら52.3回、ベースストック方策なら365回と、同じ品目の発注業務量が18倍の幅で変わります。在庫金額のほうは、定量発注方式で57万円、定期発注方式で36万円、ベースストック方策で22万円と、こちらは逆向きに動きます。品目数が数百、数千になれば、この差は担当者の人数と運転資金の桁に直結します。
この配分を動かすレバーは発注費です。第3章の経済的発注量の式で見たとおり、発注費が下がれば最適な発注量は小さくなり、発注間隔は短くなり、サイクル在庫は減ります。発注業務を電子データ交換や自動発注で省力化することは、発注費を下げることによって「在庫金額を減らしても発注工数が増えない」状態を作る投資であり、その効果は在庫金額の削減額として測れます。逆に、発注のたびに承認が何段も要る組織では発注費が事実上高く、経済的発注量は大きく、在庫は多くなります。在庫が多い原因を現場の発注担当に求める前に、発注1回にどれだけの社内工数がかかっているかを見ると、方式やパラメータより先に直すべきものが見つかることがあります。
方式の選択を誤ったときの損失の型も、この2つの軸で整理できます。連続監視ができる品目に長い間隔の定期発注を当てれば、R+L の保護期間分の安全在庫と R 分のサイクル在庫が余計に寝ます。取引記録の無い品目に定量発注方式を設定すれば、発注点を割ったことに誰も気づかず欠品します。C品目に手間のかかる方式を当てれば、在庫金額の削減効果が小さいのに発注業務だけが膨らみます。発注日が固定されているのに発注点を L の保護期間で決めれば、周期的な欠品で売上を失います。どの損失も、方式と品目の情報要件、方式と実務の制約の不一致から生じており、パラメータの精度を上げるだけでは直りません。
本章の要点は3つです。発注方式は「在庫をいつ見るか」と「いくつ頼むか」の2軸で整理でき、実務で使うのは定量発注、定期発注、発注点補充点の3方式に、簡便法の2ビンと固定費が無いときのベースストックを加えたものです。方式の違いは保護期間の違いであり、定期発注方式は保護期間が R+L になるぶん安全在庫が増える一方で、発注をまとめられ、発注日の業務量を予測できます。そして方式は品目ごとに、金額の区分で手間の水準を、需要の型でパラメータの決め方を変えて選びます。ここまでは「繰り返し補充する品目」を前提にしてきましたが、生鮮品や、販売期間の前にまとめて仕入れる季節品のように一度しか発注の機会が無い品目では、発注点も基準在庫も意味を持ちません。次の第6章では、その単期の問題を扱うニューズベンダーモデルで、過小と過大の費用の釣り合いから最適な発注量を決める考え方を見ます。
この章を深めたい方への参考書籍
『インベントリー・マネジメント:新しい在庫の考え方と発注方式の設計』(星野珙二、日経BP企画):書名のとおり、在庫の考え方と発注方式の設計を主題にした本です。本章で並べた定量発注方式や定期発注方式を、品目の条件に合わせてどう組み立てるかを設計の問題として考える際に、本章の比較表と ABC の対応表を実務に落とす手がかりになります。
『売上を伸ばす適正在庫の定め方・活かし方』(勝呂隆男、日刊工業新聞社):適正在庫の水準を定める考え方と、それを売上につなげる運用を扱った実務書です。本章で扱った発注点や基準在庫は「適正在庫」を式で表したものにあたり、実務の制約の中でそれをどう決めて活かすかを、経営に近い言葉で読み直すことができます。
第6章 ニューズベンダー問題、一度しか買えないときの最適量
第5章では、定量発注・定期発注・(s,S)・ベースストックといった発注方式を比べました。いずれも「売れ残った在庫は次の期に持ち越し、また発注する」という繰り返しを前提にした方式です。ところが、季節品・生鮮品・イベント向けの商品・限定生産品のように、販売の機会が一度しかなく、売れ残りを次に持ち越せない商品があります。この章は、そうした一度しか買えない状況で「いくつ仕入れるか」を決めるニューズベンダー問題を扱います。朝に仕入れた新聞は夕方には価値がなくなり、足りなければ売り逃し、余れば古紙になる、という新聞売りの状況が名前の由来です。
ニューズベンダー問題は在庫理論の中で最も単純な確率モデルの一つですが、答えの形は実務の直感と食い違うことが多く、ここを押さえておくと後の章の理解が楽になります。この章では、まず問題の設定と費用の見方を整理し、臨界比という一つの比率で最適発注量が決まることを導きます。次に、需要が正規分布に従う場合と、ポアソン分布のような離散分布に従う場合の解き方を、第2章で用意したサンプルデータの季節品 B001 と間欠需要品 C001 で計算します。そのうえで、粗利率と最適サービス率の関係、需要分布の推定を誤ったときの損失、過去の販売実績から直接発注量を決めるデータ駆動の方法、そして「欠品ゼロ」を目標にしたときに経営が払う代償を、金額で確かめます。売れ残りを翌期に持ち越せる多期間の問題は第7章に送ります。
一度しか買えない、という問題の形
ニューズベンダー問題の設定は次のとおりです。販売期間が始まる前に、発注量 Q を一度だけ決めます。期間中の需要 D は発注の時点では分からず、確率分布としてだけ把握できます。期間が終わったとき、需要が発注量を上回っていれば、その差は売り逃しになります。需要が発注量を下回っていれば、残った分は定価では売れず、値引き処分か廃棄になります。追加の発注は間に合わないか、間に合っても割高で、売れ残りは次の販売機会に回せない、というのが前提です。決めるものは発注量 Q だけで、発注の時期は商品の性質で決まっています。
この形に当てはまる商品は多くあります。季節品は、シーズン前に生産や輸入をまとめて手配し、シーズンが終わると見切り販売になります。生鮮品や日配品は、毎朝の仕入れが一日限りの販売機会で、閉店時に残った分は廃棄か値引きです。イベント向けの商品、例えば展示会での物販や興行のグッズは、当日の来場者数が需要で、終われば同じ物は売れません。限定生産品や書籍の初版のように、一度の生産ロットで販売を終える商品もあります。医療機関の看護師の人員配置のように、モノではなく供給能力を先に決める問題も、数学的には同じ形で扱われます。
第3章の経済的発注量や第4章の安全在庫の式が、この状況にそのまま使えないのは、費用の構造が違うためです。経済的発注量は、発注を繰り返す中で発注費と保管費のつり合いを取る式であり、安全在庫は、繰り返しの中で欠品の起きる頻度を抑える式でした。一度しか買えない問題では、発注費の分割も、翌期への持ち越しもありません。代わりに、1個余ったときの損と、1個足りなかったときの損が、そのまま利益を左右します。この2つの損失の比率だけで答えが決まる、というのがこの問題の核心です。
過小費用と過大費用、臨界比
1個足りなかったときの損失を過小費用、1個余ったときの損失を過大費用と呼びます。過小費用は、仕入れていれば得られたはずの粗利です。売価を p、原価を c とすれば、1個あたり p から c を引いた額になります。欠品によって顧客の信用を失う影響を金額に見積もれるなら、それも足します。過大費用は、売れ残った1個の処分で失う額です。処分価格を v とすれば、原価 c から v を引いた額で、廃棄なら v はゼロ、処分に費用がかかるなら v は負の値になります。
サンプルデータの季節品 B001 で数字を置きます。原価は SKU マスタどおり3,500円です。売価と処分価格はこの章の架空の設定として、売価6,000円、シーズン後の見切り価格1,500円とします。すると過小費用は6,000円から3,500円を引いた2,500円、過大費用は3,500円から1,500円を引いた2,000円です。この費用はすべて架空であり、業種によって桁が違うことは第3章で述べたとおりです。
発注量を1個増やすかどうかを考えると、最適な発注量の条件が見えてきます。発注量を Q から Q+1 に増やしたとき、需要が Q を超えていれば、増やした1個は売れて過小費用ぶんの損失を防ぎます。需要が Q 以下なら、増やした1個は余って過大費用ぶんの損失を生みます。需要が Q 以下になる確率を \( F(Q) \) と書けば、1個増やす期待の得は、超える確率 \( 1 – F(Q) \) に過小費用を掛けた額、期待の損は \( F(Q) \) に過大費用を掛けた額です。得が損を上回る間は増やし続けるのがよく、両者が等しくなるところで止めるのが最適です。等しくなる条件を整理すると、需要が発注量以下に収まる確率 \( F(Q) \) が、過小費用を過小費用と過大費用の和で割った比率に一致する、という形になります。
この比率を臨界比と呼びます。式で書けば \( CR = \frac{C_u}{C_u + C_o} \) で、\( C_u \) が過小費用、\( C_o \) が過大費用です。B001 の例では、2,500を2,500と2,000の和である4,500で割って0.5556です。最適な発注量は、需要がその量以下に収まる確率が臨界比に等しくなる量(離散分布では初めて臨界比以上になる量)、つまり需要分布の臨界比の分位点です。需要が発注量以下に収まる確率は、第4章の用語でいえばサイクルサービス率にあたります。ニューズベンダー問題では、サービス率を先に決めるのではなく、費用の比率からサービス率が決まる、という順序になります。
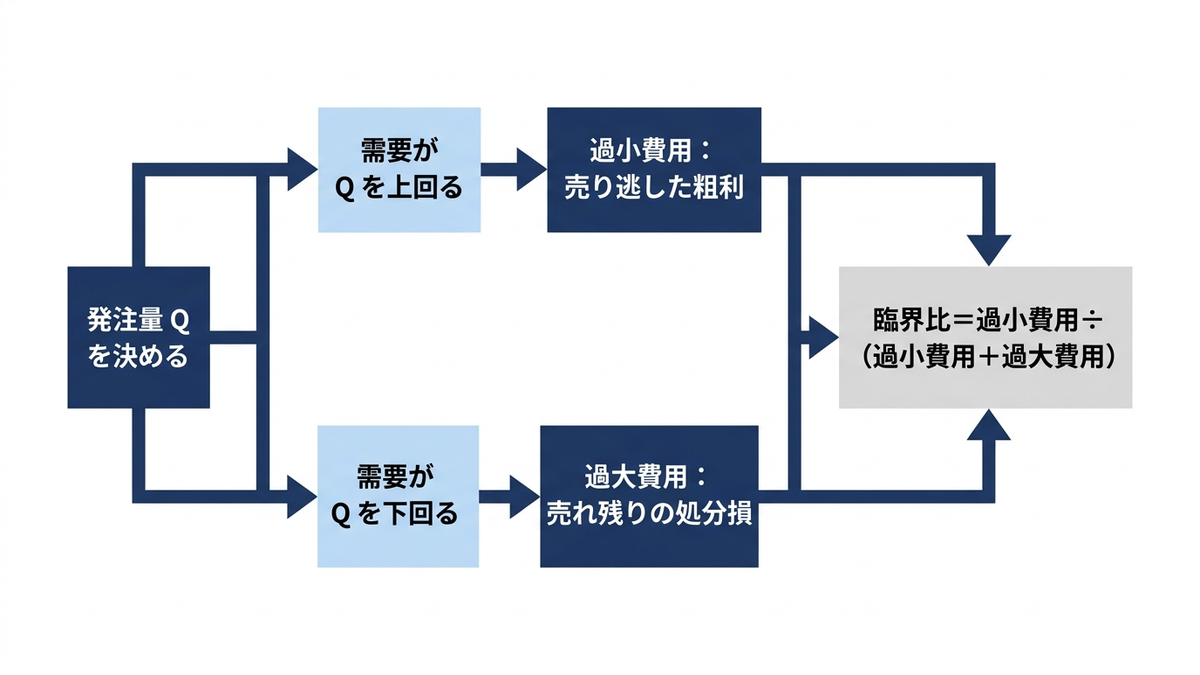
在庫方策の最適化を題に掲げた初期の論文として、1951年に Arrow、Harris、Marschak が Econometrica に発表した「Optimal Inventory Policy」があります。式は単純ですが、需要の確率分布を使って費用の期待値を最小にするという考え方は、第4章までの「サービス率を先に決める」流儀とは出発点が違います。
正規分布での解、最適発注量の導出
需要が平均 \( \mu \)、標準偏差 \( \sigma \) の正規分布に従うなら、最適発注量は \( Q^* = \mu + z\sigma \) で、z は標準正規分布の臨界比の分位点です。第4章の安全係数と同じ形ですが、z を決めるのがサービス率の目標ではなく臨界比である点が違います。scipy では norm.ppf(CR) で z が求まります。ppf は累積分布関数の逆関数で、文書には「Percent point function」と書かれています。
B001 のシーズンを6月から8月の92日間とすると、サンプルデータの3シーズンの合計需要は3,793個・3,427個・3,555個で、平均3,592個、標準偏差186個でした。ただし、この標準偏差をそのまま使うのは適切ではないと考えています。3シーズンしか観測がないうえ、このサンプルデータは日ごとの乱数のばらつきだけで作られており、天候や流行といった年ごとの当たり外れが入っていません。実際の季節品ではシーズン合計のばらつきはもっと大きいのが普通です。そこでこの章では、平均は実測を丸めて3,600個とし、標準偏差は年ごとの不確実性を含む値として720個、つまり変動係数(標準偏差を平均で割った値)20%を仮定して計算を進めます。この仮定が結果にどう効くかは、後の推定誤差の節で確かめます。
from scipy.stats import norm
from inv_data import load_skus

c = float(load_skus().loc["B001", "unit_cost"])   # 原価 3,500円
p, v = 6000.0, 1500.0                             # 売価と処分価格(架空)
Cu, Co = p - c, c - v                             # 過小費用 2,500、過大費用 2,000
CR = Cu / (Cu + Co)                               # 臨界比 0.5556

mu, sigma = 3600.0, 720.0                         # シーズン需要の平均と標準偏差(仮定)
z = norm.ppf(CR)                                  # 0.1397
Q_star = mu + z * sigma                           # 3700.6 -> 3,701 個
print(round(CR, 4), round(z, 4), round(Q_star, 1))
# 出力:
# 0.5556 0.1397 3700.6
臨界比0.5556に対応する z は0.1397で、最適発注量は3,600に0.1397掛ける720を足した3,700.6、丸めて3,701個です。平均需要より101個だけ多く仕入れるのが最適で、需要がこの量に収まる確率は約56%です。裏返せば、最適に発注しても44%のシーズンでは欠品が起きます。過小費用と過大費用が同じ桁で、粗利が特別に厚いわけではない商品では、これが普通の答えです。z がゼロに近いので、標準偏差を多少誤っても発注量はほとんど動きませんが、平均を誤ればそのまま発注量に響きます。
期待利益の計算と発注量の曲線
最適発注量が分かっても、経営の判断にはその量でいくら儲かるのか、別の量にしたらいくら失うのかが要ります。発注量 Q のときの期待利益は、売価に期待販売個数を掛け、処分価格に期待売れ残り個数を掛けて足し、原価に発注量を掛けた仕入額を引いたものです。期待販売個数は、需要と発注量の小さいほうの期待値で、平均需要から期待売り逃し個数を引けば求まります。正規分布では、期待売り逃し個数は標準偏差に標準正規の損失関数 \( L(z) = \phi(z) – z\{1 – \Phi(z)\} \) を掛けた値で、\( \phi \) と \( \Phi \) は標準正規分布の密度関数と累積分布関数です。第4章でフィルレートを計算するときに使ったのと同じ関数です。
この式で発注量3,701個の期待値を計算すると、期待販売個数は3,360.4個、期待売れ残りは340.6個、期待売り逃しは239.6個、期待利益は7,719,980円でした。発注量を2,000個から5,600個まで1個刻みで動かして期待利益を並べても最大は3,701個のときで、臨界比から求めた解と一致します。さらに、乱数で需要を20万回発生させて利益を平均するモンテカルロ法で検算すると、期待利益は7,718,621円、売れ残りの平均は340.9個で、式の値とほぼ一致しました。需要が発注量以下に収まる確率は55.6%ですが、フィルレート、つまり需要のうち在庫から供給できた割合は93.3%です。この2つの指標の違いは第4章で述べたとおりで、ニューズベンダー問題の臨界比は前者に対応します。
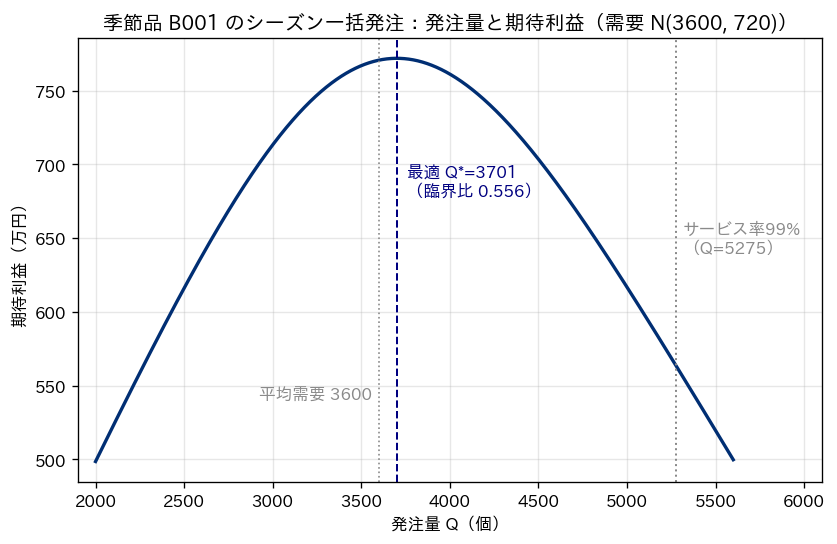
発注量と期待利益の関係を図にすると、最適値の近くでは曲線が平らで、離れるほど急に落ちることが分かります。平均需要と同じ3,600個で発注しても期待利益は770.7万円で、最適の772.0万円との差は1.3万円しかありません。一方、4,200個では743.3万円、4,500個では703.6万円、サービス率99%に相当する5,275個では563.9万円まで下がります。減り方は左右で完全には対称ではありません。1個増やしたときの期待利益の増分は、最適から大きく離れるほど、少ない側では過小費用の2,500円に、多い側では過大費用の2,000円を引いた値に近づきます。実際、2,000個付近では1個増やすごとに2,441円増え、5,600個付近では1個増やすごとに1,988円減ります。表に主な発注量の期待値をまとめます。廃棄損は過大費用に期待売れ残りを掛けた額、機会損失は過小費用に期待売り逃しを掛けた額、仕入額は原価に発注量を掛けた額です。
| 発注量 | 在庫充足確率 | フィルレート | 期待販売(個) | 期待売れ残り(個) | 期待売り逃し(個) | 期待利益(万円) | 廃棄損(万円) | 機会損失(万円) | 仕入額(万円) |
|---|---|---|---|---|---|---|---|---|---|
| 3,000 | 20.2% | 81.1% | 2,918.4 | 81.6 | 681.6 | 713.3 | 16.3 | 170.4 | 1,050.0 |
| 3,300 | 33.8% | 87.2% | 3,138.2 | 161.8 | 461.8 | 752.2 | 32.4 | 115.5 | 1,155.0 |
| 3,600 | 50.0% | 92.0% | 3,312.8 | 287.2 | 287.2 | 770.7 | 57.4 | 71.8 | 1,260.0 |
| 3,701(最適) | 55.6% | 93.3% | 3,360.4 | 340.6 | 239.6 | 772.0 | 68.1 | 59.9 | 1,295.4 |
| 3,900 | 66.2% | 95.5% | 3,438.2 | 461.8 | 161.8 | 767.2 | 92.4 | 40.5 | 1,365.0 |
| 4,200 | 79.8% | 97.7% | 3,518.4 | 681.6 | 81.6 | 743.3 | 136.3 | 20.4 | 1,470.0 |
| 4,500 | 89.4% | 99.0% | 3,563.6 | 936.4 | 36.4 | 703.6 | 187.3 | 9.1 | 1,575.0 |
| 5,275 | 99.0% | 99.9% | 3,597.6 | 1,677.4 | 2.4 | 563.9 | 335.5 | 0.6 | 1,846.2 |
この表の読み方で大事なのは、最適発注量が廃棄損と機会損失の合計を最小にする量であって、どちらか一方をゼロにする量ではないことです。最適の3,701個でも、廃棄損は68.1万円、機会損失は59.9万円が残ります。臨界比の条件が釣り合わせているのは、この2つの総額ではなく、「1個増やしたときの期待の得と損」という限界値です。この例では廃棄損と機会損失の総額も近い値になっていますが、一般に一致するとは限りません。どちらかをゼロに近づけようとすると、もう一方が加速度的に増えます。
離散分布での解、ポアソン分布と催事の例
需要が数個から数十個の商品では、正規分布の近似が粗くなります。第4章で述べたとおり、需要が小さい商品や間欠的な商品では、ポアソン分布や負の二項分布といった離散分布で考えるほうが実態に近くなります。離散分布のときの最適発注量は、需要が発注量以下に収まる確率 \( F(Q) \) が臨界比以上になる最小の整数 Q です。連続分布のときは \( F(Q) \) が臨界比にちょうど等しい Q が存在しましたが、離散では飛び飛びの値しか取れないため、臨界比を初めて超えるところで止めます。理由は同じで、その Q までは1個増やす期待の得が損を上回り、その先は下回るからです。
例として、間欠需要品 C001 を1週間の催事向けに一度だけ仕入れる状況を考えます。サンプルデータの C001 の週次需要を、期間の端の不完全な週を除いて156週ぶん集計すると、平均8.84個、分散76.97、標準偏差8.77個、最大34個で、需要がゼロの週が40週ありました。費用は架空の設定として、原価8,000円、催事での売価14,000円、催事後の処分価格5,000円とします。過小費用は6,000円、過大費用は3,000円、臨界比は6,000を9,000で割った0.6667です。粗利が厚く処分価格も比較的高いので、B001 より高い臨界比になります。
需要が平均8.84個のポアソン分布に従うと仮定して累積確率を並べると、需要が9個以下に収まる確率は0.6085、10個以下では0.7248です。臨界比0.6667を初めて超えるのは10個なので、最適発注量は10個です。scipy の poisson.ppf(CR, lam) も10を返します。期待利益は、需要の各値の確率に利益を掛けて足し合わせれば求まり、発注量10個で43,179円、9個と11個ではいずれも42,655円でした。ポアソン分布の文書には、確率質量関数が \( f(k) = e^{-\mu}\mu^k / k! \) で、形状パラメータが平均 \( \mu \) であることが書かれています。
import numpy as np
from scipy.stats import poisson
from inv_data import load_demand

wk = load_demand()["C001"].resample("W").sum().iloc[1:-1]   # 週次需要(端の週を除く)
lam = wk.mean()                                             # 8.84
c, p, v = 8000.0, 14000.0, 5000.0
CR = (p - c) / ((p - c) + (c - v))                          # 0.6667

Q_pois = int(poisson.ppf(CR, lam))                          # F(Q) >= CR となる最小の Q
sup = np.arange(0, 200)
pmf = poisson.pmf(sup, lam)
def expected_profit(Q):
    return float(np.sum(pmf * (p * np.minimum(sup, Q) + v * np.maximum(Q - sup, 0) - c * Q)))
print(Q_pois, round(poisson.cdf(9, lam), 4), round(poisson.cdf(10, lam), 4), round(expected_profit(Q_pois)))
# 出力:
# 10 0.6085 0.7248 43179
ただし、この C001 の週次需要は分散が平均の8.71倍あり、分散と平均が等しいポアソン分布の前提から大きく外れています。ゼロの週が4分の1を占め、一方で30個を超える週もあるためです。ポアソン分布で解いた10個という答えと、その前提で見積もった期待利益43,179円が、実際の需要のもとでどうなるかは、推定誤差の節とデータ駆動の節で確かめます。
粗利率と最適サービス率の関係、粗利が薄いほど欠品を許す
臨界比を売価・原価・処分価格で書き直すと、\( CR = \frac{p – c}{p – v} \) になります。処分価格がゼロ、つまり売れ残りを廃棄する商品では、分母が売価そのものになり、臨界比は売価から原価を引いて売価で割った粗利率に一致します。粗利率20%の商品なら、需要が発注量に収まる確率を20%にする量、つまり平均よりかなり少ない量が最適です。正規分布なら z はマイナス0.842で、平均から標準偏差の0.84倍を引いた量になります。粗利率70%なら臨界比は0.7、z は0.524で、平均より多めに仕入れます。粗利が薄い商品ほど欠品を許し、粗利が厚い商品ほど売れ残りを許す、というのがこの式の含意です。
処分価格が正の値なら、臨界比は粗利率より高くなります。処分価格が原価の40%なら、粗利率20%の商品の臨界比は0.294、粗利率50%なら0.625です。処分価格が原価の80%まで回収できるなら、粗利率20%でも臨界比は0.556まで上がります。売れ残りの損が小さいほど、強気に仕入れてよいということです。表と図に、粗利率と処分価格の水準ごとの臨界比と z をまとめます。
| 粗利率 | 臨界比(処分価格ゼロ) | z | 臨界比(処分価格が原価の40%) | z | 臨界比(処分価格が原価の80%) | z |
|---|---|---|---|---|---|---|
| 10% | 0.100 | -1.282 | 0.156 | -1.010 | 0.357 | -0.366 |
| 20% | 0.200 | -0.842 | 0.294 | -0.541 | 0.556 | 0.140 |
| 30% | 0.300 | -0.524 | 0.417 | -0.210 | 0.682 | 0.473 |
| 40% | 0.400 | -0.253 | 0.526 | 0.066 | 0.769 | 0.736 |
| 50% | 0.500 | 0.000 | 0.625 | 0.319 | 0.833 | 0.967 |
| 60% | 0.600 | 0.253 | 0.714 | 0.566 | 0.882 | 1.187 |
| 70% | 0.700 | 0.524 | 0.795 | 0.825 | 0.921 | 1.412 |
| 80% | 0.800 | 0.842 | 0.870 | 1.124 | 0.952 | 1.668 |
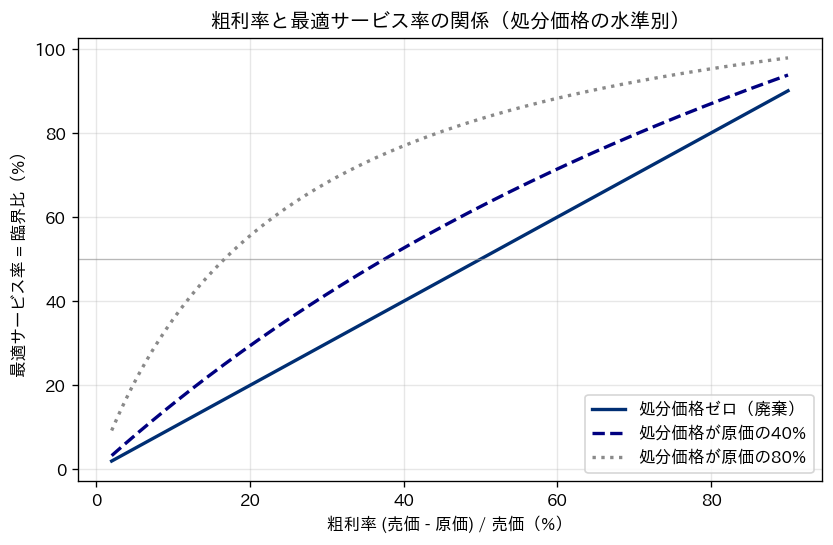
この関係は、B001 の例で処分価格だけを動かしても確かめられます。処分価格がゼロ、つまり廃棄なら臨界比は0.417、最適発注量は3,448個で、期待利益は731.4万円です。処分価格1,000円なら臨界比は0.5でちょうど平均の3,600個、期待利益756.4万円。この章の基本設定の1,500円では3,701個で772.0万円。処分価格を2,500円まで上げられれば臨界比0.714、発注量4,007個、期待利益814.3万円になります。処分価格を上げる施策、例えばシーズン後のアウトレット販路や二次流通の確保、仕入先との返品条件の交渉は、売れ残りの損を減らすだけでなく、最適発注量そのものを押し上げ、販売機会を増やす効果を持ちます。売れ残りの処分価値は在庫の後始末ではなく、発注量を決める入力の一つです。
経営の側から見ると、この節の含意は「サービス率を全品目に一律で設定してはいけない」ということです。粗利率20%の商品と70%の商品に同じ95%のサービス率を課すと、前者では大量の売れ残りを抱え、後者では取れたはずの粗利を逃します。第13章で扱う運用の失敗の型の一つ、一律のサービス率は、ニューズベンダー問題の式から見れば費用の比率を無視した設定です。品目ごとの粗利率と処分価値から臨界比を出し、それをサービス率の目標に翻訳する、という順序が式に沿った決め方です。
「欠品ゼロ」を目標にしたときの廃棄損失を経営指標で見る
「欠品は機会損失だから、欠品ゼロを目指す」という方針は、繰り返し発注できる定番品なら安全在庫の増額で対応でき、その費用も第4章の式で見積もれます。一度しか買えない商品で同じ方針を取ると、代償は売れ残りの廃棄損として一度に現れます。B001 の例で、サービス率、つまり需要が発注量に収まる確率を最適の55.6%から順に上げたときの費用を表にします。
| サービス率 | z | 発注量(個) | 期待売れ残り(個) | 廃棄損(万円) | 期待売り逃し(個) | 機会損失(万円) | 期待利益(万円) | 最適比の利益減(万円) | 仕入額(万円) |
|---|---|---|---|---|---|---|---|---|---|
| 55.6%(最適) | 0.14 | 3,701 | 340.6 | 68.1 | 239.6 | 59.9 | 772.0 | 0.0 | 1,295.4 |
| 80% | 0.84 | 4,206 | 686.4 | 137.3 | 80.4 | 20.1 | 742.6 | 29.4 | 1,472.1 |
| 90% | 1.28 | 4,523 | 957.1 | 191.4 | 34.1 | 8.5 | 700.1 | 71.9 | 1,583.1 |
| 95% | 1.64 | 4,784 | 1,199.1 | 239.8 | 15.1 | 3.8 | 656.4 | 115.6 | 1,674.4 |
| 99% | 2.33 | 5,275 | 1,677.4 | 335.5 | 2.4 | 0.6 | 563.9 | 208.1 | 1,846.3 |
| 99.9% | 3.09 | 5,825 | 2,225.2 | 445.0 | 0.2 | 0.1 | 454.9 | 317.1 | 2,038.8 |
サービス率99%を目標にすると、発注量は5,275個で、平均需要の1.47倍です。期待売れ残りは1,677個、廃棄損は335.5万円で、最適のときの68.1万円の約5倍になります。防げる機会損失は59.9万円から0.6万円への59.3万円ぶんだけで、その代わりに廃棄損が267.4万円増えるため、期待利益は772.0万円から563.9万円へ208.1万円、率にして27%減ります。さらに、仕入額は1,295.4万円から1,846.3万円へ551万円増え、この資金はシーズン中ずっと在庫として寝たうえ、その3割は見切り価格でしか回収できません。売れ残り率、つまり仕入れた個数に対する売れ残りの割合は、最適のときの9.2%に対して99%では31.8%です。欠品ゼロに近い水準を目標にするというのは、期待利益の4分の1強と運転資金の数百万円を、売り逃しを需要の0.07%(2.4個)まで下げるために、つまり最適のときに残る売り逃し239.6個のうち約237個(需要の約6.6%)を追加で取りに行くために使う判断だ、ということです。
この計算は、経営会議で「欠品率」だけが報告され「廃棄率」と「売れ残りに寝ている資金」が報告されないときに起きるずれを、数字で示しています。一度しか買えない商品では、欠品率と廃棄率は表裏で、どちらか一方をゼロにする目標は、もう一方を放置する目標と同じです。報告すべき指標は、需要に対する売り逃しの割合と、仕入に対する売れ残りの割合の両方、そしてそれぞれに過小費用と過大費用を掛けた金額です。最適に発注しても欠品は44%のシーズンで起き、売れ残りは9%残ります。この「許容される欠品と売れ残り」を、費用の比率から導いた目標として先に置いておくと、シーズン後の結果を見て発注担当を責める、あるいは翌年に過剰に積む、という反応を避けられます。
需要分布の推定誤差の影響
ここまでの計算は、需要の分布が正確に分かっている前提でした。実際には平均も標準偏差も推定値で、分布の形も仮定です。推定を誤ったときにどれだけ損をするかは、臨界比によって違います。B001 の基本設定と、売価12,000円・処分価格2,500円という高粗利の設定の2つで、真の分布は平均3,600個・標準偏差720個の正規分布のまま、推定を誤って発注したときの期待利益の減りを計算しました。
| 見積もりの誤り | 基本設定(臨界比0.556)の発注量 | 期待利益の減少 | 高粗利設定(臨界比0.895)の発注量 | 期待利益の減少 |
|---|---|---|---|---|
| 正しい見積もり | 3,701 | 0 | 4,502 | 0 |
| 平均を10%低く見積もる | 3,341 | 16.0万円(2.08%) | 4,142 | 18.9万円(0.65%) |
| 平均を10%高く見積もる | 4,061 | 15.3万円(1.98%) | 4,862 | 12.6万円(0.43%) |
| 標準偏差を186個と見積もる(3シーズンの実測値) | 3,626 | 0.7万円(0.09%) | 3,833 | 75.1万円(2.56%) |
| 標準偏差を1.5倍に見積もる | 3,751 | 0.3万円(0.04%) | 4,952 | 18.6万円(0.63%) |
| 平均を10%高く、標準偏差を1.5倍に見積もる | 4,111 | 19.7万円(2.55%) | 5,312 | 48.6万円(1.66%) |
基本設定では、臨界比が0.5に近く z が0.14しかないため、標準偏差をどう見積もっても発注量はほとんど動きません。3シーズンの実測値186個をそのまま使っても、減少は0.7万円、0.09%にとどまります。代わりに平均の誤りがそのまま効き、10%の誤りで約2%の利益を失います。高粗利設定では逆で、z が1.25あるため、標準偏差を186個と小さく見積もると発注量が4,502個から3,833個まで減り、75.1万円、2.56%を失います。臨界比が0.5から離れるほど、散らばりの推定が結果を左右する、ということです。最初の節で「3シーズンの標準偏差をそのまま使わない」と述べた理由もここにあります。粗利の厚い商品で、年ごとの当たり外れを含まない小さな標準偏差を使うと、発注が保守的になりすぎて、取れたはずの粗利を逃します。
分布の形を誤ったときの影響は、C001 の催事の例ではっきり出ます。ポアソン分布で解いた発注量10個の期待利益は、ポアソン分布の前提では43,179円でした。ところが、実際の156週の需要の分布をそのまま使って同じ10個を評価すると、期待利益は20,019円です。分散が平均の8.71倍ある需要をポアソン分布で近似すると、ばらつきを大幅に過小評価し、売れ残りも売り逃しも実際より少なく見積もることになります。発注量そのものの誤りは後述のとおり小さいのですが、利益見込みは2倍以上に膨らんでいます。分布の仮定を誤ると、発注量を少し間違えるだけでなく、その催事から得られる利益の見通し自体を誤って経営に報告することになる、という点に注意が要ります。
データ駆動の解、標本分位で決める
分布の形を仮定せず、過去の需要の実績をそのまま使う方法があります。過去 n 期の需要を小さい順に並べ、臨界比に n を掛けて切り上げた順位の値を発注量にする方法で、標本分位による解と呼びます。過去の各期を同じ確からしさで起こり得るシナリオとみなし、その経験分布で臨界比の分位点を取るのと同じことです。numpy では np.quantile(x, CR, method="inverted_cdf") がこの値を返します。既定の method は “linear” で、隣り合う順序統計量を線形補間するため、離散の需要では整数にならないことがあります。inverted_cdf は経験分布関数を逆に引く定義で、必ず実績のどれかの値が返ります。
C001 の156週の需要で計算すると、臨界比0.6667に156を掛けて切り上げた104番目の値は12個です。経験分布で見ると、需要が11個以下だった週の割合は0.6603、12個以下では0.6667で、12個が臨界比を初めて満たす量です。経験分布のもとで発注量ごとの期待利益を計算しても、最大は12個のときの20,365円でした。ポアソン分布の解である10個を同じ経験分布で評価すると20,019円で、差は1回の催事あたり346円です。発注量の差は2個、利益の差は1.7%で、この例では分布の形の誤りが発注量に与える影響は小さいことが分かります。売れ残りの期待値は10個で4.44個、12個で5.74個、売り逃しの期待値は3.28個と2.58個で、臨界比が0.5より高いぶん、標本分位の解は売り逃しを減らす側に寄っています。
x = np.sort(wk.values)                                     # 過去156週の需要を昇順に
n = len(x)
k = int(np.ceil(CR * n))                                   # 104 番目
Q_emp = int(x[k - 1])                                      # 12 個
print(Q_emp, int(np.quantile(x, CR, method="inverted_cdf")))
print(round((x <= 11).mean(), 4), round((x <= 12).mean(), 4))

# 経験分布(各週を等確率のシナリオ)での期待利益
vals, counts = np.unique(x, return_counts=True)
pmf_e = counts / n
def profit_emp(Q):
    return float(np.sum(pmf_e * (p * np.minimum(vals, Q) + v * np.maximum(Q - vals, 0) - c * Q)))
print(round(profit_emp(10)), round(profit_emp(12)))
# 出力:
# 12 12
# 0.6603 0.6667
# 20019 20365
標本分位の弱点は、標本が少ないときに分位点の推定が粗くなることです。B001 のように過去3シーズンしか無い商品では、3つの値の分位点に意味はほとんどありません。標本の大きさがどれくらい要るのかを、乱数実験で確かめました。真の分布を平均3,600個・標準偏差720個の正規分布とし、そこから n 期ぶんの標本を引いて、標本分位で発注量を決める方法と、標本の平均と標準偏差で正規分布を当てはめて発注量を決める方法の2つを比べます。決めた発注量を真の分布のもとで評価し、真の最適発注量に対する期待利益の損失の割合を、2,000回の平均で出しました。真の分布が右に裾の長い対数正規分布(平均と標準偏差は同じ)の場合も、同じ手順で計算しています。
| 標本の大きさ n | 標本分位の損失(真の分布が正規) | 正規当てはめの損失(真の分布が正規) | 標本分位の損失(真の分布が対数正規) | 正規当てはめの損失(真の分布が対数正規) |
|---|---|---|---|---|
| 5 | 2.39% | 1.59% | 2.30% | 1.73% |
| 10 | 1.17% | 0.78% | 1.19% | 0.91% |
| 20 | 0.66% | 0.44% | 0.62% | 0.50% |
| 50 | 0.25% | 0.16% | 0.27% | 0.26% |
| 100 | 0.13% | 0.08% | 0.13% | 0.17% |
| 500 | 0.03% | 0.02% | 0.03% | 0.10% |
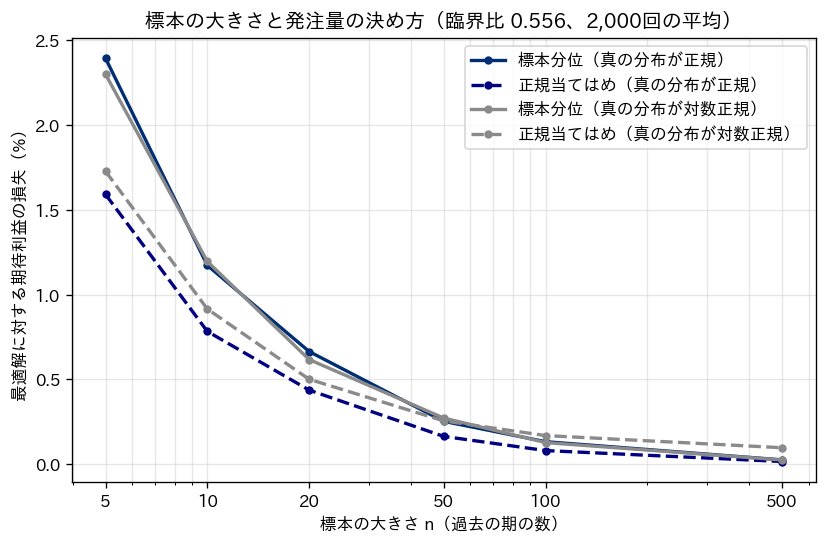
標本が5期しか無いときは、どちらの方法でも最適に対して2%前後の利益を失い、正規当てはめのほうが損失は小さくなります。分布の形を正しく仮定できるなら、平均と標準偏差の2つの数を推定するほうが、分位点を直接推定するより少ない標本で済むからです。標本が増えるにつれて両者の差は縮み、真の分布が正規なら500期で損失はどちらも0.03%以下になります。真の分布が対数正規のときは、正規当てはめの損失が標本を増やしても0.10%で下げ止まり、100期以上では標本分位が上回ります。仮定した形が真の形とずれているぶんの損失は、標本をいくら増やしても消えないためです。この例の対数正規分布は変動係数20%で歪みが小さいので差も小さいのですが、C001 のように分散が平均の8倍を超える需要では、形のずれによる損失はもっと大きくなります。
この結果から、実務での使い分けは次のようになります。過去の期が数十以上あり、需要の分布に歪みや複数の山がありそうなら、標本分位を使うほうが安全です。生鮮品や日配品のように毎日が一つの期になる商品は、1年で300期を超える標本が得られるので、この条件に合います。過去の期が10未満しか無い季節品や新製品では、分布の形を仮定して平均と散らばりを推定するほうが損失が小さく、その散らばりには前節で述べたとおり、年ごとの当たり外れを含めた値を置く必要があります。標本分位の方法に必要な標本の大きさについては、Levi、Roundy、Shmoys が2007年の論文で、真の分布を知らずに標本だけから計算した方策の期待費用が、最適方策の期待費用に任意の相対誤差で近づくために要する標本数の上界を、分布に依存しない形で示しています。また、Ban と Rudin は2019年の論文で、需要そのものを予測してから発注量を決めるのではなく、曜日や天候などの特徴量から発注量を直接決める機械学習の方法を提案し、病院の看護師配置の例で、特徴量を使う手法が既存の実務の基準より費用を24%下げたと報告しています。予測と決定を分けずに扱うこの考え方は、第8章の分位点予測と第14章の機械学習との接続で改めて触れます。
実務への応用、欠品を許す設計と処分価値
ニューズベンダー問題を実務に落とすときに要る入力は4つです。売価、原価、処分価格の3つの金額と、需要の分布または過去の実績です。金額のうち売価と原価は会計から取れますが、処分価格は「売れ残ったらどうするか」を先に決めないと定まりません。廃棄なら処分価格はゼロで、廃棄に費用がかかるなら負の値です。値引き販売なら見切り価格、返品条件があれば返品時の買い戻し価格、二次流通に流すならその卸値です。この決め方が臨界比を動かし、発注量を動かします。過小費用の側では、売り逃しが顧客の離反や取引先の信用低下を招く商品なら、粗利にその見積もりを足します。ここは金額の見積もりに幅が出ますが、幅を持たせたまま臨界比を計算し、発注量がどの範囲に収まるかを見れば、判断に使えます。
商品の型ごとの応用は次のように整理できます。生鮮品や日配品では、毎日の仕入れがそれぞれニューズベンダー問題です。過去の日次実績が豊富にあるので標本分位が使え、曜日や天候で分布が変わるなら、曜日別に標本を分けるか、前節で触れた特徴量つきの方法に進みます。臨界比から「許容する欠品の確率」を先に置き、その発注量での売れ残り率の期待値を併せて管理して、日々の廃棄率がそれを大きく外れたときだけ発注ルールを見直す、という運用になります。季節品では、シーズン前の一括発注に加えて、シーズン途中で一度だけ追加発注できる契約があれば、最初の発注を控えめにして途中の実売を見てから積み増す、という2段階の設計が可能です。この設計は需要の情報を得てから決め直す構造を持ち、第9章の2段階確率計画の形になります。イベントや限定生産では、予約販売で需要の一部を確定させると、不確実な部分の標準偏差が下がり、同じ臨界比でも売れ残りの期待値が減ります。
- 売価・原価・処分価格を品目ごとに確定させ、過小費用と過大費用を出す。処分価格は「売れ残ったらどうするか」の決定そのもの
- 臨界比を計算し、品目ごとに「許容する欠品の確率」を先に置き、その発注量での売れ残り率の期待値を併せて管理する。全品目一律のサービス率にしない
- 需要の分布は、過去の期が数十以上あれば標本分位、少なければ形を仮定して平均と散らばりを推定する。散らばりには年ごとの当たり外れを含める
- 発注量だけでなく期待利益・期待売れ残り・期待売り逃しを併せて報告し、シーズン後の実績を「想定の範囲内か」で評価する
- 処分価値を上げる施策(アウトレット販路・返品条件・二次流通)を、発注量を押し上げる投資として検討する
この章の要点は3つです。一度しか買えない商品の最適発注量は、過小費用と過大費用の比率である臨界比の分位点で決まり、サービス率は目標として置くものではなく費用から導かれる結果になります。粗利が薄いほど欠品を許し、処分価値が高いほど強気に仕入れるのが最適で、欠品ゼロを目標にすると廃棄損と寝る資金がその何倍にもなります。需要分布の推定では、臨界比が0.5に近いなら平均の推定が、離れているなら散らばりの推定が結果を左右し、標本が十分にあれば分布の形を仮定しない標本分位が安全です。次の第7章では、売れ残りを翌期に持ち越せる多期間の問題に進み、発注固定費があるときに(s,S)方策が最適になる理由と、需要が確定しているときの動的ロットサイジングを扱います。
この章を深めたい方への参考書籍
『サプライ・チェイン最適化ハンドブック』(久保幹雄、朝倉書店):線形計画・整数計画からネットワーク・在庫・スケジューリングまでを扱う数理最適化の手引きで、第10章に「新聞売り子モデル」の節があり、この章の単期の問題を経済発注量モデルや確率的在庫モデルと並べて位置づけられます。数式を Python で動かしながら読みたい方に向いています。
『Foundations of Stochastic Inventory Theory』(Evan L. Porteus、Stanford University Press):確率的在庫理論の博士課程向け教科書で、経済発注量モデルとニューズベンダーモデルの2つの基本モデルから始めて、不確実性のもとでの動的最適化へ進みます。この章の臨界比が、多期間の理論の中でどう一般化されるかを厳密に追いたい方への原典です。
第7章 多期間の在庫問題、(s,S)方策と動的ロットサイジング
第6章では、一度しか買えない品目の発注量を臨界比で決めるニューズベンダー問題を扱いました。売れ残りは廃棄か値引きで処分し、次の期には持ち越さないという前提でした。しかし多くの品目は、今週売れ残った分が来週の在庫として残ります。この「持ち越し」があるだけで、今週の発注は来週以降の在庫水準に影響し、逆に来週以降の需要の見通しが今週の発注量を左右するようになります。本章では、この多期間の問題を数理モデルとしてどう扱うかを整理し、第5章で運用面から紹介した (s,S) 方策がなぜ最適になるのか、そして需要が確定しているときにロットの大きさをどう決めるかを、第2章のサンプルデータで実際に計算しながら確かめます。
単期から多期間へ、持ち越しがあると何が変わるか
単期の問題では、決めるのは発注量ひとつでした。多期間になると、毎期の発注量を決めなければならず、しかも今期の決定は今期の在庫だけでなく、それまでの発注と需要の履歴の結果として決まる在庫水準に依存します。ここで問題を扱いやすくする考え方が、「いま在庫がいくつあるか」という状態だけを見れば十分だ、という整理です。過去にどういう経緯でその在庫になったかは、これからの費用には関係ありません。将来の費用を左右するのは、いまの在庫水準と、これから打つ手だけです。
この整理のうえで、各期の意思決定を「期首在庫が \( x \) のとき、発注後の在庫を \( y \) にする」という形で表します。発注量は \( y – x \) です。発注すると固定費 \( K \) がかかり、期中に需要 \( D \) が実現して、期末に残った在庫には保管費、足りなかった分には欠品費がかかります。本章では第1章と第3章で述べた共通の費用パラメータを使い、発注固定費は1回4,000円、保管費は原価の年20%、欠品費は原価の50%(粗利相当)とします。この設定で「毎期いくつ発注すべきか」を決める方法が、以下で説明する動的計画です。
なお、本章の前半では欠品分は翌期以降に納める(バックオーダー)ものとし、待たせた1個につき毎週欠品費がかかるとします。また、期末の在庫は原価で評価して次の期間に持ち越すため、購入費そのものは総需要に比例する定数となり、発注の判断には影響しません。したがって費用として数えるのは、発注固定費・保管費・欠品費の3つです。リードタイムはゼロ(週初に発注すればその週に使える)と単純化していますが、リードタイムが一定なら第5章の在庫ポジションで考えれば同じ構造になります。
動的計画の考え方、状態・行動・価値関数
動的計画法(ダイナミック・プログラミング)は、Bellman が1950年代に体系化した、多段階の意思決定を後ろから順に解く方法です。在庫問題に当てはめると、状態は期首在庫 \( x \)、行動は発注後の在庫 \( y \)、そして「この状態から最適に振る舞ったときの、今期以降の期待費用」を価値関数 \( V_t(x) \) と呼びます。最後の期の価値関数から始めて、1期ずつ前に戻りながら価値関数を計算していくと、各期・各状態での最適な行動が同時に決まります。
式で書くと、期 \( t \) の価値関数は \( V_t(x) = \min_{y \ge x} \{ K \cdot \mathbf{1}[y > x] + G_t(y) \} \) です。ここで \( G_t(y) = L(y) + \mathbb{E}[V_{t+1}(y – D)] \) は「発注後の在庫を \( y \) にしたときの、固定費を除く今期以降の期待費用」で、\( L(y) = \mathbb{E}[h (y – D)^+ + p (D – y)^+] \) は今期の保管費と欠品費の期待値です。言葉にすると、発注後在庫を \( y \) にする費用は、今期の保管・欠品費の期待値と、需要を引いた残りの在庫から来期以降を最適に運用したときの費用の和であり、発注するなら固定費 \( K \) が上乗せされる、ということです。
これを A001(定番品)の週次需要で実際に解きました。第2章のサンプルデータの1,096日から156週分を7日ごとに合計すると、週次需要は平均277.4個、標準偏差24.7、最小215・最大336で、この経験分布をそのまま需要の確率分布として使います。費用は週あたりに直して、保管費が1個1週あたり4.615円、欠品費が1個1週あたり600円、固定費は1回4,000円です。状態は期首在庫を1個刻みでマイナス800から2,000まで取り、52週分を後ろ向きに計算しました。中心となる1期分の計算は次のとおりです。
import numpy as np
# xs: 状態(期首在庫)の格子。vals, pmf: 週次需要の値と確率。L: 今期の保管費と欠品費の期待値
def expected_next(V):
    out = np.zeros(len(xs))
    for v, pr in zip(vals, pmf):
        out += pr * V[idx(xs - v)]        # E[V(y - D)]
    return out

def backward_step(V, K):
    G = L + expected_next(V)              # 発注後在庫 y のときの今期以降の期待費用
    suffix_min = np.minimum.accumulate(G[::-1])[::-1]   # y >= x の範囲での最小値
    order_val = K + suffix_min            # 発注する場合
    do_order = order_val < G              # 発注しない場合(G)と比べる
    V_new = np.where(do_order, order_val, G)
    return V_new, G, do_order

V = np.zeros(len(xs))                     # 計画期間の終わりの価値は 0
for t in range(52, 0, -1):
    V, G, do_order = backward_step(V, K)
    S = int(xs[np.argmin(G)])             # G を最小にする発注後在庫
    s = int(xs[do_order].max()) + 1       # 発注する最大の在庫の次が s
この計算は数秒で終わります。状態と行動を1個刻みで持っても、期ごとに配列演算をひとつ回すだけだからです。動的計画が実務で敬遠されるのは計算量そのものより、「需要の確率分布を各期について持たなければならない」「品目ごとに状態空間を用意しなければならない」という手間の側にあります。後で述べるとおり、動的計画の本当の価値は毎日これを回すことではなく、最適な方策の形を教えてくれる点にあります。
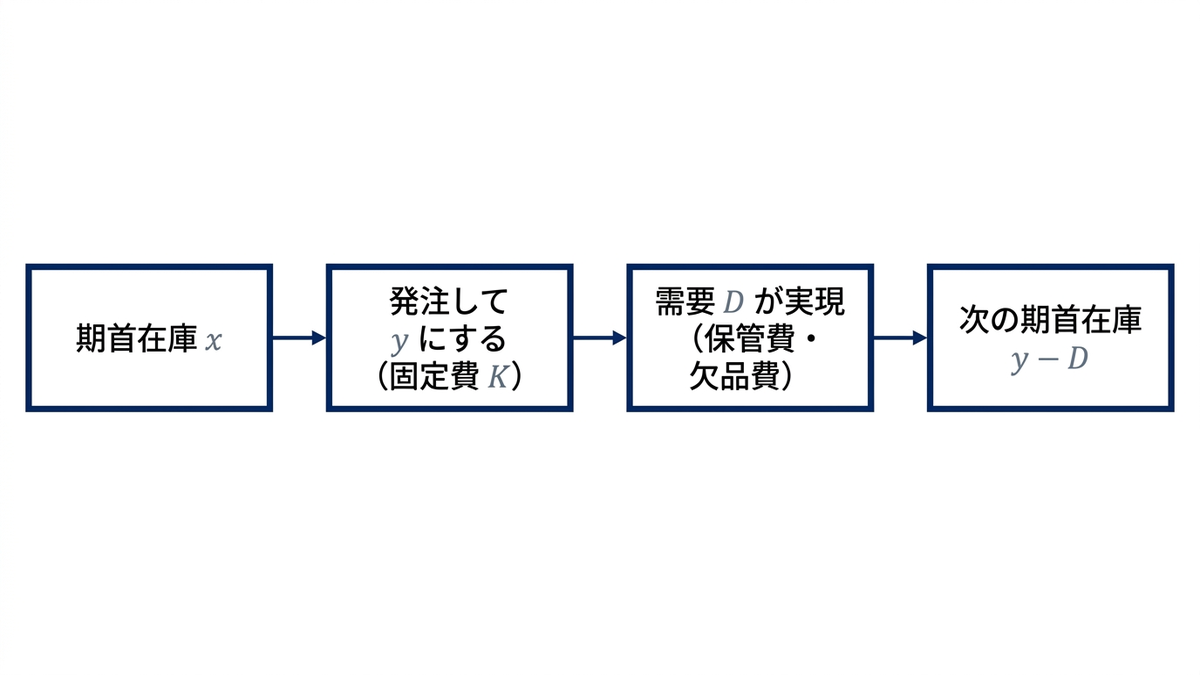
固定費が無いとき、ベースストック方策で十分な理由
まず固定費 \( K \) がゼロの場合を考えます。発注にまとまった費用がかからないなら、毎期少しずつ買っても損はありません。このとき \( G_t(y) \) は凸関数(下に膨らんだ、谷がひとつの形)になり、最適な行動は「\( G_t \) を最小にする水準 \( S_t \) まで発注する。すでにそれ以上あるなら発注しない」という形になります。これが第5章で紹介したベースストック方策で、数理的にはこの単純な形が最適であることが動的計画から導かれます。
さらに需要の分布と費用が期によって変わらないなら、\( S_t \) は全期で同じ値になり、その値は単期のニューズベンダー問題と同じ臨界比 \( p/(p+h) \) の分位点で決まります。今回の設定では臨界比は 600 ÷(600+4.615)=0.9924 で、週次需要の経験分布の0.9924分位点は334個です。実際に \( K = 0 \) として52週分の動的計画を解くと、基準在庫 \( S_t \) は第1週から第52週まですべて334個になり、単期の解と一致しました。この「今期だけを見て決めた解が多期間でも最適になる」性質は近視眼的方策の最適性と呼ばれ、どのような条件で成り立つかは Veinott(1965)をはじめとする研究で整理されています。
実務への含意は明快です。発注のたびにかかる固定費をゼロとみなせるほど小さい品目、たとえば定期便で毎週納入される定番品や、社内の工程間で補充する部品では、「毎期、基準在庫まで補充する」ベースストック方策が理論上も最適になります(固定費が無視できない大きさなら、次に見る (s,S) 型が最適です)。決めるべきパラメータは基準在庫 \( S \) ひとつで、それは第4章と第6章の考え方で、欠品費と保管費の釣り合いから計算できます。
固定費があるとき、(s,S) 方策の最適性と K 凸性の直観
固定費があると、毎期少しずつ買う運用は固定費を毎回払うことになって損です。買うときはまとめて買い、しばらく買わない、という運用が自然に浮かびますが、「いつ買うか」「いくつまで買うか」を最適に決める方策はどんな形をしているでしょうか。この問いに答えたのが Scarf(1960)で、需要が連続分布に従い、保管費と欠品費が凸であるといった条件のもとで、有限期間の最適方策が (s,S) の形、すなわち「期首在庫が \( s \) を下回ったら \( S \) まで発注し、そうでなければ発注しない」になることを証明しました。無限期間については、連続需要で Iglehart(1963)が、離散需要で Veinott と Wagner(1965)が、それぞれ最適性を示しています。
証明の道具が K 凸性 です。通常の凸関数の定義は、2点を結んだ線分が関数のグラフより上にあること、つまり \( g((1-\lambda)x + \lambda y) \le (1-\lambda) g(x) + \lambda g(y) \) ですが、K 凸関数では右辺に \( \lambda K \) を加えて \( g((1-\lambda)x + \lambda y) \le (1-\lambda) g(x) + \lambda g(y) + \lambda K \) が成り立てばよい、と条件を緩めます。直観的には、「右側の点に固定費 \( K \) ぶんの下駄を履かせても線分が関数より上にある」ということで、関数が多少波打っていても、波の高さが \( K \) を超えなければ K 凸です。Scarf は、固定費を除いた費用関数 \( G_t \) が各期で K 凸になることを後ろ向きに示し、K 凸な関数の最小点を \( S \)、そこから左に戻って初めて \( G(S) + K \) を超える手前の点を \( s \) とすれば、\( s \) と \( S \) の間では \( G \) が \( G(S) + K \) を超えないため「発注して固定費を払うより、待つ方が安い」ことを導きました。
先ほどの A001 の動的計画は、この構造をそのまま数値で見せてくれます。第1週から第49週までの最適方策は、\( s \) が290または291、\( S \) は主に628(一部の偶数週では906)で、52週すべての状態について「\( s \) 未満なら \( S \) まで発注、\( s \) 以上なら発注しない」という形に反する状態はゼロでした。第26週の \( G(y) \) を描いたのが下の図の左側で、最小点 \( S = 628 \) での値77,765円に固定費4,000円を足した81,765円の水準線と \( G \) が交わる点が \( s = 290 \) です。\( G \) は凸ではなく、334個・524個・628個・906個・1,173個に極小点を持って波打っていますが、\( s \) と \( S \) の間で81,765円を超えることはなく、これが K 凸性の意味です。なお628個と906個の費用は円単位で同じ77,765円で、2週分をまとめても3週分をまとめても差が無いため、第32週以降の偶数週では906個が \( S \) に選ばれる週もあります(差は最大でも32円)。右側は最適な発注後在庫を期首在庫の関数として描いたもので、固定費ありでは \( s \) を境に628個へ跳ぶ階段、固定費なしでは334個までの補充、という形の違いが一目でわかります。
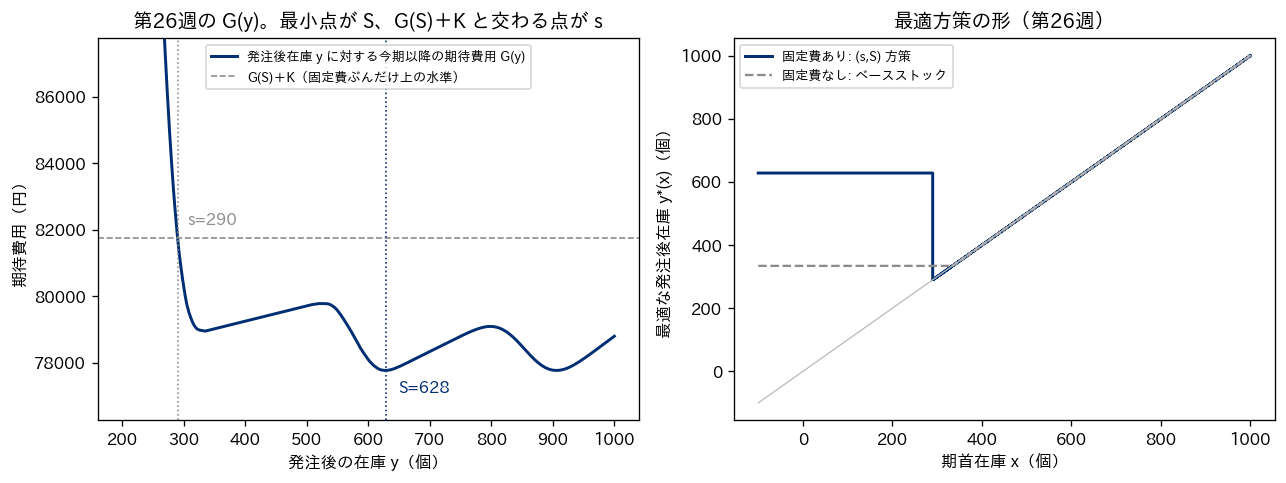
計画期間の終わり際では方策が変わります。第50週は \( S \) が910個に跳ね上がり、第52週は \( s = 285 \)、\( S = 334 \) と縮みました。残り2〜3週をまとめて買って固定費を節約し、最後の週はその週の分だけを買う、という終端の効果です。実務ではこの終端の判断は使わず、計画期間を十分に長く取って先頭の数週だけを実行し、次の期にまた解き直す(ローリング)のが普通です。この点は後の MRP の節で改めて触れます。
動的計画が教えてくれた (s,S) を、第3章や第5章の考え方で簡便に決めた方策と、同じ再帰で期待費用を計算して比べたのが次の表です。簡便な決め方では、発注点 \( s \) を週次需要の99%点である334個、\( S \) をそれに EOQ の693個を足した1,027個としました。
| 方策 | 決め方 | 52週の期待費用(円) | 最適比 |
|---|---|---|---|
| 動的計画の最適方策 | \( s = 290 \)〜291、\( S = 628 \)(一部の週は906) | 157,365 | 1.000 |
| 定量発注 | 334個を下回ったら EOQ の693個を発注 | 181,357 | 1.152 |
簡便な (s,S) | \( s = 334 \)、\( S = 1{,}027 \) | 186,593 | 1.186 |
| ベースストック | 毎週334個まで補充 | 221,998 | 1.411 |
簡便な決め方でも極端に悪いわけではありませんが、最適方策より15〜19%高く、固定費があるのに毎週補充するベースストックは41%高くなりました。差が出た理由のひとつは、EOQ が時間を連続とみなす式である一方、週に1回しか発注できない設定では発注間隔が2週か3週かの二択になる点です。動的計画は \( S – s = 337 \) 個を選び、平均週需要が約277個なので \( S = 628 \) から2週ほどで発注点を下回り、そのときの発注量はおおむね550個になります。この周期のほうが、EOQ の693個を積む方策より安くなりました。もうひとつは、発注点を「需要の99%点」のように単独で決めると、\( S \) との組み合わせが最適から外れる点です。第12章では、こうした方策の良し悪しをシミュレーションで評価する方法を扱います。
なお、実務で (s,S) のパラメータを求めるときに、毎回この動的計画を回す必要はありません。Zheng と Federgruen(1991)は、定常な需要のもとで最適な \( s \) と \( S \) を、ひとつの方策を評価するのと同程度の計算量で求めるアルゴリズムを示しています。動的計画の役割は「方策の形が (s,S) でよい」と保証することであり、その2つの数を決める段階では、より軽い方法とシミュレーションを組み合わせるのが現実的です。
需要が確定しているとき、動的ロットサイジングと Wagner-Whitin 法
ここまでは需要が確率的に揺れる前提でした。一方、受注済みの生産計画や、上位品目の計画から展開された部品の所要量のように、各期の需要が数として確定している場合があります。このとき「どの期にいくつまとめて発注すれば、固定費と保管費の合計が最小になるか」を決める問題が動的ロットサイジングで、Wagner-Whitin 法(Wagner と Whitin、1958)がその厳密解を与えます。需要・固定費・保管費が期ごとに変わってよく、欠品は許さない、という設定です。
この問題には、解を単純にする性質があります。最適な計画では、在庫が残っている期に発注することはなく、発注は必ず在庫がゼロになった期に行われ、その量はそこから何期分かの需要の合計にぴったり一致する、という性質です。おかげで「期 \( j \) に発注して期 \( j \) から \( t \) までをまかなう」という候補だけを考えればよく、期 \( t \) までを満たす最小費用 \( F_t \) は \( F_t = \min_{1 \le j \le t} \{ F_{j-1} + K + h \sum_{k=j}^{t} (k – j) d_k \} \) という再帰で前向きに計算できます。持ち越した在庫には、持ち越した期数ぶんの保管費がかかる、という式です。原論文はさらに、ある期に発注が入ることが確定すれば、それより前の計画はそれ以降のデータに影響されないという「計画期間」の性質も示しており、全期間のデータを揃えなくても先頭の判断を確定できる根拠になっています。
def wagner_whitin(d, K, h):
    n = len(d)
    F = [0.0] + [float("inf")] * n     # F[t]: 1〜t 期を満たす最小費用
    last = [0] * (n + 1)               # 期 t を満たす最後の発注が行われた期
    for t in range(1, n + 1):
        for j in range(1, t + 1):      # 期 j に発注して j〜t 期の需要をまかなう
            hold = sum(h * (k - j) * d[k - 1] for k in range(j, t + 1))
            cost = F[j - 1] + K + hold
            if cost < F[t]:
                F[t], last[t] = cost, j
    orders = [0] * n                   # 後ろからたどって発注量を復元する
    t = n
    while t > 0:
        j = last[t]
        orders[j - 1] = int(sum(d[j - 1:t]))
        t = j - 1
    return orders, F[n]
まず B001(季節品)の2025年の需要を月次に集計して解きました。月次需要は1月から順に349・327・732・934・1,049・1,176・1,261・1,118・734・681・381・278個、合計9,020個です。保管費は原価3,500円の年20%を12で割った1個1か月あたり58.33円になります。この設定で Wagner-Whitin 法を解くと、答えは「毎月その月の分だけ買う」で、発注12回、保管費ゼロ、合計48,000円でした。1月の349個を1か月持ち越すだけで保管費は20,358円かかり、固定費4,000円を大きく超えるためです。月単位で見ると、この品目は「まとめ買いの余地がない」ことが確認できたわけです。
時間の刻みを週にすると様子が変わります。同じ2025年を7日ごと(最終週のみ8日)の52週に集計すると、週次需要は最小56・最大369・平均173.5個で、保管費は1個1週あたり13.462円です。夏場の週なら1週分の持ち越しに約3,000〜5,000円かかって固定費と拮抗しますが、冬場の週は1,000円程度なので、数週分をまとめた方が安くなります。Wagner-Whitin 法の解は発注25回、発注費100,000円、保管費60,644円、合計160,644円で、下の図の上段が示すように、冬は3週分をまとめ、夏は1〜2週ごとに買う計画になりました。
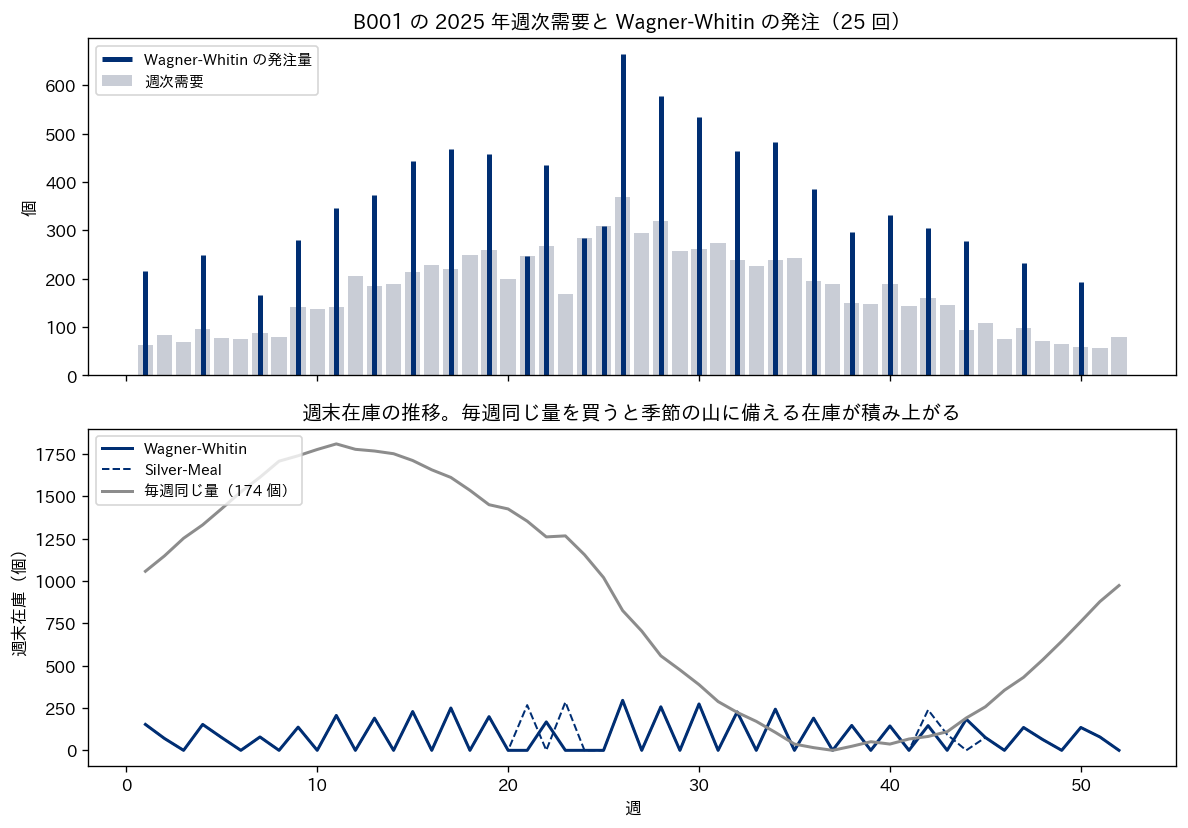
Silver-Meal 法などの近似法と、単純な規則との費用比較
Wagner-Whitin 法は厳密ですが、期数の2乗に比例する計算をし、発注の候補を全期にわたって見渡します(掲載したコードは分かりやすさを優先した素朴な実装で、内側で保管費の合計を毎回計算しているぶん、教科書の計算量より一段多く計算しています)。計算そのものは今日の計算機なら一瞬で、Wagelmans らが1992年に示したように、より少ない計算量のアルゴリズムも知られています。それでも実務では「先の需要は不確かなので、遠い将来まで見渡した最適解に意味があるのか」という疑問が残ります。そこで前向きに、目先の数期だけを見てロットを決める近似法が考案されました。代表が Silver-Meal 法(Silver と Meal、1973)です。ある期に発注するとき、まかなう期数を1期、2期と伸ばしながら「1期あたりの費用(固定費と保管費の合計を期数で割ったもの)」を計算し、それが増え始めた直前で止める、という規則です。
def silver_meal(d, K, h):
    n, i, orders = len(d), 0, [0] * len(d)
    while i < n:
        j, prev = i, None
        while j < n:
            hold = sum(h * (k - i) * d[k] for k in range(i, j + 1))
            per_period = (K + hold) / (j - i + 1)     # 1期あたりの費用
            if prev is not None:
                if per_period > prev:                  # 増え始めたら直前で止める
                    j -= 1
                    break
            prev = per_period
            j += 1
        j = min(j, n - 1)
        orders[i] = int(sum(d[i:j + 1]))
        i = j + 1
    return orders
同じ考え方で、割る対象を期数ではなく個数にしたのが最小単位費用法、保管費の累計が固定費に最も近づくところで切るのがパートピリオド・バランシングです。これらと、実務でよく見る単純な規則を同じ52週の需要に当て、費用を比べたのが次の表です。「毎週同じ量」は年間需要を52で割った174個を毎週買う方式で、夏の山で欠品しないよう年初に945個の在庫を用意する前提とし、その分の発注1回を含めています。
| 方式 | 発注回数 | 発注費(円) | 保管費(円) | 合計(円) | 最適比 | 平均在庫(個) |
|---|---|---|---|---|---|---|
| Wagner-Whitin 法(厳密解) | 25 | 100,000 | 60,644 | 160,644 | 1.000 | 86.6 |
| Silver-Meal 法 | 24 | 96,000 | 65,840 | 161,840 | 1.007 | 94.1 |
| 最小単位費用法 | 24 | 96,000 | 66,338 | 162,338 | 1.011 | 94.8 |
| パートピリオド・バランシング | 23 | 92,000 | 71,117 | 163,117 | 1.015 | 101.6 |
| 2週ごとにまとめ発注 | 26 | 104,000 | 61,802 | 165,802 | 1.032 | 88.3 |
| 毎週発注(ロット・フォー・ロット) | 52 | 208,000 | 0 | 208,000 | 1.295 | 0.0 |
| EOQ の固定量(321個) | 29 | 116,000 | 104,663 | 220,663 | 1.374 | 149.5 |
| 毎週同じ量(174個) | 53 | 212,000 | 623,363 | 835,363 | 5.200 | 890.5 |
Silver-Meal 法は厳密解より0.7%高いだけで、目先の数期しか見ないにもかかわらず、ほぼ最適な計画を出しています。3つの近似法はいずれも1.5%以内に収まりました。「2週ごとにまとめる」という定期のまとめ発注も3.2%増で悪くありません。一方、需要に季節性があるのに固定量321個を繰り返す方式は、夏場に足りずに2倍量を買い、冬場に余らせるため37%高くなり、毎週同じ量を買う方式は5.2倍になりました。ここから読み取れるのは、「需要の山谷に合わせてロットを変える」ことの効果は大きく、それをどの規則で決めるかの差は小さい、ということです。厳密解にこだわるより、需要に合わせて量を変える運用に切り替えることの方が、費用に対する効き目ははるかに大きいと言えます。
ただし、この比較は需要が確定している前提です。需要が読み違えれば、まとめ買いした分が余ったり、足りずに欠品したりします。確定需要のロットサイジングは「計画の骨格を決める」道具であり、需要のばらつきに対する備えは第4章の安全在庫と第8章の予測誤差の扱いで別に持つ、という役割分担で使うのが実務の型です。
「毎週同じ量を買う」と「需要に合わせて買う」の差を経営指標に翻訳する
先ほどの表の費用は、発注の事務費と保管費という技術的な数字です。経営の言葉に直すと、差はもっと大きく見えます。平均在庫に原価3,500円を掛けると在庫金額になり、2025年の日次平均需要24.7個で割ると在庫日数になります。Wagner-Whitin 法の計画では平均在庫86.6個、在庫金額303,221円、在庫日数3.5日です。Silver-Meal 法でも94.1個、329,202円、3.8日と大差ありません。これに対して毎週同じ量を買う計画では、平均在庫890.5個、在庫金額3,116,817円、在庫日数36.0日になります。同じ品目、同じ年間需要9,020個で、貸借対照表に載る在庫が約280万円違い、運転資金がそれだけ固定されます。
年間費用の差674,719円(835,363円と160,644円の差)は、この1品目の年間売上原価31,570,000円(9,020個×3,500円)の約2.1%に相当します。粗利率が20〜30%の商材であれば、粗利の数%から1割弱が在庫の持ち方ひとつで消えている計算です。しかも「毎週同じ量」の計画は季節の山に備える在庫を冬から積み上げるため、その在庫は最長で半年近く倉庫に置かれ、陳腐化や品質劣化の危険にさらされます。第1章で述べた保有費用のうち、資本コストと保管料だけでなく、陳腐化の損失が乗ってくるのがこの型の在庫です。
もちろん、毎週同じ量を買う運用にも理由はあります。仕入先の生産能力が平準化を求める、輸送枠が固定されている、担当者の作業を一定にしたい、といった事情です。それらは正当な制約ですが、その制約を守るために年間67万円と在庫280万円を負担している、という事実を数字で示せることが大切です。仕入先との交渉で発注固定費を下げる、輸送枠を季節で組み替える、といった施策の価値は、この差額から逆算できます。動的ロットサイジングの経営上の使い道は、最適な計画を出すことそのものより、いまの運用が払っている見えない費用を金額で見せることにあると考えています。
MRP と時間軸の発注計画、計画期間の長さとローリング
動的ロットサイジングが実務で最も使われている場所は、製造業の資材所要量計画(MRP)です。JIS Z 8141(生産管理用語)は MRP を「生産計画情報、部品構成表情報及び在庫情報に基づいて、資材の必要量と時期を求める生産管理体系」と定義しています。基準生産計画で決めた製品の生産予定を部品構成表で展開して各部品の総所要量を求め、手持在庫と発注残を引いて正味所要量を出し、それをロットにまとめ、リードタイムぶん前倒しして発注日を決める、という流れです。時間の刻みをタイムバケットと呼び、週や日で切ります。同じ規格は、ロットサイジングを「部品手配を行うとき、段取時間、発注コスト、保管コスト、納期などを考慮して、手配する部品の数量をまとめる活動」と定義しており、本章の Wagner-Whitin 法や Silver-Meal 法は、この「まとめる」段階に入る計算規則です。
MRP のロットまとめ規則として一般に用意されているのは、ロット・フォー・ロット(正味所要量をそのまま発注)、固定量、定期まとめ、そして Silver-Meal 法などの近似法です。先ほどの表は、そのまま MRP の規則の選択肢の比較として読めます。需要が平らなら固定量や定期まとめで十分ですが、季節性や受注の山谷がある部品には、需要に合わせてロットを変える規則を選ぶべきだ、というのが表の結論です。第11章では、複数品目が同じ設備や予算を取り合う場合の動的ロットサイジングを、整数計画として定式化して解きます。
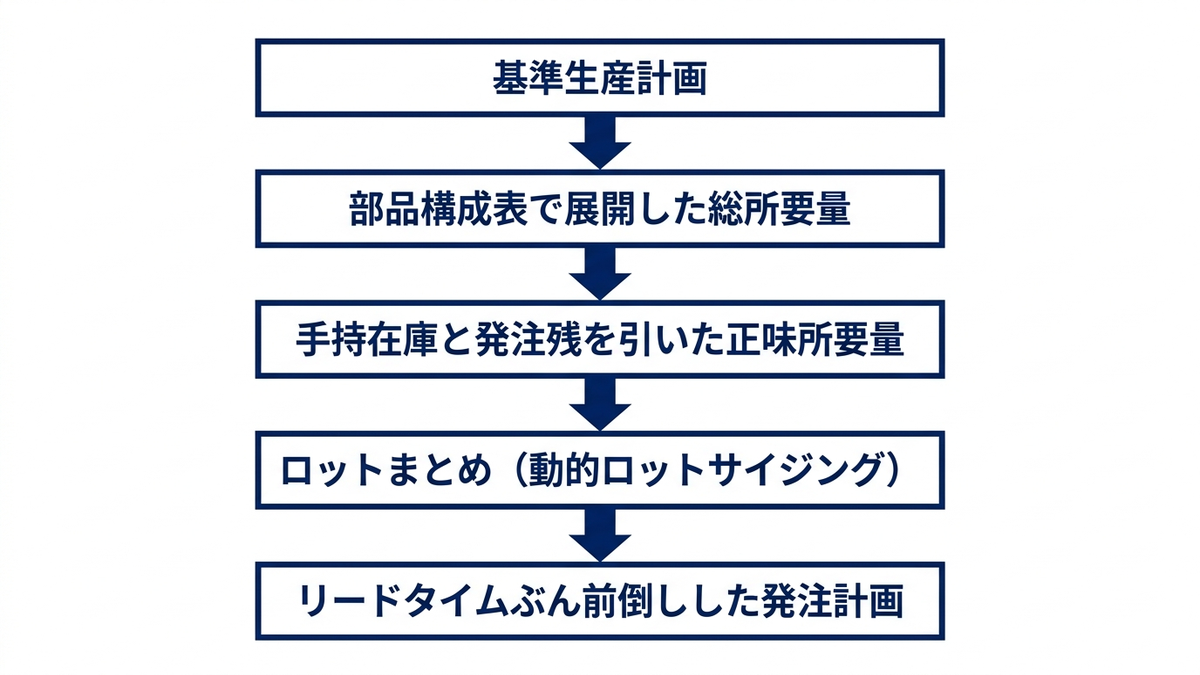
時間軸の計画には、動的計画の終端効果と同じ問題がつきまといます。計画期間の先端では「その先の需要が見えていない」ために、末尾の判断が不自然になります。実務では毎週、計画期間を1週ずつずらして解き直す(ローリング)ため、先週は「3週分まとめて買う」だった第1週の判断が、今週解き直すと「2週分」に変わる、ということが起きます。これは計画の神経質さ(ナーバスネス)と呼ばれ、仕入先や工程に発注の変更を頻繁に流す原因になります。
B001 の週次需要で、先何週まで見て解くかによって第1週の発注量がどう変わるかを確かめました。先2週までなら145個(2週分)、先3週までなら215個(3週分)、先4週までなら145個、先5週以上ならすべて215個でした。つまり、この品目では先5週以上を見て解けば第1週の判断は変わりません。これが Wagner-Whitin 法の計画期間の性質の実際の姿で、「どこまで先を見れば先頭の判断が確定するか」を品目ごとに調べておけば、計画期間を必要以上に長く取らずに済み、ナーバスネスの一因も減らせます。加えて、確定した先頭の数週は変更しない(タイムフェンス)、変更は一定以上の差があるときだけ流す、といった運用上の歯止めを組み合わせるのが一般的です。
この章のまとめと、手法の使い分け
本章で扱った手法を、何を決めるか、前提、使ってはいけない場面の3点で整理します。
| 手法 | 何を決めるか | 前提 | 使ってはいけない場面 |
|---|---|---|---|
| 動的計画(確率需要) | 各期・各在庫水準での最適な発注量。方策の形 | 需要の確率分布が各期で分かる。費用が凸 | 分布が推定できない品目。品目数が多く毎期回す用途 |
| ベースストック方策 | 基準在庫 \( S \) | 発注固定費が無視できる | 固定費が大きく、毎期補充すると発注費がかさむ品目 |
(s,S) 方策 | 発注点 \( s \) と補充水準 \( S \) | 固定費があり、需要が確率的 | 需要が確定している計画(ロットサイジングの方が適切) |
| Wagner-Whitin 法 | 各期のロットの大きさ(厳密解) | 需要が確定。欠品を許さない | 先の需要が不確かで、遠い将来まで最適化する意味がない場合 |
| Silver-Meal 法などの近似 | 各期のロットの大きさ(近似解) | 需要が確定。目先の数期を見る | 厳密解との差が問題になる高額品目(そのときは厳密解を使う) |
多期間の在庫問題は、状態を「いまの在庫」に絞れば動的計画で解け、固定費が無ければベースストック、固定費があれば (s,S) という方策の形が最適であることが、K 凸性を道具にして証明されています。需要が確定している計画では Wagner-Whitin 法が厳密解を与え、Silver-Meal 法などの近似でも1〜1.5%程度の差に収まります。そして経営の観点で最も大きいのは、厳密解と近似解の差ではなく、需要に合わせて量を変える計画と、毎週同じ量を買う計画の差でした。次の第8章では、ここまで「分かっている」と仮定してきた需要の分布や確定値が、実際には予測から来ることを踏まえ、予測誤差を安全在庫と発注にどう翻訳するかを扱います。
Anagraftでは、データ活用の構想づくりから分析の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『マルコフ決定過程:理論とアルゴリズム』(中出康一、コロナ社):本章の動的計画は、状態と行動と費用で意思決定を記述するマルコフ決定過程の一例です。価値反復や方策反復といった解法、無限期間や平均費用の扱いまで、日本語で体系的に学べます。著者は在庫理論の研究者で、在庫問題を念頭に読み進めやすい構成です。
『Pythonによる実務で役立つ最適化問題100+(2)割当・施設配置・在庫最適化・巡回セールスマン』(久保幹雄、朝倉書店):第19章が在庫最適化問題、第20章が動的ロットサイズ決定問題で、本章の Wagner-Whitin 法から第11章で扱う多品目・多段階の定式化までを、Python のコードとともに追えます。手元で動かしながら理解したい方に向いています。
第8章 需要予測と発注をつなぐ、予測誤差を在庫に翻訳する
第7章では、需要が期ごとに変わる多期間の問題で、\( (s,S) \) 方策や動的ロットサイジングがどう発注を決めるかを確認しました。そこでは各期の需要の見込みが与えられているものとして話を進めています。本章はその見込み、すなわち需要予測が、発注量と安全在庫にどうつながるかを扱います。予測の手法そのものは弊社コラム「ビジネスデータの予測に効く時系列分析、基礎から実務まで」で扱っていますので、本章では予測を受け取った後の話に絞ります。具体的には、安全在庫を決めるべきなのは需要のばらつきではなく予測誤差のばらつきであること、予測誤差をどう測るか、平均がずれた予測(バイアス)がなぜ安全在庫で救えないか、リードタイム分の誤差をどう合成するか、需要がまばらな品目をどう予測するか、そして分位点予測で発注量を直接出す考え方です。第2章で用意した架空のサンプルデータに単純な予測を当て、2025年をホールドアウト(予測に使わない検証期間)として、数字で確かめていきます。
安全在庫を決めるのは需要のばらつきではなく予測誤差のばらつき
第4章の安全在庫の式では、リードタイム中の需要の標準偏差に安全係数を掛けました。あの式の標準偏差は、教科書によって「需要の標準偏差」と書かれることも「予測誤差の標準偏差」と書かれることもあり、両者が同じものだと思われがちです。しかし安全在庫が守るべきなのは、発注時に見込んだ量と実際に売れた量の差です。見込みが的確であれば需要が季節で大きく動いていても差は小さく、見込みが的外れなら需要が安定していても差は大きくなります。したがって安全在庫の大きさを決めるのは、需要そのものがどれだけ散らばっているかではなく、予測誤差、つまり「実績から予測を引いた値」がどれだけ散らばっているかです。
需要の標準偏差と予測誤差の標準偏差が一致するのは、需要が平均のまわりでただ揺れているだけで、予測がその平均を当てるしかない場合です。第2章の定番品 A001 がまさにこれで、後で確かめるとおり両者はほぼ同じ値になります。一方、季節品 B001 は夏に山、冬に谷を持ちます。需要の標準偏差にはこの山と谷の分が入っていますが、季節を織り込んだ予測を使えば山と谷は誤差になりません。需要の標準偏差で安全在庫を決めると、予測が当てられる分まで在庫で二重に守ることになります。逆に、成長品 D001 を過去の平均で予測すると、需要の伸びがそのまま誤差に化けます。需要の標準偏差は小さく見えても、予測誤差は系統的に大きく、需要の標準偏差で決めた安全在庫では足りません。
この整理から、実務での手順が決まります。まず予測を作り、予測に使っていない期間でその誤差を測り、誤差の散らばりからリードタイム分の安全在庫を決める、という順序です。予測を良くすれば誤差が減り、安全在庫が減ります。予測を良くしても誤差が減らない品目(A001 のような品目)では、予測への投資は安全在庫を減らしません。この違いを品目ごとに数字で見ておくことが、予測精度に投資すべき品目とそうでない品目を分ける根拠になります。本章の最後で、60品目全体でこの計算をまとめます。
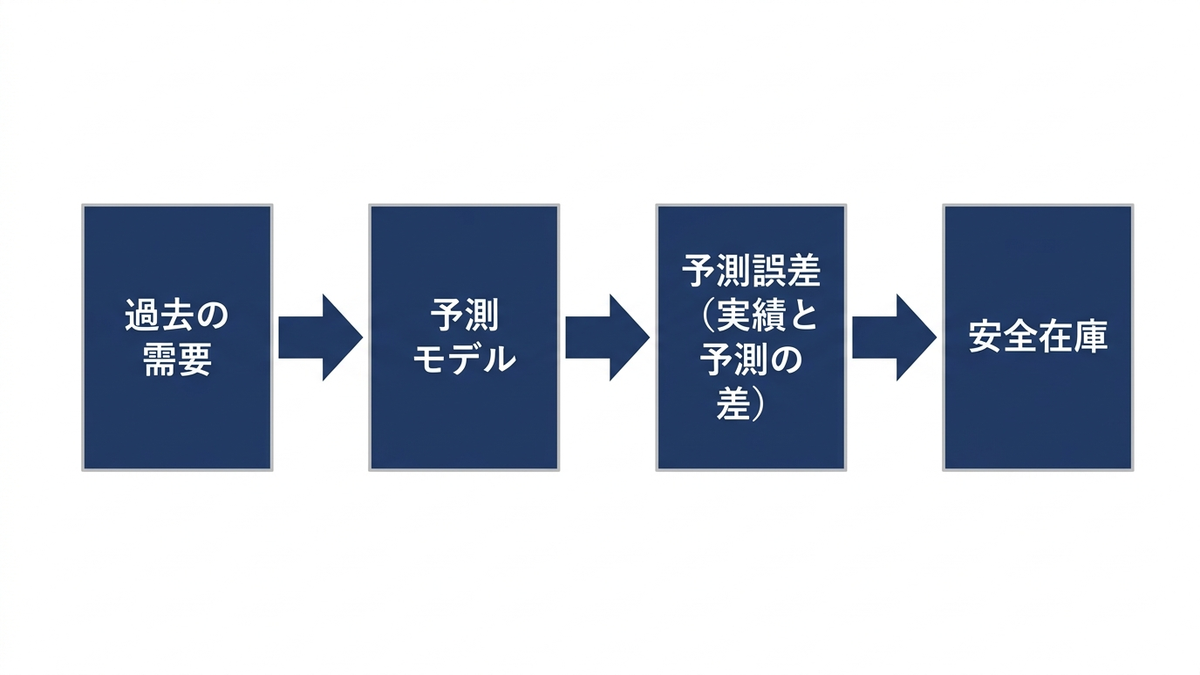
予測誤差をどう測るか、ME・MAD・RMSE と正規分布への換算
予測誤差 \( e_t = y_t – \hat{y}_t \) は、実績 \( y_t \) から予測 \( \hat{y}_t \) を引いた値です。符号を付けたまま平均したものが平均誤差(ME)で、これが0から離れていれば予測は系統的に高いか低いか、つまりバイアスがあります。絶対値の平均が平均絶対誤差(MAE、在庫管理の教科書では MAD と呼ぶことが多く、本章もそれに従います)、2乗平均の平方根が RMSE です。Hyndman と Athanasopoulos による時系列予測の標準的なオンライン教科書『予測:原理と実践』(第3版。以下「予測の教科書」と呼びます)は、MAE を最小にする予測は中央値を、RMSE を最小にする予測は平均を狙う予測になると整理しています。同書はまた、パーセント誤差(MAPE)は実績がゼロの期間があると定義できないと注意しており、後述する間欠需要では使えません。
安全在庫の計算に必要なのは誤差の標準偏差です。バイアスが無ければ RMSE は誤差の標準偏差にほぼ一致します。MAD しか手元に無いときは、正規分布の前提で換算します。正規分布では平均絶対偏差が標準偏差の \( \sqrt{2/\pi} \)、およそ 0.798 倍になるので、逆に標準偏差は MAD のおよそ 1.25 倍です(scipy で計算すると 1.2533 倍になります)。MAD に 1.25 を掛けて標準偏差の代わりに使う換算の根拠は、この正規分布の性質です。ただし、誤差の分布が正規分布から外れているとこの比は変わり、バイアスがあると MAD にバイアスの分が混ざるので、換算は成り立ちません。後で示す実測では、定番品の誤差はほぼ 1.25 倍に乗り、季節品の誤差はそれより裾が重く 1.35 倍から 1.38 倍、バイアスのある予測では 0.96 倍と、品目と予測によってばらつきました。
もう一つ、誤差をどの期間で測るかが決定的に重要です。同書は「予測の精度は、モデルの当てはめに使っていない新しいデータでどれだけ当たるかでしか判断できない」と述べ、訓練期間で計算する残差と、検証期間で計算する予測誤差を区別しています。訓練期間の残差の標準偏差で安全在庫を決めると、当てはめの良さがそのまま楽観に化けます。本章では、2023年と2024年の731日で予測モデルを推定し、2025年の365日を検証期間として、毎日予測を更新しながら翌日以降の誤差を測りました。分位点回帰の節で、訓練期間の残差の標準偏差が 34.7 だったのに対し、検証期間の誤差の標準偏差は 47.2 だったという実測を示します。安全在庫は後者で決めるべき数字です。
共通データで確かめる、定番品・季節品・成長品の予測誤差
予測には statsmodels 0.14.6 の単純指数平滑(SimpleExpSmoothing)と Holt の線形トレンド法(Holt)を使い、平滑化パラメータは initialization_method="estimated" で訓練期間から推定しました。季節品には、年周期の正弦・余弦を2組使った回帰で季節指数(平均1)を作り、季節指数で割った系列に単純指数平滑を当てて、予測時に季節指数を掛け戻す形にしました。検証期間では、毎日その日までの実績で水準を更新し、翌日から21日先までの予測を出します。次のコードは、その骨格です。
import numpy as np
from statsmodels.tsa.holtwinters import SimpleExpSmoothing
from scipy.stats import norm
from inv_data import load_demand, load_skus

dem, skus = load_demand(), load_skus()
train, test = dem.loc[:"2024-12-31"], dem.loc["2025-01-01":]
n_tr, n_te, H = len(train), len(test), 21

fit = SimpleExpSmoothing(train["A001"], initialization_method="estimated").fit()
alpha, level = float(fit.params["smoothing_level"]), float(fit.params["initial_level"])

# 検証期間の各起点から 1〜H 日先の予測を、毎日更新しながら出す
y = dem["A001"].values
F = np.full((n_te, H), np.nan)
for t in range(len(y)):
    if t >= n_tr:
        F[t - n_tr, :] = level          # 単純指数平滑の予測は地平によらず一定
    level = alpha * y[t] + (1 - alpha) * level

yt = test["A001"].values
e1 = yt - F[:, 0]                       # 1日先の誤差
L = int(skus.loc["A001", "lt_mean"])    # リードタイム 7 日
eL = np.array([yt[i:i + L].sum() - F[i, :L].sum() for i in range(n_te - L + 1)])
print("ME %.2f  MAD %.2f  RMSE %.2f  誤差SD %.2f  需要SD %.2f"
      % (e1.mean(), np.abs(e1).mean(), np.sqrt((e1 ** 2).mean()), e1.std(ddof=1), yt.std(ddof=1)))
print("L日累積誤差の SD %.2f  √L×1日SD %.2f  安全在庫(95%%) %.1f"
      % (eL.std(ddof=1), np.sqrt(L) * e1.std(ddof=1), norm.ppf(0.95) * eL.std(ddof=1)))
# 出力:
# ME -0.18  MAD 7.69  RMSE 9.50  誤差SD 9.51  需要SD 9.51
# L日累積誤差の SD 27.82  √L×1日SD 25.15  安全在庫(95%) 45.8
3つの代表品目について、1日先の予測誤差をまとめたのが次の表です。需要の標準偏差は訓練期間と検証期間の両方を載せています。
| 品目 | 予測の方法 | ME(バイアス) | MAD | RMSE | 誤差の標準偏差 | 需要の標準偏差(訓練/検証) |
|---|---|---|---|---|---|---|
| A001 定番品 | 単純指数平滑(α=0.00) | -0.18 | 7.69 | 9.50 | 9.51 | 9.84/9.51 |
| B001 季節品 | 単純指数平滑のみ(α=0.10) | -0.03 | 7.49 | 10.32 | 10.33 | 14.66/14.89 |
| B001 季節品 | 季節指数×単純指数平滑 | -0.54 | 7.47 | 10.11 | 10.11 | 14.66/14.89 |
| D001 成長品 | 訓練期間の平均で固定 | +5.58 | 6.74 | 8.54 | 6.47 | 5.56/6.47 |
| D001 成長品 | 単純指数平滑(α=0.02) | +0.61 | 5.17 | 6.42 | 6.40 | 5.56/6.47 |
| D001 成長品 | Holt の線形トレンド法 | +0.02 | 5.11 | 6.35 | 6.35 | 5.56/6.47 |
定番品 A001 では、推定された平滑化パラメータ α がほぼ0になりました。訓練期間の平均 39.68 をそのまま予測し続けるのが最善だという結果で、誤差の標準偏差 9.51 は検証期間の需要の標準偏差 9.51 と一致しています。この品目には予測で減らせるばらつきが無く、需要の標準偏差で安全在庫を決めても予測誤差で決めても同じ答えになります。季節品 B001 では、季節を織り込まない単純指数平滑でも1日先の誤差は 10.33 と、需要の標準偏差 14.89 よりかなり小さくなりました。年周期の変化はゆっくりなので、直近の水準を追いかけるだけでも翌日はそれなりに当たるためです。季節指数を掛けた予測は 10.11 で、1日先の精度ではわずかな差しかありません。この差がリードタイム分の累積になると大きく開くことを、次の節で示します。成長品 D001 は、訓練期間の平均で固定するとバイアスが 1日あたり +5.58 個も出ます。2025年の需要は1日平均 21.4 個で、訓練期間2年間の平均 15.8 個をそのまま使うと、毎日 5 個以上足りない予測を出し続けることになるからです。単純指数平滑にすると α が 0.02 とごく小さく推定され、トレンドを追いきれずに +0.61 のバイアスが残りました。Holt の線形トレンド法では +0.02 とほぼ消えています。
MAD からの換算も確かめておきます。A001 では 1.25 × MAD = 9.64 に対し実測の誤差の標準偏差は 9.51 で、比は 1.236 とほぼ正規分布どおりでした。B001 では比が 1.35 から 1.38 と大きめで、負の二項分布に由来する裾の重さと、季節によって散らばりの大きさが変わることの両方が効いています。D001 を平均で固定した予測では、MAD にバイアスが混ざって比が 0.96 まで下がりました。MAD に 1.25 を掛ける換算は、バイアスが無く分布が正規に近いときの近道であって、その前提が崩れた品目では実測の標準偏差か分位点を使うほうが安全です。
バイアスの害、平均がずれた予測は安全在庫で救えない
安全在庫は、予測が平均的には当たっていて、そのまわりで実績が上下に散らばることを前提に、上振れの側だけを守る仕組みです。予測が系統的に低い方向へ外れていると、上振れが毎回起きるのと同じことになり、安全係数で決めた分では守りきれません。予測の教科書は、良い予測の残差が満たすべき性質として「残差の平均がゼロであること。ゼロでなければ予測にはバイアスがある」を挙げ、バイアスは残差の平均を予測に足せば取り除けると述べています。取り除けるものを安全在庫で覆うのは、在庫金額の無駄です。
成長品 D001 でその害を測りました。リードタイムは10日です。需要の標準偏差から第4章の式で出した95%の安全在庫は 28.9 個ですが、訓練期間の平均で固定した予測にこの安全在庫を足して2025年を回すと、10日分の需要が「予測+安全在庫」に収まった割合はわずか 7.6% でした。予測誤差の標準偏差(10日分の累積で 20.1)から出し直しても 13.8% です。誤差の標準偏差はバイアスを含みませんから、平均が 55 個も低くずれている予測の穴を埋められません。95% を達成するには累積誤差の95%点である 89.3 個を積む必要があり、Holt 法で予測したときの累積誤差の95%点 26.4 個の 3.4 倍です(表の「安全在庫(累積誤差から)」28.0 個は誤差の標準偏差に安全係数を掛けた値で、ここでは同じ分位点どうしで比べています)。原価 2,400円の品目ですから、在庫金額にして 151,000円ほどを、予測を更新すれば要らない在庫として持つ計算になります。単純指数平滑(α=0.02)でも、トレンドを追いきれない +0.61 個/日のバイアスが10日分で 5.9 個の累積バイアスになり、誤差の標準偏差で決めた安全在庫での達成率は 91.3% にとどまりました。
この結果は「予測を当てにいく」失敗の典型でもあります。バイアスは予測の外に居座り、安全在庫の式の中には入ってきません。したがって予測を運用する側は、精度指標として MAD や RMSE だけを見るのではなく、平均誤差の符号と大きさを品目ごとに追い続ける必要があります。平均誤差が一方向に偏り続けている品目は、安全在庫を増やすのではなく、予測の更新頻度か手法を直すべき品目です。第13章で扱う例外管理の仕組みに、この監視を組み込むことをお勧めします。
リードタイム分の誤差の合成、単純に平方根倍にならない理由
安全在庫が守るのは、発注してから入荷するまでの間、つまりリードタイム \( L \) 日分の累積需要と、その期間の累積予測の差です。1日先の誤差の標準偏差 \( \sigma_1 \) が分かっているとき、教科書的な近道は「\( L \) 日分の誤差の標準偏差は \( \sqrt{L}\,\sigma_1 \)」とする方法で、第4章の合成式もこの形を含んでいます。この近道は各日の誤差が互いに独立であるときにだけ成り立ちます。ところが、同じ起点から出した 1日先、2日先、…、\( L \) 日先の予測は、どれも起点の時点の同じ情報から作られているので、その誤差は同じ向きに出やすくなります。予測が季節の上り坂を織り込んでいなければ、翌日も翌々日も実績は予測を上回り続けます。この相関があると、累積誤差の標準偏差は \( \sqrt{L}\,\sigma_1 \) より大きくなります。
この点は在庫理論の側でも指摘されています。Prak、Teunter、Syntetos の2017年の論文『On the calculation of safety stocks when demand is forecasted』は、1期先の予測誤差の分散にリードタイムを掛けて安全在庫を出す伝統的な手順について、「リードタイム内の各期の予測誤差は、需要過程そのものに自己相関が無くても正に相関する」ため安全在庫が低く出ると論じ、伝統的な手順では安全在庫が最大30%低く、サービス率が目標より最大10ポイント低くなりうると報告しています。予測の教科書も、複数期間の合計に対する予測区間は「予測誤差どうしの相関のため」単純には計算できず、一般にはシミュレーションで求めると述べています。同書が示す単純指数平滑の \( h \) 期先の予測分散 \( \sigma^2[1+\alpha^2(h-1)] \) は、地平が延びるほど1期あたりの誤差も大きくなることを表しており、これも累積誤差を \( \sqrt{L} \) 倍より膨らませる要因です。
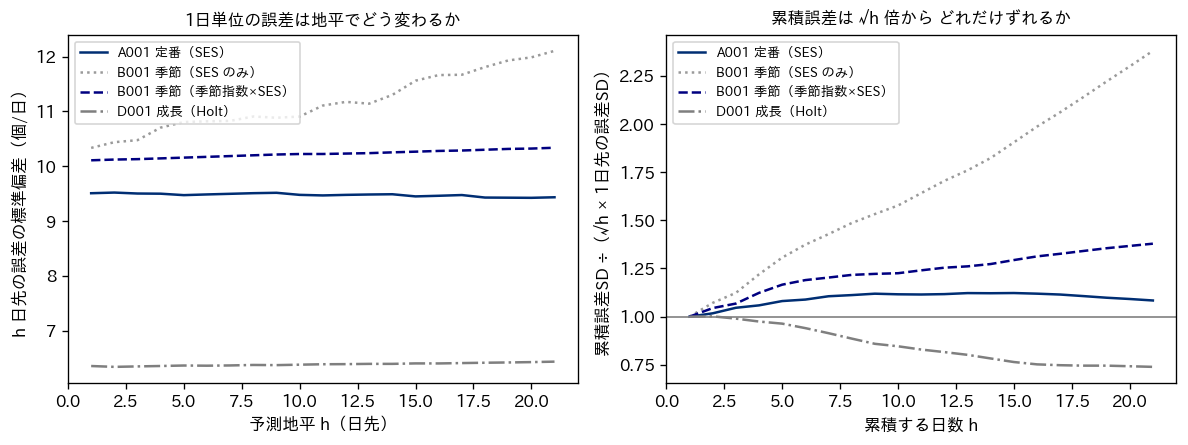
サンプルデータで、累積誤差の標準偏差を \( \sqrt{h}\,\sigma_1 \) で割った比を \( h \) =1日から21日まで測りました。季節を織り込まない単純指数平滑を季節品 B001 に当てると、比は7日で 1.43、14日で 1.82、21日で 2.38 まで膨らみます。1日先の精度では季節指数を掛けた予測とほとんど差が無かったのに、リードタイム14日分の累積誤差の標準偏差は 70.5 対 48.2 と、5割近い開きになりました。季節指数を掛けた予測でも比は 14日で 1.27 と 1 を上回っており、これは季節指数の形が2年分の訓練データから推定した近似であることの残りです。定番品 A001(リードタイム7日で 1.11)と Holt 法を当てた成長品 D001(10日で 0.85)は 1 の近くにあります。誤差が互いに独立なときでも、365日分のデータから測った比はぶれます。正規乱数で確かめると、5%点から95%点の範囲は7日で 0.87 から 1.10、10日で 0.84 から 1.13 でした。A001 の 1.11 はこの範囲の上端とほぼ同じ、D001 の 0.85 は範囲の中にあり、この2つでは近道からのずれは1年分のデータのぶれで説明できる程度です。同じ起点から出した1日先と14日先の誤差の相関を直接測ると、B001 の単純指数平滑では +0.18、季節指数×単純指数平滑では +0.10、A001 では -0.06、D001 では -0.08 でした。
実務への含意ははっきりしています。1日先の誤差から \( \sqrt{L} \) 倍で安全在庫を出すのではなく、実際のリードタイム分の累積誤差を検証期間で直接測り、その標準偏差か分位点を使うことです。本章のコードはそのために、各起点から \( L \) 日先までの予測を保存して累積誤差を計算しています。リードタイム自体がばらつく場合は、第4章の合成式のとおり、リードタイムの分散に予測水準の2乗を掛けた項を加えます。この項も、需要の標準偏差ではなく予測誤差の標準偏差と組み合わせるのが筋です。
| 品目 | 予測の方法 | L(日) | 累積誤差の標準偏差 | √L×1日先の標準偏差 | 比 | 安全在庫(訓練期間の需要の標準偏差×√L から) | 安全在庫(累積誤差から) | 達成率(需要) | 達成率(誤差) |
|---|---|---|---|---|---|---|---|---|---|
| A001 定番品 | 単純指数平滑 | 7 | 27.8 | 25.2 | 1.11 | 42.8 個 | 45.8 個 | 96.1% | 96.4% |
| B001 季節品 | 単純指数平滑のみ | 14 | 70.5 | 38.7 | 1.82 | 90.3 個 | 116.0 個 | 90.6% | 93.5% |
| B001 季節品 | 季節指数×単純指数平滑 | 14 | 48.2 | 37.8 | 1.27 | 90.3 個 | 79.2 個 | 97.7% | 96.3% |
| D001 成長品 | 訓練期間の平均で固定 | 10 | 20.1 | 20.5 | 0.98 | 28.9 個 | 33.1 個 | 7.6% | 13.8% |
| D001 成長品 | Holt の線形トレンド法 | 10 | 17.0 | 20.1 | 0.85 | 28.9 個 | 28.0 個 | 96.1% | 94.9% |
表の達成率は、2025年の各起点について、リードタイム分の累積需要が「累積予測+安全在庫」に収まった割合です。B001 を季節なしで予測すると、需要の標準偏差から出した 90.3 個の安全在庫では 90.6% にしか届きません。予測が悪いのに在庫が守ってくれると思い込む形です。季節指数を掛けた予測に切り替えると、必要な安全在庫は 79.2 個に減り、需要の標準偏差から出した 90.3 個は過剰になります(達成率 97.7%)。同じ安全在庫の式でも、標準偏差にどの数字を入れるかで、守りすぎと守り足りないの両方が起きるわけです。
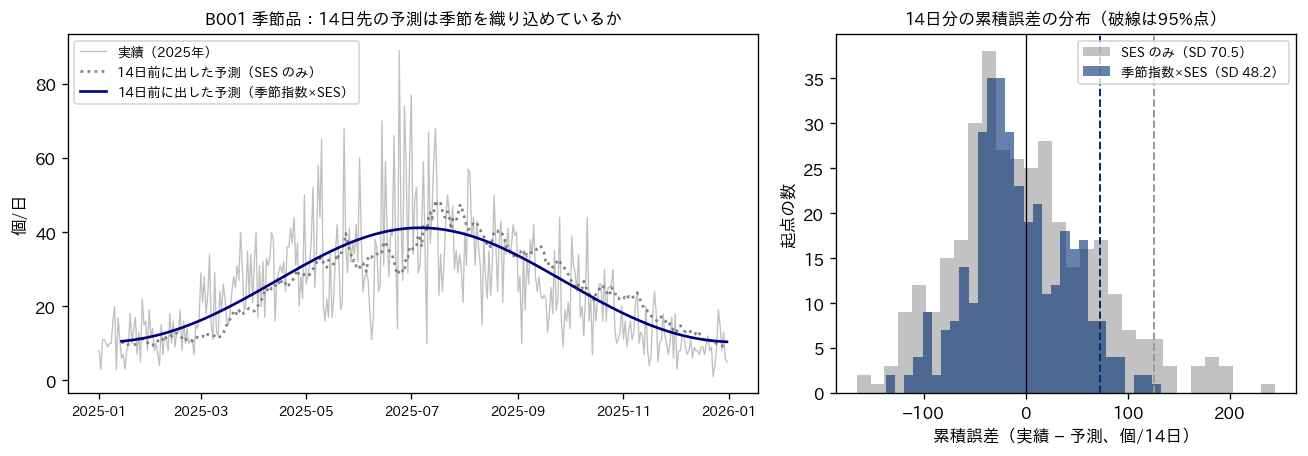
予測の更新頻度と発注周期、守るべき期間と誤差の測り方
ここまでの計算は、毎日予測を更新し、発注のたびに最新の予測を使う前提でした。実務では予測の更新周期と発注の周期が別々に決まっていることが多く、この2つの関係が守るべき期間と誤差の大きさを変えます。第5章で見たとおり、定期発注方式では発注間隔 \( R \) とリードタイム \( L \) を足した期間が保護期間になります。予測誤差の側で言えば、発注時点で持っている予測を使って \( R+L \) 日分の累積需要を見込むので、その期間の累積誤差が安全在庫の対象です。A001 を7日ごとに定期発注するなら、7日のリードタイムと合わせて14日分の累積誤差を測ることになります。
予測の更新が発注より遅いと、発注時に使う予測は最大で更新間隔の分だけ古くなります。古い予測を使うことは、予測の地平を延ばすことと同じです。サンプルデータでは、季節を織り込まない単純指数平滑を B001 に当てたときの1日あたりの誤差の標準偏差が、1日先で 10.33、21日先では 12.10 と 17% 大きくなりました。季節指数を掛けた予測では 10.11 から 10.34 へと 2% しか変わりません。予測が動きの方向を織り込んでいれば古くなっても劣化は小さく、直近の水準を追うだけの予測は古くなるほど当たらなくなります。月に1回まとめて予測を更新し週次で発注している運用では、月末に近い発注ほど大きな誤差を抱えることになり、その分を安全在庫が吸収しています。予測の更新を発注周期に合わせるだけで、安全在庫を減らせる余地があるということです。
更新の「強さ」も誤差に効きます。単純指数平滑の α は、新しい実績を予測にどれだけ反映させるかの重みです。A001 では α がほぼ0と推定されました。水準が動かない品目では、直近の実績に反応しないほうが誤差は小さくなります。一方 D001 では α=0.02 と小さく推定されたために伸びを追いきれず、バイアスが残りました。水準が動く品目には、トレンドを持つモデルか、十分な大きさの α が要ります。どの品目にどの更新の仕方が合うかは、検証期間の誤差で決めるべきことで、全品目に同じ α を当てる運用は、A001 型の品目で誤差を増やすか D001 型の品目でバイアスを残すかのどちらかになります。予測モデルの選び方と α の決め方の詳細は、前述の時系列分析のコラムに譲ります。
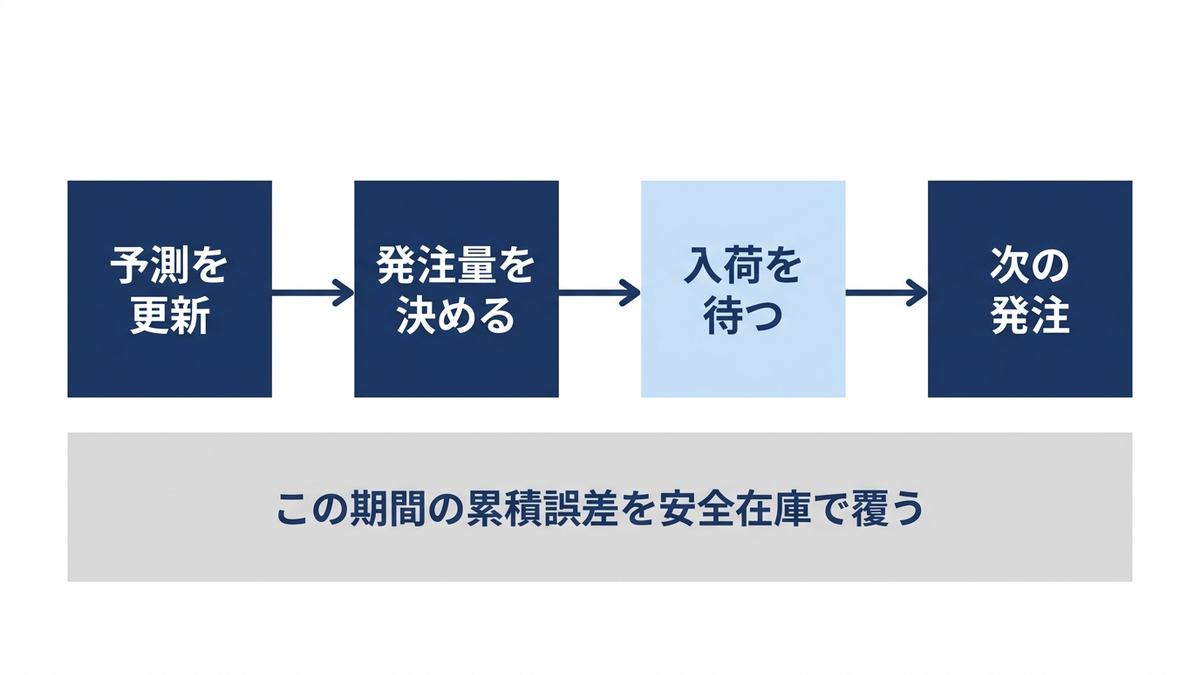
間欠需要の予測、Croston 法と SBA
第2章で分類した間欠需要品 C001 は、需要がある日が2割弱、ある日の平均は6個強という品目です。訓練期間の731日では、需要が発生した日が143日、発生時の平均は 6.41 個、発生間隔の平均は 5.11 日でした。こうした系列に単純指数平滑をそのまま当てると、需要が出た翌日に予測が跳ね上がり、ゼロが続く間に減衰していく鋸の歯のような予測になります。1972年に Croston が提案したCroston 法は、この問題を「需要が発生したときの大きさ」と「発生と発生の間隔」の2つの系列に分けて、それぞれを需要が発生した日にだけ指数平滑し、予測は大きさを間隔で割った値とする方法です。予測の教科書も、小さな整数値の需要にはこの種の方法が要ると述べたうえで、Croston 法を「2つの新しい系列 \( a \)(間隔)と \( q \)(大きさ)に別々の単純指数平滑を当てる」方法として整理し、Croston 自身は平滑化パラメータを両方とも 0.1 に置いたと説明しています。
同書は、Croston 法の予測にはバイアスがあることも指摘しています(Syntetos と Boylan の2001年の研究による)。大きさの平滑値を間隔の平滑値で割ると、割り算の性質から平均的に高めの値が出るためです。Syntetos と Boylan は2005年の論文で、Croston 法の予測に \( (1-\alpha/2) \) を掛けて補正する近似を提案し、これは提案者の名前からSBA(Syntetos-Boylan Approximation)と呼ばれています。α=0.1 なら 0.95 倍、つまり 5% 低く補正する形です。次のコードは、Croston 法を10行程度で実装したものです。
import numpy as np
from inv_data import load_demand

y = load_demand()["C001"].values

def croston(y, alpha=0.1):
    """需要が出た日に、大きさ z と間隔 p を別々に指数平滑する。予測は z / p"""
    f = np.full(len(y), np.nan)
    z = p = None
    q = 1                          # 前回の需要からの日数
    for t in range(len(y)):
        if y[t] > 0:
            if z is None:
                z, p = y[t], q     # 初期値は最初の需要とその間隔
            else:
                z = (1 - alpha) * z + alpha * y[t]
                p = (1 - alpha) * p + alpha * q
            q = 1
        else:
            q += 1
        f[t] = np.nan if z is None else z / p
    return f

alpha = 0.1
f_cro = croston(y, alpha)
f_sba = (1 - alpha / 2) * f_cro    # SBA の補正
n_tr = 731                          # 2023〜2024 年
pred, act = f_sba[n_tr - 1:-1], y[n_tr:]   # 前日に出した予測と、その日の実績
print("SBA 予測平均 %.3f  実績平均 %.3f  ME %+.3f  MAD %.3f"
      % (pred.mean(), act.mean(), (act - pred).mean(), np.abs(act - pred).mean()))
# 出力:
# SBA 予測平均 1.182  実績平均 1.290  ME +0.108  MAD 2.064
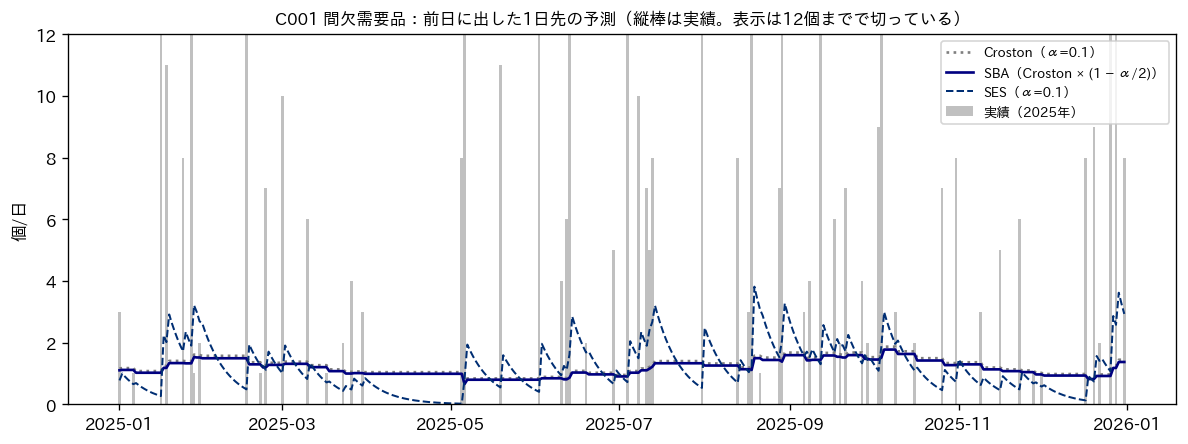
検証期間の1日先の誤差をまとめたのが次の表です。参考のために、訓練期間の平均で固定した予測と、常にゼロと予測した場合も並べています。
| 予測の方法 | 予測の平均(個/日) | 実績の平均 | ME | MAD | RMSE | 21日分の累積誤差の標準偏差 |
|---|---|---|---|---|---|---|
| Croston 法(α=0.1) | 1.245 | 1.290 | +0.046 | 2.107 | 3.687 | 15.83 |
| SBA(Croston × 0.95) | 1.182 | 1.290 | +0.108 | 2.064 | 3.687 | 15.74 |
| 単純指数平滑(α=0.1) | 1.217 | 1.290 | +0.073 | 2.105 | 3.765 | 21.26 |
| 訓練期間の平均で固定 | 1.253 | 1.290 | +0.037 | 2.121 | 3.673 | 対象外 |
| 常にゼロ | 0.000 | 1.290 | +1.290 | 1.290 | 3.893 | 対象外 |
表の右端の列は、予測を毎日更新する3つの方法について、21日分の累積誤差を比べたものです。参考として並べた「訓練期間の平均で固定」と「常にゼロ」は累積誤差の比較の対象にしていないため、対象外としています。
この表から読み取れることが3つあります。第1に、MAD が最も小さいのは「常にゼロ」です。8割の日がゼロなので、ゼロと言い続ければ8割の日は誤差ゼロになるからです。間欠需要では MAD や MAPE で予測を選ぶと、何の役にも立たないゼロ予測が勝ってしまいます。予測の良し悪しは、後述するリードタイム分の累積需要をどれだけ捉えたかで判断すべきです。第2に、Croston 法と SBA の差は理論上 5% ですが、1年分の検証では実績平均のほうが訓練期間より 3% 高かったこともあり、どちらが正確とも言えない結果でした。1日あたり 1.2 個前後の需要では、1年の平均そのものが数%はぶれます。第3に、Croston 法と単純指数平滑の差は、1日先の指標ではほとんど見えませんが、21日分の累積誤差の標準偏差では 15.8 対 21.3 と大きく開きました。単純指数平滑は需要が出るたびに予測が跳ね、その跳ねた値で21日分を見込むので、累積の見込みが大きく上下します。Croston 法の予測は安定しており、リードタイム分の見込みが安定することが、安全在庫を小さくする方向に効きます。この品目の需要発生率が変わらない限り、訓練期間の平均で固定した予測も同じくらい当たります。Croston 法の価値は、需要の間隔が伸び始めたとき(陳腐化の兆し)や大きさが変わったときに、予測がそれを追える点にあります。
間欠需要では、正規分布を前提にした安全在庫の式が日次の単位では使えません。訓練期間の日次需要は平均 1.25、標準偏差 3.28 で、正規近似の95%点は 6.65 個ですが、実際の需要はゼロが 80.4% を占め、需要がある日の中央値は5個、95%点は15個です。日次の分布は正規とはかけ離れています。ただし、リードタイムが21日と長いので、21日分の累積需要は4回前後の需要の合計になり、分布の形はかなり滑らかになります。訓練期間の21日累積需要は平均 26.4、標準偏差 13.2、95%点が48個、99%点が60個で、正規近似の95%点 47.9 個とほぼ一致しました。99%点は正規近似で 58.1 個と、実際の60個よりわずかに低く、裾はまだ正規より重い状態です。この品目では、21日分の累積需要の経験分位点をそのまま基準在庫にするのが最も素直で、48個(原価 8,000円ですから 384,000円)を基準在庫にすると、2025年の各起点で21日分の需要がこれに収まった割合は 90.1%、数量ベースの充足率は 97.5% でした。2025年は訓練期間より需要がやや多かったため、95%には届いていません。99%点の60個(480,000円)なら全起点で収まりました。目標をサイクルサービス率で持つか充足率で持つかで必要な水準が大きく違うことは、第4章の定義の違いそのものです。
分位点予測で発注量を直接出す
ここまでの手順は「点予測を出し、誤差の散らばりを測り、安全係数を掛けて足す」という2段構えでした。この手順の途中にある「誤差は正規分布に従う」「誤差の散らばりは季節によらず一定」という前提を外す方法として、必要な分位点を最初から予測する考え方があります。95% のサイクルサービス率を目標にするなら、リードタイム分の累積需要の95%点を直接予測し、それを基準在庫にします。第6章のニューズベンダー問題で、最適発注量が需要分布の臨界比の分位点だったことを思い出すと、この考え方は同じ構造です。臨界比が分位点の水準 τ を決め、その分位点を予測するモデルが発注量を出します。
分位点を直接予測する代表的な道具が、Koenker と Bassett が1978年に提案した分位点回帰です。通常の回帰が2乗誤差を最小にして平均を推定するのに対し、分位点回帰は非対称な絶対誤差を最小にします。予測の教科書は分位点予測の評価指標として、実績が分位点を上回ったときには \( 2p \) 倍、下回ったときには \( 2(1-p) \) 倍の重みで誤差を数える分位点スコアを示し、\( p \) が 0.5 より大きければ「実績が推定した分位点より大きいときの罰が重い」と説明しています。τ=0.95 なら、欠品側の外れは過剰側の外れの 19 倍重く数えられ、その重みの下で最も損失が小さい水準が95%点です。statsmodels では statsmodels.regression.quantile_regression.QuantReg がこれを実装しており、fit(q=0.95) のように分位点の水準を指定します。
import numpy as np
import pandas as pd
import statsmodels.api as sm
from statsmodels.regression.quantile_regression import QuantReg
from scipy.stats import norm
from inv_data import load_demand

y = load_demand()["B001"]
L, TAU = 14, 0.95
Y = y.rolling(L).sum().shift(-L)              # 起点の翌日から L 日分の累積需要
mid = y.index + pd.Timedelta(days=L // 2)     # 窓の中央日の年周期(フーリエ項 2 組)
doy = (mid.dayofyear.values - 1) / 365.25
X = np.column_stack([np.ones(len(y))] + [f(2 * np.pi * j * doy) for j in (1, 2) for f in (np.sin, np.cos)])
tr = ((y.index + pd.Timedelta(days=L)) <= "2024-12-31") & Y.notna()   # 窓が 2024 年内に収まる起点だけ
te = (y.index >= "2025-01-01") & Y.notna()

q95 = QuantReg(Y[tr].values, X[tr]).fit(q=TAU)         # 95% 点を直接
S_q = X[te] @ q95.params                                # 起点ごとの基準在庫
ols = sm.OLS(Y[tr].values, X[tr]).fit()                 # 点予測 + 正規分布の安全在庫
S_n = X[te] @ ols.params + norm.ppf(TAU) * ols.resid.std(ddof=1)
Yt = Y[te].values
for name, S in [("分位点回帰", S_q), ("点予測+正規SS", S_n)]:
    print("%-10s 達成率 %.3f  平均S %.1f 個" % (name, np.mean(Yt <= S), S.mean()))
# 出力:
# 分位点回帰      達成率 0.858  平均S 413.2 個
# 点予測+正規SS   達成率 0.906  平均S 419.5 個
季節品 B001 で、リードタイム14日分の累積需要の95%点を、年周期のフーリエ項を説明変数にした分位点回帰で直接予測し、点予測(同じ説明変数の最小2乗回帰)に正規分布の安全在庫を足す方法、および季節で分けずに訓練期間の累積需要の95%点をそのまま使う方法と比べました。結果は次の表のとおりです。
| 基準在庫の出し方 | 2025年の達成率 | 基準在庫の平均(個) | 基準在庫の平均(円) | 基準在庫と実績の差の平均(個) |
|---|---|---|---|---|
| 季節で分けない95%点 | 93.2% | 600.4 | 2,101,400 | 245.9 |
| 点予測+正規分布の安全在庫(57.1 個で一定) | 90.6% | 419.5 | 1,468,395 | 65.1 |
| 分位点回帰(95%点を直接) | 85.8% | 413.2 | 1,446,363 | 58.8 |
季節で分けない95%点は、夏の山に合わせた水準を一年中持つことになるので、達成率は高いものの、基準在庫と実績の差が平均 246 個、金額で約 86 万円の余剰を年中抱えます。季節を織り込んだ2つの方法は基準在庫を 3 割減らし、そのうえで達成率も大きくは落ちていません。分位点回帰の特徴は、95%点と中央値予測の差、つまり事実上の安全在庫が季節によって変わることです。実測では12月に 9.5 個、8月には 89.1 個と9倍を超える開きがあり、正規分布の安全在庫 57.1 個が季節によらず一定なのと対照的です。需要が大きい時期ほど散らばりも大きいという負の二項分布の性質を、分位点回帰は分布の形を仮定せずに拾っています。冬に薄く、夏に厚く守るほうが在庫金額の使い方として合理的です。
一方で、達成率がどちらも目標の95%に届いていない点は見逃せません。原因は2つあります。1つは、訓練期間の当てはまりで決めた散らばりが、検証期間では足りなかったことです。最小2乗回帰の訓練期間の残差の標準偏差は 34.7 でしたが、検証期間で中央値予測から測った誤差の標準偏差は 47.2 でした。分位点回帰の95%点も、訓練期間の散らばりに合わせて決まっています。もう1つは、2025年の3月に過去2年の季節パターンより 16% 多い需要が出たことです(6月も 6% 上回りました)。3月の達成率は分位点回帰で 32.3%、正規分布でも 54.8% まで落ちています。フーリエ項だけの説明変数は「毎年同じ形」を仮定しており、その年の水準のずれを追う項を持ちません。この2つは分位点回帰そのものの欠点ではなく、訓練期間の残差で散らばりを決めてはいけないこと、および直近の水準を追う仕組みを予測に持たせるべきことという、本章でここまで述べてきた原則の再確認です。前節の季節指数×単純指数平滑で、検証期間の累積誤差から出した 79.2 個の安全在庫が 96.3% を達成していたことと合わせて読むと、分位点を直接予測する方法でも、分位点の水準は訓練に使っていない期間の誤差で校正する必要があると言えます。その際、校正に使った期間でそのまま達成率を評価すると楽観的な数字になるので、校正用の期間と最終評価用の期間は分けておくのが望ましい手順です。
分位点予測の考え方は、説明変数を増やせる点で、点予測と安全在庫の2段構えより拡張しやすい面があります。販促の予定、価格、天候といった情報を説明変数に入れれば、その条件での95%点がそのまま出ます。機械学習の勾配ブースティングにも分位点損失を目的関数にする実装があり(scikit-learn の GradientBoostingRegressor は loss="quantile" で分位点を指定できます)、第14章で触れる「予測と最適化を一体で学習する」流れの入口になります。ただし、どの方法でも「訓練に使っていない期間で分位点の達成率を検証する」という手順を省いてはいけません。
予測精度への投資と安全在庫の削減を経営の数字で比べる
予測精度を上げる投資には、予測モデルの構築と運用、データ整備、担当者の時間がかかります。その投資が見合うかどうかは、安全在庫が減って浮く在庫金額と、その保有費用で測るのが筋です。ここまでの代表品目の数字をそのまま使うと、季節品 B001 では、需要の標準偏差から出した安全在庫 90.3 個(原価 3,500 円で 315,878 円)が、季節を織り込んだ予測の誤差から出すと 79.2 個(277,201 円)になり、在庫金額で 38,677 円、年20%の保管費率で年 7,735 円の差です。1品目では小さな金額ですが、品目数を掛けると桁が変わります。60品目のうち間欠需要品を除く51品目について、型ごとに単純な予測(定番品は単純指数平滑、季節品は季節指数×単純指数平滑、成長品は Holt 法)を当て、2025年の累積誤差から安全在庫を出し直した結果が次の表です。
| 需要の型 | 品目数 | 安全在庫の金額(需要の標準偏差から) | 安全在庫の金額(予測誤差から) | 差(在庫金額) | 差(年間保管費、20%) | 品目ごとの比(予測誤差÷需要)の中央値 |
|---|---|---|---|---|---|---|
| 定番品 | 20 | 1,720,539 円 | 1,695,564 円 | 24,975 円 | 4,995 円 | 0.97 |
| 季節品 | 18 | 1,795,577 円 | 1,219,814 円 | 575,763 円 | 115,153 円 | 0.82 |
| 成長品 | 13 | 1,478,579 円 | 1,585,232 円 | -106,653 円 | -21,331 円 | 1.05 |
| 合計 | 51 | 4,994,695 円 | 4,500,610 円 | 494,085 円 | 98,817 円 |
この表が示す経営上の含意は3つに分かれます。定番品では、予測の良し悪しが安全在庫をほとんど変えません(比の中央値 0.97、差は 51品目全体の 5%)。この型の品目に予測精度への投資をしても、安全在庫の削減としては回収できません。季節品では、季節を織り込むだけで安全在庫の金額が 32% 減り(品目ごとの比の中央値は 0.82)、在庫金額で 576 千円、年間保管費で 115 千円が浮きます。予測への投資の回収先は、まずこの型の品目です。成長品では逆に、需要の標準偏差から出した安全在庫が予測誤差から出した安全在庫より 7% 少なく、守り足りない側に外れていました。過去2年の標準偏差は、需要が伸びた後の散らばりの大きさを表していないためです。この型では、予測は安全在庫を減らすためではなく、欠品を防ぐために要ります。
バイアスの害を金額にすると、さらに大きな差が出ます。予測を更新せずに訓練期間の平均で固定した場合、95% のサイクルサービス率を達成するのに要る安全在庫は、成長品13品目の合計で 6,044,521 円と、型に合った予測を使った場合の 1,861,127 円の 3.25 倍でした。季節品でも 4,443,579 円対 1,362,465 円の 3.26 倍です。季節品では年間の平均誤差はほぼゼロ(累積バイアスの平均 5.6 個)ですが、夏に低く冬に高く外れる誤差を一年を通して覆うには、山の高さに合わせた安全在庫が要るからです。「予測を更新しない」ことの費用は、安全在庫の金額で言えば 3 倍を超える差になり、これが予測精度への投資と比べるべき相手です。もちろんこの試算は架空のデータと単純な予測によるもので、実際の品目構成と原価で計算し直す必要があります。しかし、型ごとに投資の回収先が違うこと、そして精度の改善よりバイアスの除去のほうが先に効くことは、このサンプルでは明確に出ており、実務でもまず確認すべき順序だと考えています。
本章で確認したことをまとめます。安全在庫を決めるのは需要のばらつきではなく、予測に使っていない期間で測った予測誤差のばらつきです。バイアスは安全在庫では覆えず、予測の更新で取り除くものです。リードタイム分の誤差は1日先の誤差の平方根倍にならないので、累積誤差を直接測ります。間欠需要では日次の指標ではなくリードタイム分の累積需要の分位点で基準在庫を決め、Croston 法や SBA はその見込みを安定させる道具です。分位点を直接予測する方法は、季節で変わる散らばりを拾える一方、分位点の水準は検証期間で校正しなければなりません。次の第9章では、需要の不確実性を分布やシナリオとして最適化の式の中に持ち込む、確率計画とロバスト最適化を扱います。
この章を深めたい方への参考書籍
『この1冊ですべてわかる 新版 需要予測の基本』(山口雄大、日本実業出版社):書名と、副題の「S&OPで経営に貢献する」のとおり、需要予測を業務として組み立て、販売と生産の計画に結びつける入門書です。本章で扱った「予測誤差を測って在庫に反映する」手順を、組織の中で回す側の視点から補う位置づけの本です。
『需要予測の戦略的活用』(山口雄大、日本評論社):副題は「マーケティングとサプライチェーンマネジメントをつなぐ」で、オペレーションズ・マネジメント選書の1冊です。需要予測を経営の判断にどうつなぐかという視点は、本章の最後で扱った「予測精度への投資をどう評価するか」を考える材料になります。
『Intermittent Demand Forecasting』(Boylan、Syntetos、Wiley):副題は「文脈・手法・応用」で、版元は、間欠需要品の予測を改善し在庫管理を高めたい人のための、間欠需要の予測に絞った最初の本だと説明しています。SBA の提案者自身による本で、本章の間欠需要の節を原典に当たって深めたい方に向いています。洋書です。
第9章 確率計画とロバスト最適化、不確実性を式に入れる
第8章では、需要予測の誤差を測り、その誤差のばらつきを安全在庫に翻訳する方法を確認しました。安全在庫の式は「予測の誤差はこの分布に従う」という前提を置き、その前提のもとで欠品の確率を狙った水準に抑える道具です。この章では、同じ「需要が分からない」という問題を、最適化の式の中に直接持ち込む方法を扱います。需要の候補をシナリオとして並べ、発注量を決めた後にシナリオごとに何が起きるかまで式に書いて、期待利益や悪いときの損失を目的関数に置く。これが確率計画とロバスト最適化の考え方です。前半でシナリオ型の2段階確率計画を PuLP で解き、後半で「悪いときの損失」を抑える CVaR と、分布を仮定しないロバスト最適化を同じ例題に当てて、4つの解を並べて比較します。
平均需要で解く最適化は何を誤るか
発注量を最適化で決めるとき、最も手軽な方法は、需要の予測値を1つ置いて、その需要が確実に来るものとして解くことです。この章ではこれを「決定論の最適化」と呼びます。決定論の解は、需要が予測どおりに来れば正しい答えですが、需要が予測から外れたときに何が起きるかを式の中に持っていません。需要が下に外れれば売れ残りが出て、上に外れれば緊急の手当てか欠品が出る。その損失の大きさが上下で違うとき、平均の需要で解いた答えは最適な答えからずれます。
ずれの正体は、利益が需要に対して直線ではないことにあります。発注量を決めた後の利益は、需要が発注量より少ない側では処分の損失で削られ、多い側では緊急調達の割増か欠品の機会損失で頭打ちになる、折れ線の形をしています。折れ線の上で「平均の需要のときの利益」と「利益の平均」は一致しません。この章の例題で言えば、平均需要の847個が確実に来るとして計算した利益は148万2,250円ですが、実際の需要のばらつきのもとで同じ発注量が生む期待利益は133万8,244円です。差の約14万円は、需要が外れたときの処分と欠品の損失の期待値であり、決定論の計算はこれを見ていません。
ただし、決定論の解そのものが大きく間違うかどうかは、費用の形によります。損失が上下で対称に近ければ、平均需要で解いた発注量は確率を考えた発注量とほとんど変わりません。処分の損失が大きい、あるいは欠品の損失が大きいというように非対称が強いほど、平均で解いた答えは片側に偏り、確率を考えた答えとの差が広がります。この差を金額で測る指標が、後で確認する「確率計画の価値」です。決定論の解を捨てるべきかどうかは、この金額を見て判断できます。
2段階確率計画、いま決める量と分かってから決める量
2段階確率計画は、意思決定を「不確実な量が分かる前に決めること」と「分かってから決めること」の2段階に分けて書く定式化です。在庫の問題では、第1段階が発注量で、第2段階が需要を見てからの対応にあたります。第2段階の対応をリコースと呼びます。リコースは確率計画の用語で、結果が分かった後に取る手当てや修正の行動を指し、需要が発注量を超えたときの緊急調達や欠品の受け入れ、需要が下回ったときの処分や持ち越しがこれにあたります。第1段階の決定は1つですが、第2段階の決定はシナリオごとに違ってよい構造になっており、これが確率計画と決定論の本質的な違いです。
需要の不確実性は、シナリオの集合として式に入れます。シナリオとは「需要がこの値になる」という候補のことで、それぞれに確率を付けます。過去のデータから作った1,000通りの需要を等確率のシナリオとして並べれば、それだけで確率分布を式に持ち込めます。目的関数は、第1段階の費用と、シナリオごとの第2段階の利益や費用を確率で重みづけした期待値の和です。言葉で書けば、次のようになります。
\( \max_{Q} \; \sum_{s} p_s \, \pi_s(Q, e_s, u_s, o_s) \)
ここで \( Q \) は発注量、\( s \) はシナリオの番号、\( p_s \) はその確率、\( \pi_s \) はシナリオ \( s \) での利益です。\( e_s \)、\( u_s \)、\( o_s \) はシナリオ \( s \) での緊急調達量、欠品量、処分量で、これらが第2段階の変数です。それぞれのシナリオで「在庫と緊急調達と欠品を合わせると需要になり、余った分は処分に回る」という収支の式を制約として置きます。需要が分かってからの対応は、そのシナリオの中で最も得になるように決まりますから、第2段階の変数は「そのシナリオが実現したときに取る最善の行動」を表しています。シナリオが有限個なら、この問題は普通の線形計画になり、CBC のようなソルバーでそのまま解けます。
この定式化の便利な点は、第6章のニューズベンダー問題を含んで、それより広い状況を同じ形で扱えることです。ニューズベンダー問題は「余ればいくら損、足りなければいくら損」という2つの単価で解けましたが、緊急調達に上限がある、処分価格が数量で変わる、複数品目が同じ予算や倉庫を使う、といった条件が加わると、閉じた式では解けなくなります。シナリオ型の確率計画は、そうした条件を制約として1行ずつ足すだけで済みます。数理最適化の定式化そのものの一般論は、弊社コラム「数理最適化の定式化パターン集」で扱っていますので、この章では在庫に必要な形に絞ります。
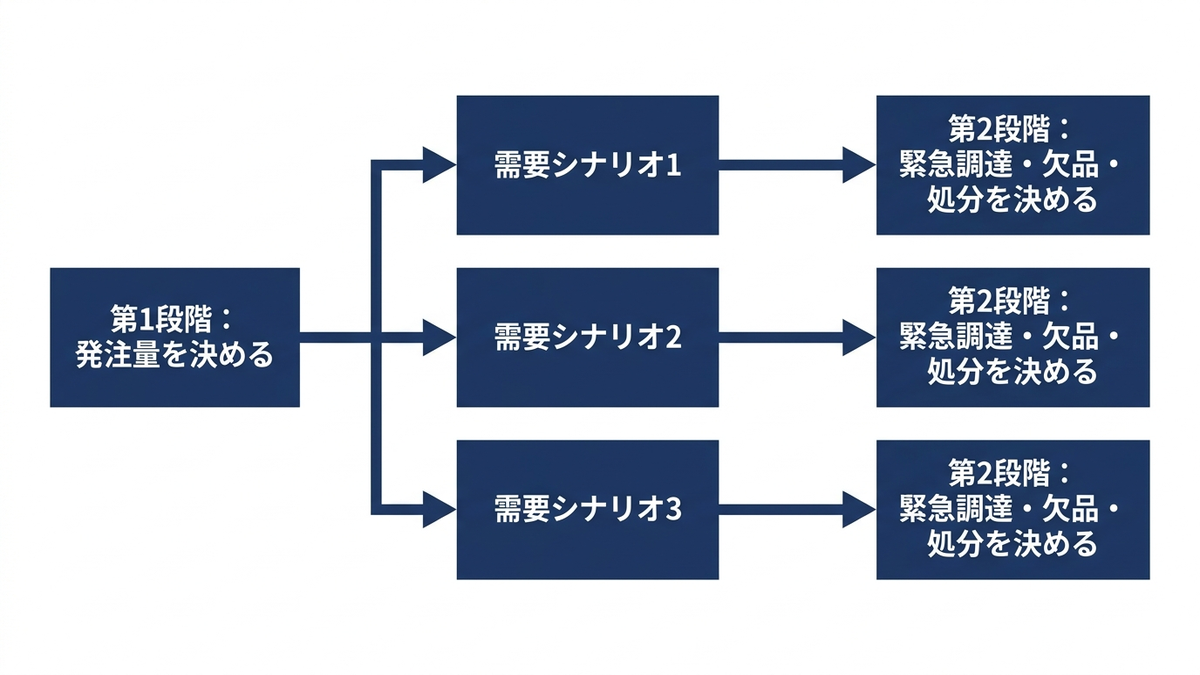
例題の設定と需要シナリオの作り方
例題には、第2章で用意したサンプルデータの季節品 B001 を使います。B001 は夏に需要の山があり、9月には日次平均が28.4個まで下がって、10月以降さらに落ちていきます。ここでは「9月分の発注量を8月中旬に決める」という状況を考えます。9月はこの品目のシーズン最後の月で、9月末に残った分は処分に回すと仮定します。翌年まで持ち越す選択肢もあり得ますが、例題では処分に単純化しています。費用の条件は次のとおりで、いずれも例題のための仮定です。第3章で断ったとおり、費用の水準は業種によって桁が違います。
| 項目 | 例題の値 | 根拠・備考 |
|---|---|---|
| 通常発注の単価 \( c \) | 3,500円 | SKU マスタの原価 |
| 販売価格 \( p \) | 5,250円 | 原価に粗利50%を乗せた値。粗利率は共通パラメータの欠品費率と揃えた |
| 緊急調達の単価 \( c_e \) | 4,550円 | 原価の1.3倍。月内に追加で調達できるが割増がつく。上限100個 |
| 処分価格 \( v \) | 2,100円 | 原価の60%。9月末の残りはこの価格で処分する |
| 1個あたりの粗利 | 1,750円 | 通常発注分が売れたときの利益 |
| 緊急調達分の粗利 | 700円 | 割増のぶん通常より1,050円薄い |
| 売れ残り1個の損失 | 1,400円 | 原価と処分価格の差 |
需要が発注量を超えたときは、まず緊急調達で埋め、上限を超えた分は欠品として売上の機会を失います。需要が下回ったときは、残りを処分価格で売ります。この3つがリコースです。緊急調達の粗利は700円で、通常の粗利1,750円より薄いものの、まだ利益が出ますから、需要が上に外れたときの損失は1個あたり1,050円(通常より薄くなる分)です。それに対して下に外れたときの損失は1個あたり1,400円で、上限を超えた欠品は1個あたり1,750円の機会損失になります。上下の損失が近い大きさなので、この例題は費用がほぼ対称な例と言えます。
需要シナリオは、データから2段階で作ります。まず、3年分の9月の日次需要(90日)から30日分を復元抽出して足し合わせ、1か月の需要を作ります。ただし、これだけでは年ごとの水準の違いを再現できません。実測の9月合計は2023年が987個、2024年が831個、2025年が734個で、3年平均は850.7個、標準偏差は127.6個、変動係数は0.150です。一方、日次の復元抽出だけで30日合計を作ると、標準偏差は60.7個にしかなりません。3年分の観測では、年ごとの差が偶然なのか構造なのかを判別できませんが、実務ではそれが判別できないまま発注を決めるのが普通です。そこでこの例題では、年の水準の変動係数を15%と置き、対数正規分布に従う水準係数(平均1)を日次の合計に掛けて、シナリオの幅を実測の年ごとの差に合わせました。第8章の言葉で言えば、水準係数は「来年の9月の予測誤差」を表しています。
import numpy as np
from inv_data import load_demand, load_skus, COST

dem, skus = load_demand(), load_skus()
SEP = dem.loc[dem.index.month == 9, "B001"]      # 3年分の9月の日次需要(90日)
LEVEL_CV = 0.15                                  # 年の水準の変動係数(例題の仮定)

def make_scenarios(rng, n, horizon=30):
    # 日次需要を復元抽出して30日分を足し、年の水準の係数(対数正規・平均1)を掛ける
    daily = rng.choice(SEP.values, size=(n, horizon), replace=True).sum(axis=1)
    sig = np.sqrt(np.log(1.0 + LEVEL_CV ** 2))
    level = rng.lognormal(mean=-0.5 * sig ** 2, sigma=sig, size=n)
    return np.round(daily * level)

d = make_scenarios(np.random.default_rng(0), 1000)
print(round(d.mean(), 1), round(d.std(), 1), np.percentile(d, [5, 50, 95]).round())
# 出力: 846.8 137.1 [ 644.  841. 1093.]
1,000本のシナリオの平均は846.8個、標準偏差は137.1個、5%点は644個、95%点は1,093個、最小は441個、最大は1,529個でした。発注量の候補は、およそ600個から1,000個の間で考えることになります。
PuLP と CBC で2段階確率計画を解く
定式化を PuLP に書き下します。変数は発注量 \( Q \) が1本と、シナリオごとに緊急調達 \( e_s \)、欠品 \( u_s \)、処分 \( o_s \) の3本で、1,000シナリオなら合計3,001本です。制約は、シナリオごとの収支の式が1,000本です。目的関数はシナリオごとの利益の平均で、これは等確率のシナリオでの期待利益にあたります。ソルバーには、手元の環境で pulp.listSolvers(onlyAvailable=True) が返した PULP_CBC_CMD を使います。PuLP の公式ドキュメントは CBC を別途導入する手順を案内していますが、この記事の環境では最初から使える状態でした。
import pulp

C_UNIT, PRICE, C_EMERG, E_MAX, SALVAGE = 3500.0, 5250.0, 4550.0, 100.0, 2100.0

def solve_two_stage(d):
    n = len(d)
    m = pulp.LpProblem("two_stage", pulp.LpMaximize)
    q = pulp.LpVariable("Q", lowBound=0)                                      # 第1段階: 発注量
    e = [pulp.LpVariable("e_%d" % s, lowBound=0, upBound=E_MAX) for s in range(n)]  # 緊急調達
    u = [pulp.LpVariable("u_%d" % s, lowBound=0) for s in range(n)]           # 欠品
    o = [pulp.LpVariable("o_%d" % s, lowBound=0) for s in range(n)]           # 処分
    profit = [PRICE * (d[s] - u[s]) - C_UNIT * q - C_EMERG * e[s] + SALVAGE * o[s]
              for s in range(n)]
    m += pulp.lpSum(profit) / n                       # 期待利益(等確率)
    for s in range(n):
        m += q + e[s] + u[s] - o[s] == d[s]           # 在庫・緊急調達・欠品で需要を受け、余りは処分
    m.solve(pulp.PULP_CBC_CMD(msg=0))
    return q.value(), pulp.value(m.objective), pulp.LpStatus[m.status]

q_sp, obj, status = solve_two_stage(d)
print(round(q_sp), round(obj), status)
# 出力: 838 1335796 Optimal
解は発注量838個、期待利益133万5,796円で、CBC の計算時間は0.13秒でした。平均需要をそのまま発注する決定論の解は847個ですから、差は9個です。この2つの発注量を、解くのに使ったものとは別に作った20,000本の独立なシナリオで評価すると、決定論の期待利益が133万8,244円、確率計画が133万8,356円で、差は112円にすぎません。下位5%のシナリオの平均利益は69万3,298円と70万5,898円、最小の利益は18万1,300円と19万3,900円で、確率計画のほうがわずかに悪い月に強い程度です。この例題では費用がほぼ対称なので、決定論の解でも実害はほとんど出ません。
ここで、確率計画の教科書が定義する2つの指標を確認しておきます。1つは完全情報の期待価値(EVPI)で、需要を事前に知ったうえで発注できる場合の期待利益と、確率計画の期待利益の差です。もう1つは確率計画の価値(VSS)で、確率計画の解の期待利益と、平均値で解いた決定論の解を同じシナリオで評価した期待利益の差です。いずれも Birge と Louveaux の教科書(後掲)の第4章にまとめられている考え方で、この記事では利益の最大化なので符号を合わせて引き算しています。例題では、需要を知ってから発注できれば期待利益は149万1,092円になるので、EVPI は15万2,737円(丸める前の値で差を取っているため、表示した金額どうしの引き算とは1円ずれます)、VSS は112円です。
この2つの数字は経営判断にそのまま使えます。EVPI の15万円は「9月の需要を完全に言い当てられる予測に、ひと月あたり払ってよい上限」です。予測の精度を上げる投資の上限がこの金額を超えることはなく、実際の予測は完全ではないので、投資の見込み効果はこれより小さくなります。VSS の112円は「平均で解く簡便法を捨てて確率計画を導入する価値」です。この例題では月112円ですから、費用が対称なこの品目に確率計画を持ち込む理由は薄いと言えます。ただし次の表のとおり、費用の形を変えると VSS は桁で変わります。表の VSS は、解くのに使った1,000本のシナリオでそのまま両方の解を評価した値なので、基本設定の行が 324円と、独立な20,000本で評価した本文の 112円より大きく出ています。経営判断の根拠にするのは独立なシナリオで評価した値のほうで、表は費用の形による桁の違いを見るためのものです。
| 費用の設定 | 決定論の発注量 | 確率計画の発注量 | 期待利益(決定論) | 期待利益(確率計画) | VSS(円/月) |
|---|---|---|---|---|---|
| 処分価格が原価の90% | 847 | 947 | 1,392,227 | 1,414,023 | 21,796 |
| 処分価格が原価の60%(基本) | 847 | 838 | 1,335,473 | 1,335,796 | 324 |
| 処分価格が原価の30% | 847 | 792 | 1,278,718 | 1,294,990 | 16,272 |
| 処分できず廃棄(処分価格0) | 847 | 769 | 1,221,963 | 1,267,923 | 45,960 |
| 緊急調達ができない | 847 | 860 | 1,311,986 | 1,312,661 | 675 |
| 緊急調達の上限が300個 | 847 | 818 | 1,348,635 | 1,351,385 | 2,750 |
| 廃棄かつ緊急調達ができない | 847 | 782 | 1,198,477 | 1,230,047 | 31,570 |
表は、解くのに使った1,000本のシナリオで両方の解を評価したものです。処分価格が高く売れ残りの損失が小さいと、確率計画は多めに発注し、決定論の解との差は月2万円を超えます。逆に処分できず廃棄になると、確率計画は769個まで発注を絞り、差は月4万6,000円です。処分の損失が大きいほど「余らせないこと」の価値が上がり、平均で解いた発注量は多すぎる側に偏ります。この方向は第6章の臨界比の考え方と同じで、確率計画は臨界比では書けない条件(緊急調達の上限など)が入っても同じ判断を機械的に出してくれます。VSS が数万円になる品目や、品目が数百あって合計が月に百万円単位になる場面が、確率計画を導入する動機になります。
サンプル平均近似、シナリオはいくつ要るか
シナリオを乱数で作って期待値を標本平均で置き換え、その問題を解く方法をサンプル平均近似(SAA)と呼びます。Kleywegt、Shapiro、Homem-de-Mello(2002)が、この方法の収束の速さや停止の規則を整理しています(SIAM Journal on Optimization 12(2), 479-502)。実務で気になるのは「シナリオを何本作れば解が安定するか」です。少なすぎれば解が乱数に振り回され、多すぎれば計算時間が伸びます。例題で、シナリオ数を20、100、500、2,000と変えて、それぞれ乱数を変えて10回ずつ解いた結果が次の表です。
| シナリオ数 | 発注量の平均(10回) | 発注量の標準偏差 | 目的関数の平均 | 独立の20,000本で評価した期待利益 | 1回の計算時間 |
|---|---|---|---|---|---|
| 20 | 836.1 | 44.9 | 1,309,606 | 1,330,643 | 0.03秒 |
| 100 | 839.7 | 15.1 | 1,339,094 | 1,337,509 | 0.04秒 |
| 500 | 839.6 | 5.8 | 1,336,963 | 1,338,257 | 0.07秒 |
| 2,000 | 838.8 | 3.8 | 1,336,713 | 1,338,316 | 0.23秒 |
シナリオが20本だと、発注量は10回の試行で標準偏差44.9個も動きます。同じデータから解いているのに、乱数の引き方しだいで発注量が平均のまわりで45個ほど上下するということです。100本で15.1個、500本で5.8個、2,000本で3.8個まで縮み、独立のシナリオで評価した期待利益も2,000本では最良の値に対して数十円の差に収まります。この例題は変数が1本なので500本もあれば十分ですが、品目数が増え、第1段階の変数が多くなるほど、必要なシナリオ数は増えます。実務では、「乱数を変えて数回解き、解のばらつきが業務上の刻み(この例なら10個単位)より小さいことを確かめる」という手順を踏めば、シナリオ数の妥当性を自分で確認できます。
もう1つ大事なのは、目的関数の値をそのまま信じないことです。20本のときの目的関数の平均は130万9,606円ですが、同じ解を独立の20,000本で評価すると133万643円で、目的関数は約2万円低く出ています。シナリオが少ないと、解いたシナリオに合わせすぎた解になり、目的関数は実力を正しく表しません。逆にシナリオが多くなると目的関数と独立評価の差は縮み、2,000本では両者の差は1,600円ほどです。解いたシナリオでの目的関数と、別に作ったシナリオでの評価を両方見ることが要ります。この習慣は、第12章でシミュレーションによる評価を扱うときにも同じ形で出てきます。
期待値だけでなく CVaR で悪いときの損失を抑える
ここまでの目的関数は期待利益でした。期待利益を最大にする発注量は、良い月と悪い月を平均して最も得になる量ですが、悪い月がどれだけ悪いかは見ていません。資金繰りに余裕がない、季節品の売れ残りが翌期の決算に響く、といった状況では、「平均して得」より「最悪の月でもこの水準を下回らない」ことのほうが重要になります。この要求を式に入れる道具がCVaR(条件付きバリューアットリスク)です。
損失の分布を考えたとき、確率95%で損失がこの値を超えない、という閾値をバリューアットリスク(VaR)と呼びます。CVaR は、直感的には、その閾値を超えた悪い側5%の損失の平均です(有限個のシナリオで閾値の点に確率が集中している場合は、後掲の式で定義される値を使います)。この章の例題は利益で考えているので、CVaR は「利益が低いほうから5%のシナリオの平均利益」と読み替えられます。VaR は「95%は大丈夫」と言うだけで、残り5%の中でどれだけ悪いかを語りませんが、CVaR は悪い側の平均を見るので、裾の深さが結果に反映されます。Rockafellar と Uryasev(2000)は、CVaR が次の式の最小値として書けることを示しました(The Journal of Risk 2(3), 21-41)。
\( \mathrm{CVaR}_{\alpha}(L) = \min_{\eta} \left\{ \eta + \frac{1}{1-\alpha} \, \mathbb{E}\big[ (L – \eta)^{+} \big] \right\} \)
\( L \) は損失、\( \alpha \) は信頼水準(例題では0.95)、\( \eta \) は閾値の候補で、\( (L-\eta)^{+} \) は損失が閾値を超えた分(超えなければ0)です。言葉にすると、「閾値と、閾値を超えた分の平均を確率で割ったものの和」を、閾値を動かして最も小さくした値が CVaR になります。同じ論文は、シナリオで期待値を置き換えれば、この最小化が閾値を超えた分を表す補助変数つきの線形計画になること、発注量のような意思決定変数と閾値を同時に動かして最小化しても答えが変わらないことを示しています。VaR そのものはシナリオから最適化しようとすると凸性が無く扱いにくいのに対して、CVaR は線形計画に乗ります。これが CVaR が実務の最適化で使われる理由です。
先ほどの2段階確率計画に、閾値 \( \eta \) と、シナリオごとの「閾値を超えた損失」 \( z_s \) を足せば、CVaR を目的関数にも制約にも置けます。目的関数を CVaR の最小化に置き換えた版と、期待利益を最大化しつつ「下位5%の平均利益が下限以上」という制約を置いた版の2つを解きます。
def solve_cvar(d, alpha=0.95, mode="min_cvar", floor=None):
    n = len(d)
    m = pulp.LpProblem("cvar", pulp.LpMaximize)
    q = pulp.LpVariable("Q", lowBound=0)
    e = [pulp.LpVariable("e_%d" % s, lowBound=0, upBound=E_MAX) for s in range(n)]
    u = [pulp.LpVariable("u_%d" % s, lowBound=0) for s in range(n)]
    o = [pulp.LpVariable("o_%d" % s, lowBound=0) for s in range(n)]
    profit = []
    for s in range(n):
        m += q + e[s] + u[s] - o[s] == d[s]
        profit.append(PRICE * (d[s] - u[s]) - C_UNIT * q - C_EMERG * e[s] + SALVAGE * o[s])
    eta = pulp.LpVariable("eta")                                       # 閾値(VaR に相当)
    z = [pulp.LpVariable("z_%d" % s, lowBound=0) for s in range(n)]    # 閾値を超えた損失
    for s in range(n):
        m += z[s] >= -profit[s] - eta                                  # 損失 = -利益
    cvar = eta + pulp.lpSum(z) / ((1.0 - alpha) * n)
    if mode == "min_cvar":
        m += -cvar                                 # CVaR の最小化(= 下位5%の平均利益の最大化)
    else:
        m += pulp.lpSum(profit) / n                # 期待利益の最大化
        m += cvar <= -floor                        # 下位5%の平均利益 >= floor
    m.solve(pulp.PULP_CBC_CMD(msg=0))
    return q.value(), pulp.LpStatus[m.status]

print(solve_cvar(d))                               # 出力: (604.0, 'Optimal')
print(solve_cvar(d, mode="constrained", floor=800000))   # 出力: (763.27143, 'Optimal')
CVaR を最小化した解は発注量604個でした。検算として、発注量を1個刻みで動かして下位5%の平均利益を直接計算しても、最大になるのは604個で一致します。20,000本の独立なシナリオで評価すると、期待利益は111万9,237円、下位5%の平均利益は100万9,066円、最小の利益は52万1,500円です。期待値最適の解(838個)と比べると、期待利益は21万9,118円(16.4%)減り、下位5%の平均利益は30万3,169円(42.9%)増え、最悪のシナリオの利益は32万7,600円増えます。発注を絞ったので、緊急調達が必要になる確率は97.6%、上限を超えて欠品になる確率は85.7%に上がり、処分は平均0.9個までほぼ消えました。CVaR 最適の解は、売れ残りの損失を極力避ける代わりに、上振れの利益を自ら手放しています。
両極端の間を埋めるのが、制約つきの版です。下位5%の平均利益の下限を70万円から95万円まで5万円刻みで置き、それぞれで期待利益を最大化した結果が次の表です。100万円の下限は、解くのに使った1,000本のシナリオでは達成できず、実行不能になりました。
| 下位5%平均利益の下限 | 発注量 | 期待利益 | 下位5%平均利益(独立評価) | 最小利益 |
|---|---|---|---|---|
| 制約なし(期待値最適) | 838 | 1,338,356 | 705,898 | 193,900 |
| 700,000円 | 835 | 1,338,236 | 710,098 | 198,100 |
| 750,000円 | 799 | 1,330,782 | 760,498 | 248,500 |
| 800,000円 | 763 | 1,312,050 | 810,898 | 298,900 |
| 850,000円 | 728 | 1,283,532 | 859,898 | 347,900 |
| 900,000円 | 692 | 1,244,508 | 910,298 | 398,300 |
| 950,000円 | 656 | 1,197,493 | 960,698 | 448,700 |
| CVaR 最小化 | 604 | 1,119,237 | 1,009,066 | 521,500 |
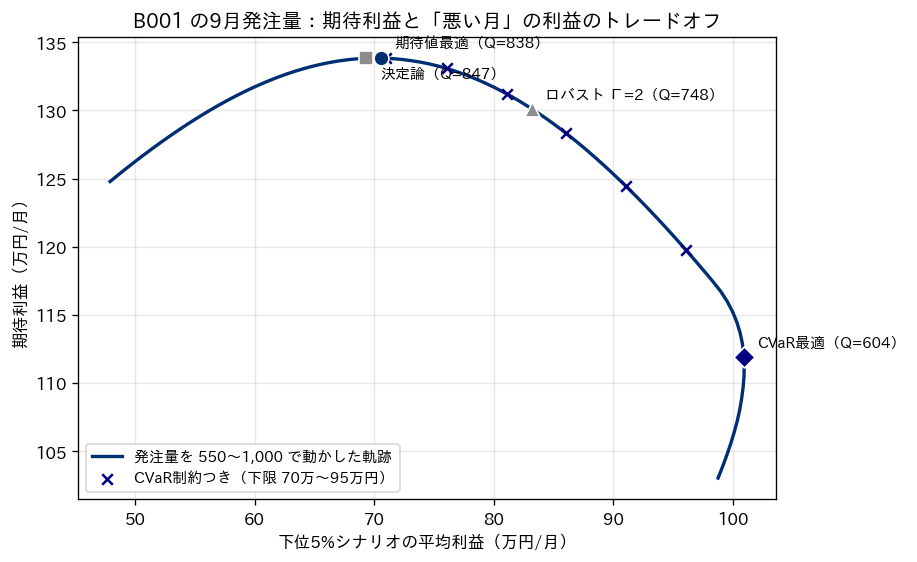
図は、横軸に下位5%の平均利益、縦軸に期待利益をとって、発注量を動かしたときの軌跡を描いたものです。期待値最適の点から右へ進むほど悪い月の利益は改善しますが、期待利益は下がり、CVaR 最適の点で横軸が最大になります。曲線の右上の縁が、期待利益と悪い月の利益を両立できる限界で、制約つきの解はこの縁の上に並びます。どの点を選ぶかは、数理の問題ではなく経営の選好の問題です。最適化ができるのは、選べる点の集合を正確に描くところまでで、そこから1点を選ぶのは意思決定者の仕事です。
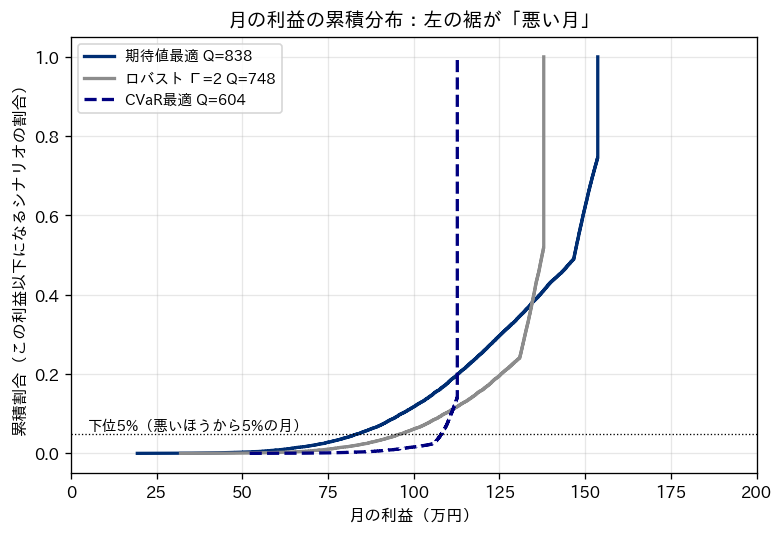
2枚目の図は、同じ3つの解について月の利益の累積分布を重ねたものです。左の裾が「悪い月」で、CVaR 最適の破線は裾が最も短く、悪い側5%の線より下にほとんど入りません。一方で右側は113万円あたりで垂直に立ち上がり、それ以上の利益が出る月がありません。発注量604個と緊急調達100個を全部売ったときの利益が上限になるためです。期待値最適の実線は右に長く伸びる代わりに、左の裾が最も深くなっています。ロバストの灰色の線はその中間です。この図を経営層と共有すると、「平均」という1つの数字ではなく、良い月と悪い月の両方を見て発注量を選ぶ議論ができます。
経営目線に翻訳すると、期待値最適と CVaR 最適の差は「最悪の月の損失をどれだけ抑えるか」の値段です。期待値最適の発注量では、悪いほうから5%の月の平均利益は70万5,900円で、最も悪いシナリオでは19万3,900円まで落ちます。CVaR 最適の発注量にすると、悪い5%の月の平均は100万9,100円、最悪でも52万1,500円を下回りません。その代わり、普通の月に得られたはずの利益を平均で月21万9,100円手放します。同じ判断を毎月繰り返す品目なら、悪い月への備えに年に約263万円の期待利益を払う計算です。この値段が高いか安いかは、その事業の資金の余裕と、悪い月が続いたときの影響で決まります。制約つきの版なら、たとえば下限を80万円に置いて、期待利益を月2万6,300円(2.0%)譲るだけで、悪い5%の月の平均を10万5,000円、最悪の月を10万5,000円引き上げられます。「平均をわずかに譲って最悪を大きく改善する」領域が曲線の最初の部分にあり、多くの現場で実際に選ばれるのはこのあたりだと考えています。
ロバスト最適化、分布を仮定せずに不確実性集合で守る
確率計画は需要の確率分布(あるいはシナリオとその確率)を前提にします。しかし、新製品や販路を変えた直後の品目では、分布を置く根拠が薄いことがあります。そうしたときに、確率を使わずに「需要はこの範囲のどこかに入る」という集合だけを前提に、範囲の中で最悪の場合でも成り立つ解を求めるのがロバスト最適化です。範囲のことを不確実性集合と呼びます。確率計画が「平均して良い」あるいは「悪い5%でも良い」を狙うのに対して、ロバスト最適化は「集合の中の最悪でも良い」を狙います。
最も素朴な不確実性集合は、不確実な量ごとに上限と下限を置き、すべてが同時に最悪の値をとると考えるものです。この考え方は Soyster(1973)にさかのぼりますが、すべてが同時に最悪になる前提は保守的すぎる、という批判が長くありました(Operations Research 21(5), 1154-1157)。Bertsimas と Sim(2004)は、不確実な量が \( n \) 個あるとき、同時に最悪の値をとれるのは高々 \( \Gamma \) 個までという「予算」を置く不確実性集合を提案しました(Operations Research 52(1), 35-53)。\( \Gamma = 0 \) なら全部が名目値で決定論と同じ、\( \Gamma = n \) なら全部が同時に最悪をとる素朴な集合と同じになり、その間の \( \Gamma \) で保守性を調整できます。論文の題名が「頑健さの値段」であるとおり、\( \Gamma \) を上げるほど最悪の場合には強くなる代わりに、名目の場合の目的関数を犠牲にします。同論文は、この集合を使ったロバスト版の問題が元の問題と同じく線形計画になることも示しており、CBC で解けます。
例題に当てはめます。9月の30日を6日ずつ5つのブロックに分け、ブロックごとの需要を不確実な量とします。名目値は3年の平均、上下の幅は3年の観測が名目値から最も離れた距離とし、確率分布は使いません。実測は次のとおりです。
| 年 | ブロック1 | ブロック2 | ブロック3 | ブロック4 | ブロック5 | 9月合計 |
|---|---|---|---|---|---|---|
| 2023年 | 209 | 237 | 138 | 246 | 157 | 987 |
| 2024年 | 187 | 165 | 170 | 164 | 145 | 831 |
| 2025年 | 149 | 192 | 131 | 137 | 125 | 734 |
| 名目値(3年平均) | 181.7 | 198.0 | 146.3 | 182.3 | 142.3 | 850.7 |
| 上下の幅(最大乖離) | 32.7 | 39.0 | 23.7 | 63.7 | 17.3 | 176.3 |
予算 \( \Gamma \) を0から5まで動かすと、不確実性集合は「名目値どおり」から「5つ全部が最悪」まで広がります。集合の頂点(\( \Gamma \) 個のブロックが上限か下限をとり、残りは名目値)を列挙し、頂点ごとにリコースを持たせて「最悪の頂点での利益」を最大化する線形計画を解きます。利益が需要に対して凹(折れ線が上に凸)なので、集合の中の最悪は必ず頂点で起きます。頂点を列挙する代わりに双対を使って制約に書き直す方法が Bertsimas と Sim の本来の形ですが、不確実な量が5個なら頂点は最大でも80個で、列挙のほうが読者には追いやすいので、ここでは列挙で解きました。この例題では利益が需要の合計だけで決まるので、コードでは頂点をその需要合計に集約し、同じ合計になる頂点を1つにまとめた候補を列挙しています(\( \Gamma = 4 \) なら頂点80個に対して需要合計の候補は74個)。表の「列挙した需要合計の数」はこの候補の数です。
import itertools

def robust_vertices(nominal, halfw, gamma):
    # gamma 個のブロックが上限か下限、残りは名目値、という頂点の需要合計を列挙する
    k = len(nominal)
    if gamma == 0:
        return np.array([nominal.sum()])
    verts = set()
    for idx in itertools.combinations(range(k), gamma):
        for signs in itertools.product([-1, 1], repeat=gamma):
            dev = np.zeros(k)
            for i, sg in zip(idx, signs):
                dev[i] = sg * halfw[i]
            verts.add(float(np.round((nominal + dev).sum())))
    return np.array(sorted(verts))

def solve_robust(vertices):
    m = pulp.LpProblem("robust", pulp.LpMaximize)
    q = pulp.LpVariable("Q", lowBound=0)
    t = pulp.LpVariable("t")                       # 最悪の頂点での利益
    n = len(vertices)
    e = [pulp.LpVariable("e_%d" % s, lowBound=0, upBound=E_MAX) for s in range(n)]
    u = [pulp.LpVariable("u_%d" % s, lowBound=0) for s in range(n)]
    o = [pulp.LpVariable("o_%d" % s, lowBound=0) for s in range(n)]
    for s in range(n):
        m += q + e[s] + u[s] - o[s] == vertices[s]
        m += t <= PRICE * (vertices[s] - u[s]) - C_UNIT * q - C_EMERG * e[s] + SALVAGE * o[s]
    m += t                                         # 最悪の頂点の利益を最大化
    m.solve(pulp.PULP_CBC_CMD(msg=0))
    return q.value(), t.value()

nominal = np.array([181.7, 198.0, 146.3, 182.3, 142.3])
halfw = np.array([32.7, 39.0, 23.7, 63.7, 17.3])
print(solve_robust(robust_vertices(nominal, halfw, 2)))   # 出力: (748.0, 1309000.0)
| 予算 \( \Gamma \) | 列挙した需要合計の数 | 発注量 | 最悪の頂点での利益 | 期待利益(独立評価) | 下位5%平均利益 | 最小利益 |
|---|---|---|---|---|---|---|
| 0 | 1 | 851 | 1,488,667 | 1,337,974 | 687,698 | 175,700 |
| 1 | 10 | 787 | 1,377,250 | 1,325,756 | 777,298 | 265,300 |
| 2 | 34 | 748 | 1,309,000 | 1,301,044 | 831,898 | 319,900 |
| 3 | 63 | 715 | 1,251,250 | 1,270,492 | 878,098 | 366,100 |
| 4 | 74 | 692 | 1,211,000 | 1,244,508 | 910,298 | 398,300 |
| 5 | 30 | 674 | 1,179,500 | 1,221,895 | 935,498 | 423,500 |
\( \Gamma = 0 \) の解は名目値の851個で、これは3年平均そのものです。\( \Gamma \) を1つ増やすごとに発注量は787、748、715、692、674個と下がり、最悪の頂点での利益は保証される代わりに、シナリオで評価した期待利益は133万7,974円から122万1,895円まで下がります。これが「頑健さの値段」です。この例題では利益が需要に対して単調に増えるので、集合の中の最悪は常に需要が最も少ない頂点で起き、ロバストの解は「守ると決めた範囲の下限に発注量を合わせる」という形になります。\( \Gamma = 2 \) の解(748個)を確率計画の解と比べると、期待利益を月3万7,312円譲って、悪い5%の月の平均利益と最悪の月の利益をそれぞれ12万6,000円引き上げており、CVaR 制約つきの解が描く曲線のほぼ上に乗っています。
ロバスト最適化で気をつけるべき点は、不確実性集合の外は一切守られないことです。今回の集合は3年の観測から作ったので、需要の範囲は最も広い \( \Gamma = 5 \) でも674個から1,027個です。ところが、年の水準の変動を入れたシナリオでは5%点が639個、95%点が1,104個で、20.2%のシナリオが集合の外に出ています。観測が3年しかなければ、観測の最大乖離は将来の最大乖離より小さいのが普通です。範囲を広げれば守られる場面は増えますが、その分だけ発注量は保守的になり、期待利益を失います。集合の幅を決めることは、確率計画で分布を決めることと同じくらい重い判断であり、「分布を仮定しないから客観的」というわけではありません。
分布ロバストの考え方
確率計画は分布を1つに決め、ロバスト最適化は分布を捨てて範囲だけを使います。その中間にあるのが分布ロバスト最適化です。分布を1つに決める代わりに、「平均と分散がこの値である分布すべて」のような分布の集合を置き、その集合の中で最悪の分布のもとでの期待費用を最小化します。分布の形(正規か、対数正規か、二峰か)を当てなくてよい代わりに、平均と分散のような要約統計量だけは信じる、という立場です。
在庫の分野でこの考え方は古く、Scarf(1958)が、需要の平均と分散だけが分かっているニューズベンダー問題について、最悪の分布を明示的に求め、そのもとで最適になる発注量を導いています。Gallego と Moon(1993)はこの結果を整理して簡潔な証明を与え、複数品目や予算制約への拡張を示しました(Journal of the Operational Research Society 44(8), 825-834)。より一般の問題では、Delage と Ye(2010)が、平均と共分散の推定誤差まで含めて分布の集合を定義し、多くの費用関数について効率よく解けることを示しています(Operations Research 58(3), 595-612)。この記事の環境には、こうした問題を解くための凸最適化のライブラリ(cvxpy 等)が入っていないので、分布ロバストの実行例は載せていません。考え方だけを押さえておけば、「分布の形に自信が無いが平均と分散は言える」場面で、確率計画とロバストのどちらに寄せるかを判断する材料になります。
分布ロバストは集合の中で最悪の分布に備えるので、集合が本当の分布を含むように設計できていれば、未知の分布のもとでの悪化を見込んだ判断になります。ただし、その結果として発注量が確率計画の解より増えるか減るかは費用構造によって決まり、常に一方向に動くわけではありません。一方で、確率の重みを一切使わないロバスト最適化よりは統計量のぶん情報が多く、両者の中間に位置づけられます。分布の集合を広くとれば(たとえば平均だけを信じる)ロバストに近づき、狭くとれば(平均・分散・歪度まで信じる)確率計画に近づきます。どの手法も、「何を信じて、何を信じないか」を式の形で宣言している点は同じです。次の表に、4つの立場が前提にする情報と守るものを並べます。
| 手法 | 前提にする情報 | 目的関数が守るもの | 向く場面 | 落とし穴 |
|---|---|---|---|---|
| 決定論(平均需要で解く) | 需要の予測値1つ | 予測どおりのときの利益 | 費用が対称で、予測の外れが小さい品目 | 非対称な費用で発注量が片側に偏る。外れたときの損失を見ていない |
| 確率計画(期待値最適) | 需要の分布(シナリオと確率) | 期待利益 | 月々の変動を平均で吸収できる、品目数が多い定番品 | 悪い月の深さを見ない。分布の裾を誤ると期待値も誤る |
| 確率計画(CVaR) | 需要の分布と信頼水準 \( \alpha \) | 悪い側 \( 1-\alpha \) の平均利益 | 資金や信用への影響が大きい高額品・季節品 | 期待利益を大きく手放すことがある。\( \alpha \) の選び方が結果を左右する |
| ロバスト最適化 | 需要の範囲と予算 \( \Gamma \) | 範囲の中の最悪での利益 | 分布を置く根拠が無い新製品・販路変更直後 | 範囲の外は守られない。範囲を広げると保守的になりすぎる |
| 分布ロバスト最適化 | 平均・分散などの要約統計量 | 統計量が合う分布の中の最悪での期待利益 | 分布の形に自信が無いが統計量は言える品目 | 専用のソルバーが要ることが多い。統計量の推定誤差も集合に入れる必要がある |
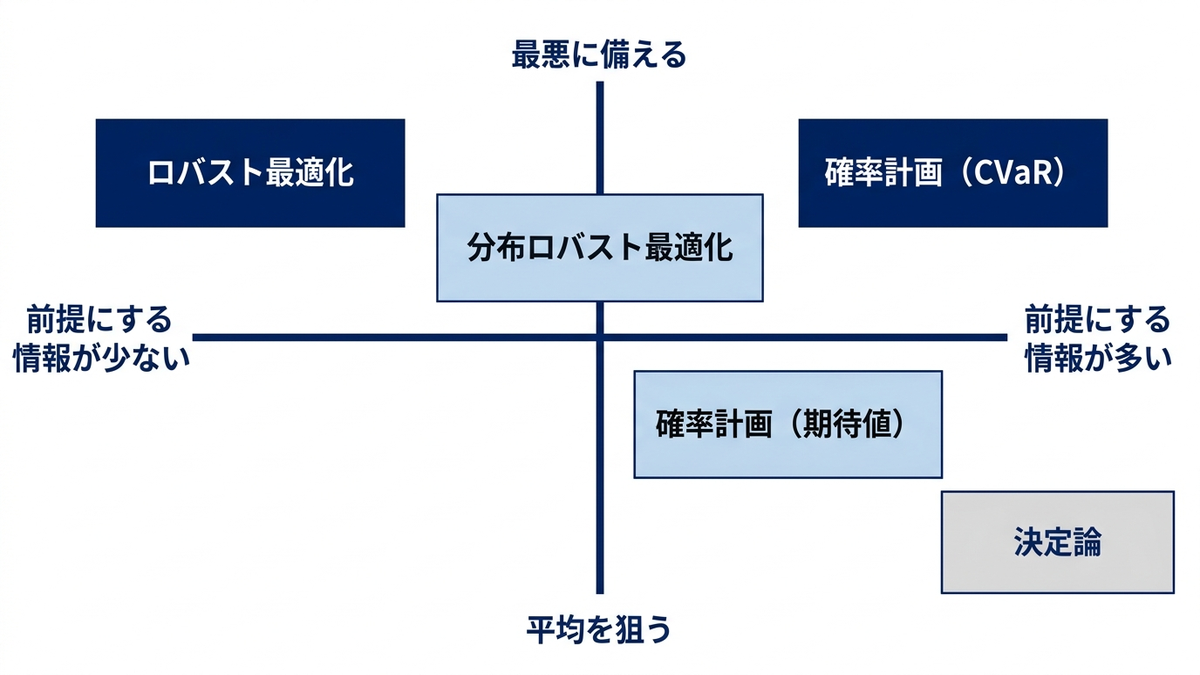
4つの解の比較と経営への翻訳
最後に、同じ例題で得た4つの発注量を、独立の20,000本のシナリオで評価して並べます。
| 解 | 発注量 | 期待利益 | 下位5%平均利益 | 最小利益 | 緊急調達が要る確率 | 欠品の確率 | 処分量の平均 |
|---|---|---|---|---|---|---|---|
| 決定論(平均需要) | 847 | 1,338,244 | 693,298 | 181,300 | 48.2% | 23.5% | 53.5個 |
| 期待値最適(確率計画) | 838 | 1,338,356 | 705,898 | 193,900 | 50.9% | 25.2% | 49.0個 |
| ロバスト(\( \Gamma = 2 \)) | 748 | 1,301,044 | 831,898 | 319,900 | 75.8% | 47.9% | 16.4個 |
| CVaR 最適 | 604 | 1,119,237 | 1,009,066 | 521,500 | 97.6% | 85.7% | 0.9個 |
4つの解は、発注量が847個から604個まで並び、期待利益と悪い月の利益が逆向きに動いています。決定論と期待値最適はほとんど同じで、この品目では平均で解いても大きな損は出ません。ロバストの解は、期待利益を月3万7,300円譲って悪い月を12万6,000円改善します。CVaR 最適は、期待利益を月21万9,100円譲って悪い月を30万3,200円改善します。悪い月の改善1円あたりに手放す期待利益は、ロバストで0.30円、CVaR 最適で0.72円です。守りを厚くするほど、守り1円あたりの値段は上がっていきます。
ここで「欠品の確率」の列を見ると、CVaR 最適では85.7%のシナリオで緊急調達の上限を超えて欠品が起きています。第4章のサービスレベルの感覚で見れば、これは受け入れがたい数字に見えるはずです。しかし CVaR 最適が守っているのは「利益の下限」であって「欠品しないこと」ではありません。この例題では欠品1個の機会損失(1,750円)が処分1個の損失(1,400円)と同程度で、しかも緊急調達で100個までは埋められるため、利益を守るには売れ残りを避けるほうが効きます。もし欠品の信用への影響が大きく、機会損失を粗利の数倍に見積もるべき品目なら、同じ CVaR 最適でも発注量は逆に増えます。手法が出す答えは、入力した費用の構造をそのまま映しているので、答えに違和感があるときは手法ではなく費用の見積もりを疑うのが先です。
実務で選ぶときの目安を挙げます。定番品で品目数が多く、月々の外れが翌月に吸収されるなら、期待値最適で十分で、費用が対称なら決定論との差も小さいので、第5章の発注方式の枠組みに乗せて運用するのが現実的です。季節品や高額品で、売れ残りが期末の在庫評価や資金繰りに直接響くなら、CVaR 制約つきの確率計画で「悪い月の下限」を経営が決め、その下限で期待利益を最大化する形が、意思決定の分担として分かりやすいと考えています。新製品や販路変更の直後で分布を置く根拠が無いなら、ロバスト最適化で範囲だけを決めて保守的に始め、実績が積み上がった時点で確率計画に切り替えるのが妥当です。どの手法でも、解いた後に独立なシナリオや第12章のシミュレーションで評価し直すことは省けません。
この章の要点は3つです。需要の不確実性は、シナリオと第2段階のリコースを式に書くことで、線形計画のまま最適化に持ち込めます。期待値を最大にする解と、悪い側の損失を抑える CVaR の解は一般に違い、その差は「最悪の月にいくら備えるか」の値段として金額で示せます。分布を置けないときは、不確実性集合の幅と予算で保守性を調整するロバスト最適化があり、分布の要約統計量だけを信じる分布ロバストがその中間にあります。ここまでは1つの品目、1つの在庫地点の話でした。次の第10章では、倉庫と店舗、部品と製品のように、在庫地点が複数つながる多段階の在庫を扱い、どこにどれだけ在庫を置くかを決めます。
この章を深めたい方への参考書籍
『確率計画法』(椎名孝之、朝倉書店):応用最適化シリーズの1冊で、リコースをもつ2段階問題、多段階の確率線形計画とシナリオ、モンテカルロ法を使う確率計画、リスクを考慮した確率計画までを日本語で体系的に扱っています。この章で PuLP に書いた定式化の理論的な背景と、大規模な問題を解くための L 字型法などの解法を学べます。
『Introduction to Stochastic Programming』(John R. Birge、François Louveaux、Springer):確率計画の標準的な教科書の第2版です。この章で使った完全情報の期待価値(EVPI)と確率計画の価値(VSS)は、同書の第4章で定義され、例題とともに解説されています。2段階問題の定式化から解法、サンプリングによる近似まで一通り載っています。
『Robust Optimization』(Aharon Ben-Tal、Laurent El Ghaoui、Arkadi Nemirovski、Princeton University Press):ロバスト最適化の理論をまとめた原典的な教科書です。不確実性集合の設計、線形計画と円錐計画のロバスト版、リコースをもつ調整可能ロバスト最適化まで扱っています。この章で列挙で解いた問題を、双対を使って制約に書き直す方法の根拠を確かめられます。
第10章 多段階在庫、どこに在庫を置くか
第9章では、需要の不確実性をシナリオや不確実性集合の形で式に入れ、発注量そのものを最適化する方法を確認しました。ここまでの章は、いずれも「1つの拠点」の在庫を対象にしてきました。工場から物流センターへ、物流センターから店舗へと品物が流れる実際のサプライチェーンでは、拠点が数珠つなぎになっており、上流の拠点が欠品すると下流の補充リードタイムが延びます。本章では、この「つながった在庫」を扱う多段階在庫(マルチエシェロン在庫)の考え方を整理します。決めることは、各拠点でいくつ持つかに加えて、そもそもどの拠点に在庫を置くか、です。
扱う内容は、拠点のつながり方の3つの型、在庫を「拠点ごと」ではなく「その拠点から下流全体」で数えるエシェロン在庫、直列系の最適方策を1拠点ずつの問題に分解できるというクラークとスカーフの結果、上流ほど発注が振れるブルウィップ効果、安全在庫の置き場所を決める保証サービス時間モデル、拠点を集約すると安全在庫がどれだけ減るかというリスクプーリング、そして取引先と在庫や計画を共有する VMI と CPFR の位置づけです。数値例には第2章で用意した架空のサンプルデータのうち、定番品 A001(平均39.6個/日、標準偏差9.7、原価1,200円)を使います。
直列・分岐・組立、多段階の3つの構造
多段階在庫の理論は、拠点のつながり方によって扱いやすさが大きく変わります。もっとも基本の型が直列系で、工場、物流センター、店舗のように、各段階に拠点が1つずつあり、品物が一本の線で流れるものです。次が分岐系(配送系)で、1つの物流センターから多数の店舗へ品物が分かれていく型です。小売や部品供給の多くはこの形をしています。3つ目が組立系で、複数の部品や原材料が1つの製品に合流していく型です。製造業の部品在庫はこれにあたります。
この3つのうち、最適な方策の構造がはっきり分かっているのは直列系です。多段階在庫の理論の出発点になった Clark と Scarf の1960年の論文Optimal Policies for a Multi-Echelon Inventory Problemは、まさにこの直列系を対象にしています。その要旨には、拠点1が拠点2から、拠点2が拠点3から補充を受ける形で複数の拠点が並んでいるとき、拠点1の補充に掛かる時間は拠点間の輸送時間だけでなく拠点2の在庫の有無にも左右される、と問題の核心が書かれています。1拠点のモデルでは「発注すれば一定の(あるいはばらつきはあっても発注量に依存しない)リードタイムで届く」と仮定していましたが、多段階では上流の欠品がそのまま下流のリードタイムの延びになります。ここが1拠点の理論をそのまま当てはめてはいけない理由です。
組立系については、Rosling が1989年の論文Optimal Inventory Policies for Assembly Systems Under Random Demandsで、一定の「長期的な均衡」の仮定のもとで組立系を直列系に組み替えて分析できることを示しました。つまり直列系で分かったことは、純粋な組立系にも持ち込めます。一方、分岐系は事情が違います。1つの上流拠点が複数の下流拠点に品物を配る場合、上流が足りないときに「どの下流に回すか」という配分の問題が入り、最適方策の構造は直列系のようには分かっていません。Federgruen と Zipkin の1984年の論文Computational Issues in an Infinite-Horizon, Multiechelon Inventory Modelは、下流に複数の拠点がある場合を一定の条件のもとで「下流が1拠点のモデル」で近似できることを示しており、実務ではこの種の近似や発見的な方法が使われます。van Houtum による2006年のチュートリアルMulti-echelon production/inventory systemsは、どの構造で最適方策が分かっていて、どの構造では近似に頼るのかを整理しており、本章の直列系の説明はこの文書の記法に沿っています。
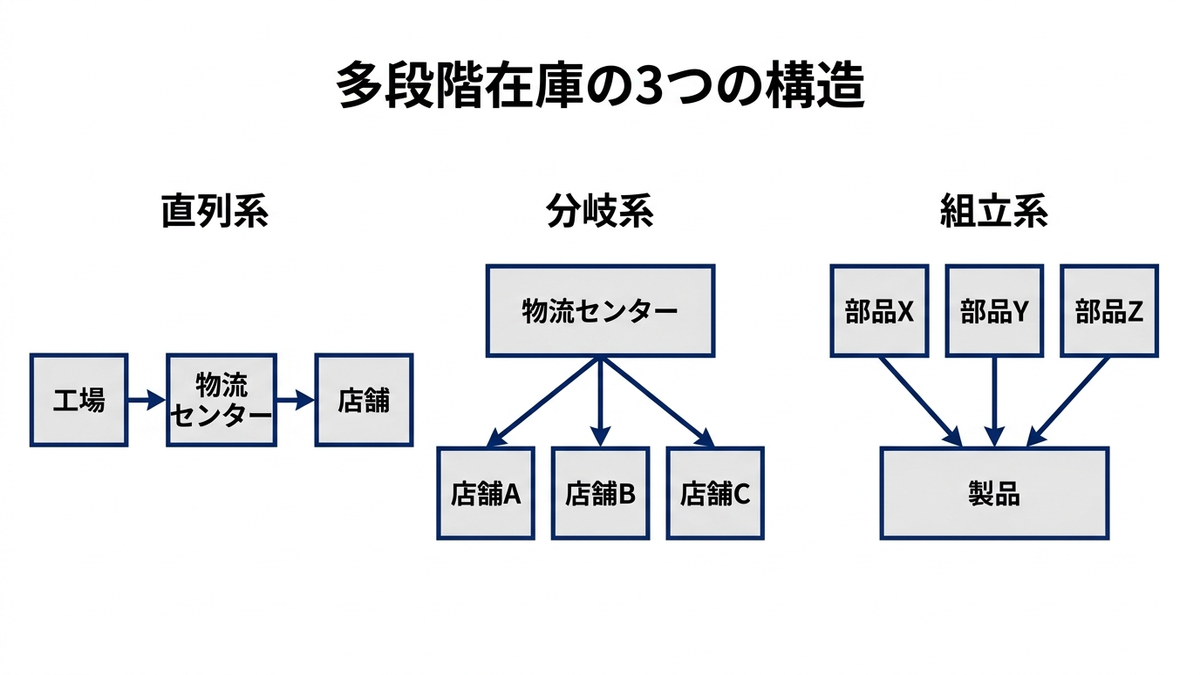
エシェロン在庫、設置在庫と何が違うか
多段階在庫を考えるときの最初の道具が、在庫の数え方の切り替えです。各拠点の手元にある在庫をその拠点の設置在庫(インストレーション在庫)と呼びます。これに対してエシェロン在庫は、ある拠点の手持ちに、その拠点から下流にある拠点の手持ちと、その間の輸送中の在庫をすべて足し、最下流のバックオーダー(未納の受注)を引いたものです。van Houtum のチュートリアルは、この概念が Clark の1958年の研究で導入されたものであることと、上の定義を明記しています。「エシェロン」は階層という意味で、ある拠点を頂点とする下流全体をひとまとまりに見る、という考え方です。
発注の判断には、さらに「その拠点へ向かって輸送中のもの」を足したエシェロン在庫ポジションを使います。言葉だけでは分かりにくいので、ある日の在庫の状態から実際に数えてみます。物流センターの手持ちが300個、センターから店舗への輸送中が120個、店舗の手持ちが90個、店舗のバックオーダーが10個、工場からセンターへの輸送中が280個だとします。
| 数え方 | 計算 | 個数 |
|---|---|---|
| 店舗の設置在庫 | 店舗の手持ち90からバックオーダー10を引く | 80 |
| センターの設置在庫 | センターの手持ち | 300 |
| エシェロン在庫1(店舗) | 店舗の設置在庫と同じ | 80 |
| エシェロン在庫2(センター) | センター手持ち300+輸送中120+店舗手持ち90、そこからバックオーダー10を引く | 500 |
| エシェロン在庫ポジション1 | エシェロン在庫1に店舗へ向かう輸送中120を足す | 200 |
| エシェロン在庫ポジション2 | エシェロン在庫2にセンターへ向かう輸送中280を足す | 780 |
この数え方に切り替えると何が変わるかというと、上流拠点の発注判断が「自分の倉庫がどれだけ減ったか」ではなく「自分から下流の全体で、顧客に対してどれだけ備えがあるか」に基づくようになります。センターの手持ちが300個あっても、店舗の手持ちが底を突きバックオーダーが積み上がっていれば、エシェロンで見た備えは薄い、という判断になります。設置在庫だけを見ていると、センターは「まだ300個ある」として発注を遅らせ、店舗は「足りない」として大量に発注する、というちぐはぐが起こります。エシェロン在庫は、この2つの拠点を1つの目で見るための数え方です。この計算を含む本章のスクリプトは _code\ch10_echelon.py にまとめました。
クラークとスカーフの結果、直列系はベースストックに分解できる
Clark と Scarf が示した結果は、次の2つにまとめられます。第1に、直列系で固定発注費が無く、保管費と欠品費が線形のとき、最適方策はエシェロン在庫ポジションに基づくベースストック方策である、つまり各段階が自分のエシェロン在庫ポジションをある基準在庫の水準まで引き上げるように発注するのが最適である、ということです。第2に、その最適な基準在庫の水準は、1変数の凸関数を最小化する問題を下流から順に解いていくことで求まる、ということです。van Houtum のチュートリアルはこれを分解の結果と呼び、Clark と Scarf が上流の費用関数に下流から「誘導される欠品費」を足す形で解いたことを説明しています。多段階の問題が、実質的に1拠点の問題の連鎖に分解できる、というのがこの結果の価値です。
2段階の直列系で、保管費と欠品費が線形のとき、最適な基準在庫は次の2つの条件で決まります(van Houtum 2006 の定理3)。段階2を上流の物流センター、段階1を下流の店舗とし、\( l_2 \) をセンターの補充リードタイム、\( l_1 \) を店舗の補充リードタイム、\( h_2 \) をエシェロン2(センターの手持ちとセンターから店舗への輸送中)の1個1日あたりの保管費、\( h_1 \) を店舗で追加で掛かる1個1日あたりの保管費、\( p \) を店舗のバックオーダー1個1日あたりの欠品費とします。
- 店舗の基準在庫 \( S_1 \) は、センターが常に出荷できると仮定したうえで、保護期間 \( l_1 + 1 \) 日の需要が \( S_1 \) を超えない確率が \( (p + h_2) / (p + h_1 + h_2) \) になる水準に取る
- センターの基準在庫 \( S_2 \) は、\( S_1 \) を固定したうえで、全体系での店舗の欠品しない確率が \( p / (p + h_1 + h_2) \) になる水準に取る
1つ目はニューズベンダー問題(第6章)と同じ形で、店舗だけを切り出した部分系の臨界比です。2つ目が多段階に固有の部分で、センターの在庫が足りず店舗が基準在庫まで補充できない「不足分」を通して、センターの基準在庫が店舗の欠品確率に効いてきます。注目すべきは、全体系で許容する欠品確率のほうが部分系より大きい(サービス率が低い)ことです。センターは長いリードタイムを引き受けるので、店舗と同じ高いサービス率を上流にまで求めると在庫が過剰になる、という理屈がこの式に入っています。
A001 でこの計算を行いました。センターの補充リードタイムを7日、店舗の補充リードタイムを3日とし、完成品1個1日の保管費は原価1,200円に年率20%を掛けて365で割った0.6575円、バックオーダー1個1日の欠品費は例題として20円を置きます。この欠品費は第3章以降で使ってきた「欠品1個あたり原価の50%」とは別の量で、納品が1日遅れるごとに掛かる費用です。実測は _out\ch10_echelon.txt に残しました。保管費の合計0.6575円のうち上流で付く価値の割合を ω として、ω を変えたときの結果が次の表です。店舗のサービス率は ω が0.5のとき0.984、0.7のとき0.990、0.9のとき0.997で、全体系のサービス率はいずれも0.968です。
| 上流の価値の割合 ω | 店舗の基準在庫 \( S_1 \) | センターの基準在庫 \( S_2 \) | 店舗の平均手持ち(個) | センターの平均手持ち(個) | 平均バックオーダー(個/日) |
|---|---|---|---|---|---|
| 0.5 | 200.2 | 502.1 | 39.7 | 26.9 | 0.316 |
| 0.7 | 204.1 | 498.8 | 42.1 | 21.2 | 0.348 |
| 0.9 | 211.6 | 496.4 | 46.5 | 14.5 | 0.382 |
| 1.0 | 無限大(全部流す) | 495.6 | 60.2 | 0.0 | 0.396 |
読み方は2つあります。1つは、基準在庫 \( S_2 \) がセンターの手持ちの目標ではなく、センターから店舗までの全体で持つ量だということです。ω が0.7の行では \( S_2 \) が498.8個ですが、センターの平均手持ちは21.2個に過ぎず、残りはセンターから店舗への輸送中(平均118.9個)と店舗の手持ち、そして需要で消えていく分です。もう1つは、価値が上流で付くほど(ω が大きいほど)在庫が下流に寄る、ということです。センターに置いても店舗に置いても在庫の価値がほとんど変わらないなら、顧客に近い店舗に置いたほうが欠品に効くので、店舗の基準在庫が上がりセンターの手持ちが減ります。極端に店舗で価値が付かない場合(ω が1.0)は、センターは受け取ったものを全部店舗へ流し、手持ちを持たないのが最適になります。van Houtum のチュートリアルはこれを系(Corollary 1)として明記しています。逆に、店舗に運ぶ段階で大きな価値が付く(輸送費や店舗での加工費が高い)なら、安い形で上流に置いておくほうが得になります。
この方策が「各拠点が勝手に安全在庫を持つ」運用とどれだけ違うかを、A001 の実データ1,096日を使った日次シミュレーションで比べました。比較対象の設置方策は、店舗もセンターもそれぞれ自分の手持ちと輸送中だけを見て、同じサービス率0.968を狙って基準在庫を置く運用です。
from scipy.stats import norm
import numpy as np
from inv_data import load_demand, load_skus, COST
dem = load_demand(); skus = load_skus()
mu, sd = dem["A001"].mean(), dem["A001"].std()
l2, l1 = 7, 3                       # センター・店舗の補充リードタイム(日)
H = skus.loc["A001", "unit_cost"] * COST["holding_rate"] / 365   # 完成品1個1日の保管費
h2, h1, p = 0.7 * H, 0.3 * H, 20.0  # 上流で付く価値7割、バックオーダー1個1日20円
# (i) 店舗のサブシステム: 保護期間 l1+1 日のニューズベンダー
S1 = norm.ppf((p + h2) / (p + h1 + h2), mu * (l1 + 1), sd * np.sqrt(l1 + 1))
# (ii) 全体系: P{店舗が欠品しない} = p/(p+h1+h2) となる S2 をモンテカルロで探す
rng = np.random.default_rng(0)
D2 = np.maximum(0, rng.normal(mu * l2, sd * np.sqrt(l2), 400_000))
D1 = np.maximum(0, rng.normal(mu * (l1 + 1), sd * np.sqrt(l1 + 1), 400_000))
def p_ok(S2):
    B1 = np.maximum(0, D2 - (S2 - S1))     # センターが出せなかった不足分
    B0 = np.maximum(0, B1 + D1 - S1)       # 店舗のバックオーダー
    return (B0 <= 0).mean()
lo, hi = S1, S1 + mu * l2 + 8 * sd * np.sqrt(l2)
for _ in range(60):
    mid = (lo + hi) / 2
    if p_ok(mid) < p / (p + h1 + h2):
        lo = mid
    else:
        hi = mid
print(round(S1, 1), round((lo + hi) / 2, 1))
# 出力: 204.1 498.8
結果は、エシェロン方策が店舗の平均手持ち42.6個とセンターの平均手持ち22.1個の合計64.7個(原価で77,645円)で充足率0.9877、バックオーダーが発生した日が40日でした。設置方策は店舗36.3個とセンター52.8個の合計89.0個(106,811円)で充足率0.9898、バックオーダー発生日は46日でした。充足率はほぼ同じで、欠品した日数はむしろ設置方策のほうが多いのに、在庫は設置方策のほうが約38%多い、という結果です。センターが自分のリードタイム分の安全在庫を独立に持つと、店舗の安全在庫との「二重取り」になるためです。なお、シミュレーションで測った平均手持ち(42.6個と22.1個)が、理論式から出した値(42.1個と21.2個)とほぼ一致していることも確認できます。
ブルウィップ効果、4つの原因と対策
多段階の在庫でもう1つ避けて通れないのが、ブルウィップ効果です。店頭の売上の変動は小さいのに、卸への発注、物流センターへの発注、工場への発注と上流に行くほど発注量の振れが大きくなる現象で、鞭を振ったときに先端ほど大きく波打つ様子になぞらえています。Lee、Padmanabhan、Whang の1997年の論文Information Distortion in a Supply Chain: The Bullwhip Effectは、下流からの「発注」が上流にとっての需要情報になるとき、その情報が歪んで伝わることをこの名前で呼び、原因を4つに整理しました。同じ著者らが同年に MIT Sloan Management Review に書いた実務向けの記事The Bullwhip Effect in Supply Chainsは、P&G の紙おむつと HP のプリンターの例でこの現象を紹介しています。
| 原因 | 何が起きるか | 対策の方向 |
|---|---|---|
| 需要シグナルの処理 | 各段階が自分に届いた発注を「需要」とみなして予測を更新し、その予測に基づいて基準在庫を動かすため、下流の小さな変化が上流では大きな発注の変化になる | 店頭の実需要を上流にも共有し、各段階が同じ需要で予測する。リードタイムを短くする |
| 配分ゲーム | 供給が逼迫すると、下流は多めに発注して配分を多く取ろうとし、上流には実需要以上の発注が届く | 配分を発注量ではなく過去の販売実績に基づいて行う |
| 発注のまとめ | 発注費や輸送単位のために発注を週1回・月1回にまとめると、上流には需要がゼロの期間と大きな発注が交互に届く | 発注費を下げて小口・高頻度にする。取引先間で発注のタイミングをずらす |
| 価格の変動 | 値引きや販促の時期に前倒しで買いだめが起き、その後の需要が落ち込む | 価格を安定させ、販促に伴う前倒し購入を減らす |
4つの原因のうち最初の「需要シグナルの処理」は、悪意も不合理もなく、各段階がそれぞれ真面目に予測して発注するだけで起きる点が重要です。Chen、Drezner、Ryan、Simchi-Levi の2000年の論文Quantifying the Bullwhip Effect in a Simple Supply Chainは、小売と製造の2段階の系で、需要予測とリードタイムという2つの要因だけを入れて発注の分散が需要の分散の何倍になるかを定量化しました。移動平均 \( p \) 日で予測し、リードタイム \( L \) 日のオーダーアップツー方式で発注するとき、発注分散と需要分散の比は \( 1 + 2L/p + 2L^2/p^2 \) 以上になります。言葉で言えば、リードタイムが長いほど、そして予測に使う過去の期間が短いほど、増幅は大きくなります。同じ論文は、多段階に拡張したとき、店頭の需要情報を全段階で共有すれば増幅を減らせるが、完全には無くせないことも示しています。
この増幅を、A001 の需要を店頭需要として、店舗、卸、物流センター、工場の4段の直列系で再現しました(_code\ch10_bullwhip.py、実測は _out\ch10_bullwhip.txt)。各段はリードタイム3日、直近7日の移動平均で1日あたりの需要を予測し、リードタイム中の需要と安全在庫(安全係数1.65)を目標にした基準在庫方式で発注します。上流は下流の発注しか見えないという運用(A)と、全段が店頭の実需要を見て予測する運用(B)、(A)に店舗の週1回まとめ発注を加えた運用(C)の3つを比べました。
import numpy as np
from inv_data import load_demand

D = load_demand()["A001"].values.astype(float)   # 店頭需要(第2章の定番品 A001)

def run_chain(demand, share_info=False, L=3, P=7, K=1.65):
    """4段直列。各段の発注系列のリストを返す。上流には下流の発注が需要として届く"""
    n = len(demand); orders = []; inp = demand.copy()
    for s in range(4):
        src = demand if share_info else inp      # 予測に使う系列
        q = np.zeros(n); pipe = np.zeros(n + L + 1)
        m0 = src[:P].mean(); sd0 = src[:P].std(ddof=1)
        oh = ip = (L + 1) * m0 + K * sd0 * np.sqrt(L + 1)
        bo = 0.0
        for t in range(n):
            oh += pipe[t]
            win = src[max(0, t - P):t] if t > 0 else src[:1]
            m = win.mean(); sd = win.std(ddof=1) if len(win) > 1 else 0.0
            target = (L + 1) * m + K * sd * np.sqrt(L + 1)
            order = max(0.0, target - ip)
            q[t] = order; ip += order; pipe[t + L] += order
            d = inp[t] + bo; ship = min(d, oh)
            oh -= ship; bo = d - ship; ip -= inp[t]
        orders.append(q); inp = q
    return orders
A = run_chain(D); B = run_chain(D, share_info=True)
v0 = D[60:].var(ddof=1)
print([round(float(o[60:].var(ddof=1) / v0), 2) for o in A])
print([round(float(o[60:].var(ddof=1) / v0), 2) for o in B])
# 出力: [3.72, 14.32, 45.02, 120.45]
# 出力: [3.72, 4.81, 5.88, 6.67]
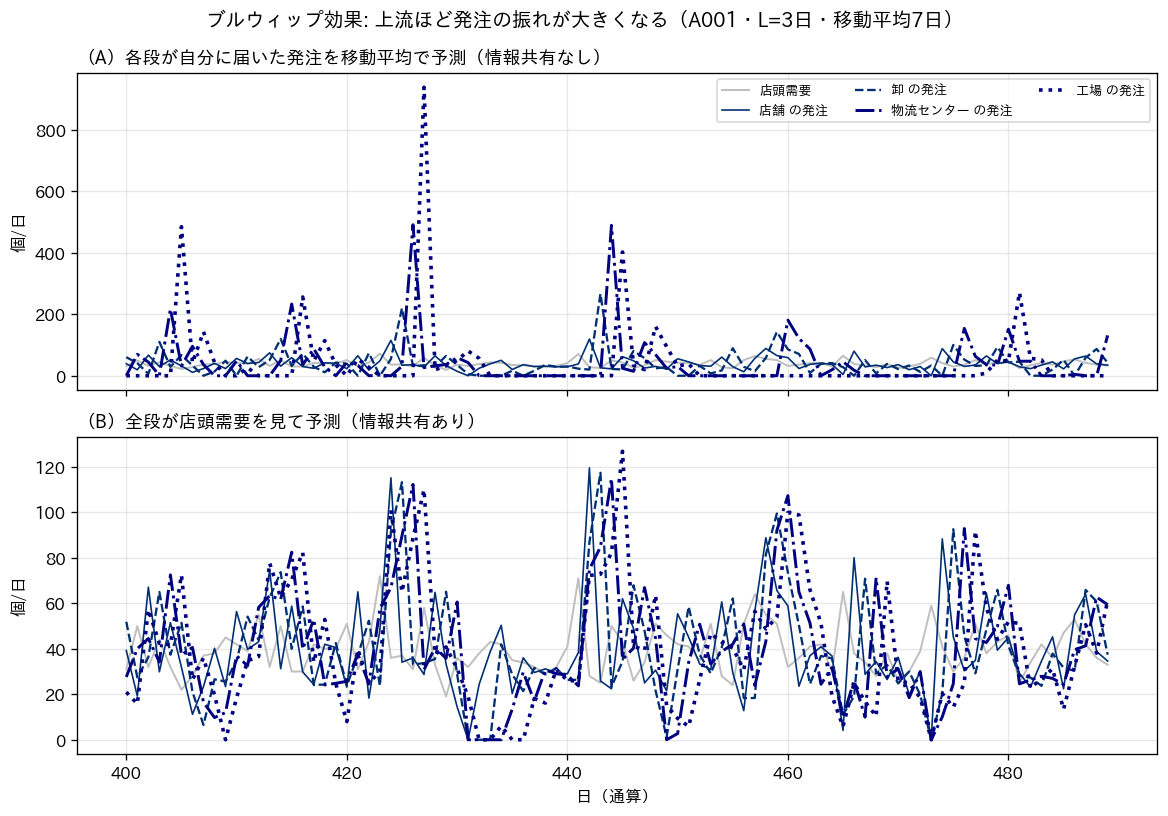
| 段階 | (A)情報共有なし | (B)情報共有あり | (C)なし+週1回まとめ発注 | (A)の発注の標準偏差(個/日) |
|---|---|---|---|---|
| 店舗 | 3.72 | 3.72 | 358.95 | 18.71 |
| 卸 | 14.32 | 4.81 | 622.37 | 36.69 |
| 物流センター | 45.02 | 5.88 | 1,435.23 | 65.06 |
| 工場 | 120.45 | 6.67 | 2,303.76 | 106.41 |
表の数値は各段の発注分散を店頭需要の分散で割った比です。店頭需要の標準偏差は9.73個/日ですが、情報共有なしの運用(A)では店舗の発注の標準偏差が18.71、工場への発注では106.41になり、分散の比で120倍に達しました。店頭では平均39.6個で標準偏差が10個弱の穏やかな需要が、工場から見ると日によってゼロから数百個まで振れる需要に見えています。グラフの上段で、工場の発注(点線)だけが900個近い山を作っているのがそれです。全段が店頭需要で予測する運用(B)では、店舗の比は同じ3.72のままですが、工場でも6.67に収まりました。増幅が消えたわけではないものの、1桁台に抑えられています。これは Chen らの「共有で減るが無くならない」という結果と整合します。
店舗の週1回まとめ発注を加えた運用(C)では、店舗の発注の分散比が358.95に跳ね上がり、工場では2,303.76になりました。まとめ発注は、需要がゼロの日が6日続いて7日目に7日分がまとまって届く形なので、それだけで発注の分散は大きくなります。発注費を下げるためのまとめ発注が、上流の生産計画から見ると最大の外乱になる、というのが4つの原因の3番目の実像です。なお、店舗段の比3.72は Chen らの式の値2.224より大きくなっていますが、これは式が下界であること、そしてこのシミュレーションでは安全在庫の項も移動窓の標準偏差で毎日更新しているためです。検算として安全在庫の項を外し、保護期間を式の \( L \) に合わせると、リードタイム3日・移動平均7日で実測2.825に対して式2.796、移動平均14日で1.723に対して1.735と、1.5%以内で一致しました。
対策は原因の裏返しです。予測に使う情報を上流にも渡す(情報共有)、リードタイムを縮める、まとめ発注の単位を小さくする、価格や販促の設計を安定させる、という方向になります。情報共有の実装が次の節以降で述べる VMI や CPFR です。また、Sterman が1989年の論文Modeling Managerial Behaviorで示したように、人が発注を決める在庫管理のシミュレーション実験では、参加者が自分の判断が系全体に与える影響に鈍感で、在庫の管理が系統的に最適から外れる傾向が観察されています。ブルウィップは仕組みの問題であると同時に、判断の癖の問題でもある、ということです。
保証サービス時間モデルによる在庫配置
クラークとスカーフの理論は「各段階が確率的に欠品し、上流の欠品が下流のリードタイムを延ばす」ことを正面から扱いますが、拠点が数十から数百に及ぶ実際のサプライチェーンで解くには重すぎます。実務で広く使われるもう1つの考え方が、Graves と Willems の2000年の論文Optimizing Strategic Safety Stock Placement in Supply Chainsで定式化された保証サービス時間モデルです。要旨によれば、このモデルの前提は、サプライチェーンをネットワークとして表せること、各段階が定期発注のベースストック方策で動くこと、需要に上限があること、そして各段階がその顧客に対して「保証されたサービス時間」を約束することの4つです。これらの仮定によって確率的な問題を確定的な最適化として書け、ネットワークが木構造(スパニングツリー)のときに安全在庫の配置を最適化するアルゴリズムが与えられています。同じ論文は、この手法が Eastman Kodak の製品フローチームで使われ、完成品在庫の削減や部品在庫の決定に役立ったことも報告しています。
仕組みを2段階で説明します。上流の段階2(工場)が原価 \( C_2 \)、リードタイム \( T_2 \) 日で、下流の段階1(物流センター)が追加の原価 \( C_1 \)、リードタイム \( T_1 \) 日とします。段階2は下流に対して「注文を受けてから \( S_2 \) 日以内に出す」と約束します。この \( S_2 \) が決定変数で、0なら即納、\( T_2 \) ならリードタイムいっぱいまで待ってもらう約束です。各段階が安全在庫でカバーしなければならない期間を正味補充時間と呼び、段階2では \( T_2 – S_2 \)、段階1では \( S_2 + T_1 \) になります。需要の上限を平均に安全係数 \( k \) と標準偏差を掛けた分を足した形で置くと、各段階の安全在庫は \( k \sigma \sqrt{\tau} \)(\( \tau \) は正味補充時間)になります。最小化する費用は、それぞれの安全在庫にその段階の累積原価と保管費率を掛けた合計です。Hua と Willems の2016年の論文Analytical insights into two-stage serial line supply chain safety stockは、この2段階の問題を解析し、最適解が必ず両端のどちらか、つまり「工場が自分のリードタイム分の安全在庫を持って即納する」か「工場は安全在庫を持たず、下流が両段階分のリードタイムをまとめてカバーする」かのどちらかになることを示しました。同じ論文は、原価の配分(上流で付く価値の割合)とリードタイムの配分が、どちらが最適かを決めることも整理しています。
A001 で計算しました(_code\ch10_gsm.py、実測は _out\ch10_gsm.txt)。工場のリードタイムを7日、物流センターのリードタイムを3日、安全係数はサービス率95%に対応する1.645、保管費率は年20%とし、完成品の原価1,200円のうち工場側で付く割合を ω として動かします。
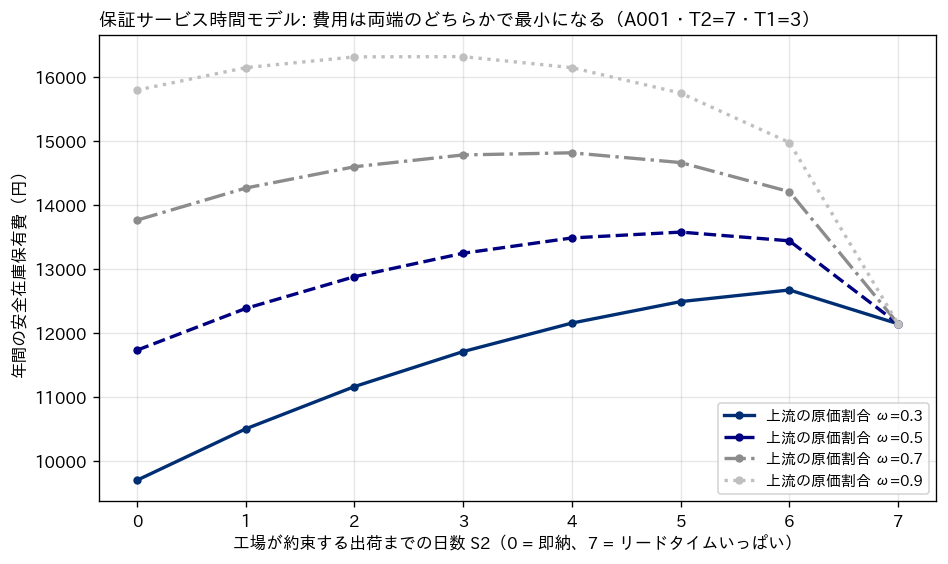
| 工場側の原価割合 ω | 工場が持つ(即納):安全在庫と年間費用 | センターに寄せる:安全在庫と年間費用 | 安いのは |
|---|---|---|---|
| 0.3 | 工場42.3個+センター27.7個、9,699円 | センター50.6個、12,143円 | 工場側 |
| 0.5 | 同上、11,731円 | 同上、12,143円 | 工場側 |
| 0.7 | 同上、13,762円 | 同上、12,143円 | センター側 |
| 0.9 | 同上、15,794円 | 同上、12,143円 | センター側 |
グラフを見ると、どの ω でも費用の曲線は途中で山になり、両端のどちらかで最小になっています。「工場に3日分、センターに4日分」のような中間の配置は、少なくともこの2段階のモデルでは、平方根の性質のせいで安いほうの端点より必ず高くなります(もう一方の端点より安いことはあります。ω が0.3のとき、工場が1日待たせる配置は10,501円で、センターに寄せる12,143円より安いものの、工場が即納する9,699円には届きません)。安全在庫は正味補充時間の平方根に比例するので、期間を2つに分けて別々にカバーすると、まとめてカバーするより個数の合計が増えるからです(この例では工場42.3個とセンター27.7個の合計70.0個に対し、センターだけなら50.6個)。それでも工場側に置くのが得になるのは、工場の在庫が安い形(原価の一部しか付いていない状態)で持てるときです。ω が0.5と0.6の間に境目があり、それより上流の価値が大きいと、安い形で持てる利点が消えて下流に寄せるほうが得になります。リードタイムの配分でも同じことが起き、合計10日のうち工場側が8日なら工場側に置き、6日以下ならセンターに寄せるのが得でした(ω は0.5)。
このモデルの使いどころと限界も述べておきます。需要に上限を置き、それを超えた分は安全在庫ではなく納期の遅れや特急対応で吸収する、という前提なので、上限をどこに置くか(安全係数)は経営が決める入力です。反対に、確率的に欠品が起きてそれが下流のリードタイムを延ばす、という現象は扱いません。Hua と Willems の論文は、この点で保証サービス時間モデルと、各段階が目標サービス率を満たすように在庫を持ち上流の欠品で補充が遅れることを認める確率的サービスモデルとを対比しています。前者は「どこに置くか」を数十段階でも解ける実務的な道具であり、後者は少数の段階を精密に扱う理論的な道具です。両方の答えが同じ方向を向いているかを見るのが、現実的な使い方だと考えています。
集中と分散、リスクプーリングと平方根の法則
「どこに置くか」の問いには、上流か下流かという縦の軸のほかに、拠点を1か所に集めるか各地に分けるかという横の軸があります。ここで働くのがリスクプーリングです。複数の拠点の需要を1か所でまとめて受けると、ある拠点の需要が多い日に別の拠点の需要が少ない、という相殺が起きるため、合計需要の標準偏差は各拠点の標準偏差の合計より小さくなります。Eppen の1979年の論文Effects of Centralization on Expected Costs in a Multi-Location Newsboy Problemは、各拠点の需要が正規分布で保管費と欠品費が線形かつ拠点間で同一という設定のもと、集約すると期待費用が下がること、そして削減の大きさが拠点間の需要の相関に依存することを示しました。
数式で言えば、n 拠点の需要が互いに独立で同じ標準偏差 σ を持つとき、合計需要の標準偏差は \( \sigma\sqrt{n} \) です。安全在庫は標準偏差に比例するので、分散して持てば安全在庫の合計は n に比例し、集約すれば \( \sqrt{n} \) に比例します。集約後の安全在庫は分散時の \( 1/\sqrt{n} \) 倍になり、これが平方根の法則と呼ばれるものです。Maister の1976年の論文(在庫の集中化と平方根の法則)がこの名前で整理したもので、倉庫を集約したときの在庫が倉庫数の平方根に比例するという主張です。拠点間の需要に相関 ρ があるときは、合計需要の分散は \( \sigma^2 (n + n(n-1)\rho) \) になり、ρ が1(全拠点の需要が完全に連動する)なら集約しても安全在庫は減りません。
A001 と同じ需要(平均39.6個/日、標準偏差9.7、リードタイム7日)を持つ拠点が n か所あるとして計算しました(_code\ch10_pooling.py、実測は _out\ch10_pooling.txt)。サービス率95%の安全係数1.645で、1拠点の安全在庫は42.3個(原価で50,797円)です。
| 拠点数 n | 分散して持つ安全在庫の合計(個) | 集約、相関ρ=0 | 集約、相関ρ=0.3 | 集約、相関ρ=0.7 | 集約、相関ρ=1.0 |
|---|---|---|---|---|---|
| 2 | 84.7 | 59.9(0.71倍) | 68.3(0.81倍) | 78.1(0.92倍) | 84.7(1.00倍) |
| 4 | 169.3 | 84.7(0.50倍) | 116.7(0.69倍) | 149.1(0.88倍) | 169.3(1.00倍) |
| 8 | 338.6 | 119.7(0.35倍) | 210.8(0.62倍) | 290.8(0.86倍) | 338.6(1.00倍) |
| 16 | 677.3 | 169.3(0.25倍) | 397.1(0.59倍) | 574.2(0.85倍) | 677.3(1.00倍) |
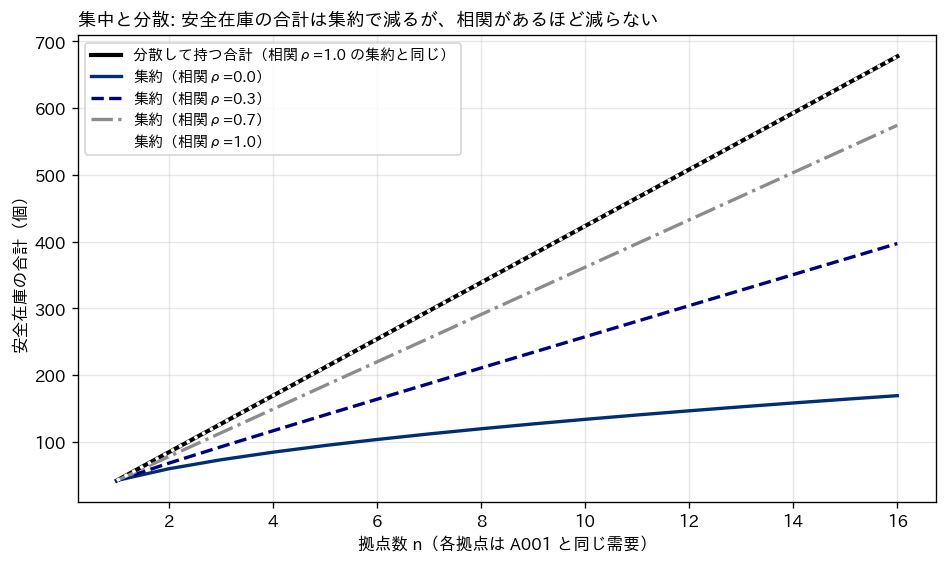
相関がゼロなら、8拠点を1か所にまとめると安全在庫は338.6個から119.7個に減り、原価で262,699円の在庫金額が浮きます。しかし相関が0.7あれば290.8個までしか減らず、削減額は57,389円にとどまります。天候や販促のように全拠点に同時に効く要因があると、拠点間の需要は正の相関を持ちます。乱数で作った8拠点の需要に共通の変動を掛けたところ、拠点間の平均相関は0.524になり、集約後の安全在庫は分散時の0.764倍で、式の値と一致しました。相関を測らずに \( 1/\sqrt{n} \) をそのまま当てはめると、集約の効果を大きく見積もりすぎます。
平方根の法則を使うときの前提を、はっきり書いておきます。各拠点の需要が同じ分布で独立していること、サービス率とリードタイムが集約の前後で変わらないこと、そして対象が安全在庫であることです。サイクル在庫については、経済的発注量が需要の平方根に比例する(第3章)ため、8拠点分の需要を1か所で発注すれば発注量は694個から1,964個になり、サイクル在庫の合計は2,777個から982個へ、やはり \( 1/\sqrt{8} \) 倍になります。一方、パイプライン在庫(輸送中の在庫)は需要とリードタイムの積で決まるので、集約しても合計は減りません。むしろ集約によって顧客までの輸送日数が延びれば増えます。Oeser の2019年の論文What’s the penalty for using the Square Root Law of inventory centralisation?は、倉庫を減らした26の企業事例でこの法則の精度を検証し、在庫総量の推定誤差が平均27.85%で、集約による在庫の削減も、分散による在庫の増加も、いずれも過大に見積もる傾向があったと報告しています。法則は方向を教える道具であって、在庫金額の予算を決める式ではない、というのが妥当な位置づけです。
集約には在庫以外の費用もついて回ります。拠点を減らせば顧客までの輸送距離が延び、輸送費と納期が悪化します。反対に拠点を増やせば納期は縮みますが、安全在庫が拠点数に比例して増え、拠点ごとの固定費もかかります。在庫の集約だけを最適化するのではなく、輸送費、拠点の固定費、納期による売上への影響を同じ表に並べて決める問題であり、拠点配置そのものの最適化は弊社コラム「数理最適化の定式化パターン集」の施設配置の章に送ります。
VMI と CPFR の位置づけ
ブルウィップ効果の対策としての情報共有を、取引先との取り決めとして制度化したものが VMI(ベンダー管理在庫)と CPFR(協働的な計画・予測・補充)です。VMI は、小売や顧客側の在庫の補充を、供給側(ベンダー)が顧客の在庫データと販売データを見ながら自分の判断で行う仕組みです。顧客側の発注という「歪んだ情報」が消え、供給側は実需要に近い情報で自分の生産と在庫を計画できます。前節までの言葉で言えば、上流が下流のエシェロン在庫を見て発注を決める仕組みであり、クラークとスカーフの「1つの目で全体を見る」方策の発想に、会社の境界を越えて近づける取り決めです。
CPFR は、米国の業界団体 VICS(Voluntary Interindustry Commerce Standards)が策定したガイドラインで、小売と製造が販売予測と発注計画を共同で作り、例外が出たときに協議して直す、という業務プロセスの標準です。GS1 US のサイトに置かれている2004年の文書Retail Event Collaboration Business Process Guideは、CPFR の中で販売予測と発注計画を誰が担うかによって、小売が両方を作る形(シナリオA)、小売が販売予測を作り製造が発注計画を作る共同管理の形(シナリオC)、製造が両方を担うベンダー管理の形(シナリオD)があると整理しています。つまり VMI は CPFR の中の1つの分担の型として位置づけられます。同じ文書は、販促やイベントが小売の需要の最大の変動要因であり、欠品と過剰在庫の大半を生むので、協働をそこに集中させる企業が多いとも述べています。ブルウィップの4つ目の原因(価格の変動)への対策が、制度としてはここに入っています。
これらの取り決めが本章の数理モデルとどう関係するかを整理しておきます。VMI や CPFR は「誰がどの情報を見て発注を決めるか」を変える仕組みであって、いくつ持つかを決める式ではありません。式の側は本章で述べたエシェロン在庫のベースストックや保証サービス時間モデルであり、取り決めの側はその式に入れる需要情報を歪みの少ないものにし、式の答えを会社の境界を越えて実行できるようにするものです。情報共有のしくみだけ入れて発注のロジックが各社の勘のままなら、ブルウィップの1つ目の原因は残ります。逆にロジックだけ整えても、上流が下流の発注しか見えなければ、シミュレーションの運用(A)のままです。両方が揃ってはじめて、運用(B)の数字になります。
工場側に寄せるか店舗側に寄せるか、経営指標への翻訳
本章の結果を、経営の判断に使える形に翻訳します。在庫を工場側(上流)に寄せる判断と店舗側(下流)に寄せる判断は、在庫金額と欠品の2つに正反対の効き方をします。上流に寄せる利点は、在庫が安い形で持てることと、複数の下流拠点の需要をまとめて受けられる(リスクプーリングが働く)ことです。保証サービス時間モデルの例では、上流で付く価値の割合が3割なら工場側に置くほうが年間の安全在庫保有費で2割安く、5割ではほぼ差がなく、7割になると下流に寄せるほうが安くなりました。リスクプーリングの例では、需要に相関がなければ8拠点の安全在庫を1か所にまとめることで原価ベースで約26万円の在庫金額が浮きました。欠点は、顧客までの距離が延びることで、下流に届くまでのリードタイムが長くなり、欠品したときの回復に時間がかかることです。下流に寄せる利点と欠点はその裏返しで、顧客に近いので欠品による売上機会の損失を抑えやすい一方、在庫は高い形(完成品・店頭配送済み)で持つことになり、拠点数に比例して安全在庫が増えます。
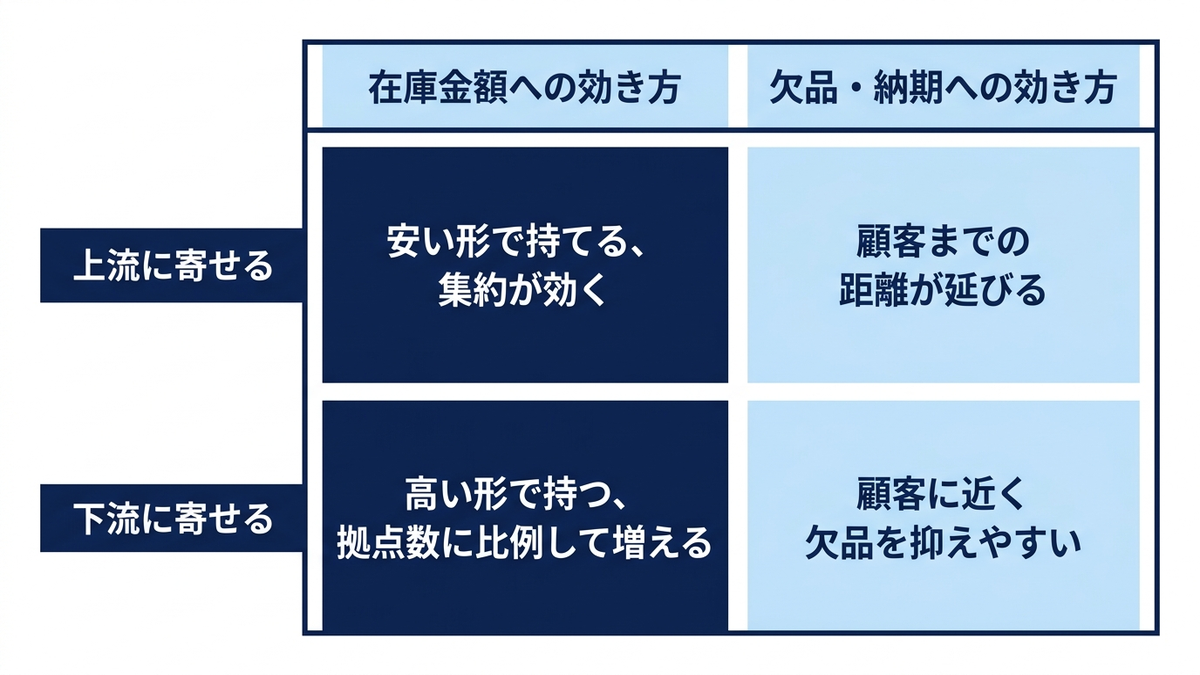
この判断を誤ったときの損失は、2つの型で現れます。1つは、下流で価値がほとんど付かない商品を、店舗ごとに手厚く持つ型です。クラークとスカーフの例で見たとおり、店舗で価値が付かないなら上流に手持ちを置かないのが最適で、各拠点が独立に安全在庫を持つ設置方策は同じ充足率を約38%多い在庫で買っていました。棚卸資産が膨らみ、回転日数が延び、運転資金が固定されます。もう1つは、上流に集約しすぎて納期が延び、欠品による売上機会損失と、それを取り返すための特急輸送費がかさむ型です。どちらの損失も、在庫金額(貸借対照表の棚卸資産)と欠品の機会損失(損益計算書に現れない売上の減少)という2つの経営指標に翻訳して、同じ表で比べる必要があります。本章のモデルは、その表を埋めるための数字(各拠点の平均在庫、欠品確率、輸送中在庫)を出す道具です。
実務での順序としては、まず自社のサプライチェーンがどの構造(直列・分岐・組立)に近いかを確かめ、次に各段階で付く価値とリードタイムの配分を数字で押さえ、それから保証サービス時間モデルの考え方で「どこに置くか」の大枠を決め、最後にエシェロン在庫のベースストックで「いくつ持つか」を決める、という流れになります。同時に、上流に届く需要情報がブルウィップで歪んでいないかを、発注分散と需要分散の比で測っておくことをお勧めします。この比が段階ごとに何倍になっているかは、本章のシミュレーションと同じ計算で、自社の受発注データからすぐに出せます。
本章では、多段階の在庫を「1つの目」で見るためのエシェロン在庫、直列系の最適方策が1拠点ずつの問題に分解できるというクラークとスカーフの結果、上流ほど発注が振れるブルウィップ効果とその4つの原因、安全在庫の置き場所を決める保証サービス時間モデル、拠点の集約で安全在庫が減るリスクプーリングとその前提を確認しました。在庫をどこに置くかは、在庫金額と欠品に正反対に効く判断であり、価値の付き方とリードタイムの配分、需要の相関を数字で押さえてから決めるものです。次の第11章では、ここまでの発注の問題を数理最適化の形で書き、段取り費や容量制約、複数品目を同時に扱う混合整数計画として解きます。
この章を深めたい方への参考書籍
『サプライチェーン・マネジメント概論:基礎から学ぶSCMと経営戦略』(苦瀬博仁 編著、白桃書房):大学の教科書として書かれた SCM の概論で、サプライチェーンにおける生産時期と在庫ポイント、物流ネットワーク、在庫と輸配送の計画と管理、情報システムまでを15章で扱います。本章の「どこに在庫を置くか」を、物流ネットワーク全体の設計の中に位置づけて読み直せます。
『グローバル・サプライチェーンにおける新しい製販協働のかたち:見えない需要を見える需要に』(永島正康、丸善プラネット):需要予測における製造と販売の協働を主題にした研究書で、協働の基礎概念、グローバル・サプライチェーンでの協働の枠組み、協働活動と成果の関係を扱います。本章の VMI と CPFR の節で述べた「誰がどの情報を見て計画するか」を、実証の側から掘り下げたい方に向いています。
『Foundations of Inventory Management』(Paul H. Zipkin、McGraw-Hill):在庫理論の英語の教科書で、本章が依拠した van Houtum のチュートリアルがエシェロン在庫の概念の参照先として挙げている本です。エシェロン在庫の概念と、その上に組み立てられる多段階の議論を理論のレベルで確かめたいときの原典として、洋書ですが挙げておきます。
第11章 数理最適化としての発注計画、複数品目と容量制約を混合整数計画で解く
第7章では、需要が期ごとに変わる確定需要のもとで「いつ、いくつ発注するか」を決める動的ロットサイジングを、Wagner と Whitin の動的計画で解きました。あの解法は1品目ずつ独立に解くことを前提にしています。しかし実務の発注計画は、倉庫の受入能力や保管スペース、資金の枠を複数の品目で分け合っており、1品目ずつ最適にしても全体では成り立たないことが珍しくありません。この章では、同じ問題を混合整数計画(連続の量と0か1の判断を同時に決める最適化の型)として書き直し、品目をまたぐ制約を式に入れて解きます。定式化の一般的な作法(決定変数・目的関数・制約の3点セット、big-M 法、線形化の技法)は弊社コラム「数理最適化の定式化パターン集」で扱っていますので、ここでは在庫に固有の書き方と、実際に解いたときに何が起きるかに絞ります。
単一品目の動的ロットサイジングを式に書く
まず1品目で、期を \( t = 1, \dots, T \)、各期の需要を \( d_t \) とします。決めたいのは各期の発注量 \( x_t \) と、その結果として各期末に残る在庫 \( s_t \) です。費用は第3章と同じ2種類で、発注1回あたりの固定費 \( K \)(円/回)と、在庫1個を1期持ち越す保管費 \( h \)(円/個/期)です。発注の固定費は「発注したかどうか」で決まり、発注量には比例しません。この「したかどうか」を表すために、0か1しか取らない変数 \( y_t \) を置きます。\( y_t = 1 \) なら第 \( t \) 期に発注し、0 なら発注しません。
目的関数は、全期間の発注固定費と保管費の合計を最小にすることです。式で書くと \( \min \sum_t (K y_t + h s_t) \) で、言葉にすれば「発注した回数に固定費を掛けたものと、各期末の在庫に保管費を掛けたものを足し合わせ、その総額を最も小さくする」となります。単価が期によって変わらないなら仕入代金の総額は需要で決まってしまうので、目的関数から外して構いません。
制約の中心は在庫バランスです。各期について「前期末の在庫に今期の入荷を足し、今期の需要を引いたものが今期末の在庫」という関係を等式で書きます。式では \( s_{t-1} + x_t = d_t + s_t \) です。期首在庫 \( s_0 \) は与えられた数値で、在庫 \( s_t \) は0以上、つまり欠品を許さない前提です。欠品を許す場合は在庫を「手持ち在庫」と「未納残」の2つの変数に分けて、未納残に欠品費を掛けて目的関数に足します。この形は第9章の確率計画でも同じ骨格でした。
この定式化は、第7章の Wagner と Whitin の方法が解いている問題と数学的に同じものです。違いは解き方だけで、動的計画は問題の構造(発注する期の在庫は必ずゼロから始まる、という性質)を使って効率よく解き、混合整数計画は構造を知らないソルバーに分枝と限定(候補を分割しながら、見込みのない枝を上界と下界の比較で切り捨てていく探索)で探索させます。単一品目で制約が在庫バランスだけなら動的計画のほうが速く、あえてソルバーに投げる理由はありません。ソルバーが必要になるのは、次の節以降で入れていく「発注の有無と発注量の連動」「複数品目で分け合う容量」「最小発注量」のように、動的計画では扱いにくい制約が入るときです。
段取り変数と big-M、発注の有無を0か1で表す
発注量 \( x_t \) と発注の有無 \( y_t \) は、そのままでは無関係な2つの変数です。「発注していないなら発注量はゼロ」という当たり前の関係を式にしないと、ソルバーは固定費を払わずに(\( y_t = 0 \) のまま)発注量を正にする解を返します。この連動を書くのが big-M 制約 と呼ばれる不等式で、十分に大きな定数 \( M \) を使って \( x_t \le M\, y_t \) と書きます。\( y_t = 0 \) なら右辺は0なので発注量は0に押さえられ、\( y_t = 1 \) なら右辺は \( M \) なので発注量は \( M \) までの範囲で自由に選べます。
\( M \) の選び方は、答えの正しさではなく計算時間に効きます。\( M \) は「その期に発注し得る最大量」以上でありさえすればよく、たとえば全期間の総需要を入れれば必ず十分です。しかし \( M \) を大きくすると、0-1 変数を連続値に緩めた線形計画(ソルバーが探索の途中で何度も解く緩和問題)の答えが実際の最適値から大きく離れ、探索の枝が増えます。動的ロットサイジングでは「第 \( t \) 期に発注する量は、第 \( t \) 期以降の残りの需要の合計を超える意味がない」ので、\( M_t = \sum_{u \ge t} d_u \) と期ごとに小さく取るのが定石です。受入能力の上限 \( C \) があるなら、残需要と \( C \) の小さい方にできます。この差がどれほど効くかは、後の節で実測して示します。
定式化として意味を持つのはここまでですが、実務では \( y_t \) を「発注の有無」だけでなく「段取りの有無」「トラックを1台立てるかどうか」「発注書を1通起こすかどうか」と読み替えます。固定費 \( K \) の中身は第3章で整理したとおり、発注事務・検収・輸送の固定分の合計です。製造ロットの計画なら、段取り替えにかかる時間そのものを容量から差し引く書き方(段取り時間に \( y_t \) を掛けた項を容量制約の左辺に足す)もあります。Trigeiro・Thomas・McClain の1989年の研究は段取り時間つきの容量制約付きロットサイジングを扱い、容量制約の締まり具合が問題の難しさをよく表す指標だと報告しています。この点は後の実測でも同じ形で現れます。
複数品目と容量制約、受入能力と保管容量を式に入れる
品目が複数になると、変数に品目の添字 \( i \) が付きます。発注量は \( x_{it} \)、期末在庫は \( s_{it} \)、発注の有無は \( y_{it} \) で、在庫バランスと big-M 制約は品目ごとに独立に並びます。ここまでなら品目ごとに別々に解いても同じ答えになります。品目をつなぐのは、複数の品目が同じ資源を分け合う制約です。
在庫の実務で最もよく現れる共有資源は、倉庫の週あたりの受入能力(検収・棚入れの人時、あるいはトラックの台数)と、保管スペース(パレット数・棚の容積)、そして在庫に寝かせてよい資金の枠です。受入能力は「各期に入荷する量の全品目合計が上限以下」という不等式で、\( \sum_i x_{it} \le C_t \) と書きます。品目ごとに1個あたりの受入工数が違うなら、係数 \( a_i \) を掛けて \( \sum_i a_i x_{it} \le C_t \) とします。保管スペースは期末在庫の合計に対する上限で \( \sum_i v_i s_{it} \le V \)(\( v_i \) は1個あたりの容積)、資金枠は、容積の係数 \( v_i \) の代わりに原価 \( c_i \) を掛ければ同じ形です。いずれも左辺が変数の一次式、右辺が定数なので、線形の制約として追加するだけで済みます。
この制約が入った瞬間に、問題の性格が変わります。受入能力に余裕のある期に先回りして発注し、忙しい期の入荷を減らす「作りだめ」が必要になり、ある品目の発注をずらすと別の品目の最適な発注時期も動きます。品目ごとに独立だったときは第7章の動的計画で厳密に解けたのに対し、容量制約が入ったロットサイジングは、単一品目の特殊な場合でも NP 困難(問題が大きくなると厳密解を求める時間が急激に伸びる型)になることが Florian・Lenstra・Rinnooy Kan の1980年の論文で示され、Bitran と Yanasse の1982年の論文は、単一品目なら易しい条件でも2品目になると NP 困難になる場合があることを示しています。混合整数計画のソルバーは、この難しさを前提に、上限時間の中で「最良の解」と「最適値の下限」を同時に追いかけ、両者の差(ギャップ)で解の質を保証するように作られています。
第3章では、複数品目が予算やスペースを分け合う問題をラグランジュ乗数で解きました。あれは各品目の発注量を一定(EOQ 型)とみなす定常的な扱いで、乗数は「制約を1単位ゆるめたときに総費用がいくら下がるか」という価格の意味を持ちました。この章の混合整数計画は、期ごとに需要が変わり、発注する期としない期があり、先回りの作りだめを許す時間軸つきの扱いです。乗数の解釈は同じ発想で使えますが、0-1 変数が入った問題では線形計画のような双対価格がそのままは出ないため、容量を1段階ずつ変えて総費用の変化を見る感度分析で代用します。後の節でその表を載せます。
最小発注量・発注単位・安全在庫を制約として書く
実務の発注には、仕入先が決める最小発注量と、ケースやパレットといった発注単位があります。最小発注量 \( Q^{\min}_i \) は「発注するなら \( Q^{\min}_i \) 以上」という条件で、big-M 制約と対にして \( x_{it} \ge Q^{\min}_i\, y_{it} \) と書きます。\( y_{it} = 0 \) なら右辺は0なので何も縛らず、\( y_{it} = 1 \) なら下限が効きます。発注単位 \( q_i \) は、整数変数 \( z_{it} \) を1つ足して \( x_{it} = q_i\, z_{it} \) と等式で結びます。発注量が10個入りの箱の整数倍になる、という条件がこれだけで表せます。どちらも第3章で「EOQ の前提が崩れるとき」として挙げた条件で、EOQ の式では扱えなかったものが、混合整数計画では制約を1行足すだけで扱えます。
安全在庫は、この章の定式化では「各期末の在庫の下限」として書きます。第4章で求めた安全在庫を \( SS_i \) とすると、制約は \( s_{it} \ge SS_i \) です。需要が確定値として与えられているこの問題には、本来ばらつきの概念がありません。安全在庫の下限を入れることで、「予測どおりに需要が来たとしても、期末には少なくとも \( SS_i \) 個は残っている」ように発注計画を組む、という意味になります。第8章で見たように予測誤差は発注周期とリードタイムの長さに応じて大きくなるので、下限を期によって変える(繁忙期は大きく、閑散期は小さく)ことも、添字を \( SS_{it} \) にするだけで自然に表せます。
この書き方には注意点が2つあります。第一に、安全在庫を下限にすると、ソルバーはその分の在庫を常に持ち続ける計画を返すので、各期の保管費に少なくとも \( h_i SS_i \) が含まれます。後述の段階3のように期首在庫も同じだけ積み増し、発注の構造が変わらない場合は、増分がちょうど \( h_i SS_i \) の \( T \) 倍になります(既存の計画で在庫が下限を上回っている期があれば、増分はそれより小さくなります)。これは安全在庫の費用そのもので、第4章のサービス率と費用の釣り合いはこの章の外で決めておく前提です。第二に、下限を入れたまま期首在庫を下限未満にすると、最初の期で在庫を下限まで引き上げる発注が強制され、リードタイムがある場合は最初の数期で実行不可能になります。計画の開始時点で既に手当てされている在庫と入荷予定を、期首在庫と「発注済みの到着予定」として正しく与えることが、モデルを動かす前の準備として欠かせません。
リードタイムの取り込み、到着期のずれ
ここまでの在庫バランスは、第 \( t \) 期に発注した分が第 \( t \) 期のうちに入荷する前提でした。リードタイムが \( L_i \) 期あるなら、第 \( t \) 期の入荷は \( L_i \) 期前に発注した分になるので、在庫バランスの入荷の項を \( x_{i,t-L_i} \) に置き換えます。式は \( s_{i,t-1} + x_{i,t-L_i} = d_{it} + s_{it} \) です。変数の添字がずれるだけで、制約の本数も変数の数も変わりません。ただし \( t – L_i \) が1未満になる最初の \( L_i \) 期は、計画の中では発注を変えられず、入荷は計画開始前に発注済みの分(到着予定)として定数で与えます。到着予定が無ければ、その期の需要と安全在庫は期首在庫だけで賄う必要があります。
受入能力の制約も、発注した期ではなく入荷する期に掛けます。第 \( t \) 期に倉庫に届く量は \( \sum_i x_{i,t-L_i} \) なので、容量制約は \( \sum_i x_{i,t-L_i} \le C_t \) になります。品目ごとにリードタイムが違うと、同じ入荷週に着く発注が品目ごとに別の週に出されることになり、発注担当者の週ごとの作業量は入荷の平準化とは別の形で分布します。計画の目的関数に発注事務の平準化まで入れたいなら、各期の発注件数 \( \sum_i y_{it} \) にも上限を置くか、その最大値を目的関数に足すことになりますが、この章では入荷側の容量に絞ります。
リードタイムが期によってばらつく場合、この確定的な定式化ではそのまま扱えません。第4章の合成式はリードタイムのばらつきを安全在庫に折り込む方法で、この章では安全在庫の下限 \( SS_i \) をその式で求めた値にすることで、ばらつきの影響を間接的に取り込みます。リードタイムを確率的に扱う定式化は第9章のシナリオ型に接続しますが、シナリオ数と 0-1 変数の積で問題が大きくなるため、実務ではこの章の確定的な計画と、第12章のシミュレーションによる検証を組み合わせるのが現実的だと考えています。
PuLP と CBC で解く、代表4品目の週次計画
ここからは第2章で用意したサンプルデータで実際に解きます。代表4品目(A001 定番品・B001 季節品・C001 間欠需要品・D001 成長品)の2025年の日次需要を7日ごとに区切って週次需要にし、夏の山に向かって需要が増える第14週から第26週までの13週(4月から6月)を計画期間にしました。費用は第3章と同じ架空の値で、発注固定費は1回4,000円、保管費は原価の年20%を52で割って週あたりに直しています(A001 は1個1週あたり4.62円、B001 は13.46円、C001 は30.77円、D001 は9.23円)。4品目の週次需要の合計は平均666個、最大は第26週の792個で、13週の合計は8,660個です。ここに「4品目の入荷の合計は週750個まで」という受入能力の制約を置きます。13週の合計能力は9,750個ですから、期間全体では11%ほどの余裕があり、需要が750個を超える2つの週(第24週の766個と第26週の792個)では前倒しの入荷が要る、という設定です。
実装は PuLP 3.3.2 と、それに同梱されている CBC 2.10.3(COIN-OR の無償の混合整数計画ソルバー)で行いました。PuLP の PULP_CBC_CMD は同梱の CBC を呼ぶ入口で、この版のドキュメント文字列には「PuLP 4.0 で削除予定。pip install pulp[cbc] で CBC を入れて COIN_CMD を使うこと」と書かれています。版が上がると呼び方が変わりますので、動かす際は手元の版のドキュメントをご確認ください。モデルの骨格は次のとおりです。weekly は週×品目の需要の表、h は品目ごとの週あたり保管費、K は発注固定費、CAP は受入能力です。
import pulp
prob = pulp.LpProblem("lot_sizing", pulp.LpMinimize)
x = {(i, t): pulp.LpVariable("x_%s_%d" % (i, t), lowBound=0) for i in items for t in T}   # 発注量
s = {(i, t): pulp.LpVariable("s_%s_%d" % (i, t), lowBound=0) for i in items for t in T}   # 週末在庫
y = {(i, t): pulp.LpVariable("y_%s_%d" % (i, t), cat="Binary") for i in items for t in T}  # 発注の有無
# 目的関数: 発注固定費 + 保管費
prob += pulp.lpSum(K * y[i, t] + h[i] * s[i, t] for i in items for t in T)
for i in items:
    for t in T:
        prev = s[i, t - 1] if t > T[0] else init_inv[i]          # 前週末在庫(初週は期首在庫)
        prob += prev + x[i, t] == weekly.loc[t, i] + s[i, t]       # 在庫バランス
        M = min(float(weekly.loc[t:, i].sum()), CAP)               # 残需要と受入能力の小さい方
        prob += x[i, t] <= M * y[i, t]                             # 発注の有無との連動
for t in T:
    prob += pulp.lpSum(x[i, t] for i in items) <= CAP              # 受入能力(全品目の合計)
prob.solve(pulp.PULP_CBC_CMD(msg=0, timeLimit=300))
print(pulp.LpStatus[prob.status], pulp.LpSolution[prob.sol_status], pulp.value(prob.objective))
# 出力: Optimal Optimal Solution Found 132493.84615384616
ここで1つ、解を読むときの注意があります。PuLP の LpStatus[prob.status] は、上限時間で打ち切られた場合でも実行可能な解が見つかっていれば Optimal を返します。最適であることが証明された解なのか、途中で止めた暫定解なのかは LpSolution[prob.sol_status] で見分けます。前者なら Optimal Solution Found、後者なら Solution Found です。この記事のコードでは両方を必ず表示し、打ち切りのときは CBC のログから最適値の下限を読み取ってギャップを計算するようにしました。安全在庫・最小発注量・発注単位は制約を足すだけで表せます。リードタイムだけは足すのではなく、在庫バランスの制約の入荷の項を「L 週前の発注量」に置き換えます。
# 安全在庫: 各週末在庫の下限
for i in items:
    for t in T:
        prob += s[i, t] >= SS[i]
# リードタイム: 在庫バランスの制約を、入荷が L 週前の発注分になる形に置き換える
#(最初の L 週は発注済みの到着予定か期首在庫で賄う)
for i in items:
    for t in T:
        prev = s[i, t - 1] if t > T[0] else init_inv[i]
        arrive = x[i, t - L[i]] if (t - L[i]) >= T[0] else 0
        prob += prev + arrive == weekly.loc[t, i] + s[i, t]
# 最小発注量: 発注するなら moq 以上(B001 は 200 個)
for t in T:
    prob += x["B001", t] >= 200 * y["B001", t]
# 発注単位: 整数変数 z を足して 10 の倍数にする(C001)
z = {t: pulp.LpVariable("z_C001_%d" % t, lowBound=0, cat="Integer") for t in T}
for t in T:
    prob += x["C001", t] == 10 * z[t]
制約を1つずつ足しながら5段階で解き、総費用と発注回数がどう変わるかを見たのが次の表です。安全在庫は例として週次需要の標準偏差の1.65倍(A001 は48個、B001 は136個、C001 は16個、D001 は30個)を置き、リードタイムは第2章のマスタの平均を週に丸めて A001 と D001 は1週、B001 は2週、C001 は3週としました。リードタイムを入れる段階では、最初の \( L_i \) 週分の需要と安全在庫を期首在庫として与えています(計画の外で既に手当てされている前提)。
| 段階 | 総費用(円) | 発注回数 | 発注費(円) | 保管費(円) | 週の入荷の最大(個) | 平均在庫金額(円) | 解時間(秒) |
|---|---|---|---|---|---|---|---|
| 1 容量制約なし | 124,554 | 21 | 84,000 | 40,554 | 1,585 | 811,077 | 0.07 |
| 2 受入能力 750個/週 | 132,494 | 25 | 100,000 | 32,494 | 750 | 649,877 | 0.64 |
| 3 安全在庫の下限を追加 | 169,174 | 25 | 100,000 | 69,174 | 750 | 1,383,477 | 0.55 |
| 4 リードタイムを追加 | 155,766 | 20 | 80,000 | 75,766 | 750 | 1,515,323 | 1.05 |
| 5 最小発注量・発注単位を追加 | 157,182 | 20 | 80,000 | 77,182 | 750 | 1,543,631 | 2.59 |
段階1と2の差が、容量制約の値段です。品目ごとに独立に最適化した段階1は、発注回数を21回に抑える代わりに、入荷が集中する週には4品目合計で1,585個が一度に届きます。750個の受入能力を超える週が13週のうち6週あり、超過分の合計は3,000個、入荷がゼロの週も4週あります。段階2はこの山を崩し、発注を25回に分けて毎週の入荷を750個以内に収めました。総費用は124,554円から132,494円へ、6.4%増えています。この7,940円が「受入能力を守るために払う費用」で、内訳は発注回数が4回増えた分の16,000円と、小刻みに入れることで在庫が減った分の保管費の減少8,060円の差です。平均在庫金額も811,077円から649,877円に下がっており、容量制約は在庫を減らす方向にも働きます。
段階3で安全在庫の下限を入れると、保管費が36,680円増えます。これは4品目の安全在庫に週あたり保管費を掛けて13週分足した値と一致し、発注の回数も時期も段階2から変わっていません。安全在庫の費用は発注計画の構造を変えず、単純に上乗せされる、ということです。段階4でリードタイムを入れると発注回数は20回に減りますが、これは最初の \( L_i \) 週分が計画の外で手当て済みという前提の変更によるもので、段階3より費用が安くなったと読むのは誤りです。段階5で最小発注量と発注単位を足すと費用は1,416円増え、C001 の発注量は40個と40個(10の倍数)、B001 の発注量の最小は246個(200個以上)になっていることを実行ログで確かめました。解時間は5段階とも3秒以内です。
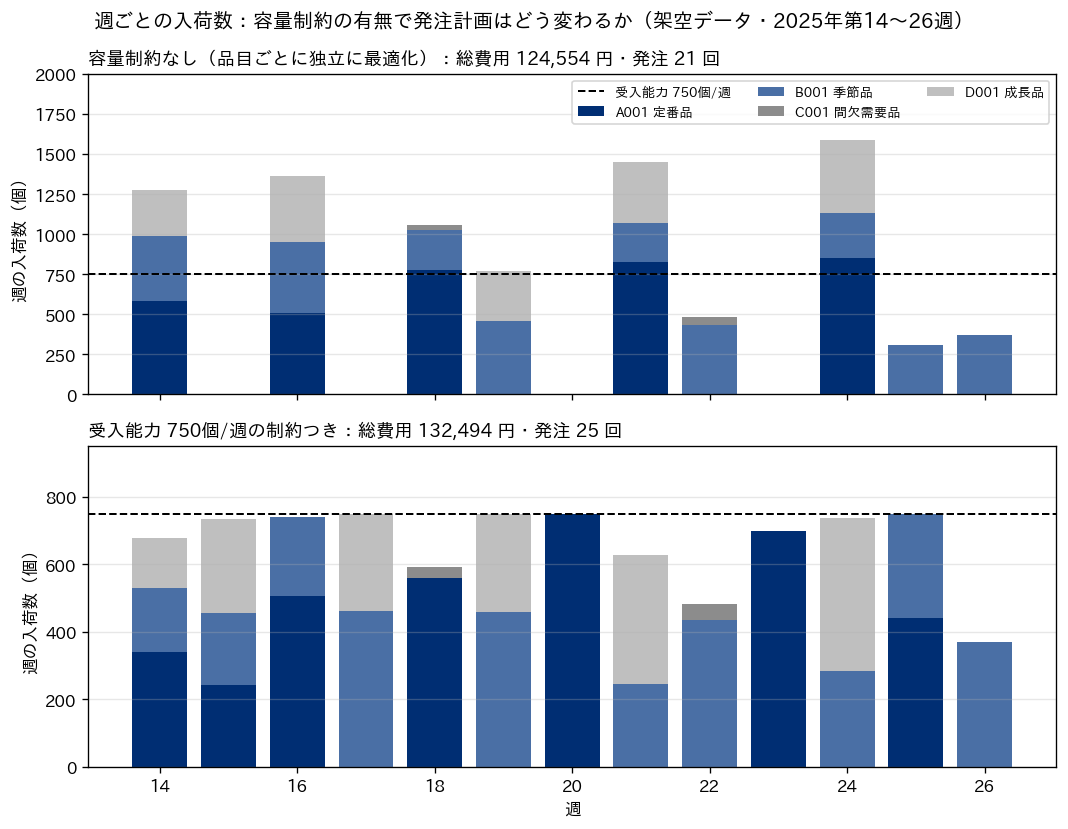
上の図は段階1と段階2の週ごとの入荷数を品目別に積み上げたものです。容量制約なしでは B001(季節品)と D001(成長品)の発注が同じ週に重なって山を作り、制約つきでは同じ需要を賄いながら山が崩されて、能力の線に沿って平らに並びます。次の図は段階5の品目別の在庫推移で、週末在庫が安全在庫の線を下回らないこと、リードタイムの分だけ発注週と入荷週がずれること、C001 の入荷が10個単位であることが読み取れます。
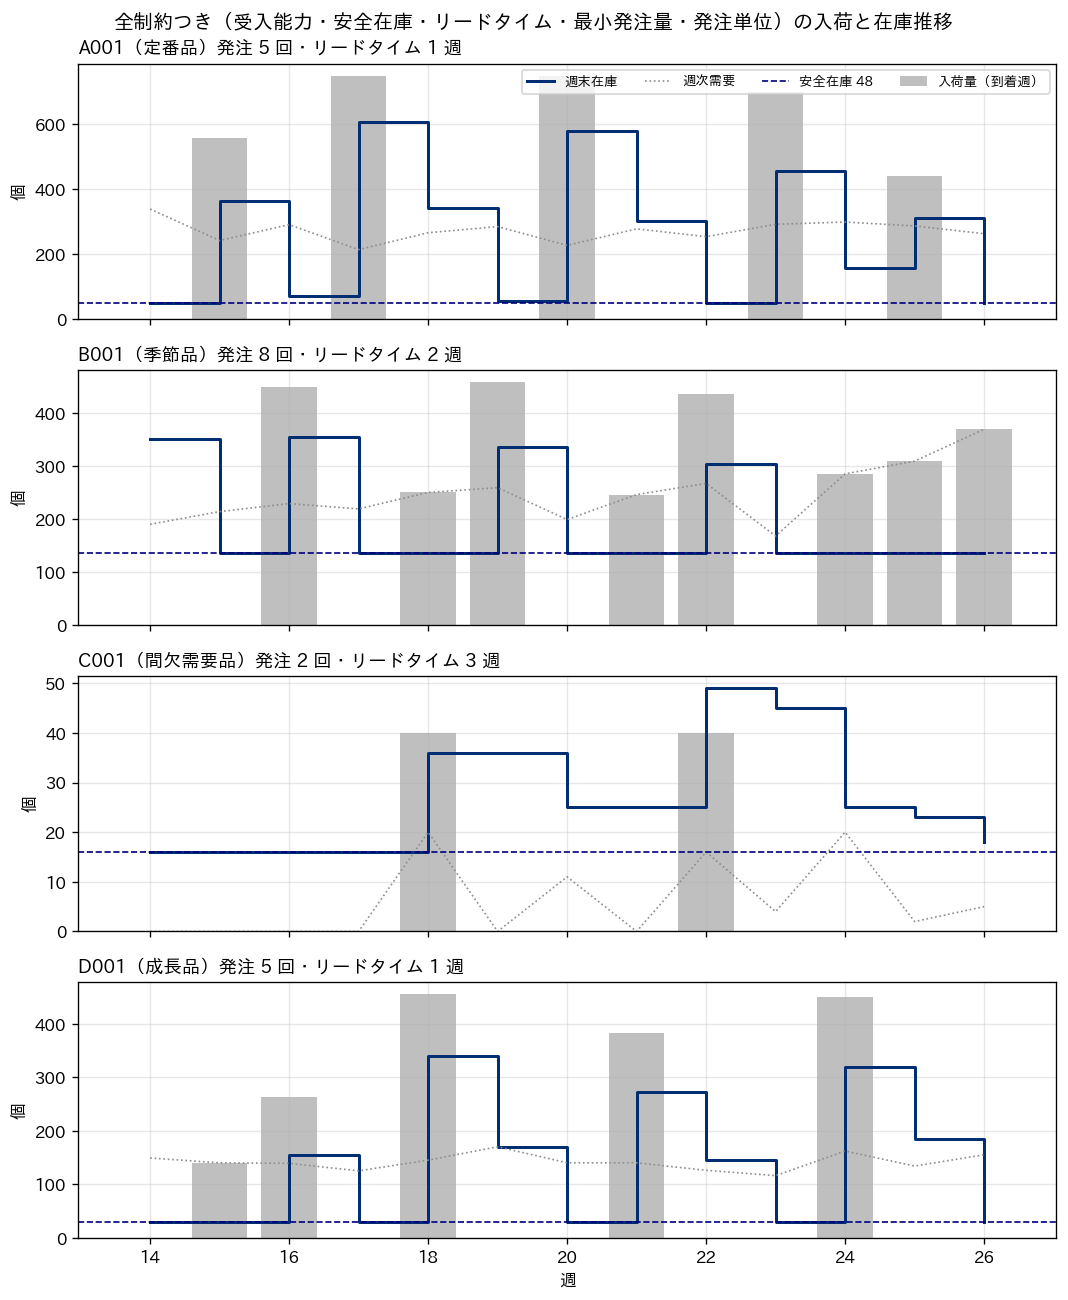
計算時間はどう増えるか、定式化の強さと打ち切り
4品目・13週なら3秒以内で解けましたが、品目数と期間数を増やすと計算時間はどう伸びるでしょうか。あわせて、同じ問題を「どう書くか」で解時間がどれほど変わるかも測りました。比較したのは3つの書き方です。1つ目は big-M 制約の \( M \) を全品目・全期間の総需要にした最も素朴な形、2つ目は \( M \) をその品目の残需要と受入能力の小さい方にした形、3つ目はそれに加えて「第 \( t \) 週の入荷のうち第 \( u \) 週の需要に充てる量」を表す変数 \( w_{itu} \) を置き、\( w_{itu} \le d_{iu}\, y_{it} \) で発注の有無と結ぶ形です。3つ目は施設配置問題(どの倉庫がどの顧客に供給するかを決める問題)と同じ構造への書き直しで、Krarup と Bilde の1977年の論文に遡ります。Barany・Van Roy・Wolsey の1984年の論文は、この種の強い不等式で書き直すと、当時の市販ソルバーでも20品目・13期の容量制約付き問題が最適解まで解けたと報告しています。変数の数は期間数の2乗のオーダーで増えますが、緩和問題の答えが実際の最適値に近づくため、探索の枝が大きく減ります。
実測は、代表4品目に残りの品目を足して4・10・20・40・60品目、期間は2025年の週次需要の第1週からの13・26・52週とし、受入能力は対象品目の週次需要合計の平均の1.12倍を10の位で切り上げた値(利用率でおよそ89%)にそろえ、CBC の上限時間を60秒にして測りました。次の表がその結果です。「60秒で打ち切り」はその時点の最良解と最適値の下限からギャップを計算しています。60品目・52週の強い定式化は、CBC のログによれば線形計画の緩和を解くのに4.6秒、その後の発見的解法で暫定解を見つけたところで上限に達し、分枝の探索には入っていません(探索した節点数は0)。モデルの書き出しと読み戻しを含めて PuLP 側で測った時間は92秒でした。
| 品目数 | 期間数 | 定式化 | 0-1変数 | 連続変数 | 制約 | 結果 | 総費用(円) | ギャップ | 解時間(秒) |
|---|---|---|---|---|---|---|---|---|---|
| 4 | 13 | big-M(総需要) | 52 | 104 | 117 | 最適 | 133,295 | 0 | 1.2 |
| 4 | 13 | big-M(残需要) | 52 | 104 | 117 | 最適 | 133,295 | 0 | 1.0 |
| 4 | 13 | 強い定式化 | 52 | 468 | 585 | 最適 | 133,295 | 0 | 0.7 |
| 4 | 26 | big-M(総需要) | 104 | 208 | 234 | 60秒で打ち切り | 262,786 | 7.90% | 60.1 |
| 4 | 26 | big-M(残需要) | 104 | 208 | 234 | 60秒で打ち切り | 257,093 | 4.01% | 60.1 |
| 4 | 26 | 強い定式化 | 104 | 1,612 | 1,846 | 60秒で打ち切り | 258,719 | 1.83% | 60.1 |
| 4 | 52 | big-M(残需要) | 208 | 416 | 468 | 60秒で打ち切り | 544,448 | 19.63% | 60.1 |
| 4 | 52 | 強い定式化 | 208 | 5,928 | 6,396 | 60秒で打ち切り | 547,220 | 8.67% | 60.3 |
| 10 | 13 | big-M(総需要) | 130 | 260 | 273 | 60秒で打ち切り | 284,340 | 7.81% | 60.1 |
| 10 | 13 | big-M(残需要) | 130 | 260 | 273 | 最適 | 281,974 | 0 | 33.6 |
| 10 | 13 | 強い定式化 | 130 | 1,170 | 1,443 | 最適 | 281,974 | 0 | 1.8 |
| 10 | 26 | big-M(残需要) | 260 | 520 | 546 | 60秒で打ち切り | 577,461 | 16.89% | 60.2 |
| 10 | 26 | 強い定式化 | 260 | 4,030 | 4,576 | 60秒で打ち切り | 557,533 | 0.43% | 60.2 |
| 20 | 13 | big-M(残需要) | 260 | 520 | 533 | 60秒で打ち切り | 583,655 | 3.70% | 60.1 |
| 20 | 13 | 強い定式化 | 260 | 2,340 | 2,873 | 最適 | 579,533 | 0 | 8.1 |
| 20 | 26 | big-M(残需要) | 520 | 1,040 | 1,066 | 60秒で打ち切り | 1,224,816 | 16.40% | 60.1 |
| 20 | 26 | 強い定式化 | 520 | 8,060 | 9,126 | 60秒で打ち切り | 1,178,282 | 0.18% | 60.5 |
| 20 | 52 | big-M(残需要) | 1,040 | 2,080 | 2,132 | 60秒で打ち切り | 2,978,959 | 36.70% | 60.1 |
| 20 | 52 | 強い定式化 | 1,040 | 29,640 | 31,772 | 60秒で打ち切り | 2,339,213 | 0.16% | 62.9 |
| 40 | 13 | big-M(残需要) | 520 | 1,040 | 1,053 | 60秒で打ち切り | 1,016,060 | 3.83% | 60.1 |
| 40 | 13 | 強い定式化 | 520 | 4,680 | 5,733 | 最適 | 1,000,748 | 0 | 18.5 |
| 60 | 13 | big-M(残需要) | 780 | 1,560 | 1,573 | 60秒で打ち切り | 1,561,548 | 5.93% | 60.1 |
| 60 | 13 | 強い定式化 | 780 | 7,020 | 8,593 | 60秒で打ち切り | 1,492,489 | 0.04% | 60.5 |
| 60 | 26 | big-M(残需要) | 1,560 | 3,120 | 3,146 | 60秒で打ち切り | 3,859,147 | 31.27% | 60.2 |
| 60 | 26 | 強い定式化 | 1,560 | 24,180 | 27,326 | 60秒で打ち切り | 3,001,464 | 0.05% | 62.7 |
| 60 | 52 | big-M(残需要) | 3,120 | 6,240 | 6,292 | 60秒で打ち切り | 8,800,510 | 47.33% | 60.4 |
| 60 | 52 | 強い定式化 | 3,120 | 88,920 | 95,212 | 60秒で打ち切り | 5,942,315 | 0.10% | 91.8 |
この表から読み取れることは3つあります。第一に、最も素朴な big-M(\( M \) を総需要にした形)は4品目・26週や10品目・13週で既に60秒に収まらず、\( M \) を残需要に締めるだけで10品目・13週は34秒で最適解まで解けます。第二に、強い定式化は変数と制約の数が4倍から15倍に増えるのに、解時間はむしろ短く、10品目・13週は1.8秒、20品目・13週は8.1秒、40品目・13週は18.5秒で最適性の証明まで終わります。60秒で打ち切りになった場合でも、残需要の big-M ではギャップが4%から47%に広がるのに対し、強い定式化では60品目・52週でも0.10%に収まっています。20品目以上の問題では、打ち切り時点の解が最適値の0.2%以内にあることが証明された状態で止まっており、実務ではこれで十分です。一方で4品目・52週のように品目が少なく期間が長い問題は、強い定式化でもギャップ8.67%で止まっており、万能ではありません。第三に、期間数の影響が品目数より大きく、4品目でも26週になると60秒では証明が終わりません。容量制約が期をまたいで作りだめの連鎖を作るため、期間が長いほど組み合わせが増えるためです。
同じ大きさでも、受入能力の締まり具合で難しさは変わります。この章の4品目の問題で、能力を週次需要の平均の1.25倍・1.12倍・1.05倍・1.02倍(利用率80%・88%・95%・98%)と変えて強い定式化で測ったところ、13週では4つとも1秒未満で最適解に達しましたが、26週(第14週から第39週)では利用率80%で8.3秒、88%で28.7秒、95%では60秒で打ち切り(ギャップ1.97%)、98%では28.2秒と、締まるほど概ね難しくなる一方で単調ではありませんでした。Trigeiro らが1989年に報告した「容量制約の締まり具合が難しさの指標になる」という観察は、この規模でも当てはまります。実務で計画を回すときは、能力の余裕が小さい期間ほど解時間が読めなくなることを前提に、上限時間を先に決めておくのが安全です。
実務の規模(数百から数千品目、13〜52期)を厳密に解き切ることは、CBC のような無償ソルバーでは難しいことが多く、市販のソルバーでも品目数が数千になれば同じ壁に当たります。そこで使うのが近似です。最も簡単なのは上限時間とギャップの許容値(PuLP なら timeLimit と gapRel)を指定して打ち切ることで、上の表のとおり、今回の実測条件では、強い定式化は20品目以上の問題で60秒の打ち切りでも0.2%以下のギャップに収まりました。「最適値との差が1%以内であることが証明された解」は、多くの発注計画では十分に実用的な候補として扱えます。ただし、費用の差が大きい案件や制約違反の余地が小さい案件では、許容するギャップを個別に決める必要があります。次に、期間を分けて解く方法があります。手前の数期の 0-1 変数だけを整数のまま解き、残りの期は連続値に緩めておいて、手前の期の発注を確定したら1期ずらして解き直す、と一般に説明される方法が relax-and-fix と呼ばれ、ロットサイジングの近似解法として使われています(Toledo らの2015年の論文は、この方法で初期解を作り、一部の変数を固定して残りを解き直す fix-and-optimize で改善する手順を多段階のロットサイジングに適用しています)。毎週の発注計画を回す運用と相性がよい方法です。さらに、第7章の Silver と Meal の方法のような発注量のヒューリスティクスを品目ごとに当てて初期解を作り、容量を超えた週の発注を前倒しする平準化の手順を足す方法もあります。Trigeiro らの1989年の論文は、容量制約をラグランジュ緩和で外して品目ごとの問題に分解し、平準化の手順で実行可能な計画を作る方法を提案しています。どの近似でも「実行可能な計画」と「最適値の下限」を並べて差を見る、という考え方は同じです。
定式化の一般論、たとえば big-M の締め方、論理条件の書き方、ソルバーが解なしや非有界を返したときの切り分けは、弊社コラム「数理最適化の定式化パターン集」に整理していますので、そちらをご参照ください。この章で扱ったロットサイジングの強い定式化は、そのコラムの技法をロットサイジングに当てはめた具体例にあたります。
容量制約を無視した計画は、残業・外注・欠品のどれに化けるか
経営の側から見ると、この章で最も重要なのは「容量制約を式に入れなかったときに何が起きるか」です。段階1の計画は、紙の上では段階2より7,940円安く見えます。しかし受入能力を超える週が6週あり、超過分の合計は3,000個です。現実にはこの3,000個は3つの形のどれかに化けます。検収と棚入れを残業や臨時要員で処理すれば人件費が増え、入荷を翌週に回せば発注のリードタイムが実質的に延びて欠品のリスクが上がり、外部倉庫や物流会社に一時保管を頼めば外注費が乗ります。どれも段階1の総費用124,554円には入っていない費用です。品目ごとに独立に最適化した計画の「安さ」は、この費用を見ていないだけです。
受入能力を1段階ずつ変えて総費用を見た感度分析が次の表です。能力を900個から680個まで下げるにつれて総費用は127,675円から149,044円まで単調に増え、発注回数は23回から32回まで増えます。能力が小さいほど発注を小刻みにして在庫を減らす計画になり、平均在庫金額はおおむね下がって713,492円から420,877円になりますが、単調ではなく、800個から750個に下げたところでは630,454円から649,877円へわずかに増えています(能力が締まると、前倒しで積む週が出るためです)。能力を670個にすると解なし(実行不可能)になりました。第14週の需要が4品目合計で678個あり、期首在庫がゼロの設定では最初の週に入荷できる量が需要に届かないためです。ソルバーの「解なし」は、その能力では欠品なしの計画が存在しないという事実の通知で、計画担当者が何を決めても欠品が起きることを意味します。
| 受入能力(個/週) | 状態 | 総費用(円) | 発注回数 | 平均在庫金額(円) | 解時間(秒) |
|---|---|---|---|---|---|
| 制約なし | 最適 | 124,554 | 21 | 811,077 | 0.07 |
| 900 | 最適 | 127,675 | 23 | 713,492 | 0.44 |
| 800 | 最適 | 131,523 | 25 | 630,454 | 0.23 |
| 750 | 最適 | 132,494 | 25 | 649,877 | 0.63 |
| 700 | 最適 | 141,103 | 29 | 502,069 | 1.03 |
| 680 | 最適 | 149,044 | 32 | 420,877 | 0.49 |
| 670 | 解なし | 計画が存在しない |
「解なし」で止めるのではなく、能力の超過を追加費用つきで許す書き方もあります。各週の超過量 \( o_t \) を0以上の変数として置き、容量制約を \( \sum_i x_{i,t-L_i} \le C_t + o_t \) にゆるめ、目的関数に超過1個あたりの追加費用(残業や外注の単価)を掛けた項を足します。この記事では例として1個あたり150円(架空)を置きました。能力670個では19個を3つの週で超過して総費用は156,856円、650個では210個を超過して176,698円、620個では600個を7つの週で超過して228,044円になります。能力の不足分を残業や外注で埋めたときの費用が、この差として数字で出てきます。ソルバーは「超過して150円払う」のと「前倒しで在庫を持って保管費を払う」のと「発注回数を増やして固定費を払う」のを比べ、最も安い組み合わせを選んでいます。単価150円を実際の残業単価や外注単価に置き換えれば、そのまま「能力を増やす投資はいくらまで正当化できるか」の判断材料になります。
この判断を経営指標に翻訳すると、次のようになります。段階1の計画をそのまま実行すれば、平均在庫金額は811,077円で、段階2より161,200円多く運転資金を寝かせます。一方で受入能力を守る段階2は発注回数が4回増え、発注事務の負荷が上がります。能力を680個まで絞れば在庫金額は420,877円まで下がりますが、発注は32回に増え、能力に対する余裕がほぼなくなるため、需要が予測より少し上に振れただけで残業か欠品が発生します。つまり、受入能力は「在庫を減らす圧力」と「予測の外れに対する耐性」の両方に効く経営変数で、在庫金額だけを見て能力を絞ると、耐性の側の損失が残業代や欠品の機会損失として後から現れます。第1章で整理した「判断を誤ったときの損失の型」で言えば、容量制約を無視した計画は在庫過剰と欠品の両方の型に同時に近づく、と考えています。
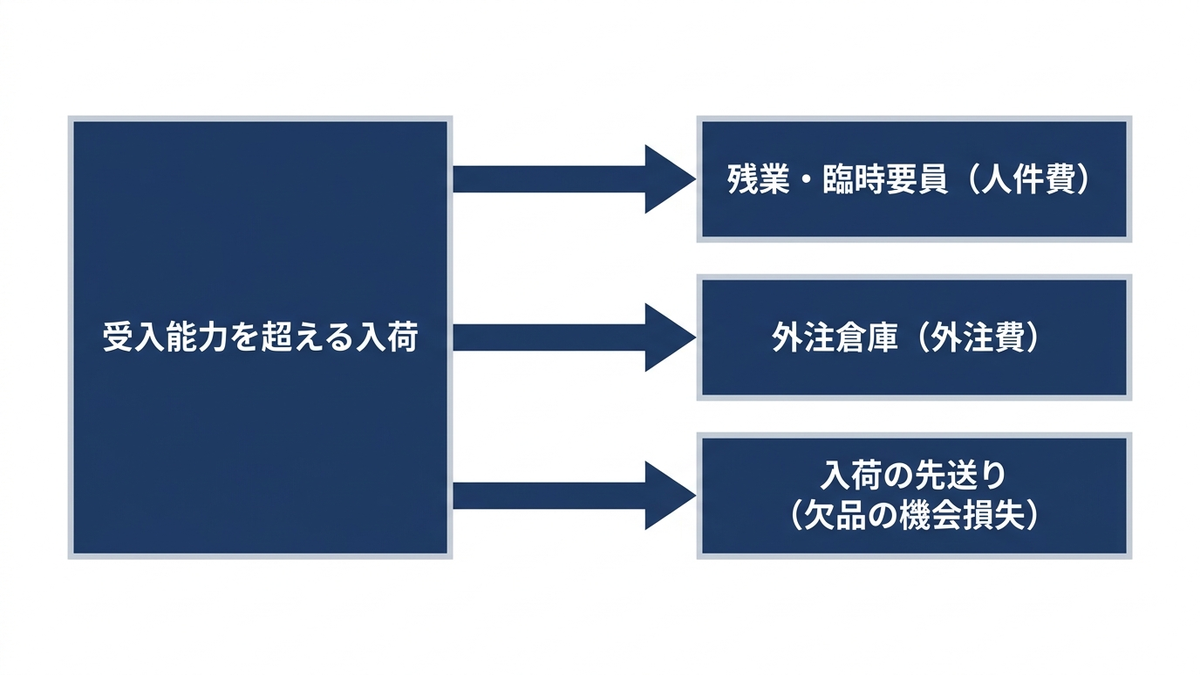
この章の要点は3つです。第一に、動的ロットサイジングは混合整数計画として書き直すことで、受入能力・保管容量・最小発注量・発注単位・安全在庫の下限・リードタイムといった実務の制約を、制約を1行ずつ足す形で取り込めます。第二に、同じ問題でも書き方で解時間が桁で変わり、施設配置型の強い定式化と上限時間つきの打ち切りを組み合わせれば、無償の CBC でも実務的な大きさの問題に暫定解とギャップを出せます。第三に、容量制約を無視した計画の「安さ」は、残業・外注・欠品として後から請求される費用を見ていないだけで、制約を式に入れて初めて能力と在庫と欠品の釣り合いが数字になります。ただし、この章の計画は需要を確定値として扱っています。需要が計画から外れたときにその計画がどう振る舞うか、安全在庫の下限は十分だったかは、実際に需要のばらつきを与えて試さなければ分かりません。次の第12章では、方策のパラメータを式で決めた後に、その方策をシミュレーションで評価する方法を扱います。
この章を深めたい方への参考書籍
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):第7章がロットサイズ決定問題にあてられ、容量制約付き複数品目ロットサイズ決定問題と多段階ロットサイズ決定問題の定式化を Python のコードとともに示しています。この章で扱った強い定式化の考え方を、さらに一般の形で学べます。ソルバーは Gurobi ですが、モデルの書き方は PuLP でもそのまま移せます。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):整数計画問題の定式化(固定費用のある目的関数、論理条件、選言的制約)と、分枝限定法・切除平面法の仕組みが体系的に説明されています。この章で「なぜ書き方で解時間が変わるのか」を直観で済ませた部分を、緩和問題と限定操作の理屈から理解できます。
『Production Planning by Mixed Integer Programming』(Yves Pochet・Laurence A. Wolsey、Springer):ロットサイジングを混合整数計画で解くための定式化と再定式化を、単一品目・容量制約なしの基本形から複数品目・多段階まで積み上げて解説した原典です。この章で使った施設配置型の書き直しや、容量制約付き問題の扱いは、この本の体系に沿っています。洋書ですが、定式化の一覧表だけでも参照する価値があると考えています。
第12章 シミュレーションで方策を評価する
第11章までで、発注点や基準在庫、発注量といった方策のパラメータを式や最適化で決める方法を確認しました。第4章の安全在庫の式は「リードタイム中の需要が正規分布に従い、在庫ポジションがちょうど発注点で発注される」という前提の上に立っており、第3章の経済的発注量も「需要が一定で、発注はいつでも即座に出せる」という前提を置いています。この章では、そうして決めたパラメータが、前提のとおりでない現実に近い条件で本当に狙いどおりのサービス水準と費用になるのかを、シミュレーションで測る方法を扱います。結論を先に書くと、式で「サイクルサービス率95%」と決めた発注点を第2章のサンプルデータで回すと、実測のサイクルサービス率は91.1%でした。この差がどこから来て、いくらの損失に相当し、どう直せばよいかを、実際に動かしたコードと数値で追っていきます。
シミュレーションの方法論そのもの、つまり離散イベントシミュレーションの仕組み、入力分布の決め方、出力分析の理論、分散減少法などの一般論は、弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」で体系的に扱っています。この章では、その中から在庫方策の評価に必要な部分だけを取り出し、Python の SimPy を使って実際に在庫システムを組み、方策を比べるところまでを扱います。
式で決めて、シミュレーションで確かめる
この章の考え方を一言でいうと、「方策のパラメータは式で出し、評価はシミュレーションで行う」です。式は速く、見通しがよく、どの入力がどう効くかが読めます。しかし式が成り立つ前提は限られていて、需要が正規分布からずれる、リードタイムが整数日で下限がある、発注は日に一度しか判断できない、欠品は失注になる、といった現実の条件は式の中に入っていません。一方でシミュレーションは、こうした条件をそのまま模型に組み込めます。代わりに、1つの答えを出すには何度も乱数を回す必要があり、パラメータをどう変えればよいかを教えてくれるわけでもありません。両者は競合する道具ではなく、役割が違う道具です。式が出した候補をシミュレーションに通し、狙いとのずれを測って直す、という往復が実務での使い方になります。
評価の対象になるのは、第5章で整理した発注方式のパラメータです。この章では \( (s,S) \) 方策、つまり在庫ポジション(手持ち在庫と発注残の合計)が発注点 s 以下になったら基準在庫 S まで発注する方策を例にとります。第7章で確認したとおり、固定費のある標準的な単品・定期発注型の動的在庫問題では、一定の仮定のもとでこの形の方策が最適になることが知られていますが、最適性の証明は「s と S を正しく決められれば」の話であって、s と S の具体的な値をどう決めるかは別の問題です。式で出した値がどれだけ狙いから外れるかは、測ってみなければ分かりません。
「測る」ときに何を見るかも、先に決めておく必要があります。第4章で確認したとおり、サービス水準の指標は1つではありません。補充サイクルの中で欠品が起きない確率(サイクルサービス率)と、需要のうち在庫から満たせた割合(フィルレート)は別の指標で、同じ安全在庫に対して通常はフィルレートのほうがずっと高く出ます。加えて、平均在庫を金額に換算したもの、在庫日数、欠品の回数、発注の回数、それらを費用に換算した総費用が要ります。経営の判断に使うのは、サービス率という技術指標ではなく、「在庫にいくら寝ているか」「欠品でいくら失っているか」という金額のほうだからです。
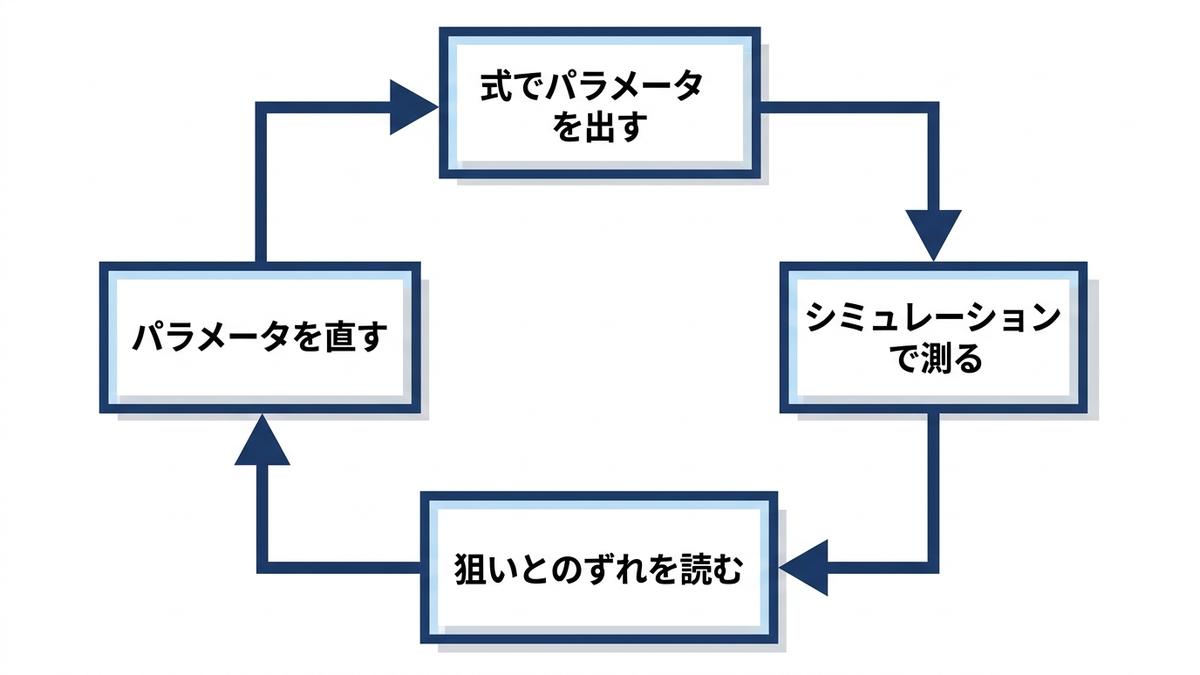
SimPy の最小構成と、同時刻イベントの処理順
在庫システムのシミュレーションは、離散イベントシミュレーションの典型的な応用です。時計を1日ずつ進め、「需要が来た」「発注した」「入荷した」というイベントが起きたときだけ状態(手持ち在庫と発注残)を書き換えます。Python では SimPy(この記事の執筆時点で導入されているのは 4.1.1)が、この時計とイベント待ち行列を提供します。使う部品は少なく、simpy.Environment() が時計を持つ環境、env.process(ジェネレータ) が「プロセス」と呼ばれる振る舞いの登録、プロセスの中の yield env.timeout(遅れ) が「指定した時間だけ待つ」、env.run(until=時刻) が実行、env.now が現在時刻です。
在庫のモデルを組む前に、1つだけ SimPy の挙動を確かめておきます。同じ時刻に2つのイベントが予定されているとき、どちらが先に処理されるかです。在庫の模型では「到着日の入荷」と「その日の需要」が同じ時刻に並ぶので、この順序がサービス率の実測値を動かします。次の最小例で確認できます。
import simpy

def daily(env, name):
    while True:
        print("t=%.1f %s: その日の需要を処理" % (env.now, name))
        yield env.timeout(1)

def delivery(env, lt):
    yield env.timeout(lt)
    print("t=%.1f 入荷(t=0 に timeout(%.1f) で予約)" % (env.now, lt))

env = simpy.Environment()
env.process(daily(env, "日次"))
env.process(delivery(env, 3))
env.run(until=4)
# 出力:
# t=0.0 日次: その日の需要を処理
# t=1.0 日次: その日の需要を処理
# t=2.0 日次: その日の需要を処理
# t=3.0 入荷(t=0 に timeout(3.0) で予約)
# t=3.0 日次: その日の需要を処理
t=3.0 では、入荷イベントがその日の需要より先に処理されています。入荷イベントは t=0 の時点で予約され、3日目の需要イベントは t=2 の時点で予約されるので、先に予約したほうが先に処理されるという規則です。導入済みの SimPy 4.1.1 のソースを見ると、Environment.schedule は「時刻、優先度、通し番号、イベント」の組をヒープに積んでおり、同じ時刻・同じ優先度なら通し番号の小さいもの、つまり先に予約されたものが先に出てきます。この規則を知らずに組むと、在庫の模型では「入荷はその日の朝に届き、その日の販売に間に合う」という前提が暗黙のうちに入ります。「入荷はその日の営業終了後で、翌日から売れる」という前提にしたければ、env.timeout(lt + 0.5) のように半日ずらして、需要の後に処理させます。同じ例で delivery(env, 3.5) とすると、出力は t=3.0 の需要の後に t=3.5 の入荷が並びます。どちらの前提が正しいかは業務によりますが、後で見るとおり、この半日の違いだけでサイクルサービス率の実測値が6ポイント近く動きます。
なお env.run(until=4) は時計が4に達したところで止まり、時刻4に予定されたイベントは処理しません。公式ドキュメントにそのとおりの記述があり、時刻 \( N \) に予定されたイベントまで処理したいときは until を \( N \) より大きくします。この記事の模型では日次需要は \( t = 0 \) から \( t = N – 1 \) の時刻で処理されるので、需要だけなら until=N で足りますが、期間の最後に予定された入荷まで拾えるように、余裕を見て日数+1 で回しています。
\( (s,S) \) 方策の在庫システムを組む
第2章で用意したサンプルデータの定番品 A001(日次需要の平均39.62個、標準偏差9.73、リードタイム7±2日、原価1,200円)を対象に、\( (s,S) \) 方策の在庫システムを SimPy で組みます。模型の前提は次のとおりです。1日を1単位時間とし、毎日、需要の処理と発注判定を行います。入荷の処理の順番は前提によって変わり、本章の既定である夕方入荷では「需要、発注判定、入荷」、朝入荷に切り替えた場合は「入荷、需要、発注判定」の順になります。需要は手持ち在庫の範囲で満たし、足りない分は失注(ロストセールス)として消えます。バックオーダー(後日納品)にはしません。在庫ポジションが s 以下になった日の夕方に S まで発注し、リードタイム後の営業終了後に入荷して翌日から売れます。リードタイムは第2章の sample_lead_times で、平均7日・標準偏差2日の正規乱数を整数に丸めて下限1日にしたものを使います。最初の90日はウォームアップとして KPI の集計から外します。初期在庫を S にしているので、最初の数十日は「たまたま満杯から始まった」影響が残るからです。
この前提はどれも、業務に合わせて変えてよい部分です。バックオーダーが普通の業態なら失注ではなく後日納品に、発注が週1回しか出せないなら発注判定を週次に、入荷が朝に届くなら「朝入荷」に変えます。大事なのは、前提を1つ変えると答えも変わるので、どの前提で測ったかを結果に添えて残すことです。次のクラスが模型の本体で、需要の系列とリードタイムを返す関数を外から与える形にしてあります。
class SSInventory:
    """(s,S) 方策の在庫システム。demand_seq は日次需要の配列、lt_fn() はリードタイム(日)を返す。"""

    def __init__(self, env, s, S, demand_seq, lt_fn, warmup=0, arrival="evening"):
        self.env, self.s, self.S = env, s, S
        self.demand_seq, self.lt_fn, self.warmup = demand_seq, lt_fn, warmup
        self.arrival = arrival    # "evening": 到着日の営業終了後に入荷 / "morning": 到着日の朝に入荷
        self.on_hand = S          # 手持ち在庫(初期値は S)
        self.position = S         # 在庫ポジション=手持ち+発注残
        self.log = []             # 日ごとの記録
        self.orders = []          # 発注の記録(発注日・数量・到着日・サイクル中の失注)
        env.process(self.daily())

    def deliver(self, qty, rec):
        lt = self.lt_fn()
        rec["arrive"] = self.env.now + lt
        # 夕方入荷は 0.5 日遅らせて、到着日の需要の後に処理させる(同時刻は予約順に処理されるため)
        delay = lt + 0.5 if self.arrival == "evening" else lt
        yield self.env.timeout(delay)
        self.on_hand += qty
        # 発注の翌日から入荷までに失注があったか(夕方入荷なら到着日の需要も含む)
        last = rec["arrive"] if self.arrival == "evening" else rec["arrive"] - 1
        rec["lost_in_cycle"] = sum(r["lost"] for r in self.log if rec["placed"] < r["day"] <= last)

    def daily(self):
        for day, d in enumerate(self.demand_seq):
            sold = min(d, self.on_hand)
            lost = d - sold
            self.on_hand -= sold
            self.position -= sold
            ordered = 0.0
            if self.position <= self.s:
                ordered = self.S - self.position
                self.position += ordered
                rec = {"placed": day, "qty": ordered, "arrive": None, "lost_in_cycle": None}
                self.orders.append(rec)
                self.env.process(self.deliver(ordered, rec))
            self.log.append({"day": day, "demand": d, "sold": sold, "lost": lost,
                             "on_hand": self.on_hand, "position": self.position, "ordered": ordered})
            yield self.env.timeout(1)
クラスの中身は、SimPy のプロセスが2種類あるだけです。daily は毎日1回動いて需要を処理し、必要なら発注して deliver プロセスを起動します。deliver はリードタイムぶん待ってから手持ち在庫を増やし、その間に失注があったかを発注の記録に書き込みます。この「発注の翌日から入荷までの間に失注があったか」で補充サイクルごとの欠品の有無を判定し、欠品がなかったサイクル数を補充サイクル数で割ったものがサイクルサービス率です。実行は env = simpy.Environment() でクラスを生成し、env.run(until=日数 + 1) で回すだけです。
KPI は日ごとの記録から次のように定義しました。費用は年あたりに換算し、費用パラメータは第3章で使った共通の値(発注固定費4,000円/回、年間保管費率20%、欠品1個あたりの機会損失は原価の50%)を使います。A001 の原価1,200円なら、保管費は1個1年あたり240円、失注1個あたり600円です。
| KPI | 定義(ウォームアップ後の期間で集計) | 経営指標への読み替え |
|---|---|---|
| フィルレート | 1 から「失注数 ÷ 需要数」を引いた値 | 売れたはずの需要のうち、実際に売れた割合 |
| サイクルサービス率 | 1 から「欠品が起きた補充サイクル数 ÷ 補充サイクル数」を引いた値 | 「発注してから届くまでに一度も切らさなかった」回の割合 |
| 平均在庫(個・金額) | 日々の手持ち在庫(その日の需要処理後)の平均、およびその原価換算 | 棚卸資産として寝ている金額 |
| 在庫日数 | 平均在庫 ÷ 1日あたり需要 | 今の在庫で何日分売れるか |
| 欠品日数 | 失注が1個以上あった日の数 | 顧客に「無い」と言った日の数 |
| 発注回数(年) | 発注した回数 ÷ 年数 | 発注事務・検収・輸送の固定費の回数 |
| 総費用(年) | 発注固定費×発注回数 + 年間保管費×平均在庫 + 失注1個の機会損失×失注数 | 方策を比べるときの物差し |
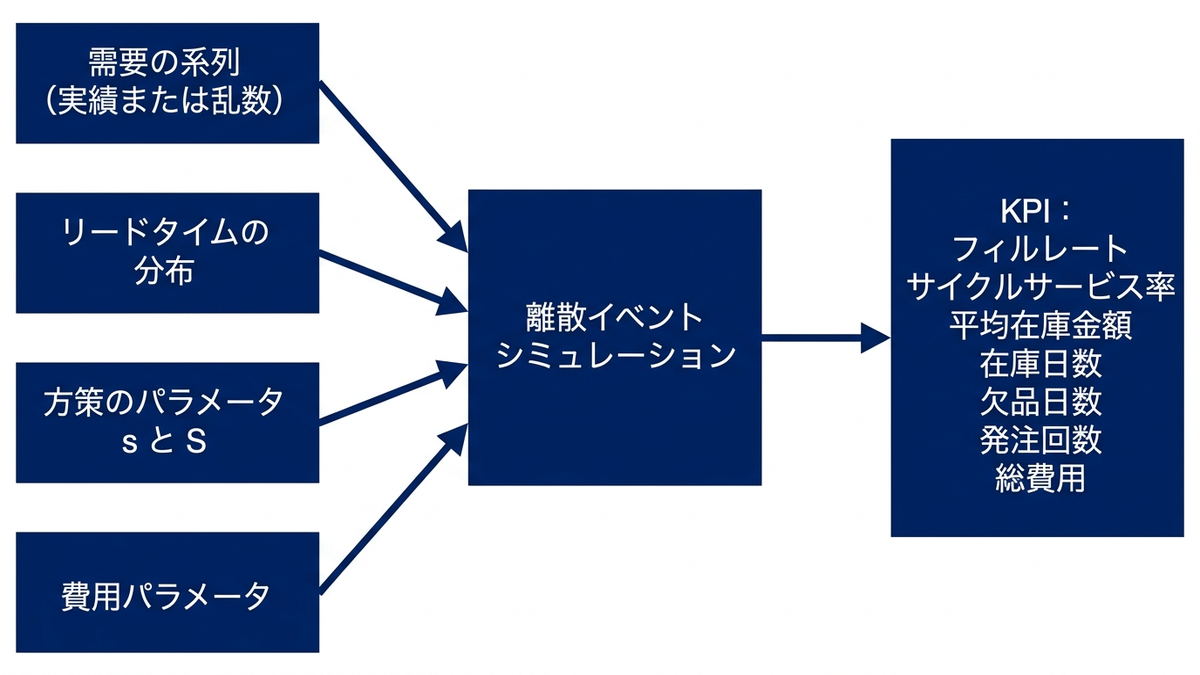
模型が動くことを確かめるための1回の実行結果(乱数のシード0。方策は次の節で式から決める s=415・S=1,110)を見ると、フィルレートは99.59%、サイクルサービス率は95.00%、平均在庫は468.2個(561,892円)、在庫日数11.8日、欠品日数は3年で7日、失注は年59.7個、発注は年20.3回、総費用は年229,512円(発注81,333円、保管112,378円、欠品35,800円)でした。次の図は、その最初の150日の在庫推移です。灰色の破線が在庫ポジション、紺の実線が手持ち在庫で、在庫ポジションが発注点415を割った日に S=1,110 まで発注し、7日前後たってから手持ち在庫が跳ね上がる様子が読めます。この150日には9回の発注があり、手持ち在庫の最小値は32個で、欠品はありません。3年分で7日あった欠品日は、いずれもこの窓の後で、2日か3日ずつ連続して起きています。
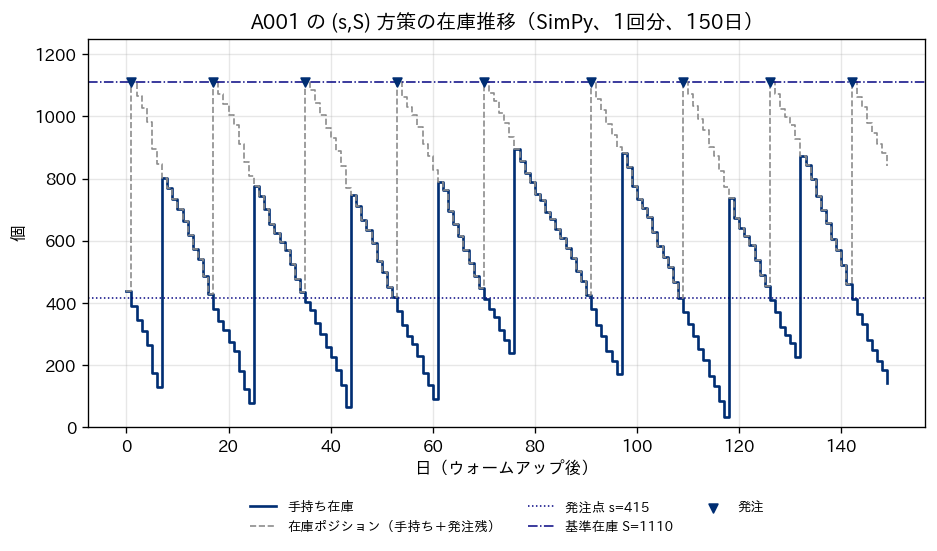
式で決めた \( (s,S) \) を回す、机上の95%と実測の91%
まず、第3章と第4章の式で s と S を決めます。リードタイム中需要の平均は 39.62×7=277.3個、標準偏差は需要とリードタイムの両方のばらつきを合成した式 \( \sqrt{L\sigma_D^2 + D^2\sigma_L^2} \) で83.3個です。サイクルサービス率95%に対応する安全係数は1.645なので、安全在庫は137.0個、発注点 s は切り上げて415個になります(第4章と第5章では同じ414.4個を四捨五入して414個としています。本章は切り上げを採り、この1個の差はそのまま残しています)。発注量は、年間需要14,474個(3年合計を3で割った値で、第3章と同じ定義)から経済的発注量の式で694.6個、切り上げて695個なので、S=s+Q=1,110個です。式が予言するフィルレートは、正規分布の損失関数を使った \( 1 – \sigma_X G(z)/Q \)(\( \sigma_X \) はリードタイム中需要の標準偏差で、上の83.3個)で99.75%になります。ここまでが「机上」の数字です。
この \( (415, 1110) \) を、A001 の3年分の実績需要から復元抽出した日次需要(ブートストラップ)で30回回した結果が次の表です。乱数のシードは回ごとに変え、平均と95%信頼区間の半幅を出しています。
| KPI | 式の予言 | シミュレーション(30回の平均 ± 95%信頼区間の半幅) |
|---|---|---|
| フィルレート | 99.75% | 99.52% ± 0.12(最小98.64%、最大99.96%) |
| サイクルサービス率 | 95%(目標) | 91.06% ± 1.13 |
| 平均在庫 | 式では出さない | 456.2個(547,477円)、在庫日数11.5日 |
| 失注(年) | 36.3個(0.25%×14,474個) | 69.7個 ± 16.6 |
| 発注回数(年) | 20.8回(14,474÷694.6) | 20.1回 |
| 総費用(年) | 式では出さない | 231,829円(発注80,533円、保管109,495円、欠品41,800円) |
フィルレートは99.75%の予言に対して99.52%で、差は0.23ポイントです。数字だけ見れば小さいのですが、サイクルサービス率は目標の95%に対して91.06%と、4ポイント近く低くなっています。同じ発注点でも「フィルレートは高く出て、サイクルサービス率は目標を割る」という組み合わせで、第4章で確認した2つの指標の性質の違いがそのまま出ています。フィルレートが目標に届いているように見えても、サイクルサービス率を目標にして決めた発注点は狙いを外していた、ということです。
差がどこから来るかは、前提を1つずつ変えて回すと切り分けられます。結果は次のとおりです。
| 前提 | フィルレート | サイクルサービス率 | 平均在庫(個) | 総費用(円/年) |
|---|---|---|---|---|
| 基準(夕方入荷、実績からのブートストラップ需要) | 99.52% ± 0.12 | 91.06% ± 1.13 | 456.2 | 231,829 |
| 朝入荷(到着日の販売に間に合う) | 99.83% ± 0.07 | 96.79% ± 0.71 | 494.6 | 214,107 |
| 正規乱数の需要(同じ平均・標準偏差) | 99.49% ± 0.13 | 90.72% ± 1.65 | 453.8 | 233,817 |
| 朝入荷、かつ正規乱数の需要 | 99.83% ± 0.08 | 96.89% ± 1.01 | 492.6 | 213,642 |
需要の分布を実績の復元抽出から正規乱数に変えても、サイクルサービス率はほとんど動きません(91.06%と90.72%で、信頼区間が重なります)。つまり「需要が正規分布ではない」ことは、この品目では主な原因ではありません。一方、入荷を夕方から朝に変えると96.79%まで上がります。前の節で確認した「同時刻イベントの処理順」がここに効いていて、朝入荷なら到着日の需要は新しい在庫で満たせるので、リードタイム中に耐えなければならない需要が実質1日分減ります。式のリードタイム7日は「発注の翌日から7日分の需要を手持ち在庫でしのぐ」という意味なので、それに揃えた前提が夕方入荷です。式とシミュレーションで「リードタイム」の意味がずれていると、比べる前から結論がずれます。
前提を揃えた夕方入荷でなお95%に届かない残りの約4ポイントは、発注のタイミングから来ています。発注時点の在庫ポジションを記録から取り出すと、s=415 をちょうど割った瞬間に発注できているわけではなく、1回分の実行では平均22.0個、最大55個、30回分をまとめると平均20.5個、発注点を割り込んだところで発注していました。需要が1日に約40個まとめて来るので、判定が日に一度である以上、在庫ポジションは s をまたいで下がります。式は「在庫ポジションがちょうど s のときに発注する」前提なので、この割り込みのぶんだけ実質の発注点が低くなります。確かめるために、s を割り込みの平均ぶん上げた \( (435, 1130) \) で回し直すと、サイクルサービス率は94.45% ± 1.05 となり、目標の95%が信頼区間に入りました。フィルレートは99.72%、平均在庫は475.7個で、基準より19.4個(23,307円)増え、年間の保管費の増分は4,661円です。総費用は219,435円で、基準の231,829円より約12,000円下がっています。
この結果を経営の言葉に翻訳しておきます。式の数字を信じて \( (415, 1110) \) を運用した場合、欠品による機会損失は年41,800円で、式が予言する失注36.3個ぶん(21,763円)より20,037円多く、これが「机上の安全在庫」と「実測のフィルレート」のずれの金額です。逆に、発注点を20個上げるだけで欠品の損失が減り、増える保管費は年4,661円なので、差し引きで総費用は年約12,000円改善します。1品目あたりの金額は小さく見えますが、この判断は品目ごとに毎年繰り返されるもので、第2章のサンプルには60品目あります。ここで本当に大事なのは金額の大小よりも、式で決めた方策が「目標のサービス率を達成していると信じられていたが、実は達成していなかった」状態が、測らなければ誰にも見えないことです。欠品の損失は請求書として届かず、売上機会の逸失として積み上がるので、測る仕組みを持たない限り費用として認識されません。
ヒストリカルシミュレーション、3年分の実績をそのまま流す
ここまでの評価は、実績需要から復元抽出した「架空の3年」を30通り作って回すものでした。これとは別に、実績の需要系列をその順番のまま1日ずつ流す方法があり、ヒストリカルシミュレーションと呼びます。復元抽出では日ごとの需要が独立になるので、実績にあった「高い日が続く」「夏に集中する」といった並びの癖が消えます。ヒストリカルシミュレーションはその癖をそのまま残せる代わりに、需要の系列が1本しか無いので、ばらつきの評価はリードタイムなど他の乱数に頼ることになります。2つは補い合う関係で、両方回して結果が近ければ「並びの癖は効いていない」と判断でき、離れていれば「並びの癖が効いている」と分かります。
A001 の2023年1月1日から2025年12月31日までの1,096日の実績需要を、ウォームアップなしで先頭から流し、リードタイムだけ乱数を変えて30回回しました。呼び出しは simulate(SKU, s, S, n_rep=30, warmup=0, seed=2, hist=dem_hist.values) のように、需要の系列を引数で渡すだけです。結果は、フィルレート99.53% ± 0.09、サイクルサービス率91.93% ± 1.29、平均在庫459.5個(551,427円)、在庫日数11.6日、失注は年67.8個、発注は年19.98回、総費用は年230,915円 ± 7,159 でした。復元抽出のときの99.52%、91.06%、456.2個、231,829円とほとんど同じです。A001 は定番品として季節性もトレンドも入れていないサンプルなので、並びの癖が無く、2つの方法が一致するのは筋が通っています。
同じことを季節品の B001(日次平均25.08個、標準偏差14.74、リードタイム14±4日、原価3,500円、月別平均は1月10.6個から7月41.0個まで動く)でやると、結果は大きく割れます。式で決めた \( (540, 864) \) を復元抽出の需要で回すとフィルレート98.82% ± 0.24、サイクルサービス率86.71% ± 1.79、失注は年107.9個、総費用は年532,593円でした。これを実績の並びのまま流すと、フィルレートは92.70% ± 0.44、サイクルサービス率は61.44% ± 1.56、失注は年668.2個、総費用は年1,522,778円になります。シード2の1回分を月別に集計すると、5月から8月はフィルレートが84.8%から88.5%に落ちて3年で1,847個を失注し、逆に11月から2月は平均在庫が470個から590個で、失注はゼロです。年間を通した1つの平均と標準偏差から決めた発注点は、夏には足りず冬には余っていて、復元抽出はその並びを壊して平らにならすので、その失敗を見せてくれません。B001 の失注1個の機会損失は原価の50%で1,750円なので、失注668個は年約117万円の損失で、復元抽出の評価より年約98万円悪い数字です。季節品には季節ごとにパラメータを変える運用(第5章と第8章)が要る、という結論は式だけからも導けますが、「変えなかったらいくら失うか」は、実績の並びを流して初めて金額になります。
ヒストリカルシミュレーションのもう1つの利点は、「いつ欠品したか」を暦の上で指せることです。A001 のシード2の1回分では、失注は2023年に58個(欠品日2日)、2024年に79個(3日)、2025年に148個(5日)で、失注の大きかった日は2025年11月18日(需要46個のうち42個を失注)、2024年5月11日(40個全部)、2025年11月19日(40個全部)でした。2025年11月18日と19日が連続しているのは、一度切らすと入荷までの数日は毎日欠品が続くという、失注モデルの当然の帰結です。実務では、こうして指した日付を実際の営業記録と突き合わせることで、「その日は本当に欠品だったのか」「キャンペーンや納期遅れなど、モデルに入れていない事情があったか」を検証でき、模型の妥当性確認(弊社コラム「シミュレーションの考え方と使いどころ、離散イベントからデジタルツインまで」の第10章)に使えます。
乱数のばらつきと反復回数
シミュレーションの結果は乱数で毎回変わります。30回の平均を出しているのはそのためで、平均に添えた「± 何々」が95%信頼区間の半幅です。計算は、反復ごとの KPI の標本標準偏差を反復回数の平方根で割り、自由度(反復回数から1を引いた数)の t 分布の97.5%点を掛けたものです。scipy.stats.t.ppf(0.975, n - 1) で係数が取れます。次のコードは、反復を回して信頼区間を出す部分の骨組みで、run_once、kpis、make_lt_fn は前の節のクラスを包んだ小さな関数です。
import math
import numpy as np
import pandas as pd
from scipy.stats import t as t_dist

def ci95(x):
    x = np.asarray(x, dtype=float)
    n = len(x)
    hw = t_dist.ppf(0.975, n - 1) * x.std(ddof=1) / math.sqrt(n)
    return x.mean(), hw

seeds = np.random.SeedSequence(0).spawn(30)     # 反復ごとに独立な乱数の種
rows = []
for r in range(30):
    rng = np.random.default_rng(seeds[r])
    demand_seq = rng.choice(dem_hist.values, size=365 * 3 + 90)   # 実績から復元抽出
    sim = run_once(s, S, demand_seq, make_lt_fn(rng, "A001"), warmup=90)
    rows.append(kpis(sim, 1200.0, 4000.0, 0.20, 0.5))
df = pd.DataFrame(rows)
print(ci95(df["fill_rate"]), ci95(df["total_cost"]))
# 出力: (np.float64(0.9951816626323094), np.float64(0.0011506827574378597)) (np.float64(231828.80730593606), np.float64(9375.04476999712))
乱数の種は numpy.random.SeedSequence(0).spawn(30) で親の種から30個の子を派生させています。反復ごとに独立で、かつ全体は種0で固定されるので、同じコードを走らせれば同じ結果が再現できます。反復回数を変えると信頼区間がどう縮むかを、別の種で100回回し、先頭の n 回だけを使って確かめた結果が次の表です。
| 反復回数 n | フィルレート 平均 ± 半幅 | 総費用(円/年)平均 ± 半幅 | 平均在庫(個)平均 ± 半幅 |
|---|---|---|---|
| 5 | 99.71% ± 0.31 | 216,804 ± 27,983 | 464.0 ± 15.1 |
| 10 | 99.64% ± 0.14 | 222,647 ± 12,953 | 464.2 ± 6.9 |
| 30 | 99.60% ± 0.09 | 225,099 ± 7,050 | 458.7 ± 4.1 |
| 100 | 99.54% ± 0.05 | 231,143 ± 4,386 | 459.1 ± 2.1 |
1回ごとの総費用の標準偏差は22,103円でした。年20万円強の費用に対して1割の幅で毎回ぶれるということで、5回の平均では半幅が約28,000円もあり、2つの方策の総費用の差が2万円程度なら、5回では区別がつきません。30回で7,000円、100回で4,400円まで縮みますが、半幅は反復回数の平方根に反比例するので、4倍回して半分にしかなりません。5回の平均が216,804円、100回の平均が231,143円と、少ない回数の平均は約14,000円も低く出ていた点も見ておく価値があります。少ない回数で「この方策は安い」と結論づけると、たまたま欠品の少ない乱数を引いただけ、ということが起こります。フィルレートのように99%台で動く指標は半幅が小さく見えますが、費用は失注数に比例して大きくぶれるので、判断に使う指標ごとに必要な反復回数が違います。
実務での目安は、「比べたい2つの方策の差」が「信頼区間の半幅」より十分大きくなるまで回すことです。今回の模型は1回の実行(3年分とウォームアップ)に0.01秒足らずで、30回で0.2秒、100回でも1秒ほどですから、迷ったら回数を増やせばよい規模です。反復回数の理屈、系列相関のある出力の扱い、共通乱数で方策どうしの比較を鋭くする方法などは、前述の弊社コラムの第9章と第11章に譲ります。ここでは、同じ種で2つの方策を回すと乱数の引きが揃うので差が見やすくなる、という点だけ書いておきます。この章の格子評価と感度分析は、すべて同じ種(0)から派生させた乱数で回しています。
パラメータ格子で s と S を選ぶ
式で出した \( (415, 1110) \) が狙いを外していることが分かったなら、次は「ではどこがよいか」です。式を直す方法もありますが、シミュレーションがあるなら、候補の格子を作って全部回すのが最も素直です。発注点 s を300から600まで50刻みの7通り、発注量の目安 Q(S と s の差)を300から1,100まで200刻みの5通り、合計35点の格子を、それぞれ20回ずつ回しました。700回の実行で計算時間は8.8秒です。次のコードは格子を回す部分で、simulate は前の節の反復をまとめた関数です。
rows = []
for s in [300, 350, 400, 450, 500, 550, 600]:
    for q in [300, 500, 700, 900, 1100]:
        d = simulate("A001", s, s + q, n_rep=20, n_days=365 * 3, warmup=90, seed=0)
        fm, fh = ci95(d["fill_rate"])
        cm, chw = ci95(d["csl"])
        tm, th = ci95(d["total_cost"])
        rows.append({"s": s, "Q": q, "fill_rate": fm, "csl": cm,
                     "avg_on_hand": d["avg_on_hand"].mean(), "total_cost": tm, "total_hw": th})
grid = pd.DataFrame(rows)
print(grid.pivot(index="s", columns="Q", values="total_cost").round(0))
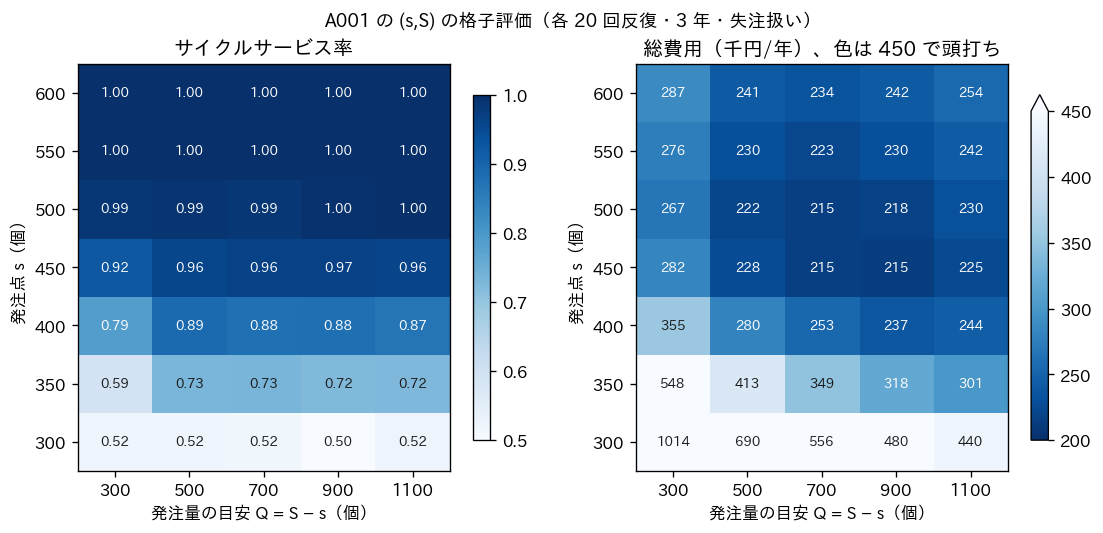
ヒートマップの左がサイクルサービス率、右が総費用です。サイクルサービス率は行(発注点 s)でほぼ決まり、列(発注量 Q)にはあまり依存しません。s=400 の行は0.79から0.89、s=450 の行は0.92から0.97、s=500 の行は0.985から0.996、s=550 以上はどの列も0.997以上です。一方で総費用は s と Q の両方で決まり、右の図では s=450 から500、Q=700 から900 のあたりが最も濃い(安い)領域です。Q=700 の列で s を動かしたときの内訳を表にすると、費用の構造が読めます。
| 発注点 s | 基準在庫 S | フィルレート | サイクルサービス率 | 平均在庫(個) | 保管費(円/年) | 欠品費(円/年) | 発注費(円/年) | 総費用(円/年) |
|---|---|---|---|---|---|---|---|---|
| 300 | 1,000 | 95.5% | 51.8% | 359.4 | 86,246 | 392,430 | 76,933 | 555,610 |
| 350 | 1,050 | 98.0% | 73.4% | 399.3 | 95,836 | 174,390 | 78,867 | 349,093 |
| 400 | 1,100 | 99.2% | 87.5% | 444.7 | 106,738 | 66,810 | 79,667 | 253,215 |
| 450 | 1,150 | 99.8% | 96.4% | 492.9 | 118,300 | 16,870 | 79,800 | 214,970 |
| 500 | 1,200 | 99.9% | 98.6% | 542.5 | 130,199 | 4,620 | 80,000 | 214,819 |
| 550 | 1,250 | 100.0% | 99.8% | 592.5 | 142,197 | 570 | 80,000 | 222,767 |
| 600 | 1,300 | 100.0% | 100.0% | 642.5 | 154,208 | 0 | 80,000 | 234,208 |
s を50個上げるごとに平均在庫はおおむね50個ずつ増え、保管費は年およそ1万円から1万2千円ずつ増えます。一方、欠品費は s=300 の392,430円から s=450 の16,870円まで急激に減り、そこから先はほとんど減りません。総費用は s=450 と500 でほぼ同じ(214,970円と214,819円)で、s=550 では保管費の増加が欠品費の減少を上回って再び増えます。格子全体で総費用が最小だったのは s=450、Q=900(S=1,350)の214,626円 ± 4,004 で、フィルレート99.90%、サイクルサービス率96.6%、平均在庫594.6個(713,532円)でした。ただし s=450 と Q=700、s=500 と Q=700 の総費用はいずれも信頼区間の中に入っており、この3点の差は乱数のぶれと区別できません。式の値に最も近い格子点 s=400、Q=700 の総費用は253,215円で、最小の格子点より年38,589円高く、サイクルサービス率は87.5%です。
格子の読み方で大事なのは、「底が平ら」であることです。s=450 から500、Q=700 から900 の範囲では総費用がほとんど変わらないので、その範囲のどこを選ぶかは費用以外の理由で決めてよいことになります。たとえばサイクルサービス率を96%以上にしたい、平均在庫を60万円以内に収めたい、発注は月2回以内にしたい、といった制約です。s=450 で Q を動かすと、Q=300 では年45.0回の発注で発注費が179,867円かかり、Q=1,100 では発注は年12.8回に減るものの平均在庫が696.1個(835,264円)に膨らみます。発注事務の人手が制約なら Q を大きめに、運転資金が制約なら Q を小さめに寄せる、という判断が、この表を見ながらできます。
費用の物差しで決めるときに注意したいのは、総費用の最小点が「欠品1個あたり600円」という機会損失の見積もりに強く依存することです。この値を原価の50%としたのは第3章の共通の仮定で、実際には粗利率や、欠品が顧客の離反につながる度合いで大きく変わります。機会損失を大きく見積もれば最小点はもっと高い s に移り、小さく見積もれば低い s に移ります。したがって格子評価の結果は「この機会損失の見積もりのもとでの最適」であり、見積もり自体をどう置くかは経営の判断です。逆にいえば、格子の表があれば「欠品1個をいくらと見るか」という経営の判断を、s の値という運用のパラメータにそのまま翻訳できます。
感度分析、リードタイムが延びたら、需要が増えたら
格子評価は「今の需要とリードタイムのもとで、どのパラメータがよいか」を答えます。もう1つ実務で必要なのは、「今のパラメータのまま、条件が変わったらどうなるか」で、これを感度分析と呼びます。仕入先の納期が延びる、需要が伸びる、納期のばらつきが増える、といった変化は珍しくなく、そのたびにパラメータを取り直す運用になっているかどうかで、損失の桁が変わります。式で決めた \( (415, 1110) \) を固定したまま、リードタイムの平均を5日から14日まで変えて回した結果と、リードタイムに合わせて式で s を取り直した結果(S は s に同じ Q=695 を足す)を並べたのが次の図と表です。各30回、乱数の種は同じです。
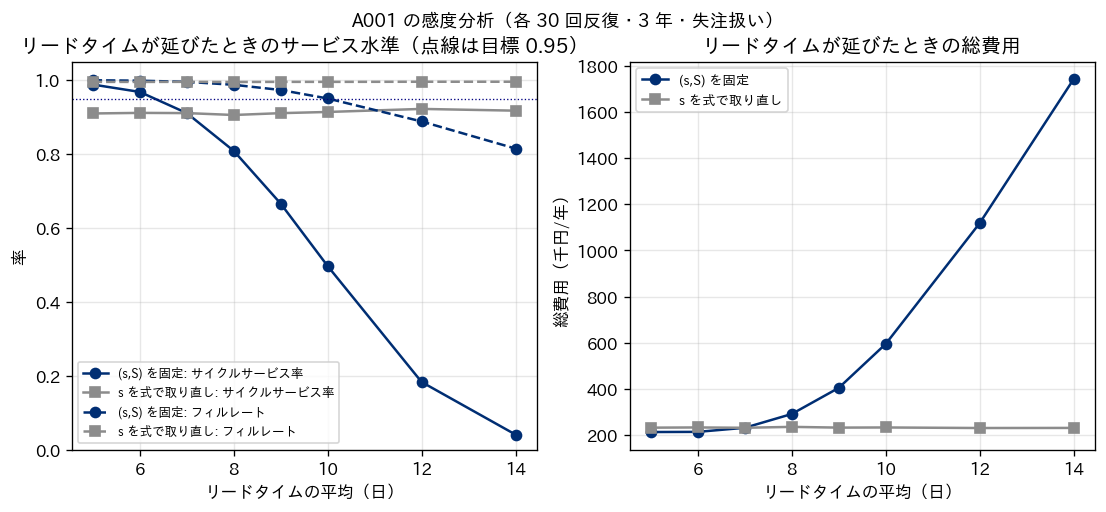
| リードタイム平均(日) | 固定:フィルレート | 固定:サイクルサービス率 | 固定:失注(個/年) | 固定:総費用(円/年) | 取り直した s | 取り直し:サイクルサービス率 | 取り直し:総費用(円/年) |
|---|---|---|---|---|---|---|---|
| 5 | 99.9% | 98.8% | 7.6 | 213,437 | 334 | 91.0% | 232,333 |
| 6 | 99.8% | 96.8% | 24.2 | 214,107 | 374 | 91.1% | 233,248 |
| 7(基準) | 99.5% | 91.1% | 69.7 | 231,829 | 415 | 91.1% | 231,829 |
| 8 | 98.7% | 80.8% | 184.9 | 291,510 | 455 | 90.6% | 235,763 |
| 9 | 97.3% | 66.6% | 388.7 | 404,518 | 496 | 91.0% | 232,548 |
| 10 | 95.0% | 49.7% | 720.8 | 594,683 | 536 | 91.4% | 233,166 |
| 12 | 88.8% | 18.3% | 1,618.9 | 1,117,486 | 618 | 92.2% | 230,798 |
| 14 | 81.5% | 4.1% | 2,680.6 | 1,740,901 | 699 | 91.7% | 231,200 |
方策を固定したままリードタイムが7日から10日に延びると、フィルレートは99.5%から95.0%へ、サイクルサービス率は91.1%から49.7%へ落ち、失注は年70個から721個に増えます。増えた651個に機会損失600円を掛けると年390,673円で、総費用は231,829円から594,683円へ、年362,854円増えます。14日まで延びれば失注は年2,681個、総費用は1,740,901円で、基準の7.5倍です。フィルレートだけを見ていると「10日に延びても95%ある」と読めてしまいますが、サイクルサービス率は半分を切っており、補充のたびに二回に一回は切らしている状態です。これが第4章で「フィルレートとサイクルサービス率は別物」と確認したことの、運用上の意味です。
一方、リードタイムに合わせて s を取り直せば、サイクルサービス率は91%前後、総費用は23万円台に留まります。ここで注目したいのは、取り直した後の平均手持ち在庫がほとんど増えないことです。リードタイム10日のとき s は536で、基準の415より121個高いのですが、平均手持ち在庫は458.6個で、基準の456.2個とほぼ同じです。発注点からリードタイム中の平均需要を引いた安全在庫の部分も、137.7個から139.8個へ2個しか増えていません。s の増加分のほとんどはリードタイム中の平均需要の増加分、つまり「届くまでに売れてしまう量」で、それは手持ち在庫ではなく発注残として存在します。実際、平均発注残は基準の317.4個から435.4個へ118.1個(原価で141,684円)増えています。リードタイムが延びると増えるのは、棚にある在庫ではなく、輸送中や仕入先で引き当て済みの在庫(第1章のパイプライン在庫)だということが、模型を回すと数字で見えます。棚だけを見て「在庫は増えていない」と判断すると、運転資金の増加を見落とします。
リードタイムの平均ではなく標準偏差が増えた場合も同じ構図です。標準偏差を2日から4日にすると、固定のままではフィルレート96.6%、サイクルサービス率75.0%、総費用479,519円まで悪化し、式で s を542に取り直せば92.6%と283,302円に戻ります。ただしこのときは安全在庫そのものが増えるので、平均手持ち在庫は456.2個から577.0個に増えます。逆に標準偏差が0、つまり納期が正確に7日になった場合、式で取り直した s は320で、安全在庫は42個まで減りますが、実測のサイクルサービス率は78.1%しかありません。安全在庫が小さいほど、前に見た「発注点の割り込み」約20個の相対的な影響が大きくなるからで、式が出す安全在庫が小さいときほど、シミュレーションで確かめる価値が高いといえます。
需要の水準が変わった場合も表にしておきます。方策を固定したまま需要が10%増えると、フィルレートは98.7%、サイクルサービス率は81.6%、失注は年211個、総費用は316,774円で、20%増では97.3%、70.0%、465個、469,228円です。逆に需要が20%減ると、フィルレートは100%、在庫日数は11.5日から16.3日へ延び、総費用は190,922円まで下がりますが、これは欠品費がほぼ0になったからで、保管費の面では在庫が5日分余っている状態です。第2章の成長品 D001 のように年率20%以上で伸びる品目は、去年決めた発注点が今年はもう足りず、逆に減退期の品目は在庫が積み上がるので、パラメータの更新頻度をどう決めるか(第13章)が、そのまま金額の問題になります。
感度分析の結果を経営の判断に使うときは、「変化の大きさ」と「気づくまでの時間」を掛け合わせて読みます。リードタイムが7日から10日に延びると、方策を固定したままでは年36万円の損失増ですが、それに3か月気づかなければ9万円、1年気づかなければ36万円が失われ、s を取り直せばそのほとんどが避けられます。つまり感度分析が教えているのは「どの条件の変化を監視すべきか」と「変化に気づいたら何をどれだけ変えるか」で、この2つを運用に落とすのが次章の主題です。
この章の要点をまとめます。方策のパラメータは式で決めてよいものの、式が成り立つ前提(発注点でちょうど発注できる、リードタイムの意味が揃っている、需要の並びに癖が無い)は現実では崩れているので、決めた方策は必ずシミュレーションで測ります。測るときは、サービス率だけでなく平均在庫の金額、失注の機会損失、総費用まで出し、反復回数を増やして信頼区間が判断に十分な幅になるまで回します。格子評価で費用の底が平らな範囲を見つけ、その中から経営の制約で選び、感度分析で「何が変わったらパラメータを取り直すか」を決めておきます。次の第13章では、こうして決めた方策を品目数が多い現場で回し続けるための運用、つまりパラメータの更新、例外管理、KPI の設計と経営報告、システム連携を扱います。
この章を深めたい方への参考書籍
『Pythonコンピュータシミュレーション入門 人文・自然・社会科学の数理モデル』(橋本洋志・牧野浩二、オーム社):第6章「経営モデル」に在庫管理(経済的発注量・発注点法・定期発注法)と待ち行列の節があり、SimPy による離散事象シミュレーションの節も置かれています。この章で組んだ在庫システムの模型を、自分のデータで組み直すときの手元の参考書として使えます。
『Excelで学ぶオペレーションズリサーチ』(大野勝久・逆瀬川浩孝・中出康一、近代科学社):第10章がシミュレーション、第11章が在庫管理で、Python を使わずに表計算で同じ考え方を追える構成です。発注方式のパラメータを表計算で決め、シミュレーションで確かめる、という往復をまず小さく試したい方に向いています。
『Discrete-Event System Simulation 第5版』(Jerry Banks・John S. Carson・Barry L. Nelson・David M. Nicol、Pearson):離散イベントシミュレーションの標準的な教科書で、第10章が検証と妥当性確認、第11章が単一モデルの出力分析、第12章が代替案の比較と評価にあてられています。この章で「30回回して信頼区間を出す」「格子の3点の差は乱数のぶれと区別できない」と書いた部分の理屈を、英語の原典で厳密に追いたいときの拠り所になります。
第13章 在庫方策を運用する、パラメータの更新から経営報告まで
第12章では、式で決めた発注点と基準在庫をシミュレーションに通し、狙いとのずれを測って直す往復を確認しました。また感度分析から、リードタイムや需要の変化に気づかずに方策を固定したままにすると損失が積み上がること、つまり「何が変わったらパラメータを取り直すか」を決めておく必要があることも見ました。この章はその続きで、決めた方策を品目数の多い現場で回し続けるための運用を扱います。数理モデルの話はここまでで一段落し、対象は仕組みと手順と報告の設計に移ります。
在庫の数理モデルが現場で使われなくなる原因は、式が間違っているからではないことが多いように思います。品目が数千あって1つずつ面倒を見られない、パラメータを決めた人が異動して根拠が分からなくなった、システムが出す発注量を担当者が信用せず手で直している、経営には在庫金額の増減しか報告されず何が効いたのか分からない、といった運用側の理由で止まります。この章では、品目数が多いときの自動化、例外管理、KPI の設計と経営報告、システム連携、導入の順序、失敗の型、担当者の勘との折り合いを、この順に扱います。コードは載せません。代わりに、どの表と図を月次で出すか、どの品目だけを人が見るか、どこから手を付けるか、という設計の判断を書きます。
品目数が多いときの自動化、ABC 別に方式と目標サービス率を決める
第4章までの計算は、1品目ずつ丁寧に行えば手作業でもできます。しかし現実の品目数は数百から数万で、MIT の講義資料(MIT OpenCourseWare で公開されている2006年の物流システムの講義で、第5章でも参照したもの)は小売の例として、4万から5万の品目を1,800店舗以上で扱い、品目と店舗の組み合わせが約7,200万から9,000万にのぼる企業を挙げています。この規模では、1品目ずつ担当者が判断する運用は成り立ちません。品目数が多いときの運用は、「品目を群に分け、群ごとに方式と目標を決め、個々の品目のパラメータは機械的に計算し、人は例外だけを見る」という形にするしかないと考えています。第5章で見た ABC 別の方式の目安は、この「群ごとに方式を決める」の部分にあたります。同じ MIT の講義資料は、A 品目を「最も経営の注意と見直しを要し、多くの例外が出る」、B 品目を「例外管理つきの自動制御」、C 品目を「制御の仕組みはできるだけ単純にする」と性格づけたうえで、この区分は「恣意的な分類である」と断っています。
群ごとに決めるものは、方式だけではありません。目標サービス率も群ごとに決めます。第4章の経営目線の節で確認したとおり、全品目に一律のサービス率を課すと、増える安全在庫の金額のほぼ8割が A 品目に積まれ、C 品目のサービス率を上げても金額はほとんど増えませんでした。そこで示した方針は「欠品1個の費用を原価の何倍と見るか」という1つの数字を経営が決め、あとは式が品目ごとの答えを出す、というものでした。運用に落とすときは、この方針を品目群ごとの規則に翻訳します。たとえば「A 品目は欠品費の比率から式で出したサービス率をそのまま使う」「B 品目は同じ式の結果を数段階に丸める」「C 品目はサービス率ではなく在庫日数の上限で管理する」のように、群が下がるほど規則を粗くするのが実務的だと考えています。丸める理由は、B 品目や C 品目で品目ごとに微妙に違うサービス率を持たせても、担当者が説明できず、監査もできないからです。
ABC の区分そのものにも注意が要ります。MIT の講義資料は、実務での ABC 区分の問題点として、下位分類や品目の粒度で一様に扱ってしまうこと、需要のばらつきをほとんど考慮しないこと、見直しの頻度が足りないことの3点を挙げています。第2章の XYZ 分析を重ねるのは1点目と2点目への対処で、区分を定期的に計算し直すのが3点目への対処です。区分は固定の属性ではなく、金額と需要の実績から毎回計算される結果だと位置づけると、成長品が B から A に上がったときも、終売が近い品目が A から C に落ちたときも、自動で方式と目標が切り替わります。ただし、区分が変わるたびに方式まで変わると現場が混乱するので、区分の境界付近の品目には一定期間の据え置き(たとえば2回連続で区分が変わったときだけ切り替える)を設けるのがよいと考えています。
次の表は、群ごとに決める項目と、その決め方を弊社の考えとして整理したものです。方式と目標サービス率は第4章と第5章の内容の再掲で、この章で足しているのは「更新の頻度」「例外の扱い」「担当者の裁量」の3列です。
| 区分 | 方式と目標(第4章・第5章) | パラメータの更新 | 例外の扱い | 担当者の裁量 |
|---|---|---|---|---|
| A 品目 | 連続監視の発注点補充点方式。サービス率は欠品費の比率から品目ごとに式で出す | 毎月。需要の平均・予測誤差・リードタイムの実績を取り直して再計算する | 欠品・過剰・滞留のすべてを個別に見る。例外が多いことを前提にする | 推奨値を上書きしてよいが、理由を記録する。上書きの結果は翌月に検証する |
| B 品目 | 定量発注方式または定期発注方式。サービス率は式の結果を数段階に丸める | 毎月から四半期ごと。自動で再計算し、変化の大きい品目だけ人が確認する | 閾値を超えた品目だけを一覧に出す。それ以外は見ない | 原則として上書きしない。上書きが続く品目は方式かパラメータの見直し対象にする |
| C 品目 | 2ビン方式・長い間隔の定期発注・仕入先への委託。サービス率ではなく在庫日数の上限で管理する | 半年から1年ごと。区分の見直しと同時に行う | 長期滞留と廃棄だけを見る。代替できる品目は欠品を代替で対応する前提にし、補修部品や規制対応品のように代替できない品目は重要度の軸で別枠にする | 裁量を残さない。規則どおりに回す |
この表で最も大切なのは、A 品目の「例外が多いことを前提にする」と C 品目の「裁量を残さない」の対比です。A 品目は金額が大きく、需要の変化や入力の誤りがあったときの損失も大きいので、式の結果をそのまま信じるより担当者が見て直すほうが損失が小さいことが多く、そのための時間を確保する必要があります。C 品目は逆で、担当者が時間を使っても削れる在庫金額が小さいので、規則で回して人の時間を A 品目に振り向けます。全品目を同じ手間で見る運用は、A 品目の見直しが足りず、C 品目に時間を使いすぎる、という2つの損失を同時に生みます。
パラメータの月次更新と、新製品・終売品の扱い
第12章の感度分析で見たとおり、需要やリードタイムが変わったのに方策のパラメータを固定したままにすると、気づくまでの時間に比例して損失が積み上がります。MIT の講義資料も、需要が定常でないことへの実務上の対処として「パラメータを定期的に再計算する」ことを挙げ、発注点と補充点を時期ごとに変える \( (R, s_t, S_t) \) のような形を示しています。したがって、パラメータは一度決めて終わりではなく、定期的に取り直すものとして運用を設計します。更新の頻度は、A 品目なら月次が妥当だと考えています。週次にすると、発注周期より短い間隔でパラメータが揺れて、担当者から見て「先週と言うことが違う」状態になり、信用を失います。四半期ごとでは季節の変わり目に遅れます。月次なら、月次の需給調整の会議と歩調が合い、更新の根拠を会議で説明できます。
月次更新で取り直す入力は4つです。第一に需要の平均で、直近の実績から季節と傾向を分けて推定します。第二に予測誤差のばらつきで、第8章で確認したとおり安全在庫は需要のばらつきではなく予測誤差のばらつきで決めるので、毎月の予測と実績の差を記録して標準偏差を更新します。第三にリードタイムの平均とばらつきで、発注日と入荷日の記録から取ります。MIT の講義資料は、発注点の式の入力について「誰がリードタイムを集めるか」「どのくらいの頻度で更新するか」「誤差はどう推定したか」「リードタイムのばらつきを含んでいるか」「サービス率は誰が定義し所有しているか」という問いを並べ、入力の質を保つのは技術とビジネスプロセスだと述べています。第四に費用のパラメータで、保管費率と発注費と欠品費の比率です。これは毎月変えるものではありませんが、金利の変化や倉庫の契約更新があれば見直します。
更新の手順で弊社が重要だと考えているのは、「計算」と「反映」を分けることです。毎月、全品目のパラメータを機械的に再計算し、現在の設定値と並べて差分の一覧を作ります。差分が小さい品目はそのまま自動で反映し、差分が大きい品目(たとえば発注点が前月比で一定割合以上動いた品目)だけを担当者が確認してから反映します。この「一定割合」の閾値は、確認の対象になる品目数が担当者の処理能力に収まるように決めます。差分が大きい品目の多くは、需要の急変か、リードタイムの記録の誤りか、単発の大口需要が平均を押し上げたかのどれかで、確認の目的は「式が間違っていないか」ではなく「入力が汚れていないか」を見ることです。
新製品と終売品は、この月次更新の枠に収まりません。新製品には需要の実績が無く、予測誤差も測れないので、式でパラメータを出せません。実務的には、類似品目の需要の型を借りて初期値を置き、実績が溜まるまでは更新の間隔を短くする(たとえば最初の3か月は隔週)運用になります。初期在庫は第6章のニューズベンダー問題として決めるのが筋で、需要の分布は類似品の立ち上がりから推定します。ここで大切なのは、新製品の初期パラメータが「借り物」であることを記録し、実績が溜まった時点で式の値に置き換える期限を決めておくことです。期限を決めないと、借り物の値がそのまま何年も残ります。終売品は逆で、需要が減っていくのに方策が過去の平均を引きずると、最後に売れ残りが出ます。終売の決定が出た時点で、発注点と補充点を段階的に下げ、最終の発注量は残りの需要見込みと廃棄費用から第6章の臨界比で決めます。終売の情報が発注の担当者に届いていないために、終売の翌月に補充が入る、という事故は珍しくないように思います。営業と商品企画から終売の情報が在庫方策に流れる経路を、運用の設計の中に明示しておく必要があります。
例外管理、担当者が見るべき品目だけを出す
品目数が多い運用で人が果たす役割は、全品目を見ることではなく、規則から外れた品目を見ることです。これを例外管理と呼びます。MIT の講義資料が B 品目の扱いとして「例外管理つきの自動制御」を挙げ、自動補充の技術を「例外ベース」と性格づけているのは、この考え方です。例外管理の設計で決めることは3つで、何を例外と定義するか、例外をどの順に並べるか、例外に対して誰が何をするか、です。
例外の定義は、第1章の損失の型に対応させると整理しやすくなります。欠品の例外は「在庫ポジションが発注点を下回っているのに発注が出ていない」「入荷予定日を過ぎても入荷していない」「手持ち在庫がリードタイム中の平均需要を下回っている」のような条件です。過剰の例外は「手持ち在庫が補充点を大きく超えている」「在庫日数が群の上限を超えている」で、発注単位が大きい品目や、需要が落ちた品目で起きます。滞留の例外は「一定期間出庫が無い」「最終出庫日からの経過日数が発注間隔とリードタイムの合計の数倍を超えている」で、方策上は要らない在庫が残っていることを示します。JIS Z 8141 は棚卸の備考で、在庫品をその活動性によって「死蔵在庫,眠り在庫,活動在庫,過剰在庫」に分けて適否を検討するとしており、滞留の例外はこの分類を毎月機械的に行うことにあたります。これらに加えて、データの例外を置くことを弊社は勧めています。「在庫がマイナスになっている」「リードタイムの実績が設定値の2倍を超えた」「予測と実績の差が連続して同じ符号になっている」といった条件で、これは在庫の問題ではなく入力の問題を知らせるものです。MIT の講義資料は、在庫ポジションが狂う原因として、誤った品目コード、入力ミス、スキャナの不調、コードの欠落、減耗、返品、そして発注残の扱い(システムが発注を生成した時点で発注残に入るのか、仕入先が受け付けた時点なのか、入荷予定日は誰が更新するのか、分納や複数仕入先はどう扱うのか)を挙げています。式がどれだけ正しくても、在庫ポジションが狂っていれば発注は狂うので、データの例外は在庫の例外より先に潰す必要があります。
例外の並べ方は、金額で並べるのが原則です。同じ「欠品の恐れ」でも、A 品目と C 品目では損失の桁が違います。欠品の例外なら「不足見込み数量×粗利」、過剰の例外なら「超過分の在庫金額×保管費率」、滞留の例外なら「滞留在庫の金額」で並べ、担当者は上から順に見ます。件数で並べたり、品目コード順に並べたりすると、金額の小さい例外に時間を使い、大きい例外が下に埋もれます。並べ替えの物差しを金額にすることは、例外管理を経営の言葉で行うための最低限の条件だと考えています。
例外に対する対応は、品目の群ごとに決めておきます。A 品目の欠品の例外なら「担当者が仕入先に納期を確認し、必要なら緊急発注か代替品の手配を行い、結果を記録する」、C 品目の滞留の例外なら「一定期間続いたら処分の判断に回す」のように、条件と対応を対にして書き出します。ここで大切なのは、例外の一覧が毎日同じ品目で埋まらないようにすることです。同じ品目が毎月例外に出るなら、それは例外ではなく、その品目の方式かパラメータが合っていないことを示しています。例外の一覧には「何回連続で出ているか」の列を置き、連続回数が一定を超えた品目は、例外の対応ではなく方策の見直しの対象に移します。例外管理は、方策の穴を見つける仕組みでもあります。
| 例外の種類 | 条件の例 | 並べ替えの物差し | 対応する損失の型(第1章) | 連続して出るときに疑うこと |
|---|---|---|---|---|
| 欠品 | 在庫ポジションが発注点を下回っているのに発注が無い。入荷予定日を過ぎている。手持ち在庫がリードタイム中の平均需要を下回る | 不足見込み数量×粗利 | 欠品 | 安全在庫の不足、リードタイムの設定値の誤り、需要の増加 |
| 過剰 | 手持ち在庫が補充点を大きく超えている。在庫日数が群の上限を超えている | 超過分の在庫金額×保管費率 | 過剰 | 発注単位が大きすぎる、需要の減少、担当者の上乗せ |
| 滞留 | 一定期間出庫が無い。最終出庫日からの経過日数が発注間隔とリードタイムの合計の数倍を超える | 滞留在庫の金額 | 過剰(陳腐化の予備軍) | 終売の情報が届いていない、見越し在庫の解消漏れ |
| データ | 在庫がマイナス。リードタイムの実績が設定値の2倍超。予測誤差の符号が連続して同じ | 該当品目の在庫金額 | すべての型の原因になる | 在庫記録の誤り、入荷処理の遅れ、予測のバイアス(第8章) |
KPI の設計、6つの指標の定義と読み方
運用が回っているかどうかを測る指標を決めます。第12章のシミュレーションで使ったフィルレート・在庫日数・欠品回数・発注回数・総費用は方策を評価する指標でしたが、運用の KPI はそれより少し広く、方策の外にある損失(滞留と廃棄)と、経営指標への翻訳(回転率)を含めます。弊社が月次で見ることを勧めている指標は6つで、在庫日数、棚卸資産回転率、フィルレート、欠品率、滞留在庫比率、廃棄率です。定義を次の表にまとめます。どの指標も「全社の1つの値」だけでなく、ABC の群別と拠点別に分解して見ることを前提にしています。
| 指標 | 定義 | 読み方 | 誤読しやすい点 |
|---|---|---|---|
| 在庫日数 | 平均在庫を1日あたりの出庫量(金額なら1日あたりの売上原価)で割った日数。第1章の定義 | 今の在庫が何日分の需要にあたるか。群ごとに上限を決めて管理する | 売上高で割るか原価で割るかで値が変わる。期末在庫で計算すると季節で歪む |
| 棚卸資産回転率 | 一定期間の所要量(売上原価)を平均在庫で割った回数。JIS Z 8141 は「一定期間における在庫の回転回数」と定義し、在庫回転日数の逆数としている | 資金が在庫を通って戻るまでの速さ。経営の共通語 | 高いほど良いとは限らない。次節で扱う |
| フィルレート | 需要のうち手持ち在庫から満たせた割合。第4章の定義 | 顧客から見たサービスの水準。粗利の機会損失に直結する | 受注行単位か数量単位かで値が変わる。欠品時に受注を断っていると需要が記録されず高く出る |
| 欠品率 | 補充サイクルのうち欠品が起きた割合、または欠品が起きた日の割合。前者は1からサイクルサービス率を引いた値 | 欠品の頻度。フィルレートが数量の指標なのに対し、こちらは回数の指標 | 定義を決めずに使うと部門ごとに違う数字が出る。どちらの定義かを表に明記する |
| 滞留在庫比率 | 一定期間出庫の無い品目の在庫金額を、在庫金額の合計で割った割合 | 方策上は要らない在庫がどれだけ混ざっているか。陳腐化の予備軍 | 「一定期間」を短くすると季節品が滞留に見える。群ごとに期間を変える |
| 廃棄率 | 一定期間に廃棄・評価減した在庫の金額を、同じ期間の仕入金額(または売上原価)で割った割合 | 過剰の型の損失が確定した金額。損益計算書に現れる | 廃棄の判断を先送りすると低く出る。滞留在庫比率と併せて読む |
6つの指標は、2つずつ対になっています。在庫日数と回転率は同じものを日数と回数で表した対で、経営には回転率、現場には在庫日数で伝えると通じやすいと考えています。フィルレートと欠品率は、欠品の「量」と「頻度」の対です。フィルレートが高いのに欠品率も高いなら、欠品は頻繁に起きるが1回あたりの不足量は小さい、ということです。発注点が少し低い可能性が高く、安全在庫を少し足すのが第一の候補になります(発注の頻度や発注単位、需要の曜日への集中、納期の遅れが原因のこともあるので、直す前に切り分けます)。逆にフィルレートが低くて欠品率が低いなら、めったに欠品しないが起きたときの不足が大きい、つまり大口需要か長い納期遅れが原因で、安全在庫より仕入先との調整や分納の仕組みが効きます。滞留在庫比率と廃棄率は、損失の「予備軍」と「確定分」の対で、滞留在庫比率が上がって数か月後に廃棄率が上がる、という時間差で動きます。廃棄率だけを見ていると、損失が確定してから気づくことになります。
指標の定義で最も注意が要るのは、フィルレートの分母です。欠品したときに受注を断ったり、顧客が別の品目に振り替えたりすると、その需要は販売の記録に残らず、フィルレートの分母から消えます。すると、欠品が多い品目ほど記録上のフィルレートが高く見える、という逆転が起きます。MIT の講義資料も、発注点の入力に関する問いとして「需要と販売は同じか」を挙げています。これを避けるには、受注時点の数量(引き合いを含む)を記録し、出荷できた数量と分けて持つ必要があります。この記録が無い会社では、フィルレートは「参考値」とし、欠品率(欠品が起きた日の割合)を主指標にするほうが、まだ実態に近いと考えています。
経営報告、月次でどの表と図を出すか
KPI を決めたら、それを誰にどう見せるかを決めます。経営への報告は、第1章で整理した4つの経営指標(在庫金額、欠品による粗利の損失、運転資金、在庫日数)を軸にし、技術指標(安全係数・サービス率・発注点)は補足に回します。弊社が月次の報告として勧めている構成は、表が3つと図が2つです。
表の1つ目は、全社の KPI の推移で、前掲の6指標を直近12か月分並べます。1か月分の値だけを出すと、良いのか悪いのかが読めません。12か月並べれば、季節の山と谷を差し引いて傾向が読めます。表の2つ目は、ABC の群別の内訳で、在庫金額、在庫日数、フィルレート、滞留在庫比率を群ごとに出します。全社の在庫日数が延びたとき、それが A 品目の需要減なのか、C 品目の滞留なのかは、この表を見て初めて分かります。第1章の「偏在の型」は全社の数字では見えないので、この分解が要ります。表の3つ目は、例外の集計で、欠品・過剰・滞留・データの各例外について、件数と金額と、そのうち対応済みの割合を出します。例外の件数が減っていれば運用が効いている証拠で、件数が減らずに対応済みの割合だけ上がっているなら、担当者が処理に追われていて根本の方策が直っていない兆候です。
図の1つ目は、在庫金額を「役割」で分けた積み上げで、第1章の4つの役割(サイクル在庫・安全在庫・見越し在庫・パイプライン在庫)に滞留在庫を足した5つに分けて、月ごとの推移を描きます。在庫金額の総額が同じでも、安全在庫が増えてサイクル在庫が減っていれば発注回数が増えているということで、滞留在庫が増えていれば処分の判断が要る、というように、内訳が施策を示します。図の2つ目は、サービス率と在庫金額の対応で、横軸に在庫金額、縦軸にフィルレートを取り、群ごとに今月の点を打ち、第4章で見た「サービス率を上げると安全在庫が加速度的に増える」曲線を背景に置きます。今の位置が曲線上にあれば方策のとおりに動いており、曲線から右に外れていれば同じサービス率をより多い在庫で達成している、つまり無駄があることが読めます。この図は、経営に「在庫を減らせ」と言われたときに「減らすとサービス率がここまで下がる」と数字で返すための道具でもあります。
| 報告物 | 中身 | 答える問い | 読み手 |
|---|---|---|---|
| 表1:全社 KPI の12か月推移 | 在庫日数・回転率・フィルレート・欠品率・滞留在庫比率・廃棄率 | 良くなっているか、悪くなっているか | 経営層 |
| 表2:ABC 群別の内訳 | 群ごとの在庫金額・在庫日数・フィルレート・滞留在庫比率 | どの群で何が起きているか | 経営層・在庫の責任者 |
| 表3:例外の集計 | 欠品・過剰・滞留・データの例外の件数・金額・対応済み割合 | 運用が回っているか、担当者が追われていないか | 在庫の責任者・担当者 |
| 図1:在庫金額の役割別の積み上げ | サイクル・安全・見越し・パイプライン・滞留の5区分の月次推移 | 在庫の増減はどの役割で起きたか | 経営層・在庫の責任者 |
| 図2:サービス率と在庫金額の対応 | 群ごとの今月の位置と、第4章の曲線 | 今の在庫は方策どおりか、無駄はどこか | 経営層 |
報告の頻度は月次が基本ですが、例外の一覧は日次で担当者が見るものなので、報告物と作業用の画面は分けます。経営に日次の例外を見せる必要はなく、担当者に12か月推移を毎日見せる必要もありません。報告の設計で起きやすい失敗は、担当者が見る画面をそのまま経営に見せることで、経営は品目コードの一覧から何も読み取れず、在庫の話題が「金額が増えたか減ったか」だけに退化します。
経営目線、在庫削減の目標を回転率だけで置くと何が起きるか
在庫の目標を経営が置くとき、最もよく使われるのが棚卸資産回転率です。JIS Z 8141 も在庫回転率の備考で「これが高いほど運転資本の回収が早くなることから経営上望ましい」と述べており、回転率を上げることが在庫の改善だという理解は広く共有されています。しかし、回転率だけを目標にして、フィルレートや欠品率を同時に置かないと、起きやすいことが3つあります。
1つ目は、欠品の増加です。回転率は平均在庫を減らせば上がるので、最も早い方法は安全在庫を削ることです。安全在庫を削ればサービス率が下がり、欠品が増えますが、欠品の損失は第1章で見たとおり「欠品損失」という科目では現れず、売上や粗利の減少に埋もれます。回転率は改善し、売上の機会損失は誰にも見えない、という状態が数か月続き、顧客が離れてから売上の減少として現れます。2つ目は、A 品目の過剰な削減と C 品目の放置です。回転率は金額の加重平均なので、金額の大きい A 品目を減らすのが最も効きます。A 品目は売れ筋で、そこを削れば欠品が最も痛い品目で欠品が起き、一方で金額の小さい C 品目の滞留は回転率にほとんど響かないので手を付けられず、廃棄の予備軍が残ります。3つ目は、期末の操作です。回転率を期末在庫で計算している会社では、期末の直前に発注を止め、期初に大量に発注する、という行動が起きます。年間の平均在庫は変わらず、期末の1日だけ在庫が少ない状態が作られ、そのために期初に欠品が出ます。
これらは担当者の怠慢ではなく、目標の置き方が引き起こす合理的な行動です。目標を1つの指標で置けば、その指標を最も安く動かす方法が選ばれます。防ぐには、回転率と対になる指標を同時に目標にすることが要ります。弊社が勧めているのは、「群ごとのフィルレートの下限を守ったうえで、在庫日数を下げる」という置き方です。フィルレートの下限を先に置けば、安全在庫を削って回転率を上げる道は閉じ、残る道は発注単位の見直し(サイクル在庫の削減)、リードタイムの短縮(安全在庫の削減)、滞留在庫の処分、予測精度の改善(第8章)になります。これらはどれも実際に費用を下げる改善で、指標の操作ではありません。目標の置き方が変わると、担当者が選ぶ手段が変わります。
もう1つ、経営が押さえておくべきことは、在庫削減の効果は一度きりだということです。在庫を1,000万円減らせば、運転資金が1,000万円解放され、年間の保有費用が保有費率20%なら200万円減ります。解放される運転資金は一度きりで、翌年また1,000万円減るわけではありません。毎年続く効果は保有費用の200万円のほうで、これは在庫が減った状態を維持している限り続きます。「在庫削減で毎年1,000万円の効果」という報告は、一度きりの資金の解放と、毎年の費用の削減を混同しています。この区別を報告の中で明示することが、在庫の施策を経営の投資判断に正しく載せるために必要だと考えています。
システム連携、ERP・MRP・WMS・需要予測ツールの役割分担
ここまでの運用を人手で回すことは、品目数が多ければ不可能で、システムの役割分担を決める必要があります。在庫に関わるシステムは大きく4つに分けられます。ERP は、JIS Z 8141 の定義では、販売・在庫管理・物流、生産管理または購買管理、管理会計または財務会計、人事管理などの基幹業務プロセスに必要な機能をあらかじめ備えた統合業務パッケージを利用して実行を支援する総合情報システムです。在庫の文脈では、在庫の残高、発注残、受注、仕入先、原価といった記録の正本を持つのが ERP の役割です。MRP(資材所要量計画)は、同じ規格の定義では、生産計画情報、部品構成表情報および在庫情報に基づいて資材の必要量と時期を求める生産管理体系で、製造業で従属需要品目(親品目の生産計画から所要量が決まる部品や材料)の手配を担います。第7章で確認したとおり、MRP は時間軸の発注計画の仕組みで、その中でどのロットでまとめるかがロットサイジングです。WMS(倉庫管理システム)は、規格の倉庫管理の定義に沿えば、入庫、保管、引当、出庫の一連の業務を効率的に行うための仕組みで、ロケーションや現品の単位で在庫を持ちます。需要予測ツールは、第8章で扱った予測とその誤差を出す仕組みで、独立した製品のこともあれば、ERP や計画システムの一部のこともあります。
役割分担で弊社が重要だと考えているのは、「この記事で扱ってきた計算(発注点・補充点・発注量・安全在庫)はどこで行うか」を1か所に決めることです。MIT の講義資料は、ERP や計画システムのベンダーが基本の補充パッケージの中に在庫モデルを提供しており、利用者がパラメータを設定しなければならず、それは「大変な仕事」であること、予測との連携はデータの水準で行われるので前提を確認する必要があること、そして専門のベンダーが ERP に接続して個別の在庫モデルを提供していることを述べています。つまり、計算は ERP の標準機能で行うことも、外部の計算の仕組みで行うこともでき、どちらでもよいのですが、両方で行ってはいけません。ERP の発注点と、表計算で担当者が持っている発注点と、予測ツールが出す推奨量が並存すると、どれが正なのか分からなくなり、後述する二重取りの温床になります。
| システム | 持つもの(正本) | この記事の計算との関係 | 連携で決めておくこと |
|---|---|---|---|
| ERP | 在庫残高・発注残・受注・仕入先・原価・リードタイムの設定値 | 在庫ポジションの入力元。発注の実行先。パラメータ(発注点・補充点)の格納先 | 在庫ポジションの定義(発注残をいつ計上するか、引当済みを引くか)。パラメータを外部から書き戻す経路 |
| MRP | 基準生産計画・部品構成表・所要量の展開結果 | 従属需要品目の時間軸の手配。ロットサイジング(第7章・第11章) | 独立需要品目と従属需要品目の境界。安全在庫を MRP のどこで持つか(完成品か部品か) |
| WMS | ロケーション別・ロット別の現品在庫、入出庫の実績 | 在庫記録の精度の源。滞留(最終出庫日)の把握元 | ERP との残高の照合の頻度。棚卸差異の処理の手順 |
| 需要予測ツール | 品目別の予測値と予測誤差の履歴 | 安全在庫の入力(予測誤差の標準偏差)。発注量の入力(予測の平均) | 予測の粒度(日・週・月)と発注周期の対応(第8章)。予測誤差を記録して渡す取り決め |
| 在庫方策の計算(ERP の標準機能か外部の仕組み) | 群の区分・方式・目標サービス率・パラメータの計算結果と更新履歴 | この記事の第3章から第12章の計算をまとめて行う場所 | 1か所に決める。計算結果を ERP に書き戻し、担当者の上書きを記録する |
連携で最も手間がかかるのは、在庫ポジションの定義を揃えることです。ERP の在庫残高には引当済みの数量が含まれているのか、発注残はシステムが発注書を作った時点で立つのか仕入先が受け付けた時点で立つのか、WMS の現品在庫と ERP の帳簿在庫はどのくらいずれているのか、といった点は、システムを見ただけでは分からず、業務の手順を確かめる必要があります。第5章で確認したとおり、発注方式はすべて在庫ポジション(手持ち在庫と発注残の合計。第5章で見た JIS の有効在庫の定義では、引当済みの量も引きます)で判断するので、この定義がずれていれば、式が正しくても発注は狂います。帳簿在庫と現品在庫のずれを小さく保つ手段が棚卸で、JIS Z 8141 は、倉庫内または棚区域を一定の量で区切って一斉ではなく順番に循環させて棚卸を行う方法を循環棚卸法と呼び、棚卸の際に判明する実在庫高と在庫台帳の残高の差異を棚卸差異と呼んでいます。年に1回の一斉棚卸だけでは、ずれは年に1回しか直りません。A 品目だけでも循環棚卸を回し、棚卸差異を KPI に入れておくことが、方策の計算を意味のあるものにするための前提だと考えています。
導入の順序、現状の可視化から評価まで
ここまでの内容を、どの順に導入するかを整理します。弊社が勧めている順序は、現状の可視化、方式の統一、パラメータの根拠づけ、自動化、評価の5段階です。この順序の要点は、「自動化は4番目」であることと、「可視化が1番目」であることです。
1段階目の現状の可視化では、品目ごとの在庫金額、在庫日数、最終出庫日、現在の発注方式(担当者が実際に何を見て発注しているか)、設定されている発注点や最小在庫、リードタイムの実績を一覧にします。この段階の目的は、改善ではなく、実態を知ることです。可視化の結果、同じ会社の中で担当者ごとに発注の方式が違う、設定値の根拠を誰も説明できない、在庫の一部が1年以上出庫していない、といったことが分かるのが普通で、これを知らずに方式を決めても現場と噛み合いません。可視化には ABC 分析と XYZ 分析(第2章)を含め、群の区分をここで作ります。
2段階目の方式の統一では、群ごとに発注方式を1つに決めます。この段階では、パラメータの値はまだ精緻でなくてよく、担当者が今使っている値をそのまま新しい方式の枠に移すだけでも構いません。目的は「全員が同じ方式で発注している」状態を作ることです。方式が統一されていないと、パラメータをいくら正しく計算しても、それを使わない担当者が残ります。3段階目のパラメータの根拠づけで、第3章から第8章の式を使って発注点・補充点・発注量・安全在庫を計算し、現在の設定値と比べ、差が大きい品目から置き換えます。ここで第12章のシミュレーションを使って、置き換えたときのサービス率と在庫金額を事前に見積もっておくと、現場の納得が得やすくなります。4段階目の自動化で、月次の再計算と例外の抽出を仕組みに載せ、担当者の作業を「例外を見る」ことに絞ります。5段階目の評価で、前掲の KPI を月次で追い、方策の効果を経営指標で報告し、第12章の感度分析で決めた「何が変わったらパラメータを取り直すか」の条件を運用に組み込みます。
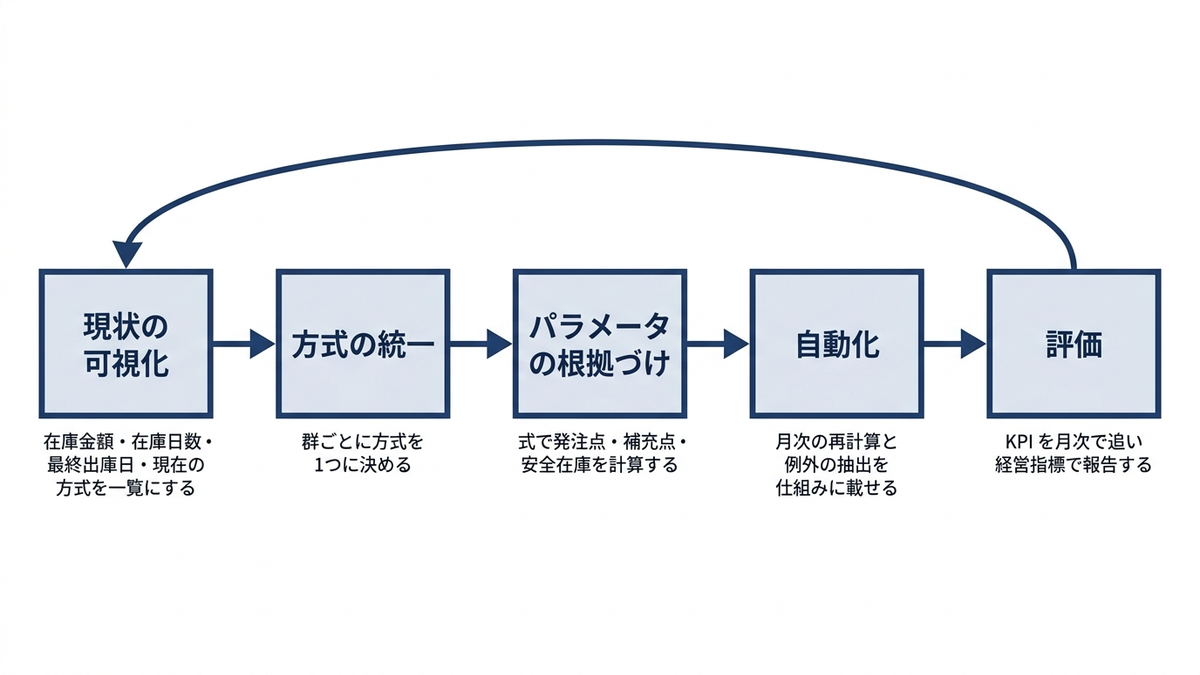
この順序を崩す典型は、自動化を最初に置くことです。在庫の自動発注の仕組みを導入すれば在庫が減る、という期待で仕組みを先に入れると、方式が統一されていないので設定できず、パラメータの根拠が無いので担当者が信用せず、結局は仕組みが出した推奨量を担当者が全部上書きする運用になります。MIT の講義資料が、良い知らせとして「理論のモデルを理解することは重要で意味がある」を、悪い知らせとして「モデルは学んだとおりには使われない」「技術が重要」「ビジネスプロセスはもっと重要」を挙げているのは、この順序の話です。第14章で扱う機械学習や生成AIも同じで、予測の道具を入れる前に、方式の統一とパラメータの根拠づけが済んでいる必要があります。
各段階の期間は会社の規模と品目数で大きく違うので、ここで目安の数字は書きません。ただ、順序の原則として、1段階目と2段階目は品目数に関わらず全品目を対象にし、3段階目以降は A 品目から始めて B 品目に広げ、C 品目は最後まで単純な規則のままにする、という進め方を勧めています。A 品目から始めれば、年間消費金額の8割を占める品目群(第2章のサンプルデータでは60品目中18品目)で効果が出るので、経営への報告が早い段階でできます。
失敗の型、5つの型と担当者の勘との折り合い
最後に、運用でよく見られる失敗の型を5つに整理し、担当者の勘とどう折り合うかを述べます。この5つは第1章の損失の型の運用版で、どれも数理モデルの誤りではなく、モデルの使い方の誤りです。
1つ目は一律のサービス率です。第4章の経営目線の節で数字を見たとおり、全品目に同じサービス率を課すと、増える安全在庫の8割が A 品目に積まれ、C 品目には効きません。運用の失敗としては、経営が「欠品ゼロ」を掲げ、担当者がそれを全品目 99% と解釈し、誰もその費用を計算しない、という形で現れます。対処は、群ごとのサービス率を欠品費の比率から導き、経営にその表を見せて承認を取ることです。2つ目は安全在庫の二重取りで、同じ不確実性に対して何重にも備えてしまうことです。システムの発注点には安全在庫が含まれているのに、担当者が「念のため」発注量を上乗せし、営業が予測に上乗せし、仕入先にも多めの内示を出す、という積み重ねで、在庫が設定値より恒常的に多くなります。この失敗の兆候は、第1章の表にもあるとおり「安全在庫の設定値より実在庫が恒常的に多い」ことで、月次の報告で設定値と実績の差を出せば見つかります。対処は、安全在庫を持つ場所を1か所に決め、担当者の上書きを記録して、上書きが翌月の実績で正しかったかを検証することです。
3つ目は予測を当てにいくことです。予測の精度を上げれば安全在庫が減るのは事実ですが(第8章)、予測は必ず外れるので、外れたときの備えが安全在庫です。運用の失敗としては、予測の的中率を担当者の評価にし、担当者が予測を実績に寄せて後から修正する、あるいは外れを恐れて予測を低めに出す、という行動が起き、予測誤差の記録が汚れて安全在庫の計算が狂います。対処は、予測の精度は予測の担当の指標にし、在庫の担当の指標はフィルレートと在庫日数にする、というように指標を分けることです。4つ目は発注単位の無視です。式が出した発注量が仕入先のケース単位やパレット単位、最小発注量と合わず、担当者が丸めるうちに式の値と実際の発注量が乖離します。第5章の運用ルールで確認したとおり、発注単位と最小発注量は方策の中に制約として組み込むもので、後から丸めるものではありません。式の出力を発注単位で丸めたうえでサービス率を計算し直す、という手順を仕組みに入れておきます。5つ目は現場の運用ルールとの衝突です。発注日が仕入先ごとに固定されている、入荷の検品に2日かかる、月末は出荷が集中して発注業務ができない、といった現場の制約を方策が無視すると、方策は使われません。第12章で確認した「机上の95%と実測の91%」の差は、在庫の判定が日に一度しかできず、在庫ポジションが発注点をまたいで下がるという、式に入っていない運用の条件から生じていました。対処は、可視化の段階で現場の運用ルールを集め、方策のパラメータ(リードタイム、発注間隔、保護期間)にそれを織り込むことです。
| 失敗の型 | 現れ方 | 見つける指標 | 対処 |
|---|---|---|---|
| 一律のサービス率 | 全品目 99% のような目標。費用を誰も計算していない | 群別の安全在庫の金額の偏り | 群ごとのサービス率を欠品費の比率から導き、経営が承認する |
| 安全在庫の二重取り | システム・担当者・営業・仕入先がそれぞれ上乗せする | 安全在庫の設定値と実在庫の恒常的な差 | 安全在庫を持つ場所を1か所に決め、上書きを記録して検証する |
| 予測を当てにいく | 予測の的中率が評価になり、予測が実績に寄せられる | 予測誤差の記録の不自然な小ささ、バイアス | 予測の指標と在庫の指標を分ける |
| 発注単位の無視 | 式の値を担当者が丸め、式と実際が乖離する | 推奨量と実発注量の差の分布 | 発注単位と最小発注量を制約として方策に組み込む |
| 現場の運用ルールとの衝突 | 固定の発注日や検品の日数が式に入っていない | 式のサービス率と実測のサービス率の差(第12章) | 可視化の段階で運用ルールを集め、パラメータに織り込む |
担当者の勘との折り合いは、この5つの型の多くに関わります。勘を否定して式だけで回そうとすると、担当者は式の結果を黙って上書きし、上書きの理由は残らず、方策の改善が止まります。第14章で扱う AI の推奨でも同じことが起きます。逆に勘を全面的に認めると、二重取りと一律の型がそのまま残ります。弊社が勧めている折り合いは、「上書きは自由、ただし記録して検証する」です。担当者が推奨量を変えたら、変えた量と理由(大口の受注が見えている、仕入先の納期遅れを聞いている、キャンペーンが予定されている、など)を記録します。翌月、上書きした品目の実績を見て、上書きが正しかった(欠品や過剰を防いだ)か、不要だった(式のままでよかった)かを集計します。この集計を続けると、2つのことが分かります。1つは、担当者の勘のうち式に入っていない情報(大口受注やキャンペーンの予定)は本当に有効で、それは式の入力に加えるべきだということです。もう1つは、「念のため」の上書きは平均すると在庫を増やすだけで、サービス率を上げていないことが多いということです。前者は仕組みに取り込み、後者は数字を見せて減らします。勘を排除するのではなく、勘の中身を「式に入れるべき情報」と「不安による上乗せ」に分けることが、折り合いの実体だと考えています。
この章の要点をまとめます。品目数が多い運用は、群ごとに方式と目標を決め、パラメータを月次で機械的に更新し、人は金額順に並べた例外だけを見る形にします。KPI は在庫日数・回転率・フィルレート・欠品率・滞留在庫比率・廃棄率の6つを対で読み、経営には4つの経営指標に翻訳した表と図を月次で出します。回転率だけを目標にすると欠品と期末の操作を招くので、群ごとのフィルレートの下限と対にして置きます。システムは在庫ポジションの定義を揃え、方策の計算を行う場所を1か所に決めます。導入は可視化から始めて自動化を4番目に置き、失敗の5つの型を指標で見つけ、担当者の勘は記録と検証で式に取り込みます。次の第14章では、公開された一次情報のある事例と、機械学習や生成AIが在庫の意思決定のどこに入り、何が人の判断として残るかを扱います。
この章を深めたい方への参考書籍
『新版 在庫マネジメントの基本』(石川和幸、日本実業出版社):会計上の在庫、流通業と製造業の「もの」としての在庫、伝統的な在庫管理手法の考え方から始まり、サプライチェーンの設計、需要予測と販売計画、需給調整、物流対応による在庫適正化を経て、第11章が「見える化」と管理指標、第12章が在庫適正化のためのシステムにあてられています。この章で扱った KPI の設計と経営報告、システムの役割分担を、日本の実務の言葉で整理したい方に向いています。2026年5月発売の新版です。
『図解入門ビジネス 最新 在庫管理の基本と仕組みがよ~くわかる本 第3版』(湯浅和夫・内田明美子・芝田稔子、秀和システム):第1章で在庫実態の「見える化」、発注支援の設定が在庫管理システムの生命線であること、ロット生産で不動在庫が大量に発生する例などを取り上げ、第4章で補充量決定の仕組みと管理体制、第5章でコンサルティングの現場から見た在庫管理システム導入の実際(在庫の仕分け、発注支援システムの構築)を扱っています。この章の導入の順序と失敗の型を、図解で具体的に確かめるのに向いています。
『エンジニアが学ぶ在庫管理システムの「知識」と「技術」』(株式会社GeNEE DX/ITソリューション事業部、翔泳社):在庫管理システムを構築する側の視点で書かれた本で、第4章が発注管理機能(発注方式の特徴、経済的発注量、ABC 分析に基づく発注ルールの策定)、第5章から第9章が生産管理・販売管理・購買管理・会計管理・原価管理という関連システムとのつながり、第10章が物流管理・輸配送管理・倉庫管理の各システムにあてられています。この章のシステム連携の節で述べた「在庫ポジションの定義を揃える」「計算を行う場所を1か所に決める」を、実際のシステムの機能に落とすときの参考になります。
第14章 事例と最新動向、機械学習と生成AIの時代の在庫管理
第13章では、在庫方策を運用に載せる順序と、途中でつまずく型を確認しました。この第14章では、視点を外に向けます。公開された一次情報から読み取れる在庫の事例、食品ロスをめぐる制度と商慣習の動き、そして機械学習と生成AIが在庫の意思決定にどう入ってくるかを、2026年9月時点で確認できる範囲で整理します。ここまでの13章で扱った手法が、実際の企業と制度の中でどう使われ、どこが人の判断として残っているかを見る章です。
この章で取り上げる企業名と数字は、すべて企業や官公庁が自ら公表した資料に書かれているものだけに限りました。報道や第三者の解説記事に載っている数字は、出典の一次資料を開いて確認できなかったものは採用していません。したがって、世の中で語られている「AI で在庫が何割減った」という話の多くはここに出てきません。それは事実でないという意味ではなく、公開された資料で裏を取れる範囲がまだ狭いという意味です。
公開された一次情報から読む在庫の事例
最初の事例は、コンビニエンスストアの発注です。株式会社ファミリーマートは2025年7月10日のニュースリリースで、AI を使った発注システム「AIレコメンド発注」を2025年6月末から全国500店舗で運用開始したと発表しました(ファミリーマート ニュースリリース 2025年7月10日)。対象はおむすび・弁当・サンドイッチなどの日配品で、過去1年間の販売実績、店舗周辺の通行量(時間帯別・性別・年代別)、気象データ、カレンダー情報を学習して、日別・便別・単品別の販売予測数を算出し、発注数を推奨します。リリースに書かれている数字は「発注業務にかかる時間を1週間あたり約6時間削減」の1つで、売上や廃棄の削減率は「500店舗での効果をふまえて展開を拡大する」という書き方に留まっています。
この事例で在庫の観点から注目したいのは、数字よりも設計です。第一に、AI が出すのは「販売予測数」と「売場ボリュームを保つ数」の2つで、後者は次の納品までの在庫の繰り越しを考慮して陳列量を維持するために加算されます。これは第4章と第5章で扱った「予測」と「基準在庫」の分離そのものです。第二に、推奨値は1日4回更新され、店舗が手動で調整できます。特に新商品・販促商品・イレギュラーなイベントは「店舗の判断による調整を推奨」と明記されています。つまり、学習データに無い変化は人が入れるという線引きが、最初から運用に組み込まれています。第三に、「お手本店」として立地環境が同様で利益額が高い店舗の販売実績を参照し、自店に無い売れ筋を推奨する仕組みがあります。これは品揃えの決定であって発注量の決定ではありませんが、在庫の問題が「いくつ買うか」だけでなく「何を置くか」と一体であることを示しています。
二つ目の事例は、食品スーパーの惣菜部門で、官公庁の支援を受けて対照実験として行われたものです。一般財団法人日本気象協会とソフトバンク株式会社は2026年8月19日、株式会社バローホールディングスと中部フーズ株式会社の協力のもと、農林水産省の「令和6年度 食品ロス削減緊急対策モデル支援事業」に採択された実証実験の結果を発表しました(日本気象協会 プレスリリース 2026年8月19日)。「スーパーマーケットバロー」20店舗を対象に、2026年1月23日から3月12日まで、気象データ・人流統計データ・販売実績・来店客数データを統合した AI の需要予測に基づく自動発注と、当日の販売進捗と在庫状況から値引きのタイミングと価格を推奨するダイナミックプライシングを導入しました。同地域・同規模の比較店舗との対照分析(リリースでは A/B テストと書かれています)で、食品廃棄量が12.6%減、発注・計画作業時間が36.5%減(週約127分から約81分)、売上高が2.9%増、売上総利益が4.1%増、欠品回数が3.2%減と報告されています。
この事例を第12章の目で読むと、価値は数字の大きさよりも「比較店舗を置いて測った」ことにあります。在庫施策の効果は、季節や商況で簡単に動きます。導入前後の単純比較では、暖冬や競合店の出店のような外部要因と切り分けられません。同じ期間に同じ地域の似た店舗と比べる設計は、第12章で述べた「方策の評価は同じ需要系列で比べる」の実店舗版です。もう一つ、廃棄が減ると同時に欠品回数も減り、売上も増えている点が重要です。第4章と第6章で繰り返したように、在庫の削減と欠品の削減は本来トレードオフです。両方が同時に改善するのは、従来の発注が「多すぎる日と少なすぎる日の両方を含んでいた」ときで、予測のばらつきを小さくすると両側が同時に縮みます。逆に言えば、すでに予測誤差が小さい品目で AI を入れても、両方が改善する余地はありません。
三つ目の事例は少し前のもので、製造業と小売業の協働に踏み込んでいます。日本気象協会は2017年6月5日、経済産業省の平成26〜28年度「次世代物流システム構築事業費補助金」の採択事業として3年間行った「需要予測の精度向上・共有化による省エネ物流プロジェクト」の最終報告を発表しました(日本気象協会 プレスリリース 2017年6月5日)。相模屋食料株式会社の豆腐「なめらか木綿」を対象に、気象予測と人工知能で特定の小売店の需要予測を高度化し、小売業が発注を1日早めても機会ロス・食品ロスが発生せず、製造業は「見込み生産」から「受注生産」へ生産方式を変更でき、製造業での予測誤差がほぼゼロになったと報告しています。リリースは、豆腐の年間消費量146万トンと製造業の余剰生産率0.4%から、全国の豆腐に適用すれば約5,840トンの食品ロスをほぼゼロにすることが「計算上可能」としています。また株式会社Mizkanでは、季節終わりの冷やし中華つゆの最終生産量を需要予測をもとに調整し、150ml商品の最終在庫を2015年比で約20%(取り組み初年度の2014年比では約35%)、360ml商品で約90%削減したとあります。
この事例は、第10章で扱った CPFR(製造・卸・小売が販売計画・需要予測・在庫補充を協働して行う取り組み)の実証です。着目すべきは「発注を1日早める」という小さな変更が、製造側の生産方式を見込みから受注に変えた点です。第4章の言葉で言えば、小売のリードタイムを1日延ばす代わりに、製造側のリードタイム中需要の不確実性を丸ごと消しています。安全在庫を持つ場所を、需要に近い小売から、不確実性を消せる製造へ動かした形です。Mizkan の最終在庫の削減は、第6章のニューズベンダー問題そのものです。季節品の最終生産量は一度しか決められず、余れば翌シーズンまで持ち越すか廃棄になります。需要予測の分布が絞れれば、同じ臨界比で見る分位点は平均に近づき、過剰在庫と欠品の両方のリスクを抑えやすくなります。高い臨界比で上側の分位点を使う季節品では、最終生産量そのものが下がる場合もあります。
| 事例 | 公表主体と時期 | 決めたこと | 公表されている数字 | この記事の対応章 |
|---|---|---|---|---|
| コンビニの日配品の発注推奨 | ファミリーマート、2025年7月 | 日別・便別・単品別の販売予測数と売場ボリュームを保つ数。店舗が手動で調整 | 発注業務の時間を週約6時間削減。500店舗で運用 | 第4章・第5章・第13章 |
| 食品スーパー惣菜の自動発注と値引き最適化 | 日本気象協会・ソフトバンク、2026年8月(農林水産省事業) | AI の需要予測に基づく自動発注、値引きのタイミングと価格の推奨、推奨理由を説明する AI エージェント | 20店舗の対照実験で廃棄12.6%減、作業時間36.5%減、売上2.9%増、売上総利益4.1%増、欠品回数3.2%減 | 第6章・第12章・第13章 |
| 豆腐の CPFR と季節品の最終生産量 | 日本気象協会、2017年6月(経済産業省事業) | 小売の発注を1日早め、製造を受注生産へ。季節終わりの最終生産量を予測で調整 | 製造業での予測誤差がほぼゼロ。冷やし中華つゆの最終在庫が約20%減と約90%減 | 第6章・第10章 |
三つの事例に共通しているのは、AI が置き換えたのが「予測」と「計算」であって、「目標」と「例外」ではないことです。ファミリーマートは新商品とイベントを店舗の判断に残し、バローの実証では推奨理由を説明する仕組みを用意して現場の納得感を高め、豆腐の CPFR は企業間の役割分担そのものを変えました。どの事例も、第13章で述べた「方式の統一とパラメータの根拠」が先にあって、その上に予測の高度化が載っています。
食品ロスと商慣習の見直し、制度が在庫の前提を変える
在庫のモデルは費用と制約を所与として最適な量を出しますが、その費用と制約は制度と商慣習で決まっています。食品の分野では、この前提が動いている最中です。食品ロス削減推進法(食品ロスの削減の推進に関する法律、令和元年法律第19号)は2019年5月31日に公布され、同年10月1日に施行されました(e-Gov 法令検索 食品ロスの削減の推進に関する法律)。第5条は事業者の責務として、国や地方公共団体の施策に協力し、食品ロスの削減に積極的に取り組むよう努めることを定め、第9条は10月を食品ロス削減月間、10月30日を食品ロス削減の日と定めています。努力義務であって罰則はありませんが、政府の基本方針と数値目標がこの法律に基づいて置かれ、商慣習の見直しに取り組む事業者の名前も農林水産省から公表されるようになりました。
数字を確認します。消費者庁・農林水産省・環境省は2026年6月30日、2024年度(令和6年度)の食品ロス量の推計値を公表しました。合計461万トン(前年度464万トン)、うち食品関連事業者から発生する事業系が237万トン(同231万トン)、家庭系が224万トン(同233万トン)です(消費者庁 2024年度食品ロス量推計値の公表について、環境省 報道発表資料)。事業系の内訳は食品製造業110万トン、食品卸売業9万トン、食品小売業48万トン、外食産業70万トンで、2000年度比では57%の削減です(農林水産省 事業系食品ロス量(2024年度推計値)を公表)。基準年の2000年度は合計980万トン(家庭系433万トン、事業系547万トン)で、2030年度の目標は家庭系が半減の216万トン、事業系が60%減の219万トンです。事業系は当初50%減が目標でしたが、2022年度の推計で8年前倒しで達成したため、2025年3月25日に閣議決定された第2次基本方針で60%減に引き上げられました(消費者庁 別添1 食品ロス量の推移と削減目標)。同時に公表された推計では、2024年度の食品ロスによる経済損失は3.8兆円、国民1人当たり年間31,097円、温室効果ガス排出量は二酸化炭素換算で978万トンとされています(消費者庁 別添2 食品ロスによる経済損失及び温室効果ガス排出量の推計結果)。
この数字を在庫の言葉に翻訳すると、事業系237万トンのうち製造業が110万トンと最大で、小売業の48万トンの2倍以上あります。店頭で見える小売段階の廃棄だけでなく、製造段階にも大きな発生源があるということです。前節の豆腐の事例が「製造を受注生産に変える」ことに価値を見出したのは、この構造と整合しています。また、事業系が2000年度比57%減まで来て目標が60%減に引き上げられたことは、簡単に減らせる分はすでに減っており、残りは商慣習と意思決定の仕組みに手を入れないと減らない段階に入ったと読めます。
その商慣習の中心が3分の1ルールです。農林水産省の「商慣習検討」のページによれば、サプライチェーンには賞味期間の3分の1以内で小売店舗に納品する慣例があり、このルールのもとでは、3分の1以内で納品できなかった商品は賞味期限まで多くの日数を残していても行き場がなくなり廃棄となる可能性があります(農林水産省 商慣習検討)。農林水産省は平成24年(2012年)10月に商慣習検討ワーキングチームを発足させ、毎年10月30日を「全国一斉商慣習見直しの日」として、小売事業者に納品期限の緩和を、製造事業者に賞味期限表示の大括り化(年月表示、日まとめ表示)と賞味期限の延長を呼びかけています。同ページの令和7年(2025年)10月時点の集計では、納品期限を緩和している食品小売事業者は377(前年339)、賞味期限表示の大括り化に取り組む食品製造事業者は365(前年350)、賞味期限延長に取り組む食品製造事業者は393(前年359)、フードバンク・子ども食堂等へ食品を提供している事業者は529(前年482)です。
これらの見直しは、在庫モデルの制約と費用を直接変えます。納品期限の緩和は、製造・卸の側から見れば「売れる期間」が延びることで、第3章で述べた賞味期限つき品目の EOQ の上限が緩み、第6章のニューズベンダー問題では売れ残りの処分価値が上がって過大費用が下がります。賞味期限表示の大括り化は、「納入済み商品より賞味期限が前の商品は受け取らない」という日付逆転の拒否を減らすもので、第10章で見た多段階の在庫が「同じ品目なのに日付ごとに別物として扱われる」細分化を解消します。賞味期限の延長は、前の2つを実施しやすくするための土台です。どれも数式の中身を変えるのではなく、数式に入れるパラメータを変えます。逆に言えば、自社の在庫モデルがこれらのパラメータを明示的に持っていなければ、商慣習が変わっても発注量は変わらず、削減の機会を逃します。
| 商慣習の見直し | 何が変わるか | 在庫モデルへの影響 | 関連する章 |
|---|---|---|---|
| 納品期限の緩和 | 賞味期間の3分の1以内という小売への納品期限を延ばす | 製造・卸の在庫が販売可能な期間が延びる。売れ残りの処分価値が上がり、ニューズベンダーの過大費用が下がる。賞味期限つき EOQ の上限が緩む | 第3章・第6章 |
| 賞味期限表示の大括り化 | 年月日表示を年月表示や日まとめ表示へ | 日付逆転による受け取り拒否が減り、同一品目の在庫が日付ごとに分断されなくなる。多段階での配分が単純になる | 第10章 |
| 賞味期限の延長 | 製造側で賞味期間そのものを延ばす | 上の2つを実施しやすくする。陳腐化費用の年率が下がり、保有費用の前提が変わる | 第1章・第3章 |
| フードバンク等への提供 | 期限内の余剰を寄附へ | 売れ残りの処分価値がゼロやマイナスから、社会的な価値を持つ経路に変わる。廃棄費用の見積もりが変わる | 第6章 |
経営目線で補足します。食品ロスの削減は環境や社会の要請として語られることが多いのですが、在庫の側から見れば「売れずに捨てる在庫」は保有費用の陳腐化部分そのものであり、第1章で述べた在庫金額と運転資金の話と地続きです。2024年度の経済損失3.8兆円という推計は国全体の合計ですが、自社の廃棄額を同じ考え方で数えれば、それは最適化で削れる費用の上限を示します。第13章で述べた KPI に「廃棄金額」と「値引き金額」を入れることは、制度への対応であると同時に、在庫モデルの費用パラメータを現実に合わせる作業でもあります。
機械学習の需要予測を発注につなぐ、点ではなく分布で受け取る
ここからは手法の動向です。機械学習による需要予測は、弊社コラム「機械学習の仕組みと使いどころ」と「ビジネスデータの予測に効く時系列分析、基礎から実務まで」で扱っているので、この記事では「予測を在庫の決定にどう渡すか」だけを見ます。第8章で述べたように、発注量の決定に要るのは需要の期待値ではなく、需要がどの範囲にどれくらいの確率で収まるかという分布です。安全在庫は予測誤差のばらつきで決まり(第4章)、ニューズベンダーの最適量は臨界比に対応する分位点で決まります(第6章)。したがって機械学習の予測モデルに求めるべき出力は、点予測ではなく、分位点、予測区間、シナリオといった分布を表すものです。この章では、安全在庫とニューズベンダーに直接つながる分位点を中心に見ます。
この認識は、予測の研究コミュニティでも共有されています。2020年に開催された M5 コンペティションは、ウォルマートが提供した42,840本の階層的な販売数量の時系列を対象に、28日先の点予測を競う部門と、確率的な予測を競う部門の2つを並行して行いました(M5 Competition、ニコシア大学 IFF)。後者では中央値と4つの予測区間(50%、67%、95%、99%)、すなわち0.005・0.025・0.165・0.250・0.500・0.750・0.835・0.975・0.995の9つの分位点を予測することが求められました(Makridakis ほか 2022、M5 uncertainty competition の結果と結論、International Journal of Forecasting)。小売の販売数量というまさに在庫の入力になるデータで、分布を予測すること自体が競技の対象になったわけです。点予測部門の結果は同じ号の別論文にまとめられています(Makridakis ほか 2022、M5 accuracy competition の結果と結論)。
分位点を予測するために使う損失関数が分位点損失(ピンボール損失)です。分位点回帰の考え方は Koenker と Bassett が1978年に提案したもので(Koenker と Bassett 1978、Regression Quantiles、Econometrica)、実績 \( y \) と予測 \( q \) の差 \( u = y – q \) に対して \( \rho_\tau(u) = u\,(\tau – \mathbf{1}[u < 0]) \) と定義されます。言葉で言えば、実績が予測を上回ったとき(在庫が足りなかったとき)は不足分に \( \tau \) を掛け、下回ったとき(余ったとき)は余剰分に \( 1 - \tau \) を掛けて足し合わせる損失です。この損失の平均を最小にする \( q \) は、需要分布の \( \tau \) 分位点になります。第6章で扱った臨界比を思い出してください。過小費用を \( c_u \)、過大費用を \( c_o \) とすると最適な発注量は需要分布の \( c_u / (c_u + c_o) \) 分位点でした。分位点損失の \( \tau \) にこの臨界比を入れれば、分位点損失を最小にする予測はそのまま最適発注量になります。つまり分位点損失は、定数倍を除けば、ニューズベンダーの費用を予測モデルの損失関数に書き写したものです。
まず、分位点損失の最小化点が本当に分位点になることを、第2章で用意した架空のサンプルデータで確認します。季節品 B001 の2025年の日次需要に対して、一定の量 \( q \) を毎日仕込むとしたときの分位点損失(臨界比0.80)を \( q \) ごとに計算し、最小になる \( q \) を探します。
import numpy as np
from inv_data import load_demand

TAU = 0.80   # 臨界比(過小費用 : 過大費用 = 4 : 1 に相当)

def pinball(y, q, tau):
    """分位点損失。y が実績、q が予測の分位点"""
    d = y - q
    return np.mean(np.maximum(tau * d, (tau - 1) * d))

dem = load_demand()
y25 = dem.loc["2025", "B001"].values
grid = np.arange(0, 120)
loss = [pinball(y25, q, TAU) for q in grid]
q_star = grid[int(np.argmin(loss))]
print("分位点損失を最小にする一定量 q* = %d" % q_star)
print("標本の %.0f%% 分位点 = %.1f" % (TAU * 100, np.quantile(y25, TAU)))
print("平均 = %.1f、q* の日数カバー率 = %.3f" % (y25.mean(), (y25 <= q_star).mean()))
# 出力: 分位点損失を最小にする一定量 q* = 36
#       標本の 80% 分位点 = 36.0
#       平均 = 24.7、q* の日数カバー率 = 0.808
分位点損失を最小にする一定量は36個で、標本の80%分位点36.0と一致しました。平均24.7個より11個ほど多い量で、需要が仕込み量以下に収まった日の割合は80.8%です。ここまでは第6章の標本分位による解と同じことを、損失関数の側から言い直しただけです。違いが出るのは、需要の分布が日によって変わるときです。
分位点損失で発注量を直接学習する
需要の分布が季節や曜日で変わる品目では、一定量を仕込むのではなく、翌日の分布を条件つきで予測して仕込み量を変えたくなります。ここに2つの行き方があります。一つは第8章までの標準的な手順で、平均を予測し、学習期間の予測誤差の標準偏差を一定とみなして、正規分布の安全係数を掛けた安全在庫を上乗せする方法です。もう一つは、勾配ブースティングなどの機械学習モデルの損失関数を分位点損失にして、臨界比の分位点を直接学習する方法です。scikit-learn(この記事の実行環境は 1.9.0)の GradientBoostingRegressor は loss="quantile" と alpha(分位点の水準)でこれを指定できます(scikit-learn GradientBoostingRegressor)。前日までの情報だけで作った特徴量(年周期の正弦・余弦、曜日、前日の需要、7日と28日の移動平均)で、2023〜2024年を学習期間、2025年を評価期間として両者を比べます。
import pandas as pd
from scipy.stats import norm
from sklearn.ensemble import GradientBoostingRegressor

s = dem["B001"]
X = pd.DataFrame({
    "doy_sin": np.sin(2 * np.pi * s.index.dayofyear / 365.0),
    "doy_cos": np.cos(2 * np.pi * s.index.dayofyear / 365.0),
    "dow": s.index.dayofweek,
    "lag1": s.shift(1),
    "ma7": s.shift(1).rolling(7).mean(),
    "ma28": s.shift(1).rolling(28).mean(),
}, index=s.index).dropna()
y = s.loc[X.index]
tr = X.index < "2025-01-01"
te = ~tr

# (a) 平均を予測し、残差の標準偏差を一定とみなして安全在庫を上乗せ
mean_model = GradientBoostingRegressor(loss="squared_error", n_estimators=300,
                                       max_depth=3, learning_rate=0.05, random_state=0)
mean_model.fit(X[tr], y[tr])
resid_sd = np.std(y[tr] - mean_model.predict(X[tr]))
q_a = mean_model.predict(X[te]) + norm.ppf(TAU) * resid_sd

# (b) 臨界比の分位点を直接学習
q_model = GradientBoostingRegressor(loss="quantile", alpha=TAU, n_estimators=300,
                                    max_depth=3, learning_rate=0.05, random_state=0)
q_model.fit(X[tr], y[tr])
q_b = q_model.predict(X[te])
# 出力: 学習期間の残差の標準偏差 = 6.89、z(0.80) = 0.842、(a) の安全在庫は一律 5.8 個
実行ログ(_out\ch14_quantile.txt)から、2025年の365日について、需要が仕込み量以下に収まった日の割合(カバー率。目標は臨界比の0.80)、分位点損失、平均の仕込み量・売れ残り・欠品を、通年と季節別に並べます。
| 期間 | 方法 | 日数 | カバー率 | 分位点損失 | 平均仕込み量 | 平均需要 | 平均売れ残り | 平均欠品 |
|---|---|---|---|---|---|---|---|---|
| 通年 | (a) 平均予測+一律の安全在庫 | 365 | 0.767 | 3.16 | 31.1 | 24.7 | 8.3 | 1.9 |
| 通年 | (b) 80%分位点を直接学習 | 365 | 0.797 | 3.00 | 31.8 | 24.7 | 8.7 | 1.6 |
| 冬(11〜2月) | (a) | 120 | 0.908 | 1.68 | 18.6 | 11.1 | 7.7 | 0.2 |
| 冬(11〜2月) | (b) | 120 | 0.833 | 1.59 | 16.4 | 11.1 | 5.8 | 0.5 |
| 夏(5〜8月) | (a) | 123 | 0.650 | 5.13 | 43.6 | 37.4 | 10.0 | 3.9 |
| 夏(5〜8月) | (b) | 123 | 0.740 | 4.88 | 45.9 | 37.4 | 11.7 | 3.2 |
| 春秋 | (a) | 122 | 0.746 | 2.62 | 30.8 | 25.3 | 7.0 | 1.5 |
| 春秋 | (b) | 122 | 0.820 | 2.47 | 32.7 | 25.3 | 8.4 | 1.0 |
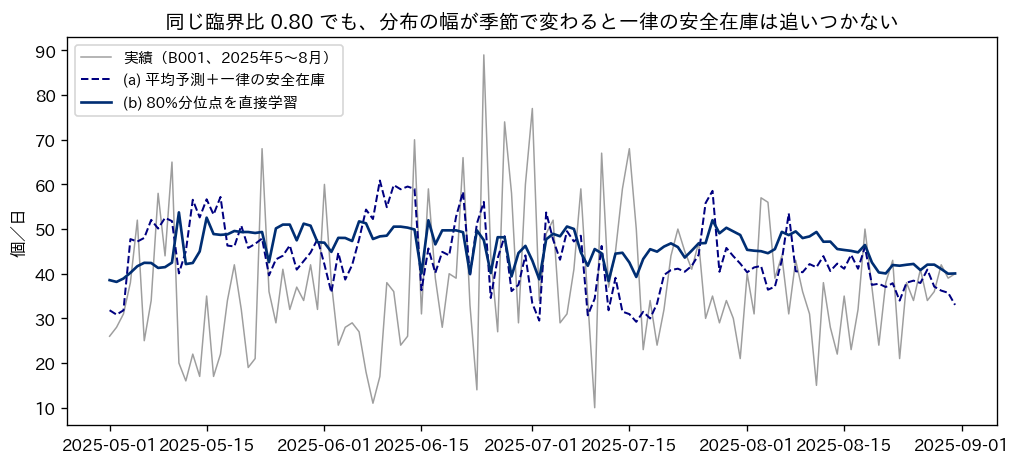
通年のカバー率は (a) が0.767、(b) が0.797で、どちらも目標の0.80に近く見えます。しかし季節で分けると差がはっきりします。(a) は冬にカバー率0.908と過剰で、夏に0.650と不足です。学習期間の残差の標準偏差6.89個に安全係数0.842を掛けた5.8個を一律に足しているため、需要が小さく散らばりも小さい冬では持ちすぎ、需要が大きく散らばりも大きい夏では足りません。(b) は冬0.833、夏0.740、春秋0.820と、どの季節でも目標に近い水準です。分位点損失も通年で3.16から3.00へ下がり、季節ごとに見ても (b) が一貫して小さくなっています。冬の平均売れ残りは7.7個から5.8個へ減り、夏の平均欠品は3.9個から3.2個へ減っています。第2章で用意したサンプルデータの季節品は負の二項分布で生成されており、分散が平均とともに大きくなります。一律の標準偏差という近似は、この性質のある品目では季節ごとの目標を外します。
結果の読み方に注意点があります。第一に、これは1品目・1年の評価であり、乱数のばらつきを含みます。第12章で述べたように、方法の優劣は複数品目・複数年で見るべきです。第二に、(b) が改善したのは「分布の幅が条件で変わる」品目だからで、定番品 A001 のように分布が安定した品目では (a) と (b) の差は小さくなります。第三に、臨界比0.80は人が与えたものです。分位点を直接学習する方法は、臨界比が決まっていることを前提にしており、臨界比が決まっていなければ何を学習すればよいかが定まりません。過小費用と過大費用の比を決めるのは第6章の仕事であり、機械学習の仕事ではありません。第四に、複数の分位点を別々に学習すると、分位点どうしの順序が逆転することがあります(0.8分位点の予測が0.9分位点の予測を上回るなど)。実務で複数の分位点を使うときは、順序を保つ後処理か、分布のパラメータを予測する形にするのが安全です。
予測と最適化を一体で学習する考え方
分位点を直接学習する方法は、「予測してから最適化する」2段階を、単期の在庫問題に限って1段階に畳んだものと見ることができます。この考え方を一般の最適化問題に広げたのが、decision-focused learning(決定を目的とする学習)と呼ばれる研究の流れです。標準的な機械学習は予測誤差を最小にするように学習しますが、その予測を下流の最適化問題に入れたときの決定の質は考慮していません。予測誤差が小さくても、最適化の答えを大きく変える方向に誤っていれば損失は大きく、逆に予測誤差が大きくても答えが変わらない方向なら損失はありません。ならば最初から「予測を使って決めた結果の費用」を損失関数にして学習しよう、というのがこの流れの出発点です。
在庫の文脈でこの考え方を最初に明確にした研究の一つが、Ban と Rudin による「ビッグデータ・ニューズベンダー」です(Ban と Rudin 2019、The Big Data Newsvendor、Operations Research)。需要そのものを予測する中間段階を置かず、特徴量から発注量を直接出す手法を提案し、病院の看護師の配置という在庫と同じ構造の問題で、最良の手法がベンチマークに対して標本外の費用を24%下げたと報告しています。Bertsimas と Kallus は、需要に直接影響する量だけでなく関連する補助的な観測データも使って、条件つきの確率最適化問題として最適な決定を処方する枠組みを提案し、データの「処方力」を測る係数を定義しました(Bertsimas と Kallus 2020、From Predictive to Prescriptive Analytics、Management Science)。年間10億個を出荷する大手メディア企業の流通部門の在庫問題に適用し、社内データと公開データを合わせることで、この係数で測って88%の改善があったとしています。
制約のある最適化問題に広げたのが Elmachtoub と Grigas の枠組みです(Elmachtoub と Grigas 2022、Smart Predict, then Optimize、Management Science)。予測が引き起こす決定の誤り(予測に基づいて決めた解の費用と、真の値で決めた解の費用の差)を SPO 損失と定義し、これを直接最小化するのは計算が難しいため、双対性(最適化問題を、それと表裏の関係にある別の問題に置き換える考え方)を使って凸な代理損失 SPO+ を導きました。目的関数が線形であれば、多面体制約、凸制約、混合整数制約まで扱えるとしています。数値実験では、予測モデルの仮定が現実とずれている(誤特定されている)ときに特に改善が大きく、SPO+ で学習した線形モデルがランダムフォレストを上回る傾向があったと報告しています。第11章で扱った混合整数計画による発注計画は目的関数が線形なので、この枠組みの対象に入ります。
この分野の全体像は、Mandi らの総説にまとまっています(Mandi ほか 2024、decision-focused learning の総説、Journal of Artificial Intelligence Research)。機械学習と制約つき最適化を端から端まで一体で学習する手法を、勾配に基づくものと勾配を使わないものに分けて整理し、7つの問題で11の手法を実証比較しています。より広く「文脈つき最適化」(不確実性のもとで文脈情報を使って決定する手法)の総説もあります(Sadana ほか 2025、文脈つき最適化の総説、European Journal of Operational Research)。組合せ最適化への適用を示した初期の研究としては Wilder らのものがあります(Wilder ほか 2019、AAAI)。
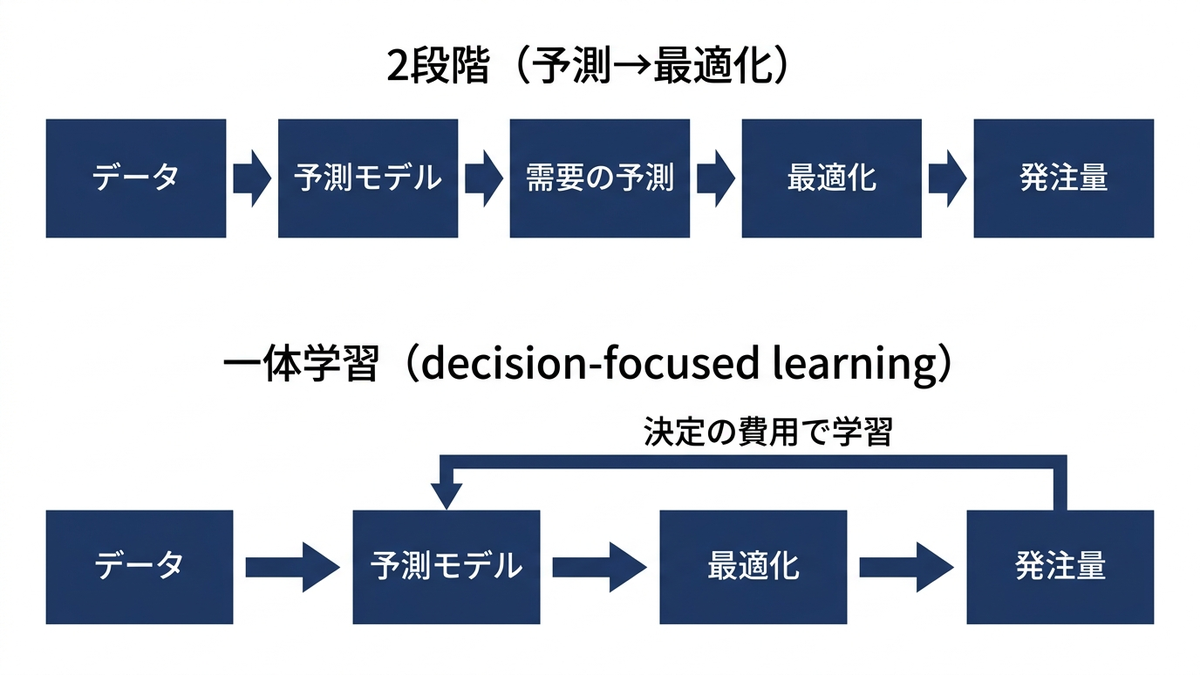
実務への含意を整理します。一体学習が効くのは、下流の最適化が予測の一部の誤りに敏感で、他の誤りには鈍感な構造を持つときです。単期の在庫問題では、臨界比の分位点さえ当たれば需要分布の他の部分は当たらなくてよく、分位点損失がまさにその構造を表しています。複数品目に予算や倉庫の容量制約がある場合(第3章のラグランジュ乗数、第11章の混合整数計画)には、どの品目の予測誤りが制約に触れるかで決定の質が決まるため、一体学習の恩恵が出やすい問題です。一方で、一体学習には前提があります。最適化問題(目的関数・制約・費用)が先に固定されていなければ、損失関数が定義できません。第13章で述べた「方式の統一とパラメータの根拠」が済んでいない段階で一体学習を持ち込んでも、学習の目標が定まらないということです。また、予測モデルが「決定に都合のよい方向」に歪むため、同じ予測を別の用途(財務の見込み、生産計画)に流用できなくなる点にも注意が要ります。
強化学習の位置づけ
多期間の在庫問題を、状態(在庫と発注残)を見て行動(発注量)を選ぶ逐次決定問題として、試行錯誤から方策を学習するのが強化学習です。第7章で見た動的計画が「モデルを知って解く」のに対し、強化学習は「モデルを知らずに経験から学ぶ」立場にあります。強化学習そのものはこの記事の範囲外なので、ここでは在庫問題における位置づけを確認するに留めます。
在庫管理への深層強化学習の適用を厳密に評価した研究として、Gijsbrechts らのものがあります(Gijsbrechts ほか 2022、深層強化学習は在庫管理を改善できるか、Manufacturing & Service Operations Management)。売り逃し(ロストセールス)、二重調達(通常便と緊急便の併用)、多段階在庫という、厳密解が実用的に求まらない3つの古典的な問題をマルコフ決定過程(今の状態だけを見て次の行動を決めてよい、と仮定した逐次的な意思決定の枠組み)として定式化し、A3C と呼ばれる深層強化学習のアルゴリズムを適用しました。結果は、既存の最良のヒューリスティックや近似動的計画と同等の性能に達したというもので、それらを大きく上回ったわけではありません。初期の調整には計算量と時間の面で大きな負担があったものの、他の問題への転用は調整パラメータの小さな変更で済んだこと、定常的な在庫問題を効果的に解けることが示された一方で、方策の構造に関する洞察を得ることや、ほぼ最適であることが証明できる専用の方策を設計することは依然として望ましい、と結論づけています。Boute らは、この分野の研究の道筋を整理した総説を出しています(Boute ほか 2022、在庫制御のための深層強化学習のロードマップ、European Journal of Operational Research)。
この記事の立場は、こうです。定常的な需要で \( (s,S) \) 方策やベースストック方策が最適に近いことが分かっている問題(第5章・第7章)では、強化学習を持ち込む理由はありません。強化学習が候補になるのは、問題に固有のヒューリスティックが無く、状態が多次元で、シミュレータ(第12章)が用意できるときです。そしてその場合でも、学習した方策は第12章のシミュレーションで既存の方策と同じ条件で比べてから使うべきで、「AI が学習したから正しい」とは言えません。強化学習の方策は、なぜその発注量になったかを説明しにくく、需要の構造が変わったときに再学習が要ります。第13章の運用の観点では、この2点が現時点では大きな負担です。
生成AIに任せられることと、人が決めること
最後に生成AIです。大規模言語モデルは、この記事で扱った数理モデルを置き換えるものではありません。発注量の計算そのものを言語モデルに任せると、もっともらしいが根拠のない数字が返ることがあり、第3章から第12章の計算はこれまでどおり数式とソルバーとシミュレーションで行うべきです。一方で、在庫の運用には、数式の前後に大量の言語作業があります。生成AIが効くのはそこです。
まず、データの整備です。第13章で述べた品目マスタの不備(同じ品目が別コードで登録されている、リードタイムが空欄、単位が混在している)は、在庫モデルの結果を最も確実に狂わせる原因ですが、これを見つけて候補を挙げる作業は言語モデルが得意です。仕入先からの納期回答のメールや PDF の見積書から数値を抜き出して構造化する作業も同様です。次に、説明文の生成です。第13章の経営報告で、KPI の表に「なぜ今月は欠品が増えたか」の説明を添える作業や、発注担当者に対して「なぜこの発注量が推奨されたか」を述べる作業は、モデルの中間出力(予測の分布、安全在庫、発注点、現在の在庫)を渡せば言語モデルが下書きできます。前節のバローの実証で、推奨理由や予測の背景を説明する「店舗運営 AI エージェント」が生成AIで構築され、現場の納得感を高めたと報告されているのは、この用途です。最後に、例外の要約です。第13章の例外管理では、毎日数十から数百のアラートが出ます。それを「対応が要るもの」と「様子見でよいもの」に分けて、担当者が読む順に並べ、理由を一行で添える作業は、生成AIに任せられます。
人が決めることは、それとは別にあります。第一に、目標サービス率と費用の重みです。臨界比を0.80にするか0.95にするかは、欠品の機会損失と廃棄の損失をどう評価するかという経営判断であり、データから自動的には出ません。第二に、例外の裁定です。アラートを要約するのは AI でよいのですが、「この品目は来月の販促のために在庫を積み増す」「この仕入先の納期遅れは契約の問題として扱う」という判断は人が下し、その判断を記録して次の学習に渡す必要があります。第三に、制約の変更です。前節の商慣習の見直しのように、納品期限や最小発注量といった制約は企業間の合意で決まっており、モデルの中で最適化する対象ではありません。ファミリーマートが新商品とイベントを店舗の判断に残し、中部フーズが「システムと人との役割分担を明確にする」とコメントしているのは、この線引きを運用に落とした形です。
| 作業 | 誰が担うか | 理由 | 関連する章 |
|---|---|---|---|
| 品目マスタ・リードタイム・単位の不備の検出と候補の提示 | 生成AI | 言語と表記ゆれの処理が得意で、量が多い | 第13章 |
| 発注量・安全在庫・発注点の計算 | 数理モデル(数式・ソルバー・シミュレーション) | 根拠のある数値が要る。言語モデルの計算は検証できない | 第3章〜第12章 |
| 推奨発注量の理由の説明文、経営報告の説明文の下書き | 生成AI(モデルの中間出力を入力にして) | 数値は模型から、文章は言語モデルからという分担が成り立つ | 第13章 |
| 例外アラートの要約と優先順位づけ | 生成AI(裁定は人) | 読む順を整えるのは AI、対応を決めるのは人 | 第13章 |
| 目標サービス率と費用の重みの決定 | 人(経営) | 欠品と過剰のどちらをどれだけ嫌うかは経営判断 | 第4章・第6章 |
| 例外の裁定と、その記録 | 人(担当者・管理者) | 学習データに無い事情を持ち込むのは人。記録が次の改善の入力になる | 第13章 |
| 納品期限・最小発注量・契約条件の変更 | 人(企業間の合意) | モデルの制約であって、最適化の対象ではない | 第3章・本章 |
AIを入れれば在庫が減る、という期待の翻訳
経営目線でこの章を締めくくります。「AI を入れれば在庫が減る」という期待は、半分は正しく、半分は決まっていないことを飛ばしています。正しい半分は、予測のばらつきが小さくなれば、同じサービス率で安全在庫が減り(第4章)、季節品の最終在庫が減り(第6章)、それは運転資金の解放と廃棄費用の削減として貸借対照表と損益計算書に現れる、ということです。前節までの事例で、廃棄が減ると同時に売上も増えたのは、予測が改善して両側の誤りが縮んだからでした。
決まっていないと減らない半分は、次の5つです。第一に、目標サービス率と費用の重みです。これが決まっていなければ、予測がいくら良くなっても「いくつ持つか」は定まりません。AI の導入プロジェクトの最初の会議で決めるべきはアルゴリズムではなく臨界比です。第二に、発注方式とそのパラメータの根拠です。予測だけ高度化して、発注方式が担当者ごとにばらばらのままでは、予測は使われません。第13章の導入の順序で、方式の統一はパラメータの根拠より前にあります。第三に、変えられない制約の確認です。リードタイム、最小発注量、納品期限、賞味期限は AI では変えられず、これらが在庫の下限を決めています。この下限が現在の在庫に近いなら、AI で減らせる余地はもともと小さく、減らすには前節の商慣習の見直しのように制約そのものに手を入れる必要があります。第四に、測り方です。導入前後の単純比較では季節と商況に紛れます。比較対照の店舗や品目群を置いて、同じ期間で測る設計を先に決めておかなければ、効果は「あったような気がする」で終わります。第五に、例外を誰が裁くかです。AI の推奨を現場が黙って上書きする運用になると、推奨は使われず、上書きの理由も残らず、改善が止まります。
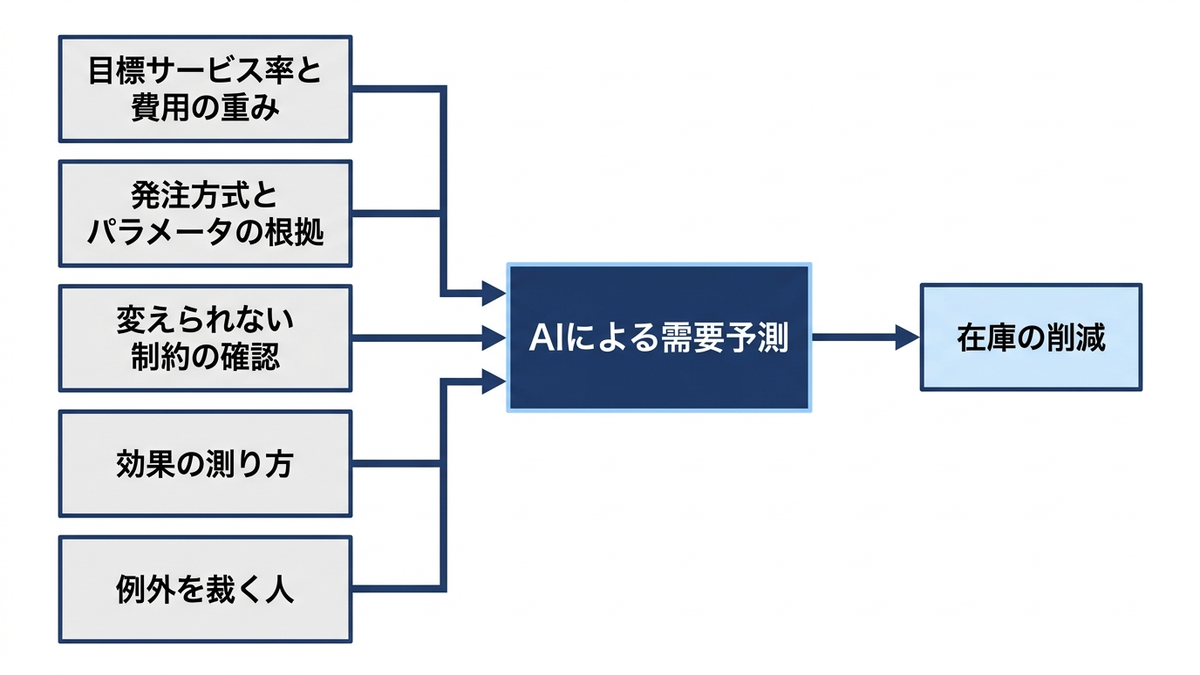
この5つは、いずれもこの記事の第1章から第13章で扱った内容です。裏返せば、機械学習と生成AIは、在庫の意思決定の新しい部品ではあっても、新しい問題を持ち込むわけではありません。何を決めるのか(いくつ買うか、いつ買うか、どれだけ余分に持つか、どこに置くか、どう評価するか)は変わらず、その各段階で予測の精度と言語作業の速さが上がるだけです。在庫は予測の問題ではなく決める問題である、という序章の主張は、AI の時代でも変わりません。終章では、この5つの問いを改めて並べ、どこから手を付けるかを整理します。
この章を深めたい方への参考書籍
『食品ロスの経済学 第4版』(小林富雄、農林統計出版):食品ロスが需給調整のどこで生まれるかを、在庫リスク・価格リスク・鮮度リスクの統合として理論化し、3分の1ルールのもとで過剰供給が生じてその費用が転嫁される仕組みをモデル化した本です。この章で扱った商慣習の見直しが、なぜ在庫の意思決定に効くのかを経済学の言葉で確かめられます。
『すごい需要予測 不確実な時代にモノを売り切る13の手法』(山口雄大、PHP研究所):需要予測をサプライチェーン管理の道具から、AI と人の感覚を組み合わせた活動へ広げて論じた新書です。この章で述べた「予測は AI、目標と例外は人」という分担を、マーケティングや営業を含む複数部門の視点から補えます。第8章で挙げた同じ著者の教科書より読みやすい入口です。
『AI時代のサプライチェーン・エコシステム 価値を生成し続けるジェネラティブSCM』(笹川亮平、日経BP):効率化を正しさの前提としてきた SCM の考え方を問い直し、AI が SCM に何をもたらすか、人と AI はどう協働するかを、国内外の事例とともに論じた2026年の本です。この章の後半で扱った生成AIと人の役割分担を、在庫より一段広いサプライチェーン全体の設計として考える材料になります。
終章 式で決めて、結果で直す
第14章まで、在庫と発注量を決める数理モデルを五つの問いに沿って見てきました。五つの問いとは、いくつずつ買うか(経済的発注量)、どれだけ余分に持つか(安全在庫とサービスレベル)、いつ買うか(発注方式)、一度しか買えないときはいくつか(ニューズベンダー問題)、どこに置くか(多段階在庫)です。この五つに、多期間の在庫方策と動的ロットサイジング、需要予測と発注の接続、不確実性を式に入れる確率計画とロバスト最適化、複数品目と容量制約を一度に扱う混合整数計画、決めた方策を評価するシミュレーション、そして運用と経営報告を、発展と評価の章として重ねました。手法は多いように見えますが、問いで整理すると数えられる程度に収まります。終章では、本コラムを通じて繰り返した2つのことを、あらためて整理して締めくくります。
費用の釣り合いで決めれば、根拠が残る
本コラムの手法はどれも、在庫を持つ費用と持たない費用の釣り合いを式にしたものです。経済的発注量は発注費用と保有費用の釣り合い、安全在庫は目標とするサービス水準、あるいは欠品費用と保有費用の重み、ニューズベンダー問題は過小費用と過大費用の釣り合いです。式で決めることの価値は、計算結果そのものよりも、なぜその量なのかという根拠が残ることにあります。担当者の経験則で決めた在庫は、担当者が変われば水準も変わり、前提が変わったときにどこを直せばよいかも分かりません。式で決めた在庫は、需要のばらつきが変わったのか、リードタイムが延びたのか、費用の重みを変えたのかを切り分けて直せます。
ただし、式は前提の上に成り立っています。正規分布を前提にした安全在庫の式は、間欠需要の品目にそのまま使うと精度が崩れやすくなります。経済的発注量は需要が一定であることを前提にしており、季節品にそのまま当てれば山の前に在庫が足りず、山の後に余ります。本コラムの各章で、手法ごとに「使ってはいけないのはどういうときか」を書いたのは、式の前提が自分の品目で崩れていないかを見極めることが、式を知ることと同じくらい大切だと考えているためです。
決めた方策は、測って直す
もう一つ繰り返したのは、式で決めた方策は、実際の需要に当てて結果を測り、前提が崩れていれば入力を直すということです。安全在庫の式は目標とするサービス率を入力にしますが、その式が実際にそのサービス率を達成しているかは、シミュレーションか実績で測らなければ分かりません。第12章では、同じ方策を乱数の需要に当てて、フィルレートや在庫日数がどの範囲に散るかを確かめる方法を扱いました。第13章では、その測定を月次の運用に組み込み、例外だけを担当者が見る仕組みにする手順を整理しました。
本コラムでは、架空のデータに需要の型を仕込み、各手法がその型に対してどう働くかを示しました。うまく働いた結果だけでなく、正規近似が間欠需要で崩れる様子や、式で決めた発注点をシミュレーションで測ると目標のサービス率に届かない様子、平均需要で解いた最適化と確率計画の差が費用の非対称の強さで桁ごと変わる様子も、そのまま載せました。手法の限界を知っていることが、実データで結果を読むときの手がかりになるためです。
経営判断に使うために
在庫の水準は、運転資金、粗利、納期、廃棄といった経営の数字に直結します。在庫削減の目標を回転率や在庫金額だけで置くと、現場は欠品を増やすか発注を先送りするかしかできません。目標とするサービス水準を先に決め、それを達成するのに必要な在庫を式で出し、実績との差を毎月見るという順序であれば、在庫の削減と欠品の抑制を、同じ指標の上で両立させる余地を探れます。分析を依頼する側にとっても、報告を受け取る側にとっても、この順序で根拠が示されているかどうかが、その在庫方針を信頼してよいかの目安になると考えています。
本コラムの記述は2026年9月時点で確認したものです。ライブラリの仕様は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。手法の考え方そのものは、ライブラリの版が変わっても変わりません。本コラムが、手元の品目に対して何を問い、どの式で決め、結果をどう測って直すかを決める際の一助になれば幸いです。
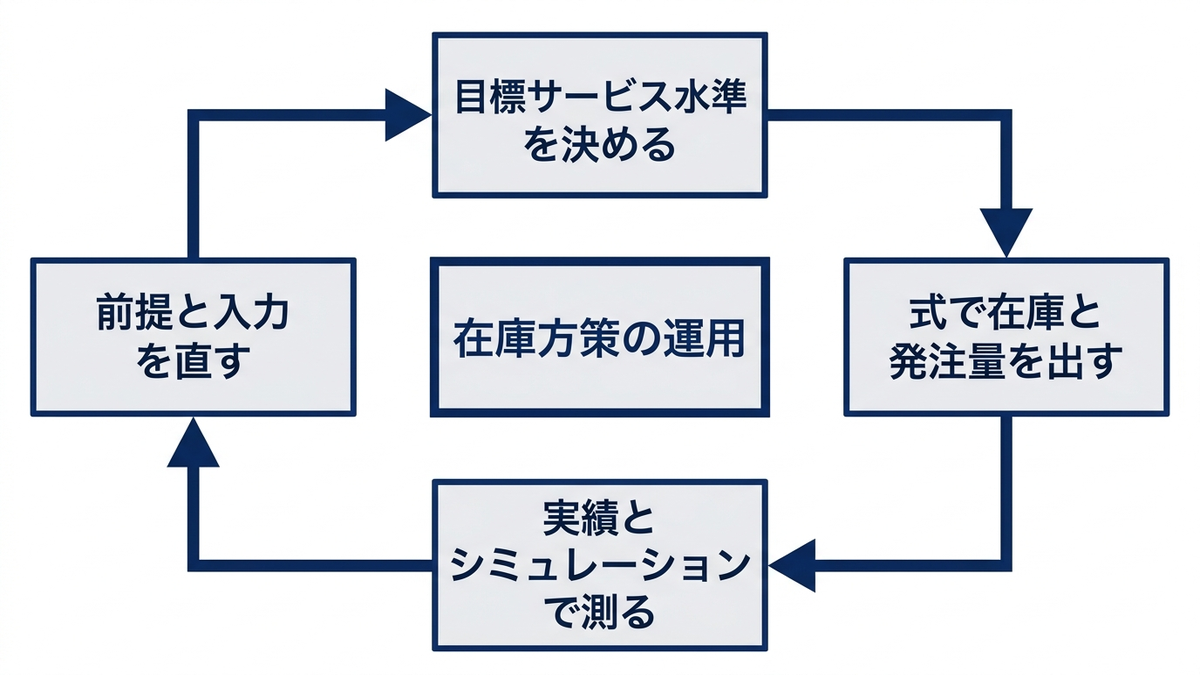
Anagraftでは、データ活用の構想づくりから分析の設計と実装、結果の読み解きと意思決定への接続、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 在庫はなぜ経営の問題なのか、費用の構造と経営指標
『手にとるようにわかる在庫管理入門:ムダのない在庫管理で利益を生み出す』(芝田稔子、かんき出版):副題に「ムダのない在庫管理で利益を生み出す」とあるとおり、在庫管理を利益と結びつけて説く2023年刊の入門書です。本章で述べた在庫の役割や費用の考え方を、実務の入門書の言葉でもう一度たどりたい方に向いていると考えています。第13章の運用の話に入る前の準備としても使えます。
『新版 財務3表一体理解法』(國貞克則、朝日新聞出版):書名のとおり、損益計算書、貸借対照表、キャッシュ・フロー計算書の3表を一体のものとして理解する方法を説く朝日新書の1冊で、2021年の新版です。本章で扱った「在庫を仕入れてもただちに費用にはならず、棚卸資産として計上され、支払いの時点で現金か買掛金に影響する」という仕組みを、会計の側から確かめたい方に向いています。在庫の判断を経営指標に翻訳して報告する立場の方に、本章と併せて読むことを勧めます。
『サプライ・チェインの設計と管理:コンセプト・戦略・事例(普及版)』(D. スミチ-レビ、P. カミンスキー、E. スミチ-レビ、久保幹雄監修、朝倉書店):サプライ・チェイン・マネジメントの教科書の日本語版で、副題のとおりコンセプト、戦略、事例を扱う構成です。本章で触れた在庫の役割を、企業の内側の問題ではなく調達から販売までの連鎖の中で位置づけ直して読むのに向いていると考えています。2017年の普及版で入手しやすくなっています。
第2章 需要とリードタイムの不確実性を記述する
『統計分布ハンドブック 増補第3版』(蓑谷千凰彦、朝倉書店):正規分布・ポアソン分布・負の二項分布を含む54の確率分布について、性質・グラフ・乱数の生成法をまとめた事典です。この章で「どの分布を需要に当てるか」を迷ったとき、候補の分布の平均・分散・形の関係を確かめるのに使えます。
『データ解析のための統計モデリング入門:一般化線形モデル・階層ベイズモデル・MCMC』(久保拓弥、岩波書店):章ごとに異なる例題を解きながら、確率分布と最尤推定から一般化線形モデル、モデル選択、階層ベイズへと進む入門書です。この章で行った「データに分布を最尤法で当てはめ、AIC で比べる」という作業の背後にある考え方を、丁寧に追うことができます。
『カウントデータの統計解析』(岩崎学、朝倉書店):個数のデータを扱う統計の教科書で、確率統計の基礎から二項分布、ベータ二項分布、ポアソン分布、負の二項分布へと進みます。日次の需要は「その日に売れた個数」というカウントデータそのものなので、この章でポアソン分布より負の二項分布のほうが当てはまった理由を、分布の性質の側から確かめたい方に向いています。
第3章 経済的発注量、いくつずつ買うか
『ロジスティクス工学』(久保幹雄、朝倉書店):日本オペレーションズ・リサーチ学会の40周年記念シリーズ「経営科学のニューフロンティア」の第8巻で、2001年刊。第2章が「経済発注量モデル」で、Harris の基本モデルから多段階への拡張までを扱い、以降の章で確率的在庫モデル・安全在庫の配置・動的ロットサイズ決定へ進む構成です。本章の EOQ を、後の章で扱う多段階在庫や動的ロットサイジングと同じ土台で見直したい方に向いています。
『Excelによる生産管理:需要予測、在庫管理からJITまで』(大野勝久、朝倉書店):2011年刊。実務家と文科系の学生に向けて、生産と在庫の管理の問題を Excel で解く手順を示した本で、目次の「確実環境下の在庫管理」が、需要を確定として扱う本章の範囲に近い部分です。Python ではなく Excel で同じ計算を手元の品目に当ててみたい方の最初の1冊として挙げます。
『Inventory Control』(Sven Axsäter、Springer):2015年刊の洋書で、Springer のオペレーションズ・リサーチと経営科学の国際叢書の1冊です。第4章「Single-Echelon Systems: Deterministic Lot Sizing」(45〜63ページ)が本章の範囲にあたり、確定需要のもとでのロットサイズの決め方を扱います。本章で言葉に言い換えた導出を、数式の側から確かめたい方向けです。
第4章 安全在庫、どれだけ余分に持つか
『適正在庫の考え方・求め方』(勝呂隆男、日刊工業新聞社):「在庫はゼロにできない」という立場から、定量発注と定期発注における安全在庫の求め方を、需要とリードタイムの変動、安全係数と正規分布、間欠需要や正規分布に従わない場合の扱いまで含めて解説した実務書です。本章で扱った合成式と正規近似の限界を、現場のデータで計算する手順として学び直したい方に向いています。
『適正在庫のテクニック』(勝呂隆男、日刊工業新聞社):同じ著者による続編で、第3章「安全在庫の求め方」と第7章「リードタイムのかぞえかた」を含む10章構成です。安全在庫の計算に入れるリードタイムをどこからどこまで数えるかは、本章の合成式の入力そのものであり、その実務的な扱いを補ってくれる1冊です。
『サプライチェーンサイエンス』(Wallace J. Hopp 著、松川弘明・佐藤知一 監訳、近代科学社):工場物理学の考え方でサプライチェーンの振る舞いの原理を説明する教科書で、第7章「在庫」がサイクル在庫、安全在庫、定期発注方式、随時発注方式、複数品目管理を扱います。本章の安全在庫の式を、ばらつきと緩衝の一般原理の中に位置づけて理解したい方に向いています。
第5章 発注方式の体系、いつ買うか
『インベントリー・マネジメント:新しい在庫の考え方と発注方式の設計』(星野珙二、日経BP企画):書名のとおり、在庫の考え方と発注方式の設計を主題にした本です。本章で並べた定量発注方式や定期発注方式を、品目の条件に合わせてどう組み立てるかを設計の問題として考える際に、本章の比較表と ABC の対応表を実務に落とす手がかりになります。
『売上を伸ばす適正在庫の定め方・活かし方』(勝呂隆男、日刊工業新聞社):適正在庫の水準を定める考え方と、それを売上につなげる運用を扱った実務書です。本章で扱った発注点や基準在庫は「適正在庫」を式で表したものにあたり、実務の制約の中でそれをどう決めて活かすかを、経営に近い言葉で読み直すことができます。
第6章 ニューズベンダー問題、一度しか買えないときの最適量
『サプライ・チェイン最適化ハンドブック』(久保幹雄、朝倉書店):線形計画・整数計画からネットワーク・在庫・スケジューリングまでを扱う数理最適化の手引きで、第10章に「新聞売り子モデル」の節があり、この章の単期の問題を経済発注量モデルや確率的在庫モデルと並べて位置づけられます。数式を Python で動かしながら読みたい方に向いています。
『Foundations of Stochastic Inventory Theory』(Evan L. Porteus、Stanford University Press):確率的在庫理論の博士課程向け教科書で、経済発注量モデルとニューズベンダーモデルの2つの基本モデルから始めて、不確実性のもとでの動的最適化へ進みます。この章の臨界比が、多期間の理論の中でどう一般化されるかを厳密に追いたい方への原典です。
第7章 多期間の在庫問題、(s,S)方策と動的ロットサイジング
『マルコフ決定過程:理論とアルゴリズム』(中出康一、コロナ社):本章の動的計画は、状態と行動と費用で意思決定を記述するマルコフ決定過程の一例です。価値反復や方策反復といった解法、無限期間や平均費用の扱いまで、日本語で体系的に学べます。著者は在庫理論の研究者で、在庫問題を念頭に読み進めやすい構成です。
『Pythonによる実務で役立つ最適化問題100+(2)割当・施設配置・在庫最適化・巡回セールスマン』(久保幹雄、朝倉書店):第19章が在庫最適化問題、第20章が動的ロットサイズ決定問題で、本章の Wagner-Whitin 法から第11章で扱う多品目・多段階の定式化までを、Python のコードとともに追えます。手元で動かしながら理解したい方に向いています。
第8章 需要予測と発注をつなぐ、予測誤差を在庫に翻訳する
『この1冊ですべてわかる 新版 需要予測の基本』(山口雄大、日本実業出版社):書名と、副題の「S&OPで経営に貢献する」のとおり、需要予測を業務として組み立て、販売と生産の計画に結びつける入門書です。本章で扱った「予測誤差を測って在庫に反映する」手順を、組織の中で回す側の視点から補う位置づけの本です。
『需要予測の戦略的活用』(山口雄大、日本評論社):副題は「マーケティングとサプライチェーンマネジメントをつなぐ」で、オペレーションズ・マネジメント選書の1冊です。需要予測を経営の判断にどうつなぐかという視点は、本章の最後で扱った「予測精度への投資をどう評価するか」を考える材料になります。
『Intermittent Demand Forecasting』(Boylan、Syntetos、Wiley):副題は「文脈・手法・応用」で、版元は、間欠需要品の予測を改善し在庫管理を高めたい人のための、間欠需要の予測に絞った最初の本だと説明しています。SBA の提案者自身による本で、本章の間欠需要の節を原典に当たって深めたい方に向いています。洋書です。
第9章 確率計画とロバスト最適化、不確実性を式に入れる
『確率計画法』(椎名孝之、朝倉書店):応用最適化シリーズの1冊で、リコースをもつ2段階問題、多段階の確率線形計画とシナリオ、モンテカルロ法を使う確率計画、リスクを考慮した確率計画までを日本語で体系的に扱っています。この章で PuLP に書いた定式化の理論的な背景と、大規模な問題を解くための L 字型法などの解法を学べます。
『Introduction to Stochastic Programming』(John R. Birge、François Louveaux、Springer):確率計画の標準的な教科書の第2版です。この章で使った完全情報の期待価値(EVPI)と確率計画の価値(VSS)は、同書の第4章で定義され、例題とともに解説されています。2段階問題の定式化から解法、サンプリングによる近似まで一通り載っています。
『Robust Optimization』(Aharon Ben-Tal、Laurent El Ghaoui、Arkadi Nemirovski、Princeton University Press):ロバスト最適化の理論をまとめた原典的な教科書です。不確実性集合の設計、線形計画と円錐計画のロバスト版、リコースをもつ調整可能ロバスト最適化まで扱っています。この章で列挙で解いた問題を、双対を使って制約に書き直す方法の根拠を確かめられます。
第10章 多段階在庫、どこに在庫を置くか
『サプライチェーン・マネジメント概論:基礎から学ぶSCMと経営戦略』(苦瀬博仁 編著、白桃書房):大学の教科書として書かれた SCM の概論で、サプライチェーンにおける生産時期と在庫ポイント、物流ネットワーク、在庫と輸配送の計画と管理、情報システムまでを15章で扱います。本章の「どこに在庫を置くか」を、物流ネットワーク全体の設計の中に位置づけて読み直せます。
『グローバル・サプライチェーンにおける新しい製販協働のかたち:見えない需要を見える需要に』(永島正康、丸善プラネット):需要予測における製造と販売の協働を主題にした研究書で、協働の基礎概念、グローバル・サプライチェーンでの協働の枠組み、協働活動と成果の関係を扱います。本章の VMI と CPFR の節で述べた「誰がどの情報を見て計画するか」を、実証の側から掘り下げたい方に向いています。
『Foundations of Inventory Management』(Paul H. Zipkin、McGraw-Hill):在庫理論の英語の教科書で、本章が依拠した van Houtum のチュートリアルがエシェロン在庫の概念の参照先として挙げている本です。エシェロン在庫の概念と、その上に組み立てられる多段階の議論を理論のレベルで確かめたいときの原典として、洋書ですが挙げておきます。
第11章 数理最適化としての発注計画、複数品目と容量制約を混合整数計画で解く
『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社):第7章がロットサイズ決定問題にあてられ、容量制約付き複数品目ロットサイズ決定問題と多段階ロットサイズ決定問題の定式化を Python のコードとともに示しています。この章で扱った強い定式化の考え方を、さらに一般の形で学べます。ソルバーは Gurobi ですが、モデルの書き方は PuLP でもそのまま移せます。
『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社):整数計画問題の定式化(固定費用のある目的関数、論理条件、選言的制約)と、分枝限定法・切除平面法の仕組みが体系的に説明されています。この章で「なぜ書き方で解時間が変わるのか」を直観で済ませた部分を、緩和問題と限定操作の理屈から理解できます。
『Production Planning by Mixed Integer Programming』(Yves Pochet・Laurence A. Wolsey、Springer):ロットサイジングを混合整数計画で解くための定式化と再定式化を、単一品目・容量制約なしの基本形から複数品目・多段階まで積み上げて解説した原典です。この章で使った施設配置型の書き直しや、容量制約付き問題の扱いは、この本の体系に沿っています。洋書ですが、定式化の一覧表だけでも参照する価値があると考えています。
第12章 シミュレーションで方策を評価する
『Pythonコンピュータシミュレーション入門 人文・自然・社会科学の数理モデル』(橋本洋志・牧野浩二、オーム社):第6章「経営モデル」に在庫管理(経済的発注量・発注点法・定期発注法)と待ち行列の節があり、SimPy による離散事象シミュレーションの節も置かれています。この章で組んだ在庫システムの模型を、自分のデータで組み直すときの手元の参考書として使えます。
『Excelで学ぶオペレーションズリサーチ』(大野勝久・逆瀬川浩孝・中出康一、近代科学社):第10章がシミュレーション、第11章が在庫管理で、Python を使わずに表計算で同じ考え方を追える構成です。発注方式のパラメータを表計算で決め、シミュレーションで確かめる、という往復をまず小さく試したい方に向いています。
『Discrete-Event System Simulation 第5版』(Jerry Banks・John S. Carson・Barry L. Nelson・David M. Nicol、Pearson):離散イベントシミュレーションの標準的な教科書で、第10章が検証と妥当性確認、第11章が単一モデルの出力分析、第12章が代替案の比較と評価にあてられています。この章で「30回回して信頼区間を出す」「格子の3点の差は乱数のぶれと区別できない」と書いた部分の理屈を、英語の原典で厳密に追いたいときの拠り所になります。
第13章 在庫方策を運用する、パラメータの更新から経営報告まで
『新版 在庫マネジメントの基本』(石川和幸、日本実業出版社):会計上の在庫、流通業と製造業の「もの」としての在庫、伝統的な在庫管理手法の考え方から始まり、サプライチェーンの設計、需要予測と販売計画、需給調整、物流対応による在庫適正化を経て、第11章が「見える化」と管理指標、第12章が在庫適正化のためのシステムにあてられています。この章で扱った KPI の設計と経営報告、システムの役割分担を、日本の実務の言葉で整理したい方に向いています。2026年5月発売の新版です。
『図解入門ビジネス 最新 在庫管理の基本と仕組みがよ~くわかる本 第3版』(湯浅和夫・内田明美子・芝田稔子、秀和システム):第1章で在庫実態の「見える化」、発注支援の設定が在庫管理システムの生命線であること、ロット生産で不動在庫が大量に発生する例などを取り上げ、第4章で補充量決定の仕組みと管理体制、第5章でコンサルティングの現場から見た在庫管理システム導入の実際(在庫の仕分け、発注支援システムの構築)を扱っています。この章の導入の順序と失敗の型を、図解で具体的に確かめるのに向いています。
『エンジニアが学ぶ在庫管理システムの「知識」と「技術」』(株式会社GeNEE DX/ITソリューション事業部、翔泳社):在庫管理システムを構築する側の視点で書かれた本で、第4章が発注管理機能(発注方式の特徴、経済的発注量、ABC 分析に基づく発注ルールの策定)、第5章から第9章が生産管理・販売管理・購買管理・会計管理・原価管理という関連システムとのつながり、第10章が物流管理・輸配送管理・倉庫管理の各システムにあてられています。この章のシステム連携の節で述べた「在庫ポジションの定義を揃える」「計算を行う場所を1か所に決める」を、実際のシステムの機能に落とすときの参考になります。
第14章 事例と最新動向、機械学習と生成AIの時代の在庫管理
『食品ロスの経済学 第4版』(小林富雄、農林統計出版):食品ロスが需給調整のどこで生まれるかを、在庫リスク・価格リスク・鮮度リスクの統合として理論化し、3分の1ルールのもとで過剰供給が生じてその費用が転嫁される仕組みをモデル化した本です。この章で扱った商慣習の見直しが、なぜ在庫の意思決定に効くのかを経済学の言葉で確かめられます。
『すごい需要予測 不確実な時代にモノを売り切る13の手法』(山口雄大、PHP研究所):需要予測をサプライチェーン管理の道具から、AI と人の感覚を組み合わせた活動へ広げて論じた新書です。この章で述べた「予測は AI、目標と例外は人」という分担を、マーケティングや営業を含む複数部門の視点から補えます。第8章で挙げた同じ著者の教科書より読みやすい入口です。
『AI時代のサプライチェーン・エコシステム 価値を生成し続けるジェネラティブSCM』(笹川亮平、日経BP):効率化を正しさの前提としてきた SCM の考え方を問い直し、AI が SCM に何をもたらすか、人と AI はどう協働するかを、国内外の事例とともに論じた2026年の本です。この章の後半で扱った生成AIと人の役割分担を、在庫より一段広いサプライチェーン全体の設計として考える材料になります。
参考情報
本コラムの記述は、次の資料を2026年9月に確認して書いています。ライブラリの関数名や引数は版によって変わりますので、実際に動かす際は各ライブラリの公式ドキュメントで現行の仕様をご確認ください。
第1章
- 在庫管理の講義ノートでは在庫をパイプライン在庫、サイクル在庫、安全在庫、季節在庫、熟成在庫、投機在庫などに分類している
https://www2.isye.gatech.edu/~mgoetsch/cali/logistics_systems_design/inventory_systems/inventory_systems.pdf - 法人税基本通達は棚卸資産の評価損を計上できる「著しい陳腐化」を、季節商品の売れ残りで今後通常の価額では販売できないことが明らかな場合と、型式・性能・品質が著しく異なる新製品の発売で通常の方法で販売できなくなった場合と例示している
https://www.nta.go.jp/law/tsutatsu/kihon/hojin/09/09_01_02.htm - 財務省の法人企業統計は棚卸資産回転期間を、棚卸資産の期首・期末平均を売上高を12で割ったもので割ると定義し、単位は月
https://www.mof.go.jp/pri/reference/ssc/results/calculation.htm - 年次別法人企業統計調査(令和7年度)は2026年9月1日公表
https://www.mof.go.jp/pri/reference/ssc/results/r7.pdf - 経済産業省のローカルベンチマークは企業の経営状態を把握する「健康診断」のツール
https://www.meti.go.jp/policy/economy/keiei_innovation/sangyokinyu/locaben/index.html - ロカベンの6つの財務指標は売上増加率、営業利益率、労働生産性、EBITDA有利子負債倍率、営業運転資本回転期間、自己資本比率で、営業運転資本回転期間は効率性の指標
https://www.meti.go.jp/policy/economy/keiei_innovation/sangyokinyu/locaben/pdf/locabenchirashi.pdf - 営業運転資本回転期間は売上債権と棚卸資産の合計から買入債務を引いた額を売上高を12で割ったもので割り、月数で表す
https://www.meti.go.jp/policy/economy/keiei_innovation/sangyokinyu/locaben/tool2022r5.xlsm - 業種別・規模別の基準値は帝国データバンクが保有する2019年4月から2022年2月の間に3期連続の決算書が収録されている約37,000社を対象にした3期平均の中央値
https://www.meti.go.jp/policy/economy/keiei_innovation/sangyokinyu/locaben/pdf/hyotei2022r.pdf - ロカベンの業種分類は日本標準産業分類の改定に伴い2024年4月1日に見直されている
https://www.meti.go.jp/policy/economy/keiei_innovation/sangyokinyu/locaben/sheet.html - 間接法の営業活動によるキャッシュ・フローの区分に、たな卸資産、売上債権、仕入債務の増減額が税金等調整前当期純利益に加減する項目として並ぶ
https://www.fsa.go.jp/p_mof/singikai/kaikei/tosin/1a909b2.htm - 『手にとるようにわかる在庫管理入門:ムダのない在庫管理で利益を生み出す』(芝田稔子、かんき出版、2023年1月)
https://ndlsearch.ndl.go.jp/books/R100000002-I032578282 - 『新版 財務3表一体理解法』(國貞克則、朝日新聞出版、朝日新書、2021年2月)
https://ndlsearch.ndl.go.jp/books/R100000002-I031258431 - 『サプライ・チェインの設計と管理:コンセプト・戦略・事例(普及版)』(D. スミチ-レビ、P. カミンスキー、E. スミチ-レビ、久保幹雄監修、朝倉書店、2017年4月)
https://ndlsearch.ndl.go.jp/books/R100000002-I028127510
第2章
- 負の二項分布の分散は μ+μ²/r
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.nbinom.html - Syntetos、Boylan、Croston の2005年の論文 On the categorization of demand patterns は Journal of the Operational Research Society 56巻5号495〜503ページ
https://doi.org/10.1057/palgrave.jors.2601841 - Syntetos、Boylan、Croston の2005年の論文 On the categorization of demand patterns は Journal of the Operational Research Society 56巻5号495〜503ページ
https://eprints.lancs.ac.uk/id/eprint/73095/ - ADI の境界1.32、CV² の境界0.49、4区分の名称(smooth・erratic・intermittent・lumpy)、境界は Croston 法と SBA の平均二乗誤差の比較から導かれた、厳密な境界は p=4/3 と v=0.5、直線で近似する別の規則
https://robjhyndman.com/papers/idcat.pdf - ADI の境界1.32、CV² の境界0.49、4区分の名称(smooth・erratic・intermittent・lumpy)、境界は Croston 法と SBA の平均二乗誤差の比較から導かれた、厳密な境界は p=4/3 と v=0.5、直線で近似する別の規則
https://doi.org/10.1057/palgrave.jors.2602211 - 4区分の割り当て(ADI 小・CV² 小=smooth、ADI 小・CV² 大=erratic、ADI 大・CV² 小=intermittent、両方大=lumpy)、ADI=総期間数÷需要のあった期間数、CV は需要のあった期間だけで計算
https://arxiv.org/abs/2103.13812 - ABC の境界は累積金額シェア80%・95%
https://acta.uni-obuda.hu/Stojanovic_Regodic_76.pdf - 『統計分布ハンドブック 増補第3版』蓑谷千凰彦、朝倉書店、2024
https://www.asakura.co.jp/detail.php?book_code=12299 - 『データ解析のための統計モデリング入門:一般化線形モデル・階層ベイズモデル・MCMC』久保拓弥、岩波書店、2012
https://www.iwanami.co.jp/book/b257893.html - 『カウントデータの統計解析』岩崎学、朝倉書店、2010(統計ライブラリー)
https://www.asakura.co.jp/detail.php?book_code=12794 - Boylan と Syntetos の書籍 Intermittent Demand Forecasting(Wiley、2021、ISBN 978-1-119-97608-0)を Wiley の書籍ページで確認したが
https://www.wiley.com/en-us/Intermittent+Demand+Forecasting%3A+Context%2C+Methods+and+Applications-p-9781119976080 - 『在庫管理のための需要予測入門』キヤノンシステムソリューションズ数理技術編(淺田克暢・岩崎哲也・青山行宏)、東洋経済新報社、2004年12月刊(ISBN 978-4-492-53187-7)を NDL サーチと版元ページ(目次7章)で確認した
https://str.toyokeizai.net/books/9784492531877/
第3章
- 総関連費用は発注費と保管費の和、最適発注量は 2KD を h で割った値の平方根、最適点で発注費と保管費が等しい、最小費用は 2KDh の平方根
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/120bf3cdc3e9b1947ae2a8d0a264d901_lect7.pdf - 式は Ford W. Harris が1913年に発表
https://doi.org/10.1287/opre.38.6.937 - 原論文の再録が同じ号にある
https://doi.org/10.1287/opre.38.6.947 - 全量割引の解き方(各単価で EOQ、価格帯の中ならそれ、下限未満なら下限で評価、総費用を比べる)
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/4851a27cb396c065d7b7c0fafa50d039_lect8.pdf - 用語「交換曲線」
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/pages/lecture-notes/ - 『ロジスティクス工学』(久保幹雄、朝倉書店、2001年6月)
https://www.asakura.co.jp/detail.php?book_code=27518 - 『Excelによる生産管理:需要予測、在庫管理からJITまで』(大野勝久、朝倉書店、2011年)
https://www.asakura.co.jp/detail.php?book_code=27554 - 『Inventory Control』(Sven Axsäter、Springer、2015年)
https://doi.org/10.1007/978-3-319-15729-0 - 同書の第4章の書誌
https://doi.org/10.1007/978-3-319-15729-0_4 - 『入門オペレーションズ・リサーチ』(松井泰子・根本俊男・宇野毅明、東海大学出版会、2008年)を候補にしたが、在庫・EOQ の章があるかを目次で確認できなかった
https://ndlsearch.ndl.go.jp/books/R100000002-I000009328246 - 勝呂隆男『適正在庫の考え方・求め方』(日刊工業新聞社、2003年)など4冊を候補にしたが、安全在庫を扱う第4章と重なりそうなので本章では載せていない
https://ndlsearch.ndl.go.jp/api/opensearch?creator=%E5%8B%9D%E5%91%82%E9%9A%86%E7%94%B7&cnt=30
第4章
- サイクルサービス率は補充サイクルあたりに欠品が起きない確率で P1、フィルレートは手持ち在庫から充足した需要の割合で P2
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/8b53c45fd26ffff706d815131e8d177e_lect11.pdf - 需要とリードタイムの両方がばらつくときの合成式(平均 μ_D L、標準偏差は L σ_D² + μ_D² σ_LT² の平方根)は教科書で標準的に使われ、出典として Silver と Peterson の 1985年の教科書が挙げられている
https://doi.org/10.1111/j.1540-5414.2004.02332.x - 需要とリードタイムの両方がばらつくときの合成式(平均 μ_D L、標準偏差は L σ_D² + μ_D² σ_LT² の平方根)は教科書で標準的に使われ、出典として Silver と Peterson の 1985年の教科書が挙げられている
https://www.kellogg.northwestern.edu/faculty/chopra/htm/research/effect%20of%20lead%20time%20uncertainty.pdf - Eppen と Martin は 1988年の論文で、正規性の仮定は一般には正当化できず欠品確率の見積もりに大きな誤りを生みうると指摘した
https://doi.org/10.1287/mnsc.34.11.1380 - Syntetos らは 7,000系列を超える間欠需要の実証研究で、需要発生がポアソン過程かベルヌーイ過程に従うとリードタイム中の合計需要は複合ポアソンか複合ベルヌーイになると述べ、負の二項分布(発生回数がポアソン、量が対数分布の複合分布)で需要をモデル化して在庫水準を決めている
https://doi.org/10.1016/j.jbusres.2015.03.034 - Syntetos らは 7,000系列を超える間欠需要の実証研究で、需要発生がポアソン過程かベルヌーイ過程に従うとリードタイム中の合計需要は複合ポアソンか複合ベルヌーイになると述べ、負の二項分布(発生回数がポアソン、量が対数分布の複合分布)で需要をモデル化して在庫水準を決めている
https://bauer.uh.edu/gardner/docs/pdf/forecasting%20intermittent%20demand%20r2%20(jbr - scipy.stats.norm の ppf は percent point function で累積分布関数の逆関数
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.norm.html - 『適正在庫の考え方・求め方』(勝呂隆男、日刊工業新聞社)
https://pub.nikkan.co.jp/book/b10019353.html - 『適正在庫のテクニック』(勝呂隆男、日刊工業新聞社)
https://pub.nikkan.co.jp/book/b10019686.html - 『サプライチェーンサイエンス』(Wallace J. Hopp 著、松川弘明・佐藤知一 監訳、近代科学社)
https://www.kindaikagaku.co.jp/book_list/detail/9784764906587/ - MIT OCW ESD.260 第12講(周期発注への変換、バックオーダーと機会損失の違い)
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/bc18dd1b2543535a61f826d00a8c6e42_lect12.pdf
第5章
- 在庫管理の方式は定量発注方式と定期発注方式に大別される
https://kikakurui.com/z8/Z8141-2001-01.html - 連続監視と定期監視の利点
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/8b53c45fd26ffff706d815131e8d177e_lect11.pdf - 定量発注方式の決め方を定期発注方式に流用する変換
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/bc18dd1b2543535a61f826d00a8c6e42_lect12.pdf - 講義資料の一覧ページ
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/pages/lecture-notes/ - ベースストック方策は1対1の補充で、4個売れたら4個発注する
https://courses.edx.org/asset-v1:MITx+CTL.SC1x_1+2T2015+type@asset+block/KeyConcept_Week7Lesson1.pdf - 両方式に同じ品切率を与えたとき、予測誤差の水準が小さい場合は定期発注方式のほうが、大きい場合は定量発注方式のほうが安全在庫を低く抑えられ、切り替え点は納入リードタイムと需要の変動係数の関係で表せる
https://www.jstage.jst.go.jp/article/jimapre/26/3/26_KJ00001728352/_article/-char/ja - 『インベントリー・マネジメント:新しい在庫の考え方と発注方式の設計』(星野珙二、日経BP企画)
https://ndlsearch.ndl.go.jp/books/R100000002-I000008322181 - 『売上を伸ばす適正在庫の定め方・活かし方』(勝呂隆男、日刊工業新聞社)
https://ndlsearch.ndl.go.jp/books/R100000002-I025904515
第6章
- scipy の norm.ppf は累積分布関数の逆関数で、文書に「Percent point function」と書かれている
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.norm.html - ポアソン分布の確率質量関数の式と、形状パラメータが平均 μ であること
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.poisson.html - numpy.quantile の既定の method は “linear”
https://numpy.org/doc/stable/reference/generated/numpy.quantile.html - 1951年に Arrow、Harris、Marschak が Econometrica に発表した「Optimal Inventory Policy」
https://doi.org/10.2307/1906813 - Levi、Roundy、Shmoys は2007年の論文で、標本だけから計算した方策の期待費用が最適方策の期待費用に任意の相対誤差で近づくために要する標本数の上界を、分布に依存しない形で示した
https://doi.org/10.1287/moor.1070.0272 - Ban と Rudin は2019年の論文で、特徴量から発注量を直接決める機械学習の方法を提案し、病院の看護師配置の例で既存の実務の基準より費用を24%下げたと報告
https://doi.org/10.1287/opre.2018.1757 - 名前の由来は新聞売り(朝仕入れて夕方には価値がなくなる)
https://www.asakura.co.jp/detail.php?book_code=27015 - 『Foundations of Stochastic Inventory Theory』(Evan L. Porteus、Stanford University Press)
https://books.google.co.jp/books/about/Foundations_of_Stochastic_Inventory_Theo.html?id=ogsrj7PnyHIC&redir_esc=y
第7章
- Wagner と Whitin(1958)による動的ロットサイジングの厳密解
https://doi.org/10.1287/mnsc.5.1.89 - 最適な計画では在庫がゼロの期にだけ発注し、その量は何期分かの需要の合計に一致する(ゼロ在庫発注の性質)
https://en.wikipedia.org/wiki/Dynamic_lot-size_model - Wagelmans らが1992年に、より少ない計算量のアルゴリズムを示した
https://doi.org/10.1287/opre.40.1.S145 - Scarf(1960)が、需要が連続分布に従い費用が凸である等の条件のもとで、有限期間の最適方策が sS の形になることを証明した
https://arxiv.org/abs/1606.00957 - Scarf の論文の書誌
https://doi.org/10.1057/9781137024381_1 - K 凸性の定義(副次確認)
https://en.wikipedia.org/wiki/K-convex_function - 無限期間については、連続需要で Iglehart(1963)が最適性を示した
https://doi.org/10.1287/mnsc.9.2.259 - 離散需要の無限期間については Veinott と Wagner(1965)が最適性を示した
https://doi.org/10.1287/mnsc.11.5.525 - Veinott(1966)の sS 最適性の新しい条件と証明(本文では直接引かず、背景として確認)
https://doi.org/10.1137/0114086 - 近視眼的方策の最適性が成り立つ条件は Veinott(1965)をはじめとする研究で整理されている
https://doi.org/10.1287/mnsc.12.3.206 - Zheng と Federgruen(1991)は、最適な s と S をひとつの方策を評価するのと同程度の計算量で求めるアルゴリズムを示した
https://doi.org/10.1287/opre.39.4.654 - Bellman が1950年代に動的計画法を体系化した
https://press.princeton.edu/books/paperback/9780691146683/dynamic-programming - Silver-Meal 法(Silver と Meal、1973)
https://en.wikipedia.org/wiki/Silver%E2%80%93Meal_heuristic - JIS Z 8141(生産管理用語)の MRP の定義「生産計画情報、部品構成表情報及び在庫情報に基づいて、資材の必要量と時期を求める生産管理体系」
https://kikakurui.com/z8/Z8141-2001-01.html - 『マルコフ決定過程:理論とアルゴリズム』(中出康一、コロナ社、2019年)
https://www.coronasha.co.jp/np/isbn/9784339028348/ - 『Pythonによる実務で役立つ最適化問題100+(2)割当・施設配置・在庫最適化・巡回セールスマン』(久保幹雄、朝倉書店、2022年)
https://www.asakura.co.jp/detail.php?book_code=12274 - Porteus の教科書 Foundations of Stochastic Inventory Theory(Stanford University Press、2002年)は K 凸性と sS 方策の最適性を証明の水準で扱う原典(本章の記述の背景として確認
https://doi.org/10.1515/9781503619883
第8章
- 予測誤差は実績から予測を引いた値
https://otexts.com/fpp3/accuracy.html - 良い予測の残差は平均がゼロ
https://otexts.com/fpp3/diagnostics.html - 予測区間は地平が延びるほど広がる
https://otexts.com/fpp3/prediction-intervals.html - 単純指数平滑の h 期先の予測分散は、1 期先の分散に 1 足す α の2乗掛ける h から 1 を引いた値 を掛けたもので、地平が延びるほど大きくなる
https://otexts.com/fpp3/ets-forecasting.html - 複数期間の合計に対する予測区間は、予測誤差どうしの相関のため単純には計算できず、一般にはシミュレーションで求める
https://otexts.com/fpp3/aggregates.html - Croston 法は需要の大きさ q と発生間隔 a の2系列に別々に単純指数平滑を当て、予測は q の平滑値を a の平滑値で割ったもの
https://otexts.com/fpp3/counts.html - 分位点スコアは、実績が分位点を上回ると 2p 倍、下回ると 2 に 1 から p を引いた値を掛けた倍率の重みで誤差を数える
https://otexts.com/fpp3/distaccuracy.html - 本文で「予測の教科書」と呼ぶ本の日本語版の題名は『予測:原理と実践(第3版)』(Hyndman と Athanasopoulos)
https://otexts.com/fppjp/ - Croston 法は1972年に Croston が提案した
https://doi.org/10.1057/jors.1972.50 - Syntetos と Boylan は2005年の論文で Croston 法の予測に、1 から α の半分を引いた値を掛ける補正を提案し、SBA と呼ばれる
https://doi.org/10.1016/j.ijforecast.2004.10.001 - Syntetos と Boylan は2005年の論文で Croston 法の予測に、1 から α の半分を引いた値を掛ける補正を提案し、SBA と呼ばれる
https://nixtlaverse.nixtla.io/statsforecast/docs/models/crostonsba.html - 安全在庫の式の標準偏差は、需要そのものから推定される場合も1期先の予測誤差から推定される場合もある
https://research.rug.nl/en/publications/on-the-calculation-of-safety-stocks-when-demand-is-forecasted - 1期先の予測誤差の分散にリードタイムを掛ける伝統的な手順は、リードタイム内の各期の予測誤差が、需要過程に自己相関が無くても正に相関するため安全在庫が低く出る
https://doi.org/10.1016/j.ejor.2016.06.035 - 分位点回帰は Koenker と Bassett が1978年に提案した
https://doi.org/10.2307/1913643 - 正規分布では平均絶対偏差が標準偏差のおよそ 0.798 倍、標準偏差は MAD のおよそ 1.25 倍(1.2533 倍)
https://en.wikipedia.org/wiki/Average_absolute_deviation - statsmodels の SimpleExpSmoothing と Holt は initialization_method に estimated を指定でき、fit の結果の params から smoothing_level と initial_level を取れる
https://www.statsmodels.org/stable/generated/statsmodels.tsa.holtwinters.SimpleExpSmoothing.html - statsmodels の QuantReg は分位点回帰を実装し、fit の q で分位点の水準を指定する
https://www.statsmodels.org/stable/generated/statsmodels.regression.quantile_regression.QuantReg.html - scikit-learn の GradientBoostingRegressor は loss に quantile を指定して分位点回帰ができる
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.GradientBoostingRegressor.html - 『Intermittent Demand Forecasting』(Boylan、Syntetos、Wiley)
https://www.wiley.com/en-us/Intermittent+Demand+Forecasting%3A+Context%2C+Methods+and+Applications-p-9781119976080
第9章
- CVaR は閾値と閾値超過分の期待値を確率で割ったものの和の、閾値についての最小値として書ける
https://sites.math.washington.edu/~rtr/papers/rtr179-CVaR1.pdf - Rockafellar と Uryasev(2000)「Optimization of conditional value-at-risk」The Journal of Risk 2(3), 21-41
https://doi.org/10.21314/JOR.2000.038 - Bertsimas と Sim(2004)「The Price of Robustness」Operations Research 52(1), 35-53
https://doi.org/10.1287/opre.1030.0065 - 予算 Γ の不確実性集合
https://optimization-online.org/wp-content/uploads/2012/10/3640.pdf - 全部が同時に最悪をとる素朴な不確実性集合は Soyster(1973)にさかのぼる
https://doi.org/10.1287/opre.21.5.1154 - サンプル平均近似(SAA)
https://doi.org/10.1137/S1052623499363220 - 分布ロバスト最適化
https://doi.org/10.1287/opre.1090.0741 - Scarf(1958)は平均と分散だけが分かるニューズベンダー問題で最悪の分布を明示的に求め、最適な発注量を導いた
https://arxiv.org/pdf/2301.02662 - Gallego と Moon(1993)「The Distribution Free Newsboy Problem」(分布によらない新聞売り子問題の整理と拡張)Journal of the Operational Research Society 44(8), 825-834
https://doi.org/10.1057/jors.1993.141 - EVPI(完全情報の期待価値)と VSS(確率計画の価値)の定義は Birge と Louveaux の教科書第4章にまとめられている
https://doi.org/10.1007/978-1-4614-0237-4_4 - EVPI(完全情報の期待価値)と VSS(確率計画の価値)の定義は Birge と Louveaux の教科書第4章にまとめられている
https://arxiv.org/pdf/2208.05550 - PuLP の公式ドキュメントは CBC を別途導入する手順を案内している
https://coin-or.github.io/pulp/ - 『確率計画法』(椎名孝之、朝倉書店、2015、応用最適化シリーズ5、ISBN 978-4-254-11790-5)
https://www.asakura.co.jp/detail.php?book_code=11790 - 『Introduction to Stochastic Programming』(John R. Birge、François Louveaux、Springer、2011、第2版)
https://doi.org/10.1007/978-1-4614-0237-4 - 『Robust Optimization』(Aharon Ben-Tal、Laurent El Ghaoui、Arkadi Nemirovski、Princeton University Press、2009)
https://doi.org/10.1515/9781400831050 - 『Robust Optimization』(Aharon Ben-Tal、Laurent El Ghaoui、Arkadi Nemirovski、Princeton University Press、2009)
https://press.princeton.edu/books/hardcover/9780691143682/robust-optimization - 日本語のロバスト最適化の単行本は見当たらなかったので洋書を挙げた
https://ndlsearch.ndl.go.jp/api/opensearch?title=%E3%83%AD%E3%83%90%E3%82%B9%E3%83%88%E6%9C%80%E9%81%A9%E5%8C%96&cnt=50
第10章
- Clark と Scarf の1960年の論文が多段階在庫の理論の出発点で、直列系を対象にしている
https://doi.org/10.1287/mnsc.6.4.475 - Rosling の1989年の論文は、長期的な均衡の仮定のもとで組立系を直列系に組み替えて分析できることを示した
https://doi.org/10.1287/opre.37.4.565 - Federgruen と Zipkin の1984年の論文は、下流に複数拠点がある場合を一定の条件で下流1拠点のモデルで近似できることを示した
https://doi.org/10.1287/opre.32.4.818 - 分岐系では最適方策の構造が直列系のようには分かっておらず、近似や発見的方法が使われる
https://pure.tue.nl/ws/files/2166749/614894.pdf - Lee、Padmanabhan、Whang の1997年の論文がブルウィップ効果を命名し、原因を4つ(需要シグナルの処理・配分ゲーム・発注のまとめ・価格の変動)に整理し、対策も論じている
https://doi.org/10.1287/mnsc.43.4.546 - 同じ著者らの MIT Sloan Management Review の記事(1997年春)が P&G の紙おむつと HP のプリンターの例で現象を紹介している
https://sloanreview.mit.edu/article/the-bullwhip-effect-in-supply-chains/ - Chen、Drezner、Ryan、Simchi-Levi の2000年の論文は、小売と製造の2段階で需要予測とリードタイムの2要因により発注分散/需要分散を定量化し、多段階では需要情報の共有で増幅を減らせるが完全には無くせないと示した
https://doi.org/10.1287/mnsc.46.3.436.12069 - 移動平均 p 期・リードタイム L のオーダーアップツー方式で、発注分散/需要分散は 1 + 2L/p + 2L²/p² 以上(下界)
https://arxiv.org/abs/1309.7374 - Sterman の1989年の論文は、人が発注を決める実験で、参加者が自分の判断が環境に与える影響に鈍感で、在庫管理が系統的に最適から外れることを示した
https://doi.org/10.1287/mnsc.35.3.321 - Graves と Willems の2000年の論文の4つの前提(ネットワーク・定期発注のベースストック・需要に上限・保証サービス時間)、確率的な問題を確定的最適化として書けること、木構造での配置アルゴリズム、Eastman Kodak での適用
https://doi.org/10.1287/msom.2.1.68.23267 - 2段階の保証サービス時間モデルの定式化
https://doi.org/10.1016/j.ijpe.2015.10.010 - Eppen の1979年の論文:各拠点の需要が正規分布で保管費と欠品費が線形かつ同一の多拠点ニューズボーイ問題で、集約すると期待費用が下がり、削減の大きさは需要の相関に依存する
https://doi.org/10.1287/mnsc.25.5.498 - Maister の1976年の論文が平方根の法則の名前で整理し、集約後の在庫が倉庫数の平方根に比例するとした
https://doi.org/10.1108/eb014366 - Oeser の2019年の論文:倉庫を減らした26の企業事例で平方根の法則の推定誤差が平均27.85%、集約の削減も分散の増加もいずれも過大に見積もる傾向
https://doi.org/10.1108/IJRDM-05-2017-0108 - CPFR は VICS が策定したガイドライン
https://documents.gs1us.org/adobe/assets/deliver/urn:aaid:aem:f3eda6eb-eb78-4738-9d79-83cf124b0f2c/Guideline-Retail-Event-Collaboration-Business-Process-Guide.pdf - 『サプライチェーン・マネジメント概論:基礎から学ぶSCMと経営戦略』苦瀬博仁 編著、白桃書房、2017年5月
https://www.hakutou.co.jp/book/b286591.html - 『サプライチェーン・マネジメント概論:基礎から学ぶSCMと経営戦略』苦瀬博仁 編著、白桃書房、2017年5月
https://ci.nii.ac.jp/ncid/BB23622281
第11章
- 容量制約付きロットサイジングは単一品目の特殊な場合でも NP 困難になることが Florian・Lenstra・Rinnooy Kan の1980年の論文で示された
https://doi.org/10.1287/mnsc.26.7.669 - Bitran と Yanasse の1982年の論文は、単一品目なら易しい条件でも2品目になると NP 困難になる場合があることを示した
https://doi.org/10.1287/mnsc.28.10.1174 - Trigeiro・Thomas・McClain の1989年の研究は段取り時間つきの容量制約付きロットサイジングを扱い、容量制約の締まり具合が難しさの指標になると報告した
https://doi.org/10.1287/mnsc.35.3.353 - 施設配置問題と同じ構造への書き直しは Krarup と Bilde の1977年の論文に遡る
https://doi.org/10.1007/978-3-0348-5936-3_10 - Barany・Van Roy・Wolsey の1984年の論文は、強い不等式で書き直すと当時の市販ソルバーでも20品目・13期の容量制約付き問題が最適解まで解けたと報告した
https://doi.org/10.1287/mnsc.30.10.1255 - relax-and-fix はロットサイジングの近似解法として使われている
https://link.springer.com/article/10.1007/s10732-015-9295-0 - PuLP の最新ドキュメントは CBC を COIN_CMD 経由で使い、PULP_CBC_CMD を同梱しなくなったと書いている
https://coin-or.github.io/pulp/guides/how_to_configure_solvers.html - PuLP の COIN_CMD の引数に timeLimit・gapRel・logPath・threads がある
https://coin-or.github.io/pulp/technical/solvers.html - 『あたらしい数理最適化 Python言語とGurobiで解く』(久保幹雄・J. P. ペドロソ・村松正和・A. レイス、近代科学社、2012年12月、ISBN 978-4-7649-0433-0)
https://www.kindaikagaku.co.jp/book_list/detail/9784764904330/ - 『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』(梅谷俊治、講談社、2020年10月、ISBN 978-4-06-521270-7)
https://www.kspub.co.jp/book/detail/5212707.html - 『Production Planning by Mixed Integer Programming』(Yves Pochet・Laurence A. Wolsey、Springer、2006年、ISBN 978-0-387-29959-4)
https://doi.org/10.1007/0-387-33477-7
第12章
- 導入済みの SimPy は 4.1.1
https://pypi.org/project/simpy/ - SimPy の部品は Environment、process、timeout、run、now
https://simpy.readthedocs.io/en/latest/topical_guides/events.html - SimPy の部品は Environment、process、timeout、run、now
https://simpy.readthedocs.io/en/latest/topical_guides/environments.html - 同じ時刻のイベントは先に予約したものが先に処理される
https://simpy.readthedocs.io/en/latest/api_reference/simpy.core.html - 発注点は「リードタイム中の平均需要+安全係数×標準偏差」、サイクルサービス率は「リードタイム中需要が発注点以下になる確率」
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/8b53c45fd26ffff706d815131e8d177e_lect11.pdf - 一覧ページ(Lecture 11 の位置づけ)
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/pages/lecture-notes/ - リードタイム中需要の標準偏差の合成式 √(Lσ_D² + D²σ_L²)
https://en.wikipedia.org/wiki/Safety_stock - 信頼区間の半幅は標本標準偏差÷√n × t 分布の 97.5% 点
https://docs.scipy.org/doc/scipy/reference/generated/scipy.stats.t.html - numpy.random.SeedSequence(0).spawn(30)で反復ごとに独立な乱数の種を派生させる
https://numpy.org/doc/stable/reference/random/bit_generators/generated/numpy.random.SeedSequence.spawn.html - 『Pythonコンピュータシミュレーション入門 人文・自然・社会科学の数理モデル』(橋本洋志・牧野浩二、オーム社、2021 年)
https://www.ohmsha.co.jp/book/9784274226984/ - 『Excelで学ぶオペレーションズリサーチ』(大野勝久・逆瀬川浩孝・中出康一、近代科学社、2014 年)
https://www.kindaikagaku.co.jp/book_list/detail/9784764904514/ - 『Discrete-Event System Simulation 第5版』(Jerry Banks・John S. Carson・Barry L. Nelson・David M. Nicol、Pearson)
https://www.pearson.com/en-us/subject-catalog/p/Banks-Discrete-Event-System-Simulation-5th-Edition/P200000003161 - 『Discrete-Event System Simulation 第5版』(Jerry Banks・John S. Carson・Barry L. Nelson・David M. Nicol、Pearson)
https://openlibrary.org/isbn/9780136062127.json
第13章
- MIT の講義資料は小売の例として、4万から5万の品目を1,800店舗以上で扱い、品目と店舗の組み合わせが約7,200万から9,000万にのぼる企業を挙げている
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/bcf10afe4e14d0bbf0a2a3e45166d45b_lect16.pdf - 講義16 の位置づけ(MIT の講義一覧に、在庫管理の8回目「実務における在庫管理と最適化」として掲載)
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/pages/lecture-notes/ - 講義16 の位置づけ(MIT の講義一覧に、在庫管理の8回目「実務における在庫管理と最適化」として掲載)
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/resources/lect16/ - A 品目は「最も経営の注意と見直しを要し、多くの例外が出る」、B 品目は「例外管理つきの自動制御」、C 品目は「制御の仕組みはできるだけ単純にする」、この区分は「恣意的な分類である」
https://ocw.mit.edu/courses/esd-260j-logistics-systems-fall-2006/8b53c45fd26ffff706d815131e8d177e_lect11.pdf - JIS Z 8141 は在庫回転率を「一定期間における在庫の回転回数」と定義し、在庫回転日数の逆数とし、備考で「これが高いほど運転資本の回収が早くなることから経営上望ましい」と述べている
https://kikakurui.com/z8/Z8141-2001-01.html - 『新版 在庫マネジメントの基本』(石川和幸、日本実業出版社)
https://www.njg.co.jp/book/9784534062734/ - 『図解入門ビジネス 最新 在庫管理の基本と仕組みがよ~くわかる本 第3版』(湯浅和夫・内田明美子・芝田稔子、秀和システム)
https://www.shuwasystem.co.jp/book/9784798057330.html - 『エンジニアが学ぶ在庫管理システムの「知識」と「技術」』(株式会社GeNEE DX/ITソリューション事業部、翔泳社)
https://www.hanmoto.com/bd/isbn/9784798176932
第14章
- 食品ロス削減推進法は令和元年法律第19号、公布2019年5月31日、施行2019年10月1日
https://laws.e-gov.go.jp/law/501AC1000000019 - 2024年度の食品ロス量は461万トン、事業系237万トン、家庭系224万トン(前年度は464・231・233)
https://www.caa.go.jp/notice/entry/046549/ - 2024年度の食品ロスによる経済損失は3.8兆円、国民1人当たり年間31,097円、温室効果ガス排出量は二酸化炭素換算で978万トン
https://www.caa.go.jp/notice/assets/consumer_education_cms201_260630_03.pdf - 2000年度の食品ロス量は980万トン(家庭系433・事業系547)
https://www.caa.go.jp/notice/assets/consumer_education_cms201_260630_02.pdf - 2024年度の事業系食品ロス237万トンの内訳は食品製造業110万トン、食品卸売業9万トン、食品小売業48万トン、外食産業70万トン
https://www.maff.go.jp/j/press/shokuhin/recycle/260630.html - 環境省も同日に同じ推計値を公表
https://www.env.go.jp/press/press_05155.html - 3分の1ルールは賞味期間の3分の1以内で小売店舗に納品する慣例
https://www.maff.go.jp/j/shokusan/recycle/syoku_loss/161227_3.html - ファミリーマートは2025年6月末から全国500店舗で「AIレコメンド発注」の運用を開始
https://www.family.co.jp/company/news_releases/2025/20250710_01.html - 日本気象協会とソフトバンクが、バローホールディングスと中部フーズの協力のもと、農林水産省「令和6年度 食品ロス削減緊急対策モデル支援事業」に採択された実証を、スーパーマーケットバロー20店舗で2026年1月23日から3月12日に実施
https://www.jwa.or.jp/news/2026/08/43478/ - 日本気象協会が経済産業省の平成26〜28年度「次世代物流システム構築事業費補助金」の採択事業として3年間実施した「需要予測の精度向上・共有化による省エネ物流プロジェクト」の最終報告(2017年6月5日)
https://www.jwa.or.jp/news/2017/06/4476/ - M5 コンペティションは2020年3月2日から6月30日に開催
https://www.unic.ac.cy/iff/research/forecasting/m5-competition/ - M5 uncertainty competition は9つの分位点(0.005、0.025、0.165、0.250、0.500、0.750、0.835、0.975、0.995)の予測を求めた
https://doi.org/10.1016/j.ijforecast.2021.10.009 - M5 uncertainty competition の要旨(42,840系列、ウォルマート、9分位点)
https://ideas.repec.org/a/eee/intfor/v38y2022i4p1365-1385.html - M5 accuracy competition(点予測部門)の結果は同じ号の別論文
https://doi.org/10.1016/j.ijforecast.2021.11.013 - 分位点回帰は Koenker と Bassett が1978年に提案
https://doi.org/10.2307/1913643 - Ban と Rudin のビッグデータ・ニューズベンダーは、需要を予測する中間段階を置かず特徴量から発注量を直接出す
https://doi.org/10.1287/opre.2018.1757 - Bertsimas と Kallus は補助的な観測データも使う条件つき確率最適化の枠組みと処方力の係数を提案
https://doi.org/10.1287/mnsc.2018.3253 - Elmachtoub と Grigas の SPO 枠組み
https://doi.org/10.1287/mnsc.2020.3922 - Mandi らの decision-focused learning 総説
https://doi.org/10.1613/jair.1.15320 - Sadana らの文脈つき最適化の総説
https://doi.org/10.1016/j.ejor.2024.03.020 - Wilder らの組合せ最適化への decision-focused learning
https://doi.org/10.1609/aaai.v33i01.33011658 - Gijsbrechts らは売り逃し・二重調達・多段階在庫の3問題をマルコフ決定過程として A3C を適用し、最良のヒューリスティックや近似動的計画と同等の性能
https://doi.org/10.1287/msom.2021.1064 - Boute らの在庫制御のための深層強化学習のロードマップ
https://doi.org/10.1016/j.ejor.2021.07.016 - scikit-learn の GradientBoostingRegressor は loss に quantile を指定でき、alpha が分位点の水準(既定0.9)
https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.GradientBoostingRegressor.html - 『食品ロスの経済学 第4版』(小林富雄、農林統計出版、2023年)
https://www.jstage.jst.go.jp/article/arfe/60/1/60_65/_html/-char/ja - 『すごい需要予測 不確実な時代にモノを売り切る13の手法』(山口雄大、PHP研究所、2022年)
https://www.php.co.jp/books/detail.php?isbn=978-4-569-85181-5 - 『AI時代のサプライチェーン・エコシステム 価値を生成し続けるジェネラティブSCM』(笹川亮平、日経BP、2026年)
https://bookplus.nikkei.com/atcl/catalog/26/06/19/02671/