※本コラムは、以前に個人ブログとして公開していた内容を、加筆・再構成のうえ掲載しております。技術的な内容は執筆当時のものであり、現在とは異なる場合がございます。
こんにちは、Anagraftの伊藤です。
今回は、AWS・Microsoft Azure・Google Cloud の主要なサービスを役割ごとに整理し、選定の場面でどこを見て決めればよいかをまとめました。3社それぞれについて別々に書いていたノートを1本にまとめ直したうえで、記載しているサービス176件の現況を公式ドキュメントで1件ずつ確認して書き直しています。
まとめ直した理由は2つあります。1つは、3社を別々に読んでいると、読者にとって最も知りたいはずの「同じことをしたいとき、3社では何がどう違うのか」がどこにも書かれないためです。もう1つは、確認作業の過程で、サービスの名前と構成が想像以上に動いていることが分かったためです。改称されたもの、統合されたもの、提供が終わったもの、そして一度は新規の受付を止めたのに再開したものまでありました。名前を覚える形の知識では、選定のたびに確かめ直すことになります。
そこで本コラムは、サービス名の一覧ではなく、役割の地図として組み立てました。「仮想的な計算機を貸す役割」「オブジェクトを置く役割」「権限を決める役割」といった役割を軸に章を並べ、各社のサービス名はその役割の現在の呼び名として示しています。名前が変わったときに、どこを差し替えればよいかが分かる形にしたつもりです。
あわせて、対応表を載せる箇所には必ず注記を添えました。同じ役割の枠に入ることと、同じものであることは違います。たとえば仮想ネットワークは3社とも似た名前で呼ばれますが、Google Cloud のものだけが全世界を範囲とする資源として説明されており、他の2社はリージョンに属します。対応表だけを見て構成を移すと、こうした前提の違いが後から効いてきます。
想定している読者は、クラウドの選定や見直しを任された方、特定の1社は使っているが他の2社の全体像を把握しておきたい方、そして技術的な詳細よりも判断の軸と落とし穴を知っておきたい経営層の方です。専門用語には平易な補足を添えました。
なお、具体的な料金額は書いていません。クラウドの料金は改定が頻繁で、構成や利用量によっても変わります。記事に書けばその時点から古くなり、見積りに使われると不利益が生じます。費用については、金額ではなく考え方と見積りの立て方を第12章で扱います。どの1社が優れているかという結論も書いていません。3社は設計思想が異なり、適不適は要件で決まるためです。
本コラムの記述は2026年9月時点で確認したものです。必要な章だけを拾ってお読みいただく使い方も想定していますが、その場合も第1章だけは先にご覧いただくと、以降の章で使う用語の対応関係が分かるようになっています。3社で呼び名の違うものを、第1章でまとめて揃えているためです。
目的別の読み方の目安を挙げておきます。これから移行先を選ぶ段階であれば、第1章で用語を揃えたうえで、第11章の移行と併用の判断、第12章の費用の考え方、第13章の対応関係をご覧いただくと、検討の骨格が組めると思います。すでに特定の1社を使っていて他社の状況を把握しておきたい場合は、第13章の対応表から入り、気になった領域の章へ戻る読み方が早いはずです。数年前に作った構成の見直しであれば、第14章で名前と構成の動きを確認してから、該当する領域の章をご覧ください。
データ活用の基盤づくりが目的の場合は、第5章のデータ分析基盤と第6章の機械学習およびAIのサービスが中心になります。この2つの章は、モデルの作り方そのものではなく、作ったものをどこに載せるかを扱っています。分析や機械学習の手法については、弊社の他のコラムで個別に取り上げていますので、そちらとあわせてご覧いただければと思います。
権限設計やセキュリティの検討から入る場合は、第9章を先にお読みいただくとよいかもしれません。3社で最も設計思想が分かれる領域であり、ここでの前提の違いが、後続の設計に最も広く影響します。

目次
序章 クラウドの見取り図は、名前で覚えると古くなる
クラウドの主要なサービスを一覧にした資料は、世の中に数多くあります。それでも実際の選定の場面で困るのは、一覧そのものが手元に無いからではなく、手元にある一覧が今の実態と合っているかどうかを確かめられないからではないかと思います。本コラムは、AWS・Microsoft Azure・Google Cloud の主要なサービスを役割ごとに並べ直し、そのうえで「何をどう選ぶか」を扱います。
本コラムを準備するにあたって、3社の主要サービス176件について、公式ドキュメントを1件ずつ開いて現況を確かめました。その作業から分かったことを先に申し上げます。名前は、想像以上に動いています。
確かめてみると、名前はこれだけ動いていました
いくつか具体例を挙げます。いずれも公式ドキュメントで確認したものです。
Azure Active Directory は Microsoft Entra ID になりました。名称の変更が公表されたのは2023年7月11日です。Microsoft の AI 関連サービス群は、Cognitive Services から Azure AI services を経て、現在は Foundry Tools と呼ばれています。2段階動いたことになります。Amazon SageMaker は SageMaker AI に改称され、それと同時に「Amazon SageMaker」という名前のほうが、より上位の統合プラットフォームを指すものとして付け替えられました。同じ名前が、以前とは別のものを指しています。Amazon QuickSight は Amazon Quick に改称され、従来の可視化の機能は Amazon Quick の中の Amazon Quick Sight として続いています。Google Cloud の Vertex AI は Gemini Enterprise Agent Platform に統合され、公式ドキュメントには、Vertex AI のサービスは Gemini Enterprise Agent Platform の一部となったため最新の情報は Agent Platform 側の文書を参照するように、という案内が出ています。
提供が終わったものも、終了の予定が告知されたものもあります。AWS CodeStar はサポートが2024年7月25日に終了しました。Azure Database for MariaDB は2025年9月に提供を終えました。Azure Blueprints は、2026年7月31日から段階的な終了が始まっており(まず新しい定義の作成が止まり、以後は更新や割り当てが順に止まります)、2027年1月31日に提供を終えることが告知されています。プレビューの位置づけのまま終わることになります。
一方で、終わったように見えて戻ったものもあります。AWS CodeCommit は2024年7月25日に新規のお客様への提供を停止しましたが、2025年11月に一般提供へ復帰しています。ここを「終了した」と覚えていると、選定の場面で誤った判断につながります。
この一覧を見ていただきたいのは、変化の量に驚いていただくためではありません。名前を覚える形の知識は、覚えた先から古くなるという一点をお伝えするためです。だとすれば、見取り図の持ち方そのものを変える必要があります。
役割で覚え、名前は現在の呼び名として扱う
本コラムでは、各章を「この役割を担う部品が各社にある」という形で組み立てました。仮想的な計算機を貸す役割、オブジェクトを置く役割、権限を決める役割、といった具合です。役割の側は、名前ほど速くは変わりません。そのうえで、その役割の現在の呼び名として各社のサービス名を示しています。名前が変わったときに差し替えるべき場所が、役割の側に紐づいて特定できるようになります。
もうひとつ、本コラムを通じて繰り返しお伝えすることがあります。同じ役割の枠に入ることと、同じものであることは違います。対応表は便利ですが、そのまま置き換えられると受け取られると、かえって害になります。
分かりやすい例を挙げます。仮想ネットワークは3社ともよく似た名前で呼ばれており、対応表を作れば同じ行に並びます。ところが公式ドキュメントを読むと、Google Cloud のものだけが全世界を範囲とする資源として説明されており、AWS と Azure のものはリージョンに属します。役割は対応していても、設計上の前提が違います。同じ行に並んでいるという理由だけで構成を移そうとすると、この違いが後から効いてきます。
権限管理はさらに差が大きい領域です。AWS はポリシーを利用者側と資源側の双方に付ける形を取り、Azure はセキュリティプリンシパルと役割定義と適用範囲の3要素で表し、Google Cloud は上位の階層に与えた許可が配下すべてに及ぶ形を取ります。考え方そのものが違うため、片方の設計をもう片方へ機械的に写すことができません。本コラムでは第9章でこの点を扱います。
本コラムが扱わないこと
具体的な料金額は書きません。クラウドの料金は改定が頻繁で、構成や利用量によっても変わります。記事に金額を書けば、書いた時点から古くなり、それを見積りに使った読者に不利益が生じます。費用の考え方と見積りの立て方は第12章で扱いますが、金額そのものは扱いません。実際の金額は、各社が公開している料金計算ツールで、その時点の条件を入れてお出しになることをおすすめします。
どの1社が優れているか、という結論も書きません。3社は設計思想が異なり、適不適は要件で決まります。本コラムがお伝えしたいのは順位ではなく、どの軸で比べれば自社の要件と噛み合うかという見方のほうです。
また、本コラムは網羅を目的にしていません。3社が提供するサービスの総数は、それぞれ数百に及びます。ここで扱うのは、多くの企業システムで実際に選択の対象になる範囲に絞ったものです。
想定している読者
- クラウドの選定や見直しを任され、3社の資料を読み比べる必要がある方
- 特定の1社は使っているが、他の2社の全体像を把握しておきたい方
- 数年前に作った構成を見直すにあたって、現在の選択肢を確かめたい方
- 技術的な詳細よりも、判断の軸と落とし穴を知っておきたい経営層の方
専門用語には平易な補足を添えました。クラウドの実務経験が浅い方でも、最初の章から順に読んでいただければ、以降の章で使う用語は分かるようになっています。
記述の基準時点について
本コラムの記述は、2026年9月時点で各社の公式ドキュメントを開いて確認したものです。確認できなかった事項については、断定を避けるか、記載していません。改称や提供終了の時期は、各社が告知した文書で確認できたものだけを年月とともに記しています。
ただし、ここまで述べたとおり、クラウドのサービスは動きます。本コラムも例外ではなく、時間が経てば実態とずれていきます。実際の選定にあたっては、各社の公式ドキュメントで現況をご確認ください。本コラムは、確認すべき箇所がどこかを見つけるための地図としてお使いいただくのが、最も役に立つ形だと考えています。
Anagraftでは、データ活用の構想づくりから基盤の選定、分析の実装、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
全体の地図
本コラムは14の章で構成しています。章の並びは、クラウドを構成する要素を下から順に積み上げる形にしました。土台となる考え方を最初に置き、計算資源、データの置き場所、データの使い方、つなぎ方、守り方、運用、そして選定と費用へと進みます。最後の2つの章は、それまでの章を横に貫く形で、3社の対応関係と、名前や構成がどう動いてきたかを扱います。
必要な章だけを拾って読む使い方も想定しています。その場合は、第1章だけは先に目を通していただくと、以降の章で使う用語の対応関係が分かるようになっています。3社で呼び名が違うものを、第1章でまとめて揃えているためです。
| 章 | 扱う内容 | この章で答えたいこと |
|---|---|---|
| 第1章 クラウドを読むための土台 | リージョンと可用性の単位、責任共有モデル、サービス形態の区分、アカウントと組織の単位 | 3社の資料を並べて読むために、最初に揃えておくべき用語は何か |
| 第2章 コンピューティングとコンテナ | 仮想マシン、コンテナ実行基盤、Kubernetes のマネージド、アプリケーション実行環境 | 運用をどこまで手放すかで、選ぶものがどう変わるか |
| 第3章 ストレージ | オブジェクト、ブロック、ファイル、アクセス階層とライフサイクル | アクセス頻度と保管期間から、置き場所をどう決めるか |
| 第4章 データベース | リレーショナルのマネージド、分散、キーバリューや文書型、キャッシュ | 整合性と規模の拡大を、どこで折り合いをつけるか |
| 第5章 データ分析基盤 | データウェアハウス、データレイク、変換の流れ、ストリーミング、可視化 | 分析基盤を組むとき、どの部品がどの役割を担うか |
| 第6章 機械学習とAIのサービス | 学習と運用の基盤、学習済みの機能、生成AIの基盤、検索との連携、安全性の機能 | 自分で作る領域と、載せるだけで済む領域の境目はどこか |
| 第7章 サーバーレスとイベント駆動 | 関数、コンテナ型の実行、メッセージング、イベントの配送、処理の連結 | 常時動かさない処理を、どう組み立てるか |
| 第8章 ネットワーキング | 仮想ネットワーク、負荷分散、配信、名前解決、拠点との接続 | 同じ名前で呼ばれる部品が、3社でどう違うか |
| 第9章 セキュリティとID | 権限の設計、鍵と機密情報、脅威の検出、監査の記録 | 3社で最も設計思想が分かれる領域を、どう読み解くか |
| 第10章 開発と運用 | 継続的な統合と配信、構成をコードで扱う考え方、監視と可観測性 | 作ったものを、動かし続けるために何が要るか |
| 第11章 移行とハイブリッドとマルチクラウド | 移行の型、既存資産の扱い、複数のクラウドを併用する判断 | 複数のクラウドを使う理由と、使わない理由は何か |
| 第12章 コストの考え方 | 課金の型、見積りの立て方、使われ続ける無駄の見つけ方 | 費用を、技術ではなく設計と運用の問題として扱うには |
| 第13章 3社の対応関係の地図 | 役割ごとの対比を集約し、対応が付かないものを明示する | 置き換えられるものと、置き換えられないものはどれか |
| 第14章 サービスの名前と構成はどう動いてきたか | 改称、統合、提供終了と、その背景 | 名前で覚えた知識が古くなるのを、どう防ぐか |
この表は章の役割を示したものです。3社のサービスを役割ごとに突き合わせた対応表は第13章にまとめてありますので、対応関係だけを確認したい場合はそちらをご覧ください。
本コラムで採った3つの方針
第一に、名前ではなく役割で覚える構成にしました。クラウドのサービス名は動きます。本コラムを準備する過程でも、公式ドキュメントを1件ずつ確かめたところ、改称や統合や提供終了が数多く見つかりました。名前を覚える読み方では、覚えた先から古くなります。そこで各章は「この役割を担う部品が各社にある」という形で並べ、名前はその役割の現在の呼び名として示しています。
第二に、3社を横に並べる表を各章に置きつつ、同じ役割の枠に入ることと、同じものであることは違うという注記を必ず添えました。対応表は便利ですが、そのまま置き換えられると受け取られると害になります。たとえば仮想ネットワークは3社ともよく似た名前で呼ばれますが、Google Cloud のものだけが公式に全世界を範囲とする資源として説明されており、他の2社はリージョンに属します。役割は対応していても、設計上の前提が違います。
第三に、具体的な料金額を書かないことにしました。クラウドの料金は改定が頻繁で、構成や利用量によっても変わります。記事に書いた瞬間から古くなり、読者が実際の見積りに使えば害になります。第12章では費用の考え方と見積りの手順を扱いますが、金額そのものは扱いません。その理由も同章で述べます。
本コラムの記述は2026年9月時点で公式ドキュメントを確認したものです。クラウドのサービスは今後も動きますので、実際の選定にあたっては各社の公式ドキュメントで現況をご確認ください。
第1章 クラウドを読むための土台
クラウドのサービス名を覚える前に、片づけておいたほうがよいことがあります。AWS・Microsoft Azure・Google Cloud の3社が、同じような役割の枠に対してそれぞれ別の言葉を使っている、という事実です。データセンターをどう束ねるか、障害の影響をどこで切るか、利用者と事業者の責任がどこで分かれるか、アカウントや組織をどう数えるか。どれも3社に共通して存在する考え方ですが、呼び名も単位も揃っていません。ここを曖昧にしたまま個別のサービスを比べ始めると、対応表を作っても意味の取り違えが残ります。
本章は、第2章以降で3社のサービスを横に並べるための土台を作ります。扱うのは、リージョンとゾーン、責任の分担、IaaS・PaaS・SaaSという区分、運用をどこまで手放すかという軸、アカウントと組織と課金の単位、そしてSLAという言葉の読み方です。記述は各社の公式ドキュメントで直接確かめたものに限り、確かめられなかったことは確かめられなかったと書いています。
3社の言葉は、同じ地図の上には載っていない
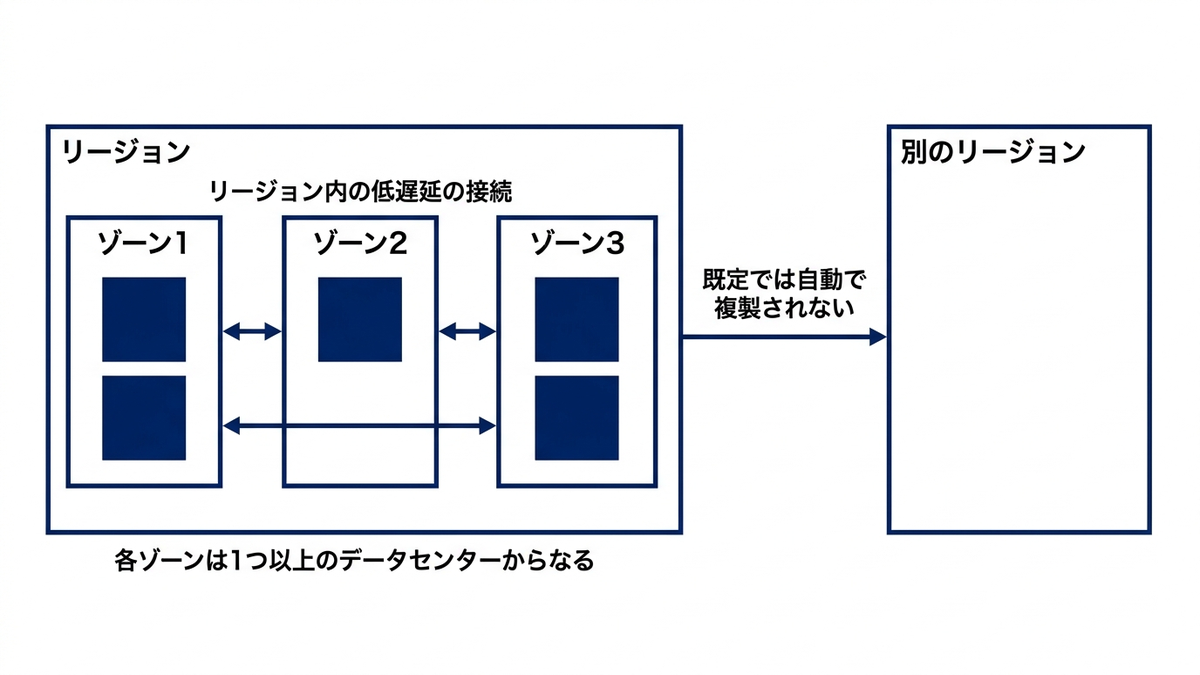
いちばん基礎になる地理の単位から揃えます。3社とも「リージョン」という言葉を使いますが、その下の単位の呼び名は違います。AWSはアベイラビリティゾーン、Azureは可用性ゾーン、Google Cloudは単に「ゾーン」と呼びます。役割はどれも「1つのリージョンの中で、障害の影響範囲を切り分ける単位」です。ところが公式の定義を並べると、数の前提も、データセンターとの結びつき方も、同じではありません。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 地理的に独立した最大の単位 | リージョン | リージョン | リージョン |
| リージョン内で障害を切り分ける単位の呼び名 | アベイラビリティゾーン | 可用性ゾーン | ゾーン |
| 1リージョンあたりの数の公式の記述 | 最低3つ | 多くのリージョンが提供する。すべてではない | 3つ以上 |
| データセンターとの関係の公式の記述 | 1つ以上の独立したデータセンターからなる | 1つ以上の物理的に分かれたデータセンターの論理的なまとまり | 物理資源の論理的な抽象。3つ以上のデータセンターに置かれるのが基本で、例外もある |
| リージョンどうしの関係 | 他から隔離されるよう設計され、資源は自動的に複製されない | リージョンは互いに独立している | リージョンは独立した地理的領域である |
この表の読み方を先に断っておきます。横に並んでいるからといって、同じものではありません。同じ役割の枠に入るだけです。AWSは「各リージョンは最低3つの、隔離され物理的に分離されたアベイラビリティゾーンからなる」と書いていますが、Azureは「多くのリージョンが可用性ゾーンを提供する」と書き、可用性ゾーンを持たないリージョンが存在することを図で明示しています。AWSの感覚のまま「どのリージョンにも3つある」と考えてAzureの構成を組むと、選んだリージョンにゾーンが無いという形で最初につまずきます。
リージョンは地理の単位であり、サービスの単位ではない
AWSはリージョンを「データセンターを集約している世界各地の物理的な場所」と定義し、リージョンどうしは隔離されるよう設計されていること、資源はリージョンをまたいで自動的には複製されないことを明記しています。Google Cloudも「リージョンはゾーンから構成される、独立した地理的領域である」と定義し、Azureも「リージョンは互いに独立している」と書いています。リージョンをまたいだ瞬間に、それは別の世界の話になります。災害対策として別リージョンに複製したいなら、それは自分で設計する対象であって、既定で付いてくるものではありません。
Azureはこの上にもう1つ層を持っています。「ジオ」です。公式ドキュメントは「Azureは世界で70を超えるリージョンを提供している。各ジオは、たとえば米国や欧州といった、データが置かれる境界を表す」と説明し、「各ジオは、可用性ゾーンを備えたリージョンを少なくとも1つ持つ」とも書いています。データの所在に要件がある場合は、まずジオを選び、その中のリージョンを選ぶ順序になります。AWSとGoogle Cloudの公式ドキュメントに、これと同じ役割の名前が付いた層があるかどうかは本章の調査では確認できませんでした。確認できていないので、対応表の行としては立てていません。
リージョンを選ぶときの観点として、Azureの公式ドキュメントは3つを挙げています。利用者との地理的な近さによる遅延、可用性ゾーンの有無、データの所在の境界です。加えて、特定のリージョンに紐づかない「非リージョンのサービス」が存在することも明記しています。リージョンは「どこに置くか」だけでなく「そこで何が使えるか」まで決めてしまう単位である、と読むのが安全です。
ゾーンは、数え方も名前の見え方も3社で違う
ゾーンは、この章でいちばん取り違えが起きやすいところです。AWSはアベイラビリティゾーンを「1つ以上の独立したデータセンターで、冗長化された電源・ネットワーク・接続性を備えたもの」と定義し、「各リージョンは最低3つの、隔離され物理的に分離されたアベイラビリティゾーンからなる」「数キロメートル以上離れているが、いずれも互いに100キロメートル以内にある」「各アベイラビリティゾーンは独立した電源・冷却・物理セキュリティを持ち、冗長かつ超低遅延のネットワークで接続されている」と書いています。
ここに実務へ効く落とし穴が1つあります。AWSの公式ドキュメントは、もともとアベイラビリティゾーンとコードの対応をAWSアカウントごとに独立して割り当てていた、つまり自分のアカウントの us-east-1a と別のアカウントの us-east-1a は同じ物理的な場所とは限らない、と説明しています。2012年11月より後に導入されたリージョンは一律の対応になっており、独立した割り当てが残るリージョンについても2025年11月以降に作成されたアカウントは同じ対応になる、と明記されています。アカウントをまたいで場所を揃えたいときは use1-az1 のような「AZ ID」を使うよう案内されています。複数のAWSアカウントで環境を分けている組織では、ゾーンの名前だけを見て「同じ場所に寄せた」と判断できない場合がある、ということです。
Azureの可用性ゾーンは定義そのものが少し違い、「リージョン内にある、1つ以上の物理的に分離されたデータセンターの論理的なまとまり」とされています。ゾーン間の通信は「往復の遅延がおよそ2ミリ秒未満になることを目指している」と書かれています。加えてAzureには、他の2社の説明には出てこない区別があります。ゾーン冗長のリソースと、ゾーンのリソースの区別です。前者はサービス側が複数の可用性ゾーンに分散または複製し、障害時の切り替えも事業者が管理します。後者は利用者が自分で1つのゾーンを選んで配置するもので、公式ドキュメントは「ゾーンの障害に対する回復性は自動的には得られない。切り替えは利用者の責任である」と明記しています。物理ゾーンと論理ゾーンの対応はサブスクリプションごとに異なるとも書かれており、名前と場所の対応が利用者ごとに違いうる点は、呼び名は違えどAWSと似た注意点です。
Google Cloudのゾーンは「リージョン内でGoogle Cloudの資源を配置する領域」と定義されています。「1つのリージョンは3つ以上のゾーンを持ち、それらは3つ以上の物理データセンターに収容される」と書かれていますが、同じページに例外も明記されています。ストックホルム・メキシコ・大阪・モントリオールのリージョンは、3つのゾーンが1つまたは2つの物理データセンターに収容されている、というものです。そのうえで「ゾーンとリージョンは、その下にある物理資源の論理的な抽象である」と断っています。「ゾーンが3つあるから、必ず3つの建物に分かれている」とは読めない、と公式が自分で書いているわけです。
Azure固有の言葉を、3社の地図のどこに置くか
Azureには、他の2社の用語集に対応物を探すと迷う言葉があります。代表がリージョンペアと可用性セットです。3社を対等に読むには、これらを「Azureだけが持つ言葉」として一度切り離すほうが早いと考えています。
リージョンペアは「Microsoftは一部のリージョンを別のリージョンと関連づけており、その2つは通常同じジオに属する。この組み合わせをリージョンペアと呼ぶ」と説明されています。利点として挙げられているのは、ジオ全体に及ぶ障害が起きた場合にペアの一方が復旧の優先対象になること、計画的な更新をペア間でずらすこと、データの所在の要件を満たしやすいことの3つです。ペアは利用者が選べません。そして公式ドキュメントは「ペアのリージョンに資源を配置しただけでは、自動的に回復性が高くなるわけではないし、高可用性や災害復旧の機能や切り替えが自動的に提供されるわけでもない」と明記しています。ペアは必ずしも対称でもなく、ブラジル南部は米国中南部とペアになっているがその逆は成立せず、しかもこのペアはブラジルのジオの外に出る、という例が挙げられています。さらに「新しいリージョンの多くはペアを持たず、可用性ゾーンを主な冗長の手段としている」とも書かれています。
可用性セットは「関連する仮想マシンが同時に落ちる確率を下げるための、仮想マシンの論理的なまとまり」と定義されています。更新ドメインは同時に再起動されうる仮想マシンと物理ハードウェアのまとまり、障害ドメインは電源とネットワークスイッチを共有する仮想マシンのまとまりで、1つの可用性セットは最大3つの障害ドメインと20の更新ドメインを持つとされます。重要なのは、公式ドキュメント自身が「可用性セットは高可用性をもたらすが、可用性ゾーンと同じ水準の回復性は提供しない」と書き、可用性ゾーンが無いリージョンで特に有用だと位置づけていることです。
この2つを見ると、3社の用語を1対1で対応させられる範囲が見えてきます。リージョンとゾーンまでは「同じ役割の枠」として並べられます。その先は各社が自社の運用の都合で作った独自の概念であり、対応表の行を作ること自体が誤解のもとになります。本記事では、対応が付かないものは無理に対応させず、片方にしかないものとして扱います。カテゴリごとの対応関係は第13章でまとめて整理します。
責任の分担は、3社とも同じ絵ではない
クラウドを使うとは、これまで自社で担っていた作業の一部を事業者に預けることです。どこまでを預け、どこからを自分で持つのかを整理した考え方が責任共有モデルです。3社ともこの言葉を使いますが、説明の切り口は違います。
AWSは「クラウドの安全性」と「クラウド内の安全性」という言い方をします。公式ページは「AWSはAWSクラウドで提供されるすべてのサービスを動かす基盤を保護する責任を負う」「利用者の責任は、利用者が選んだサービスによって決まる」と書き、仮想マシンでは利用者がゲストOSの管理、更新とセキュリティ修正、導入したアプリケーション、事業者が提供するファイアウォールの設定に責任を持つと例示しています。一方でオブジェクトストレージやキーバリューのデータベースについては「AWSが基盤の層、OS、プラットフォームを運用し、利用者は保存と取得の入口を使う。利用者はデータの管理、資産の分類、AWS IAMによる適切な権限の適用に責任を持つ」と説明しています。
Azureは表で示します。オンプレミス・IaaS・PaaS・SaaSの4つの形態を列に取り、顧客データ、構成と設定、ID と利用者、クライアント端末、アプリケーション、ネットワーク制御、オペレーティングシステム、物理ホスト、物理ネットワーク、物理データセンターを行に並べ、「どの形態であっても利用者が常に持ち続ける責任」としてデータ、エンドポイント、アカウント、アクセス管理の4つを挙げています。Google Cloudは責任共有に加えて「運命の共有」という言葉を出します。「責任共有モデルは、クラウドの利用者がより良いセキュリティの結果を得るには十分ではないとGoogleは考えている。責任を分けるのではなく、運命を共有すると考える」と述べ、安全な既定値、設計図、ガバナンスの道具などを挙げています。
| 観点 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 切り口の呼び方 | クラウドの安全性と、クラウド内の安全性を分ける | 形態別の責任の表として示す | 責任共有に加えて「運命の共有」を掲げる |
| 事業者が担うとされる範囲 | サービスを動かす基盤の保護 | 物理データセンター、物理ネットワーク、物理ホスト。形態が上がるとOSやネットワーク制御も | IaaSでは基盤と物理セキュリティが中心。形態が上がるほど広がる |
| 利用者に必ず残るとされるもの | 選んだサービスによって決まると説明 | データ、エンドポイント、アカウント、アクセス管理の4つを明示 | アクセス制御と、保存すると決めたデータ |
| 特徴的な説明の仕方 | 仮想マシンと抽象化されたサービスを対比して例示 | 10の責任領域を4つの形態で表にする | 安全な既定値や設計図の提供まで踏み込む |
この表も、横に並んでいるだけで同じものではありません。3社は同じ問いに答えていますが、答えの粒度も、責任という言葉に込めているものも違います。Azureの公式ドキュメントは自社の表について「ここでいう責任はガバナンス上の意味であり、誰が各制御を設定・運用・監視することを期待されているかを指す。法的な結論を示すものではなく、契約条件を変更するものでもない」と注記しています。責任共有モデルは、契約書ではなく設計の道具として読むのが正しい読み方です。契約上どうなるかは、各社の利用規約と個別の合意で決まります。
IaaS・PaaS・SaaSという区分では、実際のサービスは分類しきれない
IaaS・PaaS・SaaSという3分類は、米国国立標準技術研究所が2011年9月に公表した文書「クラウドコンピューティングの定義」で整理されたものです。著者はP. M. MellとT. Granceの2名です。この文書はSaaSを「事業者のアプリケーションを利用者が使う形態」、PaaSを「事業者が用意した言語や道具で作ったアプリケーションを、利用者がクラウド基盤の上に配置する形態」、IaaSを「処理・保管・ネットワークなどの基礎的な計算資源が提供され、利用者が任意のソフトウェアを動かせる形態」と定義しています。この3分類は責任の所在を語るときによく効きます。Azureの責任の表も、Google Cloudの責任共有の説明も、この3つを軸に組まれています。
ところが実際のサービスをこの3つに仕分けようとすると、途端に手が止まります。Azureの公式ドキュメントはこれを正面から認めています。「Azureのソリューションの多くは、複数のサービスモデルを組み合わせて使う」と書かれています。もう1つの例がAWSの説明の仕方です。AWSは責任共有モデルの説明で、仮想マシンをIaaSの例として挙げる一方、オブジェクトストレージやキーバリューのデータベースを「抽象化されたサービス」と呼んで別の説明を与えています。3分類の外側にもう1本の線を引いているということです。3分類が間違っているのではなく、サービスの実物を並べるには目盛りが粗いのだと考えています。本記事ではこの3分類を責任の所在を説明する語彙としては使いますが、サービスを分類する棚としては使いません。
「どこまで運用を手放すか」という軸
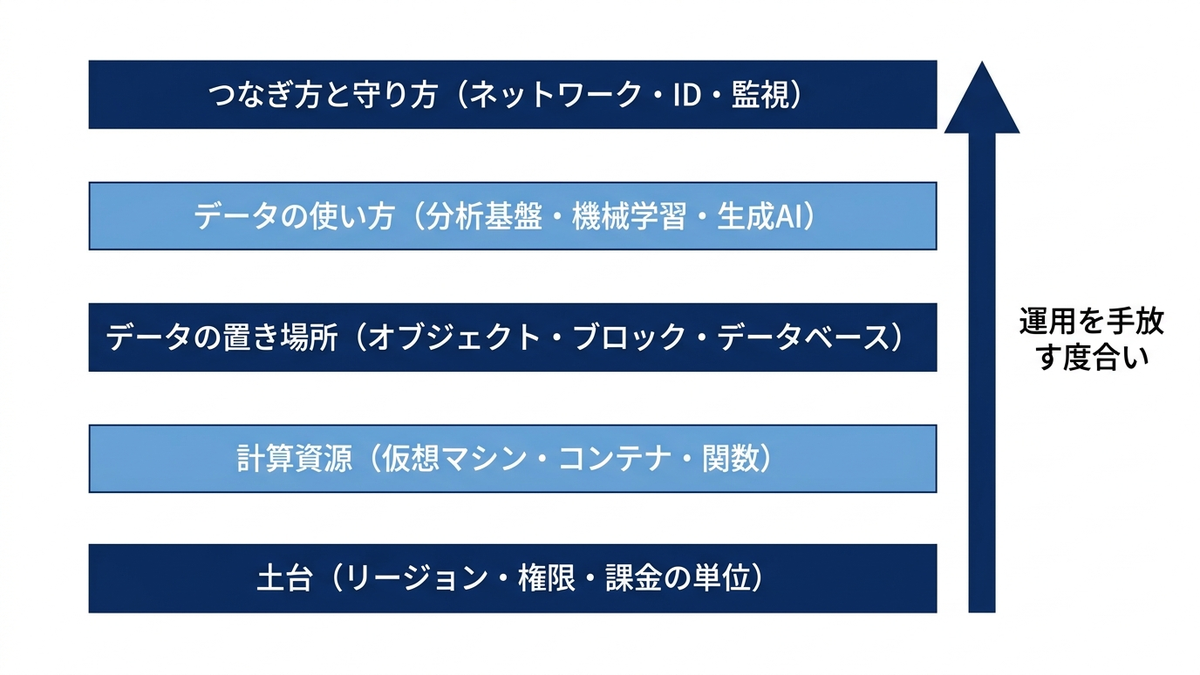
3社のサービスを比べるときに、本記事が繰り返し使う軸が1つあります。マネージドの度合い、つまり「その仕組みを動かし続けるための作業を、どこまで事業者に預けるか」です。責任共有モデルを、セキュリティではなく日々の運用の側から見直したものだと考えると分かりやすいと思います。
同じ目的を果たすのに、3社ともたいてい複数の選択肢を用意しています。仮想マシンを借りて自分で組む方法、実行環境だけを借りて中身に集中する方法、出来合いのサービスを呼び出すだけで済ませる方法。どれを選んでも動きますが、その後に手元に残る作業の量が違います。OSの更新、バックアップの取得、障害時の切り替え、規模の増減。これらを誰が持つのかが、選択によって変わります。
この軸には表と裏があります。運用を手放すほど日々の手間は減りますが、同時に、選べる範囲、細かく調整できる範囲、中で何が起きているかを自分で確かめられる範囲は狭くなります。どちらが良いという話ではなく、その組織がどこに人手をかけたいのかで決まる話だと考えています。人手が限られている組織ほど、手放せるものは手放したほうが結果として安定することが多いように思います。第2章以降、各カテゴリでこの軸を使います。「これは何ができるサービスか」ではなく「これを選ぶと、自分の手元に何が残るか」を毎回書く、というのが本記事の書き方です。
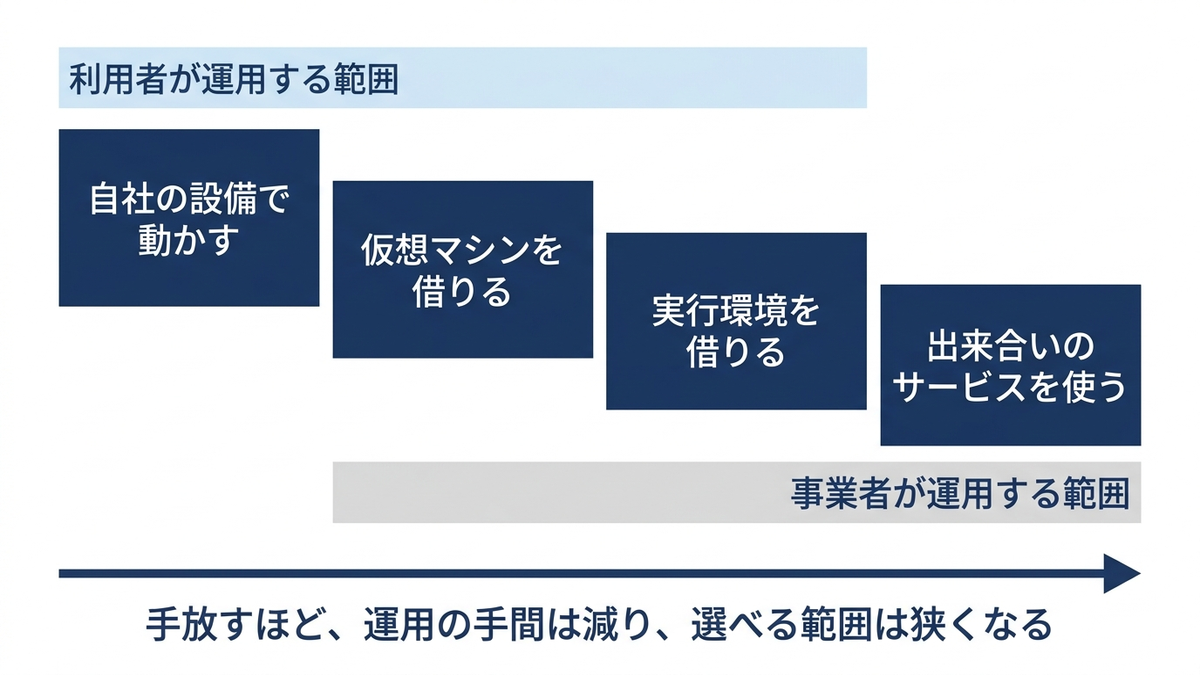
アカウント・組織・課金の単位の考え方
もう1つ最初に揃えておきたいのが「入れ物」の単位です。どのクラウドでも資源を裸で作ることはできず、必ず何かの器の中に作ります。この器の名前と階層が3社でかなり違います。
AWSでは、AWSアカウントが器です。公式ドキュメントは「AWSアカウントはAWSの資源の入れ物である」と定義し、複数のアカウントを使う理由として、費用の境界になること、セキュリティのために資源を分離できることを挙げています。複数のアカウントをまとめるのがAWS Organizationsで、頂点にルートがあり、その下に組織単位を作って入れ子にできます。深さはルートと最下層のアカウントを除いて5段までです。組織には管理アカウントが1つあり、「支払いアカウントの役割を持ち、組織内のアカウントが発生させたすべての請求を支払う責任を負う」と説明されています。ただしサービスコントロールポリシーは組織の管理アカウントには適用されない、という但し書きが付いています。
Azureは4段の入れ子です。管理のスコープを、管理グループ、サブスクリプション、リソースグループ、リソースの4つの水準に分け、「下の水準は上の水準の設定を継承する」と説明しています。リソースグループについては「各リソースは1つのリソースグループにのみ存在できる」「リソースグループを削除すると、その中のすべての資源も削除される」と明記されています。サブスクリプションは「管理・課金・スケールの単位」であり「規模、割り当て、コスト、ガバナンス、セキュリティ、IDの各制御の境界」とされ、1つのMicrosoft Entra テナントに結び付きます。管理グループの階層は最大6段で、ディレクトリごとに1つだけあるルート管理グループの識別子はテナントの識別子と同じ値になります。
Google Cloudは3段です。頂点に組織があり、その下に任意で使えるフォルダがあり、その下にプロジェクトがあり、プロジェクトの中に資源が入ります。フォルダは「組織の中のサブ組織として機能する」、プロジェクトは「基本となる組織化の実体」で、サービスの利用、APIの有効化、課金の有効化に必要だとされます。権限は「フォルダに付与したロールは、配下のすべてのプロジェクトとフォルダに継承される」と明記されています。課金については、1つの請求先アカウントが複数のプロジェクトの費用を支払えること、請求先アカウントの所有は1つの組織に限られること、そして「請求先アカウントはIAMの意味でプロジェクトの親ではないため、プロジェクトが請求先アカウントから権限を継承することはない」ことが説明されています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 階層の頂点 | 組織のルート | ルート管理グループ。識別子はテナントの識別子と同じ | 組織 |
| 中間のグループ | 組織単位。ルートと最下層を除いて5段まで | 管理グループ。最大6段 | フォルダ。任意 |
| 資源を入れる器 | AWSアカウント | サブスクリプションとリソースグループ | プロジェクト |
| 器の性格の公式の記述 | 資源の入れ物であり、費用の境界かつ分離の境界 | 管理・課金・スケールの単位。1つのテナントに結び付く | サービスの利用、APIの有効化、課金の有効化に必要な基本の実体 |
| 上位の設定の及び方 | ルートや組織単位に付けたポリシーが配下に及ぶ | 下の水準が上の水準の設定を継承する | 上位で付与したロールが配下に継承される |
| 支払いの持ち方の公式の記述 | 管理アカウントが組織内の全アカウントの請求を支払う | サブスクリプションが課金の単位 | 1つの請求先アカウントを複数のプロジェクトに紐づけられる |
この表も、同じ役割の枠に入るだけで同じものではありません。AWSアカウントとAzureのサブスクリプションとGoogle Cloudのプロジェクトを「だいたい同じもの」と読まないことが肝心です。段数が違い、権限の継承の効き方が違い、課金との結びつき方も違います。実務に効く例を挙げると、Azureの公式ドキュメントは「仮想ネットワークはサブスクリプションをまたいで共有できない」と書いています。器をどう割るかは、後からネットワークの構成にまで跳ね返ります。
本記事では利用料金の金額を一切書きません。理由は第12章で説明します。ここで押さえたいのは金額ではなく「どの単位で費用がまとまるか」です。器の割り方を決めることは、費用の見え方と、権限の届く範囲と、障害時の影響範囲を、まとめて決めることになります。後から変えるのは作るときより手間が大きくなりがちで、最初に決める価値がある数少ない項目の1つだと考えています。
SLAという言葉の読み方
最後に、選定の場でいちばん誤読されやすい言葉を扱います。SLAです。Azureの公式のフレームワークは3つの言葉をこう定義しています。SLAは「サービス提供者とサービス利用者の間の契約上の合意。合意を満たせなかった場合、提供者に金銭的な結果が生じることがある」。SLOは「ワークロードやアプリケーションの性能と信頼性の尺度であり、特定の顧客体験に対して設定する具体的で測定可能な目標」。SLIは「サービスの性能の特定の側面を定量的に測定したもの」。SLAは契約、SLOは自分たちで置く目標、SLIはそれを測る計器です。同じ数字の形をしていても役割は違います。
中身の作りは、AWSの計算サービス向けSLAが分かりやすい例です。この文書は月間の稼働率を定義し、下回った場合の救済としてサービスクレジットを定めています。公式の文言は「サービスクレジットによって、AWSからの返金その他の支払いを受ける権利が生じるものではない」というもので、将来の請求への充当であり払い戻しではありません。さらに「本SLAは、可用性に関する利用者の唯一かつ排他的な救済手段と、AWSの唯一かつ排他的な義務を定めるものである」と書かれています。受け取るには利用者からの申請が必要で、事象が起きた請求サイクルの次の次のサイクルの終わりまでに、日時、対象のリージョン、資源の識別子、裏付けとなる記録を添えて提出することが求められます。AWSの制御が及ばない外部要因や、利用者の行為や機器に起因する停止は対象から除かれます。
3社ともSLAはサービスごとに用意されています。AWSは「有料で一般提供されているすべてのサービスについてSLAを提供する」と述べ、Google Cloudもサービスごとの一覧を公開しています。Azureの公式のフレームワークは「サービスごとにSLAは異なり、同じサービスの中でも製品によって異なることがある」と明記し、読み方についての警告も書いています。「SLAは提供内容の全体を保証するものではない」。あるサービスの可用性が特定の応答を返すことで定義されている場合、その定義の外にある機能には金銭的な裏付けのある保証は付かない、という例が挙げられています。「高い数字が書いてあるから大丈夫」ではなく、「何が可用と定義されているか」を読むのが正しい読み方です。同じ文書は「複合のSLOの値は、寄与する各要素の積になる」とも書いています。依存を足していくと全体の水準は下がり、さらに利用者側の不具合や構成の誤りや変更作業による停止は、事業者のSLAの外側にあります。
本記事では具体的なSLAの数値を書きません。サービスごとに違い、構成によって違い、そして改定されるからです。持ち帰っていただきたいのは数値ではなく4つの問いです。1つ、その文書は何を可用と定義しているか。2つ、除外されているのはどんな場合か。3つ、達成されなかったときの救済は何で、どうすれば受け取れるのか。4つ、自分の構成は依存をいくつ積み重ねているか。この4つを確かめられれば、どのサービスのSLAを渡されても読めます。
本章では3社に共通して出てくる前提を揃えました。リージョンとゾーンは呼び名だけでなく数の前提も違うこと、責任の分担は3社とも同じ絵ではないこと、IaaS・PaaS・SaaSではサービスを分類しきれないこと、器の単位と課金の単位は最初に決める価値があること、SLAは数値ではなく定義と除外を読むものであることです。第2章からはこの土台の上で個別のカテゴリに入ります。最初は計算資源とコンテナで、選択の軸は本章で置いた「どこまで運用を手放すか」になります。
この章を深めたい方への参考書籍
『図解即戦力 ITインフラのしくみと技術がこれ1冊でしっかりわかる教科書』(鶴長鎮一・山本尚明・山根武信・北崎恵凡、技術評論社):ネットワーク、サーバー、クラウドサービスの基礎を、事業者に依存しない形で通して押さえられる1冊です。本章で扱ったデータセンターやリージョンの話は、そもそもの物理的な仕組みを知っていると腹落ちが早くなります。
『図解即戦力 Microsoft Azureのしくみと技術がこれ1冊でしっかりわかる教科書』(竹島友理・横山依子、技術評論社):本章で「Azure固有の言葉」として切り出したジオ、リージョンペア、可用性セット、サブスクリプション、リソースグループを、1冊でまとめて追えます。Azureの語彙は他の2社と対応させにくいので、独立した1冊で覚えるほうが早いと考えています。
『図解即戦力 Google Cloudのしくみと技術がこれ1冊でしっかりわかる教科書[改訂2版]』(株式会社grasys・大沼翔・西岡典生、技術評論社):組織とフォルダとプロジェクトという階層や、ゾーンの考え方を図で確認できます。クラウドの書籍は版が進むのが速いので、購入時は最新の版をご確認ください。
第2章 コンピューティングとコンテナ
前章では、3社に共通して出てくる前提を揃えました。リージョンとゾーンは呼び名も数の前提も違うこと、責任の分担は3社とも同じ絵ではないこと、そして本記事が繰り返し使う軸として「どこまで運用を手放すか」を置いたことです。本章では、その軸をいちばん具体的に確かめられる領域に入ります。プログラムを実際に動かす場所、つまり計算資源とコンテナです。
この領域は、3社とも選択肢が多く、しかも用途が重なっています。仮想マシンを借りて中身を自分で組むこともできますし、コンテナを動かすための基盤を借りることも、出来上がったアプリケーションを載せるだけで動く環境を選ぶこともできます。どれを選んでも、同じアプリケーションはたいてい動きます。違うのは、動かし続けるために自分の手元に残る作業の量と、そのかわりに狭くなる自由度です。本章では、3社のサービスを横に並べながら、それぞれの選択で何が残り、何が消えるのかを見ていきます。なお、関数を単位にする実行環境、いわゆる関数型のサーバーレスは第7章で扱います。ネットワークの設計は第8章、権限の設計は第9章、費用の考え方は第12章です。
仮想マシンは、いちばん多くを自分の手元に残す選択肢
3社とも、計算資源のいちばん下の層として仮想マシンを提供しています。AWSはAmazon EC2、AzureはAzure Virtual Machines、Google CloudはCompute Engineです。公式の説明の言い回しは3社で少しずつ違います。AWSは自社のサービス概要で、Amazon EC2を「安全で、大きさを変えられる計算能力をクラウドで提供するウェブサービス」と説明しています。Azureは、Azure Virtual Machinesを「Azureが提供する、要求に応じて使える拡張可能な計算資源のうちの1つの型」と説明しています。Google Cloudは、Compute Engineを「自分で管理する仮想マシンのインスタンスとベアメタルのインスタンスを提供するIaaSの製品」と説明しています。
この3つの説明を並べると、Google Cloudだけが「自分で管理する」という言葉を定義の中に入れていることに気づきます。これは書き方の癖の違いにも読めますが、仮想マシンという選択肢の性格を最も率直に言い表してもいます。仮想マシンを選ぶということは、OSの更新も、ミドルウェアの導入も、障害時の入れ替えも、規模の増減も、原則として自分の側で設計するということです。前章の責任共有モデルでいえば、事業者が持つのは物理的な基盤と仮想化の層までで、その上はほぼすべて利用者の側に残ります。
手元に残るものが多いということは、裏返せば選べる範囲が広いということでもあります。特定のOSのバージョンが要る、ライセンスの都合で決まった構成にしなければならない、既存の運用手順をそのまま持ち込みたい、といった事情があるときは、仮想マシンがいちばん素直な答えになります。Compute Engineの説明にベアメタルのインスタンスが併記されているのも同じ文脈で、仮想化そのものが制約になる要件のために、より下の層まで開けてあるということです。
逆に、仮想マシンを選ばないほうがよい場面もはっきりしています。動かしたいものが一般的なウェブアプリケーションで、OSの細部にこだわりが無く、運用に割ける人手が限られている場合です。その条件で仮想マシンを選ぶと、本来やりたかったことではない作業、つまりOSの更新や監視の作り込みや障害時の手当てが、恒常的な負担として残り続けます。本章の後半で扱う実行環境やコンテナの基盤は、その負担を減らすために用意されている選択肢だと考えると位置づけが分かりやすくなります。
台数を増減させる仕組みは、3社とも「群れ」を単位にする
仮想マシンを1台だけ立てて運用することは、実務ではあまりありません。負荷に応じて台数を増減させたい、1台が壊れても止まらないようにしたい、という要求が必ず出てくるからです。3社はこの要求に対して、よく似た考え方の仕組みを用意しています。同じ構成の仮想マシンをひとまとまりの群れとして扱い、その群れに対して台数を指示するという考え方です。
AWSはこれをAmazon EC2 Auto Scalingと呼び、群れをAuto Scalingグループと呼びます。公式ドキュメントは、この仕組みを「アプリケーションの負荷を処理するのに正しい台数のEC2インスタンスが用意されている状態を保つのを助けるもの」と説明しています。グループには最小の台数、最大の台数、そして希望する台数を指定でき、指定した最小を下回らないこと、最大を上回らないことが保証されます。スケーリングポリシーを指定すれば、需要の増減に応じて起動と終了が自動で行われます。加えて、実行中のインスタンスの健全性と可用性を監視し、終了したものや不調になったものを置き換えて希望する台数を保つことが明記されています。アプリケーションが期待どおりに応答しているかを見る独自のヘルスチェックを定義でき、それに失敗したインスタンスも置き換えの対象になります。
Azureの対応物はAzure Virtual Machine Scale Setsです。公式ドキュメントは「負荷分散された仮想マシンのインスタンスの集まりを作成して管理できるようにするもの」と定義し、台数は「需要または定められたスケジュールに応じて自動的に増減しうる」と書いています。可用性ゾーンや障害ドメインにまたがってインスタンスを分散させることで可用性と回復性を高めること、需要が低いときに不要な仮想マシンの数を減らせることも挙げられています。規模については、標準の市場提供イメージとAzure Compute Galleryの独自イメージでは最大1,000インスタンス、マネージドイメージを使う場合は600インスタンスという上限が明記されています。不調な個体の入れ替えについては、概要とは別のページに自動インスタンス修復という機能の説明があります。スケールセットに自動修復のポリシーを有効にしておくと、Application Health拡張機能またはロードバランサーのヘルスプローブが不健全なインスタンスを見つけたときに、既定では削除して新しいインスタンスに置き換え、設定によっては再イメージ化や再起動で回復を試みる、という仕組みです。ポリシーを有効にしなければ動きません。
もう1つ、Azureにはこの領域に固有の分岐があります。オーケストレーションのモードです。公式ドキュメントはFlexibleというモードについて、リージョン内やゾーン内の障害ドメインに仮想マシンを分散させることで最大1,000台までの可用性の保証を提供すると説明し、定足数を必要とする処理、オープンソースのデータベース、状態を持つアプリケーションなどを適した用途として挙げています。そして重要な但し書きがあります。オーケストレーションのモードはスケールセットを作るときに決まり、あとから変更も更新もできません。作る前に決める項目である、ということです。
Google Cloudの対応物はマネージドインスタンスグループです。公式ドキュメントは「同一の複数の仮想マシンの上でアプリケーションを運用できるようにするもの」と説明し、自動修復、自動スケーリング、自動更新、リージョン単位の配置、負荷分散との連携を機能として挙げています。自動修復については、ヘルスチェックによってアプリケーションが応答しているかを確かめ、失敗した仮想マシンを自動的に修復すると書かれています。自動スケーリングについては、需要に合わせてグループ内の台数を増やし、需要が下がれば減らすと説明されています。リージョンのマネージドインスタンスグループは複数のゾーンに負荷を分散でき、ゾーン単位の障害から守られるとされています。あわせて、任意の構成の仮想マシンを自由に出し入れできるアンマネージドのインスタンスグループも存在します。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 仮想マシンのサービス | Amazon EC2 | Azure Virtual Machines | Compute Engine |
| 同じ構成の仮想マシンをまとめる単位 | Auto Scalingグループ | 仮想マシンスケールセット | マネージドインスタンスグループ |
| 台数の増減についての公式の記述 | 最小・最大・希望する台数を指定し、スケーリングポリシーに応じて起動と終了を行う | 需要または定められたスケジュールに応じて自動的に増減しうる | 需要に合わせて台数を増やし、需要が下がれば減らす |
| 障害の分散についての公式の記述 | 複数のアベイラビリティゾーンを指定でき、増減に合わせて均等に配置する | 可用性ゾーンまたは障害ドメインにまたがって分散させる | リージョンのグループは複数のゾーンに負荷を分散する |
| 不調な個体の入れ替えについての公式の記述 | 健全性を監視し、終了したものや不調なものを置き換える。独自のヘルスチェックも定義できる | 自動修復のポリシーを有効にすると、Application Health拡張機能またはロードバランサーのヘルスプローブで不健全と判定された個体を、置き換え・再イメージ化・再起動のいずれかで回復させる | ヘルスチェックに失敗した仮想マシンを自動的に修復する |
| 作る前に決める必要がある分岐 | 本章の照合では、あとから変更できない選択の明記は確認していない | オーケストレーションのモードは作成時に決まり、変更できない | 本章の照合では、あとから変更できない選択の明記は確認していない |
この表は横に並んでいるだけで、同じ役割の枠に入るというだけであり、同じものではありません。とくに最後の行は、3社の差ではなく調べ方の差かもしれない点に注意してください。空欄に近い書き方をしたセルは「そのような仕組みが無い」という意味ではなく、本章の照合で公式ドキュメントの記述を確認できなかった、という意味です。なお、不調な個体の入れ替えの行は、3社とも仕組みがある点では揃いましたが、Azureのものはポリシーを有効にして使う機能であり、既定で動くものではありません。逆に、確認できた範囲でも読み替えは危険です。Azureのオーケストレーションのモードのように、あとから変えられない分岐がある仕組みと、そうした分岐が公式ドキュメントに見当たらない仕組みを、同じ手順で設計すると事故になります。台数を増減させる仕組みは3社とも似ていますが、作る前に決めなければならない項目の数は同じではありません。
コンテナを動かす基盤は、Kubernetesを使うかどうかで分かれる
仮想マシンの次の層がコンテナです。コンテナは、アプリケーションと、それが動くのに必要な部品をひとまとめに詰めた実行の単位です。同じ入れ物をそのまま別の場所へ持って行けるため、開発した環境と本番の環境の食い違いが減り、台数を増やすときの手順も揃います。ただし、コンテナは1つ動かすだけなら簡単でも、多数を継続して動かすとなると、どこに配置するか、落ちたらどうするか、更新をどう配るかを誰かが決めなければなりません。この役割を担う仕組みがオーケストレータで、3社が提供しているコンテナの実行基盤は、事実上ここの選び方の話になります。
いちばん大きな分岐は、オーケストレータとしてKubernetesを使うかどうかです。Kubernetesはコンテナを配置し、稼働を維持し、規模を増減させるためのオープンソースの仕組みで、事業者をまたいで基本的な考え方と設定の書き方の多くが通用します。3社とも、このKubernetesを自社で動かして提供するサービスを持っています。AWSのAmazon EKS、AzureのAzure Kubernetes Service、Google CloudのGoogle Kubernetes Engineです。これらをまとめてマネージドKubernetesと呼びます。公式の説明はそれぞれ、Amazon EKSが「Kubernetesを使ってコンテナ化されたアプリケーションを配置し、管理し、規模を変えることを容易にするもの」、Azure Kubernetes Serviceが「コンテナ化されたアプリケーションを配置し管理するためのマネージドのKubernetesサービス」、Google Kubernetes Engineが「オープンソースのコンテナオーケストレーション基盤であるKubernetesのマネージドな実装」となっています。
もう一方の道が、Kubernetesを使わないコンテナの実行基盤です。AWSはAmazon ECSを持っており、公式は「Dockerのコンテナに対応した、拡張性と性能の高いコンテナオーケストレーションのサービス」と説明しています。AzureにはAzure Container Instancesがあり、公式は「仮想マシンを一切管理することなく、また上位のサービスを採用することもなく、LinuxまたはWindowsのコンテナをAzureで動かす最も速く簡単な方法」と説明しています。この言い回しは、そのまま位置づけの説明にもなっています。Azure Container Instancesは、オーケストレータを持ち込まずにコンテナを単発で動かすための場所である、ということです。実際、公式は多数の関連するコンテナグループを扱うためのNGroupsという機能や、Azure Kubernetes Serviceのクラスターから仮想ノードを通じてコンテナグループを配置する使い方も併記しており、単体で完結させるだけの道具ではないことが読み取れます。ただしNGroupsについては、その説明ページに、利用するにはプレビュー版のAPIバージョン(正式提供前の試験的な版の呼び出し口)を使い、プレビュー機能を契約の単位であるサブスクリプションに登録する必要があると書かれています。つまり、まだ正式提供の機能ではありません。採用を検討するときは、この前提を先に確かめる必要があります。
ここで、経営の側で判断が要る論点を1つ挙げておきます。Kubernetesを選ぶかどうかは、技術の好みではなく、組織が抱える運用の量を決める選択です。Kubernetesは事業者をまたいで通用する共通の語彙を与えてくれますが、そのぶん覚えることが多く、設定の自由度が高く、間違えられる箇所も多くなります。一方で、事業者に固有のオーケストレータを選ぶと、覚えることは減りますが、その事業者の外へ同じ構成を持ち出しにくくなります。どちらが良いという話ではなく、その組織がどこに人手をかけたいのか、そして将来どの程度の移動可能性を求めるのかで決まる話だと考えています。移行やマルチクラウドの観点からの整理は第11章で扱います。
マネージドKubernetesを選んでも、選択はまだ終わらない
「マネージド」という言葉は、その仕組みを動かし続ける作業を事業者が引き受けてくれることを意味します。ところがKubernetesの場合、引き受けてもらえる範囲が2段階に分かれています。1つはクラスターの頭脳にあたる制御プレーンで、これは3社とも事業者が管理します。Azureの公式ドキュメントは、クラスターを作ると制御プレーンが自動的に作成・構成されること、健全性の監視や保守といった重要な運用はAzureが引き受けること、利用者が費用を負担するのはアプリケーションを動かすノードであることを明記しています。もう1つが、実際にコンテナが載るノード、つまり仮想マシンの群れです。ここを誰が持つかが、いま3社で最も動きのある論点になっています。
Azureは、この分岐をクラスターのモードとして正面から製品化しました。公式ドキュメントは、Azure Kubernetes Serviceに2つのモードがあると書いています。AKS Automaticは「本番に耐える既定値を備えた、完全にマネージドな体験」で、ノードの管理、規模の調整、セキュリティ、監視、更新をAzureが自動的に行うとされ、「ほとんどのチームとワークロードに推奨」と明記されています。AKS Standardは「クラスターの構成とノードプールの管理を完全に制御できる」形で、固有の基盤の要件がある場合や、既存の自動化がある場合に推奨されています。加えて、独自のネットワーク構成、Windowsのノードプール、Automaticでまだ使えない特定の仮想マシンのSKUが必要な場合、あるいは手動のクラスター管理を前提にした自動化がすでにある場合はAKS Standardを使う、という具体的な判断基準も書かれています。
Google Cloudも同じ分岐を持っており、こちらはモードの名前がAutopilotとStandardです。公式ドキュメントはAutopilotを「Googleが基盤の大部分を引き受けるマネージドな体験で、利用者はアプリケーションに集中できるもの」と説明し、Googleがノード、規模の調整、セキュリティなどの構成を管理すること、ワークロードに合わせてノードを新しく作ったり自動の更新と修復を設定したりする必要が無いことを挙げています。そのうえで「Autopilotのクラスターは、クラスター全体がGoogleのベストプラクティスを既定で使うため、GKEを使ううえで推奨される方法である」と明記しています。Standardについては「クラスターの基盤を自分で制御し、ほとんどの設定を変更できる」と説明されています。
AWSでこの位置に当たるものは、本章の照合で2つ確認できました。1つはEKS Auto Modeです。Amazon EKSのユーザーガイドは、EKS Auto Modeを「Kubernetesのクラスターに対するAWSの管理をクラスターそのものの外へ広げ、ワークロードを円滑に動かすための基盤もAWSが用意し管理できるようにするもの」と説明し、AWSが管理する基盤の例として、計算資源の自動スケーリング、ポッドとサービスのネットワーク、アプリケーションの負荷分散、クラスターのDNS、ブロックストレージ、GPUの対応を挙げています。責任分担の節には、起動されるEC2インスタンスの構成、管理、セキュリティ、規模の調整をEKS Auto Modeが引き受けると書かれており、ノードへのSSHやSSM(AWS Systems Manager の遠隔操作の仕組み)による直接のアクセスは許可されないこと、ノードには最長21日の寿命があり自動的に新しいノードへ置き換えられることも明記されています。新しいクラスターとして作ることも、既存のクラスターで有効にすることもできます。そして、コンソールから始める入門ページの冒頭には、EKS Auto Modeがノードを配置するうえで望ましい方法である、と明記されています。ノードの選択肢を並べたページによれば、Amazon EKSのクラスターは、EKS Auto Modeが管理するノード、自分で管理するノード、マネージドノードグループ(ノードの更新や入れ替えをAWSが代行する形)、AWS Fargate、ハイブリッドノード(自社の建物にある機械をノードとしてつなぐ形)のどの組み合わせにもポッドを配置できます。
もう1つがAWS Fargateです。Amazon EKSのユーザーガイドは、Fargateを「コンテナのために、必要なときに必要な大きさの計算能力を提供する技術」と説明し、コンテナを動かすために仮想マシンの群れを自分で用意し、設定し、規模を調整する必要が無いこと、サーバーの種類を選んだり、ノードのグループをいつ増やすか決めたり、クラスターの詰め込み方を最適化したりする必要が無いことを挙げています。どのポッドをFargateで動かすかはFargateプロファイルで制御します。Amazon ECSの開発者ガイドにも同じ趣旨の説明があり、こちらでは仮想マシンのクラスターを用意・設定・拡張することなくコンテナを動かせる技術として位置づけられています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| マネージドKubernetesのサービス | Amazon EKS | Azure Kubernetes Service | Google Kubernetes Engine |
| ノードの持ち方についての選択肢 | EKS Auto Modeをクラスターで有効にすると、ノードの用意から規模の調整までをAWSが引き受ける。Fargateプロファイルを使えば、指定したポッドをノードを自分で用意せずに動かせる。自分で管理するノードやマネージドノードグループとも組み合わせられる | AKS AutomaticとAKS Standardの2つのクラスターモード | AutopilotモードとStandardモード。Standardクラスターの中でも、ComputeClassを使えば一部のワークロードをAutopilotモードで動かせる |
| 公式が新規に薦めている形 | 入門ページの冒頭に、EKS Auto Modeがノードを配置するうえで望ましい方法と明記 | ほとんどの新しいワークロードにはAKS Automaticを推奨と明記 | Autopilotのクラスターが推奨される方法と明記 |
| 手放したときに事業者が引き受けるもの | EKS Auto Modeでは、起動されるEC2インスタンスの構成・管理・セキュリティ・規模の調整と、負荷分散・IPアドレスの管理・ネットワークポリシー・ブロックストレージ。Fargateでは、仮想マシンの用意・設定・規模の調整、サーバーの種類の選択 | ノードの用意、規模の調整、セキュリティ、監視、更新 | ノード、規模の調整、セキュリティなどの構成 |
| 手放した結果として受ける制約の例 | EKS Auto Modeではノードへの直接のアクセスが不可、Windowsのコンテナは非対応、独自のAMI(仮想マシンの起動に使う自前のイメージ)は使えない。EKSのFargateではデーモンセットに非対応、GPUを使えない、Amazon EBSのボリュームを付けられない、ポッドはプライベートサブネットでのみ動く | 独自のネットワーク構成、Windowsのノードプール、Automaticで未提供の仮想マシンのSKUが必要ならAKS Standardを使う | Autopilotでは、特権モードのコンテナ(通常より広い権限で動かすコンテナ)は動かせない(Googleのパートナーが配置するものを除く)、ホストの名前空間(コンテナからノードの機械そのものの資源を直接見る設定)は使えない、hostPathのボリューム(ノードの記録媒体を直接つなぐ設定)は書き込みモードでは使えない、hostNetwork(ノードのネットワークをそのまま使う設定)は使えない、ノードへのSSHは不可 |
この表も、横に並んでいるだけで同じものではありません。とくに2行目は、単位の違うものを同じ行に置いています。AzureのAKS AutomaticとAKS Standardはクラスターの単位で決まる設定です。Google CloudのAutopilotとStandardもクラスターのモードですが、それだけではありません。公式ドキュメントには、ComputeClassというKubernetesのカスタムリソースでAutopilotモードを有効にすれば、Standardクラスターの中でも一部のワークロードをAutopilotモードで動かせること、つまりAutopilotのワークロードはAutopilotクラスターでもStandardクラスターでも動かせることが書かれています。AWSはさらに分かれていて、EKS Auto Modeはクラスターに対して有効にする設定で、有効にしたあとも他の種類のノードと組み合わせられます。FargateプロファイルはKubernetesのモードではなく、どのポッドをどこで動かすかという、より細かい単位の指定です。「クラスターを作るときにモードを1回選べば終わり」という筋書きは、少なくともGoogle CloudとAWSには当てはまりません。ノードを手放す単位がクラスター全体なのか、その中の一部のワークロードなのかを、選ぶ前に確かめる必要があります。もう1つ強調しておきたいのは5行目です。運用を手放すと、選べる範囲が具体的に狭くなります。Amazon EKSのFargateについて公式が挙げている制約は、どれも設計の初期に効いてくるものばかりです。デーモンセットが使えないなら、ログ収集や監視の常駐プロセスは各ポッドの中に同居させる作りに変える必要があります。EKS Auto Modeでは、ノードにSSHで入る運用がそもそもできません。Google CloudのAutopilotについても、特権モードのコンテナやホストの名前空間が使えないといった制約が公式に整理されています。いずれも、コンテナにノードの機械そのものを直接触らせる種類の設定で、そうした権限を前提にした構成は持ち込めません。自社のコンテナがこの種の設定を使っているかどうかは、開発の担当に確かめる必要があります。この種の制約は、選んだあとに気づくと構成をやり直すことになります。
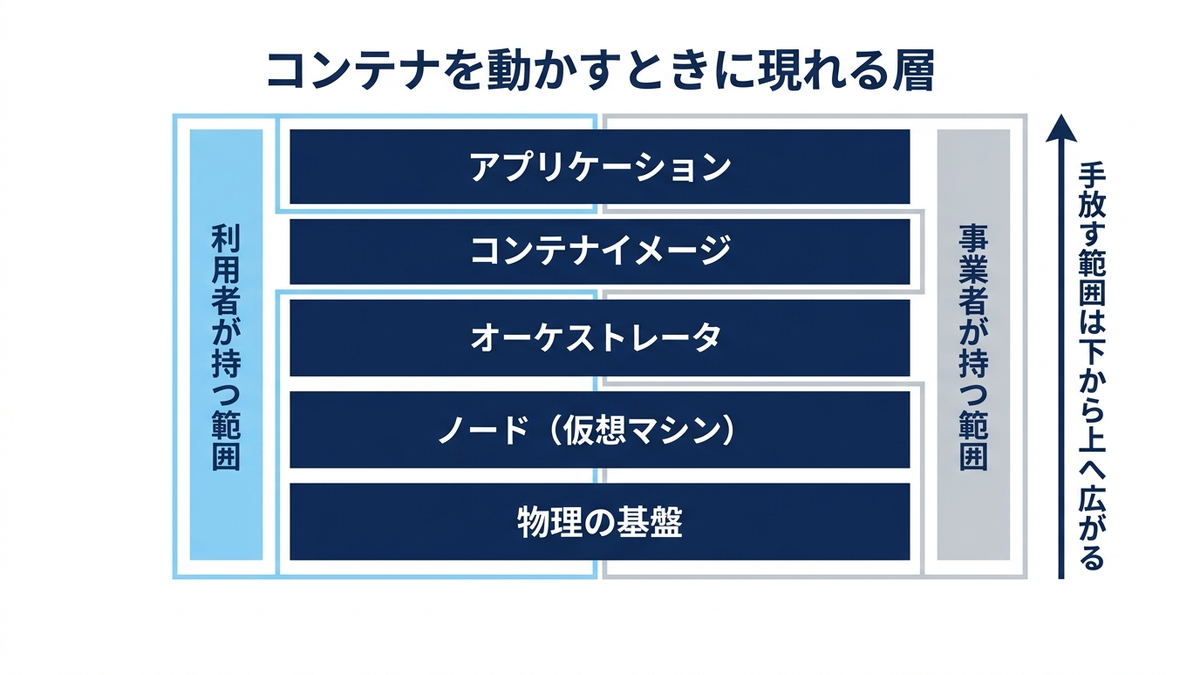
コンテナの置き場所を決めるレジストリ
コンテナを動かす基盤を決めたら、そのコンテナのイメージをどこに置くかを決める必要があります。これを担うのがコンテナレジストリです。地味な部品ですが、開発の側から見れば毎回の配置で必ず経由する場所であり、権限やネットワークの設計にも関わるため、あとから移すと手間がかかります。
AWSはAmazon ECRを提供しています。公式は「フルマネージドのDockerコンテナレジストリ」と説明しています。AzureはAzure Container Registryで、公式は「オープンソースのDockerの基盤に基づくマネージドのレジストリサービス」と説明しています。Google CloudはArtifact Registryで、公式は「成果物とビルドの依存関係を、Google Cloudの統合された体験の一部として一元的に保管できるようにするもの」と説明しています。3つとも「コンテナイメージを置く場所」として横に並びますが、Google Cloudの説明だけが、コンテナイメージに限定していない言い回しになっている点は覚えておく価値があります。
この分野には、本記事全体を通しても重要な実例があります。Google CloudのContainer Registryは、すでに停止しています。公式の廃止に関するページには、2025年3月18日をもってContainer Registryは停止され、Container Registryへのイメージの書き込みはできない、と明記されています。同じページは、Google Cloudにおけるコンテナイメージの保管と管理には、Artifact Registryが推奨されるサービスであると述べています。
ここで、調べ方の落とし穴を1つ共有します。Artifact Registryの概要ページには「Artifact RegistryはContainer Registryの機能を広げたもので、Google Cloudで推奨されるコンテナレジストリである」という趣旨のことしか書かれていません。この一文だけを読むと、「新しいほうが推奨されているが、古いほうもまだある」と読めてしまいます。停止の日付は、廃止の専用ページを開かないと出てきません。名前が似ていて後継関係にあるサービスは、後継側のページだけを見て現況を判断すると誤ります。これは第14章で扱う「名前と構成の動き方」にも直結する話です。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 現行のコンテナレジストリ | Amazon ECR | Azure Container Registry | Artifact Registry |
| 公式の説明の要点 | フルマネージドのDockerコンテナレジストリ | オープンソースのDockerの基盤に基づくマネージドのレジストリサービス | 成果物とビルドの依存関係を一元的に保管する |
| 前の世代のレジストリの扱い | 本章の照合では、前の世代にあたるレジストリの終了告知は確認していない | 本章の照合では、前の世代にあたるレジストリの終了告知は確認していない | Container Registryは2025年3月18日に停止し、イメージの書き込みができない |
この表も、同じ役割の枠に入るだけで同じものではありません。3つとも「コンテナイメージの置き場所」ですが、対象の範囲、他のサービスとの結びつき方、権限の与え方は揃っていません。表の3行目についても、AWSとAzureの欄は「前の世代のレジストリが今も使える」という意味ではなく、本章の照合ではそのような告知を確認していない、という意味です。前章で述べたとおり、公式の一覧に載っていないことは提供終了の証明にも現役の証明にもなりません。
アプリケーションを載せるだけの実行環境と、3社で割れた姿勢
ここまでは、仮想マシンとコンテナという「入れ物」の話でした。もう1つ、3社とも古くから持っている選択肢があります。出来上がったアプリケーションを載せるだけで動く実行環境です。利用者はプログラムを渡すだけで、その下の仮想マシン、OS、ミドルウェア、負荷分散、規模の増減は事業者が面倒を見ます。前章の区分でいえばPaaSにあたり、本章の軸でいえば「運用を大きく手放した側」に位置します。
AWSのAWS Elastic Beanstalkは、公式に「ウェブアプリケーションとサービスを配置し、規模を変えるための、使いやすいサービス」と説明されています。AzureのAzure App Serviceは「基盤の管理を気にすることなく、ウェブアプリケーション、モバイルのバックエンド、RESTfulなAPIを動かせる基盤」と説明されています。Google CloudのApp Engineには、standard環境とflexible環境という2つの環境があります。
この3つは、対応表を作れば同じ行に並びます。ところが、2026年9月時点で公式ドキュメントを読み比べると、各社の姿勢は同じではありません。これは対応表からは絶対に読み取れず、しかも新規の採用の判断に直接効くので、事実として書いておきます。
Google CloudのApp Engineの公式ドキュメントには、次の趣旨の記述があります。新しくGoogle Cloudを使う利用者には、App Engineよりも推奨される代替としてCloud Runを使うことを薦める。Cloud Runは完全にマネージドな現代的なアプリケーションのホスティング基盤であり、GPUのような進んだ機能により低い費用で使える。これから始める案件についてはCloud Runを評価すること、あるいは既存のアプリケーションを新しくするためにCloud Runを使うことを薦める。つまり、公式が新規の利用者を別のサービスへ誘導しています。ただしApp Engineが提供終了になったわけではありません。standard環境とflexible環境の説明は現在もページに存在します。
一方、AWS Elastic Beanstalkの開発者ガイドの概要ページを通して読んでも、非推奨の告知も、保守だけの状態にするという告知も、他のサービスへの誘導も、1つも書かれていません。それどころか、AWSのサービス概要には「Amazon Lightsail、AWS Elastic Beanstalk、Amazon EC2のどれを選ぶか」という判断のためのガイドへのリンクが置かれており、現役の選択肢として案内されています。Azure App Serviceの概要ページも同様で、Azure Container Appsへ誘導する記述はありません。むしろ、レガシーな資産のための新しい選択肢が追記されています。
そして、この領域で本章の照合中に見つかった、いちばん見落としやすい事実があります。AWSには、より新しく、より簡単な選択肢としてAWS App Runnerがありましたが、これは新規の受け付けを終えています。AWSの公式のライフサイクルの一覧のうち、新規に利用を開始できない「保守の段階」にあるサービスの表に、AWS App Runnerが2026年3月31日の告知として掲載されています。新規の顧客を受け付けなくなったのは、同じ告知によれば2026年4月30日からです。App Runnerの開発者ガイドの冒頭にも、新規の顧客には開かれておらず、既存の顧客はこれまでどおり利用できる、という告知が出ています。専用のページには、慎重な検討の結果として新規の顧客に対してApp Runnerを閉じることを決めたこと、既存の顧客は新しい資源やサービスの作成を含めてこれまでどおり使えること、セキュリティと可用性への投資は続けるが新機能の追加は予定していないことが書かれています。移行先として案内されているのはAmazon ECS Express Modeで、こちらは1回のAPIの呼び出しでコンテナのイメージと2つのIAMのロールを渡すと、Fargateの上のECSのサービス、アプリケーションロードバランサー、自動の規模調整、ネットワークまでを一式作る仕組みだと説明されています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 古くからあるPaaS型の実行環境 | AWS Elastic Beanstalk | Azure App Service | App Engine |
| 公式ドキュメントの現在の姿勢 | 誘導も終了の告知も無い。判断のガイドで現役の選択肢として案内 | 誘導も終了の告知も無い。レガシー資産向けの選択肢が追記されている | 新規の利用者にはCloud Runを推奨と明記。ただし提供終了ではない |
| あとから加わったコンテナ寄りの実行環境 | AWS App Runner | Azure Container Apps | Cloud Run。詳細は第7章 |
| 新規の受け付けについての告知 | App Runnerは2026年3月31日の告知で新規に開始できない段階の一覧に掲載。移行先はAmazon ECS Express Mode | 本章の照合では、該当する告知は確認していない | 本章の照合では、該当する告知は確認していない |
この表も、同じ役割の枠に入るだけで同じものではありません。そのうえで、この表から読み取ってよいことと、読み取ってはいけないことを分けておきます。読み取ってよいのは、「初期からあるPaaS型の実行環境について、新しい選択肢へ明示的に誘導しているのはGoogle Cloudだけである」という事実です。AWS Elastic BeanstalkとAzure App Serviceには、誘導も終了の告知もありません。読み取ってはいけないのは、そこから導かれるように見える優劣です。誘導しているから見放しているとも、誘導していないから安泰だとも言えません。実際、AWSは古いほうのAWS Elastic Beanstalkを現役として案内しつつ、新しいほうのAWS App Runnerを新規に開かない側へ動かしました。「新しいサービスのほうが長く続く」という直感は、この事例では成り立ちません。新規に採用する場面では、そのサービスのライフサイクルの状態を公式の一覧で確かめる、という手順を毎回踏むほうが確実です。各社の一覧の所在と読み方は第14章で整理します。
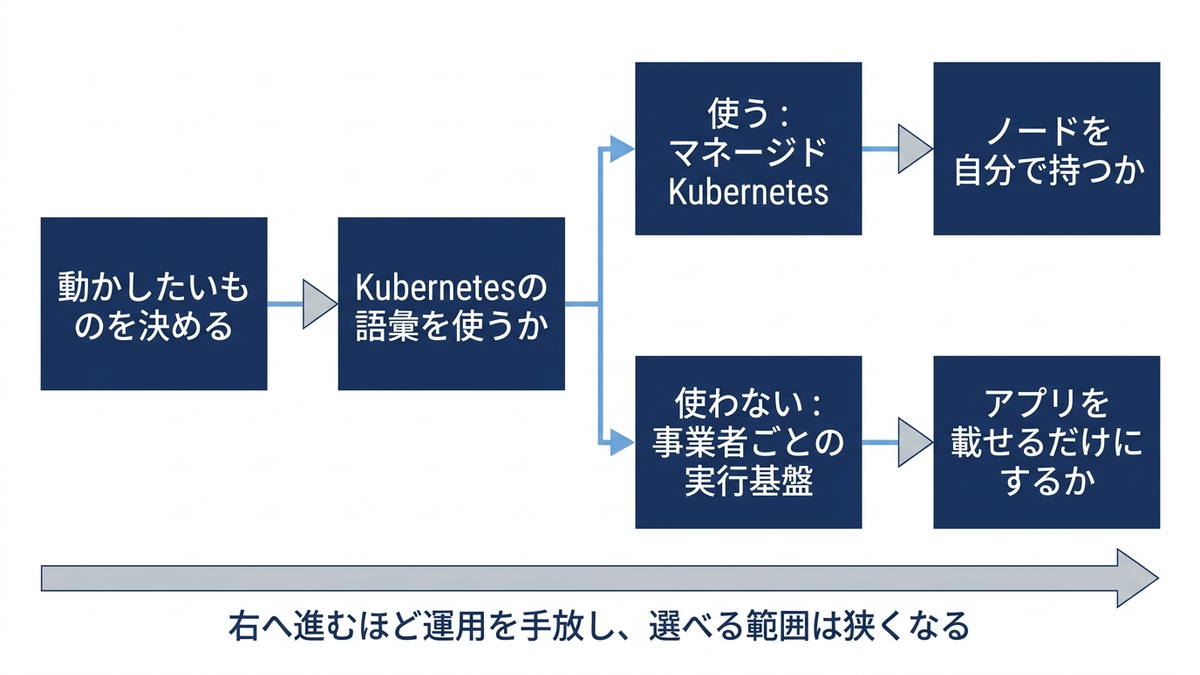
コンテナ型の実行環境が、関数の置き場所にもなっている
本章で扱ってきた「コンテナを載せる実行環境」は、いま別の役割も引き受け始めています。関数の置き場所です。ここは第7章の担当範囲に深く関わるので、本章では接続だけを書きます。
AzureのAzure Container Appsは、公式に「基盤を管理することなくコンテナ化されたアプリケーションを動かすための、サーバーレスの基盤」と説明されています。ここまでは、本章で扱ってきた実行環境の1つです。ところがAzure Kubernetes Serviceの公式ドキュメントにある「Azureのコンテナの選択肢」の表を見ると、Azure Container Appsの資源の種別は「マネージドKubernetes」と書かれています。同じ表で、Azure Container Instancesの種別は「マネージドなDockerコンテナのインスタンス」です。利用者から見ればKubernetesを意識しない実行環境でも、事業者の分類ではKubernetesの側に置かれている、ということです。
さらに、Azure Functionsのホスティングの選択肢が再編され、その選択肢の中にAzure Container Appsが含まれる形になっています。現在の公式の表に並ぶのは、推奨とされるFlex Consumptionプラン、Premiumプラン、Dedicatedプラン、Container Apps、そして「従来のサーバーレスのプラン。新しいアプリにはFlex Consumptionプランを使うこと」と注記されたConsumptionプランの5つです。公式ドキュメントは、Azure Container Appsの上のAzure Functionsについて、Azure Functionsのイベント駆動の性質とContainer Appsの機能を組み合わせた、完全にマネージドなサーバーレスのホスティング環境だと説明しています。適した場面として、関数をマイクロサービスやAPIやウェブサイトといった他のコンテナ化されたアプリケーションと並べて動かしたいとき、独自の依存関係が必要なとき、GPUが必要なときが挙げられています。制約も明記されており、配置スロットに非対応であること、Functionsのプロキシに非対応であること、ストレージアカウントの紐づけが必須であることが書かれています。
ここから言えるのは1つです。「関数を使うか、コンテナを使うか」という二択の立て方は、少なくともAzureについては現在の姿を写していません。コンテナの実行環境が関数の置き場所になり、関数の側もコンテナの機能を使えるようになっています。関数そのものの比較と、イベント駆動の設計は第7章で扱います。本章では、コンテナの実行環境を選ぶときに「ここには関数も置ける」という選択肢が増えている、という点だけを押さえておいてください。
仮想デスクトップと、既存の仮想化基盤の持ち込み
最後に、本章の軸から少し外れるものの、計算資源のカテゴリに置かれている2種類のサービスに触れておきます。1つは仮想デスクトップ、もう1つは既存の仮想化基盤をそのまま持ち込むための選択肢です。
Azureは、Azure Virtual Desktopを提供しています。公式は「Azureの上で動く、デスクトップとアプリケーションの仮想化のサービス」と説明しています。同じページには、このサービスが以前はWindows Virtual Desktopという名前だったことも書かれています。改称の日付は本章の照合では確認できなかったため、時期は書きません。用途としては、業務用の端末環境そのものをクラウド側に置き、利用者はどの端末からでも同じ環境に入る、という形になります。サーバーの実行環境とは目的が異なるので、本章の「運用を手放す度合い」の軸とは別の判断で選ぶことになります。
もう1つが、すでに自社で動かしている仮想化の基盤を、そのままクラウドへ持ち込む選択肢です。Google CloudのGoogle Cloud VMware Engineは、公式に「VMwareの基盤をGoogle Cloudで動かせるようにする、完全にマネージドなサービス」と説明されています。既存の仮想マシンの構成や運用の手順を大きく変えずに移すことを狙う場合の選択肢になります。
同じくGoogle Cloudには、専用の物理サーバーを使うBare Metal Solutionがあります。公式は「高性能なベアメタルのサーバーの上で、特殊なワークロードを動かせる安全な環境を提供する」と説明しています。ただしこのサービスには重要な注記が付いています。公式ドキュメントには、Bare Metal Solutionの提供が、許可リストに載った利用者だけを対象とする専用のモデルへ移行しつつあること、既存の顧客はGoogleの担当に連絡し、OracleとGoogle Cloudの新しい提携による提供内容への移行の価値を検討してほしいことが書かれています。これは提供終了ではありませんが、誰でも申し込める状態でもありません。移行の計画にこのサービスを組み込む場合は、まず利用できるかどうかの確認から始める必要があります。移行の型そのものは第11章で扱います。
本章では、計算資源とコンテナの選択肢を、前章で置いた「どこまで運用を手放すか」という軸に沿って並べました。仮想マシンは最も多くを手元に残す選択肢であり、群れとして扱う仕組みは3社とも似ていますが、作る前に決めなければならない項目の数は同じではありません。コンテナの基盤はKubernetesを使うかどうかで大きく分かれ、マネージドKubernetesを選んだあとにも、ノードを自分で持つかどうかという分岐が残ります。そして、アプリケーションを載せるだけの実行環境については、新しい選択肢へ明示的に誘導しているのはGoogle Cloudだけで、AWSはむしろ新しいほうのサービスを新規に開かない側へ動かしました。ここで持ち帰っていただきたいのは、個々のサービス名ではなく、選ぶときに毎回同じ2つを確かめる習慣です。手放した先で自分の手元に何が残るのか、そして手放した結果として何が選べなくなるのか。次の第3章では、同じ問いをデータの保管、つまりストレージに対して繰り返します。
この章を深めたい方への参考書籍
『Kubernetes完全ガイド 第2版』(青山真也、インプレス):本章で「マネージドKubernetes」として3社を横に並べた部分を、Kubernetesそのものの側から深く追える1冊です。事業者ごとのサービス名ではなく共通の語彙のほうを理解しておくと、AWS・Azure・Google Cloudのどれを選んでも設計の考え方を持ち運べます。分量のある本なので、通読よりも必要な章を引く使い方が向いています。
『[改訂新版]イラストでわかるDockerとKubernetes』(徳永航平、技術評論社):コンテナとオーケストレータのしくみを図で押さえたい方に向く1冊です。本章では「コンテナは実行の単位、オーケストレータは配置と維持を決める仕組み」という粒度までしか書いていませんが、その中身を具体的に知っておくと、ノードを手放したときに何が起きるのかが実感として分かります。改訂新版はコンテナランタイム周辺の記述が更新されています。
『AWSコンテナ設計・構築[本格]入門 増補改訂版』(新井雅也・馬勝淳史、SBクリエイティブ):Kubernetesを使わない側、つまりAmazon ECSとFargateを中心にした設計と構築を、手を動かしながらたどれる1冊です。本章で述べた「Kubernetesを選ぶかどうかは運用の量を決める選択である」という論点を、実際の構成の形で確かめられます。クラウドの書籍は版が速く古くなるため、購入時は最新の版をご確認ください。
第3章 ストレージ
前章では計算資源とコンテナを扱い、「どこまで運用を手放すか」という軸で選択肢を並べました。計算する仕組みだけを決めても、そこには何も残りません。処理した結果を置く場所、置いたものを後から取り出す手段、そして置き続けているあいだの手間を誰が持つのか。この3つを決めるのがストレージの選択です。
本章で扱うのは、保管の形が3つに分かれる理由と、その上に載るアクセス階層、階層を自動で動かす仕組み、冗長化の選び方、そしてオンプレミスとの橋渡しです。中心はオブジェクトの保管に置きます。3社とも品ぞろえがいちばん厚く、最初に触れる可能性も高い一方で、他の2つの形との違いが曖昧なまま使われやすい領域だからです。データベースは第4章、保管したデータを分析の基盤として使う話は第5章、保管にかかる費用の考え方は第12章、誰がどのデータに触れてよいかという権限の話は第9章で扱います。本章に書いたサービス名と状態は、各社の公式ドキュメントを直接開いて確かめたものに限りました。確かめられなかったことは、確かめられなかったと書いています。
保管の形は、置き方の違いで3つに分かれる
クラウドのストレージを一覧で眺めると、名前がよく似たサービスがいくつも並んでいて、どれを見ればよいのか決めにくくなります。ここは製品名から入らず、「使う側から見て、どうつながっているか」で3つに割ると見通しがよくなります。割り方は3社に共通しています。
1つめがブロックストレージです。1台の計算資源に接続して、その計算資源からだけ使う器にあたります。利用者から見ると、サーバーに刺さっているディスクとほとんど同じように見えます。オペレーティングシステムを入れる場所、データベースの実体を置く場所、書き込みの遅さがそのまま処理の遅さになるような用途は、ここに置きます。逆に、複数の計算資源から同時に読み書きする用途には向きません。
2つめがファイルストレージです。フォルダとファイルという木の構造を、複数の計算資源が同時にたどれる形で提供します。社内のファイルサーバーをそのままクラウドに持ってきたい場合や、同じ設定ファイルや素材を多数のサーバーから参照したい場合に選びます。既存のアプリケーションを書き換えずに動かしたいときの受け皿になりやすい形でもあります。
3つめがオブジェクトストレージです。ここだけは考え方が違います。ファイルの木をたどるのではなく、入れ物の中に置いた1つ1つの塊に名前を付け、その名前を指定してネットワーク越しに取り出します。オペレーティングシステムから見てディスクのように扱うものではないため、既存のアプリケーションがそのまま使えるとは限りません。その代わり、容量の上限を利用者が気にしなくてよく、置いたまま何年も動かさない使い方に耐えます。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 1台の計算資源に接続して使う器 | Amazon EBS | Azure Managed Disks | Hyperdisk、Persistent Disk |
| 複数の計算資源が同時にたどる共有の木 | Amazon EFS、Amazon FSx の各種 | Azure Files | Filestore |
| 名前を指定して取り出す塊の置き場 | Amazon S3 | Azure Blob Storage | Cloud Storage |
| 取り出しに時間がかかる保管の層 | S3 Glacier 系のストレージクラス | Blob Storage の Archive 層 | Archive storage クラス |
| 機器を送って大量に運ぶ経路 | Snow ファミリ。後述のとおり縮小している | Azure Data Box | Transfer Appliance |
この表は、同じ役割の枠に入るというだけで、同じものではありません。横に並んだ3つは、性能の刻み方も、冗長化の選択肢も、取り出しにかかる時間も揃っていません。たとえば同じ「取り出しに時間がかかる層」の行にあるものでも、AWSとAzureは取り出しの前に復元やリハイドレートという別の操作を要求しますが、Google Cloudの公式ドキュメントは自社のArchive storageについて、データは時間や日の単位ではなくミリ秒で利用できると書いています。行が揃っていることは、置き換えられることを意味しません。
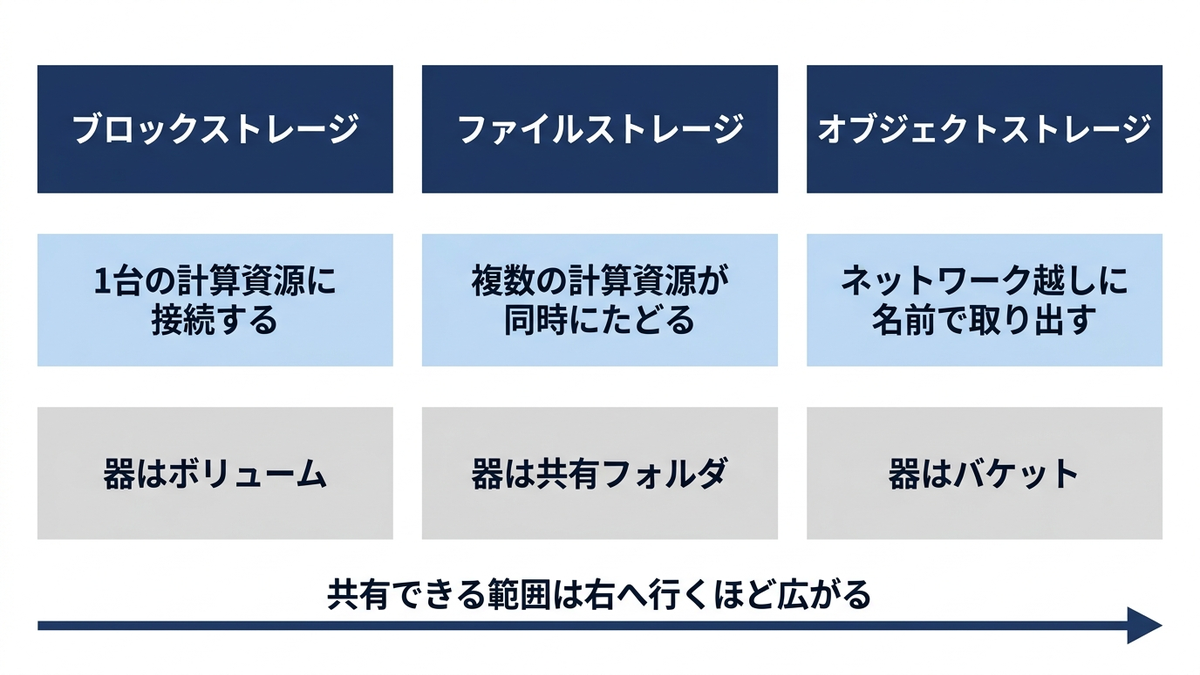
オブジェクトストレージは、置き場ではなく取り出し方で決まる
3社の説明の仕方を並べると、この形が何を売りにしているかが見えてきます。AWSはAmazon S3を、規模・可用性・安全性・性能に優れたオブジェクトストレージのサービスと説明し、11個の9が並ぶ耐久性を目指して設計されていると書いています。Azureは Azure Blob Storage を、マイクロソフトのクラウド向けオブジェクトストレージの解と説明しています。Google CloudはCloud Storageを、バケットと呼ばれる入れ物にオブジェクトとしてデータを保存できる、規模の拡張が効くマネージドのサービスと説明しています。
言葉は違いますが、共通しているのは容量の設計を利用者に求めていない点です。ブロックストレージでは、あらかじめ何ギガバイトの器を作るかを決め、足りなくなったら広げる作業が発生します。オブジェクトの置き場にはその作業がありません。置いた量がそのまま保管量になります。これは運用上かなり大きな違いで、「どれくらい増えるか読めないもの」を置く先としては、まずここが候補になります。ログ、画像、動画、機器から上がってくる測定値、外部から受け取ったファイル。いずれも増え方を事前に読み切れないものです。
選ばないほうがよい場面もはっきりしています。1つは、既存のアプリケーションがファイルの木をたどることを前提に書かれている場合です。書き換えが必要になり、その書き換えは小さくありません。もう1つは、1つのファイルの一部だけを何度も書き換える使い方です。オブジェクトは塊として置き換えるのが基本の形なので、この使い方とは相性がよくありません。データベースの実体を置く先にオブジェクトストレージを選ばないのは、この2つの理由によります。
なお、3社とも入れ物を作るときに置き場所を選びます。Google Cloudのドキュメントは、Cloud Storageのバケットの置き場所として、単一のリージョン、特定の2つのリージョンの組、そして2つ以上のリージョンを含む広い地理的領域という3つの種別に加えて、リージョンの中の1つのゾーンを指定する種別を説明しています。ゾーン単位の種別は、後述する Rapid Bucket でだけ使えるものです。ここも3社で揃っていない部分で、「リージョンを1つ選ぶ」以外の選択肢が最初から用意されているかどうかは、公式ドキュメントで確かめてから設計する価値があります。
アクセス階層は、取り出しをどれだけ待てるかで分かれる
オブジェクトストレージの選択が、単純な置き場の選択で終わらない理由がここにあります。3社とも、同じ入れ物の中に「取り出しやすさの違う層」を用意していて、どの層に置くかで待ち時間と手数が変わります。選択の軸は、アクセス頻度と保管期間の2つです。そして層が冷たくなるほど、最低限置き続けなければならない期間が長くなります。
AWSのS3には、既定のS3 Standard、取り出しが少ないデータ向けのS3 Standard-IAとS3 One Zone-IA、単一のアベイラビリティゾーンに置いて遅延を詰めたS3 Express One Zone、そして長期保管のためのS3 Glacier系が並びます。S3 Glacier系はさらに3つに分かれ、ミリ秒で取り出せるS3 Glacier Instant Retrieval、分から時間の単位で取り出すS3 Glacier Flexible Retrieval、時間の単位で取り出すS3 Glacier Deep Archiveがあります。後ろの2つは、そのままでは読めません。公式ドキュメントは、これらの層のデータは実時間の利用ができず、先に復元の操作をする必要があると明記しています。最低限の保管期間は、S3 Standard-IAとS3 One Zone-IAが30日、S3 Glacier Instant RetrievalとS3 Glacier Flexible Retrievalが90日、S3 Glacier Deep Archiveが180日です。なお、S3 Glacier Flexible Retrieval は公式ページに旧称がAmazon Glacierであると明記されていますが、改称がいつ行われたかは本章の照合では確認できませんでした。
Azureの Blob Storage は、Hot、Cool、Cold、Archive、そしてSmartの5つの層を持ちます。CoolとColdは、名前は似ていても別の層です。最短の保管期間はCoolが30日、Coldが90日、Archiveが180日と公式ドキュメントに書かれています。Archiveだけは性格が違い、公式ドキュメントが「オフラインの層」と呼んでいます。その層にあるあいだは読むことも書き換えることもできず、読むにはオンラインの層へ戻す操作が要ります。この操作には最大15時間かかると明記されています。Smartは層そのものではなく、Hot・Cool・Coldの3つのあいだを利用状況に応じて自動で動かす仕組みとして説明されています。
Google CloudのCloud Storageは、Rapid storage、Standard storage、Nearline storage、Coldline storage、Archive storageの5つです。ただしRapid storageは、公式ドキュメントによれば入出力の多い処理に向けた高性能のクラスで、ゾーン単位のバケット(Rapid Bucket。前述の置き場所の種別のうちゾーンを指定するもの)でだけ使えると書かれています。取り出しの頻度と保管の期間で選ぶ他の4つとは、選ぶ理由が異なります。最短の保管期間はNearlineが30日、Coldlineが90日、Archiveが365日と説明されています。ここでいちばん目立つのは Archive storage の扱いで、公式ドキュメントは他のクラウド事業者のもっとも冷たいサービスとは異なり、自社のデータは時間や日ではなくミリ秒で利用できると書いています。3社の階層でもっとも大きく分かれるのは、この「もっとも冷たい層に置いたあと、どうやって読むか」です。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 既定で置かれる層 | S3 Standard | Hot | Standard storage |
| 取り出しが少ないデータの層 | S3 Standard-IA、S3 One Zone-IA | Cool | Nearline storage |
| さらに取り出しが少ない層 | S3 Glacier Instant Retrieval | Cold | Coldline storage |
| ほとんど取り出さない層 | S3 Glacier Flexible Retrieval、S3 Glacier Deep Archive | Archive | Archive storage |
| 最短の保管期間についての公式の記述 | 30日、90日、180日の3段 | 30日、90日、180日の3段 | 30日、90日、365日の3段 |
| もっとも冷たい層からの取り出し | 先に復元の操作が必要。分から時間の単位 | オンラインの層へ戻す操作が必要。最大15時間 | ミリ秒で利用できると公式に記載 |
| 層のあいだを自動で動かす仕組み | S3 Intelligent-Tiering | Smart tier | Autoclass |
この表も、同じ役割の枠に入るだけで同じものではありません。とくに最下段の3つは、名前の似ている度合いに比べて中身の差が大きく、単純に置き換えられません。またAzureのArchiveには、他の2社の説明には出てこない制約があります。公式ドキュメントは、Archiveへ移せるのはLRS、GRS、RA-GRSの構成をとるストレージアカウントだけであり、ZRS、GZRS、RA-GZRSでは使えないと明記しています。ここでいうストレージアカウントとは、Azureで保管の資源をまとめる器のことで、冗長化の方式や既定の設定はこの単位で決まります。LRSやZRSといった略称は、その冗長化の方式を指すもので、本章の後半であらためて整理します。冗長化の選び方が、使える層を先に決めてしまうということです。Archiveに置いたものがある状態で冗長化の構成を変えるには、まず全部をオンラインの層へ戻す必要があるとも書かれています。
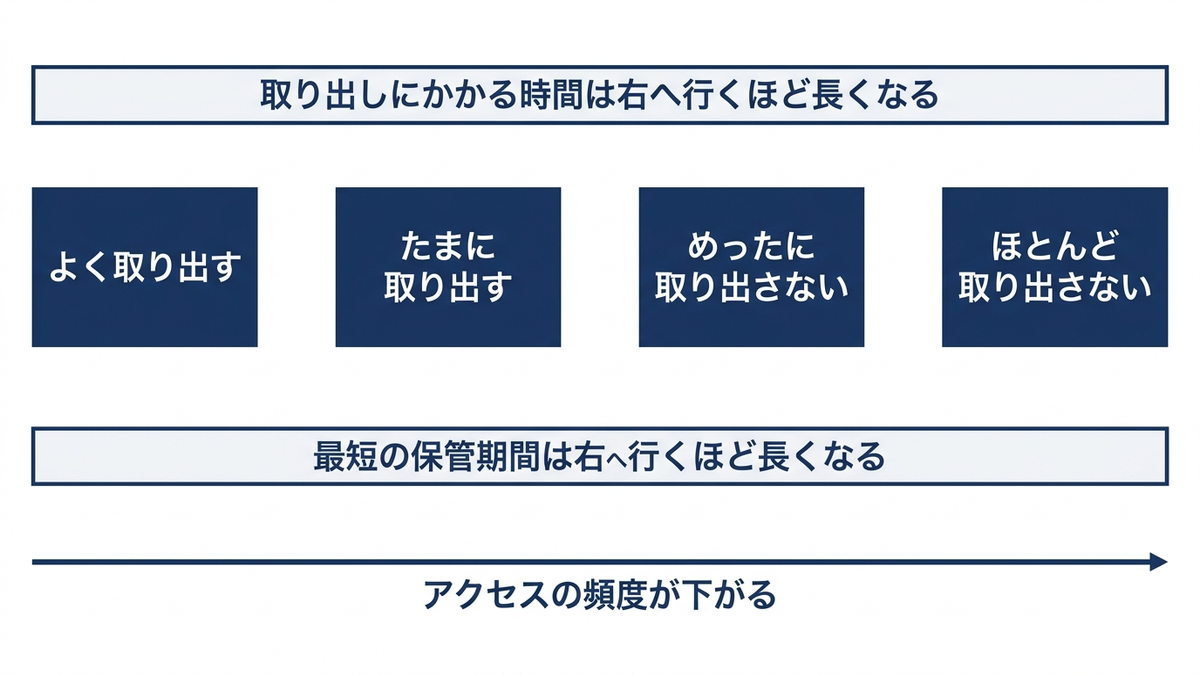
階層を人手で動かさないための仕組み
層を分けても、置いたものを人が見て回って移し替えるのでは続きません。そこで3社とも、条件を書いておけば自動で移す仕組みを用意しています。これがライフサイクル管理です。
AWSのS3では、入れ物ごとに規則の集まりを作ります。公式ドキュメントは、規則が取る行動は2種類だと説明しています。別のストレージクラスへ移す行動と、期限が来たものを削除する行動です。作成から30日でS3 Standard-IAへ移し、1年でS3 Glacier Flexible Retrievalへ移す、といった書き方ができます。注意したいのは、規則を追加した時点で、すでに置いてあるものにも適用される点です。公式ドキュメントは、作成から30日で削除する規則を今日追加すると、30日より古いものが削除の待ち行列に入ると明記しています。過去に置いたものを消すつもりがなかった場合、これは事故になります。
Azureの Blob Storage も同じ考え方ですが、判定に使える条件が明示されています。作成時刻、最終更新時刻、そしてアクセス時刻の記録を有効にしている場合は最終アクセス時刻です。規則を追加または変更してから実際に効き始めるまで最大24時間かかること、Archiveにあるものをライフサイクルの規則でオンラインの層へ戻すことはできないことも、公式ドキュメントに書かれています。
Google CloudのCloud Storageでは、この機能をObject Lifecycle Managementと呼びます。取れる行動は、削除、ストレージクラスの変更、そして途中で止まった分割アップロードの中止の3つです。設定の変更が効き始めるまで最大24時間かかり、そのあいだは古い設定にもとづく処理が行われる可能性があると明記されています。
これとは別に、条件を書かずに自動で層を動かす仕組みも3社にあります。AWSのS3 Intelligent-Tiering は、取り出しの様子を見て層を移します。公式ドキュメントによれば、30日連続で取り出されなかったものを低頻度の層へ、90日連続で取り出されなかったものを即時に取り出せる保管の層へ移します。さらに任意で、90日以上または180日以上取り出されないものを、より冷たい層へ移す設定も加えられます。ただし128キロバイトに満たない小さなものは監視の対象外で、常にいちばん手前の層に置かれます。Azureの Smart tier とGoogle CloudのAutoclassも同じ発想の仕組みです。ただしSmart tierには前提があり、公式ドキュメントは、汎用v2のストレージアカウントで、可用性ゾーンをまたぐ冗長化(ZRS、GZRS、RA-GZRS)を選んでいることを条件に挙げ、Archiveの層は対象にしないと明記しています。Archiveへ移せるのがLRS、GRS、RA-GRSだけであることと合わせて読むと、冗長化の選び方は、自動で層を動かす仕組みを使えるかどうかも決めることになります。Autoclassについて公式ドキュメントは、ストレージクラスを変更する規則やストレージクラスを条件にする指定と同時には使えないと明記しています。自動で動かす仕組みと、条件を書いて動かす仕組みは、重ねて使えるとは限らないということです。
ブロックストレージは、性能の刻み方が3社でいちばん細かい
ブロックストレージは、計算資源に接続して使う以上、性能の話から逃げられません。3社とも複数の種類を用意していて、選択の主な軸は、1秒あたりの入出力の回数を重視するか、1秒あたりに流せる量を重視するかです。前者は小さな読み書きが大量に発生する用途、たとえばデータベースに効きます。後者は大きなファイルを順に読み書きする用途に効きます。
AWSのAmazon EBSは、公式ドキュメントによればアベイラビリティゾーンの中で自動的に複製される永続的なブロックストレージです。種類は半導体の記録媒体を使うものと磁気の記録媒体を使うものに分かれ、前者に汎用の gp3 と gp2、入出力の回数を確保する io2 Block Express と io1、後者に量を重視する st1 と、もっとも安い sc1 があります。旧世代として磁気の standard も残っていますが、公式ドキュメントは現行の種類を使うよう勧めています。
Azureは Azure Managed Disks という呼び方で、公式ドキュメントは種類が5つあると明記しています。Ultra Disks、Premium SSD v2、Premium SSD、Standard SSD、Standard HDDです。可用性については、データの複製を3つ持つこと、単一のデータセンター内で複製する構成では1年あたり11個の9、複数の可用性ゾーンにまたがる構成では12個の9の耐久性を目指すことが書かれています。ここには期限つきの予告も出ています。公式ドキュメントは、2028年9月8日に Standard HDD をオペレーティングシステム用のディスクとして使う機能が終了すると告知しています。サービス自体は残るのに、特定の使い方だけが終わるという形です。
Google Cloudは、永続的なブロックストレージとしてHyperdiskとPersistent Diskの2つを説明しています。公式ドキュメントは、Hyperdiskの利点として性能を細かく指定できることと総合的な性能の高さを挙げ、もっとも高い性能と進んだ機能を求めるならHyperdiskを使うよう勧めています。さらに、Persistent Diskは最新の機種系列では使えないとも明記しています。これは「まだ使えるが、新しく選ぶものではない」という状態で、提供終了の告知とは区別して読む必要があります。このほかに、計算資源に直結する一時的な記録媒体としてLocal SSDがあります。こちらは計算資源を止めると内容が残らない前提のもので、永続的な保管とは別の道具です。
ファイルストレージは、既存の仕組みを変えずに動かすための受け皿
ファイルストレージを選ぶ理由は、たいてい「既存のものを変えたくない」です。3社の説明も、そこを正面から扱っています。
AWSのAmazon EFSは、公式ドキュメントによれば容量や性能をあらかじめ用意しなくてよい、伸縮する共有のファイル保管です。使う手順はネットワークファイルシステムの第4版で、追加のソフトウェアを入れずに既存の道具がそのまま動くと書かれています。置き方はリージョン全体に広げるものと1つのアベイラビリティゾーンに置くものの2つがあり、公式は前者を勧めています。ここには読み落としやすい制約が1つあります。公式ドキュメントは、Windowsを載せた計算資源との組み合わせには対応していないと明記しています。Windowsの共有が必要な場合は、Amazon FSx for Windows File Server という別のサービスが用意されています。AWSにはこのほかに、高性能計算向けの Amazon FSx for Lustre、既存の製品と同じ機能を持たせた Amazon FSx for NetApp ONTAP と Amazon FSx for OpenZFS が並びます。
Amazon EFSには階層の考え方も入っています。公式ドキュメントは、標準の層、取り出しが少ないデータの層、そしてArchiveの層の3つを挙げ、既定では30日取り出されないものを2つめへ、90日取り出されないものを3つめへ移すと説明しています。既定では、冷たい層にあるものを読んでも標準の層には戻りません。戻す設定も選べますが、そこは利用者が決める項目です。なお、ファイル名や所有者や木の構造といった情報は常に標準の層に置かれる、とも書かれています。
Azure Files は、SMBとNFSという2つの手順で共有を提供します。公式ドキュメントは、SMBが3.1.1、3.0、2.1に、NFSが4.1に対応し、Windows、Linux、macOSから同時に接続できると説明しています。記録媒体は半導体のものと磁気のものの2つで、NFSの共有は半導体のものだけで使えます。冗長化の選択肢も媒体で変わり、磁気のものは4種類すべて、半導体のものは単一データセンター内の複製と可用性ゾーンをまたぐ複製の2つだけです。作成したあとで媒体を直接変えることはできず、新しい共有を作って中身を移す必要があるとも明記されています。後から変えにくい項目は、最初に決める価値があります。
Google CloudのFilestoreは、公式ドキュメントによれば完全に管理されたファイルサーバーで、さまざまな種類の接続元から使えます。手順はNFSの第3版が中心で、新しいサービス階層では4.1も使えると説明されています。階層はゾーン単位のものと地域単位のものがあり、旧来の階層も残っています。
Azure Data Lake Storage は独立したサービスではない
ここで1つ、読者が別のサービスだと思い込みやすい箇所を明示しておきます。Azure Data Lake Storage です。名前が並びで出てくるため、Blob Storage とは別の製品だと受け取られがちですが、公式ドキュメントは正面からそれを否定しています。
公式の文言は、Azure Data Lake Storage は専用のサービスでもストレージアカウントの種類でもなく、Azure Storageのアカウントが持つ Blob Storage と組み合わせて使う機能の集まりとして実装されている、というものです。そしてその機能は、階層型の名前空間という設定を有効にすることで使えるようになる、と書かれています。実際、同じページには「取り込んだデータはストレージアカウントの中にオブジェクトとして残り、それを管理しているのは Blob Storage である」とも書かれています。診断の記録、アクセス階層、ライフサイクルの規則といった Blob Storage の機能がそのまま使えるのも、同じ理由によります。
この点を押さえておくと、見積りや設計の会話が1段はっきりします。「データレイクのサービスを新しく契約する」のではなく、「すでにあるオブジェクトの置き場に、木の構造とファイル単位の権限を足す設定を入れる」という理解になるからです。データレイクを分析の基盤としてどう組むかは第5章で扱います。
なお、名前の似た旧世代のものは提供を終了しています。Azure Data Lake Storage Gen1です。切り替えの期限として案内されたのは2024年2月29日で、マイクロソフトのライフサイクル情報では終了日が2024年3月1日と表示されています。現在の製品ドキュメントは、Gen1は終了しており、その資源にはもう接続できないと書いています。
冗長化はバックアップではない
ストレージの選択でもっとも誤解が起きやすいのが、ここだと考えています。3社とも、置いたデータの複製を複数持ちます。しかしそれは、消えたものを取り戻す仕組みではありません。
Azureの公式ドキュメントは、この点を1文で書いています。冗長化はハードウェアの故障からは守るが、データを書き換える操作からは守らない、というものです。同じページには、複製はすべて同じ最新の状態を映しており、削除も上書きもすべての複製へ同時に適用されるとも書かれています。誤って消したものは、複製を何個持っていても消えます。
そのうえで、冗長化の選択は「どの範囲の障害まで耐えるか」を決める項目です。Azureは6つの選択肢を持ちます。単一のデータセンター内で複製するLRS、3つ以上の可用性ゾーンへ同期して書き込むZRS、LRSに加えて別のリージョンへ非同期で複製するGRS、ZRSに加えて別のリージョンへ複製するGZRS、そして後ろの2つに二次リージョンからの読み取りを足したRA-GRSとRA-GZRSです。二次リージョンのデータは、切り替えを行わない限り読むことも書くこともできない点が明記されています。AWSのS3では、選択はストレージクラスに埋め込まれています。S3 Standardをはじめとする多くのクラスは3つ以上のアベイラビリティゾーンに置かれますが、S3 One Zone-IAとS3 Express One Zoneは1つだけです。公式ドキュメントは、S3 One Zone-IAについて、ゾーンが物理的に失われた場合にデータは残らないと明記し、作り直せるデータに使うよう勧めています。
取り戻すための仕組みは、これとは別に用意されています。AWSにはAWS Backupがあり、公式ドキュメントは、複数のサービスにまたがるデータの保護を1か所に集め、方針を書いて自動で実行させる完全マネージドのサービスだと説明しています。取ったものは元の資源から切り離された保管庫に置かれ、公式ドキュメントは、元の計算資源やボリュームを削除しても、決めた期間だけ保管庫に残ると書いています。書き込んだあとは誰も消せない状態にする仕組みも用意されています。Azureには Azure Backup があり、公式ドキュメントはデータを控えとして取り、Azureのクラウドから復旧するための仕組みだと説明しています。Azure Files には共有の断面を取る機能があり、公式ドキュメントによれば1つの共有につき最大200個まで、最長10年まで保持できます。誤って共有ごと消した場合に備える一時的な保留の設定も、新しいストレージアカウントでは既定で有効になっていると書かれています。
したがって、ストレージの設計は2つの問いに分けて考えるのが安全です。1つ、機器やデータセンターが壊れたときに、どこまで耐えたいか。これが冗長化の選択です。2つ、人が誤って消したときや、内容が壊れたときに、いつの時点まで戻したいか。これがバックアップの選択です。前者を厚くしても後者の答えにはなりません。
オンプレミスとの橋渡しは、回線で送るか機器で運ぶか
すでに手元に大量のデータがある場合、それをどうやってクラウドへ入れるかという問題が残ります。手段は大きく2つで、回線を通して送るか、記録機器に入れて物理的に運ぶかです。判断の目安は単純で、回線の太さで割ったときに現実的な日数に収まるかどうかです。Google Cloudのドキュメントは、毎秒100メガビットの回線で300テラバイトを送ると9か月ほどかかるが、Transfer Appliance を使えば機器を受け取ってデータを入れ終えるまでを25日未満に収められると説明しています。ただし、その25日は機器への取り込みまでの日数です。送り返したデータがCloud Storageで読めるようになるまでには、通常さらに10営業日以内かかるとも書かれています。回線の代わりに機器を選ぶときは、この2段の日数を足して比べる必要があります。
回線で送る側では、AWSにAWS DataSyncがあります。公式ドキュメントは、オンプレミスのNFS、SMB、Hadoopの分散ファイルシステム、オブジェクトの保管と、AWS側のS3、EFS、FSxの各種のあいだを行き来できると説明しています。興味深いことに、他社のクラウドも転送元として一覧に入っていて、Azure Blob Storage、Azure Files、Google Cloudのオブジェクトストレージが名前を挙げられています。Google CloudにはStorage Transfer Serviceがあり、公式ドキュメントによれば他社のオブジェクトストレージ、オンプレミスのデータセンター、Hadoopの分散ファイルシステム、公開されたURLからCloud Storageへ移せます。
常時つないでおく形もあります。AWS Storage Gateway は、公式ドキュメントによればオンプレミスに置く仮想の機器または専用の機器を通じて、手元のアプリケーションからそのままクラウドの保管を使えるようにする仕組みです。接続の手順はNFS、SMB、iSCSIという標準的なものです。用途別に4種類があり、S3を後ろに置くAmazon S3 File Gateway、Amazon FSx for Windows File Server の共有へつなぐ Amazon FSx File Gateway、テープ装置のように見せる Tape Gateway、ボリュームとして見せる Volume Gateway が用意されています。ただし、この4種類と2つの置き方のすべてが、これから選ぶ人に開かれているわけではありません。Amazon FSx File Gateway の公式ドキュメントは、2024年10月28日から新規の顧客には提供せず、既存の顧客は引き続き通常どおり使えると告知しています。専用の機器である AWS Storage Gateway Hardware Appliance についても、公式ドキュメントは2025年5月12日をもって提供を終え、既存の顧客は2028年5月まで利用と支援を受けられると告知しています。この2つの告知を重ねて読むと、これから選ぶ場合の候補は、仮想の機器で動かす Amazon S3 File Gateway、Tape Gateway、Volume Gateway になります。Azureでは、オンプレミスのWindowsサーバーに共有の内容をキャッシュしておく Azure File Sync が同じ役割を担います。
機器で運ぶ側は、提供の終了と機種の入れ替えが続いているところです。AWSのSnowファミリは大きく縮小しました。AWSの終了したサービスの公式一覧には、AWS Snowmobile が2024年3月14日、AWS Snowblade が2024年11月12日、AWS Snowball Edge と旧世代の2機種が2025年11月12日という日付で載っています。この一覧の定義は、載ったものはAWSの品ぞろえから完全に取り除かれ、いかなる形でも利用も支援も受けられない、というものです。AWS Snowcone については、公式ブログが2024年11月12日をもって提供を終了したと告知しています。Snowball Edge の開発者向けドキュメントの冒頭にも、新規の顧客には提供しないという告知が置かれ、代わりにオンラインの移行にはAWS DataSyncを、物理的な移送にはAWS Data Transfer Terminal を、現場側での計算(エッジコンピューティング)にはAWS Outpostsを検討するよう案内されています。この告知の日付は開発者向けドキュメントには書かれていませんが、AWS Snowball の公式FAQは、2025年11月7日以降は既存の顧客だけに提供すると告知しています。終了の一覧にある2025年11月12日と、この2025年11月7日は、別の日付で別の意味を持ちます。前者は品ぞろえから完全に取り除いたとする日付、後者は新規の申し込みを受けなくなったとする日付です。
ただし、ファミリ全体が終わったとは書けません。同じ開発者向けドキュメントの本文は、210テラバイトの保管重視の機種と、計算重視の機種の2つを現行のものとして説明し続けています。またAWSのサービス一覧のホワイトペーパーにも、Snowファミリが現行の選択肢として載っている箇所があります。確定できるのは、終了の一覧に載った行と、新規受付を停止した告知文の2つだけです。ここを「Snowはもう無い」とまとめてしまうと、既存の利用者の判断を誤らせます。
Azureには Azure Data Box があります。公式ドキュメントは、機器を送って受け取り、手元でデータを入れてから返送し、Azureのデータセンターで自動的に取り込む流れだと説明しています。次世代の機種として説明されているのは、使える容量が120テラバイトのものと525テラバイトのものの2つです。ここでも整理が進んでいて、Azure Data Box Heavy はすでに終了して注文を受け付けておらず、80テラバイトの機種も次世代機の提供地域が広がるのに合わせて順次終了すると告知されています。同じページには80テラバイトの機種の説明もまだ残っていて、終了した地域では新規の注文を受け付けなくなるが、すでに受けた注文は引き続き支援されると書かれています。Heavyがいつ終了したかは、本章の照合では確認できませんでした。Google Cloudには Transfer Appliance があり、公式ドキュメントは大容量の保管機器を借りて、データを入れてGoogleの取り込み施設へ送る仕組みだと説明しています。終了や停止の告知は、本章の照合では見つかりませんでした。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 回線を通してまとめて転送する | AWS DataSync | 本章の照合では確認していません | Storage Transfer Service |
| 機器を送って運ぶ | Snow ファミリ。上記のとおり縮小している | Azure Data Box | Transfer Appliance |
| オンプレミスの機器から標準の手順でクラウドの保管を使う | AWS Storage Gateway | Azure File Sync | 本章の照合では確認していません |
| 取ったものを1か所で管理する仕組み | AWS Backup | Azure Backup | 本章の照合では確認していません |
この表も、同じ役割の枠に入るだけで同じものではありません。そして空欄の意味を取り違えないでください。「本章の照合では確認していません」と書いた欄は、そのクラウドに同じ役割のものが存在しないという意味ではありません。本章で公式ドキュメントに当たった範囲では確かめられなかった、という意味です。公式の一覧に見当たらないことを、無いことの証明として使わないのは、本記事を通しての作法です。
本章では、保管の形が3つに分かれる理由と、その上に載る階層とライフサイクル、冗長化とバックアップの違い、そしてオンプレミスとの橋渡しを整理しました。押さえておきたい順序は、まず接続のしかたで3つのどれかを決め、次にアクセスの頻度と保管する期間で層を決め、その層を自動で動かす規則を最初から入れておく、というものです。冗長化をどれだけ厚くしても、消したものは戻らないという一点も、設計の前に共有しておく価値があります。次章では、同じデータでも構造を持たせて問い合わせる仕組み、すなわちデータベースに入ります。選択の軸は、整合性をどこまで求めるかと、規模をどう広げるかになります。
この章を深めたい方への参考書籍
『絵で見てわかるOS/ストレージ/ネットワーク 新装版』(木村達也・西田光志・鳥嶋一孝・田中彰人 著、小田圭二 監修、翔泳社):本章でブロックとファイルとオブジェクトを分けた根拠は、突き詰めれば記録媒体と入出力の仕組みにあります。クラウドのサービス名からいったん離れて、ディスクとファイルシステムがどう動いているかを図で押さえておくと、性能の種類がなぜあの刻み方になっているのかが腹落ちします。
『図解即戦力 Amazon Web Servicesのしくみと技術が これ1冊でしっかりわかる教科書[改訂2版]』(小笠原種高、技術評論社):AWSの各サービスをカラーの図で通して確認できる1冊で、ストレージのサービスに1章が割かれています。本章では選択の軸を中心に書いたため個々の設定画面には触れていませんが、実際に手を動かす段になったら、この種の解説書と公式ドキュメントを並べて使うのが早いと考えています。クラウドの書籍は版が進むのが速いので、購入時は最新の版をご確認ください。
『ひと目でわかるAzure 基本から学ぶサーバー&ネットワーク構築 第4版』(横山哲也、日経BP):Azureの仮想マシンと仮想ネットワークを作る手順を追う構成で、Azureへ控えを取る章が独立して置かれています。本章の最後で述べた「冗長化とバックアップは別の話である」という点を、実際の手順の側から確かめるのに向いています。こちらも版が進む書籍なので、購入時は最新の版をご確認ください。
第4章 データベース
前章では、置いたものを後から取り出すための保管の仕組みを、接続のしかたとアクセスの頻度という2つの軸で整理しました。保管の仕組みは、置いた塊をそのまま返すところまでを引き受けます。しかし業務で扱うデータは、置いたまま眠っているだけではありません。誰かの注文が入れば在庫が減り、支払いが確定すれば残高が動き、同じ瞬間に別の担当者が同じ行を見に来ます。この「同時に触られても壊れない」を引き受けるのがデータベースです。
本章では、業務システムを支えるデータベースのマネージドサービスを扱います。行と列の表を持つリレーショナルのもの、規模の拡大と整合性の両立をうたう系統、鍵を指定して取り出すものと文書をそのまま置くもの、そして手前に置いて応答を速くするキャッシュ。この4つを順に見ていきます。選択の軸は、整合性をどこまで求めるか、規模をどう広げるか、アプリケーションがどういう形でデータに触るか、そして既存の資産をどれだけ持ち込めるかの4つです。分析のために大量のデータをまとめて集計する仕組み、いわゆるデータウェアハウスは第5章で扱います。保管や実行にかかる費用の考え方は第12章、誰がどのデータに触れてよいかという権限の設計は第9章です。本章に書いたサービス名と状態は、各社の公式ドキュメントを2026年9月に直接開いて確かめたものに限りました。確かめられなかったものは、確かめられなかったと書いています。
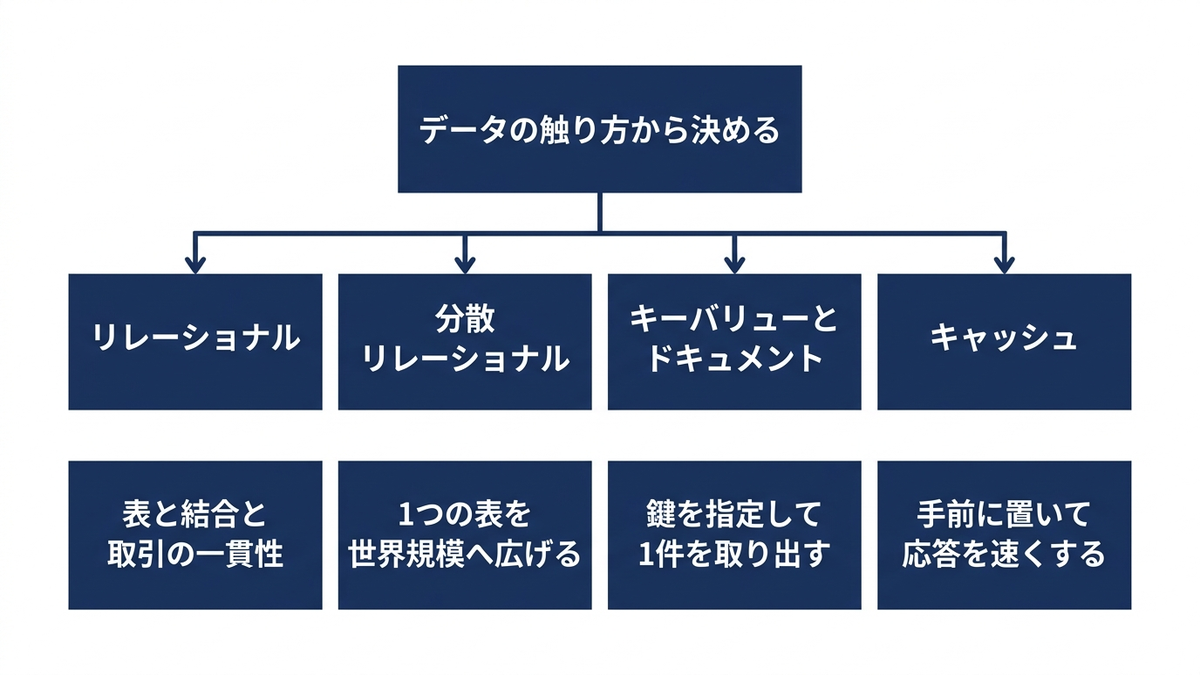
リレーショナルのマネージドは、どこまで手放すかで並ぶ
いちばん多く使われているのは、いまも行と列の表を扱うリレーショナルデータベースです。3社ともここに複数の選択肢を持っていますが、並べ方は共通していて、既存のエンジンをそのまま動かすものと、事業者が独自に手を入れて性能や規模を伸ばしたものの2段構えになっています。
AWSの入口はAmazon RDSです。公式ドキュメントは、クラウドの中でリレーショナルデータベースを立ち上げ、動かし、規模を広げることを容易にするサービスだと説明しています。対応するエンジンはIBM Db2、MariaDB、Microsoft SQL Server、MySQL、Oracle Database、PostgreSQLの6つです。同じページには、オンプレミスの運用、計算資源の上に自分で入れる運用、そしてRDSの3つを並べた責任分担の表が載っています。この表の読み方が、マネージドという言葉の中身そのものです。規模の変更、高可用性、控えの取得、データベースソフトウェアの修正適用と導入、オペレーティングシステムの修正適用と導入、機器の保守と更改、電源と回線と冷却は、いずれもAWS側の担当と書かれています。利用者側に残るのはアプリケーションの最適化だけです。さらに公式ドキュメントは、問い合わせ文の調整は利用者の責任であると明記しています。マネージドにしても、遅い問い合わせは速くなりません。ここを取り違えたまま導入すると、期待と結果がずれます。
その上に載るのがAmazon Auroraです。公式ドキュメントは、MySQLとPostgreSQLに互換性のある完全マネージドのデータベースエンジンであり、同等の機器で動かした素のPostgreSQLおよび素のMySQLに対して最大6倍の処理量を出すと説明しています。保管の領域は必要に応じて自動的に広がり、1つのクラスタで最大256テビバイトまで伸びると明記されています。運用上の位置づけとして押さえておきたいのは、Auroraが独立した別サービスではなく、Amazon RDSというマネージドサービスの一部として扱われている点です。新しいデータベースを立てるときに、エンジンの選択肢としてAurora MySQLかAurora PostgreSQLを選ぶ、という形になっています。
Azureの主力はAzure SQL Databaseです。公式ドキュメントは、更新、修正適用、控えの取得、監視といったデータベース管理の大半を利用者の関与なしに処理する、完全マネージドのプラットフォーム型のデータベースエンジンだと説明しています。ここで注意したいのは、購入の形が2つに分かれていることです。仮想コア数を選ぶ形と、計算資源と記憶装置と入出力を混ぜた単位で選ぶ形があり、それぞれに3つのサービス階層が用意されています。仮想コア数を選ぶ形の3階層はHyperscale、Business Critical、General Purposeで、公式ドキュメントはHyperscaleに recommended と付記し、ほとんどの業務向けの負荷に向けて設計されていると書いています。Hyperscaleは記憶容量を128テラバイトまで伸ばせ、読み取り専用の複製を最大30個まで名前付きで持てるとも書かれています。加えて、負荷に応じて計算資源を自動で伸縮させるサーバーレスの計算階層があり、これは仮想コア数を選ぶ形のGeneral PurposeとHyperscaleで使えると明記されています。
Google CloudはCloud SQLです。公式ドキュメントは、MySQL、PostgreSQL、SQL Serverのための完全マネージドのリレーショナルデータベースサービスだと説明しています。対応するエンジンは3つで、Amazon RDSより絞られています。その上位に置かれているのがAlloyDB for PostgreSQLで、公式ドキュメントは、完全マネージドでPostgreSQLに互換性のあるデータベースサービスであり、Googleが独自に作ったデータベースエンジンと、複数ノードで構成するクラウド上の仕組みを組み合わせて、要求の厳しいアプリケーション向けに企業水準の性能と信頼性と可用性を届けるものだと説明しています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 既存のエンジンをそのまま動かすマネージド | Amazon RDS | Azure Database for MySQL flexible server、Azure Database for PostgreSQL flexible server | Cloud SQL |
| 事業者が独自に手を入れた上位の選択肢 | Amazon Aurora | Azure SQL Database | AlloyDB for PostgreSQL |
| マネージドの窓口で選べるエンジンの数 | 6種類 | MySQL、PostgreSQL、SQL Server の3系統に加え、Azure SQL Database が独立して存在する | 3種類 |
| 公式が推奨と明記している構成 | 本章の照合では確認していません | Azure SQL Database の Hyperscale 階層 | 本章の照合では確認していません |
| 保管容量の上限についての公式の記述 | Aurora のクラスタで最大256テビバイト | Hyperscale で最大128テラバイト | 本章の照合では確認していません |
この表は、同じ役割の枠に入るというだけで、同じものではありません。とくに2行目の3つは、成り立ちがまったく違います。Amazon Auroraは、MySQLとPostgreSQLへの互換性を保ったまま保管の仕組みを作り替えたものです。Azure SQL Databaseは、Microsoft SQL Serverの系譜にあるエンジンをクラウド向けに作り直したもので、互換性の対象が別のエンジンです。AlloyDB for PostgreSQLはPostgreSQLへの互換性をうたいます。つまり「上位の選択肢」という枠は同じでも、移行元として想定されている資産が3社で異なります。手元の資産がOracle Databaseなら、この行のどれを選んでも素直には載りません。その場合はAmazon RDSやCloud SQLのように、そのエンジンを直接扱えるマネージドを見ることになります。互換性の対象は、表を横に読むより先に確かめる項目です。
単一サーバーとフレキシブルサーバーを混ぜない
Azureのオープンソース系のデータベースには、読者がもっとも取り違えやすい事情があります。同じ製品名の下に、世代の違う2つの提供形態があり、古いほうはすでに終わっているという点です。資料や記事に「Azure Database for MySQL」とだけ書かれていた場合、それが単一サーバーの話なのかフレキシブルサーバーの話なのかで、書いてある内容の有効性が変わります。
確定していることから並べます。Azure Database for MySQL の単一サーバーは提供を終了しました。マイクロソフトのライフサイクル情報の表には、終了日として2024年9月17日6時59分59秒という太平洋時間の表記が載っています。同じページが案内する移行のお知らせは、その転送先のアドレス自体が「2024年9月16日までにAzure Database for MySQL のフレキシブルサーバーへ移行すること」という文言になっています。現在のAzure Database for MySQL の製品ドキュメントには、フレキシブルサーバーしか出てきません。公式ドキュメントは、これをマイクロソフトのクラウド上で動く完全マネージドの本番向けリレーショナルデータベースサービスであり、MySQL Community Edition のバージョン5.7、8.0、8.4にもとづくと説明しています。ただし、版ごとの扱いは版のサポート方針のページに別にまとめられており、そこでは5.7が一般提供ではあるものの退役済み、つまり動かし続けることはできるが新しく選ぶ版ではなくサポートの期限が決まっている状態、8.0と8.4が一般提供、9.5が公開プレビューという状態で載っています。5.7については、Azureの標準サポートの終了日が2026年7月31日、その後の延長サポートが2026年8月1日から2029年3月31日までと書かれています。概要ページに並ぶ版の一覧と、版ごとの状態とは別のページで確かめる必要がある、という例です。計算資源の階層はBurstable、General Purpose、Memory-Optimizedの3つで、高可用性は可用性ゾーンをまたぐ構成と同一ゾーン内の構成の2つから選べます。読み取り専用の複製は最大10個まで作れると書かれています。
Azure Database for MariaDB は、サービスそのものが終了しました。マイクロソフトが公開している終了予定の一覧には、対象が「サービス全体」、終了日が2025年9月19日として載っており、移行先の案内としてAzure Database for MySQL のフレキシブルサーバーが示されています。ライフサイクル情報の表では同じ終了が2025年9月20日6時59分59秒という太平洋時間の表記になっています。日付の表記が1日ずれて見えるのは時間帯の扱いによるもので、本文で1日単位まで断定したい場合は、どちらの表記を引いているかを併記するのが安全です。
Azure Database for PostgreSQL の単一サーバーも、提供を終了しています。マイクロソフトの公式ドキュメントのうちAzure Backup の解説ページに、Azure Database for PostgreSQL の単一サーバーという提供形態は2025年3月28日に終了した、と明記されています。同じページには、その日に単一サーバーを対象とする定期的な控えの取得が恒久的に停止されたこと、残っている控えから復元する場合は、復元したファイルから新しいフレキシブルサーバーを手作業で作る必要があることも書かれています。受け皿はフレキシブルサーバーです。なお、ライフサイクル情報の該当ページは開けず、製品ドキュメント側の移行の解説ページも、たどると製品の入口のページへ転送されます。終了日の根拠が製品自体のページではなく、隣接するAzure Backup のページにあるという点は、書き添えておきます。現在の製品ドキュメントの入口が案内しているのはフレキシブルサーバーと、横方向に規模を広げるための elastic clusters という選択肢だけであり、単一サーバーへの案内は残っていません。念のため付け加えると、公式の一覧に見当たらないことだけでは、終了したことの証明にはなりません。本章で終了と書けるのは、終了日を明記した公式の記述に到達できたからです。この作法は本記事を通じて守っています。
実務上の対処は単純です。社内の設計書や引き継ぎ資料でAzureのオープンソース系データベースに触れるときは、必ず世代を書き添えることです。「Azure Database for PostgreSQL のフレキシブルサーバー」まで書けば、読み手が世代を推測する余地はなくなります。名前だけを書くと、5年前の資料と今年の資料が同じ顔で並び、どちらが現役か分からなくなります。
規模の拡大と整合性の両立をうたう系統
リレーショナルデータベースには、長く付き合ってきた制約があります。1台の機械に収まらない量になったとき、表を分割して複数の機械へ配ると、複数の行にまたがる取引の一貫性を保つのが難しくなる、というものです。実務ではこれを、書き込みを1か所に集めて読み取りだけを複製へ逃がす、という形でしのいできました。ここに正面から取り組むのが分散リレーショナルと呼ばれる系統です。
Google CloudのSpannerが代表格です。本章の着手時点では、このサービスの現在の名称と定義が確定していませんでした。参照先のアドレスが転送と不存在を繰り返し、本文を取得できていなかったためです。今回あらためて公式ドキュメントの入口を開いて確かめたところ、本文の表記はCloud SpannerではなくSpannerであり、定義は次のように書かれていました。完全マネージドで基幹業務向けのデータベースサービスであり、リレーショナル、グラフ、キーバリュー、検索を1つにまとめたものである。世界規模で取引の一貫性を提供し、高可用性のために自動かつ同期的な複製を行い、2つのSQLの方言に対応する。方言はGoogleSQLとPostgreSQLの2つです。仕組みの解説文書では、時刻の不確かさを織り込んだ独自の時刻の仕組みを使い、取引の確定時刻が実時間として確実に過ぎるまで数ミリ秒だけ待つ操作を挟むことで、強い整合性を担保していると説明されています。この待ち時間は欠陥ではなく、整合性を成立させるための設計上の対価です。
AWSにも同じ系統があります。Amazon Aurora DSQLです。公式ドキュメントは、取引を伴う処理に最適化した、サーバーレスで分散型のリレーショナルデータベースサービスだと説明しています。事実上無制限の規模を提供し、基盤の管理を利用者に求めないこと、書き込みを複数の拠点で同時に受ける構成により単一リージョンで99.99パーセント、複数リージョンで99.999パーセントの可用性を提供することが明記されています。SQLの方言はPostgreSQL互換で、現在の互換対象はPostgreSQLのバージョン16です。整合性については、原子性、一貫性、独立性、耐久性を備えた取引を、強い整合性とスナップショット分離のもとで提供すると書かれています。複数リージョンで組んだ場合も、2つの接続先が1つの論理的なデータベースを見せ、両方で同時に読み書きでき、読み手は常に同じデータを見る、と説明されています。ただし制約も明記されています。複数リージョンの構成は決められた地域のまとまりの中でしか組めず、大陸をまたぐ構成には対応していないと書かれています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 規模の拡大と強い整合性の両立をうたうサービス | Amazon Aurora DSQL | 本章の照合では確認していません | Spanner |
| 使えるSQLの方言 | PostgreSQL互換。互換対象はバージョン16と明記 | 本章の照合では確認していません | GoogleSQL と PostgreSQL の2方言 |
| 地理的な広がりについての公式の記述 | 単一リージョンと複数リージョン。大陸をまたぐ構成は非対応と明記 | 本章の照合では確認していません | 世界規模での取引の一貫性を提供と明記 |
| 整合性についての公式の記述 | 強い整合性とスナップショット分離 | 本章の照合では確認していません | 強い整合性。時刻の仕組みと待ち時間で担保 |
この表も、同じ役割の枠に入るだけで同じものではありません。そして空欄を「Azureにはこの系統が無い」と読まないでください。「本章の照合では確認していません」と書いた欄は、本章で公式ドキュメントに当たった範囲で該当を1つに決められなかった、という意味です。Azureの製品群には、横方向に規模を広げるための仕組みが複数の製品名にまたがって存在しており、どれをこの行に置くべきかを一次情報で確定できませんでした。断定を避けて空けてあります。
選ぶときの注意も1つ挙げておきます。この系統は「速いリレーショナルデータベース」ではありません。解こうとしているのは、1台に収まらない規模と、複数行にまたがる取引の一貫性を同時に成り立たせるという問題です。1台のマネージドに収まる規模であれば、素直にAmazon RDSやCloud SQLやAzure SQL Databaseを選ぶほうが、運用も移行も既存の道具の使い回しも楽になります。将来の規模を根拠にこの系統を先に選ぶと、当面のあいだ、複雑さだけを先払いすることになります。
キーバリューとドキュメントは、アクセスの形から決まる
表と結合を前提にしないデータベースを選ぶ理由は、たいてい「触り方が決まっている」ことです。会員番号から会員情報を1件、機器の識別子から直近の測定値を1件、といった具合に、取り出す鍵があらかじめ決まっているなら、表の全体を見渡す仕組みは要りません。その代わりに、鍵を指定した1件の取得を、量が増えても同じ速さで返すことに全部を賭ける、という設計になります。
AWSのAmazon DynamoDBは、公式の分類ページで、キーバリューとドキュメントのデータベースであり、どのような規模でも1桁ミリ秒の性能を出すと説明されています。設計の要は、鍵の決め方がそのまま性能を決めるという点です。鍵を後から変えることは容易ではないため、アクセスの形が固まっていない段階でこれを選ぶと、作り直しになります。
AzureのAzure Cosmos DBは、公式ドキュメントの現在の説明が「完全マネージドのNoSQLかつベクトルのデータベース」に変わっています。文書、ベクトル、キーバリュー、グラフ、表という複数のデータの持ち方を1つのサービスで扱えることを前面に出しており、MongoDB、Apache Cassandra、Apache Gremlin、Azure Table Storage といった既存の製品に対して通信手順の互換性を持つ複数の窓口を用意しています。同じページには向き不向きも明記されていて、向いている例として柔軟な構造で反復的に開発したい場合、遅延に敏感な処理、伸縮の激しい処理、処理量の大きい処理、可用性が重要な基幹の処理が挙げられ、向かない例として分析用途と、関係の強いアプリケーションが挙げられています。前者にはMicrosoft Fabricを、後者にはAzure SQL DatabaseまたはAzure Database for MySQLを検討するように書かれています。公式が自ら不向きを書いているのは珍しく、選定の材料として素直に使える記述です。
Google CloudにはFirestoreとBigtableがあります。Firestoreについて公式ドキュメントは、企業水準のNoSQLの文書データベースであり、MongoDBへの互換性を持ち、自動的な規模の拡大、高い性能、アプリケーション開発のしやすさのために作られていると説明しています。Bigtableは性格が違います。公式ドキュメントは、まばらに埋まった表であり、数十億の行と数千の列まで規模を広げられ、テラバイトからペタバイトの規模のデータを保管できると説明しています。行と列で整理された、鍵で並べ替えられた対応表という構造で、これがワイドカラムと呼ばれる形です。向いているのはキーバリューのデータに対して高い処理量と規模の拡大が要る用途で、1つの値の大きさが概ね10メガバイトを超えない場合だと明記されています。逆に、原子性のある取引とSQLに近い問い合わせを備えた文書データベースが要るならFirestoreを、対話的な集計にはBigQueryを検討するように書かれています。公式が自社の他製品へ誘導している箇所は、選定の分岐としてそのまま使えます。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 鍵を指定して1件を取り出す用途の中心 | Amazon DynamoDB | Azure Cosmos DB | Firestore、Bigtable |
| MongoDB互換をうたう文書データベース | Amazon DocumentDB | Azure DocumentDB。加えて Azure Cosmos DB の MongoDB 向けの窓口 | Firestore |
| ワイドカラムの形 | Amazon Keyspaces(for Apache Cassandra) | Azure Cosmos DB の Apache Cassandra 向けの窓口 | Bigtable |
| 大きな値を扱うときの公式の目安 | 本章の照合では確認していません | 本章の照合では確認していません | Bigtable は1つの値が概ね10メガバイトまでと明記 |
| 公式が明記している不向きな用途 | 本章の照合では確認していません | 分析用途、関係の強いアプリケーション | Bigtable は取引と問い合わせの豊かさが要る場合、対話的な集計 |
この表も、同じ役割の枠に入るだけで同じものではありません。1行目に並ぶ3つは、規模の広げ方も、整合性の選び方も、鍵の設計に対する要求も揃っていません。とくにGoogle Cloudの欄に2つ書いてあるのは、片方が文書の形、もう片方がまばらな表の形で、公式ドキュメント自身が両者を別の用途として説明しているためです。1つの枠に無理に1つを入れると、その時点で誤りになります。
名前が衝突している。Amazon DocumentDB と Azure DocumentDB は別物である
本章でもっとも注意を促したいのがここです。AWSとAzureに、ほぼ同じ名前の別サービスが存在します。検索でも、社内資料でも、外部の記事でも取り違えが起きうる状態なので、独立した項目として書きます。
AWS側の正式名称は Amazon DocumentDB (with MongoDB compatibility) です。公式ドキュメントは、速く、信頼でき、完全に管理されたデータベースサービスであり、MongoDBに互換性のあるデータベースをクラウドで立ち上げ、動かし、規模を広げることを容易にするものだと説明しています。MongoDBで使っているのと同じアプリケーションのコード、同じ接続用の部品、同じ道具がそのまま使えると書かれています。構成は、インスタンスを並べる形の集まりと、伸縮する形の集まりの2種類です。保管の領域は10ギガバイト単位で自動的に広がり、エンジンのバージョン8.0以降では最大256テビバイトまで伸びます。読み取り用の複製は最大15個まで作れ、保管の層では3つのアベイラビリティゾーンにまたがってデータの複製を6つ持つと明記されています。計算と保管が分かれている構造です。
Azure側は Azure DocumentDB です。公式ドキュメントの定義は、完全に管理された、オープンソースの、MongoDBに99.03パーセント互換のデータベース、というものです。中身の説明はさらに具体的で、DocumentDBという名前のオープンソースの文書データベースがLinux Foundationの管理下で寛容な条件のもとに公開されており、Azure DocumentDBはその上に構築されている、と書かれています。そのオープンソースのDocumentDBは、PostgreSQLのエンジンの上に作られています。そして公式ドキュメントは、Azure DocumentDBがMongoDBのデータベースサーバーもそのコードも動かしていないと明記しています。
マイクロソフト自身も、自社製品どうしの使い分けをAzure Cosmos DBのページで説明しています。そこではAzure Cosmos DBを、世界規模での分散、大きな規模、瞬時の伸縮が要る、横方向に広げる用途に最適化したものと位置づけ、複数リージョンで99.999パーセントの可用性の合意水準を示しています。対してAzure DocumentDBは仮想コア数で選ぶ形で、縦方向に伸ばす用途に最適化しており、豊かな問い合わせ能力と使い慣れた開発の作法を重視する場合に向くとしています。合意水準は99.995パーセントと書かれています。複雑な集計の連なり、分析寄りの問い合わせ、進んだ文書データベースの機能に強く、内容管理の仕組み、分析の基盤、MongoDBからの移行、そして込み入った問い合わせが要るアプリケーションに向く、とも書かれています。加えて、複数のクラウドにまたがって同じ道具立てを保ちたい場合にも向くと説明されています。
整理すると、両者は名前が近いだけで、成り立ちも、規模の広げ方も、根拠にしているエンジンも違います。AWSのものはAWSが自社で作った文書データベースにMongoDB互換の窓口を付けたもので、規模は横方向へ広げる構造を持ちます。Azureのものは、PostgreSQLのエンジンの上に作られたオープンソースの実装を、Azureがマネージドとして提供しているもので、Azure Cosmos DBとの比較のうえでは縦方向に伸ばす用途に位置づけられています。ただしこれは比較表の中での位置づけであり、Azure DocumentDB自体の概要ページは、縦方向と横方向の両方の規模の拡大に対応し、既存のデータベースを停止なしに分割できると説明しています。横に広げられないという意味ではありません。社内の資料に「DocumentDB」とだけ書くのは避けてください。読み手がどちらのクラウドの話か判断できず、見積りも設計も別のものになります。なお、Azure DocumentDB がいつ登場したのか、あるいは何かから改称されたのかは、本章の照合では確認できませんでした。したがって時期は書きません。
Cloud Datastore は Firestore が引き取っている
古い設計書や技術記事に残っている名前として、Cloud Datastore があります。ここも状態がはっきりしています。Google Cloudの公式ドキュメントは、Firestore が Datastore の後継である、と1文で書いています。
現在の形は、Firestore in Datastore mode という呼び方になっています。公式ドキュメントは、Datastore への互換性はFirestore の上に載る窓口の層であり、可用性、性能、整合性、規模の拡大についてはFirestore と同じものだと説明しています。過去のCloud Datastore のデータベースはFirestore in Datastore mode へ引き上げられた、とも書かれています。ただしこの引き上げがいつ行われたのかは、参照した2つのページのどちらにも日付が書かれていませんでした。本章では時期を書きません。
使い分けについての公式の推奨も明確です。Datastore への互換性は、Datastore の窓口に依存しているアプリケーション、たとえば古いApp Engine のアプリケーションにだけ使うこと、と書かれています。さらに踏み込んで、そうした資産が無い限り互換の形は使わないよう勧めており、理由として、互換の形にするとFirestore の価値ある機能の多くに手が届かなくなる点を挙げています。互換の形では使えなくなるものとして、強い整合性を持つ保管の層、集まりと文書というデータの持ち方、変更が即座に伝わる仕組み、携帯端末とブラウザ向けの部品、進んだ問い合わせ、幅広い索引の種類が並べられています。
実務としての結論は単純です。いま新しくGoogle Cloud で文書のデータベースを選ぶなら、Firestore をそのまま選びます。Cloud Datastore という選択肢を新規に取ることはありません。既存の資産で Datastore の窓口を使っているなら、互換の形が用意されているので、移行の計画を立てる時間は確保できます。
整合性は、設定で選ぶものになっている
ここまでのサービスを横に並べると、共通する軸が見えてきます。読み取ったデータが最新であることを、どこまで保証してほしいかという軸です。かつては製品の設計思想として固定されていたこの性質が、いまは設定として選べるようになっています。そして選び方が3社で揃っていません。
Amazon DynamoDBは2択です。公式ドキュメントは、表と局所的な副次索引について、結果整合性のある読み取りと強い整合性のある読み取りの2つを提供すると説明しています。既定は前者です。前者では、直前に完了した書き込みの結果が読み取りに反映されていない場合があり、少し時間をおいて読み直せば新しい内容が返るはずだ、と書かれています。後者は読み取りの要求に指定を付けて選ぶ形で、それまでに成功したすべての書き込みを反映した最新のデータが返ります。ここには重要な制約があります。強い整合性のある読み取りが使えるのは表と局所的な副次索引だけで、全域の副次索引と変更の流れからの読み取りには使えないと明記されています。複数リージョンにまたがる構成では、既定が結果整合性で、書き込みを別のリージョンへ同期的に複製してから返す強い整合性の方式も選べると書かれています。
Azure Cosmos DBは5段階です。公式ドキュメントは、市場にある多くの分散型のNoSQLが強い整合性と結果整合性の2つしか提供しないのに対し、自社は明確に定義された5つの水準を提供すると書いています。強いほうから順に、Strong、Bounded staleness、Session、Consistent prefix、Eventualです。中間の水準の性格が実務的です。Bounded staleness は、2つの拠点のあいだのデータの遅れを、更新の回数か時間の長さのどちらか先に到達したほうで上限を切ります。Session は1つの利用者の作業単位の中で、自分が書いたものは自分が読める、という保証を与えるもので、公式ドキュメントは、単一の拠点でも世界に分散した構成でも、もっとも広く使われている水準だと書いています。そして重要な制約が明記されています。複数の拠点で書き込みを受ける構成では、Strong を使えません。理由として、分散した仕組みでは復旧地点の目標と復旧時間の目標をどちらもゼロにはできないこと、そして書き込みをすべての拠点へ複製して確定する必要がある以上、遅延の面でも利点が無いことが挙げられています。
Spannerは、世界規模での取引の一貫性を提供すると公式が明記しています。仕組みの解説文書には、既定で外部整合性という、取引処理の仕組みとしてもっとも厳しい性質を提供すると書かれており、これは前の節で強い整合性と呼んだものを、書き込みの確定の順序まで含めてさらに厳密にした性質です。整合性の強さを設計の前提に置き、その代わりに確定のたびに数ミリ秒の待ち時間を挟む、という作りです。ただし読み取りの側には選択の余地があります。読み取りについての公式ドキュメントは、既定では強い読み取りを使うと説明しています。書き込みの側の外部整合性を、読み取りの側で受け取る仕組みが強い読み取りです。強い読み取りとは現在の時刻での読み取りで、読み取りの開始までに確定したすべてのデータが見えることを保証するものです。そのうえで、過去の時刻で読む古い読み取りも用意されており、遅れの上限を指定する形と、時刻を正確に指定する形の2つがあります。位置づけは明確で、遅延の面で強い読み取りが難しい場面において、できるだけ新しいデータでなくてよい箇所に限って使うもの、と書かれています。Azure Cosmos DBのように水準そのものを段階から選ぶ形ではなく、既定の強い整合性の上に、読み取りの側だけに古さを許す選択肢がある、と整理できます。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 整合性の選択肢の数 | Amazon DynamoDB は2つ | Azure Cosmos DB は5段階 | Spanner は水準を段階として選ぶ形ではない。読み取りに限り、強い読み取りと古い読み取りを選べる |
| 既定の水準 | 結果整合性のある読み取り | 利用者がアカウントの単位で設定する | 強い整合性 |
| 強い整合性が使えない場面についての公式の記述 | 全域の副次索引、変更の流れからの読み取り | 複数の拠点で書き込みを受ける構成 | 本章の照合では確認していません |
| 複数リージョンにまたがるときの扱い | 結果整合性が既定。強い整合性の方式も選べる | 水準ごとに復旧地点の目標が変わると明記 | 世界規模での一貫性を提供と明記 |
この表も、同じ役割の枠に入るだけで同じものではありません。段階の数が2と5で違うだけでなく、そもそも何を選ばせているかが違います。Amazon DynamoDBは読み取りの要求ごとに選ばせます。Azure Cosmos DBはアカウントの単位で既定を決めたうえで、要求ごとに弱いほうへ上書きできる形です。Spannerは水準そのものを選ばせず、読み取りの要求ごとに古い読み取りを許すかどうかだけを選ばせます。したがって「整合性の水準を5段階から選べるほうが優れている」という読み方は成り立ちません。水準を段階として並べないことは、設計上の割り切りです。
この軸を経営の言葉に置き換えると、決めるべきことは「最新でなくてよい場面はどこか」という業務の話になります。閲覧数の集計や、いいねの数のように、数秒の遅れが業務上の意味を持たない場面は弱い水準で足ります。残高、在庫、座席、権限のように、古い値を読んだ結果が実害になる場面は強い水準が要ります。この線引きは技術側だけでは決められません。どこまで古い値を許容できるかを業務側と一緒に決めることが、実際にはサービス選定より先に来ます。
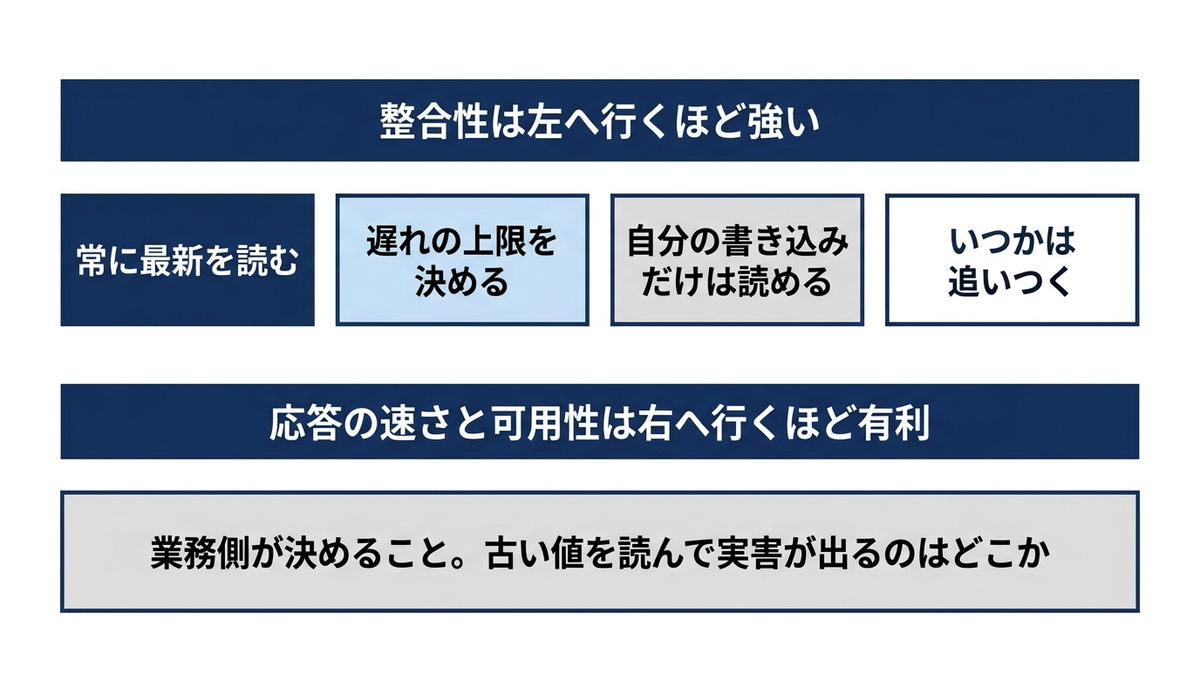
キャッシュには、期日の付いたものがある
データベースの手前に置いて、よく読まれるものを記憶装置の上に保持し、応答を速くする仕組みがキャッシュです。3社ともマネージドを持っていますが、この領域は今後数年で構成が大きく動くことが、すでに公式に告知されています。
AWSはAmazon ElastiCacheです。公式ドキュメントは、クラウドの中で分散型の記憶装置上のデータ置き場、あるいはキャッシュの環境を、立ち上げ、管理し、規模を広げることを容易にするサービスだと説明しています。使い方は2つで、サーバーレスのキャッシュとして始めるか、ノードを並べた集まりを作るかです。対応するエンジンはValkey、Memcached、Redis OSSの3つです。サーバーレスの形は、Valkey は7.2以降、Memcached は1.6.22以降、Redis OSS は7.1に対応すると書かれています。
AWSにはもう1つ、性格の違うサービスがあります。Amazon MemoryDBです。公式ドキュメントは、記憶装置の上で動く耐久性のあるデータベースサービスであり、極めて速い性能を提供すると説明しています。ValkeyとRedis OSSに互換性を持ちますが、決定的な違いは、複数のアベイラビリティゾーンにまたがる取引の記録を使ってデータを耐久的に保存する点です。公式ドキュメントは、記憶装置上の性能と複数ゾーンにまたがる耐久性の両方を提供することで、高性能な主データベースとして使え、キャッシュと耐久性のあるデータベースを別々に管理する必要が無くなると書いています。キャッシュと同じ窓口に見えても、前提が違います。キャッシュは消えてよいものですが、これは消えない前提のものです。
Azureは、この領域でもっとも大きな変化が起きています。Azure Cache for Redis の終了に関する公式の案内には、階層ごとの期日がはっきり書かれています。Basic、Standard、Premium の各階層のすべての実体は2028年9月30日に終了し、残っているものは2028年10月1日から使えなくなります。Enterprise と Enterprise Flash の階層は2027年3月31日に終了し、2027年4月1日から使えなくなります。移行先として案内されているのは Azure Managed Redis です。製品ドキュメントの冒頭にも、すべての種別について終了の日程を告知したこと、できるだけ早く Azure Managed Redis へ移すことを勧める旨が置かれています。
移行先の Azure Managed Redis について、公式ドキュメントは Redis Enterprise のソフトウェアにもとづく記憶装置上のデータ置き場だと説明しています。階層は4つで、記憶容量を重視するMemory Optimized、釣り合いを取ったBalanced、処理量を重視するCompute Optimized、そして使用頻度の低いデータを不揮発性の記録媒体へ自動的に移すFlash Optimizedです。既定で集まりの形をとるため、接続する部品の設定を集まり向けに変える必要がある、とも書かれています。移行は接続先を差し替えるだけでは終わらない場合がある、ということです。
Google CloudはMemorystoreです。公式ドキュメントで確認できたのは、Redisの記憶装置上のデータ置き場にもとづき、1ミリ秒未満でデータに手が届くアプリケーション向けのキャッシュを作るための完全マネージドのサービスであるMemorystore for Redis、その集まりの形にあたるMemorystore for Redis Cluster、Memorystore for Valkey、そしてMemorystore for Memcached の4つです。Memorystore for Valkey は、完全マネージドのValkey のサービスであり、集まりの形を有効にした構成と無効にした構成の両方に対応すると説明されています。有効にした構成は複数の断片を持てますが、無効にした構成は1つの断片で動きます。Memorystore for Memcached は、オープンソースのMemcached の上に作られた完全マネージドのサービスだと説明されていますが、こちらには期日が付いています。公式の非推奨化の案内には、非推奨の日付として2026年1月20日、停止の日付として2029年1月31日が載っています。あわせて、2027年2月1日を過ぎると、すでにこのサービスの実体を持つプロジェクトを除き、新しいプロジェクトでは作成できなくなること、停止の日付を過ぎると使えなくなることが明記されています。移行先として案内されているのはMemorystore for Valkey です。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 記憶装置上のマネージドなキャッシュ | Amazon ElastiCache | Azure Managed Redis | Memorystore for Redis、Memorystore for Redis Cluster、Memorystore for Valkey |
| 終了が告知されているもの | 本章の照合では確認していません | Azure Cache for Redis。Enterprise 系は2027年3月31日、Basic から Premium は2028年9月30日 | Memorystore for Memcached。非推奨は2026年1月20日、停止は2029年1月31日 |
| 対応するエンジンについての公式の記述 | Valkey、Memcached、Redis OSS | Azure Managed Redis は Redis Enterprise にもとづくと明記 | Redis、Valkey、Memcached。ただし Memcached は停止が告知済み |
| 消えない前提の記憶装置上のデータベース | Amazon MemoryDB | 本章の照合では確認していません | 本章の照合では確認していません |
この表も、同じ役割の枠に入るだけで同じものではありません。とくに2行目は、空欄を「AWSのキャッシュは安泰である」と読まないでください。本章で当たった公式ドキュメントの範囲で終了の告知を確認できなかった、という意味にすぎません。加えて、AzureとGoogle Cloudの欄に書いた日付は、移行の計画を立てるうえで実際に効いてくる情報です。2027年、2028年、2029年は、いま検討している構成が本番に入ってから訪れます。キャッシュは差し替えが軽いと思われがちですが、接続する部品の設定変更を伴う場合があることは前述のとおりです。期日のある移行として、計画に載せておく価値があります。
選ぶときの順序
ここまでを、判断の順序としてまとめておきます。データベースの選定は選択肢が多く、名前から入ると迷います。次の順で問いを立てると、候補が機械的に絞れます。
- アプリケーションがデータに触る形は決まっているか。決まっているならキーバリューやドキュメントの系統が候補に入ります。決まっていないなら、まずリレーショナルを選びます。
- 古い値を読んだときに実害が出るか。出るなら強い整合性が要ります。出ないなら弱い水準を選べる余地があり、応答の速さと可用性の面で有利になります。
- 1台のマネージドに収まる規模か。収まるならリレーショナルのマネージドで足ります。収まらないと確度をもって言えるなら、分散リレーショナルの系統を検討します。
- 持ち込む既存の資産は何か。エンジンの互換性がここで効きます。上位の選択肢は3社で互換の対象が違うため、資産の側から絞れます。
- 選んだサービスに終了や移行の告知が出ていないか。これは各社の公式の告知で毎回確かめます。名前が現役の一覧に載っていることは、状態の証明になりません。
5番目を最後ではなく、候補を絞る途中で1度は挟むことをおすすめします。本章で見たとおり、Azure Cache for Redis のように、現役として広く使われている最中に期日が告知されている例があります。
本章では、リレーショナルのマネージドを「どこまで手放すか」で並べ、規模の拡大と整合性の両立をうたう系統を分けて置き、鍵で取り出す系統とキャッシュを整理しました。押さえておきたいのは、整合性が製品の性質ではなく設定として選ぶものになったこと、Azureのオープンソース系には終わった世代と現行の世代があること、そしてAmazon DocumentDB と Azure DocumentDB のように名前が衝突している箇所があることの3つです。次章では、同じデータを日々の処理ではなく分析のために集めて使う仕組み、すなわちデータウェアハウスとデータレイクを中心とした分析の基盤に入ります。本章で扱ったデータベースは業務を動かすためのもので、次章で扱うのは意思決定のために読むためのものです。同じデータでも、置き方も問い合わせ方も変わります。
この章を深めたい方への参考書籍
『データ指向アプリケーションデザイン』(Martin Kleppmann 著、斉藤太郎 監訳、玉川竜司 訳、オライリー・ジャパン):本章で扱った整合性の水準、複製の取り方、データの分割といった論点を、製品名から離れて原理の側から説明した1冊です。なぜ強い整合性に待ち時間が伴うのか、なぜ複数の拠点で書き込みを受ける構成で強い整合性を保とうとすると、待ち時間や地理的な範囲の制限といった対価が要るのかを理解しておくと、各社の公式ドキュメントの制約の記述が、制限ではなく設計上の帰結として読めるようになります。
『SQLアンチパターン 第2版』(Bill Karwin 著、和田卓人 監訳、児島修 訳、オライリー・ジャパン):データベースの選定を終えても、実際に困るのは表と問い合わせの作り方であることが多いように思います。本章でAmazon RDSの責任分担に触れ、問い合わせ文の調整が利用者側に残ると述べましたが、その残された部分を扱うのがこの本です。よくある設計上の失敗を型として並べ、どう直すかまで書かれています。
『失敗から学ぶ RDBの正しい歩き方』(曽根壮大 著、技術評論社):リレーショナルデータベースの運用で起きる問題を、実際に起きた形から逆算して解説した1冊です。本章では選択の軸を中心に書いたため運用の細部には触れていませんが、マネージドにしても消えない仕事が何かを知っておくと、移行の見積りが現実的になります。
第5章 データ分析基盤
前章では、業務を動かすためのデータベースを、整合性の求め方と規模の広げ方という軸で整理しました。そこで扱ったものは、いずれも「いま起きていることを壊さずに書き込む」ための仕組みです。本章で扱うのは、その反対側にあたります。すでに書き込まれた大量のデータを、意思決定のためにまとめて読む仕組みです。同じ会社の同じデータであっても、書くための置き方と読むための置き方は違います。分析基盤という言葉が指しているのは、この「読むための置き方」を成立させる部品の集まりです。
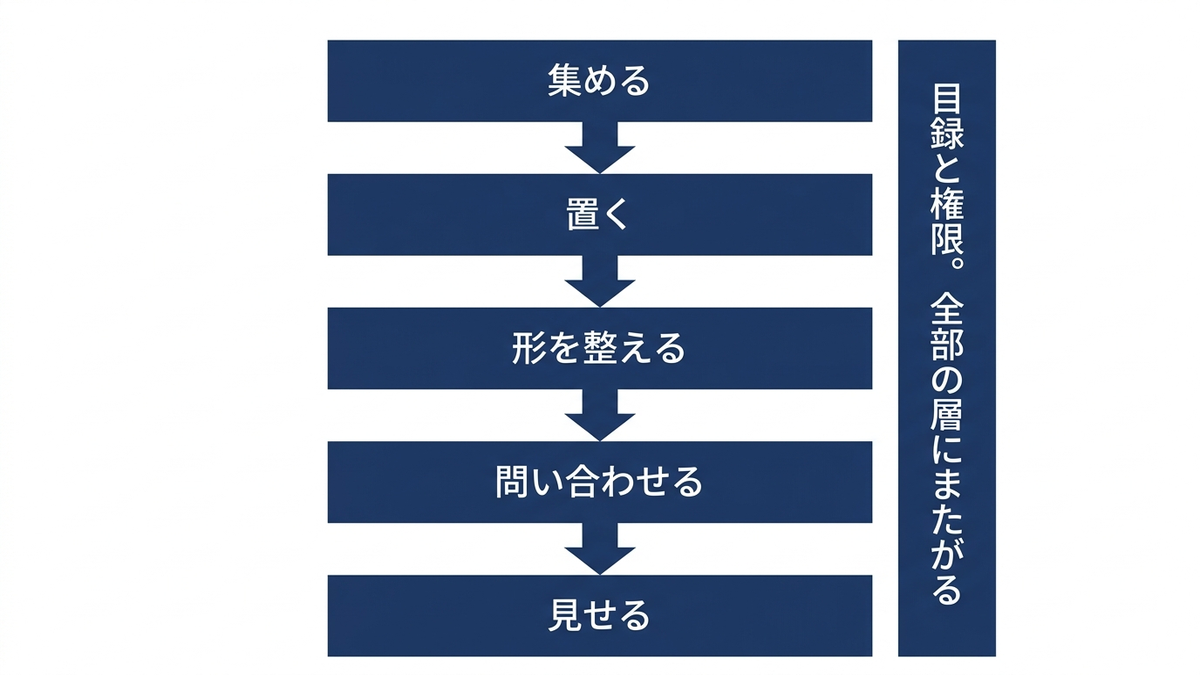
本章では、その部品を7つに分けて見ていきます。分析専用の問い合わせ基盤であるデータウェアハウス、加工前のデータをそのまま置いておくデータレイクと、そこに表の性質を持ち込むレイクハウスと呼ばれる形、データを運びながら形を整える変換の流れ、大量のデータを複数の機械に分けて処理する分散処理の枠組み、絶え間なく届くデータをその場で扱うストリーミング、結果を人が見る形にする可視化とBI、そして全体を横断してデータの所在と権限を管理するカタログとガバナンスです。この7つは、どれか1つを選ぶものではなく、組み合わせて1つの流れを作るものです。下の図では、この7つの部品を、データが流れる順に「集める」「置く」「形を整える」「問い合わせる」「見せる」の5つの層に置き直し、目録と権限を全部の層にまたがる帯として描いています。部品と層は1対1ではなく、たとえばデータウェアハウスは、置く層と問い合わせる層の両方にかかります。
この領域は、本記事が扱う全カテゴリの中で、5年のあいだに名前がもっとも激しく動いた場所でもあります。同じサービスが別の名前になり、別のサービスに束ねられ、あるいは終了しています。本章に書いたサービス名と状態は、3社の公式ドキュメントを2026年9月に直接開いて確かめたものだけです。確かめられなかったものは、確かめられなかったと書いています。機械学習のモデルを作る話は第6章、保管の仕組みそのものは第3章、費用の考え方は第12章で扱います。
データウェアハウスは、読むために形を変えた置き場である
分析の話は、たいていデータウェアハウスから始まります。業務のデータベースをそのまま集計に使うと、集計の重い処理が業務の応答を巻き込んで遅くします。加えて、業務のデータベースは1件を素早く書き換えるために作られているので、数億行を横断して合計を出す使い方には向きません。そこで、読むことに特化した別の置き場を用意します。それがデータウェアハウスです。
AWSはAmazon Redshiftです。公式ドキュメントは、これを完全マネージドでペタバイト規模のクラウド上のデータウェアハウスサービスだと説明しています。使い方は2つに分かれます。1つはAmazon Redshift Serverlessで、公式ドキュメントは、これを使えば、あらかじめ用意したデータウェアハウスの設定をすべて済ませなくてもデータに手が届き、資源は自動的に用意され、容量は要求の厳しい予測しにくい負荷に対しても速さが出るように賢く伸縮すると書いています。利用していないあいだは請求が発生しないとも明記されています。もう1つは、自分で資源を管理したい場合に選ぶ、あらかじめ用意する形のクラスタです。ここで1つ、期日のある変更が告知されています。公式ドキュメントの冒頭に、Amazon RedshiftはPythonのユーザー定義関数の利用を2026年6月30日以降サポートしないこと、そして段階的に適用していくことが掲示されています。その段階は、動作の変更を一覧にした公式ドキュメントに2つに分けて書かれています。まず、2025年10月30日より後は、新しいPythonのユーザー定義関数を作れなくなります。既存のものは、この時点では通常どおり動き続けるとされています。そして2026年6月30日より後は、既存のものを含めてPythonのユーザー定義関数のサポートが終わります。代わりに使うものとして案内されているのは、Lambdaのユーザー定義関数です。新しく作れなくなる日と、既存のものを含めてサポートが終わる日は、8か月離れています。既存の分析処理でこの仕組みを使っている場合は、計画に載せる対象になります。
Azureの該当はAzure Synapse Analyticsです。公式ドキュメントは、これをデータウェアハウスとビッグデータの仕組みを横断して洞察までの時間を短くする企業向けの分析サービスだと説明しています。中に入っているものは1つではありません。企業のデータウェアハウスで使われるSQLの技術、ビッグデータで使われるSpark、記録や時系列の分析に使うData Explorer、データの統合と変換に使うパイプライン、そしてPower BIをはじめとする他のAzureサービスとの深い連携です。SQLの側は、あらかじめ処理能力を確保する専用の形と、常時利用できるサーバーレスの形の2つを持ちます。ここでいうサーバーレスとは、利用者が計算資源をあらかじめ用意しておかなくても動く形のことで、詳しくは第7章で扱います。予測できる性能を求めるなら前者、計画外の突発的な負荷には後者、という書き分けがされています。ただしData Explorerについては、プレビュー段階のまま2025年10月7日に終了しています。これはSynapse本体ではなく、その中の1機能の話です。
Google CloudはBigQueryです。公式ドキュメントは、これを完全マネージドでAIに対応したデータの基盤であり、機械学習、検索、地理空間の分析、そしてBIといった機能が組み込まれた形でデータの管理と分析を助けるものだと説明しています。設計上の特徴として明記されているのが、保管する層と計算する層を意図的に分けている点です。公式ドキュメントは、この分離によって、片方の性能や可用性に影響を与えることなく、それぞれが資源を動的に割り当てられると書いています。読み書きと分析の処理が同じ資源を奪い合う、従来型の作りで起きる問題を避けるための設計です。加えてサーバーレスであり、資源を用意することも手作業で伸縮させることも必要ないと明記されています。SQLの中から機械学習を呼び出すBigQuery MLも、外部の製品ではなくBigQueryの機能として説明されています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 分析専用の問い合わせ基盤 | Amazon Redshift | Azure Synapse Analytics | BigQuery |
| 容量をあらかじめ決めずに使う形 | Amazon Redshift Serverless | Synapse SQL のサーバーレスの形 | 公式ドキュメントがサーバーレスと明記 |
| SQLの中から機械学習を呼ぶ仕組み | 本章の照合では確認していません | T-SQL の PREDICT 関数 | BigQuery ML |
| 期日が告知されている変更 | Pythonによるユーザー定義関数は、新規作成が2025年10月30日より後は不可、サポートは2026年6月30日より後に終了 | Data Explorer は2025年10月7日に終了 | 本章の照合では確認していません |
この表は、同じ役割の枠に入るというだけで、同じものではありません。1行目の3つは、成り立ちがかなり違います。Amazon Redshiftは分析専用のデータウェアハウスとして独立しており、データレイクや分散処理の部品は別のサービスとして並んでいます。Azure Synapse Analyticsは逆で、SQLとSparkとパイプラインを1つの製品の中に同居させた作りです。BigQueryはデータウェアハウスという呼び方をされることが多いものの、公式ドキュメント自身は「データの基盤」という言い方をしており、検索や地理空間の分析まで守備範囲に含めています。したがって「Redshiftに相当するのはどれか」という問いは、Azureでは製品の一部に、Google Cloudでは製品の一機能に答えが分かれます。4行目の空欄も、その事業者に期日のある変更が無いという意味ではありません。本章で当たった公式ドキュメントの範囲で確認できなかった、という意味にすぎません。
データレイクと、レイクハウスと呼ばれる形
データウェアハウスに入れるには、あらかじめ表の形を決めておく必要があります。しかし現実に集まってくるものは、機器の記録、アプリケーションの記録、写真、音声、外部から届く様々な形式のファイルです。形を決めてから集めようとすると、決めるまでのあいだ集まりません。そこで、まず生のまま安価な置き場へ入れておき、使うときに形を与えるという順番が採られるようになりました。この置き場がデータレイクです。
3社とも、データレイクの土台はオブジェクトの置き場です。AWSはAmazon S3、AzureはAzure Data Lake Storage、Google CloudはCloud Storageで、これらの性質は第3章で扱いました。ここで扱うのは、その上に「表として問い合わせられる」性質をどう足すかです。生のファイルの山は、置いておくだけなら安く済みますが、そのままではSQLで問い合わせられません。かといって全部をデータウェアハウスへ複製すると、二重に持つことになります。この両方を避けようとする形が、近年レイクハウスと呼ばれるようになったものです。
AWSでこの性質を担っているのが、Amazon AthenaとAmazon S3 Tablesです。Amazon Athenaについて公式ドキュメントは、Amazon S3の中のデータを標準のSQLで直接分析することを容易にする対話的な問い合わせサービスだと説明しています。管理画面でわずかな操作をすればS3のデータを指し示せ、標準のSQLで随時の問い合わせを始めて数秒で結果を得られる、と書かれています。Apache Sparkを使った分析も、資源の計画も設定も管理もせずに対話的に実行できると明記されており、SQLの側もSparkの側もサーバーレスで、実行した問い合わせのぶんだけ支払う形だとされています。Amazon S3 Tablesはもう一段踏み込んでいて、公式ドキュメントは、これを分析の処理に最適化したS3の保管であり、表形式のデータを保管するために作られたものだと説明しています。データはテーブルバケットという新しい種類のバケットに入り、テーブルバケットはApache Icebergの形式で表を保管することに対応します。公式ドキュメントは、Amazon Athena、Amazon Redshift、Apache Sparkといった、Icebergに対応する問い合わせの実行系から標準のSQL文で問い合わせられると書いています。この考え方はオープンテーブル形式と呼ばれ、レイクハウスという言葉の実質にあたります。表の定義と履歴をファイルと一緒に置いておき、どの実行系からも同じ表として読めるようにする、という発想です。
Azureは、この性質をMicrosoft Fabricという形でまとめています。公式ドキュメントは、Microsoft Fabricを、データの取り込み、変換、リアルタイムの流れの処理、分析、報告までを含む端から端までのデータの流れを支える分析の基盤だと説明しています。提供の形はサービスとしてのソフトウェアであり、OneLakeという中央の論理的なデータレイクを使って、すべての作業単位を横断してデータを保管しアクセスすると書かれています。OneLakeはAzure Data Lake Storage Gen2の上に作られていると明記されています。つまり第3章で扱った置き場の上に、テナント全体で1つという整理を載せたものです。レイクハウスという語も公式ドキュメントに定義があり、ファイルとフォルダと表の集まりであって、データレイクの上でデータベースのように振る舞うもの、と書かれています。加えてショートカットという仕組みがあり、公式ドキュメントは、これによってAzure Data Lake Storage、Amazon S3、Google Cloud Storageといった外部のデータの元に対して、変換の処理もデータの移動も伴わずに複製なしでアクセスできると説明しています。
Google Cloudは、BigQueryの側からこの性質に手を伸ばしています。公式ドキュメントは、BigQueryがApache Iceberg、Delta、Apache Hudiといったオープンテーブル形式に対応し、外部の表や連携の問い合わせを使えば、データが置かれている場所でそのまま問い合わせられると書いています。同じページには、Cloud Storage、Amazon S3、Azure Blob StorageのそれぞれについてBigLakeの表を作って問い合わせる手引きが並んでいます。このBigLakeという名前は、いま Lakehouse に変わっています。公式ドキュメントの掲示に、2026年4月20日をもってBigLakeはLakehouseと呼ばれるようになり、BigLake metastoreはLakehouse runtime catalogと呼ばれるようになったこと、そしてAPI、クライアントライブラリ、コマンド行の道具、権限管理の名前は変わらず、いまもBigLakeを指していることが明記されています。BigQueryのリリースノートでも、2026年4月22日の項に、BigLakeはGoogle Cloud Lakehouseと呼ばれるようになったという告知があります。改称後のページは、これをApache Icebergのオープンテーブル形式と完全マネージドの保管を組み合わせて、公開されたデータレイクハウスを作るための保管の実行系だと説明しています。なお、そのページの見出しはBorderless Lakehouseという表記で、掲示の表記ともリリースノートの表記とも少しずつ違います。掲示の4月20日とリリースノートの項の4月22日が2日ずれている理由は、どちらの文書にも書かれていません。本コラムでは以後、掲示の表記に合わせて Lakehouse と書きます。ドキュメントのアドレスも biglake という旧名のままです。ここで3社の形の違いがはっきりします。AWSは保管の側に表の性質を足しました。Azureは分析の基盤ごと新しい製品としてまとめました。Google Cloudはデータウェアハウスの側から外部の形式へ手を伸ばしました。向かっている方向は似ていますが、どこを起点にしているかが違います。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| データレイクの土台になる置き場 | Amazon S3 | Azure Data Lake Storage | Cloud Storage |
| 置いたファイルへ直接SQLを投げる仕組み | Amazon Athena | Synapse SQL のサーバーレスの形 | BigQuery の外部の表 |
| 表の性質を持ち込む仕組み | Amazon S3 Tables のテーブルバケット | Microsoft Fabric のレイクハウス | Lakehouse と、オープンテーブル形式への対応。Lakehouse の旧称は BigLake |
| 公式が名前を挙げているオープンテーブル形式 | Apache Iceberg | Delta Lake の形式で保管と明記 | Apache Iceberg、Delta、Apache Hudi |
| 複製せずに外部の置き場を読む仕組み | 本章の照合では確認していません | OneLake のショートカット | 本章の照合では確認していません |
この表も、同じ役割の枠に入るだけで同じものではありません。とくに3行目は、単位がそろっていません。Amazon S3 Tablesは保管の側の機能で、バケットの種類として現れます。Microsoft Fabricのレイクハウスは分析の基盤の中の作業単位で、製品を導入する話になります。Lakehouseは、公式ドキュメントが保管の実行系と説明しているもので、BigQueryからは外部の表として問い合わせる形になります。したがってこの行を「同じものの各社版」として読むと、導入の規模も、関わる部署も、見積りの前提も取り違えます。5行目の空欄についても、その仕組みが無いという意味ではなく、本章で当たった範囲の公式ドキュメントに該当を1つに決められる記述が無かった、という意味です。
Azure Synapse Analytics と Microsoft Fabric の関係は、慎重に書く必要がある
ここで、資料や社内の議論でよく揺れる論点を1つ、はっきりさせておきます。Azure Synapse AnalyticsとMicrosoft Fabricの関係です。結論から書くと、本章の照合の範囲では「Synapseは提供中であり、終了の告知は見つかっていない」までしか書けません。
実際に確かめたことを並べます。Azure Synapse Analyticsの概要ページには、提供終了、非推奨、サポート終了、Fabricへの移行を促す記述のいずれも見当たりませんでした。ページの中身は、SQLの側とSparkの側とData Explorerとパイプラインの説明のままです。一方で、Microsoft Fabricの概要ページには、Azure Synapse Analyticsへの言及がありません。そしてFabricの側には、Synapseからの移行の手引きが部品ごとに整備されています。Data Explorerからの移行、専用のSQLプールからの移行、Sparkからの移行が、それぞれ別の手引きとして用意されています。
この3つを並べると、新しく組むならFabricが事実上の推奨先である、という状況は読み取れます。しかし「SynapseはFabricに置き換えられた」「Synapseは終了する」と書くことはできません。それを述べた一次情報を確認できていないためです。公式の一覧に出てこないことは、終了したことの証明にはなりません。この作法は本記事を通じて守っています。もう1つ付け加えると、Azure Synapse Analyticsの概要ページは、記事としての更新日が2024年7月で止まっています。更新が止まっているページは、現況の裏づけとしては弱いものです。したがって実務上は、この関係について社内で方針を決める前に、マイクロソフトの窓口へ直接確かめることをおすすめします。本記事の役割は、公開されている一次情報で確かめられる範囲を正確に示すところまでです。
同じ注意は、Azure Data FactoryとFabricの関係にも当てはまります。ただしこちらは、公式ドキュメントがもう少し踏み込んでいます。Azure Data Factoryの概要ページには、Microsoft FabricのData Factoryが「Azure Data Factoryの次の世代」であるという掲示が置かれ、データの統合が初めてなら、まずFabricのData Factoryから始めるように案内されています。既存のAzure Data Factoryの処理は、Fabricへ引き上げることで、データサイエンス、リアルタイムの分析、報告といった新しい機能に手が届くとも書かれています。ここでも「Azure Data Factoryが終了する」とは書かれていません。新規の推奨先が移った、という事実だけが書かれています。
変換の流れ。ETLとELTのどちらが先かで設計が変わる
置き場と問い合わせの仕組みがそろっても、そのあいだをつなぐものが要ります。業務のデータベースから分析の置き場へデータを運び、途中で形を整える工程です。この工程には古くから2つの型があり、抽出して変換してから読み込む型と、抽出して読み込んでから変換する型に分かれます。前者がETL、後者がELTです。
どちらを選ぶかは好みの問題ではなく、置き場の性質で決まります。読み込む先が高価で融通の利かない機械だった時代は、入れる前に絞り込んで整えるETLが合理的でした。読み込む先が安価で伸縮する置き場になり、その上の計算資源も伸縮するようになると、まず生のまま入れてしまい、必要になった形を後から作るELTのほうが手戻りが少なくなります。この転換は、本章のここまでで見たデータレイクとレイクハウスの広がりと、同じ流れの中にあります。ただしELTが常に正しいわけではありません。個人情報のように、そもそも分析の置き場へ生のまま入れてはいけないものがあります。その場合は、入れる前に落とすか隠すかという判断が要り、ETLの型に戻ります。
AWSの中心はAWS Glueです。公式ドキュメントは、これをサーバーレスのデータ統合サービスであり、分析の利用者が複数の元からデータを見つけ、整え、動かし、統合することを容易にするものだと説明しています。70を超える多様なデータの元に接続でき、中央のデータカタログでデータを管理できると書かれています。視覚的な操作で変換の流れを作り、実行し、監視できることも明記されています。重要なのは、公式ドキュメントがETLだけでなくELTとストリーミングも1つのサービスで柔軟に扱えると明記している点です。型を選び直すたびに製品を入れ替えなくてよい、という意味になります。あわせて、クローラという仕組みが用意されており、データの構造を自動的に推測してAWS Glue Data Catalogへ取り込むと書かれています。
Azureの中心はAzure Data Factoryです。公式ドキュメントは、これを、複雑で混成的なETL、ELT、データ統合の案件のために作られたマネージドのクラウドサービスだと説明しています。構成要素は、処理のまとまりであるパイプライン、その中の1工程であるアクティビティ、データの構造を表すデータセット、接続先の情報を持つリンクされたサービス、変換の流れを組むデータフロー、そして実行の場を提供する統合ランタイムです。実行のきっかけを与えるトリガーも別に定義されています。マッピングデータフローという仕組みについて、公式ドキュメントは、Sparkのクラスタを理解することもSparkの書き方を覚えることも必要なく、変換の流れを組んで維持できると書いています。裏でSparkが立ち上がって落ちるため、クラスタを管理する必要はないとも明記されています。
Google Cloudには、性格の違う2つがあります。Dataflowについて公式ドキュメントは、多様なデータ処理の型を実行するためのマネージドサービスだと説明しています。プログラムの書き方はApache BeamのSDKで、これは公開された開発の型であり、まとめて処理する流れと絶え間なく届く流れの両方を同じ書き方で作れると説明されています。1つの書き方で両方を扱える点が、この製品のいちばんの特徴です。もう1つがCloud Data Fusionで、公式ドキュメントは、これを完全マネージドでクラウド生まれの企業向けのデータ統合サービスであり、データのパイプラインを素早く作って管理するためのものだと説明しています。こちらは画面の上で組む形が中心です。
工程を順番に回す仕組みも、この層に含まれます。AWSはAmazon Managed Workflows for Apache Airflowで、公式ドキュメントは、Apache Airflowのマネージドサービスを使って、クラウドの中で規模を保ったままデータのパイプラインを立ち上げて動かせると説明しています。Apache Airflow自体は、処理の流れを作り、予定を組み、監視するための公開された道具だと書かれています。Google Cloudの該当は、Managed Service for Apache Airflow です。かつてCloud Composerと呼ばれていたものが、この名前に変わりました。公式ドキュメントの本文に、以前はCloud Composerとして知られていた、という記述が明示されています。改称の理由も公式に書かれており、公開されたソフトウェアによる解決策への顧客の選好が高まっていることを、より強く受け止めるためだとされています。ドキュメントは第3世代、第2世代、第1世代の3つの手引きに分かれており、複数の世代が併存しています。世代ごとの期日は、入口のページではなくバージョンの概要を説明するページに書かれています。第2世代のうち2.0.x系の版は、2026年9月15日に計画された提供終了を迎え、それ以降は使えなくなるとされています。第1世代は、2024年3月25日に保守後の段階に入りました。この段階では、Airflowの新しい版も、不具合の修正も、安全性の更新も提供されません。そして2026年9月15日には、第1世代のすべての環境が計画された提供終了を迎えて使えなくなるとされています。保守後の段階に入った日と、使えなくなる日は別の日付で、2年半離れています。更新が止まった時点で移行の計画を始めていないと、期日の直前に慌てることになります。Azureは、Azure Data Factoryのトリガーとパイプラインがこの役割を担います。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| データ統合と変換の中心 | AWS Glue | Azure Data Factory | Dataflow、Cloud Data Fusion |
| 公式がETLとELTの両方を明記しているか | ETL、ELT、ストリーミングを1つのサービスで扱うと明記 | ETLとELTの案件のために作られたと明記 | Dataflow は多様なデータ処理の型と記載 |
| 工程を順番に回す仕組み | Amazon Managed Workflows for Apache Airflow | Azure Data Factory のパイプラインとトリガー | Managed Service for Apache Airflow。旧称は Cloud Composer |
| 構造を自動で推測して目録へ入れる仕組み | AWS Glue のクローラ | 本章の照合では確認していません | 本章の照合では確認していません |
| 公式が示している新規の推奨先 | 本章の照合では確認していません | Microsoft Fabric の Data Factory | 本章の照合では確認していません |
この表も、同じ役割の枠に入るだけで同じものではありません。3行目に置いたものは、AWSとGoogle Cloudが同じApache Airflowのマネージドサービスであるのに対し、Azureは製品の中の機能です。したがってAzureでは「順番を回す道具を別に導入する」という発想そのものが生じません。また、Google Cloudの欄に旧称を併記したのは、この名前が実務で混乱を起こしやすいためです。ドキュメントのアドレスは今も composer という旧名のままで、ページの見出しだけが新しい名前になっています。アドレスを見て名前を判断すると、変化に気づけません。前の節で見たLakehouseも同じ形でした。同じことがもう1件あり、次の節で扱います。
分散処理の枠組みは、名前が公開ソフトウェアの側に寄っていく
データの量が1台の機械に収まらなくなると、処理を複数の機械へ分けて同時に走らせることになります。この分野は、クラウド以前から公開されたソフトウェアが主役でした。したがって3社の製品も、独自の実装というより、それらを載せて運用の面倒を引き受けるという性格が強くなります。
AWSはAmazon EMRです。公式ドキュメントは、これを、以前はAmazon Elastic MapReduceと呼ばれていたものであり、Apache HadoopやApache Sparkといったビッグデータの枠組みをAWSの上で動かすことを簡単にする、マネージドのクラスタの基盤だと説明しています。分析や事業の判断のためのデータ処理に使え、Amazon S3やAmazon DynamoDBといった他の置き場との間で大量のデータを出し入れできるとも書かれています。この改称は本記事が扱う期間より前に済んでいます。期間内の変更は確認できませんでした。
AzureはAzure HDInsightです。公式ドキュメントは、これを企業向けのマネージドで全方位の、公開ソフトウェアによる分析サービスだと説明しています。Apache Spark、Apache Hive、LLAP、Apache Kafka、Hadoopといった枠組みをAzureの環境で使えると書かれています。クラスタの種別は5つで、Apache Hadoop、Apache Spark、Apache HBase、Apache Interactive Query、Apache Kafkaです。概要ページに終了や非推奨の記述はありませんでした。ただしバージョン単位では期日が決まっています。公式のバージョン表によれば、HDInsight 5.1は標準の支援対象で、支援の終了日も廃止の日も「未告知」となっています。一方でHDInsight 5.0と4.0は限定的な支援の対象で、支援の終了日も廃止の日も2025年3月31日です。同じページには廃止の意味も定義されており、退役した版については支援も保守も提供されず、管理画面からもコマンドからも開発キットからも新しいクラスタを作れなくなること、そして廃止日以降はいつでも当該の版の実体を削除する権利を留保することが書かれています。サービスが生きていることと、いま動かしている版が生きていることは別の話です。
Google Cloudには、本章でもっとも注意すべき改称があります。かつてCloud Dataprocと呼ばれていたものは、いま Managed Service for Apache Spark です。公式ドキュメントの掲示には、この名前が、以前はクラスタとして配置する形の「Dataproc on Compute Engine」、およびサーバーレスとして配置する形の「Google Cloud Serverless for Apache Spark」として知られていた製品の新しい名前である、と明記されています。つまり2つの旧称が1つの新しい名前に束ねられました。ページの見出しはすでに新しい名前になっており、製品の説明は、クラスタの上でこのサービスを使うことで、まとめて処理する用途、問い合わせ、絶え間ない流れの処理、機械学習に対して、公開されたデータの道具を活かせるというものです。ここでも、ドキュメントのアドレスは dataproc という旧名のままです。APIの参照、研修の題名、コードの見本の置き場所にも旧名が残っています。アドレスや周辺の表記を見て名前を確かめたつもりになると、古い名前のまま資料を書くことになります。
この領域では、終わったものもはっきりしています。Azure Data Lake Analyticsです。公式ドキュメントの冒頭に、2024年2月29日に廃止されたことが明記されており、データの分析には Azure Synapse Analytics か Microsoft Fabric を使うように案内されています。ページ自体が過去の版の置き場へ移されており、保存済みであることを示す情報も付いています。U-SQLという独自の問い合わせ言語ごと終わったことになります。独自の言語を採用するときは、その言語がその製品の寿命と運命を共にすることを、判断の材料に入れておく必要があります。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 公開ソフトウェアの分散処理を載せる基盤 | Amazon EMR | Azure HDInsight | Managed Service for Apache Spark |
| 本記事が扱う期間の名前の変化 | 変更なし | 変更なし | Cloud Dataproc から改称。2つの旧称が1つに束ねられた |
| 版ごとに期日が告知されているもの | 本章の照合では確認していません | 4.0 と 5.0 は2025年3月31日に廃止。現行は5.1で期日は未告知 | 本章の照合では確認していません |
| この領域で提供が終わったもの | 本章の照合では確認していません | Azure Data Lake Analytics。2024年2月29日 | 本章の照合では確認していません |
この表も、同じ役割の枠に入るだけで同じものではありません。1行目のうち、Azure HDInsightは5種類のクラスタ種別を持ち、Kafkaによる流れの取り込みまで同じ製品の中に含みます。Google CloudのManaged Service for Apache SparkはSparkに焦点を絞った名前になっており、Kafkaは別の製品として存在します。Amazon EMRはその中間で、HadoopとSparkを中心に据えつつ複数の枠組みを載せられます。つまり「同じ枠に入るから同じ範囲を持つ」わけではなく、1つのサービスがどこまで抱えるかが3社で違います。置き換えの検討をするときは、いま使っている部品の一覧を先に作り、それが移行先の1製品に収まるのか、複数に割れるのかを確かめるところから始めることになります。
ストリーミングは、受け口と処理を分けて考える
ここまでは、すでに溜まったデータをまとめて扱う話でした。絶え間なく届き続けるデータを、届いた端から扱いたい場面もあります。機器の測定値、利用者の操作の記録、決済の明細などです。この領域を見るときの要点は、受け口と処理を別のものとして分けて考えることです。受け口は届いたデータを順番に保持して複数の受け手へ配るもの、処理はその流れに対して集計や判定を行うものです。この2つを混ぜて考えると、3社の製品の対応づけがすぐに崩れます。
AWSは、この領域をKinesisという名前でまとめてきました。公式ドキュメントによれば、いまこの基盤に含まれるのは、Amazon Kinesis Data Streams、Amazon Data Firehose、Amazon Kinesis Video Streams、Amazon Managed Service for Apache Flinkの4つです。このうち2つは、本記事が扱う期間に名前が変わっています。Amazon Data Firehoseは、かつてAmazon Kinesis Data Firehoseと呼ばれていました。改称の発表は2024年2月9日です。公式ドキュメントは、これを、Amazon S3、Amazon Redshift、Amazon OpenSearch Service、Splunk、Apache Icebergの表、任意のHTTPの届け先といった宛先へ、絶え間なく届くデータをそのまま配送するための完全マネージドのサービスだと説明しています。アプリケーションを書く必要も資源を管理する必要もない、とされています。用語も変わっており、流れの実体は「Firehose stream」と呼ばれます。もう1つがAmazon Managed Service for Apache Flinkで、かつてはAmazon Kinesis Data Analyticsという名前でした。改称の発表は2023年8月30日です。公式ドキュメントは、Java、Scala、Python、SQLを使って流れてくるデータを処理し分析できると説明し、計算資源の用意、可用性ゾーンの障害への耐性、並列の計算、自動的な伸縮、控えの取得といった中核の機能を引き受けると書いています。
ここで、改称と廃止を混同しないことが重要です。同じKinesis Data Analyticsという名前の下に、Apache Flinkを使う形とSQLを使う形の2つがありました。改称して生き残ったのは前者です。後者は廃止されました。公式ドキュメントには段階が3つ書かれています。2025年9月1日からは不具合の修正を提供しないこと、2025年10月15日からは新しいアプリケーションを作れないこと、そして2026年1月27日からアプリケーションを削除し、起動も運用もできなくなり、支援も提供されなくなることです。「Kinesis Data Analyticsは無くなった」と一括りに書くと誤りになり、「Kinesis Data Analyticsは名前が変わっただけ」と書いても誤りになります。2つに分かれた、というのが正確な書き方です。名前が変わっていないのはAmazon Kinesis Data StreamsとAmazon Kinesis Video Streamsで、前者について公式ドキュメントは、大量の記録の流れをリアルタイムに集めて処理するために使えるものだと説明しています。
Azureは、受け口と処理がきれいに分かれています。受け口がAzure Event Hubsで、公式ドキュメントは、これを完全マネージドのリアルタイムのデータの流れの基盤であり、毎秒数百万の出来事を低い遅延で取り込めるものだと説明しています。Apache Kafkaとの互換性が組み込まれている点が明記されており、既存のKafkaの処理をコードの変更もクラスタの管理も無しに動かせるとされています。保持できる期間は階層で決まり、標準の階層で最大7日、上位の階層と専用の階層で最大90日と書かれています。Captureという機能を使うと、リアルタイムの処理に使っているのと同じ流れから、Azure Blob StorageやAzure Data Lake Storageへほぼ即時に書き出せます。処理の側がAzure Stream Analyticsで、公式ドキュメントは、これを完全マネージドの流れの処理の実行系であり、大量の流れてくるデータをミリ秒未満の遅延で分析し処理するものだと説明しています。書き方はSQLの問い合わせ言語に時間に関する強力な条件を足したもので、単純なデータの操作、集計、地理空間の関数、型の照合、異常の検知に対応すると書かれています。信頼性についても明記があり、出来事の処理はちょうど1回、配送は少なくとも1回を保証するとされ、管理されたサービスとして分単位の粒度で99.9パーセントの可用性で処理を保証すると書かれています。
Google Cloudの受け口はPub/Subです。これはメッセージングの仕組みとして第7章でも扱いますが、分析の文脈では取り込みの入口として現れます。1点だけ、期日のある変更があります。Pub/Sub Liteです。公式ドキュメントに、Pub/Sub Liteは非推奨であり、2027年1月31日をもって停止されると明記されています。ただし、期日はこの1つではありません。Pub/SubとPub/Sub Liteの選び方を説明する公式ドキュメントには、この掲示に続けて、段階が3つに分けて書かれています。新規の顧客に対しては、2024年9月24日より後は提供されていません。既存の顧客に対しては2027年1月31日まで機能し続けますが、2025年7月15日に先立つ90日間に一度も使っていなかった場合は、2025年7月15日から利用できなくなるとされています。つまり、新規受付の停止、使っていない既存の利用者の停止、全体の停止という3つの期日が、別々に置かれています。「停止」と一言で書くと、この3つの違いが消えます。移行先として案内されているのは、Google Cloud Managed Service for Apache KafkaとPub/Subの2つです。前者について公式ドキュメントは、Apache Kafkaのクラスタを立ち上げ、守り、保守し、規模を広げることを助けるものだと説明しています。本体のPub/Subには変更がありません。終わるのはLiteだけです。処理の側は、流れの処理をDataflowで書く形になります。前の節で見たとおり、Apache Beamの書き方は、まとめて処理する流れと絶え間なく届く流れの両方に同じ形で使えます。
この領域を設計するときに、3社共通で必ず決めることが1つあります。ウィンドウの取り方です。絶え間なく届くデータには終わりがないので、「直近5分の合計」のように時間で区切らないと集計ができません。そして、届く順番が乱れたり、遅れて届いたりする記録をどう扱うかを決めなければなりません。これは製品選びではなく業務の話です。3分遅れて届いた売上を当日の集計に入れるのか、翌日に回すのかは、技術側だけでは決められません。ここを曖昧にしたまま作ると、数字が合わない理由を後から誰も説明できなくなります。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 絶え間なく届くデータの受け口 | Amazon Kinesis Data Streams | Azure Event Hubs | Pub/Sub |
| 受け取ってそのまま宛先へ配送する仕組み | Amazon Data Firehose。旧称は Kinesis Data Firehose | Azure Event Hubs の Capture | Pub/Sub のエクスポートのサブスクリプション |
| 流れに対する集計や判定 | Amazon Managed Service for Apache Flink。旧称は Kinesis Data Analytics | Azure Stream Analytics | Dataflow |
| Apache Kafka との関係についての公式の記述 | 本章の照合では確認していません | Event Hubs に Kafka 互換が組み込みと明記 | Google Cloud Managed Service for Apache Kafka が別に存在 |
| 期日が告知されているもの | SQL版の Kinesis Data Analytics は2026年1月27日から削除 | 本章の照合では確認していません | Pub/Sub Lite は2027年1月31日に停止。新規の顧客への提供は2024年9月24日より後は無し |
この表も、同じ役割の枠に入るだけで同じものではありません。3行目がとくに揃っていません。AWSのものはApache Flinkの上に自分で処理を書く形です。AzureのものはSQLに近い独自の問い合わせ言語で書く形です。Google CloudのものはApache Beamの書き方で、まとめて処理する用途と共通の道具になります。したがって「同じことができるか」ではなく「誰が、どの言語で、どこまで書くのか」で選ぶ対象が変わります。SQLだけで済ませたい組織と、開発の作法をそのまま持ち込みたい組織では、答えが逆になります。加えて、AWSの欄に旧称を併記したのは、この2件の改称がいまも資料の側で追いついていない場面が多いためです。旧称で書かれた資料が誤りだとは限らず、単に書かれた時期が古いだけの場合があります。
可視化とBIは、名前がいちばん動いた領域である
ここまでの部品をどれだけ丁寧に組んでも、結果を人が見られなければ何も起きません。その最後の一段を担うのが可視化とBIです。そしてこの領域は、本章の中で名前がもっとも動いた場所です。3社のうち2社で名前が変わっており、しかもそのうち1つは、かつての名前に戻るという形の変化です。
AWSは、2025年10月9日に大きく変わりました。かつてAmazon QuickSightと呼ばれていたものは、いまAmazon Quickです。公式ドキュメントは、Amazon Quickを、作業の自動化、データの分析、ウェブアプリケーションの構築、調査のためのAIを使ったサービスだと説明しています。自然な言葉によるやり取りで使い、AIの担い手が接続されたデータの元やアプリケーションに対して要求を処理する、という作りです。含まれる機能として、対話的なデータの可視化とBIを担うAmazon Quick Sight、繰り返しの作業を自動化するAmazon Quick Flows、業務の処理を自動化するAmazon Quick Automate、組織の文書とデータの元を接続するAmazon Quick Index、調査を行うAmazon Quick Research、そしてAmazon Quickの中で作るアプリケーションが挙げられています。つまり、かつてBIの製品だったものが、より広い枠の中の1機能になりました。公式ドキュメントの注記には、Amazon QuickはAmazon QuickSightから発展したものであり、QuickSightはAmazon Quickの中の機能であるAmazon Quick Sightとして続くこと、そして既存のQuickSightのAPI、開発キット、連携はすべて変更なしに動き続けることが明記されています。なお、公式ブログでは「Amazon Quick Suite」という呼び方も使われています。この呼び方とAmazon Quickの関係は、本章の照合では確認できませんでした。したがって断定しません。本章はドキュメント側の表記に合わせています。
AzureのPower BIは、名前も位置づけも変わっていません。公式ドキュメントは、これをマイクロソフトの事業分析の基盤であり、データを実際に動ける洞察へ変えることを助けるものだと説明しています。主な部品は、報告書を作るためのPower BI Desktop、共有と共同作業のためのPower BI サービス、そして持ち歩いて見るためのモバイルのアプリです。Microsoft Fabricとの関係も明記されており、Power BIはFabricの中核となる部品の1つであり、分析と可視化の機能を提供すると書かれています。ここで読者に効く記述が1つあります。移行は不要であり、既存のPower BIの内容も作業領域もそのままであること、既存のPower BIまたはMicrosoft 365のアカウントでそのまま入れること、Fabricは新しい機能を足すがPower BIの画面と使い勝手は変わらないことが、はっきり書かれています。基盤の側が大きく作り替えられても、利用者の手元は変わらない場合がある、という具体例です。
Google Cloudは、2つの製品が並んでいます。1つはLookerで、公式ドキュメントは、これをGoogle CloudのBI、データを使うアプリケーション、組み込みの分析のための基盤だと説明しています。名前は変わっていません。もう1つが無償の道具で、こちらは Data Studio です。かつてData Studioと呼ばれ、その後Looker Studioに改称され、いままたData Studioに戻りました。公式ドキュメントのページには、Looker Studioはいま Data Studio と呼ばれているという掲示がはっきり置かれています。定義は、費用のかからない道具であり、データを分かりやすく、読みやすく、共有しやすく、全面的に手を入れられるダッシュボードと報告書に変えるもの、というものです。有償の形は Data Studio Pro です。ここで必ず押さえておきたいのは、LookerとData Studioは別の製品であり、その関係自体は変わっていないことです。公式ドキュメントには両者を比べるページが用意されており、Lookerは主要な指標の定義に対する統制、堅牢なデータへのアクセス権限、共有と予定と警報、業務の分析、既存の道具への分析の組み込みを必要とする組織に向くと整理されています。データを扱う人のための統合開発環境や、開発者向けの組み込みとAPIの機能も挙げられています。対してData Studioは、自分で行う分析、柔軟な随時の報告、1回限りの可視化に向くとされ、扱いやすい引いて落とす形の編集画面と、1000を超えるデータの元が特徴として挙げられています。したがって「Lookerの無償版がData Studio」という理解は正しくありません。設計思想が違う2つの製品です。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 可視化とBIの中心 | Amazon Quick Sight。Amazon Quick の中の機能 | Power BI | Looker |
| 本記事が扱う期間の名前の変化 | Amazon QuickSight から Amazon Quick へ。2025年10月9日 | 変更なし | Looker Studio から Data Studio へ |
| 費用のかからない自分で行う分析の道具 | 本章の照合では確認していません | 本章の照合では確認していません | Data Studio。有償の形は Data Studio Pro |
| 既存の資産への影響についての公式の記述 | 既存のAPI、開発キット、連携は変更なしに動くと明記 | 移行は不要で内容も作業領域もそのままと明記 | 本章の照合では確認していません |
この表も、同じ役割の枠に入るだけで同じものではありません。1行目の3つは、置かれている位置が違います。Amazon Quick SightはAmazon Quickという上位の枠の中の1機能です。Power BIはMicrosoft Fabricの中核の作業単位でありながら、独自の画面と道具を持ち続けています。LookerはGoogle Cloudの中で単独の製品として立っています。そして3行目のとおり、費用のかからない自分で行う分析の道具を本章の照合の範囲で明確に確認できたのは、Google Cloudです。ただしこの空欄も、AWSとAzureにそうした道具が無いという意味ではなく、本章で当たった範囲の公式ドキュメントで該当を確認できなかった、という意味です。もう1つ、4行目は選定の実務でとても効きます。名前が変わったこと自体より、既存の資産が動き続けるかどうかのほうが、意思決定への影響が大きいためです。
カタログとガバナンスが無い分析基盤は、いずれ止まる
最後に、ここまでの部品を横断する層を扱います。データがどこに何件あり、どういう意味を持ち、誰が触れてよいのかを管理する層です。この層は、作り始めの時期にはほとんど必要に見えません。部門が1つで、扱う表が10個で、担当者が2人なら、頭の中に入るからです。しかし表が数百になり、部門をまたぎ、担当者が入れ替わると、状況は一変します。同じ名前の表が2つあり、どちらが正しいか誰も分からなくなります。ある集計が別の集計と合わず、原因を追える人がいなくなります。分析基盤が止まるとき、原因は性能ではなく、この層の欠落であることが多いように思います。だからこの層を、後から足す飾りではなく、最初から設計に入れる部品として扱う必要があります。
この層の中心にあるのがデータカタログです。データの目録であり、どこに何があるかを記録します。AWSではAWS Glue Data Catalogがこれにあたります。前の節で見たとおり、AWS Glueのクローラがデータの構造を自動的に推測してここへ取り込みます。権限の側を担うのがAWS Lake Formationで、公式ドキュメントは、これを、分析と機械学習のためにデータを中央で統治し、守り、世界規模で共有することを助けるものだと説明しています。Amazon S3の上のデータレイクのデータと、AWS Glue Data Catalogの上のメタデータに対して、細かい粒度でのアクセス制御を管理できると書かれています。粒度の説明が具体的です。列、行、セルの水準での細かい制御が、Amazon Athena、Amazon Quick、Amazon Redshift Spectrum、Amazon EMR、AWS Glueといった分析と機械学習のサービスを横断して適用されると明記されています。加えて、既存の権限の設定を止めずに段階的に導入するための混成のアクセス方式が用意されており、1つの用途ずつ移していけると書かれています。この段階的な導入の道が用意されていることは、実務では大きな意味を持ちます。統治の仕組みは、全部を一度に切り替えようとすると必ず頓挫するためです。より事業寄りの語彙で目録を持つ層としてはAmazon DataZoneがあり、公式ドキュメントは、AWSの中、社内の設備、外部の提供元にまたがって保管されたデータを、目録に載せ、見つけ、共有し、統治することを速く簡単にするデータ管理のサービスだと説明しています。
AzureはMicrosoft Purviewです。公式ドキュメントは、これを、データがどこにあっても、AIの時代においてデータを統治し、守り、管理することを助ける包括的な解決策の集まりだと説明しています。データの統治の側に含まれるものとして、Microsoft Purview Data MapとMicrosoft Purview Unified Catalogが挙げられています。データの安全の側には、情報の保護、データの流出の防止、内部の危険の管理などが並びます。Microsoft Fabricとの関係も明記されています。Fabricの概要ページには、統治の機能が権限、機密の分類、監査を含み、それらがMicrosoft Purviewによって支えられていると書かれています。つまりAzureでは、分析の基盤と統治の仕組みが別の製品でありながら、片方がもう片方の中に組み込まれている形です。
Google Cloudには、本章で見たLakehouseと同じ2026年4月の改称が、この層にもあります。かつてDataplex Universal Catalogと呼ばれていたものは、いま Knowledge Catalog です。公式ドキュメントの掲示に、2026年4月10日をもってDataplex Universal CatalogはKnowledge Catalogと呼ばれるようになったこと、そしてAPI、クライアントライブラリ、コマンド行の道具、権限管理の名前は変わらないことが明記されています。定義は、AIを使ったデータの目録であり、データの資産の全体に対して事業上の文脈と統治を提供するもの、というものです。ここでも、APIやアドレスの側には旧名が残ります。本章で見た4件目の同じ型です。名前を確かめる手がかりとして、アドレスもAPIの名前も使えない、ということになります。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 技術的なデータの目録 | AWS Glue Data Catalog | Microsoft Purview Data Map | Knowledge Catalog。旧称は Dataplex Universal Catalog |
| 事業の語彙で持つ目録 | Amazon DataZone | Microsoft Purview Unified Catalog | Knowledge Catalog |
| 細かい粒度の権限 | AWS Lake Formation。列、行、セルの水準と明記 | Microsoft Purview の統治の機能 | 本章の照合では確認していません |
| 段階的に導入する道が用意されているか | 混成のアクセス方式があると明記 | 本章の照合では確認していません | 本章の照合では確認していません |
この表も、同じ役割の枠に入るだけで同じものではありません。もっとも大きな違いは、製品の切り分け方です。AWSは、目録、権限、事業の語彙を3つの別々のサービスに分けています。Azureは、それらをMicrosoft Purviewという1つの傘の下に置き、しかもその傘は分析基盤に限らず、社内の文書や電子メールまで守備範囲に含みます。Google Cloudは1つの製品名の下に目録の機能をまとめています。したがってこの層の導入は、AWSでは部品の組み合わせを設計する仕事になり、Azureでは全社的な統治の方針を決める仕事になりやすい傾向があります。関わる部署も、承認を得る相手も変わります。3行目と4行目の空欄は、その機能が無いという意味ではなく、本章で当たった範囲で確認できなかった、という意味です。
選ぶときの順序
本章で見た部品を、判断の順序としてまとめておきます。分析基盤は部品が多く、製品名から入ると必ず迷います。次の順で問いを立てると、候補が絞れます。
- いま出せていない答えは何か。分析基盤は道具であって目的ではありません。答えたい問いを先に1つか2つ決めると、必要な部品が半分以下に減ります。
- データはいつ使うか。溜めてからまとめて読むならデータウェアハウスとデータレイクの組み合わせが中心になります。届いた端から扱う必要があるなら、受け口と流れの処理を先に設計します。
- 形を決めてから入れるか、入れてから形を与えるか。個人情報や規制の対象を含むなら、入れる前に落とすか隠す工程が要ります。それ以外なら、まず入れてから形を与えるほうが手戻りが少なくなります。
- 誰が問い合わせを書くか。SQLだけで完結させたいのか、開発の作法をそのまま持ち込みたいのかで、選ぶ製品が変わります。とくに流れの処理では、この違いが製品の選択を分けます。
- 目録と権限を誰が持つか。ここを決めずに始めると、表が増えた時点で止まります。段階的に導入できる仕組みがあるかどうかを、最初に確かめておきます。
- 選んだ部品に期日のある告知が出ていないか。本章だけでも、廃止、版の退役、機能のサポート終了が複数ありました。名前が現役の一覧に載っていることは、状態の証明にはなりません。
6番目については、名前の確認のしかたにも注意が要ります。本章で確認した4件の改称は、いずれもドキュメントのアドレスが旧名のままでした。Lakehouse、Managed Service for Apache Spark、Managed Service for Apache Airflow、Knowledge Catalogの4件です。加えてAmazon Quickも、ドキュメントのアドレスは旧名のままです。アドレスを見て名前が変わっていないと判断すると、古い名前で資料を書き続けることになります。確かめるべきなのは、ページの見出しと、そこに置かれた掲示です。
本章では、データウェアハウスとデータレイクを分けて置き、そのあいだを埋めるレイクハウスと呼ばれる形を整理し、変換の流れ、分散処理、ストリーミング、可視化、そして目録と権限までを見ました。押さえておきたいのは、ETLとELTのどちらを選ぶかが好みではなく置き場の性質で決まること、ストリーミングでは受け口と処理を分けて考えないと3社の対応づけが崩れること、そして名前の変化がドキュメントのアドレスに現れないため、見出しと掲示を読むしかないことの3つです。次章では、ここに集めたデータを使って予測や判断を行う側、すなわち機械学習とAIのサービスに入ります。本章で扱ったのはデータを集めて読める形にするところまでで、次章で扱うのは、そのデータから何かを予測したり、生成したりする仕組みです。
この章を深めたい方への参考書籍
『[増補改訂]ビッグデータを支える技術』(西田圭介 著、技術評論社):本章で並べた部品が、なぜそういう形になったのかを、製品名から離れて仕組みの側から説明した1冊です。手元の1台で試せる構成を使って、置き場、変換、問い合わせ、可視化の各層が何をしているかを順に確かめられます。3社の製品を比べる前にこの本を通しておくと、公式ドキュメントの説明文が、宣伝ではなく設計上の選択として読めるようになります。
『データエンジニアリングの基礎』(Joe Reis、Matt Housley 著、中田秀基 訳、オライリー・ジャパン):データの取得から保管、変換、提供までを1つの生涯として捉え、どの段階で何を決めるべきかを整理した1冊です。本章では選択の軸を中心に書きましたが、この本は組織の成熟度に応じて設計を変えるという視点を加えてくれます。特定の事業者に依存しない書き方をしているため、複数のクラウドを比較検討する場面でそのまま使えます。
『実践的データ基盤への処方箋』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社):本章の最後で扱った目録と権限の話を、組織の側から具体的に扱った1冊です。データの管理は技術だけでは成立せず、誰が責任を持ち、どういう役割分担で回すかという話に必ず行き着きます。分析基盤を作ったあとに使われなくなる、という失敗の型を避けたい場合に、先に読んでおく価値があります。
第6章 機械学習とAIのサービス
前章では、データを集めて整え、集計し、可視化するまでの基盤を見ました。倉庫に貯め、湖に置き、流れてくるものを受け止め、意味づけの台帳で管理する。そこまでが済むと、次に出てくる問いはたいてい同じです。集めたこのデータで、何かを予測したり、判断を助けたり、文章や画像を作らせたりできないのか、という問いです。本章はその問いに対して、3社が何を用意しているのかを整理します。
先に、この章がどこに立っているかを申し上げます。弊社の既刊コラムには、統計学、機械学習、深層学習、時系列、因果推論といった分野のものがあり、それらはいずれもモデルを作る側を扱っています。どういう手法があり、どう当てはめ、どう評価するかという話です。それに対して本章が扱うのは、作ったものを載せる側です。アルゴリズムの説明はしません。どのサービスがどの役割の枠に入り、どういうときにそれを選び、どういうときに選ばないのかという、選定のための地図を書きます。
この領域には、本記事の他のどの章よりも強い注意が要ります。名前が変わったもの、統合されたもの、新規の受付を止めたもの、提供を終えたものが、いずれも突出して多いからです。しかも、名前が変わっただけのものと、指している対象そのものが変わったものが混ざっています。以下では、公式ドキュメントを2026年9月に直接開いて読めたことだけを書き、読めなかったものは読めなかったと明記します。費用の考え方は第12章、誰がどのデータに触れてよいかという権限の設計は第9章、データウェアハウスや可視化の道具は第5章で扱います。
先に、名前の取り違えを片づける
この章の内容に入る前に、名前の話を先に済ませます。順序を逆にすると、以降の説明がすべて別の製品の話に読めてしまうためです。取り違えが起きやすい箇所が4つあります。
1つ目はAWSです。Amazon SageMaker AI の開発者ガイドは、2024年12月3日に Amazon SageMaker が Amazon SageMaker AI へ改称されたと明記しています。ここまでなら単なる改称です。問題はその先で、同じ日に「Amazon SageMaker」という名前が、別のもっと大きなものに付け直されています。公式ドキュメントは、現在の Amazon SageMaker をデータと分析とAIのための統合されたプラットフォームであると説明し、その内訳として Amazon SageMaker AI、Amazon SageMaker Lakehouse、SQL Analytics、Amazon SageMaker Data Processing、Amazon SageMaker Unified Studio、そして Amazon Bedrock を挙げています。つまりAWSの公式は、生成AIの基盤である Bedrock を、SageMaker という統合プラットフォームの一構成要素として数える書き方をしています。したがって本記事では、単独の「SageMaker」という略記を使いません。従来の機械学習基盤を指すときは Amazon SageMaker AI と書き、統合プラットフォームを指すときはそう明示します。なお同ページは、APIの名前空間、コマンド、エンドポイント、コンソールのアドレス、ドキュメントのアドレスは後方互換のために変えていないとも書いています。名前は動いたが、書いたコードは動く、ということです。
2つ目はGoogle Cloudです。製品ページの見出しは Gemini Enterprise Agent Platform であり、そこに formerly Vertex AI という表記が入っています。Vertex AI のリリースノートの冒頭には、Vertex AI のドキュメントはもう更新されず、Vertex AI のサービスは Gemini Enterprise Agent Platform の一部になったという告知が出ています。なお、この告知が出ている同じページに、2026年8月と9月の日付の項目も載っています。2026年4月22日付の公式ブログ(日本時間では4月23日にあたります)は、これを Vertex AI の進化形であると述べ、今後すべての Vertex AI のサービスと計画は単独のサービスとしてではなく Agent Platform を通じて提供されると書いています。「Vertex AI」という名前で書かれた資料は、この統合より前のものだと考えて読む必要があります。
3つ目も同じくGoogle Cloudで、ここが読者のいちばん混乱する箇所です。Gemini Enterprise と Gemini Enterprise Agent Platform は別物です。Gemini Enterprise のドキュメントは、これを社内検索とAIアシスタントとエージェントの基盤であると説明しており、Confluence、Jira、Microsoft SharePoint、ServiceNow といった第三者のアプリケーション向けのコネクタが用意されていると書いています。つまりGemini Enterprise は従業員が業務で使うアプリケーションであり、Gemini Enterprise Agent Platform は開発者がエージェントやモデルを扱う基盤です。名前がほとんど同じで、層が違います。社内で導入を検討するとき、この2つを取り違えると、話している相手と話がまるで噛み合いません。
4つ目はAzureです。Microsoft Foundry の概要ページには、これまでの呼び名と現在の呼び名を並べた対照表があります。そこには、Azure AI Studio および Azure AI Foundry が Microsoft Foundry になったこと、Azure AI Services が Foundry Tools になったことが明記されています。さらに移行の案内ページには、Azure Cognitive Services から Azure AI Services を経て Foundry Tools に至ったという3段階の経緯と、それらがすべて同じものを指しているという説明があります。ただし、各段階がいつだったかは、この2ページのどちらにも書かれていません。したがって本章では改称の年月を書きません。あわせて、同じページには、Azureのリソース種別は今も変わっていないという記述があります。表示上の名前が2回変わっても、テンプレートやコードの中の識別子は変わっていないという意味です。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 資料でよく見かける古い名前 | Amazon SageMaker | Azure AI Studio、Azure AI Foundry、Azure Cognitive Services | Vertex AI |
| 従来の機械学習基盤を指す現在の名前 | Amazon SageMaker AI | Azure Machine Learning | Gemini Enterprise Agent Platform の機械学習の領域 |
| 生成AIの基盤を指す現在の名前 | Amazon Bedrock | Microsoft Foundry | Gemini Enterprise Agent Platform |
| 出来合いのAI機能群を指す現在の名前 | 個別のサービス名のまま | Foundry Tools | 個別のサービス名のまま |
| 改称の年月を公式で確認できたか | 2024年12月3日と明記 | 年月の記載を確認できていません | 2026年4月22日付の公式ブログで発表(日本時間では4月23日) |
この表は、同じ役割の枠に入るというだけで、同じものではありません。とくに2行目と3行目の関係が3社で違います。AWSは、従来の機械学習基盤である Amazon SageMaker AI と、生成AIの基盤である Amazon Bedrock を別のサービスとして残したうえで、その両方を含む上位の名前として Amazon SageMaker を作り直しました。Azureは、Microsoft Foundry を新しい入口として立てながら、Azure Machine Learning を吸収せずに隣に残しています。Google Cloudは、従来の Vertex AI が持っていた機械学習の機能ごと、1つの新しい名前に統合しました。つまり「従来型の機械学習と生成AIを、1つの製品にまとめるか、分けたまま置くか」の答えが3社で分かれています。ここは表を横に読んで置き換えられる箇所ではありません。
機械学習の基盤は、学習と配備と運用の場所である
まず、自分でモデルを作る場合の受け皿を見ます。この層のサービスが引き受けるのは、学習を回す計算資源の用意、実験の記録、出来上がったモデルの保管、推論のための窓口の公開、そして運用に入ってからの監視です。手法そのものは利用者が選びます。ここを取り違えて「基盤を導入すれば精度が出る」と考えると、期待と結果がずれます。
AWSの Amazon SageMaker AI について、公式ドキュメントは、完全マネージドの機械学習サービスであり、データサイエンティストや開発者がモデルを構築し、学習させ、本番運用できる環境へ配備できるものだと説明しています。統合開発環境をまたいで機械学習の道具を使えるようにする画面が用意されていること、大規模なデータに対して分散環境で効率よく動く用意済みのアルゴリズムを備えていること、自前のアルゴリズムや枠組みを持ち込めることが明記されています。
AzureのAzure Machine Learningについて、公式ドキュメントは、機械学習の案件の生涯を通じた管理を速めるクラウドサービスであり、モデルの学習と配備、そして運用の管理に日々使われるものだと説明しています。ここで重要なのは、このサービスが Microsoft Foundry に吸収されていないという点です。同ページには、Azure Machine Learning のスタジオでも Microsoft Foundry でも大規模言語モデルを扱えるので、どちらのスタジオを使うかを選ぶための案内に従ってほしい、という趣旨の記述があります。加えて Microsoft Foundry 側のドキュメントには、モデルを専用の計算資源に配備する仕組みが Azure Machine Learning の基盤の上に築かれていると書かれています。つまり Azure Machine Learning は、別の入口として選べるスタジオであると同時に、新しい基盤を支える土台でもあるという二重の位置づけです。AWSの Amazon SageMaker AI と Amazon Bedrock の関係とは、形が違います。
Google Cloudでは、この層は Gemini Enterprise Agent Platform の中にあります。入門ガイドのナビゲーションには、自分のモデルを作るための項目が置かれ、その下に学習方式の解説が並んでいます。ただし本章の照合では、特徴量の管理やモデルの登録簿、パイプラインといった個別の機能の現況までは公式ドキュメントの本文で確認できませんでした。Googleのドキュメントは、開こうとするとページの大半がナビゲーションで占められ、本文まで届かないことがあり、本章でも複数のページでこれに当たりました。確認できなかったものは、確認できなかったと書いておきます。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 自分でモデルを作るための基盤 | Amazon SageMaker AI | Azure Machine Learning | Gemini Enterprise Agent Platform の機械学習の領域 |
| 生成AIの基盤との関係 | 別サービス。上位の Amazon SageMaker が両方を含む | 吸収されていない。並存し、同時に土台にもなっている | 同じ製品の中に取り込まれている |
| 公式が「どちらを使うか選べ」と書いているか | 本章の照合では確認していません | 2つのスタジオの選び分けの案内があると明記 | 本章の照合では確認していません |
| 名前についての注意 | 「SageMaker」という略記は2つの意味を持つ | 名前は変わっていない | 旧称 Vertex AI |
この表も、同じ役割の枠に入るというだけで、同じものではありません。2行目の違いは、社内での説明の仕方に直接効きます。Azureでは「従来の機械学習は Azure Machine Learning、生成AIは Microsoft Foundry」と説明しても、どちらの入口も現役なので破綻しません。Google Cloudでは同じ説明が成り立たず、どちらも Gemini Enterprise Agent Platform の中の話になります。AWSでは、話している「SageMaker」がどちらなのかを毎回はっきりさせないと、聞き手が Bedrock を含む話なのかどうか判断できません。3社の設計思想の違いが、そのまま社内文書の書き方の違いになります。
学習済みのAPIは、作らずに呼ぶための層である
次は、モデルを作らずに出来合いの機能を呼ぶ層です。画像に何が写っているかを返す、音声を文字にする、文字を音声にする、文章から固有名詞を抜き出す、帳票から項目を取り出す、といった機能が、それぞれ独立したサービスとして用意されています。この層を選ぶ理由は単純で、自社に学習用のデータが無いか、あっても揃えるほうが高くつくときです。逆に、自社の業務に固有の判別が必要で、そのための正解付きデータが十分にあるなら、前節の基盤で作るほうが結果は良くなります。
AWSは、これらを個別のサービス名のまま提供しています。本章で公式ドキュメントを開いて確認できたのは、文書の内容から知見を取り出すAmazon Comprehend、文書から文字を検出して解析するAmazon Textract、音声を文字に変換するAmazon Transcribe、文字を人間らしい音声に変換するAmazon Polly、文章を翻訳するAmazon Translate、音声と文字で対話する仕組みを作るAmazon Lex V2です。いずれのページにも、提供終了や新規受付停止の告知は出ていませんでした。画像と動画を扱う Amazon Rekognition も本体は提供中ですが、人物の移動を追う機能については、2025年10月31日でサポートを終了するという告知が機能側のページに出ています。この告知は概要ページには反映されておらず、概要ページの機能一覧には今もその機能が載っています。機能単位の状態は、その機能のページを開いて確かめる必要がある、という実例です。
Azureは、この層を Foundry Tools という1つのくくりにまとめています。その概要ページの現行の一覧に載っているのは、Speech、Translator、Language、Content Understanding、Document Intelligence、Vision、Azure AI Search、Content Safety、Custom Vision、Immersive Reader です。このうち Content Understanding は、文書と画像と音声と動画を1つのAPIで扱い、生成AIを使って利用者が定めた形式に整えるものだと公式ドキュメントに書かれており、これまで別々に並んでいた帳票の読み取りと画像の解析と動画の解析を、1つに束ねる位置にあります。
そのうえで、Azureにはこの章でいちばん実務に効く変化があります。Azure Language の概要ページが、機能を2つの区分に分けているのです。新しい開発に推奨されると明記された中核の区分に入っているのは、個人を特定できる情報の検出、言語の判定、固有表現の抽出、医療分野の文章解析の4つです。一方、既存の実装のために支えられていると書かれた旧来の区分には、会話の意図理解、独自の文章分類、実体のリンク付け、キーフレーズの抽出、処理の振り分け、質問応答、感情分析、要約が入っています。つまり、多くの資料が Azure の言語系サービスの代表として挙げてきた感情分析、キーフレーズ抽出、要約は、いま旧来の区分に置かれています。提供が終わったわけではありません。しかし「新しい開発に推奨」ではありません。同じことが画像側でも起きており、Azure Vision の概要ページでは、画像解析と文字認識の見出しに旧来を意味する表記が付き、画像解析の4.0は2028年9月25日に提供を終えると告知されています。改称の一覧だけを追いかけていると、こういう変化を見落とします。読者に効くのは名前ではなく、この格下げのほうです。
Google Cloudは、この層の名前が動いていません。本章の照合の範囲では、Cloud Vision API、Video Intelligence API、Cloud Natural Language API、Cloud Speech-to-Text、Cloud Text-to-Speech、Cloud Translation、Document AI、Dialogflow のいずれも、名称と提供状態に変更はありませんでした。「Vision AI」という書き方も見かけますが、これはGoogle Cloud の製品ページの見出しに使われている公式の名前で、画像や動画を扱う製品をまとめて指しています。その中の個別のAPIを指すドキュメントの見出しは Cloud Vision API です。本章では個別のAPIを指すときは Cloud Vision API と書きます。Dialogflow については、上位版と標準版の2つの構成が維持されている一方で、画面の呼び名が移行中で、旧来の画面は非推奨と書かれています。ただし製品名そのものが変わったという記述は無かったので、本章では画面の呼び名の話としてだけ書きます。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 画像の解析 | Amazon Rekognition | Azure Vision。画像解析と文字認識は旧来の区分 | Cloud Vision API |
| 音声を文字にする | Amazon Transcribe | Azure Speech | Cloud Speech-to-Text |
| 文字を音声にする | Amazon Polly | Azure Speech | Cloud Text-to-Speech |
| 文章の解析 | Amazon Comprehend | Azure Language。感情分析や要約は旧来の区分 | Cloud Natural Language API |
| 翻訳 | Amazon Translate | Azure Translator | Cloud Translation |
| 帳票や文書の読み取り | Amazon Textract | Azure Document Intelligence | Document AI |
| 対話する仕組み | Amazon Lex V2 | Azure AI Bot Service。新規は Copilot Studio を推奨 | Dialogflow |
| まとめ方 | 個別のサービスとして並ぶ | Foundry Tools という1つのくくり | 個別のサービスとして並ぶ |
この表も、同じ役割の枠に入るというだけで、同じものではありません。3社で違うのは、対応する言語の範囲、扱えるファイルの形式、リアルタイム処理への対応、そして自分のデータで微調整できるかどうかです。Azureの音声サービスは、公式ドキュメントに、リアルタイムの音声対話、合成した人物の映像、高速な書き起こしといった機能が並んでおり、「音声認識と音声合成」という一言で説明できる範囲を超えています。また Azure だけが1つのくくりにまとめている点も、実務では効きます。まとまっていると、契約と権限の管理は1か所で済みますが、そのくくり全体の名前が変わると、社内のすべての資料が一斉に古くなります。実際、この5年でその名前は2回変わっています。
AutoMLという言葉の中身が、Google Cloudでは大きく変わった
学習済みのAPIと、自分でモデルを作る基盤の中間に、かつて自動機械学習という層がありました。データを与えれば手法の選択と調整を自動で行い、モデルを作ってくれるという触れ込みのものです。Google Cloudでは、この層の単独製品がすべて姿を消しています。
非推奨の一覧ページには、旧来の単独製品の終了日が並んでいます。表形式データ向けが2024年7月24日、画像向けと動画向けが2024年7月31日、自然言語向けが2024年8月7日です。さらに、統合先に残っていたテキスト向けが2025年6月15日、動画向けが2025年7月31日に終了しています。加えて、翻訳向けの AutoML Translation については、翻訳側の非推奨の告知ページに、2024年9月16日に非推奨となり、2025年9月30日をもって利用できなくなり、独自モデルの機能と管理は Cloud Translation の上位版に引き継がれると書かれています。この1件は、機械学習側の非推奨一覧には載っていませんでした。横断の一覧に無いことは、終わっていないことの証明にはならない、という実例です。
現在も AutoML の名前で残っているのは、Gemini Enterprise Agent Platform の中の学習方式としての、画像データと表形式データの扱いだけです。したがって「AutoMLでテキストを分類する」「AutoMLで翻訳モデルを作る」と書かれた資料は、すべて古い記述です。Google Cloudの公式は、テキストと動画の後継として、Gemini のチューニングを案内しています。なおAzure側では、Custom Vision の移行先の1つとして Azure Machine Learning の自動機械学習が名指しされており、同じ「AutoML」という語が、3社で違う位置づけになっている点にも注意が要ります。
生成AIの基盤は、モデルを選ぶ入口である
ここからは、生成AIの基盤を扱います。本章のなかで、もっとも動きの速い領域です。3社とも、複数の提供元の基盤モデルを1つの窓口から呼べる仕組みを用意し、そこに業務のデータや道具をつなぐための部品を揃えています。共通しているのは、特定のモデルに固定させない構えを前面に出している点です。
Amazon Bedrockについて、公式ドキュメントは、主要なAI企業の高性能な基盤モデルへの安全な企業向けのアクセスを提供する完全マネージドのサービスであると説明しています。同ページには、100を超える基盤モデルに対応し、提供元には Amazon、Anthropic、DeepSeek、Moonshot AI、MiniMax、OpenAI、xAI が含まれると書かれています。自社の Amazon Nova も、他社のモデルと同じ図の中に並べられています。
Microsoft Foundry について、公式ドキュメントは、エージェントとモデルと道具を1つの管理単位にまとめ、追跡、監視、評価、企業向けの初期設定といった機能を組み込んだものだと説明しています。モデルカタログは Microsoft Foundry Models と呼ばれ、Microsoft、OpenAI、Anthropic、Meta などから1万を超えるモデルを利用できると書かれています。ここで押さえるべきなのはカタログの構造で、公式は、Azureが販売するモデルと、パートナーおよびコミュニティのモデルの2つに分けています。前者はMicrosoftが自ら提供し、自社の製品条項の下でサポートと企業向けの品質保証が付きます。後者は別扱いで、Anthropic のモデルや Hugging Face の公開モデルがこちらに置かれています。同じカタログに並んでいても、契約と責任の所在が違うということです。
Gemini Enterprise Agent Platform については、モデルの窓口が Model Garden と呼ばれています。公式ブログは、そこから世界の主要なモデル200以上に一級の形でアクセスできると書いています。本章でドキュメント側の一覧を開いて確認できたのは、Googleの自社モデルである Gemini、Veo、Imagen、Gemma のほか、Claude、Grok、Llama、Mistral AI、DeepSeek、Qwen といった名前です。ただし Model Garden そのものの定義文は、本章の照合では取得できませんでした。ページの本文がナビゲーションに埋もれて読めなかったためです。モデルの一覧は動きが速いので、実際の選定にあたっては公式の一覧を直接ご確認ください。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 生成AIの基盤 | Amazon Bedrock | Microsoft Foundry | Gemini Enterprise Agent Platform |
| モデルの窓口の呼び名 | Bedrock のモデル一覧 | Microsoft Foundry Models | Model Garden |
| 公式が示すモデルの数 | 100を超える基盤モデル | 1万を超えるモデル。毎月およそ50が追加 | 200を超えるモデル。公式ブログの記述 |
| 数えている対象 | Bedrock から直接呼べる基盤モデル | 公開モデルを含むカタログ全体 | ブログの記述。ドキュメント側は確認できていません |
| 自社の基盤モデル | Amazon Nova | 本章の照合ではブランド名を確認していません | Gemini、Gemma、Veo、Imagen |
| 他社モデルの位置づけ | 自社モデルと同列に並べる | 販売元によって契約上2つに分ける | 基盤の名前そのものが自社モデル名を含む |
この表も、同じ役割の枠に入るというだけで、同じものではありません。そして3行目のモデル数は、絶対に横に並べて比べてはいけない数字です。数えている対象が違うからです。Azureの1万という数は公開モデルを含むカタログ全体の規模であり、AWSの100という数は Bedrock から直接呼べる基盤モデルの数です。この2つを並べて「100倍の品揃え」と読むのは誤りです。4行目に何を数えた数かを併記したのはそのためです。選定の材料として意味があるのは総数ではなく、自社が使いたい特定のモデルがそこにあるか、契約とサポートの条件がどうなっているか、リージョンの制約がどうかの3点です。6行目の違いも実務に効きます。プラットフォームの名前そのものが自社モデル名を含む構えと、中立的な名前を掲げる構えとでは、将来どの方向に投資が向くかの読み方が変わります。
検索との連携が、業務で使えるかどうかを決める
基盤モデルは、一般的な知識は持っていますが、自社の規程や商品情報や過去の案件は知りません。そこで、質問に応じて自社のデータから関連する部分を探し、それをモデルに渡してから答えさせる方法が使われます。これを検索拡張生成と呼びます。業務で使えるかどうかは、生成の性能よりも、この探す側の精度と権限管理で決まることが多いように思います。
AWSは、この仕組みを生成AIの基盤の中に取り込みました。Amazon Bedrock Knowledge Basesについて、公式ドキュメントは、基盤モデルの応答を自社の情報で改善するための仕組みだと説明し、2つの形態を挙げています。取り込みも索引も保管も検索もBedrock側が持つ形と、自前のベクトル保管庫を使って組み立てる形です。後者の選択肢としては Amazon OpenSearch Serverless、Amazon Aurora、Amazon Neptune が挙げられています。なおAWSには、独立したエンタープライズ検索のサービスとして Amazon Kendra がありますが、こちらは新規の受付を止めています。ページの最上部に、新規の顧客には提供しておらず、同等の機能としては Bedrock Knowledge Bases を検討してほしいと書かれています。
Azureは、検索のサービスを残したまま、その上に知識の層を載せる構造にしています。Azure AI Search は完全マネージドの検索サービスとして現役で、公式ドキュメントは、1回の要求で応える従来型の検索と、大規模言語モデルの助けを借りて並行的に繰り返し探す方式の2つのエンジンを持つと説明しています。その上にFoundry IQ があり、公式ドキュメントは、これを複数の情報源をまとめ、権限を踏まえた応答をエージェントに提供する知識ベースの仕組みだと説明しています。索引と検索の土台は Azure AI Search が提供すると明記されています。つまりAzureは、AWSより層が1つ多い構造です。
Google Cloudは、検索拡張生成の部品と検索の製品が別になっています。RAG Engine は Gemini Enterprise Agent Platform の一構成要素として、文脈を補ったアプリケーションを作るための枠組みを提供します。一方でAgent Search は、公開しているWebサイトやモバイルアプリケーション向けの検索と推薦を作るものだと説明されており、想定している用途が違います。なお、この Agent Search が「Vertex AI Search からの改称」であると告知した一次情報は、本章の照合では見つかりませんでした。アドレスには旧名が残っていますが、それは改称の証明になりません。したがって本章では、旧称との対応関係を断定しません。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 検索拡張生成のマネージドな仕組み | Amazon Bedrock Knowledge Bases | Foundry IQ | RAG Engine |
| 検索そのもののサービス | Amazon Kendra。新規受付を停止 | Azure AI Search | Agent Search |
| 構造 | 生成AIの基盤の内部機能 | 検索サービスの上に知識の層を重ねる2層 | 検索拡張生成の部品と検索の製品が別 |
| 想定している主な用途 | 自社データに基づく応答 | 社内データに基づく応答。権限を踏まえると明記 | 公開サイトやモバイルアプリ向けの検索と推薦 |
この表も、同じ役割の枠に入るというだけで、同じものではありません。とくに2行目は、そのまま置き換えると設計を誤ります。Azure AI Search は社内の文書を対象にした検索を主目的として説明されているのに対し、Agent Search は公開しているサイトやアプリケーションの検索と推薦という説明で、想定されている読み手と権限の前提が違います。また1行目のAWSとAzureの違いも重要です。AWSは基盤サービスの内部機能なので、基盤ごと選べば付いてきます。Azureは検索サービスと知識の層が別に存在するため、どこまで自分で組むかを選べる代わりに、構成要素が1つ増えます。権限を踏まえた応答をどう実現するかは、第9章で扱う権限設計と地続きの論点です。
エージェントを作る仕組みは、部品売りと一体売りに分かれる
基盤モデルに道具を持たせ、複数の手順を自分で判断させながら実行させる作り方を、各社ともエージェントと呼んでいます。3社とも、ローコードで宣言的に作る道と、自分のコードを持ち込む道の2本立てを用意しています。違いは、その2本をどう束ねているかです。
AWSのAmazon Bedrock AgentCoreについて、公式ドキュメントは、任意の枠組みと任意の基盤モデルを使い、安全に規模を広げてエージェントを構築、配備、運用するための基盤だと説明しています。特徴的なのは構えで、公式は、CrewAI、LangGraph、LlamaIndex、Strands Agents といったオープンソースの枠組みと、任意の基盤モデルとで動くと明記しています。構成は実行環境、記憶、接続の窓口、識別、コード実行、ブラウザ操作、可観測性、支払い、評価、最適化、方針、登録簿といった部品に分かれており、個別にも組み合わせても使える部品売りの形です。なお前身にあたる Amazon Bedrock Agents は、現在 Agents Classic という名前になり、新規の受付を停止しています。ページには、同等の機能としては AgentCore を検討してほしいこと、既存の利用者はそのまま使い続けられることが書かれています。
AzureのMicrosoft Foundry Agent Serviceについて、公式ドキュメントは、AIエージェントを構築し、配備し、規模を広げるためのマネージドな基盤だと説明しています。用意されているのは2種類で、指示とモデルと道具を定義するだけでMicrosoft側が動かしてくれるプロンプトエージェントと、自分のコードと枠組みを持ち込み、コンテナとして動かしてもらう形です。後者で使える枠組みとして、Microsoft自身の枠組みのほか LangGraph、OpenAI Agents SDK、Anthropic Agent SDK、GitHub Copilot SDK の名前が挙がっています。AWSの部品売りに対して、こちらは1つのサービスの中に2つの道を用意する形です。
Google Cloudでは、Gemini Enterprise Agent Platform がこの役割を担います。2026年4月22日付の公式ブログは、ローコードの画面である Agent Studio、コードから書くための Agent Development Kit、状態を長く保つ Agent Runtime、長期の文脈を保持する Memory Bank、エージェントごとに固有の識別子を与える Agent Identity、社内のエージェントと道具を索引する Agent Registry、通信を統制する Agent Gateway、模擬的な利用者との対話で試す Agent Simulation、実際の通信に対して継続的に採点する Agent Evaluation、推論の過程を可視化する Agent Observability、生成されたコードを安全に実行する Agent Sandbox、失敗を集めて指示文の改善を提案する Agent Optimizer を挙げています。ただし、これは発表時点のブログの記述です。本章では、これに対応するドキュメント側の構成一覧を取得できませんでした。ページの本文がナビゲーションに埋もれて読めなかったためで、確認できた範囲を明示しておきます。
もう1つ、分類の注意があります。Microsoft Copilot Studio は、AIを使ったエージェントと業務の流れを作るためのローコードの画面だと公式ドキュメントが説明していますが、これをAzureのクラウド基盤サービスとして数えるのは実態に合いません。本章の実測では、ドキュメントがAzureの区画の外に置かれていること、入口が独立したWebアプリケーションであることが確認できました。一方で Microsoft Foundry 側からは連携先として参照されており、Foundry IQ の知識ベースを Copilot Studio のエージェントにつなぐ手順が用意されています。つまり「Azureのサービス」ではなく「Microsoft Foundry と連携する別系統の道具」として位置づけるのが正確です。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| エージェント構築の基盤 | Amazon Bedrock AgentCore | Microsoft Foundry Agent Service | Gemini Enterprise Agent Platform |
| まとめ方 | 部品に分かれ、個別にも使える | 1つのサービスに2つの作り方 | 用途ごとに名前の付いた部品が並ぶ |
| 自前の枠組みを持ち込めるか | 任意の枠組みと任意のモデルで動くと明記 | 持ち込んだコードをコンテナとして動かす形を用意 | コードから書くための開発キットを用意 |
| 新規受付を止めた前身 | Amazon Bedrock Agents Classic | 本章の照合では確認していません | 本章の照合では確認していません |
| ローコードの入口 | 本章の照合では確定していません | Microsoft Copilot Studio。ただしAzure配下ではありません | Agent Studio |
この表も、同じ役割の枠に入るというだけで、同じものではありません。2行目の違いは、導入の進め方に直結します。部品売りは、必要なものだけを段階的に足せる代わりに、どれを使うかを自分で決める必要があります。1つのサービスにまとまっている形は、始めるまでが速い代わりに、その枠組みの想定から外れたときに逃げ道が少なくなります。また4行目と5行目の空欄は、「そのようなものが無い」という意味ではありません。本章で一次情報に当たった範囲では、該当を1つに決められなかった、という意味です。とくにAWSのローコードの入口については、業務担当者向けの製品の中に近いものがありそうだと見えていますが、公式の記述で確定できなかったので空けてあります。
安全性の機能は、3社で束ね方が違う
生成AIを業務に載せるとき、必ず出てくるのが、出してはいけない内容をどう止めるかという問題です。有害な内容、機密情報の漏れ、根拠のない断定、そして利用者からの不正な指示。これらを検査して遮る仕組みを、AWSとAzureはガードレールという言葉で呼んでいます。
AWSのAmazon Bedrock Guardrailsについて、公式ドキュメントは、安全な生成AIアプリケーションを作るための設定可能な安全装置を提供するものだと説明しています。用意されているのは6種類です。憎悪、侮辱、性的、暴力、不正行為、プロンプト攻撃といった区分で検出する内容の絞り込み、アプリケーションの文脈で望ましくない話題の遮断、完全一致する語句の遮断、個人を特定できる情報の遮断とマスキング、出典に基づかない応答の検出、そして論理規則に照らして応答の正しさを検証する仕組みです。モデルを呼ばずに検査だけを実行するAPIが用意されている点も明記されています。既存の仕組みに後から検査だけを差し込める、という意味で実務上は便利です。
Azureは2層になっています。土台にあるのがAzure AI Content Safety で、公式ドキュメントは、利用者が作った内容とAIが作った内容の両方から有害なものを検出するサービスだと説明しています。有害の区分は性的、暴力、憎悪、自傷の4つで、機能としてはプロンプトの防御、根拠の有無の検出、保護された文章の検出、指示への忠実さを見るAPI、文章と画像の解析APIなどが並びます。その上に、Microsoft Foundry 側の統制の枠組みがあり、公式ドキュメントは、検出する危険と、検査する介入点と、検出したときの動作を組み合わせて名前を付けたものだと説明しています。介入点が4つある点が特徴的で、利用者の入力、道具の呼び出し、道具からの応答、そして出力です。検出する危険は12種類が挙げられており、そこには間接的な攻撃や、課された作業からの逸脱といった、エージェントの運用を念頭に置いた項目が含まれています。つまりAzureは、部品としての検査モデルと、運用の枠組みとしてのガードレールを分けています。AWSは Bedrock Guardrails という1つに寄せているので、同じ枠に入れても構造が違います。
Google Cloudは、独立した名前を持つサービスと、基盤モデルに付属する仕組みの両方で構成されています。Model Armor について、公式ドキュメントは、AIアプリケーションの安全性を高めるための Google Cloud のサービスであり、大規模言語モデルへの入力と応答を事前に検査して各種の危険から守るものだと説明しています。検査の種類としては、責任あるAIの安全フィルタ、プロンプトインジェクションと制限の回避を狙う入力の検出、機密データの保護、悪意あるURLの検出が並び、文書と画像の検査にも対応すると書かれています。構成図では、入力を Model Armor が検査してからモデルへ送り、応答も Model Armor が検査してから利用者へ返す、という流れが示されています。一方で Gemini Enterprise Agent Platform 側には安全性のページがあり、利用できる道具として、既定で働く設定不可のフィルタ、システム指示、有害の種類ごとにしきい値を設定できるコンテンツフィルタ、Gemini 自身を検査役に使う方法、機密データの保護、Model Armor、生成した画像に来歴を示す署名付きの情報を付ける仕組みが列挙されています。つまりGoogleは、モデルに付属する層と、独立したサービスの層の2つを、1つのページで並べて案内する形です。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 安全性の仕組みの名前 | Amazon Bedrock Guardrails | Microsoft Foundry の統制の枠組みと Azure AI Content Safety | Model Armor と、Gemini Enterprise Agent Platform のモデルに付属する安全フィルタ |
| 構造 | 生成AIの基盤の機能として1つにまとまる | 検査モデルの部品と運用の枠組みの2層 | 独立したサービスと、モデルに付属する層の2つ |
| 検査する場所 | 入力と応答 | 入力、道具の呼び出し、道具からの応答、出力の4か所 | 入力と応答 |
| モデルを呼ばずに検査だけ実行できるか | 専用のAPIがあると明記 | 本章の照合では確認していません | できる。公式ドキュメントは、Model Armor の REST API を直接呼んで検査できること、プロンプトの検査と応答の検査が別々の呼び出しであることを明記 |
この表も、同じ役割の枠に入るというだけで、同じものではありません。1行目と2行目のとおり、束ね方が3社で違います。AWSは生成AIの基盤の機能に寄せ、Azureは検査モデルの部品と運用の枠組みに分け、Googleはモデルに付属する層と独立したサービスを並べています。同じ「入力と応答を検査する」という説明でも、どこに設定を置き、誰が管理するかが変わります。また3行目の違いは、エージェントを業務に載せるときに効きます。道具の呼び出しまで検査できるかどうかは、外部のシステムを動かす作りにするなら、設計の前提そのものになります。比較表で「未確認」と「無い」を区別せずに書くと、読者は「無い」と読みます。本記事では、その2つを書き分けており、この表でも確認していない欄はそのように書いています。
新規受付を止めたもの、終了が決まったものを、先に把握する
この領域では、提供が終わったわけではないが、新しくは使えないという中間の状態が多く発生しています。資料や記事で名前を見かけても、いま新規に採用できるとは限りません。本章の照合で確認できたものを整理します。
AWSでは4件あります。1つ目は前述の Amazon Bedrock Agents で、現在は Agents Classic となり新規受付を止めています。2つ目はAmazon Q Business で、ページ最上部に、新規の顧客には提供しておらず、同等の機能としては Amazon Quick を検討してほしいと書かれています。ドキュメントの更新履歴には、2026年7月31日から新規の顧客には開かれなくなるという6月30日付の予告と、7月31日付の停止の記録が残っています。専用の案内ページには、既存の利用者向けの不具合修正と安全性の更新は続くが、新機能の要望は受け付けないとも書かれています。3つ目が Amazon Kendra で、こちらも新規受付を止め、Bedrock Knowledge Bases が案内されています。4つ目はAmazon Q Developer で、こちらはサービス自体ではなく、開発環境に組み込む拡張機能について、2027年4月30日にサポートを終了すると予告されています。後継としては Kiro が案内されており、AWSの公式ホワイトペーパーの機械学習とAIの一覧にも Kiro の名前が載っていることが照合で確認されています。ただし Kiro がAWSのサービスとしてどう位置づけられるかまでは、本章では確定できませんでした。開発者向けの支援の話は第10章で扱います。なお、これら4件の提供終了日については、いずれも公式の告知を確認できていません。新規受付の停止と提供終了は別の段階であり、混同すると判断を誤ります。
Azureでは、Foundry Tools の概要ページに、終了が予定されているものの一覧が置かれています。そこに載っているのは Anomaly Detector、Content Moderator、Language Understanding、Metrics Advisor、Personalizer、QnA Maker の6つで、既存のアプリケーションでは引き続き使えるが新しいAI用途には使わないように、と書かれています。個別ページで日付まで確認できたものを挙げると、Anomaly Detector は2023年9月20日以降は新規のリソースを作れず、2026年10月1日に提供を終えると明記されています。本章の執筆時点で、3週間ほど先です。Metrics Advisor は2026年5月18日に提供を終えたと個別ページに書かれています。Personalizer は2026年8月25日をもって提供を終えると告知されていますが、ページの文面が予定を表す言い方のままなので、本章では告知の事実として書きます。Content Moderator は2024年2月に非推奨となり2027年3月15日に終了する予定で、後継は Azure AI Content Safety だと書かれています。あわせてCustom Vision は、既存の利用者への完全なサポートを2028年9月25日まで提供したうえで終了すると告知されており、Azure Vision の画像解析の4.0も同じ日に終了する予定です。
ここで1つ、実務に効く注意があります。Azureでは、Foundry Tools の概要ページに載っている一覧と、個別のサービスのページの記述が食い違う例が本章の照合で2件見つかっています。概要ページが「これから終了する」と書いているものが個別ページでは「終了済み」であったり、概要ページの現行の一覧に載っているものが個別ページでは終了を告知していたりします。一覧は入口としてしか使えません。状態は必ず個別のページで確かめてください。同じことがAWSでも起きており、概要ページの機能一覧に、すでにサポートを終えた機能が残っている例がありました。
| 状態 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 新規受付を止めたもの | Amazon Bedrock Agents Classic、Amazon Q Business(2026年7月31日から)、Amazon Kendra | Anomaly Detector、Personalizer は2023年9月20日以降は新規作成不可 | 本章の照合では確認していません |
| 終了日が決まっているもの | Amazon Q Developer の開発環境向け拡張機能が2027年4月30日 | Anomaly Detector が2026年10月1日、Content Moderator が2027年3月15日、Custom Vision と画像解析の4.0が2028年9月25日 | 本章の担当範囲では確認していません。AI以外では Pub/Sub Lite が2027年1月31日で、第5章で扱います |
| すでに終了したもの | 本章の担当範囲では確認していません | Metrics Advisor が2026年5月18日 | 旧来の AutoML の各製品が2024年、統合先のテキストと動画が2025年、翻訳向けが2025年9月30日 |
| 後継として案内されているもの | Amazon Bedrock AgentCore、Amazon Quick、Amazon Bedrock Knowledge Bases、Kiro | Microsoft Fabric、Azure AI Content Safety、Azure Machine Learning の自動機械学習、Azure Content Understanding | Gemini のチューニング、Cloud Translation の上位版 |
この表も、同じ役割の枠に入るというだけで、同じものではありません。3社で、状態の告知の仕方そのものが違います。AWSには提供を終えたサービスの公式な一覧ページがあり、日付つきで確認できます。Azureは、Foundry Tools の一覧に終了予定の区画を設けていますが、前述のとおり個別ページとの食い違いがあります。Google Cloudは、製品ごとの非推奨ページに書かれており、横断の一覧に載っていない終了もあります。したがって「一覧に無いから終わっていない」も「一覧にあるから現役」も、どちらも成り立ちません。本記事が、状態を必ず個別のページで確かめるという作法を通しているのは、この3社の差があるためです。
この層を選ぶときに、どの順で考えるか
ここまで見てきたものを、選定の順番として並べ直します。最初に決めるのは、製品名ではなく層です。やりたいことが、出来合いの機能で足りるのか、自社のデータでモデルを作る必要があるのか、基盤モデルに業務のデータをつないで文章や判断を作らせたいのか。この3つは必要な人材も期間も運用の重さも違うので、ここを飛ばして製品を比べると、比べる意味のないものを並べることになります。
層が決まったら、次に見るのは入れ替えのしやすさです。基盤モデルは、この5年でもっとも速く入れ替わってきた部品です。特定のモデルに合わせてアプリケーションを作り込むと、次のモデルが出るたびに作り直しになります。3社とも複数の提供元のモデルを1つの窓口から呼べる構えにしているのは、この問題への答えです。選定の際は、モデルの総数ではなく、使いたいモデルが実際にそこにあるか、契約とサポートの条件がどうなっているか、必要なリージョンで使えるかを確かめてください。
3つ目は検索と権限です。業務で生成AIを使う場合、答えの品質は、探す側の精度と、誰がどの文書を見てよいかの制御でほぼ決まります。ここは第9章で扱う権限設計と地続きなので、生成AIの検討を情報システム部門の一部門だけで進めると、後から作り直しになりがちです。
4つ目は検査をどこに入れるかです。入力と出力だけを見るのか、道具の呼び出しまで見るのか。外部のシステムを動かすエージェントを作るなら、この差が設計の前提になります。
最後に、名前の変化に耐える書き方を社内で決めておくことをおすすめします。本章で見たとおり、この5年で、AWSの主力サービスの名前は二重化し、Google Cloudの機械学習基盤の名前は入れ替わり、Azureの出来合いAI群の名前は2回変わりました。一方で、APIの識別子もリソースの種別もエンドポイントも、ほとんど変わっていません。つまり動いているのは表示上の名前であって、作ったものではありません。社内の設計書に製品名だけを書くと、数年で読めなくなります。何をする役割の部品なのかを併記しておけば、名前が変わっても意味は残ります。
本章では、機械学習とAIのサービスを、出来合いの機能を呼ぶ層、自分でモデルを作る層、基盤モデルに載せる層の3つに分けて整理し、そこに検索との連携、エージェント、安全性の仕組みを重ねて見ました。3社とも同じ役割の枠は揃えていますが、束ね方は揃っておらず、AWSは部品を分けたまま上位の名前で束ね、Azureは新旧の入口を並存させ、Google Cloudは1つの名前に統合しました。そして、この領域では「新規受付の停止」と「提供終了」と「旧来の区分への格下げ」という3つの中間状態が同時に走っています。次章では、こうしたAIのサービスも含めて多くのクラウド機能の実行基盤になっている、サーバーレスとイベント駆動の仕組みを扱います。
この章を深めたい方への参考書籍
『Amazon Bedrock 生成AIアプリ開発入門 [AWS深掘りガイド]』(御田稔、熊田寛、森田和明、SBクリエイティブ):本章で「生成AIの基盤」として整理した Amazon Bedrock を、実際に手を動かして確かめるための1冊です。社内文書を検索して答えさせる仕組みと、自律的に動くエージェントの作り方が、手順として書かれています。刊行は2024年6月で、本章で触れた Amazon Bedrock Agents Classic の新規受付の停止と Amazon Bedrock AgentCore への移行より前の内容を含みます。Amazon Bedrock 自体は提供が続いていますので、サービス名と状態は公式ドキュメントで併せてご確認ください。
『AWSではじめる生成AI』(Chris Fregly、Antje Barth、Shelbee Eigenbrode 著、オライリー・ジャパン):本章の「検索との連携」と「モデルの選び方」を、もう一段深く扱った書籍です。検索拡張生成の作り込み、基盤モデルの微調整、複数の形式を扱う使い方までを通して読めます。原著は Generative AI on AWS で、日本語版の刊行は2024年8月です。
『Azure OpenAI Serviceではじめる ChatGPT/LLMシステム構築入門』(永田祥平ほか著、技術評論社):本章のAzure側、とくに社内システムとして生成AIを組み込む場合の進め方を扱っています。基盤の概念から、実際に社内向けの仕組みを作るところまでが1本の流れになっているため、企画の段階で読むと検討の抜けを見つけやすい構成です。刊行は2024年1月で、本章で触れた Microsoft Foundry への再編、すなわち Azure OpenAI の資源が Foundry の資源へ統合される前の内容です。
第7章 サーバーレスとイベント駆動
前章では、機械学習とAIのサービスを、モデルを自分で作る側からではなく、出来上がった機能を自社のシステムに載せる側から見ました。本章で扱うのは、その「載せる」ための土台のうち、いま最も動きが速い領域です。プログラムを常時動かしておくのではなく、何かが起きたときにだけ動かす。この作り方を支えるサービス群を、3社それぞれの現在の姿で確認していきます。
先に範囲を区切っておきます。仮想マシン、Kubernetes、アプリケーションを載せるだけの実行環境は第2章で扱いました。ネットワークの経路や負荷分散やCDNの設計は第8章、権限の設計は第9章、費用の考え方は第12章です。本章が扱うのは4つで、関数を単位にした実行環境、コンテナを単位にしたサーバーレスの実行環境、メッセージとイベントを運ぶ仕組み、そして複数の処理をつなぐワークフローです。加えて、Amazon API Gatewayについては、ネットワークの入口としてではなく、イベントの入口としての側面だけを扱います。
「サーバーレス」は、もう「関数」だけを指す言葉ではない
最初に言葉の整理をします。サーバーレスとは、サーバーが存在しないという意味ではありません。サーバーを用意し、台数をそろえ、更新を当て、壊れたら入れ替えるという作業を、利用者が引き受けなくてよいという意味です。第1章の言葉でいえば、責任の境目が利用者の側から事業者の側へ大きく移った状態を指します。
3社の公式ドキュメントの言い回しを並べると、この語がどこまで広がっているかが見えます。AWSはAWS Lambdaの開発者ガイドで、Lambdaを「サーバーレスの計算のサービス」と定義し、「サーバーを用意したり管理したりすることなくコードを実行できる」と説明しています。Azureは、Azure Functionsを「より少ないコードで、より少ない基盤で、堅牢なアプリケーションを作れるようにするサーバーレスの解決策」と説明しています。ここまでは、いずれも関数の話です。
ところが、同じ「サーバーレス」という語は、コンテナを動かす実行環境にも使われています。Azure Container Appsの公式ドキュメントは、これを「基盤を管理することなくコンテナ化されたアプリケーションを動かすためのサーバーレスの基盤」と定義しています。Google CloudのCloud Runの公式ドキュメントは、Cloud Runを「Googleの拡張性の高い基盤の上で、コード、関数、コンテナのいずれかを動かすための、完全にマネージドなアプリケーションの基盤」と説明しています。1つの製品が、コードも関数もコンテナも同じ場所で受け入れると宣言しているわけです。
この章を読むうえで、まずここを押さえておいてください。イベント駆動という設計、つまり「何かが起きたら、それに応じて処理が走る」という組み立て方は3社に共通していますが、その処理を置く場所は、関数とコンテナのどちらか一方には決まらなくなっています。第2章の末尾で触れた「ここには関数も置ける」という状況を、本章では逆側から、つまり関数の側から見ていくことになります。
関数を単位にする実行環境は、3社とも作りが変わった
関数とは、入力を受け取って処理を行い、結果を返す短いプログラムです。関数を単位にする実行環境では、利用者はその関数のコードだけを渡し、いつ何個動かすかは事業者側が決めます。呼び出しが無ければ1つも動かず、呼び出しが集中すれば自動的に数が増えます。3社ともこの形の製品を持っていますが、中身は5年前とかなり違います。
AWSのAWS Lambdaは、現在、性格の異なる2つの計算の単位を提供する形に整理されています。1つはLambda Functionsで、公式ドキュメントは「イベントまたはAPIの呼び出しに応じて、サーバーを管理することなくコードを実行する」ものと説明しています。ハンドラとなる関数を書き、トリガーにつなぐと、Lambdaがそれを実行します。トリガーとして挙げられているのは、Amazon API Gateway、Amazon S3、Amazon SQS、Amazon EventBridge、その他200を超えるAWSのサービスです。呼び出しはそれぞれ独立して走り、状態は共有されず、需要に合わせて横に広がります。もう1つがLambda MicroVMsで、こちらは「ほぼ即座に起動し、最大8時間にわたって状態を保持できる、隔離された計算の環境」と説明されています。個々の利用者や個々のジョブごとに専用の計算環境が要る用途のために用意されたもので、利用者が自分でイメージを持ち込み、任意のポートで待ち受けることができます。「関数を動かす場所」という一言で括れなくなっている、ということです。
Azureは、関数そのものよりもホスティングの選び方が大きく変わりました。Azure Functionsのホスティングの比較ページに並ぶ選択肢は、現在5つです。推奨と明記されたFlex Consumptionプラン、常に温まったインスタンスを持つPremiumプラン、既存のApp Serviceプランの中で動かすDedicatedプラン、Azure Container Apps、そしてConsumptionプランです。最後のConsumptionプランには「従来のホスティングプラン」という注記が付いており、公式は「新しいサーバーレスの関数アプリにはFlex Consumptionプランを使うこと」「既存のConsumptionプランのアプリはFlex Consumptionプランへ移行すること」と書いています。あわせて期限も明示されています。LinuxのConsumptionプランで、サポートが終了しているv3のランタイムを動かしているアプリは2026年9月30日以降は動かなくなること、そしてLinuxでConsumptionプランを使う選択肢そのものが2028年9月30日に提供終了となることです。Windowsで動いているアプリは現時点では影響を受けないとも書かれています。
Google Cloudの変化は、名前そのものです。Cloud Runの公式ドキュメントには「Cloud FunctionsはCloud Run functionsに改称されました」と明記されています。改称の時期は、Cloud Run functionsのリリースノートの2024年8月21日の項に記録されており、そこには「Cloud FunctionsはCloud Run functionsに改称された」に続けて、Cloud Functions (1st gen)はCloud Run functions (1st gen)として、Cloud Functions (2nd gen)はCloud Run functionsとして知られるようになった、と書かれています。確認できるのは、改称が事実であること、その告知の日付、そして現在の版が「Cloud Runの上にサービスとしてデプロイされる、関数の最新の版」と説明されていることです。以前の第1世代は消えたわけではなく、Cloud Run functions (1st gen)という名前で残っています。公式はこれを「かつてCloud Functions (1st gen)として知られていた、関数の元々の版」と説明し、イベントのトリガー、ランタイム、設定の自由度が限られていると書いています。既存の資産のために、gcloud functions deployコマンド、Cloud Functionsの第2世代のAPI、対応するTerraformの設定は後方互換のために引き続き使えるとも明記されています。Cloud Run functionsという名前は、単なる呼び替えではなく、関数の置き場所がCloud Runに統合されたことを表しています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 関数を動かすサービスの現在の名前 | AWS Lambda | Azure Functions | Cloud Run functions |
| 名前の変化についての公式の記述 | 本章の照合では、改称の告知は確認していない | 本章の照合では、改称の告知は確認していない | 「Cloud FunctionsはCloud Run functionsに改称された」と明記。リリースノートの2024年8月21日の項に記録 |
| 置き場所の選び方 | Lambda Functionsと、状態を保持するLambda MicroVMsの2つの計算の単位 | ホスティングの選択肢が5つ。Flex Consumptionプランが推奨と明記 | Cloud Runの上にサービスとしてデプロイされる。第1世代は別の名前で併存 |
| 古い形についての公式の扱い | 本章の照合では、旧世代を区別する記述は確認していない | Consumptionプランは従来のホスティングプランと注記。Linuxでの提供は2028年9月30日に終了 | 第1世代は「イベントのトリガー、ランタイム、設定の自由度が限られている」と説明 |
| 既存資産のための互換 | 本章の照合では、特段の互換の記述は確認していない | Flex Consumptionプランへの移行の手順が案内されている | 第2世代のAPIとコマンドが後方互換のために使える |
この表は横に並んでいるだけで、同じ役割の枠に入るというだけであり、同じものではありません。3社とも「短いコードをイベントに応じて動かす」点は共通していますが、置き場所の決め方がそろっていません。AWSは1つのサービスの中に性格の違う2つの計算の単位を持ち、Azureは1つのサービスに対して5つのホスティングを選ばせ、Google Cloudは関数をコンテナの実行基盤の上に載せ替えました。したがって「他社のLambda相当は何か」という問いには、この領域では答えが一意に決まりません。問うべきは「自分たちの処理を、どの制約の下で動かしたいか」であり、その制約はまず実行時間の上限に現れます。
実行時間の上限は、いま3社でいちばん差が出ている
関数型のサーバーレスには、長らく「短い処理にしか使えない」という共通の制約がありました。この前提が、いま3社で別々の方向に動いています。ここは移行や設計のやり直しに直結するので、公式の数字をそのまま並べます。
AWS Lambdaは、1回の呼び出しで実行できる時間の上限が900秒、つまり15分です。公式のクォータのページは「Lambdaは、呼び出しをまたいで状態を保持したり状態に依存したりしない、短命な計算の処理のために設計されている」と明記しており、通常の構成ではこの上限は引き上げられません。ただし同じクォータの表には、AWS Lambda Managed Instances(関数を自分のアカウントのEC2インスタンスの上で動かす形で、公式は台数の増減や更新をAWSが引き受けると説明しています)を使う関数の非同期呼び出しなどに限って最大5,400秒、つまり90分まで許される、という注記が付いています。本章では通常の構成の上限として900秒を扱います。メモリは128MBから10,240MBまで1MB刻みで指定でき、CPUの割り当てはメモリの量に比例します。一方で、後述するLambdaの耐久実行の仕組みを使うと、複数段階のワークフローとしては最長1年にわたって進行させられる、とも書かれています。
Azure Functionsは、選んだホスティングによって上限が変わります。Consumptionプランは既定30分ではなく既定5分、最大10分です。Flex Consumptionプラン、Premiumプラン、Dedicatedプラン、Container Appsは既定30分で、最大値については「強制される実行時間の上限は無い」と書かれています。ただし無制限という意味ではなく、規模を縮めるときに与えられる猶予は60分、基盤の更新のときの猶予は10分と明記されています。そしてもう1つ、プランに関係なく効く上限があります。HTTPで起動された関数が応答を返すまでに使える時間は230秒までです。これはAzure Load Balancerの既定のアイドルタイムアウトに由来するものだと公式が説明しており、これより長い処理には、後述する非同期の型を使うか、実際の作業を後回しにして先に応答を返す作りにすることが薦められています。
Cloud Runは、置ける処理の形によって上限の種類が違います。まずサービスについては、リクエストのタイムアウトが既定で5分、つまり300秒で、最大60分、つまり3600秒まで延ばせます。時間内に応答が返らなければネットワークの接続が閉じられ、エラーが返りますが、そのリクエストを処理していたインスタンス自体は終了しないと明記されています。公式は、15分を超える設定にする場合は、クライアント側またはCloud Run側の障害で接続が切れる可能性が上がるため、再試行と再接続に耐える作りにすることを薦めています。Cloud Run functionsについても、HTTPの関数は最大60分のタイムアウトを設定できると書かれています。一方、ジョブの上限はリクエストではなくタスクの単位で決まります。ジョブのタスクのタイムアウトのページによれば、各タスクは既定で最大10分動き、設定によって短くも長くもでき、最長は168時間、つまり7日です。GPUを使うタスクについては最大1時間と別に書かれています。そして、ジョブの実行そのものには明示的なタイムアウトが無く、すべてのタスクが終わればジョブの実行が終わる、と明記されています。「Cloud Runは最大60分」という一言は、サービスのリクエストについてだけ正しい、ということです。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 関数の1回の実行時間の上限 | 900秒、つまり15分。通常の構成では引き上げ不可。Managed Instances を使う非同期呼び出し等に限り最大5,400秒の例外がある | Consumptionプランは既定5分・最大10分。他の4つは強制される上限が無い | Cloud Run functionsのHTTPの関数は最大60分 |
| コンテナ側の実行時間の上限 | 本章の照合では、Fargateのタスクに一律の実行時間の上限の記述は確認していない | Container Appsでのホスティングも強制される上限が無い | Cloud Runのサービスのリクエストは既定300秒・最大3600秒。ジョブの各タスクは既定10分・最長168時間。GPUを使うタスクは最大1時間 |
| プロトコルに由来する別の上限 | 本章の照合では、該当する記述は確認していない | HTTPで起動された関数の応答は230秒まで | 本章の照合では、該当する記述は確認していない |
| 長い処理を進めるための仕組み | Lambdaの耐久実行は最長1年。AWS Step Functionsの標準ワークフローも最長1年 | Durable Functions。Azure Logic Appsのワークフロー | Workflowsは最長1年待てる |
この表も、横に並ぶだけで同じものではありません。とくに注意していただきたいのは、「上限が無い」と「制限が無い」は違うということです。Azureの4つのホスティングについて公式が書いているのは「強制される実行時間の上限が無い」であって、規模の縮小や基盤の更新のときには猶予の時間で打ち切られます。同じく、Cloud Runのサービスの60分は「その時間まで待てる」という意味であって、その間ずっと安全だという保証ではありません。また、Cloud Runのジョブのように、そもそもリクエストの単位ではなくタスクの単位で上限が決まるものもあります。そして、上限がいちばん明快なのはAWS Lambdaです。通常の構成では15分は引き上げられません。この1点だけで、3社の間で処理の分け方が変わります。ある社では1つの関数で終わる処理が、別の社では複数段階に割らなければならない、ということが普通に起きます。
コンテナ型のサーバーレスと、関数との境目が消えた
関数の次に見るのが、コンテナを単位にしたサーバーレスの実行環境です。第2章では、これを「運用をどこまで手放すか」の軸に沿って扱いました。本章で見るのは、その同じ実行環境が関数の置き場所にもなっている、という点です。
AWSのAWS Fargateについて、Amazon ECSの開発者ガイドは「Amazon ECSと一緒に使うことで、サーバーやAmazon EC2インスタンスのクラスターを管理することなくコンテナを動かせる技術」と説明しています。仮想マシンのクラスターを用意し、設定し、規模を変える作業が不要になること、そのためサーバーの種類を選ぶ必要も、いつクラスターを拡張するか決める必要も、クラスターの詰め込み方を最適化する必要も無くなることが明記されています。利用者がすることは、アプリケーションをコンテナに包み、CPUとメモリの要求量を指定し、ネットワークと権限の方針を定めて起動することです。タスクごとに隔離の境界があり、下にあるカーネル、CPU、メモリ、ネットワークインターフェースを他のタスクと共有しないとも書かれています。Amazon EKSから使ったときの説明と、選んだ結果として何が使えなくなるかは第2章で確認しました。
Google CloudのCloud Runは、置ける処理の形が4つに増えています。公式が挙げているのは、サービス、ジョブ、ワーカープール、インスタンスです。サービスは「一意で安定したエンドポイントに届くHTTPのリクエストに応答するもので、状態を持たないコンテナのインスタンスを使い、自動と手動の両方で規模を変えられる」ものです。ジョブは「手動またはスケジュールによって実行され、完了まで走る、並列化できる処理」です。ワーカープールは「メッセージキューからの処理のような、常時動き続ける背景の処理」のためのもので、インスタンスは「単一の実行環境を必要とする長命の処理」のためのものです。ただし4つが同じ段階にあるわけではなく、同じページに、インスタンスはプレビューの段階であり、一般提供前の提供条件の対象になると明記されています。採用を検討する際は、この位置づけが変わっていないかを公式ページでご確認ください。サービスについては、リクエストが来なくなれば「最後に残った1つのインスタンスさえ取り除かれる」と明記されています。これがゼロまで縮退するという性質です。
AzureのAzure Container Appsは、HTTPの通信量、イベント駆動の処理、CPUやメモリの負荷、そしてKEDAが対応するあらゆるスケーラを根拠に規模を変えられると説明されています。ほとんどのアプリケーションはゼロまで縮退できますが、CPUやメモリの負荷を根拠にするものはゼロにできない、という注記が付いています。
ここまでは第2章の続きです。本章で重要なのはこの先です。Azure Container Apps上のAzure Functionsの公式ドキュメントは、この組み合わせを「Azure Functionsのイベント駆動の能力と、Container Appsの機能を組み合わせた、完全にマネージドなサーバーレスのホスティング環境」と定義しています。Container Apps側の機能として挙げられているのは、Kubernetesを基礎にしたオーケストレーション、KEDAによる自動の規模調整、Daprとの統合、GPUを使う処理への対応、サイドカーへの対応、仮想ネットワークへの接続、リビジョンの管理です。規模は、ゼロまで縮み、最大1,000インスタンスまで広がります。
公式が薦めている使い場面もはっきりしています。関数をマイクロサービスやAPIやウェブサイトといった他のコンテナ化されたアプリケーションと並べて動かしたいとき、独自の依存関係を関数のコードと一緒に包みたいとき、AI推論のように計算量の多い処理でGPUが要るときです。同時に、できないことも明記されています。配置スロットは使えず、ブルーグリーンの配置で代替すること。Azure Functionsのプロキシは使えず、APIの入口が要るならAzure API Managementと組み合わせること。ストレージアカウントの紐づけは必須であること。さらに、Blob Storageのトリガーで自動的に規模を変えられるのはAzure Event Gridを源にした場合だけであり、Durable Functionsの自動の規模調整はMicrosoft SQL ServerとDurable Task Schedulerというストレージの提供元に限られることです。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| コンテナを動かすサーバーレスの実行環境 | AWS Fargate | Azure Container Apps | Cloud Run |
| 公式の説明の要点 | サーバーやEC2インスタンスのクラスターを管理せずにコンテナを動かす技術 | 基盤を管理することなくコンテナ化されたアプリケーションを動かすサーバーレスの基盤 | コード、関数、コンテナのいずれかを動かす、完全にマネージドなアプリケーションの基盤 |
| 置ける処理の形 | タスクとサービス。Amazon ECSとAmazon EKSから利用する | APIのエンドポイント、背景の処理のジョブ、イベント駆動の処理、マイクロサービス | サービス、ジョブ、ワーカープール、インスタンスの4つ。インスタンスはプレビューの段階と明記 |
| 関数との関係についての公式の記述 | 本章の照合では、Fargateを関数の置き場所として説明する記述は確認していない | Azure Functionsのホスティングの選択肢の1つとして正式に位置づけられている | Cloud Run functionsがCloud Runの上にサービスとしてデプロイされる |
| ゼロまで縮退するか | 本章の照合では、該当する記述は確認していない | ほとんどのアプリは縮退できる。CPUやメモリの負荷で規模を変えるものは不可 | リクエストが無ければ最後の1インスタンスも取り除かれる |
この表も、同じ役割の枠に入るだけで同じものではありません。3行目と4行目を見比べていただくと分かるように、置ける処理の形も、ゼロまで縮むかどうかも、そろっていません。そして注意していただきたいのは4行目のAWSの欄です。これは「Fargateがゼロまで縮まない」という意味ではなく、本章の照合で公式ドキュメントに該当する記述を見つけられなかった、という意味です。空欄に近いセルを「そのような性質が無い」と読み替えると、設計を誤ります。
本章の要点として持ち帰っていただきたいのは、「関数を使うか、コンテナを使うか」という二択が、少なくともAzureとGoogle Cloudでは成り立たなくなっているという事実です。Azureは関数のホスティングの選択肢としてコンテナの実行環境を正式に並べ、Google Cloudは関数をコンテナの実行基盤の上へ移しました。AWSは向きが逆で、Fargateを関数の置き場所として説明する記述は確認していませんが、AWS Lambdaの側がコンテナを受け入れています。コンテナイメージから関数を作るページは、配置の単位としてコンテナイメージとzipのアーカイブの2種類に対応すると書き、コンテナイメージは圧縮前で最大10GBまで、Linuxを基にしたものに限ると明記しています。関数をコンテナの基盤に載せるのか、コンテナを関数の入れ物にするのかという向きの違いはあっても、境目が薄れている点は3社に共通しています。選ぶときの問いは「関数かコンテナか」ではなく、「自分で持ち込みたい依存関係があるか」「他のアプリケーションと同じ環境に並べたいか」「GPUのような特別な計算資源が要るか」に変わっています。
メッセージとイベントは、同じものではない
実行の場所の次は、処理と処理をつなぐ仕組みです。ここでまず押さえておきたい区別があります。Microsoftの公式ドキュメントは、イベントとメッセージを次のように分けています。イベントは「条件や状態の変化を知らせる軽い通知」であり、「発行した側は、それがどのように扱われるかについて期待を持たない」ものです。メッセージは「別の場所で消費されるか保管されるために、あるサービスが作り出した生のデータ」であり、「発行する側と消費する側の間に契約が存在する」ものです。
この区別は、Azureの製品を説明するために書かれたものですが、3社に共通する設計の分かれ目を言い当てています。知らせるだけでよいのか、それとも確実に受け取って処理しきる必要があるのか。ここが決まらないうちにサービスを選ぶと、あとで作り直しになります。
キューから見ていきます。AWSのAmazon SQSは、公式に「安全で、耐久性があり、可用性のある、ホストされたキューを提供し、分散したソフトウェアのシステムや構成要素を統合し、切り離せるようにするもの」と説明されています。メッセージは複数のサーバーに複製して保管され、標準のキューは「少なくとも1回の配送」、FIFOのキューは「ちょうど1回の処理」に対応します。処理中のメッセージは可視性タイムアウトの間だけ他の受信要求から隠され、処理が終わったら消費側が削除します。保管の期間には既定があり、既定は4日、設定できる範囲は60秒から1,209,600秒、つまり14日までです。届けられなかったメッセージや処理できなかったメッセージを別に貯めておくデッドレターキューという仕組みも用意されています。
通知の側がAmazon SNSです。公式は「発行する側から購読する側へのメッセージの配送を提供する、完全にマネージドなサービス」と説明しています。発行者はトピックにメッセージを送り、トピックは論理的なアクセス点であり通信の経路として働きます。購読先として挙げられているのは、Amazon SQS、Lambda、HTTPとHTTPSのエンドポイント、電子メール、モバイルのプッシュ通知、SMS、Amazon Data Firehose、そして外部のサービス提供者です。1つのメッセージを複数の届け先へ同時に複製して押し出す形はファンアウトと呼ばれ、公式は、購読側が停止しているときにメッセージを失わないために、Amazon SNSとAmazon SQSを組み合わせることを薦めています。
ここで、ライフサイクルについて1つ実例を挙げておきます。Amazon SNSそのものは現役ですが、その中のMessage Data Protectionという機能は、新規に利用を開始できない段階の一覧に、2026年3月31日の告知として掲載されています。この一覧の定義は「その段階にあるサービスや機能には、新しく利用を始めることができない。すでに使っている顧客は使い続けられる。運用と支援は続けるが、機能の強化や追加は行わない」というものです。サービスの単位ではなく機能の単位でも状態が動く、ということです。第2章では同じ一覧にAWS App Runnerが載っていることを確認しました。採用の判断をするときに公式の一覧を確かめる作業は、サービス名だけでなく、使おうとしている機能についても必要になります。
Azureのキューに当たるのがAzure Service Busです。公式は「メッセージのキューと、発行と購読のためのトピックを備えた、完全にマネージドな企業向けのメッセージブローカー」と定義し、競合する複数の処理役の間で作業を分散させること、サービスやアプリケーションの境界を越えてデータと制御を安全に受け渡すこと、高い信頼性を必要とするトランザクション的な作業を調整することを利点として挙げています。備えている機能は幅広く、順序を保証するためのメッセージセッション、複数の操作をひとまとまりにするトランザクション、届けられなかったメッセージを貯めるデッドレターの副キュー、指定した時刻に処理させるスケジュール配信、いま処理できないメッセージを脇に置く延期、送信の重複を取り除く重複検出などが並びます。配送はプルの方式で、要求があったときにだけ届けられると明記されています。主たる通信の規約はAMQP 1.0で、PremiumはJava Message Service 2.0のAPIに完全準拠しているとも書かれています。
Google CloudのPub/Subは、公式に「メッセージを作り出すサービスと、そのメッセージを処理するサービスを切り離す、非同期で拡張性のあるメッセージングのサービス」と説明されています。発行者と購読者は、同期的な遠隔手続き呼び出しではなく、出来事を放送する形で非同期にやり取りします。トピックに届いたメッセージを受け取るにはサブスクリプションを作る必要があり、「1つのトピックは複数のサブスクリプションを持てるが、あるサブスクリプションは1つのトピックにだけ属する」と明記されています。サブスクリプションの種類は、購読側から取りに行くプル、Pub/Sub側から届け先へ要求を出すプッシュ、そしてBigQuery、Bigtable、Cloud Storageへ書き出すエクスポートに分かれます。配送の保証については、同じページに「既定では、すべての種類のサブスクリプションで、順序の保証なしに少なくとも1回の配送を提供する」とあり、続けて「ちょうど1回の配送にも対応する」と明記されています。購読側が確認応答を返せないメッセージの受け皿もあり、デッドレタートピックのページは、これを「デッドレターキューとしても知られる」と補足したうえで、配送の試行回数が設定した上限に達したメッセージをそこへ転送すると説明しています。試行回数の上限は既定が5回で、5回から100回の範囲で設定でき、転送は最善努力で行われるため回数はおおよそのものである、とも書かれています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 順番に取り出して処理するキュー | Amazon SQS | Azure Service Bus | Pub/Sub。プルのサブスクリプション |
| 1つの発行を複数へ配る仕組み | Amazon SNS | Azure Service Busのトピックとサブスクリプション | Pub/Sub。1つのトピックに複数のサブスクリプション |
| 配送の保証についての公式の記述 | 標準のキューは少なくとも1回の配送、FIFOのキューはちょうど1回の処理 | 既定の受信の形では少なくとも1回の配送、受信と同時に削除する形では最大1回の配送。セッションは順序の処理のための仕組みで、公式は「ちょうど1回の処理」という呼び方は正確ではないと注記している | 既定は少なくとも1回の配送。ちょうど1回の配送にも対応 |
| 届かなかったメッセージの受け皿 | デッドレターキュー | デッドレターの副キュー | デッドレタートピック |
| 保管の期間についての公式の記述 | 既定4日。60秒から14日の範囲で設定できる | 本章の照合では、概要のページに具体的な期間を確認していない | 本章の照合では、概要のページに具体的な期間を確認していない |
この表も、同じ役割の枠に入るだけで同じものではありません。3社の対応づけがとくに崩れるのが2行目です。AWSはキューのAmazon SQSと、配布のAmazon SNSを別のサービスとして持っていますが、Azureは1つのAzure Service Busの中にキューとトピックの両方を持ち、Google CloudはPub/Subという1つのサービスの中で、サブスクリプションの作り方によって両方の形をとります。したがって「Amazon SQSの相当物はどれか」という問いには、Azureでは製品ではなく機能が、Google Cloudでは設定が答えになります。加えて、5行目のように「本章の照合では確認していない」と書いたセルは、その性質が無いという意味ではありません。概要のページに書かれていなかった、という意味です。
Azure自身は、この領域の3つの製品を横に並べた比較を公式に出しています。メッセージングのサービスの比較ページによれば、Azure Event Gridの主な目的は「反応的なイベントのルーティング」、Azure Event Hubsは「大量のデータの流し込みと取り込み」、Azure Service Busは「企業向けのトランザクション的なメッセージング」です。使う場面としては、それぞれ「状態の変化に反応する、サーバーレスの構成」「テレメトリ、分散したデータの流し込み、リアルタイムの分析」「注文の処理、金融の取引、ワークフロー」が挙げられています。順序の保証、トランザクション、重複検出、デッドレターの有無も製品ごとに違います。1つの事業者の中でさえこれだけ分かれているのですから、他社との1対1の対応づけが成り立たないのは当然だとお考えください。なお、大量のデータを流し込むAzure Event Hubsは、Apache Kafkaに標準で対応する実時間のデータ配信の基盤であり、これはデータ分析の文脈になるため第5章で扱います。
イベントを配るための、もう1つの層
キューやトピックは、送り手と受け手が互いを知っている前提で使われることが多い仕組みです。これに対して、誰が受け取るかを送り手が知らないまま出来事を投げ、受け取り方は受け手の側で決める、という層が3社とも別に用意されています。
AWSのAmazon EventBridgeは、公式に「イベントを使ってアプリケーションの構成要素をつなぐ、サーバーレスのサービス」と定義されています。イベント駆動の設計については「イベントを発し、イベントに応答することで協調する、疎に結合されたソフトウェアのシステムを作る様式」という説明が添えられています。処理と配送の方式は2つあります。イベントバスは「イベントを受け取り、0個以上の届け先へ配るルータ」で、自社のアプリケーション、AWSのサービス、第三者のソフトウェアといった多くの源から、組織の中の多くの届け先へイベントを配ることに向いています。もう1つのEventBridge Pipesは1つの源から1つの届け先への点と点の統合のためのもので、届ける前に高度な変換や情報の付加ができます。公式は、パイプの届け先をイベントバスにして両方を組み合わせる使い方も紹介しています。さらにEventBridge Schedulerがあり、cronの式や間隔の式による繰り返しの起動、1回きりの起動、配送の時間の窓の設定、再試行の上限、失敗した呼び出しの最大の保持時間を1か所で管理できると説明されています。
AzureのAzure Event Gridは、公式に「メッセージの配布のための、拡張性が高く完全にマネージドな、発行と購読のサービス」と定義されています。ここで見落としやすいのは、このサービスが2つの顔を持っていることです。1つはHTTPを使ったイベントの配送で、もう1つはMQTTのブローカーとしての機能です。公式は、MQTT v3.1.1、WebSocket上のMQTT v3.1.1、MQTT v5、WebSocket上のMQTT v5に対応すると明記しており、IoTの機器やアプリケーションが互いに通信するための基盤として位置づけています。HTTPの側では、届け先を指定してAzure Event Gridから送り出すプッシュの配送と、購読側がAzure Event Gridに接続して取りに行くプルの配送の両方が選べます。プッシュの配送には、指数的に間隔を広げながら24時間再試行する仕組みがあると書かれています。相互運用のために、CloudEvents 1.0の仕様に対応しているとも明記されています。「Azure Event GridはAmazon EventBridgeに当たる」と単純に対応づけると、MQTTのブローカーであるという側面がまるごと落ちます。
Google Cloudの対応する層がEventarcです。公式は「下にある基盤を実装したり、手を入れたり、維持したりすることなく、イベント駆動のアーキテクチャを作れるようにするもの」と説明し、イベントはCloudEventsの形式で届け先に配送されると明記しています。Eventarcには2つの形があります。Standardは「イベントの提供元から届け先へ、単純にイベントを届けることに焦点がある用途に薦められる」もので、届け先はCloud Run functions、Cloud Runのサービス、VPCの内部のHTTPのエンドポイント、GKEのサービスの公開されたエンドポイント、Workflowsです。Advancedは「イベント駆動のアーキテクチャを作るための完全にマネージドな基盤」で、中央のバスに発行し、多くの提供元から多くの届け先へ配る形に対応します。届け先にはCloud Runのジョブ、Pub/Subのトピック、Eventarc Advancedのバスが加わります。
時刻をきっかけにする起動も、この層に含まれます。Google CloudのCloud Schedulerは「定めた時刻または一定の間隔で実行される作業の単位を設定する」ものと説明され、送り先としてHTTPとHTTPSのエンドポイント、Pub/Subのトピック、App EngineのHTTPとHTTPSのアプリケーションが挙げられています。ここで公式が明確に釘を刺している点があります。Cloud Schedulerは「少なくとも1回」の配送を提供するように設計されており、1回の予定に対して少なくとも1回は実行される、と書かれています。そのうえで「繰り返し実行されても害のある副作用が起きないようにコードを書くこと」「送り先は冪等であるべきこと」が求められています。これは3社に共通する注意で、イベント駆動の設計では、同じ通知が二重に届く前提で受け手を作る必要があります。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| イベントを受けて届け先へ配る層 | Amazon EventBridgeのイベントバス | Azure Event Grid | Eventarc。StandardとAdvancedの2つ |
| 点と点の統合のための仕組み | EventBridge Pipes | 本章の照合では、独立した名前の機能は確認していない | 本章の照合では、独立した名前の機能は確認していない |
| 時刻をきっかけにする起動 | EventBridge Scheduler | Azure Functionsのタイマーのトリガー、Azure Logic Appsの繰り返しのトリガー | Cloud Scheduler |
| 公開仕様への対応についての記述 | 本章の照合では、CloudEventsへの対応の明記は確認していない | CloudEvents 1.0に対応。MQTT v3.1.1とMQTT v5にも対応 | イベントはCloudEventsの形式で配送される |
この表も、同じ役割の枠に入るだけで同じものではありません。2行目のように、一方にだけ独立した名前が付いている機能があります。これは他方に同じことができないという意味ではなく、製品の切り方が違うということです。4行目も同じで、対応の明記を確認できたかどうかを書いているにすぎません。この層で本当に効いてくる違いは、名前の対応ではなく、届け先として何が正式に挙げられているかです。Eventarcの届け先の一覧にWorkflowsが入っていることは、次の節の話につながります。
処理を連結する仕組みは、月や年の単位を語り始めた
関数は短い処理のためのもので、キューやイベントの層は1回の受け渡しのためのものです。ところが実務で必要になるのは、複数の処理を順番につなぎ、途中で人の承認を待ち、失敗したら決めた回数だけやり直し、全体としてどこまで進んだかを記録しておく仕組みです。この役割を担うのがワークフローのサービスで、3社とも用意しています。
AWSのAWS Step Functionsは、ステートマシンと呼ばれるワークフローを作る仕組みです。ワークフローは一連のイベント駆動の段階で構成され、各段階を状態と呼びます。処理の実体は他のAWSのサービスが担い、走っているワークフローの実体は実行と呼ばれます。ワークフローには2つの型があり、ここが選択の分かれ目になります。標準のワークフローは「ちょうど1回」の実行で、最長1年動かすことができ、実行の履歴と視覚的な追跡ができます。Expressのワークフローは「少なくとも1回」の実行で、最長5分です。実行の速度も違い、標準は毎秒2,000件、Expressは毎秒100,000件と明記されています。他のサービスとのつなぎ方は3種類あり、呼び出して応答が返れば次に進む形、ジョブの完了まで待つ形、そしてタスクトークンが返ってくるまで待つ形です。ただし、3種類がどちらの型でも使えるわけではありません。公式は「標準のワークフローとExpressのワークフローは、同じ統合に対応するが、同じ統合の型には対応しない」と明記しており、Expressのワークフローで使えるのは応答が返れば次に進む形だけです。ジョブの完了まで待つ形とタスクトークンを待つ形は、標準のワークフローで、しかも対応するサービスに限って使えます。人の承認を挟むワークフローは3つ目の形で作るので、標準のワークフローを選ぶことになります。
そのAWSに、もう1つ新しい選択肢が加わっています。AWS Lambdaの耐久実行の仕組みです。公式ドキュメントは「中断があっても確実に前へ進みながら、最長1年にわたって実行できる、複数段階のアプリケーションとAIのワークフローを作れる」と説明しています。仕掛けはチェックポイントと再生で、途中経過を記録しておき、中断から再開したときはコードを最初から走らせつつ、すでに終わった部分は記録された結果で読み替えます。待ちの操作の間は関数が中断され、計算の資源を使いません。そして公式は、この仕組みとAWS Step Functionsの違いを自ら書いています。耐久実行はLambdaの中で動き、普通のプログラミング言語で書くもので、業務のロジックとワークフローが強く結びついている場合に向いています。AWS Step Functionsは独立したサービスで、グラフの形の記述か視覚的な設計画面を使い、AWSのサービスをまたいだ調整に向いています。同じ会社の中に、同じ目的の道具が2つ並んだということです。
Azureには、性格の違う2つの道具があります。1つがDurable Functionsで、公式は「Azure Functionsの拡張であり、オーケストレーターの関数、アクティビティの関数、エンティティの関数をコードで書くことによって、サーバーレスの環境で状態を持つワークフローを作れるようにするもの」と定義しています。状態、チェックポイント、再試行、復旧はランタイムが管理するため、ワークフローを長い期間にわたって確実に動かせると書かれています。ここで1つ、調べるときに引っかかる点があります。Durable Functionsの公式ドキュメントの正規のURLは、現在Azure Functionsの配下ではなく、Durable Taskという別の系統の配下に移っています。推奨されるバックエンドとしてDurable Task Schedulerが案内されており、Azure Functionsを使わない独立したSDKの選択肢も提示されています。名前は変わっていませんが、置かれている場所は動いています。動かせる期間については、Durable Taskの概要のページが「ワークフローは時間、日、あるいは月の単位でも動かすことができ、どのような異常停止、再起動、再配置のあとでも、最後に完了した段階から確実に再開する」と説明しています。ただし、AWSやGoogle Cloudのような「最長1年」という具体的な上限の数字は、このページには書かれていません。
もう1つがAzure Logic Appsで、公式は「企業や組織のソフトウェアの生態系の内側でも、それをまたいでも、その外側でも、自動化されたワークフローを作って動かせるクラウドの基盤」と説明しています。特徴はコードを書かずに組み立てられることで、1,400を超える出来合いの接続先が用意されていると明記されています。ワークフローは必ず1つのトリガーから始まり、その後に1つ以上のアクションが続きます。リソースの型はConsumptionとStandardの2つで、前者は1つのワークフローだけを持ち複数の利用者で基盤を共有する形、後者は複数のワークフローを持ち単一の利用者の基盤で動く形です。配送については「少なくとも1回」であり、重複を扱えないのであれば冪等性を自分で実装する必要があると明記されています。Azure Functionsとの違いについて、公式は「Azure Functionsはコードが先、Azure Logic Appsはオーケストレーションが先」と端的に書いています。1回の実行を続けられる長さには上限があり、上限と設定の一覧のページによれば、実行の長さは既定で90日です。Consumptionの型では、この日数は最短7日から最長365日の範囲で変えられます。Standardの型でも既定は90日で、設定を追加することで増減できると書かれています。なお、Standardの型のうち状態を持たないワークフローは既定5分です。
Google CloudのWorkflowsは、公式に「自分で定めた順にサービスを実行する、完全にマネージドなオーケストレーションの基盤」と定義されています。組み合わせられるのは、Cloud RunやCloud Run functionsに載せた独自のサービス、Vision AIやBigQueryといったGoogle Cloudのサービス、そしてHTTPを使うあらゆるAPIです。ワークフローは少なくとも1つの段階を持ち、既定では順序のある一覧として1つずつ実行されます。そして「ワークフローは状態を保持し、再試行し、繰り返し問い合わせ、最長1年待つことができる」と明記されています。障害が起きたときの振る舞いは例外の処理で調整でき、指数的に間隔を広げながらHTTPの呼び出しをやり直す仕組みや、独自のエラーの処理役を定義する仕組みが用意されています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 処理を連結するサービス | AWS Step Functions | Durable Functions、Azure Logic Apps | Workflows |
| 公式が明記している最長の期間 | 標準のワークフローは1年、Expressのワークフローは5分 | Durable Functionsは「時間、日、月の単位」と説明され、上限の数字は示されていない。Azure Logic Appsは1回の実行が既定90日、Consumptionの型は最長365日 | 状態を保ち、最長1年待てる |
| 定義の書き方 | 状態を並べたステートマシン。視覚的な編集と追跡ができる | Durable Functionsはコード。Azure Logic Appsは視覚的な設計画面と出来合いの接続先 | 順序のある段階の一覧。HTTPを使うAPIを組み合わせられる |
| 関数の中で完結する選択肢 | Lambdaの耐久実行。最長1年。公式がStep Functionsとの違いを明記 | Durable Functions。ドキュメントの置き場所がDurable Taskの配下へ移っている | 本章の照合では、関数の中で完結する同種の仕組みは確認していない |
| 重複への備えについての公式の記述 | Expressのワークフローは少なくとも1回の実行 | Azure Logic Appsは少なくとも1回。冪等性は利用者が実装する | Cloud Schedulerは少なくとも1回。送り先は冪等であるべき |
この表も、同じ役割の枠に入るだけで同じものではありません。とくに1行目は、Azureだけ2つ並んでいます。これは製品が多いという話ではなく、「コードで書くワークフロー」と「画面で組むワークフロー」を別の製品として分けているということです。AWSは1つのAWS Step Functionsの中に視覚的な設計と記述の両方を持ち、そこへ後から関数の中で完結する選択肢を足しました。Google Cloudは記述の形に寄せています。組織の中で誰がワークフローを保守するのか、開発者なのか業務の担当者なのかによって、向く形が変わります。AWSとGoogle Cloudが「最長1年」を明示し、Azureも「月の単位」や「最長365日」という長さを公式に書いていることは、この領域が短い処理の連結から、業務の期間をまたぐ処理の管理へ広がったことを示しています。ただし2行目のとおり、Azureの上限は製品と型によって扱いが違い、1つの数字にはまとまりません。
APIの入口を、イベントの入口として見る
ここまで見てきた仕組みは、いずれもクラウドの内側で起きた出来事に反応するものでした。最後に、外側からの呼び出しを受ける入口を見ます。ネットワークの経路や証明書や負荷分散の設計は第8章の担当なので、ここでは「イベントの入口」としての側面だけを扱います。
AWSのAmazon API Gatewayは、公式に「あらゆる規模で、REST、HTTP、WebSocketのAPIを作成し、公開し、維持し、監視し、保護するためのAWSのサービス」と定義されています。位置づけについては「アプリケーションが、背後にあるサービスのデータ、業務のロジック、機能へアクセスするための玄関口として働く」と書かれており、背後のサービスとして挙げられているのはAmazon EC2の上の処理、AWS Lambdaのコード、あらゆるウェブアプリケーション、実時間の通信を行うアプリケーションです。引き受ける仕事も明記されていて、同時に何十万というAPIの呼び出しを受け付けて処理すること、その中には通信量の管理、認可とアクセス制御、監視、APIの版の管理が含まれます。そして公式は「AWS Lambdaとあわせて、AWSのサーバーレスの基盤のうちアプリケーションに面する部分を構成する」と述べています。
Azureの対応する製品はAzure API Managementで、公式は「あらゆる環境にまたがるAPIのための、ハイブリッドでマルチクラウドの管理の基盤」と定義しています。構成要素は3つで、すべての要求が最初に到達しバックエンドへ振り分けるAPIゲートウェイ、設定と管理を行う管理プレーン、そしてAPIの文書を公開する開発者ポータルです。ゲートウェイが担う仕事として、APIキーやJWTや証明書の検証、利用の上限と速度の制限の適用、要求と応答の変換、応答のキャッシュ、記録と計測の出力が挙げられています。料金の階層のうち1つはサーバーレスのゲートウェイと説明されており、サーバーレスの計算資源やマイクロサービスを使う構成、通信量が変動する用途のために設計されているとされています。
Google Cloudについては、本章で確認できなかったことを正直に書いておきます。Apigeeという製品が同じ役割の枠にありますが、公式ドキュメントの本文を取得できず、一文の定義を確認できませんでした。したがって本章では、Apigeeを3社対比の表に並べることも、その性質を説明することもしません。読者が実際に選ぶときは、Google Cloudの公式ドキュメントを直接ご確認ください。確認できていないものを、対応表の形が整うからという理由で埋めるのは、この記事がいちばん避けたい書き方です。
選ぶときに決める4つのこと
ここまでサービスを並べてきましたが、実務で必要なのは名前の一覧ではなく、選ぶための問いです。本章の範囲では、次の4つを先に決めると迷いが減ります。
1つ目は起動の頻度です。1日に数回しか動かない処理と、常時大量の呼び出しを受ける処理では、向く形が変わります。呼び出しが途切れる時間が長い処理は、ゼロまで縮退する形が向きます。Cloud Runはリクエストが無ければ最後の1つのインスタンスも取り除き、Azure Container Appsもほとんどのアプリケーションをゼロまで縮められます。逆に、ほぼ常時動いている処理については、Azureの公式が「関数アプリが継続して、あるいはほぼ継続して動いている場合」をPremiumプランの検討条件として挙げています。
2つ目は実行時間の上限です。前述のとおり、AWS Lambdaは通常の構成では15分で切れます。Azure FunctionsはHTTPで起動された関数の応答が230秒までです。Cloud Runは、サービスのリクエストが最大60分、ジョブの各タスクが最長168時間です。ここは要件から逆算できる数少ない項目なので、最初に確認してください。上限を超える処理は、関数を分割してワークフローでつなぐか、コンテナ型の実行環境に移すか、ワークフローのサービスに任せることになります。
3つ目は状態を持つかどうかです。1回の呼び出しで完結する処理なら、関数型のサーバーレスがそのまま使えます。前の段階の結果を持ち越す必要がある処理、途中で人の承認を待つ処理、数日から数週間にわたる業務の処理は、状態を管理する仕組みが要ります。それがAWS Step Functions、Lambdaの耐久実行、Durable Functions、Azure Logic Apps、Workflowsです。状態を関数の中で自力で管理しようとすると、再試行のたびに二重に処理が走る問題に必ずぶつかります。そして、外部のイベントやメッセージの配送を挟む場合は、少なくとも1回の配送、つまり同じものが二重に届きうるという前提が残るので、受け手を冪等に作る作業からは逃れられません。AWS Step Functionsの標準のワークフローのように「ちょうど1回」の実行を明記する仕組みはありますが、それはワークフローの内側の話です。本章で見たAmazon SQSの標準のキュー、Pub/Sub、Cloud Scheduler、Azure Logic Appsは、いずれも「少なくとも1回」を明記しています。
4つ目は起動の遅れをどこまで許容するかです。呼び出しが無い間はインスタンスを持たない仕組みは、久しぶりの1回目の呼び出しで待たされます。これがコールドスタートです。Azureの公式ドキュメントは、この振る舞いをホスティングごとに整理しています。Flex Consumptionプランは、ゼロまで縮んだ場合でもコールドスタートが改善されており、あらかじめ用意しておくインスタンスを持てます。Premiumプランは、常に温めたインスタンスを1つ以上維持することでコールドスタートを避けます。Dedicatedプランは決めた台数で継続して動くため、コールドスタートは問題にならないとされています。Container Appsは、最小のレプリカ数をゼロにするか1以上にするかで振る舞いが変わります。Consumptionプランは、待機時にゼロまで縮むため一部の要求で起動の遅れが出る、と明記されています。AWS Lambdaについては、実行環境が使い回されること、ただし呼び出しをまたいで状態が残るとは限らないことが公式に書かれています。「速い」「遅い」ではなく、「いくら余分に用意しておけば、どこまで遅れが減るか」という取引として理解してください。この取引には費用が伴いますが、その考え方は第12章で扱います。
5つ目とまでは言いませんが、もう1つ習慣にしていただきたいことがあります。採用の前に、そのサービスと、使おうとしているその機能のライフサイクルの状態を、公式の一覧で確かめることです。本章では、Amazon SNSという現役のサービスの中の1つの機能が、新規に利用を開始できない段階の一覧に載っていることを見ました。第2章では、比較的新しいサービスのほうが先に新規の受け付けを止めた例を見ました。新しいから安泰でもなく、古いから危ういわけでもありません。各社の一覧の所在と読み方は第14章で整理します。
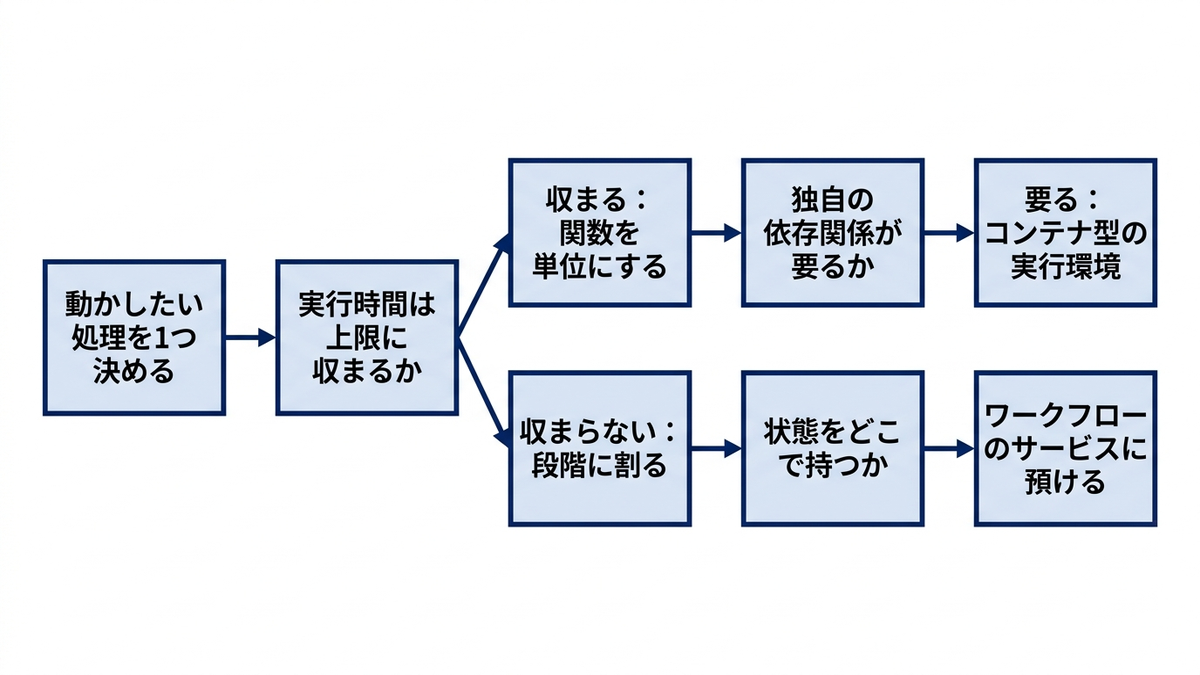
本章では、サーバーレスとイベント駆動の領域を、関数、コンテナ型の実行環境、メッセージとイベントの配送、処理の連結という4つの層に分けて見てきました。確認できたことを3つに絞ります。第一に、関数とコンテナの境目は3社とも溶けつつあります。Azureは関数のホスティングの選択肢にコンテナの実行環境を正式に並べ、Google Cloudは関数をCloud Runの上へ移して名前も変えました。AWSは向きが逆で、AWS Lambdaがコンテナイメージを配置の単位として受け入れています。第二に、実行時間の上限は3社で明確に違い、AWS Lambdaの15分は、通常の構成では引き上げられない硬い制約として残っています。第三に、処理を連結する仕組みは、AWSとGoogle Cloudでは「最長1年」が明示され、Azureでも月の単位や最長365日という長さが公式に書かれるところまで広がりました。短い処理をつなぐ道具だったものが、業務の期間をまたぐ処理を預かる道具になっています。ただしAzureの上限は製品と型によって扱いが違い、1つの数字にはまとまりません。
そして本章でも、対応表の限界が繰り返し現れました。Amazon SQSとAmazon SNSという2つのサービスに対して、Azureは1つの製品の中の2つの機能で応じ、Google Cloudは1つの製品のサブスクリプションの作り方で応じます。Azure Event GridをAmazon EventBridgeの相当物と見ると、MQTTのブローカーであるという側面が落ちます。横に並べた表は入口として便利ですが、置き換えの計画書としては使えません。次の第8章では、同じ姿勢でネットワーキングを見ていきます。仮想ネットワーク、負荷分散、CDN、専用線、そしてプライベートな接続という、本章までの実行環境を実際につなぐ層です。
この章を深めたい方への参考書籍
『AWS Lambda実践ガイド 第2版』(大澤文孝、インプレス):本章で扱った関数型のサーバーレスを、AWS Lambdaを題材に手を動かしながら理解できる1冊です。本章では実行時間の上限や起動の遅れといった制約の側から説明しましたが、その制約が実際の設計にどう効いてくるのかは、1つの環境で通しで作ってみるといちばん腑に落ちます。クラウドの書籍は版が速く古くなるため、購入時は最新の版と、本文が前提にしているサービスの現況をあわせてご確認ください。
『マイクロサービスパターン 実践的システムデザインのためのコード解説』(Chris Richardson、インプレス):本章の後半で扱ったメッセージング、イベントの配送、処理の連結を、事業者のサービス名ではなく設計の型の側から追える1冊です。プロセスの間の通信、トランザクション、データベースの分け方といった論点が、1つのサンプルの題材を通して具体的に説明されます。本章で述べた「少なくとも1回の配送を前提に受け手を冪等に作る」という話が、なぜ避けられないのかを理解する助けになります。
『ソフトウェアアーキテクチャ・ハードパーツ』(Neal Ford ほか、オライリー・ジャパン):分散したアーキテクチャで避けて通れない判断を、正解を示すのではなく取捨の分析として扱う1冊です。本章では「関数かコンテナか」ではなく「どの制約の下で動かしたいか」を問うべきだと述べましたが、本書はその問いの立て方そのものを主題にしています。とくに後半で扱われるワークフローの調整やサガの型は、本章の処理の連結の節と直接つながります。
第8章 ネットワーキング
前章では、処理を関数やイベントの形で切り出し、呼び出されたときだけ動かすという作り方を見ました。呼び出しの仕組みが決まると、次に問題になるのは、その呼び出しがどの経路を通って届くのかです。本章はネットワークを扱います。利用者の端末から、名前を引き、どこかの拠点で受け止め、振り分けられ、目的のサーバーに届くまでの経路の話です。
この章は、3社の対応表がいちばん危ういところでもあります。仮想ネットワーク、負荷分散、配信、名前解決、専用の接続。役割の名前は3社ともほとんど同じで、表にすると気持ちよく埋まります。ところが埋まった表のいちばん基礎になる1行で、3社は別のことを言っています。そこから始めます。なお、権限の設計、鍵の管理、脅威の検出といったIDとセキュリティの話は第9章で扱います。本章は経路そのものに絞ります。
仮想ネットワークは、3社で範囲そのものが違う
クラウドで最初に作る入れ物のうち、費用や権限の器がアカウントやプロジェクトだとすれば、通信の器が仮想ネットワークです。Amazon VPC、Azure Virtual Network、Google Cloud の VPC。3社ともほぼ同じ言葉で呼び、公式の説明もよく似ています。AWSは「論理的に隔離された、自分で定義した仮想ネットワークの中にAWSの資源を起動できる」と書き、Azureは「Azureにおけるプライベートなネットワークの基本的な構成要素を提供する」と書きます。ここまでは横に並べられます。
並ばなくなるのは、その仮想ネットワークがどこまで広がるかという一点です。Google Cloud の公式ドキュメントは、VPCネットワークを「グローバルな資源であり、データセンター内にあるリージョン単位の仮想サブネットワークの一覧からなり、それらがグローバルな広域網で接続されている」と定義しています。全世界を範囲とする資源だと公式に明記しているのは、確認できたかぎり Google Cloud だけです。AWSの資料は、1つのリージョンの中の各アベイラビリティゾーンに1つずつサブネットを置いた構成を例として説明しており、Azureの資料は「仮想ネットワークとサブネットはリージョン内のすべての可用性ゾーンにまたがる」と書いています。Azureのページは、仮想ネットワークがリージョンをまたぐとは書いていません。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 仮想ネットワークの名前 | Amazon VPC | Azure Virtual Network | VPC |
| 広がる範囲についての公式の記述 | リージョンの中に作るものとして説明される。リージョンごとに既定のVPCが用意される | 仮想ネットワークとサブネットはリージョン内のすべての可用性ゾーンにまたがる、と明記。リージョンをまたぐとは書かれていない | VPCネットワークはグローバルな資源である、と明記 |
| サブネットの置かれ方 | サブネットは1つのアベイラビリティゾーンの中に置かれなければならない、と明記 | サブネットもリージョン内のすべての可用性ゾーンにまたがる | リージョン単位の仮想サブネットワークである、と明記 |
| ネットワークどうしをつなぐ手段 | VPCピアリング接続、Transit Gateway。Transit Gateway はリージョンをまたぐピアリングにも対応する | 仮想ネットワークピアリング。つなぐ相手は同じリージョンでも別のリージョンでもよい、と明記 | 1つのVPCネットワークがリージョンをまたぐ、というのが公式の定義 |
| 公式が同じカテゴリに置いているもの | ゲートウェイ、エンドポイント、ピアリング接続、Transit Gateway、VPN接続、フローログをVPCの機能として列挙 | Network Foundations のカテゴリ。同じカテゴリに Azure DNS と Azure Private Link が入る | Compute Engine、GKE、サーバーレスのワークロードにネットワーク機能を提供する、と説明 |
この表も、同じ役割の枠に入るだけで同じものではありません。3社とも仮想ネットワークという言葉を使いますが、指しているものの寸法が違います。「VPC」という3文字が、AWSでは1つのリージョンの中の話であり、Google Cloud では世界全体の話です。ここを取り違えたまま対応表を作ると、表は正しく見えるのに、その表を根拠にした設計が成り立たなくなります。念のため付け加えると、AWSとAzureのネットワークがリージョンをまたげない、と公式が書いているわけではありません。各社とも別リージョンとつなぐ手段を持っています。確認できた事実は、全世界を範囲とする資源だと公式に書いているのは Google Cloud だけである、という点です。
範囲の違いは、設計のどこに出るか
この違いは、抽象的な言葉遊びではなく、作業量として現れます。複数のリージョンにまたがる構成を組む場面を考えます。AWSでは、リージョンごとにVPCを作り、それらをVPCピアリング接続や Transit Gateway でつなぐという作業が発生します。Transit Gateway の公式ドキュメントは、これを「VPCとオンプレミスのネットワークを相互に接続するためのネットワークの中継拠点」と定義し、クラウドの基盤が世界へ広がるにつれてリージョンをまたぐピアリングが中継拠点どうしを結ぶ、と説明しています。Azureでも同様に、仮想ネットワークピアリングでつなぐことになります。Azureのページは、つなぐ相手が別のリージョンでもよいと明記しています。一方 Google Cloud では、1つのVPCネットワークがすでにリージョンをまたいでいます。
もう1つ、日々のIPアドレスの設計に直結する違いがあります。サブネットという言葉が、3社で違う単位を指しています。AWSは「サブネットは1つのアベイラビリティゾーンの中に置かれなければならない」と明記しています。したがって3つのゾーンに冗長に配置したければ、少なくとも3つのサブネットを切り、3つのアドレス範囲を設計することになります。Azureは「仮想ネットワークとサブネットはリージョン内のすべての可用性ゾーンにまたがる」と書き、ゾーンに合わせてサブネットを割る必要はないと明言しています。Google Cloud のサブネットもリージョン単位です。同じ「サブネットを3つ作る」という言葉が、AWSでは冗長化のための必須の手順であり、他の2社では別の意図を持った作業になります。
どちらが優れているという話ではありません。ゾーンごとにサブネットを切るという作り方は、どのゾーンにどの資源があるかがアドレスの見た目から分かるという利点を持ちます。リージョン全体にまたがるサブネットは、設計が簡素になるかわりに、その情報がアドレスからは読み取れません。選ぶときの観点は、複数のリージョンにまたがる構成をどれだけ前提にしているか、アドレスの設計を誰がどれだけ細かく管理したいか、この2つだと考えています。
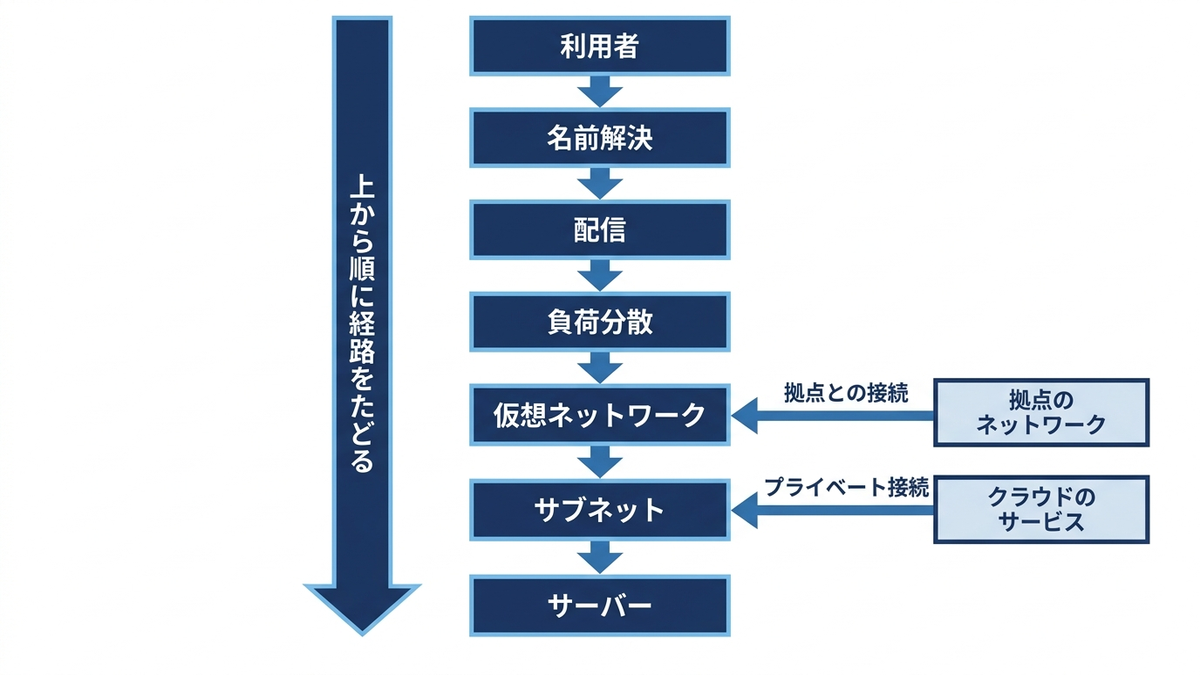
負荷分散は、層と範囲で分かれる
仮想ネットワークの中に受け皿を置いたら、次は届いた通信をどう振り分けるかです。Elastic Load Balancing の公式ドキュメントは、この役割を「受信するトラフィックを、1つ以上のアベイラビリティゾーンにある複数のターゲットへ自動的に分散する」「登録されたターゲットの健全性を監視し、健全なターゲットにだけトラフィックを送る」「受信トラフィックの変化に応じて容量を自動的に拡張する」と説明しています。振り分けと死活監視と自動的な拡縮の3つが一組になっている、と読めます。
振り分けの判断をどこで行うかには、大きく2つの層があります。宛先のアドレスと番号だけを見て振り分けるのがトランスポート層、URLや要求の中身まで見て振り分けるのがアプリケーション層です。前者のほうが速く、後者のほうが細かい制御ができます。
3社とも複数の種類を用意していますが、分け方の思想が違います。AWSは現行世代として Application Load Balancer、Network Load Balancer、Gateway Load Balancer の3つを挙げ、それぞれに独立した利用者ガイドを置いています。Azureは、トランスポート層の振り分けを Azure Load Balancer、アプリケーション層の振り分けを Azure Application Gateway、世界規模の配信と振り分けを Azure Front Door、DNSによる振り分けを Azure Traffic Manager と、別々のサービス名で分けています。Application Gateway のページは、この使い分けを自分で案内しており、TLSの終端やHTTPの要求ごとの処理が不要でDNSによる世界規模の振り分けをしたいなら Traffic Manager を、世界規模の切り替えを速くしたいなら Front Door を、トランスポート層の負荷分散なら Load Balancer を見るように書いています。Google Cloud は Cloud Load Balancing という1つの名前の下に種別を並べる形を取っており、Application Load Balancers と Network Load Balancers に大きく分け、後者をさらにプロキシ型と通過型に分けています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| アプリケーション層での振り分け | Application Load Balancer | Azure Application Gateway。OSI第7層で動き、URLのパスやホストヘッダーといったHTTPの要求の属性で振り分けを判断する、と明記 | Cloud Load Balancing の Application Load Balancers。グローバル外部、リージョン外部、classic、リージョン内部、リージョンをまたぐ内部の5種別 |
| トランスポート層での振り分け | Network Load Balancer | Azure Load Balancer。現行のSKUは Standard と Gateway の2つ | Cloud Load Balancing の Network Load Balancers。プロキシ型と通過型に分かれる |
| 仮想アプライアンスへの引き込み | Gateway Load Balancer | Azure Load Balancer の Gateway SKU(Gateway Load Balancer)。第三者の仮想アプライアンスを挟む用途と公式が説明 | 本章では対応するものを確認していない |
| 世界規模での振り分け | AWS Global Accelerator。1つ以上のリージョンにある複数のロードバランサーへ分散する、と公式が説明 | Azure Front Door。DNSによる振り分けは Azure Traffic Manager | グローバルの種別が Application 側にも Network 側にも用意されている |
| 前の世代として残っているもの | Classic Load Balancer。前世代であり現行世代への移行が推奨されている。提供終了の告知はこのページには無い | Basic SKU は2025年9月30日に提供終了。Application Gateway の v1 SKU は2026年4月28日に提供終了 | classic という種別が Application 側にも Proxy Network 側にも残る。提供終了の告知は確認できていない |
この表も、横に並んでいるだけで同じものではありません。とくに注意が要るのは、AWSの3つ、Azureの4つ、Google Cloud の種別が、それぞれ別の基準で切られていることです。AWSは製品として分け、Azureはサービス名として分け、Google Cloud は1つのサービスの中の種別として分けています。Google Cloud で「ロードバランサーを選ぶ」という作業は、AWSやAzureで「サービスを選ぶ」という作業とは手触りが違い、アプリケーション層かネットワーク層か、グローバルかリージョンか、プロキシか通過型か、という3つの軸を順に決める作業になります。種別の全部を覚える必要はなく、この3つの軸で自分の要件を言えるようにしておけば選べます。
サービスは続いているのに、等級が終わることがある
ここで、サービス名だけを追いかけていると絶対に見つからない種類の変化に触れておきます。Azure Load Balancer の公式ドキュメントは、冒頭に「2025年9月30日に Basic Load Balancer は提供終了しました」と掲げ、本文にも「現行のSKUは Standard と Gateway の2つである。3つ目のSKUである Basic は2025年9月30日に提供終了した」と書いています。終わったのはサービスではなくSKU、つまり等級です。Azure Load Balancer そのものは提供中で、無くなったのは Basic という等級だけです。同じことが Azure Application Gateway でも起きており、公式ドキュメントは現行世代を v2 のSKUファミリだと述べたうえで、v1 のSKUは2026年4月28日に提供終了しサポートされない、と明記しています。
この2件は、名称の一覧を突き合わせる方法では拾えません。サービス名は変わっていないからです。拾うには、概要ページを開いて冒頭の告知とSKUの表を読むしかありませんでした。「終了」という一語を使うときは、何が終了したのかを必ず一緒に書く必要があります。サービスなのか、等級なのか、種別なのか、利用の入口なのか。この4つは読者にとってまったく違う意味を持ちます。「Azure Load Balancer が終了した」と書けば重大な誤りになり、読者に不要な移行を促してしまいます。
あわせて、この終了の実質が何だったのかにも触れる価値があります。同じページは、Standard のロードバランサーとパブリックIPアドレスは既定で受信接続に対して閉じている、Basic Load Balancer は既定でインターネットに開いていた、と書き分けています。等級の整理は、性能の話であると同時に、既定値を「閉じている」側へ寄せる作業でもあったと読めます。クラウドの世代交代には、機能の追加よりも既定値の変更のほうが実質的な意味を持つ場面がある、という例です。
配信とエッジでの防御
次は配信です。利用者に近い場所にコンテンツを置いて、遠くまで取りに行かせない仕組みを指します。AWSは Amazon CloudFront を「HTMLやCSS、JavaScript、画像といった静的および動的なWebコンテンツの、利用者への配信を速くするWebサービス」と定義し、Azureは Azure Front Door を「クラウドのための高度なコンテンツ配信ネットワーク」と定義しています。Google Cloud は Cloud CDN を「Googleのグローバルなエッジネットワークを使い、コンテンツを利用者の近くで配信することで、Webサイトとアプリケーションを速くする」と説明しています。ここまでは3社が同じことを言っているように読めます。
ところが Cloud CDN には、他の2つに無い前提があります。公式ドキュメントは、Cloud CDN が「グローバルな外部 Application Load Balancer、または classic の Application Load Balancer と組み合わせて」コンテンツを配信すると書いています。つまり Cloud CDN は単体で立っているサービスではなく、Cloud Load Balancing の外部ロードバランサーとセットで使う機能です。CloudFront や Front Door を単体で立ち上げる感覚のまま「Google Cloud でも同じものを使えばよい」と考えると、前提のロードバランサーが要るという設計の差に、作り始めてから気づくことになります。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 配信のサービス名 | Amazon CloudFront | Azure Front Door | Cloud CDN |
| 公式の一言の説明 | 静的および動的なWebコンテンツの配信を速くするWebサービス | クラウドのための高度なコンテンツ配信ネットワーク | Googleのグローバルなエッジネットワークを使い、コンテンツを利用者の近くで配信する |
| 単体で使えるか | 単体のサービスとして立っている | 単体のサービスとして立っている | 単体では使えない。グローバルな外部 Application Load Balancer、または classic の Application Load Balancer と組み合わせて動く、と公式が明記 |
| 入口での防御にあたるもの | Application Load Balancer は AWS WAF のウェブアクセス制御リストの規則で要求を許可または遮断できる、と公式が説明 | Azure Web Application Firewall と Azure DDoS Protection が、Azure自身の Network Security のカテゴリに置かれている | Google Cloud Armor。分散サービス拒否の攻撃、クロスサイトスクリプティング、SQLインジェクションといった脅威から守る、と説明 |
この表の3列は、同じ役割の枠に入るだけで同じものではありません。とくに Cloud CDN を CloudFront や Front Door と横並びに読まないでください。前者は機能であり、後者は単体のサービスです。表の形が同じでも、選定のときに立てる問いが変わります。CloudFront や Front Door を選ぶときの問いは「この配信サービスを使うかどうか」ですが、Cloud CDN を選ぶときの問いは「どの外部ロードバランサーを前に置き、その上で配信を有効にするかどうか」になります。あわせて、エッジでの防御の行も、3社で製品の切り方が違う点に注意が要ります。AWSでは負荷分散の製品と防御の製品が別に立ち、Azureでは防御にあたるものを自社の分類でネットワークセキュリティ側に置き、Google Cloud では Cloud Armor が独立した名前を持っています。
名前解決は、振り分けの道具でもある
経路の話でいちばん最初に通るのに、いちばん軽く扱われがちなのがDNSです。3社とも、DNSを単なる名前解決の道具としてではなく、振り分けの道具として位置づけています。Amazon Route 53 の公式ドキュメントは、Route 53 を「可用性が高くスケールするDNSのWebサービス」と定義したうえで、ドメイン名の登録、DNSによる振り分け、ヘルスチェックの3つの機能を任意の組み合わせで使える、と説明しています。ドメイン名の登録まで同じサービスに含めているのは、本章で確認した範囲ではAWSだけでした。
Azure DNS は少し変わった作りをしています。Azure DNS の概要ページは Azure DNS を「Microsoft Azure の基盤を使って、アプリケーションのためのDNSのホスティング、名前解決、負荷分散を提供する」と定義し、続けて「次のサービスを提供する」として5つを挙げます。Azure Public DNS、Azure Private DNS、Azure DNS Private Resolver、Azure Traffic Manager、DNS Resolver Policy です。Azure DNS は1つのサービスというより、5つの機能を束ねた名前になっており、その傘の下に Azure Traffic Manager が入っています。ページは Traffic Manager を「DNSにもとづくトラフィックのロードバランサー」と説明しています。負荷分散を扱う章でも、名前解決を扱う章でも顔を出すサービスだ、ということです。なお、この5つという数え方は概要ページのものです。Azureのネットワーキングサービスを6つのカテゴリに分けて案内する公式ページでは、Azure DNS は Azure Public DNS、Azure Private DNS、Azure DNS Private Resolver の3つからなると書かれ、Traffic Manager は同じカテゴリの中の別のサービスとして並んでいます。同じ会社の公式ページの間でも、束ね方が揃っていないということです。
Cloud DNS は「高性能で回復力のある、グローバルなDNSサービスであり、ドメイン名をグローバルなDNSに公開する」と定義され、公開ゾーンと非公開の管理ゾーンの両方を扱えると書かれています。非公開のゾーンは、指定した1つ以上のVPCネットワークからだけ見える、と説明されています。加えて、エニーキャストを使って世界中の複数の場所から管理ゾーンを配信し、要求は自動的に最も近い場所へ送られる、とも書かれています。振り分けの機能も持っており、DNSルーティングポリシーの公式ドキュメントは、公開ゾーンと非公開ゾーンのリソースレコードセットに対して、特定の条件にもとづいてトラフィックを誘導するポリシーを設定できると説明し、重み付きラウンドロビン、地理的位置、フェイルオーバーの3つの型を挙げています。内部ロードバランサーと外部のエンドポイントについてはヘルスチェックにも対応し、エンドポイントがヘルスチェックに失敗したときに自動的にフェイルオーバーする、とも書かれています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 名前解決のサービス名 | Amazon Route 53 | Azure DNS | Cloud DNS |
| 公式の一言の説明 | 可用性が高くスケールするDNSのWebサービス | Azureの基盤を使ったDNSのホスティング、名前解決、負荷分散 | 高性能で回復力のある、グローバルなDNSサービス |
| ドメイン名の登録 | 3つの主要機能の1つとして明記されている | 本章では確認していない | 本章では確認していない |
| 内部向けの名前解決 | VPC Resolver。複数のVPCやアカウントに設定をまとめて適用する Route 53 Profiles もある | Azure Private DNS、Azure DNS Private Resolver | 非公開の管理ゾーン。指定したVPCネットワークからだけ見える |
| DNSによる振り分け | Traffic Flow。地理的な近さ、遅延、健全性などをもとに最適なエンドポイントへ振り分ける、と説明 | Azure Traffic Manager。Azure DNS の概要ページでは Azure DNS の傘の下に置かれている | DNSルーティングポリシー。重み付きラウンドロビン、地理的位置、フェイルオーバーの3つの型があり、内部ロードバランサーと外部のエンドポイントについてはヘルスチェックによる自動的なフェイルオーバーにも対応する、と説明 |
| DNSに対する防御 | Resolver DNS Firewall。VPC内の再帰的な問い合わせを守る、と説明 | DNS Resolver Policy が Azure DNS の概要ページで5つの機能の1つとして挙げられている | 本章では確認していない |
この表の3列も、同じ役割の枠に入るだけで同じものではありません。DNSによる振り分けの機能を3社とも持っている点は共通ですが、その機能の置き場所が違います。Azureは Azure Traffic Manager という独立した名前の製品を、概要ページの整理ではDNSの傘に入れ、AWSは Traffic Flow をDNSのサービスの中の1機能として持ち、Google Cloud は Cloud DNS のルーティングポリシーという設定の形で持っています。「DNSのサービスを選ぶ」と言ったとき、3社とも振り分けの規則の置き場所まで一緒に決めることになりますが、その規則が独立した名前の製品なのか、DNSのサービスの中の設定なのかは違います。移行を検討する場面では、名前解決の設定だけを移せば済むと考えず、振り分けの規則をどこに書いているかを先に洗い出すほうが安全です。
拠点との接続は、公衆網を通るかどうかで分かれる
自社の拠点とクラウドをつなぐ手段は、3社とも2つの系統に分かれます。公衆のインターネットを通す代わりに暗号化する系統と、公衆のインターネットを通さない専用の接続を引く系統です。公式ドキュメントの説明が、この分かれ目をそのまま言葉にしています。Azure ExpressRoute のページは「ExpressRoute の接続は公衆インターネットを通らないため、インターネット経由の一般的な接続に比べて、信頼性、速度、遅延の一貫性、安全性が高い」と書き、Azure VPN Gateway のページは「Azureの仮想ネットワークとオンプレミスの拠点の間で、公衆インターネット越しに暗号化されたトラフィックを送るために使える」と書いています。同じ会社の2つのページが、同じ観点で自分たちを説明し分けています。
AWSも同じ構図です。AWS Direct Connect は「内部のネットワークを、標準的なイーサネットの光ファイバーケーブルで Direct Connect のロケーションに接続する」と説明され、AWS Site-to-Site VPN は「VPN接続を作り、その接続を通るように経路を設定することで、VPCからリモートの機器へのアクセスを有効にできる」と説明されます。Google Cloud も、Cloud Interconnect を「低遅延で可用性の高い接続を提供し、ネットワーク間でデータを確実に転送できる」と説明し、Cloud VPN を「IPsec のVPN接続を通じて、ピアとなるネットワークをVPCネットワークへ安全に拡張する」と説明しています。
ここで表記について1つ断っておきます。AWSについては、2つのVPNを束ねる傘としての単一のサービス名を、公式ドキュメントで確認できませんでした。実在を確認できたのは AWS Site-to-Site VPN と AWS Client VPN の2つで、両者はドキュメントの体系を共有しているものの、片方が他方を含む上位の名前だと明言した文は見当たりませんでした。したがって本記事では、この2つを分けて書きます。AWS Client VPN は「マネージドのクライアント型のVPNサービスで、AWSの資源とオンプレミスのネットワークの資源に安全にアクセスできる」と説明されており、拠点ではなく端末からつなぐための仕組みです。Azureでは、この2つの用途が Azure VPN Gateway という1つのサービスの中の接続の型として整理されており、拠点間のものを site-to-site、1台の計算機からのものを point-to-site と呼び分けています。
| 経路の性格 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 公衆網を通らない専用の接続 | AWS Direct Connect | Azure ExpressRoute | Cloud Interconnect |
| 拠点どうしを暗号化して結ぶ接続 | AWS Site-to-Site VPN | Azure VPN Gateway の site-to-site | Cloud VPN |
| 端末から個別につなぐ接続 | AWS Client VPN | Azure VPN Gateway の point-to-site | 本章では確認していない |
| 公衆網についての公式の記述 | Direct Connect は光ファイバーのケーブルで接続の拠点に直結する、と説明 | ExpressRoute は公衆インターネットを通らない、VPN Gateway は公衆インターネット越し、と両ページが書き分けている | Cloud VPN は IPsec のVPN接続、Cloud Interconnect は低遅延で可用性の高い接続、と説明 |
| 接続の方式の内訳 | 本章では方式の一覧を確認していない | 本章では方式の一覧を確認していない | Dedicated Interconnect、Partner Interconnect、Cross-Cloud Interconnect、Partner Cross-Cloud Interconnect、Cross-Site Interconnect の5つ |
| 世代交代についての注記 | 本章では該当する記述を確認していない | 可用性ゾーンに対応していない VpnGw1 から VpnGw5 までのSKUは、2025年11月1日以降は新しいVPNゲートウェイを作成できない。既存のゲートウェイは2025年9月から2026年9月までの移行期間に、可用性ゾーンに対応したSKUへ手動で移行できる。旧SKUは2026年9月より後に非推奨化される予定、と明記 | Cloud VPN には HA VPN と Classic VPN があり、高い可用性が要る場合は HA VPN が勧められている。Classic VPN 全体の提供終了の告知は確認できていない。ただし Classic VPN のトンネルの動的ルーティング(BGP)は2025年8月1日に非推奨化され、同日以降は動的ルーティングを使う Classic VPN のトンネルを新しく作成できない。既存のそのトンネルは動き続けるが可用性のSLAは無い。静的ルーティングを使う Classic VPN のトンネルは引き続き作成とサポートの対象、と明記 |
この表も、同じ役割の枠に入るだけで同じものではありません。とくに Google Cloud の行にある Cross-Cloud Interconnect は、他の2社の列に対応するものを置けなかった項目です。これは Google Cloud と他社のクラウドを直接つなぐための方式で、3社が互いを排除する前提で製品を作っていないことを示す例の1つになります。1社に決めるという問いの立て方そのものを、各社の製品構成が少しずつ緩めている、と読むこともできます。マルチクラウドを選ぶ理由と選ばない理由は第11章で扱います。
表の「世代交代についての注記」の行も、前の節で述べた「何が終了したのか」を分けて読む必要があります。Azure VPN Gateway については、SKUの対応関係を説明する公式ドキュメントが、3つの状態を日付つきで書き分けています。可用性ゾーンに対応していない VpnGw1 から VpnGw5 までのSKUで新しいVPNゲートウェイを作成できなくなったのが2025年11月1日、既存のゲートウェイを可用性ゾーンに対応したSKUへ手動で移行できる期間が2025年9月から2026年9月まで、そして旧SKUの非推奨化が予定されているのが2026年9月より後、という並びです。サービスは続き、等級が入れ替わるという型は Azure Load Balancer の Basic SKU と同じですが、こちらは終了ではなく、新規作成の停止と非推奨化の予定という段階にあります。Google Cloud の Classic VPN については、動的ルーティングの非推奨化を告知する公式ドキュメントが、非推奨化されたのは Classic VPN そのものではなく、Classic VPN のトンネルで動的ルーティング(BGP)を使う構成だと明記しています。日付は2025年8月1日で、同日以降はその構成のトンネルを新しく作成できず、既存のものは動き続けるが可用性のSLAは付かず、静的ルーティングを使う構成は引き続き作成とサポートの対象です。「Classic VPN が非推奨になった」と縮めると、静的ルーティングで使い続けている構成まで移行が要るように読めてしまいます。非推奨化の対象がサービスなのか、等級なのか、構成の一部なのかを、ここでも分けて読む必要があります。
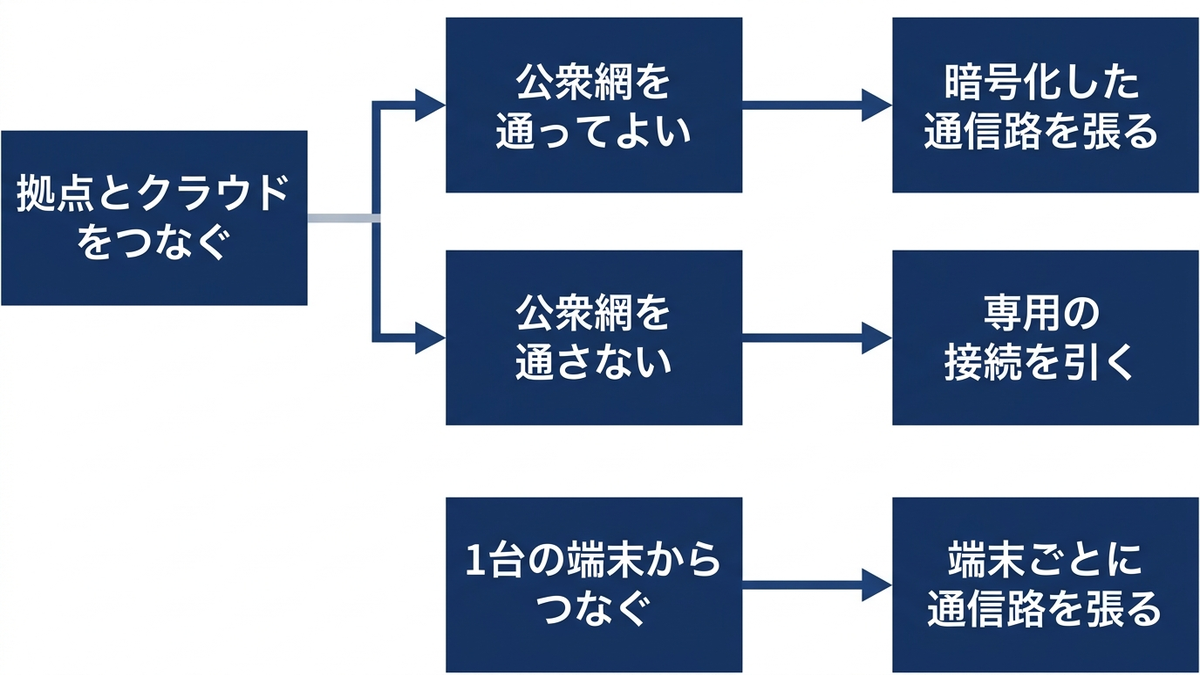
プライベート接続と踏み台
拠点との接続が「外から中へ入る経路」だとすれば、もう1つ、「中からクラウドのサービスへ出ていく経路」の設計があります。オブジェクトストレージやマネージドのデータベースは、既定では公衆網の側に入口を持つことが多く、そこへ社内のネットワークから届かせようとすると、経路の一部が公衆網に出ます。これを避けるための仕組みが、3社ともプライベート接続として用意されています。
AWS PrivateLink の公式ドキュメントは、これを「VPCを、サービスや資源へ、それらが自分のVPCの中にあるかのようにプライベートに接続できる、可用性が高くスケールする技術」と定義しています。効果をいちばんよく表しているのは次の一文です。インターネットゲートウェイ、NATの機器、パブリックIPアドレス、Direct Connect の接続、Site-to-Site VPN の接続のいずれも使わずに、プライベートなサブネットからサービスや資源と通信できる、と書かれています。本章でここまで挙げてきた接続の手段を、まとめて要らなくする方向の技術だということです。あわせて、AWS PrivateLink の概念を説明する公式ドキュメントは、サービスの提供者にはAWSやパートナーだけでなく他のAWSアカウントも含まれ、提供者はエンドポイントサービスを作ることで自分のサービスをリージョンの中で利用できるようにする、と説明しています。作成時にはロードバランサーを指定しなければならず、そのロードバランサーが利用者からの要求を受けてサービスへ送る、とも書かれています。
Azureの Azure Private Link は「Azure の PaaS のサービスや、Azure上にある顧客やパートナーのサービスに、仮想ネットワークの中のプライベートエンドポイント経由でアクセスできる」と説明され、仮想ネットワークとサービスの間のトラフィックは Microsoft のバックボーンのネットワークを通るため、サービスを公衆インターネットに公開する必要はなくなる、と書かれています。あわせて、プライベートエンドポイントはサービス全体ではなくPaaSの資源の個々のインスタンスに対応づけられ、利用者はその特定の資源にしか接続できない、という説明もあります。データが持ち出される経路を狭める効果まで踏み込んで書いている点が、この製品の説明の特徴です。Google Cloud の Private Service Connect は「利用する側が、自分のVPCネットワークの中からマネージドサービスにプライベートにアクセスできる、Google Cloud のネットワークの機能」と定義され、自分の内部IPアドレスを使い、VPCネットワークから出ずにサービスにアクセスできる、と説明されています。
| 観点 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 名称 | AWS PrivateLink | Azure Private Link | Private Service Connect |
| 公式の一言の説明 | VPCを、サービスや資源が自分のVPCの中にあるかのようにプライベートに接続できる技術 | プライベートエンドポイント経由で、PaaSのサービスなどにアクセスできる | 利用する側が自分のVPCネットワークの中からマネージドサービスにプライベートにアクセスできる機能 |
| 公衆網を外せる根拠として書かれていること | インターネットゲートウェイ、NATの機器、パブリックIPアドレス、Direct Connect、Site-to-Site VPN のいずれも使わずに通信できる | トラフィックは Microsoft のバックボーンを通る。サービスを公衆インターネットに公開する必要はなくなる | 自分の内部IPアドレスを使い、VPCネットワークから出ずにサービスにアクセスできる |
| 自分がサービスを提供する側になれるか | 提供者はエンドポイントサービスを作ることで、自分のサービスをリージョンの中で利用できるようにする。作成時にロードバランサーを指定しなければならず、そのロードバランサーが利用者からの要求を受けてサービスへ送る、と明記 | 標準のロードバランサーの背後に自分のサービスを置くことで提供する側になれる、と明記 | 提供する側は自分の別のVPCネットワークでサービスをホストし、プライベートな接続を提供できる、と明記 |
| 別リージョンへの適用 | 本章では記述を確認していない | 利用する側の仮想ネットワークと、接続先のサービスが別のリージョンにあってもよい、と明記 | 本章では記述を確認していない |
この表も、同じ役割の枠に入るだけで同じものではありません。3社とも「公衆網を経由せずにサービスへ届く」という同じ目的を掲げていますが、説明の重心が違います。AWSは概要のページで要らなくなる手段を列挙し、Azureは通る経路と漏えいへの保護を強調し、Google Cloud は利用する側と提供する側という役割の対で説明しています。なお、提供する側と利用する側という整理はAWSの概念のページにもあり、3社とも自分が提供する側になれる点では共通です。置き換えの表として読むのではなく、自分たちがどの説明の仕方に納得できるかで読むほうが、選定には役立ちます。
最後に踏み台です。仮想マシンに管理者としてつなぐとき、そのために公衆網へ入口を開けたくない、という要求は残り続けます。Azure Bastion は、この用途に対する完全にマネージドのPaaSのサービスとして提供されており、公式ドキュメントは「Azureのポータルから、あるいはローカルの計算機にすでに入っているSSHやRDPのクライアントから、TLS越しに仮想マシンへ安全でシームレスな接続を提供する」と説明しています。同じ位置づけの製品がAWSと Google Cloud にあるかどうかは、本章では確認していません。確認していないので、対比表の行としては立てていません。
ここで、分類について1つ断っておきます。Azure Bastion がどのカテゴリに属するかは、Azureの公式ドキュメントの中でもページによって違います。Bastion の個別のページは、Bastion を Network Security、つまりネットワークセキュリティのカテゴリを構成するサービスの1つだと注記し、同じカテゴリとして Azure DDoS Protection、Azure Firewall、Azure Web Application Firewall を挙げています。一方、Azureのネットワーキングサービスを6つのカテゴリに分けて案内する公式ページは、Bastion を Virtual Network、Private Link、Azure DNS、Route Server、NAT Gateway、Traffic Manager と同じ Networking foundation のカテゴリに置き、ネットワークセキュリティのカテゴリには Firewall Manager、Azure Firewall、Web Application Firewall、DDoS Protection の4つを挙げています。本記事はこれをネットワーキングの章で扱いましたが、どちらの分類を正とするかは公式の側でも揃っていない、というのが確認できた事実です。第1章でも触れたとおり、3社の公式のカテゴリと本記事のカテゴリは一致しません。カテゴリの一致を前提に各社のサービス一覧を突き合わせると、必ずどこかで取りこぼしが出ます。本記事は役割で並べる方針を取っていますが、各社の一覧を自分で見に行くときは、探しているものが自分の思うカテゴリに入っていない可能性を先に疑うほうが早いと考えています。
なお、経路の話とIDの話が近づく領域も生まれています。Microsoft Entra のファミリには、社内のアプリケーションや資源へのアクセスを守る Microsoft Entra Private Access と、SaaSを含むインターネット上の資源へのアクセスを守る Microsoft Entra Internet Access が並んでおり、公式はこのファミリ全体を、組織がゼロトラストの戦略を実装するのを助ける、ID とネットワークアクセスの製品群だと説明しています。ネットワークの境界で守るという発想から、誰が何にアクセスするかで守るという発想へ、製品の側が移りつつあるということです。この設計思想の違いは第9章で扱います。
本章では、経路にかかわるサービスを役割ごとに並べました。仮想ネットワークは3社で範囲そのものが違い、全世界を範囲とする資源だと公式に書いているのは Google Cloud だけであること、負荷分散は製品として分けるか種別として分けるかで手触りが変わること、Cloud CDN だけは単体で立っておらずロードバランサーとセットで使うこと、拠点との接続は公衆網を通るかどうかで分かれること、そして「終了」という言葉はサービスと等級と種別と入口を区別して読む必要があることです。第9章では、この経路の上を誰が通ってよいのかを決める側、すなわちIDとセキュリティの設計に移ります。3社の設計思想がもっとも分かれるのはそこだと考えています。
この章を深めたい方への参考書籍
『Amazon Web Services基礎からのネットワーク&サーバー構築 改訂4版』(大澤文孝・玉川憲・片山暁雄・今井雄太、日経BP):本章で扱った仮想ネットワークとサブネット、経路の設定、公衆網に出る口と出ない口という話を、実際に手を動かしながら確かめられる1冊です。ゾーンごとにサブネットを切るという作り方が身体で分かると、3社の違いを読むときの基準ができます。改訂が重ねられている書籍なので、購入時は最新の版をご確認ください。
『インフラ/ネットワークエンジニアのためのネットワーク技術&設計入門 第2版』(みやたひろし、SBクリエイティブ):負荷分散、冗長化、アドレスの設計といった、クラウドに固有ではない土台をまとめて押さえられます。本章の対比表は、この土台の言葉が入っていると読み解きが速くなります。クラウドの用語から入って、そもそもの設計の考え方が抜けていると感じた方に向いています。
『DNSがよくわかる教科書 第2版』(株式会社日本レジストリサービス(JPRS)渡邉結衣・熊谷維魅・佐藤新太・藤原和典、SBクリエイティブ):本章の名前解決の節は、DNSそのものの仕組みを知っていると意味が変わります。ゾーンとレコードの考え方が分かると、3社のDNSのサービスが何を代行してくれているのかを自分で判断できるようになります。ドメイン名を管理する立場の組織が書いている点も、内容の確かさにつながっています。
第9章 セキュリティとID
前章では、仮想ネットワークから負荷分散、内容配信、専用線とプライベート接続までを見て、通信の経路をどう引くかを整理しました。経路を絞ることには効果がありますが、その経路を通って入ってきた相手が何をしてよいのかは、経路とは別の仕組みが決めています。本章はその仕組み、つまり権限とIDを扱います。
この章は、本記事が扱う分野の中で3社の設計思想がもっとも離れているところです。計算資源やストレージであれば、名前が違っても発想はおおむね揃っています。ところが権限については、公式ドキュメントの書き出しの一文からすでに違います。しかもその違いが表に出るのは、たいてい設計をひととおり終えて運用に入ったあとです。そこで本章は、サービス名を並べる前に、3社が「許可」というものをどう組み立てているのかを、それぞれの公式ドキュメントの説明のまま並べるところから始めます。そのうえで、ディレクトリとID基盤、鍵と機密情報、脅威の検出、機密データの取り扱い、証明書と監査へ進みます。ネットワークの経路そのものは第8章、監視と可観測性の一般論は第10章で扱いますので、本章は監査の記録と脅威の検出に絞ります。
権限の設計は、3社でいちばん考え方が離れている
AWSから見ます。その前に言葉を1つ揃えておきます。IAMとは、誰がどの資源に対して何をしてよいかを決めるための仕組みの総称です。3社ともこの役割を担うサービスを持っており、AWSではサービスの名前がそのまま AWS IAM になっています。AWS IAM の公式ドキュメントは、AWSにおけるアクセス管理をこう説明します。ポリシーを作り、それを IAM のアイデンティティ、すなわち利用者・利用者のグループ・ロールに付けるか、あるいはAWSのリソースに付ける。ポリシーとはAWSの中の1つのオブジェクトであり、アイデンティティかリソースに結び付いたときに、その権限を定めるものである。ここで効いてくるのは後半です。許可を書く場所が、人や役割の側だけではありません。
この、資源の側に許可を書くやり方がリソースベースのポリシーです。公式の定義では、リソースにインラインのポリシーを付けるもので、代表例として Amazon S3 のバケットポリシーと IAM ロールの信頼ポリシーが挙げられています。そして重要な一文が続きます。リソースベースのポリシーは、ポリシーの中で指定されたプリンシパルに権限を与えるものであり、そのプリンシパルはリソースと同じアカウントにいてもよいし、別のアカウントにいてもよい、というものです。つまりバケットの側に「どのアカウントの誰に許すか」を直接書けます。アカウントをまたぐ共有が組みやすいのは、この設計の帰結です。
そのうえでAWSは、現在サポートするポリシーの種類として9つを挙げています。アイデンティティベースのポリシー、リソースベースのポリシー、VPCエンドポイントのポリシー、アクセス許可の境界、AWS Organizations のサービスコントロールポリシー、AWS Organizations のリソースコントロールポリシー、アクセス制御リスト、Resource Access Manager による共有、セッションポリシーの9つです。9種類あるという事実そのものが、AWSの権限設計の性格を表しています。これは欠点ではありません。組織の単位からも、資源の側からも、一時的な資格情報の側からも許可を絞れるということです。半面、ある人がある資源に触れられる理由が1か所に集まりません。
次にAzureです。Azure RBAC は、Azure Resource Manager の上に構築された認可の仕組みであり、Azureの資源に対する細かなアクセス管理を提供するものだと定義されています。そして公式ドキュメント自身が「これは理解すべき鍵となる概念である」と断っている一文があります。ロールの割り当ては、セキュリティプリンシパル、ロール定義、スコープという3つの要素からなる、というものです。セキュリティプリンシパルは、Azureの資源へのアクセスを求めている利用者・グループ・サービスプリンシパル・マネージドIDを表すオブジェクト。ロール定義は権限の集まりで、読み取り・書き込み・削除といった実行できる操作を並べたもの。スコープはアクセスが適用される資源の範囲です。
スコープは4つの水準で指定できます。管理グループ、サブスクリプション、リソースグループ、リソースの4つで、これらは親子関係になっており、どの水準でもロールを割り当てられると書かれています。ここまでは、階層に権限を付けるという意味で、次に見るGoogle Cloudと似た形に見えます。ところが重なったときの扱いが違います。
Azure RBAC は加算モデルであり、実効的な権限はロールの割り当ての合計になる、と公式ドキュメントは明記しています。ページが挙げている例が分かりやすいので、そのまま紹介します。ある利用者にサブスクリプションのスコープで共同作成者のロールを与え、あるリソースグループに閲覧者のロールを与えたとします。共同作成者の権限と閲覧者の権限の合計は、実質的にサブスクリプションに対する共同作成者のロールになります。したがって、この場合の閲覧者のロールの割り当ては何の影響も与えない、とページは書いています。絞りたい場合には拒否の割り当てが必要で、アクセスの評価手順にも「拒否の割り当てが当てはまる場合、アクセスは遮断される」と書かれています。
最後にGoogle Cloudです。公式ドキュメントは、IAM を Google Cloud の細かな認可を管理する道具だと定義したうえで、言い換えとして「誰が、何を、どの資源に対してできるかを制御できるようにするもの」と書いています。権限を与えることは3つの要素からなるとされ、プリンシパルは権限を与えたい人やシステムの身元、ロールはそのプリンシパルに与えたい権限の集まり、リソースはそのプリンシパルにアクセスさせたいGoogle Cloudの資源です。そして、プリンシパルに資源へのアクセス権を与えるには、その資源に対してロールを付与する、その付与は許可ポリシーを使って行う、と説明されています。
階層についても定義があります。組織が階層の根であり、フォルダは組織または別のフォルダの子、プロジェクトは組織またはフォルダの子です。そして決定的な一文がここにあります。コンテナにあたる資源に許可ポリシーを設定すると、その許可ポリシーはそのコンテナの中のすべての資源にも適用される、というものです。上に付ければ下すべてに及びます。上位に付けた許可を下位の許可ポリシーで取り消せるという説明は、この概要ページには見当たりませんでした。したがって、許可ポリシーだけを見る限り、上位に広く付ければその下すべてに及ぶ、という前提で設計する必要があります。ただし、許可ポリシーとは別の制御として拒否ポリシーがあります。公式ドキュメントは、IAMではアクセスを拒否ポリシーで拒否する、拒否ポリシーは組織かフォルダかプロジェクトに付けるものである、そして拒否ポリシーは許可ポリシーを上書きする、と説明しています。拒否ポリシーも資源の階層を通じて継承され、組織の水準で権限を拒否すると、その中のフォルダとプロジェクト、各プロジェクトのサービス固有の資源でも拒否される、と書かれています。一方で、拒否できる権限は一部に限られる、とも明記されています。
| 観点 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 公式が説明の冒頭に置く言葉 | ポリシーを作り、それをIAMのアイデンティティに付けるか、AWSのリソースに付ける | ロールの割り当ては、セキュリティプリンシパル、ロール定義、スコープの3つの要素からなる | 誰が、何を、どの資源に対してできるかを制御する |
| 許可を書く場所 | プリンシパルの側と資源の側の双方。ポリシーは9種類 | ロールの割り当て。プリンシパルとロール定義とスコープの組 | 資源、および階層のコンテナに付ける許可ポリシー |
| 範囲の決め方 | ポリシーの中の資源の指定と条件 | スコープの4階層。管理グループ、サブスクリプション、リソースグループ、リソース | 階層。組織、フォルダ、プロジェクト、資源 |
| 重なったときの扱いについての公式の記述 | 複数のポリシーを論理和として重ね合わせ、明示的な拒否が優先する | 加算モデルであり、実効的な権限は割り当ての合計になる | コンテナにあたる資源に許可ポリシーを設定すると、その中のすべての資源にも適用される |
| 絞り込みの手段として公式が挙げるもの | アクセス許可の境界、サービスコントロールポリシー、リソースコントロールポリシー、セッションポリシーなど | 拒否の割り当て | 拒否ポリシー。許可ポリシーを上書きし、階層を通じて継承される。拒否できる権限は一部に限られる |
この表も、横に並んでいるだけで同じ役割の枠に入るだけであり、同じものではありません。3社とも「誰に何を許すか」を扱っている点は共通ですが、許可という物の形そのものが違います。AWSで資源の側に書いたポリシーに相当する概念は、Azureのロールの割り当てにも、Google Cloud の許可ポリシーにも、そのままの形では見当たりません。逆に、Azureの加算モデルという明文の規則に相当するものを、AWSやGoogle Cloud の同じ位置づけのページから読み取ることもできませんでした。3社の設計は、どれが優れているという関係ではなく、前提の置き方が違うという関係にあります。読者の要件がアカウントをまたぐ共有に寄っているのか、階層でまとめて統治することに寄っているのかで、書きやすさが変わります。
「ロール」という同じ言葉が、3社で違うものを指している
3社を横に読むときに、いちばん気づかれにくい取り違えを起こすのが、この言葉です。先ほど引いた公式の定義をもう一度見比べると、位置づけが違うことが分かります。AWSは、ポリシーを付ける相手であるIAMのアイデンティティとして、利用者・利用者のグループ・ロールの3つを並べています。つまりAWSのロールは、権限を与えられる側、身元の側に数えられています。一方でAzureのロール定義は「権限の集まり」であり、Google Cloud のロールも「プリンシパルに与えたい権限の集まり」です。こちらのロールは、与えられる側ではなく、与えるものの側にあります。
この差は、会話の中で最初に噛み合わなくなるところです。AWSでロールを作るという作業は、おおまかに言えば「引き受けられる立場を1つ用意する」ことにあたります。人ではないものにも身元を持たせられる仕組みで、そこにポリシーを付けて権限を決めます。AzureやGoogle Cloud でロールを作るという作業は、これとは別の作業で、「操作の束に名前を付ける」ことにあたります。作った束を誰に当てるかは、割り当てや付与という別の手順です。同じ言葉が、片方では身元、もう片方では権限の束を指しています。設計書の言葉づかいをそのまま持ち込むと、レビューの席で全員が違うものを想像したまま合意してしまいます。
片方の設計を、もう片方へ機械的に写すことはできない
ここまでを踏まえると、「AWSのIAMポリシーをAzureのロールに置き換える」といった読み替えは成り立ちません。抽象的な話に聞こえるので、具体的にどう困るかを3つ挙げます。
1つ目は、資源の側に書いた許可の移し先が無いことです。AWSで、あるバケットの側に「別のアカウントのこの相手に読み取りを許す」と書いてある構成があったとします。この情報は資源に付いています。移行先で同じことをしようとすると、資源の側には書けないので、相手の側に権限を作り直すことになります。ここで落ちるのは、権限そのものではなく「誰と共有していたか」という一覧です。資源の側に散らばって書かれていたものを集めきれないまま移すと、移行後に一部の相手だけ、誰にも気づかれないままアクセスできなくなります。逆に安全側に倒して広く許可を作ると、共有相手が増えたことに誰も気づきません。
2つ目は、絞ったつもりで絞れていない状態が生まれることです。AWSに慣れた設計者は、明示的な拒否が優先するという前提を持っています。その感覚のまま、Azureで「上位に広い権限を付けておいて、下位に弱いロールを付けて絞る」という組み方をすると、公式の例のとおり、下位の割り当ては何の影響も与えません。問題は、この失敗が画面上ではまったく普通に見えることです。割り当ては正しく作成され、一覧にも表示されます。効いていないという事実だけが表示されません。絞るつもりなら、上位の割り当てを見直すか、拒否の割り当てを使うことになります。
3つ目は、上に付けた許可の広がり方です。Google Cloud では、組織やフォルダに付けた許可ポリシーが、その配下のすべての資源に及びます。組織の階層は、たいてい部門や事業の単位で作られます。運用を楽にしようとして上の階層に権限を付けると、その下に将来作られるプロジェクトにも及びます。付けた時点では正しく、増えるにつれて広くなる、という種類の設計になります。許可ポリシーだけを見る限り、上で与えた許可を下で個別に外して回るという発想は通じません。別の制御として拒否ポリシーがあり、これは許可ポリシーを上書きしますが、拒否できる権限は一部に限られています。したがって、どの階層に何を付けるかを最初に決める価値が大きくなります。
もう1つ、棚卸しのやり方も3社で違います。AWSでは、ある人がある資源に触れられる理由が9種類の場所のどれかにあります。Azureでは、いくつかのスコープに付いた割り当てを足し合わせないと実効的な権限が出ません。Google Cloud では、その資源から階層をさかのぼらないと、どこで許可されたのかが分かりません。3社とも「権限の一覧を目で見て確かめる」が素直には成り立たない構造で、しかも成り立たない理由がそれぞれ違います。したがって、移行や見直しの場面でやるべきことは、権限の一覧を移すことではなく、「誰に何を許したいのか」を要件の側から書き直すことになります。これは手間のかかる作業ですが、写して動かすより結果的に速いことが多いように思います。
社員のIDと、アプリを使う人のIDは別の問題である
権限の話と並んで整理しておきたいのが、IDの置き場所です。ここには性質のまったく違う2つの問題が同居しています。1つは、自社の社員や委託先の人が業務システムにログインするためのID。もう1つは、自社が世の中に出しているアプリを使う人のIDです。この2つを1つの仕組みで扱おうとすると、どこかで無理が出ます。数が2桁も3桁も違い、退職や異動という概念があるかどうかが違い、要求される画面の作り込みも違うからです。3社とも、この2つには別の製品を当てています。
AWSで社員側にあたるのが AWS IAM Identity Center です。公式ドキュメントは、これを、社内の利用者をAWSが管理するアプリケーションやその他のAWSの資源につなぐためのAWSの解決策だと定義し、既存のIDプロバイダーを接続して利用者とグループを同期するか、IAM Identity Center の中で直接利用者を作って管理するかを選べる、と説明しています。ここで AWS IAM との関係を整理しておきます。AWS IAM のユーザーガイドは、社内の人にあたるIDは IAM Identity Center の利用者であると書き、集中的なアクセス管理には IAM Identity Center を使うことを勧めています。同じガイドの最善の慣行のページも、人間の利用者にはIDプロバイダーとのフェデレーションを使わせ、一時的な資格情報でAWSにアクセスさせることを求めています。一方で IAM の利用者の主な用途は、IAM ロールを使えないワークロードにAPIやCLIからの要求を行わせることだとされています。つまり AWS IAM は権限の評価とロールの土台であり、社員のIDの置き場所としては IAM Identity Center が中心です。なお AWS IAM Identity Center は、2022年7月26日に AWS Single Sign-On から改称されたもので、APIの名前空間やコンソールのURLには旧名に由来する語が残っていると公式ページに書かれています。
AWSでアプリの利用者を扱うのが Amazon Cognito です。公式ドキュメントは、これをWebアプリとモバイルアプリのためのIDのプラットフォームだと定義し、利用者のディレクトリであり、認証のサーバーであり、OAuth 2.0 のアクセストークンとAWSの資格情報のための認可のサービスである、と説明しています。3つの役割を1つで担っている点が、この製品の位置づけを表しています。
Azureは、社員側と社外側で名前が分かれています。社員側の土台が Microsoft Entra ID で、公式ページはこれを Microsoft Entra の基礎となる製品と呼び、利用者・端末・アプリ・資源に対する認証と、ポリシーの適用と、保護を提供するクラウドベースのIDとアクセス管理のサービスだと説明しています。社外側が Microsoft Entra External ID です。公式ドキュメントはこれを、組織の外にいる人と仕事をするための解決策をまとめたものだと定義し、2つの場面を挙げています。1つは、消費者向けのアプリを作る側が、認証と顧客のIDとアクセス管理を素早く足す場面。この場合、社員や社内資源を持つテナントとは別の「外部」の構成のテナントを作って、そこでアプリの利用者を管理します。もう1つは、社員が取引先やゲストと共同作業をする場面で、こちらは社員のいるテナントの中にゲストの利用者オブジェクトが作られます。入り口が1つでも、置き場所は分けられているということです。
ここに、名前の扱いで注意が要る製品があります。Azure AD B2C です。この製品は改称されていませんが、公式ページに次の重要な告知が出ています。2025年5月1日をもって、Azure AD B2C は新規のお客様が購入することはできなくなった、というものです。ページ自身も、Azure AD B2C を顧客のIDとアクセス管理のための従来からの解決策だと書いており、後継にあたる位置づけは Microsoft Entra External ID です。ただし公式のよくある質問のページは、External ID は Azure AD B2C の新しい名前ではない、とも明言しています。同じページは、既存の Azure AD B2C のお客様は製品を使い続けることができ、新しいテナントやユーザーフローの作成を含む製品の体験は変わらず、サービス水準の合意やセキュリティ更新やコンプライアンスといった運用上の約束も変わらない、と書いています。さらに、少なくとも2030年5月までは Azure AD B2C のサポートを続ける、ともあります。したがって、いま動いているものが止まると読むのは誤りです。変わったのは、新規のお客様が新たに購入するときの選択肢から外れたという点であり、既存のお客様が新しいテナントを作ることまでは制限されていません。
Google Cloud も2つに分かれています。社員側にあたるのが Cloud Identity で、公式ドキュメントは、利用者とグループを中央で管理する、サービスとしてのIDの解決策だと定義しています。アプリの利用者側にあたるのが Identity Platform で、公式ドキュメントは、利用者がマルチテナントのSaaSアプリ、モバイルやWebのアプリ、ゲーム、APIなどに認証できるようにするものだと説明しています。製品を比較したページには、Identity Platform は Firebase Authentication の背後で動くものであり、同じ機能を提供する、という趣旨の記述があります。なお、Cloud Identity と Google Workspace の関係については、概要ページから読み取ることができませんでした。本章では触れません。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 社員や組織の利用者のディレクトリ | AWS IAM Identity Center(外部のIDプロバイダーとの連携、または内蔵のIDソース)。AWS IAM 自体は権限の評価とロールの土台 | Microsoft Entra ID | Cloud Identity |
| 自社が出すアプリの利用者のID | Amazon Cognito | Microsoft Entra External ID の外部テナント | Identity Platform |
| 取引先やゲストとの共同作業 | 未確認。本章では専用の製品名を公式の記述で当たっていない | Microsoft Entra External ID のB2Bコラボレーション | 未確認。本章では専用の製品名を公式の記述で当たっていない |
| 従来からの解決策の扱い | 未確認。本章では該当する記述に当たっていない | Azure AD B2C は2025年5月1日以降、新規のお客様は購入できない。既存のお客様は利用を続けられ、少なくとも2030年5月までサポートされる | 未確認。本章では該当する記述に当たっていない |
| 古い認証方式を使うアプリの受け皿 | 未確認。本章では公式の記述に当たっていない | Microsoft Entra Domain Services | 未確認。本章では公式の記述に当たっていない |
この表も、同じ役割の枠に入るだけで同じものではありません。とくに1行目と2行目は、名前を置き換えれば済むという関係にありません。AWSは IAM Identity Center と Amazon Cognito という別の製品に分かれ、しかも Amazon Cognito のほうは利用者のディレクトリと認証サーバーと認可サービスを1つで兼ねています。Azureは社員のテナントと外部のテナントを構成として分けており、Google Cloud は Cloud Identity と Identity Platform という別の製品に分かれています。「アプリの利用者を管理する仕組み」を移すという計画は、実際には認証の画面、利用者の属性、トークンの発行、既存の利用者データの移送を全部含みます。表の1行に見えても、作業としては1行ではありません。また、表に「未確認」と書いた欄は「存在しない」という意味ではありません。本章で公式の記述に当たっていない、という意味です。同じ粒度の単独の製品が無いのか、こちらが当たっていないだけなのかは、その欄だけでは決まりません。
Microsoft Entra Domain Services については、公式ページに珍しく「選ばないほうがよい場合」が書かれているので触れておきます。この製品は、ドメイン参加、グループポリシー、LDAP、Kerberos や NTLM による認証といった管理されたドメインのサービスを、クラウドにドメインコントローラーを配置して管理し修正を当てる必要なしに使えるようにするものです。そのうえでページは、これを、古い認証方式を必要とするAzure上のワークロードのための移行期の機能として使うものであり、オンプレミスの Active Directory の全般的な置き換えや、クラウドを前提としたIDのサービスの代わりとして使うものではない、と明記しています。公式が自ら用途を限定している数少ない例なので、選定の場ではそのまま使える記述です。
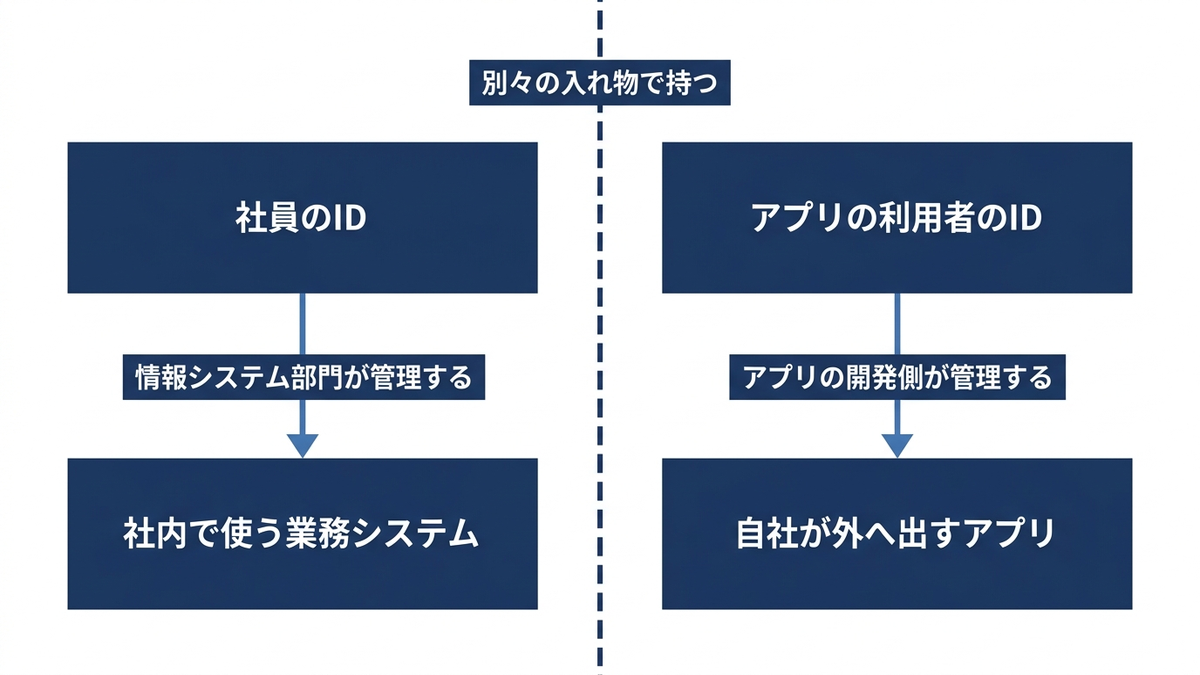
Microsoft Entra への改称で、変わったものと変わらなかったもの
IDの分野でこの5年に起きた変化のうち、読者がいちばん多く目にするのが Azure Active Directory の改称です。公式ページによれば、Microsoft Entra ID という新しい名前は2023年7月11日に公表されました。表示名の切り替えはMicrosoftの各種の体験で2023年8月15日から、SKUとサービスプランの表示名は2023年10月1日から、とされています。
ここで押さえたいのは、変わらなかったもののほうです。同じページは、ライセンス、契約条件、サービス水準の合意、製品の認証、サポート、価格は同じままだと書き、さらに既存のログインのURL、API、PowerShell のコマンドレット、Microsoft の認証ライブラリはすべてそのままであると明記しています。つまりこの改称は、動いているものを作り直す必要がある種類の変更ではありません。変わったのは呼び名と画面の表示です。社内の資料や手順書の用語を揃える作業は発生しますが、実装の作り直しは発生しない、というのが公式の説明です。
混同しやすい点を2つ挙げておきます。1つ、Windows Server の Active Directory は改称されていません。名前が似ているために「社内のADも名前が変わった」と受け取られることがありますが、改称の対象はクラウド側の製品です。2つ、先ほど触れたとおり Azure AD B2C も改称されていません。改称された範囲を広く取りすぎると、変わっていないものまで探しに行くことになります。
もう1つ、名前の構造が変わった点も押さえておく価値があります。Microsoft Entra は1つの製品の名前ではなく、製品のファミリの名前です。公式ページは Microsoft Entra を、組織がゼロトラストのセキュリティ戦略を実装することを助ける、IDとネットワークアクセスの製品のファミリだと定義しています。そしてその配下に、Microsoft Entra ID、Microsoft Entra Domain Services、Microsoft Entra Private Access、Microsoft Entra Internet Access、Microsoft Entra ID Governance、Microsoft Entra ID Protection、Microsoft Entra Verified ID、Microsoft Entra External ID、Microsoft Entra Workload ID、Microsoft Entra Agent ID の10製品が並びます。「Entra」という語が出てきたときに、それが製品全体を指すのか、その中の1つを指すのかを読み分ける必要があります。
この10製品のうち、Microsoft Entra Agent ID は、扱う対象そのものが新しいものです。公式ページはこれを、Microsoft Entra の機能をAIエージェントへ広げるIDとセキュリティの枠組みだと説明し、こうした人ではないIDを企業の規模で認証し、認可し、統治し、保護するための、目的に合わせて作られたIDの構成要素を提供する、と書いています。AIエージェントに身元を与えて統治するという発想が、IDのサービスの正規のラインナップに入ったということです。本章の調査では、これと同じ位置づけの製品を他の2社について確認していません。無いという意味ではなく、当たっていないという意味です。
鍵と機密情報と証明書を、どこに置くか
暗号鍵、パスワードやAPIキーのような機密情報、そしてサーバー証明書。この3つは扱いが似ているようで、要求される性質が違います。鍵は取り出せないことに価値があり、機密情報は取り出せることに価値があり、証明書は期限が来る前に入れ替わることに価値があります。3社の分け方は、ここで見事に分かれます。
AWSは役割ごとにサービスが分かれています。AWS KMS は、データの暗号化と署名に使う鍵を作成し制御することを容易にする、AWSが管理するサービスだと定義されています。より厳しい要件のために AWS CloudHSM があり、これはAWSクラウドの利点と、ハードウェアセキュリティモジュールの安全性を組み合わせるものだと説明されています。機密情報には AWS Secrets Manager があり、データベースの資格情報、アプリケーションの資格情報、OAuthのトークン、APIキーなどの機密情報を、そのライフサイクルを通じて管理し、取得し、入れ替えることを助けるものだとされています。証明書には AWS Certificate Manager があり、公開および非公開のSSL/TLSのX.509証明書と鍵の作成・保管・更新の複雑さを引き受ける、と書かれています。
Azureはこれを1つにまとめています。Azure Key Vault は、安全な機密情報の保管庫であり、機密情報と鍵と証明書の管理を提供し、そのいずれもハードウェアセキュリティモジュールに裏打ちされている、と説明されています。ページが立てている見出しも、機密情報の管理、鍵の管理、証明書の管理の3つです。認証は Microsoft Entra ID が担い、認可は Azure RBAC か Key Vault のアクセスポリシーで行う、とも明記されています。
Google Cloud はAWSに近い分かれ方をしています。Cloud KMS は、対応する Google Cloud のサービスと自分のアプリケーションで使う暗号鍵を作成し管理できるようにするもの。Secret Manager は、APIキー、利用者名、パスワード、証明書などの機微なデータを保管し管理できるようにする、機密情報と資格情報の管理サービス。Certificate Manager は、TLS証明書の取得と配備と管理を簡単にするもので、Google Cloud のロードバランサーに対して全世界向けとリージョン向けの証明書を配備できると書かれています。
ハードウェアセキュリティモジュール、いわゆるHSMで鍵を守る選択肢は3社とも持っていますが、製品の立て方が違います。AWSは AWS CloudHSM という独立したサービスです。Azureの鍵管理の概要ページは、クラウドで鍵を保管し管理する選択肢として、Azure Key Vault、Azure Key Vault Managed HSM、Azure Cloud HSM、Azure Payment HSM(決済処理向けのHSM)を挙げています。同じページによれば、Azure Key Vault の standard 階層の鍵はソフトウェアで保護され、premium 階層は Microsoft が管理し運用するHSMを共有するマルチテナントの提供です。鍵の主権や単一テナントが要るなら Azure Key Vault Managed HSM を検討するようにと書かれており、こちらは利用者がHSMを完全に制御できる単一テナントの提供です。Azure Cloud HSM は、HSMに対する完全な管理権限を利用者に与える単一テナントのサービスで、Azure Dedicated HSM の後継だとされています。その Azure Dedicated HSM は退役が進んでおり、新規のお客様の受け入れは行わず、既存のお客様は2028年7月31日まで完全にサポートされる、と明記されています。Google Cloud は独立した製品としてではなく、Cloud KMS の保護レベルとして用意しています。Cloud KMS の概要ページは、保護レベルとしてソフトウェア、Cloud HSM、Cloud EKM(Google Cloud の外に置いた鍵管理の仕組みにある鍵を使う形)、Single-tenant Cloud HSM を挙げ、Cloud HSM のページは、これを Cloud KMS を入口として使う、クラウドで提供されるHSMのサービスだと説明しています。同じHSMという語でも、独立したサービスなのか、階層なのか、保護レベルなのかが3社で違います。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 暗号鍵の作成と管理 | AWS KMS | Azure Key Vault の鍵の管理 | Cloud KMS |
| パスワードやAPIキーなどの機密情報 | AWS Secrets Manager | Azure Key Vault の機密情報の管理 | Secret Manager |
| サーバー証明書の取得と更新 | AWS Certificate Manager | Azure Key Vault の証明書の管理 | Certificate Manager |
| HSMでの鍵の保管 | AWS CloudHSM | Azure Key Vault の premium 階層(Microsoft が運用する共有のHSM)。専有が要るなら Azure Key Vault Managed HSM か Azure Cloud HSM | Cloud KMS の保護レベルとしての Cloud HSM。専有が要るなら Single-tenant Cloud HSM |
| サービスの分かれ方 | 役割ごとに4つに分かれている | 1つのサービスが3つの役割を扱う | 役割ごとに3つに分かれている |
この表も、同じ役割の枠に入るだけで同じものではありません。読んでいただきたいのは最後の行です。役割ごとに分かれているか、1つにまとまっているかは、そのまま権限設計の手数と、事故が起きたときの範囲の違いになります。分かれていれば、鍵を触れる人と機密情報を触れる人を別々に決められますが、決めるべき場所が増えます。まとまっていれば、1か所の権限の切り方が全部を決めるので、設計は速く済み、切り方を誤ったときの範囲は広くなります。どちらが良いという話ではなく、その組織に権限を細かく設計する人手があるかどうかで向き不向きが変わります。
名前の衝突にも触れておきます。AWSの証明書のサービスは AWS Certificate Manager、Google Cloud の証明書のサービスは Certificate Manager です。頭に社名が付くかどうかしか違いません。検索して出てきた手順書がどちらのものかを取り違えると、存在しない画面を探すことになります。3社を横断して調べるときは、社名まで含めて呼ぶ習慣を持っておくと安全です。
脅威の検出は、仕組みを入れれば済むものではない
脅威の検出は、有効にした瞬間から検出事項が出てきます。出てきたものを誰が読み、どこまで調べ、何をもって閉じるのかを決めていないと、有効にしただけの状態が続きます。この分野のサービスを選ぶときは、機能の比較よりも先に、検出事項を読む人が確保できるかを見たほうがよいと考えています。
AWSは目的ごとにサービスが分かれています。Amazon GuardDuty は、AWSの環境にあるデータソースとログを継続的に監視し、分析し、処理する脅威検出のサービスだと定義されています。名前は変わっていませんが、対象は大きく広がっています。現在のページが列挙している保護の対象には、EKSの監査ログ、RDSへのログインの活動、S3のデータイベント、EBSのボリューム、Amazon EC2 や EKS や Fargate 上のECSのランタイムの監視、Lambdaのネットワークの活動のログ、そして Amazon Bedrock、Amazon Bedrock AgentCore、Amazon SageMaker AI に対する CloudTrail のデータイベントが含まれます。また、複数の段階にまたがる攻撃の連なりを1つの検出事項としてまとめる Extended Threat Detection が、GuardDuty を有効にしたすべてのアカウントで追加の費用なく自動的に有効になる、とも書かれています。名前が同じであることは、中身が同じであることを意味しません。
脆弱性の側を担うのが Amazon Inspector で、ワークロードを自動的に発見し、ソフトウェアの脆弱性と意図しないネットワークの露出がないかを継続的に検査する脆弱性管理のサービスだと定義されています。ここで名前の書き分けが必要になります。提供が終了したのは Amazon Inspector Classic であり、サポートの終了日は2026年5月20日です。AWSの終了したサービスの一覧は、完全終了に分類されたサービスと機能はAWSの製品群から完全に取り除かれ、いかなる形でも利用もサポートもされない、と定義しています。Amazon Inspector 本体は現役です。Classic という語が抜けると意味が反転しますので、資料に書くときは必ず添えてください。
検出したあとの調査を担うのが Amazon Detective で、セキュリティの検出事項や不審な活動の根本の原因を分析し、調査し、素早く特定することを助けるものだと説明されています。検出と調査に別のサービスが立っていること自体が、この作業が2段階であることを示しています。
Azureは、姿勢の管理から実行時の保護までを1つの製品にまとめています。Microsoft Defender for Cloud はCNAPP、すなわちクラウドを前提としたアプリケーション保護のプラットフォームであり、複数のクラウドセキュリティの道具を組み合わせて、アプリケーションをその一生を通じて守る統合された解決策だと定義されています。柱として挙げられているのは、クラウドのセキュリティ姿勢の管理、開発工程へのセキュリティの組み込み、そしてクラウドのワークロードの保護の3つです。そして、この製品はAzureだけを守るものではありません。ページは、Azure、Amazon Web Services、Google Cloud Platform、およびオンプレミスのシステムにまたがって環境を守ることを助ける、と明記しています。3社を比べている読者にとって、これは前提を揺らす事実です。1社を選ぶという問いの立て方そのものが、製品の側では必ずしも前提にされていません。なお、このページの冒頭には、Defender for Cloud が Defender のポータルへ広がっており、一部の機能はすでにそちらで使える、という重要なお知らせが出ています。改称の経緯については本章の調査で確認できていないため、年月には触れません。
ログを集めて相関を見る側にあるのが Microsoft Sentinel です。公式ドキュメントは、これをクラウドを前提としたSIEMの解決策で、複数のクラウドと複数のプラットフォームにまたがって、規模を広げられ費用の効率もよいセキュリティを提供するものだと定義しています。ここには期日のある変更が1つあります。2027年3月31日より後、Microsoft Sentinel は Azure ポータルではサポートされなくなり、Microsoft Defender ポータルでのみ利用できるようになる、と明記されています。これはサービスの終了ではなく、入口の終了です。サービス自体は続きます。加えて、2025年7月以降、一定の権限を持つ新規のお客様のワークスペースは、Sentinel へのオンボードと同時に Defender ポータルへも自動的にオンボードされる、という記述もあります。改称の経緯は本章の調査では確認できていないため、触れません。
Google Cloud は Security Command Center が中心です。公式ドキュメントは、これをクラウドを前提としたリスク管理の解決策で、セキュリティの担当者がセキュリティ上の問題を予防し、検出し、対応することを助けるものだと定義しています。こちらにも期日のある変更があります。Security Command Center の Enterprise のサービス階層は2027年5月21日に終了し、Enterprise を使っている組織は、その日以降に自動的に Premium のサービス階層へ移る、と書かれています。ページが階層として挙げているのは、Standard-legacy、Standard、Premium、非推奨となった Enterprise の4つです。終わるのはサービスではなく上位の階層で、しかも移行は自動です。
| 観点 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 公式が名乗っている位置づけ | 目的ごとに分かれた複数のサービス。脅威検出、脆弱性管理、調査 | Microsoft Defender for Cloud をCNAPPと名乗る | Security Command Center をクラウドを前提としたリスク管理の解決策と名乗る |
| 継続的な脅威の検出 | Amazon GuardDuty | Microsoft Defender for Cloud のワークロード保護の柱 | Security Command Center |
| ログを集めて相関を見る仕組み | 未確認。本章では、同じ粒度の単独の製品を公式の記述で当たっていない | Microsoft Sentinel | 未確認。本章では、同じ粒度の単独の製品を公式の記述で当たっていない |
| 他社のクラウドを守る旨の公式の記述 | 未確認。本章では公式の記述に当たっていない | Azure、Amazon Web Services、Google Cloud Platform、オンプレミスにまたがると明記 | 未確認。本章では公式の記述に当たっていない |
| 期日が告知されている変更 | Amazon Inspector Classic のサポート終了が2026年5月20日。Inspector 本体は現役 | Microsoft Sentinel は2027年3月31日より後、Azureポータルでの提供を終了。Defenderポータルでは継続 | Enterprise のサービス階層が2027年5月21日に終了し、Premium へ自動的に移る |
この表も、同じ役割の枠に入るだけで同じものではありません。とくに1行目と2行目は、粒度がそもそも違います。AWSは目的ごとに小さく分かれ、Azureは1つの製品に束ね、Google Cloud は1つの製品を階層で分けています。「GuardDuty に相当するものはどれか」という問いの立て方をすると、どの答えも半分しか合いません。表に「未確認」と書いた欄も、存在しないという意味ではなく、本章で同じ粒度の単独の製品を公式の記述で当たっていないという意味です。また、表の一番下の行は、この章でいちばん誤読されやすいところです。3つとも「終了」という語で報じられがちですが、終わるものが違います。AWSは旧世代のサービスそのもの、Azureは使うための入口、Google Cloud は料金と機能の階層です。社内に共有するときは、何が終わるのかを一語添えてください。「Sentinel が終わる」と書けば移行の要否を誤って判断させますし、「Security Command Center が終わる」と書けば、自動で下位の階層に移るだけの話が大ごとになります。
機密データの在りかを探すサービス
権限を正しく設計しても、そもそもどこに何が置いてあるかを把握していなければ、設計の当たりどころが決まりません。個人情報や資格情報が、想定していない場所に紛れ込んでいないかを探す仕組みが、この節の対象です。
AWSでは Amazon Macie がこれにあたります。公式ドキュメントは、これを、機械学習とパターンの照合によって機微なデータを発見し、データのセキュリティ上のリスクを可視化し、そのリスクに対する自動的な保護を可能にするデータセキュリティのサービスだと定義しています。対象は Amazon S3 の汎用バケットで、有効にするとバケットの目録を自動的に作り、セキュリティとアクセス制御の観点で継続的に評価と監視を行います。バケットが公開されるようになったといった問題を見つけると検出事項を作る、とも書かれています。機微なデータの検出には、Macie が用意している組み込みの基準と、自分で正規表現などを使って定義する基準の両方を使えます。
Google Cloud では Sensitive Data Protection がこれにあたります。公式ドキュメントは、これを、Google Cloud の内側と外側にある機微なデータの発見と分類と匿名化を助けるものだと定義しています。ここには書き方の注意が2つあります。1つ目は、旧名との関係です。公式ページの書きぶりは、Cloud Data Loss Prevention は現在 Sensitive Data Protection の一部である、というものです。改称されたとは書かれていません。より大きな枠のほうに名前が付き、従来のものはその中に入った、という説明のされ方をしています。2つ目は、APIの名前は変わっていないことです。ページは、APIの名前は同じままであるとはっきり書いています。製品の名前と、実装で目にする名前がずれているということです。資料の中で名前が2つ出てくることになるので、読者が混乱しないよう、どちらの層の名前なのかを添えておくと親切です。なお、この変更がいつのことかは、本章の調査では確認できていません。年月には触れません。
Azureについては、この2つと同じ粒度の単独の製品を本章の調査で確認していないため、表の行は立てていません。ただし機能としては、Microsoft Defender for Cloud の側に機微なデータを探す仕組みがあります。Microsoft Defender for Storage の機微データの脅威検出について、公式ドキュメントは、危険にさらされているデータの機微さを考慮して、セキュリティのアラートに優先順位を付けて調べることを助けるものだと説明しています。これは Defender for Storage のプランの中で有効か無効かを選べる機能で、エージェントを要しない機微データ発見のエンジンが標本抽出の方法でデータの在りかを探し、Microsoft Purview の機微情報の種類と分類ラベルと連携する、とされています。同じエンジンを Defender CSPM も使っている、ともあります。つまり Amazon Macie や Sensitive Data Protection のような単独の製品ではなく、脅威の検出の製品に組み込まれた機能として提供されている、というのが公式の記述から読み取れる形です。製品の粒度が違うので、表で横に並べると同じものに見えてしまいます。対応する行が空いていることを「Azureに無い」と読むのも、機能の名前だけを見て「同じものがある」と読むのも、どちらも誤りになりえます。必要であれば、選定の場でその1点だけを各社に確認するのが早いと考えています。
監査の記録は、設定しなくても残るものが3社で違う
事故が起きたあと、あるいは監査を受けるときに最初に問われるのは、「誰が、いつ、何をしたか」を示せるかどうかです。3社とも記録の仕組みを持っていますが、設定をしないままで何がどれだけ残るかが違います。ここは対応表を作っただけでは危ないところで、初期状態の差がそのまま「後から答えられるか」の差になります。
AWSは AWS CloudTrail です。公式ドキュメントは、これをAWSアカウントの運用とリスクの監査、ガバナンス、コンプライアンスを可能にすることを助けるサービスだと定義し、利用者やロールやAWSのサービスが行った操作がイベントとして記録されると書いています。記録の持ち方は3通りあります。1つ目がイベント履歴で、これは1つのリージョンにおける直近90日間の管理イベントについての、閲覧でき、検索でき、ダウンロードでき、改変されない記録です。アカウントを作った時点で自動的に使えるようになる、と明記されています。2つ目が CloudTrail Lake で、監査とセキュリティのために利用者とAPIの活動を取り込み、保管し、参照し、分析するためのマネージドのデータレイクです。保持できる期間は選ぶ料金の方式によって決まり、長いほうを選ぶと約10年に相当する日数まで保持できるとされています。3つ目が証跡で、記録をS3のバケットへ配信して保管するものです。
Azureは Azure Monitor のアクティビティログです。公式ドキュメントは、これがAzureの資源に対する管理の操作を記録するものだと説明し、仮想マシンの作成、キーコンテナーのアクセスポリシーの変更、Resource Manager による配備のエラーなどを例に挙げています。これらは制御プレーンの操作と呼ばれます。設定なしに既定で収集されること、システムが生成するので利用者が変更も削除もできないこと、読み取りの操作は通常は記録されないことが、いずれも明記されています。保持は90日で、その後は削除されます。長く持ちたい場合は診断設定を作って別の場所へ集めることになります。同じページには、資源を誰が作ったのかを保持しているのはアクティビティログだけである、という記述もあります。
Google Cloud は Cloud Audit Logs です。公式ドキュメントは、Google Cloud のサービスが管理上の活動と資源へのアクセスを記録した監査ログを書くこと、そしてこれを使うことで、オンプレミスの環境と同じ水準の透明性で「誰が、何を、どこで、いつ」に答えられることを説明しています。ログは4種類に分かれており、管理アクティビティ、データアクセス、システムイベント、ポリシー拒否です。ここに2つの重要な既定値があります。管理アクティビティの監査ログは常に書かれ、設定することも除外することも無効にすることもできない、と明記されています。一方、データアクセスの監査ログは、BigQuery を除いて既定では無効です。理由として、大量のデータを生み出しうることが挙げられています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 管理操作の記録を担う仕組み | AWS CloudTrail | Azure Monitor のアクティビティログ | Cloud Audit Logs |
| 設定をしなくても残るもの | 直近90日間の管理イベントがイベント履歴として残る | 制御プレーンの操作が既定で収集される | 管理アクティビティの監査ログが常に書かれる |
| 利用者が書き換えたり止めたりできるかについての公式の記述 | イベント履歴は改変されない記録であると明記 | システムが生成し、変更も削除もできないと明記 | 管理アクティビティは設定も除外も無効化もできないと明記 |
| データそのものへのアクセスの記録 | イベント履歴に残るのは管理イベント。それ以外は証跡やデータレイクを自分で作る | データプレーンの操作はリソースログにあたり、既定では収集されず診断設定が要る | データアクセスの監査ログはBigQueryを除いて既定で無効 |
| コンプライアンス文書の入口 | AWS Artifact | Microsoft の Service Trust Portal | Compliance Reports Manager |
この表も、同じ役割の枠に入るだけで同じものではありません。横に並んだ3つの記録は、粒度も保持の考え方も違います。それでも4行目には共通の形があります。3社とも、管理の操作は最初から残るのに対し、データそのものに誰が触れたかという記録は、自分で有効にするか、別の入れ物を用意する必要がある、という形になっています。ここは事故のあとに効く差です。「どの利用者が、どのファイルを見たのか」を後から問われる可能性がある業務なら、その記録は最初の構築時に有効にしておく必要があります。後から有効にしても、過去には遡れません。
表の最後の行にあるコンプライアンスの文書についても補足します。AWS Artifact は、AWSのセキュリティとコンプライアンスの文書を必要なときにダウンロードできるようにするものだと定義されています。Microsoft の Service Trust Portal は、Microsoft のクラウドサービスに関する監査報告書やコンプライアンスに関連する情報を公開するための公開の場で、外部の監査人が作成した監査報告書をダウンロードできると説明されています。資料の一部を見るには、Microsoft Entra の組織のアカウントでサインインし、コンプライアンス資料に関する秘密保持の契約に同意する必要があるとも書かれています。Google Cloud の Compliance Reports Manager は、ISO や IEC の証明書、SOCの報告書、自己評価といった資料に、追加の費用なく必要なときにアクセスできるようにするものだとされ、一部の資料はアカウントでのサインインが必要だとされています。3社とも、文書は事業者の側が持っていて、利用者が自分で取りに行く形になっています。監査の準備で最初に効くのはここなので、選定の段階で誰がアクセス権を持つのかを決めておくと、後の作業が軽くなります。
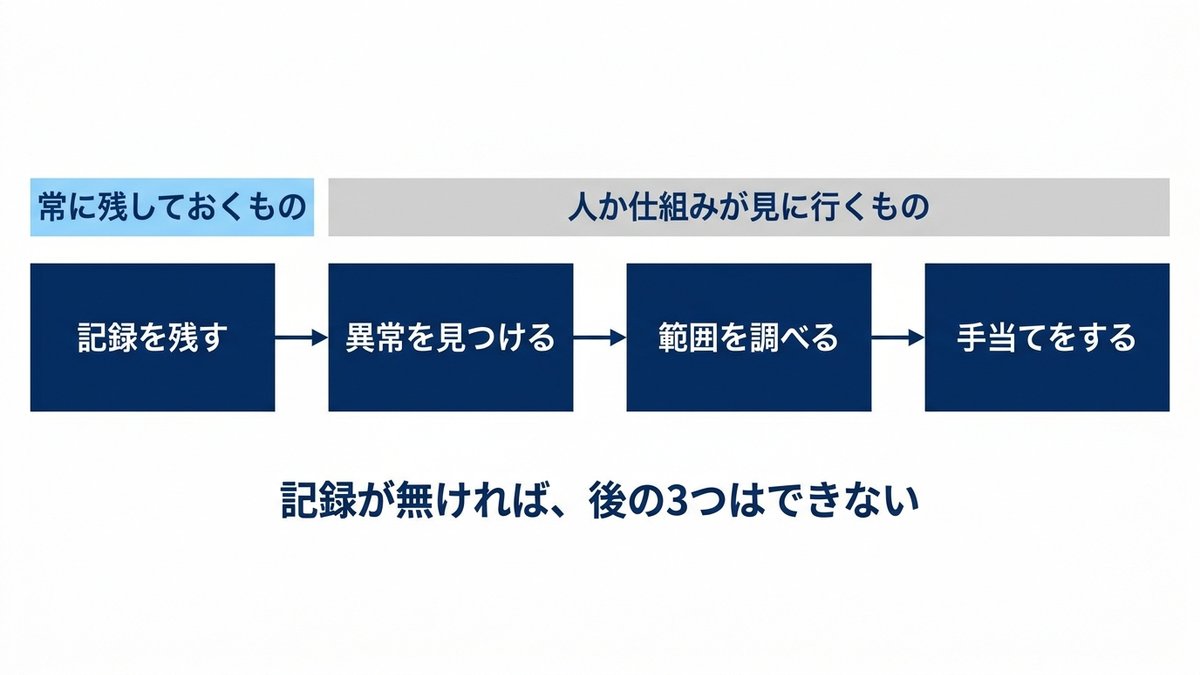
本章では、3社の権限の設計がそれぞれ別の前提の上に立っていること、社員のIDとアプリの利用者のIDは別の問題として扱われていること、鍵と機密情報と証明書の分け方が2通りに割れていること、脅威の検出は目的ごとに分かれる形と1つに束ねる形があること、そして監査の記録は既定で残る範囲が3社で違うことを見てきました。この分野は、名前の置き換えでは移せません。移せるのは「誰に何を許したいのか」という要件のほうであり、それをどう書くかは移った先で決め直すことになります。次の第10章では、ここまでで決めた構成を実際に作り、動かし続けるための仕組み、つまり継続的な統合と配信、コードによる基盤の管理、監視と可観測性へ進みます。
Anagraftでは、データ活用の構想づくりから基盤の選定、分析の実装、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
この章を深めたい方への参考書籍
『AWSではじめるクラウドセキュリティ クラウドで学ぶセキュリティ設計/実装』(松本照吾・桐谷彰一・畠中亮・前田駿介、テッキーメディア):本章で扱ったAWS側の話、とくにポリシーをどこに書くかという設計を、実際に手を動かしながら確かめられる1冊です。ポリシーが9種類あるという事実は、読むだけでは腹に落ちにくいところなので、環境を作って挙動を見るのが近道だと考えています。
『ひと目でわかるMicrosoft Entra ID』(竹島友理、日経BP):改称後の名前で書かれた解説書です。テナントの構成、利用者とグループの管理、Azureと Microsoft Entra のロールの管理、条件付きアクセス、IDガバナンスまでを順に追えます。この本自体が、2020年12月に出た『ひと目でわかるAzure Active Directory 第3版』の後継として作られたものだと説明されており、本章で触れた改称がそのまま書籍の側にも表れている例になっています。
『マルチクラウドセキュリティの教科書 クラウド横断で実現する堅牢なセキュリティ基盤』(大島悠司ほか、翔泳社):3社を横断して見る立場から、IDとアクセス管理、ネットワークの防御、データの保護とコンプライアンスを扱っています。本章の中心に置いた「片方の設計をもう片方へ機械的に写せない」という問題を、実務でどう吸収するかを考えるときの手がかりになります。複数のクラウドを併用している組織の担当者に向いています。
第10章 開発と運用
前章では、誰が何をしてよいかを決める権限の設計、鍵や機密情報の預け方、そして監査の記録の残り方が3社で大きく違うことを確認しました。権限と記録の枠組みが決まったあとに残るのは、実際にシステムを作り、変え、動かし続ける工程です。この章では、変更を届ける仕組み、構成をコードで扱う考え方、動いているものを見る仕組み、そして設定をそろえて統制する仕組みを順に扱います。移行やハイブリッドの選択は第11章、費用の管理は第12章の担当ですので、ここでは運用と信頼性の面に絞ります。
この章には、サービスの一覧としてではなく読み方として持ち帰っていただきたいことが1つあります。クラウドのサービスの状態は「使える」と「使えない」の2つではなく、少なくとも4つに分かれます。提供中のもの、提供は続いているが事業者が別の選択肢を勧めているもの、既存の利用者だけが使えるもの、そして完全に終わったものです。この章で扱う開発者向けの道具と構成管理の領域は、直近の数年でこの4つの状態が最も激しく入れ替わった領域でした。個々のサービス名を覚えるより、いま検討しているサービスがこの4つのどれなのかを確かめる習慣のほうが、長く役に立ちます。
変更を届ける仕組みは、3社とも部品の集まりである
まず用語をそろえます。継続的な統合とは、開発者が書いた変更をこまめに1つの本流へ取り込み、そのたびにビルドと自動テストを回す進め方のことです。継続的な配信とは、そこで作られた成果物を、いつでも本番へ出せる状態まで自動で運ぶ進め方を指します。手作業の手順書で毎回同じ操作を繰り返すのをやめ、その手順を機械が実行できる形で書いておく、というのが両方に共通する考え方です。
AWSは、この工程を役割ごとに分けた別々のサービスとして提供しています。AWS CodeBuild は、公式ドキュメントの言葉を借りれば「クラウド上のフルマネージドなビルドサービス」で、ソースコードをコンパイルし、単体テストを実行し、配布できる成果物を作ります。ビルドサーバーを自分で用意して更新し続ける必要がなくなる点が要旨です。AWS CodeDeploy は、その成果物を配る側の役割を担い、Amazon EC2 のインスタンス、オンプレミスのサーバー、AWS Lambda の関数、Amazon ECS のサービスという4つの宛先に配布できます。配り方には、稼働中の環境をそのまま順に入れ替えていく方式と、新しい環境を横に作ってから通信を切り替える方式の2つがあり、後者は切り戻しが速いという性質があります。そして AWS CodePipeline が、これらの段取り全体をつなぐ役割を持ちます。
Azureは、同じ工程を1つの傘の下にまとめています。Azure DevOps は、公式が「ソフトウェア開発チーム向けの統合されたツールを提供するクラウドベースのプラットフォーム」と説明しているとおり、5つのサービスの集合体です。作業項目と計画を扱う Azure Boards、ソースコードを預かる Azure Repos、ビルドと配布を実行する Azure Pipelines、テスト計画を管理する Azure Test Plans、パッケージを保管する Azure Artifacts の5つです。自社のデータセンターに置く形態として Azure DevOps Server も別途あります。
Google Cloudは、ビルドと配布を2つのサービスに分けています。Cloud Build が「Google Cloud 上でビルドを実行するサービス」で、Cloud Deploy が「定められた昇格の順序に従って、一連の対象環境へアプリケーションの配信を自動化するマネージドサービス」です。Cloud Deploy の配布先として公式が挙げているのは、Google Kubernetes Engine、Cloud Run、外部のクラスタを接続した形態、そして利用者が定義するカスタムの対象です。開発環境から検証環境、本番環境へと段階的に上げていく流れそのものを製品の中心に据えている点が特徴です。
選び方の軸は、どこまでを1つの製品でそろえたいかにあります。課題管理からソース管理、ビルド、テスト計画、成果物の保管までを一式で導入したい組織には、Azure DevOps のような統合型が向きます。すでに社外のソース管理サービスを使っていて、クラウド側にはビルドと配布だけを任せたい組織には、AWSやGoogle Cloudの部品型が合います。どちらが優れているという話ではなく、既存の開発体制のどこを置き換えるつもりがあるかで決まります。すでに定着している課題管理の道具を捨てさせる移行は、技術ではなく現場の合意の問題になりがちです。
開発者向けの道具は、この数年でいちばん入れ替わった
この領域を扱うとき、記憶で書くと必ず誤ります。AWSは2024年7月25日に、開発者向けのサービスをまとめて整理しました。AWS General Reference の完全終了サービスの一覧には AWS CodeStar が2024年7月25日の日付で載っています。同じ一覧のページは、完全終了を「サービスや機能のライフサイクルの最終段階であり、AWSの製品群から完全に取り除かれ、いかなる形でも利用も支援もされない状態」と定義しています。プロジェクトのひな型を作る道具として知られていた CodeStar は、この意味で終わっています。
ところが、名前の似たものが生きています。AWS CodeStar Connections は CodeStar 本体とは別のサービスで、開発者ツールのコンソールのドキュメントによれば、2024年3月29日に AWS CodeConnections へ改称されました。同ページには、2024年7月1日以降にコンソールが作成する接続の識別子が新しい表記になることも書かれています。「CodeStar は終了した」とだけ聞いた人が、CodeConnections まで終わったと受け取る誤解は起こりやすいところです。名前が似ているサービスは、正式名称のページを開いて、そのページ自身が名乗っている名前で判断するのが確実です。
AWS Cloud9 は、同じ2024年7月25日に新規の受付を止めました。ドキュメントの冒頭には「AWS Cloud9 は新規のお客様には提供されていません。既存のお客様は通常どおりサービスを利用し続けることができます」という趣旨のバナーが出ています。これは提供終了ではありません。完全終了の一覧にも載っていません。新規受付停止と提供終了は、読者にとってまったく意味が違います。前者は「いまから採用することはできないが、いま使っているものは動く」、後者は「いずれ動かなくなる」です。
そして、いったん止まったものが戻ることもあります。AWS CodeCommit は2024年7月25日に新規の受付を止めましたが、2025年11月24日付のAWSの公式ブログは「CodeCommit は完全な一般提供へ即時に復帰する」「本日より新規のお客様の登録を再開する」と告知しています。2024年から2025年前半の情報だけを読んで「CodeCommit は終わった」と判断すると、いまは誤りになります。クラウドのサービスの状態に関する記憶には賞味期限がある、ということです。採用を判断する時点で、公式ドキュメントに当たり直す以外に確実な方法はありません。
AWSは、こうした段階を サービスのライフサイクル変更の説明ページで3つに整理しています。1つめがメンテナンスで、「新規に利用を開始することはできない。すでに利用している顧客は継続できる。AWSは運用と支援を続けるが、機能の強化や追加はしない」と定義されています。2つめがサンセットで、終了までの期間はおおむね12か月とされ、その日にAWSが運用と支援を終えると書かれています。3つめが先ほどの完全終了です。この3段階に「提供は続くが推奨が変わった」という状態を足したものが、実務で必要な4つの区分になります。
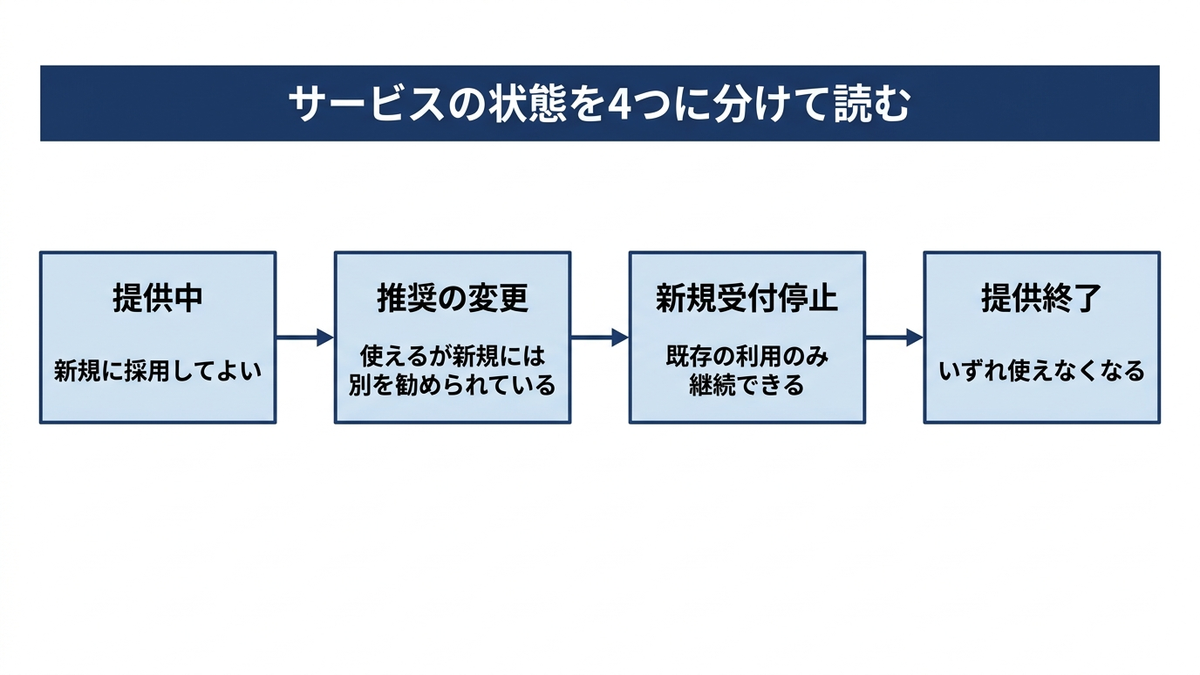
提供終了と、推奨が変わったことは、別のできごとである
この章の調べ物のなかで最も多く出てきたのは、提供終了ではなく推奨の変更でした。サービスは動き続けているのに、事業者自身が「新しく作るならこちらを使ってほしい」と別の選択肢を案内している状態です。読者が新規採用を判断しているとき、この状態を「まだ現役です」とだけ伝えるのは役に立ちません。数年後に作り直しになる選択を、そのまま通してしまうからです。
具体例を3つ挙げます。1つめが、AWS Auto Scaling のスケーリングプランです。終了や非推奨の告知は出ていません。しかし同じページに「予測スケーリングだけを目的にスケーリングプランを使っているなら、予測スケーリングのポリシーを Auto Scaling の対象リソースへ直接設定することを強く推奨する。そちらのほうが機能が多い」という趣旨の注意が置かれ、移行手順の専用ページまで用意されています。AWS Auto Scaling が廃止されたと書けば誤りですが、いまから予測スケーリングだけのために採用するのは公式の推奨から外れます。
2つめが、AzureのARMテンプレートの概要ページです。ここには「ARMテンプレートと同じ機能を、より使いやすい構文で提供する Bicep という新しい言語を導入した。Bicep のファイルは配備時に自動的にARMテンプレートへ変換される。構成をコードで扱う選択肢を検討しているなら、Bicep を見ることを推奨する」という趣旨の案内が、ページの冒頭近くに置かれています。ARMテンプレートは現役ですが、公式は新規の検討者に Bicep を勧めています。
3つめが、Cloud Trace のクライアントライブラリです。公式ドキュメントは、Trace のエクスポーターから OpenTelemetry の受け口へ移行する案内を出し、「OpenTelemetry のライブラリのほうが、単純であり、トレースのデータを標準の形式で送出できるため望ましい」という趣旨を書いています。ただし、Trace のクライアントライブラリの提供終了日は書かれていません。したがって「廃止された」とは書けません。推奨が変わったことと、終了が決まったことは、公式の書き方の上でもはっきり違います。本コラムでは、告知に日付があるものだけを終了として扱い、日付のないものは推奨の変更として書き分けています。
構成をコードで扱うという考え方
ここからが、この章の中心の1つです。Infrastructure as Codeとは、サーバーやネットワークやデータベースといった資源の構成を、画面の操作ではなくテキストのファイルに書いて管理する進め方を指します。日本語では「構成をコードで扱う」と言い換えられます。書いたファイルはソースコードと同じ場所に保管し、変更のたびにレビューを通し、履歴を残します。
なぜこれが経営の関心事になるのかを、3つの角度から説明します。1つめは再現性です。検証環境と本番環境の差が人の手作業から生まれると、検証で通ったものが本番で動かない事故が起きます。同じファイルから両方を作れば、その差は原理的に減ります。2つめは属人化の解消です。画面の操作で作られた環境は、作った人の頭の中にしか手順がありません。担当者が異動すれば、誰も触れなくなります。3つめは監査です。誰がいつ何を変えたかが、ソース管理の履歴として残ります。これは第9章で扱った監査ログとは別の層の記録で、「実際に何が起きたか」ではなく「何を意図したか」が残る点に価値があります。
技術的な性質としては、宣言的であることが要点です。ARMテンプレートの概要ページは、この性質を「作成の手順をプログラムの命令として書き並べるのではなく、何を配備したいのかを述べる構文である」と説明し、あわせて4つの利点を挙げています。同じファイルを何度配備しても同じ状態になること、資源どうしの依存関係の順序を利用者が考えなくてよいこと、配備の前に「この操作で何が作られ、何が変わり、何が消えるか」を確認できること、そして配備の前に検証が走るため中途半端な状態で止まりにくいことです。手順書を書いて人が順に実行する運用と比べたときの差は、この4つに集約されます。
3社とも、宣言的な土台と書きやすい層の二層になっている
3社の構成をコードで扱う仕組みを並べると、AWSとAzureに同じ形が現れます。下に宣言的な土台があり、その上に人が書きやすい記法の層が載っている二層構造です。
AWSの土台は AWS CloudFormation です。公式は「AWSの資源をモデル化してセットアップする手助けをするサービス」と説明しています。その上に載るのが AWS CDK で、公式の定義は「クラウドのインフラをコードで定義し、AWS CloudFormation を通じてそれを配備するための、オープンソースのソフトウェア開発フレームワーク」です。つまり CDK は CloudFormation の置き換えではなく、CloudFormation を生成する上位の書き方です。対応する言語として公式が挙げているのは TypeScript、JavaScript、Python、Java、C#/.Net、Go です。なお CDK のバージョン1は2022年6月1日に保守段階へ入り、2023年6月1日にサポートを終えています。現行はバージョン2です。
Azureも同じ形です。土台がARMテンプレートというJSONのファイルで、その上に Bicep という記法が載ります。Bicep の公式ドキュメントは、自身を「Resource Manager のJSONテンプレートに対する透過的な抽象であり、JSONテンプレートの能力を失わないもの」と説明し、配備のときに Bicep のコマンドが Bicep のファイルをJSONテンプレートへ変換すると書いています。ここを取り違えて「Bicep はARMテンプレートの後継だから、ARMの知識は不要になる」と読むと、実運用で困ります。配備の実体はARMテンプレートのままなので、エラーの読み方も権限の考え方もARM側の理解が要ります。
Google Cloudは、この二層構造を取っていません。Infrastructure Manager は「Google Cloud のインフラ資源の配備と管理を単純化し自動化するマネージドサービス」と定義されていますが、その入力は自社独自の記法ではなく Terraform の構成ファイルです。公式は「Terraform の構成、別名ブループリントを使うことで、Infra Manager は構成をコードで扱うワークフローを実装するためのマネージドなツールチェーンを提供する」と書いています。構成ファイルは Cloud Storage のバケット、Gitのリポジトリ、手元のディレクトリのいずれからでも配備できます。
Google Cloudで構成の配備を担ってきた Cloud Deployment Manager は、サポートが終了した状態にあります。公式ドキュメントの冒頭に「Cloud Deployment Manager は2026年3月31日にサポートを終了した」と書かれ、移行先として Infrastructure Manager または別の配備技術が案内されています。ただし、サポートの終了とサービスの停止は同じ日ではありません。日付は次のとおり分かれています。非推奨化の案内ページは、2026年4月1日以降はサポートの対象外であること、2026年6月30日以降は新規の利用者がAPIの有効化や最初の配備の作成をできなくなっていること、既存の利用者向けにはサービスが2027年6月30日まで稼働し、その後に停止されることを、それぞれ分けて書いています。すでに使っている組織にとっては「いま動いているが、支援は受けられず、停止の日も決まっている」という状態です。この1件は、古い解説記事をそのまま参照すると確実に踏む落とし穴です。Google Cloudには終了サービスの横断的な一覧ページが見当たらないため、製品ごとに一次情報を当てる必要があります。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| ビルドを実行する | AWS CodeBuild | Azure Pipelines(Azure DevOps の一部) | Cloud Build |
| 成果物を環境へ配る | AWS CodeDeploy | Azure Pipelines | Cloud Deploy |
| 工程全体をつなぐ | AWS CodePipeline | Azure Pipelines | Cloud Deploy の昇格の順序 |
| ソースコードを預かる | AWS CodeCommit(2024年7月25日に新規受付を停止し、2025年11月24日付の公式ブログで再開を告知) | Azure Repos | 本章の照合では確認していません |
| 作業項目と成果物を管理する | 本章の照合では確認していません | Azure Boards・Azure Test Plans・Azure Artifacts | 本章の照合では確認していません |
| 宣言的なIaCの土台 | AWS CloudFormation | ARMテンプレート(JSON) | Terraform の構成ファイル |
| 書きやすさを足した上の層 | AWS CDK(TypeScript・JavaScript・Python・Java・C#/.Net・Go) | Bicep(公式が推奨) | 該当する層を持たない |
| 配備を実行するマネージドサービス | AWS CloudFormation | Azure Resource Manager | Infrastructure Manager |
| すでに終わった、または終わる予定のもの | AWS CodeStar(2024年7月25日に提供終了) | Azure Blueprints(2027年1月31日に提供終了予定。段階的な終了の開始は2026年7月31日) | Cloud Deployment Manager(2026年3月31日にサポート終了済み。既存の利用者向けの稼働は2027年6月30日まで) |
同じ役割の枠に入るというだけで、同じものではありません。とくにこの表の「宣言的なIaCの土台」の行は、3社で意味の重さが違います。AWSとAzureの土台は自社が定義した記法であり、その事業者の資源しか扱いません。Google Cloudの欄に書いた Terraform の構成ファイルは第三者が定義した記法で、同じ書き方でほかの事業者の資源も扱えます。したがって、この行を「置き換えられる」と読むと判断を誤ります。また Azure Pipelines が3つの行に登場しているのは、Azureが工程を分けずに1つのサービスで担っているからで、AWSの3つのサービスを足したものと厳密に同じ機能を持つという意味ではありません。「本章の照合では確認していません」と書いた欄は、そのサービスが存在しないという意味ではなく、今回の照合で公式の記述に当たれなかったという意味です。表は入口であって、採用の根拠ではありません。
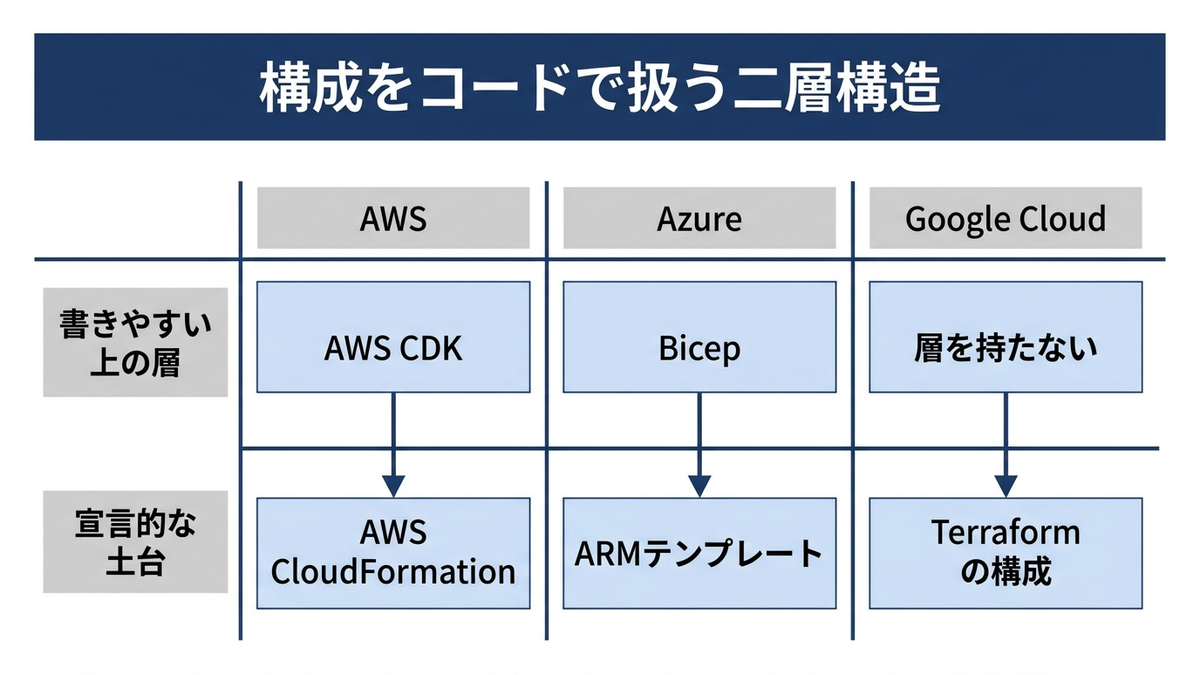
Terraform を、3社はどう位置づけているか
構成をコードで扱う道具として広く使われている Terraform は、3社とも第三者製として公式に扱っています。ただし、扱いの深さが同じではありません。ここは選定の判断に直接効く違いなので、順に見ます。
AWSは、推奨ガイダンスの文書として Terraform の AWS プロバイダを使うときのベストプラクティスを公開しています。文書の冒頭は、そのプロバイダの提供元が HashiCorp であることを明記しています。つまり、AWSは自社の製品としてではなく、第三者の道具を上手に使うための助言として位置づけています。
Azureは、開発者向けドキュメントに専用のセクションを設け、Terraform を「クラウドのインフラを構成し配備するための、オープンソースの構成をコードで扱う道具」と紹介しています。Azure向けのプロバイダは1つではなく、AzureRM、AzAPI、AzureAD、AzureDevops、AzureStack が案内されています。このうち AzureDevops のプロバイダの提供元は Microsoft です。さらに AzAPI と AzureRM の使い分けについては、Microsoft と HashiCorp の共同の見解を参照するよう案内されています。第三者製ではありますが、共同で方針を出す関係にあるということです。
Google Cloudは、もう一段深いところにあります。公式ドキュメントに専用のセクションがあるのはAzureと同じですが、それに加えて、前節で見たとおり Infrastructure Manager という自社のマネージドサービスの入力そのものが Terraform の構成ファイルです。第三者製の記法が、自社サービスの中身になっている点で、3社のなかで扱いが一段深いといえます。
ここから導ける実務的な示唆は次のとおりです。1つの事業者だけを使うと決まっている組織では、その事業者の純正の道具を使うほうが、新機能への追随が速く、ドキュメントも探しやすくなります。複数の事業者にまたがる構成を1つの書き方で管理したい組織では、Terraform を共通の記法として選ぶ判断がありえます。ただし、複数の事業者を使うこと自体の是非は第11章で扱います。ここでは「3社とも第三者製の道具を認めているが、認め方の深さが違う」という事実までを確認しておきます。
Azure Blueprints の終了と、公式ドキュメントの中に残った矛盾
この章で最も注意して書くべき項目が、Azure Blueprints です。組織の標準に沿った資源の組み合わせを、再現できる形でまとめて配る仕組みとして紹介されてきました。公式の定義は「クラウドのアーキテクトや情報システムの中央部門が、組織の標準、パターン、要件を実装しそれに従う、繰り返し利用できるAzure資源の集合を定義できるようにするもの」です。
その概要ページの冒頭には、いま次の告知が出ています。Azure Blueprints は2027年1月31日に提供を終了する予定で、段階的な終了は2026年7月31日から始まっているというものです。移行先として案内されているのは Deployment Stacks と Template Specs の2つで、公式は前者を推奨としています。ブループリントの構成要素は、ARMのJSONテンプレートまたは Bicep のファイルへ変換され、それが Deployment Stacks の定義として使われる、と書かれています。告知の詳細を載せた終了の案内ページによれば、この終了はもともと2023年9月14日に、2026年7月11日を終了日として告知され、のちに2027年1月31日へ延長されたものです。段階の中身も日付つきで示されています。2026年7月31日に新しいブループリントの定義とバージョンを作れなくなり、2026年10月31日に既存の定義の変更と新しい割り当ての作成ができなくなり、2026年12月31日に既存の割り当ての変更ができなくなり、2027年1月31日にAPIが応答しなくなって提供終了となります。終了の時点でエクスポートしていない定義、バージョン、割り当ては自動的に削除される一方で、ブループリントを通じて作られた資源そのものは残り、削除されないと明記されています。「終了する」という1語の裏に、作れなくなる日、変えられなくなる日、消える日が別々にあるということです。
もう1つ見落としやすい点があります。このページは製品名を「Azure Blueprints(Preview)」と表記しています。つまり、正式提供に至らないまま終了する製品です。プレビューの機能を本番の統制の土台に据えることの是非は一般論として語れますが、この事例はその一般論に実例を与えています。
移行先の Deployment Stacks は、公式の定義では「一群のAzure資源を、単一のまとまった単位として管理できるようにする資源」です。Bicep のファイルまたはARMのJSONテンプレートを渡すと、そのスタックが管理する資源が決まります。テンプレートから資源を取り除いたときに、その資源を管理から外すだけにするのか削除するのかを、設定で選べます。加えて、管理下の資源に対する削除や変更を拒否する設定を持てる点が、単なるテンプレートの配備との違いです。
ここからが、この記事で書き残しておきたい話です。公式ドキュメントの中で、記述が食い違っています。先ほど引いたARMテンプレートの概要ページには、ARMテンプレートを選ぶ利点を並べた箇条書きの中に、いまも「配備のブループリント」という項目があり、規制や準拠の基準を満たすために Microsoft が提供する Blueprints を活用できる、という趣旨が書かれています。このページの更新日は2026年6月26日で、Blueprints の終了告知が出たあとに更新されています。Bicep の概要ページにも、Bicep が連携するAzureのサービスとして Blueprints を挙げる記述が残っています。
どちらを正とすべきかは明らかです。終了を告知しているページを正とします。本コラムはその判断で書いています。そのうえで、この食い違いそのものに実務上の意味があると考えています。公式ドキュメントは1つの意思で一斉に更新されるものではなく、製品ごと、ページごとに更新の速さが違います。したがって、あるサービスの状態を1ページだけで判断すると、更新の遅れている側を拾ってしまいます。状態を確かめるときは、そのサービス自身の概要ページと、終了や非推奨を告知するページの両方に当たるのが安全です。これは第14章で扱う「名前と構成がどう動いてきたか」を読むときの作法にもつながります。
動いているものを見る仕組みと、可観測性という言葉
次は監視です。監視とは、あらかじめ決めた指標がしきい値を超えたら知らせる仕組みを指します。これに対して可観測性は、外から観測できる出力だけを手がかりに、システムの内部で何が起きているかを説明できる状態を指す言葉です。前者は「あらかじめ何を見るか決めておく」もので、後者は「決めていなかった問いにも答えられるようにしておく」ものだと整理すると、違いがつかみやすくなります。分散した多数のサービスが関わる構成では、障害の原因が事前に想定した指標の外にあることが増えるため、後者の考え方が重視されるようになりました。
AWSの傘は Amazon CloudWatch です。公式は「AWSの資源とAWS上で動くアプリケーションをリアルタイムに監視し、アプリケーションの性能、運用の健全性、資源の利用状況について、システム全体を見渡す可観測性を与える多くの道具を提供する」と説明しています。指標、警報、ダッシュボード、ログの検索、合成監視、サービスレベル目標の管理までが同じ傘の下にあります。
Azureの傘は Azure Monitor です。公式の定義は「クラウド環境とハイブリッド環境からテレメトリーを収集し、分析し、それに基づいて行動するための、Microsoft の統一された可観測性サービス」です。
Google Cloudの傘は、名前が変わっています。かつて Cloud Operations Suite と呼ばれていたものは、現在 Google Cloud Observability という名前になっています。公式の定義は「アプリケーションの挙動、健全性、性能を理解する助けとなる可観測性のサービス群を含む」というものです。含まれる製品として公式ページが挙げているのは、Cloud Monitoring、Cloud Logging、Cloud Trace、Error Reporting、Cloud Profiler、Application Monitoring、Google Cloud Managed Service for Prometheus、Ops Agent です。ただし、この改称がいつ、どの告知で行われたのかは、本コラムの調査では確認できていません。確認できたのは、現在のページがこの名前を名乗っていることだけです。ドキュメントのURLがいまも旧称の語を含んだままである点も、名前の変遷を追いにくくしています。URLに含まれる語は、現在の製品名の証拠にはなりません。
この領域でいま起きている最も大きな変化は、OpenTelemetryという業界標準が3社に共通の下地になりつつあることです。CloudWatch の公式ドキュメントは「OpenTelemetry の標準を用いて指標、ログ、トレースを取り込むための、ネイティブなOTLPの受け口を提供する」と書き、独自の代理プログラムや形式の変換を挟まずに送れるとしています。OTLPは、OpenTelemetryが定めているデータの送信形式のことです。指標は「OpenTelemetry Metrics(推奨)」と「CloudWatch Metrics(Classic)」の2種類に分かれ、公式が前者を推奨と明示しています。Google Cloudの Cloud Trace も、前節で見たとおり OpenTelemetry のライブラリを望ましいものとして案内しています。Azure Monitor の公式ドキュメントも、アプリケーションの性能監視を担う Application Insights を「Azure Monitor の OpenTelemetry の機能」と位置づけ、事業者に依存しない方法でテレメトリーを集めて分析できることを利点として挙げています。3社が別々に同じ標準へ寄せてきたという点が、この数年でいちばん大きな構造の変化です。
これは選定の判断に効きます。計測の仕組みを事業者ごとの独自形式で作り込むと、事業者を変えるときに計測の作り直しが発生します。標準の形式で送っておけば、送り先を変えるだけで済む可能性が高まります。いまから監視の基盤を作るなら、計測の部分を標準に寄せておくかどうかを最初に決めておくのが合理的だと考えています。
なお、傘としてのサービスが健在でも、その中の機能が終わることはあります。Amazon CloudWatch Evidently は、AWSの完全終了の一覧に2025年10月17日の日付で載っています。また AWS Systems Manager の公式ドキュメントの冒頭には、Systems Manager の CloudWatch ダッシュボードが2026年4月30日以降は利用できなくなり、以後は Amazon CloudWatch のコンソールでダッシュボードを扱うようにという告知が出ています。この日付はすでに過ぎていますが、告知はいまも同じ文面で掲げられています。サービス名で調べて「提供中」と分かっても、使おうとしている機能が終わっていないかは別に確かめる必要があります。
設定をそろえ、逸脱を見つけ、組織として統制する
ここからは、動かし続ける側の仕組みです。3社とも、対象を一元的に操作する層、構成の状態を記録して評価する層、複数の契約単位をまとめて統制する層に分かれています。
AWS Systems Manager は、公式の定義では「AWS上、オンプレミス、複数のクラウドにまたがるノードを、大規模に一元的に閲覧、管理、運用する助けとなる」サービスです。パッチの適用、コマンドの一斉実行、設定値の保管といった日常の運用作業が、対象へ個別に接続することなく行えます。なお公式ドキュメントには、統合されたコンソールが2024年11月21日に提供開始されたと書かれています。
AWS Config は、公式の言葉では「アカウント内のAWS資源の構成について詳細な把握を提供する」サービスです。いまどうなっているかだけでなく、いつどう変わったかを記録します。定めたルールから外れた資源を検出する用途に使われます。そして AWS Organizations が、「資源が増え規模が大きくなるにつれて、環境を一元的に管理し統制する助けとなる」層を担います。複数のアカウントを束ね、組織全体の方針を上から効かせる仕組みです。
Azureでは、Azure Policy がこの役割の中心にいます。公式は、組織の標準を強制し、大規模に準拠の状態を評価する助けとなるものだと説明しています。前節で見た Deployment Stacks が「決めた構成を配って守る」側だとすれば、Azure Policy は「決めた条件から外れる作成を止める、あるいは外れているものを見つける」側です。Azure Arc は、公式の定義では「一貫したマルチクラウドとオンプレミスの管理基盤を提供することで、統制と管理を単純化する」もので、管理できる対象としてサーバーと仮想マシン、Kubernetes のクラスタ、Azureのデータサービス、SQL Server が挙げられています。ここで1点だけ注意があります。Azure Arc の間接接続モードは、2025年9月に廃止されています。古い構成の記事を参照して設計すると、いまは選べない前提で組んでしまいます。
構成管理の考え方そのものにも変化があります。かつては、稼働中のサーバーへ入って設定を目的の状態へ収束させる方式の道具が広く使われていました。AWSでその系統に属していた AWS OpsWorks の一式は、完全終了の一覧に2024年5月1日の日付で載っています。この事実だけから業界全体の方向を断定することはできませんが、いまから構成管理を設計するのであれば、稼働中の機械を直す前提ではなく、構成をコードから作り直す前提で組むほうが、3社の現行の道立てに合っていると考えています。
推奨事項の自動検出と、開発者向けのAI支援
3社は、利用者の環境を自動的に点検して改善案を出す仕組みを持っています。AWS Trusted Advisor は、公式の定義では「AWSの環境を検査し、費用の節約、システムの可用性と性能の改善、セキュリティ上の隙間を塞ぐ機会があるときに推奨事項を出す」ものです。費用の観点は第12章の担当ですので、ここでは可用性、性能、上限値の管理の面に絞ります。
採用を検討するうえで重要な点が1つあります。Trusted Advisor のすべての検査項目が、誰にでも見えるわけではありません。公式ドキュメントは、Trusted Advisor の検査は AWS Business Support+、AWS Enterprise Support、AWS Unified Operations のいずれかの契約を持つ顧客が利用できるものだと明記しています。基本の契約では、サービスの上限値のカテゴリと、セキュリティおよび障害耐性の一部の検査に限られ、自動での更新も行われません。「無料で環境を自動診断してくれる道具がある」という理解のまま計画を立てると、実際に見える情報が想定と違うことになります。さらに同じページの冒頭には、サポートの契約自体についての終了告知が3件出ています。Developer Support、Business Support、Enterprise On-Ramp のそれぞれについて、2027年1月1日という日付が示されています。いずれも AWS GovCloud(US)では継続する旨の注記が付いています。運用の体制を契約と一体で設計している組織は、ここを確認しておく必要があります。
Azureの対応するものが Azure Advisor です。公式は「Azureの配備を最適化するためのベストプラクティスに従う手助けをする、デジタルなクラウドのアシスタント」と説明しています。推奨事項は5つのカテゴリに分かれており、公式ページの表記では信頼性、セキュリティ、パフォーマンス、コスト、オペレーショナルエクセレンスです。このうちコストは第12章の担当ですので、この章では残る4つを念頭に置いてください。利用の条件も、AWSとは考え方が違います。Azure Advisor は、対象のサブスクリプションや資源グループや資源に対して所有者、共同作成者、閲覧者のいずれかの役割を持っていれば推奨事項を参照できると公式に書かれており、サポート契約の等級による制限は示されていません。同じ「推奨事項の自動検出」という枠に入っていても、誰が見られるかの前提が違うということです。
Google Cloudの対応するものが Recommender です。公式は「Google Cloud の製品とサービスに対する利用上の推奨事項とインサイトを提供する、Google Cloud 上のサービス」と説明しています。インサイトとは、公式の説明では「資源の使われ方の重要なパターンに先回りして注意を向けるために使える所見」のことで、推奨事項とは独立に使えるものもあれば、推奨事項に結びついてその根拠を示すものもあります。あわせて Active Assist という呼び名があり、公式は「Google Cloud のプロジェクトを最適化する助けとなる推奨事項とインサイトを生成するために Google Cloud で使われる道具の一群」と定義したうえで、そこに推奨事項とインサイトを生成する個々の推奨機能(レコメンダー)と分析の道具が含まれると書いています。つまり Recommender という1つのサービス名と、それを含む一群を指す Active Assist という呼び名が併存しています。例として公式が挙げているのは、権限についての推奨事項を出す IAM の推奨機能で、第9章で扱った権限の設計とつながる話です。利用の条件については、公式が「推奨事項の種類とインサイトの種類ごとに、参照を制御する固有の役割と権限がある」と書いており、サポート契約の等級で区切る書き方はされていません。ただし、個々の推奨事項をどの役割で見られるかまでは、本章の照合では確認していません。
最後に、開発者向けのAI支援です。この領域は、この章のなかでも名前の動きが最も速いところです。AWSが提供していたコード補完の Amazon CodeWhisperer は、Amazon Q Developer のドキュメント履歴に「CodeWhisperer の統合」として2024年4月30日の日付で記録があり、Amazon Q Developer の一部になりました。Amazon Q Developer 自体は、公式の定義では「AWSのアプリケーションを理解し、構築し、拡張し、運用する助けとなる、生成AIを用いた対話型のアシスタント」で、Amazon Bedrock の上に構築されていると書かれています。
ここで止まらないところがこの領域の特徴です。同じページの冒頭には、終了の告知が出ています。2027年4月30日に、AWSは Amazon Q Developer の統合開発環境向けプラグインのサポートを終了するという内容で、同等の機能については Kiro を検討するよう案内されています。つまり、コード補完の道具は数年のうちに2度、名前と入れ物が変わったことになります。この領域の道具を採用するときは、名前が続く前提で社内の手順書を書かないほうが安全だと考えています。手順書には製品名ではなく、その道具が果たす役割を書いておき、製品名は付録として差し替えられる形にしておく、という運用が現実的です。
AzureとGoogle Cloudにも、同じ枠に入る道具があります。Azure側は GitHub Copilot for Azure で、公式は「開発者が自然言語で、Azureの機能を学び、Azureの資源を配備し、Azureの資源の情報を得て、Azureの資源の問題を診断して解決できるようにする、GitHub Copilot の拡張機能」と説明しています。利用にはAzureのサブスクリプションと GitHub Copilot の契約の両方が要ると明記されており、対応する開発環境ごとに一般提供とパブリックプレビューが混在しています。つまりAzureの開発者向けAI支援は、Azure単体のサービスではなく、GitHub Copilot という別の製品の拡張として提供されている構造です。Google Cloud側は Gemini Code Assist で、公式は Standard と Enterprise の2つの版について「ソフトウェア開発のライフサイクル全体を通じて、開発チームがアプリケーションを構築し、配備し、運用する助けとなるAIによる支援を提供する」と説明しています。ここにも名前の動きがあります。同じページの冒頭の注記には、道具を Antigravity という単一のマルチエージェントの基盤へ統合したこと、2026年6月18日以降、個人向けの Gemini Code Assist と Google AI Pro および Google AI Ultra の階層では Gemini Code Assist の統合開発環境向け拡張機能と Gemini CLI が要求の処理を停止したこと、該当する利用者は Antigravity へ移行するよう案内されていることが書かれています。Standard と Enterprise の版は、同じページで提供中のものとして説明されています。AWSで見た「入れ物が変わる」動きは、Google Cloudでも同じ時期に起きています。この領域の製品名を社内の手順書に固定しないほうがよいという先ほどの考えは、3社のどれを選ぶ場合でも変わりません。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 監視と可観測性の傘 | Amazon CloudWatch | Azure Monitor | Google Cloud Observability |
| ログの収集と検索 | Amazon CloudWatch Logs | Azure Monitor のログ | Cloud Logging |
| 指標の収集と警報 | Amazon CloudWatch の指標とアラーム | Azure Monitor の指標とアラート | Cloud Monitoring |
| 分散トレースとアプリケーションの性能監視 | Amazon CloudWatch のOpenTelemetry対応 | Azure Monitor の Application Insights | Cloud Trace |
| ノードの一元的な運用 | AWS Systems Manager | Azure Arc | 本章の照合では確認していません |
| 構成の記録と評価 | AWS Config | Azure Policy | 本章の照合では確認していません |
| 組織単位での統制 | AWS Organizations | Azure Policy と管理グループ | 本章の照合では確認していません |
| 推奨事項の自動検出 | AWS Trusted Advisor(対象は契約により異なる) | Azure Advisor | Recommender(Active Assist と呼ばれる道具の一群に含まれる。参照できる範囲は推奨事項の種類ごとの役割と権限で決まる) |
| 開発者向けのAI支援 | Amazon Q Developer(統合開発環境向けプラグインは2027年4月30日にサポート終了予定) | GitHub Copilot for Azure(GitHub Copilot の拡張機能。Azureのサブスクリプションと GitHub Copilot の契約が要る) | Gemini Code Assist(Standard と Enterprise の版。個人向け等の階層は2026年6月18日に要求の処理を停止し、Antigravity へ移行を案内) |
この表も、同じ役割の枠に入るというだけで、同じものではありません。3社は傘の切り方が違います。Google Cloud Observability は複数の独立した製品をまとめた呼び名であり、その中の Cloud Monitoring と Cloud Logging はそれぞれ単独のサービスとして使えます。Amazon CloudWatch は、指標もログもトレースも1つのサービス名の下にある構成です。Azure Monitor はその中間で、統一された可観測性サービスと名乗りつつ内部が機能ごとに分かれています。したがって「CloudWatch を Cloud Monitoring に置き換える」といった対応の付け方は、実際の作業量を見誤らせます。また Azure Arc と AWS Systems Manager を同じ行に置きましたが、前者は管理面を外部の環境まで広げる仕組み、後者は個々のノードへの運用操作を担う仕組みで、重なる部分はあっても目的が同じではありません。「本章の照合では確認していません」の欄は、存在しないという意味ではなく、今回の照合で公式の記述に当たれなかったという意味です。
この章では、変更を届ける仕組み、構成をコードで扱う二層構造、監視と可観測性、そして統制の仕組みを3社で並べました。要点は3つです。1つめは、構成をコードで扱う仕組みはAWSとAzureが宣言的な土台と書きやすい層の二層で、Google Cloudは第三者製の Terraform を自社サービスの中身に据えているという構造の違いです。2つめは、Azure Blueprints のように終了が決まっている一方で、公式ドキュメントの別のページには推奨する記述が残っている場合があり、状態は終了告知の側を正として読むべきだということです。3つめは、この領域で最も多いのは提供終了ではなく推奨の変更であり、「まだ使えます」だけでは新規採用の判断材料として足りないということです。次の第11章では、既存の資産をどう動かすか、ハイブリッドやマルチクラウドをどういう理由で選び、どういう理由で選ばないのかを扱います。この章で見た構成をコードで扱う道具の選び方は、そこでの判断とも直接つながります。
この章を深めたい方への参考書籍
『詳解 Terraform 第3版』(Yevgeniy Brikman 著、松浦隼人 訳、オライリー・ジャパン):この章で扱った構成をコードで扱う考え方を、Terraform という具体的な道具に沿って基礎から本番の運用まで追える1冊です。複数の開発チームが同じ構成を触るときの分割やレビューの進め方まで踏み込んでいるため、Google Cloudの Infrastructure Manager を検討する場合はもちろん、AWSやAzureで第三者製の道具を使う判断をした場合にも読み込む価値があります。2023年11月刊行の第3版です。
『オブザーバビリティ・エンジニアリング』(Charity Majors、Liz Fong-Jones、George Miranda 著、大谷和紀・山口能迪 訳、オライリー・ジャパン):この章の後半で扱った可観測性について、言葉の定義から実践、さらに組織への定着までを1冊で論じた本です。あらかじめ決めた指標を見る監視と、決めていなかった問いに答えられる状態を作ることの違いが丁寧に整理されているため、監視の仕組みを作り直す前の共通言語として使えます。2023年1月刊行です。
『LeanとDevOpsの科学[Accelerate] テクノロジーの戦略的活用が組織変革を加速する』(Nicole Forsgren、Jez Humble、Gene Kim 著、武舎広幸・武舎るみ 訳、インプレス):道具ではなく、開発と運用の進め方が組織の成果にどう効くのかを、調査に基づいて論じた本です。この章で扱った継続的な統合と配信を「入れたかどうか」ではなく「何が改善したか」で語るための枠組みが得られます。経営の側がこの領域の投資を判断するときの物差しとして読める1冊です。2018年11月刊行です。
第11章 移行とハイブリッドとマルチクラウド
前章では、作ったものを動かし続けるための仕組み、つまり継続的な統合と配信、構成をコードで扱う考え方、監視と可観測性を見ました。本章が扱うのは、その手前にある問いです。すでに動いている資産を、どうやってクラウドへ持っていくのか。あるいは、持っていかないのか。そして、持っていく先を1社に決めるのか、複数にするのか。この3つは別々の問いに見えて、実際には同じ判断の系列に並んでいます。
本章は4つの部分でできています。前半では移行の型と、移行を助けるサービスを見ます。次に、既存の仮想化基盤をそのまま持ち込む選択肢を、移行の文脈で整理します。その次に、クラウドの側を自社の建物に置くハイブリッドの選択肢を並べます。最後に、この章の中心である、マルチクラウドを選ぶ理由と選ばない理由を、どちらも具体的に書きます。費用の見方そのものは第12章で扱いますので、本章では金額に踏み込まず、判断の材料だけを置きます。
移行の型は、3社とも用意しているが、名前も数も揃っていない
移行の計画づくりは、たいてい「何をどうするかの分類」から始まります。この分類を、3社とも公式のドキュメントで示しています。ところが、名前も数も揃っていません。まずここを揃えないと、3社の資料を並べて読むだけで混乱します。
AWSは移行戦略についての規範的ガイダンスで、移行の戦略は7つあると明記しています。これが7つのRと呼ばれるものです。使うのをやめる、いまの環境に残す、そのまま移す、場所だけを移す、別の製品に買い替える、土台を載せ替える、そして作り替える、の7つです。英語の頭文字がすべてRで始まることから、この呼び名が付いています。同じページには、大規模な移行でよく使われるのは、そのまま移す、土台を載せ替える、場所だけを移す、使うのをやめる、の4つであり、作り替えることは大規模な移行には勧めない、という記述もあります。理由は、作り替えは移行と同時に近代化を行うことであり、戦略の中で最も複雑だからです。AWSは、まず移し、移行が終わってから近代化することを勧めています。
Azureはクラウド導入フレームワークの移行戦略の選び方で、8つを並べています。使うのをやめる、そのまま移す、土台を載せ替える、コードを直す、構成を組み直す、市販のサービスに置き換える、一から作り直す、いまの環境に残す、の8つです。AWSの分類と重なる部分は多いのですが、AWSが1つにまとめている「作り替える」を、Azureは「コードを直す」と「構成を組み直す」と「一から作り直す」の3つに割っています。そしてAzureの側にも、AWSとは別の助言が書かれています。そのまま移すという選択は、その処理が今後2年は現状のままだと確信できる場合にだけ向いている、という趣旨の記述です。近代化の可能性があるなら、コードを直すか構成を組み直すほうを検討して、二度手間を避けなさい、と続きます。
Google CloudはGoogle Cloudへの移行の入口となる文書で、まず移行の道のりを4つの段階に分けます。評価、計画、展開、最適化の4つです。評価の段階では既存の環境を調べて棚卸しを作り、計画の段階では受け皿となる基盤を用意し、展開の段階で実際に移し、最適化の段階でクラウドに合わせた作りに寄せていく、という並びです。そのうえで移行の種類を6つ挙げています。そのまま移す、土台を載せ替える、コードを直す、構成を組み直す、一から作り直す、市販のサービスに買い替える、の6つです。
| 観点 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 公式が示す分類の数 | 7つ | 8つ | 6つ。加えて4つの段階を別に定義 |
| 作り替えの扱い | 1つにまとめている | コードを直す、構成を組み直す、一から作り直すの3つに分けている | コードを直す、構成を組み直す、一から作り直すの3つに分けている |
| 他社と線の引き方が違う点 | 場所だけを移すという型を独立して置いている | 使うのをやめる、いまの環境に残すの2つ(AWSにもある)を含めたうえで、作り替えを3つに分けている(分割そのものは Google Cloud にもある)。この2つの特徴を両方とも備えるのはAzureだけで、数が最も多い | 移行の段階を、型とは別の軸として明示している |
| 公式が付けている注意 | 大規模な移行では作り替えを勧めない。移してから近代化する | そのまま移すのは、2年は現状のままだと確信できる場合に限る | 評価の段階で棚卸しを作ることを、最初の作業として置いている |
| 分類が置かれている場所 | 移行の規範的ガイダンス | クラウド導入フレームワーク | アーキテクチャセンターの移行の手引き |
この表も、横に並んでいるだけであり、同じ役割の枠に入るというだけで、同じものではありません。3社とも「何をどうするか」を分類している点は共通ですが、線の引き方が違います。AWSが独立して置いている「場所だけを移す」は、仮想化の基盤ごと移す場合を指しており、他の2社の分類には同じ名前の項目がありません。逆に「一から作り直す」は、AzureとGoogle Cloudの両方が独立した型として置いていますが、AWSの分類には同じ名前の項目がありません。また「使うのをやめる」と「いまの環境に残す」は、AWSとAzureの分類にはあり、Google Cloudの6つの中にはありません。したがって、3社の資料を横断して読むときは、型の名前ではなく「作りをどこまで変えるか」という物差しのほうを共通の軸に据えるのが安全です。
読者の判断に直結する点を1つだけ補います。上に挙げた助言は、AWSとAzureで方向が違って見えます。AWSは大規模な移行で作り替えを避けよと言い、Azureはそのまま移すのは2年もつ場合に限れと言います。これは矛盾ではなく、前提にしている規模が違うだけだと考えています。数百台を一斉に動かす計画では、1つずつ作りを変える判断を挟むと計画そのものが止まります。一方、数個の重要な処理を動かす計画では、そのまま移して1年後に作り替えることになると、移行の作業を二度払うことになります。自社の移行が「台数の問題」なのか「重要度の問題」なのかを先に決めると、どちらの助言に従うべきかが決まります。
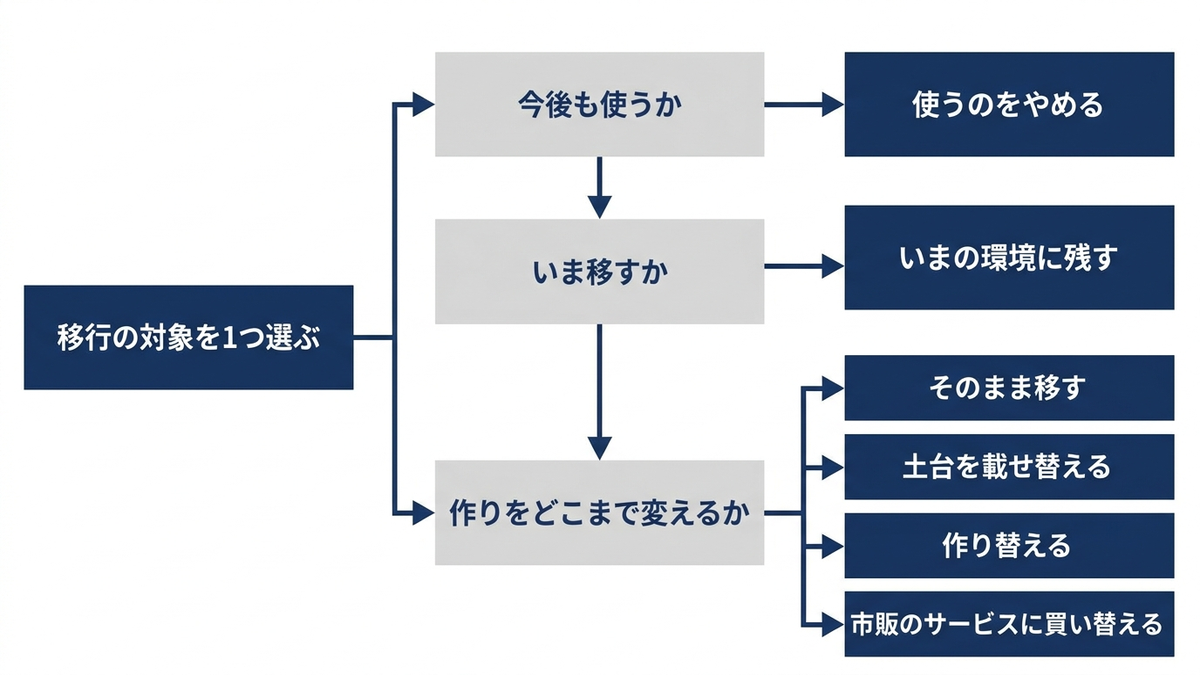
型を決める前に、いま何があるのかを数える
型の議論は面白いのですが、実務では先に別の作業があります。何台あって、どれとどれがつながっていて、どれが誰にも使われていないのかを数える作業です。3社ともこの工程に専用のサービスを置いています。そして、この領域はここ数年でいちばん動いた場所でもあります。
AWSでは、長らくAWS Application Discovery Serviceが棚卸しの役割を担ってきました。エージェントを入れずに仮想化基盤の側から集める方法、各サーバーにエージェントを入れる方法、手元の一覧を取り込む方法の3通りが用意されています。ところが公式ドキュメントの冒頭に、このサービスは新規の顧客に開かれていない旨の告知が出ています。提供状況の変更を説明したページには、2025年11月7日から新規の受け付けを停止したこと、既存の顧客は進行中の案件を完了できること、代替としてAWS Transformを勧めることが書かれています。2026年からAWSへの移行を新しく始める組織は、このサービスを前提に計画を立てられません。
代替として案内されているAWS Transformは、公式には、基盤とアプリケーションとコードの変革を、エージェント型のAIによって進める道具だと説明されています。担う範囲は棚卸しだけではありません。棚卸し、移行計画の立案、受け皿となるアカウント構成の作成、ネットワーク構成の移し替え、サーバーの移行、ソースコードからのコンテナ化までが並んでいます。移行の道具が1つのサービスに束ねられ、そこにAIによる自動化が乗った形になっており、この構図は元の見取り図には無かったものです。
AzureではAzure Migrateが同じ役割を担います。公式には、Azureへの移行を決め、計画し、実行することを助けるサービスであり、サーバー、データベース、Webアプリケーション、仮想デスクトップ、そして大量の資料を回線を使わずに運ぶ方法までを支える、と説明されています。棚卸しの方法は、自社の環境に仮想の機器を置いて継続的に情報を送る方法が中心ですが、それとは別にAzure Migrate Collectorという仕組みが用意されており、外部と接続していない環境や、通信が制限された環境でも、一度きりの断面として棚卸しができるようになっています。加えて、収集した情報をもとに対話形式で計画を検討するAzure Copilot migration agentがプレビューとして含まれています。
Google CloudではMigration Centerが入口になります。公式には、いまのオンプレミス環境や他社のクラウド環境からGoogle Cloudまでの道のり全体を速めるための統合された基盤である、と説明されています。担うのは資産の発見、基盤の評価、そして移行後の見積りです。サーバーだけでなく、SQL Server、MySQL、PostgreSQLといったデータベースも棚卸しの対象に入っています。
この工程で、もう1つ注意しておきたいことがあります。AWSの完全に提供を終えたサービスの一覧には、AWS Database Migration Service Fleet Advisorが2026年5月20日の日付で載っています。Fleet Advisorは、データベースの側の棚卸しを担っていた機能です。ところが、後述するAWS Database Migration Serviceの入口のページには、いまもFleet Advisorが機能として紹介されています。公式のドキュメントどうしで記述が食い違っているので、片方のページだけを見て計画に組み込むと危険です。この種の食い違いに出会ったときは、終了を告知している側のページを正として読むのが安全だと考えています。同じ一覧には、AWS Application Discovery Serviceの収集用の部品が2025年11月17日に提供を終えたことも記載されています。
サーバーをそのまま移す道具
型のうち「そのまま移す」を選んだ場合に使う道具を見ます。ここは3社とも成熟していて、考え方もよく似ています。動いているサーバーの記憶装置を継続的に複製しておき、切り替えたい時刻に複製を止めて、複製先で起動する、という流れです。
AWSの道具はAWS Transform MGNです。以前はAWS Application Migration Serviceという名前で、略称はMGNです。2026年6月8日の告知で、AWS Application Migration ServiceがAWS Transform MGNとして提供されるようになったことが公表されました。告知には、この改称は、前述のエージェント型の移行サービスであるAWS Transformの複製の仕組みをこのサービスが担っていることを名前に反映したものだ、という趣旨の説明があります。公式のリリースノートには、改称後も機能とAPIと複製の仕組みは変わらないと書かれています。公式の説明は、物理サーバー、仮想サーバー、他社クラウドのサーバーをAWSへ移す作業を自動化し、停止時間は通常は数分の切り替えで済む、というものです。仕組みとしては記憶装置をブロック単位で継続的に複製し、AWSで起動できる形に変換します。移行の管理の単位にも特徴があります。サーバーをアプリケーションにまとめ、アプリケーションを移行の波にまとめて、設定の変更や切り替えの操作を、サーバー単位でも、アプリケーション単位でも、波の単位でも実行できるようになっています。数百台を一度に扱う計画では、この単位の切り方そのものが計画書になります。
ここで略称について1つ確認しておきます。旧称のAWS Application Migration Serviceの時代からの公式な略称はMGNで、AWS Transform MGNへの改称後も変わっていません。AMSはAWS Managed Servicesという別のサービスの略称で、そちらはAWSの基盤の運用を代行する企業向けのサービスです。名前が似ているうえに、どちらもAWSの移行と運用の文脈で登場するため、社内の資料で取り違えると話が噛み合わなくなります。加えて、この領域では2023年4月1日にAWS Server Migration Serviceが提供を終えています。後継はMGNです。古い手順書がこの名前で書かれている場合は、道具の名前から書き換えが必要になります。
AzureではAzure Migrateが移行の実行まで担います。公式ドキュメントによれば、VMwareの仮想マシンはエージェントを入れる方法と入れない方法の両方に対応し、Hyper-Vの仮想マシンにも対応します。ここで注目したいのは物理サーバーの扱いです。公式には、物理サーバーを移せるだけでなく、他の仮想化基盤のサーバーや他の公衆クラウドの仮想マシンも、物理サーバーとして扱うことで移せると書かれています。つまりAzureは、他社クラウドからの移行を、専用の経路ではなく物理サーバーの経路に寄せて受けています。
Google Cloudの道具はMigrate to Virtual Machinesです。このサービスは以前Migrate for Compute Engineという名前でしたが、2022年7月5日に現在の名前へ改称されています。旧世代の4系は2024年4月30日に提供を終えました。公式の説明では、移行元として、自社のデータセンターのvSphere環境、AWS、Azure、そしてGoogle Cloud VMware Engineが名指しで挙げられています。他社クラウドが移行元として公式に明記されている点は、後半のマルチクラウドの議論にそのままつながります。
データベースを移す道具は、3社で守備範囲が違う
サーバーの移行は3社でよく似ていますが、データベースの移行は守備範囲が大きく違います。同じ略称で呼ばれているために、かえって誤解が起きやすいところです。
AWS Database Migration Serviceは、公式には、リレーショナルデータベース、データウェアハウス、キーバリュー型などのデータベース、そのほかの保管先を移せるサービスだと説明されています。移す先はAWSの中だけでなく、クラウドと自社設備を組み合わせた構成にも対応します。エンジンを変える移行のために、スキーマを自動で評価して変換する機能と、手元の端末で動かす変換用の道具の2通りが用意されています。対応しているエンジンどうしであれば、異なるエンジンの間の移行に完全に対応している、という趣旨の記述もあります。任意のエンジンの組み合わせを移せるという意味ではなく、移行元と移行先の対応表を先に確かめる必要があります。
Azure Database Migration Serviceは、公式には、複数の供給元からAzureのデータ基盤への移行を停止時間を抑えて行うためのマネージドサービスだと説明されています。ただし同じページに、現在対応しているのはSQL Databaseの近代化である、と明記されています。移行先として並んでいるのも、Azure SQL Database、Azure SQL Managed Instance、Azureの仮想マシン上のSQL Serverです。名前と略称はAWSのものとよく似ていますが、いま公式が示している守備範囲は、AWSのそれよりかなり狭い形になっています。
Google CloudのDatabase Migration Serviceは、移行先としてCloud SQLとAlloyDB for PostgreSQLを挙げ、移行元としてMySQL、PostgreSQL、SQL Server、Oracleに対応します。同じエンジンどうしの移行と、異なるエンジンの間の移行の両方に対応し、後者のスキーマ変換には生成AIの機能が組み込まれています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 棚卸しと計画 | AWS Transform。従来のApplication Discovery Serviceは2025年11月7日から新規の受け付けを停止 | Azure Migrate。接続できない環境向けにAzure Migrate Collectorを用意 | Migration Center。資産の発見と評価と見積りを担う |
| サーバーをそのまま移す | AWS Transform MGN。2026年6月8日にAWS Application Migration Serviceから改称。略称はMGN | Azure Migrate。他社クラウドの仮想マシンは物理サーバーとして扱う | Migrate to Virtual Machines。移行元にAWSとAzureを明記 |
| データベースを移す | AWS Database Migration Service。リレーショナル、データウェアハウス、キーバリュー型などに対応 | Azure Database Migration Service。公式は現在SQL Databaseの近代化に対応と明記 | Database Migration Service。移行先はCloud SQLとAlloyDB for PostgreSQL |
| コンテナへ作り替えて移す | AWS Transformのソースコードからのコンテナ化。移行先はAmazon ECSとAmazon EKS | Azure MigrateによるWebアプリケーションの移行。移行先はAzure App ServiceとAzure Kubernetes Service | Migrate to Containers。移行先はGKEとCloud Run |
| 提供を終えたもの | AWS Server Migration Serviceは2023年4月1日、DMS Fleet Advisorは2026年5月20日 | 棚卸しの統合先として案内されていたMovereは2024年3月1日に提供終了 | Migrate for Compute Engineの4系は2024年4月30日に提供終了 |
この表についても、同じ行に並んでいることは、同じものであることを意味しません。とくにデータベースの行は、名前と略称が3社でほぼ同じであるにもかかわらず、公式が示す守備範囲が最も離れています。AWSのものを念頭に「DMSで移せます」と社内で説明し、実際にはAzureで別のエンジンを移す計画だった、という食い違いは起こりえます。役割の名前ではなく、移行元のエンジンと移行先のサービスを1件ずつ突き合わせて確認してください。また、この表の左の列は「役割」であり、工程の順序ではありません。実際の計画では、棚卸しが終わる前に移行の道具を選ぶことはできません。
作り替えて移す道は、コンテナに寄っている
作りを変えて移す型を選んだとき、3社が用意している道具は、いずれも移行先をコンテナか、マネージドな実行環境に寄せています。3社すべてがコンテナだけを出口にしているわけではなく、後述のとおりAzureはWebアプリケーションの移行先にAzure App Serviceも挙げています。それでも、第2章で見たとおり、コンテナは事業者をまたいで通用する共通の語彙になっているため、作り替えの受け皿として選ばれやすい形です。
Google CloudのMigrate to Containersは、公式には、従来の仮想マシンで動いているアプリケーションを、GKEまたはCloud Runで動く本来のコンテナへ近代化するために使う、と説明されています。ドキュメントは現存し、提供終了の告知もありません。ただし、この道具については操作手段の変化を押さえておく必要があります。公式のリリースノートには、処理用のクラスタを使って移行を行う方式のコンソール画面とmigctlという命令行の道具が、2024年1月3日に非推奨とされ、2024年5月6日に利用できなくなったことが記載されています。数年前の手順書はそのままでは動きません。
AWSでは、前述のAWS Transformが担う範囲の中に、ソースコードからアプリケーションをコンテナ化してAmazon ECSまたはAmazon EKSへ配置する工程が含まれています。Azureでは、Azure MigrateがWebアプリケーションの移行を担い、移行先としてAzure App ServiceとAzure Kubernetes Serviceが挙げられています。3社とも、作り替えの出口をコンテナとマネージドな実行環境に寄せている点は共通です。
ここで、先ほどの助言の違いがもう一度効いてきます。作り替えは、移行と同時にやるか、移行が終わってからやるかで、難しさがまったく変わります。同時にやると、動かなくなったときに「移したせいなのか、作りを変えたせいなのか」を切り分けられません。この切り分けができないまま切り戻しの判断を迫られるのが、移行の現場でいちばん重い局面だと考えています。移行と近代化を同じ期間に置かないというだけで、判断の難しさは大きく下がります。
既存の仮想化基盤を、そのまま持ち込む
第2章で、既存の仮想化の基盤をクラウドへ持ち込む選択肢に簡単に触れました。ここでは移行の文脈で、3社の対応を並べます。この選択肢が意味を持つのは、移行の型でいえば「場所だけを移す」を選ぶ場合です。仮想マシンの構成も、運用の手順も、担当者の技能も、大きく変えずに置き場所だけを変えられます。
AWSにはAmazon Elastic VMware Serviceがあります。略称はAmazon EVSで、公式には、VMware Cloud Foundationの環境を、仮想プライベートクラウドの中のEC2のベアメタルのインスタンス上に直接構築して動かせるサービスだと説明されています。公式が挙げる特徴には、自社のネットワークをそのまま延長でき、IPアドレスを変えず、担当者を再教育せず、運用の手順書を書き直さずに移せる、という趣旨の記述があります。
AzureにはAzure VMware Solutionがあります。公式には、Azureの専用のベアメタルの基盤の上に構築したVMware vSphereのクラスタからなるプライベートクラウドを提供する、と説明されています。最小の構成は3ホストで、1つのクラスタあたり最大16ホストまで増やせます。用意されるプライベートクラウドには、vCenter Server、vSAN、vSphere、NSXが含まれます。自社の環境との接続にはExpressRoute Global Reachが使われます。
Google CloudにはGoogle Cloud VMware Engineがあります。公式には、VMwareの基盤をGoogle Cloudで動かせるようにする完全にマネージドなサービスであり、vSphere、vCenter、vSAN、NSX、HCXとそれに対応する道具が含まれるので、既存の道具、教育してきた技能、慣れたチームの手順とそのまま互換である、と説明されています。
3社とも似た形に見えますが、移行の計画としては1つ注意があります。この選択肢は移行の完了ではなく、移行の第一段階です。置き場所は変わりますが、クラウドの他のサービスに寄せる作業はまだ残っています。前に見たとおり、Google CloudのMigrate to Virtual Machinesは、Google Cloud VMware Engineを移行元の1つとして明記しています。つまりベンダー自身が、仮想化基盤ごと持ち込んだあとに、そこからさらに移す道筋を用意しているということです。この選択肢を採るときは、次の一手を計画に書いてから始めるほうがよいと考えています。書かないままだと、そのままの形が何年も残り、クラウドへ移った意味が費用の話にしか現れなくなります。
クラウドの側を、自社の建物に置く
ここまでは資産をクラウドへ動かす話でした。逆に、動かさずに、クラウドの側を自社の建物へ持ってくる選択肢もあります。これがハイブリッドと呼ばれる形です。動かせない理由は、規制であったり、通信の遅延であったり、通信が切れても止められない現場であったりします。
AWSの選択肢はAWS Outpostsです。公式には、AWSの基盤、サービス、API、道具を顧客の敷地へ延長する完全にマネージドなサービスだと説明されています。設置されるのはAWSが運用し監視する計算資源と記憶資源の集まりで、これはAWSのリージョンの一部として扱われます。形は2種類あります。業界標準の42Uのラックとして設置するものと、標準的な19インチのラックに収まる小型のサーバーとして設置するものです。後者は、設置場所が狭い拠点や、必要な容量が小さい拠点に向けたものだと説明されています。ラックのほうが動かせるサービスの種類は多く、小型のサーバーでは動かせないものがあります。
Azureの選択肢は2つの層に分かれています。1つはAzure Arcです。公式には、一貫したマルチクラウドおよびオンプレミスの管理基盤を提供することで、統治と管理を簡単にするものだと説明されています。管理できる対象として挙げられているのは、サーバーと仮想マシン、Kubernetesのクラスタ、Azureのデータサービス、そしてSQL Serverです。Azureの外にある資産をAzure Resource Managerに写し取ることで、Azureで動いているかのように扱う、という考え方です。なお、このサービスには廃止された動作モードがあります。公式ドキュメントには、間接的に接続する方式が2025年9月に廃止されたことが記されています。もう1つはAzure Localで、こちらは顧客が所有する環境へAzureの機能を延長する分散型の基盤であり、Azure Arcを共通の制御の面として使う、と説明されています。クラウドに接続した状態でも、接続していない状態でも配置できる点が明記されています。
Google Cloudの選択肢はGoogle Distributed Cloudです。公式には、Google Cloudの基盤とサービスを、主権が求められる環境や顧客のデータセンターへ延長する、完全にマネージドなハードウェアとソフトウェアの組み合わせの総称だと説明されています。形は複数あります。データが生まれる場所や使われる場所の近くへ寄せる接続型、Google Cloudへの接続を一切必要としない完全に切り離された型、そして顧客のハードウェア上で動かすソフトウェアのみの型です。ソフトウェアのみの型は、ベアメタルの構成とVMwareの構成の両方が用意されています。
この領域では、名前の消滅を1つ押さえておく必要があります。Google Cloudのハイブリッドの選択肢として長く紹介されてきたAnthosという名前は、いまは単独の製品として存在しません。GKE Enterpriseのリリースノートのページには、GKE Enterpriseの一部であった機能は標準のGoogle Kubernetes Engineの提供内容の一部になったか、GKEに加えて使える製品または機能になった、と書かれています。同じページには、GKEは単一の提供であり、版や階層の区別は無い、とも明記されています。Anthosを前提に書かれた社内の資料や提案書は、名前の対応が付かない状態になっています。なお、この統合がいつ行われたのかについては、告知の一次情報を確認できていないため、本章では時期を書きません。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 自社設備に置く形 | AWS Outposts。42Uのラックと小型のサーバーの2形態 | Azure Local。接続した状態でも切り離した状態でも配置できる | Google Distributed Cloud。接続型、完全に切り離した型、ソフトウェアのみの型 |
| 外にある資産をまとめて管理する仕組み | AWS Systems Manager。AWS、自社設備、複数クラウドの環境のノードを対象とすると明記 | Azure Arc。一貫したマルチクラウドおよびオンプレミスの管理基盤と明記 | 本章の照合では、他の2社と同じ位置づけの単独のサービスを確認していない |
| 既存の仮想化基盤の持ち込み | Amazon Elastic VMware Service | Azure VMware Solution | Google Cloud VMware Engine |
| 名前の変化 | サーバー移行の道具の改称は前掲のとおり。この表に挙げたハイブリッドと仮想化基盤の持ち込みの範囲では、AWS Systems Managerが以前はAmazon Simple Systems ManagerおよびAmazon EC2 Systems Managerと呼ばれていたと公式が記しており、略称のSSMはその名残。それ以外の改称は本章の照合では確認していない | この表に挙げたハイブリッドと仮想化基盤の持ち込みの範囲では、本章の照合で改称は確認していない | Anthosは単独の製品として存在しない。GKE Enterpriseにあった機能は、標準のGKEに含まれるものと、GKEに加えて使う製品や機能とに整理された |
この表も、同じ行に入るというだけで、同じものではありません。とくに1行目は、提供の形そのものが違います。AWS Outpostsは、AWSが所有し運用する機器を顧客の敷地に置くものです。Azure LocalとGoogle Distributed Cloudのソフトウェアのみの形は、顧客の側が用意したハードウェアの上でソフトウェアを動かす形を含みます。誰が機器を所有し、誰が保守するのかが違えば、契約も、保守の手順も、故障時の連絡先も違います。役割が対応しているからといって、調達の条件まで対応しているとは限りません。2行目についても、AWSとAzureで挙げたサービスは、複数のクラウドを対象にすると公式が明記している点では共通ですが、AWS Systems Managerがノードの操作を中心に据えているのに対し、Azure Arcは資産をAzureの資源として写し取る点に重心があります。
マルチクラウドを選ぶ理由
ここからが本章の中心です。複数のクラウドを併用するかどうかは、技術の議論に見えて、実際には調達と組織の議論です。そこで、選ぶ理由と選ばない理由を、どちらも具体的に並べます。本章では、マルチクラウドがよいとも、よくないとも書きません。要件によって答えが変わる問いだからです。
まず、選ぶ理由です。第一に可用性です。1社の大規模な障害で事業が完全に止まる状態を避けたい、という要求は、金融、決済、医療、公共の分野で実際に出てきます。ただし後述のとおり、この効果を実際に得るには相応の設計が要ります。
第二に、調達上の交渉力です。1社だけを使っている状態と、他社でも動かせる状態とでは、契約の更新時に取れる姿勢が変わります。特定の事業者に縛られること、いわゆるベンダーロックインを避けたいという動機は、経営の側からいちばん出やすい理由でもあります。
第三に、規制とデータの所在です。特定の国や分野の規則によって、扱えるデータの置き場所や、事業者の要件が限定されることがあります。3社ともこの要求に応じる形を用意しており、たとえばGoogle Distributed Cloudの完全に切り離された形は、規制と適合の要件のために用意されていると公式に説明されています。要件が複数あり、それぞれ別の答えを要求する場合、結果として複数の事業者を使うことになります。
第四に、買収や合併です。これは選んだというより、既成事実として複数になる形です。買収した会社が別のクラウドを使っていれば、統合の日からマルチクラウドになります。この場合、選ぶかどうかではなく、いつまでにどちらへ寄せるか、あるいは寄せないと決めるか、という判断になります。
第五に、特定のサービスが片方にしかない場合です。これがいちばん実務的な理由になりやすいところです。そして、この理由を裏づける材料は、3社の公式ドキュメントの側にも用意されています。BigQuery Omniは、Amazon S3またはAzure Blob Storageに置かれたデータに対して、BigQueryの分析をそのまま実行できると説明されています。Cross-Cloud Interconnectは、Google Cloudと他社のクラウドとの間に広い帯域の専用の接続を用意する製品であり、接続先としてAmazon Web Services、Microsoft Azure、Oracle Cloud Infrastructure、Alibaba Cloudが名指しで挙げられています。AWS Systems Managerは、AWSと自社設備と複数クラウドの環境にあるノードを対象として、まとめて見て、管理して、操作することを助けると公式に説明されています。3社とも、他社のクラウドが存在することを前提にした製品を持っています。複数のクラウドを使う構成は、事業者の側から見ても例外的な使い方ではなくなっています。
マルチクラウドを選ばない理由
次に、選ばない理由です。ここは可用性の話ほど語られませんが、実際に負担として現れるのはこちら側です。
いちばん重いのは、権限の設計です。第9章で確認したとおり、権限とIDは、本記事が扱う分野の中で3社の設計思想がもっとも離れている領域です。AWSは、許可を人や役割の側にも資源の側にも書けます。バケットの側に「どのアカウントの誰に許すか」を直接書ける設計で、公式が挙げるポリシーの種類は9つあります。Azureは加算モデルであり、実効的な権限は割り当ての合計になります。上位に広い権限を付けたまま下位に弱いロールを付けても、下位の割り当ては効きません。絞りたければ拒否の割り当てを使うことになります。Google Cloudは階層に付けた許可ポリシーが、その配下のすべての資源に及びます。さらに、ロールという同じ言葉が、AWSでは権限を与えられる身元の側を指し、AzureとGoogle Cloudでは権限の束の側を指します。
この違いが、マルチクラウドの実務では次のように現れます。ある人がある資源に触れられる理由を調べる作業が、3通り必要になります。AWSでは9種類の場所のどれかを探し、Azureではいくつかのスコープに付いた割り当てを足し合わせ、Google Cloudでは資源から階層をさかのぼります。棚卸しの手順が3通りに分かれるだけではありません。事故の形も3通りに分かれます。AWSでは資源の側に書いた共有の設定が一覧から漏れ、Azureでは絞ったつもりの割り当てが効いておらず、Google Cloudでは上位に付けた許可が新しく作られたプロジェクトにまで及びます。監査のたびに、3つの異なる失敗の型を別々に点検することになります。これが、マルチクラウドで最も見積もりにくい負担だと考えています。
2つ目は、運用の二重化です。監視の設定、ログの保管、当番の手順、障害時の連絡経路、構成をコードで書く記法。これらが2組になります。前章で見たとおり、3社は宣言的な土台とその上の書きやすい層という似た構造を持っていますが、記法そのものは共通ではありません。第三者製の道具を使って記法を1つに寄せる方法はありますが、その場合も、対象の資源の側の作法は事業者ごとに残ります。
3つ目は、人材の分散です。同じ人数で2つの事業者を扱うと、片方に厚く、もう片方に薄くなります。そして事故は、たいてい薄い側で起きます。薄い側は経験が溜まらないので、原因の特定にも時間がかかります。可用性を上げるために複数にしたはずが、薄い側の運用の質によって全体の可用性が決まる、という逆転が起こりえます。
4つ目は、ネットワークの費用と遅延です。事業者をまたぐ通信は、同じ事業者の中の通信と同じようには扱えません。専用の接続を引く手段は用意されていますが、それ自体が設計と調達の対象になります。遅延についても、事業者をまたぐ経路は、同じリージョンの中の経路より長くなります。応答時間に厳しい処理を、事業者をまたぐ経路の上に置く設計は、避けるほうが無難です。データの分析についても制約はあります。前に挙げたBigQuery Omniは、問い合わせを、対象のデータがある場所と同じ場所で処理する仕組みになっており、他社のリージョンとGoogle Cloudのリージョンの対応があらかじめ決められています。どこでも自由に処理できるわけではありません。費用そのものの考え方は第12章で扱います。
5つ目は、監視の分断です。複数の事業者にまたがる1つの処理で不具合が起きたとき、片方の画面だけを見ても原因は見えません。両方の記録を時刻で突き合わせる作業が要りますが、記録の粒度も、保持の期間も、時刻の扱いも事業者ごとに違います。第10章で扱った可観測性の話は、事業者が2つになると、そのまま2倍にはならず、それ以上の手間になります。
最後に、判断の順序について弊社の考えを書きます。複数のクラウドを使うかどうかは、最初に決める問いではないと考えています。先に決めるべきなのは、何を守りたいのかです。1社の障害で止まらないことを守りたいのか、調達の交渉力を守りたいのか、規制への適合を守りたいのか、買収した組織の稼働を守りたいのか。守りたいものが決まると、複数のクラウドを使う範囲も決まります。全社の資産をすべて二重に持つ必要がある組織は、実際にはほとんどありません。止まってはいけない一部の処理だけを二重にし、残りは1社に寄せる、という形が現実的な落とし所になることが多いように思います。そのとき、二重にする範囲を最小に保てるかどうかが、上に挙げた5つの負担の大きさをそのまま決めます。
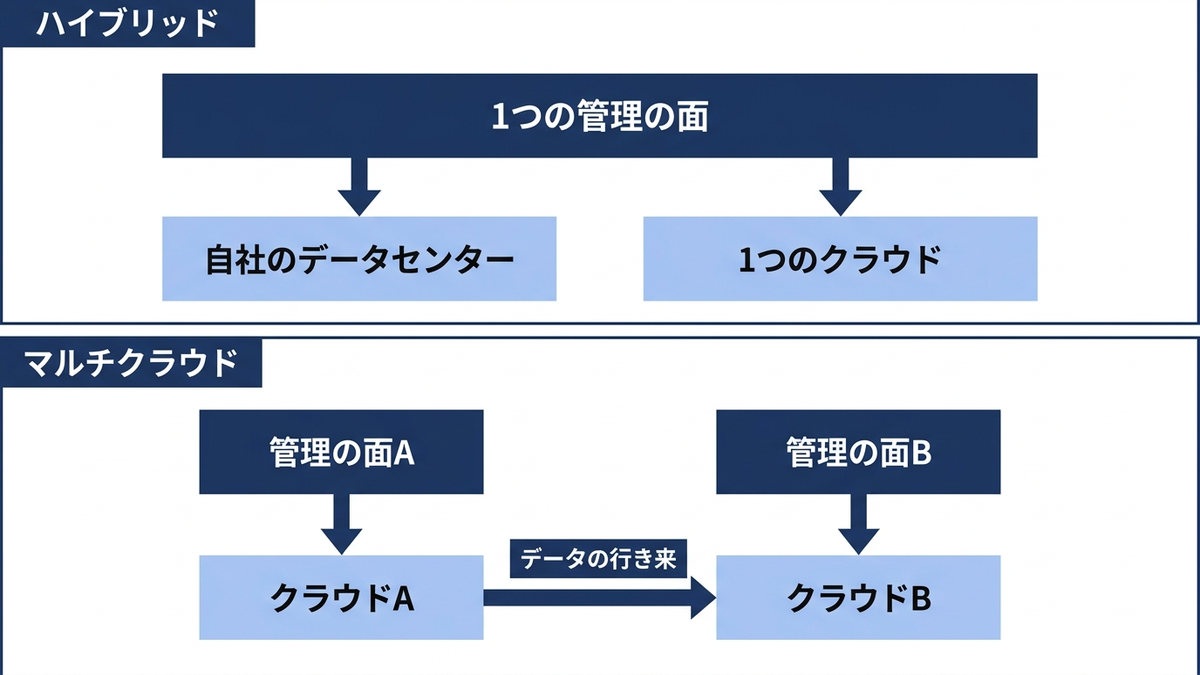
本章の要点を3つにまとめます。第一に、移行の型は3社とも公式に示していますが、名前も数も揃っていないため、型の名前ではなく「作りをどこまで変えるか」を共通の軸に据えて読む必要があります。第二に、移行を助けるサービスは、この数年で最も動いた領域の1つであり、棚卸しの入口だったAWS Application Discovery Serviceが新規の受け付けを終え、AWS Server Migration ServiceとDMS Fleet Advisorが提供を終え、AWS Application Migration ServiceはAWS Transform MGNに改称され、Anthosという名前は単独の製品としては無くなり、その機能は標準のGKEに含まれるものと、GKEに加えて使う製品や機能とに整理されました。数年前の手順書は、そのままでは使えません。第三に、マルチクラウドの判断は、可用性や交渉力といった得たいものと、権限の設計を3通り抱える負担とを、同じ表に並べて比べるべき問いです。次章では、ここで意識的に触れなかった費用の考え方を、課金の型と見積りの手順の側から扱います。
この章を深めたい方への参考書籍
『クラウドシステム移行・導入 アーキテクチャからハイブリッドクラウドまで』(金子格 編著、オーム社):本章で扱った移行の設計と、ハイブリッドの構成を1冊で通して扱っている書籍です。移行の設計、アーキテクチャの基礎、開発と運用、セキュリティ、法制度までを章立てで並べており、本章が事業者ごとのサービス名の側から書いた内容を、事業者に依存しない設計の側から補ってくれます。2022年の刊行なので、サービス名と現況は公式ドキュメントで確かめながら読むことをお勧めします。
『業務システム クラウド移行の定石』(吉羽龍太郎、日経BP):移行を、道具の話ではなく進め方の話として扱った書籍です。企画、戦略と分析、試行、設計と移行、運用と改善という5つの段階に分けて、それぞれで決めることを具体的に並べています。本章で「型を決める前に、いま何があるのかを数える」と書いた工程が、実際にはどれだけの作業量になるのかを掴めます。2018年の刊行のため、登場するサービスの名前は現在と異なります。
『モノリスからマイクロサービスへ』(Sam Newman 著、島田浩二 訳、オライリー・ジャパン):移行の型のうち「作り替える」を選んだ場合に、実際に何をどの順で分解するのかを扱った書籍です。本章では、移行と近代化を同じ期間に置かないほうがよいと述べましたが、では近代化の側をどう刻むのか、という問いにはこの本のほうが詳しく答えています。既存の仕組みを止めずに少しずつ切り出していく手順が、パターンとして整理されています。
第12章 コストの考え方
前章では、既存の資産をどう動かすか、ハイブリッドやマルチクラウドをどういう理由で選び、どういう理由で選ばないかを整理しました。移行の議論は、どの経路をたどっても最後は費用の話に着地します。この章では、クラウドの費用がどういう仕組みで決まるのか、どこで見積りが外れるのか、そして使われ続けている無駄にどうやって気づくのかを、経営の側から扱います。
この記事に料金の金額を書かない理由
最初に、この章の書き方について断っておきます。この記事には、クラウドの料金の金額を1つも書きません。単価も、通貨に換算した例も、割引の率も書きません。数字を出したほうが分かりやすいことは承知したうえで、あえて書かない方針にしています。
理由は3つあります。1つめは、変動が速いことです。クラウドの料金は改定されますし、新しい世代の資源が出れば旧世代との関係も変わります。記事に書いた金額は、書いた時点から古くなり始めます。2つめは、金額が単独では決まらないことです。同じサービスでも、リージョン、構成、契約の形態、支払い方、そして為替によって請求額は変わります。条件を全部書かずに金額だけを載せると、読者は自分の条件に当てはまらない数字を受け取ることになります。3つめが最も重いのですが、記事に載った金額は、読者の見積りにそのまま使われてしまうからです。参考のつもりで書いた1つの数字が、稟議の資料に転記され、予算の根拠になり、あとで実際の請求額とずれて問題になる。これは読者にとって害です。
では代わりに何をするのか。答えははっきりしていて、料金は必ず各社の公式の料金計算ツールで、その時点の条件を入れて自分で出す、ということです。AWSには AWS Pricing Calculator があり、Microsoftには Azure pricing calculator があり、Googleには Google Cloud Pricing Calculator があります。いずれも公開されたツールで、その時点の条件を入れて試算できます。AWS Pricing Calculator については、公式ドキュメントが無償のツールだと明記しています。他の2社の計算ツールが無償かどうかは、本章の照合では確認していません。
ただし、これらのツールの出力も「請求額の保証」ではありません。Google Cloud Pricing Calculator のページには「このツールは、あなたが入力した前提に基づいて費用の見積りを作成します。この見積りは、月々の請求額を正確に反映しない場合があります」という趣旨の注記が置かれています。AWS Pricing Calculator の公式ドキュメントも、料金の掲載ページとツールの値が食い違う場合は掲載ページの値を使うと明記しています。ツールは、条件を整理して比較するための道具であって、見積書ではありません。経営の側は、見積りを一点の数字ではなく幅として受け取るべきです。
課金モデルには4つの型がある
個々の料金表を覚える必要はありません。覚えるべきは型です。3社の課金の仕組みは、大きく4つの型に整理できます。
1つめが従量課金です。使った分だけ払う形で、事前の約束はいりません。いつでも止められる代わりに、単価は最も高くなります。使用量が読めないもの、期間が短いもの、これから作るものはここから始めるのが自然です。2つめが、使う量を先に約束して割安にする型です。1年や3年といった期間の利用を確約する代わりに単価が下がります。3つめが、中断を受け入れて安く実行する型です。クラウド側に余っている容量を借りる形で、事業者が容量を必要としたときには止められます。4つめが無料枠です。試す段階のための入口で、運用の設計に使うものではありません。
この4つは排他ではありません。実務では、常時動く基盤を2つめの型で押さえ、変動する部分を1つめで受け、バッチや実験を3つめに逃がす、という組み合わせになります。どの型を使うかは、単価の話ではなくワークロードの性質の話です。止められない処理を3つめに置けば事故になりますし、来月には作り直す予定のものを2つめで3年約束すれば損をします。
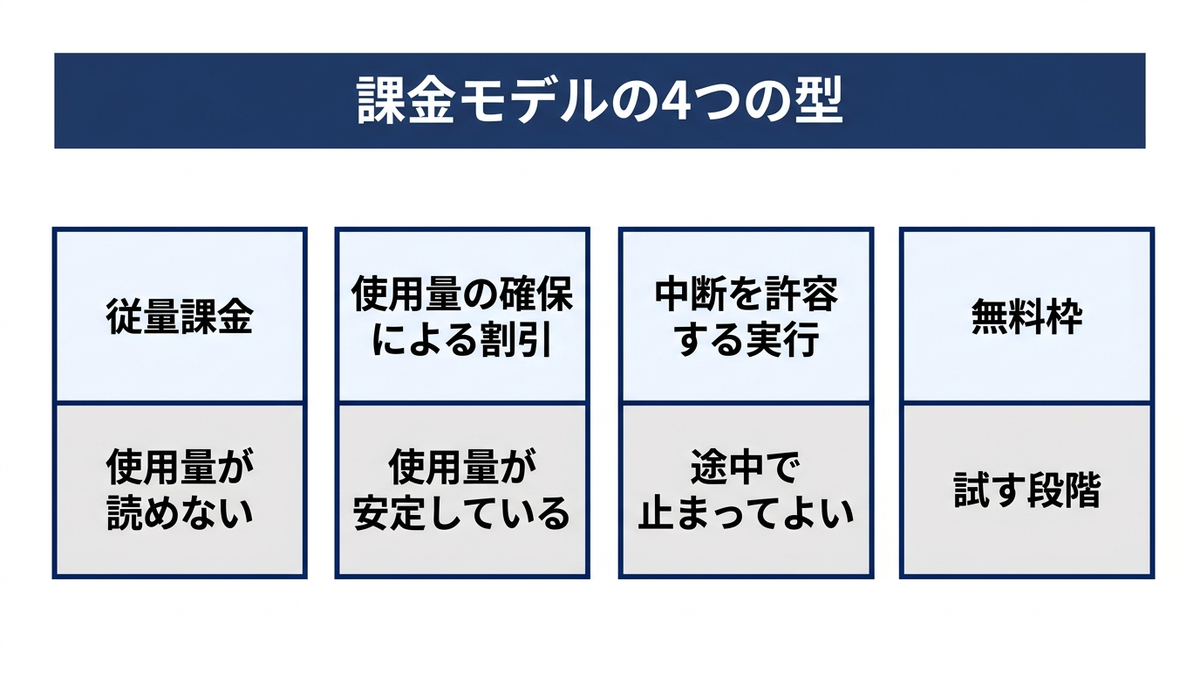
使う量を先に約束する型は、どのワークロードに向くか
3社とも、確約と引き換えに割安にする仕組みを持っています。ただし中身の設計は同じではありません。
AWSの Savings Plans は、1年または3年の期間について、1時間あたりの計算能力の使用を確約する形です。公式ドキュメントには Compute Savings Plans、Database Savings Plans、EC2 Instance Savings Plans、SageMaker AI Savings Plans の4種類が挙げられています。Compute Savings Plans はインスタンスファミリ、サイズ、OS、テナンシー、リージョンを問わず自動で適用され、Fargate と Lambda の使用にも及びます。EC2 Instance Savings Plans は、選んだリージョンの特定のインスタンスファミリに絞る代わりに、割引が深くなります。支払い方は全額前払い、一部前払い、前払いなしの3通りです。公式ドキュメントは「確約の条件は購入後に変更できない」と明記しています。これに加えて、資源そのものを指定して確保する Reserved Instances があります。
Azureは Azure Reservations と savings plan の2本立てです。Reservations は1年または3年で、購入時に選んだSKU(製品の種類やサイズを識別する品目の単位)、リージョン、適用範囲に一致した使用量へ自動的に割引が当たります。savings plan は1時間あたりの支出額を確約する形で、Savings plan for compute が1年と3年、Savings plan for databases が1年です。公式ドキュメントは両者の違いを明快に書いていて、savings plan は対象のサービスとリージョンをまたいで自動適用されるので変化するワークロードに向き、Reservations は資源とサイズとリージョンを固定するぶん割引が深く、使用量が安定している場合に向く、としています。運用上の差も見逃せません。Reservations には交換と払い戻しの制度がありますが、savings plan は購入後にキャンセルも払い戻しもできません。ただし交換の制度には変更が告知されています。公式ドキュメントは、2027年2月1日以降に購入した予約は、対応するサービスが savings plan の対象であれば交換の対象外になり、それより前に購入した予約には最後の1回の交換の権利が残る、と書いています。払い戻しにも、一定期間内の合計額の上限などの制限が付いています。また savings plan では、ある時間に使い切らなかった確約分は繰り越されずに消えます。
Google Cloudの committed use discounts は、支出ベースとリソースベースの2種類です。支出ベースは1年または3年で、一定額の支出を確約します。リソースベースは Compute Engine 専用で、vCPU、メモリ、GPU、ローカルSSD、単一テナントノード、OSライセンスといった資源の量を確約し、期間は最長6年まで取れます。加えて Google Cloud には、確約しなくても自動的に付く継続利用割引があります。公式ドキュメントは、請求月の4分の1を超えて対象の資源を使うと、それ以降の増分の時間に自動で割引が付き、有効にするための操作は不要だと説明しています。対象はN1、N2、N2D、C2、M1、M2といった機種と単一テナントノード、そしてN1に接続したGPUです。
経営の側が押さえるべき点は1つです。確約は契約であり、使わなくても支払いは発生します。したがって確約してよいのは、事業の判断として「1年後も3年後も動いている」と言い切れる部分だけです。実験、季節性の強い処理、廃止の検討が始まっている系は対象にしません。判断の材料は各社が推奨として出してくれますが、推奨は過去の使用量から作られるので、来期の計画は入っていません。推奨をそのまま買わないことです。
中断を受け入れる型と、無料枠の読み方
3社とも、余っている容量を安く提供する仕組みを持っています。共通しているのは、いつ止められても文句を言えないという条件です。
AWSのSpot Instancesは、事業者が容量を回収するときに停止、休止、または終了されます。公式ドキュメントによれば、中断の通知は2分前に出ます。加えて、中断の危険が高まった段階で事前に知らせる仕組みも用意されています。向く用途としてAWS自身が挙げているのは、データ分析、バッチ処理、バックグラウンドの処理、必須ではないタスクです。注意点として、Spot Instances には Savings Plans の割引は重ならず、Spot への支出は Compute Savings Plans の確約の消化にも使われません。
Azure Spot Virtual Machines には可用性の保証がありません。公式ドキュメントは、Azureが容量を必要としたときに30秒前の通知で退避させると書いています。退避のポリシーは、停止して割り当てを解除する形と、削除する形の2つから選びます。前者を選ぶと再度立ち上げ直せますが、その間もディスクの保管の費用は続きます。ここは見落とされやすいところです。なお Azure Batch のドキュメントは、この仕組みを Spot VM と呼んでいますが、APIのパラメータとメトリクスの名前には Low-Priority という旧来の呼び方が残っています。表に見える名前と、内部の名前がずれたまま並走するというのは、クラウドではよくある状態です。この点は第14章でも改めて扱います。
Google Cloud の Spot VMs は、公式ドキュメントが「preemptible VMs の最新版」と位置づけています。耐障害性のあるワークロード向けで、明示的に制限しない限り実行時間の下限も上限もありません。バッチ処理のように、一部のVMが途中で止まっても全体としては遅くなるだけで止まらない構造の仕事に向く、という説明がされています。
逆に向かないものもはっきりしています。1台の退避で全体をやり直すことになる長時間の並列ジョブ、すぐに容量が必要な処理、そして状態をVM内部にだけ持っている処理です。この型を使うなら、途中経過を外部に保存して再開できる作りが前提になります。安さは設計の対価であって、設定の対価ではありません。
無料枠は、3社とも形が違います。AWSは現在、無料のプランと有料のプランという2つの入り口を用意し、月間の上限内で常に無料で使えるサービス群は両方のプランで使えるとしています。Azureは、無期限に無料のもの、12か月無料のもの、30日間無料のものが混在しており、公式ドキュメント自身が「制約をよく見るように」と注意を促しています。Google Cloudは、90日間の無料トライアルと、月次の上限内であれば継続して無料になる枠と、製品ごとの試用期間という3層です。無料トライアルは期間か与信を使い切った時点で請求先が閉じられ、関連するプロジェクトと資源が停止します。
無料枠の扱い方の原則は簡単です。無料枠は入口の設計であって、運用の設計ではありません。上限を前提に本番を組むと、利用が伸びた瞬間に費用が立ち上がります。無料枠は、技術を試して判断するための時間を買うものだと考えるのが安全です。
3社の課金モデルとコスト管理の道具
ここまでの内容を、役割ごとに並べます。各社の公式ドキュメントで名称と位置づけを確認したものだけを載せています。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 支出額を確約して広く適用する割引 | Savings Plans(Compute・Database・EC2 Instance・SageMaker AI の4種類) | savings plan(Savings plan for compute・Savings plan for databases) | 支出ベースの committed use discounts |
| 資源を指定して確保する割引 | Reserved Instances | Azure Reservations | リソースベースの committed use discounts |
| 確約なしで自動的に付く継続利用の割引 | 本章の照合では確認していません | 本章の照合では確認していません | sustained use discounts |
| 中断を受け入れる安価な実行 | Amazon EC2 Spot Instances | Azure Spot Virtual Machines | Spot VMs |
| 費用の分析と可視化 | AWS Cost Explorer | Microsoft Cost Management の Cost Analysis | Cloud Billing のレポート |
| 予算と超過の通知 | AWS Budgets | Microsoft Cost Management の予算アラート | Cloud Billing の予算とアラート |
| 想定外の増加の検知 | Cost Anomaly Detection | Microsoft Cost Management の異常検出 | 本章の照合では確認していません |
| 改善の推奨事項の自動検出 | AWS Trusted Advisor・AWS Compute Optimizer・Cost Optimization Hub | Azure Advisor | Active Assist の Recommender・FinOps Hub |
| 費用を組織に割り当てる仕組み | コスト配分タグ・コストカテゴリ | リソースタグ・管理グループ・請求プロファイル | ラベル・プロジェクト |
| 明細を外部へ出す仕組み | データエクスポート | エクスポート・Cost Details API | BigQuery への課金データのエクスポート |
| 事前の見積り | AWS Pricing Calculator | Azure pricing calculator | Google Cloud Pricing Calculator |
同じ役割の枠に入るというだけで、同じものではありません。とくに割引の仕組みは、適用の範囲、柔軟性、購入の単位が3社で違います。AWSの Compute Savings Plans は計算能力の使用を時間あたりで確約する形、Azureの savings plan は支出額を時間あたりで確約する形、Google Cloudの支出ベースの割引はさらに別の設計です。確約した分を使い切らなかったときの扱いも、途中で構成を変えたときに割引が付いてくる範囲も、解約や交換ができるかどうかも、それぞれ条件が異なります。表の1行は「この役割を担うものが各社にある」ことだけを示しており、乗り換えの可否や置き換えの容易さを示すものではありません。具体的な条件は、購入を判断する時点の公式ドキュメントで必ず確かめてください。また「本章の照合では確認していません」と書いた欄は、そのサービスが存在しないという意味ではなく、今回の調査で公式の記述に当たれなかったという意味です。
オンプレミスとの比較で誤りやすいこと
クラウドの費用を、自社の設備を持つ場合と比べるときに、誤りやすい点が4つあります。
1つめは、初期投資が運用費に変わることです。機器を購入して資産に計上し減価償却する形から、毎月の費用として計上する形へ変わります。これは技術の話ではなく会計と予算編成の話であり、稟議の通し方も、部門ごとの予算の立て方も変わります。設備投資の枠が余っていても、費用の枠が足りなければ止まります。この点を先に社内で合意しておかないと、技術的には正しい移行が予算の都合で止まります。
2つめは、使わなければ止められることです。設備は買った瞬間に費用が確定しますが、クラウドは止めれば止まります。開発環境を夜間と週末に停止する、といった運用が費用に直結します。ただし「止まるもの」と「止まらないもの」があり、そこを取り違えると期待した効果が出ません。
3つめが、その裏返しで、止め忘れが積み上がることです。設備の場合、使われなくなったサーバはラックに残るだけで追加の支出は生みません。クラウドでは、存在しているかぎり課金が続きます。分かりやすい例が、外向きの通信を中継する NAT ゲートウェイです。AWSの公式ドキュメントは「NATゲートウェイをプロビジョニングすると、そのゲートウェイが利用可能である各時間と、処理された各ギガバイトについて課金される」と書いています。トラフィックがゼロでも、置いてあるだけで時間あたりの課金は立ちます。設備の世界の「置いてあるだけなら無害」という感覚が、そのままでは通用しません。
4つめが、誰も発注しないことです。設備であれば購買の手続きを通るので、必ずどこかで人が承認します。クラウドでは、開発者が操作を1回行えば資源が増えます。承認という関門が消えたぶんを、可視化と事後の点検で埋める必要があります。ここが次の2節の主題です。
見積りの立て方と、見積りが外れる典型的な原因
見積りの手順そのものは単純です。構成を決め、各社の料金計算ツールに条件を入れ、月次の想定額を出し、幅を持たせて社内に出す。AWSの場合は、公開の計算ツールが定価での試算であるのに対し、コンソール内の見積り機能では自社の割引や購入済みの確約を反映した試算ができます。この2つは別物なので、どちらの数字なのかを明示して扱ってください。
問題は、見積りが外れるときの外れ方に、はっきりした型があることです。実務で繰り返し起きるものを5つ挙げます。
データ転送。計算資源やストレージとは別に、通信そのものに課金の軸が立ちます。先ほどのNATゲートウェイの例では、時間あたりの課金と処理量あたりの課金の2軸がありました。AWSの公式ドキュメントは、可用性ゾーンをまたぐ通信が多い場合の対策として、資源をゲートウェイと同じゾーンに寄せるか、ゾーンごとにゲートウェイを置くかを挙げています。これは単価の問題ではなく、配置の設計の問題です。見積りの段階で通信の経路を描いていないと、まず抜けます。
ストレージの階層。保存の階層を落とすと保管の費用は下がりますが、取り出しの費用や最低の保管期間といった条件が付くことがあります。見積りでは保存量だけを入力し、読み出しの頻度を入力しないため、実際の請求が想定を超えます。階層の選択は第3章で扱ったとおり、アクセス頻度と保管期間の設計そのものです。
アイドル状態のリソース。作ったまま使われていないものです。AWS Trusted Advisor がコスト最適化の項目として拾うものを見ると、関連付けのない Elastic IP アドレス、アイドル状態のロードバランサー、使用率の低い EBS ボリューム、使用率の低い EC2 インスタンス、アイドル状態の RDS DBインスタンス、アイドル状態の NATゲートウェイ、使われていない VPC のインターフェイスエンドポイントといった項目が並びます。これらを見積りに織り込む人はいません。見積りは「これから使うもの」の計算であり、「使わなくなったのに残るもの」は計算の外側にあるからです。
ログの保存量。監視や監査を厚くすると、ログの取り込みと保管が費用の柱になります。AWSの CloudWatch Logs には、通常のログの取り込みと分析に使う Standard と Infrequent Access という2つのログクラスがあり、公式ドキュメントによれば両者の費用の違いは取り込みの費用だけです。このほかに、Lambda のログを Amazon S3 や Amazon Data Firehose へ配送する用途に限った Delivery というクラスが別枠で置かれており、こちらはログの保持期間が2日で固定されています。ただし公式ドキュメントは、ロググループを作成したあとにログクラスを変更できないと明記しています。つまりこれは運用で調整できる項目ではなく、設計時に決める項目です。ログの設計を第10章の話として切り離しておくと、費用の見積りからは丸ごと落ちます。
マネージドサービスの最小構成。マネージドのサービスには、使用量にかかわらず立つ最小の費用があります。Azure の App Service が分かりやすい例です。公式ドキュメントによれば、課金の単位はアプリではなく App Service プランで、専用の階層ではプランが持つVMインスタンスの数に対して課金されます。同じプランに複数のアプリを載せれば資源を共有しますが、逆に「アプリごとにプランを分ける」設計にすると、アプリの数だけ最小構成が積み上がります。同種のことは、マネージドのデータベース、検索、メッセージングでも起こります。
この5つを踏まえたうえで、実務としては、運用を始めて1か月たった時点で見積りと実測を突き合わせ、差の原因を1つずつ潰す作業を必ず予定に入れてください。見積りは当てるものではなく、外れ方を学ぶための道具です。
使われ続ける無駄をどう見つけるか
費用を減らす作業は、金額を睨むところからは始まりません。誰の費用かを決めるところから始まります。
そのための最初の道具がタグ付けと原価配賦です。資源にタグを付け、そのタグを軸に費用を切り分け、部門や案件や環境に割り当てます。ここに、3社に共通する落とし穴があります。AWSでは、資源にタグを付けただけでは費用の側に現れません。請求のコンソールでそのタグをコスト配分タグとして有効化する操作が別に必要で、AWSが自動生成するタグとユーザーが定義するタグは、それぞれ別に有効化します。公式ドキュメントは、タグが請求の画面に現れるまで最大で24時間かかるとしています。「タグは付けているのに費用が割り当てられない」という相談の多くは、この有効化を忘れているか、有効化した時期より前の期間を見ていることが原因です。
Azureでは、リソースタグに加えて、管理グループ、サブスクリプション、リソースグループ、請求プロファイルと請求書のセクション、企業向け契約の部門と登録アカウントといった階層が、そのまま費用の切り口になります。公式ドキュメントは「リソースタグは、費用の明細に自社の業務上の文脈を持ち込める唯一の手段」と書いています。Google Cloudでは、ラベルとプロジェクトが主な切り口になり、さらに課金データを BigQuery へ書き出して分析できます。書き出しの形式には、標準の使用量と費用、資源の粒度まで含む詳細な使用量と費用、料金データ、そして事業者をまたいで正規化する FOCUS の形式があります。
2つめの道具が予算アラートです。3社とも、予算の額と閾値を設定して通知を出せます。ここで最も高くつく誤解を潰しておきます。予算を置いただけでは、利用も課金も止まりません。Google Cloudの公式ドキュメントは「アラートのみの予算を設定しても、使用量や支出が自動的に上限で止まるわけではない」と明確に書いています。Azureの公式ドキュメントも、予算の閾値を超えると通知は出るが、リソースは影響を受けず消費も止まらない、と書いています。止めるための仕組みは各社に用意されていますが、それぞれ範囲に条件が付きます。AWS Budgets には、閾値を超えたときに IAM ポリシーやサービスコントロールポリシーを適用したり、指定した EC2 や RDS のインスタンスを対象に処理を実行したりする budget actions という機能があり、自動で実行するか、手動の承認を挟んでから実行するかを選べます。Google Cloudには、指定したサービスの利用を上限で自動的に一時停止する spend cap の予算がありますが、公式ドキュメントはこれをプレビューの機能と位置づけ、対象を一部のAPIベースのサービスに限ったうえで、単一のプロジェクトと単一のサービスに絞った月次の予算でしか使えない、と書いています。Azureでは、予算にアクショングループを結び付けて、通知の先で処理を呼び出す形になります。予算は、まず気づくための道具です。止めるところまで使うなら、何を、どの範囲で、誰の承認で止めるのかを設計して初めて機能します。予算を置いただけで安心してはいけません。
3つめが、推奨事項の自動検出です。AWS Trusted Advisor は、コスト最適化、パフォーマンス、セキュリティ、耐障害性、サービスの制限、運用上の優秀性という6つの分類で点検を行います。ただし全項目を見るには対象のサポートプランへの加入が要り、基本のプランでは見られる範囲が限られます。AWS Compute Optimizer は、標準では直近14日分の利用状況の指標から、サイズの適正化と遊休の判定を行います。公式ドキュメントによれば、観測する期間は推奨の設定を有効にすると最長93日分まで延ばせるほか、遊休の判定では資源の種類によって別の期間が使われます。AWS Cost Optimization Hub は、これらの推奨をアカウントとリージョンをまたいで1つの画面に集約し、自社の割引や購入済みの確約を織り込んだうえで並べ替えられるようにしたものです。Azureでは Azure Advisor が、信頼性、セキュリティ、パフォーマンス、コスト、オペレーショナルエクセレンスの5分類で推奨を出します。Google Cloudでは Active Assist という枠組みのもとに各種の Recommender が置かれ、FinOps Hub がそれらを集約します。FinOps Hub の公式ドキュメントは、推奨を「遊休資源の停止」「サイズの適正化」「構成の変更」「確約利用割引の購入」という4つの実践に沿って提示すると説明しています。
4つめが、未使用リソースの棚卸しです。推奨事項の機能は「今そこにある無駄」を出しますが、「無駄が作られ続ける仕組み」までは出しません。検証のために立てた環境が消されない、退職した担当者の作った資源が残る、廃止したはずのサービスの周辺が生きている。こうしたものは、四半期に一度、環境と担当者を軸に人が棚卸しをするしかありません。自動検出と棚卸しは、代わりになるものではなく、両方を回すものです。
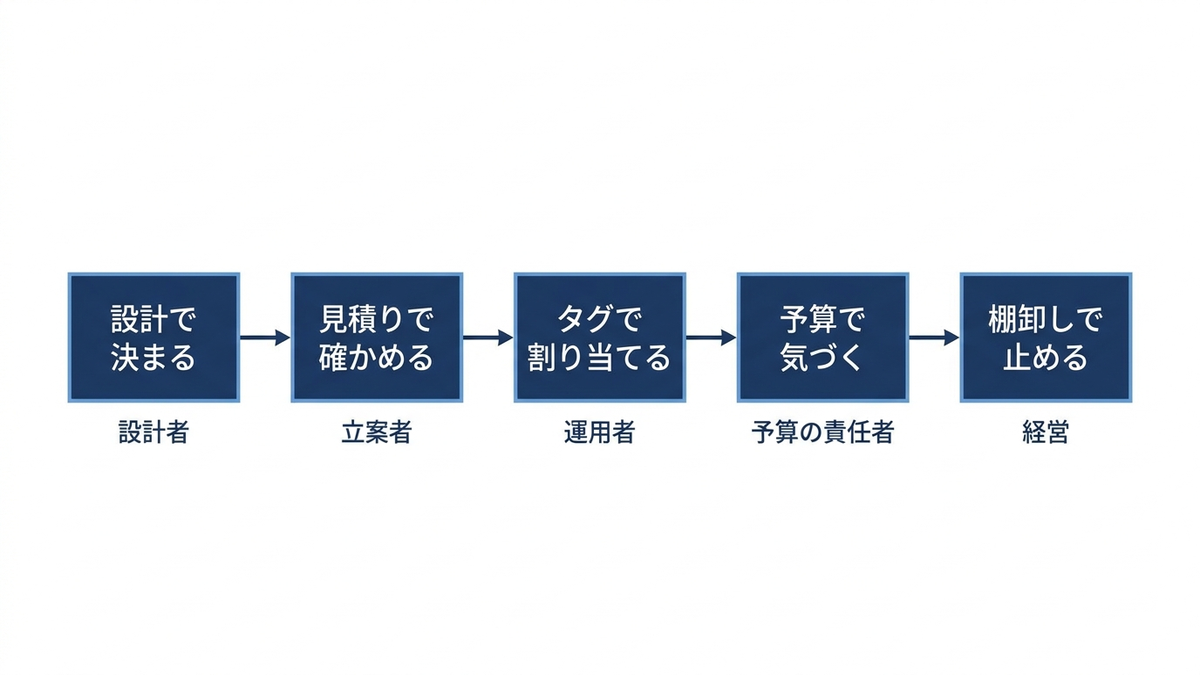
誰が、いつ、どの単位で責任を持つのか
ここが、この章で最も経営に近い部分です。結論を先に書きます。クラウドのコストは技術の話ではなく、設計と運用の話です。そして設計と運用は、組織の決め事がないと動きません。
この見方は、3社の公式の指針が揃って示しているものでもあります。AWSの Well-Architected フレームワークのコスト最適化の柱は、2024年6月27日付の文書として公開されており、達成すべき目標として「クラウド財務管理の実践」「支出と使用の把握」「費用対効果の高いリソース」「需要と供給の管理」「継続的な最適化」の5つを挙げます。読者として想定しているのは技術と財務の両方で、CTOとCFOが並記されています。Azure の Well-Architected フレームワークのコスト最適化の柱は、設計原則として「コスト管理の規律を作る」「費用効率を意識した設計」「使用量の最適化のための設計」「レートの最適化のための設計」「継続的な監視と最適化」の5つを置いています。Google Cloud のアーキテクチャフレームワークのコスト最適化は、「クラウドの支出を事業価値に合わせる」「コストを意識する文化を育てる」「リソースの使用を最適化する」「継続的に最適化する」の4原則です。
3社が別々に書いているのに、言っていることはほぼ同じです。文化と規律が先で、道具は後です。Google Cloud の文書は、2つめの原則の説明として「組織の全員が自分の判断と活動の費用への影響を意識し、そのために必要な費用の情報にアクセスできる状態にすること」という趣旨のことを書いています。情報が見えない人に責任を持たせることはできない、という当たり前の話です。
実務に落とすなら、決めることは4つです。1つめ、割り当ての単位を決める。案件なのか、部門なのか、環境なのか。ここが決まらないと、誰の費用か分からず、誰も減らせません。2つめ、単位ごとにオーナーを1人決める。複数人で見る体制は、実質的に誰も見ない体制になります。3つめ、見る頻度を決める。月次の締めを待つと、気づいたときには1か月分が確定しています。週次で見れば、止められる余地が残ります。4つめ、閾値を決めて自動で通知する。ただし前節のとおり、通知だけでは止まりません。通知を受けた人が何をするか、自動で止める範囲をどこまでにするかを、あらかじめ手順にしておきます。
経営が下すべき最も重要な決定は、個々の金額の承認ではありません。割り当ての単位と、その単位のオーナーを決めることです。ここが決まっていれば、金額の判断は現場で回ります。決まっていなければ、経営がいくら金額を睨んでも減りません。
FinOpsという言葉の位置づけ
ここまで述べてきたことをまとめて呼ぶ言葉として、FinOpsが広く使われるようになりました。用語としての位置づけを整理しておきます。
FinOps Foundation は、この言葉を次のように定義しています。「FinOpsは、技術の事業価値を最大化し、適時のデータに基づく意思決定を可能にし、エンジニアリング・財務・事業の各チームの協働を通じて財務上の説明責任を生み出す、運用のフレームワークであり文化的な実践である」。この定義は FinOps Foundation のフレームワークのページから引きました。同ページには2026年3月20日付でフレームワークの更新が告知されており、配布されている資料も2026年3月の日付になっています。団体の定義を借りるときは、借りた時点の版を明示してください。フレームワークは更新されるので、数年後には別の言い回しになっている可能性があります。ここに書いたのは、2026年9月時点で公開されている版です。
定義を読むと分かるとおり、FinOpsは「コスト削減の活動」ではありません。目的は事業価値の最大化であって、支出の最小化ではないからです。単に安くしたいだけなら、使うのをやめるのが最も安く済みます。FinOpsが問うているのは、支出に見合う価値が出ているか、その判断に必要な情報が関係者に届いているか、そして判断の責任が明確かどうかです。コスト削減の施策集として読むと、この言葉は誤解されます。
もう1つ、規模の話をしておきます。Google Cloud のアーキテクチャフレームワークは「FinOpsは、規模やクラウドの成熟度にかかわらず、どの組織にも関係がある」という趣旨のことを書いています。専任のチームを置ける規模でなければ意味がない、という話ではありません。担当者が1人でも、決めることは同じ4つ、つまり割り当ての単位、オーナー、頻度、通知後の手順です。役割が分かれていない組織では、同じ人が技術と財務の両方の帽子をかぶるというだけのことです。
この章では、課金の4つの型と、それぞれが向くワークロード、見積りが外れる5つの典型、そして無駄を見つけるための道具と組織の決め事を整理しました。要点は2つです。1つは、料金の金額は各社の公式ツールでその時点の条件を入れて出すものであり、記事や資料に書き写した数字を使い回さないこと。もう1つは、費用は買うときに決まるのではなく、設計するときと止め忘れるときに決まるということです。次の第13章では、ここまでの各章で扱ってきた3社のサービスの対応関係を、カテゴリごとの表として1か所に集めます。対応表は便利ですが、同じ枠に入るというだけで置き換えられるわけではないという点を、そこでも繰り返し確認していきます。
この章を深めたい方への参考書籍
『クラウドFinOps(第2版)』(J.R. Storment、Mike Fuller、オライリー・ジャパン):この章の後半で扱った「誰が、いつ、どの単位で責任を持つのか」を1冊かけて論じた本です。原著の第2版の翻訳で、費用の可視化から配賦、確約の判断、組織としての運営までを段階として整理しています。道具の使い方ではなく組織の設計の本として読むと、社内で議論を始めるときの共通言語になります。
『AWSコスト最適化ガイドブック』(門畑顕博ほか、KADOKAWA):AWSに絞って、費用の構造の読み方と削減の打ち手を具体的に扱った本です。この章では金額を書かない方針をとりましたが、実際に自社の請求を分解する段では、サービスごとの課金の軸を1つずつ確認する作業が要ります。その手順を追いたい方に向いています。刊行は2023年なので、サービス名と機能の現況は公式ドキュメントで補ってください。
『[PM&スタートアップのための]はじめてのクラウドコスト管理』(津郷晶也、技術評論社):インフラの費用と会計をつなぐ視点で書かれた入門書です。この章の「初期投資が運用費に変わる」という論点を、事業計画や損益の見方の側から補ってくれます。技術者ではない立場でクラウドの費用を説明する必要がある方の、最初の1冊として使えます。
第13章 3社の対応関係の地図
前章では、課金の型と見積りの立て方、そして使われ続ける無駄をどう見つけるかを整理しました。ここまでの12の章で、領域ごとに3社のサービスを見てきたことになります。この章では、それを1つの地図に集めます。カテゴリごとに「役割」と3社のサービス名を並べた表を置き、そのうえで、対応表という道具そのものが持っている危うさを扱います。表は便利ですが、便利であるぶん誤読されやすい道具でもあります。
この地図の読み方を、先に3つ決めておく
表を並べる前に、読み方の前提を3つ決めておきます。この3つを共有しないまま対応表を配ると、社内の議論がかえって荒くなります。
1つめは、同じ役割の枠に入るというだけで、同じものではないということです。表の同じ行に並んでいるのは「その会社では、だいたいこの役割をこのサービスが担っている」という程度の意味しか持ちません。管理の単位、広がる範囲、既定の設定、上限、運用のときに必要になる周辺の部品は、いずれも同じではありません。この章で並べる表のうち、いくつかの行では、同じ名前の枠に入っているのに前提がはっきり違うところまで踏み込みます。
2つめは、対応が付かないものがあるということです。対応表は、どの行にも3つのマス目があるという形をしているので、埋まっていることが自然に見えます。しかし実際には、片方にしか無いもの、1つのサービスが他社の複数に相当するもの、逆に他社の複数が1つに相当するものがあります。表の形式そのものが、この事情を隠します。この章では、隠れるほうを明示的に取り出して節を分けました。
3つめは、この地図は出発点であって、選定の根拠ではないということです。地図の役割は、検討の入口でカテゴリの当たりを付けることまでです。要件を満たすかどうかは、必ずその時点の公式ドキュメントで確かめる必要があります。クラウドのサービスは、名前が同じまま中身が変わることも、中身が同じまま名前が変わることもあります。第14章で扱うとおり、この記事が対象にしている期間だけでも、改称と統合と提供終了がかなりの数ありました。
なお、この章の表に載せているのは、第1章から第12章までの各章で公式ドキュメントを直接確認したものだけです。確認できなかったものは、空欄にせず「本記事の照合では確認していません」と書いてあります。空欄と「確認していません」は違います。前者は「無い」と読まれますが、後者は「調べた範囲では見つからなかった」という意味しか持ちません。公式の一覧に載っていないことは、そのサービスが存在しないことの証明にはなりません。
土台の層。計算資源とコンテナ、ストレージ、データベース
まず、いちばん土台に近い層からです。仮想マシン、コンテナの実行基盤、アプリケーションを載せるだけの実行環境が、この層に入ります。詳細は第2章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 仮想マシン | Amazon EC2 | Azure Virtual Machines | Compute Engine |
| 同じ構成の仮想マシンをまとめて増減させる単位 | Auto Scalingグループ | 仮想マシンスケールセット | マネージドインスタンスグループ |
| マネージドKubernetes | Amazon EKS | Azure Kubernetes Service | Google Kubernetes Engine |
| ノードを自分で用意しない形 | EKS Auto Mode、Fargateプロファイル | AKS Automatic | Autopilotモード |
| コンテナの置き場所を決めるレジストリ | Amazon ECR | Azure Container Registry | Artifact Registry |
| 古くからあるPaaS型の実行環境 | AWS Elastic Beanstalk | Azure App Service | App Engine |
| あとから加わったコンテナ寄りの実行環境 | AWS App Runner | Azure Container Apps | Cloud Run |
| 仮想デスクトップ | Amazon WorkSpaces | Azure Virtual Desktop | 本記事の照合では確認していません |
この表の行は、置き換え可能であることを意味しません。たとえば「ノードを自分で用意しない形」の行は、3社とも似た言葉で説明されていますが、手放した結果として受け入れる制約は同じではありません。Amazon EKS では、クラスターの基盤ごとAWSに任せる EKS Auto Mode と、ポッドの単位で置き場所を指定する Fargate プロファイルとで、手放す範囲そのものが違います。このうち Fargate プロファイルでは、公式ドキュメントがデーモンセットに対応しないこと、GPUを使えないこと、Amazon EBS のボリュームを付けられないこと、ポッドがプライベートサブネットでのみ動くことを明記しています。Azure Kubernetes Service では、独自のネットワーク構成やWindowsのノードプールが必要ならAKS Standardを使うようにと案内されています。同じ「手放す」でも、手放せないものが会社ごとに違うということです。
もう1つ、この表を読むときに注意が要る行があります。「あとから加わったコンテナ寄りの実行環境」です。AWSの App Runner は、2026年3月31日の告知で新規に開始できない段階の一覧に掲載され、2026年4月30日から新規の顧客を受け付けなくなりました。既存の利用者は、新しい資源やサービスの作成を含めてこれまでどおり使えると公式に記載されており、移行先として Amazon ECS Express Mode が案内されています。告知の日と受け付けを止めた日は別の日付で、状態も「終了」ではなく「新規の受け付けの停止」です。表の同じ行に並んでいても、これから新しく使い始められるかどうかが違います。対応表は現在の状態を写した静止画であって、これからも同じであることを保証しません。
次はストレージです。詳細は第3章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 名前を指定して取り出す塊の置き場 | Amazon S3 | Azure Blob Storage | Cloud Storage |
| 1台の計算資源に接続して使う器 | Amazon EBS | Azure Managed Disks | Hyperdisk、Persistent Disk |
| 複数の計算資源が同時にたどる共有の木 | Amazon EFS、Amazon FSx の各種 | Azure Files | Filestore |
| 既定で置かれる層 | S3 Standard | Hot | Standard storage |
| 取り出しが少ないデータの層 | S3 Standard-IA、S3 One Zone-IA | Cool | Nearline storage |
| さらに取り出しが少ない層 | S3 Glacier Instant Retrieval | Cold | Coldline storage |
| ほとんど取り出さない層 | S3 Glacier Flexible Retrieval、S3 Glacier Deep Archive | Archive | Archive storage |
| 層のあいだを自動で動かす仕組み | S3 Intelligent-Tiering | Smart tier | Autoclass |
| 機器を送って大量に運ぶ経路 | Snow ファミリ。第3章で扱ったとおり縮小している | Azure Data Box | Transfer Appliance |
ここでも、同じ行に並ぶことと同じものであることは別です。いちばん分かりやすいのが「ほとんど取り出さない層」の行です。3社とも Archive という語を使っていますが、そこから取り出すときの前提が違います。AWSでは先に復元の操作が必要で、待ち時間は分から時間の単位です。Azureではオンラインの層へ戻す操作が必要で、公式ドキュメントは最大15時間と記載しています。Google Cloudの Archive storage は、公式ドキュメントがミリ秒で利用できると明記しています。同じ名前の層に置いたつもりで、事業継続の計画がまったく別物になる行です。最短の保管期間についても、AWSとAzureが30日、90日、180日の3段であるのに対し、Google Cloudは30日、90日、365日の3段です。表の「取り出しが少ないデータの層」が30日、「さらに取り出しが少ない層」が90日にあたり、AWSでは S3 Glacier Flexible Retrieval も90日で、180日にあたるのは S3 Glacier Deep Archive だけです。
続いてデータベースとキャッシュです。この領域は、対応表がいちばん誤解を招きやすいところです。同じ「マネージドなリレーショナルデータベース」という枠でも、どこまでを事業者が引き受けるかが違いますし、同じ「文書データベース」でも中の作りが違います。詳細は第4章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 既存のエンジンをそのまま動かすマネージド | Amazon RDS | Azure Database for MySQL flexible server、Azure Database for PostgreSQL flexible server | Cloud SQL |
| 事業者が独自に手を入れた上位の選択肢 | Amazon Aurora | Azure SQL Database | AlloyDB for PostgreSQL |
| 規模の拡大と強い整合性の両立をうたう系統 | Amazon Aurora DSQL | 本記事の照合では確認していません | Spanner |
| 鍵を指定して1件を取り出す用途の中心 | Amazon DynamoDB | Azure Cosmos DB | Firestore、Bigtable |
| MongoDB互換をうたう文書データベース | Amazon DocumentDB | Azure DocumentDB、および Azure Cosmos DB の MongoDB 向けの窓口 | Firestore |
| ワイドカラムの形 | Amazon Keyspaces | Azure Cosmos DB の Apache Cassandra 向けの窓口 | Bigtable |
| 記憶装置上のマネージドなキャッシュ | Amazon ElastiCache | Azure Managed Redis | Memorystore for Redis、Memorystore for Redis Cluster、Memorystore for Valkey |
この表は、置き換えの手順書としては使えません。ここでいう整合性とは、書き込んだ直後の読み取りで何が返るかの約束のことです。書き込み直後でも必ず最新の値が読めることを保証するのが強い整合性、少し前の値が返りうることを許すのが結果整合性で、詳しくは第4章で扱いました。整合性の扱いだけを見ても、Amazon DynamoDB は選択肢が2つ、Azure Cosmos DB は5段階をアカウントの単位で設定する形、Spanner は選択式ではなく設計として強い整合性に固定されています。アプリケーションの側が「結果整合性でも動く」前提で書かれているかどうかで、移した先での挙動が変わります。整合性は設定の項目に見えますが、実際にはアプリケーションの設計に食い込む前提です。
もう1つ、この表には期日が入っている行があります。Azureの記憶装置上のキャッシュは、現行が Azure Managed Redis で、旧来の Azure Cache for Redis については Enterprise 系が2027年3月31日、Basic から Premium が2028年9月30日という終了の日付が告知されています。対応表の同じ行に「Redis のマネージドなキャッシュ」として並んでいても、3社のうち1社だけが移行の期限を持っている、という状態が起こります。
データ分析基盤と、機械学習とAI
次は、データを集めて読む層です。この領域は、本記事が扱う範囲のなかで名前がいちばん動きました。詳細は第5章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 分析専用の問い合わせ基盤 | Amazon Redshift | Azure Synapse Analytics | BigQuery |
| データレイクの土台になる置き場 | Amazon S3 | Azure Data Lake Storage | Cloud Storage |
| 置いたファイルへ直接SQLを投げる仕組み | Amazon Athena | Synapse SQL のサーバーレスの形 | BigQuery の外部の表 |
| データ統合と変換の中心 | AWS Glue | Azure Data Factory | Dataflow、Cloud Data Fusion |
| 工程を順番に回す仕組み | Amazon Managed Workflows for Apache Airflow | Azure Data Factory のパイプラインとトリガー | Managed Service for Apache Airflow |
| 公開ソフトウェアの分散処理を載せる基盤 | Amazon EMR | Azure HDInsight | Managed Service for Apache Spark |
| 絶え間なく届くデータの受け口 | Amazon Kinesis Data Streams | Azure Event Hubs | Pub/Sub |
| 流れに対する集計や判定 | Amazon Managed Service for Apache Flink | Azure Stream Analytics | Dataflow |
| 可視化とBIの中心 | Amazon Quick Sight。Amazon Quick の中の機能 | Power BI | Looker |
| 費用のかからない自分で行う分析の道具 | 本記事の照合では確認していません | 本記事の照合では確認していません | Data Studio。有償の形は Data Studio Pro |
| 技術的なデータの目録 | AWS Glue Data Catalog | Microsoft Purview Data Map | Knowledge Catalog |
この表の3社の列は、同じ言葉で呼ばれていた時期の記憶とずれています。Google Cloudの列に並んでいる Managed Service for Apache Spark は、以前 Dataproc と呼ばれていたものです。Managed Service for Apache Airflow は Cloud Composer でした。Data Studio は Looker Studio でした。いずれも公式ドキュメントの見出しが新しい名前に変わっていますが、ドキュメントのURLは旧名のままです。URLを見て名前を確認すると、改称に気づけません。AWSの列でも、Amazon Quick Sight が Amazon Quick という傘の中の機能という位置づけに変わり、Amazon Managed Service for Apache Flink は Kinesis Data Analytics という旧称を持っています。改称そのものと、なぜ起きたのかは第14章で扱います。
続いて、機械学習とAIの層です。詳細は第6章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 自分でモデルを作るための基盤 | Amazon SageMaker AI | Azure Machine Learning | Gemini Enterprise Agent Platform の機械学習の領域 |
| 生成AIの基盤 | Amazon Bedrock | Microsoft Foundry | Gemini Enterprise Agent Platform |
| モデルの窓口の呼び名 | Bedrock のモデル一覧 | Microsoft Foundry Models | Model Garden |
| 画像の解析 | Amazon Rekognition | Azure Vision | Cloud Vision API |
| 音声を文字にする | Amazon Transcribe | Azure Speech | Cloud Speech-to-Text |
| 文章の解析 | Amazon Comprehend | Azure Language | Cloud Natural Language API |
| 帳票や文書の読み取り | Amazon Textract | Azure Document Intelligence | Document AI |
| 対話する仕組み | Amazon Lex V2 | Azure AI Bot Service。新規は Copilot Studio を推奨 | Dialogflow |
| 検索拡張生成のマネージドな仕組み | Amazon Bedrock Knowledge Bases | Foundry IQ | RAG Engine |
| エージェントを作る基盤 | Amazon Bedrock AgentCore | Microsoft Foundry Agent Service | Gemini Enterprise Agent Platform |
| 安全性の仕組み | Amazon Bedrock Guardrails | Microsoft Foundry の統制の枠組みと Azure AI Content Safety | Model Armor |
この表は、他のどの表よりも短い賞味期限しか持ちません。3社とも、生成AIまわりの製品の構成をこの数年で大きく組み替えています。とくに Gemini Enterprise Agent Platform は、従来の機械学習の基盤と生成AIの基盤が同じ製品の中に入っている形なので、AWSやAzureのように「機械学習の基盤」と「生成AIの基盤」を別のサービスとして数える見方がそのままでは当てはまりません。Azureは両者が並存しており、公式ドキュメントに2つのスタジオの選び分けの案内があります。AWSは Amazon SageMaker AI と Amazon Bedrock が別のサービスで、上位の Amazon SageMaker という名前が両方を含みます。数え方そのものが3社で違うということです。
「安全性の仕組み」の行の Google Cloud 欄は、第6章の照合では確認していないものですが、本章で Model Armor の公式ドキュメントを直接確認しました。公式は Model Armor を、AIアプリケーションのセキュリティと安全性を高めるための Google Cloud のサービスと定義し、モデルへのプロンプトと応答を検査して、悪意のある入力の防止、内容の安全性の確認、機密データの保護を行うものと説明しています。単体のサービスとしても Security Command Center の一部としても購入できると書かれており、AWSの Amazon Bedrock Guardrails が生成AIの基盤の中の機能であるのに対し、Google Cloud ではセキュリティ製品の側に置かれているという位置づけの違いがあります。ここも、同じ行に入るだけで同じものではない例です。
この表について、もう1つ書いておくべきことがあります。この記事では、3社が公表しているモデルの数を並べて比較しません。公式の記述を拾うと、AWSは100を超える基盤モデル、Azureは1万を超えるモデル、Google Cloudは200を超えるモデルとなりますが、数えている対象が違います。AWSの数は生成AIの基盤から直接呼べる基盤モデルの数で、Azureの数は公開モデルを含むカタログ全体の数、Google Cloudの数は公式ブログに記された数です。分母が違う数字を横に並べると、比較の形をした誤りができあがります。選定の場面で意味を持つのは総数ではなく、自社が使いたい特定のモデルがその基盤で使えるかどうかです。
サーバーレスとイベント駆動
関数、コンテナ型のサーバーレス、メッセージング、ワークフローの層です。詳細は第7章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 関数を単位にする実行環境 | AWS Lambda | Azure Functions | Cloud Run functions |
| コンテナを動かすサーバーレスの実行環境 | AWS Fargate | Azure Container Apps | Cloud Run |
| 順番に取り出して処理するキュー | Amazon SQS | Azure Service Bus | Pub/Sub のプルのサブスクリプション |
| 1つの発行を複数へ配る仕組み | Amazon SNS | Azure Service Bus のトピックとサブスクリプション | Pub/Sub の1つのトピックに複数のサブスクリプション |
| イベントを受けて届け先へ配る層 | Amazon EventBridge のイベントバス | Azure Event Grid | Eventarc |
| 時刻をきっかけにする起動 | EventBridge Scheduler | Azure Functions のタイマーのトリガー、Azure Logic Apps の繰り返しのトリガー | Cloud Scheduler |
| 処理を連結する仕組み | AWS Step Functions | Durable Functions、Azure Logic Apps | Workflows |
この表で、いま3社の差がいちばん大きく出るのは実行時間の上限です。AWS Lambda の1回の実行は900秒、つまり15分が上限で、公式のクォータのページは、この項目を含む表の値は注記のあるもの以外は変更できないとしています。その注記にあたる例外が1つあり、AWS Lambda Managed Instances を使う関数を非同期で呼び出す場合と、Amazon MQ と Amazon DocumentDB を除くイベントソースマッピングから呼び出す場合に限って、最大5,400秒、つまり90分まで設定できると書かれています。この章では通常の構成の上限として900秒を扱います。Azure Functions は、Consumptionプランが既定5分で最大10分、他の4つのホスティングの選択肢には強制される上限がありません。ただし、これは関数そのものの処理時間の上限の話で、それとは別の層の制約として、HTTPで起動された関数が応答を返すまでに使える時間は、プランにかかわらず230秒までと公式ドキュメントに明記されており、これは Azure Load Balancer の既定のアイドルタイムアウトに由来すると説明されています。Cloud Run functions のHTTPの関数は最大60分です。同じ「関数」という枠に入っていても、載せられる処理の長さが違います。上限は設定の細目ではなく、その関数で何ができるかを決める境界です。
キューとメッセージングの行も、そのまま置き換えられるものではありません。Amazon SQS は標準のキューが少なくとも1回の配送、FIFOのキューがちょうど1回の処理と説明されており、保管の期間は既定4日で、60秒から14日の範囲で設定できます。Azure Service Bus は、既定の PeekLock の受信モードで少なくとも1回、ReceiveAndDelete の受信モードで最大1回の配送と説明されています。セッションを使うと関連するメッセージを順序どおりに処理できますが、ちょうど1回の処理が得られるとは書かれていません。公式ドキュメントは、セッションの状態とトランザクションを組み合わせた一貫性の仕組みが他社の製品で「ちょうど1回の処理」と呼ばれることがあるとしたうえで、トランザクションが失敗すればメッセージは再配送されるので、その呼び方は正確ではないと注記しています。送信側の再送で生じた複製については、同じ MessageId を持つものをキューやトピックの側で捨てる重複検出という別の機能があります。Google Cloudの Pub/Sub は、公式ドキュメントが、既定ではすべての種類のサブスクリプションで順序の保証なしに少なくとも1回の配送を提供し、ちょうど1回の配送にも対応すると明記しています。同じ「ちょうど1回」という言葉でも、Amazon SQS は「処理」について、Pub/Sub は「配送」について書いており、Azure Service Bus はその呼び方自体を避けています。この行を判断に使うなら、必ず個別のドキュメントに当たる必要があります。
ネットワーク。同じ名前の枠に入るのに、範囲そのものが違う
ネットワークの層には、この章の主張をいちばんはっきり示す例があります。詳細は第8章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 仮想ネットワーク | Amazon VPC | Azure Virtual Network | VPC |
| アプリケーション層での振り分け | Application Load Balancer | Azure Application Gateway | Cloud Load Balancing の Application Load Balancers |
| トランスポート層での振り分け | Network Load Balancer | Azure Load Balancer | Cloud Load Balancing の Network Load Balancers |
| 世界規模での振り分け | AWS Global Accelerator | Azure Front Door | グローバルの種別が Application 側にも Network 側にも用意されている |
| 配信 | Amazon CloudFront | Azure Front Door | Cloud CDN |
| 入口での防御 | AWS WAF | Azure Web Application Firewall、Azure DDoS Protection | Google Cloud Armor |
| 名前解決 | Amazon Route 53 | Azure DNS | Cloud DNS |
| 公衆網を通らない専用の接続 | AWS Direct Connect | Azure ExpressRoute | Cloud Interconnect |
| 拠点どうしを暗号化して結ぶ接続 | AWS Site-to-Site VPN | Azure VPN Gateway の site-to-site | Cloud VPN |
| プライベート接続 | AWS PrivateLink | Azure Private Link | Private Service Connect |
この表のいちばん上の行が、この章でもっとも重要な例です。3社とも仮想ネットワークという同じ枠に入っていますが、その資源が広がる範囲が違います。Google Cloudの公式ドキュメントは、VPCネットワークは全世界を範囲とする資源であり、データセンターにあるリージョン単位の仮想サブネットワークの一覧からなり、それらが全世界規模の広域ネットワークで接続されていると明記しています。一方で Amazon VPC はリージョンの中に作るものとして説明され、各リージョンに既定のVPCが用意されます。Azure Virtual Network は、仮想ネットワークとサブネットがリージョン内のすべての可用性ゾーンにまたがると書かれていますが、リージョンをまたぐとは書かれていません。
この違いは、設計の作業量として現れます。AWSとAzureで複数のリージョンを使う構成にするなら、リージョンごとに仮想ネットワークを作り、それらをつなぐ設計が要ります。Google Cloudでは、1つのVPCネットワークがリージョンをまたいで存在するというのが公式の定義なので、同じ課題が同じ形では現れません。対応表の同じ行に入っているのに、設計に必要な作業の単位そのものが違うという、この章の主張の代表例です。表だけを見て「どこも仮想ネットワークがあるから同じように組める」と考えると、見積りが崩れます。
もう1つ、「配信」の行にも注意が要ります。Amazon CloudFront と Azure Front Door は、いずれも単体のサービスとして立っています。ところが Cloud CDN は違います。公式ドキュメントは、Cloud CDN が全世界向けの外部 Application Load Balancer、または classic の Application Load Balancer と組み合わせて動くと明記しています。単体で使えるものではありません。横並びの表で見ると3つとも同じ粒度のサービスに見えますが、Google Cloudでは負荷分散の構成が先にあって、その機能として配信が有効になる、という順序です。導入の手順も、費用の考え方も、この違いから変わります。
「世界規模での振り分け」と「配信」の2つの行に、Azureだけ Azure Front Door が2回出てくることにも触れておきます。これは表の書き間違いではなく、1つのサービスが他社の2つの役割にまたがっているということです。1対1で対応しないものの実例で、後の節で改めて扱います。
セキュリティとID。3社でいちばん設計思想が離れている
権限の設計は、3社の考え方がもっとも離れている領域です。ここは対応表を作ること自体が難しく、無理に作ると害のほうが大きくなります。詳細は第9章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 許可を書く場所 | プリンシパルの側と資源の側の双方。ポリシーは9種類 | ロールの割り当て。セキュリティプリンシパルとロール定義とスコープの組 | 資源、および階層のコンテナに付ける許可ポリシー |
| 範囲の決め方 | ポリシーの中の資源の指定と条件 | スコープの4階層。管理グループ、サブスクリプション、リソースグループ、リソース | 階層。組織、フォルダ、プロジェクト、資源 |
| 重なったときの扱い | 複数のポリシーを論理和として重ね、明示的な拒否が優先する | 加算モデルであり、実効的な権限は割り当ての合計になる | コンテナにあたる資源に許可ポリシーを設定すると、その中のすべての資源にも適用される |
| 社員や組織の利用者のディレクトリ | AWS IAM のアイデンティティ | Microsoft Entra ID | Cloud Identity |
| 自社が出すアプリの利用者のID | Amazon Cognito | Microsoft Entra External ID の外部テナント | Identity Platform |
| 暗号鍵の作成と管理 | AWS KMS | Azure Key Vault の鍵の管理 | Cloud KMS |
| パスワードやAPIキーなどの機密情報 | AWS Secrets Manager | Azure Key Vault の機密情報の管理 | Secret Manager |
| サーバー証明書の取得と更新 | AWS Certificate Manager | Azure Key Vault の証明書の管理 | Certificate Manager |
| 継続的な脅威の検出 | Amazon GuardDuty | Microsoft Defender for Cloud | Security Command Center |
| 管理操作の記録 | AWS CloudTrail | Azure Monitor のアクティビティログ | Cloud Audit Logs |
この表の上から3行は、サービス名ではなく考え方を並べています。ここだけは、サービス名の対応を作ってもほとんど役に立たないからです。AWSは、ポリシーを作ってIDの側に付けるか、資源の側に付けるかを選びます。Azureは、セキュリティプリンシパルとロール定義とスコープの3つがそろって初めて1つのロールの割り当てになります。Google Cloudは、組織、フォルダ、プロジェクト、資源という階層があり、上位のコンテナに付けた許可が配下すべてに及びます。許可を「どこに書くか」の答えが、3社で別々の場所を指しています。
とくに注意が要るのが、重なったときの扱いです。Azureの公式ドキュメントは、Azureのロールに基づくアクセス制御が加算モデルであり、実効的な権限は割り当ての合計になると明記しています。サブスクリプションの範囲で強い権限を割り当てた人に、リソースグループの範囲で弱い権限を追加しても、弱いほうで絞ることはできません。合計が効くので、強いほうがそのまま残ります。絞るには拒否の割り当てという別の仕組みが要ります。これは「上に強い権限、下で弱い権限」という直感が通用しないということで、AWSの明示的な拒否が優先するという考え方に慣れた人ほど、間違えやすいところです。
Google Cloudでは、コンテナに設定した許可ポリシーがその中のすべての資源にも適用されるので、上位に付けた許可が広く効きます。本記事の照合では、上位の許可を下位で取り消す仕組みを概要のページで確認していません。この3つの設計は、片方の設計をもう片方へ機械的に写せるものではありません。移行や併用を検討するときに、権限の設計だけは「同じ役割の枠」で考えず、その会社の考え方で組み直すのが安全です。対応表がいちばん役に立たないのが、この領域です。
開発と運用、移行、そしてコスト
最後に、日々の運用に関わる層です。詳細は第10章から第12章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| ビルドを実行する | AWS CodeBuild | Azure Pipelines | Cloud Build |
| 成果物を環境へ配る | AWS CodeDeploy | Azure Pipelines | Cloud Deploy |
| 工程全体をつなぐ | AWS CodePipeline | Azure Pipelines | Cloud Deploy の昇格の順序 |
| ソースコードを預かる | AWS CodeCommit | Azure Repos | 本記事の照合では確認していません |
| 宣言的なIaCの土台 | AWS CloudFormation | ARMテンプレート | Terraform の構成ファイル |
| 書きやすさを足した上の層 | AWS CDK | Bicep | 該当する層を持たない |
| 監視と可観測性の傘 | Amazon CloudWatch | Azure Monitor | Google Cloud Observability |
| 構成の記録と評価 | AWS Config | Azure Policy | 本記事の照合では確認していません |
| 組織単位での統制 | AWS Organizations | Azure Policy と管理グループ | 本記事の照合では確認していません |
| 推奨事項の自動検出 | AWS Trusted Advisor | Azure Advisor | 本記事の照合では確認していません |
この表は、粒度がそろっていないことがはっきり見える表です。AWSの列は役割ごとにサービスが分かれていて、ビルド、配布、工程の連結が別々の名前を持っています。Azureの列は、その3つがすべて Azure Pipelines という1つのサービスの中に入ります。Google Cloudの列では、工程の連結にあたるものが Cloud Deploy の中の昇格の順序という機能として存在します。同じ役割を実現するために契約や設定の単位がいくつ必要になるかが、会社によって違うということです。導入の手順書を他社の例から写すと、ここでずれます。
構成をコードで書く層も、3社の形が違います。AWSとAzureは、宣言的な土台の上に、書きやすさを足した層があるという二層です。Google Cloudでは、公式ドキュメントが宣言的な土台として Terraform の構成ファイルを案内しており、その上に自社製の書きやすい層を置いていません。ここは「同じものが無い」ではなく「同じ構造になっていない」という違いです。表の空欄と、この行の「該当する層を持たない」は、意味が違います。
移行とコストの層も並べておきます。詳細は第11章と第12章で扱いました。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 棚卸しと計画 | AWS Transform | Azure Migrate | Migration Center |
| サーバーをそのまま移す | AWS Transform MGN(旧 AWS Application Migration Service) | Azure Migrate | Migrate to Virtual Machines |
| データベースを移す | AWS Database Migration Service | Azure Database Migration Service | Database Migration Service |
| コンテナへ作り替えて移す | AWS Transform のソースコードからのコンテナ化 | Azure Migrate によるWebアプリケーションの移行 | Migrate to Containers |
| 自社設備に置く形 | AWS Outposts | Azure Local | Google Distributed Cloud |
| 既存の仮想化基盤の持ち込み | Amazon Elastic VMware Service | Azure VMware Solution | Google Cloud VMware Engine |
| 支出額を確約して広く適用する割引 | Savings Plans | savings plan | 支出ベースの committed use discounts |
| 資源を指定して確保する割引 | Reserved Instances | Azure Reservations | リソースベースの committed use discounts |
| 確約なしで自動的に付く継続利用の割引 | 本記事の照合では確認していません | 本記事の照合では確認していません | sustained use discounts |
| 中断を受け入れる安価な実行 | Amazon EC2 Spot Instances | Azure Spot Virtual Machines | Spot VMs |
| 費用の分析と可視化 | AWS Cost Explorer | Microsoft Cost Management の Cost Analysis | Cloud Billing のレポート |
| 予算と超過の通知 | AWS Budgets | Microsoft Cost Management の予算アラート | Cloud Billing の予算とアラート |
割引の行は、名前が似ているぶん誤読が起きやすい行です。AWSの Savings Plans とAzureの savings plan は、どちらも支出額を確約する形ですが、運用の制度が違います。Azureの savings plan は購入後にキャンセルも払い戻しもできず、確約分を使い切らなかった時間は繰り越されません。Azure Reservations には交換と払い戻しの制度があります。Google Cloudには、確約しなくても一定以上使うと自動的に付く継続利用の割引があり、これは他の2社の列が「確認していません」になっている行です。割引は値引きの率ではなく、契約の条件として読むべきものです。金額そのものは、第12章に書いたとおり各社の料金計算ツールでその時点の条件を入れて出してください。割引以外の行も、同じ枠に入るだけで同じものではありません。とくにデータベースを移す道具は3社で守備範囲が大きく違い、自社設備に置く形は所有者と保守の担い手が3社で異なります。これらの行を実際の判断に使うときは、第11章の各節に付けた注記をあわせてお読みください。
1対1で対応しないもの
ここまでの表は、どの行にも3つのマス目があるという形で書いてきました。しかし実際には、1つのサービスが他社の複数に相当することも、他社の複数が1つに相当することもあります。表の形式そのものが、この事情を隠します。ここで、隠れているほうを取り出しておきます。
いちばん分かりやすいのが、Azureの Azure Pipelines です。AWSでは、ビルドを実行する AWS CodeBuild、成果物を環境へ配る AWS CodeDeploy、工程全体をつなぐ AWS CodePipeline という3つの名前があります。Azureでは、この3つがすべて Azure Pipelines の中に入ります。表の3つの行に同じ名前が並ぶのは、粒度が違うからです。同じことが Azure Key Vault にも起きています。AWSでは鍵の管理、機密情報の管理、証明書の管理、専用ハードウェアでの保管が AWS KMS、AWS Secrets Manager、AWS Certificate Manager、AWS CloudHSM の4つに分かれています。Google Cloudでは Cloud KMS、Secret Manager、Certificate Manager の3つです。Azureでは1つのサービスが3つの役割を扱います。「AWSの4つに相当するAzureのサービスはどれか」という問いには、1つの答えしかありません。
逆向きの例もあります。Google Cloudの Gemini Enterprise Agent Platform は、従来の機械学習の基盤、生成AIの基盤、エージェントを作る基盤という3つの役割を1つの製品の中に持っています。AWSでは、この3つが Amazon SageMaker AI、Amazon Bedrock、Amazon Bedrock AgentCore という別々の名前です。Azureでは Azure Machine Learning と Microsoft Foundry が並存し、エージェントは Microsoft Foundry Agent Service という形になります。「Google Cloudのこの製品に相当するAWSのサービスは何か」と聞かれても、1つでは答えられません。
データベースにも同じことが起きています。Azure Cosmos DB は、鍵を指定して1件を取り出す用途、MongoDB向けの窓口、Apache Cassandra向けの窓口という複数の役割を1つのサービスの中で担います。AWSでは Amazon DynamoDB、Amazon DocumentDB、Amazon Keyspaces がそれぞれ独立したサービスです。ネットワークでは、すでに触れたとおり Azure Front Door が世界規模での振り分けと配信の2つの行に現れます。移行の領域では、Azure Migrate が棚卸しとサーバーの移行とWebアプリケーションの移行の3つを担い、AWSでは AWS Transform と AWS Transform MGN(旧 AWS Application Migration Service)に分かれます。
この形の食い違いは、選定の作業に直接効きます。サービスの数を数えて「AWSのほうが機能が多い」と読むのは誤りです。同じ機能を4つの製品に分けて売っているか、1つにまとめて売っているかの違いにすぎません。逆に、1つにまとまっているほうが常に楽だとも言えません。まとまっている製品は、必要な部分だけを使いたいときに、いらない部分の設定や権限まで面倒を見る必要が出ることがあります。見るべきなのは数ではなく、自社の運用体制で扱いやすい単位になっているかどうかです。
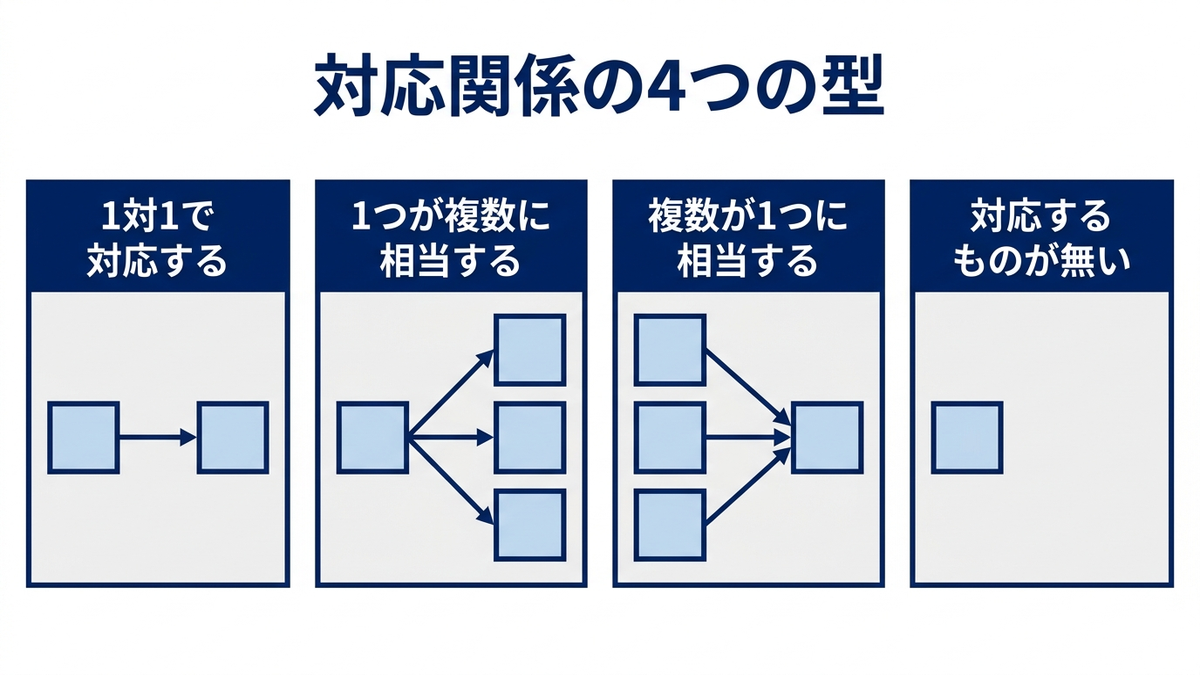
片方にしかないもの
次に、対応するものを見つけられなかったものです。ここで言葉を厳密にしておきます。以下に挙げるのは「他社に存在しない」ものではありません。「本記事が第1章から第12章で公式ドキュメントを照合した範囲では、対応するものを確認できなかった」ものです。公式の一覧に載っていないことは、そのサービスが存在しないことの証明にはなりません。この区別を崩すと、地図が誤った断定の道具になります。
AWSの側では、仮想アプライアンスへ通信を引き込む Gateway Load Balancer について、Azureにも Gateway Load Balancer という同じ名前のものがあり、公式ドキュメントは Azure Load Balancer の等級(SKU)の1つで、第三者のネットワーク仮想アプライアンスを経路に透過的に挿し込むためのものと説明しています。AWSでは現行世代のロードバランサーの3種類の1つ、Azureでは1つのサービスの中の等級という位置づけの違いはありますが、役割としては対応します。Google Cloudでは、本記事の照合では対応する単独のサービスを確認していません。専用ハードウェアで鍵を保管する AWS CloudHSM は、Google Cloudでは独立した製品として確認していません。Azure Key Vault はハードウェアセキュリティモジュールに裏打ちされると記載されており、独立した製品ではなく前提として組み込まれています。記憶装置の上で動きながら消えない前提を持つ Amazon MemoryDB についても、他の2社で対応するものを確認していません。端末から個別につなぐ AWS Client VPN は、Google Cloudで対応するものを確認していません。
Azureの側では、ログを集めて相関を見る Microsoft Sentinel について、AWSとGoogle Cloudで独立した製品としては確認していません。Microsoft Defender for Cloud は、Azure、Amazon Web Services、Google Cloud Platform、オンプレミスにまたがって守ると公式に明記しており、他の2社ではその旨の記述を確認していません。古い認証方式を使うアプリケーションの受け皿になる Microsoft Entra Domain Services も、他の2社で対応するものを確認していません。外にある資産をまとめて管理する仕組みは、AWSに AWS Systems Manager、Azureに Azure Arc がありますが、Google Cloudでは同じ位置づけの単独のサービスを確認していません。
Google Cloudの側では、確約しなくても自動的に付く継続利用の割引について、他の2社で対応するものを確認していません。費用のかからない自分で行う分析の道具である Data Studio も同様です。Apache Kafka については、Google Cloud Managed Service for Apache Kafka という独立したサービスがあり、Azureでは Azure Event Hubs にKafka互換が組み込まれているという形になっていて、そもそも提供の形が違います。
この節でいちばん伝えたいのは、空欄の読み方です。対応表の空欄は3通りに読めます。1つめは「他社にその機能が無い」。2つめは「他社では別の名前の別の製品に含まれている」。3つめは「調べた範囲では見つからなかった」。この3つは意味がまったく違うのに、表の上では同じ空白として見えます。本記事は、3つめを「本記事の照合では確認していません」と書き分けました。社内で対応表を作るときも、この書き分けは残したほうがよいと考えています。空欄のまま回覧すると、読んだ人が1つめの意味で受け取ります。
名前が同じでも中身が違うもの、名前が衝突しているもの
対応表を名前で作ると、確実に誤ります。3社は互いの用語を意識して名前を付けているわけではないので、同じ言葉が違うものを指すことも、違う会社が同じ名前を使うこともあります。ここでは、実際に確認できたものを挙げます。
いちばんはっきりしているのが、文書データベースの名前の衝突です。AWSには Amazon DocumentDB があり、Azureには Azure DocumentDB があります。製品名の主要部分が同じです。ところが中身は違います。Amazon DocumentDB は、公式ドキュメントが計算と保管を分ける構造だと説明しており、保管の層は3つのアベイラビリティゾーンにまたがって6つの複製を持ちます。Azure DocumentDB は、完全に管理されたオープンソースのMongoDB互換のデータベースで、互換率は99.03パーセントと公式に記載されています。その土台になっているオープンソースの DocumentDB は Linux Foundation の管理下でMITライセンスのもとに公開されており、PostgreSQL のエンジンの上に作られています。公式ドキュメントは、Azure DocumentDB がMongoDBのサーバーもコードも動かしていないと明記しています。名前で対応を取ると、この2つを同じものとして扱ってしまいます。本記事の照合では、Azure DocumentDB がいつ登場したのか、何かからの改称なのかは確認していないため、時期については書きません。
負荷分散の領域にも、名前の重なりがあります。AWSには Application Load Balancer という名前のサービスがあります。Google Cloudでは、Cloud Load Balancing の中の種別の名前が Application Load Balancers です。同じ語が、片方ではサービスの名前、もう片方ではサービス内の種別の名前になっています。さらに、両社とも classic という語を持っています。AWSの Classic Load Balancer は前世代であり現行世代への移行が推奨されているもので、Google Cloudの classic は Application 側にも Proxy Network 側にも残る種別の名前です。会話の中で「クラシックのロードバランサー」と言ったとき、指しているものが同じとは限りません。
1つの会社の中でも、名前が2つの意味を持つことがあります。AWSの「SageMaker」という略記は、上位の傘としての Amazon SageMaker と、従来の機械学習の基盤である Amazon SageMaker AI の両方を指しうる状態になっています。Google Cloudでは、Gemini Enterprise と Gemini Enterprise Agent Platform が別物です。前者は社内検索とAIアシスタントとエージェントの基盤にあたるアプリケーション、後者は開発者がモデルやエージェントを作るための基盤です。名前が長く似ているので、社内の資料では取り違えが起きやすいところです。
言葉のほうにも同じ現象があります。第1章で扱ったとおり、リージョンの中で障害を切り分ける単位は、AWSがアベイラビリティゾーン、Azureが可用性ゾーン、Google Cloudがゾーンで、1リージョンあたりの数についての公式の記述もそろっていません。第9章で扱ったとおり、「ロール」という同じ言葉が3社で違うものを指しています。第7章で扱ったとおり、「サーバーレス」はもう関数だけを指す言葉ではなくなりました。用語は共通語ではなく、各社の方言だと考えたほうが安全です。
加えて、表に見える名前と内部の名前がずれたまま並走することもあります。Azureの中断を受け入れる実行の仕組みは Azure Spot Virtual Machines という名前ですが、Azure Batch のドキュメントでは、APIのパラメータや指標の名前に Low-Priority という旧来の呼び方が残っています。ドキュメントの見出しだけを見て名前を確定させると、実際の設定画面やAPIで別の言葉に出会うことがあります。
この地図の使い方。地図は出発点であって、選定の根拠ではない
ここまで10の表を並べてきましたが、最後に使い方を書いておきます。この地図でできるのは、検討の入口でカテゴリの当たりを付けることまでです。ここから先は、必ず公式ドキュメントに当たる必要があります。
手順としては、3段階で考えるのが現実的だと考えています。1段階めは、この地図で「自分がやりたいことは、どのカテゴリの話なのか」を決めることです。実務では、ここが決まっていないまま議論が始まることがよくあります。データを貯める話なのか、貯めたものを読む話なのか、読んだ結果を業務に返す話なのかが分かれていないと、比較の土俵ができません。2段階めは、そのカテゴリの中で候補になるサービスを2つか3つに絞り、その時点の公式ドキュメントで制約を確かめることです。確かめるべきなのは、上限、既定値、対応するリージョン、必要になる周辺の部品、そして提供の状態です。3段階めは、小さく試して決めることです。表と公式ドキュメントで分かるのは前提までで、実際に自社のデータと自社の運用体制で回るかどうかは、動かしてみないと分かりません。
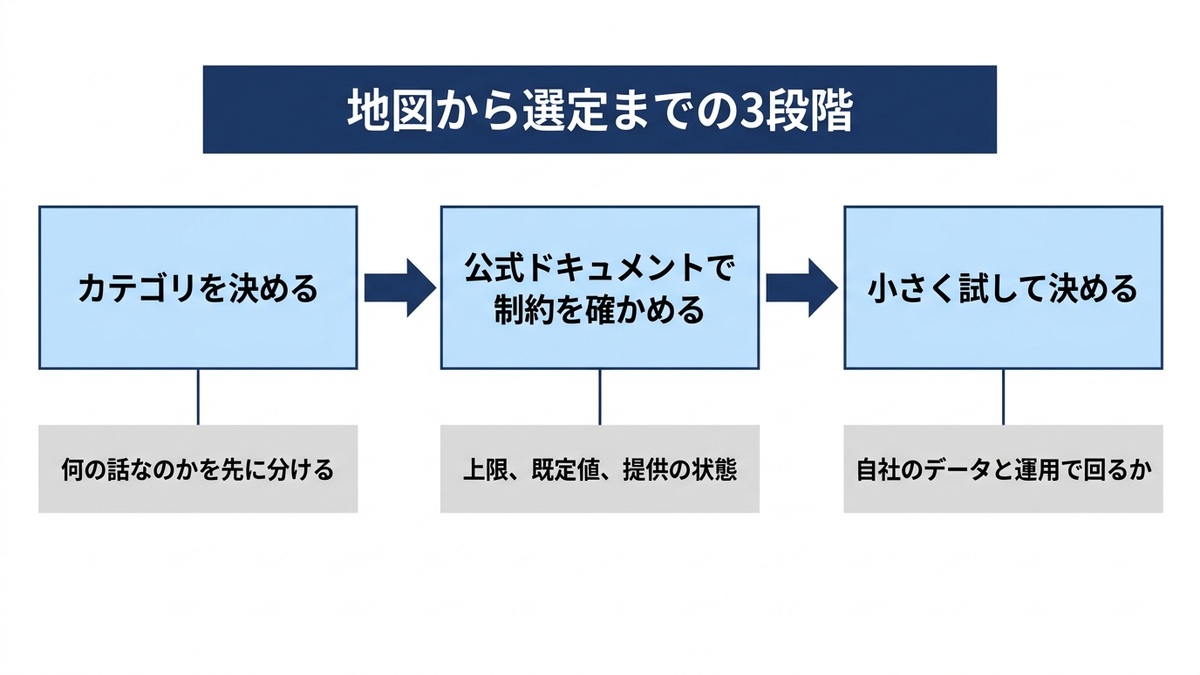
逆に、この地図でやってはいけないことも書いておきます。1つめは、対応表を根拠にして移行を決めることです。「AWSのこれはAzureのこれに当たるから、置き換えられる」という説明は、この章で見たとおり成り立ちません。権限の設計、仮想ネットワークの範囲、整合性の扱い、実行時間の上限は、いずれも表の行の中に収まっていません。2つめは、サービスの数や、モデルの数を比較の材料にすることです。粒度も数え方も会社ごとに違うので、数の大小には意味がありません。3つめは、この表を社内の標準資料として固定することです。本記事の基準時点は2026年9月で、その時点でも改称と提供終了が進行中でした。表を配るなら、いつ時点のものかを必ず添えてください。
それでも対応表に価値があるのは、知らない領域について「何を調べればよいか」を教えてくれるからです。ある会社のサービスしか知らない状態から、他社の同じ役割の名前を1つ知るだけで、公式ドキュメントの入口にたどり着けます。この章の表は、そのための索引として作りました。判断の材料としてではなく、調べ始めるための索引として使っていただくのがよいと考えています。
この章では、第1章から第12章までで扱った3社のサービスをカテゴリごとに10の表へ集め、同じ役割の枠に入るだけで同じものではないこと、1対1で対応しないものと片方にしかないものがあること、そして名前が同じでも中身が違う例があることを確認しました。要点は2つです。1つは、対応表は調べ始めるための索引であって、選定の根拠にはならないということ。もう1つは、表の空欄には「無い」と「別の形で含まれている」と「確認できなかった」の3つが混ざっており、書き分けないと誤読されるということです。次の第14章では、なぜここまで名前が動いたのかを扱います。改称、統合、提供終了を告知した一次情報の日付をたどりながら、各社の製品構成がどの方向へ動いてきたのかを整理します。
この章を深めたい方への参考書籍
『マルチクラウドネットワークの教科書』(宮川亮、翔泳社):複数のクラウドをまたいでネットワークを設計するときの型を扱った本です。この章では、仮想ネットワークの広がる範囲が3社で違うという例を挙げましたが、その違いを実際の構成へ落とすとどうなるかは、本書のデザインパターンの章が具体的です。耐障害性と冗長性を軸に組み立てられているので、対応表からは見えない設計の作業量を掴むのに向いています。刊行は2023年なので、個々のサービス名と機能の現況は公式ドキュメントで補ってください。
『マルチクラウドデータベースの教科書』(朝日英彦、小林隆浩、矢野純平、翔泳社):データベースを複数のクラウドで扱うときの考え方をまとめた本です。この章で触れたとおり、データベースは対応表がもっとも誤解を招きやすい領域で、整合性の扱いや移行の可否は表の行の中に収まりません。特定のクラウドに閉じ込められる状態をどう避けるかという観点で書かれているので、地図から一歩進んで要件を詰める段で役に立ちます。
『図解まるわかり クラウドのしくみ』(西村泰洋、翔泳社):クラウドの構成要素を1項目ずつ図で説明した入門書です。この章の表は、カテゴリの言葉が読者と共有できていることを前提にしています。仮想化、負荷分散、オブジェクトストレージといった語の中身から確認したい方は、こちらを先に通しておくと表の読み方が変わります。特定の1社に寄らない書き方なので、3社を横に並べて考える立場に合います。
第14章 サービスの名前と構成はどう動いてきたか
前章では、3社のサービスを役割ごとに横へ並べ、同じ枠に入ることと同じものであることは違う、という点を繰り返し確かめました。本章はその続きで、対応表そのものが時間とともに崩れていくという話です。名前は変わり、系列は統合され、提供は終わり、ときには終わったように見えたものが戻ります。
本章の記述は、各社が改称や終了を告知した文書に当たって確かめたものです。告知の日付を確認できたものにだけ、年月日を添えました。経緯は分かっていても時期の根拠を持てなかったものについては、時期を書いていません。書いていないのは変化が無かったからではなく、日付の裏づけを持っていないからです。ここを曖昧にすると、読者が自社の記録に写したときに誤りが伝わります。
名前が動くのは、設計が見直されている印である
クラウドのサービス名は、商標や語感の都合だけで動いているわけではありません。公式ドキュメントの改称の告知を読んでいくと、名前の変更のほとんどが、その裏側で製品の境界そのものが引き直されたことの結果として書かれています。ある機能群が1つの製品にまとめられた、逆に1つの製品が上下の層に分かれた、公開ソフトウェアとの関係を前面に出すことにした、といった説明が添えられているのです。名前は、そうした再編の一番外側に見えている部分にすぎません。
そうであれば、改称の多い会社を落ち着きがないと評するのは的を外しています。改称の頻度は、設計を見直した回数のあらわれであって、良し悪しではありません。本コラムの照合では、名前がよく動いたのは機械学習と分析の領域で、3社ともここに集中していました。逆にネットワークやセキュリティの基本部品は、同じ照合でほとんど名前が動いていませんでした。動く領域と動かない領域があり、それは各社の性格というより、その分野がいま作り替えられているかどうかで決まっています。
読者にとって実務上の含意は1つです。名前で覚えると古くなるので、役割で覚えるということです。「仮想的な計算機を貸す役割」「オブジェクトを置く役割」「権限を決める役割」という覚え方は、数年では崩れません。崩れるのは、その役割にいま付いている呼び名のほうです。社内の資料や標準構成の文書を作るときも、役割の側を見出しに置き、サービス名は役割の下に置く形にしておくと、名前が変わったときに直すべき箇所がその1行に限定されます。名前を見出しにしてしまうと、文書全体を読み直さなければ、どこが古いのか分かりません。
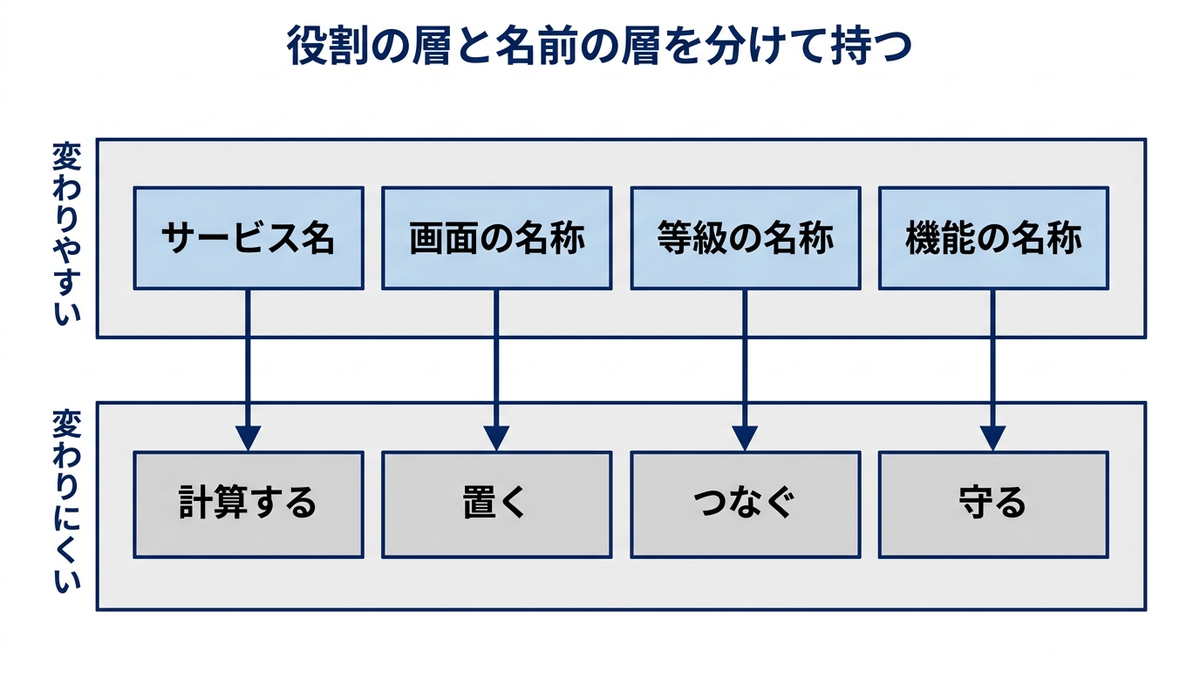
改称を、役割の枠と告知の日付で並べ直す
まず、同じ役割の枠のなかで、どこの名前が動いたのかを見ていただきます。次の表で「照合では変化なし」と書いたものは、本コラムの照合作業のなかで改称を確認しなかった、という意味です。今後も変わらないという意味ではありません。
| 役割 | AWS | Azure | Google Cloud |
|---|---|---|---|
| 機械学習を作って運用する基盤 | Amazon SageMaker から Amazon SageMaker AI へ(2024年12月3日) | Azure Machine Learning。照合では変化なし | Vertex AI が Gemini Enterprise Agent Platform へ統合 |
| 学習済みのAIを呼ぶサービス群 | 個別のサービス名のまま。照合では変化なし | Azure Cognitive Services から Azure AI Services を経て Foundry Tools へ | Cloud Vision API ほか。照合では変化なし |
| 可視化とビジネスインテリジェンス | Amazon QuickSight から Amazon Quick へ(2025年10月9日) | Power BI。照合では変化なし | Looker Studio から Data Studio へ |
| 流れてくるデータを処理する基盤 | Kinesis Data Analytics から Managed Service for Apache Flink へ(2023年8月30日) | Azure Stream Analytics。照合では変化なし | Dataflow。照合では変化なし |
| まとめて分散処理する基盤 | Amazon EMR。照合では変化なし | Azure HDInsight。照合では変化なし | Cloud Dataproc から Managed Service for Apache Spark へ |
| 関数を単位にする実行環境 | AWS Lambda。照合では変化なし | Azure Functions。照合では変化なし | Cloud Functions から Cloud Run functions へ |
| 社員のIDを扱う基盤 | AWS IAM のアイデンティティ。照合では変化なし | Azure Active Directory から Microsoft Entra ID へ(2023年7月11日) | Cloud Identity。照合では変化なし |
この表も、前章までの対応表と同じ読み方をしていただく必要があります。同じ行に並んでいることは、同じものであることを意味しません。たとえば機械学習の行に並ぶ3つは、いずれも「モデルを学習させて動かす場所」ですが、Google Cloud のものは生成AIのエージェントを作る基盤へ統合されたのに対し、Azure のものは生成AI向けの新しい系列とは別建てのまま残っています。行の一致は役割の一致であって、移行できるという意味ではありません。
ここからは、会社ごとに改称を並べます。日付は、改称を告知した文書で確認できたものだけを書いています。日付の欄が空いているものは、経緯そのものは公式に確認できたものの、いつそうなったのかの根拠を得られなかったものです。
| 以前の名前(AWS) | 現在の名前 | 告知の日付 |
|---|---|---|
| Amazon SageMaker | Amazon SageMaker AI | 2024年12月3日 |
| Amazon QuickSight | Amazon Quick。可視化の部分は Amazon Quick Sight | 2025年10月9日 |
| Amazon CodeWhisperer | Amazon Q Developer の一部へ | 2024年4月30日 |
| Amazon Kinesis Data Analytics | Amazon Managed Service for Apache Flink | 2023年8月30日 |
| Amazon Kinesis Data Firehose | Amazon Data Firehose | 2024年2月9日 |
| AWS CodeStar Connections | AWS CodeConnections | 2024年3月29日 |
| AWS Application Migration Service | AWS Transform MGN。公式な略称は MGN のまま | 2026年6月8日 |
AWSの改称は、サービスの更新情報やドキュメント履歴のページに日付つきで残っていることが多く、日付を取りやすい部類でした。Amazon Data Firehose への改称の告知は、名前が変わるだけで接続先、API、コマンド行の道具、権限のポリシー、監視の指標のいずれも変わらない、と明記しています。改称の告知にこの一文があるかどうかは、読む側にとってかなり重要です。あれば、既存の構成に手を入れる必要はありません。
| 以前の名前(Azure) | 現在の名前 | 告知の日付 |
|---|---|---|
| Azure Active Directory | Microsoft Entra ID | 2023年7月11日 |
| Azure Cognitive Search | Azure AI Search | 2023年11月 |
| Power Virtual Agents | Microsoft Copilot Studio | 2023年11月15日 |
| Azure Cognitive Services | Azure AI Services を経て Foundry Tools | 確認できず |
| Azure Form Recognizer | Azure Document Intelligence | 確認できず |
| Azure Bot Service | Azure AI Bot Service | 確認できず |
Azureで最も広く影響したのは、Azure Active Directory から Microsoft Entra ID への改称です。公式ページは、ライセンス、契約条件、稼働率の保証、認定、サポート、価格のいずれも変わらないこと、そして既存のログイン用のアドレス、API、コマンド、認証ライブラリがそのまま使えることを明記しています。名前だけが変わりました。あわせて、Azure AD B2C は改称の対象ではないこと、Windows Server の Active Directory も改称されていないことがはっきり書かれています。この2つを巻き込んで「全部 Entra になった」と理解すると、社内の説明が混乱します。
一方、Azure Cognitive Services から Azure AI Services を経て Foundry Tools に至る経緯は、公式の対照表で確定できました。同じ文書が、これらの名前はすべて同じ土台を指していると述べています。ただし各段階がいつだったかは、この文書にも、たどれる範囲の告知にも書かれていませんでした。したがって本コラムでは、この改称に年月を付けていません。経緯が分かっていることと、時期が分かっていることは別です。
| 以前の名前(Google Cloud) | 現在の名前 | 告知の日付 |
|---|---|---|
| Vertex AI | Gemini Enterprise Agent Platform へ統合 | 2026年4月22日の公式ブログ(日本時間では4月23日) |
| Dataplex Universal Catalog | Knowledge Catalog | 製品ページの掲示は2026年4月10日、BigQuery のリリースノートの項は4月22日 |
| Cloud Dataproc | Managed Service for Apache Spark | 2026年4月22日(BigQuery のリリースノートの項) |
| Cloud Composer | Managed Service for Apache Airflow | 確認できず |
| Looker Studio | Data Studio。有償の形は Data Studio Pro | 2026年4月22日(BigQuery のリリースノートの項) |
| BigLake | Google Cloud Lakehouse。製品ページの見出しは Borderless Lakehouse。APIやアドレスには BigLake の名が残る | 製品ページの掲示は2026年4月20日、BigQuery のリリースノートの項は4月22日 |
| Cloud Functions | Cloud Run functions | 2024年8月21日(リリースノートの項) |
| Cloud Operations Suite | Google Cloud Observability | 確認できず |
| Cloud Data Loss Prevention | Sensitive Data Protection の一部へ | 確認できず |
| Cloud Datastore | Firestore が後継 | 確認できず |
| Anthos。のちに GKE Enterprise | 単独の製品としては消滅。機能は標準の Google Kubernetes Engine の提供内容に含まれるものと、GKE に加えて使う製品または機能とに整理 | 確認できず |
Google Cloud は、3社のなかで名前の動きが最も多く、そして日付が最も取りにくい会社でした。改称は製品ページの掲示で分かるのですが、その掲示に日付が入っていないことが多いためです。Knowledge Catalog への改称のように「2026年4月10日から」と明記されている例もありますが、例外的です。ただし、製品ページに日付が無くても、別の場所に告知が残っていることがあります。BigQuery のリリースノートの2026年4月22日の項には、Dataproc、BigLake、Dataplex Universal Catalog、Looker Studio の4件の改称の告知がまとめて載っていました。表の Dataproc と Looker Studio の日付はこれを根拠にしています。製品ページの掲示にある日付(Knowledge Catalog は4月10日、Lakehouse は4月20日)とリリースノートの項の日付は一致しないため、両方が分かるものは両方を書いています。
この会社の改称には、はっきりした方向性が読み取れます。Managed Service for Apache Airflow のドキュメントは、改称の理由として、公開ソフトウェアによる解決策への利用者の支持を強く受け止めるため、という趣旨を書いています。Managed Service for Apache Spark も同じ形で、独自のブランド名を捨てて「Apache 何々のマネージドサービス」という言い方に寄せています。この流れを知っていれば、個別の名前を暗記しなくても、Google Cloud の分散処理まわりの名前は当てやすくなります。
もう1つ、Looker Studio と Data Studio は名前が往復しています。かつて Data Studio と呼ばれていたものが Looker Studio になり、現在は 再び Data Studio です。公式ページには「Looker Studio は現在 Data Studio と呼ばれています」という掲示が出ています。有償の形も Data Studio Pro であって、Looker Studio Pro という名前はページ上にありません。なお、有償のビジネスインテリジェンス基盤である Looker と、この無償の道具が別の製品である、という関係のほうは変わっていません。
名前が指すものが入れ替わる、という別種の危険
ここまでは「AがBという名前になった」という形の変化でした。もう1つ、これとは性質の違う変化があります。名前の再利用です。古い名前がそのまま残っているのに、その名前が指す対象のほうが別のものへ入れ替わっている状態を指します。改称よりも見つけにくく、そして誤解を生みやすい変化です。
最も分かりやすい例が Amazon SageMaker です。公式の開発者ガイドは、2024年12月3日に Amazon SageMaker が Amazon SageMaker AI へ改称されたこと、そして同じ日に次の世代の Amazon SageMaker が発表されたことを、続けて書いています。つまり、それまで SageMaker と呼ばれていた機械学習の基盤は SageMaker AI という名前になり、空いた「Amazon SageMaker」という名前は、データと分析と人工知能を束ねた、より上位の統合基盤の名前として作り直されました。現在の Amazon SageMaker は、SageMaker AI のほか、レイクハウス、統合の作業画面、データ処理の系列、SQLによる分析、そして Amazon Bedrock までを含む枠です。
このとき何が起きるかを考えてみます。社内の資料に「機械学習の基盤として Amazon SageMaker を採用」と書いてあったとします。この文は今も文字としては正しく読めますが、指しているものは以前より広い枠になっています。数年後にこの資料を読んだ人が、書かれているとおりに Amazon SageMaker のドキュメントを開くと、統合基盤の説明が出てきて、当初の意図とずれます。改称であれば名前が合わないので気づけますが、名前の再利用は名前が合ってしまうので気づけません。
Amazon QuickSight から Amazon Quick への改称も、同じ形をしています。QuickSight という単独のビジネスインテリジェンスのサービスが、Quick という分析と人工知能の基盤へ広がり、従来の可視化の部分は Quick Sight という名前でその中の1つの機能になりました。QuickSight という1語が、Quick と Quick Sight という2語に分かれたわけです。公式ページは、既存のAPI、開発キット、連携はいずれもそのまま動くと明記していますので、稼働中の仕組みへの実害はありません。実害があるのは、文書と会話のほうです。
Google Cloud にも同じ性質のものがあります。Gemini Enterprise という名前と、Gemini Enterprise Agent Platform という名前は、似ていますが別のものを指します。前者は利用者が使うアプリケーションで、後者はエージェントを作るための基盤です。この2つの区別は第6章で扱いました。名前が長く似ているものが並ぶときは、どちらの層の話をしているのかを毎回確かめる必要があります。
名前の衝突も起きています。Amazon DocumentDB と Azure DocumentDB は、名前がほとんど同じですが別の製品です。この点は第4章で扱いました。会社をまたいで資料を読むときは、サービス名だけで判断せず、どの会社のものかを必ず添えて記録することをおすすめします。
名前は変わっても、実体はたいてい変わらない
ここまで変化の話ばかりを書いてきましたが、実務にとってはむしろ次の事実のほうが重要です。改称のほとんどは表示上の名前だけの変更で、動いている仕組みには手を入れなくてよい形で行われています。各社の告知は、この点をかなり丁寧に書いています。
Azure の Foundry Tools は、Cognitive Services から数えて2段階名前が変わりましたが、Azure 上の資源の種別は今も Microsoft.CognitiveServices/accounts のままです。つまり、既存の構成をコードで管理している場合、名前が2回変わってもテンプレートは壊れていません。Document Intelligence も同様で、開発キットの名前には今も FormRecognizer が残り、作業画面のアドレスにも formrecognizer が入っています。SageMaker では、API の名前空間、コマンド行の道具、権限のポリシーの接頭辞、接続先、構成管理の資源の型、ドキュメントのアドレスのいずれも、後方互換のために変えていないと明記されています。Knowledge Catalog への改称でも、API とクライアントライブラリとコマンド行の道具と権限の名前は変わらない、と掲示に書かれています。
この「変えない」方針には副作用があります。アドレスを見ても改称に気づけないのです。Google Cloud の3件、すなわち Dataproc、Composer、Looker Studio は、いずれもドキュメントのアドレスが旧名のままです。composer というアドレスを開くと、Managed Service for Apache Airflow という見出しのページが出てきます。アドレスで確認したつもりになっていると、改称を丸ごと見落とします。加えて Google Cloud のドキュメントは、cloud.google.com の配下から docs.cloud.google.com の配下へ転送されるようになっているため、社内の資料に古いアドレスが残っていても、転送されて開けてしまいます。開けたことは、内容が同じであることの証明にはなりません。
もう1つ、請求書の側にも名前は残ります。Azure の公式ページは、Cognitive Services と Applied AI Services という名前が、請求、費用の分析、価格表、価格の API では今も使われ続けている、と書いています。ドキュメント上の名前と、請求書に出てくる名前が一致しないという状態です。費用を部門別に集計している場合、名前の変更にあわせて集計の条件を変えてしまうと、かえって突き合わせができなくなります。
読者にとって実務的な結論は次のようになります。改称の告知を読むときは、名前そのものより「何を変えなくてよいか」の一文を先に探してください。接続先、API、コマンド、権限、監視の指標が変わらないと書かれていれば、対応すべきなのは文書と説明だけです。逆にその一文が無い場合は、単なる改称ではなく再編である可能性があるため、移行の案内を探す必要があります。
「終了」という一語には、少なくとも4つの段階がある
提供終了という言葉は、実際にはかなり幅の広い状態をまとめて指しています。本コラムの照合では、次の4つの段階を区別しないと、読者の判断を誤らせることが分かりました。とくに、いま新規に採用してよいかどうかを決めるとき、この区別がそのまま結論を左右します。
| 段階 | 何が起きているか | 新規に採用してよいか | 実例 |
|---|---|---|---|
| 推奨の変更 | 終了の告知は無い。ただし事業者自身が別の選択肢を勧めている | 勧められない | App Engine。Azure Bot Service。ARMテンプレート |
| 新規受付停止 | 既存の利用者は使い続けられる。新規に開始できない | できない | AWS App Runner。AWS Cloud9。AWS Data Pipeline。AWS Application Discovery Service |
| 提供終了の告知 | 終了する日付が決まっている。ただし期日の前でも、新規の作成や変更が段階的に止まることがある | 移行の期限を承知のうえでなければ勧められない | Azure Blueprints(プレビューのまま終了。期日の前に段階的な制限がある)。Pub/Sub Lite。Azure Custom Vision |
| 提供終了 | すでに止まっている | できない | AWS CodeStar。Azure Data Lake Analytics。Azure Metrics Advisor |
この4段階のうち、照合作業でいちばん多く出てきたのは提供終了ではなく推奨の変更でした。サービスは動き続けていて、告知も出ていないのに、公式ドキュメントの本文が「新しく作るならこちらを使ってほしい」と別の選択肢を案内している状態です。ここを「まだ現役です」とだけ読むと、数年後に作り直しになる選択をそのまま通してしまいます。
具体例を挙げます。App Engine の公式ドキュメントは、Google Cloud を新しく使い始める利用者には App Engine よりも Cloud Run を勧める、と明記しています。App Engine には終了の告知は出ていません。それでも、これから新規に採用するのであれば、公式の推奨から外れた選択になります。Azure Bot Service も同じ形で、対話するアプリを初めて作るなら Copilot Studio から始めることを勧める、と書かれています。構成をコードで扱う領域でも同じ形があり、この点は第10章で扱いました。
段階どうしは、重なることもあります。Azure Functions の従来の従量プランがその例で、新しいアプリには別のプランを使い、既存のアプリは移行するように、という推奨の変更が出ているのに加えて、Linux で使う場合については2028年9月30日という期日まで付いています。つまり、推奨の変更と期日つきの終了が同時に起きています。段階の区別は、状態を1つに決めるための分類ではなく、確かめるべき点を漏らさないための分類だとお考えください。推奨だけが変わったのか、期日も出ているのか、その両方かを、毎回3点とも見る必要があります。
期日つきの終了にも、期日の前に段階があります。Azure Blueprints の終了の案内は、2027年1月31日の終了に先立って、2026年7月31日に新しい定義と版の作成が、2026年10月31日に既存の定義の変更と新しい割り当ての作成が、2026年12月31日に既存の割り当ての変更が、順に止まることを表にしています。終了の期日だけを台帳に写すと、その半年前から新規の作成ができなくなっていることを見落とします。同じ案内には、この終了がもともと2023年9月14日に2026年7月11日を期日として告知され、のちに2027年1月31日へ延ばされたことも書かれています。期日そのものが動くことがあり、期日の前に使える範囲が狭まることもあります。台帳には終了の期日だけでなく、段階の始まる日も写しておく必要があります。
興味深いのは、初期からある実行環境に対する3社の姿勢が割れている点です。新しい選択肢へはっきり誘導しているのは Google Cloud だけで、AWS の Elastic Beanstalk と Azure の App Service には、本コラムの照合の範囲では誘導も終了の告知も見当たりませんでした。誘導が無いことは、そのまま使い続けてよいことの保証ではありません。誘導を出すかどうかは事業者の方針で決まるので、告知が無い場合は、利用の実績と新機能の追加状況から自分で判断する必要があります。
サービスは残るのに、使い方のほうが終わることがある
サービス名だけを追いかけていると、まったく見つからない種類の変化があります。サービス自体は現役なのに、その中の等級、入口、階層、実行の形、機能、版といった単位で終了が起きる型です。名前の一覧を毎年見比べても、この変化は1件も検出できません。本コラムの照合では、次の6つの型が出てきました。
| 終わる単位 | 実例 | 期日 |
|---|---|---|
| 等級 | Azure Basic Load Balancer | 2025年9月30日に終了の期日を迎えた。既存のものは動き続けるが、サポートと稼働率の保証の対象外 |
| 等級 | Azure Application Gateway の v1 の等級 | 2026年4月28日に提供終了 |
| 等級 | Azure Cache for Redis の Basic・Standard・Premium の等級 | 2028年9月30日に終了。移行先は Azure Managed Redis |
| 入口 | Microsoft Sentinel の Azure ポータルでの提供 | 2027年3月31日より後は Defender ポータルのみ |
| 階層 | Security Command Center の Enterprise の階層 | 2027年5月21日に終了し Premium へ自動的に移る |
| 実行の形 | Azure Functions を Linux の従来の従量プランで動かす選択肢 | 2028年9月30日に提供終了 |
| 機能 | Amazon SNS のメッセージのデータ保護 | 2026年3月31日に告知。2026年4月30日から新規の利用者には提供されない。既存の利用者は使い続けられる |
| 機能 | Amazon Redshift の Python のユーザー定義関数 | 2026年6月30日より後はサポート外 |
| 版 | Azure HDInsight の 4.0 と 5.0 | 2025年3月31日に終了の期日を迎えた。新しいクラスターは作れず、既存のクラスターにはサポートも保守も提供されない。現行は 5.1 |
この表も、同じ行に並んでいるからといって同じ重さではありません。等級の終了は構成の作り直しで済むことが多い一方、入口の終了は運用手順書と教育資料の書き換えを伴います。階層の終了は、自動的に別の階層へ移る場合、使える機能が減ることがあります。Microsoft Sentinel の例で言えば、サービスは何も終わりません。終わるのは Azure ポータルからの入口だけで、Defender ポータルからは引き続き使えます。ところが「Sentinel が2027年に終了」とだけ社内に伝わると、移行検討の会議が立ち上がってしまいます。
期日を迎えたことと、止まったことも同じではありません。Basic Load Balancer の公式の案内は、既存のものは2025年9月30日のあとも動き続けるが、使い続ける場合はサポートも稼働率の保証も無いことを承知したものとみなす、と書いています。HDInsight の終了した版についても、既存のクラスターが直ちに消えるのではなく、サポートと保守が提供されず、新しいクラスターは作れず、事業者が期日のあとはいつでも止めたり消したりする権利を留保する、という状態です。「終了した」を「止まっている」と読み替えると、実際にはまだ動いているものを台帳から消してしまい、逆に「まだ動いている」を「まだ使える」と読み替えると、保証の無い状態を見過ごします。台帳には、期日と、その期日を過ぎた状態の中身を分けて書く必要があります。
もう1つ、名前の一部が欠けるだけで意味が反転する例を挙げます。終了しているのは Amazon Inspector Classic であって、2026年5月20日にサポートを終えました。AWSの終了したサービスの一覧にその行があります。しかし Amazon Inspector 本体は現役です。末尾の1語を落として記録すると、現役のサービスが終了したことになってしまいます。社内の台帳にサービス名を書くときは、公式ドキュメントの見出しから一字も省かずに写すのが確実です。
閉じたものが戻ることがあり、新しいほうが先に閉じることもある
ライフサイクルは一方向に進むもの、と考えたくなりますが、実際にはそうとも限りません。本コラムの照合で最もはっきりした反例が AWS CodeCommit です。このサービスは2024年7月25日に新規の受け付けを止めましたが、2025年11月24日の公式ブログで一般提供への復帰が告知されました。ブログには、2024年7月に利用の傾向と顧客の必要性の評価にもとづいて重点を下げる計画を発表したこと、そして即日で一般提供へ戻ること、新規の申し込みを再び受け付けることが書かれています。ユーザーガイドのドキュメント履歴にも、止めた日と戻した日の両方が行として残っています。
「あのサービスは終わった」という記憶には、賞味期限があります。2024年から2025年前半の情報だけを見て CodeCommit は終わったと書けば、いまは誤りです。逆に言えば、社内の標準構成から一度外したサービスについても、外した理由が新規受付停止であったなら、その理由がまだ生きているかを確かめる価値があります。
もう1つの思い込みは、終了は古いものから順に起きるだろう、というものです。これも実際とは違いました。AWS App Runner は2026年3月31日に告知され、2026年4月30日から新規の顧客に閉じられ、移行先として Amazon ECS の簡易な実行の形が案内されています。告知は、既存の利用者はこれまでどおり使えること、安全性と可用性への投資は続けるが新機能の追加は予定していないことを明記しています。一方で、前節で触れた Elastic Beanstalk と App Service には、終了の告知も新規受付停止の告知も出ていません。同じ「アプリケーションを載せるだけで動かせる」役割の枠のなかで、閉じたほうと閉じていないほうが分かれています。後から加わった選択肢のほうが先に閉じることがあります。新しいから安心という判断は成り立ちません。
似た名前どうしで、片方だけが終わっている例もあります。AWS CodeStar は2024年7月25日にサポートを終えましたが、名前のよく似た AWS CodeStar Connections は終わっておらず、2024年3月29日に AWS CodeConnections へ改称されて現役です。同じく、Kinesis Data Analytics は Apache Flink を使う形が Managed Service for Apache Flink へ改称されて生きている一方、SQL を使う形のほうは段階を踏んで廃止され、アプリケーションの削除まで完了しています。「Kinesis Data Analytics は無くなった」と一括りにすると誤りになります。系列の名前で状態を語らず、実際に使っている形の単位で確かめる必要があります。
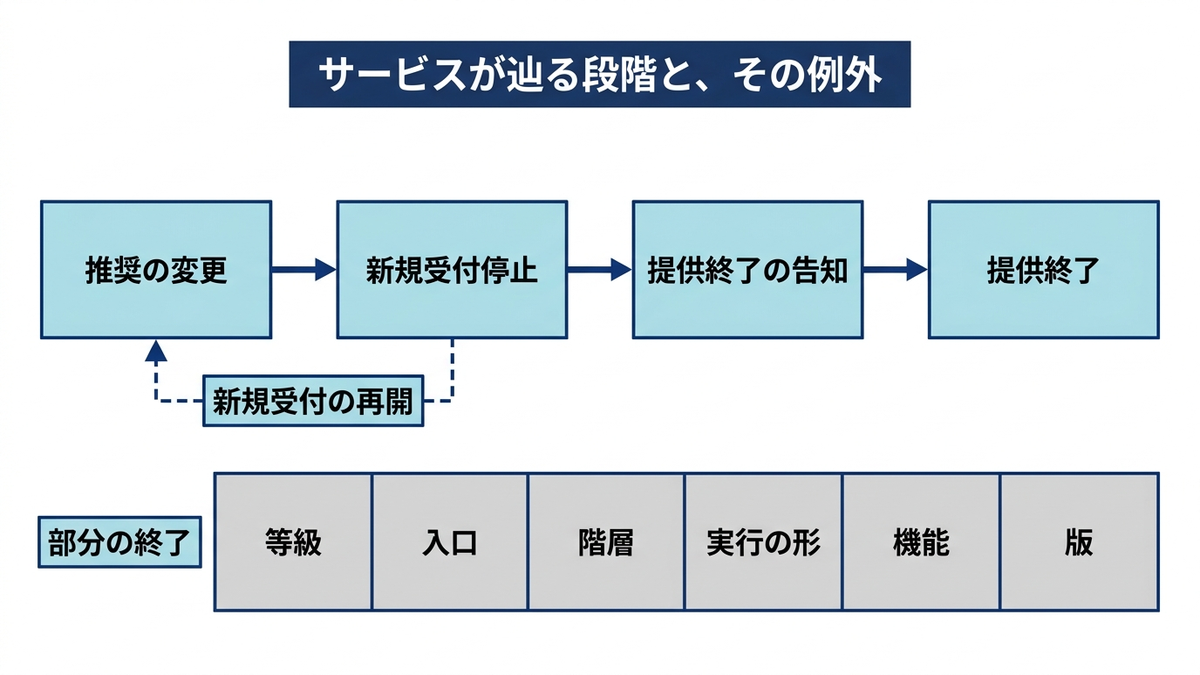
生成AIの登場が、製品構成そのものを動かした
ここまで挙げてきた変化を並べると、時期と領域が偏っていることに気づきます。名前と構成が最も大きく動いたのは機械学習と人工知能の領域で、しかも2023年以降に集中しています。生成AIの登場が、各社の製品構成そのものを組み替えたと読むのが自然です。以下、3社それぞれで何が起きたかを整理します。
Google Cloud で最も大きかったのは、AutoML が単独の製品としては姿を消したことです。この変化は、3つの層に分けて読む必要があります。1つめは、旧来の単独の製品の終了です。公式の非推奨の一覧には、表形式データを扱う旧製品が2024年7月24日、画像と動画を扱う旧製品が2024年7月31日、自然言語(テキスト)を扱う旧製品が2024年8月7日に停止したと記録されており、移行先は当時の Vertex AI で、旧製品の機能はすべてそちらに含まれると書かれています。2つめは、その統合先に残った学習方式のうち、テキストが2025年6月15日、動画が2025年7月31日に終わったことです。こちらの移行先は Gemini のモデルを自社のデータで調整する手立てで、旧製品の終了とは移行先が違います。3つめは、いまも残っているもので、Agent Platform の AutoML の入門ガイドが扱うのは、画像と表形式データに対する学習方式だけです。これらとは別に、翻訳の AutoML も2025年9月30日に提供を終え、独自モデルの機能と管理は Cloud Translation の上位版へ引き継がれました。「AutoML でテキストを分類する」「AutoML で翻訳モデルを作る」という書き方は、いまは成り立ちません。
そして Vertex AI そのものが、Gemini Enterprise Agent Platform へ統合されました。2026年4月22日(日本時間では4月23日)の公式ブログがこの統合を Vertex AI の発展形として説明しており、同じ日付の Agent Platform のリリースノートには、Vertex AI から引き継いだ機能の以前の名前と新しい名前を並べた一覧が載っています。Vertex AI のリリースノートの冒頭には、Vertex AI のドキュメントはもう更新されず、最新の情報は Agent Platform のドキュメントを見るように、という掲示が出ています。ただしリリースノートのページそのものには、その後も2026年9月の項目まで新しい記載が加わっており、項目に書かれる製品名は Agent Platform 側の名前です。機械学習の基盤という枠が、エージェントを作る基盤という枠に置き換わったことになります。
AWS では、2024年12月3日の SageMaker の再編がこれに当たります。前述のとおり、機械学習の基盤が SageMaker AI という名前になり、空いた名前が、分析と人工知能を束ねた統合基盤へ付け替えられました。その統合基盤には Amazon Bedrock が含まれています。生成AIの基盤サービスを、従来の分析と機械学習の系列の内側に取り込む形の再編です。開発者向けの道具でも同じ流れが見えます。CodeWhisperer が2024年4月30日に Amazon Q Developer の一部となり、さらに Q Developer の統合開発環境向けの追加機能については、2027年4月30日にサポートを終了し、以後は Kiro という別の道具を使うよう案内が出ています。同じ役割の道具が、数年のあいだに名前を変え、さらに別の道具への移行を案内されたことになります。この領域の変化の速さは、他の領域とは水準が違います。
Azure の再編は、名前の変更としては最も大がかりでした。AI 関連のサービス群が Cognitive Services から Azure AI Services を経て Foundry Tools になり、その配下のサービスも Speech、Language、Vision といった短い名前へ整理されています。しかし読者への影響という点では、改称よりも次の2つの変化のほうが大きいと考えています。
1つめは、言語のサービスで、機能が「新規の開発に推奨するもの」と「既存の実装のために提供を続けるもの」の2つに分けられたことです。後者には、感情分析、キーフレーズの抽出、要約、会話の意図の理解、独自のテキスト分類といった、この分野の代表的な機能が置かれています。これらは終了していません。しかし新規の開発に推奨されてもいません。同じことが画像のサービスでも起きており、画像の解析と文字認識には見出しの段階で従来からのものという注記が付いています。改称の一覧だけを見ていると、この格下げは1件も検出できません。
2つめは、これらの役割を束ねる新しいサービスが現れたことです。文書、画像、音声、動画を1つの入口で扱う仕組みが加わり、独自の画像分類を作るための Custom Vision には、2028年9月25日まで既存の利用者を全面的に支えたうえで提供を終えるという告知が出ています。その移行先として案内されているのは、従来型の自動機械学習と、生成AIを使う新しい仕組みの2つです。Content Moderator も2024年2月に非推奨となり、2027年3月15日に終了する予定で、後継は Content Safety です。その Content Safety の現在の機能を見ると、プロンプトへの攻撃の検出や、生成された文章が根拠に基づいているかの判定といった、生成AIを前提にしたものが中心になっています。同じ「有害な内容を検出する」という役割の中身が、入れ替わっています。
3社を並べたとき、変化の方向はよく似ています。個別の機能を売る形から、モデルを選んで組み合わせる基盤を売る形へ移り、従来の学習済みAPIや自動機械学習は、その基盤の内側へ畳み込まれるか、既存の利用者向けの位置に下がりました。ただし、進み方の速さと、どこまで統合したかは3社で違います。この違いをどちらが優れていると読むのは適切ではありません。統合が進んでいる側は選択肢が絞られていて分かりやすく、統合が緩い側は従来の資産をそのまま使い続けやすい、という性質の違いです。なお、各社が扱えるモデルの数を並べて比較することは、本コラムでは行いません。数え方が各社で違うため、数字を並べても比較になりません。
終了・非推奨の告知は、どこを見れば分かるか
ここまでの内容を読者ご自身で確かめ、そして今後も追い続けるための入口を整理します。本コラムの照合では、3社の告知の出し方がかなり違うことが分かりました。同じ手間で3社を追えると考えて計画を立てると、Google Cloud のところで工数が合わなくなります。これは告知を公開する形の違いであって、3社の優劣を示すものではありません。
| 会社 | 横断の一覧 | 入口 | 使うときの注意 |
|---|---|---|---|
| AWS | ある。3段階に分かれる | サービスのライフサイクルのページを親として、新規受付停止、終了予定、完全終了の3つの一覧が並ぶ | 新規受付停止の一覧には終了日が無く、告知日だけが載る。3つの一覧をまとめて文字列で検索するのが速い |
| Azure | ある。2つの経路 | 公開されている終了一覧のデータと、更新情報の配信を終了の分類で絞り込む経路 | データは機能の単位で並ぶ。更新情報の側は一度に取れる件数に上限があるため、分けて取らないと気づかないまま取りこぼす |
| Google Cloud | 無い | 製品ごとの非推奨のページが一部にあるだけ。ほかはリリースノートの分類で拾う | 主要な製品ほど非推奨のページが無い。リリースノートは日付の単位で並ぶので、製品名では引けない |
3社の欄が横に並んでいますが、これも同じものではありません。AWS の一覧はサービスのライフサイクルのページを親として、新規に利用を開始できない段階の一覧と、終了予定の一覧と、完全に終了した一覧の3つに分かれています。この3つは、サービスと機能を同じ表に並べる作りです。Azure の一覧は公開されているデータで、こちらは1行が機能に対応し、製品ごと終わる場合は機能の欄に全体を指す語が入ります。同じ「一覧」という言葉でも、行の意味が違うということです。Google Cloud には全社をまたぐ一覧が無く、リリースノートを日付の単位で追うか、製品ごとの非推奨のページを個別に開くことになります。
ここからが本節で最もお伝えしたい点です。横断の一覧は入口であって、状態を判定する根拠にはなりません。本コラムの照合では、両方向の反例が実際に出ました。
まず、一覧に載っていないのに終了しているものがあります。翻訳の AutoML は2025年9月30日に提供を終えていますが、統合先の非推奨の横断一覧には載っておらず、告知は翻訳のサービス側の専用ページにだけ置かれていました。AWS でも同じことが起きています。AWS Data Pipeline は、公式ドキュメントの冒頭に、新規の利用者には提供せず既存の利用者は使い続けられるという掲示が出ているのに、本コラムの照合の時点では、前述の3つの一覧のどこにも載っていませんでした。AWS CodeCommit の新規受付停止と一般提供への復帰の経緯も、3つの一覧には出てこず、そのサービス自身のドキュメント履歴と公式ブログにだけ記録されています。一覧に無いことは、現役であることの証明ではありません。
逆に、一覧に載っているのに新規に使えないものもあります。AWS のホワイトペーパーの分析のカテゴリの一覧には、AWS Data Pipeline が今も載っていますが、このサービスは2024年7月25日に新規の受け付けを止め、保守の段階に入っています。カテゴリの一覧は名前しか持っておらず、状態の情報を持っていません。
さらに、公式の一覧表のほうが個別ページより古いことがあります。Foundry Tools の概要ページは、Metrics Advisor をこれから終了するものとして表に置いていましたが、Metrics Advisor 自身のページには2026年5月18日に終了したと書かれていました。どちらも公式のページです。同種のずれが Custom Vision でも起きていました。一覧表と個別ページで食い違ったときは、個別ページを採るのが妥当です。
技術的な落とし穴も2つ記録しておきます。1つは、cloud.google.com が存在しないアドレスに対しても正常の応答を返し、本文だけが見つからないという表示になることです。応答の状態だけで、そのページが実在すると判定してはいけません。必ず本文を読む必要があります。もう1つは、Azure の人間向けの更新情報のページが利用者側で描画される作りになっていて、機械的に取得しても項目が1件も取れないことです。自動で監視の仕組みを作る場合は、上に挙げたデータのほうを使うことになります。
採用したサービスを、どう見張るか
最後に、読者が実際に取れる運用を書きます。ここまでの内容を、社内の作業に落とすとどうなるか、という話です。
第1に、採用しているサービスの台帳を作り、役割を主語にして書きます。1行に、その役割、現在のサービス名、公式ドキュメントの入口のアドレス、最後に状態を確認した日付を並べます。サービス名を主語にすると、改称のたびに行の同一性が失われますが、役割を主語にしておけば、名前の欄を書き換えるだけで履歴がつながります。最後に確認した日付の欄は、面倒でも入れておく価値があります。本コラムの照合で最も困ったのは、情報が古いことではなく、その情報がいつ時点のものか分からないことでした。
第2に、確認の頻度を役割ごとに変えます。本コラムの照合の結果からいえば、機械学習と分析と人工知能の領域は年に1回では足りません。ネットワークやストレージの基本部品は、年に1回で十分に追いつきます。すべてを同じ頻度で見ようとすると続かないので、動きの速い領域に手間を寄せるのが現実的です。
第3に、確認の中身を3点に絞ります。見るのは、名前が変わっていないか、終了や新規受付停止の告知が出ていないか、そして公式が別の選択肢を勧め始めていないかの3つです。3つめが抜けやすく、そして最も判断に効きます。前述のとおり、実際に最も多く起きているのは推奨の変更だからです。この確認は、そのサービスの概要ページを1枚開けば、たいてい冒頭の掲示で分かります。
第4に、新規の採用を決める場面では、必ず公式ドキュメントの現物を開きます。社内の標準構成の資料、過去の提案書、技術ブログ、そして本コラムのような記事は、いずれも書かれた時点の情報です。名前が動く速さを考えると、採用の判断だけは一次の情報に当てるのが妥当だと考えています。開く先は、そのサービスの概要ページと、上の表に挙げた終了の一覧の2つで足ります。
第5に、期日の付いた変更を予算と計画に載せます。等級の終了や実行の形の終了は、数年先の日付で告知されることが多く、告知の時点では急ぎに見えません。しかし移行には設計と試験の期間が要ります。台帳の行に期日の欄を設け、その年度の計画に自動的に上がるようにしておくと、直前に慌てずに済みます。
第6に、外部の資料を読むときは日付を先に見ます。クラウドのサービス名を扱った資料は、書かれた時期によって内容が変わります。とくに2023年より前に書かれたものは、本章で挙げた変化の大半より前の内容です。日付が書かれていない資料は、その点だけで扱いを軽くしてよいと考えています。
本章で確かめたことを3つにまとめます。名前は動くので、覚えるべきは役割のほうです。「終了」という一語には、推奨の変更から完全な停止まで少なくとも4つの段階があり、実際に最も多いのは推奨の変更で、加えてサービスは残るのに等級や入口や機能だけが終わる型があります。そして、各社が用意した横断の一覧は探し始める入口としては有用ですが、状態を判定する根拠にはならず、判定は必ず個別の告知に当たる必要があります。次の終章では、ここまでの14章を通して、読者が最初の一歩をどう踏み出すかを整理します。
この章を深めたい方への参考書籍
『進化的アーキテクチャ 絶え間ない変化を支える』(Neal Ford ほか著、オライリー・ジャパン):土台となる技術が変わり続けることを前提に、システムの設計をどう保つかを扱った本です。本章で見たとおり、クラウドのサービス名と構成は数年で動きます。個々の名前を追いかけるのではなく、変化に耐える構造をどう作るかという観点は、台帳の作り方や標準構成の決め方にそのまま応用できます。
『Googleのソフトウェアエンジニアリング 持続可能なプログラミングを支える技術、文化、プロセス』(Titus Winters ほか編、オライリー・ジャパン):ソフトウェアを時間の経過のなかで維持することを主題に置いた本で、廃止をどう計画し、どう進めるかを正面から扱った章があります。事業者の側が何を考えて終了を告知しているのかを知っておくと、告知の文面から読み取れることが増えます。
『ソフトウェアアーキテクチャの基礎 第2版 エンジニアリングに基づく体系的アプローチ』(Mark Richards、Neal Ford 著、オライリー・ジャパン):設計の判断には正解が無く、あるのは取捨だけである、という立場から書かれた本です。本コラムが一貫して「どの1社が優れているか」ではなく「どの軸で選ぶか」を書いてきた理由と重なります。判断の記録を残す方法についても触れられており、本章で述べた台帳の運用と併せて読むと役に立ちます。
終章 クラウドの選定を、経営の意思決定として扱う
第14章まで、3社のサービスを役割ごとに並べ、対応関係を集約し、名前と構成がどう動いてきたかを見てきました。ここまでの内容は、形のうえでは技術の話です。仮想マシンの選び方、権限の設計、費用の見方といった項目が並んでいます。それでも本コラムを準備しながら繰り返し感じたのは、これらの多くが、情報システム部門の中だけでは決めきれない性質を持っているということでした。終章では、その点を整理して締めくくります。
3社を比べる作業は、技術の比較にとどまらない
クラウドの選定は、しばしば技術的な比較として扱われます。どの仮想マシンが速いか、どのデータベースが安いか、どの機械学習の基盤が使いやすいか、という形です。こうした比較は必要ですが、それだけで決着することはあまり無いように思います。理由は単純で、比較の結果として出てくる差の多くが、技術の優劣ではなく前提の違いだからです。
第1章で見たとおり、3社は障害を切り分ける単位の数え方から違います。第9章の権限管理では、AWSがポリシーを利用者側と資源側の双方に付けるのに対し、Azureは範囲と役割の組み合わせで表し、Google Cloudは上位の階層に与えた許可が配下すべてに及ぶ形を取ります。第8章の仮想ネットワークでは、Google Cloudのものだけが公式に全世界を範囲とする資源として説明されています。これらは、どちらが優れているかという問いに答えられる種類の差ではありません。自社の組織の形、既存の資産、運用を担う人の数、守るべき規程に対して、どの前提が噛み合うかという問いです。
そして、その問いに答えられるのは技術部門だけではありません。組織をどの単位で区切るか、権限を誰が持つか、どこまでを外部に任せるか、費用をどの部門に帰属させるかは、いずれも経営の側にある論点です。クラウドの選定が技術の議論として始まっても、途中で必ず経営の議論に変わります。最初からそう扱っておくほうが、後戻りが少なくて済むと考えています。
本コラムを通じて繰り返した3つのこと
全14章で、同じことを何度か書きました。あらためて3つにまとめます。
第一に、名前ではなく役割で覚えるということです。第14章で見たとおり、サービス名は動きます。改称、統合、提供終了、新規受付の停止、推奨の変更が、いずれも実際に起きています。名前を覚える形の知識は、覚えた先から古くなります。役割の側は名前ほど速くは変わりませんので、役割を軸に持っておき、名前はその時点の呼び名として扱うほうが持ちがよくなります。
第二に、同じ役割の枠に入ることと、同じものであることは違うということです。第13章で対応表を集約しましたが、そこで最も紙幅を割いたのは、対応が付かないものと、名前が似ているのに前提が違うものでした。対応表は当たりを付けるための道具であって、置き換えの根拠ではありません。
第三に、横断的な一覧は入口であって、判定の根拠にはならないということです。第14章で見たとおり、終了や非推奨の横断の一覧に載っていないのに、提供を終えたり新規の受付を止めたりしているものがあり、逆にカテゴリの一覧に名前が載り続けているのに、新規には使えなくなっているものもあります。一覧で当たりを付け、個別のページで確かめる。この二段構えを崩すと、判断を誤ります。
経営として持っておきたい問い
技術の詳細に立ち入らなくても、決めておくべきことがあります。以下は、本コラムの各章から取り出した論点を、経営が答えるべき問いの形に置き直したものです。
| 問い | なぜ経営が決めるべきか | 本コラムの該当章 |
|---|---|---|
| どこまでの運用を、自社で担い続けるのか | 担う範囲が人員計画と採用計画を決める。技術的にはどの選択肢も成り立つため、要員の制約からしか決まらない | 第1章・第2章 |
| データをどこに置き、どの範囲まで移動を許すのか | 規程と法令の適用範囲に直結する。技術の可否ではなく、負う責任の範囲を決める問いである | 第3章・第9章 |
| 権限を誰が付与し、誰が定期的に見直すのか | 3社で設計思想が異なり、組織の階層と対応づける必要がある。組織図を持っている側でなければ決められない | 第9章 |
| 費用をどの単位で捉え、誰が責任を負うのか | アカウントや資源の区切り方が、そのまま原価の見え方を決める。後から組み替えるのは難しい | 第1章・第12章 |
| 複数のクラウドを併用するのか、しないのか | 併用は選択肢を増やす一方で、運用の負荷と必要な技能を増やす。事業上の必要が無ければ選ばないという判断もある | 第11章 |
| 採用したサービスの終了告知を、誰がいつ確認するのか | 確認する人が決まっていないと、告知は誰にも届かない。移行の猶予は数か月から数年で、気づくのが遅れるほど選択肢が減る | 第14章 |
この表は、答えを示したものではありません。答えは企業ごとに違います。示したかったのは、これらが技術部門に委ねきれない問いだということのほうです。
選定を一度きりの行事にしない
クラウドの選定は、大きな案件として一度行われ、そのあと長く触れられないことがあります。しかし本コラムで見てきたとおり、選定の前提のほうが動きます。採用したサービスが改称され、上位の基盤に統合され、あるいは新規の受付を止めることがあります。第14章で挙げた例のうち、AWS App Runnerの新規受付停止は2026年3月31日に告知され、2026年4月30日から新規の顧客を受け付けなくなったものです。既存の利用者はそのまま使い続けられます。比較的新しい選択肢が先に閉じることもあります。
したがって、選定そのものよりも、見直しの周期を先に決めておくことをおすすめしています。年に一度でも構いません。決めるのは日程だけではなく、そのときに何を見るかまでです。採用しているサービスの一覧、それぞれの現在の状態、告知の有無、代替の選択肢。この4つが揃っていれば、見直しは半日で終わります。揃っていなければ、毎回一から調べ直すことになります。
この作業は、専任の担当を置くほどの量にはなりません。むしろ、置かないことによって誰の仕事でもなくなるほうが問題になりやすいと考えています。担当を1人決めておく。それだけで、告知に気づかないまま猶予を使い切る事態は避けられます。
決めたことは、決めた理由とともに残す
見直しを実際に機能させるために、もうひとつ必要なものがあります。意思決定の記録です。
クラウドの構成には、後から見ると理由の分からない選択が残りがちです。なぜこのデータベースなのか、なぜこの区切り方なのか、なぜこの機能を使っていないのか。当時は理由がありました。既存システムとの兼ね合い、規程上の制約、その時点で提供されていなかった機能、といったものです。理由が残っていないと、見直しのたびに同じ検討を繰り返すことになります。逆に理由が残っていれば、前提が変わったかどうかを確かめるだけで済みます。
残すべきなのは、選んだものの名前ではありません。何を比べ、何を優先し、何を諦めたかのほうです。名前は第14章で見たとおり変わりますが、優先した理由は変わりません。前提が変わったときに読み直せるのは、理由の側だけです。
形式は問いません。数行の文章で十分です。判断を下した会議の議事録に一段落を足しておくだけでも、数年後の見直しの負担はかなり変わってきます。
分からないことを、分からないまま扱う
本コラムを準備する過程で、公式ドキュメントを開いても確定できなかった事項がいくつも出ました。改称が行われたことは公式の記述で確認できるのに、それがいつ行われたかを告知した文書が見つからない、という形が最も多くありました。そうした事項については、時期を書かず、確認できた範囲だけを記しています。
この扱い方は、そのまま社内の検討にも当てはまると考えています。クラウドの選定では、確かめきれない事項が必ず残ります。将来の値上げ、機能の提供継続、性能の実測値といったものです。これらを推測で埋めて資料の体裁を整えると、資料は読みやすくなりますが、後から読んだ人は推測と事実を区別できません。確かめられなかったことは、確かめられなかったと書いておくほうが、資料としては長持ちします。
あわせて、確かめる手順を持っておくことにも意味があります。第14章で3社の終了告知をどこで引くかを整理しました。Google Cloudには、終了の告知に絞った全社横断の一覧が無く、全製品をまたぐリリースノートはありますが、直近60日分が日付の単位で並ぶものですので、製品ごとのページとリリースノートを組み合わせて確かめることになります。こうした事情を知っているかどうかで、調べ物にかかる時間は大きく変わります。
3社を比べるという作業の、本当の効き目
1社しか使わないと決めている企業にとっても、3社を比べる作業には意味があると考えています。理由は、比べることでしか見えない前提があるからです。
1社の資料だけを読んでいると、その会社の言葉づかいと設計思想が、クラウドとはそういうものだという理解になります。可用性ゾーンの数え方、権限の与え方、ネットワークの範囲。いずれも3社を並べて初めて、それが選択の結果であって必然ではないことが分かります。自社の構成のどこが技術的な必然で、どこが採用したクラウドの流儀に合わせただけなのかを切り分けられるようになります。
この切り分けは、他社への移行を検討するときだけに効くものではありません。同じクラウドの中で構成を組み直すときにも、あるいは新しいサービスを採用するかどうかを判断するときにも効きます。前提を前提として認識できているかどうかの差です。
おわりに
本コラムは、3社の主要サービスを役割ごとに並べ直したものです。ここに書いた内容は、2026年9月時点で公式ドキュメントを開いて確認したものですが、時間が経てば実態とずれていきます。本コラムをお使いいただくにあたっては、確認すべき箇所を見つけるための地図として扱っていただくのが、最も役に立つ形だと考えています。
クラウドを使うかどうかは、多くの企業ですでに決着した論点になりました。これから増えるのは、使い方を見直す場面のほうだと思われます。数年前に組んだ構成が今の要件に合っているか、当時は無かった選択肢が出ていないか、採用したサービスが今も推奨されているか。こうした問いに答えるには、名前の一覧ではなく、役割の地図と、確かめる手順が要ります。本コラムがその一助になれば幸いです。
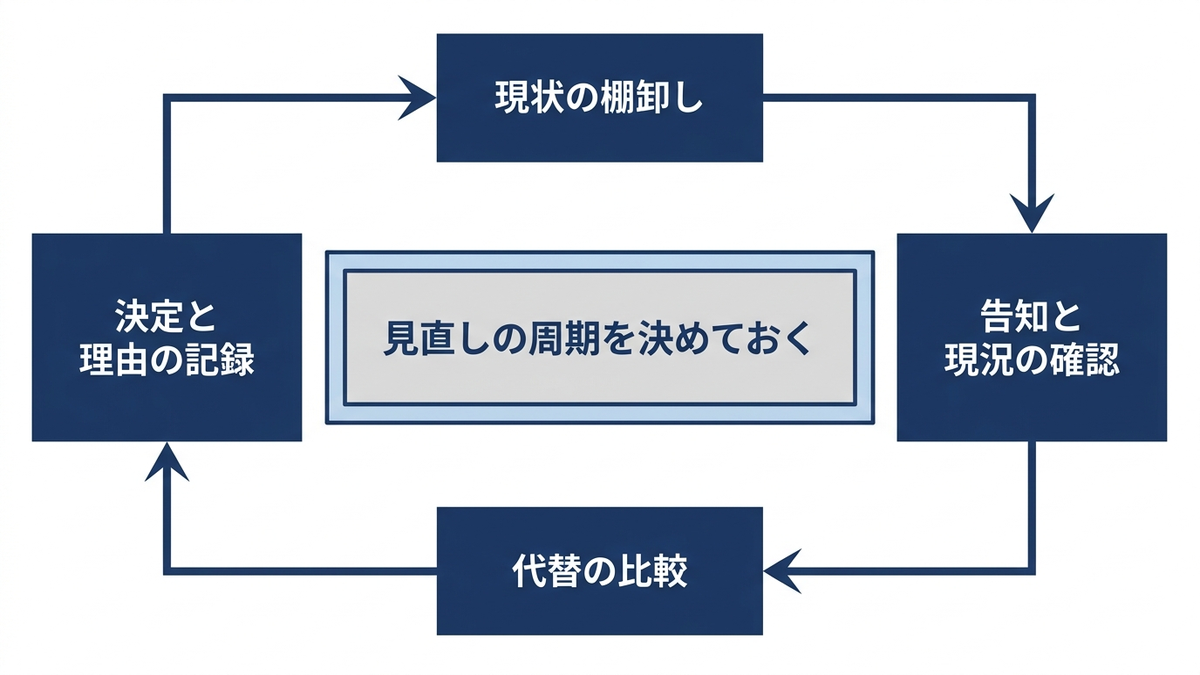
Anagraftでは、データ活用の構想づくりから基盤の選定、分析の実装、社内への定着までを一貫したご支援を行っています。会社概要・ご支援内容の詳細は、以下の資料からご覧いただけます。
本コラムで紹介した書籍一覧
各章末でご紹介した書籍をまとめました。それぞれ、本コラムのどの部分と結びつくかを添えています。
第1章 クラウドを読むための土台
『図解即戦力 ITインフラのしくみと技術がこれ1冊でしっかりわかる教科書』(鶴長鎮一・山本尚明・山根武信・北崎恵凡、技術評論社):ネットワーク、サーバー、クラウドサービスの基礎を、事業者に依存しない形で通して押さえられる1冊です。本章で扱ったデータセンターやリージョンの話は、そもそもの物理的な仕組みを知っていると腹落ちが早くなります。
『図解即戦力 Microsoft Azureのしくみと技術がこれ1冊でしっかりわかる教科書』(竹島友理・横山依子、技術評論社):本章で「Azure固有の言葉」として切り出したジオ、リージョンペア、可用性セット、サブスクリプション、リソースグループを、1冊でまとめて追えます。Azureの語彙は他の2社と対応させにくいので、独立した1冊で覚えるほうが早いと考えています。
『図解即戦力 Google Cloudのしくみと技術がこれ1冊でしっかりわかる教科書[改訂2版]』(株式会社grasys・大沼翔・西岡典生、技術評論社):組織とフォルダとプロジェクトという階層や、ゾーンの考え方を図で確認できます。クラウドの書籍は版が進むのが速いので、購入時は最新の版をご確認ください。
第2章 コンピューティングとコンテナ
『Kubernetes完全ガイド 第2版』(青山真也、インプレス):本章で「マネージドKubernetes」として3社を横に並べた部分を、Kubernetesそのものの側から深く追える1冊です。事業者ごとのサービス名ではなく共通の語彙のほうを理解しておくと、AWS・Azure・Google Cloudのどれを選んでも設計の考え方を持ち運べます。分量のある本なので、通読よりも必要な章を引く使い方が向いています。
『[改訂新版]イラストでわかるDockerとKubernetes』(徳永航平、技術評論社):コンテナとオーケストレータのしくみを図で押さえたい方に向く1冊です。本章では「コンテナは実行の単位、オーケストレータは配置と維持を決める仕組み」という粒度までしか書いていませんが、その中身を具体的に知っておくと、ノードを手放したときに何が起きるのかが実感として分かります。改訂新版はコンテナランタイム周辺の記述が更新されています。
『AWSコンテナ設計・構築[本格]入門 増補改訂版』(新井雅也・馬勝淳史、SBクリエイティブ):Kubernetesを使わない側、つまりAmazon ECSとFargateを中心にした設計と構築を、手を動かしながらたどれる1冊です。本章で述べた「Kubernetesを選ぶかどうかは運用の量を決める選択である」という論点を、実際の構成の形で確かめられます。クラウドの書籍は版が速く古くなるため、購入時は最新の版をご確認ください。
第3章 ストレージ
『絵で見てわかるOS/ストレージ/ネットワーク 新装版』(木村達也・西田光志・鳥嶋一孝・田中彰人 著、小田圭二 監修、翔泳社):本章でブロックとファイルとオブジェクトを分けた根拠は、突き詰めれば記録媒体と入出力の仕組みにあります。クラウドのサービス名からいったん離れて、ディスクとファイルシステムがどう動いているかを図で押さえておくと、性能の種類がなぜあの刻み方になっているのかが腹落ちします。
『図解即戦力 Amazon Web Servicesのしくみと技術が これ1冊でしっかりわかる教科書[改訂2版]』(小笠原種高、技術評論社):AWSの各サービスをカラーの図で通して確認できる1冊で、ストレージのサービスに1章が割かれています。本章では選択の軸を中心に書いたため個々の設定画面には触れていませんが、実際に手を動かす段になったら、この種の解説書と公式ドキュメントを並べて使うのが早いと考えています。クラウドの書籍は版が進むのが速いので、購入時は最新の版をご確認ください。
『ひと目でわかるAzure 基本から学ぶサーバー&ネットワーク構築 第4版』(横山哲也、日経BP):Azureの仮想マシンと仮想ネットワークを作る手順を追う構成で、Azureへ控えを取る章が独立して置かれています。本章の最後で述べた「冗長化とバックアップは別の話である」という点を、実際の手順の側から確かめるのに向いています。こちらも版が進む書籍なので、購入時は最新の版をご確認ください。
第4章 データベース
『データ指向アプリケーションデザイン』(Martin Kleppmann 著、斉藤太郎 監訳、玉川竜司 訳、オライリー・ジャパン):本章で扱った整合性の水準、複製の取り方、データの分割といった論点を、製品名から離れて原理の側から説明した1冊です。なぜ強い整合性に待ち時間が伴うのか、なぜ複数の拠点で書き込みを受ける構成で強い整合性を保とうとすると、待ち時間や地理的な範囲の制限といった対価が要るのかを理解しておくと、各社の公式ドキュメントの制約の記述が、制限ではなく設計上の帰結として読めるようになります。
『SQLアンチパターン 第2版』(Bill Karwin 著、和田卓人 監訳、児島修 訳、オライリー・ジャパン):データベースの選定を終えても、実際に困るのは表と問い合わせの作り方であることが多いように思います。本章でAmazon RDSの責任分担に触れ、問い合わせ文の調整が利用者側に残ると述べましたが、その残された部分を扱うのがこの本です。よくある設計上の失敗を型として並べ、どう直すかまで書かれています。
『失敗から学ぶ RDBの正しい歩き方』(曽根壮大 著、技術評論社):リレーショナルデータベースの運用で起きる問題を、実際に起きた形から逆算して解説した1冊です。本章では選択の軸を中心に書いたため運用の細部には触れていませんが、マネージドにしても消えない仕事が何かを知っておくと、移行の見積りが現実的になります。
第5章 データ分析基盤
『[増補改訂]ビッグデータを支える技術』(西田圭介 著、技術評論社):本章で並べた部品が、なぜそういう形になったのかを、製品名から離れて仕組みの側から説明した1冊です。手元の1台で試せる構成を使って、置き場、変換、問い合わせ、可視化の各層が何をしているかを順に確かめられます。3社の製品を比べる前にこの本を通しておくと、公式ドキュメントの説明文が、宣伝ではなく設計上の選択として読めるようになります。
『データエンジニアリングの基礎』(Joe Reis、Matt Housley 著、中田秀基 訳、オライリー・ジャパン):データの取得から保管、変換、提供までを1つの生涯として捉え、どの段階で何を決めるべきかを整理した1冊です。本章では選択の軸を中心に書きましたが、この本は組織の成熟度に応じて設計を変えるという視点を加えてくれます。特定の事業者に依存しない書き方をしているため、複数のクラウドを比較検討する場面でそのまま使えます。
『実践的データ基盤への処方箋』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社):本章の最後で扱った目録と権限の話を、組織の側から具体的に扱った1冊です。データの管理は技術だけでは成立せず、誰が責任を持ち、どういう役割分担で回すかという話に必ず行き着きます。分析基盤を作ったあとに使われなくなる、という失敗の型を避けたい場合に、先に読んでおく価値があります。
第6章 機械学習とAIのサービス
『Amazon Bedrock 生成AIアプリ開発入門 [AWS深掘りガイド]』(御田稔、熊田寛、森田和明、SBクリエイティブ):本章で「生成AIの基盤」として整理した Amazon Bedrock を、実際に手を動かして確かめるための1冊です。社内文書を検索して答えさせる仕組みと、自律的に動くエージェントの作り方が、手順として書かれています。刊行は2024年6月で、本章で触れた Amazon Bedrock Agents Classic の新規受付の停止と Amazon Bedrock AgentCore への移行より前の内容を含みます。Amazon Bedrock 自体は提供が続いていますので、サービス名と状態は公式ドキュメントで併せてご確認ください。
『AWSではじめる生成AI』(Chris Fregly、Antje Barth、Shelbee Eigenbrode 著、オライリー・ジャパン):本章の「検索との連携」と「モデルの選び方」を、もう一段深く扱った書籍です。検索拡張生成の作り込み、基盤モデルの微調整、複数の形式を扱う使い方までを通して読めます。原著は Generative AI on AWS で、日本語版の刊行は2024年8月です。
『Azure OpenAI Serviceではじめる ChatGPT/LLMシステム構築入門』(永田祥平ほか著、技術評論社):本章のAzure側、とくに社内システムとして生成AIを組み込む場合の進め方を扱っています。基盤の概念から、実際に社内向けの仕組みを作るところまでが1本の流れになっているため、企画の段階で読むと検討の抜けを見つけやすい構成です。刊行は2024年1月で、本章で触れた Microsoft Foundry への再編、すなわち Azure OpenAI の資源が Foundry の資源へ統合される前の内容です。
第7章 サーバーレスとイベント駆動
『AWS Lambda実践ガイド 第2版』(大澤文孝、インプレス):本章で扱った関数型のサーバーレスを、AWS Lambdaを題材に手を動かしながら理解できる1冊です。本章では実行時間の上限や起動の遅れといった制約の側から説明しましたが、その制約が実際の設計にどう効いてくるのかは、1つの環境で通しで作ってみるといちばん腑に落ちます。クラウドの書籍は版が速く古くなるため、購入時は最新の版と、本文が前提にしているサービスの現況をあわせてご確認ください。
『マイクロサービスパターン 実践的システムデザインのためのコード解説』(Chris Richardson、インプレス):本章の後半で扱ったメッセージング、イベントの配送、処理の連結を、事業者のサービス名ではなく設計の型の側から追える1冊です。プロセスの間の通信、トランザクション、データベースの分け方といった論点が、1つのサンプルの題材を通して具体的に説明されます。本章で述べた「少なくとも1回の配送を前提に受け手を冪等に作る」という話が、なぜ避けられないのかを理解する助けになります。
『ソフトウェアアーキテクチャ・ハードパーツ』(Neal Ford ほか、オライリー・ジャパン):分散したアーキテクチャで避けて通れない判断を、正解を示すのではなく取捨の分析として扱う1冊です。本章では「関数かコンテナか」ではなく「どの制約の下で動かしたいか」を問うべきだと述べましたが、本書はその問いの立て方そのものを主題にしています。とくに後半で扱われるワークフローの調整やサガの型は、本章の処理の連結の節と直接つながります。
第8章 ネットワーキング
『Amazon Web Services基礎からのネットワーク&サーバー構築 改訂4版』(大澤文孝・玉川憲・片山暁雄・今井雄太、日経BP):本章で扱った仮想ネットワークとサブネット、経路の設定、公衆網に出る口と出ない口という話を、実際に手を動かしながら確かめられる1冊です。ゾーンごとにサブネットを切るという作り方が身体で分かると、3社の違いを読むときの基準ができます。改訂が重ねられている書籍なので、購入時は最新の版をご確認ください。
『インフラ/ネットワークエンジニアのためのネットワーク技術&設計入門 第2版』(みやたひろし、SBクリエイティブ):負荷分散、冗長化、アドレスの設計といった、クラウドに固有ではない土台をまとめて押さえられます。本章の対比表は、この土台の言葉が入っていると読み解きが速くなります。クラウドの用語から入って、そもそもの設計の考え方が抜けていると感じた方に向いています。
『DNSがよくわかる教科書 第2版』(株式会社日本レジストリサービス(JPRS)渡邉結衣・熊谷維魅・佐藤新太・藤原和典、SBクリエイティブ):本章の名前解決の節は、DNSそのものの仕組みを知っていると意味が変わります。ゾーンとレコードの考え方が分かると、3社のDNSのサービスが何を代行してくれているのかを自分で判断できるようになります。ドメイン名を管理する立場の組織が書いている点も、内容の確かさにつながっています。
第9章 セキュリティとID
『AWSではじめるクラウドセキュリティ クラウドで学ぶセキュリティ設計/実装』(松本照吾・桐谷彰一・畠中亮・前田駿介、テッキーメディア):本章で扱ったAWS側の話、とくにポリシーをどこに書くかという設計を、実際に手を動かしながら確かめられる1冊です。ポリシーが9種類あるという事実は、読むだけでは腹に落ちにくいところなので、環境を作って挙動を見るのが近道だと考えています。
『ひと目でわかるMicrosoft Entra ID』(竹島友理、日経BP):改称後の名前で書かれた解説書です。テナントの構成、利用者とグループの管理、Azureと Microsoft Entra のロールの管理、条件付きアクセス、IDガバナンスまでを順に追えます。この本自体が、2020年12月に出た『ひと目でわかるAzure Active Directory 第3版』の後継として作られたものだと説明されており、本章で触れた改称がそのまま書籍の側にも表れている例になっています。
『マルチクラウドセキュリティの教科書 クラウド横断で実現する堅牢なセキュリティ基盤』(大島悠司ほか、翔泳社):3社を横断して見る立場から、IDとアクセス管理、ネットワークの防御、データの保護とコンプライアンスを扱っています。本章の中心に置いた「片方の設計をもう片方へ機械的に写せない」という問題を、実務でどう吸収するかを考えるときの手がかりになります。複数のクラウドを併用している組織の担当者に向いています。
第10章 開発と運用
『詳解 Terraform 第3版』(Yevgeniy Brikman 著、松浦隼人 訳、オライリー・ジャパン):この章で扱った構成をコードで扱う考え方を、Terraform という具体的な道具に沿って基礎から本番の運用まで追える1冊です。複数の開発チームが同じ構成を触るときの分割やレビューの進め方まで踏み込んでいるため、Google Cloudの Infrastructure Manager を検討する場合はもちろん、AWSやAzureで第三者製の道具を使う判断をした場合にも読み込む価値があります。2023年11月刊行の第3版です。
『オブザーバビリティ・エンジニアリング』(Charity Majors、Liz Fong-Jones、George Miranda 著、大谷和紀・山口能迪 訳、オライリー・ジャパン):この章の後半で扱った可観測性について、言葉の定義から実践、さらに組織への定着までを1冊で論じた本です。あらかじめ決めた指標を見る監視と、決めていなかった問いに答えられる状態を作ることの違いが丁寧に整理されているため、監視の仕組みを作り直す前の共通言語として使えます。2023年1月刊行です。
『LeanとDevOpsの科学[Accelerate] テクノロジーの戦略的活用が組織変革を加速する』(Nicole Forsgren、Jez Humble、Gene Kim 著、武舎広幸・武舎るみ 訳、インプレス):道具ではなく、開発と運用の進め方が組織の成果にどう効くのかを、調査に基づいて論じた本です。この章で扱った継続的な統合と配信を「入れたかどうか」ではなく「何が改善したか」で語るための枠組みが得られます。経営の側がこの領域の投資を判断するときの物差しとして読める1冊です。2018年11月刊行です。
第11章 移行とハイブリッドとマルチクラウド
『クラウドシステム移行・導入 アーキテクチャからハイブリッドクラウドまで』(金子格 編著、オーム社):本章で扱った移行の設計と、ハイブリッドの構成を1冊で通して扱っている書籍です。移行の設計、アーキテクチャの基礎、開発と運用、セキュリティ、法制度までを章立てで並べており、本章が事業者ごとのサービス名の側から書いた内容を、事業者に依存しない設計の側から補ってくれます。2022年の刊行なので、サービス名と現況は公式ドキュメントで確かめながら読むことをお勧めします。
『業務システム クラウド移行の定石』(吉羽龍太郎、日経BP):移行を、道具の話ではなく進め方の話として扱った書籍です。企画、戦略と分析、試行、設計と移行、運用と改善という5つの段階に分けて、それぞれで決めることを具体的に並べています。本章で「型を決める前に、いま何があるのかを数える」と書いた工程が、実際にはどれだけの作業量になるのかを掴めます。2018年の刊行のため、登場するサービスの名前は現在と異なります。
『モノリスからマイクロサービスへ』(Sam Newman 著、島田浩二 訳、オライリー・ジャパン):移行の型のうち「作り替える」を選んだ場合に、実際に何をどの順で分解するのかを扱った書籍です。本章では、移行と近代化を同じ期間に置かないほうがよいと述べましたが、では近代化の側をどう刻むのか、という問いにはこの本のほうが詳しく答えています。既存の仕組みを止めずに少しずつ切り出していく手順が、パターンとして整理されています。
第12章 コストの考え方
『クラウドFinOps(第2版)』(J.R. Storment、Mike Fuller、オライリー・ジャパン):この章の後半で扱った「誰が、いつ、どの単位で責任を持つのか」を1冊かけて論じた本です。原著の第2版の翻訳で、費用の可視化から配賦、確約の判断、組織としての運営までを段階として整理しています。道具の使い方ではなく組織の設計の本として読むと、社内で議論を始めるときの共通言語になります。
『AWSコスト最適化ガイドブック』(門畑顕博ほか、KADOKAWA):AWSに絞って、費用の構造の読み方と削減の打ち手を具体的に扱った本です。この章では金額を書かない方針をとりましたが、実際に自社の請求を分解する段では、サービスごとの課金の軸を1つずつ確認する作業が要ります。その手順を追いたい方に向いています。刊行は2023年なので、サービス名と機能の現況は公式ドキュメントで補ってください。
『[PM&スタートアップのための]はじめてのクラウドコスト管理』(津郷晶也、技術評論社):インフラの費用と会計をつなぐ視点で書かれた入門書です。この章の「初期投資が運用費に変わる」という論点を、事業計画や損益の見方の側から補ってくれます。技術者ではない立場でクラウドの費用を説明する必要がある方の、最初の1冊として使えます。
第13章 3社の対応関係の地図
『マルチクラウドネットワークの教科書』(宮川亮、翔泳社):複数のクラウドをまたいでネットワークを設計するときの型を扱った本です。この章では、仮想ネットワークの広がる範囲が3社で違うという例を挙げましたが、その違いを実際の構成へ落とすとどうなるかは、本書のデザインパターンの章が具体的です。耐障害性と冗長性を軸に組み立てられているので、対応表からは見えない設計の作業量を掴むのに向いています。刊行は2023年なので、個々のサービス名と機能の現況は公式ドキュメントで補ってください。
『マルチクラウドデータベースの教科書』(朝日英彦、小林隆浩、矢野純平、翔泳社):データベースを複数のクラウドで扱うときの考え方をまとめた本です。この章で触れたとおり、データベースは対応表がもっとも誤解を招きやすい領域で、整合性の扱いや移行の可否は表の行の中に収まりません。特定のクラウドに閉じ込められる状態をどう避けるかという観点で書かれているので、地図から一歩進んで要件を詰める段で役に立ちます。
『図解まるわかり クラウドのしくみ』(西村泰洋、翔泳社):クラウドの構成要素を1項目ずつ図で説明した入門書です。この章の表は、カテゴリの言葉が読者と共有できていることを前提にしています。仮想化、負荷分散、オブジェクトストレージといった語の中身から確認したい方は、こちらを先に通しておくと表の読み方が変わります。特定の1社に寄らない書き方なので、3社を横に並べて考える立場に合います。
第14章 サービスの名前と構成はどう動いてきたか
『進化的アーキテクチャ 絶え間ない変化を支える』(Neal Ford ほか著、オライリー・ジャパン):土台となる技術が変わり続けることを前提に、システムの設計をどう保つかを扱った本です。本章で見たとおり、クラウドのサービス名と構成は数年で動きます。個々の名前を追いかけるのではなく、変化に耐える構造をどう作るかという観点は、台帳の作り方や標準構成の決め方にそのまま応用できます。
『Googleのソフトウェアエンジニアリング 持続可能なプログラミングを支える技術、文化、プロセス』(Titus Winters ほか編、オライリー・ジャパン):ソフトウェアを時間の経過のなかで維持することを主題に置いた本で、廃止をどう計画し、どう進めるかを正面から扱った章があります。事業者の側が何を考えて終了を告知しているのかを知っておくと、告知の文面から読み取れることが増えます。
『ソフトウェアアーキテクチャの基礎 第2版 エンジニアリングに基づく体系的アプローチ』(Mark Richards、Neal Ford 著、オライリー・ジャパン):設計の判断には正解が無く、あるのは取捨だけである、という立場から書かれた本です。本コラムが一貫して「どの1社が優れているか」ではなく「どの軸で選ぶか」を書いてきた理由と重なります。判断の記録を残す方法についても触れられており、本章で述べた台帳の運用と併せて読むと役に立ちます。
参考情報
本コラムの記述は、次の資料を2026年9月に確認して書いています。クラウドのサービスは変わりますので、実際の判断にあたっては各社の公式ドキュメントで現況をご確認ください。
第1章
- AWSのリージョンは「データセンターを集約している世界各地の物理的な場所」
https://aws.amazon.com/about-aws/global-infrastructure/regions_az/ - リージョンは互いに隔離され、資源は自動的に複製されない
https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/using-regions-availability-zones.html - AZの名前はアカウントごとに異なる物理位置を指しうる。AZ IDで揃える
https://docs.aws.amazon.com/global-infrastructure/latest/regions/az-ids.html - Azureの可用性ゾーンは「1つ以上の物理的に分離されたデータセンターの論理的なまとまり」
https://learn.microsoft.com/en-us/azure/reliability/availability-zones-overview - Azureは70を超えるリージョンを提供
https://learn.microsoft.com/en-us/azure/reliability/regions-overview - Google Cloudのリージョンは「ゾーンから構成される独立した地理的領域」
https://docs.cloud.google.com/docs/geography-and-regions - Google Cloudのゾーン名がプロジェクトごとに別の物理ゾーンを指すかどうか
https://docs.cloud.google.com/compute/docs/regions-zones - リージョンペアの定義
https://learn.microsoft.com/en-us/azure/reliability/regions-paired - 可用性セットの定義
https://learn.microsoft.com/en-us/azure/virtual-machines/availability-set-overview - AWSは「クラウドの安全性」と「クラウド内の安全性」を分ける
https://aws.amazon.com/compliance/shared-responsibility-model/ - Azureの責任マトリクスの行と列
https://learn.microsoft.com/en-us/azure/security/fundamentals/shared-responsibility - Google Cloudは「運命の共有」を掲げる
https://docs.cloud.google.com/architecture/framework/security/shared-responsibility-shared-fate - 3分類はNISTが2011年9月に公表した文書で整理された。著者はP. M. MellとT. Grance
https://nvlpubs.nist.gov/nistpubs/Legacy/SP/nistspecialpublication800-145.pdf - AWSアカウントは資源の入れ物。費用の境界かつ分離の境界
https://docs.aws.amazon.com/organizations/latest/userguide/orgs_getting-started_concepts.html - Azureの管理スコープは4水準で、下位が上位を継承する
https://learn.microsoft.com/en-us/azure/azure-resource-manager/management/overview - サブスクリプションは管理・課金・スケールの単位で、各種制御の境界
https://learn.microsoft.com/en-us/azure/cloud-adoption-framework/ready/landing-zone/design-area/resource-org-subscriptions - 管理グループの階層は最大6段。ルート管理グループの識別子はテナントの識別子と同じ
https://learn.microsoft.com/en-us/azure/governance/management-groups/overview - Google Cloudは組織・フォルダ・プロジェクト・資源の階層
https://docs.cloud.google.com/resource-manager/docs/cloud-platform-resource-hierarchy - 1つの請求先アカウントが複数のプロジェクトの費用を払える
https://docs.cloud.google.com/billing/docs/concepts - SLA・SLO・SLIの定義
https://learn.microsoft.com/en-us/azure/well-architected/reliability/metrics - サービスクレジットは返金ではない
https://aws.amazon.com/compute/sla/ - AWSは有料で一般提供中のすべてのサービスにSLAを提供する
https://aws.amazon.com/legal/service-level-agreements/ - Google Cloudもサービスごとの一覧を公開している
https://cloud.google.com/terms/sla - Google CloudのSLAの細部(金銭的クレジットの請求期限・排他的救済の文言)
https://cloud.google.com/compute/sla - 『図解即戦力 ITインフラのしくみと技術がこれ1冊でしっかりわかる教科書』(鶴長鎮一・山本尚明・山根武信・北崎恵凡、技術評論社)
https://gihyo.jp/book/2024/978-4-297-14592-7 - 『図解即戦力 Microsoft Azureのしくみと技術がこれ1冊でしっかりわかる教科書』(竹島友理・横山依子、技術評論社)
https://gihyo.jp/book/2026/978-4-297-15521-6 - 『図解即戦力 Google Cloudのしくみと技術がこれ1冊でしっかりわかる教科書[改訂2版]』(株式会社grasys・大沼翔・西岡典生、技術評論社)
https://gihyo.jp/book/2024/978-4-297-14347-3 - 『Amazon Web Services 基礎からのネットワーク&サーバー構築 改訂4版』(大澤文孝・玉川憲・片山暁雄・今井雄太、日経BP、2023年5月8日、ISBN 9784296202041)
https://bookplus.nikkei.com/atcl/catalog/23/04/06/00757/ - Amazon QuickSight は Amazon Quick に改称され、従来の可視化の機能は Amazon Quick の中の Amazon Quick Sight として続いている(序章)
https://docs.aws.amazon.com/quicksight/latest/user/welcome.html - Amazon QuickSight の改称の日付は2025年10月9日(序章の本文には日付を書いていない)
https://docs.aws.amazon.com/quicksight/latest/user/doc-history.html - Vertex AI のサービスは Gemini Enterprise Agent Platform の一部となり、最新の情報は Agent Platform 側の文書を参照するよう案内が出ている(序章
https://docs.cloud.google.com/vertex-ai/docs/release-notes - Azure Blueprints は2026年7月31日から段階的に終了し、2027年1月31日に提供を終えることが告知されている。プレビューの位置づけのまま終わる(序章)
https://learn.microsoft.com/en-us/azure/governance/blueprints/overview - AWS CodeStar はサポートが2024年7月25日に終了した(序章)
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - Azure Database for MariaDB は2025年9月に提供を終えた(序章)
https://learn.microsoft.com/en-us/lifecycle/products/azure-database-for-mariadb - AWS CodeCommit は2024年7月25日に新規のお客様への提供を停止した(序章)
https://docs.aws.amazon.com/codecommit/latest/userguide/history.html - AWS CodeCommit は2025年11月に一般提供へ復帰した(序章。日は書かない)
https://aws.amazon.com/blogs/devops/aws-codecommit-returns-to-general-availability/
第2章
- Amazon EC2 は「安全で、大きさを変えられる計算能力をクラウドで提供するウェブサービス」
https://docs.aws.amazon.com/whitepapers/latest/aws-overview/compute-services.html - Azure Virtual Machines は「Azureが提供する、要求に応じて使える拡張可能な計算資源のうちの1つの型」
https://learn.microsoft.com/en-us/azure/virtual-machines/overview - Compute Engine は「自分で管理する仮想マシンのインスタンスとベアメタルのインスタンスを提供するIaaSの製品」
https://docs.cloud.google.com/compute/docs/overview - Amazon EC2 Auto Scaling は「負荷を処理するのに正しい台数のEC2インスタンスがある状態を保つのを助けるもの」
https://docs.aws.amazon.com/autoscaling/ec2/userguide/what-is-amazon-ec2-auto-scaling.html - Azure Virtual Machine Scale Sets は「負荷分散された仮想マシンのインスタンスの集まりを作成して管理できるようにするもの」
https://learn.microsoft.com/en-us/azure/virtual-machine-scale-sets/overview - マネージドインスタンスグループは「同一の複数の仮想マシンの上でアプリケーションを運用できるようにするもの」
https://docs.cloud.google.com/compute/docs/instance-groups - Amazon ECS は「Dockerのコンテナに対応した、拡張性と性能の高いコンテナオーケストレーションのサービス」
https://docs.aws.amazon.com/whitepapers/latest/aws-overview/containers.html - Azure Kubernetes Service は「コンテナ化されたアプリケーションを配置し管理するためのマネージドのKubernetesサービス」
https://learn.microsoft.com/en-us/azure/aks/what-is-aks - Google Kubernetes Engine は「オープンソースのコンテナオーケストレーション基盤であるKubernetesのマネージドな実装」
https://docs.cloud.google.com/kubernetes-engine/docs/concepts/kubernetes-engine-overview - Azure Container Instances は「仮想マシンを一切管理することなく、また上位のサービスを採用することもなく、LinuxまたはWindowsのコンテナをAzureで動かす最も速く簡
https://learn.microsoft.com/en-us/azure/container-instances/container-instances-overview - GKE Autopilot は Google が基盤の大部分を引き受ける形で、ノード・規模の調整・セキュリティなどの構成を Google が管理する
https://docs.cloud.google.com/kubernetes-engine/docs/concepts/autopilot-overview - GKE Standard は「クラスターの基盤を自分で制御し、ほとんどの設定を変更できる」
https://docs.cloud.google.com/kubernetes-engine/docs/concepts/choose-cluster-mode - Fargate は「コンテナのために、必要なときに必要な大きさの計算能力を提供する技術」で、仮想マシンの群れを自分で用意・設定・拡張する必要が無い
https://docs.aws.amazon.com/eks/latest/userguide/fargate.html - Amazon ECS 側でも、仮想マシンのクラスターを用意・設定・拡張せずにコンテナを動かせる技術として説明されている
https://docs.aws.amazon.com/AmazonECS/latest/developerguide/AWS_Fargate.html - Azure Container Registry は「オープンソースのDockerの基盤に基づくマネージドのレジストリサービス」
https://learn.microsoft.com/en-us/azure/container-registry/container-registry-intro - Artifact Registry は「成果物とビルドの依存関係を一元的に保管できるようにするもの」
https://docs.cloud.google.com/artifact-registry/docs/overview - Container Registry は2025年3月18日に停止し、イメージの書き込みができない
https://docs.cloud.google.com/container-registry/docs/deprecations/container-registry-deprecation - AWS Elastic Beanstalk は「ウェブアプリケーションとサービスを配置し、規模を変えるための、使いやすいサービス」
https://docs.aws.amazon.com/elasticbeanstalk/latest/dg/Welcome.html - Azure App Service は「基盤の管理を気にすることなく、ウェブアプリケーション、モバイルのバックエンド、RESTfulなAPIを動かせる基盤」
https://learn.microsoft.com/en-us/azure/app-service/overview - App Engine の公式が、新規の利用者に Cloud Run を推奨している
https://docs.cloud.google.com/appengine/docs/the-appengine-environments - AWS App Runner は、新規に利用を開始できない段階の一覧に 2026年3月31日の告知として載っている
https://docs.aws.amazon.com/general/latest/gr/maintenance_services.html - 開発者ガイドの冒頭にも新規に開かれていない旨の告知が出ている
https://docs.aws.amazon.com/apprunner/latest/dg/what-is-apprunner.html - 慎重な検討の結果として新規の顧客に閉じることを決めた。既存の顧客は新しい資源やサービスの作成を含めてこれまでどおり使える。セキュリティと可用性への投資は続けるが新機能の追加は予定していない
https://docs.aws.amazon.com/apprunner/latest/dg/apprunner-availability-change.html - Amazon ECS Express Mode は、1回のAPIの呼び出しでコンテナのイメージと2つのIAMのロールを渡すと、Fargate上のECSのサービス、アプリケーションロードバランサー、自動
https://docs.aws.amazon.com/AmazonECS/latest/developerguide/express-service-getting-started.html - Azure Container Apps は「基盤を管理することなくコンテナ化されたアプリケーションを動かすための、サーバーレスの基盤」
https://learn.microsoft.com/en-us/azure/container-apps/overview - Azure Functions のホスティングは Flex Consumption プラン(推奨)/Premium プラン/Dedicated プラン/Container Apps/Consumpti
https://learn.microsoft.com/en-us/azure/azure-functions/functions-overview - Container Apps 上の Azure Functions は、Functions のイベント駆動の性質と Container Apps の機能を組み合わせた、完全にマネージドなサーバーレスの
https://learn.microsoft.com/en-us/azure/container-apps/functions-overview - Azure Virtual Desktop は「Azureの上で動く、デスクトップとアプリケーションの仮想化のサービス」
https://learn.microsoft.com/en-us/azure/virtual-desktop/overview - Google Cloud VMware Engine は「VMwareの基盤をGoogle Cloudで動かせるようにする、完全にマネージドなサービス」
https://docs.cloud.google.com/vmware-engine/docs/overview - Bare Metal Solution は「高性能なベアメタルのサーバーの上で、特殊なワークロードを動かせる安全な環境を提供する」
https://docs.cloud.google.com/bare-metal/docs/bms-overview - 『Kubernetes完全ガイド 第2版』(青山真也、インプレス)
https://book.impress.co.jp/books/1119101148 - 『[改訂新版]イラストでわかるDockerとKubernetes』(徳永航平、技術評論社)
https://gihyo.jp/book/2024/978-4-297-14055-7 - 『AWSコンテナ設計・構築[本格]入門 増補改訂版』(新井雅也・馬勝淳史、SBクリエイティブ)
https://www.sbcr.jp/product/4815626044/ - EKS Auto Mode は「Kubernetesのクラスターに対するAWSの管理をクラスターそのものの外へ広げ、ワークロードを円滑に動かすための基盤もAWSが用意し管理できるようにするもの」
https://docs.aws.amazon.com/eks/latest/userguide/automode.html - 入門ページの冒頭に、EKS Auto Mode がノードを配置するうえで望ましい方法と明記
https://docs.aws.amazon.com/eks/latest/userguide/getting-started-console.html - Amazon EKS のクラスターは、EKS Auto Mode が管理するノード、自分で管理するノード、マネージドノードグループ、AWS Fargate、ハイブリッドノードのどの組み合わせにもポッド
https://docs.aws.amazon.com/eks/latest/userguide/eks-compute.html - GKE は Standard クラスターの中でも ComputeClass を使えば一部のワークロードを Autopilot モードで動かせる
https://docs.cloud.google.com/kubernetes-engine/docs/concepts/about-autopilot-mode-standard-clusters - Autopilot の制約の例: 特権モードのコンテナは動かせない(Googleのパートナーが配置するものを除く)、ホストの名前空間は使えない、hostPath のボリュームは書き込みモードでは使えな
https://docs.cloud.google.com/kubernetes-engine/docs/concepts/autopilot-security - Azure VMSS の自動インスタンス修復: Application Health 拡張機能またはロードバランサーのヘルスプローブで不健全と判定された個体を、置き換え・再イメージ化・再起動のいずれか
https://learn.microsoft.com/en-us/azure/virtual-machine-scale-sets/virtual-machine-scale-sets-automatic-instance-repairs - NGroups を利用するには、プレビュー版のAPIバージョンを使い、プレビュー機能をサブスクリプションに登録する必要がある
https://learn.microsoft.com/en-us/azure/container-instances/container-instance-ngroups/container-instances-about-ngroups - Bare Metal Solution の提供が許可リストに載った利用者だけを対象とする専用のモデルへ移行しつつある(7 節の再照合)
https://docs.cloud.google.com/bare-metal/docs/bms-planning - AWS App Runner が新規の顧客を受け付けなくなったのは2026年4月30日から
https://aws.amazon.com/about-aws/whats-new/2026/03/aws-service-availability/
第3章
- Amazon S3 は規模・可用性・安全性・性能に優れたオブジェクトストレージ
https://docs.aws.amazon.com/whitepapers/latest/aws-overview/storage-services.html - Azure Blob Storage はマイクロソフトのクラウド向けオブジェクトストレージの解
https://learn.microsoft.com/en-us/azure/storage/blobs/storage-blobs-introduction - Cloud Storage はバケットと呼ばれる入れ物にオブジェクトとして保存する、規模の拡張が効くマネージドのサービス
https://docs.cloud.google.com/storage/docs/introduction - Cloud Storage のバケットの置き場所は、単一リージョン・2リージョンの組・2つ以上のリージョンを含む広域の3種別
https://docs.cloud.google.com/storage/docs/locations - 出典はすべて
https://docs.aws.amazon.com/AmazonS3/latest/userguide/storage-class-intro.html - 出典はすべて 2026-06-15)
https://learn.microsoft.com/en-us/azure/storage/blobs/access-tiers-overview - 出典
https://docs.cloud.google.com/storage/docs/storage-classes - S3 のライフサイクルの行動は「別のストレージクラスへ移す」と「期限が来たら削除する」の2種類
https://docs.aws.amazon.com/AmazonS3/latest/userguide/object-lifecycle-mgmt.html - Azure の判定に使える条件は Creation Time / Last Modified Time / Last Accessed Time(アクセス時刻の記録を有効にしている場合)
https://learn.microsoft.com/en-us/azure/storage/blobs/lifecycle-management-overview - Cloud Storage の Object Lifecycle Management の行動は Delete / SetStorageClass / AbortIncompleteMultipart
https://docs.cloud.google.com/storage/docs/lifecycle - Autoclass はアクセスの様子に応じて自動でクラスを移す。SetStorageClass を使う規則や matchesStorageClass 条件とは同時に使えない
https://docs.cloud.google.com/storage/docs/autoclass - EBS の種類は gp3 / gp2(汎用SSD)、io2 Block Express / io1(Provisioned IOPS SSD)、st1(Throughput Optimized HDD
https://docs.aws.amazon.com/ebs/latest/userguide/ebs-volume-types.html - Azure Managed Disks は5種類。Ultra Disks / Premium SSD v2 / Premium SSD / Standard SSD / Standard HDD
https://learn.microsoft.com/en-us/azure/virtual-machines/managed-disks-overview - Google Cloud の永続的なブロックストレージは Hyperdisk と Persistent Disk の2つ
https://docs.cloud.google.com/compute/docs/disks - Amazon EFS は容量や性能をあらかじめ用意しなくてよい、伸縮する共有のファイル保管
https://docs.aws.amazon.com/efs/latest/ug/whatisefs.html - EFS には標準の層・取り出しが少ない層・Archive の3つがあり、既定で30日/90日で移る。既定では読んでも標準へ戻らない
https://docs.aws.amazon.com/efs/latest/ug/lifecycle-management-efs.html - Azure Files は SMB と NFS の2つの手順。SMB は 3.1.1 / 3.0 / 2.1、NFS は 4.1
https://learn.microsoft.com/en-us/azure/storage/files/storage-files-planning - Windows、Linux、macOS から同時に接続できる
https://learn.microsoft.com/en-us/azure/storage/files/storage-files-introduction - Filestore は完全に管理されたファイルサーバーで、さまざまな接続元から使える
https://docs.cloud.google.com/filestore/docs/overview - Azure Data Lake Storage は専用のサービスでも口座の種類でもなく、Blob Storage と組み合わせて使う機能の集まりである
https://learn.microsoft.com/en-us/azure/storage/blobs/data-lake-storage-introduction - Azure Data Lake Storage Gen1 は提供終了。切り替えの期限として案内されたのは2024年2月29日、ライフサイクル情報の終了日は2024年3月1日
https://learn.microsoft.com/en-us/azure/data-lake-store/data-lake-store-overview - Azure Data Lake Storage Gen1 は提供終了。切り替えの期限として案内されたのは2024年2月29日、ライフサイクル情報の終了日は2024年3月1日
https://learn.microsoft.com/en-us/lifecycle/products/azure-data-lake-storage-gen1 - 冗長化はハードウェアの故障からは守るが、データを書き換える操作からは守らない
https://learn.microsoft.com/en-us/azure/storage/common/storage-redundancy - AWS Backup は複数サービスにまたがるデータ保護を1か所に集め、方針を書いて自動実行させる完全マネージドのサービス
https://docs.aws.amazon.com/aws-backup/latest/devguide/whatisbackup.html - Azure Backup はデータを控えとして取り、Azureのクラウドから復旧するための仕組み
https://learn.microsoft.com/en-us/azure/backup/backup-overview - 毎秒100メガビットの回線で300テラバイトを送ると9か月ほど、機器を使えば25日を切る
https://docs.cloud.google.com/transfer-appliance/docs/4.0/overview - AWS DataSync はオンプレミスのNFS・SMB・HDFS・オブジェクトの保管と、S3・EFS・FSx の各種のあいだを行き来できる
https://docs.aws.amazon.com/datasync/latest/userguide/what-is-datasync.html - Storage Transfer Service は他社のオブジェクトストレージ・オンプレミス・HDFS・公開URLから Cloud Storage へ移せる
https://docs.cloud.google.com/storage-transfer/docs/overview - AWS Storage Gateway はオンプレミスの仮想機器または専用機器を通じて、手元のアプリケーションからそのままクラウドの保管を使えるようにする
https://docs.aws.amazon.com/storagegateway/latest/userguide/WhatIsStorageGateway.html - AWS Snowmobile は 2024年3月14日、AWS Snowblade は 2024年11月12日、AWS Snowball Edge と旧世代の2機種は 2025年11月12日という日付
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - AWS Snowcone は 2024年11月12日をもって提供を終了したと公式ブログが告知している
https://aws.amazon.com/blogs/storage/aws-snow-device-updates/ - Snowball Edge の開発者向けドキュメント冒頭に新規の顧客には提供しないという告知があり、代わりに AWS DataSync、AWS Data Transfer Terminal、AWS O
https://docs.aws.amazon.com/snowball/latest/developer-guide/whatisedge.html - AWS のサービス一覧のホワイトペーパーにも Snow ファミリが現行の選択肢として載っている箇所がある
https://docs.aws.amazon.com/whitepapers/latest/aws-overview/compute-services.html - 機器を送って受け取り、手元でデータを入れて返送し、Azureのデータセンターで自動的に取り込む流れ
https://learn.microsoft.com/en-us/azure/databox/data-box-overview - 『絵で見てわかるOS/ストレージ/ネットワーク 新装版』
https://www.shoeisha.co.jp/book/detail/9784798158488 - 『図解即戦力 Amazon Web Servicesのしくみと技術が これ1冊でしっかりわかる教科書[改訂2版]』
https://gihyo.jp/book/2025/978-4-297-14820-1 - 『ひと目でわかるAzure 基本から学ぶサーバー&ネットワーク構築 第4版』
https://bookplus.nikkei.com/atcl/catalog/22/11/30/00527/ - Amazon FSx File Gateway は2024年10月28日から新規の顧客には提供せず、既存の顧客は引き続き通常どおり使える
https://docs.aws.amazon.com/filegateway/latest/filefsxw/what-is-file-fsxw.html - Amazon FSx File Gateway は2024年10月28日から新規の顧客には提供せず、既存の顧客は引き続き通常どおり使える
https://docs.aws.amazon.com/filegateway/latest/filefsxw/doc-history.html - AWS Storage Gateway Hardware Appliance は2025年5月12日をもって提供を終え、既存の顧客は2028年5月まで利用と支援を受けられる
https://docs.aws.amazon.com/storagegateway/latest/tgw/hardware-appliance.html - AWS Snowball の公式FAQは、2025年11月7日以降は既存の顧客だけに提供すると告知している
https://aws.amazon.com/snowball/faqs/ - Snowball Edge のドキュメント履歴
https://docs.aws.amazon.com/snowball/latest/developer-guide/document-history.html - Smart tier の前提は汎用v2のストレージアカウントと可用性ゾーンをまたぐ冗長化(ZRS、GZRS、RA-GZRS)で、Archive の層は対象にしない
https://learn.microsoft.com/en-us/azure/storage/blobs/access-tiers-smart
第4章
- Amazon RDS は、クラウドの中でリレーショナルデータベースを立ち上げ・運用・拡張することを容易にするサービス
https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/Welcome.html - Amazon Aurora は MySQL と PostgreSQL に互換。素のエンジンに対して最大6倍の処理量
https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_AuroraOverview.html - (採用しなかった数値) ホワイトペーパー側は Aurora を「MySQLの5倍・PostgreSQLの3倍」「128TBまで自動拡張」と書いている
https://docs.aws.amazon.com/whitepapers/latest/aws-overview/database.html - Azure SQL Database は、更新・修正適用・控え・監視の大半を利用者の関与なしに処理する完全マネージドのPaaS型データベースエンジン
https://learn.microsoft.com/en-us/azure/azure-sql/database/sql-database-paas-overview - Cloud SQL は MySQL・PostgreSQL・SQL Server のための完全マネージドのリレーショナルデータベースサービス
https://docs.cloud.google.com/sql/docs/introduction - AlloyDB for PostgreSQL は完全マネージドでPostgreSQL互換。Google製エンジンと複数ノード構成の組み合わせ
https://docs.cloud.google.com/alloydb/docs/overview - Azure Database for MySQL の単一サーバーは終了。ライフサイクル表の終了日は 2024年9月17日6時59分59秒(太平洋時間表記)
https://learn.microsoft.com/en-us/lifecycle/products/azure-database-for-mysql-single-server - 現在の Azure Database for MySQL のドキュメントにはフレキシブルサーバーしか出てこない
https://learn.microsoft.com/en-us/azure/mysql/flexible-server/overview - Azure Database for MariaDB はサービス全体が終了。終了日 2025年9月19日、移行先は Azure Database for MySQL のフレキシブルサーバー
https://raw.githubusercontent.com/Azure/EOL/main/service_list.json - ライフサイクル情報の表では 2025年9月20日6時59分59秒(太平洋時間表記)。表記が1日ずれる旨を本文に併記した
https://learn.microsoft.com/en-us/lifecycle/products/azure-database-for-mariadb - Azure Database for PostgreSQL の単一サーバーの終了日
https://learn.microsoft.com/en-us/lifecycle/products/azure-database-for-postgresql-single-server - 現在の Azure Database for PostgreSQL のドキュメントの入口は flexible server と elastic clusters を案内しており、単一サーバーへの案内は
https://learn.microsoft.com/en-us/azure/postgresql/ - Spanner の現在の名称と定義(_facts\基盤サービス_20260909.md で未確認だった論点)
https://docs.cloud.google.com/spanner/docs - 製品ページ側の表記も Spanner
https://cloud.google.com/spanner - 確定時刻が実時間として過ぎるまで数ミリ秒待つ操作を挟むことで強い整合性を担保する
https://docs.cloud.google.com/spanner/docs/whitepapers/life-of-reads-and-writes - Amazon Aurora DSQL は取引処理に最適化したサーバーレスで分散型のリレーショナルデータベースサービス
https://docs.aws.amazon.com/aurora-dsql/latest/userguide/what-is-aurora-dsql.html - Amazon Keyspaces は規模の拡大に対応した高可用のマネージドな Apache Cassandra 互換サービス
https://docs.aws.amazon.com/keyspaces/latest/devguide/what-is-keyspaces.html - Azure Cosmos DB は完全マネージドのNoSQLかつベクトルのデータベース
https://learn.microsoft.com/en-us/azure/cosmos-db/introduction - MongoDB・Apache Cassandra・Apache Gremlin・Azure Table Storage への通信手順互換の窓口を持つ
https://learn.microsoft.com/en-us/azure/cosmos-db/consistency-levels - Firestore は企業水準のNoSQLの文書データベースで、MongoDBへの互換性を持つ
https://docs.cloud.google.com/firestore/docs/firestore-or-datastore - Bigtable はまばらに埋まった表で、数十億の行と数千の列まで規模を広げられる
https://docs.cloud.google.com/bigtable/docs/overview - AWS 側の正式名称は Amazon DocumentDB (with MongoDB compatibility)
https://docs.aws.amazon.com/documentdb/latest/developerguide/what-is.html - Azure DocumentDB は完全に管理されたオープンソースのMongoDB互換データベースで、互換率は99.03パーセント
https://learn.microsoft.com/en-us/azure/documentdb/overview - Firestore は Datastore の後継である
https://docs.cloud.google.com/datastore/docs/firestore-or-datastore - Amazon DynamoDB は結果整合性と強い整合性の2択。既定は結果整合性
https://docs.aws.amazon.com/amazondynamodb/latest/developerguide/HowItWorks.ReadConsistency.html - Amazon ElastiCache は、分散型の記憶装置上のデータ置き場またはキャッシュ環境の構築・管理・拡張を容易にするサービス
https://docs.aws.amazon.com/AmazonElastiCache/latest/dg/WhatIs.html - Amazon MemoryDB は記憶装置上で動く耐久性のあるデータベースサービス
https://docs.aws.amazon.com/memorydb/latest/devguide/what-is-memorydb.html - Azure Cache for Redis の Basic / Standard / Premium は 2028年9月30日に終了し、2028年10月1日から使えなくなる
https://learn.microsoft.com/en-us/azure/azure-cache-for-redis/retirement-faq - 製品ドキュメントの冒頭にも、すべての種別について終了の日程を告知した旨の案内がある
https://learn.microsoft.com/en-us/azure/azure-cache-for-redis/cache-overview - Azure Managed Redis は Redis Enterprise のソフトウェアにもとづく
https://learn.microsoft.com/en-us/azure/redis/overview - Memorystore for Redis は、Redisにもとづき1ミリ秒未満でデータに手が届くキャッシュを作る完全マネージドのサービス
https://docs.cloud.google.com/memorystore/docs/redis/redis-overview - Memorystore for Valkey は完全マネージドのValkeyサービスで、集まりの形を有効にした構成と無効にした構成の両方に対応。有効なら複数の断片、無効なら1つの断片
https://docs.cloud.google.com/memorystore/docs/valkey/product-overview - 『データ指向アプリケーションデザイン』(Martin Kleppmann 著、斉藤太郎 監訳、玉川竜司 訳、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784873118703/ - 『SQLアンチパターン 第2版』(Bill Karwin 著、和田卓人 監訳、児島修 訳、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784814400744/ - 『失敗から学ぶ RDBの正しい歩き方』(曽根壮大 著、技術評論社)
https://gihyo.jp/book/2019/978-4-297-10408-5 - (採用しなかった書籍) 『達人に学ぶDB設計徹底指南書 第2版』(ミック、翔泳社)
https://www.shoeisha.co.jp/book/detail/9784798186627 - Memorystore for Memcached は、オープンソースのMemcached の上に作られた完全マネージドのサービス
https://docs.cloud.google.com/memorystore/docs/memcached/memcached-overview - Memorystore for Memcached の非推奨の日付は2026年1月20日、停止の日付は2029年1月31日
https://docs.cloud.google.com/memorystore/docs/memcached/deprecation - 停止の日付を過ぎると使えなくなる。移行先は Memorystore for Valkey
https://docs.cloud.google.com/memorystore/docs/memcached/deprecation/memcached - Azure Database for PostgreSQL の単一サーバーという提供形態は2025年3月28日に終了した
https://learn.microsoft.com/en-us/azure/backup/backup-azure-database-postgresql-overview - 製品ドキュメント側の移行の解説ページは製品の入口へ転送される
https://learn.microsoft.com/en-us/azure/postgresql/migrate/whats-happening-to-postgresql-single-server - (補助・本文の根拠にしていない)マイクロソフトの告知投稿も同じ日付
https://techcommunity.microsoft.com/t5/azure-database-for-postgresql/announcement-retiring-azure-postgresql-single-server-in-2025-and/td-p/3820887 - Spanner は既定で外部整合性という、取引処理の仕組みとしてもっとも厳しい性質を提供する
https://docs.cloud.google.com/spanner/docs/true-time-external-consistency - 読み取りは既定で強い読み取り。強い読み取りは現在の時刻での読み取りで、開始までに確定したすべてのデータが見える
https://docs.cloud.google.com/spanner/docs/reads - Azure Database for MySQL の版ポリシーで 5.7 が一般提供ではあるが退役済み、8.0 と 8.4 が一般提供、9.5 が公開プレビュー
https://learn.microsoft.com/en-us/azure/mysql/concepts-version-policy - Azure Cosmos DB との比較のうえでは縦方向に伸ばす用途に位置づけられている
https://learn.microsoft.com/en-us/azure/cosmos-db/overview
第5章
- Amazon Redshift は完全マネージドでペタバイト規模のクラウド上のデータウェアハウスサービス
https://docs.aws.amazon.com/redshift/latest/mgmt/welcome.html - Azure Synapse Analytics はデータウェアハウスとビッグデータの仕組みを横断して洞察までの時間を短くする企業向けの分析サービス
https://learn.microsoft.com/en-us/azure/synapse-analytics/overview-what-is - Synapse Data Explorer は2025年10月7日に終了
https://learn.microsoft.com/en-us/fabric/real-time-intelligence/migrate-synapse-data-explorer - Fabric 側に Synapse からの移行の手引きが部品ごとに整備されている
https://learn.microsoft.com/en-us/fabric/fundamentals/migration - BigQuery は完全マネージドでAIに対応したデータの基盤。機械学習・検索・地理空間の分析・BIが組み込み
https://docs.cloud.google.com/bigquery/docs/introduction - Amazon Athena は Amazon S3 の中のデータを標準のSQLで直接分析する対話的な問い合わせサービス
https://docs.aws.amazon.com/athena/latest/ug/what-is.html - Amazon S3 Tables は分析の処理に最適化した S3 の保管。表形式のデータを保管するために作られた
https://docs.aws.amazon.com/AmazonS3/latest/userguide/s3-tables.html - Microsoft Fabric は取り込み・変換・リアルタイムの処理・分析・報告までを含む分析の基盤
https://learn.microsoft.com/en-us/fabric/fundamentals/microsoft-fabric-overview - AWS Glue はサーバーレスのデータ統合サービス。複数の元からデータを見つけ、整え、動かし、統合する
https://docs.aws.amazon.com/glue/latest/dg/what-is-glue.html - Azure Data Factory は複雑で混成的なETL・ELT・データ統合の案件のために作られたマネージドのクラウドサービス
https://learn.microsoft.com/en-us/azure/data-factory/introduction - Dataflow は多様なデータ処理の型を実行するためのマネージドサービス
https://docs.cloud.google.com/dataflow/docs - Cloud Data Fusion は完全マネージドでクラウド生まれの企業向けデータ統合サービス。パイプラインを素早く作って管理する
https://docs.cloud.google.com/data-fusion/docs - Amazon Managed Workflows for Apache Airflow は Apache Airflow のマネージドサービス。クラウドの中で規模を保ったままデータのパイプラインを動か
https://docs.aws.amazon.com/mwaa/latest/userguide/what-is-mwaa.html - Cloud Composer は Managed Service for Apache Airflow へ改称された
https://docs.cloud.google.com/composer/docs - Amazon EMR は以前 Amazon Elastic MapReduce と呼ばれていた、マネージドのクラスタの基盤
https://docs.aws.amazon.com/emr/latest/ManagementGuide/emr-what-is-emr.html - Azure HDInsight は企業向けのマネージドで全方位の、公開ソフトウェアによる分析サービス
https://learn.microsoft.com/en-us/azure/hdinsight/hdinsight-overview - HDInsight 5.1 は標準の支援対象で、支援の終了日も廃止の日も未告知。5.0 と 4.0 は限定的な支援で、いずれも2025年3月31日
https://learn.microsoft.com/en-us/azure/hdinsight/hdinsight-component-versioning - Cloud Dataproc は Managed Service for Apache Spark へ改称された
https://docs.cloud.google.com/dataproc/docs - Azure Data Lake Analytics は2024年2月29日に廃止。代わりに Azure Synapse Analytics か Microsoft Fabric を使うよう案内
https://learn.microsoft.com/en-us/azure/data-lake-analytics/data-lake-analytics-overview - Kinesis の基盤に含まれるのは Kinesis Data Streams / Firehose / Kinesis Video Streams / Managed Service for Apa
https://docs.aws.amazon.com/streams/latest/dev/introduction.html - Amazon Kinesis Data Firehose は Amazon Data Firehose へ改称。発表は2024年2月9日
https://aws.amazon.com/about-aws/whats-new/2024/02/amazon-data-firehose-formerly-kinesis-data-firehose/ - Amazon Data Firehose は Amazon S3、Amazon Redshift、Amazon OpenSearch Service、Splunk、Apache Iceberg の表、
https://docs.aws.amazon.com/firehose/latest/dev/what-is-this-service.html - Amazon Kinesis Data Analytics は Amazon Managed Service for Apache Flink へ改称。発表は2023年8月30日
https://aws.amazon.com/about-aws/whats-new/2023/08/amazon-managed-service-apache-flink/ - Managed Service for Apache Flink は Java・Scala・Python・SQL で流れてくるデータを処理し分析できる
https://docs.aws.amazon.com/managed-flink/latest/java/what-is.html - SQL版の Kinesis Data Analytics は廃止。段階は3つ
https://docs.aws.amazon.com/kinesisanalytics/latest/dev/what-is.html - Azure Event Hubs は完全マネージドのリアルタイムのデータの流れの基盤。毎秒数百万の出来事を低い遅延で取り込める
https://learn.microsoft.com/en-us/azure/event-hubs/event-hubs-about - Azure Stream Analytics は完全マネージドの流れの処理の実行系。大量の流れてくるデータをミリ秒未満の遅延で分析し処理する
https://learn.microsoft.com/en-us/azure/stream-analytics/stream-analytics-introduction - Pub/Sub Lite は非推奨。2027年1月31日をもって停止される
https://docs.cloud.google.com/pubsub/lite/docs - Google Cloud Managed Service for Apache Kafka は Kafka のクラスタを立ち上げ、守り、保守し、規模を広げることを助ける
https://docs.cloud.google.com/managed-service-for-apache-kafka/docs - 本体の Pub/Sub は変更なし
https://docs.cloud.google.com/pubsub/docs - Amazon QuickSight は Amazon Quick へ改称。2025年10月9日
https://docs.aws.amazon.com/quicksight/latest/user/doc-history.html - Amazon Quick は作業の自動化・データの分析・ウェブアプリケーションの構築・調査のためのAIを使ったサービス
https://docs.aws.amazon.com/quicksight/latest/user/welcome.html - 「Amazon Quick Suite」と「Amazon Quick」の関係
https://aws.amazon.com/blogs/business-intelligence/reimagine-business-intelligence-amazon-quicksight-evolves-to-amazon-quick-suite/ - Power BI はマイクロソフトの事業分析の基盤。データを実際に動ける洞察へ変える
https://learn.microsoft.com/en-us/power-bi/fundamentals/power-bi-overview - Looker は Google Cloud のBI、データを使うアプリケーション、組み込みの分析のための基盤
https://docs.cloud.google.com/looker/docs - Looker Studio は Data Studio へ改称された
https://docs.cloud.google.com/looker/docs/studio - Looker と Data Studio は別の製品で、比較のページが用意されている
https://docs.cloud.google.com/looker/docs/studio-comparison - AWS Lake Formation は分析と機械学習のためにデータを中央で統治し、守り、世界規模で共有することを助ける
https://docs.aws.amazon.com/lake-formation/latest/dg/what-is-lake-formation.html - Amazon DataZone は AWS の中・社内の設備・外部の提供元にまたがるデータを目録に載せ、見つけ、共有し、統治するデータ管理のサービス
https://docs.aws.amazon.com/datazone/latest/userguide/what-is-datazone.html - Microsoft Purview は、データがどこにあってもAIの時代においてデータを統治し、守り、管理することを助ける包括的な解決策の集まり
https://learn.microsoft.com/en-us/purview/purview - Dataplex Universal Catalog は Knowledge Catalog へ改称された。2026年4月10日
https://docs.cloud.google.com/dataplex/docs - 『[増補改訂]ビッグデータを支える技術』(西田圭介 著、技術評論社)
https://gihyo.jp/book/2021/978-4-297-11952-2 - 『データエンジニアリングの基礎』(Joe Reis、Matt Housley 著、中田秀基 訳、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784814400652/ - 『実践的データ基盤への処方箋』(ゆずたそ、渡部徹太郎、伊藤徹郎 著、技術評論社)
https://gihyo.jp/book/2021/978-4-297-12445-8 - BigLake は Lakehouse へ改称された。製品のページの掲示では2026年4月20日
https://docs.cloud.google.com/biglake/docs/introduction - BigQuery のリリースノートは2026年4月22日の項で Google Cloud Lakehouse への改称を告知
https://docs.cloud.google.com/bigquery/docs/release-notes - Pub/Sub Lite は新規の顧客には2024年9月24日より後は提供されず、2025年7月15日に先立つ90日間に未使用の既存顧客は2025年7月15日から利用不可、全体は2027年1月31日に
https://docs.cloud.google.com/pubsub/docs/choosing-pubsub-or-lite - Managed Service for Apache Airflow の第2世代 2.0.x 系は2026年9月15日に計画された提供終了。第1世代は2024年3月25日に保守後の段階に入り、2026
https://docs.cloud.google.com/composer/docs/composer-versioning-overview - Amazon Redshift の Python ユーザー定義関数は、2025年10月30日より後は新規作成不可(既存は動く)、2026年6月30日より後はサポート終了。代替は Lambda UDF
https://docs.aws.amazon.com/redshift/latest/mgmt/behavior-changes.html
第6章
- 2024年12月3日に Amazon SageMaker が Amazon SageMaker AI へ改称
https://docs.aws.amazon.com/sagemaker/latest/dg/whatis.html - 製品ページの見出しに (formerly Vertex AI) が入っている
https://cloud.google.com/products/gemini-enterprise-agent-platform - Vertex AI のドキュメントは更新されず、サービスは Gemini Enterprise Agent Platform の一部になった
https://docs.cloud.google.com/vertex-ai/docs/release-notes - 2026年4月23日の公式ブログが Vertex AI の進化形であると述べ、今後は単独サービスではなく Agent Platform を通じて提供されると書いている
https://cloud.google.com/blog/products/ai-machine-learning/introducing-gemini-enterprise-agent-platform - Gemini Enterprise は社内検索とAIアシスタントとエージェントの基盤
https://docs.cloud.google.com/gemini/enterprise/docs - Azure AI Studio / Azure AI Foundry → Microsoft Foundry、Azure AI Services → Foundry Tools
https://learn.microsoft.com/en-us/azure/foundry/what-is-foundry - Azure Cognitive Services → Azure AI Services → Foundry Tools の3段階。すべて同じものを指す
https://learn.microsoft.com/en-us/azure/foundry/how-to/navigate-from-classic - Azure Machine Learning の定義(機械学習の案件の生涯を管理するクラウドサービス)
https://learn.microsoft.com/en-us/azure/machine-learning/overview-what-is-azure-machine-learning - 専用の計算資源への配備が Azure Machine Learning の基盤の上に築かれている
https://learn.microsoft.com/en-us/azure/foundry/concepts/foundry-models-overview - Gemini Enterprise Agent Platform の中に AutoML の学習方式がある。ナビゲーションに自分のモデルを作るための項目が並ぶ
https://docs.cloud.google.com/vertex-ai/docs/beginner/beginners-guide - Amazon Comprehend は自然言語処理で文書の内容から知見を取り出す
https://docs.aws.amazon.com/comprehend/latest/dg/what-is.html - Amazon Textract は文書の文字検出と解析を追加する
https://docs.aws.amazon.com/textract/latest/dg/what-is.html - Amazon Transcribe は音声を文字に変換する
https://docs.aws.amazon.com/transcribe/latest/dg/what-is.html - Amazon Polly は文字を人間らしい音声に変換する
https://docs.aws.amazon.com/polly/latest/dg/what-is.html - Amazon Translate は文章を翻訳する
https://docs.aws.amazon.com/translate/latest/dg/what-is.html - Amazon Lex V2 は音声と文字で対話する仕組みを作る
https://docs.aws.amazon.com/lexv2/latest/dg/what-is.html - Amazon Rekognition の人物の移動を追う機能は2025年10月31日にサポート終了。概要ページの機能一覧には残っている
https://docs.aws.amazon.com/rekognition/latest/dg/persons.html - Amazon Rekognition Person Pathing は提供終了サービスの公式一覧にも載っている
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - Foundry Tools の現行一覧は Speech / Translator / Language / Content Understanding / Document Intelligence
https://learn.microsoft.com/en-us/azure/ai-services/what-are-ai-services - Azure Content Understanding は文書・画像・動画・音声を1つのAPIで扱い、生成AIで利用者が定めた形式に整える
https://learn.microsoft.com/en-us/azure/ai-services/content-understanding/overview - Azure Language が Core と Legacy の2区分に分かれている
https://learn.microsoft.com/en-us/azure/ai-services/language-service/overview - Azure Vision の画像解析と文字認識の見出しに (legacy) が付く。Image Analysis 4.0 は2028年9月25日に retire
https://learn.microsoft.com/en-us/azure/ai-services/computer-vision/overview - Cloud Vision API は名称・提供とも変更なし。公式表記は “Vision AI” ではなく Cloud Vision API
https://docs.cloud.google.com/vision/docs - Video Intelligence API / Cloud Natural Language API / Cloud Speech-to-Text / Cloud Text-to-Speech /
https://docs.cloud.google.com/video-intelligence/docs - Video Intelligence API / Cloud Natural Language API / Cloud Speech-to-Text / Cloud Text-to-Speech /
https://docs.cloud.google.com/natural-language/docs - Video Intelligence API / Cloud Natural Language API / Cloud Speech-to-Text / Cloud Text-to-Speech /
https://docs.cloud.google.com/speech-to-text/docs - Video Intelligence API / Cloud Natural Language API / Cloud Speech-to-Text / Cloud Text-to-Speech /
https://docs.cloud.google.com/text-to-speech/docs - Video Intelligence API / Cloud Natural Language API / Cloud Speech-to-Text / Cloud Text-to-Speech /
https://docs.cloud.google.com/translate/docs - Document AI は名称・提供とも変更なし
https://docs.cloud.google.com/document-ai/docs - Dialogflow は ES と CX の2エディション構成を維持。画面の呼び名が Conversational Agents console へ移行中で、旧来の画面は非推奨
https://docs.cloud.google.com/dialogflow/docs - Azure AI Bot Service は提供中で、新規は Copilot Studio を推奨
https://learn.microsoft.com/en-us/azure/bot-service/bot-overview - Azure Speech にリアルタイム音声対話・合成アバター・高速書き起こしがある
https://learn.microsoft.com/en-us/azure/ai-services/speech-service/overview - 旧来の単独 AutoML の終了日。表形式2024年7月24日、画像2024年7月31日、動画2024年7月31日、自然言語2024年8月7日
https://docs.cloud.google.com/vertex-ai/docs/deprecations - AutoML Translation は2025年9月30日に終了。独自モデルの機能と管理は Cloud Translation の上位版へ
https://docs.cloud.google.com/translate/automl/docs - Custom Vision の移行先の1つが Azure Machine Learning の自動機械学習
https://learn.microsoft.com/en-us/azure/ai-services/custom-vision-service/overview - Amazon Bedrock の定義
https://docs.aws.amazon.com/bedrock/latest/userguide/what-is-bedrock.html - Model Garden で確認できたモデル名(Gemini、Veo、Imagen、Gemma、Claude、Grok、Llama、Mistral AI、DeepSeek、Qwen)
https://docs.cloud.google.com/vertex-ai/generative-ai/docs/learn/models - Amazon Bedrock Knowledge Bases は検索拡張生成で応答を改善する仕組み。2形態ある
https://docs.aws.amazon.com/bedrock/latest/userguide/knowledge-base.html - Amazon Kendra は新規受付を停止し、Bedrock Knowledge Bases を案内
https://docs.aws.amazon.com/kendra/latest/dg/what-is-kendra.html - Azure AI Search は完全マネージドの検索サービス。従来型の検索と、大規模言語モデルを使って繰り返し探す方式の2エンジン
https://learn.microsoft.com/en-us/azure/search/search-what-is-azure-search - Foundry IQ は複数の情報源をまとめ、権限を踏まえた応答をエージェントに提供する知識ベース。索引と検索の土台は Azure AI Search
https://learn.microsoft.com/en-us/azure/foundry/agents/concepts/what-is-foundry-iq - RAG Engine は Gemini Enterprise Agent Platform の一構成要素
https://docs.cloud.google.com/gemini-enterprise-agent-platform/build/rag-engine/rag-overview - Agent Search は公開サイトやモバイルアプリ向けの検索と推薦を作るもの
https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/vertex-ai-search - Azure Cognitive Search → Azure AI Search(2023年11月)の改称
https://learn.microsoft.com/en-us/azure/search/whats-new - Amazon Bedrock AgentCore の定義
https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/what-is-bedrock-agentcore.html - Amazon Bedrock Agents は Agents Classic となり新規受付を停止。後継は AgentCore
https://docs.aws.amazon.com/bedrock/latest/userguide/agents.html - Microsoft Foundry Agent Service の定義と2種類のエージェント
https://learn.microsoft.com/en-us/azure/foundry/agents/overview - Microsoft Copilot Studio はローコードの画面。ドキュメントは learn.microsoft.com/azure/ 配下ではなく、入口も独立したWebアプリ
https://copilotstudio.microsoft.com - Microsoft Copilot Studio はローコードの画面。ドキュメントは learn.microsoft.com/azure/ 配下ではなく、入口も独立したWebアプリ
https://learn.microsoft.com/en-us/microsoft-copilot-studio/fundamentals-what-is-copilot-studio - Amazon Bedrock Guardrails の定義と6種類の安全装置
https://docs.aws.amazon.com/bedrock/latest/userguide/guardrails.html - Azure AI Content Safety の定義と有害の4区分
https://learn.microsoft.com/en-us/azure/ai-services/content-safety/overview - Microsoft Foundry 側の統制の枠組み。介入点4つと危険12種類
https://learn.microsoft.com/en-us/azure/foundry/guardrails/guardrails-overview - Amazon Q Business は新規受付を停止。後継として Amazon Quick を案内
https://docs.aws.amazon.com/amazonq/latest/qbusiness-ug/what-is.html - Amazon Q Developer の開発環境向け拡張機能は2027年4月30日にサポート終了。後継として Kiro を案内
https://docs.aws.amazon.com/amazonq/latest/qdeveloper-ug/what-is.html - Kiro の名前がAWS公式ホワイトペーパーの機械学習とAIの一覧に載っている
https://docs.aws.amazon.com/whitepapers/latest/aws-overview/machine-learning.html - Kiro がAWSのサービスとしてどう位置づけられるか
https://kiro.dev/docs/ - Anomaly Detector は2023年9月20日以降は新規作成不可、2026年10月1日に提供終了
https://learn.microsoft.com/en-us/azure/ai-services/anomaly-detector/overview - Metrics Advisor は2026年5月18日に提供終了
https://learn.microsoft.com/en-us/azure/ai-services/metrics-advisor/overview - Personalizer は2023年9月20日以降は新規作成不可、2026年8月25日に提供終了と告知
https://learn.microsoft.com/en-us/azure/ai-services/personalizer/what-is-personalizer - Content Moderator は2024年2月に非推奨、2027年3月15日に終了予定。後継は Azure AI Content Safety
https://learn.microsoft.com/en-us/azure/ai-services/content-moderator/overview - Pub/Sub Lite は2027年1月31日に終了予定
https://docs.cloud.google.com/pubsub/lite/docs - 『Amazon Bedrock 生成AIアプリ開発入門 [AWS深掘りガイド]』(御田稔、熊田寛、森田和明、SBクリエイティブ)
https://www.sbcr.jp/product/4815626440/ - 『AWSではじめる生成AI』(Chris Fregly、Antje Barth、Shelbee Eigenbrode 著、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784814400720/ - 『Azure OpenAI Serviceではじめる ChatGPT/LLMシステム構築入門』(永田祥平ほか著、技術評論社)
https://gihyo.jp/book/2024/978-4-297-13929-2 - HTTP 404
https://docs.cloud.google.com/gemini-enterprise-agent-platform/docs/multimodal/configure-safety-filters - 本文がナビゲーションのみで、有害カテゴリの一覧に到達できず
https://docs.cloud.google.com/vertex-ai/generative-ai/docs/multimodal/configure-safety-filters - ページタイトル HarmCategory に続けて Gemini Enterprise Agent Platform は取得。enum の表は本文に無し
https://docs.cloud.google.com/gemini-enterprise-agent-platform/reference/rest/v1/HarmCategory - 同上(タイトルは Agent Platform API に続けて Gemini Enterprise Agent Platform)
https://docs.cloud.google.com/vertex-ai/docs/reference/rest/v1/HarmCategory - ページタイトル Agent Platform overview は取得。定義文と構成要素の本文に到達できず
https://docs.cloud.google.com/gemini-enterprise-agent-platform/overview - ページタイトル Overview of Model Garden は取得。定義文に到達できず
https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/model-garden/explore-models - 「Vision AI」は Google Cloud の製品ページの見出しに使われている公式の名前で、画像や動画を扱う製品をまとめて指す。個別のAPIのドキュメント見出しは Cloud Vision A
https://cloud.google.com/vision - Model Armor は AIアプリケーションの安全性を高める Google Cloud のサービスで、大規模言語モデルへの入力と応答を事前に検査する
https://docs.cloud.google.com/model-armor - Model Armor は AIアプリケーションの安全性を高める Google Cloud のサービスで、大規模言語モデルへの入力と応答を事前に検査する
https://docs.cloud.google.com/model-armor/overview - Gemini Enterprise Agent Platform の安全性のページに、利用できる道具として、既定で働く設定不可のフィルタ、システム指示、コンテンツフィルタ、Gemini 自身を検査役に
https://docs.cloud.google.com/gemini-enterprise-agent-platform/govern/safety - AutoML Translation は2024年9月16日に非推奨、2025年9月30日をもって利用不可
https://docs.cloud.google.com/translate/automl/docs/deprecations - ドキュメントの更新履歴に、2026年7月31日から新規の顧客には開かれなくなるという6月30日付の予告と、7月31日付の停止の記録がある
https://docs.aws.amazon.com/amazonq/latest/qbusiness-ug/doc-history.html - 専用の案内ページに、既存の利用者向けの不具合修正と安全性の更新は続くが、新機能の要望は受け付けないと書かれている
https://docs.aws.amazon.com/amazonq/latest/qbusiness-ug/qbusiness-availability-change.html - Bedrock 本の段落: 新規受付を停止したのは Amazon Bedrock Agents Classic であり、Amazon Bedrock 自体は提供が続く
https://docs.aws.amazon.com/bedrock/latest/userguide/agents-classic-maintenance-mode.html - Model Armor は REST API を直接呼んで検査でき、プロンプトの検査と応答の検査は別々の呼び出し(表「モデルを呼ばずに検査だけ実行できるか」の Google Cloud 欄)
https://docs.cloud.google.com/model-armor/sanitize-prompts-responses
第7章
- AWS Lambda は「サーバーレスの計算のサービス」で「サーバーを用意したり管理したりすることなくコードを実行できる」
https://docs.aws.amazon.com/lambda/latest/dg/welcome.html - Azure Functions は「より少ないコードで、より少ない基盤で、堅牢なアプリケーションを作れるようにするサーバーレスの解決策」
https://learn.microsoft.com/en-us/azure/azure-functions/functions-overview - Azure Container Apps は「基盤を管理することなくコンテナ化されたアプリケーションを動かすためのサーバーレスの基盤」
https://learn.microsoft.com/en-us/azure/container-apps/overview - Cloud Run は「Googleの拡張性の高い基盤の上で、コード、関数、コンテナのいずれかを動かすための、完全にマネージドなアプリケーションの基盤」
https://docs.cloud.google.com/run/docs/overview/what-is-cloud-run - Consumption プランは「従来のホスティングプラン」で、新規は Flex Consumption、既存は移行と案内
https://learn.microsoft.com/en-us/azure/azure-functions/functions-scale - Cloud Functions は Cloud Run functions に改称された
https://docs.cloud.google.com/run/docs/functions-with-run - 現在の版は「Cloud Run の上にサービスとしてデプロイされる、関数の最新の版」
https://docs.cloud.google.com/functions/docs/concepts/version-comparison - Lambda の1回の呼び出しの上限は 900秒(15分)。引き上げ不可
https://docs.aws.amazon.com/lambda/latest/dg/gettingstarted-limits.html - Cloud Run のリクエストのタイムアウトは既定 300秒(5分)、最大 3600秒(60分)
https://docs.cloud.google.com/run/docs/configuring/request-timeout - AWS Fargate は「Amazon ECS と一緒に使うことで、サーバーや Amazon EC2 インスタンスのクラスターを管理することなくコンテナを動かせる技術」
https://docs.aws.amazon.com/AmazonECS/latest/developerguide/AWS_Fargate.html - Azure Container Apps 上の Azure Functions は「Azure Functions のイベント駆動の能力と Container Apps の機能を組み合わせた、完全にマ
https://learn.microsoft.com/en-us/azure/container-apps/functions-overview - イベントは「条件や状態の変化を知らせる軽い通知」で「発行した側はどう扱われるかについて期待を持たない」
https://learn.microsoft.com/en-us/azure/service-bus-messaging/compare-messaging-services - Amazon SQS は「安全で、耐久性があり、可用性のある、ホストされたキューを提供し、分散したソフトウェアのシステムや構成要素を統合し、切り離せるようにするもの」
https://docs.aws.amazon.com/AWSSimpleQueueService/latest/SQSDeveloperGuide/welcome.html - Amazon SNS は「発行する側から購読する側へのメッセージの配送を提供する、完全にマネージドなサービス」
https://docs.aws.amazon.com/sns/latest/dg/welcome.html - Amazon SNS の Message Data Protection は、新規に利用を開始できない段階の一覧に 2026年3月31日の告知として掲載
https://docs.aws.amazon.com/general/latest/gr/maintenance_services.html - 本章で扱った主要サービスが終了・保守の一覧に載っていないこと
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - Azure Service Bus は「メッセージのキューと、発行と購読のためのトピックを備えた、完全にマネージドな企業向けのメッセージブローカー」
https://learn.microsoft.com/en-us/azure/service-bus-messaging/service-bus-messaging-overview - Pub/Sub は「メッセージを作り出すサービスと、そのメッセージを処理するサービスを切り離す、非同期で拡張性のあるメッセージングのサービス」
https://docs.cloud.google.com/pubsub/docs/overview - 1つのトピックは複数のサブスクリプションを持てるが、1つのサブスクリプションは1つのトピックにだけ属する
https://docs.cloud.google.com/pubsub/docs/subscription-overview - Azure Event Hubs は Apache Kafka に標準で対応する実時間のデータ配信の基盤(第5章へ送るための1文のみ)
https://learn.microsoft.com/en-us/azure/event-hubs/event-hubs-about - Amazon EventBridge は「イベントを使ってアプリケーションの構成要素をつなぐ、サーバーレスのサービス」
https://docs.aws.amazon.com/eventbridge/latest/userguide/eb-what-is.html - Azure Event Grid は「メッセージの配布のための、拡張性が高く完全にマネージドな、発行と購読のサービス」
https://learn.microsoft.com/en-us/azure/event-grid/overview - Eventarc は「下にある基盤を実装したり、手を入れたり、維持したりすることなく、イベント駆動のアーキテクチャを作れるようにするもの」
https://docs.cloud.google.com/eventarc/docs/overview - Cloud Scheduler は「定めた時刻または一定の間隔で実行される作業の単位を設定する」もの
https://docs.cloud.google.com/scheduler/docs/overview - Azure の時刻起動として Azure Functions のタイマーのトリガーと Azure Logic Apps の繰り返しのトリガーを挙げた
https://learn.microsoft.com/en-us/azure/logic-apps/logic-apps-overview - AWS Step Functions はワークフロー(ステートマシン)を作る仕組みで、各段階を状態と呼ぶ
https://docs.aws.amazon.com/step-functions/latest/dg/welcome.html - Lambda の耐久実行は「中断があっても確実に前へ進みながら、最長1年にわたって実行できる、複数段階のアプリケーションとAIのワークフローを作れる」
https://docs.aws.amazon.com/lambda/latest/dg/durable-functions.html - Durable Functions は「Azure Functions の拡張で、オーケストレーターの関数・アクティビティの関数・エンティティの関数をコードで書くことで、サーバーレスの環境で状態を持つ
https://learn.microsoft.com/en-us/azure/durable-task/durable-functions/durable-functions-overview - ドキュメントの正規URLが azure/durable-task/ 配下へ移っている
https://learn.microsoft.com/en-us/azure/azure-functions/durable/durable-functions-overview - Workflows は「自分で定めた順にサービスを実行する、完全にマネージドなオーケストレーションの基盤」
https://docs.cloud.google.com/workflows/docs/overview - Amazon API Gateway は「あらゆる規模で、REST、HTTP、WebSocket の API を作成し、公開し、維持し、監視し、保護するためのAWSのサービス」
https://docs.aws.amazon.com/apigateway/latest/developerguide/welcome.html - Azure API Management は「あらゆる環境にまたがるAPIのための、ハイブリッドでマルチクラウドの管理の基盤」
https://learn.microsoft.com/en-us/azure/api-management/api-management-key-concepts - 『AWS Lambda実践ガイド 第2版』(大澤文孝、インプレス)
https://book.impress.co.jp/books/1121101032 - 『マイクロサービスパターン 実践的システムデザインのためのコード解説』(Chris Richardson、インプレス)
https://book.impress.co.jp/books/1118101063 - 『ソフトウェアアーキテクチャ・ハードパーツ』(Neal Ford ほか、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784814400065/ - Cloud Run のジョブは各タスクが既定で最大10分、最長168時間(7日)、GPUを使うタスクは最大1時間。ジョブの実行そのものには明示的なタイムアウトが無い
https://docs.cloud.google.com/run/docs/configuring/task-timeout - Durable Task(Durable Functions を含む)のワークフローは「時間、日、あるいは月の単位」でも動く。上限の数字はこのページに無い
https://learn.microsoft.com/en-us/azure/durable-task/common/what-is-durable-task - Azure Logic Apps の1回の実行の長さは既定90日。Consumption(マルチテナント)は最短7日・最長365日。Standard は既定90日で設定により増減。Standard の
https://learn.microsoft.com/en-us/azure/logic-apps/logic-apps-limits-and-config - Pub/Sub のデッドレタートピック。配送の試行回数の上限は既定5回・5〜100回・転送は最善努力でおおよそ
https://docs.cloud.google.com/pubsub/docs/handling-failures - Cloud Functions → Cloud Run functions の改称は、リリースノートの 2024年8月21日 の項に記録
https://docs.cloud.google.com/functions/docs/release-notes - AWS Lambda はコンテナイメージを配置の単位として受け入れる。配置の単位はコンテナイメージと zip の2種類。圧縮前で最大10GB。Linux を基にしたものに限る
https://docs.aws.amazon.com/lambda/latest/dg/images-create.html - Azure Service Bus の配送保証: PeekLock で少なくとも1回、ReceiveAndDelete で最大1回。セッションは順序。「ちょうど1回の処理」という呼び方は正確ではないと
https://learn.microsoft.com/en-us/azure/service-bus-messaging/service-bus-azure-and-service-bus-queues-compared-contrasted - AWS Lambda Managed Instances は関数を自分のアカウントのEC2インスタンスの上で動かす形。台数の増減や更新はAWSが引き受ける
https://docs.aws.amazon.com/lambda/latest/dg/lambda-managed-instances.html
第8章
- Google Cloud の VPC ネットワークだけが公式に「グローバルな資源」と明記されている
https://docs.cloud.google.com/vpc/docs/overview - Amazon VPC はリージョンの中に作るものとして説明される
https://docs.aws.amazon.com/vpc/latest/userguide/what-is-amazon-vpc.html - Azure Virtual Network はリージョンに属する(リージョンをまたぐとは書かれていない)
https://learn.microsoft.com/en-us/azure/virtual-network/virtual-networks-overview - Cloud CDN は単体では使えず、外部の Application Load Balancer とセットで使う
https://docs.cloud.google.com/cdn/docs/overview - 「AWS VPN」という単一のサービスは公式で確認できなかった。実在を確認できたのは Site-to-Site VPN と Client VPN の2つ
https://docs.aws.amazon.com/vpn/latest/s2svpn/VPC_VPN.html - 「AWS VPN」という単一のサービスは公式で確認できなかった。実在を確認できたのは Site-to-Site VPN と Client VPN の2つ
https://docs.aws.amazon.com/vpn/latest/clientvpn-admin/what-is.html - Azure Basic Load Balancer は2025年9月30日に提供終了(サービスではなくSKUの終了)
https://learn.microsoft.com/en-us/azure/load-balancer/load-balancer-overview - Azure 自身は Bastion を「ネットワーク」ではなく Network Security に分類している
https://learn.microsoft.com/en-us/azure/bastion/bastion-overview - Transit Gateway の定義、リージョンをまたぐピアリング
https://docs.aws.amazon.com/vpc/latest/tgw/what-is-transit-gateway.html - ELBの定義、現行世代3種、Classic の位置づけ、AWS WAF・ACM・Global Accelerator との関係
https://docs.aws.amazon.com/elasticloadbalancing/latest/userguide/what-is-load-balancing.html - Route 53 の定義、3つの主要機能、VPC Resolver・Resolver DNS Firewall・Traffic Flow・Profiles
https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/Welcome.html - Application Gateway の定義、OSI第7層、v1 SKU の提供終了日、他の負荷分散サービスとの使い分けの案内
https://learn.microsoft.com/en-us/azure/application-gateway/overview - Private Link の定義、プライベートエンドポイント、バックボーン経由、漏えいへの保護、別リージョンへの適用、提供する側になる方法、Network Foundations のカテゴリ
https://learn.microsoft.com/en-us/azure/private-link/private-link-overview - Cloud DNS の定義、公開ゾーンと非公開ゾーン、エニーキャスト
https://docs.cloud.google.com/dns/docs/overview - Private Service Connect の定義、内部IPアドレスでの利用、提供する側の位置づけ
https://docs.cloud.google.com/vpc/docs/private-service-connect - Cloud Load Balancing は Application Load Balancers と Network Load Balancers に分かれ、後者はプロキシ型と通過型に分かれる。Ap
https://docs.cloud.google.com/load-balancing/docs/load-balancing-overview - Amazon CloudFront は静的および動的なWebコンテンツの配信を速くするWebサービス
https://docs.aws.amazon.com/AmazonCloudFront/latest/DeveloperGuide/Introduction.html - Azure Front Door は「クラウドのための高度なコンテンツ配信ネットワーク」
https://learn.microsoft.com/en-us/azure/frontdoor/front-door-overview - Google Cloud Armor は分散サービス拒否の攻撃、クロスサイトスクリプティング、SQLインジェクションといった脅威から守る
https://docs.cloud.google.com/armor/docs/cloud-armor-overview - Azure DNS はDNSのホスティング、名前解決、負荷分散を提供する
https://learn.microsoft.com/en-us/azure/dns/dns-overview - AWS PrivateLink は、VPCをサービスや資源へ、それらが自分のVPCの中にあるかのようにプライベートに接続できる技術
https://docs.aws.amazon.com/vpc/latest/privatelink/what-is-privatelink.html - Microsoft Entra は ID とネットワークアクセスの製品ファミリで、ゼロトラストの戦略の実装を助ける。Private Access は社内のアプリと資源、Internet Access
https://learn.microsoft.com/en-us/entra/fundamentals/what-is-entra - Amazon Web Services基礎からのネットワーク&サーバー構築 改訂4版
https://bookplus.nikkei.com/atcl/catalog/23/04/06/00757/ - インフラ/ネットワークエンジニアのためのネットワーク技術&設計入門 第2版
https://www.sbcr.jp/product/4797396805/ - DNSがよくわかる教科書 第2版
https://jprs.co.jp/topics/2026/260311.html - Cloud DNS はDNSルーティングポリシーという振り分けの機能を持ち、公開ゾーンと非公開ゾーンのリソースレコードセットに対して条件にもとづいてトラフィックを誘導するポリシーを設定できる。型は重み
https://docs.cloud.google.com/dns/docs/routing-policies-overview - Classic VPN のトンネルの動的ルーティング(BGP)は2025年8月1日に非推奨化され、同日以降は動的ルーティングを使う Classic VPN のトンネルを新しく作成できない
https://docs.cloud.google.com/network-connectivity/docs/vpn/deprecations/classic-vpn-deprecation - 可用性ゾーンに対応していない VpnGw1 から VpnGw5 までのSKUは、2025年11月1日以降は新しいVPNゲートウェイを作成できない
https://learn.microsoft.com/en-us/azure/vpn-gateway/gateway-sku-consolidation - AWS PrivateLink では、提供者はエンドポイントサービスを作ることで自分のサービスをリージョンの中で利用できるようにする。作成時にロードバランサーを指定しなければならず、そのロードバランサ
https://docs.aws.amazon.com/vpc/latest/privatelink/concepts.html - Azureのネットワーキングサービスを6つのカテゴリに分けて案内する公式ページは、Bastion を Networking foundation のカテゴリに置き、ネットワークセキュリティのカテゴリに
https://learn.microsoft.com/en-us/azure/networking/networking-overview - 仮想アプライアンスへの引き込みの Azure 欄: Azure Load Balancer の Gateway SKU(Gateway Load Balancer)
https://learn.microsoft.com/en-us/azure/load-balancer/gateway-overview
第9章
- Amazon Macie
https://docs.aws.amazon.com/macie/latest/user/what-is-macie.html - Cloud Audit Logs
https://docs.cloud.google.com/logging/docs/audit - Microsoft Entra External ID
https://learn.microsoft.com/en-us/entra/external-id/external-identities-overview - Azure Monitor のアクティビティログ
https://learn.microsoft.com/en-us/azure/azure-monitor/platform/activity-log - AWS CloudTrail
https://docs.aws.amazon.com/awscloudtrail/latest/userguide/cloudtrail-user-guide.html - Google Cloud Identity Platform
https://docs.cloud.google.com/identity-platform/docs/concepts-authentication - Google Cloud Secret Manager
https://docs.cloud.google.com/secret-manager/docs/overview - Google Cloud Certificate Manager
https://docs.cloud.google.com/certificate-manager/docs/overview - コンプライアンス文書の入口(Azure・Google Cloud)
https://learn.microsoft.com/en-us/purview/get-started-with-service-trust-portal - コンプライアンス文書の入口(Azure・Google Cloud)
https://cloud.google.com/security/compliance/compliance-reports-manager - 404。concepts-authentication に差し替えた
https://docs.cloud.google.com/identity-platform/docs/concepts-overview - 404。/purview/get-started-with-service-trust-portal に差し替えた
https://learn.microsoft.com/en-us/compliance/regulatory/get-started-service-trust-portal - 503。書籍の照合は openBD に切り替えた
https://www.hanmoto.com/bd/isbn/ - 403。同上
https://www.shoeisha.co.jp/book/detail/9784798190716 - エラーページが返った。同上
https://books.rakuten.co.jp/rb/17398571/ - AWSはポリシーを作り、IAMのアイデンティティに付けるか、AWSのリソースに付ける
https://docs.aws.amazon.com/IAM/latest/UserGuide/access_policies.html - Azure RBAC は Azure Resource Manager の上に構築された認可の仕組み
https://learn.microsoft.com/en-us/azure/role-based-access-control/overview - Google Cloud の IAM は「誰が・何を・どの資源に対してできるか」を制御する
https://docs.cloud.google.com/iam/docs/overview - Amazon Cognito はWebとモバイルのアプリのためのIDプラットフォームで、ディレクトリ・認証サーバー・認可サービスを兼ねる
https://docs.aws.amazon.com/cognito/latest/developerguide/what-is-amazon-cognito.html - Microsoft Entra ID は Microsoft Entra の基礎となる製品で、認証・ポリシーの適用・保護を提供する
https://learn.microsoft.com/en-us/entra/fundamentals/what-is-entra - Azure AD B2C は改称されていない
https://learn.microsoft.com/en-us/entra/fundamentals/new-name - Cloud Identity は利用者とグループを中央で管理するIDaaS
https://docs.cloud.google.com/identity/docs/overview - Identity Platform は Firebase Authentication の背後で動き、同じ機能を提供する
https://docs.cloud.google.com/identity-platform/docs/product-comparison - Microsoft Entra Domain Services は、ドメイン参加・グループポリシー・LDAP・Kerberos や NTLM の認証を、ドメインコントローラーを自分で運用せずに使えるよ
https://learn.microsoft.com/en-us/entra/identity/domain-services/overview - AWS KMS はデータの暗号化と署名に使う鍵の作成と制御を容易にするAWS管理のサービス
https://docs.aws.amazon.com/kms/latest/developerguide/overview.html - AWS CloudHSM はAWSクラウドの利点とハードウェアセキュリティモジュールの安全性を組み合わせる
https://docs.aws.amazon.com/cloudhsm/latest/userguide/introduction.html - AWS Secrets Manager はDBの資格情報・アプリの資格情報・OAuthトークン・APIキーなどをライフサイクルを通じて管理・取得・入れ替えする
https://docs.aws.amazon.com/secretsmanager/latest/userguide/intro.html - AWS Certificate Manager は公開・非公開のSSL/TLSのX.509証明書と鍵の作成・保管・更新の複雑さを引き受ける
https://docs.aws.amazon.com/acm/latest/userguide/acm-overview.html - Azure Key Vault は機密情報・鍵・証明書の管理を提供し、いずれもHSMに裏打ちされる
https://learn.microsoft.com/en-us/azure/key-vault/general/overview - Cloud KMS は対応するGoogle Cloudのサービスと自分のアプリで使う暗号鍵を作成・管理できる
https://docs.cloud.google.com/kms/docs/key-management-service - Amazon GuardDuty はAWS環境のデータソースとログを継続的に監視・分析・処理する脅威検出サービス
https://docs.aws.amazon.com/guardduty/latest/ug/what-is-guardduty.html - Amazon Inspector はワークロードを自動発見し、脆弱性と意図しないネットワークの露出を継続的に検査する
https://docs.aws.amazon.com/inspector/latest/user/what-is-inspector.html - Amazon Inspector Classic のサポート終了日は2026年5月20日。Inspector 本体は現役
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - Amazon Detective はセキュリティの検出事項や不審な活動の根本原因を分析・調査・特定するのを助ける
https://docs.aws.amazon.com/detective/latest/userguide/what-is-detective.html - Microsoft Defender for Cloud は CNAPP であり、複数のクラウドセキュリティの道具を組み合わせてアプリケーションを一生を通じて守る
https://learn.microsoft.com/en-us/azure/defender-for-cloud/defender-for-cloud-introduction - Microsoft Sentinel はクラウドを前提としたSIEMで、複数のクラウドとプラットフォームにまたがる
https://learn.microsoft.com/en-us/azure/sentinel/overview - Security Command Center はクラウドを前提としたリスク管理の解決策で、予防・検出・対応を助ける
https://docs.cloud.google.com/security-command-center/docs/security-command-center-overview - Sensitive Data Protection は Google Cloud の内外にある機微なデータの発見・分類・匿名化を助ける
https://docs.cloud.google.com/sensitive-data-protection/docs/sensitive-data-protection-overview - AWS Artifact はAWSのセキュリティとコンプライアンスの文書を必要なときにダウンロードできるようにする
https://docs.aws.amazon.com/artifact/latest/ug/what-is-aws-artifact.html - 確認の方法: WebSearch で候補を挙げ、openBD の書誌API(
https://api.openbd.jp/v1/get?isbn= - (同上)本書が『ひと目でわかるAzure Active Directory 第3版』の後継である
https://bookplus.nikkei.com/atcl/catalog/23/11/30/01130/ - AWS IAM Identity Center は、社内の利用者をAWSが管理するアプリケーションやその他のAWSの資源につなぐためのAWSの解決策。既存のIDプロバイダーを接続して利用者とグループを
https://docs.aws.amazon.com/singlesignon/latest/userguide/what-is.html - AWS IAM のユーザーガイドは、社内の人にあたるIDは IAM Identity Center の利用者であると書き、集中的なアクセス管理には IAM Identity Center を勧める
https://docs.aws.amazon.com/IAM/latest/UserGuide/introduction_identity-management.html - 最善の慣行として、人間の利用者にはIDプロバイダーとのフェデレーションを使わせ、一時的な資格情報でアクセスさせる
https://docs.aws.amazon.com/IAM/latest/UserGuide/best-practices.html - Microsoft Entra External ID は Azure AD B2C の新しい名前ではない
https://learn.microsoft.com/en-us/entra/external-id/customers/faq-customers - Security Command Center の階層は Standard-legacy、Standard、Premium、非推奨となった Enterprise の4つ
https://docs.cloud.google.com/security-command-center/docs/billing-questions - Azureがクラウドで鍵を保管し管理する選択肢として挙げるのは Azure Key Vault、Azure Key Vault Managed HSM、Azure Cloud HSM、Azure Pa
https://learn.microsoft.com/en-us/azure/security/fundamentals/key-management - Cloud HSM は Cloud KMS を入口として使う、クラウドで提供されるHSMのサービス。Single-tenant Cloud HSM が存在する
https://docs.cloud.google.com/kms/docs/hsm - Google Cloud の拒否ポリシー。組織かフォルダかプロジェクトに付け、許可ポリシーを上書きし、階層を通じて継承される。拒否できる権限は一部に限られる
https://docs.cloud.google.com/iam/docs/deny-access - Microsoft Defender for Storage の機微データの脅威検出は、危険にさらされているデータの機微さを考慮してアラートの優先順位付けと調査を助ける。Defender for St
https://learn.microsoft.com/en-us/azure/defender-for-cloud/defender-for-storage-data-sensitivity - Azure Payment HSM(決済処理向けのHSM)
https://learn.microsoft.com/en-us/azure/payment-hsm/overview
第10章
- AWS CodeBuild は「クラウド上のフルマネージドなビルドサービス」で、コンパイル・単体テスト・成果物の作成を行う
https://docs.aws.amazon.com/codebuild/latest/userguide/welcome.html - AWS CodeDeploy は Amazon EC2・オンプレミス・AWS Lambda・Amazon ECS の4つの宛先に配布する
https://docs.aws.amazon.com/codedeploy/latest/userguide/welcome.html - AWS CodePipeline は工程全体をつなぐ継続的デリバリーのサービス
https://docs.aws.amazon.com/codepipeline/latest/userguide/welcome.html - Azure DevOps は「ソフトウェア開発チーム向けの統合されたツールを提供するクラウドベースのプラットフォーム」
https://learn.microsoft.com/en-us/azure/devops/user-guide/what-is-azure-devops - Cloud Build は「Google Cloud 上でビルドを実行するサービス」
https://docs.cloud.google.com/build/docs/overview - Cloud Deploy は「定められた昇格の順序に従って、一連の対象環境へアプリケーションの配信を自動化するマネージドサービス」
https://docs.cloud.google.com/deploy/docs/overview - AWS CodeStar は2024年7月25日に提供終了
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - AWSはサービスの状態を Maintenance / Sunset / Full Shutdown の3段階に整理している。Maintenance は「新規に利用を開始できないが、既存の利用者は継続で
https://docs.aws.amazon.com/general/latest/gr/service-lifecycle.html - AWS CodeStar Connections は2024年3月29日に AWS CodeConnections へ改称された。CodeStar 本体とは別物
https://docs.aws.amazon.com/dtconsole/latest/userguide/rename.html - AWS Cloud9 は新規受付停止であって提供終了ではない
https://docs.aws.amazon.com/cloud9/latest/user-guide/welcome.html - AWS CodeCommit は2024年7月25日に新規受付を止め、2025年11月24日に一般提供へ復帰した
https://aws.amazon.com/blogs/devops/aws-codecommit-returns-to-general-availability/ - AWS Auto Scaling のスケーリングプランに終了告知は無い。ただし予測スケーリングだけが目的なら、Auto Scaling の対象リソースへ直接ポリシーを設定するようAWSが強く推奨してい
https://docs.aws.amazon.com/autoscaling/plans/userguide/what-is-a-scaling-plan.html - ARMテンプレートは現役だが、公式が新規の検討者に Bicep を勧めている
https://learn.microsoft.com/en-us/azure/azure-resource-manager/templates/overview - Cloud Trace は OpenTelemetry のライブラリを望ましいものとして案内している。ただしクライアントライブラリの提供終了日は書かれていない
https://docs.cloud.google.com/trace/docs/overview - AWS CloudFormation は「AWSの資源をモデル化してセットアップする手助けをするサービス」
https://docs.aws.amazon.com/AWSCloudFormation/latest/UserGuide/Welcome.html - AWS CDK は「クラウドのインフラをコードで定義し、AWS CloudFormation を通じてそれを配備するための、オープンソースのソフトウェア開発フレームワーク」
https://docs.aws.amazon.com/cdk/v2/guide/home.html - Bicep は「宣言的な構文でAzureの資源を配備する、ドメイン固有の言語」
https://learn.microsoft.com/en-us/azure/azure-resource-manager/bicep/overview - Infrastructure Manager は「Google Cloud のインフラ資源の配備と管理を単純化し自動化するマネージドサービス」で、入力は Terraform の構成ファイル
https://docs.cloud.google.com/infrastructure-manager/docs/overview - Cloud Deployment Manager は2026年3月31日にサポート終了済み。移行先は Infrastructure Manager または別の配備技術
https://docs.cloud.google.com/deployment-manager/docs - AWSは Terraform の AWS プロバイダのベストプラクティスを推奨ガイダンスとして公開し、提供元が HashiCorp であることを明記している
https://docs.aws.amazon.com/prescriptive-guidance/latest/terraform-aws-provider-best-practices/introduction.html - Azureは Terraform を「クラウドのインフラを構成し配備するための、オープンソースの構成をコードで扱う道具」と紹介している
https://learn.microsoft.com/en-us/azure/developer/terraform/overview - Google Cloud は公式ドキュメントに Terraform の専用セクションを持つ
https://docs.cloud.google.com/docs/terraform - Azure Blueprints は2027年1月31日に提供終了。段階的な終了は2026年7月31日から。移行先は Deployment Stacks(推奨)と Template Specs
https://learn.microsoft.com/en-us/azure/governance/blueprints/overview - Deployment Stacks は「一群のAzure資源を、単一のまとまった単位として管理できるようにする資源」。テンプレートから外した資源を切り離すか削除するかを設定で選べ、管理下の資源への削除
https://learn.microsoft.com/en-us/azure/azure-resource-manager/bicep/deployment-stacks - Amazon CloudWatch は「AWSの資源とAWS上で動くアプリケーションをリアルタイムに監視し、システム全体を見渡す可観測性を与える多くの道具を提供する」
https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/WhatIsCloudWatch.html - Azure Monitor は「クラウド環境とハイブリッド環境からテレメトリーを収集し、分析し、それに基づいて行動するための、Microsoft の統一された可観測性サービス」
https://learn.microsoft.com/en-us/azure/azure-monitor/fundamentals/overview - Google Cloud Observability は「アプリケーションの挙動、健全性、性能を理解する助けとなる可観測性のサービス群を含む」
https://docs.cloud.google.com/stackdriver/docs - Cloud Logging は「保管、検索、分析、監視に対応したリアルタイムのログ管理システム」
https://docs.cloud.google.com/logging/docs/overview - Cloud Monitoring は Google Cloud Observability の構成要素として提供中
https://docs.cloud.google.com/monitoring/docs/monitoring-overview - AWS Systems Manager の CloudWatch ダッシュボードは2026年4月30日以降利用できなくなる
https://docs.aws.amazon.com/systems-manager/latest/userguide/what-is-systems-manager.html - AWS Config は「アカウント内のAWS資源の構成について詳細な把握を提供する」。過去の構成と変化も記録する
https://docs.aws.amazon.com/config/latest/developerguide/WhatIsConfig.html - AWS Organizations は「資源が増え規模が大きくなるにつれて、環境を一元的に管理し統制する助けとなる」
https://docs.aws.amazon.com/organizations/latest/userguide/orgs_introduction.html - Azure Policy は組織の標準を強制し、大規模に準拠の状態を評価する
https://learn.microsoft.com/en-us/azure/governance/policy/overview - Azure Arc は「一貫したマルチクラウドとオンプレミスの管理基盤を提供することで、統制と管理を単純化する」
https://learn.microsoft.com/en-us/azure/azure-arc/overview - AWS Trusted Advisor は「AWSの環境を検査し、費用の節約、システムの可用性と性能の改善、セキュリティ上の隙間を塞ぐ機会があるときに推奨事項を出す」
https://docs.aws.amazon.com/awssupport/latest/user/trusted-advisor.html - Azure Advisor は「Azureの配備を最適化するためのベストプラクティスに従う手助けをする、デジタルなクラウドのアシスタント」
https://learn.microsoft.com/en-us/azure/advisor/advisor-overview - Amazon CodeWhisperer は2024年4月30日に Amazon Q Developer の一部になった
https://docs.aws.amazon.com/amazonq/latest/qdeveloper-ug/doc-history.html - Amazon Q Developer は「AWSのアプリケーションを理解し、構築し、拡張し、運用する助けとなる、生成AIを用いた対話型のアシスタント」で、Amazon Bedrock の上に構築されて
https://docs.aws.amazon.com/amazonq/latest/qdeveloper-ug/what-is.html - 『詳解 Terraform 第3版』(Yevgeniy Brikman 著、松浦隼人 訳、オライリー・ジャパン、2023年11月21日刊)
https://www.oreilly.co.jp/books/9784814400522/ - 『オブザーバビリティ・エンジニアリング』(Charity Majors、Liz Fong-Jones、George Miranda 著、大谷和紀・山口能迪 訳、オライリー・ジャパン、2023年1月27
https://www.oreilly.co.jp/books/9784814400126/ - 『LeanとDevOpsの科学[Accelerate] テクノロジーの戦略的活用が組織変革を加速する』(Nicole Forsgren、Jez Humble、Gene Kim 著、武舎広幸・武舎るみ
https://book.impress.co.jp/books/1118101029 - (採用しなかった候補)『Infrastructure as Code』(Kief Morris、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784873117966/ - Cloud Deployment Manager は「サポートが終了した状態」。2026年4月1日以降はサポートの対象外、2026年6月30日以降は新規の利用者がAPIの有効化や最初の配備の作成をでき
https://docs.cloud.google.com/deployment-manager/docs/deprecations - Recommender は「Google Cloud の製品とサービスに対する利用上の推奨事項とインサイトを提供する、Google Cloud 上のサービス」
https://docs.cloud.google.com/recommender/docs - Active Assist は「Google Cloud のプロジェクトを最適化する助けとなる推奨事項とインサイトを生成するために Google Cloud で使われる道具の一群」で、推奨事項とインサ
https://docs.cloud.google.com/recommender/docs/overview - インサイトは「資源の使われ方の重要なパターンに先回りして注意を向けるために使える所見」。推奨事項とは独立に使えるものもあれば、推奨事項に結びついて根拠を示すものもある
https://docs.cloud.google.com/recommender/docs/insights/using-insights - Azure Blueprints は2027年1月31日に提供を終了する予定で、段階的な終了は2026年7月31日から始まっている(時点表現の修正)
https://aka.ms/AzureBlueprintsRetirement - Azure Blueprints の終了は2023年9月14日に、2026年7月11日を終了日として告知され、のちに2027年1月31日へ延長された。段階: 2026年7月31日に新しい定義とバージョ
https://learn.microsoft.com/en-us/azure/governance/blueprints/blueprint-retirement - GitHub Copilot for Azure は「開発者が自然言語で、Azureの機能を学び、Azureの資源を配備し、Azureの資源の情報を得て、Azureの資源の問題を診断して解決できるよう
https://learn.microsoft.com/en-us/azure/developer/github-copilot-azure/introduction - Gemini Code Assist の Standard と Enterprise の版は「ソフトウェア開発のライフサイクル全体を通じて、開発チームがアプリケーションを構築し、配備し、運用する助けと
https://docs.cloud.google.com/gemini/docs/codeassist/overview - 取得できなかったURL: 404。URLの推測が外れただけで、insights/using-insights で代替できた)
https://docs.cloud.google.com/recommender/docs/insights/insights-overview
第11章
- AWSは移行の戦略を7つとし、7つのRと呼んでいる
https://docs.aws.amazon.com/prescriptive-guidance/latest/large-migration-guide/migration-strategies.html - Azureは8つの戦略を並べている
https://learn.microsoft.com/en-us/azure/cloud-adoption-framework/plan/select-cloud-migration-strategy - Google Cloudは移行を評価・計画・展開・最適化の4段階に分けている
https://docs.cloud.google.com/architecture/migration-to-gcp-getting-started - AWS Application Discovery Service は、エージェントレス・エージェント・取り込みの3通りの棚卸しの方法を持つ
https://docs.aws.amazon.com/application-discovery/latest/userguide/what-is-appdiscovery.html - 新規の受け付け停止は2025年11月7日から。既存の顧客は進行中の案件を完了できる。代替はAWS Transform
https://docs.aws.amazon.com/application-discovery/latest/userguide/application-discovery-service-availability-change.html - AWS Transform は、基盤・アプリケーション・コードの変革をエージェント型のAIで進める道具である
https://docs.aws.amazon.com/transform/latest/userguide/what-is-service.html - Azure Migrate は、Azureへの移行を決め・計画し・実行することを助ける
https://learn.microsoft.com/en-us/azure/migrate/migrate-services-overview - Migration Center は、いまのオンプレミスや他社クラウドからGoogle Cloudまでの道のり全体を速める統合された基盤である
https://docs.cloud.google.com/migration-center/docs/migration-center-overview - AWS Server Migration Service は2023年4月1日に提供終了
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - DMS の入口のページには、いまも Fleet Advisor が機能として紹介されており、記述が食い違う
https://docs.aws.amazon.com/dms/latest/userguide/Welcome.html - Application Migration Service の公式な略称は MGN であり、現在の見出しは AWS Transform MGN
https://docs.aws.amazon.com/mgn/latest/ug/what-is-application-migration-service.html - AMS は AWS Managed Services の略称で、AWSの基盤の運用を代行する別のサービスである
https://docs.aws.amazon.com/managedservices/latest/userguide/what-is-ams.html - Migrate to Virtual Machines の移行元に、vSphere・AWS・Azure・Google Cloud VMware Engine が明記されている
https://docs.cloud.google.com/migrate/virtual-machines/docs/5.0/getting-started/migrate-to-virtual-machines - Migrate for Compute Engine から Migrate to Virtual Machines への改称は2022年7月5日
https://docs.cloud.google.com/migrate/virtual-machines/docs/5.0/resources/release-notes - Azure DMS は複数の供給元からAzureのデータ基盤への移行を停止時間を抑えて行うマネージドサービスである
https://learn.microsoft.com/en-us/azure/dms/dms-overview - Google の Database Migration Service は移行先が Cloud SQL と AlloyDB for PostgreSQL
https://docs.cloud.google.com/database-migration/docs/overview - Migrate to Containers は、仮想マシンで動くアプリケーションを GKE または Cloud Run のコンテナへ近代化するために使う
https://docs.cloud.google.com/migrate/containers/docs/getting-started - コンソール画面と migctl は2024年1月3日に非推奨、2024年5月6日に利用できなくなった
https://docs.cloud.google.com/migrate/containers/docs/release-notes - Amazon EVS は VMware Cloud Foundation の環境を、VPC 内の EC2 ベアメタルのインスタンス上に直接構築して動かせる
https://docs.aws.amazon.com/evs/latest/userguide/what-is-evs.html - Azure VMware Solution は専用のベアメタルの基盤の上の vSphere クラスタからなるプライベートクラウド
https://learn.microsoft.com/en-us/azure/azure-vmware/introduction - Google Cloud VMware Engine は VMware の基盤を Google Cloud で動かせる完全にマネージドなサービス
https://docs.cloud.google.com/vmware-engine/docs/overview - AWS Outposts は AWS の基盤・サービス・API・道具を顧客の敷地へ延長する完全にマネージドなサービス
https://docs.aws.amazon.com/outposts/latest/userguide/what-is-outposts.html - Azure Arc は一貫したマルチクラウドおよびオンプレミスの管理基盤を提供する
https://learn.microsoft.com/en-us/azure/azure-arc/overview - Azure Local は顧客が所有する環境へ Azure の機能を延長する分散型の基盤で、Azure Arc を制御の面として使う
https://learn.microsoft.com/en-us/azure/azure-local/overview - Google Distributed Cloud は、Google Cloud の基盤とサービスを主権が求められる環境や顧客のデータセンターへ延長する、マネージドなハードウェアとソフトウェアの組み合わ
https://docs.cloud.google.com/distributed-cloud/docs/overview - Anthos は単独の製品として存在せず、標準の GKE へ統合された
https://docs.cloud.google.com/anthos/docs/concepts/gke-editions - GKE Enterprise が標準 GKE へ統合された時期
https://docs.cloud.google.com/kubernetes-engine/docs/release-notes - GKE Enterprise が標準 GKE へ統合された時期
https://docs.cloud.google.com/kubernetes-engine/docs/release-notes-archive - AWS Systems Manager は AWS・自社設備・複数クラウドの環境のノードを対象とする
https://docs.aws.amazon.com/systems-manager/latest/userguide/what-is-systems-manager.html - BigQuery Omni は Amazon S3 または Azure Blob Storage のデータに BigQuery の分析をそのまま実行できる
https://docs.cloud.google.com/bigquery/docs/omni-introduction - Cross-Cloud Interconnect は Google Cloud と他社クラウドとの間に広い帯域の専用の接続を用意する製品である
https://docs.cloud.google.com/network-connectivity/docs/interconnect/concepts/cci-overview - 『クラウドシステム移行・導入 アーキテクチャからハイブリッドクラウドまで』(金子格 編著、オーム社)
https://www.ohmsha.co.jp/book/9784274228360/ - 『業務システム クラウド移行の定石』(吉羽龍太郎、日経BP)
https://bookplus.nikkei.com/atcl/catalog/18/268940/ - 『モノリスからマイクロサービスへ』(Sam Newman 著、島田浩二 訳、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784873119311/ - AWS Application Migration Service は2026年6月8日に AWS Transform MGN へ改称された
https://aws.amazon.com/about-aws/whats-new/2026/06/aws-transform-mgn-rebrand/ - 改称後も機能とAPIと複製の仕組みは変わらない
https://docs.aws.amazon.com/mgn/latest/ug/mgn-release-notes.html - (補強)製品ページも旧称を併記している
https://aws.amazon.com/application-migration-service/ - (補強)ドキュメント履歴には改称の項目が無い
https://docs.aws.amazon.com/mgn/latest/ug/doc-history.html - Movere は2024年3月1日に提供終了
https://learn.microsoft.com/en-us/azure/migrate/whats-new
第12章
- AWS Savings Plans は1年または3年の期間について時間あたりの計算能力の使用を確約する
https://docs.aws.amazon.com/savingsplans/latest/userguide/what-is-savings-plans.html - Savings Plans は Compute / Database / EC2 Instance / SageMaker AI の4種類
https://docs.aws.amazon.com/savingsplans/latest/userguide/plan-types.html - AWS には資源を指定して確保する Reserved Instances がある
https://docs.aws.amazon.com/cost-management/latest/userguide/what-is-costmanagement.html - Azure Reservations は1年または3年で、SKU・リージョン・スコープの属性に一致した使用量へ自動適用される
https://learn.microsoft.com/en-us/azure/cost-management-billing/reservations/save-compute-costs-reservations - Azure の savings plan は Savings plan for compute(1年・3年)と Savings plan for databases(1年)の2つ
https://learn.microsoft.com/en-us/azure/cost-management-billing/savings-plan/savings-plan-compute-overview - Google Cloud の committed use discounts は支出ベースとリソースベースの2種類
https://cloud.google.com/docs/cuds - Google Cloud の committed use discounts は支出ベースとリソースベースの2種類
https://docs.cloud.google.com/docs/cuds - Google Cloud には確約なしで自動的に付く継続利用割引(sustained use discounts)がある
https://docs.cloud.google.com/compute/docs/sustained-use-discounts - AWS Spot Instances は中断の2分前に通知が出る
https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/using-spot-instances.html - Azure Spot Virtual Machines には可用性の保証がなく、30秒前の通知で退避される
https://learn.microsoft.com/en-us/azure/virtual-machines/spot-vms - Azure Batch のドキュメントは Spot VM と呼ぶが、APIとメトリクスには Low-Priority の名が残る
https://learn.microsoft.com/en-us/azure/batch/batch-spot-vms - Google Cloud の Spot VMs は preemptible VMs の最新版
https://docs.cloud.google.com/compute/docs/instances/spot - AWSは無料のプランと有料のプランという2つの入り口を持ち、常時無料の枠は両方のプランで使える
https://aws.amazon.com/free/ - Azureは無期限に無料のもの・12か月無料のもの・30日無料のものが混在し、公式が制約に注意するよう促している
https://learn.microsoft.com/en-us/azure/cost-management-billing/cost-management-billing-overview - Google Cloud は90日間の無料トライアル・月次上限内で継続して無料の枠・製品ごとの試用の3層
https://docs.cloud.google.com/free/docs/free-cloud-features - Google Cloud の予算はアラートのみでは使用量や支出を自動的に止めない
https://docs.cloud.google.com/billing/docs/how-to/budgets - 課金データを BigQuery へ書き出せ、標準・詳細・料金・FOCUS の形式がある
https://docs.cloud.google.com/billing/docs/how-to/export-data-bigquery - Google Cloud の推奨の枠組みは Active Assist、個別の仕組みが Recommender
https://docs.cloud.google.com/recommender/docs/overview - FinOps Hub は推奨を「遊休資源の停止」「サイズの適正化」「構成の変更」「確約利用割引の購入」の4つに沿って提示する
https://docs.cloud.google.com/billing/docs/how-to/finops-hub - Google Cloud Pricing Calculator が正式名称で、見積りは請求額を正確に反映しない場合があると注記されている
https://cloud.google.com/products/calculator - AWS Pricing Calculator は無償で、掲載ページとツールの値が食い違う場合は掲載ページの値を使う
https://docs.aws.amazon.com/pricing-calculator/latest/userguide/what-is-pricing-calculator.html - AWS Trusted Advisor は現在もこの名称
https://docs.aws.amazon.com/awssupport/latest/user/trusted-advisor.html - 点検の分類は Cost optimization / Performance / Security / Fault tolerance / Service limits / Operational E
https://docs.aws.amazon.com/awssupport/latest/user/get-started-with-aws-trusted-advisor.html - コスト最適化の項目に、関連付けのない Elastic IP アドレス/アイドル状態のロードバランサー/使用率の低い EBS ボリューム/使用率の低い EC2 インスタンス/アイドル状態の RDS DB
https://docs.aws.amazon.com/awssupport/latest/user/cost-optimization-checks.html - AWS Compute Optimizer は直近14日分の利用状況の指標から適正化と遊休を判定する
https://docs.aws.amazon.com/compute-optimizer/latest/ug/what-is-compute-optimizer.html - AWS Cost Optimization Hub はアカウントとリージョンをまたいで推奨を集約し、自社の割引や購入済みの確約を織り込んで並べ替えられる
https://docs.aws.amazon.com/cost-management/latest/userguide/cost-optimization-hub.html - Azure Advisor の分類は信頼性・セキュリティ・パフォーマンス・コスト・オペレーショナルエクセレンスの5つ
https://learn.microsoft.com/en-us/azure/advisor/advisor-overview - NATゲートウェイは、利用可能である各時間と処理した各ギガバイトの両方に課金される
https://docs.aws.amazon.com/vpc/latest/userguide/nat-gateway-pricing.html - CloudWatch Logs に Standard と Infrequent Access の2つのログクラスがあり、取り込みの費用が異なる
https://docs.aws.amazon.com/AmazonCloudWatch/latest/logs/CloudWatch_Logs_Log_Classes.html - Azure App Service の課金の単位はアプリではなくプランで、専用の階層ではVMインスタンスの数に対して課金される
https://learn.microsoft.com/en-us/azure/app-service/overview-hosting-plans - AWSのタグは、付けただけでは費用に現れず、コスト配分タグとして有効化する操作が別に要る
https://docs.aws.amazon.com/awsaccountbilling/latest/aboutv2/cost-alloc-tags.html - 有効化した時期より前の期間には遡らない、という趣旨
https://docs.aws.amazon.com/awsaccountbilling/latest/aboutv2/cost-allocation-tags-timeline.html - AWS Well-Architected のコスト最適化の柱は2024年6月27日付の文書
https://docs.aws.amazon.com/wellarchitected/latest/cost-optimization-pillar/welcome.html - Azure Well-Architected のコスト最適化の設計原則は5つ
https://learn.microsoft.com/en-us/azure/well-architected/cost-optimization/ - Google Cloud のアーキテクチャフレームワークのコスト最適化は4原則
https://docs.cloud.google.com/architecture/framework/cost-optimization - FinOps Foundation の定義
https://www.finops.org/framework/ - 『クラウドFinOps(第2版)』(J.R. Storment、Mike Fuller、オライリー・ジャパン)
https://books.rakuten.co.jp/search?sitem=%E3%82%AF%E3%83%A9%E3%82%A6%E3%83%89FinOps&g=001 - 『AWSコスト最適化ガイドブック』(門畑顕博、仁戸潤一郎、KADOKAWA)
https://books.rakuten.co.jp/search?sitem=FinOps&g=001 - 『AWSコスト最適化ガイドブック』(門畑顕博、仁戸潤一郎、KADOKAWA)
https://books.rakuten.co.jp/search?sitem=%E3%82%AF%E3%83%A9%E3%82%A6%E3%83%89+%E3%82%B3%E3%82%B9%E3%83%88&g=001 - 『[PM&スタートアップのための]はじめてのクラウドコスト管理』(津郷晶也、技術評論社)
https://books.rakuten.co.jp/search?sitem=%E3%81%AF%E3%81%98%E3%82%81%E3%81%A6%E3%81%AE%E3%82%AF%E3%83%A9%E3%82%A6%E3%83%89%E3%82%B3%E3%82%B9%E3%83%88%E7%AE%A1%E7%90%86&g=001 - Google Cloud には指定したサービスの利用を上限で自動的に一時停止する spend cap の予算があるが、プレビューで、対象は一部のAPIベースのサービス、単一プロジェクト×単一サービス、
https://docs.cloud.google.com/billing/docs/how-to/budgets-spend-caps - AWS Budgets には閾値超過時に IAM ポリシーやサービスコントロールポリシーを適用したり、指定した EC2 や RDS のインスタンスを対象に処理を実行したりする budget actio
https://docs.aws.amazon.com/cost-management/latest/userguide/budgets-controls.html - Azure の予算は閾値を超えると通知は出るが、リソースは影響を受けず消費も止まらない。予算にアクショングループを結び付けて処理を呼び出せる
https://learn.microsoft.com/en-us/azure/cost-management-billing/costs/tutorial-acm-create-budgets - AWS Compute Optimizer は標準では直近14日分、推奨の設定を有効にすると最長93日分を分析する
https://docs.aws.amazon.com/compute-optimizer/latest/ug/metrics.html - 遊休の判定では資源の種類によって別の期間が使われる
https://docs.aws.amazon.com/compute-optimizer/latest/ug/view-idle-recommendations.html - Azure Reservations の交換の制度に変更が告知されている。2027年2月1日以降に購入した予約は、対応するサービスが savings plan の対象であれば交換の対象外。それより前に
https://learn.microsoft.com/en-us/azure/cost-management-billing/reservations/exchange-and-refund-azure-reservations - Azure pricing calculator の存在とURL
https://azure.microsoft.com/pricing/calculator/
第13章
- Google Cloud の VPC ネットワークは全世界を範囲とする資源であり、データセンターにあるリージョン単位の仮想サブネットワークの一覧からなり、全世界規模の広域ネットワークで接続されている
https://docs.cloud.google.com/vpc/docs/overview - Amazon VPC はリージョンの中に作るものとして説明され、各リージョンに既定のVPCが用意される
https://docs.aws.amazon.com/vpc/latest/userguide/what-is-amazon-vpc.html - Azure Virtual Network は、仮想ネットワークとサブネットがリージョン内のすべての可用性ゾーンにまたがると書かれているが、リージョンをまたぐとは書かれていない
https://learn.microsoft.com/en-us/azure/virtual-network/virtual-networks-overview - Cloud CDN は単体では使えず、全世界向けの外部 Application Load Balancer または classic の Application Load Balancer と組み合わせ
https://docs.cloud.google.com/cdn/docs/overview - Amazon DocumentDB は計算と保管を分ける構造で、保管の層は3つのアベイラビリティゾーンにまたがって6つの複製を持つ
https://docs.aws.amazon.com/documentdb/latest/developerguide/what-is.html - Azure DocumentDB は完全に管理されたオープンソースのMongoDB互換のデータベースで、互換率は99.03パーセント
https://learn.microsoft.com/en-us/azure/documentdb/overview - オープンソースの DocumentDB は PostgreSQL のエンジンの上に作られている
https://learn.microsoft.com/en-us/azure/cosmos-db/introduction - Azureのロールに基づくアクセス制御は加算モデルであり、実効的な権限は割り当ての合計になる
https://learn.microsoft.com/en-us/azure/role-based-access-control/overview - Google Cloud の IAM は「誰が、何を、どの資源に対してできるか」を制御する
https://docs.cloud.google.com/iam/docs/overview - 仮想デスクトップは AWS が Amazon WorkSpaces
https://docs.aws.amazon.com/workspaces/latest/adminguide/amazon-workspaces.html - 仮想デスクトップは Azure が Azure Virtual Desktop
https://learn.microsoft.com/en-us/azure/virtual-desktop/overview - Managed Service for Apache Spark は Dataproc の、Managed Service for Apache Airflow は Cloud Composer の改
https://docs.cloud.google.com/dataproc/docs - Managed Service for Apache Spark は Dataproc の、Managed Service for Apache Airflow は Cloud Composer の改
https://docs.cloud.google.com/composer/docs - Data Studio は Looker Studio からの改称で、有償の形は Data Studio Pro
https://docs.cloud.google.com/looker/docs/studio - Gemini Enterprise(アプリ)と Gemini Enterprise Agent Platform(基盤)は別物
https://docs.cloud.google.com/gemini/enterprise/docs - Gemini Enterprise(アプリ)と Gemini Enterprise Agent Platform(基盤)は別物
https://cloud.google.com/products/gemini-enterprise-agent-platform - Gemini Enterprise Agent Platform の旧称は Vertex AI
https://docs.cloud.google.com/vertex-ai/docs/release-notes - AWSはポリシーを作ってIDの側か資源の側に付ける。ポリシーは9種類。複数のポリシーを論理和として重ね、明示的な拒否が優先する
https://docs.aws.amazon.com/IAM/latest/UserGuide/access_policies.html - Azure Key Vault はハードウェアセキュリティモジュールに裏打ちされると記載され、鍵・機密情報・証明書の3つの役割を1つのサービスが扱う
https://learn.microsoft.com/en-us/azure/key-vault/general/overview - Azureの savings plan は購入後にキャンセルも払い戻しもできず、使い切らなかった確約分は繰り越されない。Azure Reservations には交換と払い戻しの制度がある
https://learn.microsoft.com/en-us/azure/cost-management-billing/savings-plan/savings-plan-compute-overview - マルチクラウドネットワークの教科書 耐障害性と冗長性を実現するデザインパターン
https://books.rakuten.co.jp/search?sitem=%E3%83%9E%E3%83%AB%E3%83%81%E3%82%AF%E3%83%A9%E3%82%A6%E3%83%89%E3%81%AE%E6%95%99%E7%A7%91%E6%9B%B8&g=001 - 図解まるわかり クラウドのしくみ
https://books.rakuten.co.jp/search?sitem=%E5%9B%B3%E8%A7%A3%E3%81%BE%E3%82%8B%E3%82%8F%E3%81%8B%E3%82%8A%E3%80%80%E3%82%AF%E3%83%A9%E3%82%A6%E3%83%89%E3%81%AE%E3%81%97%E3%81%8F%E3%81%BF&g=001 - AWS App Runner は2026年3月31日の告知で新規に開始できない段階の一覧に掲載
https://docs.aws.amazon.com/general/latest/gr/maintenance_services.html - AWS App Runner は2026年4月30日から新規の顧客を受け付けなくなった
https://docs.aws.amazon.com/apprunner/latest/relnotes/relnotes.html - AWS App Runner は2026年4月30日から新規の顧客を受け付けなくなった
https://aws.amazon.com/apprunner/ - 告知日(2026年3月31日)と新規受付停止日(2026年4月30日)が同じ1本の告知に書かれている
https://aws.amazon.com/about-aws/whats-new/2026/03/aws-service-availability/ - 既存の利用者は新しい資源やサービスの作成を含めてこれまでどおり使える。移行先は Amazon ECS Express Mode
https://docs.aws.amazon.com/apprunner/latest/dg/apprunner-availability-change.html - AWS Lambda の1回の実行は900秒が上限。クォータの表の値は注記のあるもの以外は変更できない
https://docs.aws.amazon.com/lambda/latest/dg/gettingstarted-limits.html - Azure Functions は Consumption プランが既定5分・最大10分、他の4つには強制される上限が無い
https://learn.microsoft.com/en-us/azure/azure-functions/functions-scale - Azure Service Bus は既定の PeekLock の受信モードで少なくとも1回、ReceiveAndDelete の受信モードで最大1回の配送
https://learn.microsoft.com/en-us/azure/service-bus-messaging/service-bus-azure-and-service-bus-queues-compared-contrasted - セッションを使うと関連するメッセージを順序どおりに処理できる。ちょうど1回の処理が得られるとは書かれていない
https://learn.microsoft.com/en-us/azure/service-bus-messaging/message-sessions - 送信側の再送で生じた複製は、同じ MessageId を持つものをキューやトピックの側で捨てる重複検出という別の機能がある
https://learn.microsoft.com/en-us/azure/service-bus-messaging/duplicate-detection - Pub/Sub は既定ではすべての種類のサブスクリプションで順序の保証なしに少なくとも1回の配送を提供し、ちょうど1回の配送にも対応
https://docs.cloud.google.com/pubsub/docs/subscription-overview - Azureにも Gateway Load Balancer があり、Azure Load Balancer の等級(SKU)の1つで、第三者のネットワーク仮想アプライアンスを経路に透過的に挿し込むため
https://learn.microsoft.com/en-us/azure/load-balancer/gateway-overview - Model Armor は、AIアプリケーションのセキュリティと安全性を高めるための Google Cloud のサービス。プロンプトと応答を検査し、悪意のある入力の防止、内容の安全性の確認、機密デー
https://docs.cloud.google.com/security-command-center/docs/model-armor-overview - Amazon Bedrock Guardrails は生成AIの基盤の中の機能
https://docs.aws.amazon.com/bedrock/latest/userguide/guardrails.html - Gemini Enterprise Agent Platform の概要にある Agent Gateway の記述
https://docs.cloud.google.com/gemini-enterprise-agent-platform/docs/overview - Gemini Enterprise Agent Platform の概要にある Agent Gateway の記述
https://docs.cloud.google.com/gemini-enterprise-agent-platform/docs - ストレージの中間層は S3 Glacier Instant Retrieval・Cold・Coldline storage で、最短の保管期間はいずれも90日
https://docs.aws.amazon.com/AmazonS3/latest/userguide/storage-class-intro.html - ストレージの中間層は S3 Glacier Instant Retrieval・Cold・Coldline storage で、最短の保管期間はいずれも90日
https://learn.microsoft.com/en-us/azure/storage/blobs/access-tiers-overview - ストレージの中間層は S3 Glacier Instant Retrieval・Cold・Coldline storage で、最短の保管期間はいずれも90日
https://docs.cloud.google.com/storage/docs/storage-classes - HTTP 404。実物は にあり、上の表に「確認」で記録した
https://aws.amazon.com/service-availability-updates/ - ノードを自分で用意しない形の AWS 欄に EKS Auto Mode を追加
https://docs.aws.amazon.com/eks/latest/userguide/automode.html - ノードを自分で用意しない形の AWS 欄に EKS Auto Mode を追加
https://docs.aws.amazon.com/eks/latest/userguide/getting-started-console.html - サーバーをそのまま移す道具は AWS Transform MGN(旧 AWS Application Migration Service)
https://aws.amazon.com/about-aws/whats-new/2026/06/aws-transform-mgn-rebrand/
第14章
- Amazon SageMaker は Amazon SageMaker AI へ改称。2024年12月3日
https://docs.aws.amazon.com/sagemaker/latest/dg/whatis.html - Amazon QuickSight は Amazon Quick へ改称。2025年10月9日。可視化の部分は Amazon Quick Sight
https://docs.aws.amazon.com/quicksight/latest/user/welcome.html - Amazon QuickSight は Amazon Quick へ改称。2025年10月9日。可視化の部分は Amazon Quick Sight
https://docs.aws.amazon.com/quicksight/latest/user/doc-history.html - Amazon CodeWhisperer は Amazon Q Developer の一部へ。2024年4月30日
https://docs.aws.amazon.com/amazonq/latest/qdeveloper-ug/doc-history.html - Amazon Q Developer の統合開発環境向けの追加機能は2027年4月30日にサポート終了。以後は Kiro を案内
https://docs.aws.amazon.com/amazonq/latest/qdeveloper-ug/what-is.html - Kinesis Data Analytics は Amazon Managed Service for Apache Flink へ改称。2023年8月30日
https://aws.amazon.com/about-aws/whats-new/2023/08/amazon-managed-service-apache-flink/ - Kinesis Data Firehose は Amazon Data Firehose へ改称。2024年2月9日。接続先・API・コマンド行の道具・権限のポリシー・監視の指標に変更なし
https://aws.amazon.com/about-aws/whats-new/2024/02/amazon-data-firehose-formerly-kinesis-data-firehose/ - AWS CodeStar Connections は AWS CodeConnections へ改称。2024年3月29日。CodeStar 本体とは別物で現役
https://docs.aws.amazon.com/dtconsole/latest/userguide/rename.html - AWS Application Migration Service の公式な略称は MGN。現在の見出しは AWS Transform MGN
https://docs.aws.amazon.com/mgn/latest/ug/what-is-application-migration-service.html - Azure Active Directory は Microsoft Entra ID へ改称。2023年7月11日に公表
https://learn.microsoft.com/en-us/entra/fundamentals/new-name - Azure Cognitive Services は Azure AI Services を経て Foundry Tools になった。すべて同じ土台を指す
https://learn.microsoft.com/en-us/azure/foundry/how-to/navigate-from-classic - Azure 上の資源の種別は Microsoft.CognitiveServices/accounts のまま
https://learn.microsoft.com/en-us/azure/ai-services/what-are-ai-services - Azure Cognitive Search は Azure AI Search へ改称。2023年11月
https://learn.microsoft.com/en-us/azure/search/whats-new - Azure Form Recognizer は Azure Document Intelligence へ改称。同一のサービスである
https://learn.microsoft.com/en-us/azure/ai-services/document-intelligence/faq - Power Virtual Agents は Microsoft Copilot Studio へ。2023年11月15日
https://www.microsoft.com/en-us/microsoft-copilot/blog/copilot-studio/microsoft-power-virtual-agents-now-part-of-microsoft-copilot-studio/ - Azure Bot Service は Azure AI Bot Service へ。改称の告知日は確認できず
https://learn.microsoft.com/en-us/azure/bot-service/bot-overview - Power BI は改称されておらず、移行作業も発生しない
https://learn.microsoft.com/en-us/power-bi/fundamentals/power-bi-overview - Azure Machine Learning は改称されていない
https://learn.microsoft.com/en-us/azure/machine-learning/overview-what-is-azure-machine-learning - Azure Stream Analytics は改称されていない
https://learn.microsoft.com/en-us/azure/stream-analytics/stream-analytics-introduction - Azure HDInsight は改称されていない
https://learn.microsoft.com/en-us/azure/hdinsight/hdinsight-overview - Azure HDInsight の 4.0 と 5.0 は2025年3月31日に終了。現行は 5.1
https://learn.microsoft.com/en-us/azure/hdinsight/hdinsight-component-versioning - Cloud Identity は改称されていない
https://docs.cloud.google.com/identity/docs/overview - 構成をコードで扱う領域でも推奨の変更が起きている(第10章で扱った)
https://learn.microsoft.com/en-us/azure/azure-resource-manager/templates/overview - Vertex AI は Gemini Enterprise Agent Platform へ統合。2026年4月23日の公式ブログ
https://cloud.google.com/blog/products/ai-machine-learning/introducing-gemini-enterprise-agent-platform - Vertex AI は Gemini Enterprise Agent Platform へ統合。2026年4月23日の公式ブログ
https://docs.cloud.google.com/vertex-ai/docs/release-notes - Dataplex Universal Catalog は Knowledge Catalog へ改称。2026年4月10日。API・クライアントライブラリ・コマンド行の道具・権限の名前は変わらない
https://docs.cloud.google.com/dataplex/docs - Cloud Dataproc は Managed Service for Apache Spark へ改称
https://docs.cloud.google.com/dataproc/docs - Cloud Composer は Managed Service for Apache Airflow へ改称。理由は公開ソフトウェアへの利用者の支持
https://docs.cloud.google.com/composer/docs - Looker Studio は Data Studio へ改称。有償の形は Data Studio Pro。Looker Studio Pro という名前はページ上に無い
https://docs.cloud.google.com/looker/docs/studio - Looker と Data Studio は別の製品である
https://docs.cloud.google.com/looker/docs/studio-comparison - Cloud Functions は Cloud Run functions へ改称
https://docs.cloud.google.com/run/docs/functions-with-run - Cloud Operations Suite は Google Cloud Observability という名前になっている
https://docs.cloud.google.com/stackdriver/docs - Cloud Data Loss Prevention は Sensitive Data Protection の一部になった。API の名前は元のまま
https://docs.cloud.google.com/sensitive-data-protection/docs/sensitive-data-protection-overview - Cloud Datastore は Firestore が後継
https://docs.cloud.google.com/datastore/docs/firestore-or-datastore - Anthos は GKE Enterprise を経て標準の GKE へ統合された
https://docs.cloud.google.com/anthos/docs/concepts/gke-editions - Dataflow は改称されていない
https://docs.cloud.google.com/dataflow/docs - AWS CodeStar は2024年7月25日にサポートを終えた
https://docs.aws.amazon.com/general/latest/gr/full_shutdown_services.html - AWS CodeCommit は2024年7月25日に新規受付を止め、2025年11月24日に一般提供へ復帰した
https://aws.amazon.com/blogs/devops/aws-codecommit-returns-to-general-availability/ - AWS CodeCommit は2024年7月25日に新規受付を止め、2025年11月24日に一般提供へ復帰した
https://docs.aws.amazon.com/codecommit/latest/userguide/history.html - AWS App Runner は新規の顧客に閉じられた。2026年3月31日の告知。移行先は Amazon ECS の簡易な実行の形。既存の利用者は継続でき、新機能の追加は予定されていない
https://docs.aws.amazon.com/apprunner/latest/dg/apprunner-availability-change.html - AWS App Runner は新規の顧客に閉じられた。2026年3月31日の告知。移行先は Amazon ECS の簡易な実行の形。既存の利用者は継続でき、新機能の追加は予定されていない
https://docs.aws.amazon.com/general/latest/gr/maintenance_services.html - AWS Cloud9 は2024年7月25日に新規受付停止
https://docs.aws.amazon.com/cloud9/latest/user-guide/welcome.html - AWS Data Pipeline は2024年7月25日に新規受付停止。保守の段階に入っている
https://docs.aws.amazon.com/datapipeline/latest/DeveloperGuide/what-is-datapipeline.html - AWS Data Pipeline は、いまも AWS のホワイトペーパーの分析のカテゴリの一覧に載っている
https://docs.aws.amazon.com/whitepapers/latest/aws-overview/analytics.html - AWS Application Discovery Service は2025年11月7日に新規受付停止。代替は AWS Transform
https://docs.aws.amazon.com/application-discovery/latest/userguide/application-discovery-service-availability-change.html - Amazon Redshift の Python のユーザー定義関数は2026年6月30日より後はサポート外
https://docs.aws.amazon.com/redshift/latest/mgmt/welcome.html - Kinesis Data Analytics の SQL を使う形は段階を踏んで廃止され、アプリケーションの削除まで行われた
https://docs.aws.amazon.com/kinesisanalytics/latest/dev/what-is.html - Azure Data Lake Analytics は2024年2月29日に提供終了
https://learn.microsoft.com/en-us/azure/data-lake-analytics/data-lake-analytics-overview - Azure Metrics Advisor は2026年5月18日に提供終了
https://learn.microsoft.com/en-us/azure/ai-services/metrics-advisor/overview - Azure Custom Vision は2028年9月25日まで既存の利用者を全面的に支えたうえで提供を終える。移行先は従来型の自動機械学習と、生成AIを使う仕組みの2つ
https://learn.microsoft.com/en-us/azure/ai-services/custom-vision-service/overview - Azure Blueprints は2027年1月31日に提供終了。段階的な終了は2026年7月31日から
https://learn.microsoft.com/en-us/azure/governance/blueprints/overview - Azure Basic Load Balancer は2025年9月30日に提供終了(等級の終了)
https://learn.microsoft.com/en-us/azure/load-balancer/load-balancer-overview - Azure Application Gateway の v1 の等級は2026年4月28日に提供終了
https://learn.microsoft.com/en-us/azure/application-gateway/overview - Azure Cache for Redis の Basic・Standard・Premium の等級は2028年9月30日に終了。移行先は Azure Managed Redis
https://learn.microsoft.com/en-us/azure/azure-cache-for-redis/retirement-faq - Azure Functions を Linux の従来の従量プランで動かす選択肢は2028年9月30日に提供終了
https://learn.microsoft.com/en-us/azure/azure-functions/functions-scale - Microsoft Sentinel は2027年3月31日より後は Azure ポータルでサポートされず、Defender ポータルでのみ使える。サービス自体は終了しない
https://learn.microsoft.com/en-us/azure/sentinel/overview - Security Command Center の Enterprise の階層は2027年5月21日に終了し、Premium へ自動的に移る
https://docs.cloud.google.com/security-command-center/docs/security-command-center-overview - Pub/Sub Lite は2027年1月31日に提供終了予定。本体の Pub/Sub は変更なし
https://docs.cloud.google.com/pubsub/lite/docs - App Engine の公式が、新規の利用者に Cloud Run を勧めている
https://docs.cloud.google.com/appengine/docs/the-appengine-environments - Azure Database for MariaDB は提供終了している
https://raw.githubusercontent.com/Azure/EOL/main/service_list.json - 旧来の単独の AutoML は、表形式が2024年7月24日、画像と動画が2024年7月31日、自然言語が2024年8月7日に提供終了
https://docs.cloud.google.com/vertex-ai/docs/deprecations - AutoML Translation は2025年9月30日に提供終了。独自モデルの機能と管理は Cloud Translation の上位版へ
https://docs.cloud.google.com/translate/automl/docs - 現在も AutoML として残るのは、画像と表形式データに対する学習方式
https://docs.cloud.google.com/vertex-ai/docs/beginner/beginners-guide - Azure の言語のサービスは、機能が「新規の開発に推奨するもの」と「既存の実装のために提供を続けるもの」に二分されている。後者に感情分析、キーフレーズの抽出、要約、会話の意図の理解、独自のテキスト分
https://learn.microsoft.com/en-us/azure/ai-services/language-service/overview - Azure の画像のサービスでは、画像の解析と文字認識の見出しに従来からのものという注記が付いている
https://learn.microsoft.com/en-us/azure/ai-services/computer-vision/overview - 文書・画像・音声・動画を1つの入口で扱う仕組みが Azure に加わった
https://learn.microsoft.com/en-us/azure/ai-services/content-understanding/overview - Content Moderator は2024年2月に非推奨となり、2027年3月15日に終了予定。後継は Content Safety
https://learn.microsoft.com/en-us/azure/ai-services/content-moderator/overview - Content Safety の現在の機能は、プロンプトへの攻撃の検出や、生成された文章が根拠に基づいているかの判定が中心
https://learn.microsoft.com/en-us/azure/ai-services/content-safety/overview - AWS には3段階の公式一覧がある。親はサービスのライフサイクルのページ
https://docs.aws.amazon.com/general/latest/gr/service-lifecycle.html - Azure には公開されている終了一覧のデータがあり、機能の単位で並ぶ
https://github.com/Azure/EOL - リリースノートは日付の単位で並ぶため、製品名では引けない
https://docs.cloud.google.com/release-notes - リリースノートは日付の単位で並ぶため、製品名では引けない
https://docs.cloud.google.com/feeds/gcp-release-notes.xml - 『進化的アーキテクチャ 絶え間ない変化を支える』(Neal Ford ほか著、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784873118567/ - 『Googleのソフトウェアエンジニアリング 持続可能なプログラミングを支える技術、文化、プロセス』(Titus Winters ほか編、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784873119656/ - 『ソフトウェアアーキテクチャの基礎 第2版 エンジニアリングに基づく体系的アプローチ』(Mark Richards、Neal Ford 著、オライリー・ジャパン)
https://www.oreilly.co.jp/books/9784814401550/ - 同じ日付の Agent Platform のリリースノートに、Vertex AI から引き継いだ機能の以前の名前と新しい名前を並べた一覧が載っている
https://docs.cloud.google.com/gemini-enterprise-agent-platform/release-notes - Amazon SNS のメッセージのデータ保護は2026年3月31日に告知。2026年4月30日から新規の利用者には提供されない。既存の利用者は使い続けられる
https://docs.aws.amazon.com/sns/latest/dg/sns-message-data-protection-availability-change.html - Azure Blueprints は2027年1月31日の終了に先立ち、2026年7月31日に新しい定義と版の作成、2026年10月31日に既存の定義の変更と新しい割り当ての作成、2026年12月31
https://learn.microsoft.com/en-us/azure/governance/blueprints/blueprint-retirement - Azure Basic Load Balancer は2025年9月30日に終了の期日を迎えた。既存のものは動き続けるが、サポートと稼働率の保証の対象外
https://learn.microsoft.com/en-us/azure/load-balancer/load-balancer-basic-upgrade-guidance - AWS Data Pipeline は、公式ドキュメントの冒頭に新規の利用者には提供しない旨の掲示が出ているのに、3つの一覧のどこにも載っていない。AWS CodeCommit の停止と復帰の経緯も3
https://docs.aws.amazon.com/general/latest/gr/sunset_services.html - Agent Platform の AutoML の入門ガイドが扱うのは画像と表形式データに対する学習方式だけ
https://docs.cloud.google.com/gemini-enterprise-agent-platform/machine-learning/beginner/beginners-guide - (参考)Agent Platform の名前の変更の一覧ページ
https://docs.cloud.google.com/gemini-enterprise-agent-platform/vertex-ai-name-changes - AWS App Runner の新規受付停止は2026年3月31日に告知された
https://aws.amazon.com/about-aws/whats-new/2026/03/aws-service-availability/ - 2026年4月30日から新規の顧客を受け付けなくなった
https://aws.amazon.com/apprunner/ - (本文に書いていない)製品カタログに Deprecated の区分がある(Codexの指摘)
https://cloud.google.com/products?pds=CAQ - AWS Application Migration Service → AWS Transform MGN の告知日 2026年6月8日
https://aws.amazon.com/about-aws/whats-new/2026/06/aws-transform-mgn-rebrand/ - Cloud Functions → Cloud Run functions の告知 2024年8月21日
https://docs.cloud.google.com/functions/docs/release-notes - Dataproc・Looker Studio の改称の告知が BigQuery リリースノートの 2026年4月22日の項にまとまっている。BigLake → Google Cloud Lakehou
https://docs.cloud.google.com/bigquery/docs/release-notes - Dataproc・Looker Studio の改称の告知が BigQuery リリースノートの 2026年4月22日の項にまとまっている。BigLake → Google Cloud Lakehou
https://docs.cloud.google.com/biglake/docs/introduction